第17讲 · EECS 189:神经网络与万能逼近
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Neural Networks, Why We Need Depth, Universal Approximation Theorem, Activation Functions |
| 视频 | https://www.youtube.com/watch?v=bMJ9igfvn1M |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 17) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第17讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
期待已久的神经网络来了:
- 数据流形(data manifold):为什么高维图像其实住在一个低维流形上;
- 从生物神经元到人工神经元:内积 + 激活函数;
- 为什么需要激活:XOR 不可线性可分、深度线性网络 = 线性网络;
- 万能逼近定理(UAT) 及其「三个星号」:为什么深度才重要;
- 激活函数演进(Step → Sigmoid → ReLU → Leaky ReLU);
- PyTorch 入门与神经网络「等价再参数化 / 权重窃取」趣题。
📷 标题页
回到原视频 (00:00:20)
📷 议程
回到原视频 (00:01:33)
一、从数据流形到神经网络
(参考时间: 00:00)
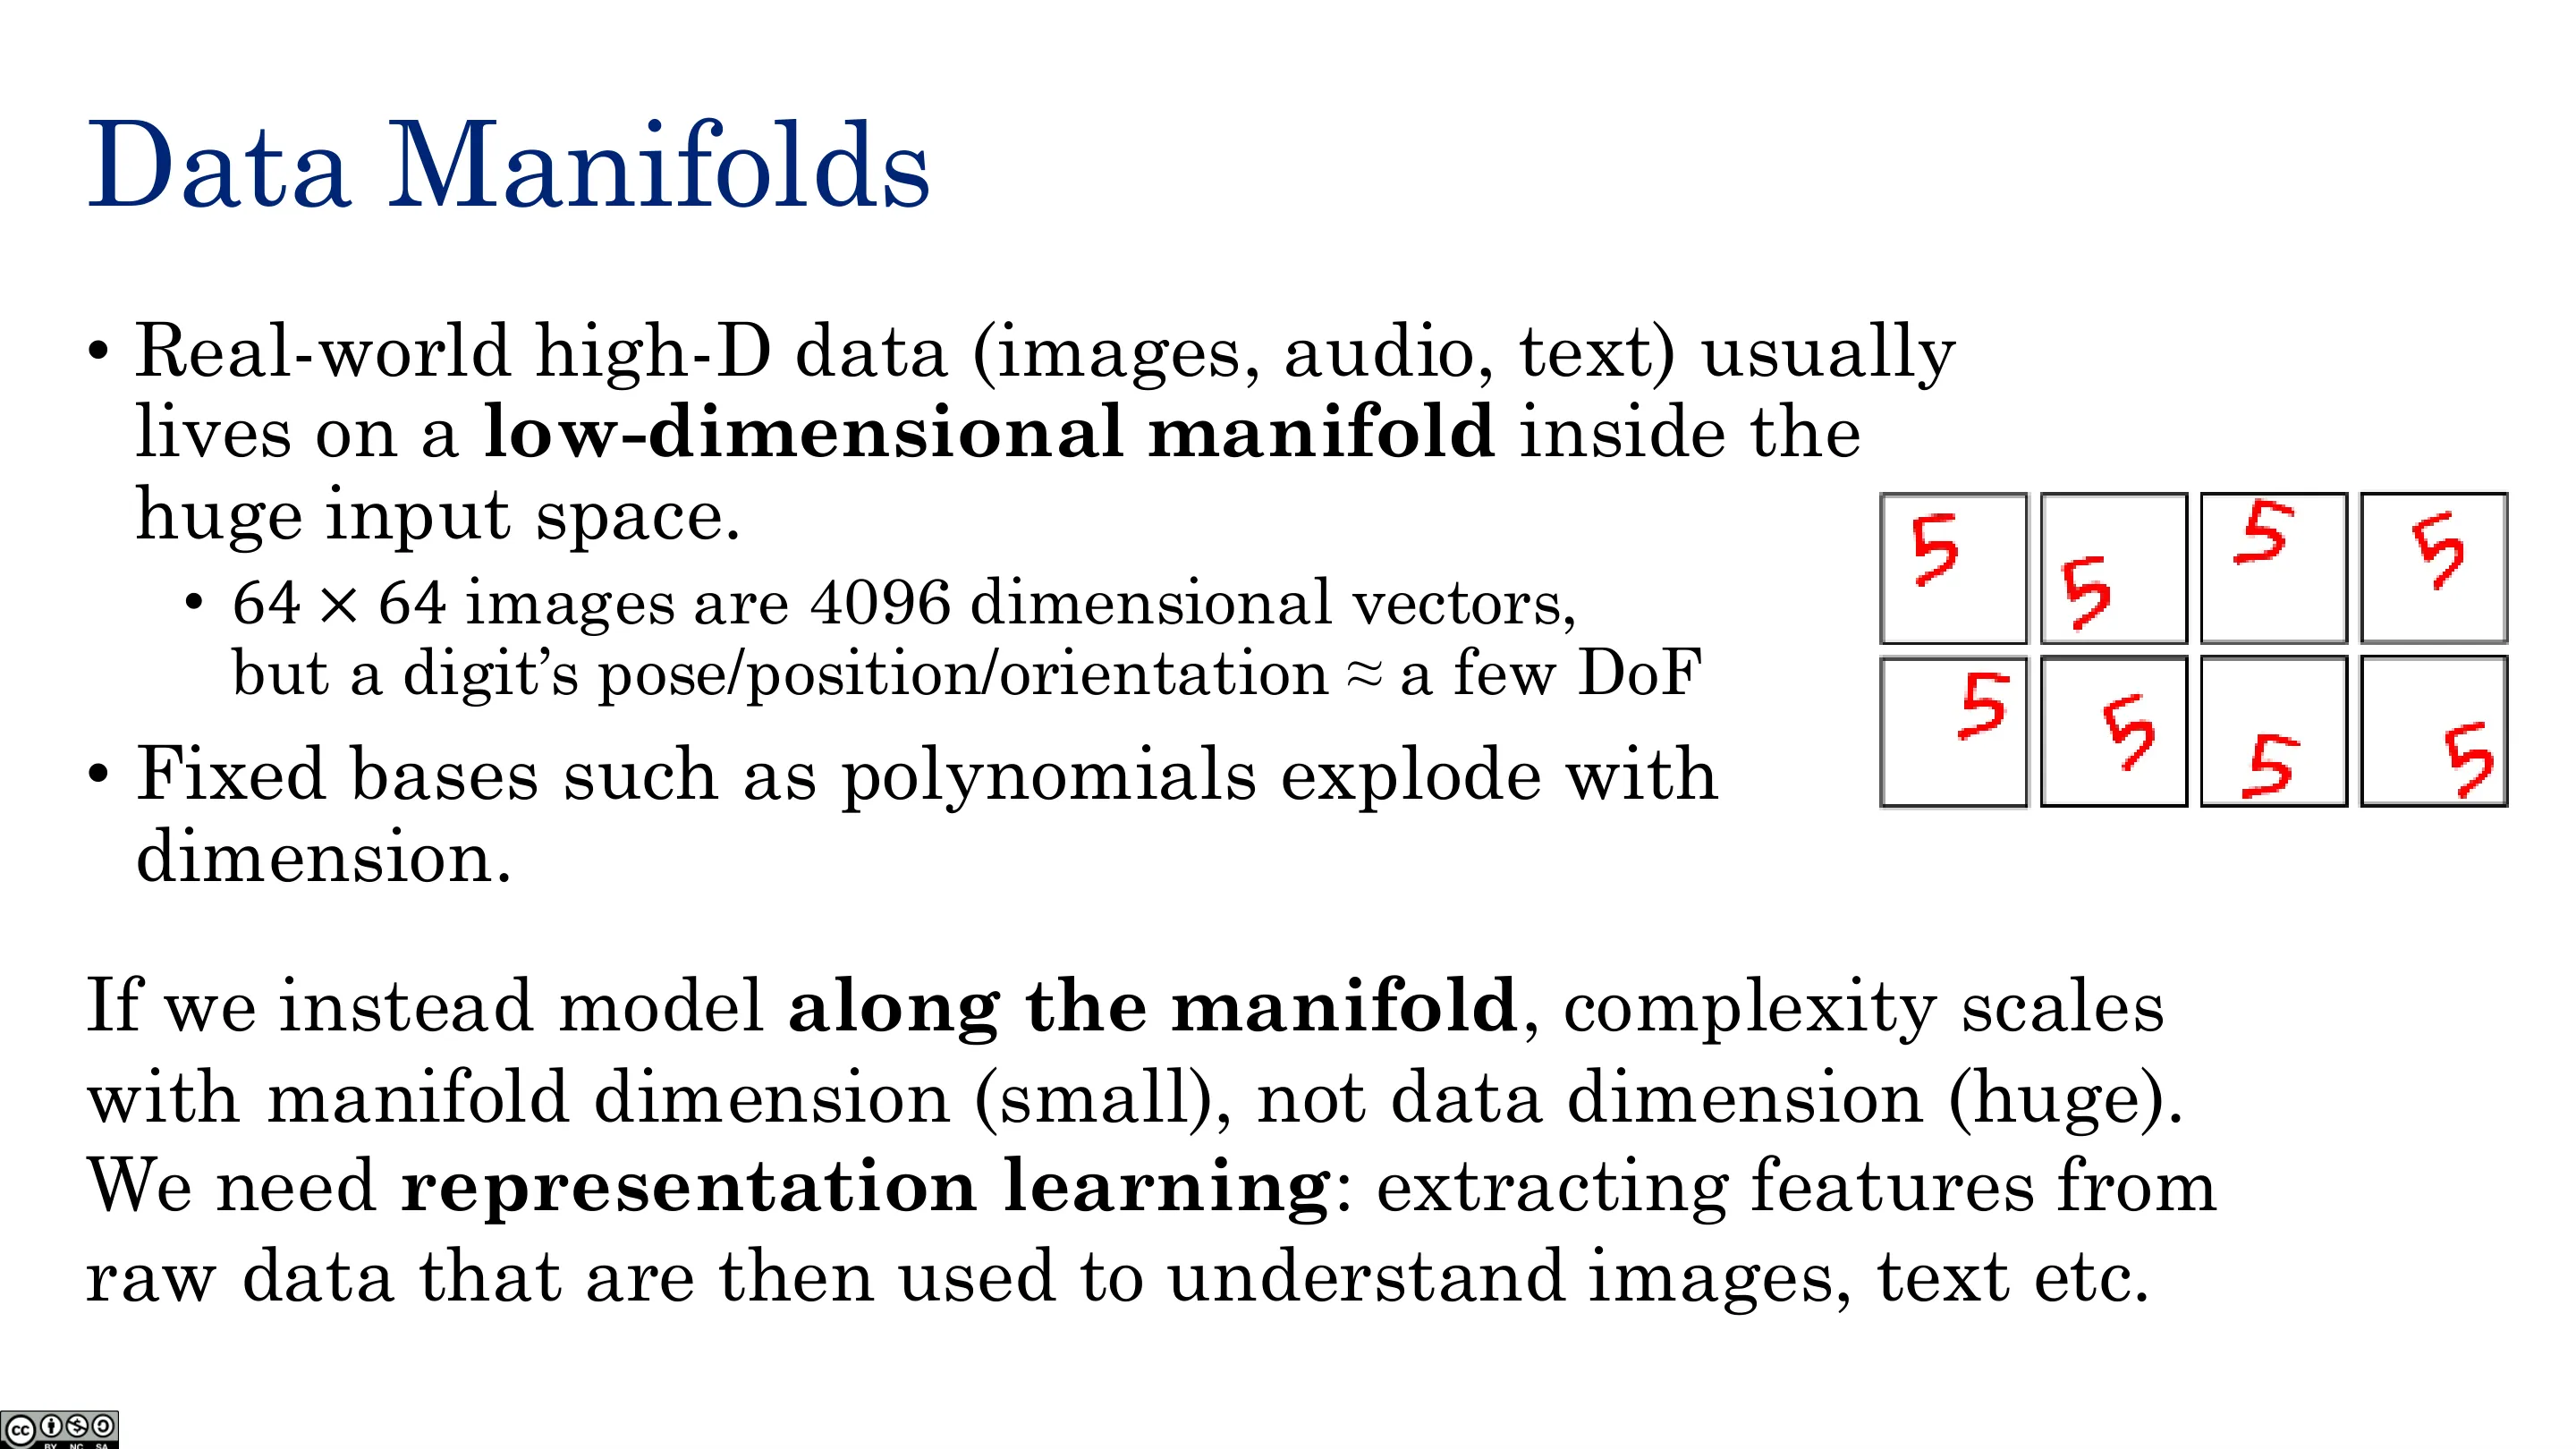
一张 $64\times64$ 灰度图是 4000 维向量(彩色则 ×3)。我们却毫不费力就看出「这是 5」——因为我们相信:自然图像其实落在一个低维流形上(可能只需 ~100 个数就能描述)。所以智能 ≈ 压缩 + 表示学习(representation learning)。
神经网络就是数据驱动地学习这种表示:把 4000 维投影到学到的中间表示(边缘、曲率……),再据此分类。它学到「流形上哪些方向对任务是重要的」。
多项式等已知基函数效果不好;多层才是捕捉结构的关键。
📷 数据流形
回到原视频 (00:02:46)
📷 数据流形 → 神经网络
回到原视频 (00:03:59)
📷 神经网络
回到原视频 (00:05:12)
二、神经元:从生物到人工
(参考时间: 00:04)
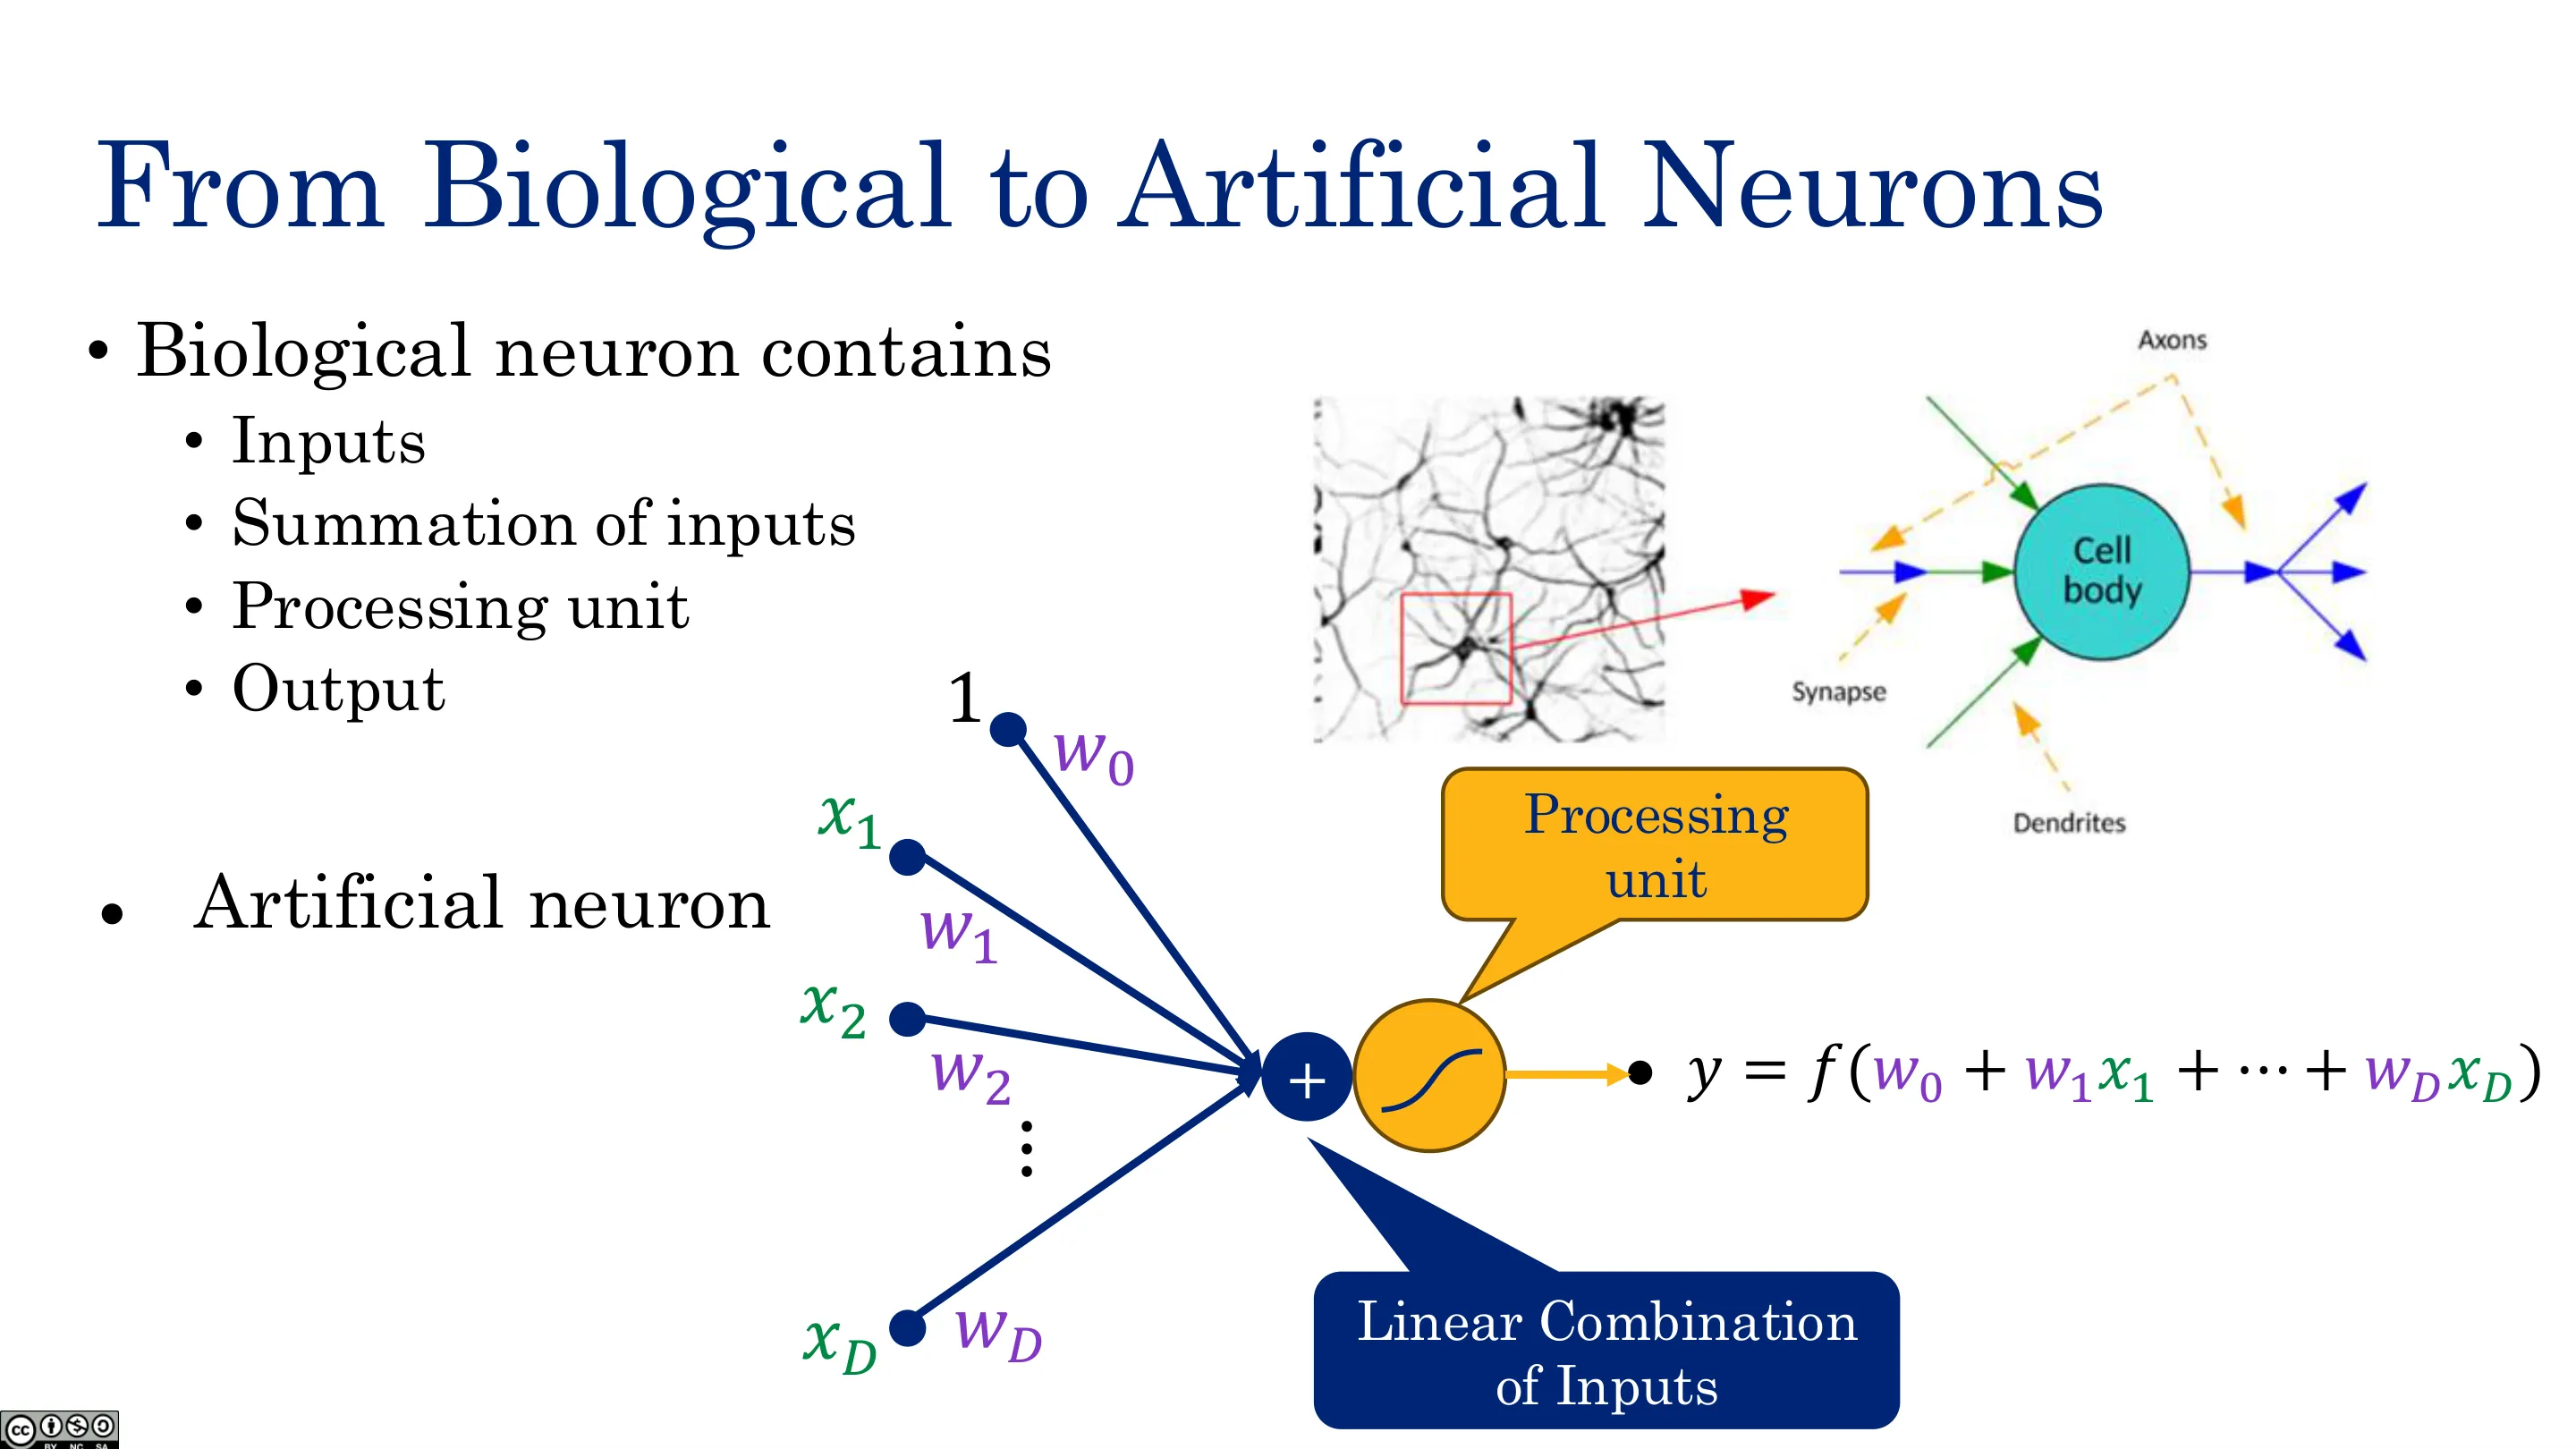
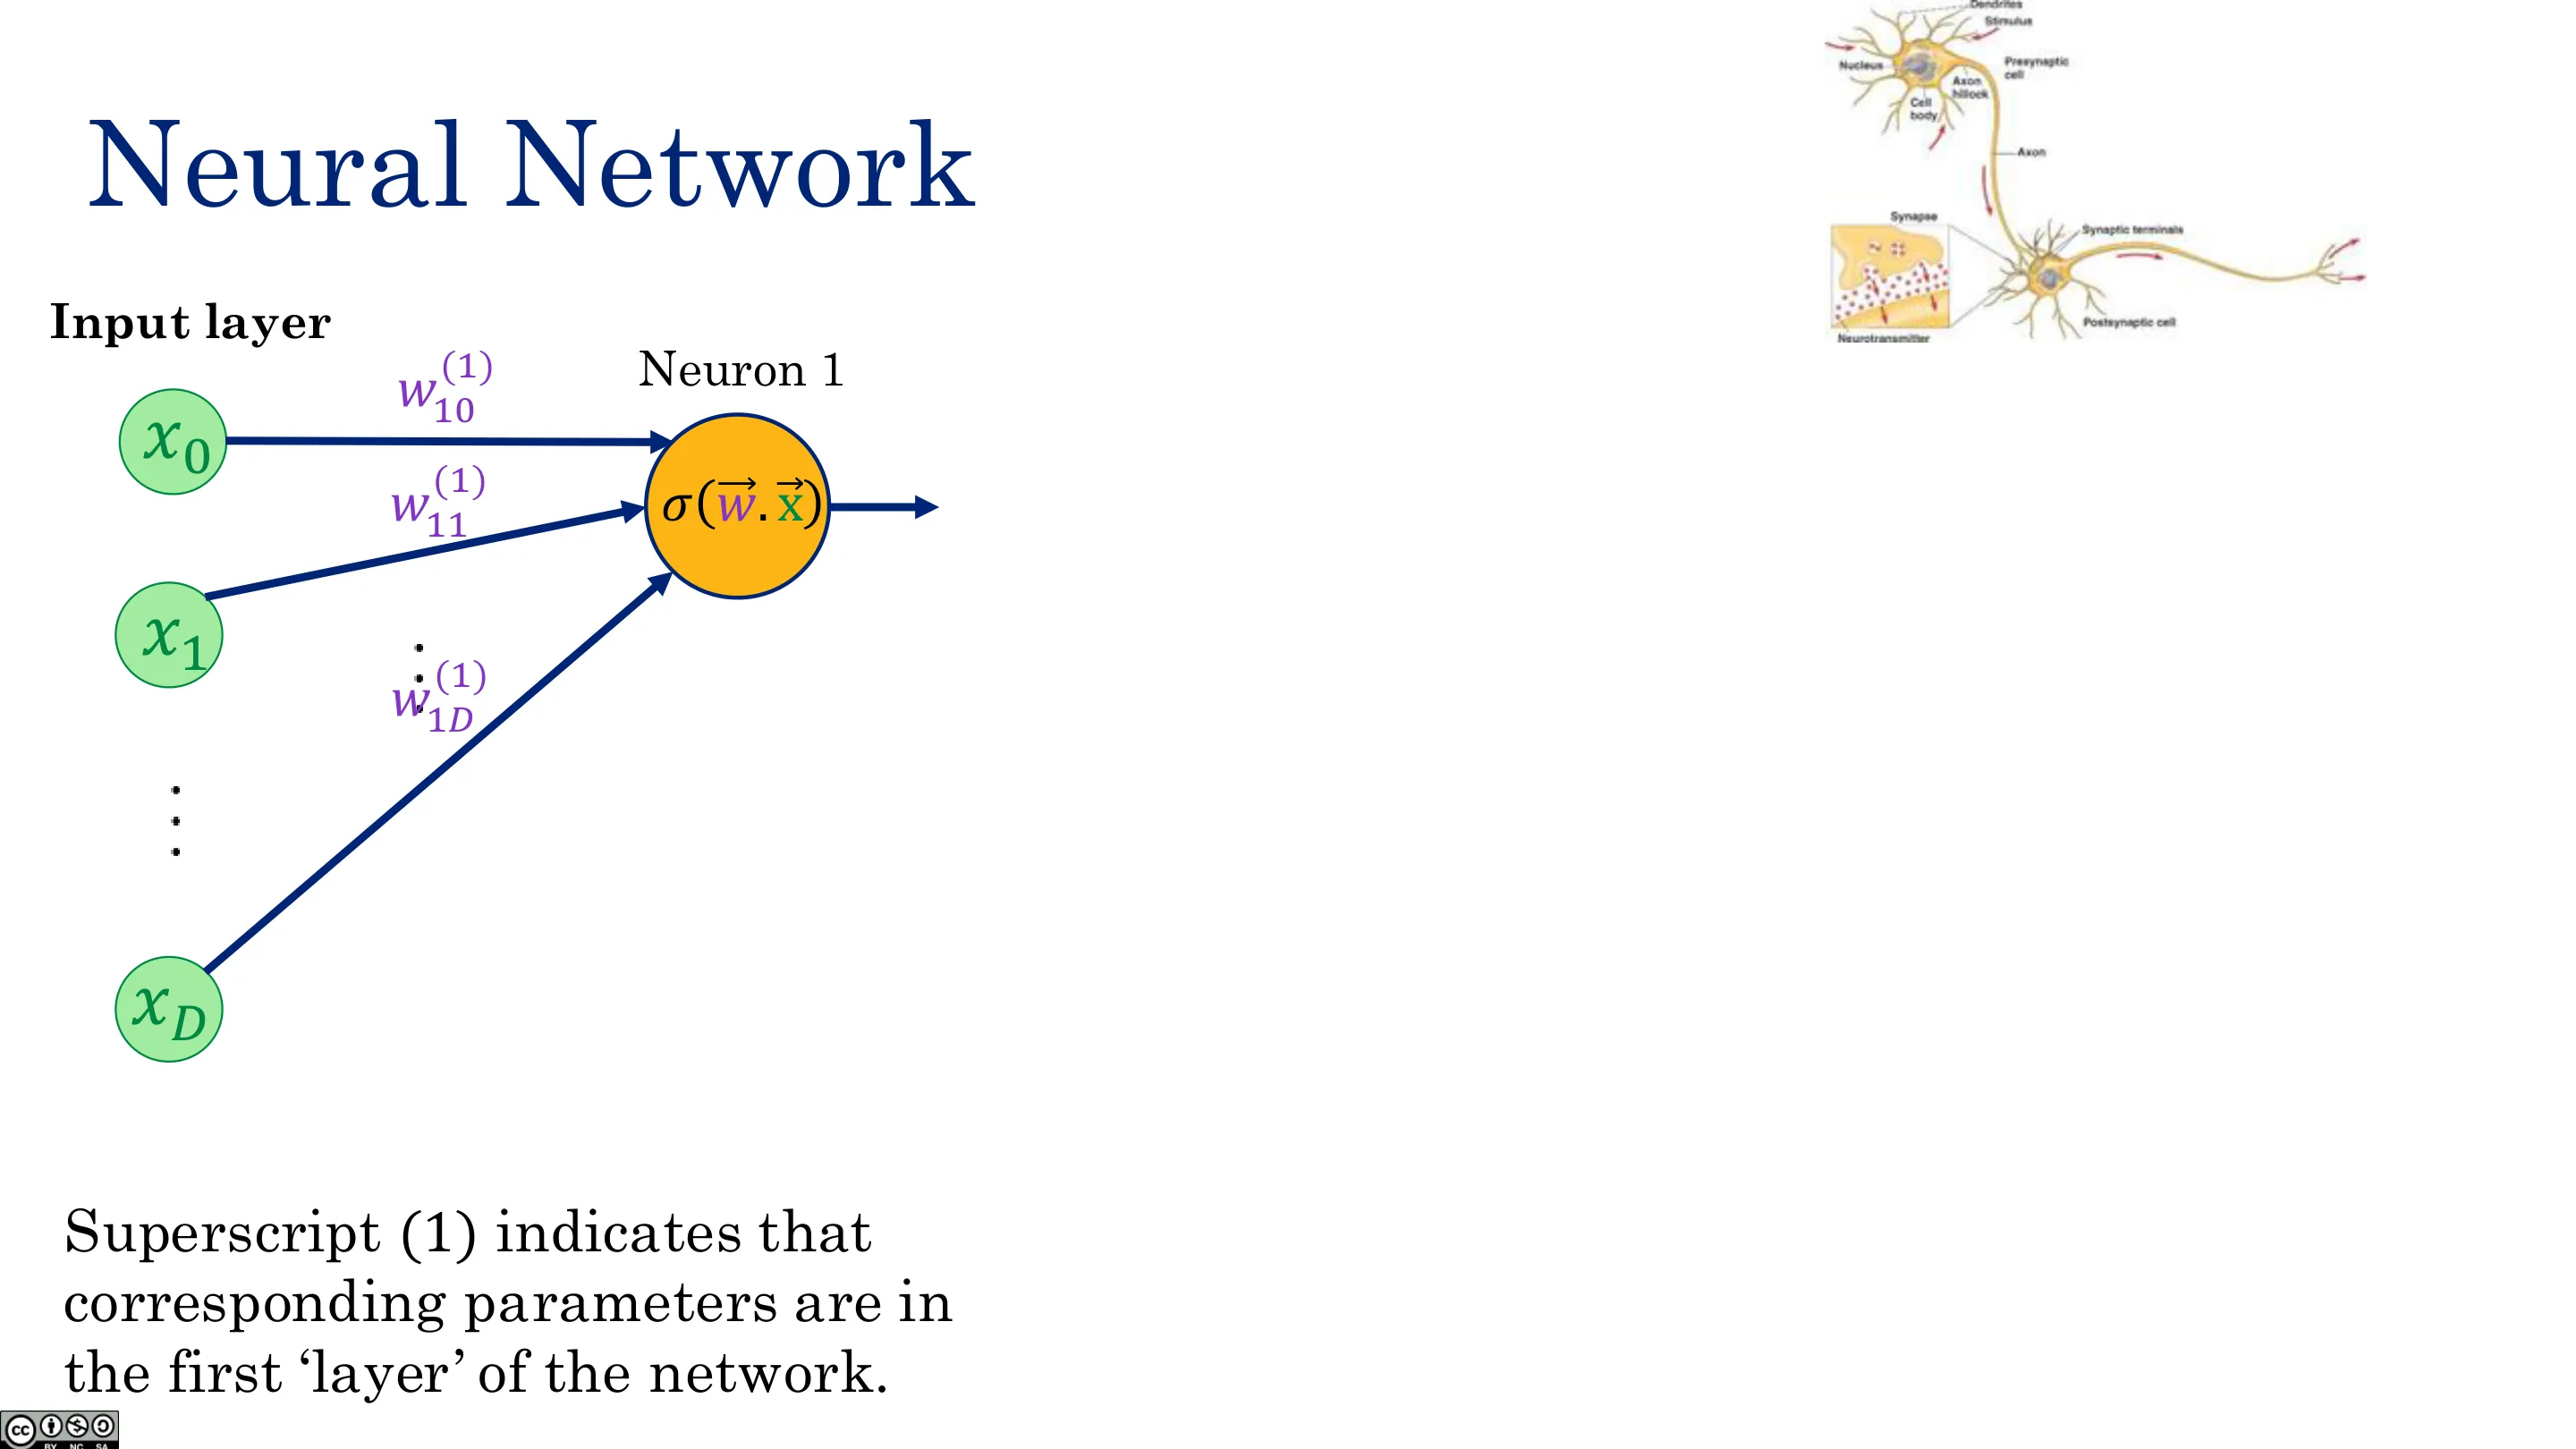
生物神经元:树突(dendrite) 收集输入 → 聚合(突触可兴奋/抑制,即乘正/负数)→ 轴突 输出单值。学习发生在突触强度(权重)上:婴儿的权重是随机的,随经验更新。
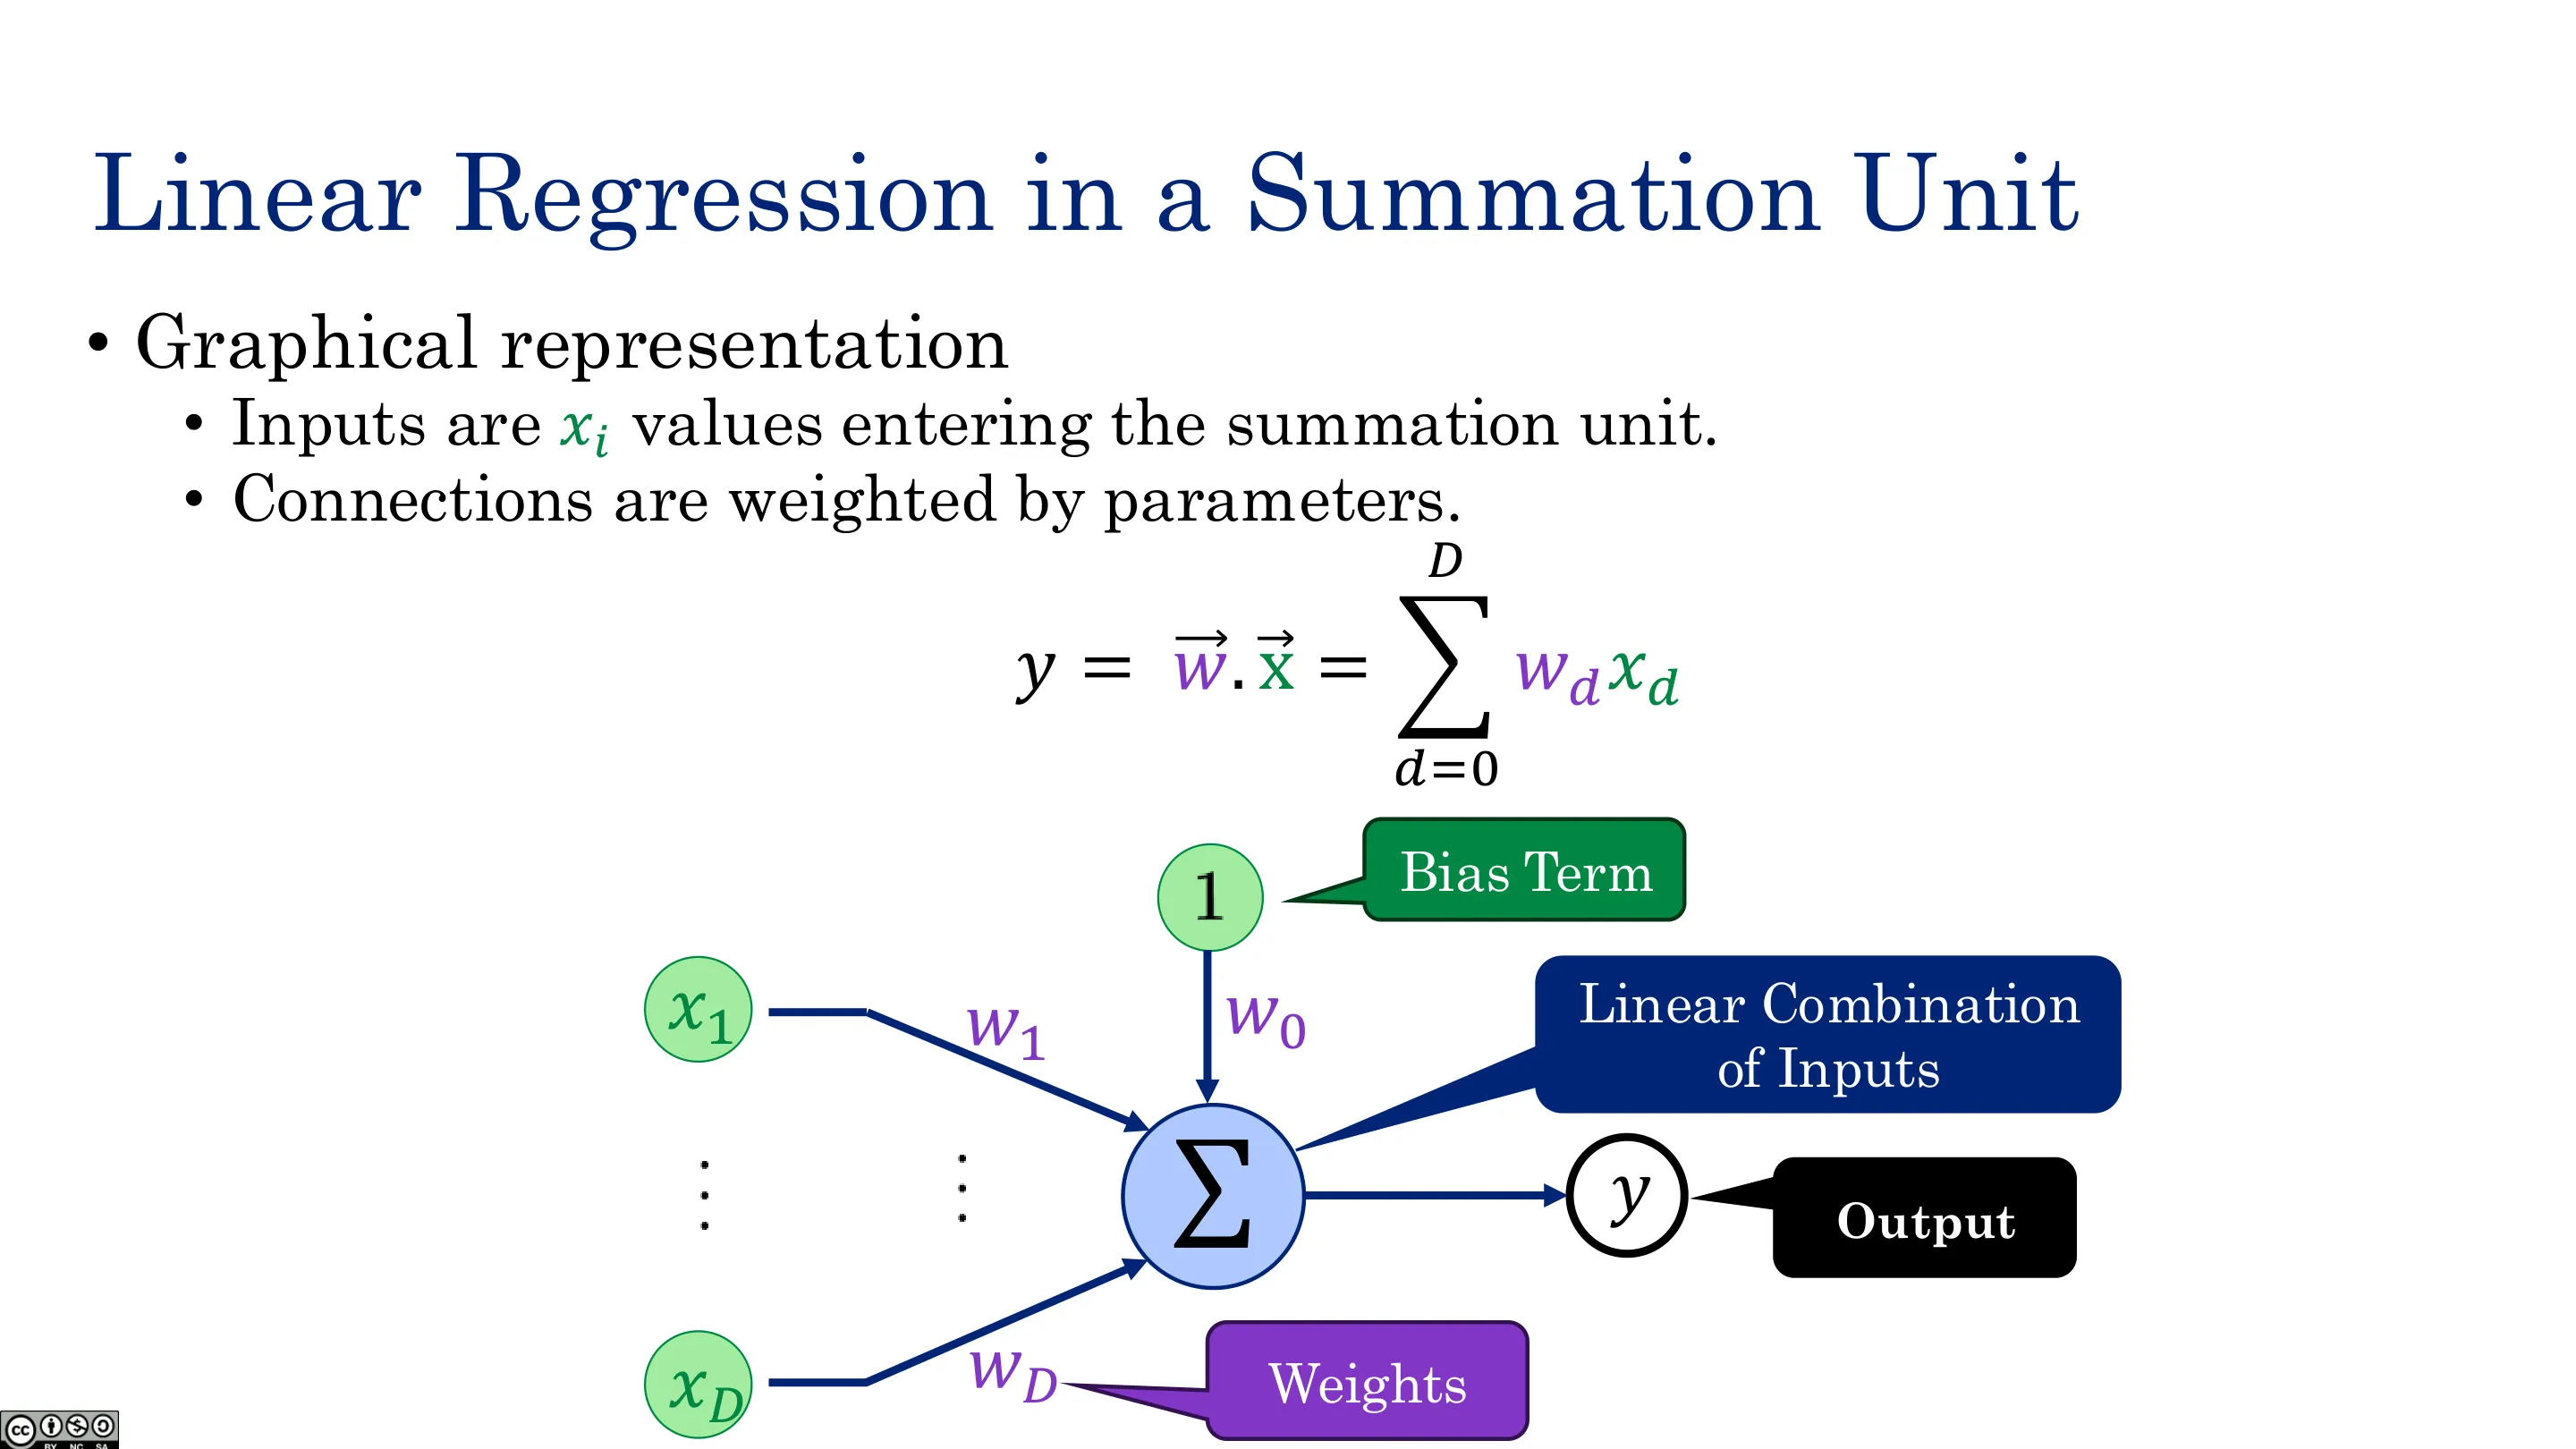
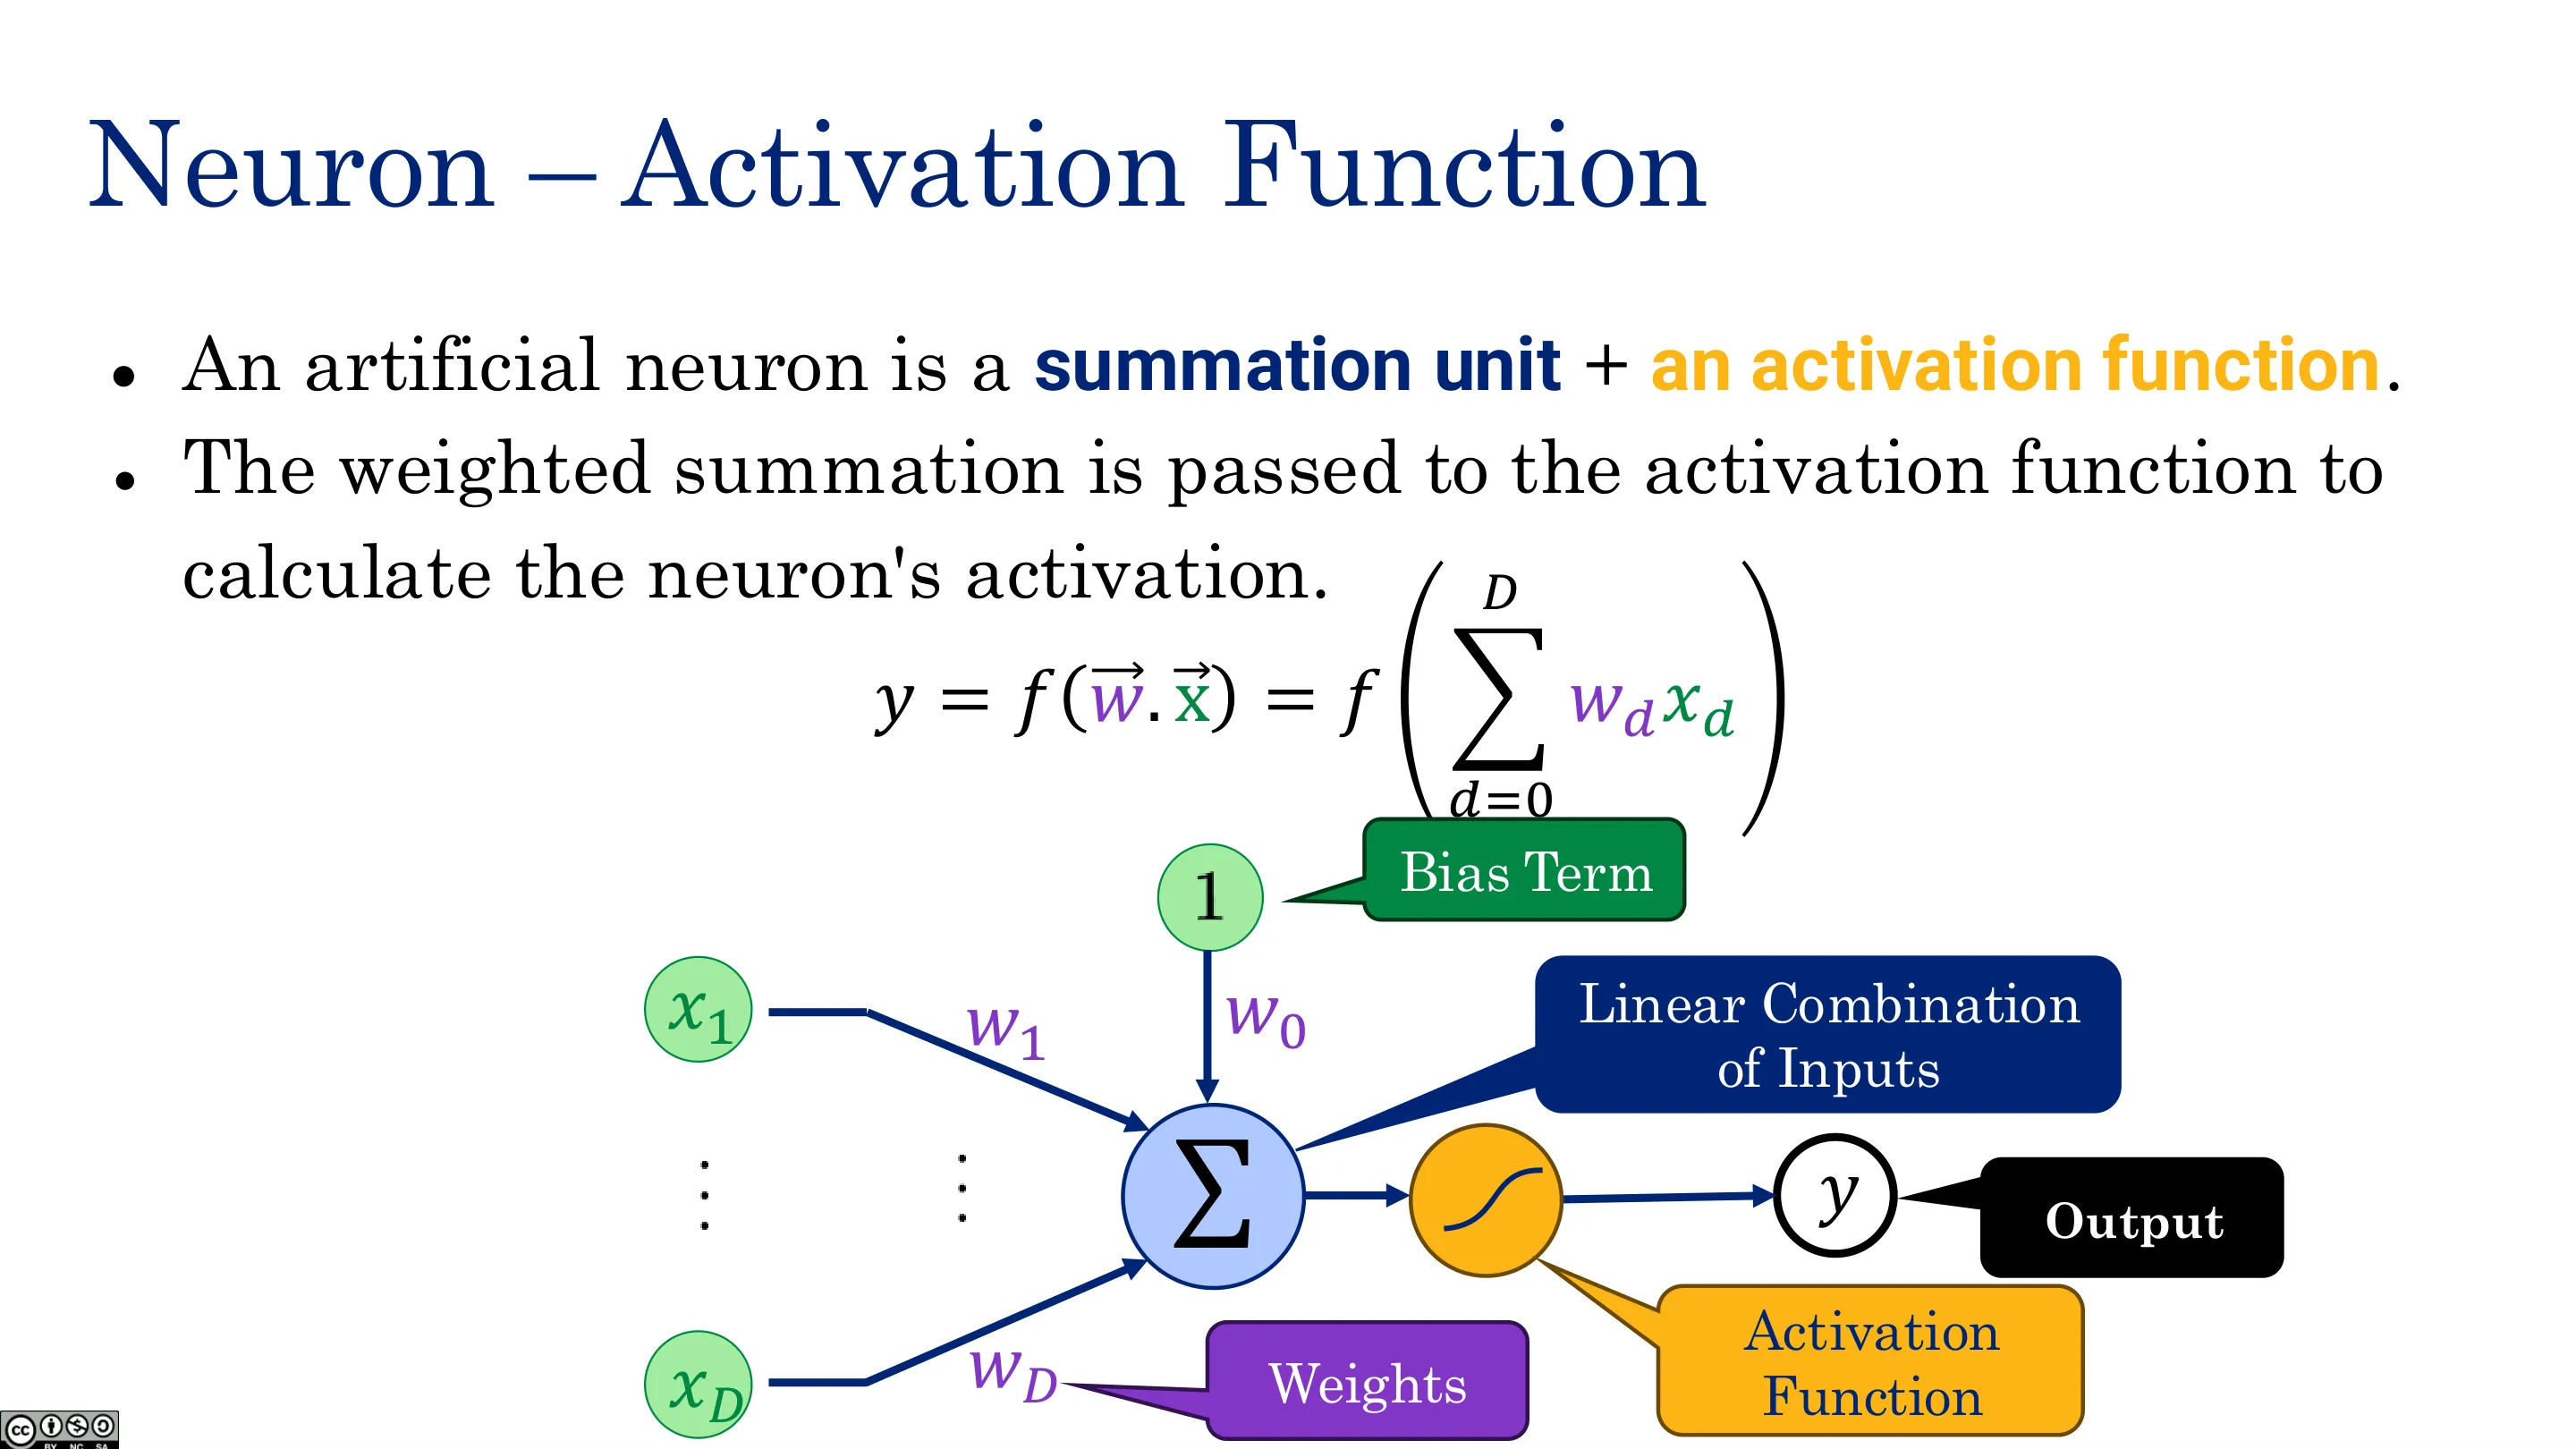
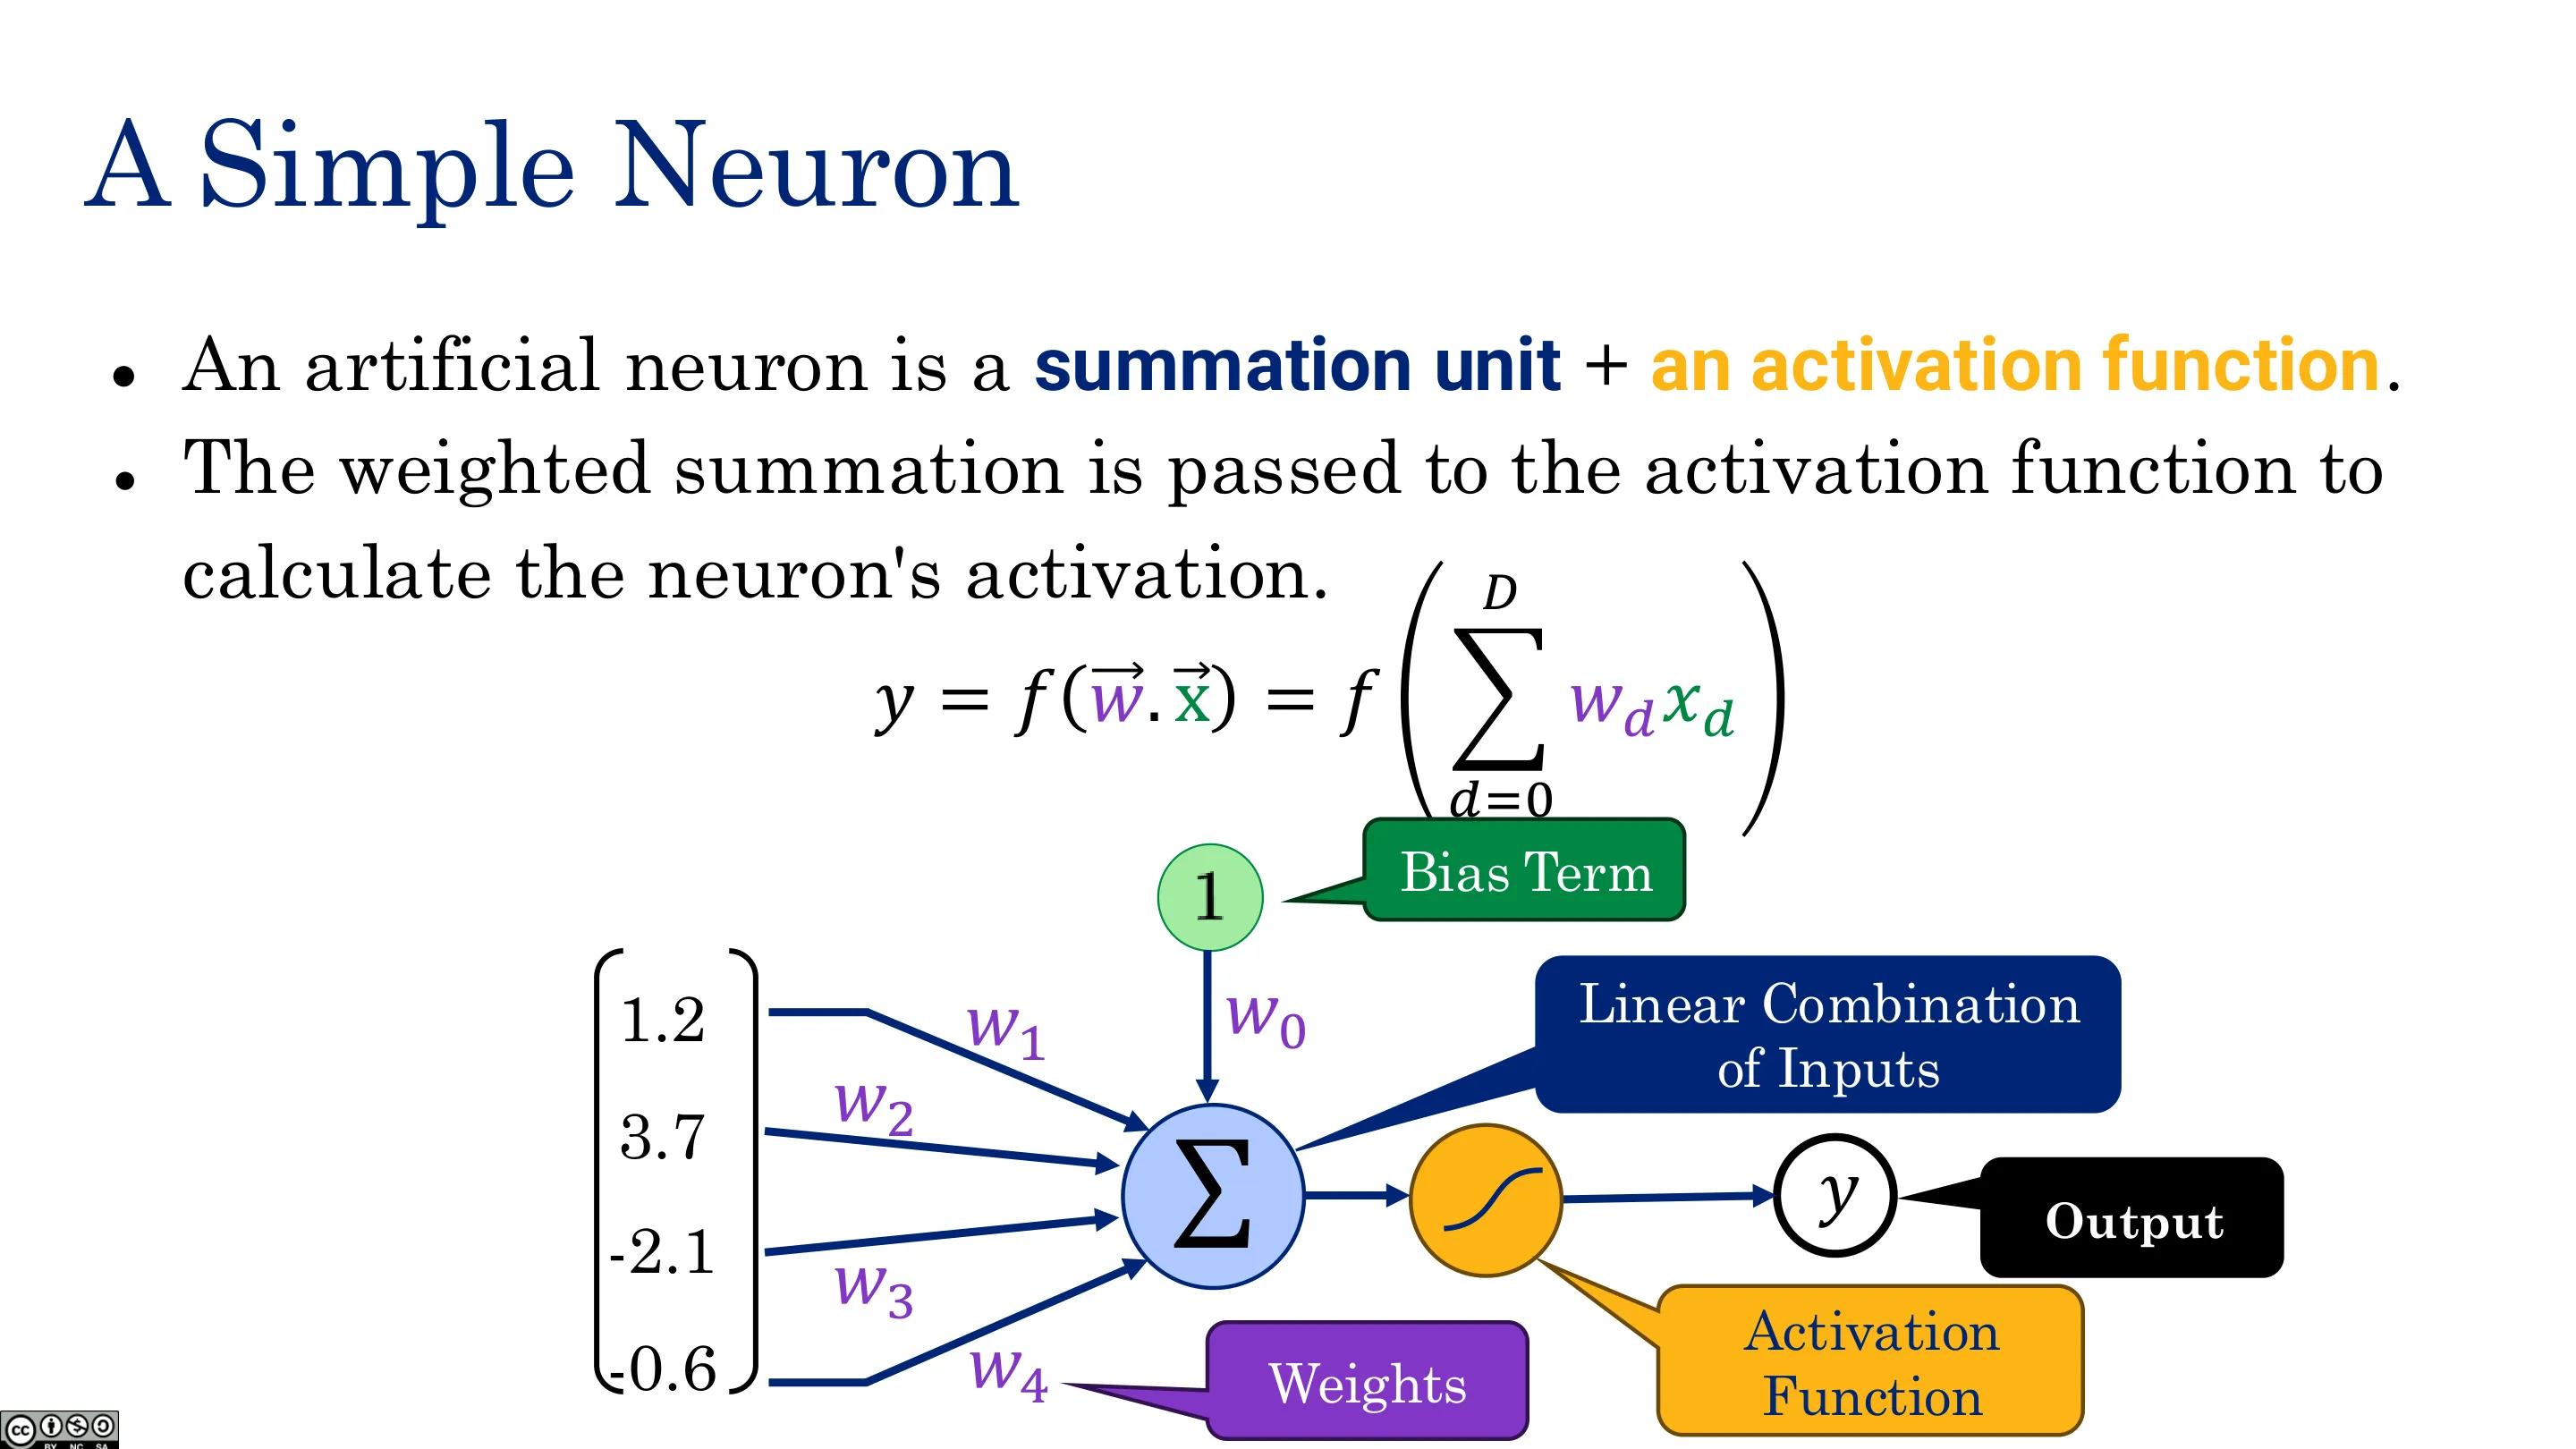
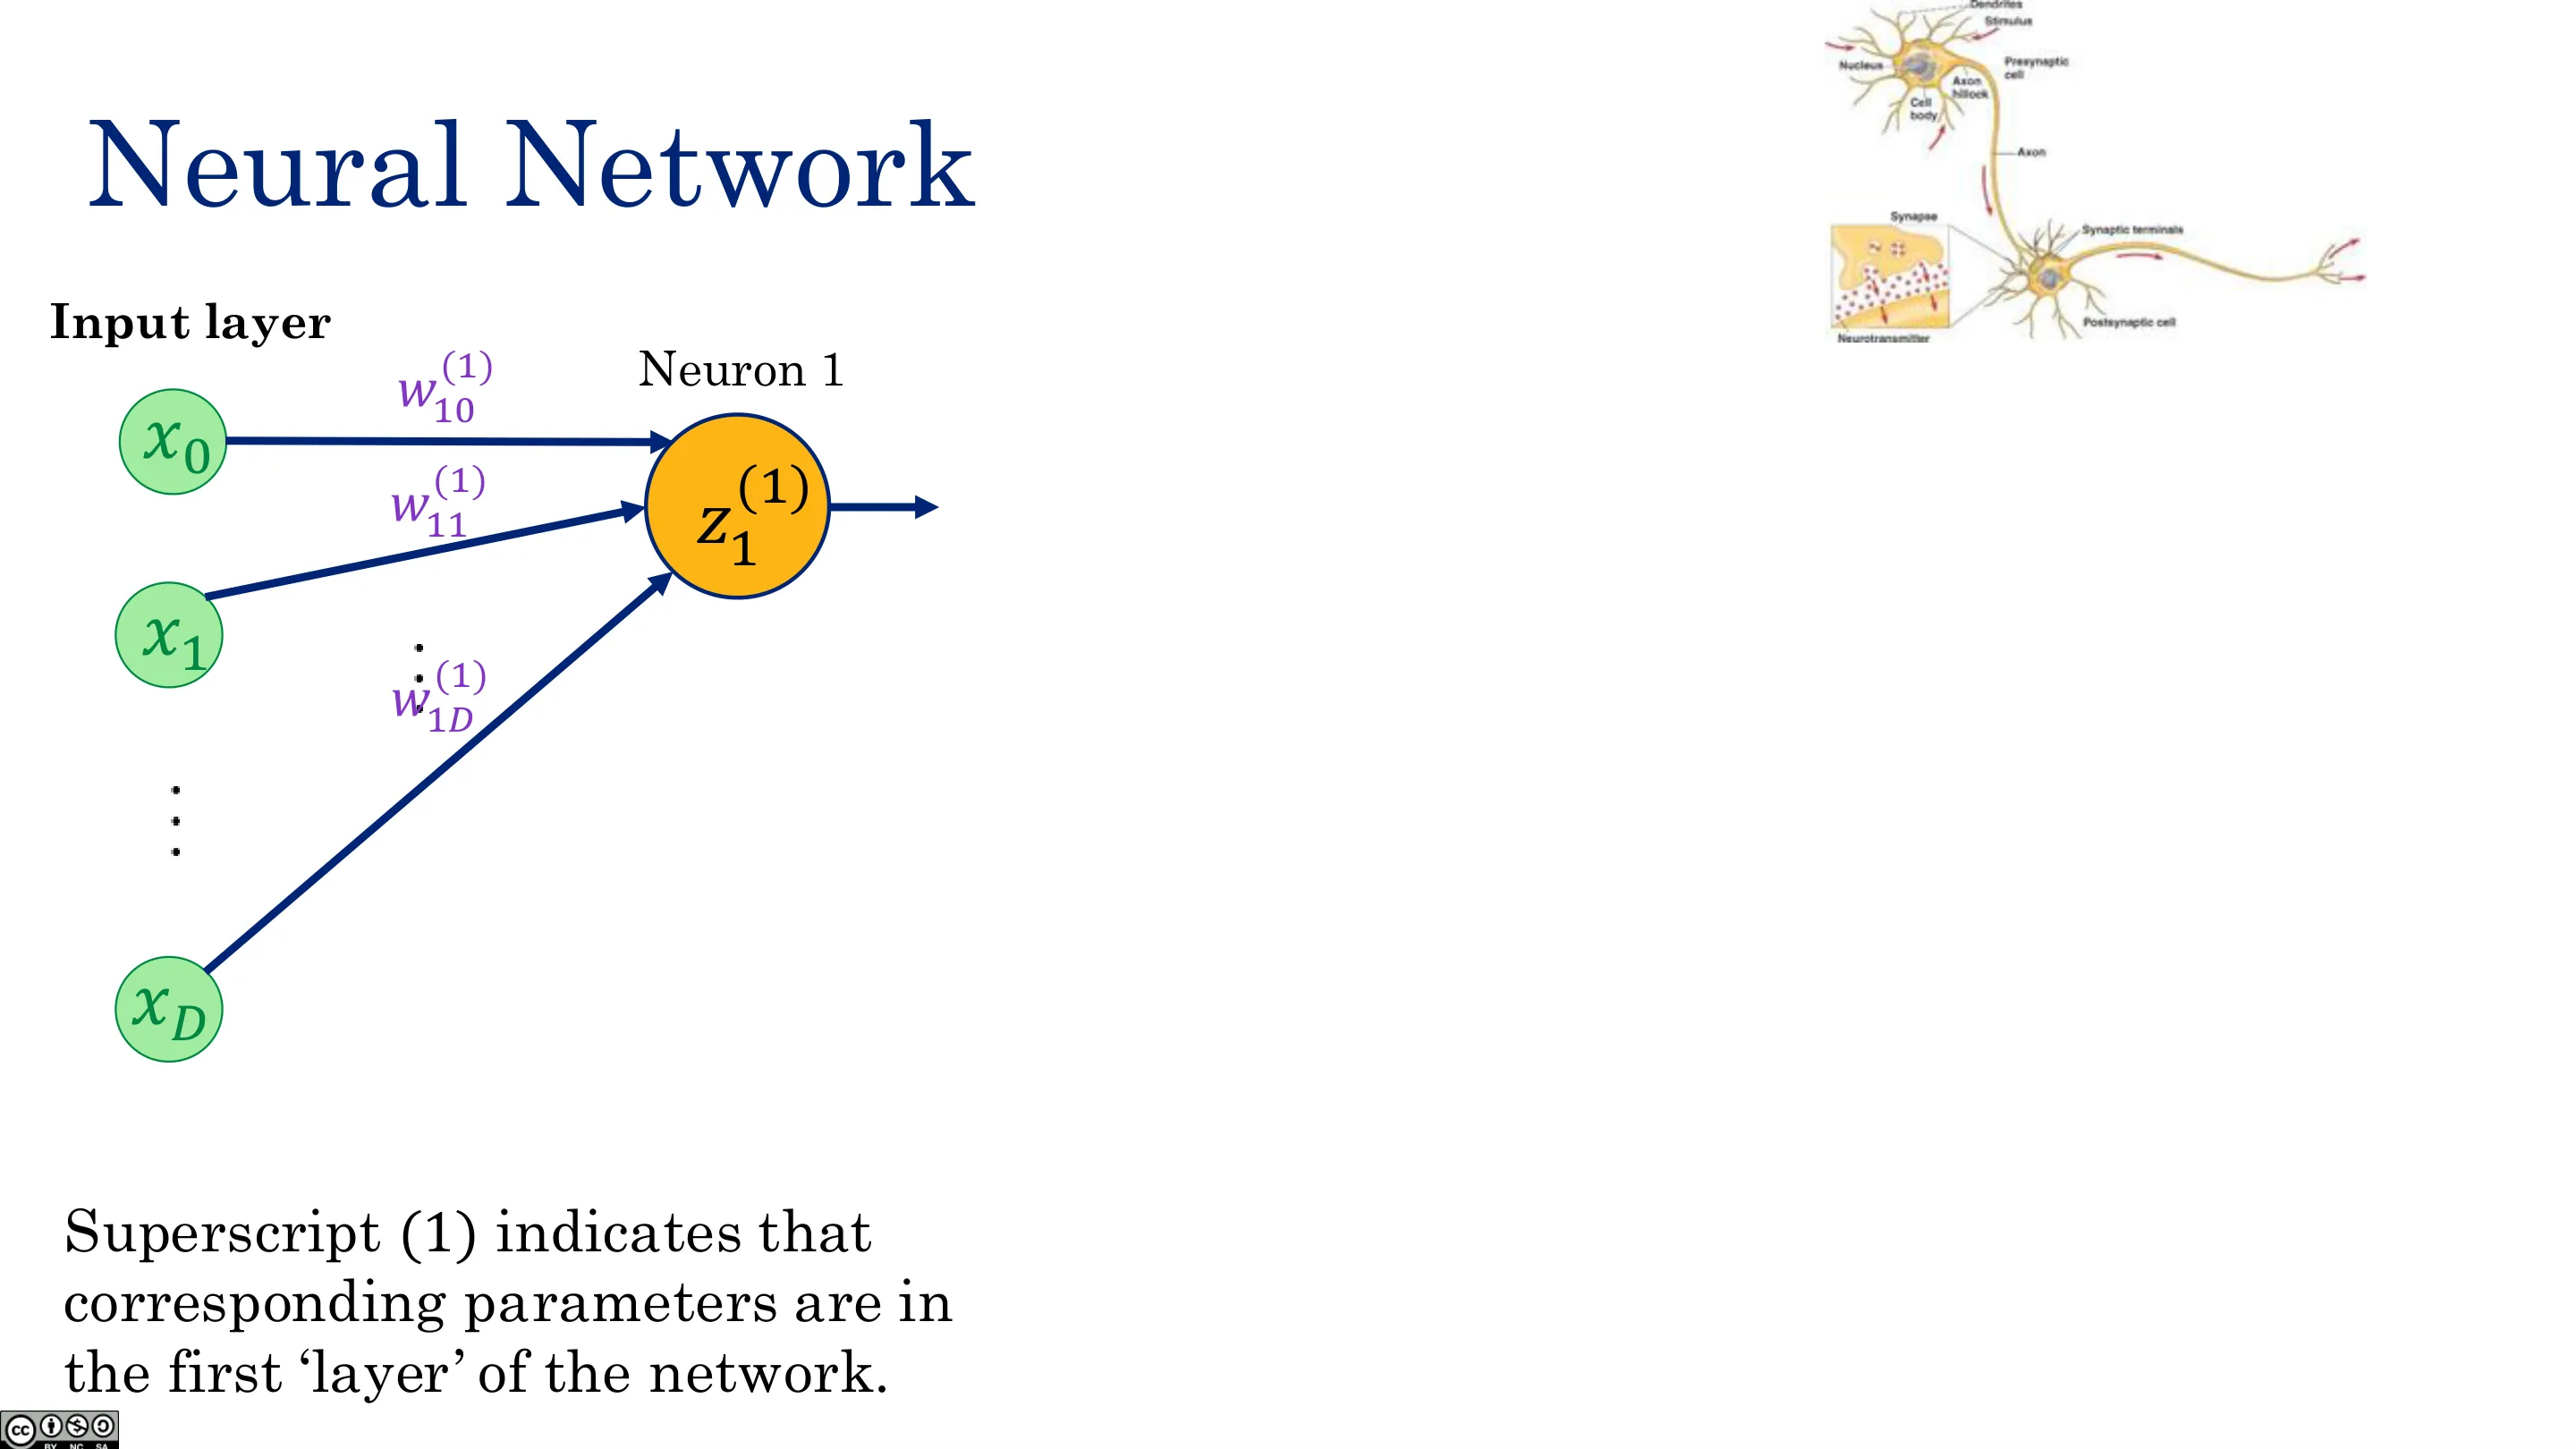
人工神经元:输入 $x_1,\dots,x_d$(外加恒为 1 的偏置输入)→ 加权求和 $z=\sum w_ix_i$ →(可选)过激活函数 $f$ → 输出。
- 没有激活 ⇒ 就是线性回归;
- 激活 = Sigmoid ⇒ 就是逻辑回归;
- 神经网络 = 一堆逻辑回归,前一层输出作为后一层的特征。
📷 神经元
回到原视频 (00:06:25)
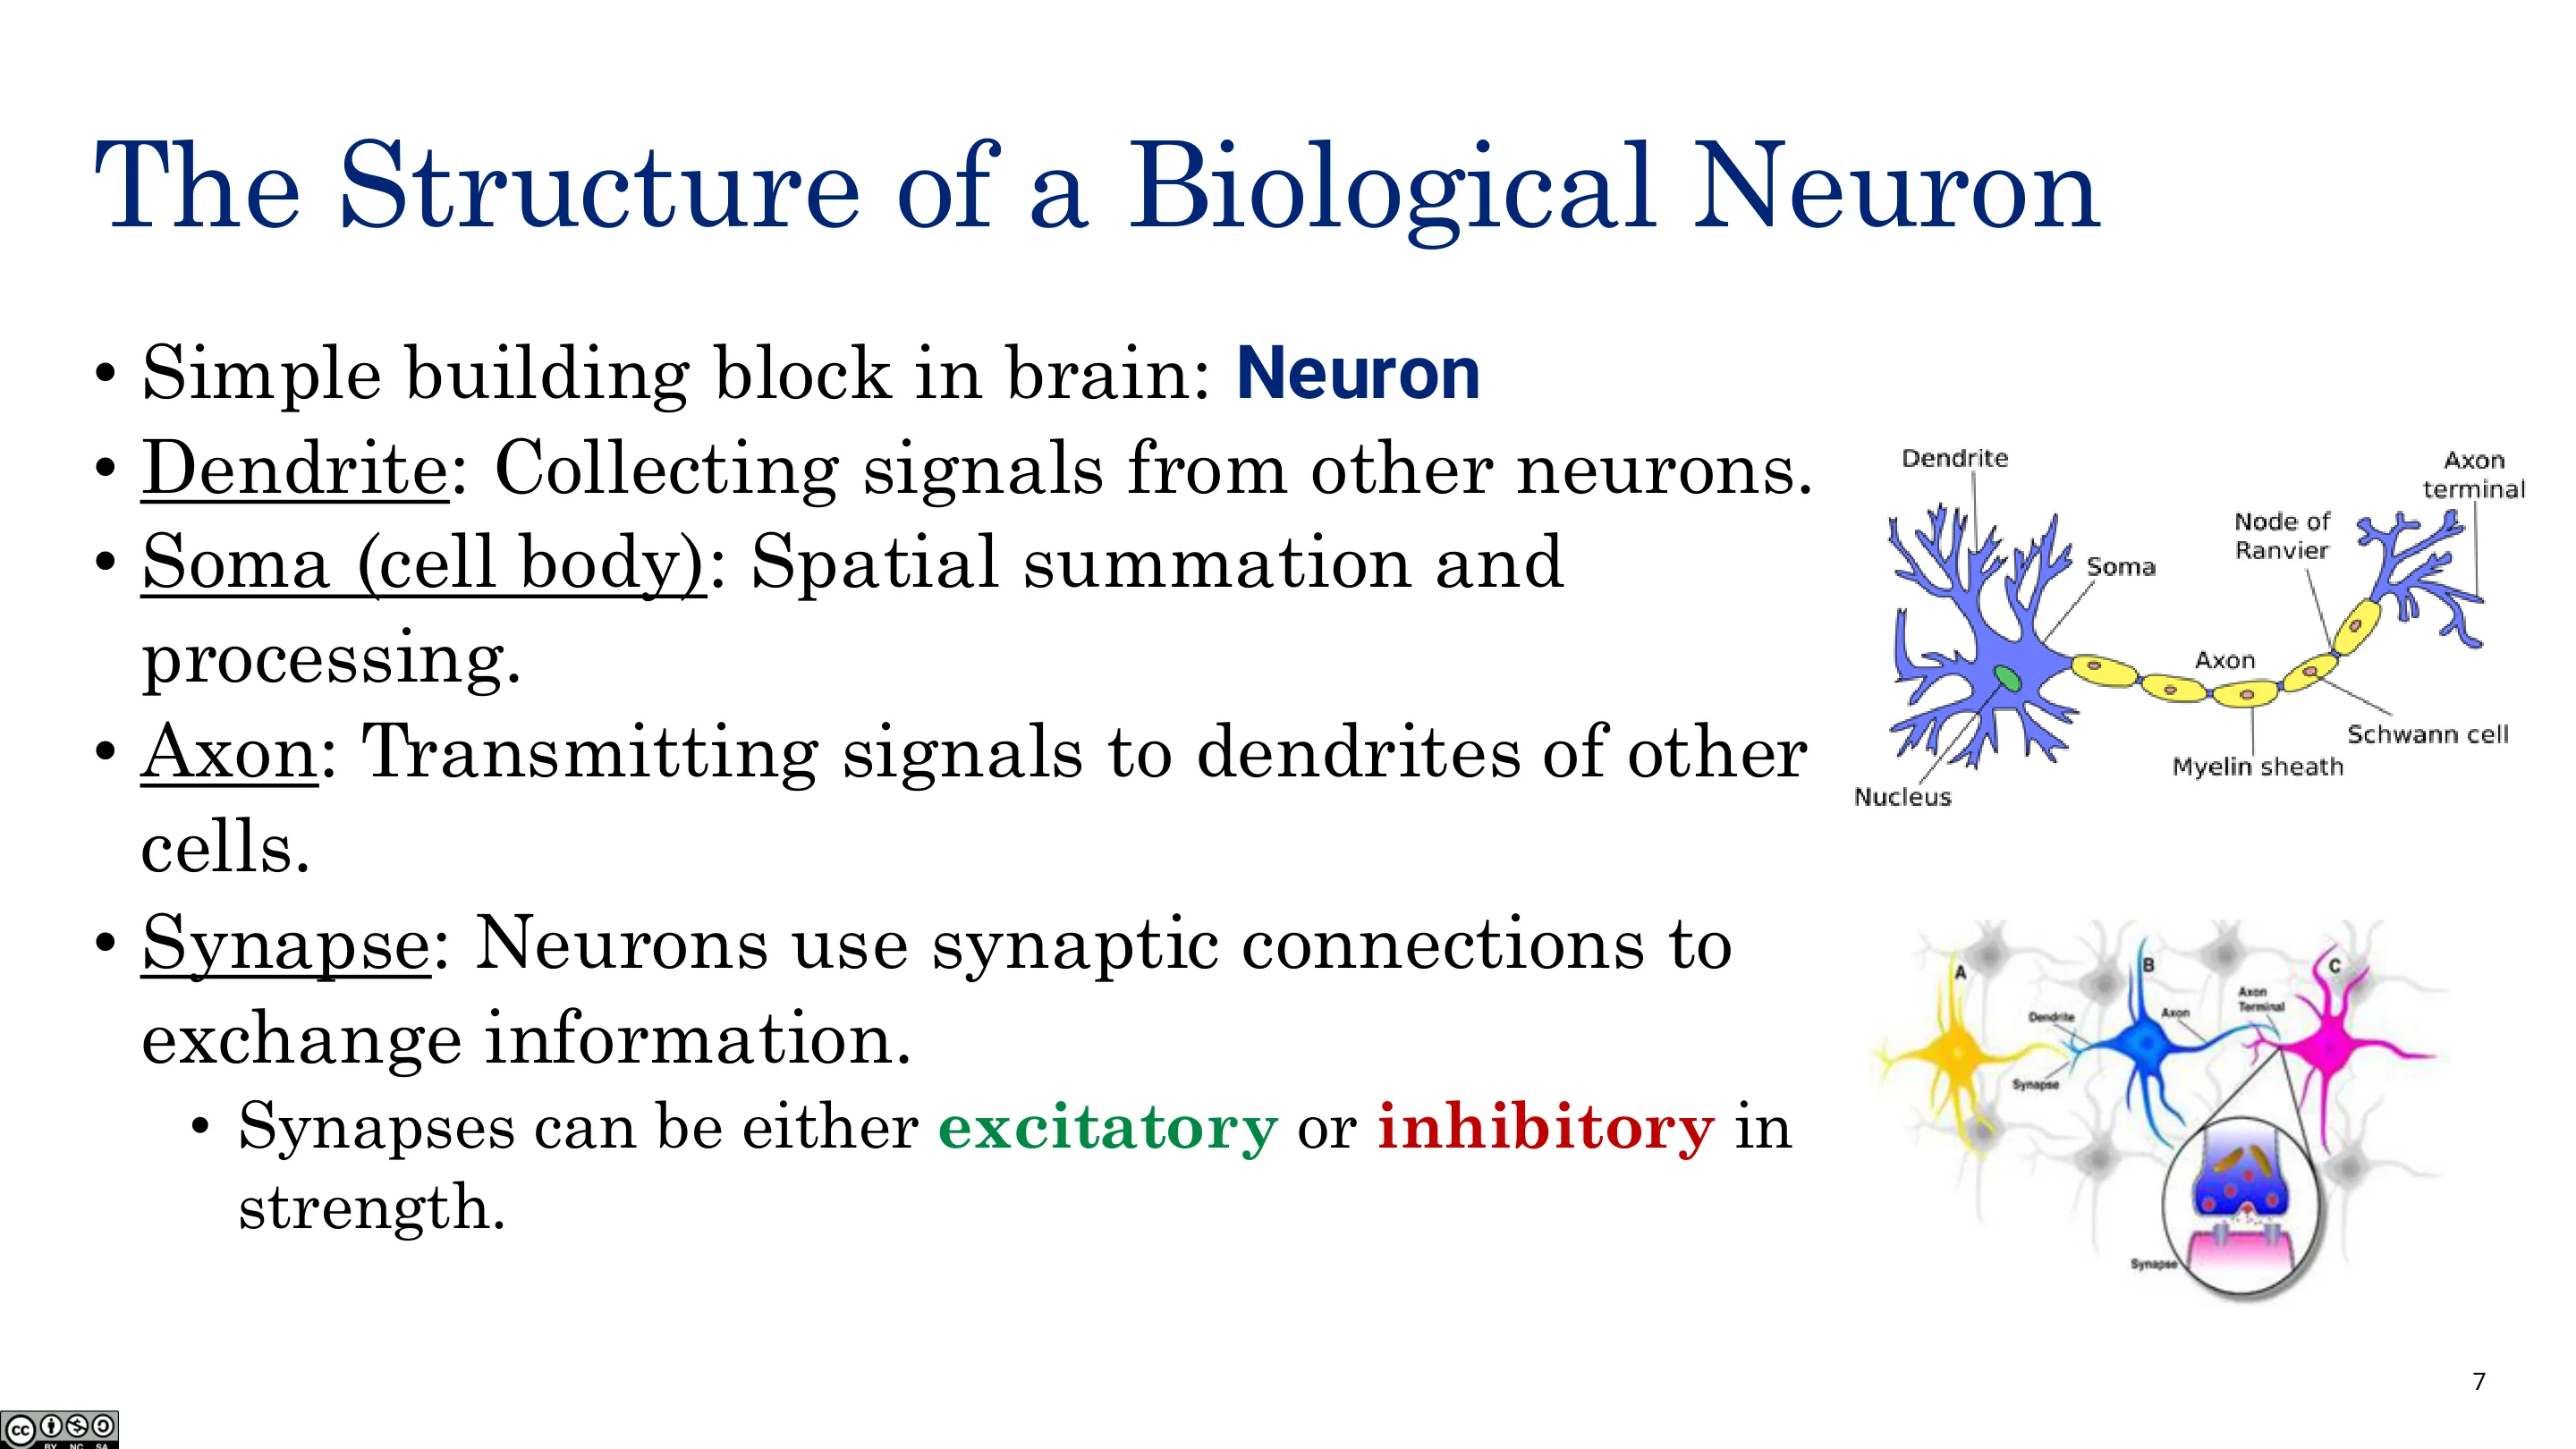
📷 生物神经元的结构
回到原视频 (00:07:38)
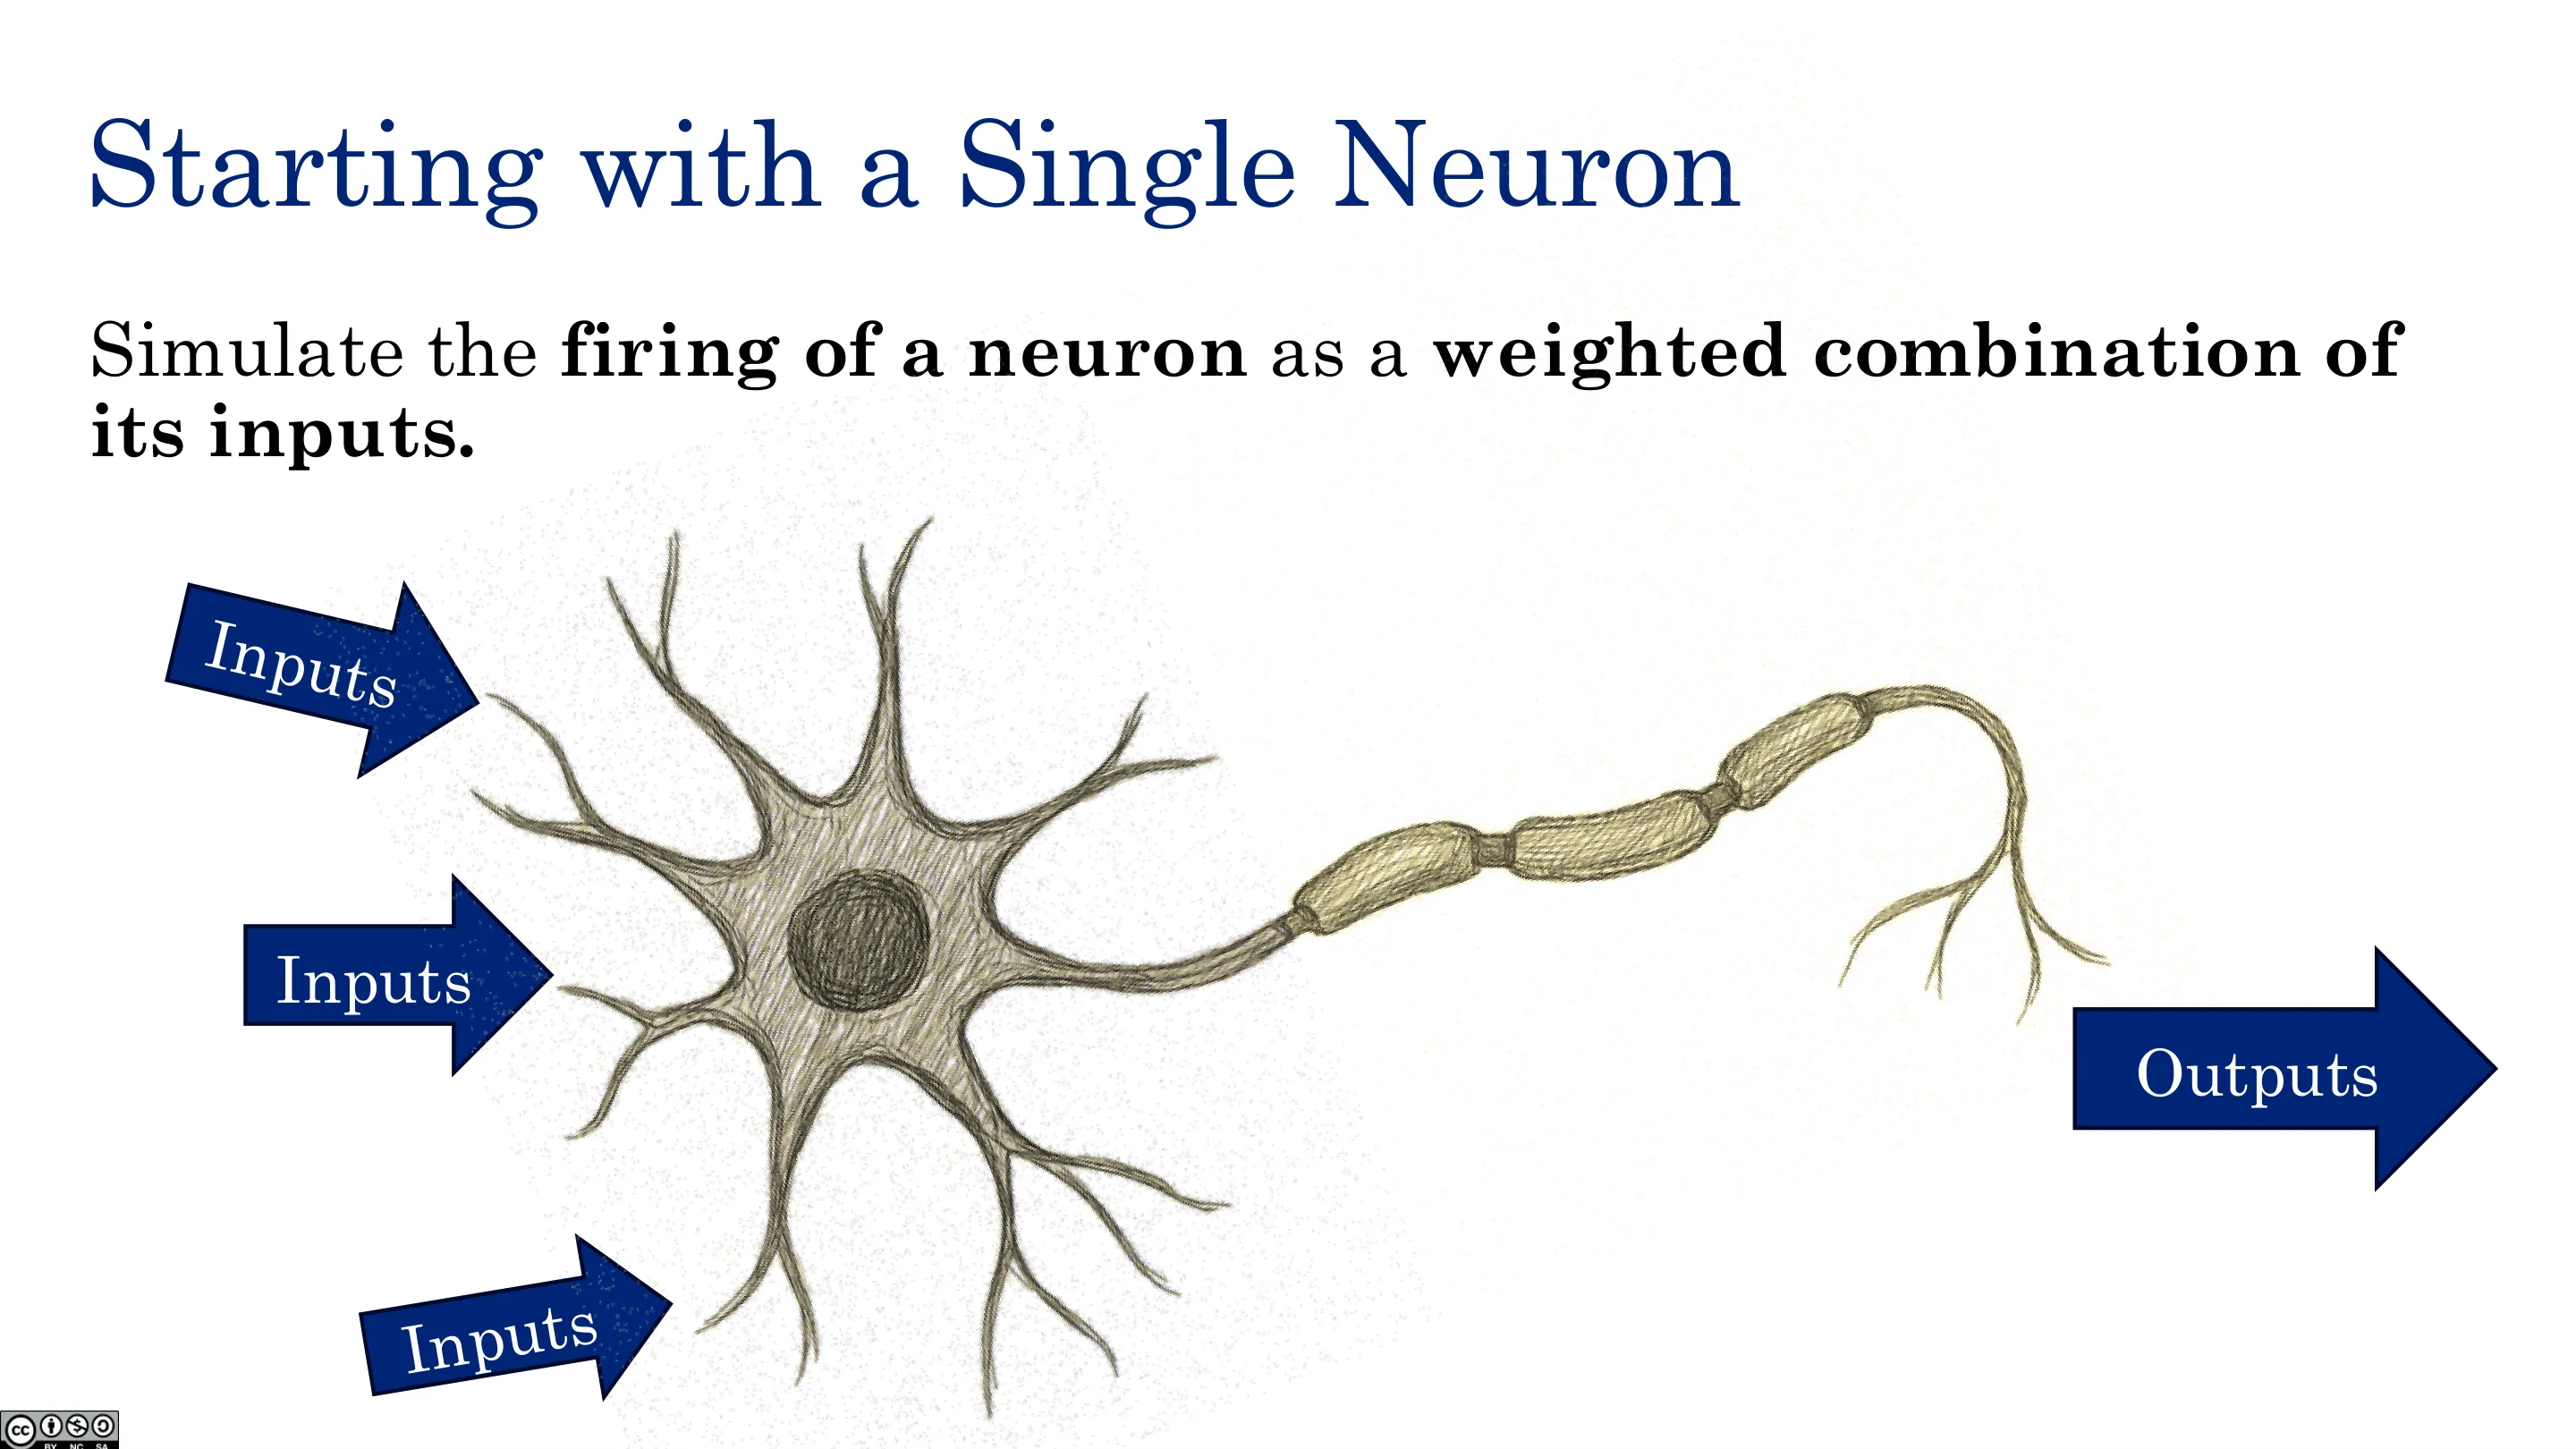
📷 从单个神经元开始
回到原视频 (00:08:51)
📷 从生物到人工神经元
回到原视频 (00:10:04)
📷 求和单元里的线性回归
回到原视频 (00:11:17)
📷 神经元的激活函数
回到原视频 (00:12:30)
📷 一个简单的神经元
回到原视频 (00:13:43)
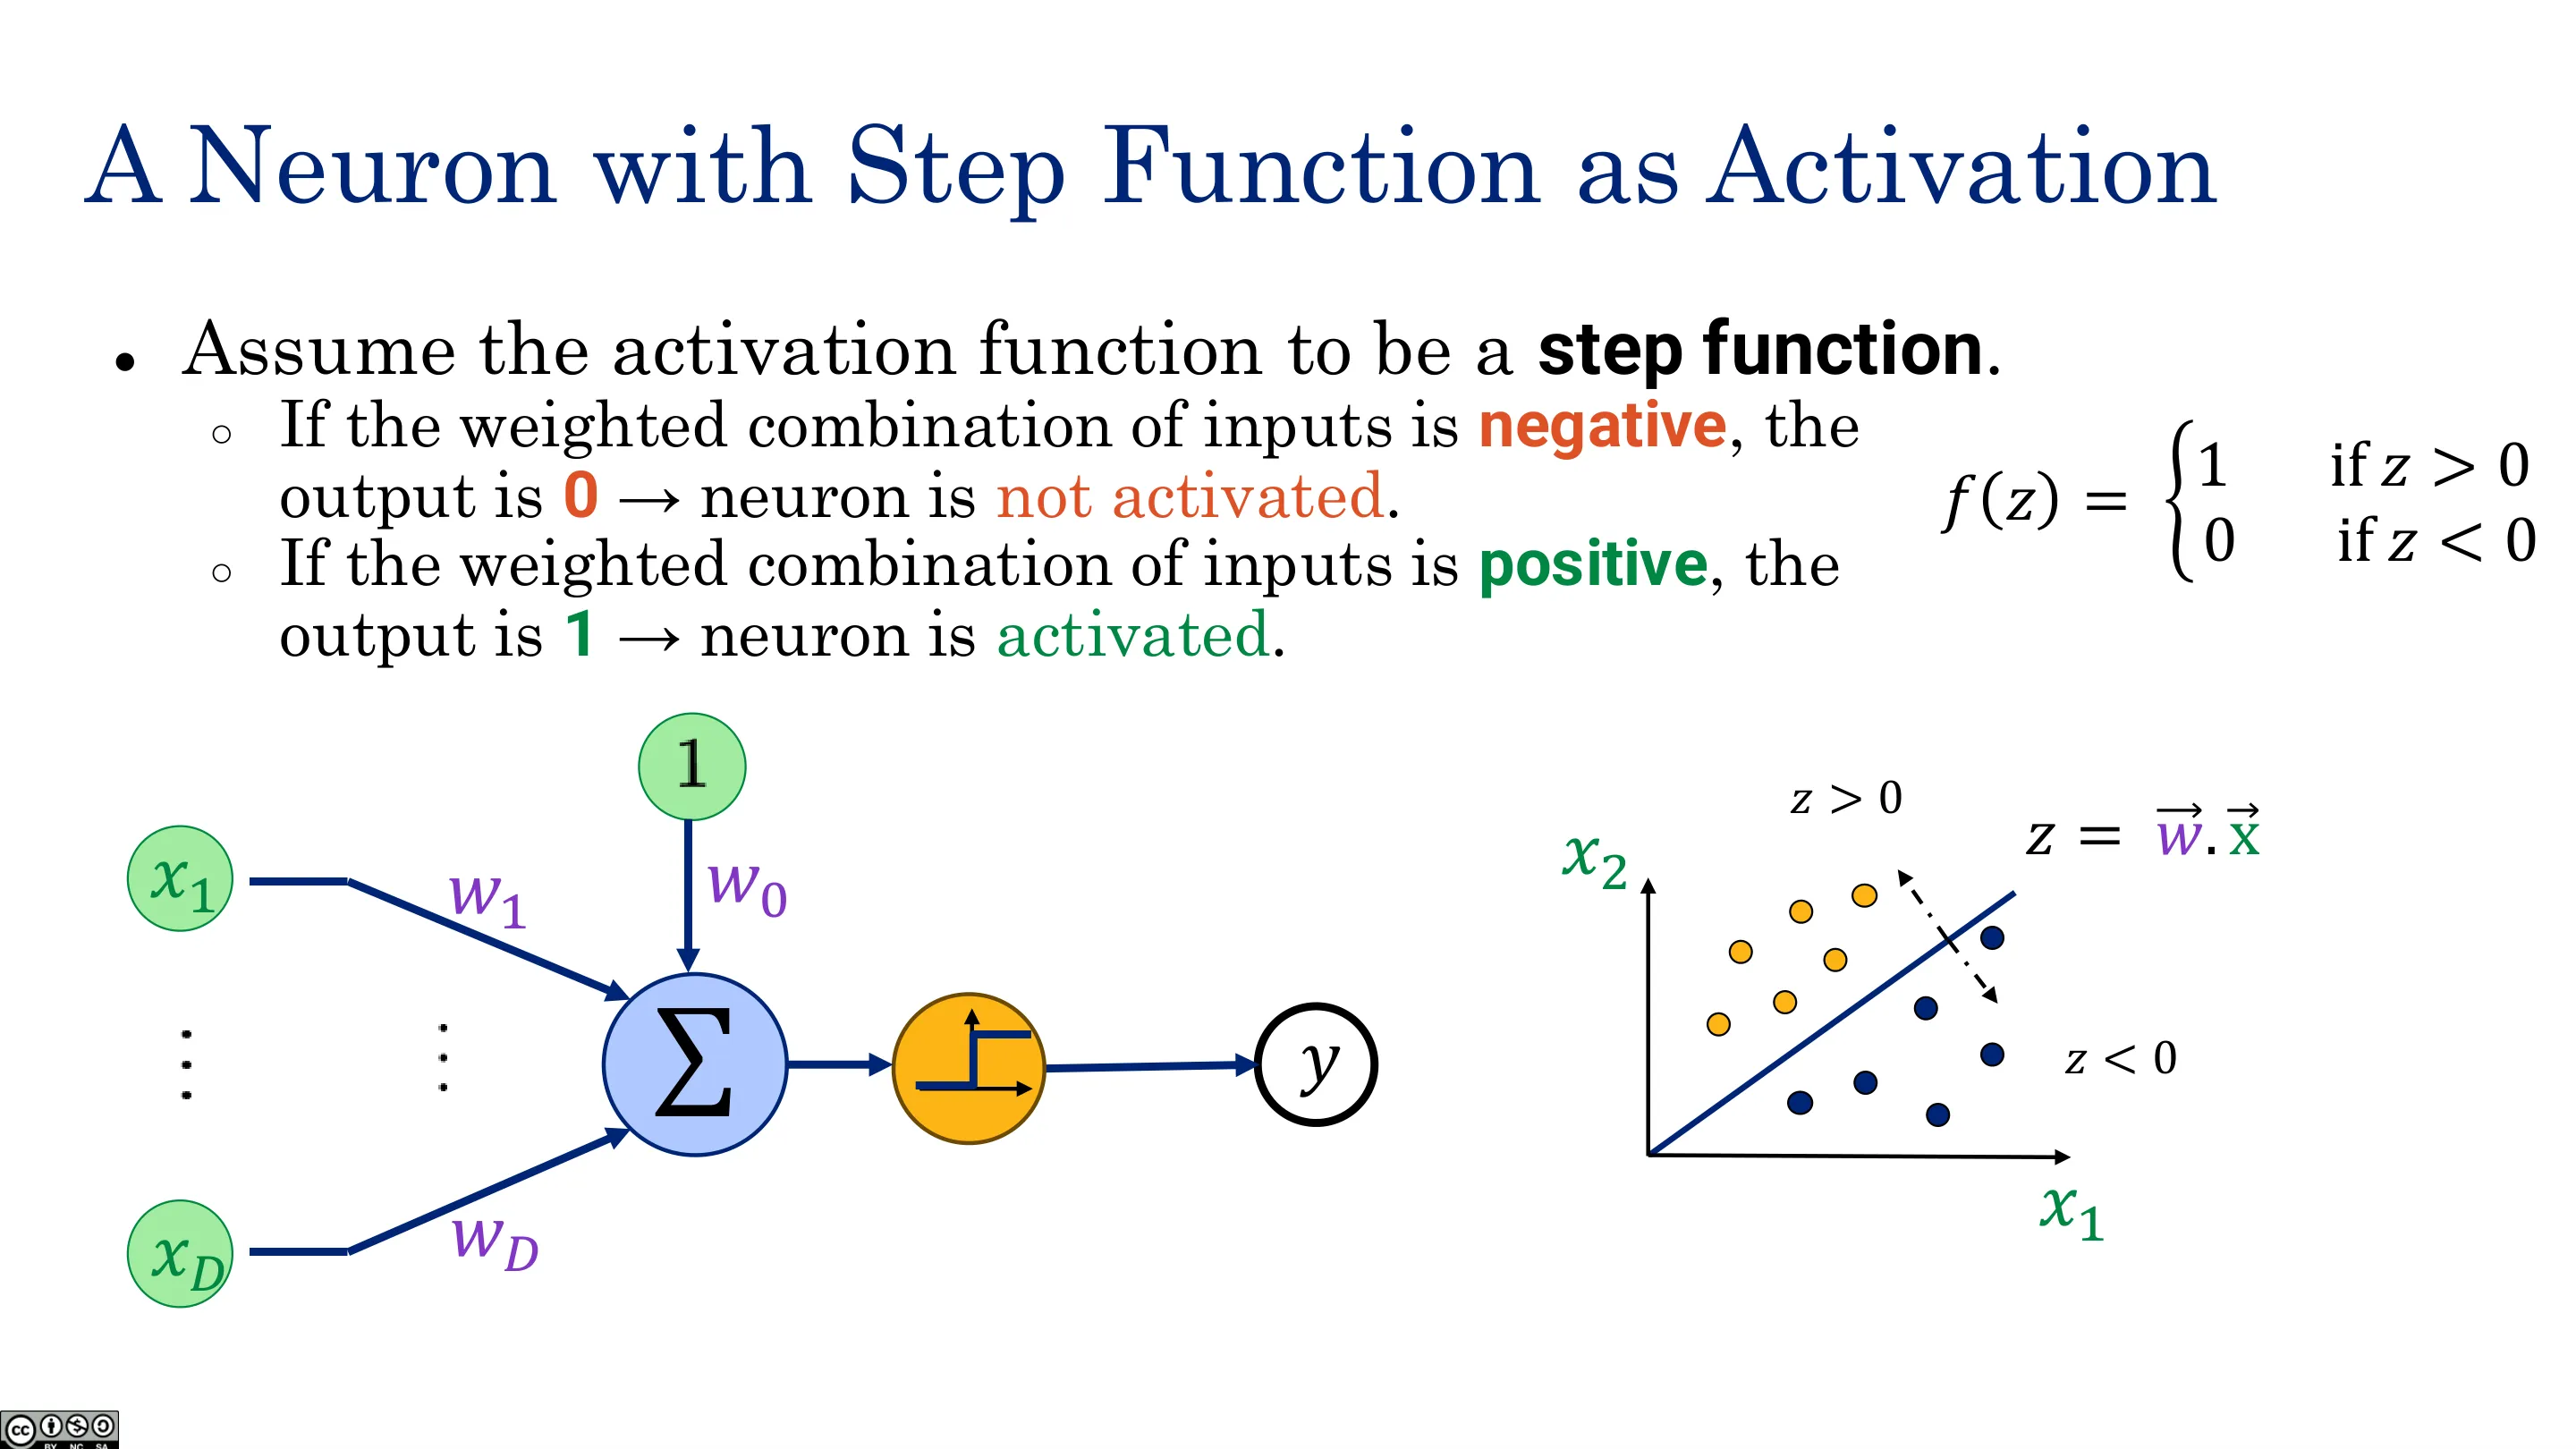
📷 带阶跃激活的神经元
回到原视频 (00:14:56)
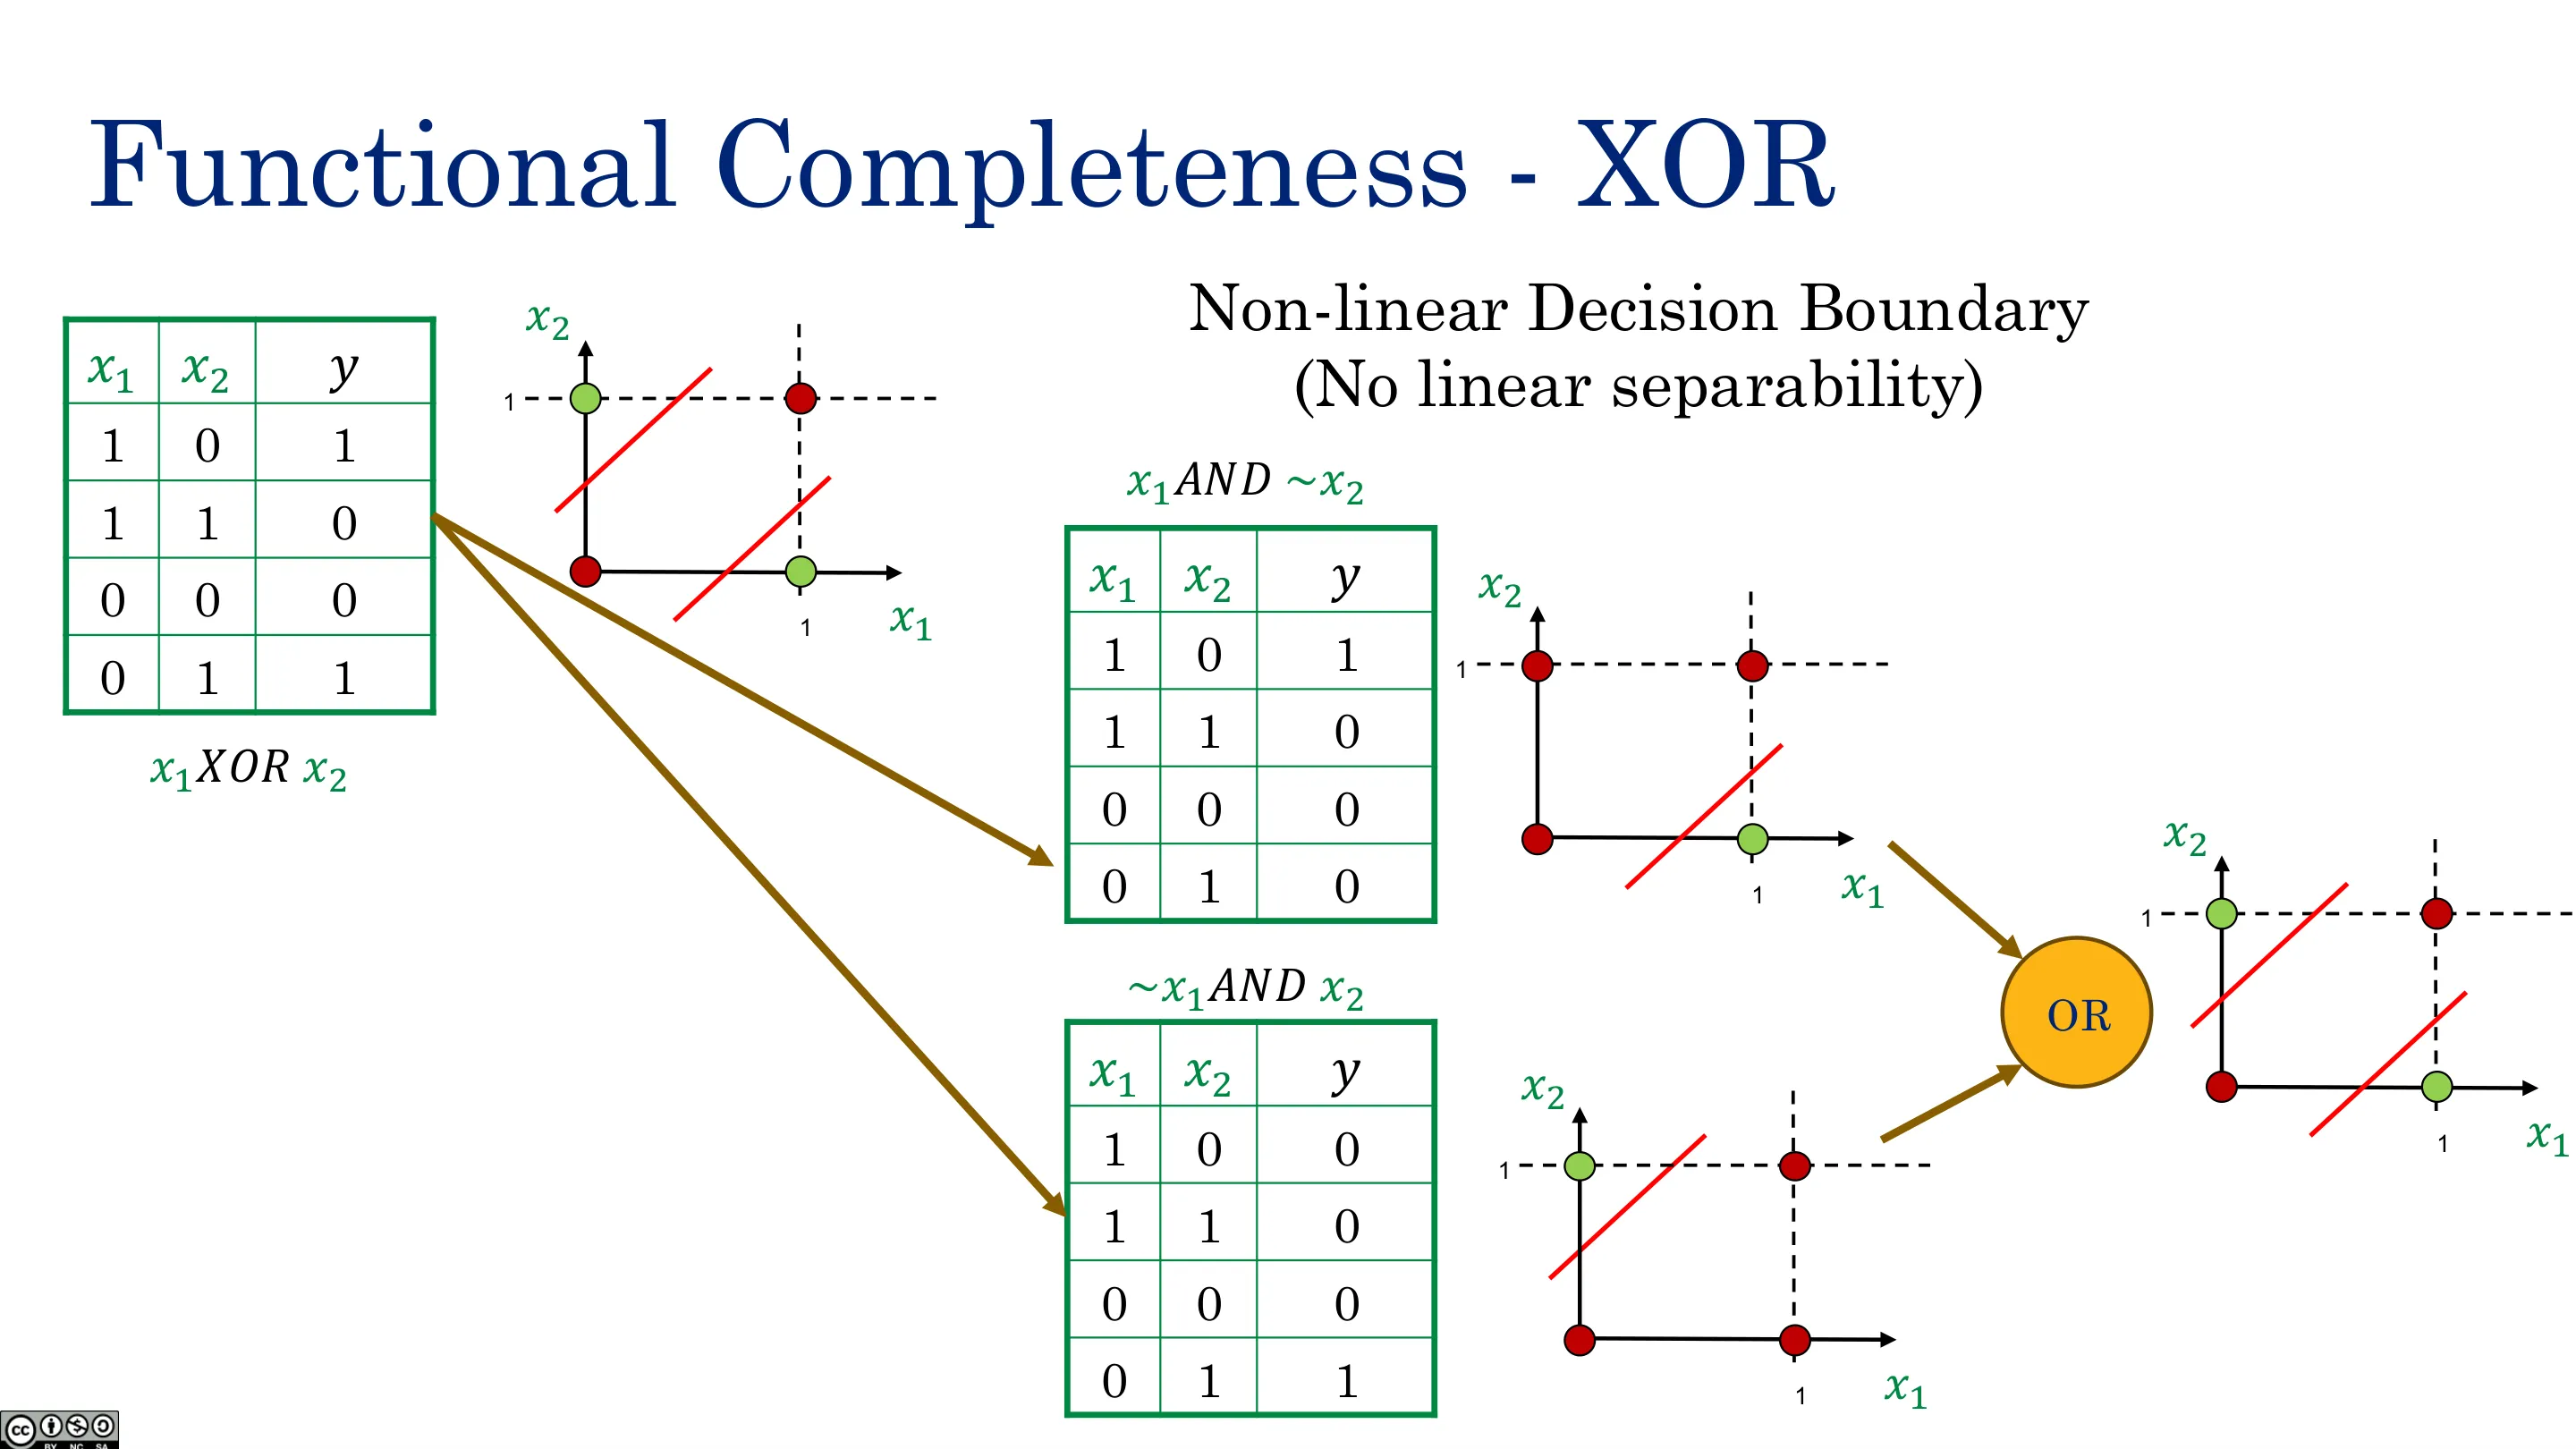
2.1 布尔函数的函数完备性
AND 是线性可分的;XOR 不是——这正是当年「感知机」被否定、神经网络在 70 年代遇冷的原因。
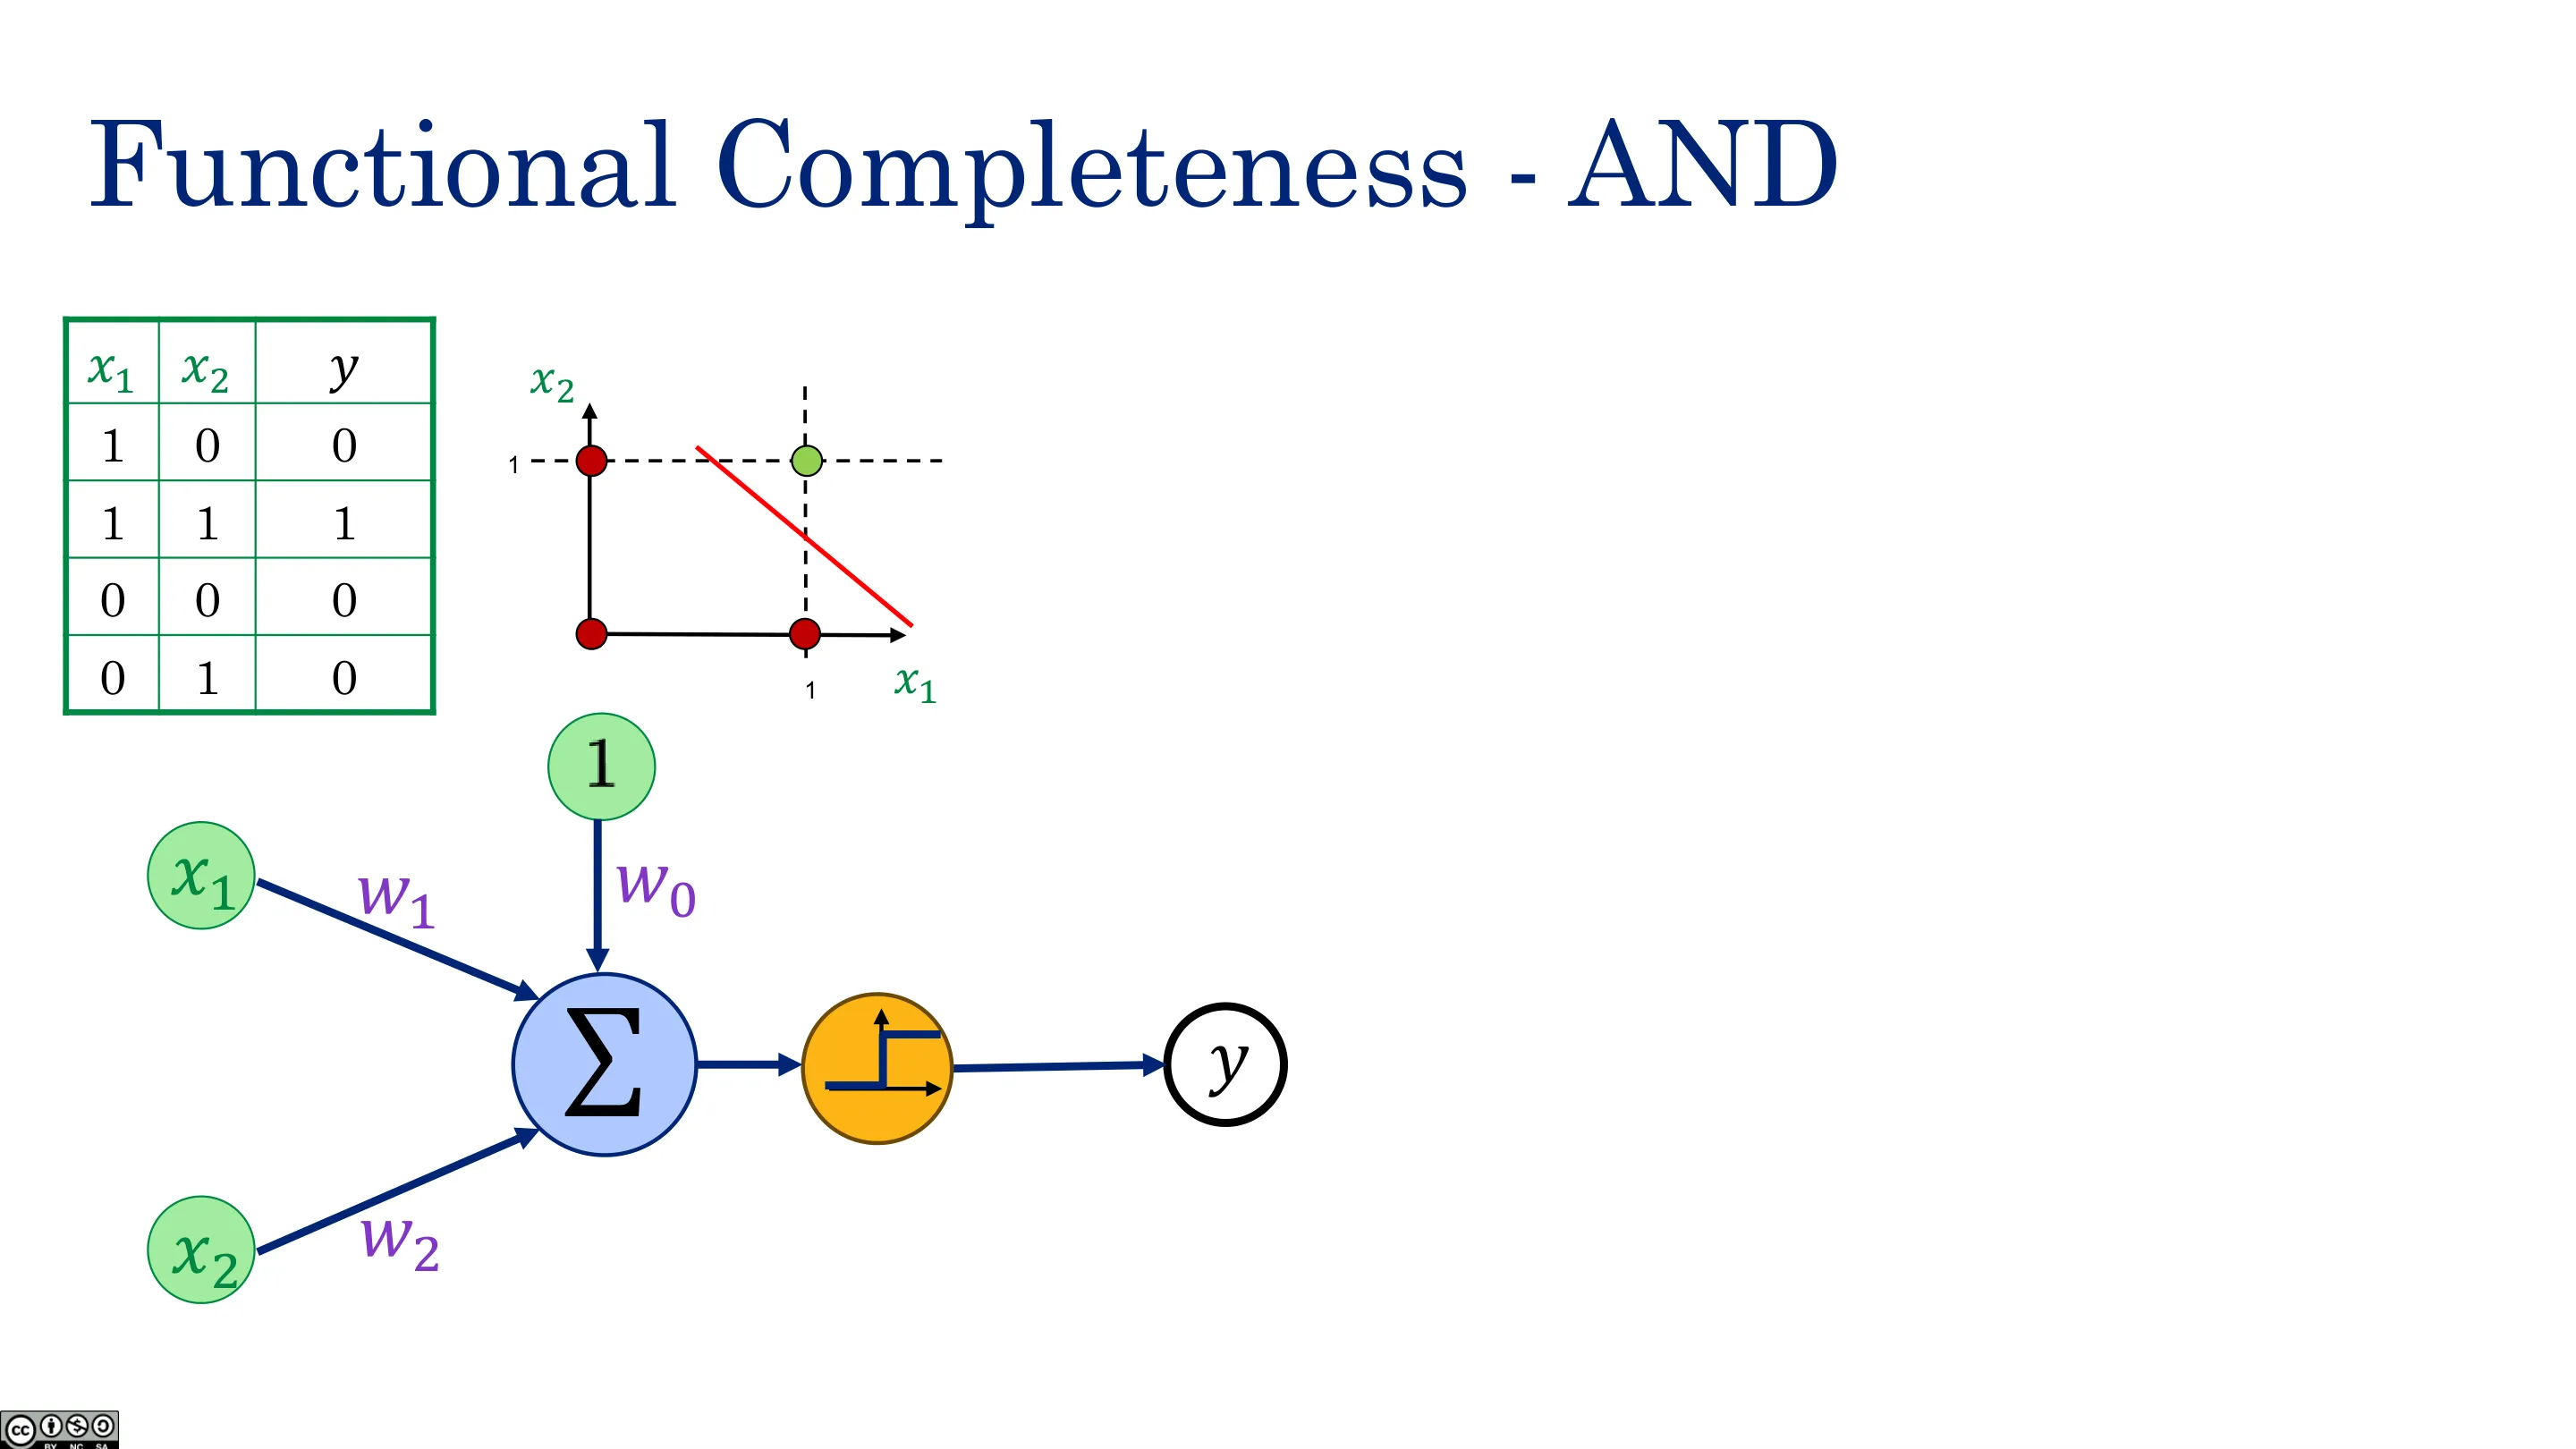
📷 函数完备性:AND(一)
回到原视频 (00:16:09)
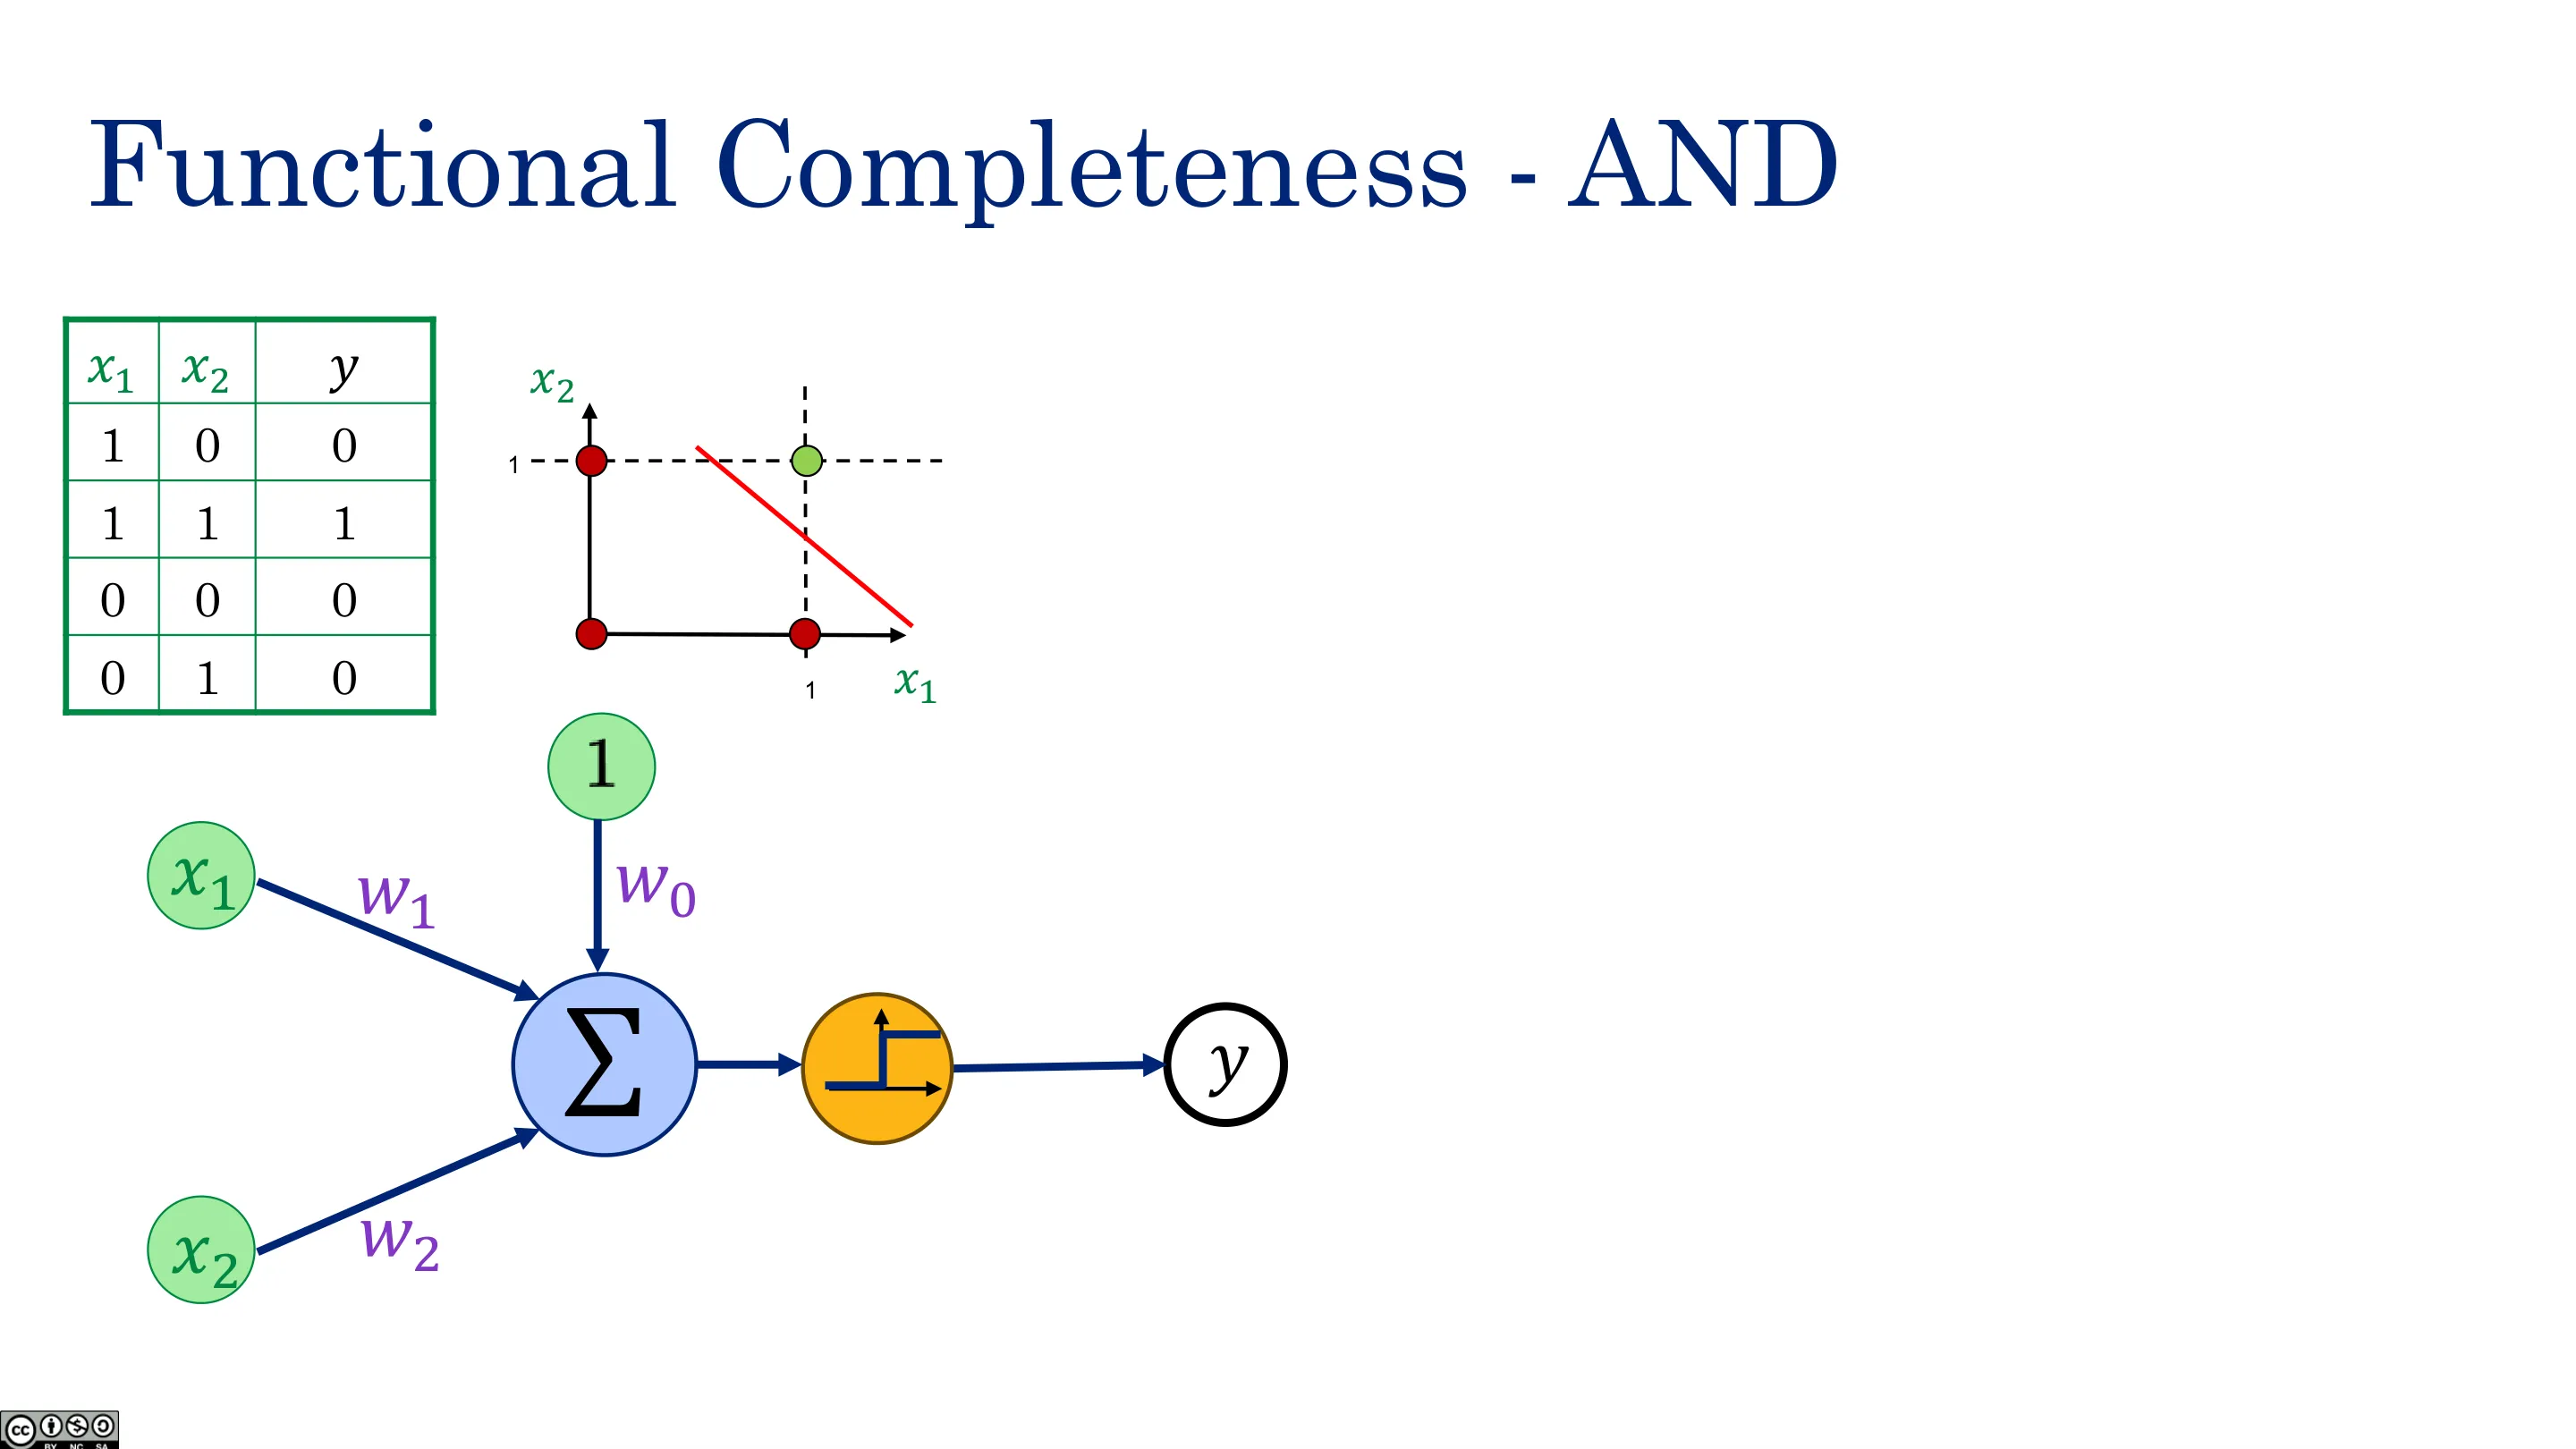
📷 函数完备性:AND(二)
回到原视频 (00:17:22)
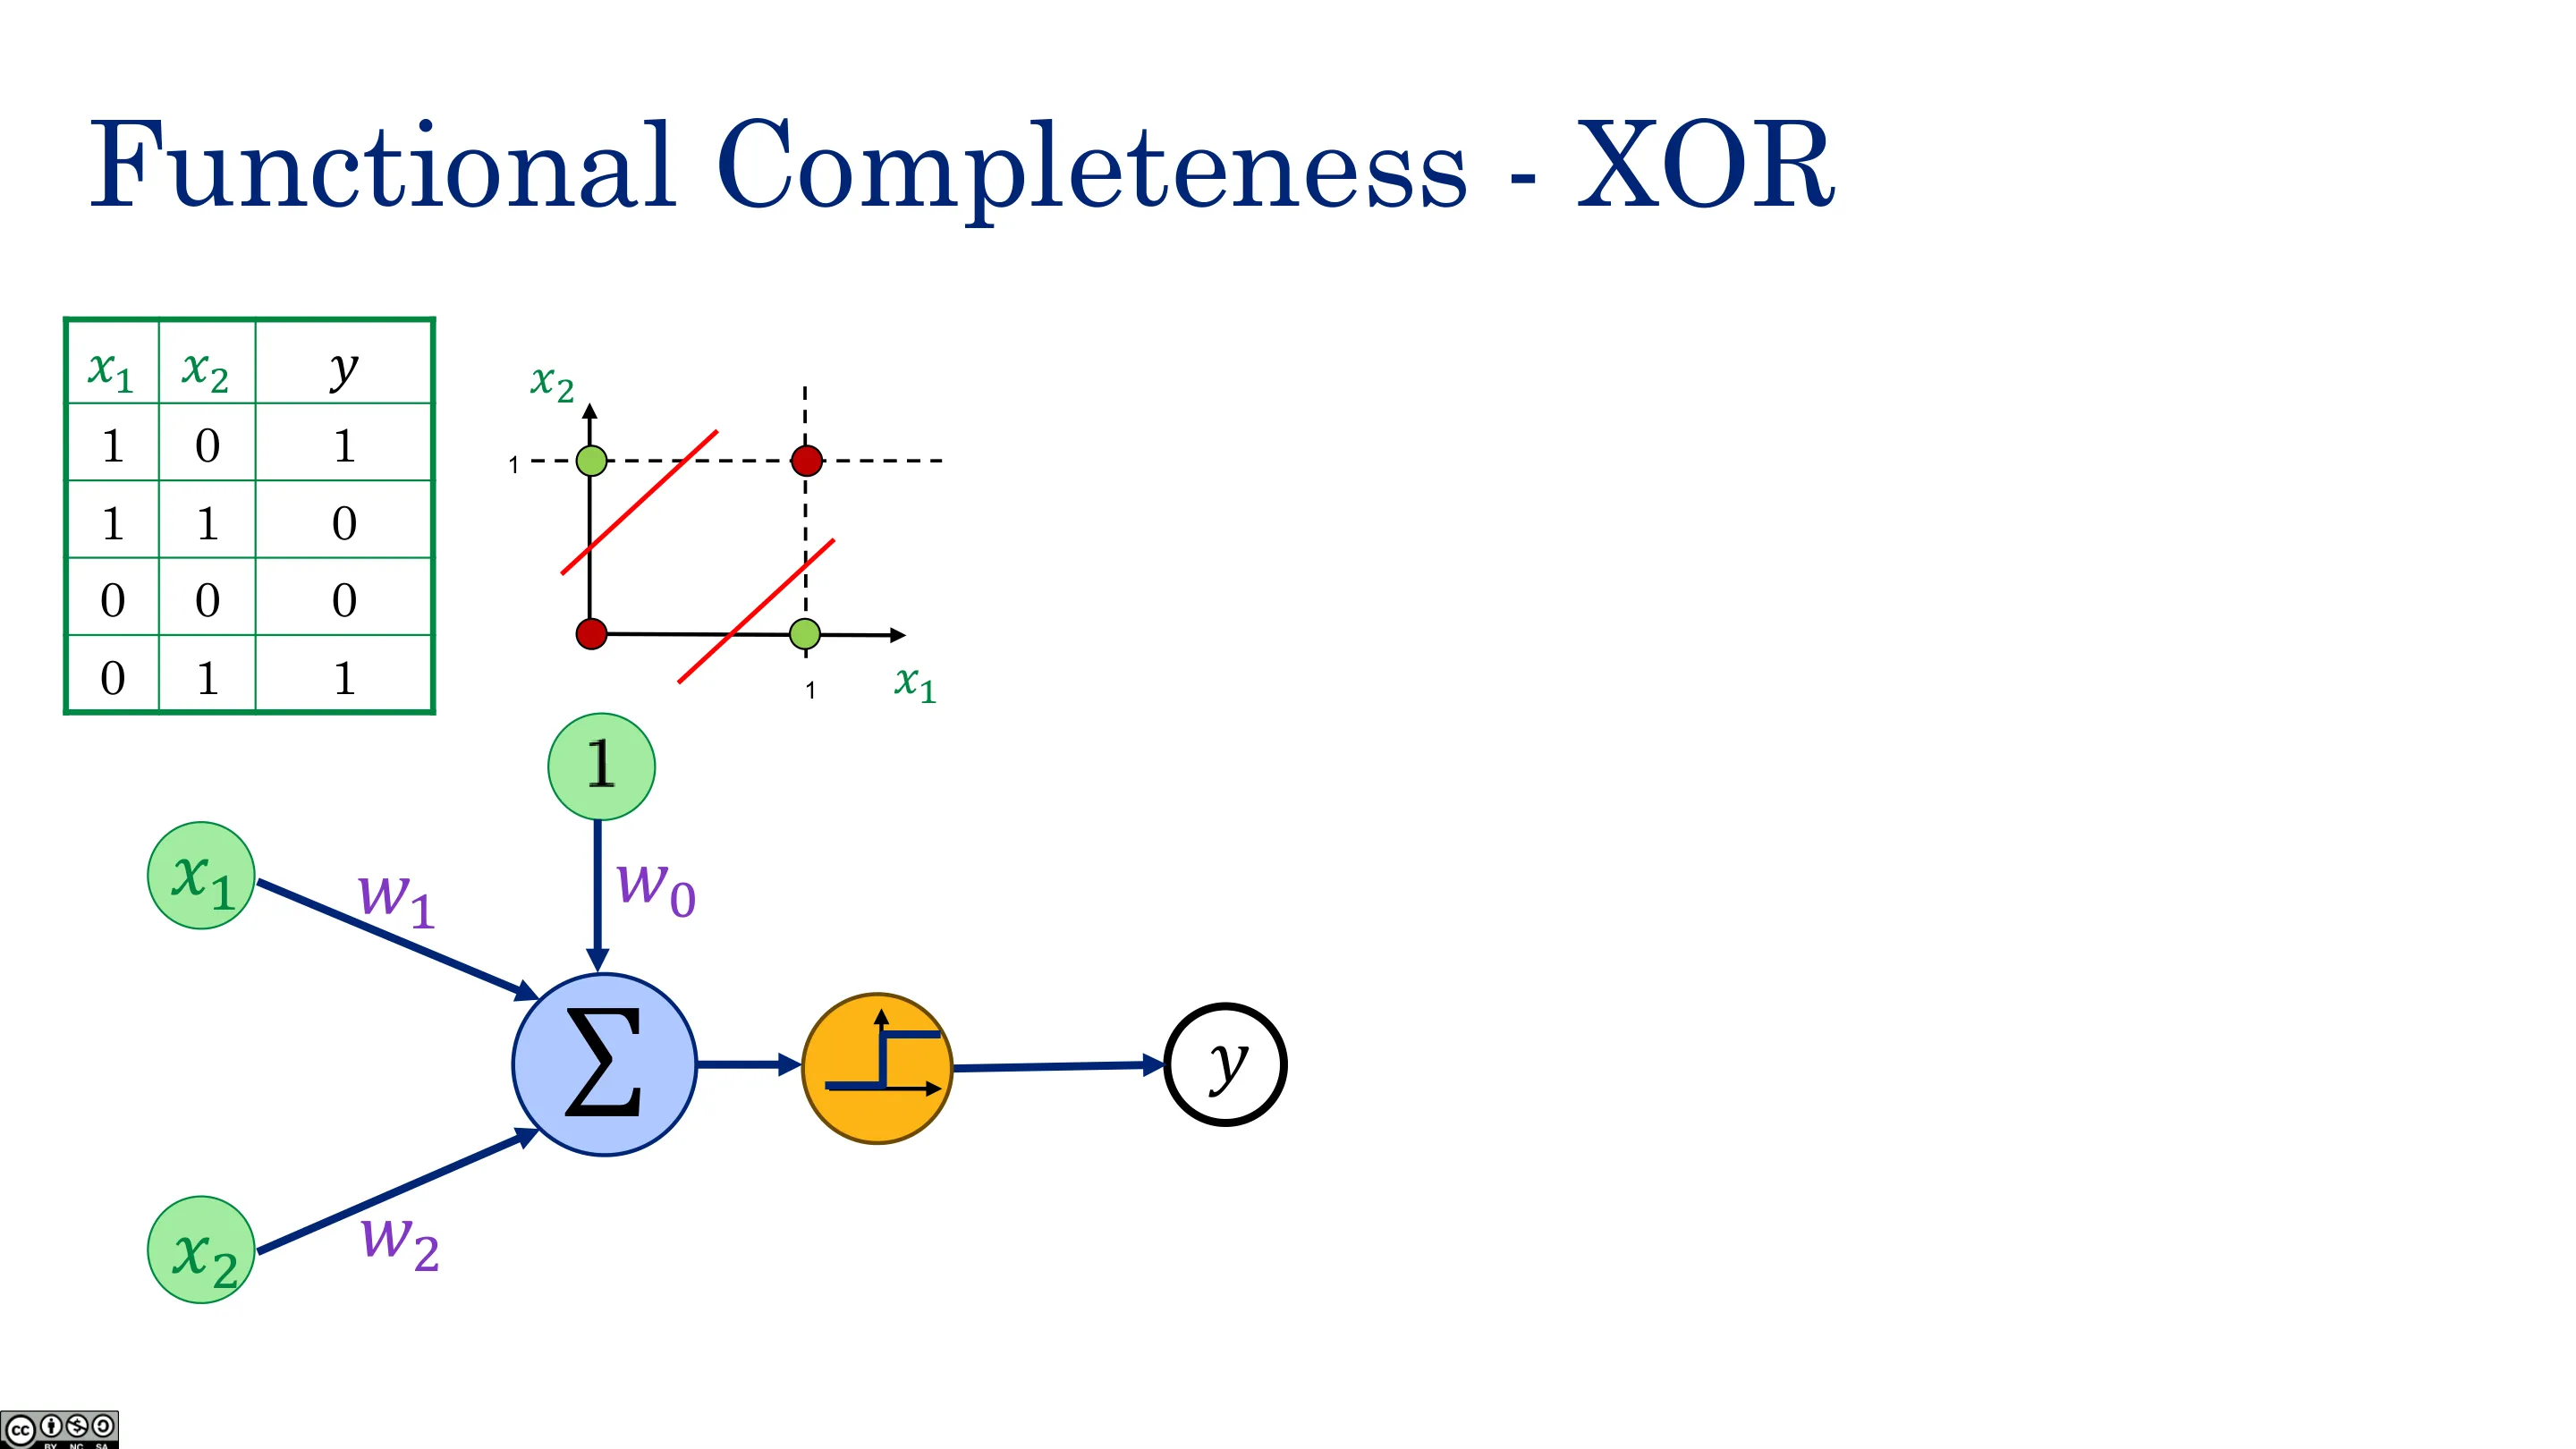
📷 函数完备性:XOR(一)
回到原视频 (00:18:35)
📷 函数完备性:XOR(二)
回到原视频 (00:19:48)
📷 前馈
回到原视频 (00:21:01)
📷 神经网络(一)
回到原视频 (00:22:14)
📷 神经网络(二)
回到原视频 (00:23:27)
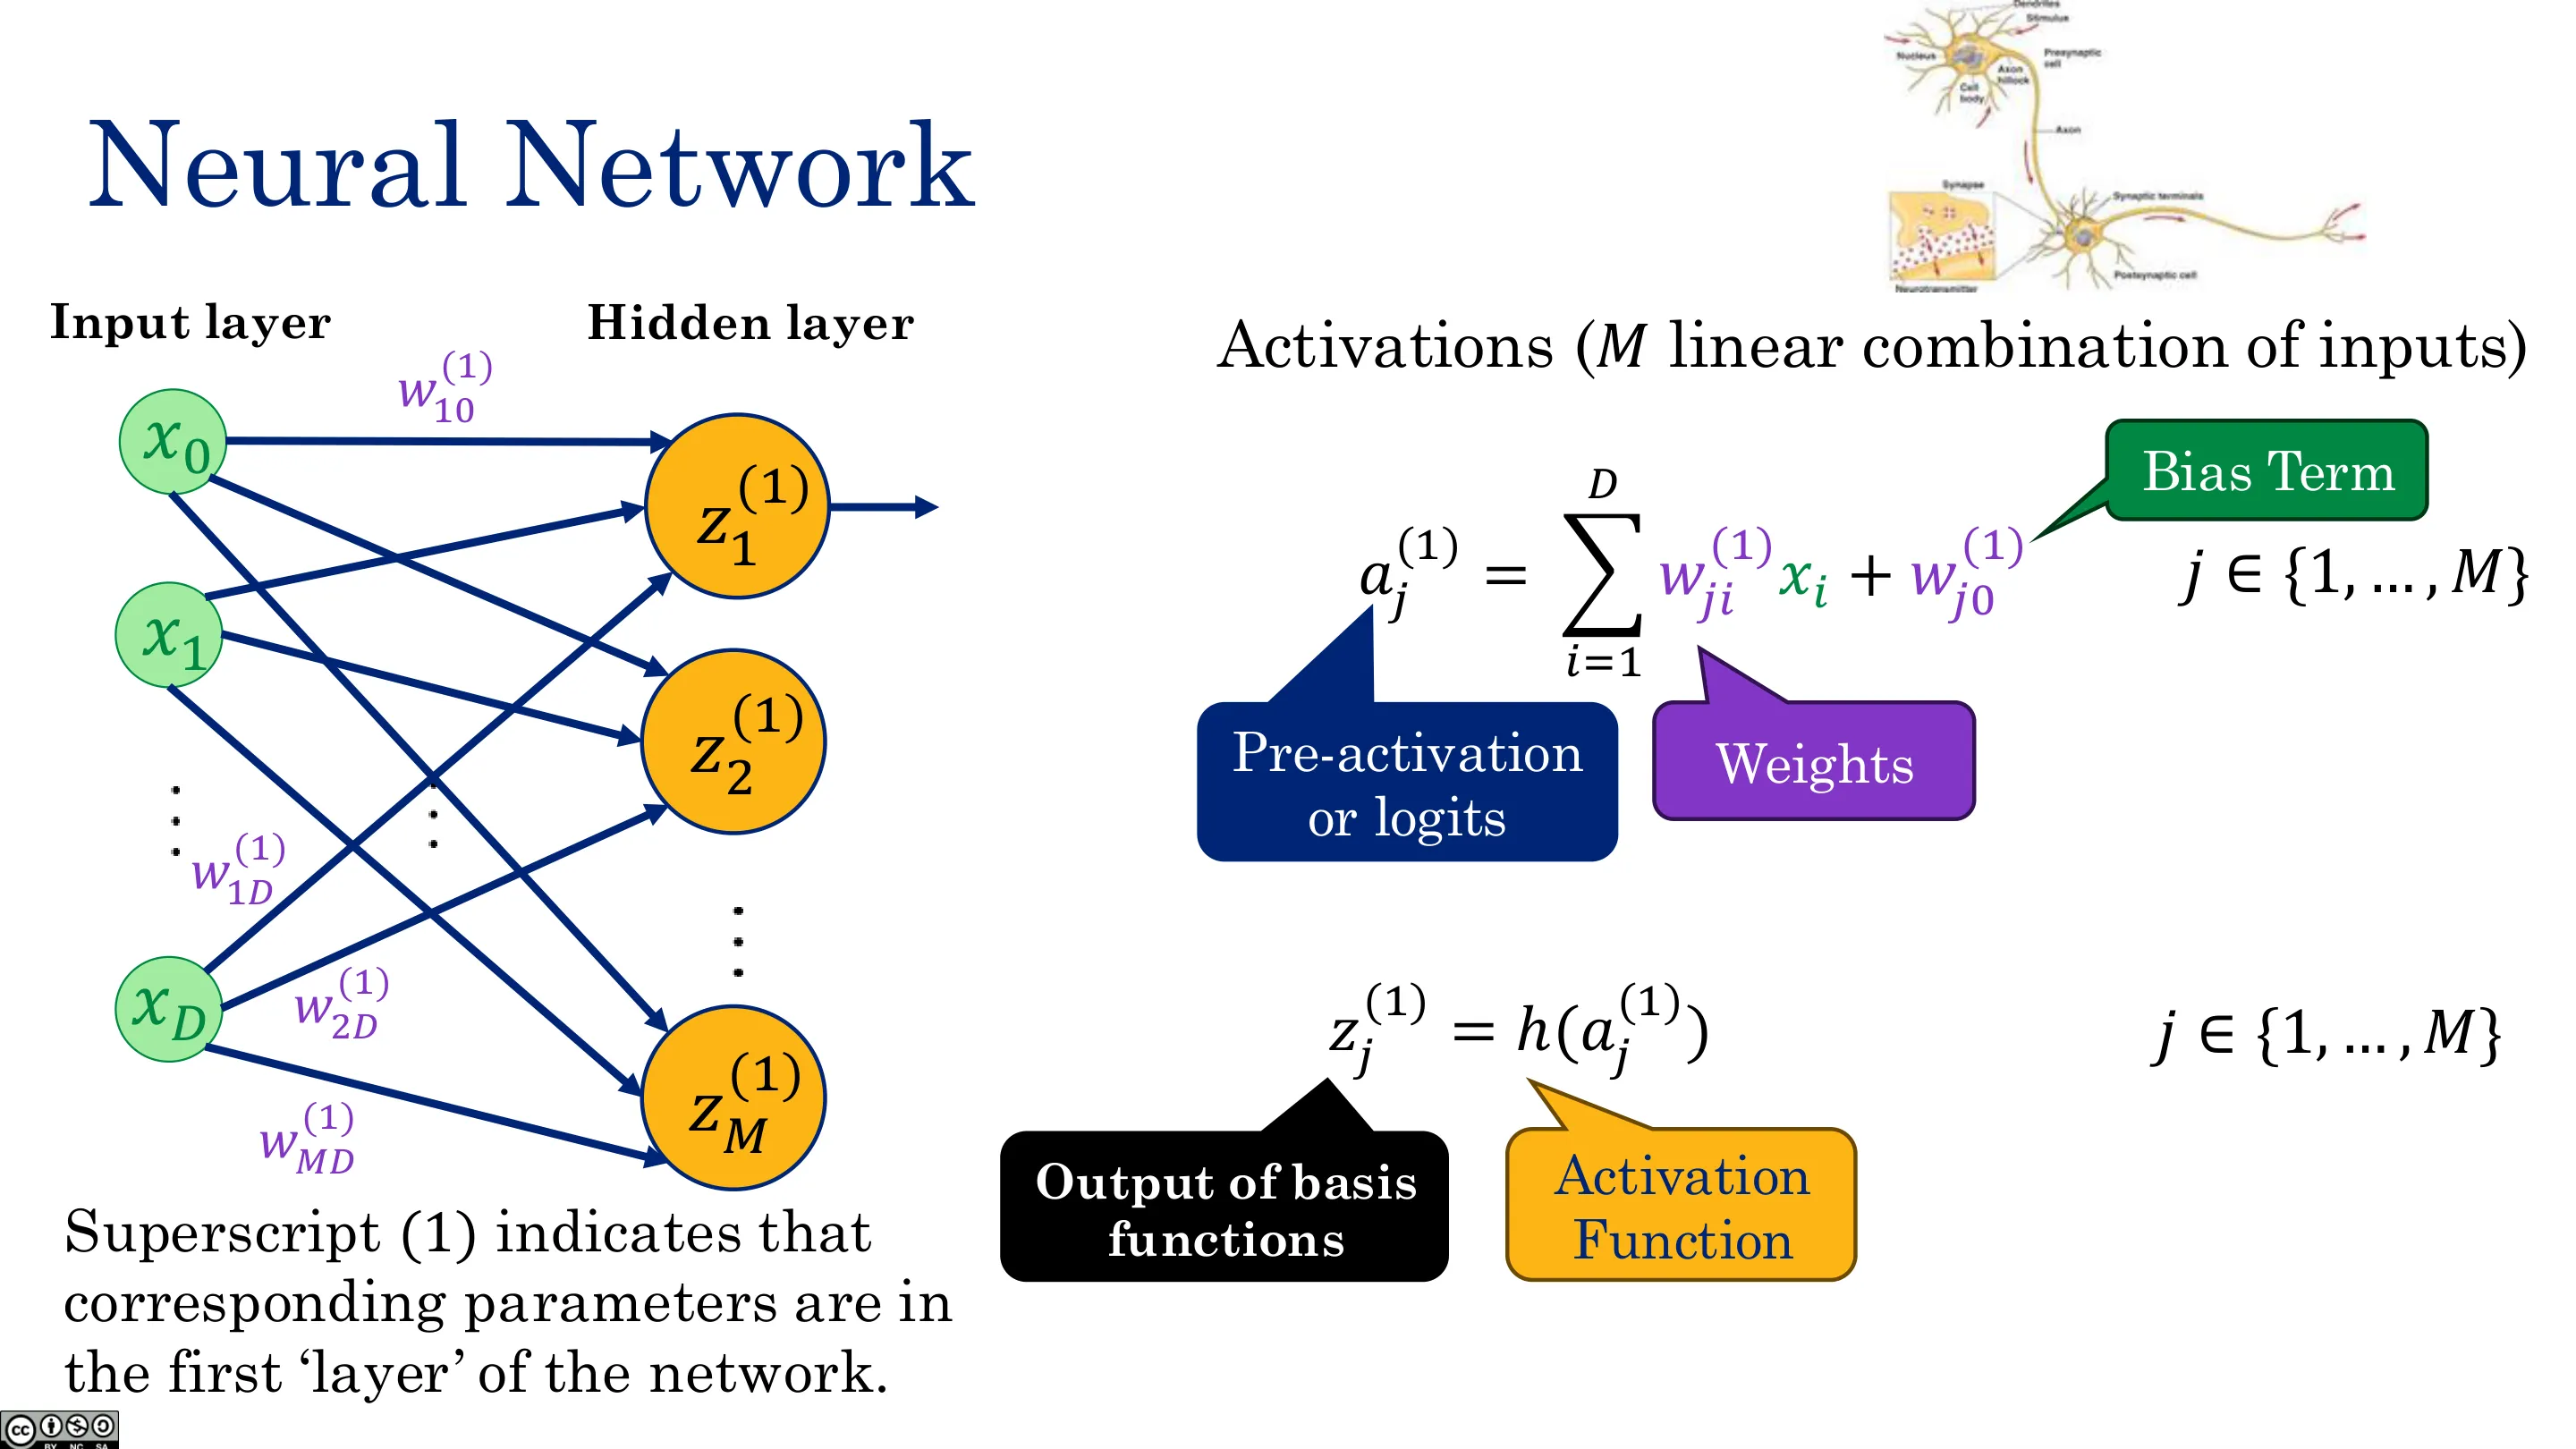
📷 神经网络(三)
回到原视频 (00:24:40)
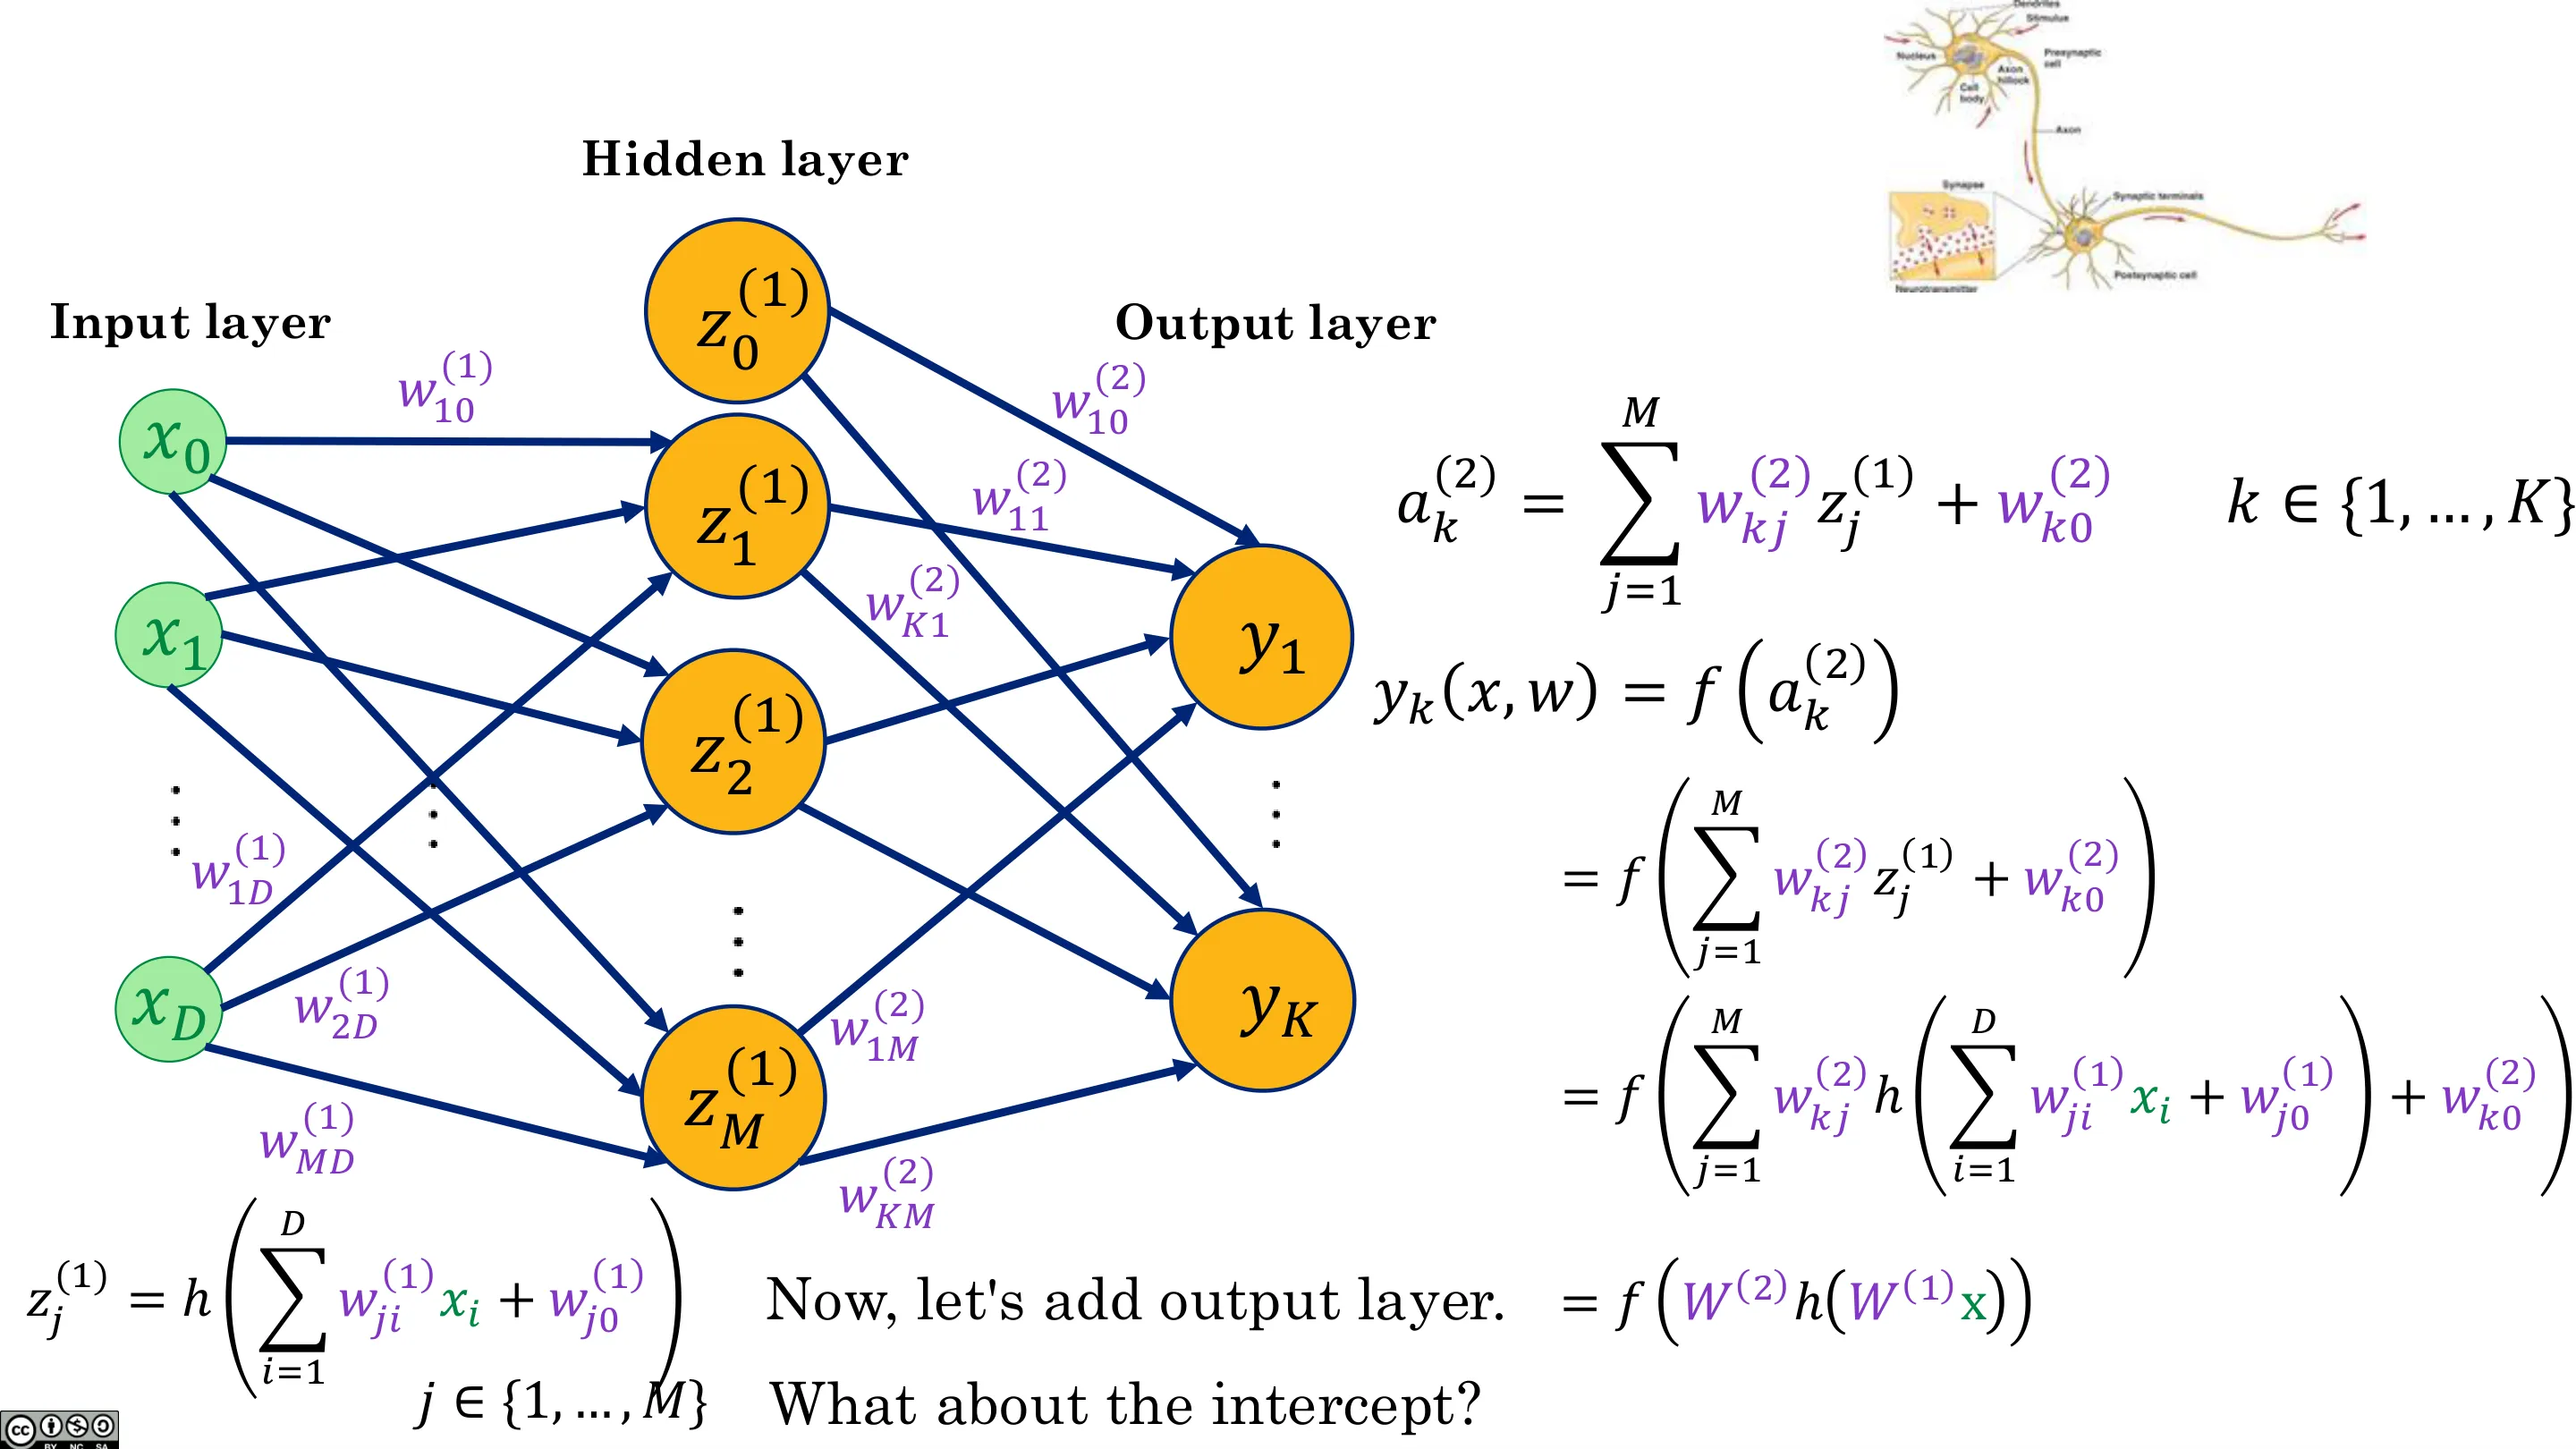
📷 神经网络(四)
回到原视频 (00:25:53)
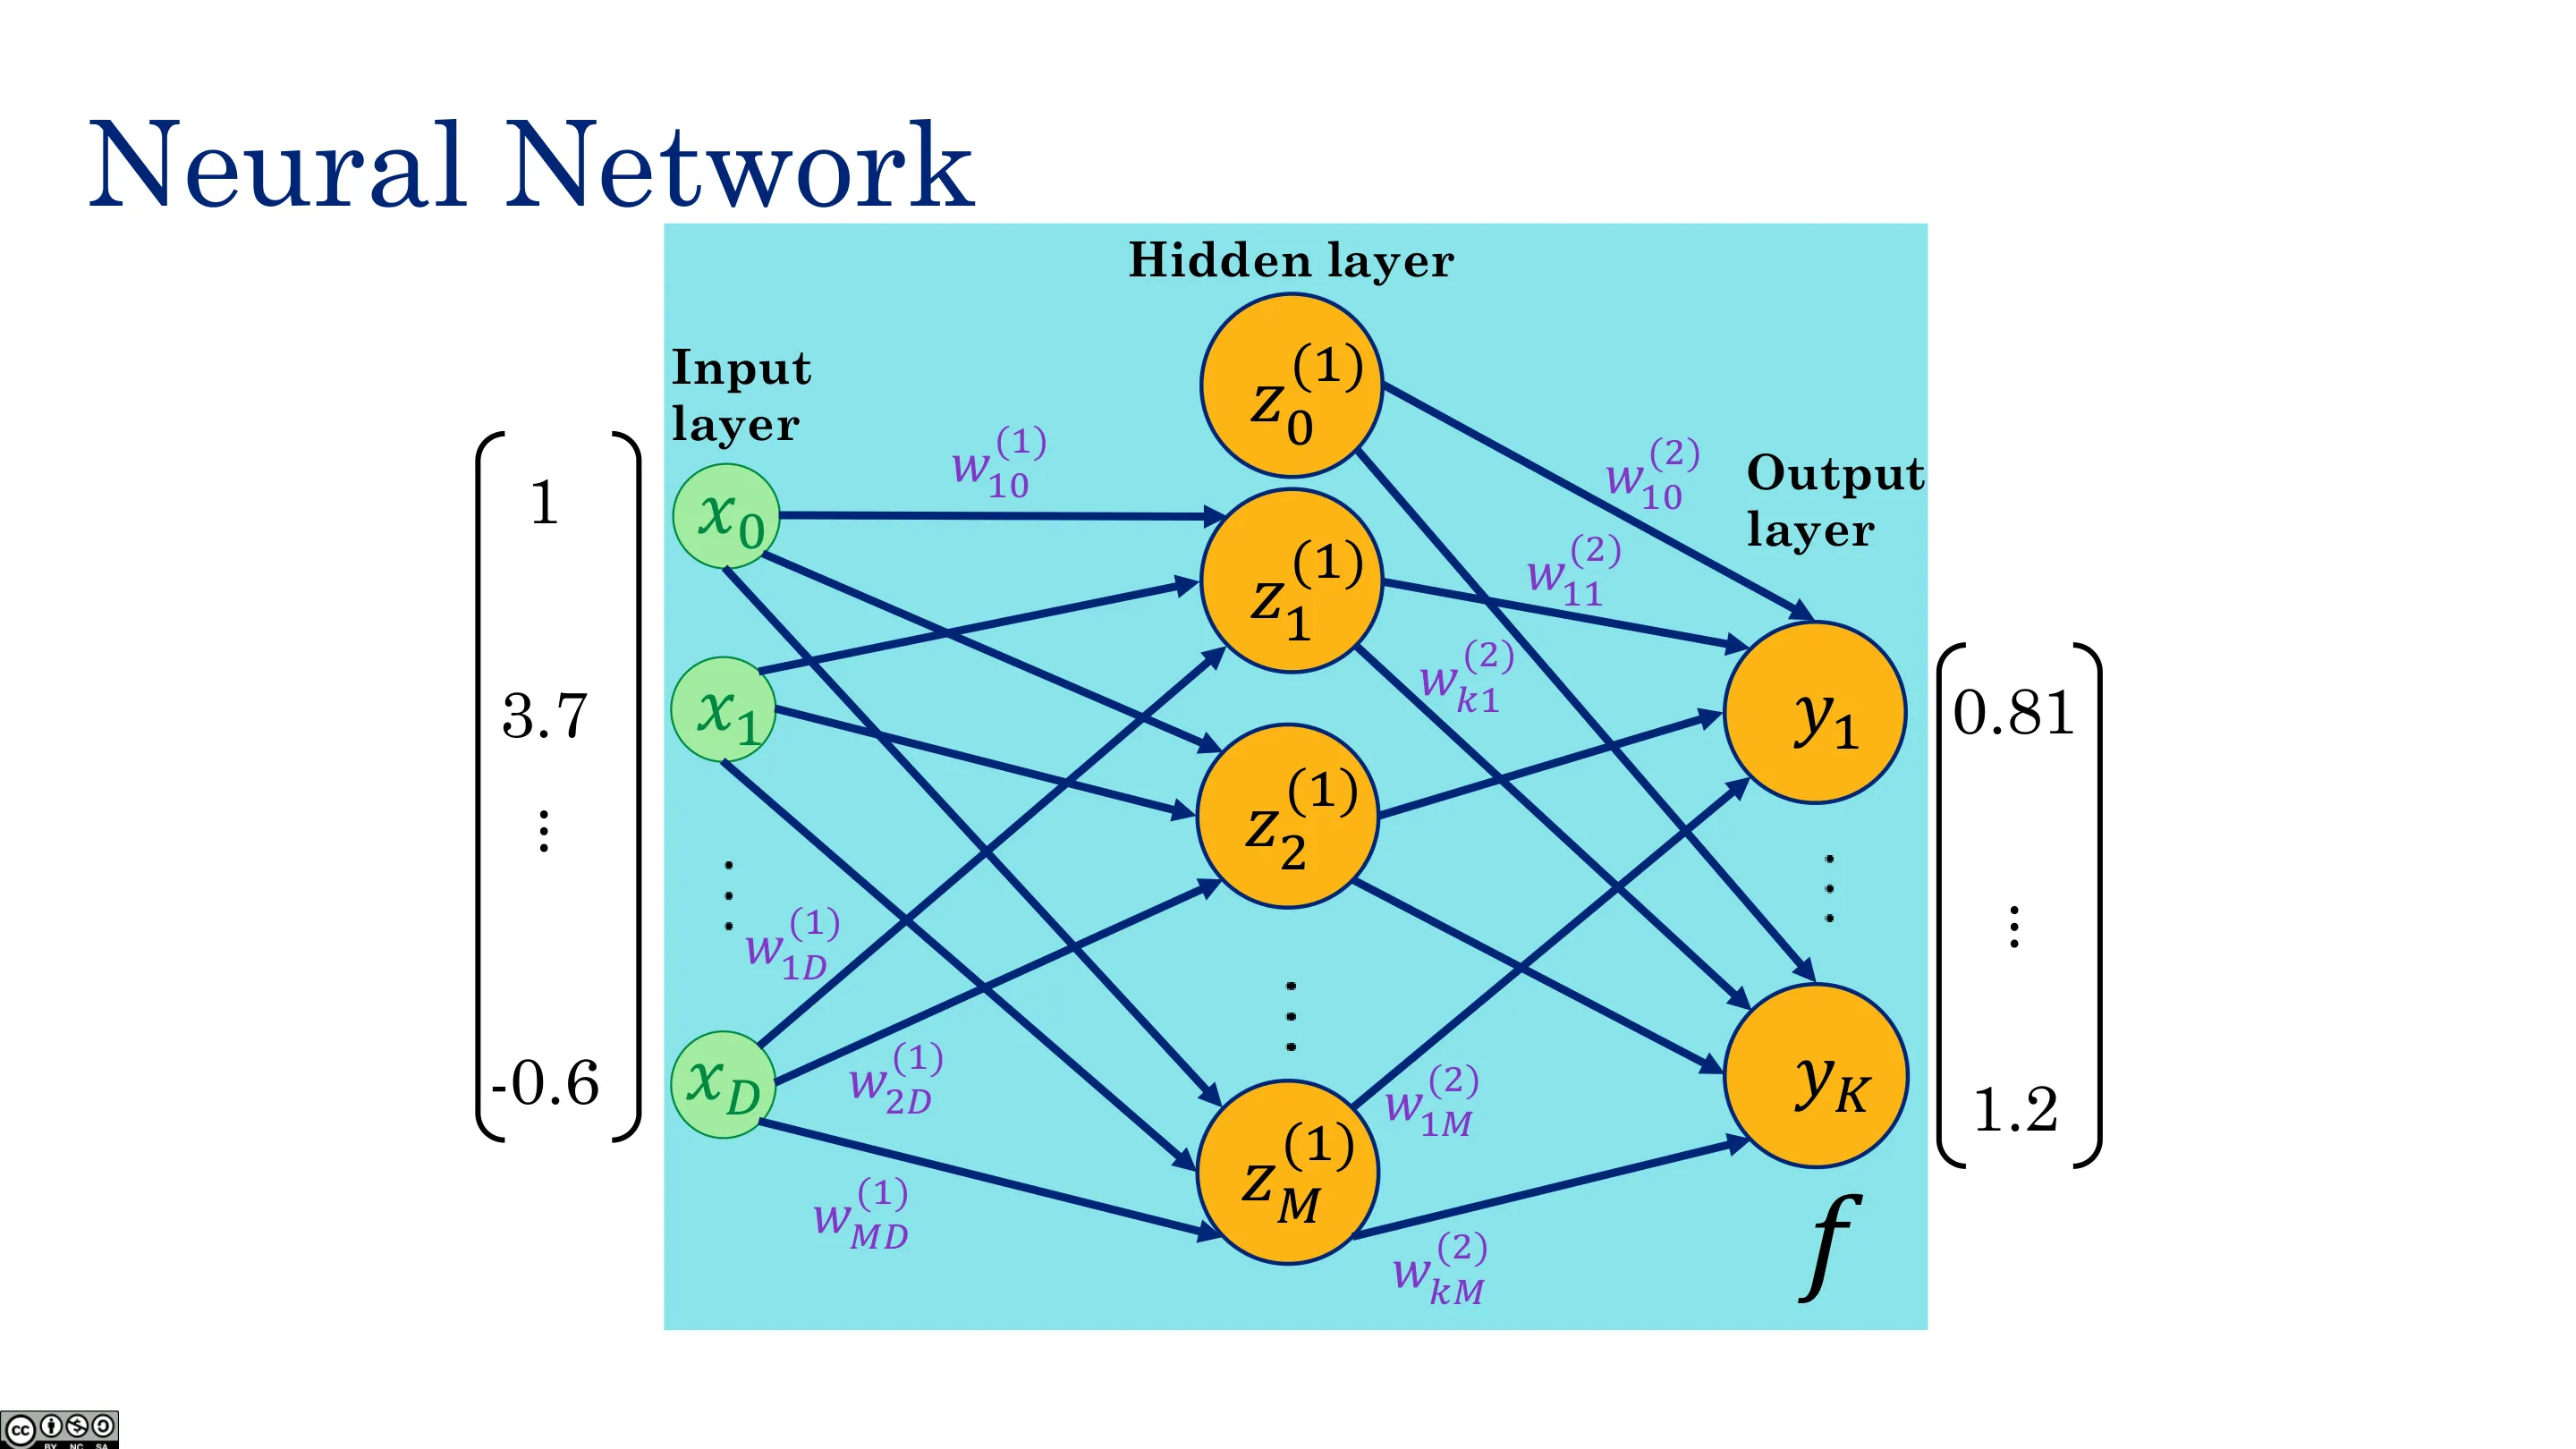
📷 神经网络(五)
回到原视频 (00:27:06)
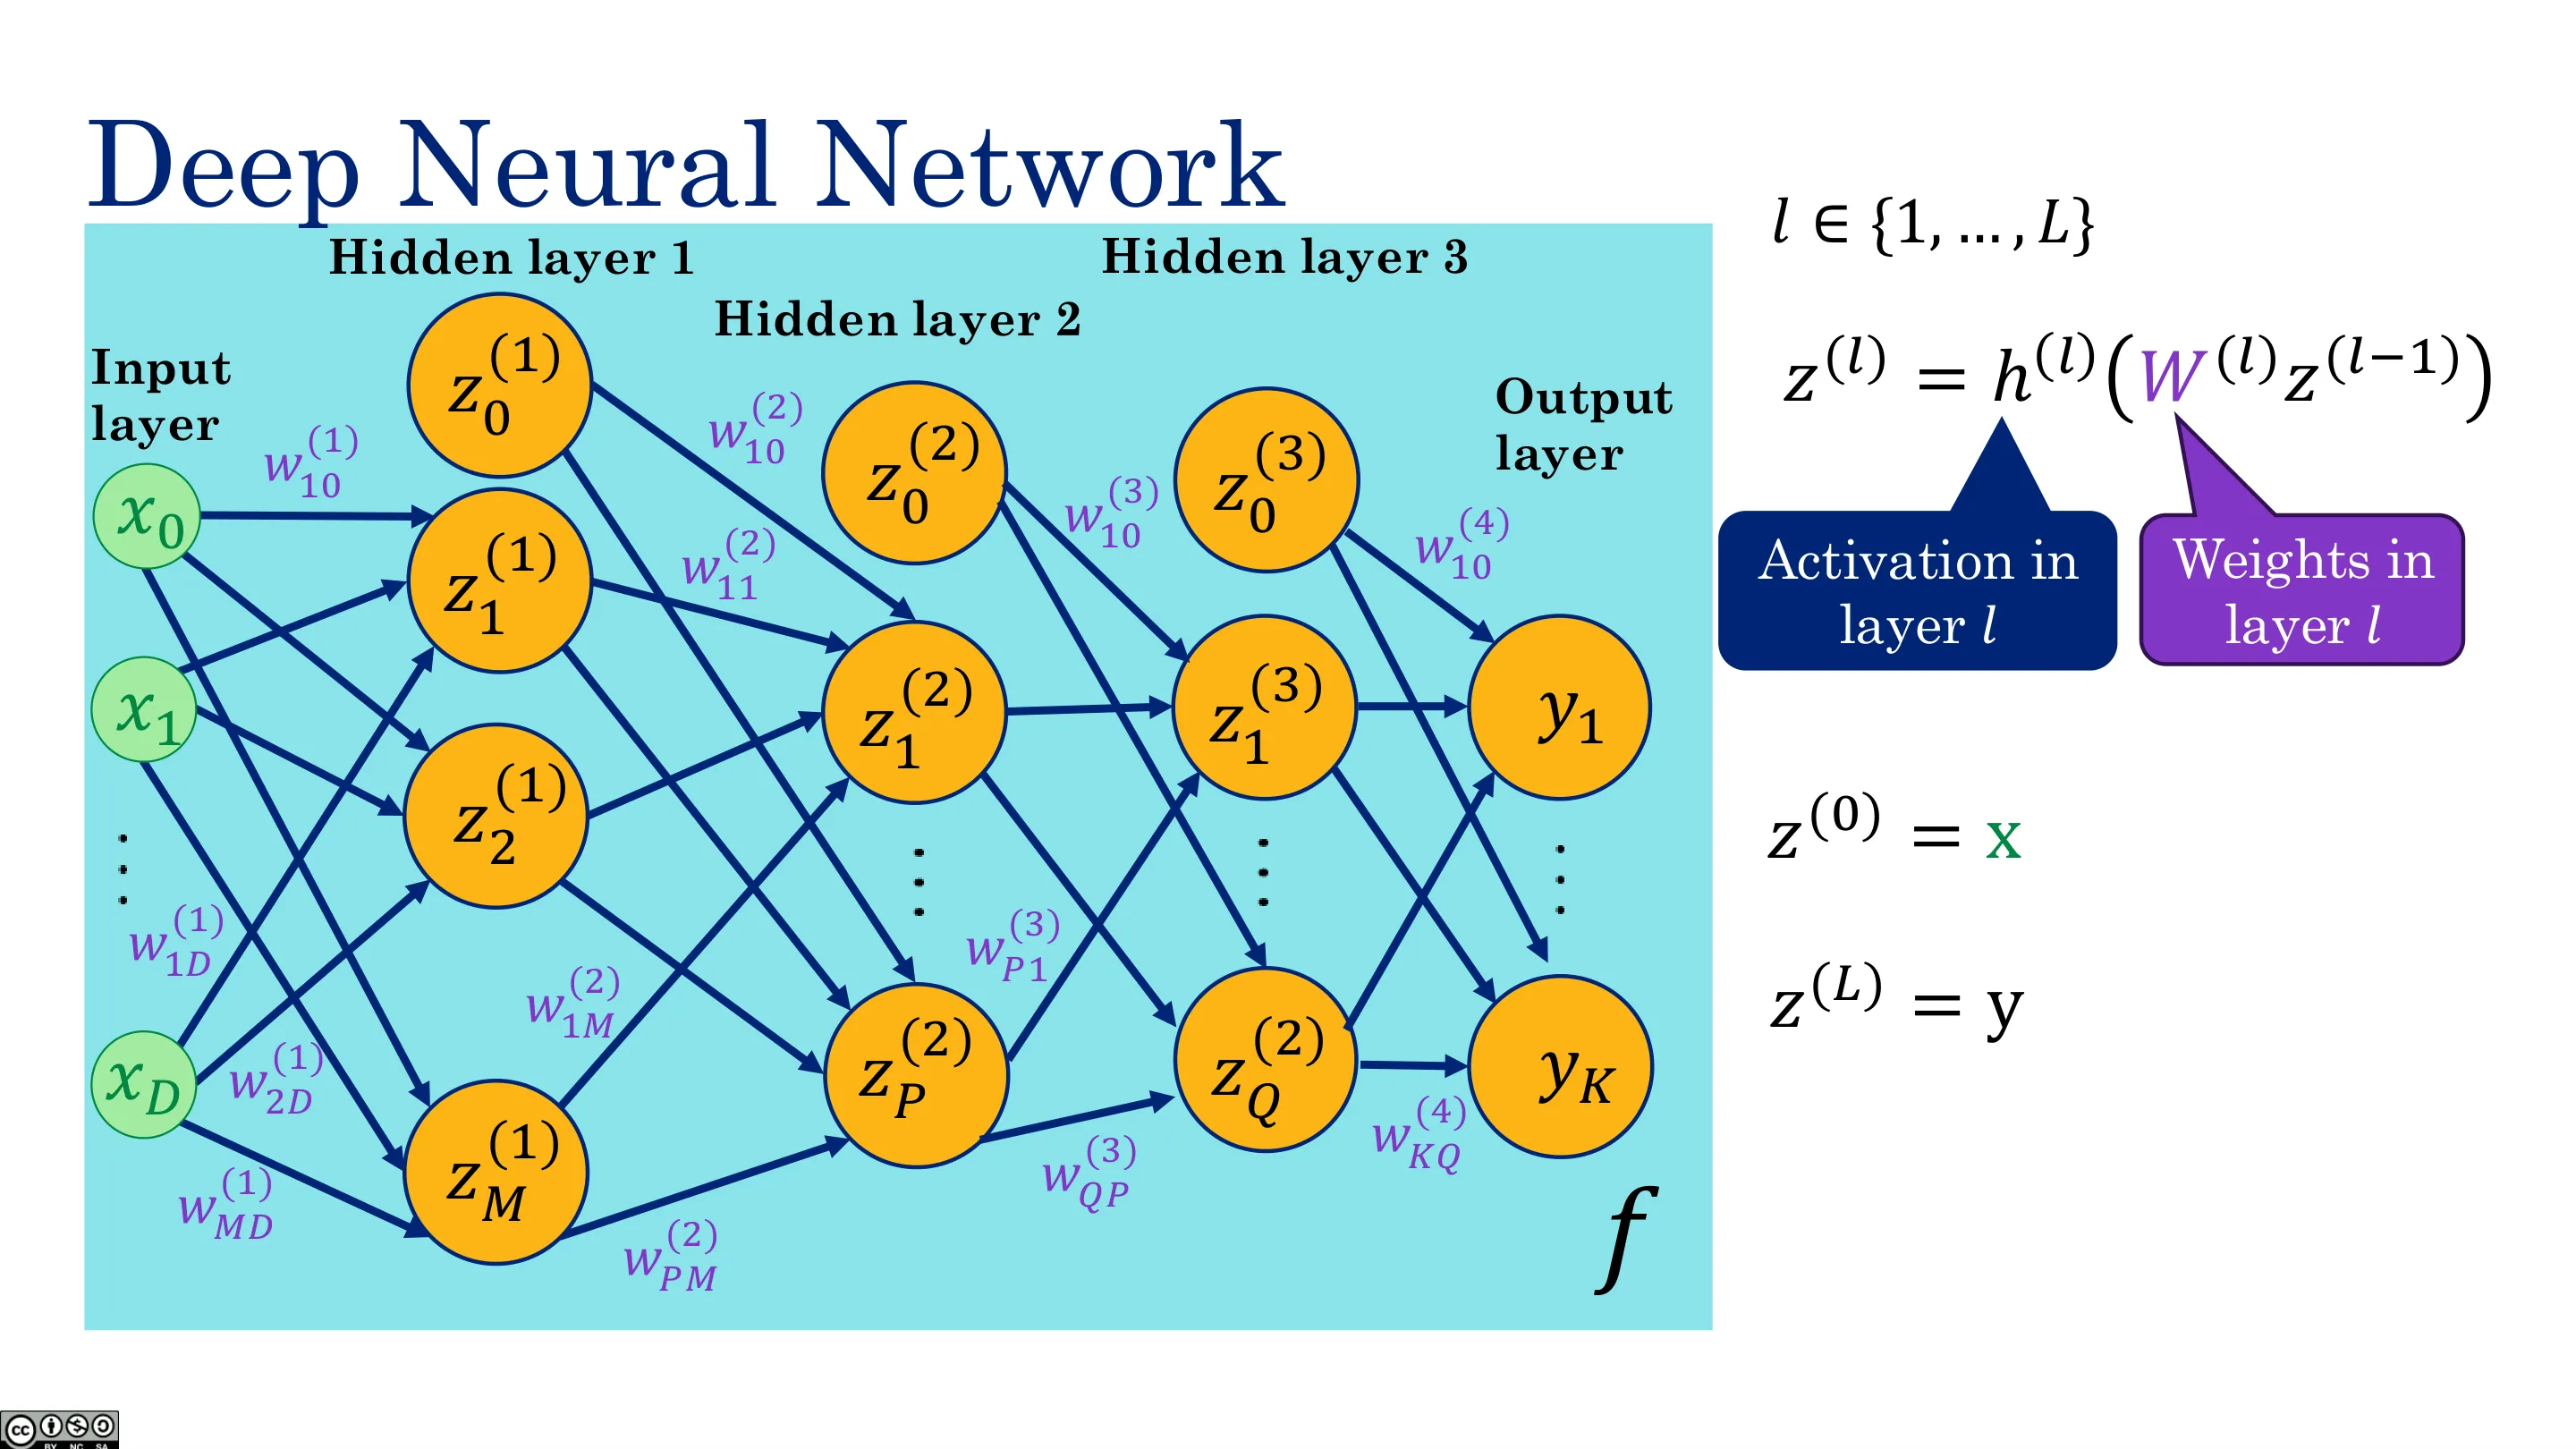
📷 深度神经网络
回到原视频 (00:28:19)
三、XOR 手算例子:为什么需要激活
(参考时间: 00:13)
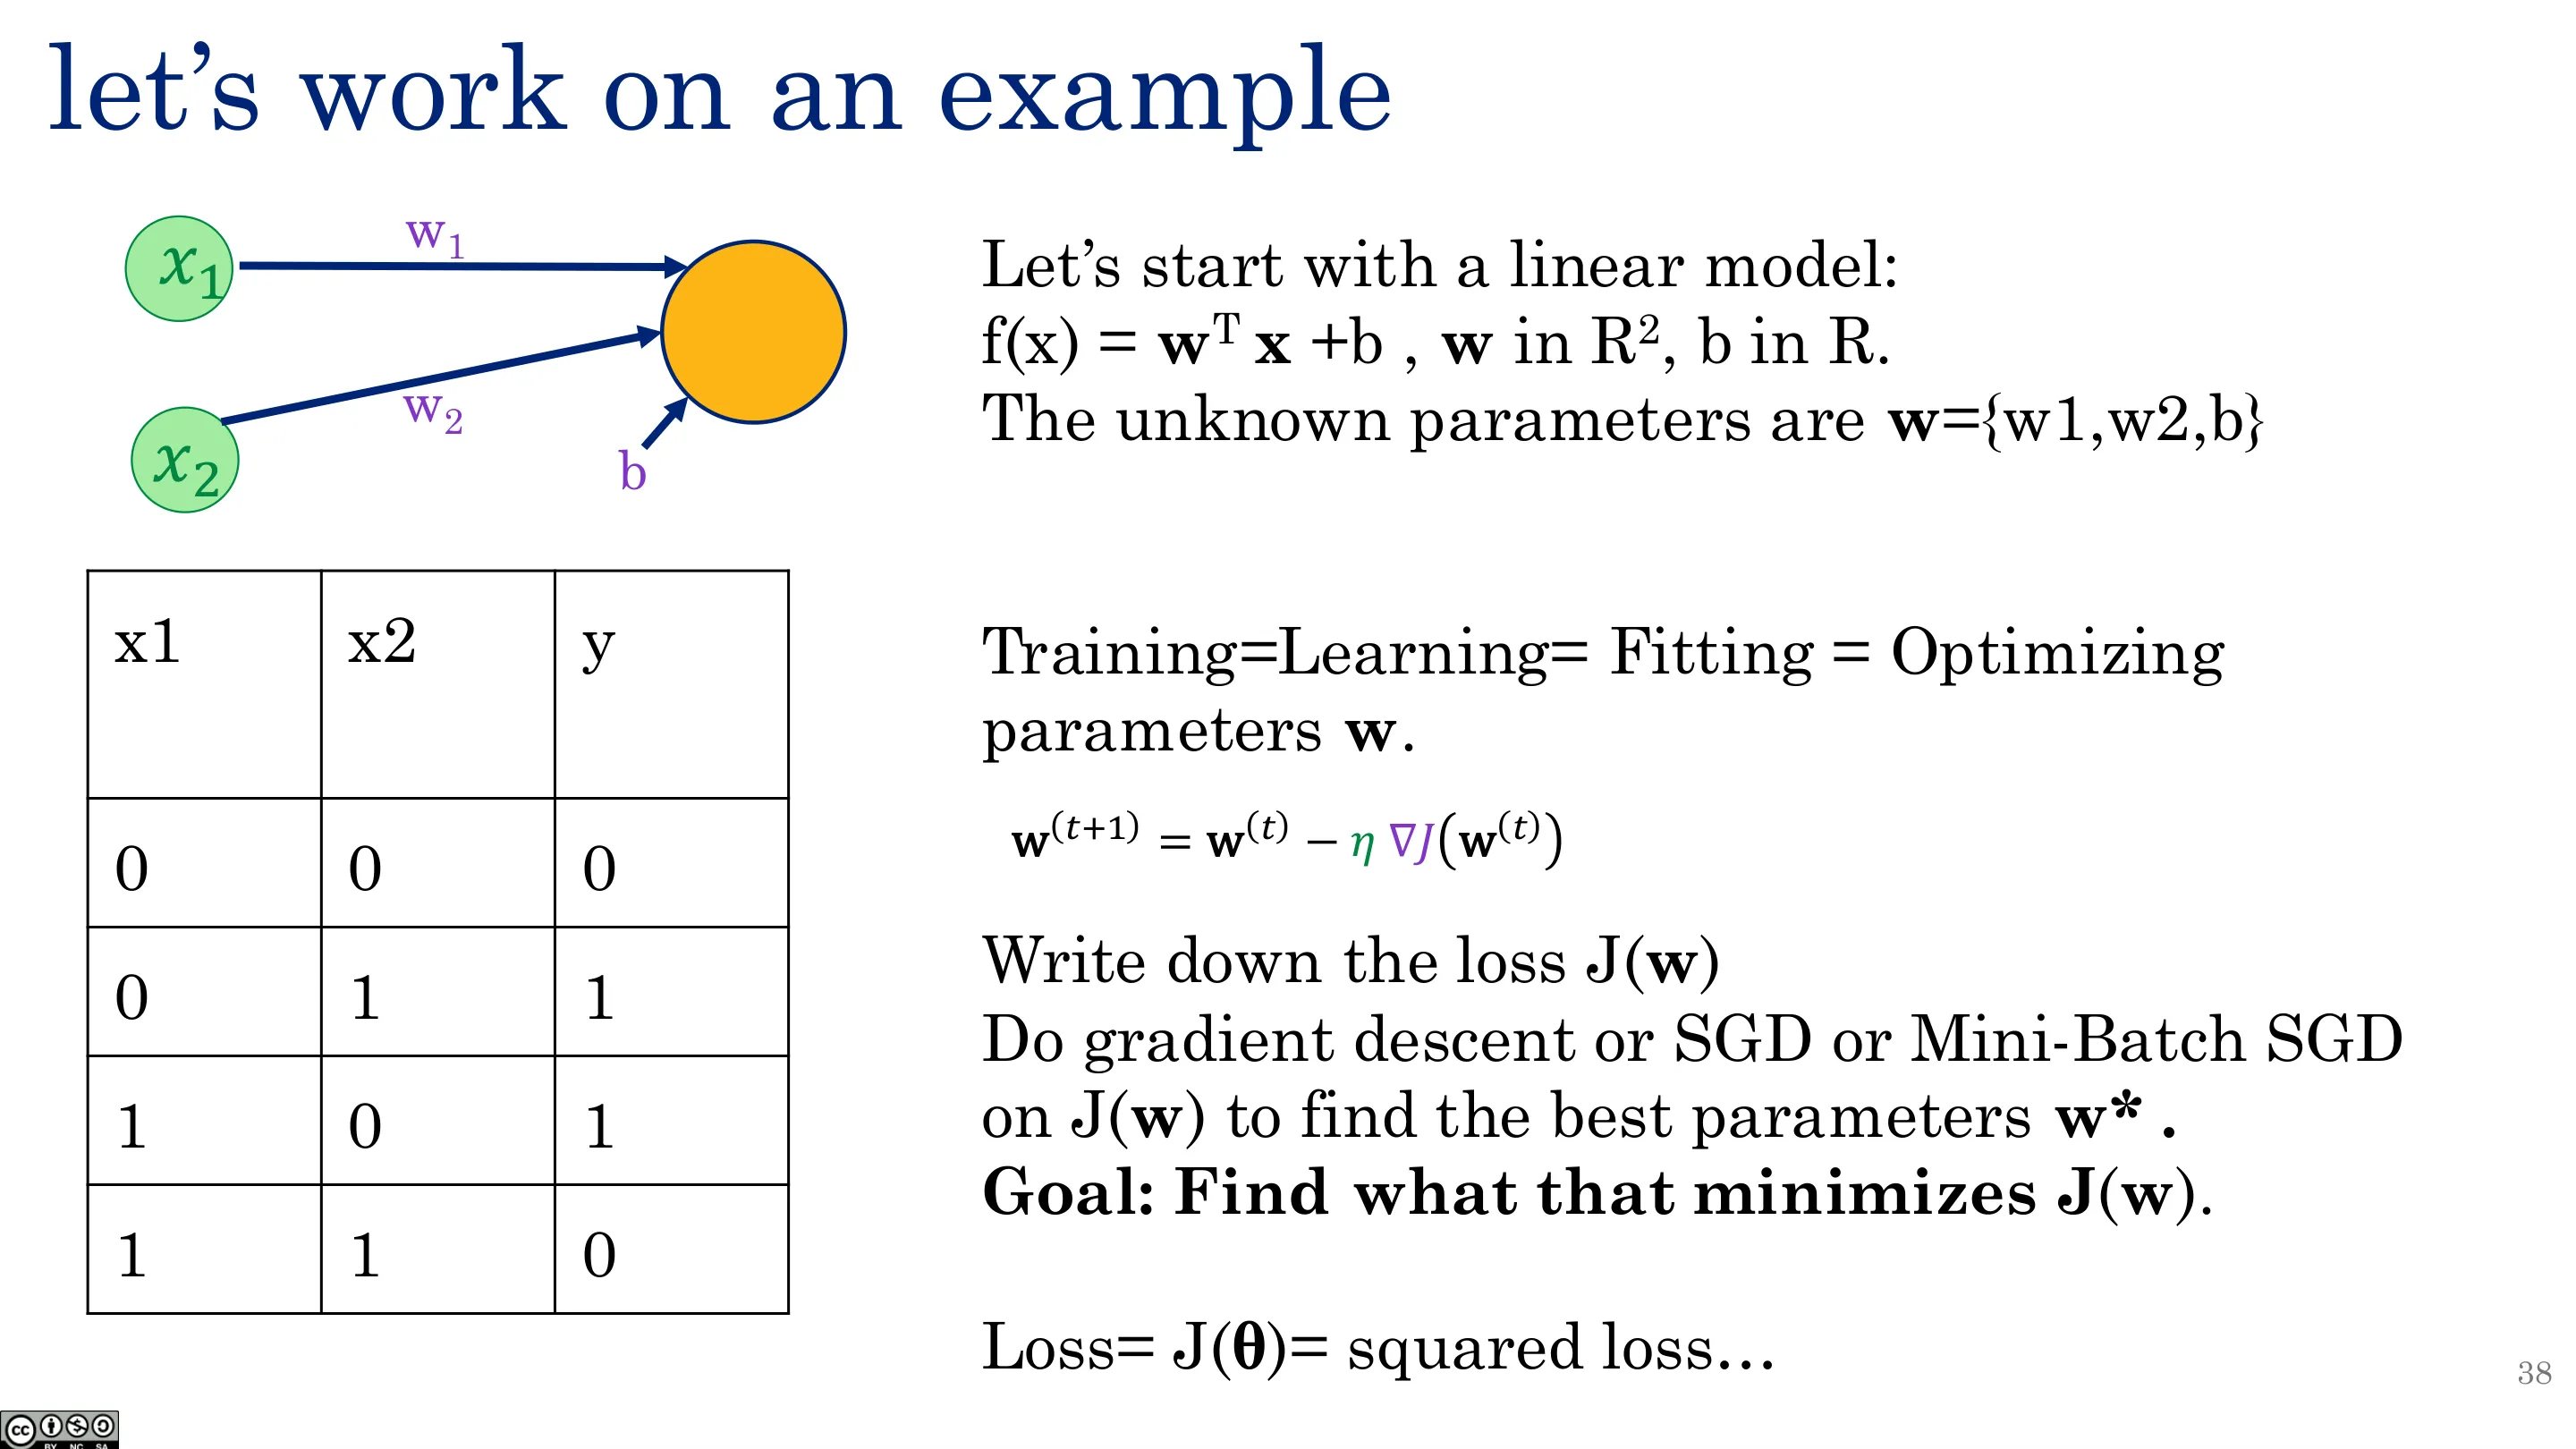
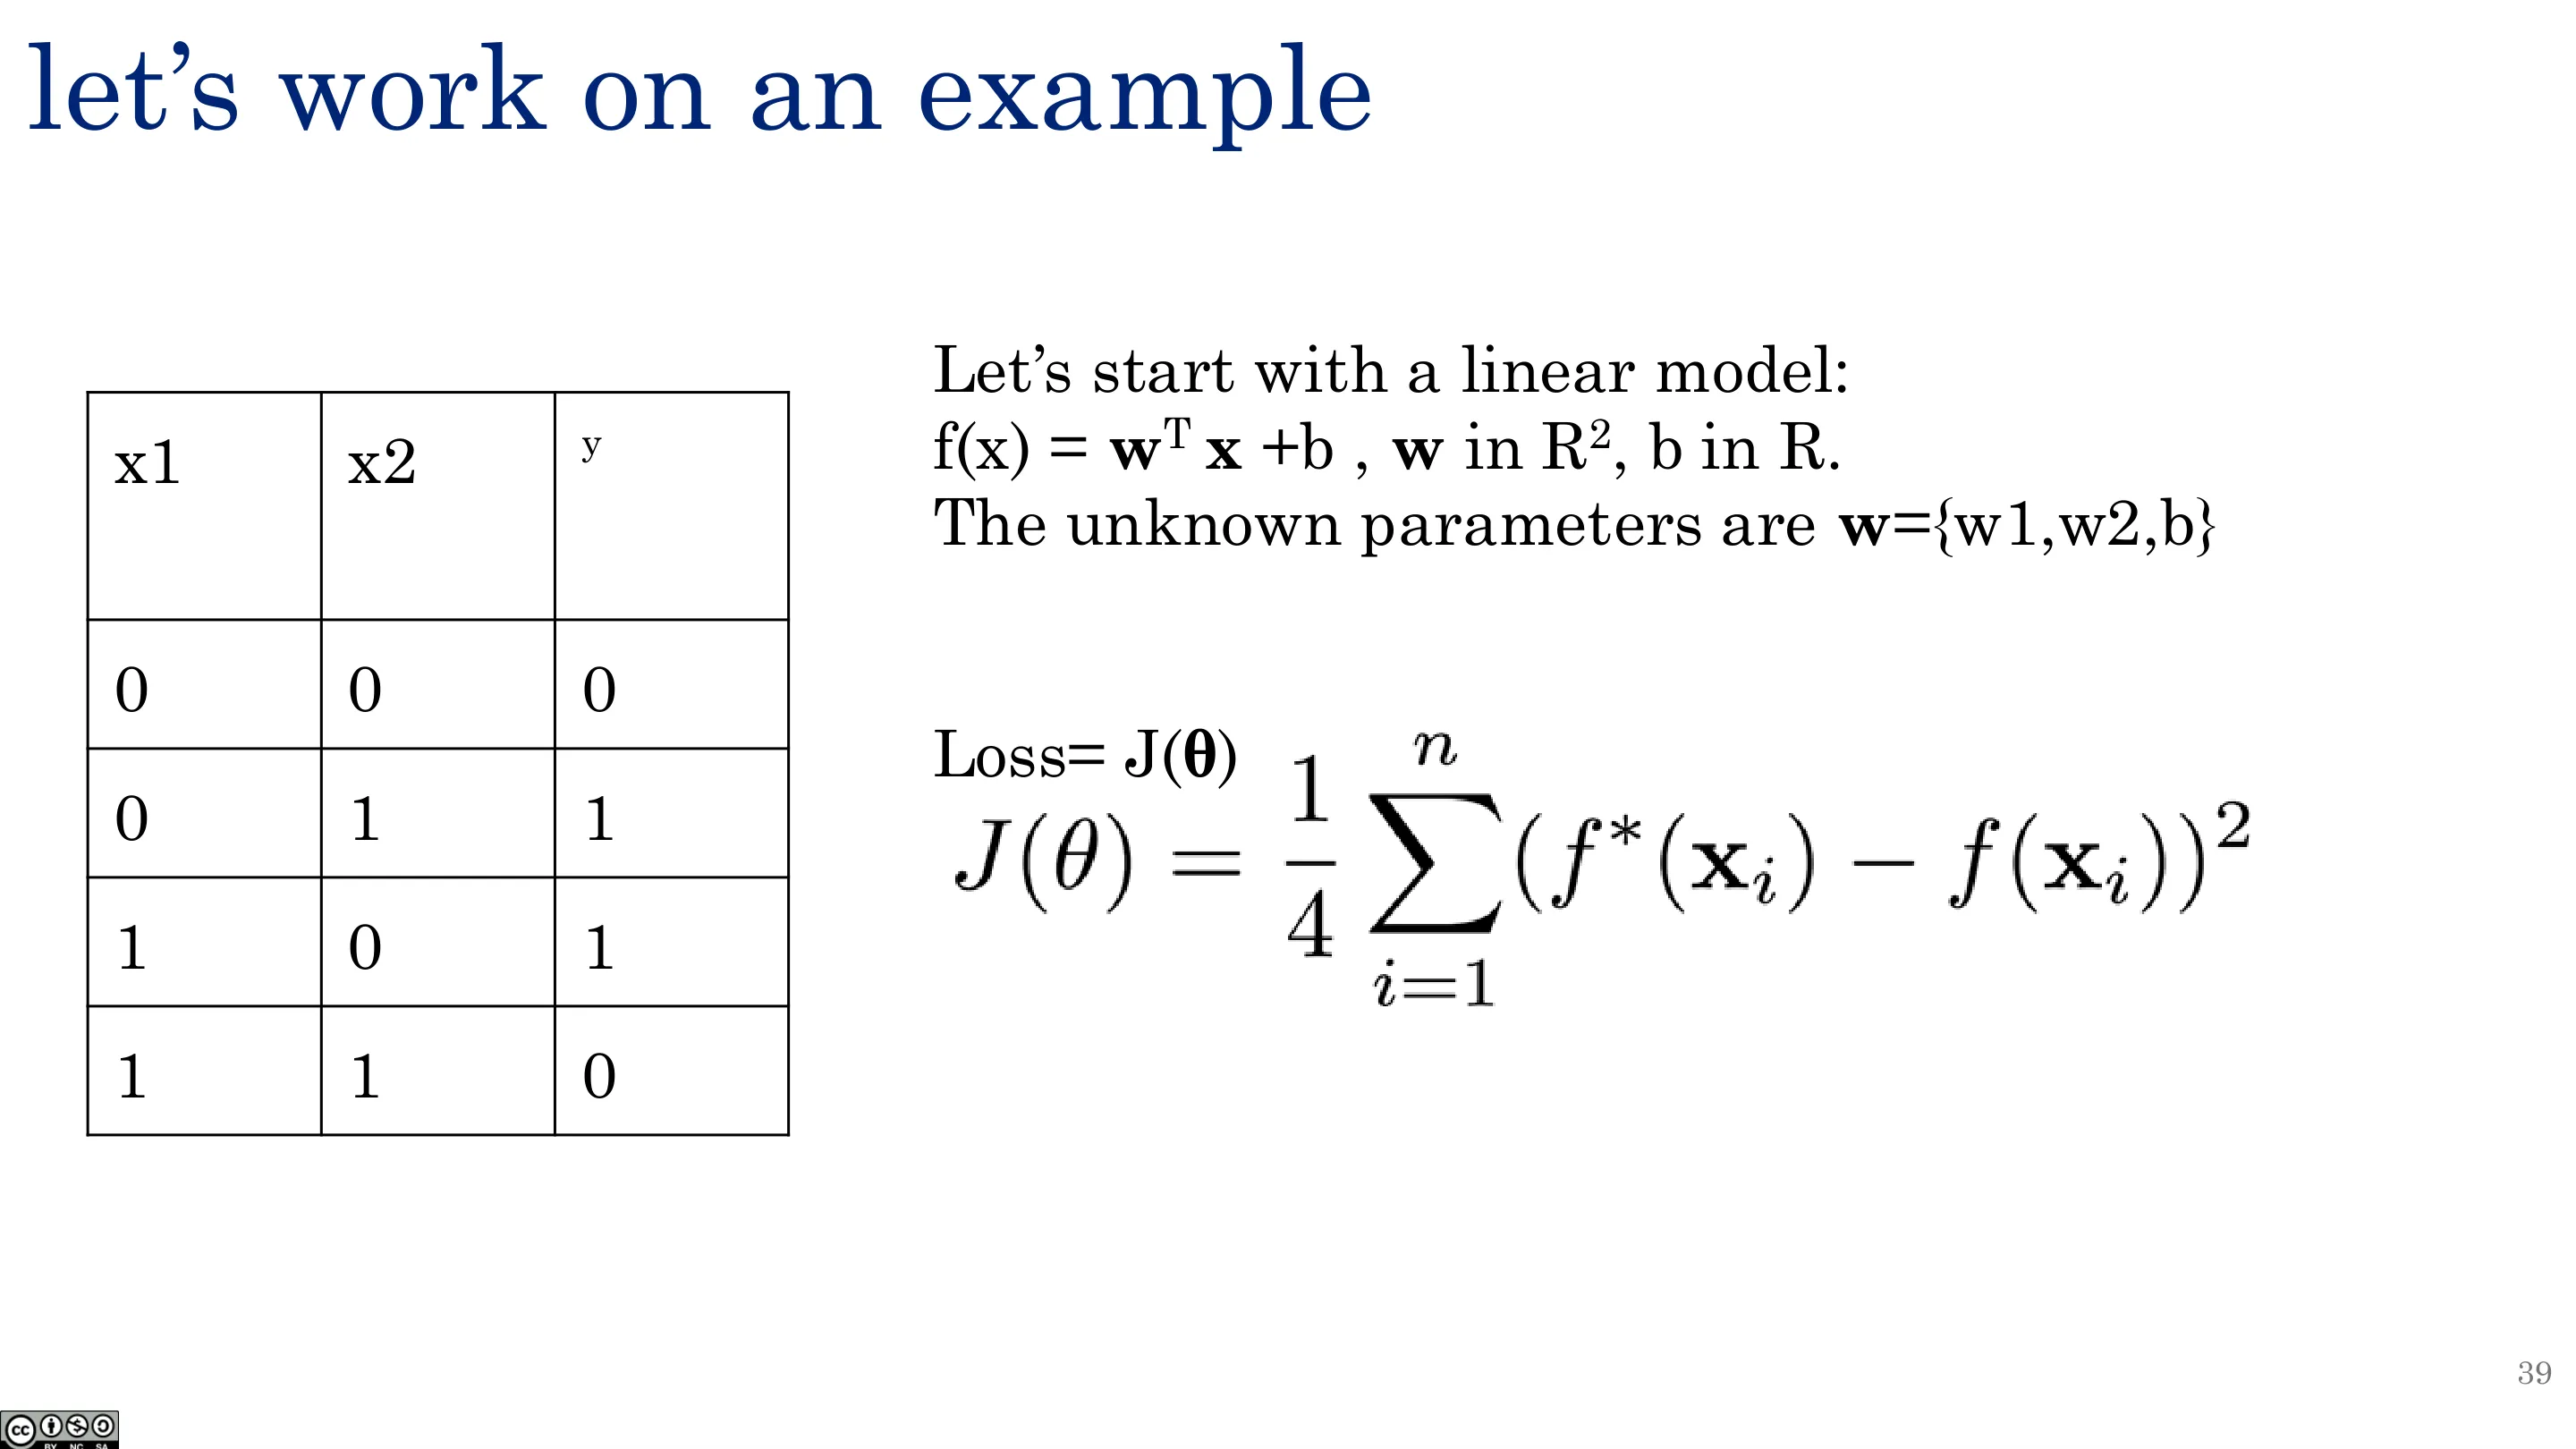
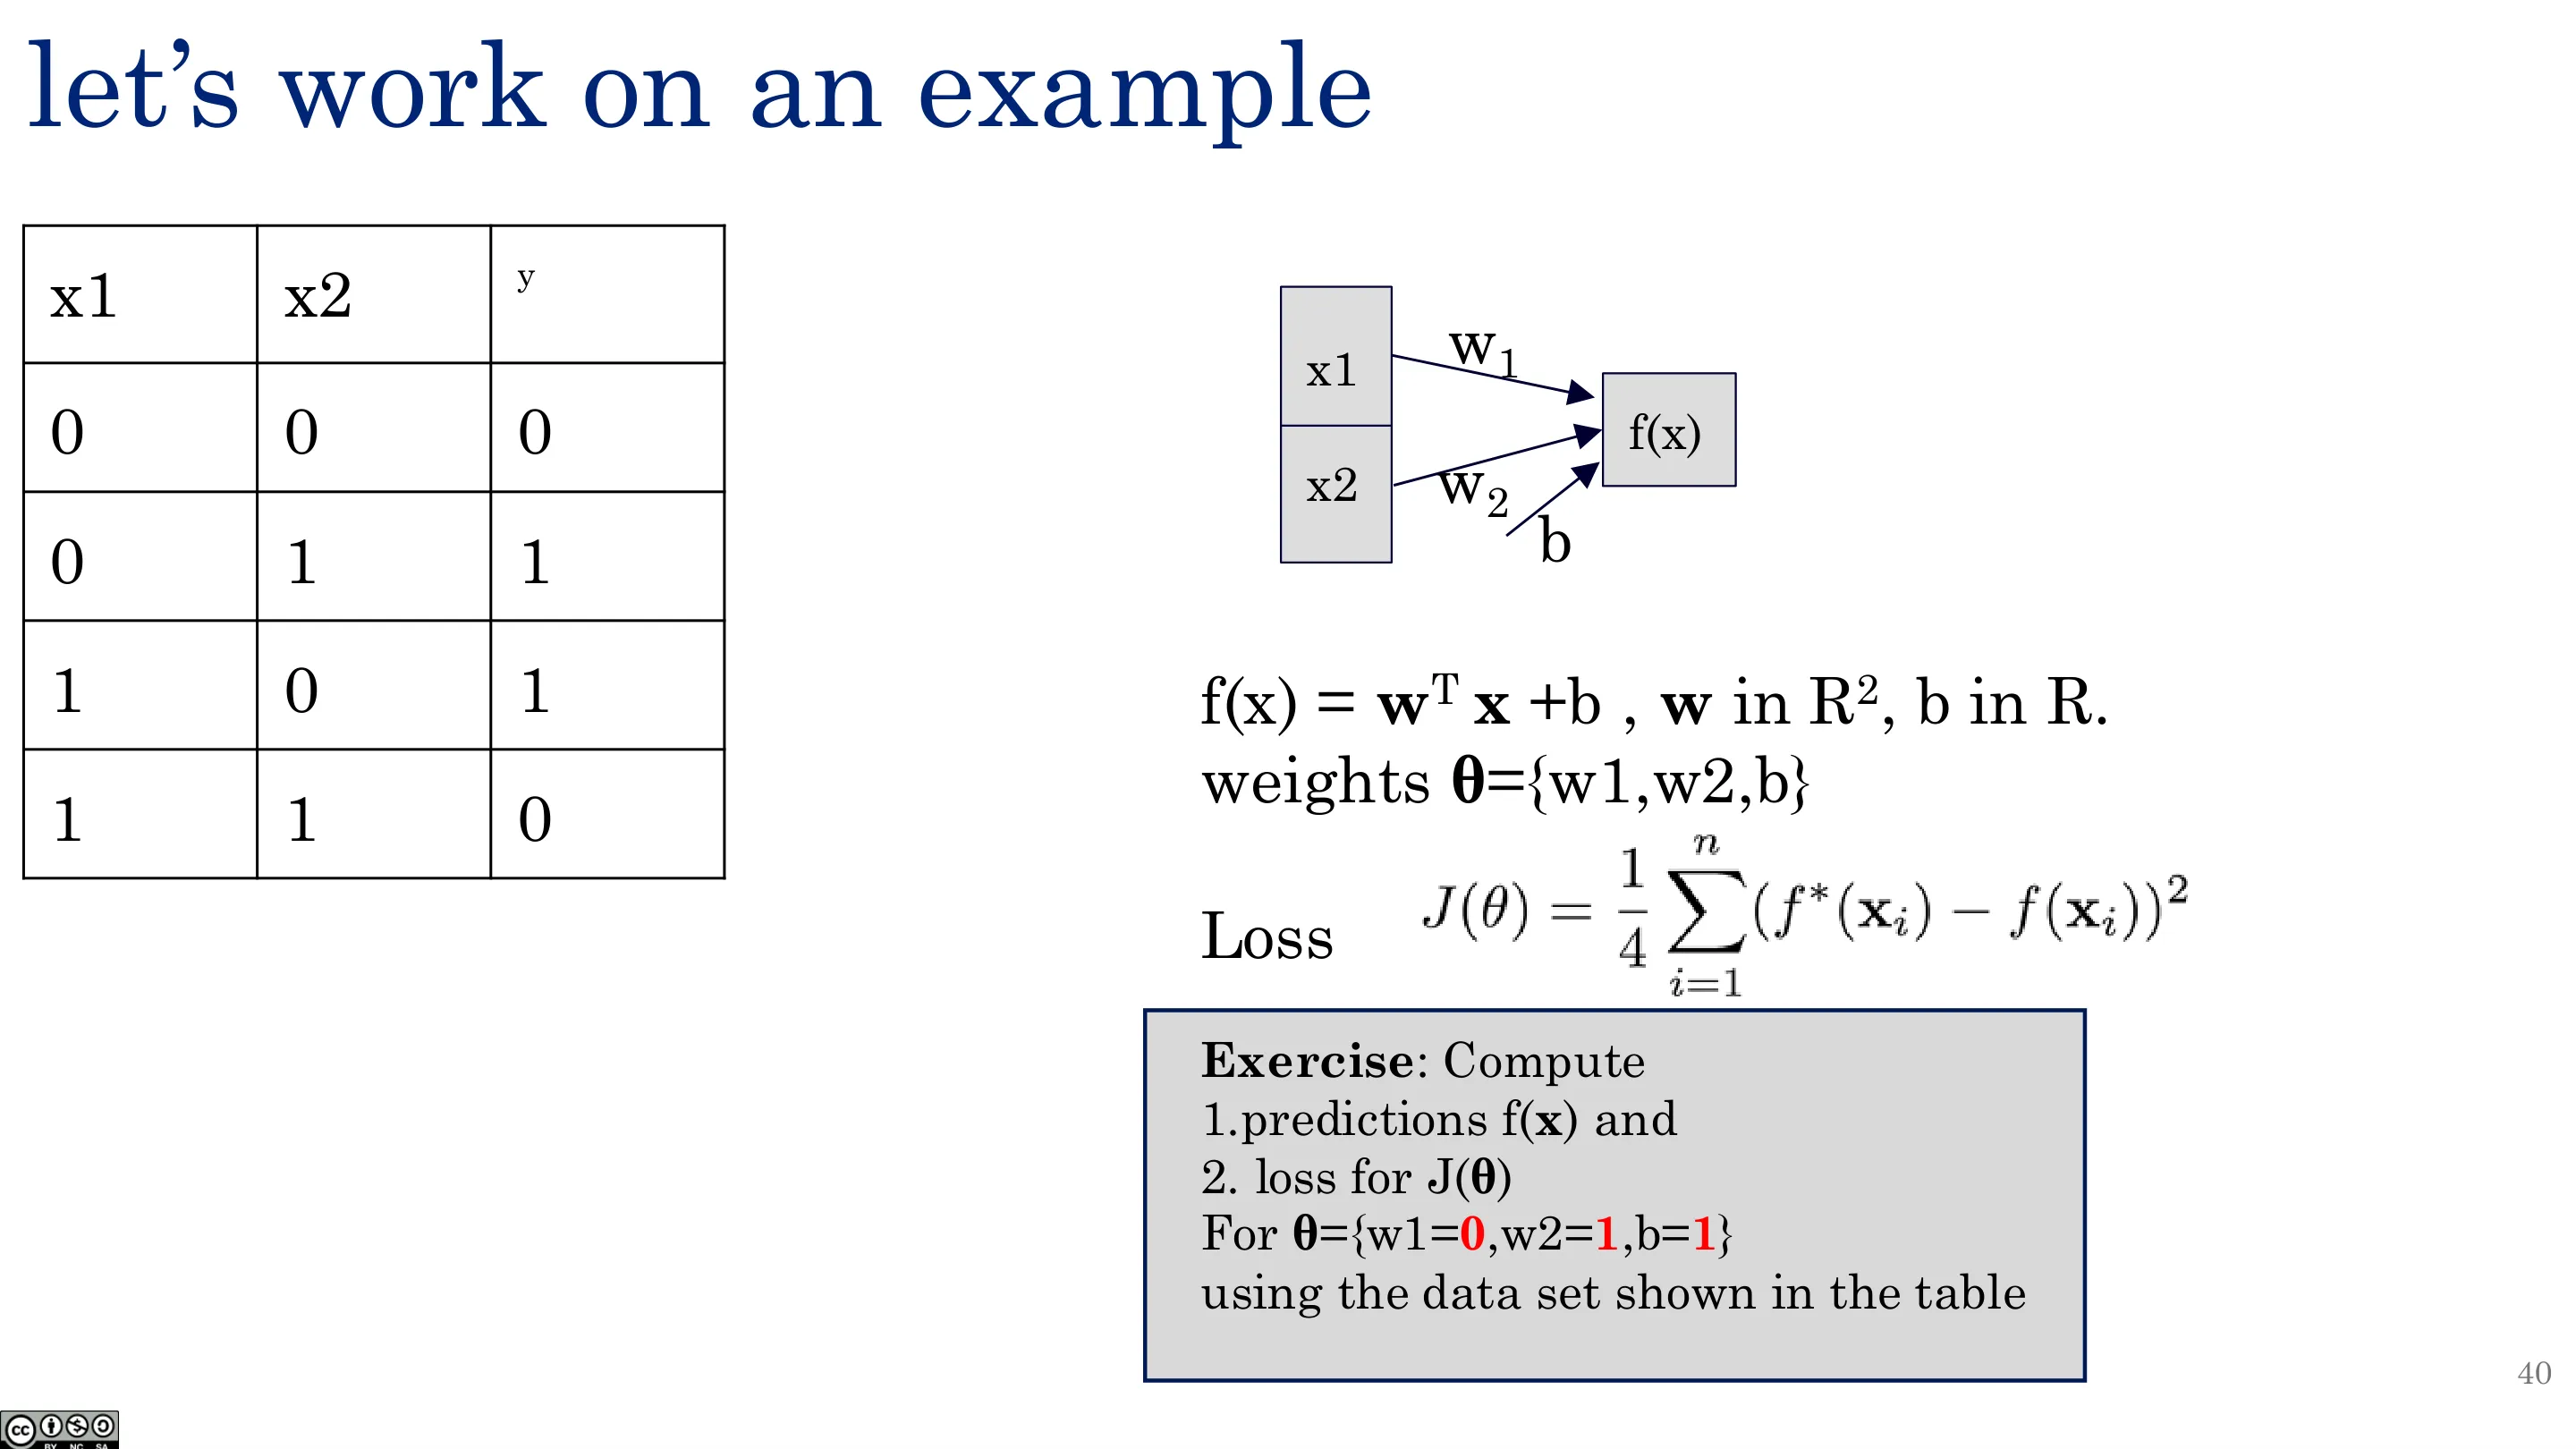
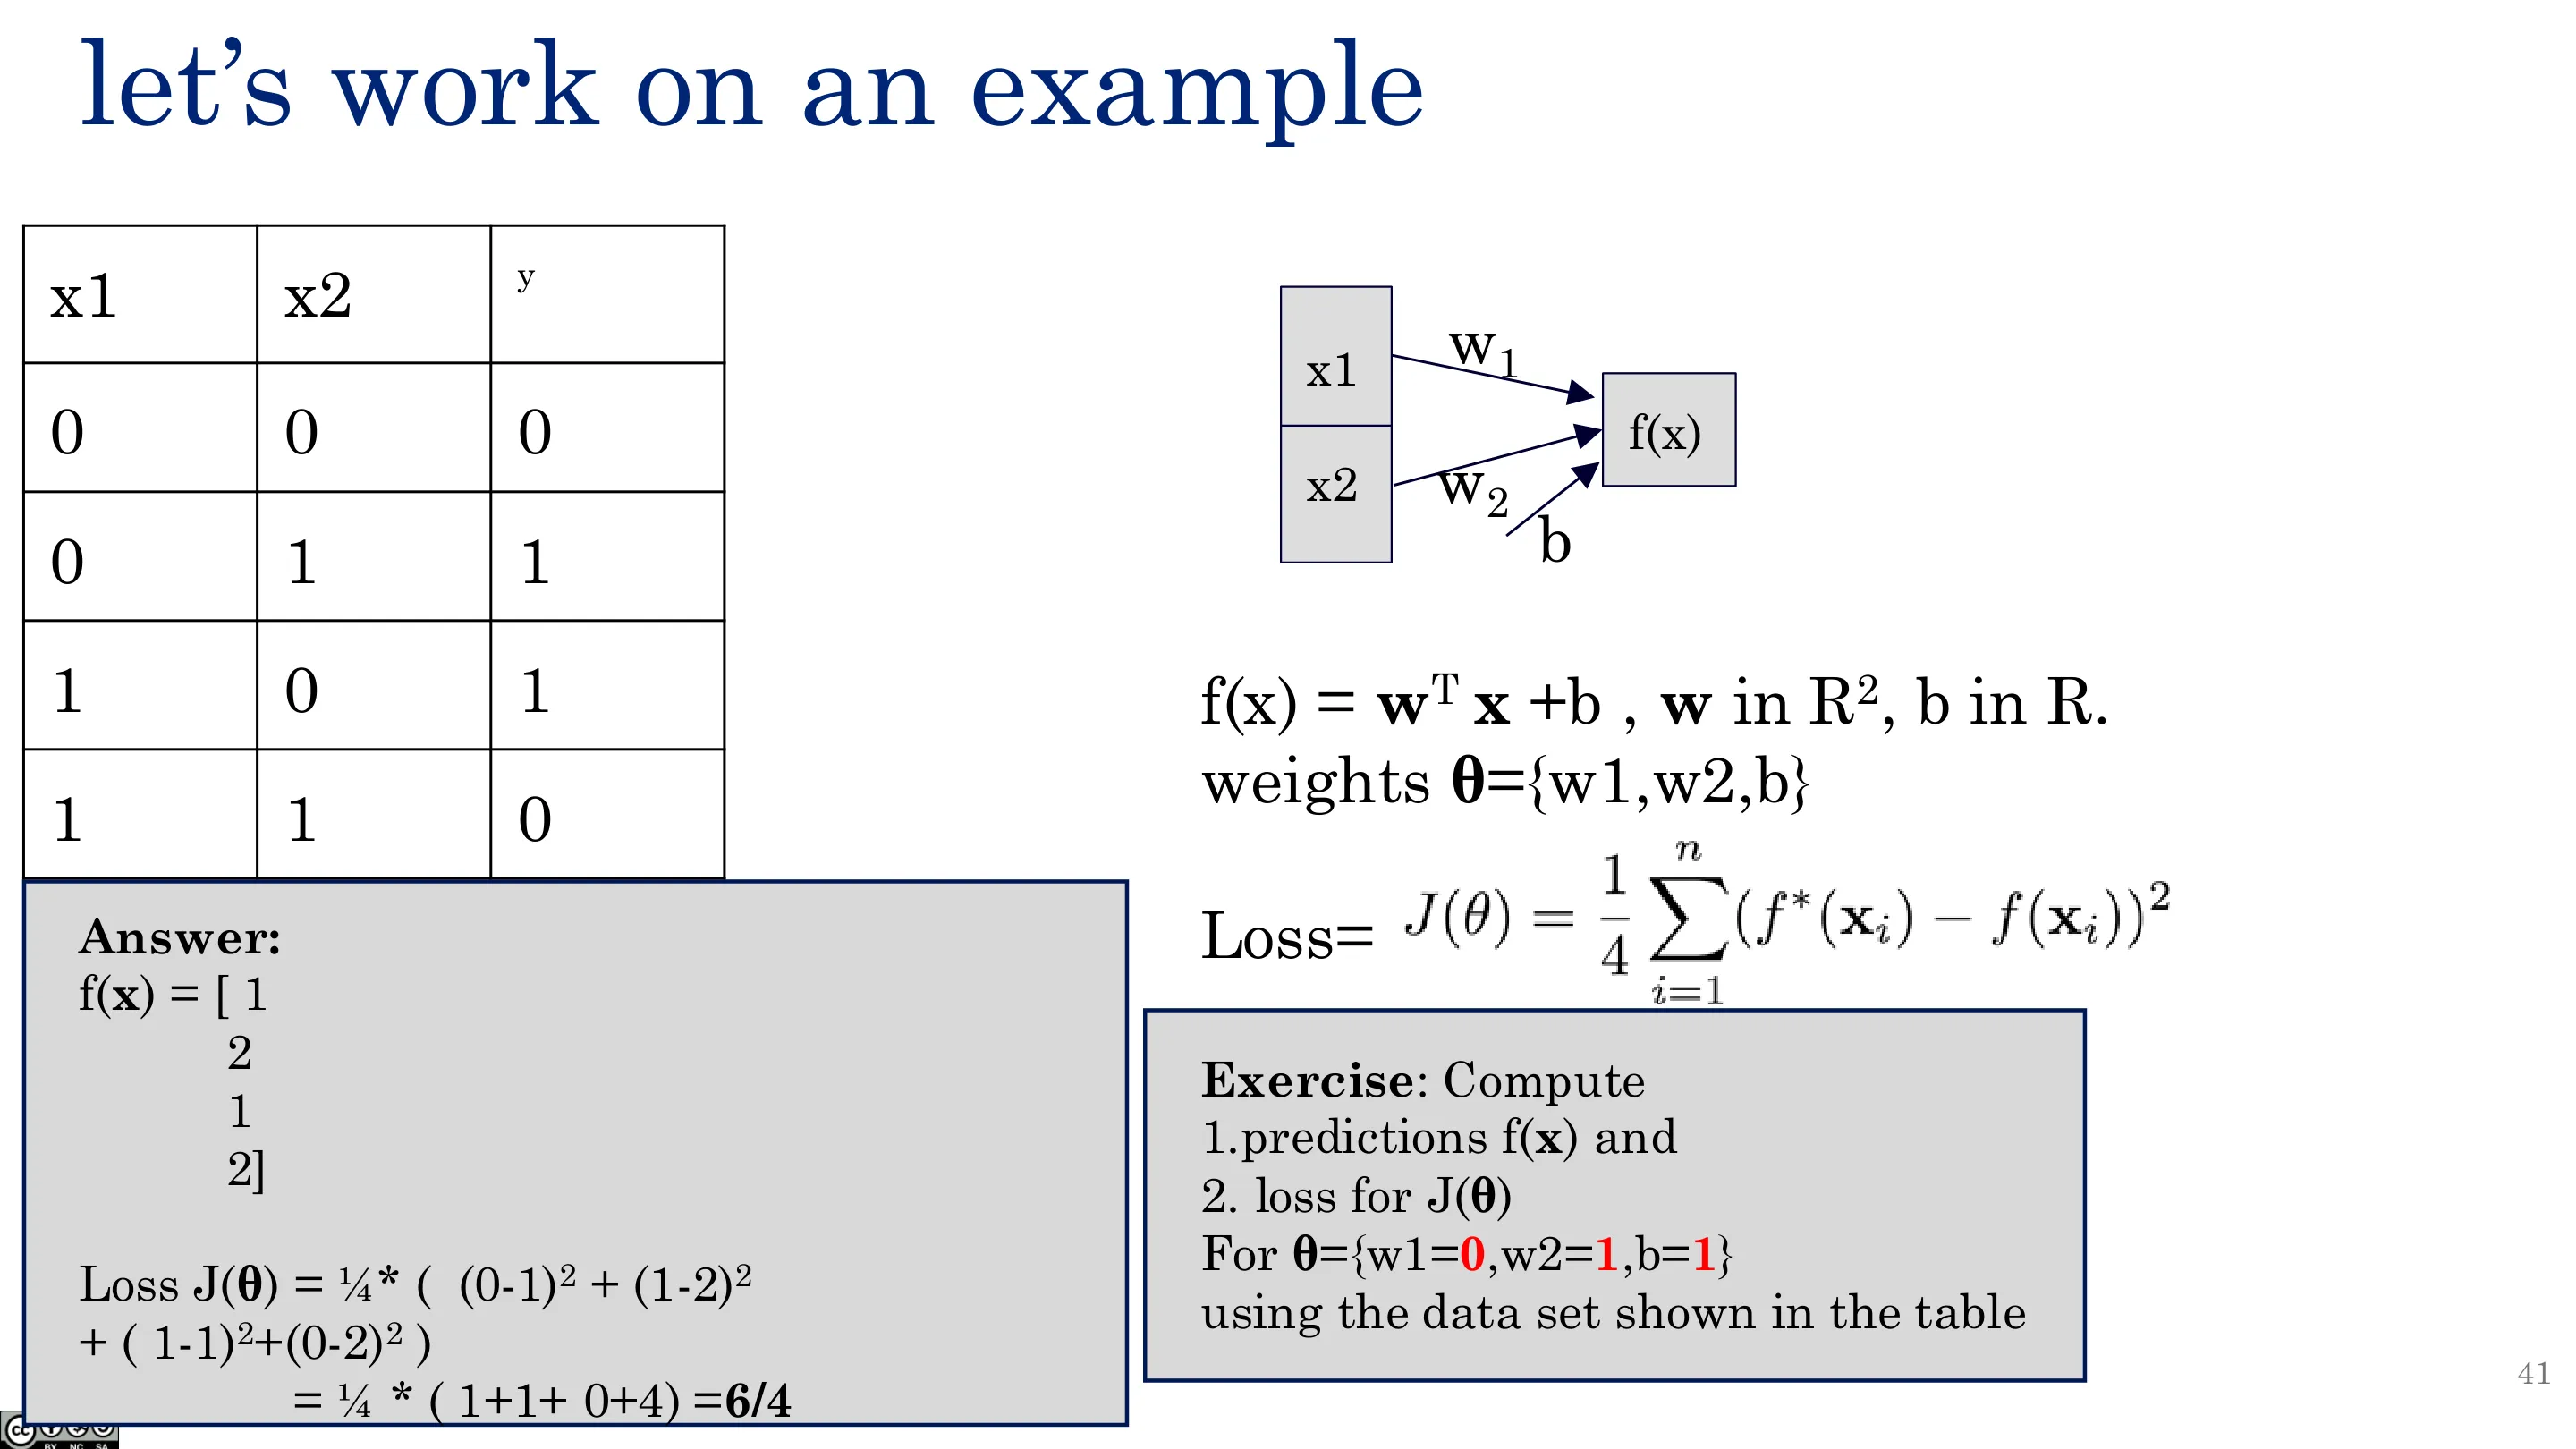
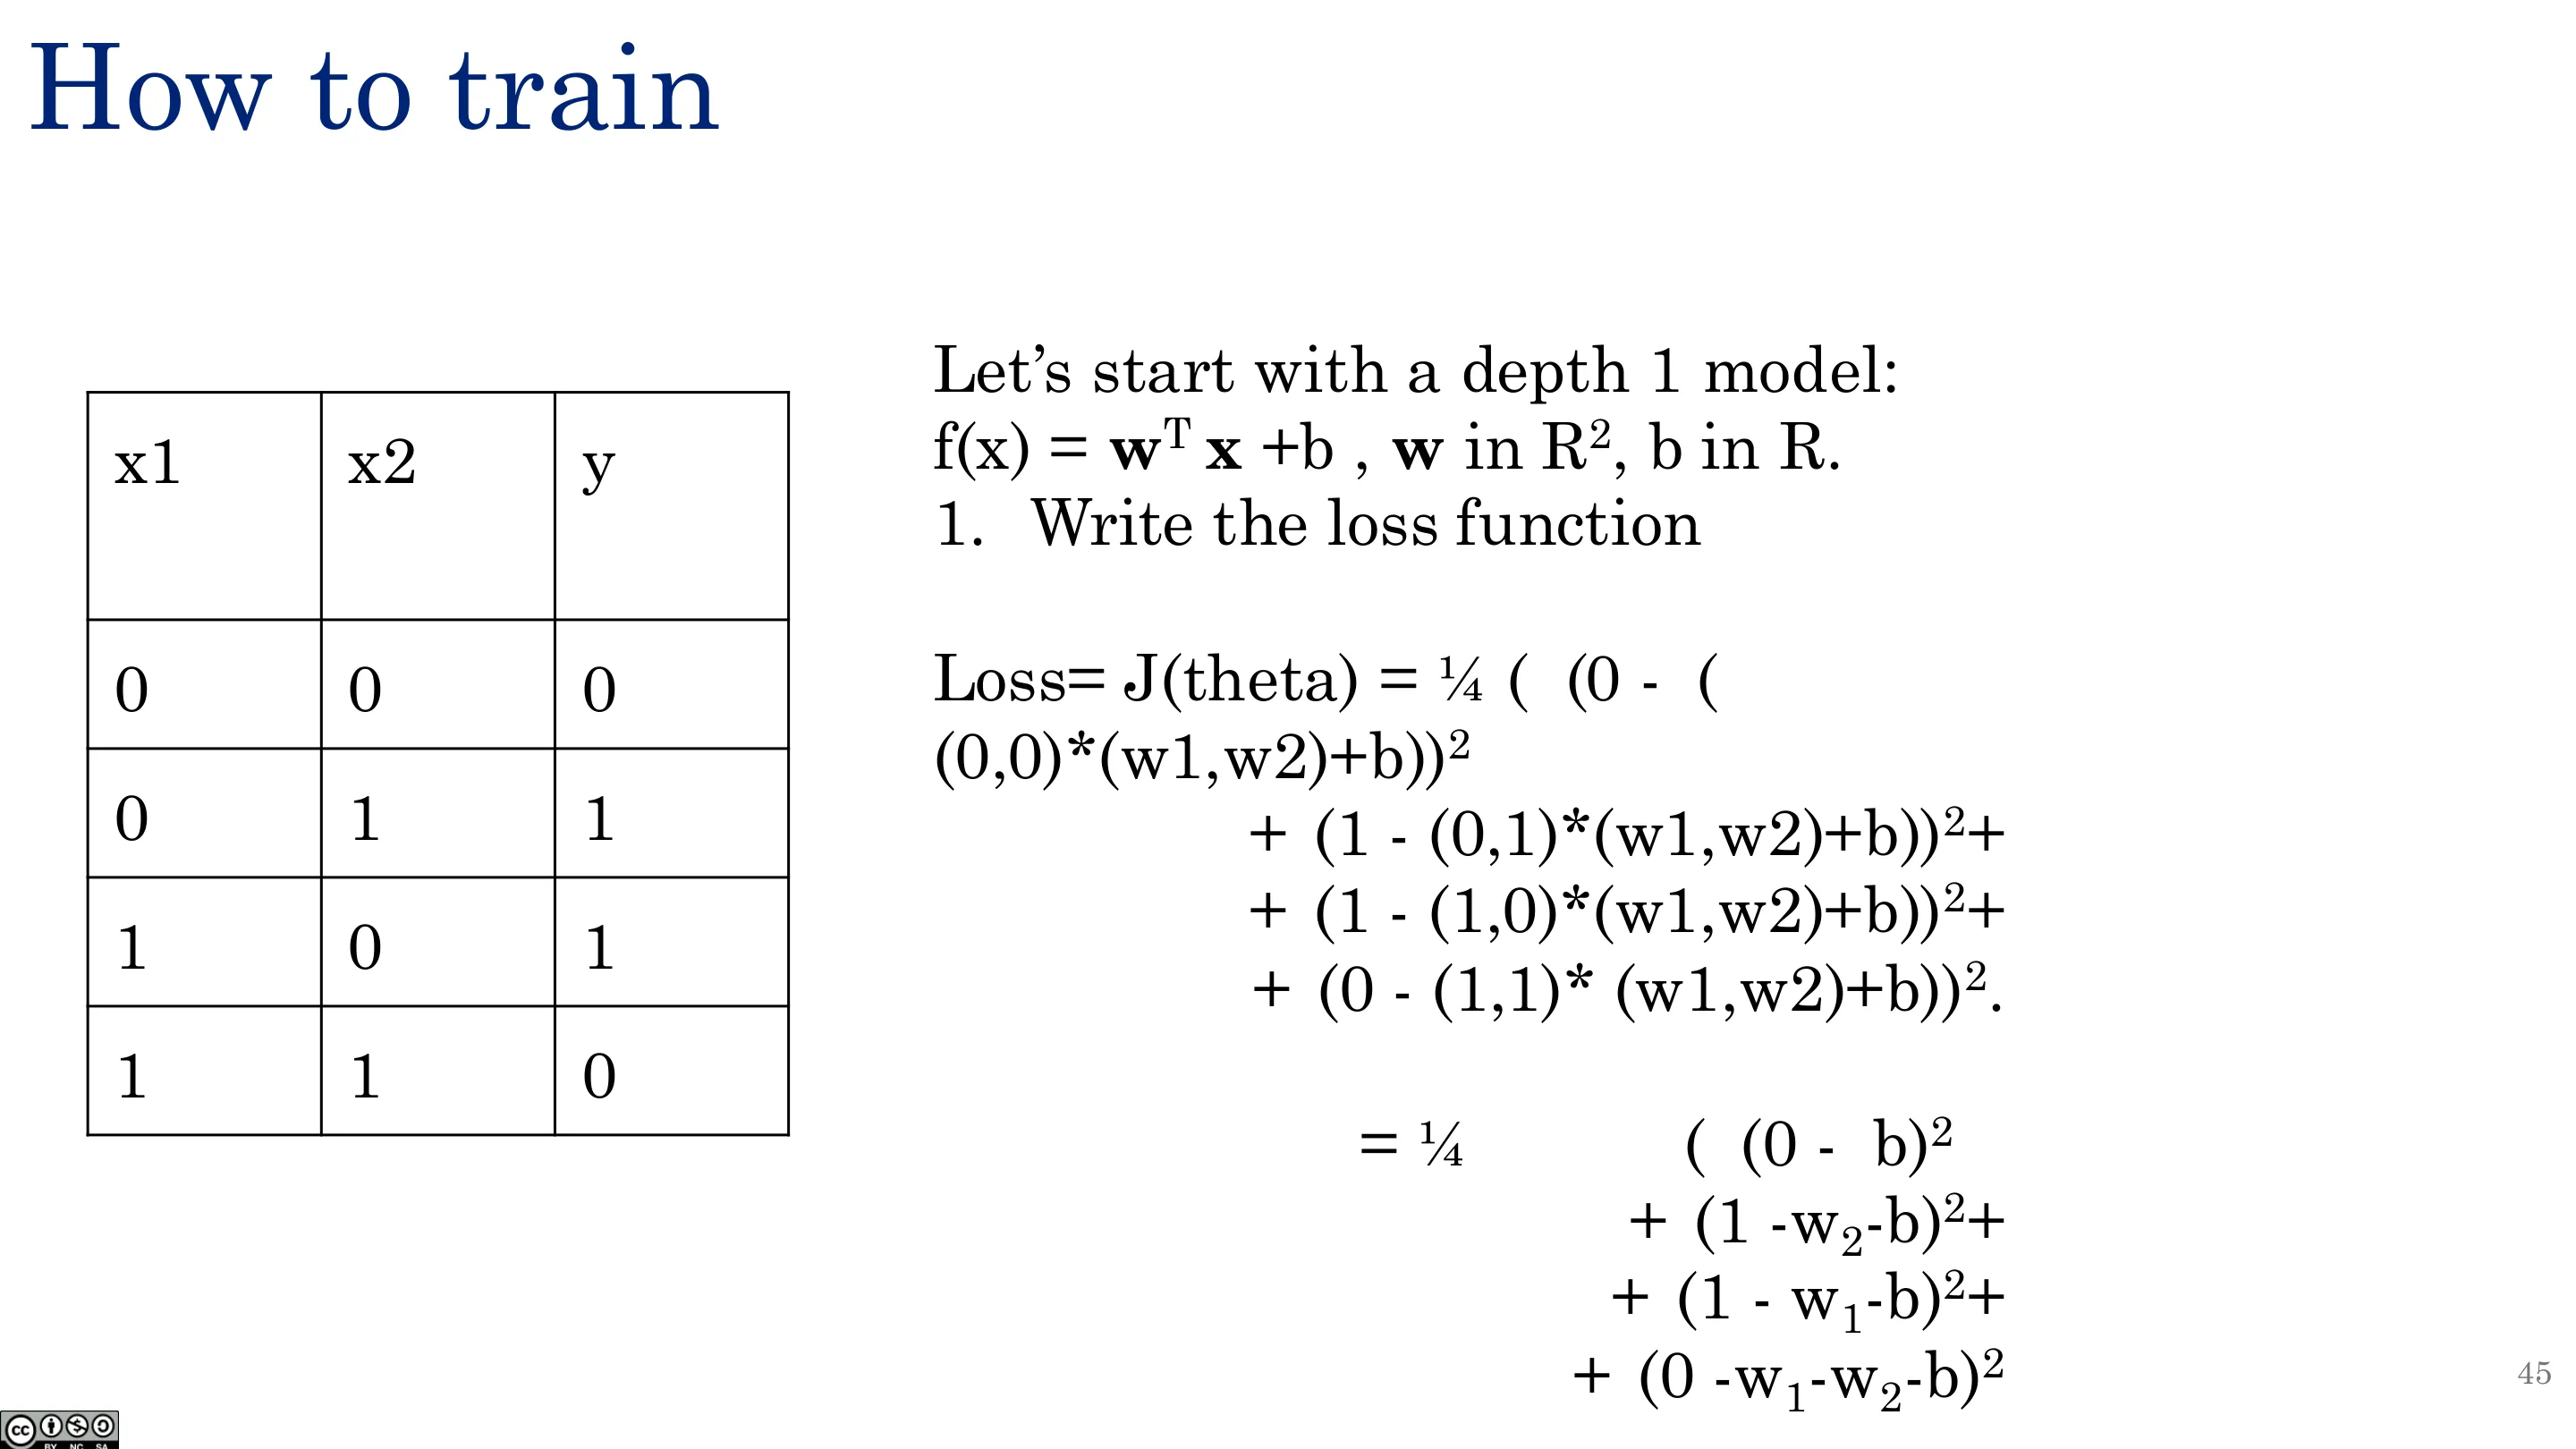
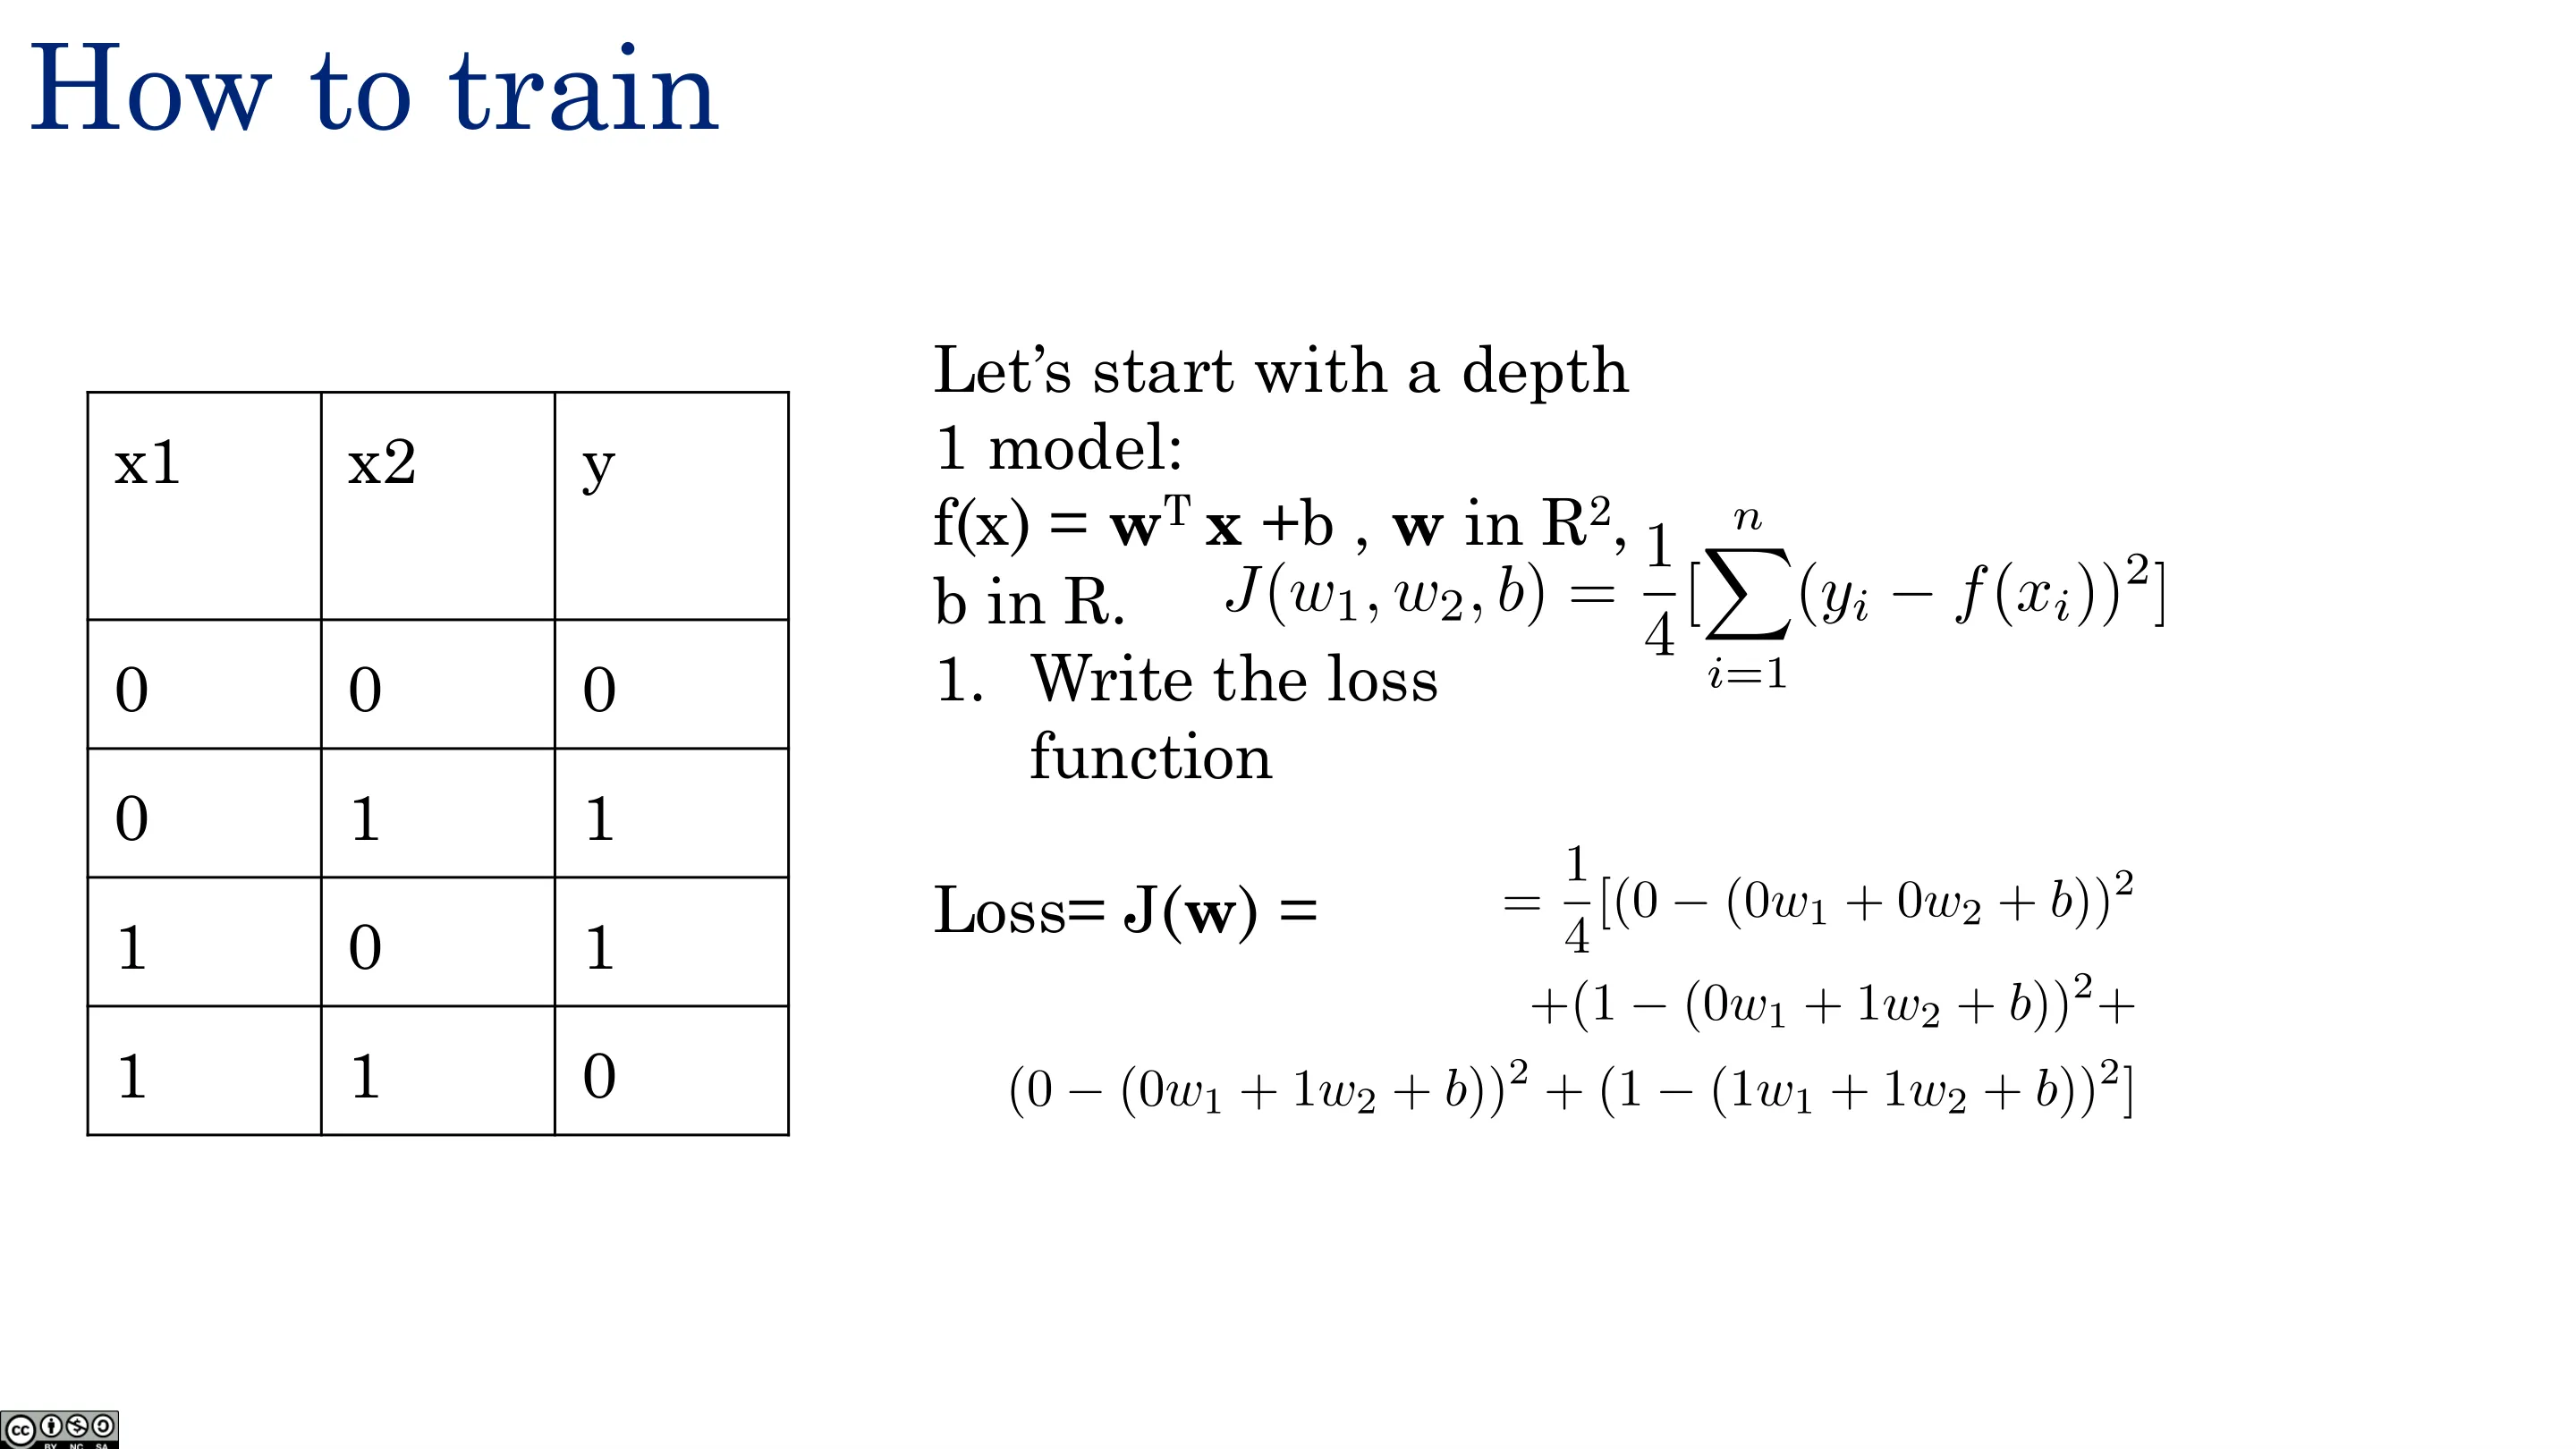
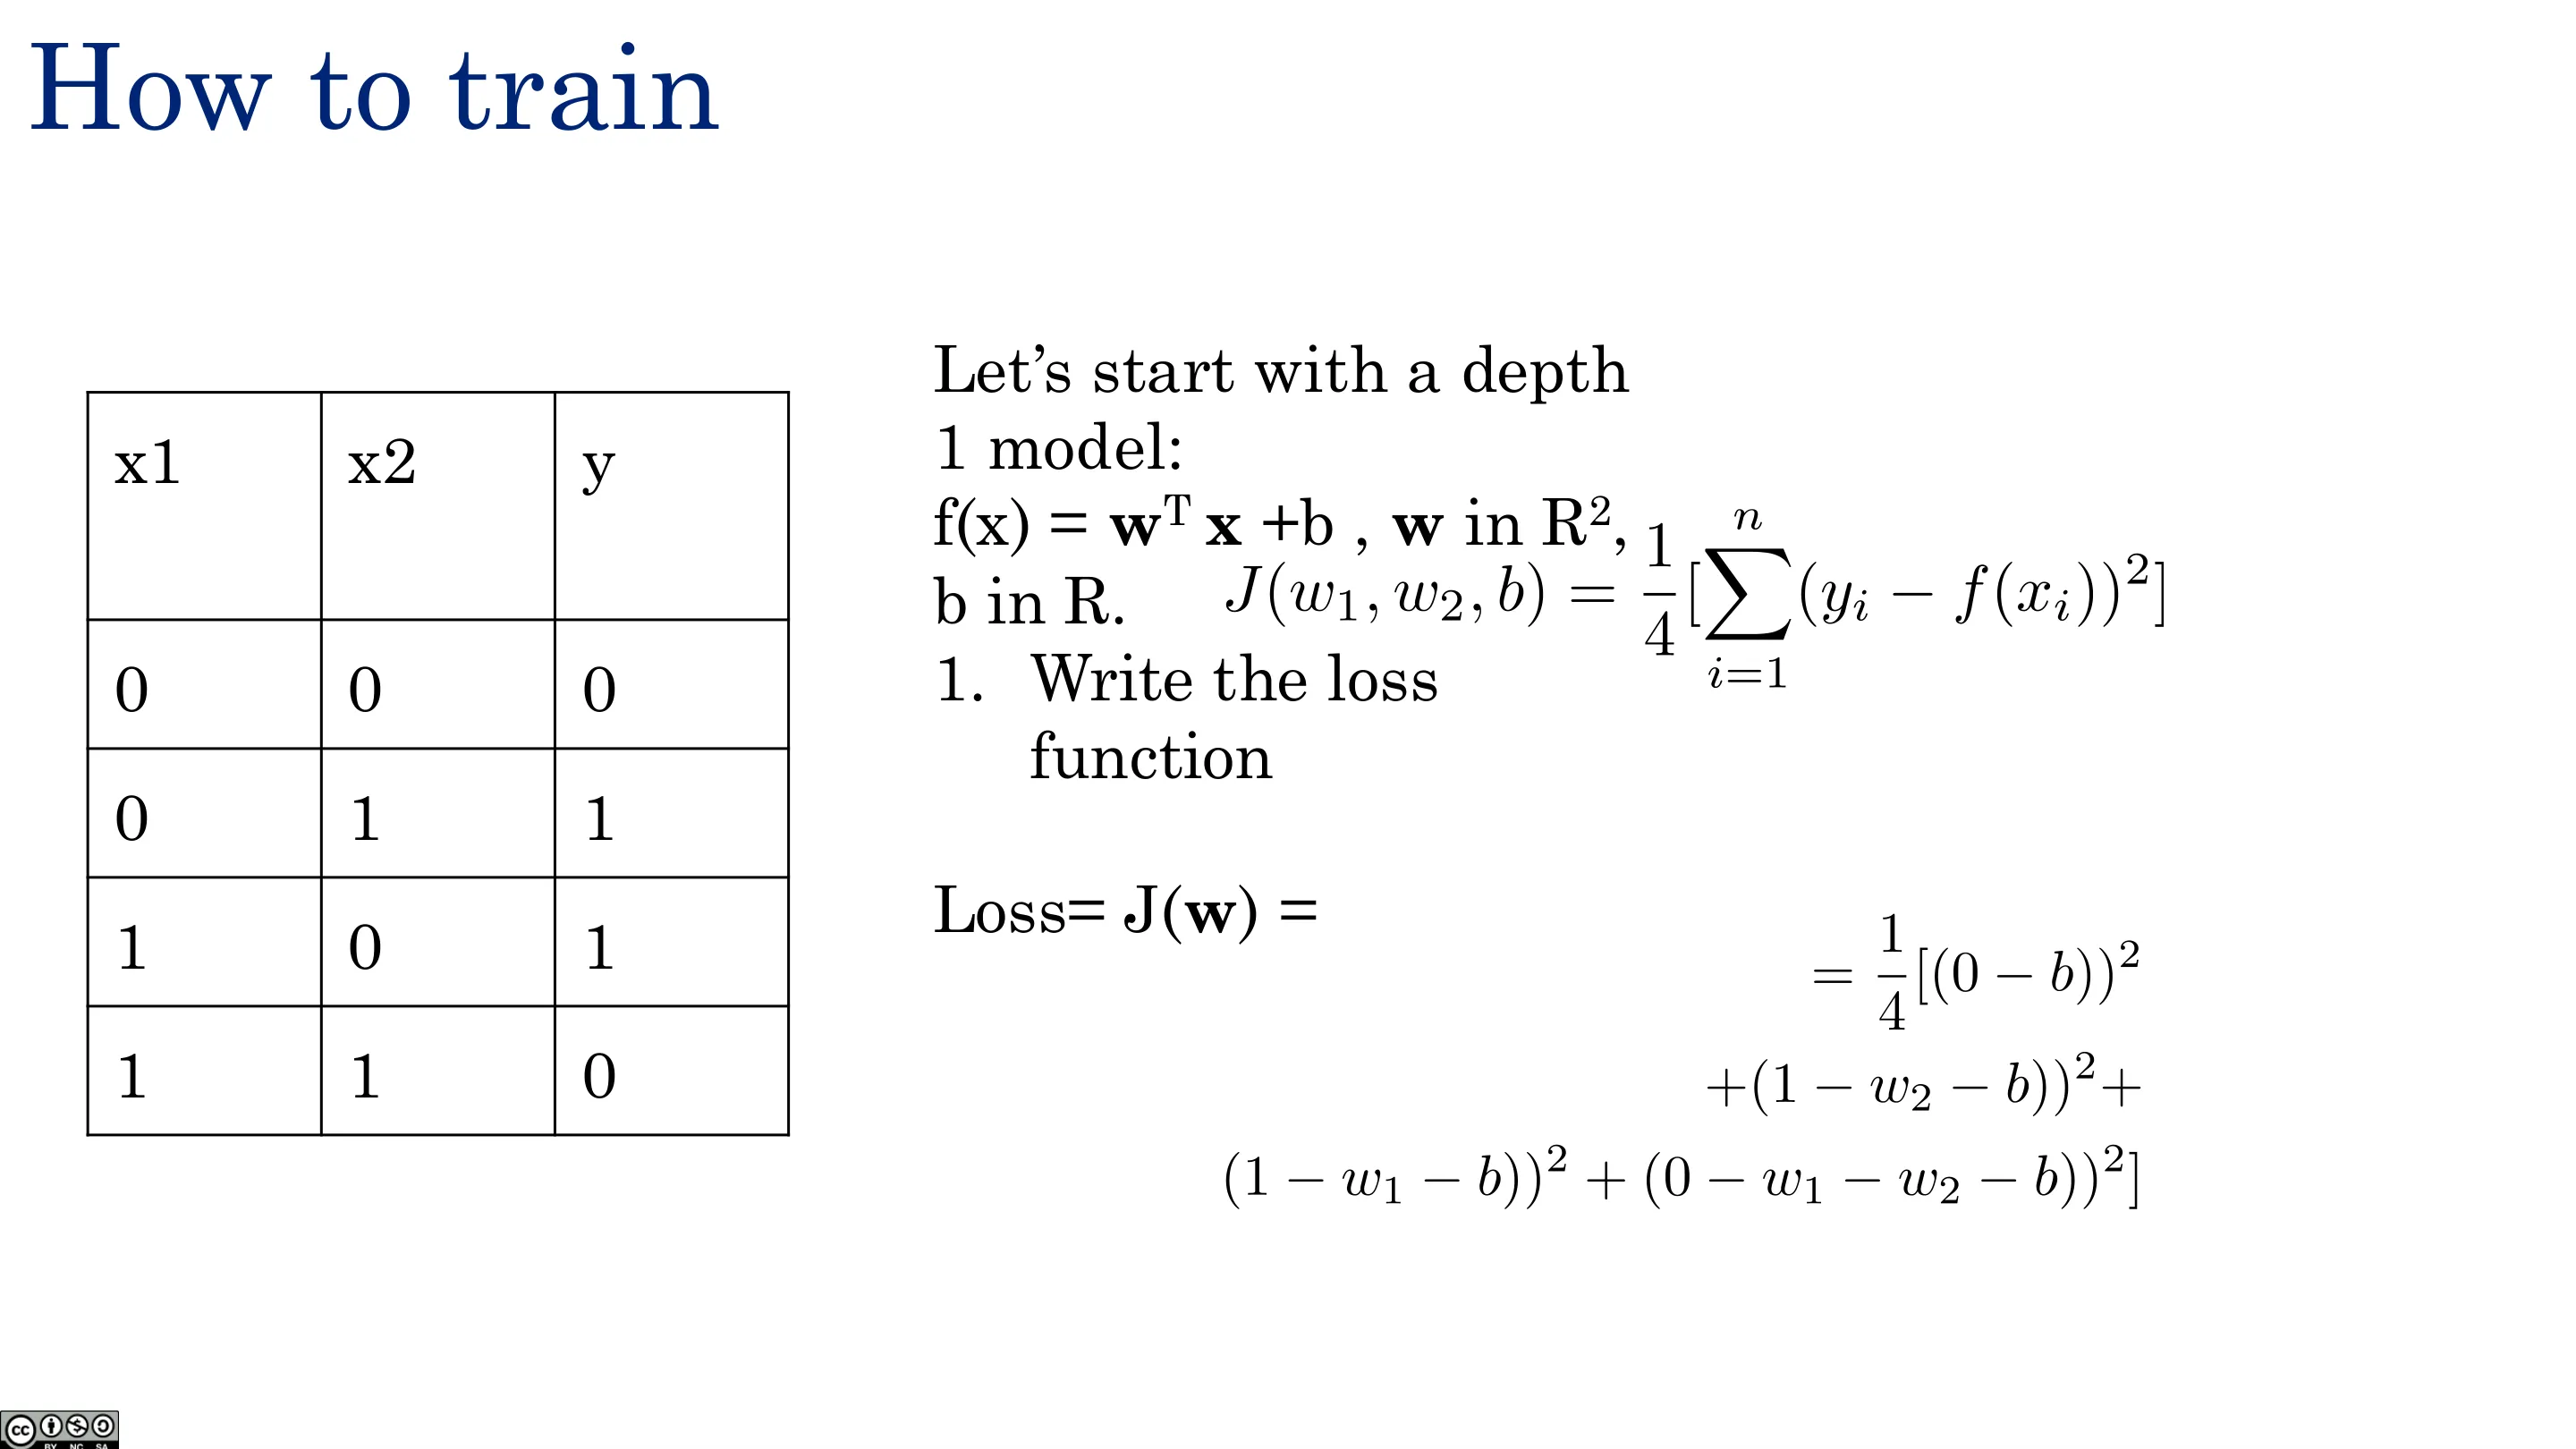
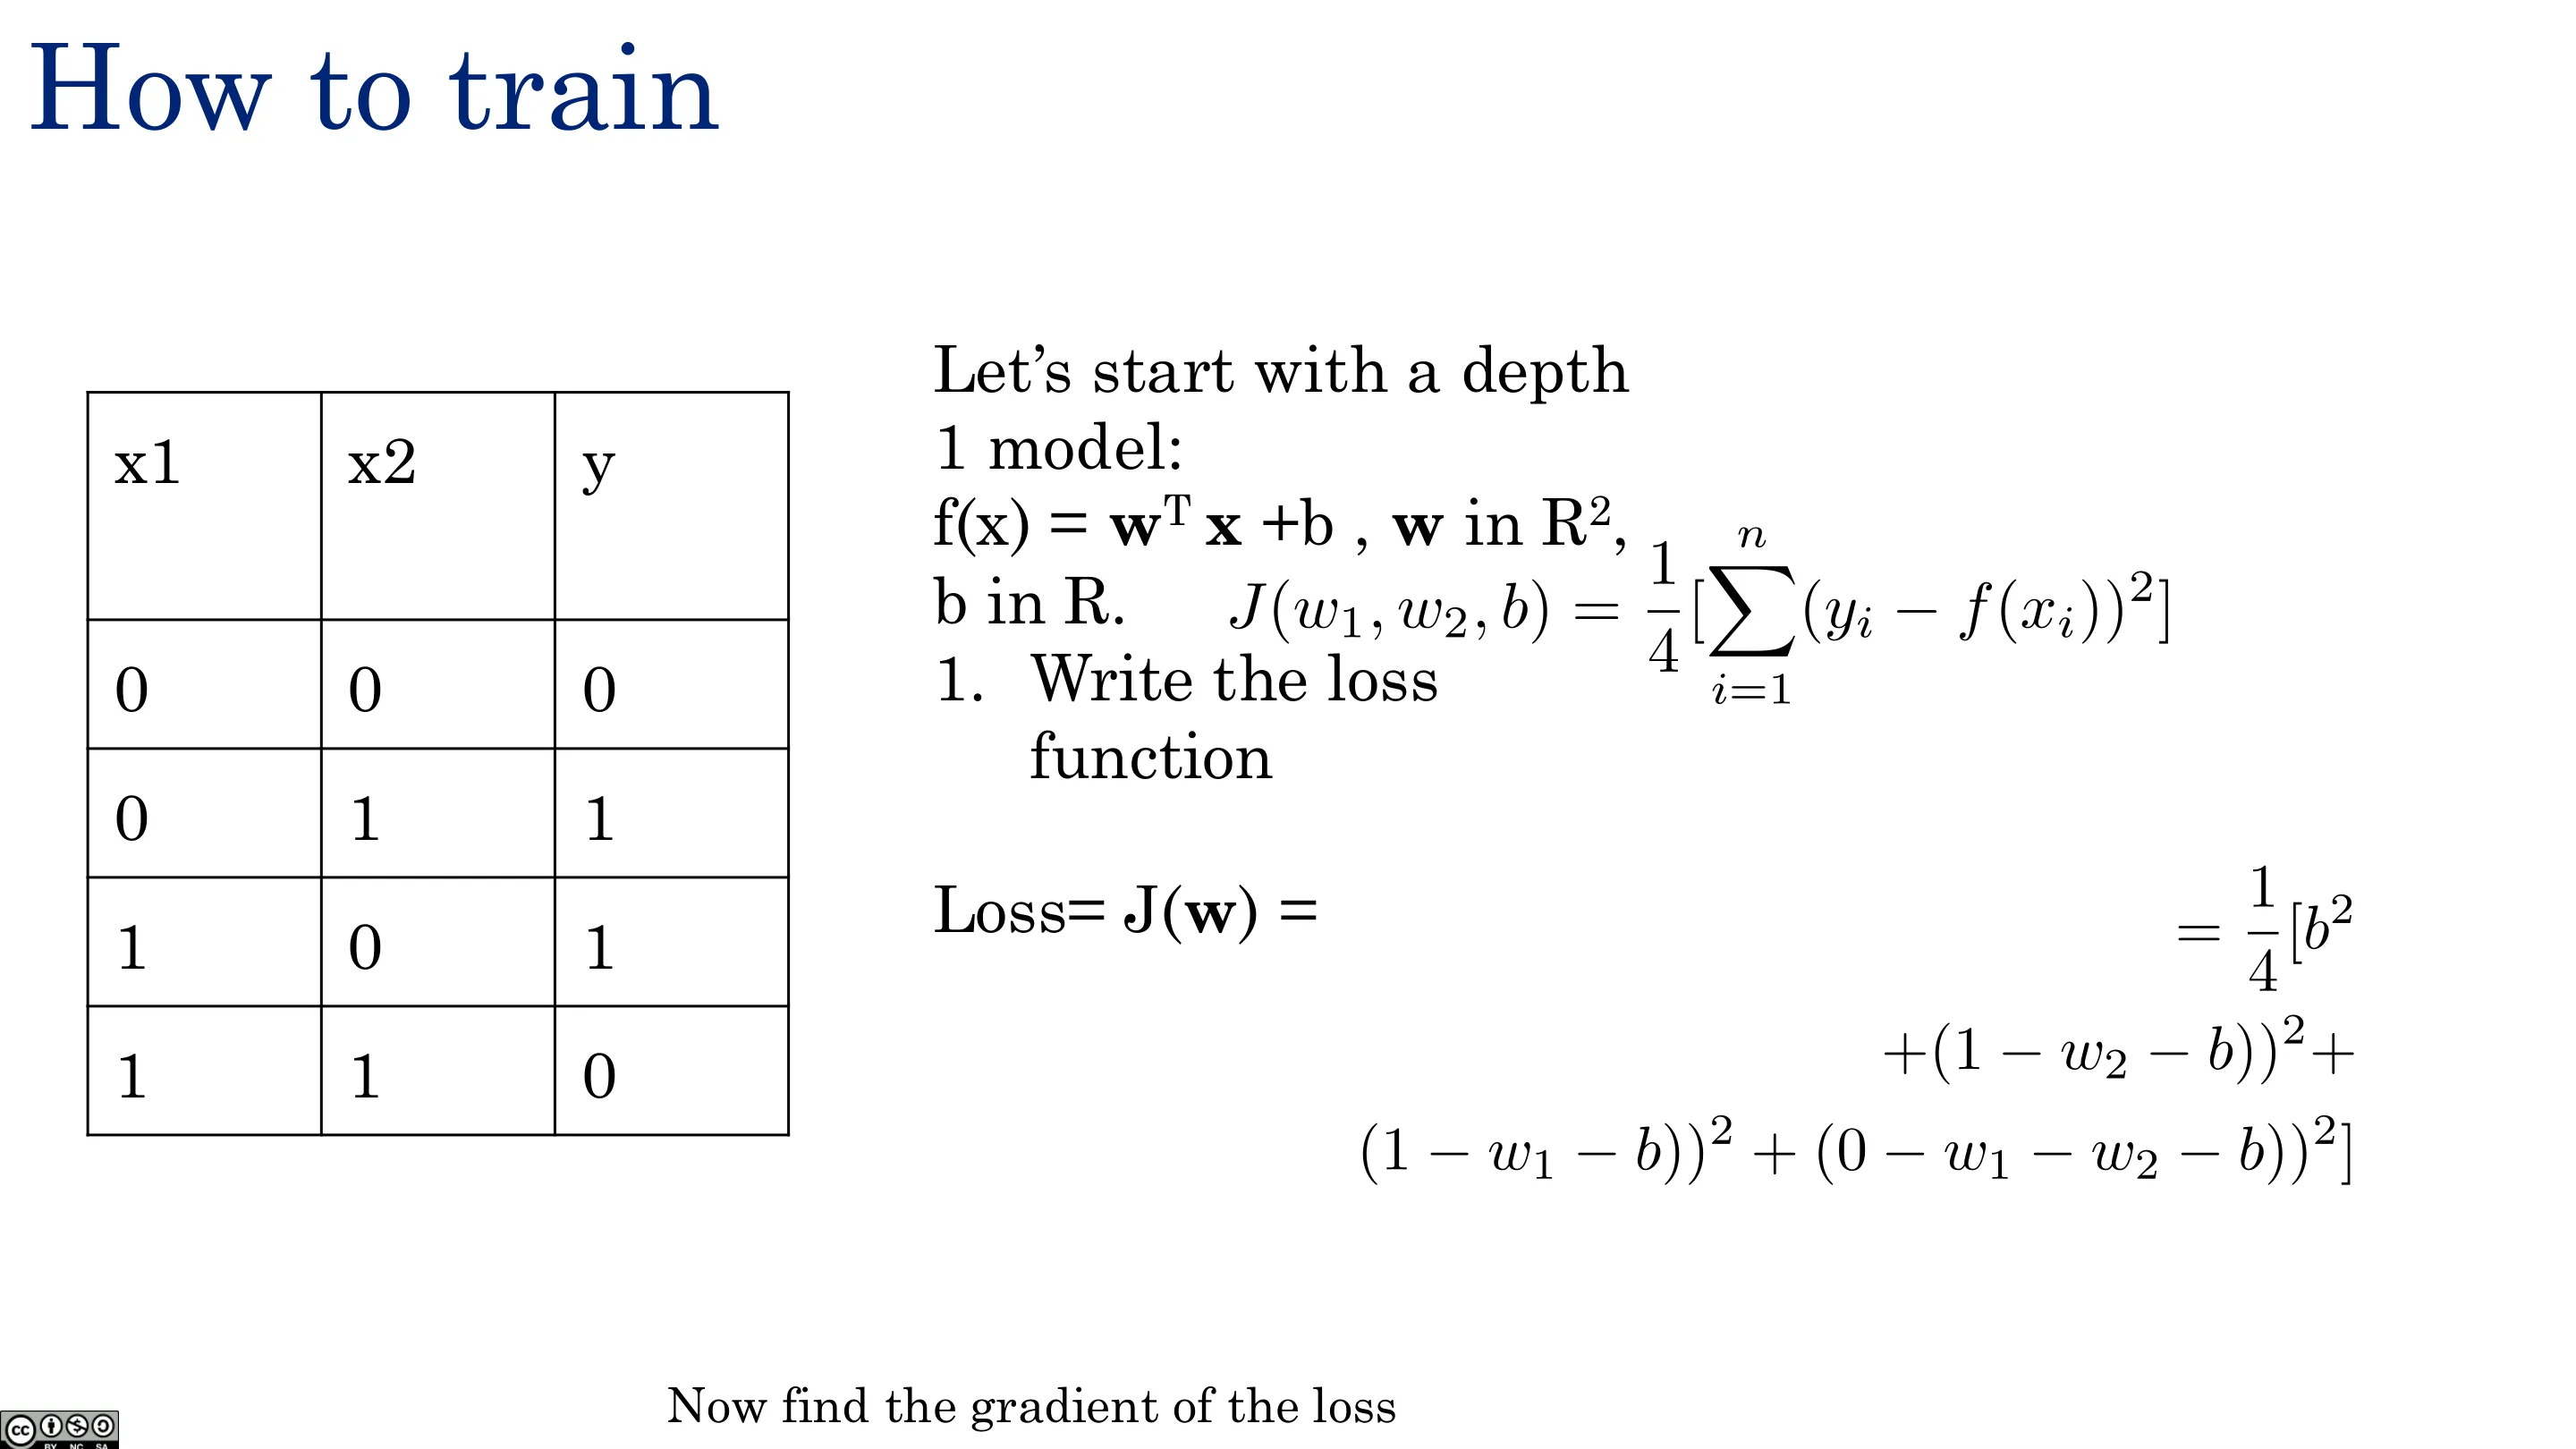
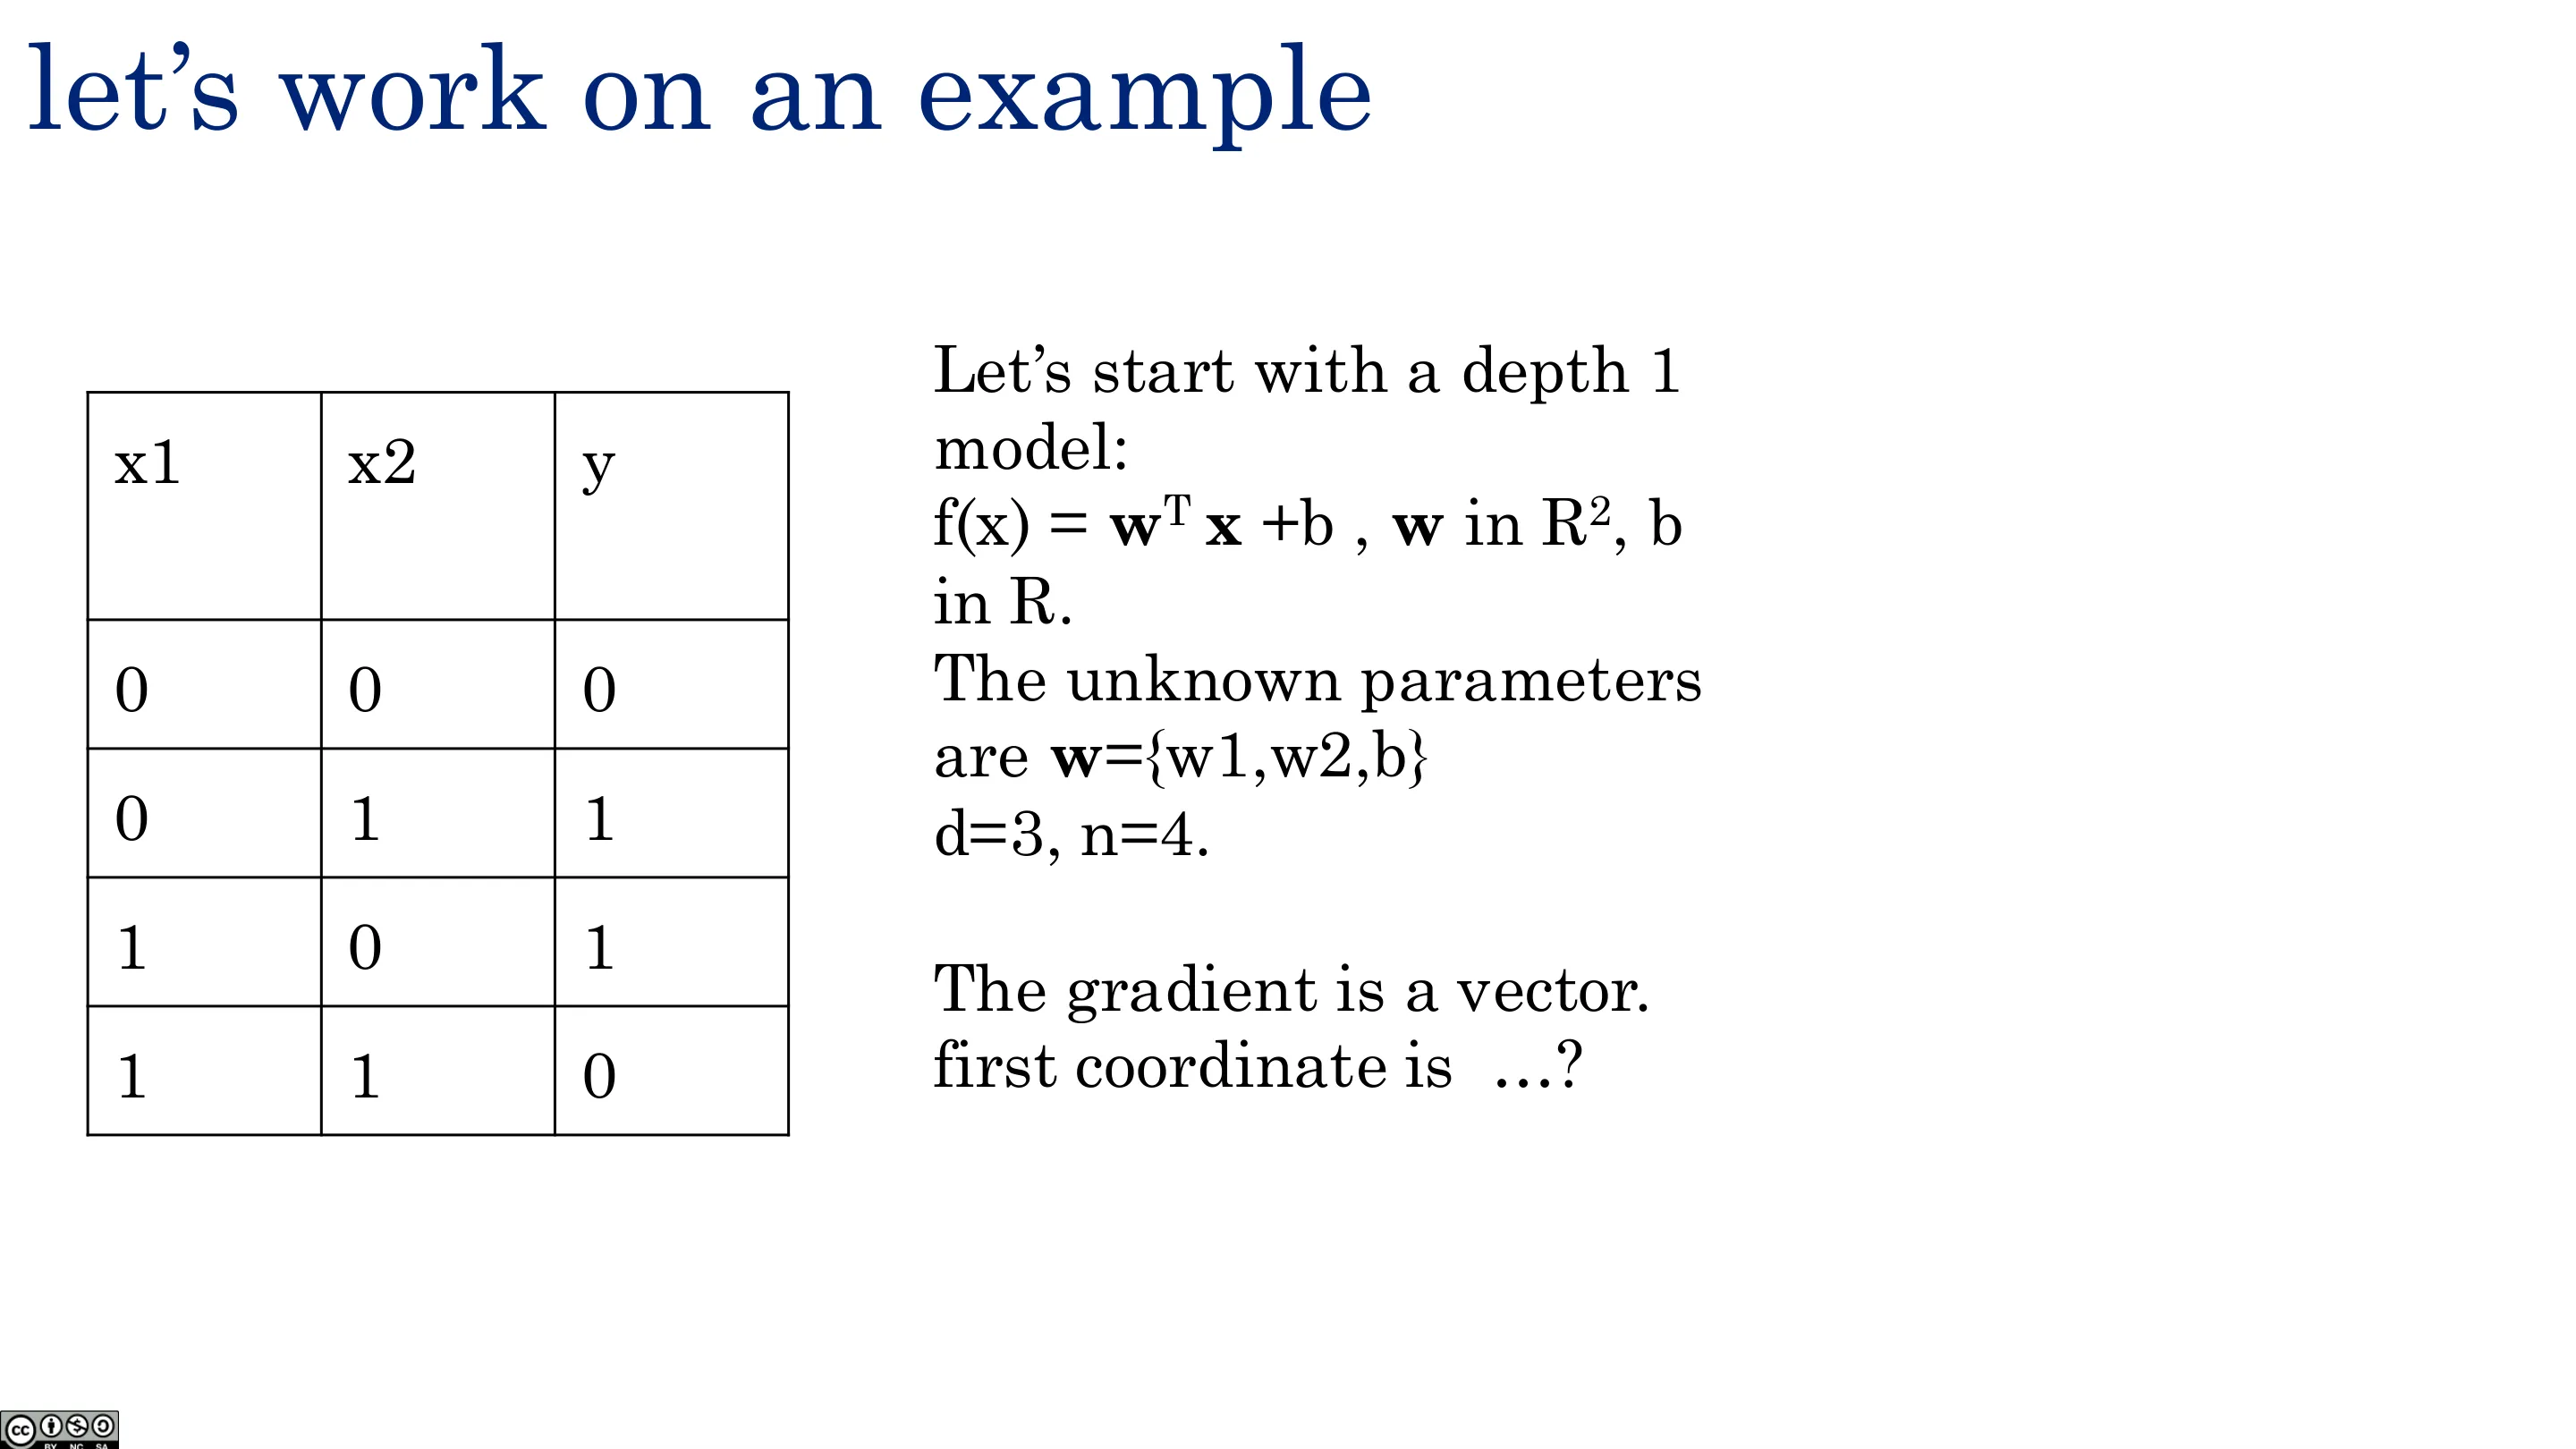
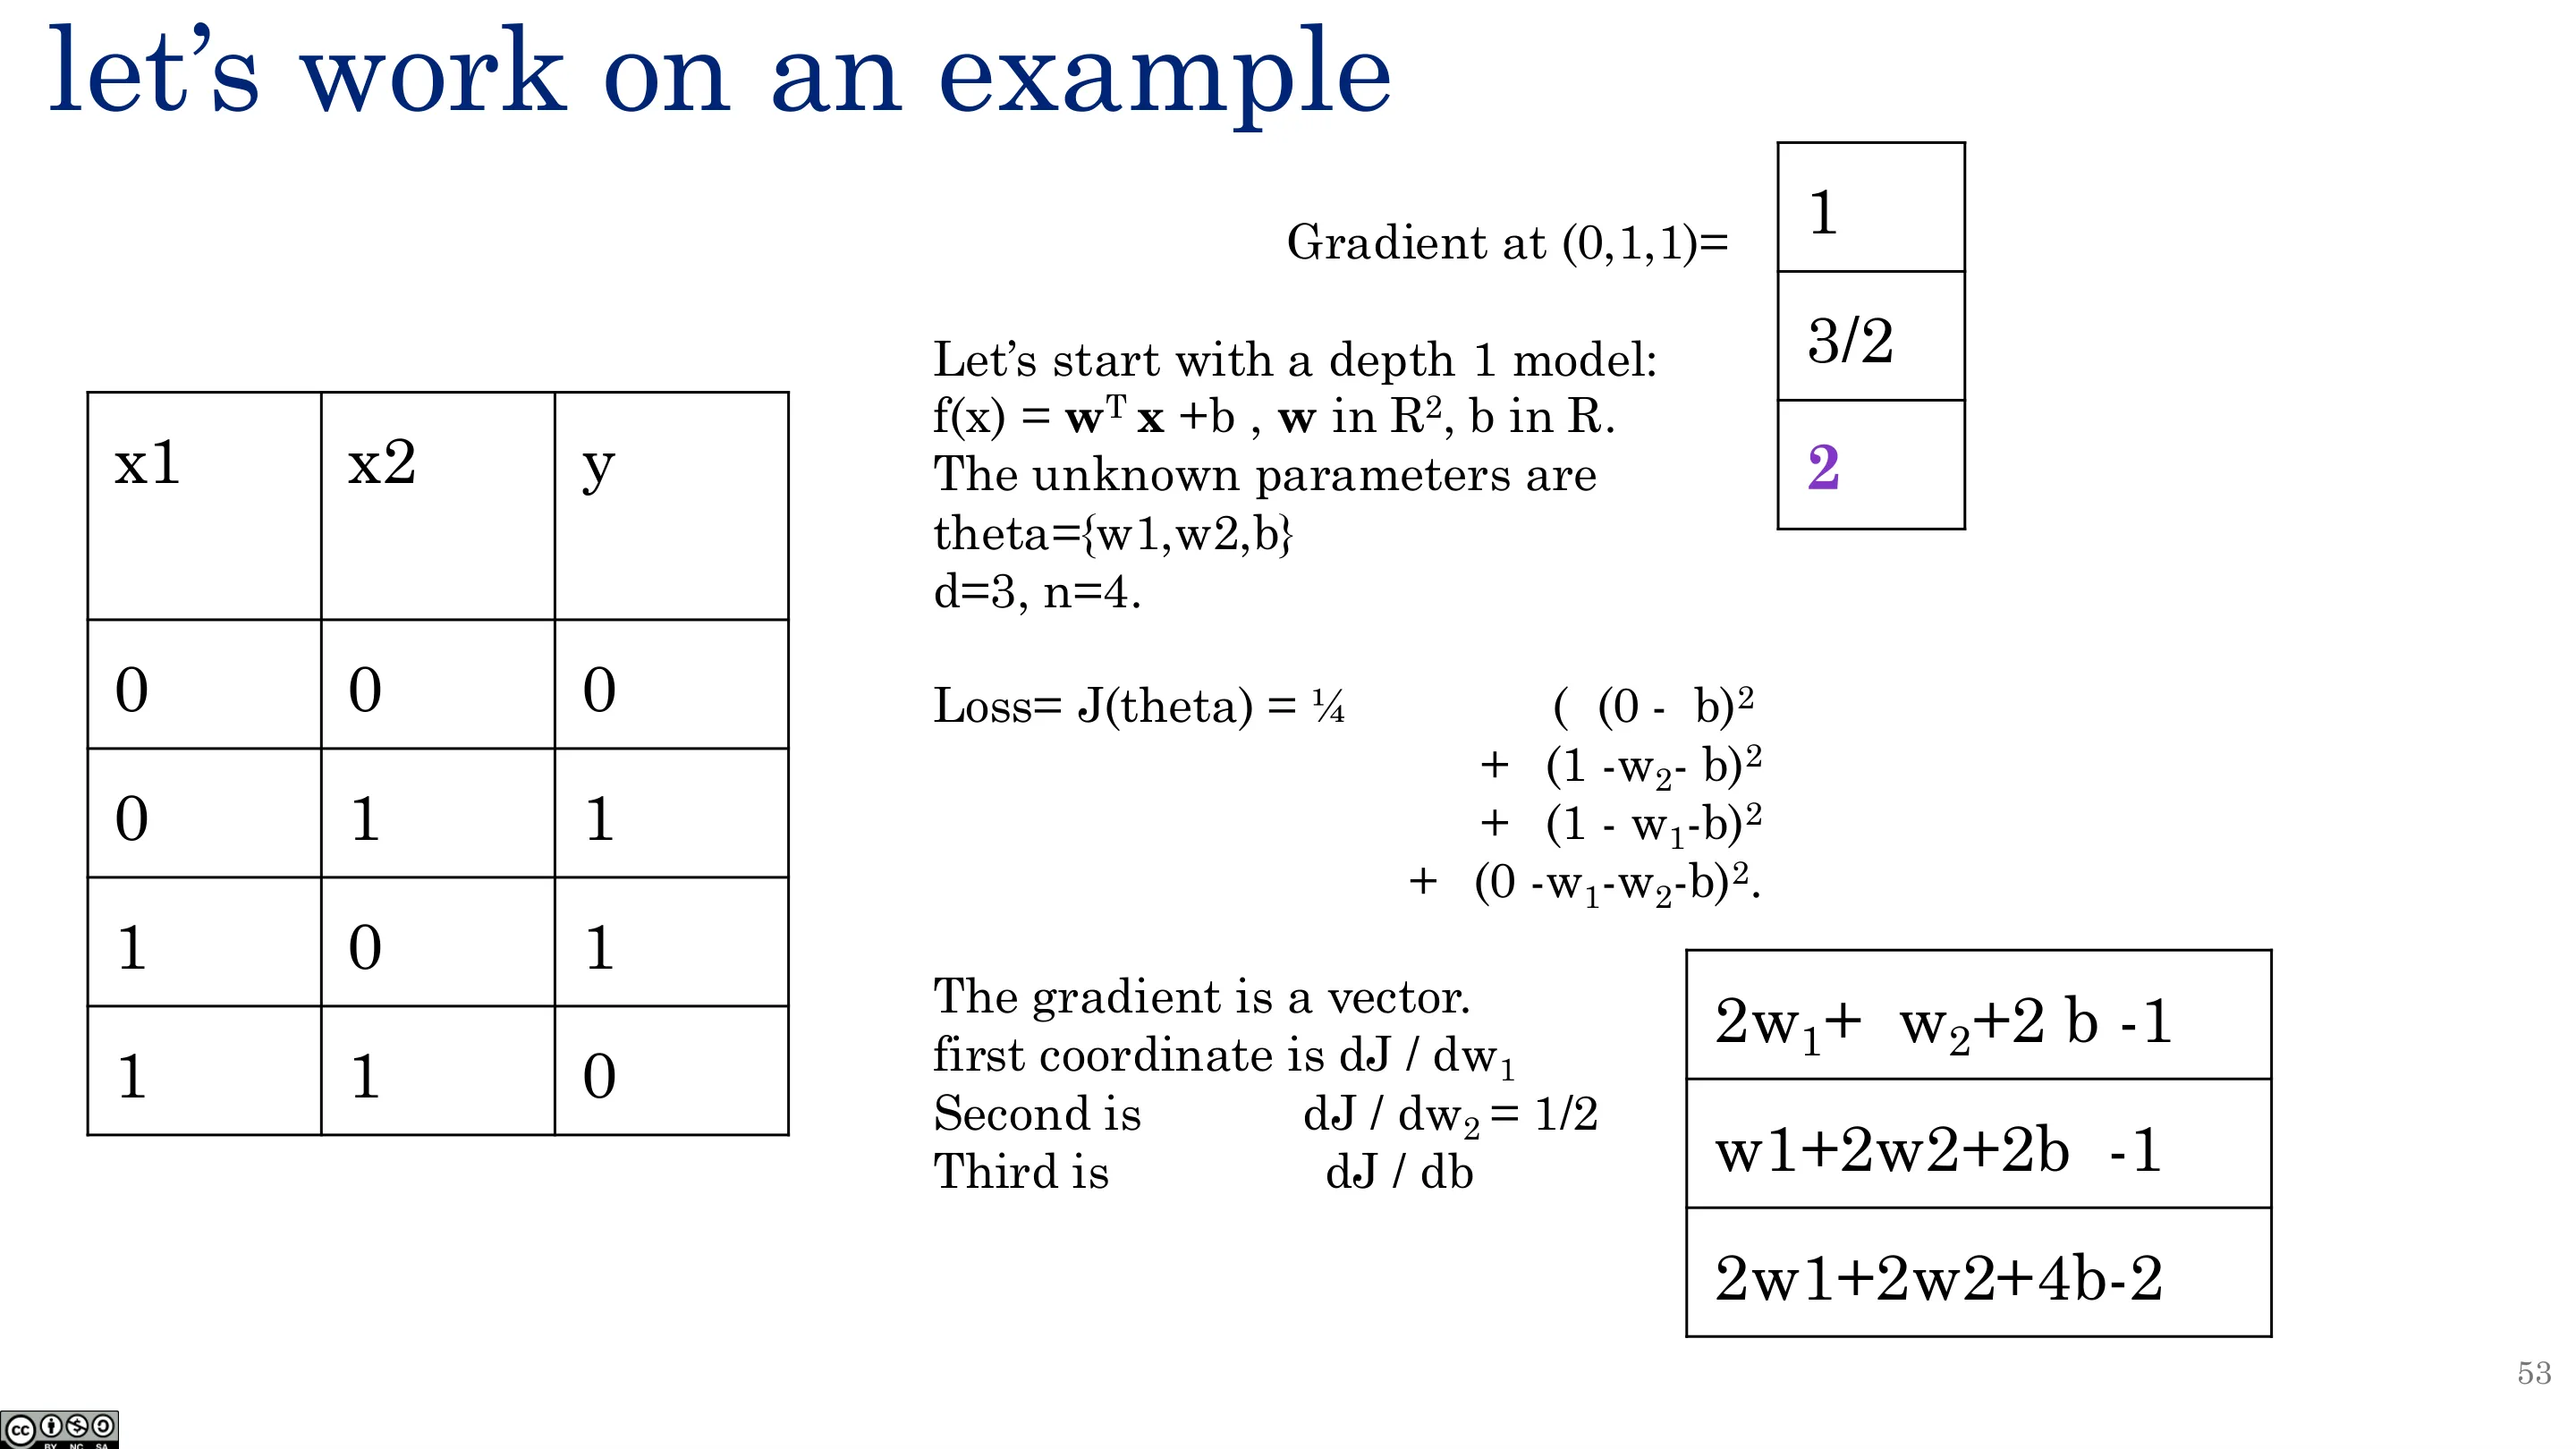
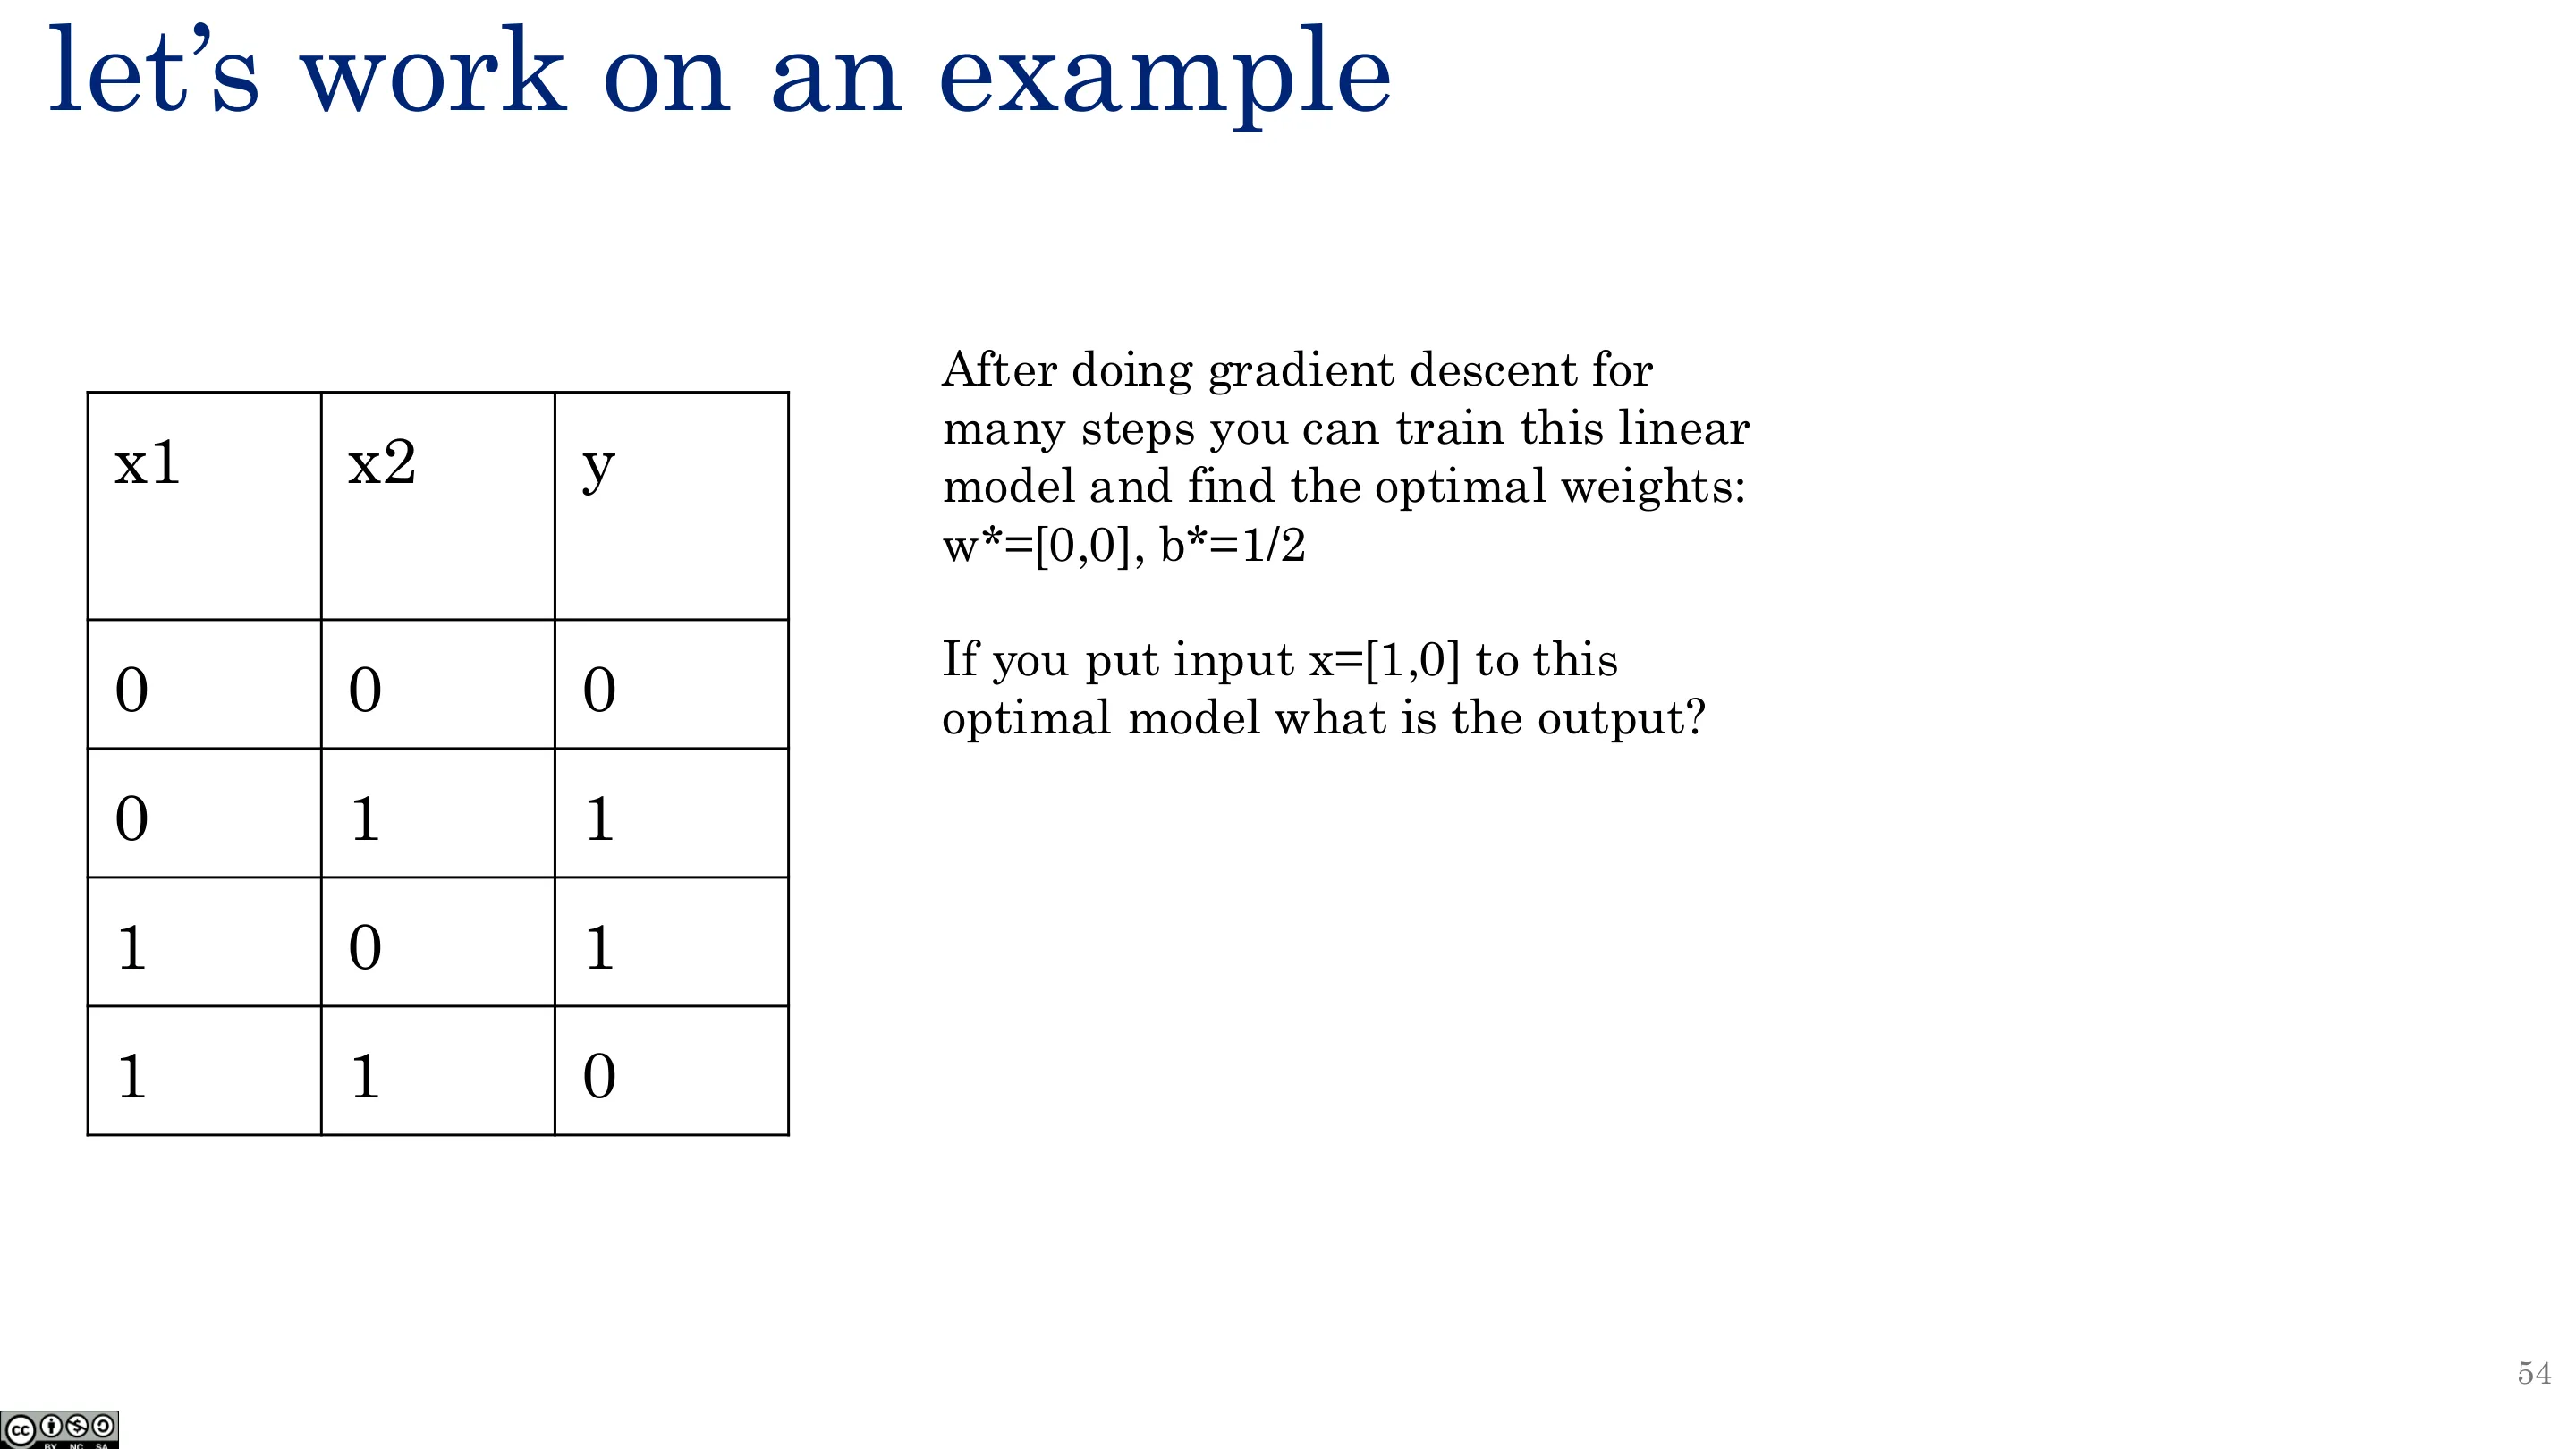
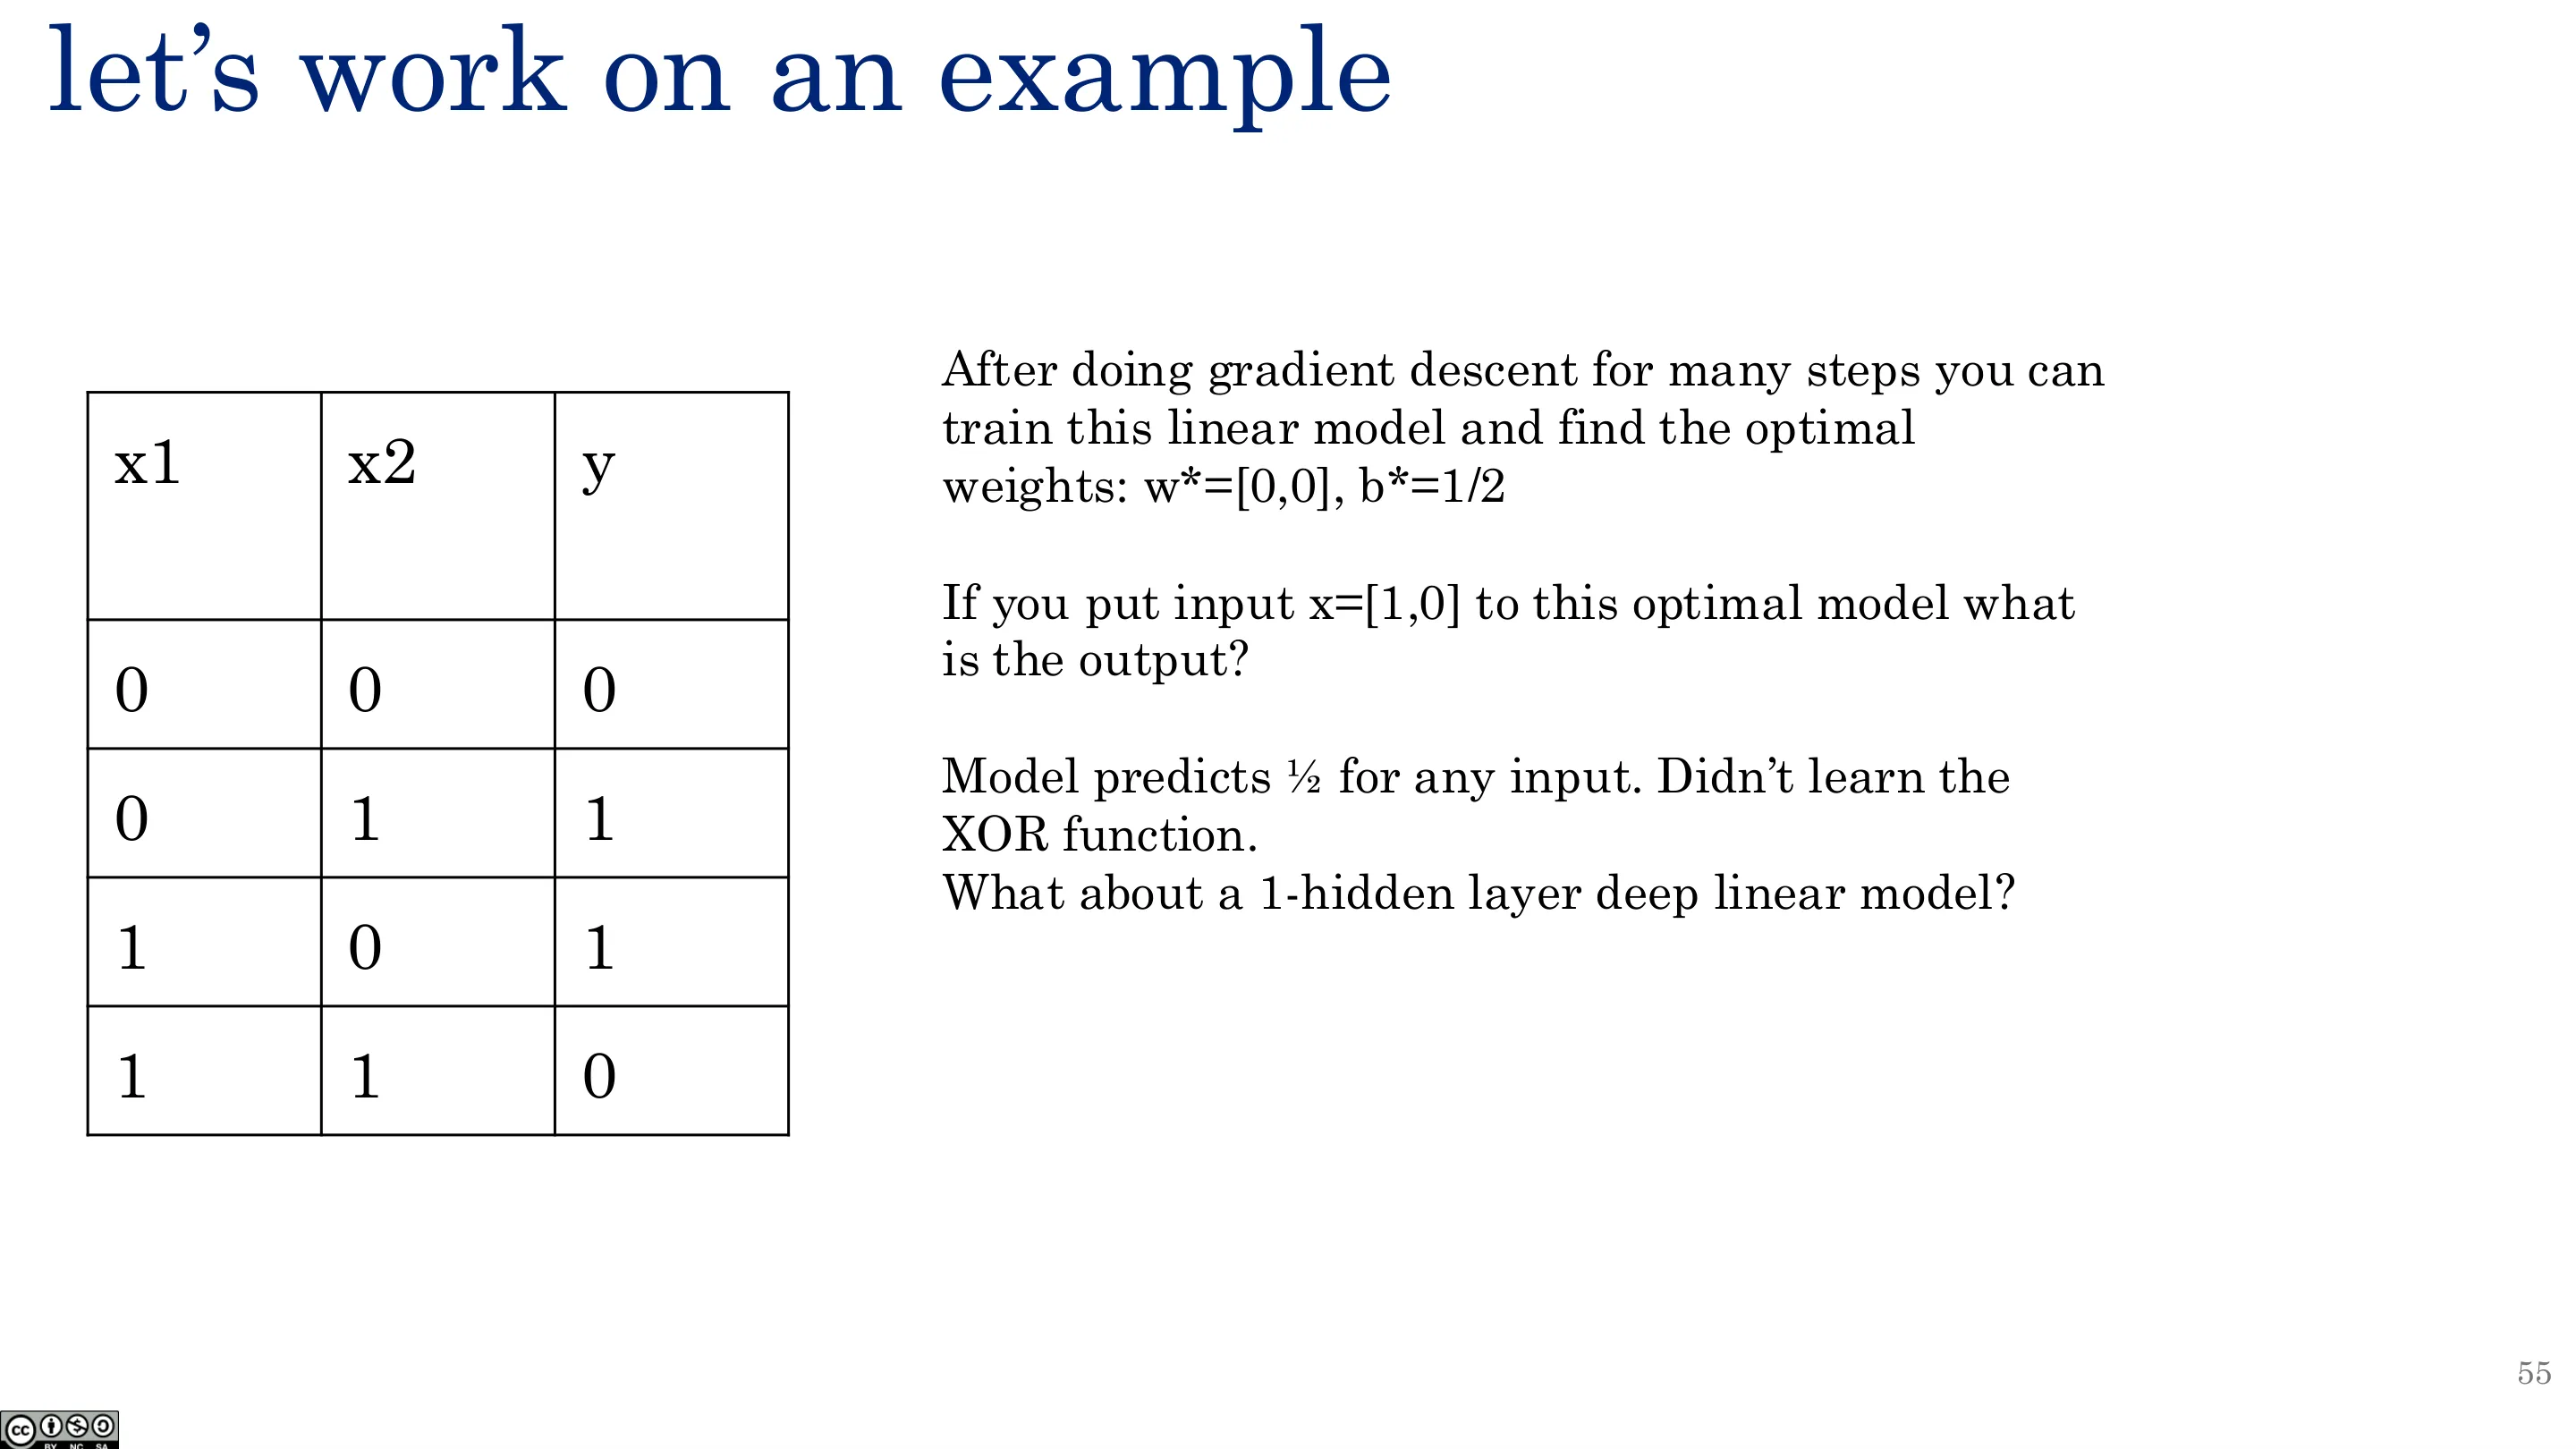
先看纯线性(无激活)的网络:数据是 XOR
| $x_1$ | $x_2$ | $t$ |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
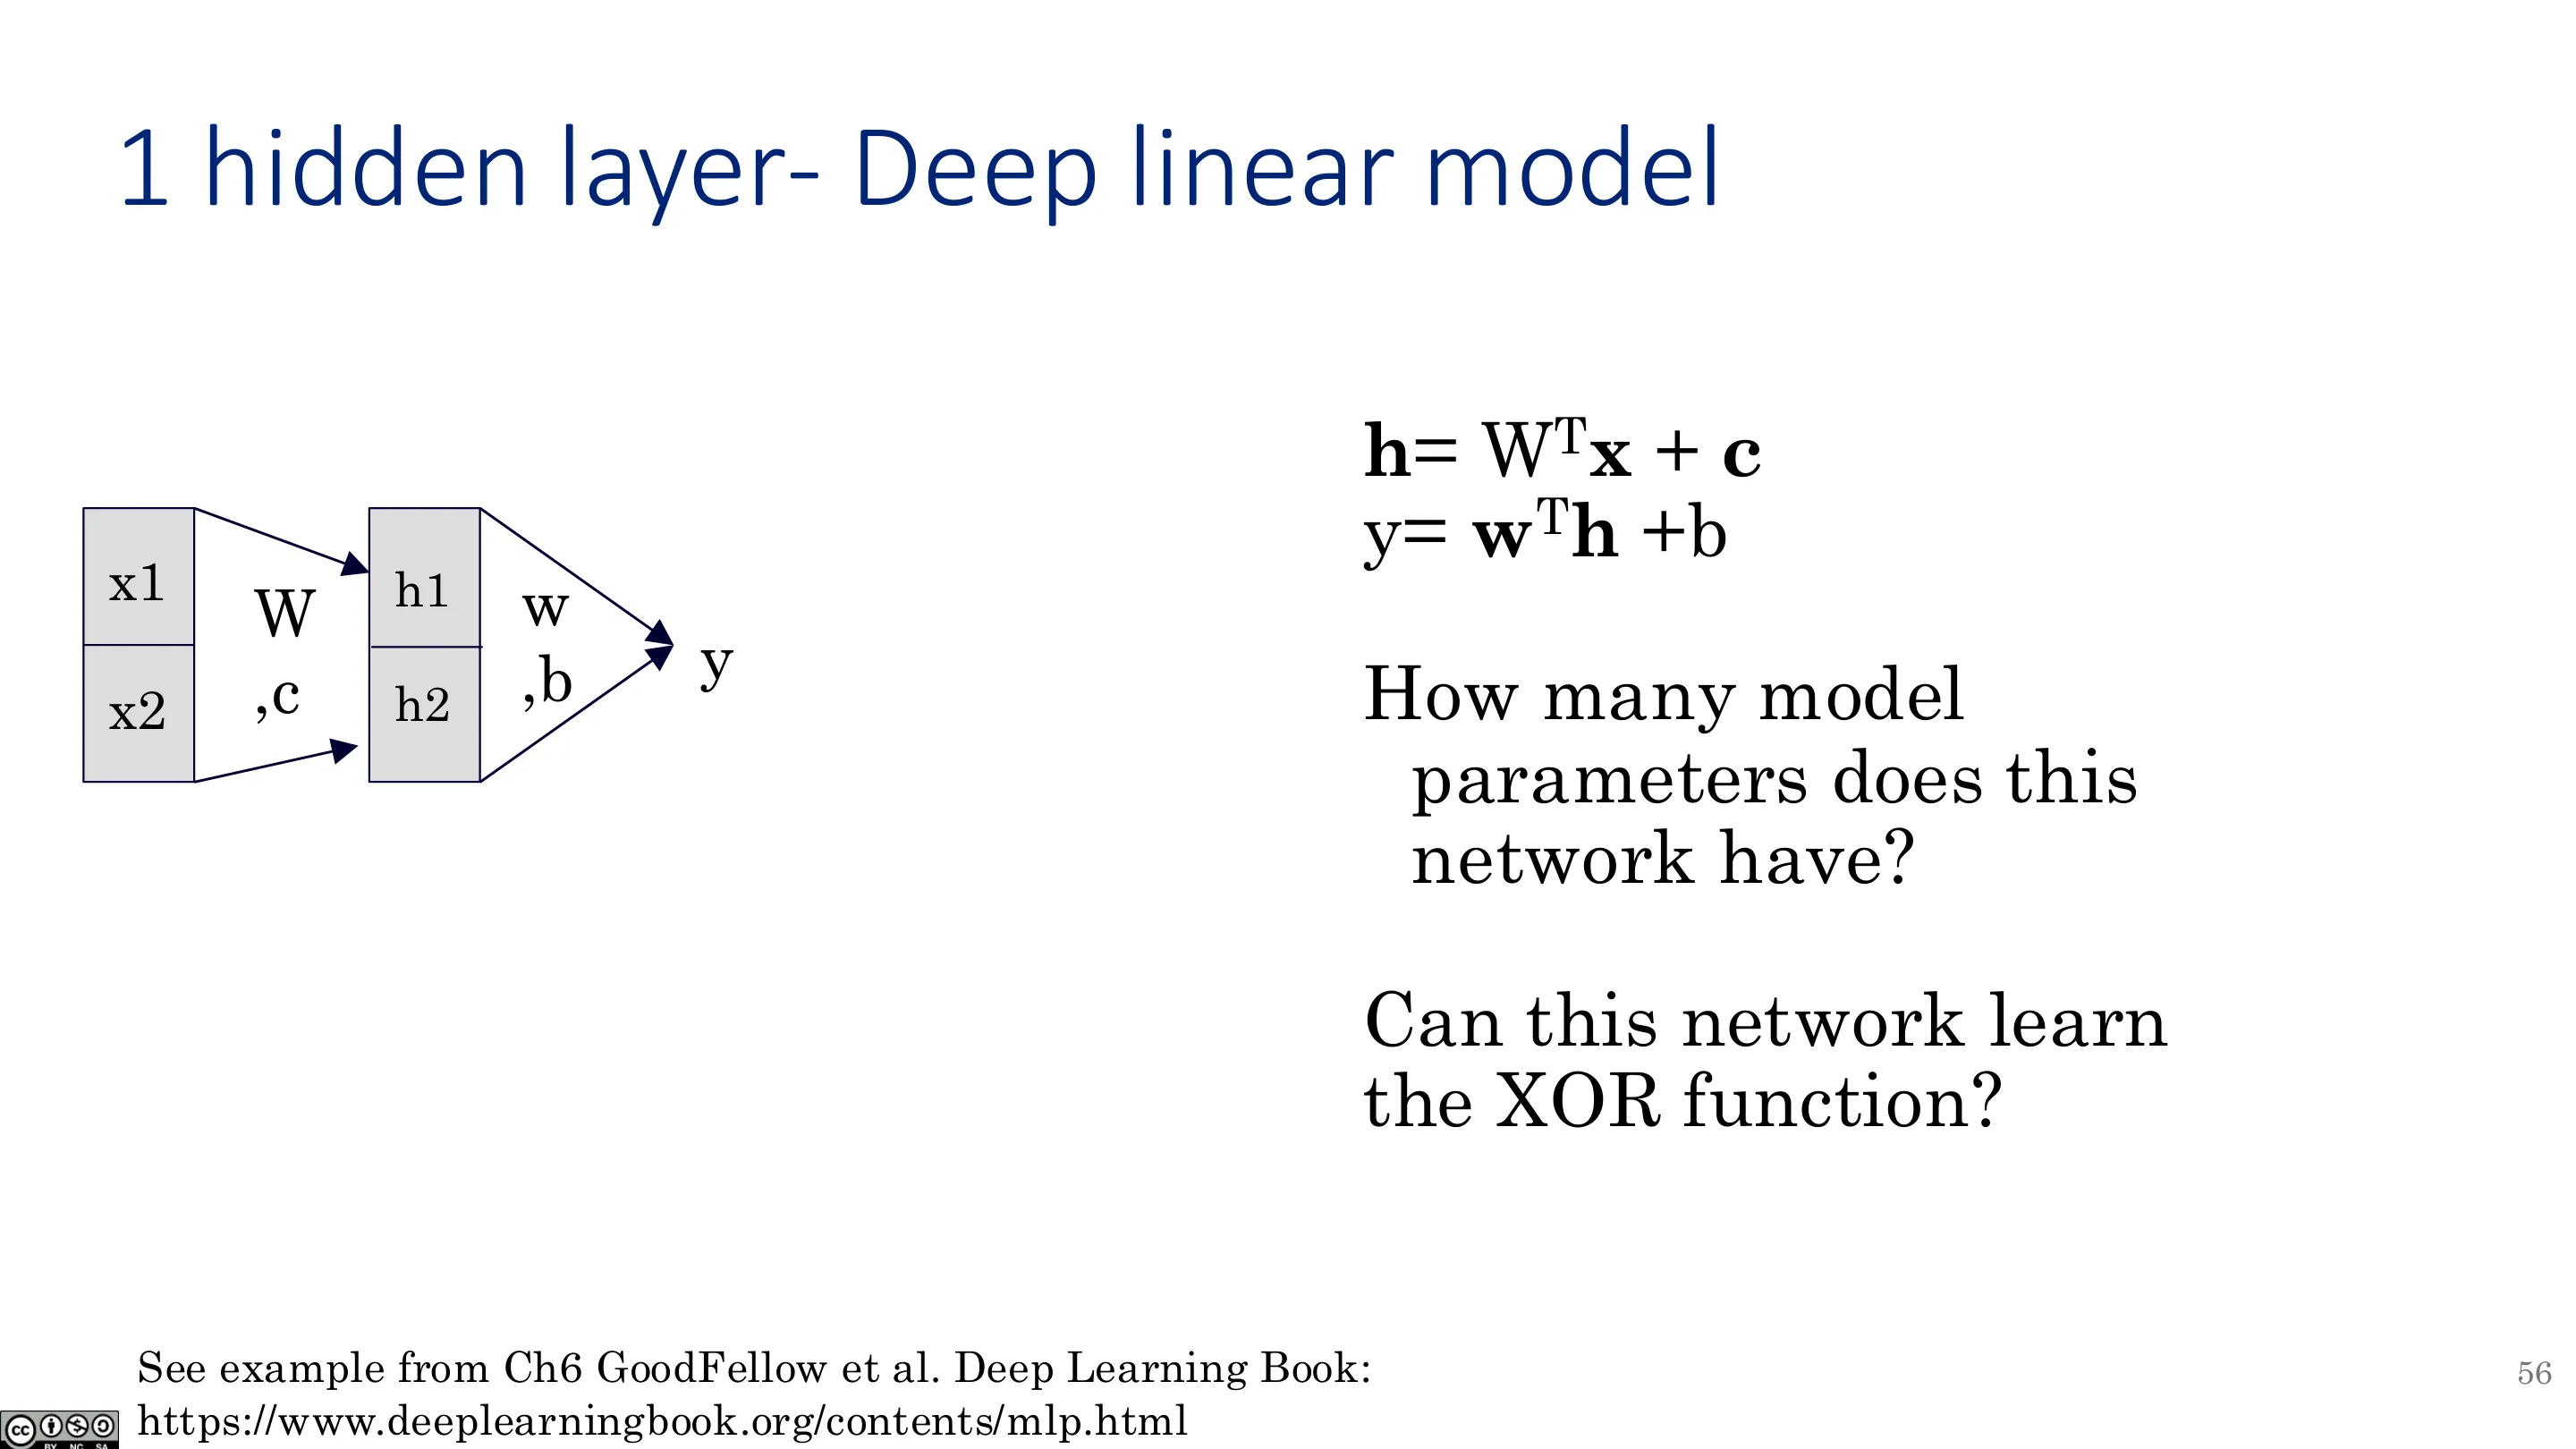
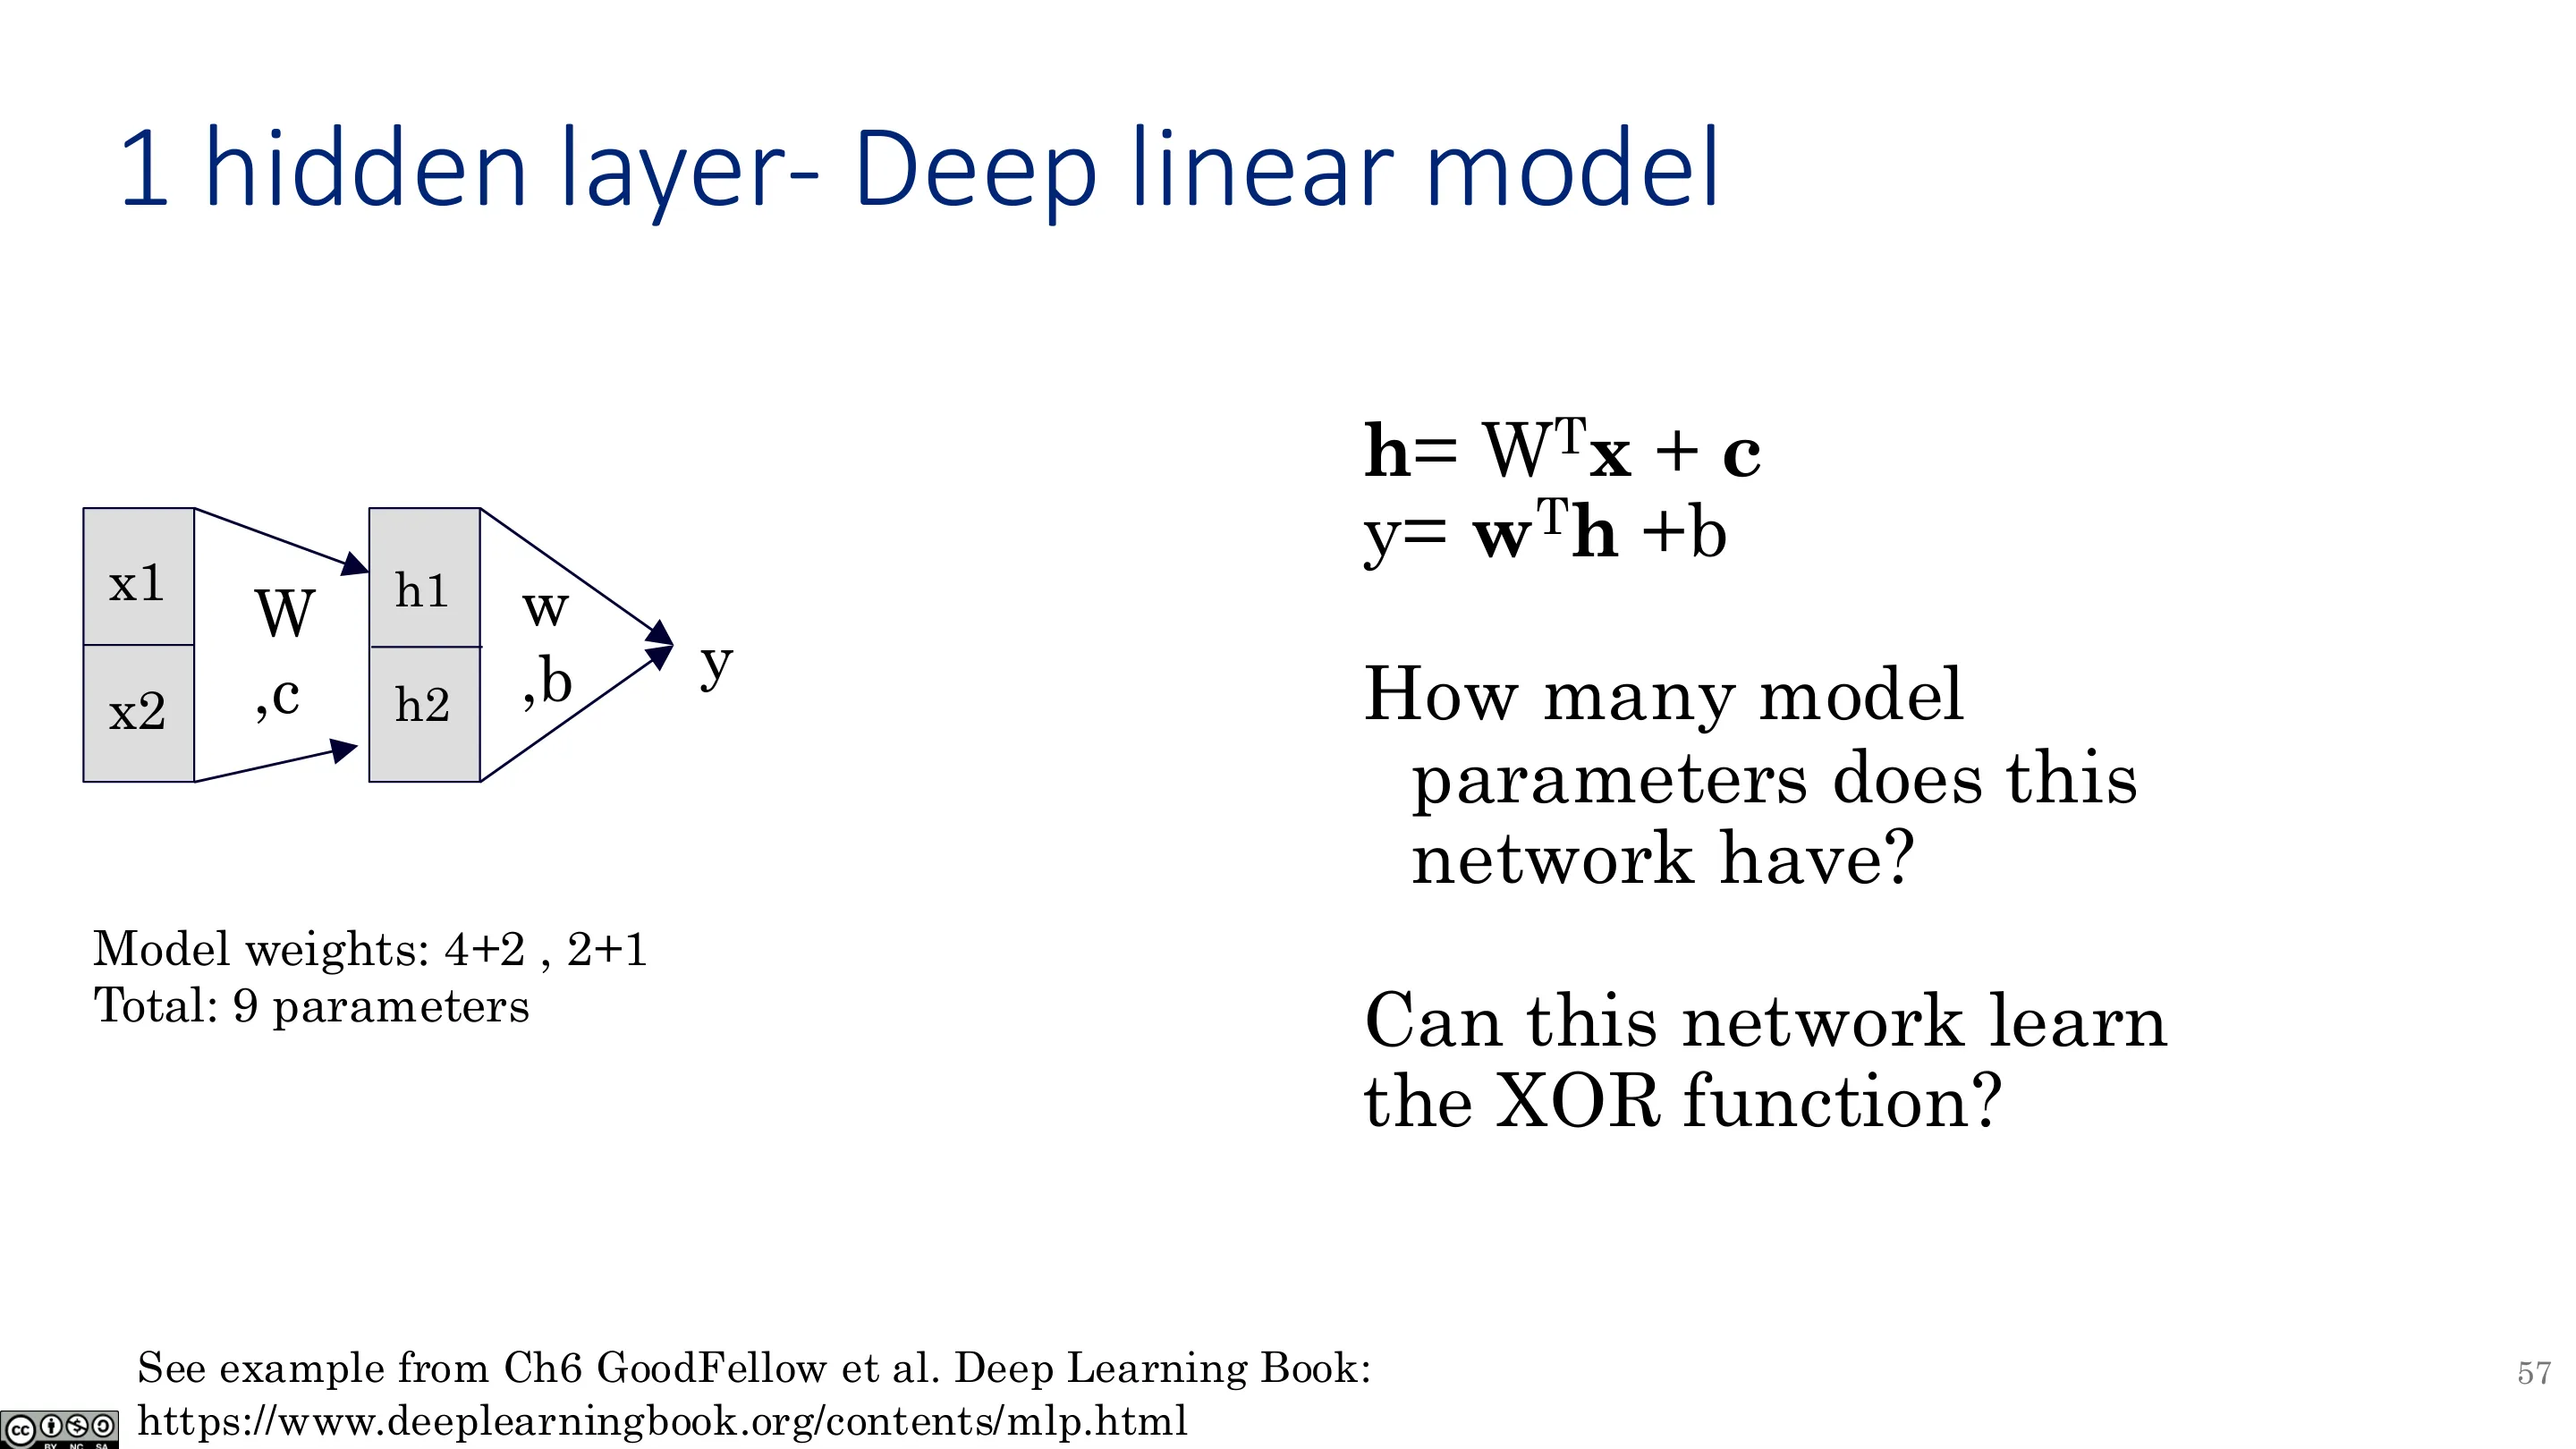
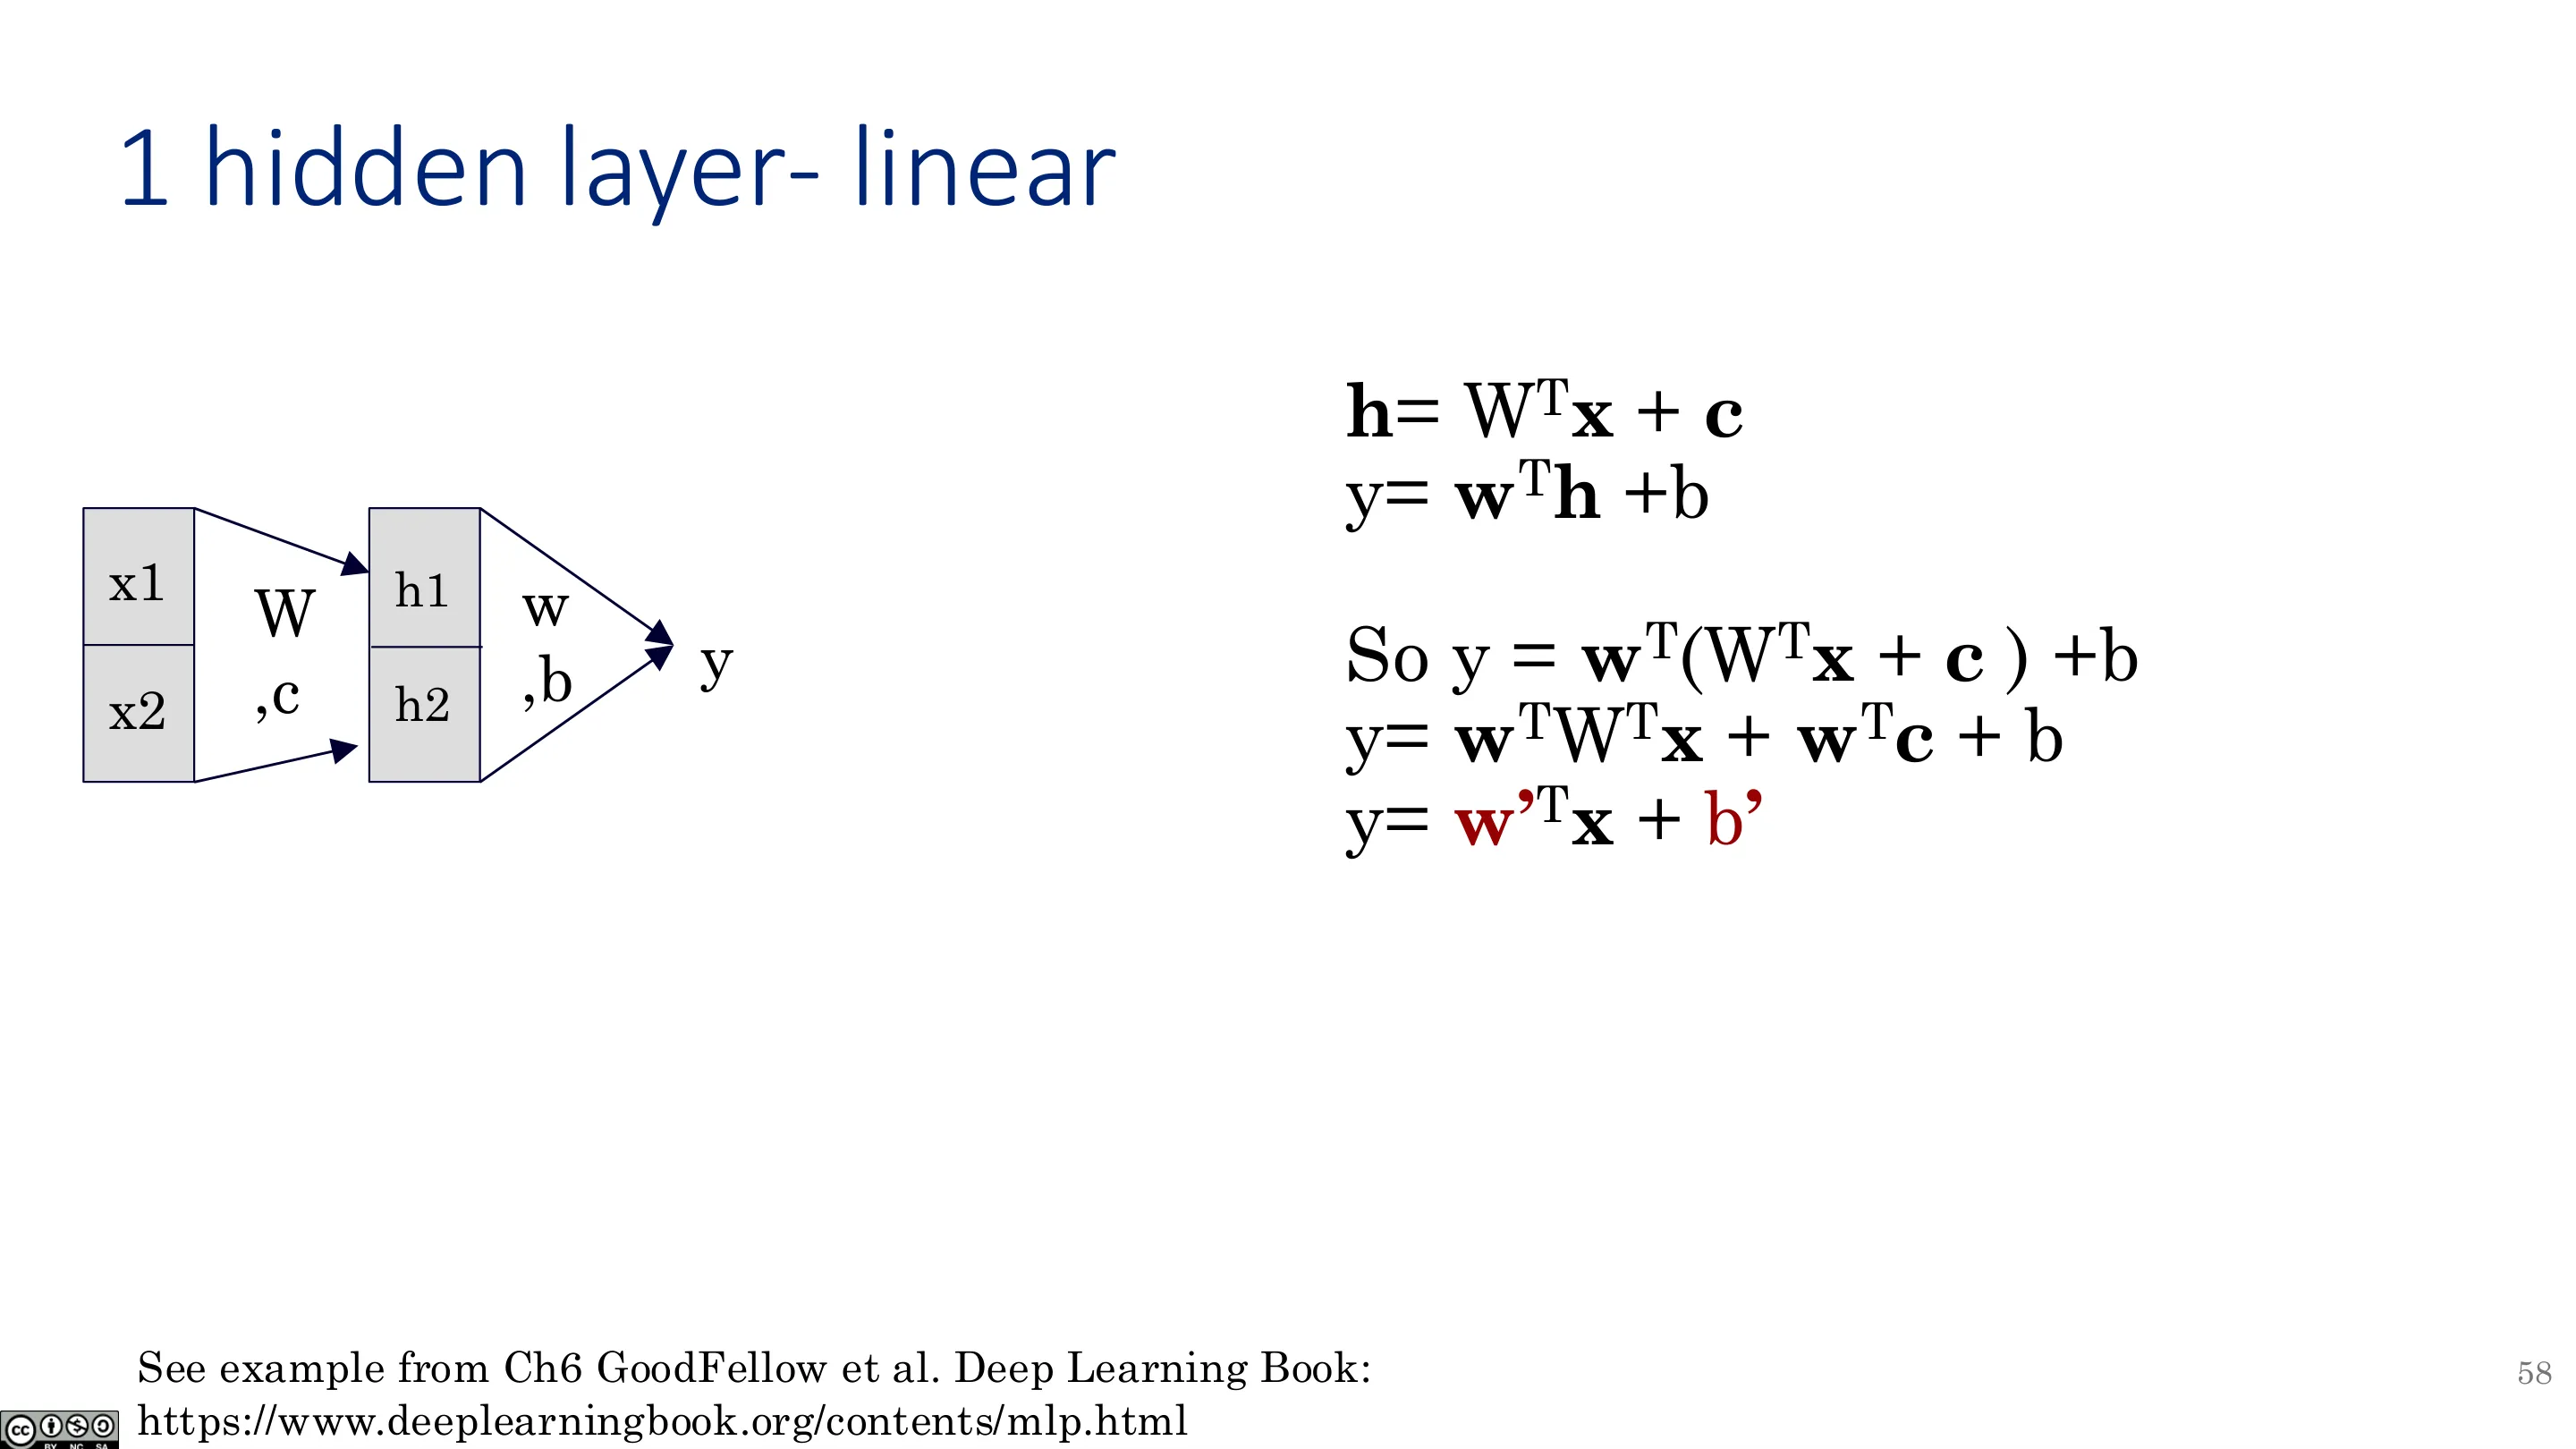
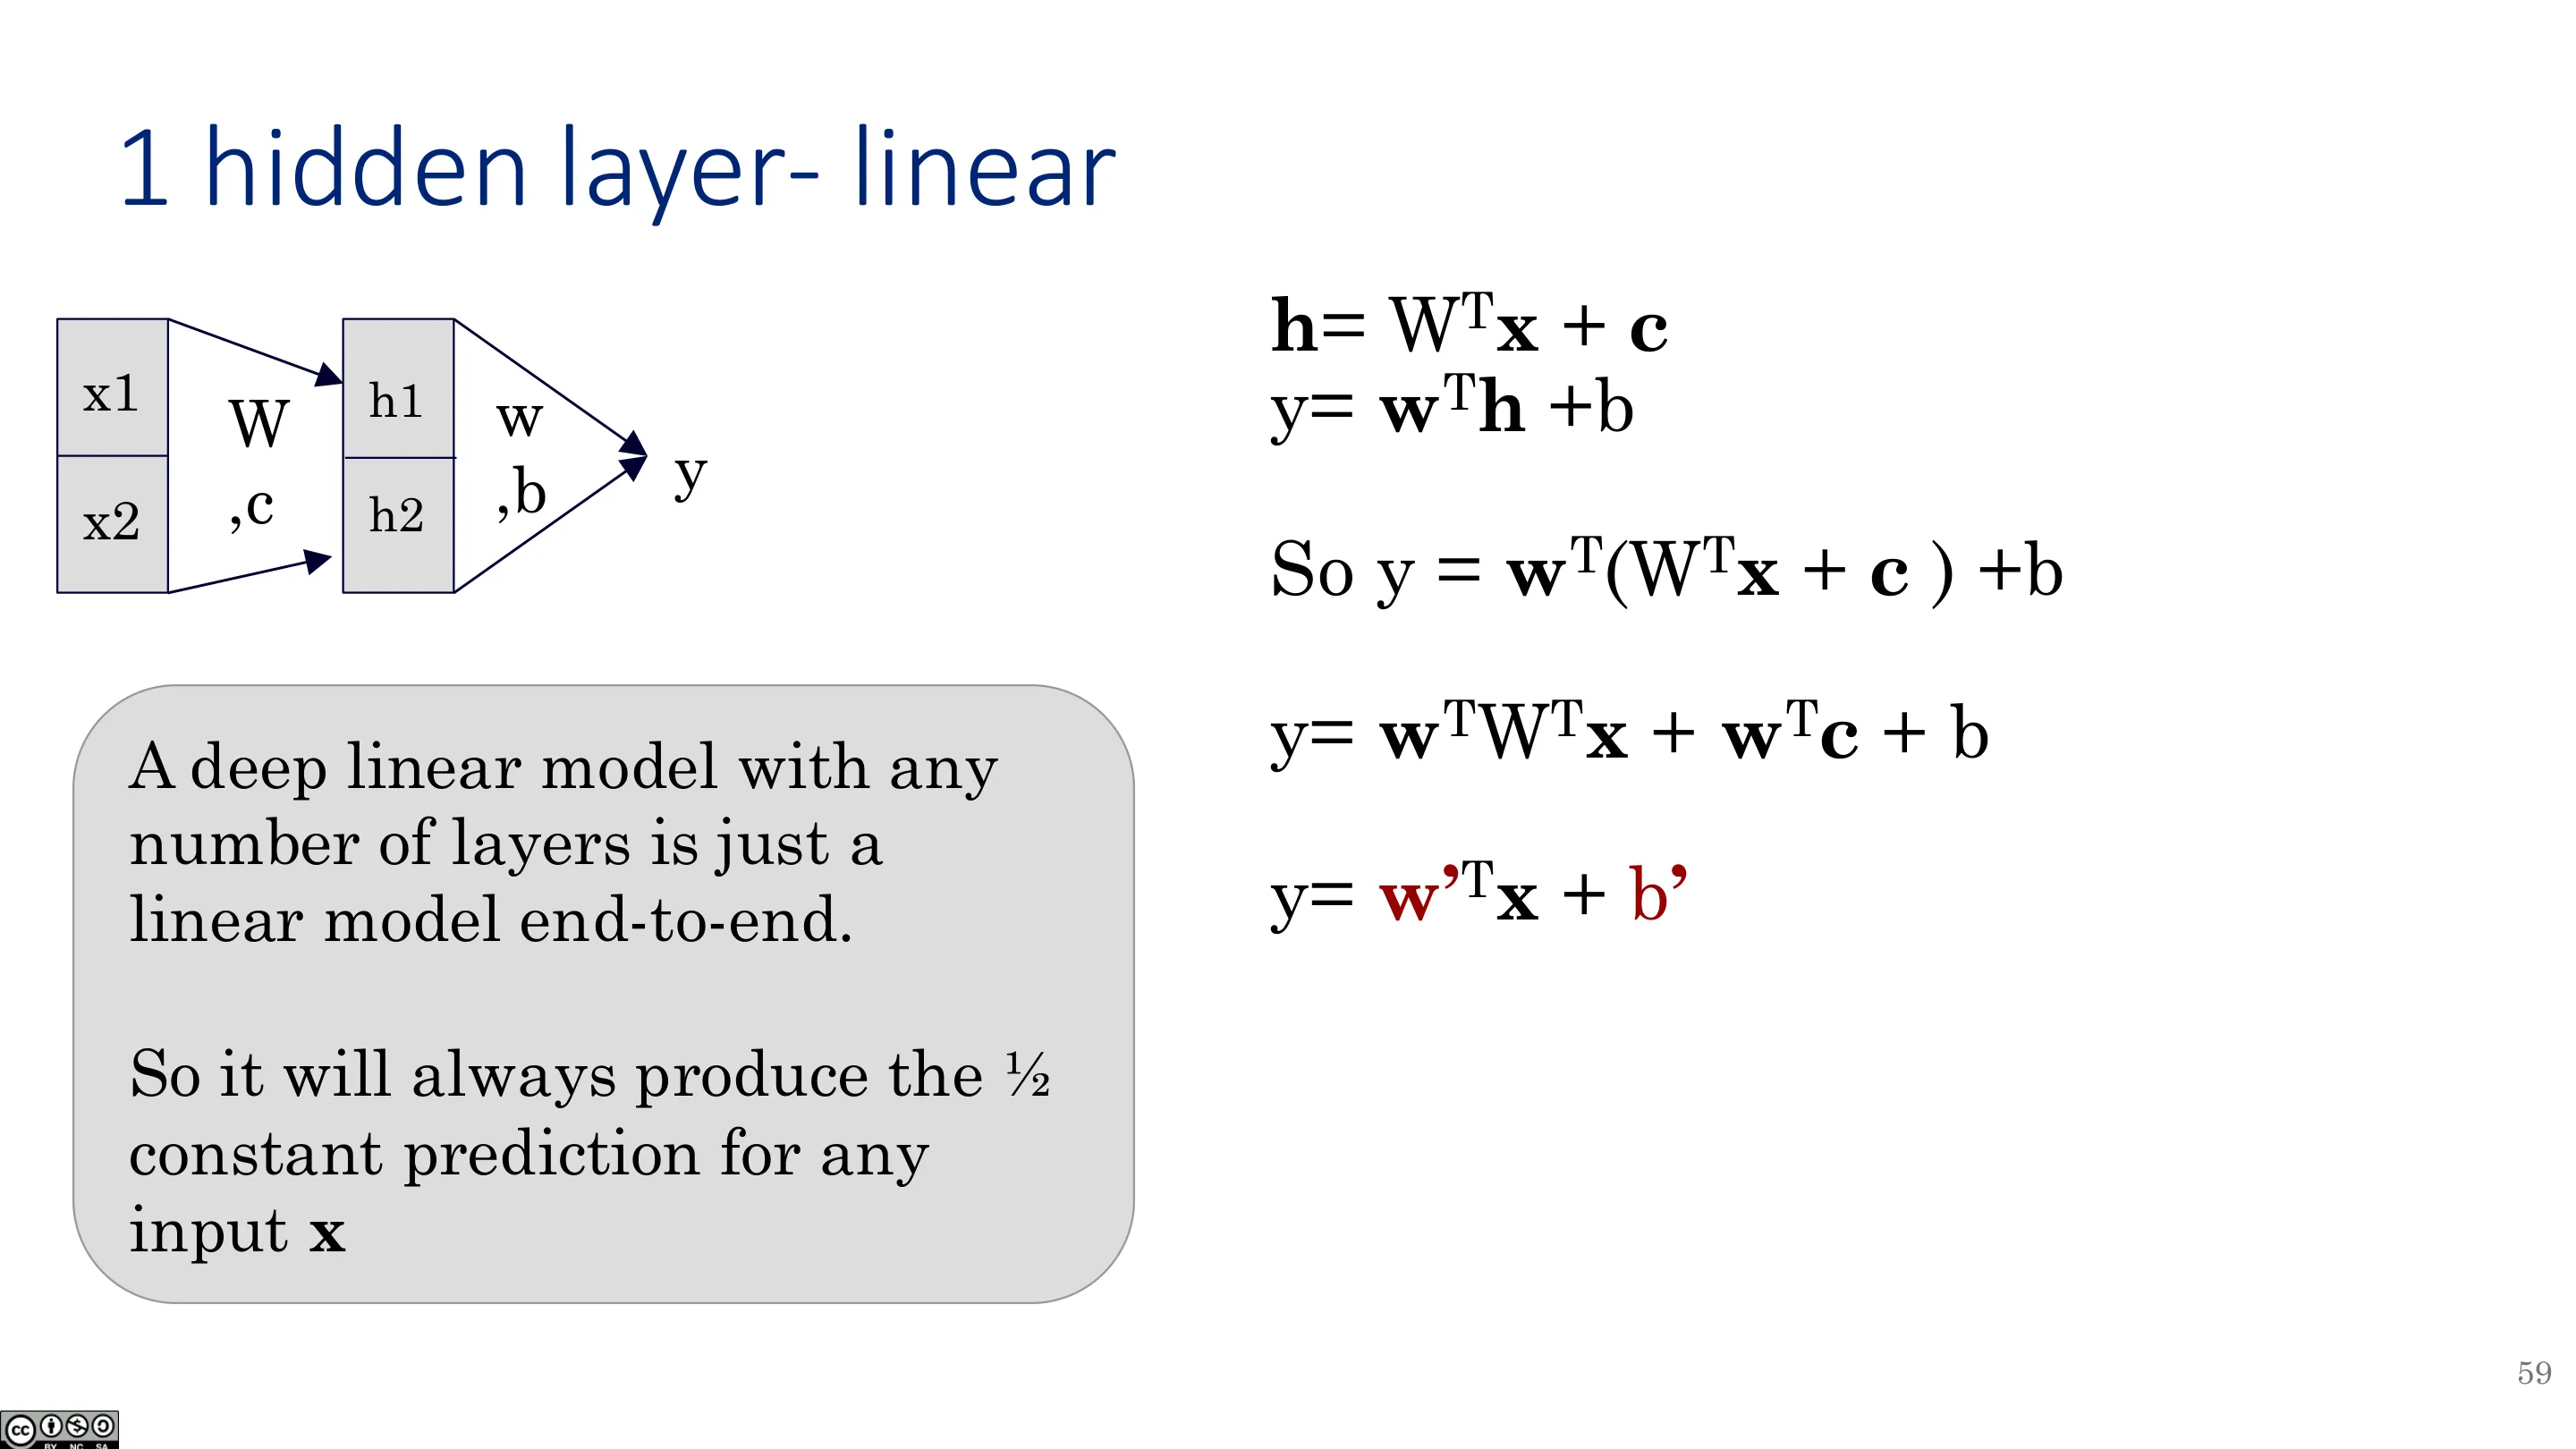
即使加一个隐藏层(无激活),因为 $H=W^\top X+C$ 代回输出 $= w^\top H+b = (w^\top W^\top)X+(w^\top C+b)$,整体仍是线性:
- 看起来有 9 个参数,实则等价于 3 个;
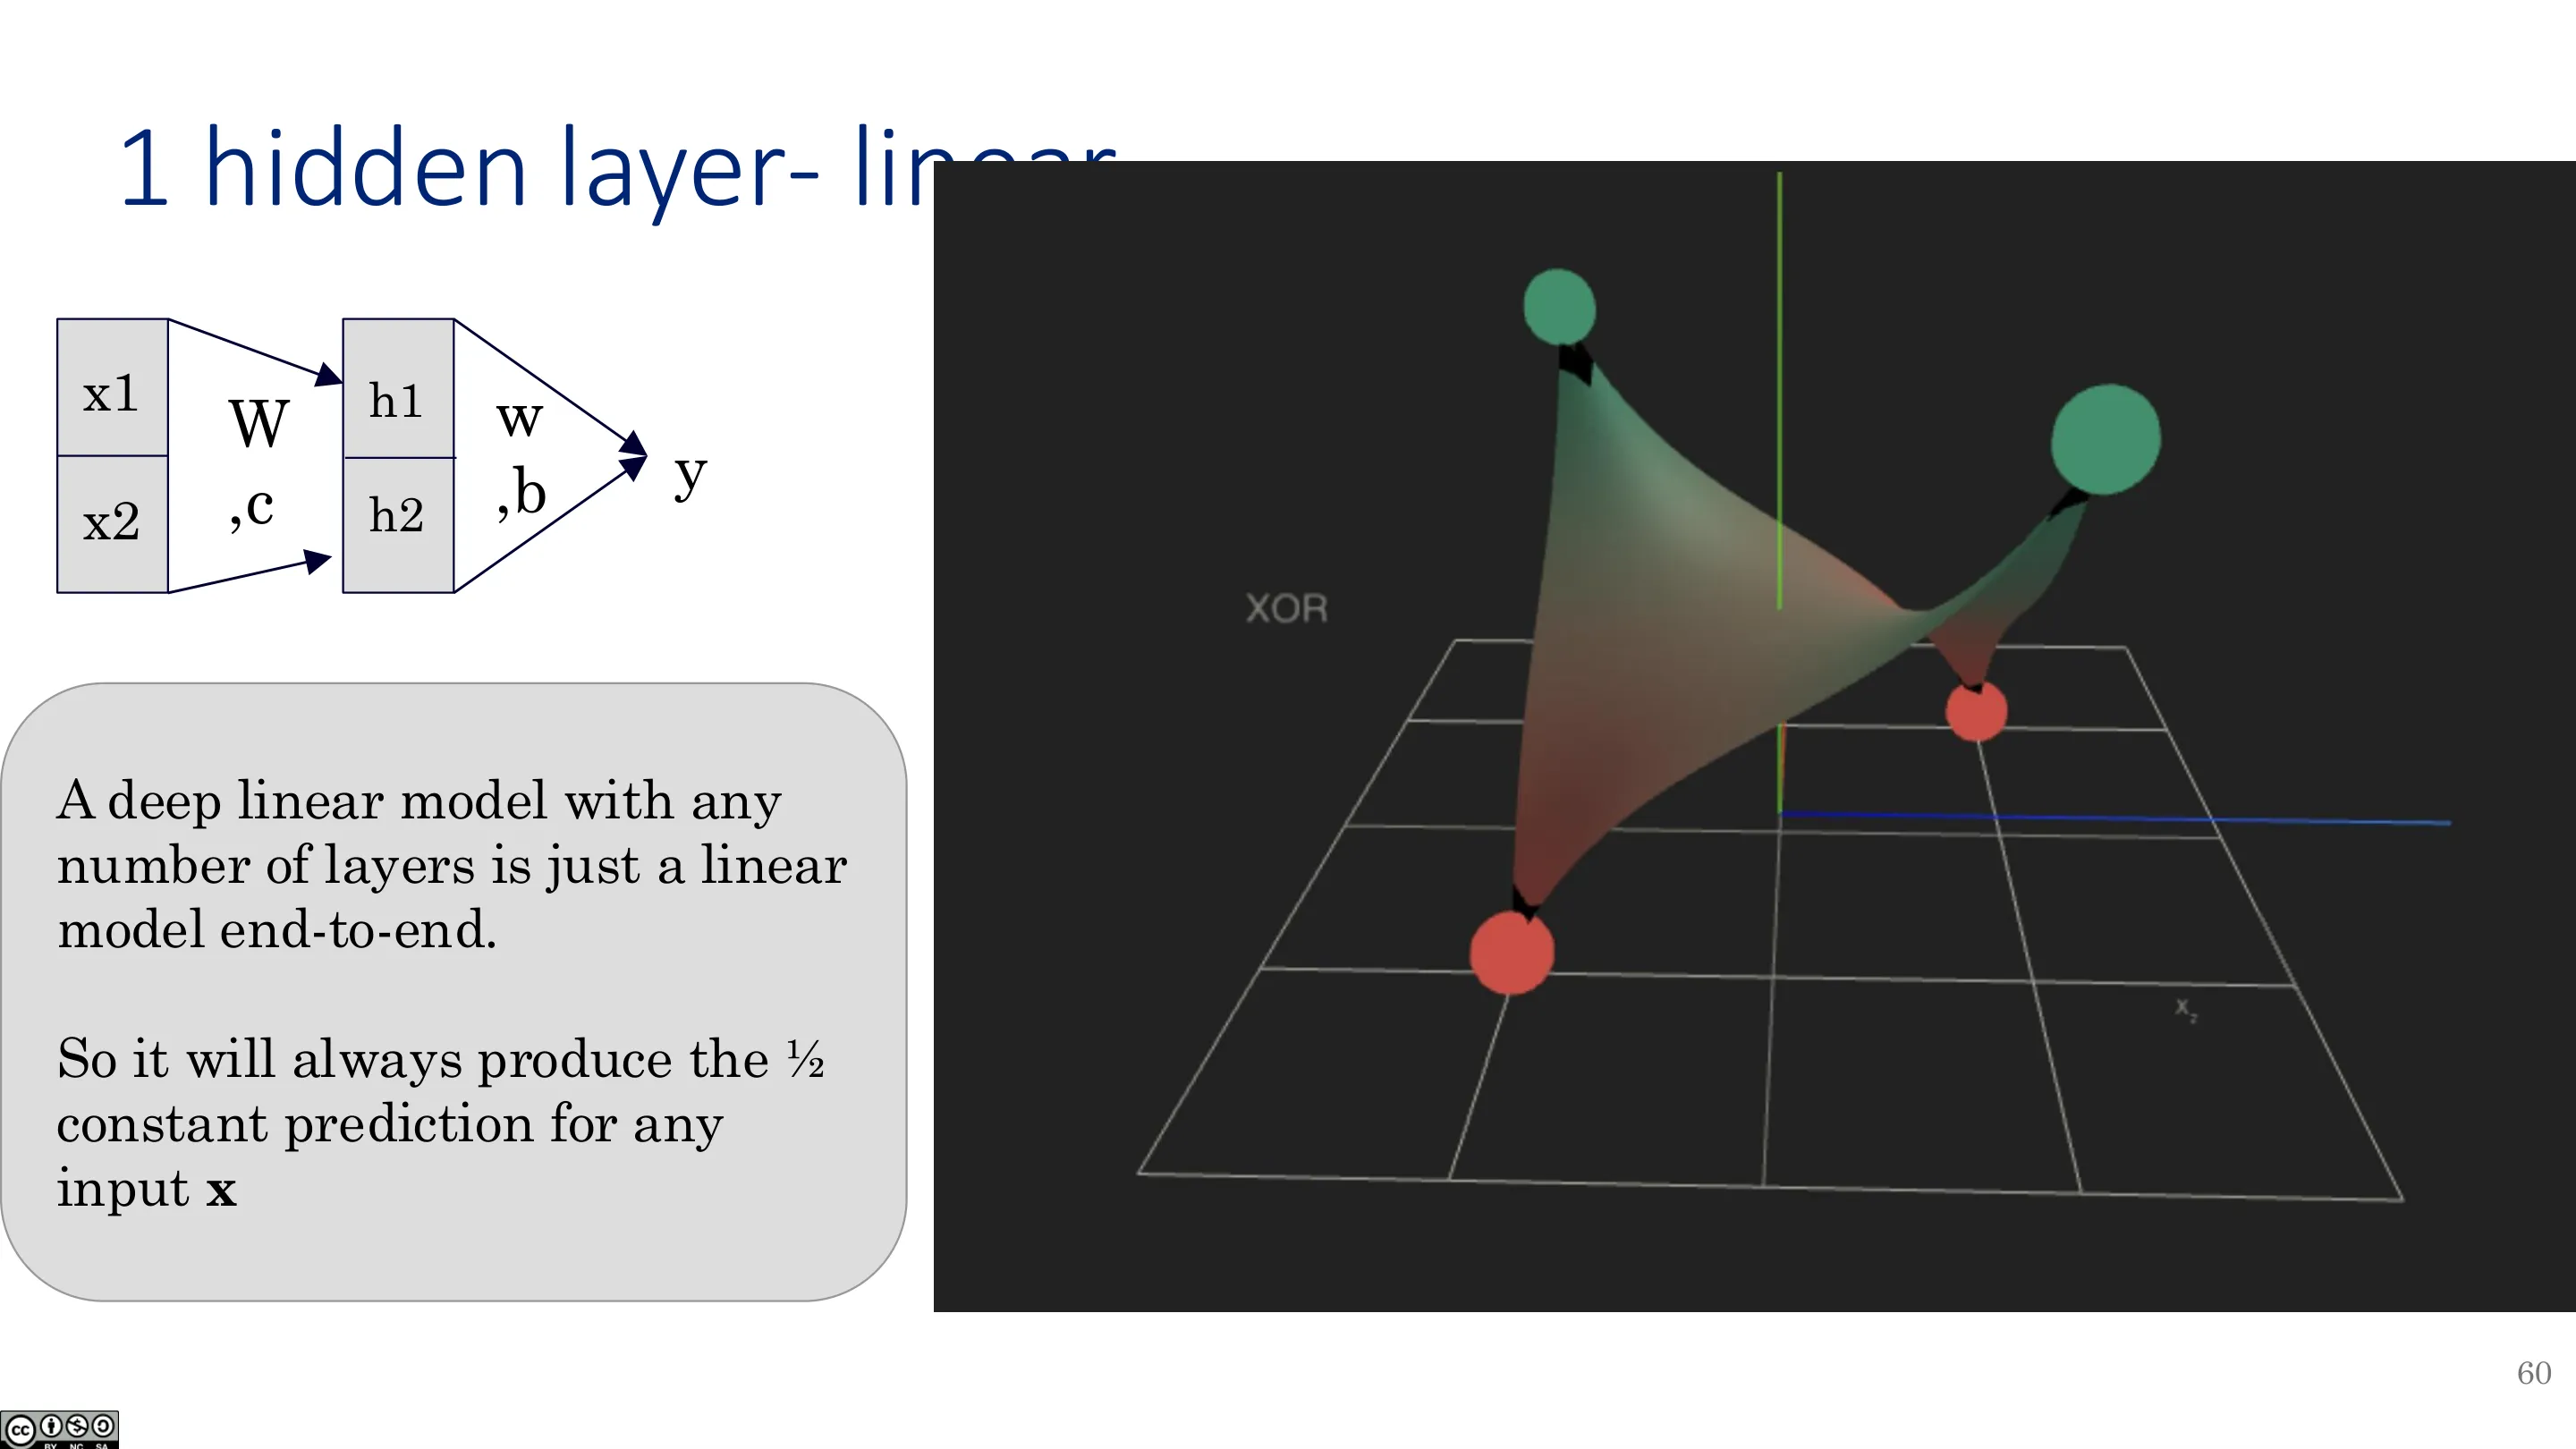
- 「深度线性网络 = 线性网络」,永远学不会 XOR;
- 用最小二乘求最优:得 $w=(0,0,b=0.5)$,即对任何输入都输出 0.5(「最蠢的平面」)——因为「对一堆数做平方误差最小化,最优值就是均值」,而 0 和 1 的均值是 0.5。
这解释了一个历史教训:没有非线性,深度毫无意义。
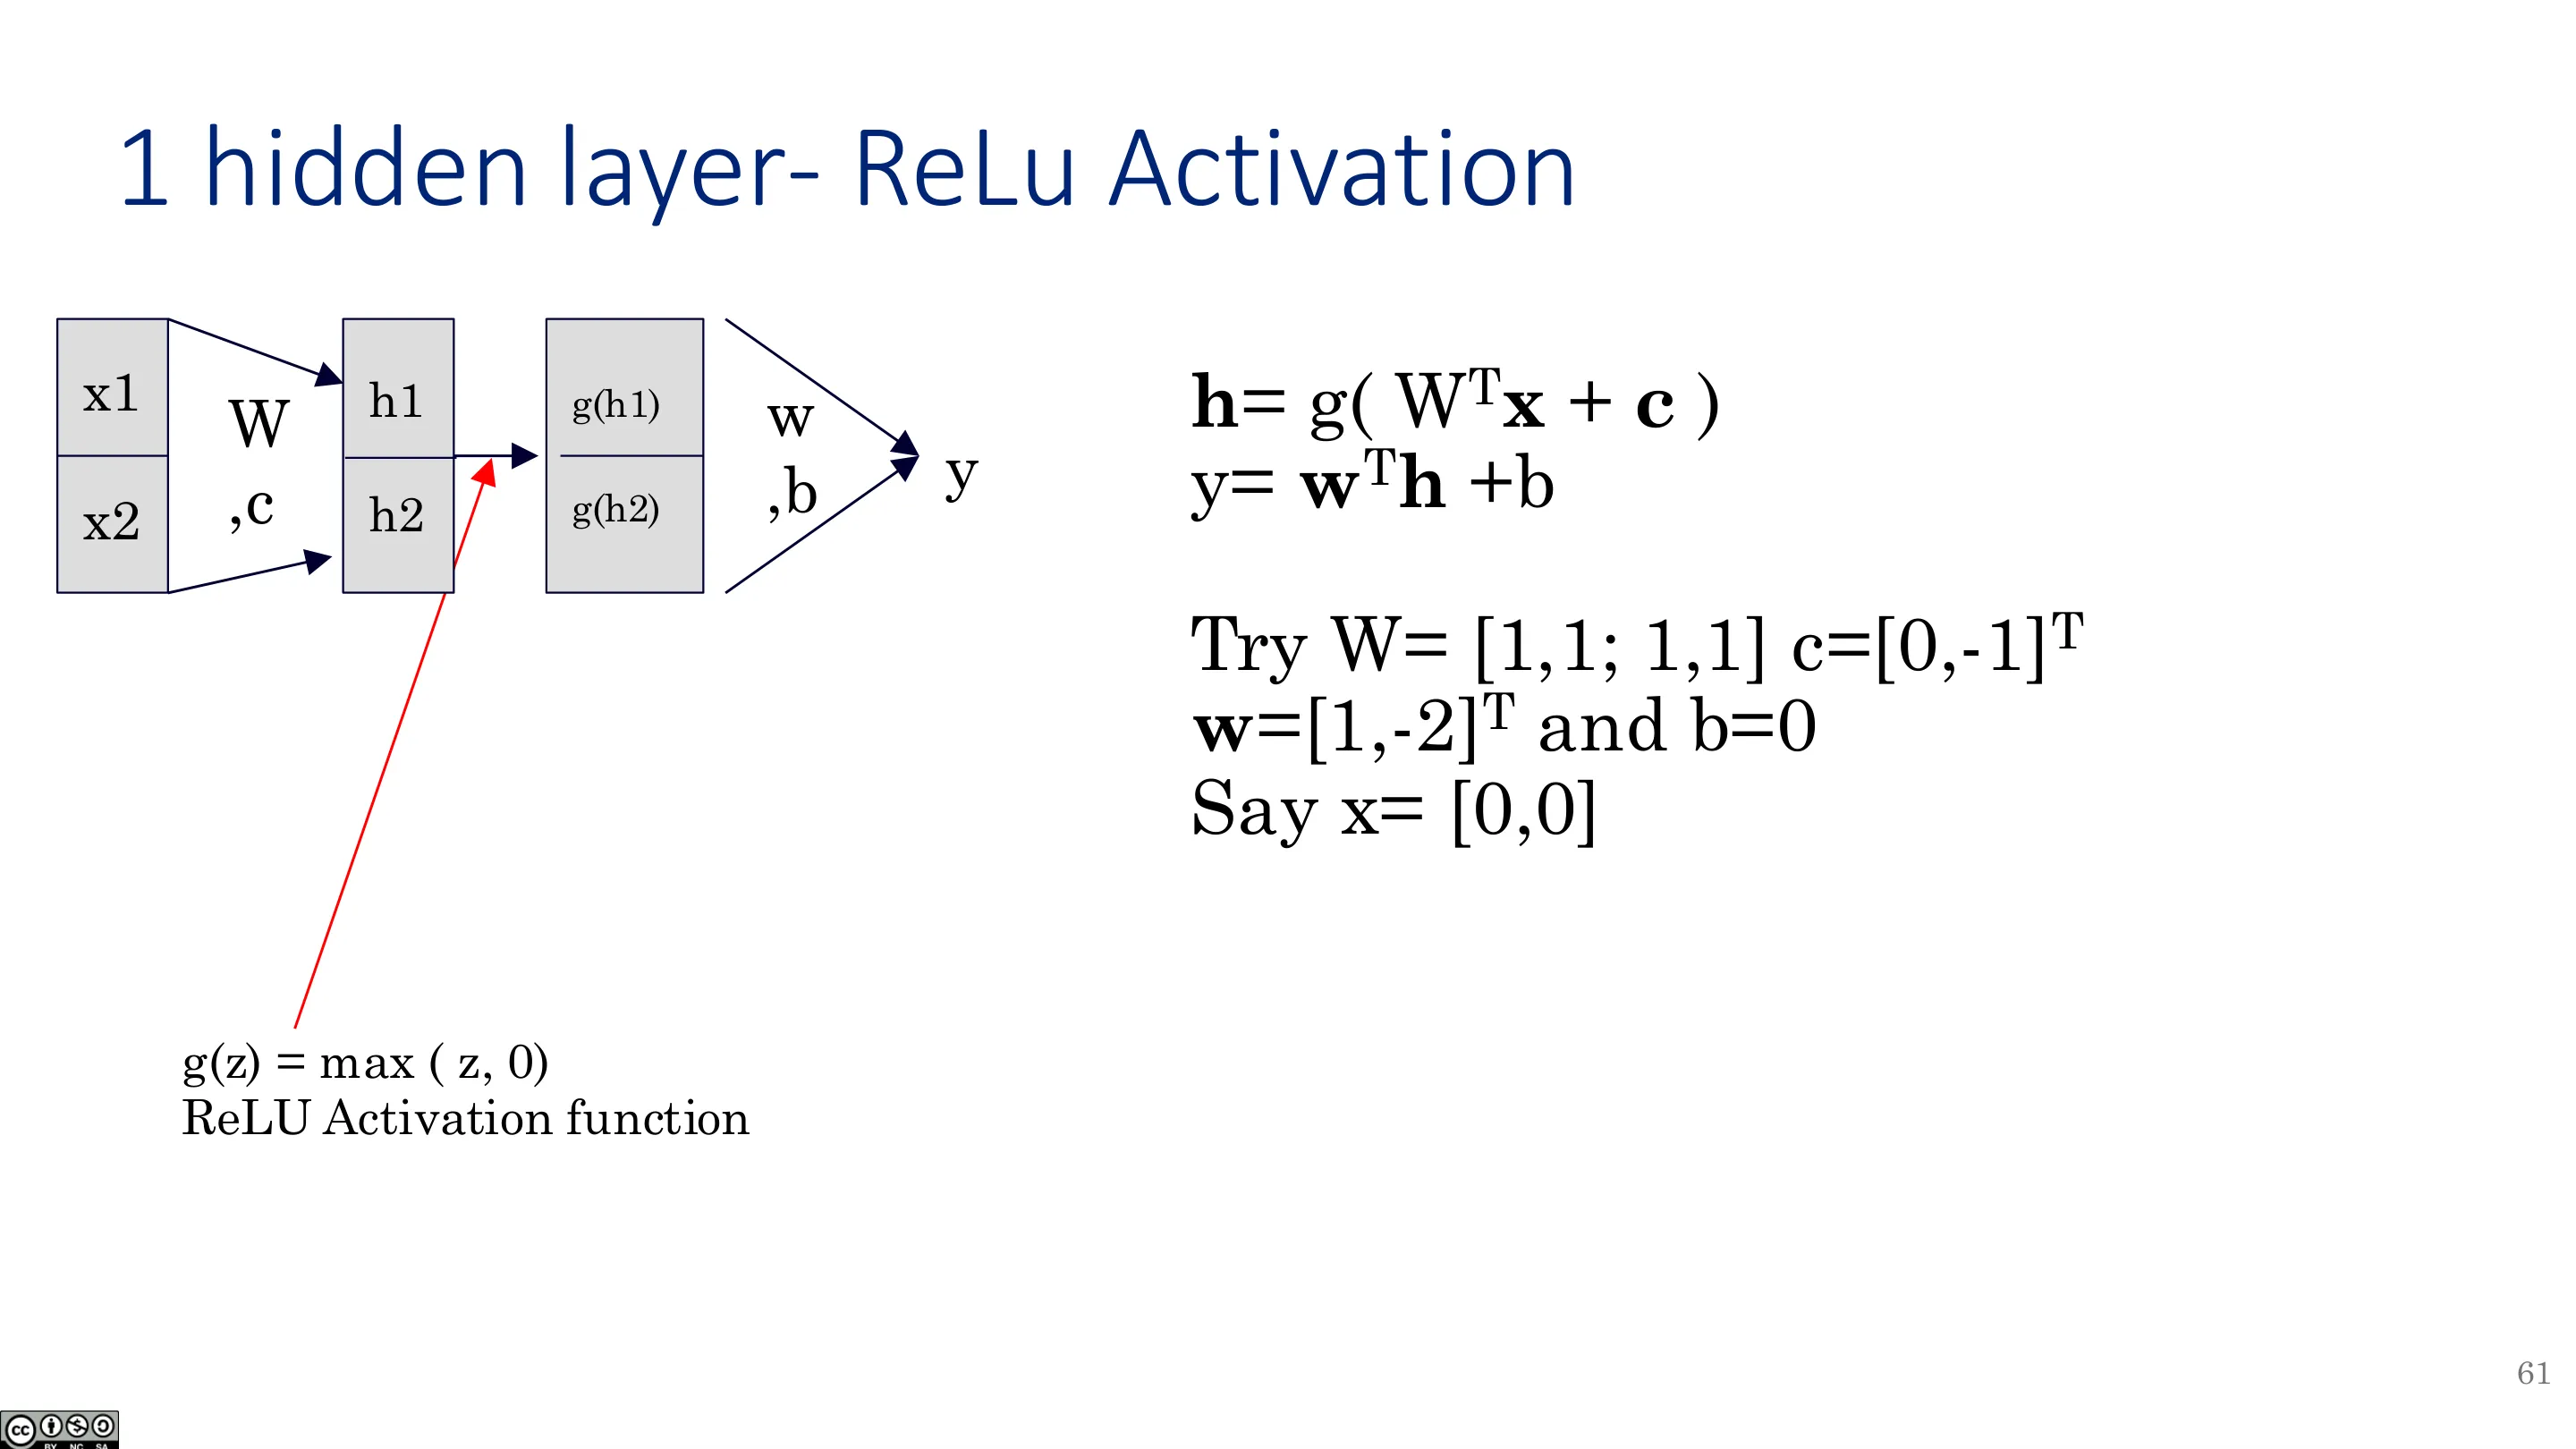
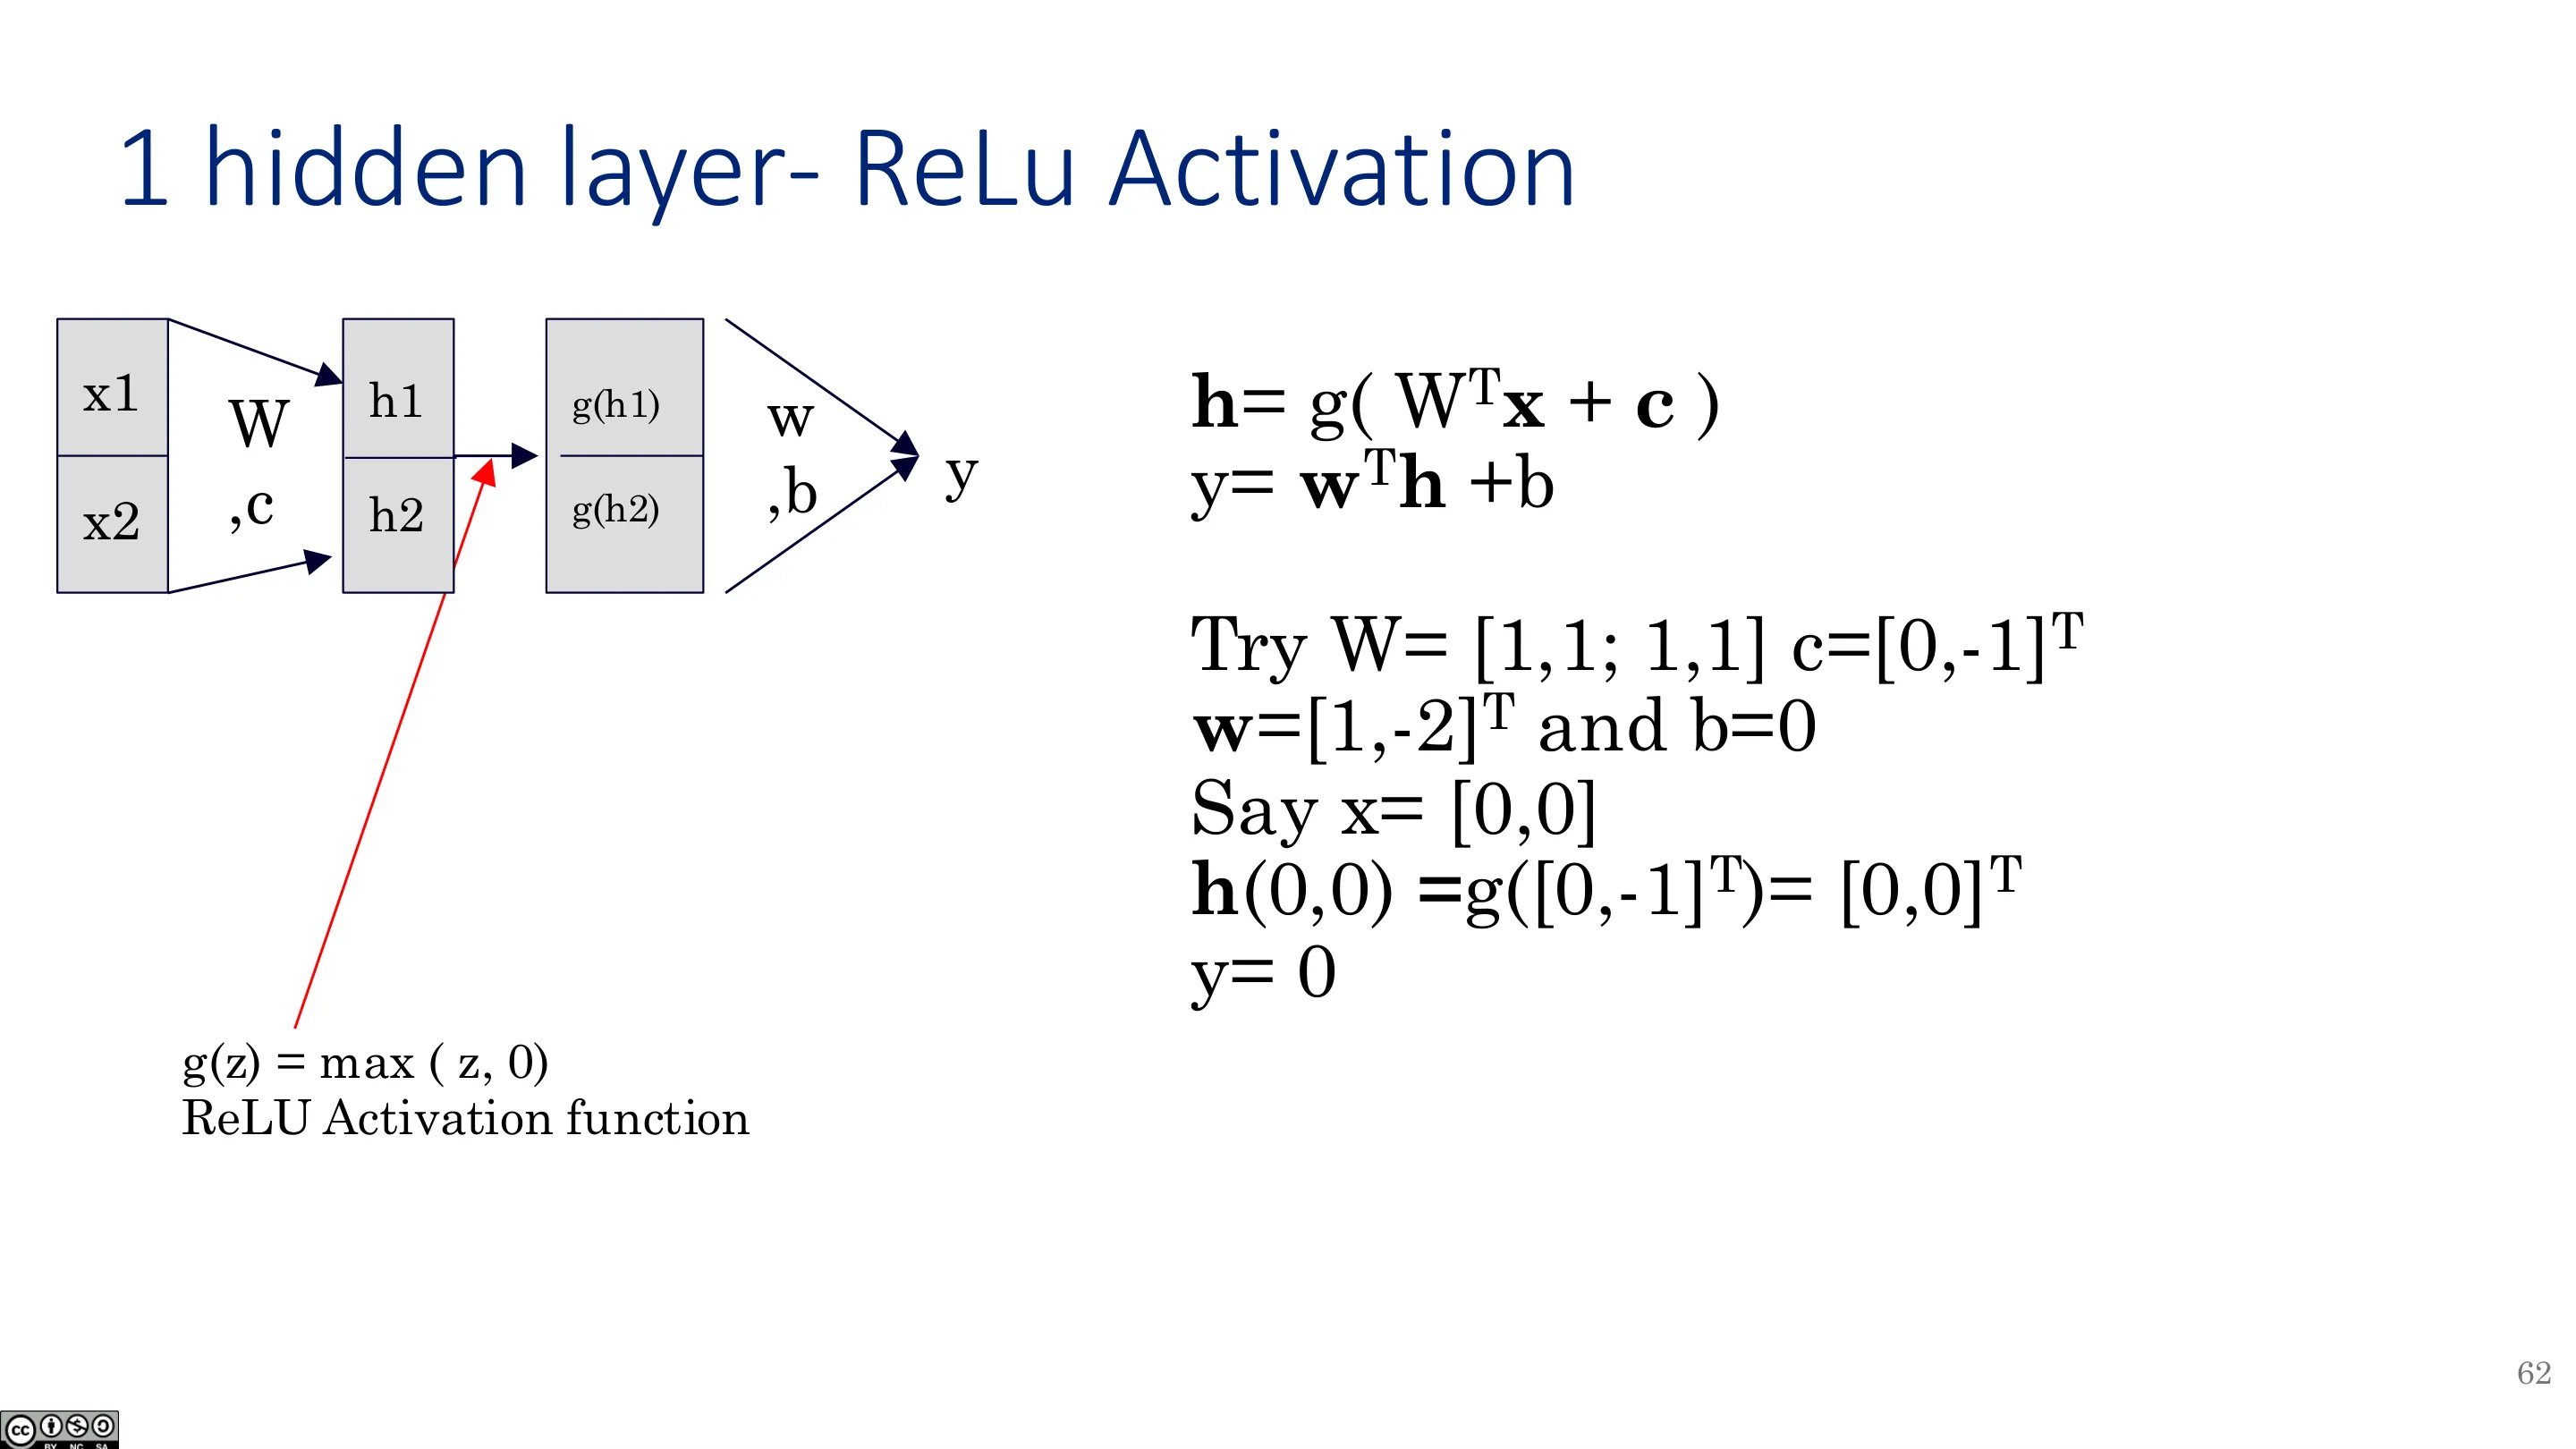
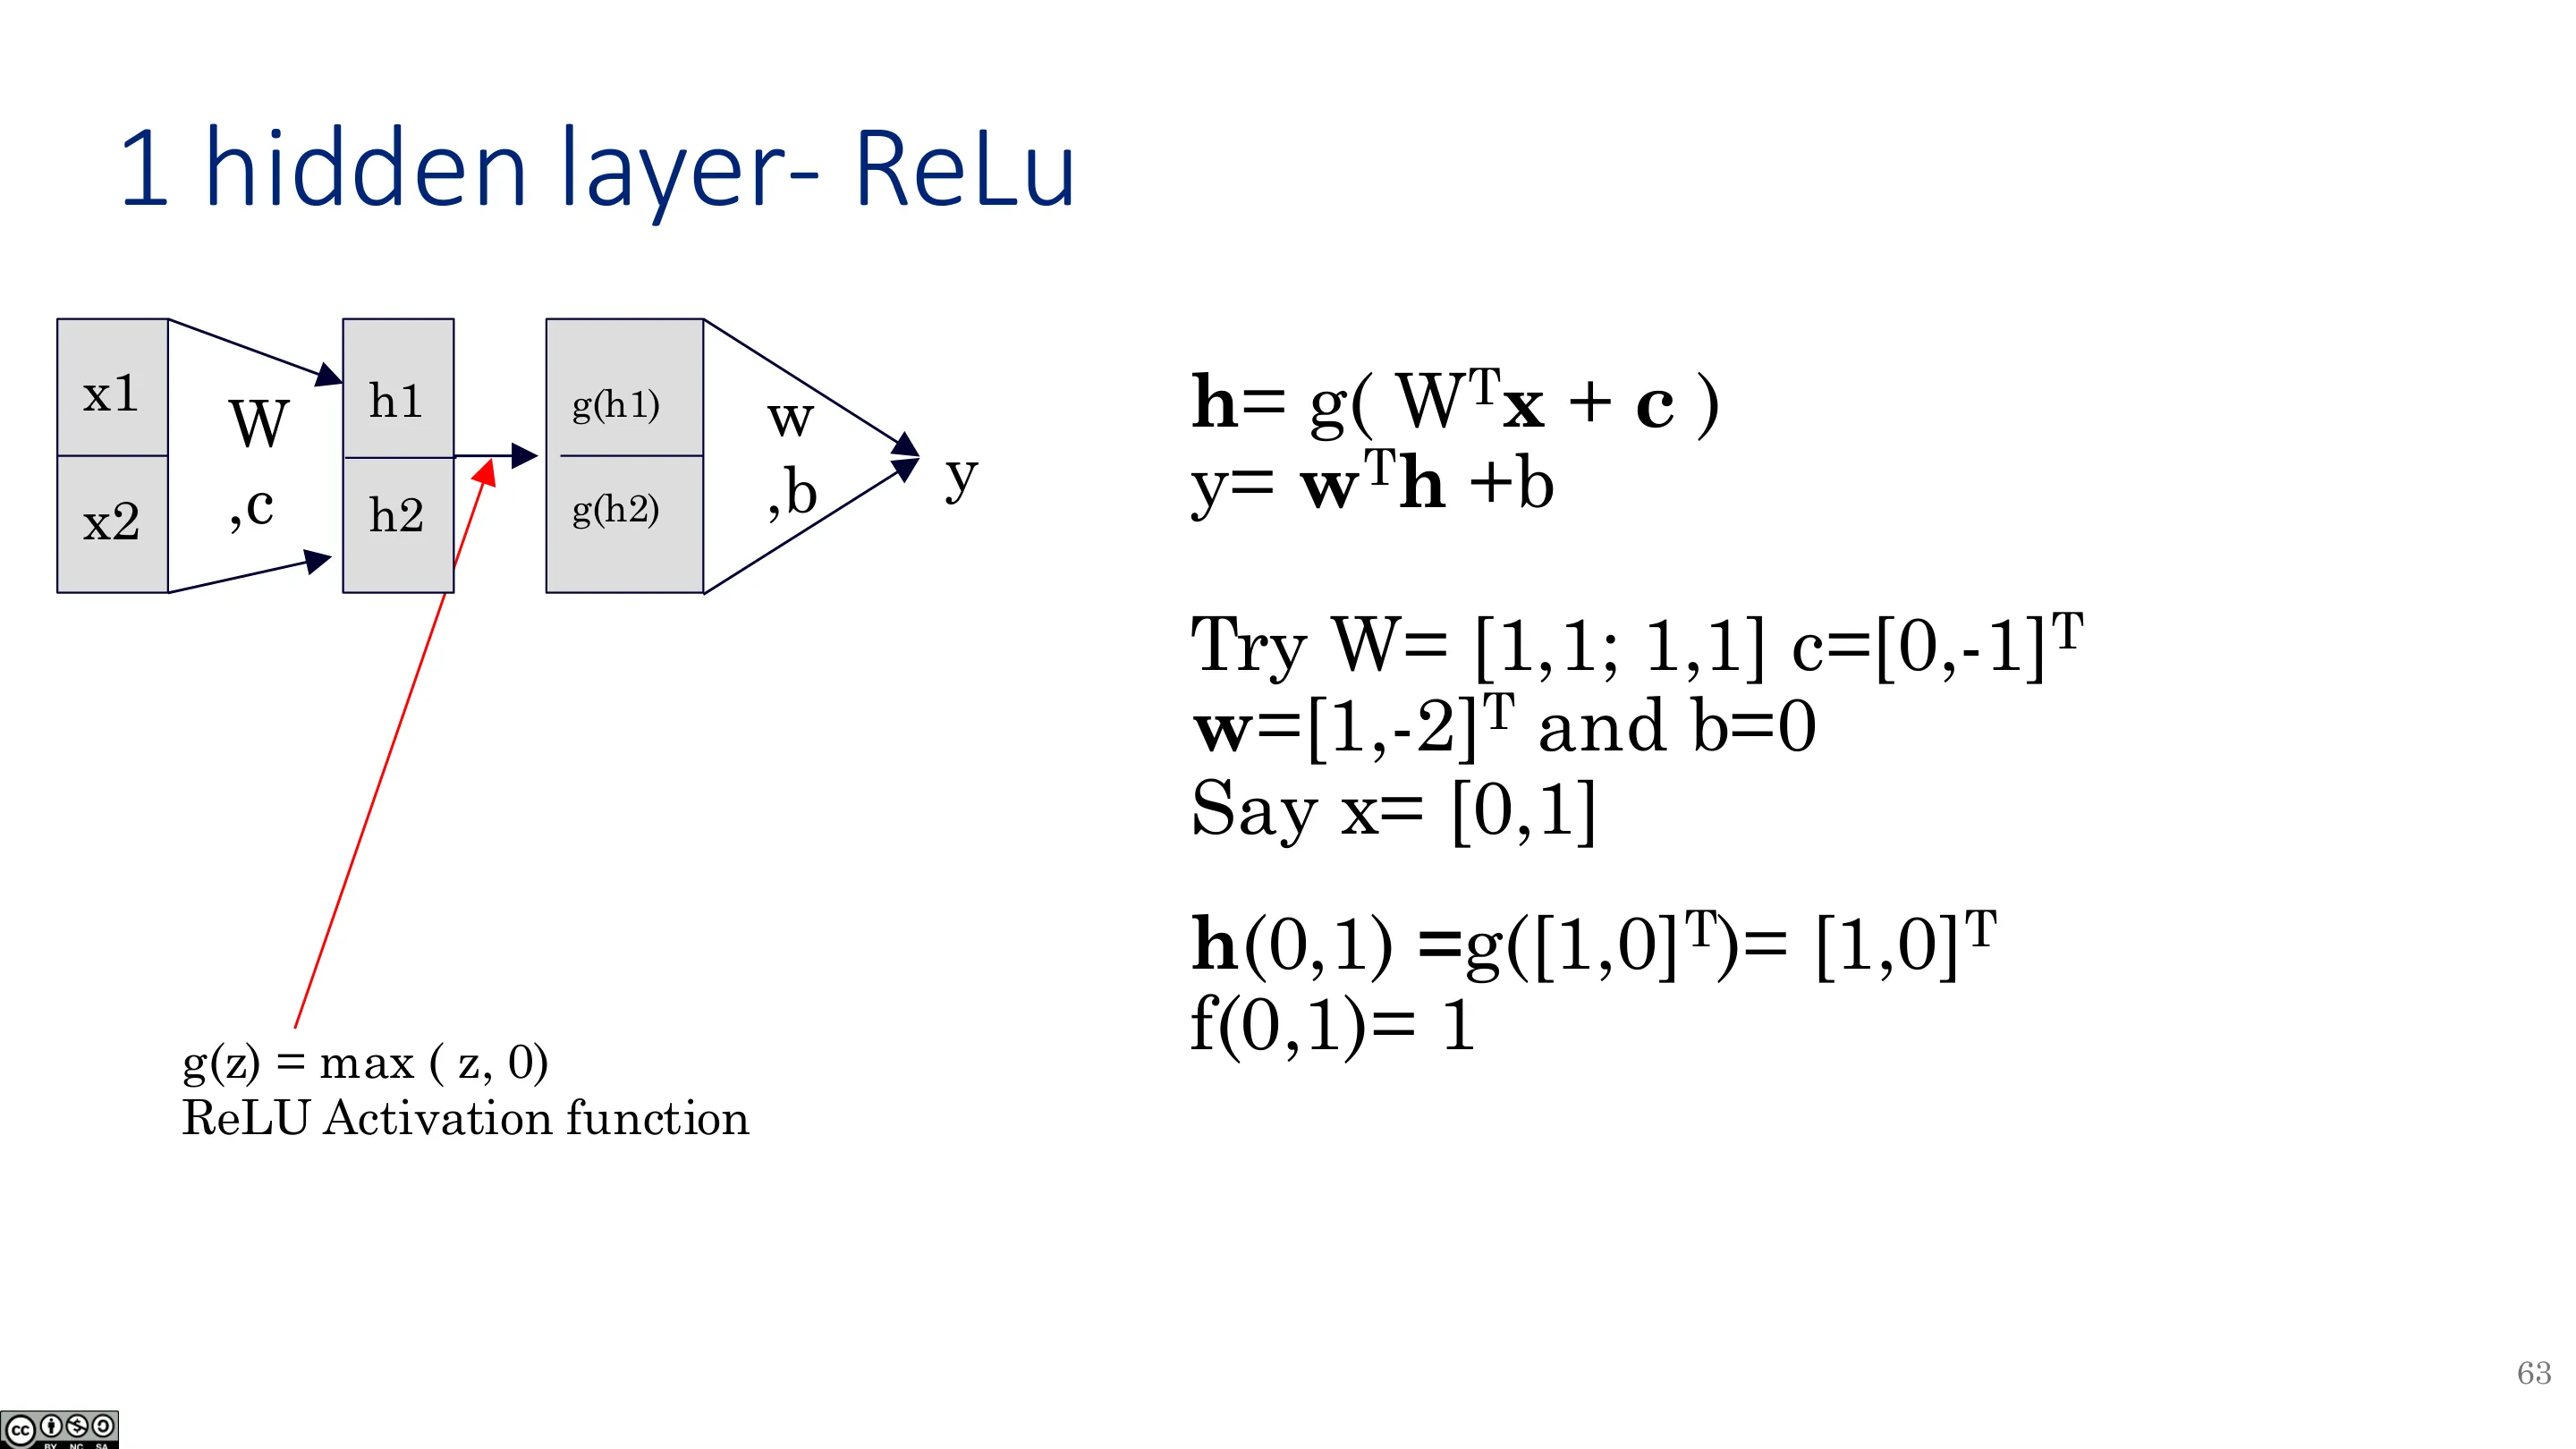
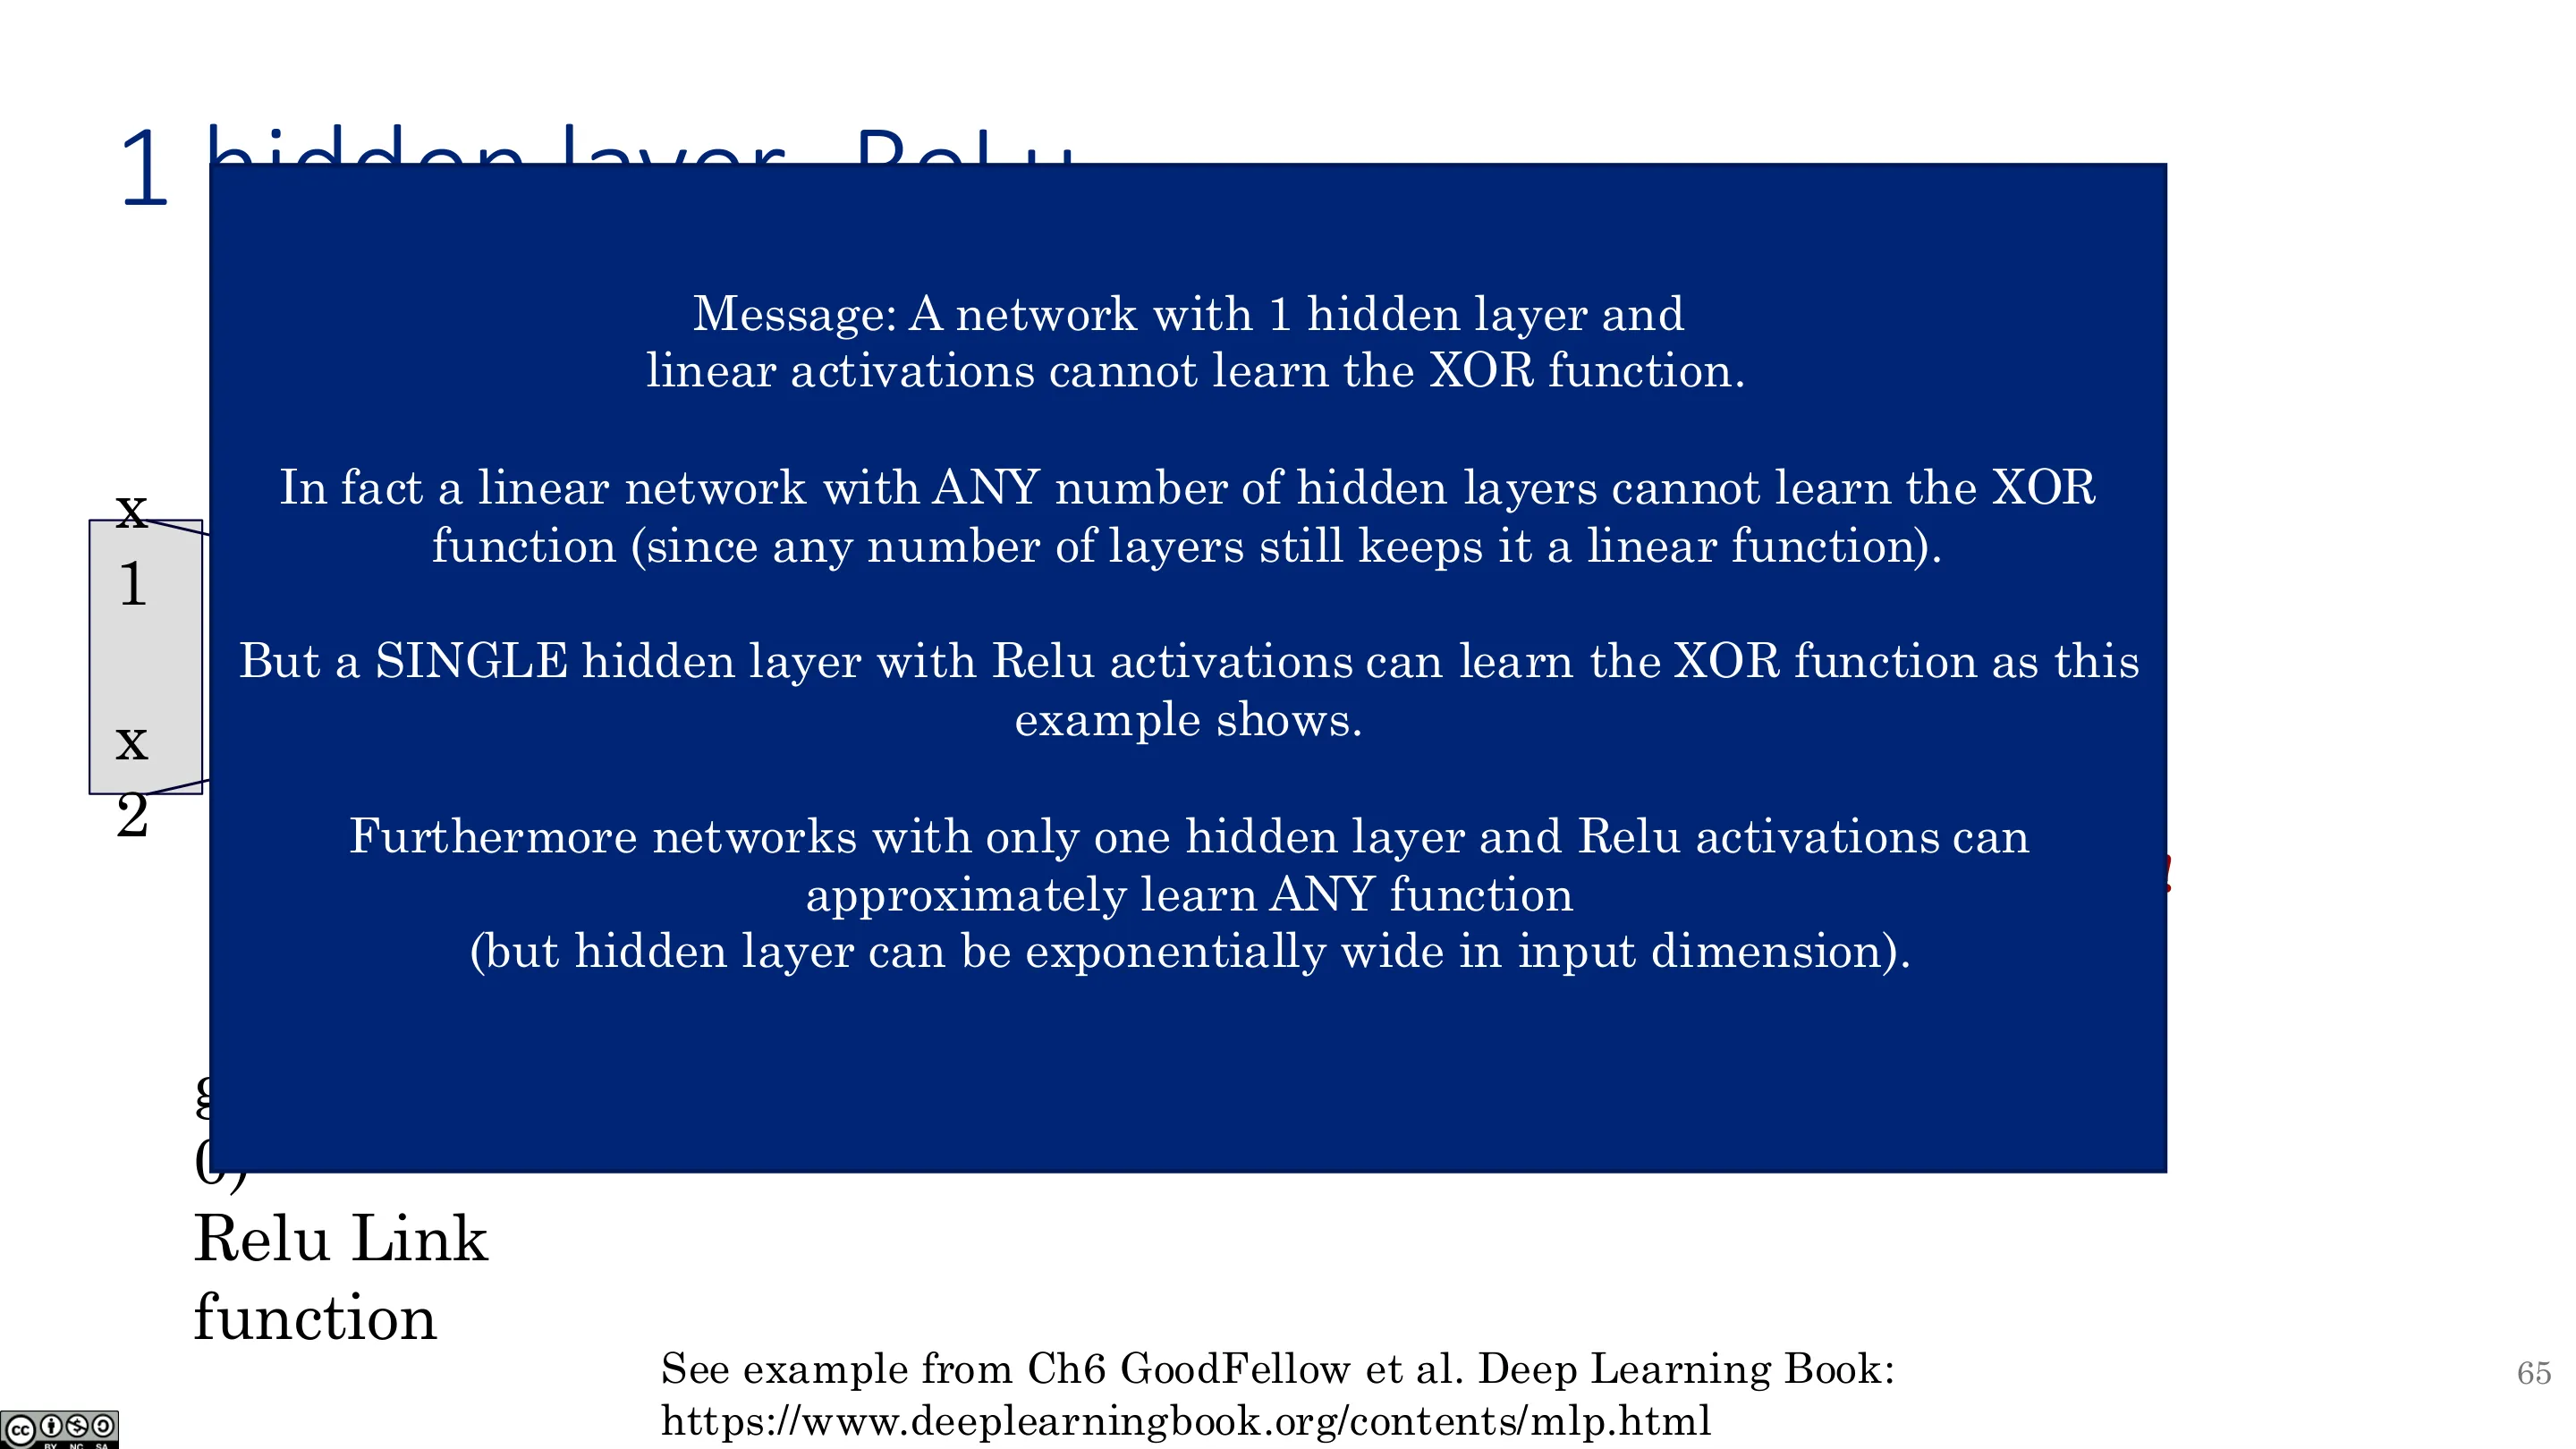
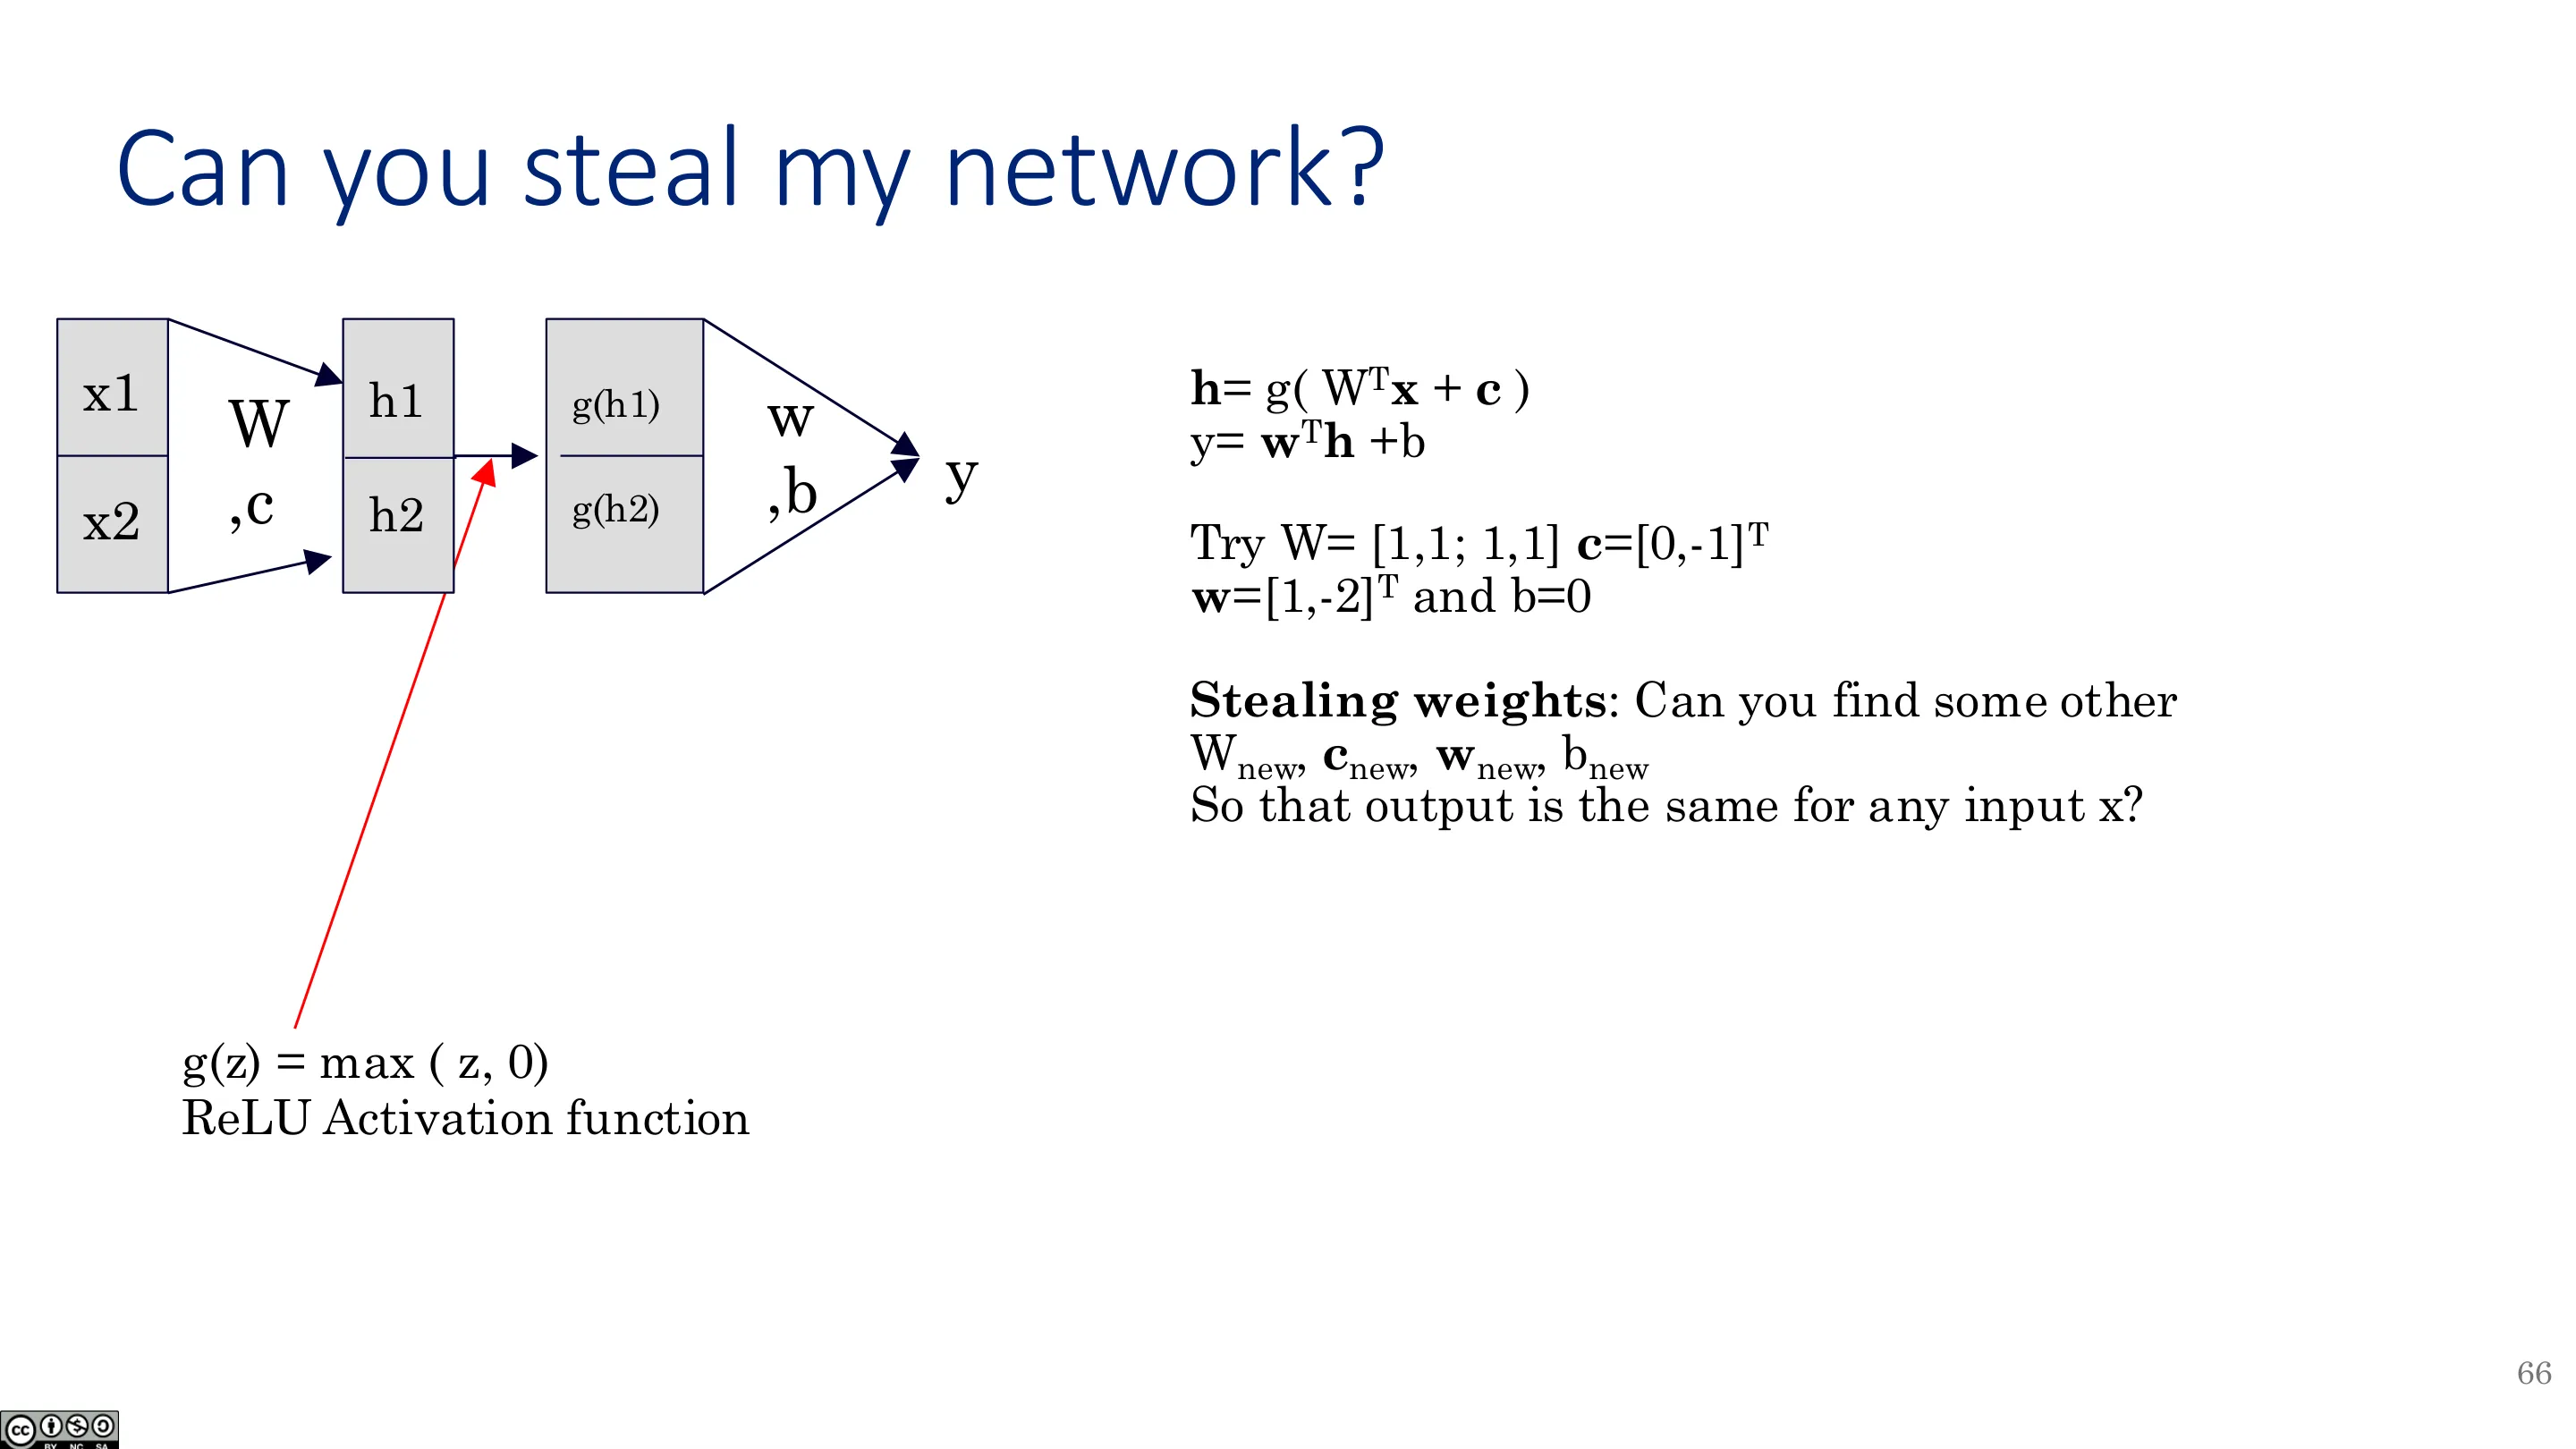
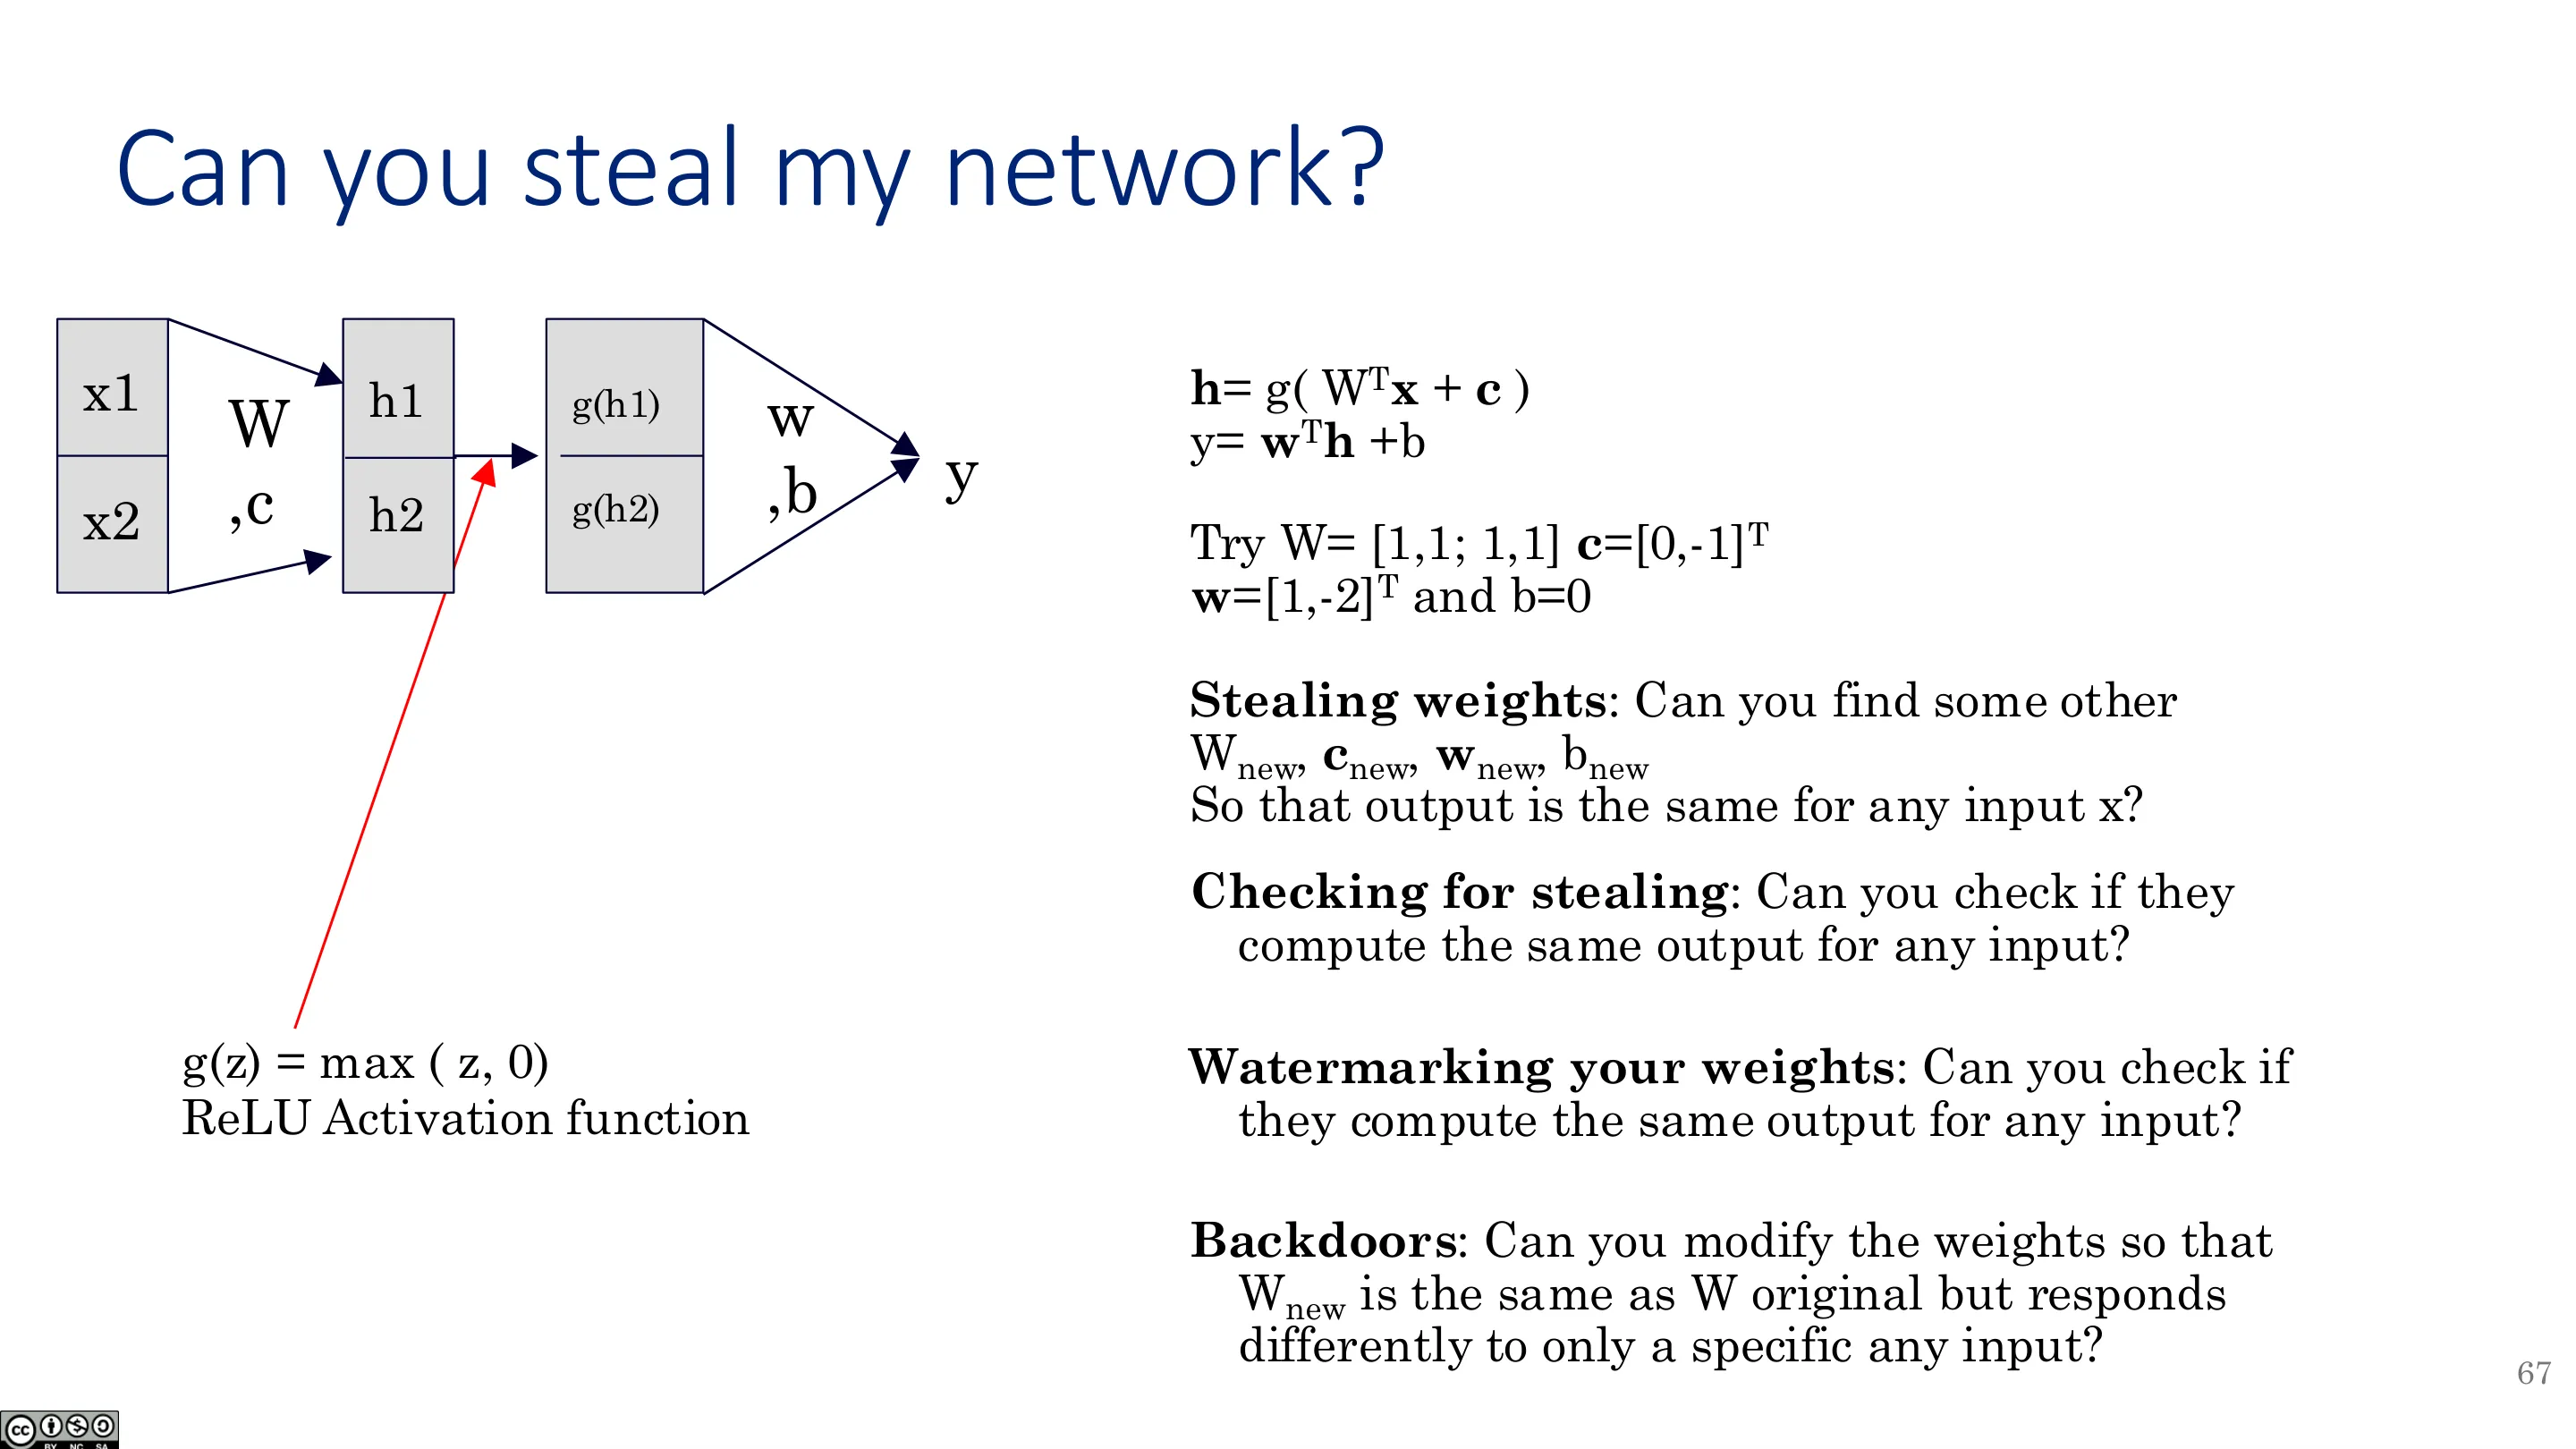
再看加 ReLU 隐藏层:$\mathrm{ReLU}(z)=\max(z,0)$。取 $W=[[1,1],[1,1]]$、$C=(0,-1)$、$w=(1,-2)$、$b=0$:
- 输入 $(0,0)$:$H=\mathrm{ReLU}((0,-1))=(0,0)$ ⇒ 输出 $0$ ✓
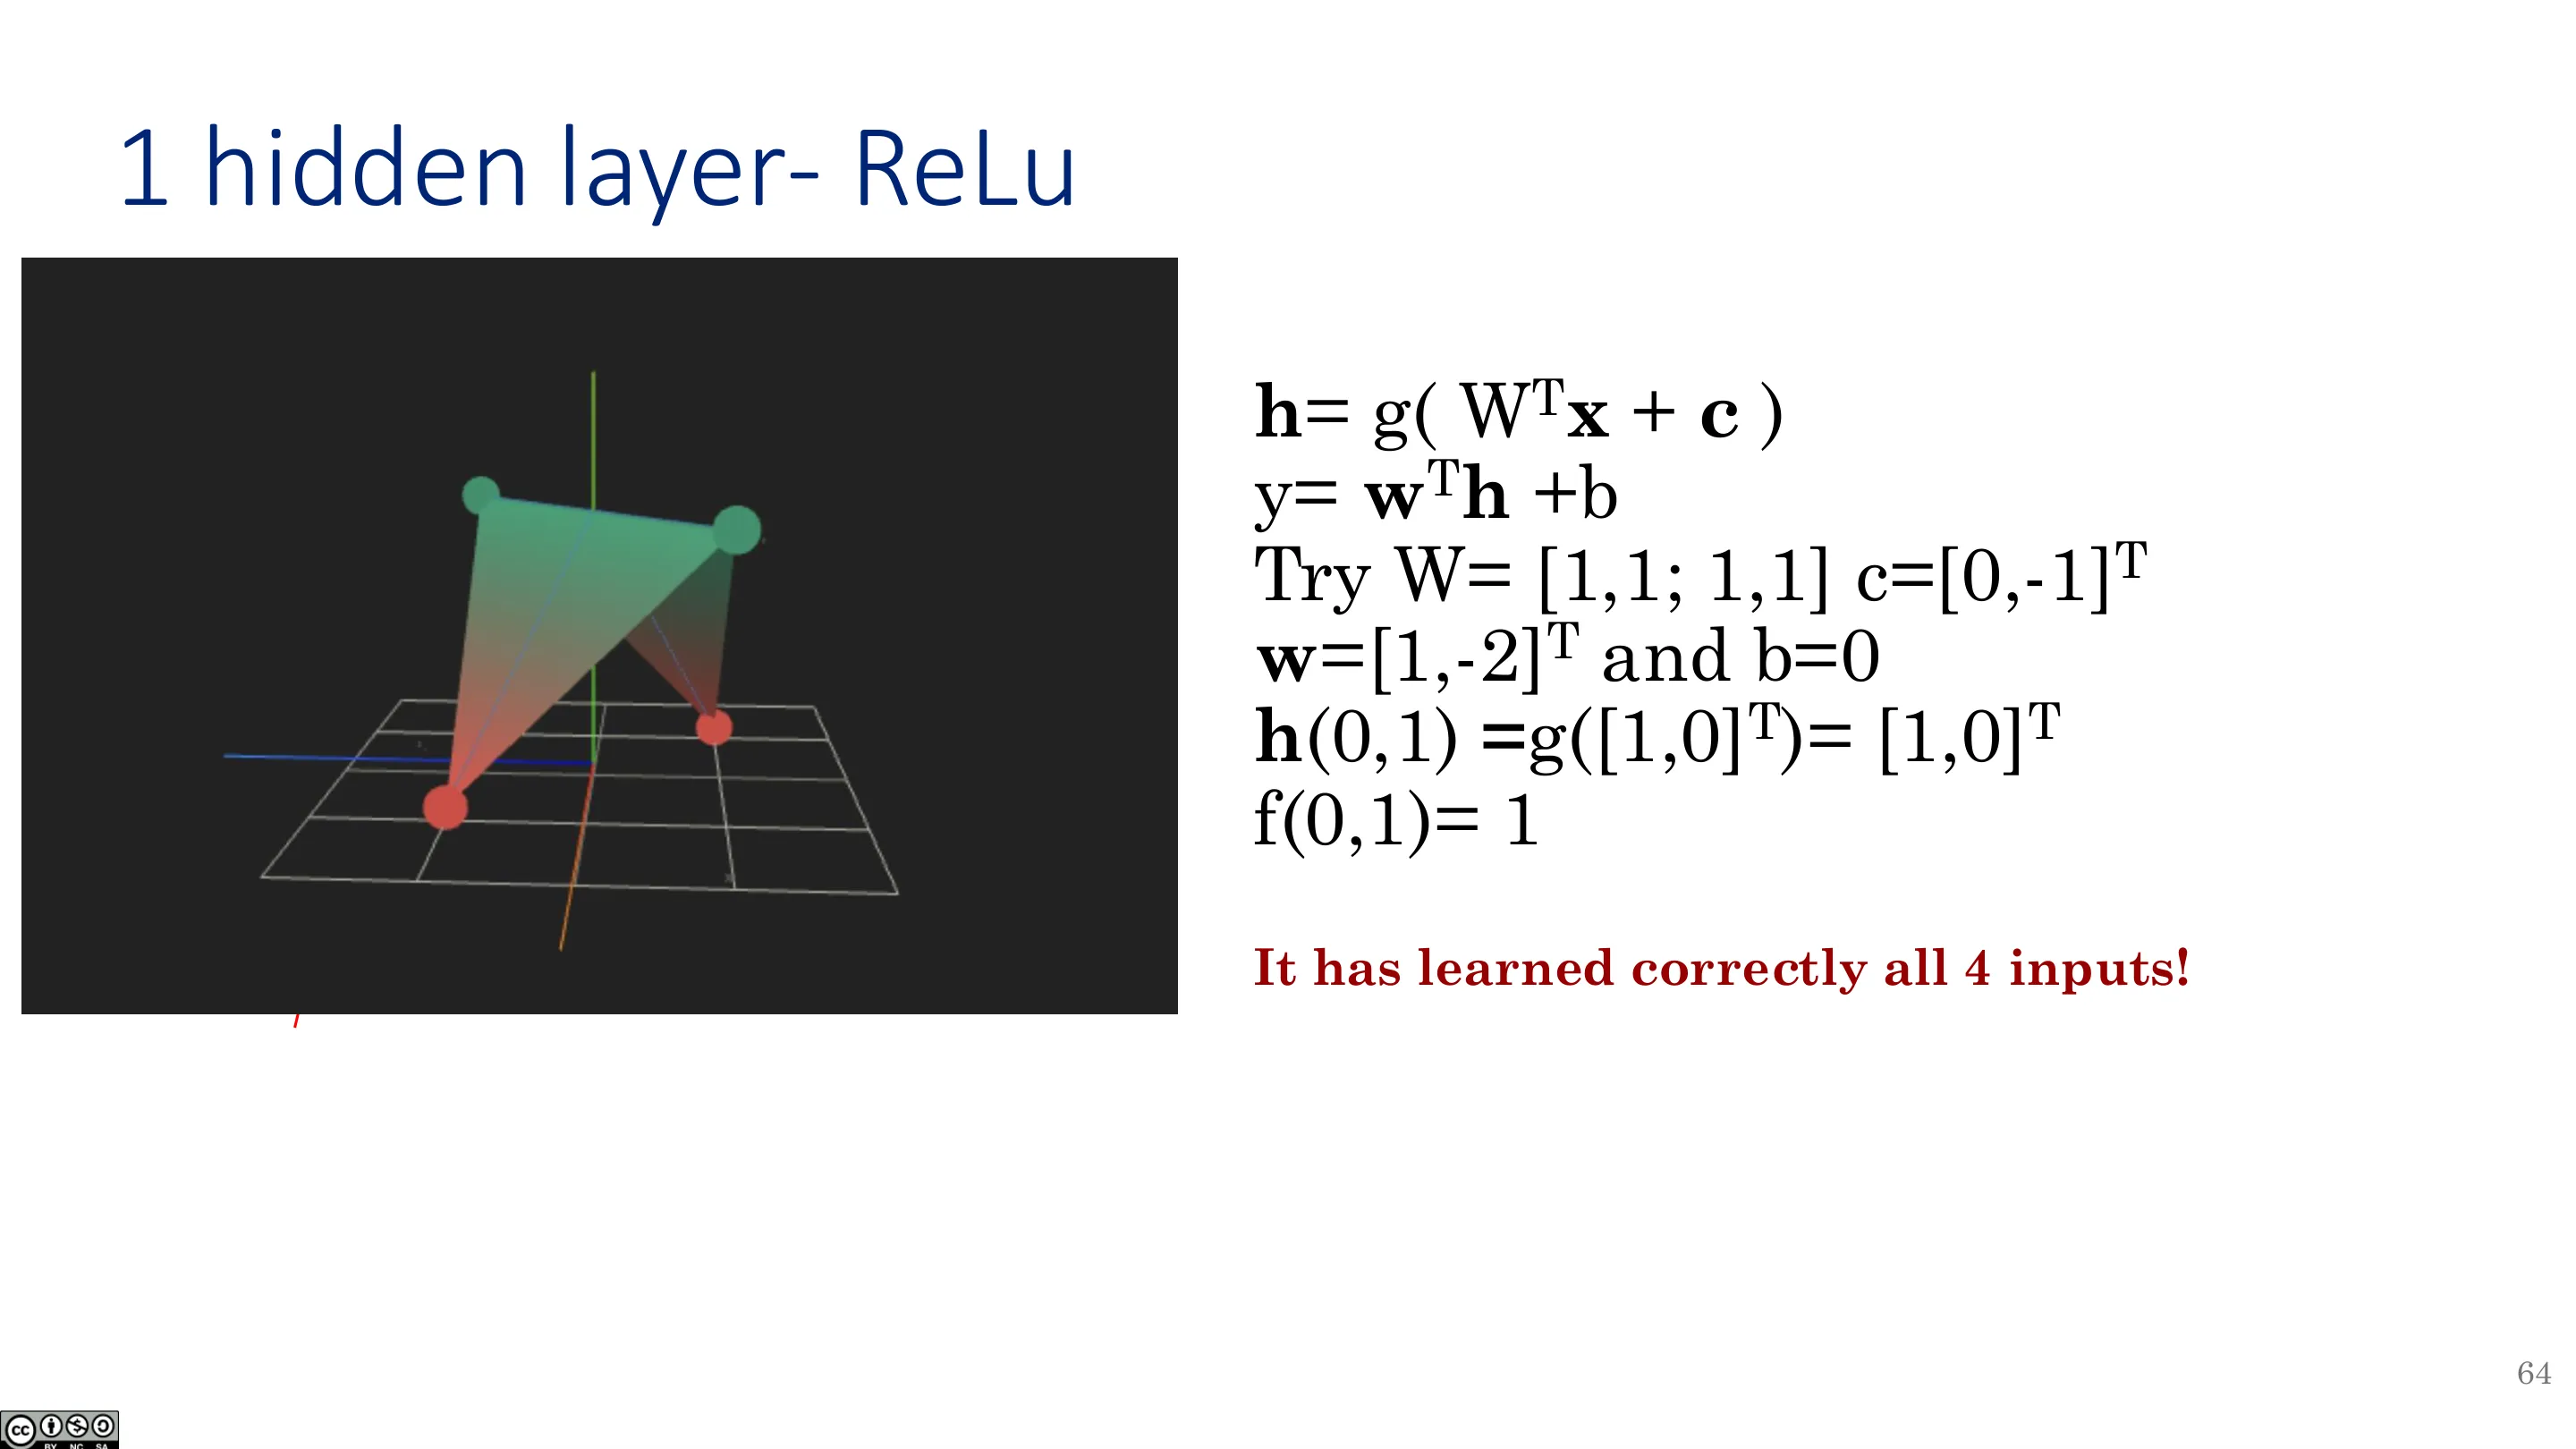
- 输入 $(0,1)$:$W^\top x=(1,1)$,加 $C$ 得 $(1,0)$,ReLU 后 $(1,0)$,与 $w$ 内积得 $1$ ⇒ 输出 $1$ ✓
网络完美学出 XOR,且整体是分片线性(piecewise linear) 的——拐点正是 ReLU 触零处。
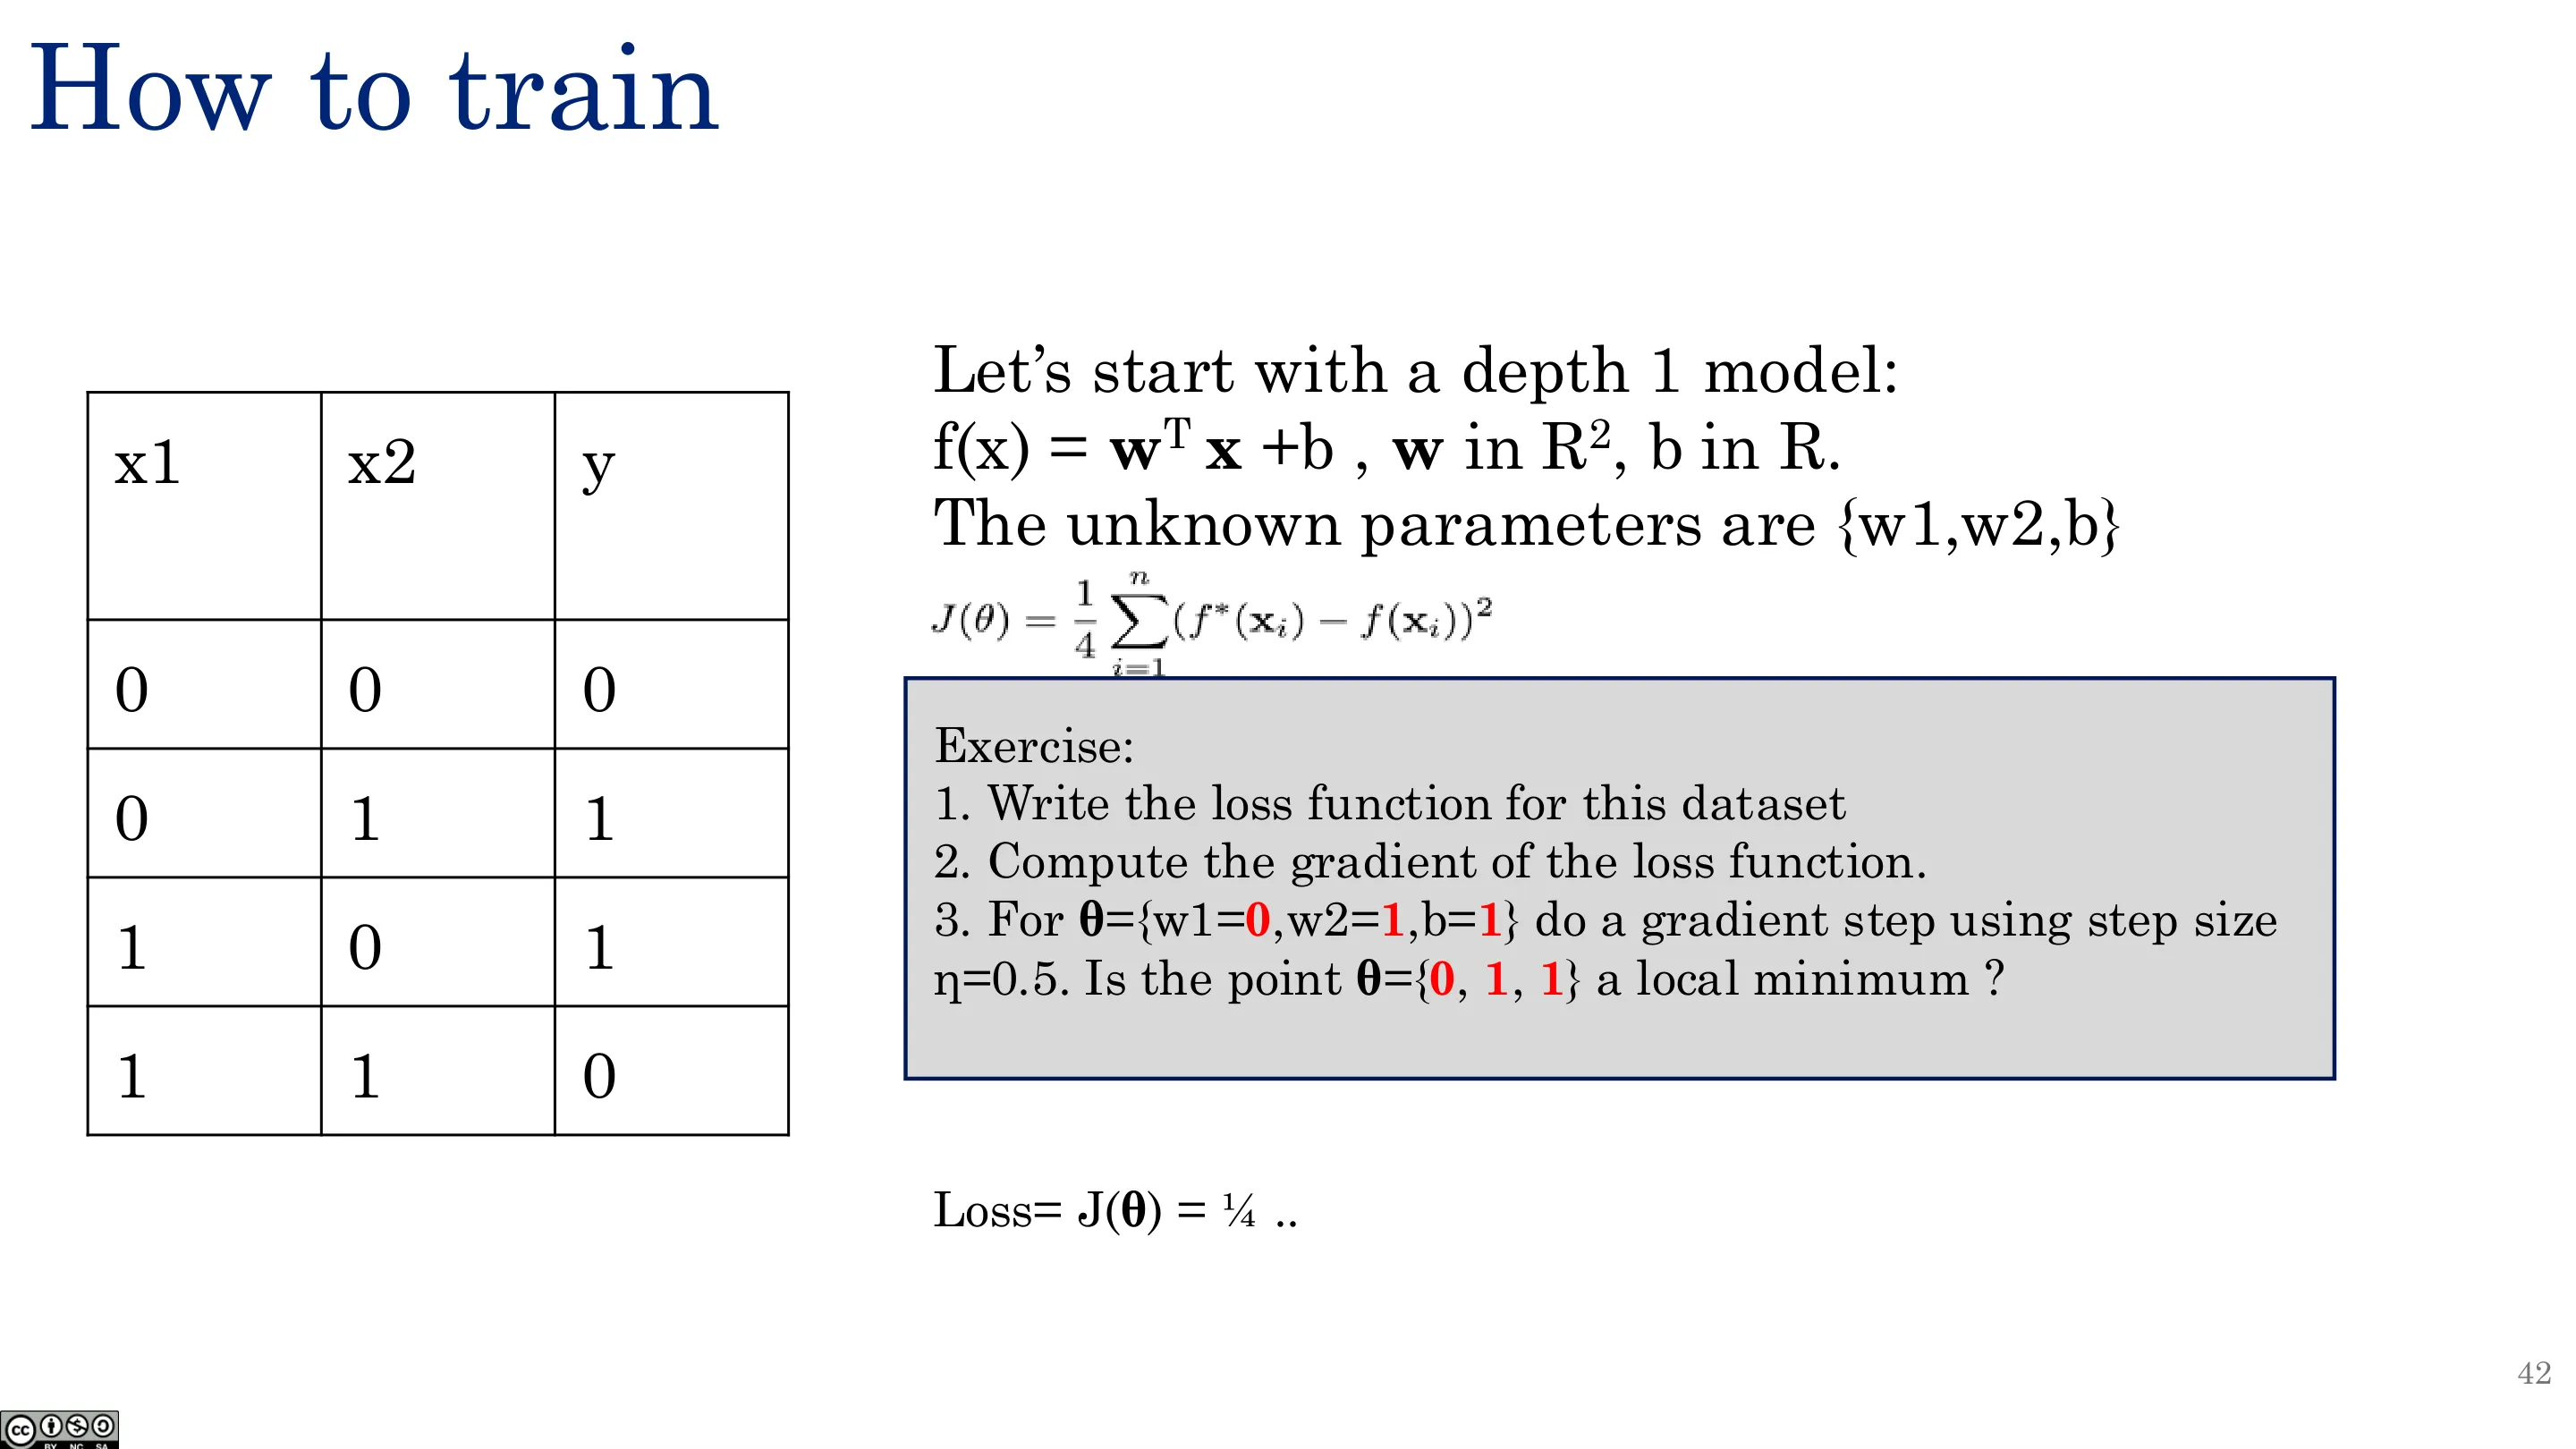
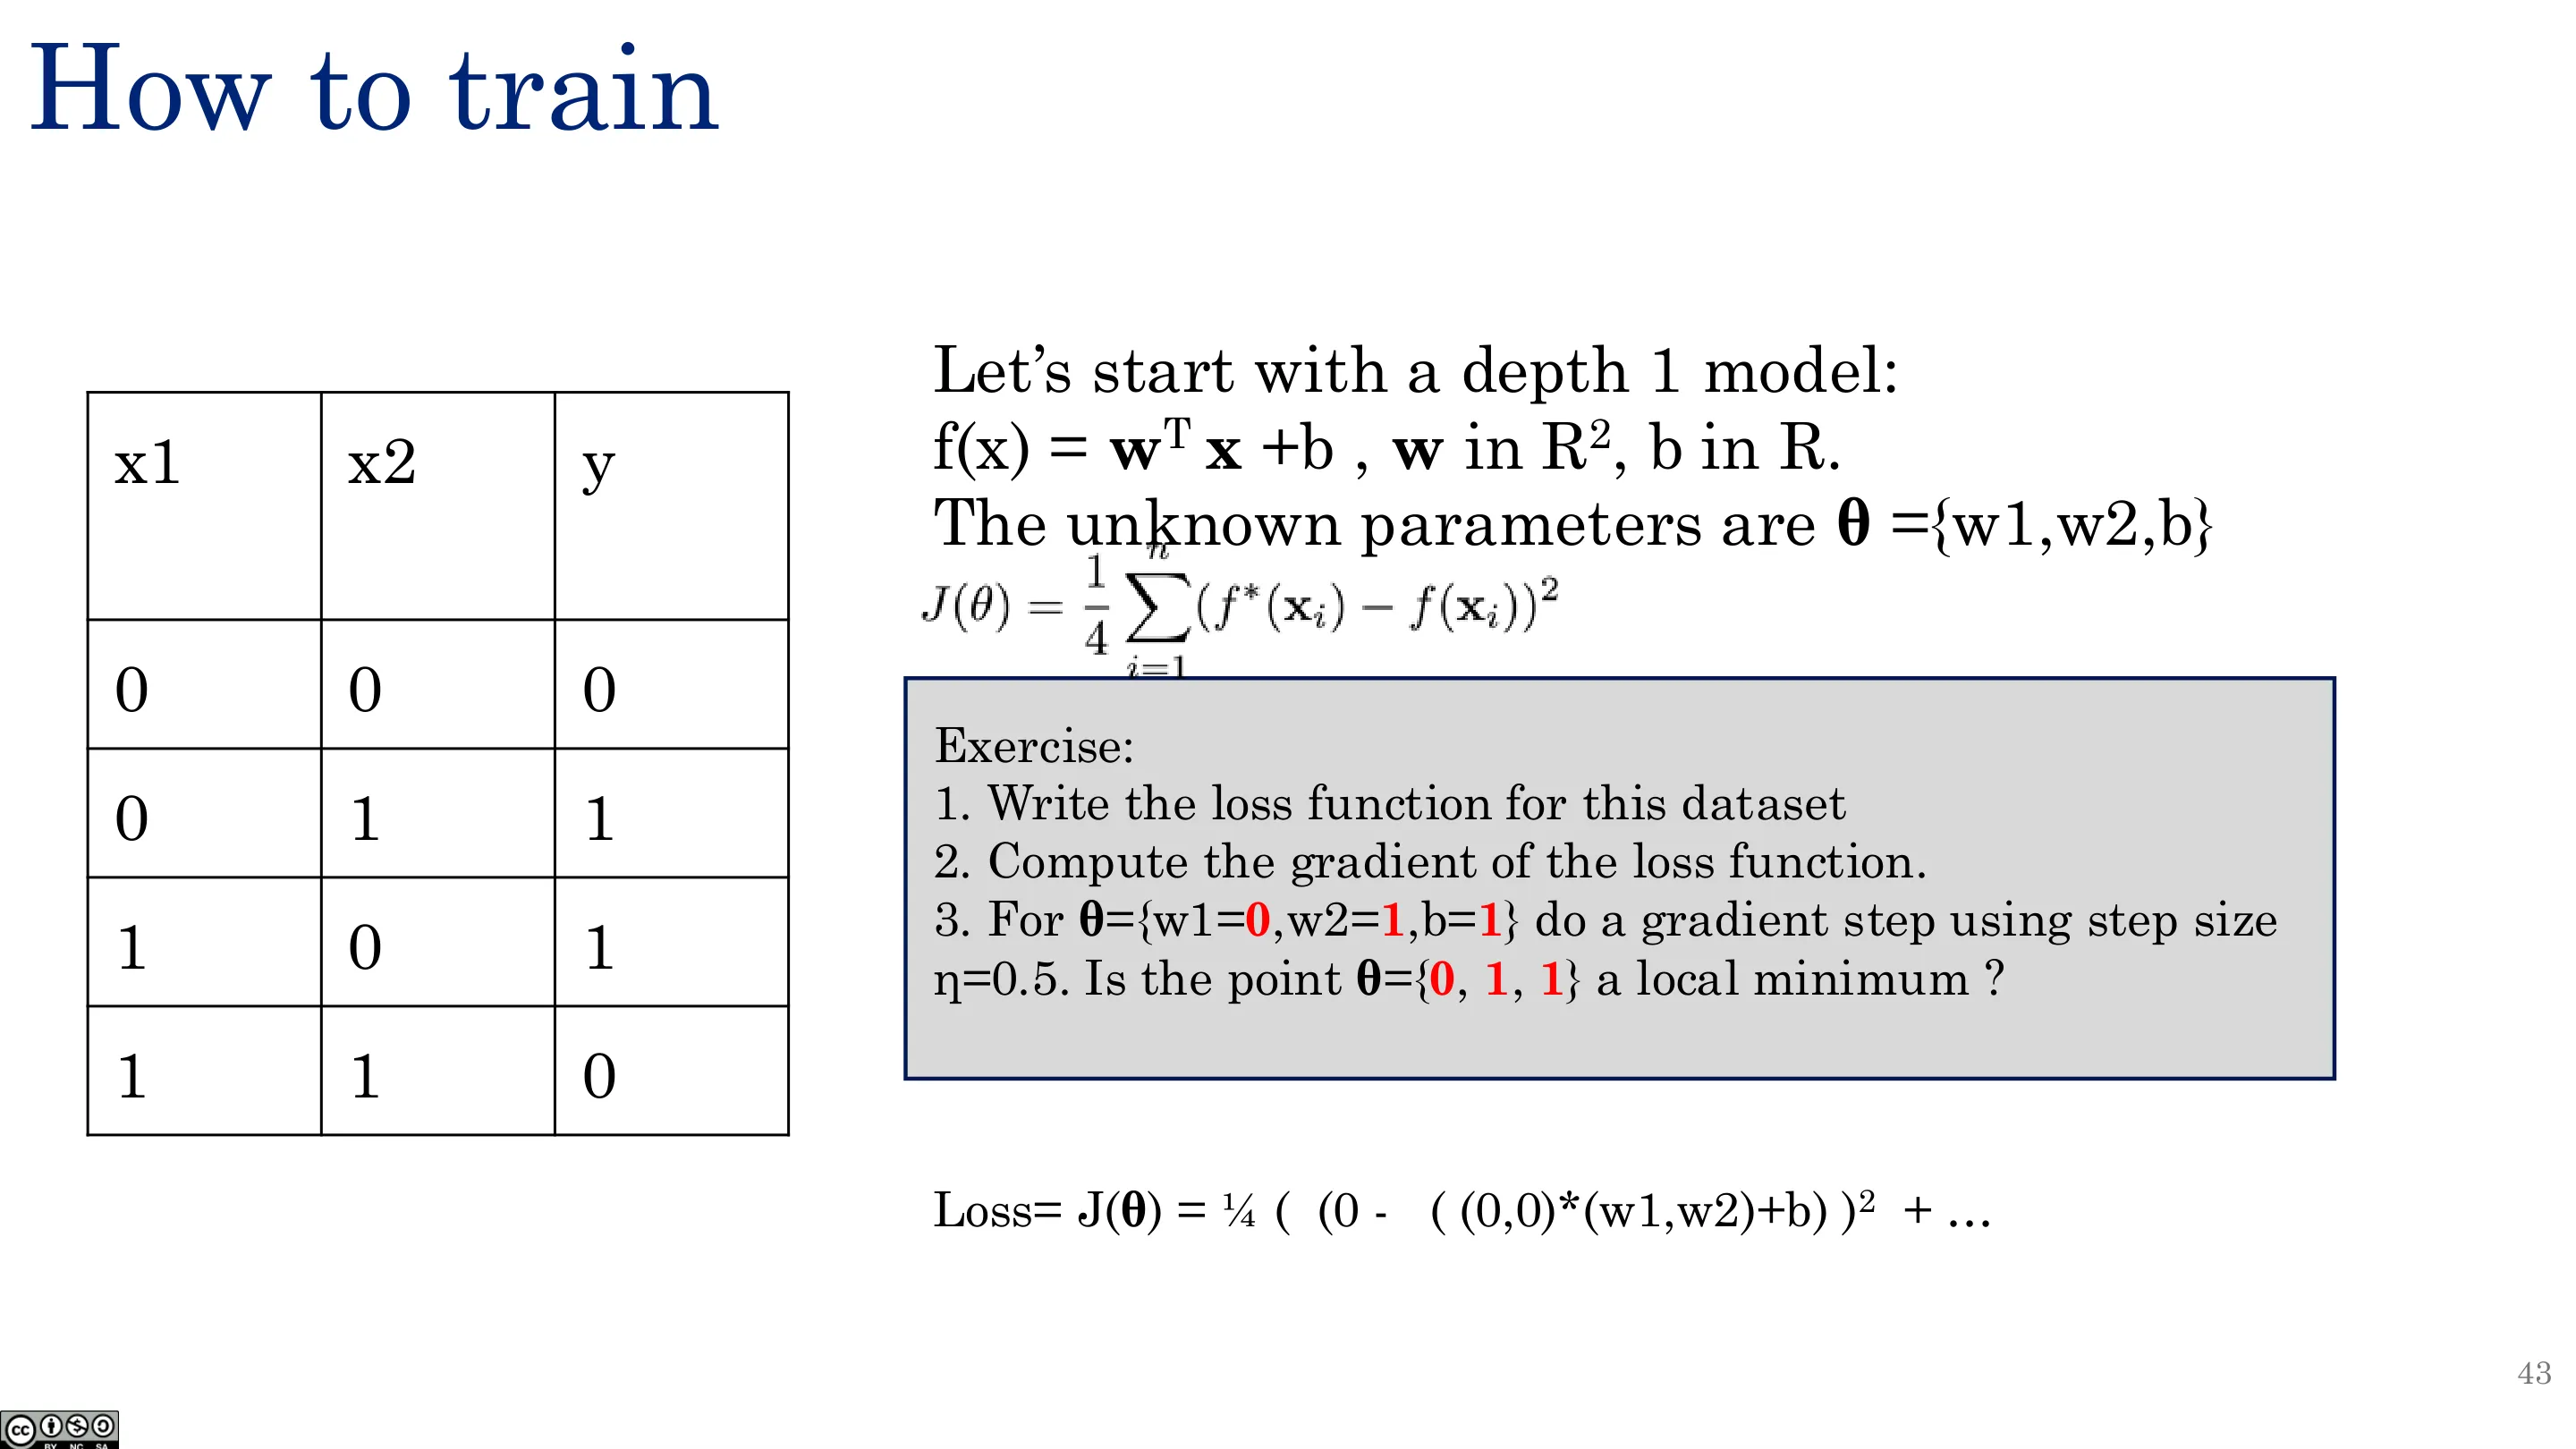
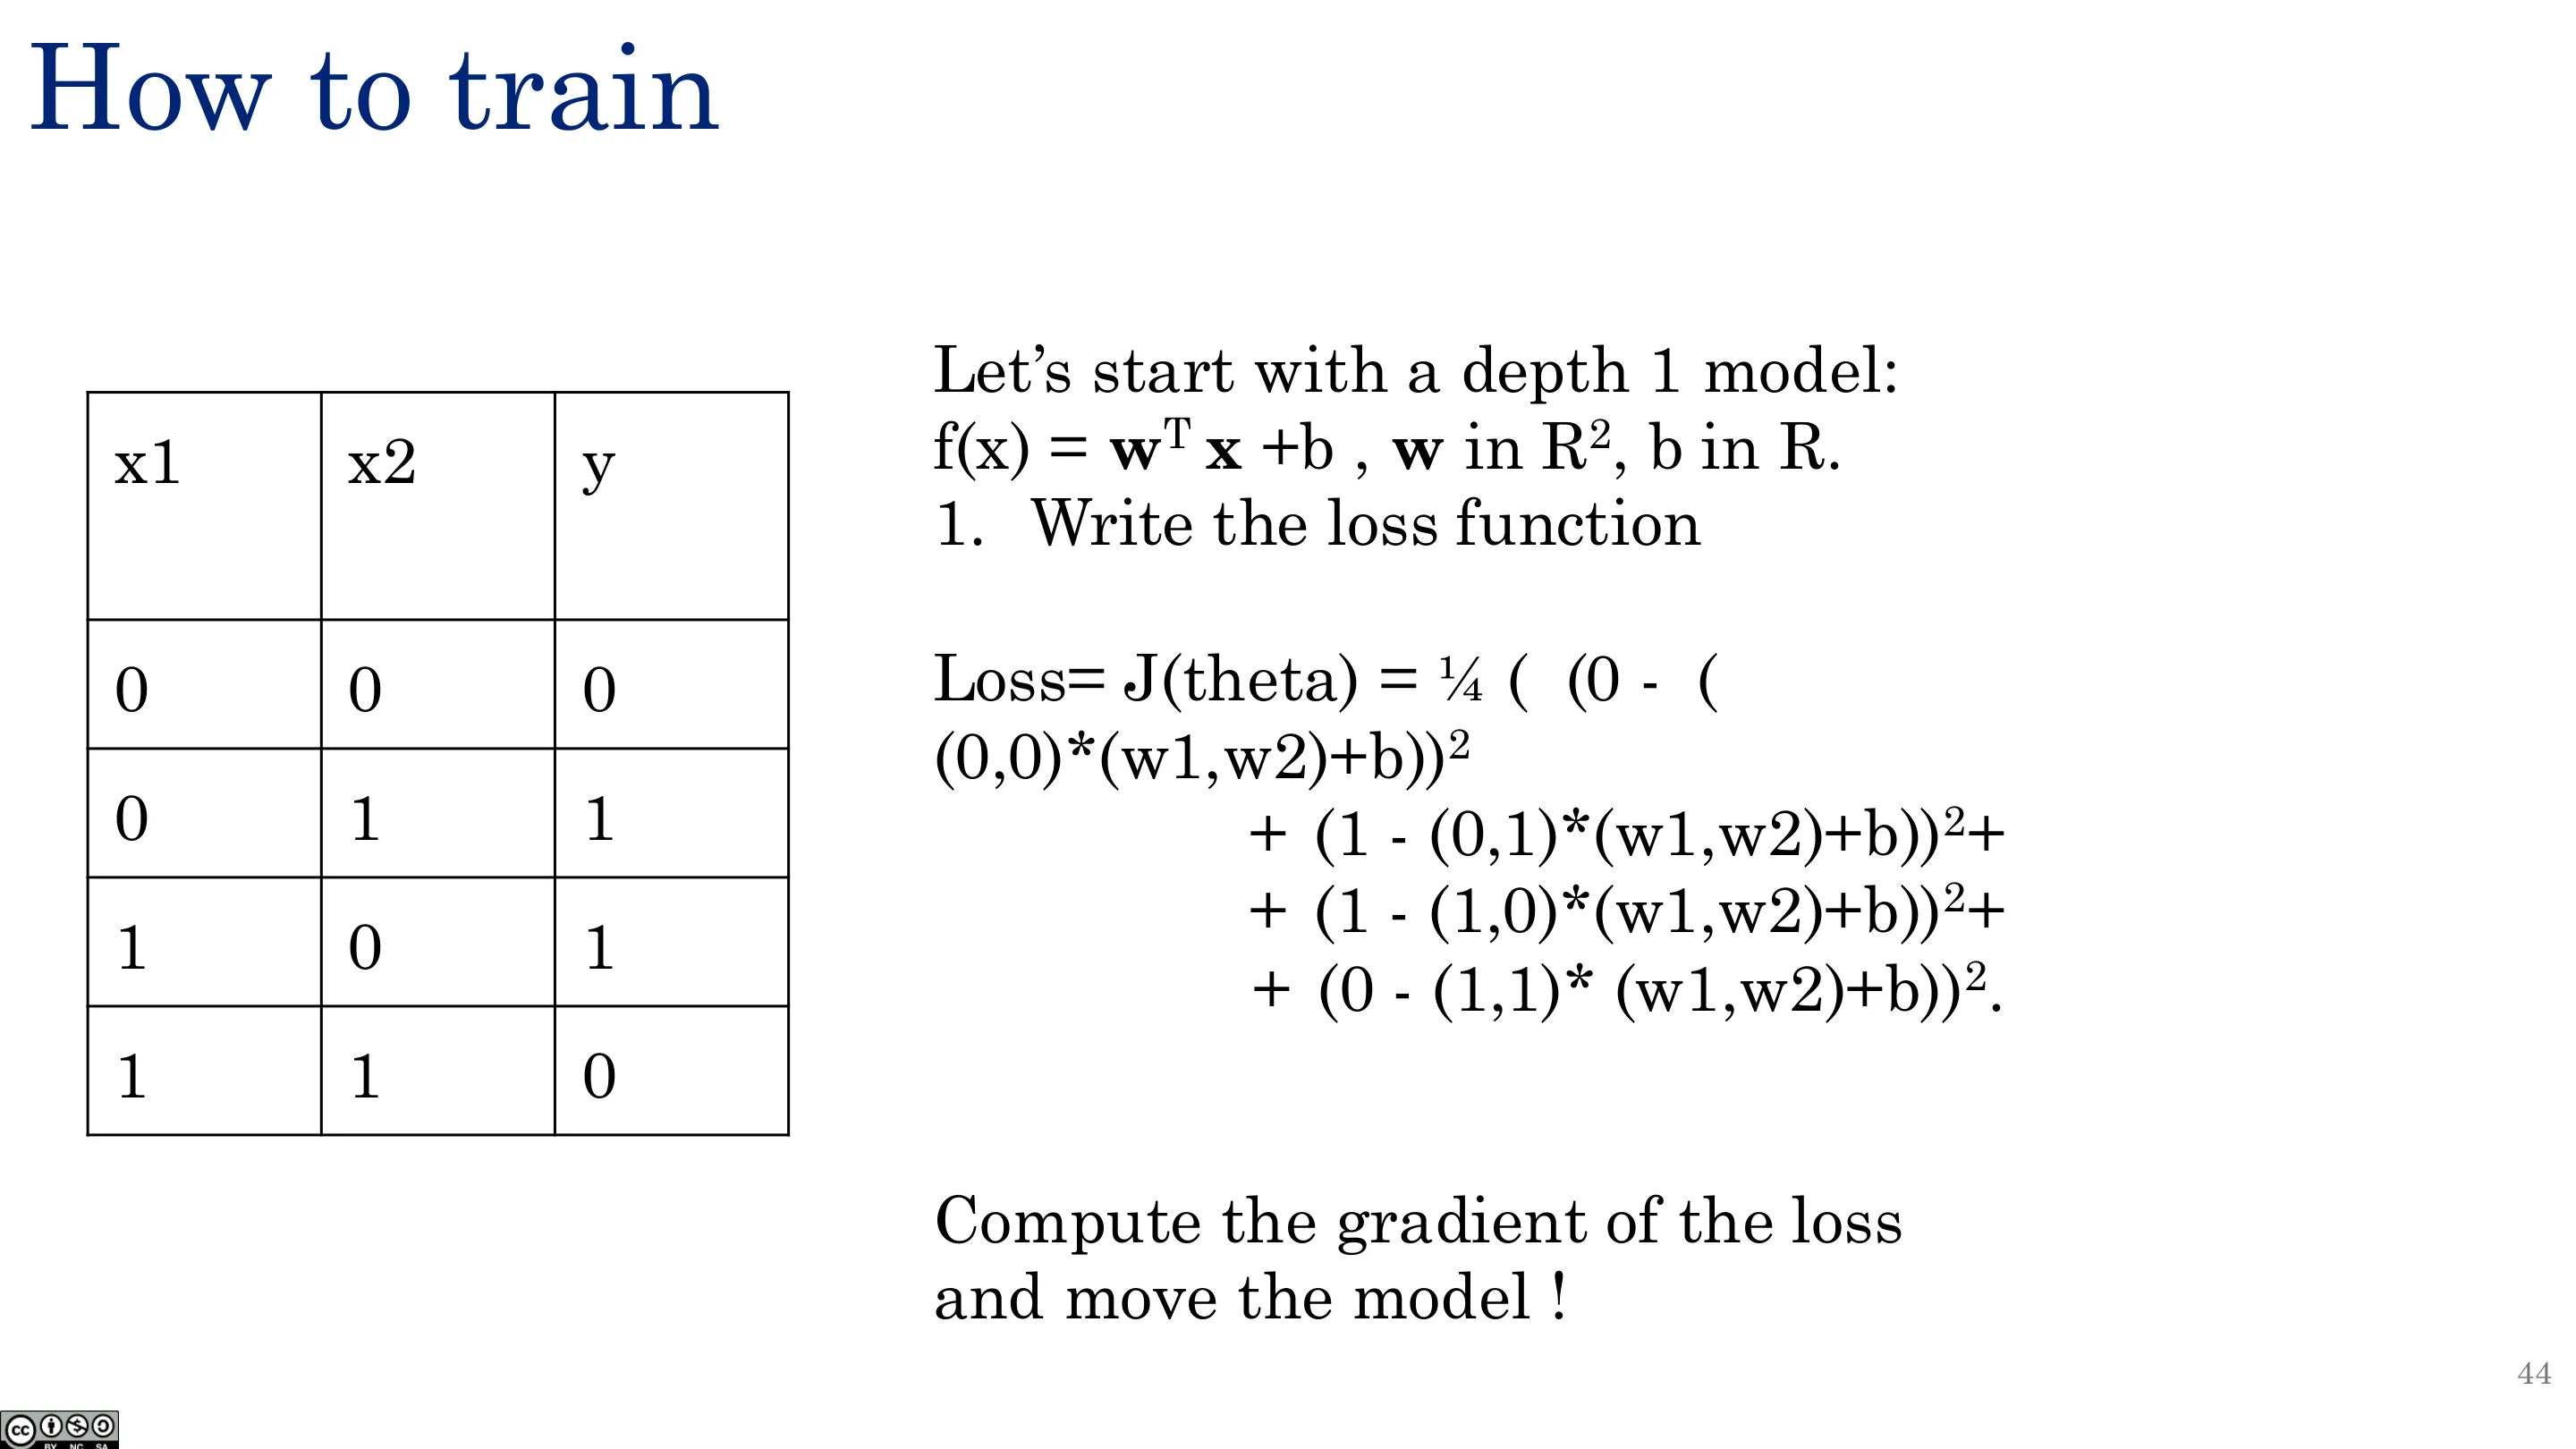
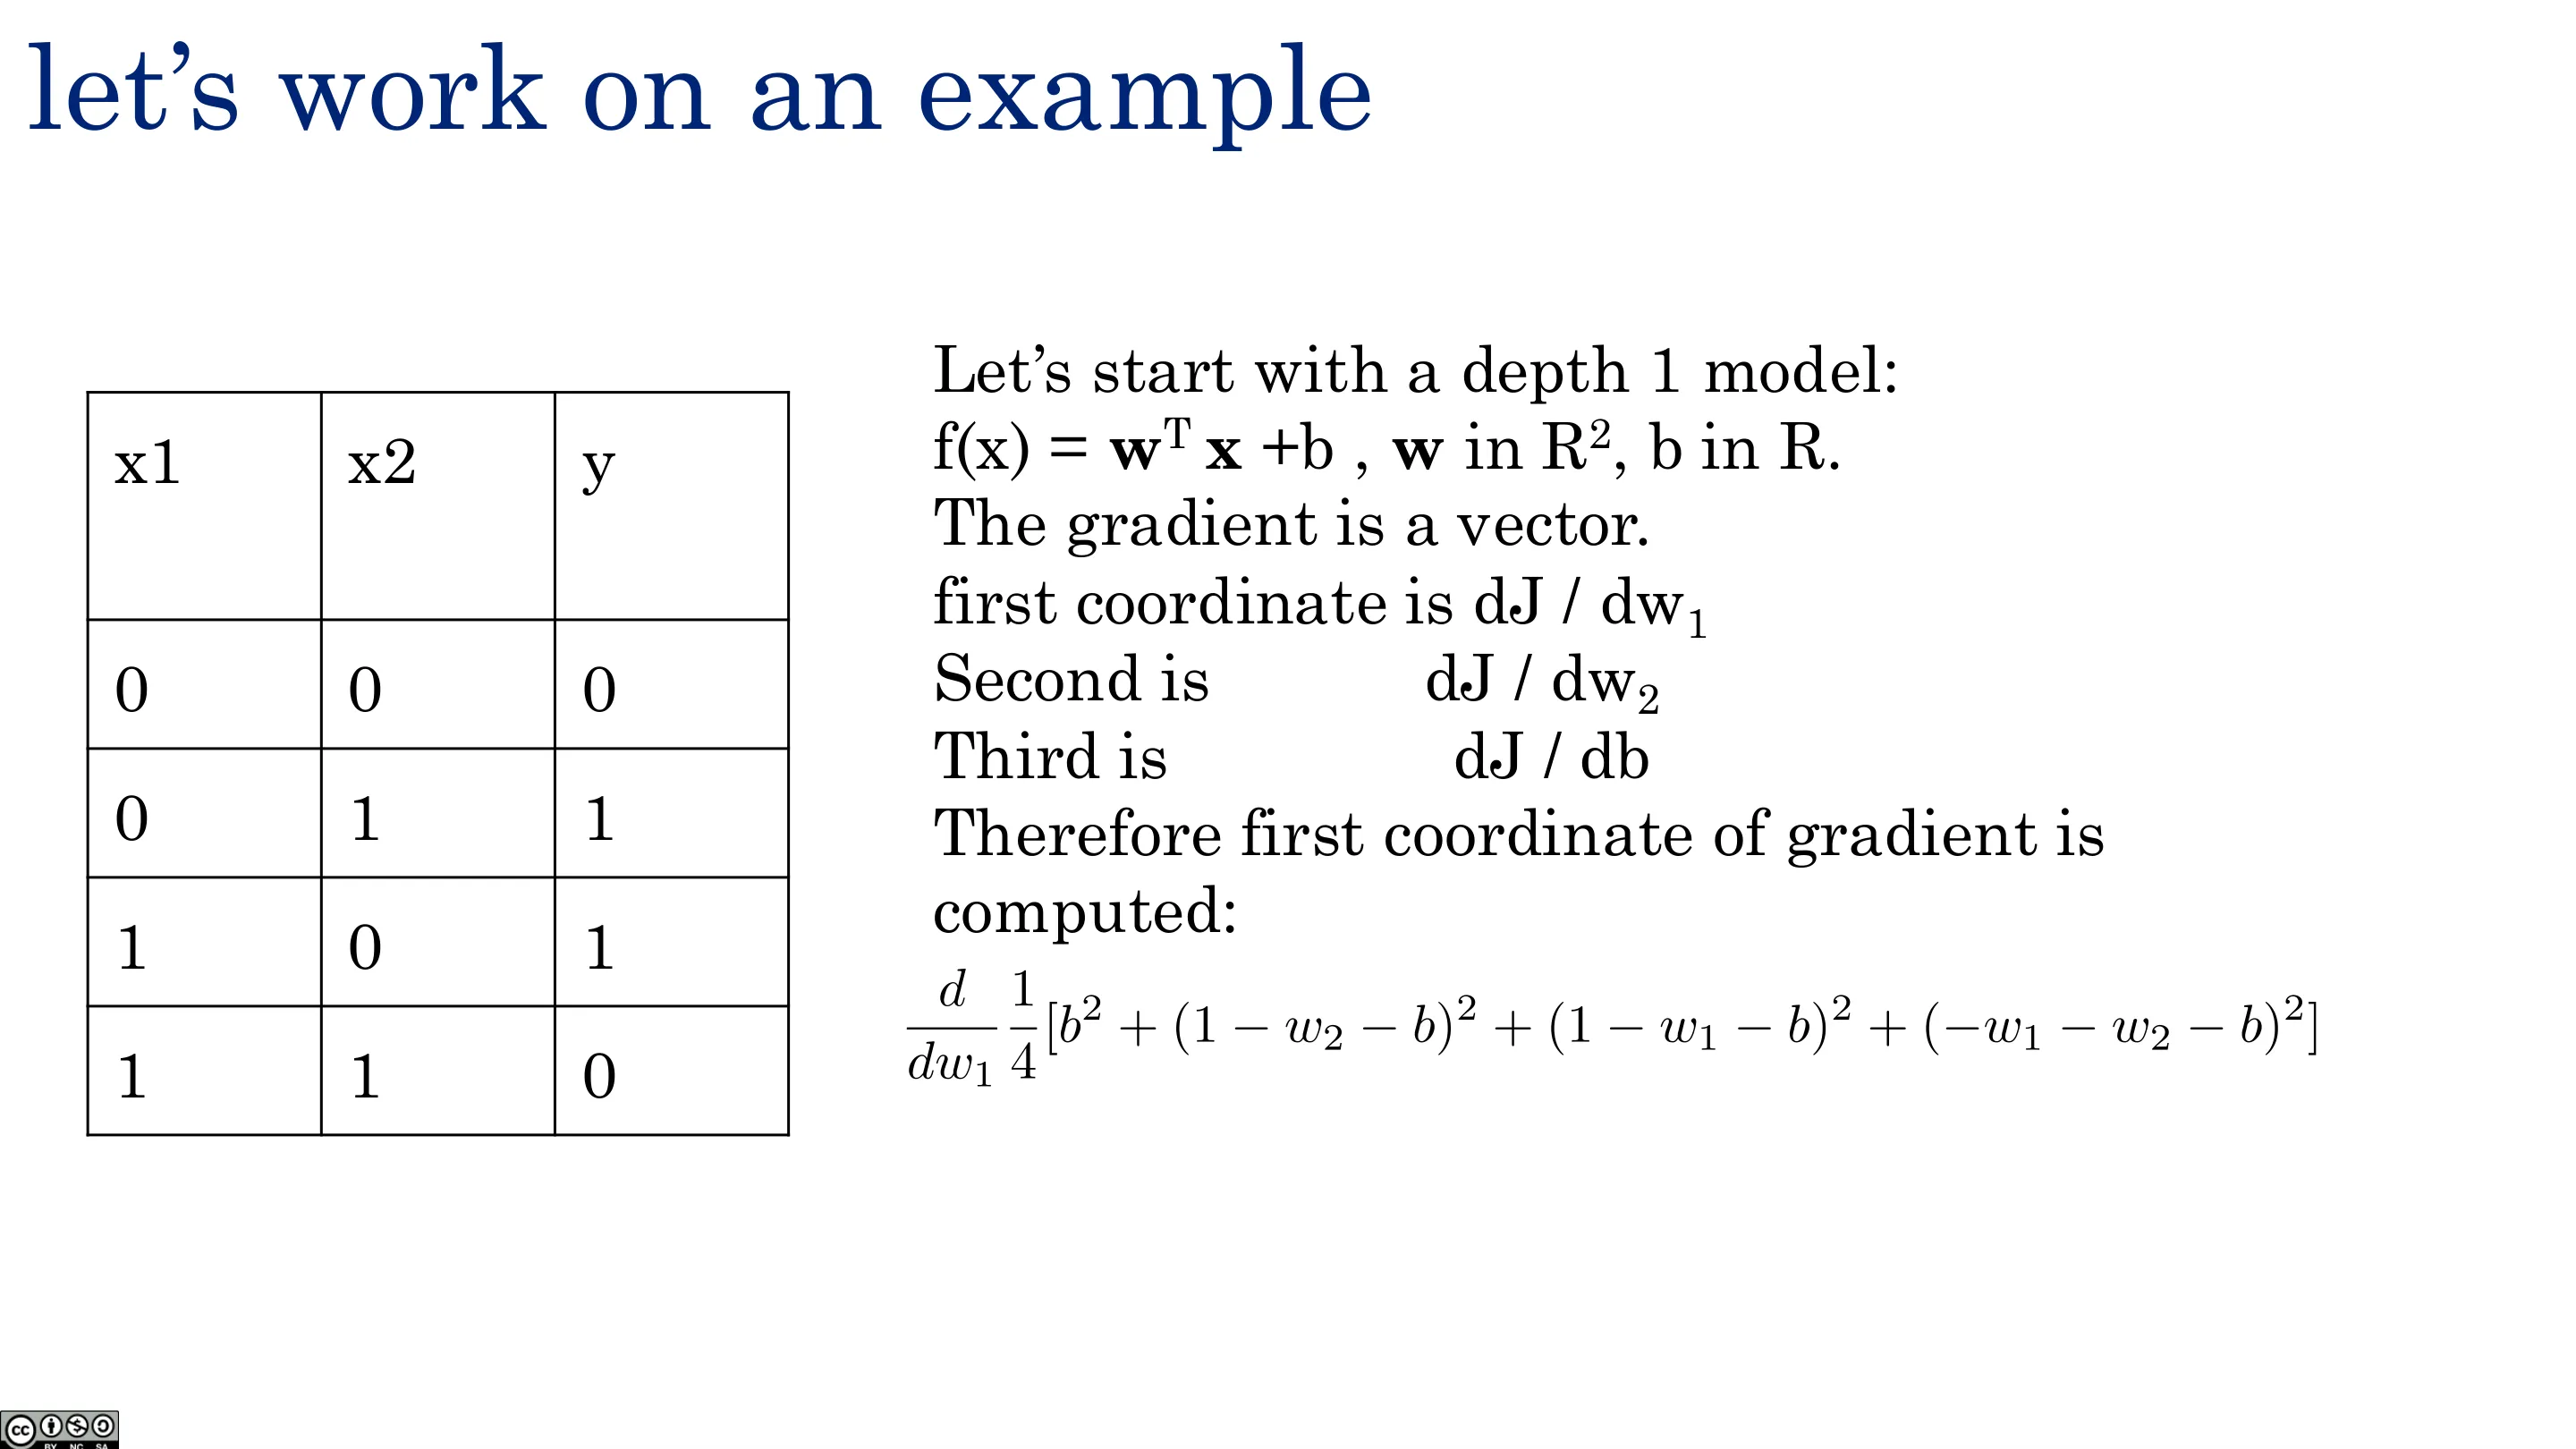
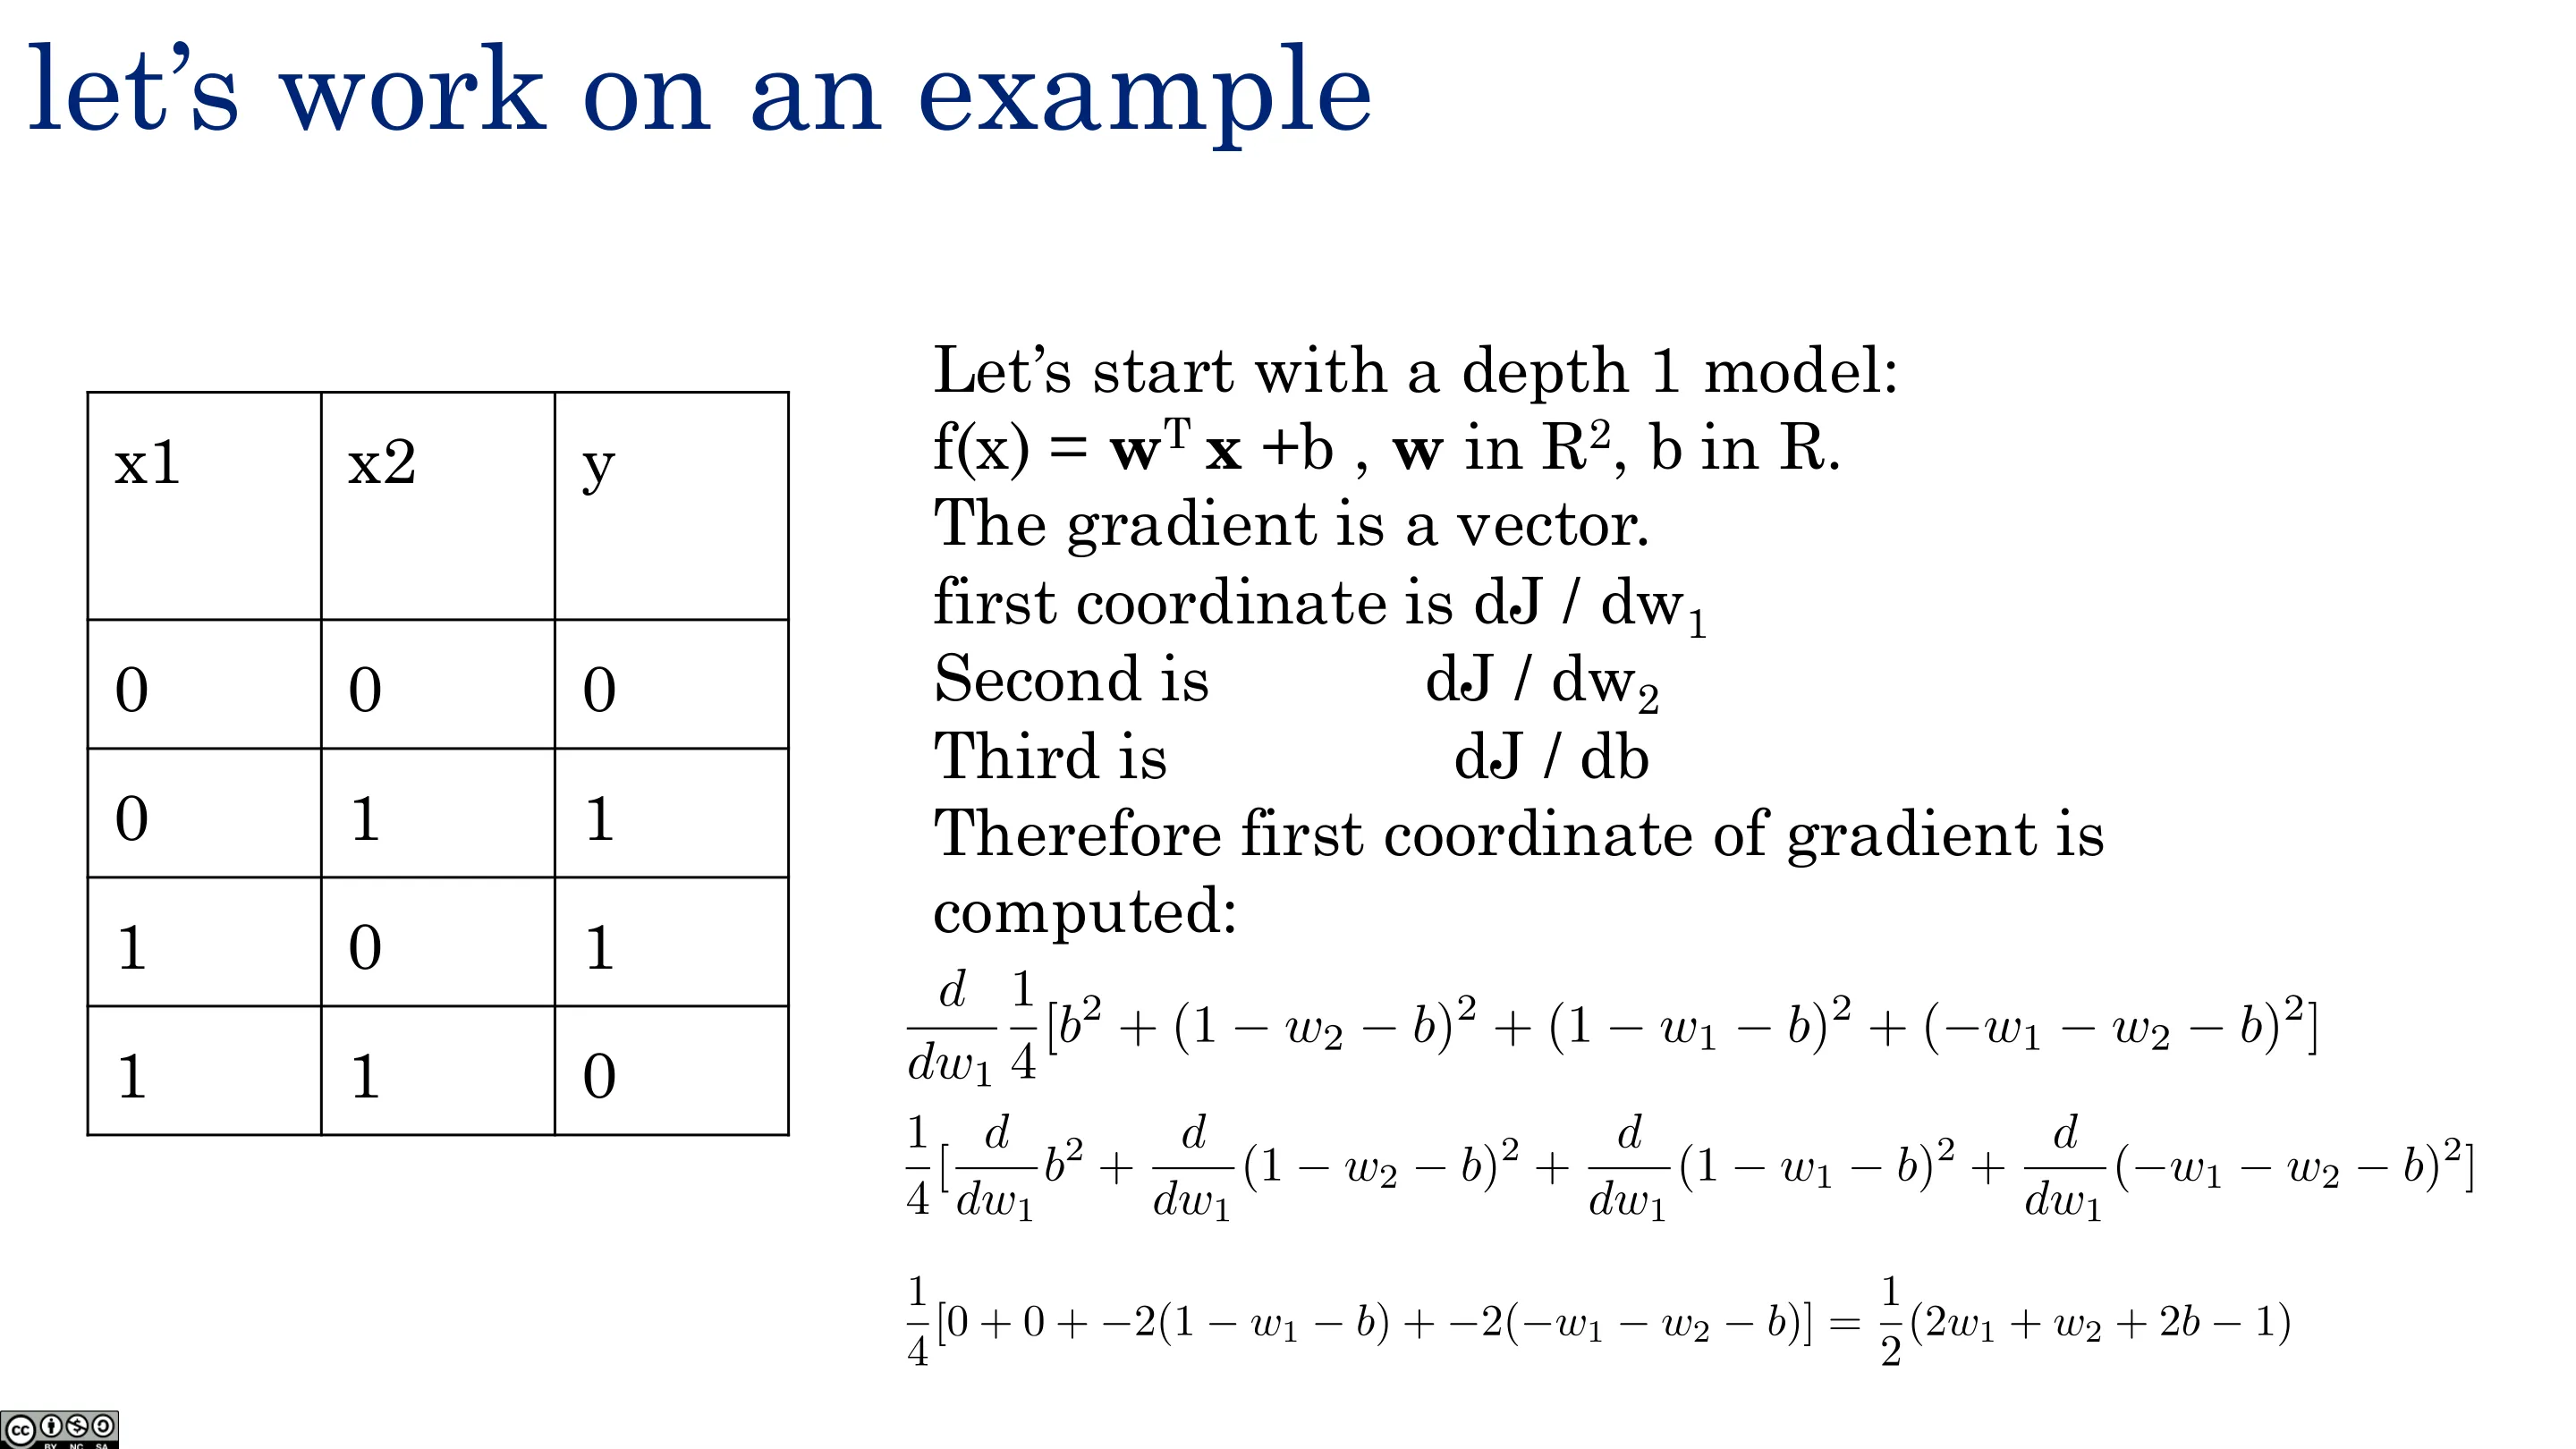
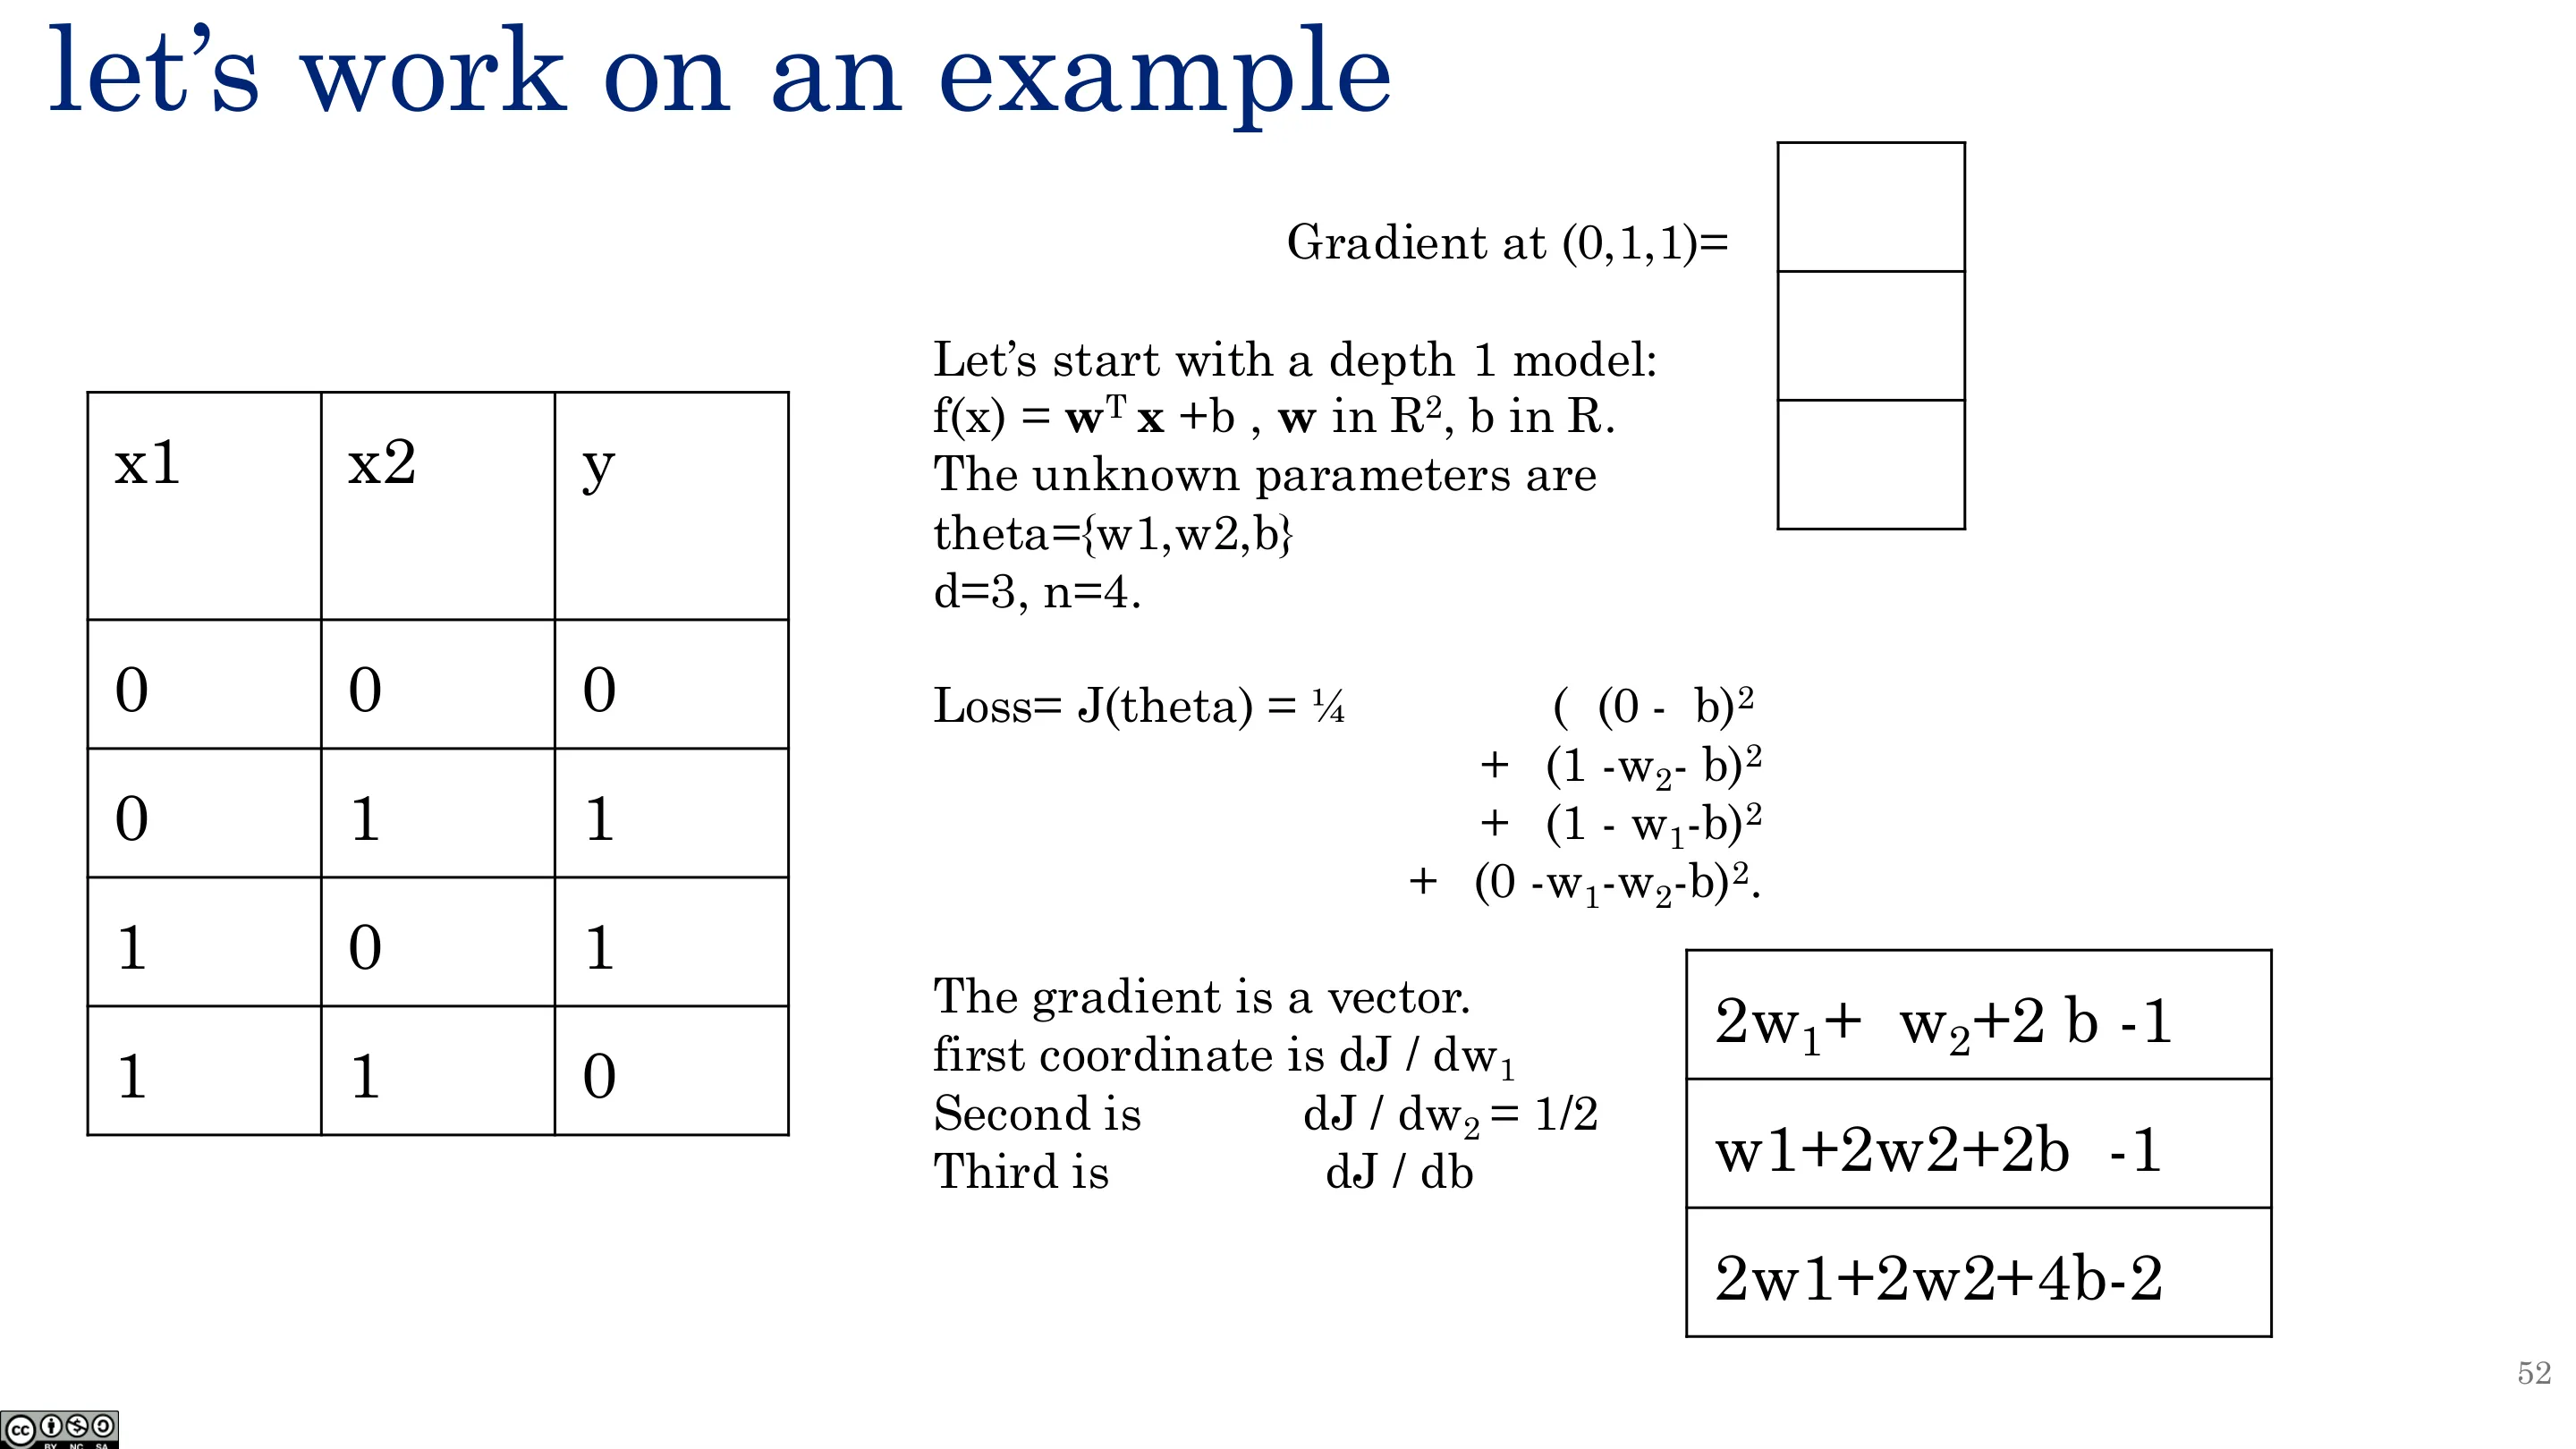
训练:写出平方损失、对 9 个参数做梯度下降(见上两讲)。未知数多于方程时有无穷多解,加 L2 正则可得到唯一解。
📷 万有性
回到原视频 (00:29:32)
📷 万能逼近定理(一)
回到原视频 (00:30:45)
📷 万能逼近定理(二)
回到原视频 (00:31:58)
📷 万能逼近定理(三)
回到原视频 (00:33:11)
📷 为什么要深?类比
回到原视频 (00:34:24)
📷 激活
回到原视频 (00:35:37)
📷 激活函数
回到原视频 (00:36:50)
📷 其他激活函数(一)
回到原视频 (00:38:03)
📷 其他激活函数(二)
回到原视频 (00:39:16)
📷 为什么要隐藏层(一)
回到原视频 (00:40:29)
📷 为什么要隐藏层(二)
回到原视频 (00:41:42)
📷 给定 d 个特征
回到原视频 (00:42:55)
📷 为什么要隐藏层(三)
回到原视频 (00:44:08)
📷 手算示例(一)
回到原视频 (00:45:21)
📷 手算示例(二)
回到原视频 (00:46:34)
📷 手算示例(三)
回到原视频 (00:47:47)
📷 手算示例(四)
回到原视频 (00:49:00)
📷 如何训练(一)
回到原视频 (00:50:13)
📷 如何训练(二)
回到原视频 (00:51:26)
📷 如何训练(三)
回到原视频 (00:52:39)
📷 如何训练(四)
回到原视频 (00:53:52)
📷 如何训练(五)
回到原视频 (00:55:05)
📷 如何训练(六)
回到原视频 (00:56:18)
📷 如何训练(七)
回到原视频 (00:57:31)
📷 手算示例(五)
回到原视频 (00:58:44)
📷 手算示例(六)
回到原视频 (00:59:57)
📷 手算示例(七)
回到原视频 (01:01:10)
📷 手算示例(八)
回到原视频 (01:02:23)
📷 手算示例(九)
回到原视频 (01:03:36)
📷 手算示例(十)
回到原视频 (01:04:49)
📷 手算示例(十一)
回到原视频 (01:06:02)
📷 1 隐藏层 - 深度线性模型(一)
回到原视频 (01:07:15)
📷 1 隐藏层 - 深度线性模型(二)
回到原视频 (01:08:28)
📷 1 隐藏层 - 线性(一)
回到原视频 (01:09:41)
📷 1 隐藏层 - 线性(二)
回到原视频 (01:10:54)
📷 1 隐藏层 - 线性(三)
回到原视频 (01:12:07)
📷 1 隐藏层 - ReLU 激活(一)
回到原视频 (01:13:20)
📷 1 隐藏层 - ReLU 激活(二)
回到原视频 (01:14:33)
📷 1 隐藏层 - ReLU(一)
回到原视频 (01:15:46)
📷 1 隐藏层 - ReLU(二)
回到原视频 (01:16:59)
📷 1 隐藏层 - ReLU(三)
回到原视频 (01:18:12)
四、万能逼近定理与「为什么深度」
(参考时间: 00:47)
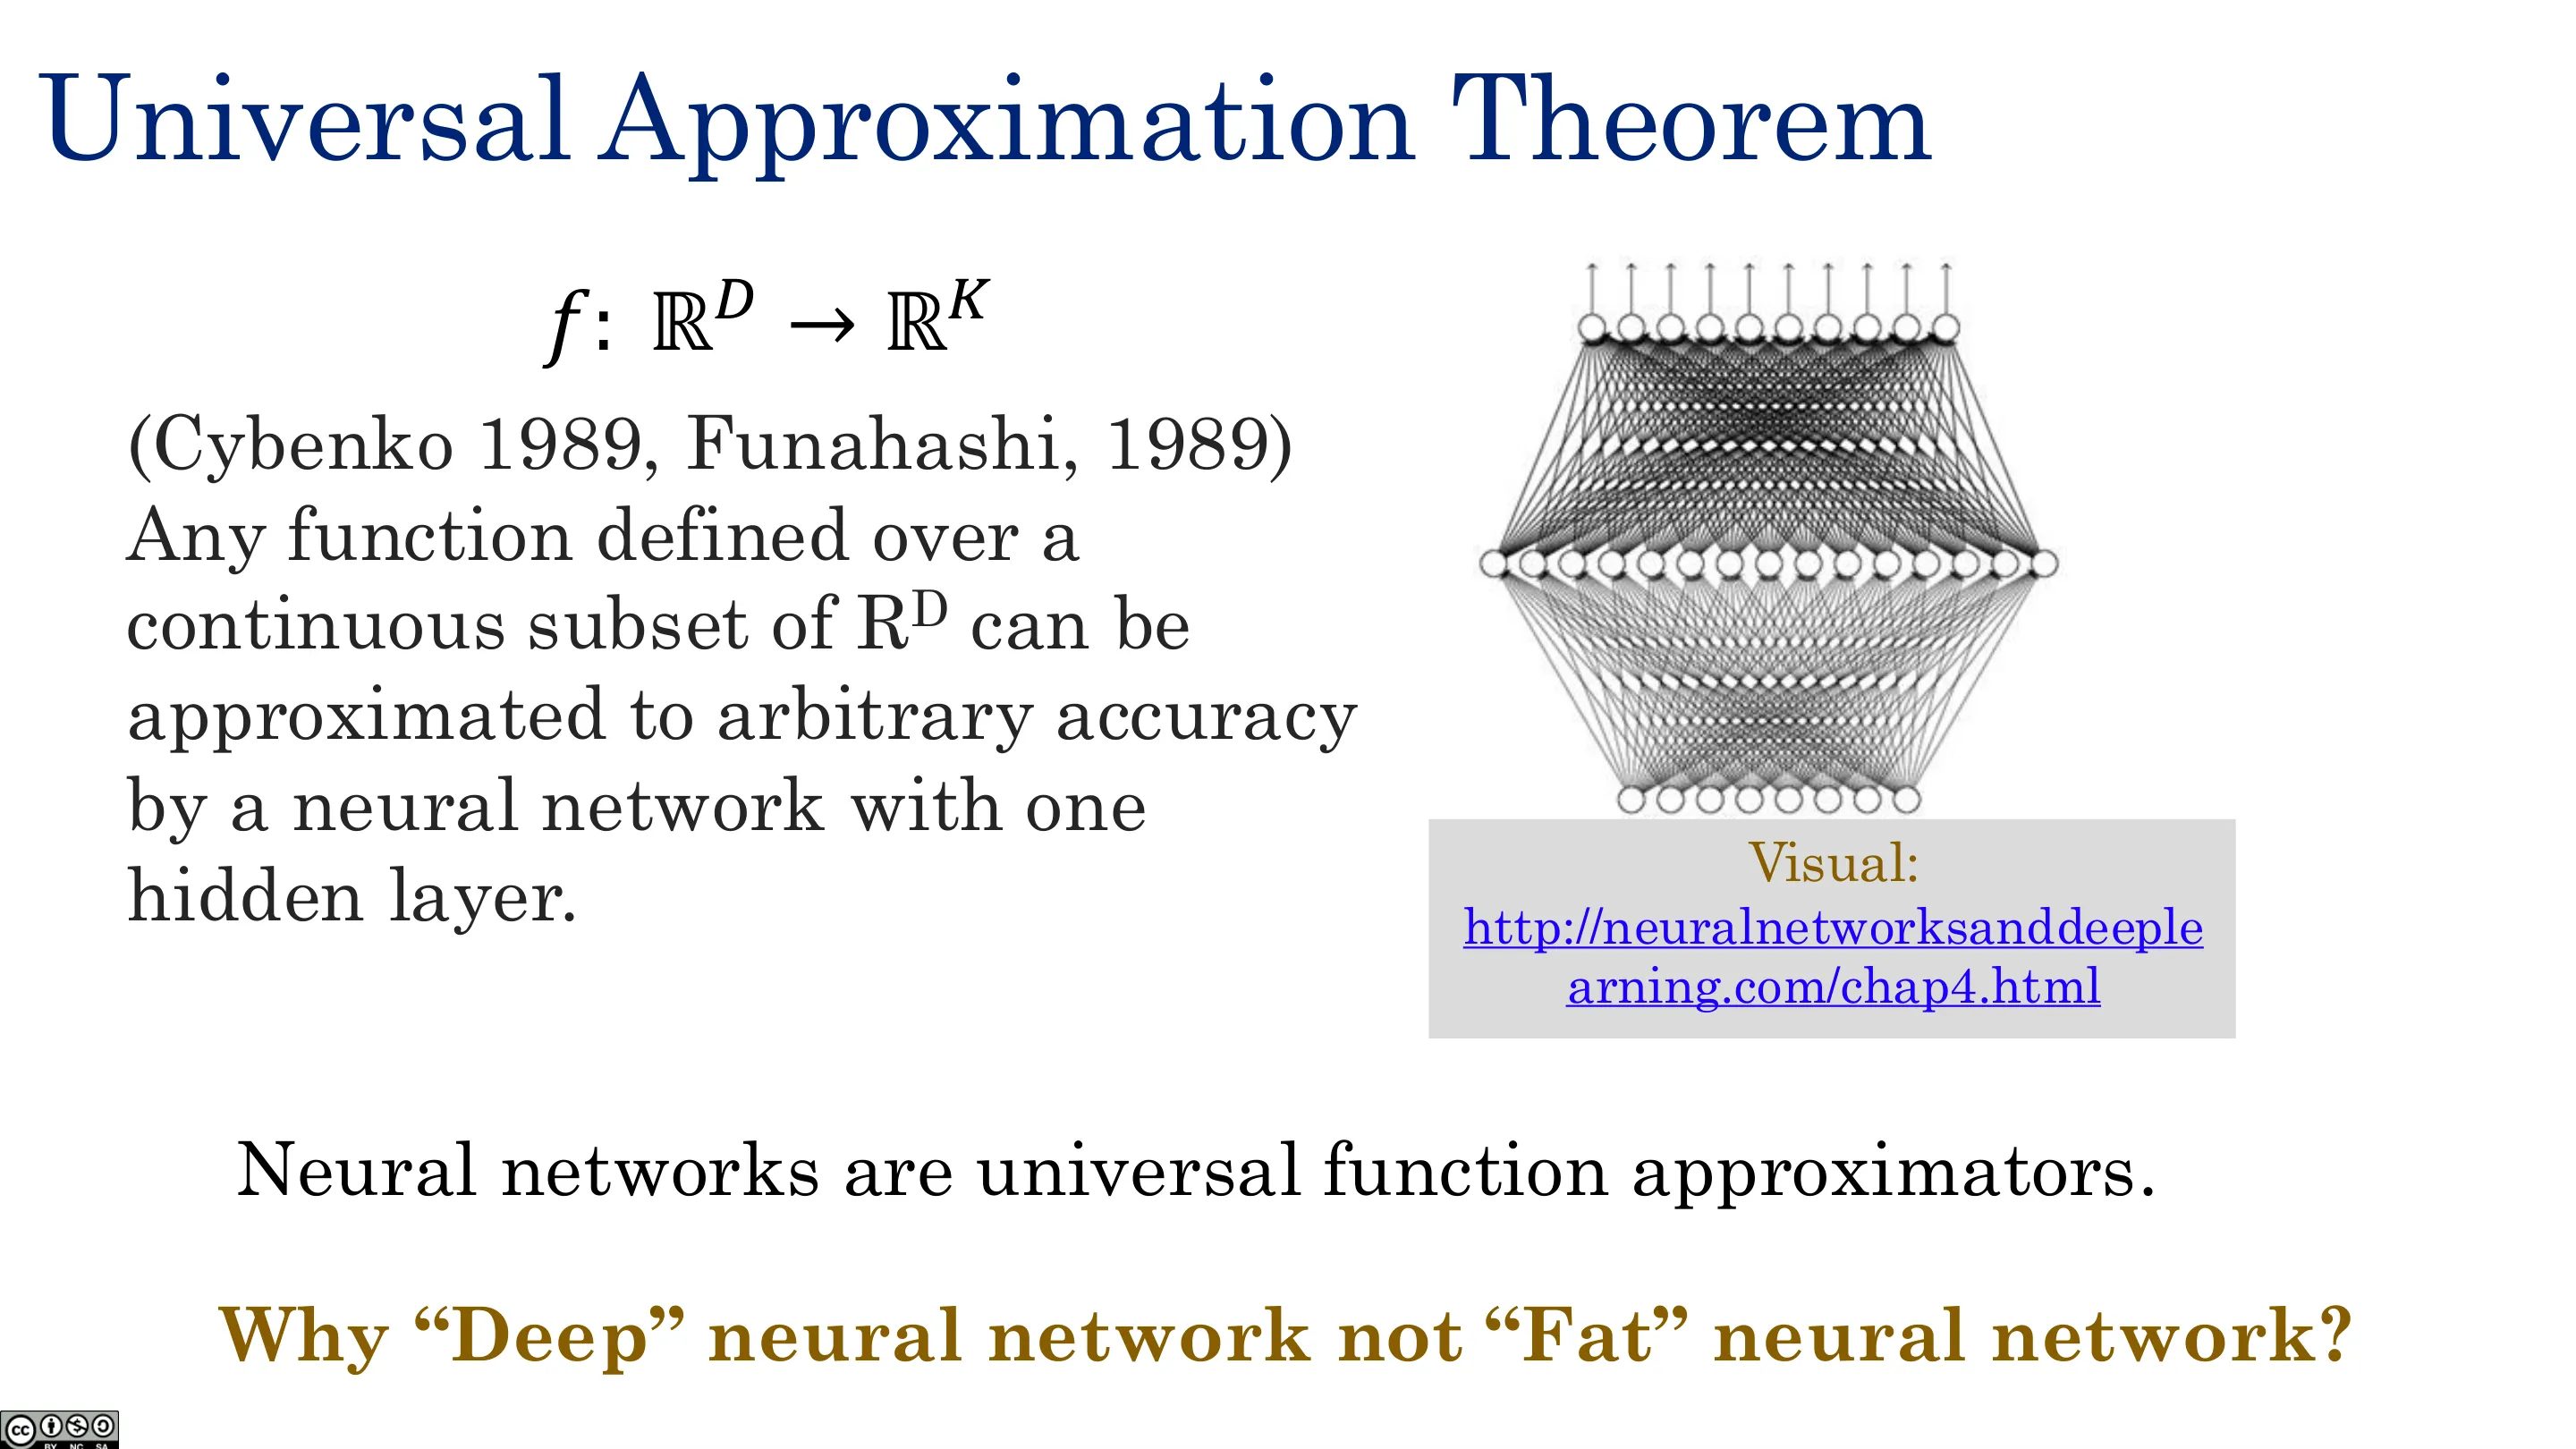
万能逼近定理(UAT,Cybenko 等):任何在紧集(如单位立方体)上的连续函数,都可用单个隐藏层的神经网络逼近到任意精度。
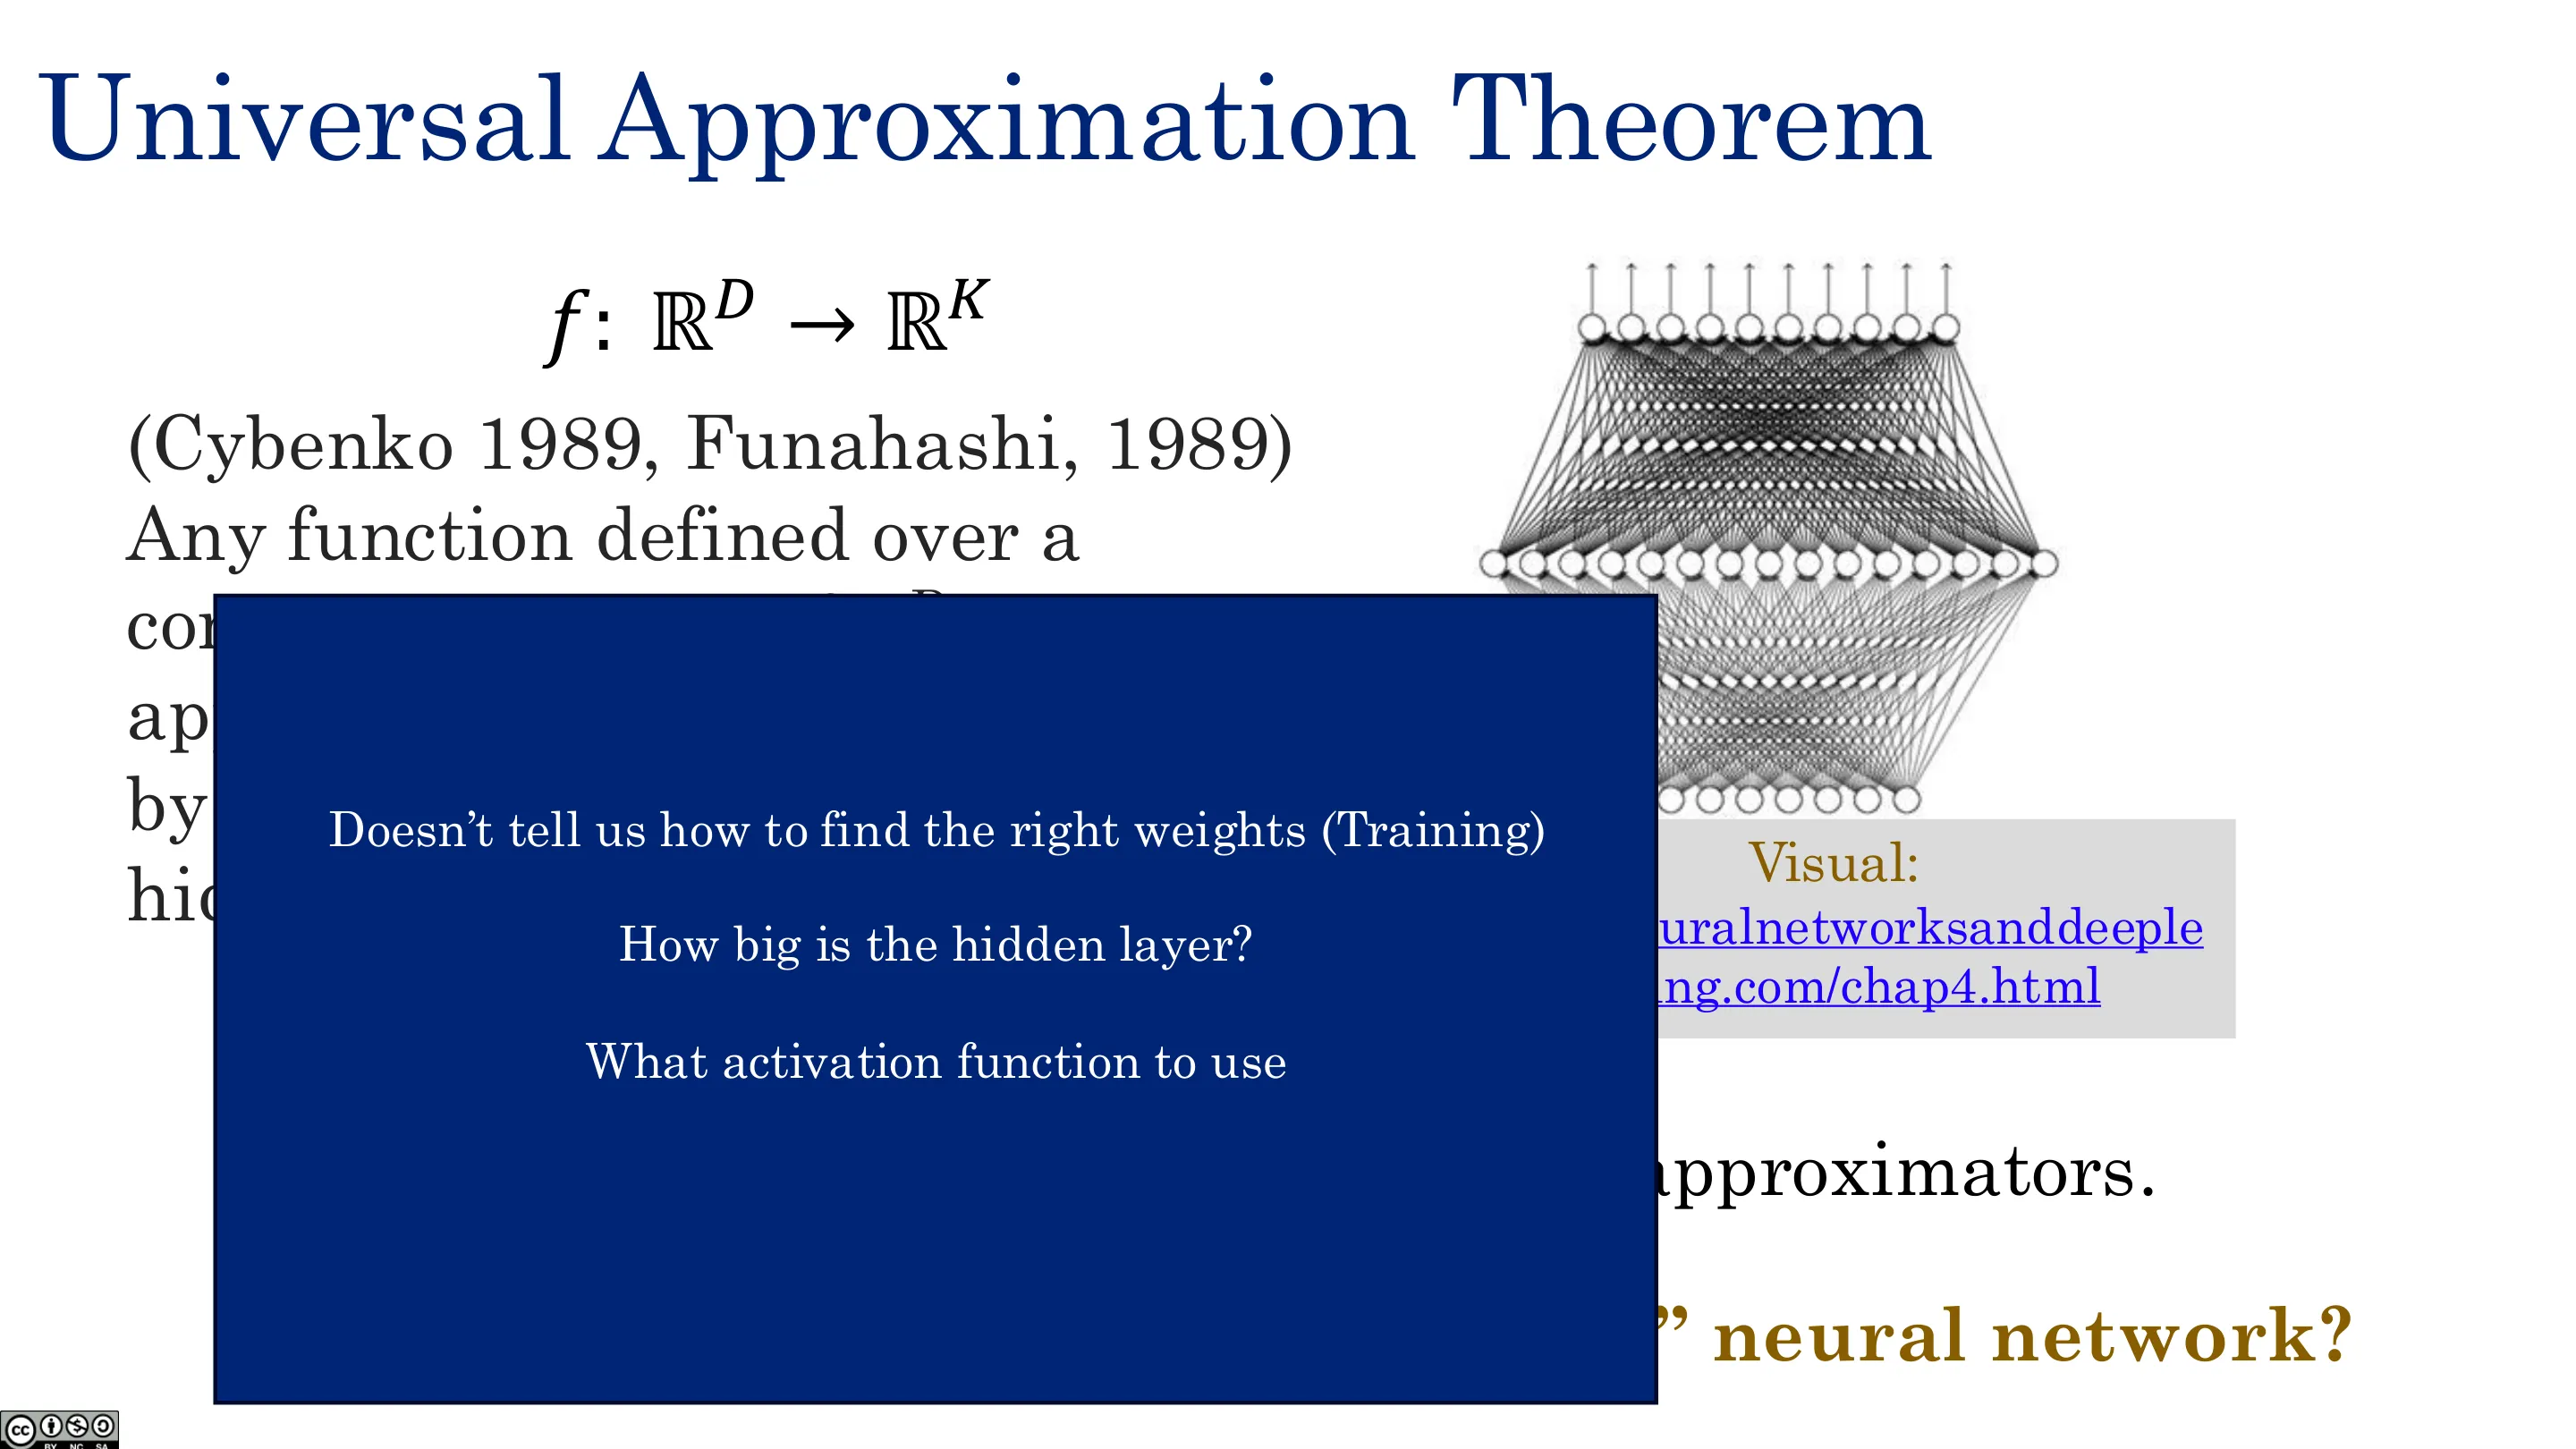
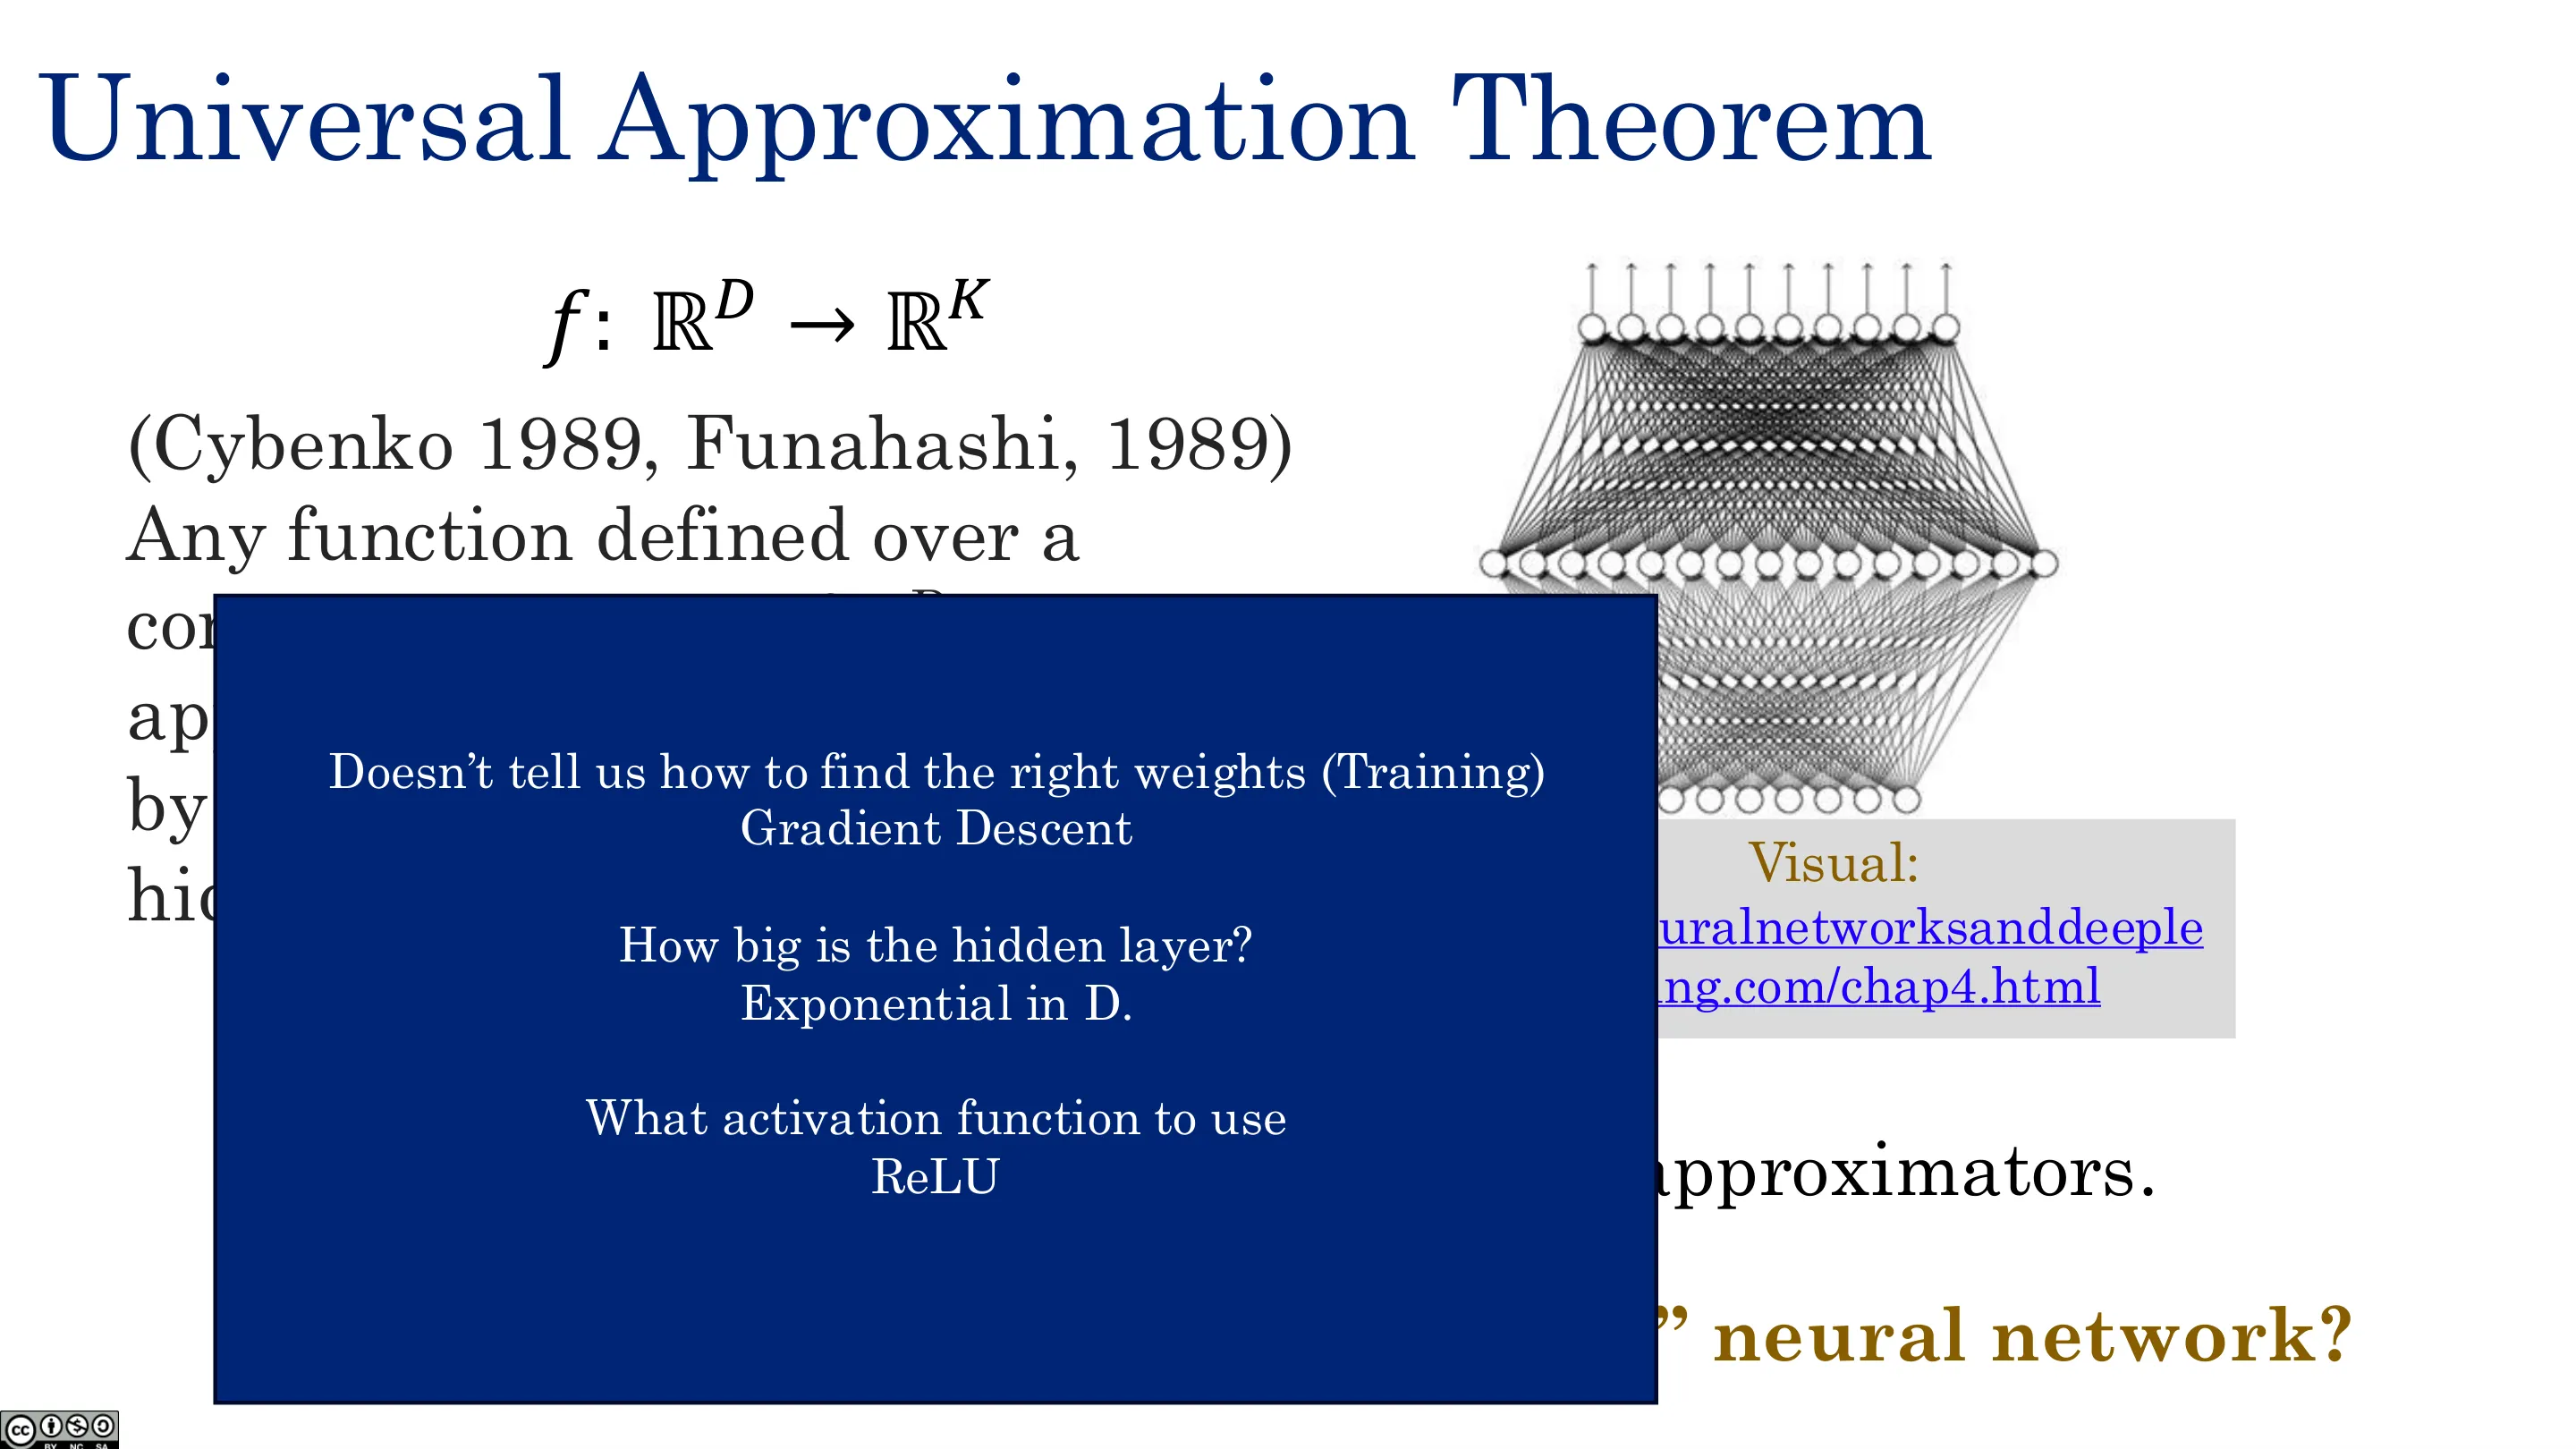
但有三个「星号」:
- 它不告诉你如何找权重——现实中就是梯度下降(令人惊讶的是它居然 work,不会卡在局部极小,尤其在过参数化时);
- 宽度可能指数级:那个隐藏层可能需要 $2^d$ 个神经元($d=4000$ ⇒ 天文数字)。这是最大的问题;
- 必须非线性激活(线性激活退化成一个 $d\times k$ 矩阵,且表示方式极其浪费)。
为什么还需要深度? 因为单层「对函数结构是盲的」。现实中的图像/语音/语言有巨大结构:多层让底层学边缘/拐角、中层学眼睛/耳朵/毛发、高层才判猫狗——这就是表示学习 / 可解释性(「Jennifer Aniston 神经元」)。
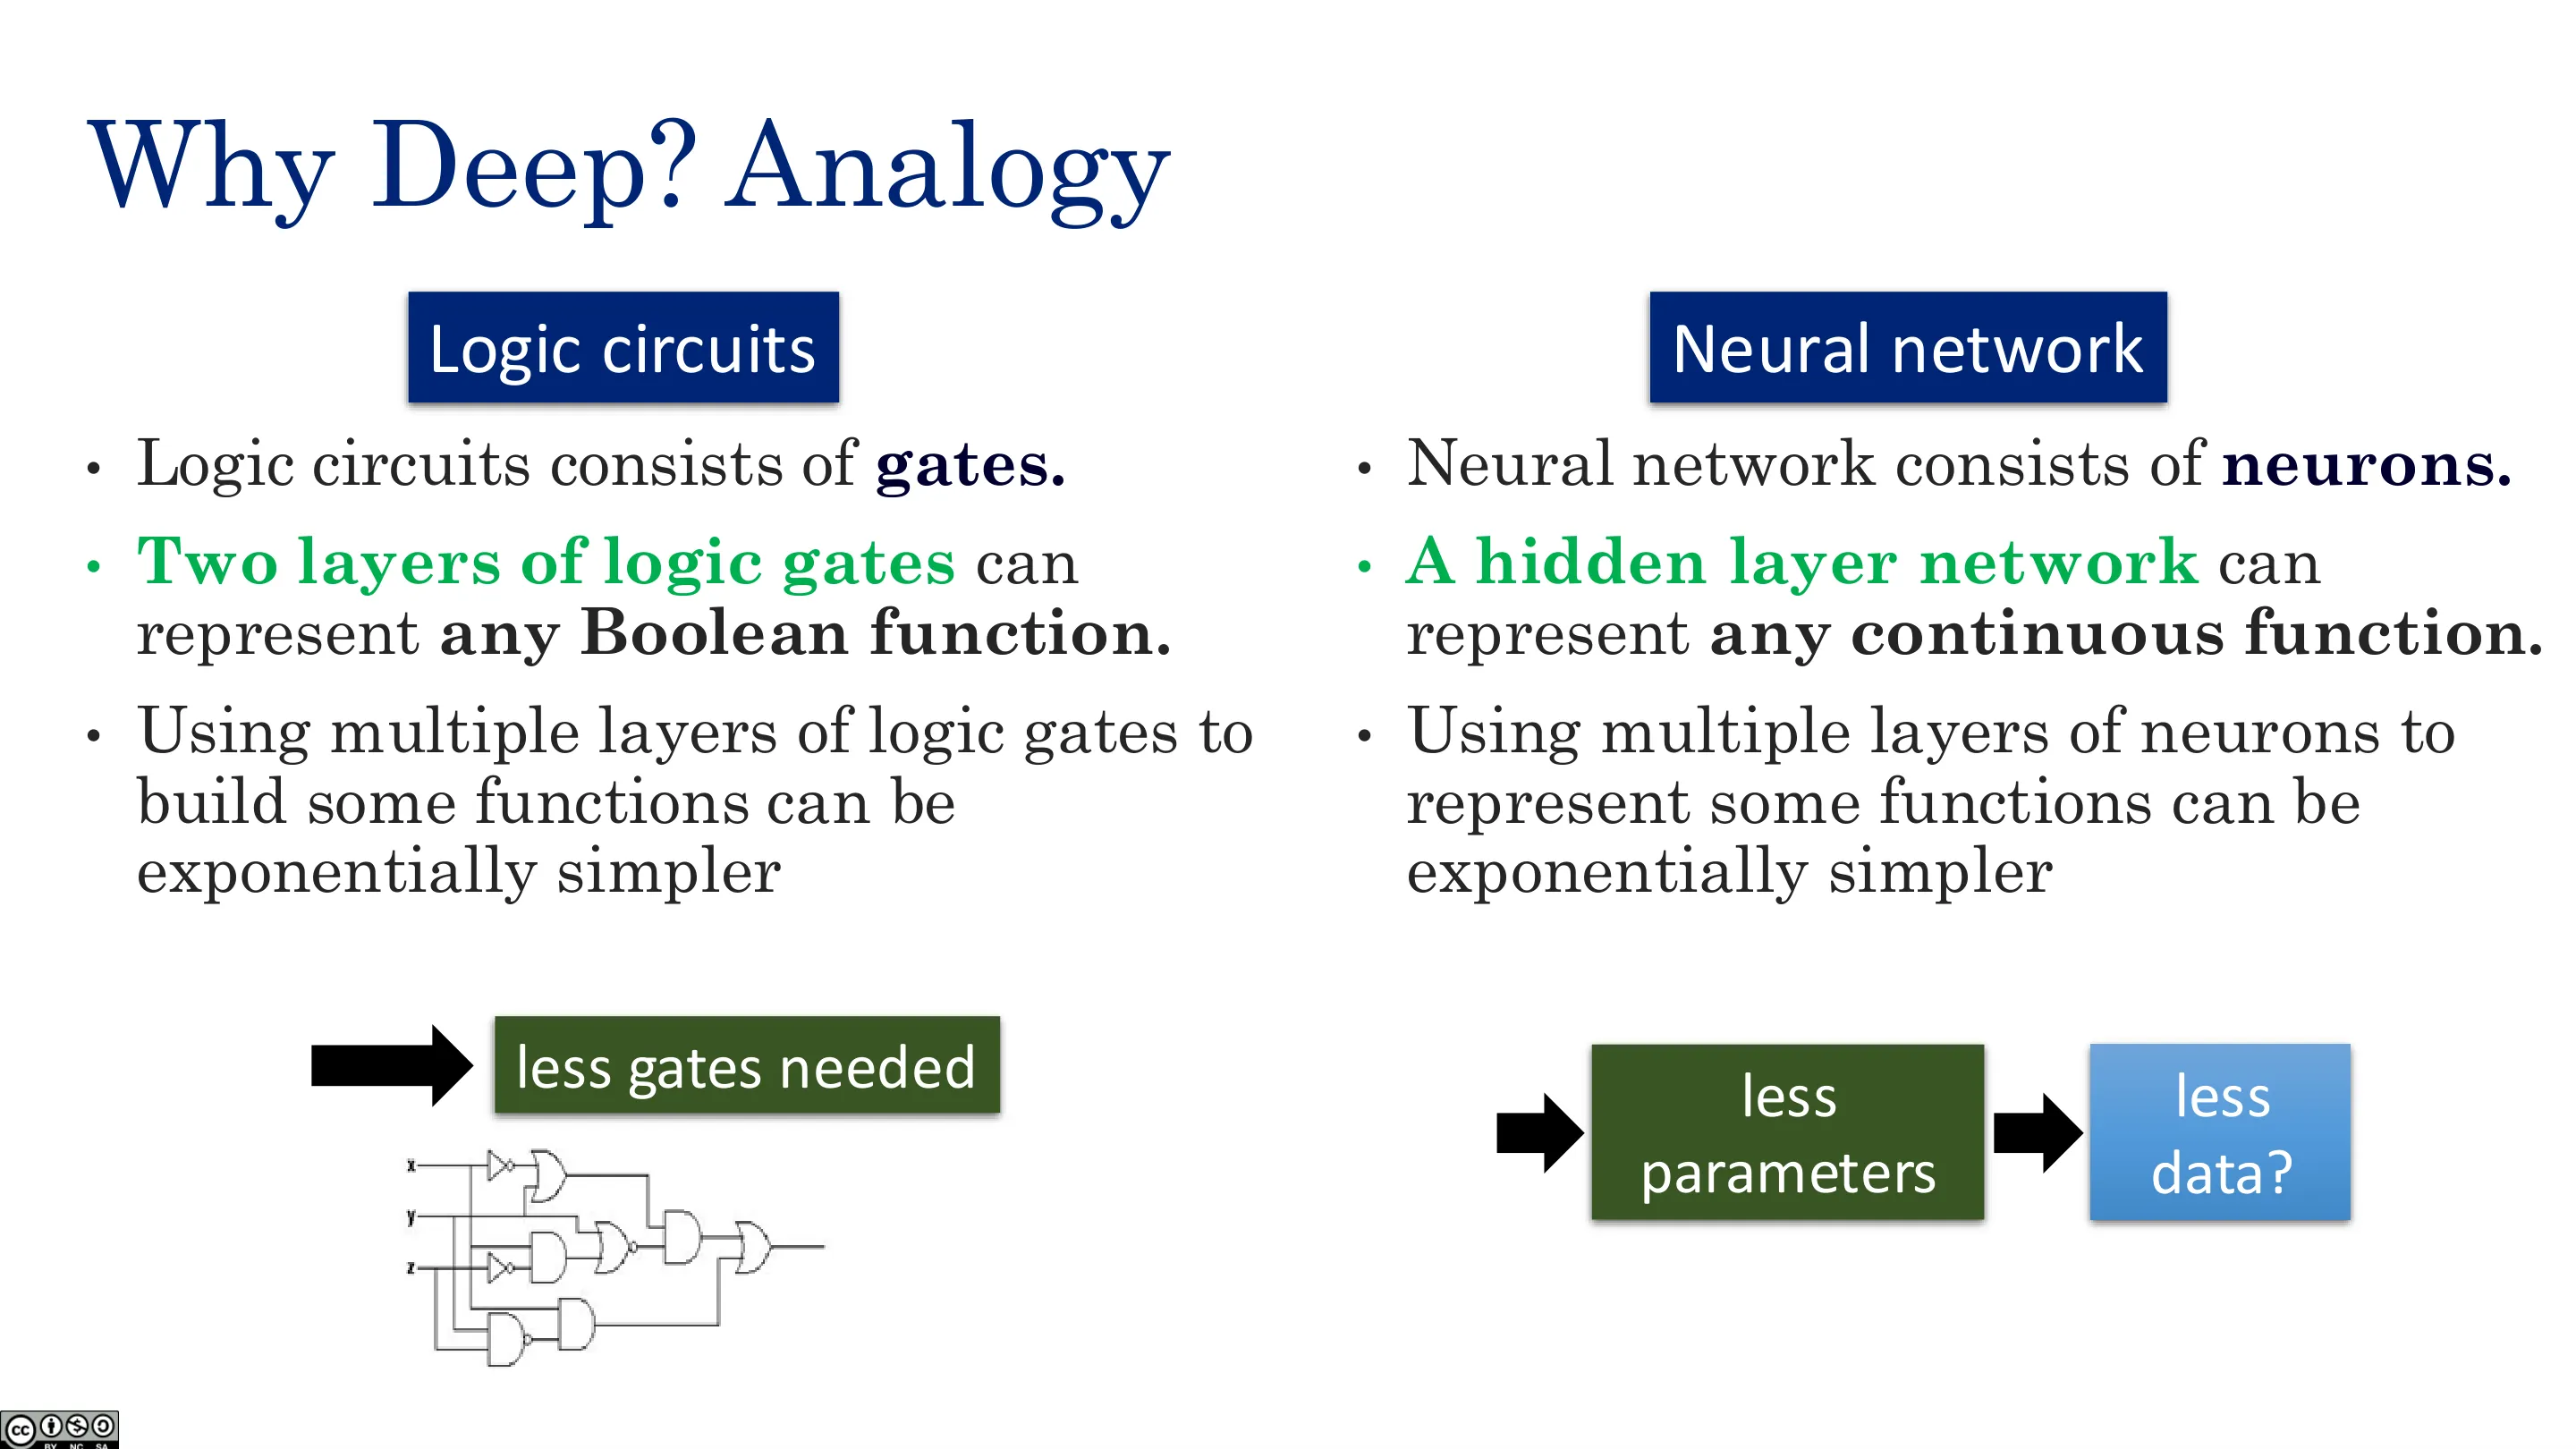
类比:布尔函数只需两层逻辑门就可表示,但那要求中间层指数大;多层可指数级更简单。神经网络同理。
📷 可窃取我的网络吗(一)
回到原视频 (01:19:25)
📷 可窃取我的网络吗(二)
回到原视频 (01:20:38)
五、激活函数的演进
(参考时间: 01:00)
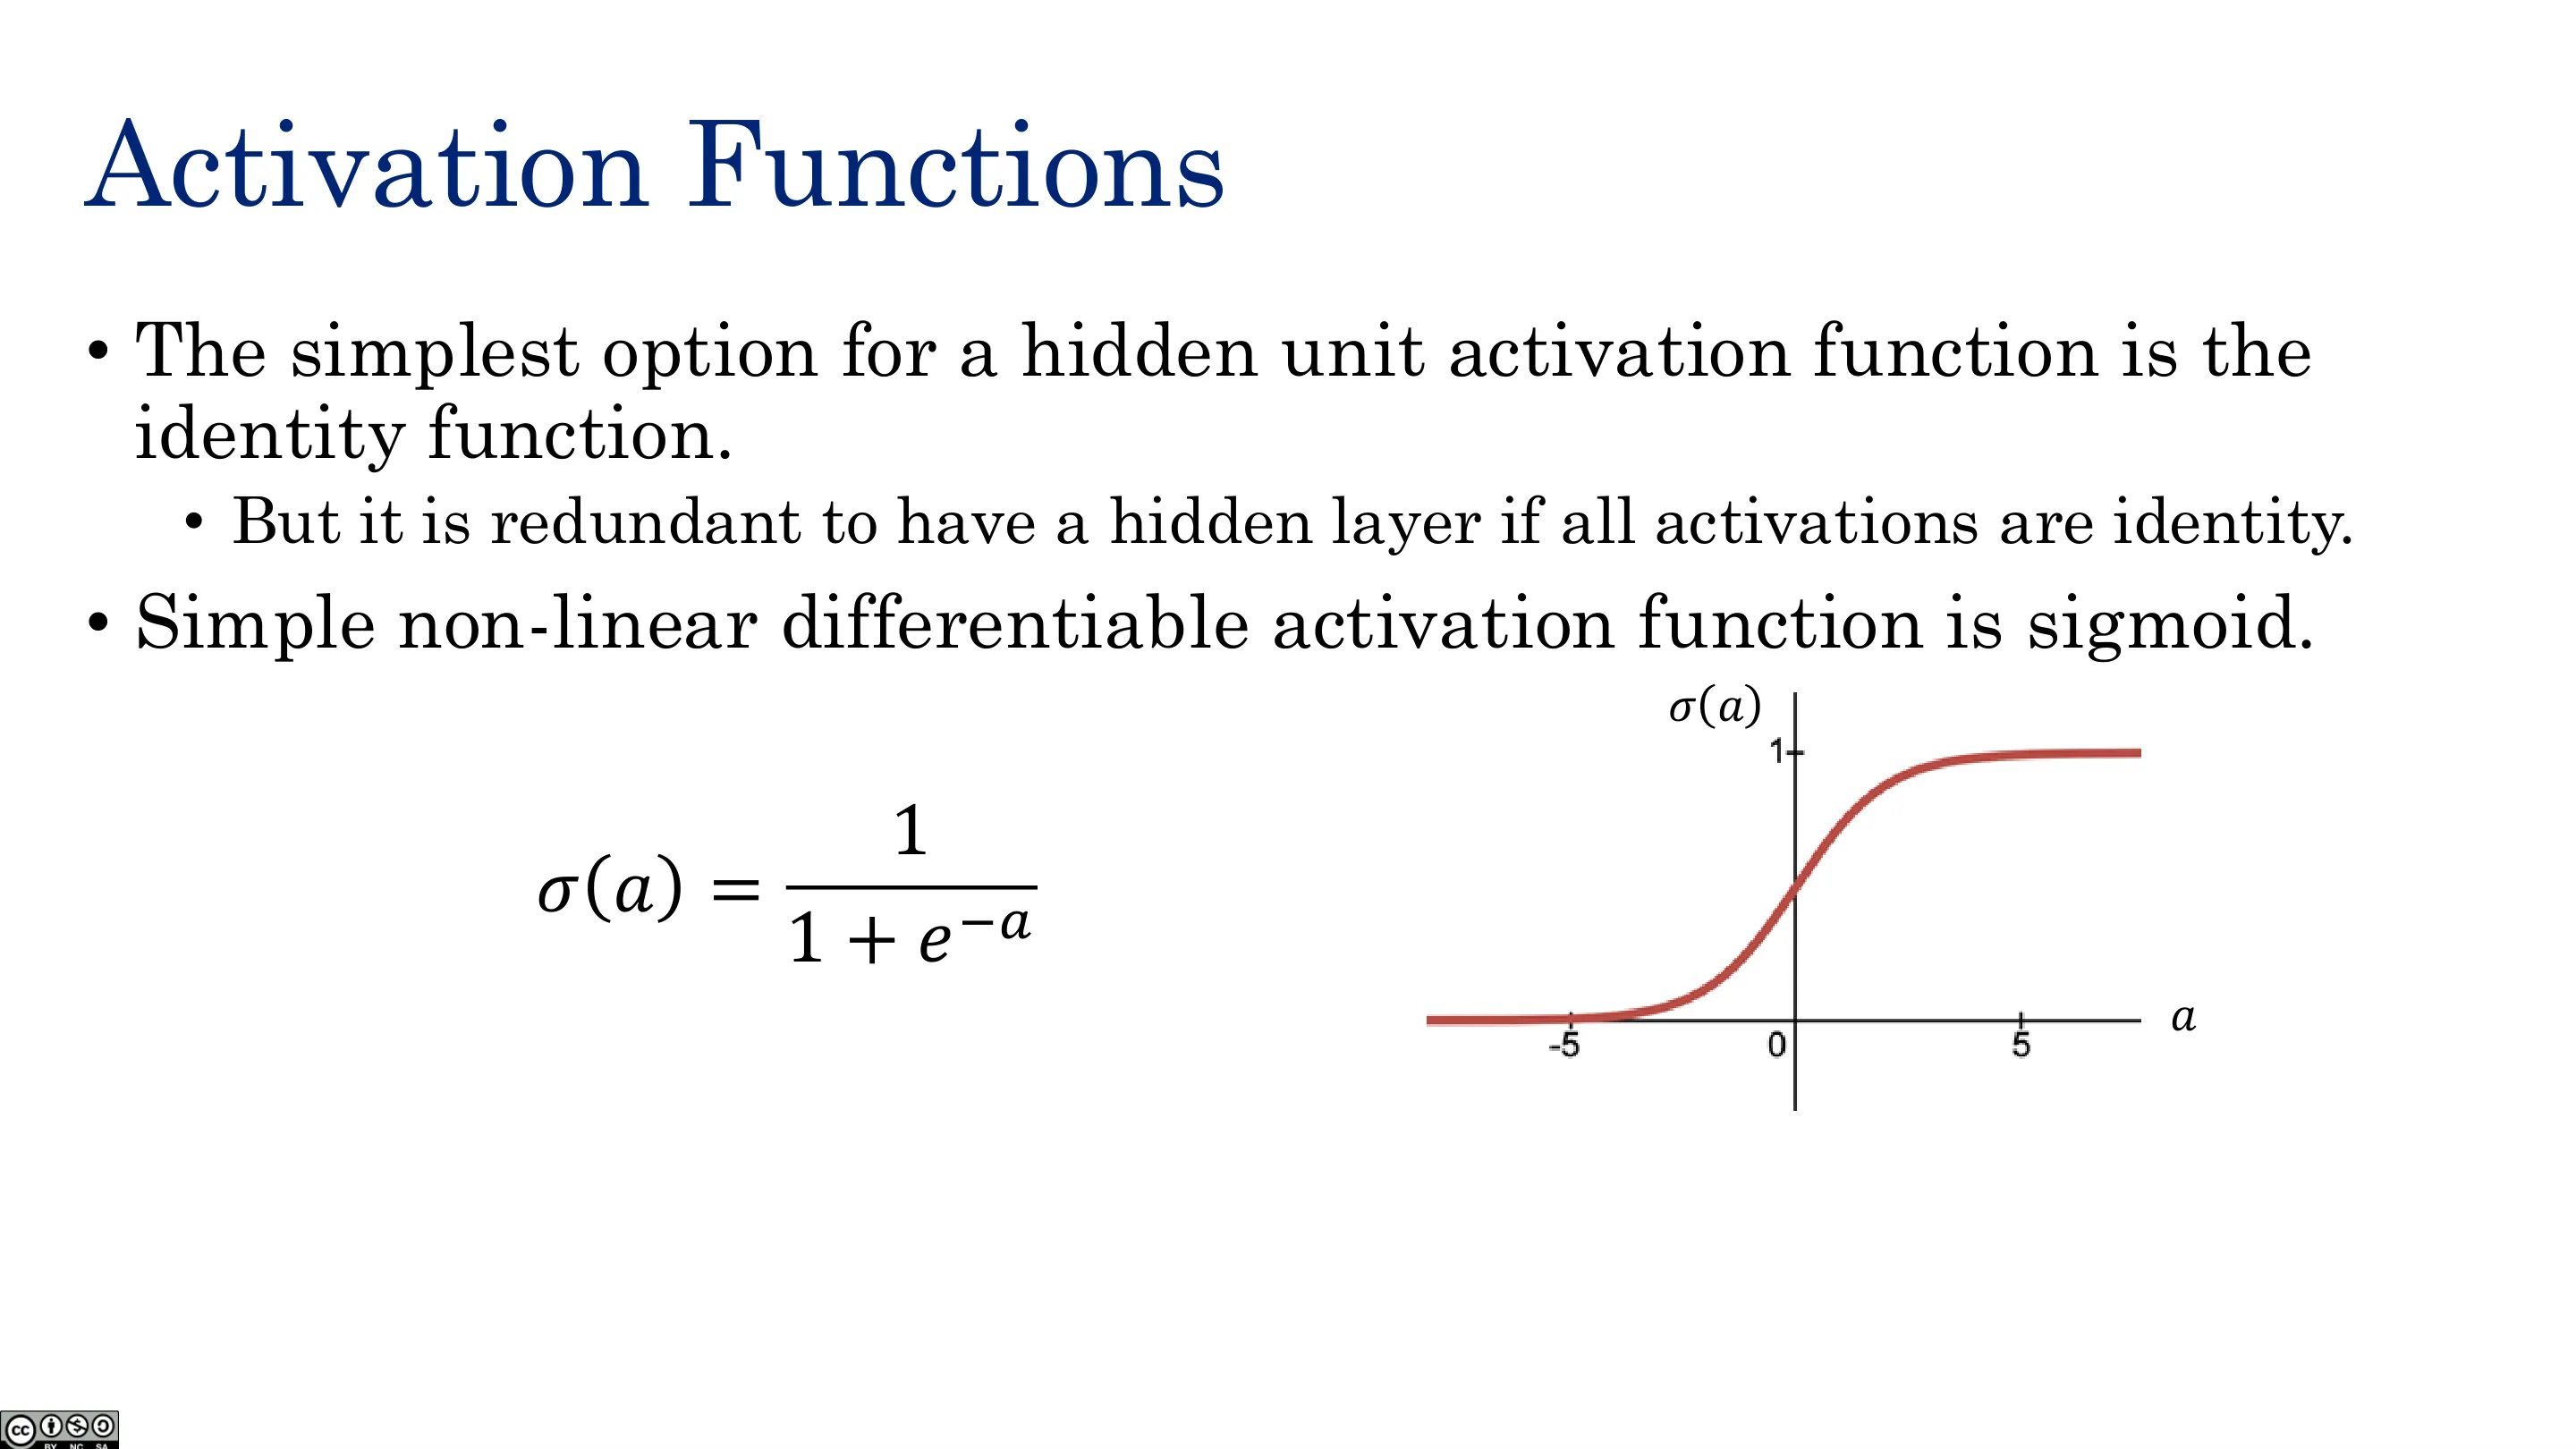
- 阶跃函数(来自神经科学):无法做梯度下降(不可微、不连续)。
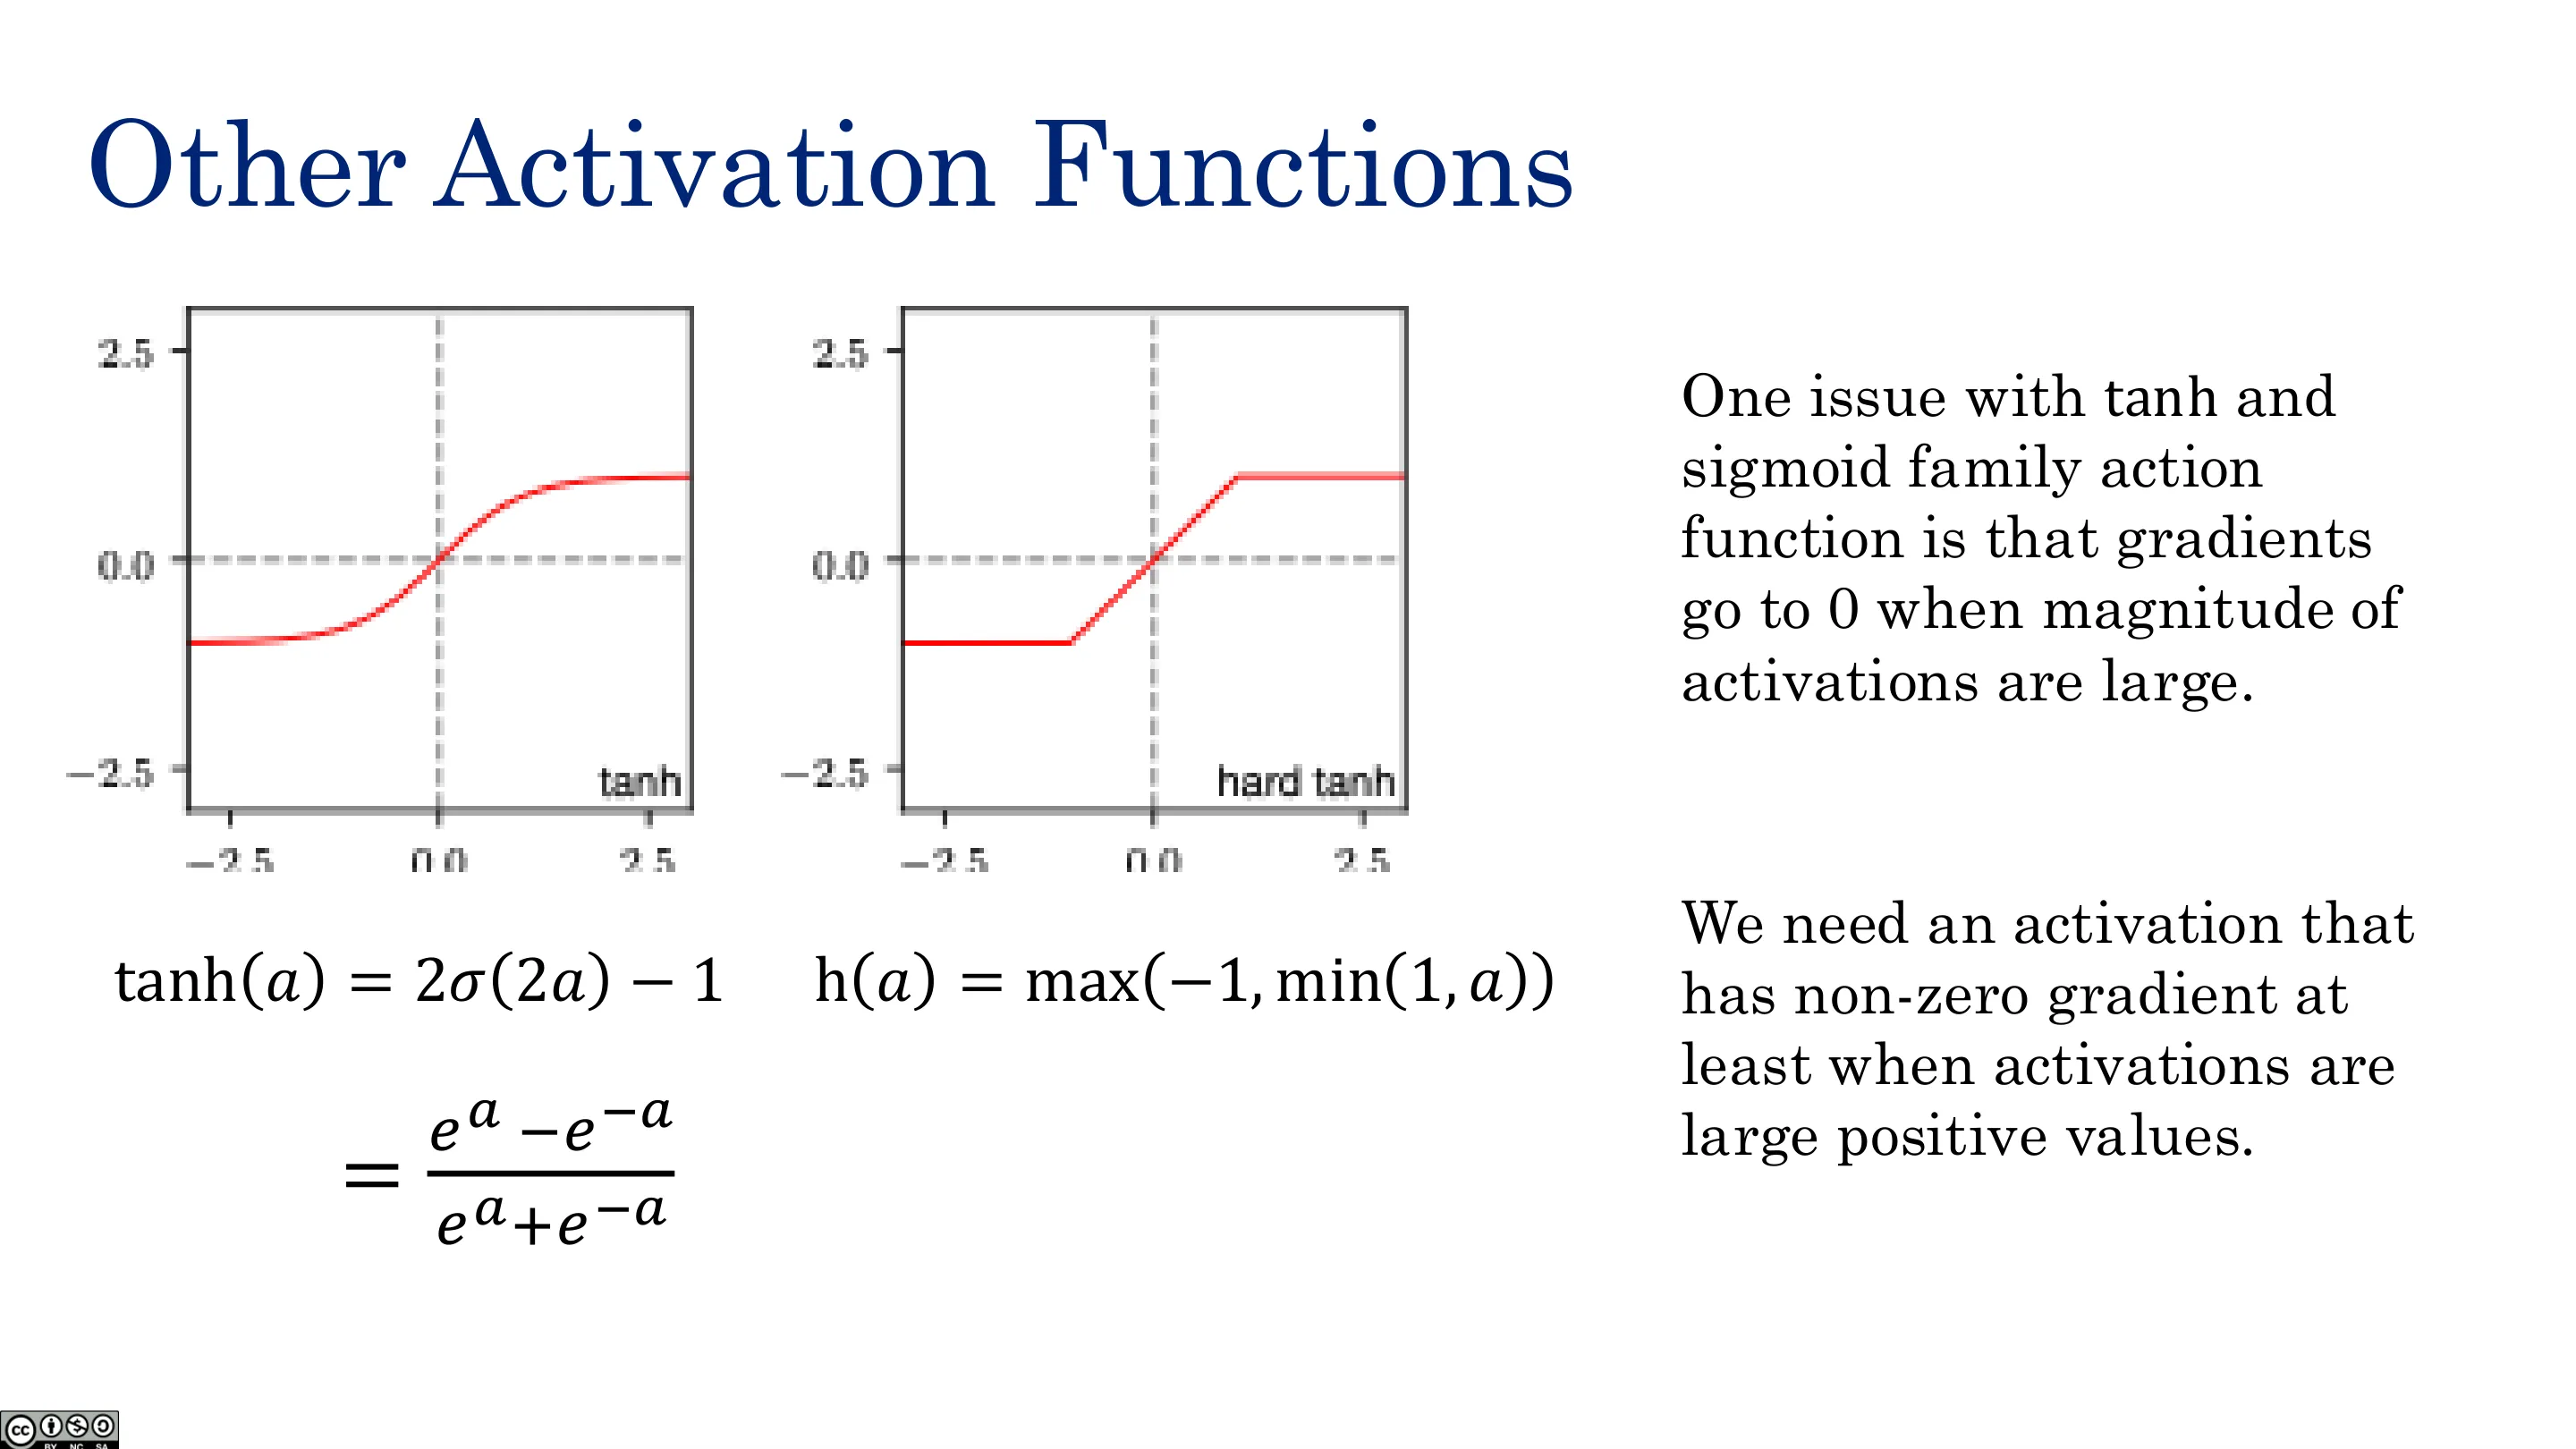
- Sigmoid / tanh(「平滑化」的阶跃):一旦神经元「非常兴奋/非常不兴奋」,梯度趋零 ⇒ 梯度消失,训练死掉。这批函数「杀死了」神经网络 20 年。
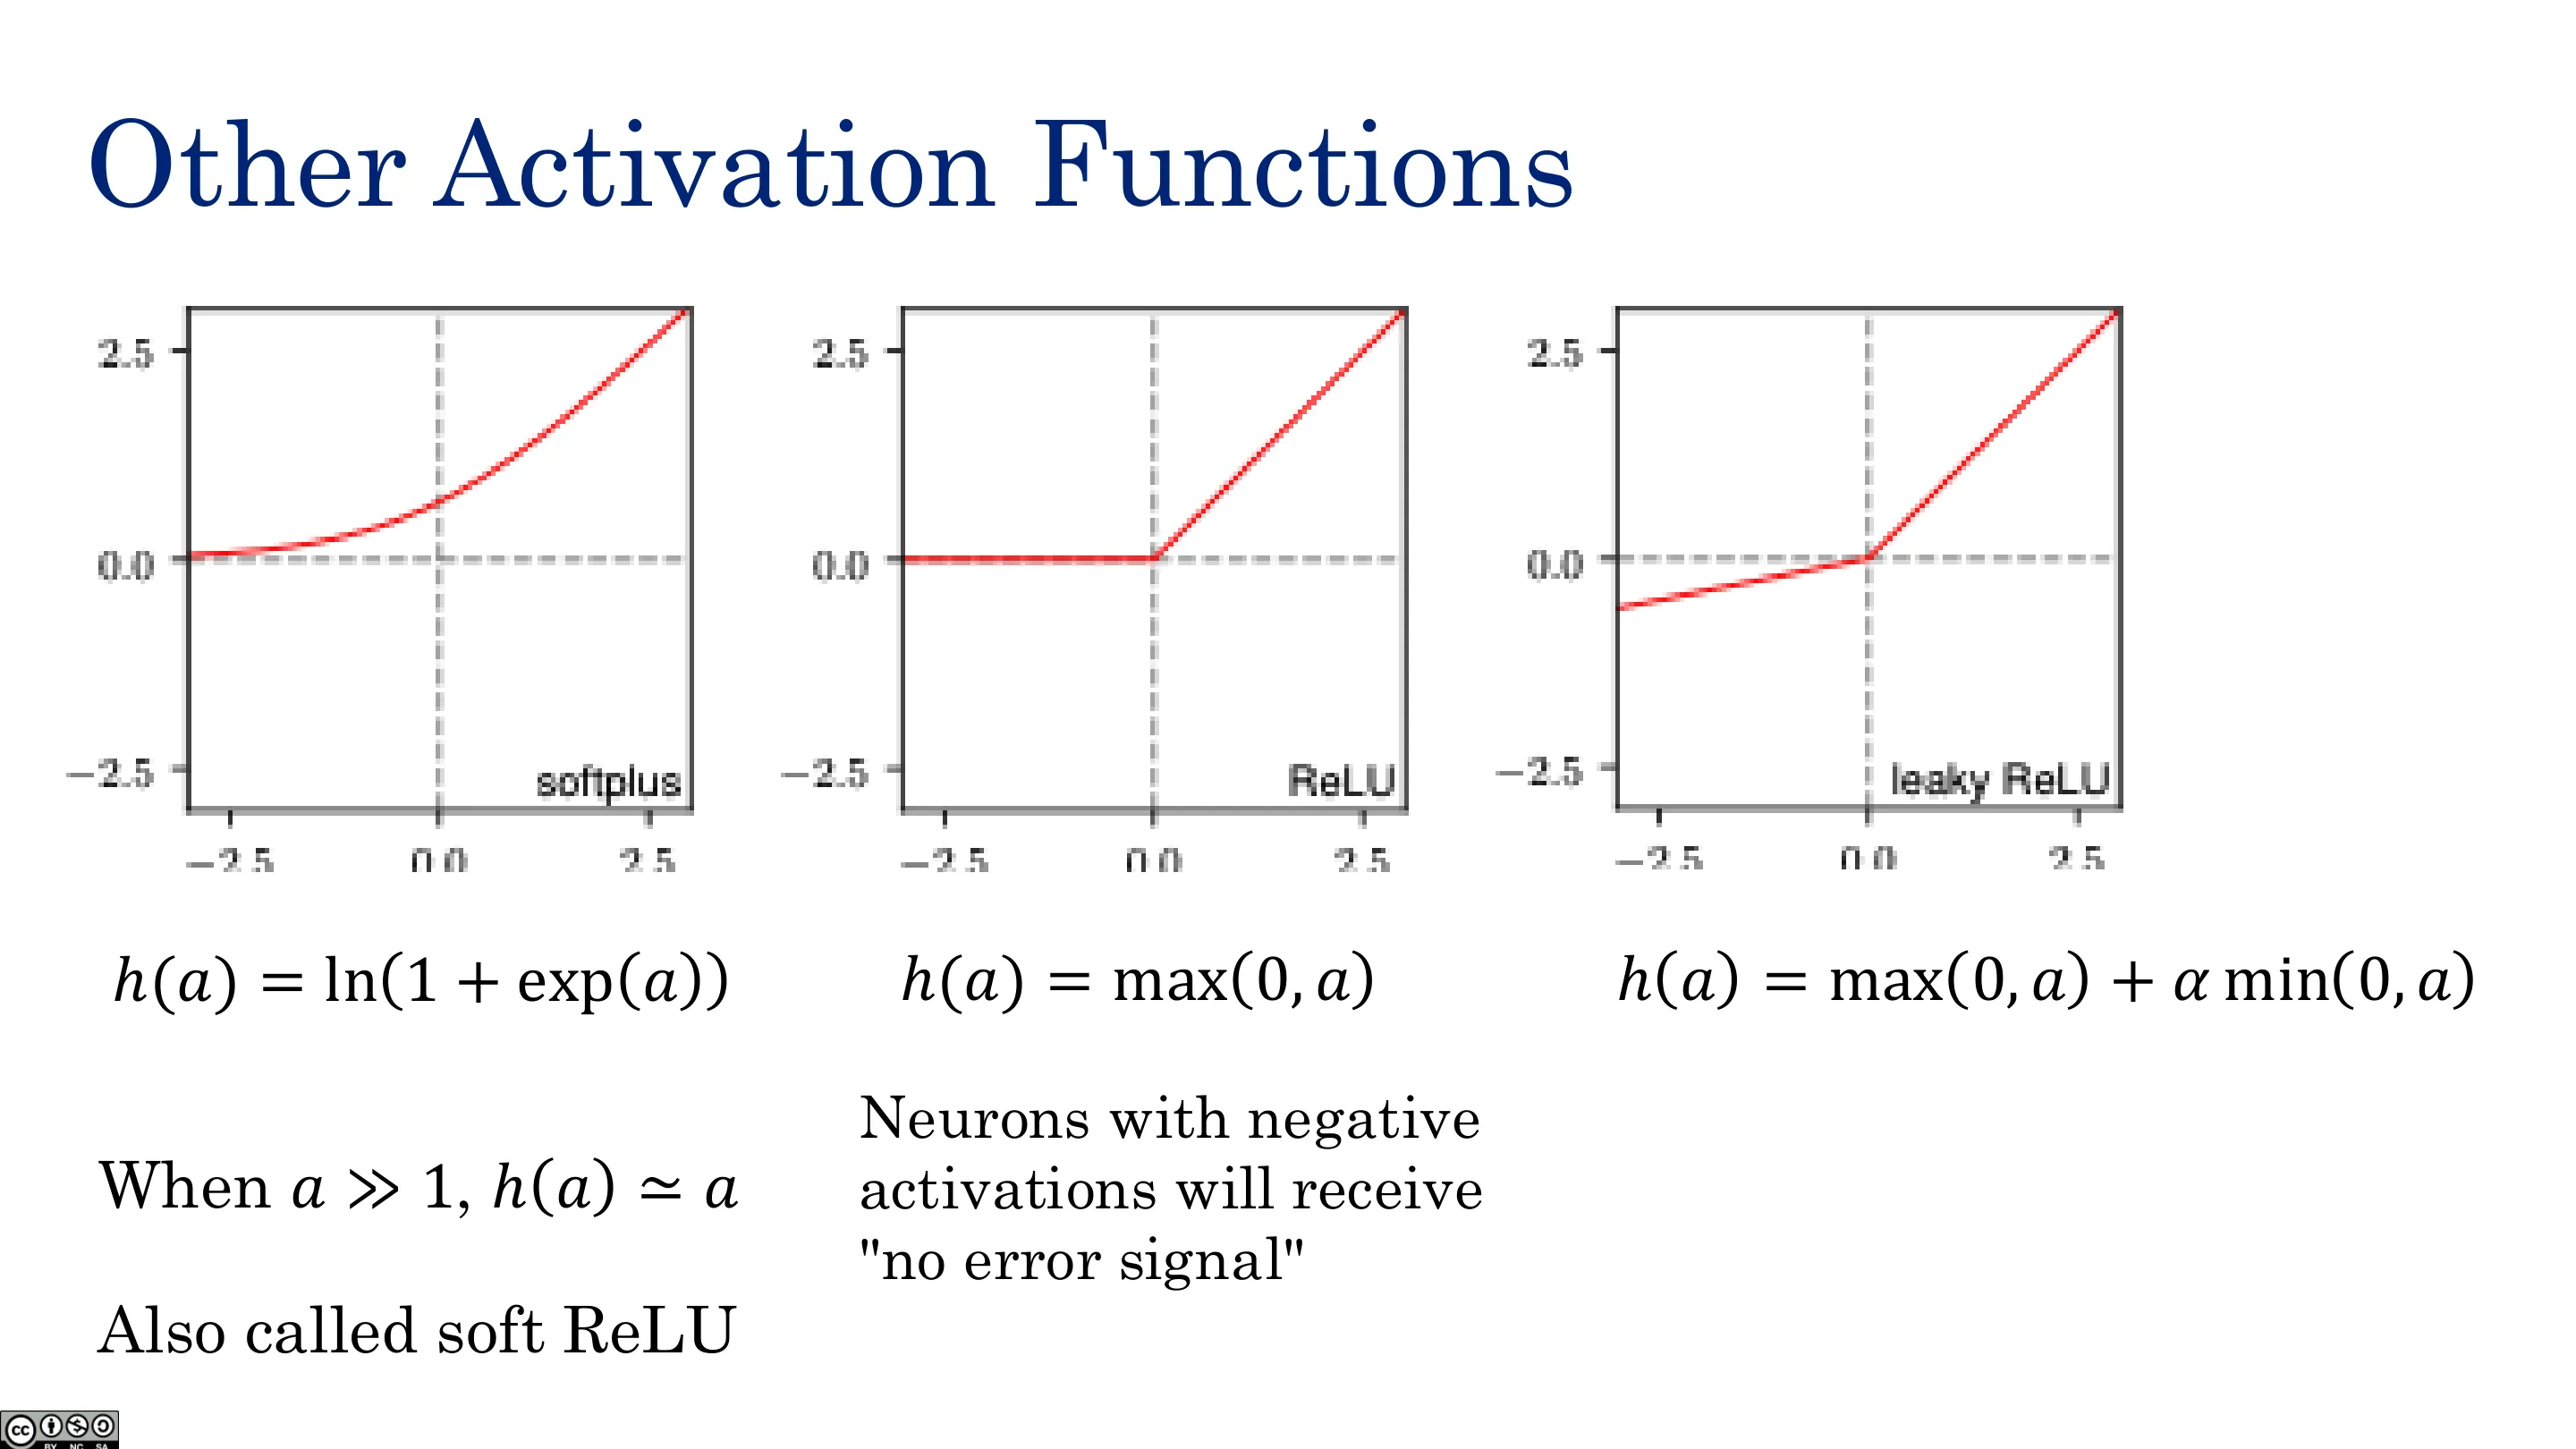
- ReLU $\max(z,0)$:最简单的、有梯度的函数——激活时梯度为 1,不激活时为 0,与激活强度无关。训练终于可行。
- 变体:Softplus、Leaky ReLU(负半轴有小斜率)、ELU 等——「有百万篇论文」的平滑 ReLU 变体,但核心都是「长这样」。
关键经验:需要在激活值大且为正处仍有非零梯度的激活函数。
📷 构建与训练深度网络
回到原视频 (01:21:51)
趣题:你能偷走我的网络吗? 神经网络只是矩阵乘法 + ReLU,因此有无穷多组等价权重: - 重缩放:某层乘 $5$、下一层乘 $1/5$(或改激活的缩放),函数不变; - 置换:用置换矩阵重排神经元顺序,函数不变(
reverse identity等)。 - 想检测抄袭 → 只做输入输出一致性测试;想更稳 → 给权重加水印(历史上正是「对数表里的故意小错」),甚至可以讨论后门注入。这是一个庞大且重要的研究方向。
📷 最广泛使用的深度学习框架
回到原视频 (01:23:04)
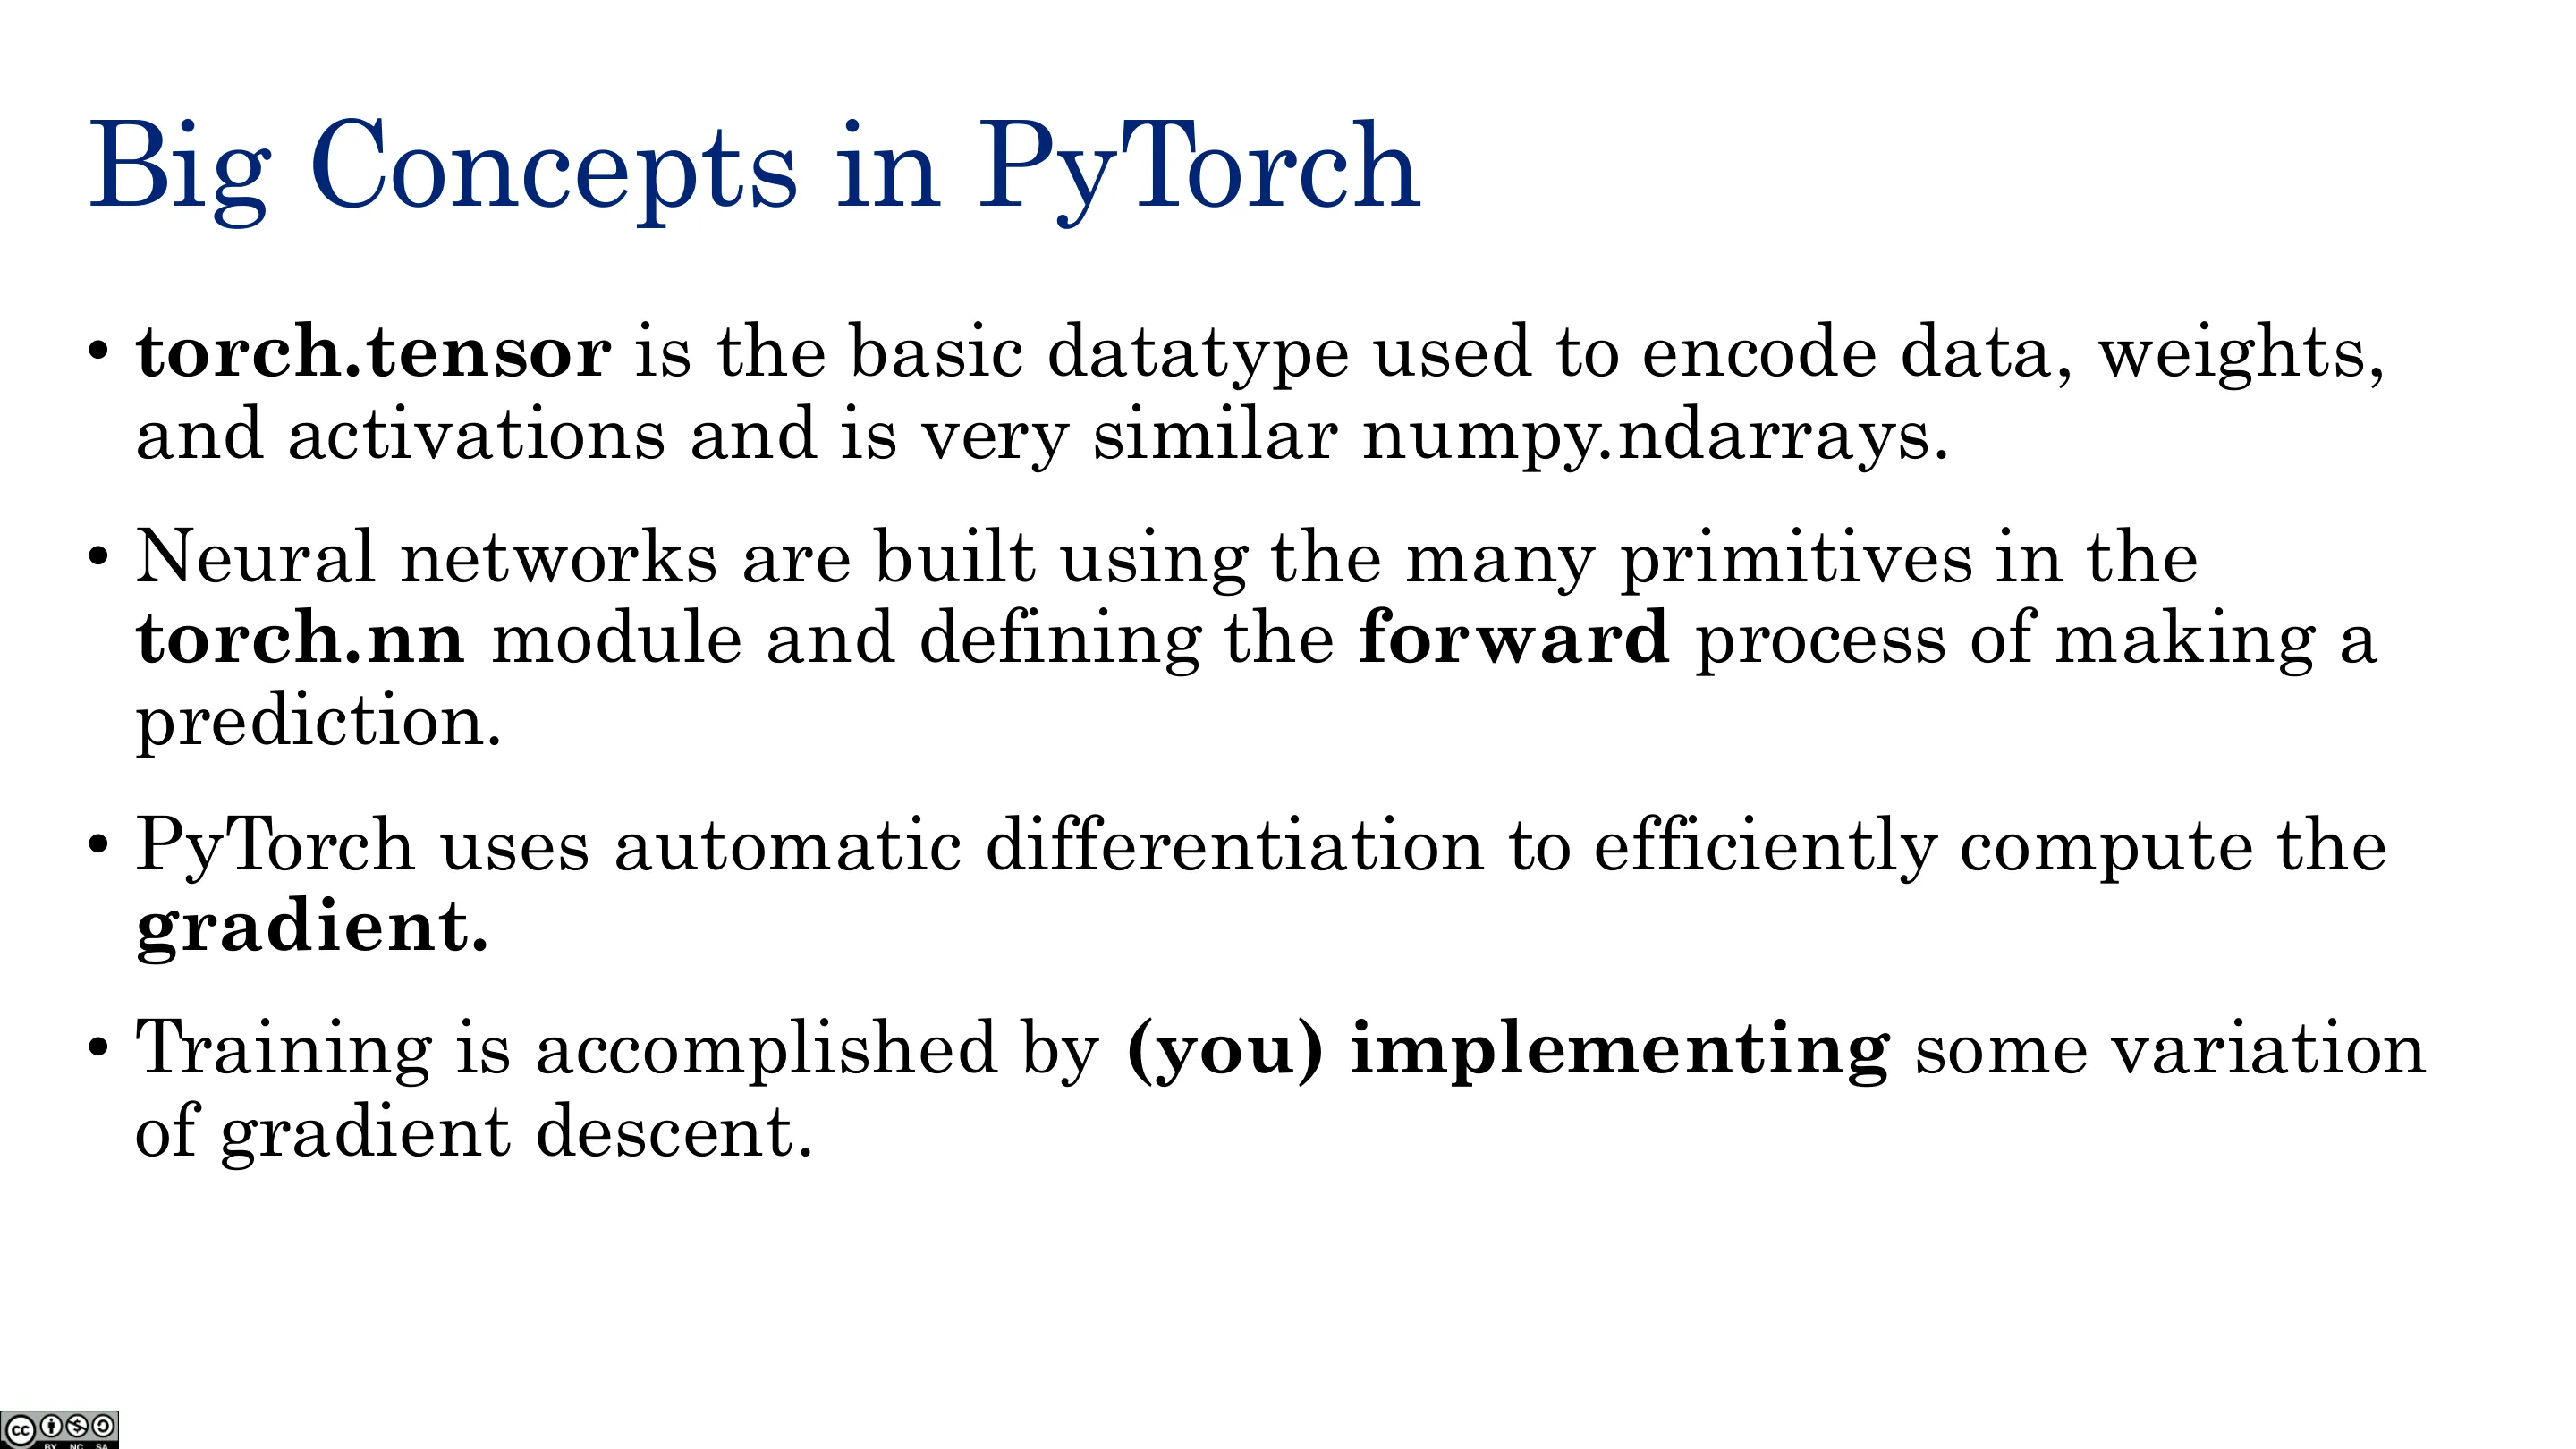
📷 PyTorch 的核心概念
回到原视频 (01:24:17)
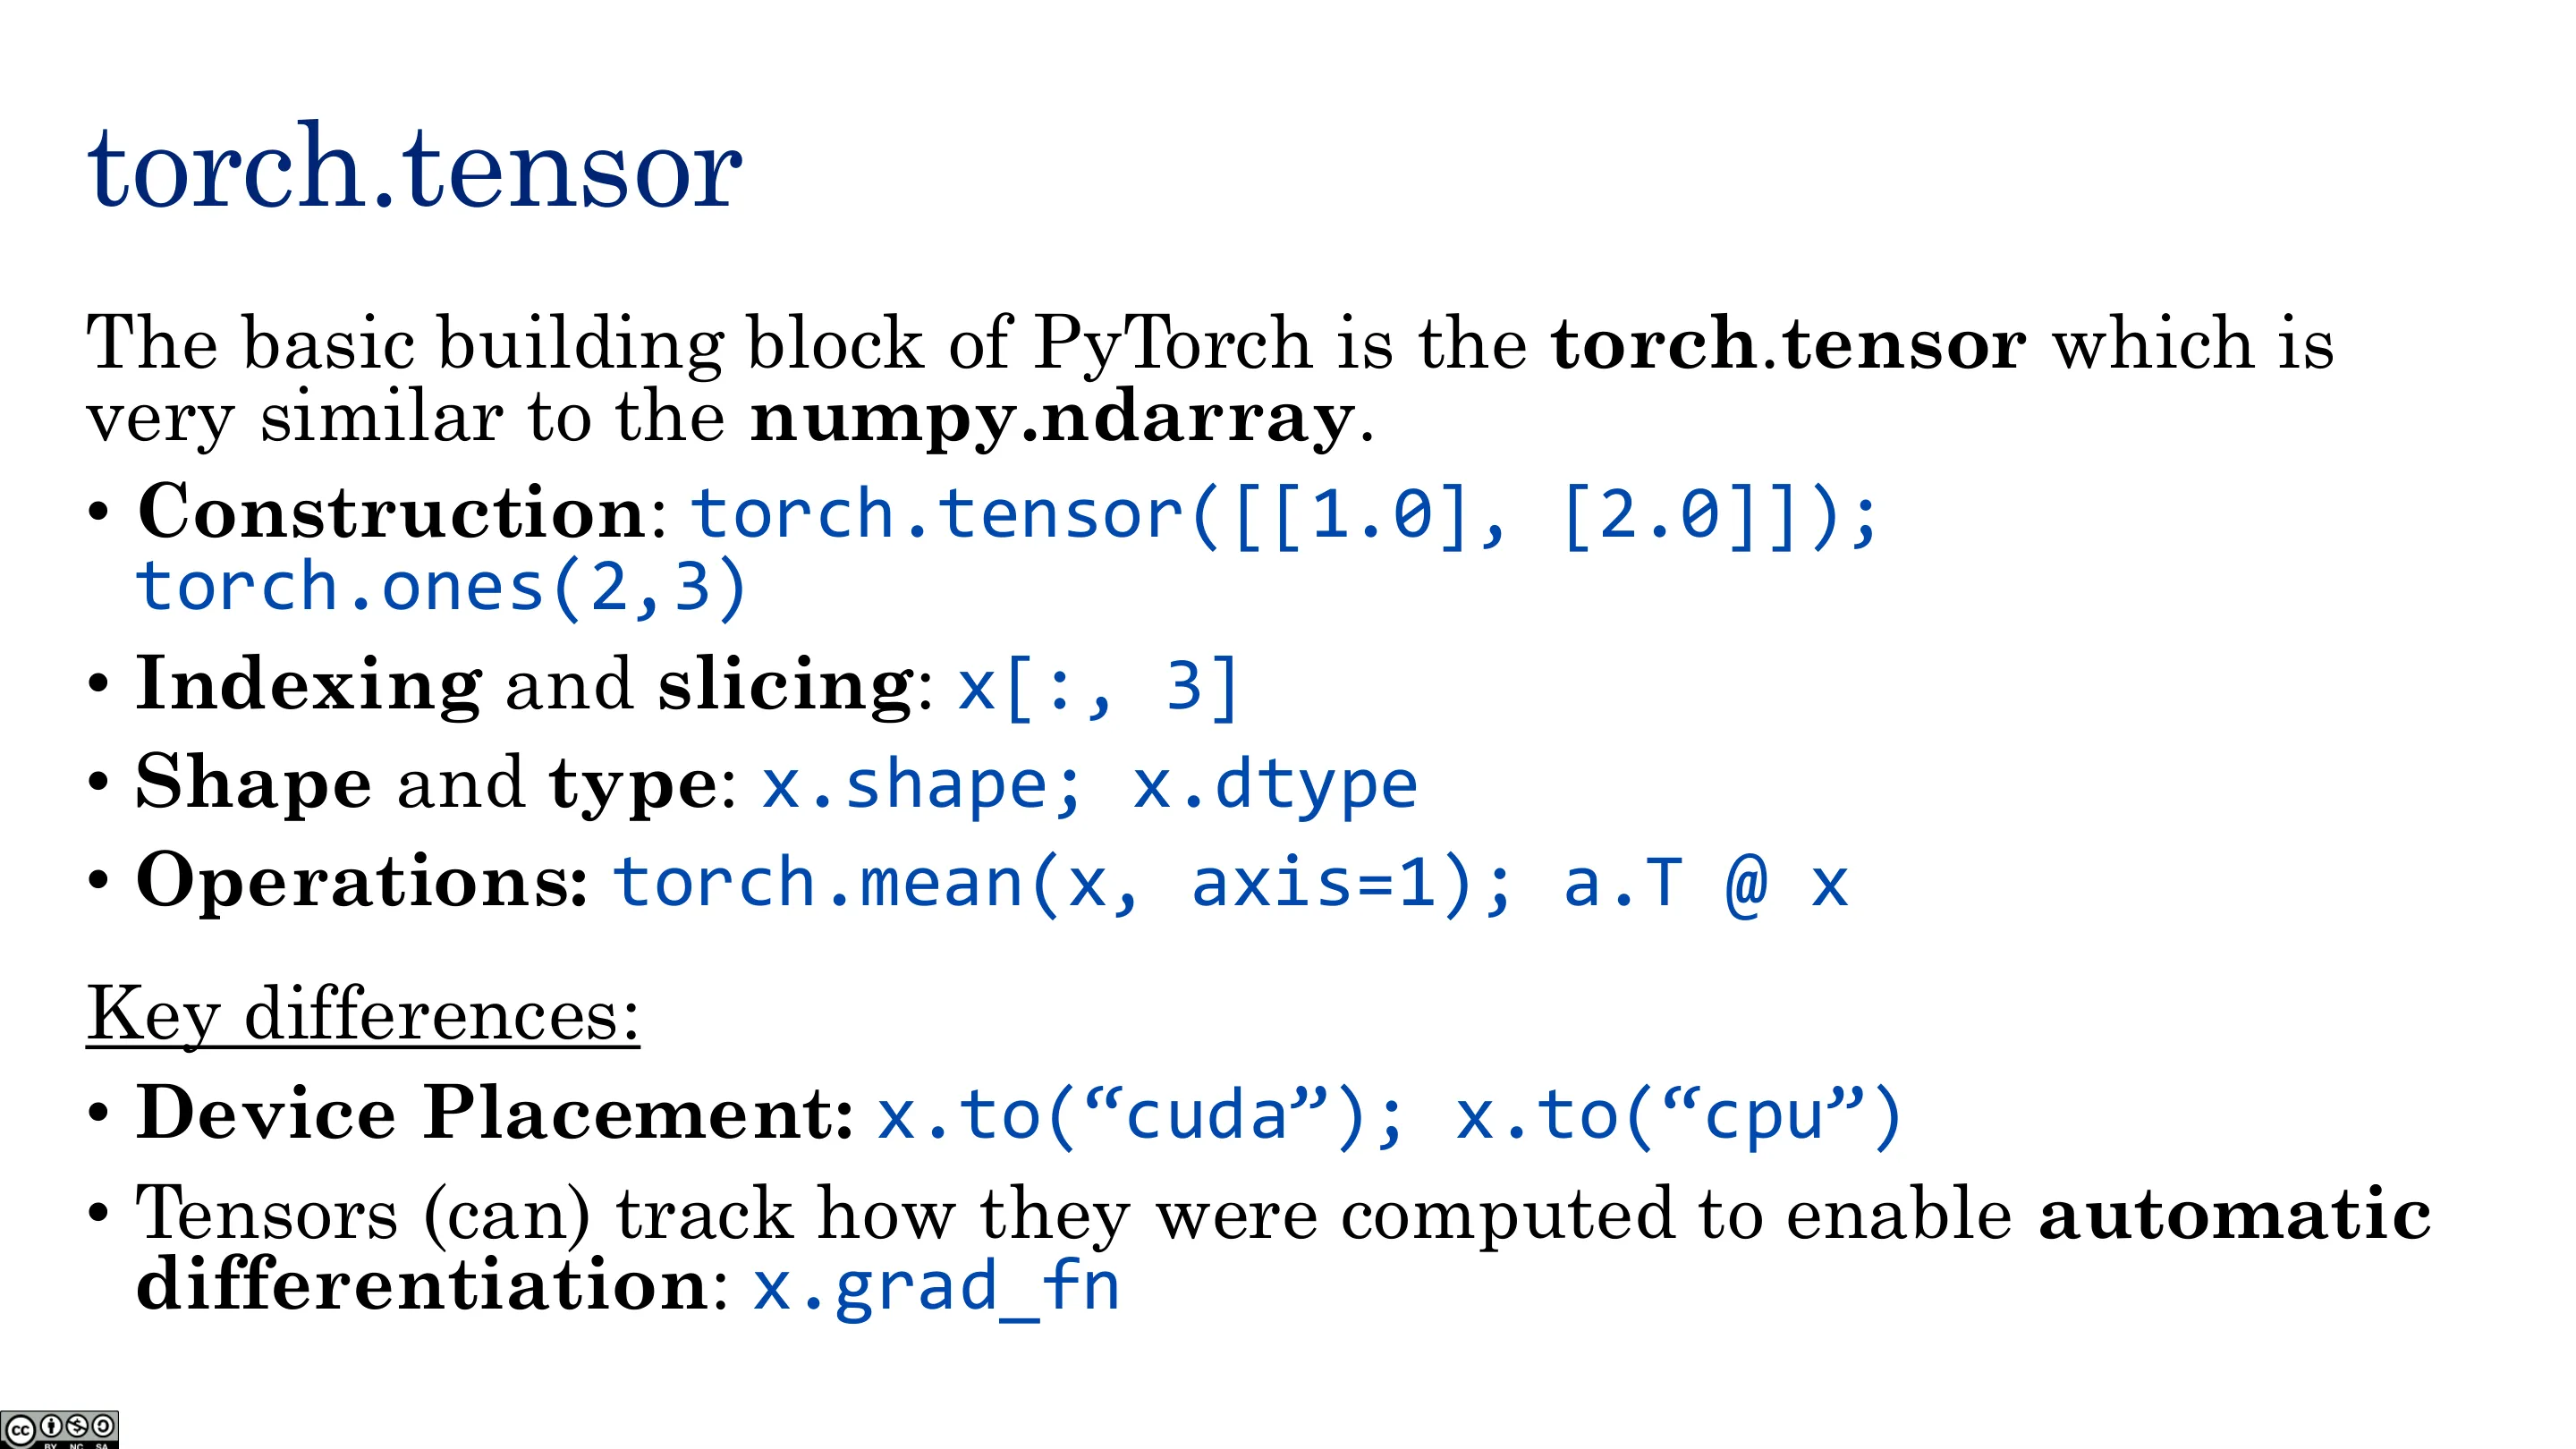
📷 torch.tensor
回到原视频 (01:25:30)
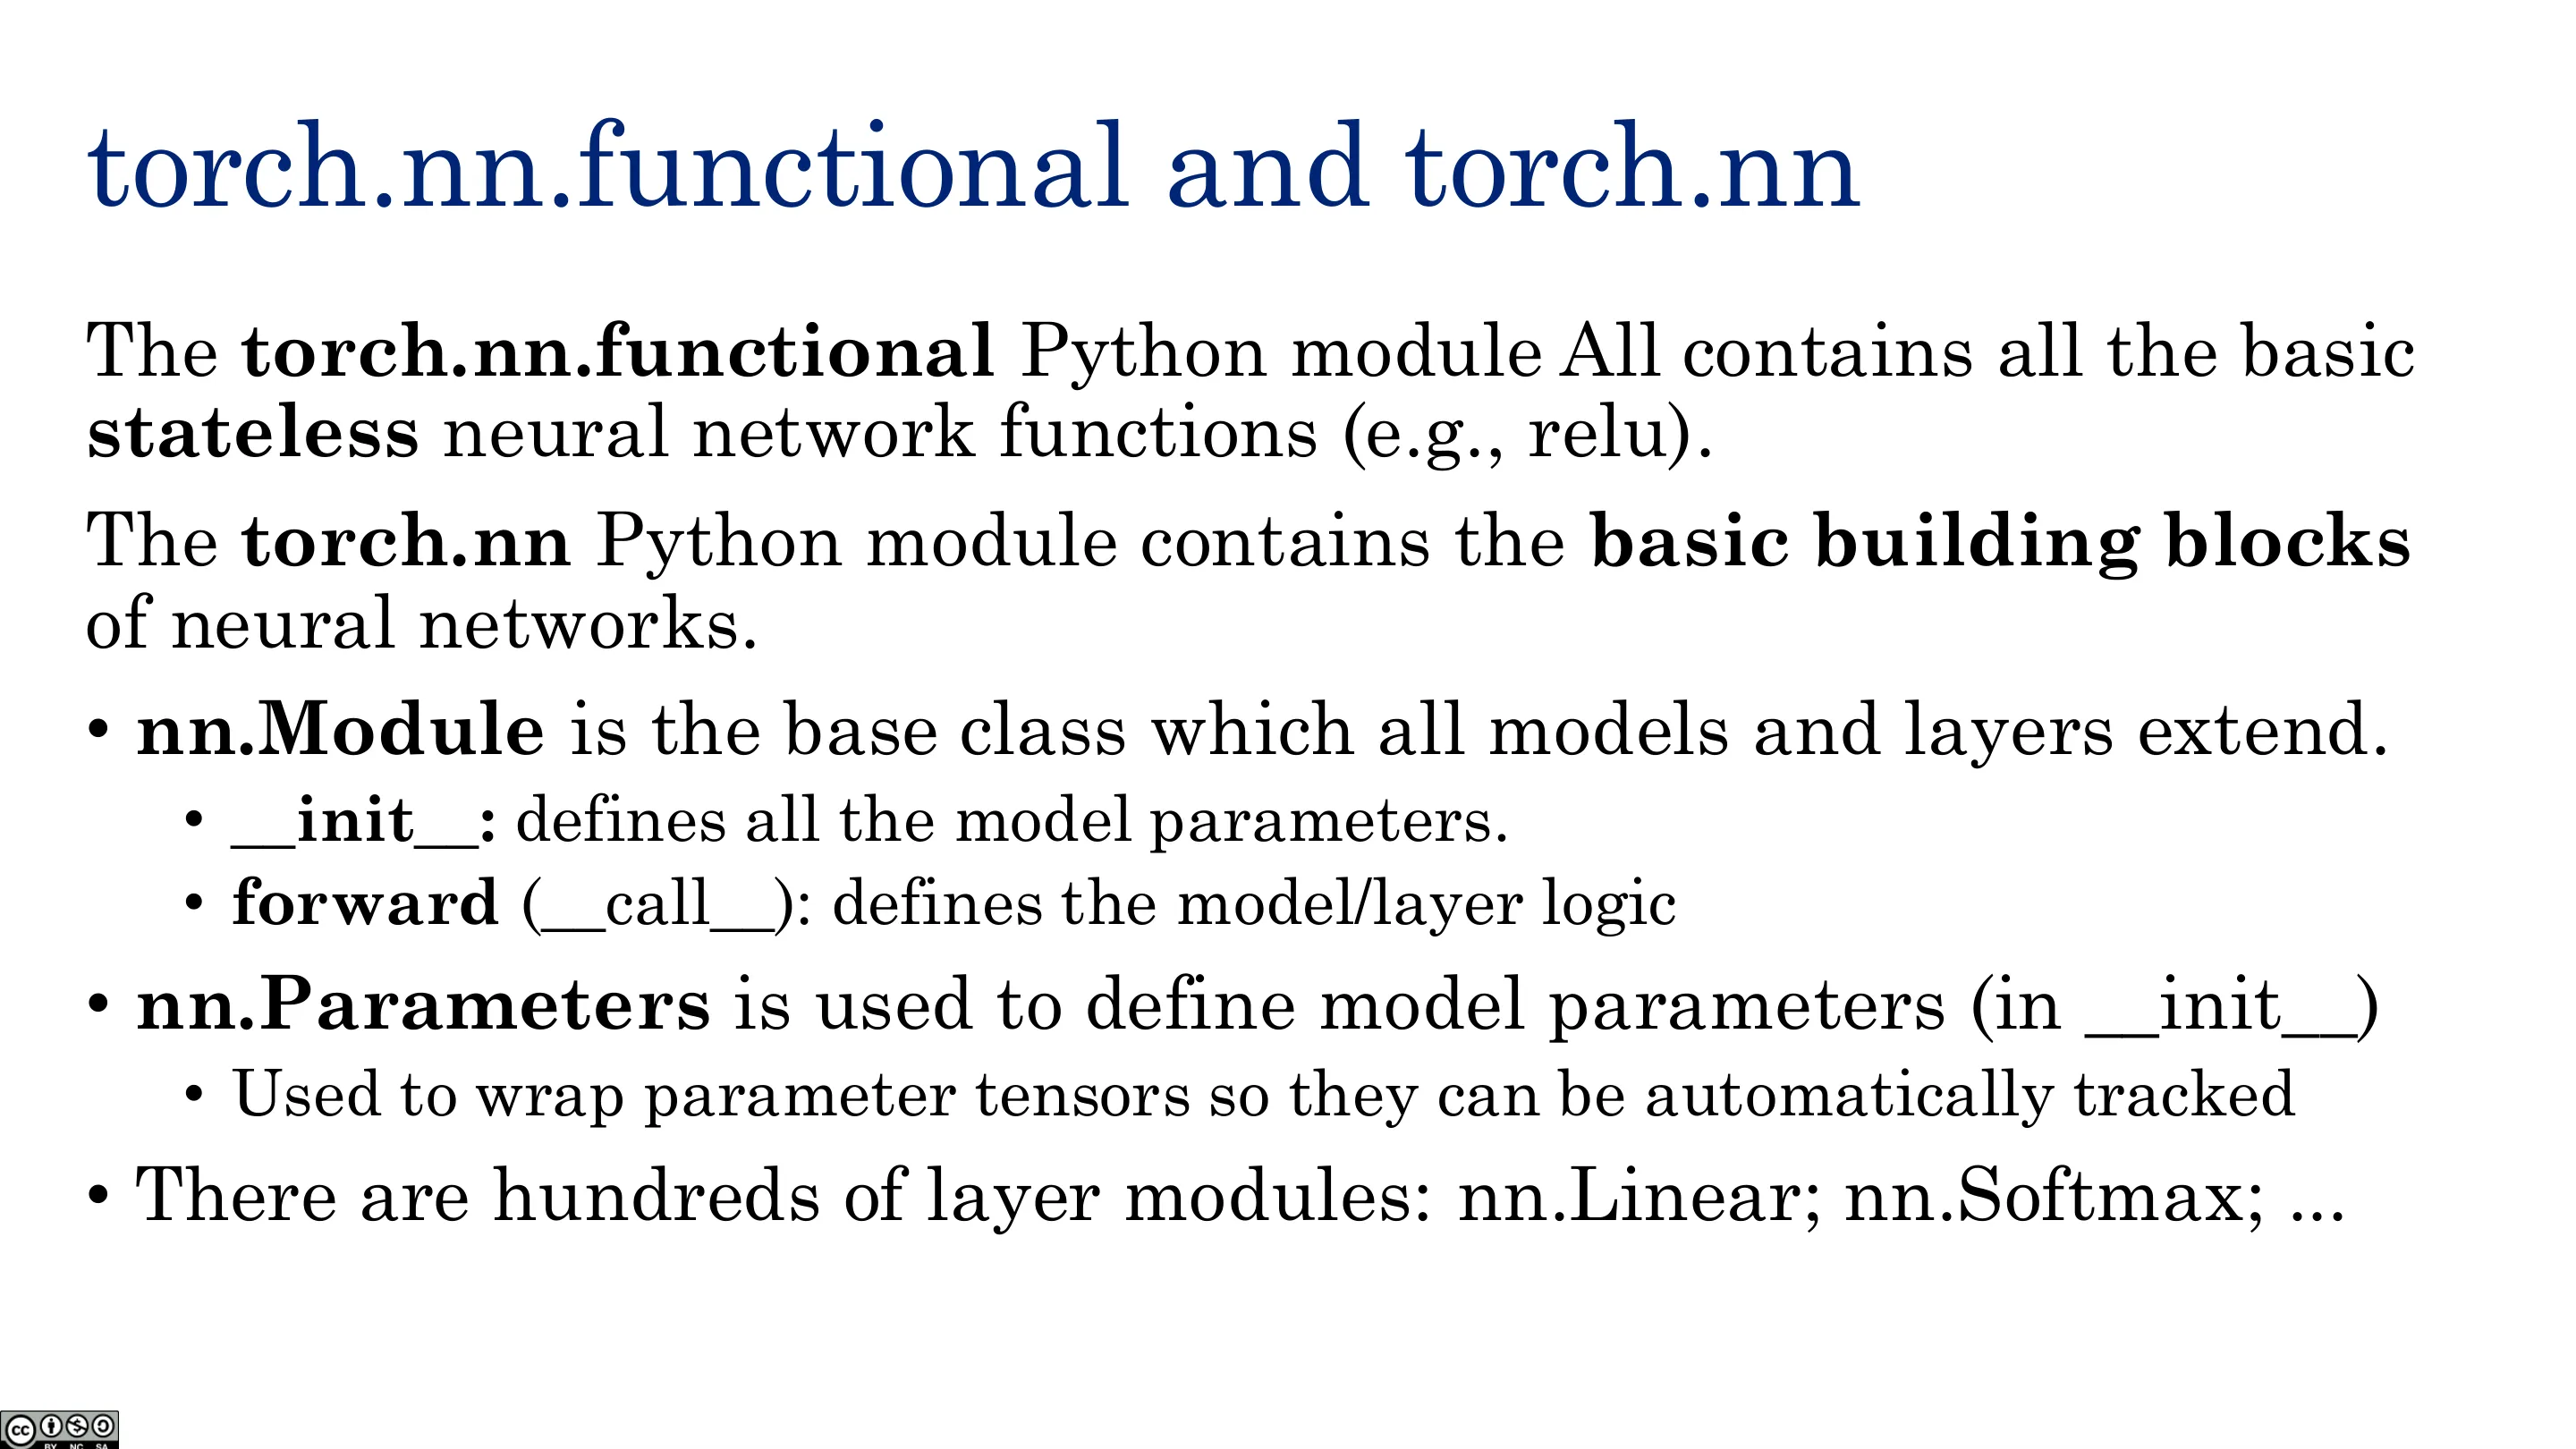
📷 torch.nn.functional 与 torch.nn
回到原视频 (01:26:43)
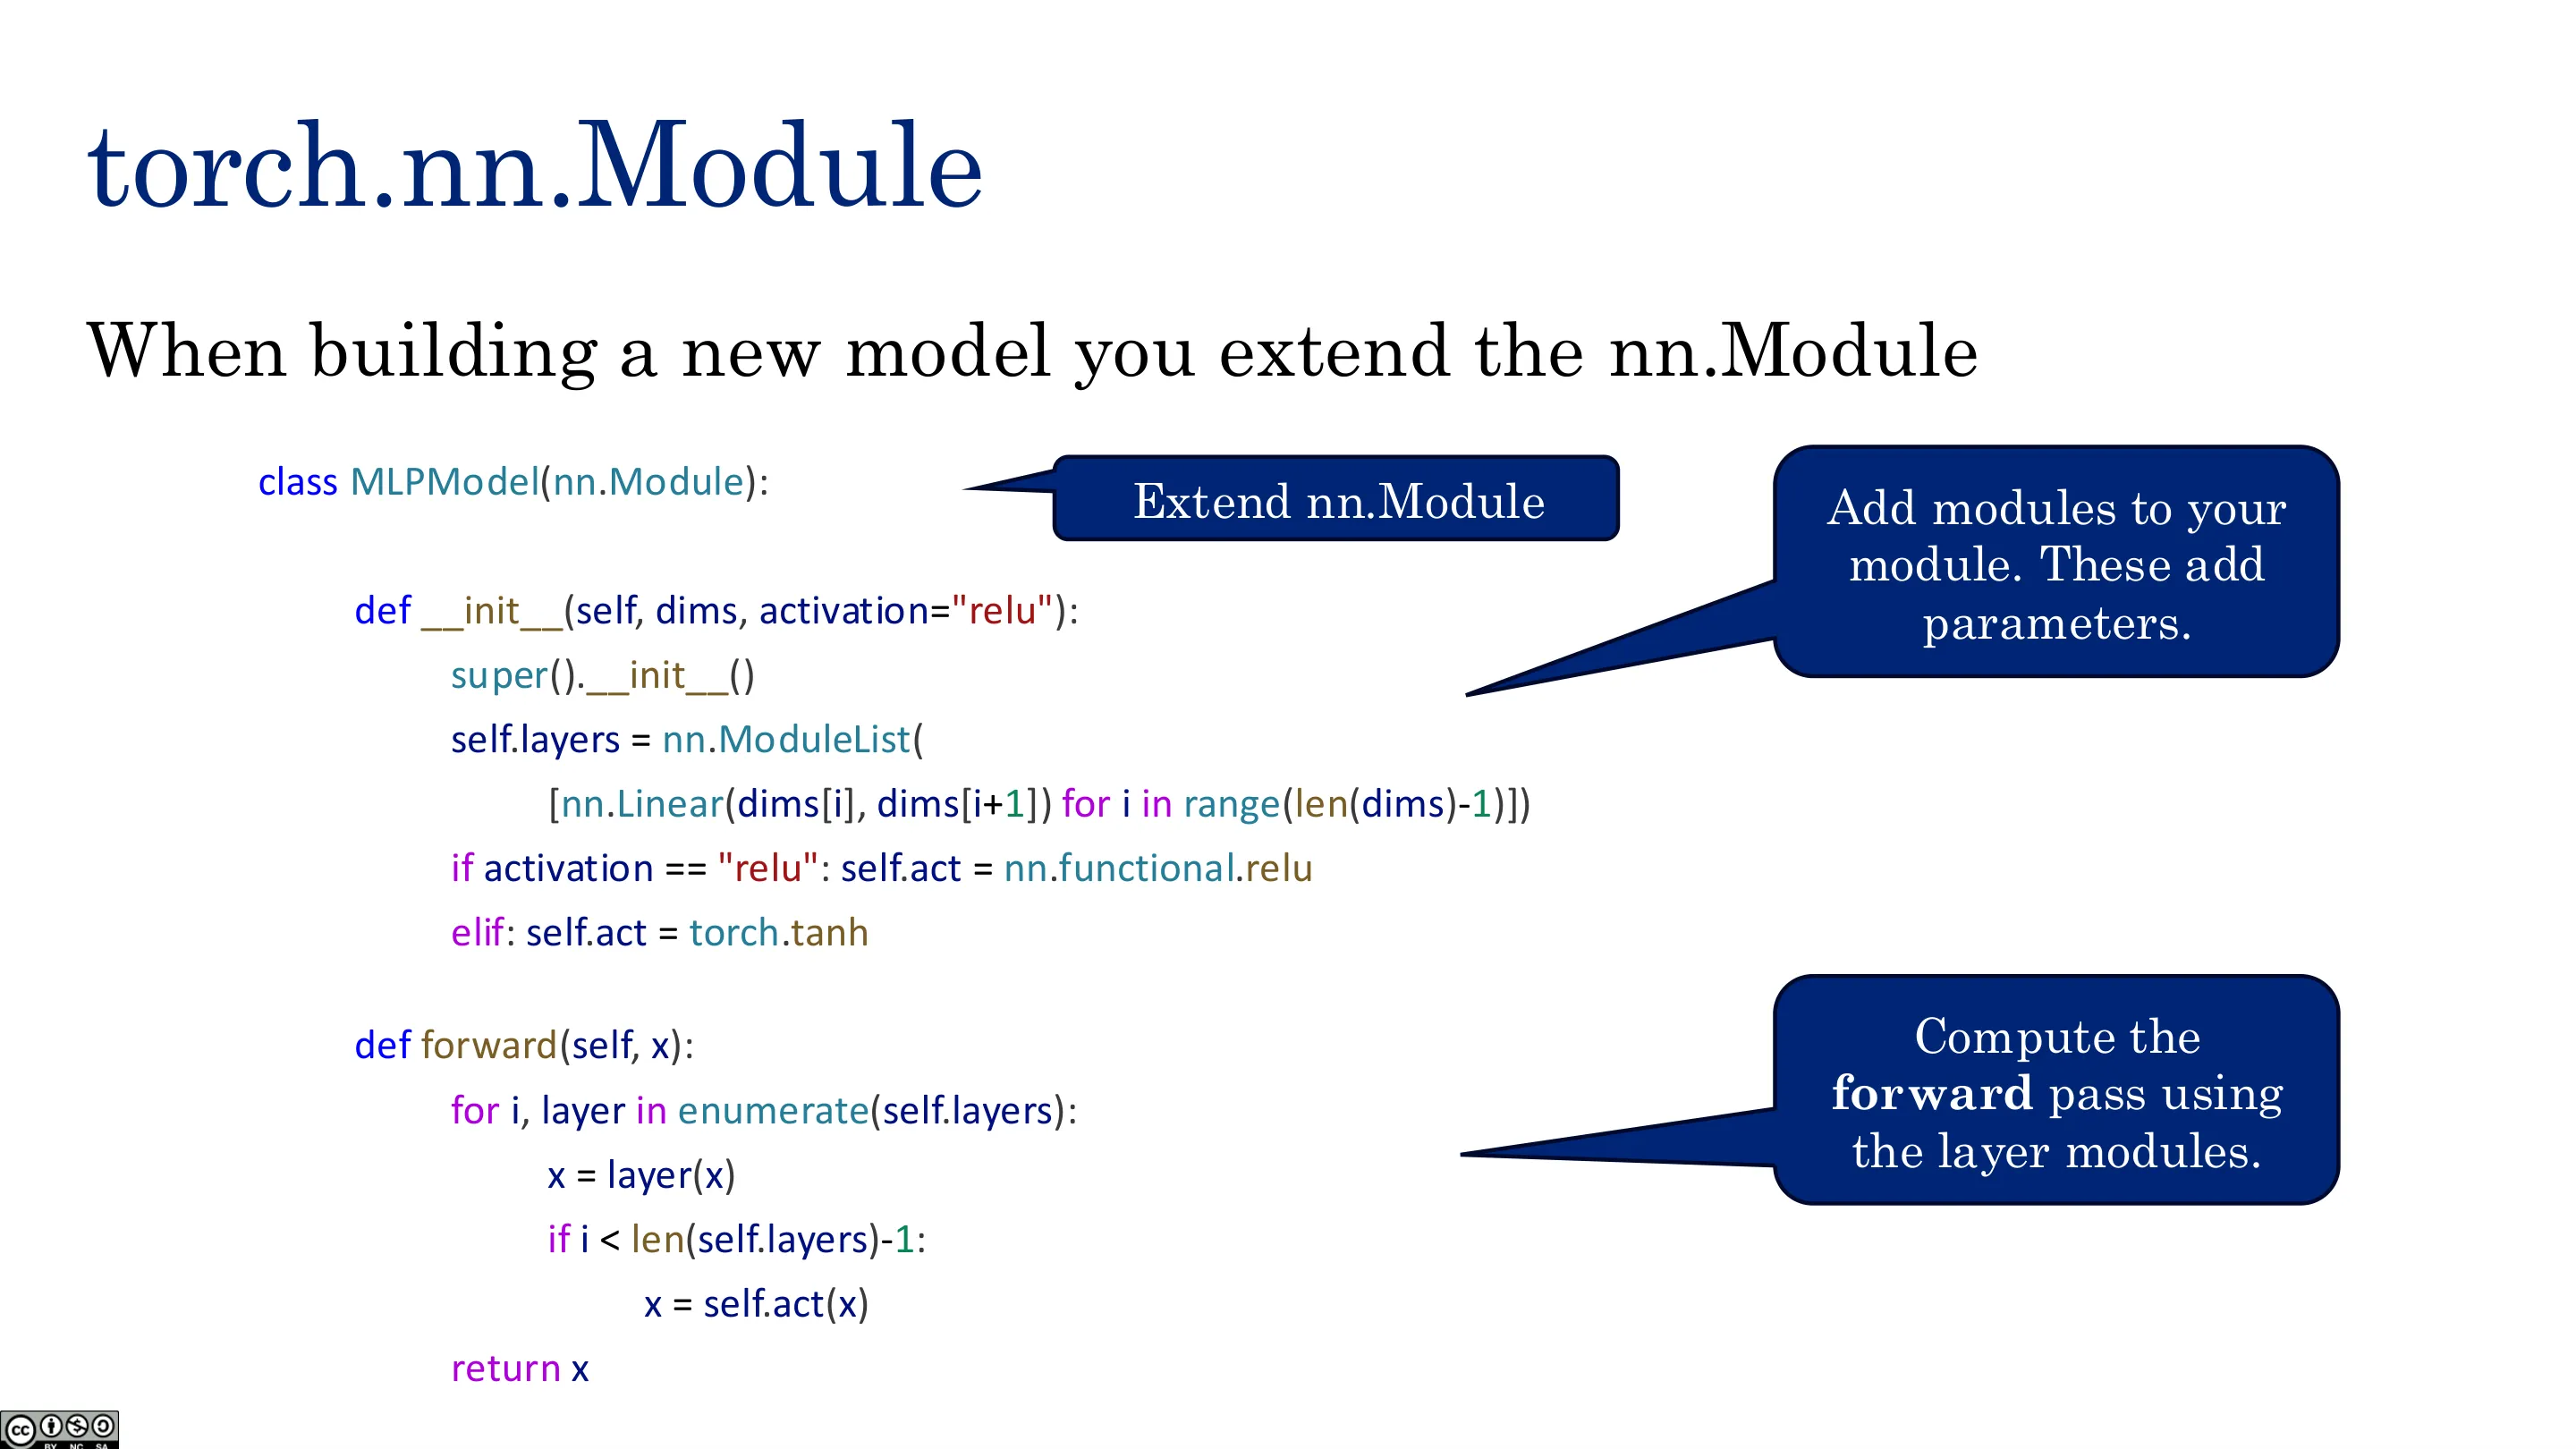
📷 torch.nn.Module
回到原视频 (01:27:56)
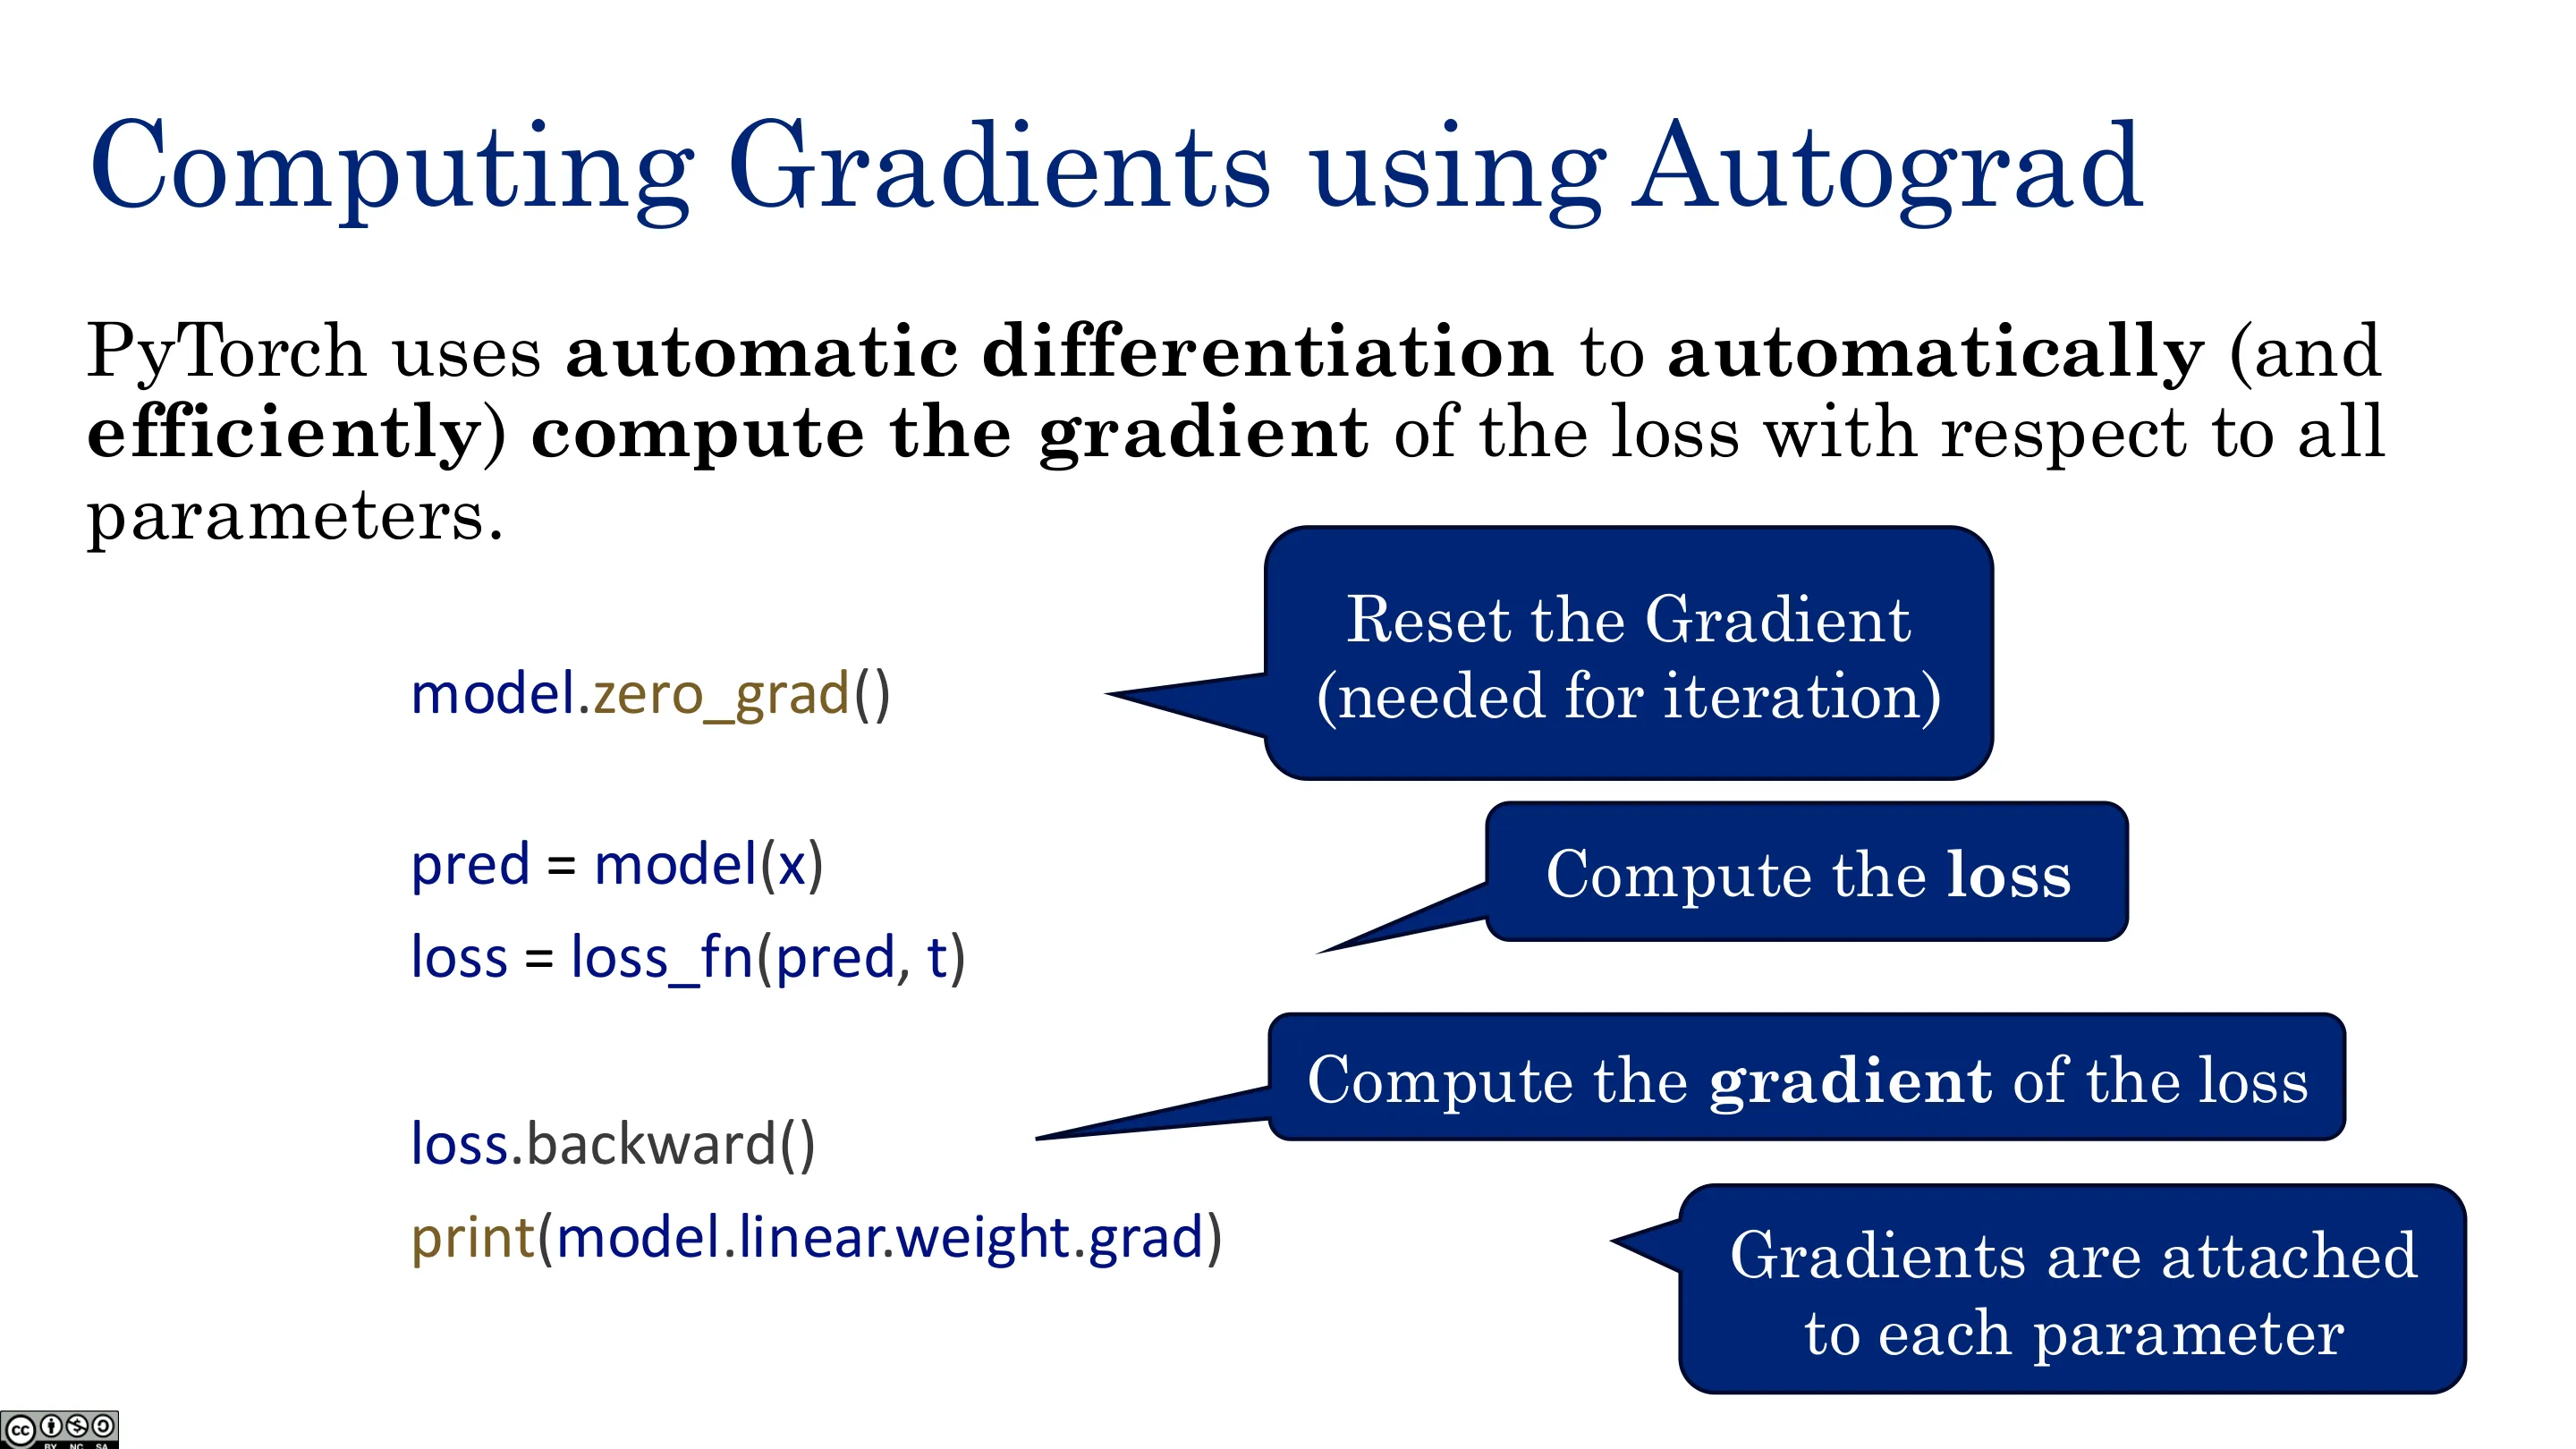
📷 用 Autograd 计算梯度
回到原视频 (01:29:09)
📷 神经网络与(下一讲预告)
回到原视频 (01:30:22)
总结(Takeaways)
- 神经元 = 内积 + 激活:无激活即线性回归,Sigmoid 即逻辑回归。
- 必须非线性:XOR 不可线性可分;任意深度的纯线性网络仍等于线性网络。
- UAT:单隐藏层理论上可逼近任意连续函数,但宽度可能指数级、不告诉你权重、必须非线性。
- 深度的价值:多层能指数级更简洁地表示结构化函数,并学到层次化表示(表示学习)。
- 激活函数:阶跃/sigmoid 因梯度趋零而失败;ReLU 及其变体因处处(正半轴)有梯度而成功。
- 网络是多对一的(重缩放/置换等无穷多等价参数)⇒ 权重可被「窃取」,催生水印/后门研究。
- PyTorch:
tensor、nn.Module、autograd是三大支柱。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=bMJ9igfvn1M |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 17) | Google Drive 文件夹 |
| Goodfellow, Bengio, Courville, Deep Learning | 第 6 章(前馈网络、XOR 例子) · https://www.deeplearningbook.org/ |
| Cybenko (1989), Hornik et al. | 万能逼近定理 · https://link.springer.com/article/10.1007/BF02551274 |
| 教材 Machine Learning: A First Course for Engineers and Scientists | 神经网络、表示学习相关章节 · https://doi.org/10.1017/9781108919371 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。