第18讲 · EECS 189:神经网络与反向传播
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Neural Networks, Backpropagation |
| 视频 | https://www.youtube.com/watch?v=XlaV_z2knjA |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 18) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第18讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
本讲全部围绕一个问题:如何高效地计算神经网络的梯度?
- 回顾:神经元、深度网络、激活函数、训练流程;
- 朴素做法:把损失写成 $w,b$ 的复合函数,用大一链式法则硬求导;
- 计算图(computation graph) 与反向传播:从损失倒着走、复用中间导数;
- 通用算法:拓扑排序 + 误差信号(bar 记号);多元链式法则处理「一个节点多个子节点」;
- 向量化、消息传递视角、计算复杂度(与参数量线性!);
- 梯度计算的另外三个视角与激活函数的梯度问题。
本讲幻灯片改编自 Roger Grosse(多伦多大学)的 backprop 讲义。
📷 标题页
回到原视频 (00:00:20)
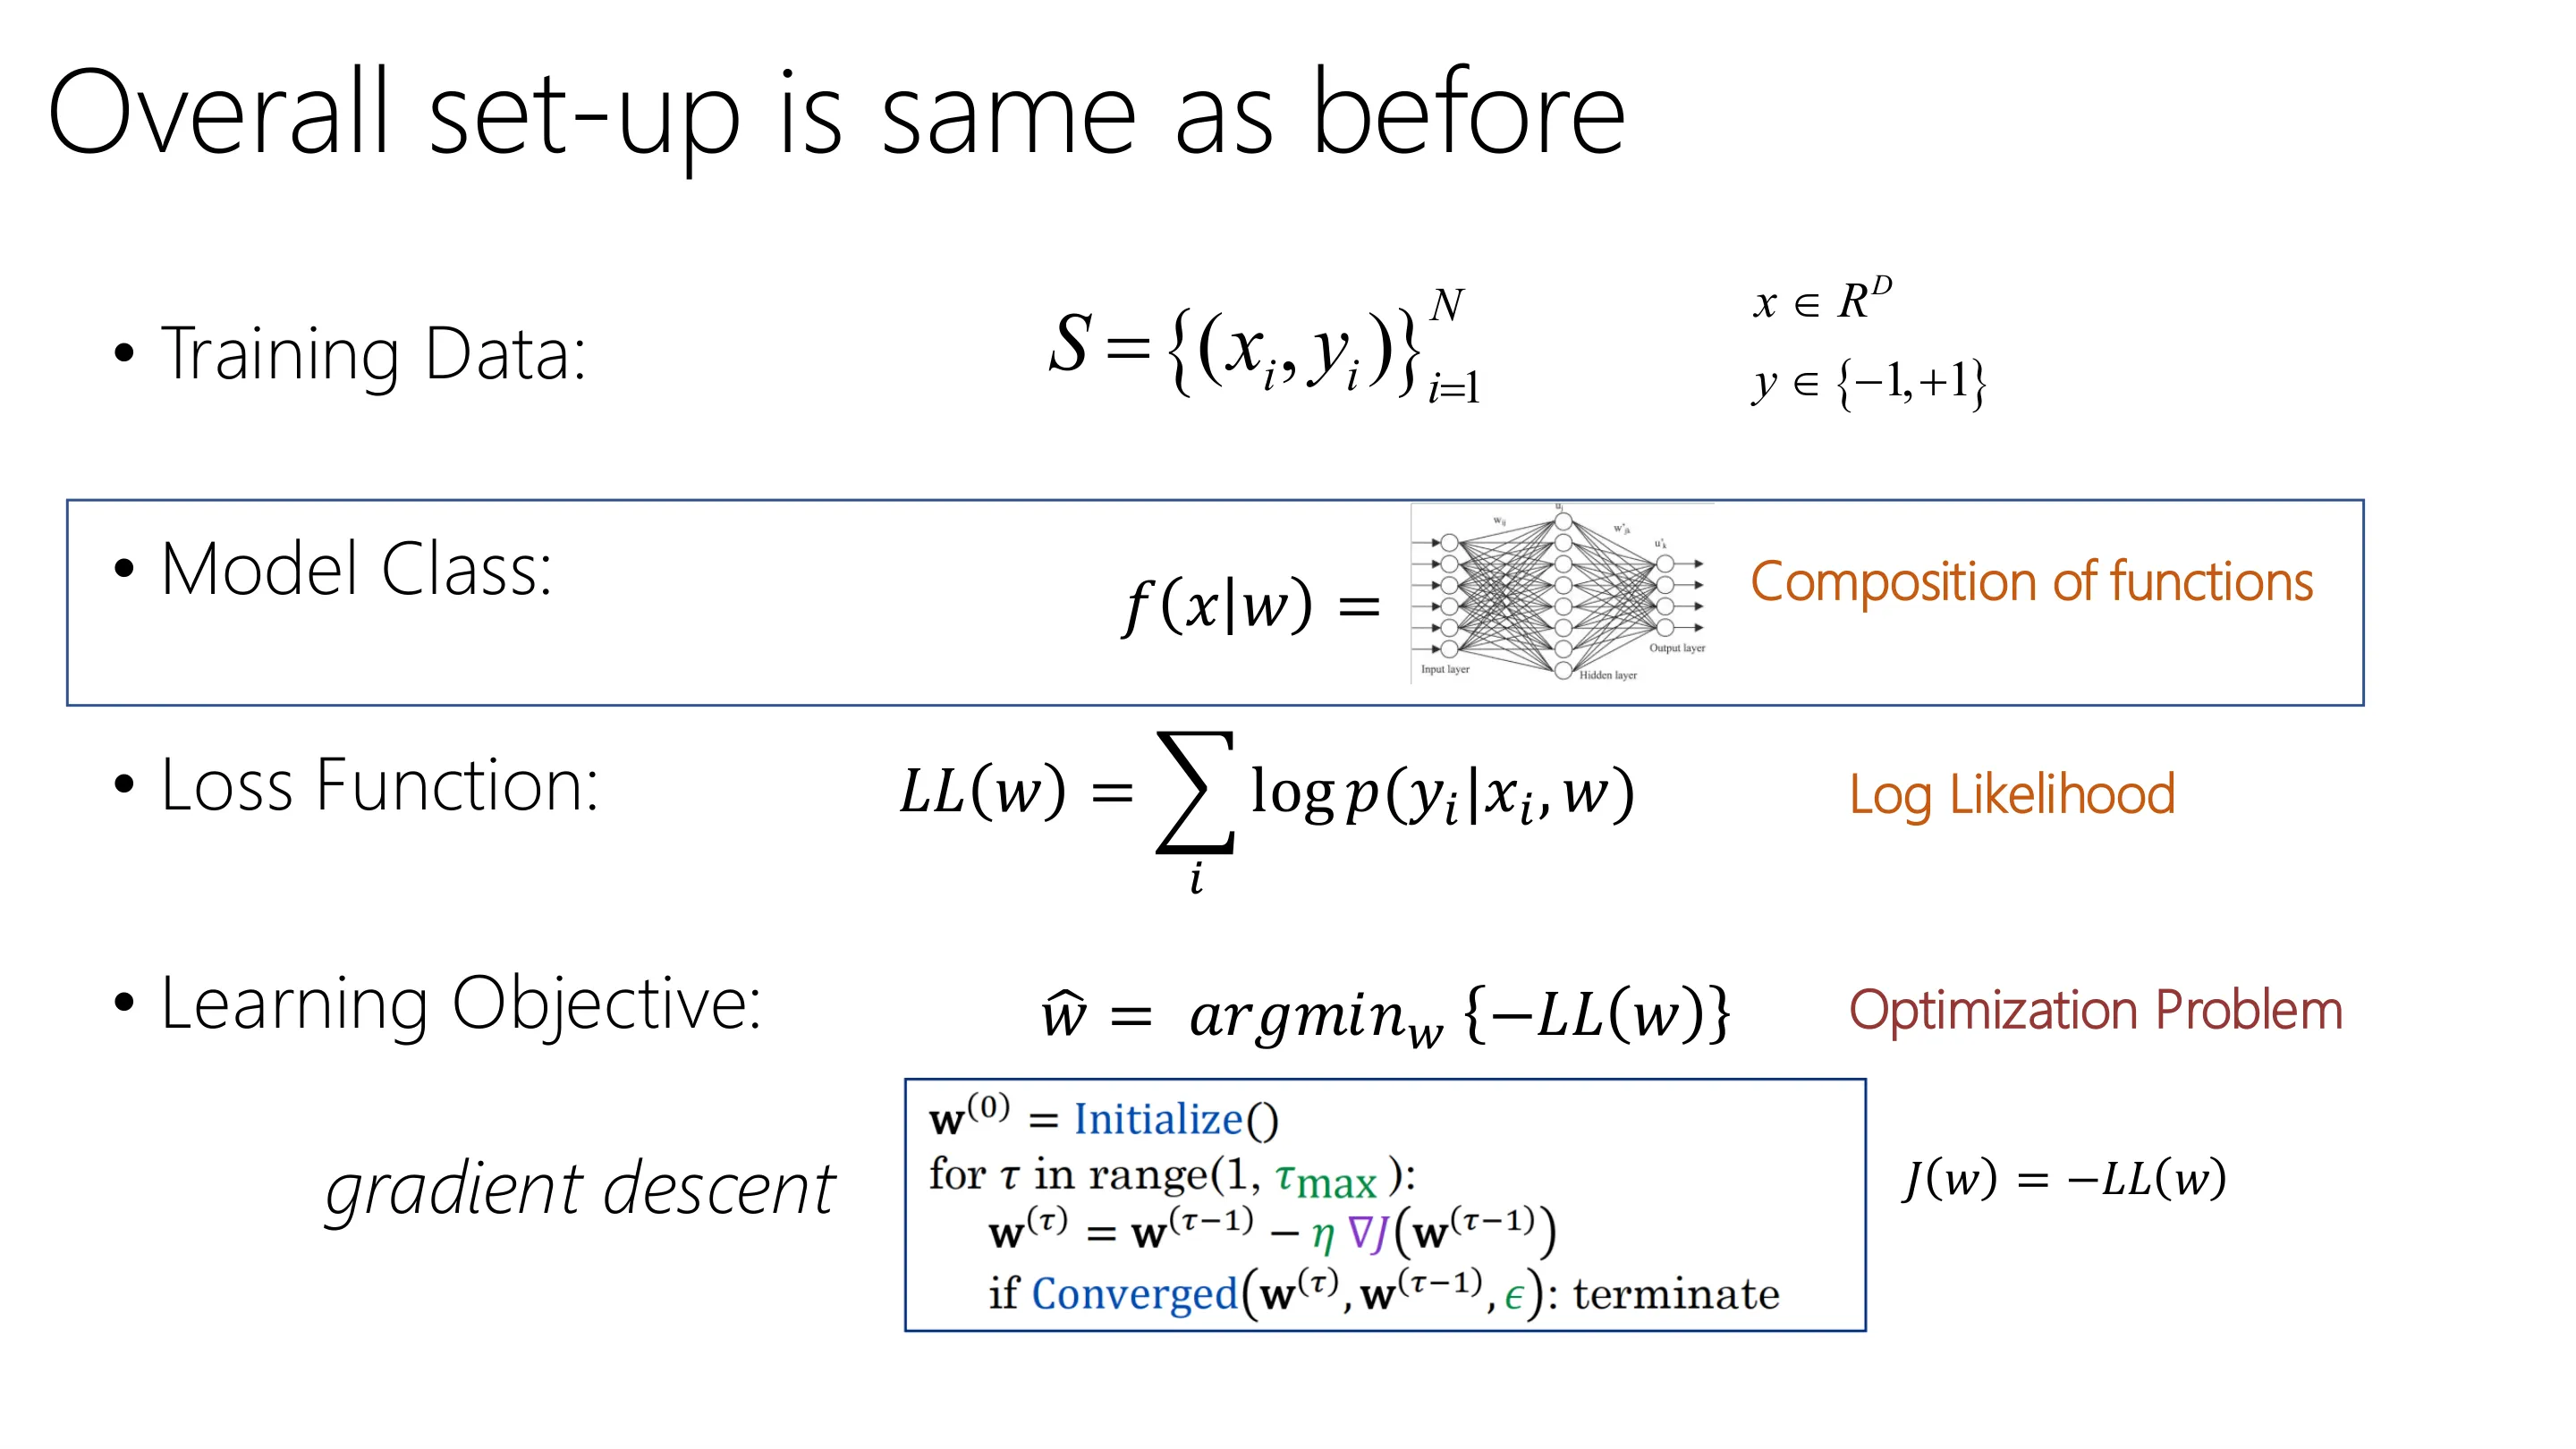
📷 整体设定与之前相同
回到原视频 (00:01:33)
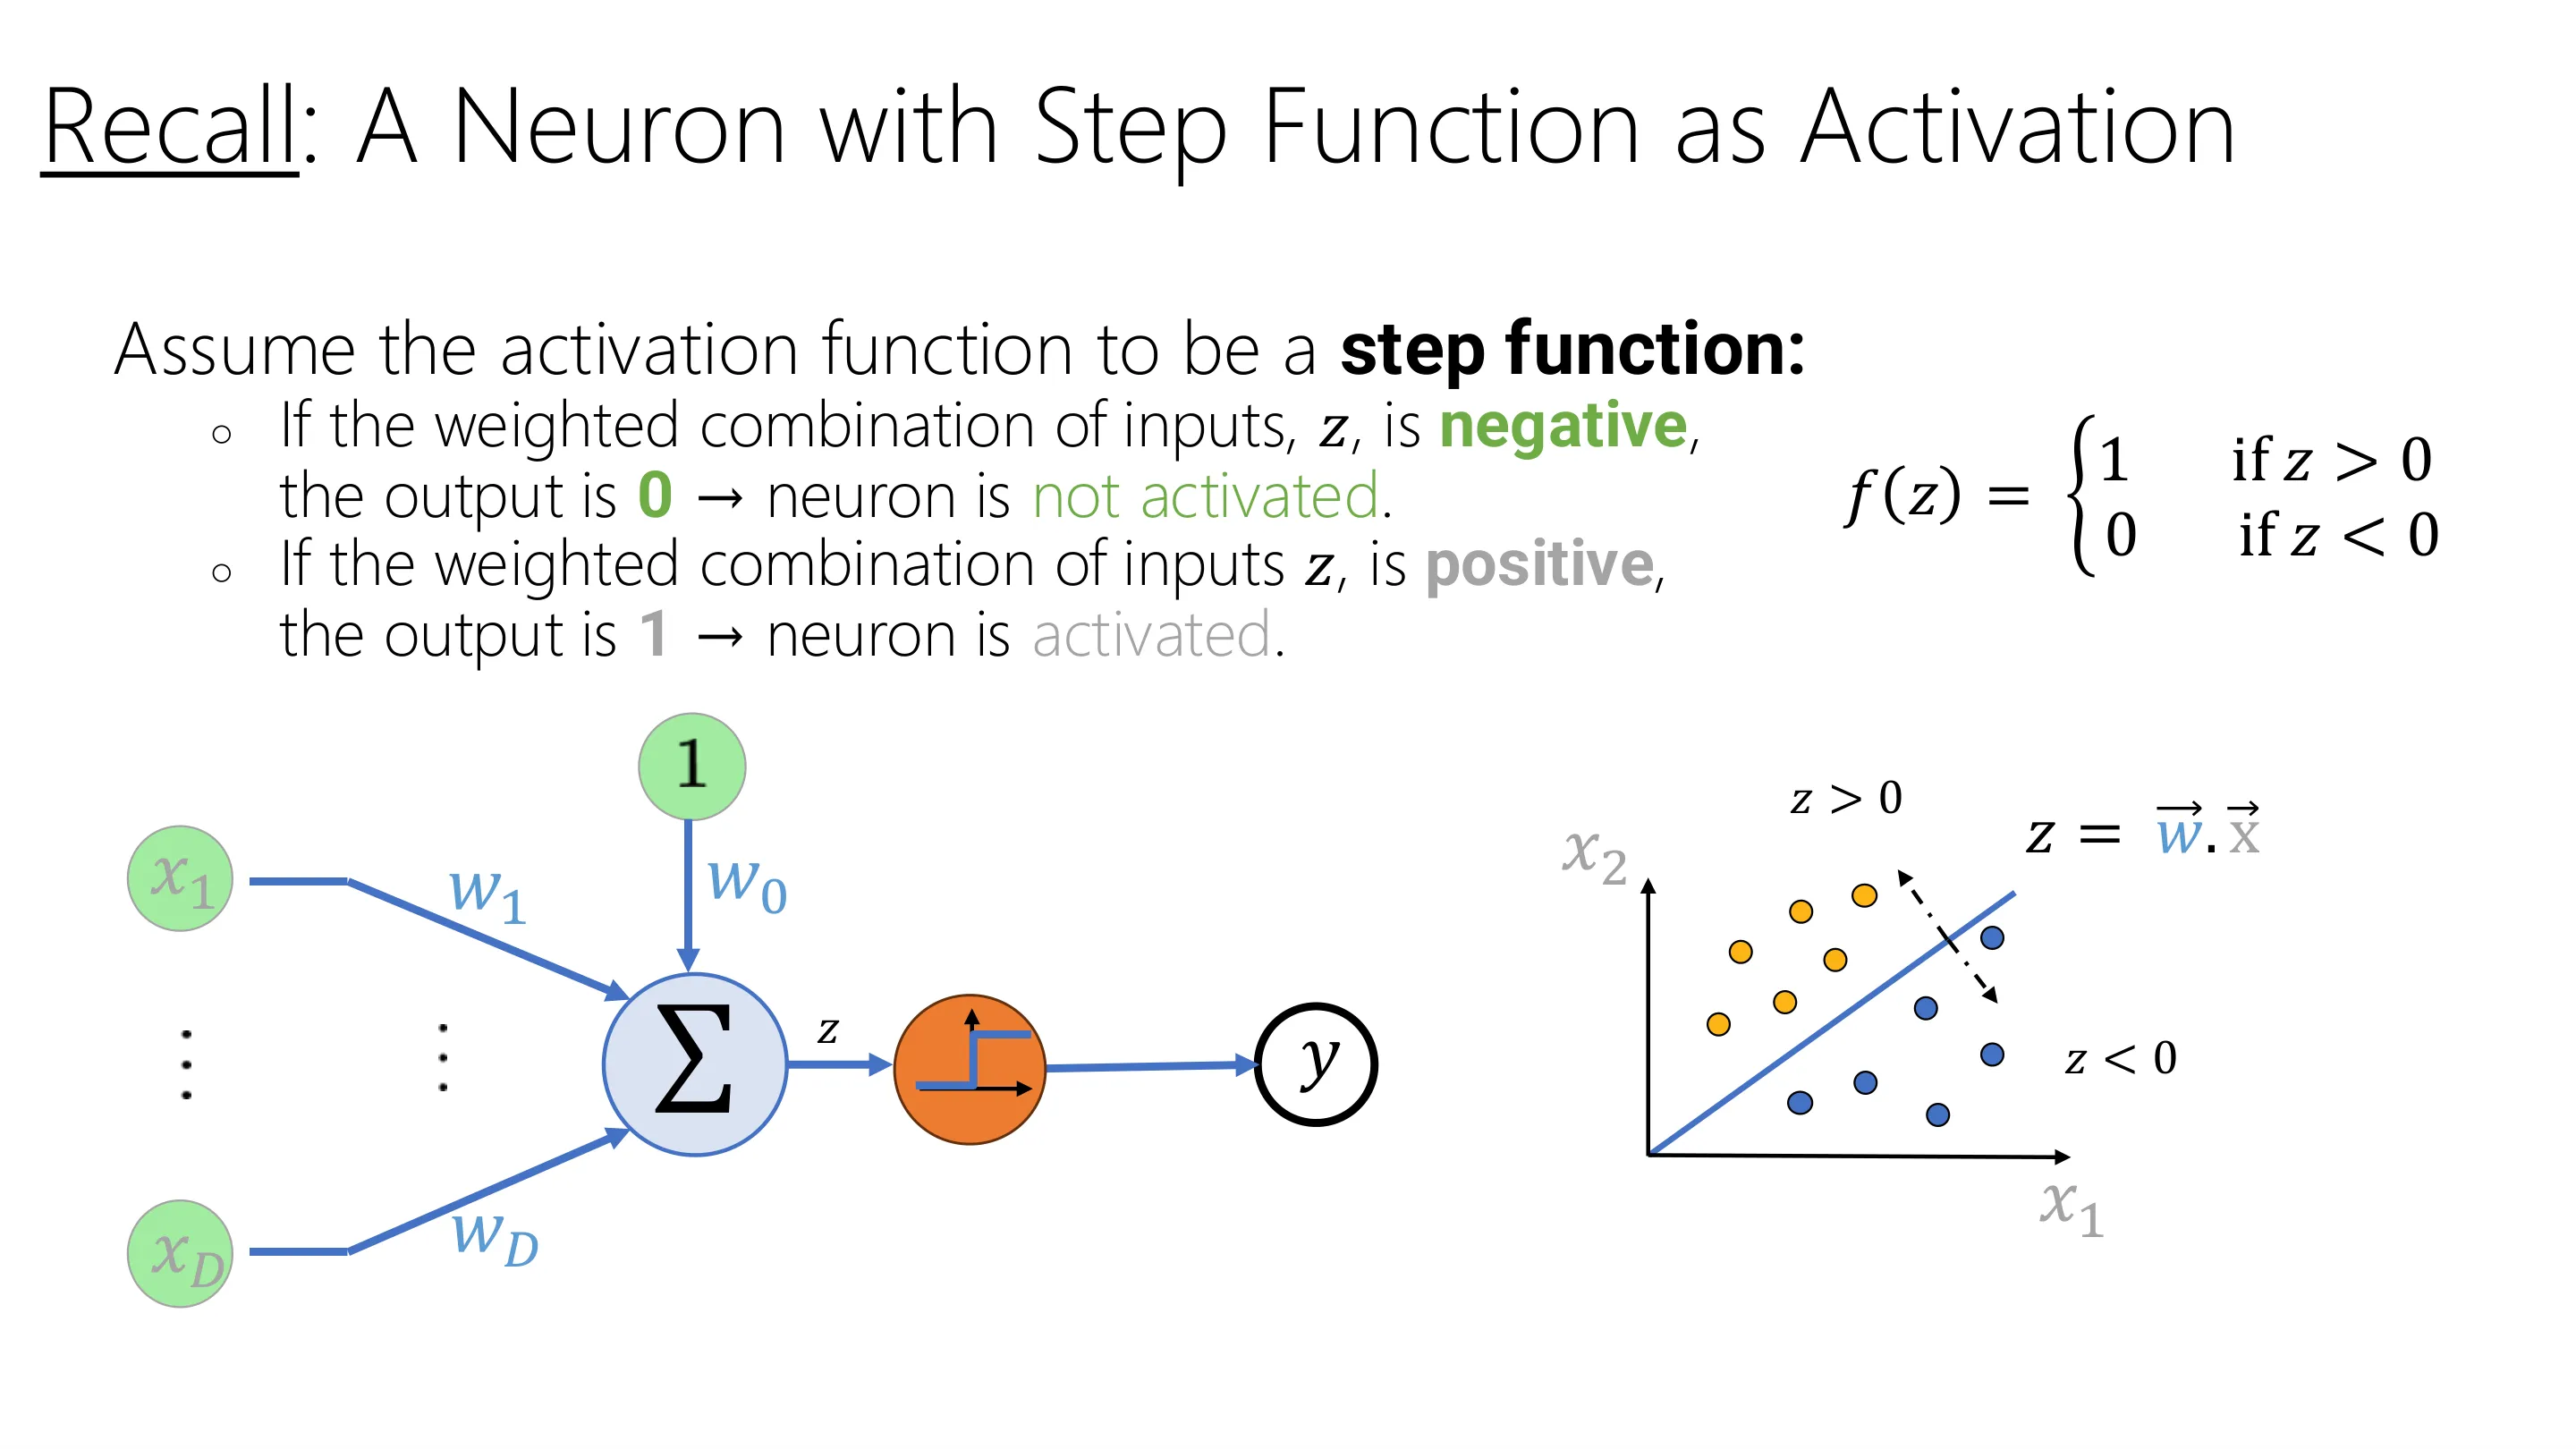
📷 回顾:带阶跃激活的神经元
回到原视频 (00:02:46)
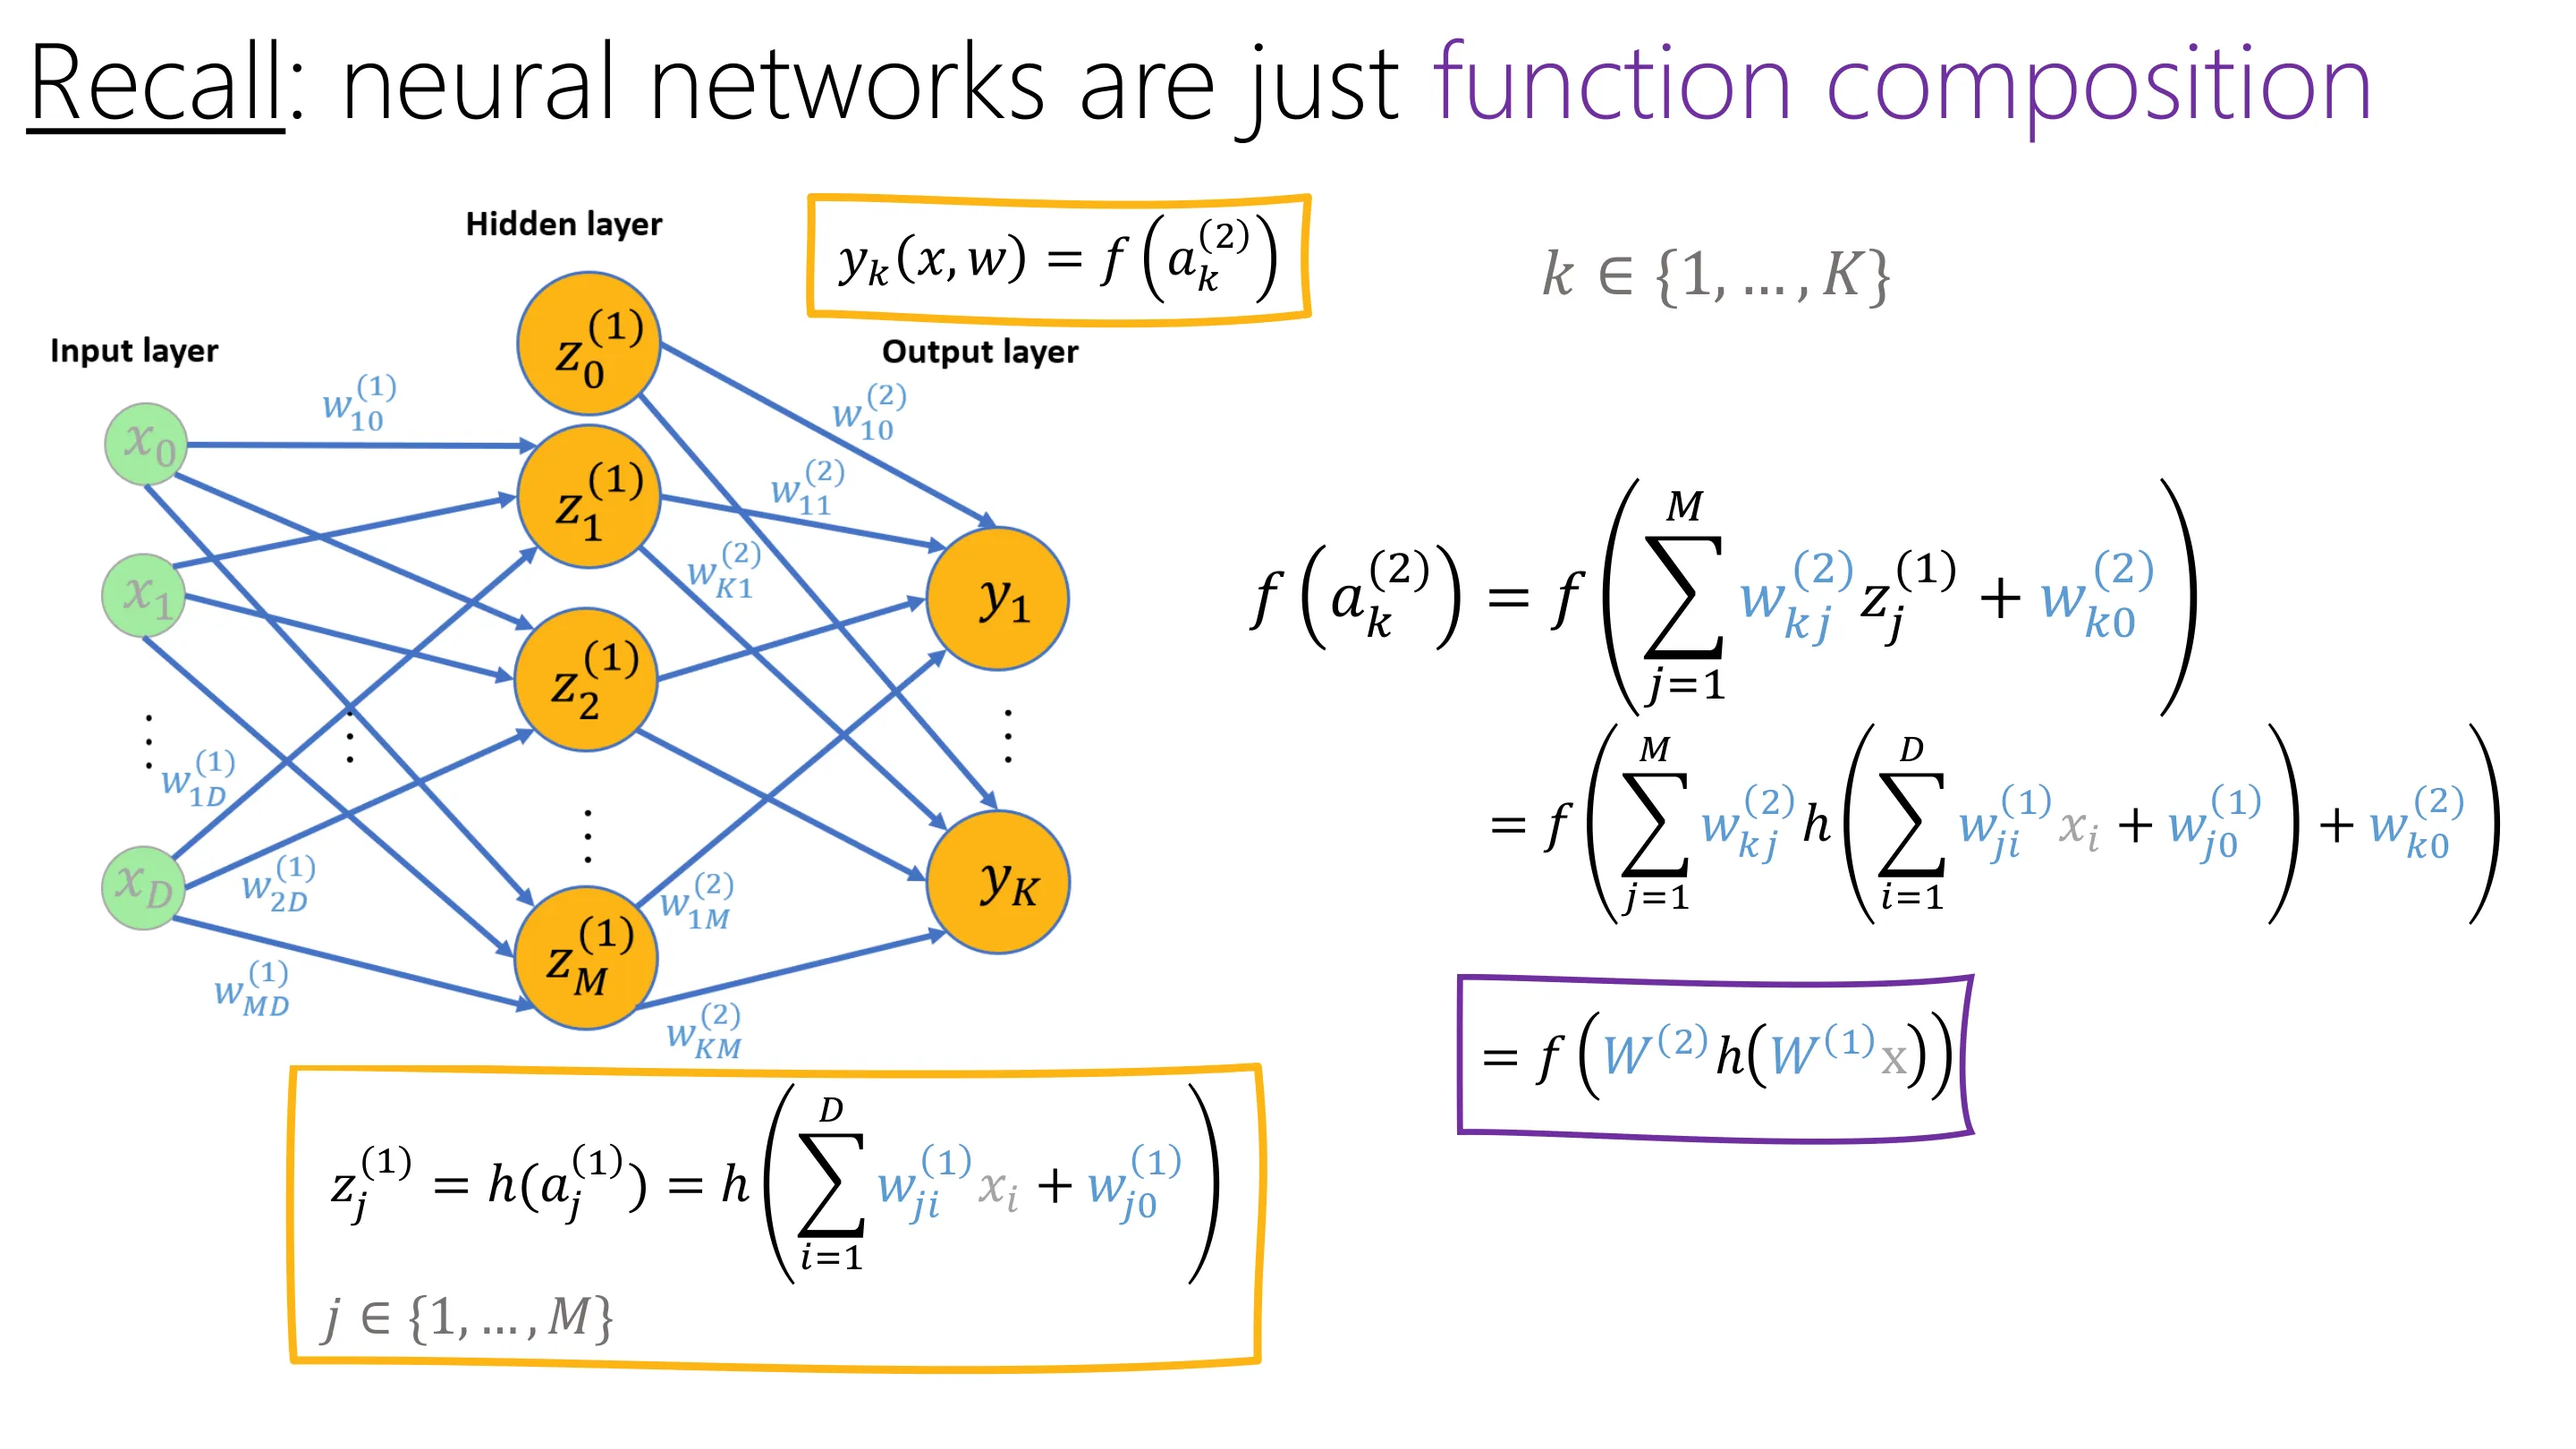
📷 k ∈ {1, …, K}
回到原视频 (00:03:59)
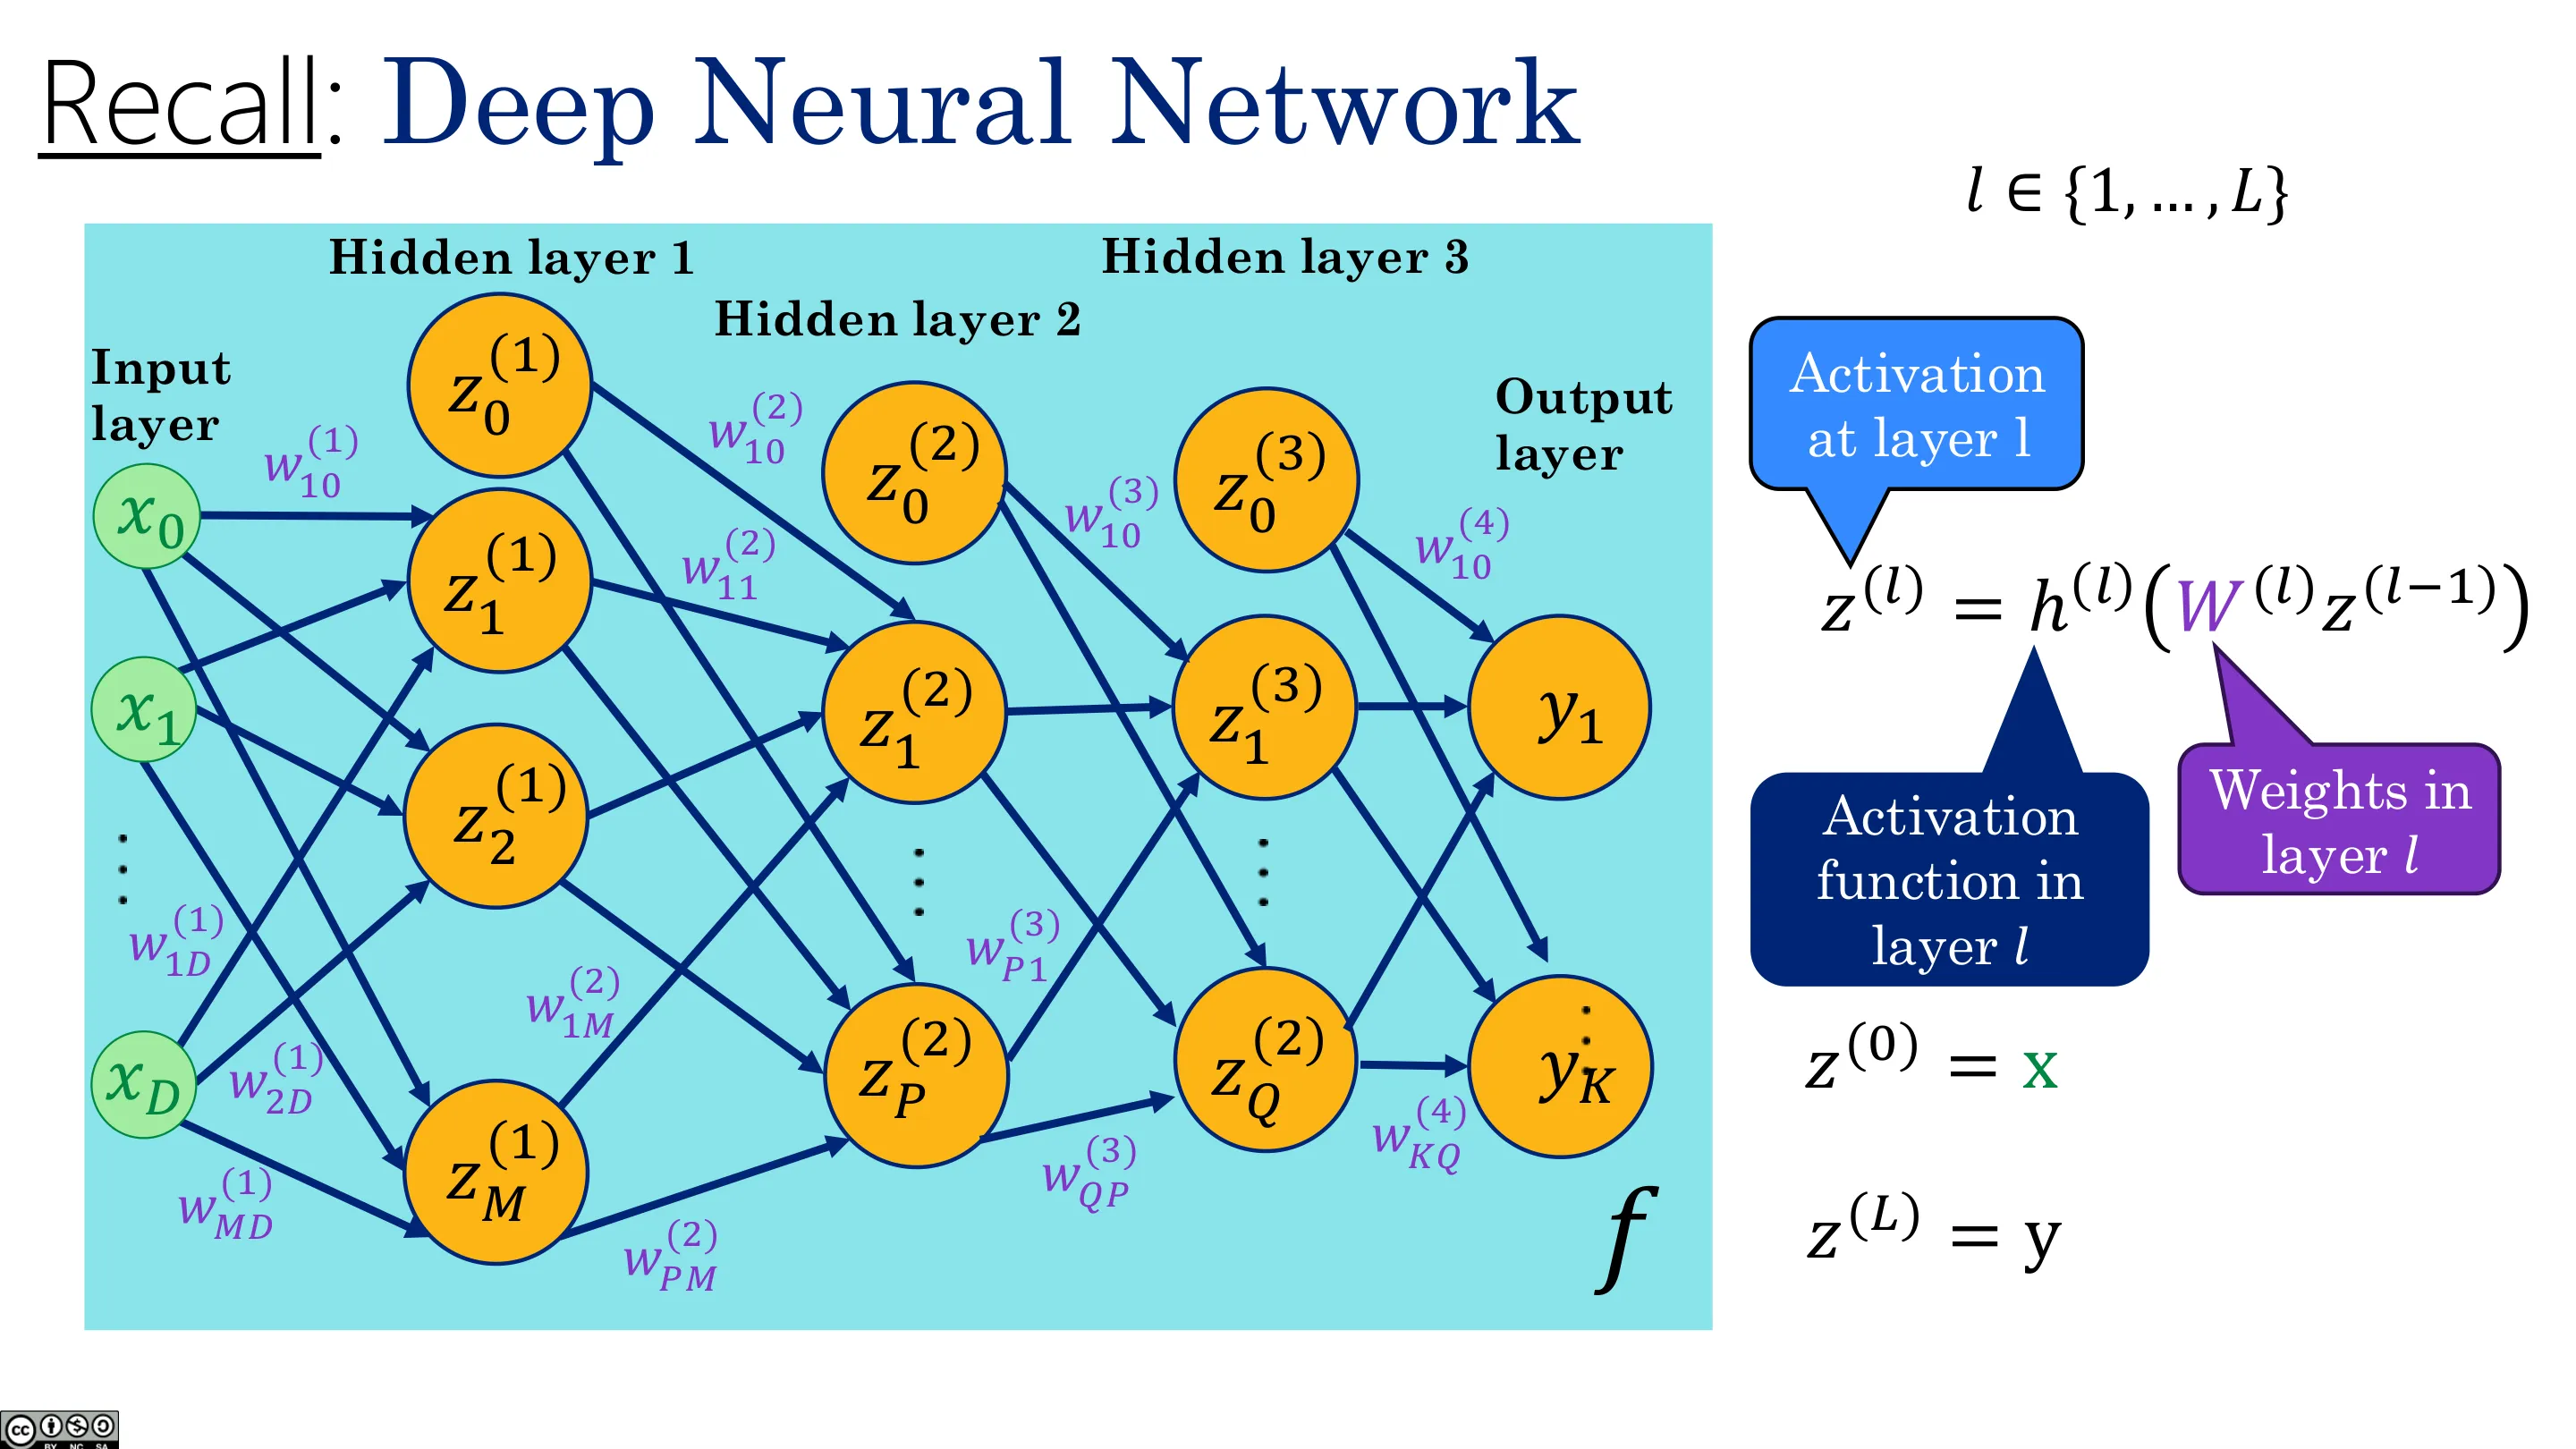
📷 回顾:深度神经网络
回到原视频 (00:05:12)
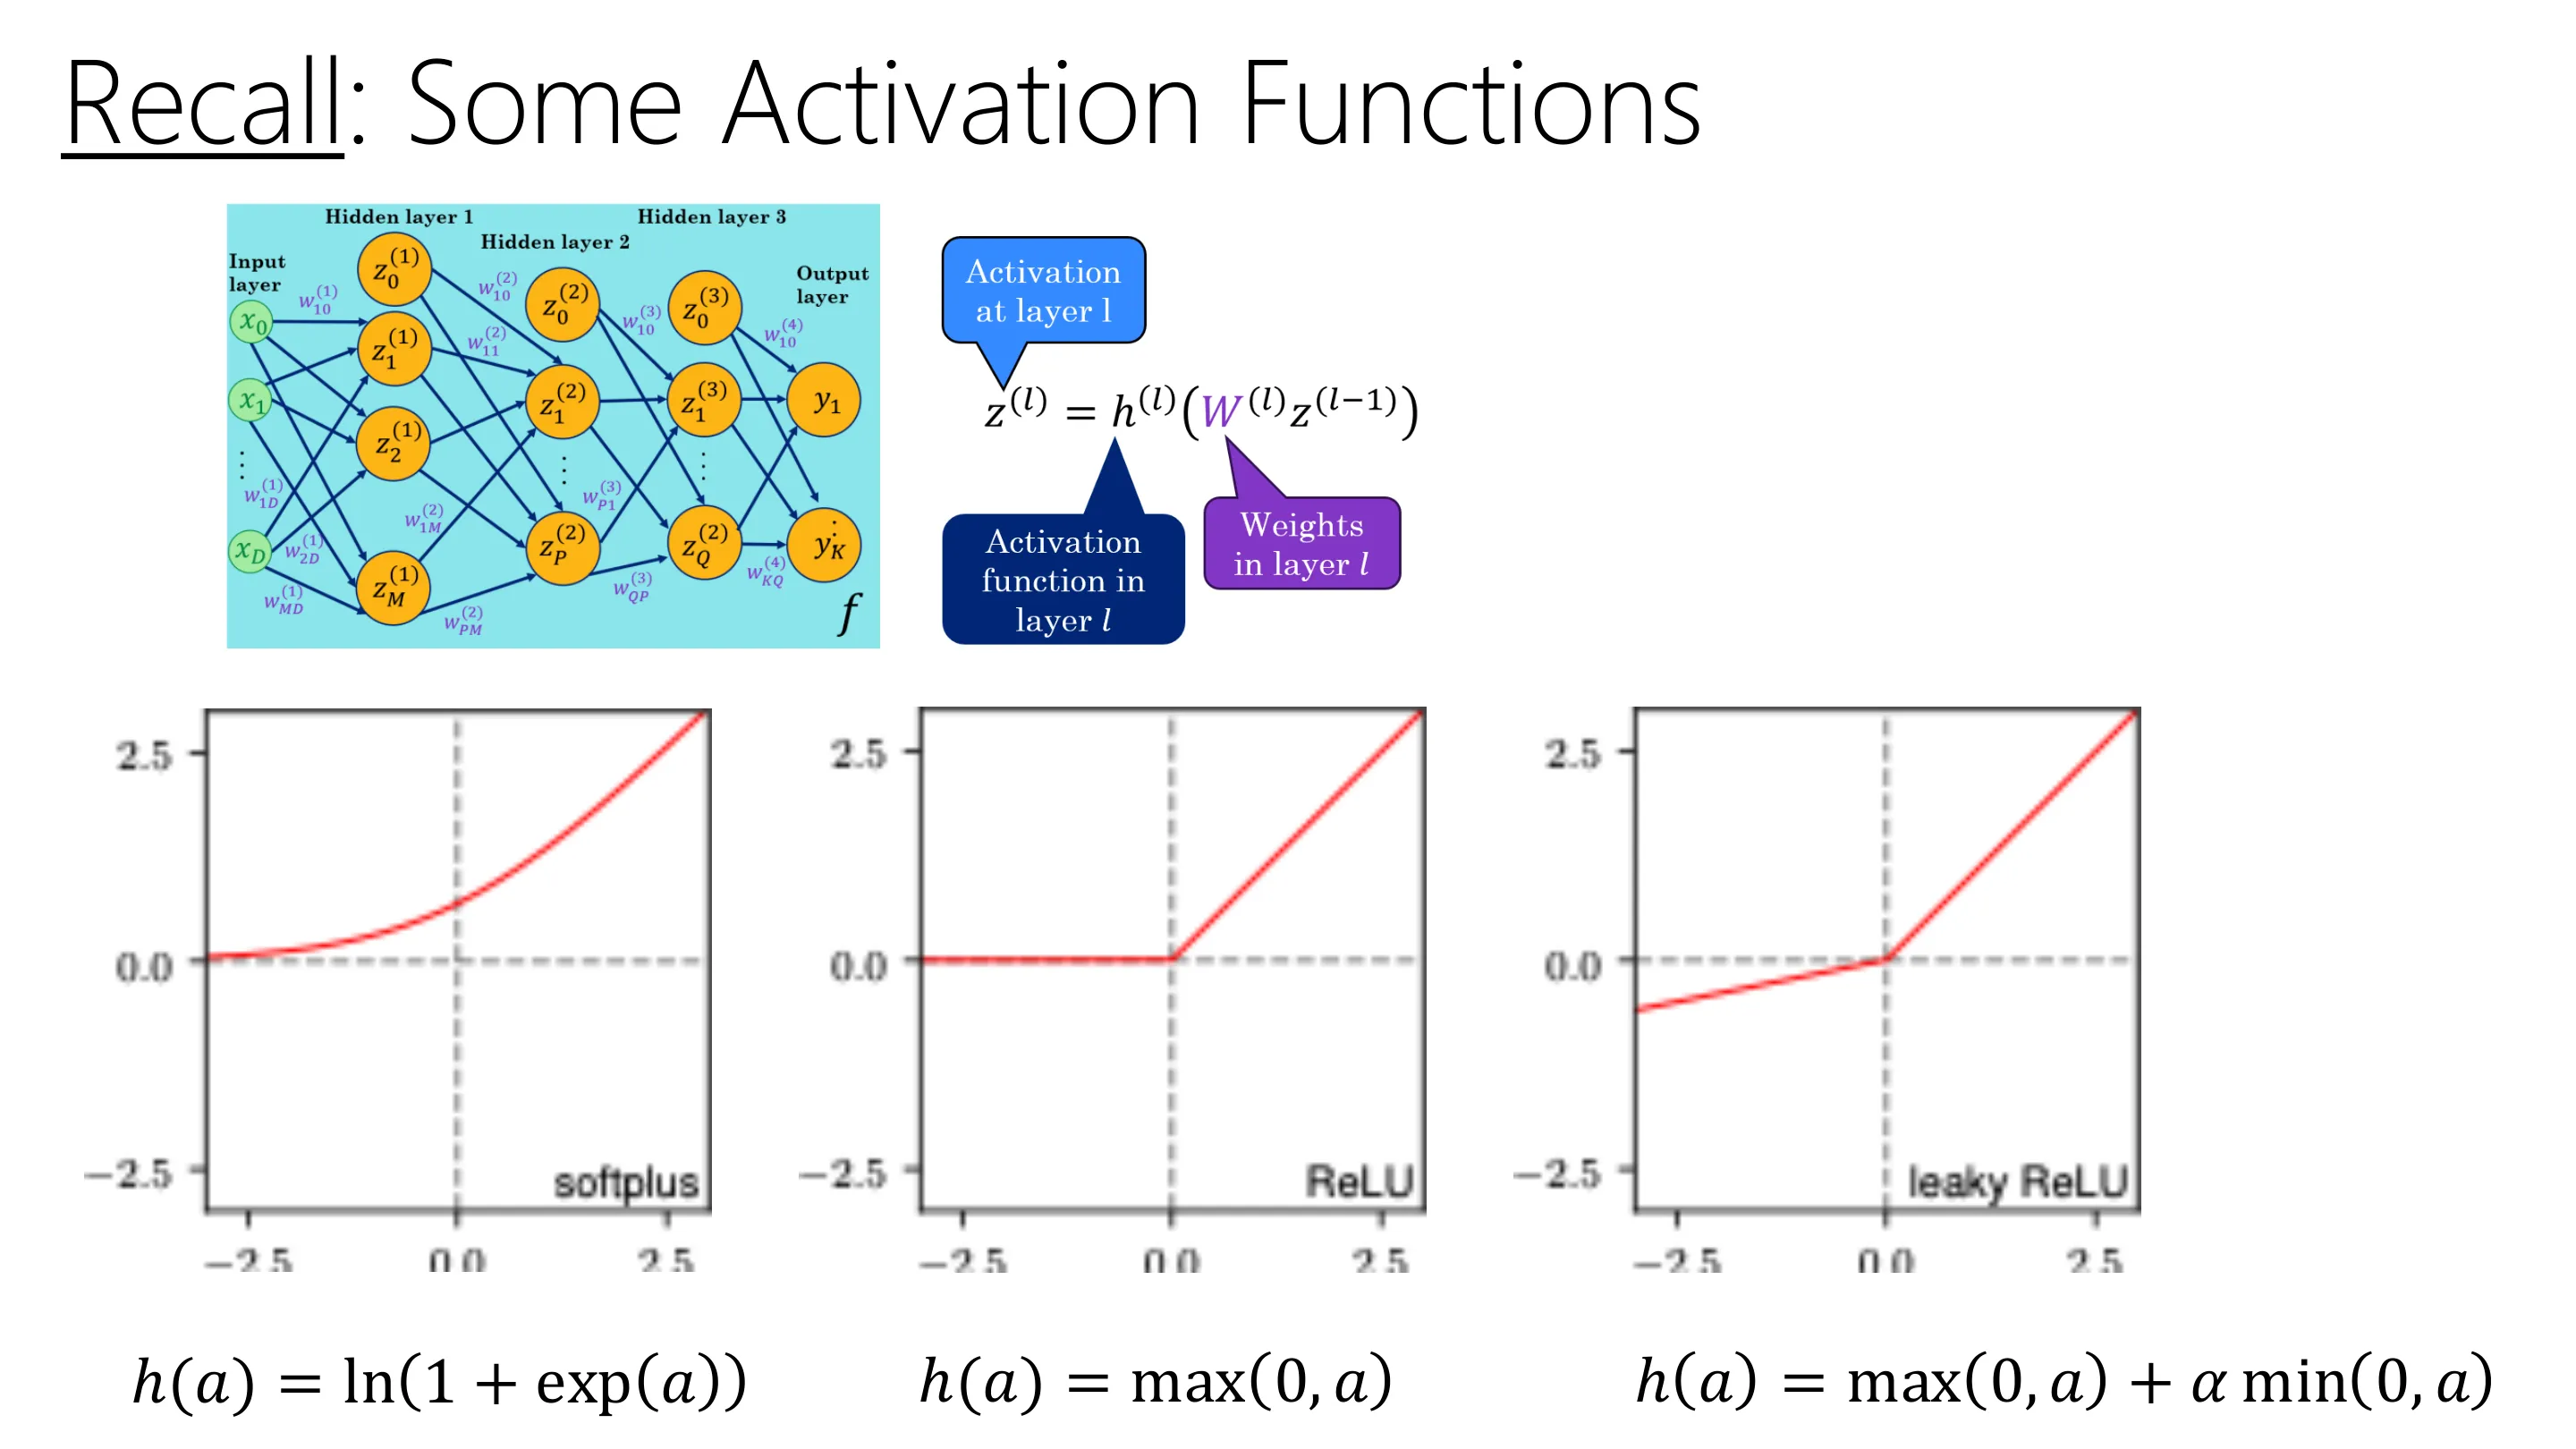
📷 回顾:一些激活函数
回到原视频 (00:06:25)
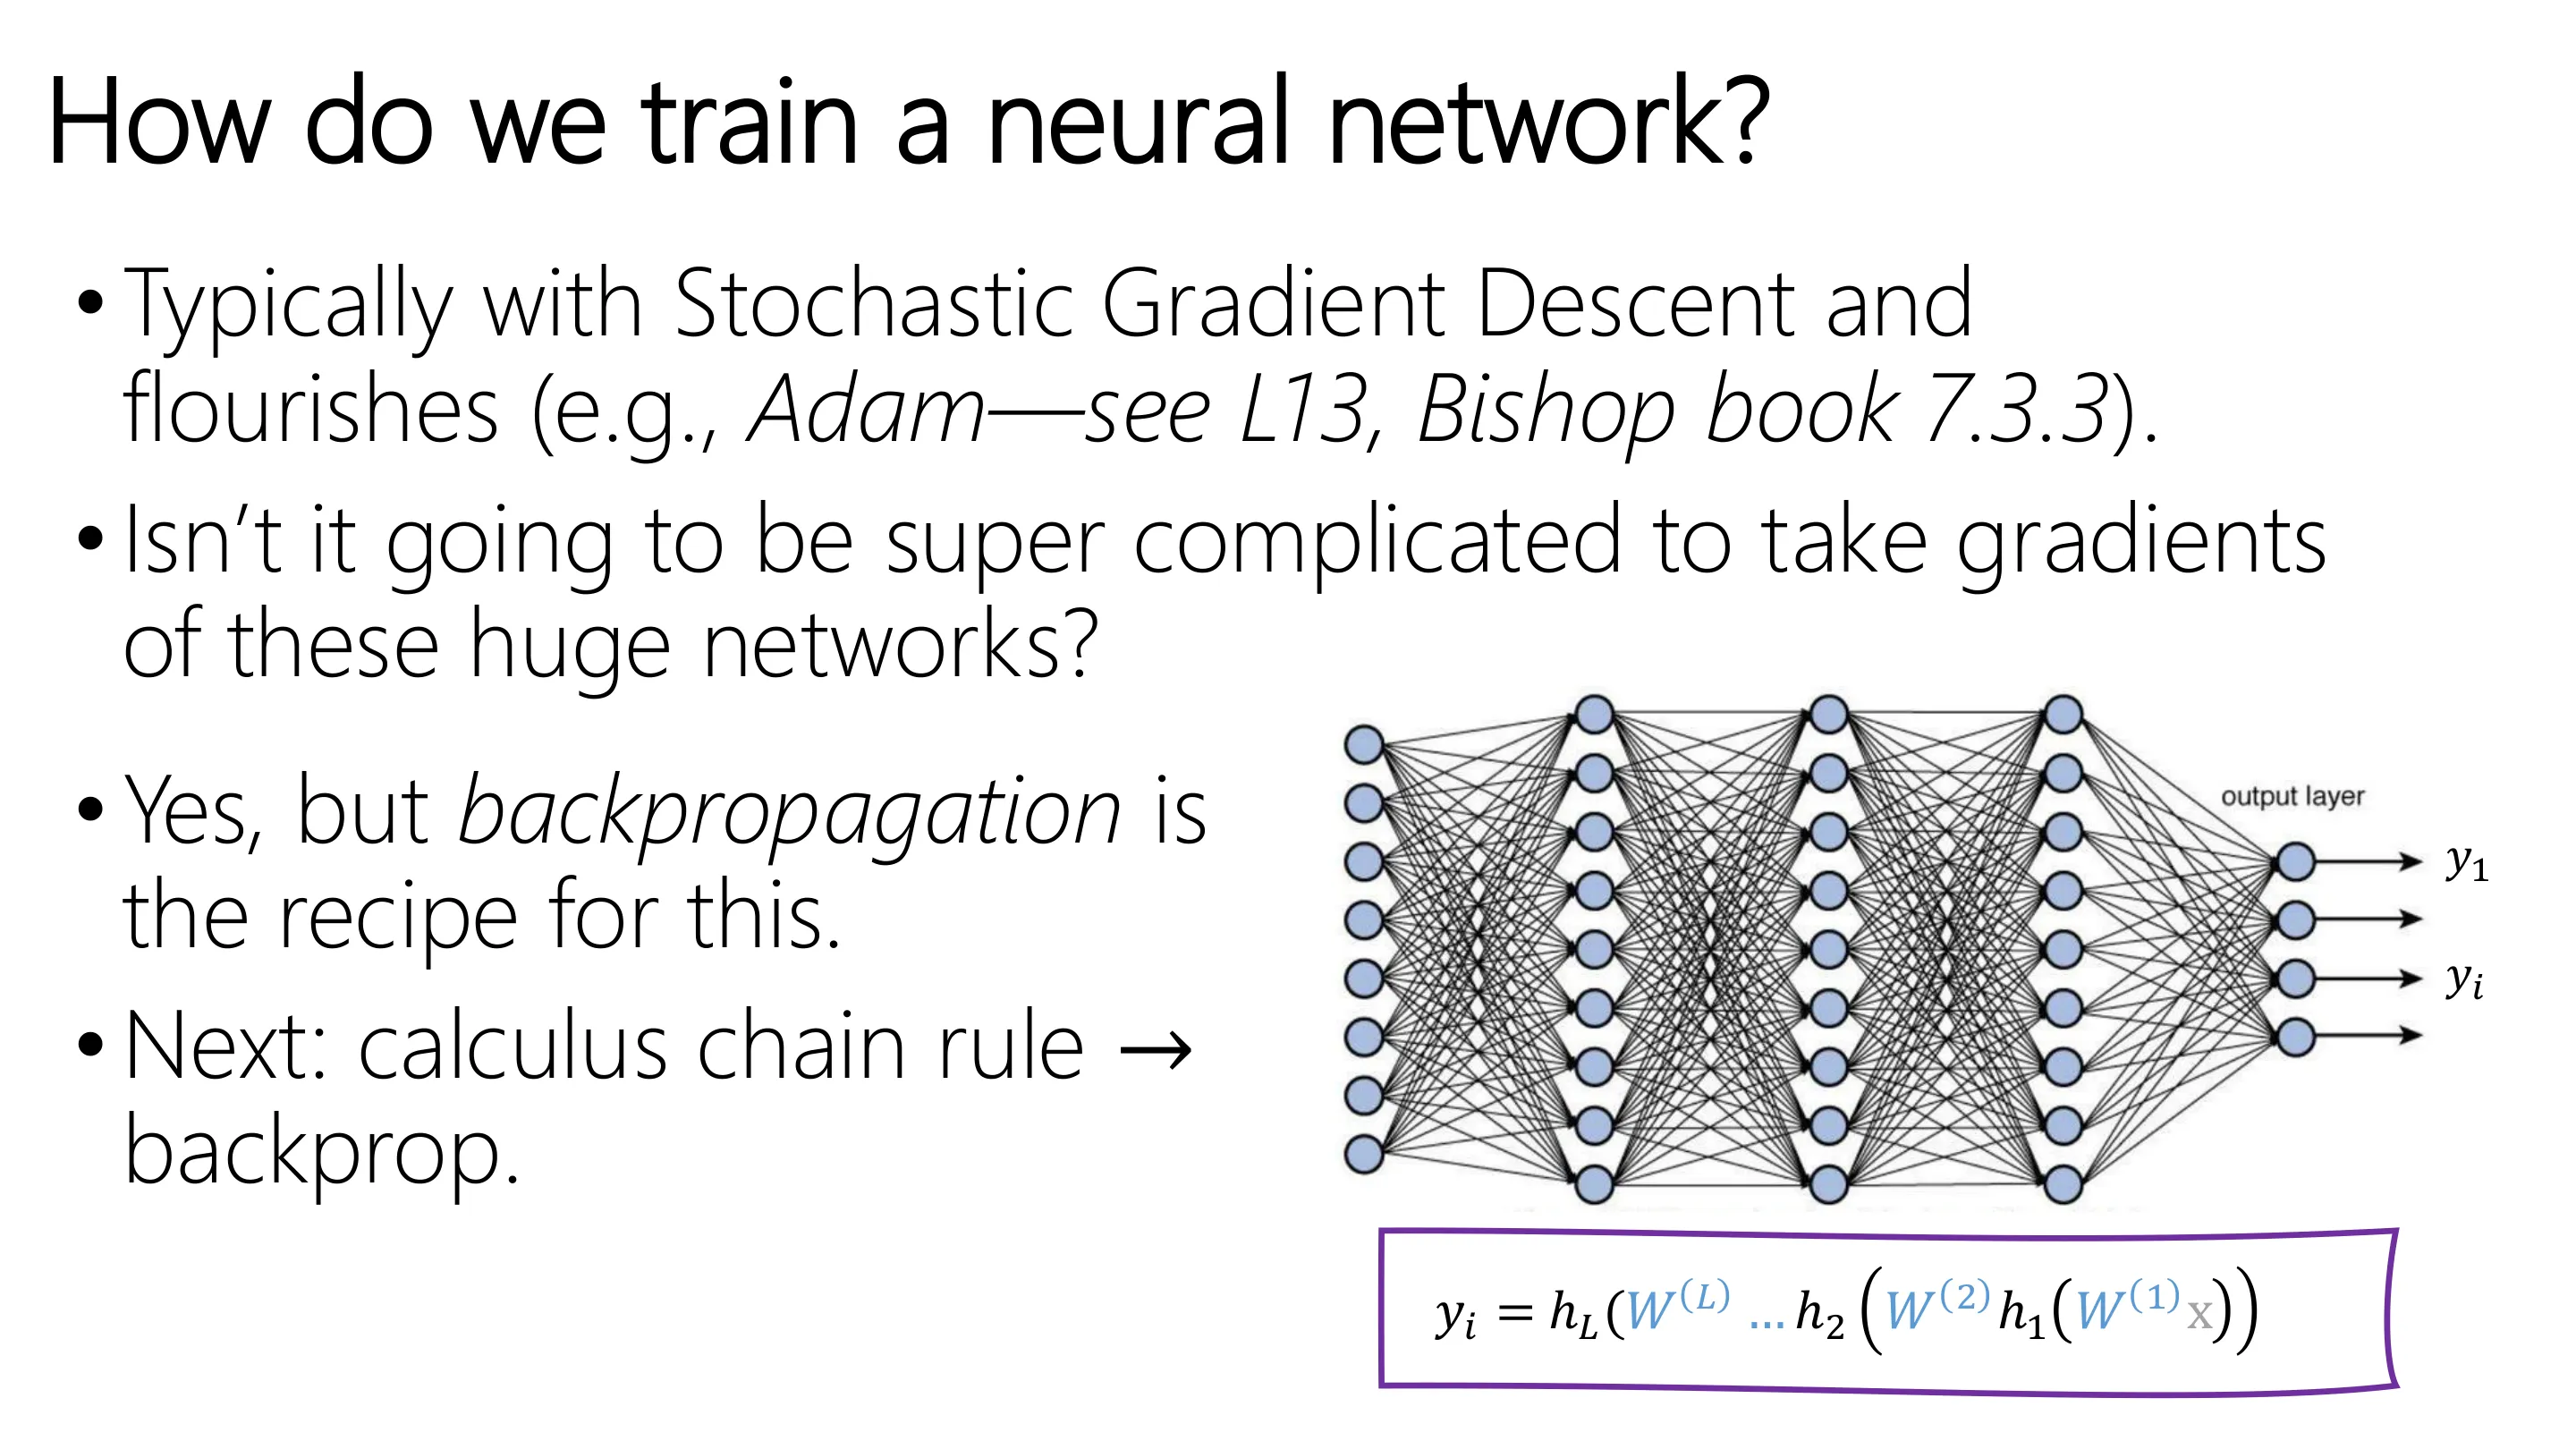
📷 我们如何训练神经网络?
回到原视频 (00:07:38)
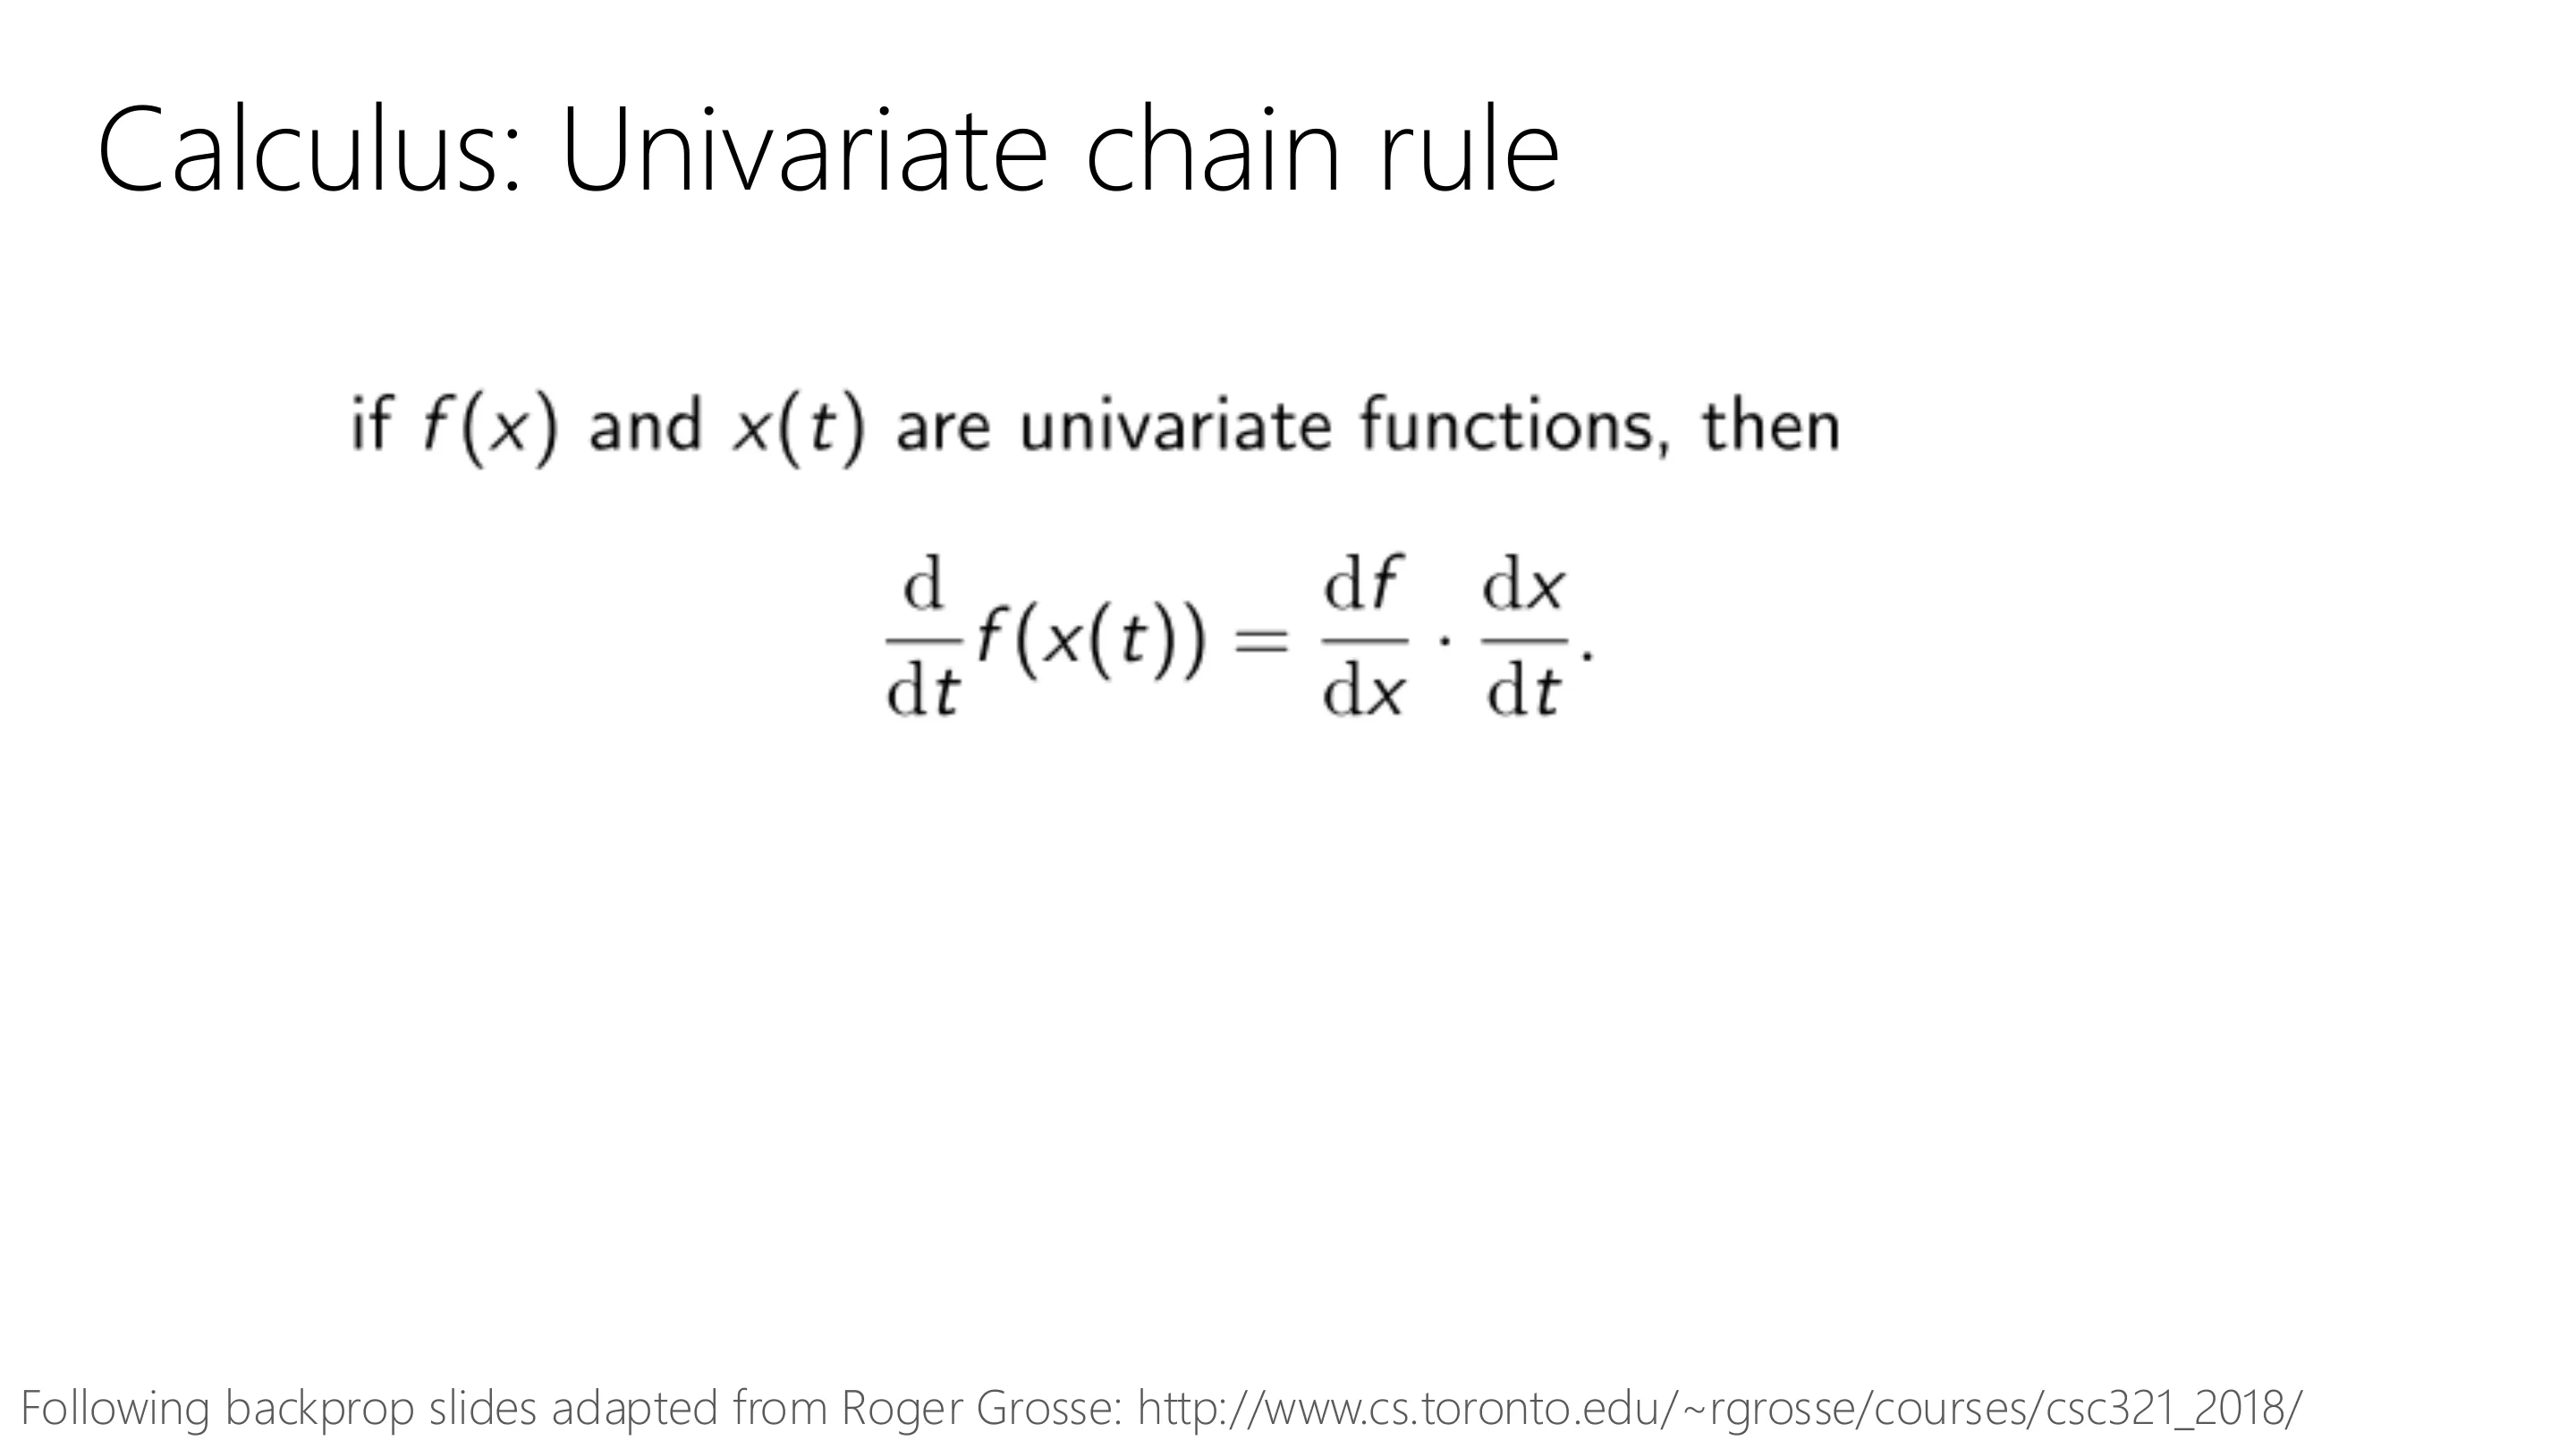
📷 反向传播幻灯片改编自 Roger Grosse
回到原视频 (00:08:51)
一、一个简单的非线性回归例子
(参考时间: 00:09)
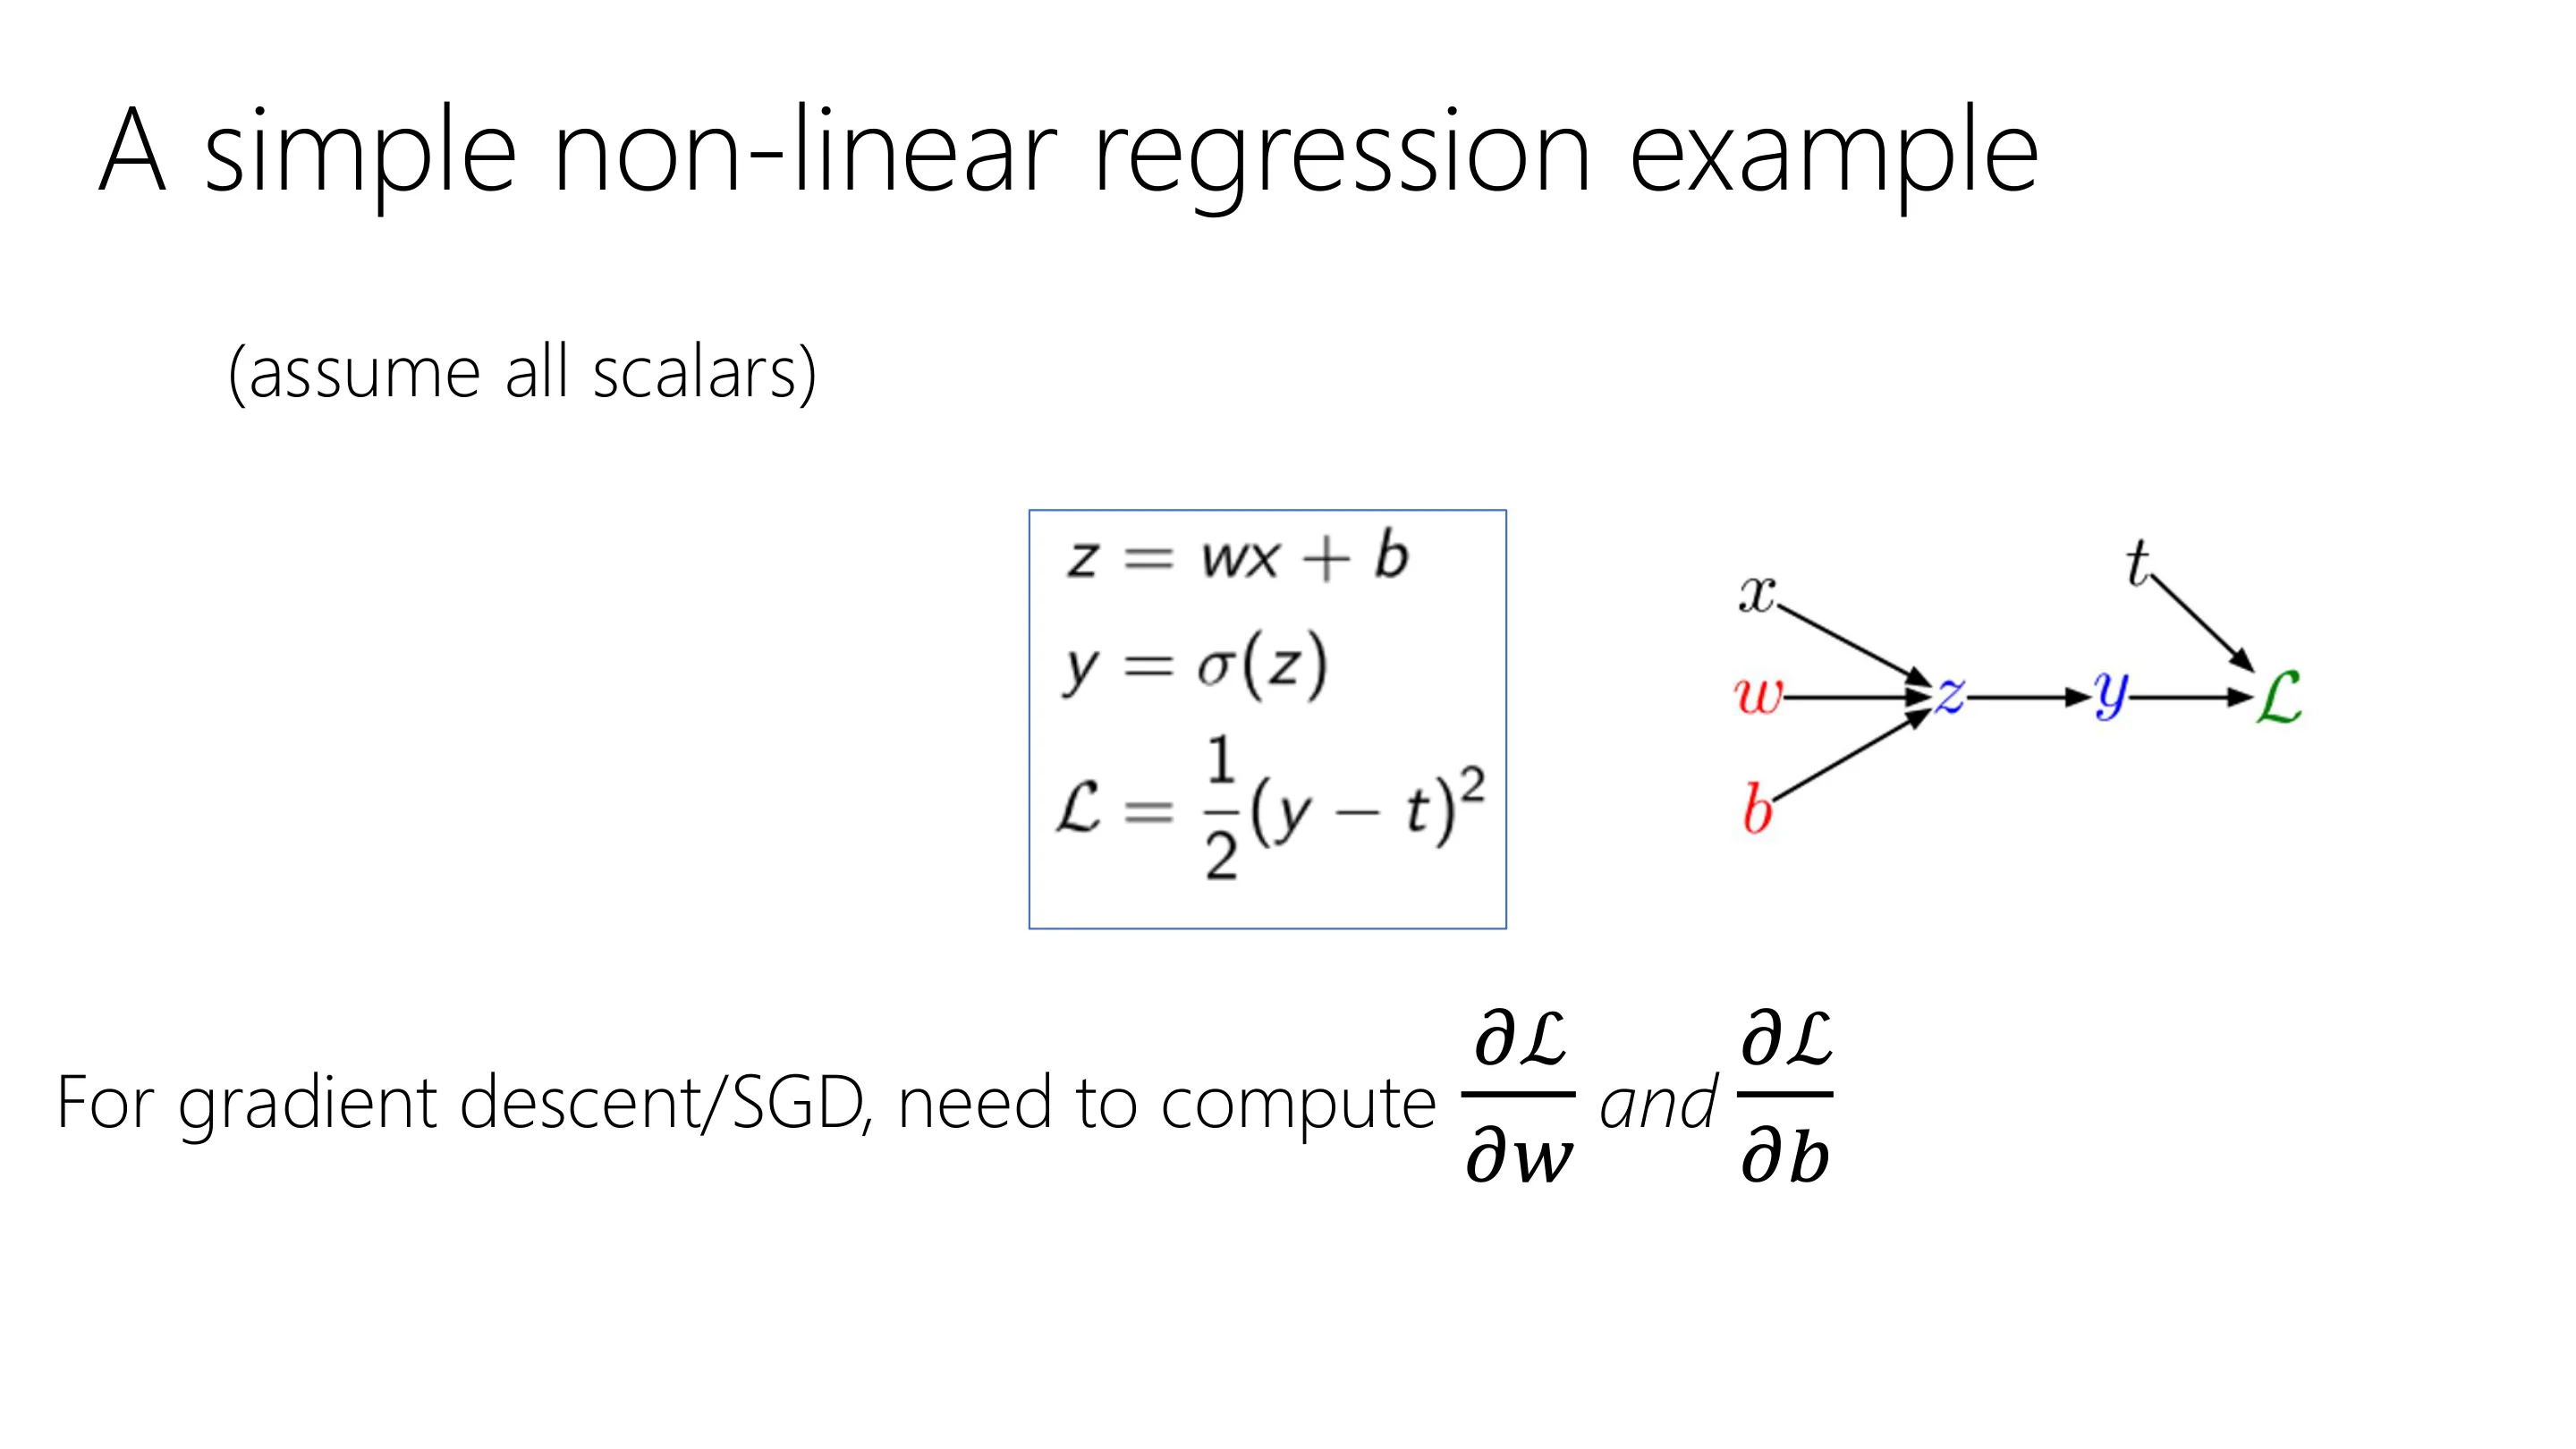
标量例子:数据 $x$、标签 $t$,参数 $w,b$。
$$ z = wx+b,\qquad y=\sigma(z),\qquad L=\tfrac12(y-t)^2 $$
- 前向传播:先算中间量 $z$(预激活),再过非线性 $\sigma$ 得 $y$,最后算损失 $L$;
- 目标是求 $\dfrac{\partial L}{\partial w},\dfrac{\partial L}{\partial b}$,用于梯度下降。
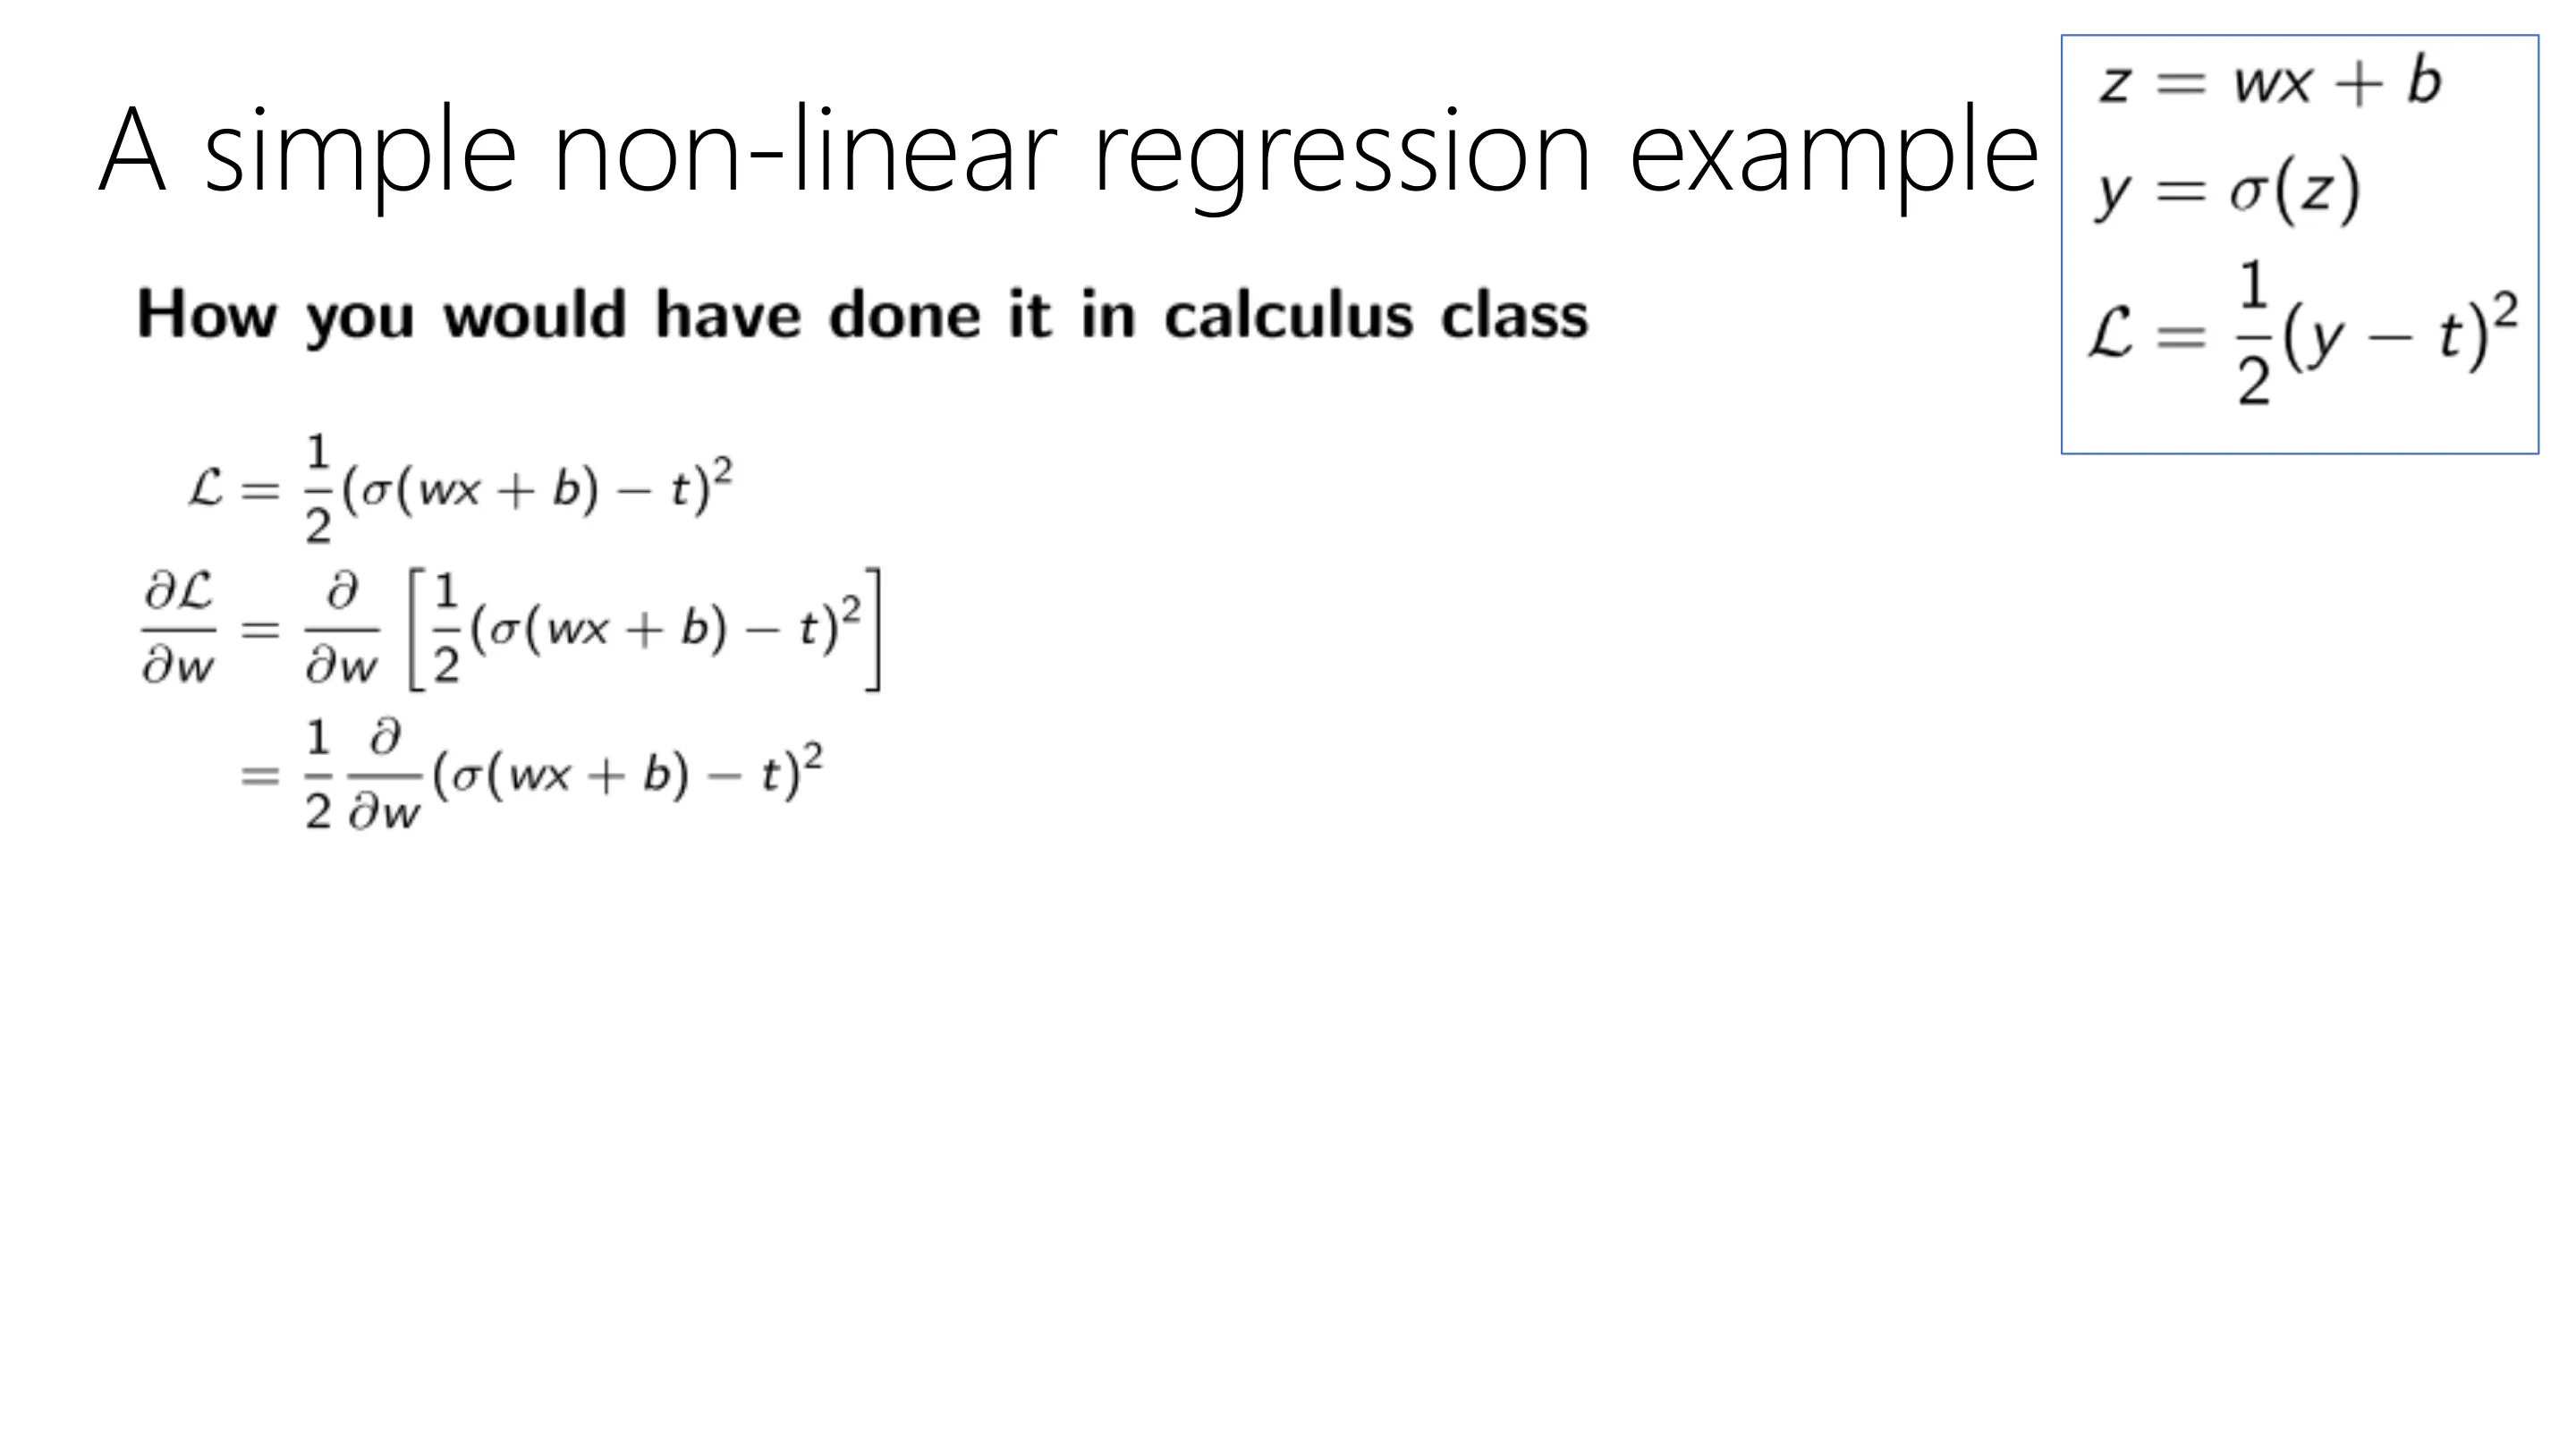
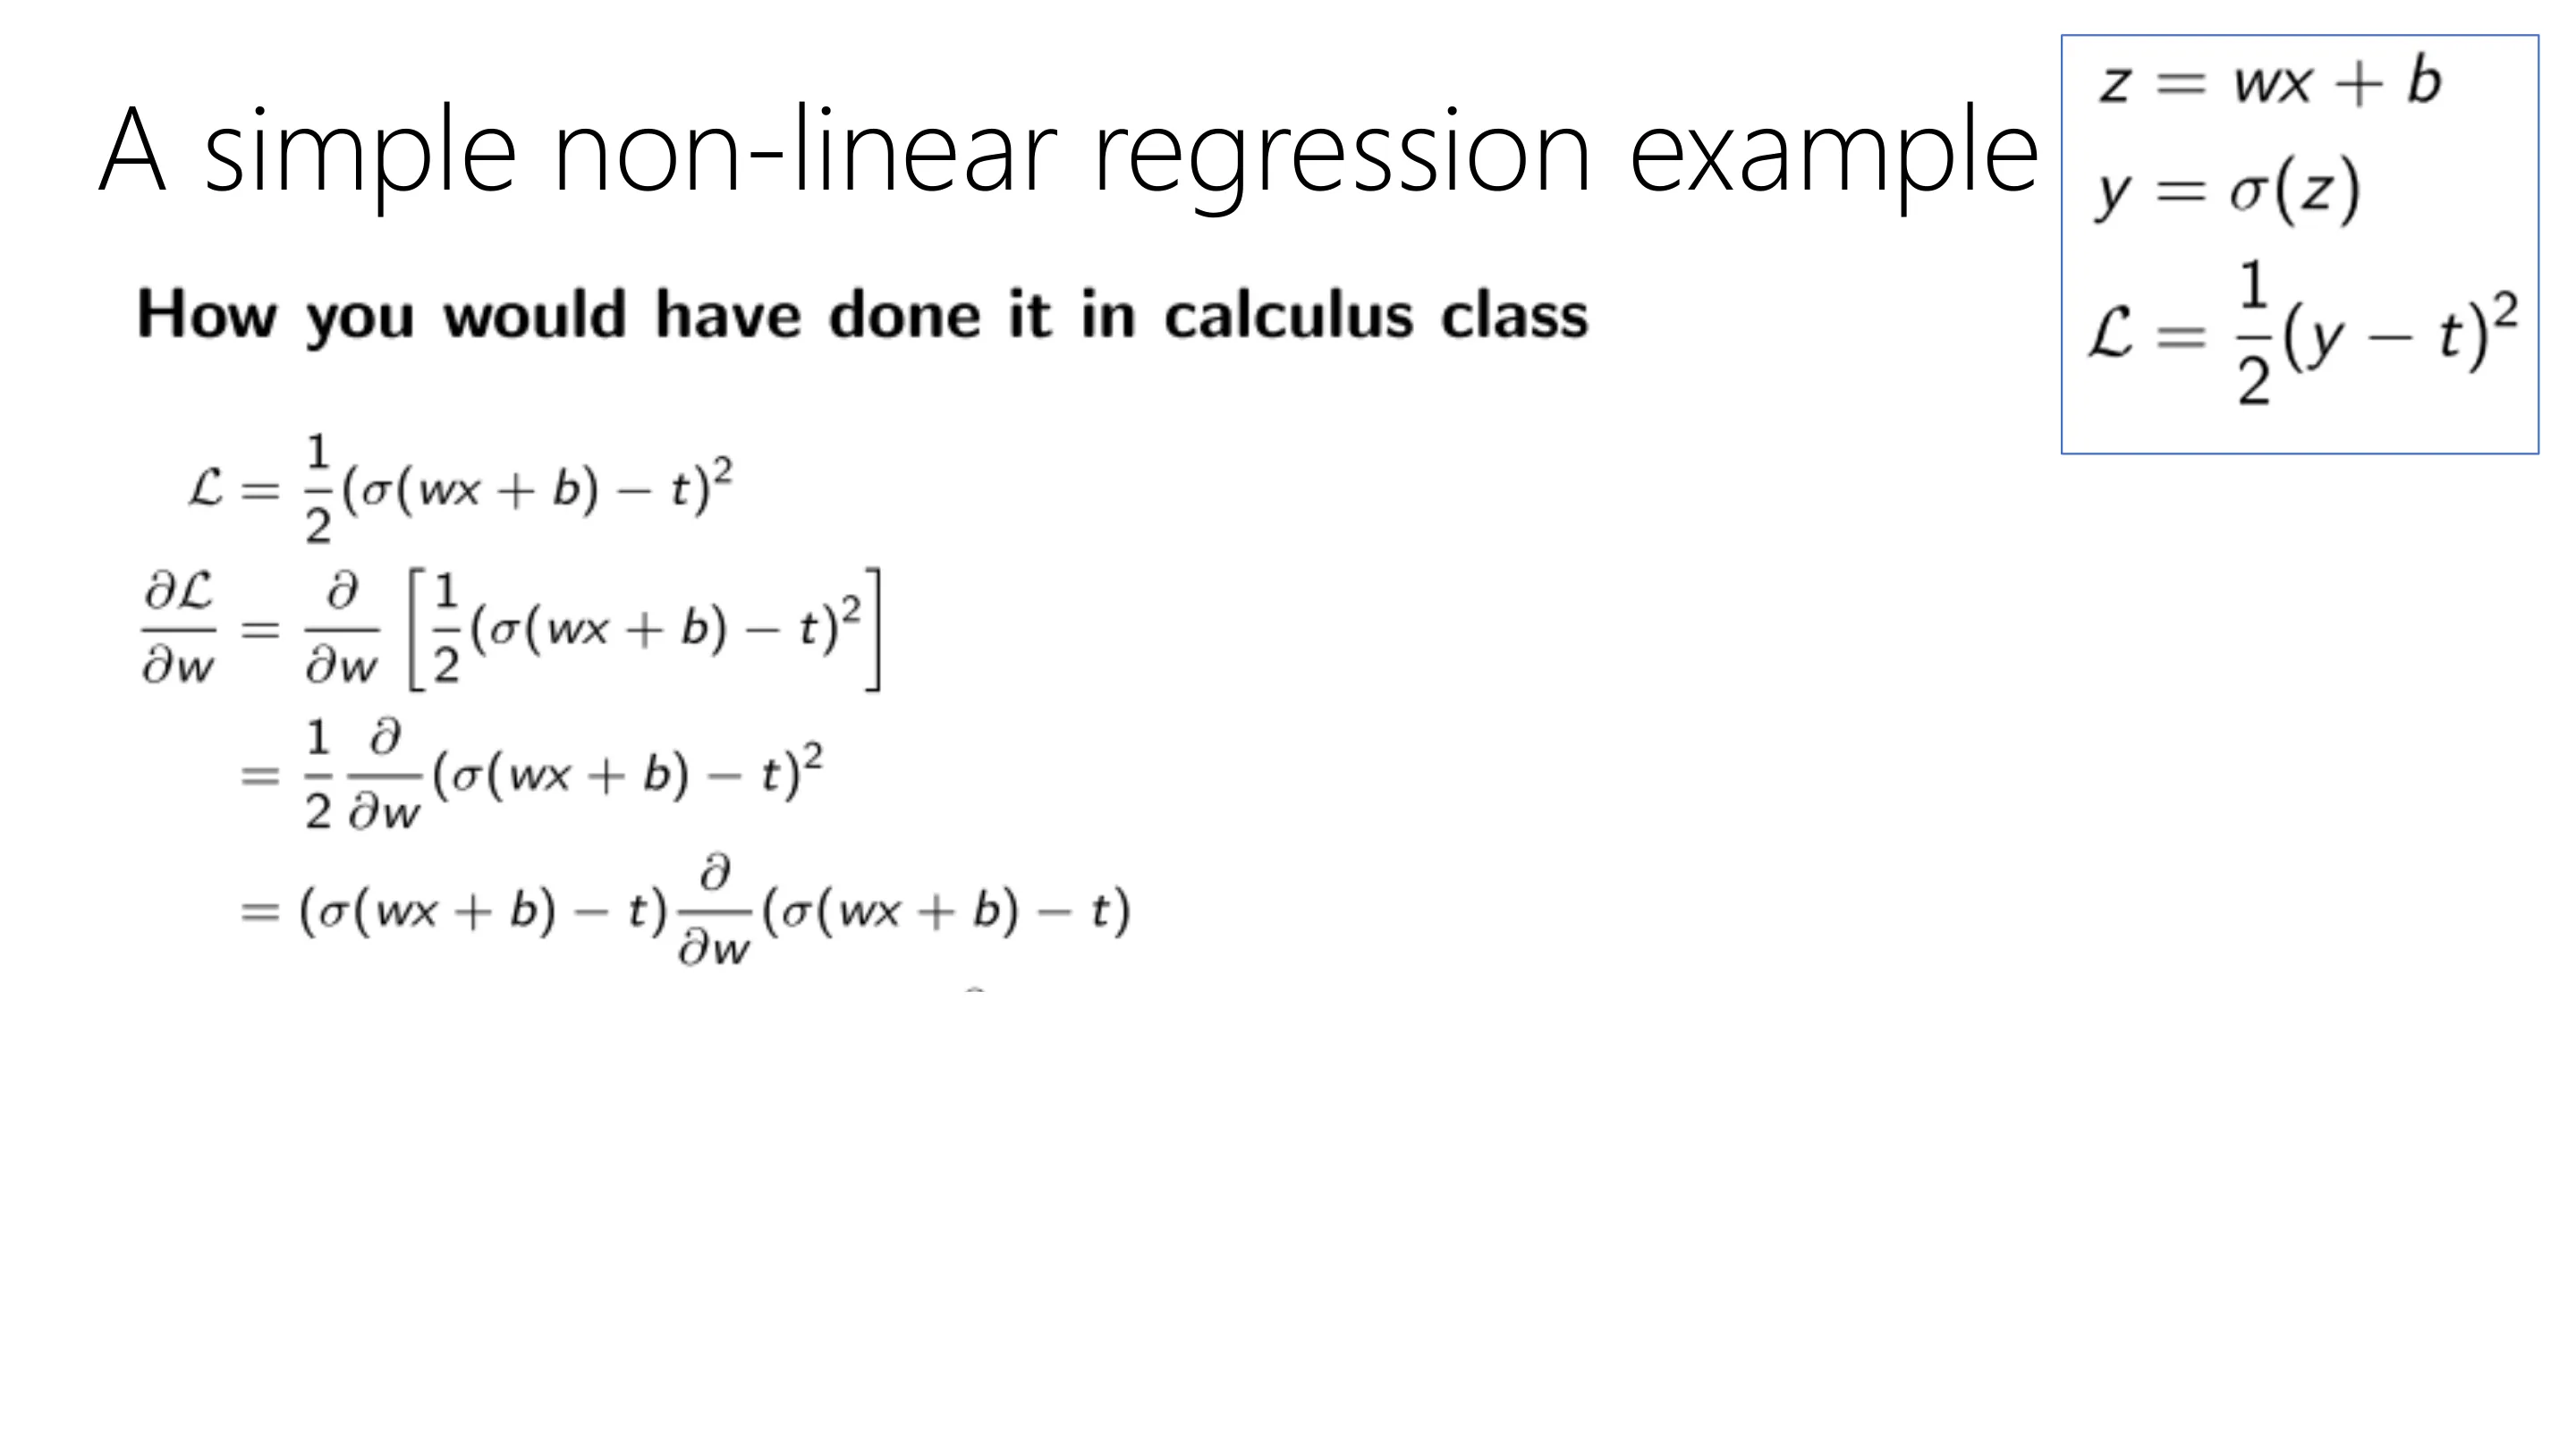
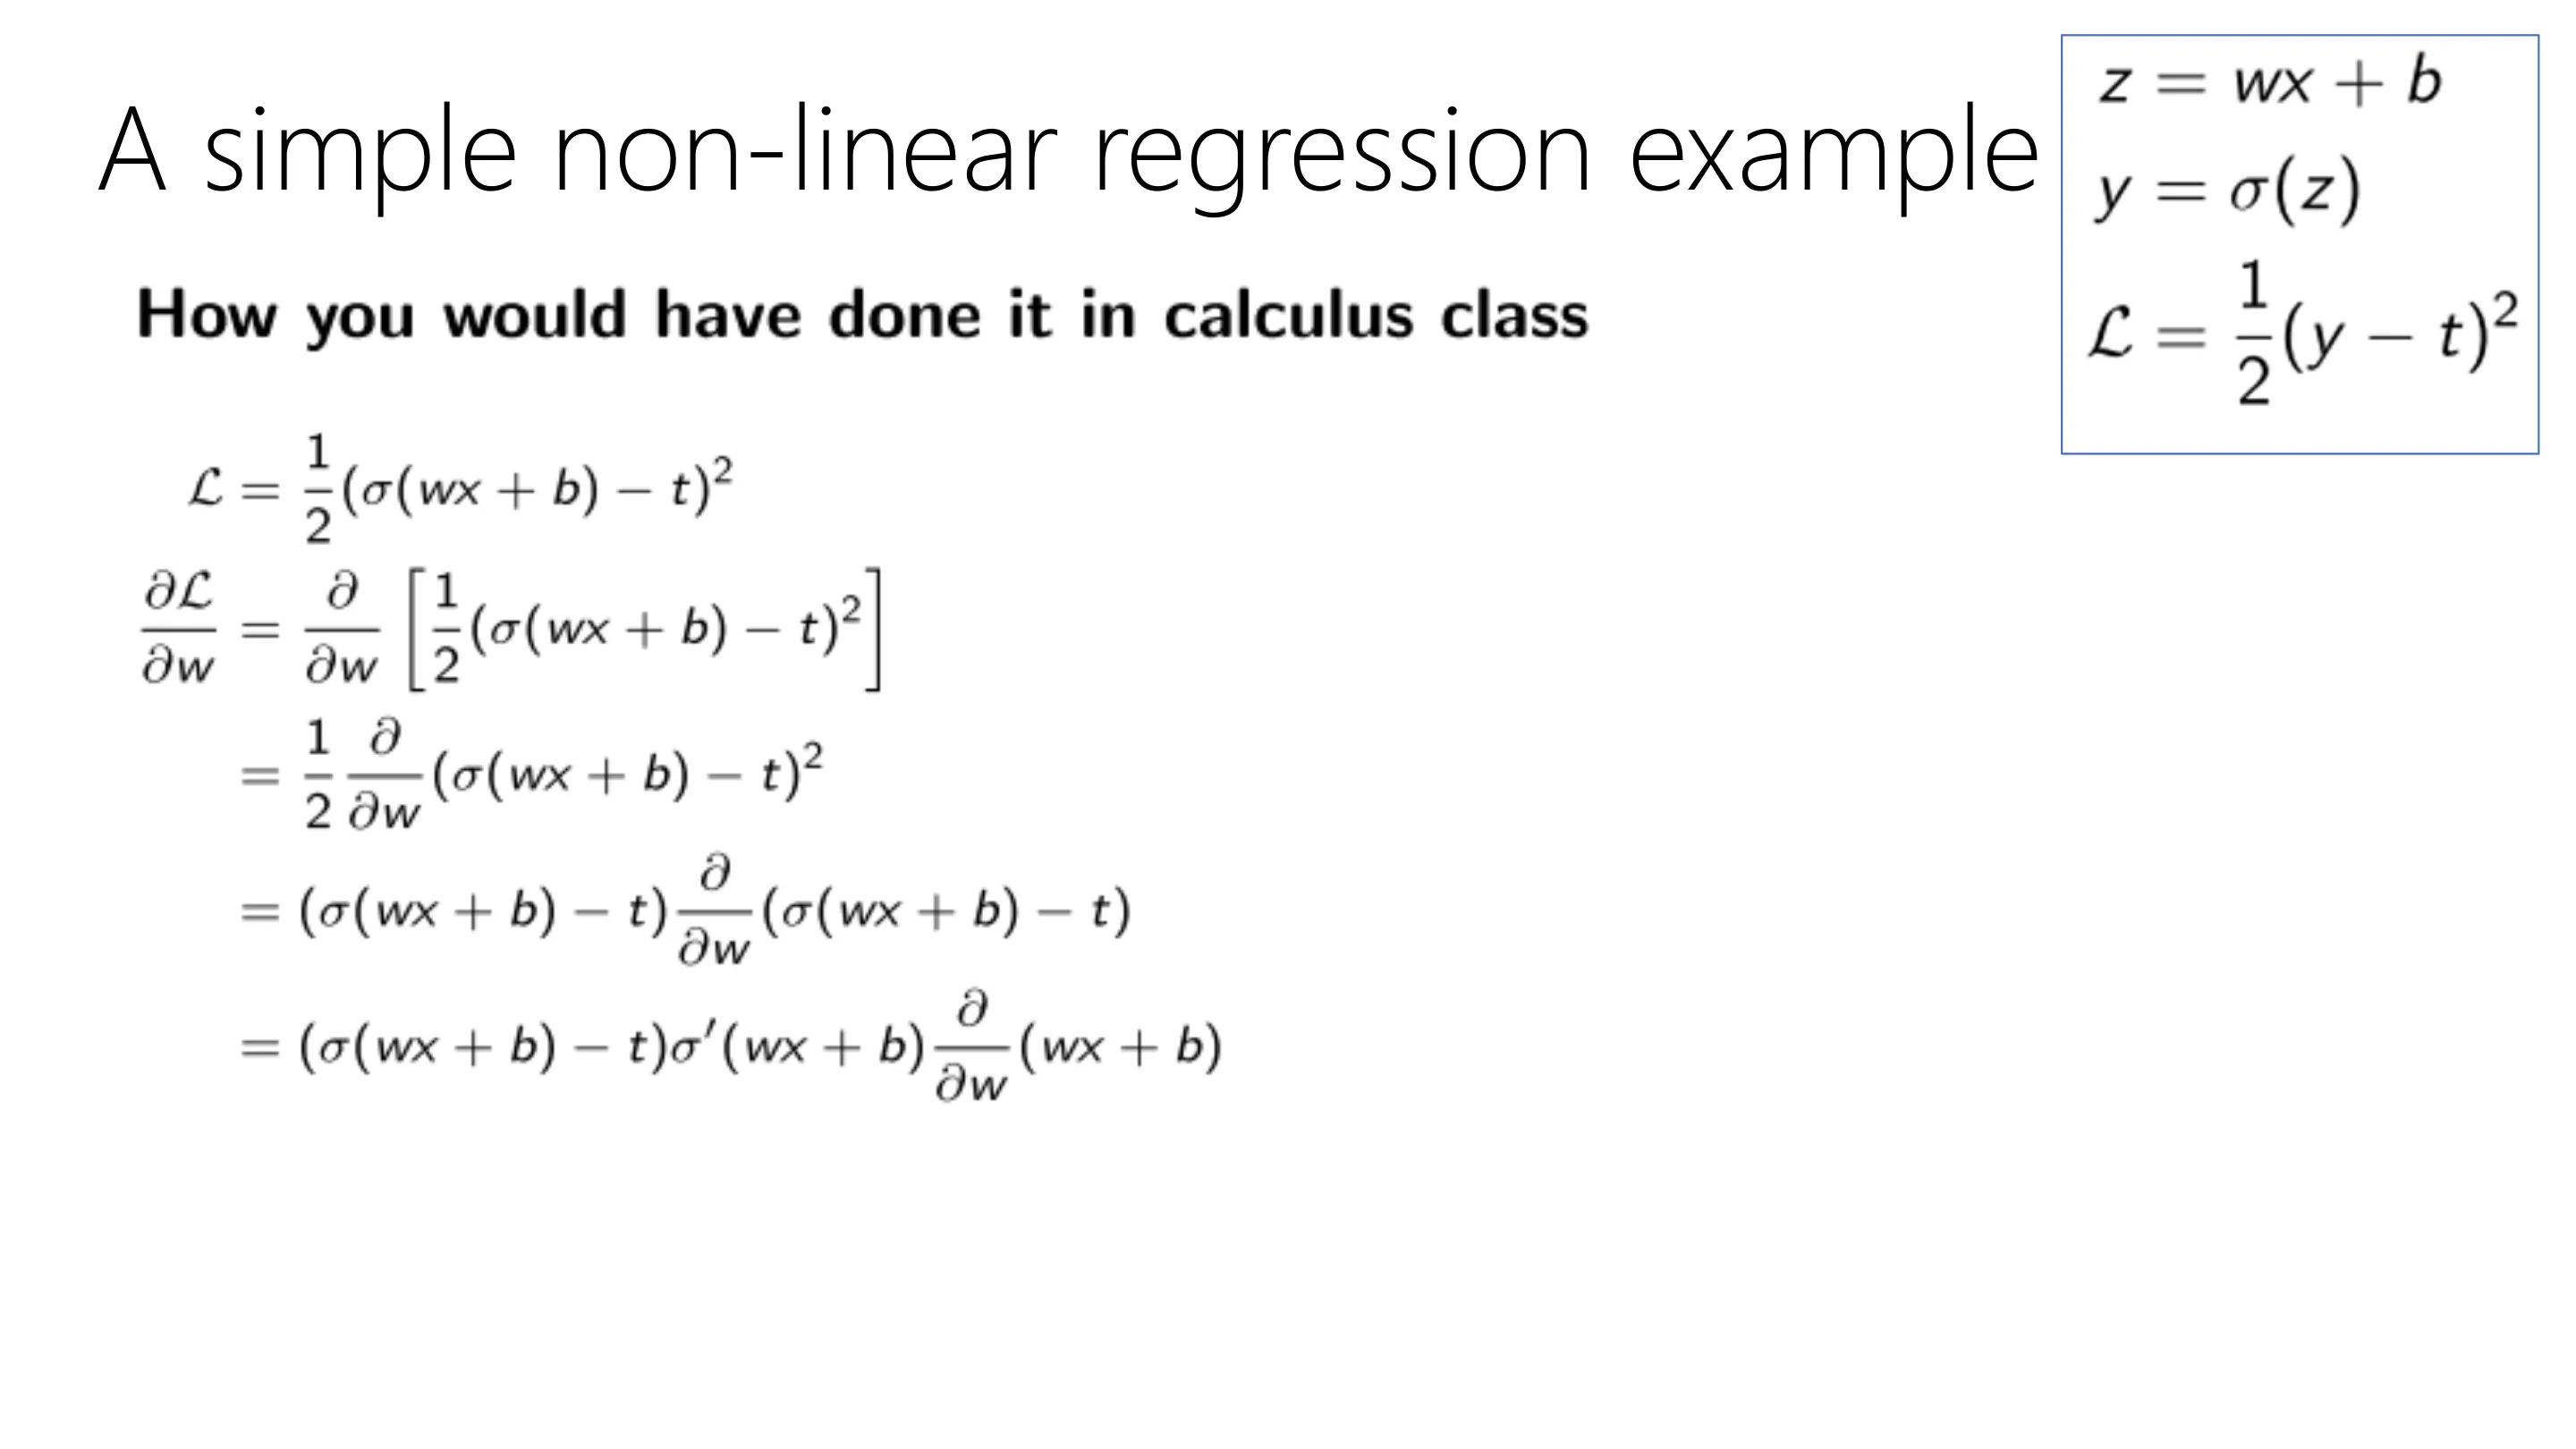
朴素做法(「假装没上过这门课」):把 $L$ 完全展开成 $w,b$ 的复合函数,再用链式法则一次性求出。可以 work,但每次都要重新推导,且会反复重算相同的项——对大网络极其低效。
📷 简单非线性回归示例(一)
回到原视频 (00:10:04)
📷 简单非线性回归示例(二)
回到原视频 (00:11:17)
📷 简单非线性回归示例(三)
回到原视频 (00:12:30)
📷 简单非线性回归示例(四)
回到原视频 (00:13:43)
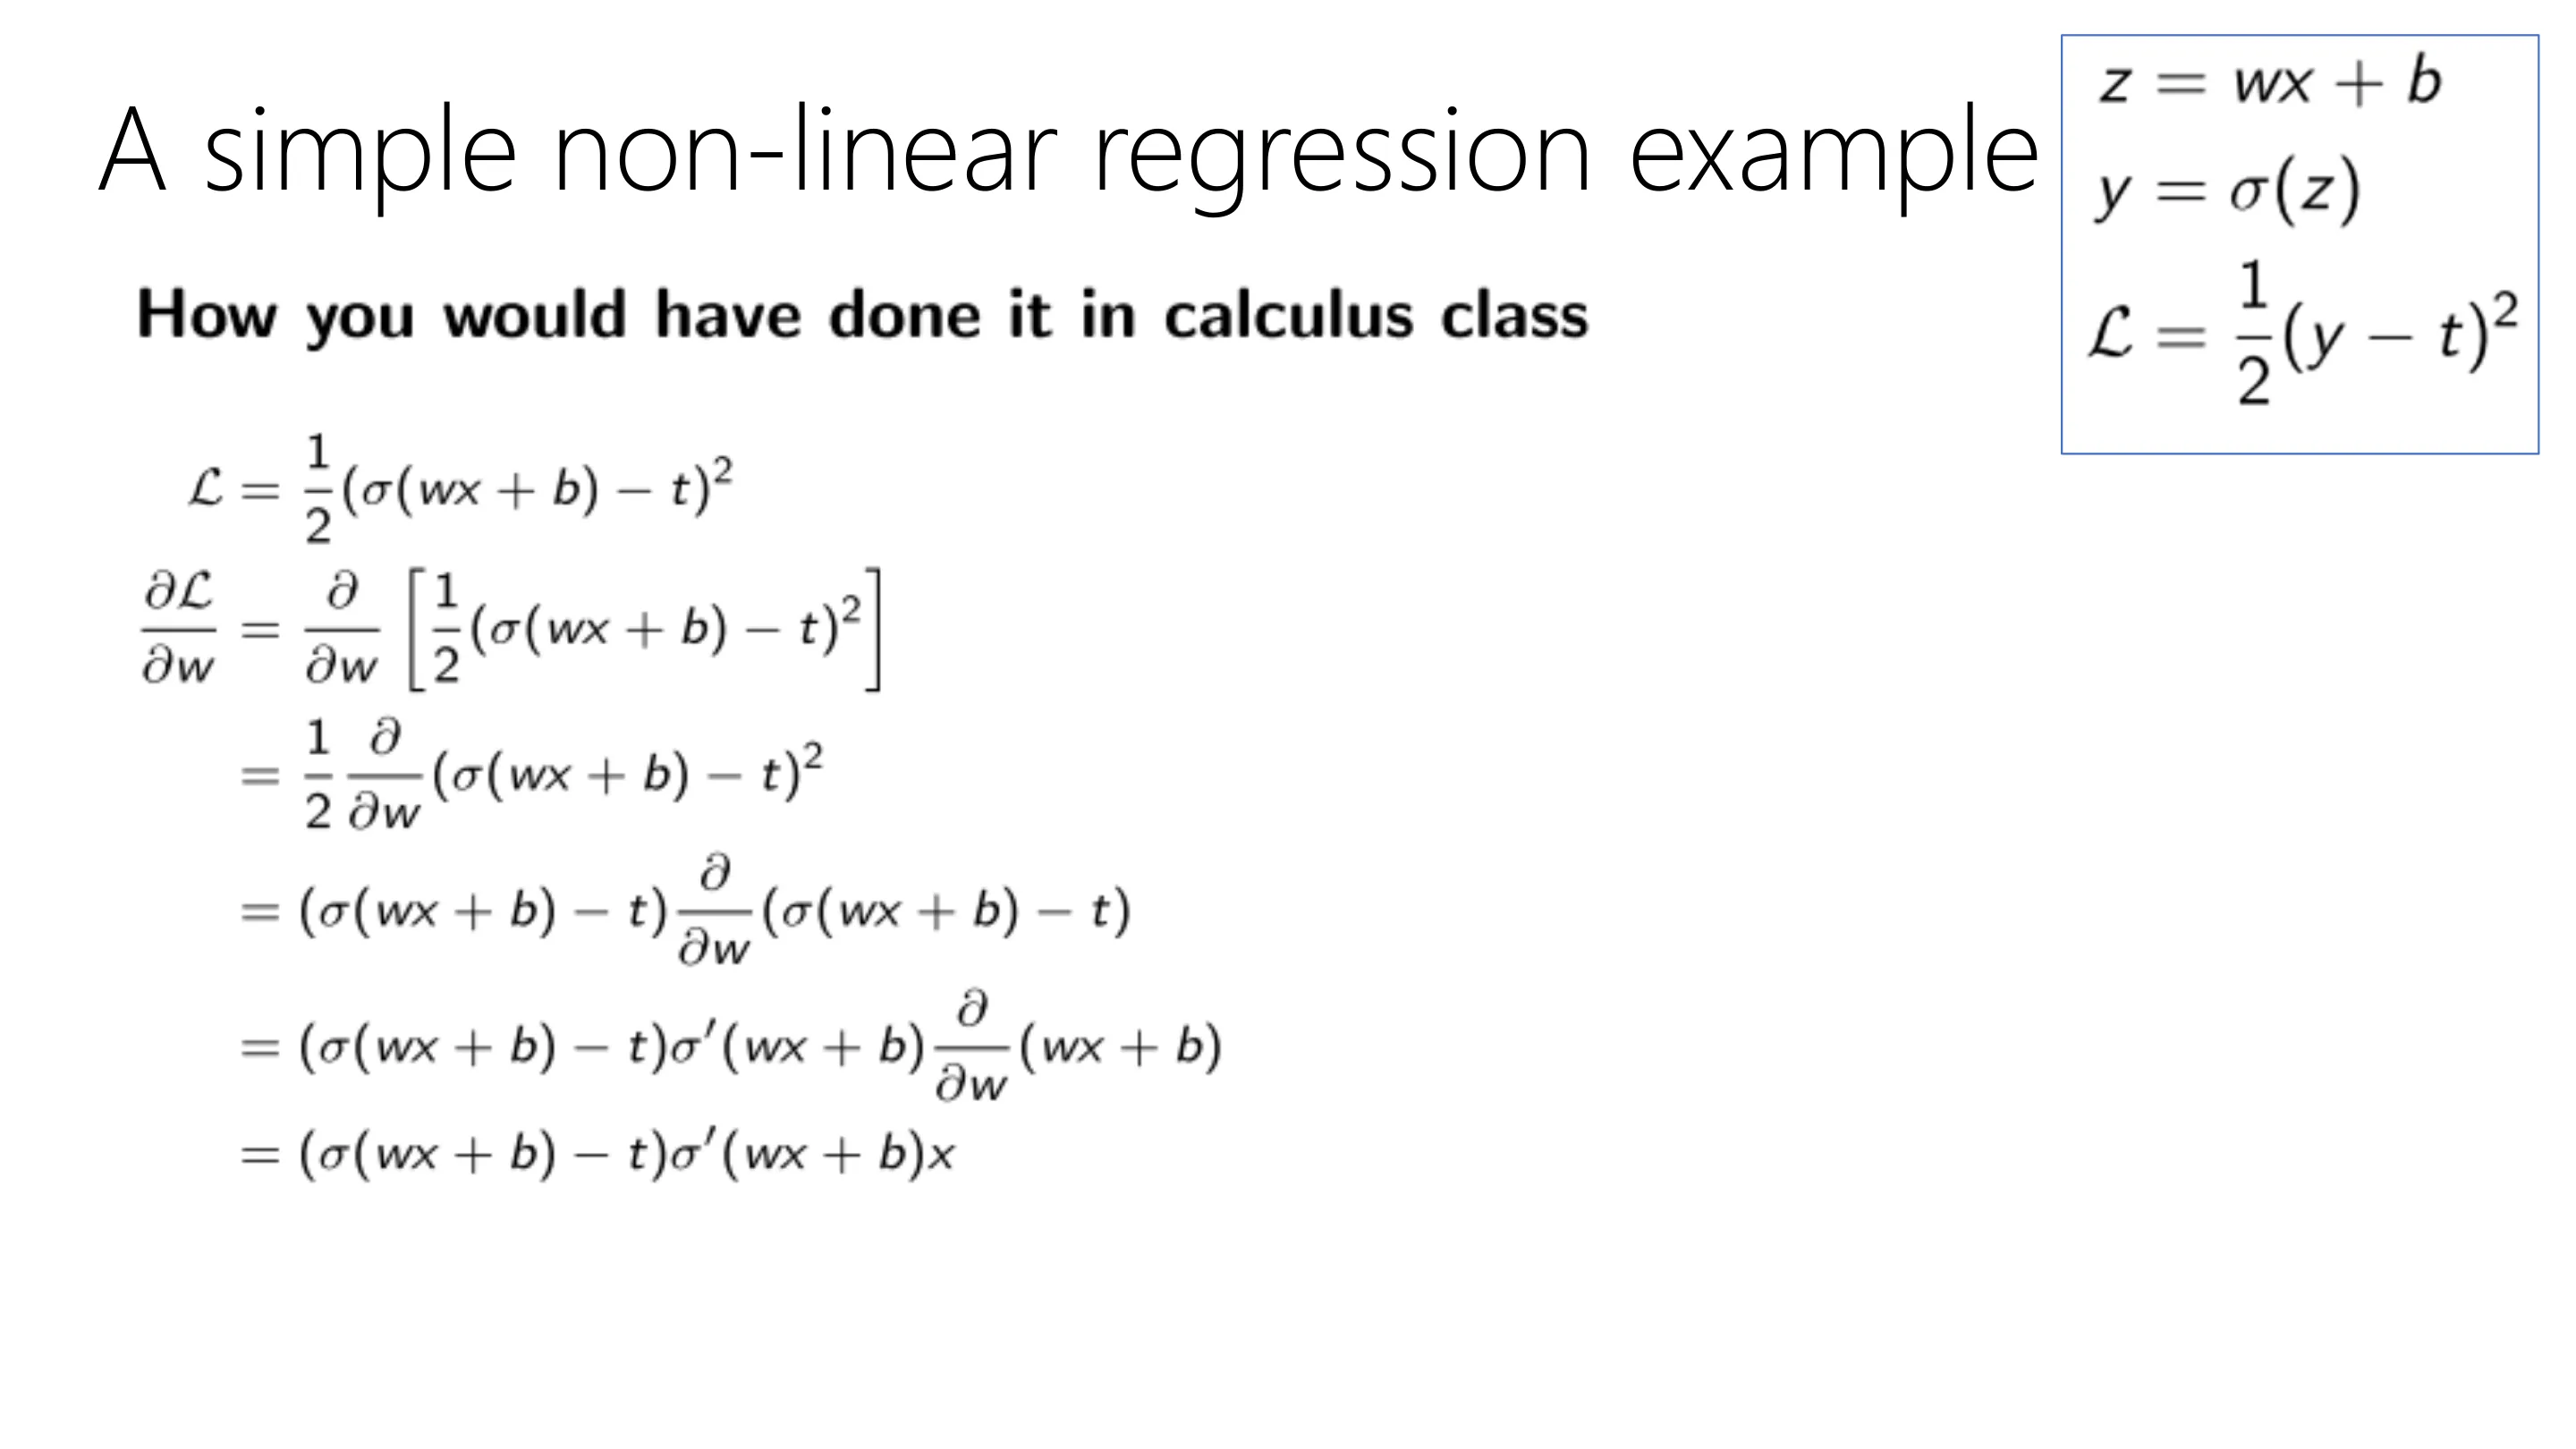
📷 简单非线性回归示例(五)
回到原视频 (00:14:56)
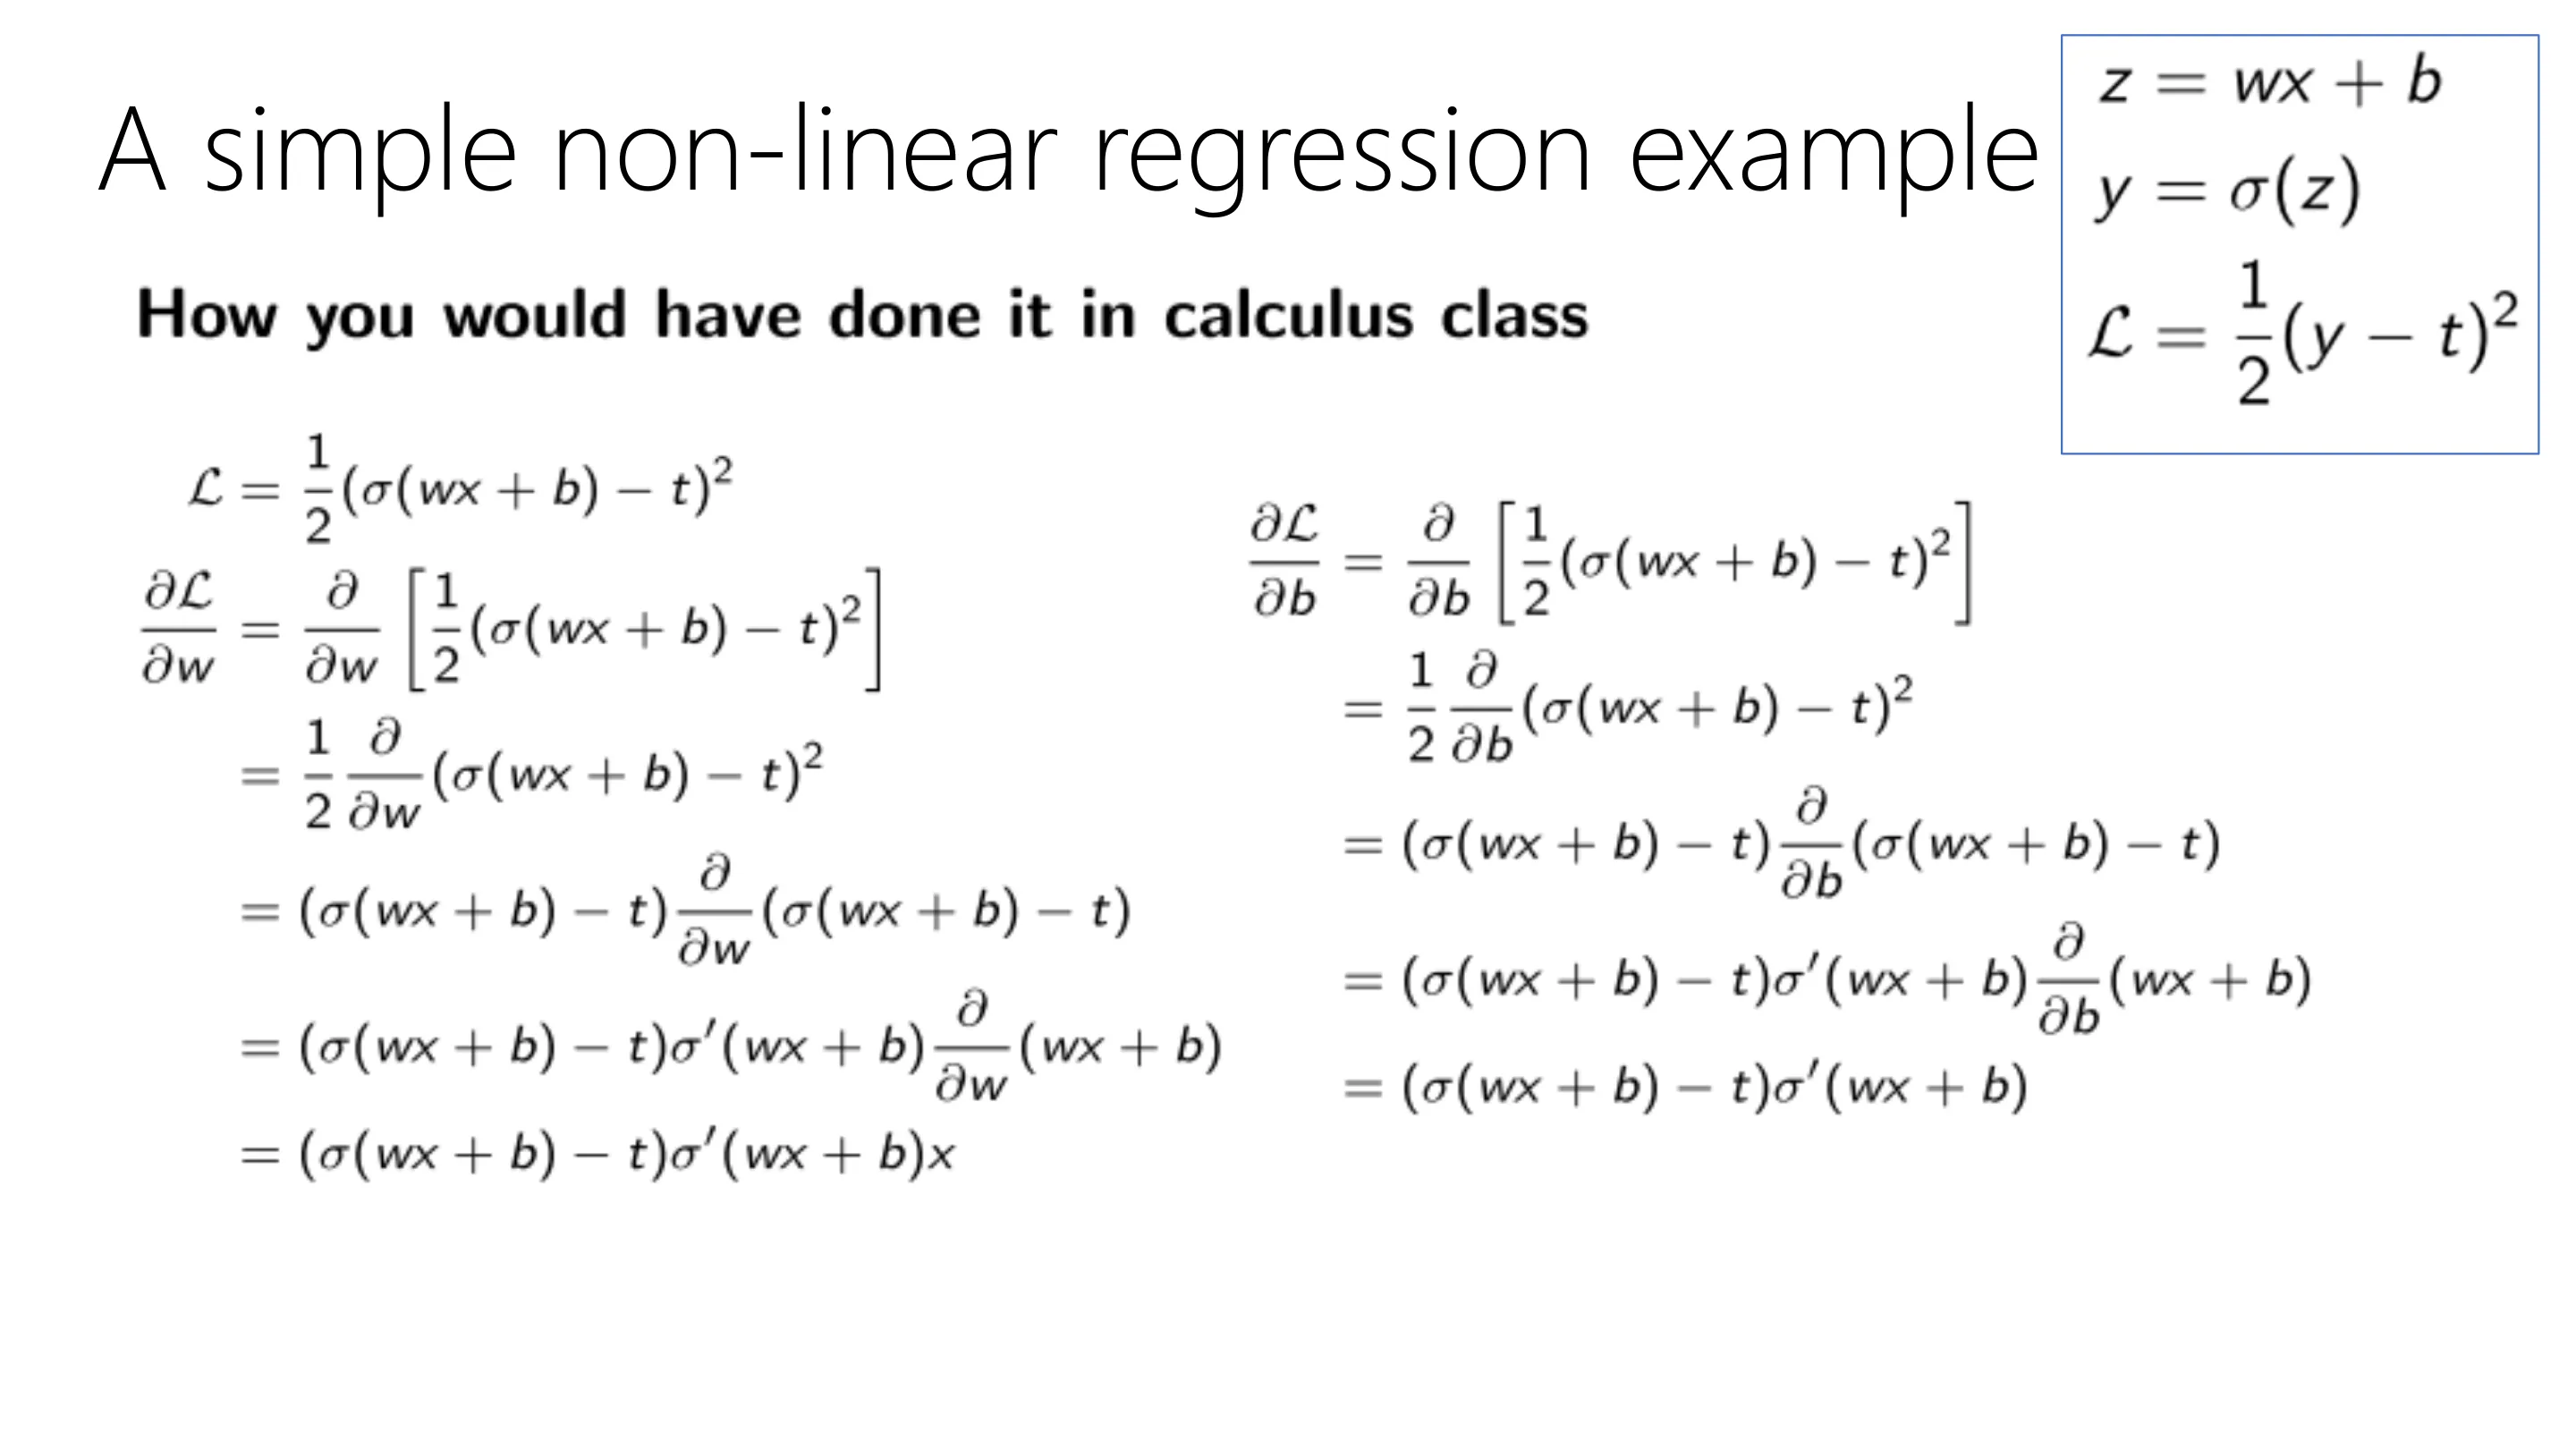
📷 简单非线性回归示例(六)
回到原视频 (00:16:09)
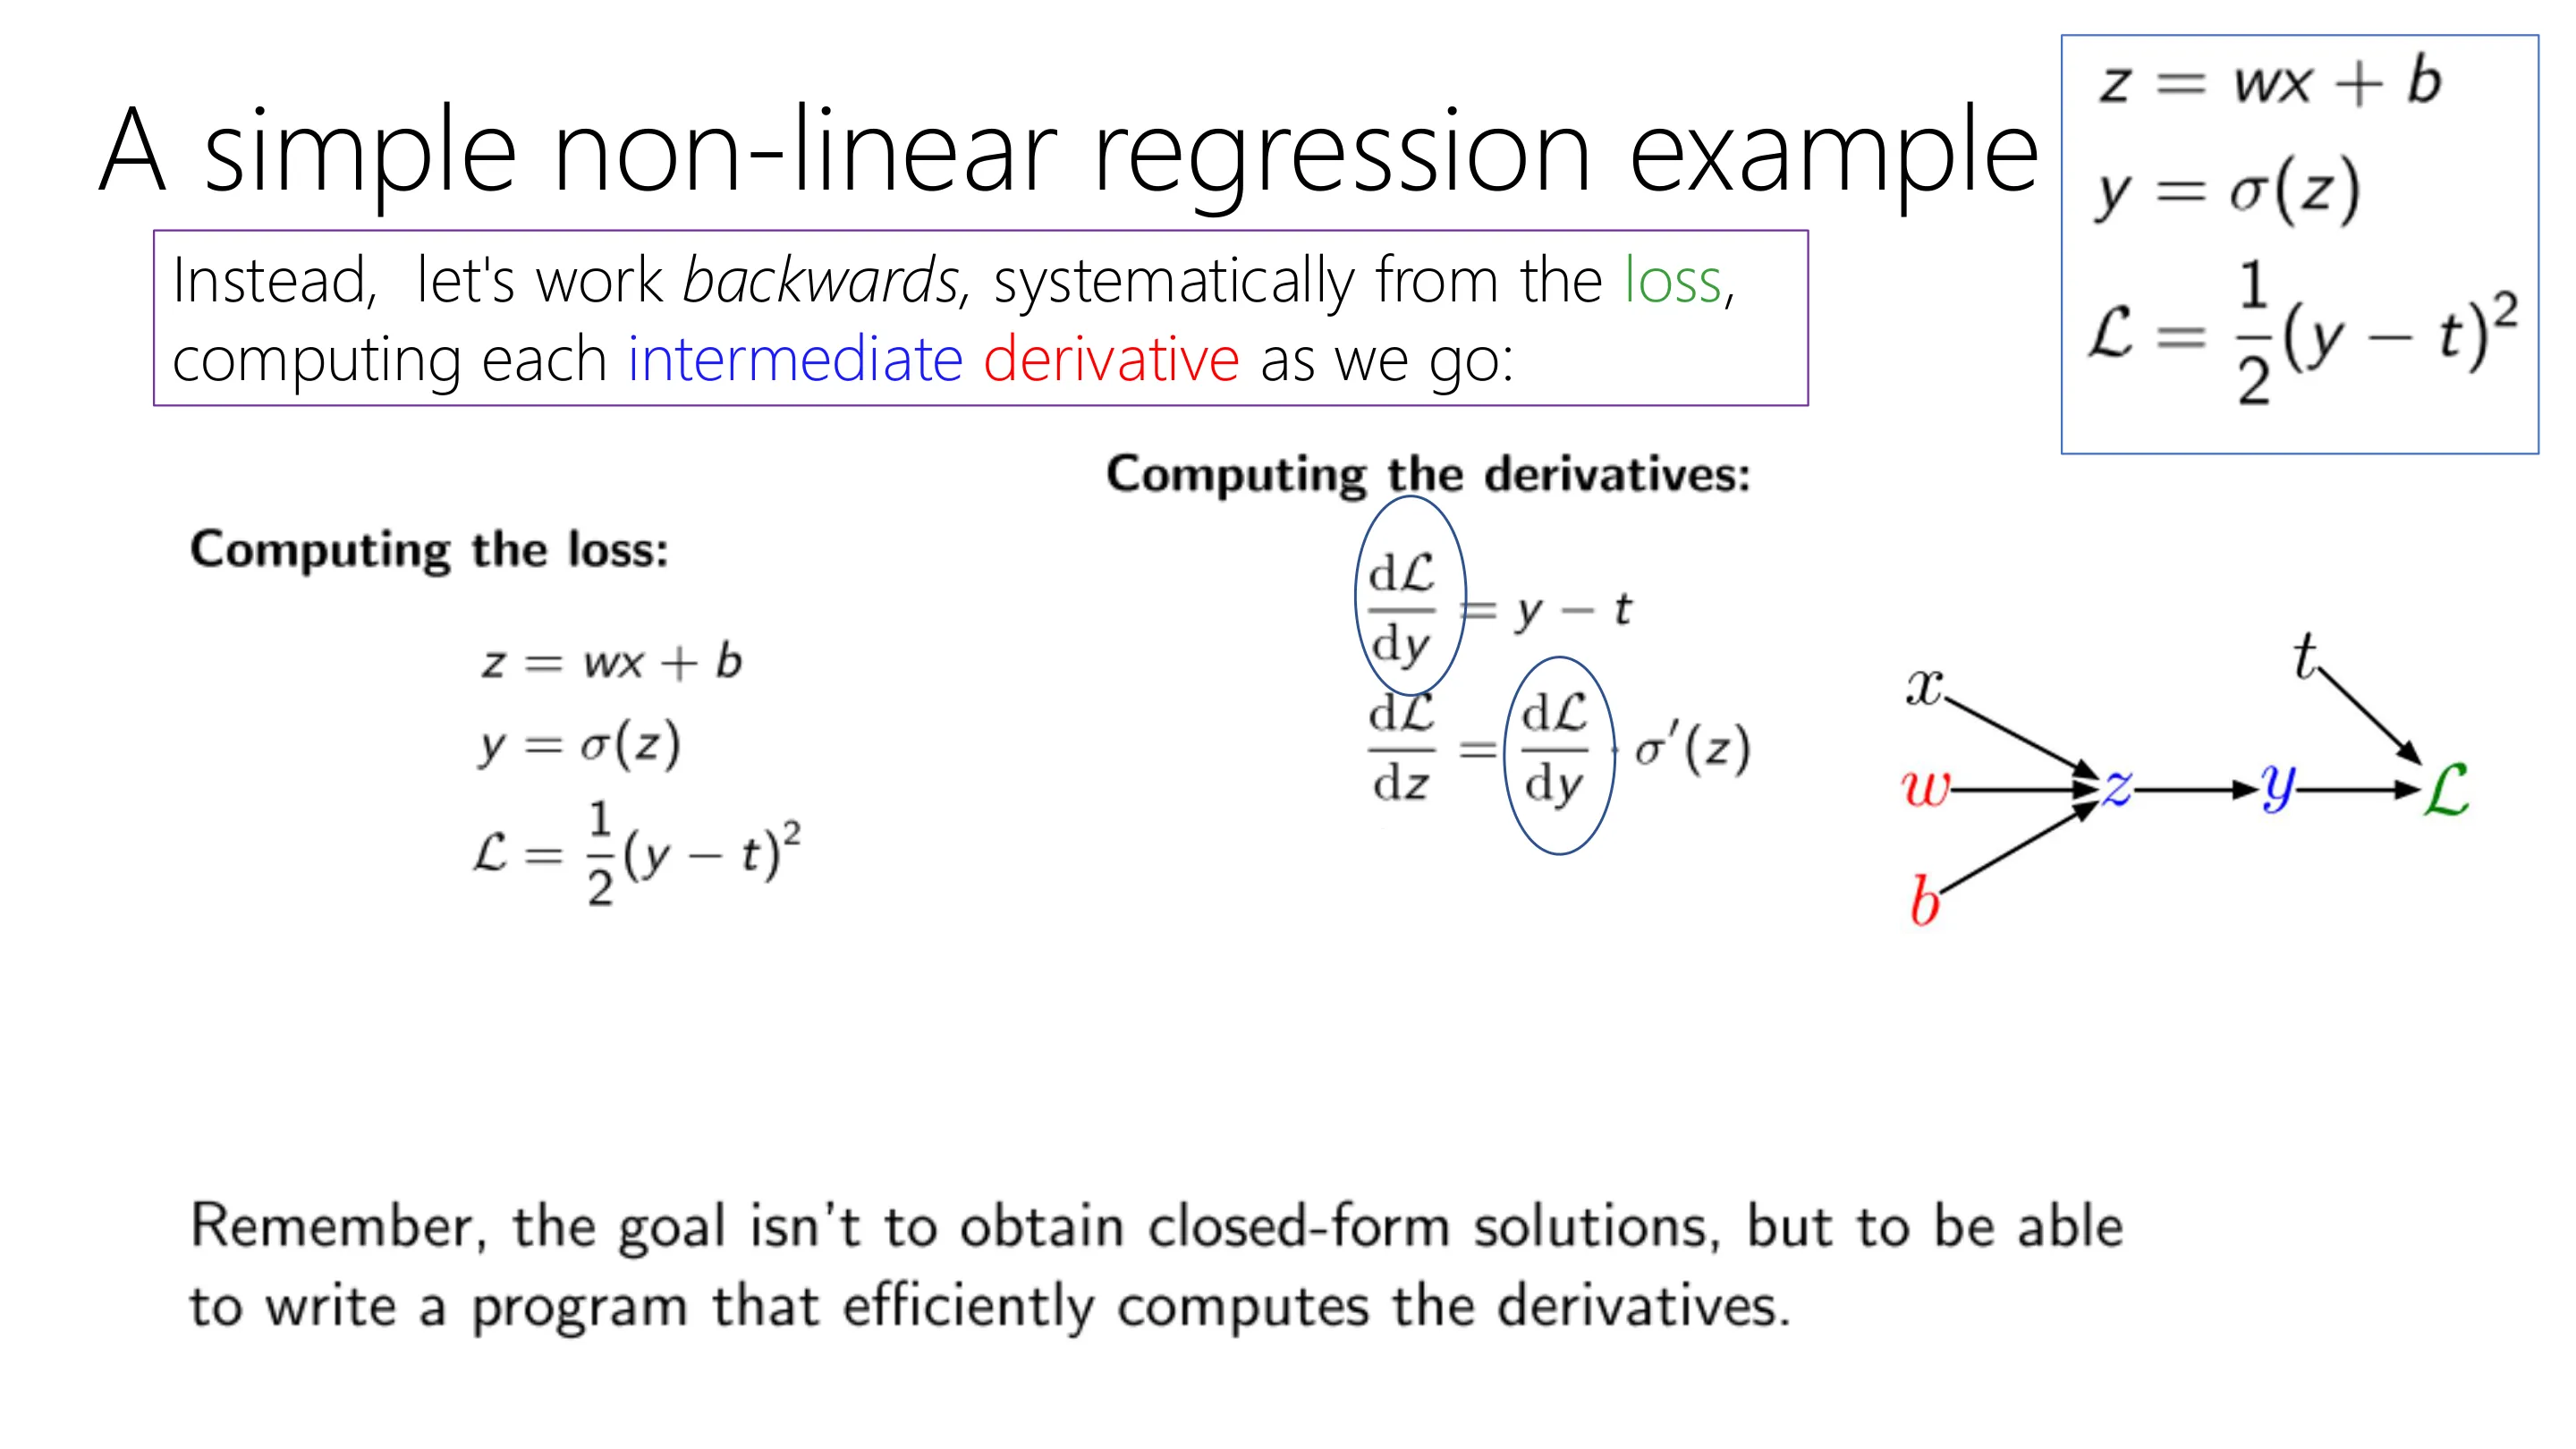
📷 简单非线性回归示例(七)
回到原视频 (00:17:22)
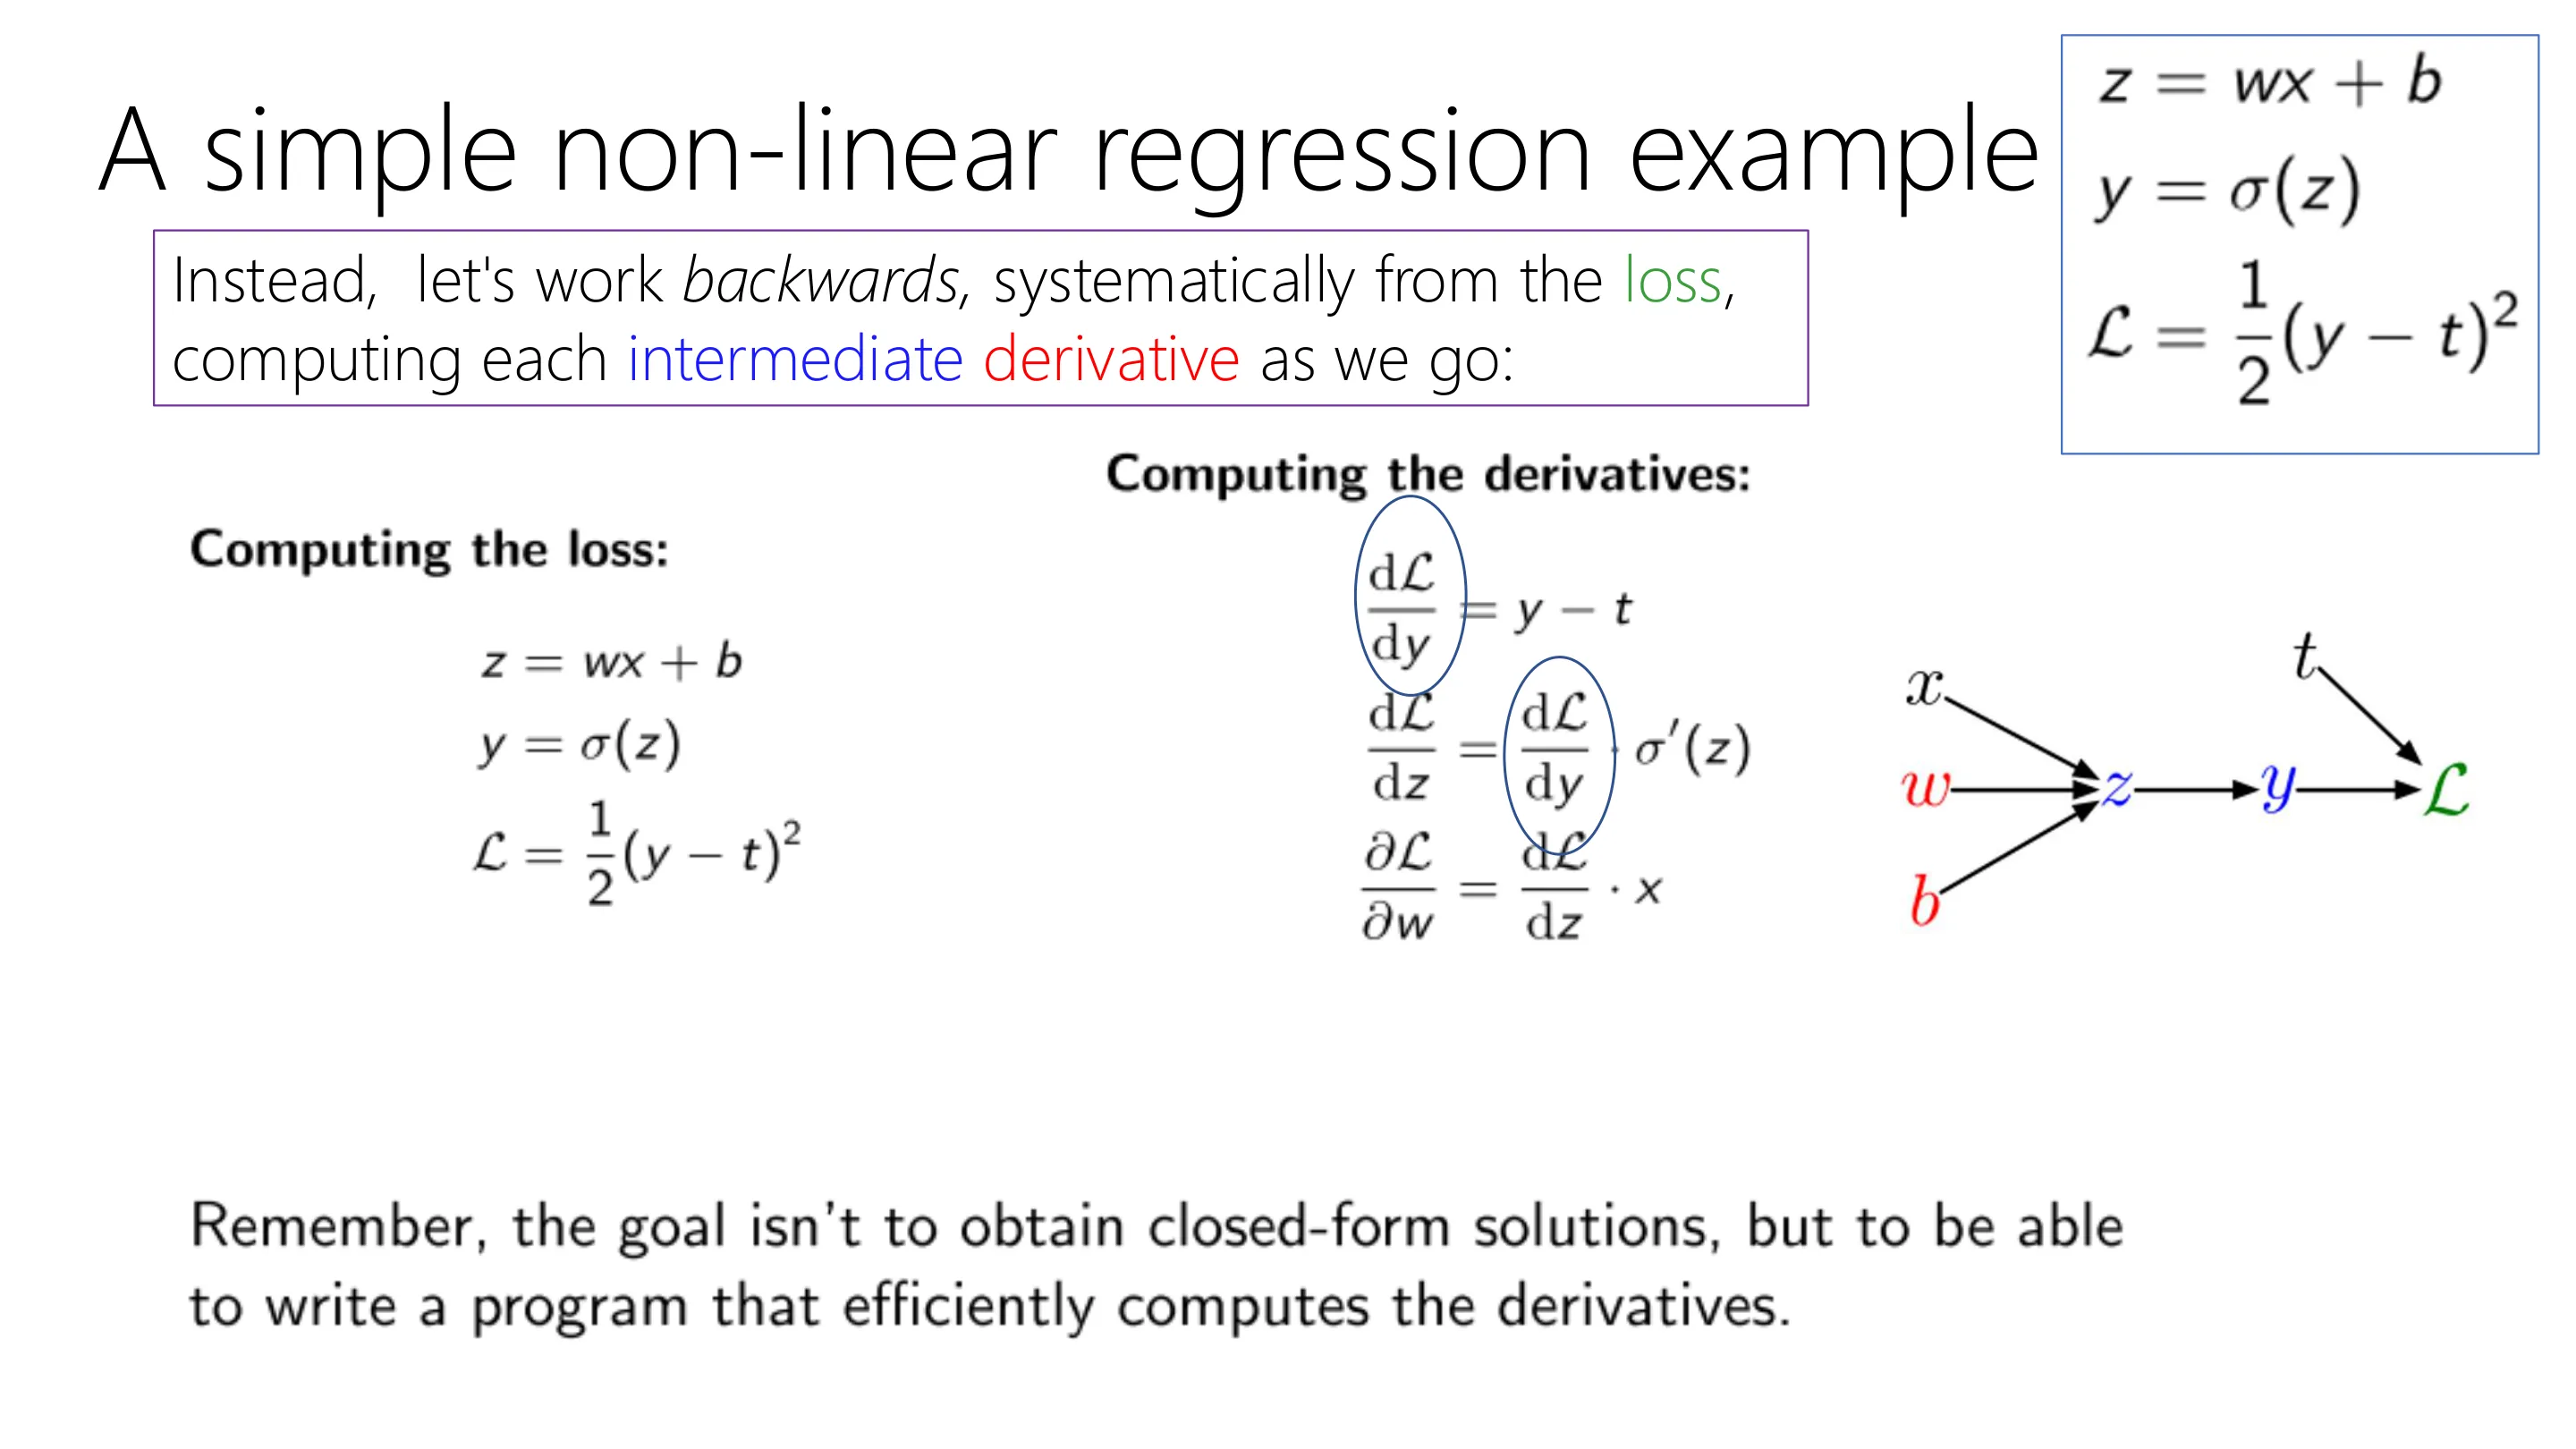
📷 简单非线性回归示例(八)
回到原视频 (00:18:35)
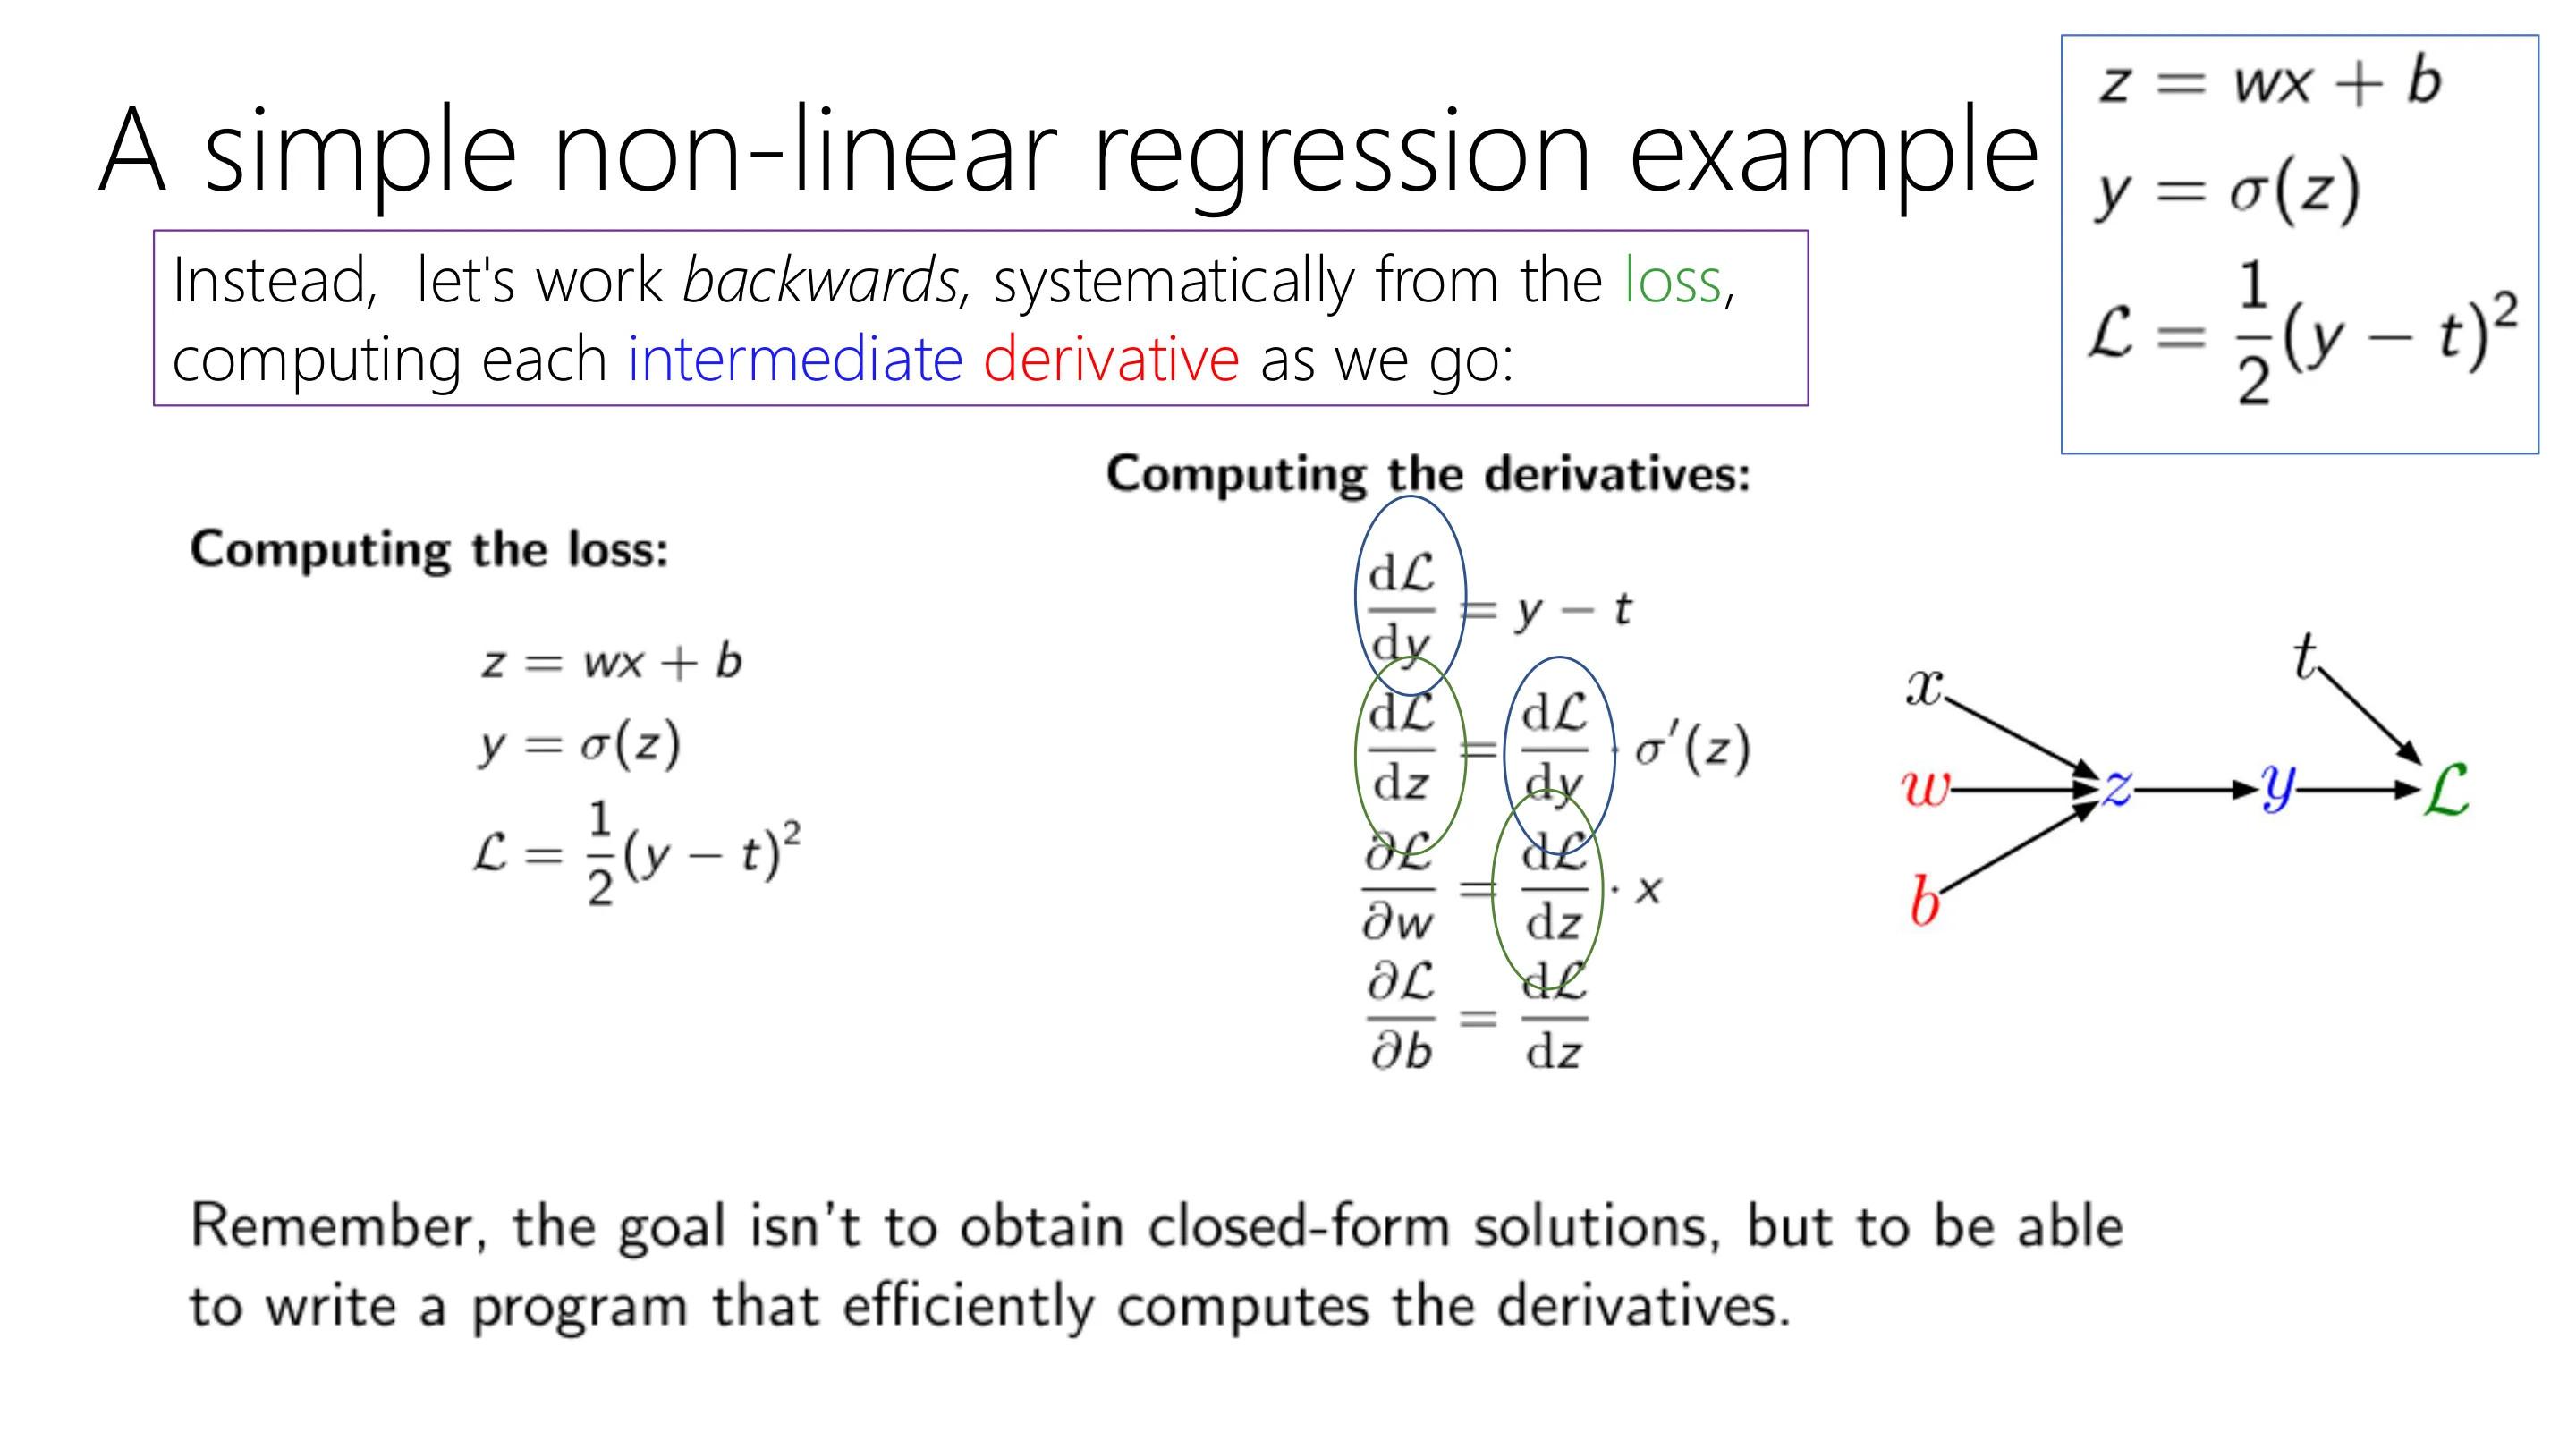
📷 简单非线性回归示例(九)
回到原视频 (00:19:48)
1.1 计算图
你看到结构了吗? 依赖关系是:$z$ 依赖 $(x,w,b)$,$y$ 依赖 $z$,$L$ 依赖 $(t,y)$。把它画成一个有向图就是计算图:
x ─┐
w ─┼─► z ─► y ─┐
b ─┘           ├─► L
t ─────────────┘
前向传播:沿箭头算出所有中间值,最后得到 $L$。
反向传播:从 $L$ 开始逆着箭头算导数——这就是「back-propagation」名字的来源。
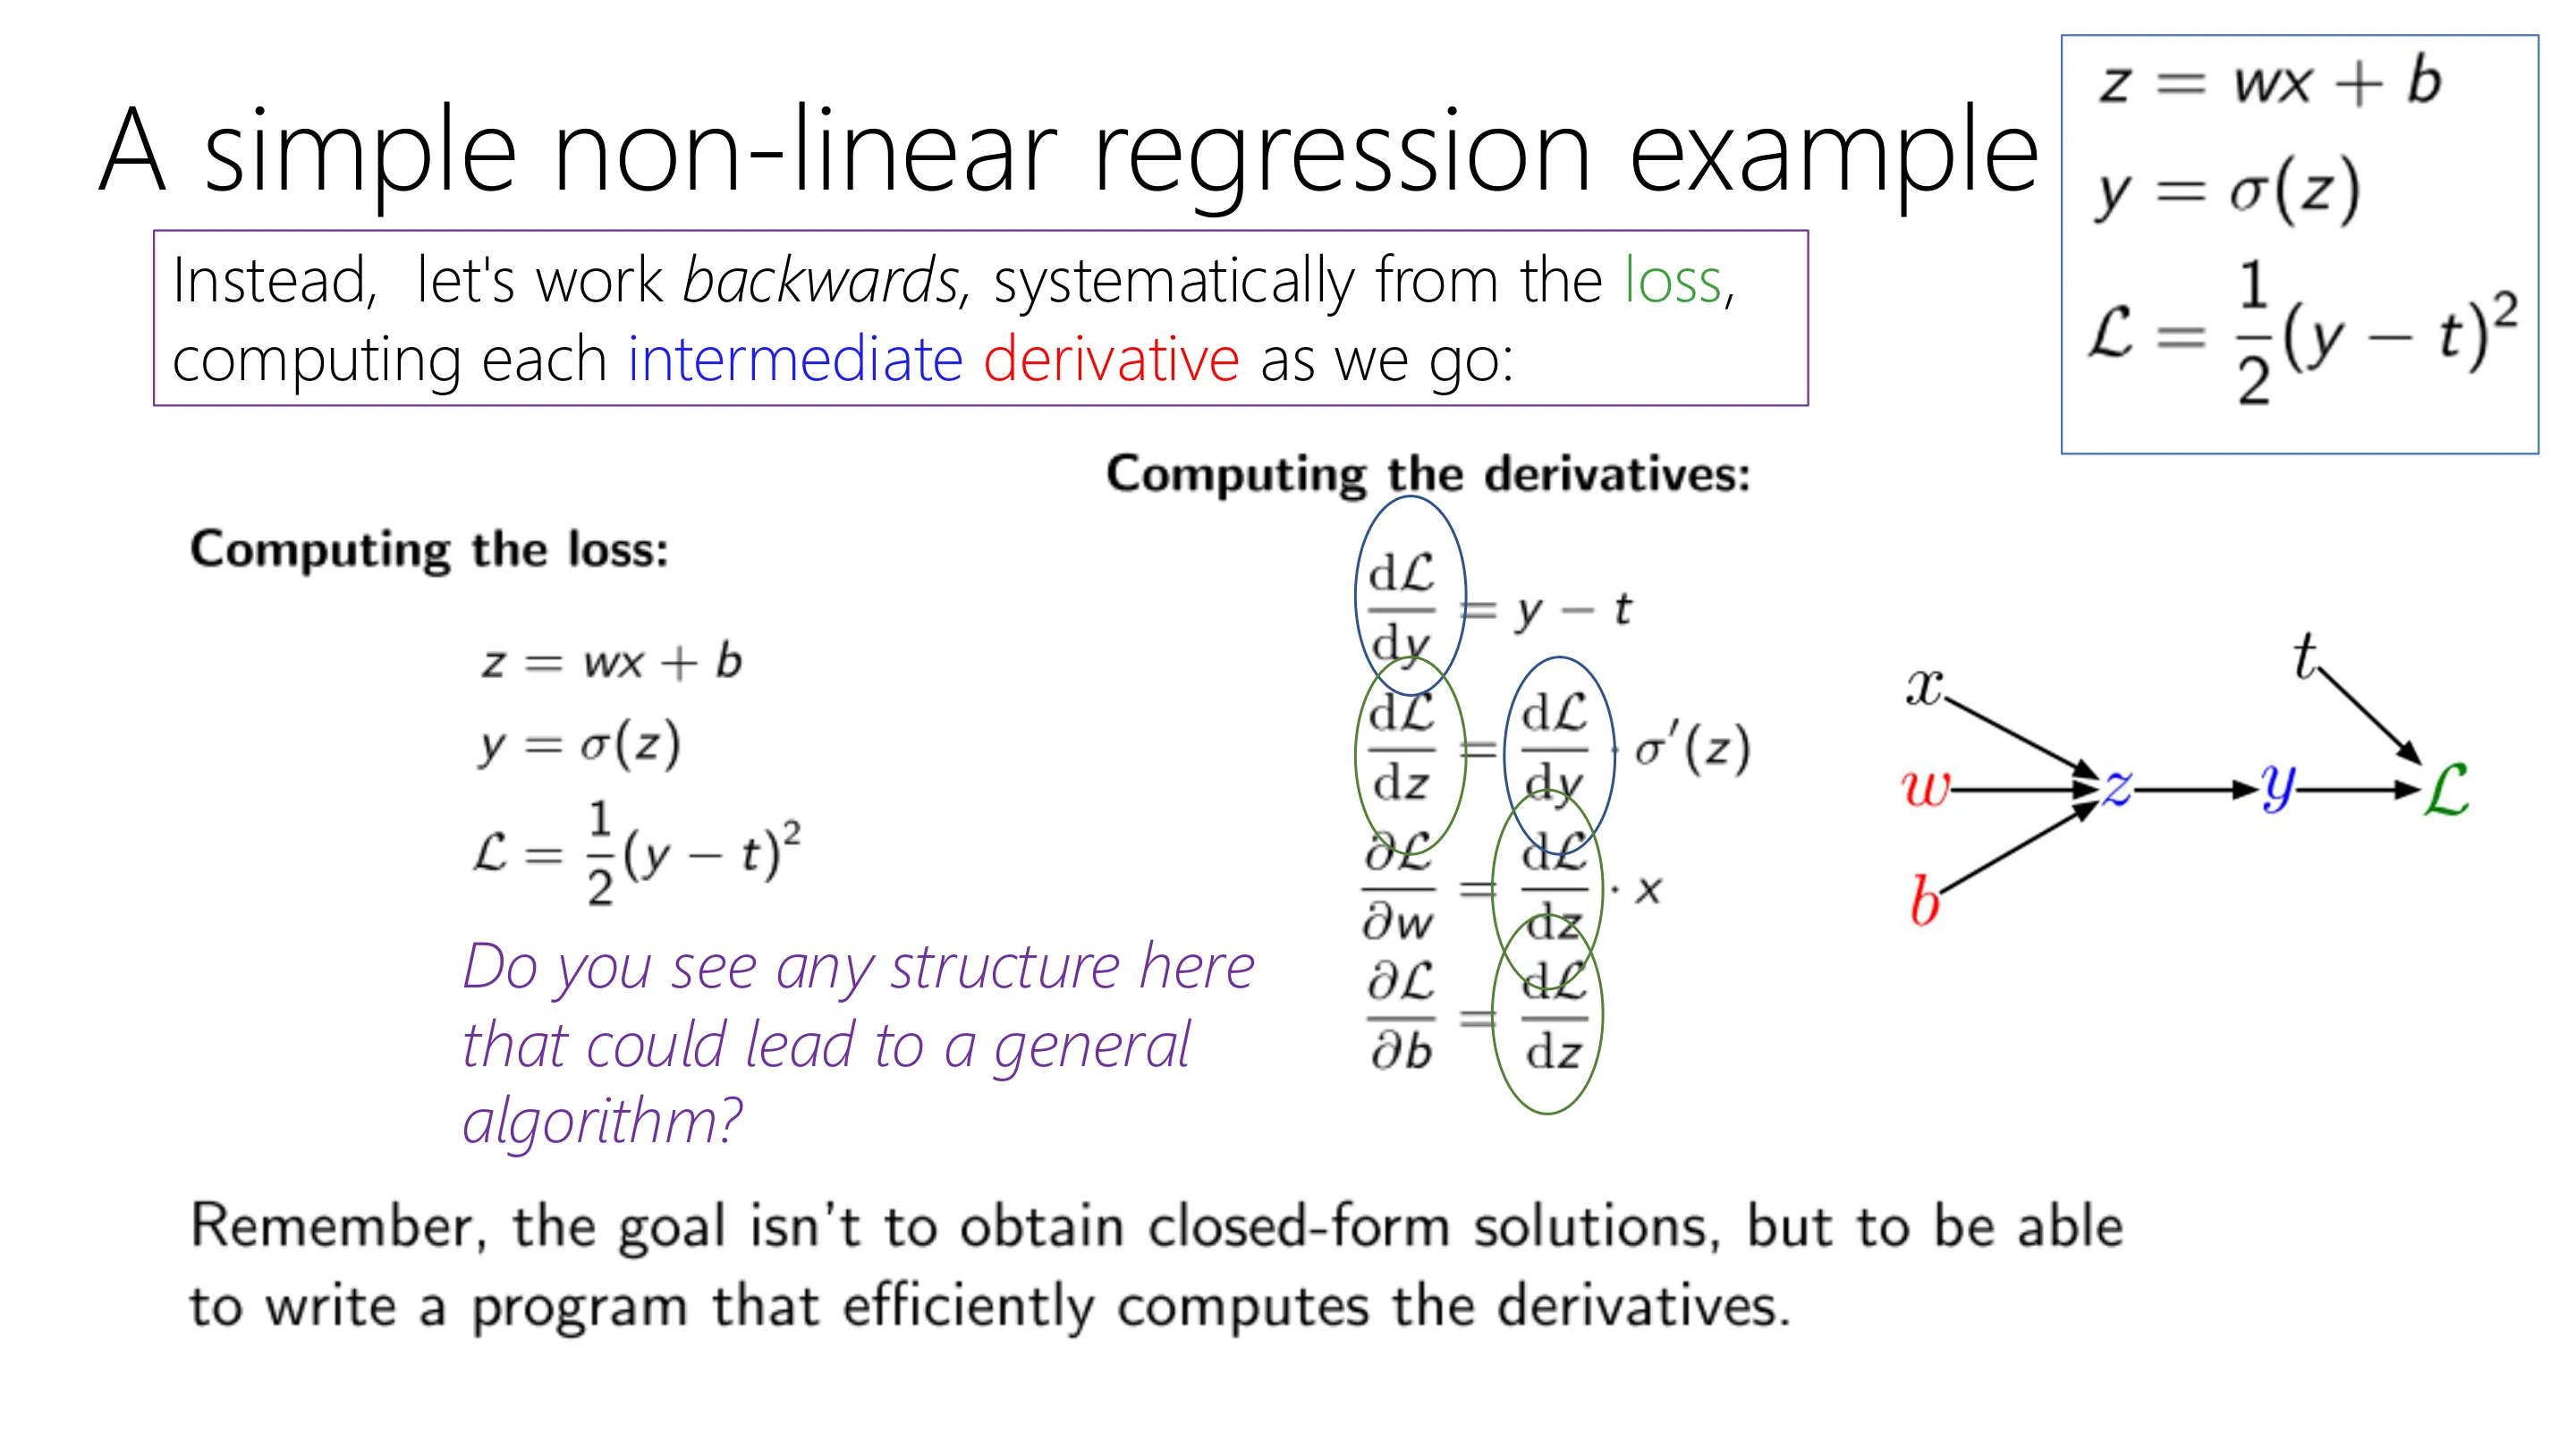
📷 你看到结构了吗
回到原视频 (00:21:01)
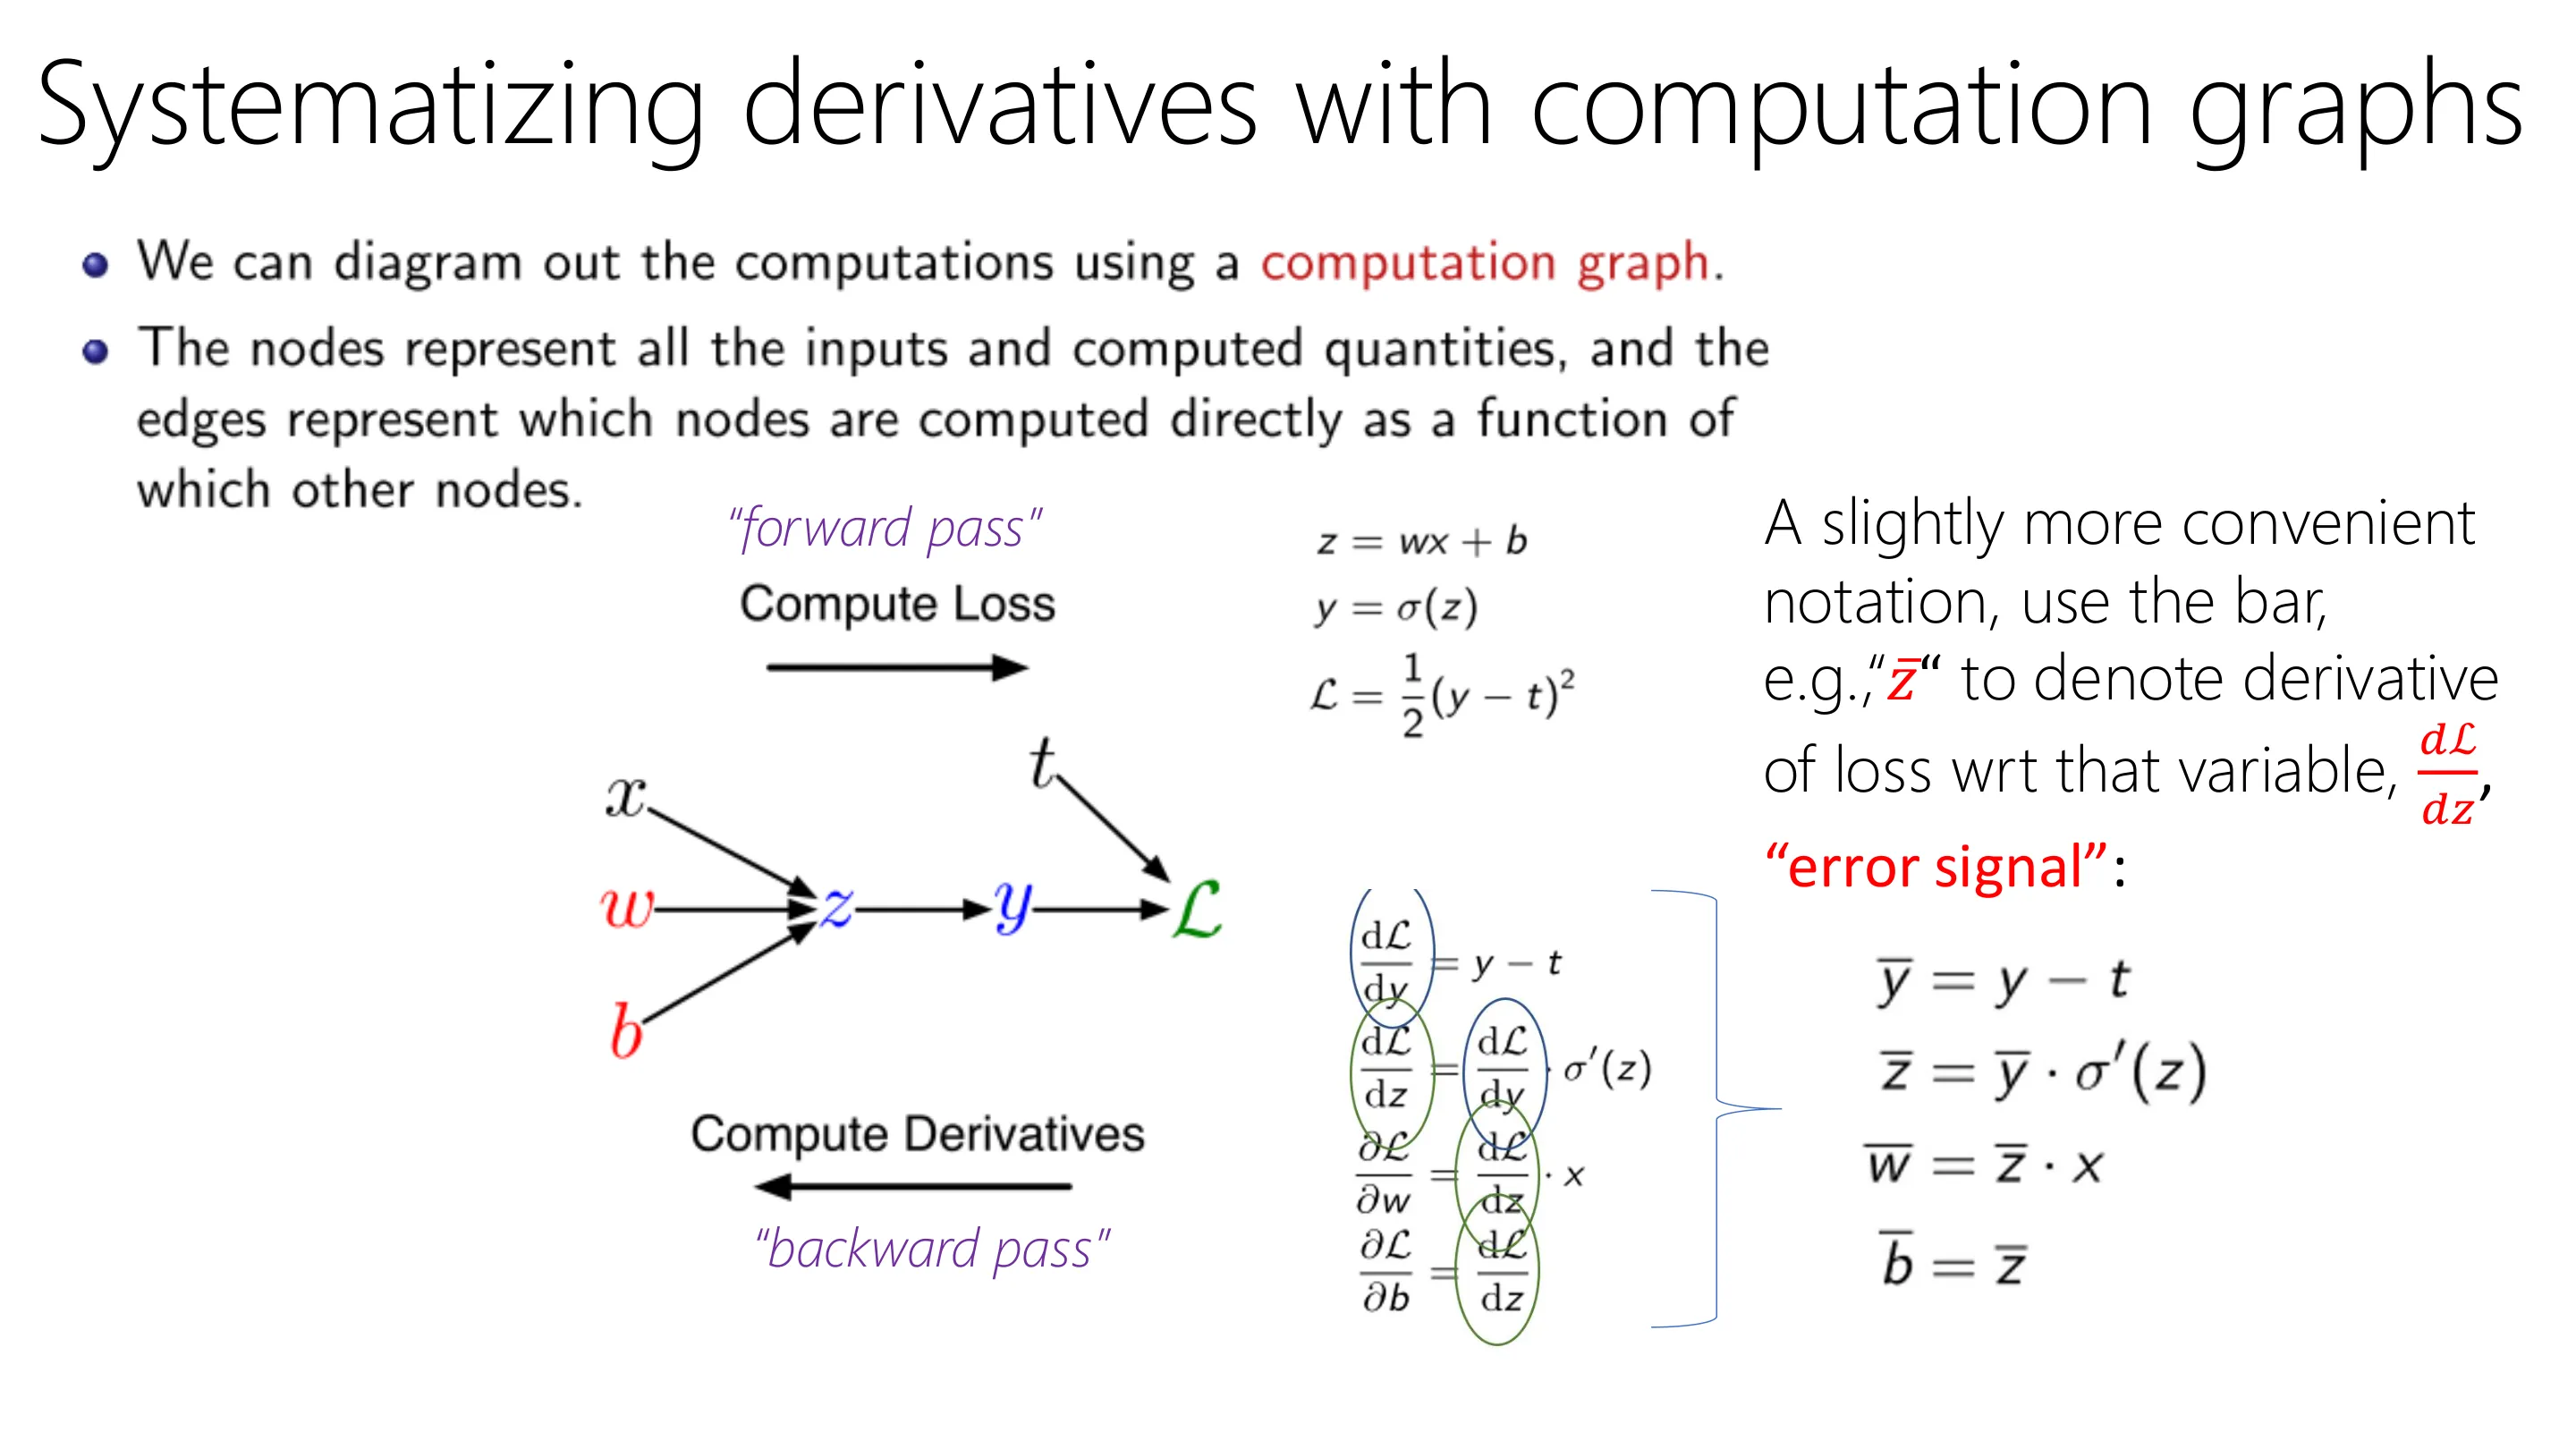
📷 用计算图系统化导数(一)
回到原视频 (00:22:14)
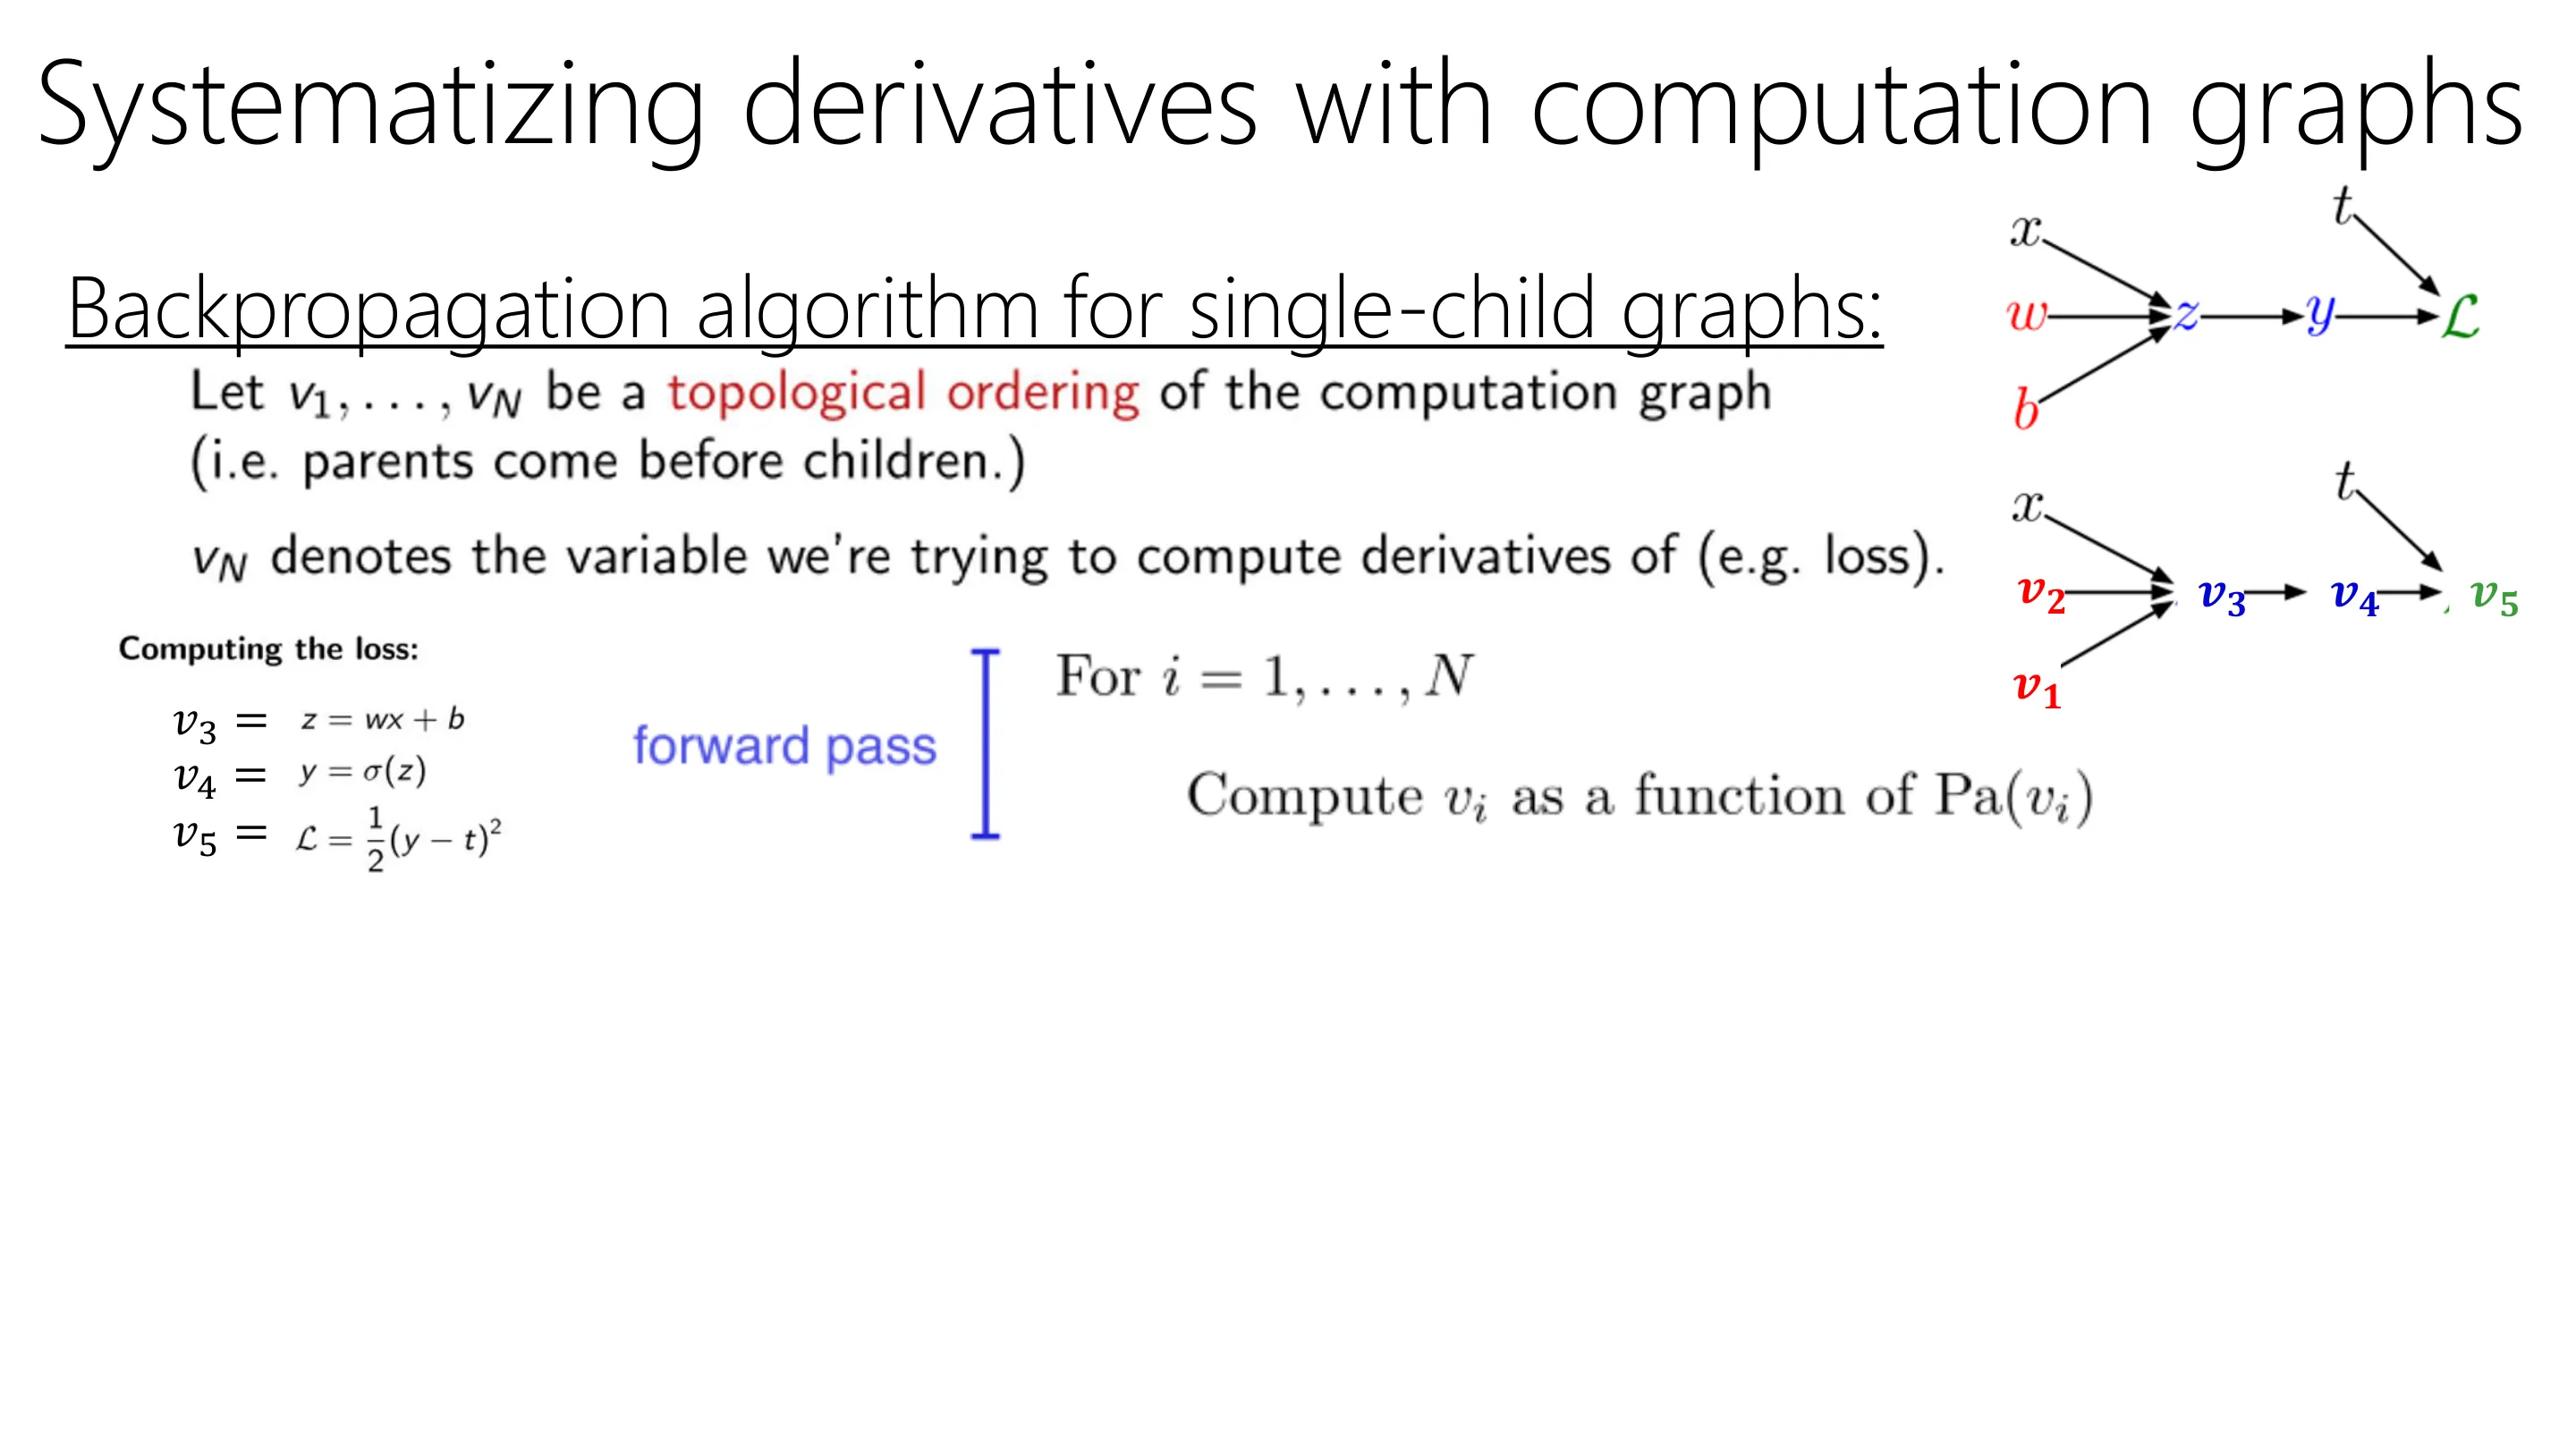
📷 用计算图系统化导数(二)
回到原视频 (00:23:27)
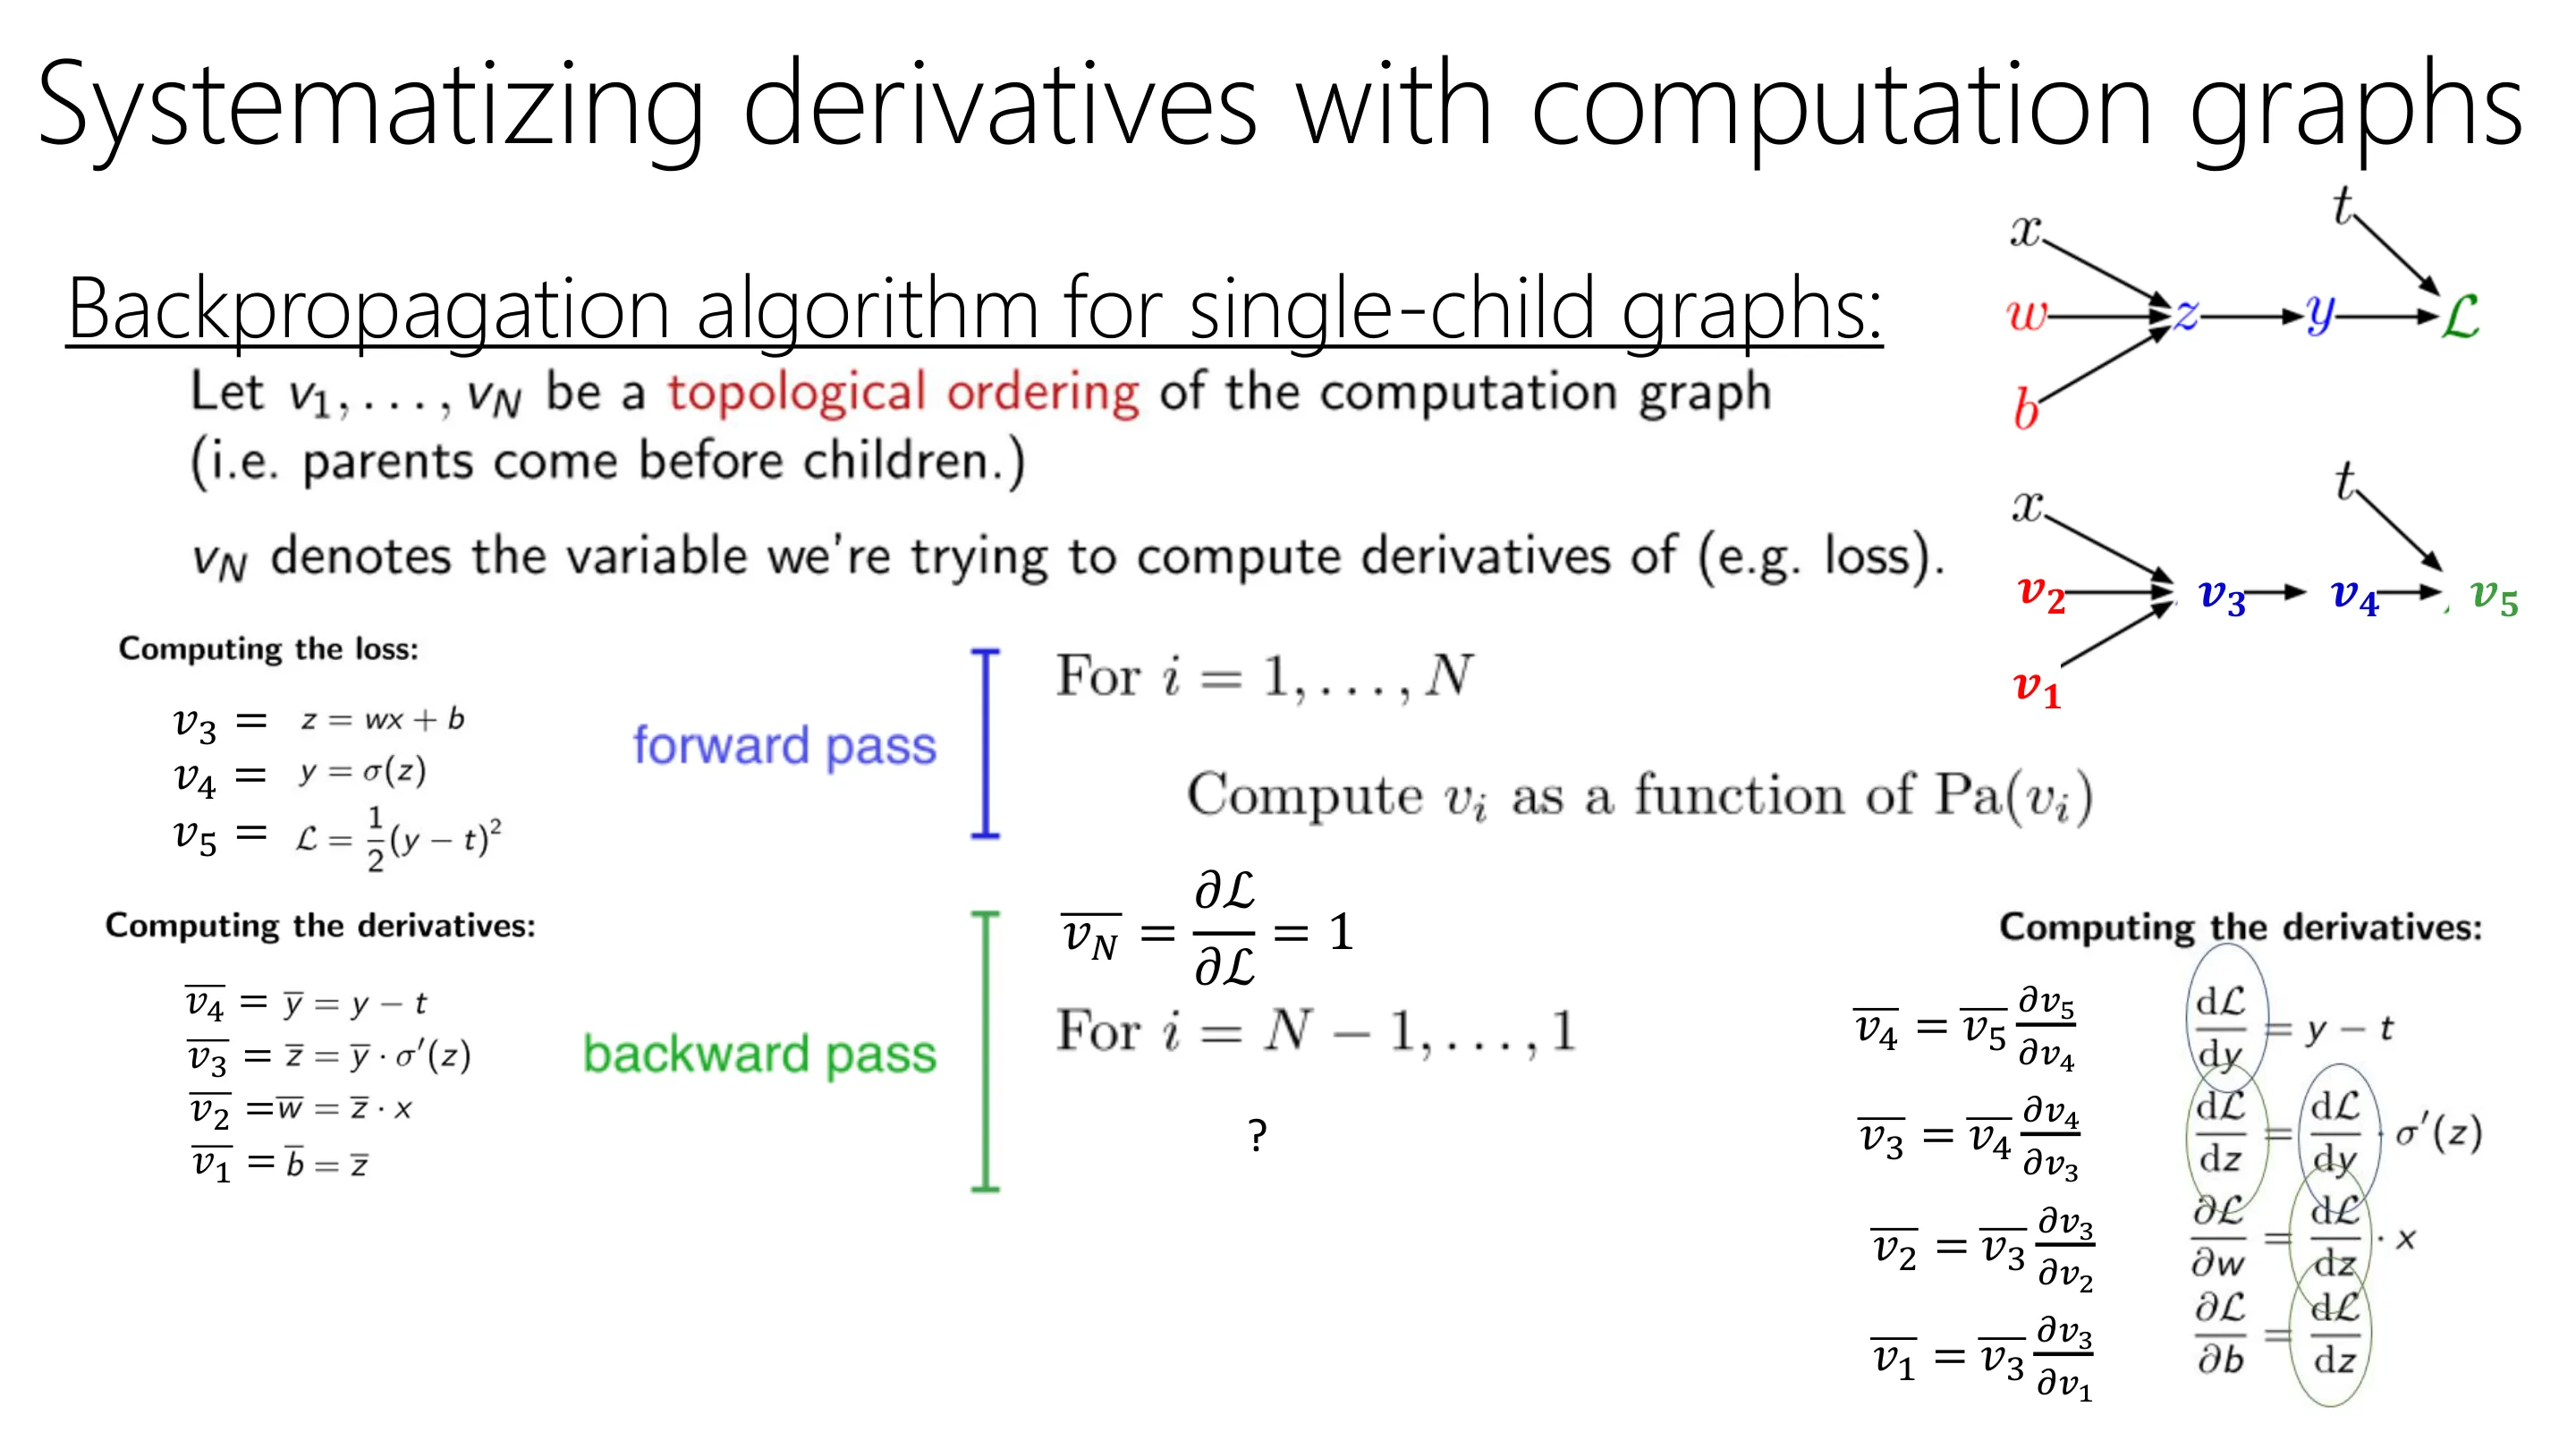
📷 用计算图系统化导数(三)
回到原视频 (00:24:40)
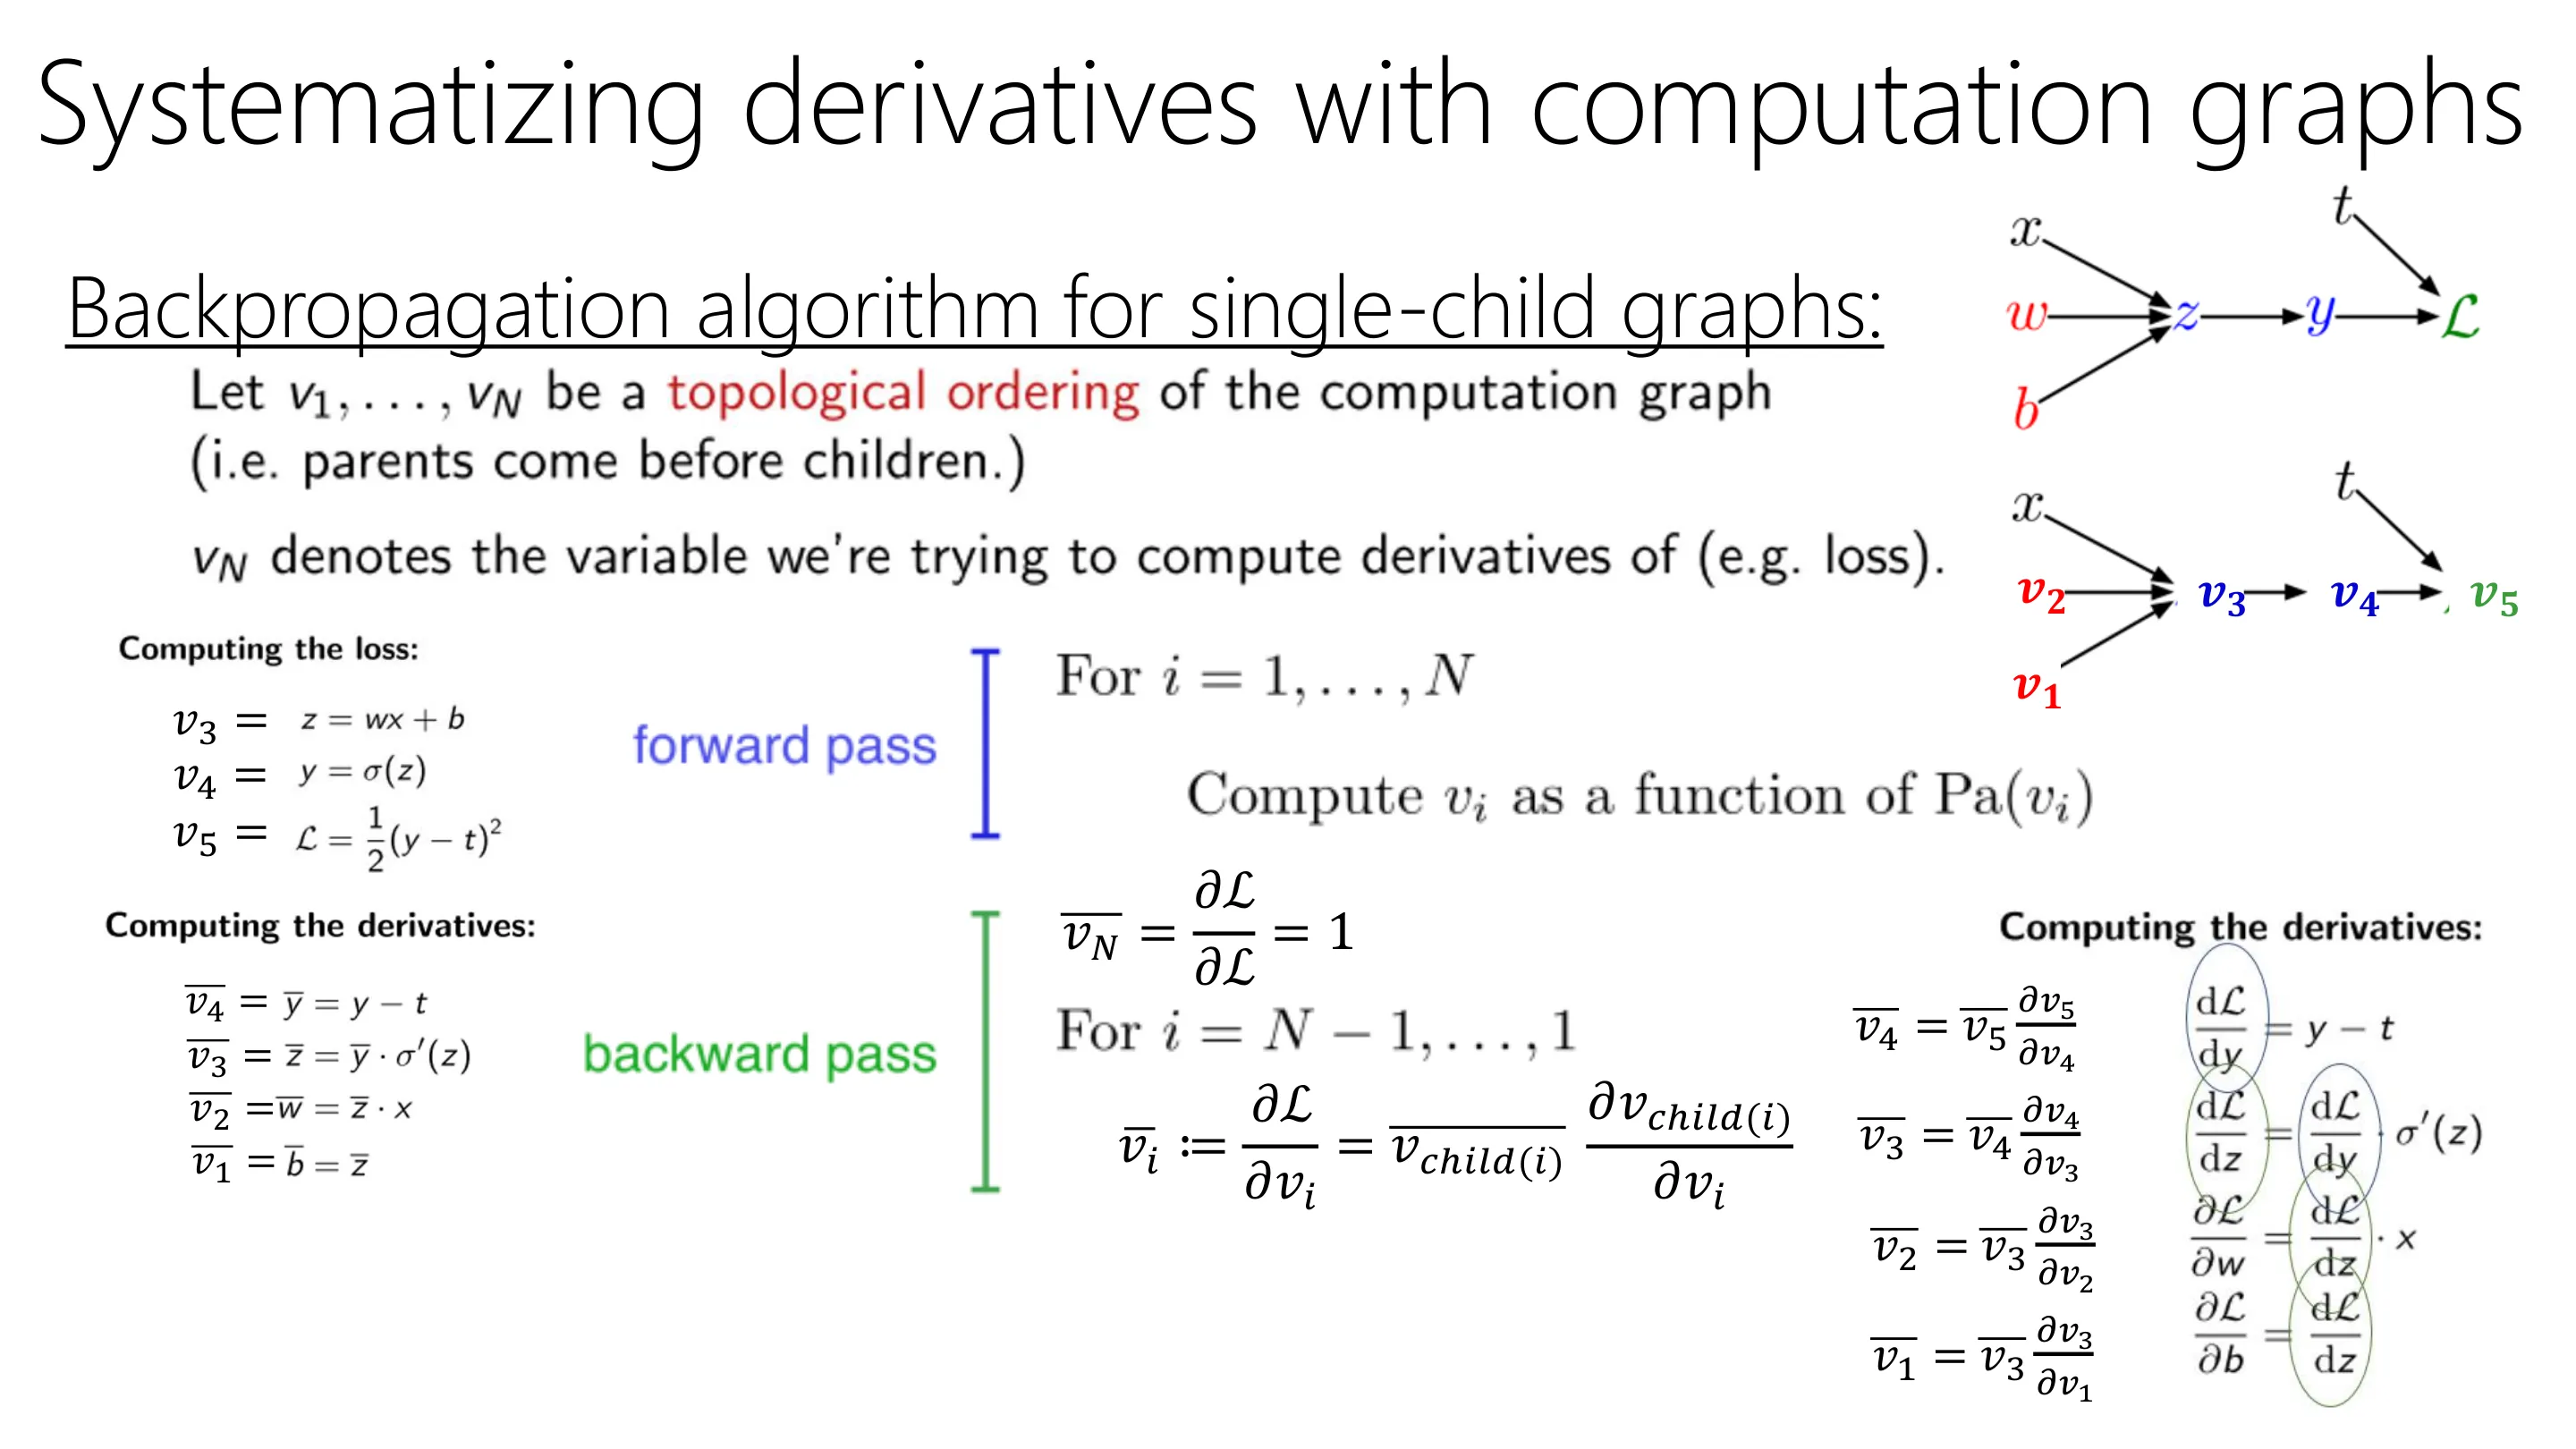
📷 用计算图系统化导数(四)
回到原视频 (00:25:53)
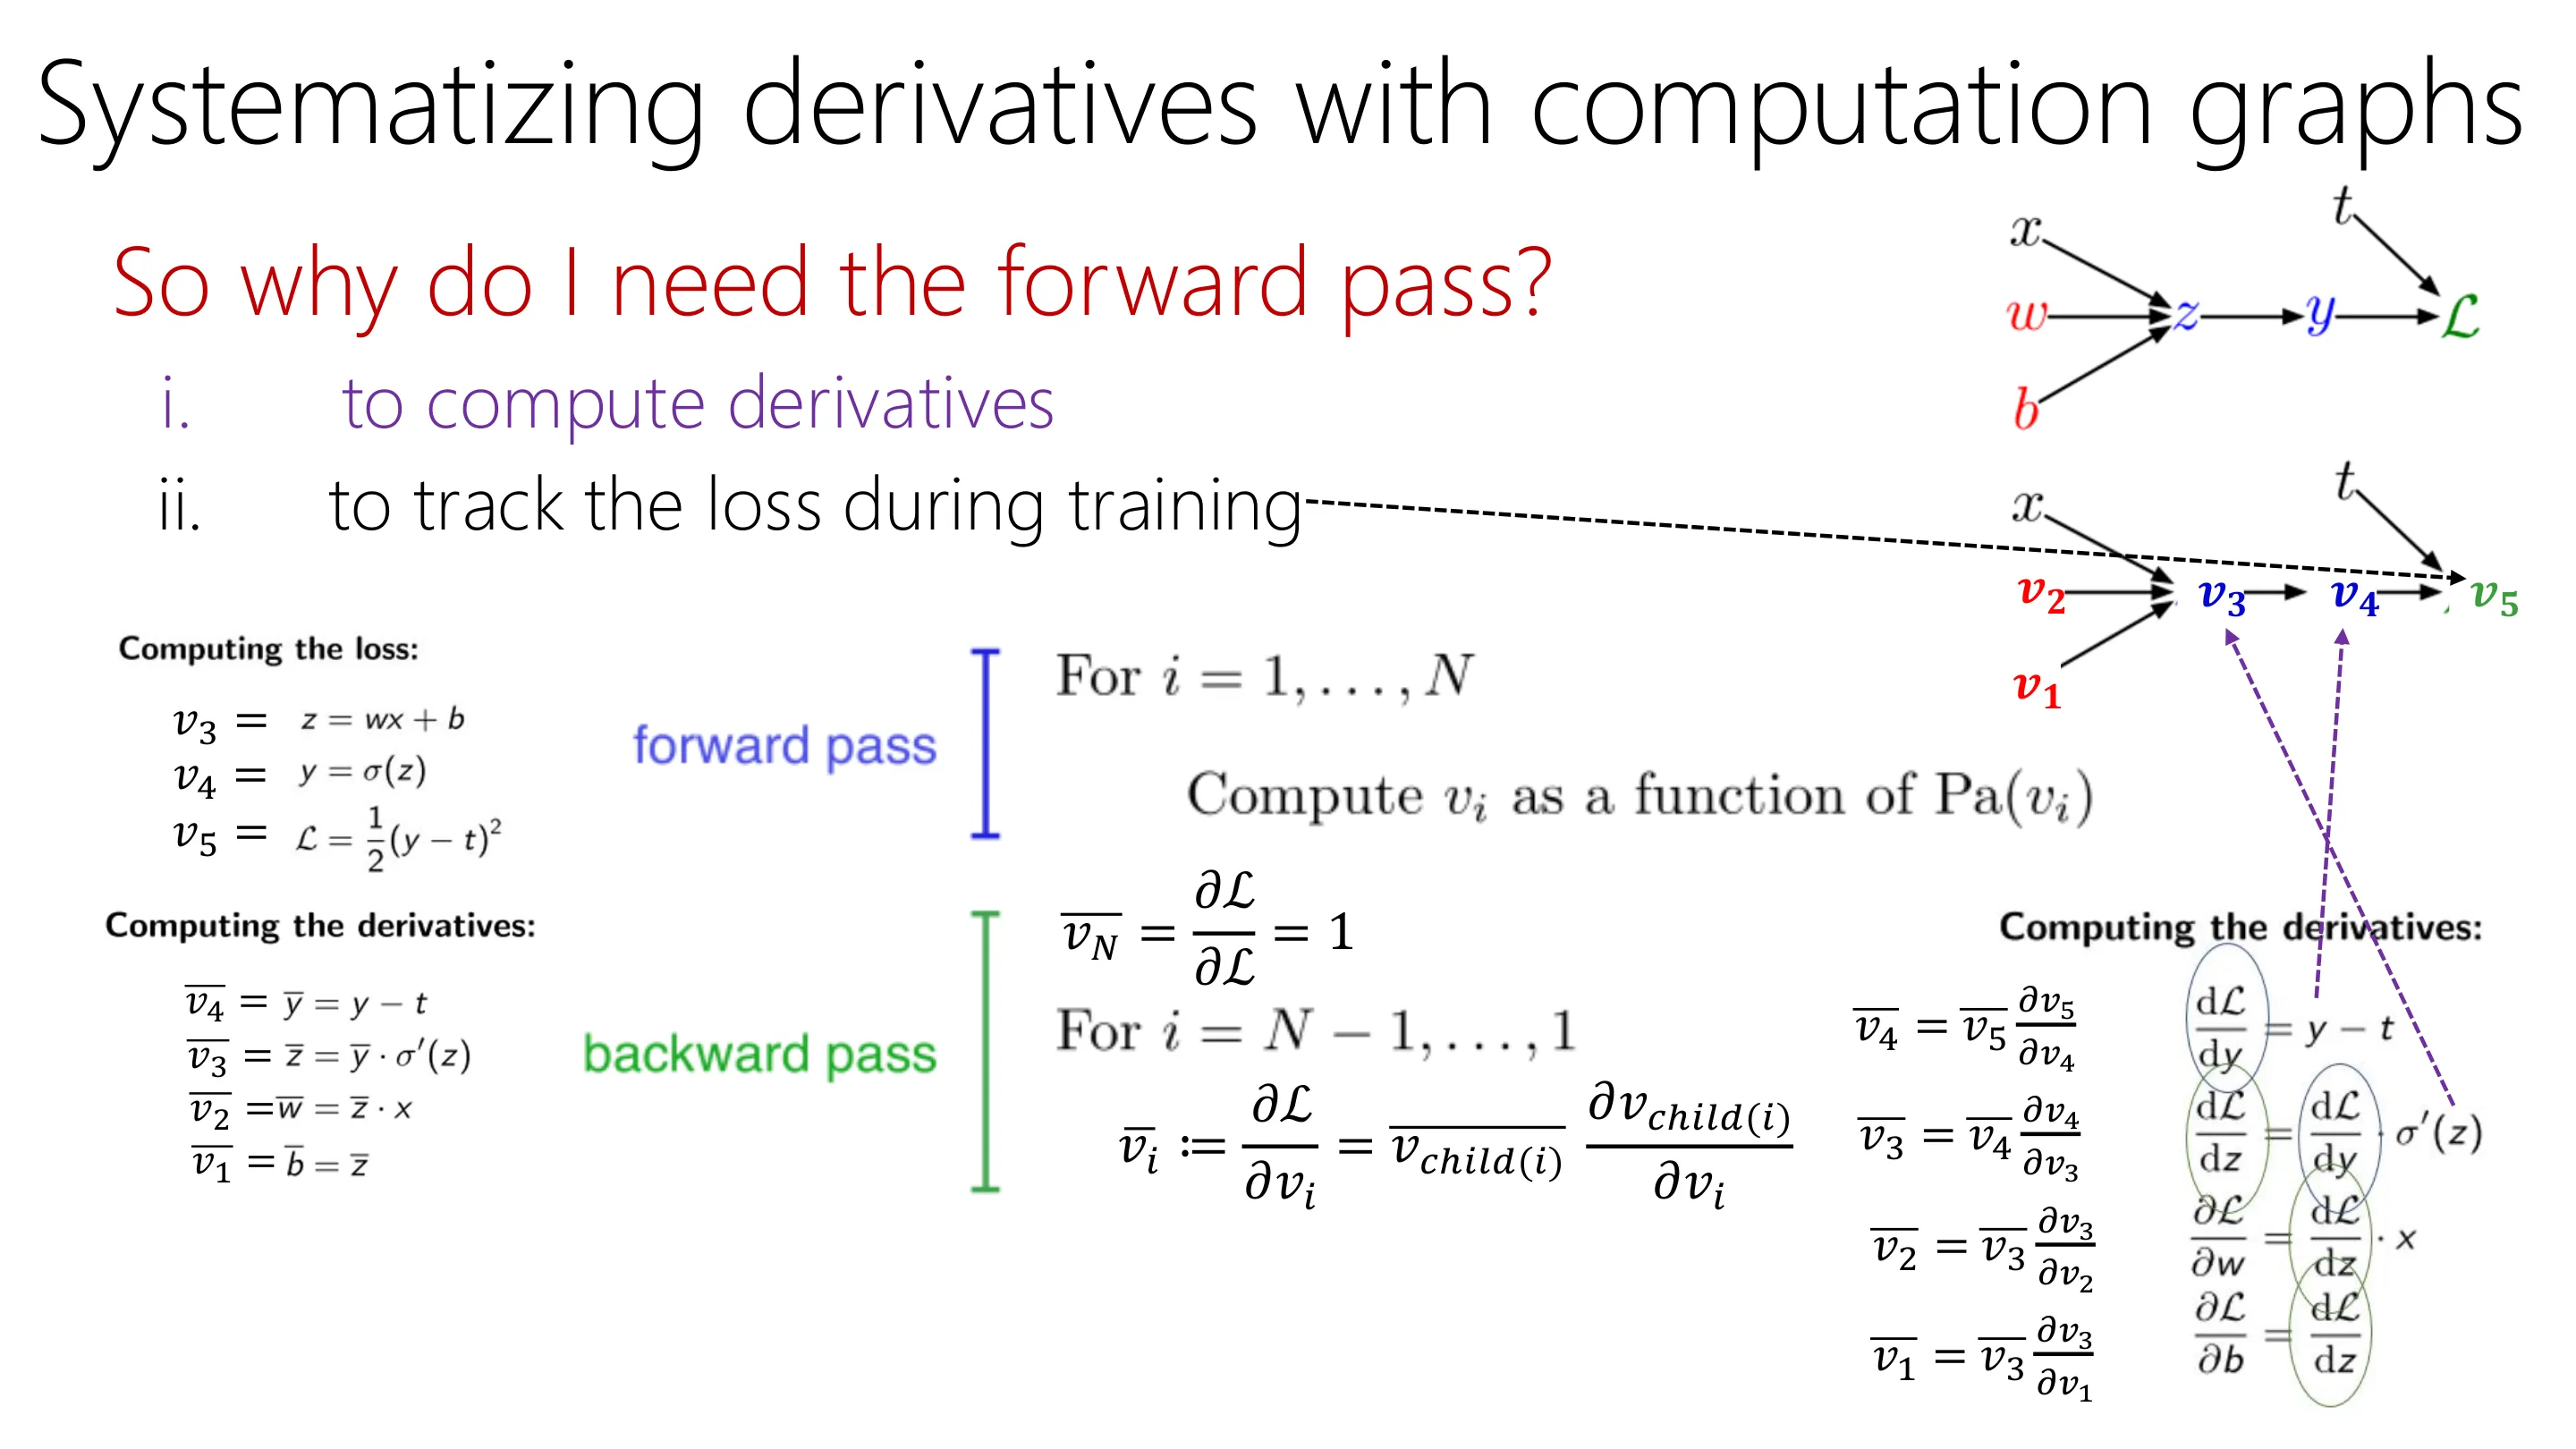
📷 用计算图系统化导数(五)
回到原视频 (00:27:06)
二、反向传播:复用中间导数
(参考时间: 00:28)
Bar 记号(误差信号):$\bar v \equiv \dfrac{\partial L}{\partial v}$。
单子节点图的反向规则(先算 $\bar L = 1$,再往前推):
$$ \bar L = 1,\qquad \bar y = \frac{\partial L}{\partial y},\qquad \bar z = \bar y\,\sigma'(z),\qquad \bar w = \bar z\,x,\qquad \bar b = \bar z\cdot1 $$
关键洞见:计算 $\bar w$ 时需要的 $\bar z$ 已经在前一步算过——复用(caching)。函数复合越深,可复用的项越多。这正是动态规划:沿图反向、以正确的偏序依次计算,避免重复。
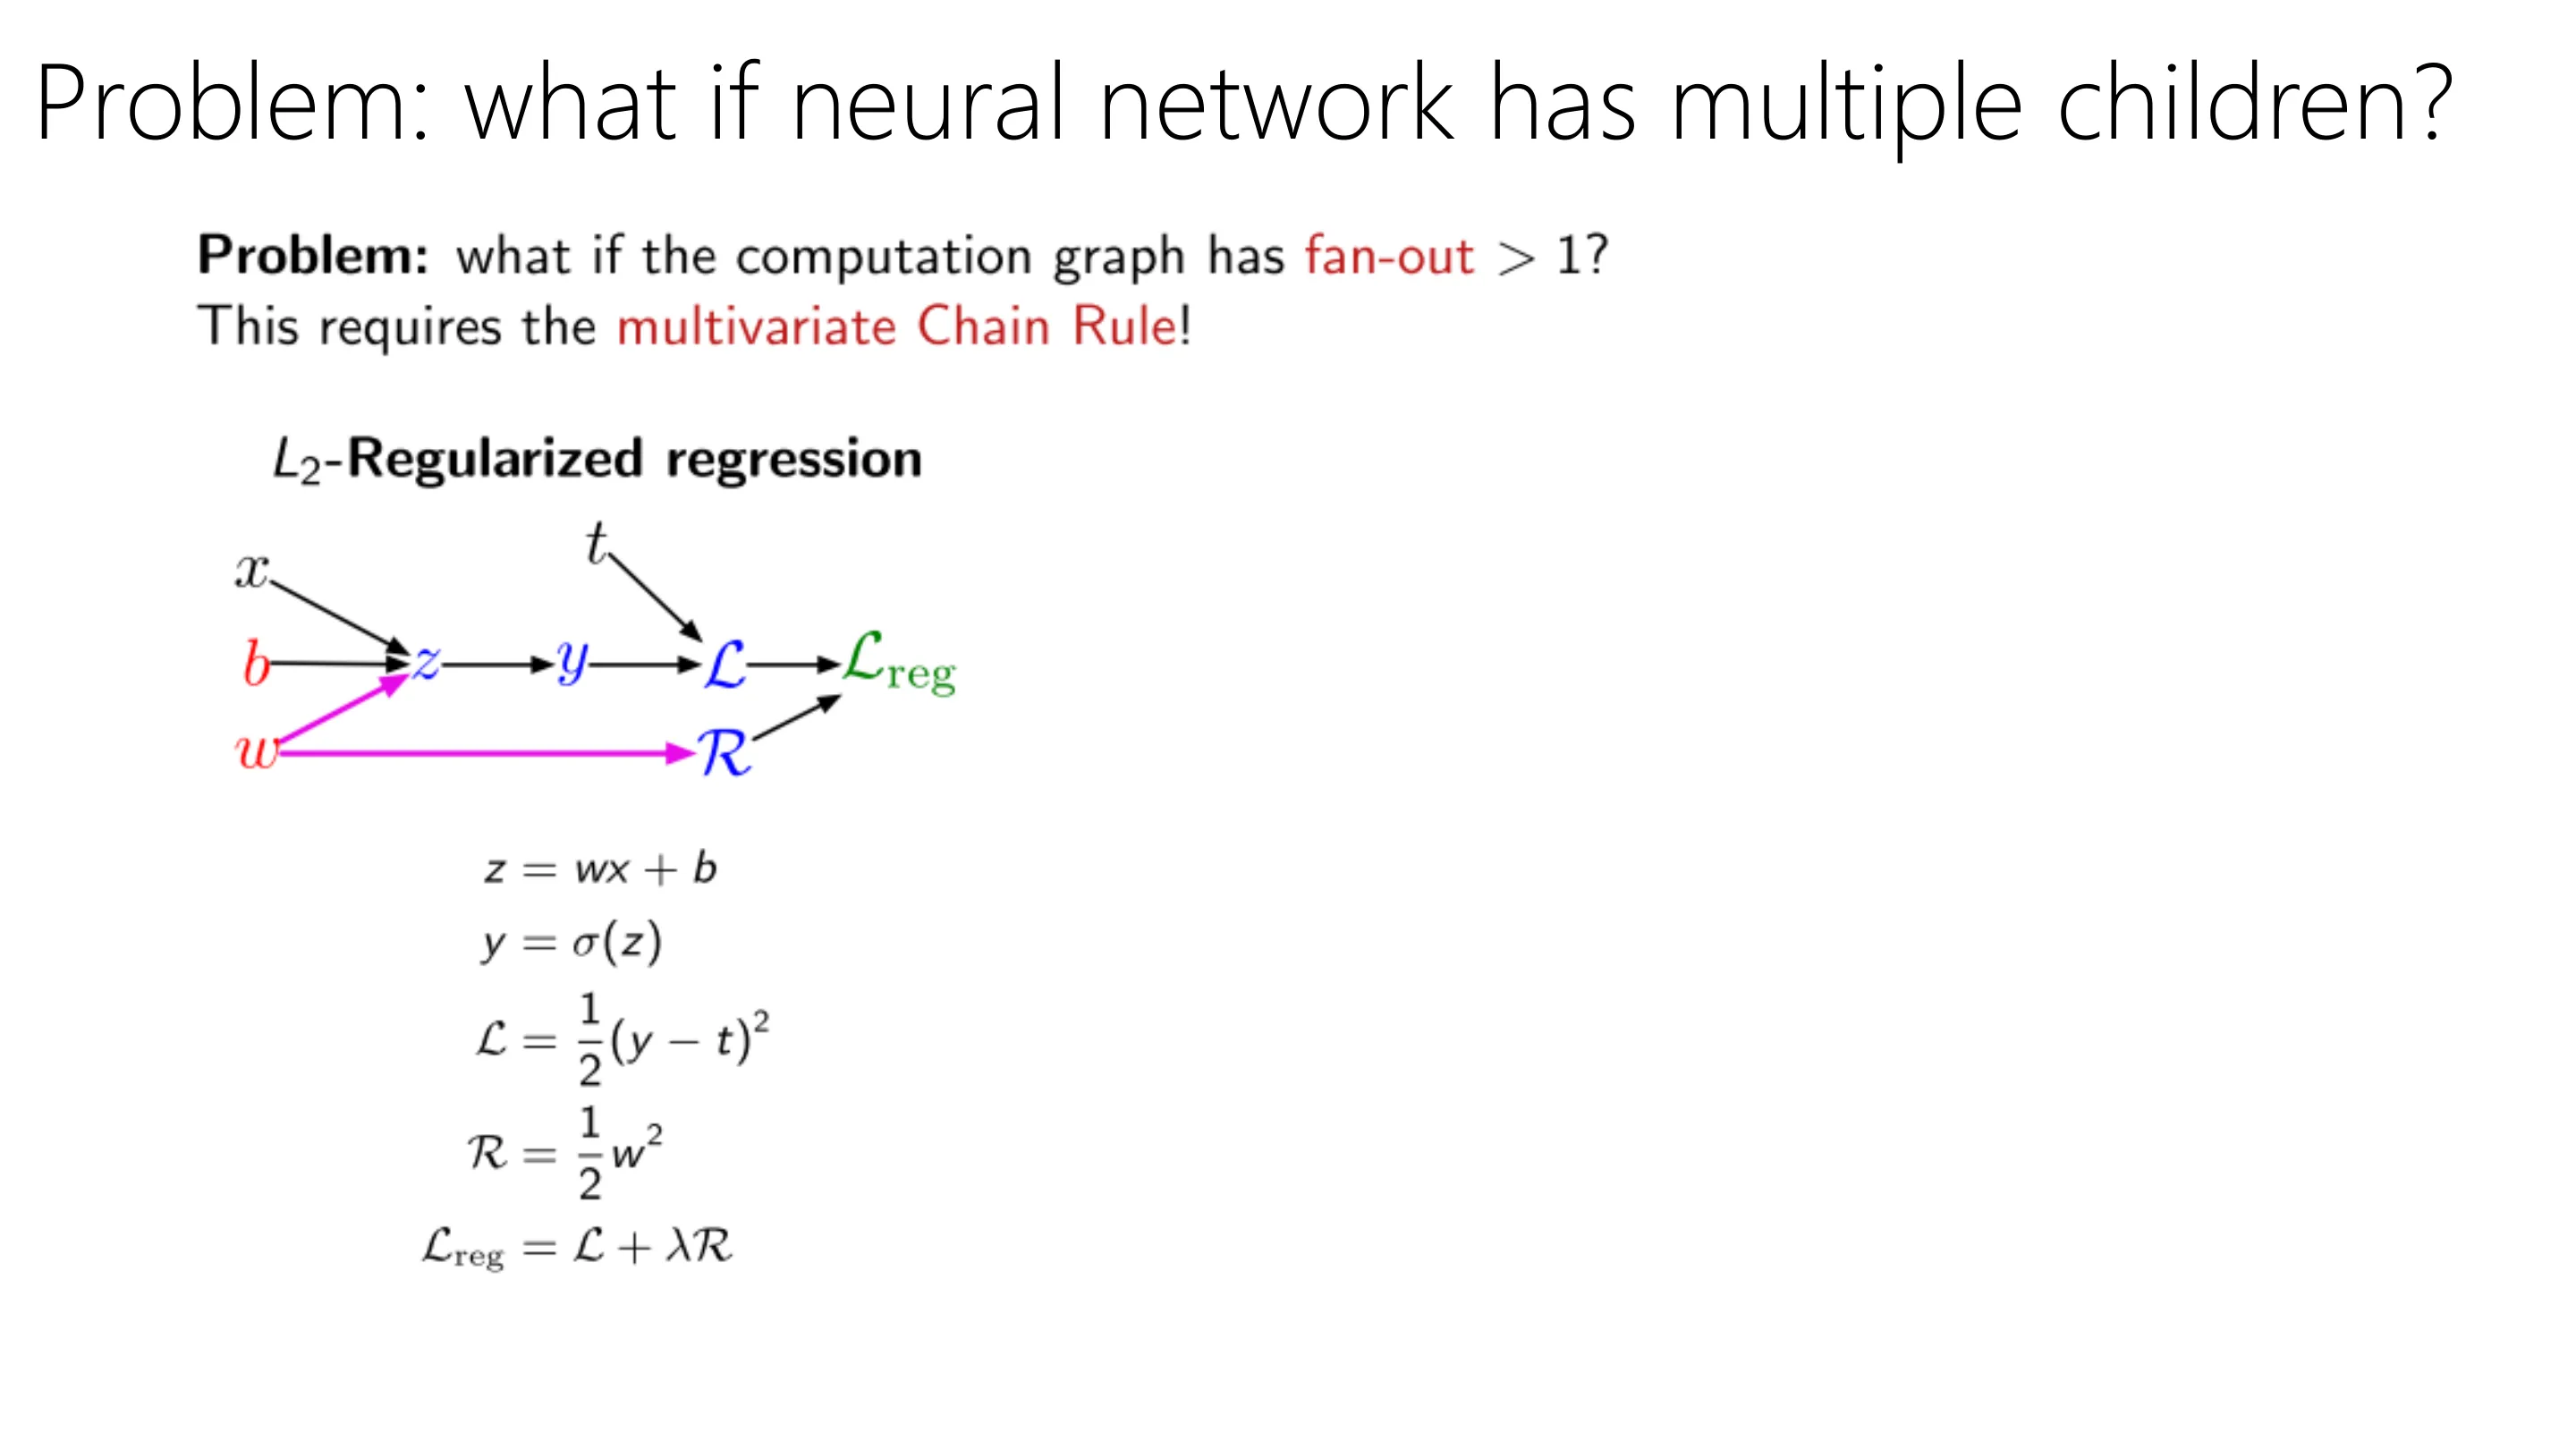
📷 如果网络有多个子节点?
回到原视频 (00:28:19)
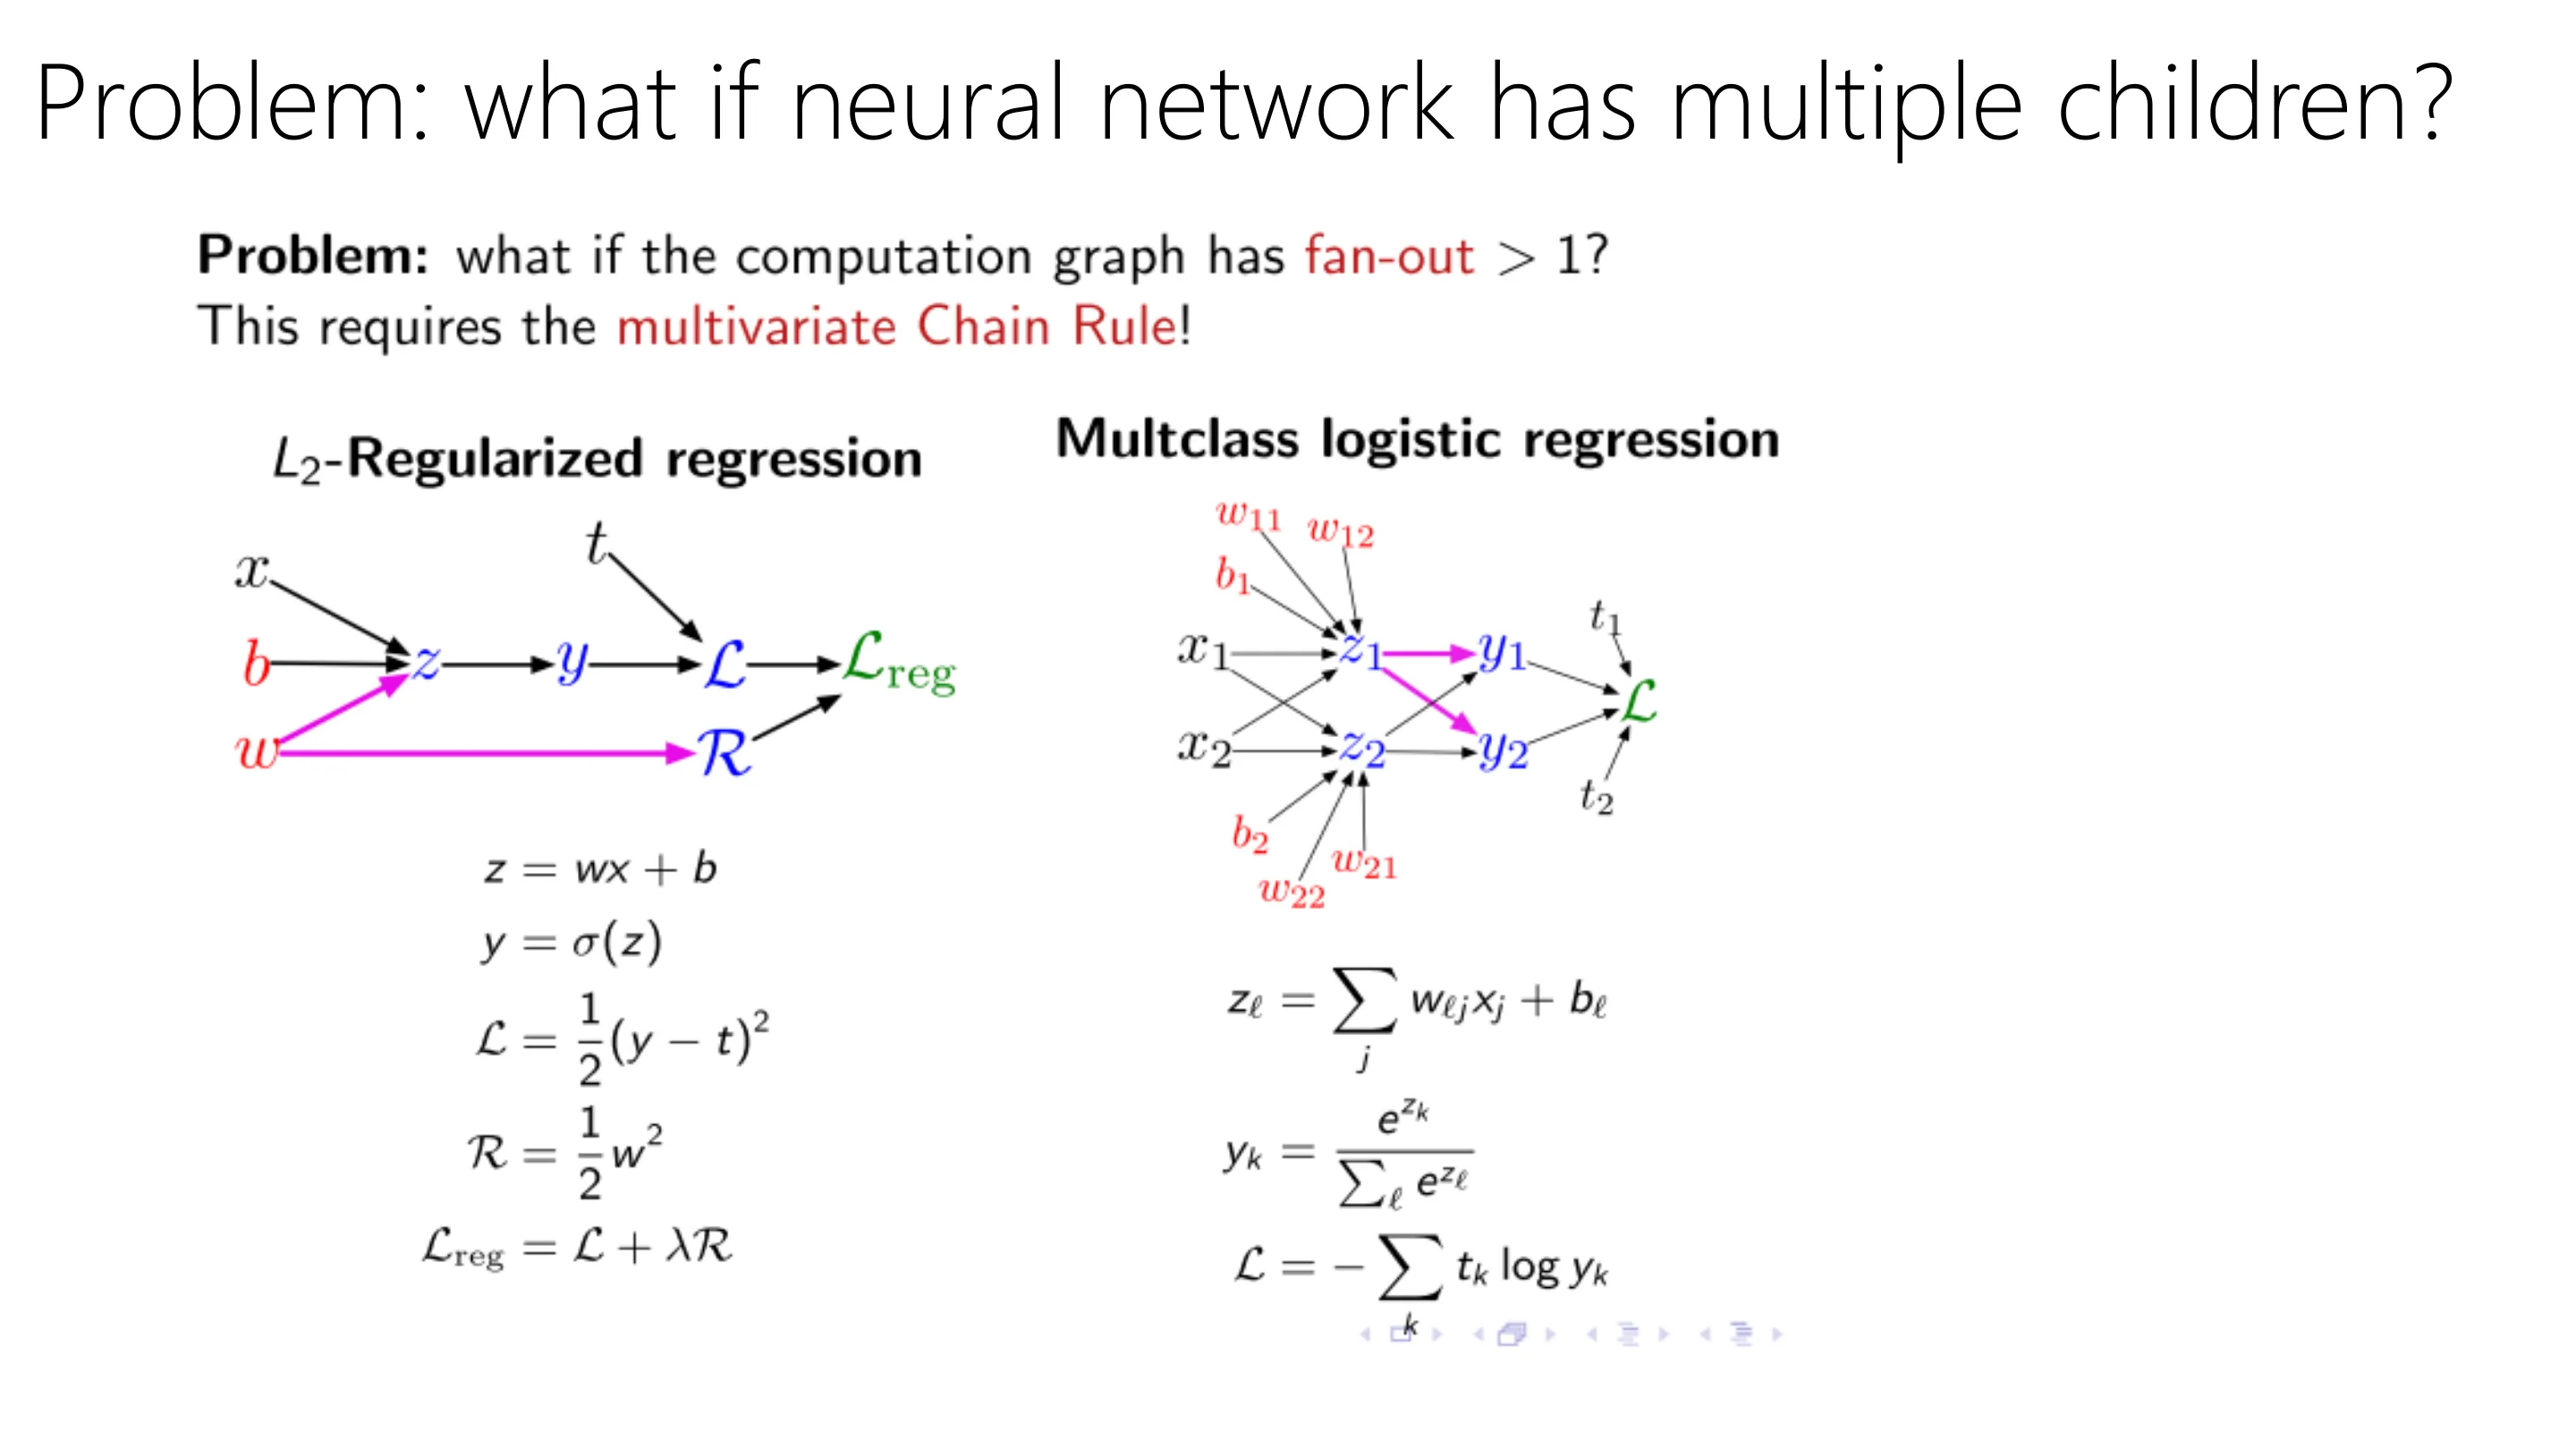
📷 如果网络有多个子节点?(续)
回到原视频 (00:29:32)
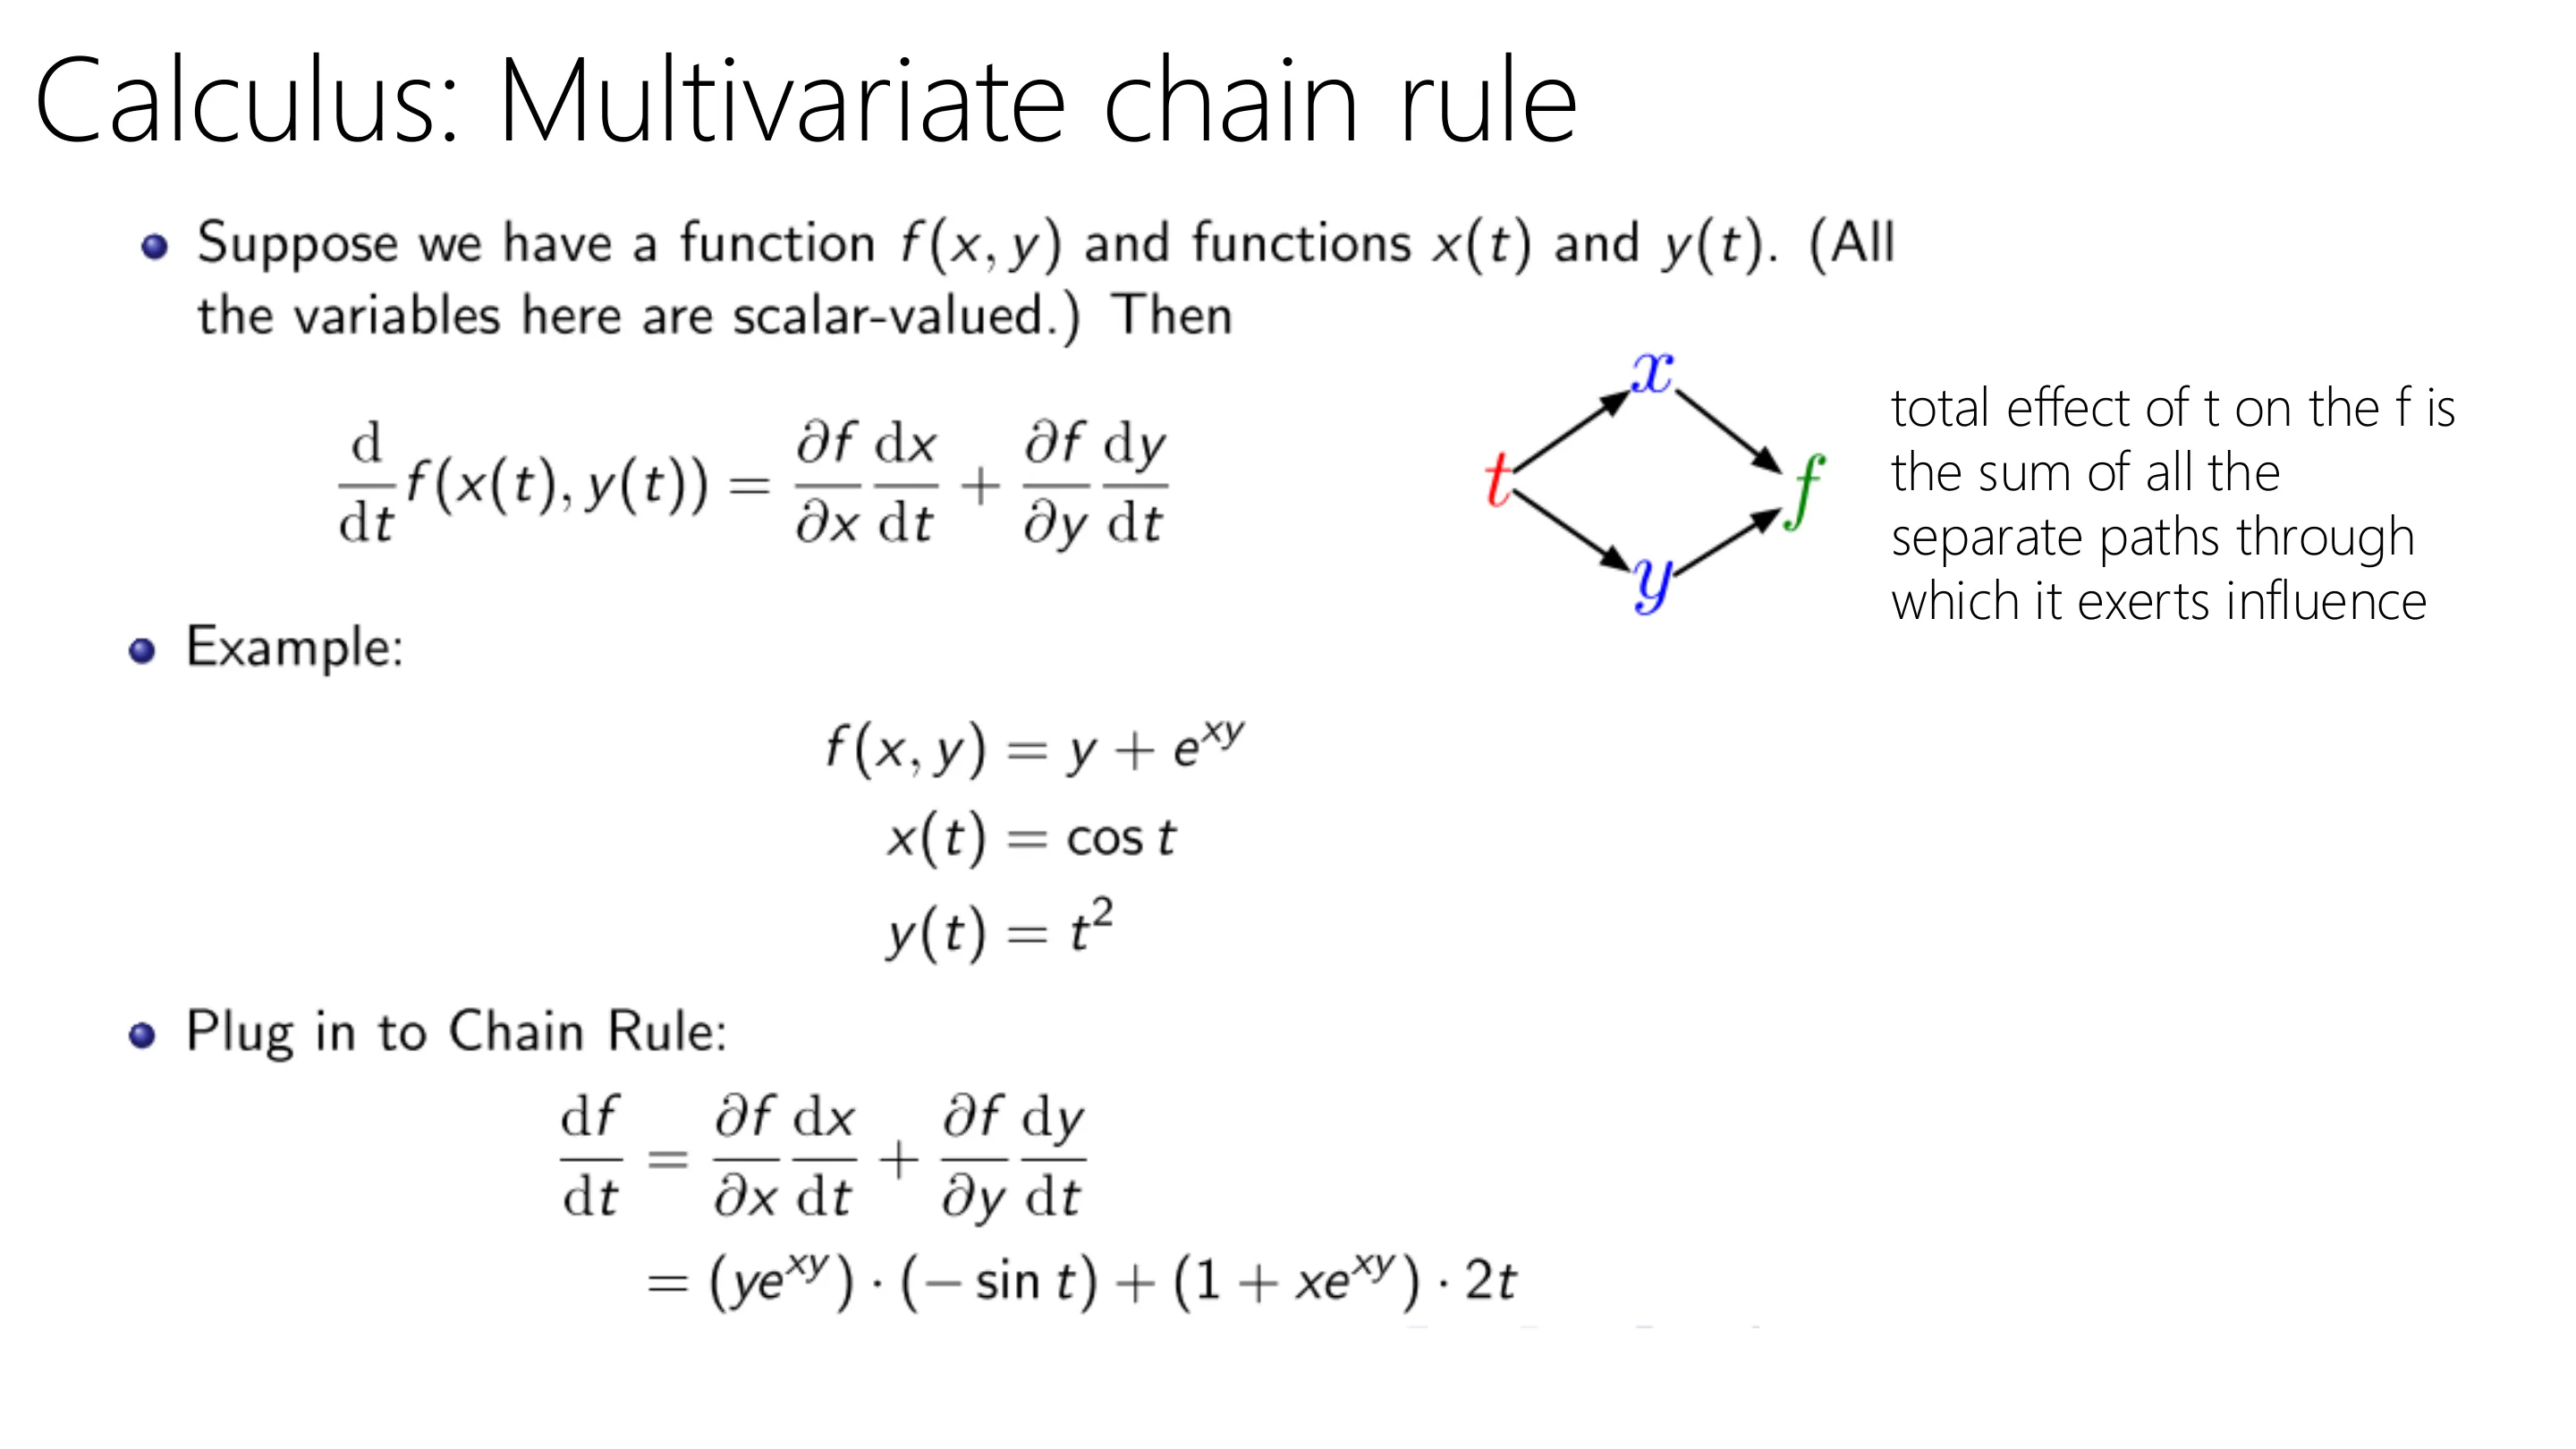
📷 微积分:多元链式法则
回到原视频 (00:30:45)
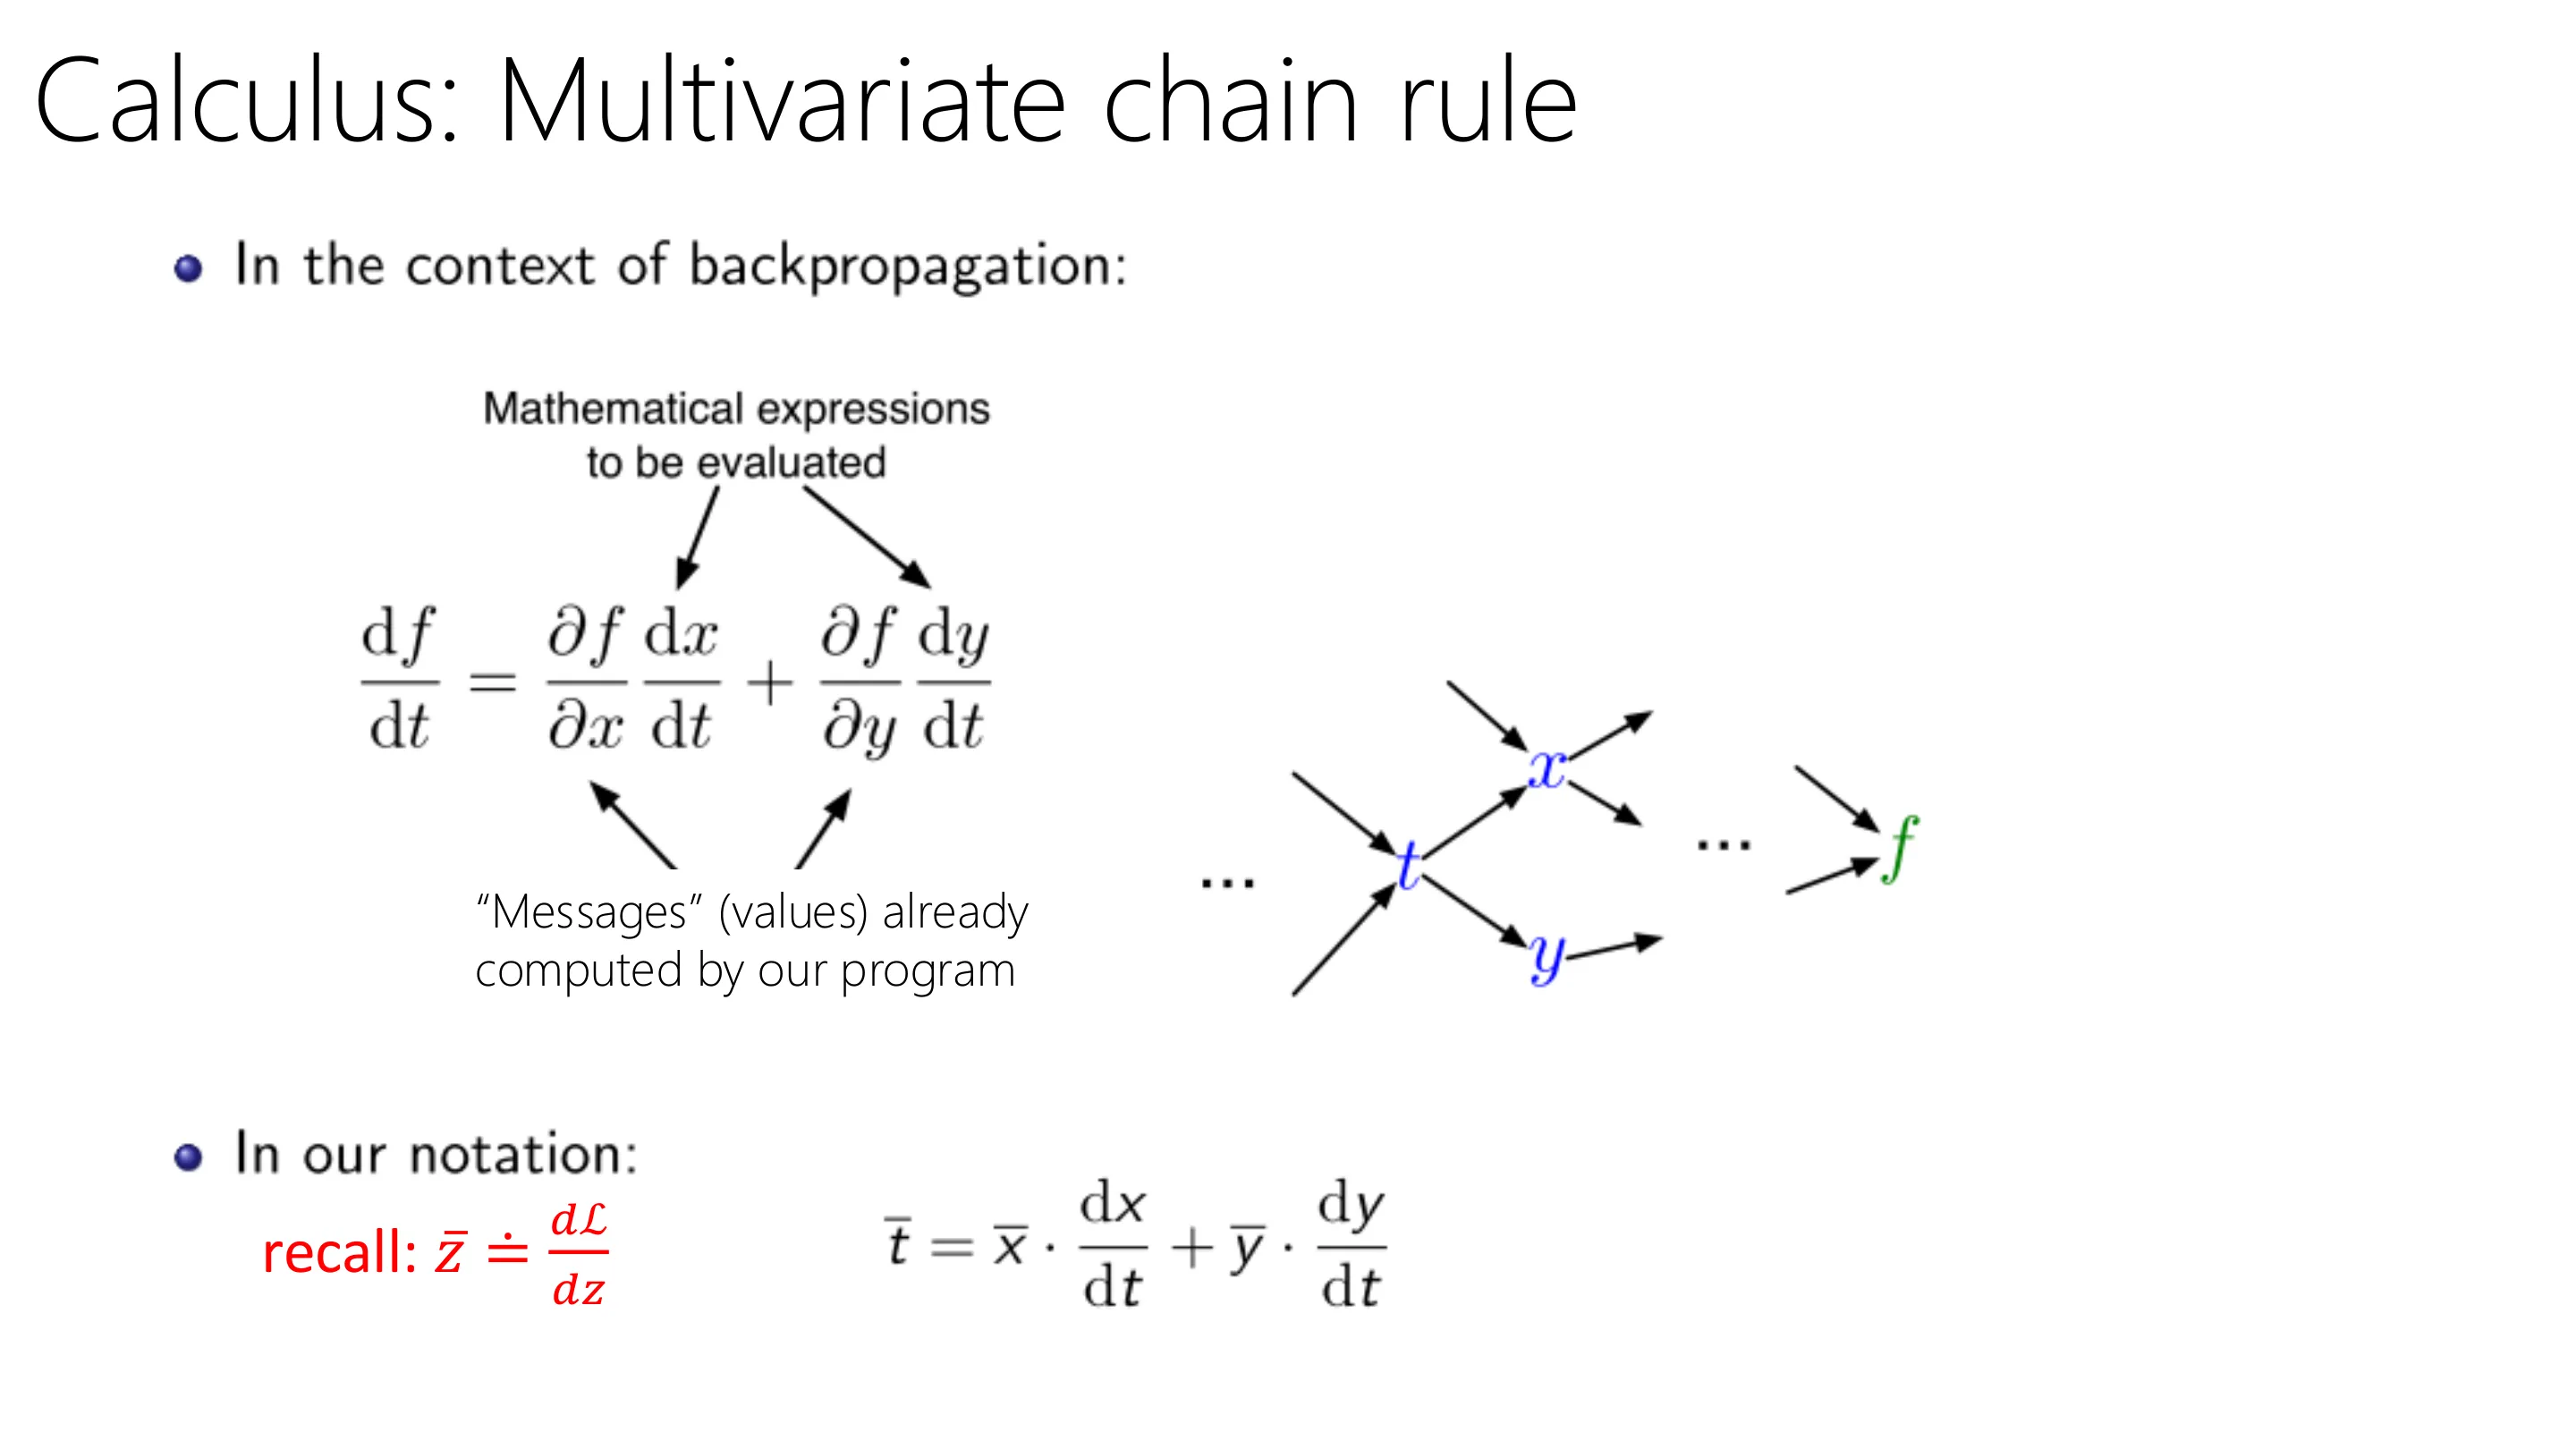
📷 「消息」(值)已经……
回到原视频 (00:31:58)
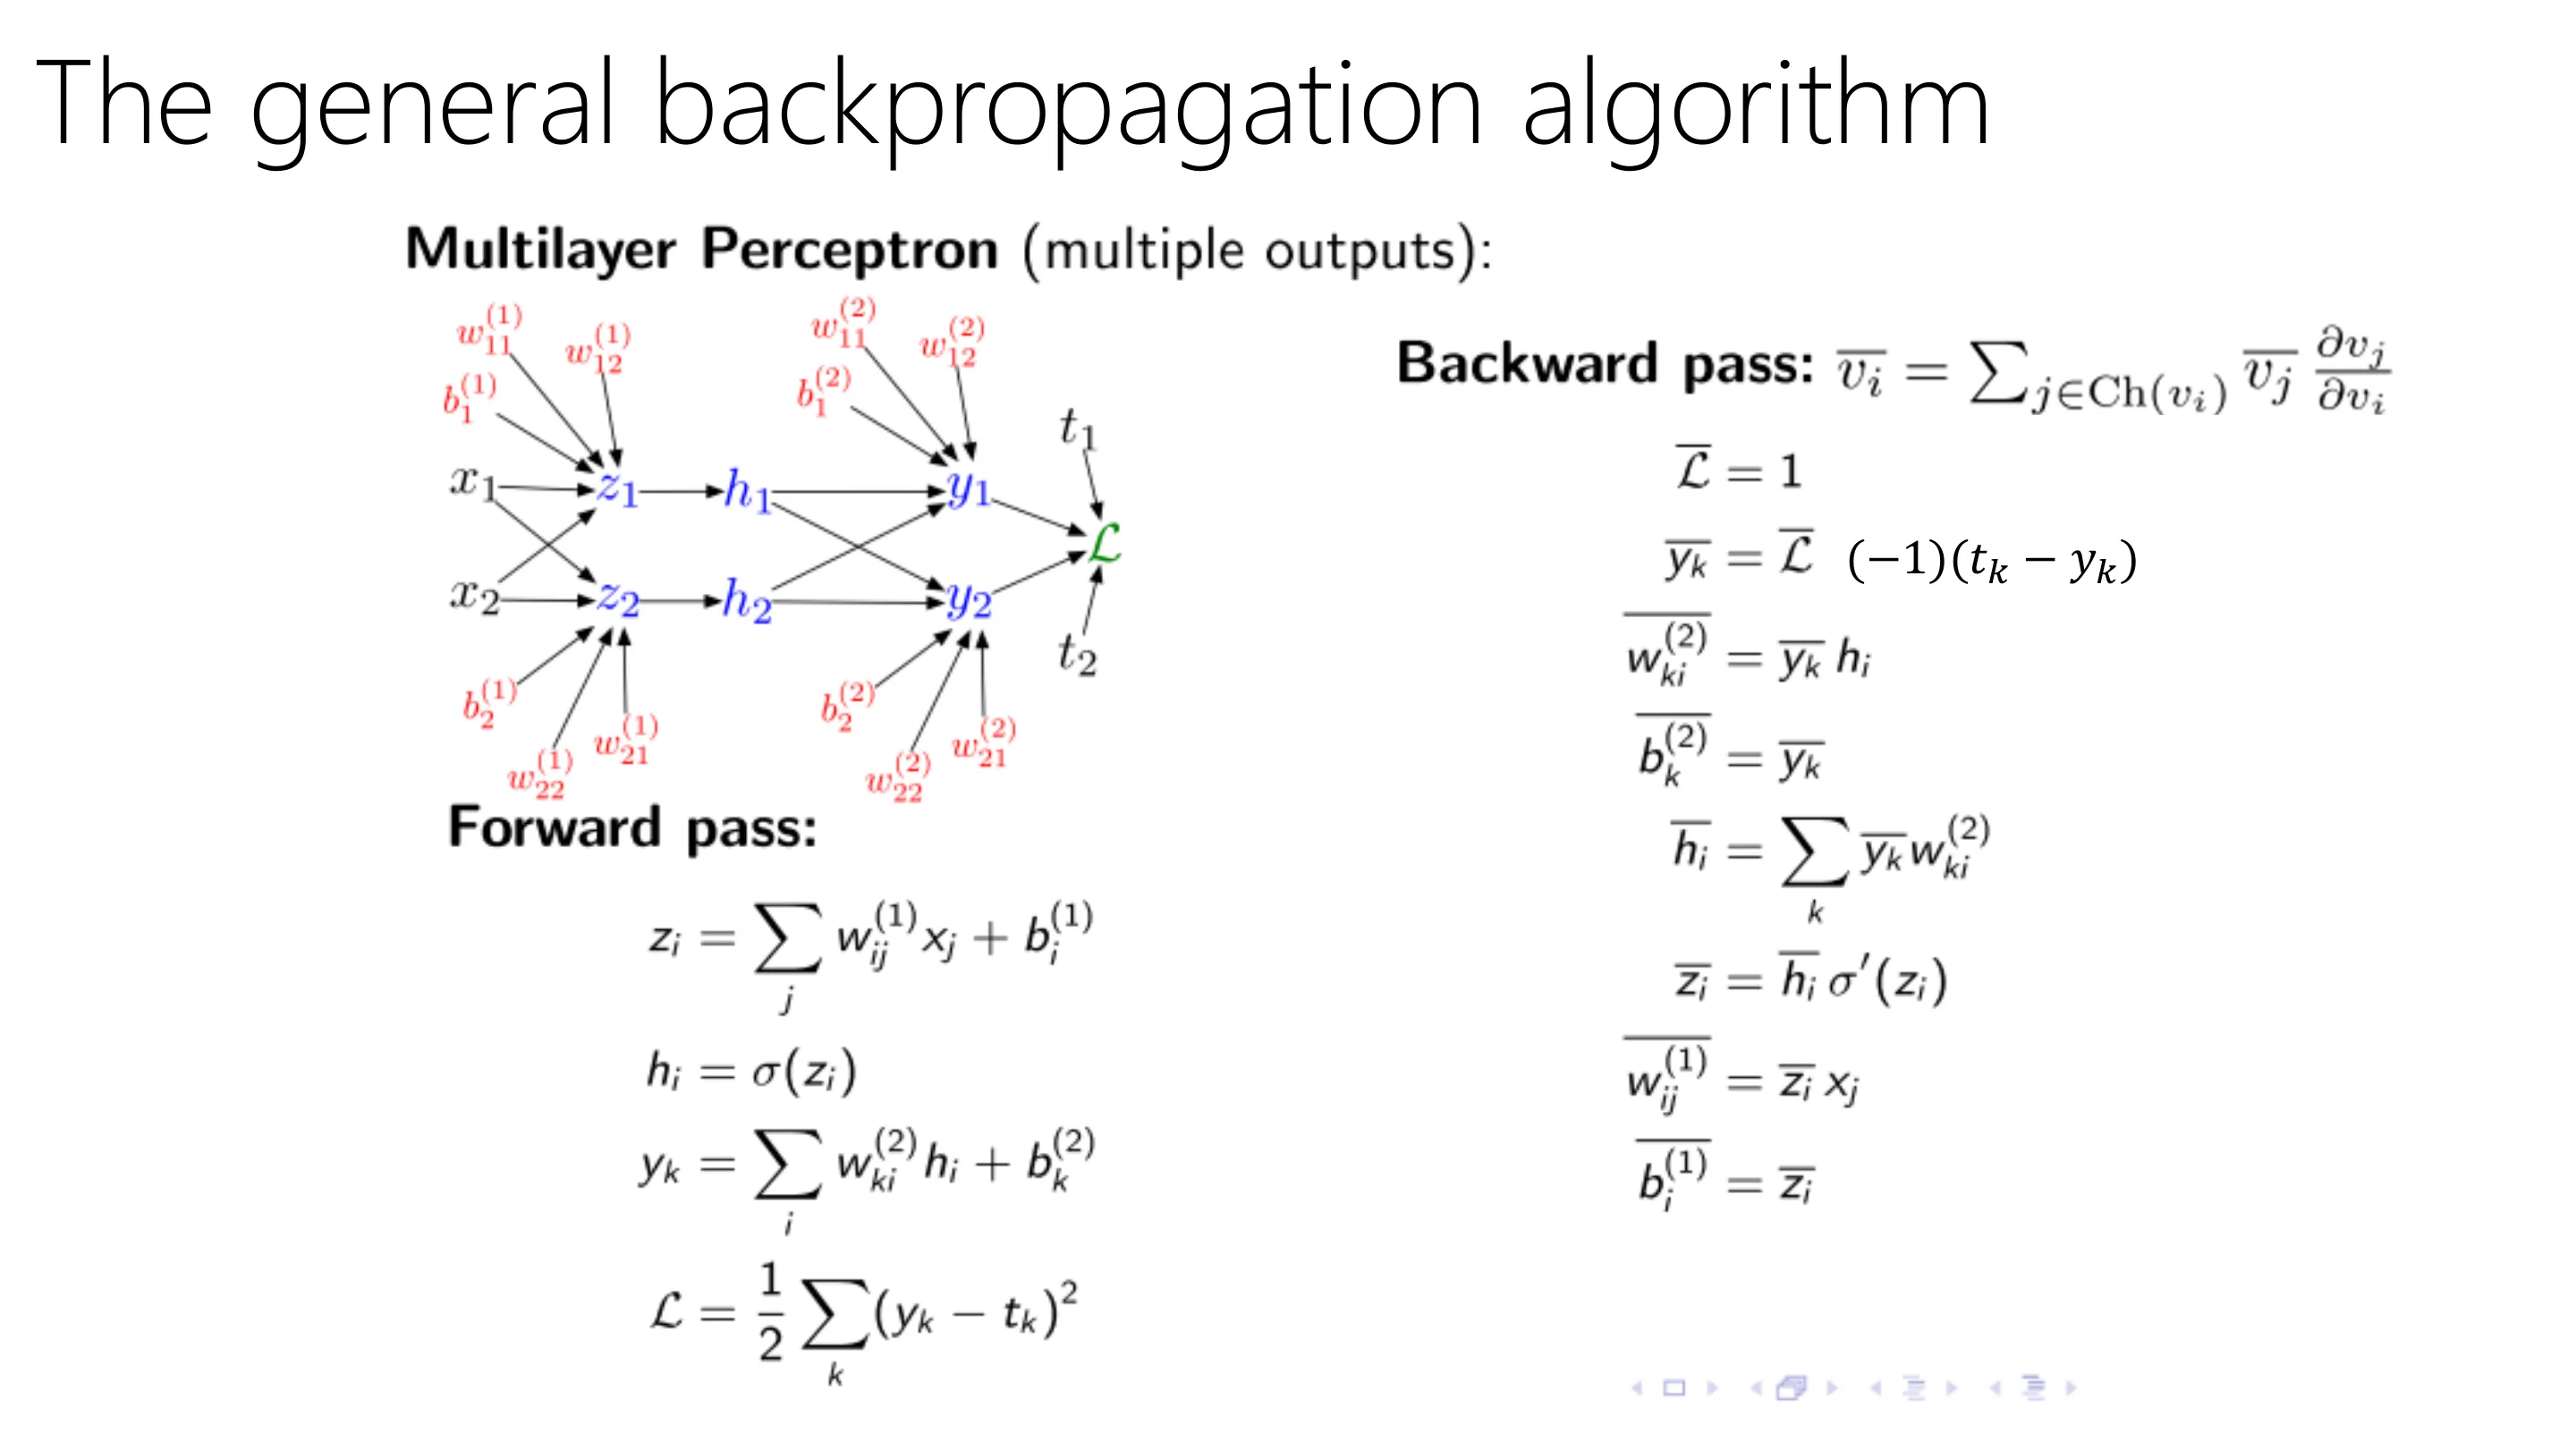
通用规则(单子节点情形):要求某个变量的 $\bar{\ }$,就用它的子节点的 $\bar{\ }$ 乘以「子节点对该变量的偏导」。损失对自身的导数是基本情况 1——算法从这里开始递归回溯。
讲师提到幻灯片里的一处笔误(把「子节点」写成了「$i+1$」)经现场同学指出后更正:应当是「对这个节点的每个子节点 $j$,取 $\bar v_j\,\partial v_j/\partial v_i$」。
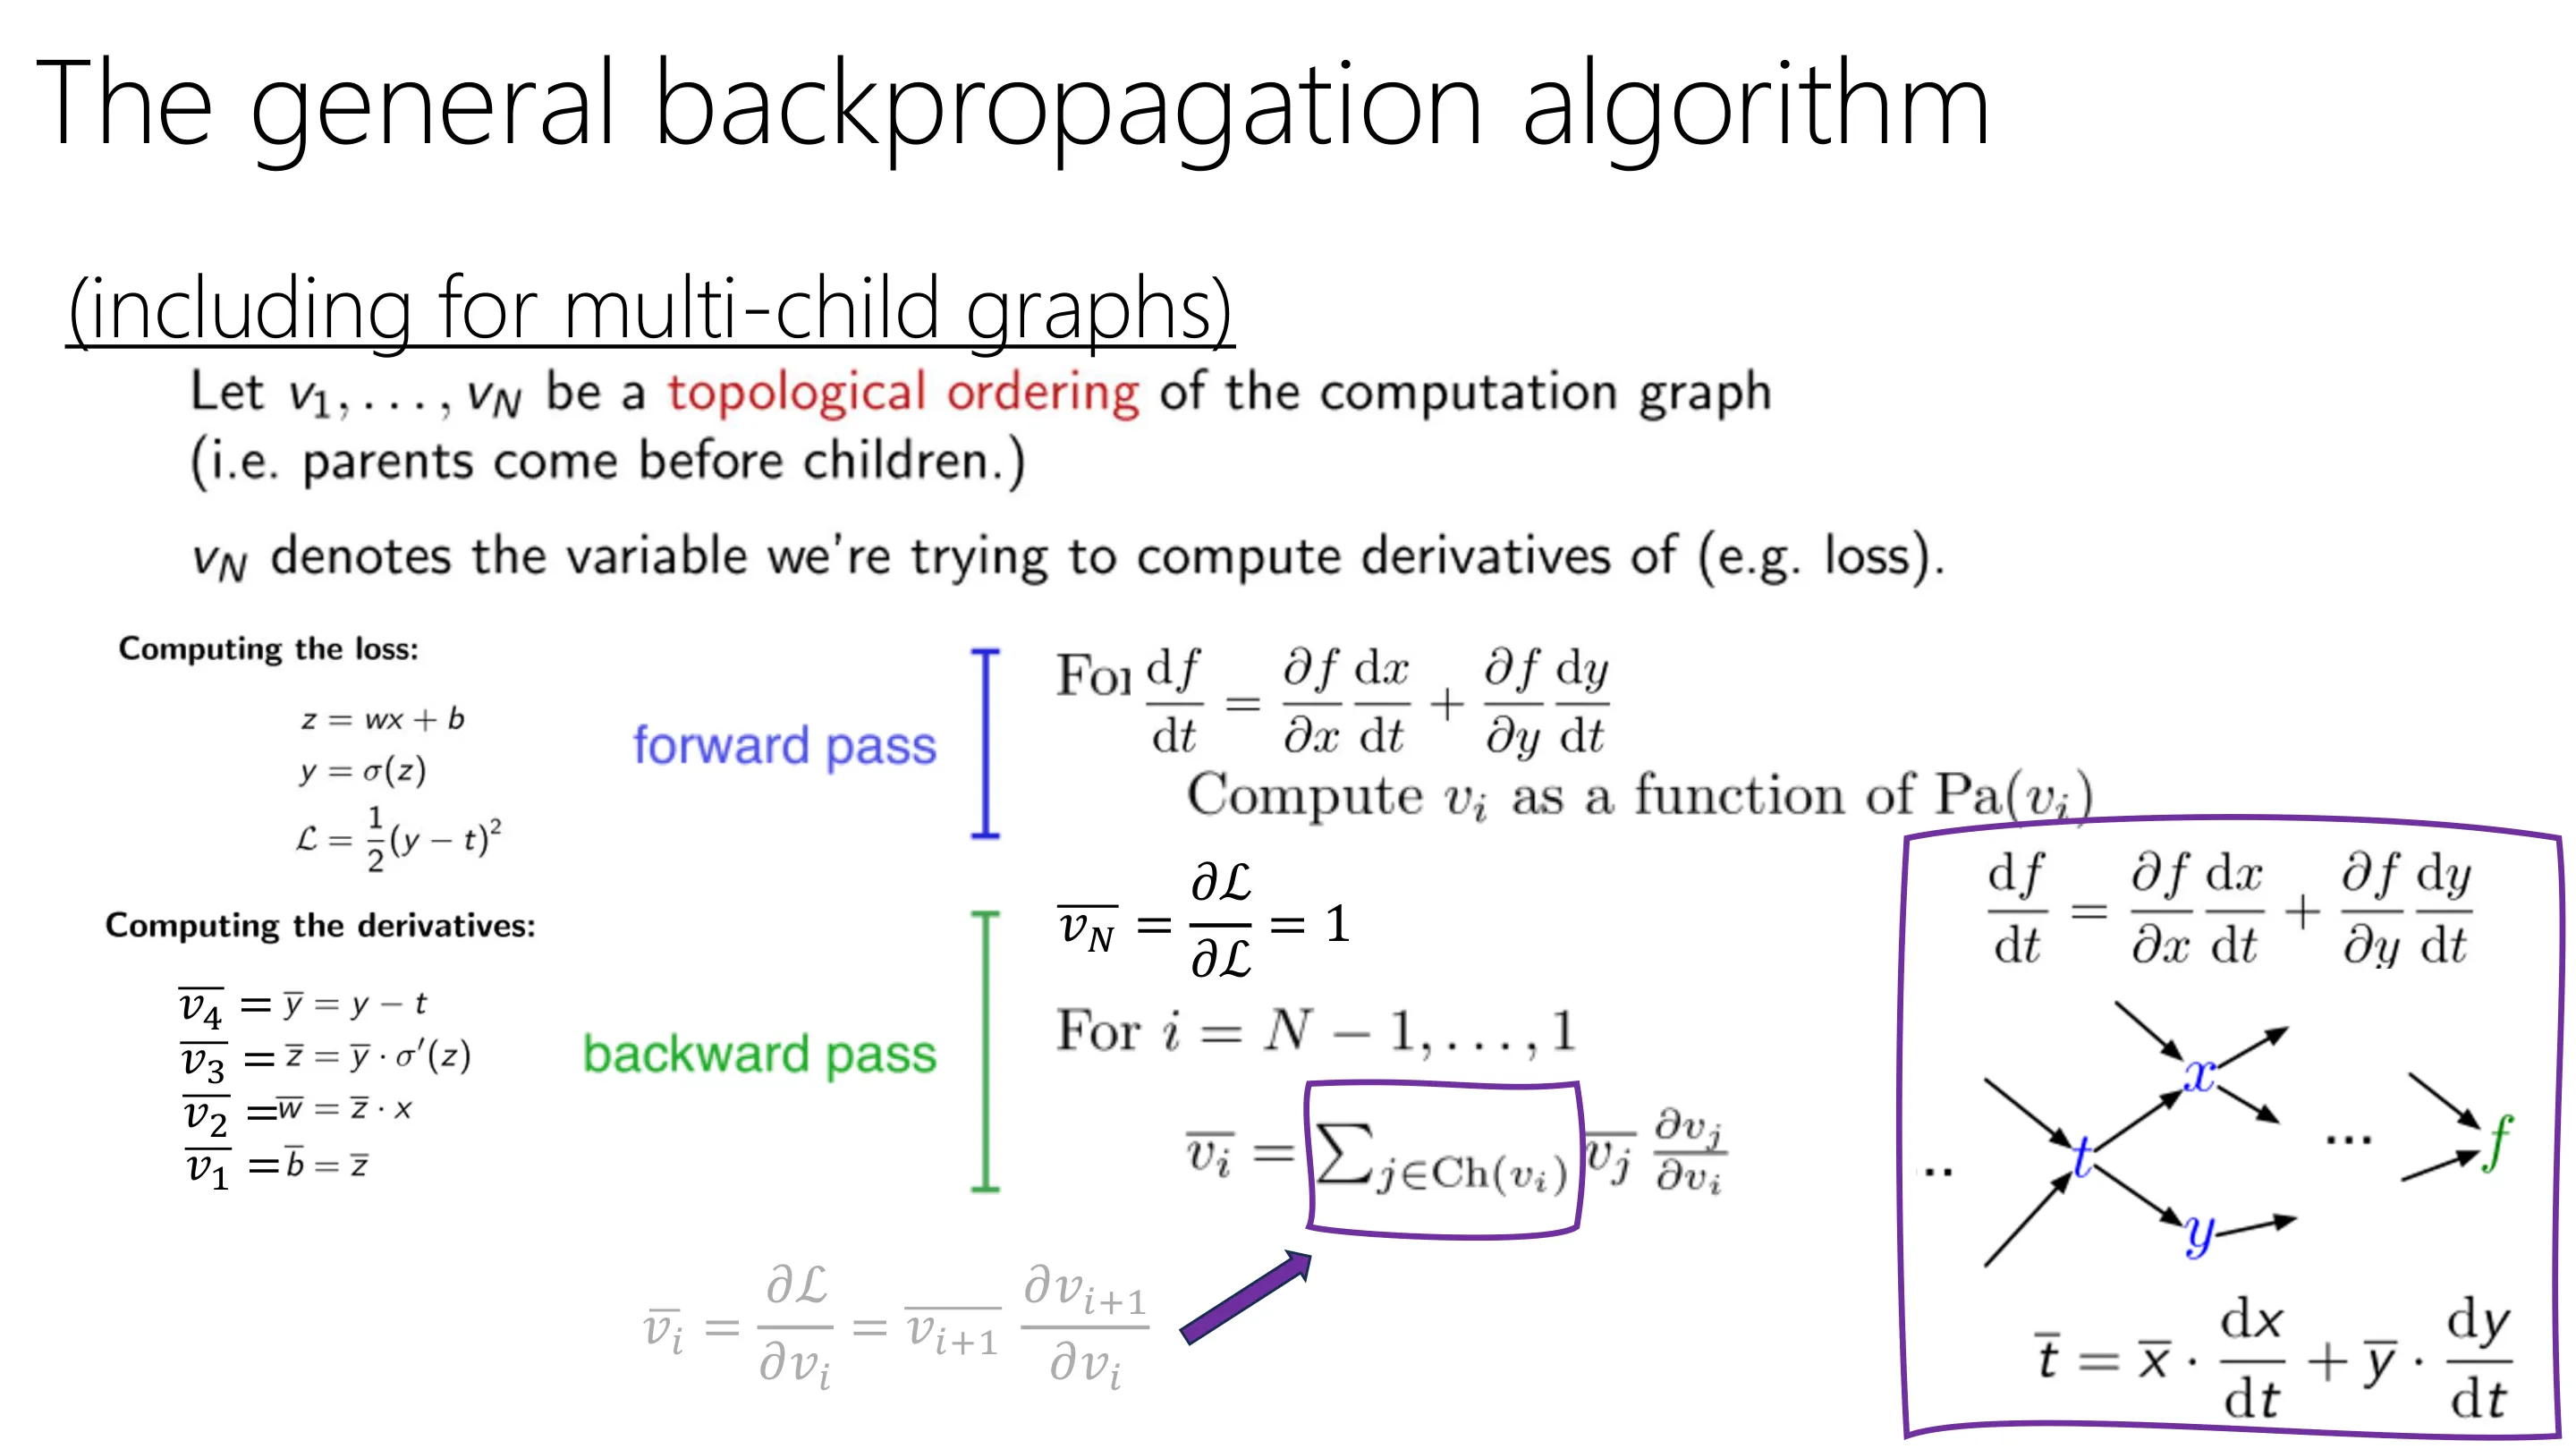
📷 通用反向传播算法(一)
回到原视频 (00:33:11)
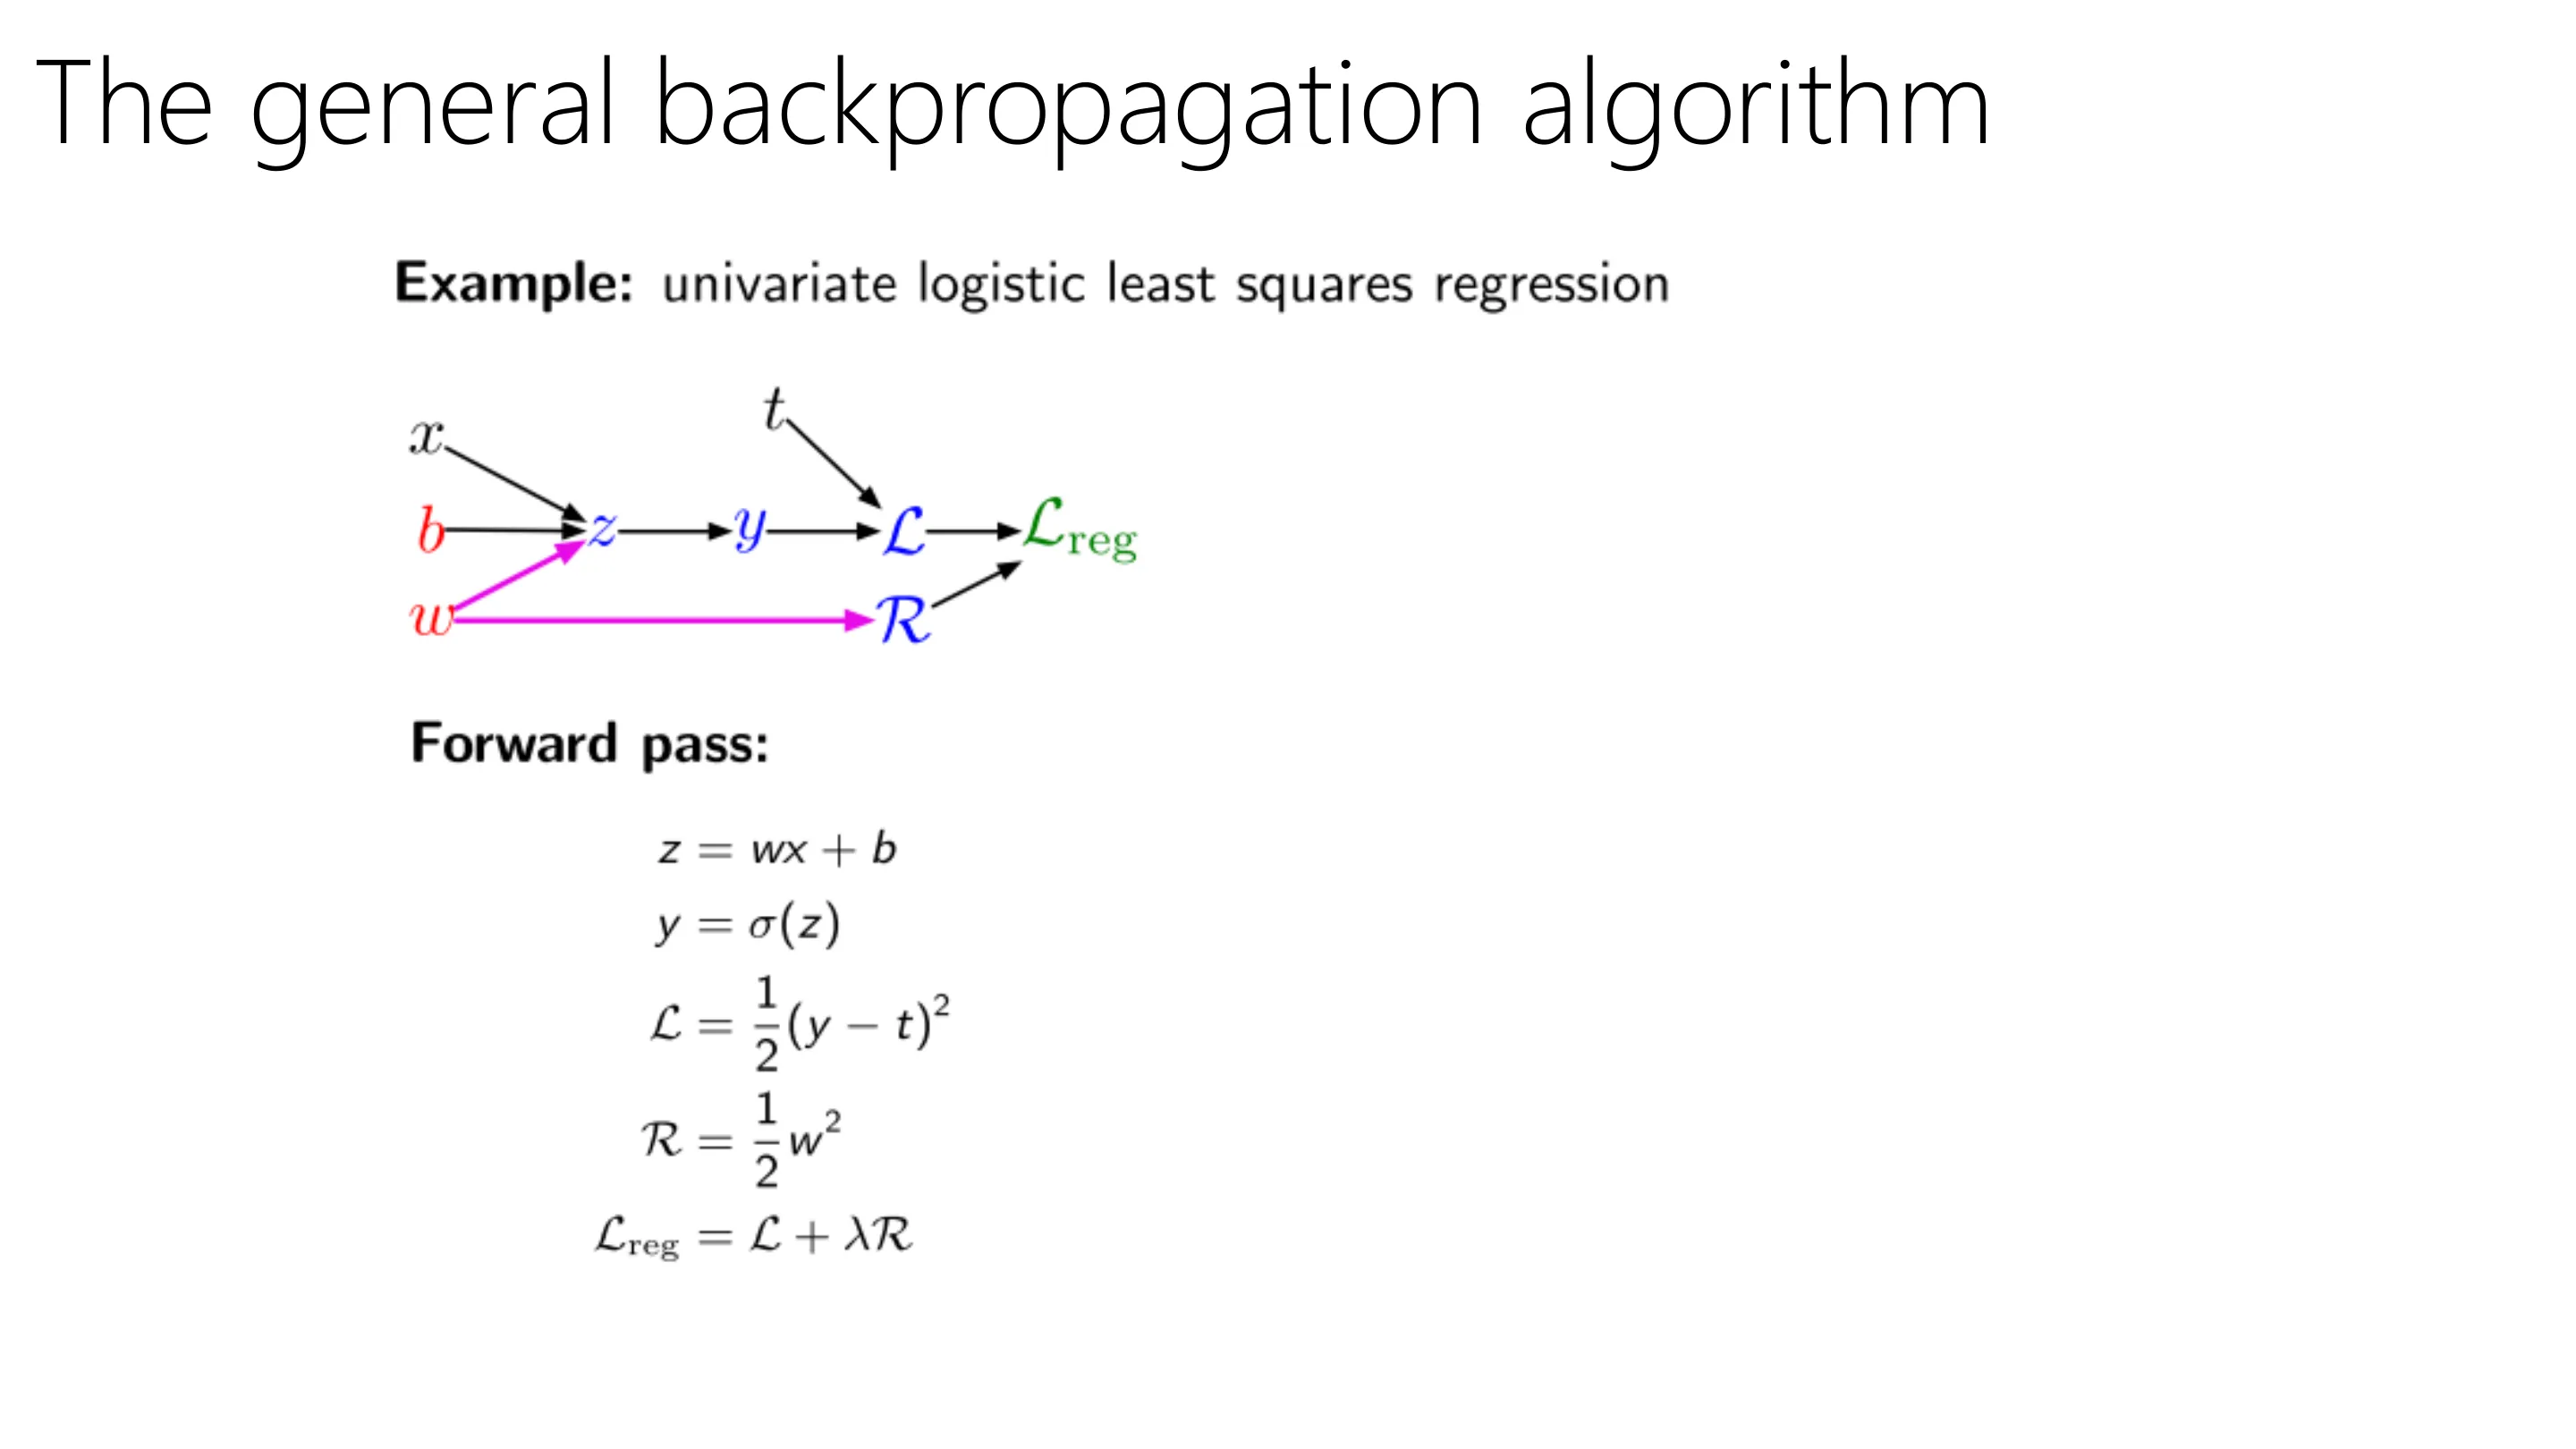
📷 通用反向传播算法(二)
回到原视频 (00:34:24)
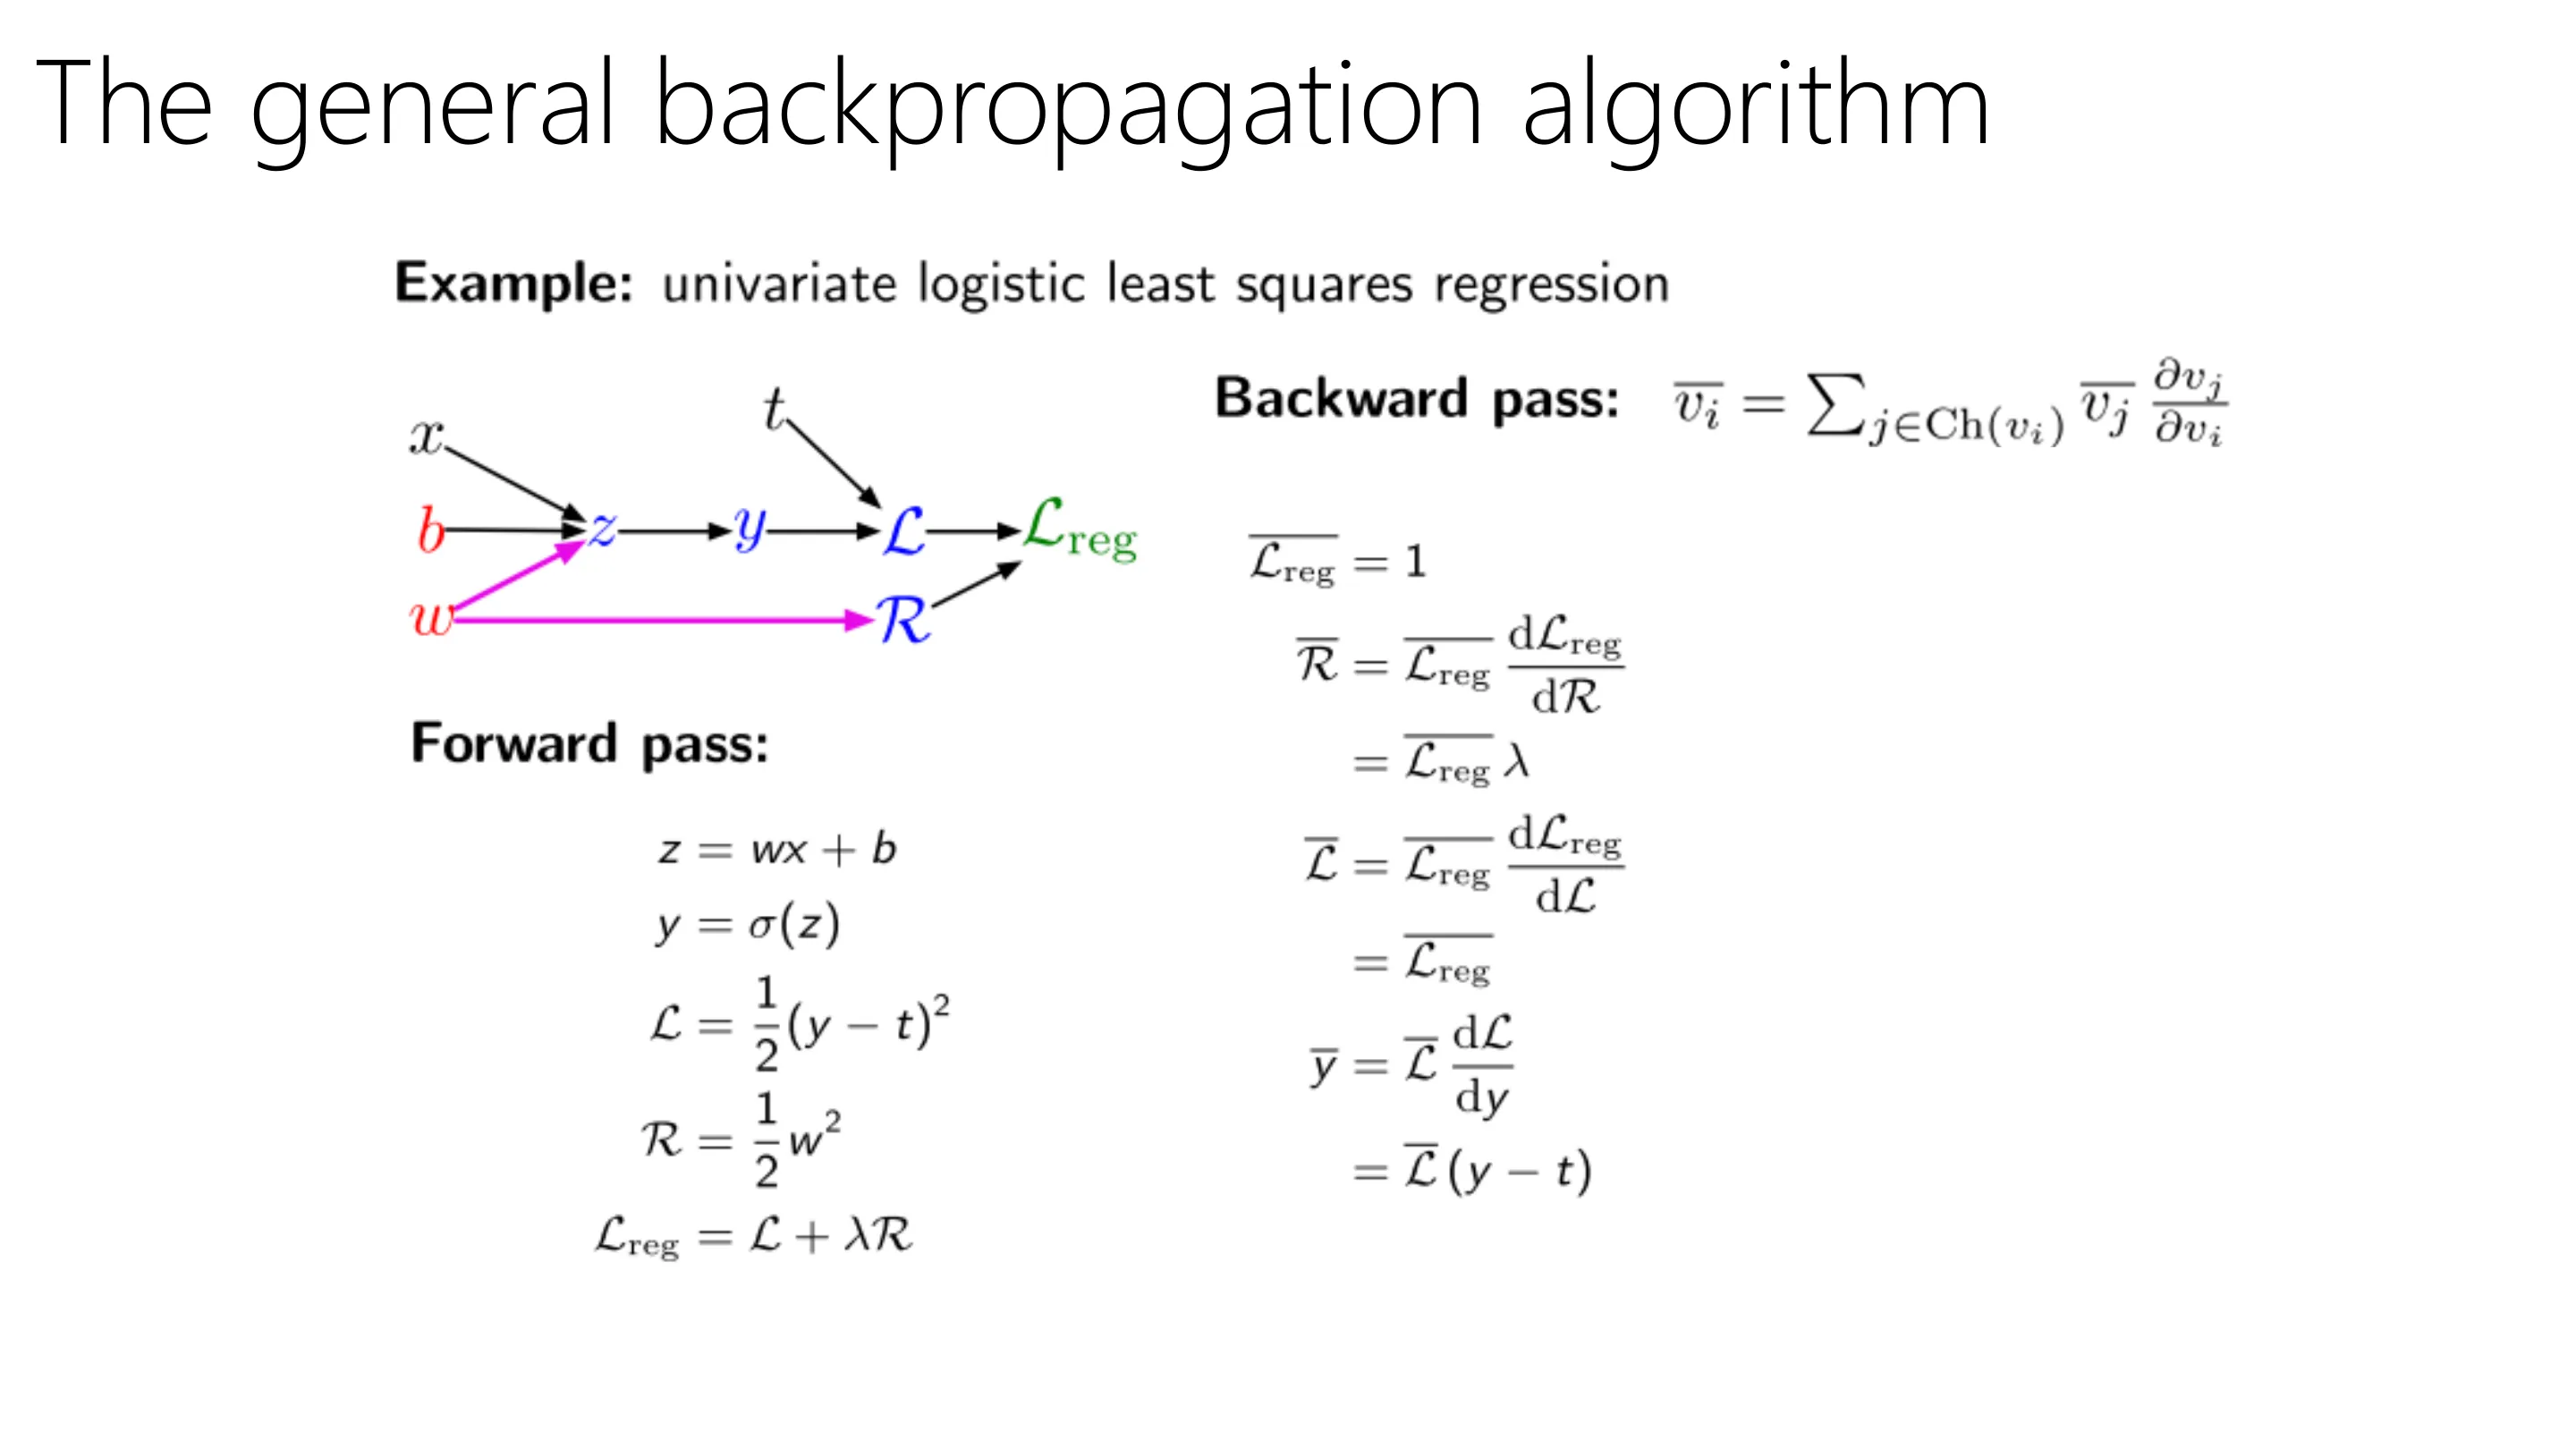
📷 通用反向传播算法(三)
回到原视频 (00:35:37)
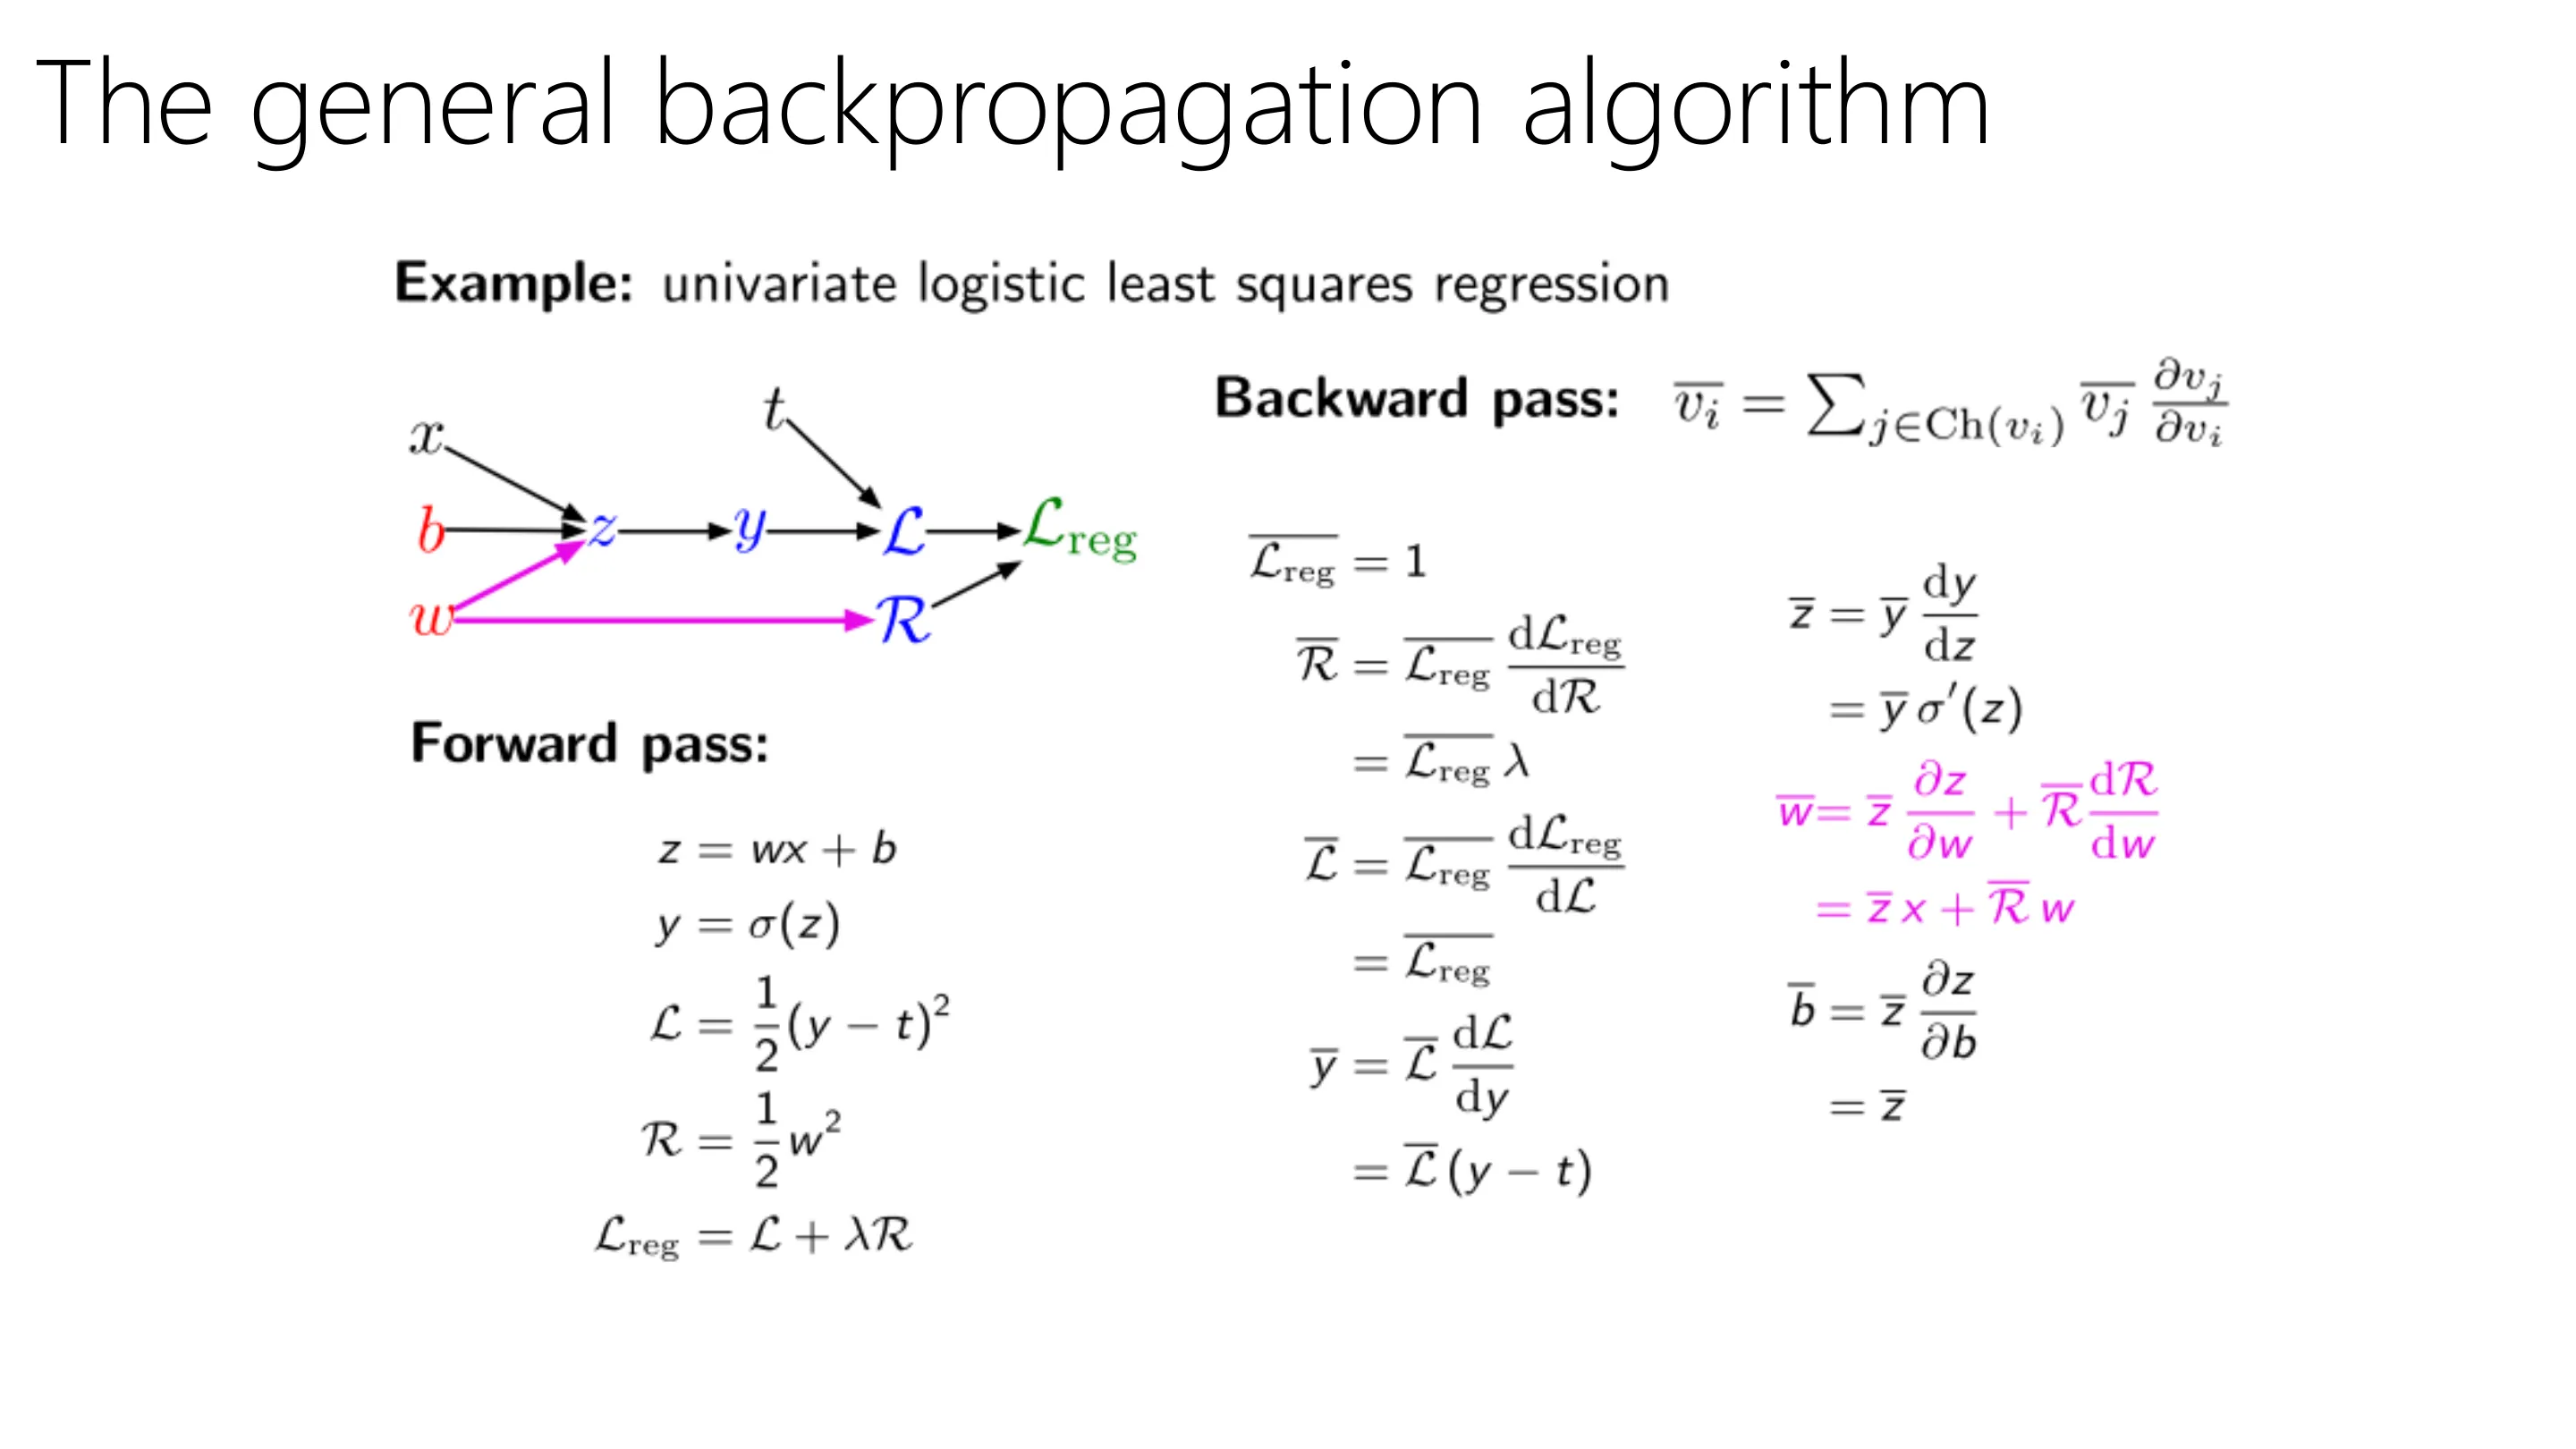
📷 通用反向传播算法(四)
回到原视频 (00:36:50)
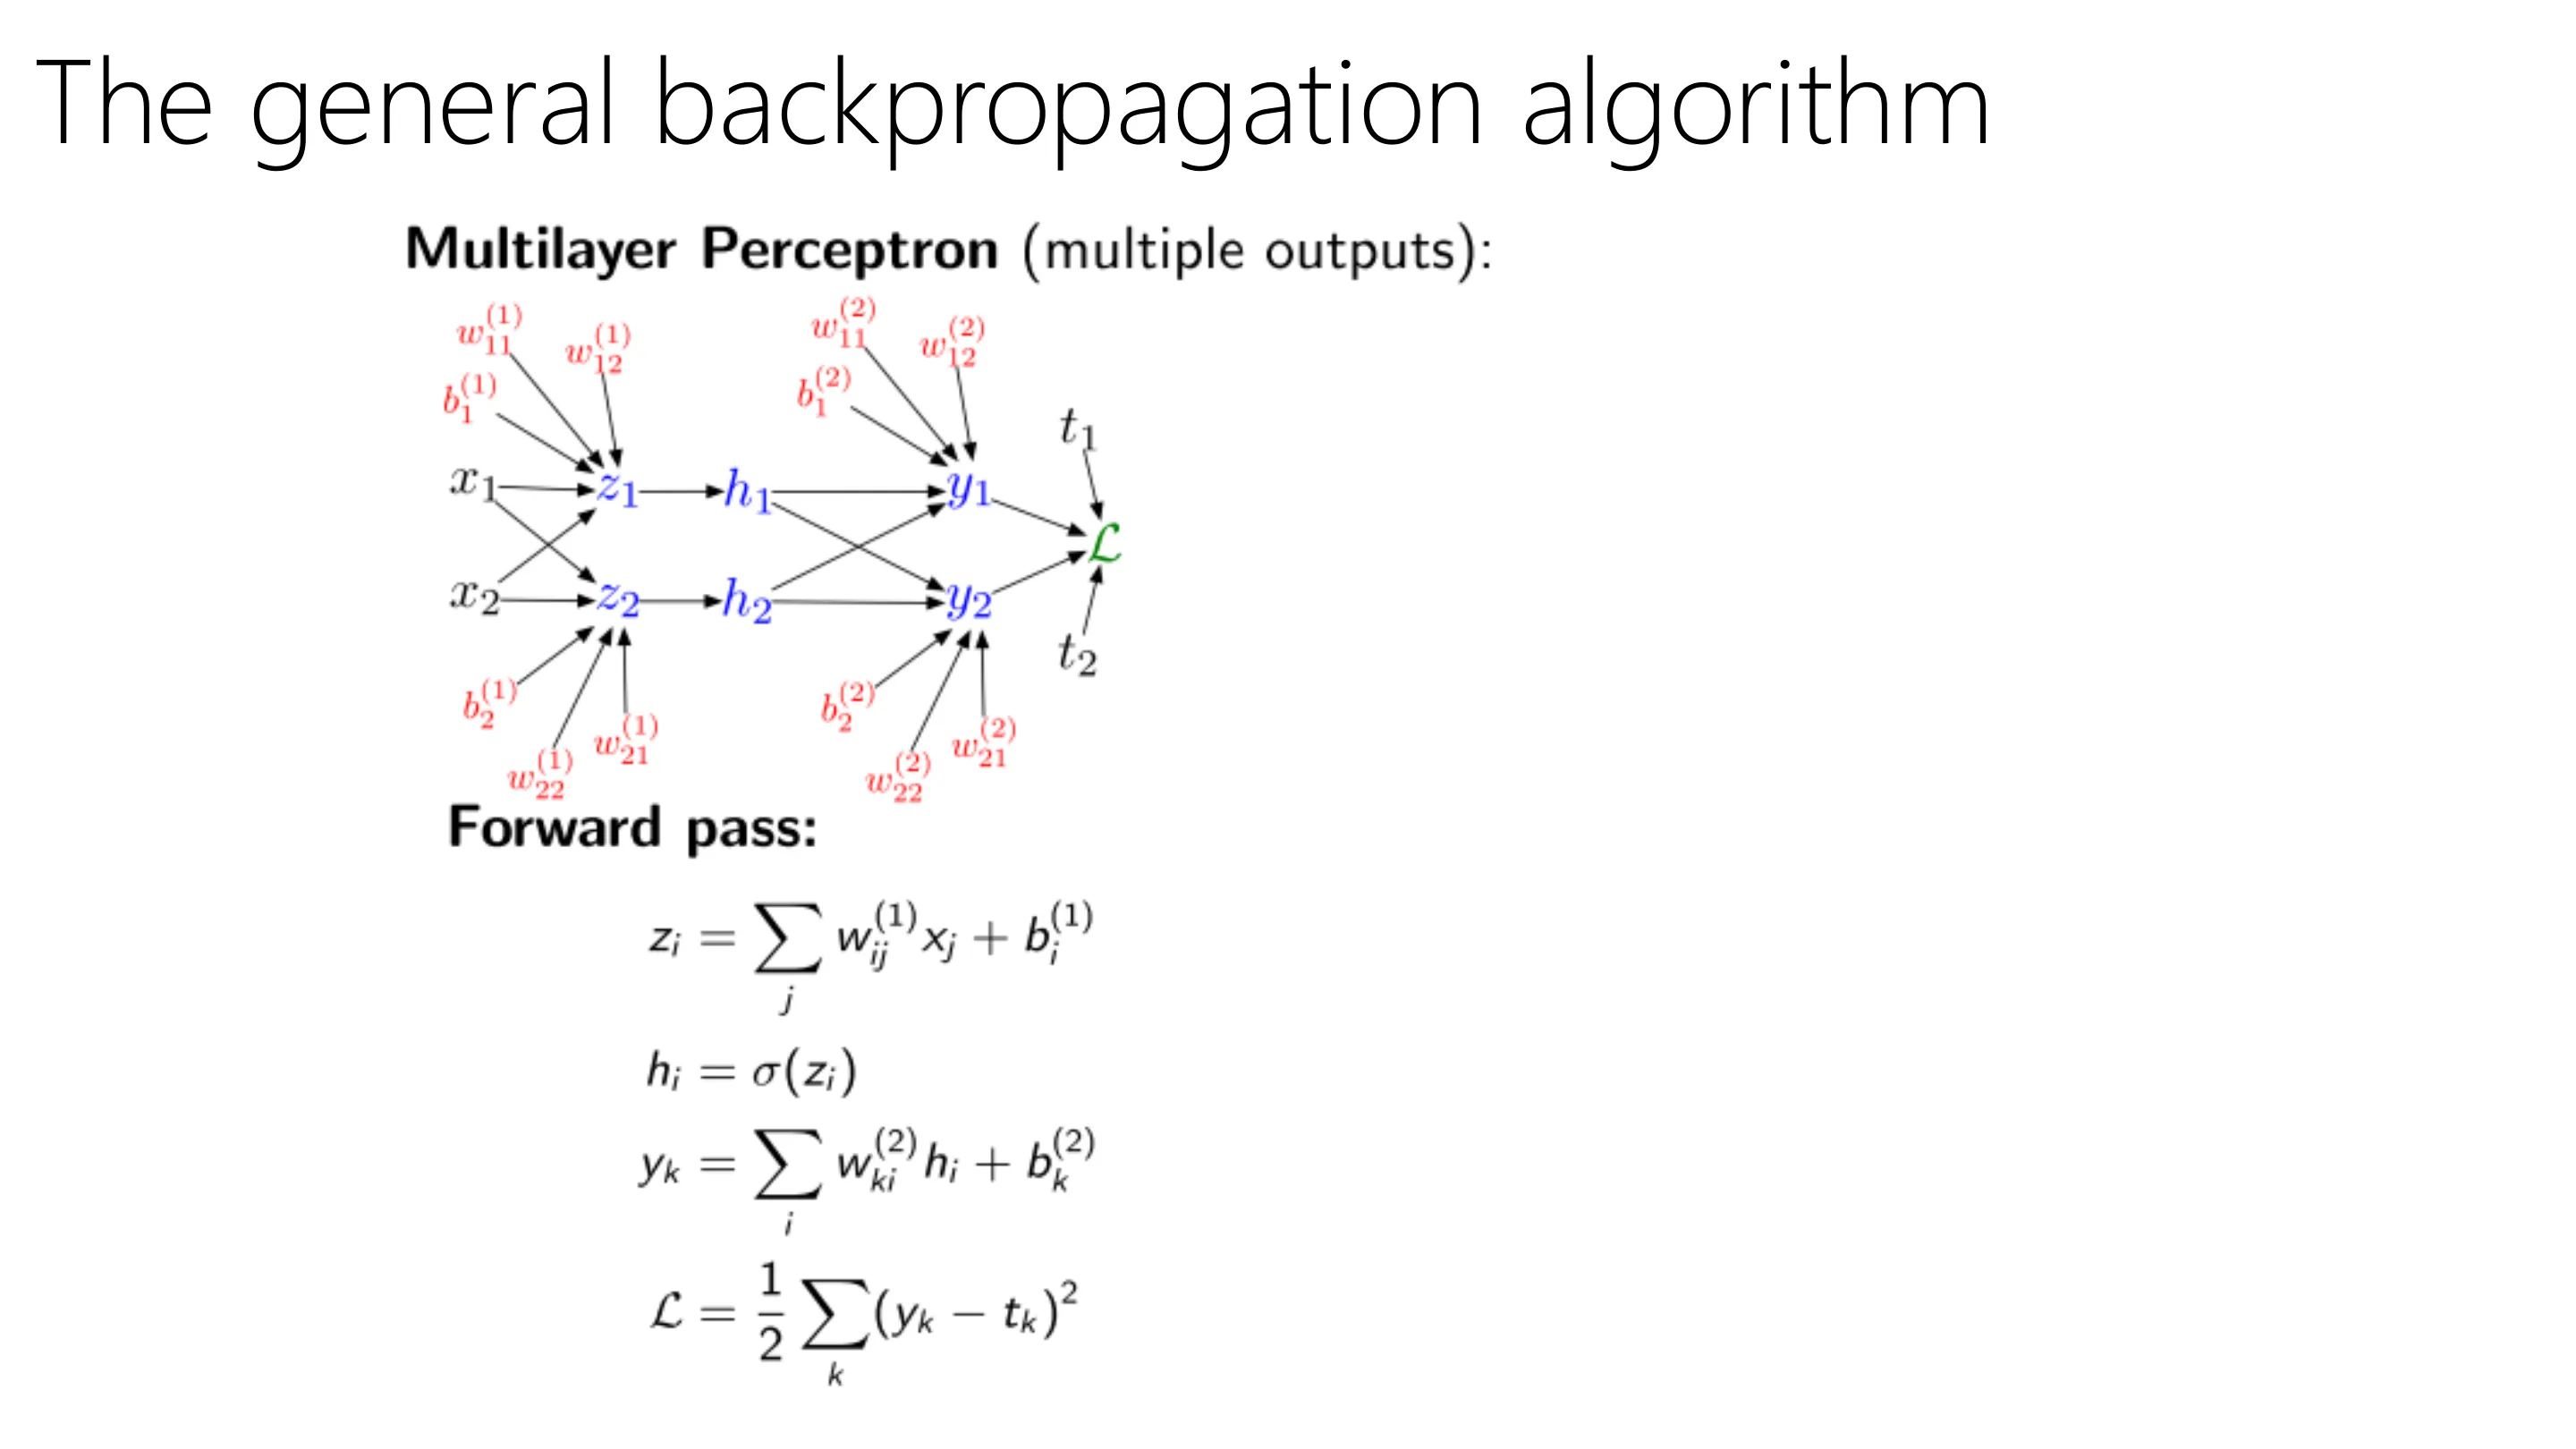
📷 通用反向传播算法(五)
回到原视频 (00:38:03)
📷 通用反向传播算法(六)
回到原视频 (00:39:16)
2.1 多个子节点:多元链式法则
问题:若某变量有多个子节点(例如 L2 正则项让 $L$ 同时依赖「数据损失」和「惩罚 $R$」,或多类 softmax 中某中间量指向每个类别),单子节点规则不再够用。
多元链式法则:$f=f(x,y)$,$x=x(t)$,$y=y(t)$:
$$ \frac{df}{dt}=\frac{\partial f}{\partial x}\frac{dx}{dt}+\frac{\partial f}{\partial y}\frac{dy}{dt} $$
即沿所有路径的信息流求和。于是通用规则的紫色部分变成:
$$ \bar v_i=\sum_{j\,\in\,\text{children}(i)} \bar v_j\,\frac{\partial v_j}{\partial v_i} $$
「扇出(fan-out)> 1」 就是「一个节点有多个子节点」。这条求和规则就是完整、最一般的反向传播。
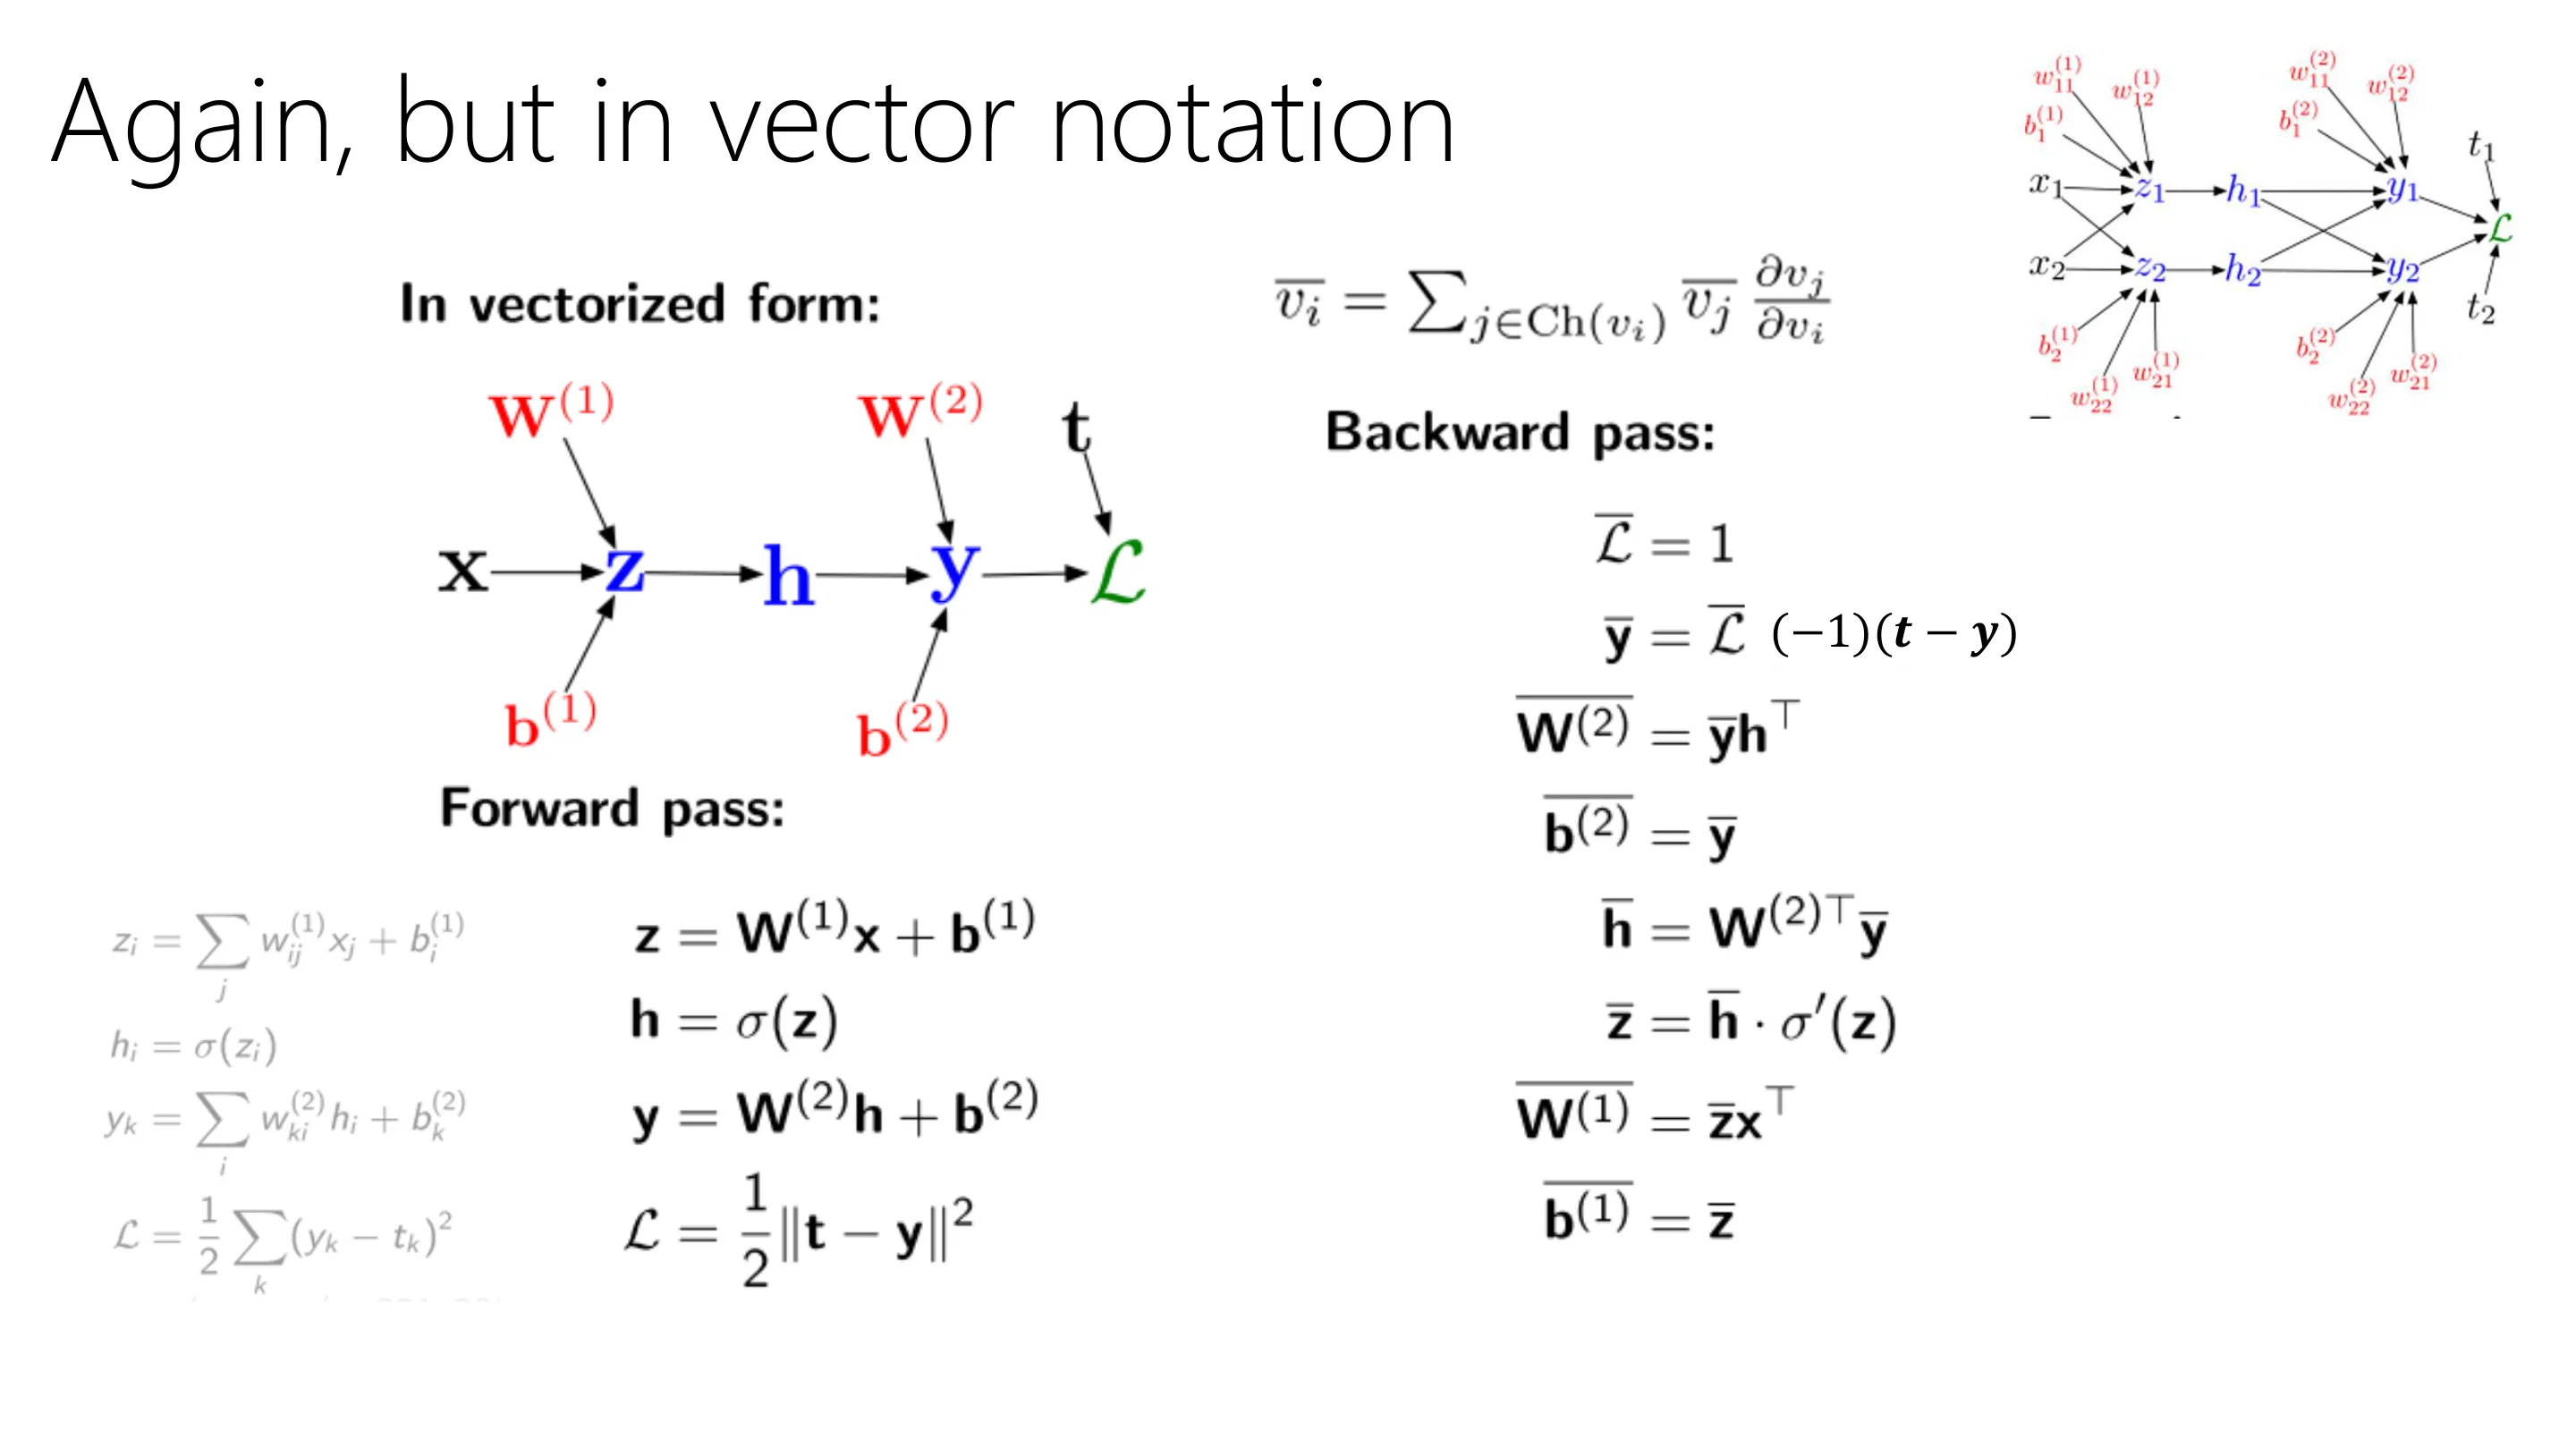
📷 通用反向传播算法(向量记号)
回到原视频 (00:40:29)
向量化:实际实现时把所有 $z,h,\dots$ 堆成向量/矩阵,用矩阵微积分——几行代码搞定整层,通常也是人们做法。
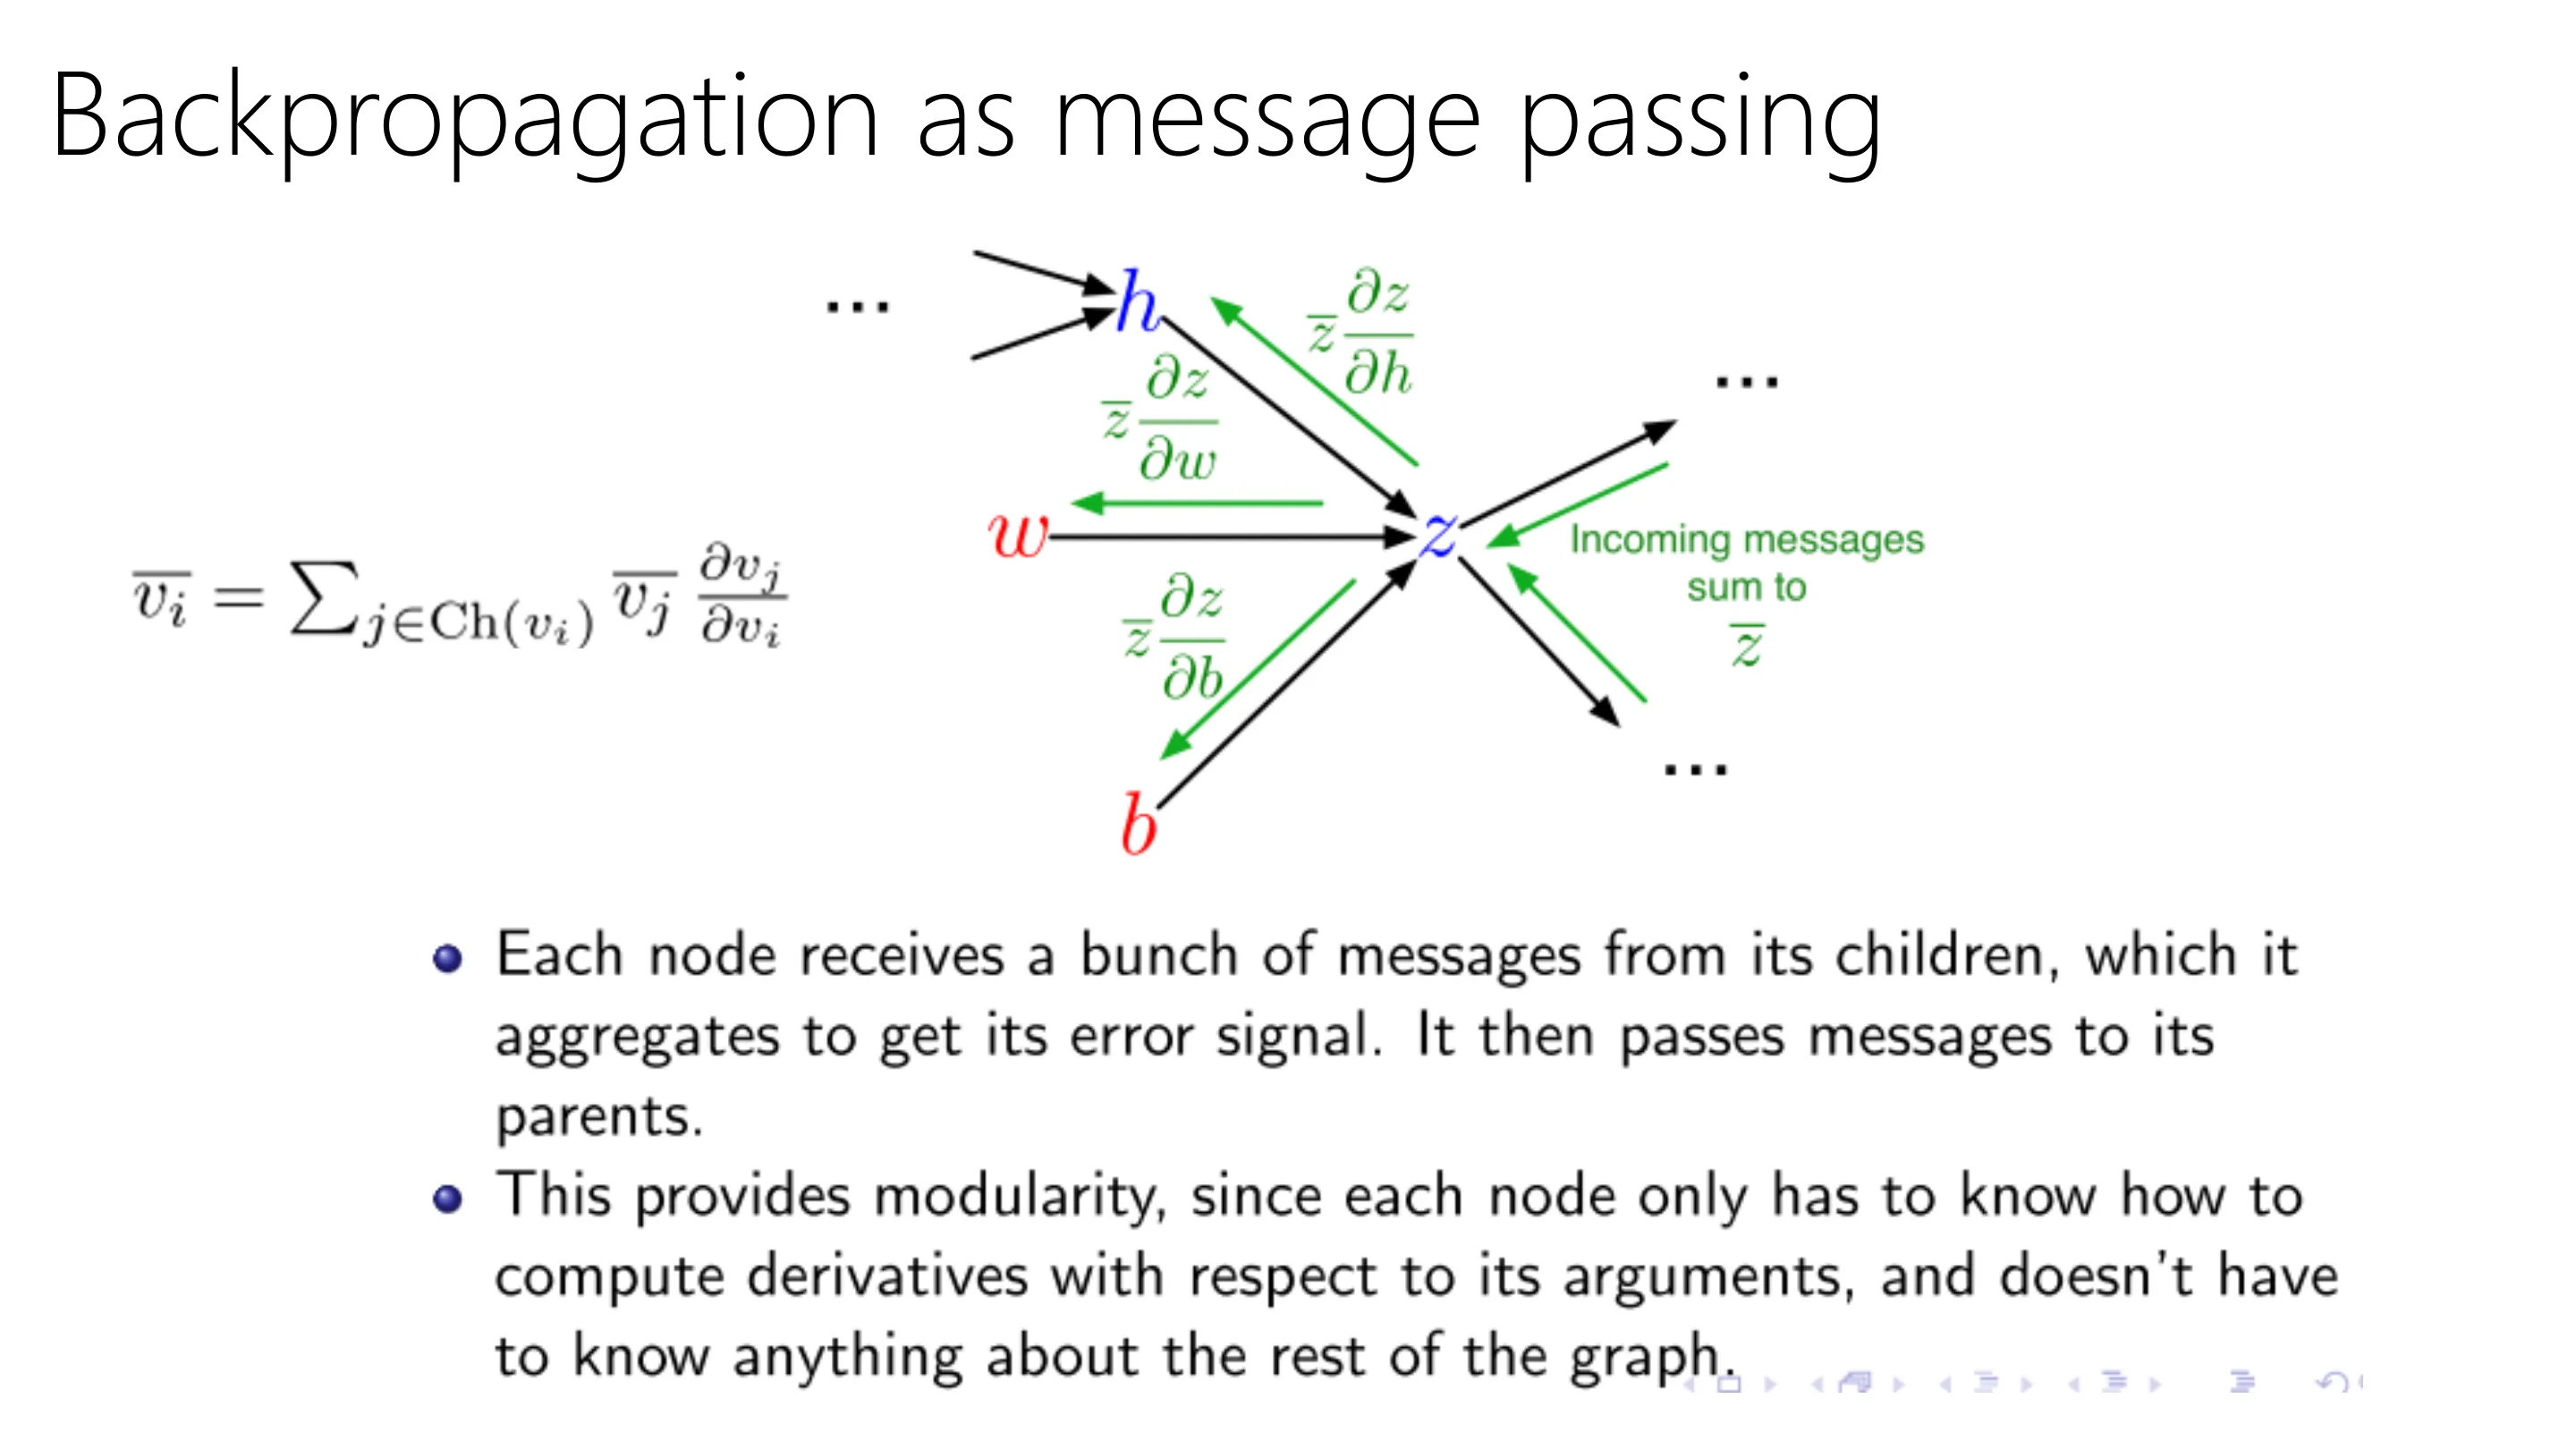
📷 作为消息传递的反向传播
回到原视频 (00:41:42)
消息传递视角:每个节点只需局部信息(来自子节点的 $\bar{\ }$)就能算出自己的 $\bar{\ }$ 并传给父节点,无需知道图的其余部分。这带来极好的模块化——每个节点只需实现「如何对自己的参数求导」。
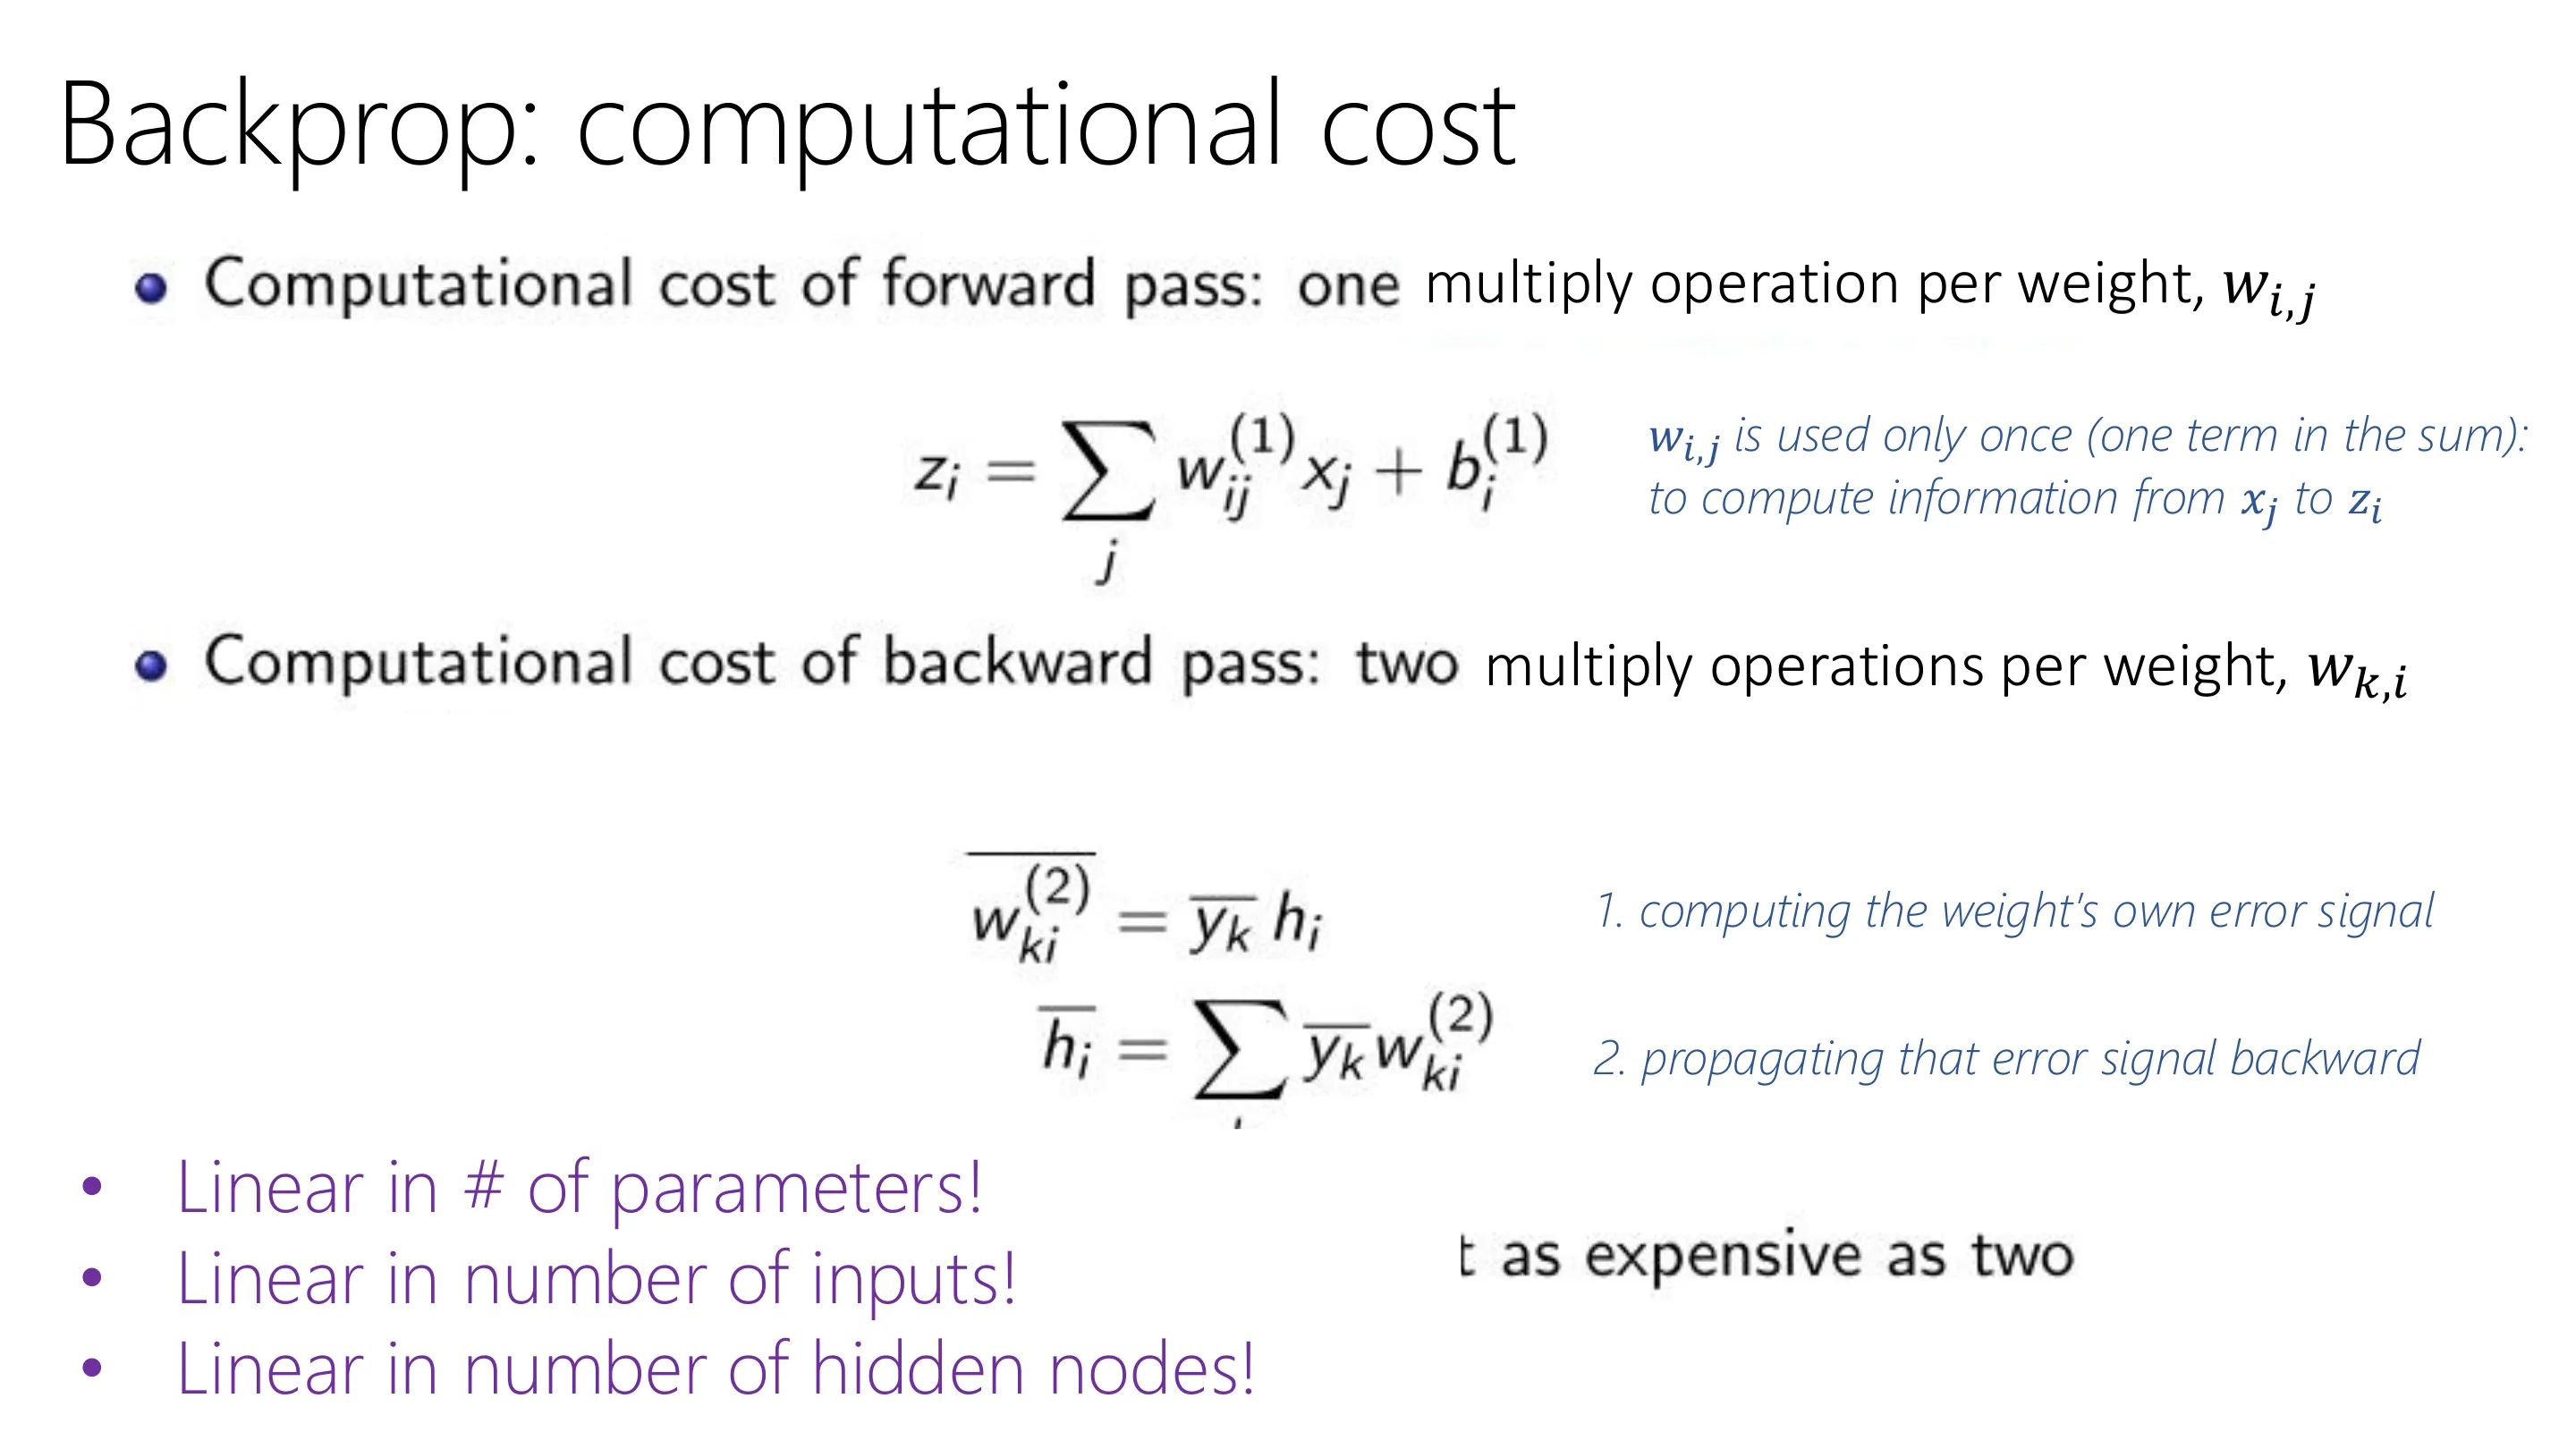
📷 反向传播的计算代价
回到原视频 (00:42:55)
计算复杂度(至关重要):每个参数在前向被用一次,在反向被访问两次(算自身误差信号、作为回传求和的一项)⇒ 一次反向约等于两次前向。更重要的是,总代价与参数量(以及输入数、隐藏单元数)成线性。用传统符号微积分则未必线性——正是这种线性让深度网络可行。
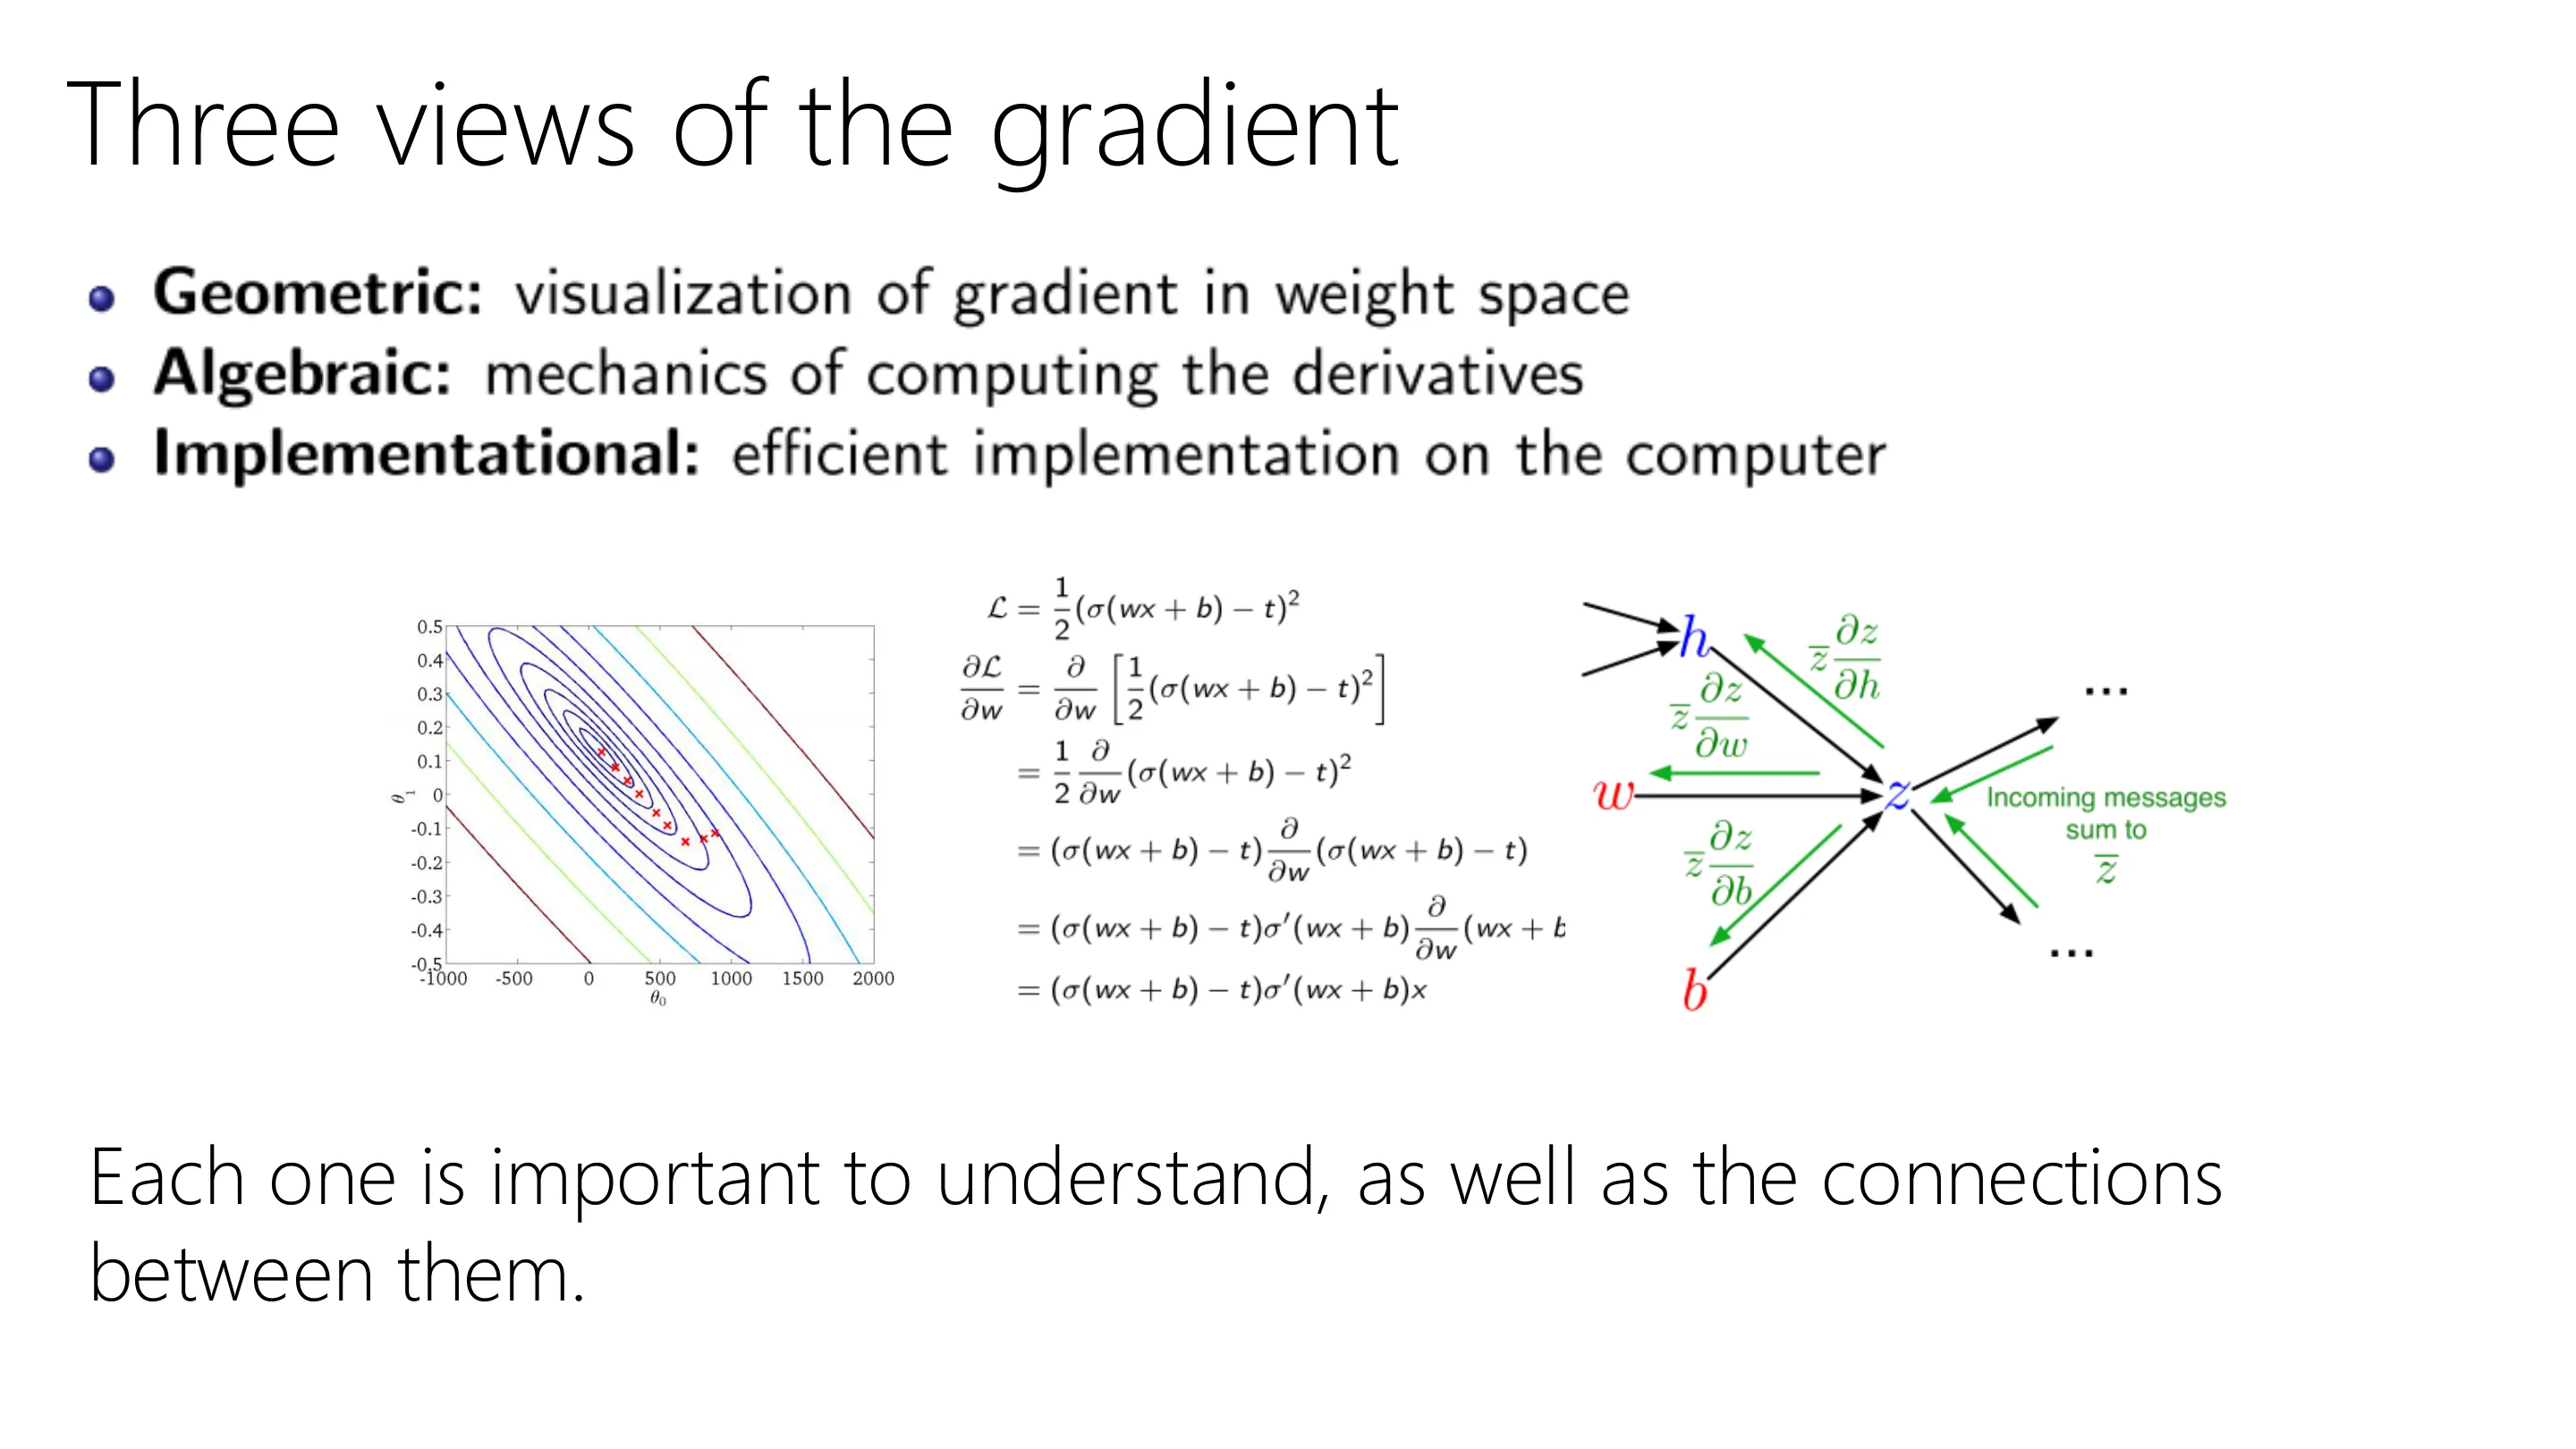
📷 梯度的三种视角
回到原视频 (00:44:08)
梯度的三种视角:
- 几何:最速上升方向(沿 $-\nabla$ 下降);
- 一阶微积分:链式法则的机械计算;
- 算法/动态规划/消息传递:图上的高效反向遍历。
三、激活函数的梯度与其它求导方式
(参考时间: 01:14)
- Sigmoid / tanh 的问题:当神经元非常兴奋或非常不兴奋时,梯度趋近于 0 ⇒ 无法判断「正向大」还是「负向大」,梯度消失让训练停滞。
- ReLU 解决了一半($x>0$ 时梯度恒为 1);变体如 Leaky ReLU 进一步在负半轴保留小斜率。
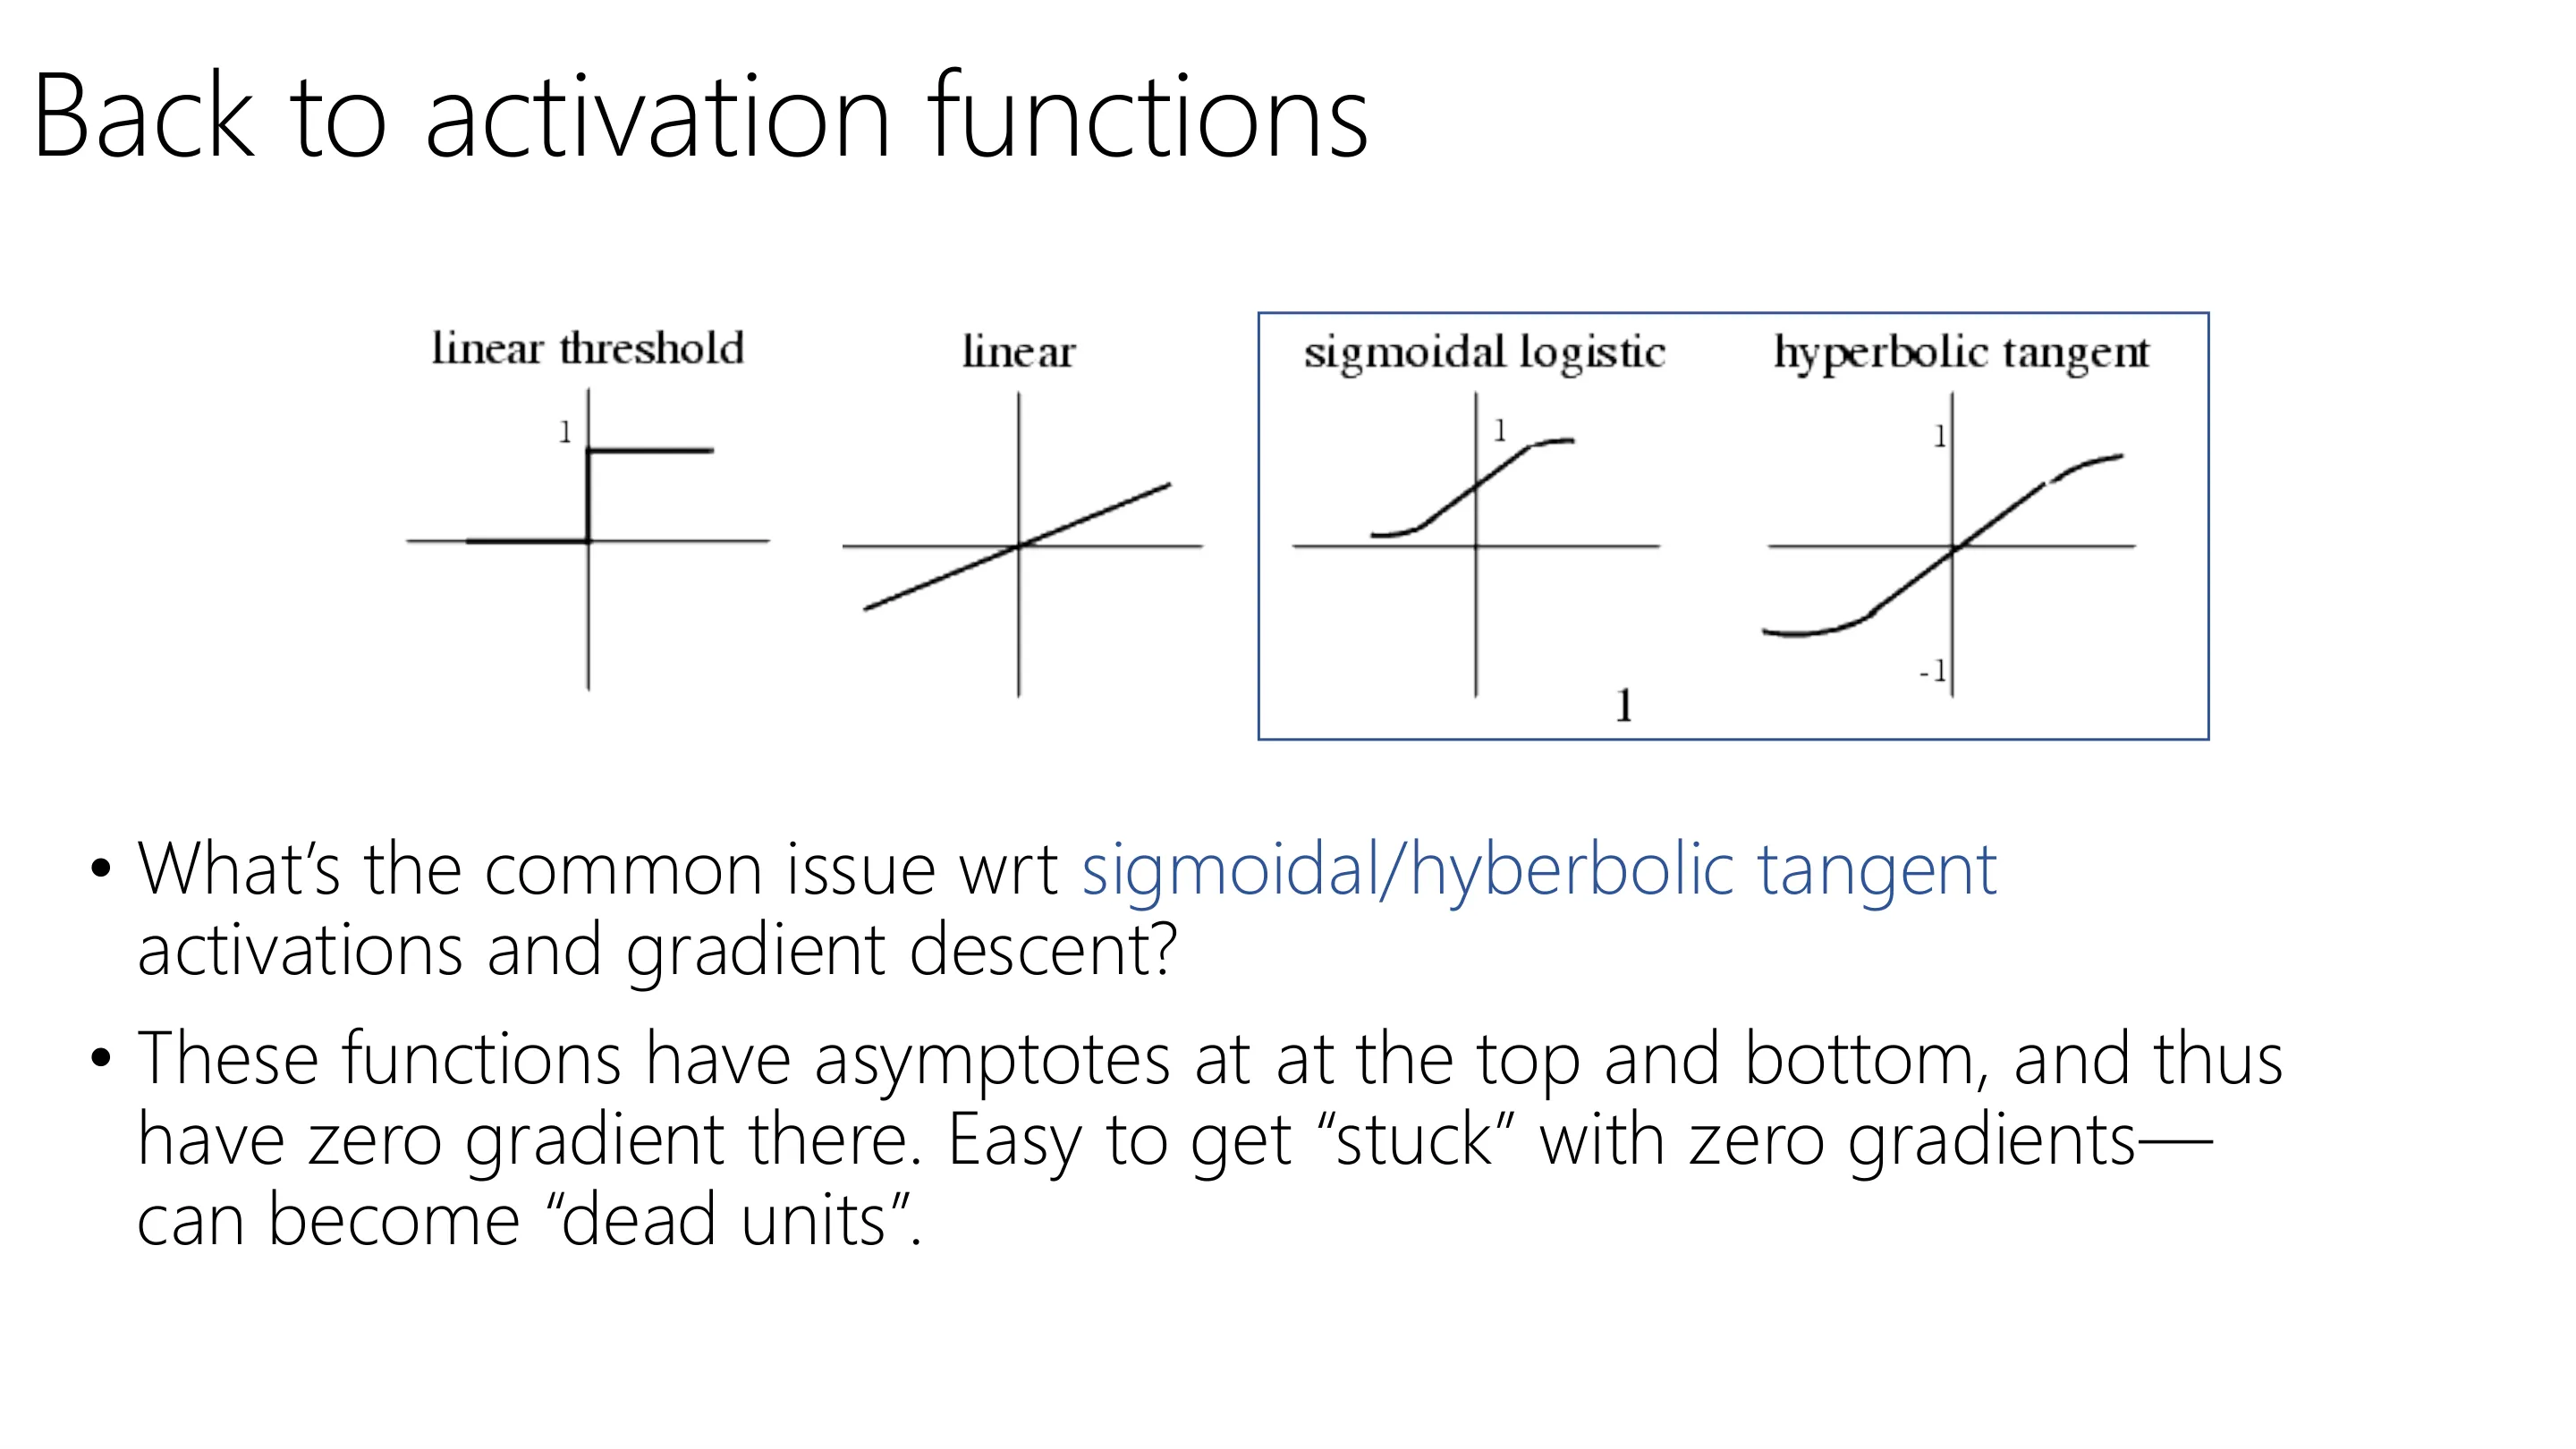
📷 Sigmoid/tanh 的共同问题
回到原视频 (00:45:21)
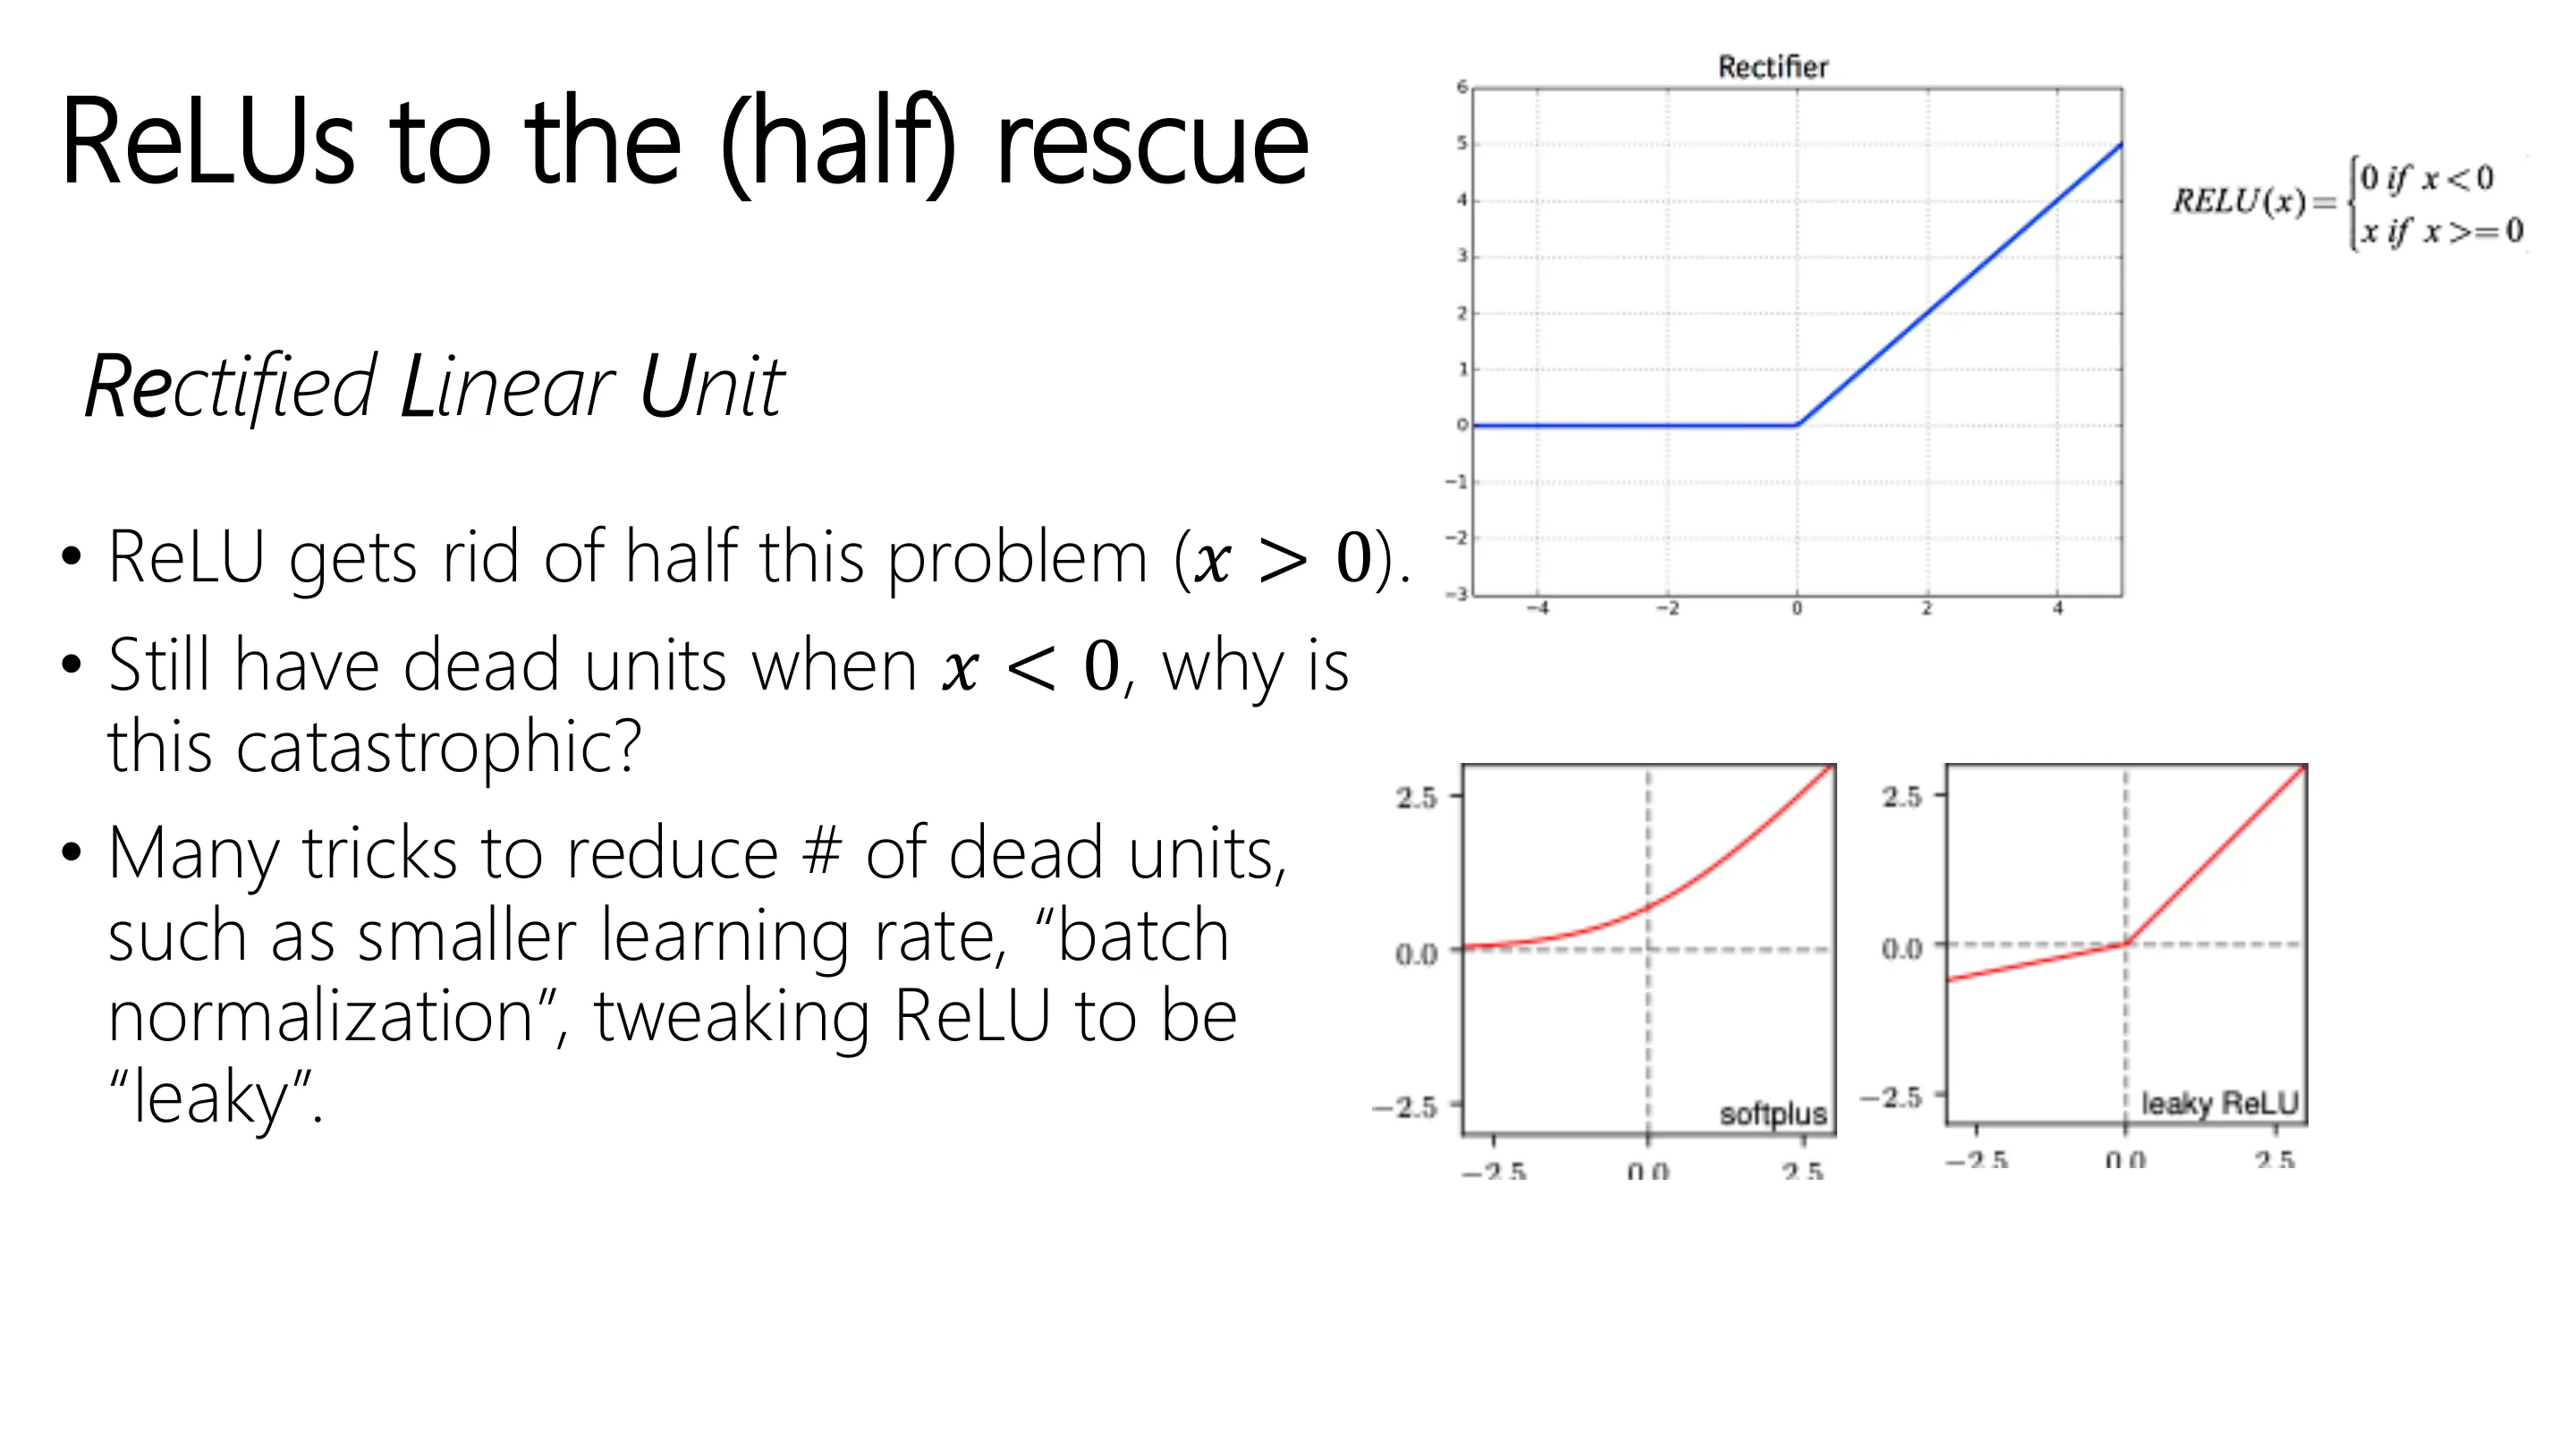
📷 ReLU 解决了一半问题
回到原视频 (00:46:34)
其它获取梯度的方式:
- 数值微分(numerical differentiation):有限差分——简单但不精确、代价高,常用于梯度检验;
- 计算机代数系统(如 SymPy):符号自动化,但对大网络表达式爆炸;
- 自动微分(autograd):现代框架(PyTorch/TensorFlow)的做法,本质就是本讲反向传播的推广——你可以声明式地搭建图,框架自动反向。
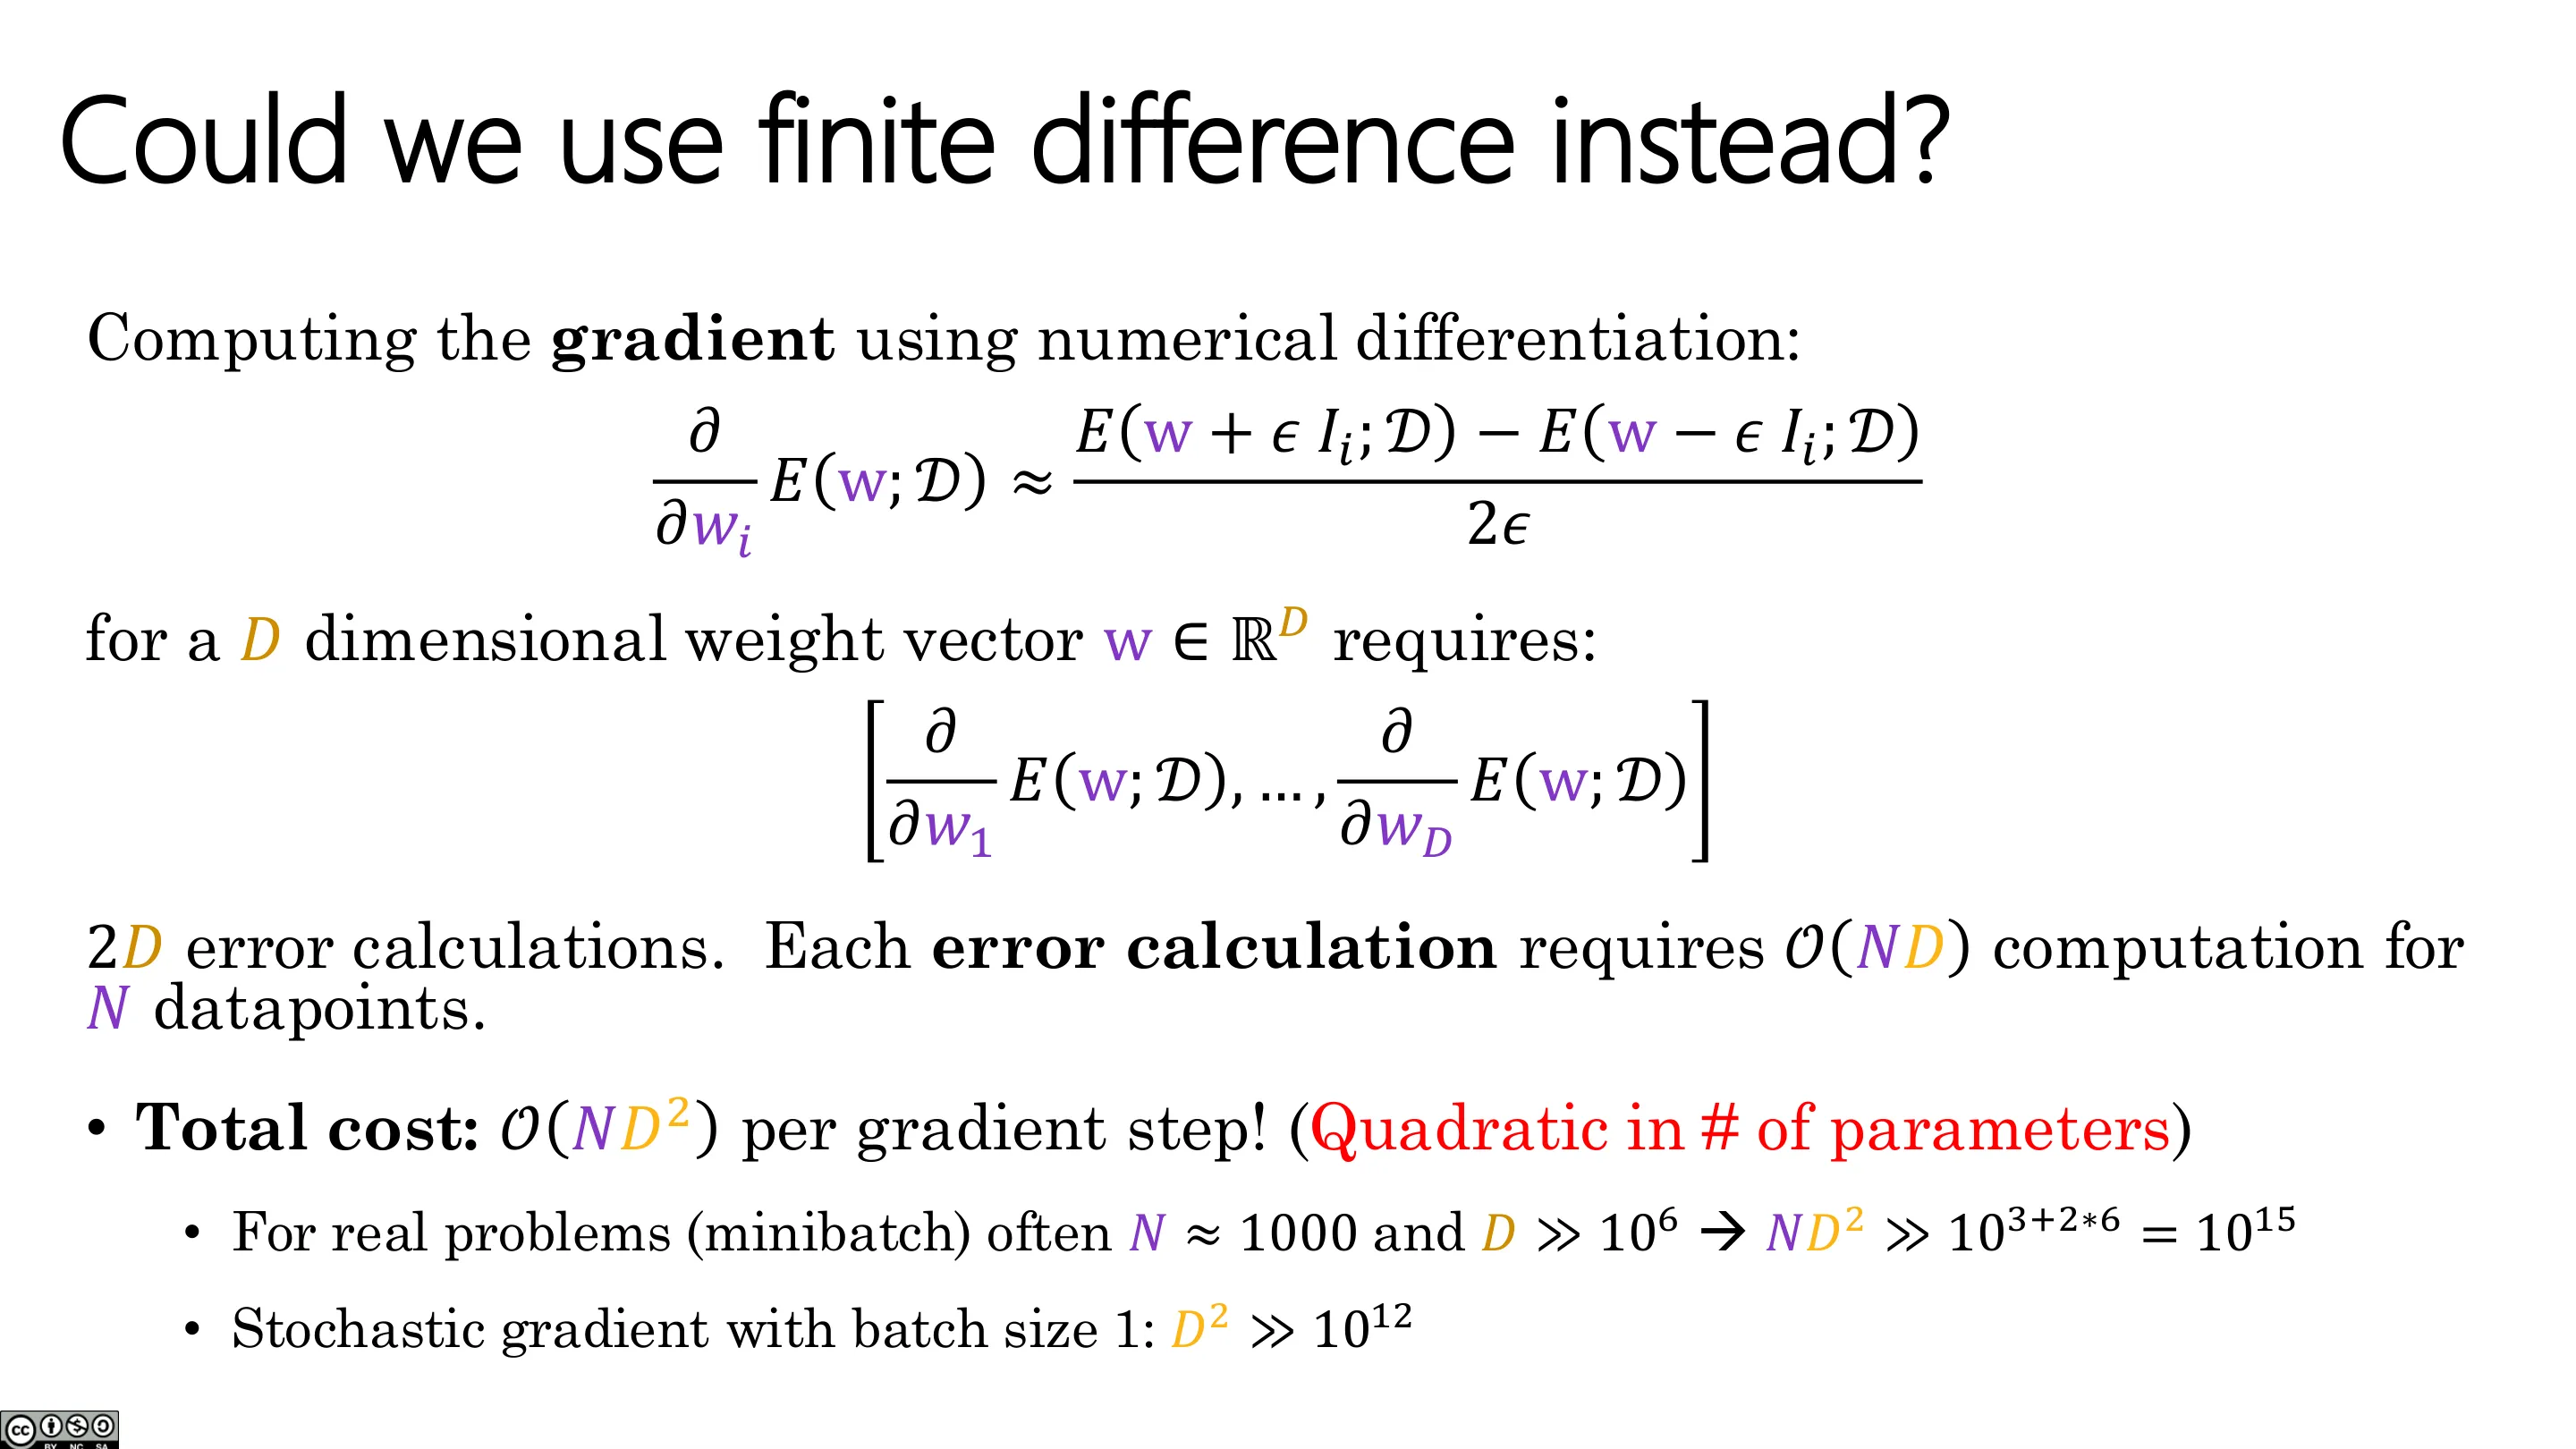
📷 用数值微分计算梯度
回到原视频 (00:47:47)
📷 SymPy 等计算机代数系统
回到原视频 (00:49:00)
面试题:什么叫反向传播?——从概念上讲,它就是在计算梯度,以便做梯度下降。很多人能写出公式,却说不出这一句。
📷 为什么深度网络这么好?
回到原视频 (00:50:13)
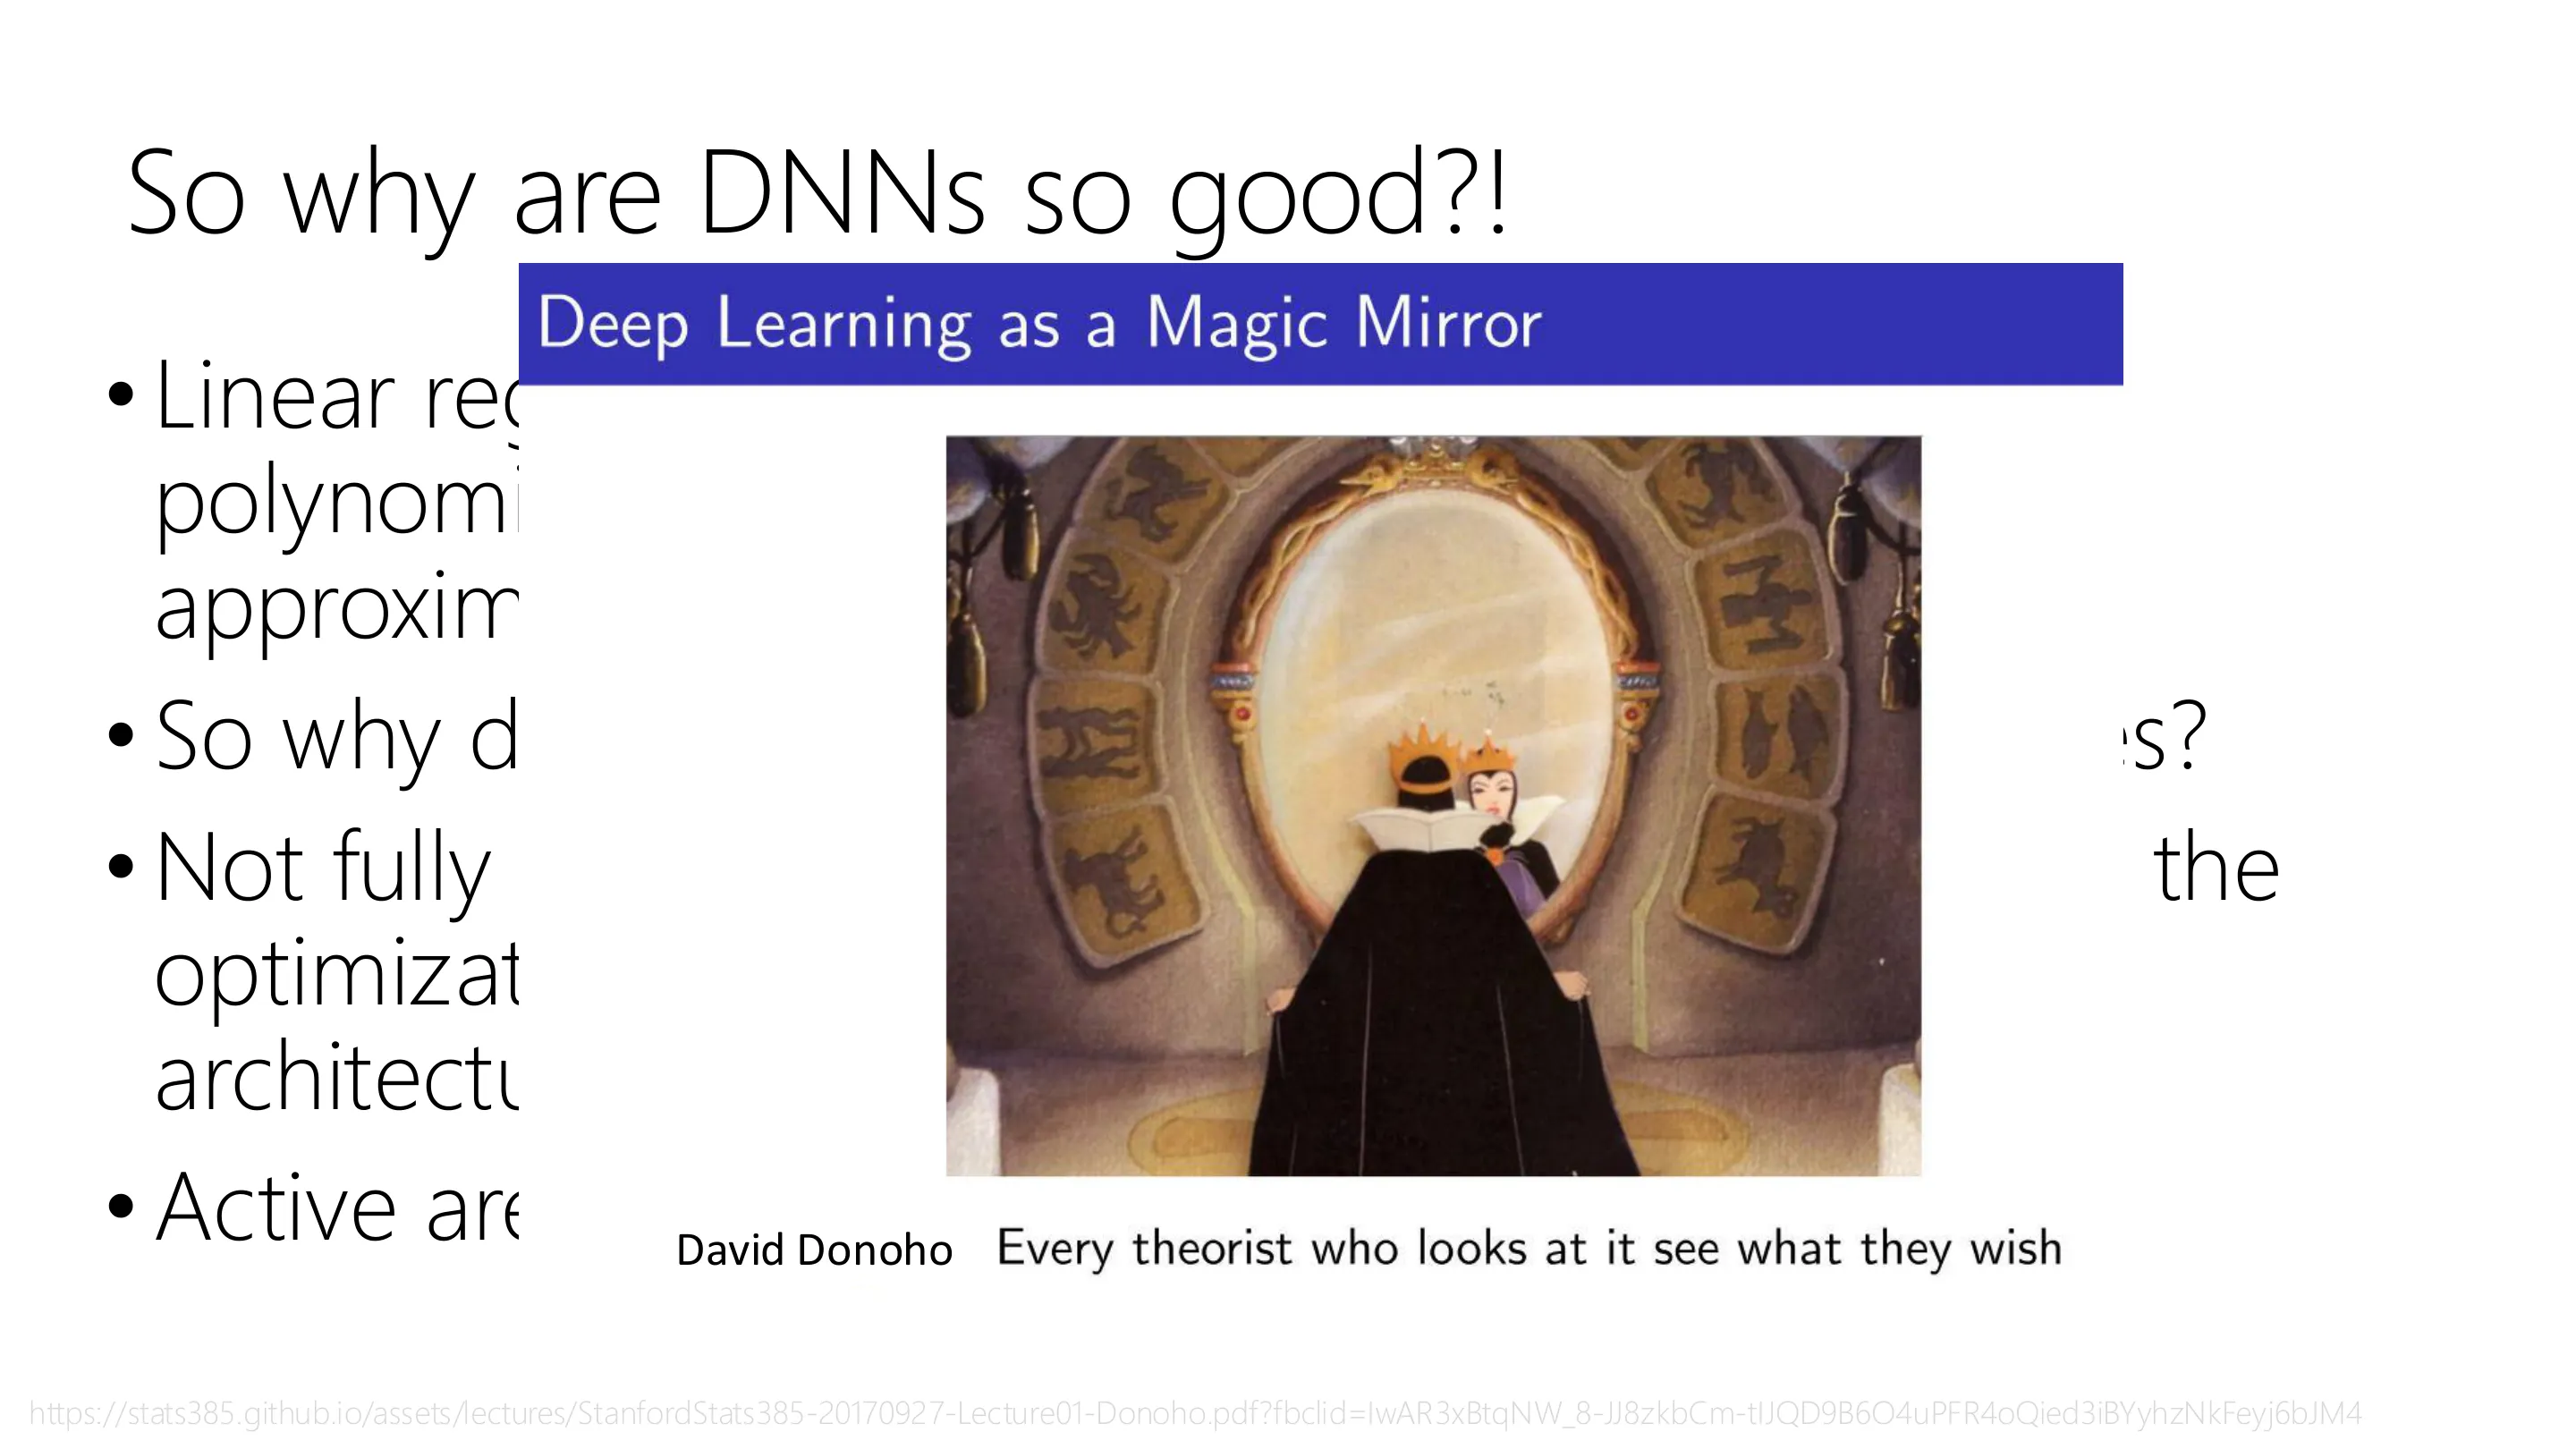
📷 为什么深度网络这么好?(续)
回到原视频 (00:51:26)
总结(Takeaways)
- 神经网络 = 函数复合;训练 = 对(负对数似然/交叉熵)损失做梯度下降。
- 计算图把依赖关系显式化;前向算损失,反向算梯度。
- 反向传播 = 动态规划 + 链式法则:用 bar 记号 $\bar v=\partial L/\partial v$,从 $\bar L=1$ 出发,按拓扑序反向逐个算出各变量的导数,复用已算的中间项。
- 多子节点 ⇒ 多元链式法则 ⇒ 对子节点求和。
- 实现上向量化;概念上是消息传递,高度模块化。
- 代价与参数量线性(反向 ≈ 2 次前向)——这是深度网络可行的关键。
- 激活函数的梯度:Sigmoid/tanh 会梯度消失;ReLU 让训练可行。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=XlaV_z2knjA |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 18) | Google Drive 文件夹 |
| Roger Grosse, CSC321 Introduction to Neural Networks(backprop 讲义) | http://www.cs.toronto.edu/~rgrosse/courses/csc321_2018/ |
| Bishop, Pattern Recognition and Machine Learning | 第 5 章(神经网络、反向传播) · https://www.microsoft.com/en-us/research/publication/pattern-recognition-machine-learning/ |
| Goodfellow et al., Deep Learning | 第 6 章(反向传播、计算图) · https://www.deeplearningbook.org/ |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。