第20讲 · EECS 189:卷积神经网络(续)
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Convolutional Neural Networks (cont.) — Pooling, Training, and Double Descent |
| 视频 | https://www.youtube.com/watch?v=4LrCyN7URuY |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 20) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第20讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- 统一卷积的两种直觉:局部连接 + 权重共享(1D/2D);
- padding 与经典滤波器(边缘/锐化检测器);
- RGB 多通道与「
depth术语之乱」; - 池化(pooling):max pooling、局部平移不变性、感受野;
- 训练 CNN:权重共享、过 max pooling 的反向传播、迁移学习;
- 学习曲线与早停、Dropout、双下降(double descent)。
📷 标题页
回到原视频 (00:00:20)
📷 CS 189/289
回到原视频 (00:01:33)
一、统一卷积的两种直觉
1.1 局部连接 + 权重共享
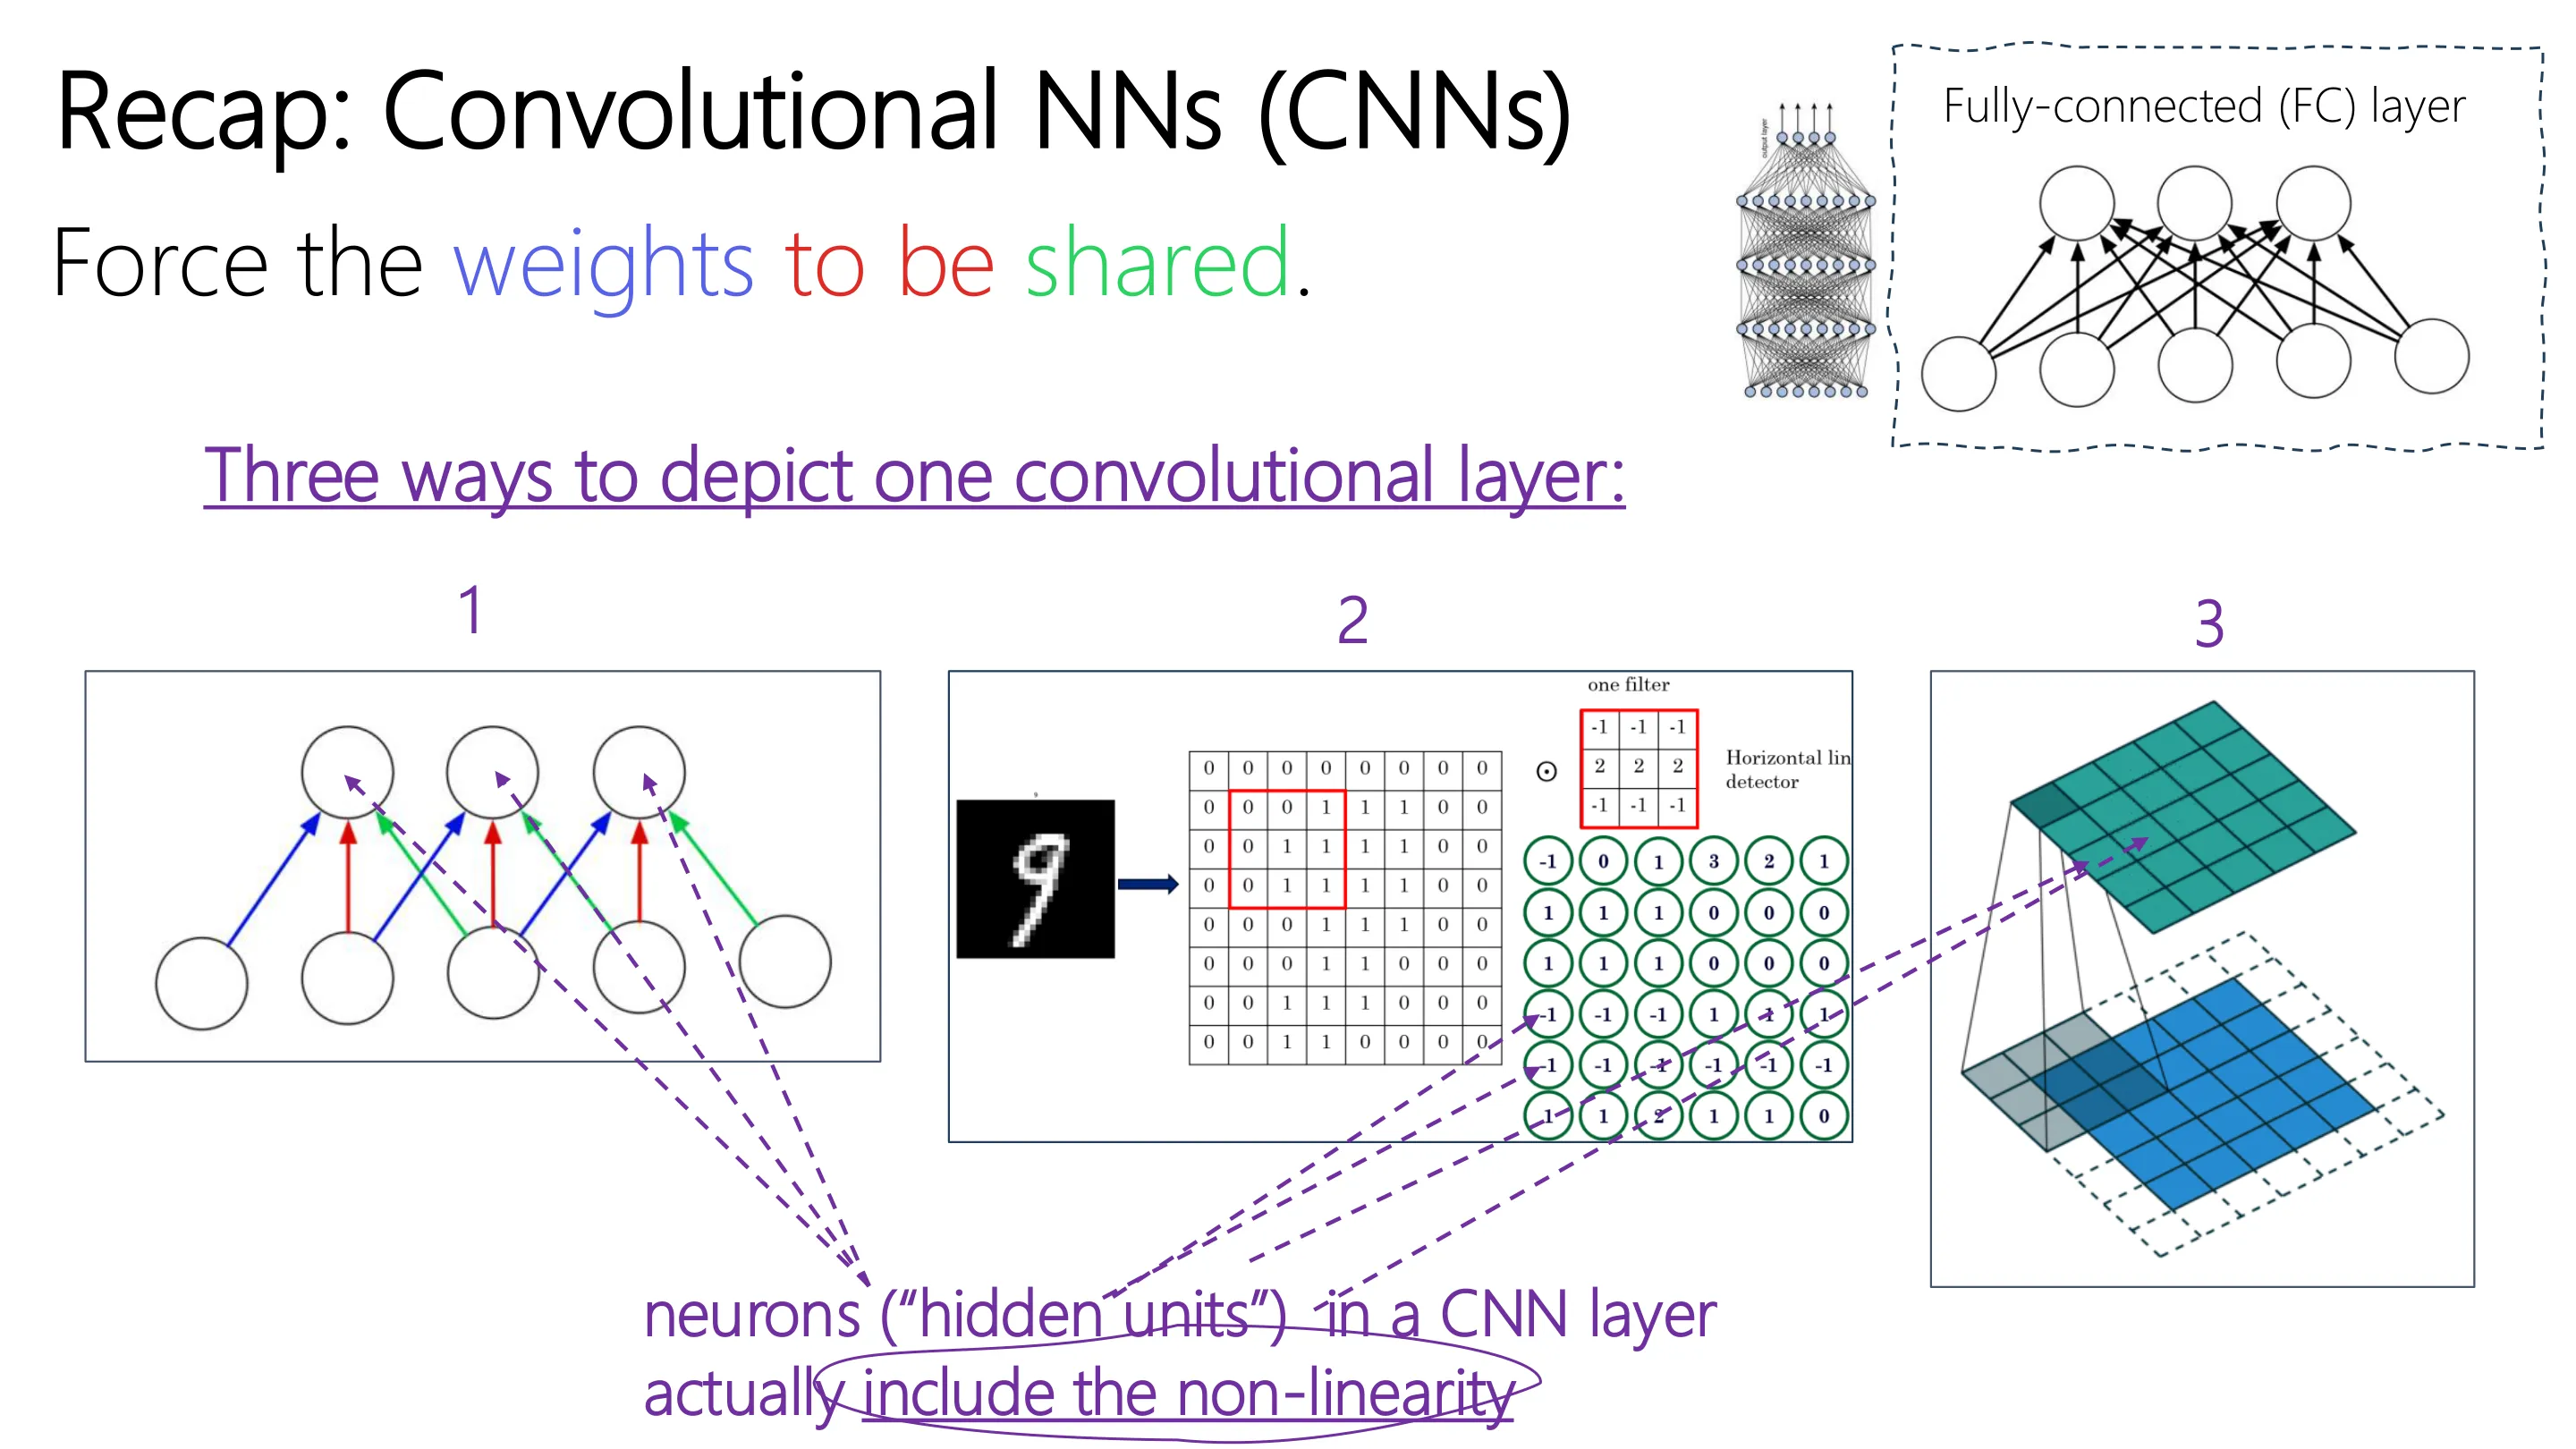
与全连接层对比:全连接中每个输入连到每个神经元;卷积层中只有稀疏的连接,而且权重着色相同 ⇒ 权重在每个位置取相同值(蓝/红/绿 = 一个滤波器)。这就是局部连接 + 权重共享——一维卷积最直观。
1.2 滤波器在二维图像上滑动
二维视角:蓝色是图像(二维),灰/绿/红/蓝的 $3\times3$ 是核(kernel/滤波器),在图上滑动,每次做一个点积,结果写进上方的神经元。
两种直觉画在同一张幻灯片上后,卷积就清楚了:同一个模板在整个输入上滑动并做点积。
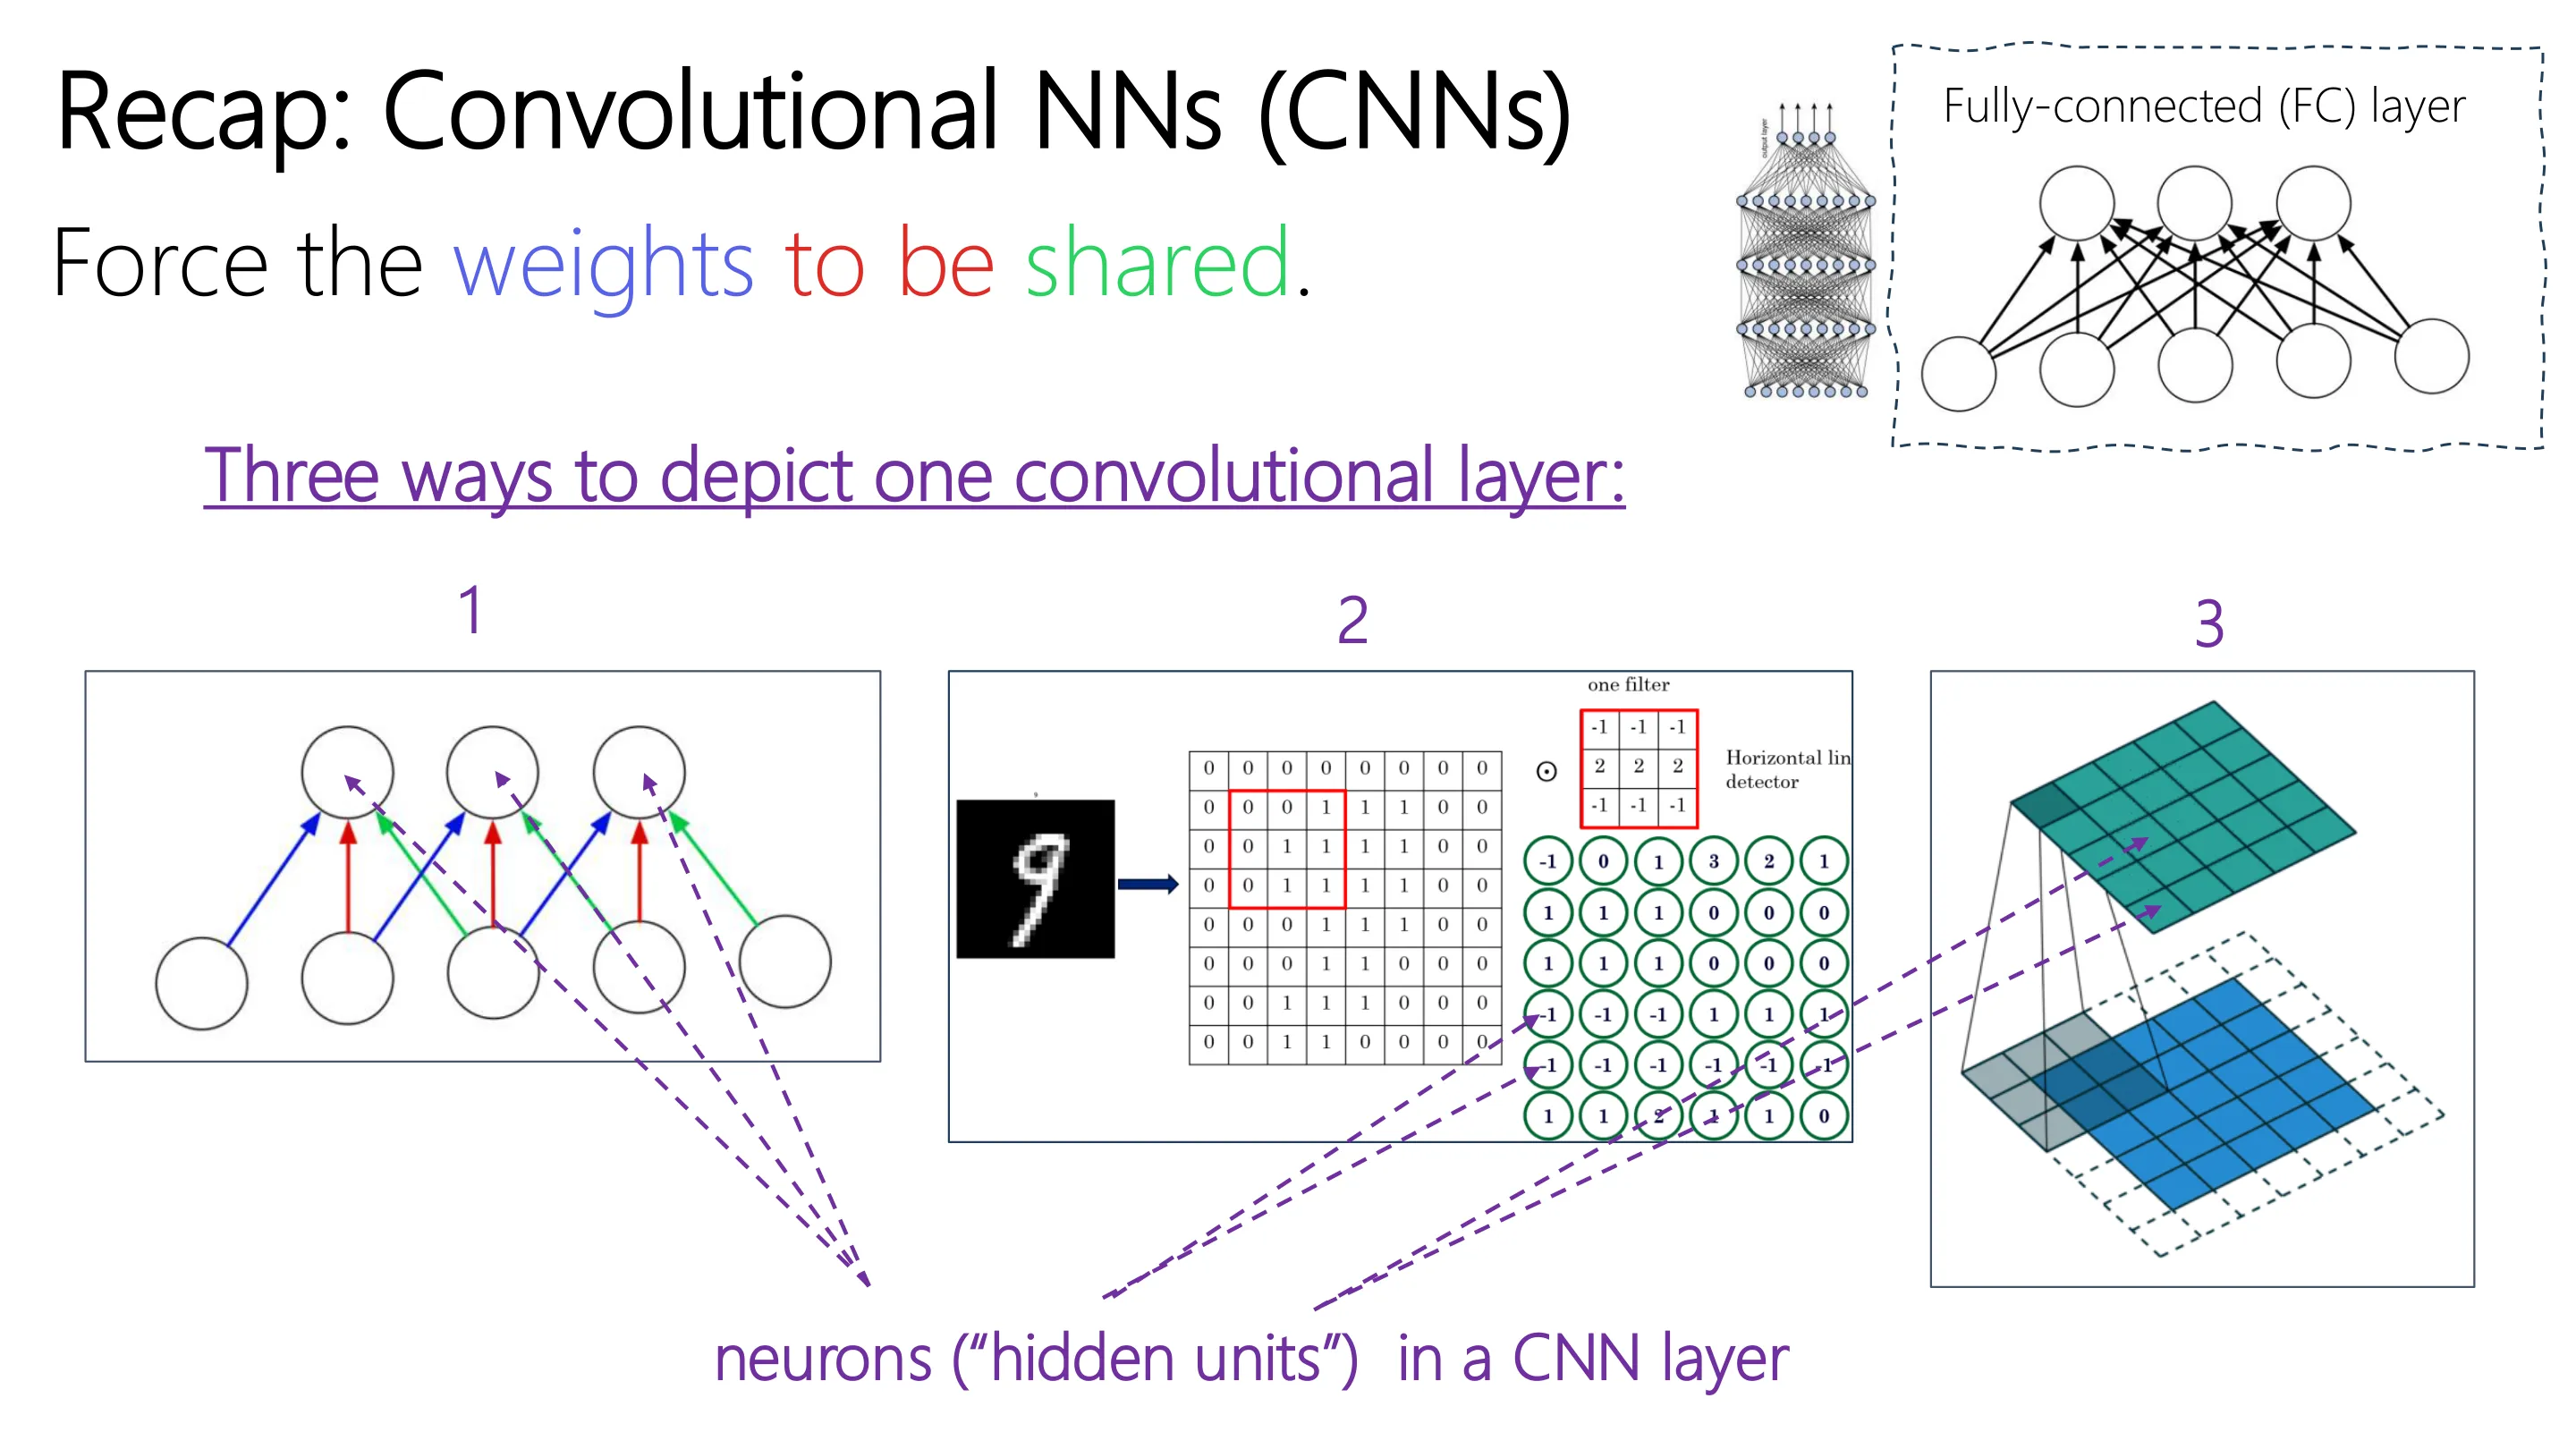
📷 强制权重共享
回到原视频 (00:02:46)
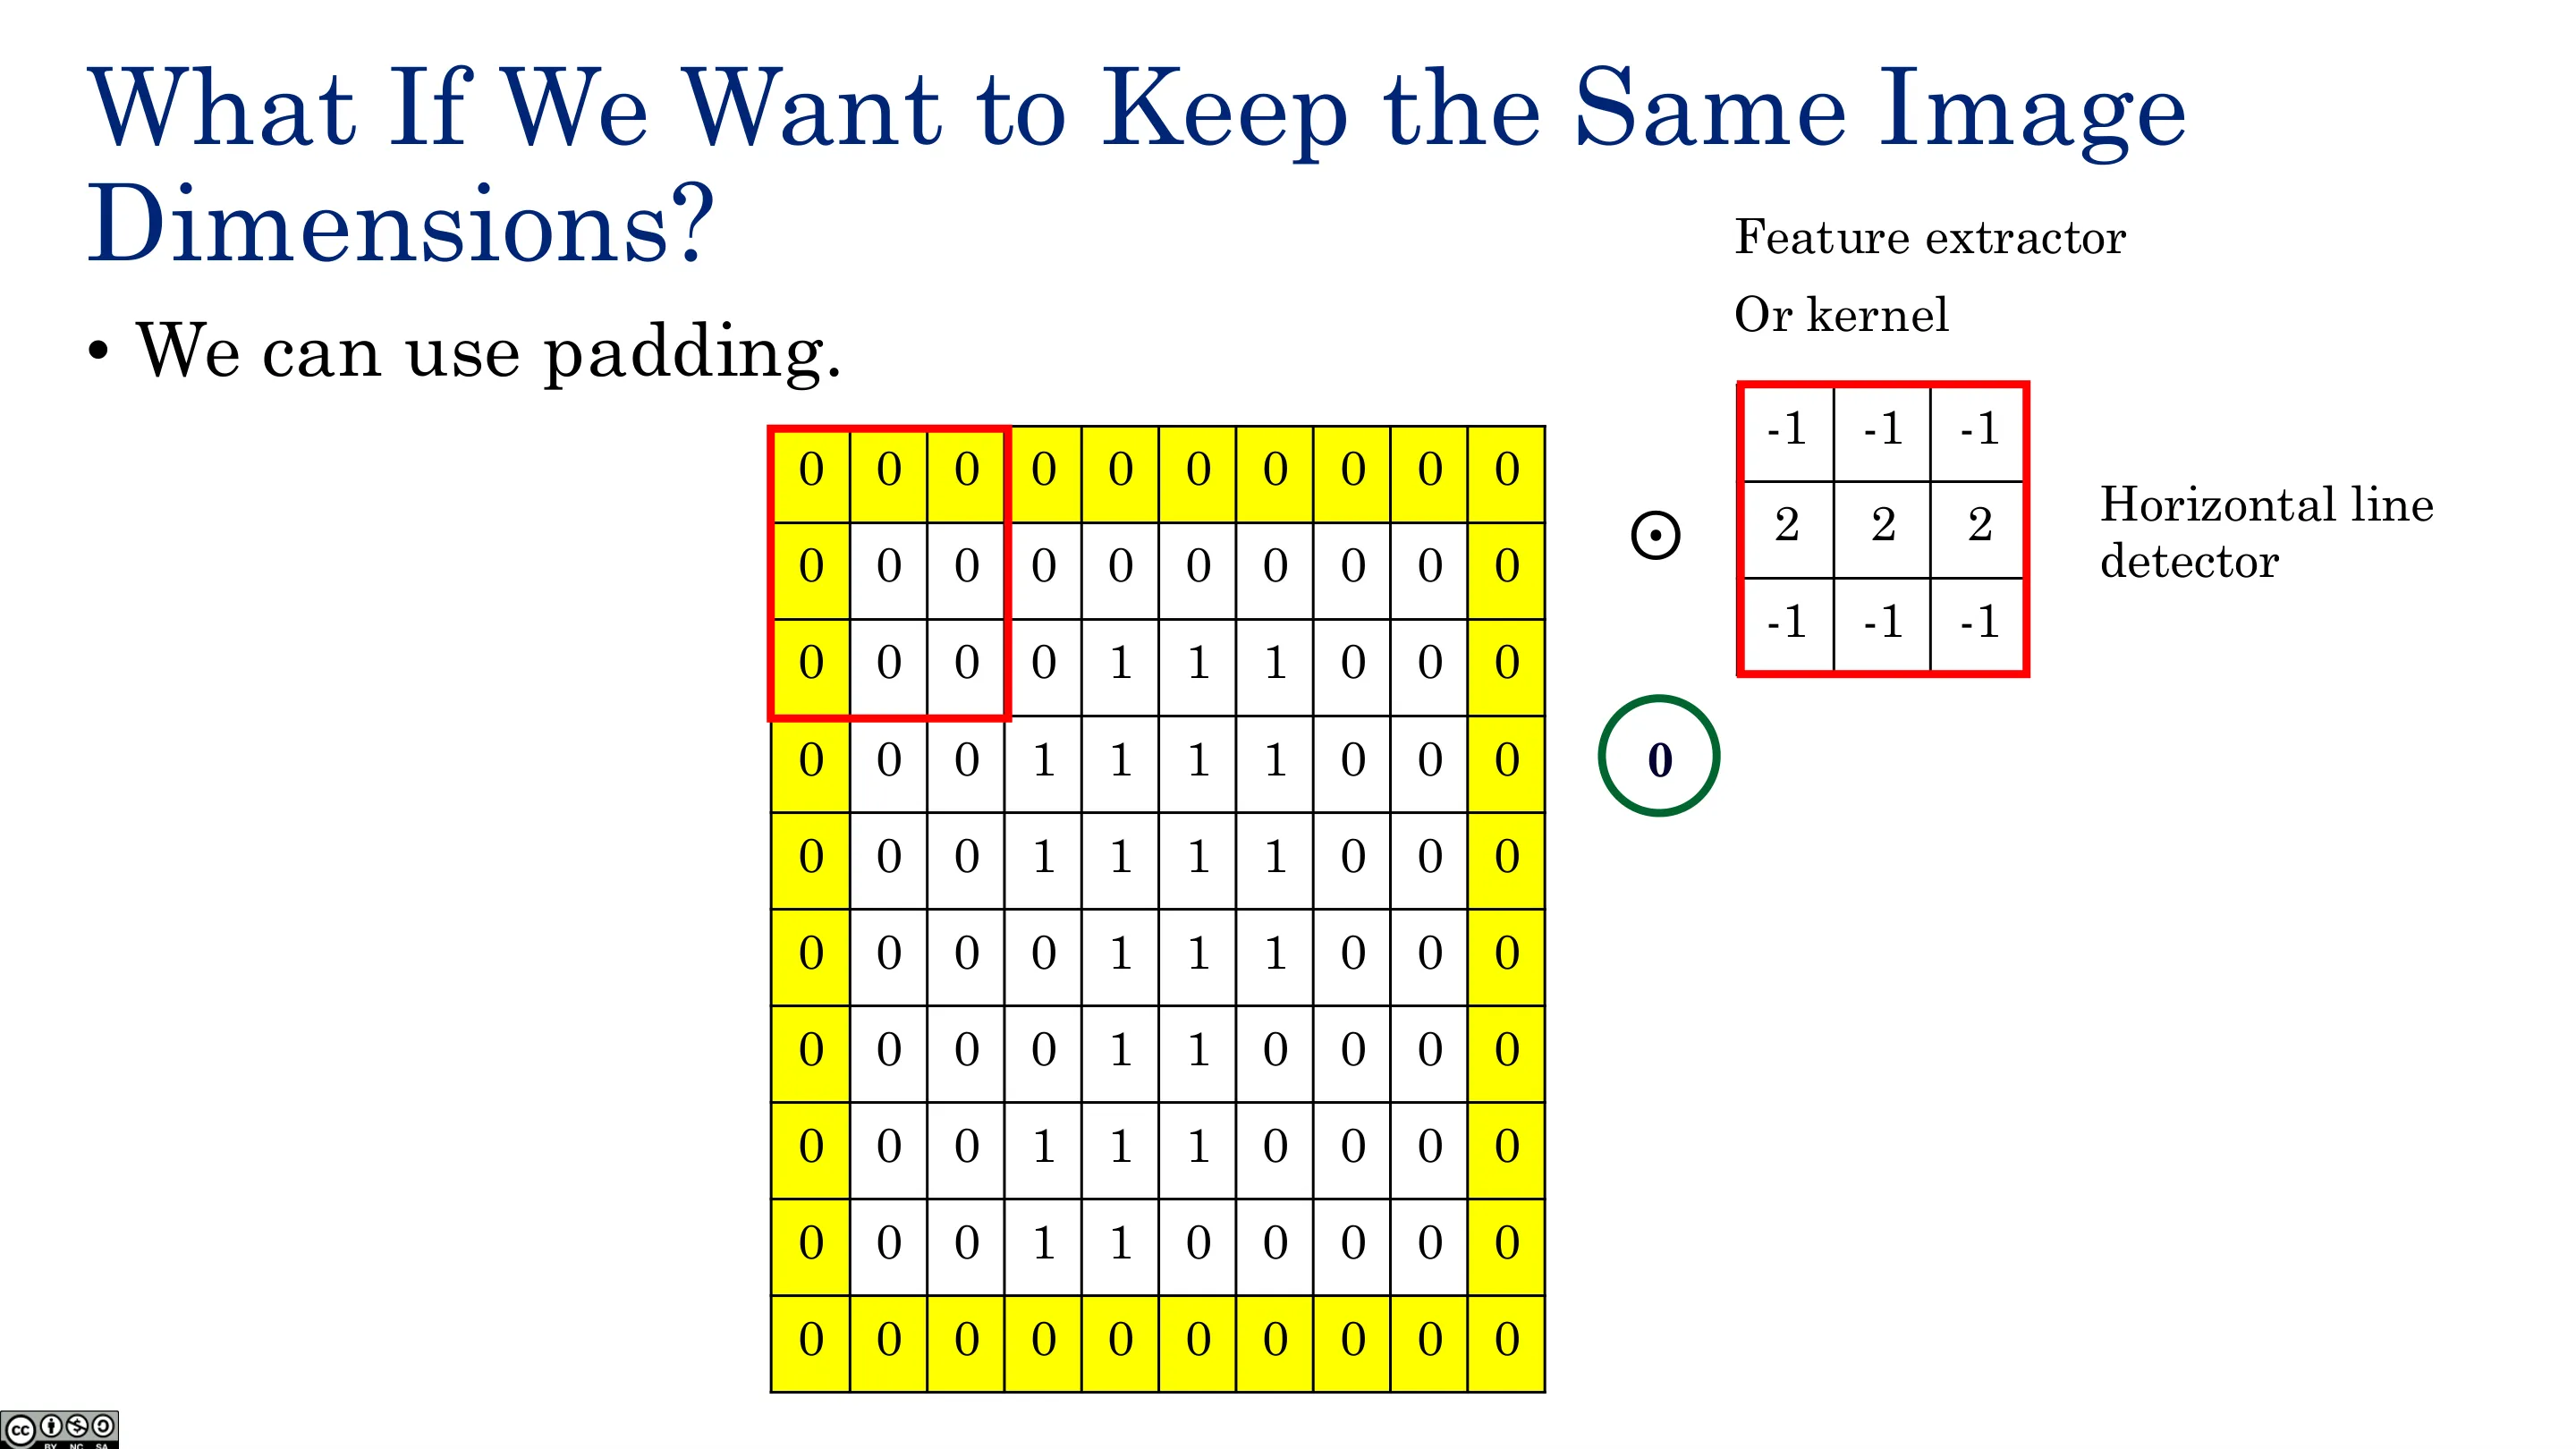
📷 如果我们想保持图像尺寸不变?(一)
回到原视频 (00:03:59)
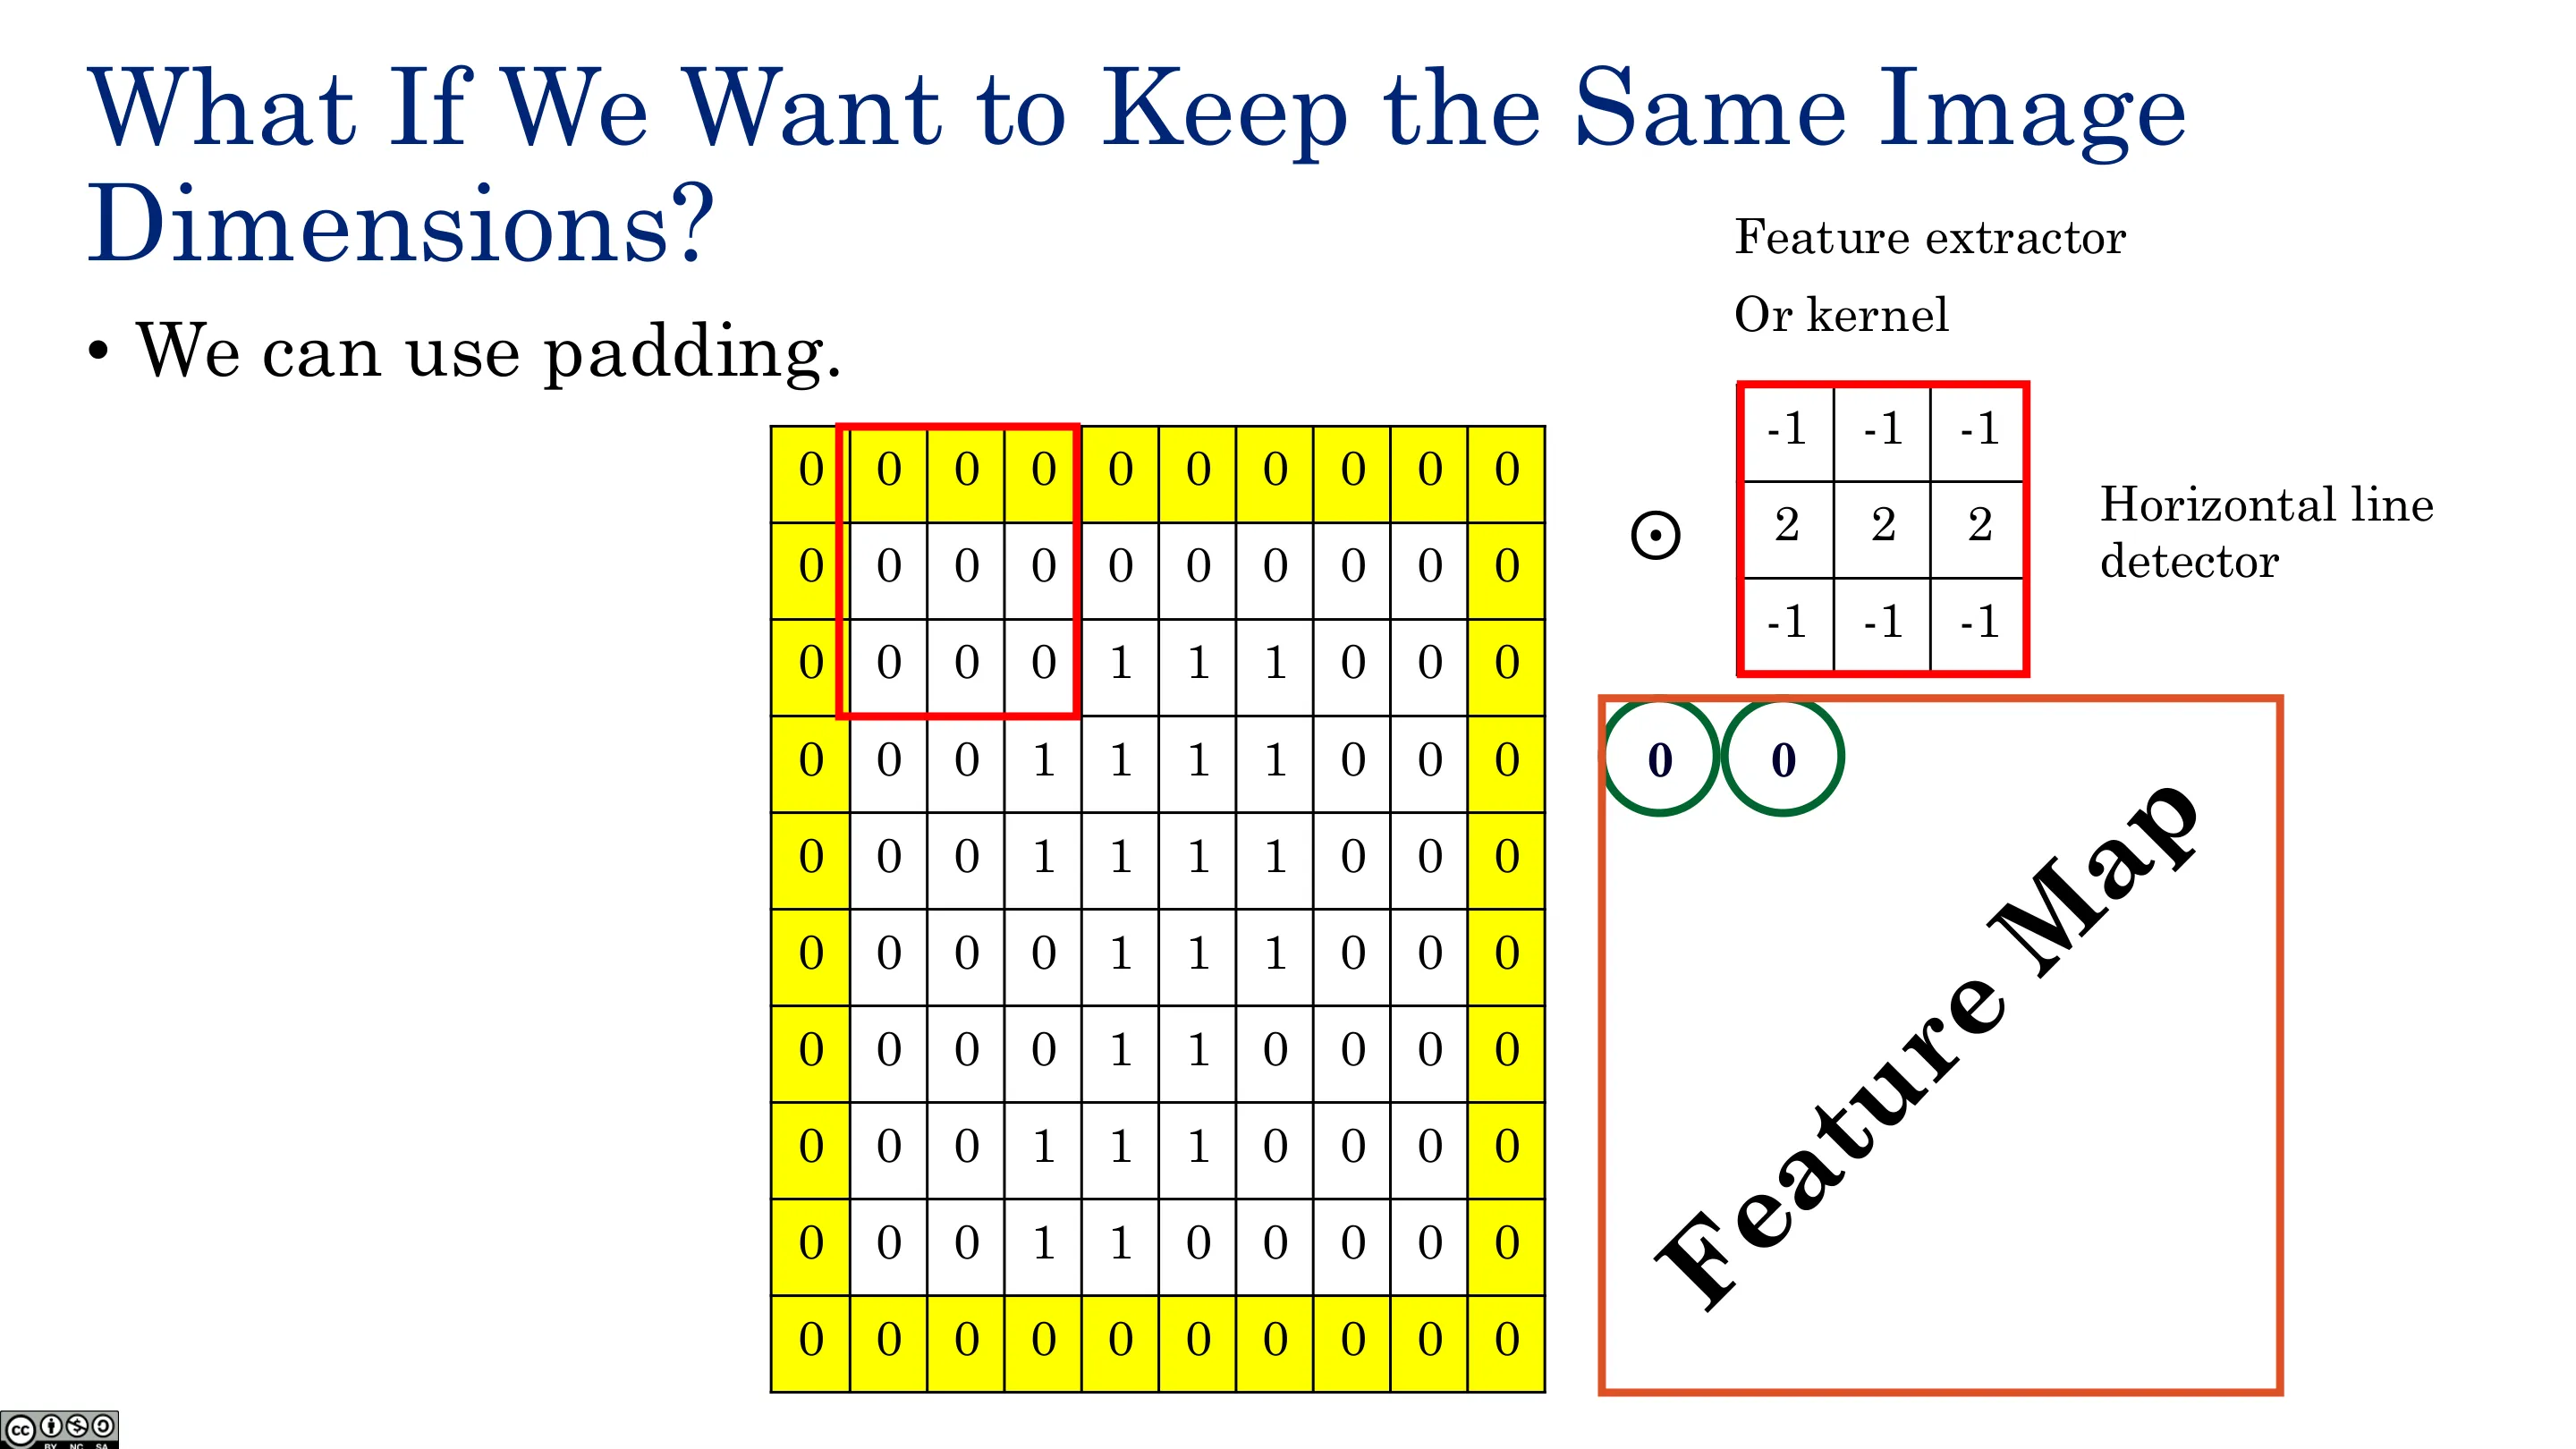
📷 如果我们想保持图像尺寸不变?(二)
回到原视频 (00:05:12)
1.3 Padding 与经典滤波器
Padding:若不在边缘补零,卷积核只能从有数据的地方开始,输出会变小。补零(zero padding)后可以把核移到角落,输出变大。(经典图像处理还会用镜像等填充。)
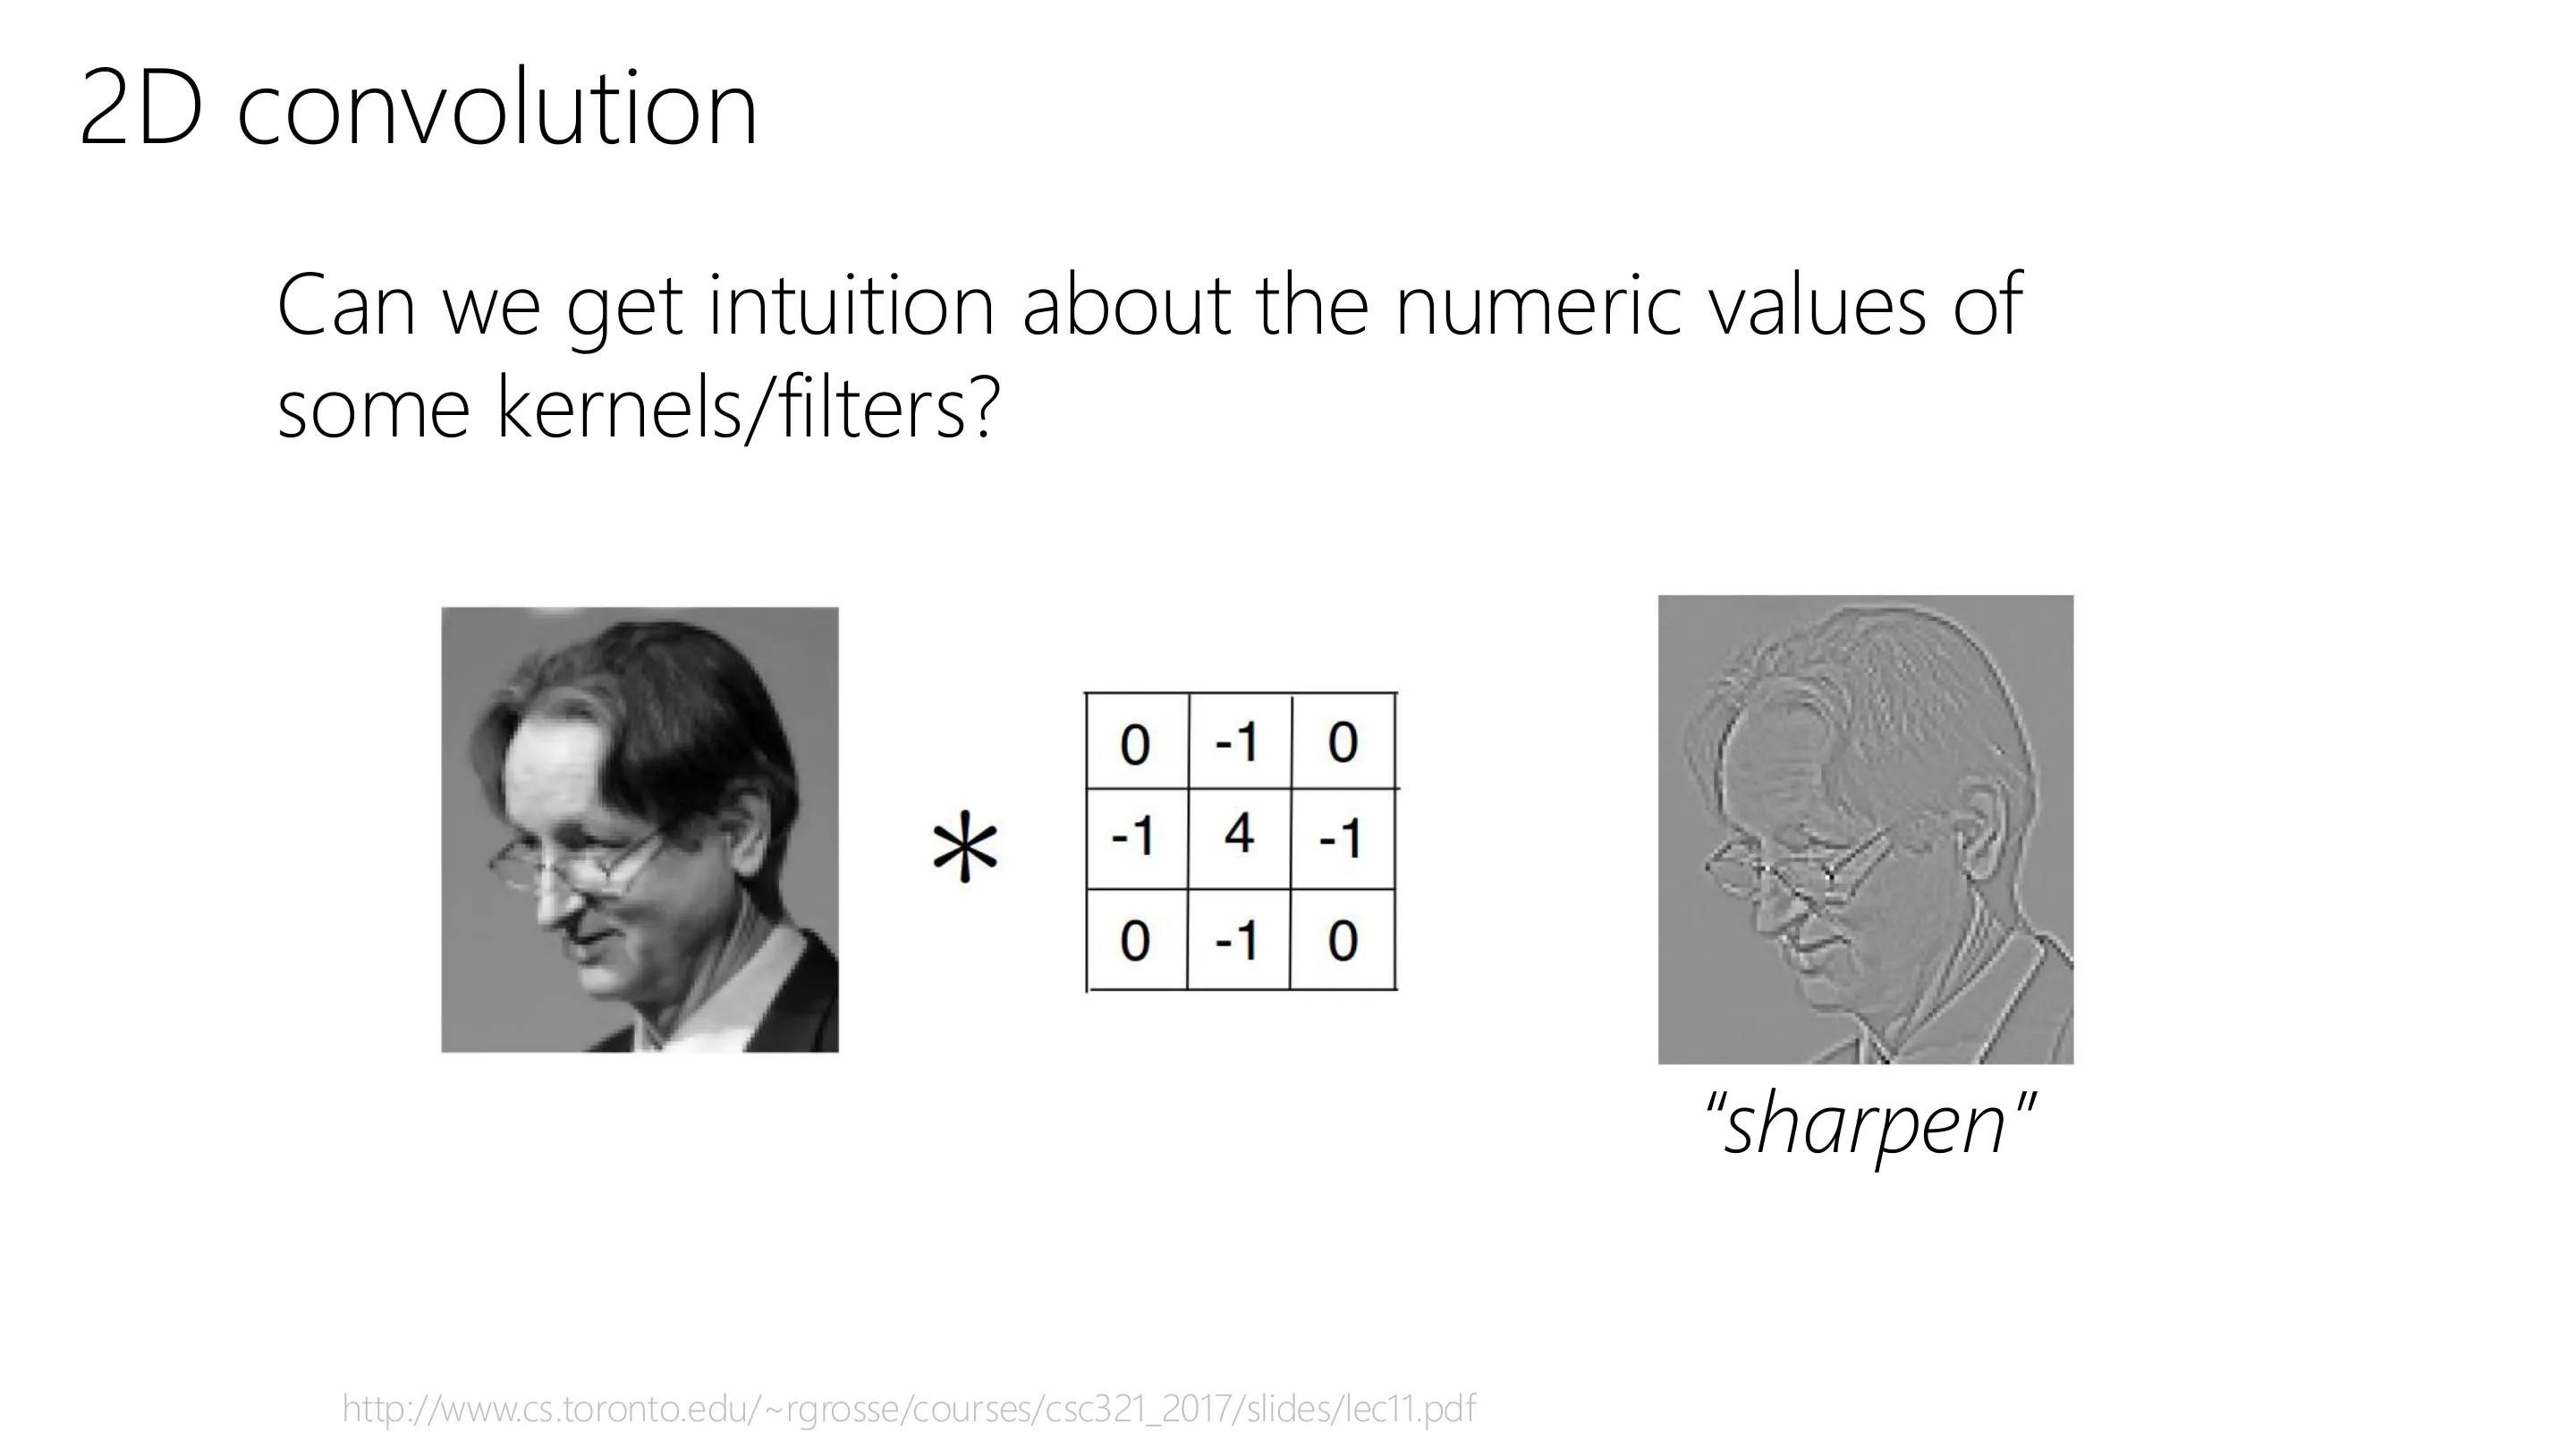
经典手写滤波器(帮助直觉):
- 水平/垂直边缘检测器:看左右/上下的差异;
- 模糊核:中心权重最大、邻域权重小 ⇒ 平滑;
- 锐化核:本质是各方向的边缘检测。
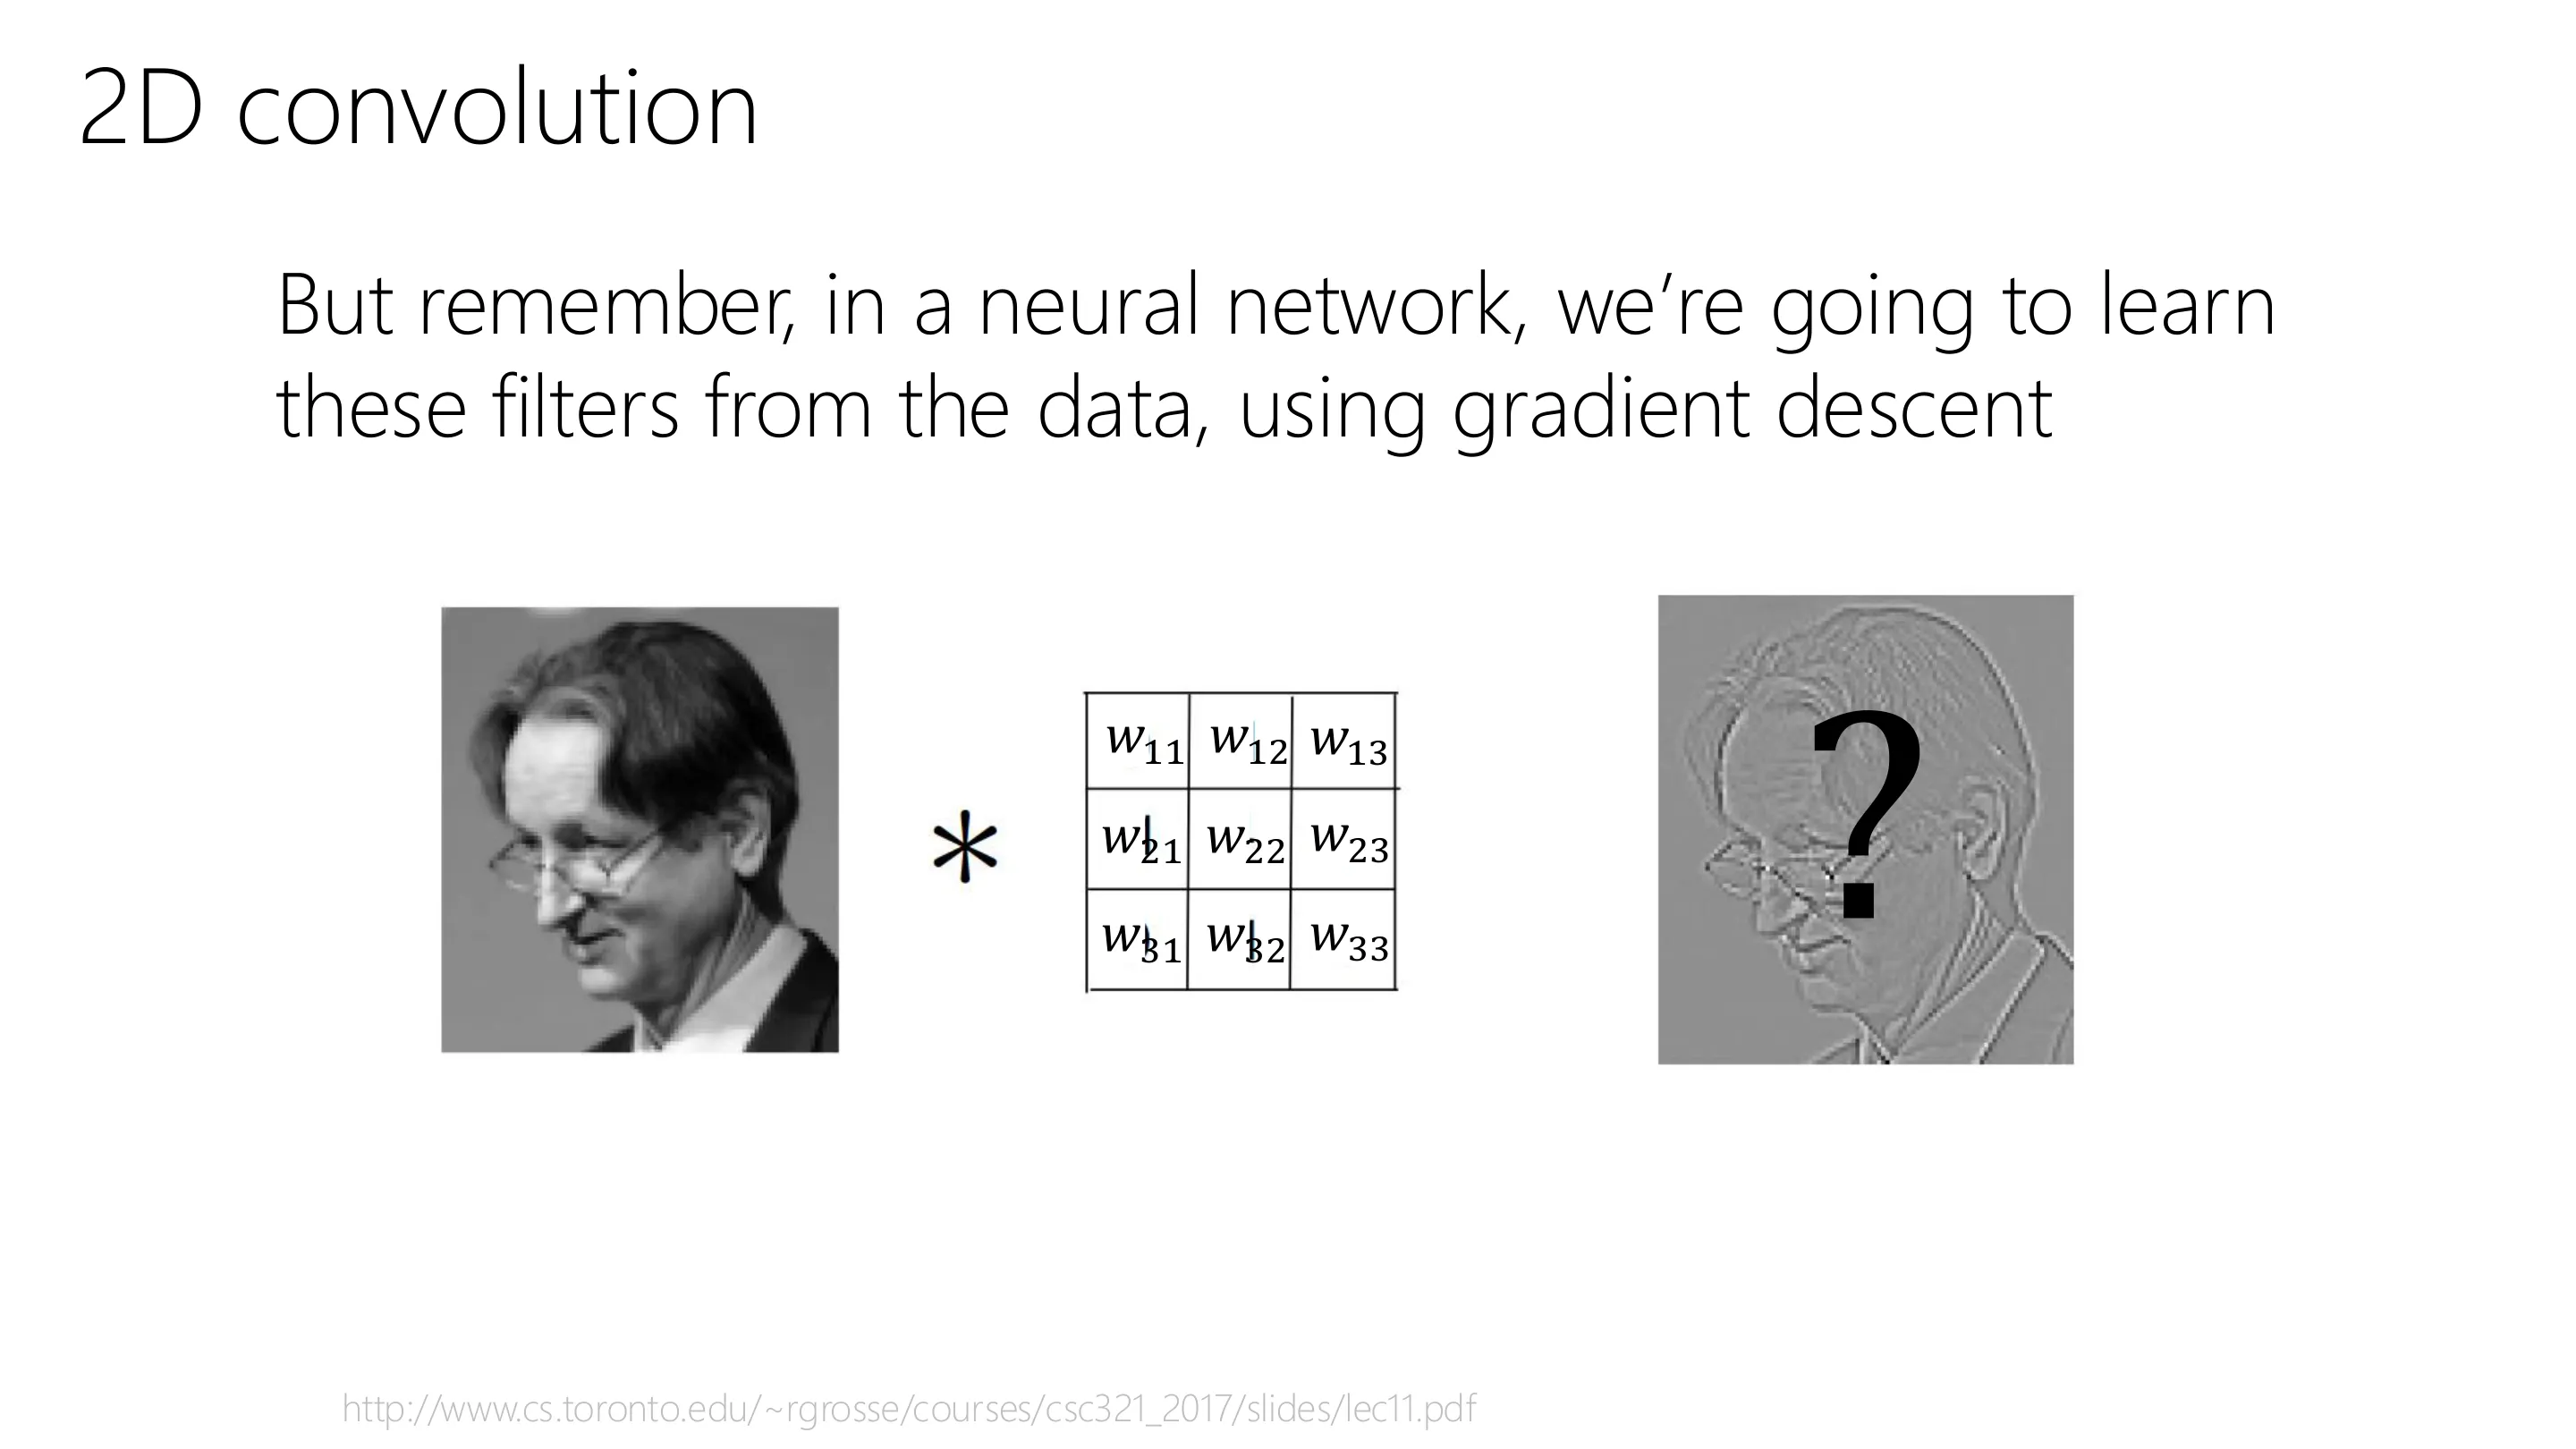
关键:CNN 中的这些核不再是手工设计,而是可学习的自由参数——浅层常自动学成不同方向的边缘检测器,再逐层组装成眼睛、脸等。
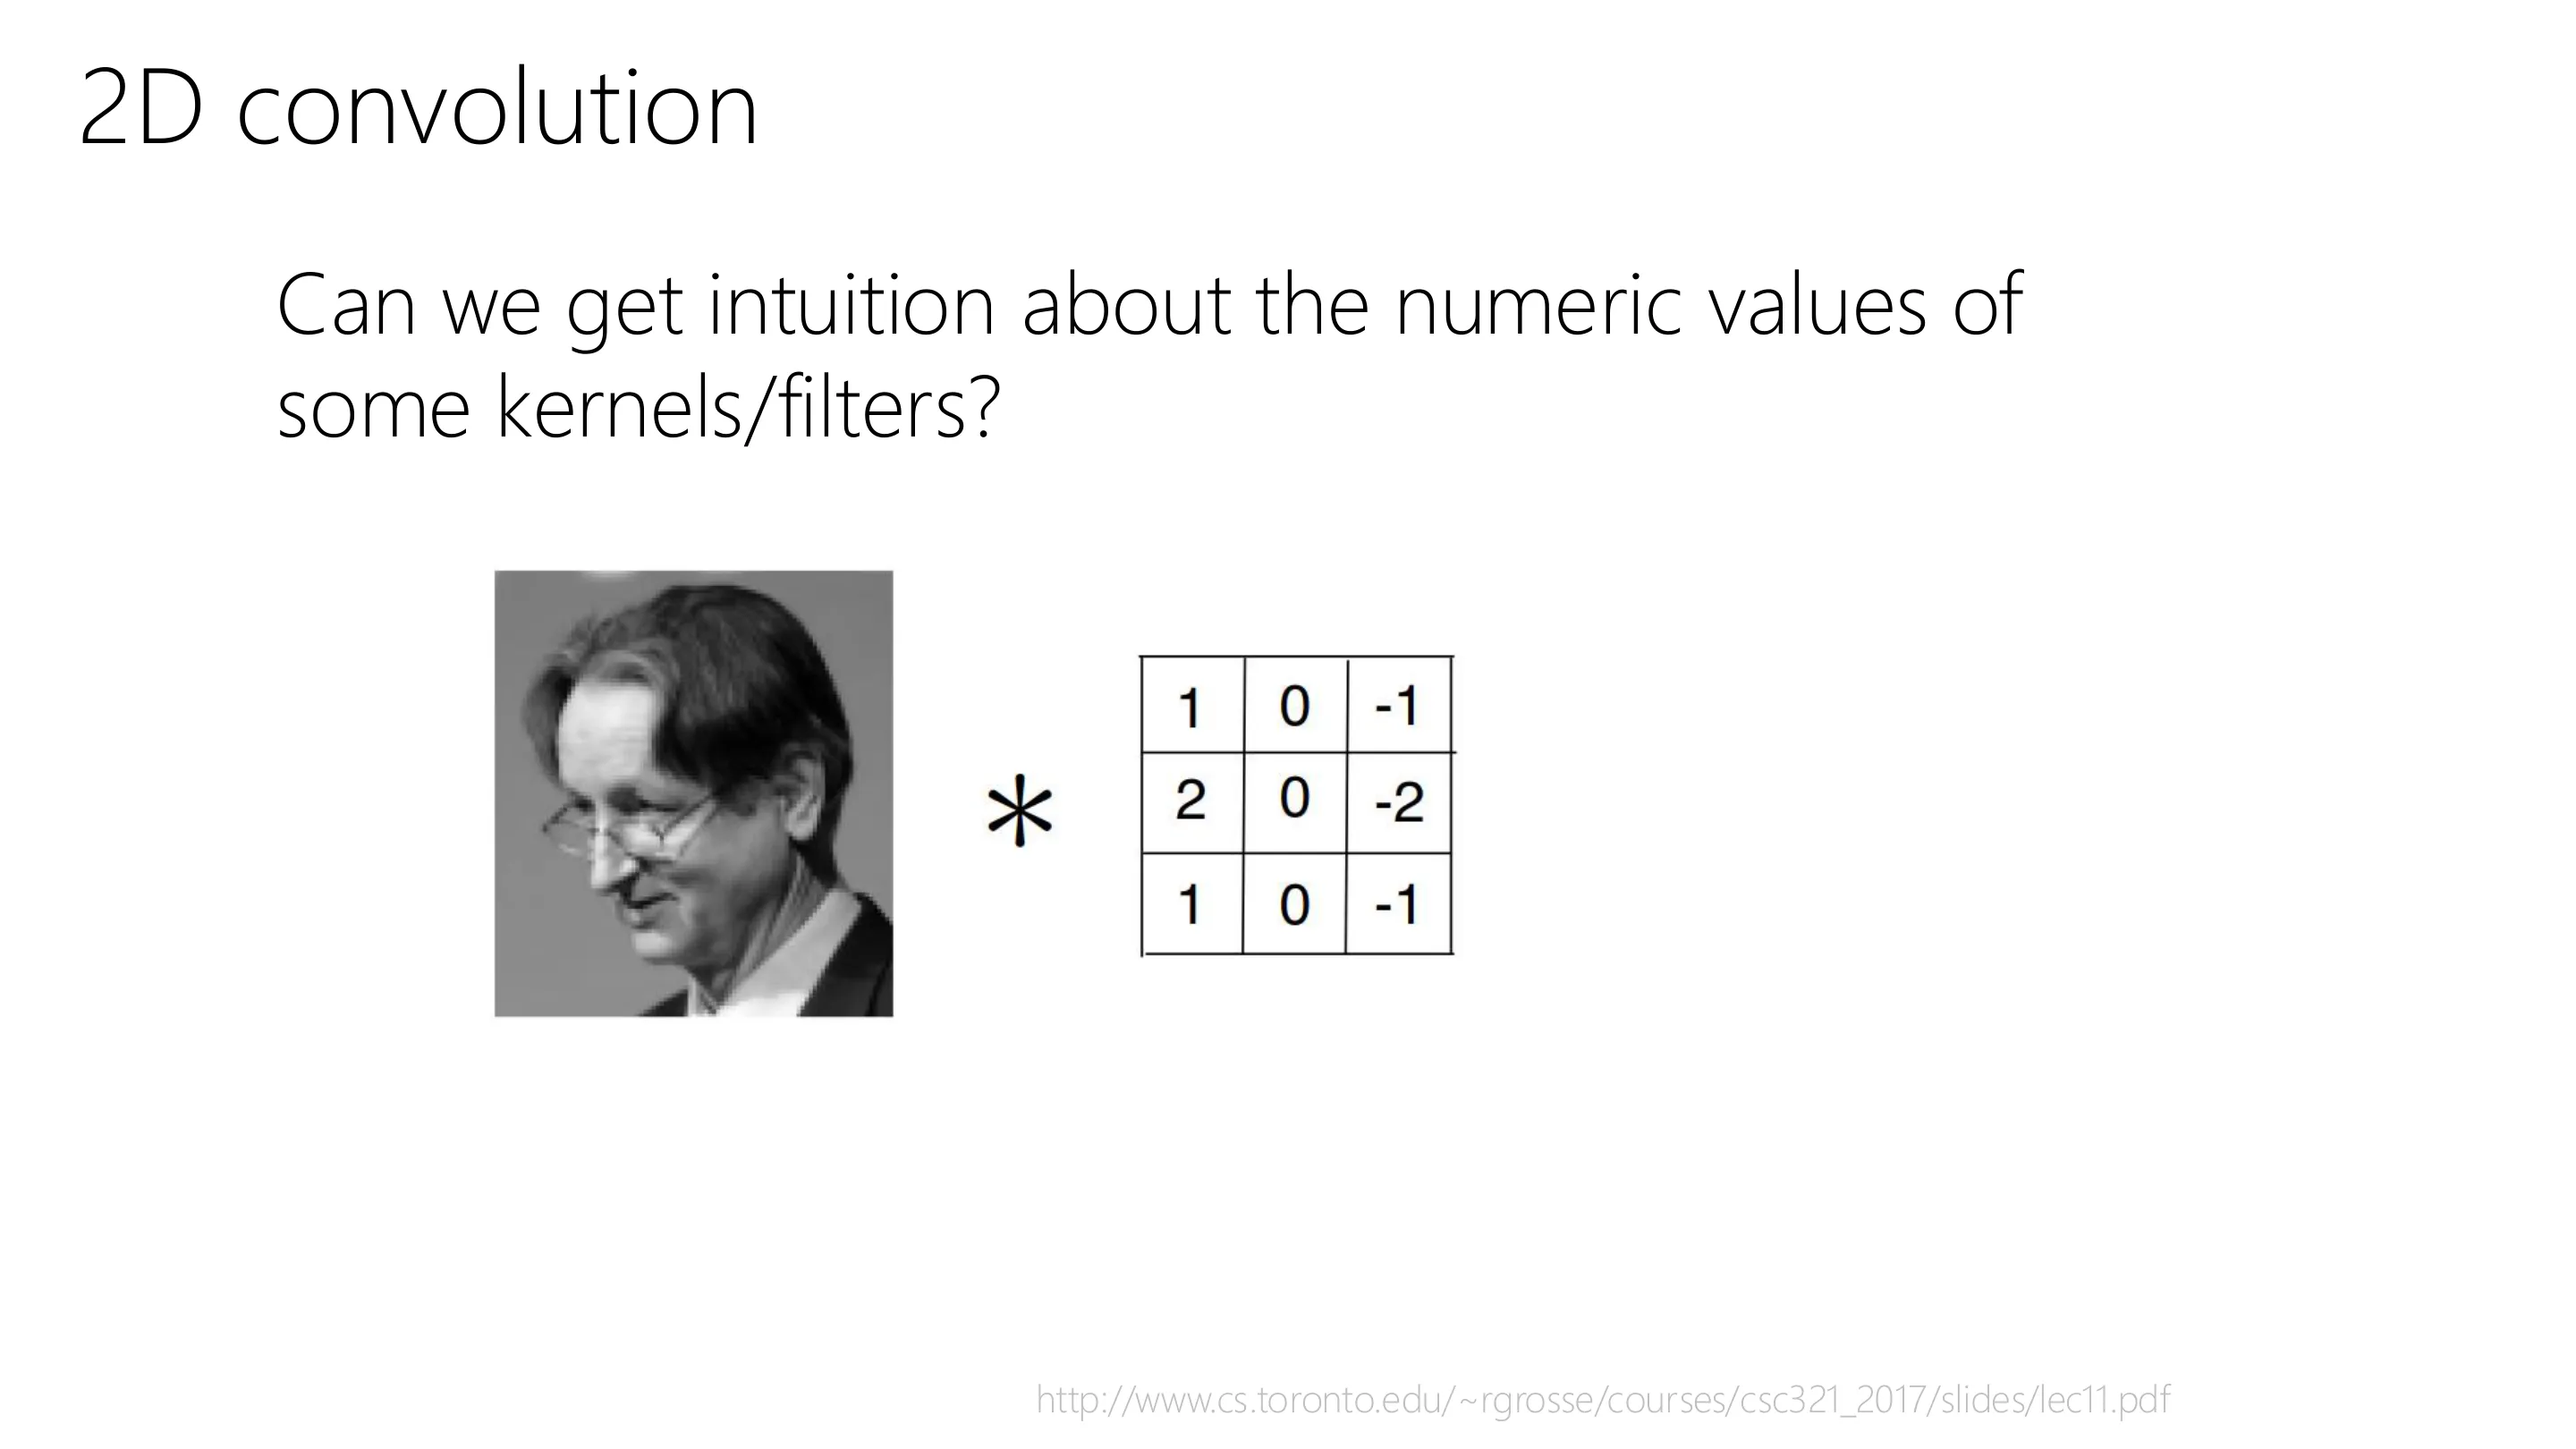
📷 padding 示例(引文 1)
回到原视频 (00:06:25)
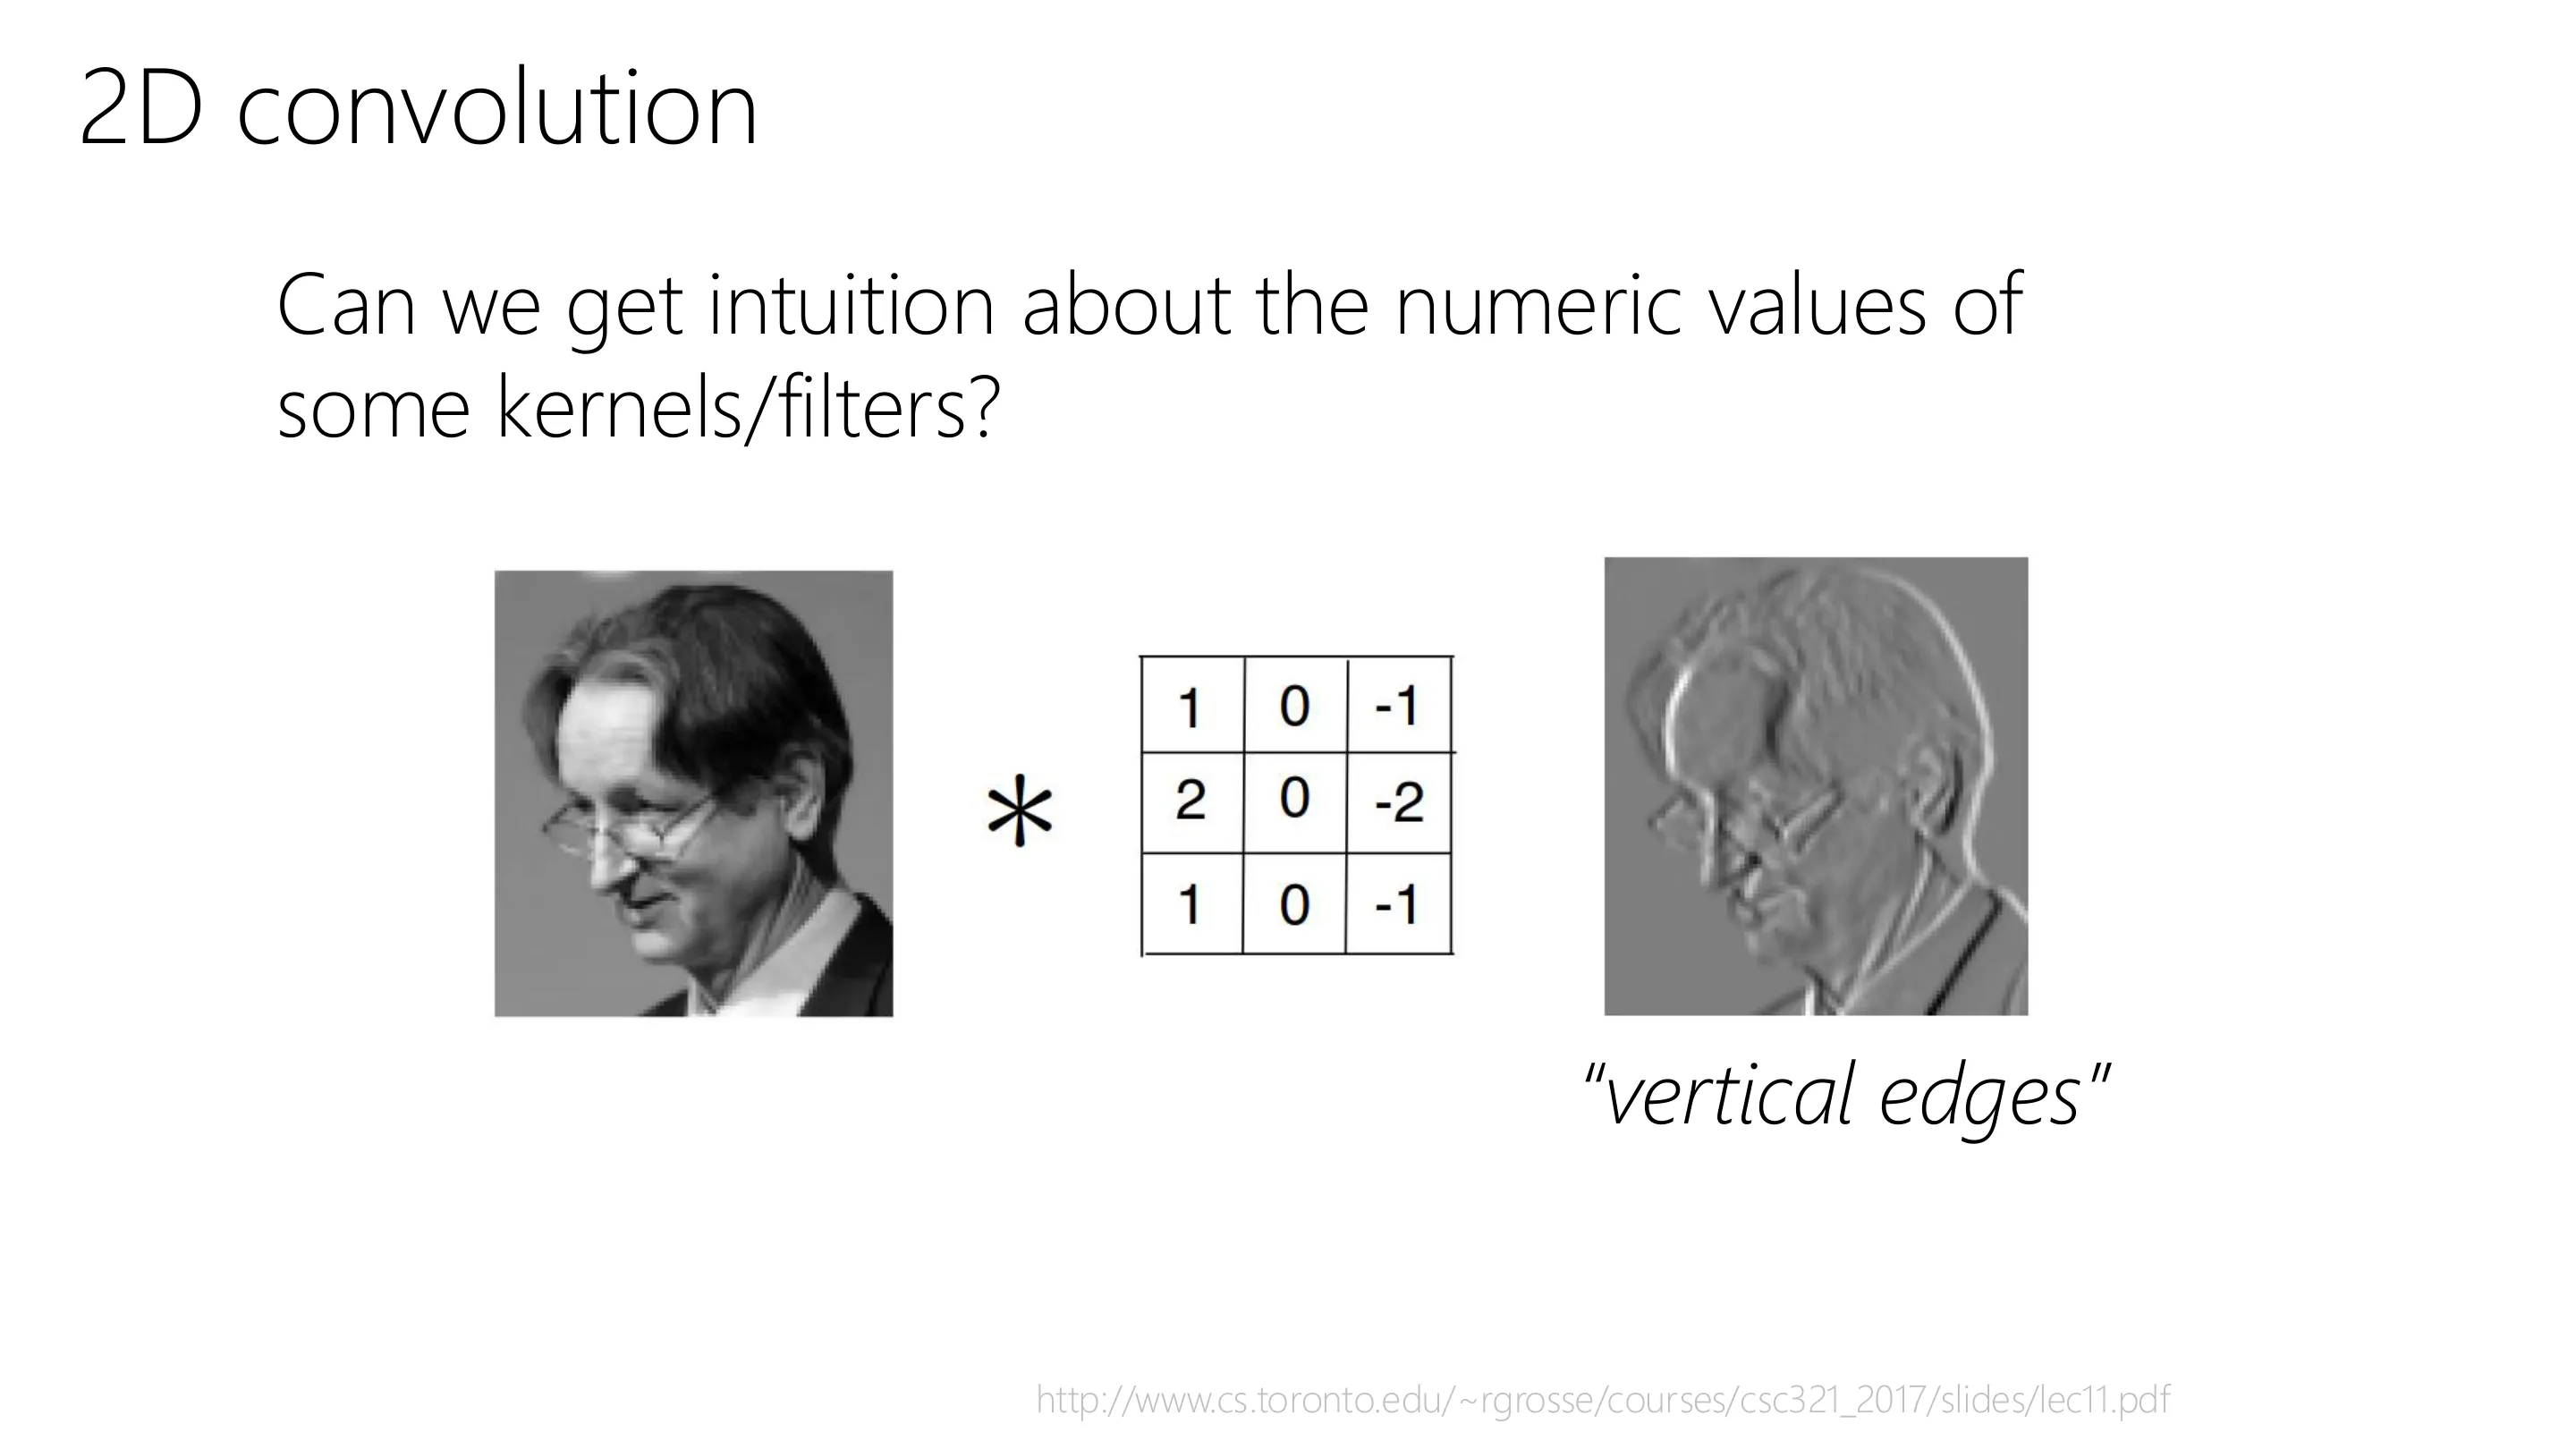
📷 经典滤波器示例(引文 2)
回到原视频 (00:07:38)
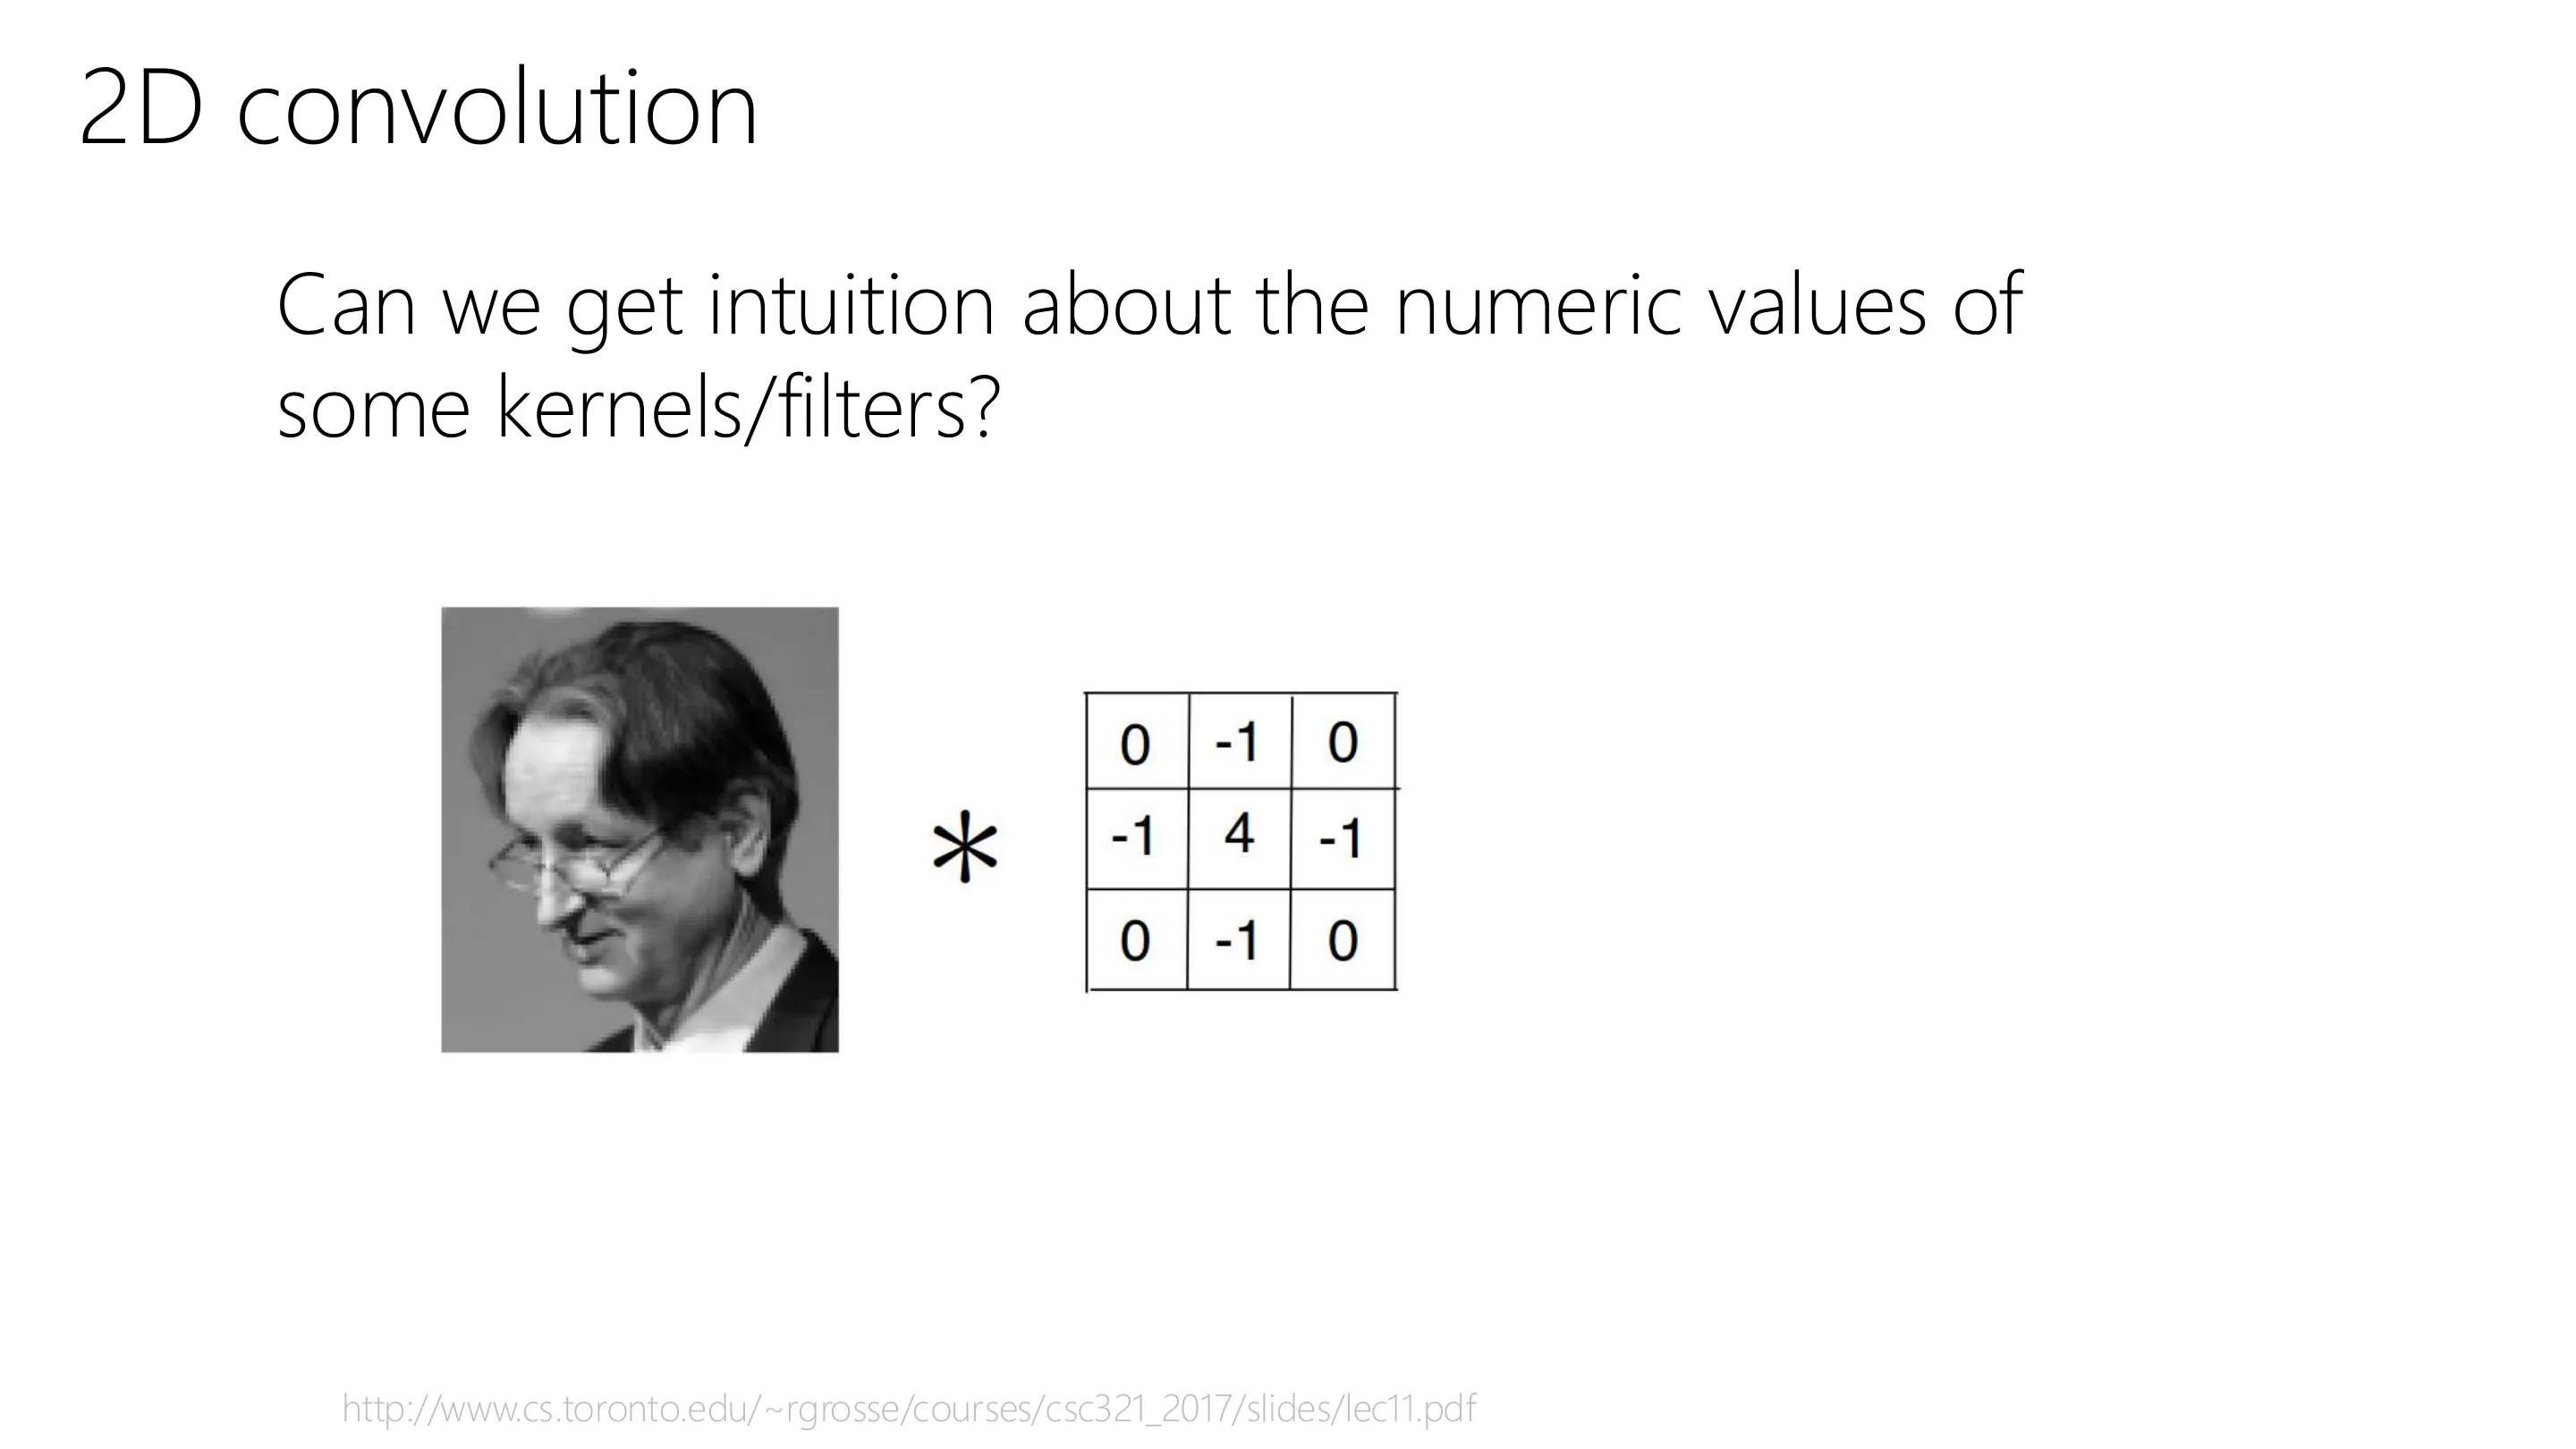
📷 经典滤波器示例(引文 3)
回到原视频 (00:08:51)
📷 经典滤波器示例(引文 4)
回到原视频 (00:10:04)
📷 经典滤波器示例(引文 5)
回到原视频 (00:11:17)
1.4 多通道与「depth」术语
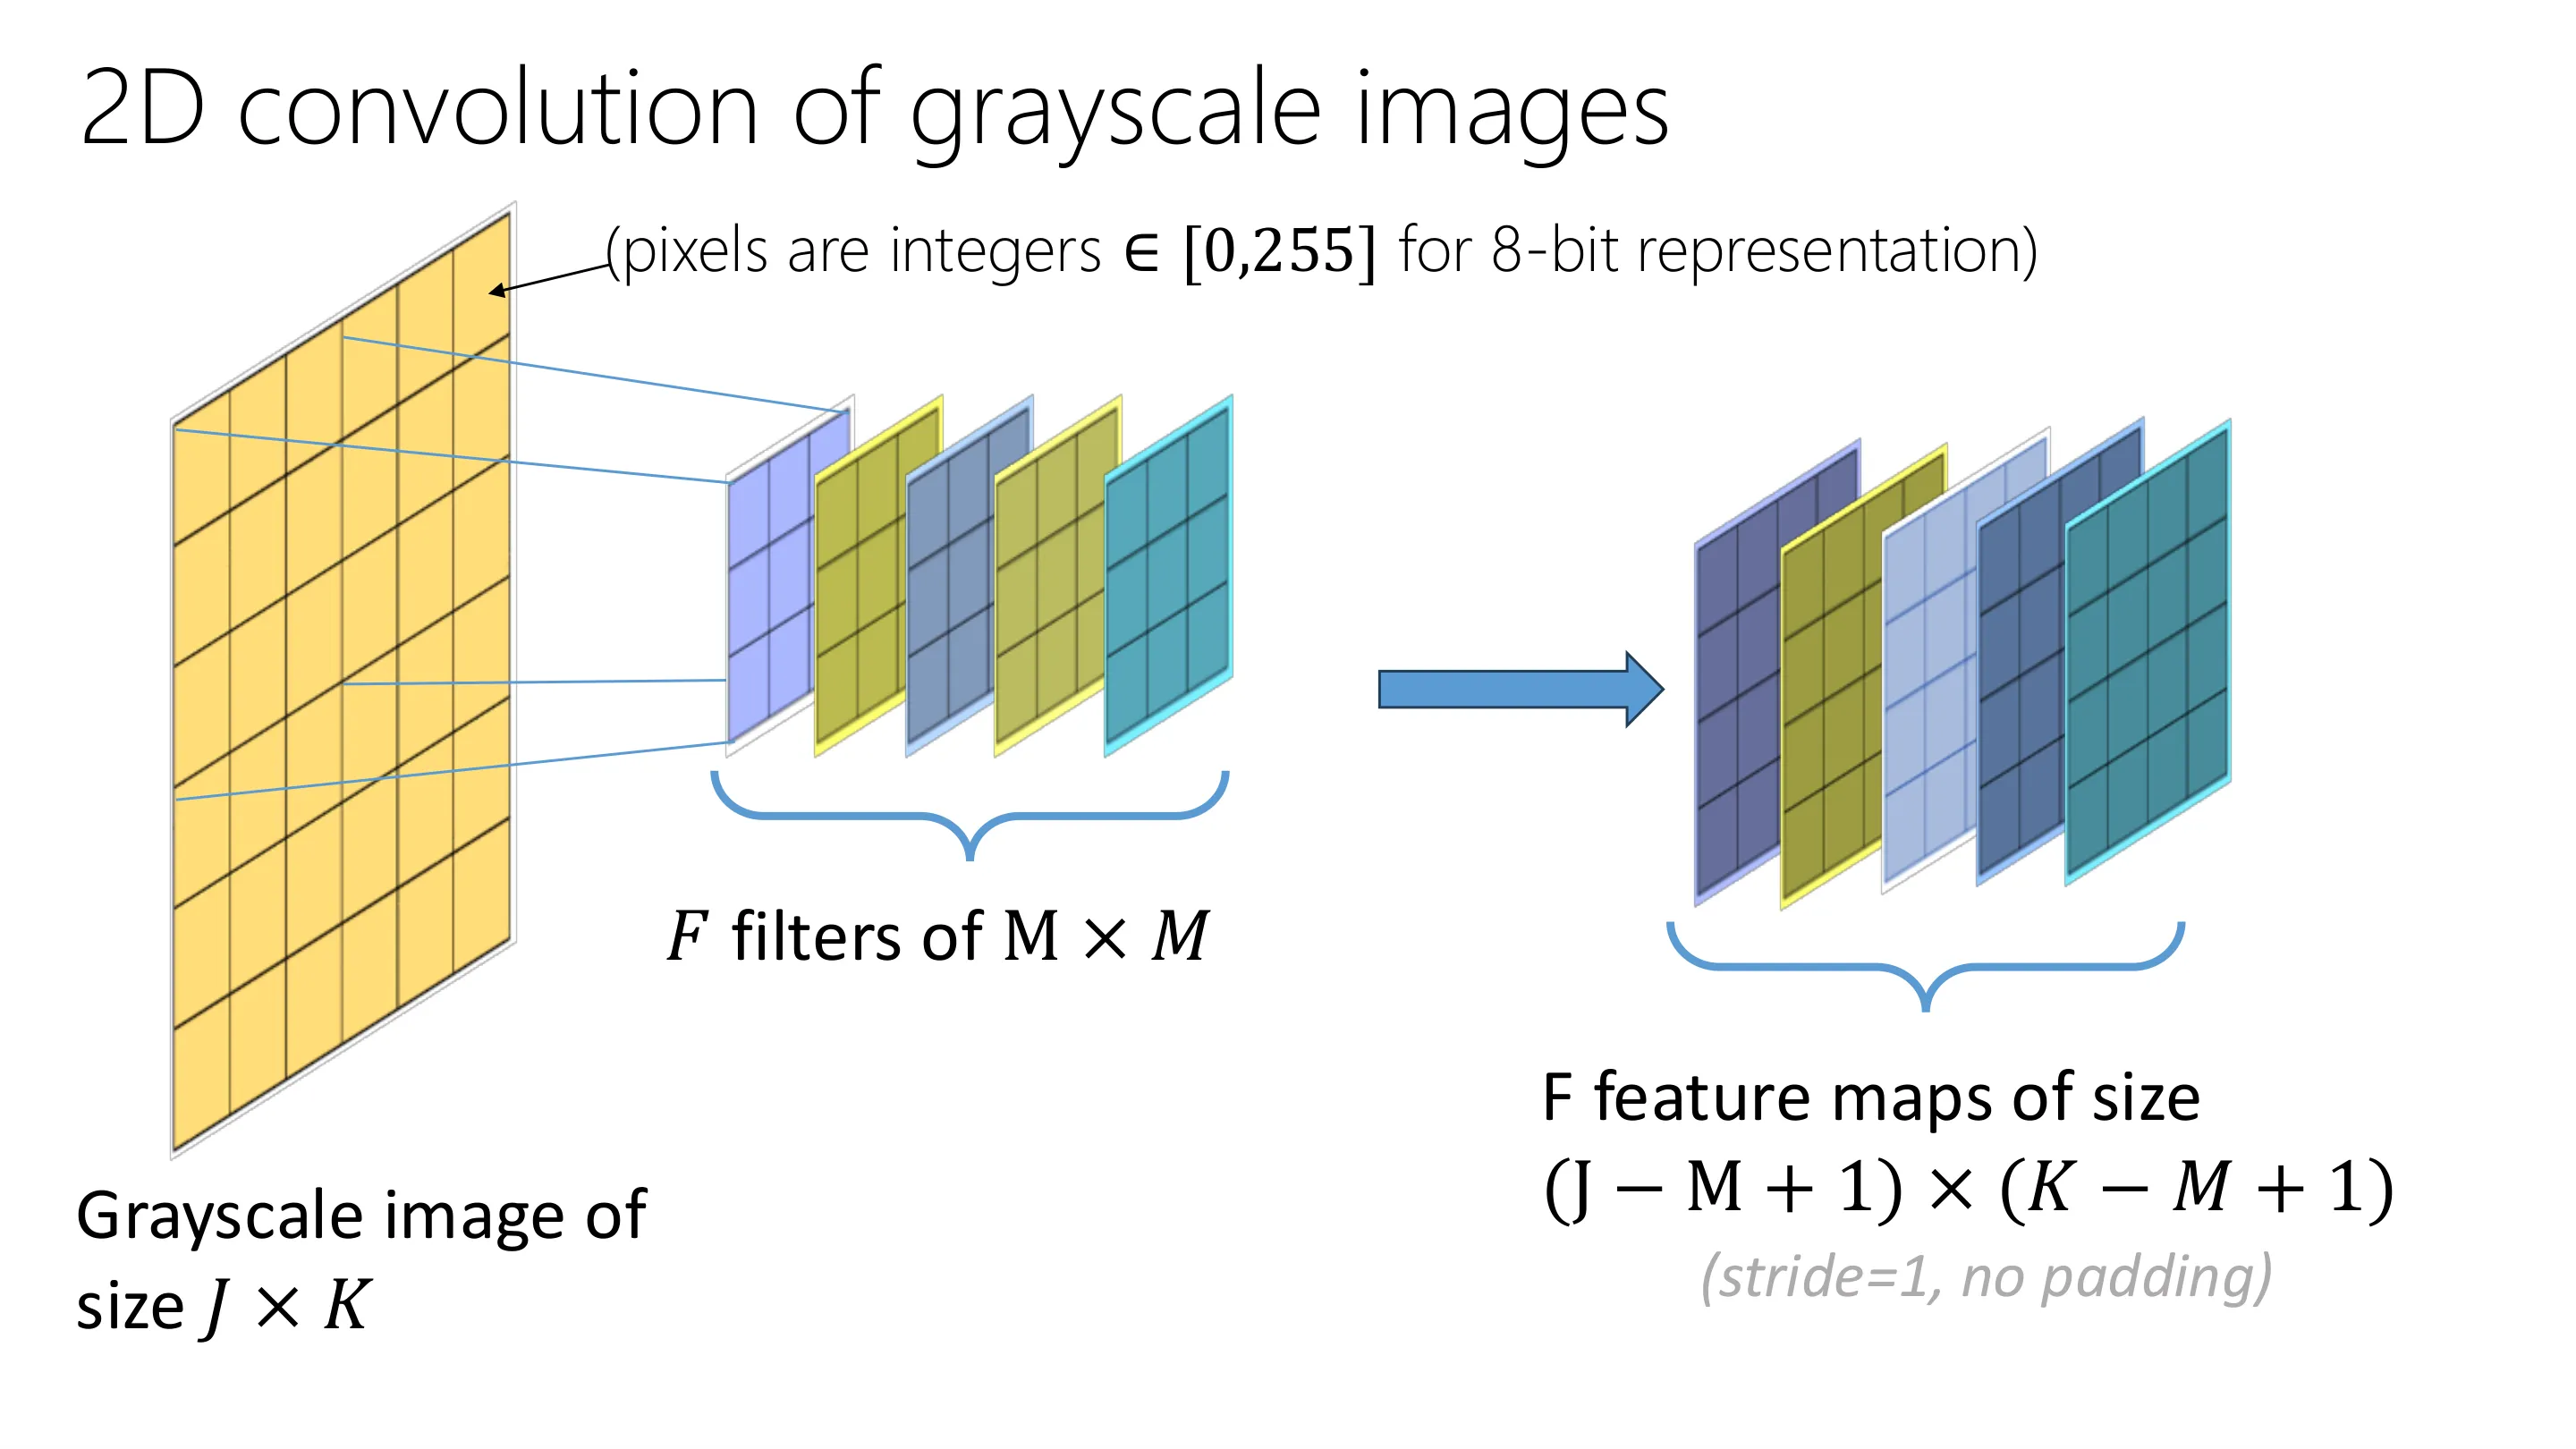
灰度图:像素 0–255。你可以先决定有 $F$ 个滤波器、每个 $m\times m$,每个滤波器卷积得到一张特征图;特征图尺寸取决于是否 padding、stride、图像与核的尺寸。
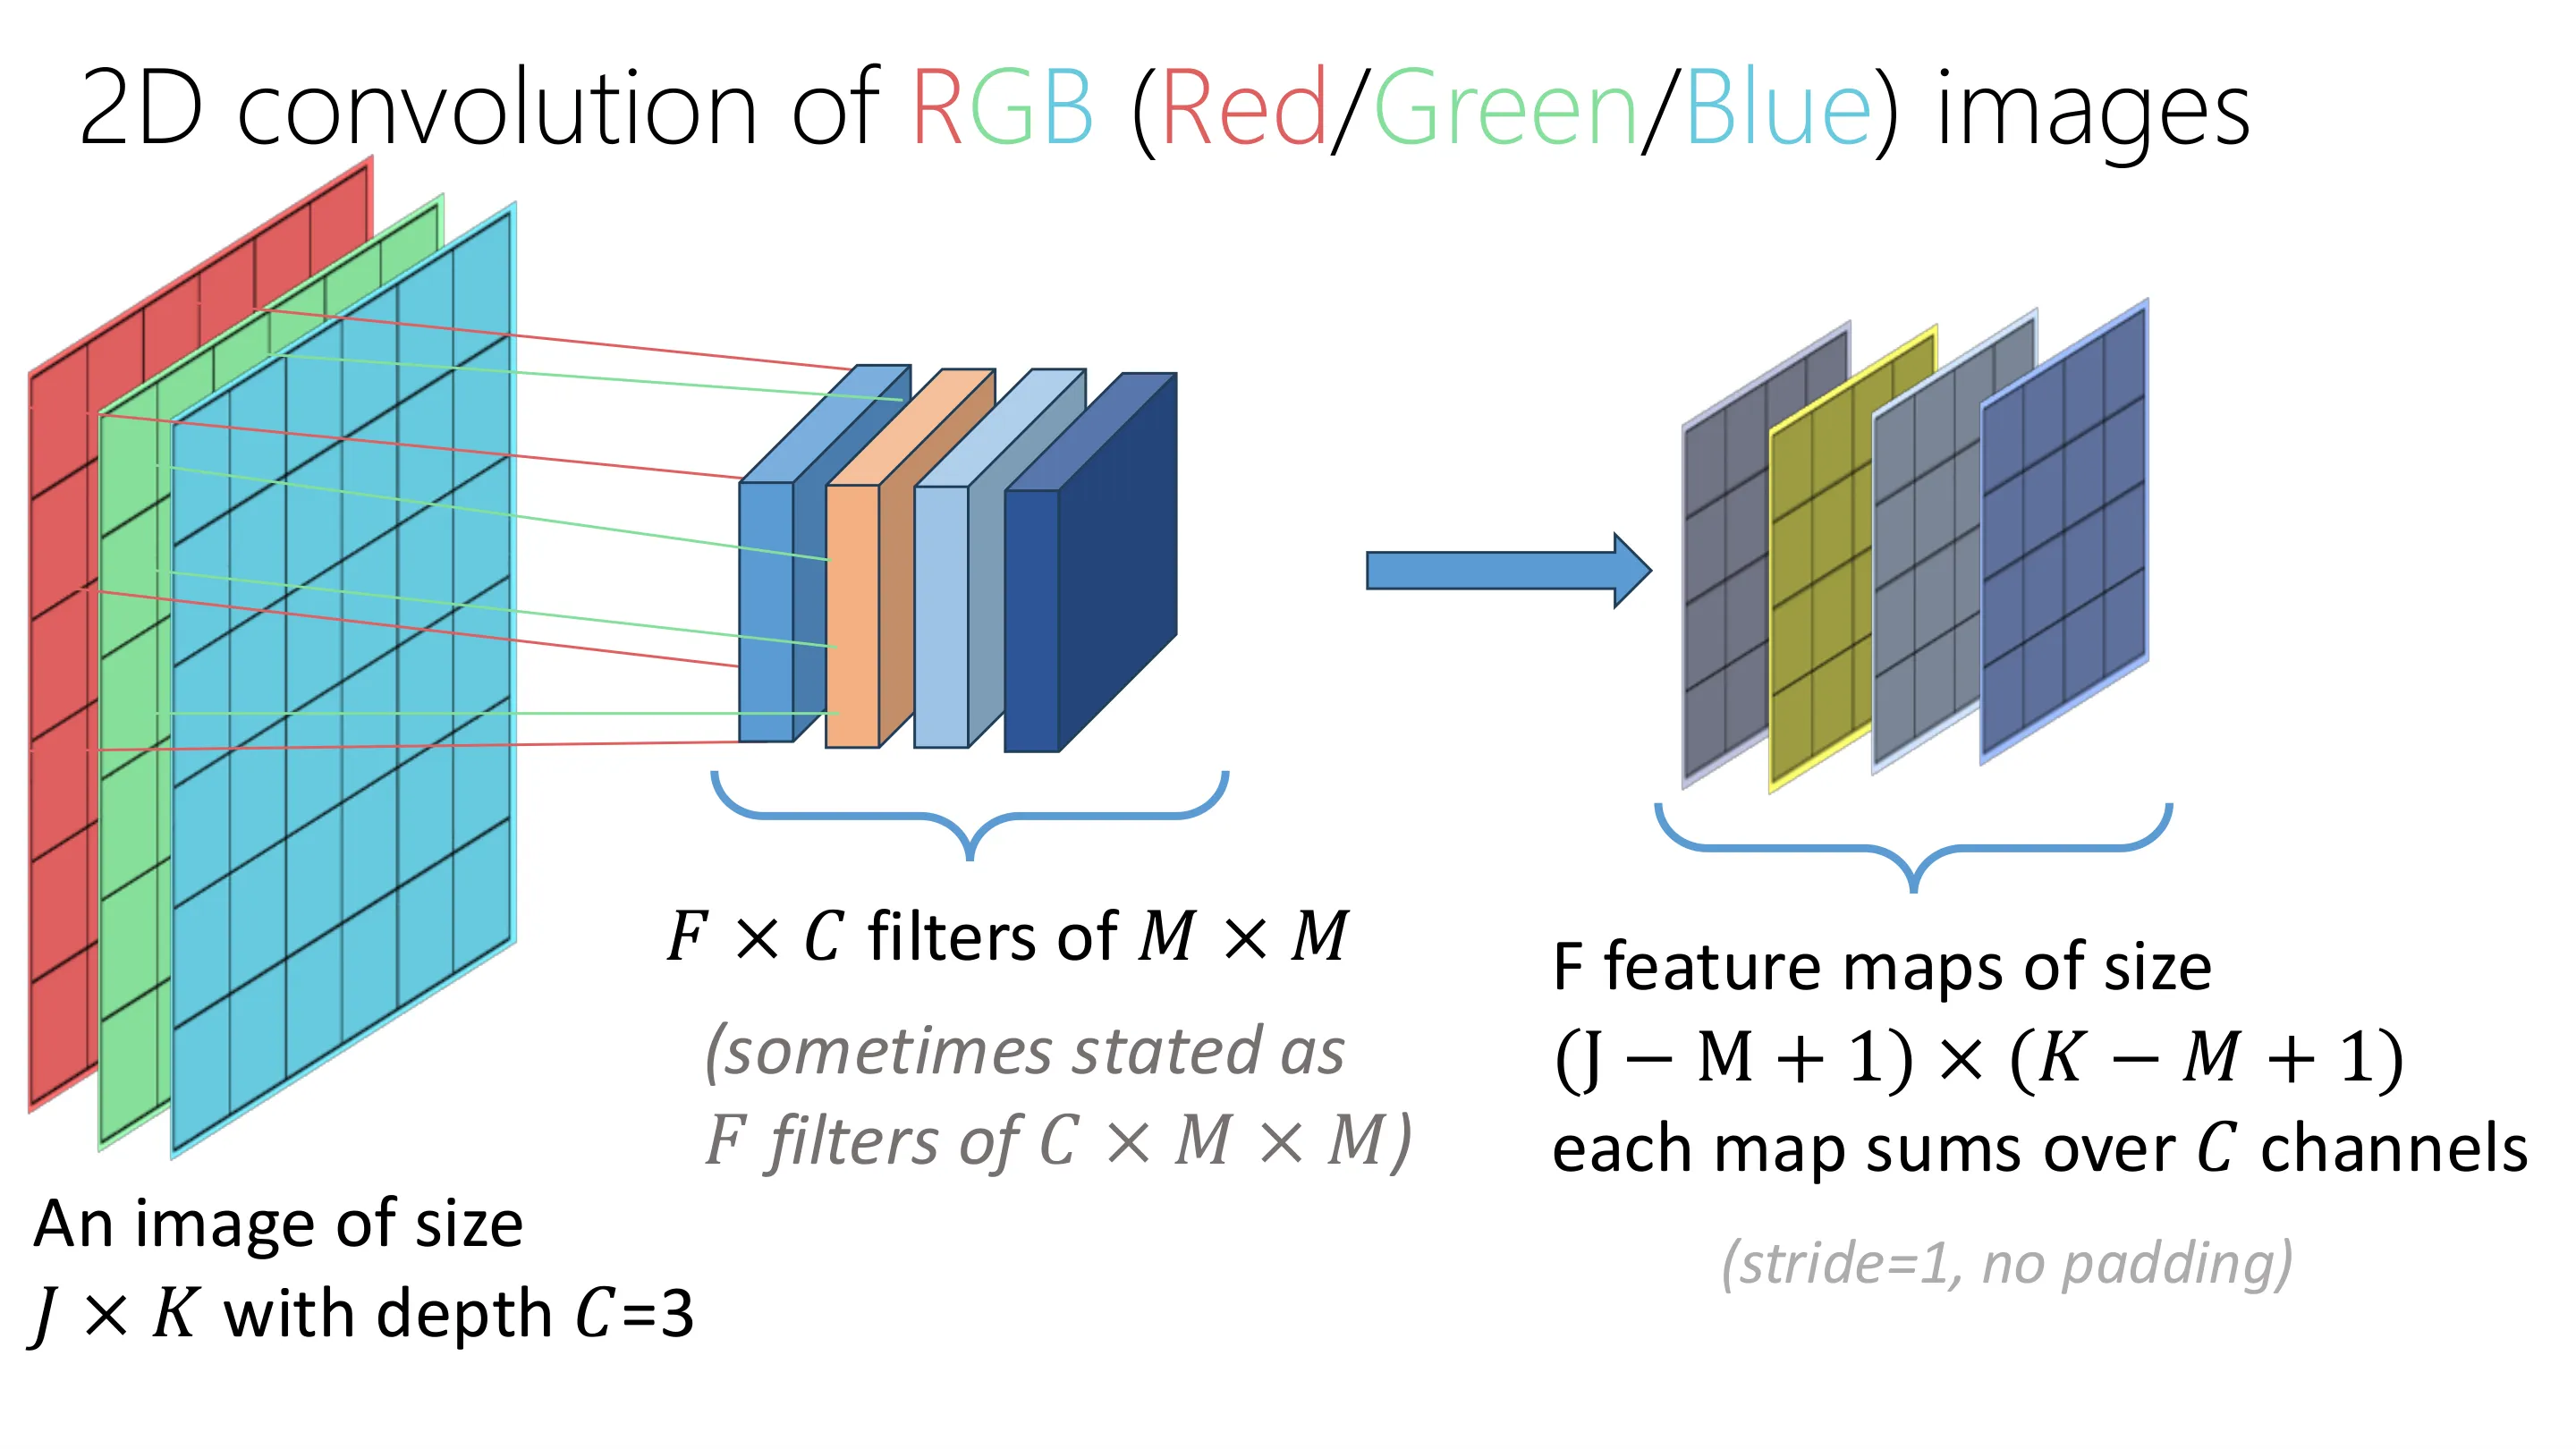
彩色图 RGB:有红/绿/蓝三个通道。做法是每个通道分别做二维卷积,且通道间不共享权重。所以「$F$ 个 $C\times M\times M$ 的滤波器」这种说法,只是把 $C$ 个二维滤波器堆成一个三维对象,实际做的仍是二维卷积(不是三维卷积)。三维卷积只在体数据(如某些医学影像)上才有意义。
术语警告:ML 里
depth、feature map等词被滥用,含义随上下文变化——这是 ML 最让人困惑的地方,不是技术内容,而是不精确的措辞。
📷 $F$ 个 $M\times M$ 的滤波器
回到原视频 (00:12:30)
📷 一个尺寸为 …… 的图像
回到原视频 (00:13:43)
二、池化(Pooling)
(参考时间: 00:14)
CNN 不只是卷积层:典型结构是 conv (+ ReLU) → pooling 反复堆叠,最后 flatten 再接全连接层 / 分类头 / 回归头。可以把最后几层看成在学到的特征上做逻辑回归 / 线性回归。
池化做什么?
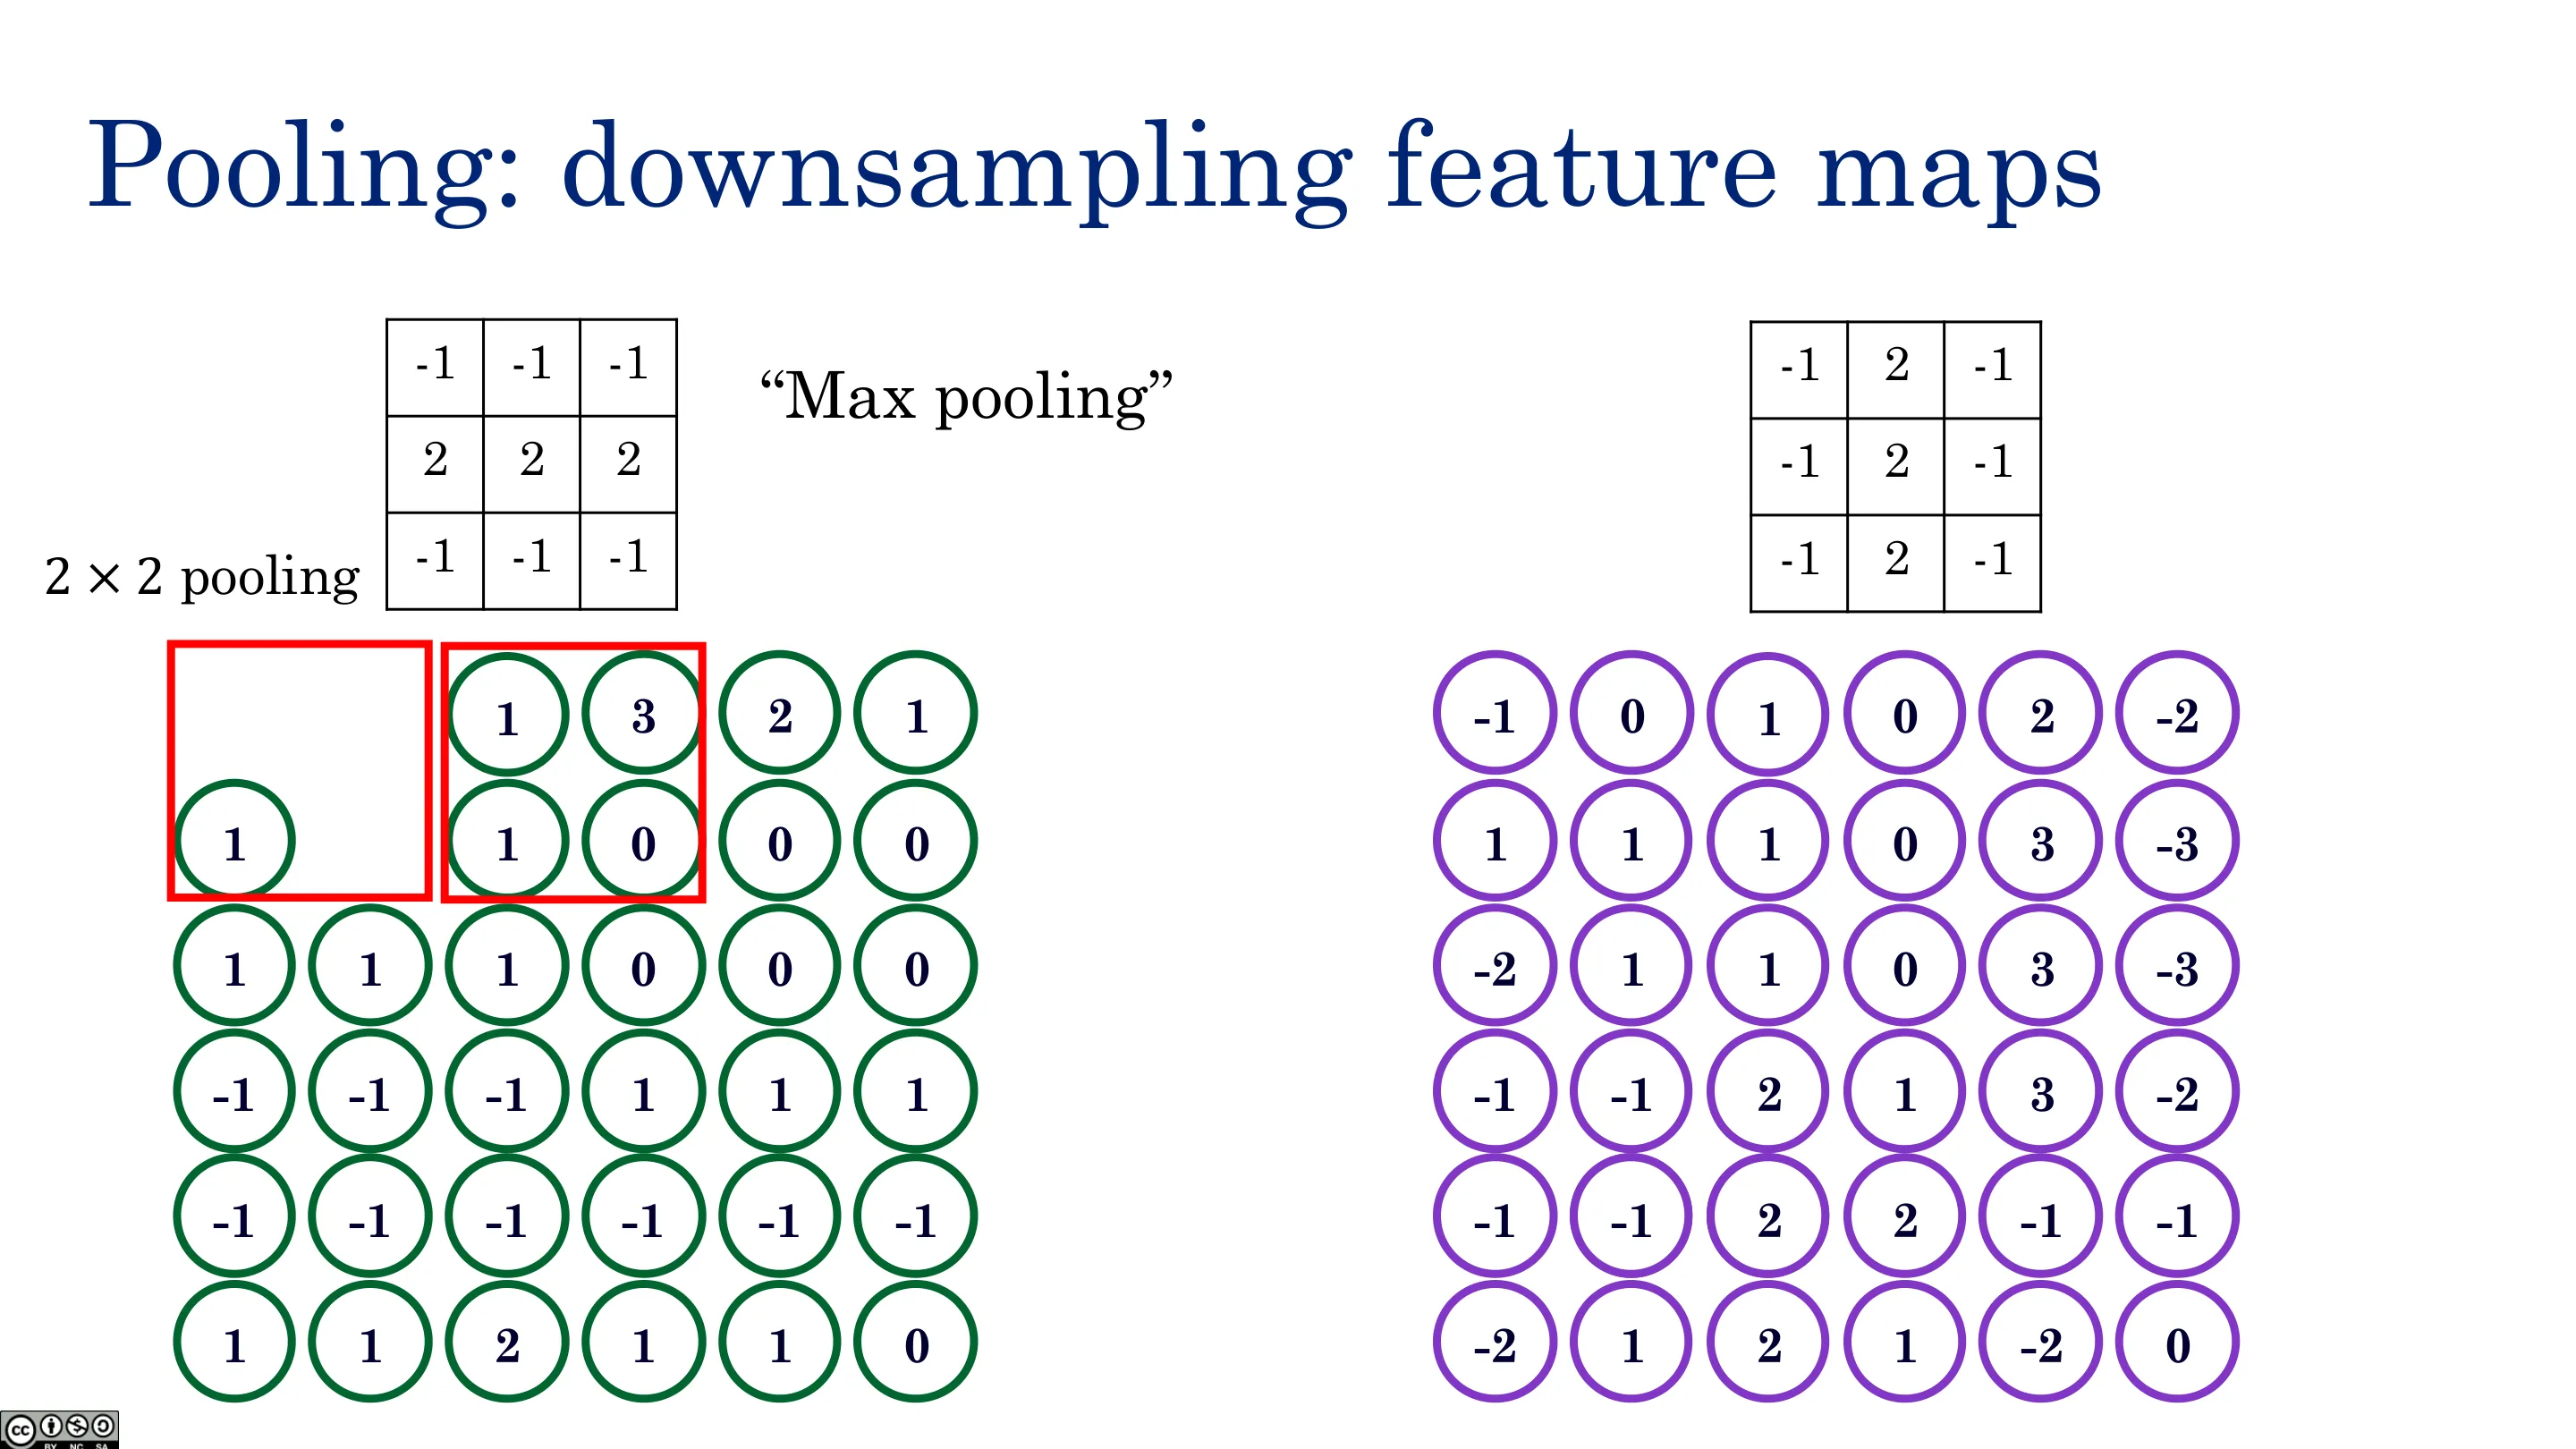
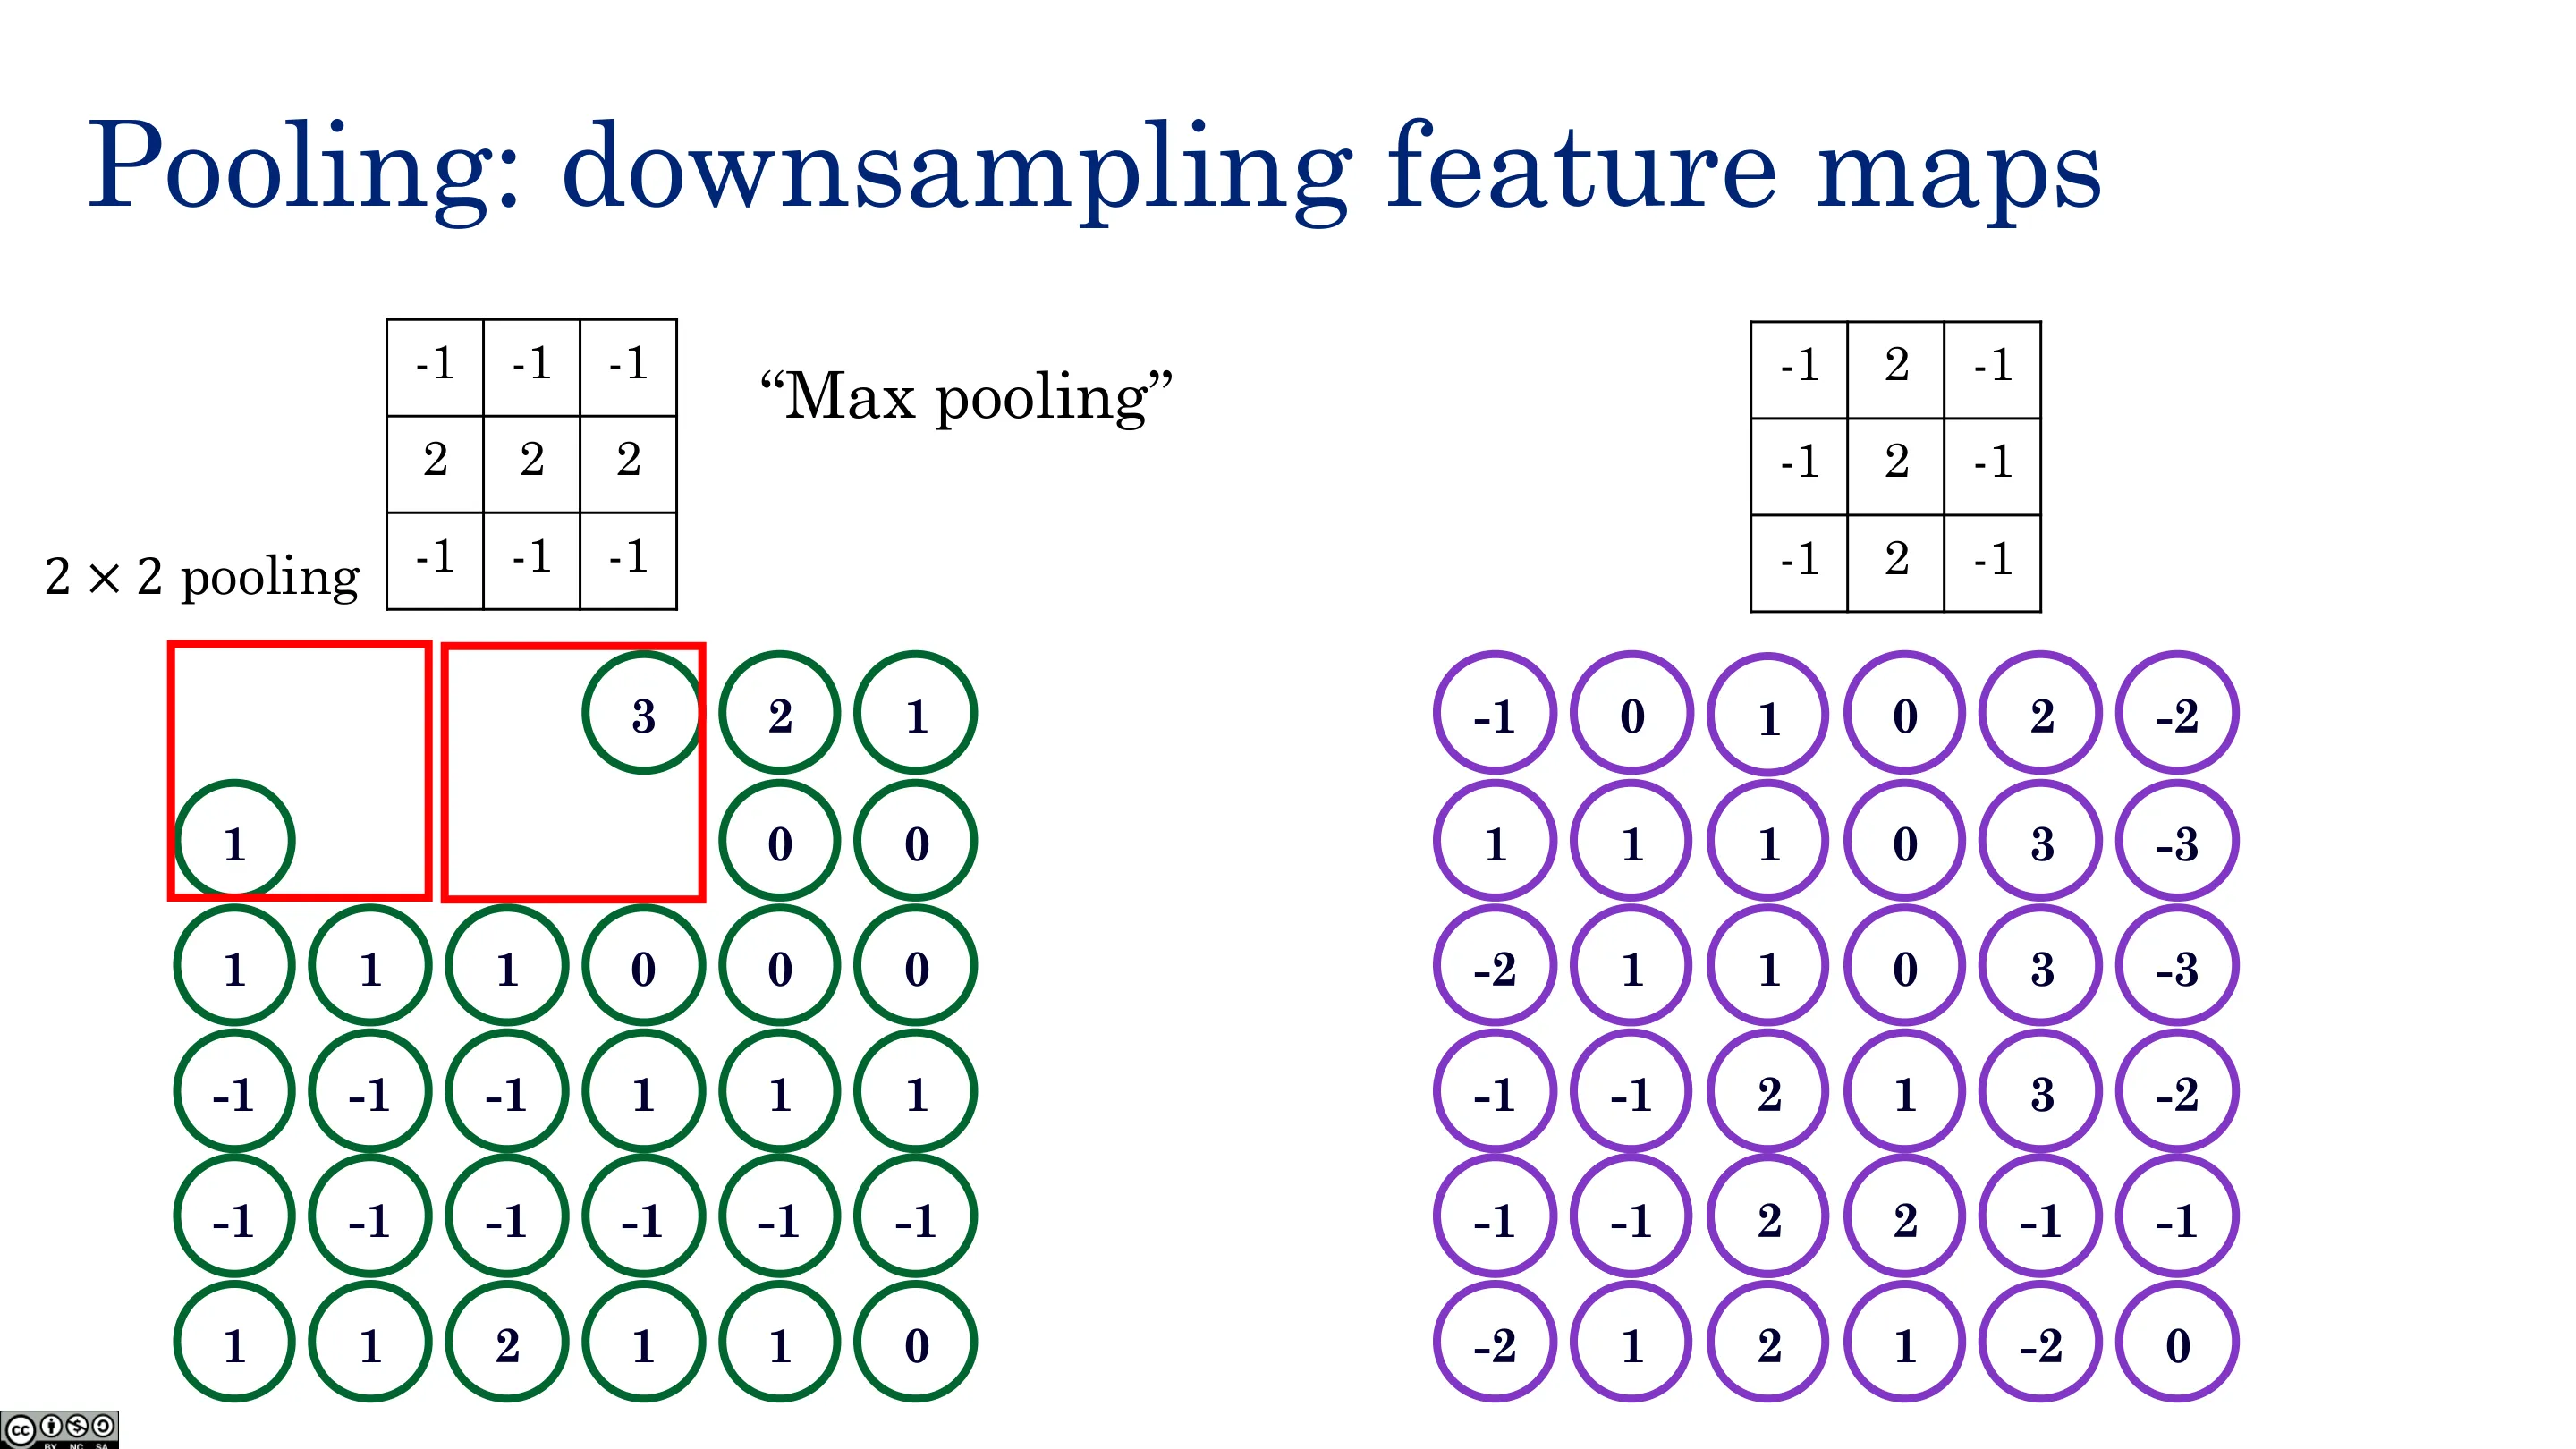
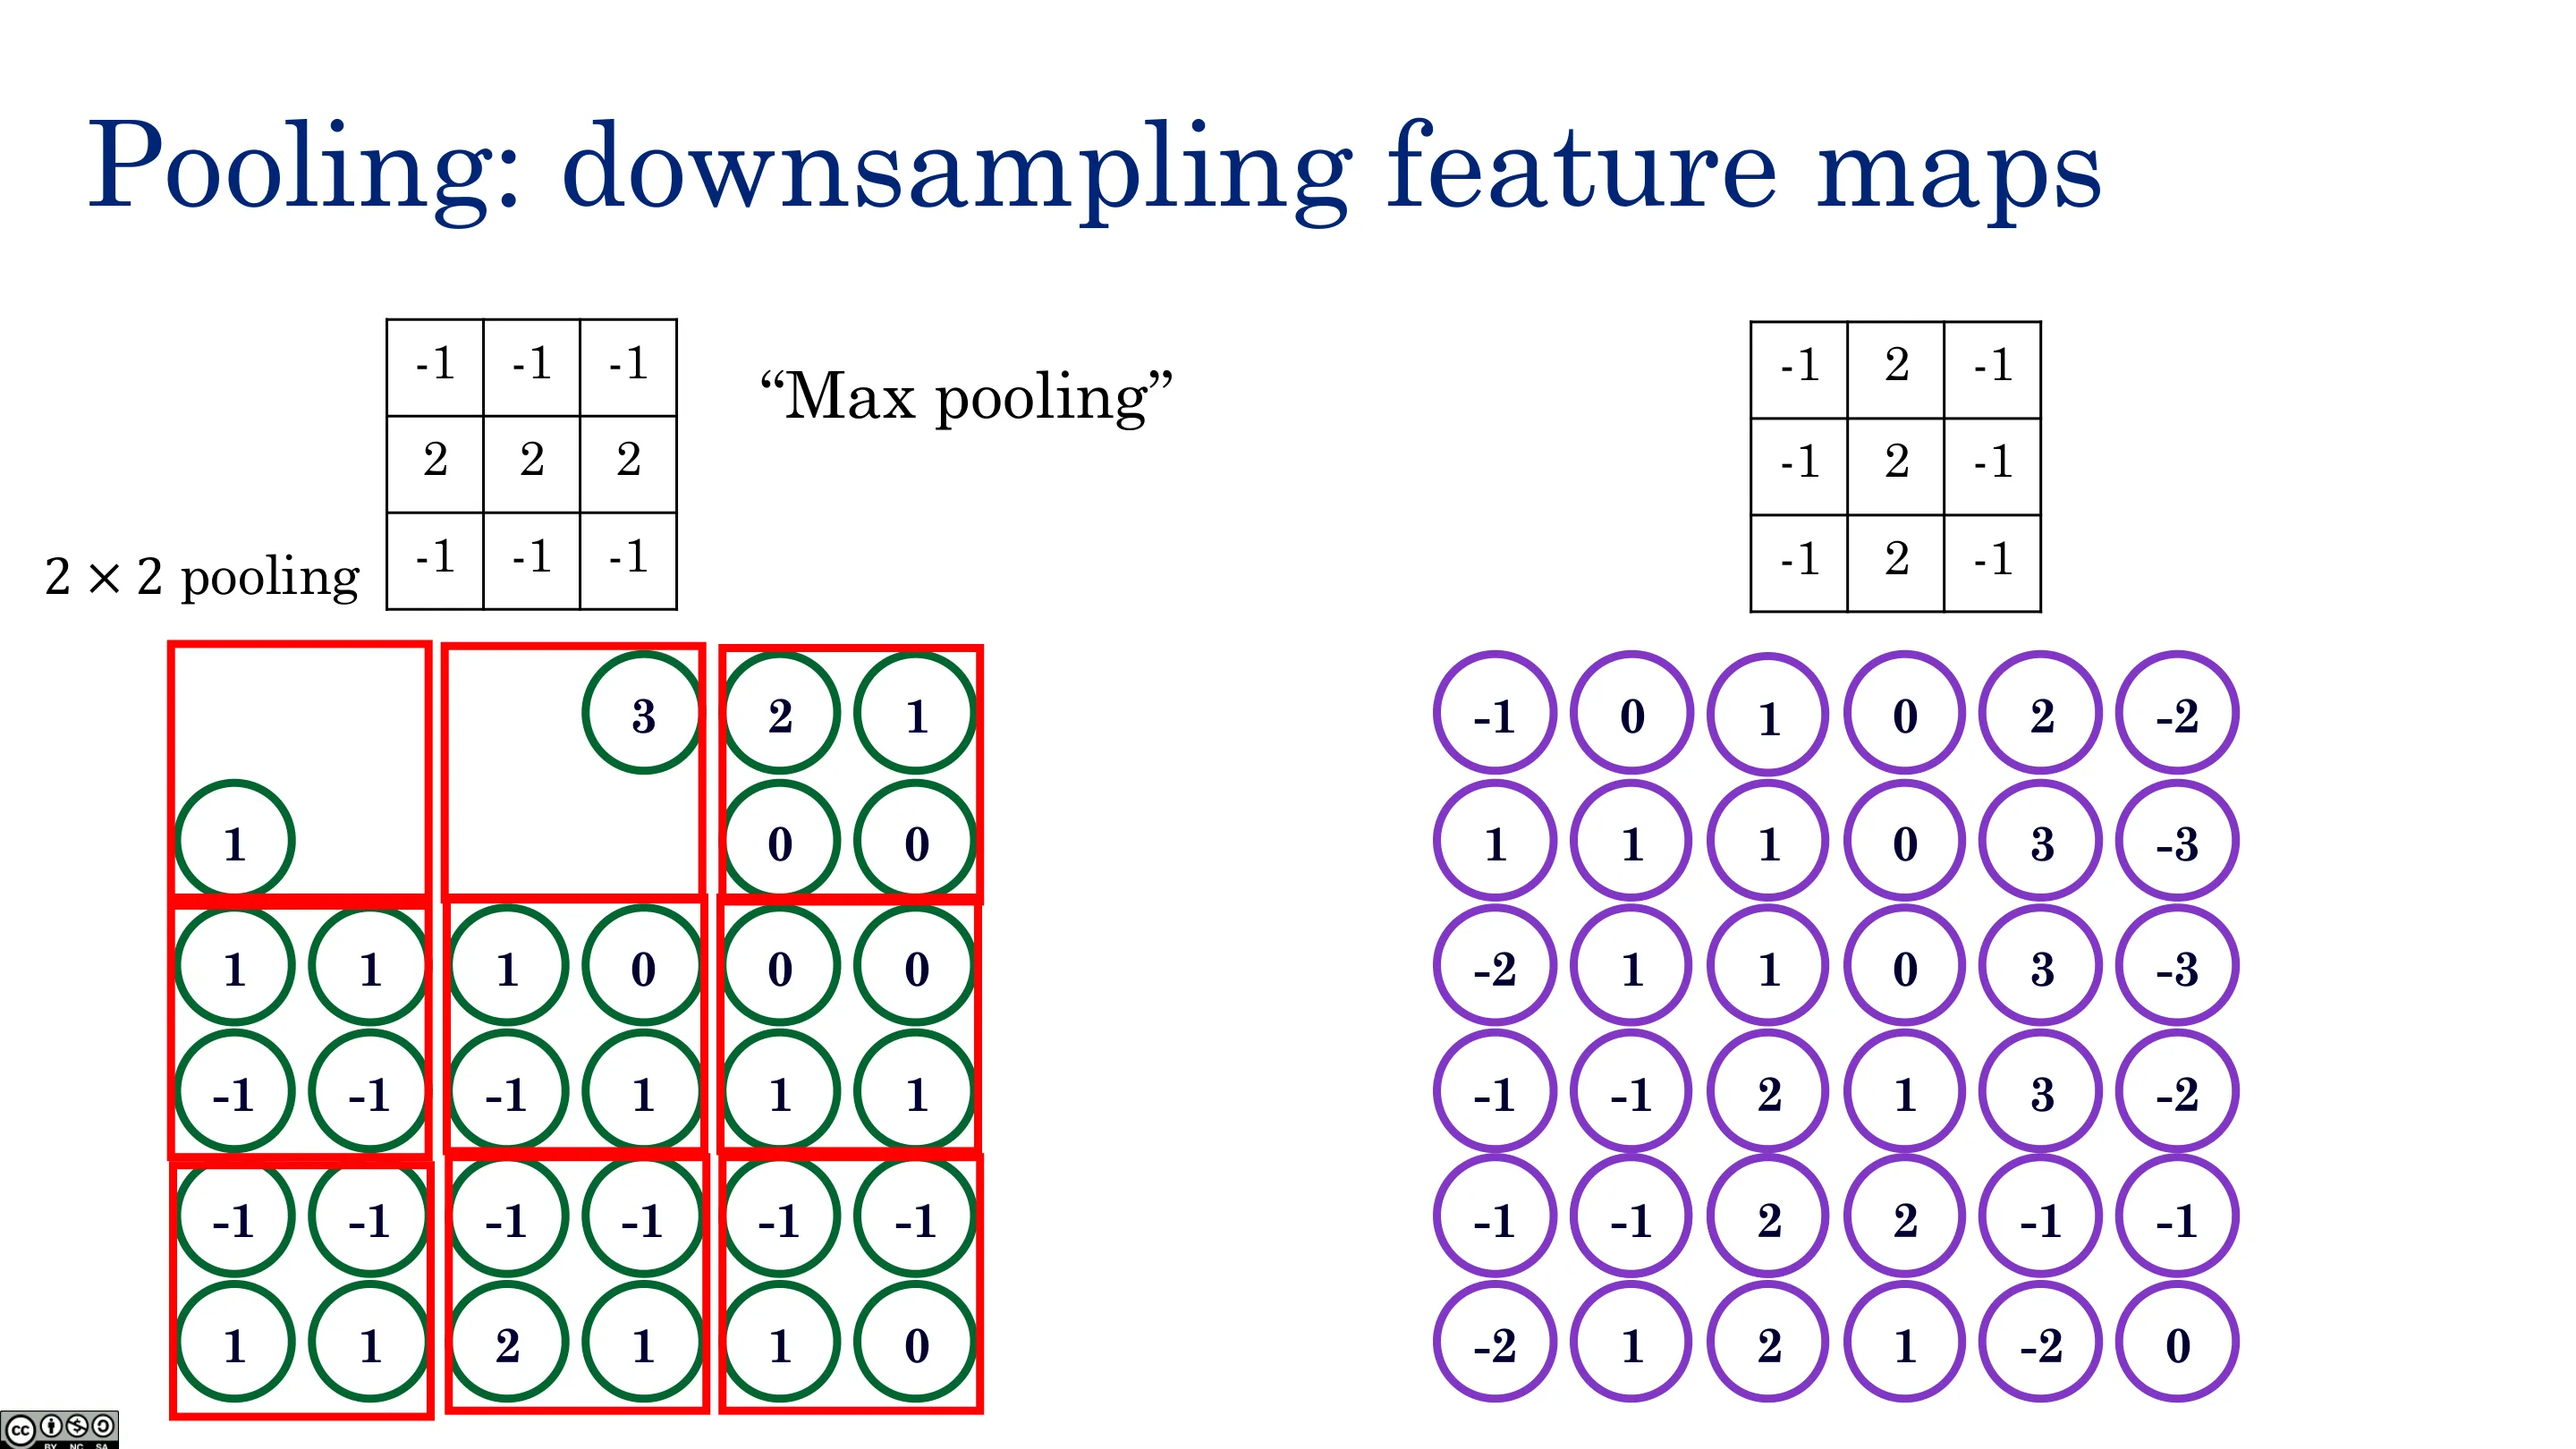
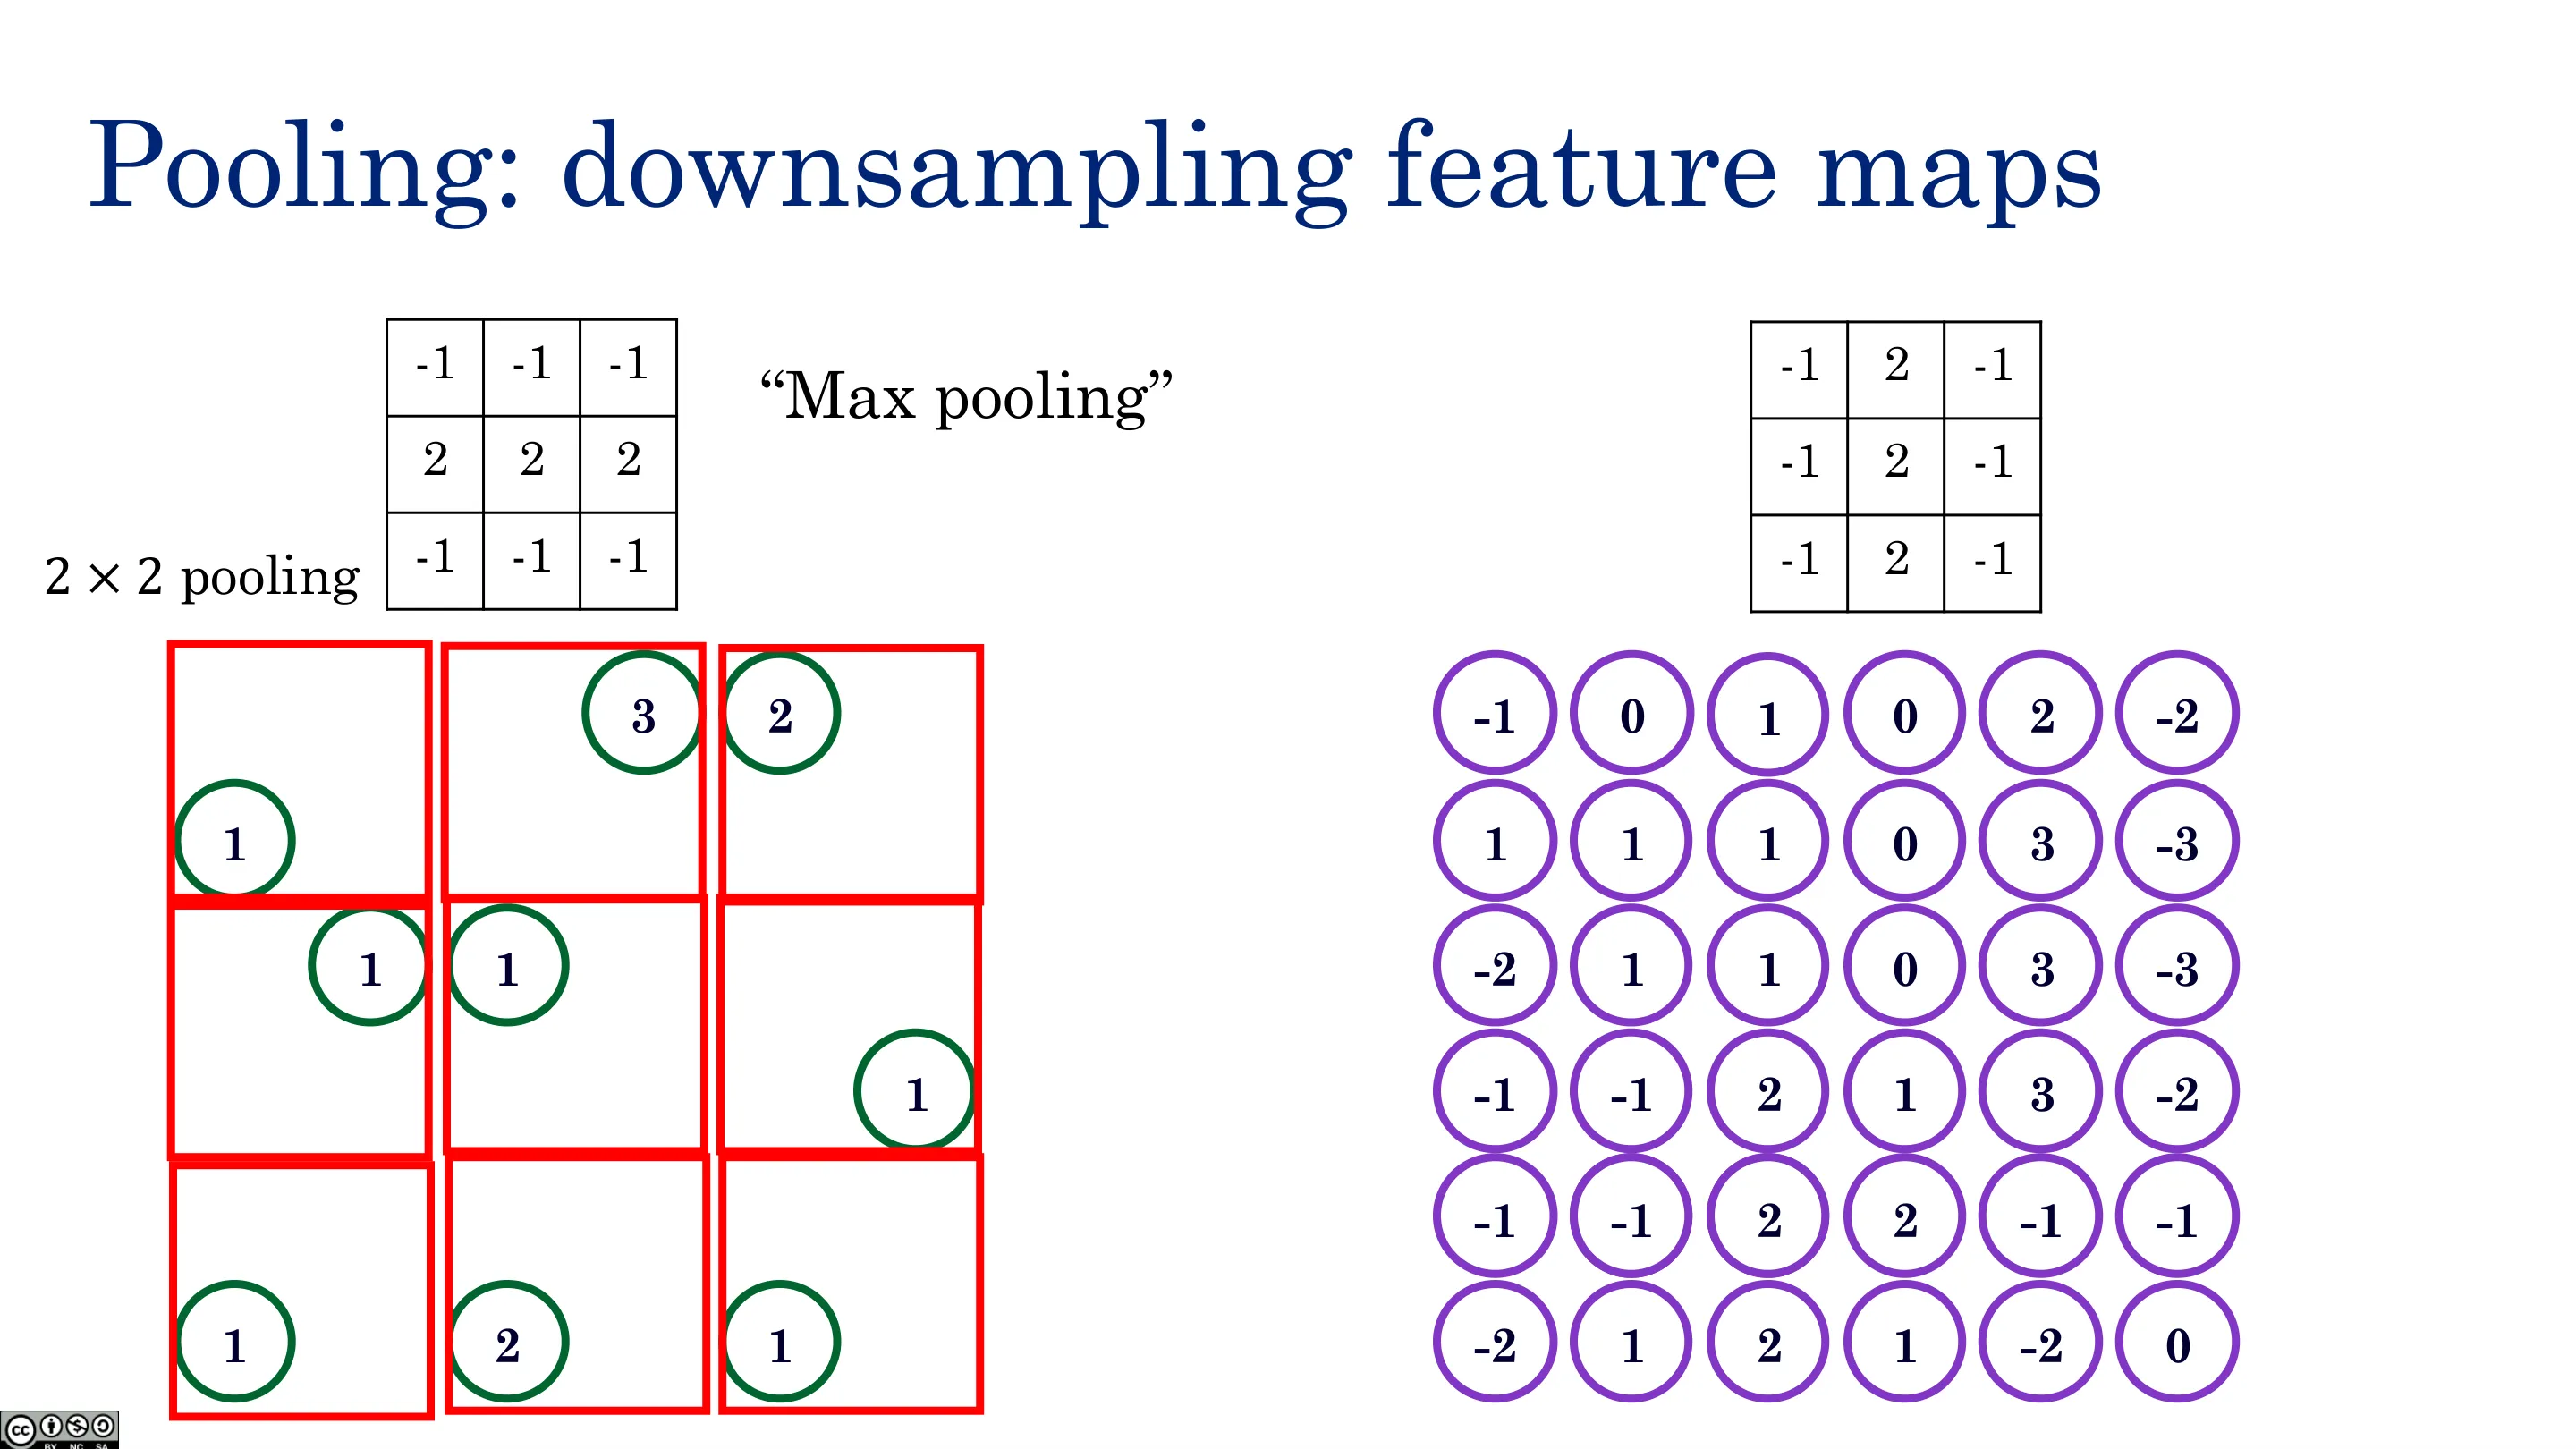
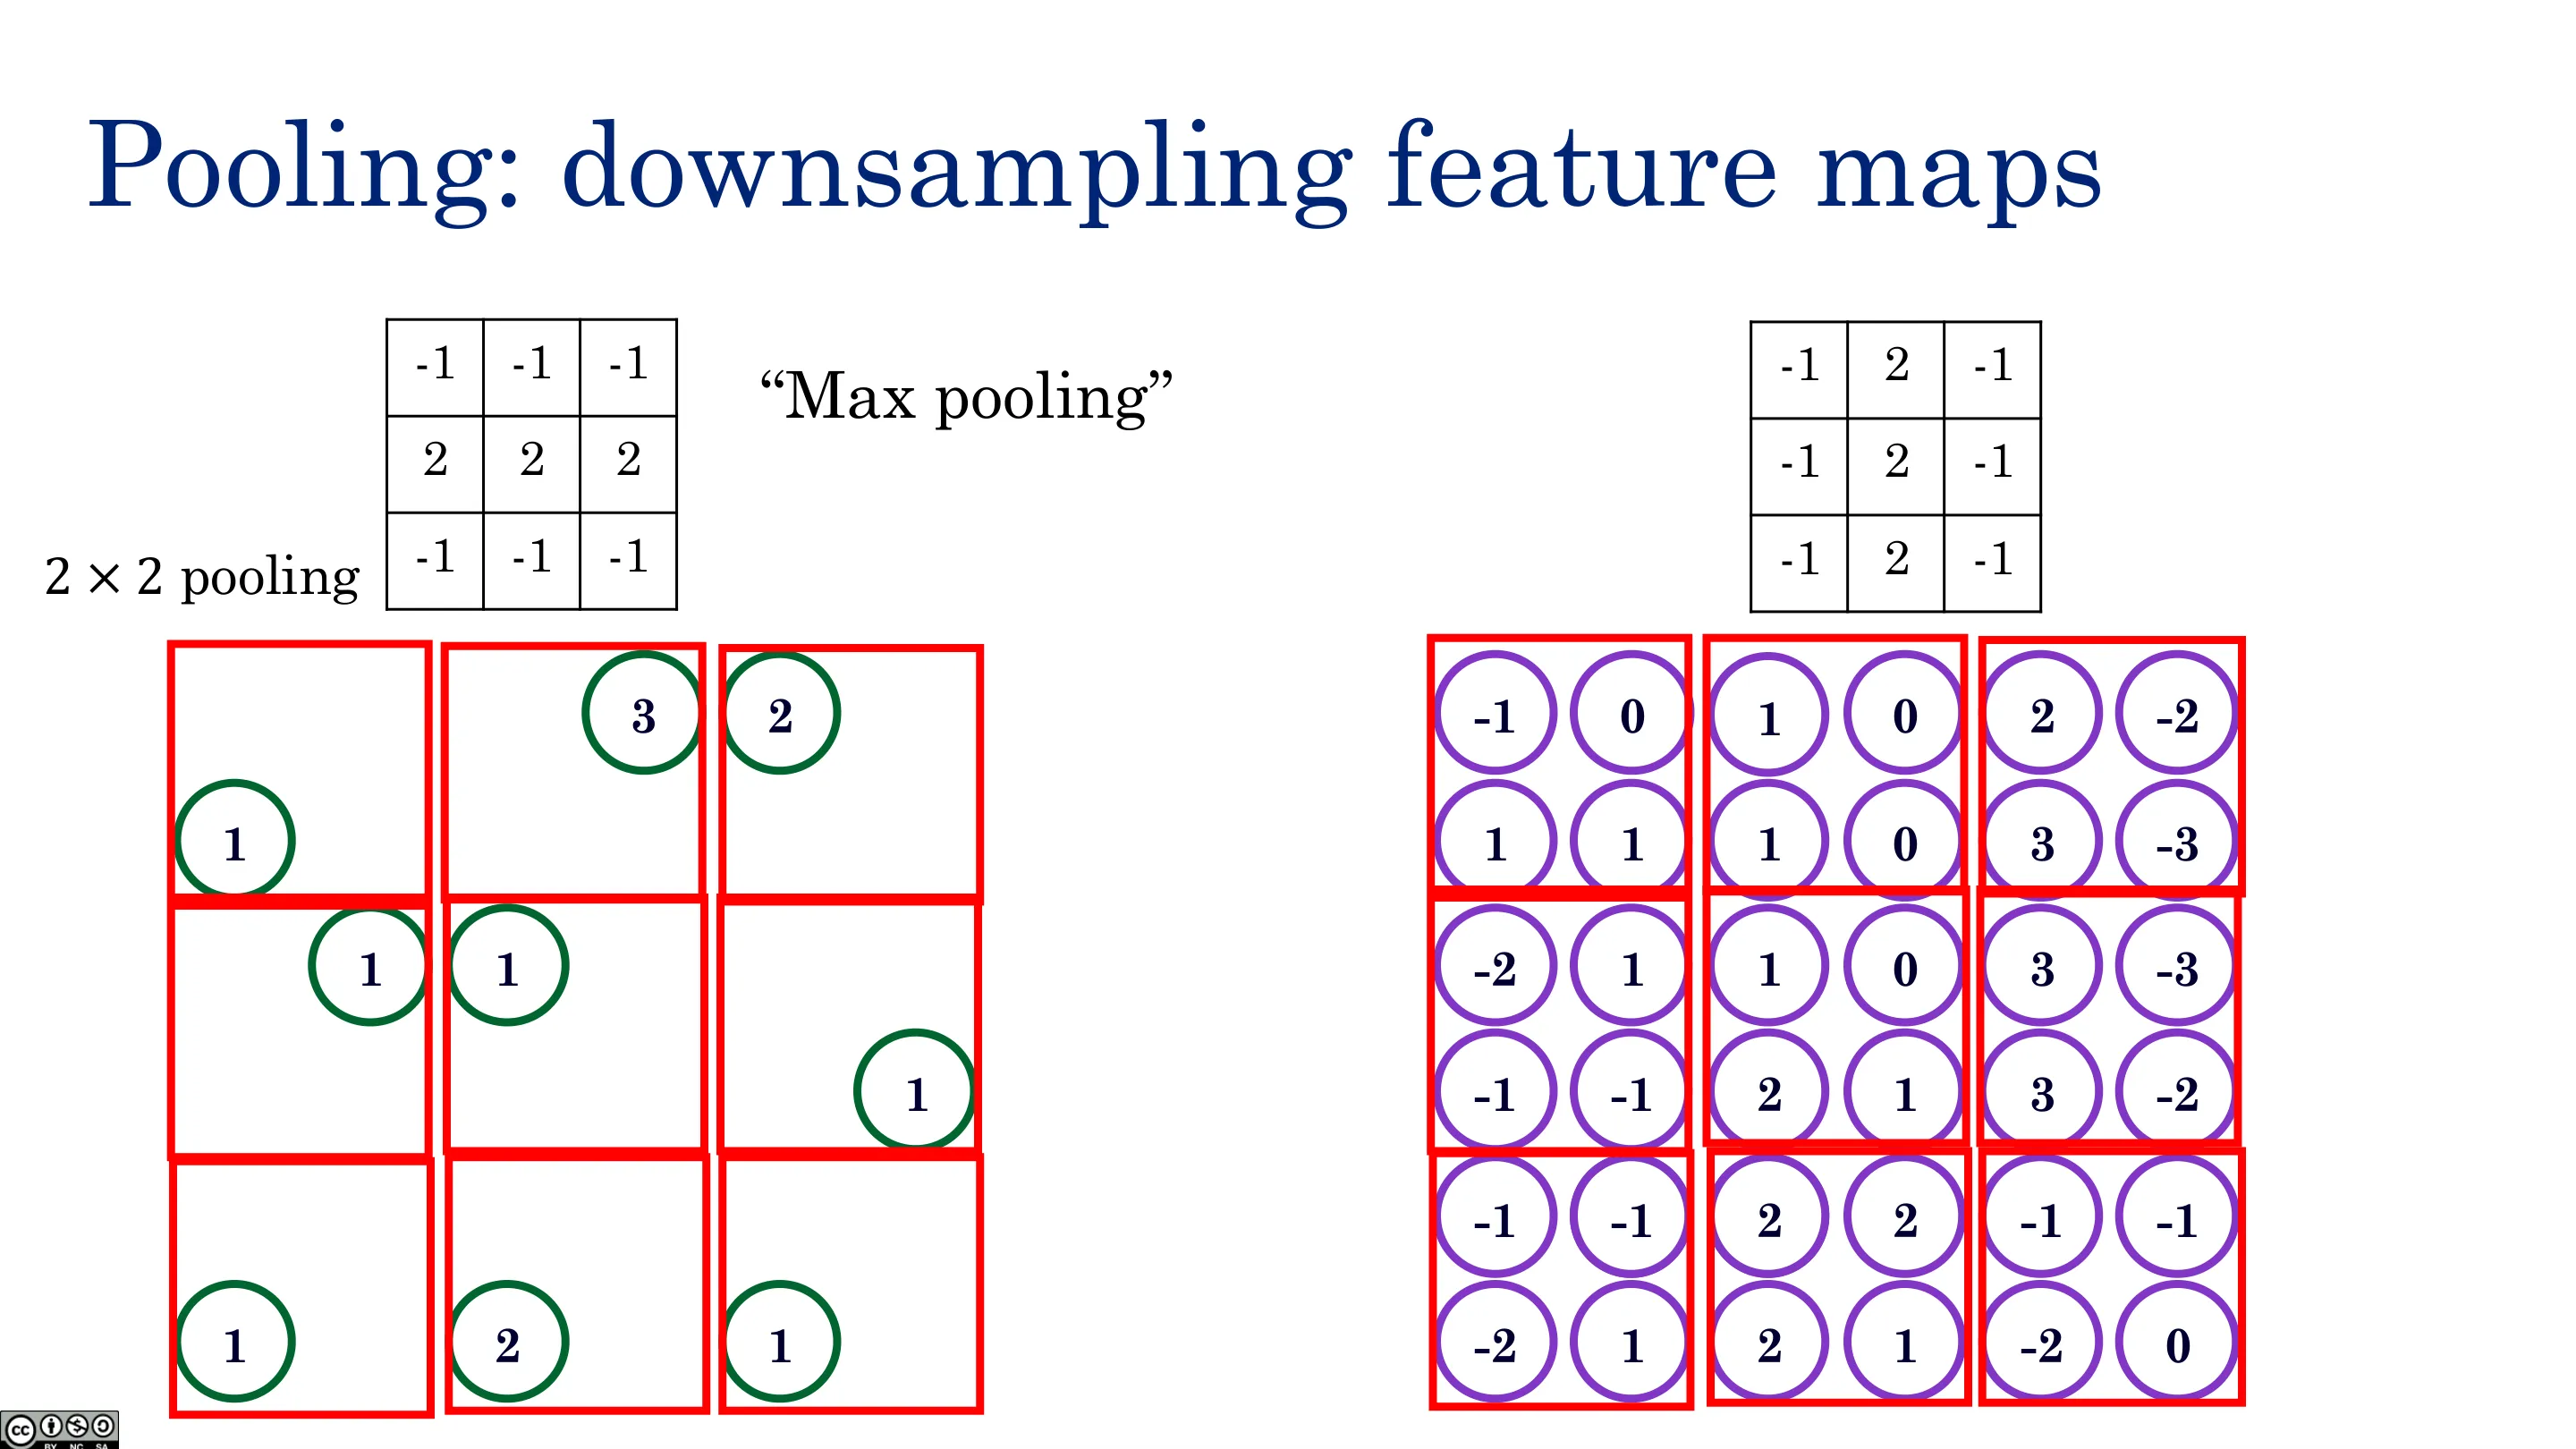
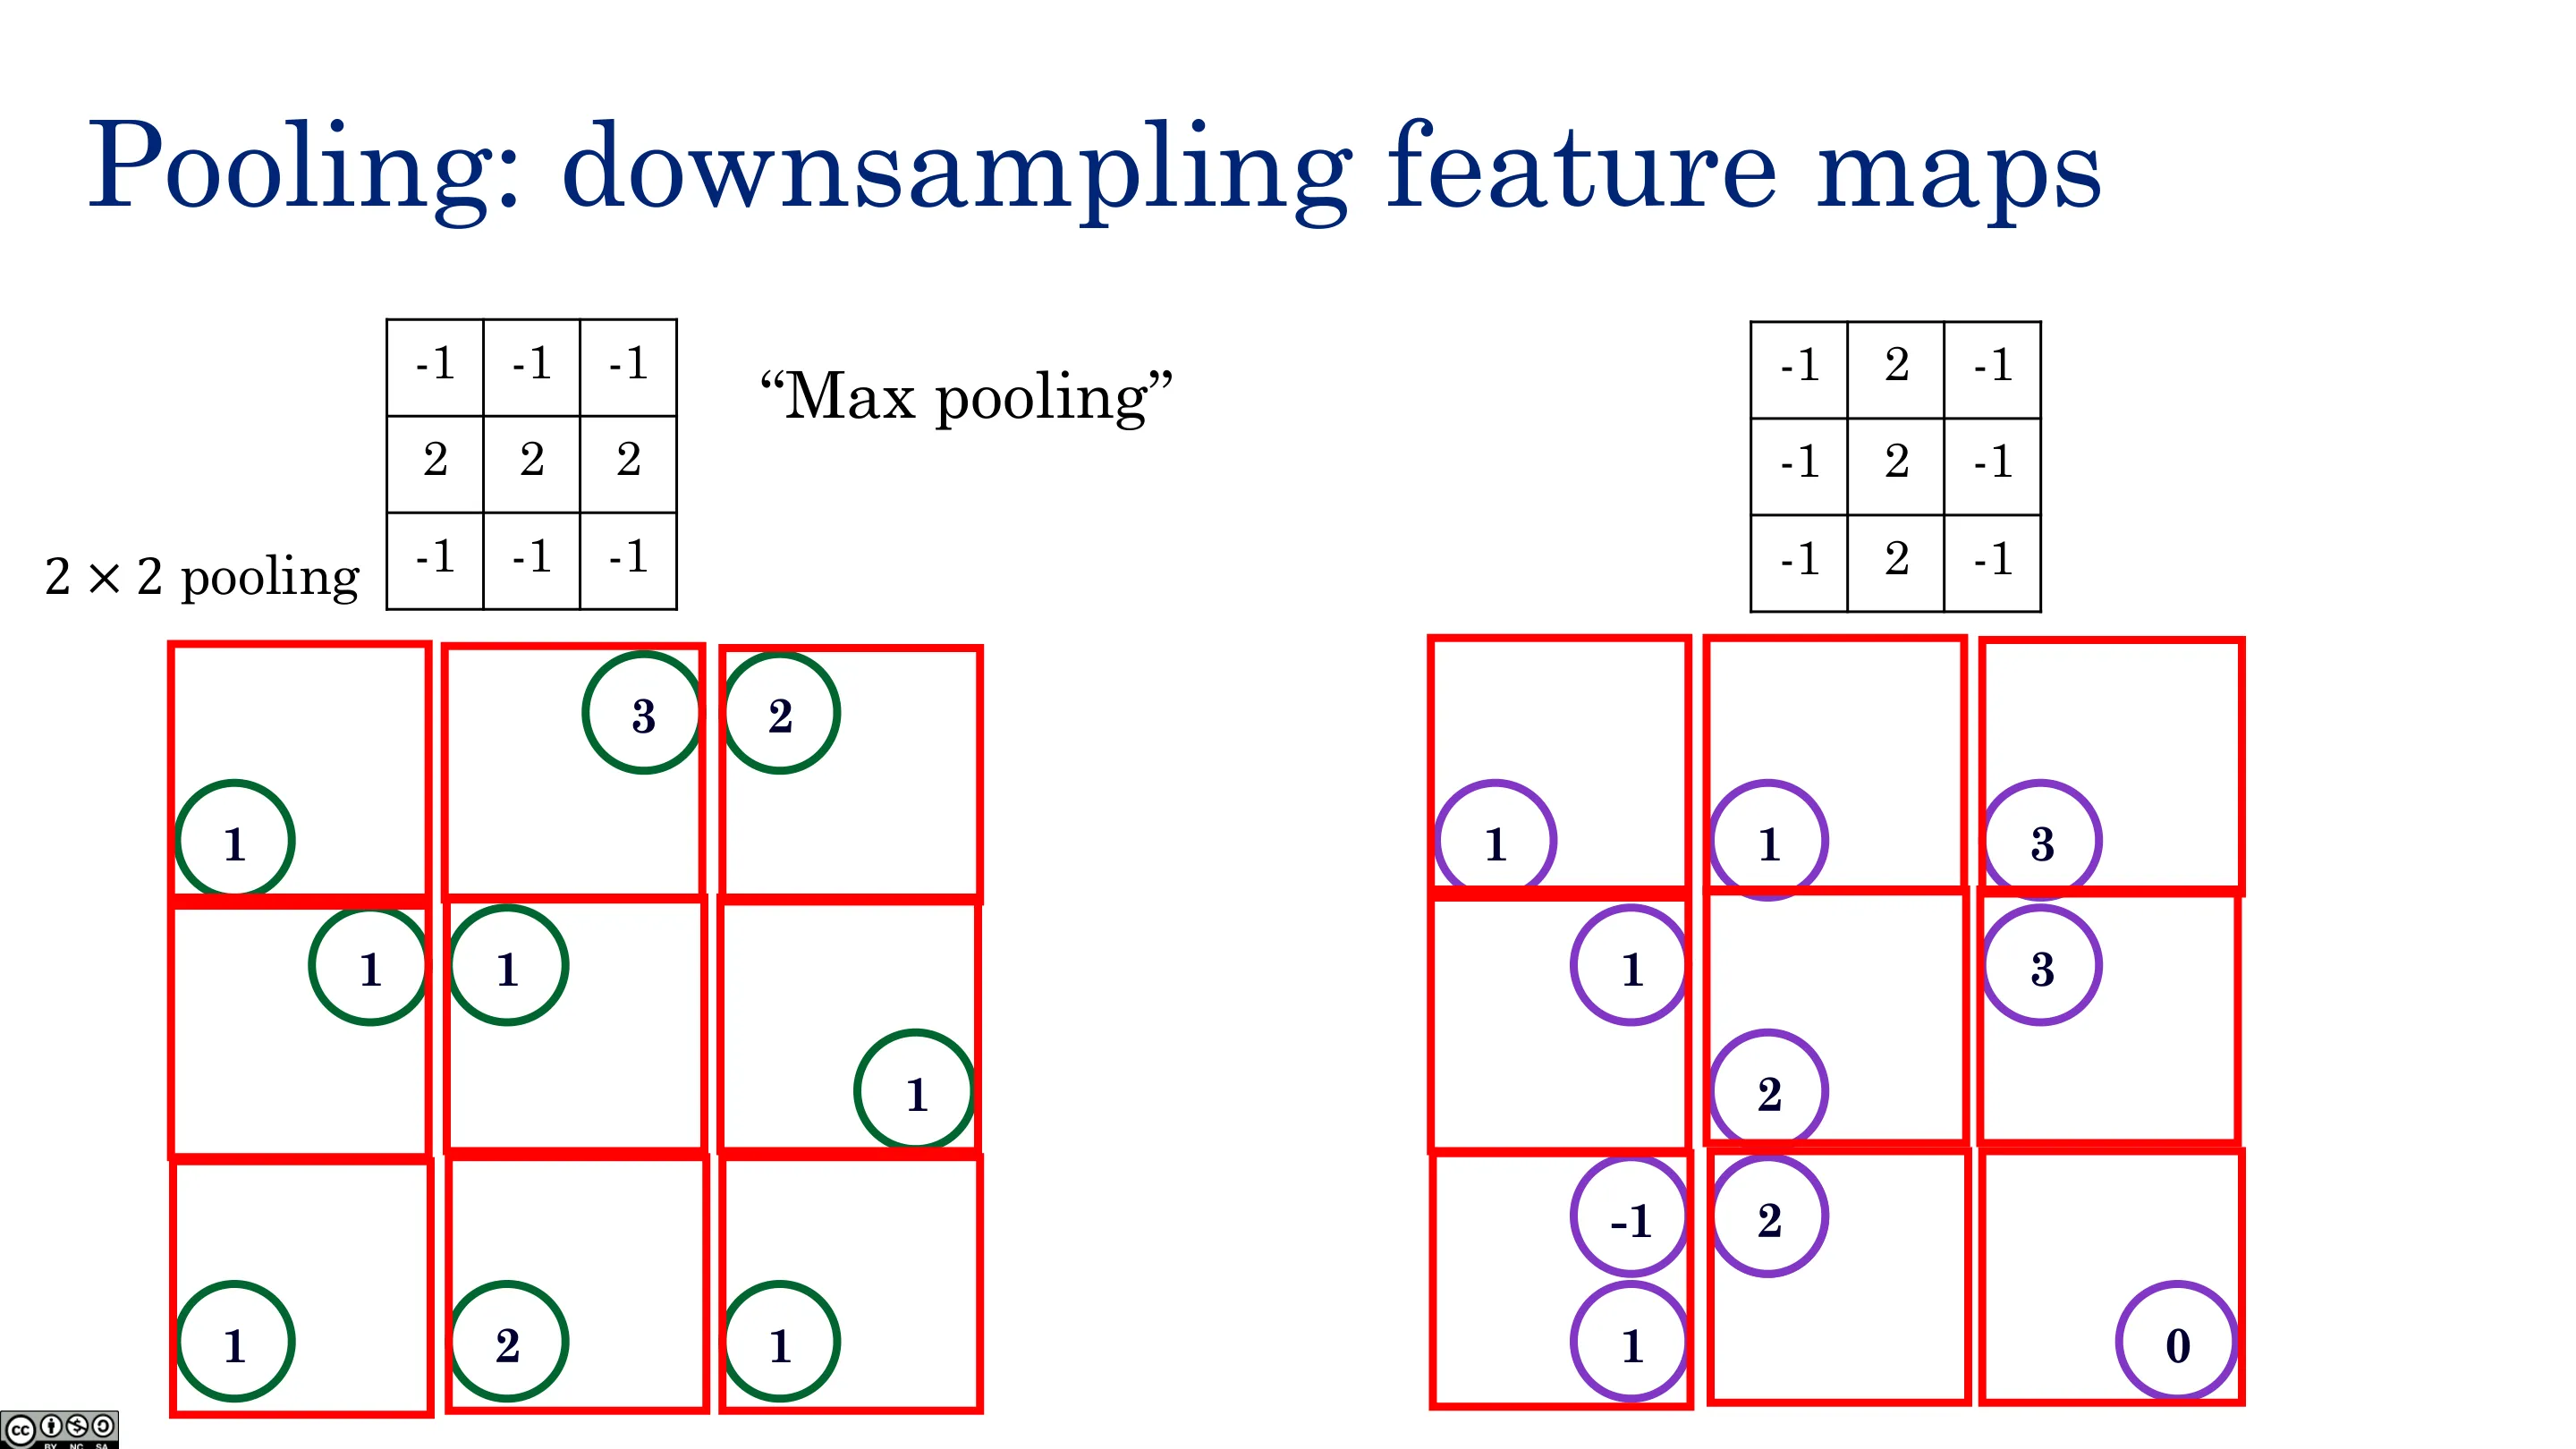
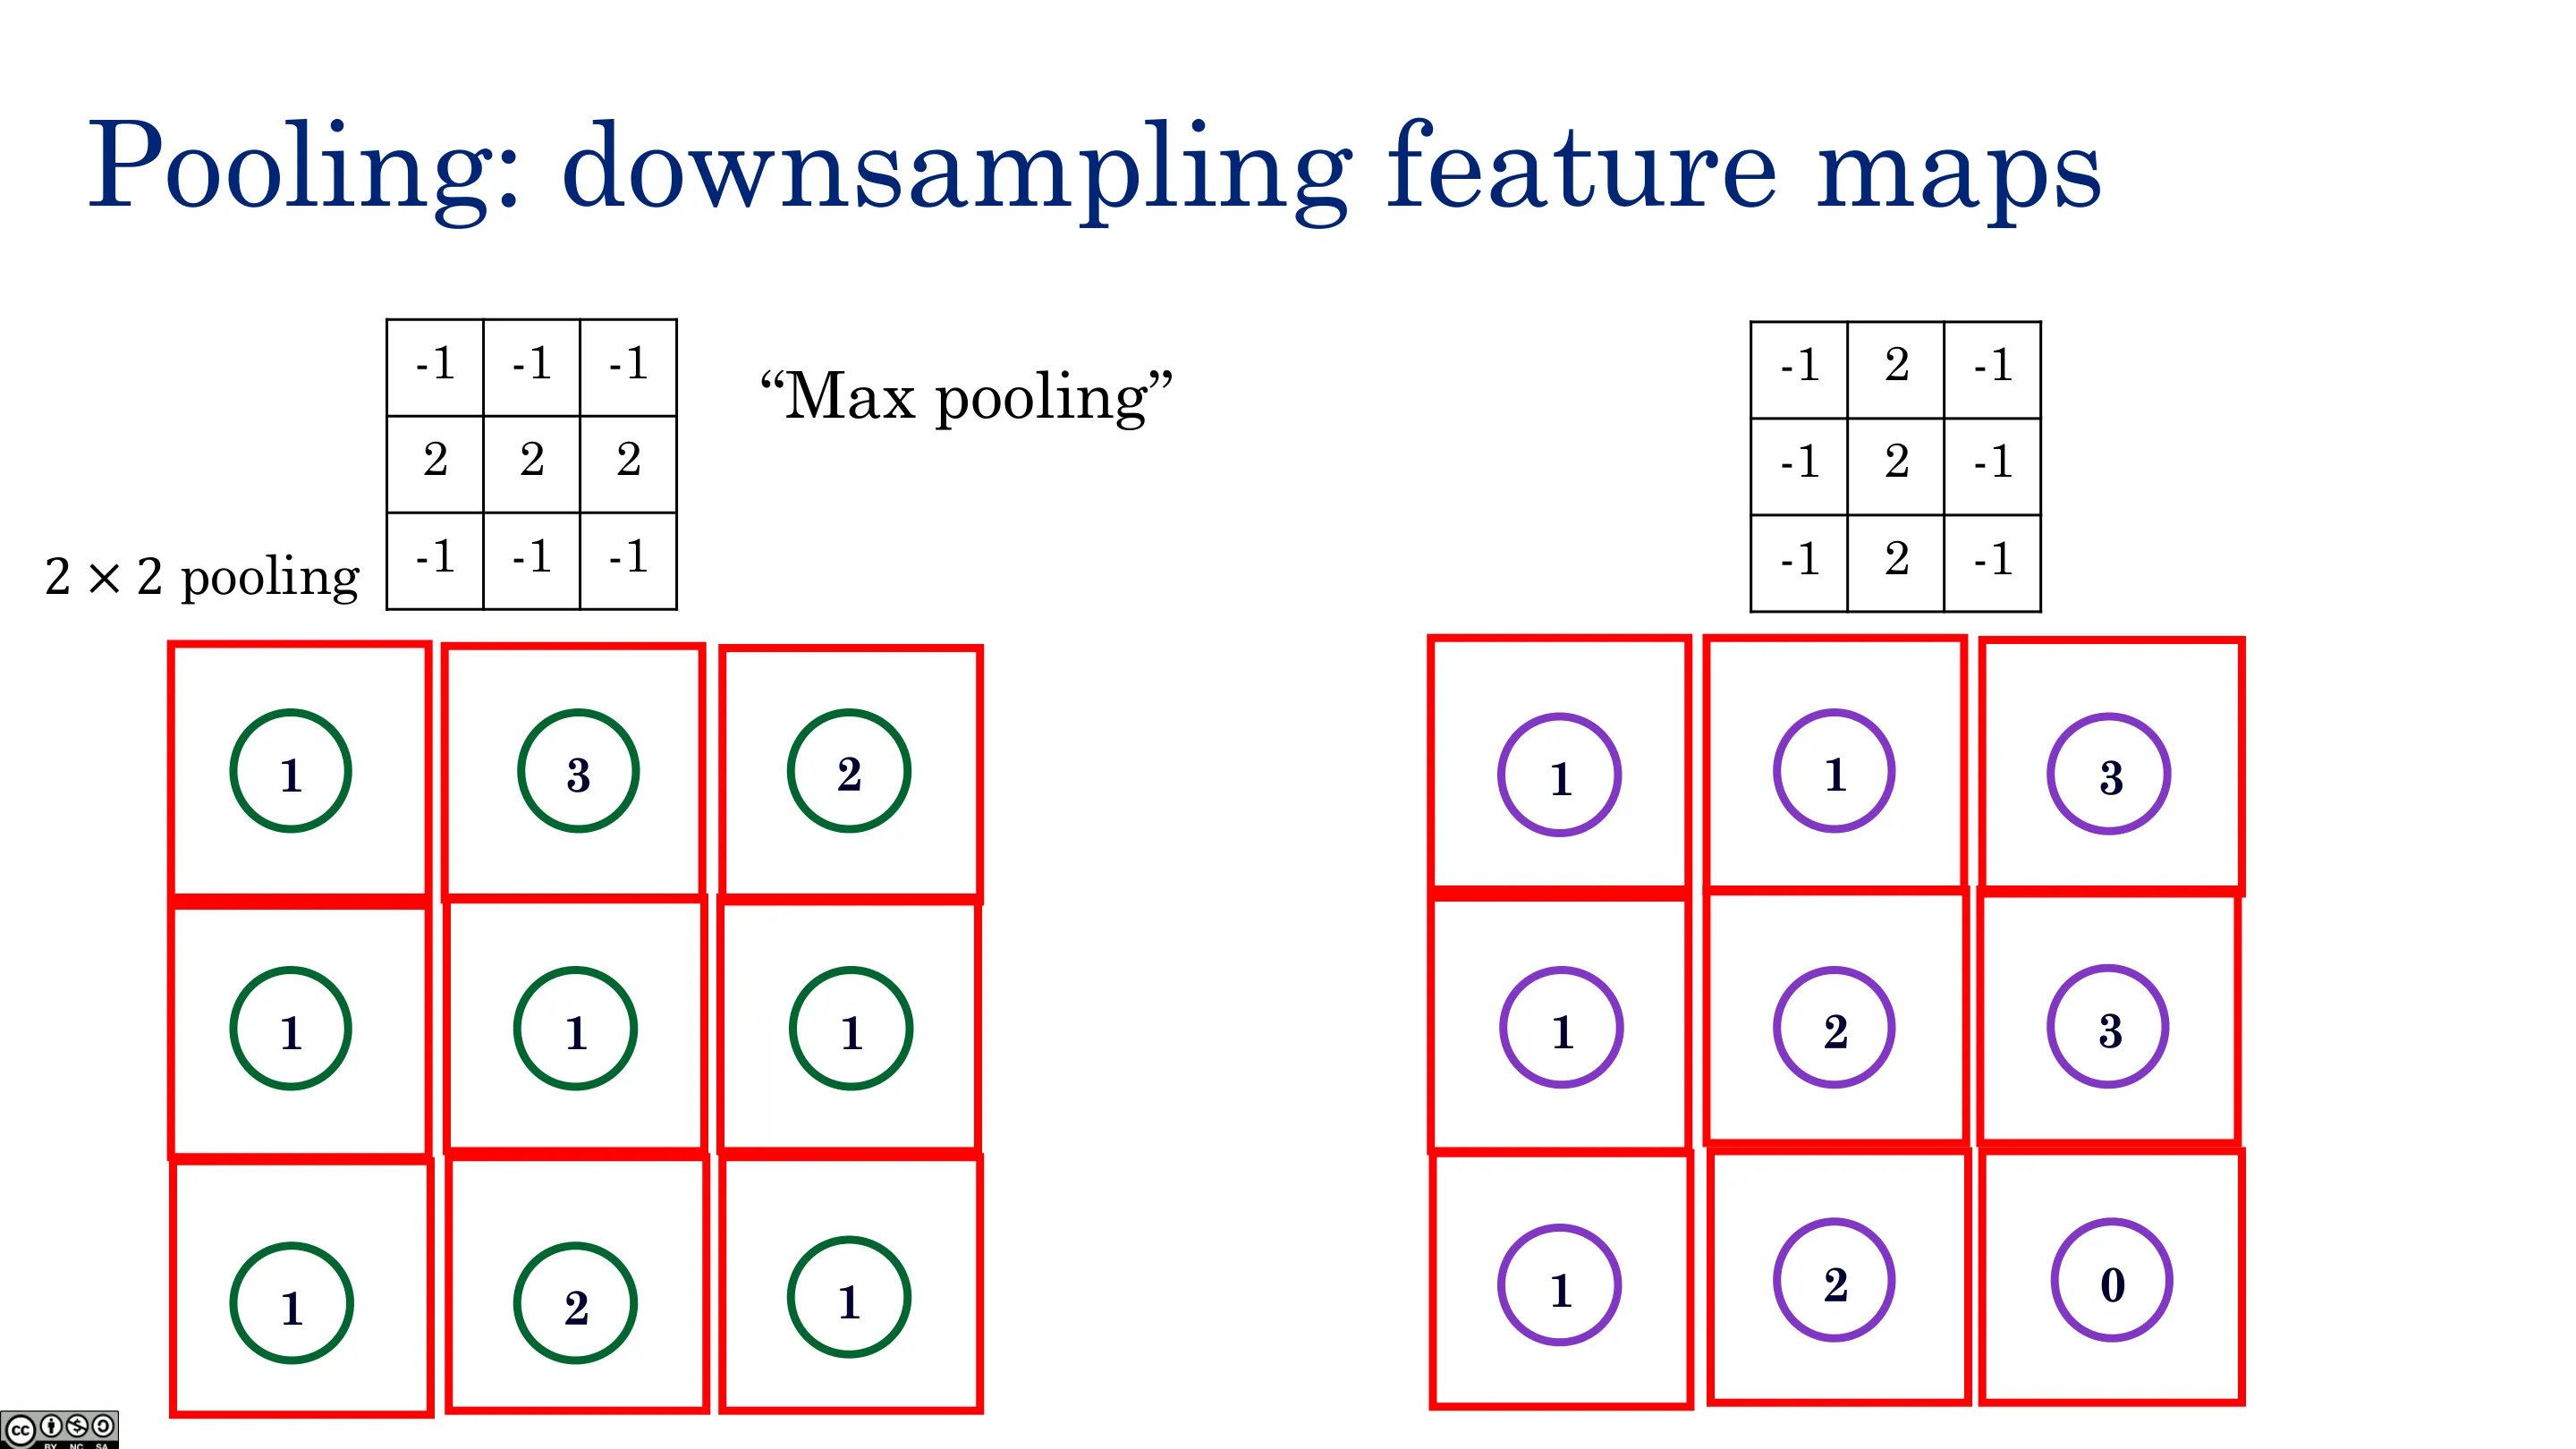
- 逐步降维:经验上「慢慢降维」比「一下子变小」更好。池化按窗口(如 $2\times2$)汇总,也带 stride;
- 局部不变性:max pooling 取窗口内最大值 ⇒ 只要特征(如「眼睛」)落在窗口内,稍微平移不影响输出。
机制:池化没有可学习参数,本质是取 max(max 本身是非线性)。
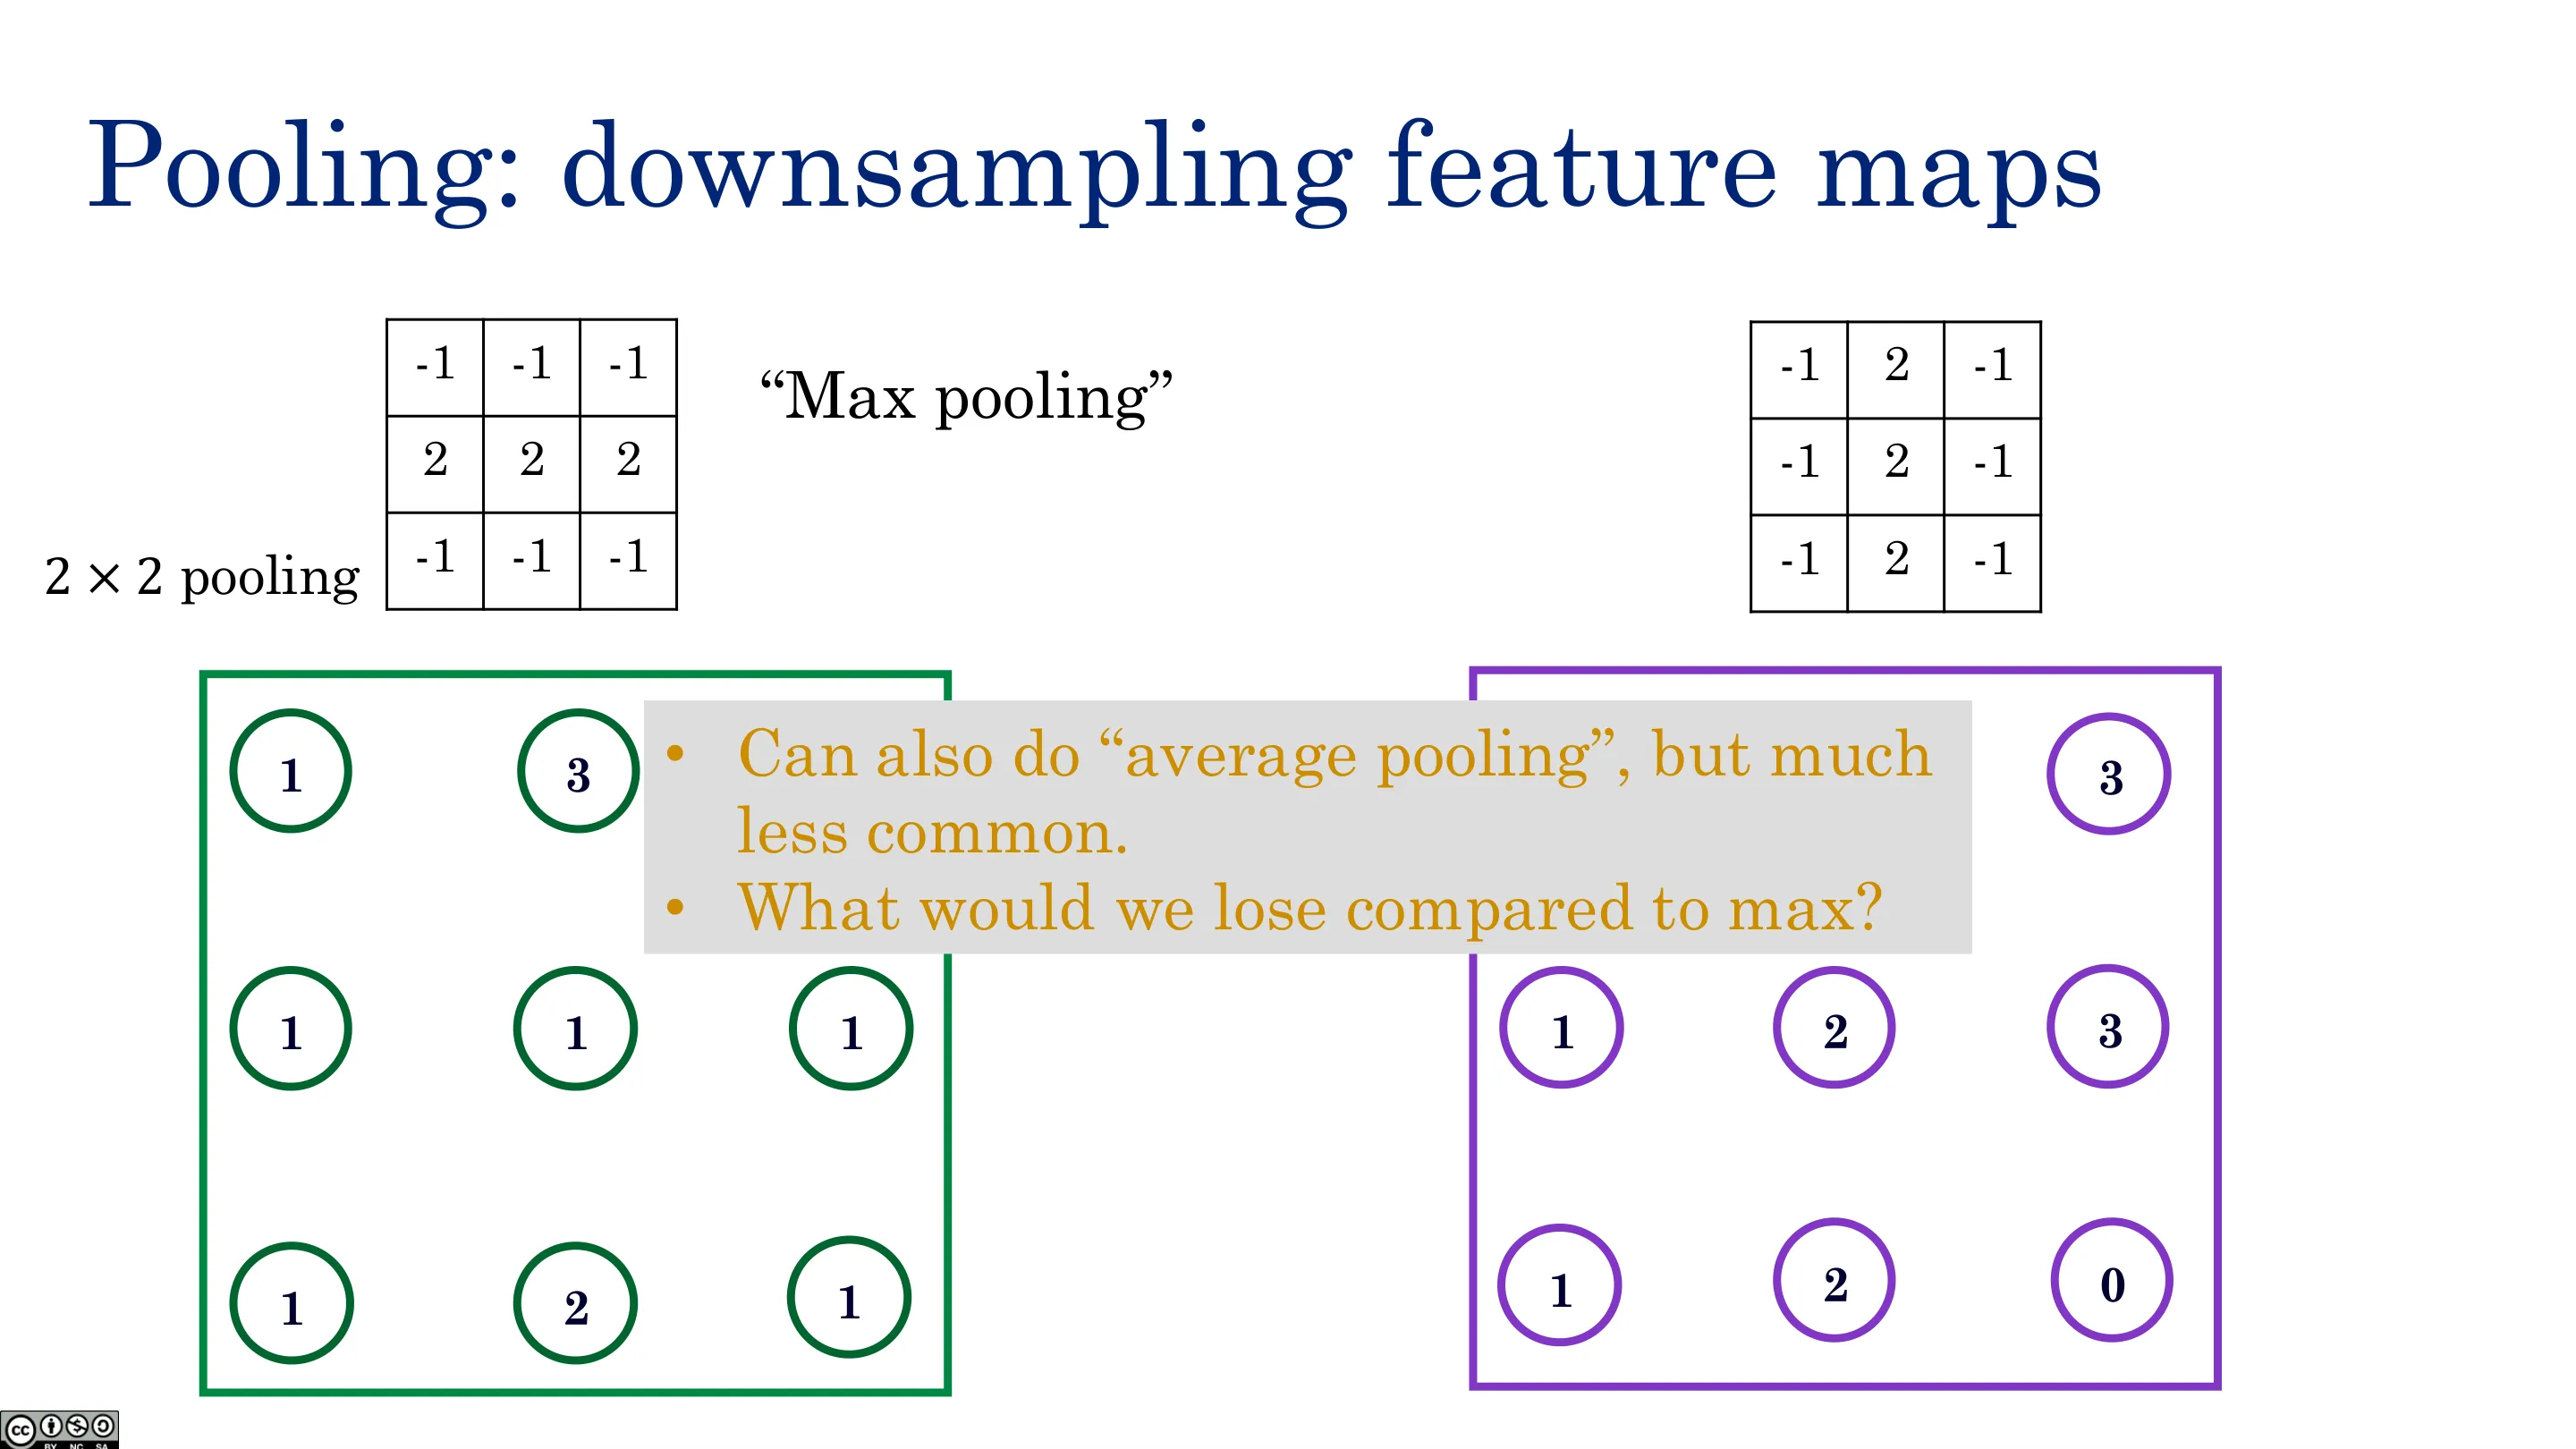
max vs average pooling:
- max:提供局部平移不变性,且引入非线性,最常用;
- average:线性操作,会丢失平移不变性,较少用。
- min pooling:可以,但通常 max 更好(除非在 max 前有非对称非线性,网络可通过翻转权重模拟 min——但中间的非线性会破坏这种对称)。
步骤示例:对两张特征图分别做 $2\times2$ max pooling,$4\to1$,特征图缩小为原来的 $1/4$;反复下来逐步降维。
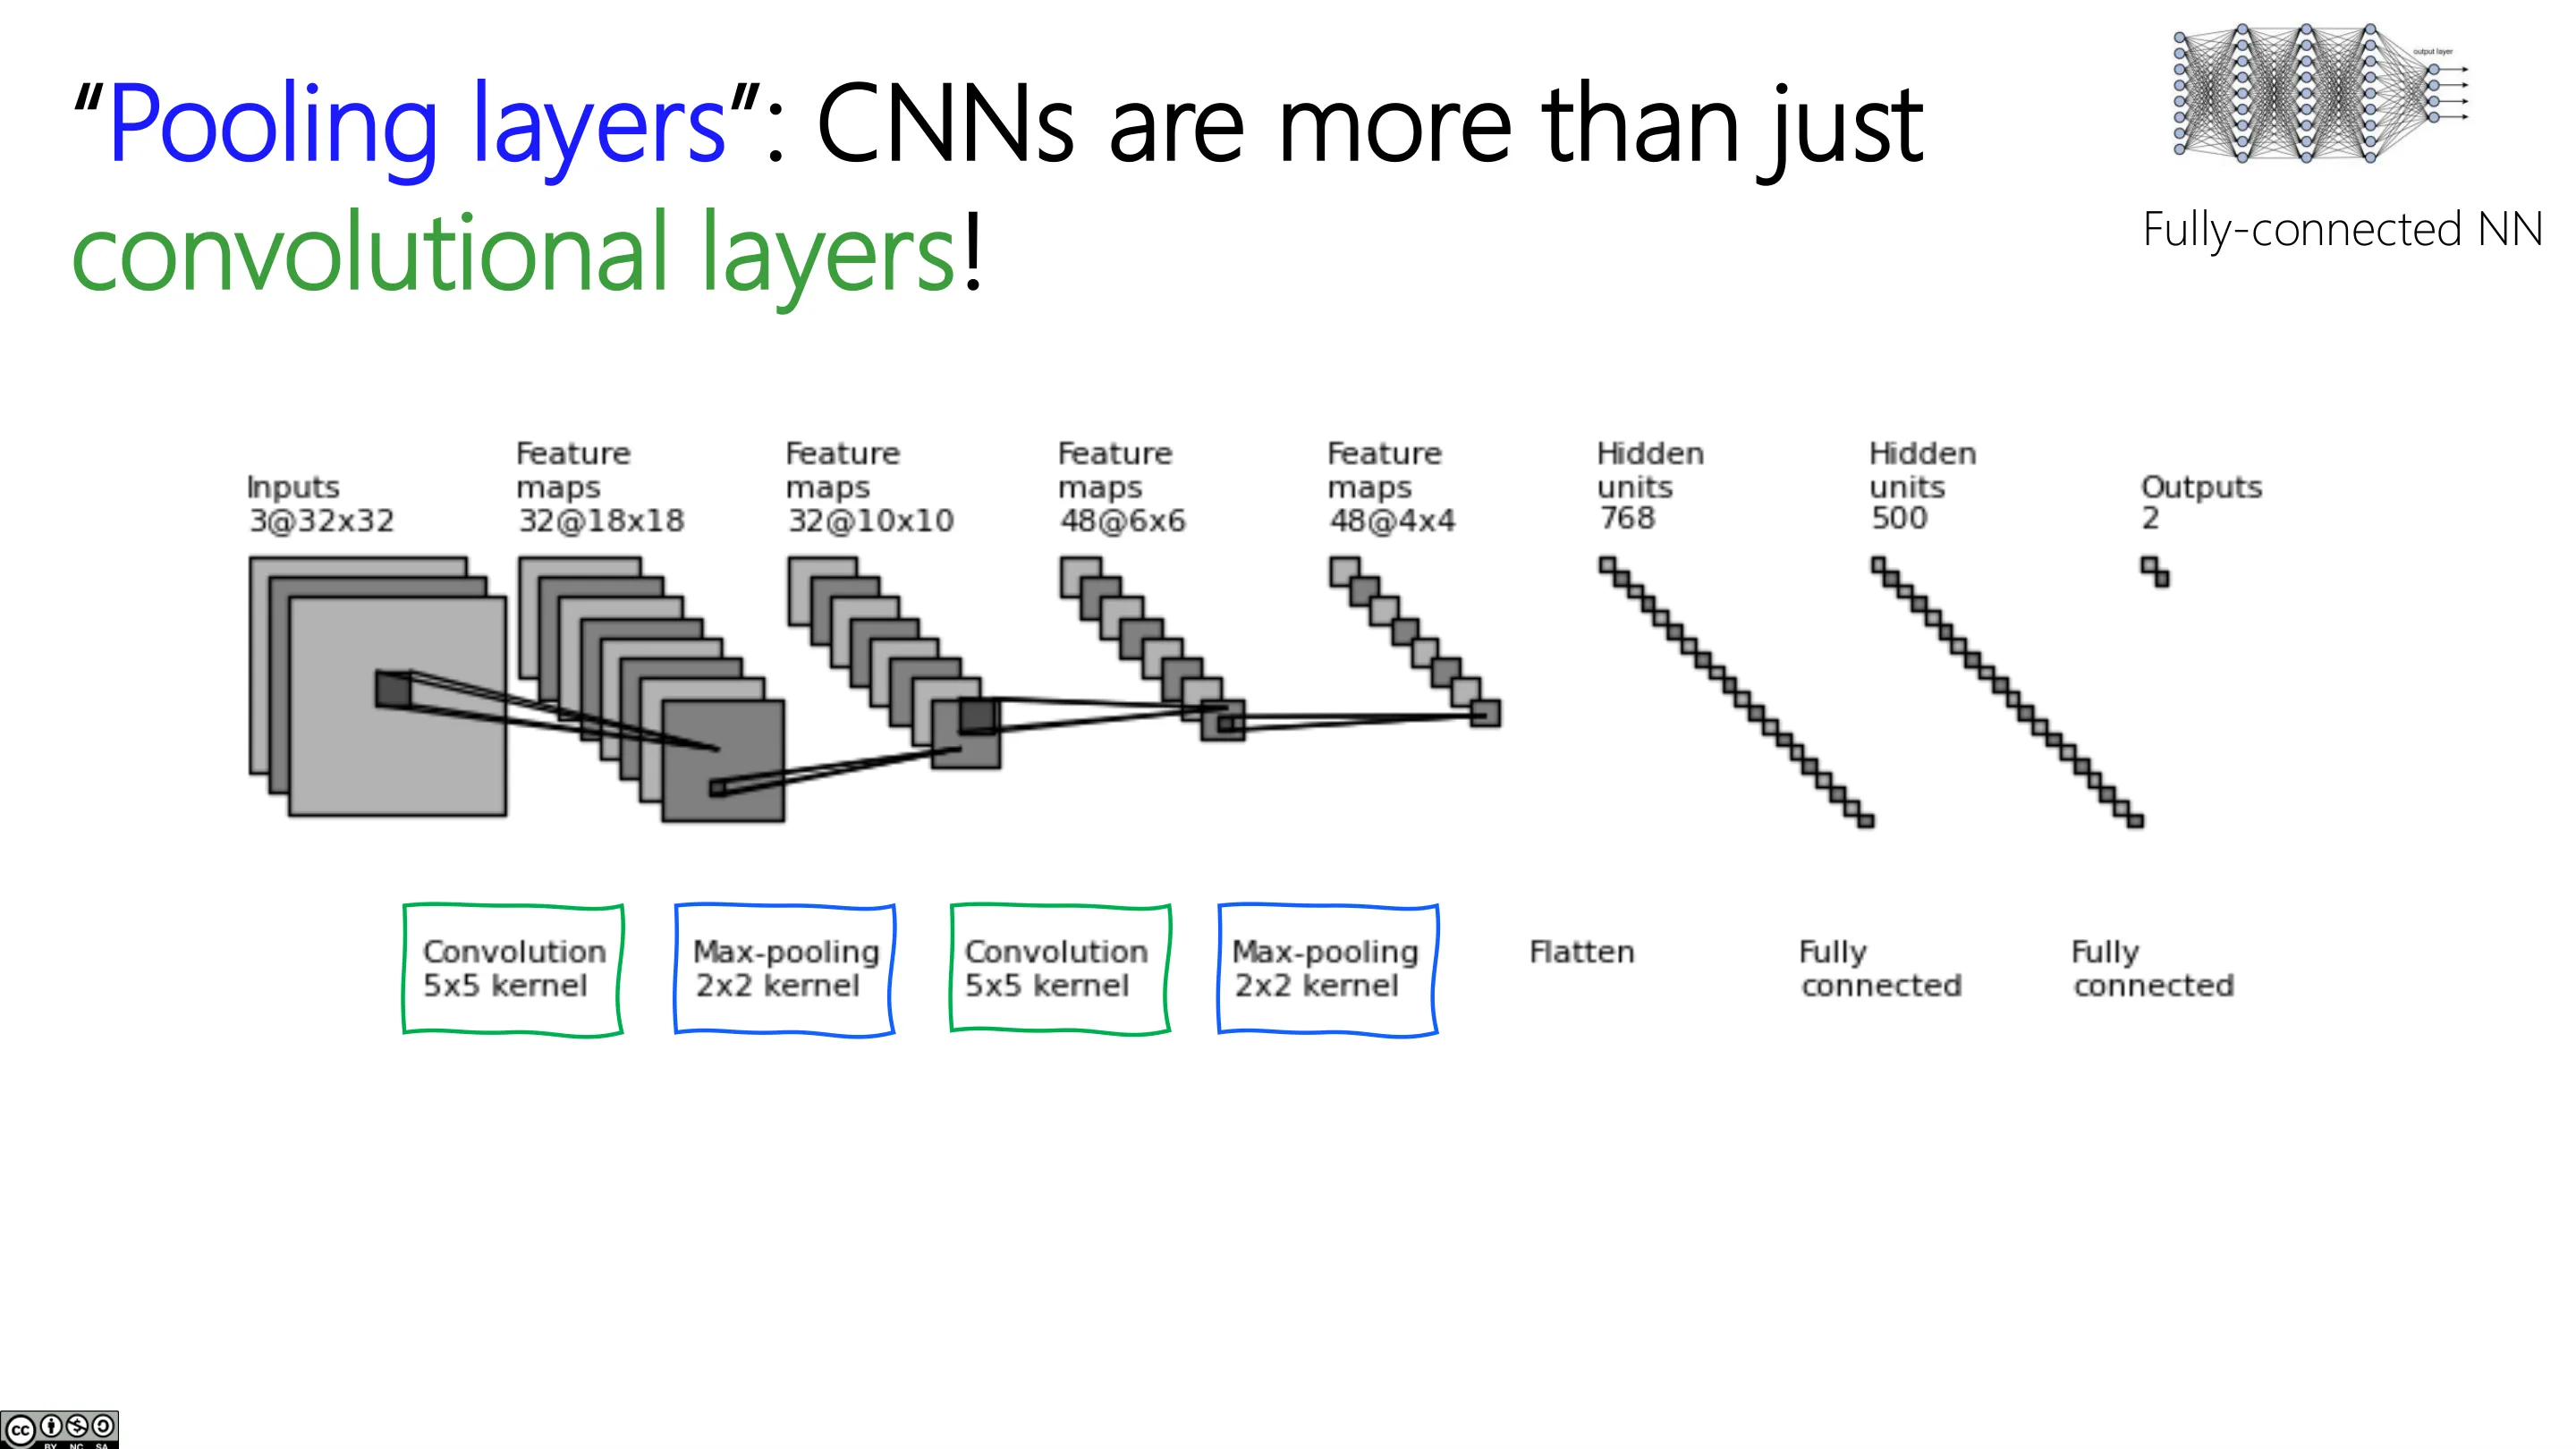
📷 「池化层」:CNN 不只是……
回到原视频 (00:14:56)
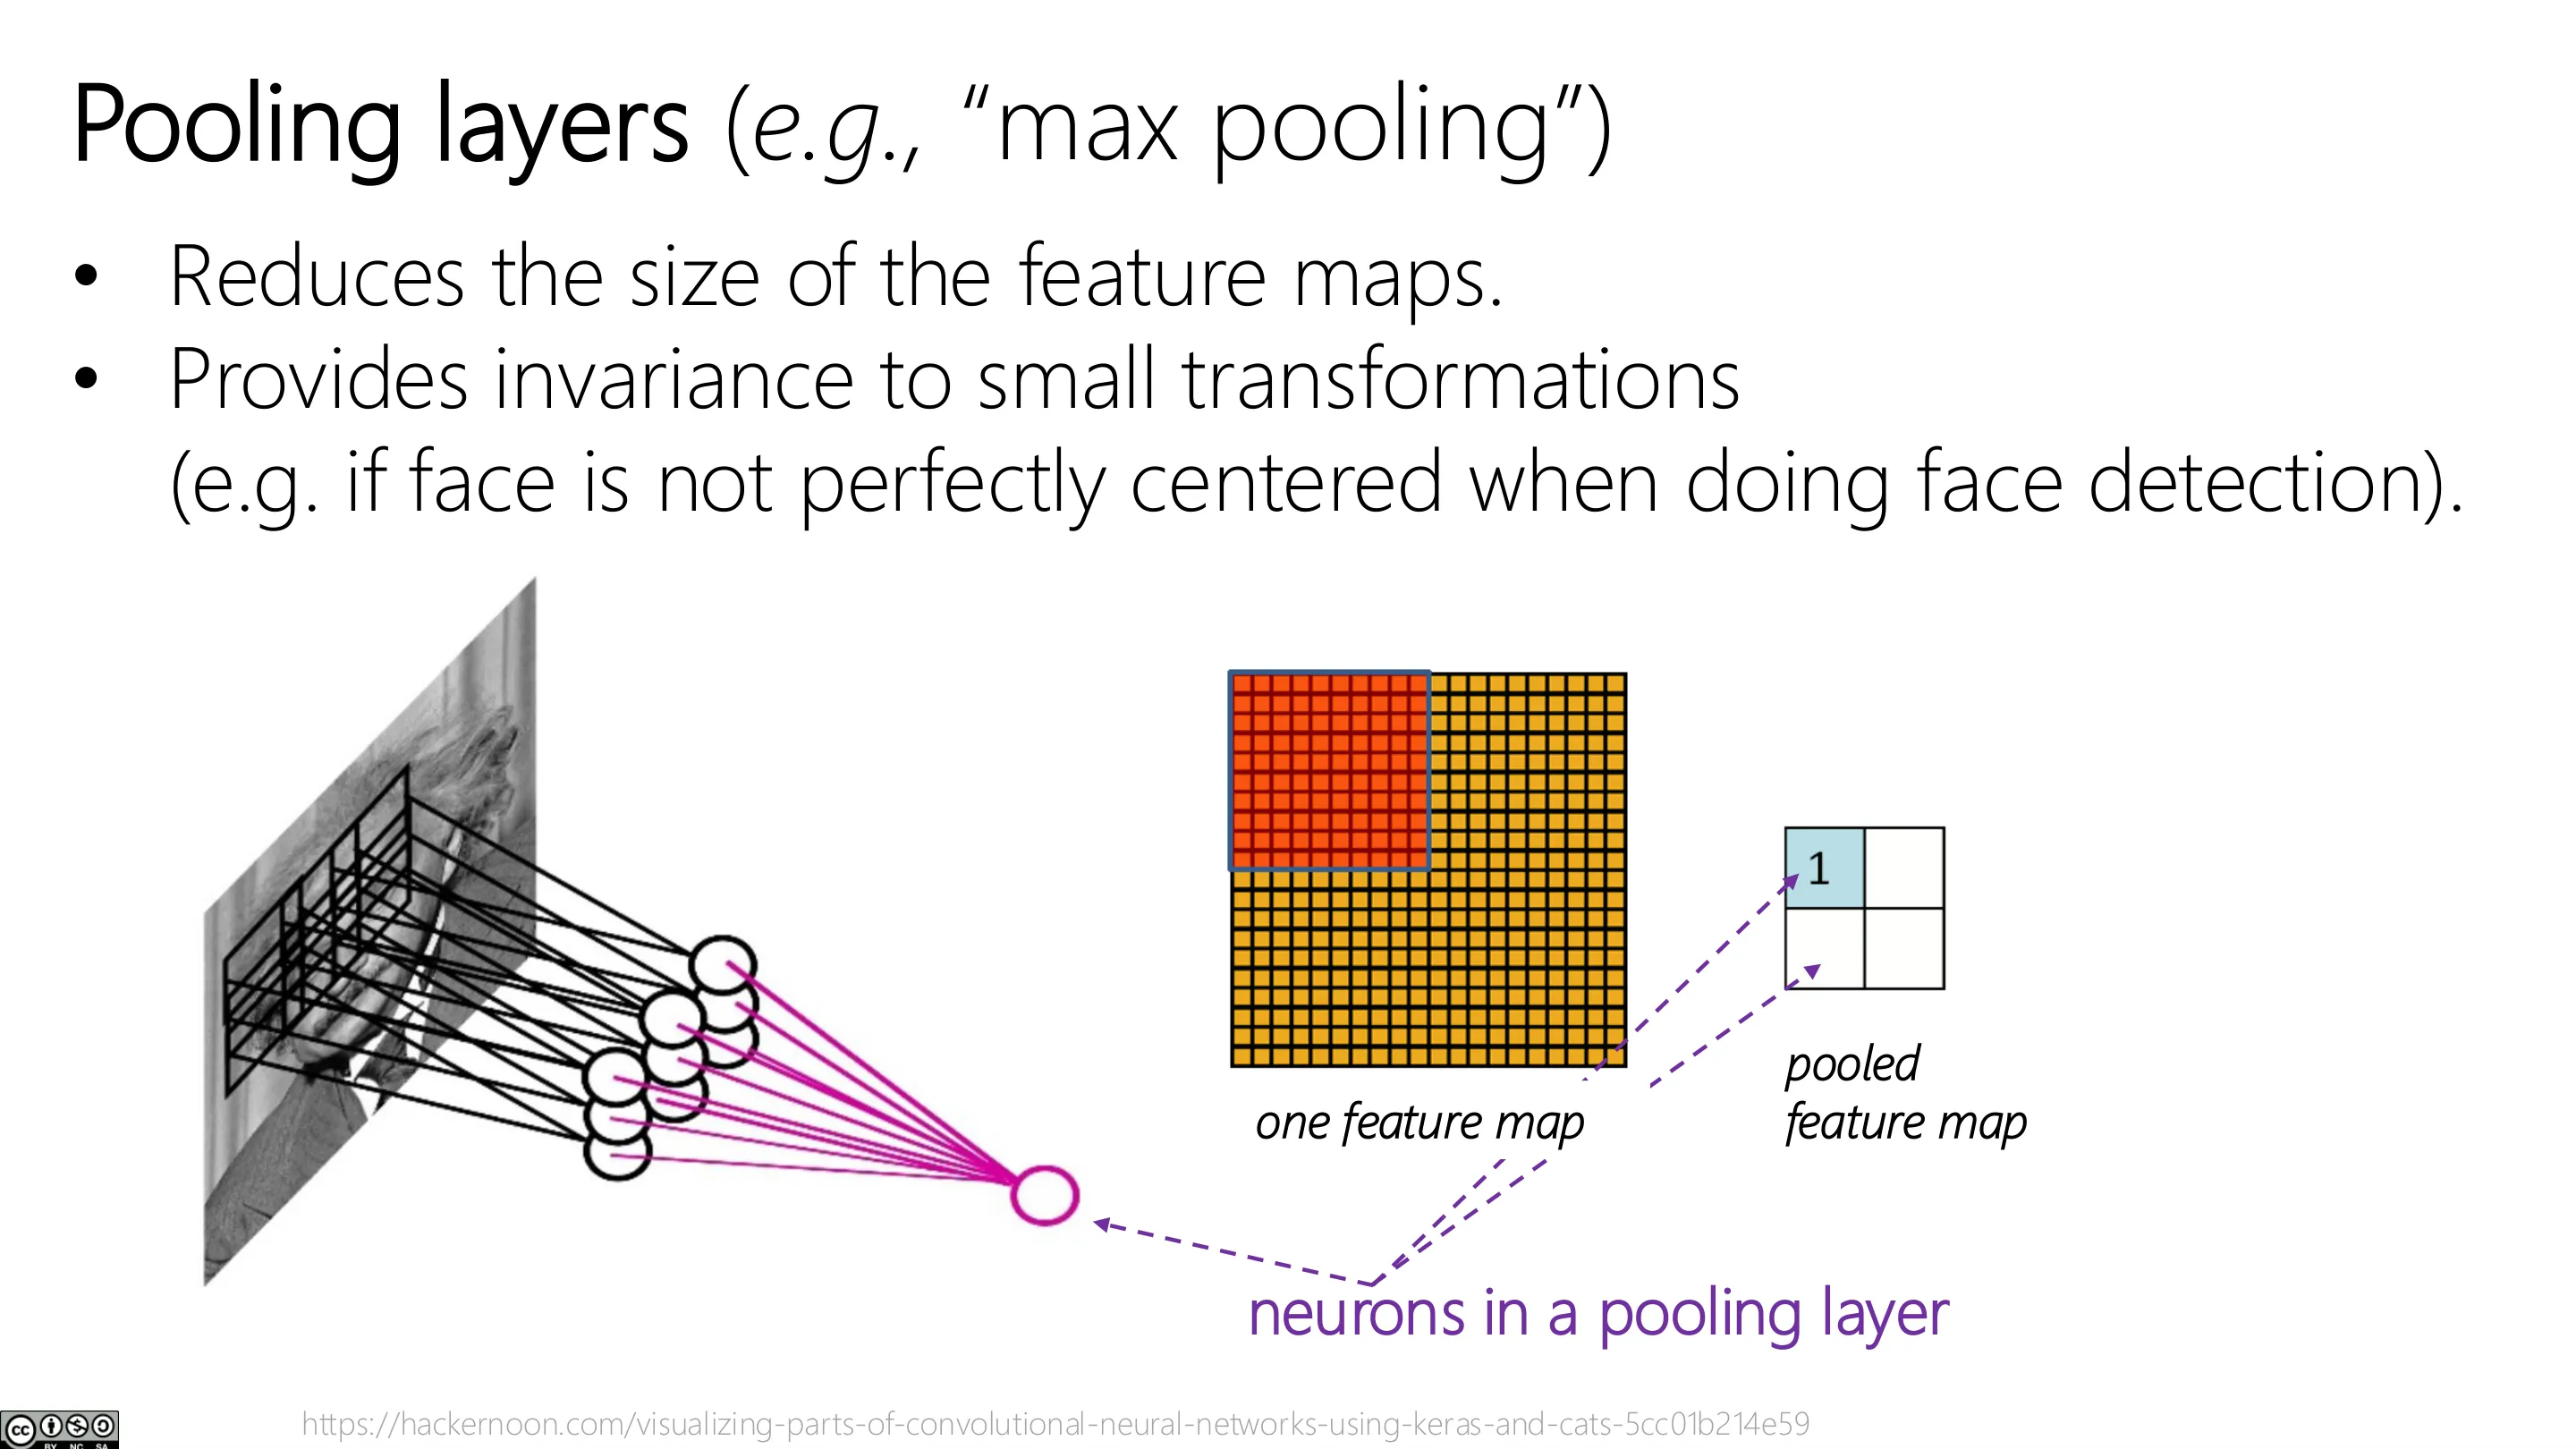
📷 减小特征图尺寸
回到原视频 (00:16:09)
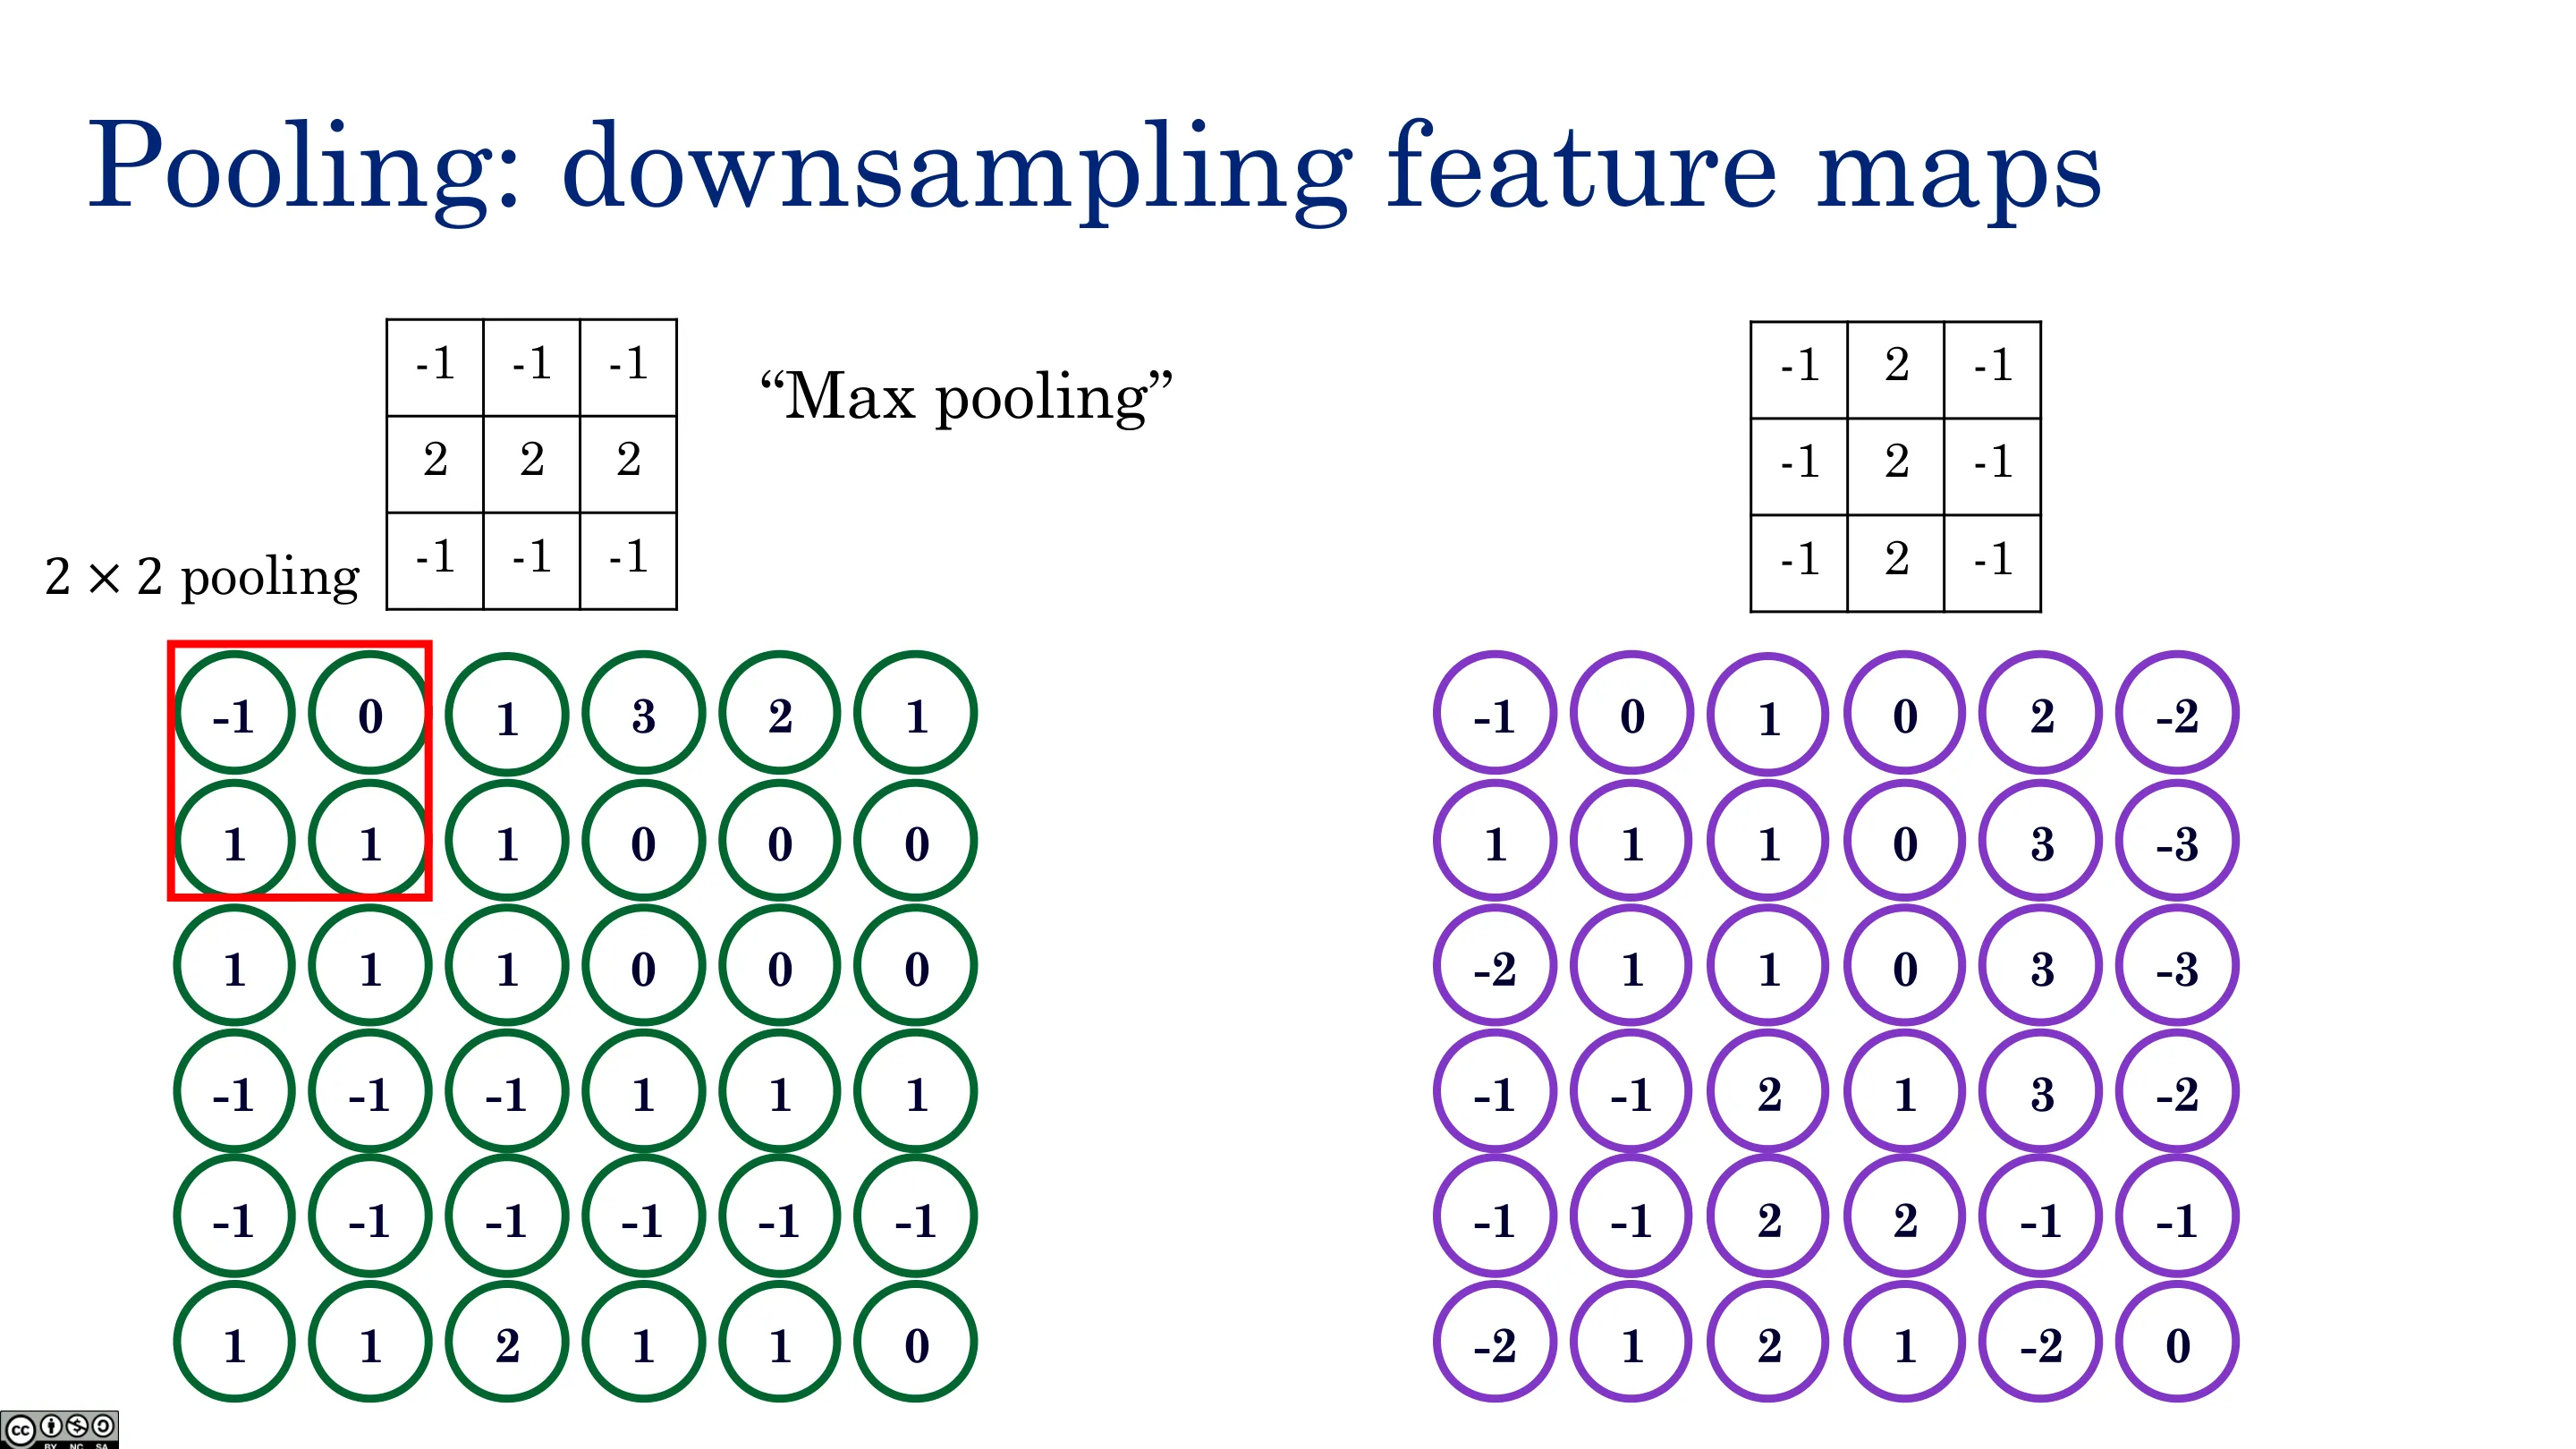
📷 池化:下采样特征图
回到原视频 (00:17:22)
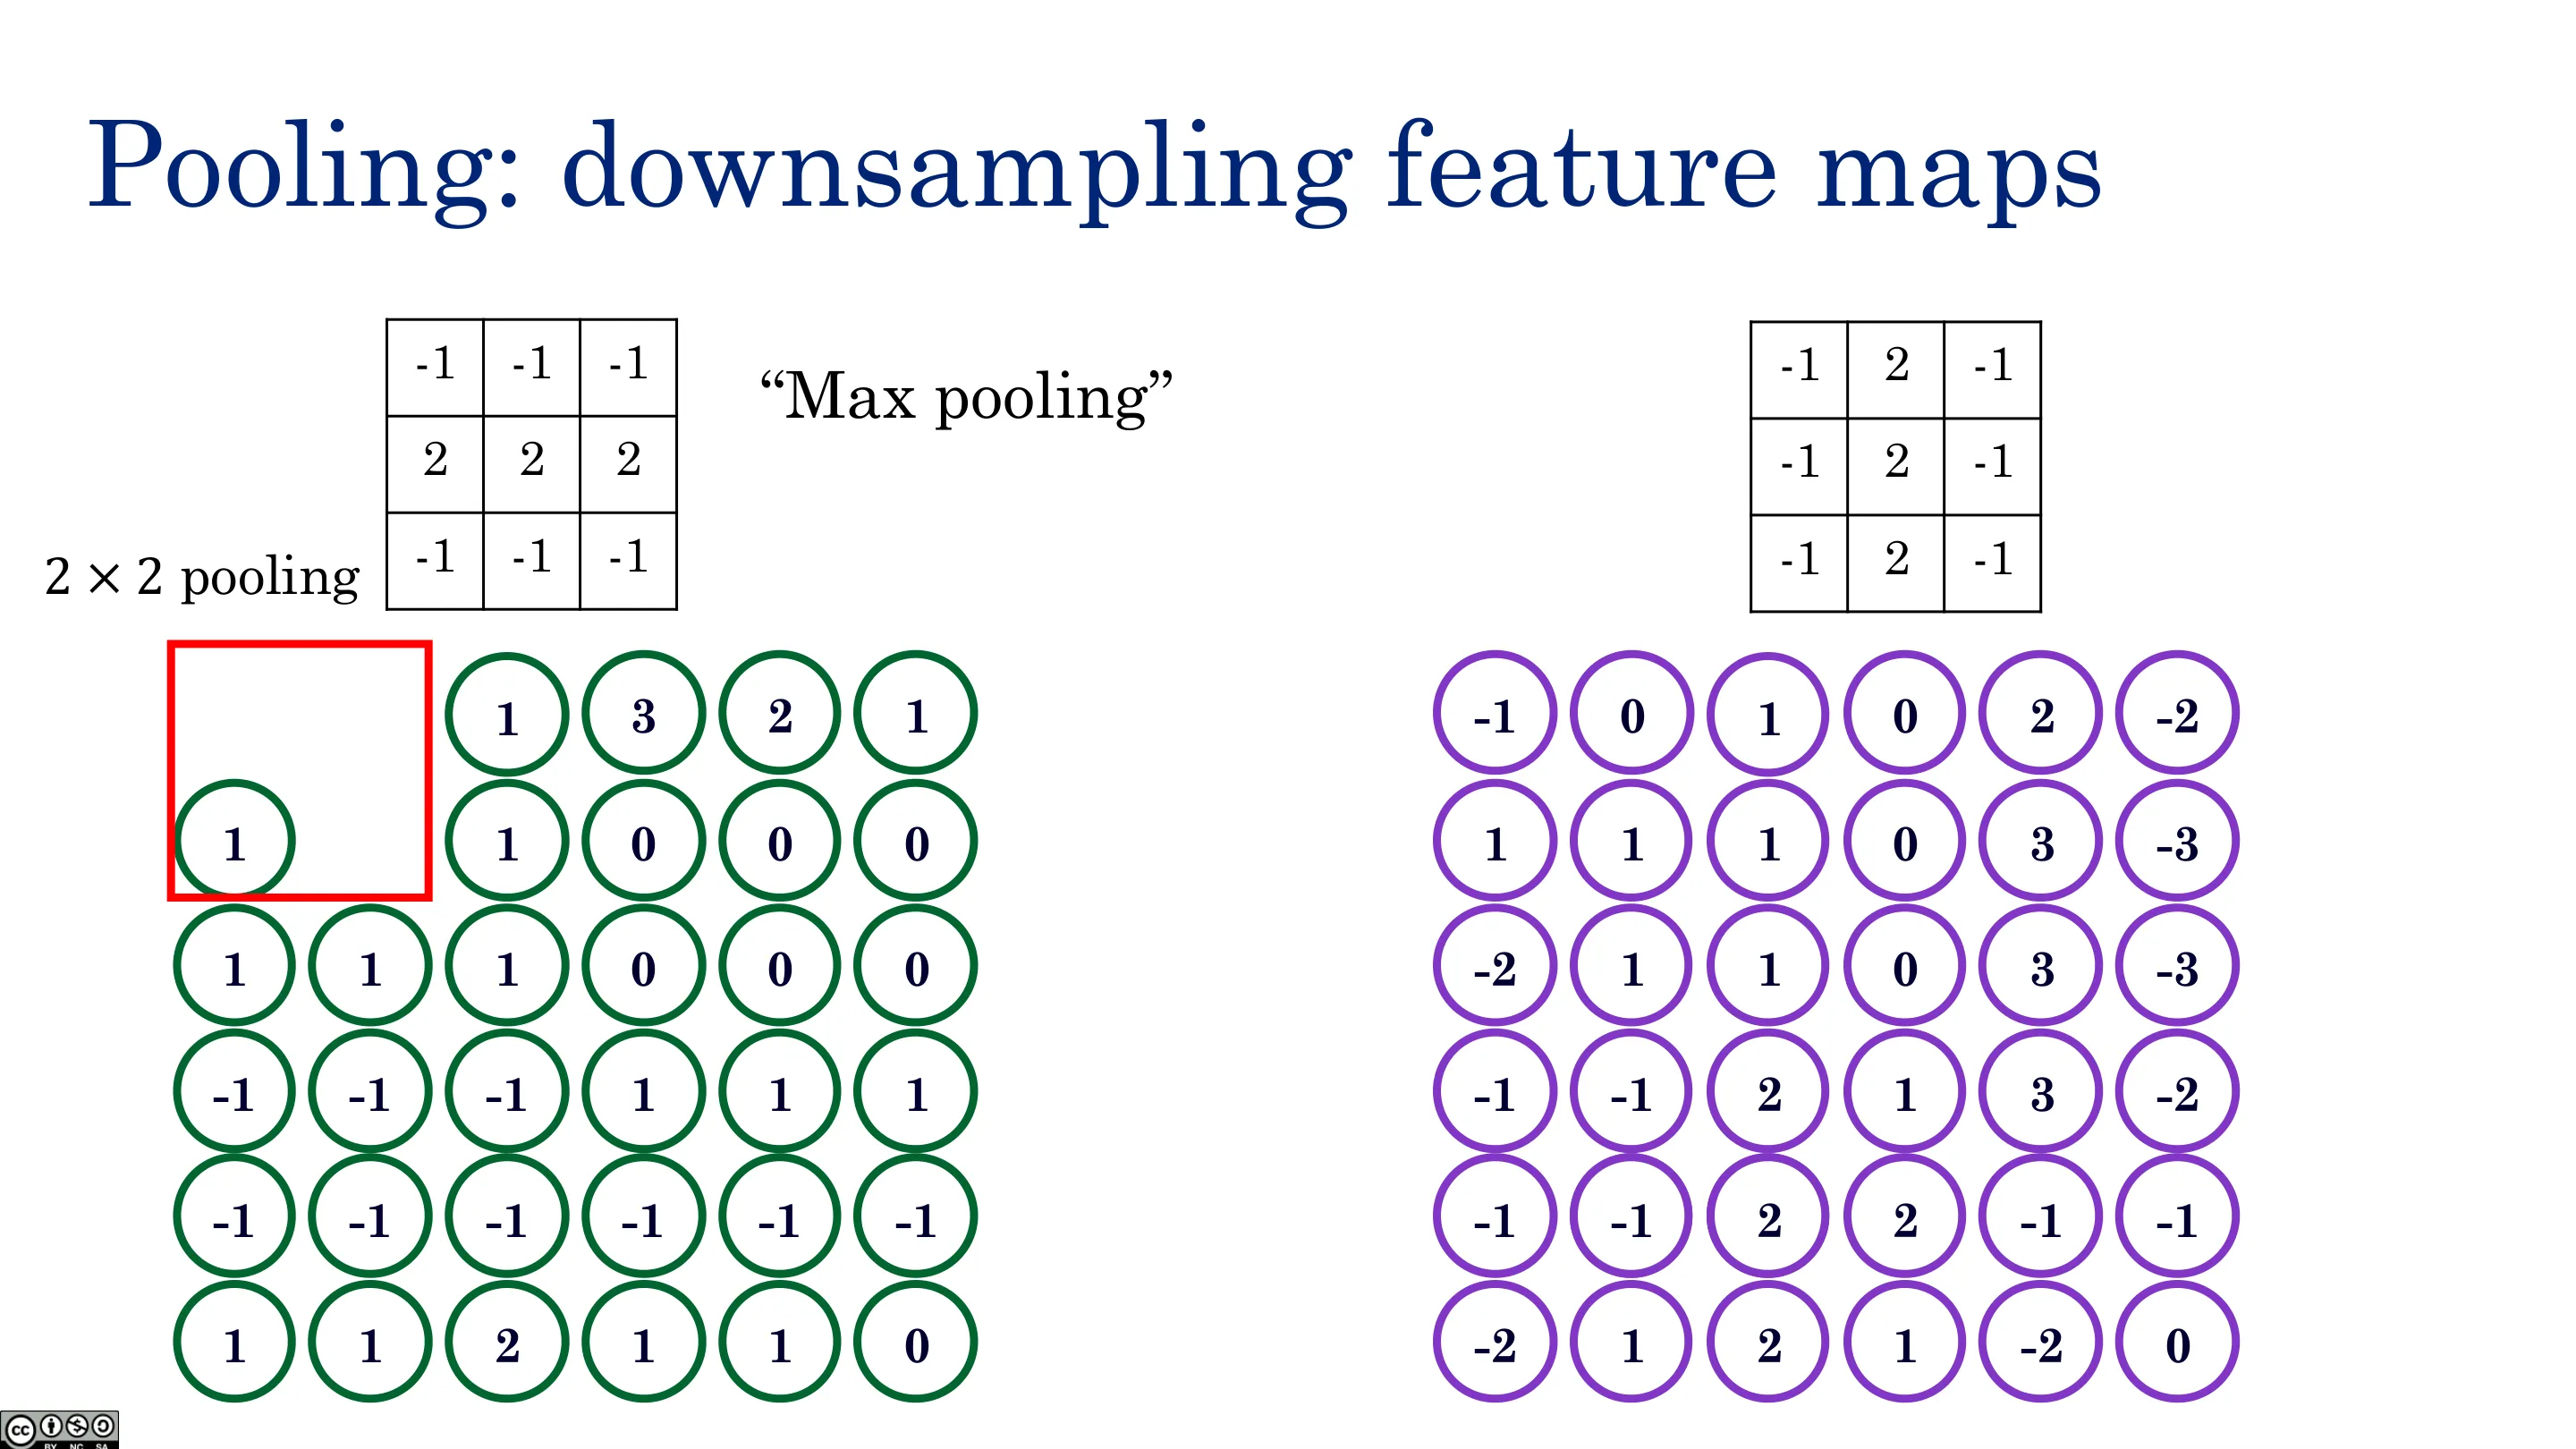
📷 池化动画(帧 1)
回到原视频 (00:18:35)
📷 池化动画(帧 2)
回到原视频 (00:19:48)
📷 池化动画(帧 3)
回到原视频 (00:21:01)
📷 池化动画(帧 4)
回到原视频 (00:22:14)
📷 池化动画(帧 5)
回到原视频 (00:23:27)
📷 池化动画(帧 6)
回到原视频 (00:24:40)
📷 池化动画(帧 7)
回到原视频 (00:25:53)
📷 池化动画(帧 8)
回到原视频 (00:27:06)
📷 池化动画(帧 9)
回到原视频 (00:28:19)
2.1 感受野(receptive field)
高层的一个神经元受原图很大一片区域影响——因为卷积 + 池化不断把信息汇聚。这叫感受野:这个神经元的输出依赖原图哪一片。层层向上,感受野越来越大,最终分类节点的感受野 = 整幅图。这正是层次化特征(边缘 → 眼睛/鼻子 → 脸)自然涌现的原因。
一个重要的术语澄清:「神经元」通常包含激活函数之后的输出;卷积层 = 卷积 + 逐点非线性(ReLU);其输入(未过激活)叫预激活,过了激活的才是特征图。
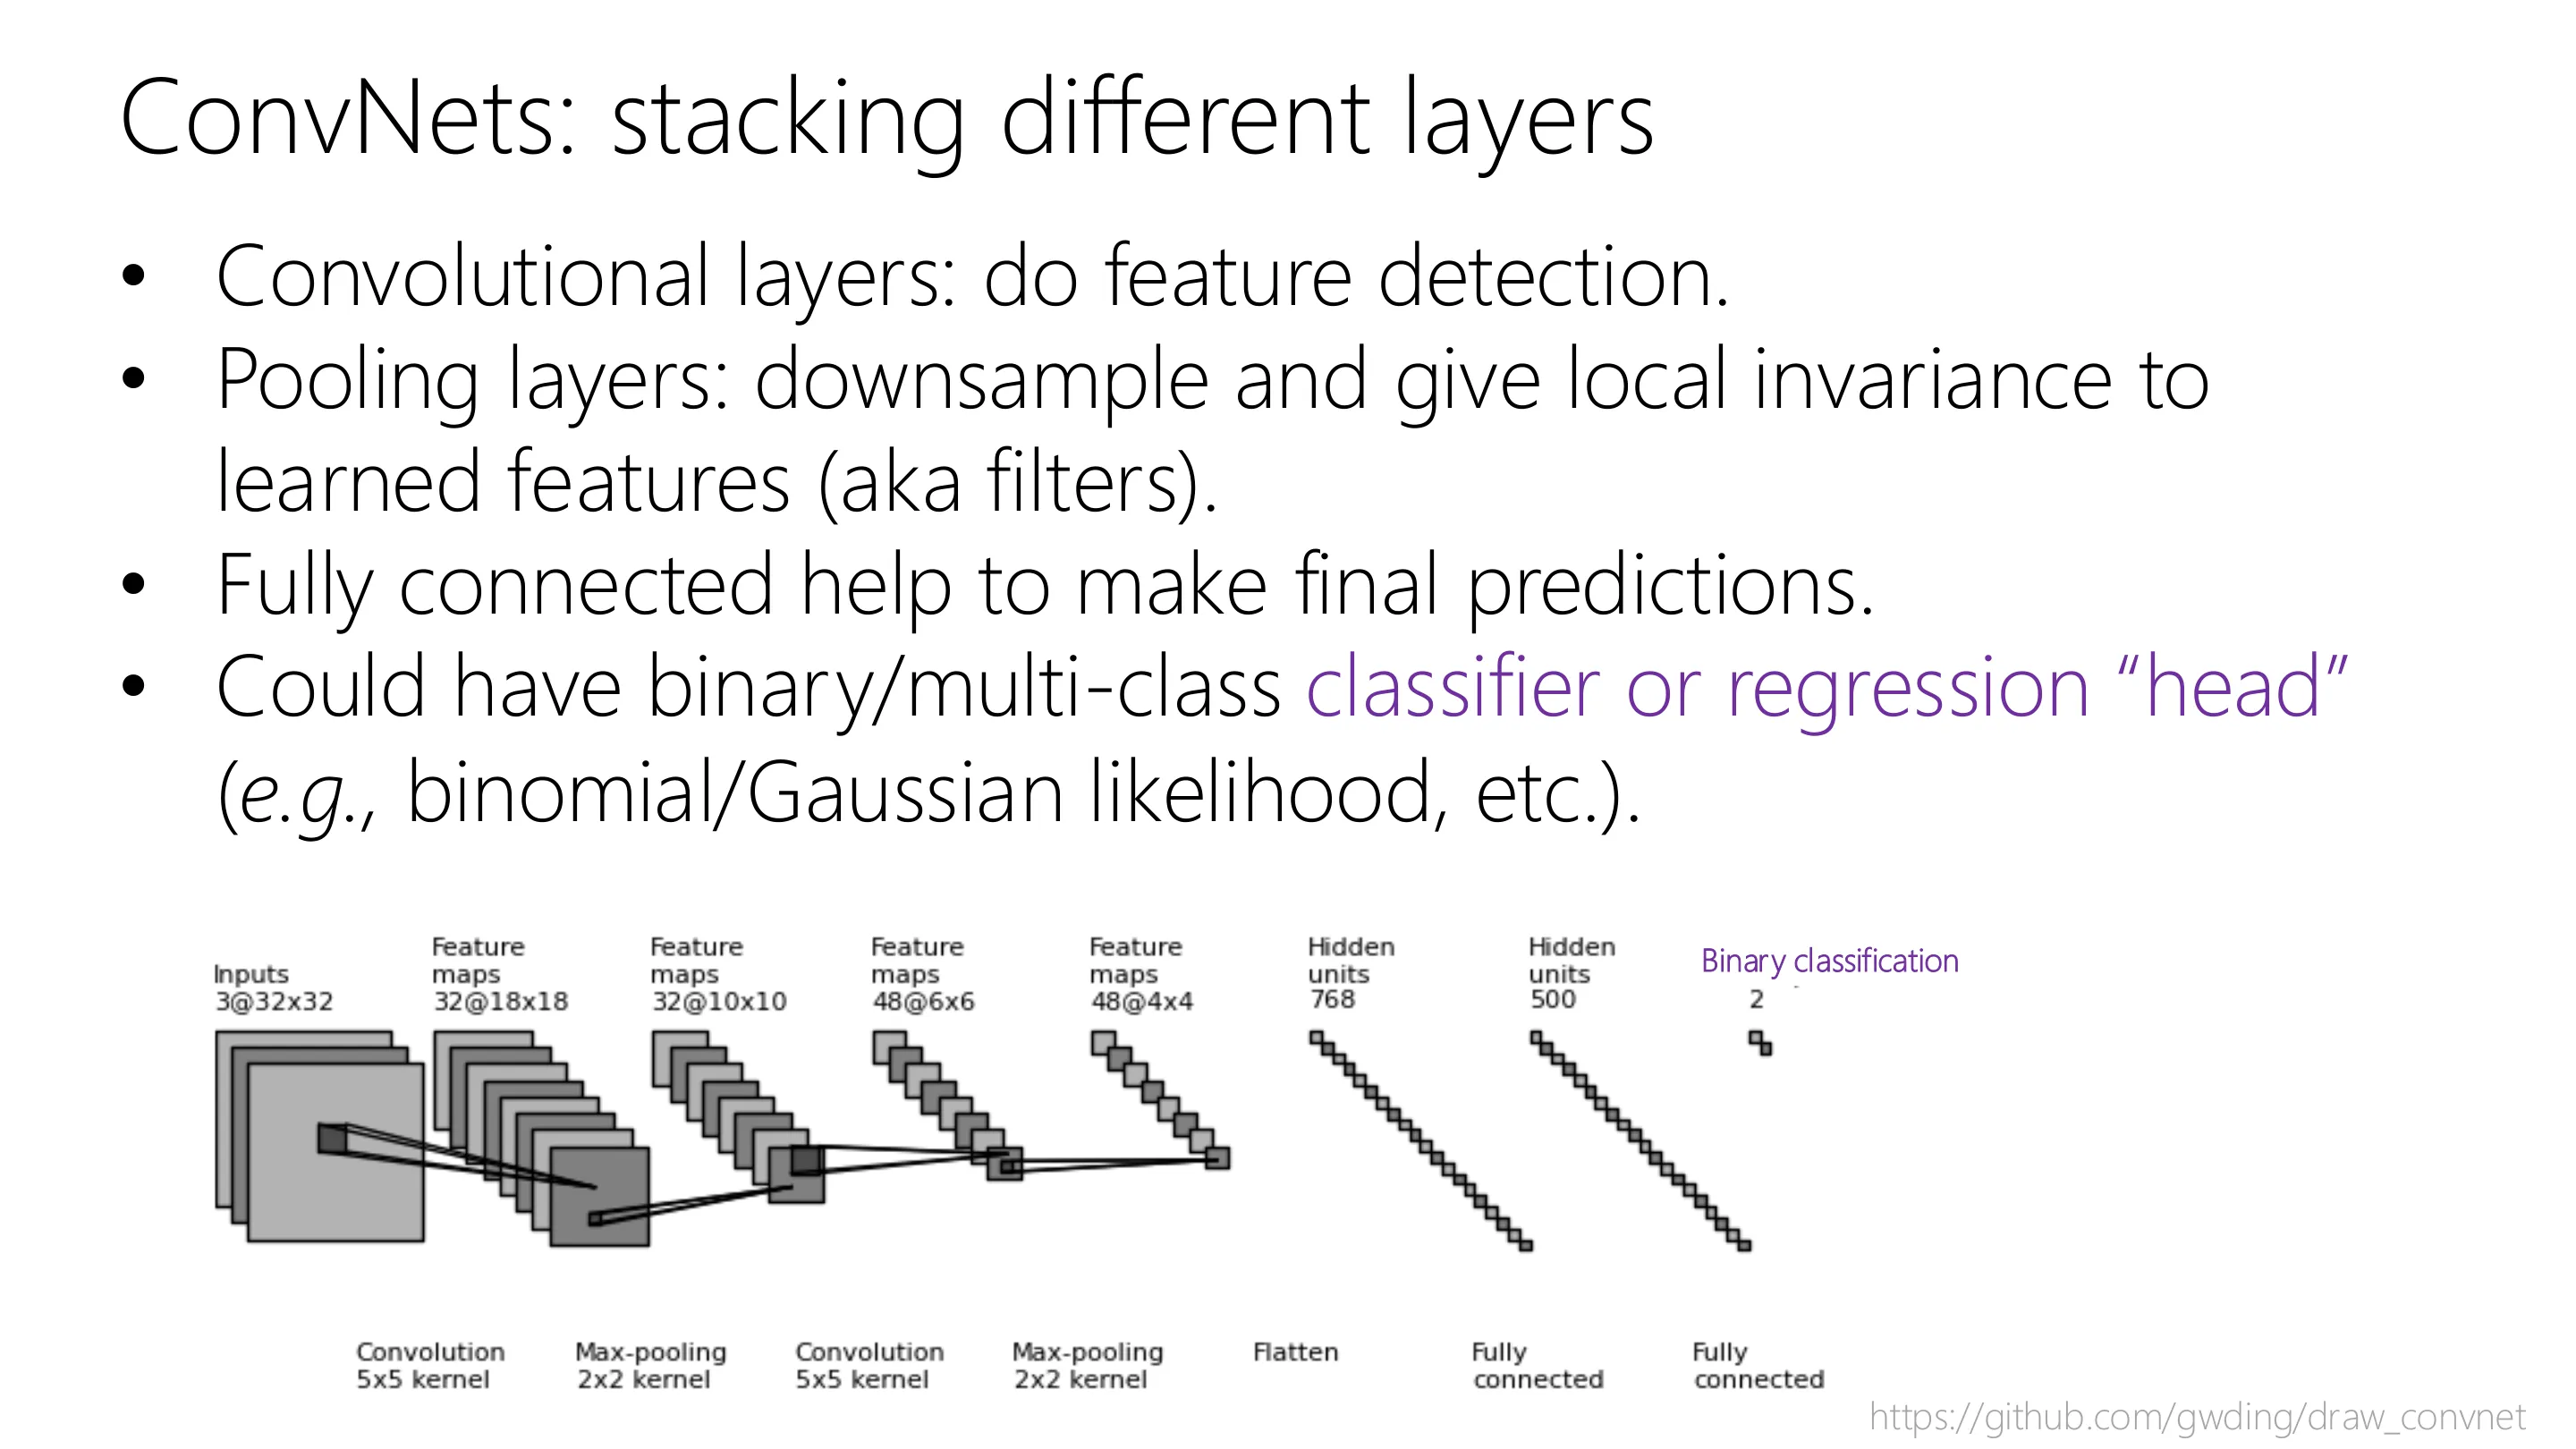
📷 ConvNets:堆叠不同的层
回到原视频 (00:29:32)
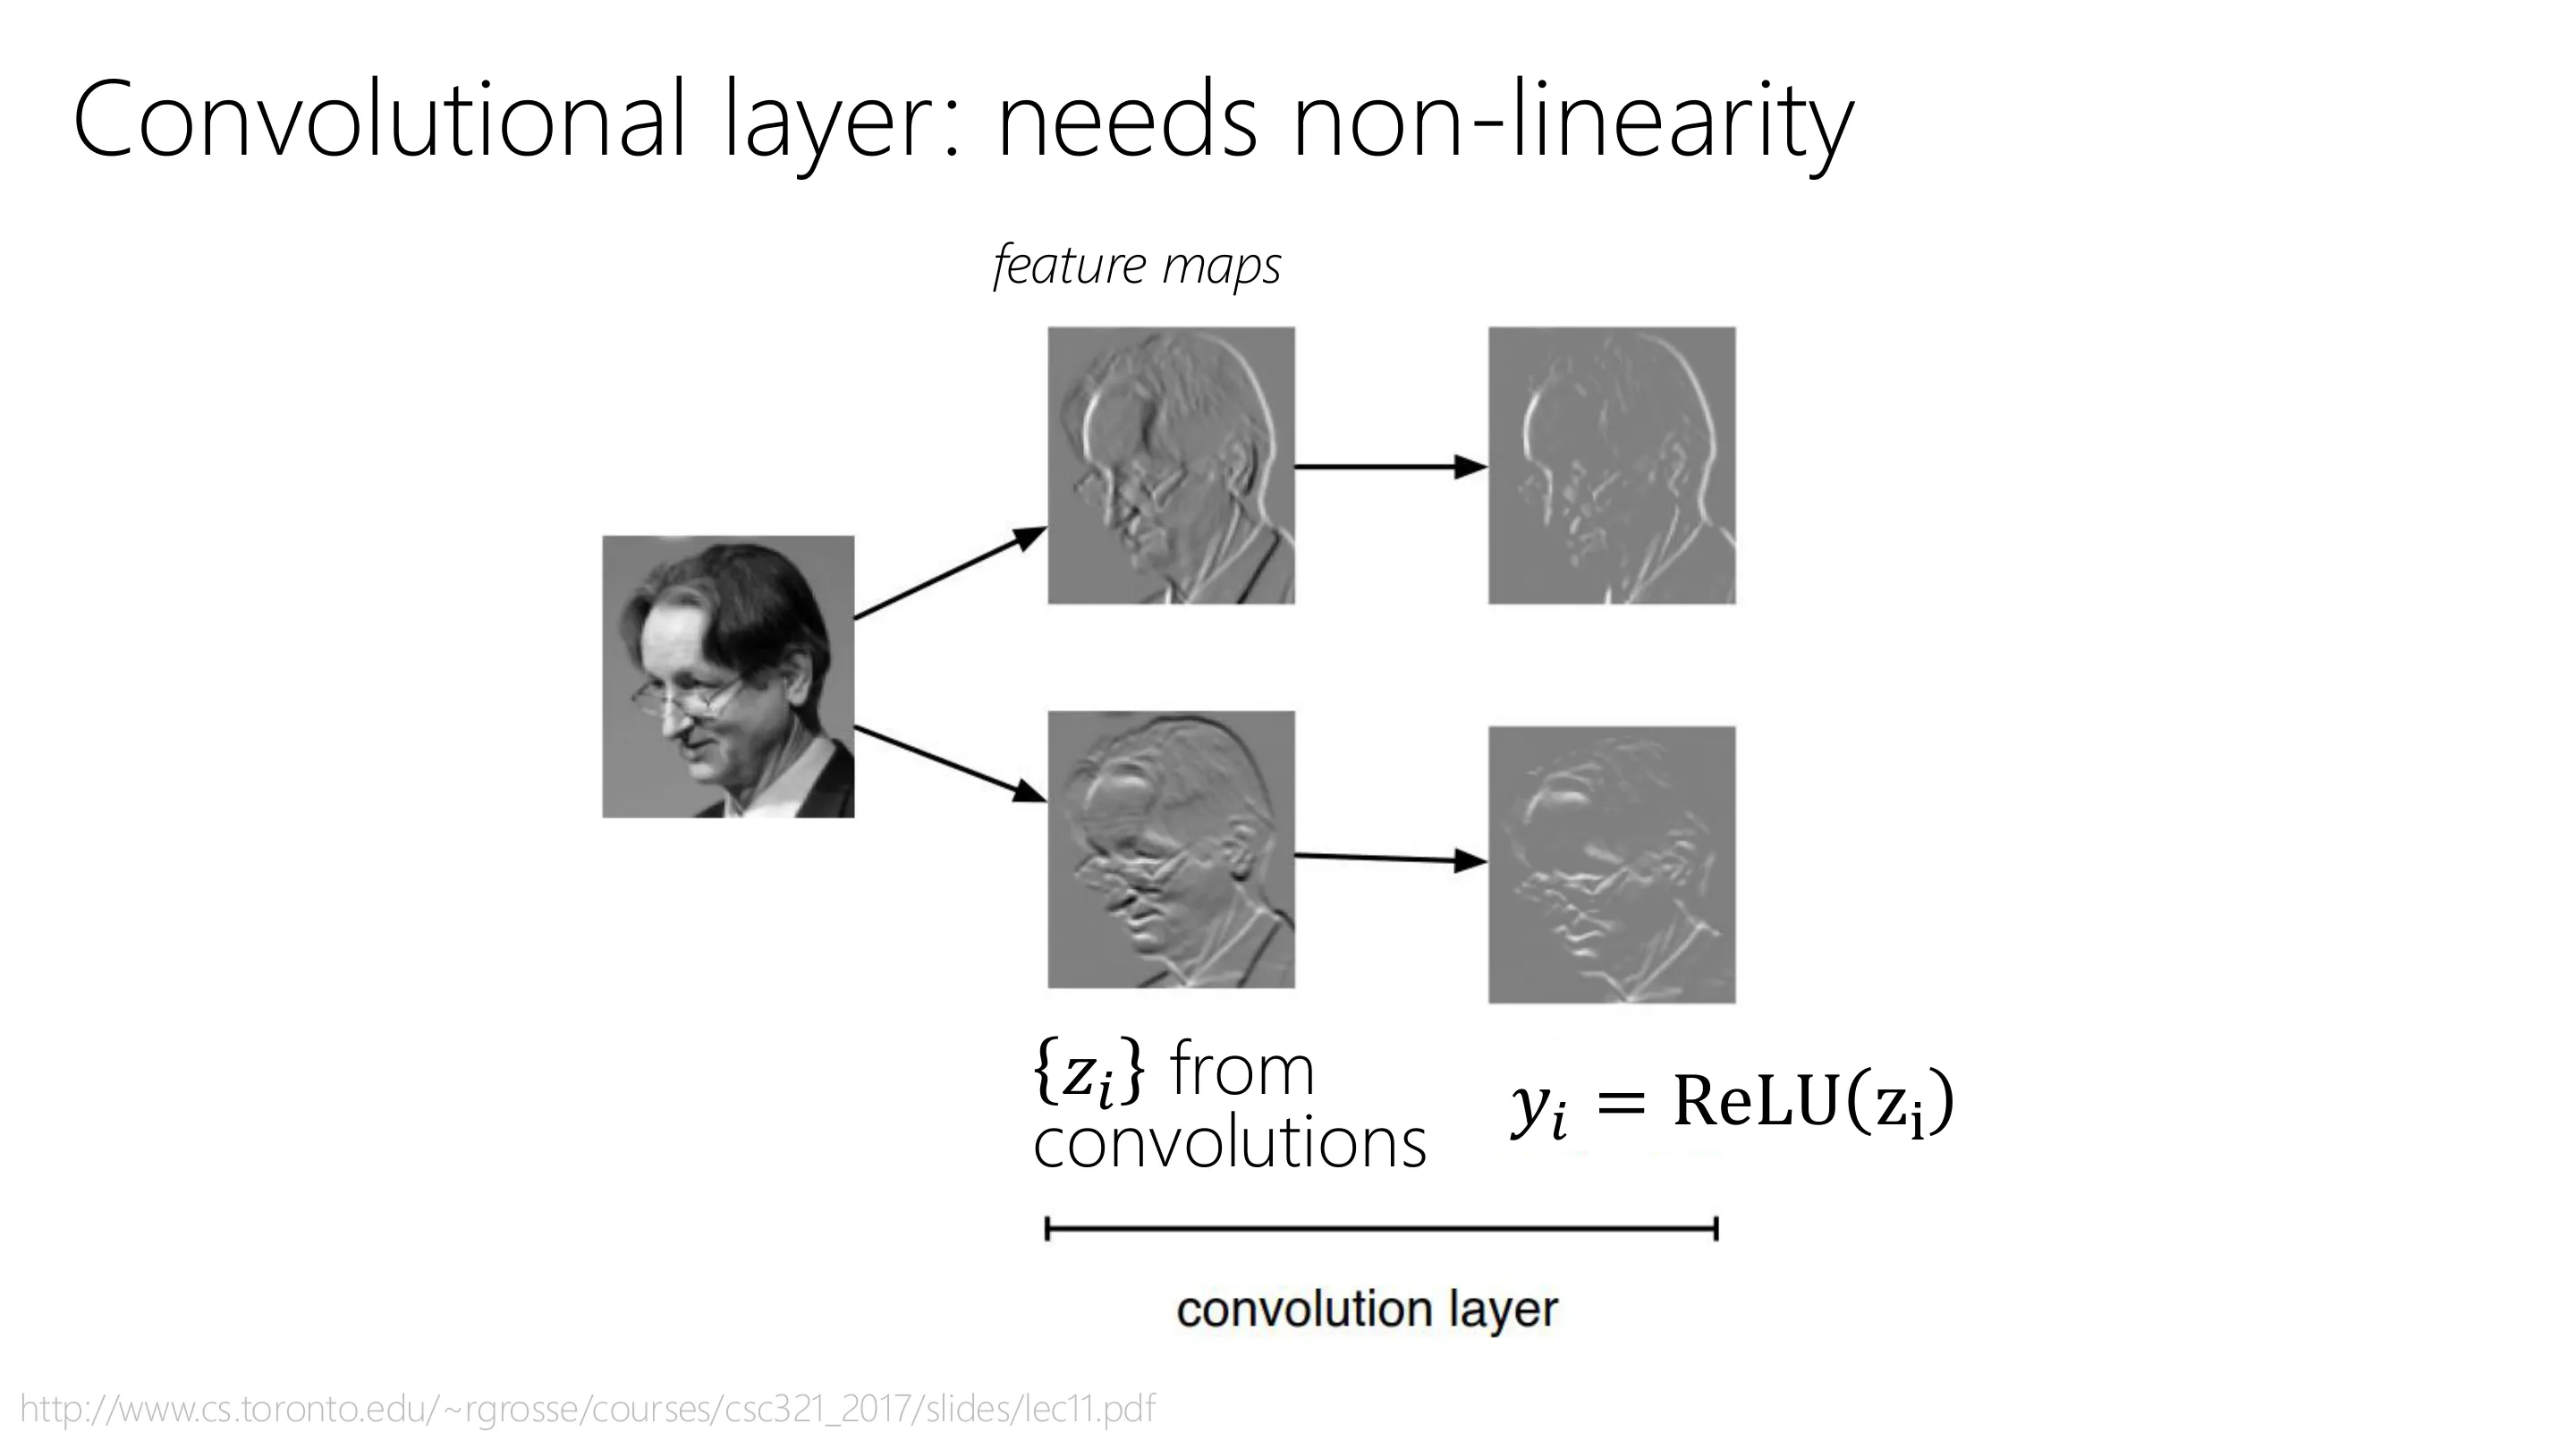
📷 卷积层需要非线性
回到原视频 (00:30:45)
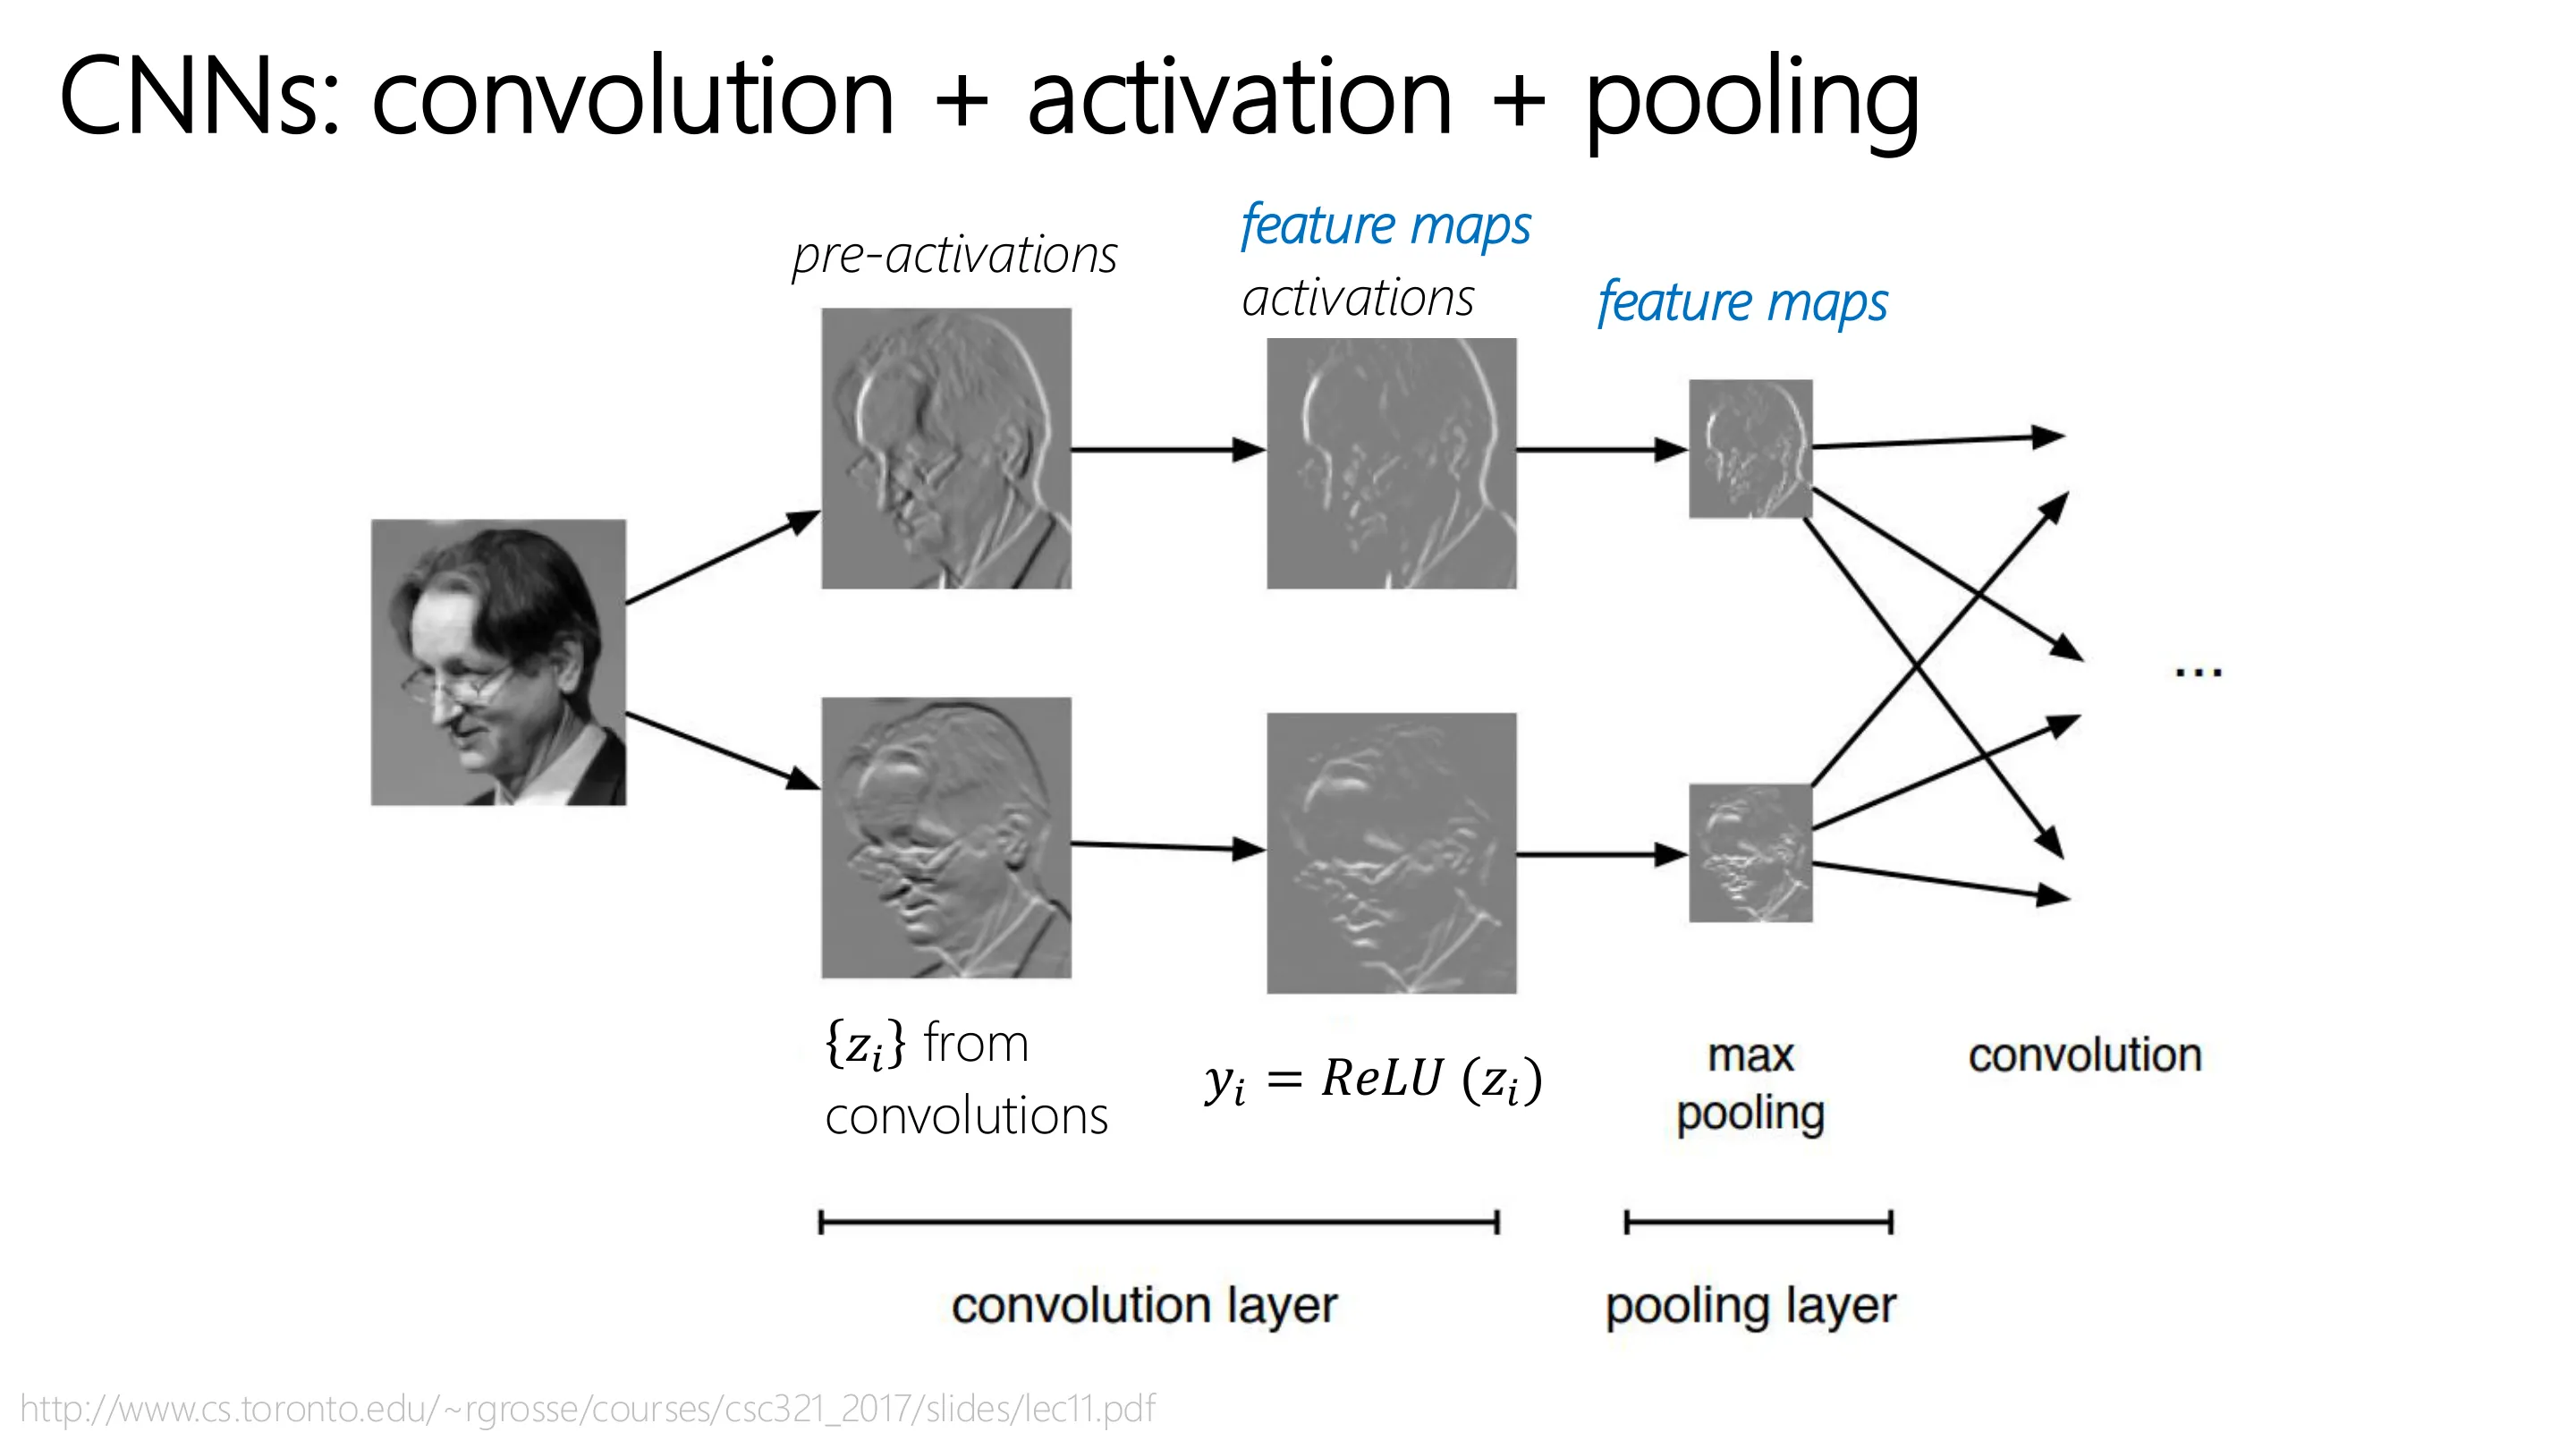
📷 $y_i=\mathrm{ReLU}(z_i)$
回到原视频 (00:31:58)
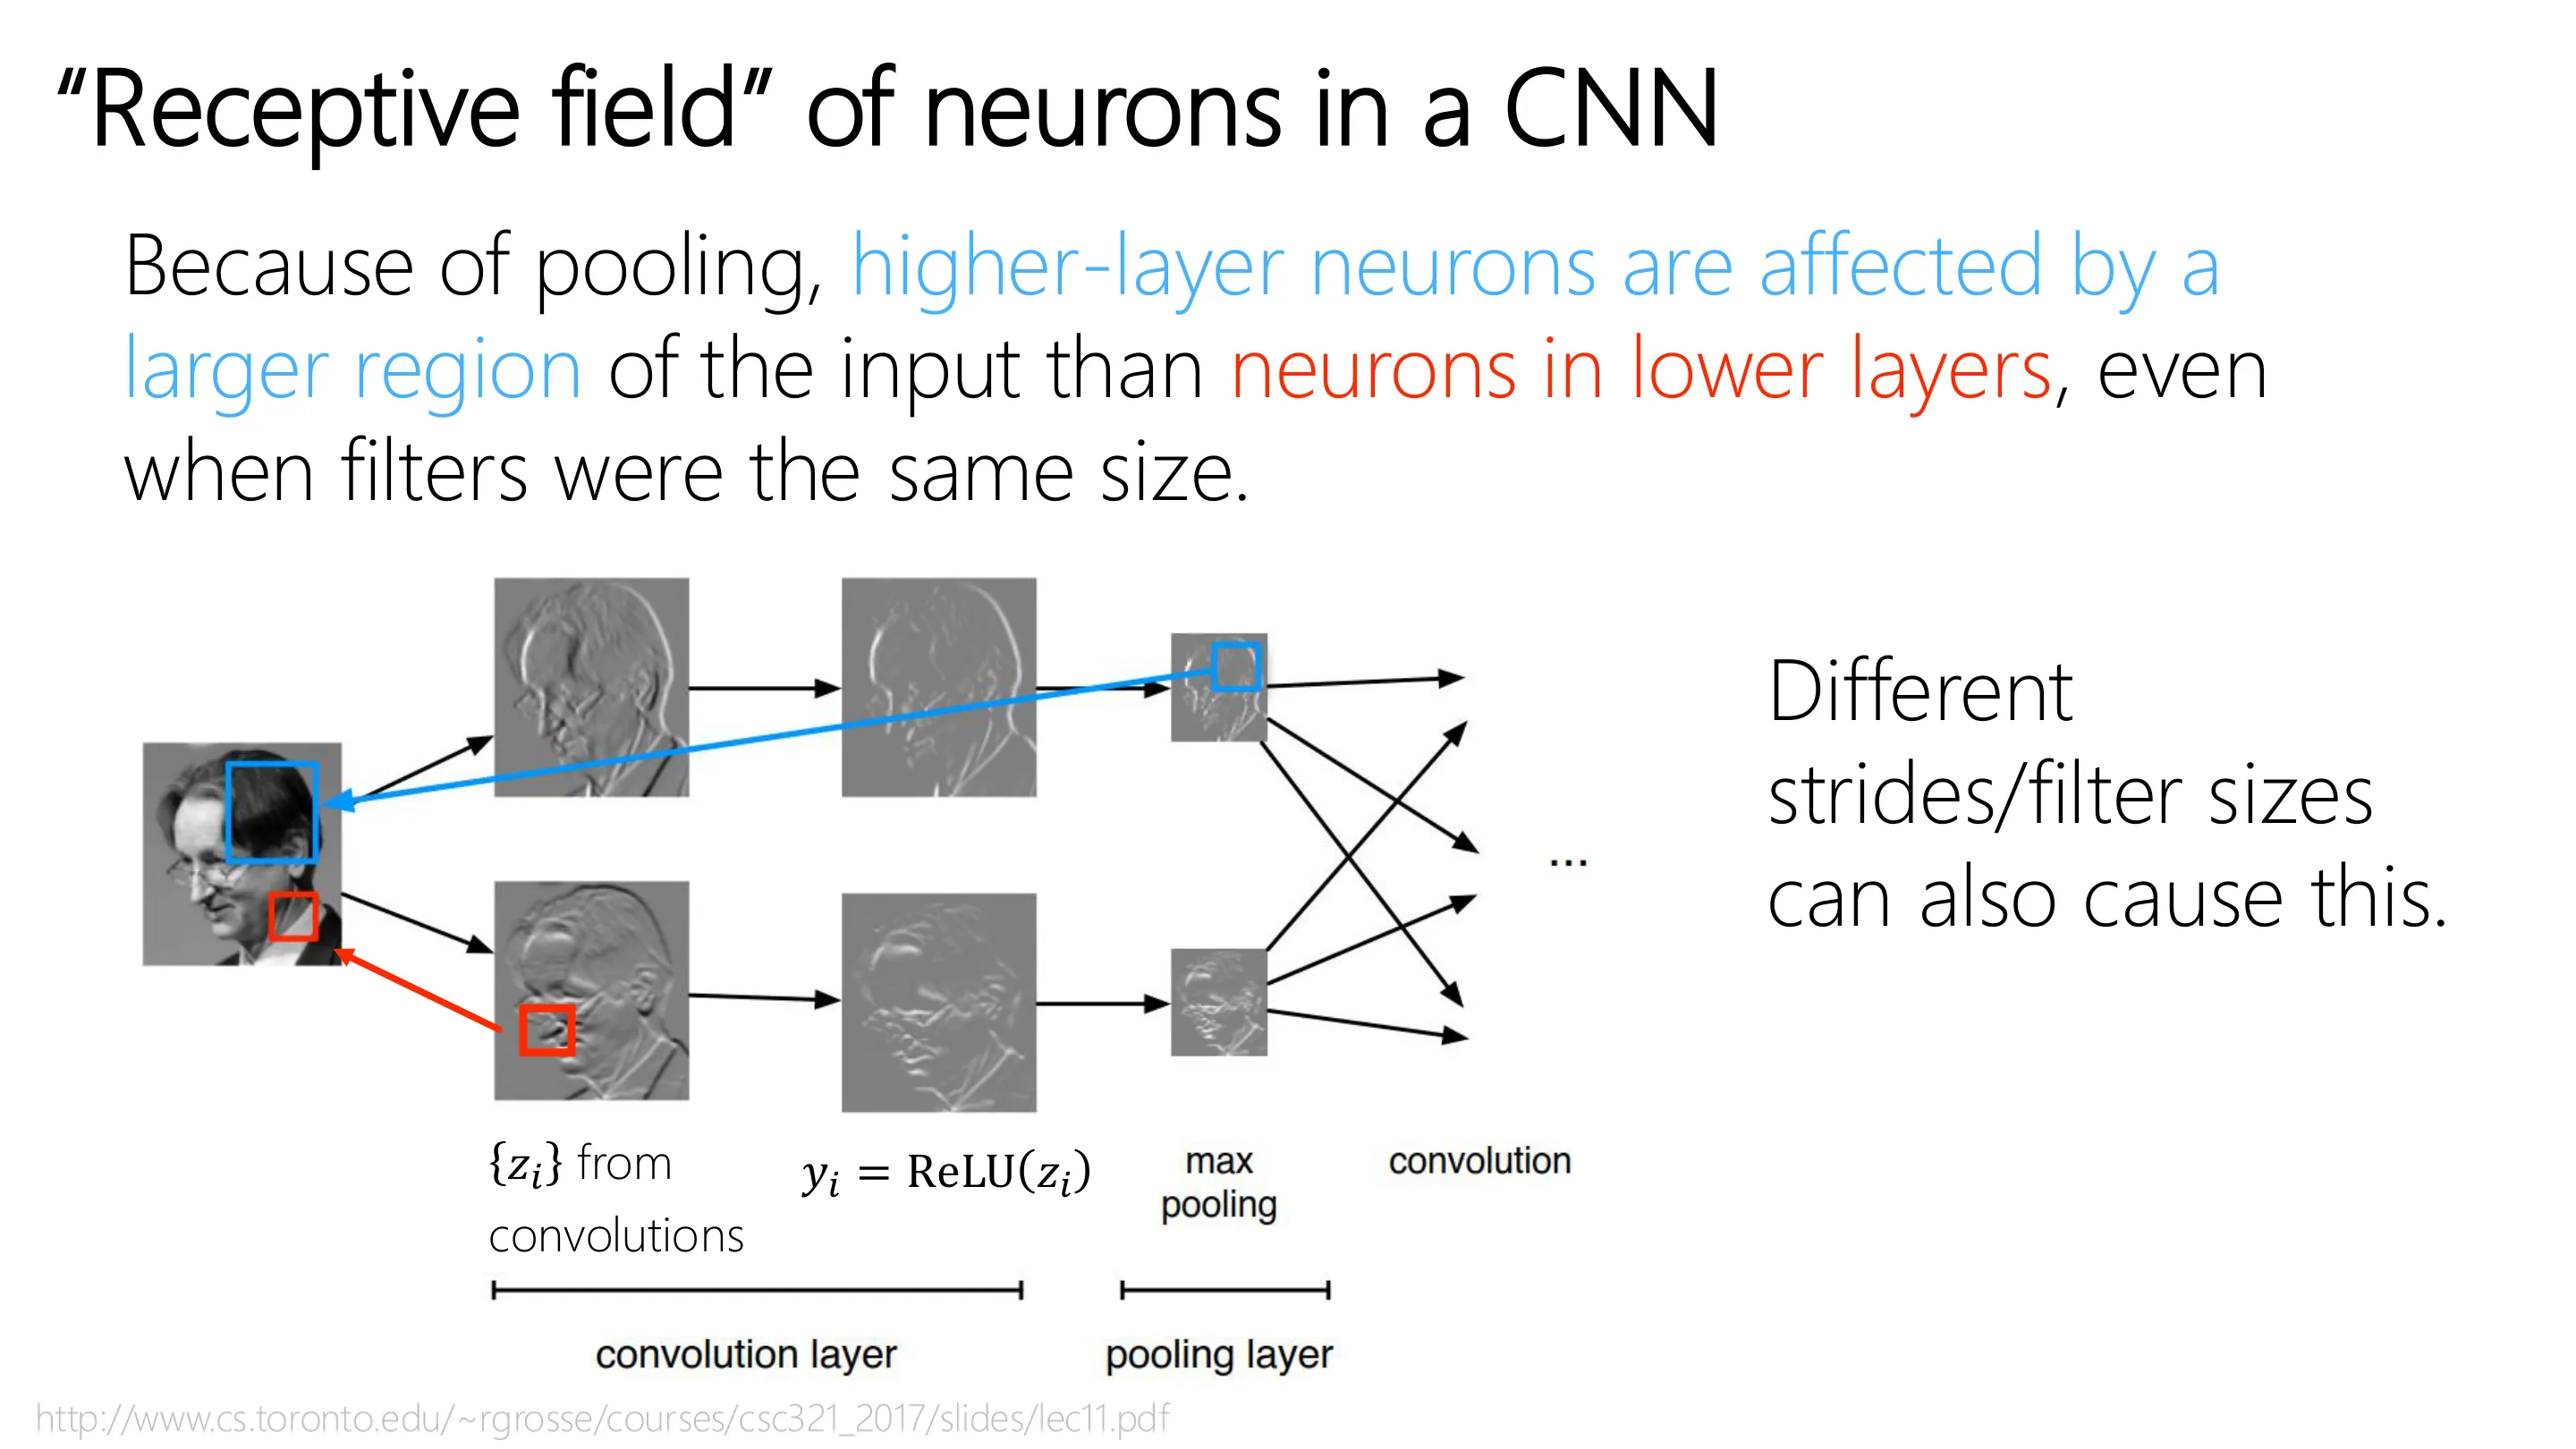
📷 (引文)
回到原视频 (00:33:11)
📷 强制权重共享
回到原视频 (00:34:24)
三、训练 CNN
(参考时间: 00:35)
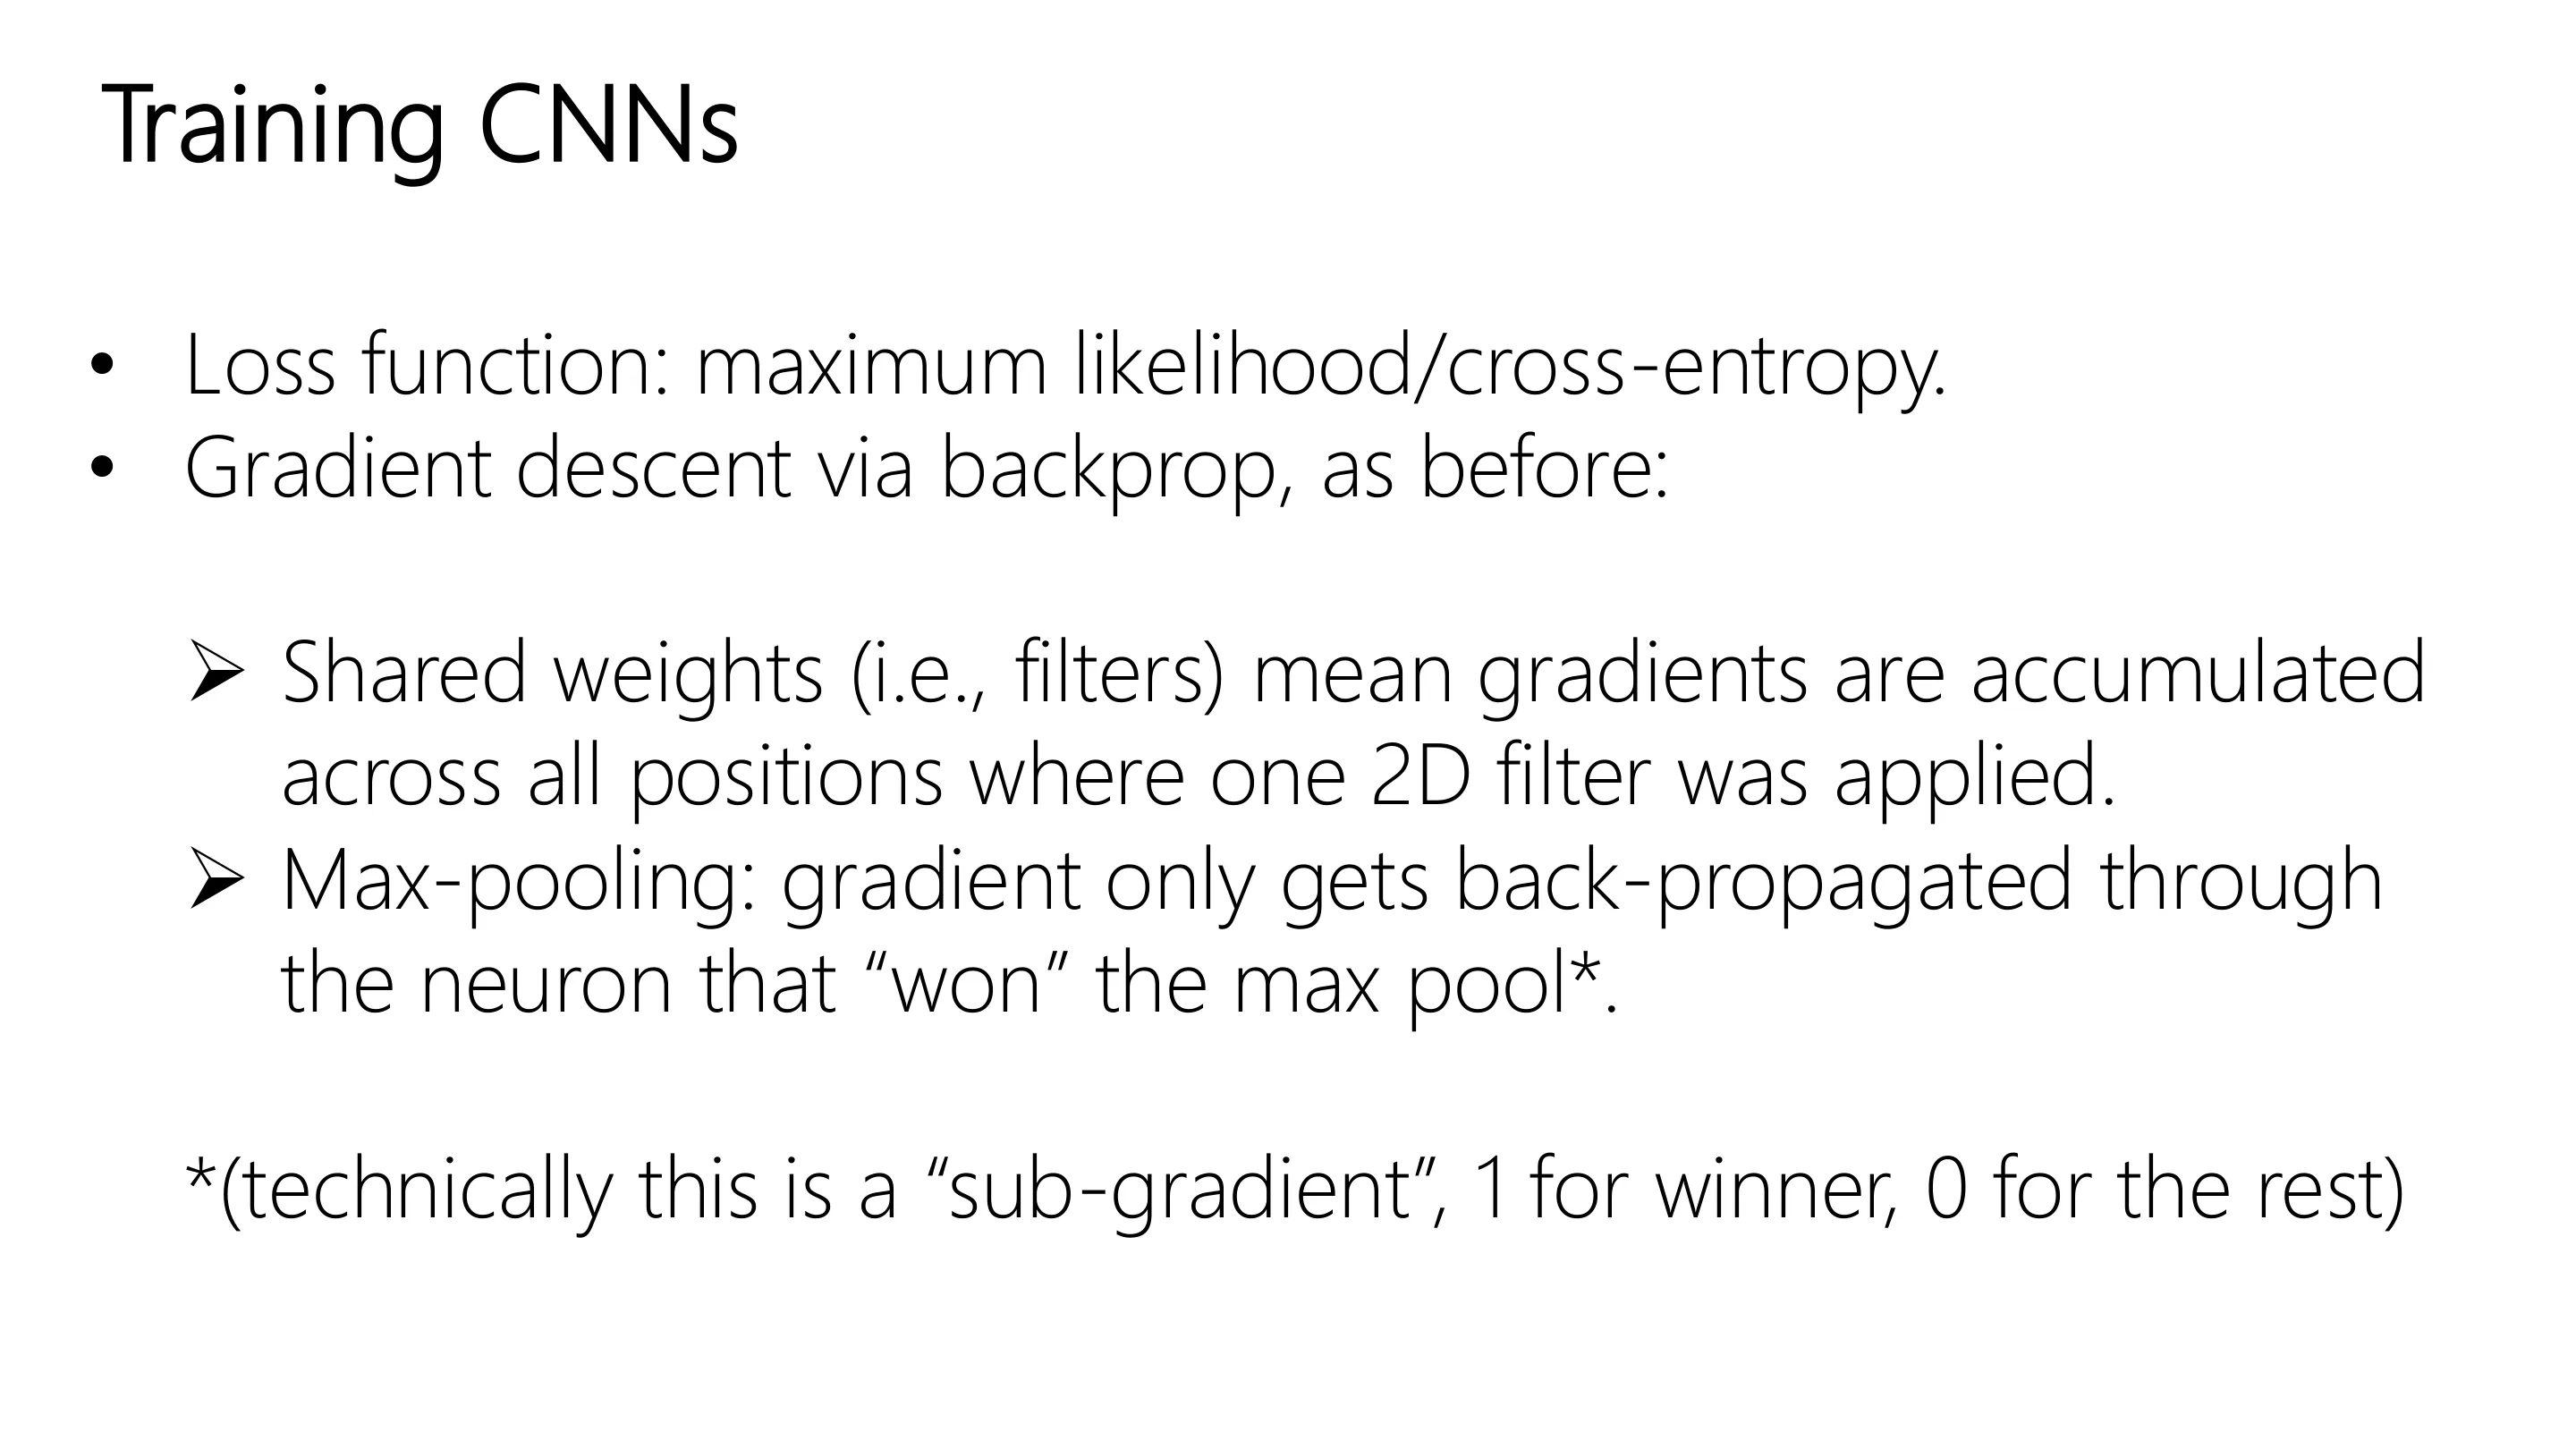
目标:最大化似然(实际常叫「最小化交叉熵」),用梯度下降 + 反向传播。几乎不需要特别技巧,两个例外:
- 权重共享:同一个滤波器反复使用 ⇒ 对它的梯度要累加它在每个位置产生的贡献(一个滤波器在一张图里有很多「样本」)。实现上「转一下曲柄」基本就自动搞定。
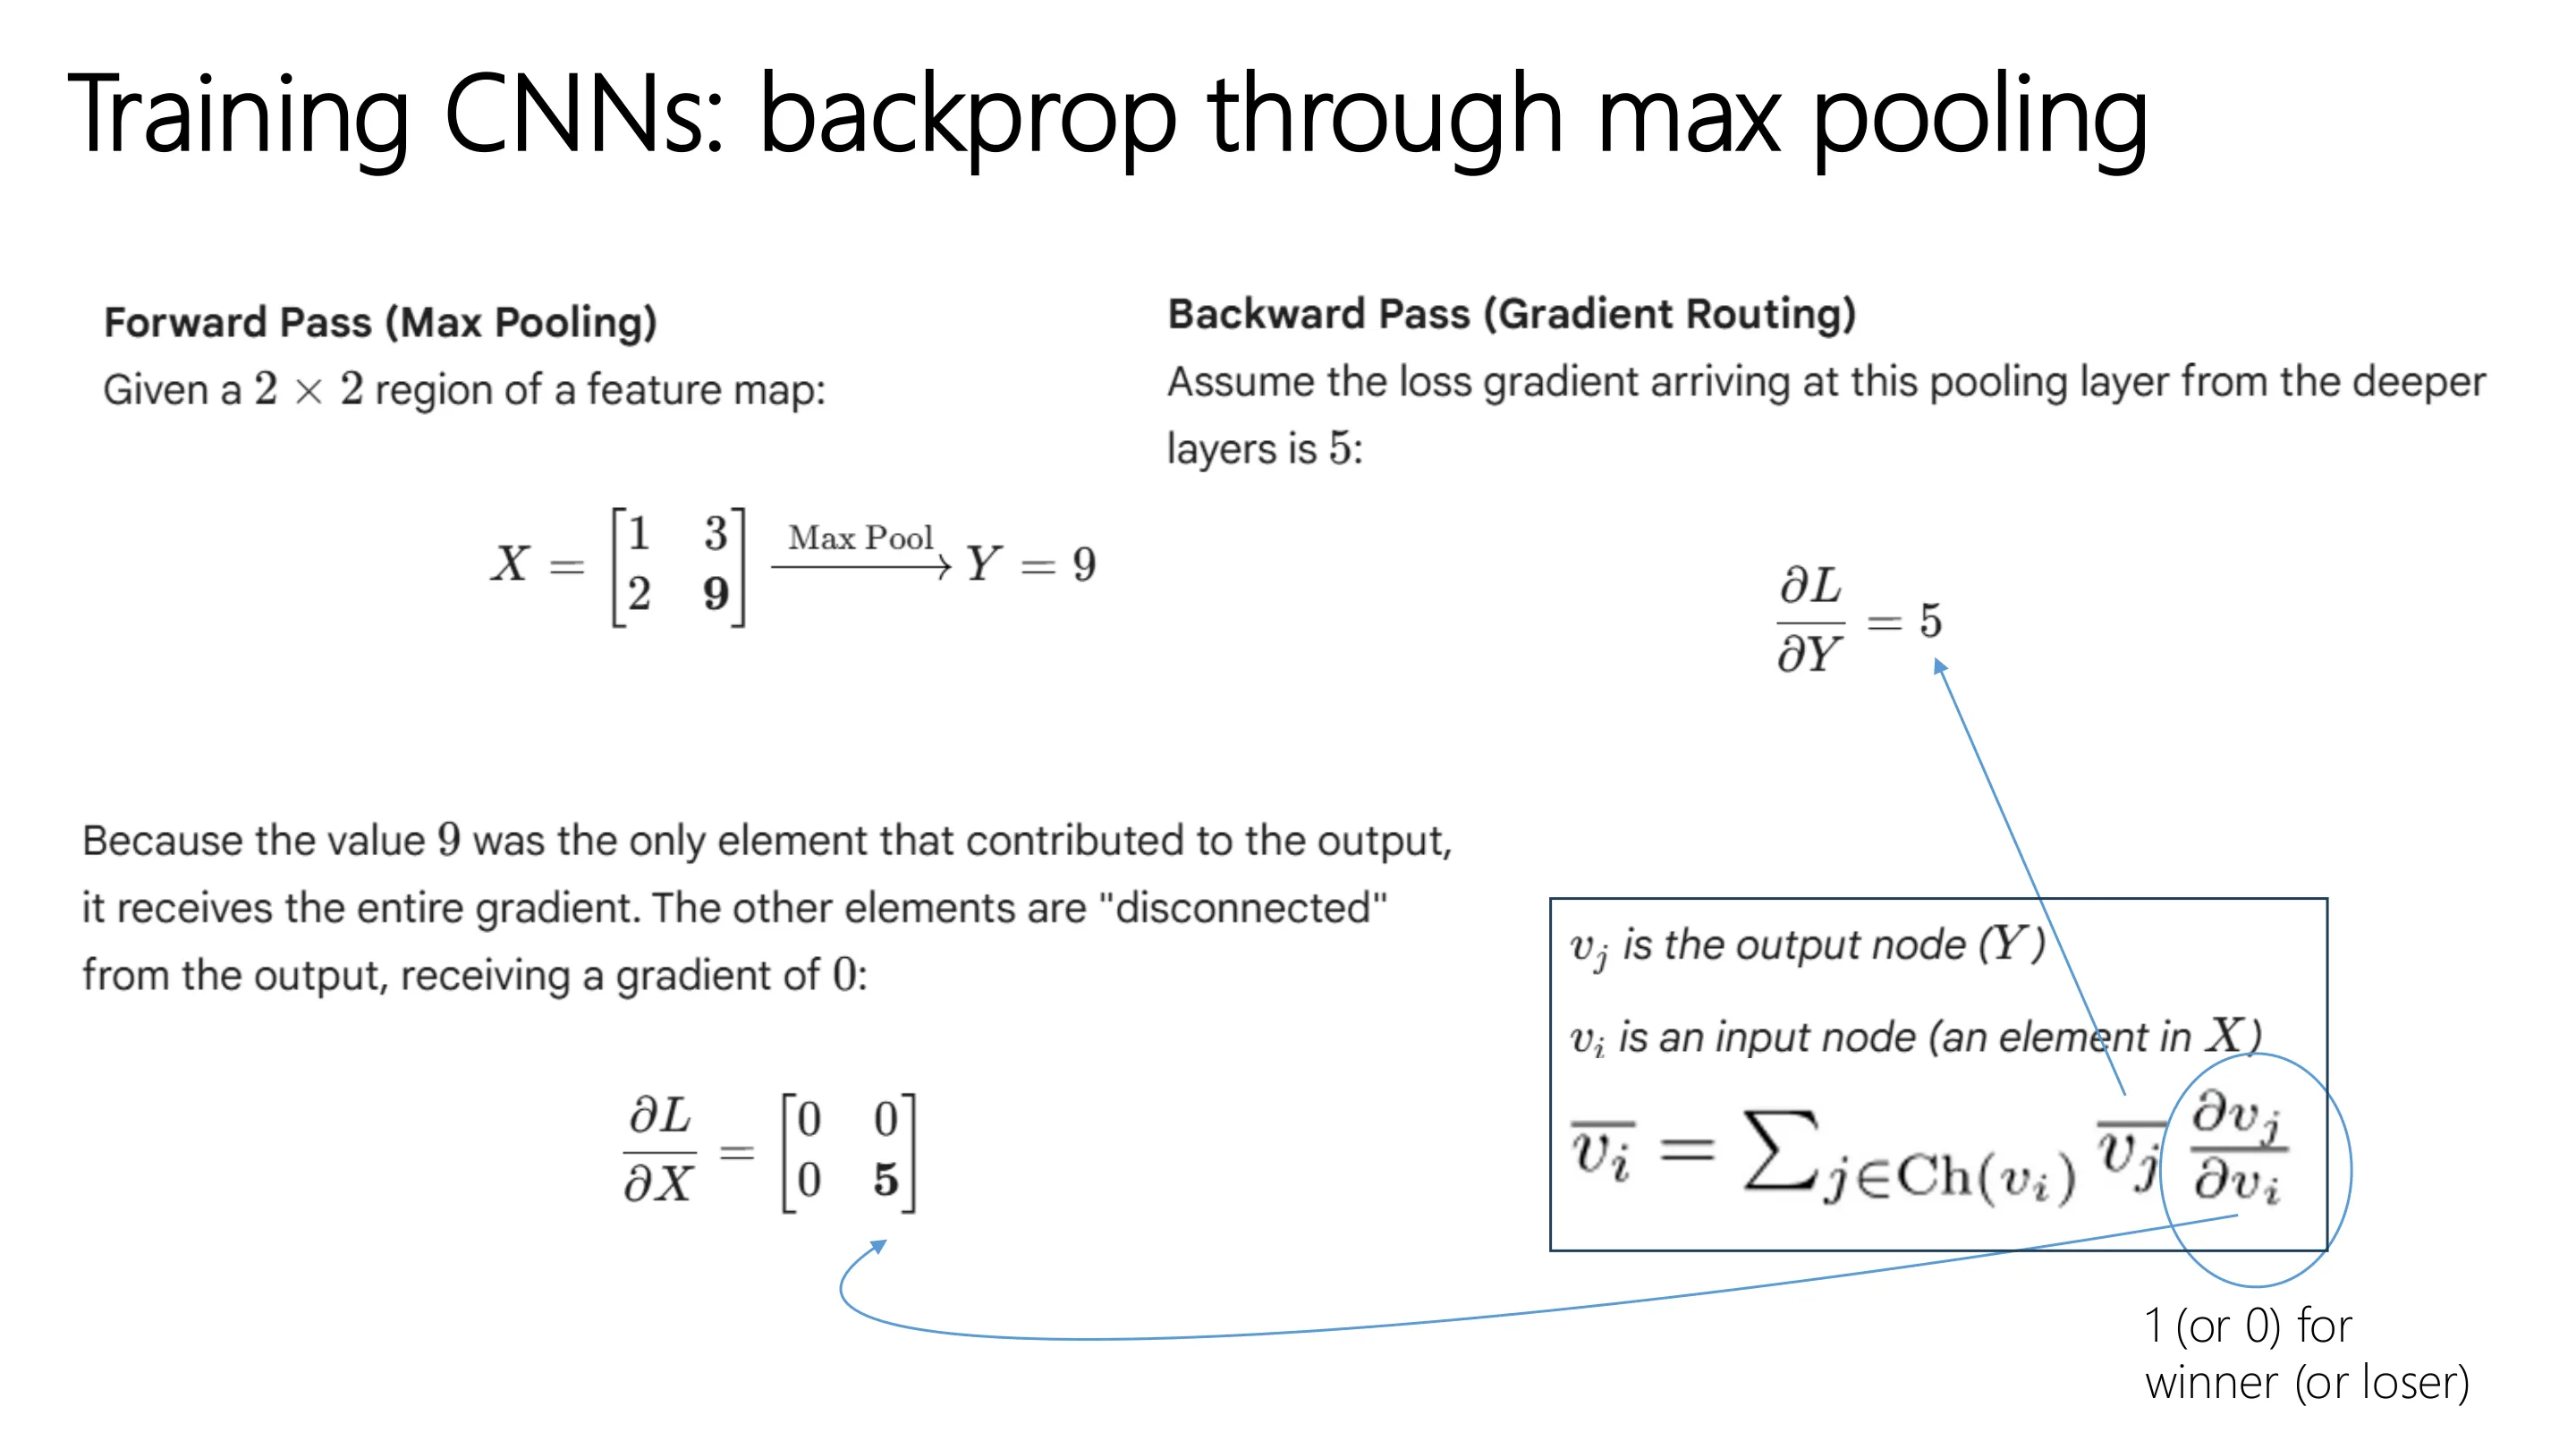
- 过 max pooling 的反向传播:用次梯度——梯度只回传给「赢家」(取到 max 的那个位置),其余位置梯度为 0。PyTorch 会自动这样做。
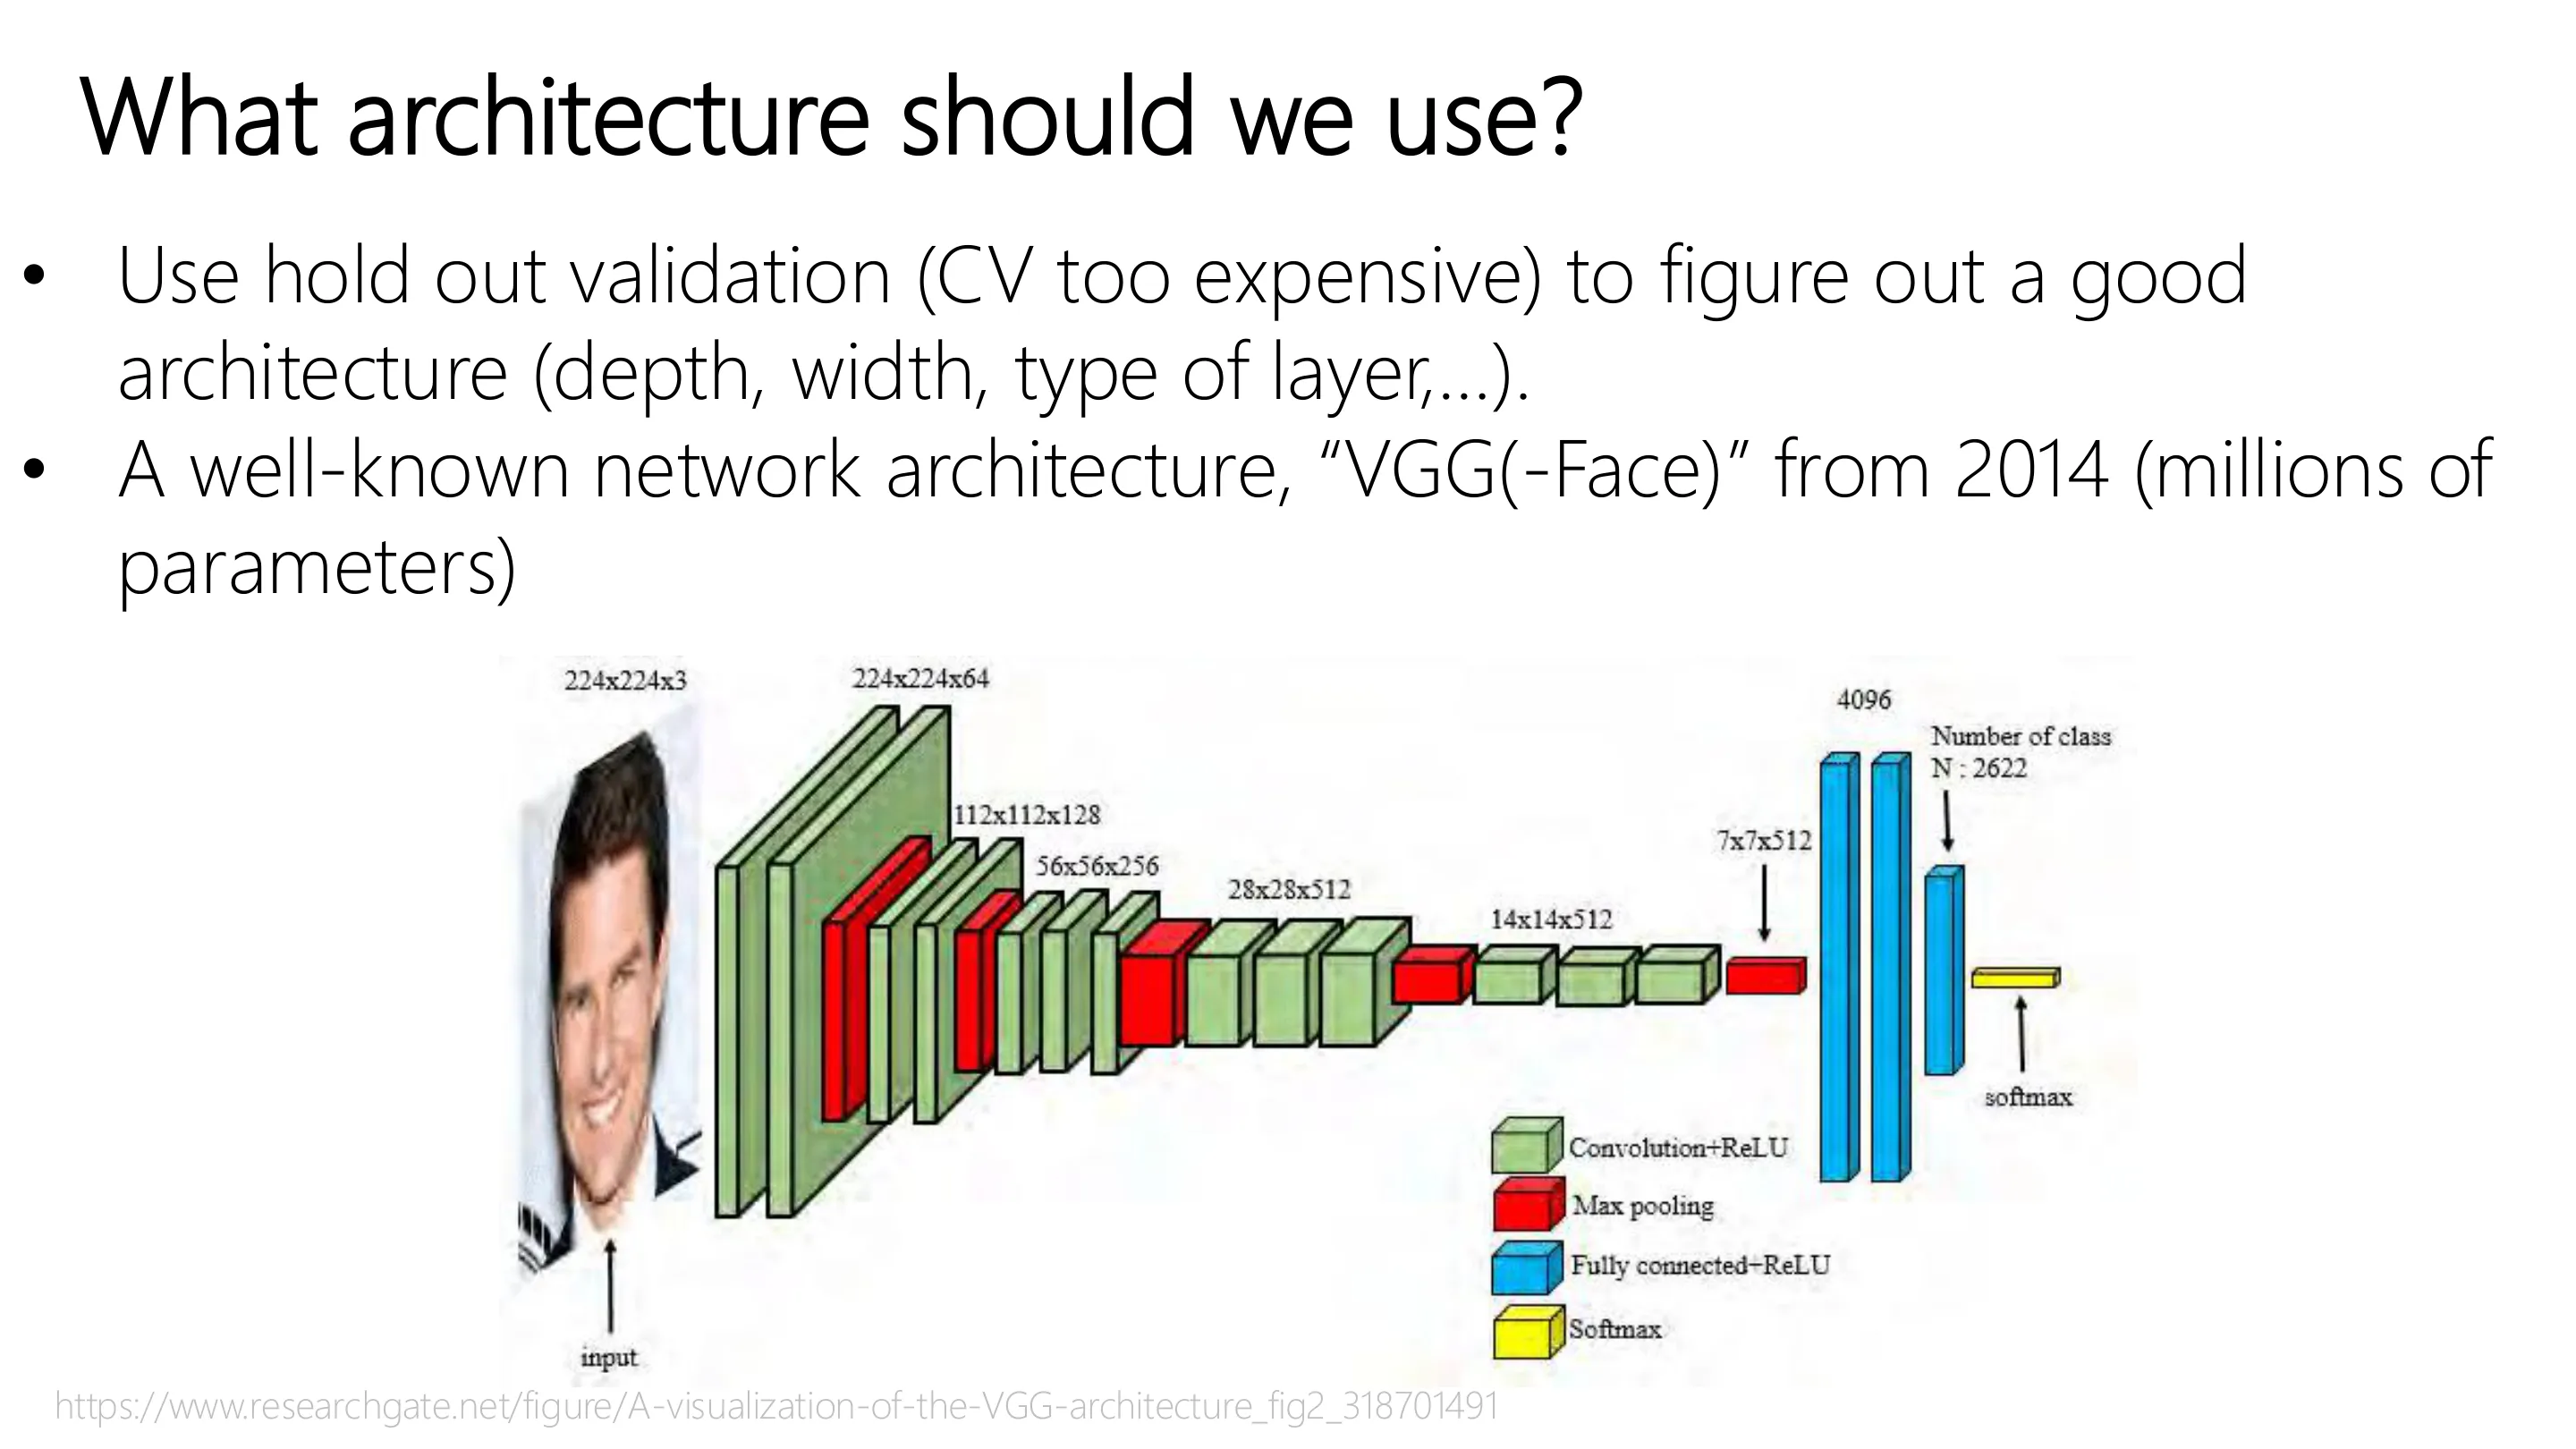
架构怎么选? 多少层、核多大、stride、全连接/池化方式……没有正确答案。由于深网太大,通常不做交叉验证,而是只切一次 train/val/test。
迁移学习 / 重用一个预训练模型:冻结前面所有层,只换一个分类头。这相当于固定的基展开——复用第一个任务学到的特征;学习快,因为只需训练最后几层(反传也省了)。
📷 训练 CNN
回到原视频 (00:35:37)
📷 过 max pooling 的反向传播
回到原视频 (00:36:50)
📷 我们应该用什么架构?
回到原视频 (00:38:03)
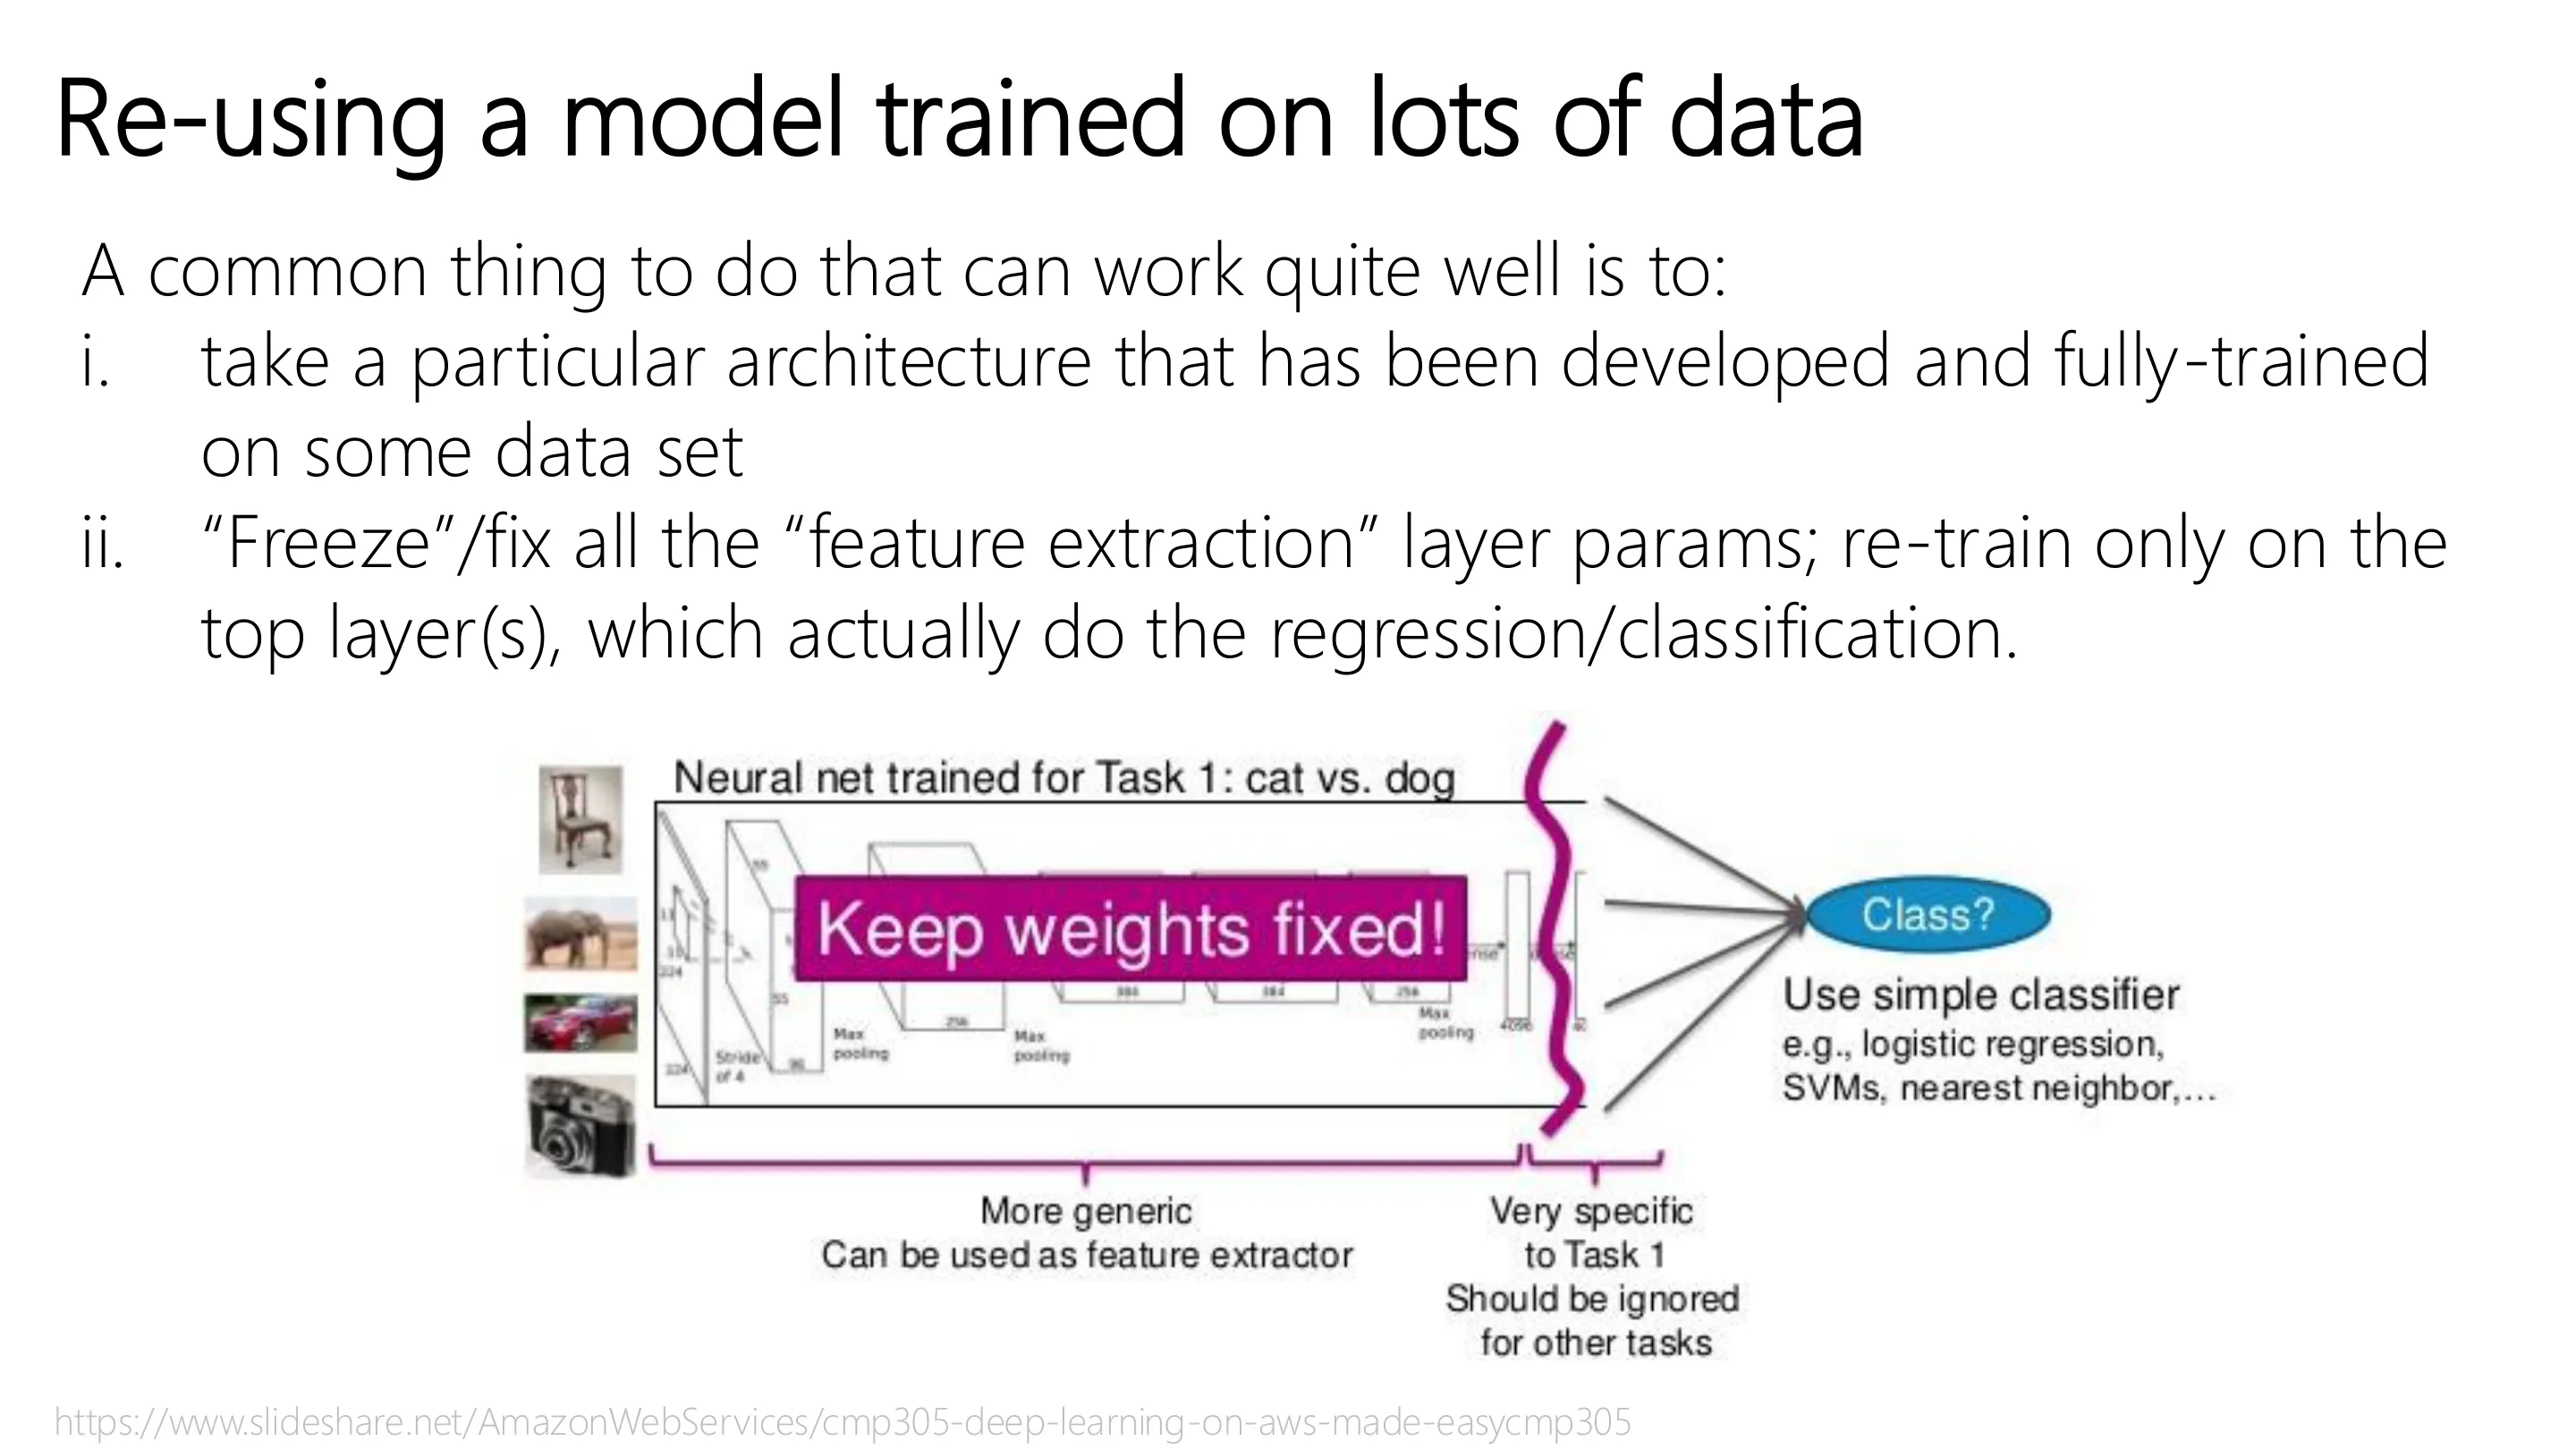
📷 重用一个在大数据上训练好的模型
回到原视频 (00:39:16)
📷 CS 189/289
回到原视频 (00:40:29)
四、学习曲线、早停与正则化
(参考时间: 00:46)
学习曲线:同时追踪训练误差和验证误差。训练误差会一直下降,但验证误差(未参与梯度下降的新数据)几乎必然在某个点回升——那就是过拟合。于是在验证误差开始上升前停下,用验证集决定何时停。
早停 = 一种正则化(讲师调侃这是「土拨鼠之日」:他读博时大家觉得早停老土,现在大模型反倒都这么做)。因为:
- 参数初始化为接近 0,梯度下降让它们远离 0;
- 训练到收敛 ⇒ 权重走得远;早停 ⇒ 权重保留在较小的幅值;
- 这相当于一种 L2 式正则(「weight decay」)。
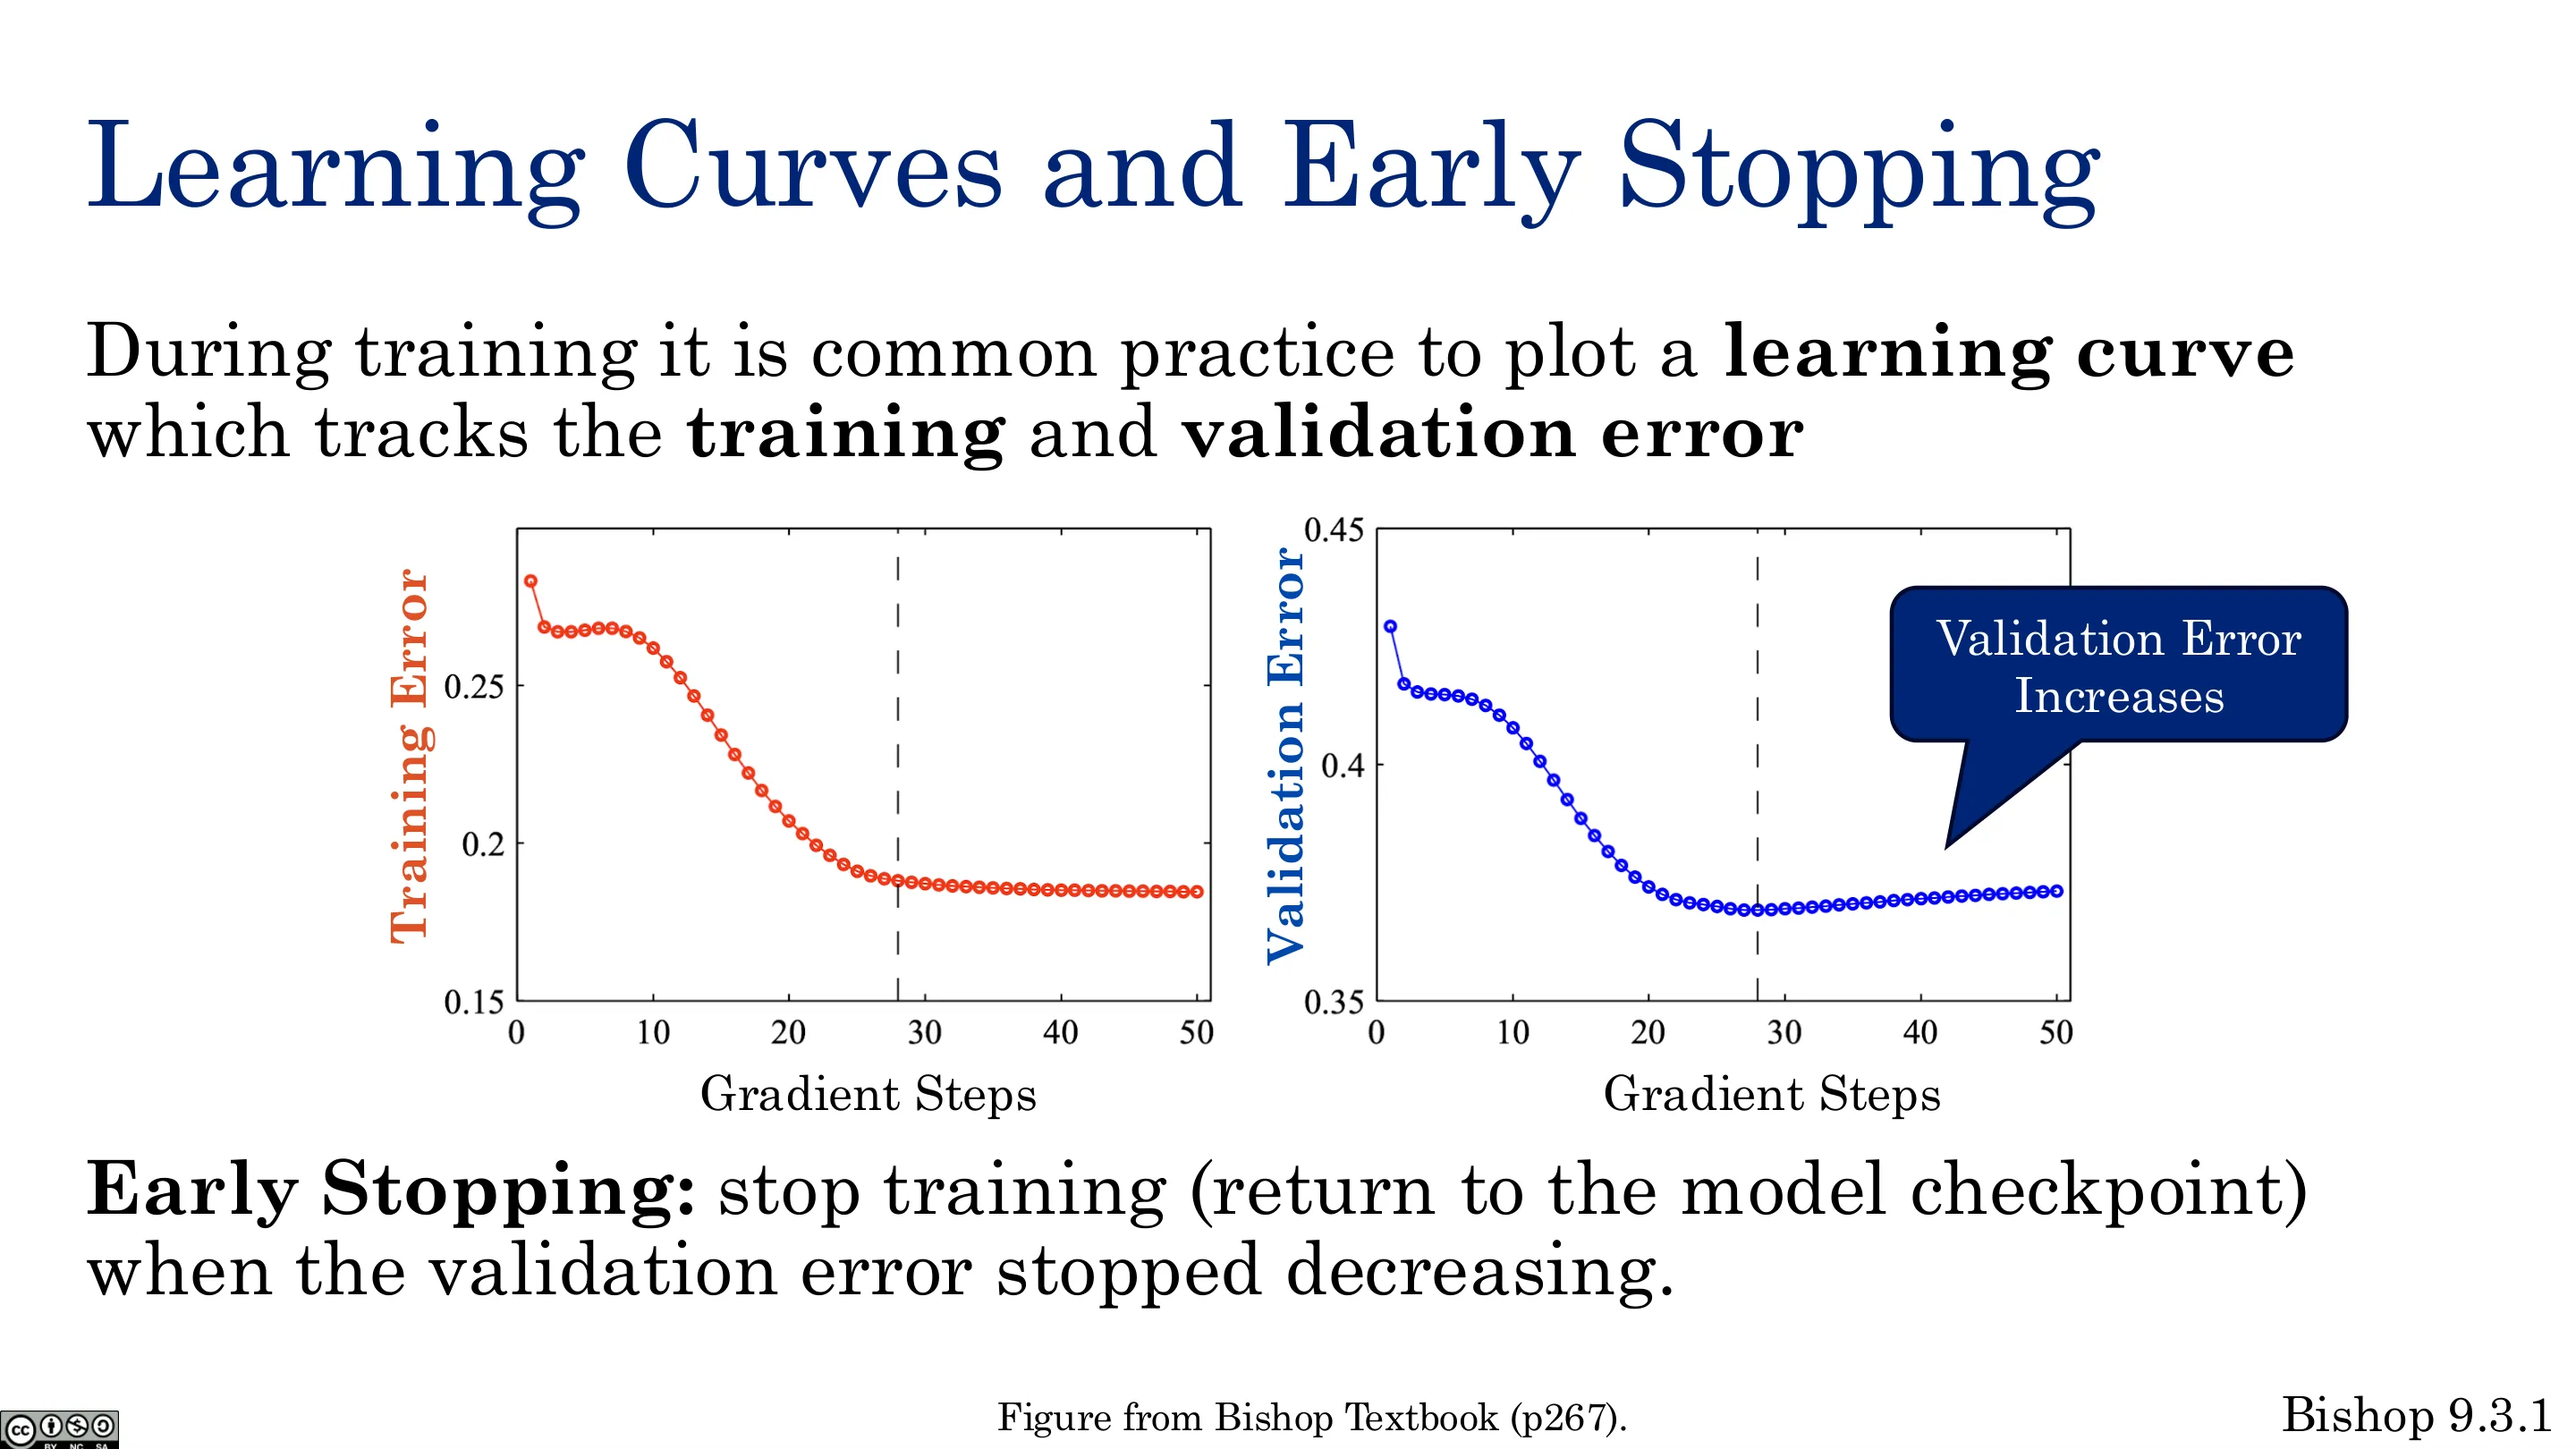
📷 学习曲线与早停
回到原视频 (00:41:42)
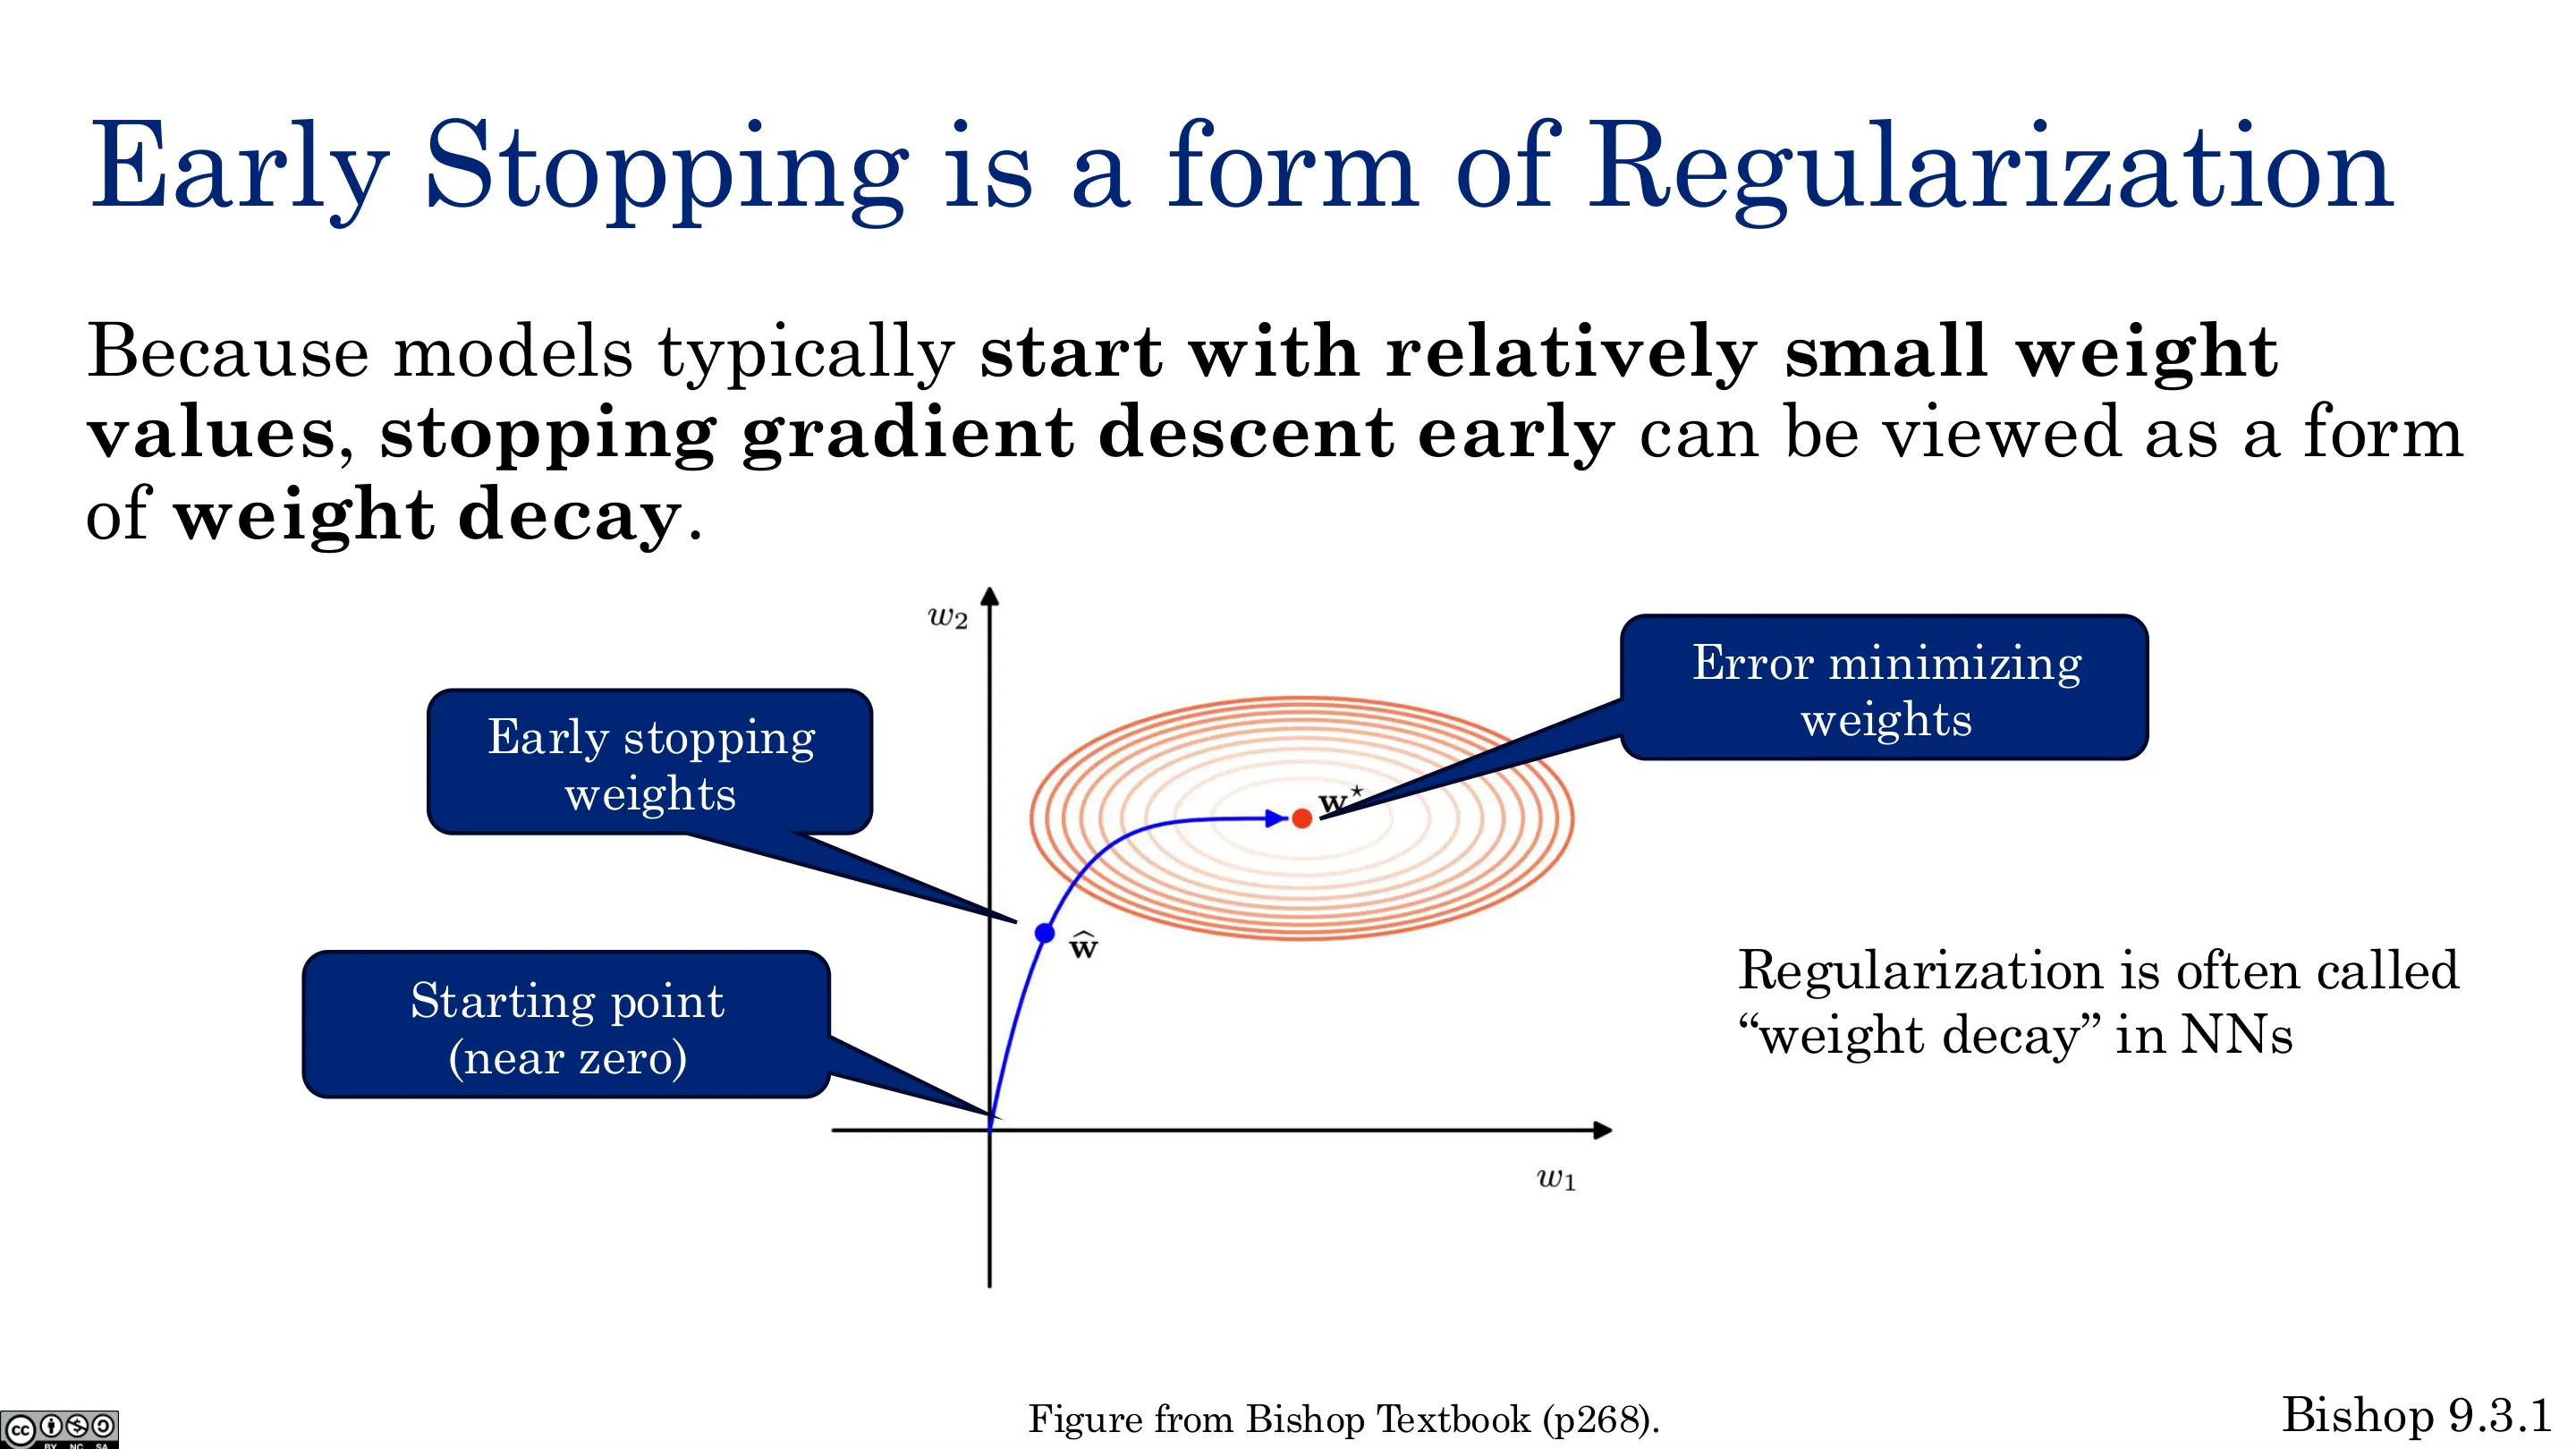
📷 早停是一种正则化
回到原视频 (00:42:55)
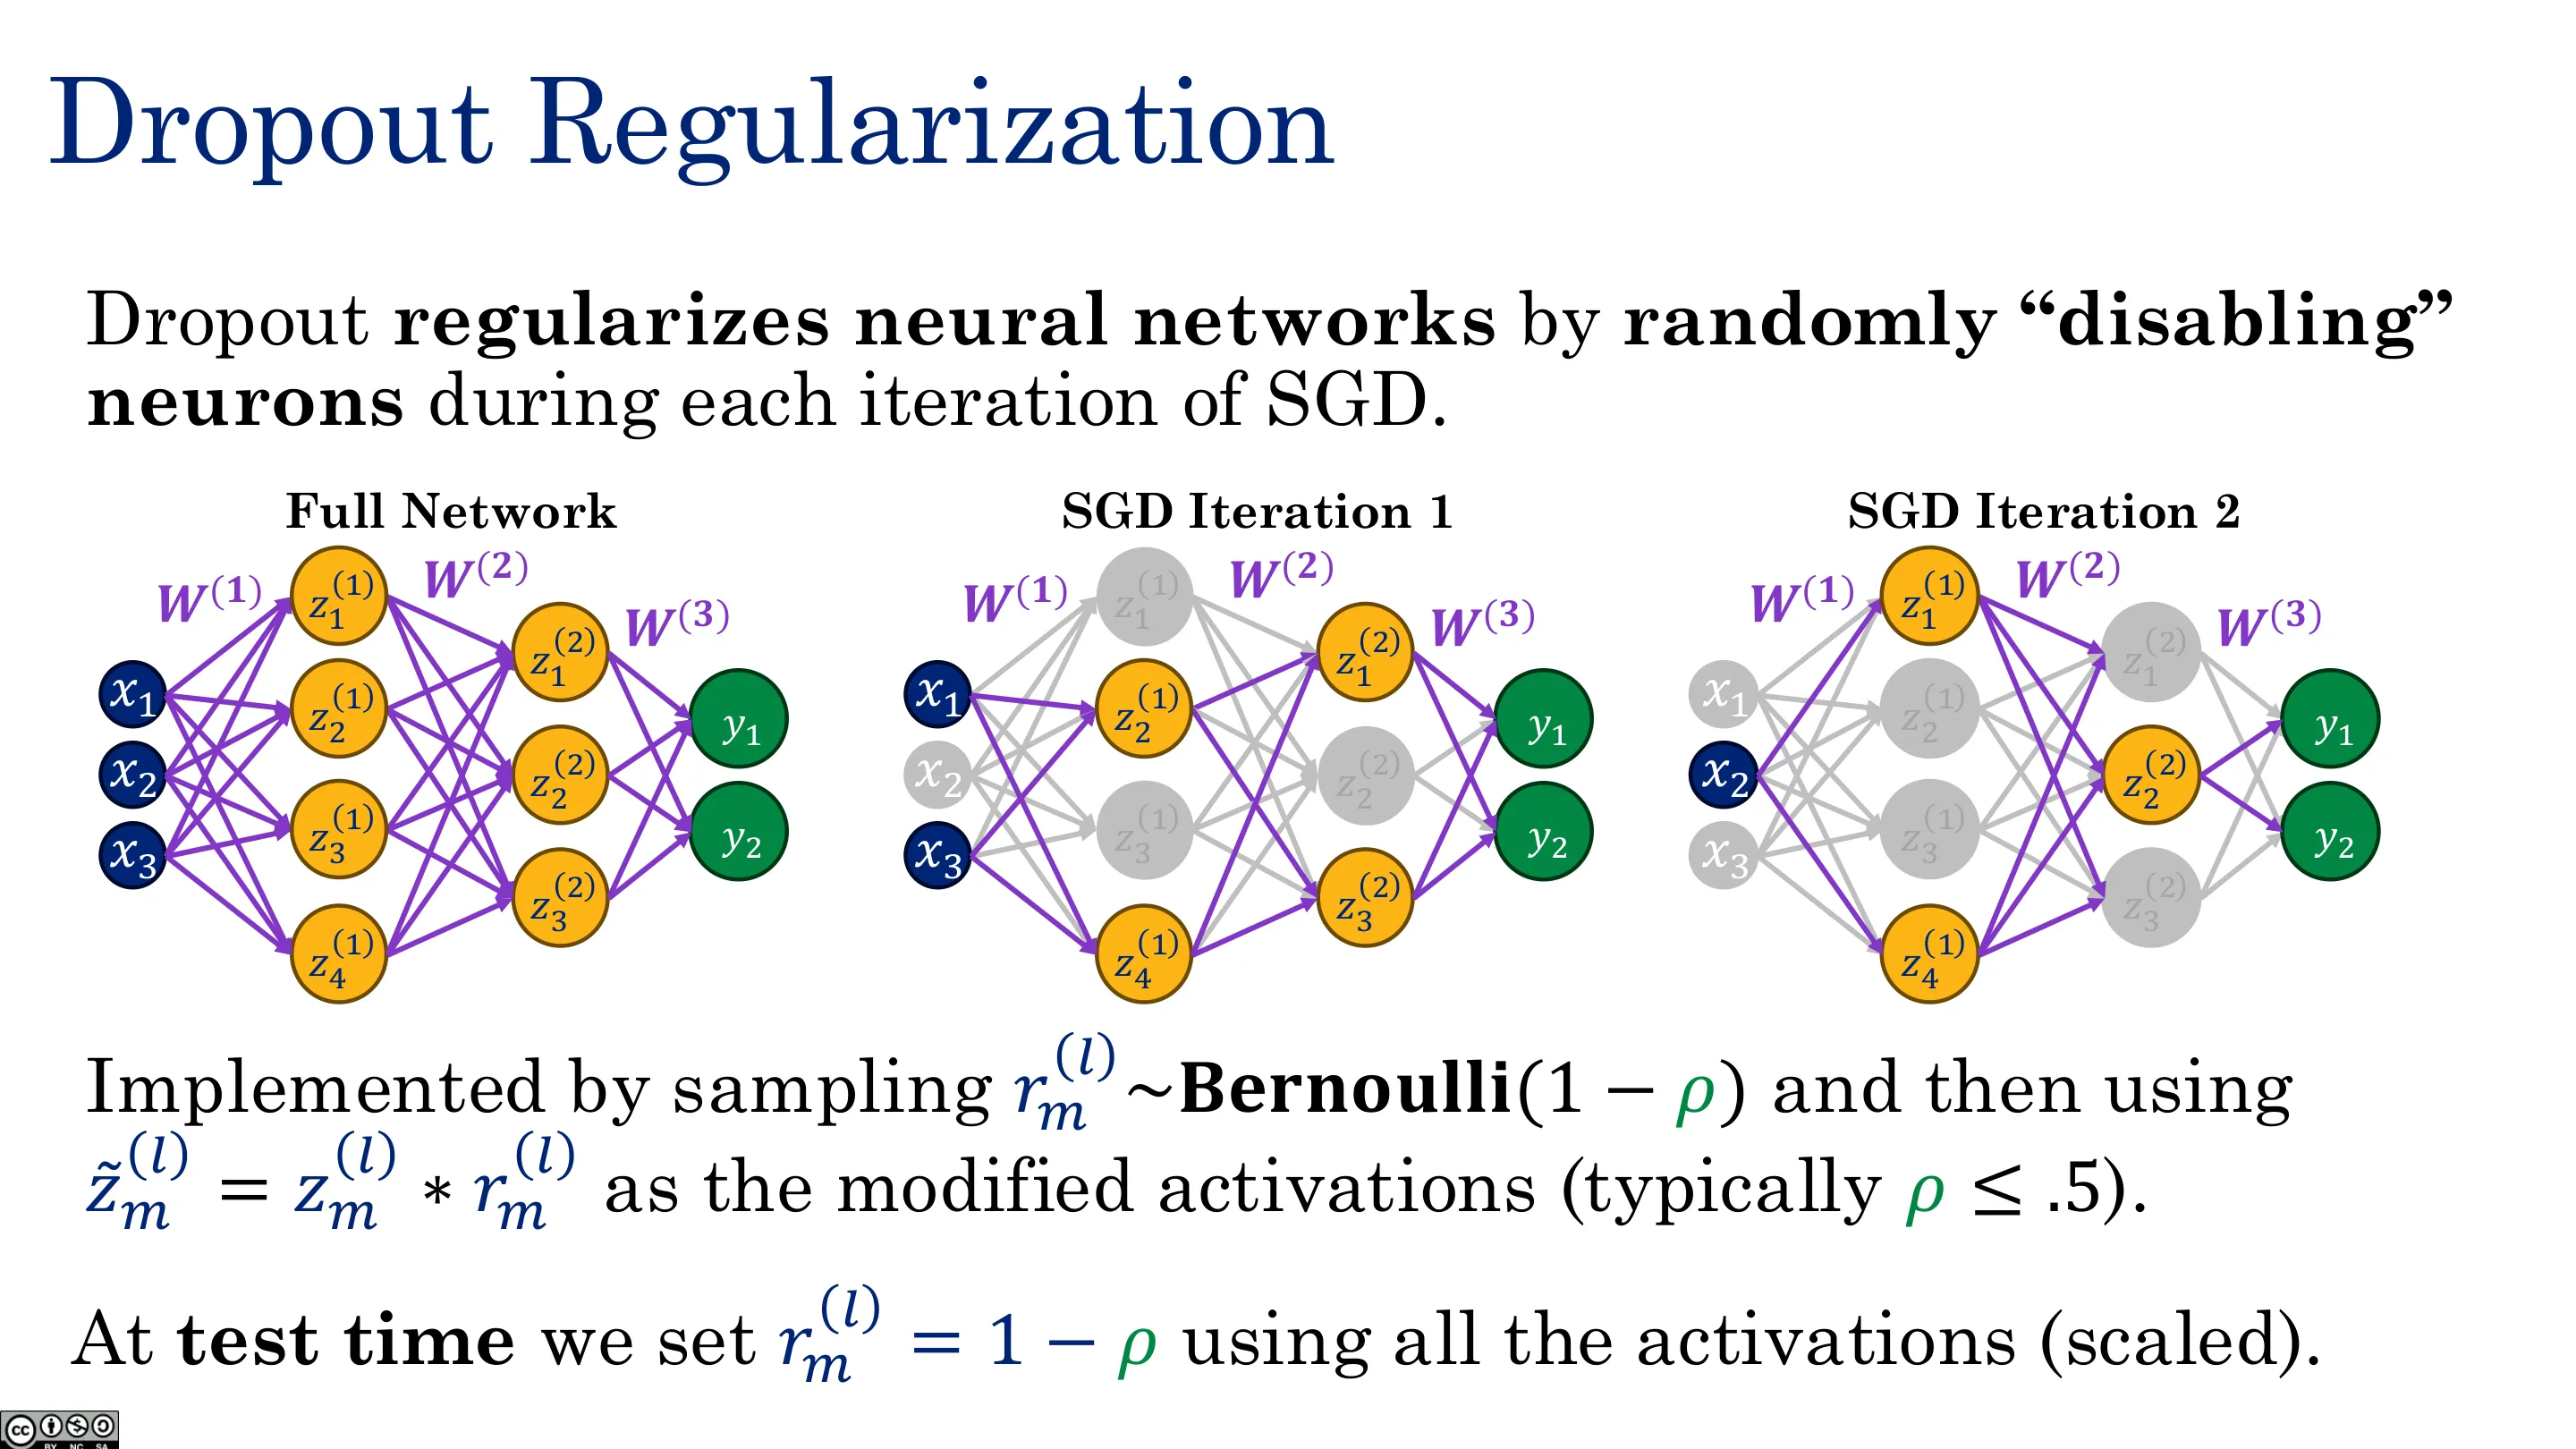
Dropout 正则化:每次迭代(mini-batch)按 Bernoulli 概率随机「丢弃」一部分神经元/参数,迫使网络具备冗余/平滑,从而控制复杂度、抑制拟合噪声。每次迭代丢的是不同的一组(否则只是换了个怪架构)。测试时用上所有权重,但按丢弃比例相应下调以保持尺度。
- 一个进阶视角:测试时也做多次 dropout、再平均预测,可给出贝叶斯解释——但这是「先有启发式、后补理论」。
📷 Dropout 正则化
回到原视频 (00:44:08)
五、偏差-方差与双下降
(参考时间: 00:53)
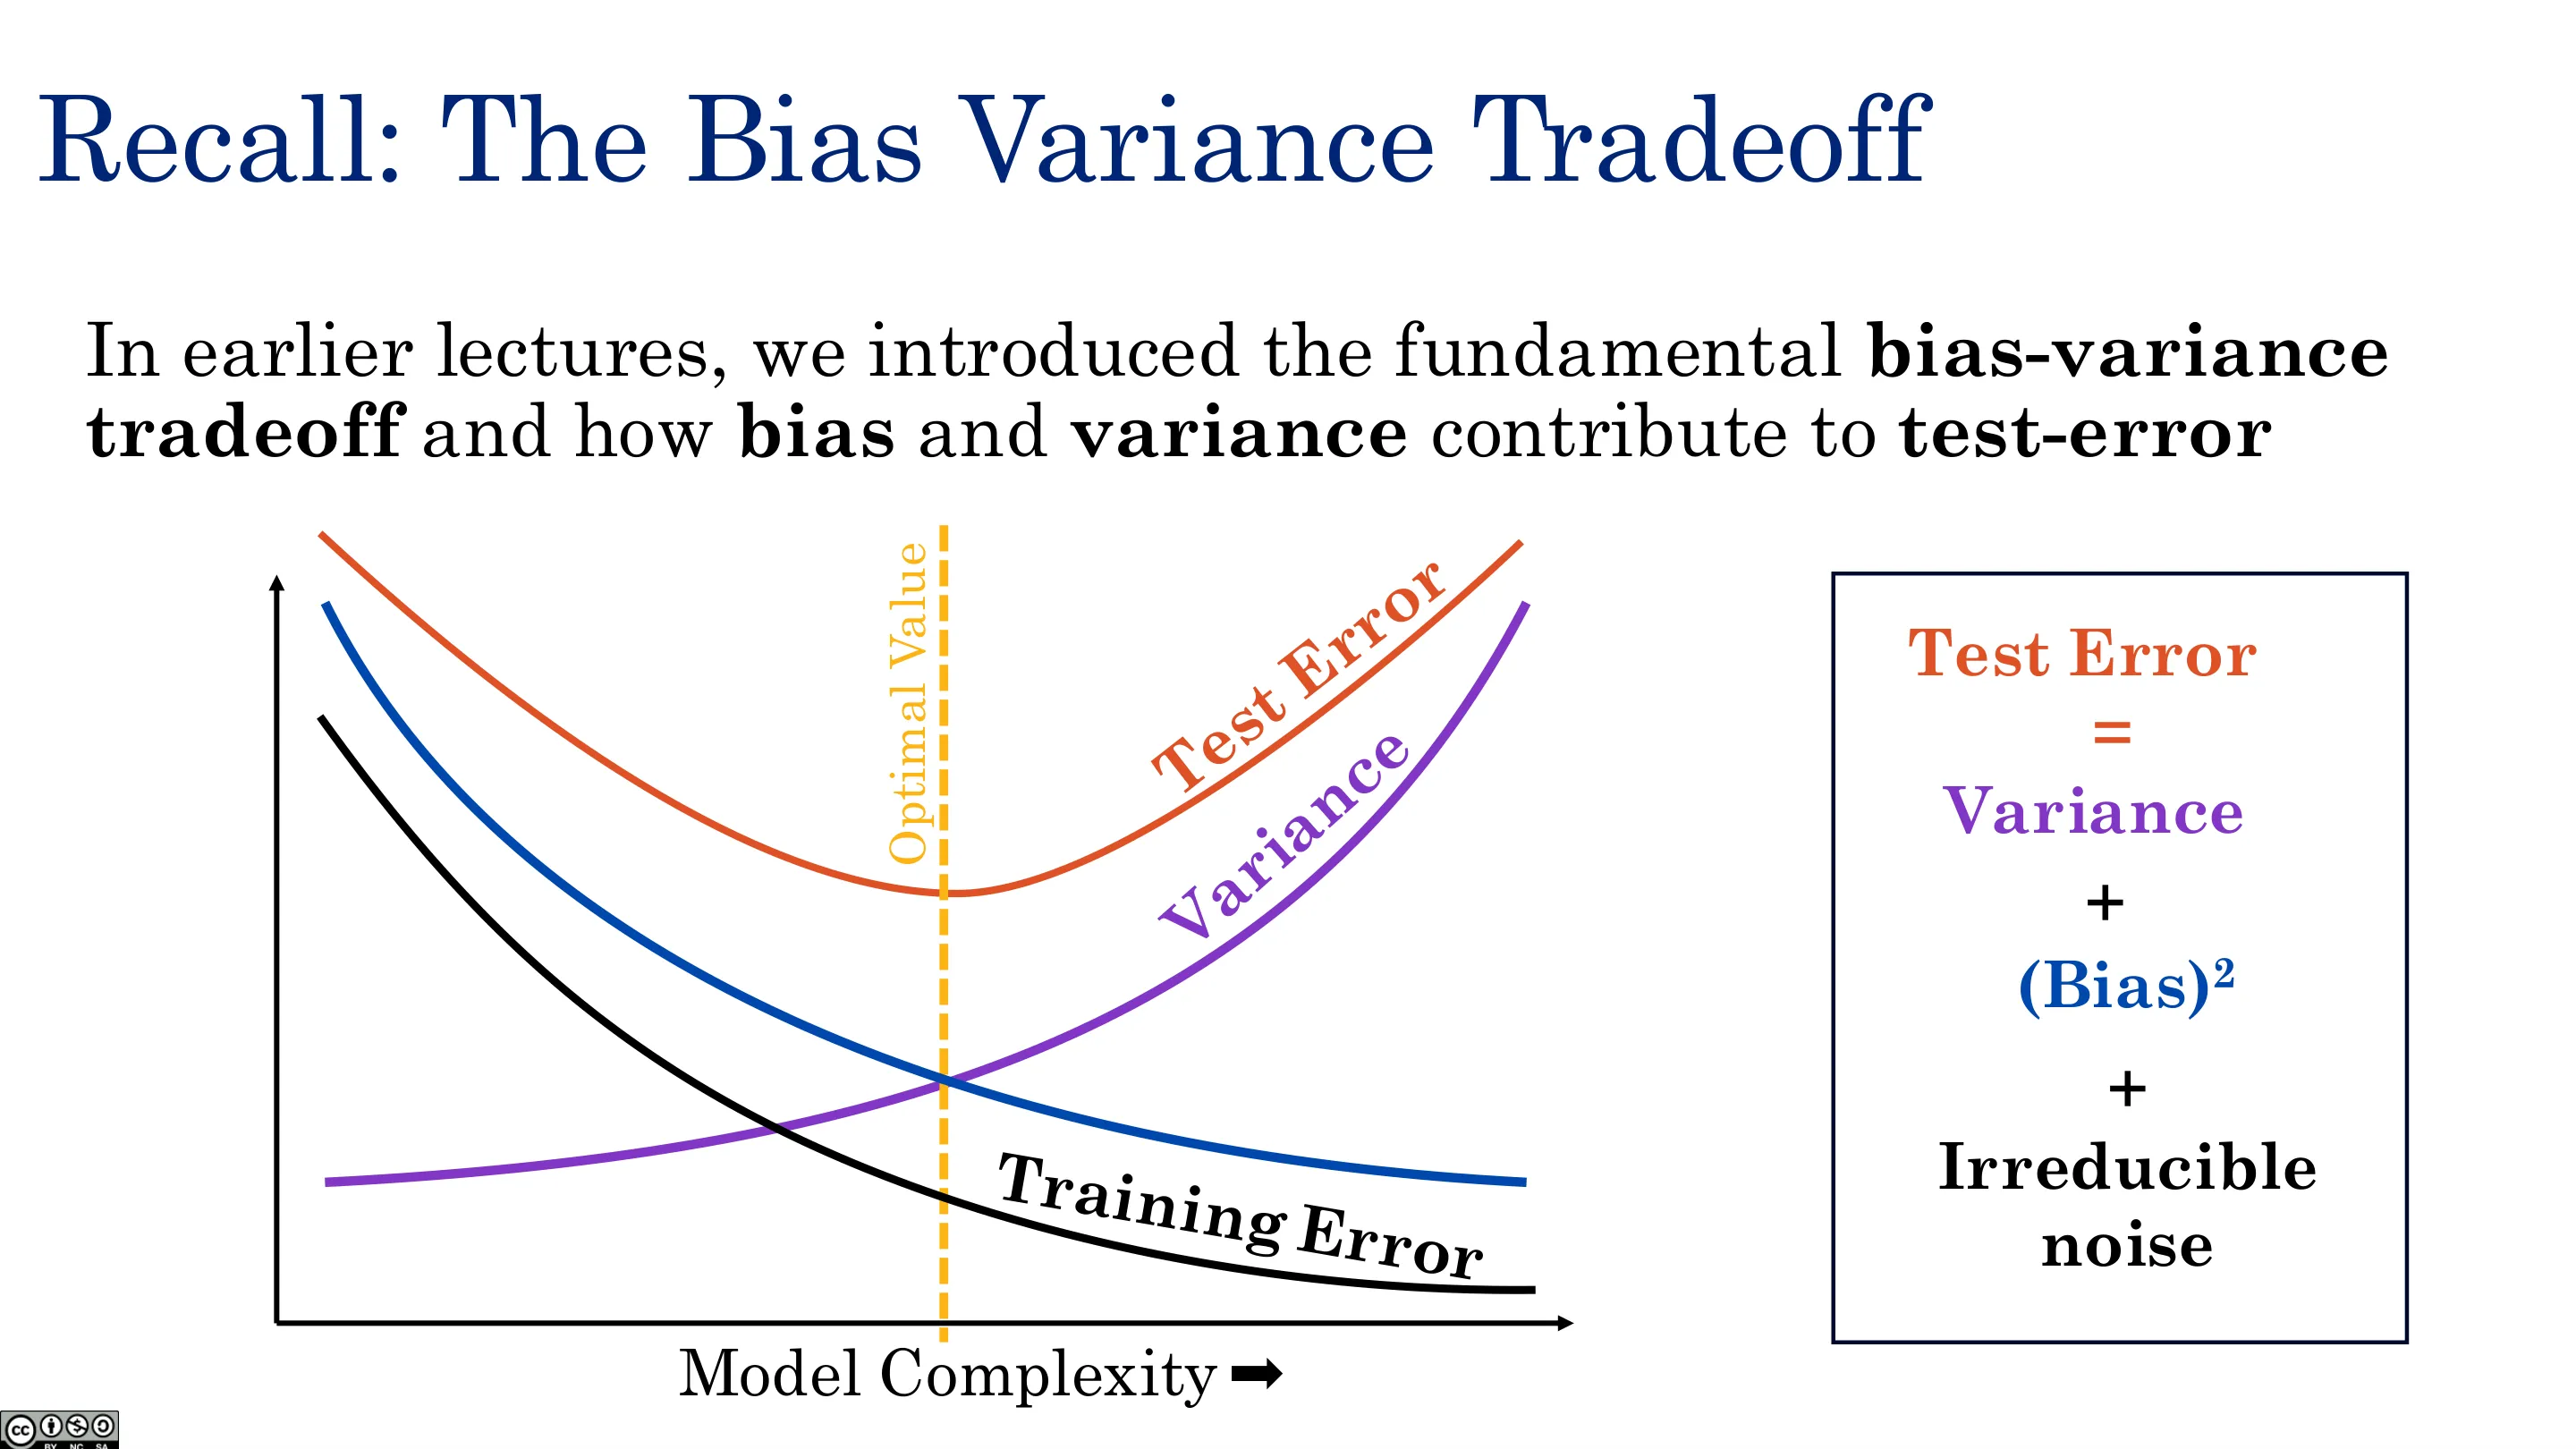
经典图像(复习):横轴是模型复杂度,测试误差 = 偏差² + 方差 + 不可约噪声;简单模型高偏差、复杂模型高方差,中间有个甜点。注意:这只在简单线性模型上能精确计算;深网无法计算这一分解。
📷 回顾:偏差-方差权衡
回到原视频 (00:45:21)
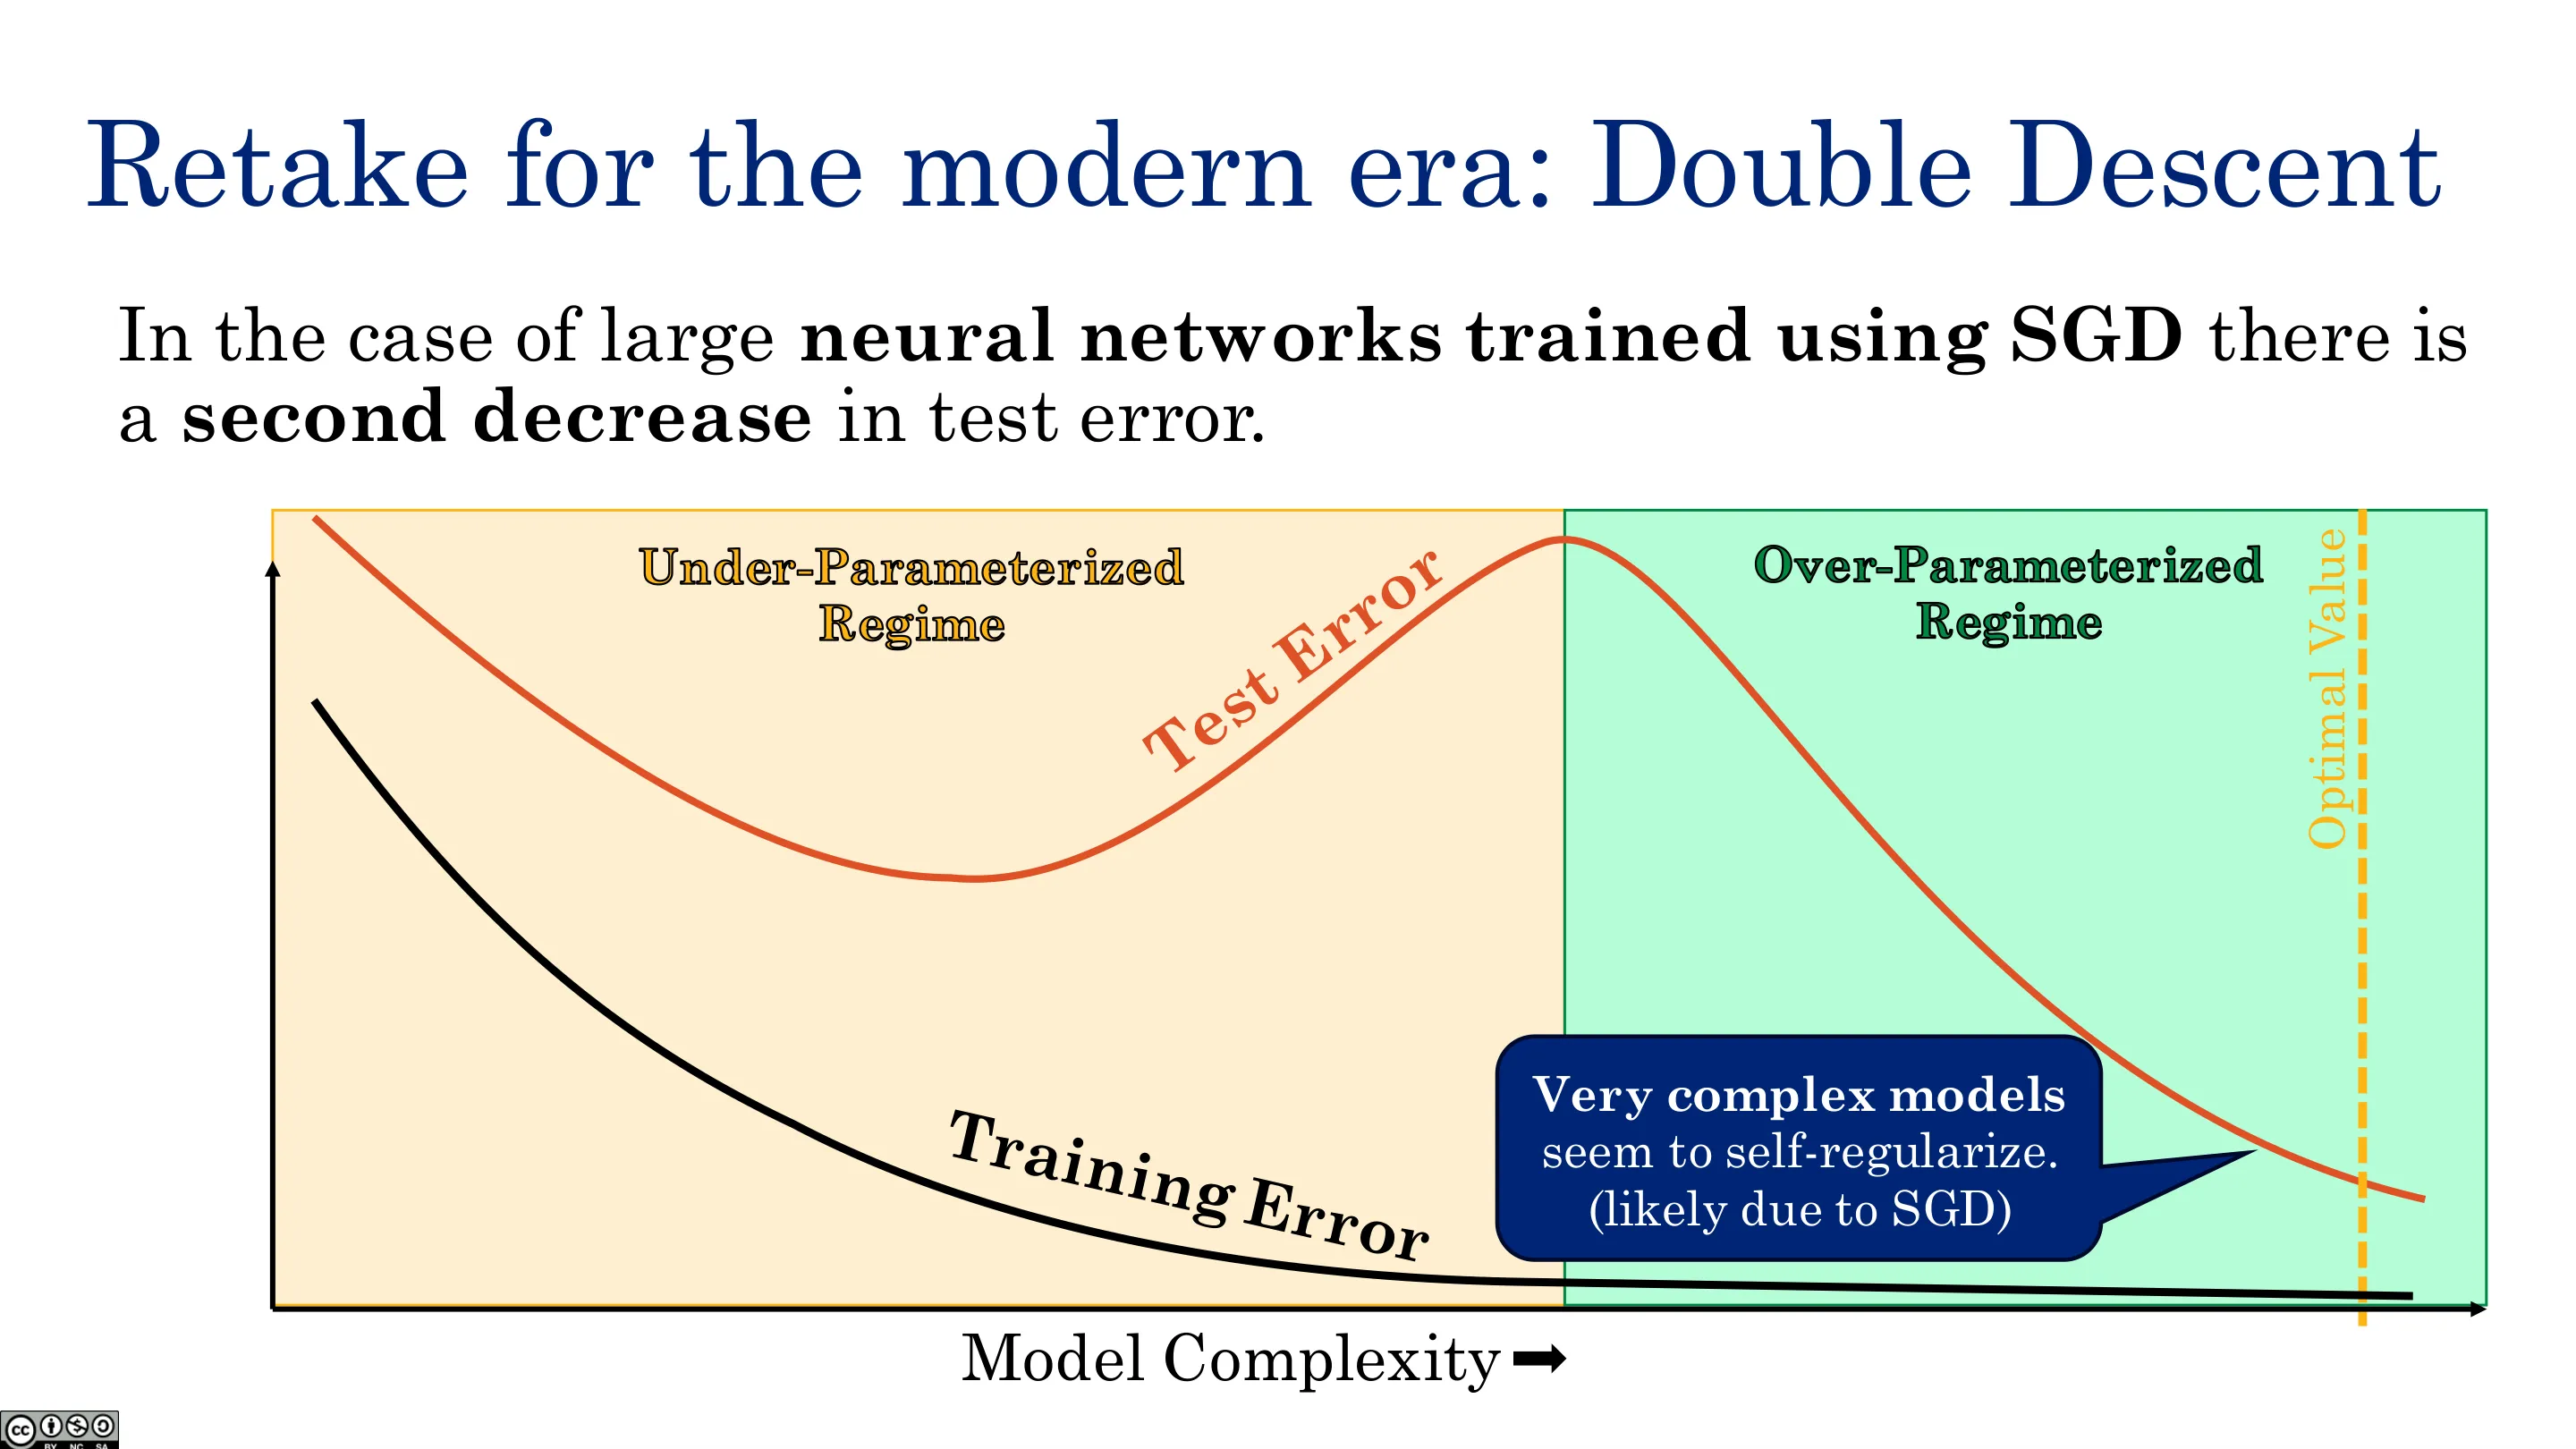
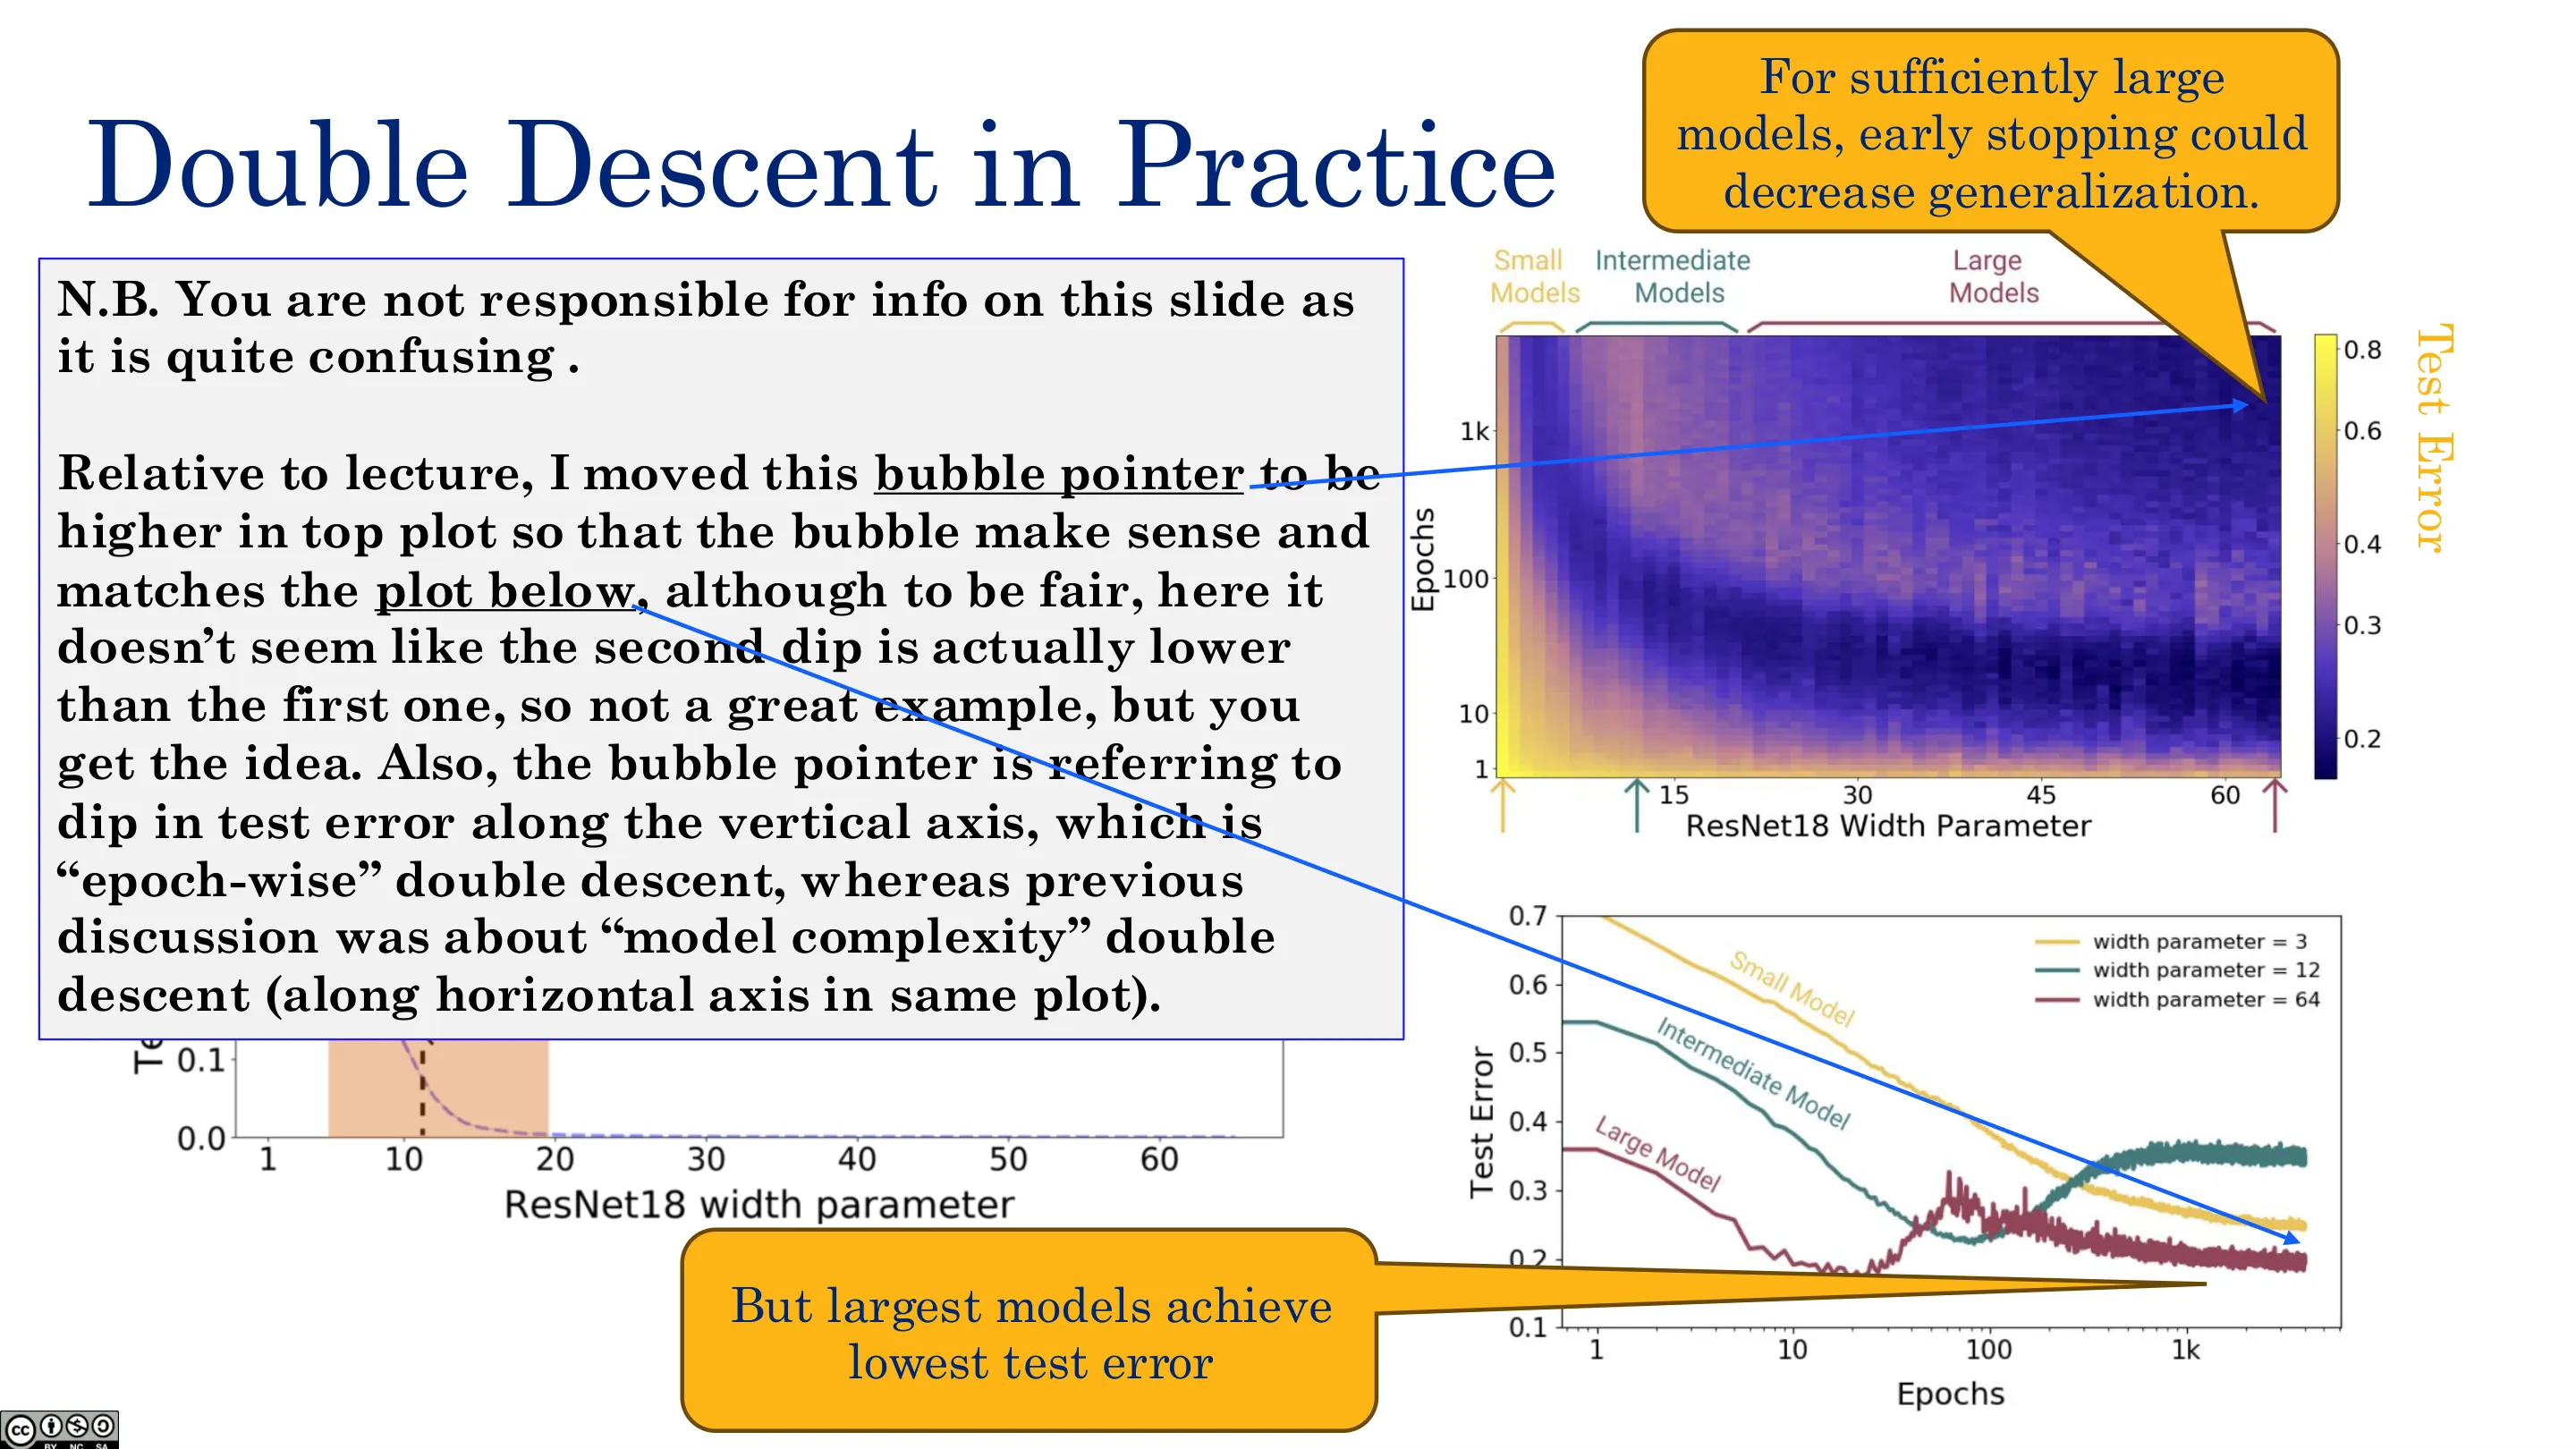
现代发现——双下降(double descent):把模型复杂度继续推高,测试误差再次下降,形成第二个谷(比经典甜点还低):
- 经典区域(欠参数化)→ 测试误差下降;
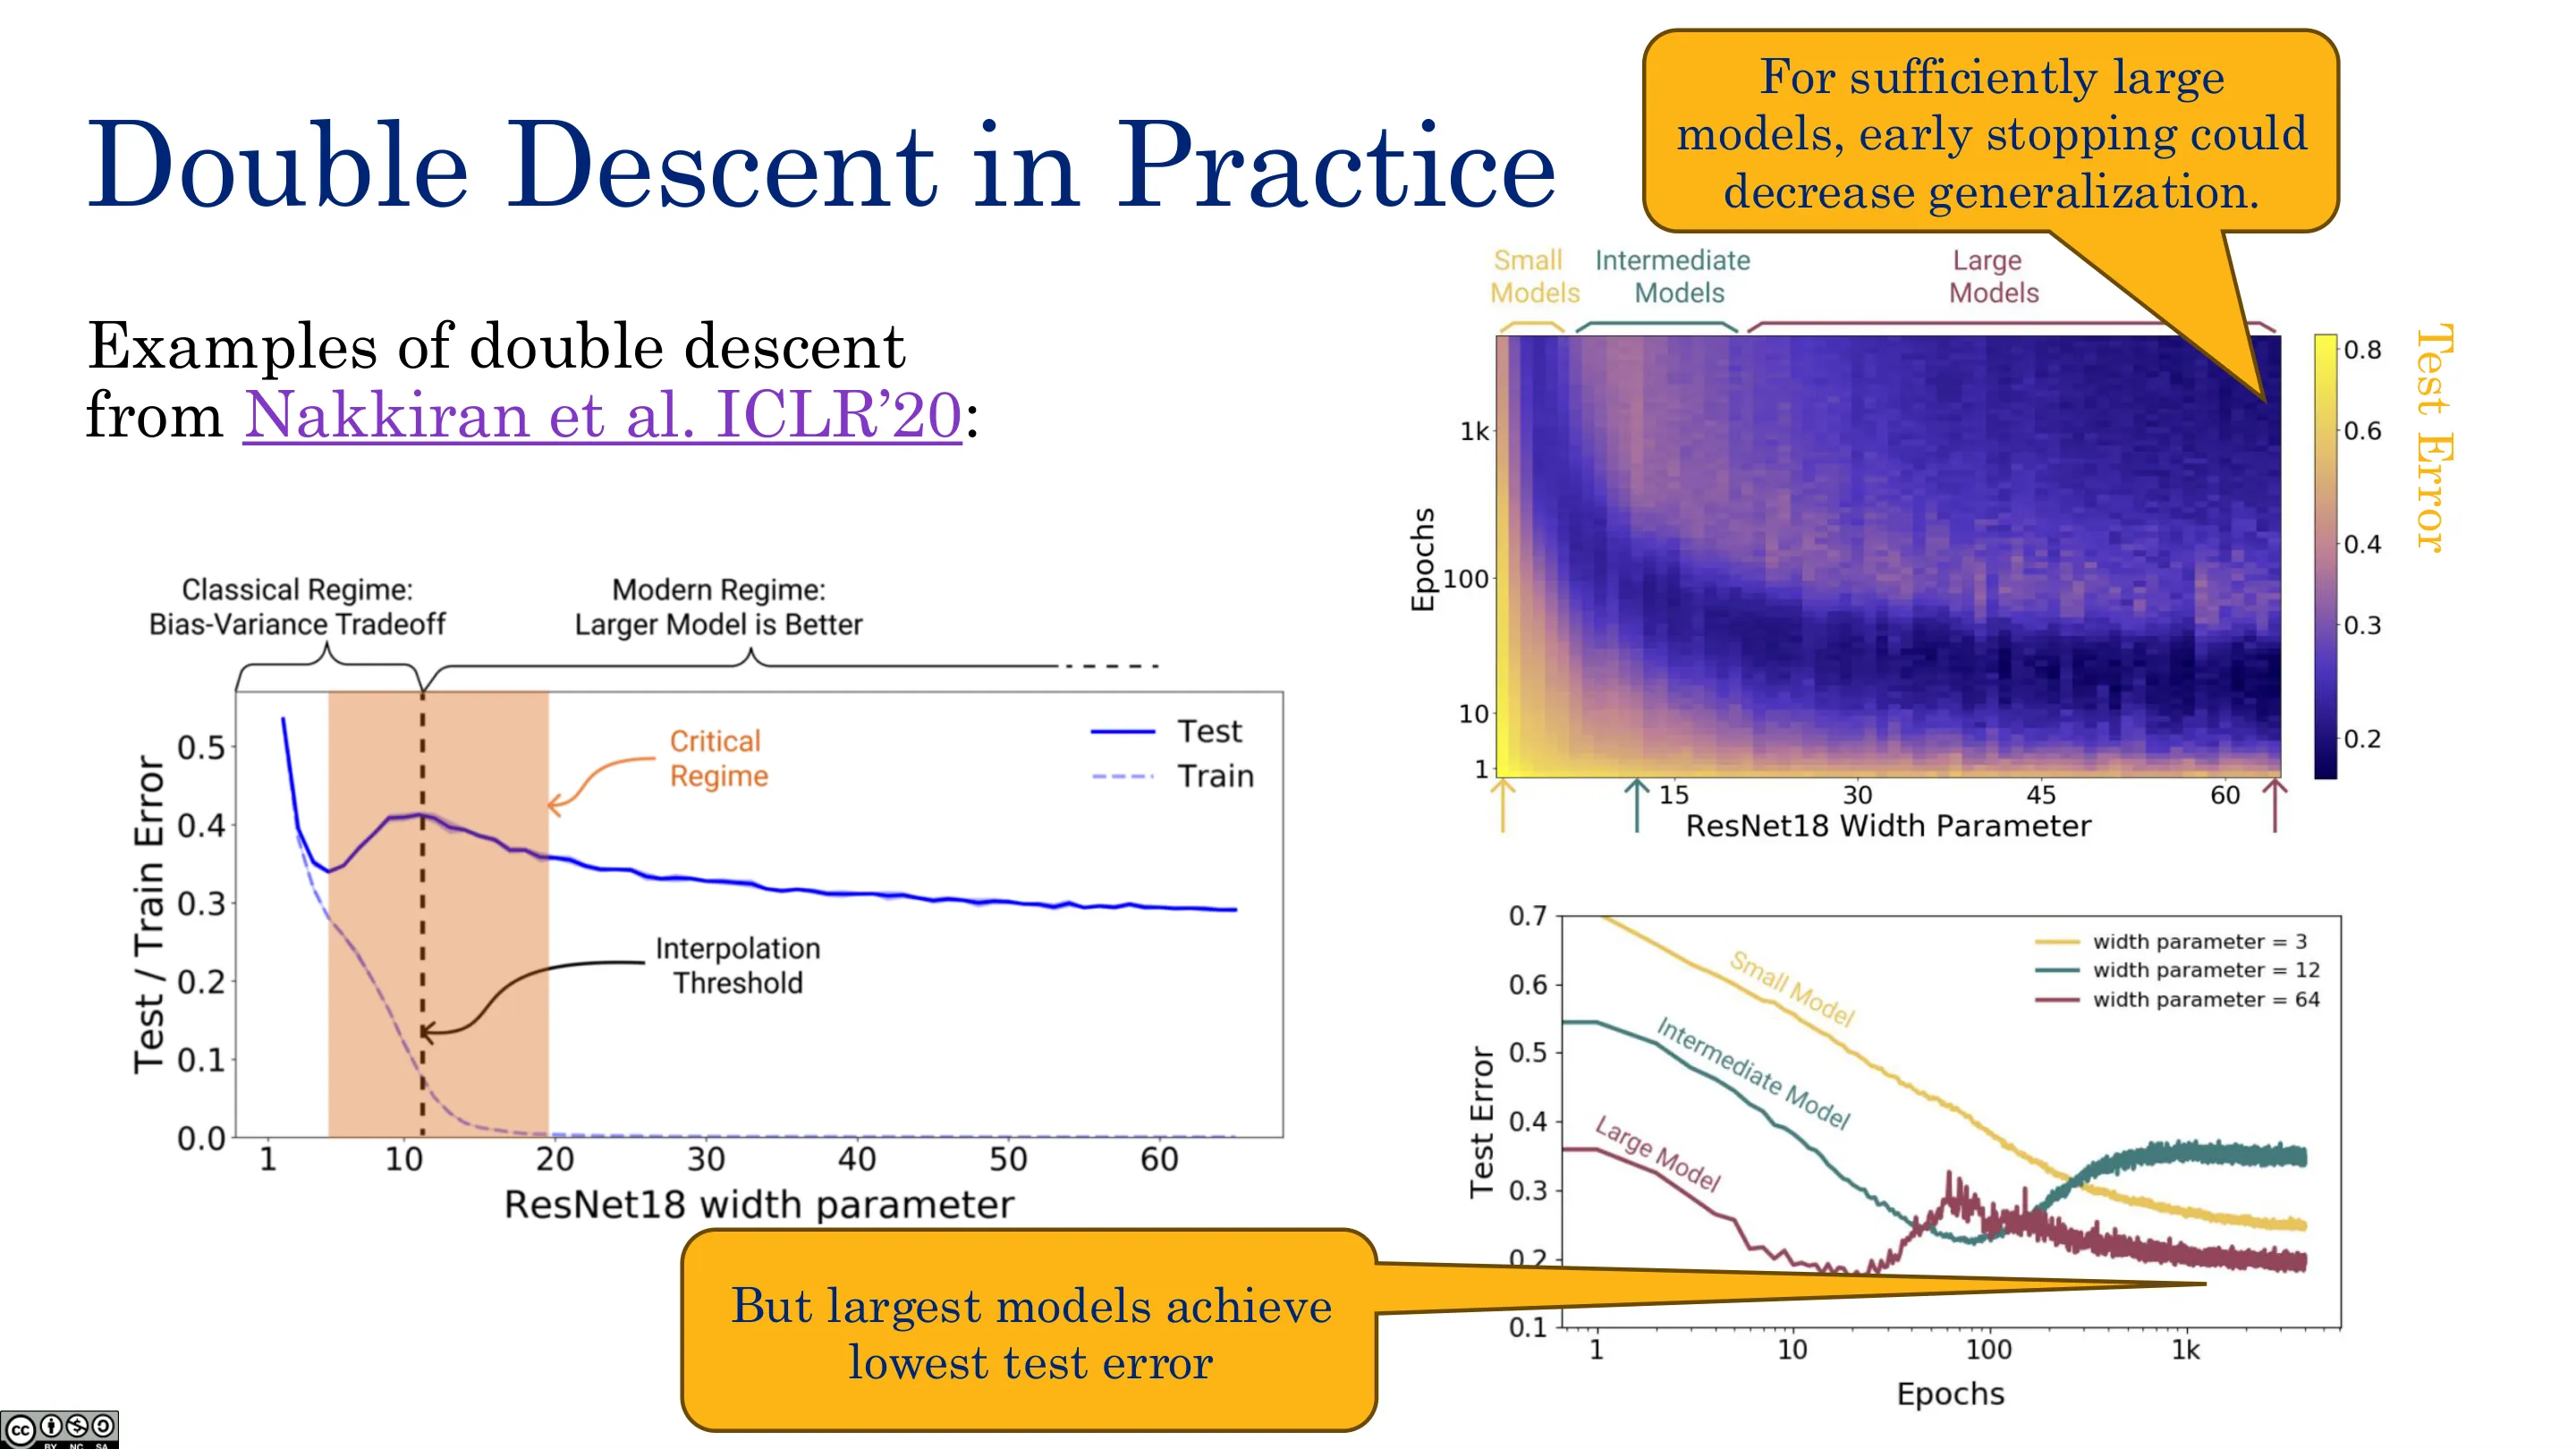
- 在插值阈值(interpolation threshold)处,训练误差首次降到 0,此时测试误差达到峰值;
- 继续增大模型(过参数化)→ 测试误差再次下降,往往低于经典甜点。
「插值阈值」这个词与统计里的插值毫无关系:它指训练误差首次到 0 的复杂度点。
直觉:刚到阈值时,模型只有近乎唯一的一组参数能零训练误差,几乎必然拟合噪声;继续加参数给出更多「呼吸空间」,零训练误差有很多种解,而 SGD(本身是带噪声的随机游走)倾向于找到泛化更好的解——即自正则化。前提是正则化不能太强(否则进不了第二区域)。
实践:Scheffe 例(ResNet 宽度扫描)确实观察到双下降;大模型(GPT 等)正处在「第二区域」,这解释了「越大越好」的军备竞赛。此外,对足够大的模型,早停可能反而降低泛化。
📷 欠参数化
回到原视频 (00:46:34)
📷 双下降(实践,一)
回到原视频 (00:47:47)
📷 双下降(实践,二)
回到原视频 (00:49:00)
📷 (空白页)
回到原视频 (00:50:13)
总结(Takeaways)
- 卷积 = 局部连接 + 权重共享;滤波器在图上滑动做点积,得到特征图。
- padding 控制输出尺寸;RGB 各通道各做二维卷积、通道间不共享权重;「三维滤波器」术语易误导。
- 池化(尤其 max pooling)逐步降维 + 提供局部平移不变性;无学习参数;感受野随层数增大,最终覆盖整图,形成层次化特征。
- 训练用梯度下降 + 反向传播;两个特殊点:权重共享(梯度累加)与max pooling 的次梯度(只回传赢家)。
- 迁移学习:冻结主干、只换头 = 固定基展开。
- 早停是正则化(控制权重幅值);Dropout 通过随机丢弃控制复杂度。
- 双下降:过参数化区域测试误差再次下降,是有别于经典偏差-方差的现代现象。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=4LrCyN7URuY |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 20) | Google Drive 文件夹 |
| Roger Grosse, CSC321 讲义(CNN) | http://www.cs.toronto.edu/~rgrosse/courses/csc321_2017/slides/lec11.pdf |
| Nakkiran et al., Deep Double Descent | 双下降现象 · https://arxiv.org/abs/1912.02292 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。