第21讲 · EECS 189:Transformer(上)
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Transformers and Attention (Part 1) |
| 课堂进度提示 | 本讲讲到幻灯片 59("Stopped Here");幻灯片 60–119 为下一讲内容,放在文末附录。 |
| 视频 | https://www.youtube.com/watch?v=mqaFEvi5rWE |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 21) | Google Drive PDF |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第21讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- 背景:
Attention Is All You Need(NeurIPS 2017)、注意力的历史; - 特征变换 / 表示学习:从 MLP 到 CNN;
- 卷积的根本局限:感受野有限、无法「长程上下文」;
- 文档表示与 RNN:bag-of-words、TF-IDF、RNN 图像描述;
- 注意力:基于位置(location-based,soft/hard)→ 基于内容(content-based)。
📷 标题页
回到原视频 (00:00:20)
📷 (概述)
回到原视频 (00:01:33)
📷 (概述)
回到原视频 (00:02:46)
一、Transformer 的由来
(参考时间: 00:00)
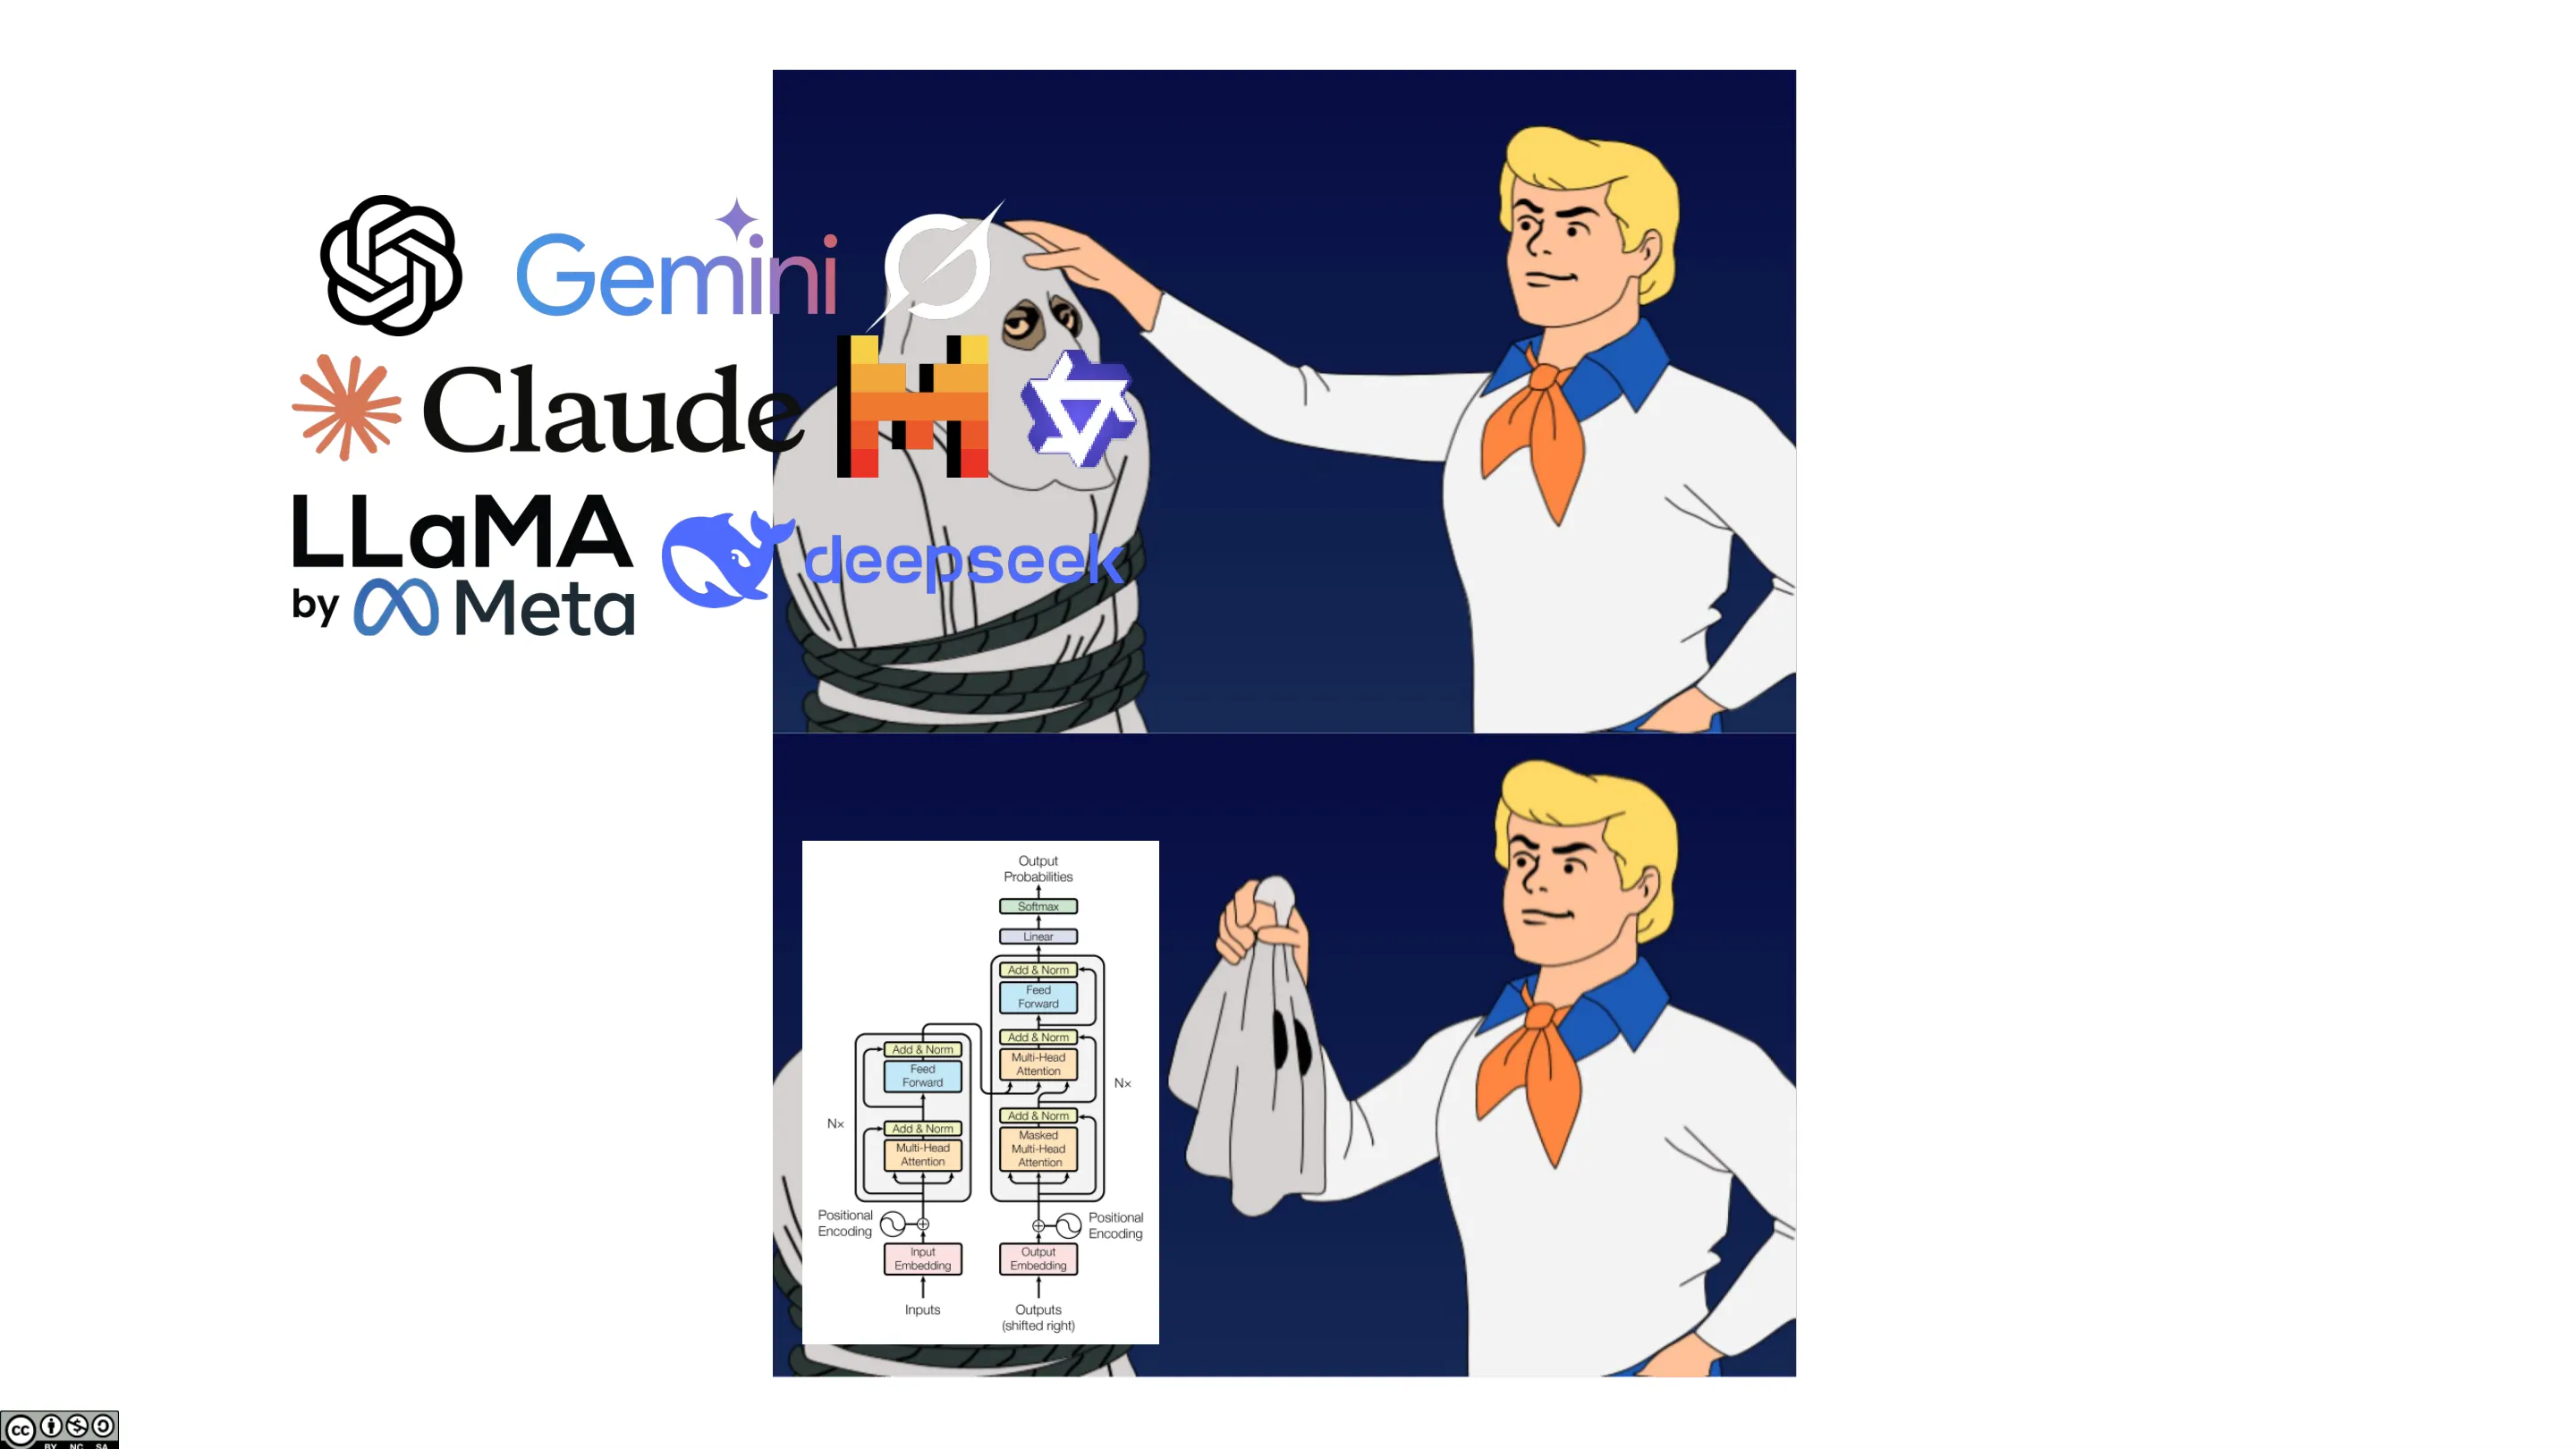
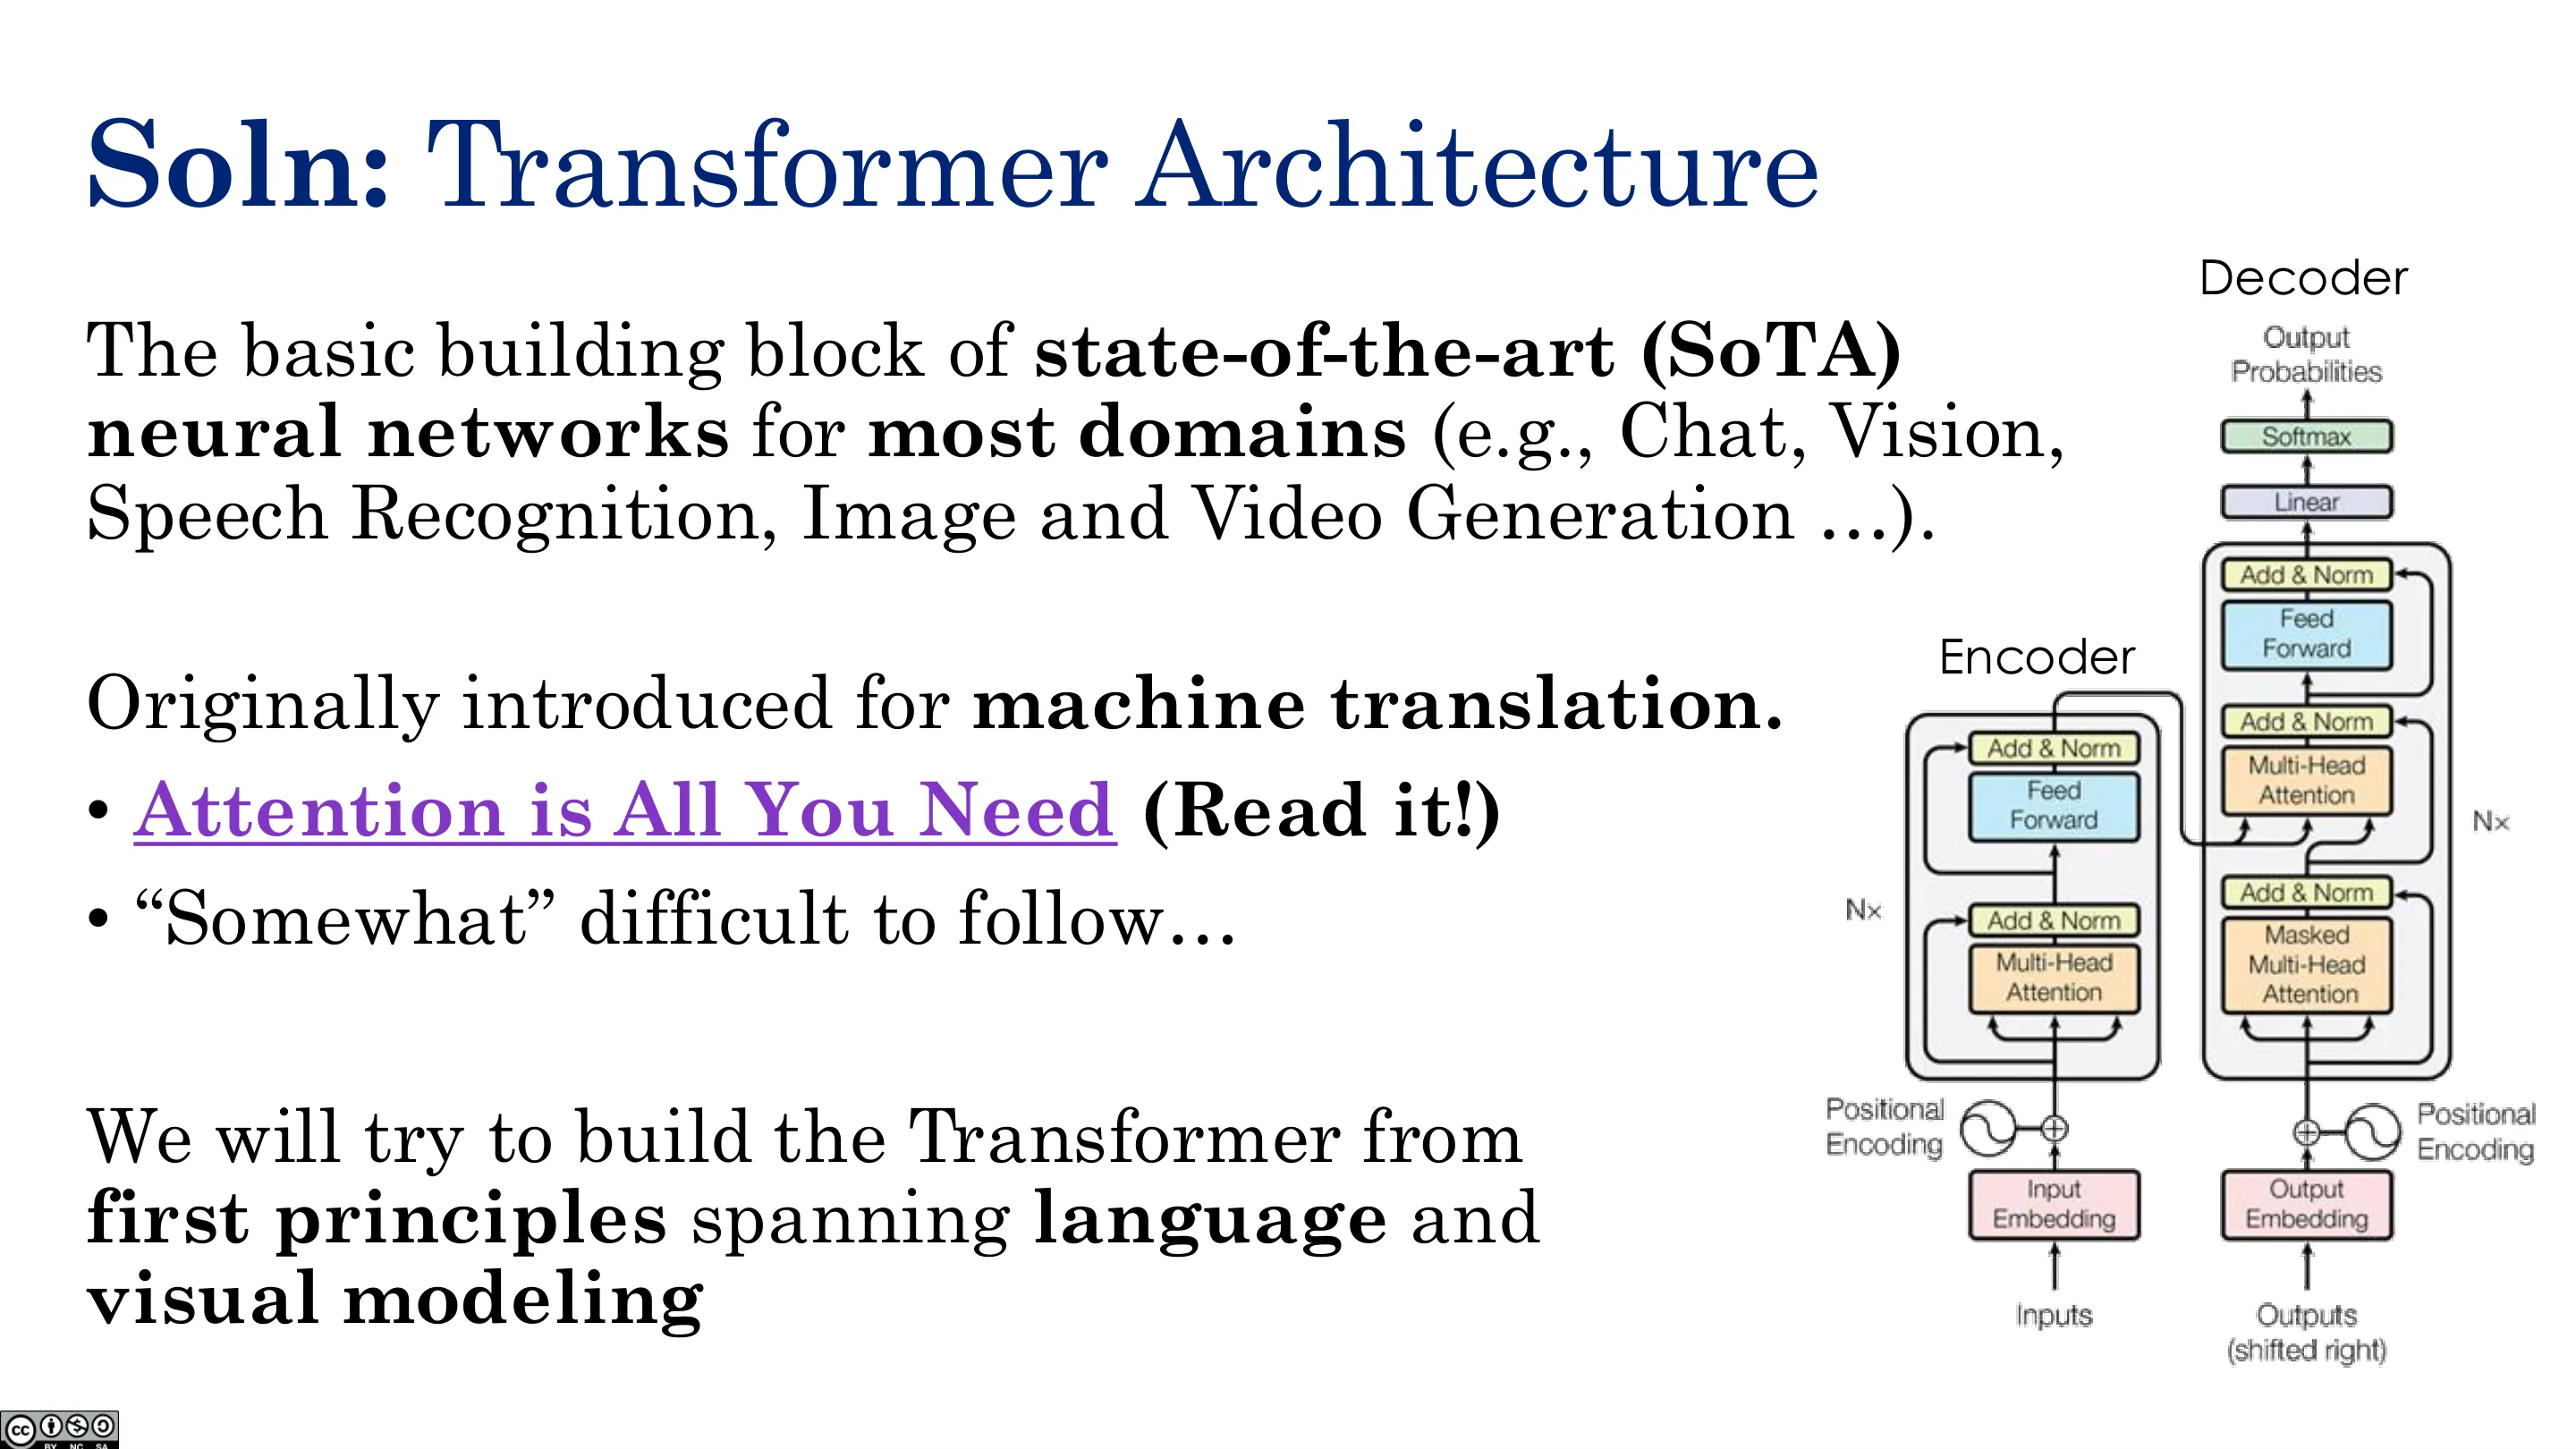
几乎今天你能想到的所有模型(LLM、扩散模型……)底层都是 Transformer / 注意力。起点是 2017 年 NeurIPS 论文 《Attention Is All You Need》(多伦多大学 + Google Brain)。
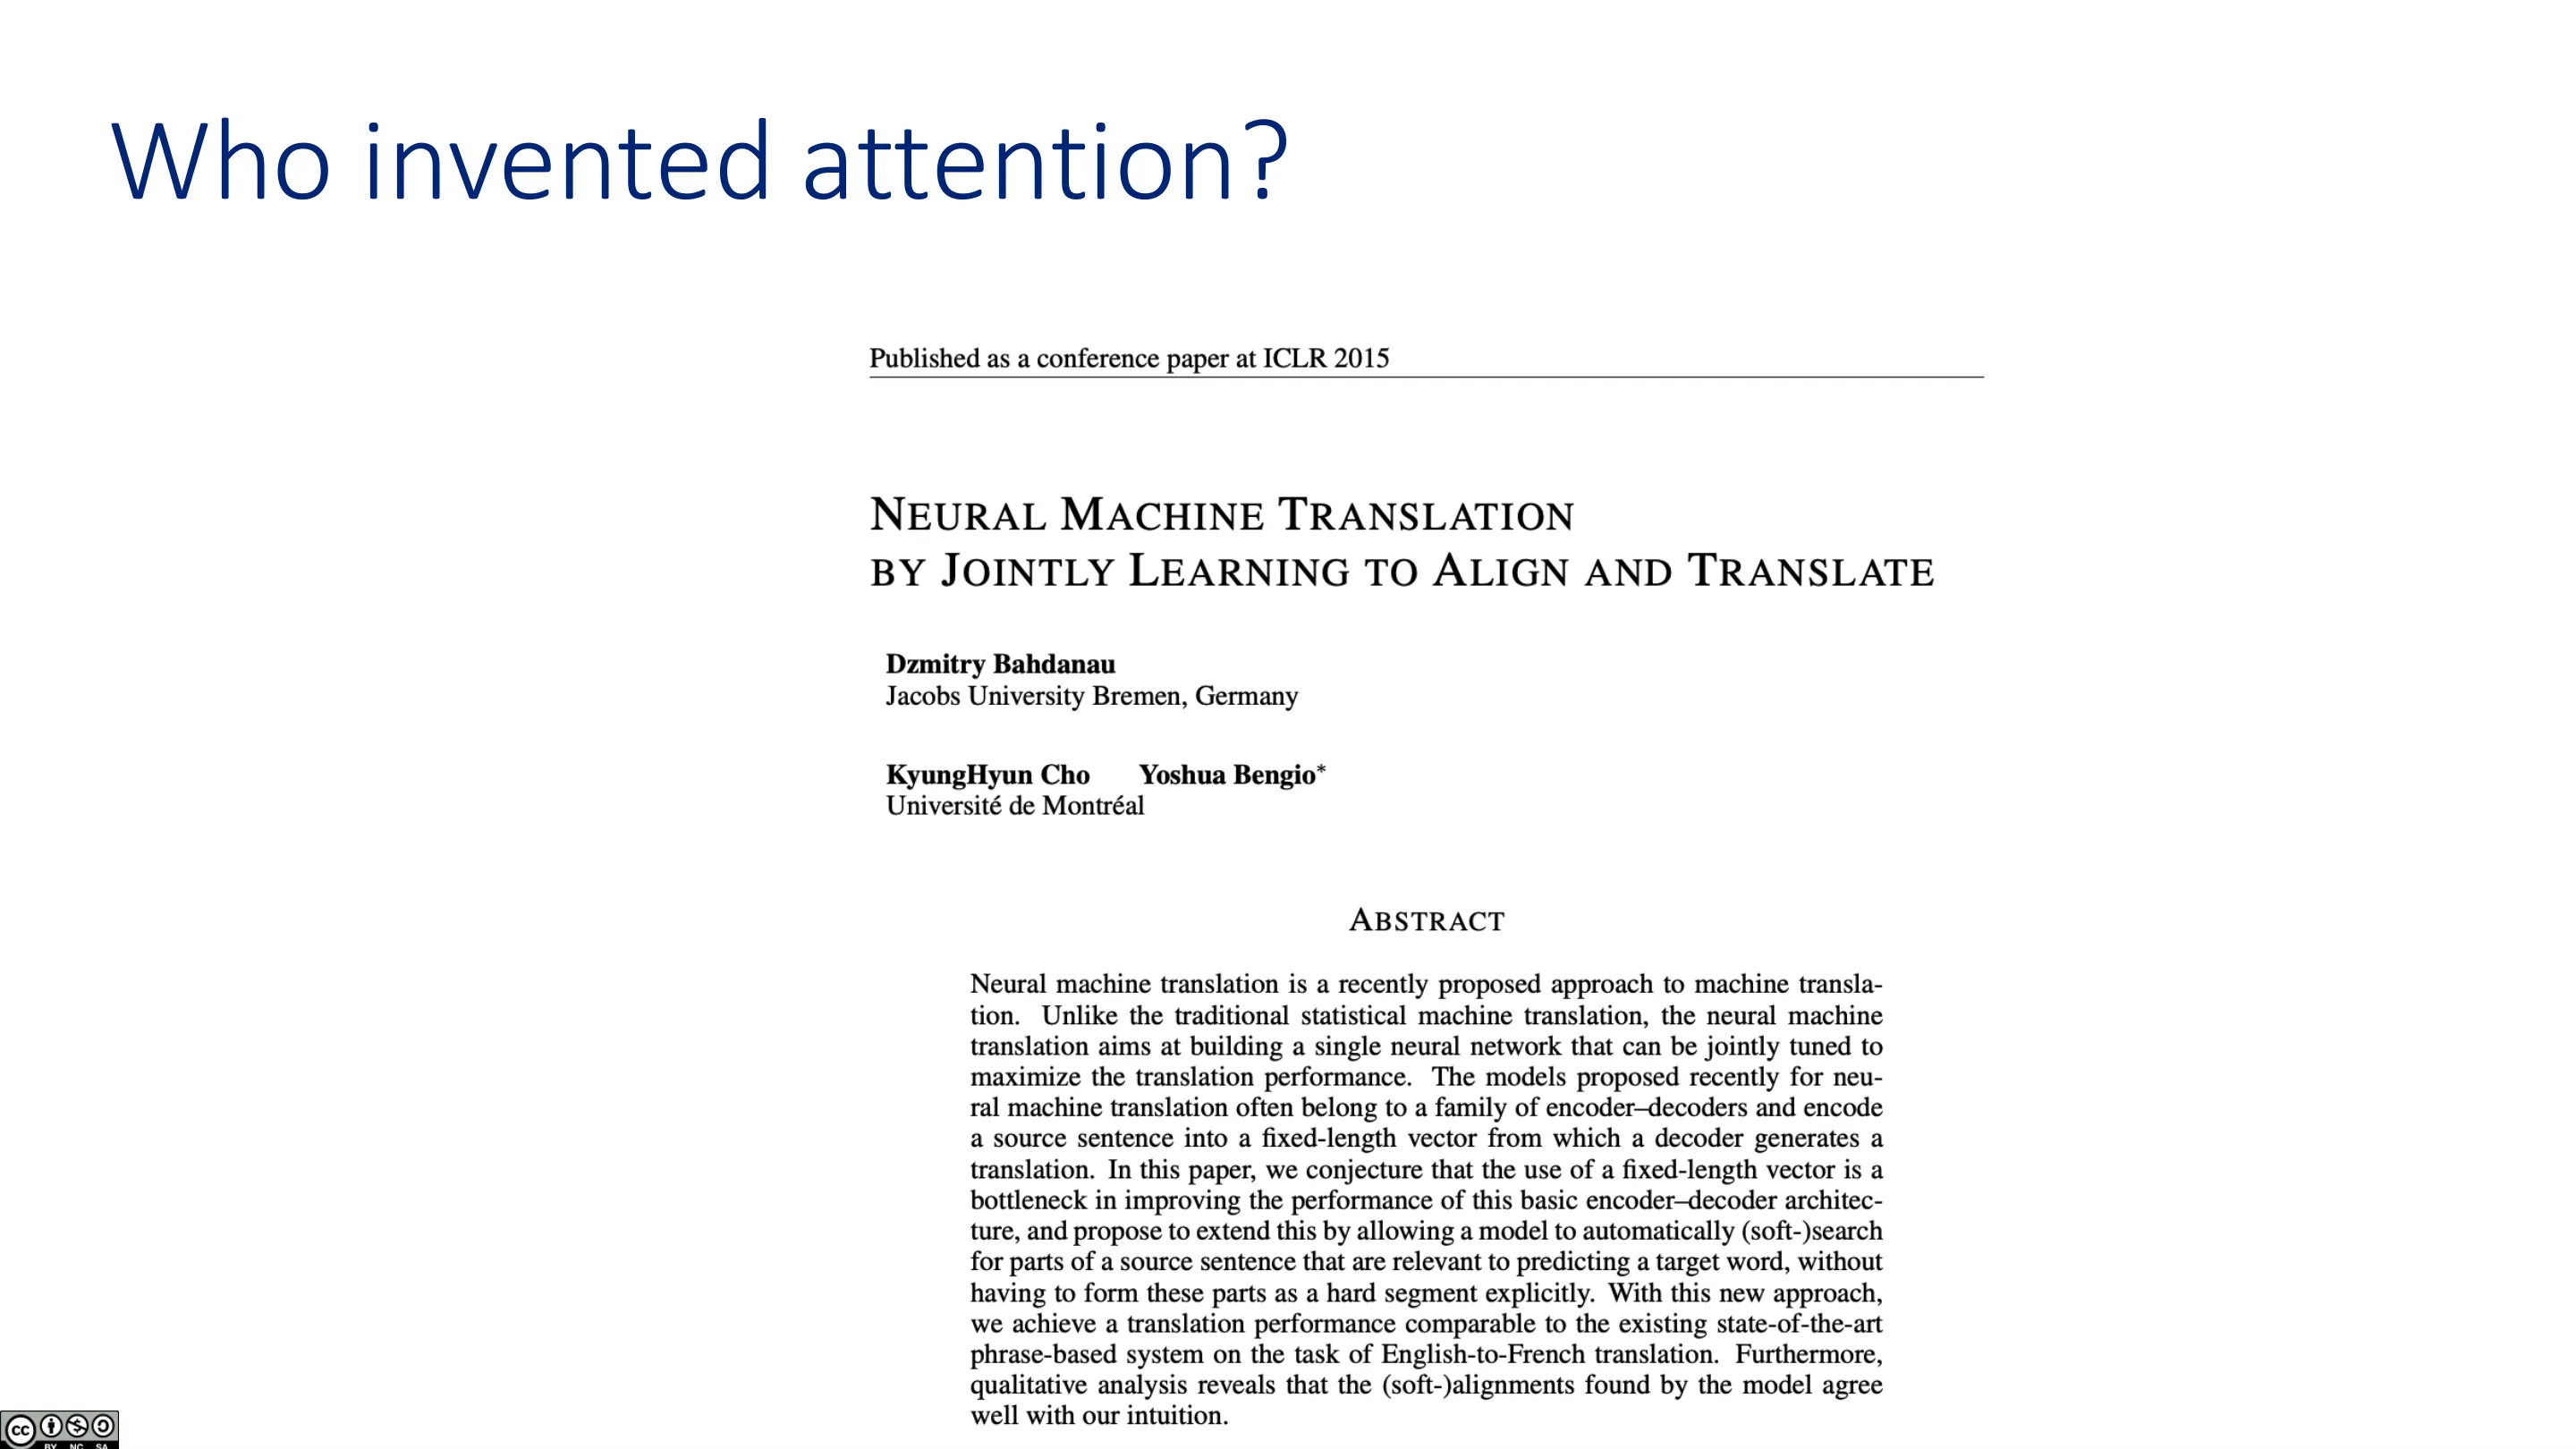
论文标题的弦外之音:「你不需要别的」——具体说,你不需要 RNN。注意力本身不是新东西(2014 年就有了,见 Bahdanau 等),但它总和 RNN 搭配使用;这篇论文的 punchline 是把 RNN 扔掉,只留下注意力,这就是 Transformer。
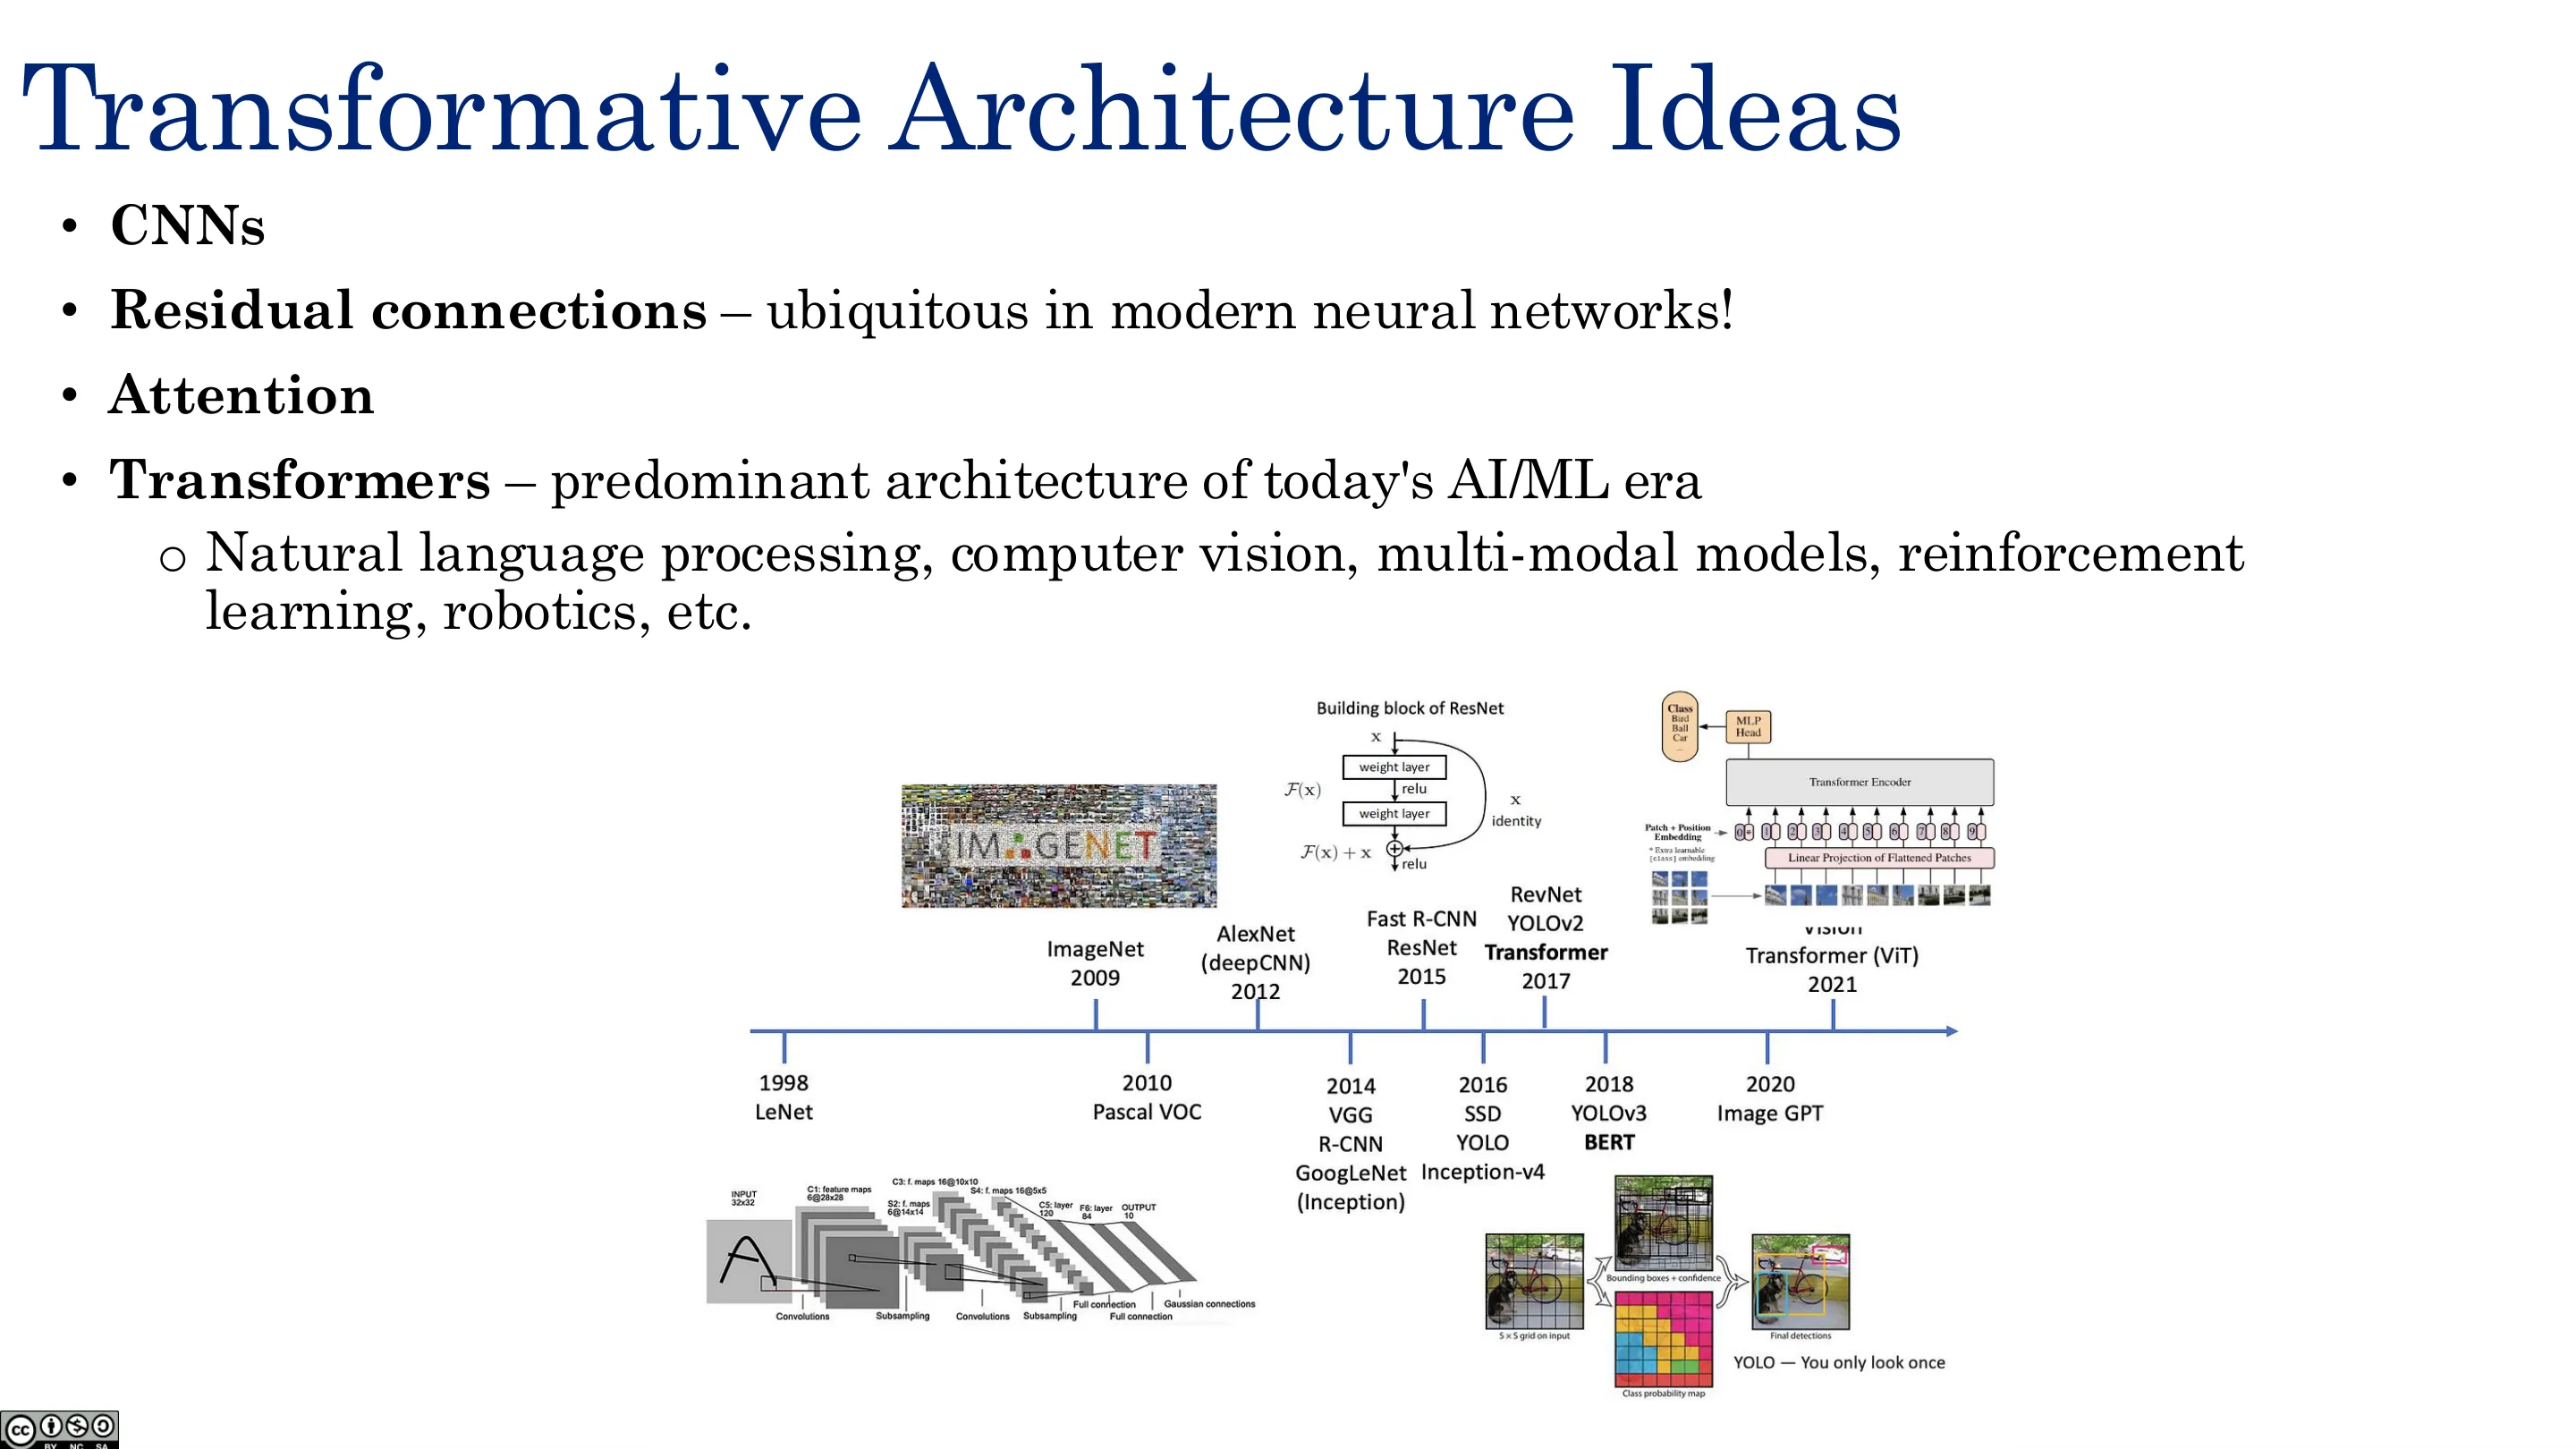
架构演进主线:全连接/卷积 → 残差连接 → 注意力 → Transformer(「注意力就是全部」)。Transformer 最初用于自然语言,如今广泛用于视觉、多模态、图像/视频生成,被认为是最强的通用架构。
讲师强调:数据集同样是历史的重要驱动力(如 ImageNet)——每出现一个新数据集,就可能催生超越前人的新架构。
📷 NeurIPS 2017(一)
回到原视频 (00:03:59)
📷 NeurIPS 2017(二)
回到原视频 (00:05:12)
📷 谁发明了注意力?
回到原视频 (00:06:25)
📷 变革性的架构思想
回到原视频 (00:07:38)
二、表示学习:从 MLP 到 CNN
(参考时间: 00:07)
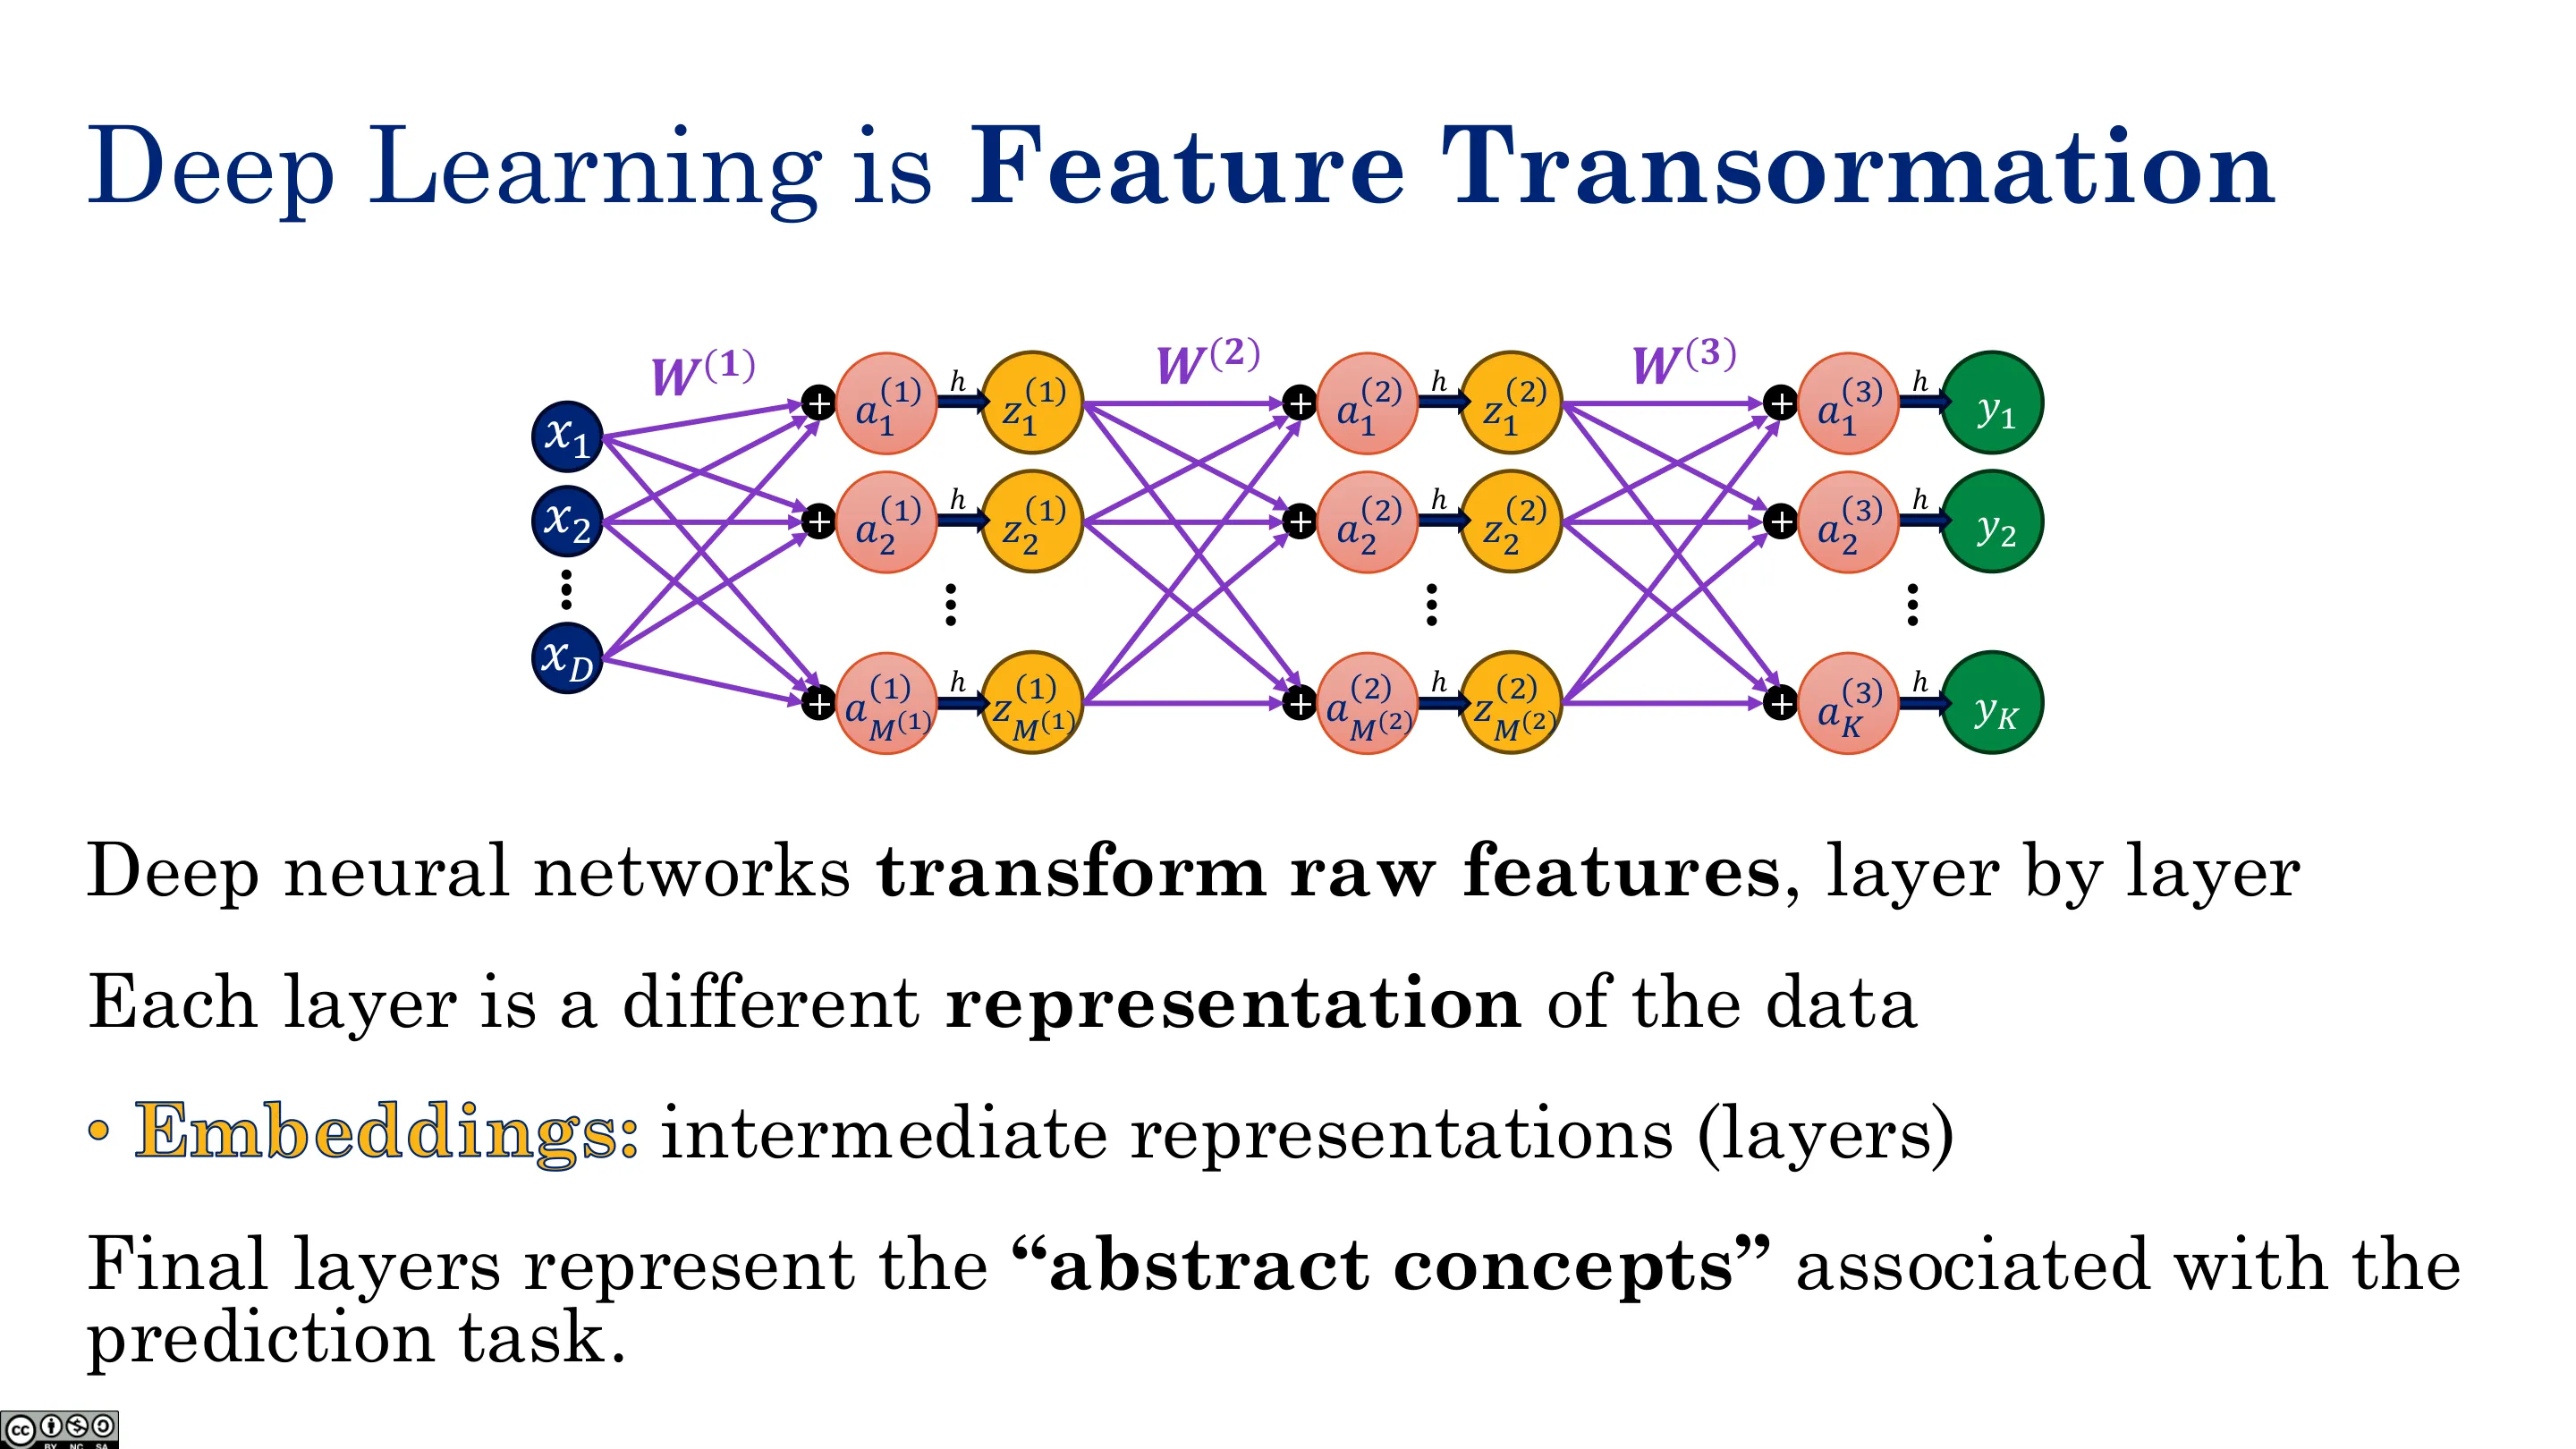
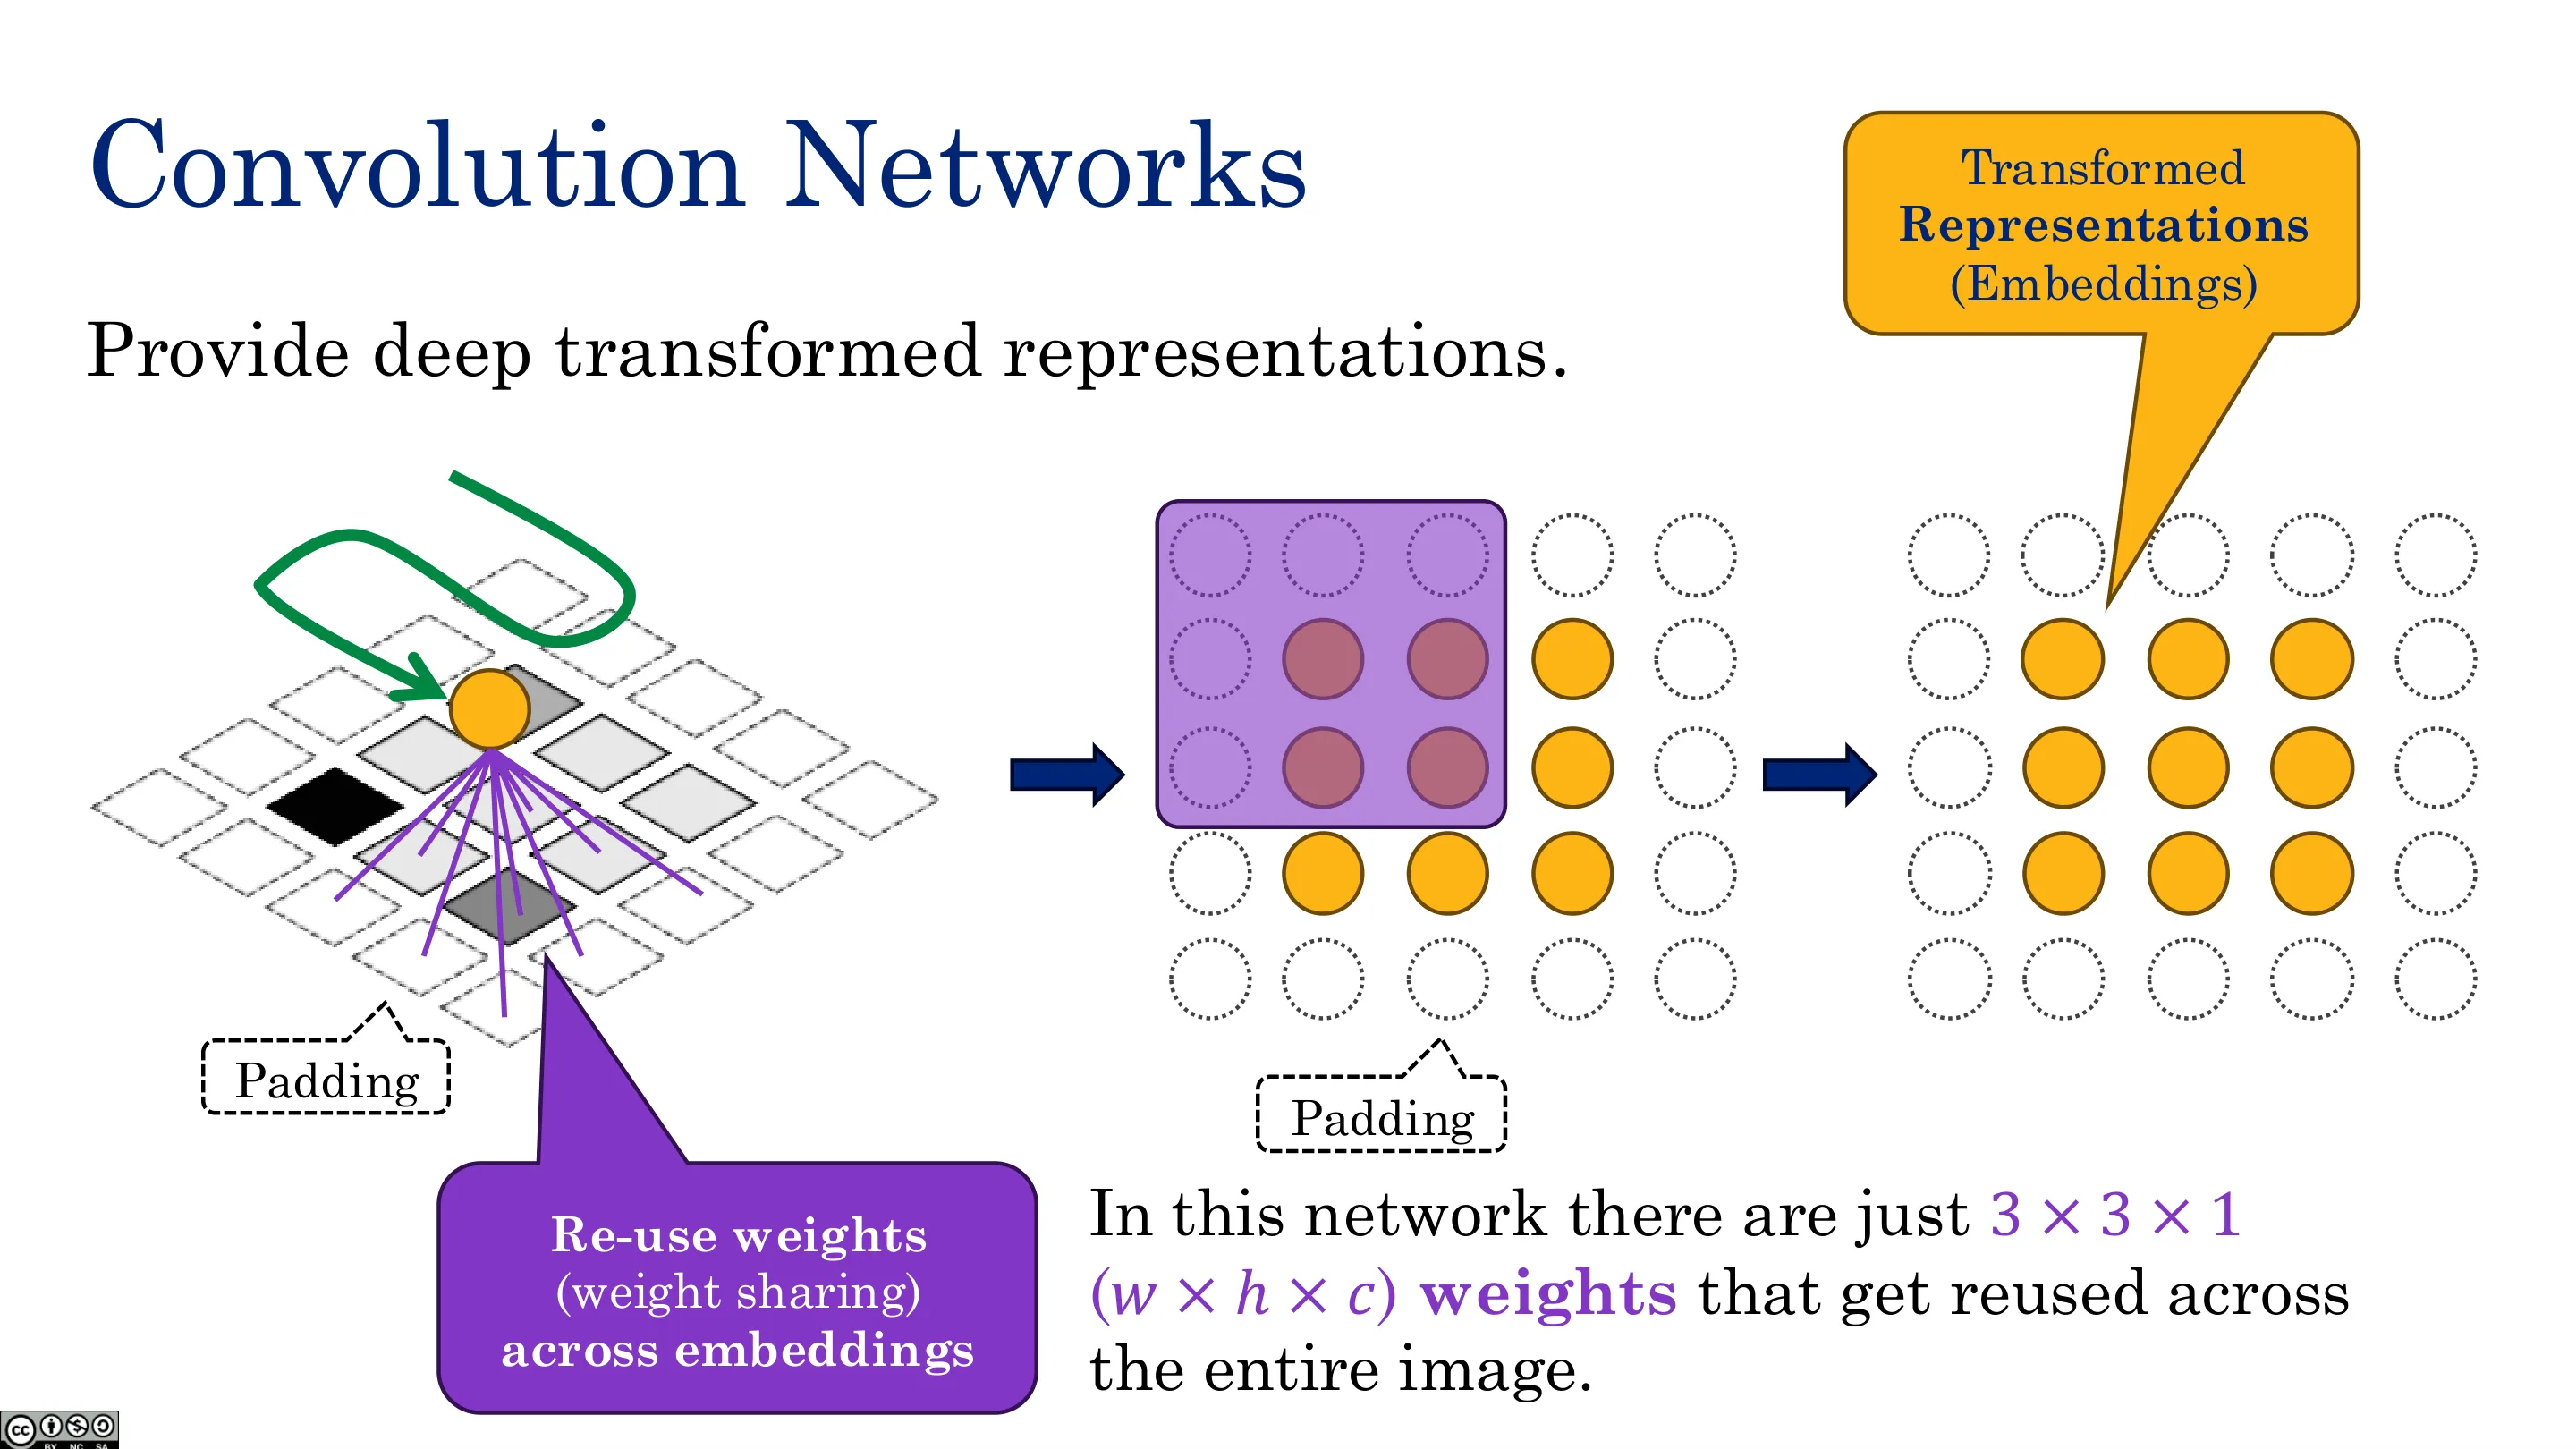
核心思想:所有架构都在做特征变换 / 表示学习——把像素或词变成向量(embedding),逐层得到越来越抽象、越来越「上下文化」的表示(像素 → 猫须/猫耳 → 抽象的「猫 vs 狗」概念)。
2.1 MLP(多层感知机)
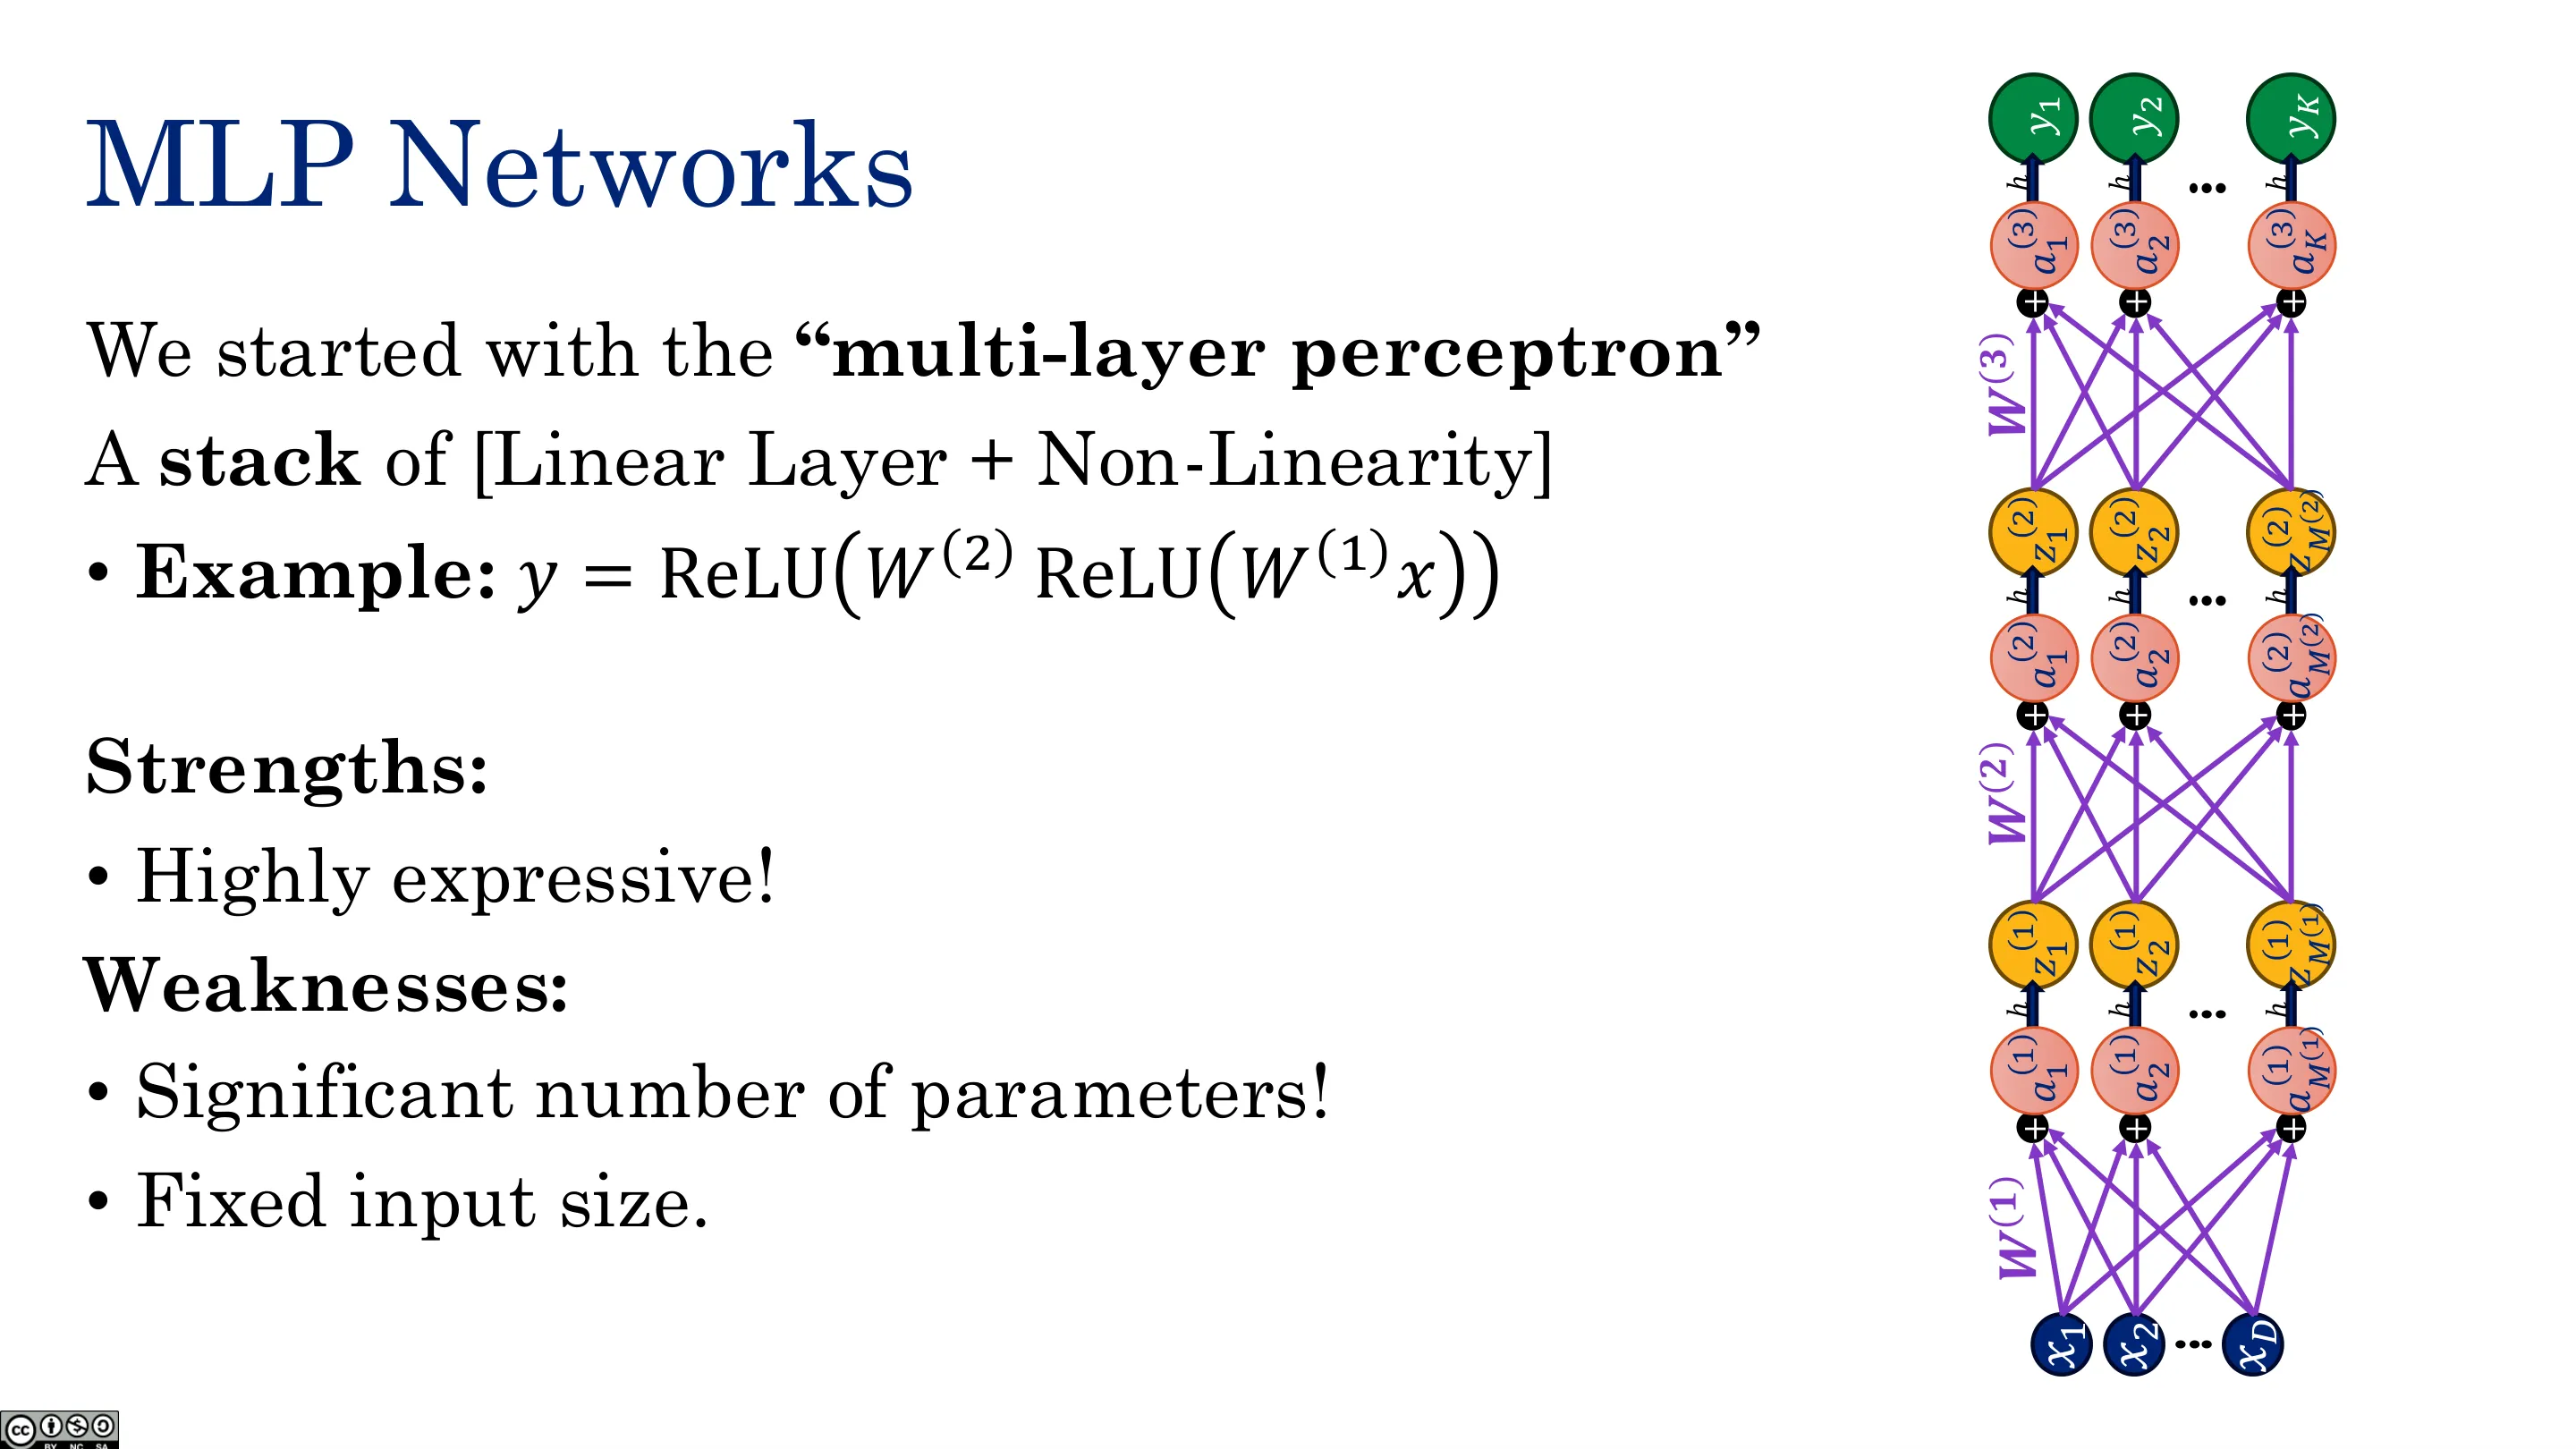
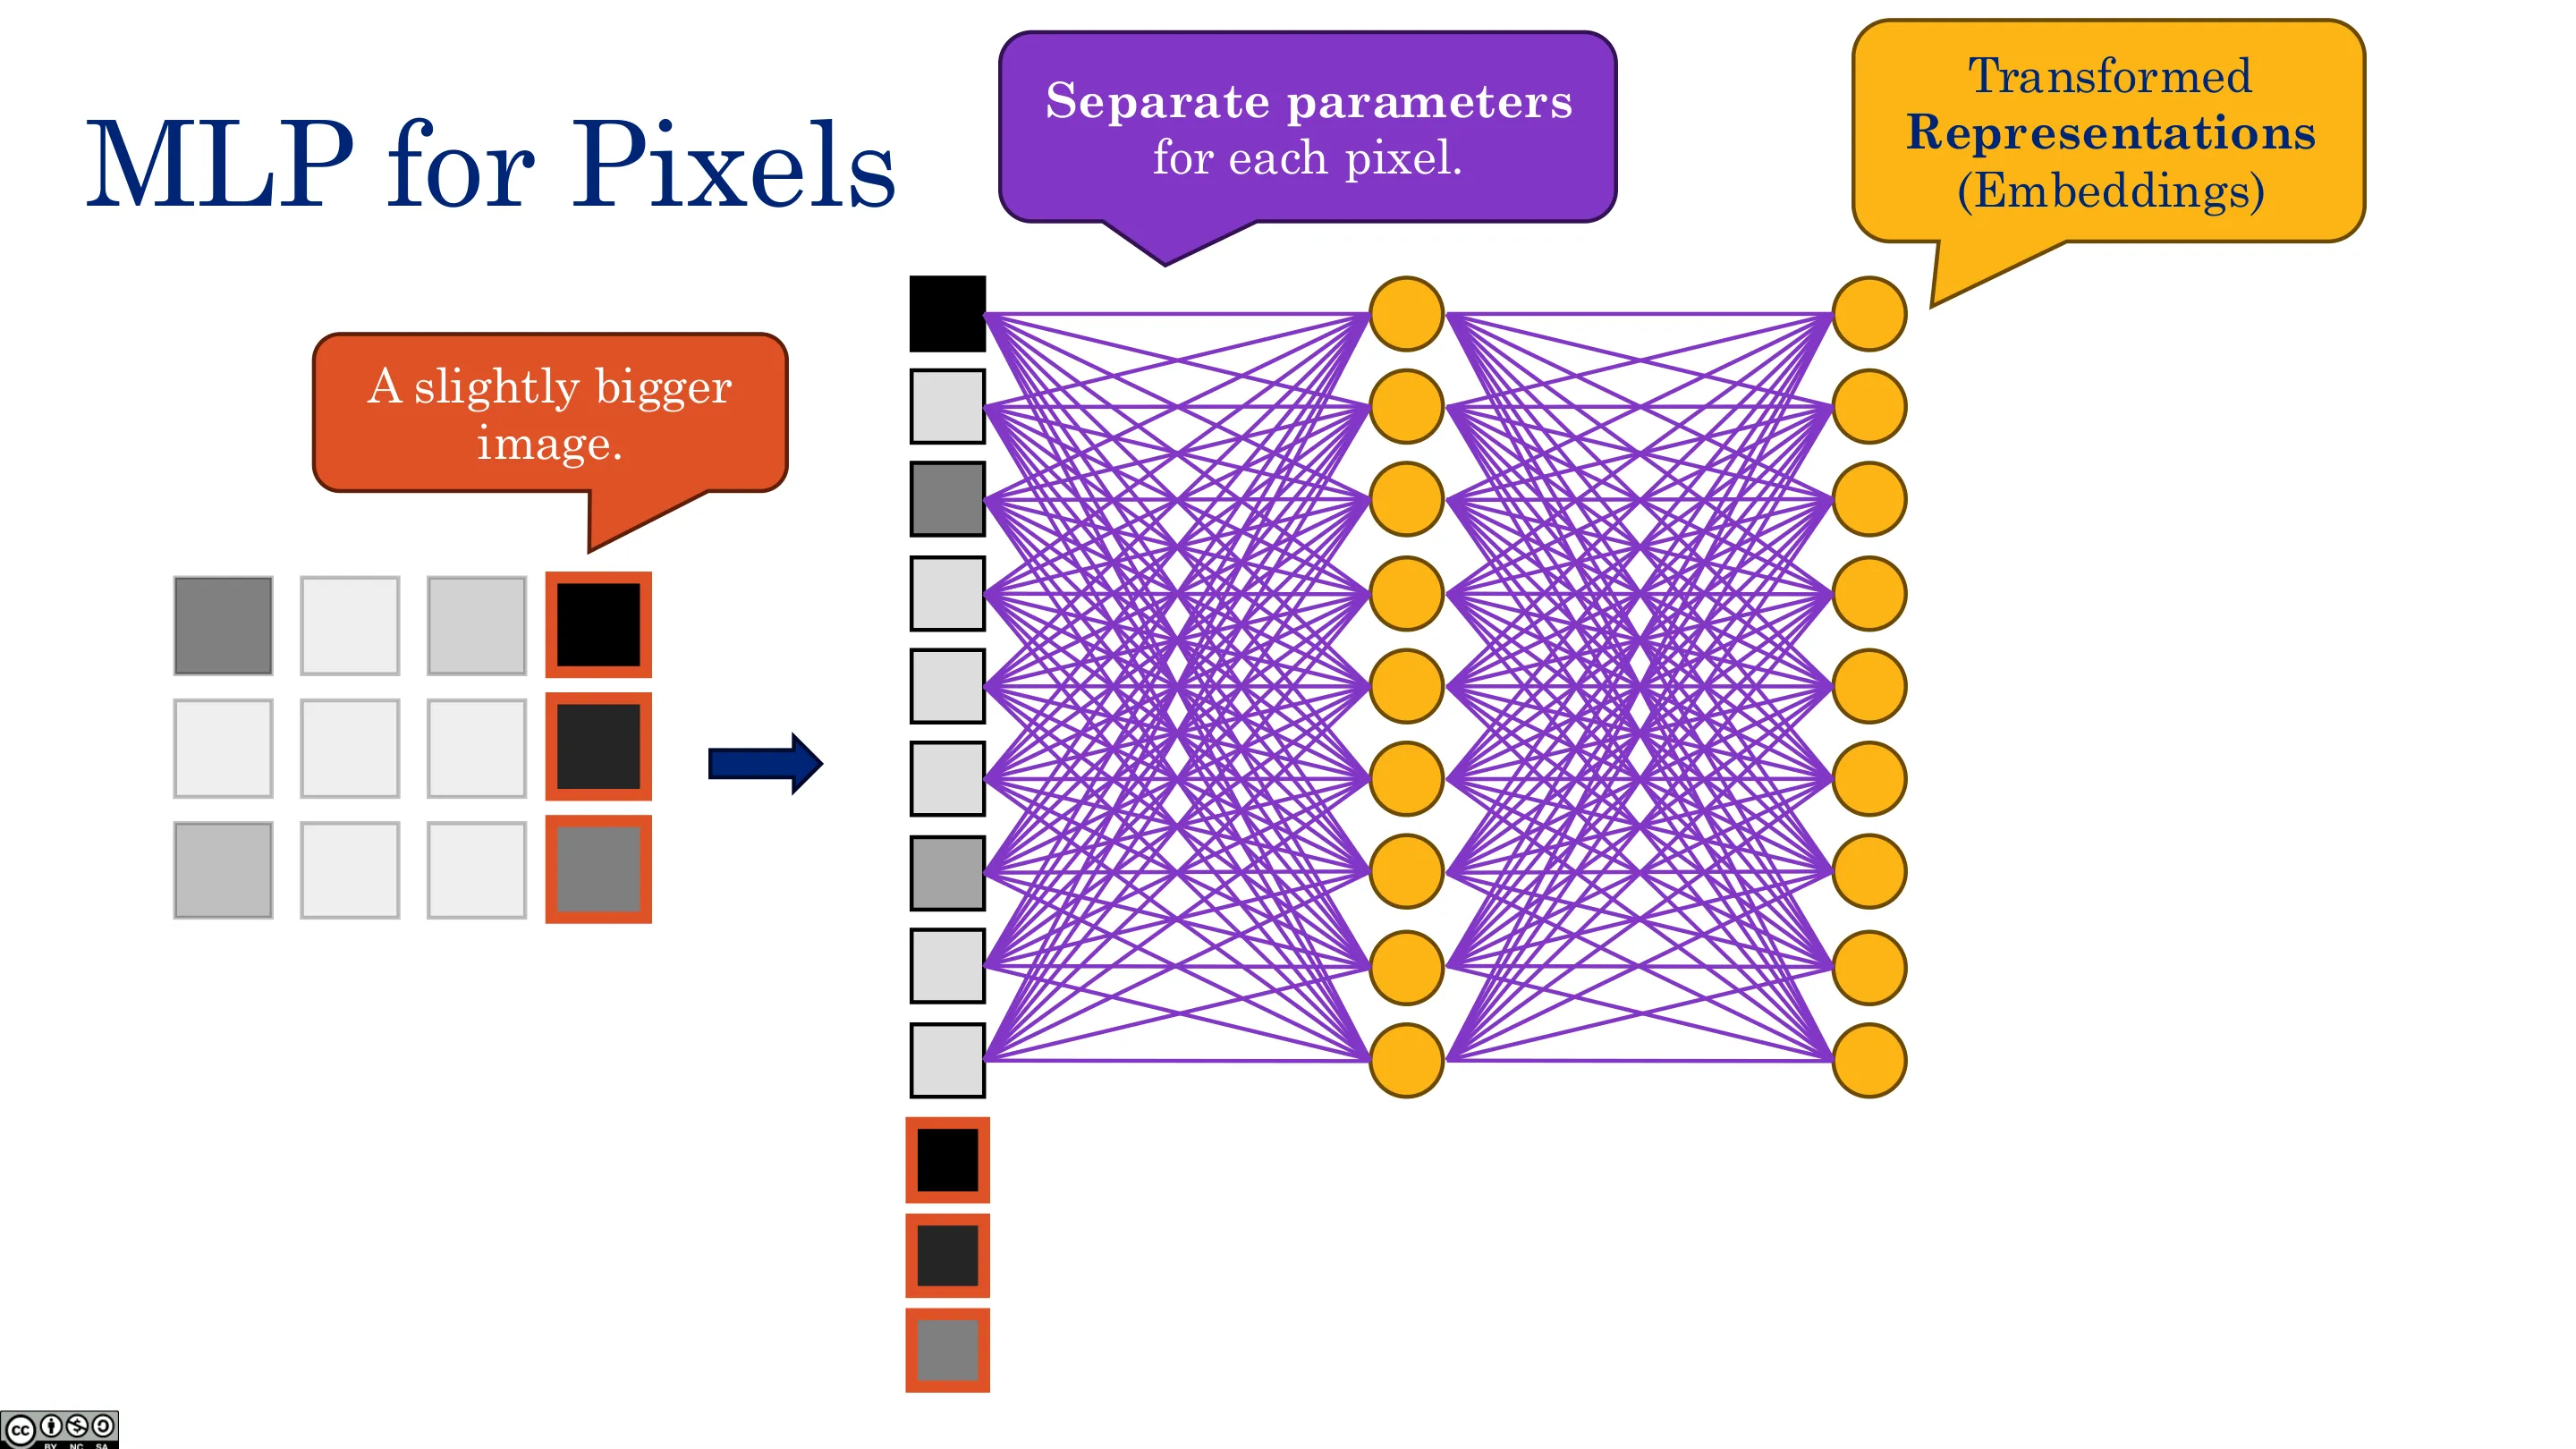
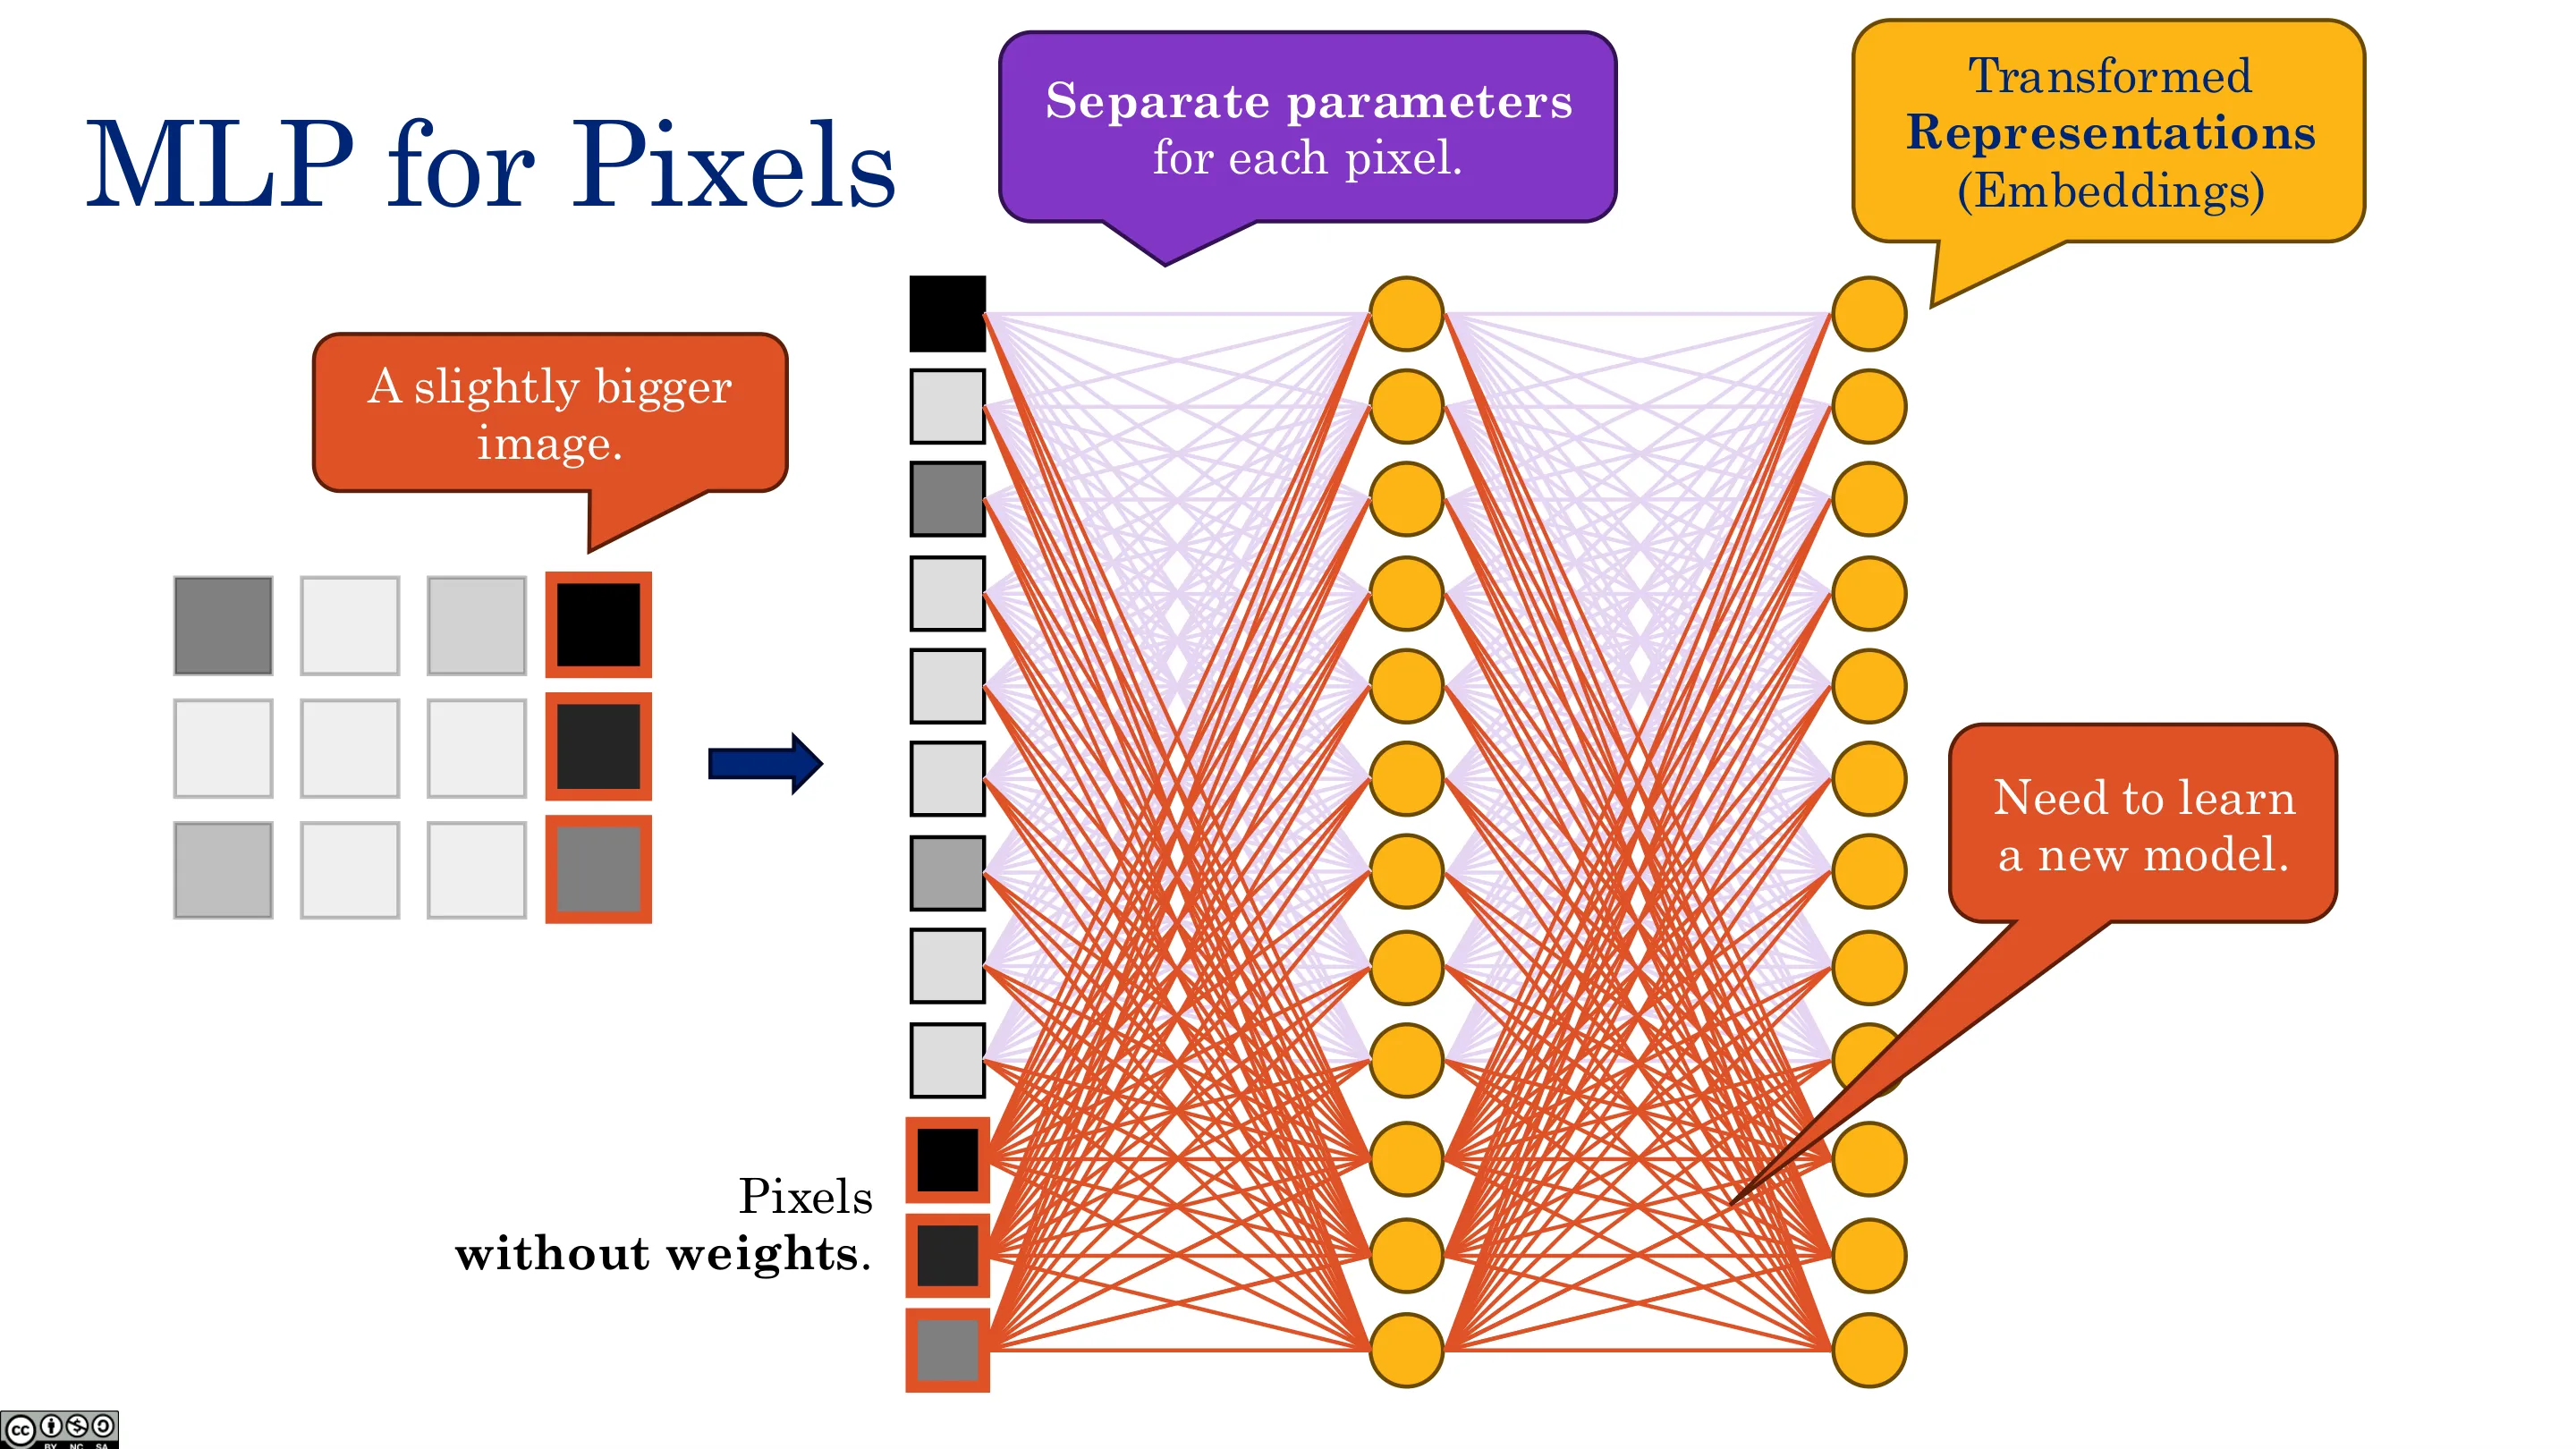
线性层(矩阵乘)+ ReLU 反复堆叠。极强表达力(任何架构都能被超大 MLP 模拟),但:
- 参数爆炸:每层 $D\times D$,$L$ 层 ⇒ $\mathcal{O}(LD^2)$;现代 embedding 维度可达 512–16000,$\Rightarrow$ 极大;
- 输入尺寸不能变:换个尺寸就得重训。
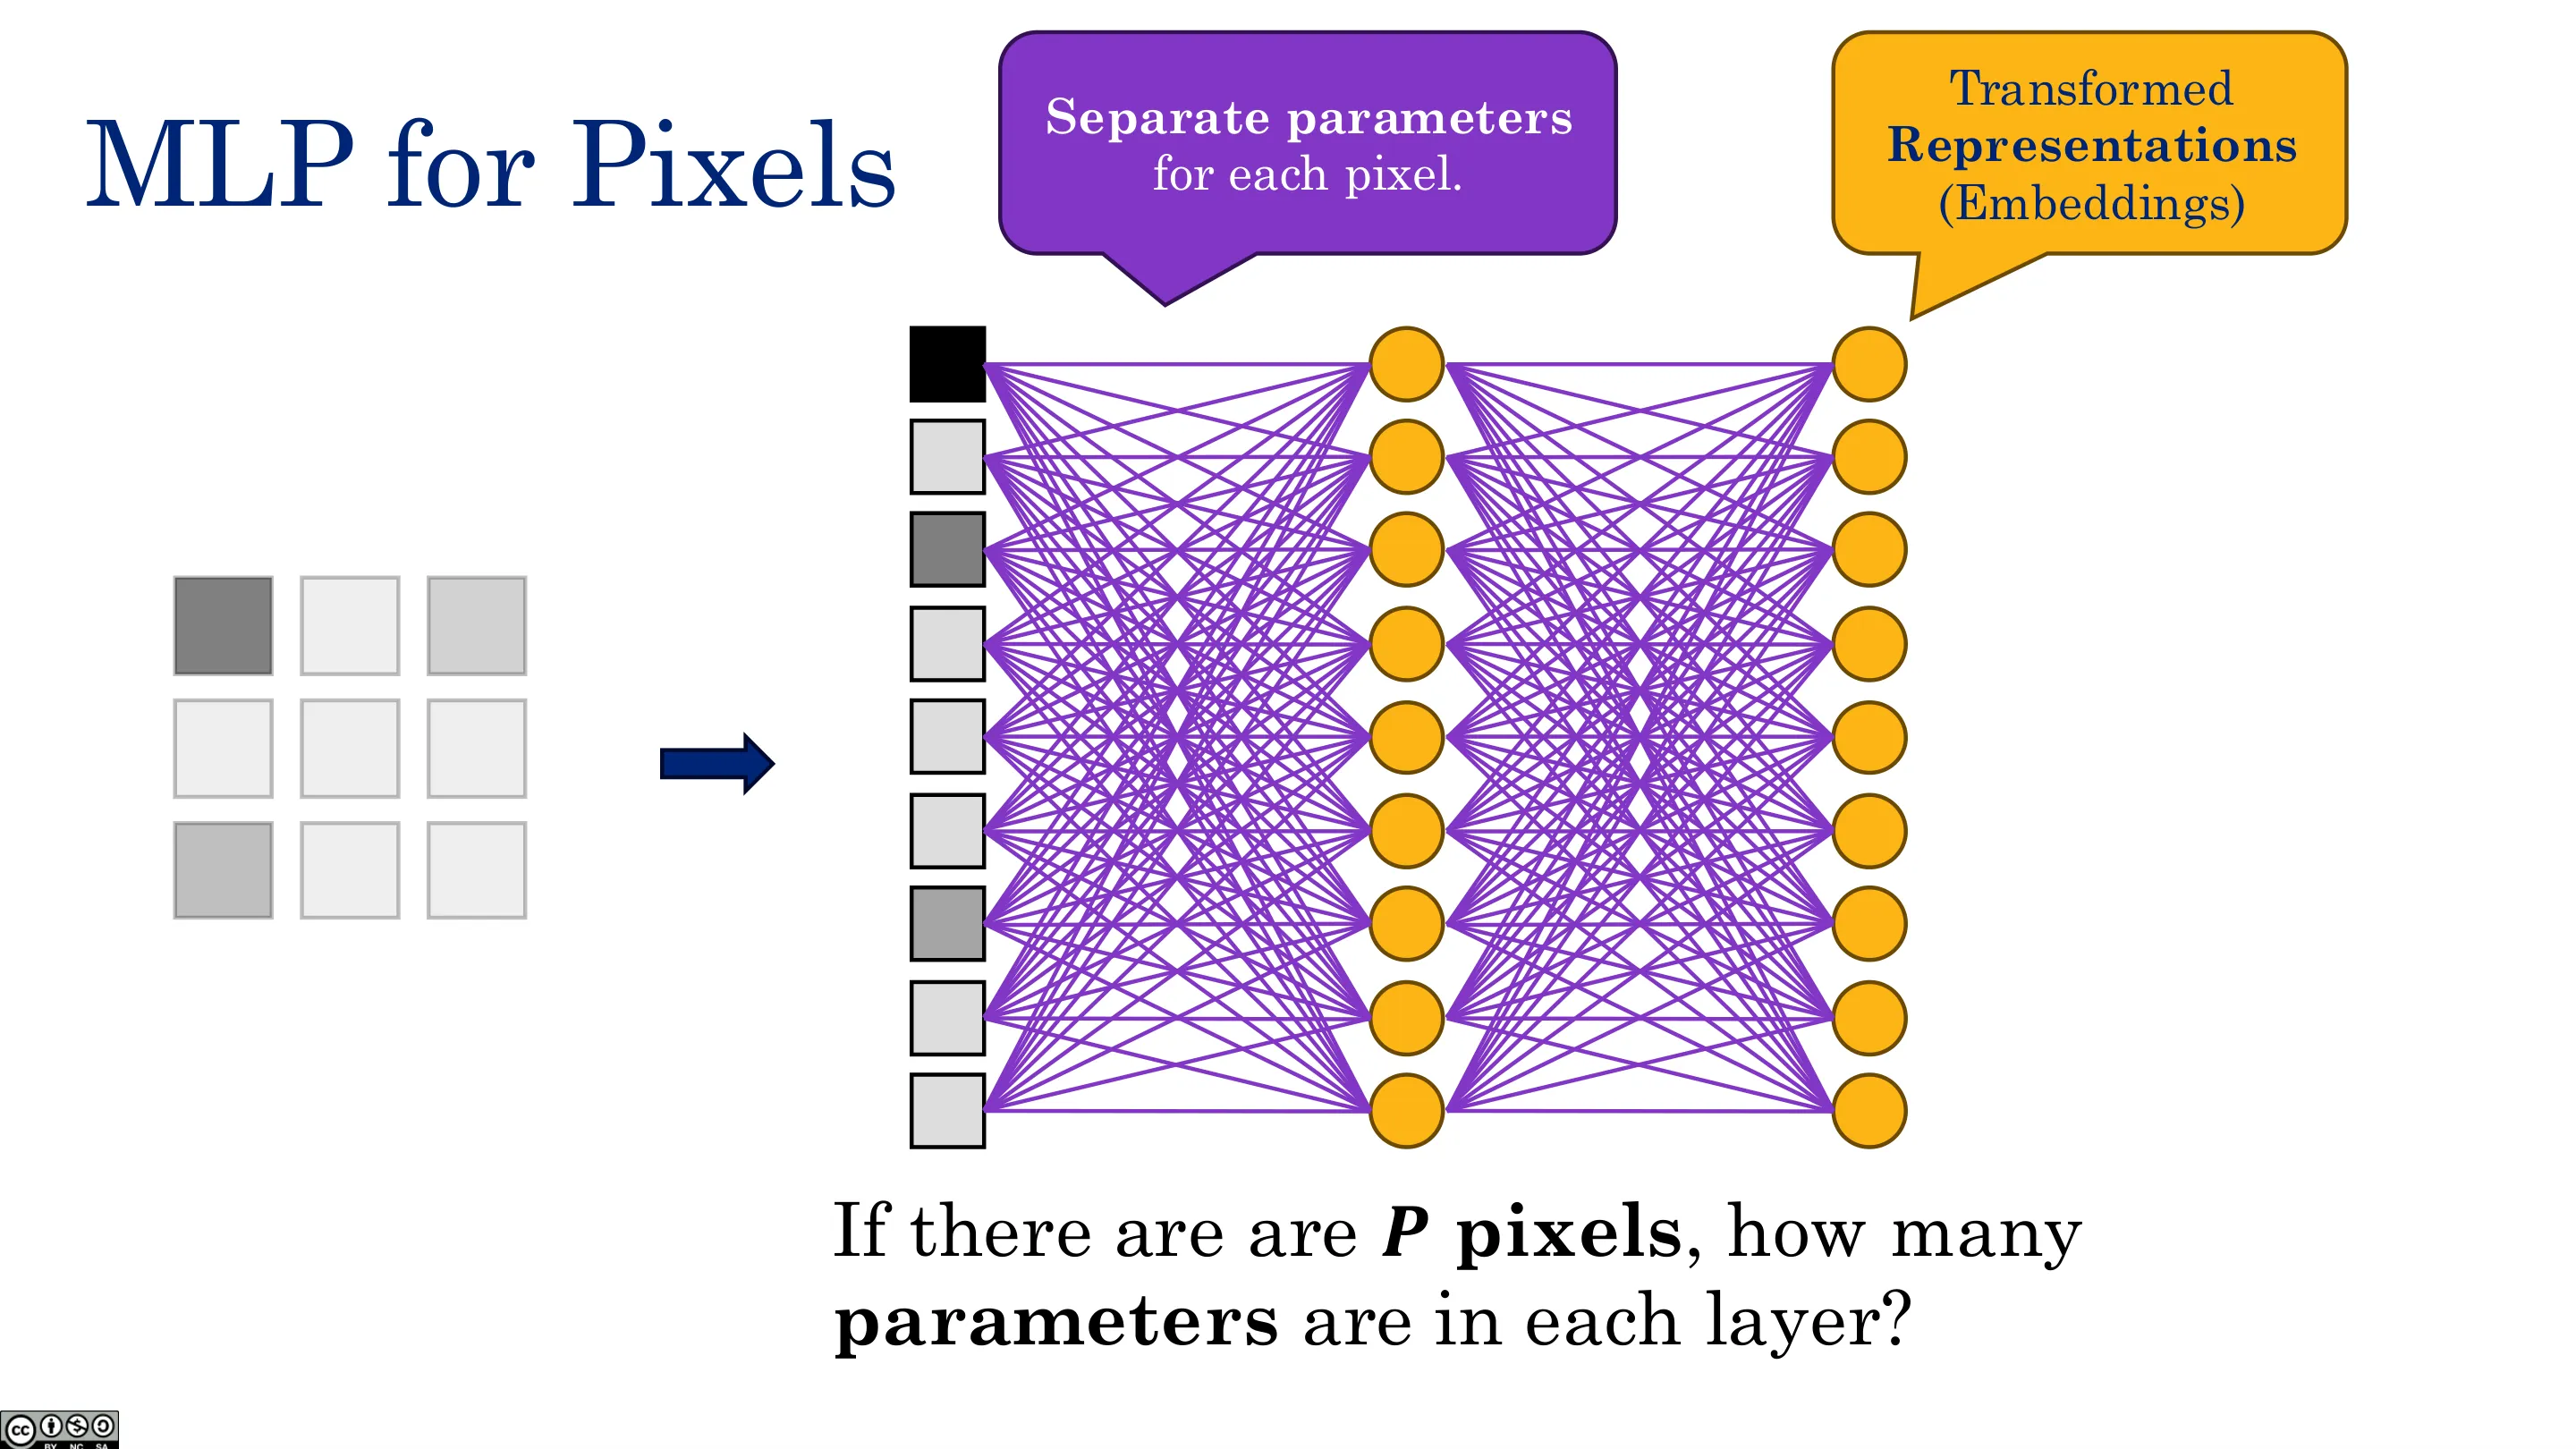
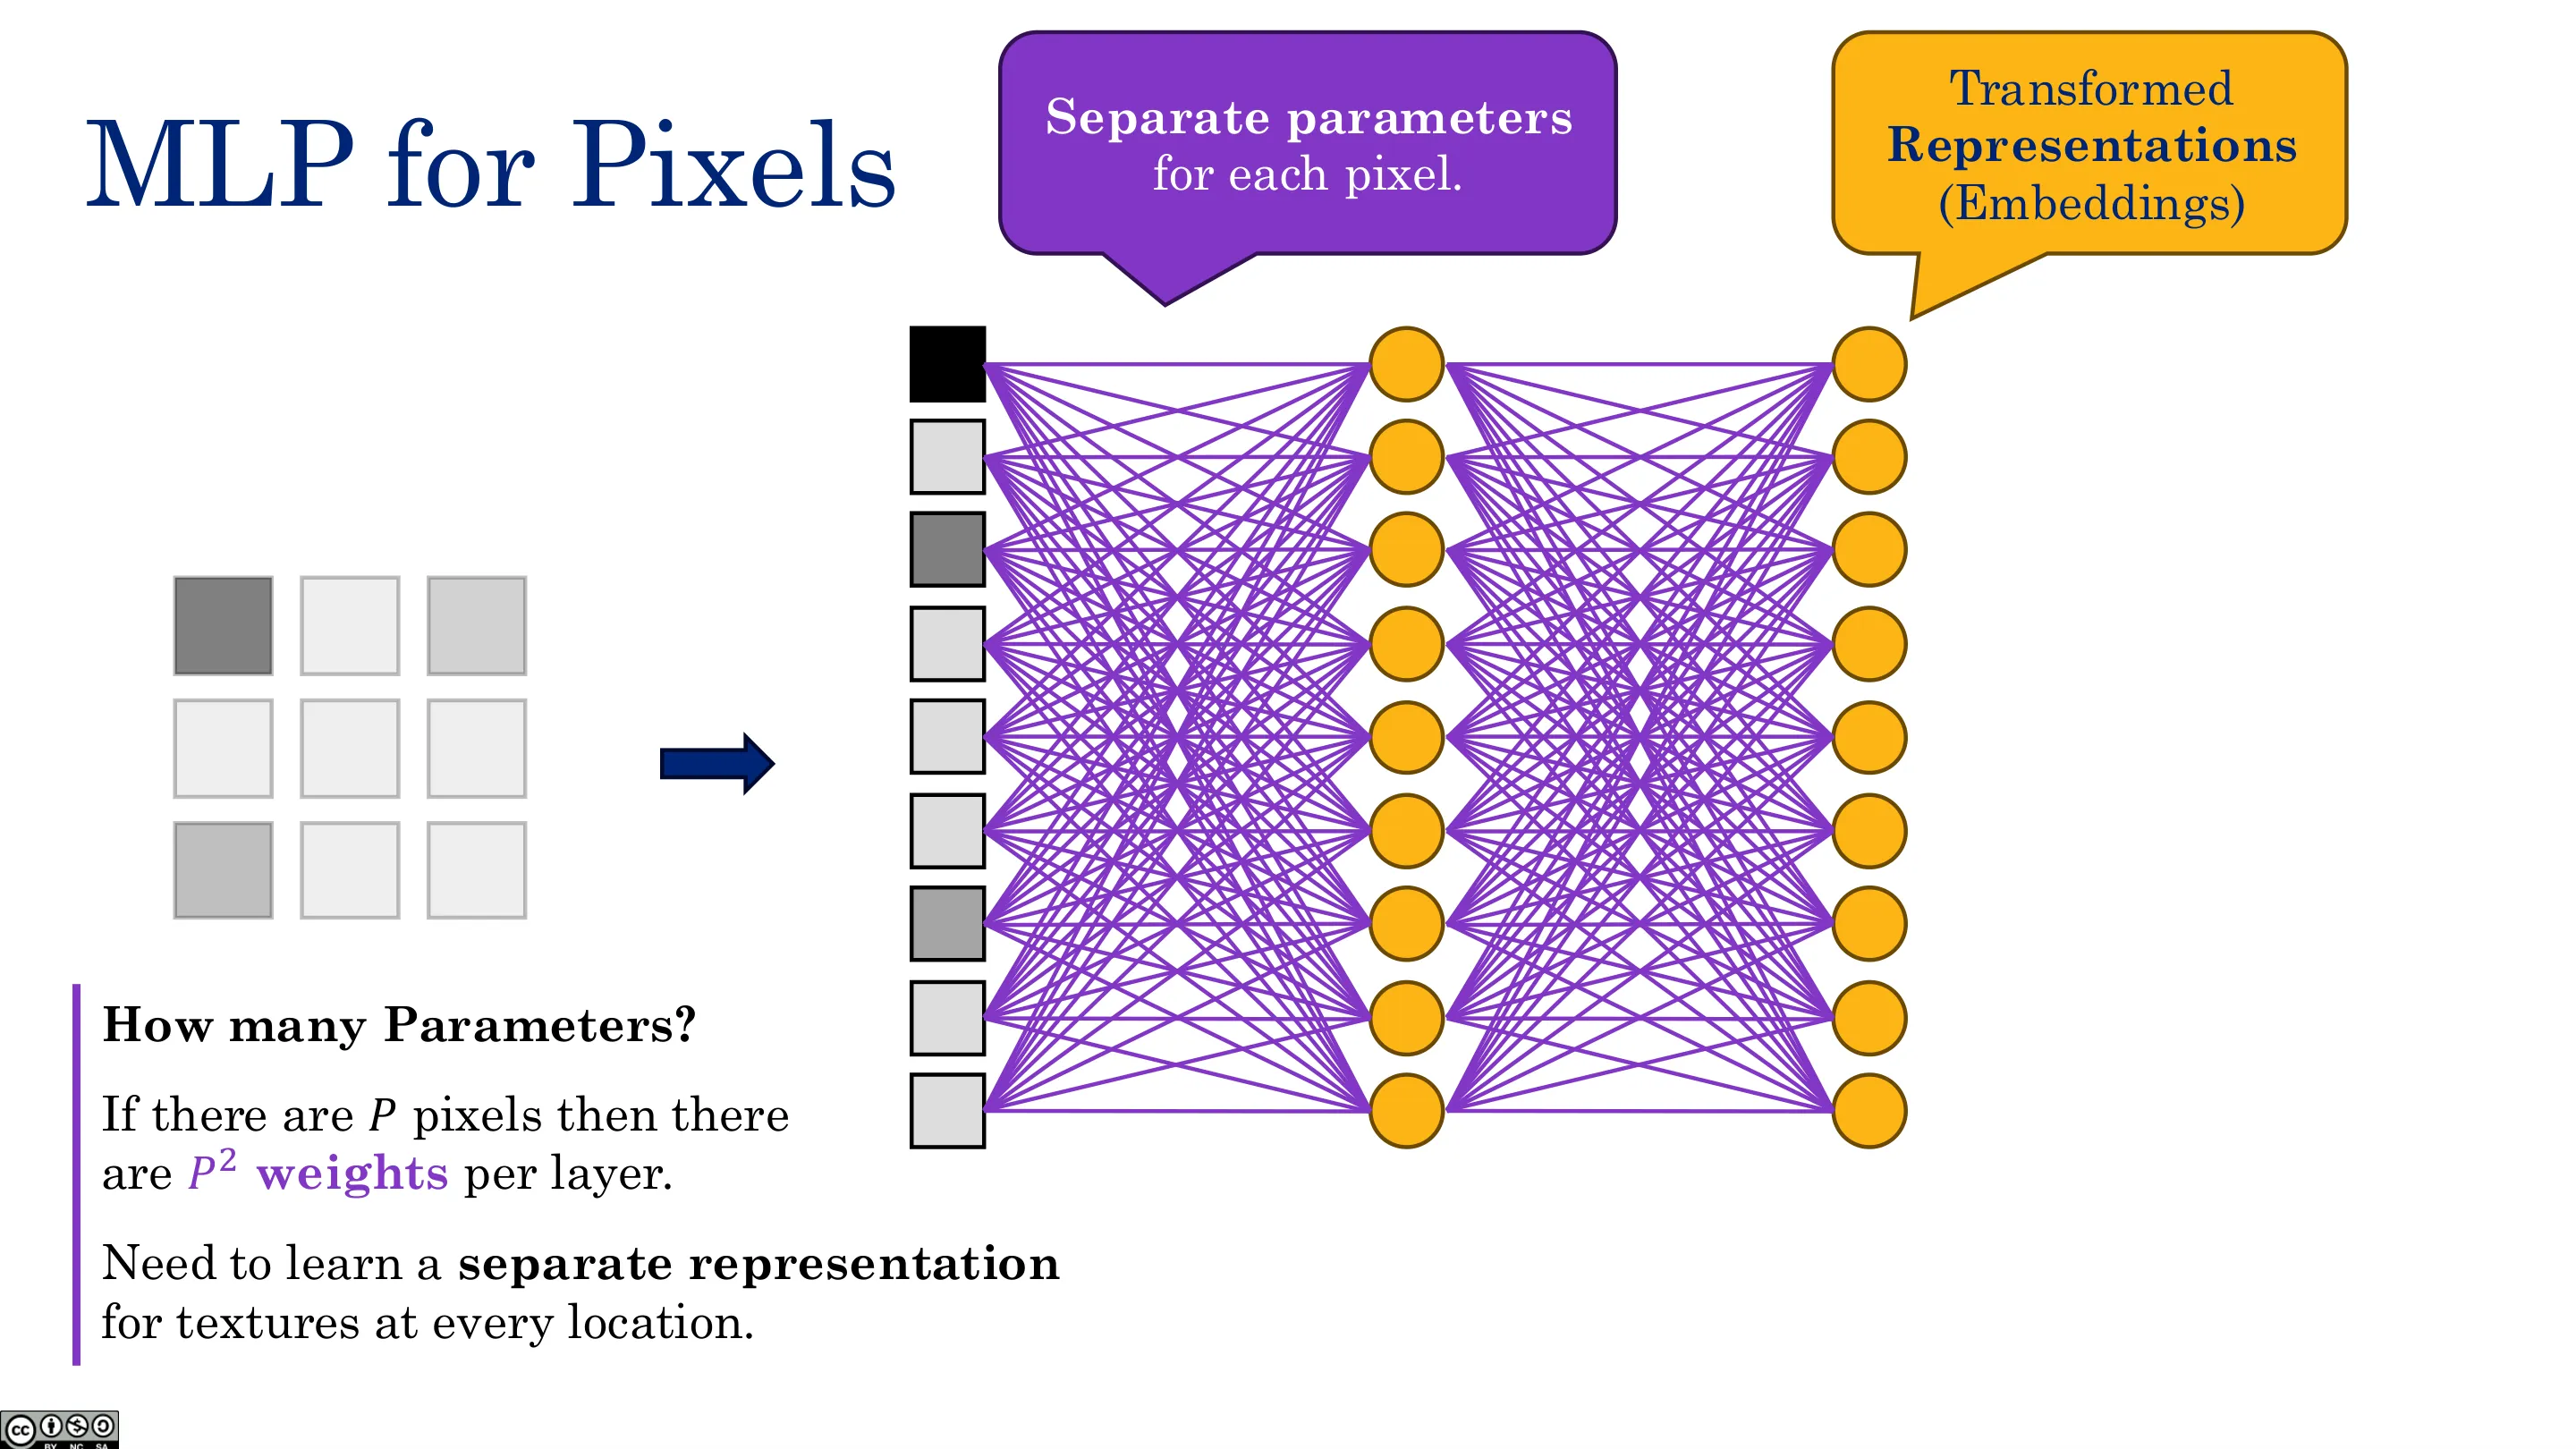
对图像,$P$ 像素 ⇒ 每层 $P^2$ 参数,$1000\times1000$ 图像完全不可行。
📷 深度学习就是特征变换
回到原视频 (00:08:51)
📷 MLP 网络
回到原视频 (00:10:04)
📷 用于像素的 MLP(一)
回到原视频 (00:11:17)
📷 用于像素的 MLP(二)
回到原视频 (00:12:30)
📷 用于像素的 MLP(三)
回到原视频 (00:13:43)
📷 用于像素的 MLP(四)
回到原视频 (00:14:56)
📷 用于像素的 MLP(五)
回到原视频 (00:16:09)
2.2 卷积网络(CNN)
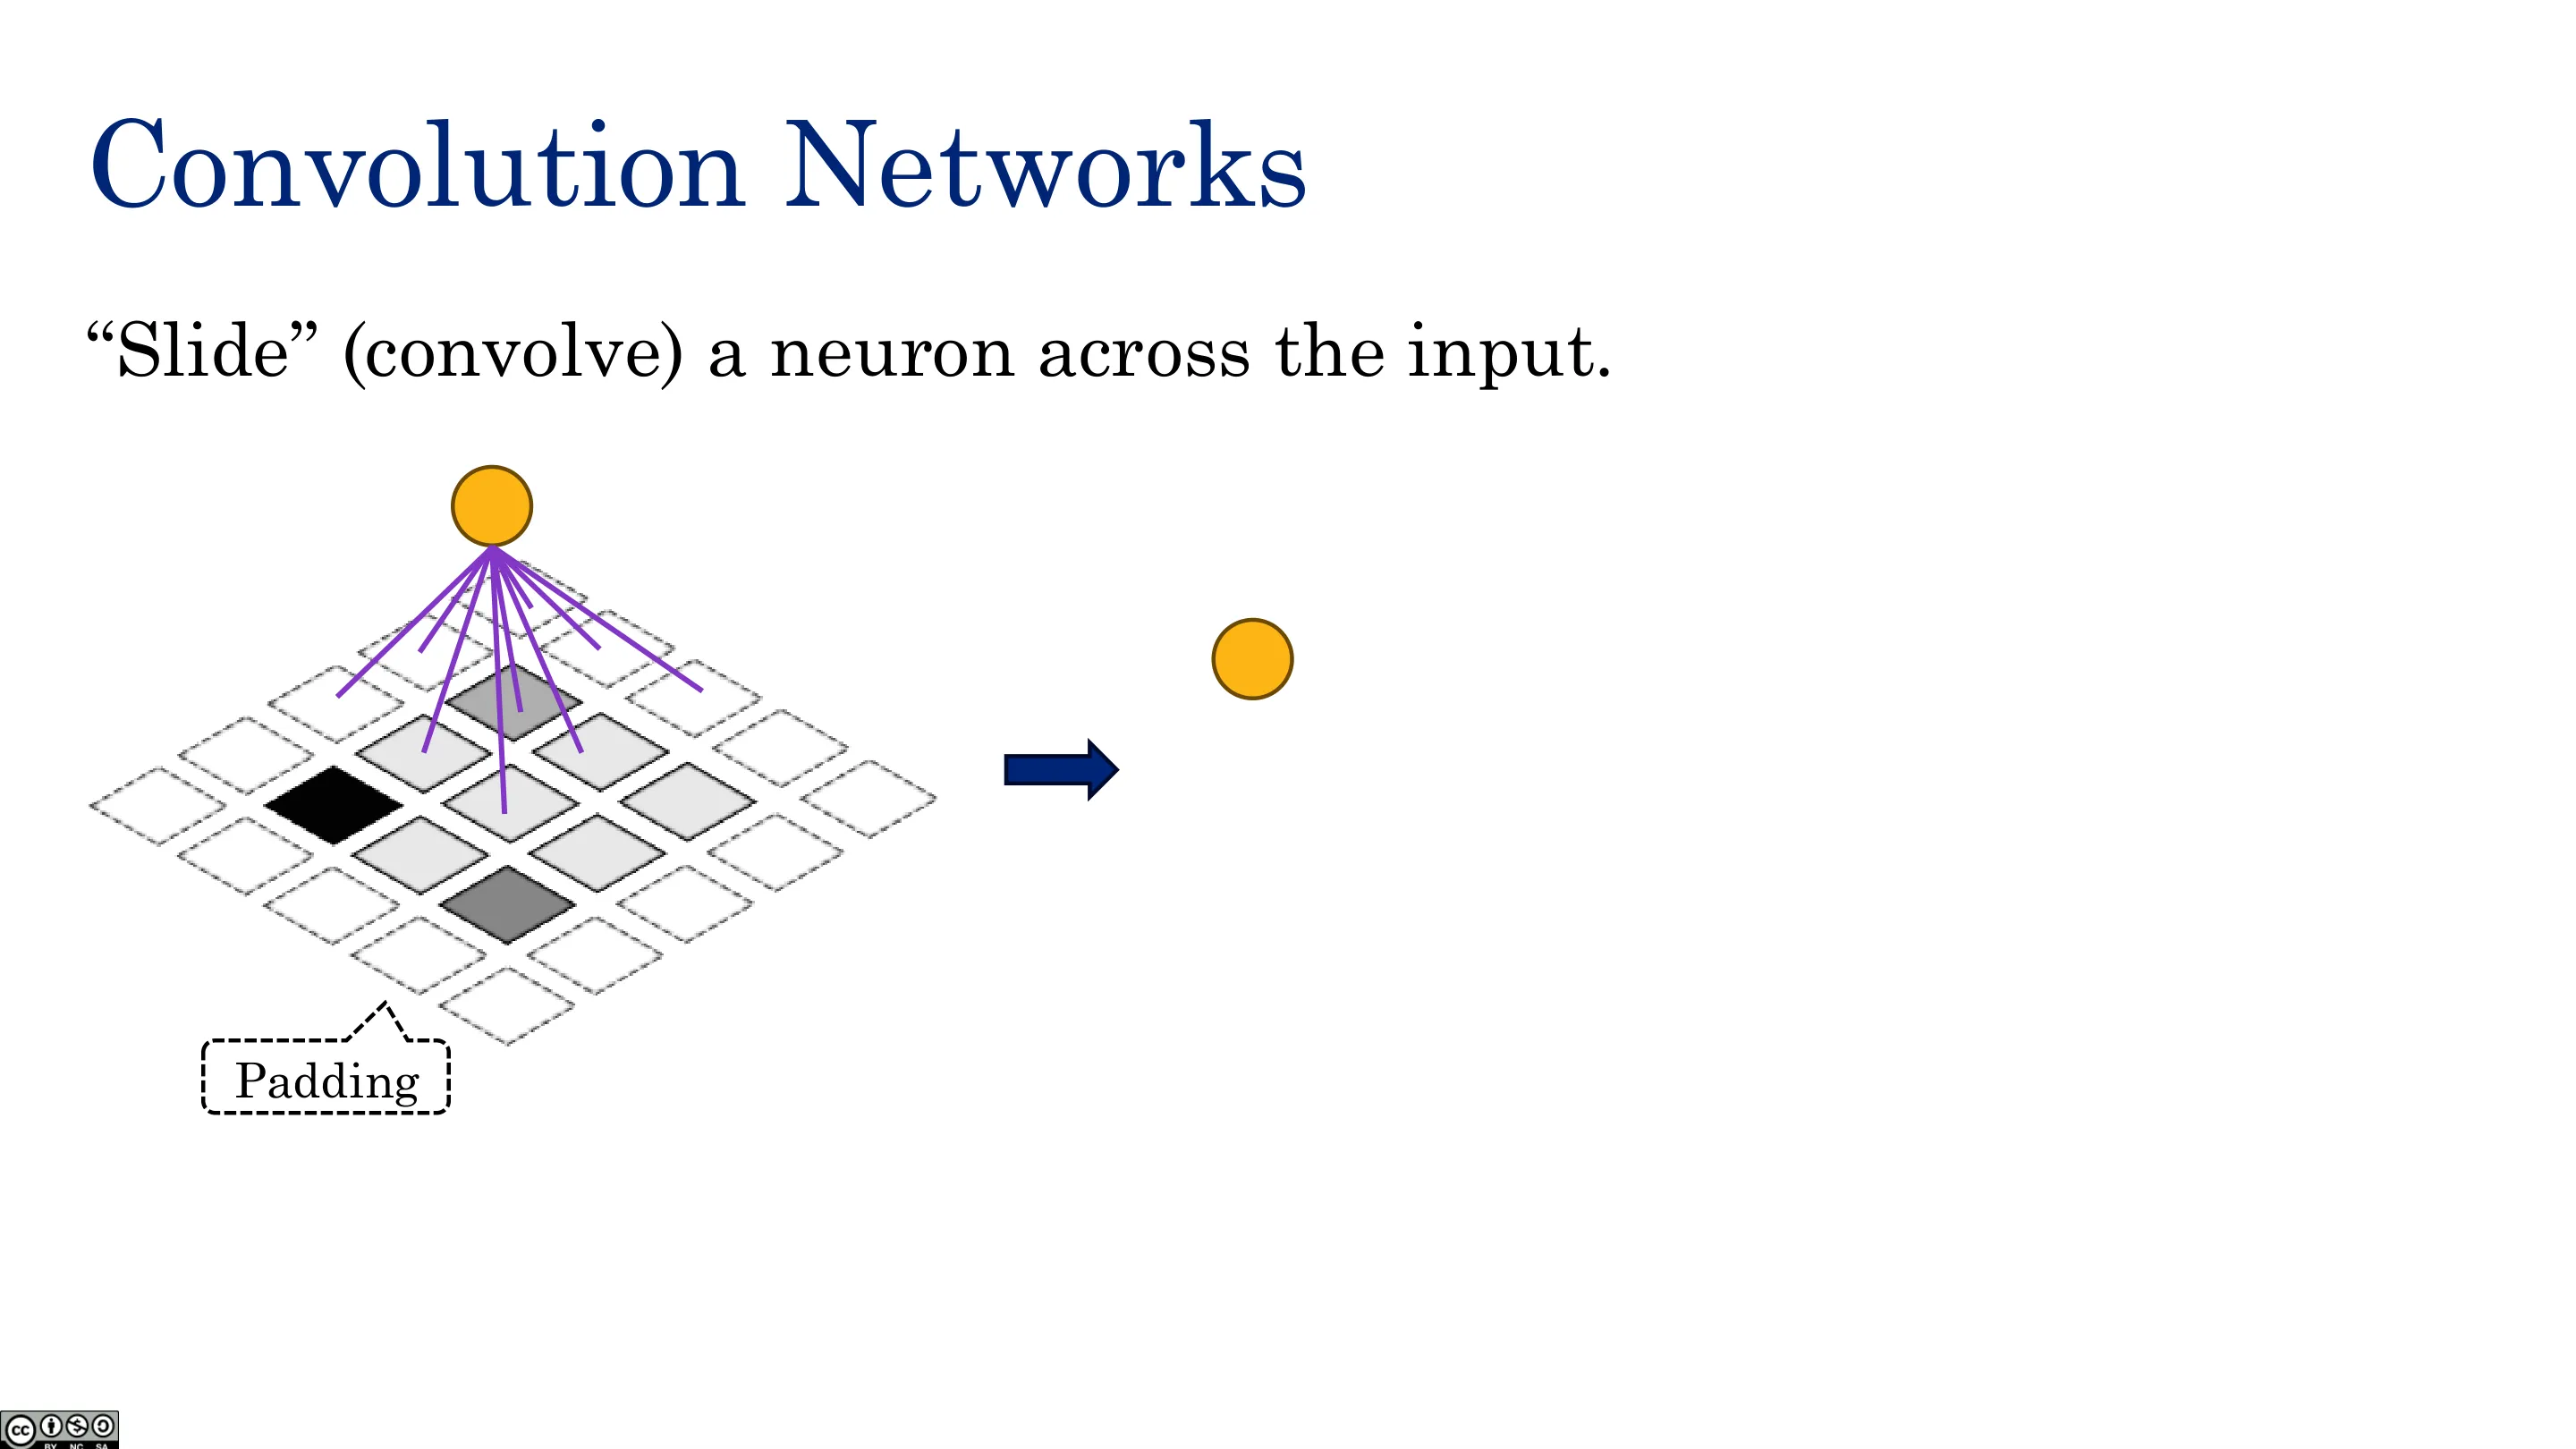
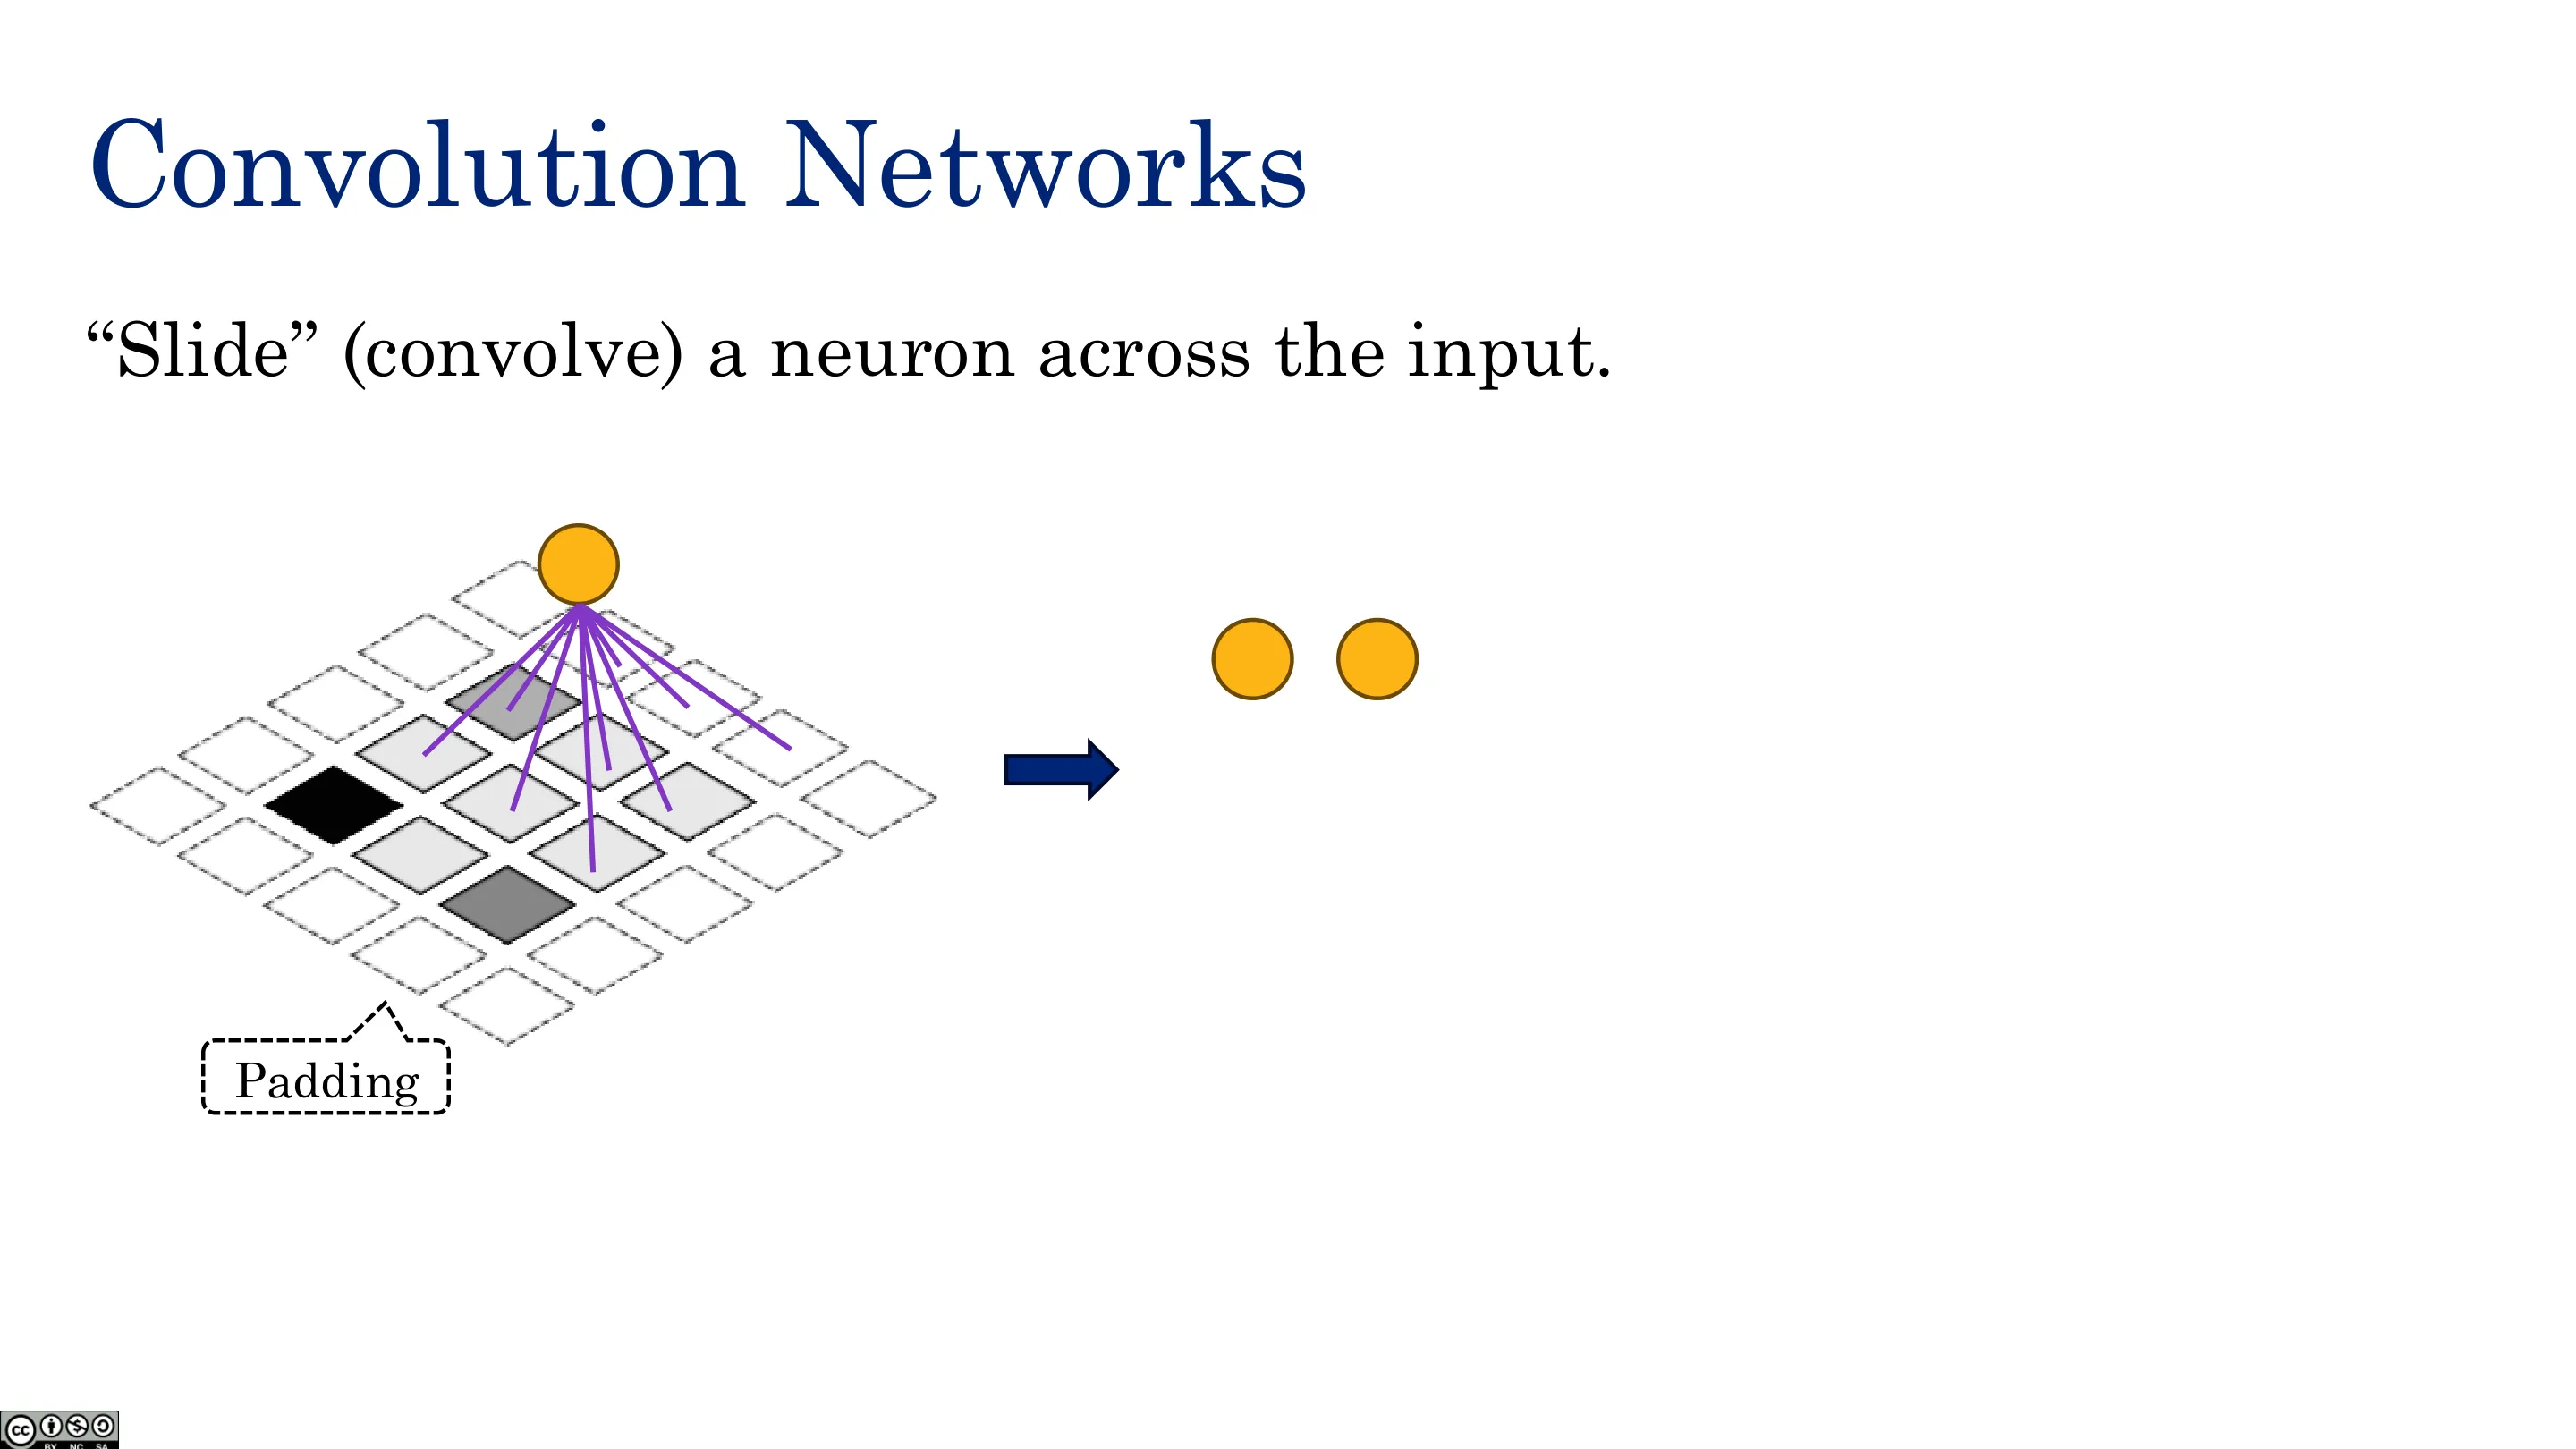
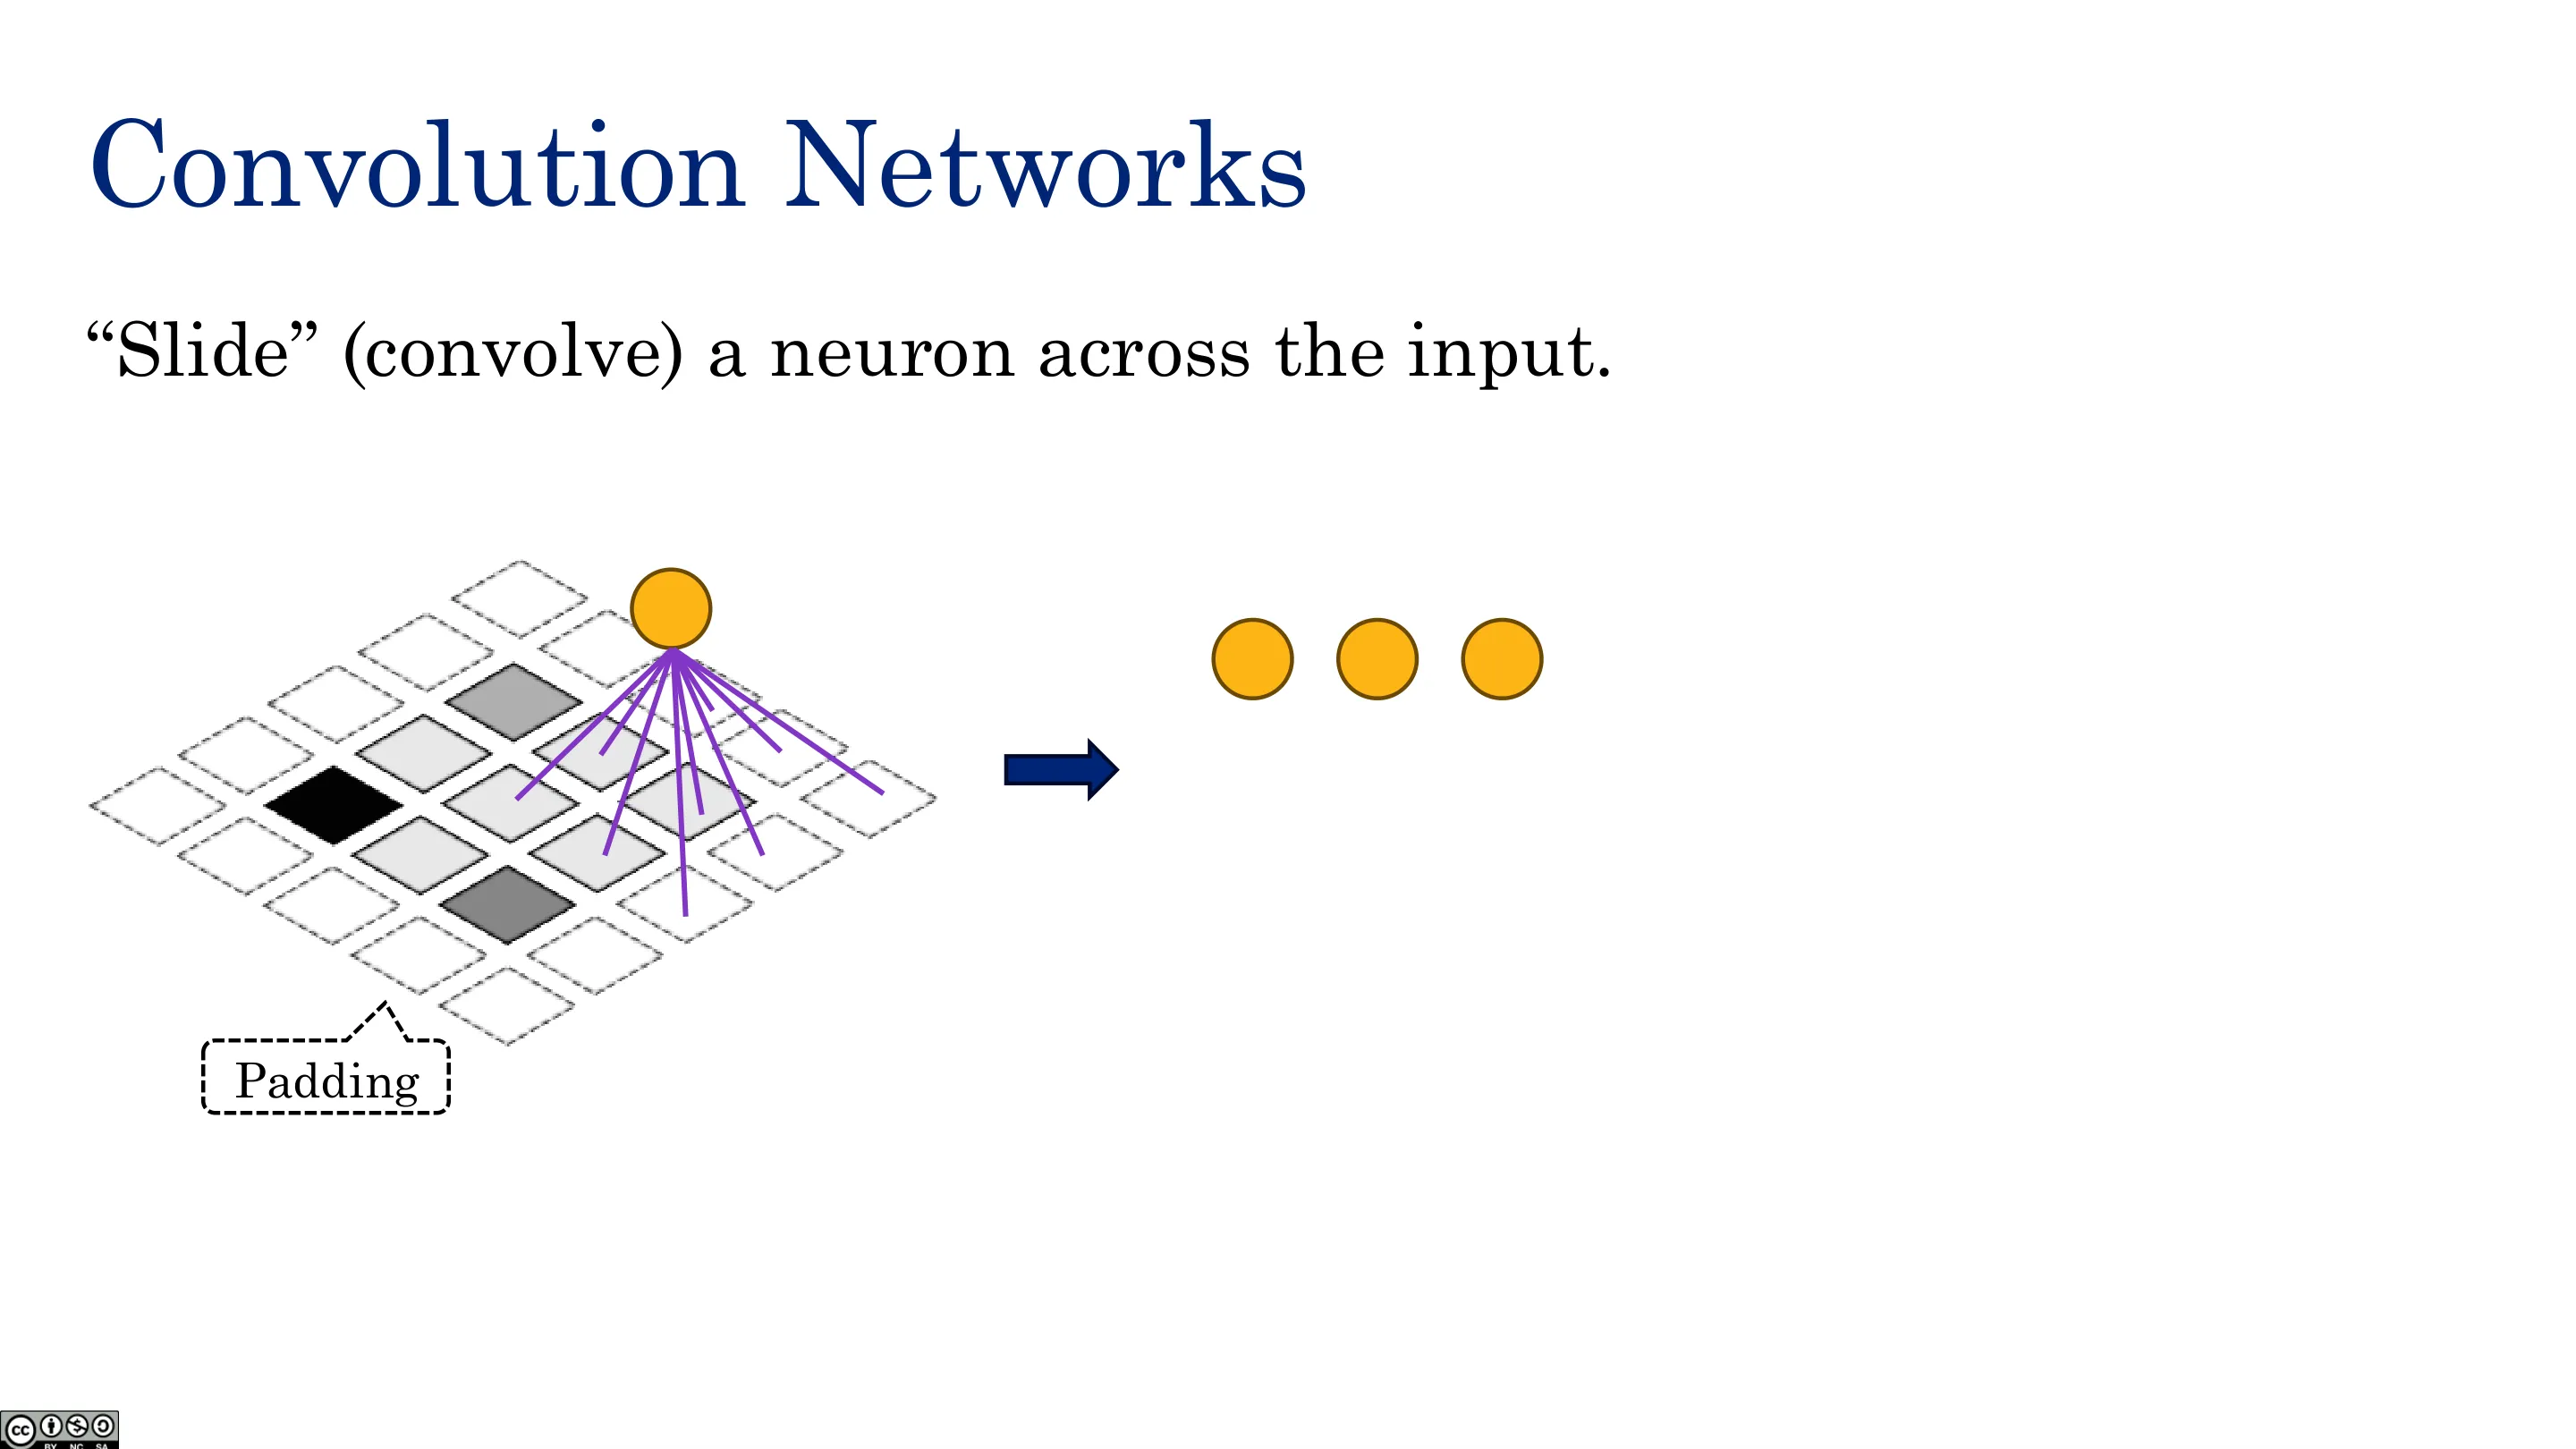
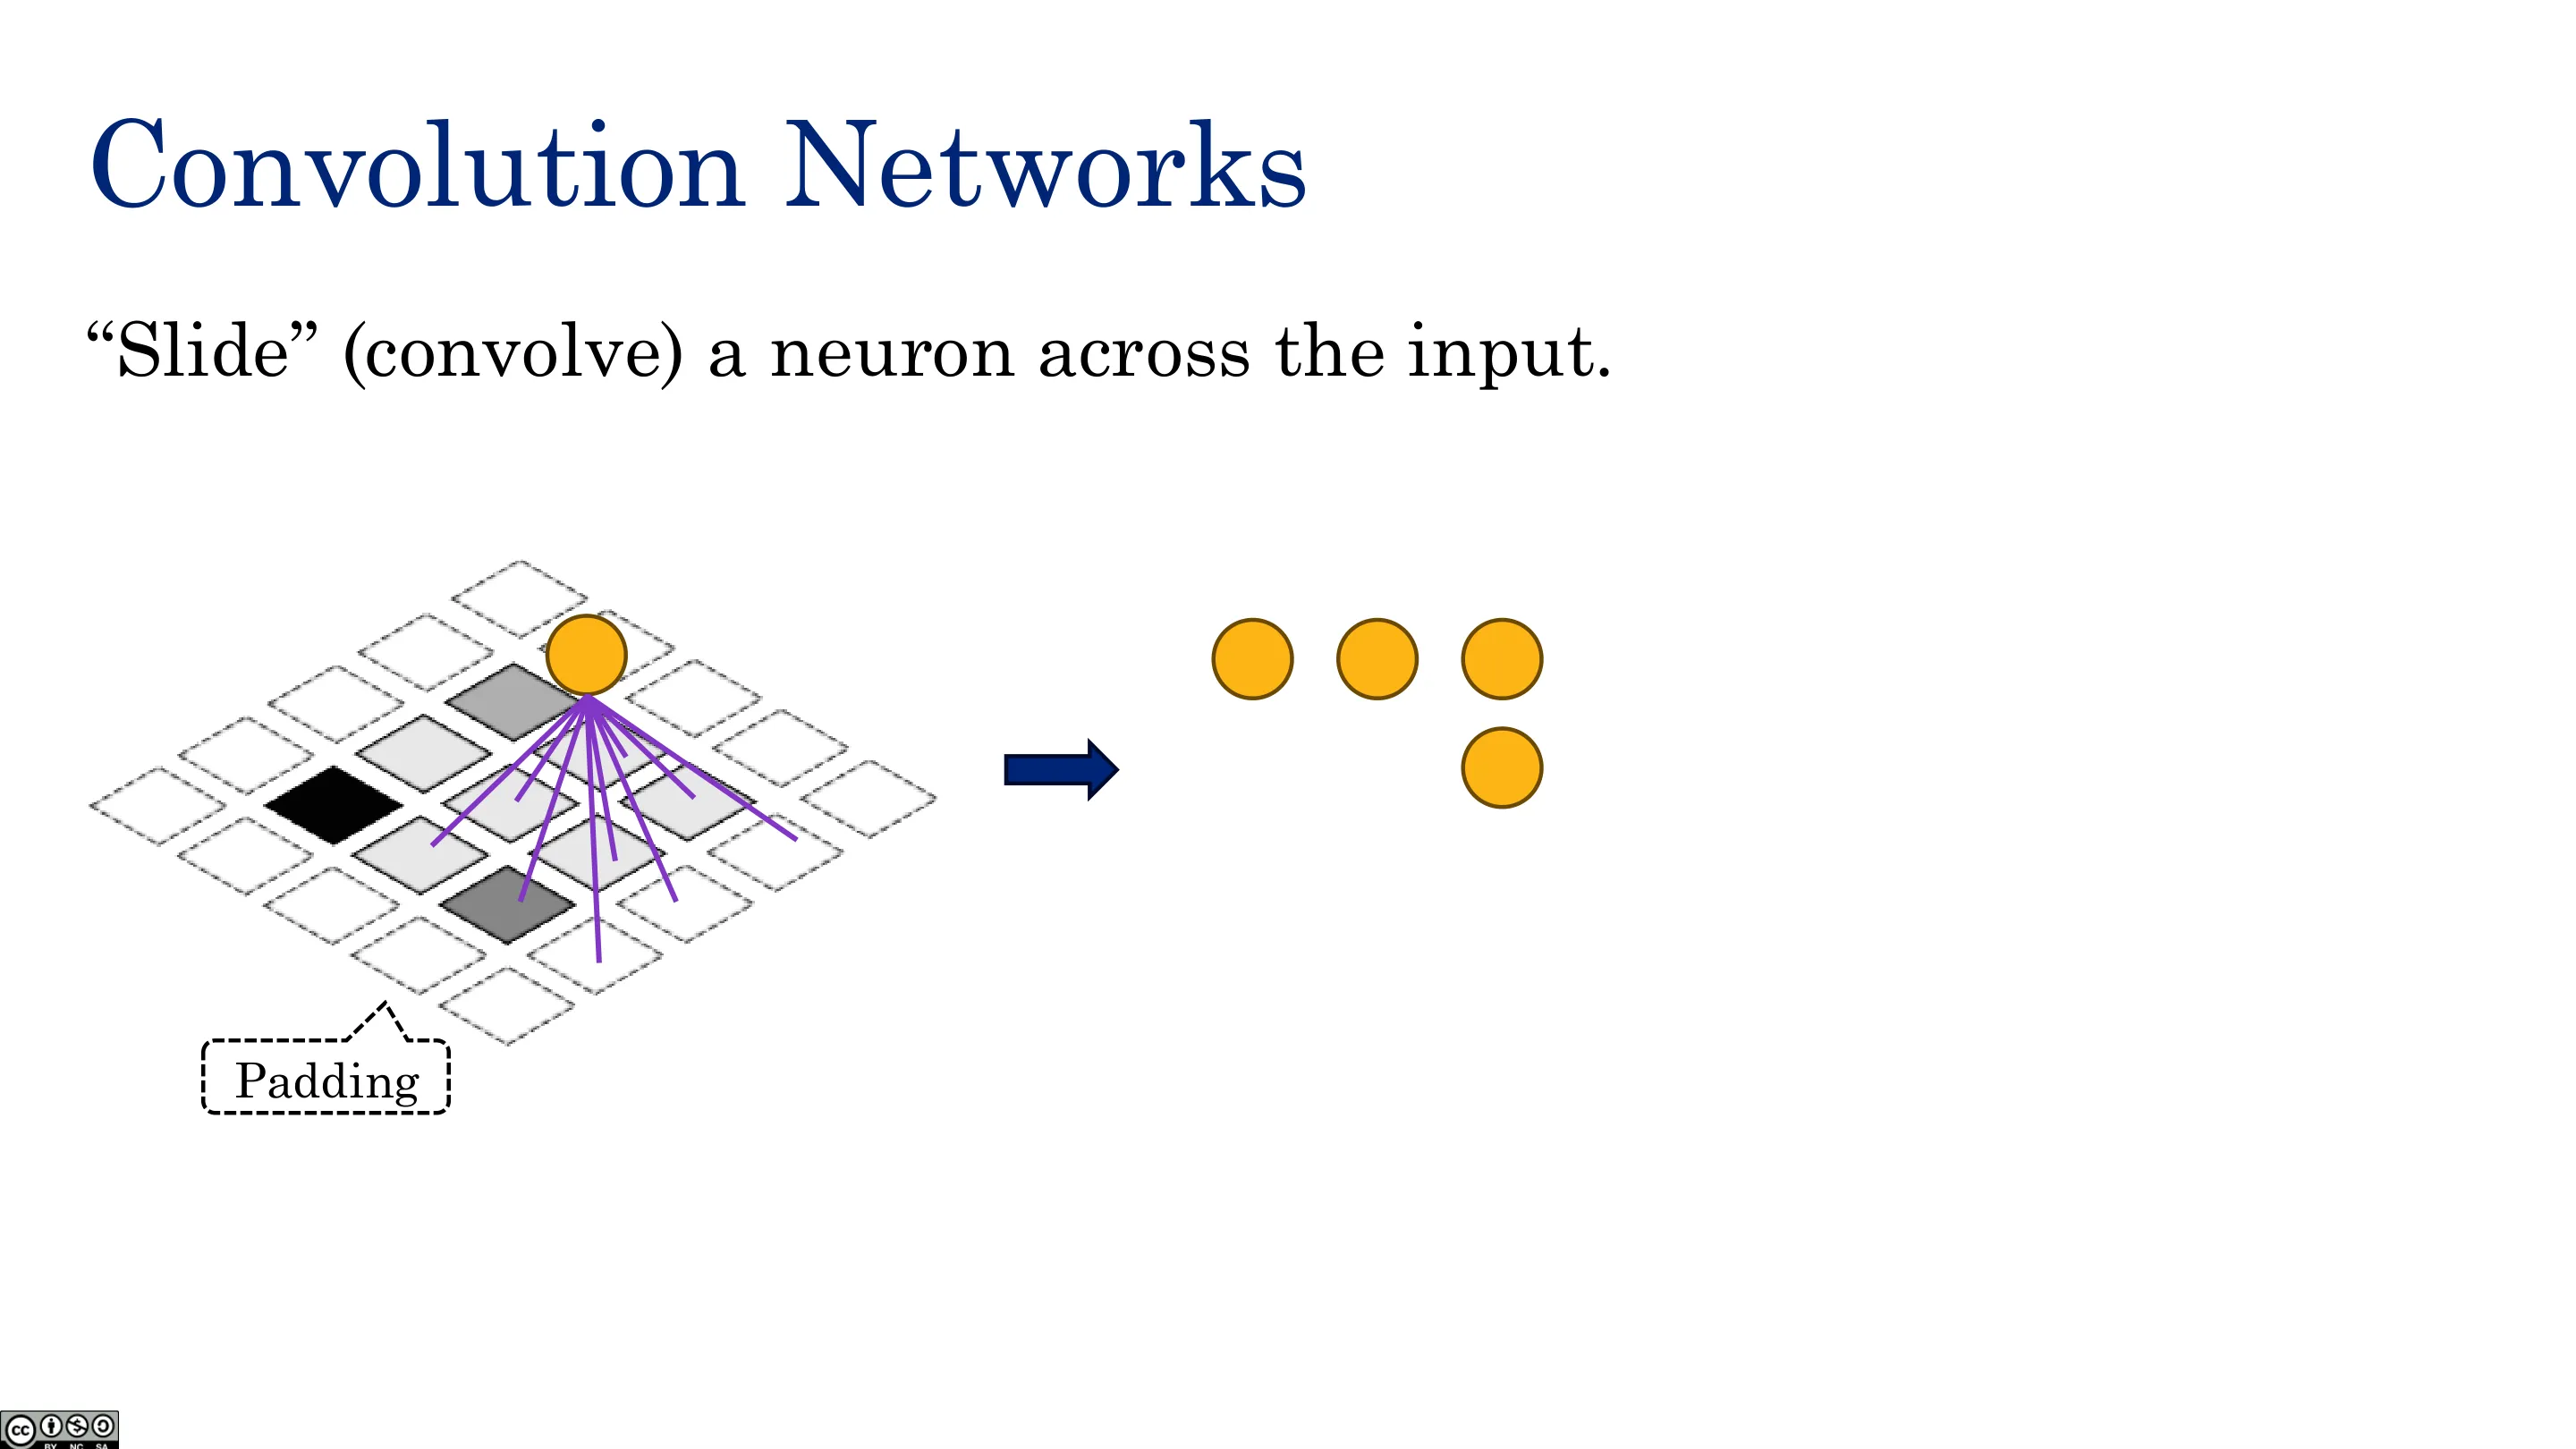
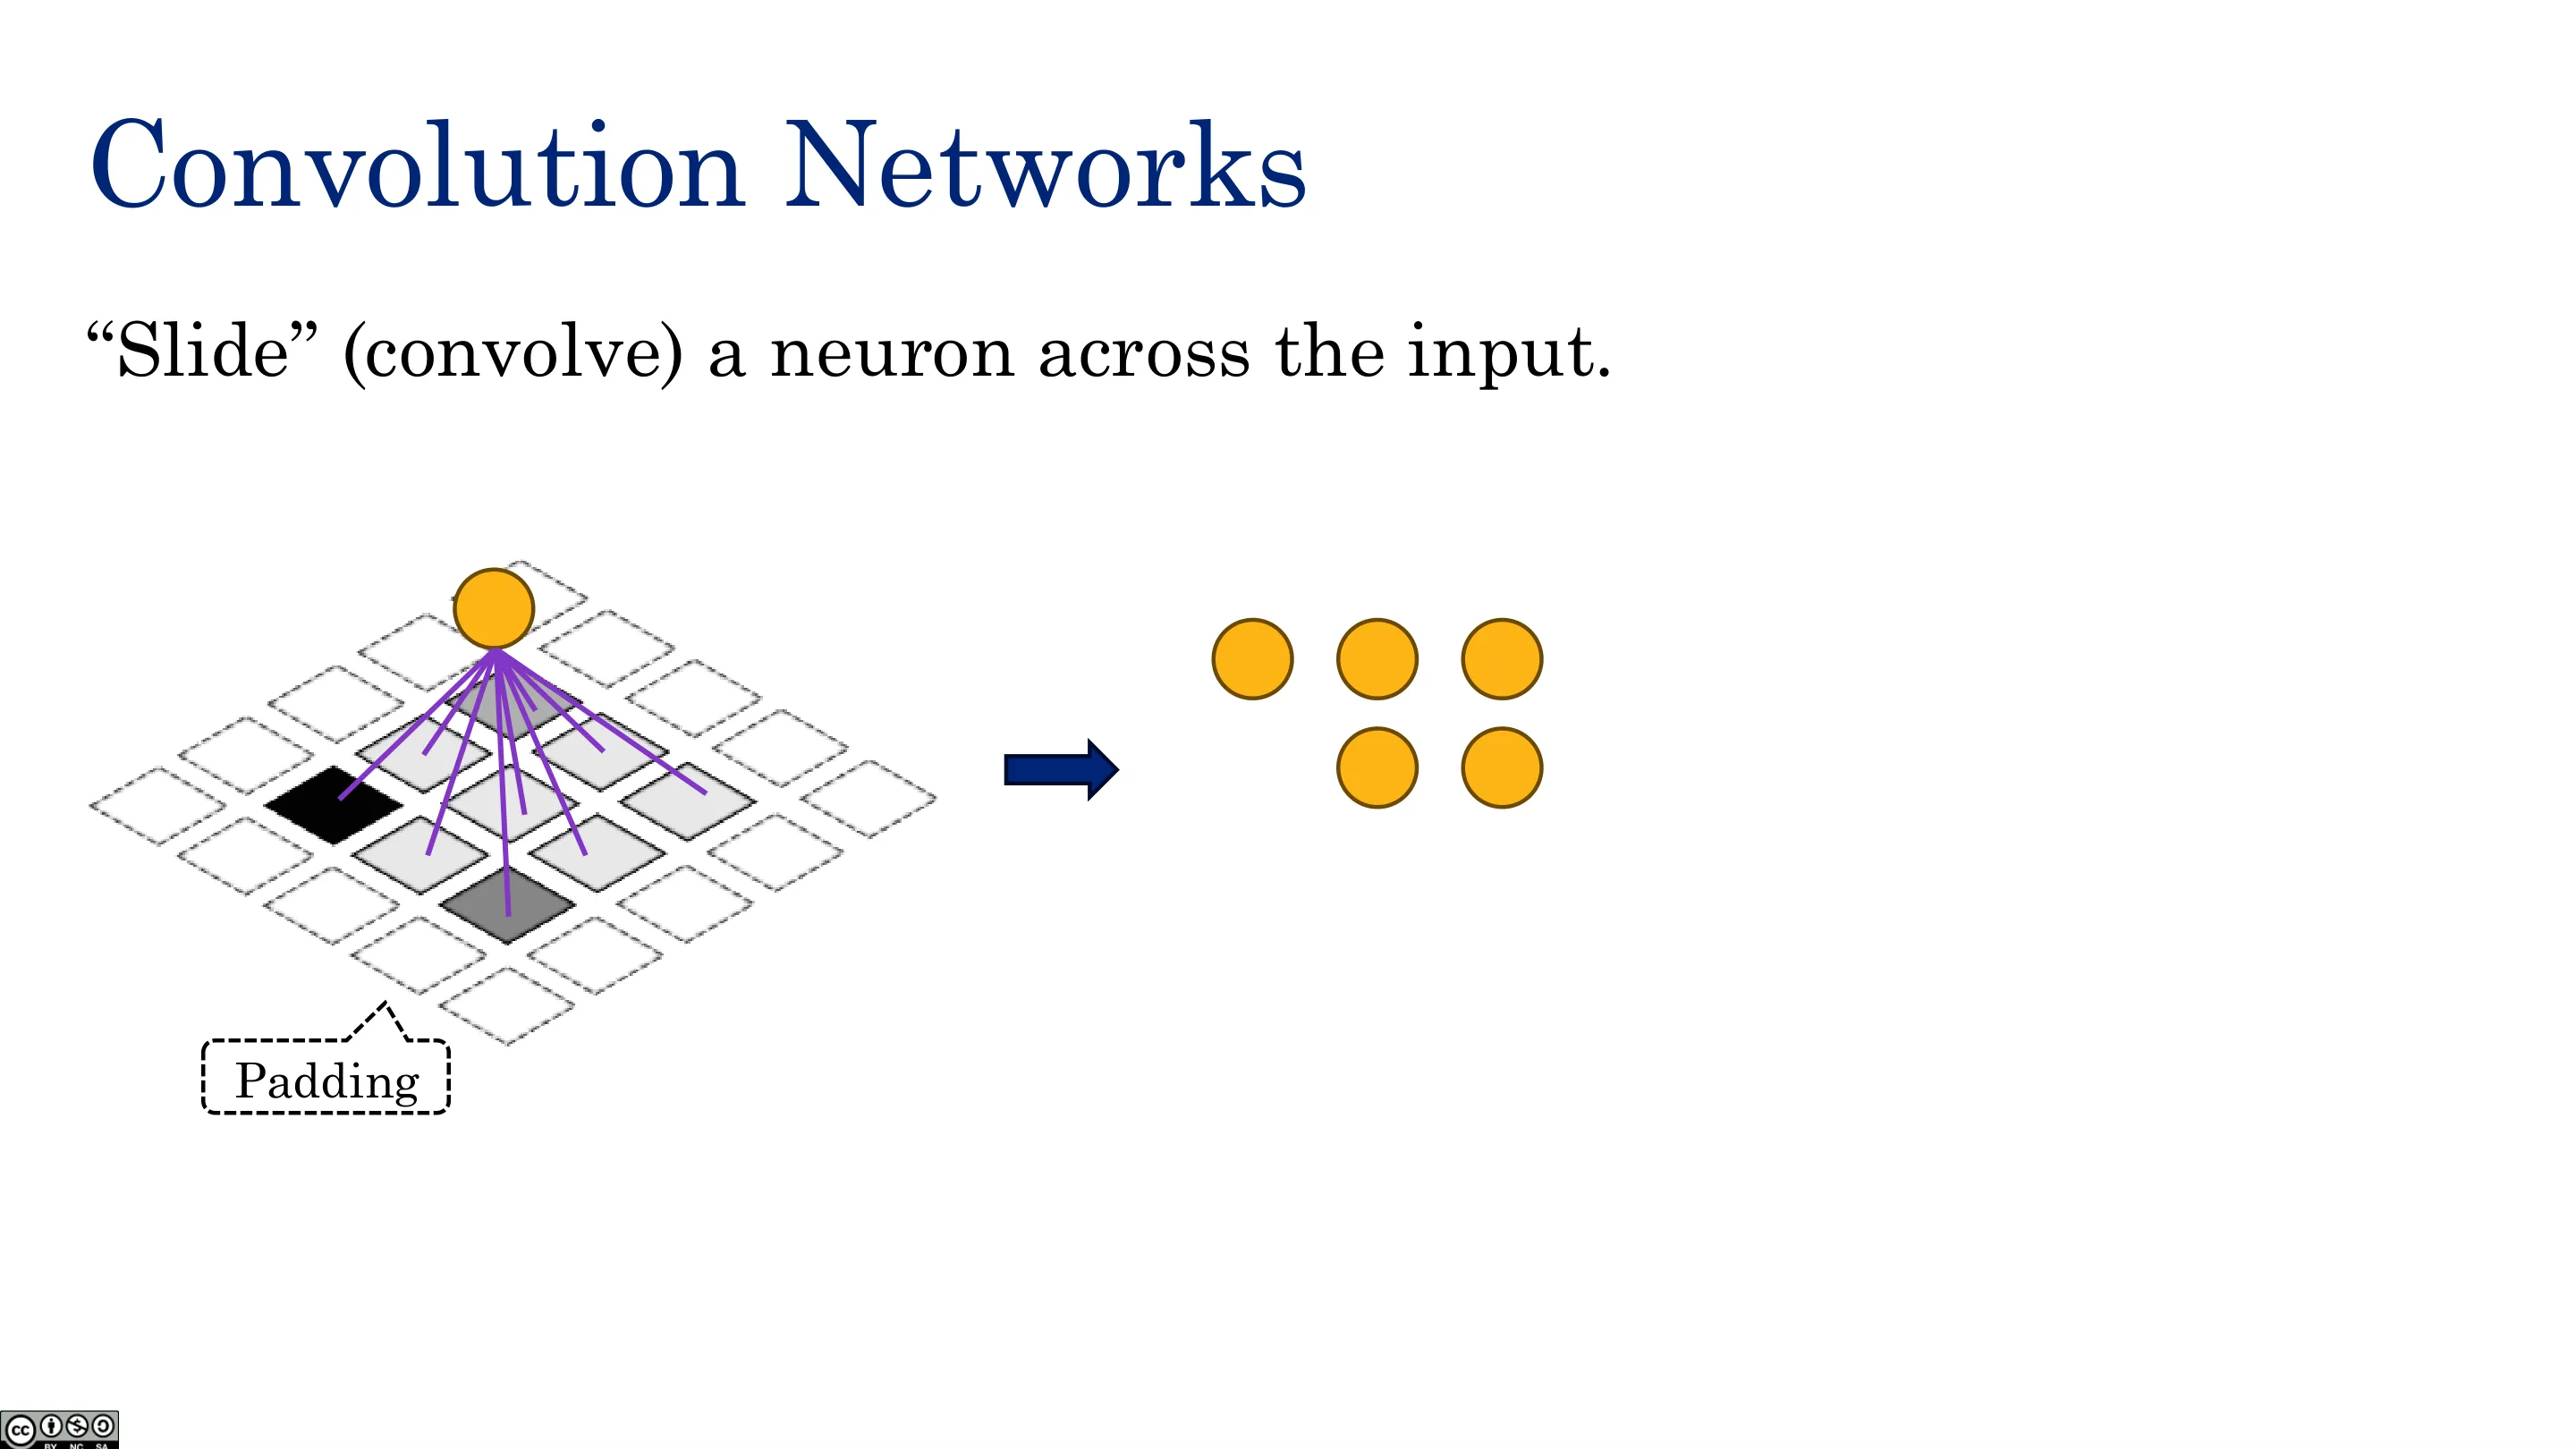
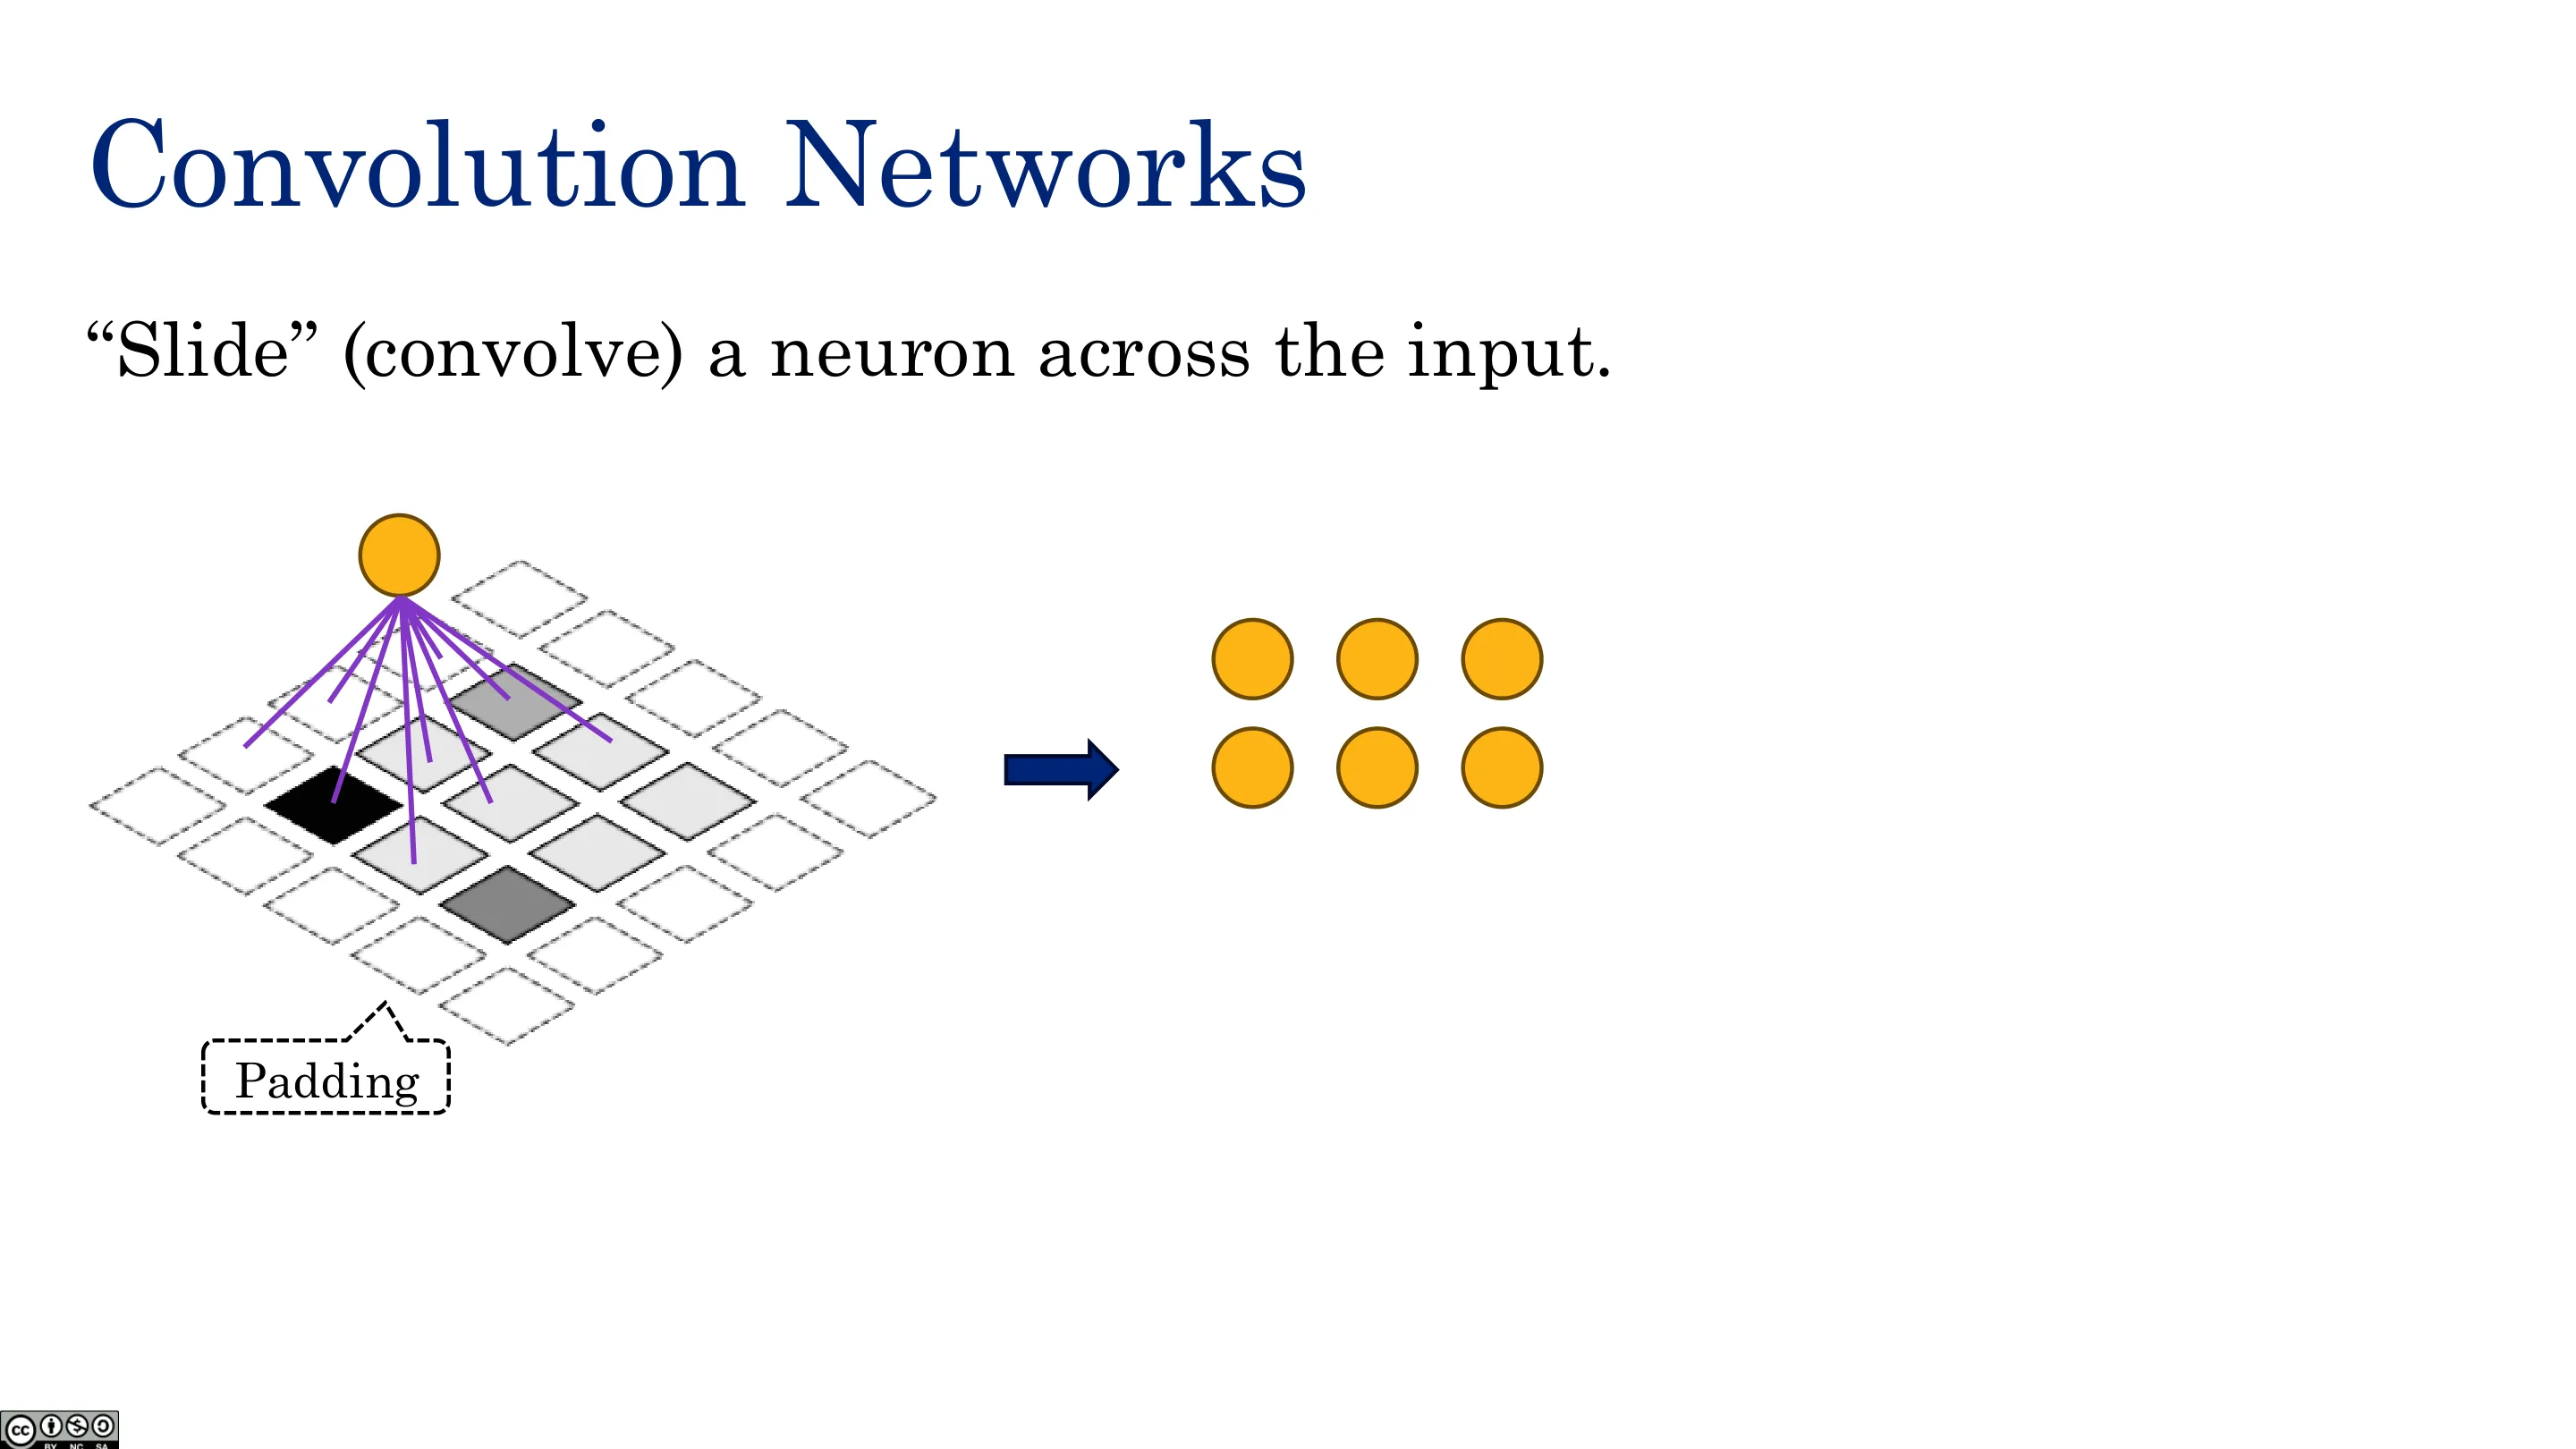
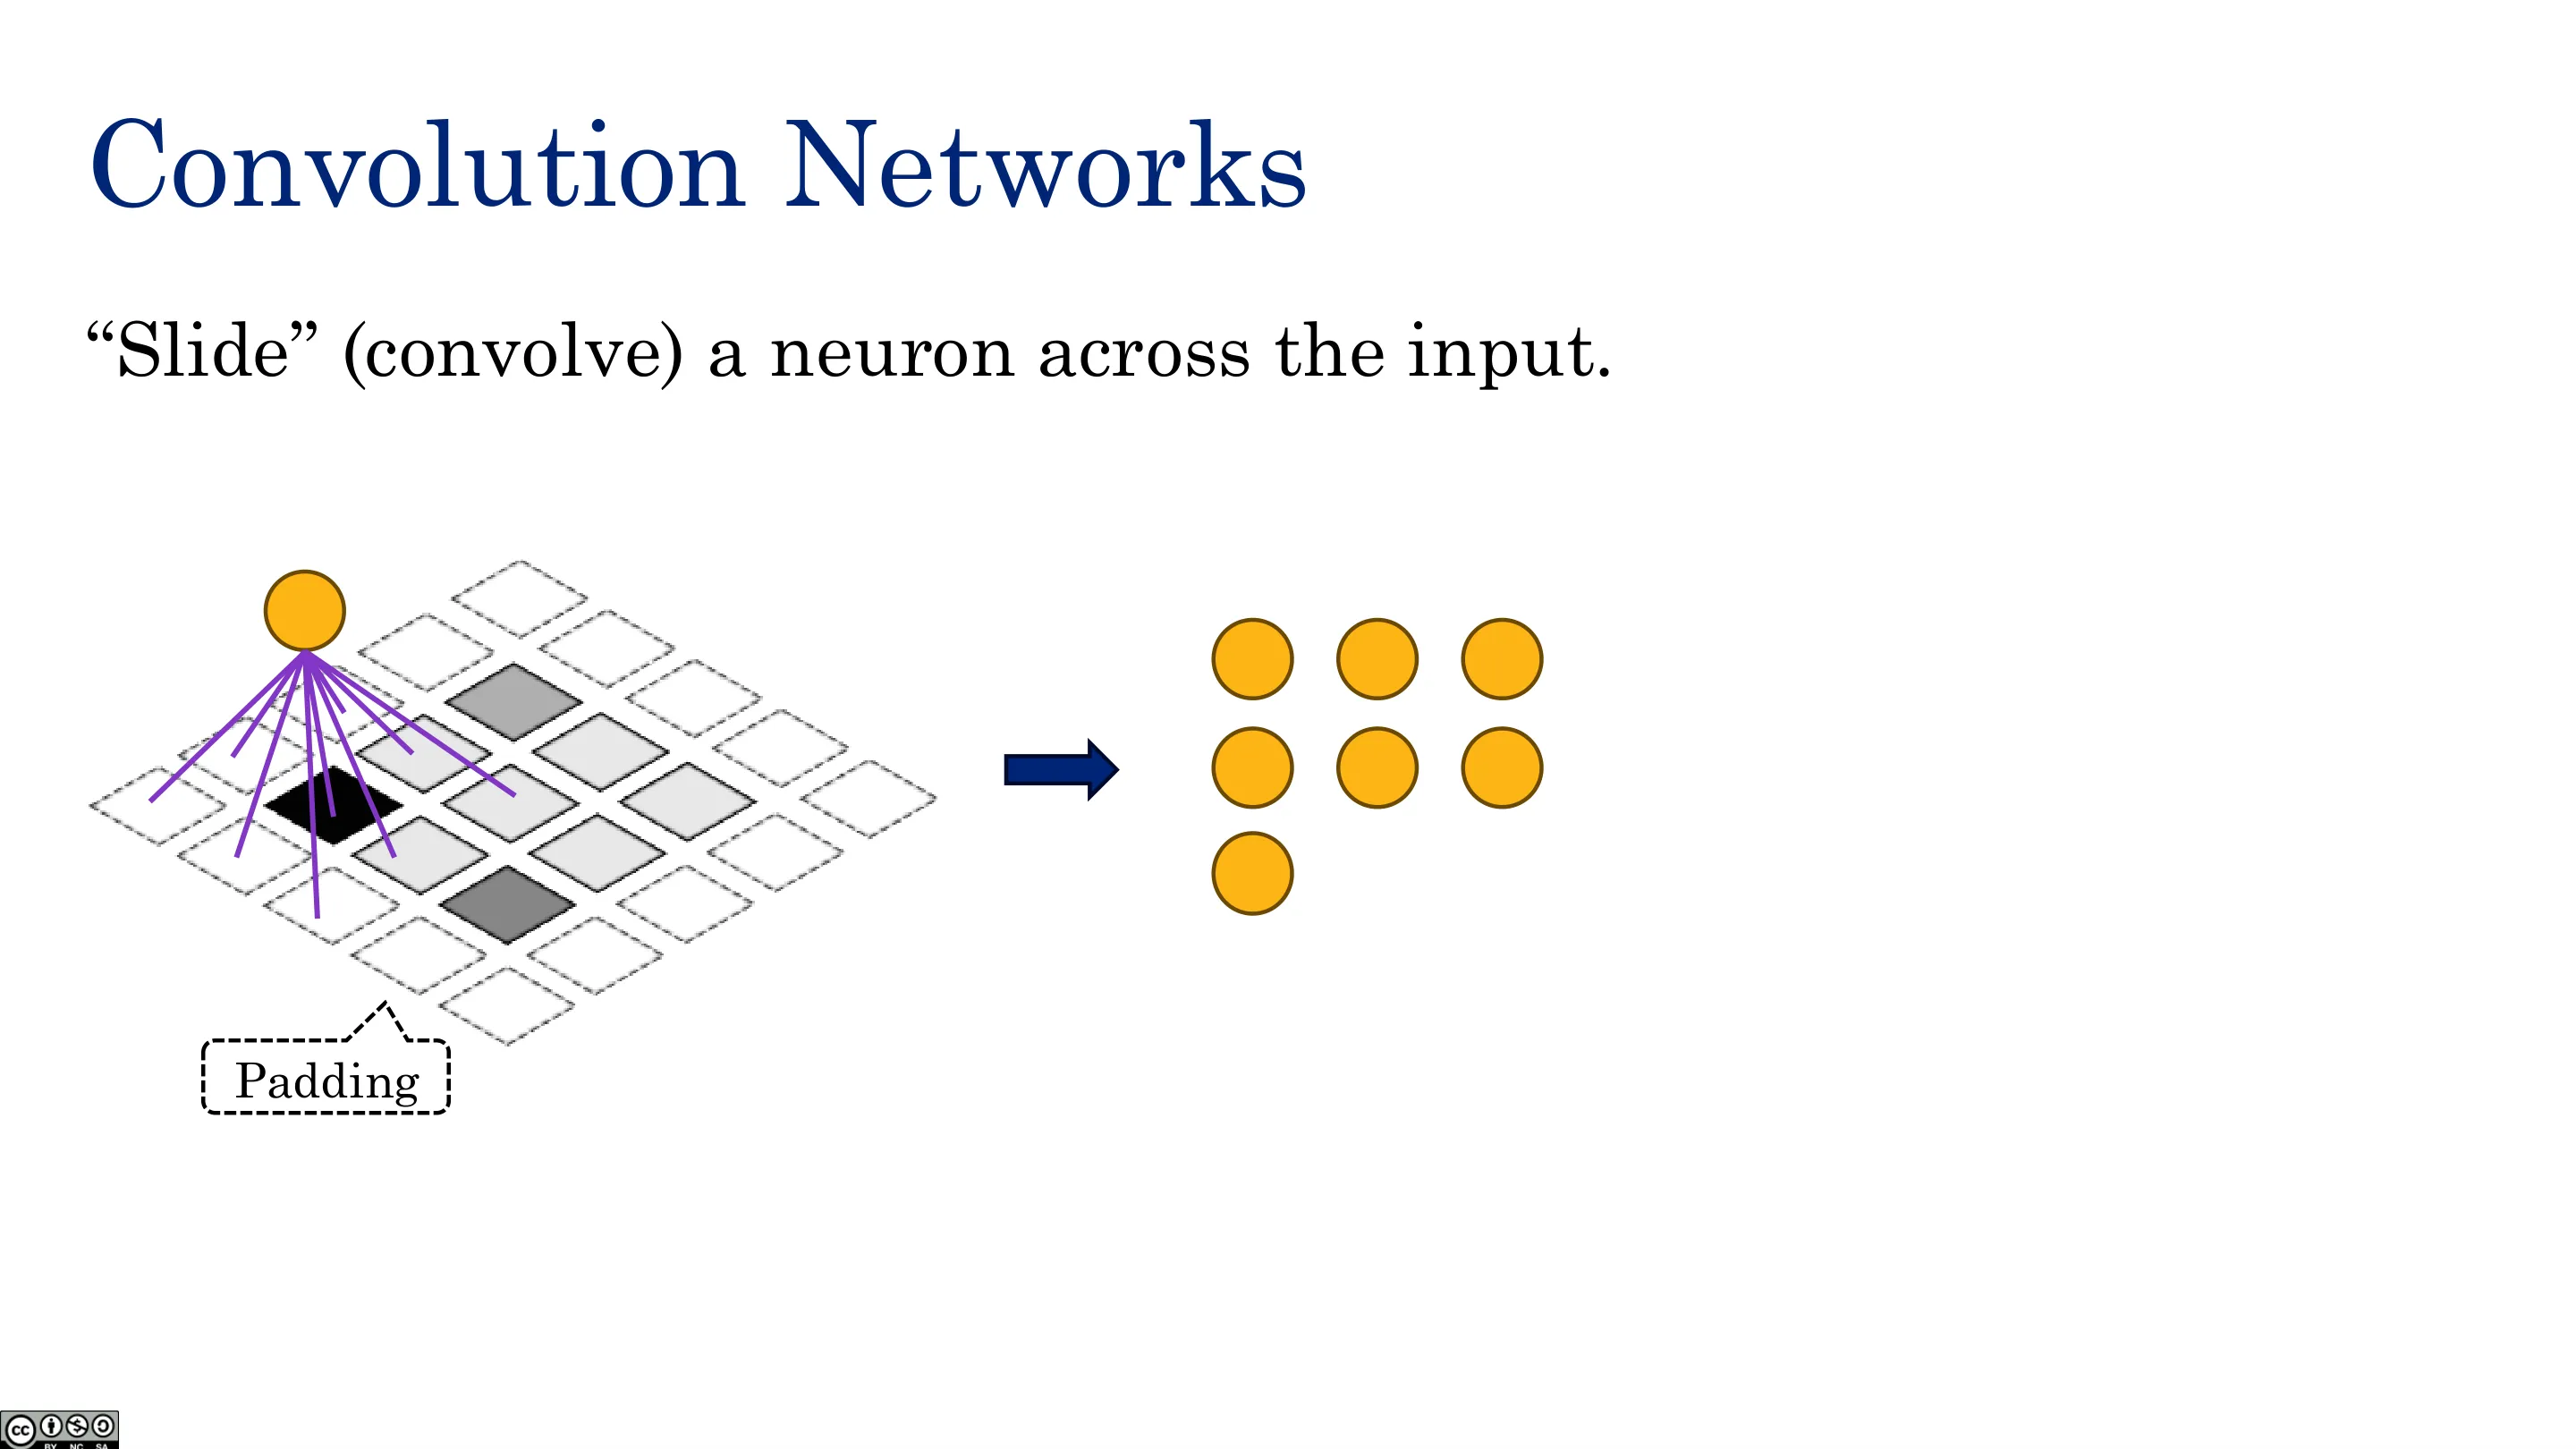
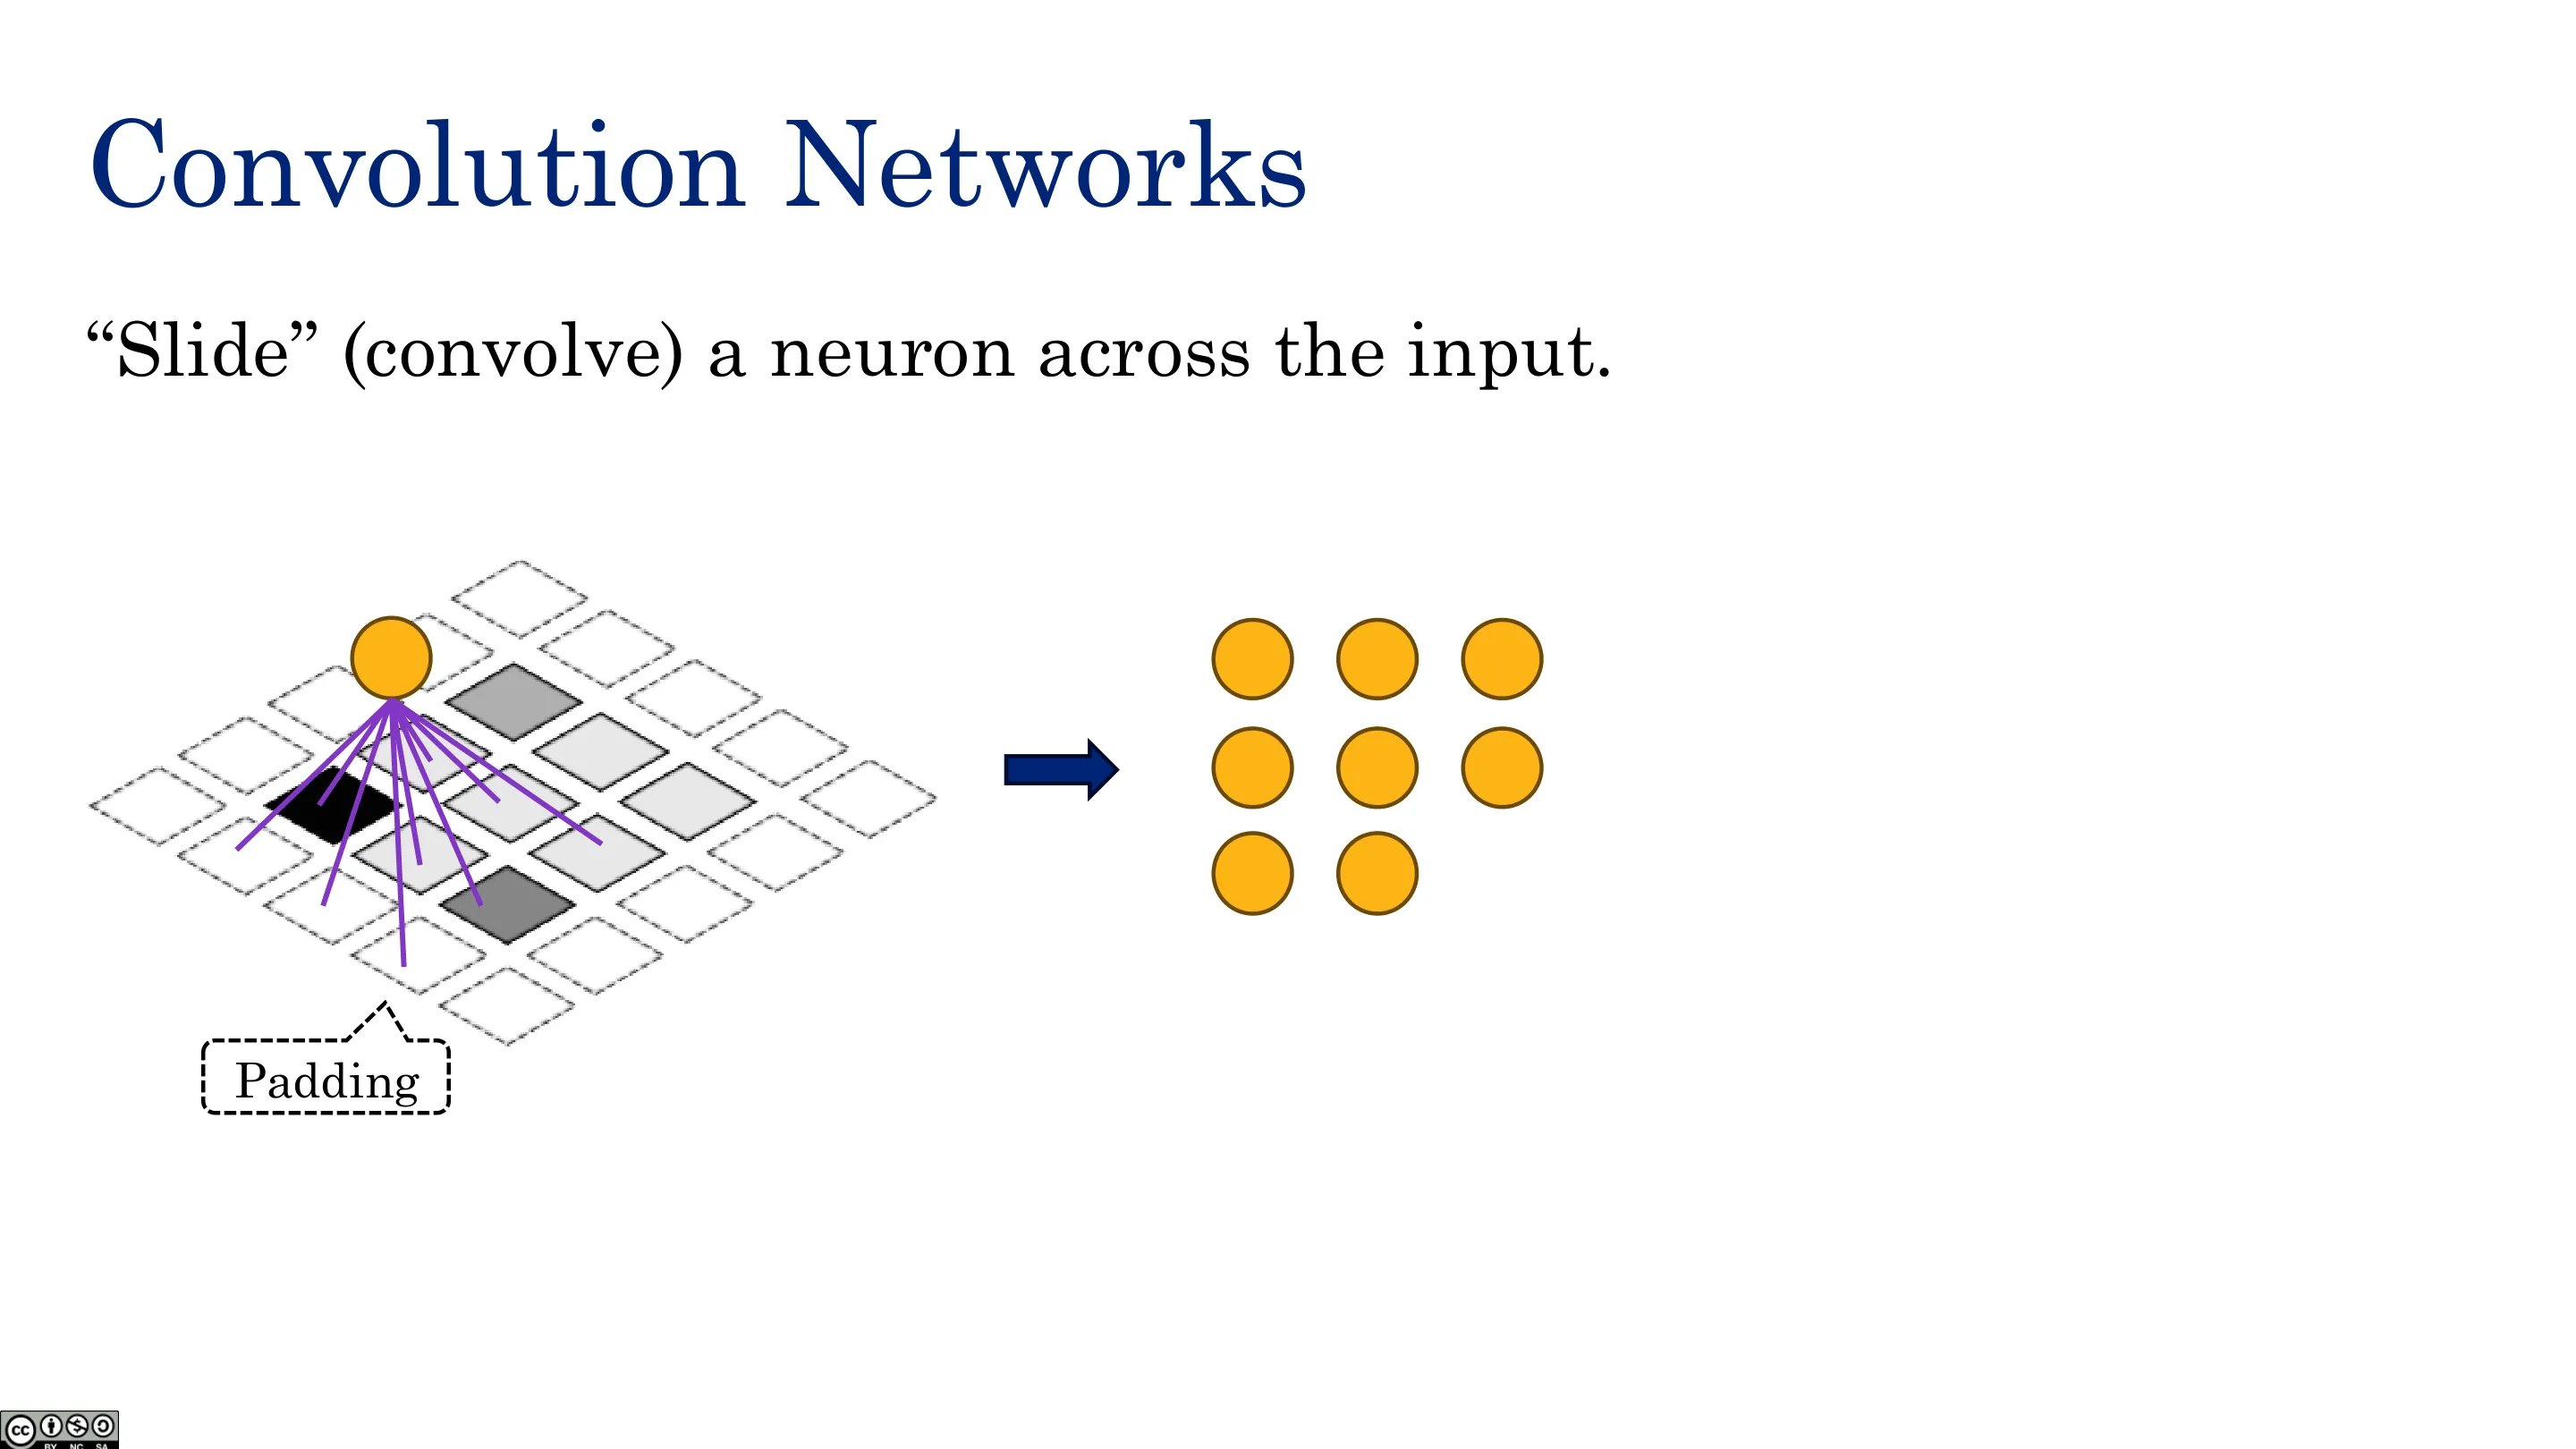
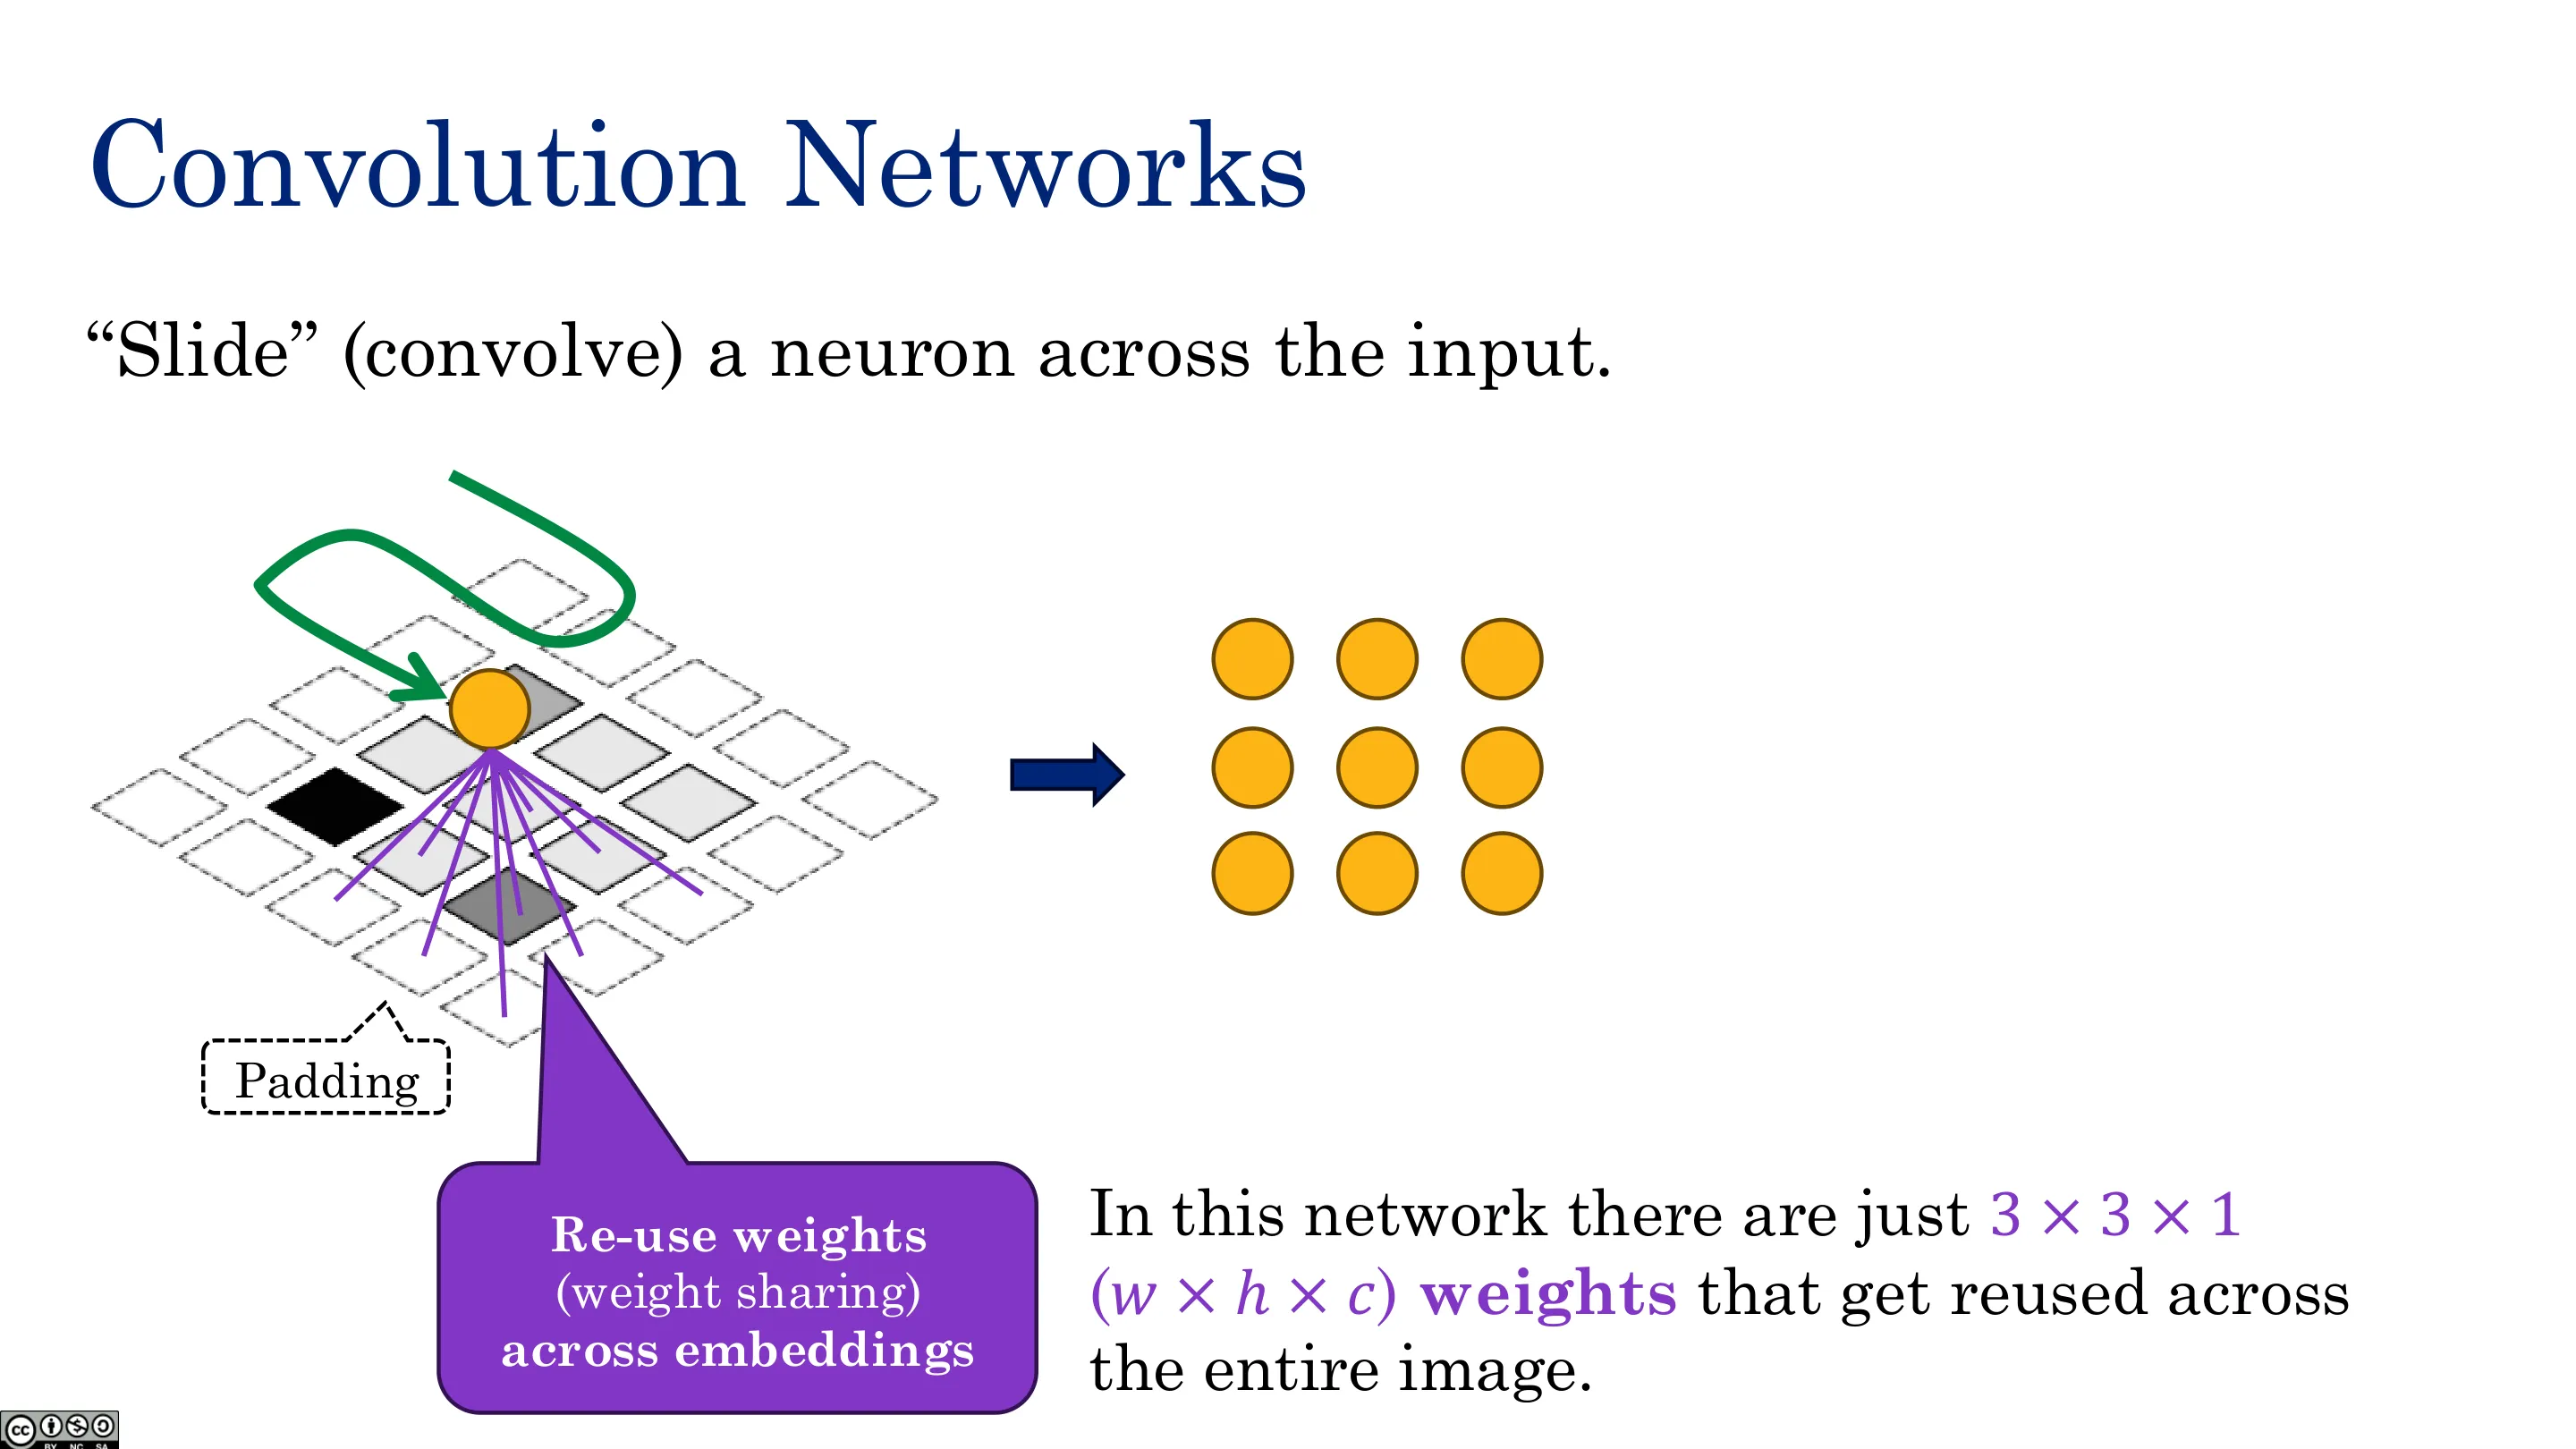
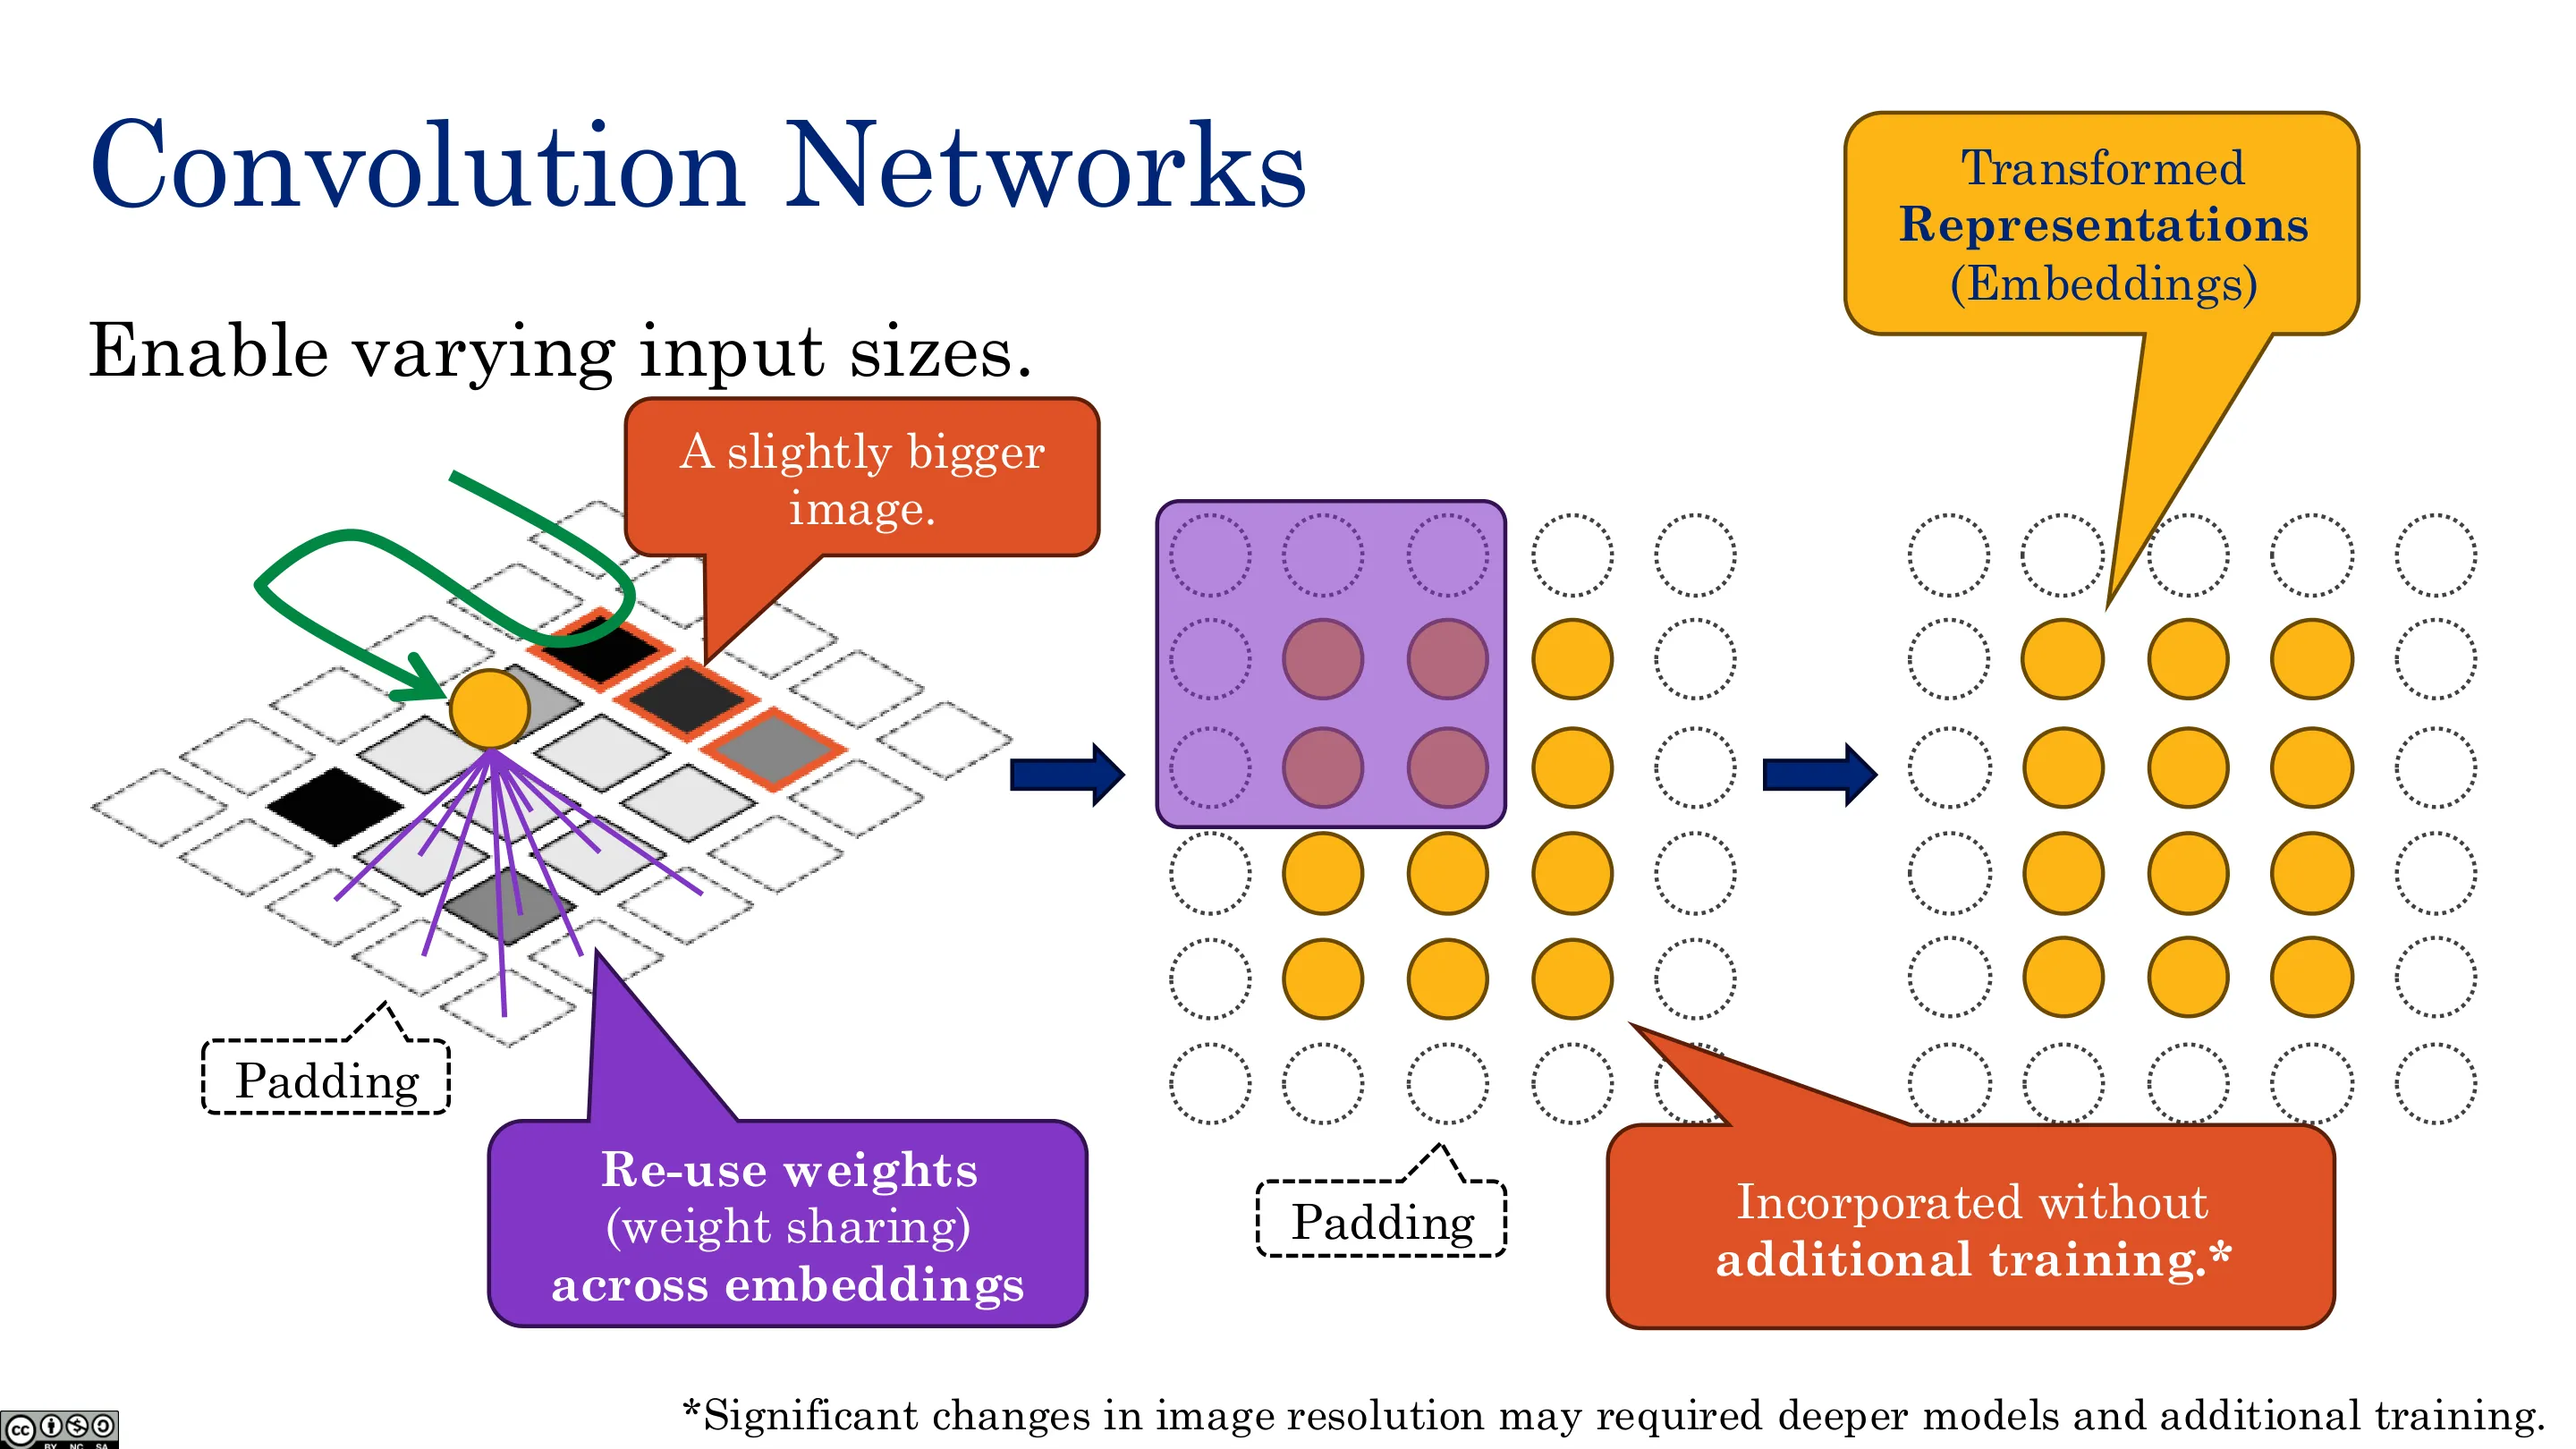
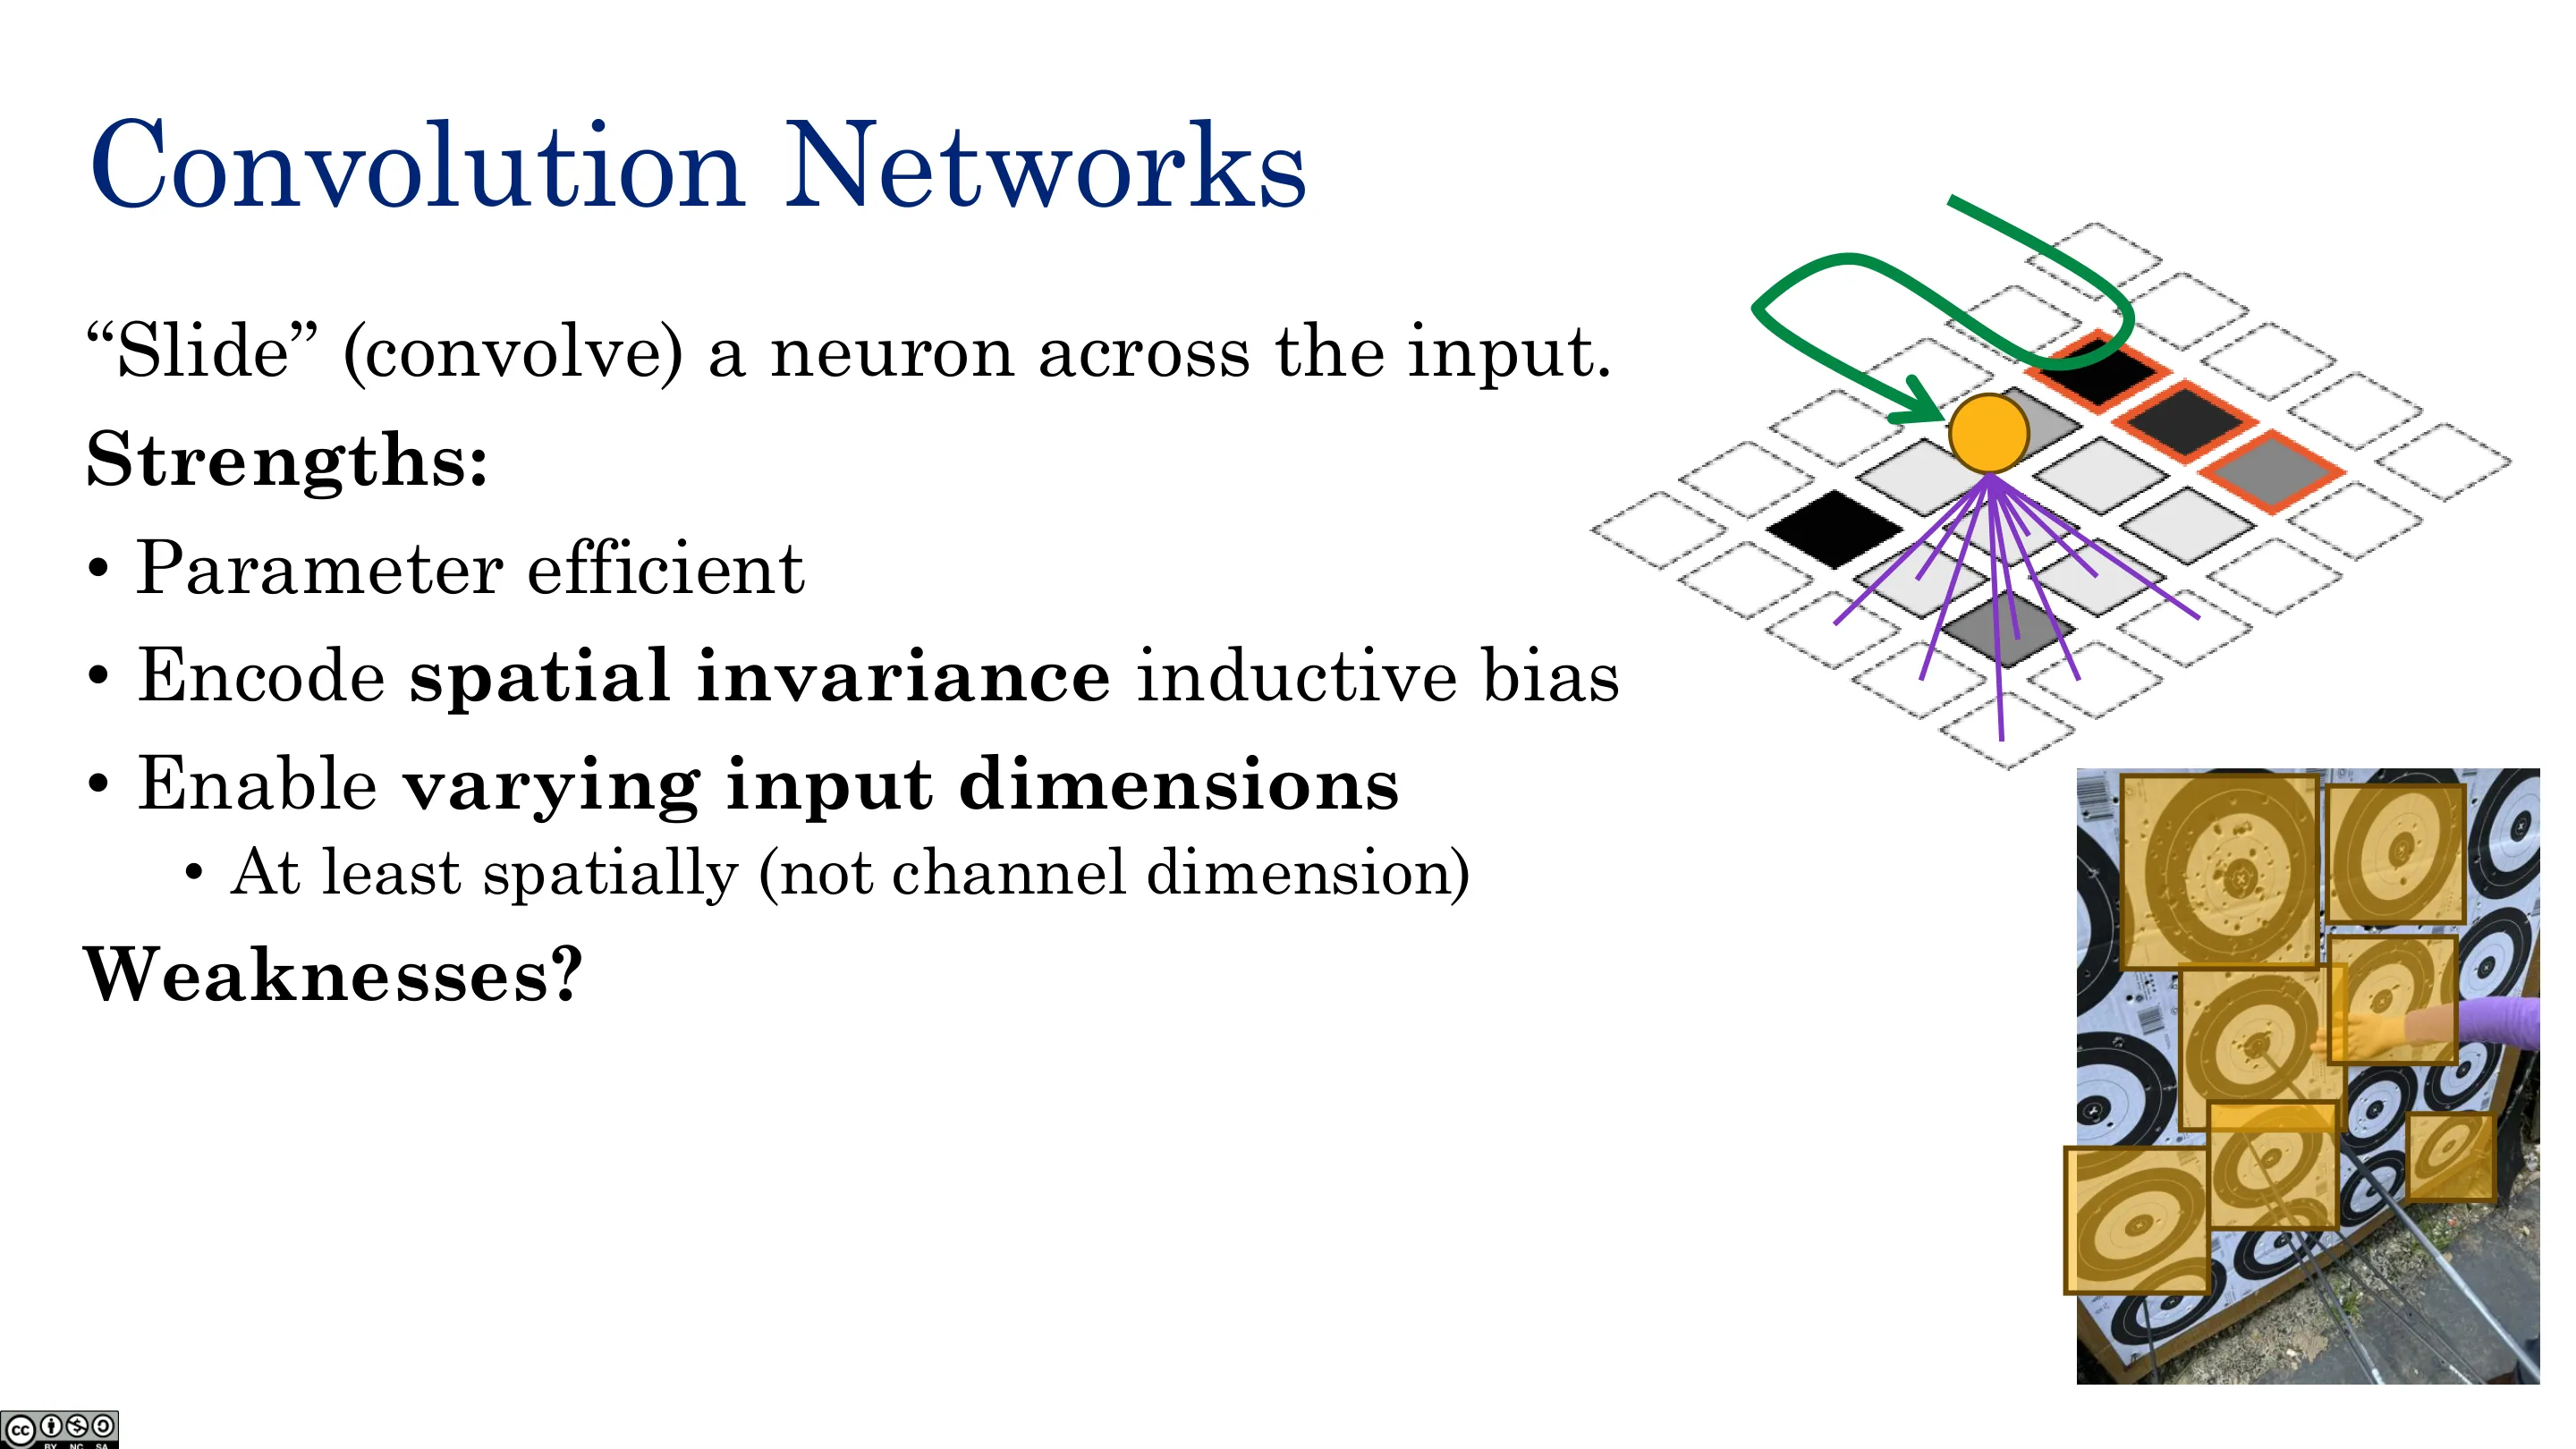
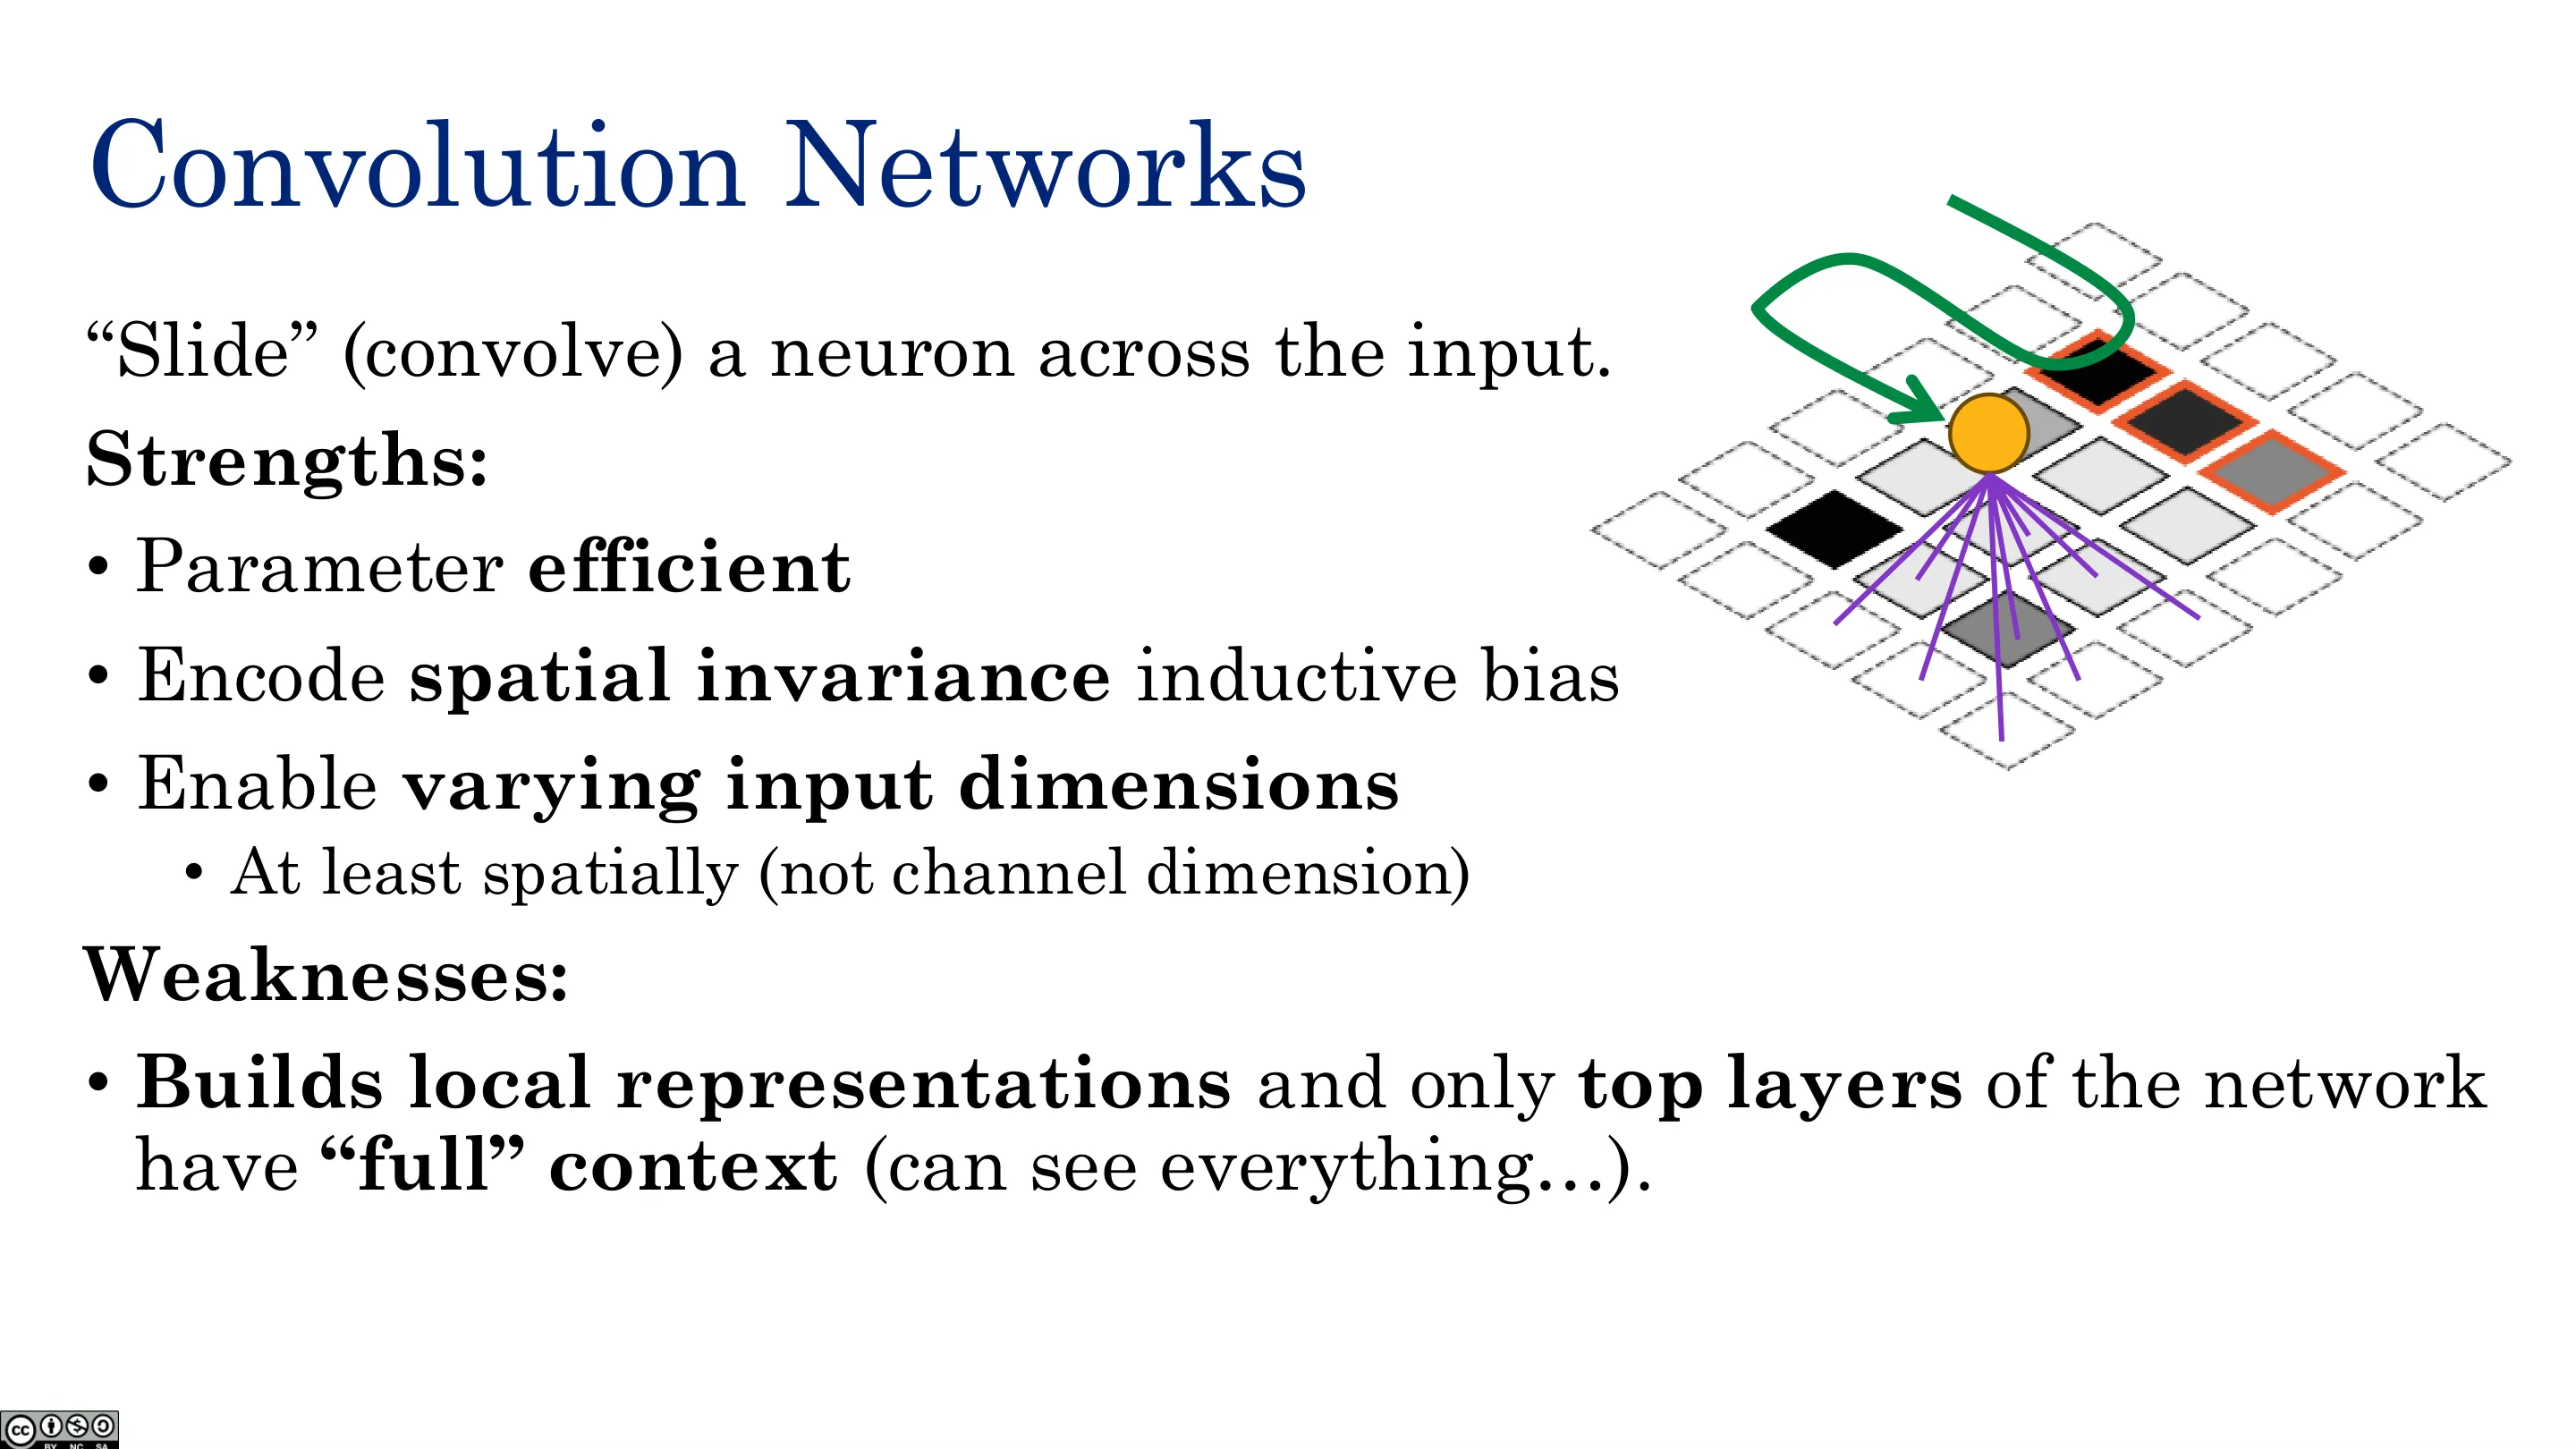
固定感受野的核在输入上滑动,权重被复用:
- $3\times3$ 卷积核 = 9 个权重,扫过整幅图;
- padding 处理边界(如补零);
- 优点:参数高效(权重数不随图像尺寸增长)、编码空间不变性(归纳偏置)、可变输入尺寸(至少在空间维度);
- 注意:通道数变化(灰度→RGB)不能靠滑动解决。
📷 卷积网络(一)
回到原视频 (00:17:22)
📷 卷积网络(二)
回到原视频 (00:18:35)
📷 卷积网络(三)
回到原视频 (00:19:48)
📷 卷积网络(四)
回到原视频 (00:21:01)
📷 卷积网络(五)
回到原视频 (00:22:14)
📷 卷积网络(六)
回到原视频 (00:23:27)
📷 卷积网络(七)
回到原视频 (00:24:40)
📷 卷积网络(八)
回到原视频 (00:25:53)
📷 卷积网络(九)
回到原视频 (00:27:06)
📷 卷积网络(十)
回到原视频 (00:28:19)
📷 卷积网络(十一)
回到原视频 (00:29:32)
📷 卷积网络(十二)
回到原视频 (00:30:45)
2.3 卷积的根本局限
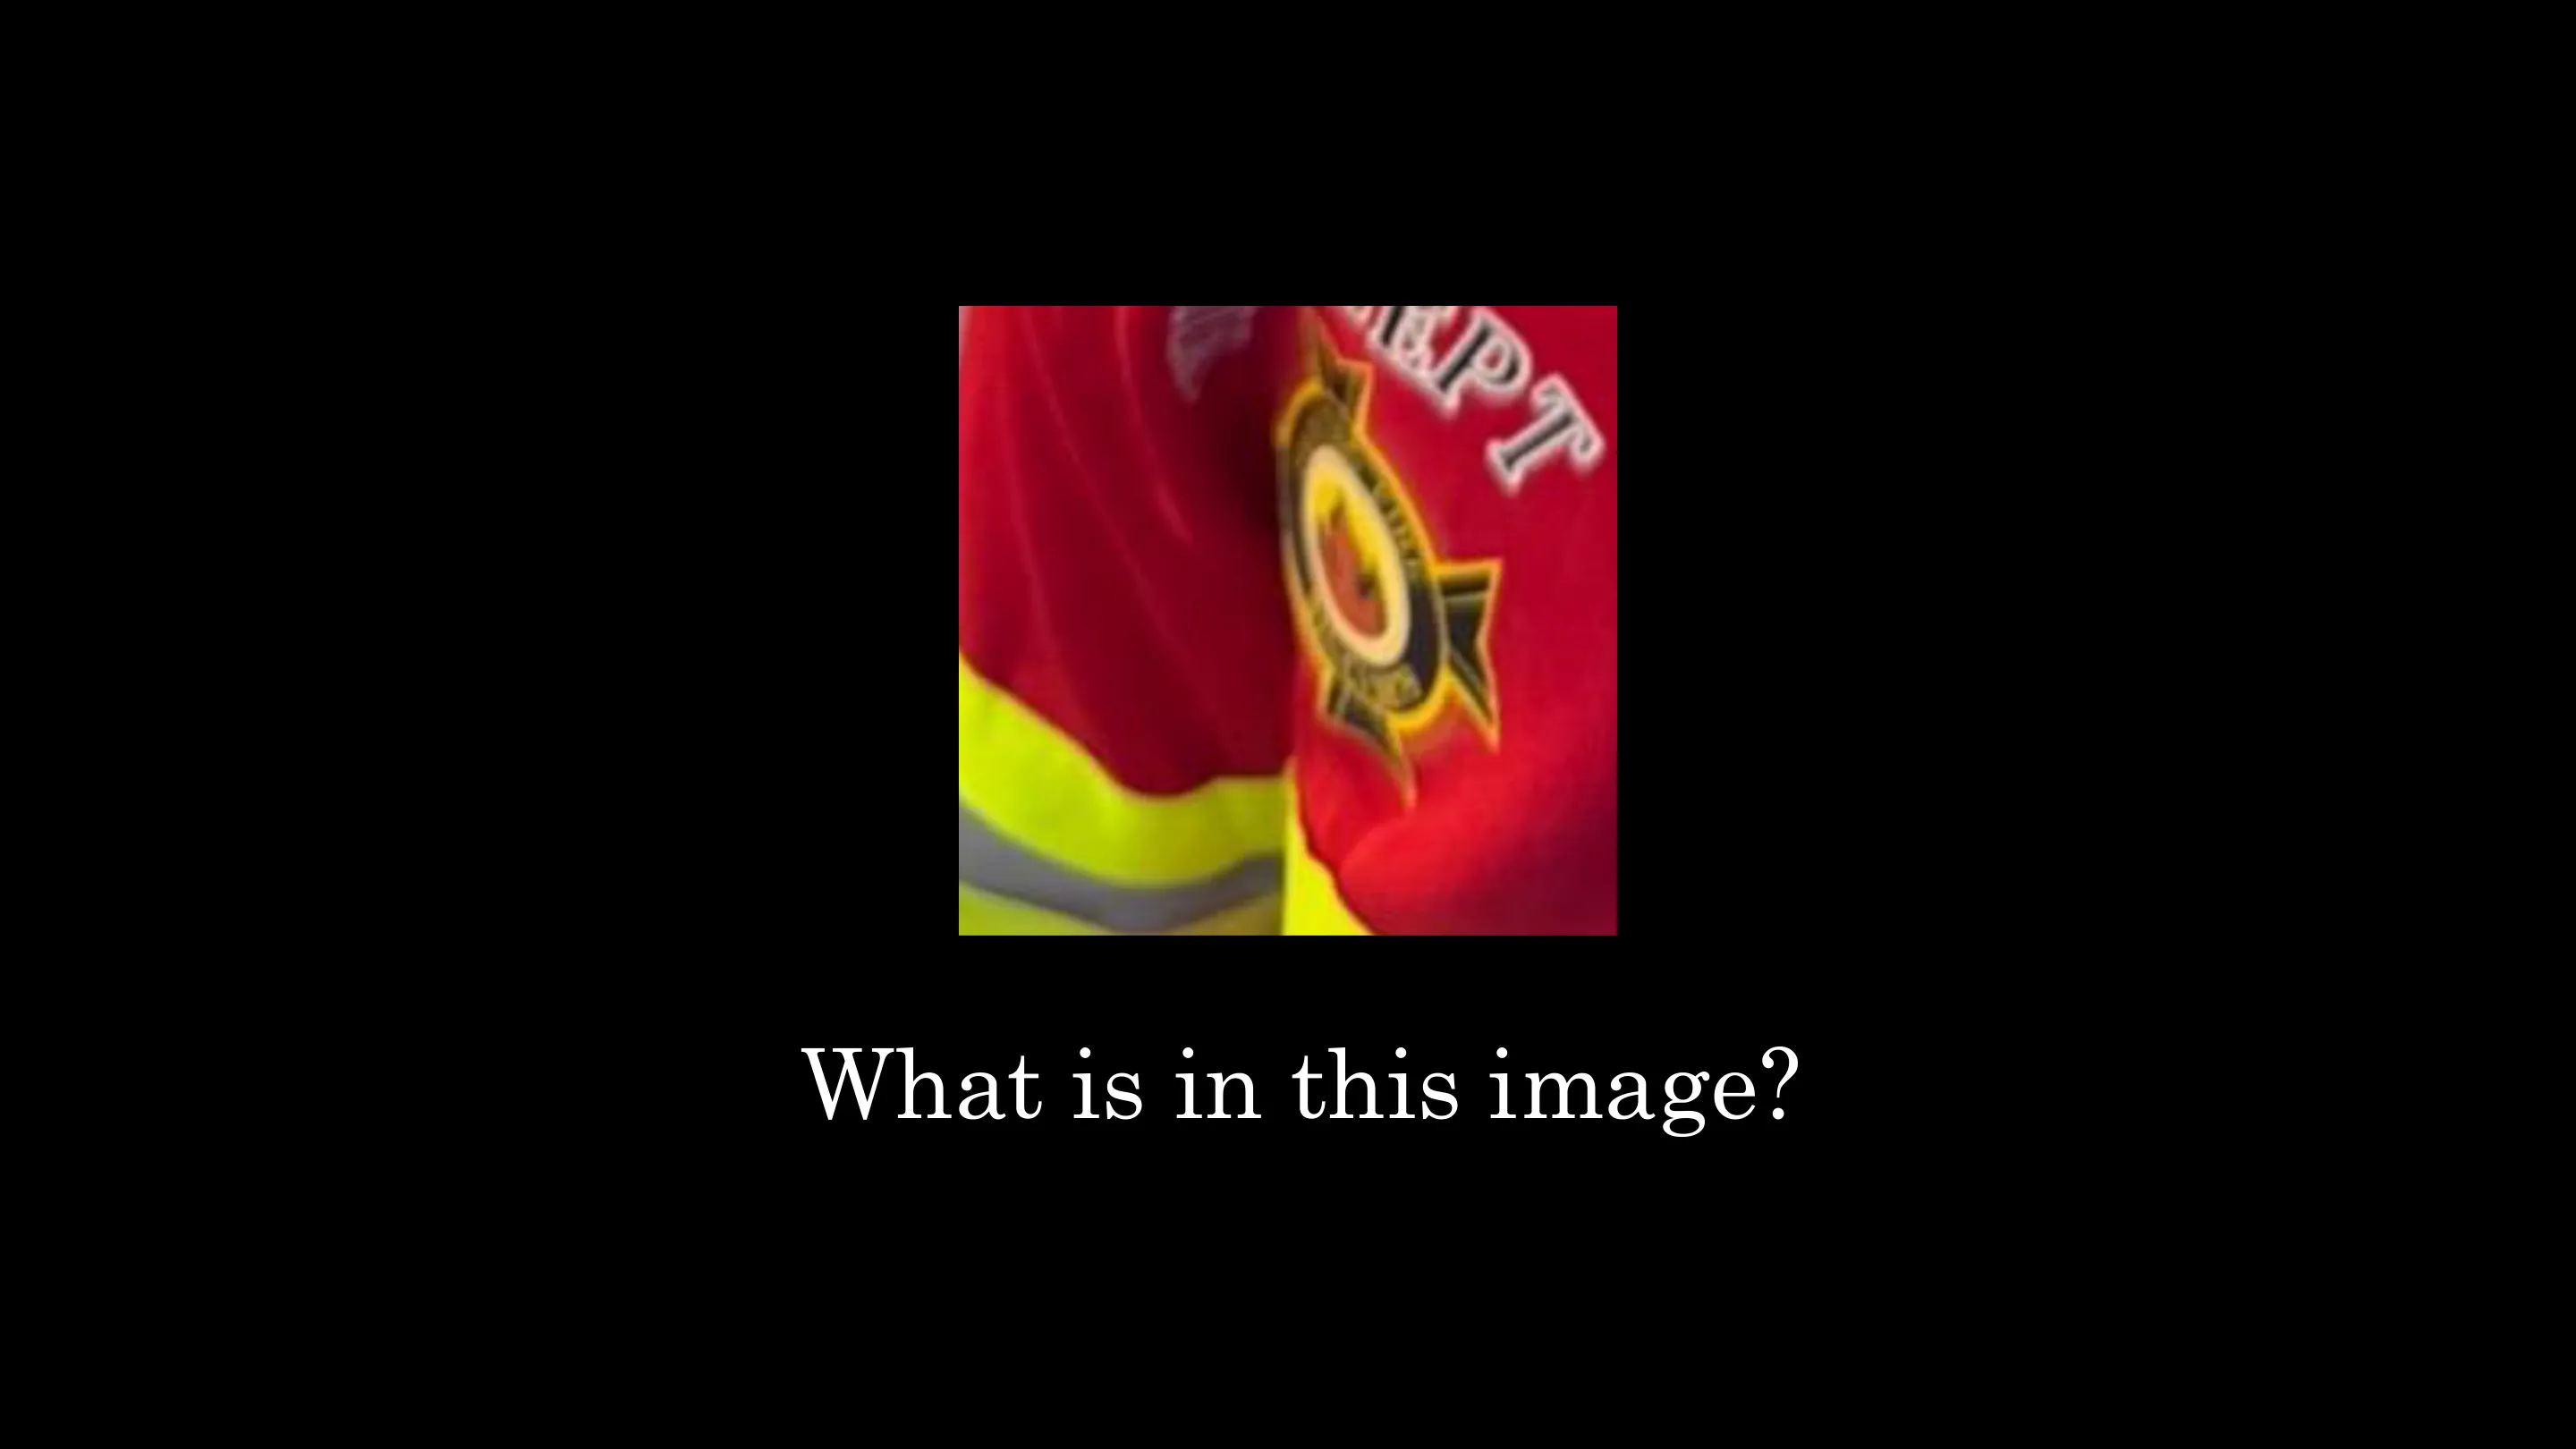
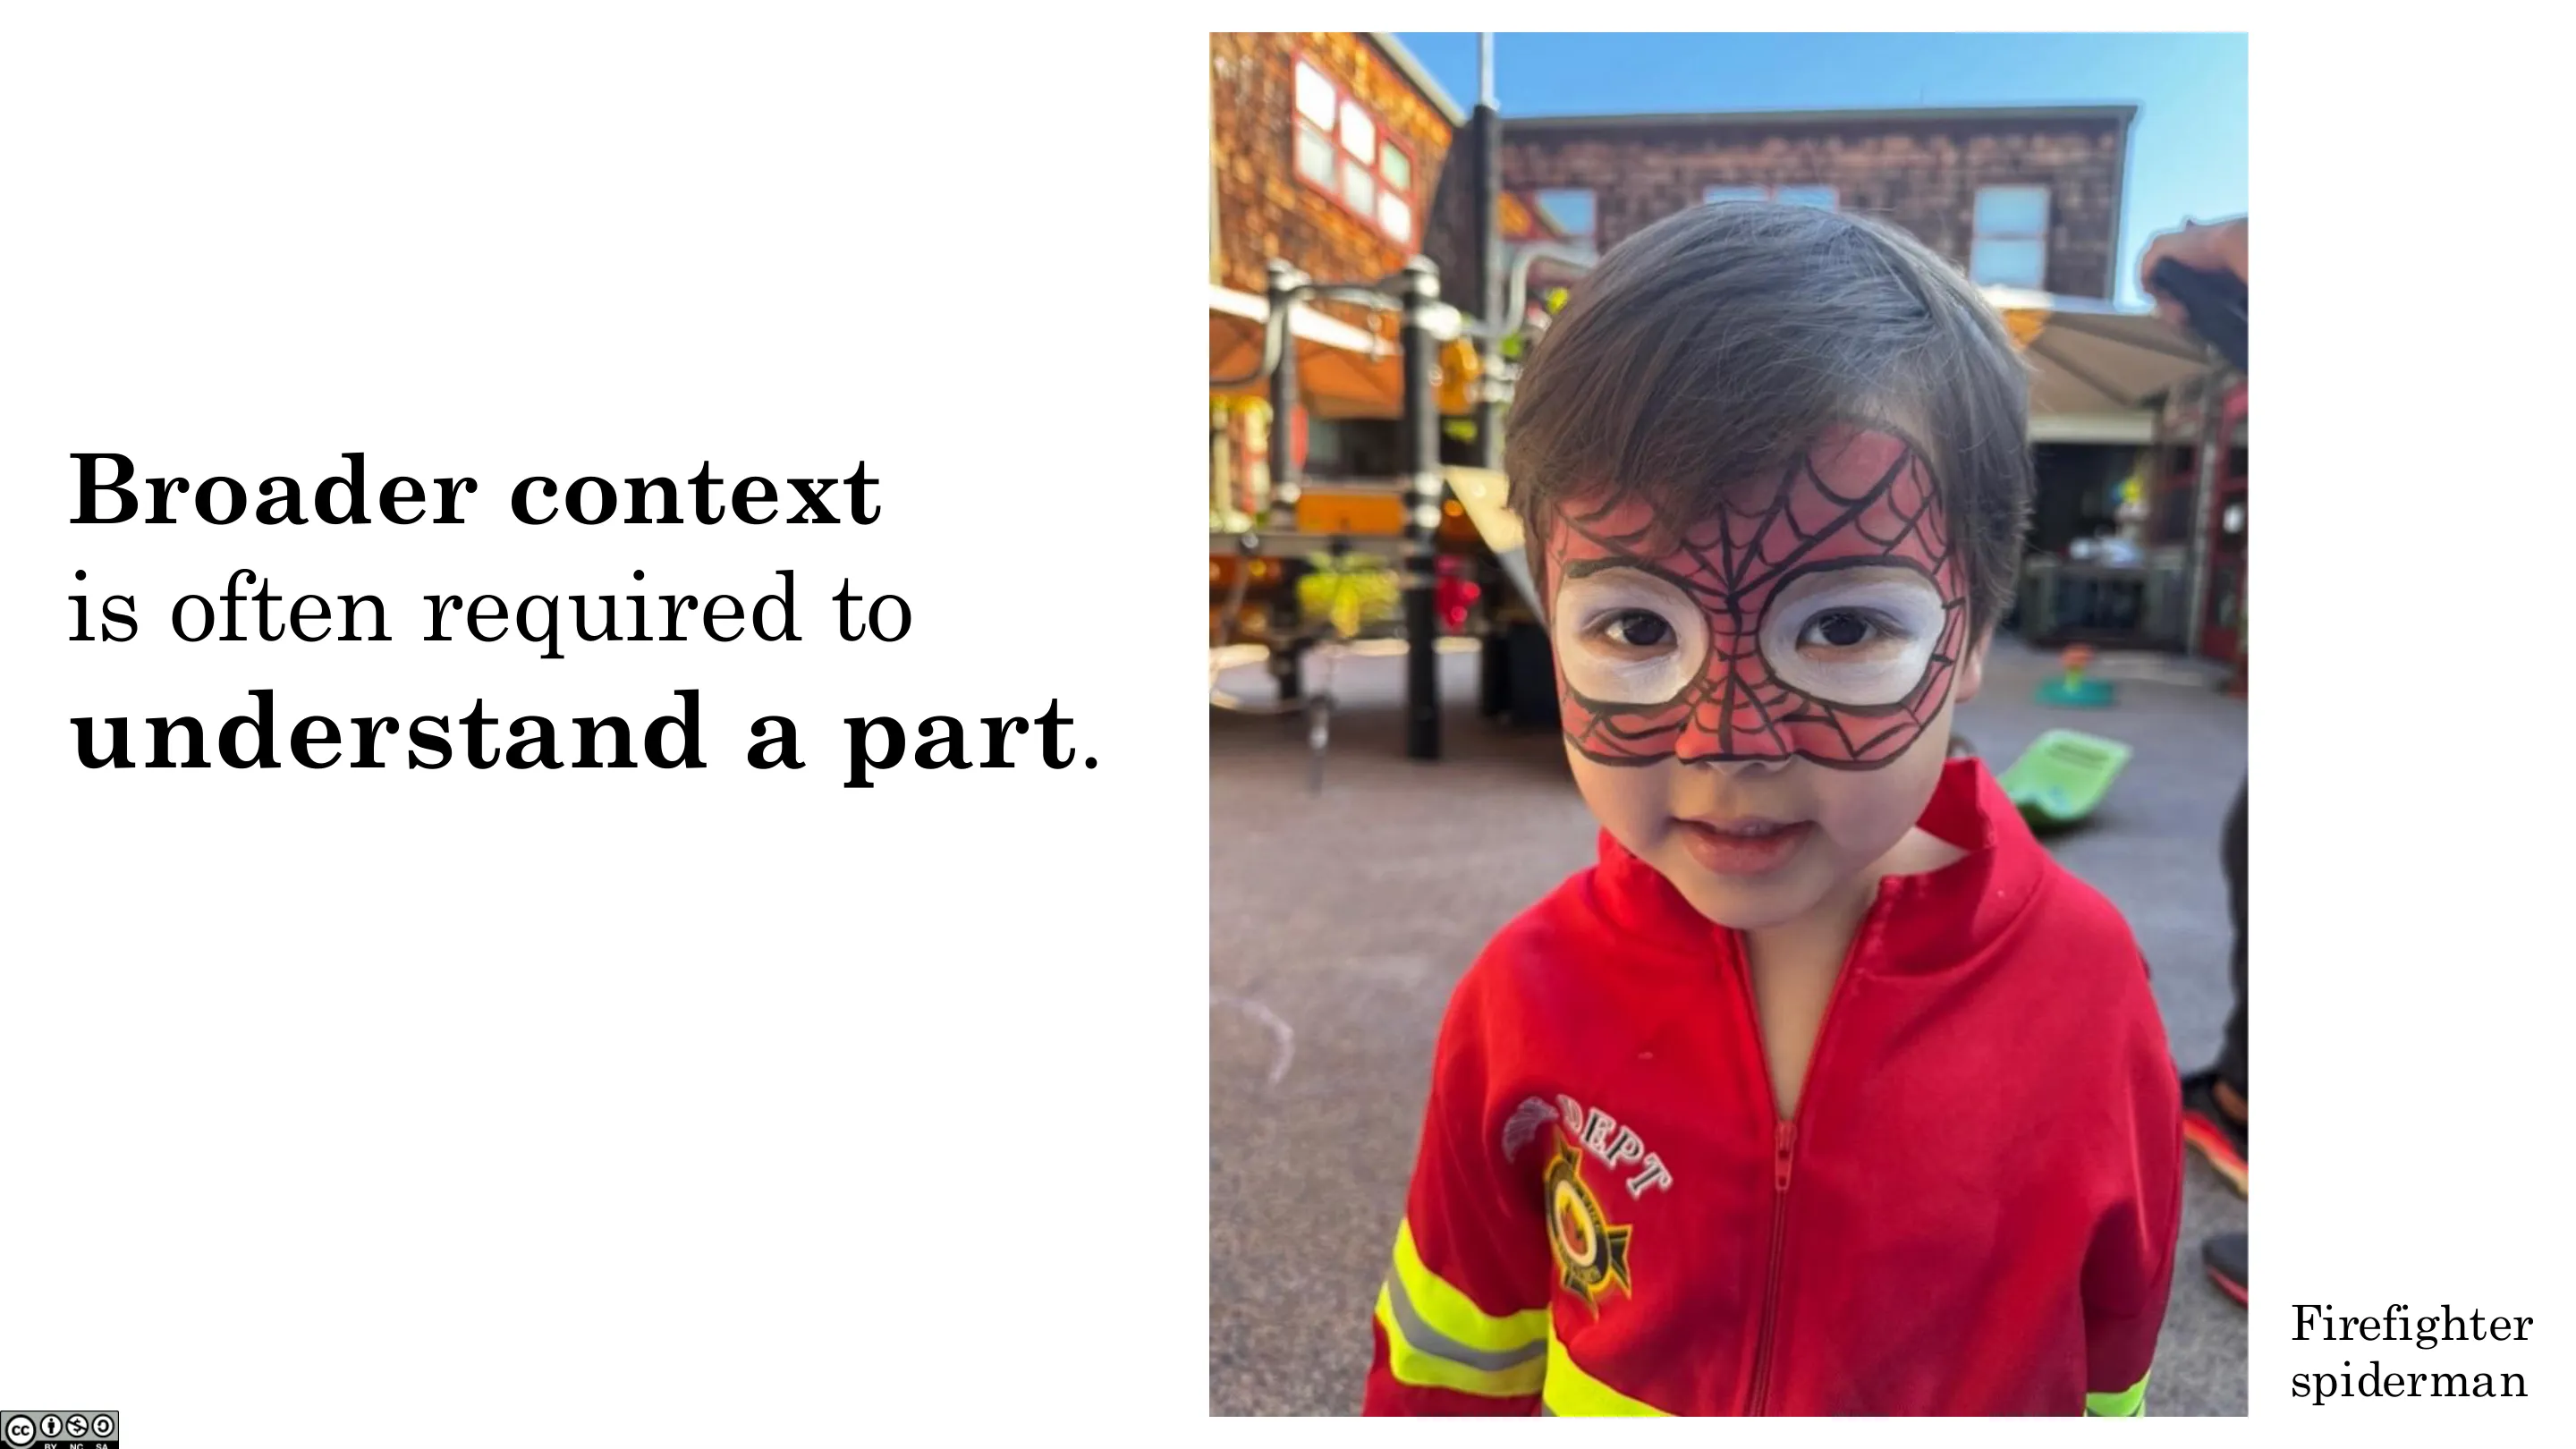
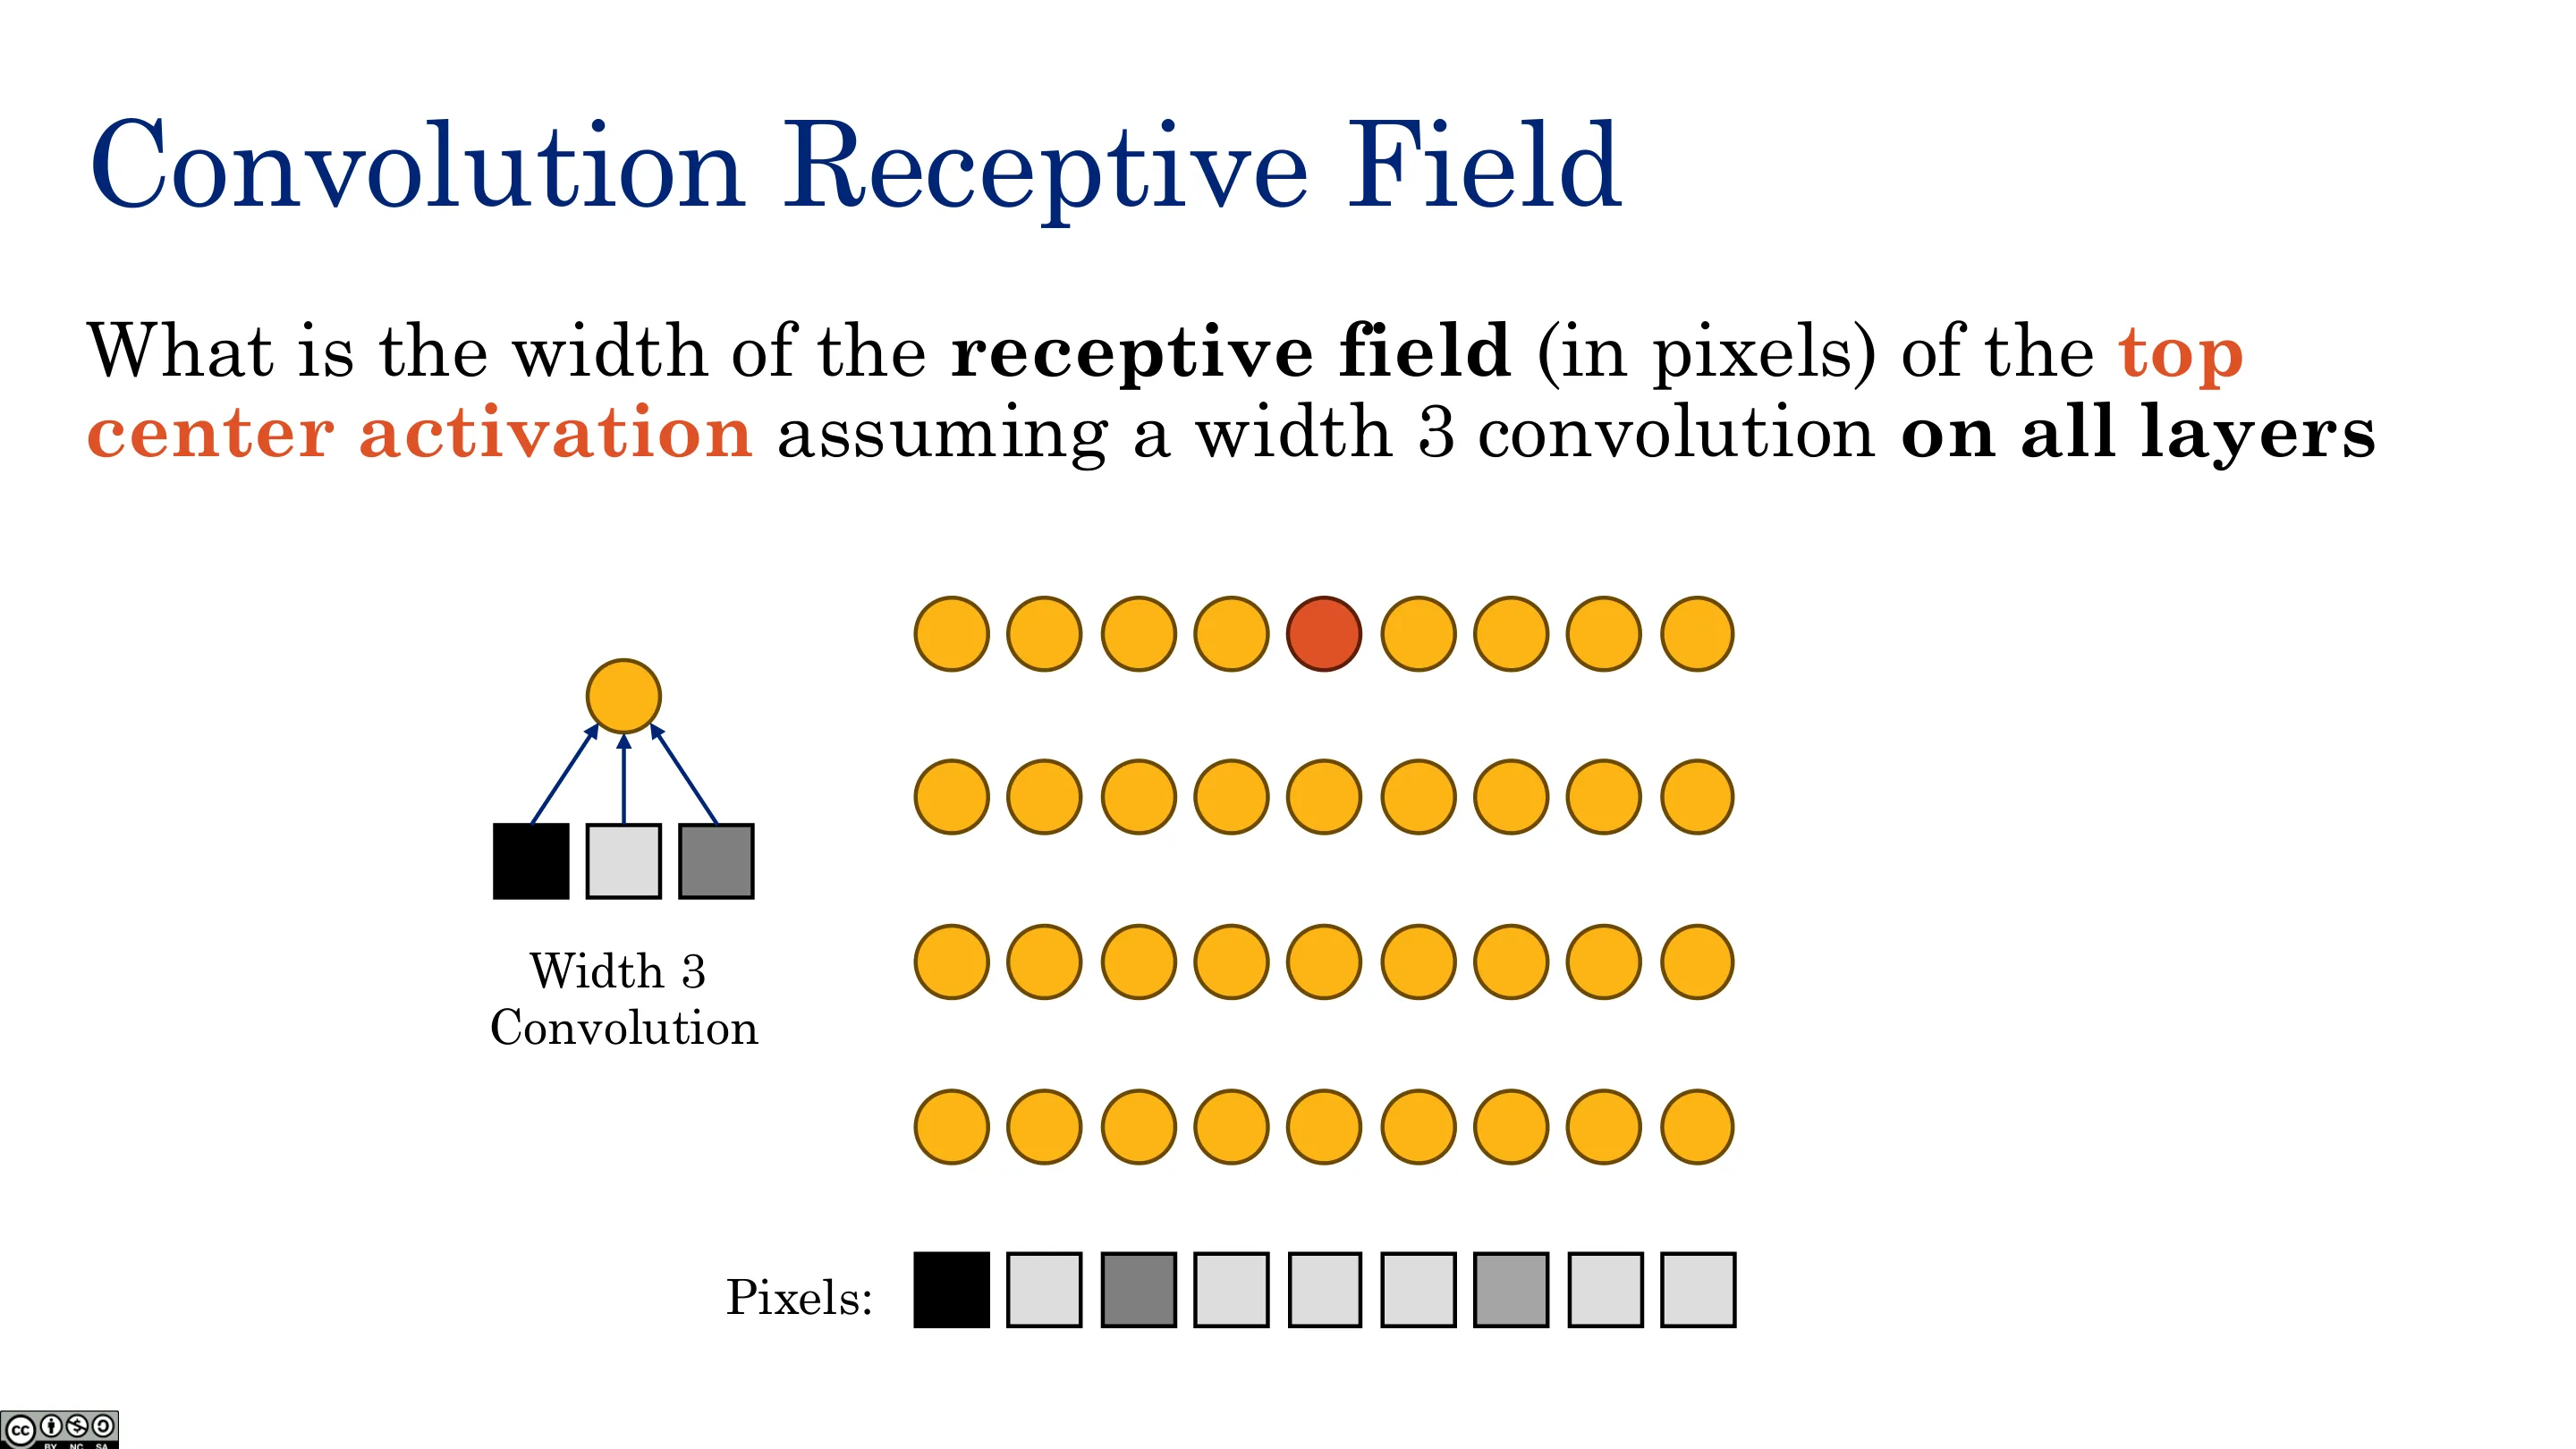
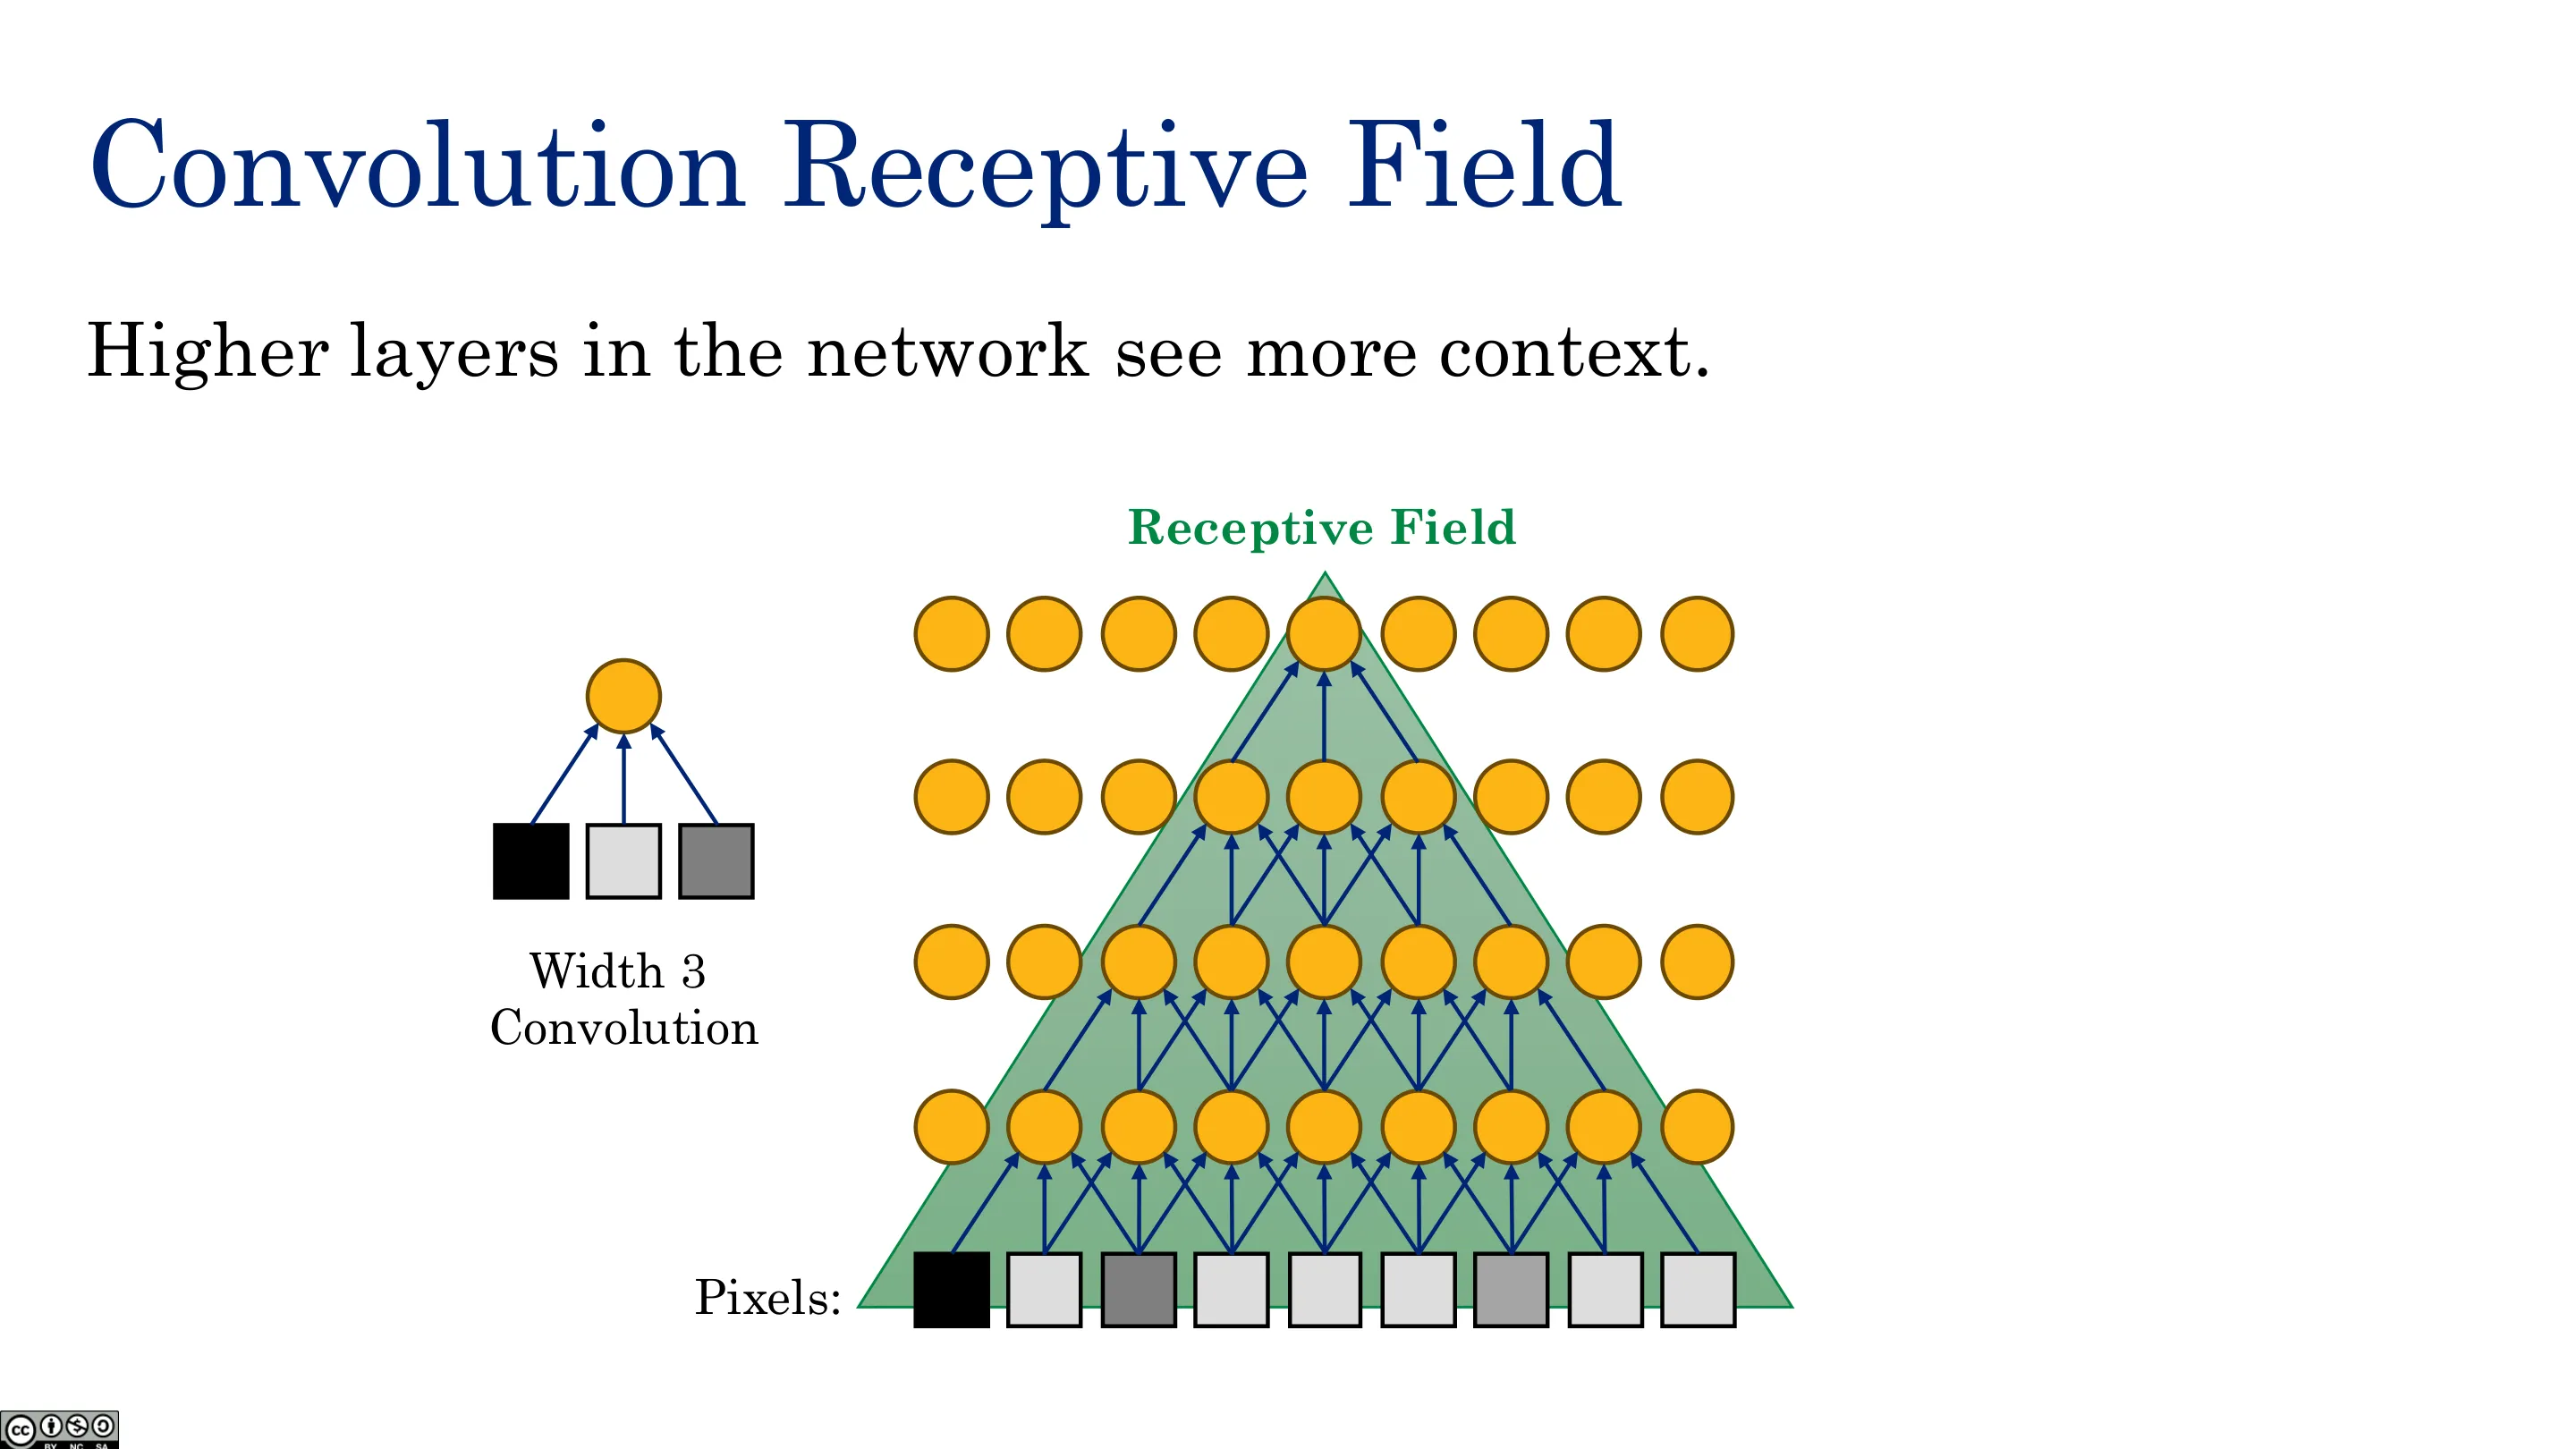
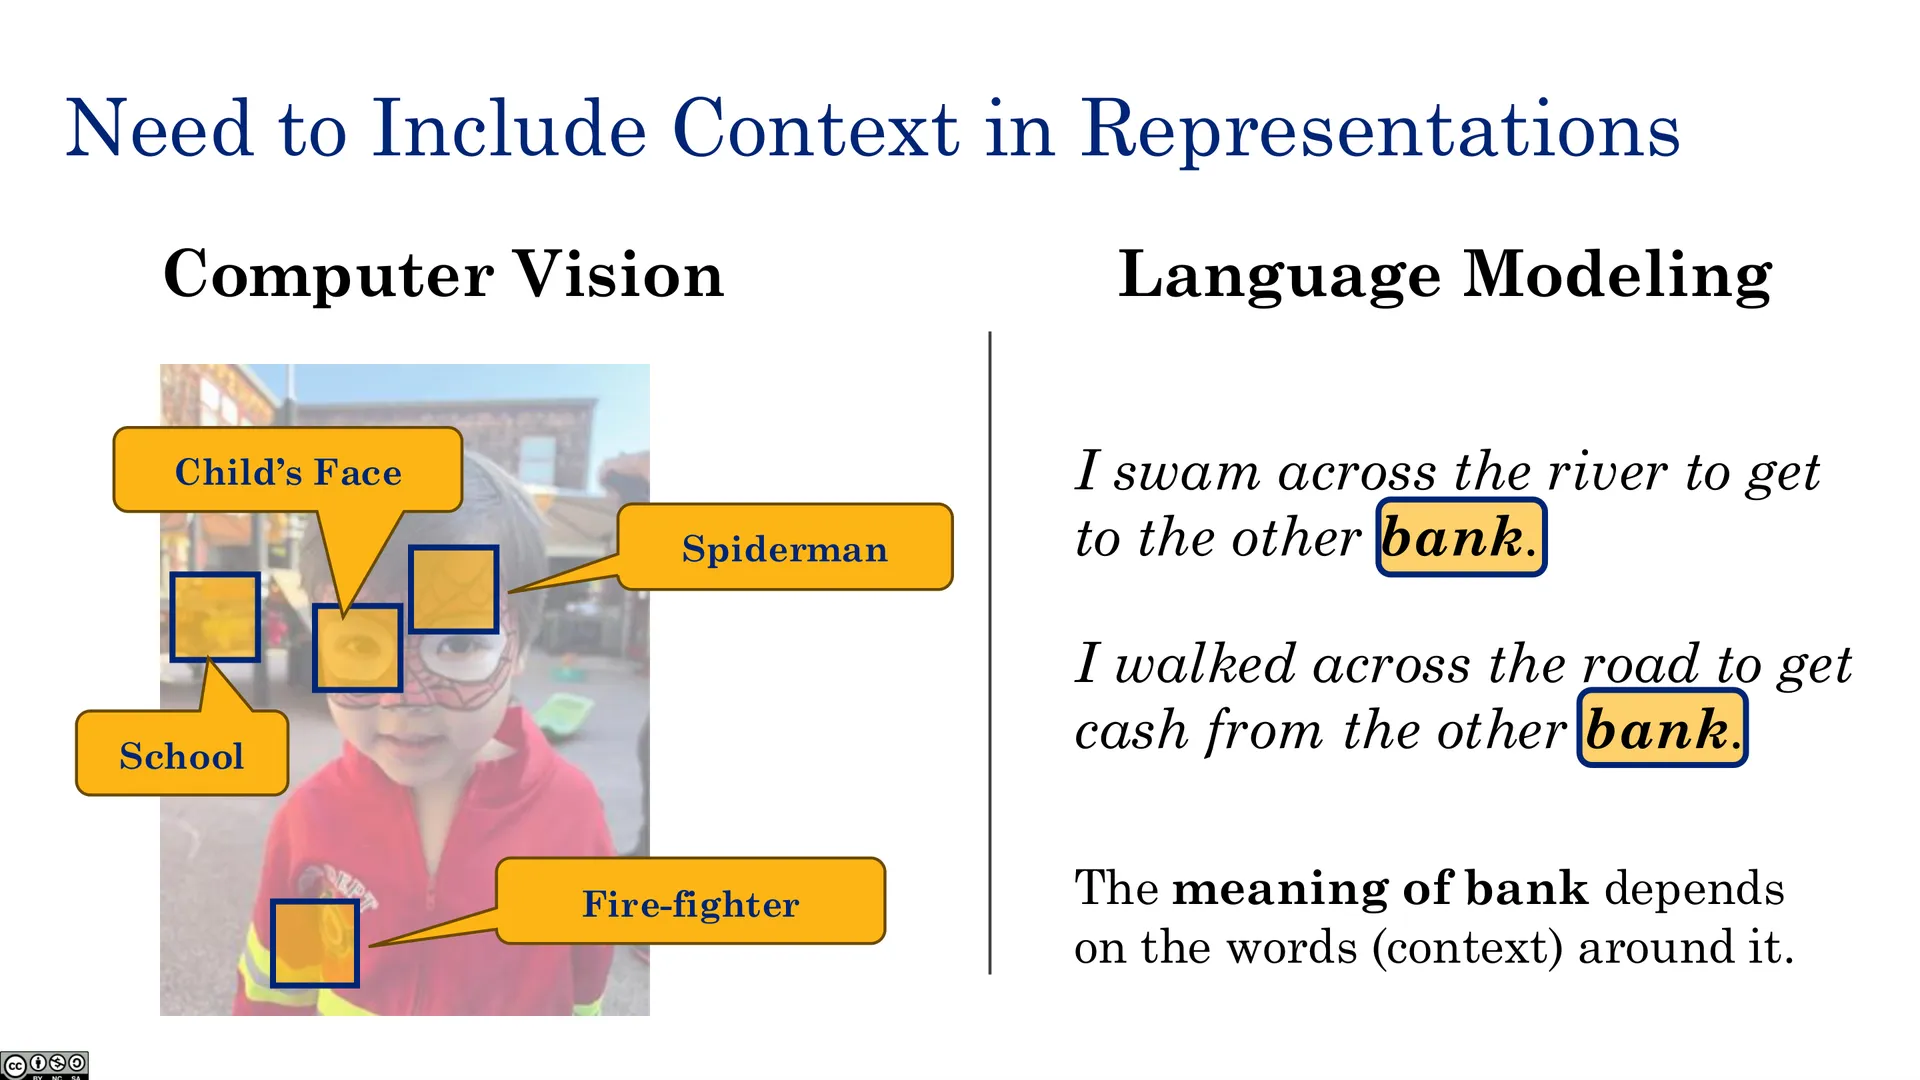
例子:一张很难辨认的图(原来是「消防员版蜘蛛侠」)。当你只看一个 $20\times20$ 的小块,根本不知道这是什么——理解图像需要把整幅图「上下文化」,需要远距离信息。
- 卷积的感受野随层数/核大小/stride 增大,但信息通道是「有损的」:一旦表示固定,后续层只能通过中间层间接获取远处信息,无法主动「回头看」;
- 它不支持长程相关(long-range correlation)。
关键铺垫:这个「信息瓶颈」问题,正是注意力要解决的——后面在 RNN 图像描述里会再次出现(「母亲级别的动机」)。
📷 这张图里是什么?
回到原视频 (00:31:58)
📷 消防员(蜘蛛侠)
回到原视频 (00:33:11)
📷 卷积感受野(一)
回到原视频 (00:34:24)
📷 卷积感受野(二)
回到原视频 (00:35:37)
📷 卷积网络(十三)
回到原视频 (00:36:50)
📷 解决方案:Transformer 架构
回到原视频 (00:38:03)
三、文档表示与 RNN
3.1 文档 → 向量
📷 路线图
回到原视频 (00:39:16)
📷 把文档表示为向量
回到原视频 (00:40:29)
📷 文档到向量
回到原视频 (00:41:42)
📷 路线图
回到原视频 (00:42:55)
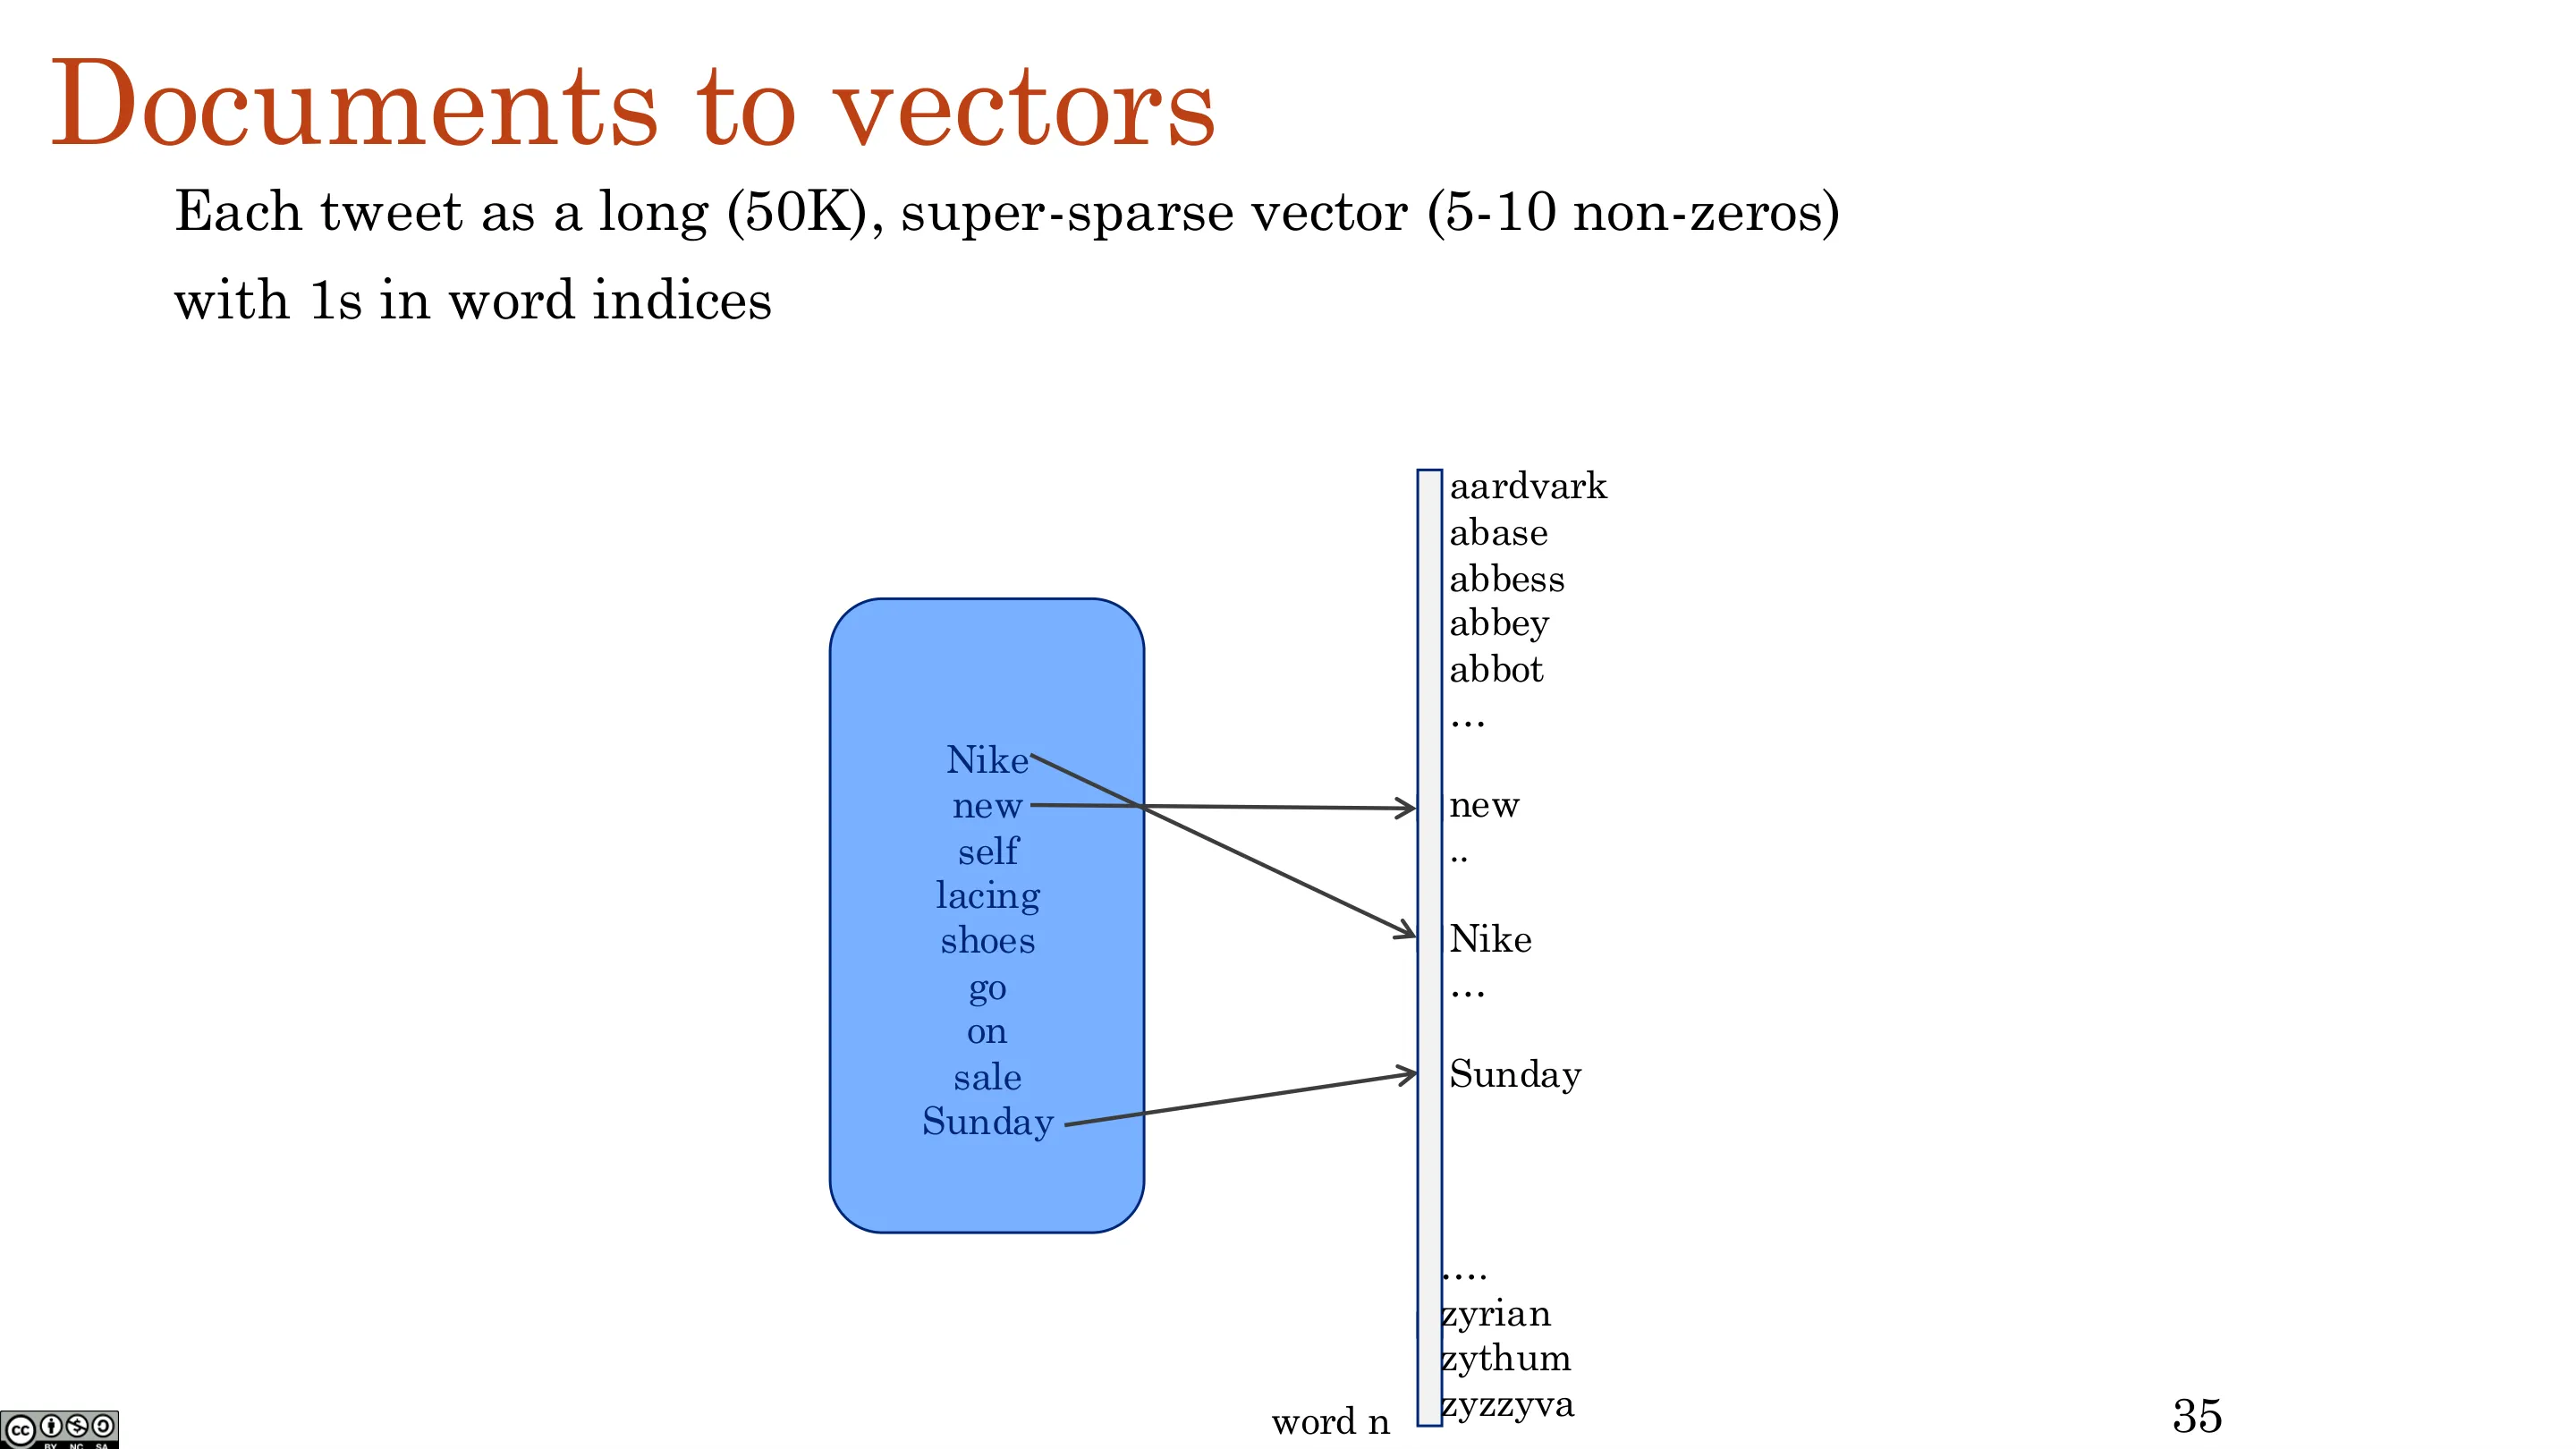
Bag of Words(词袋):英文词表约 5 万维;文档中出现的词记 1(或用词频)。优点:整个文档一个向量、维度不随文档长度变化。缺点:丢失词序(把《哈利波特》拆碎丢进袋子数词频,最高频的词永远是 "the")。
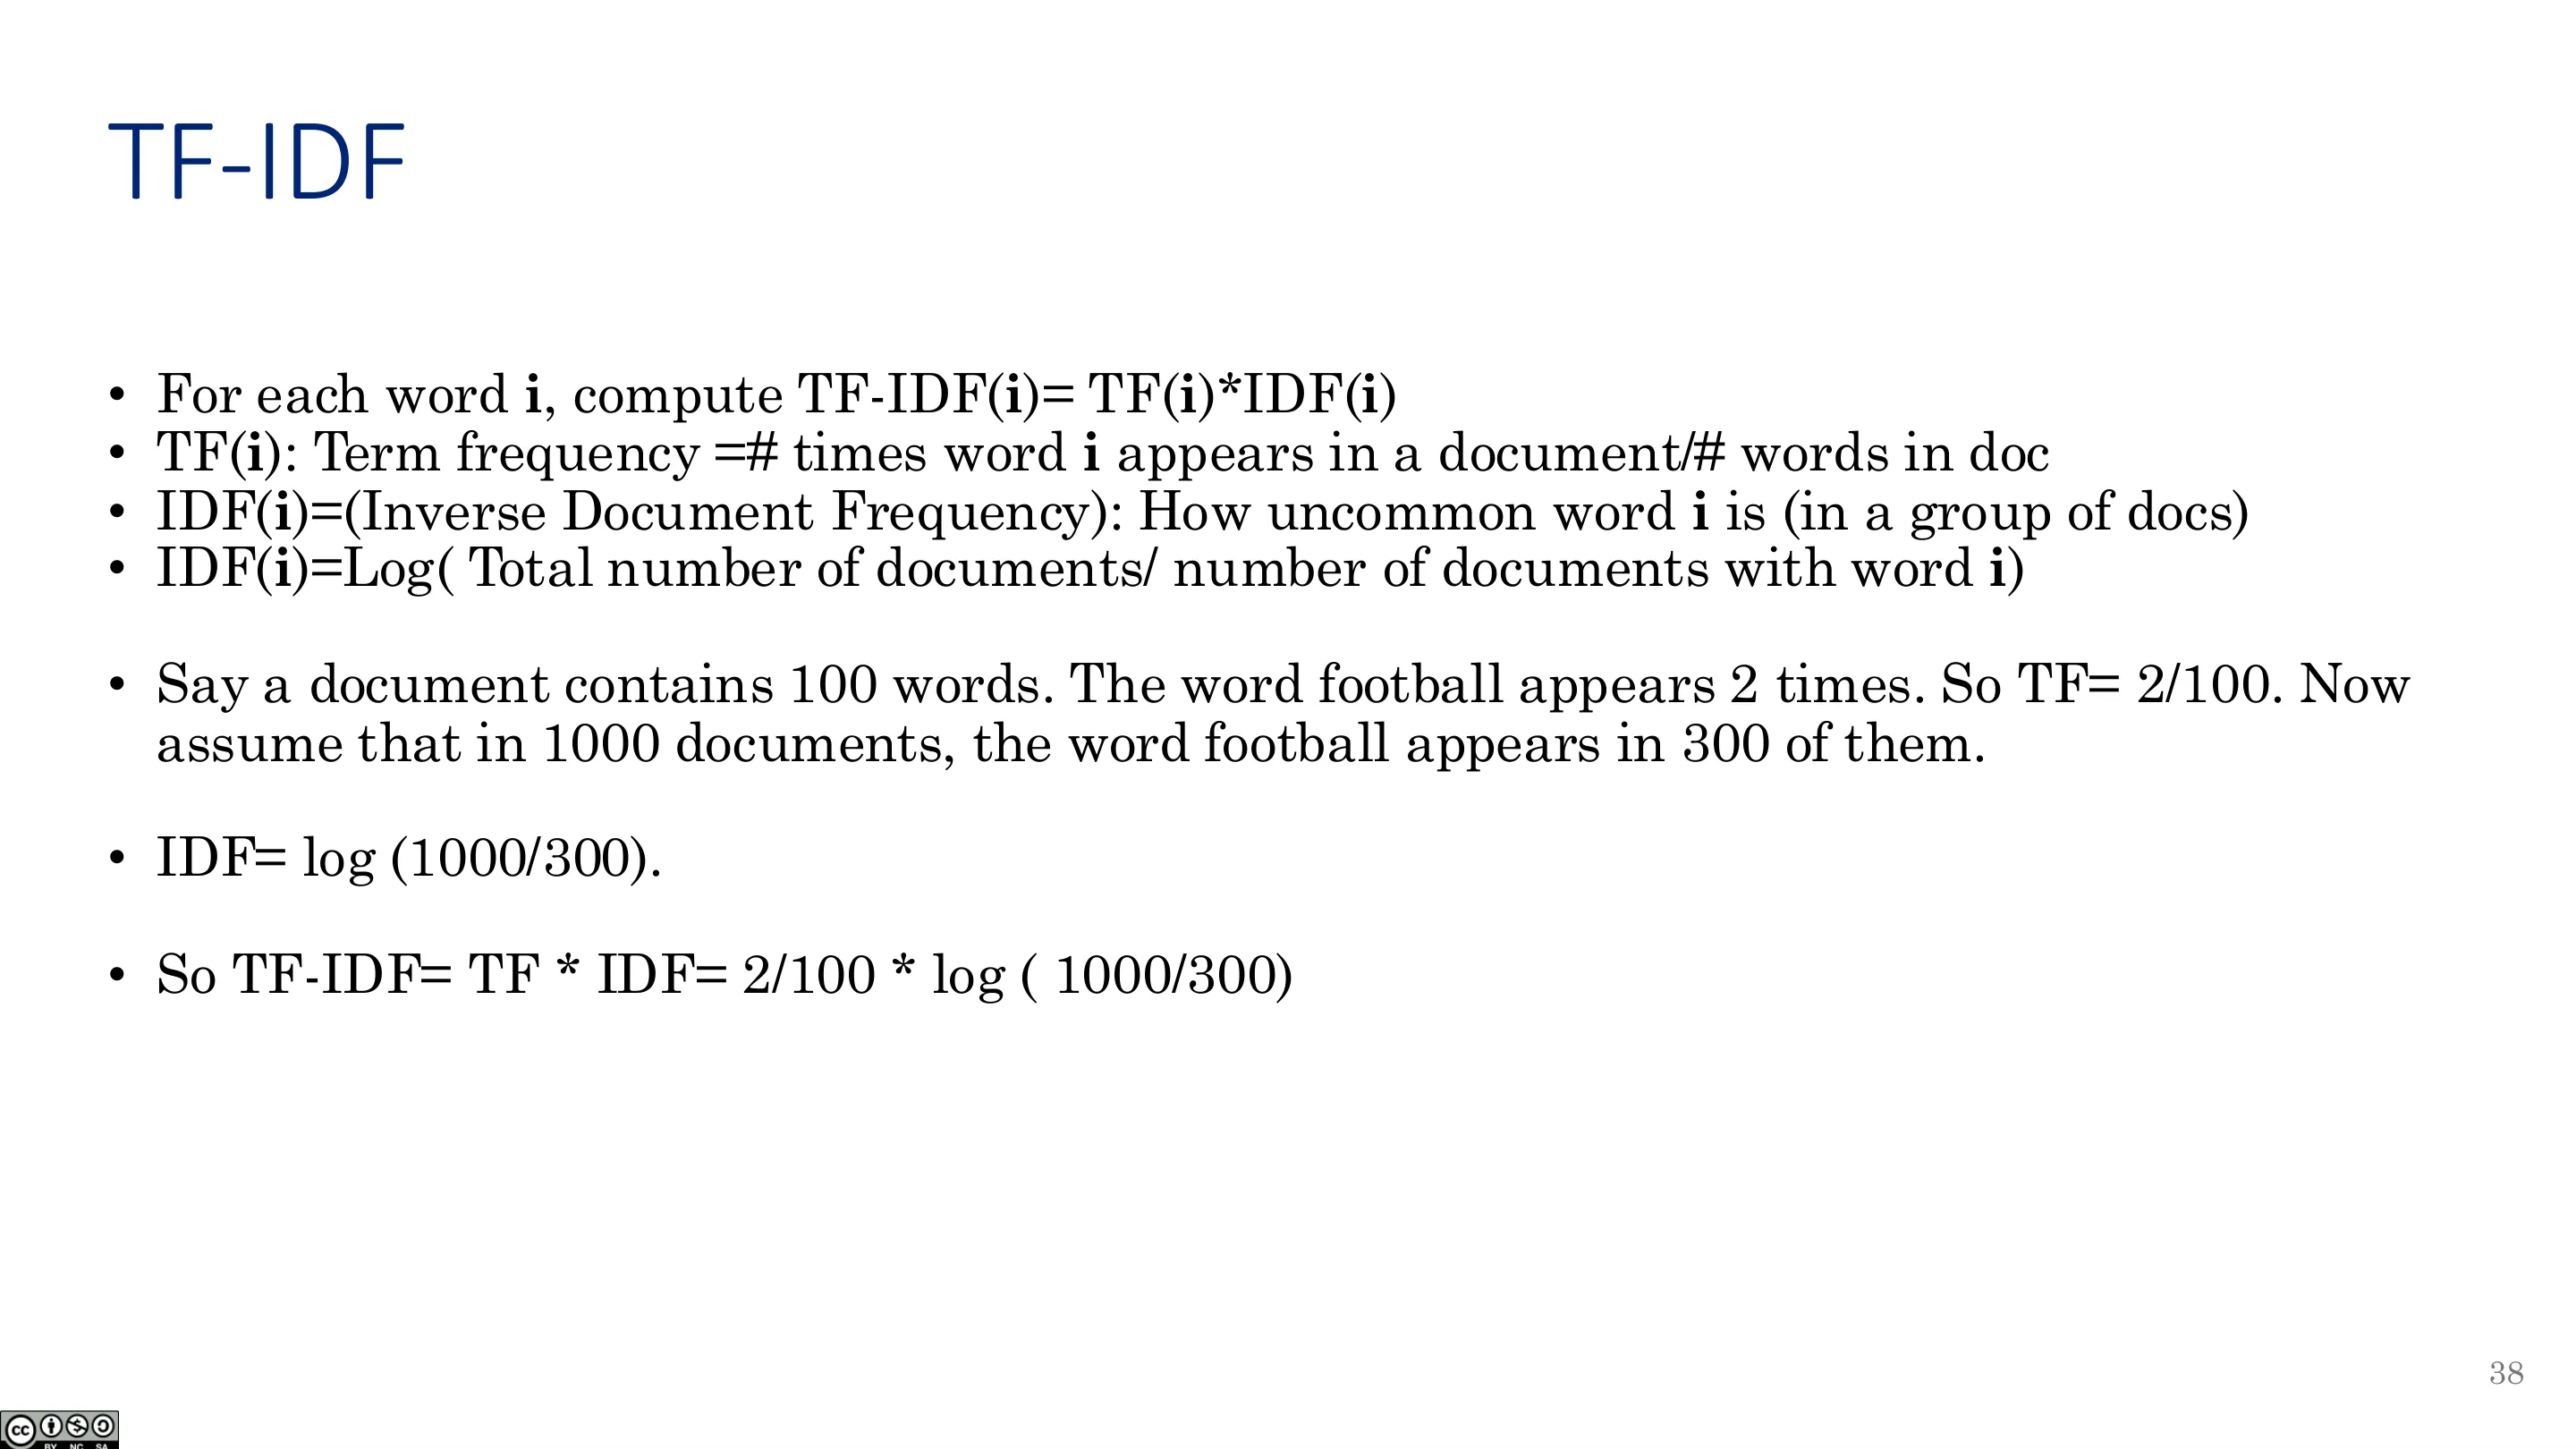
TF-IDF:$\text{TF}$ 是词在文档内的归一化频率;$\text{IDF}$ 是「词在各文档中多罕见」的对数倒数。二者相乘 ⇒ 常见词降权、有信息量的词升权。历史方法,如今少用。
📷 用词袋表示文档
回到原视频 (00:44:08)
📷 TF-IDF
回到原视频 (00:45:21)
3.2 循环神经网络(RNN)
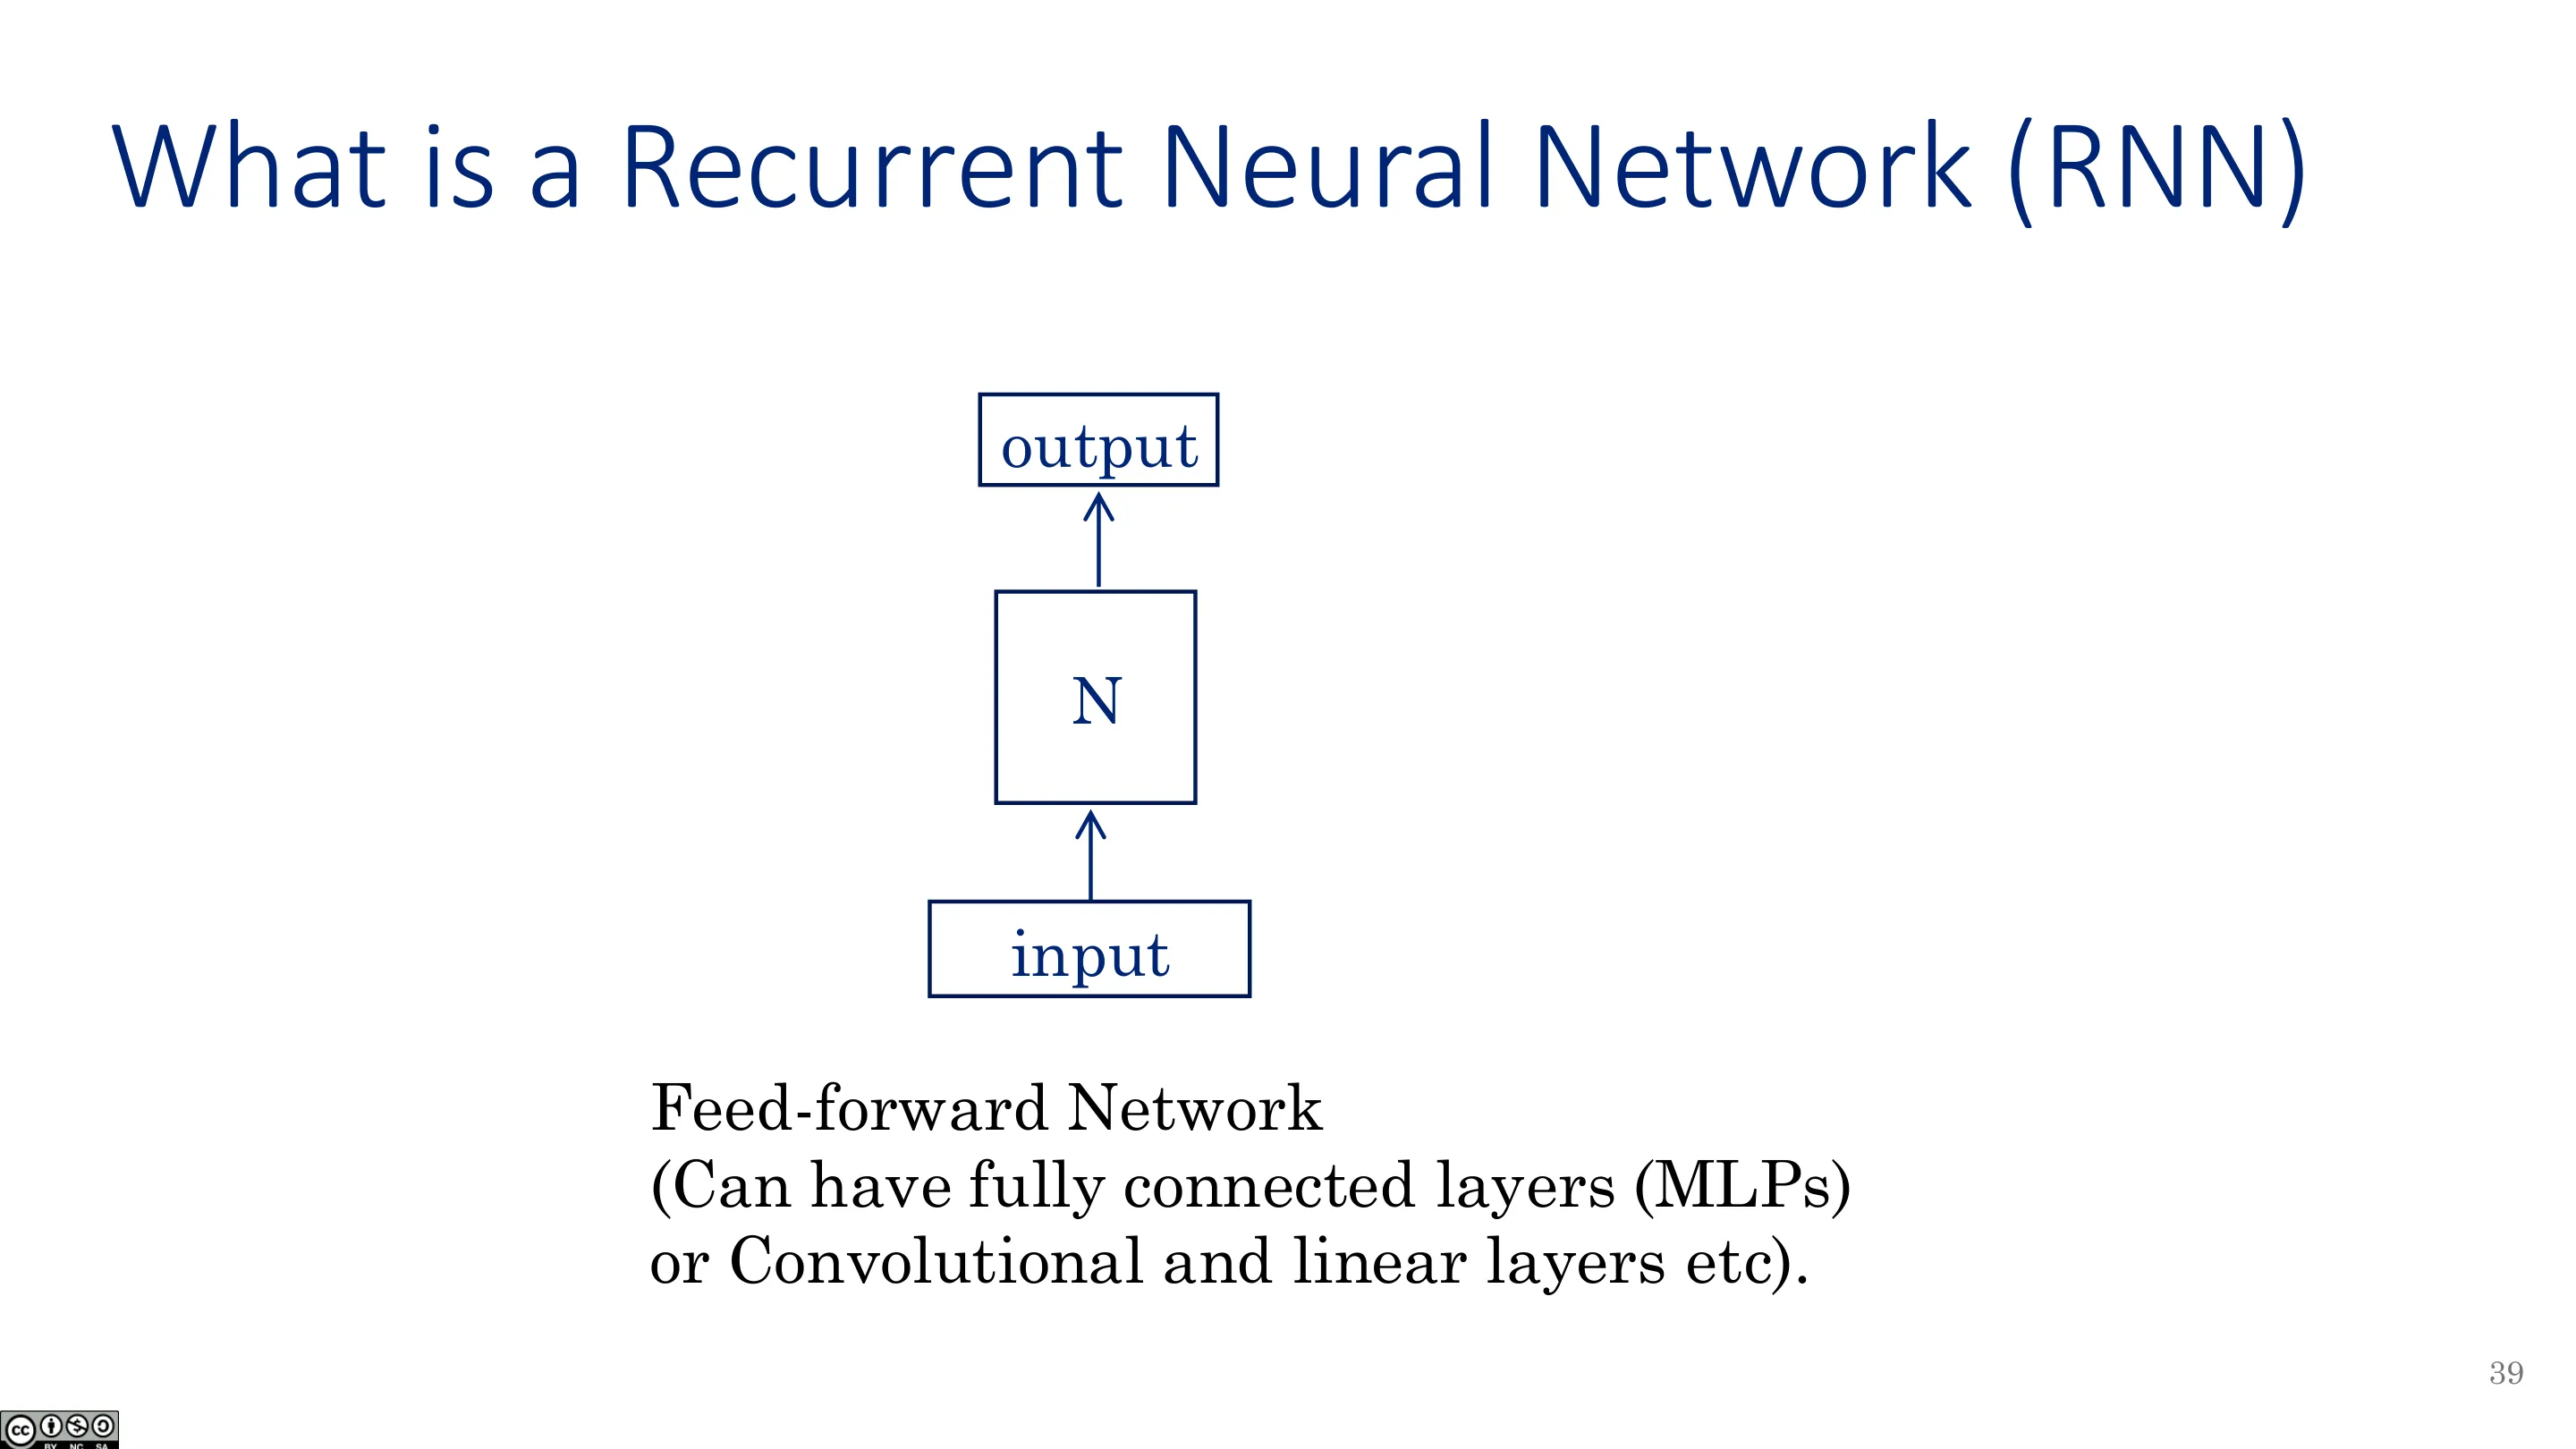
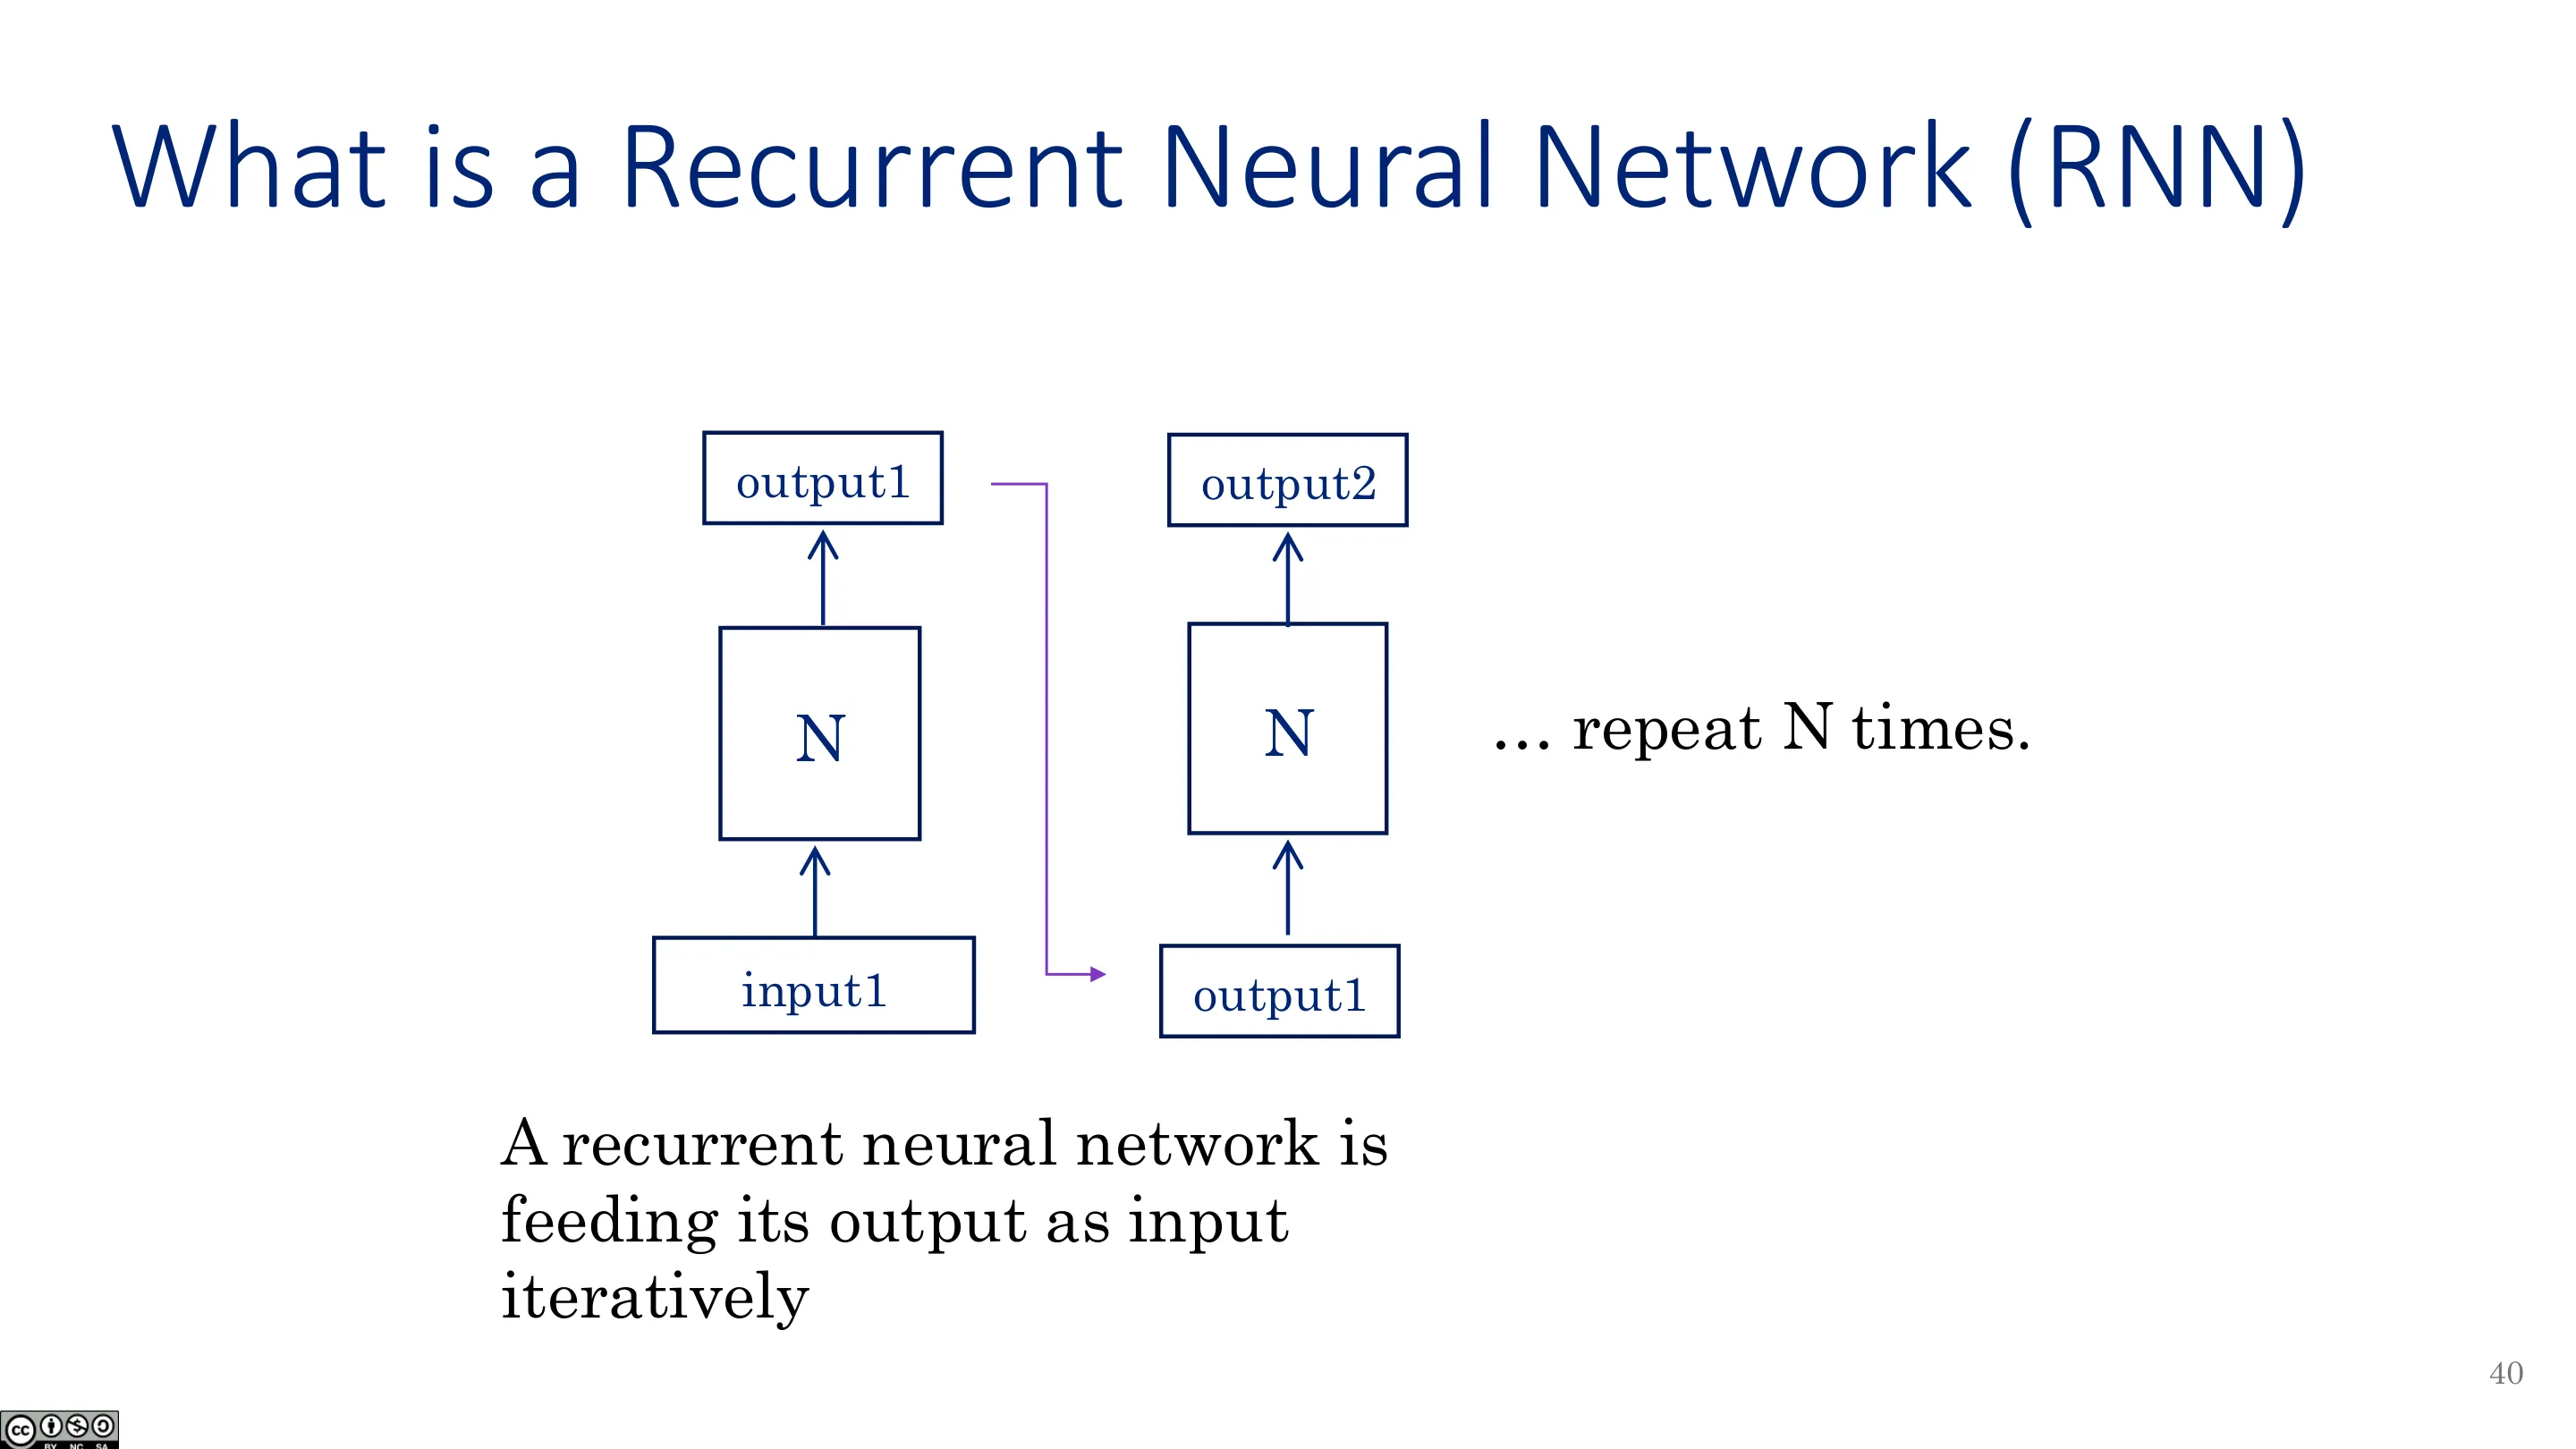
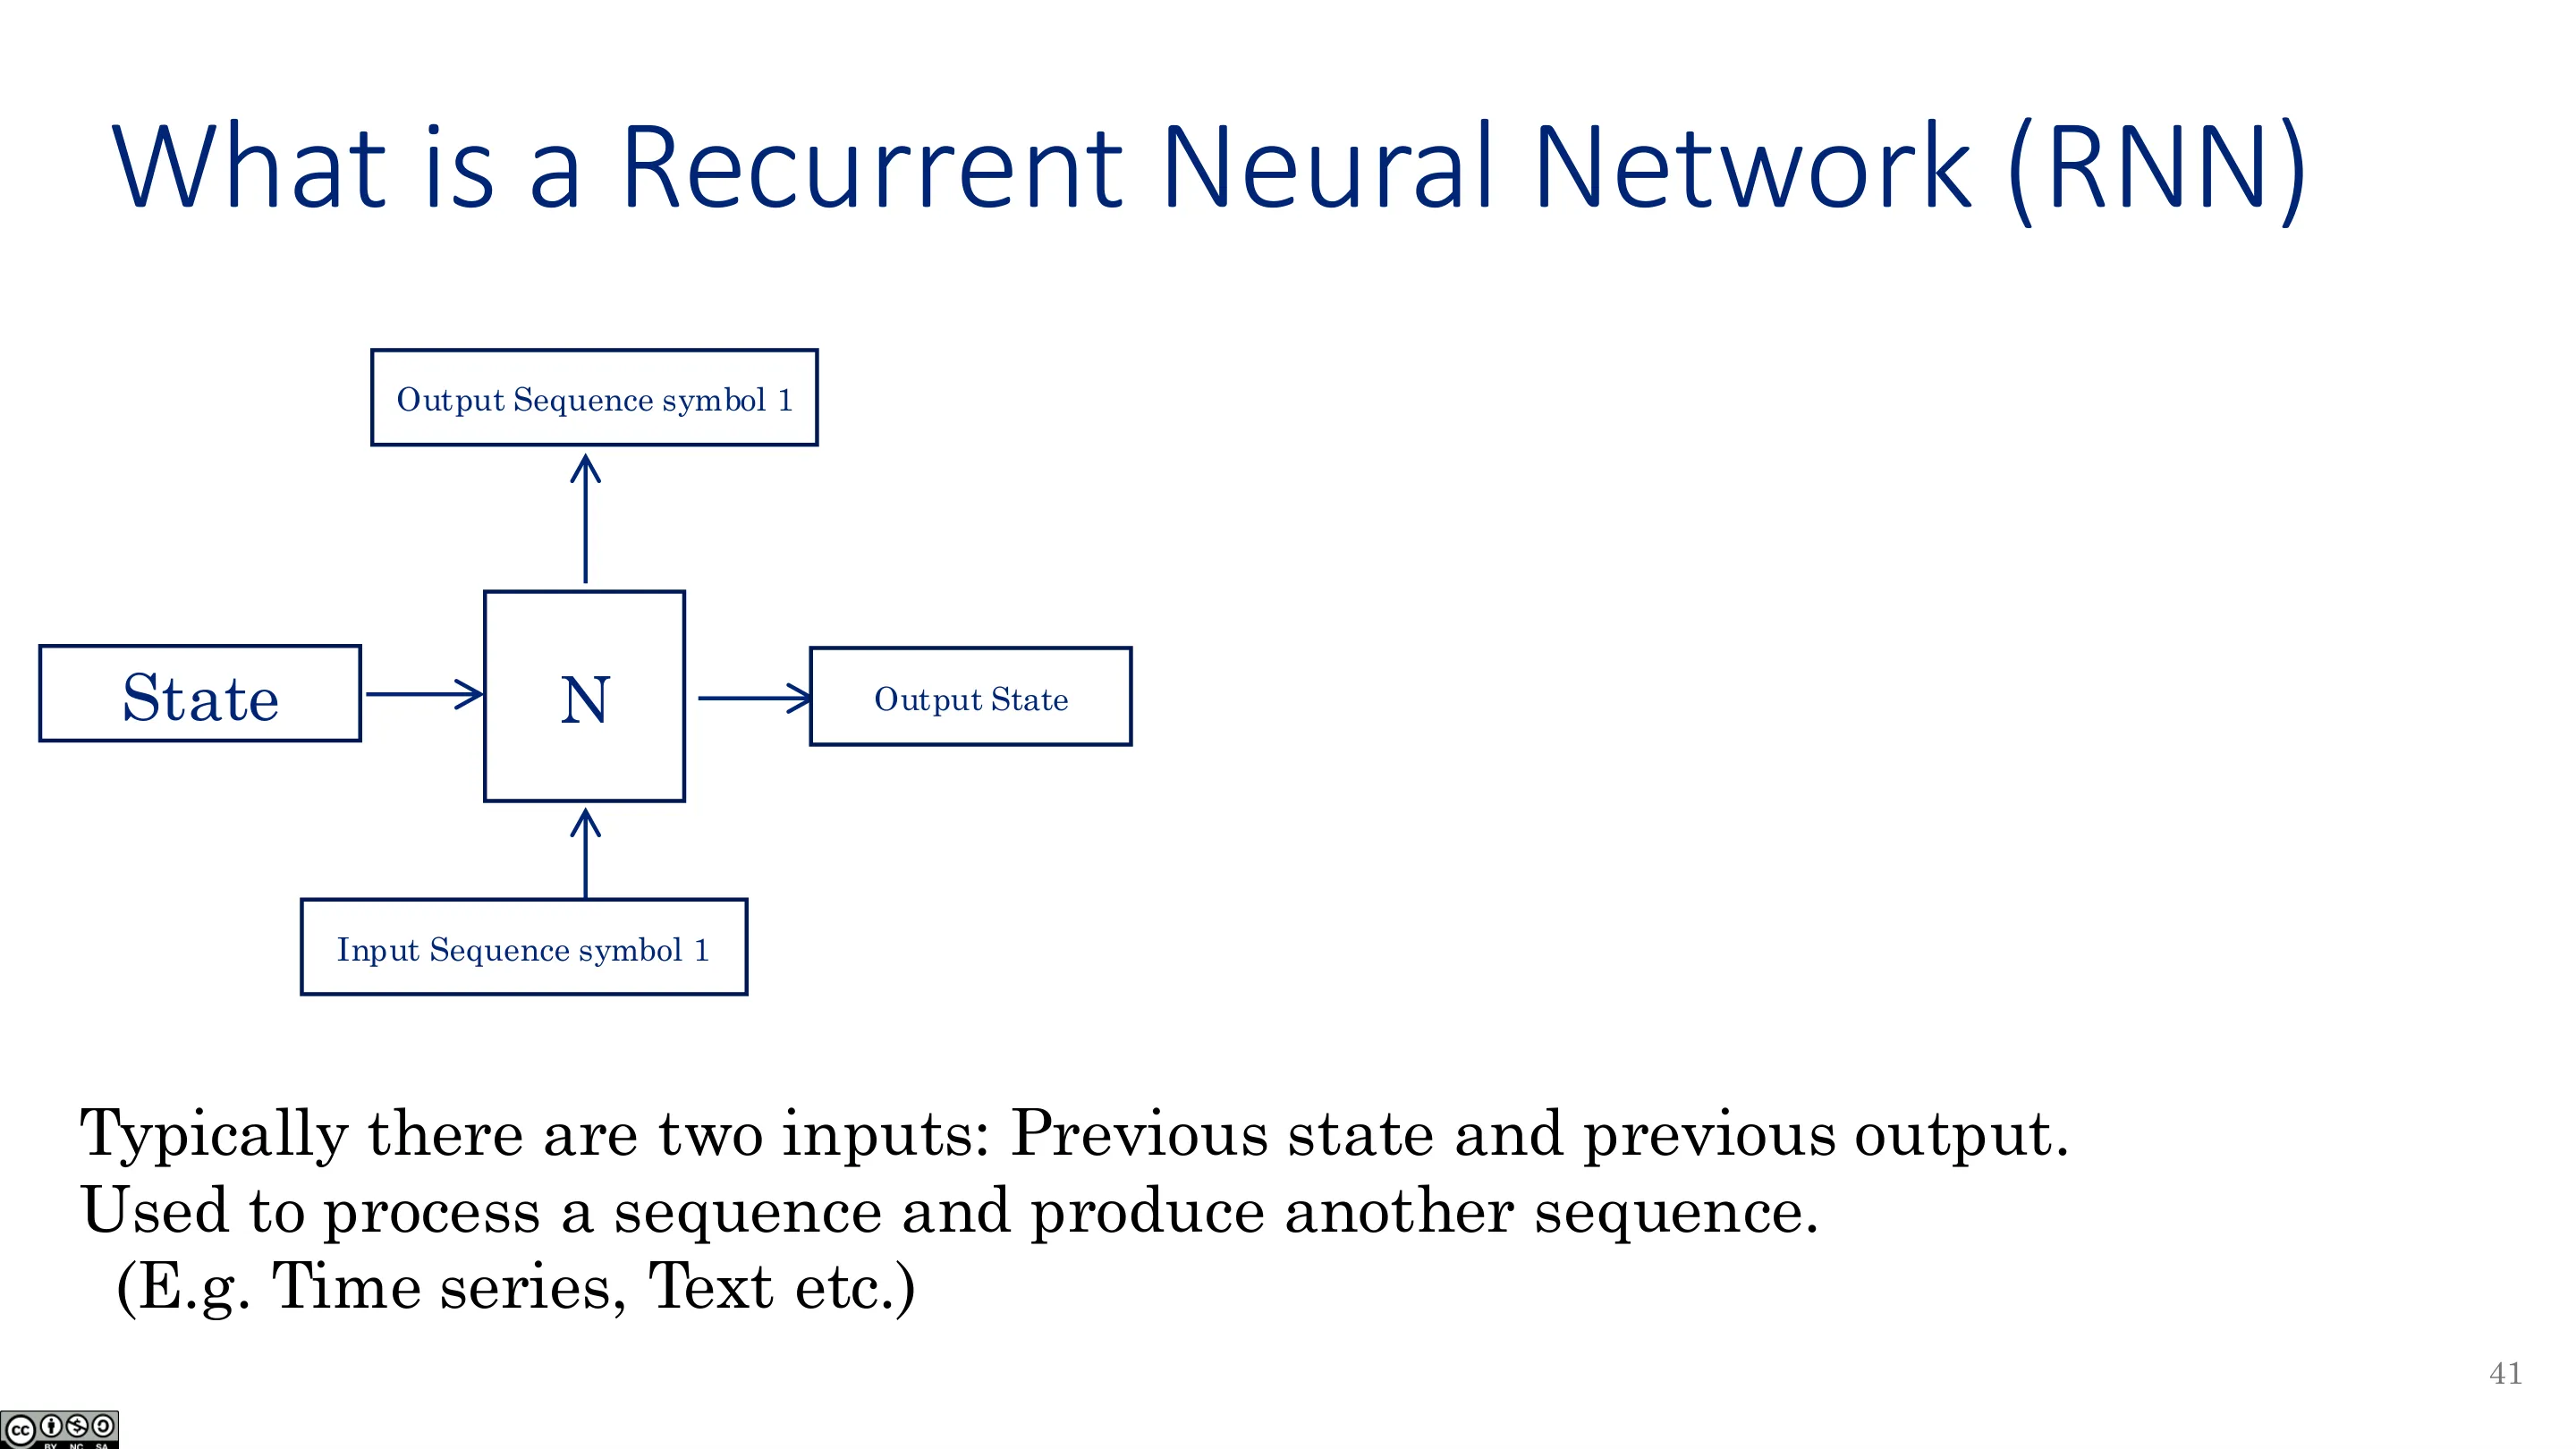
思想:把网络的输出再喂回网络(同一组权重反复使用)。数学上:$(s_t,y_t)=f(s_{t-1},x_t)$。好处:权重可随输入长度复用,能处理任意长度序列。
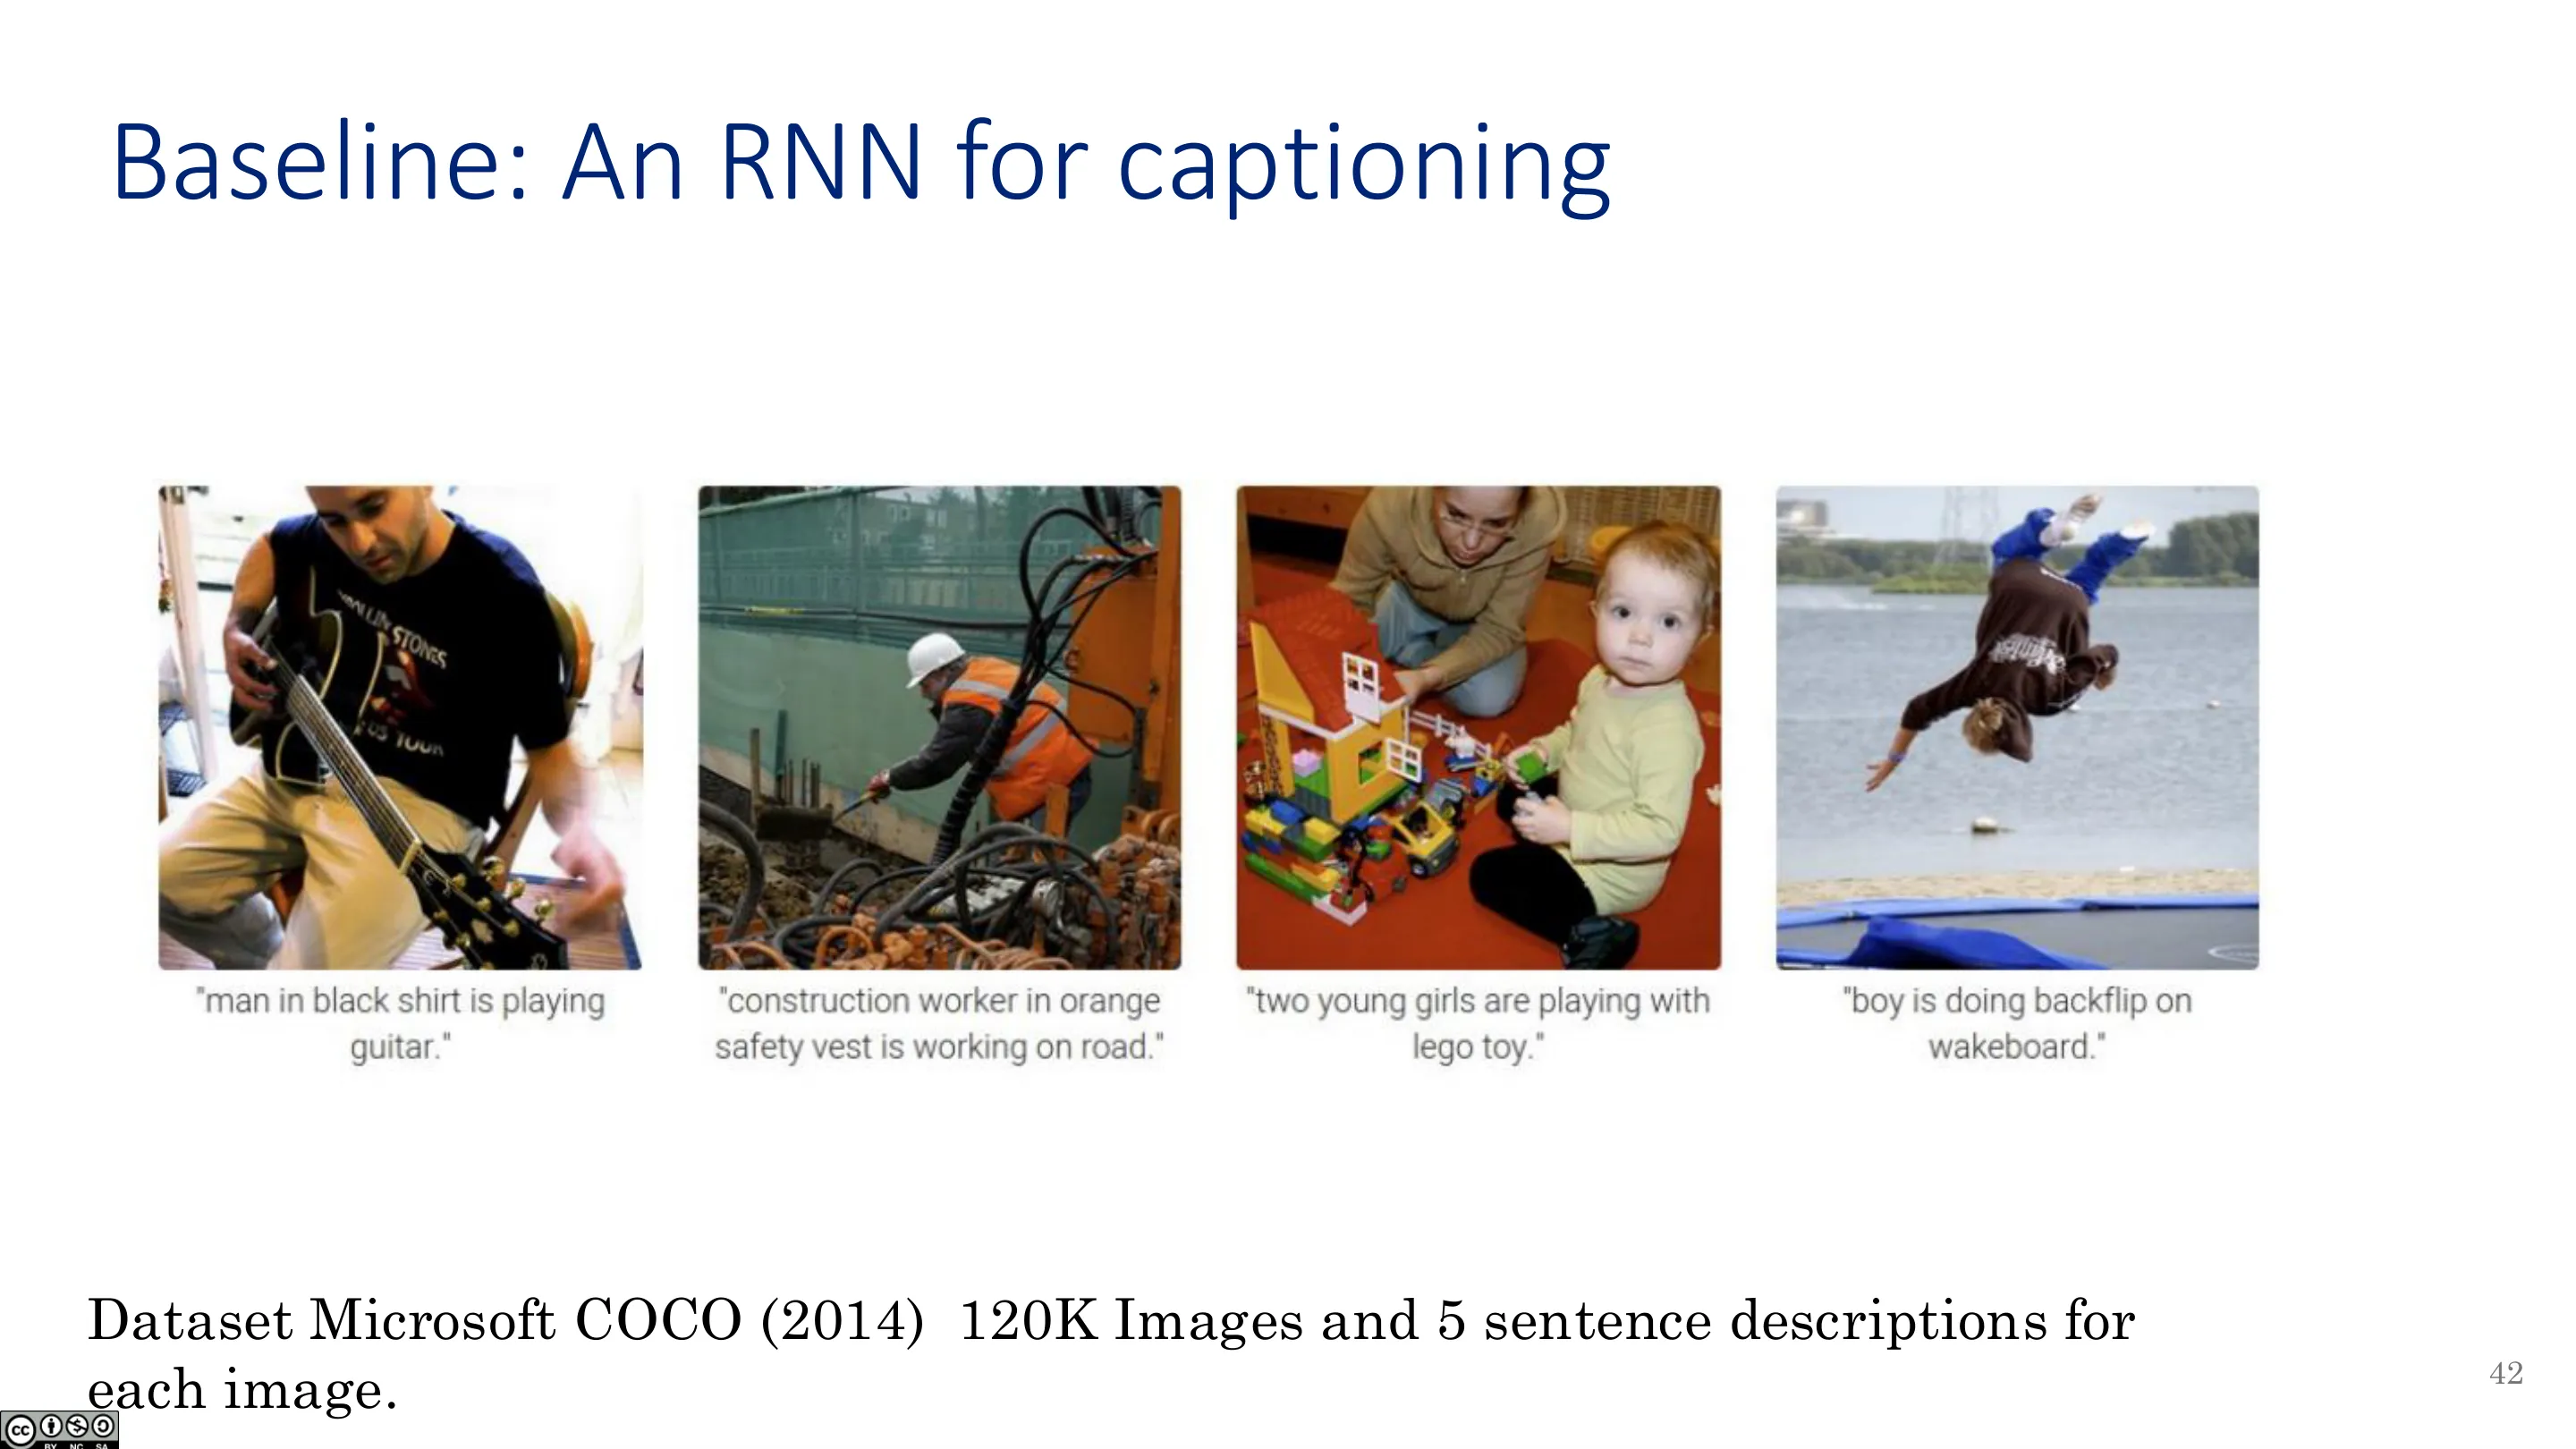
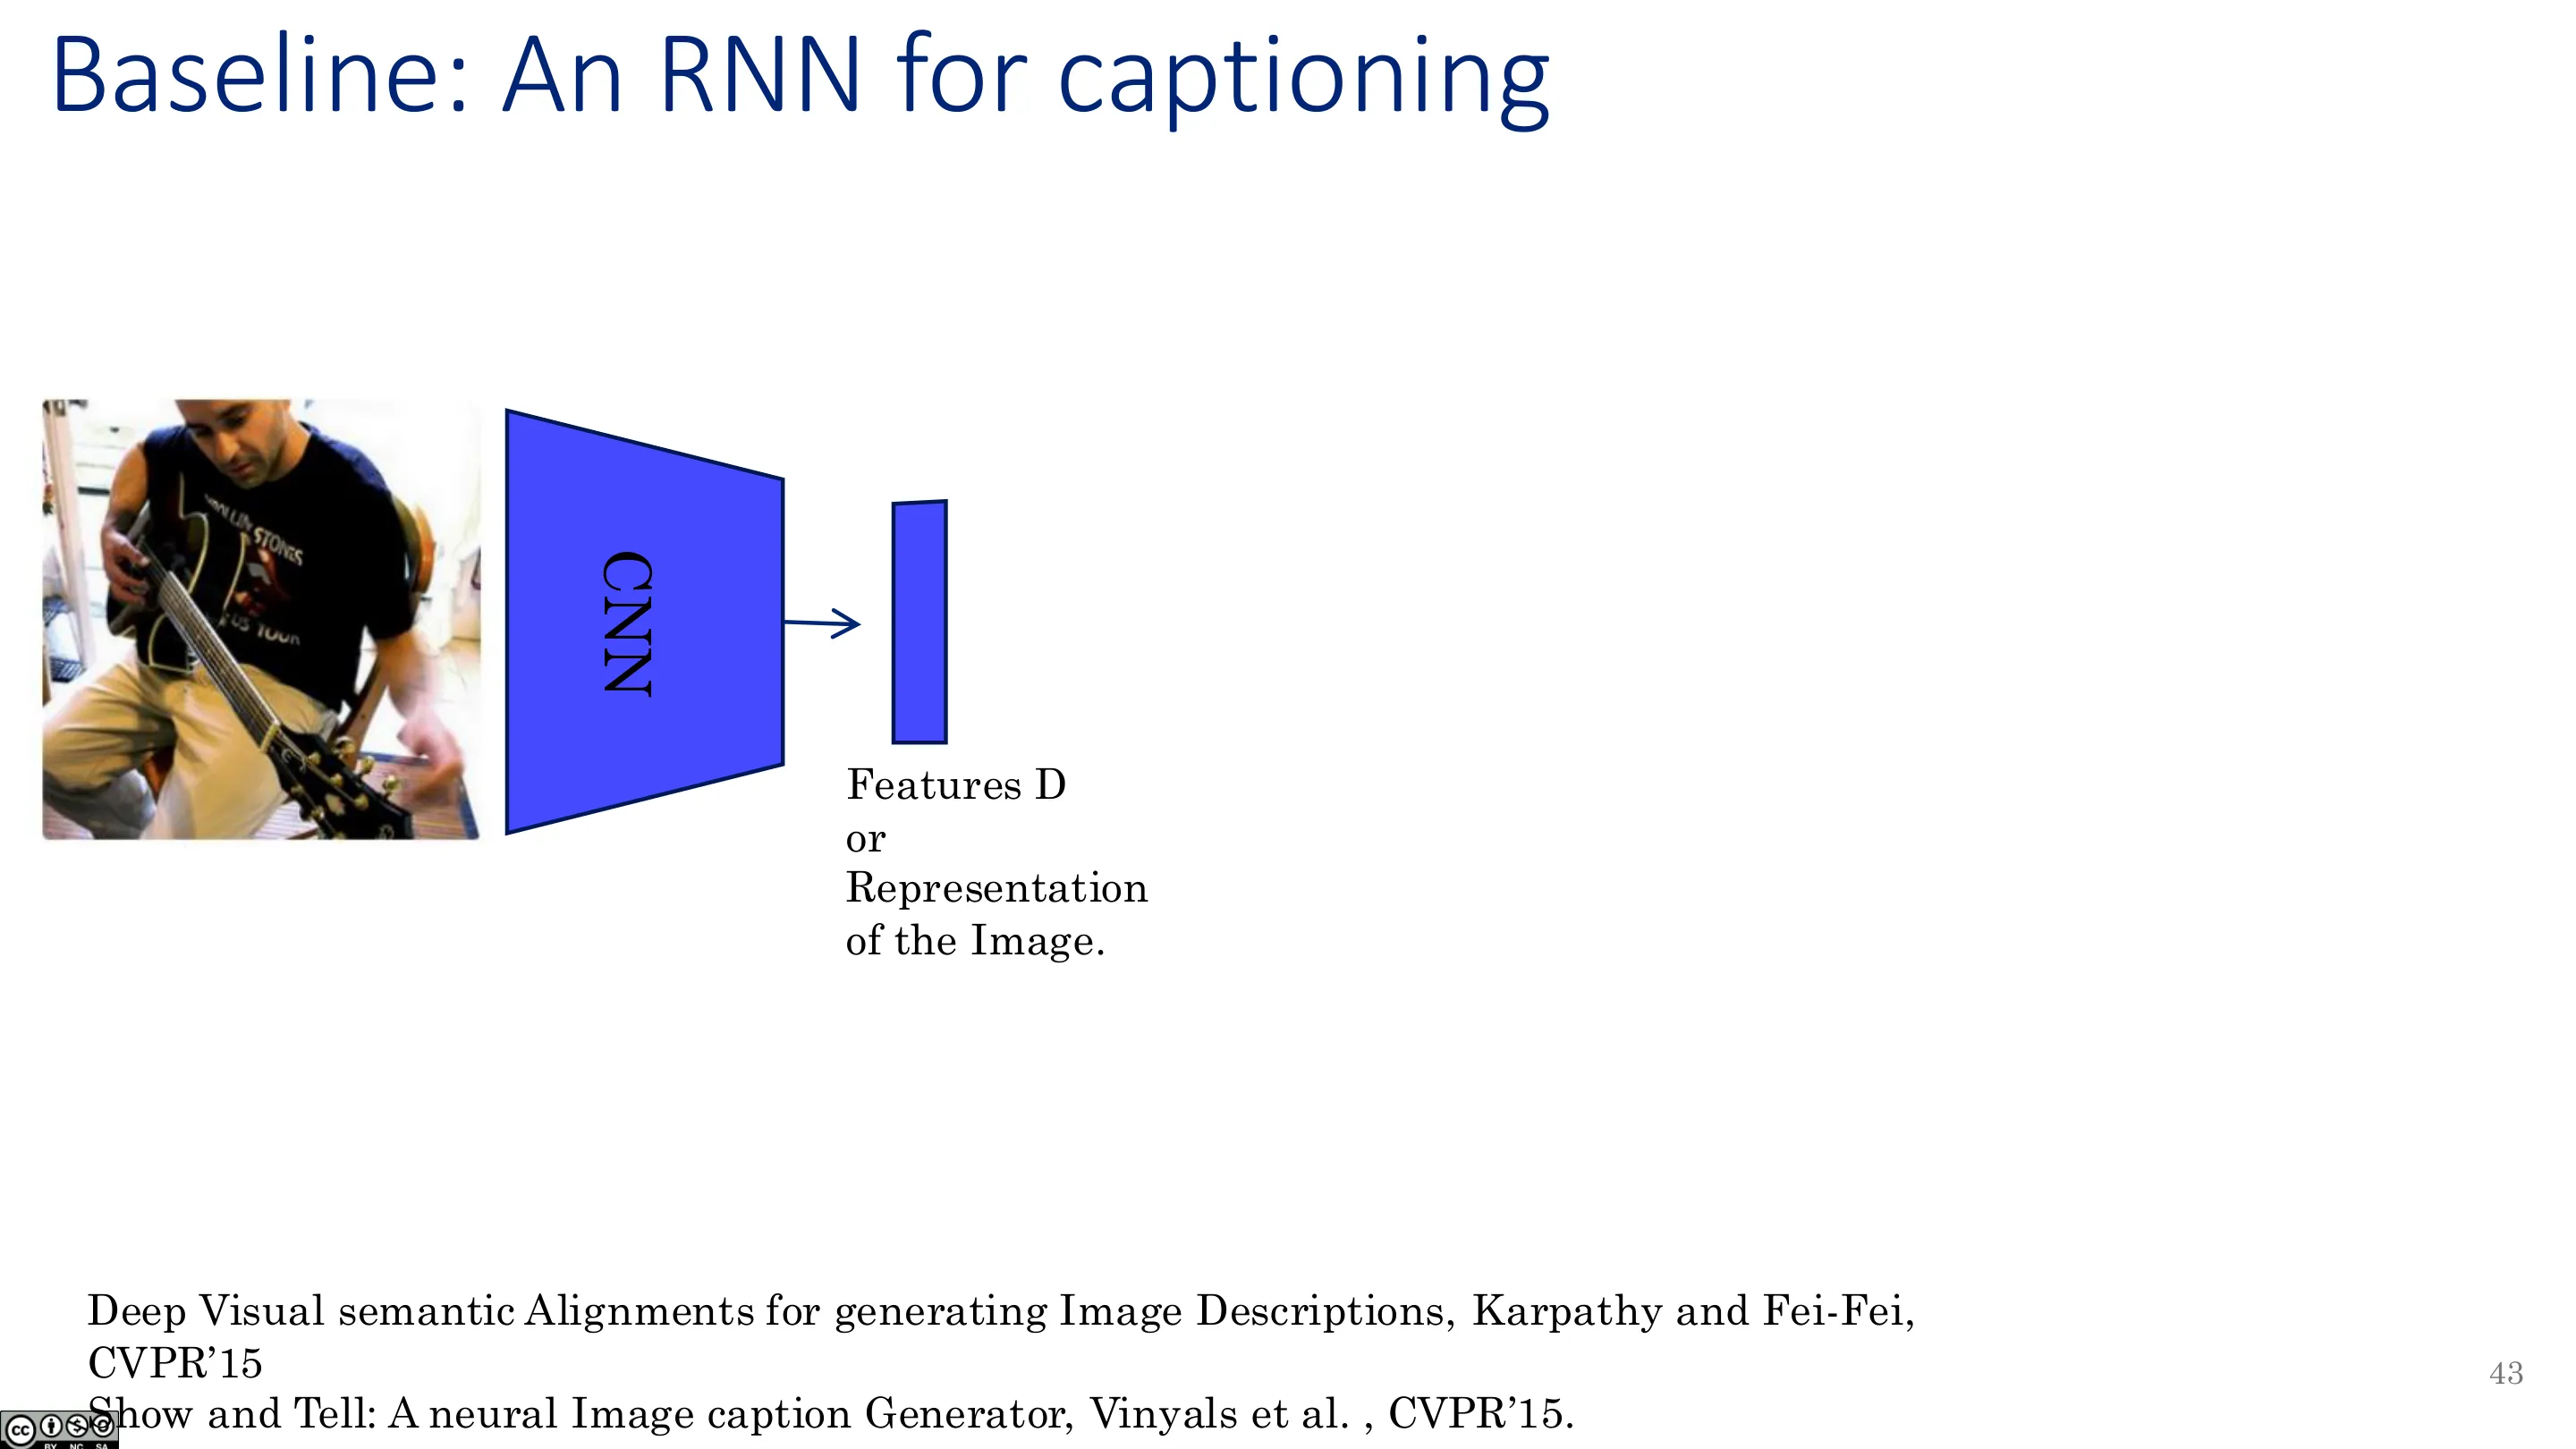
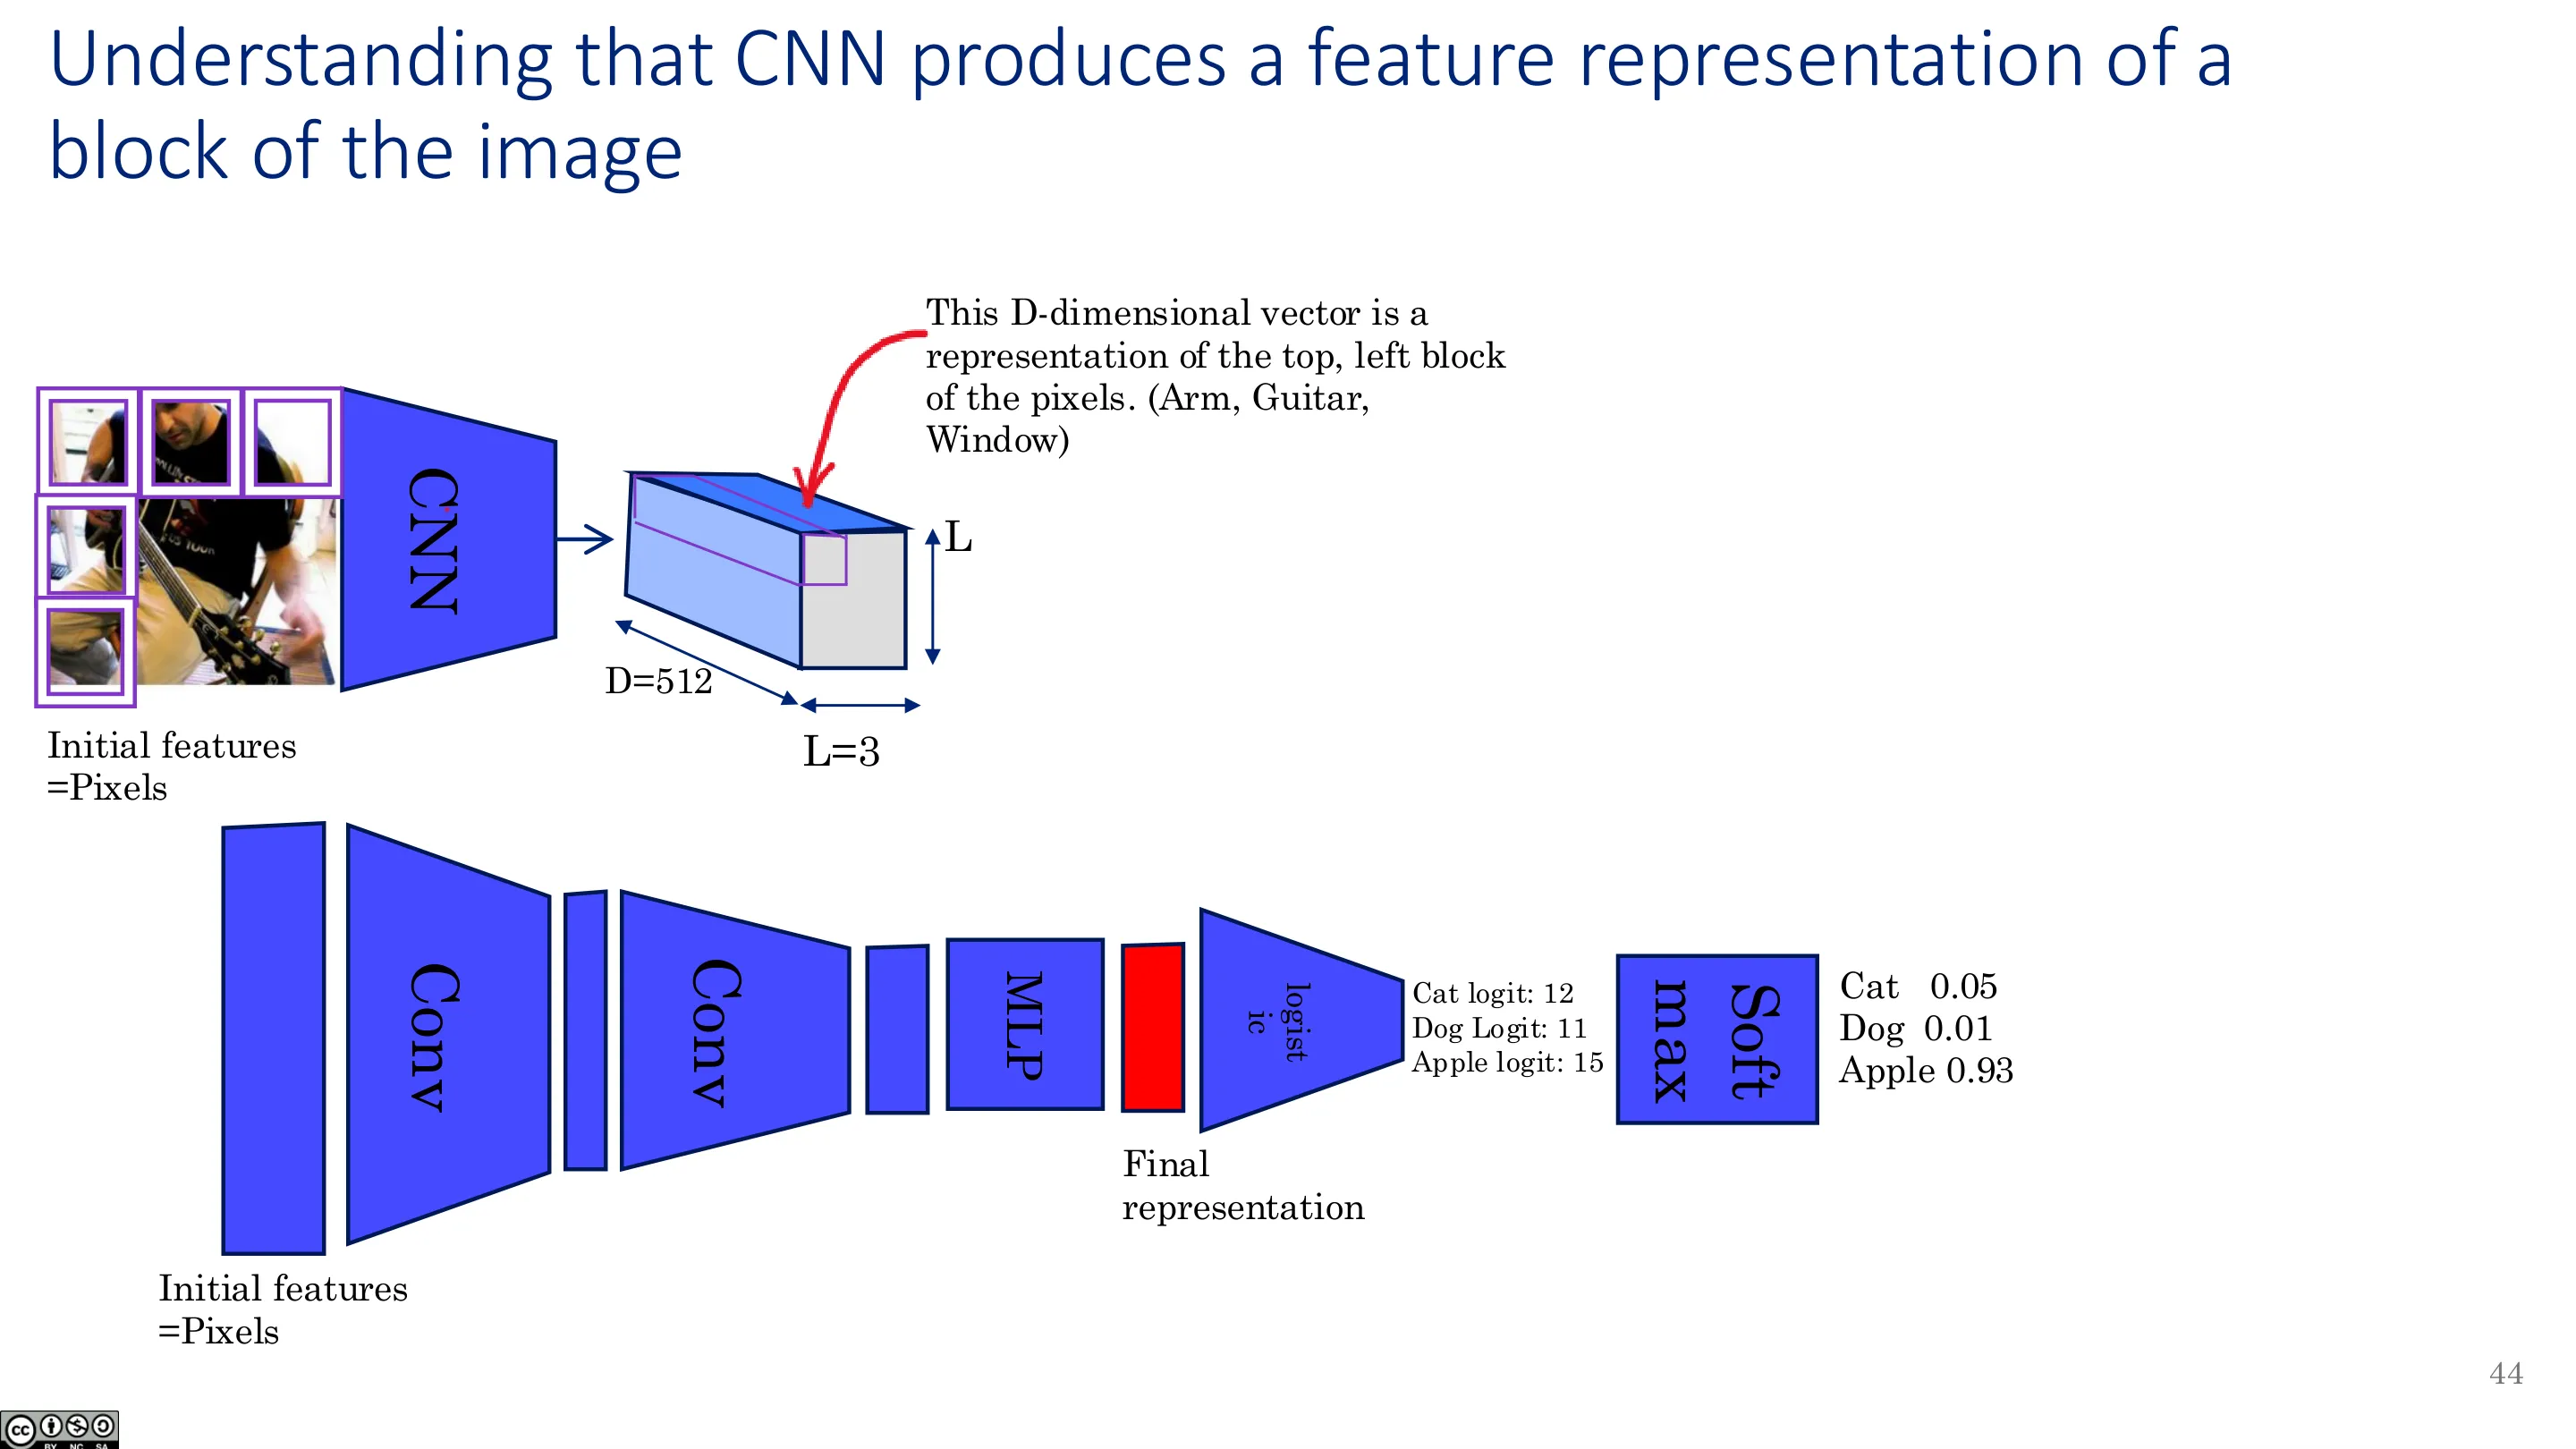
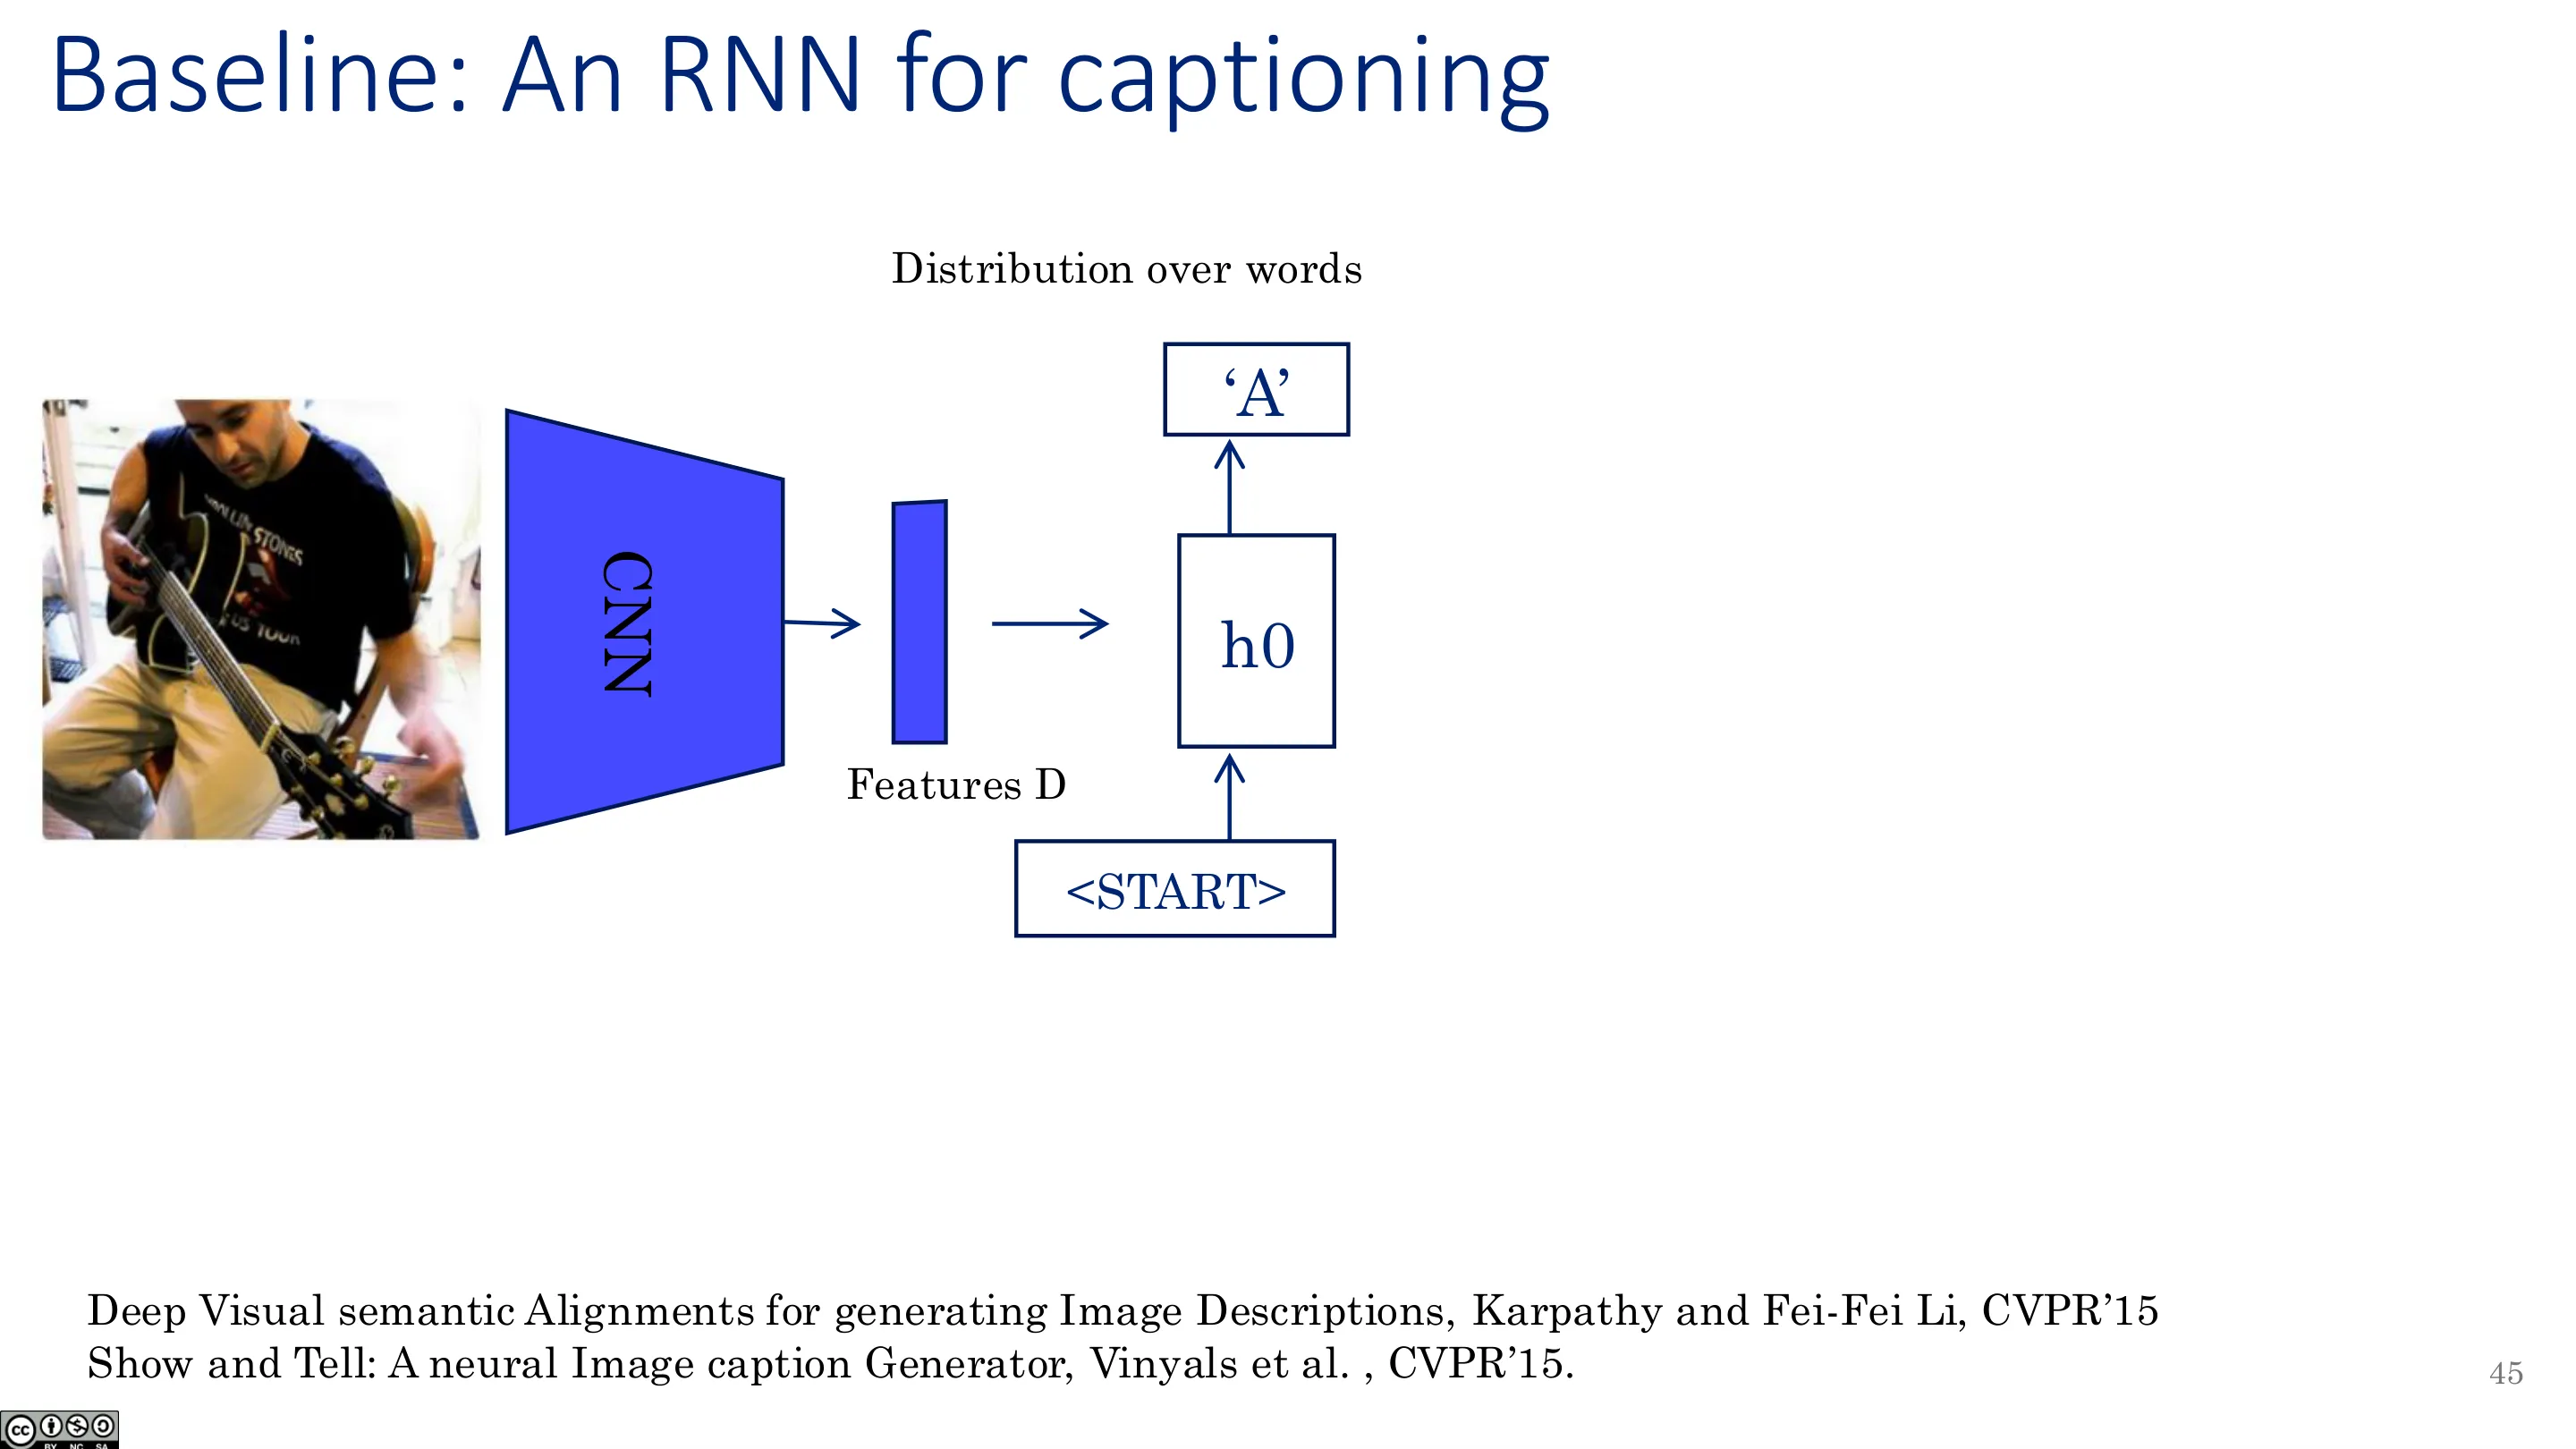
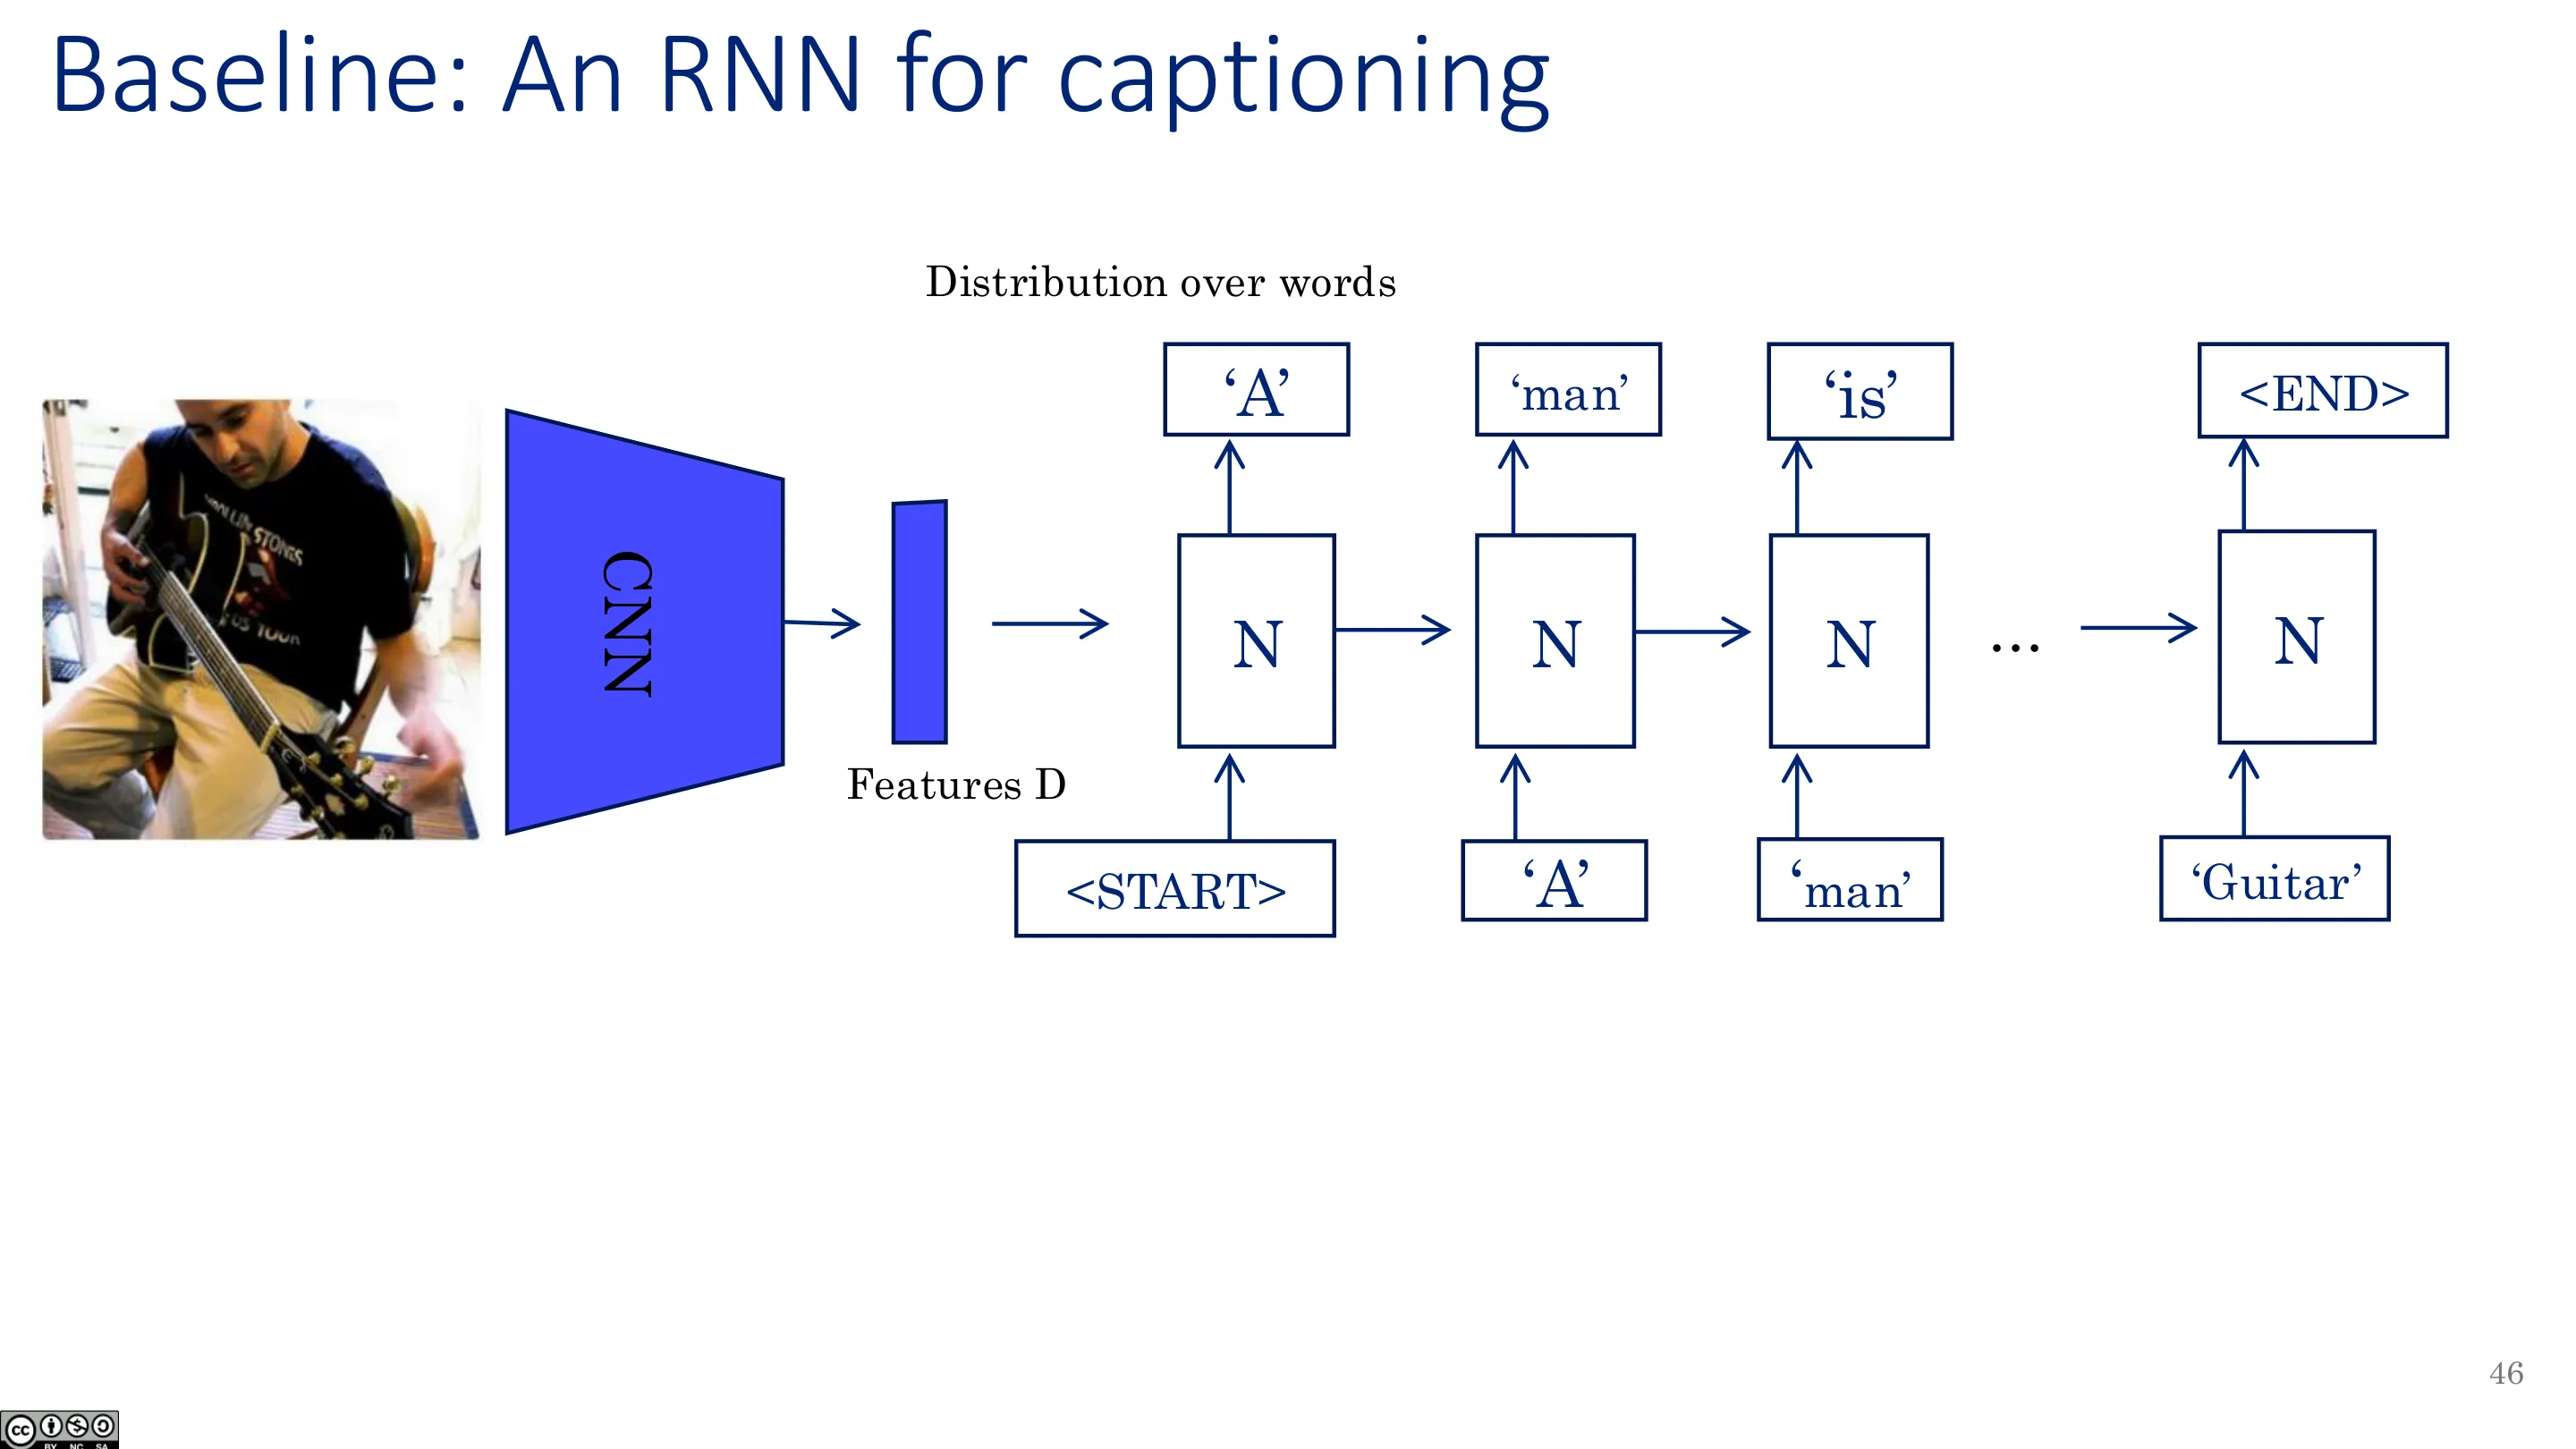
基线任务:MS COCO(2014,约 12 万图 + 描述)上的图像描述(captioning)——用预训练 CNN 把图像编成特征($3\times3$ 的格,每格是 $D$ 维向量),再用 RNN 逐词生成「a man is playing the guitar」。
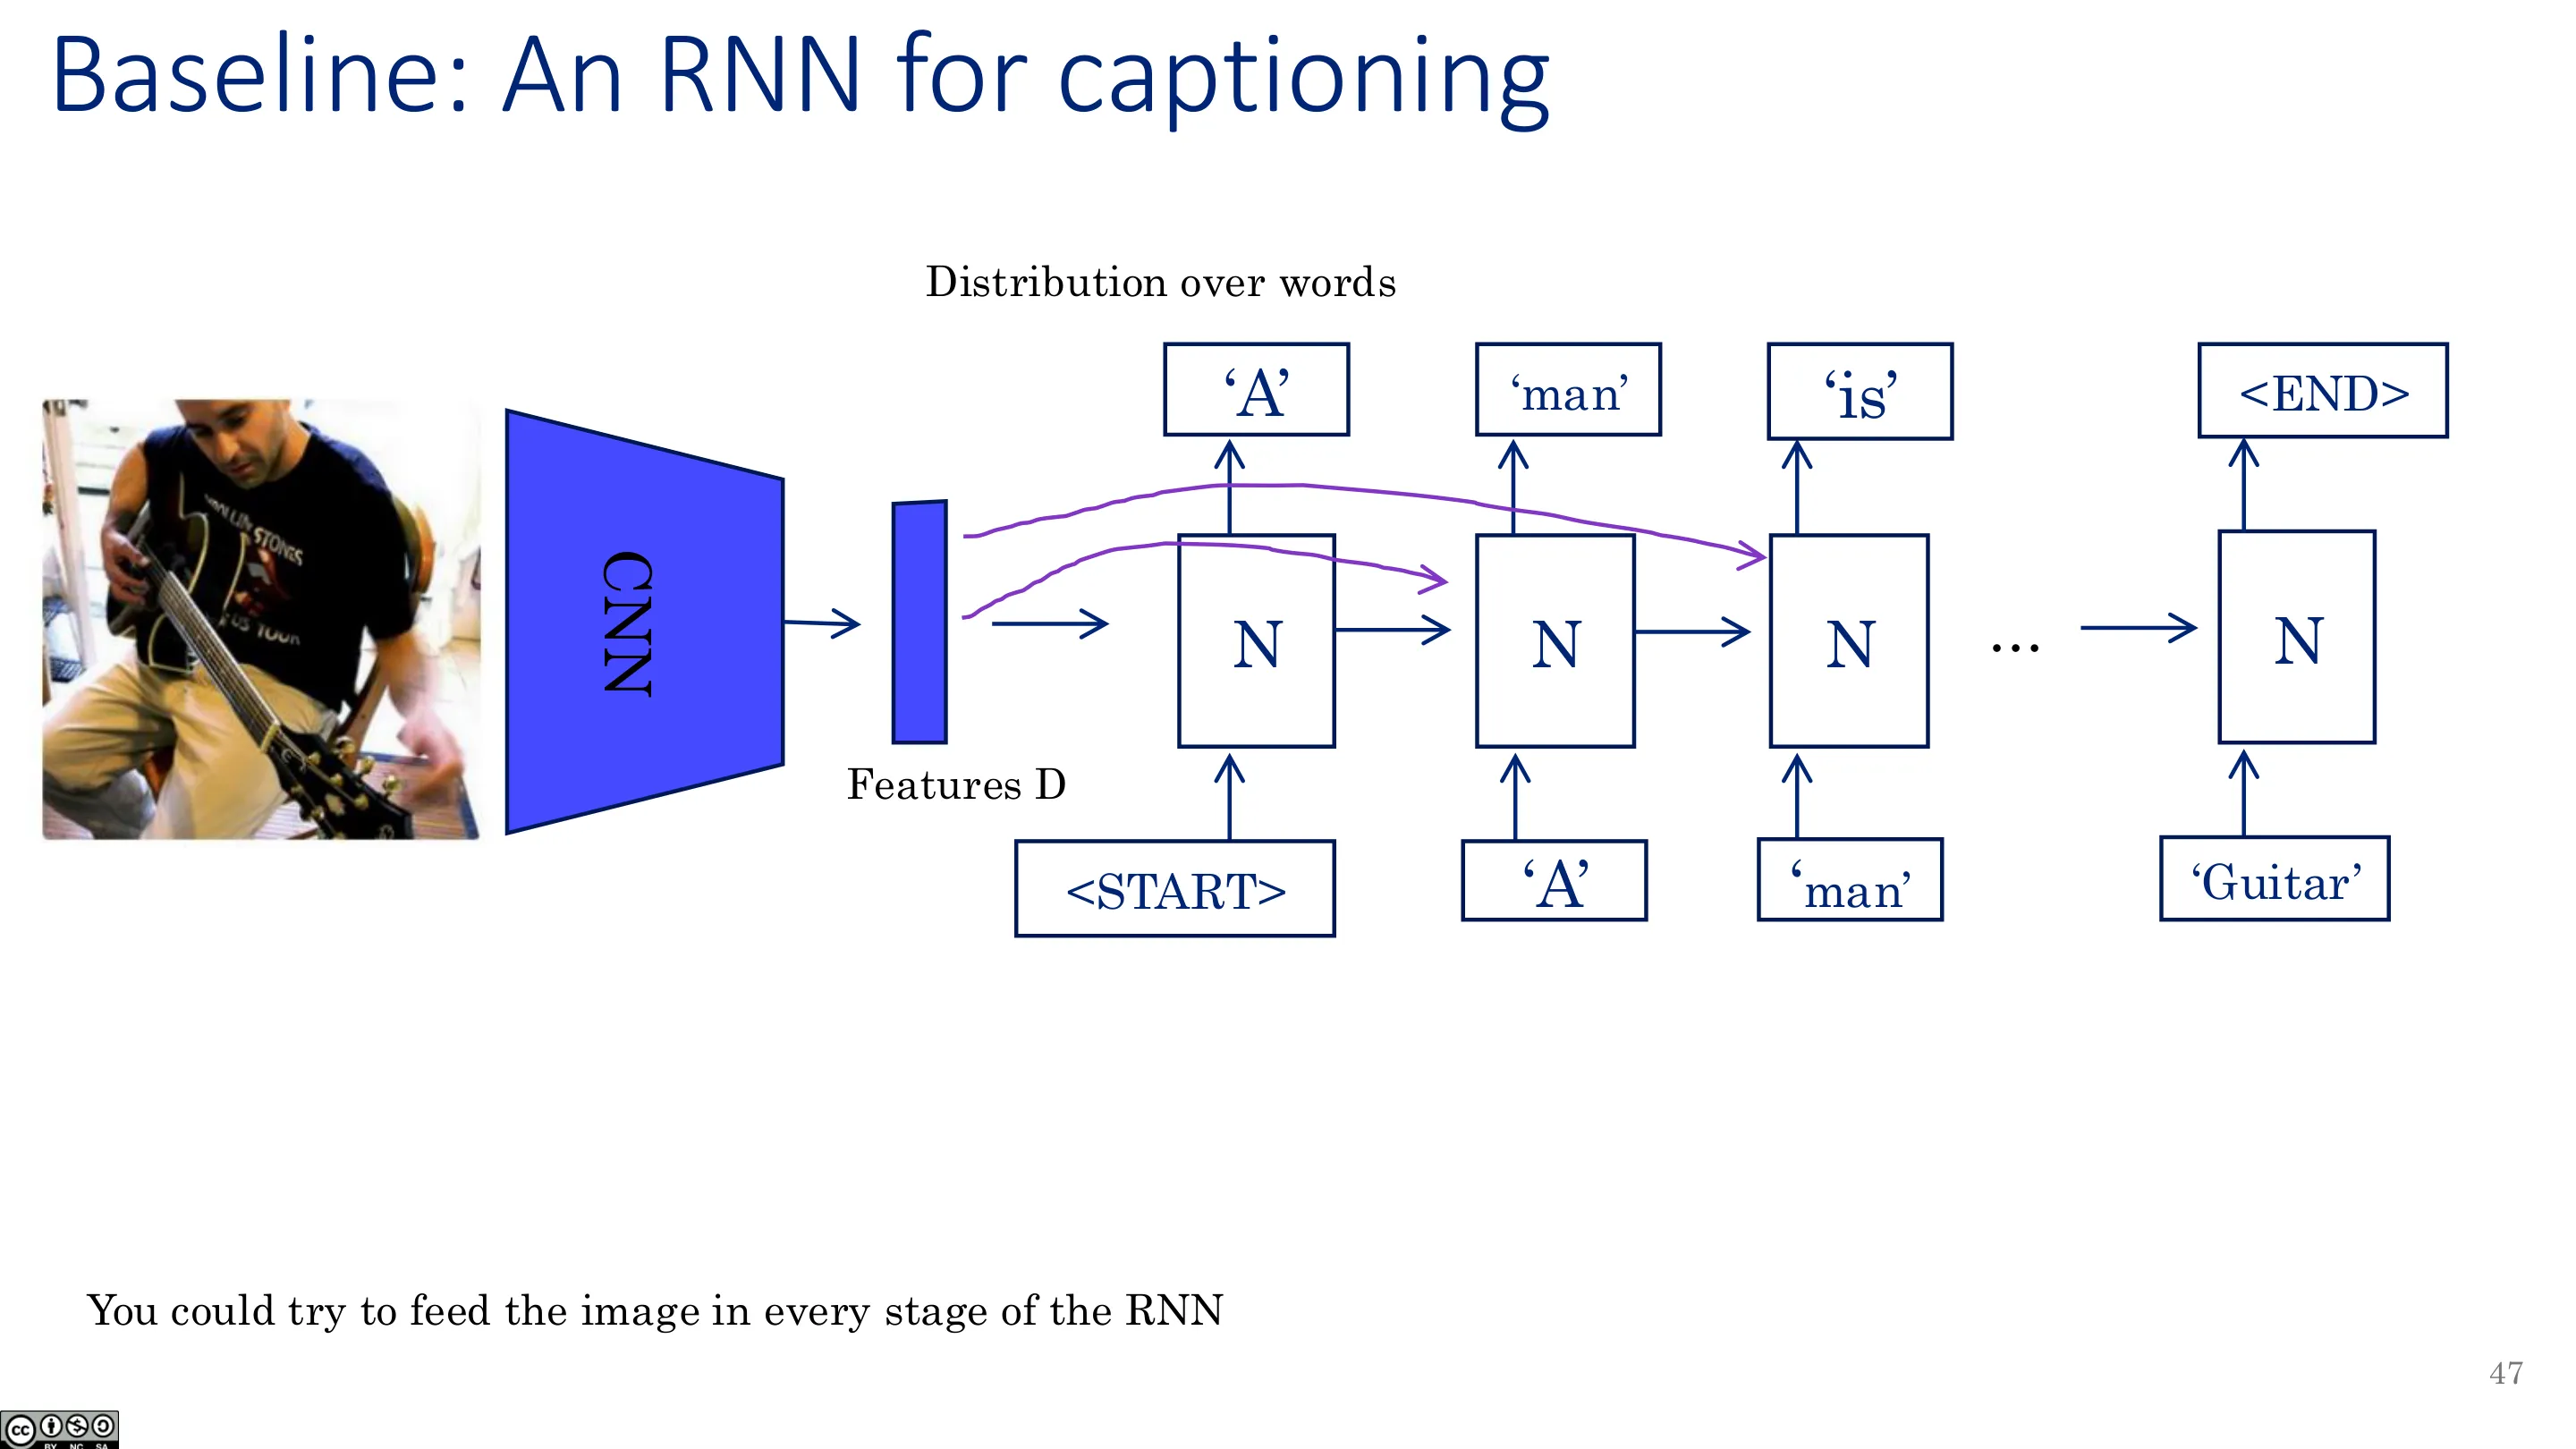
RNN 的问题(信息瓶颈):生成到后面时,网络只能通过被反复变换的隐状态获取图像信息,无法重新查看图像的某个部分 ⇒ 会漏掉「吉他」「窗户」等。如果每步都把整幅图塞进去,又会信息过载,反复念叨同一个东西。
解决方案:让网络自己决定每一步看哪里——这就是注意力。
📷 什么是 RNN(一)
回到原视频 (00:46:34)
📷 什么是 RNN(二)
回到原视频 (00:47:47)
📷 什么是 RNN(三)
回到原视频 (00:49:00)
📷 基线:用于描述的 RNN(一)
回到原视频 (00:50:13)
📷 基线:用于描述的 RNN(二)
回到原视频 (00:51:26)
📷 CNN 产生特征表示
回到原视频 (00:52:39)
📷 基线:用于描述的 RNN(三)
回到原视频 (00:53:52)
📷 基线:用于描述的 RNN(四)
回到原视频 (00:55:05)
📷 基线:用于描述的 RNN(五)
回到原视频 (00:56:18)
四、注意力:从位置到内容
4.1 基于位置的软注意力
(参考时间: 00:42)
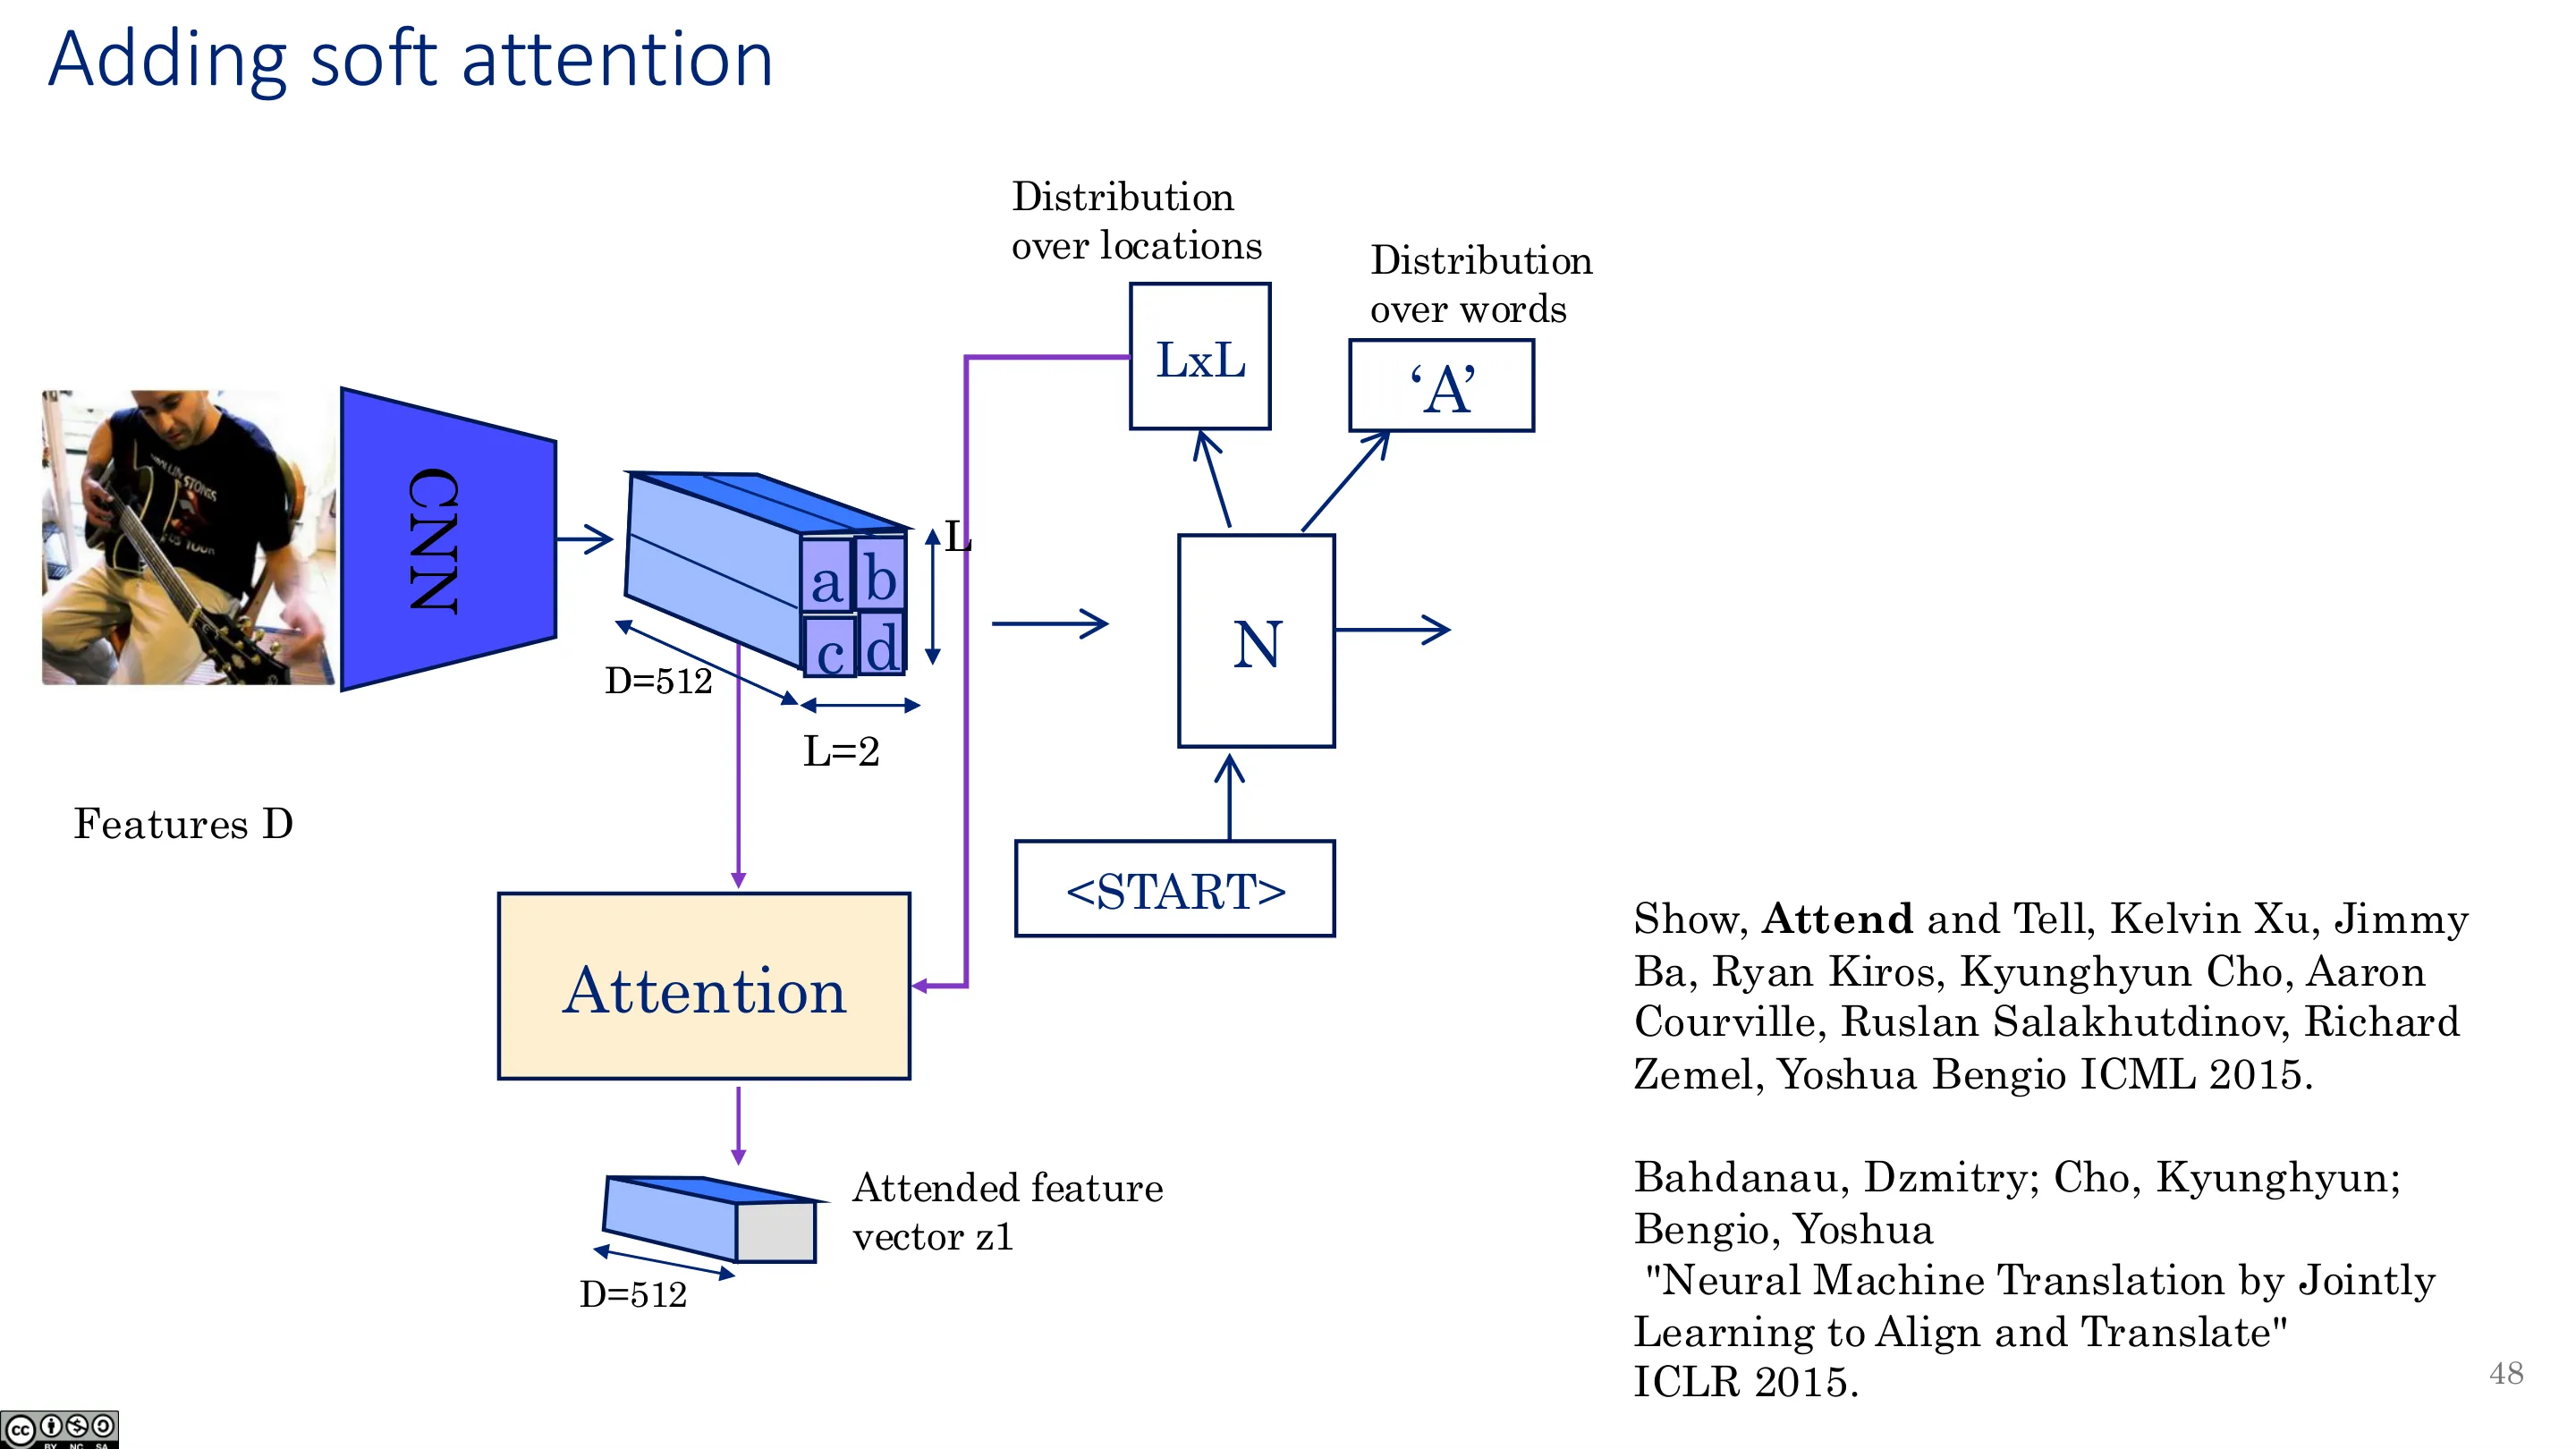
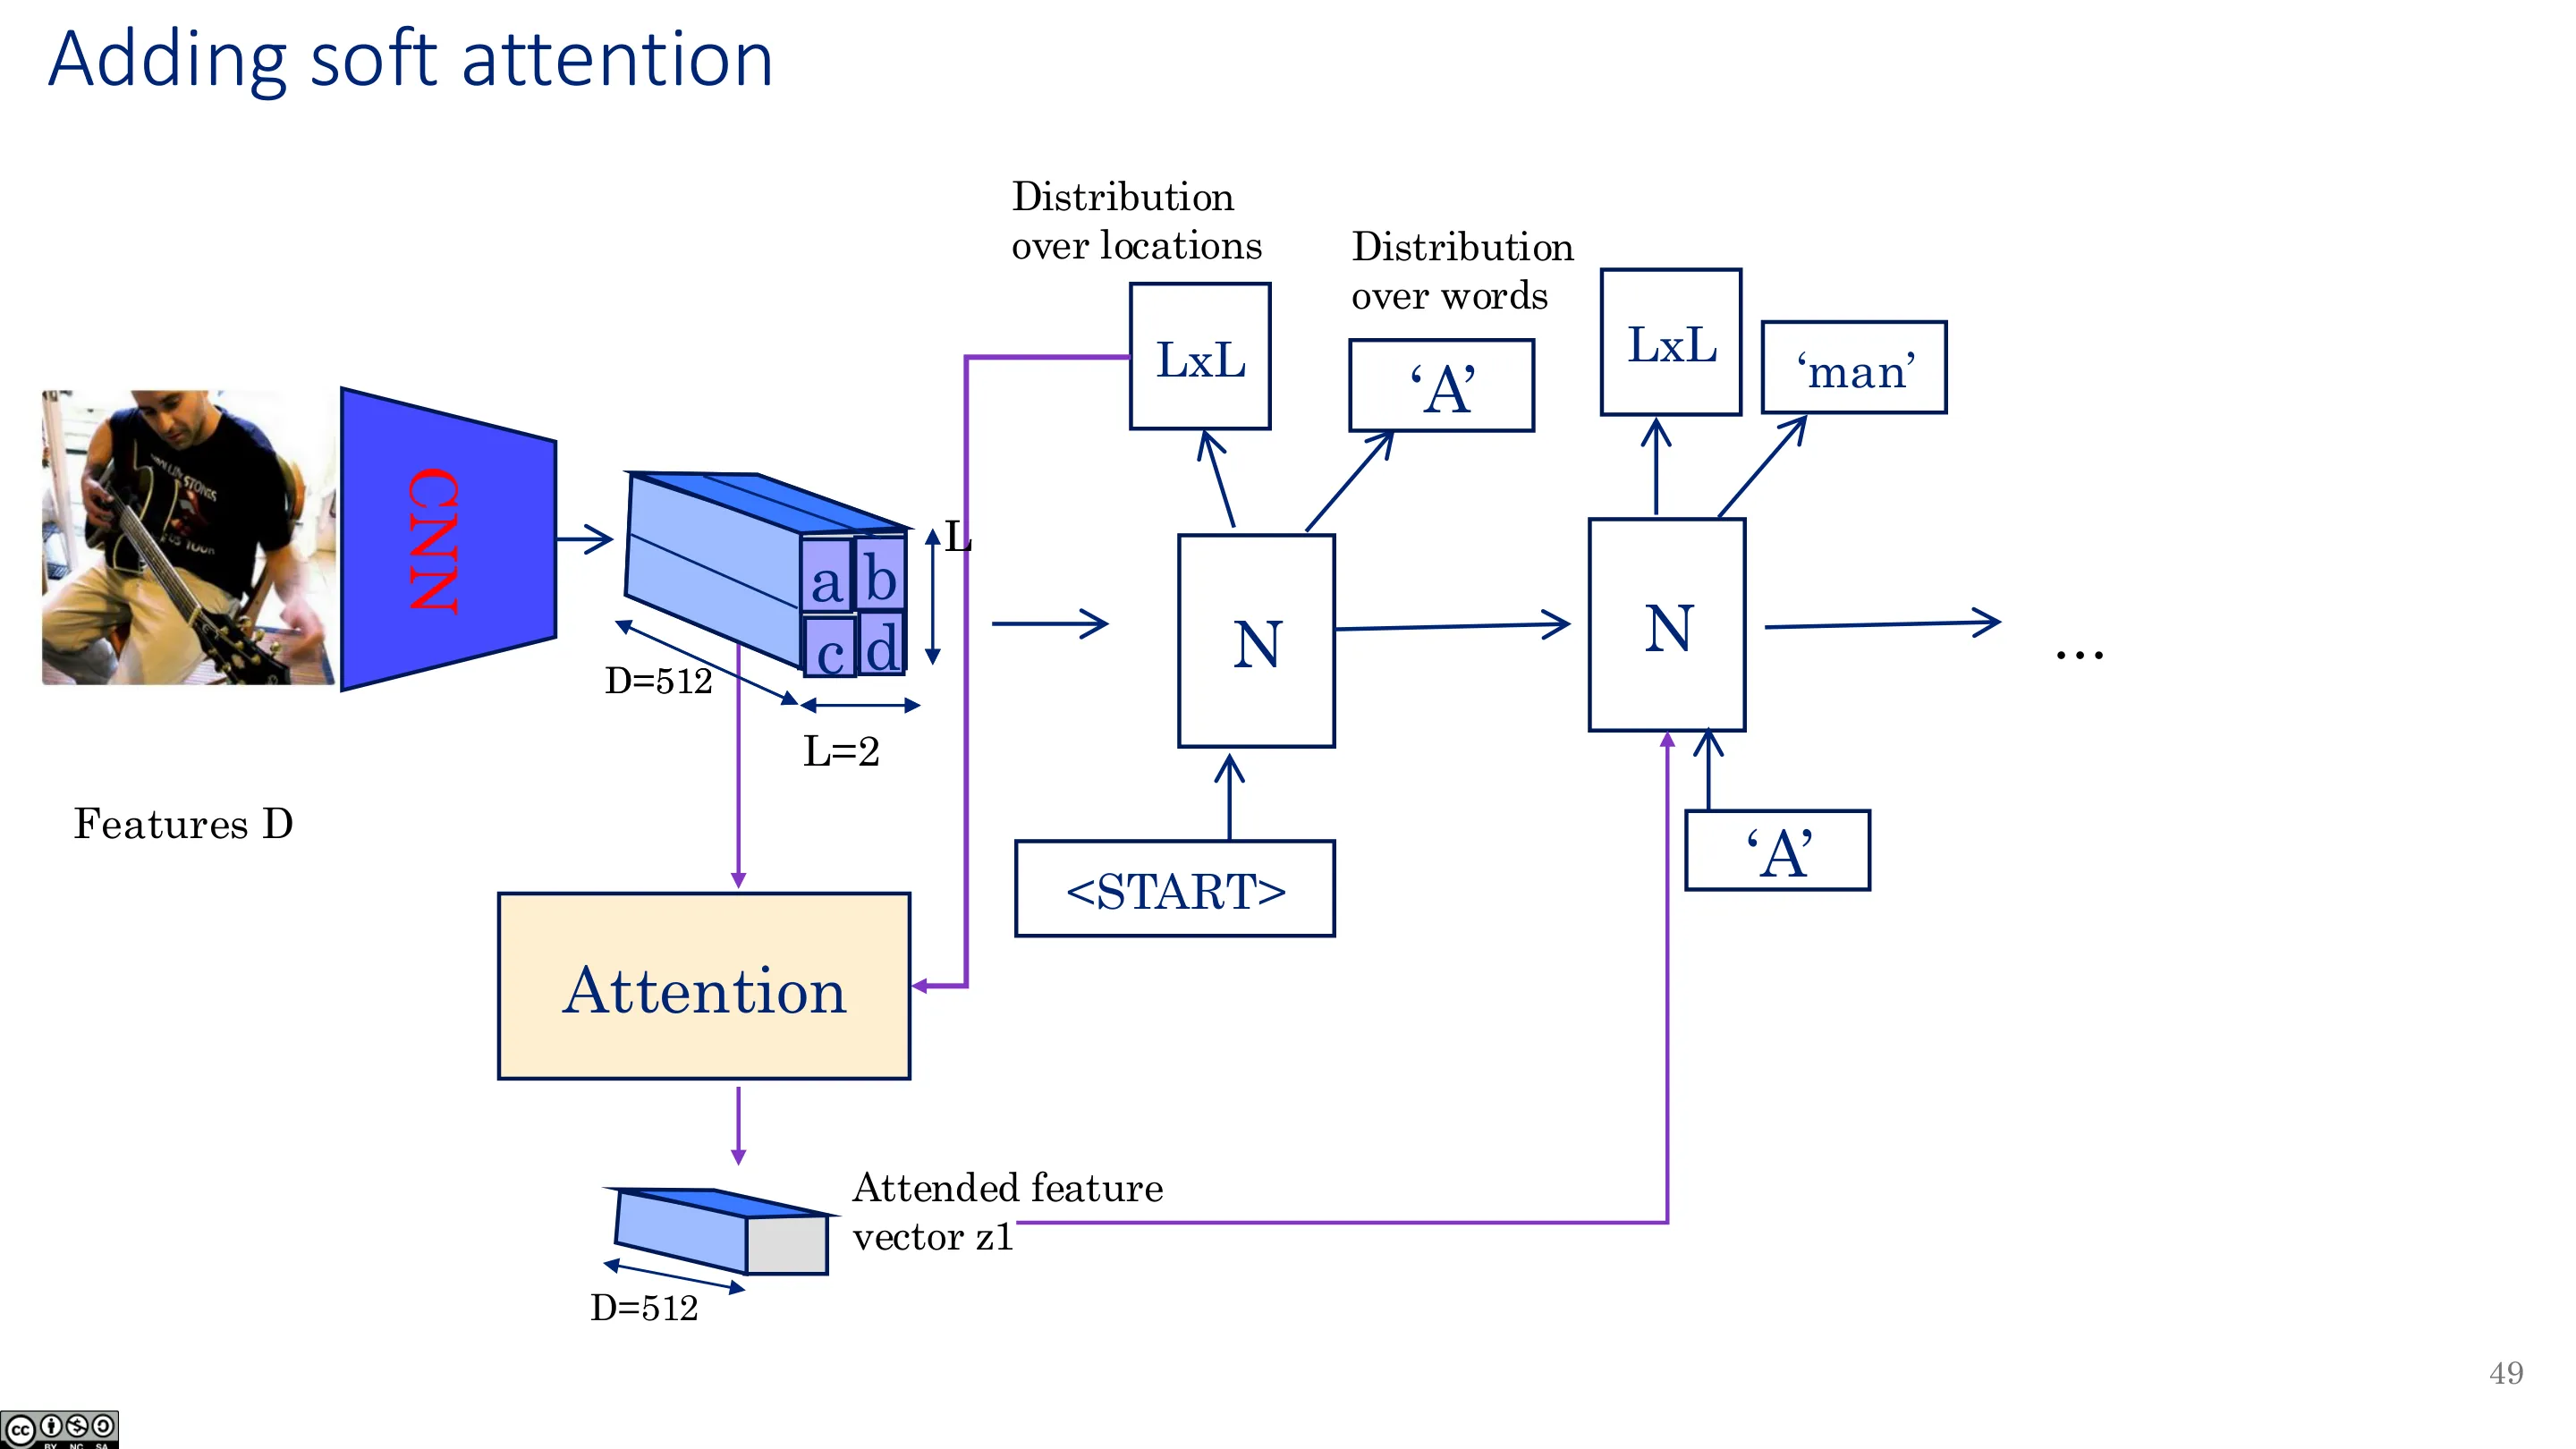
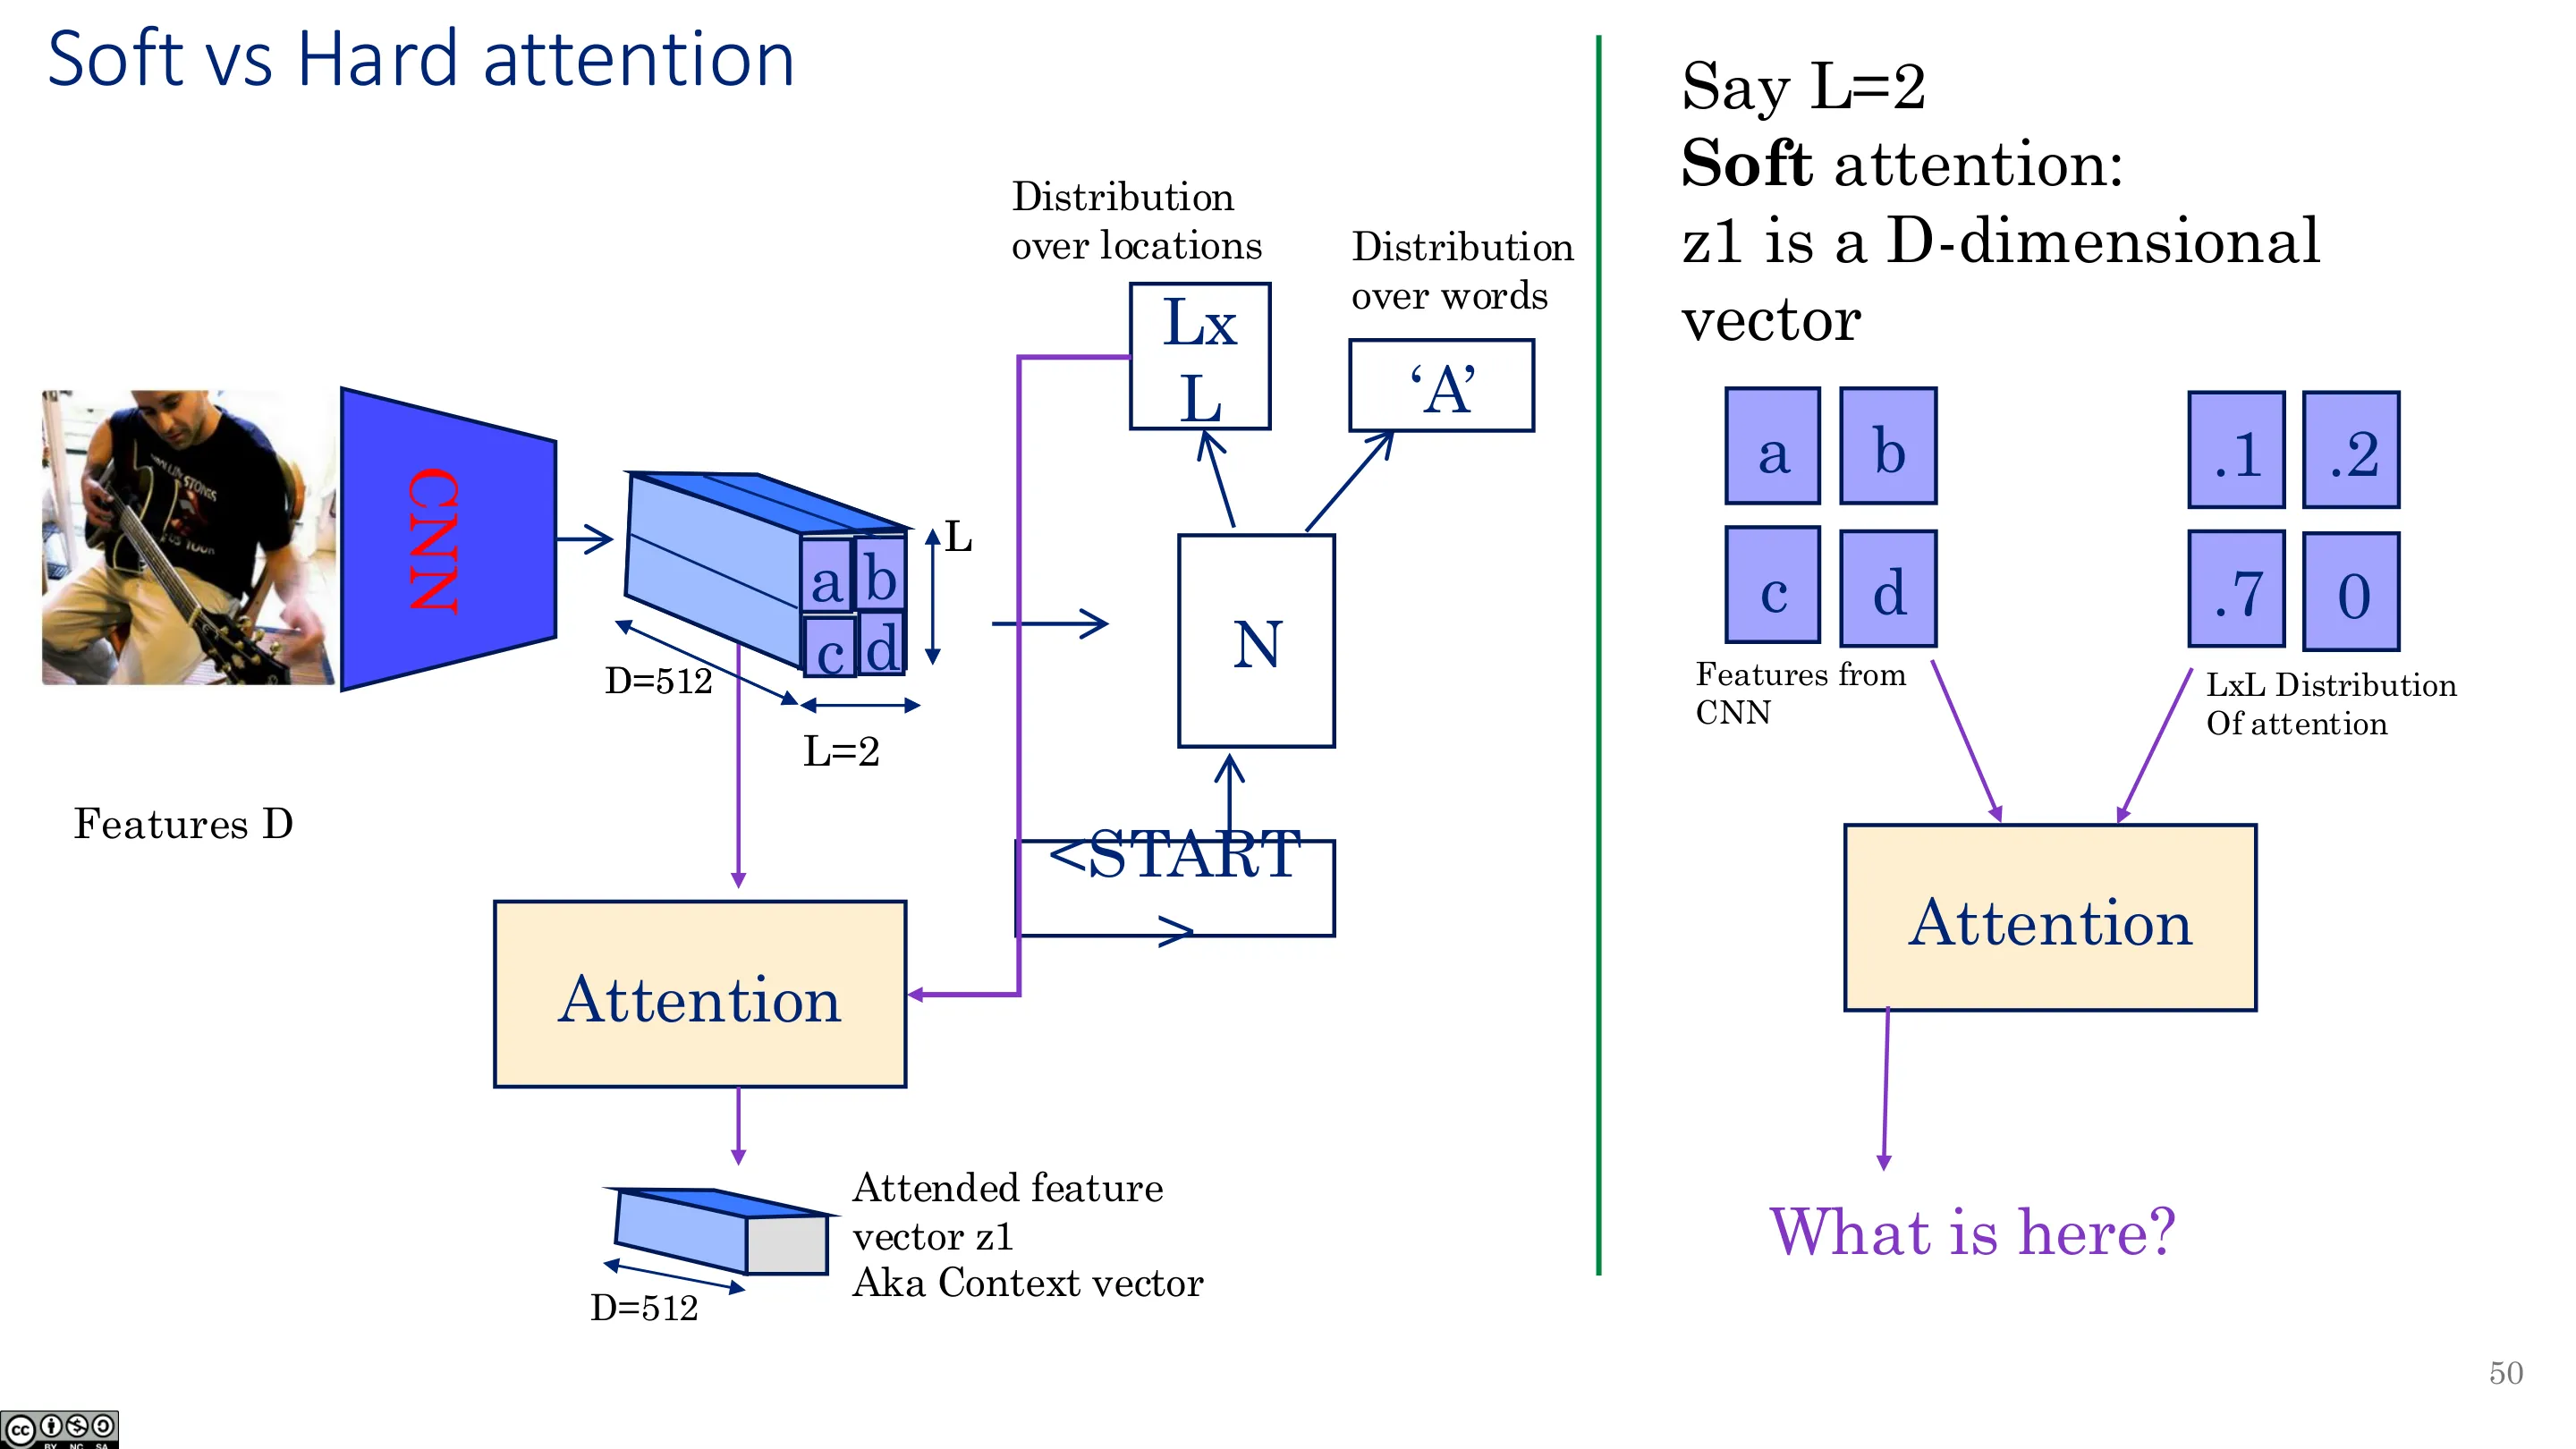
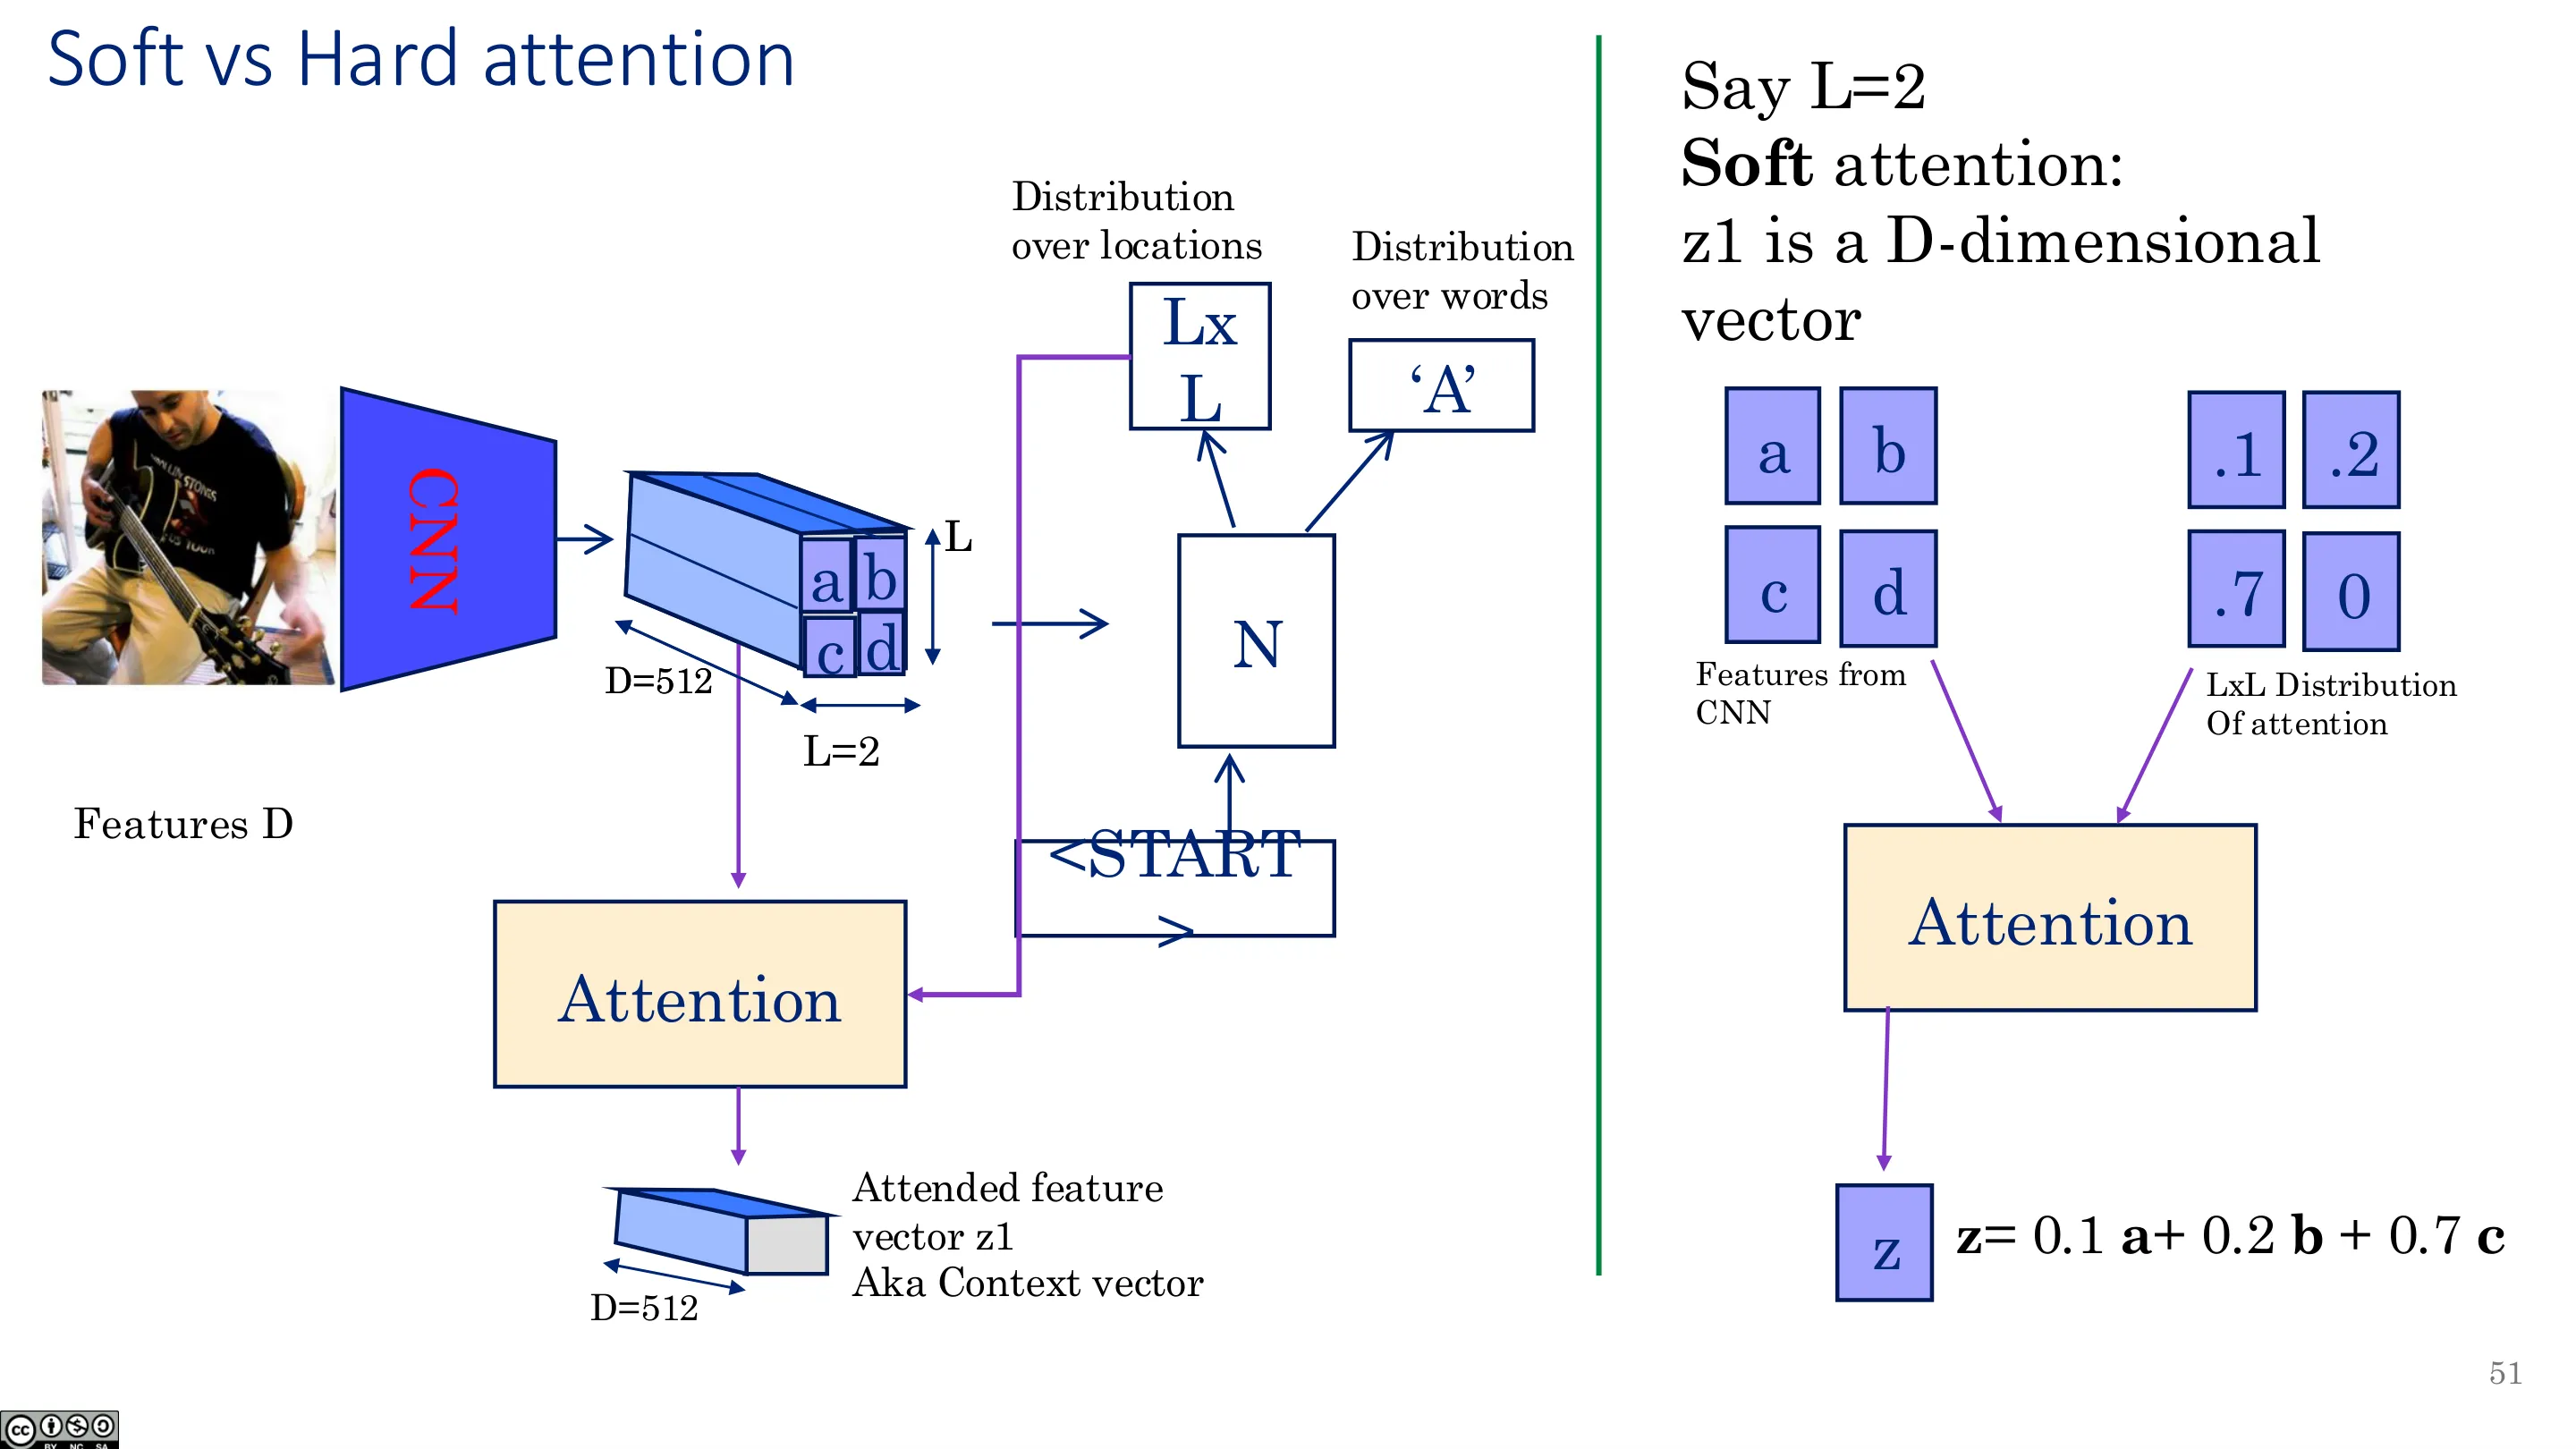
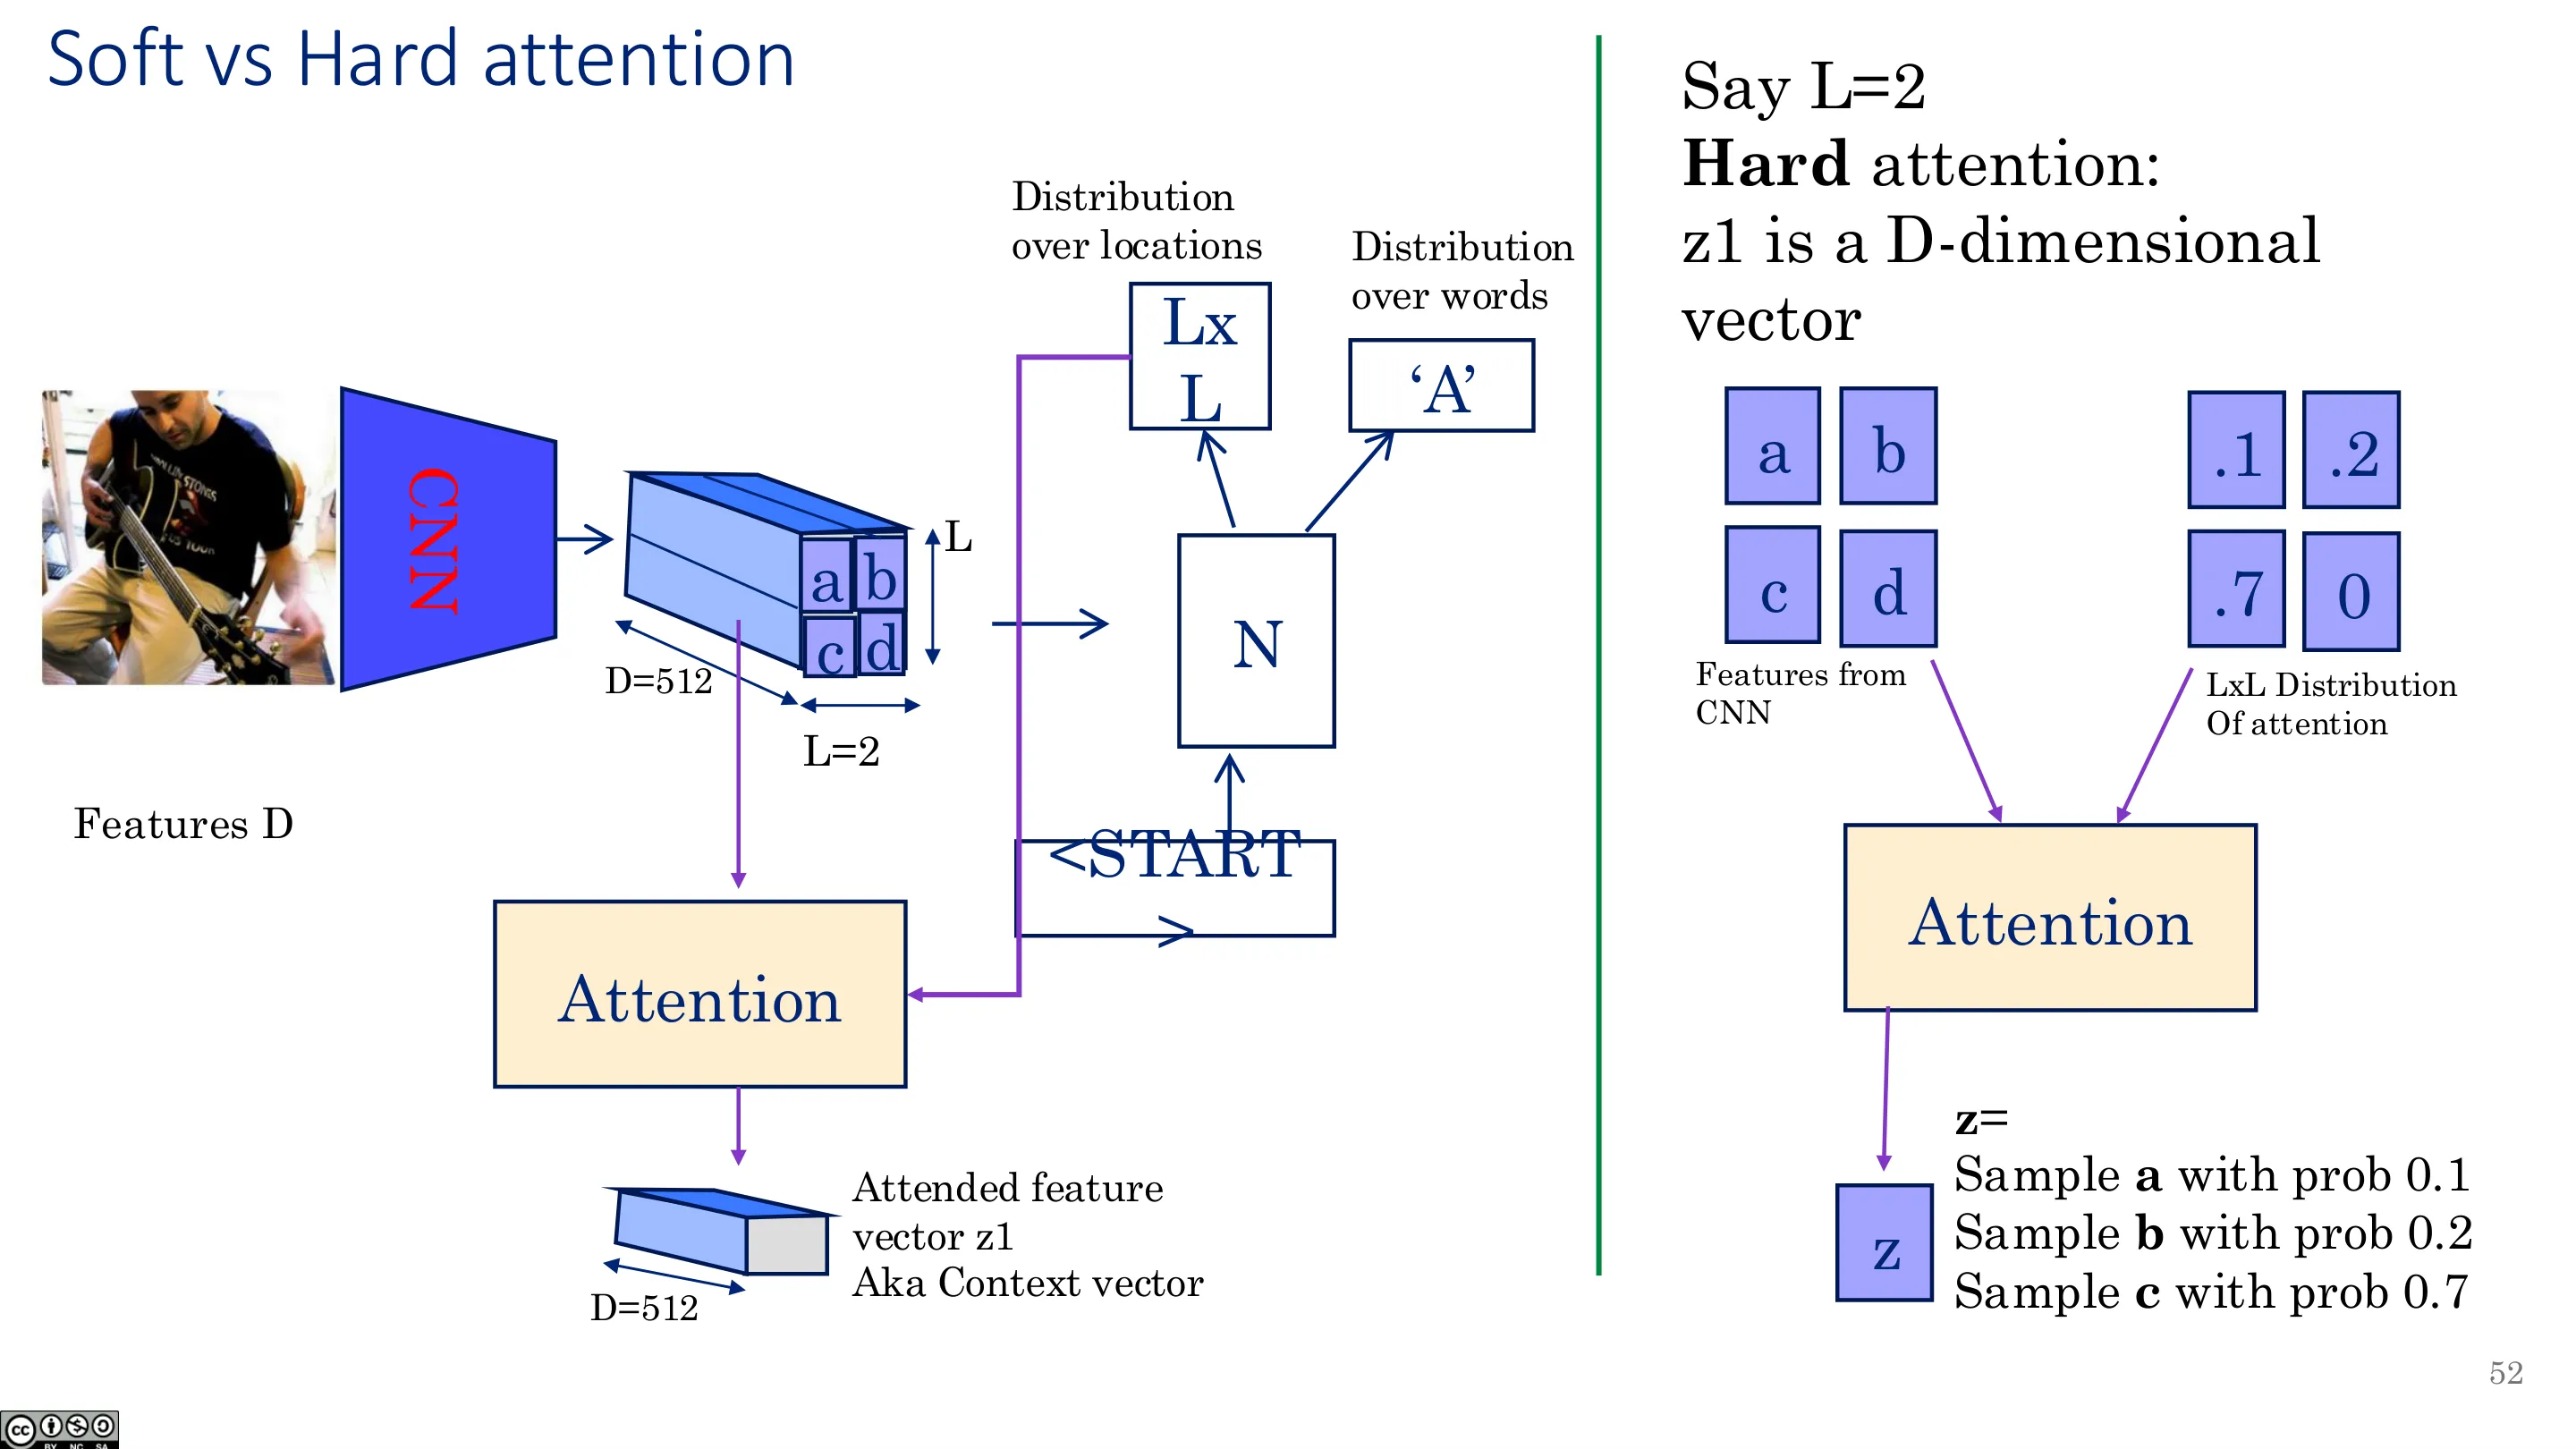
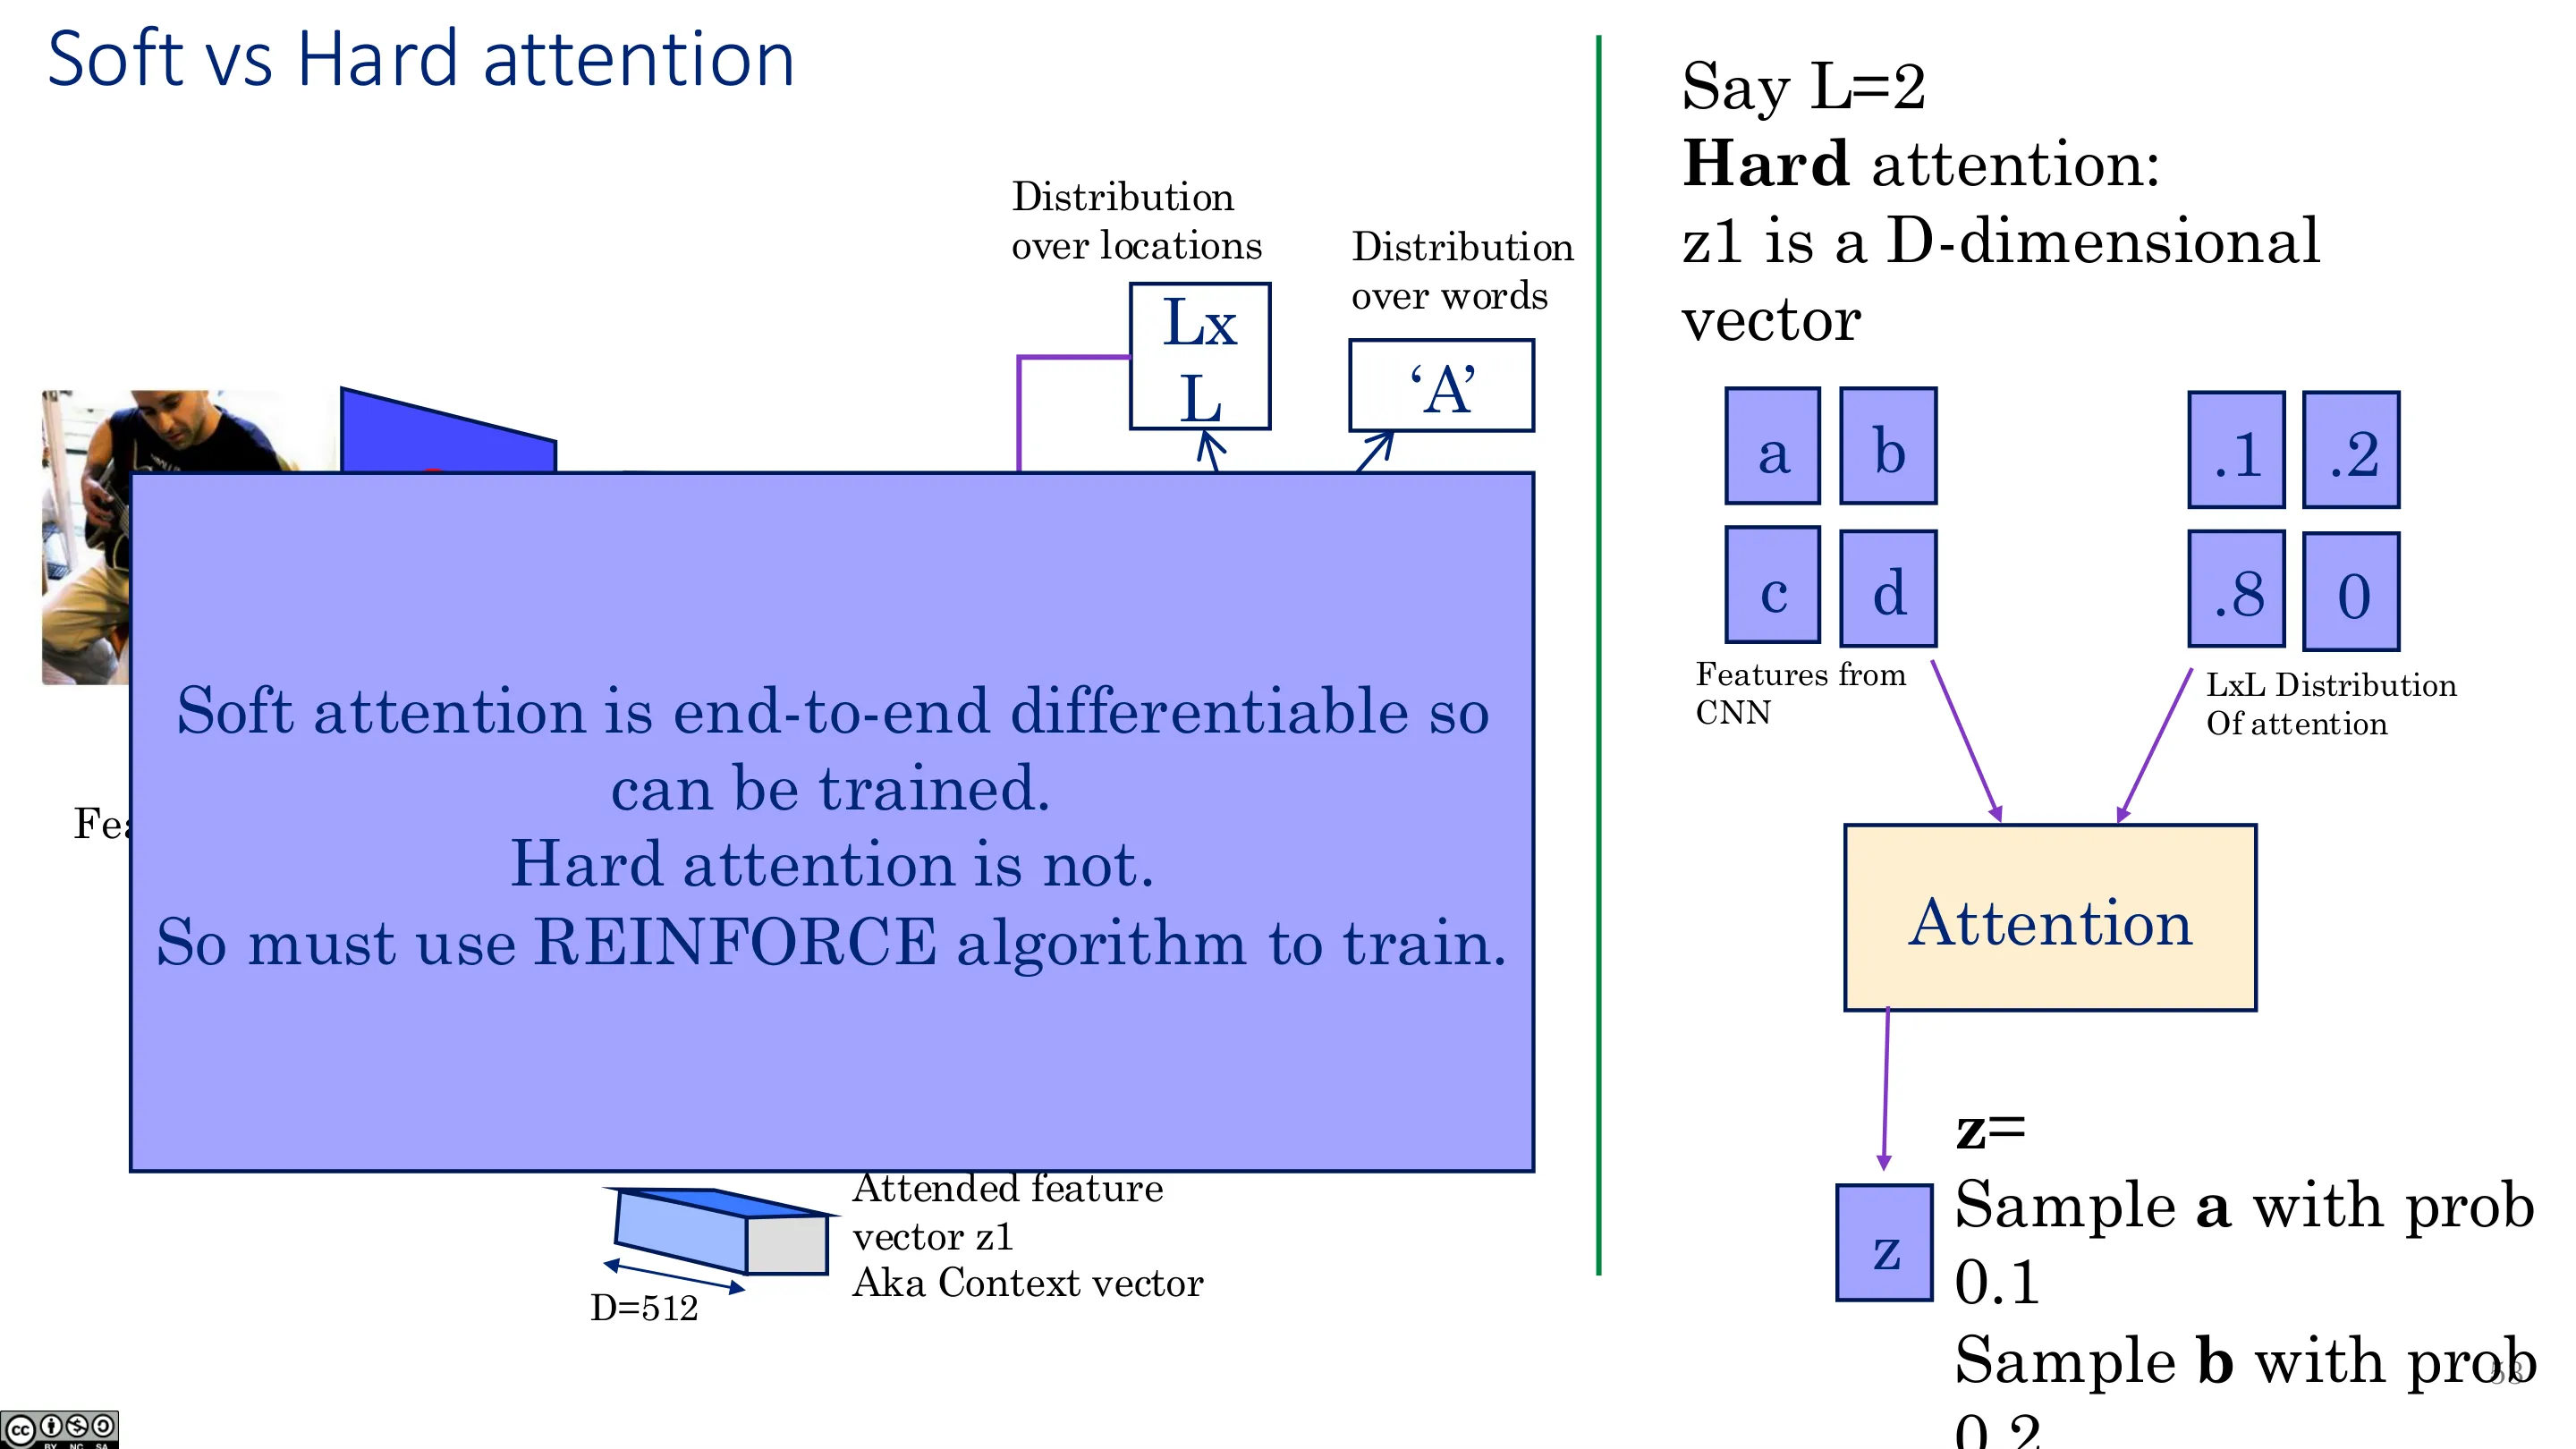
Show, Attend and Tell(ICML 2015,Bahdanau/Bengio 等)在 Show and Tell 的基础上加入注意力:网络除了输出下一个词,还输出一个关于「看哪里」的分布($\ell\times\ell$ 的位置图)。注意力块据此把图像各块的向量加权组合成上下文向量(attended features)$z$。
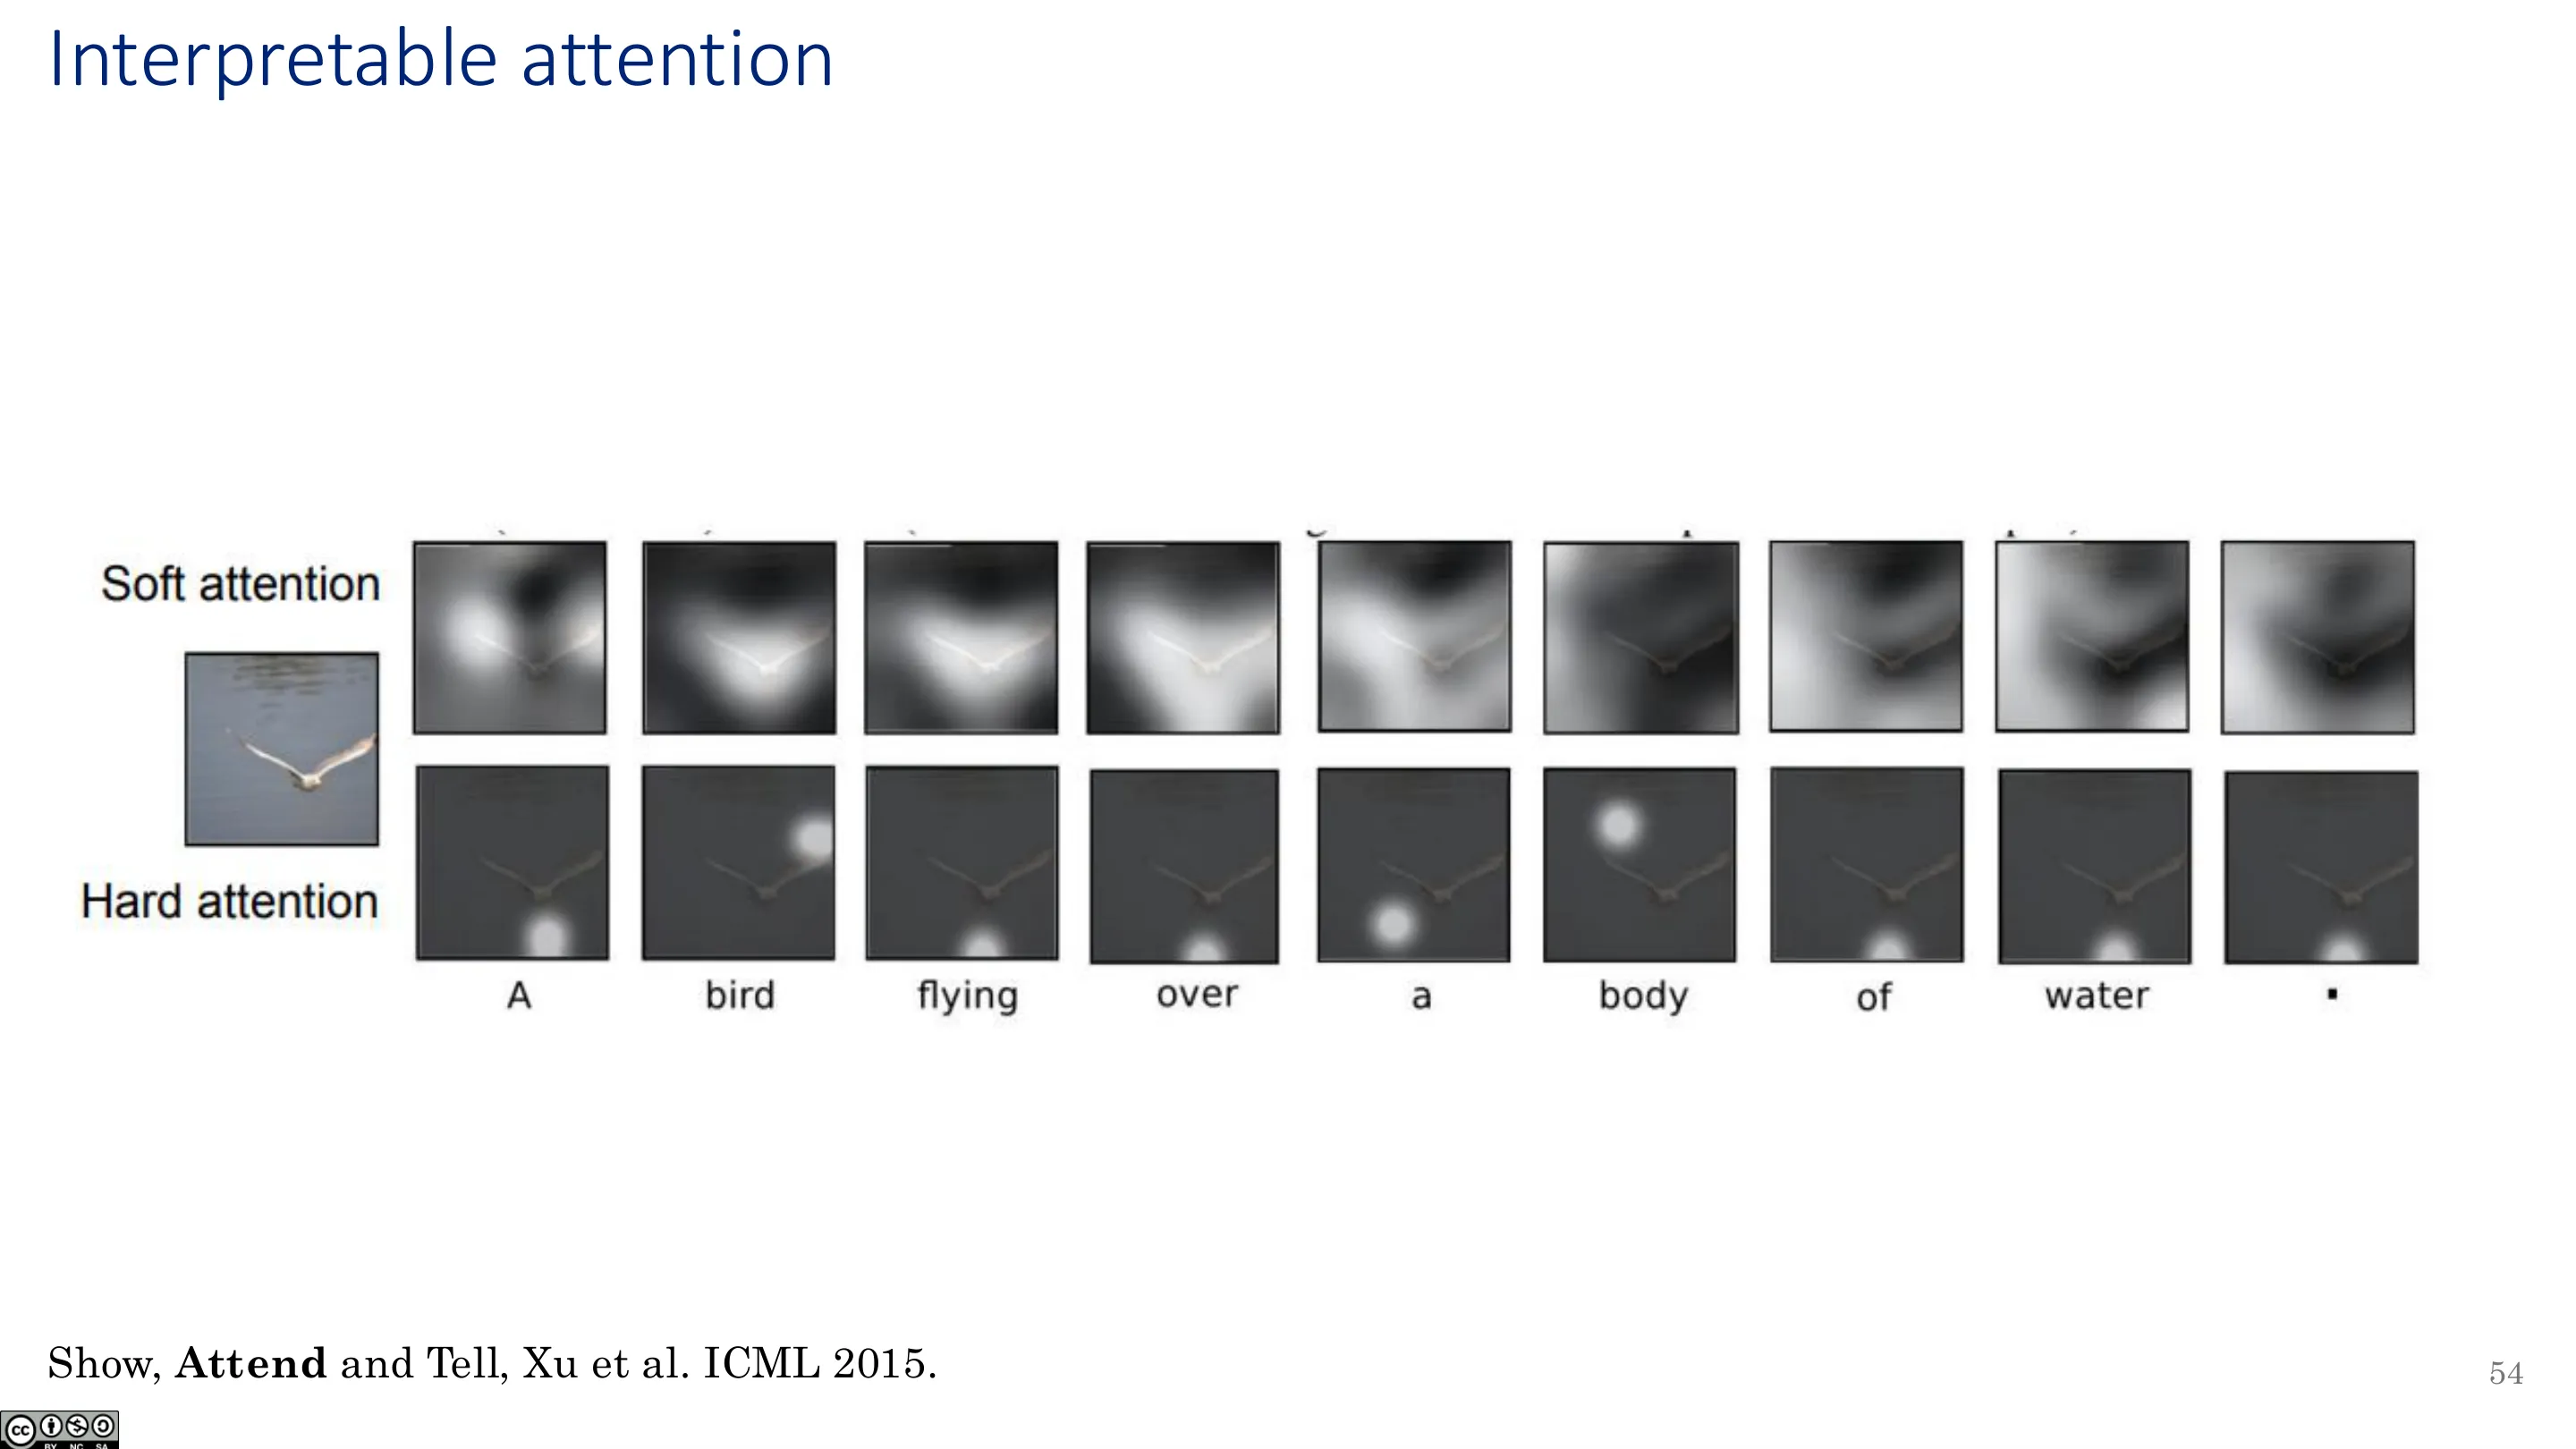
- Soft attention:对位置分布做加权平均(可微,直接反向传播);
- Hard attention:按位置分布采样一个位置(随即取其一,随机、需 REINFORCE 等)。
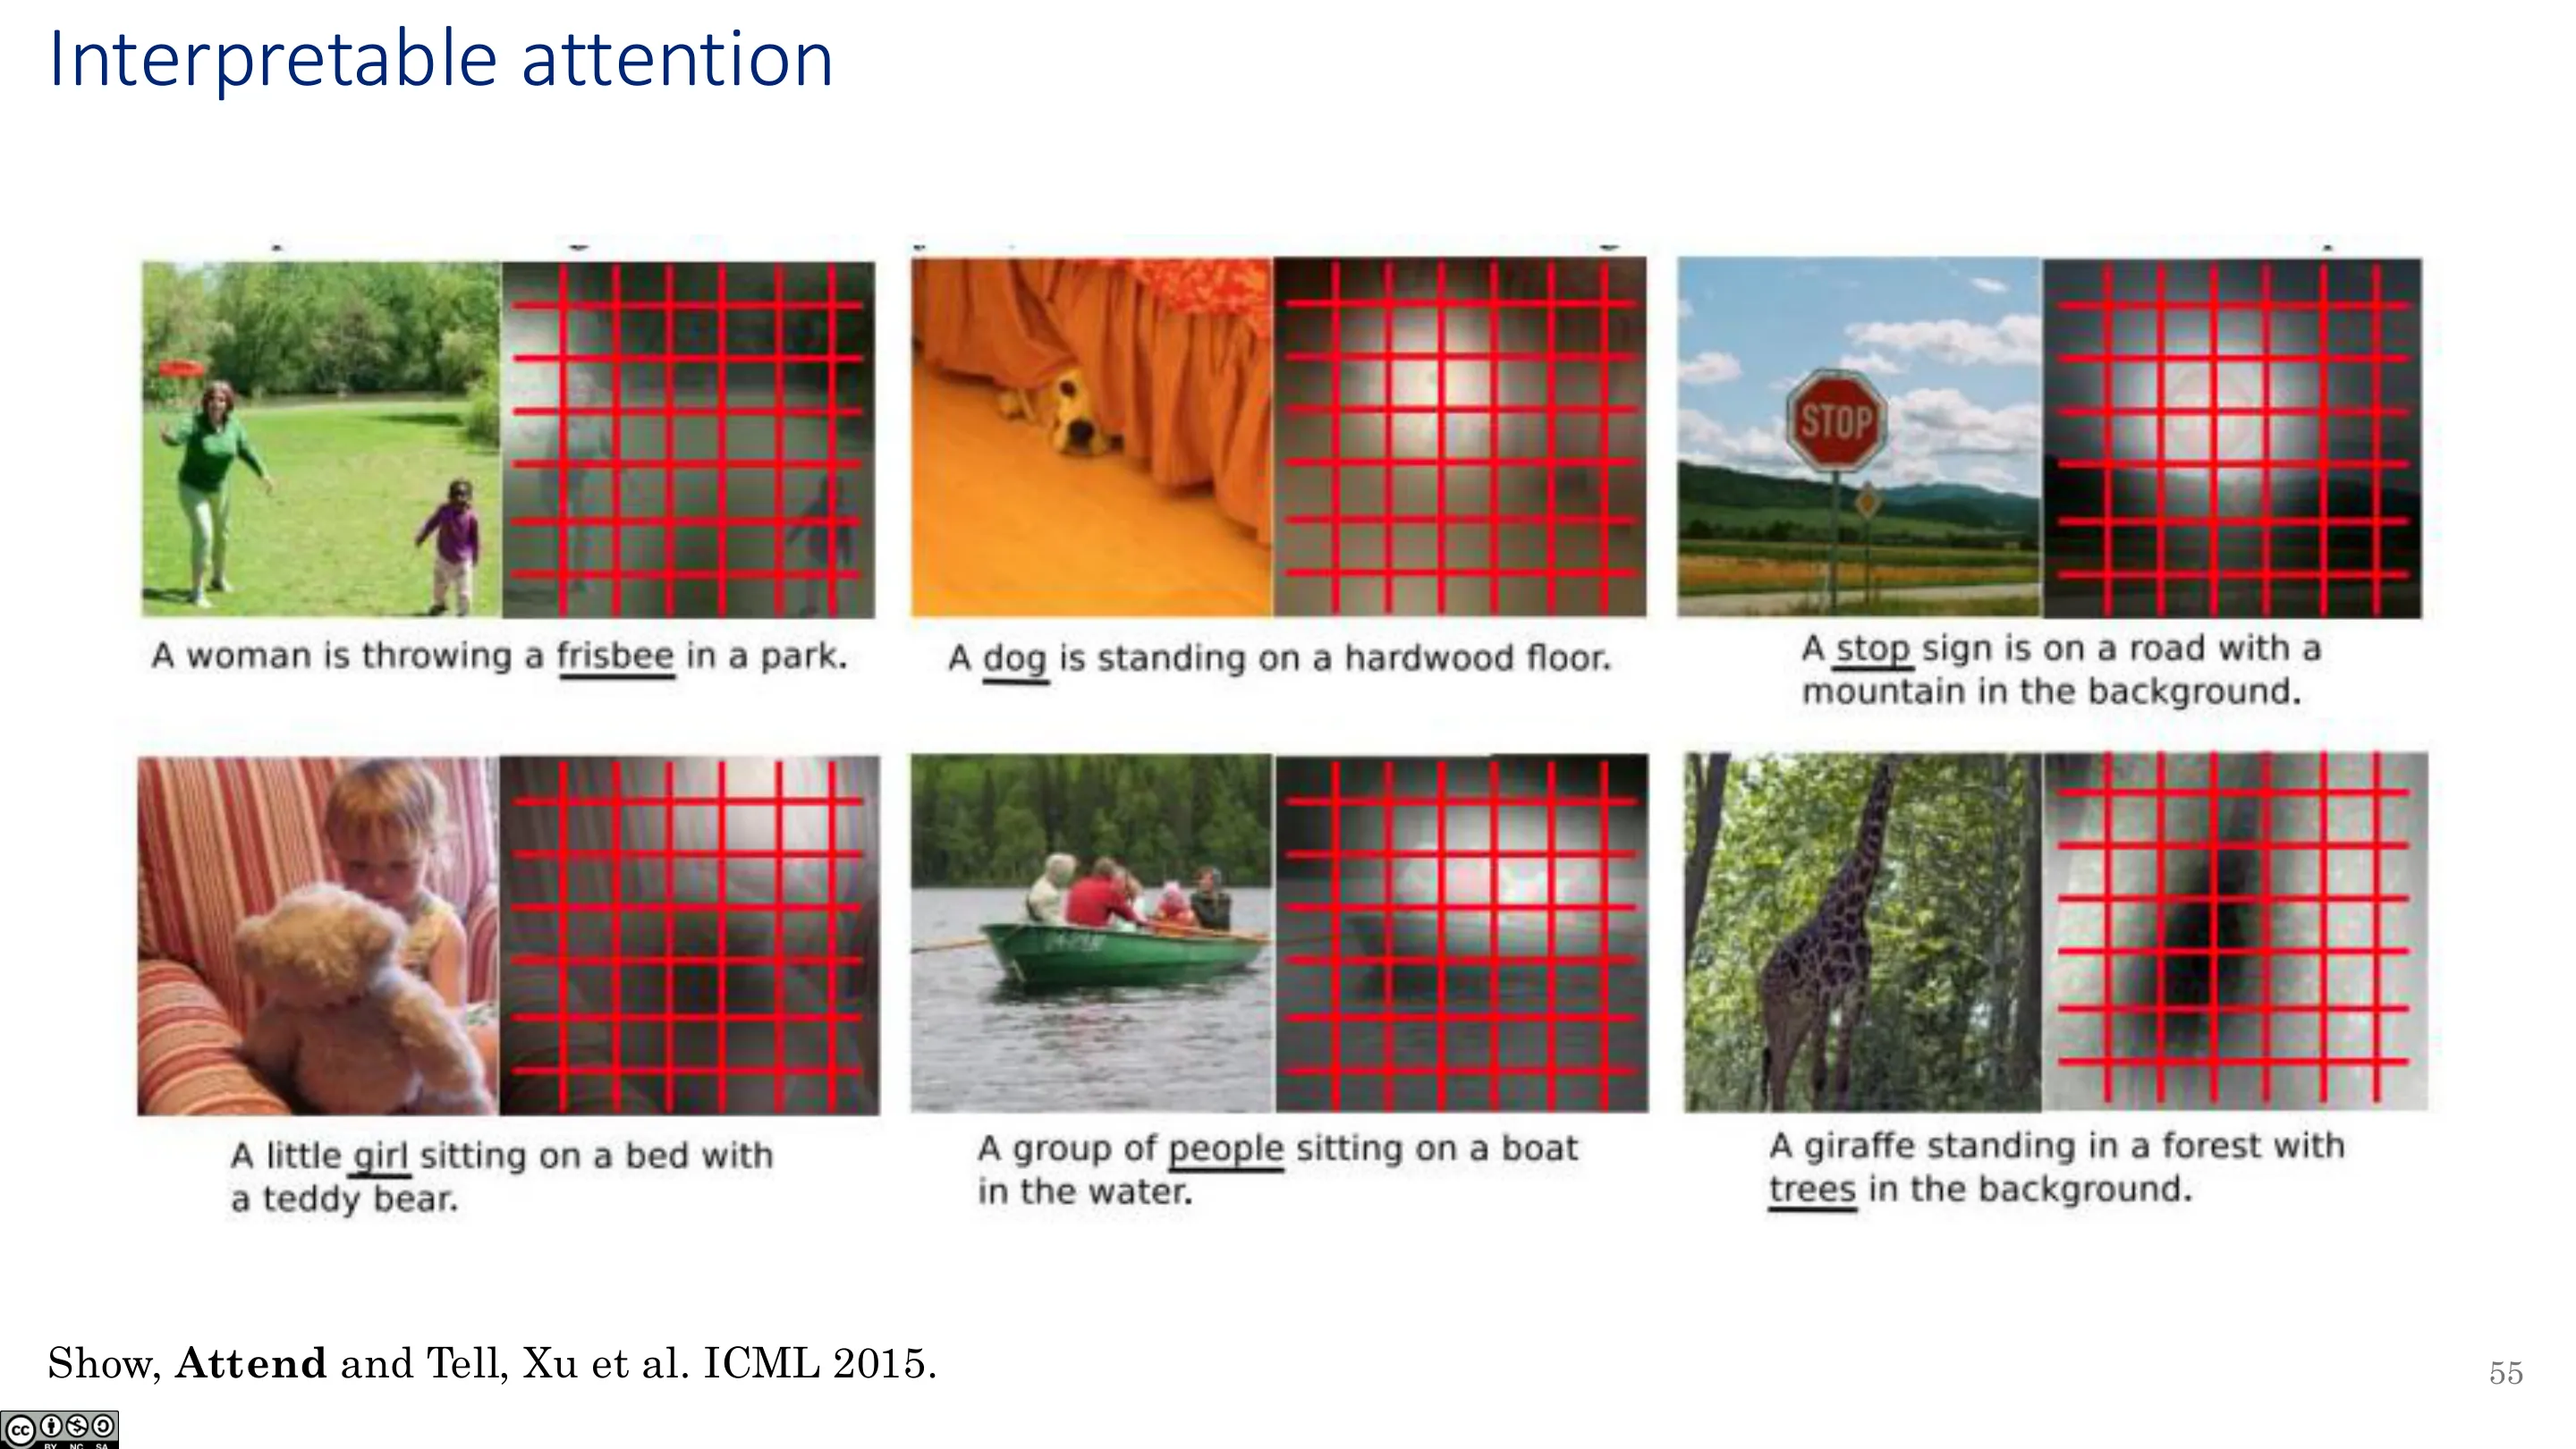
可解释性:训练后,位置图自动学到在说 "bird" 时看鸟、说 "water" 时看水——完全由梯度下降学出,没人手工标注位置。
📷 加入软注意力(一)
回到原视频 (00:57:31)
📷 加入软注意力(二)
回到原视频 (00:58:44)
📷 软注意力 vs 硬注意力(一)
回到原视频 (00:59:57)
📷 软注意力 vs 硬注意力(二)
回到原视频 (01:01:10)
📷 软注意力 vs 硬注意力(三)
回到原视频 (01:02:23)
📷 软注意力 vs 硬注意力(四)
回到原视频 (01:03:36)
📷 可解释的注意力(一)
回到原视频 (01:04:49)
📷 可解释的注意力(二)
回到原视频 (01:06:02)
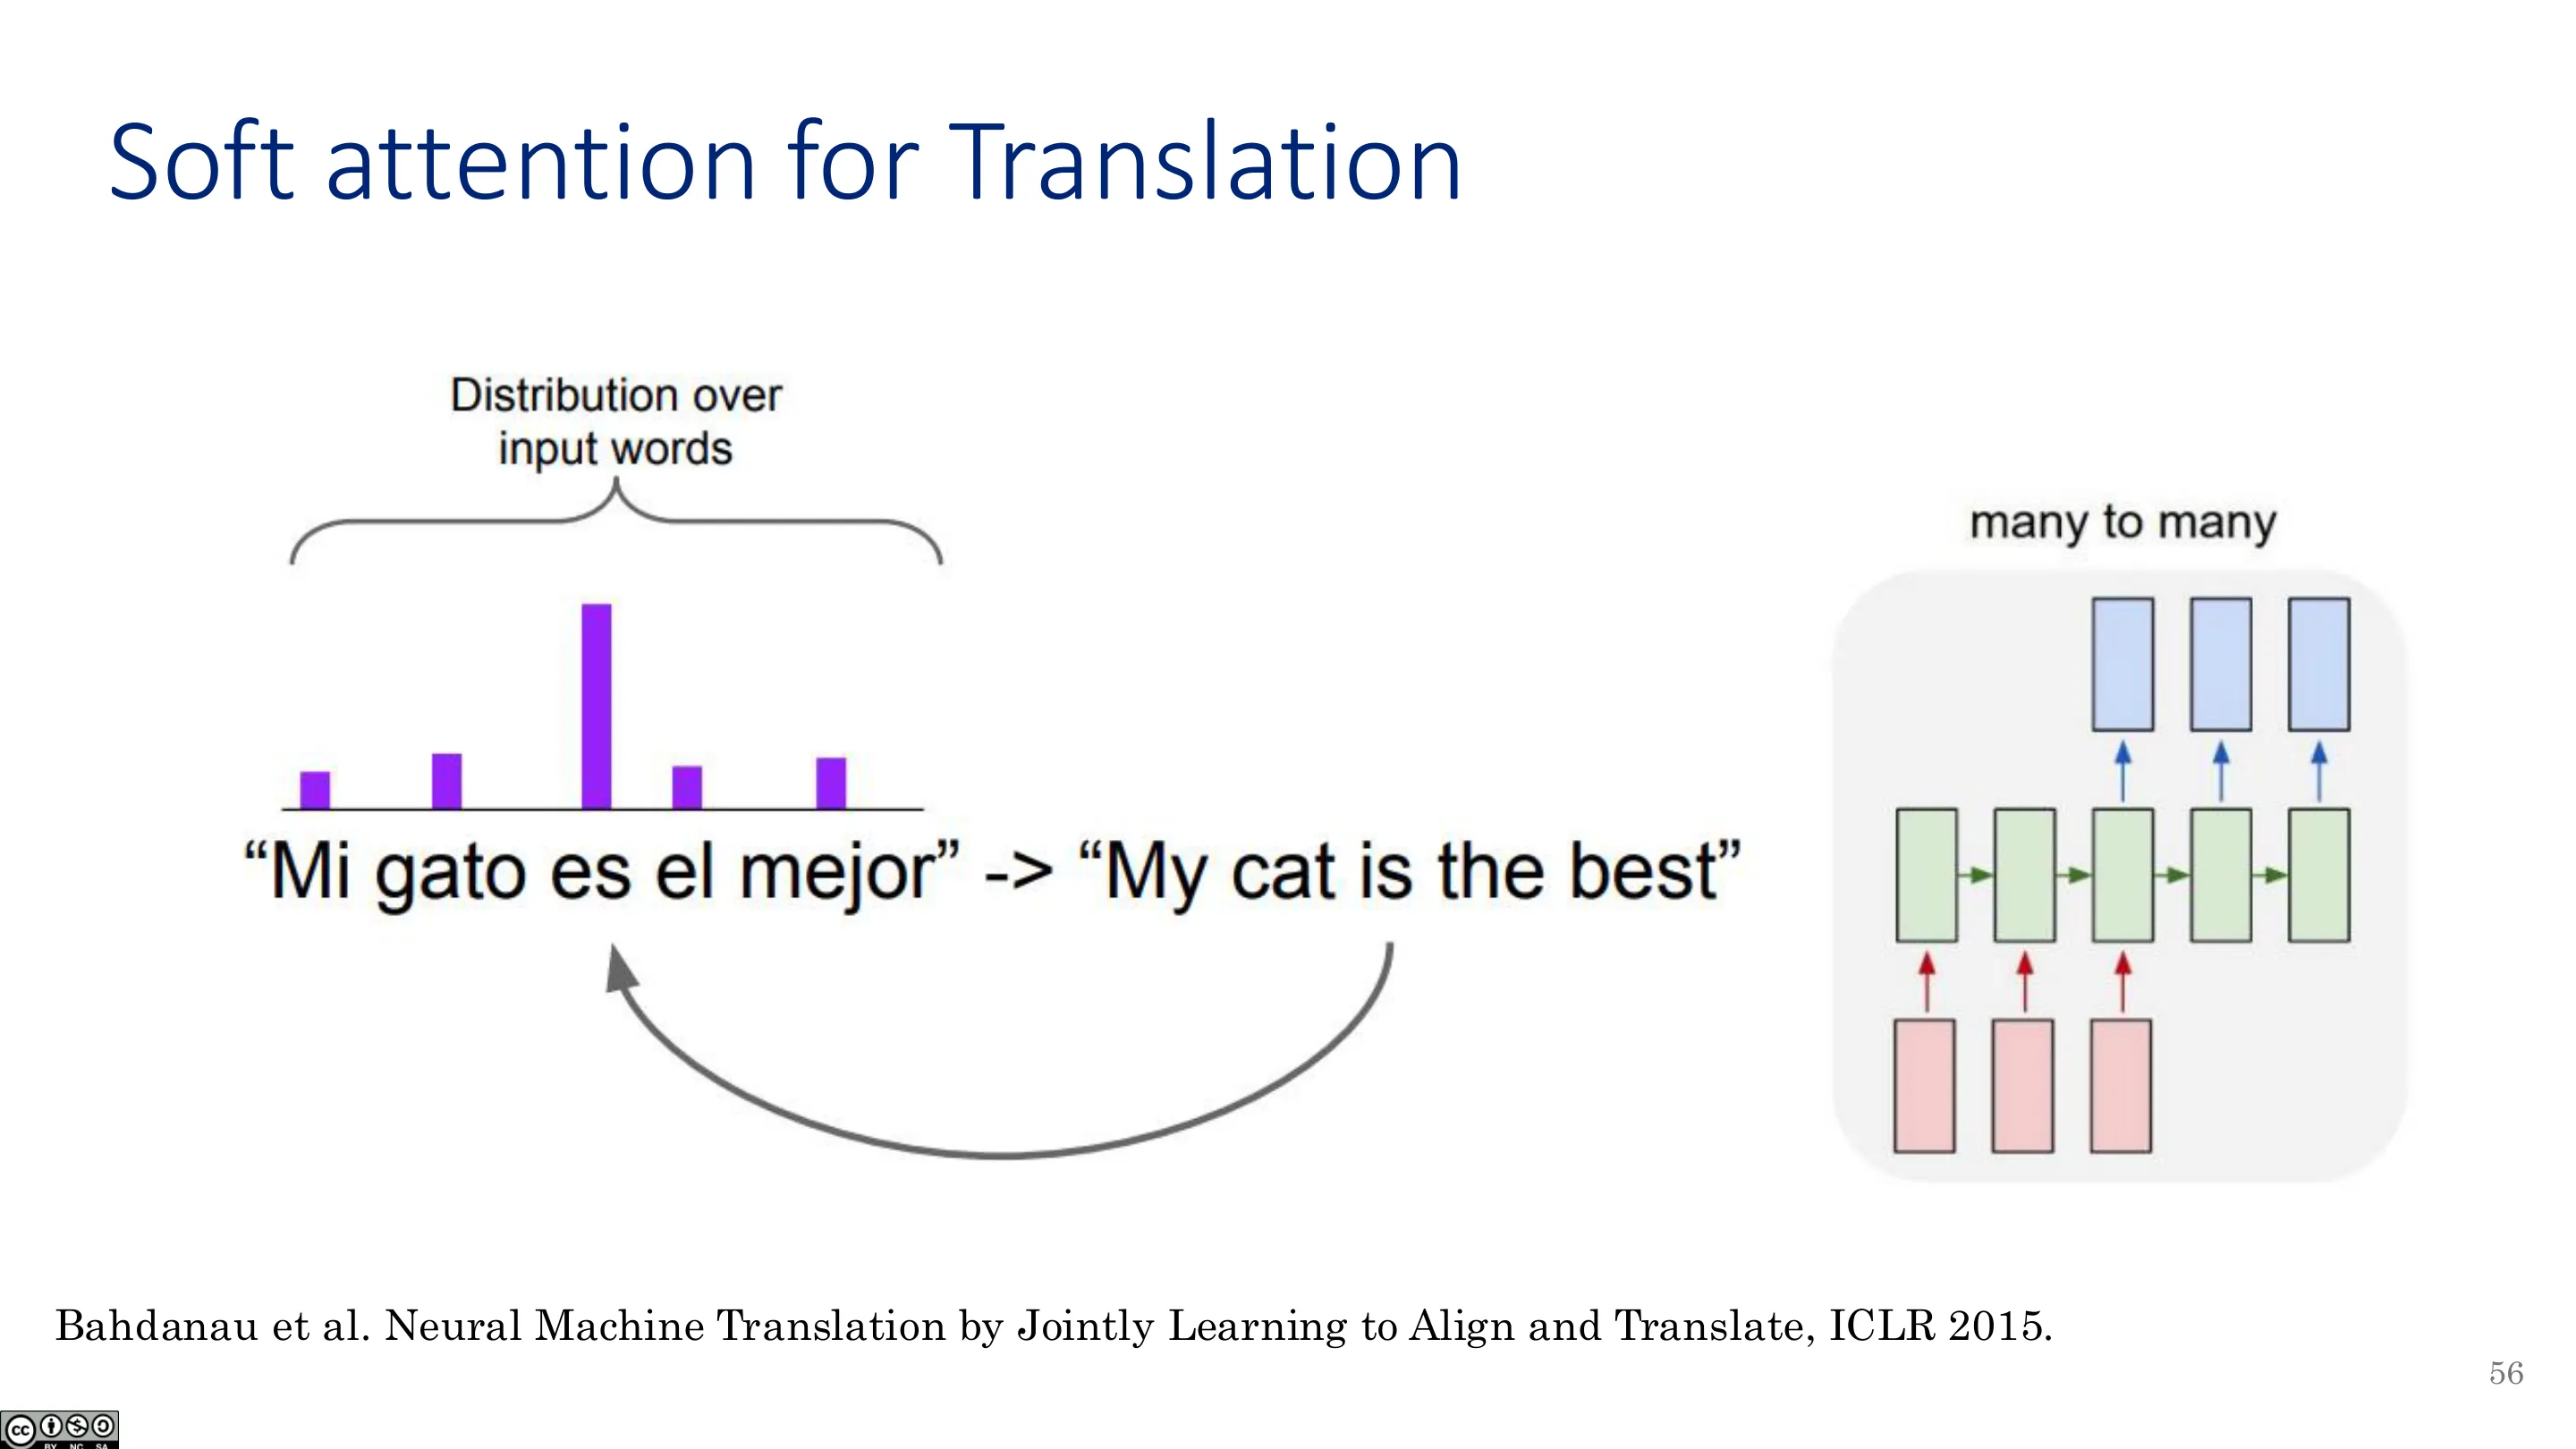
用于翻译:输入西语、输出英语,网络每吐一个词就产生一个关于输入词的位置分布(注意力)——这是注意力最早的应用(Bahdanau 等 2014/2015)。
📷 用于翻译的软注意力
回到原视频 (01:07:15)
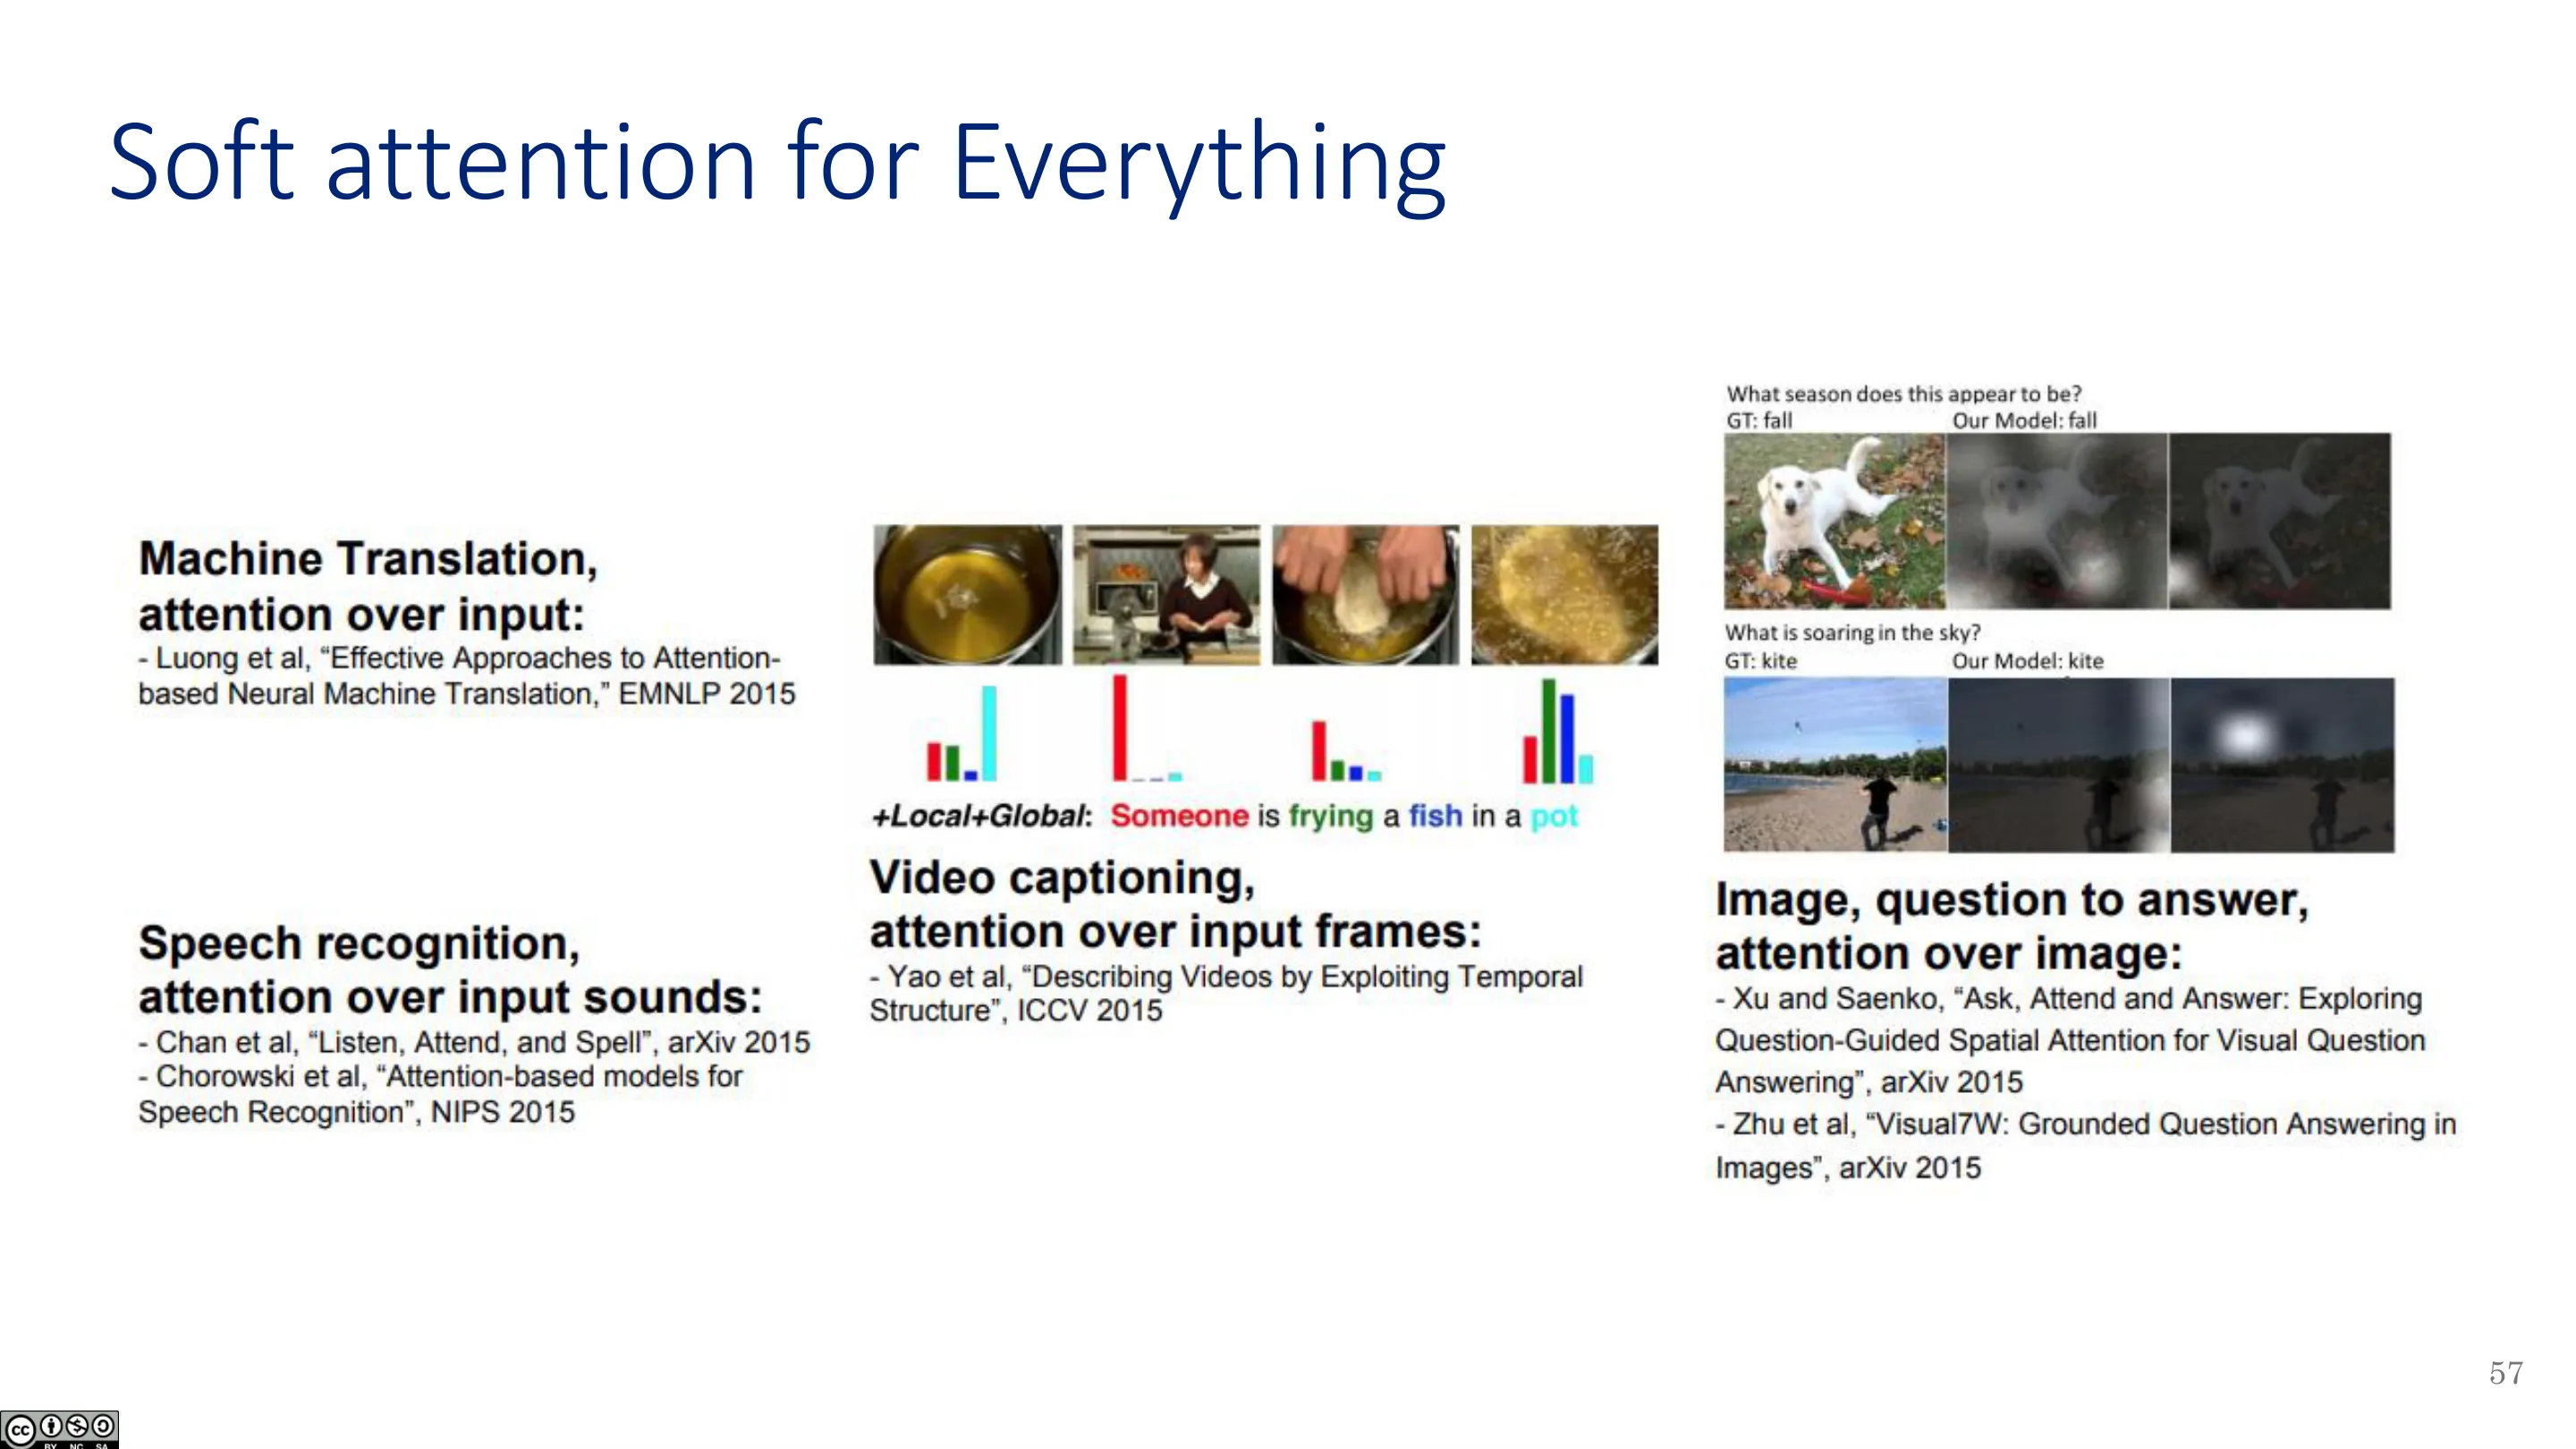
📷 软注意力用于一切
回到原视频 (01:08:28)
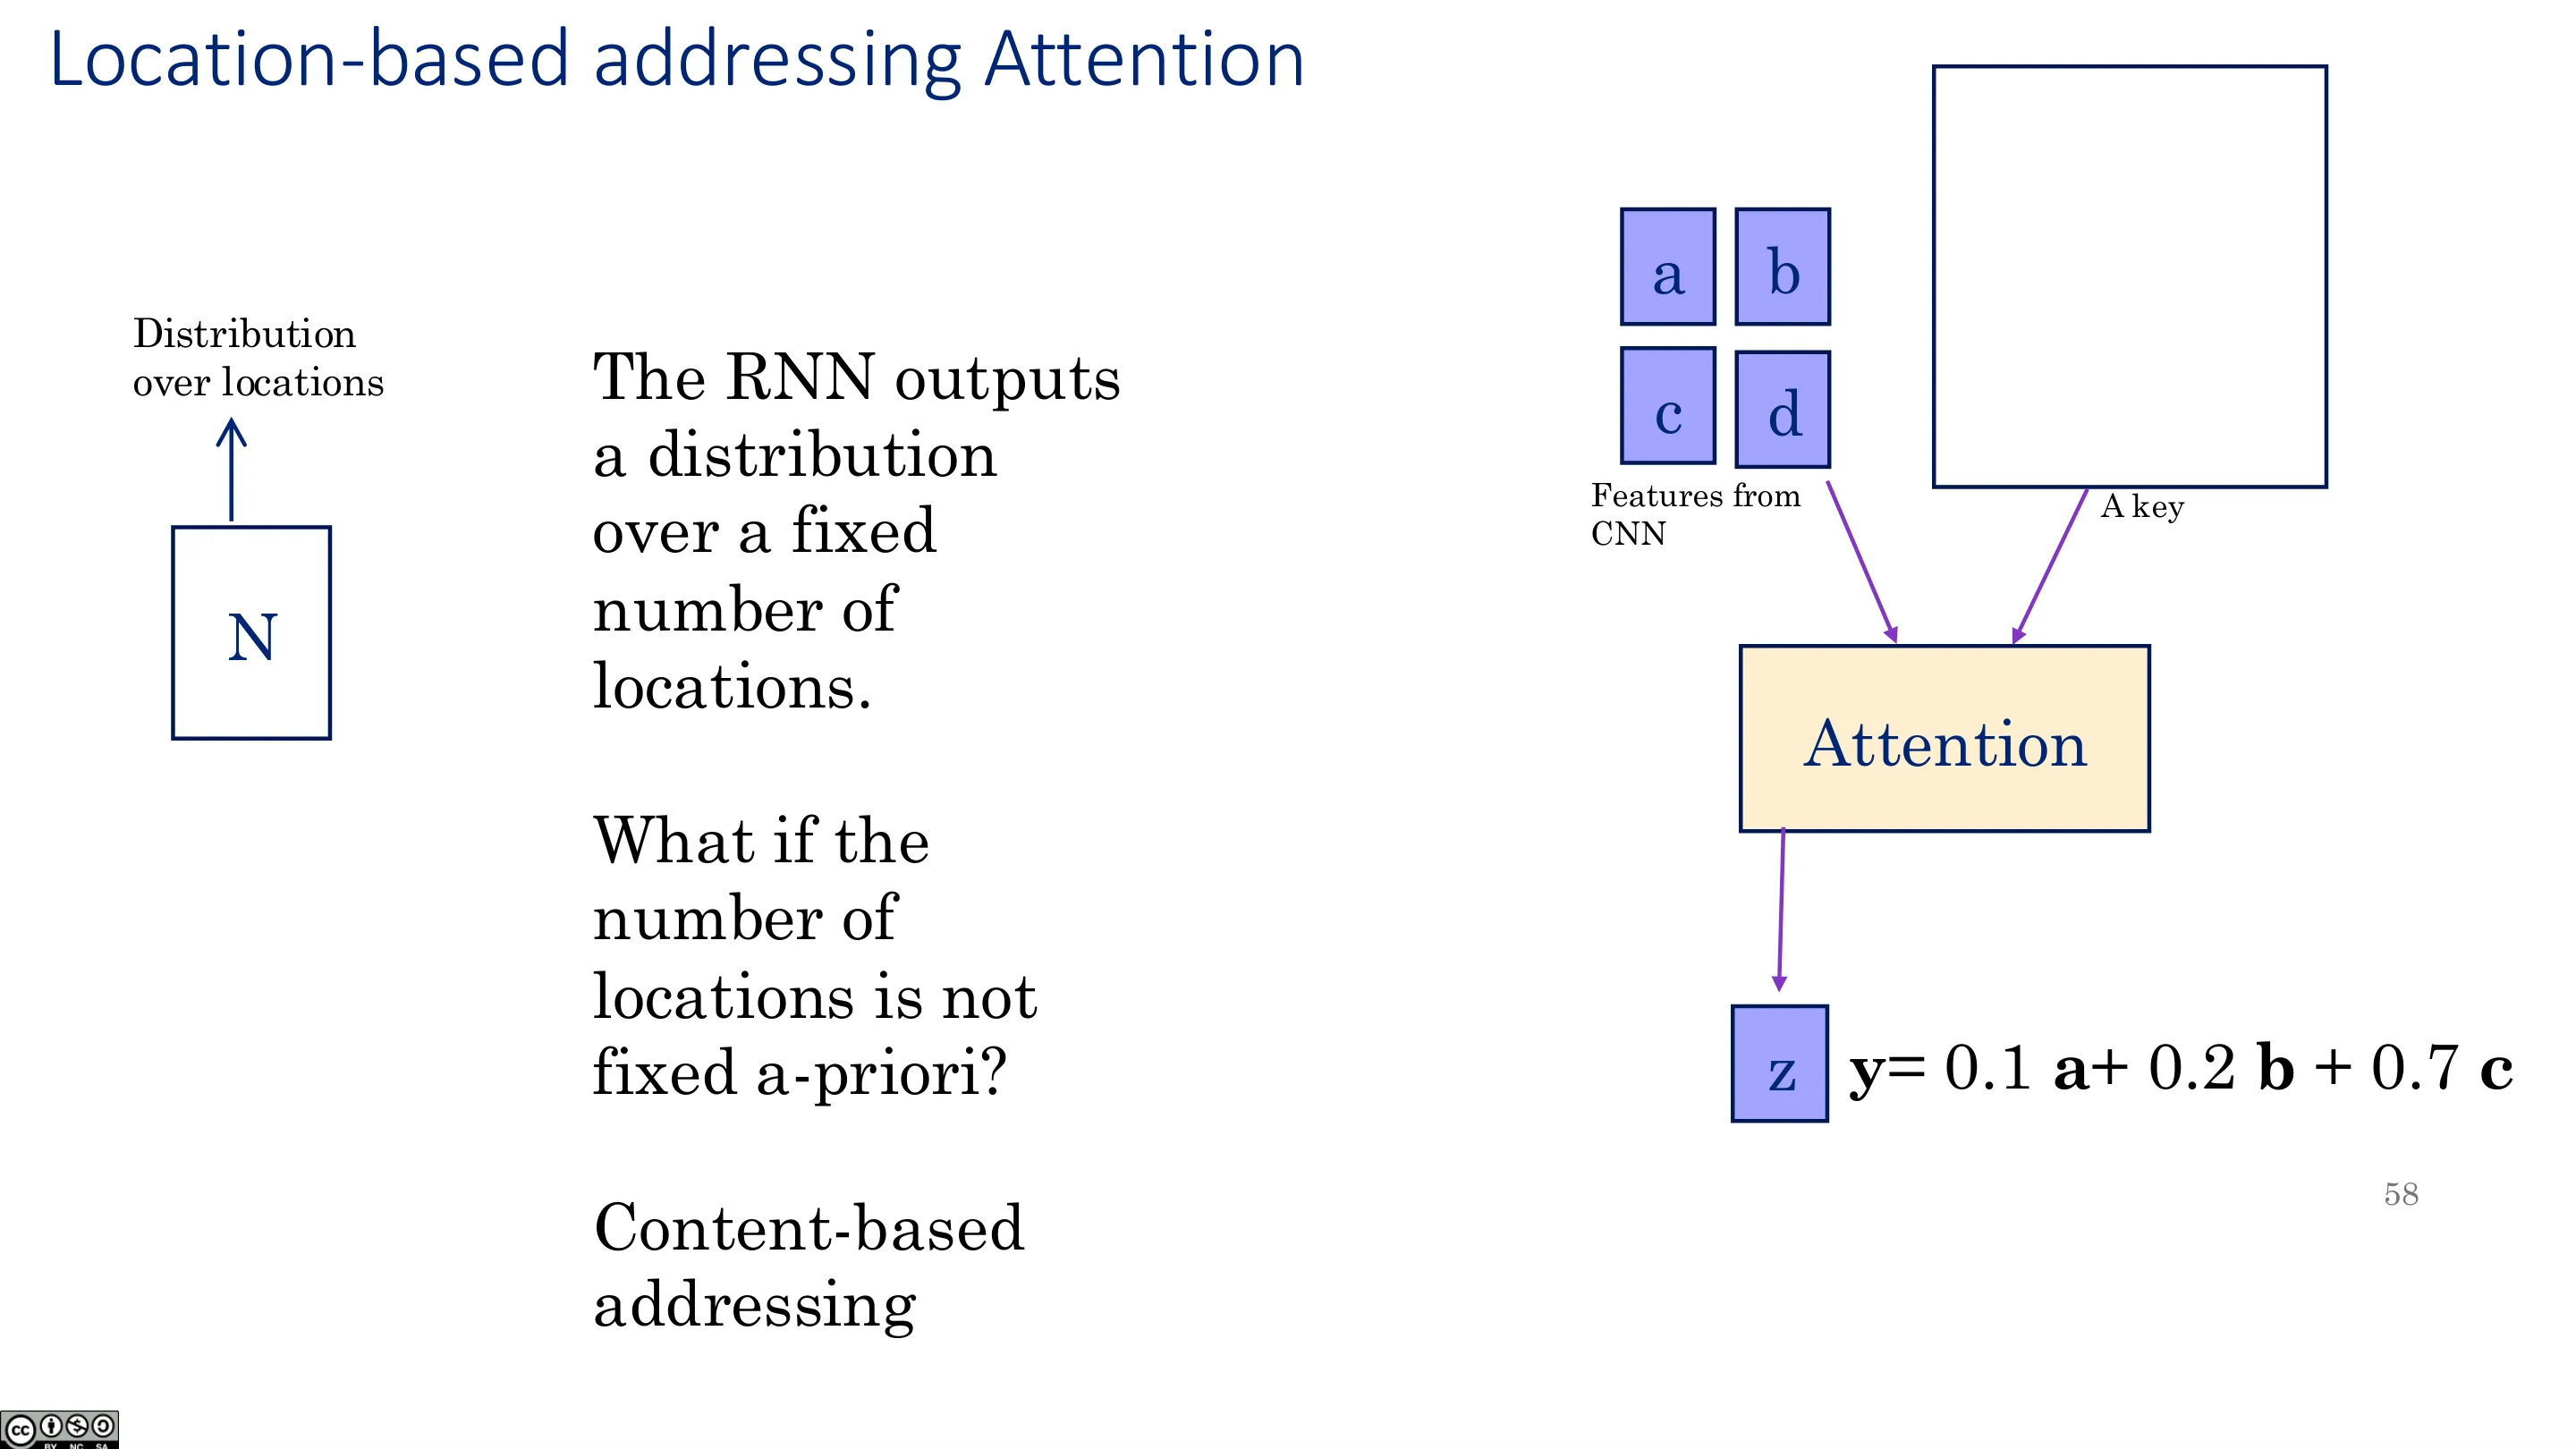
📷 基于位置的寻址注意力
回到原视频 (01:09:41)
📷 (本讲讲到此处)
回到原视频 (01:10:54)
4.2 基于内容的注意力
(参考时间: 01:01)
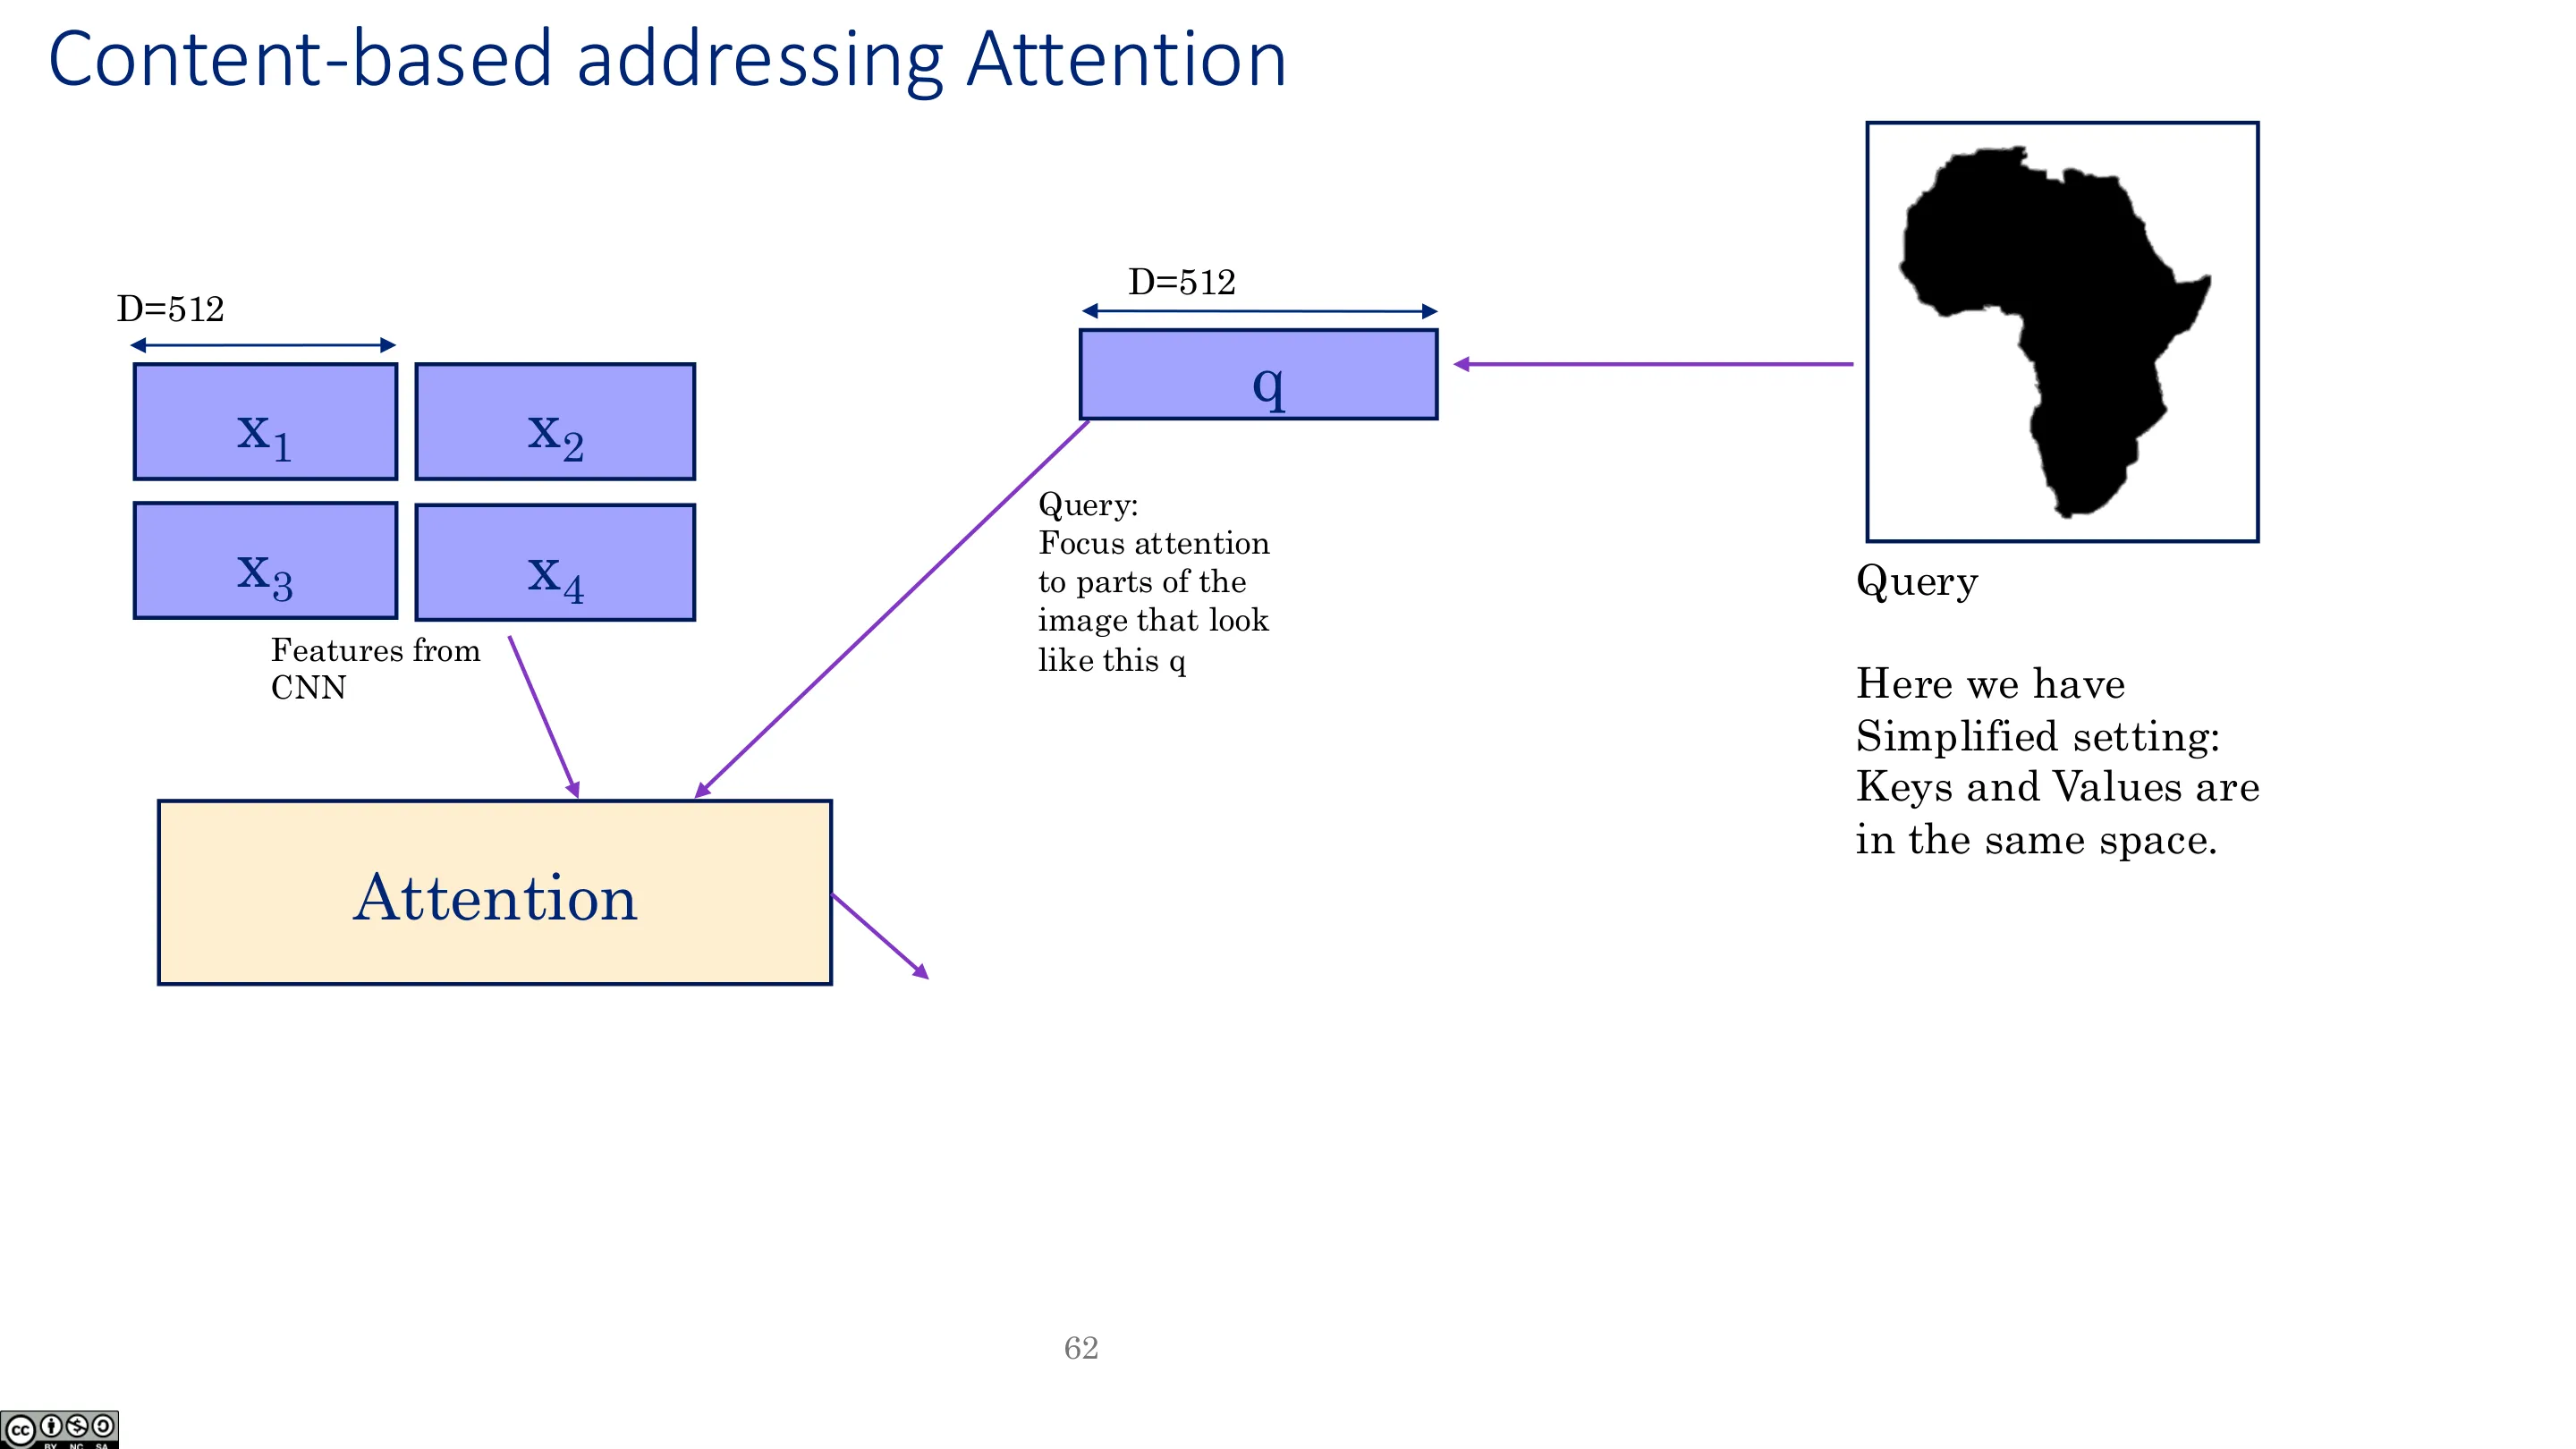
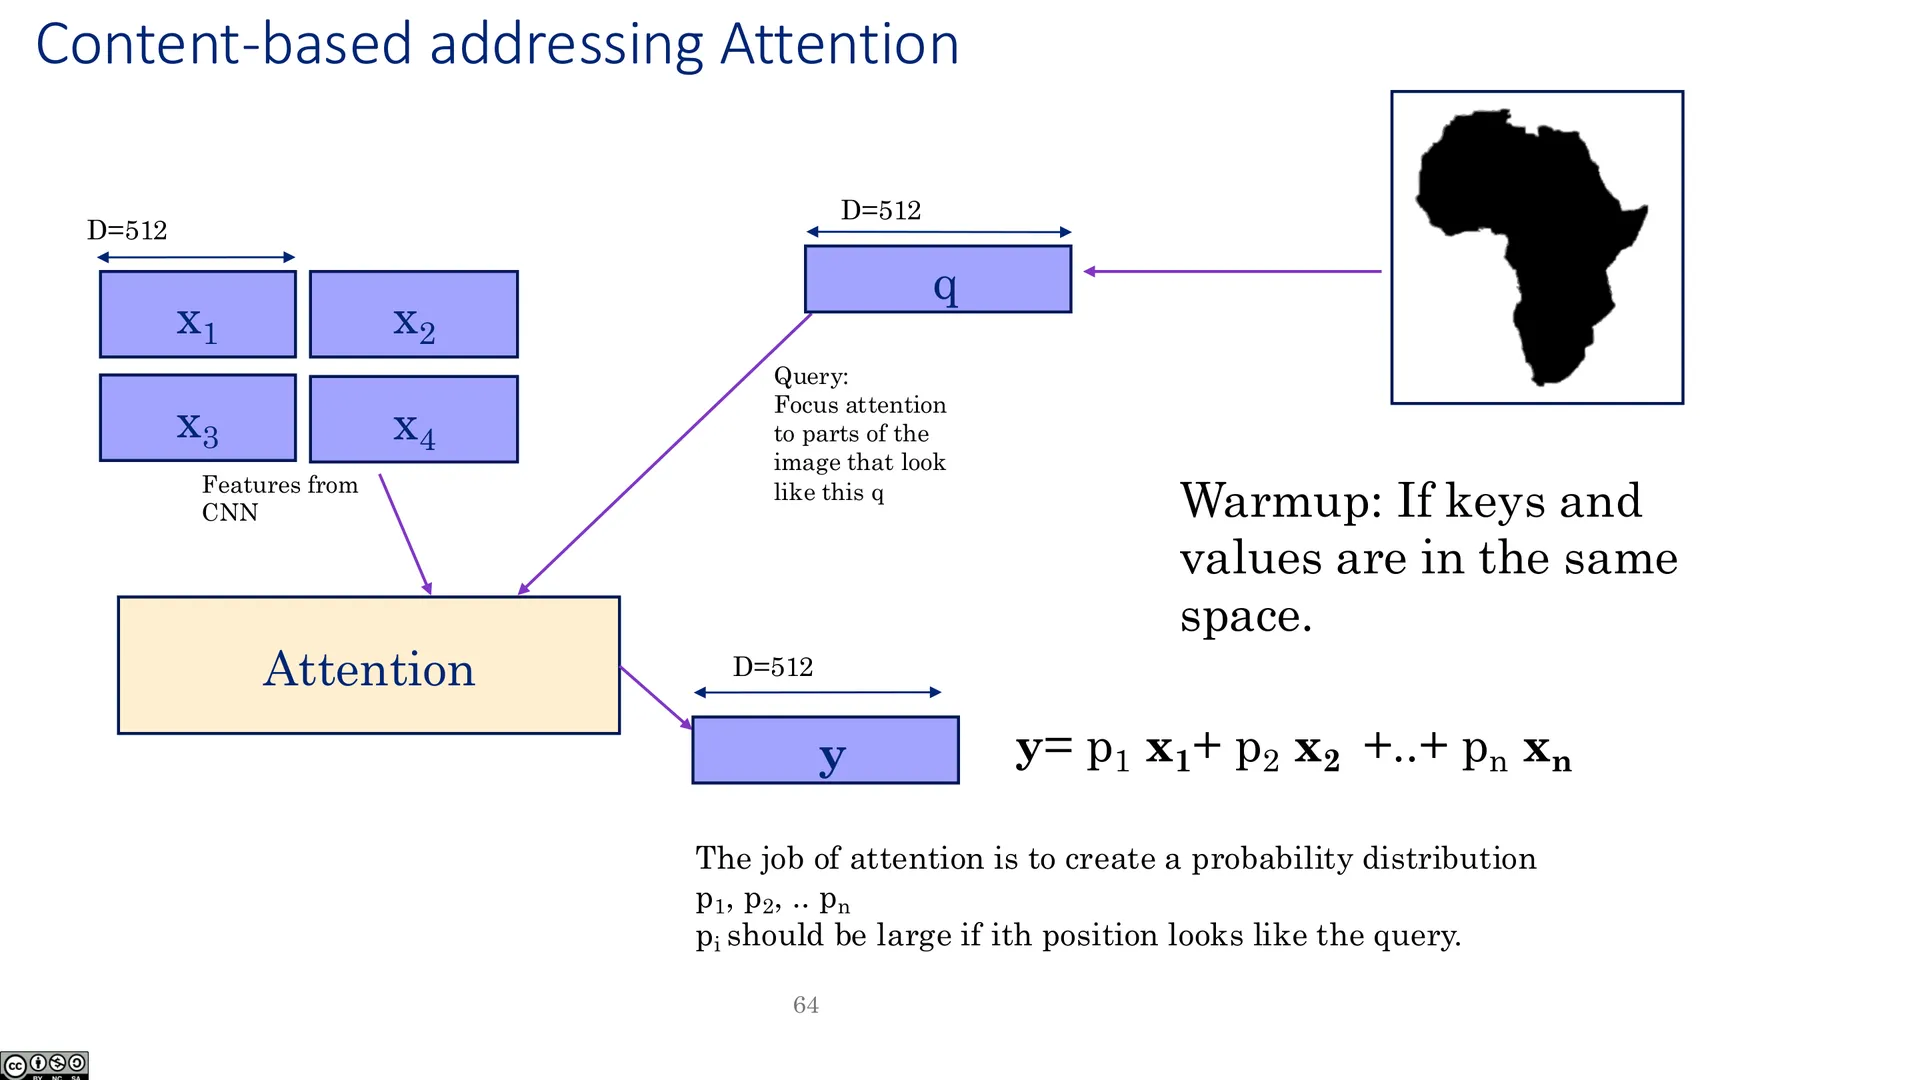
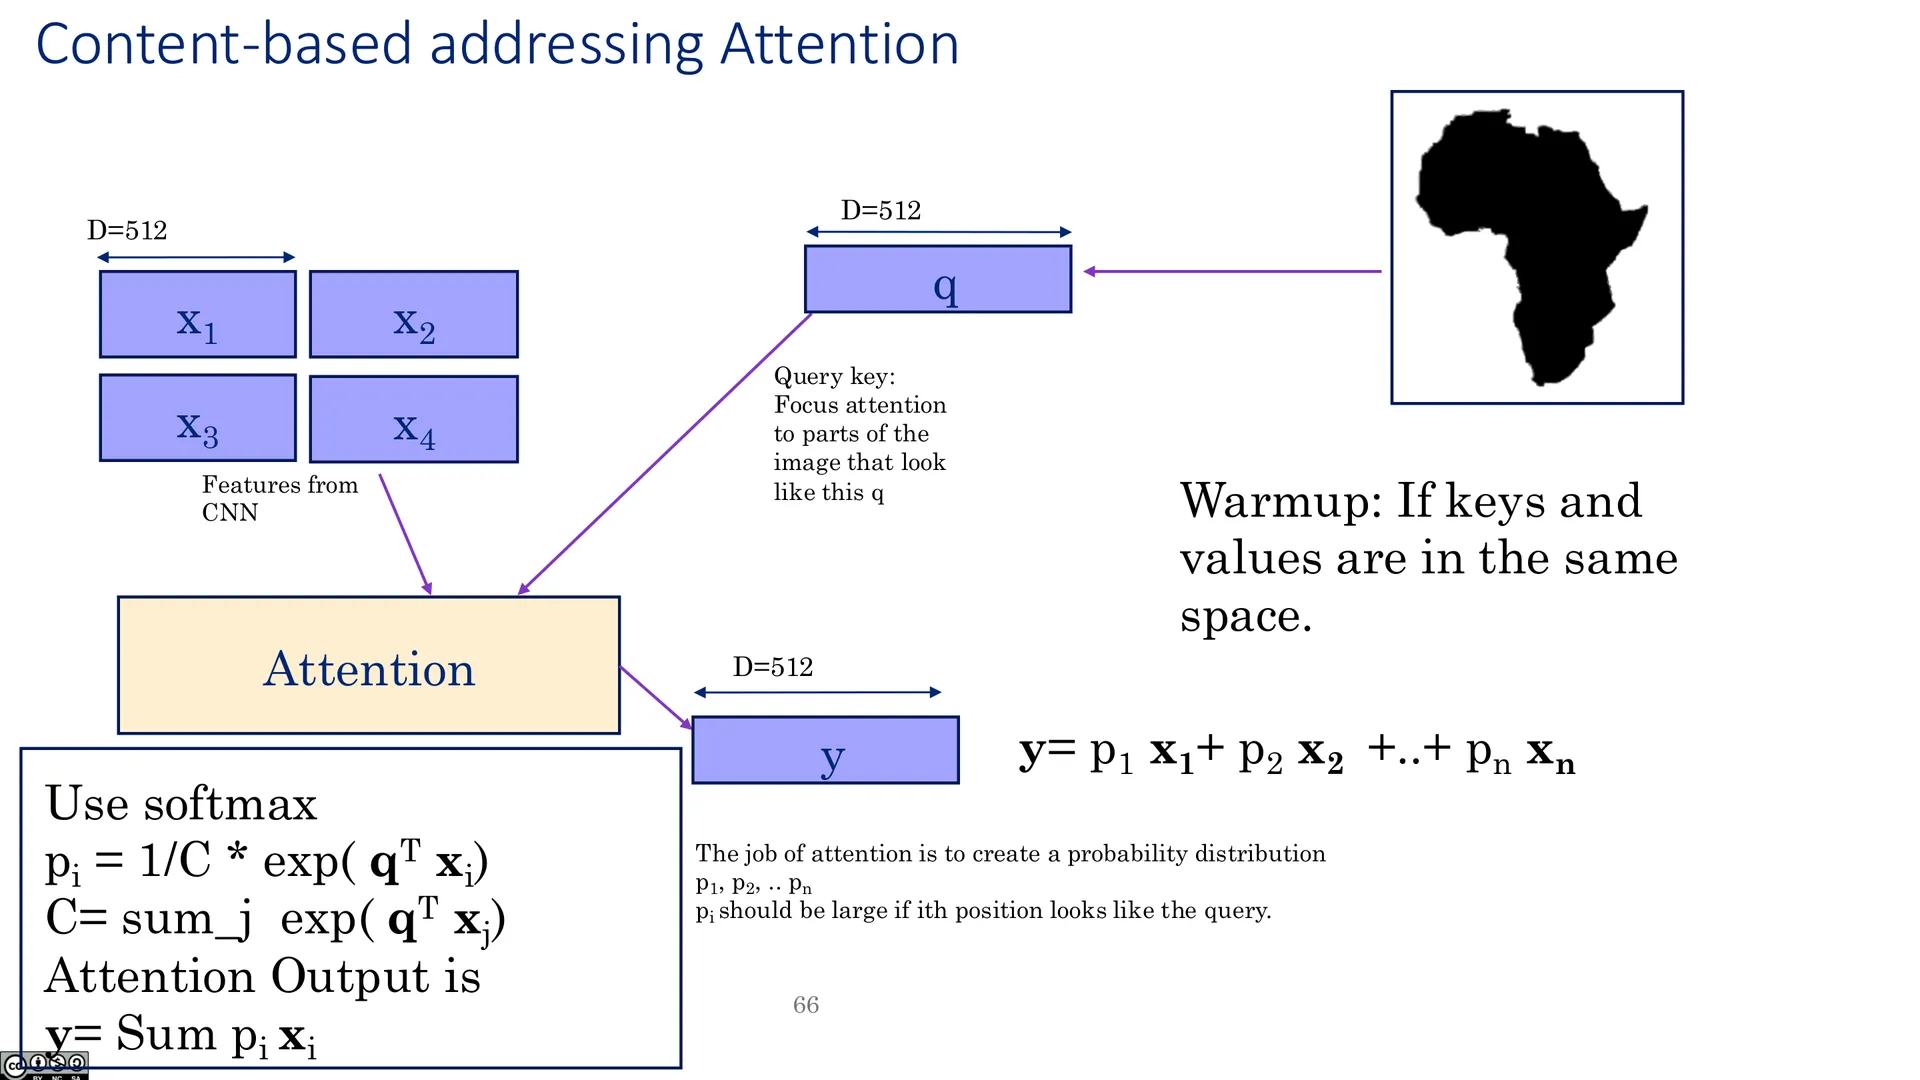
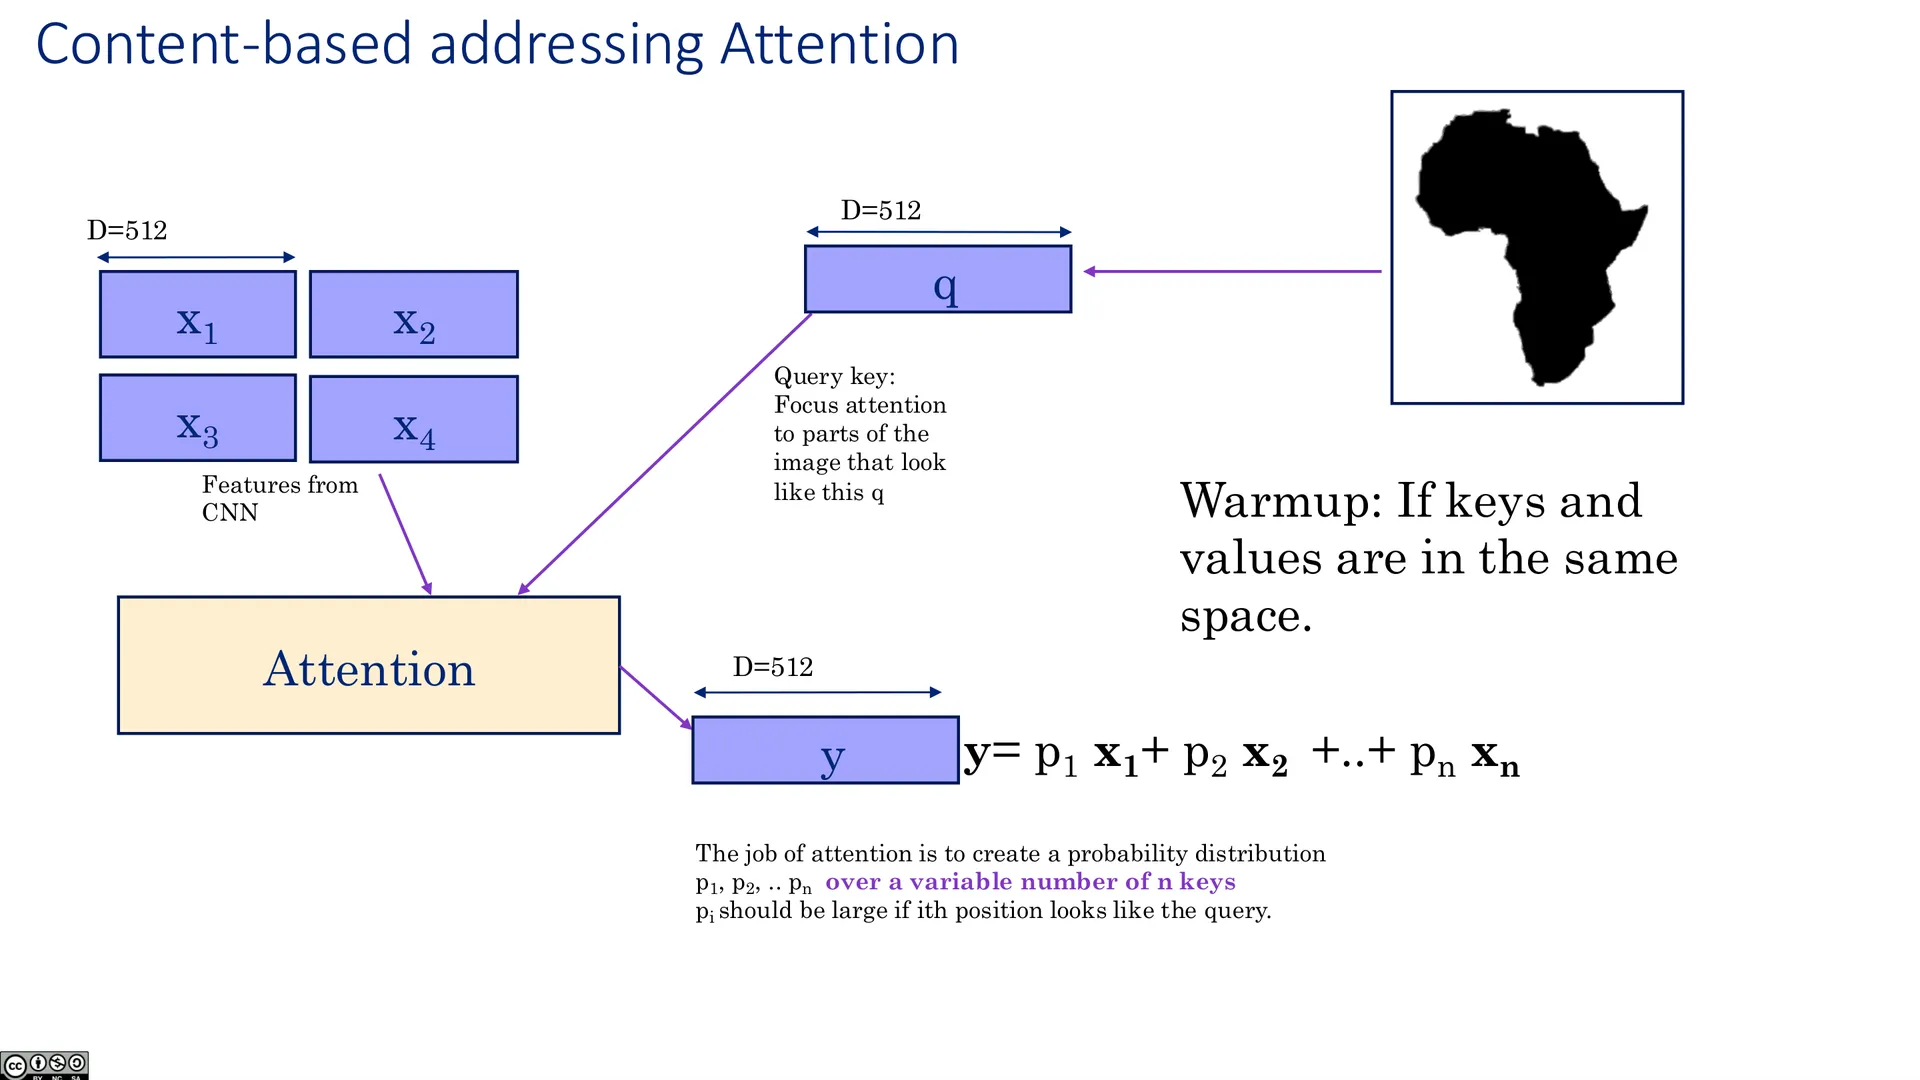
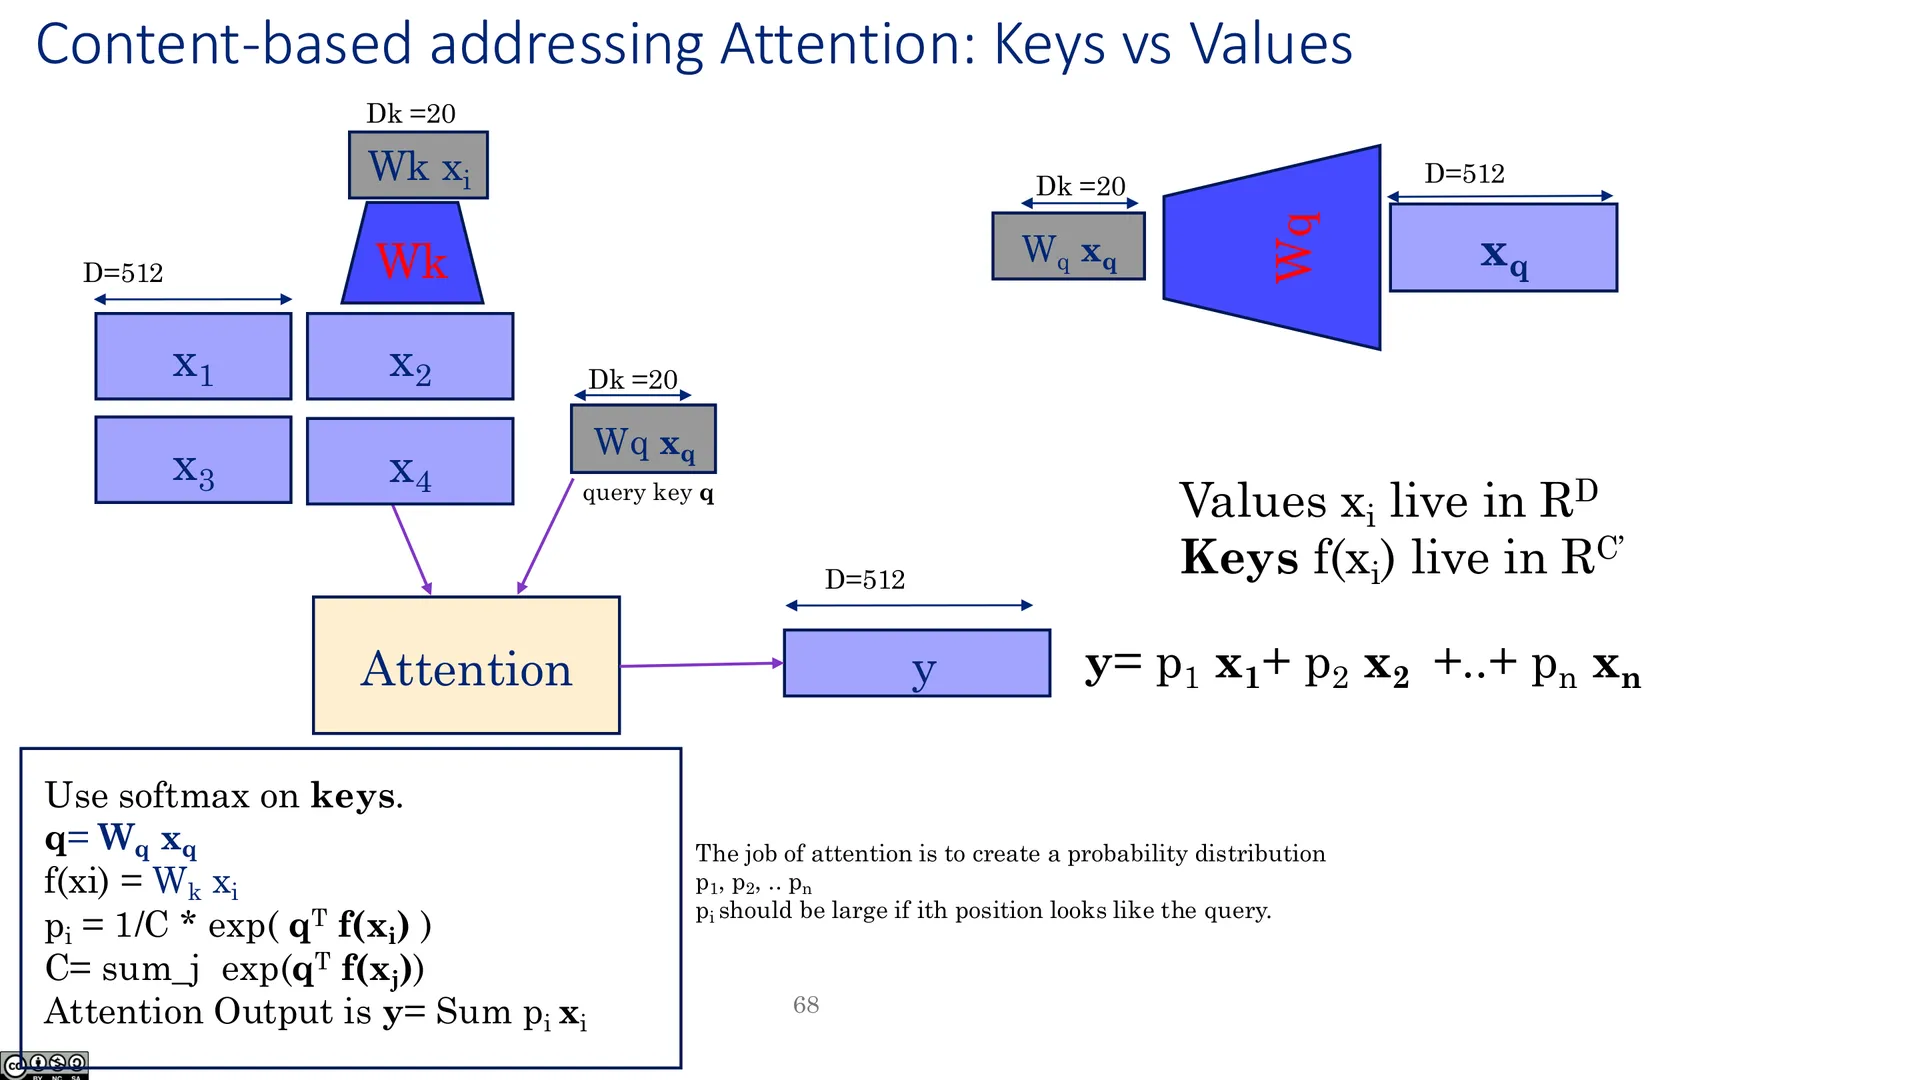
位置注意力的问题:位置数固定。内容注意力让网络产生一个查询向量 $Q$(语义,如「把有吉他的向量给我」),而不是位置分布。
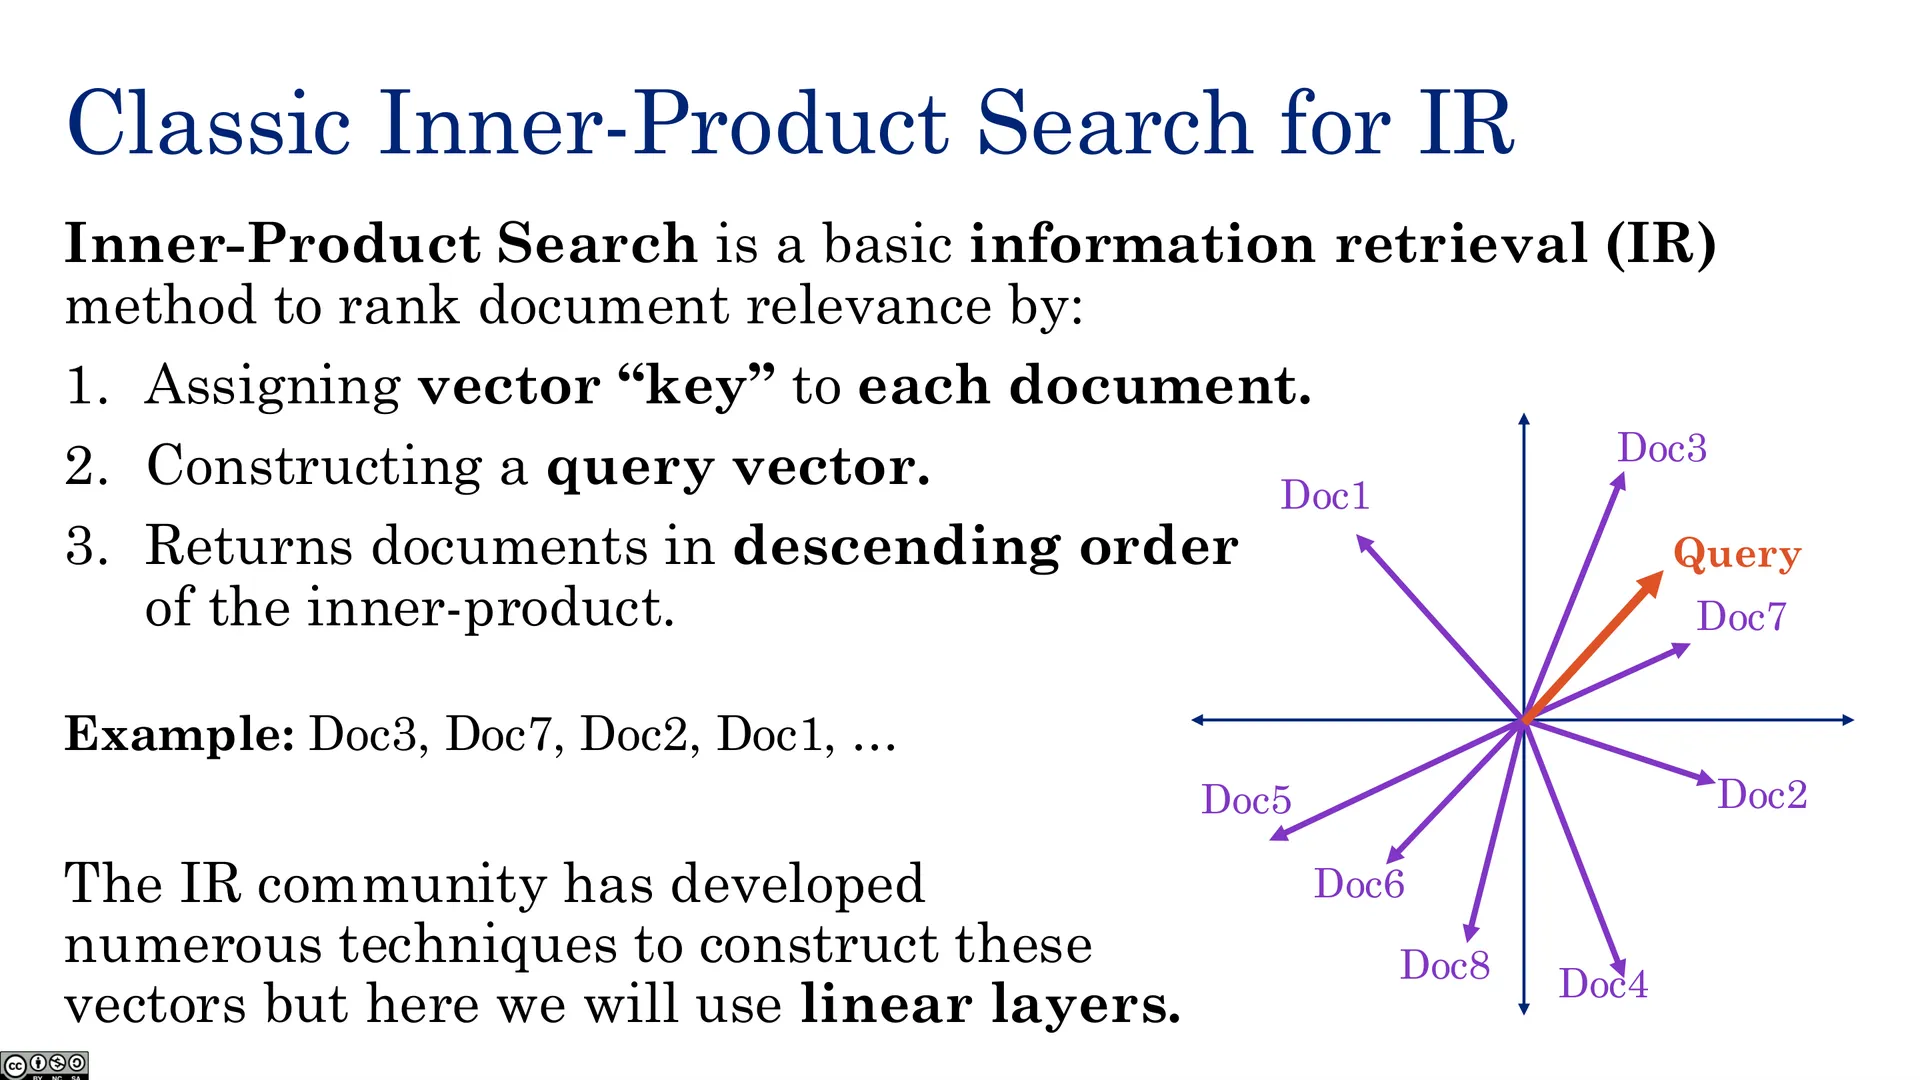
核心直觉:内积 = 相似度(当向量归一化时即余弦相似度)。对每个 $x_i$ 计算 $Q^\top x_i$,得到一组相似度分数。
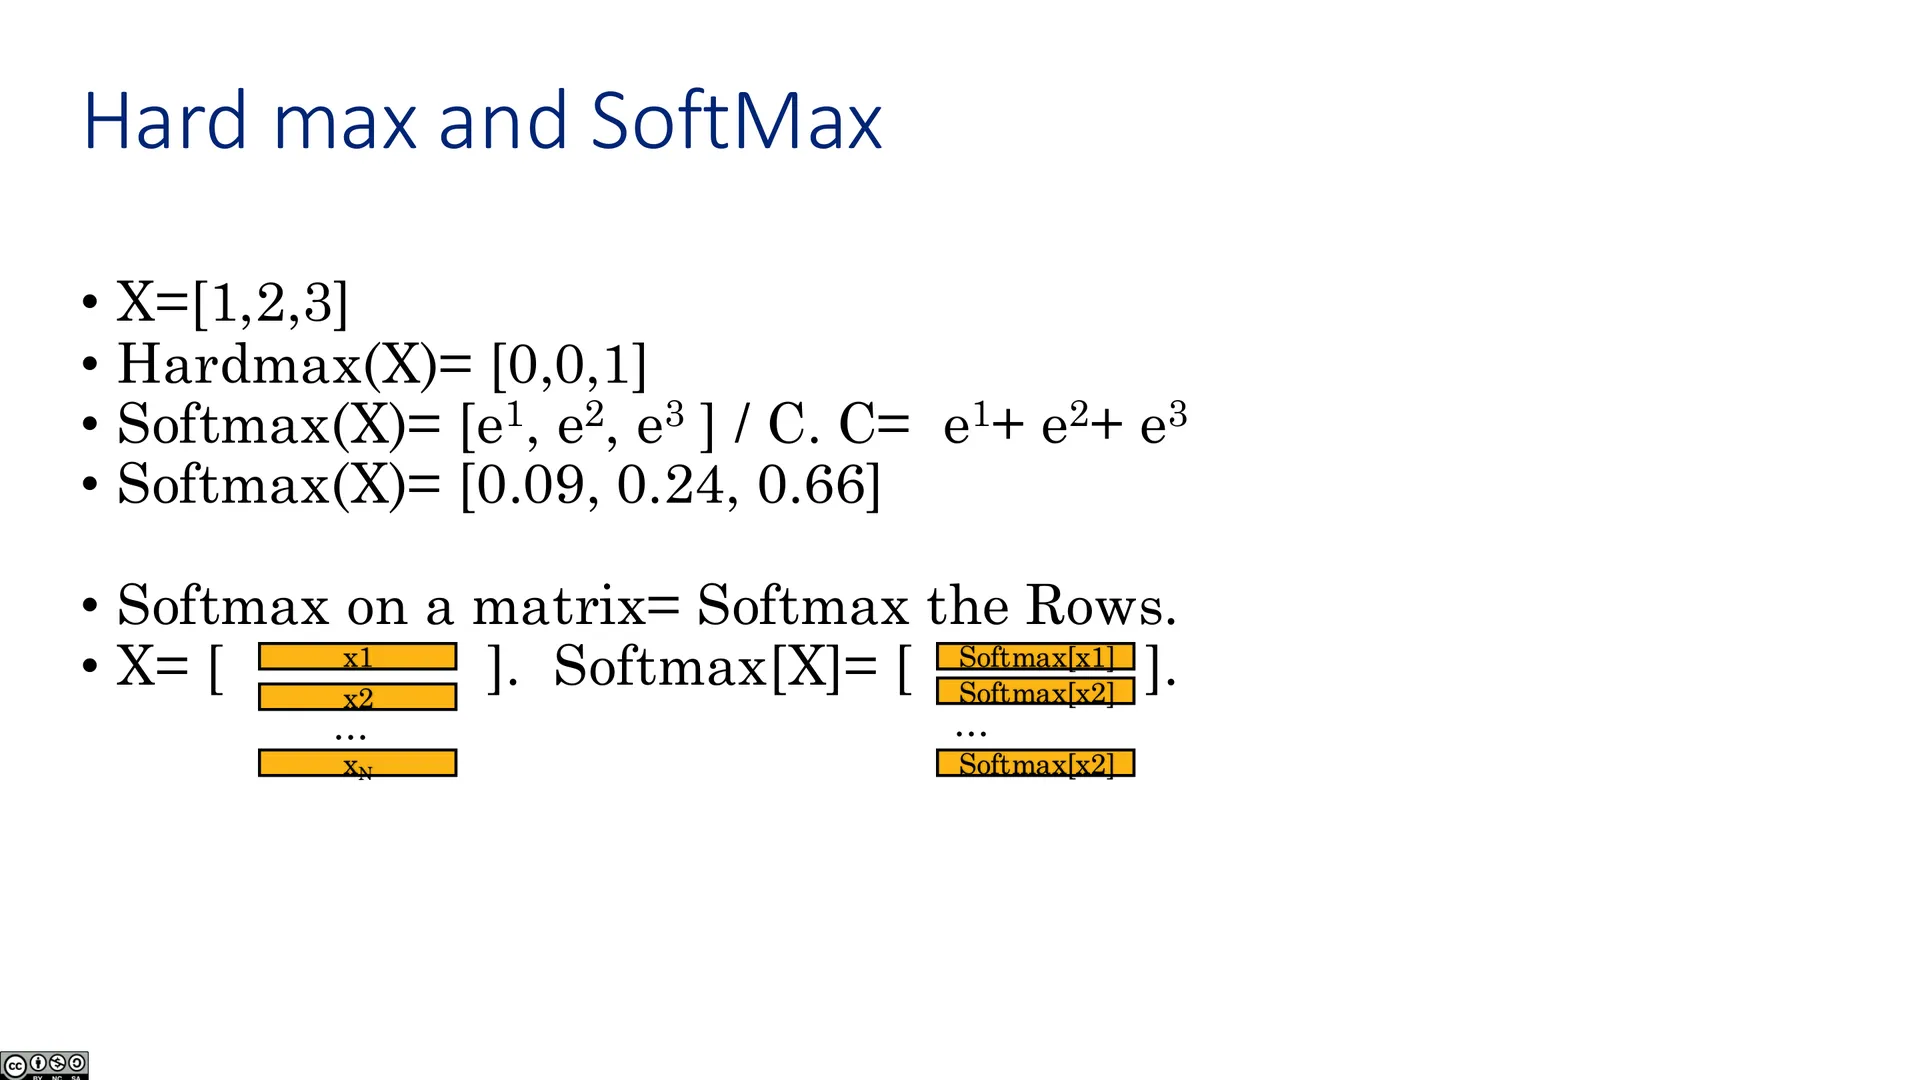
- 分数不是概率(可正可负)⇒ 用 Softmax 转成分布:
$$ p_i=\frac{\exp(Q^\top x_i)}{\sum_j\exp(Q^\top x_j)} $$
- attended 向量 $z=\sum_i p_i x_i$ ——按相似度加权组合原向量。
警告:若向量长度很大,内积会因模长主导而失真 ⇒ 应归一化,否则「大向量会吸引所有注意力」(实践中可通过乘 5 倍让某个表示更受关注)。
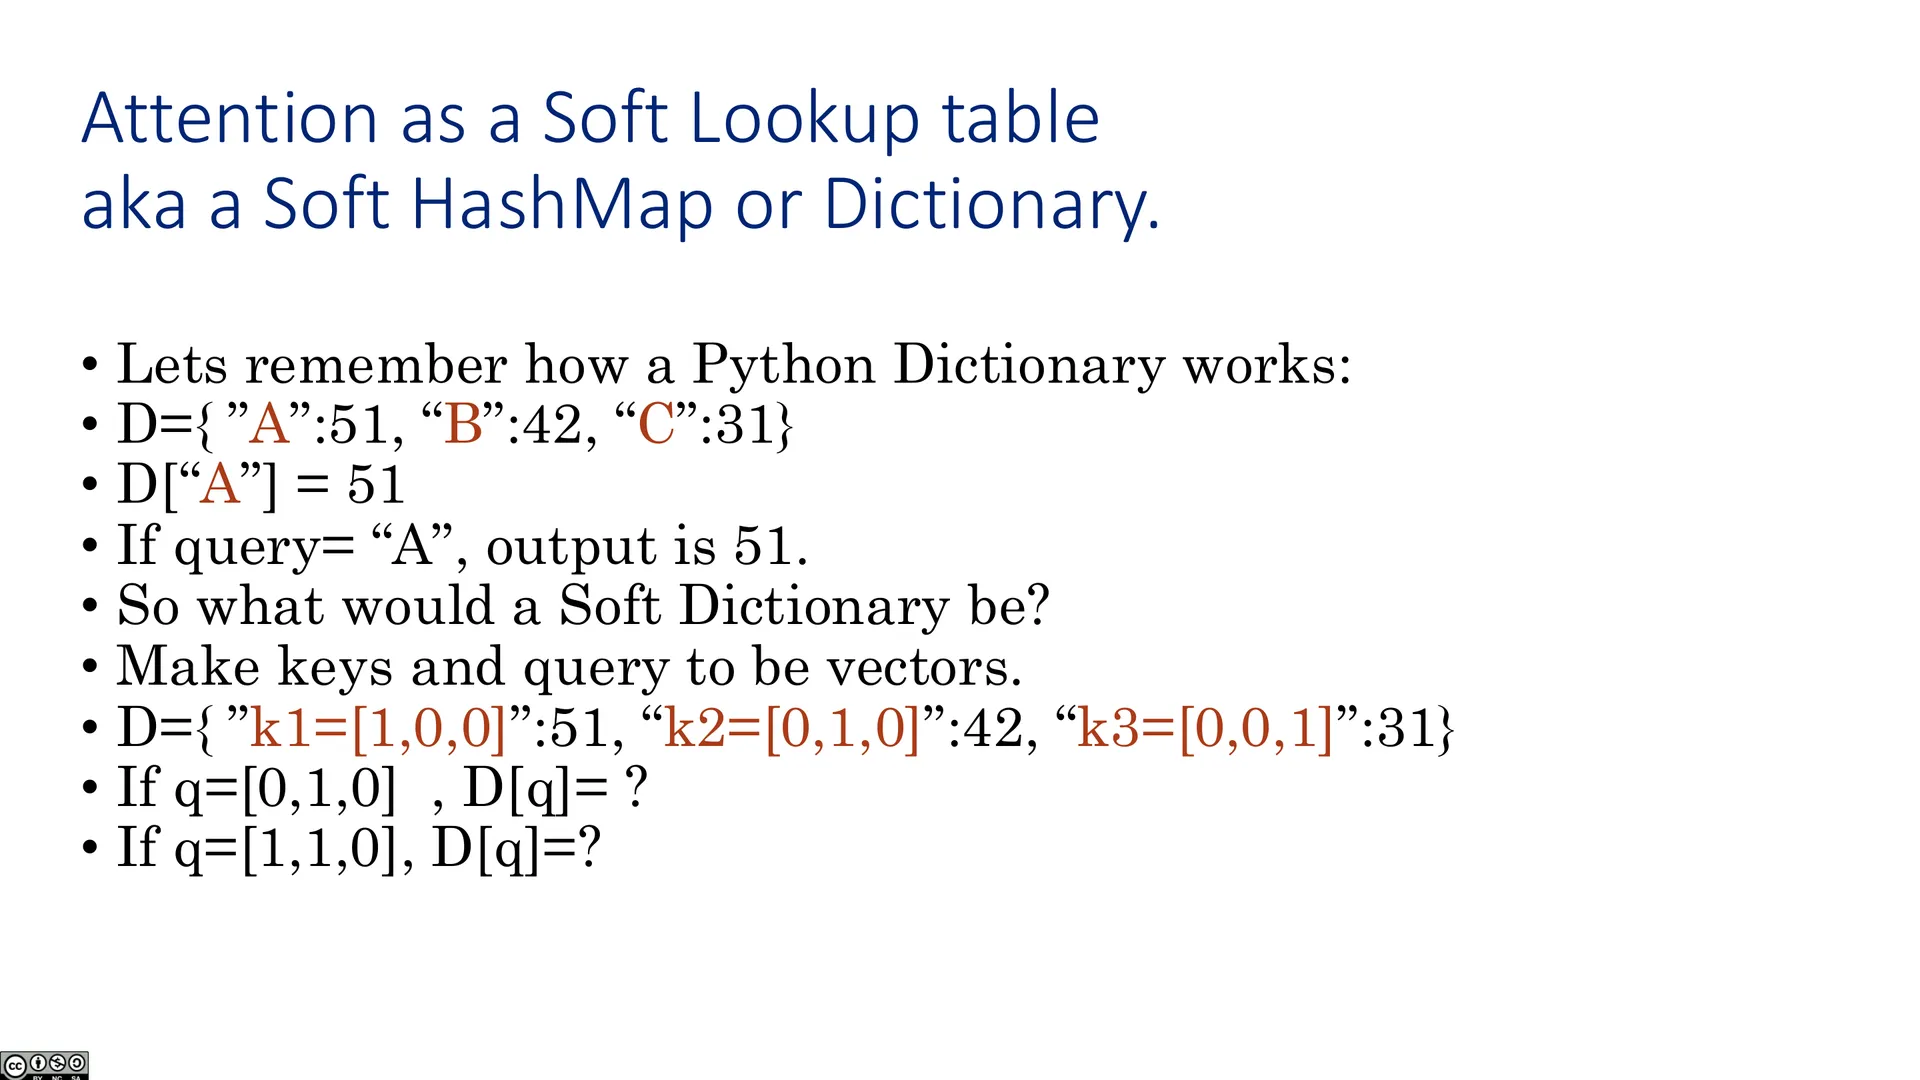
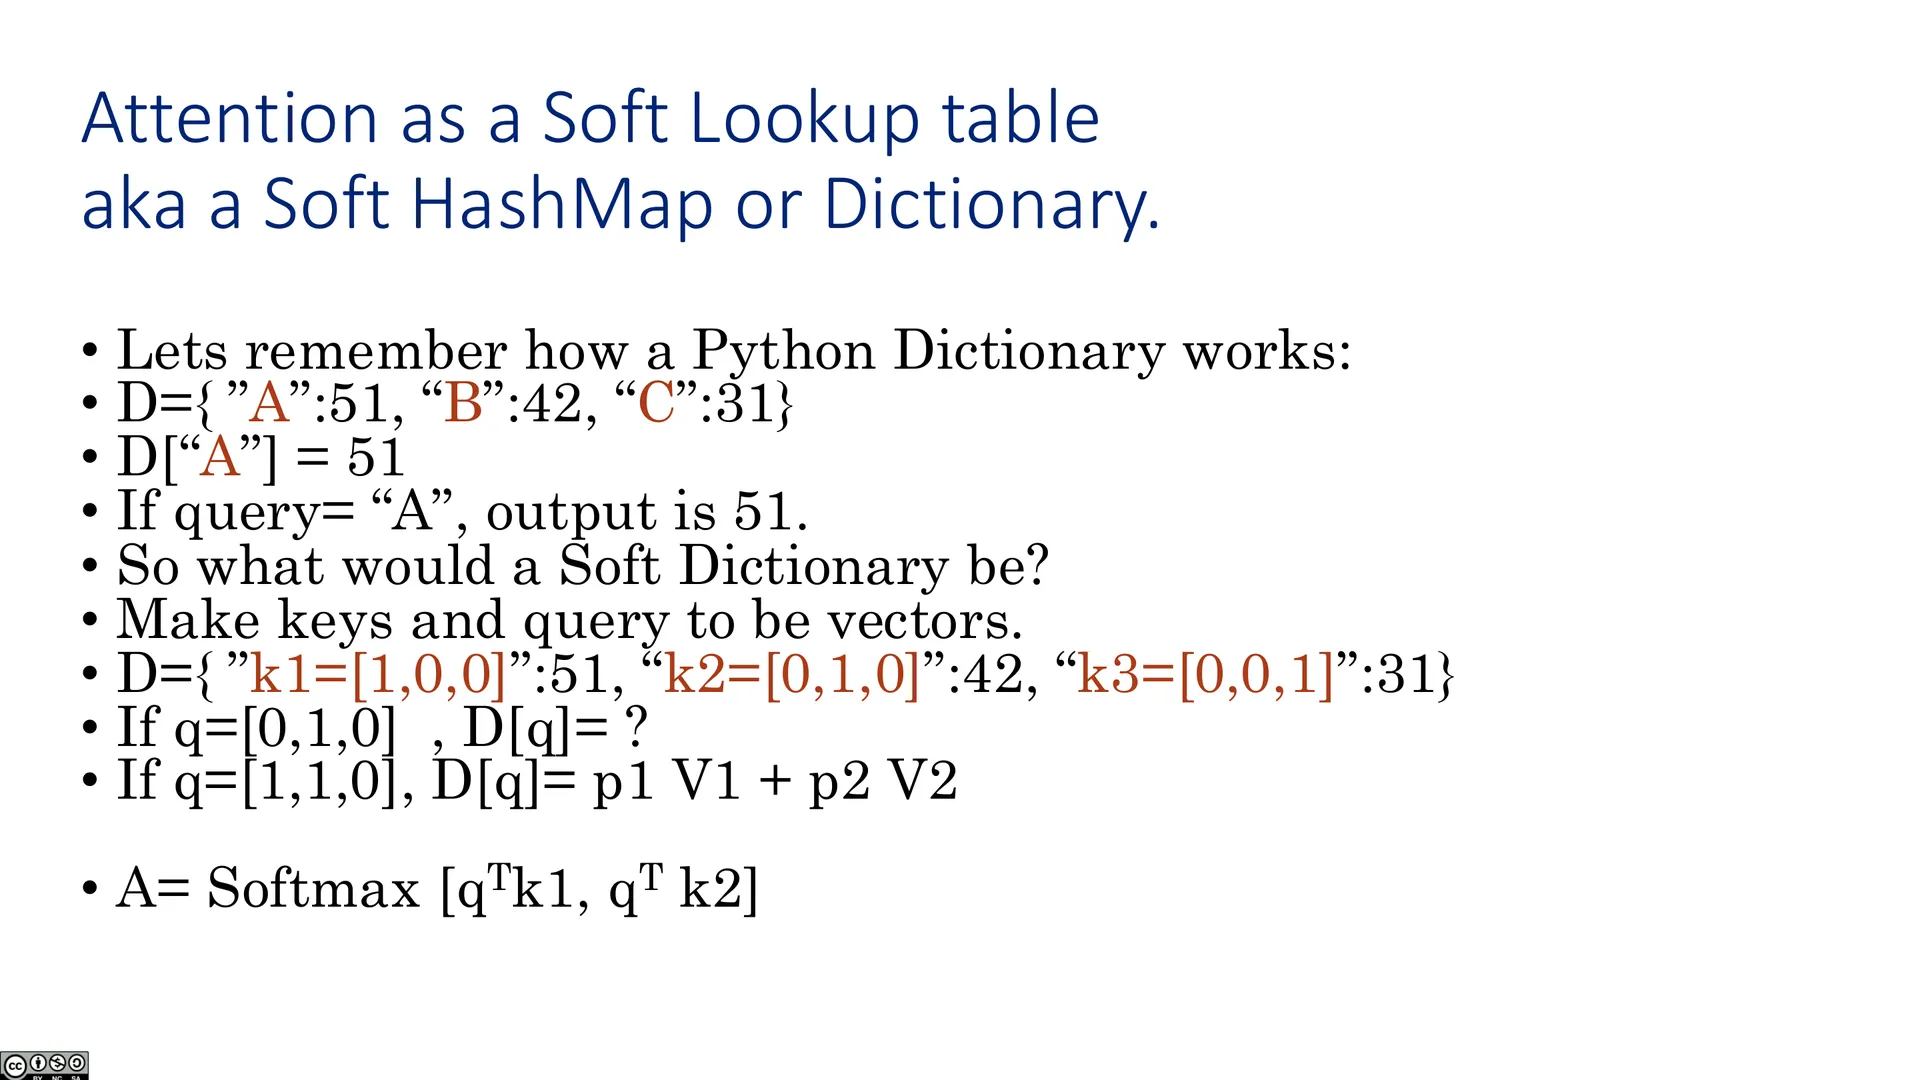
这本质是 soft 的键值查找 / 向量数据库检索(如 RAG):给出 query,按相似度软选择最相关的表示。
📷 基于内容的注意力(一)
回到原视频 (01:12:07)
📷 基于内容的注意力(二)
回到原视频 (01:13:20)
📷 基于内容的注意力(三)
回到原视频 (01:14:33)
本讲到此处结束。下一讲继续:Keys/Values、Self-Attention 的矩阵形式、多头注意力、Transformer 层、位置编码——见文末附录。
附录:本讲未展示的幻灯片(下一讲继续,幻灯片 63–119)
以下幻灯片属于本讲课件,但因课堂时间未讲到,按惯例置于附录。它们将在第二十二讲(Transformer 续)中讲解。
🖼️ Hard max 与 Softmax
🖼️ 基于内容的寻址注意力(一)
🖼️ 经典的 IR 内积检索
🖼️ 基于内容的寻址注意力(二)
🖼️ 基于内容的寻址注意力(三)
🖼️ 基于内容的寻址注意力:Keys 与 Values
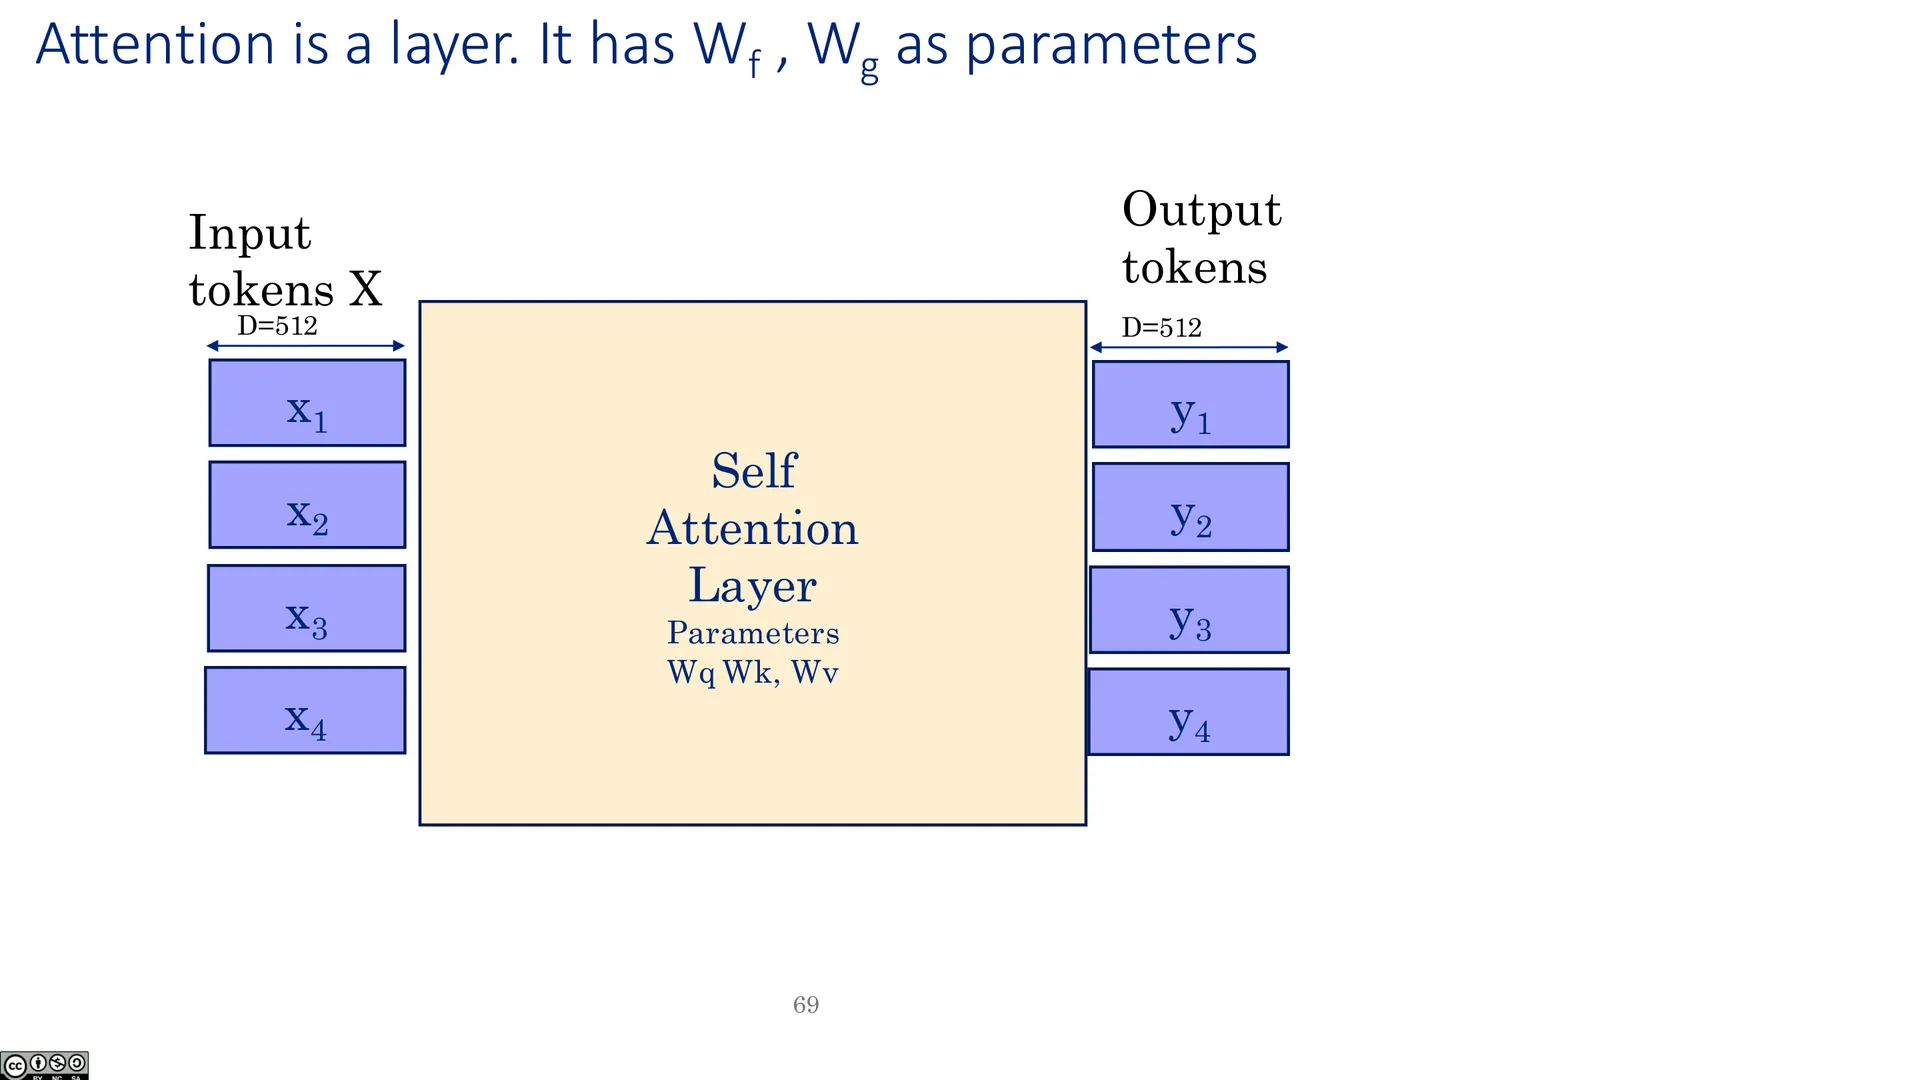
🖼️ 注意力是一个层:$W_f,W_g$ 是参数
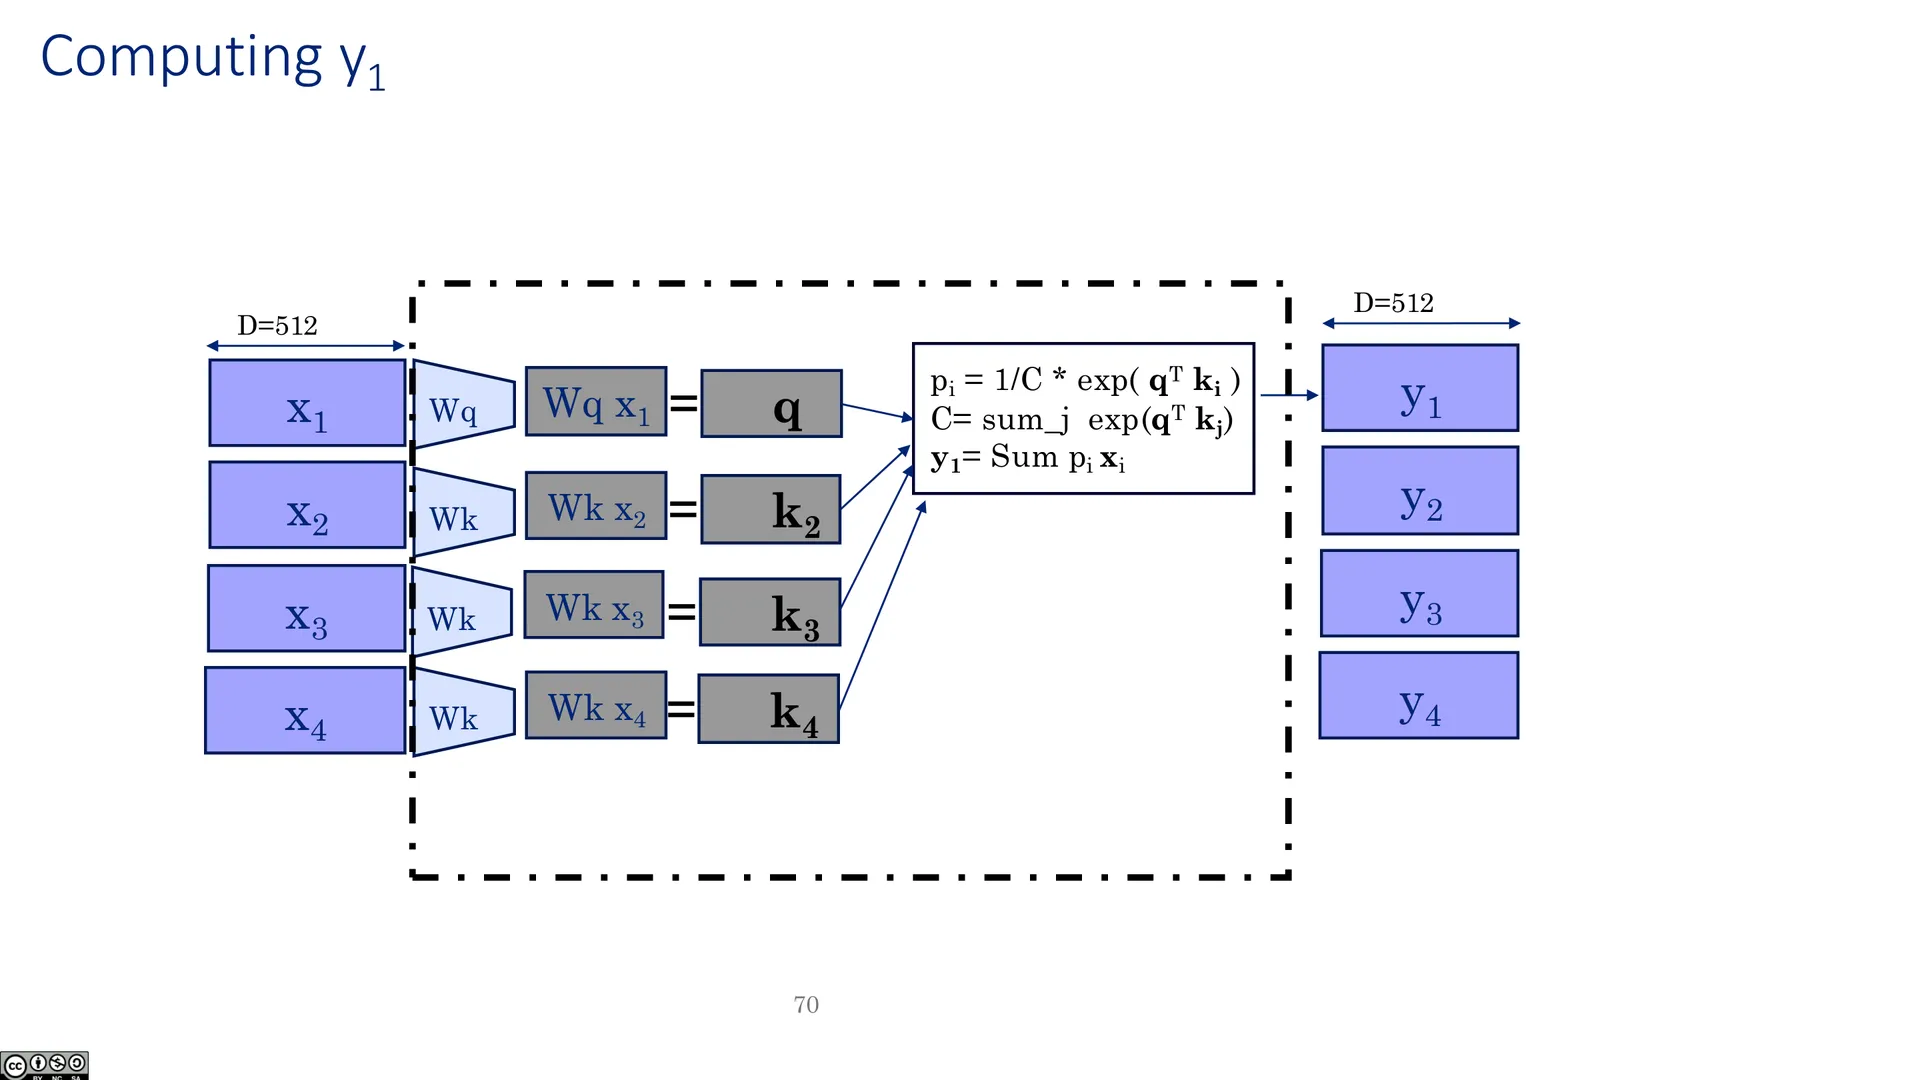
🖼️ $x_1$(一)
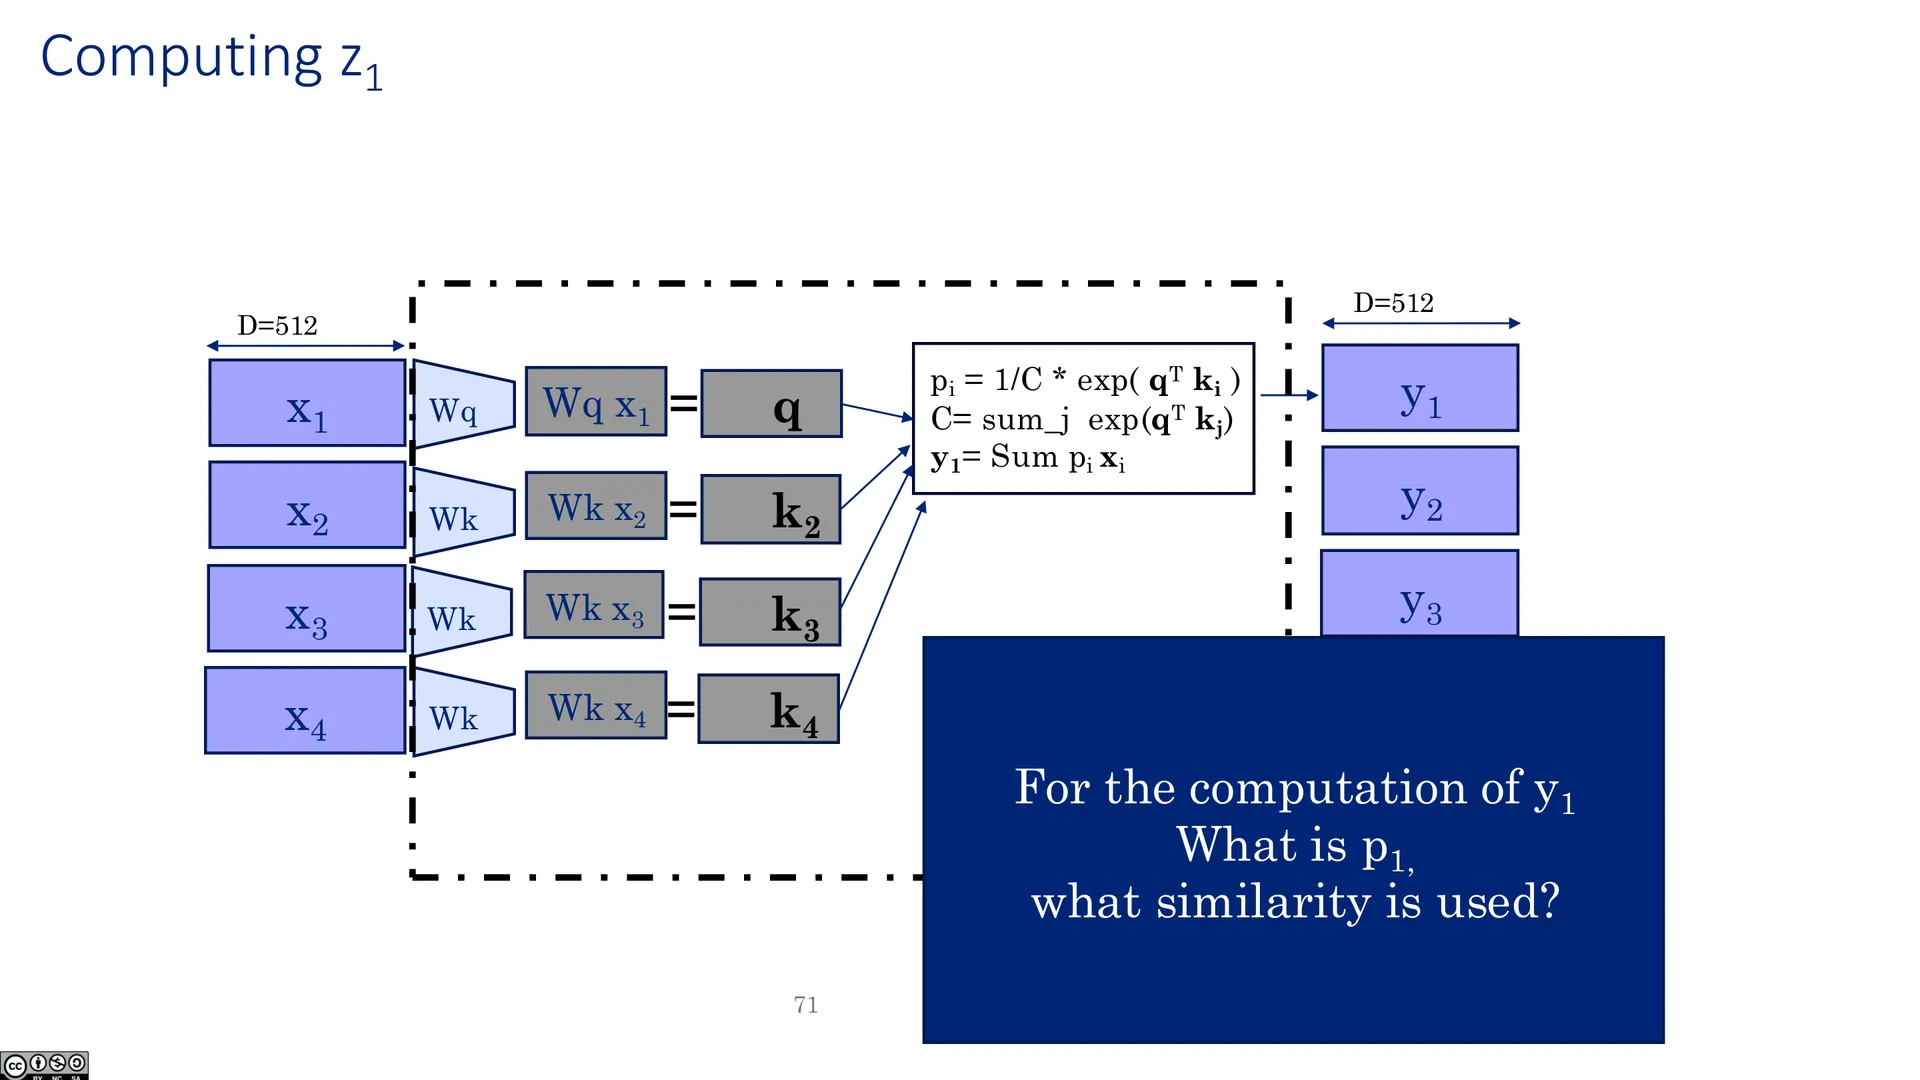
🖼️ $x_1$(二)
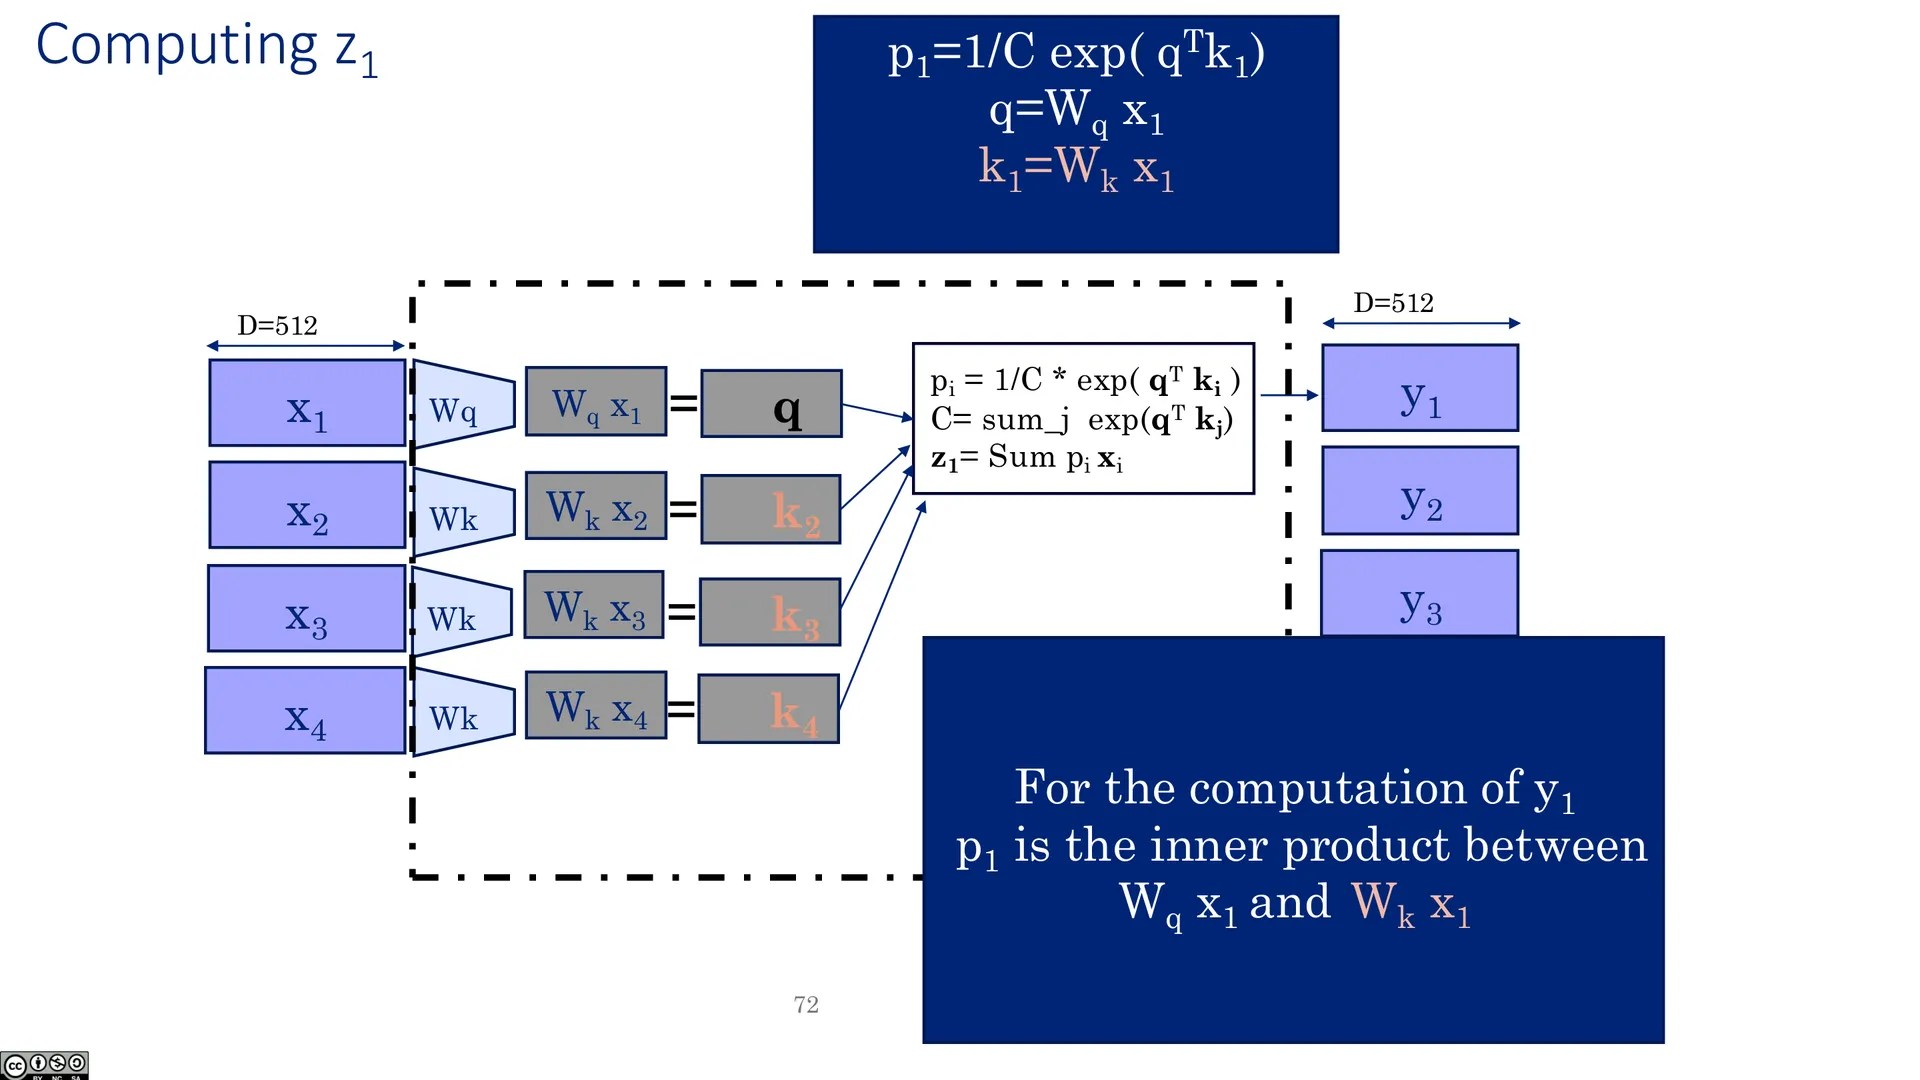
🖼️ 计算 $z_1$
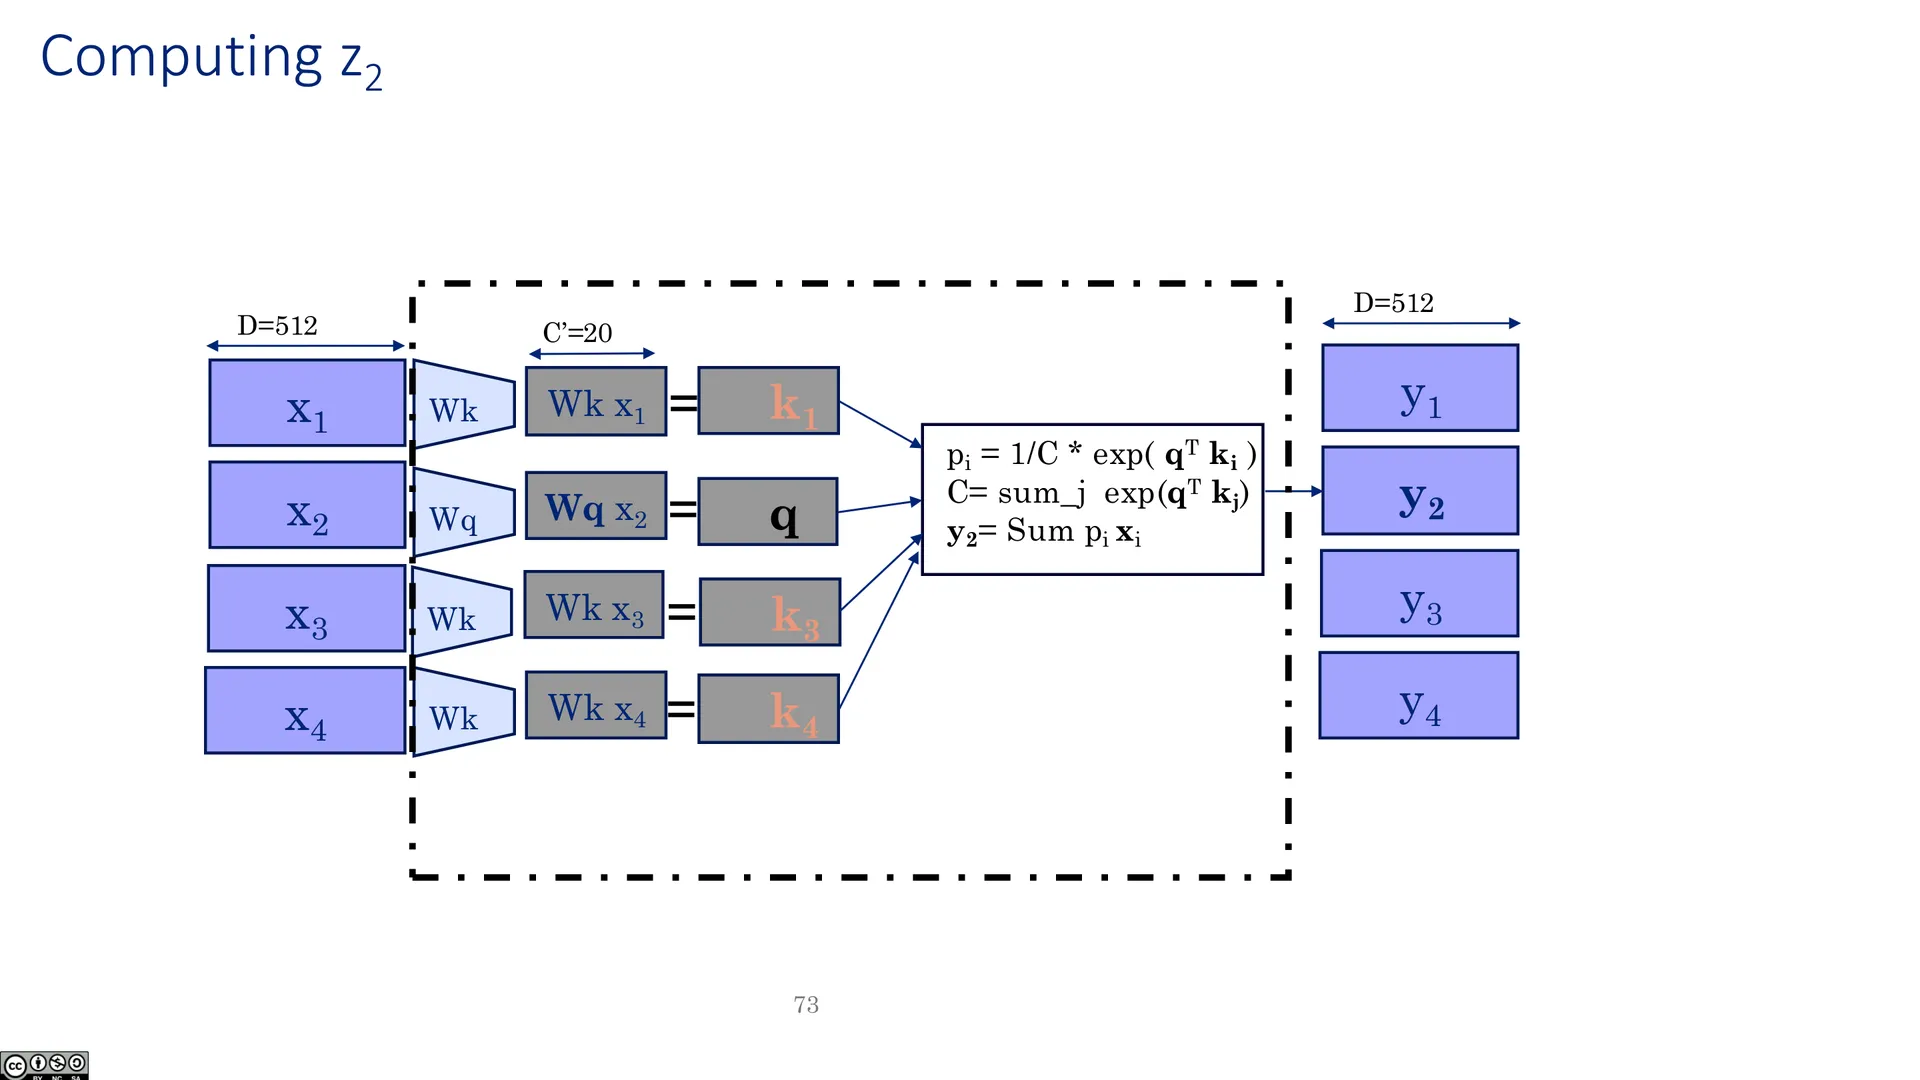
🖼️ $x_1$(三)
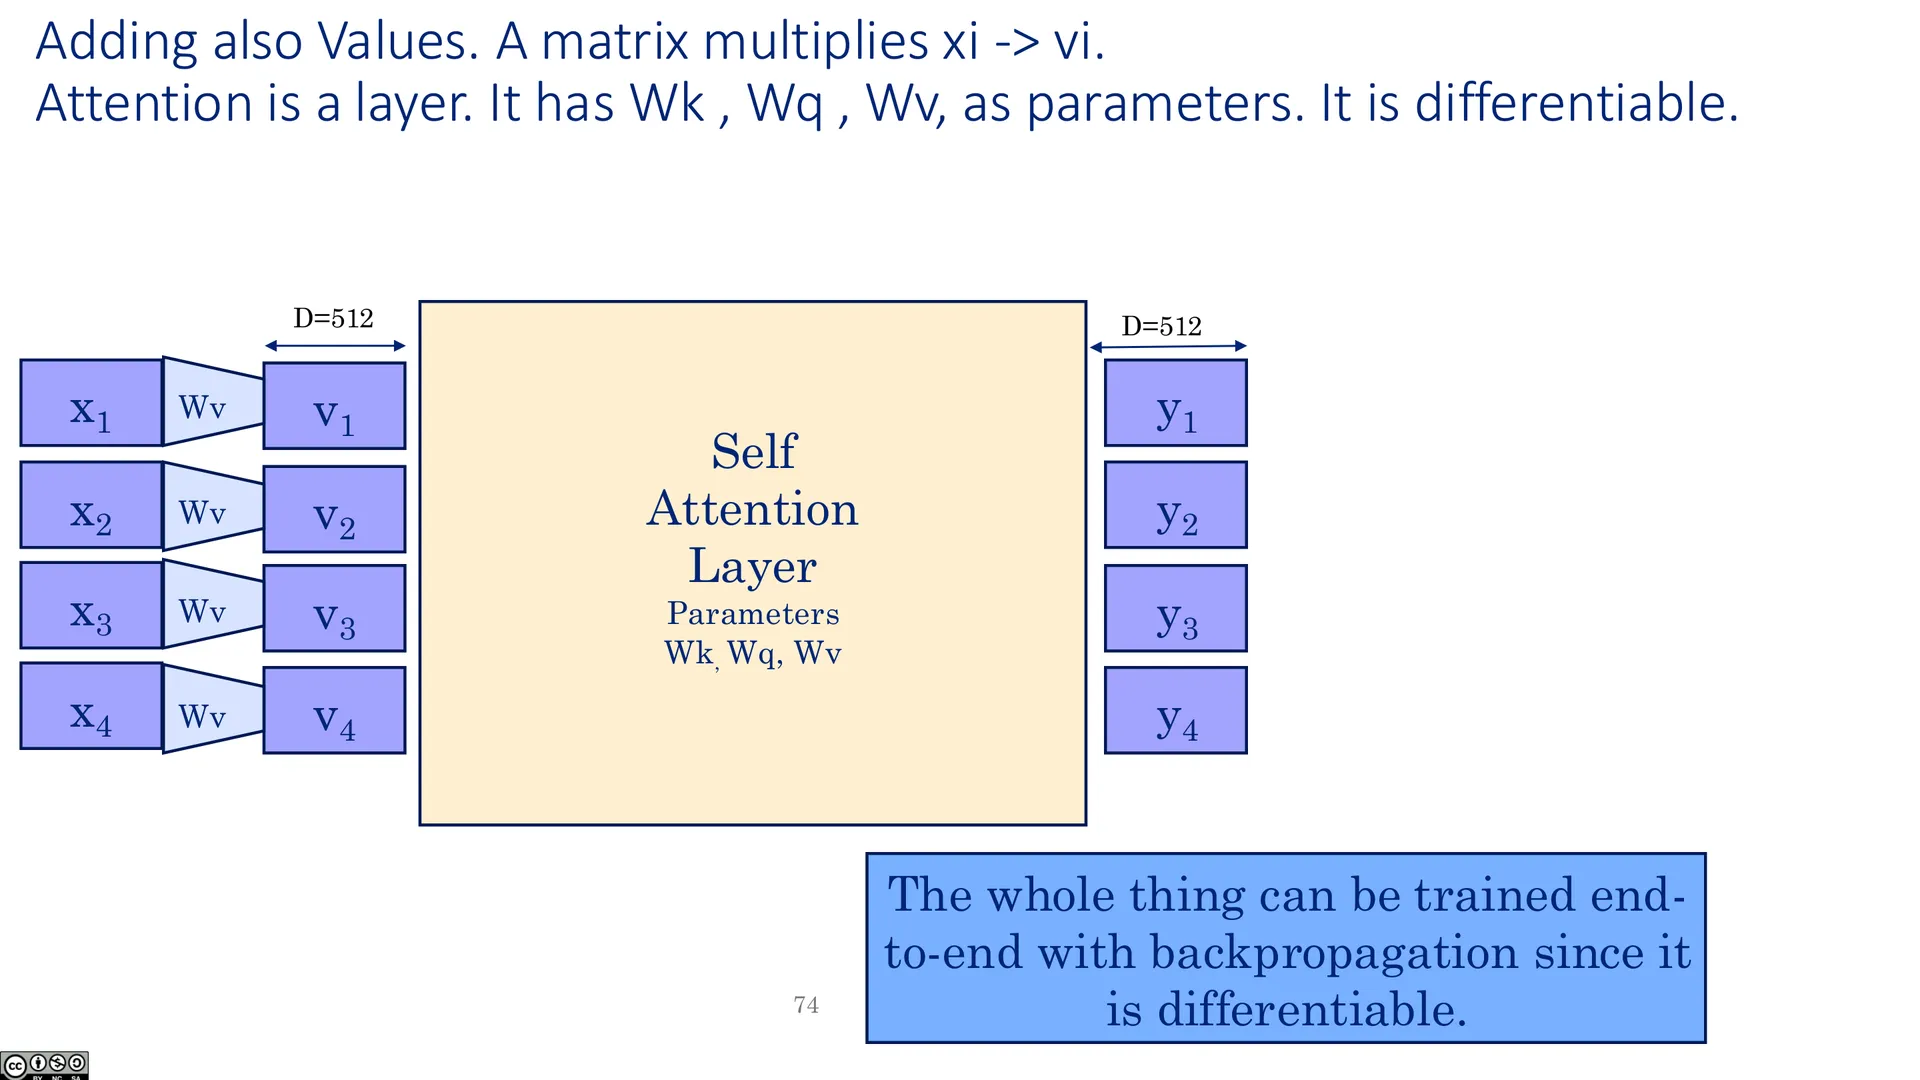
🖼️ 加入 Values:矩阵把 $x_i$ 映到 $v_i$
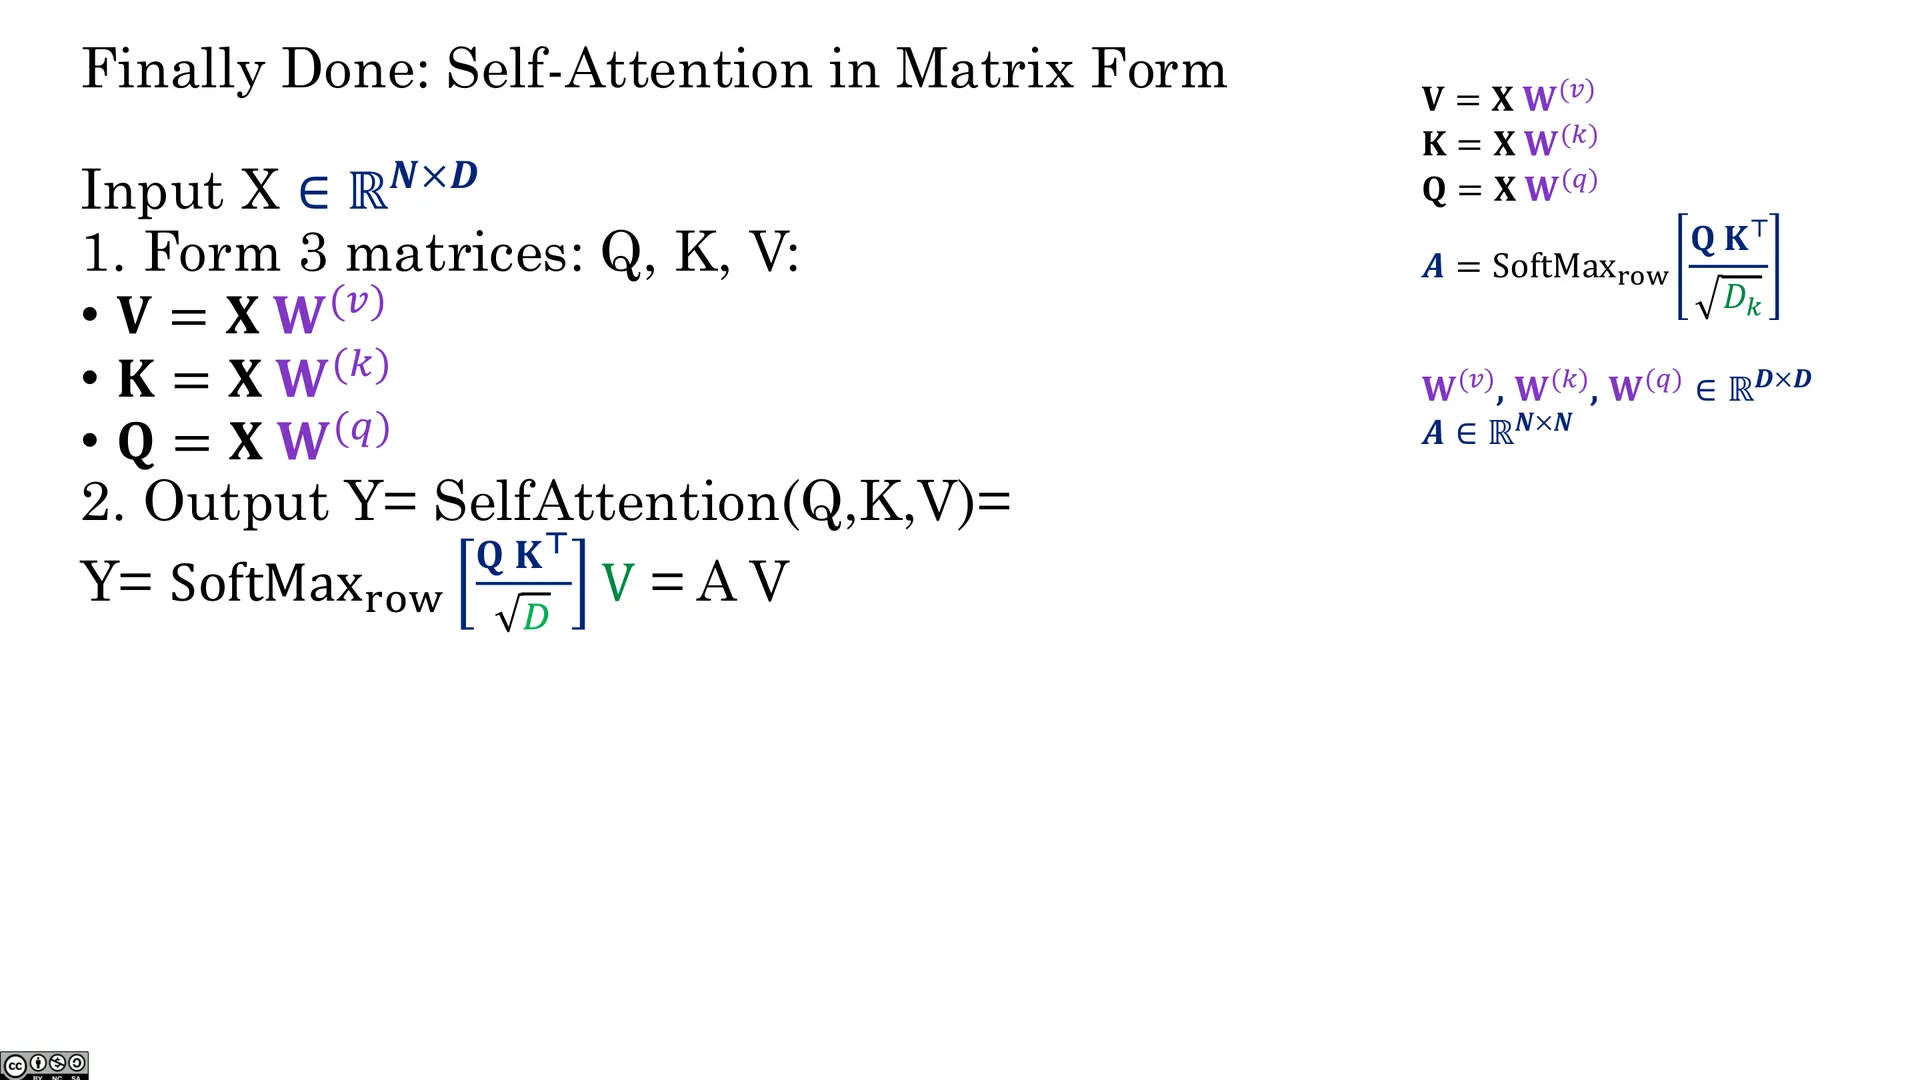
🖼️ 终于完成:矩阵形式的自注意力
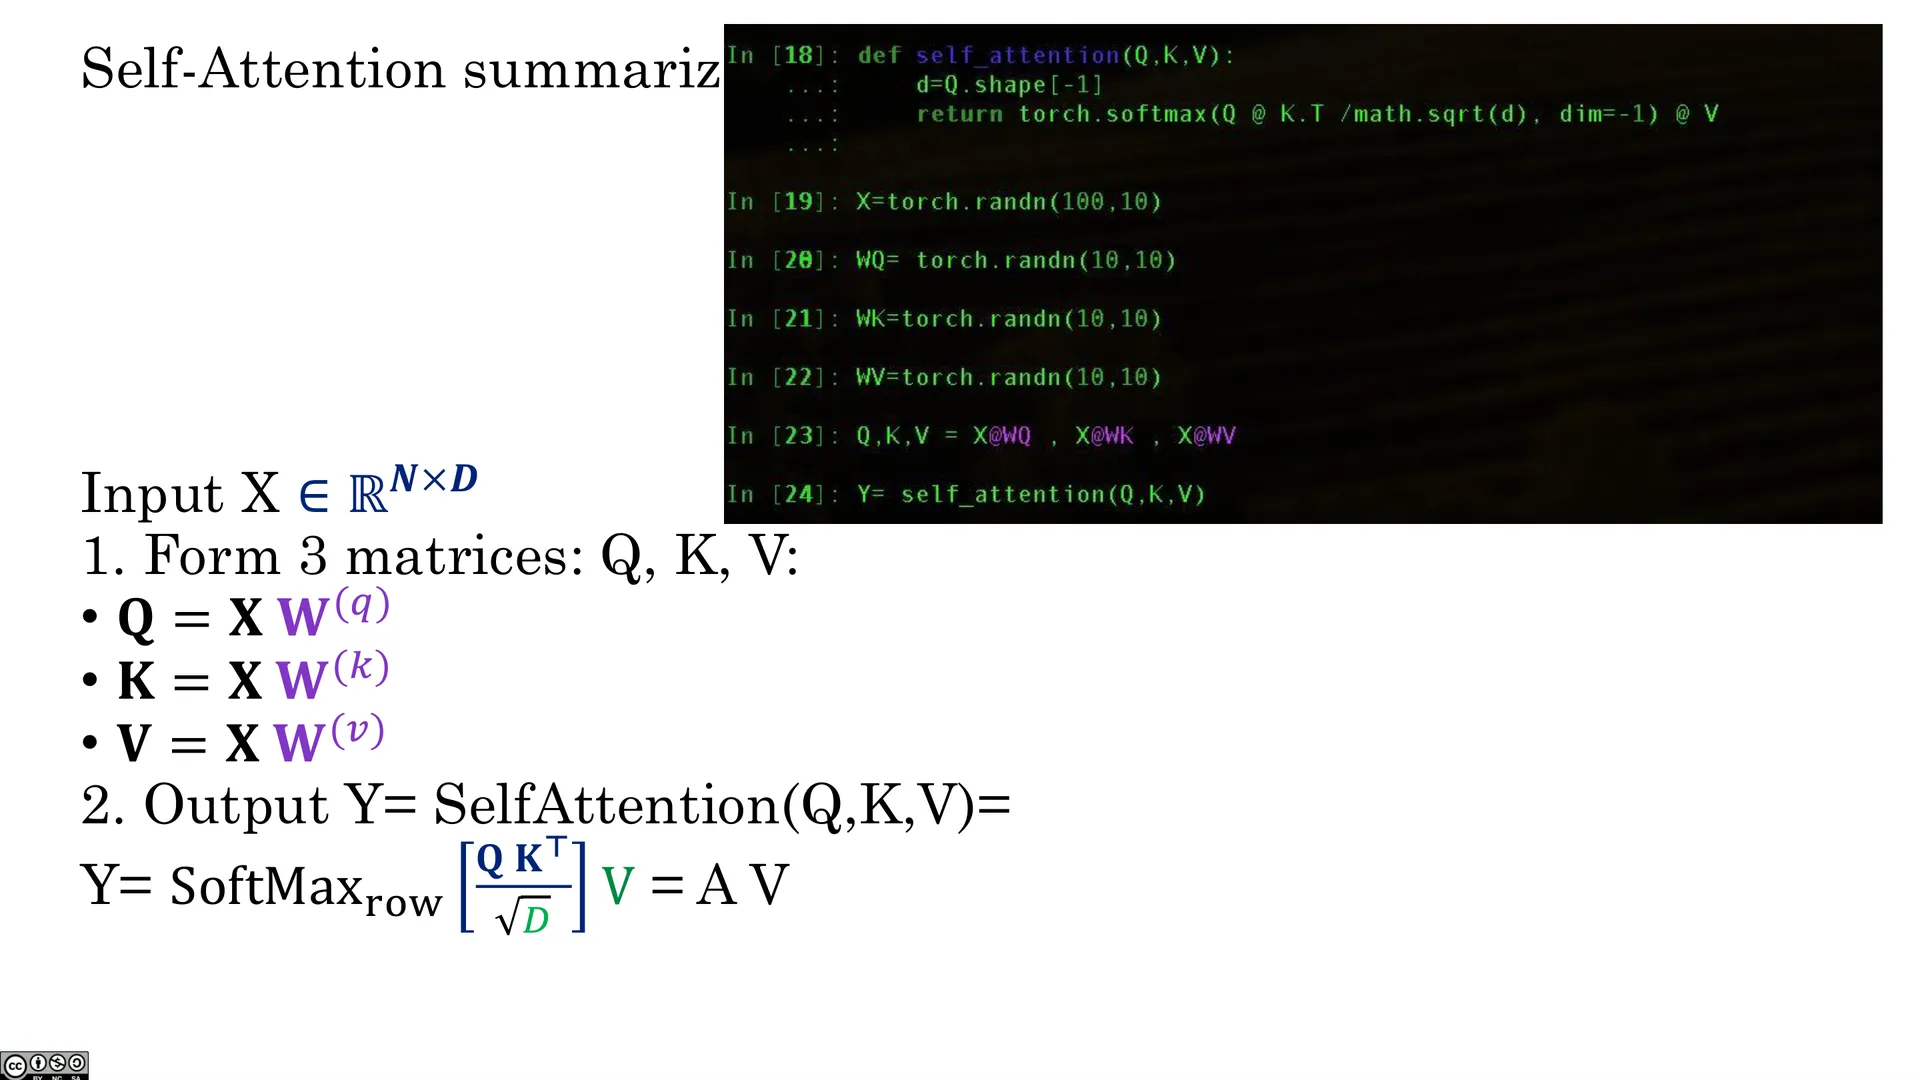
🖼️ 自注意力总结
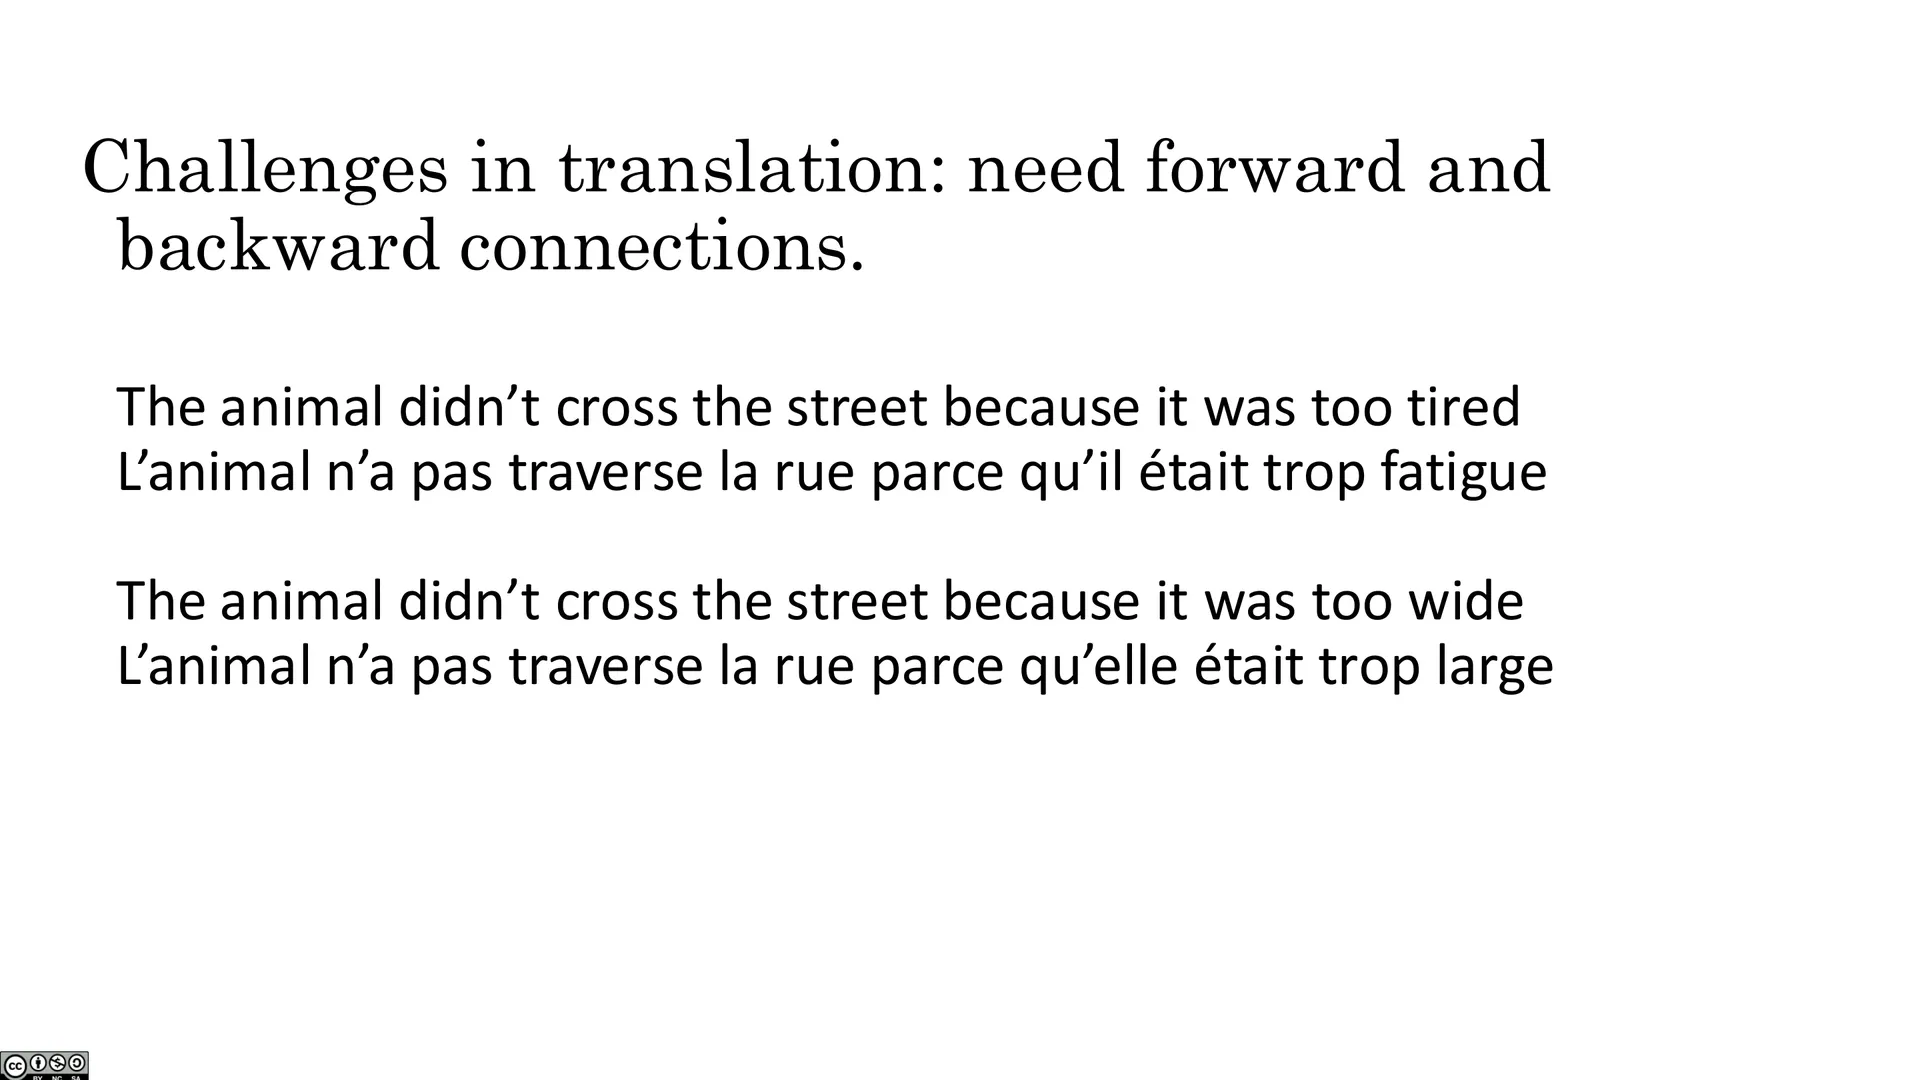
🖼️ 翻译的挑战:需要向前与向后(一)
🖼️ 翻译的挑战:需要向前与向后(二)
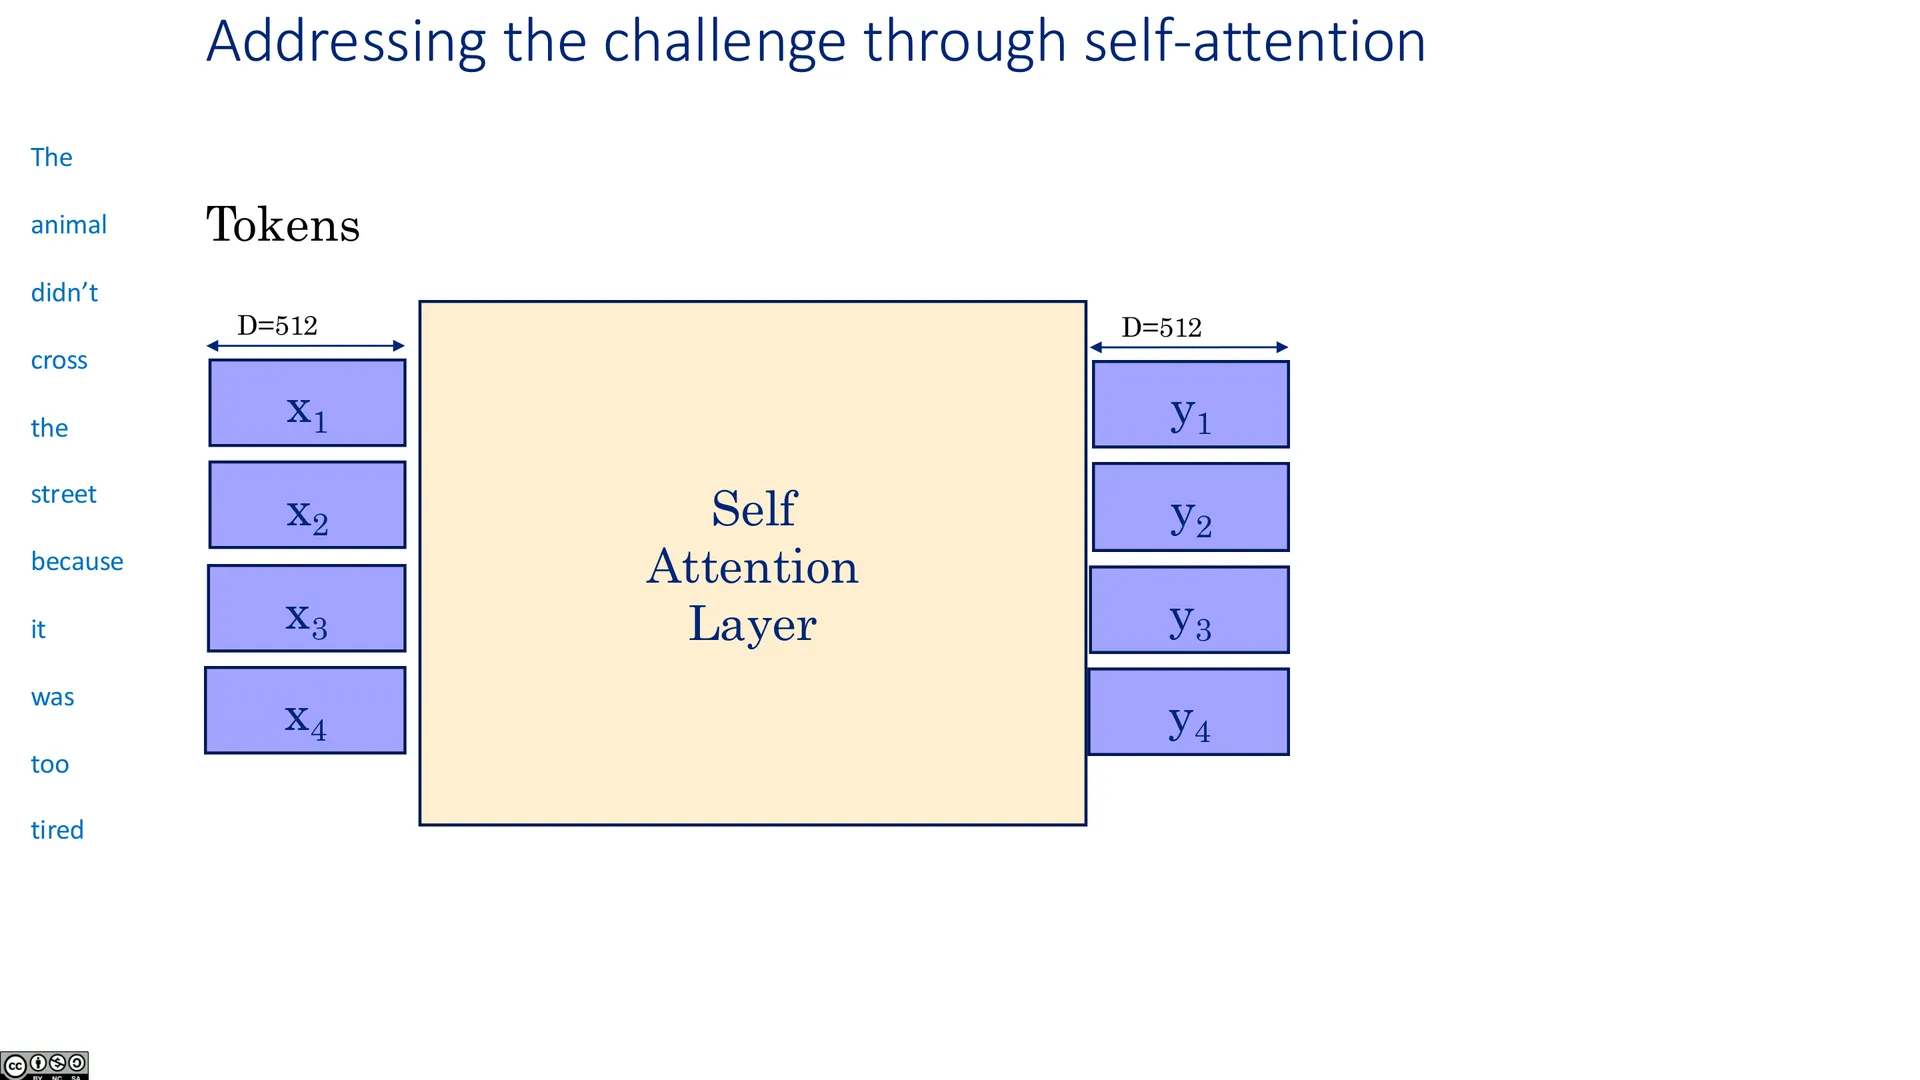
🖼️ 通过自注意力解决该挑战
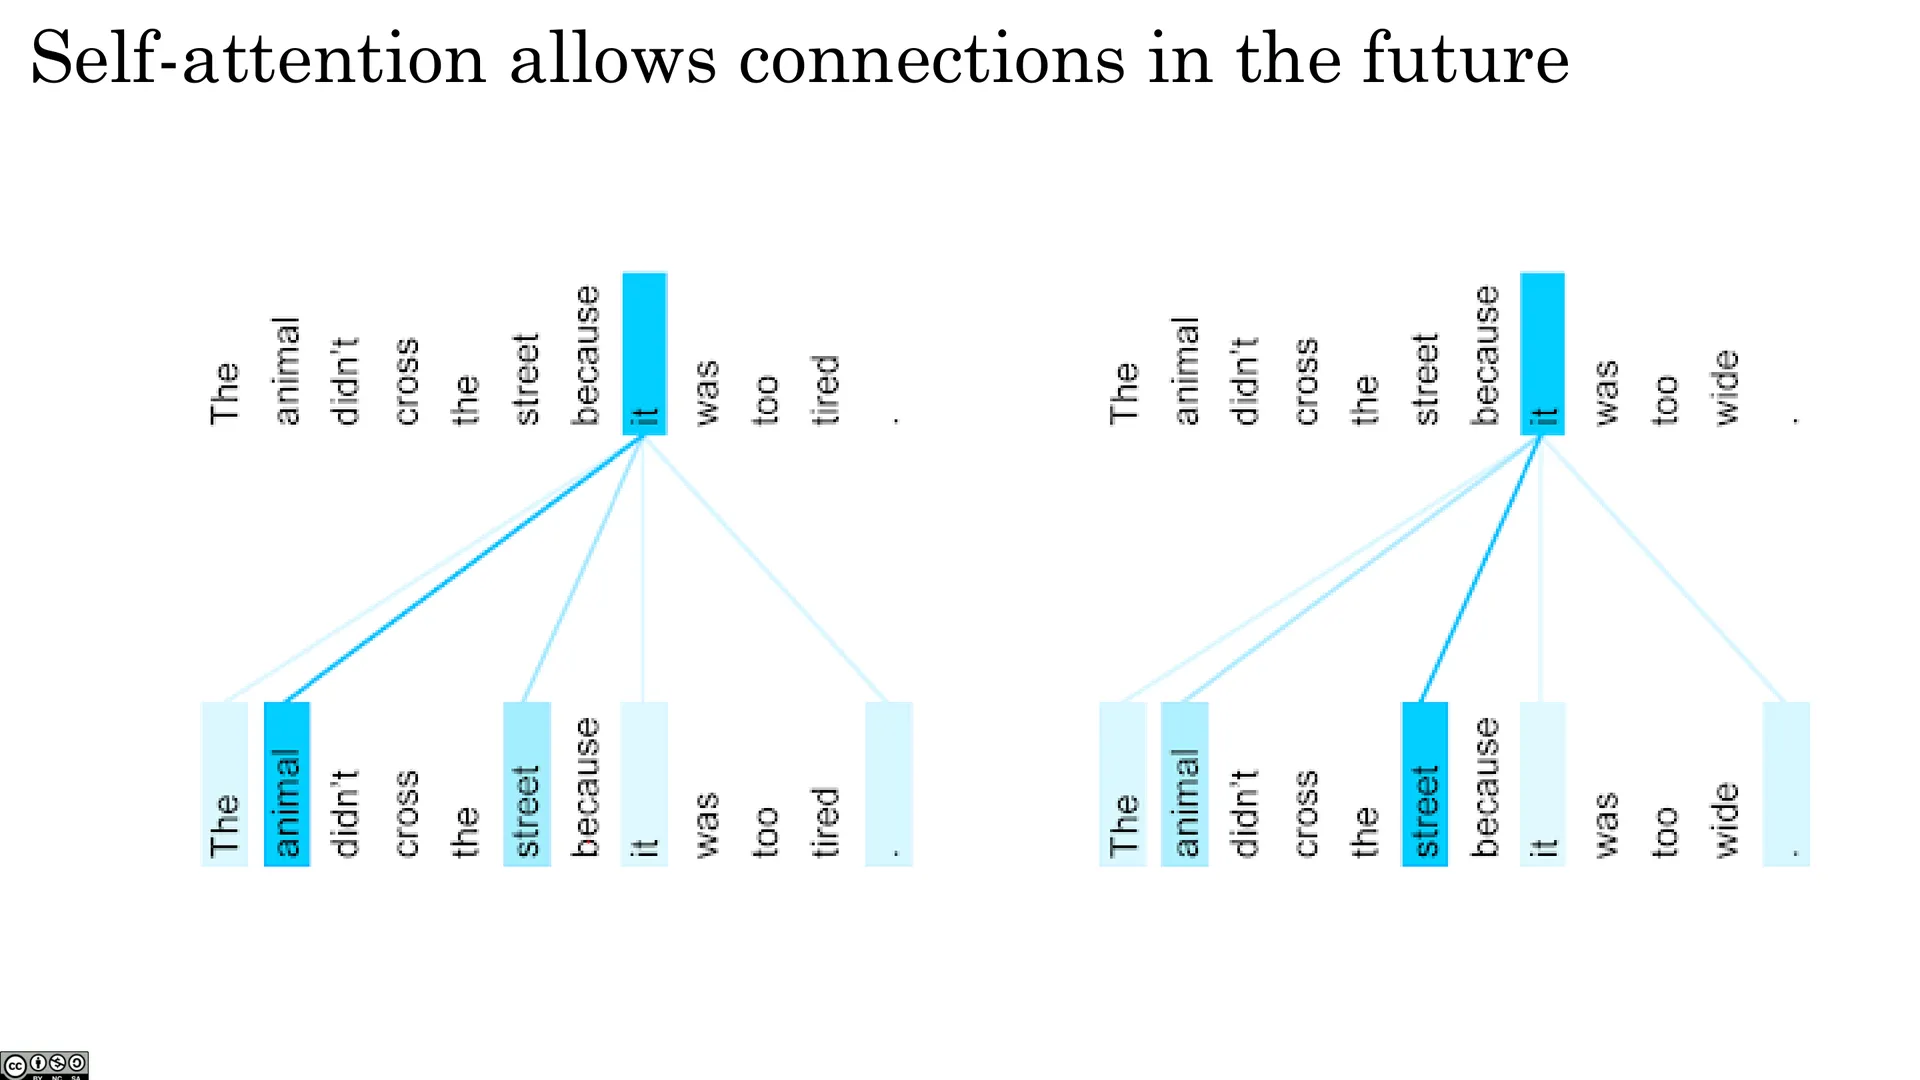
🖼️ 自注意力允许与未来的连接
🖼️ 需要在表示中包含上下文
🖼️ 从 Token 嵌入开始
🖼️ Transformer 层的基本设置
🖼️ 融入其他 Token 的上下文
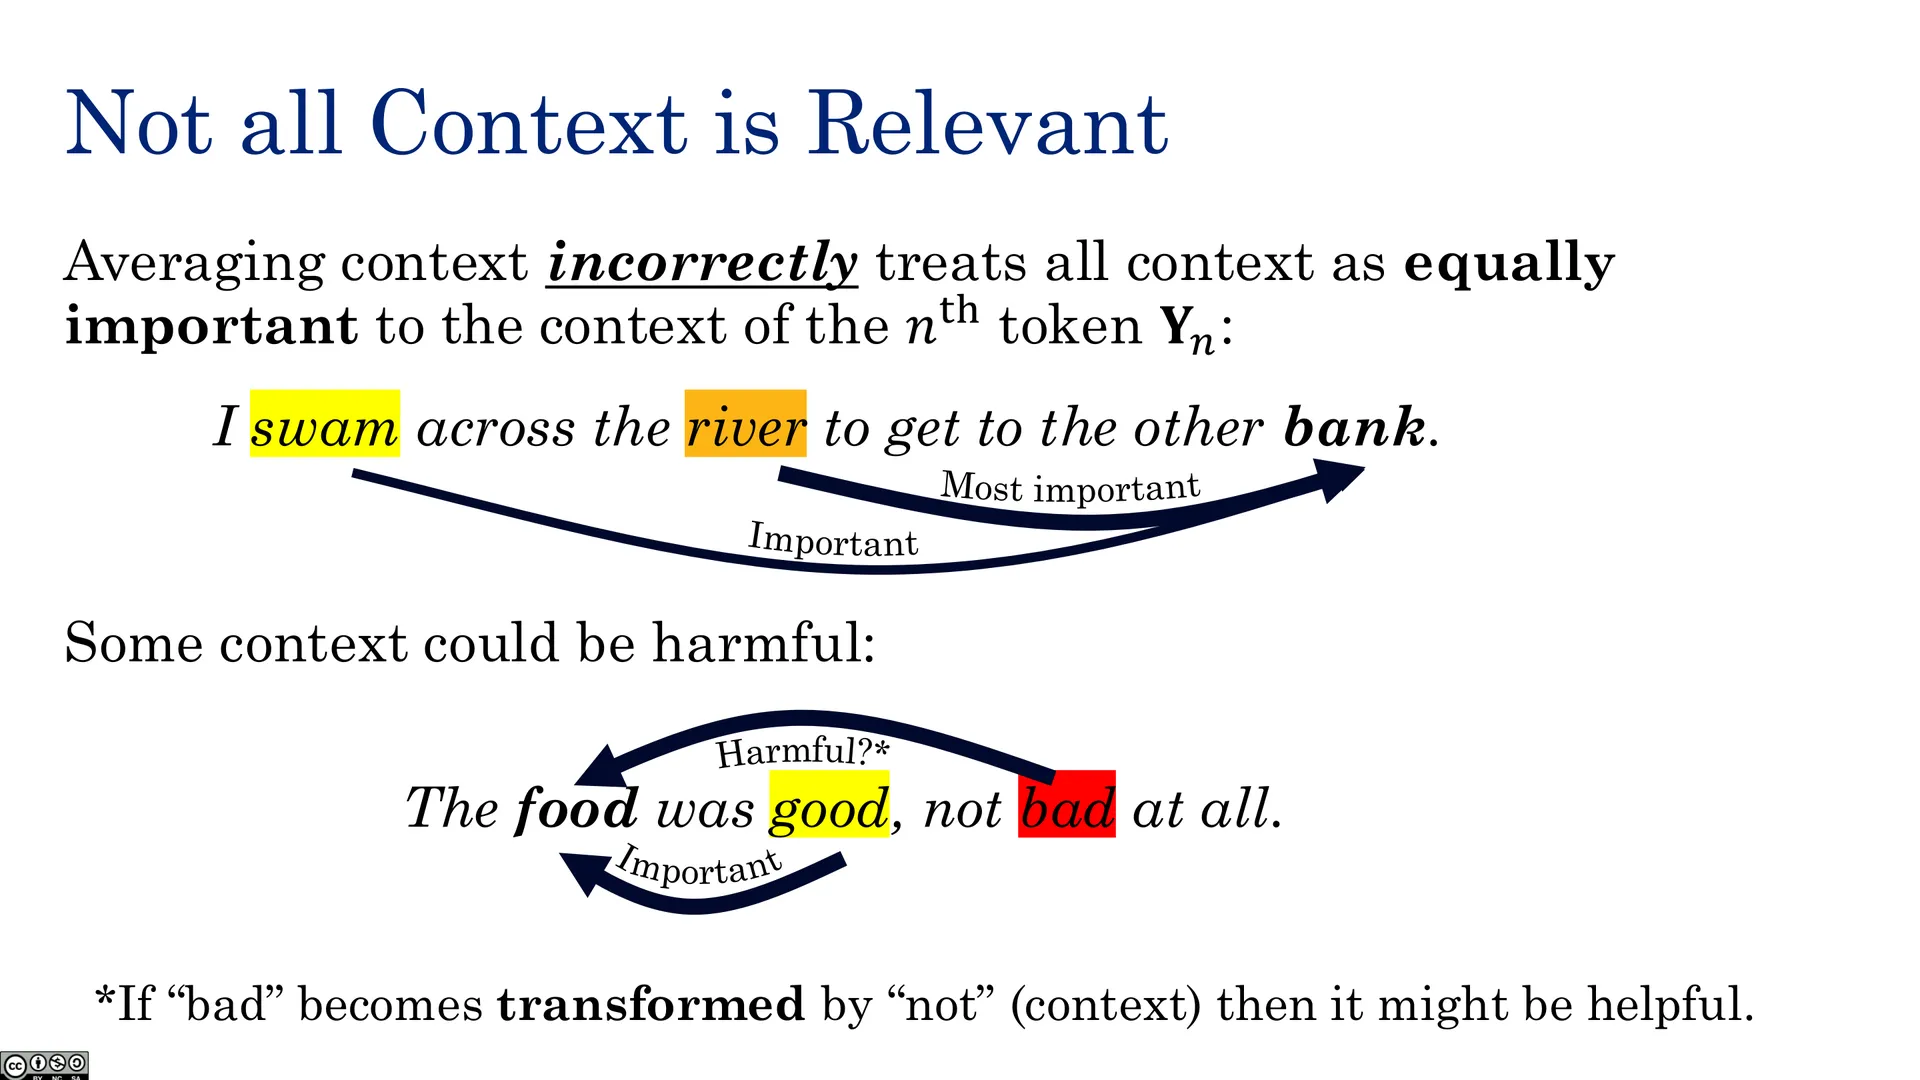
🖼️ 并非所有上下文都相关
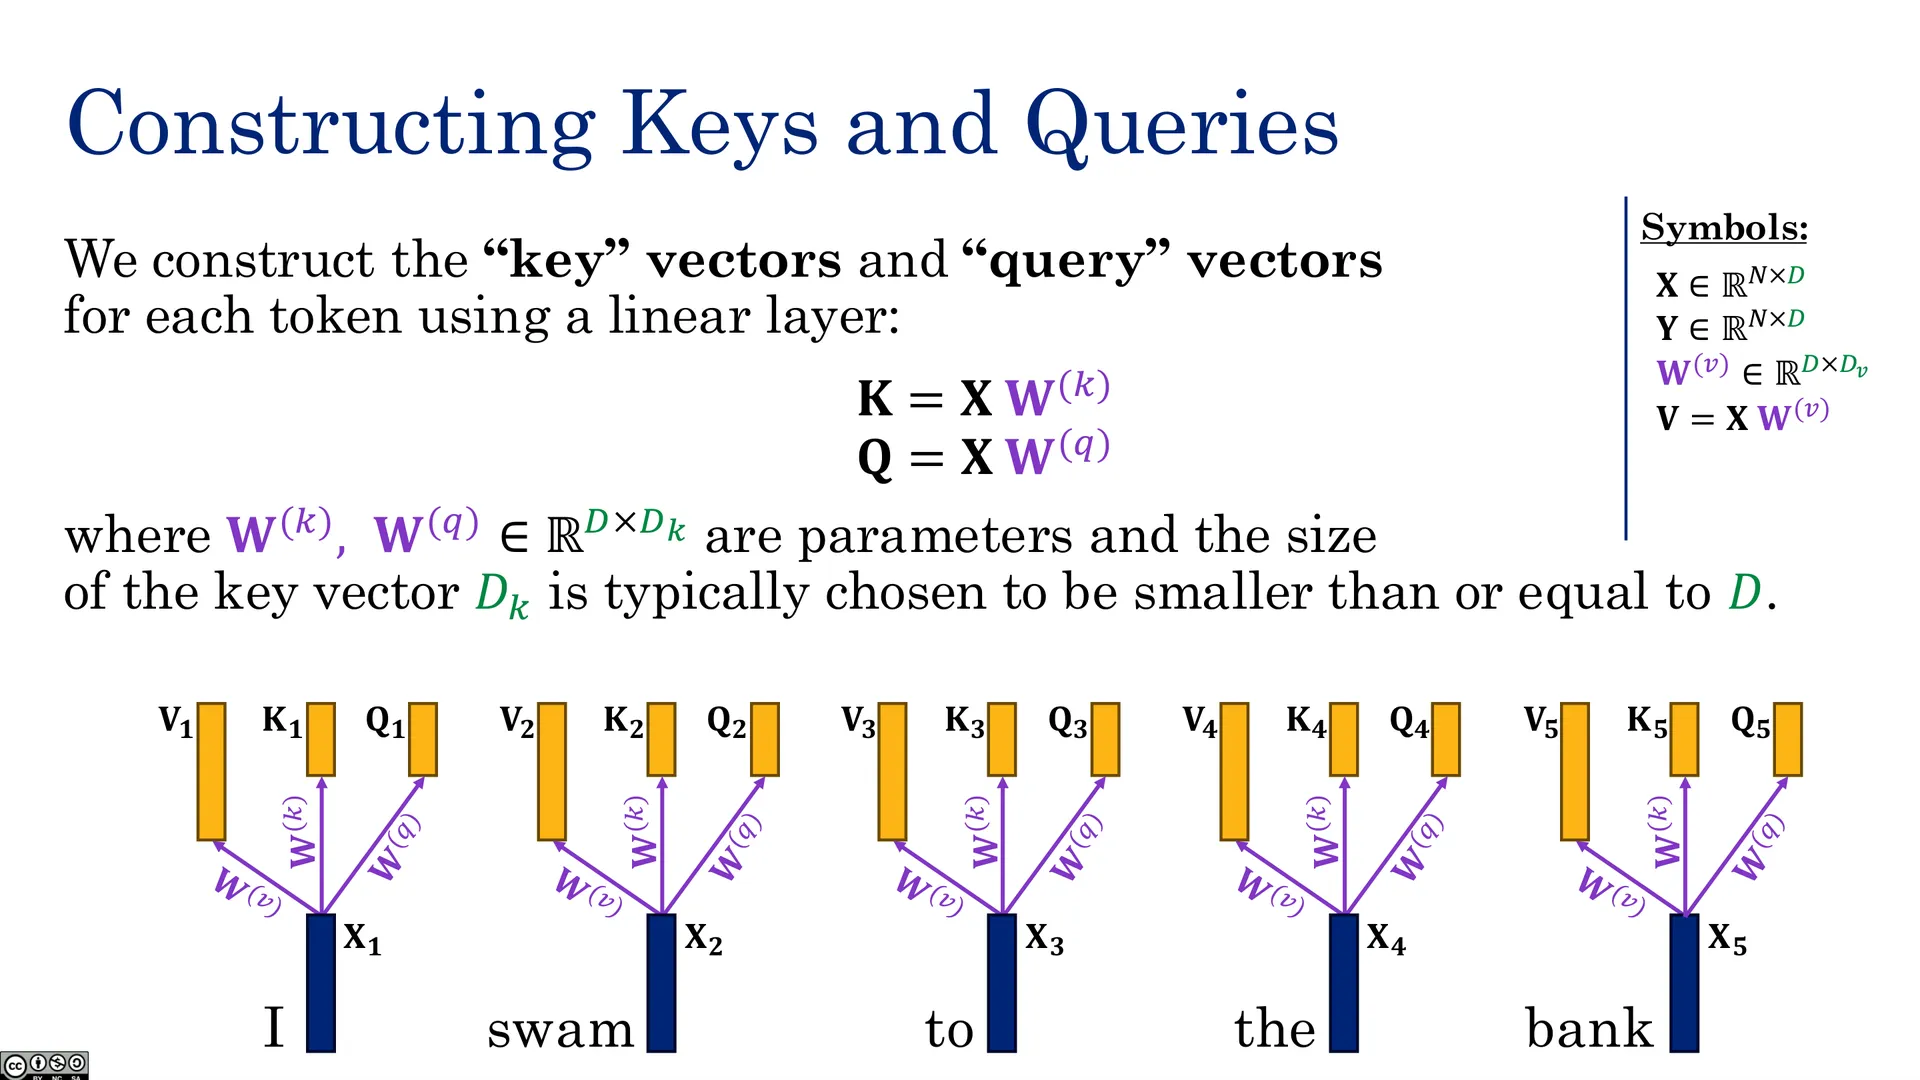
🖼️ 构造 Keys 与 Queries
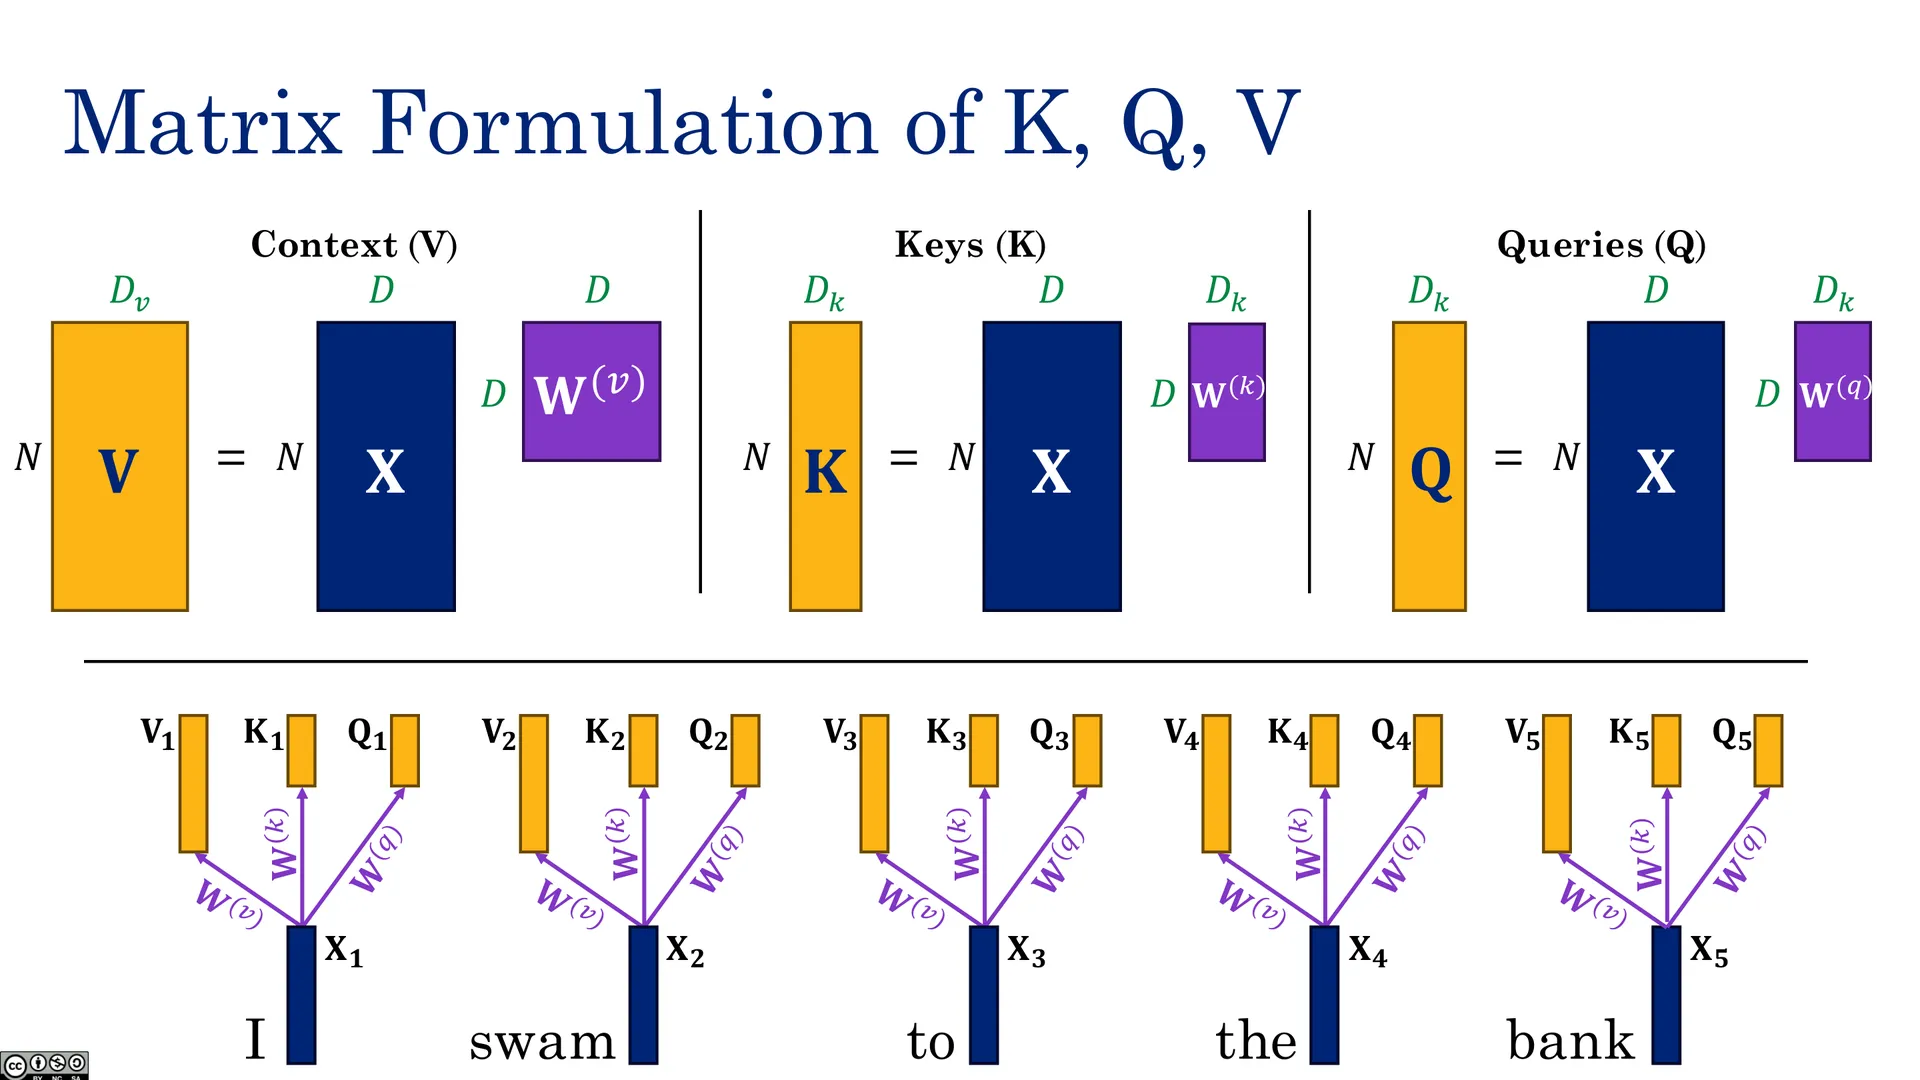
🖼️ $V_1$
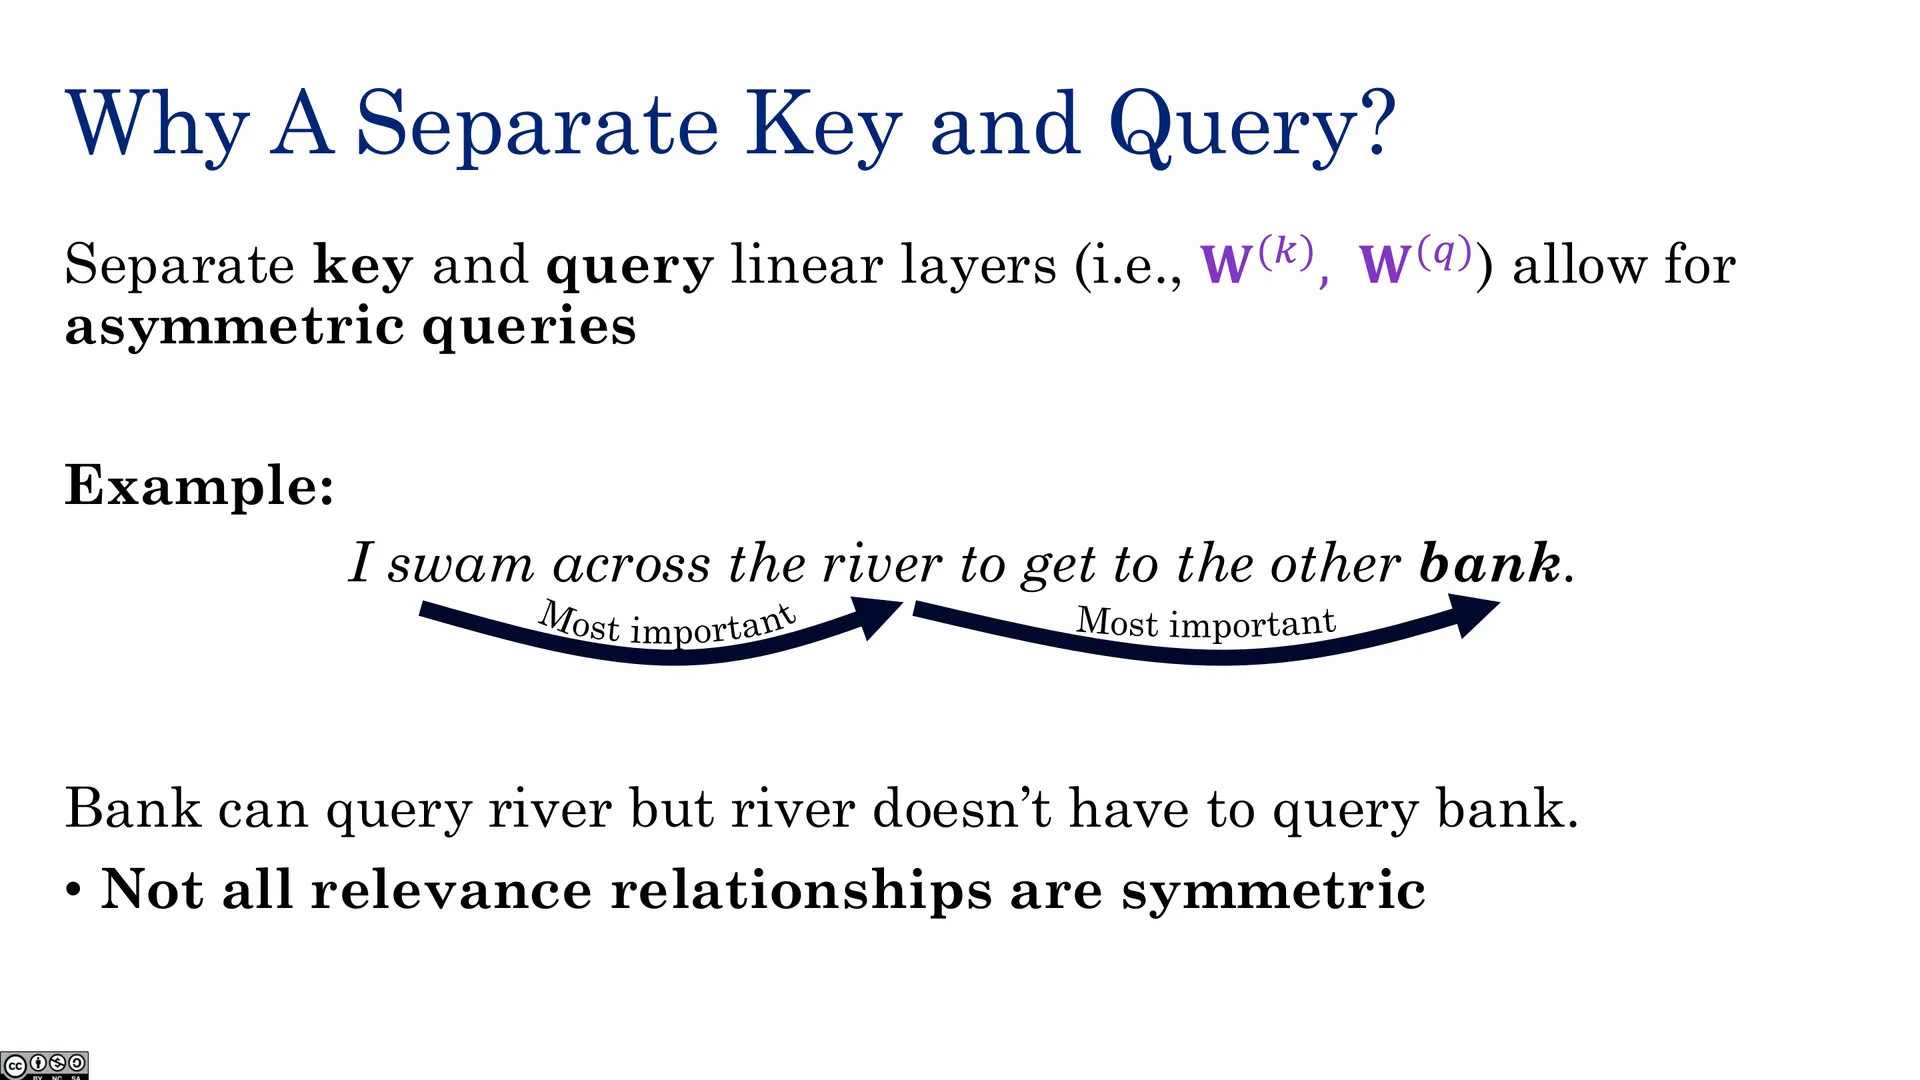
🖼️ 为什么需要分开的 Key 与 Query?
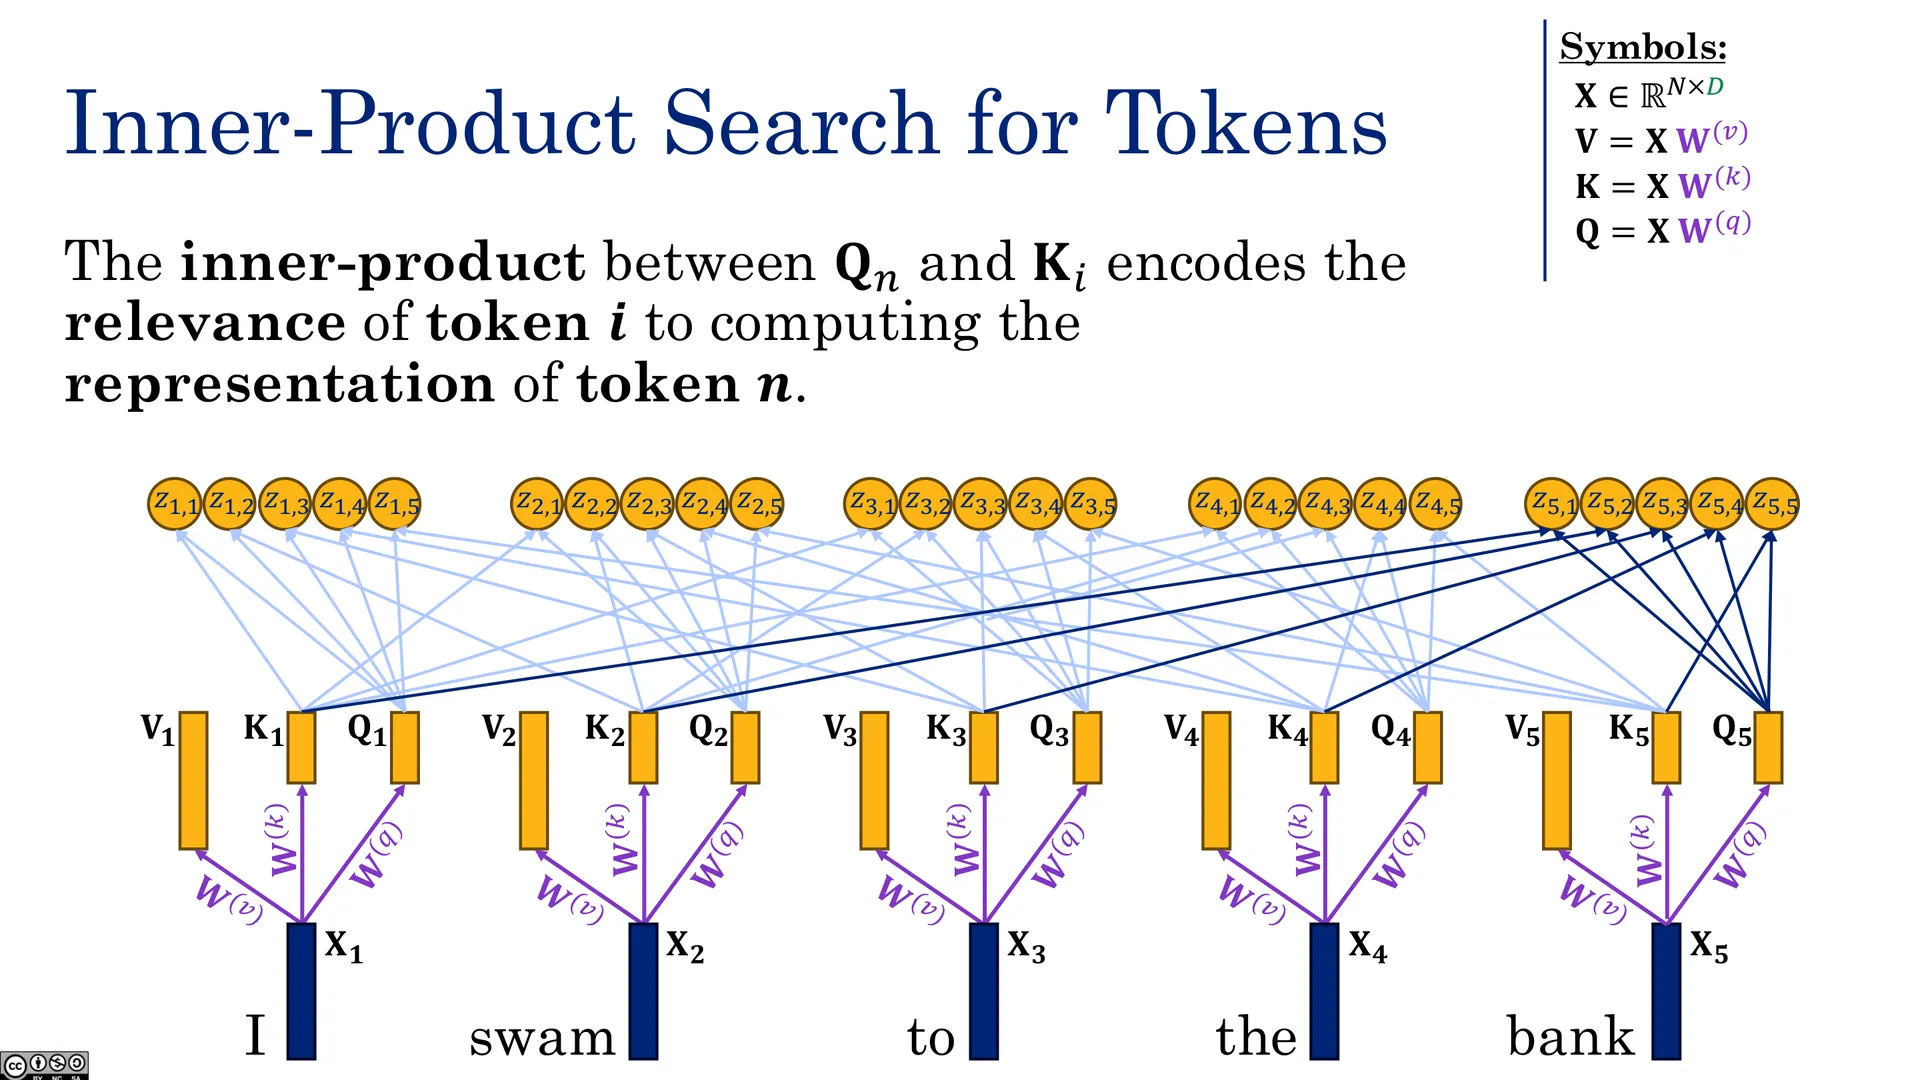
🖼️ $Q_2$
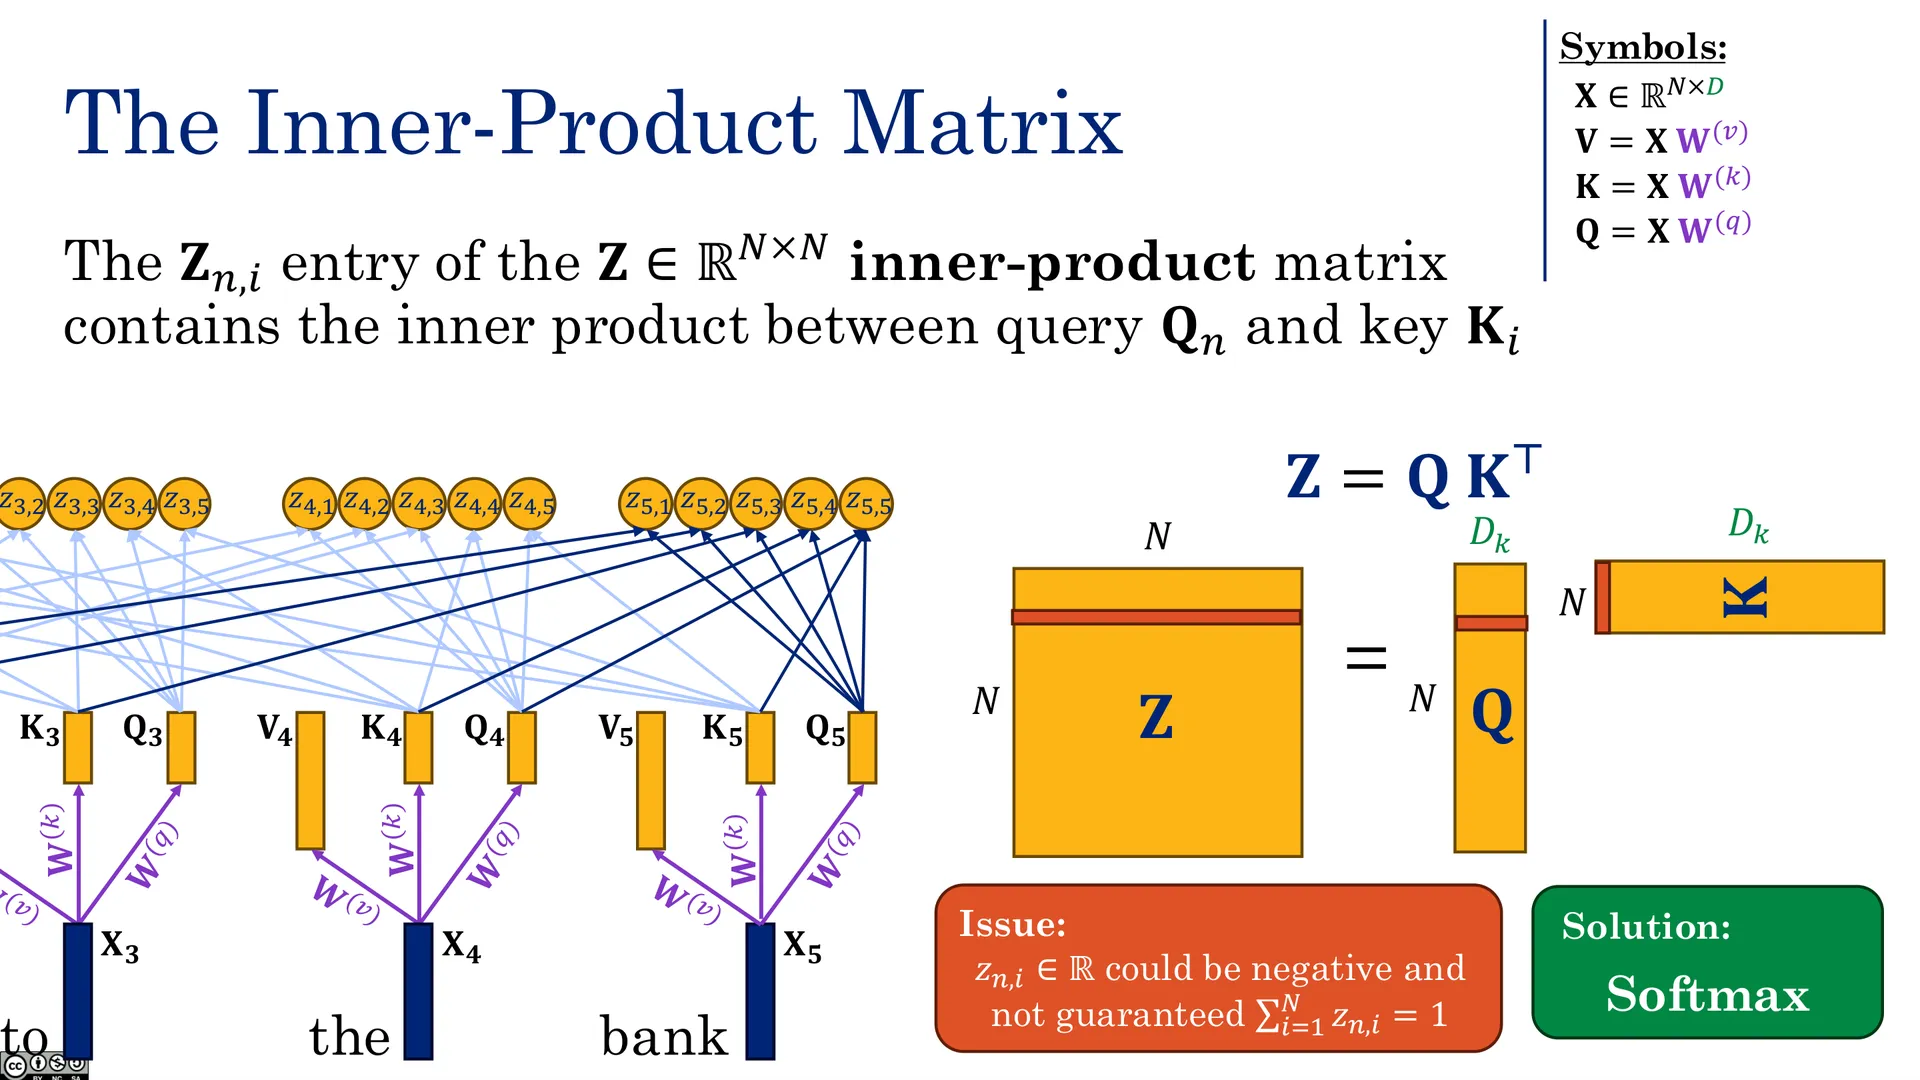
🖼️ $K_3$(一)
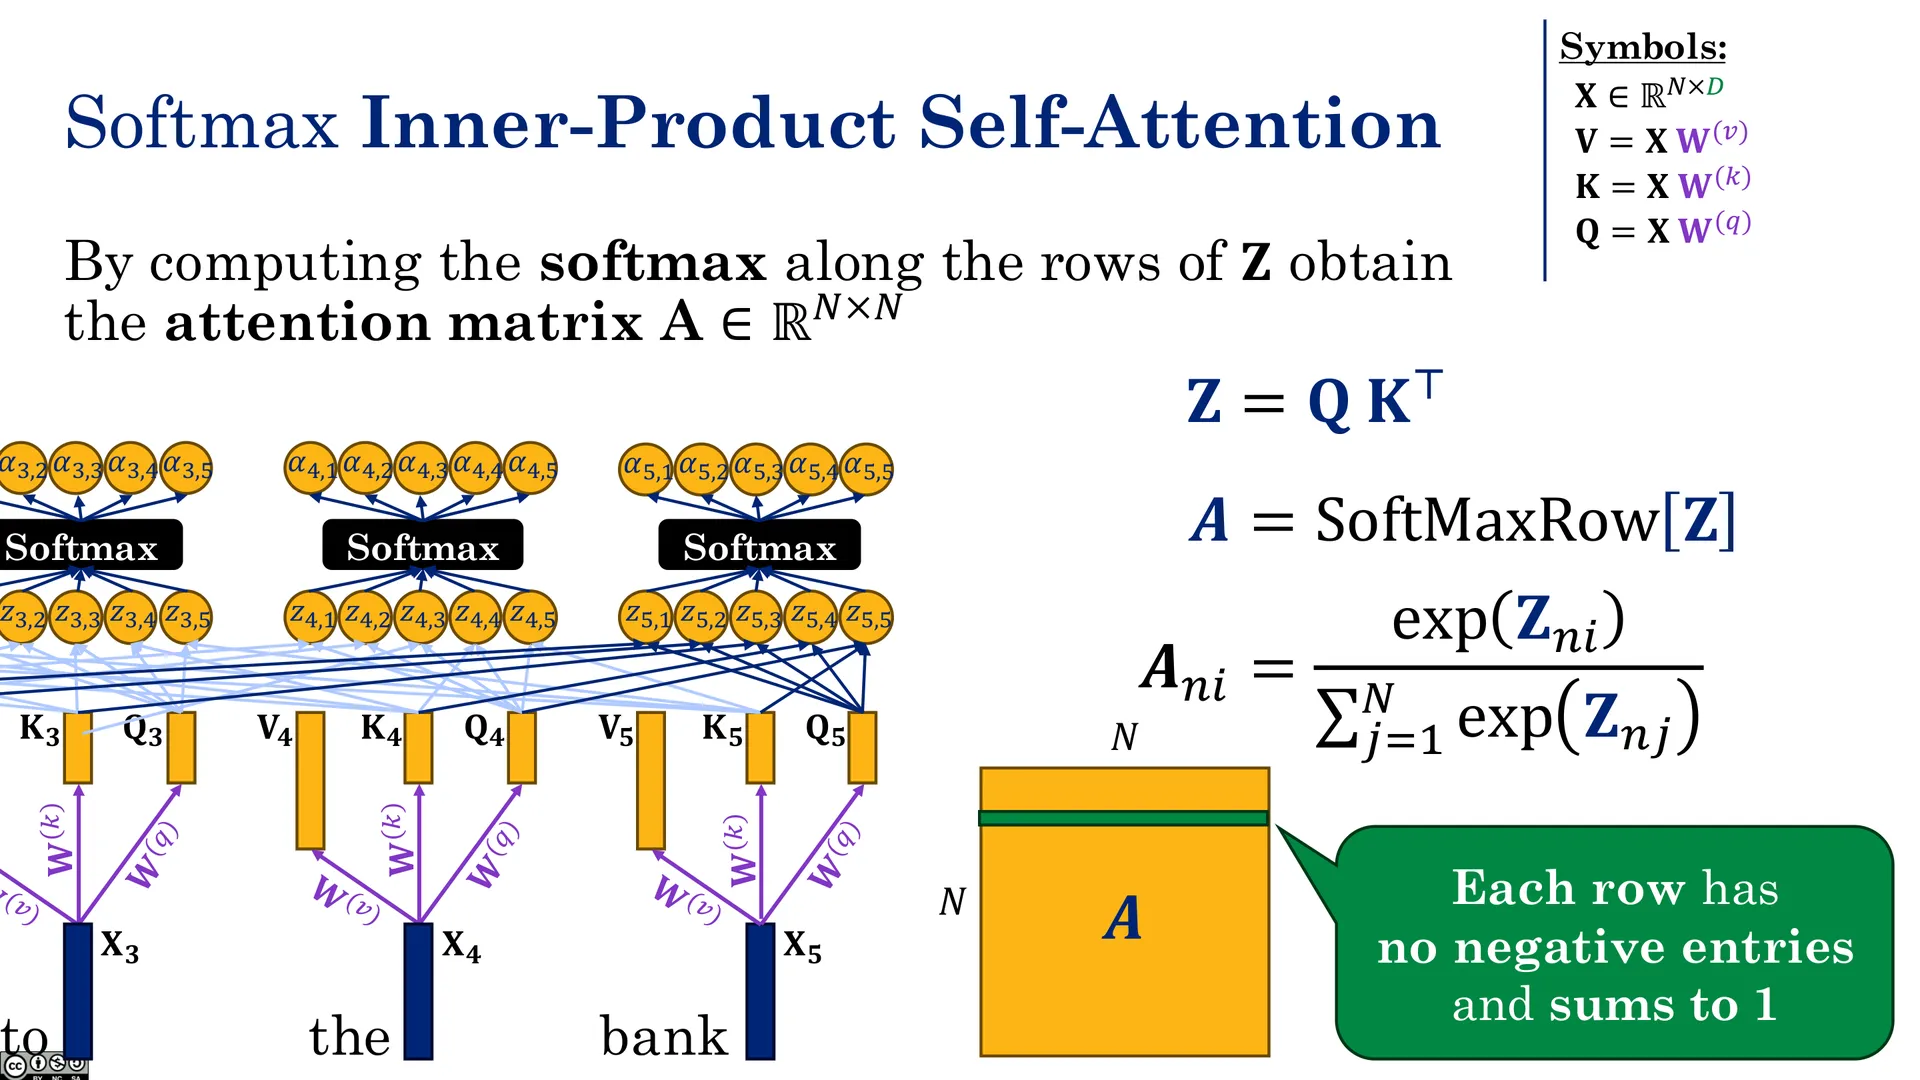
🖼️ $K_3$(二)
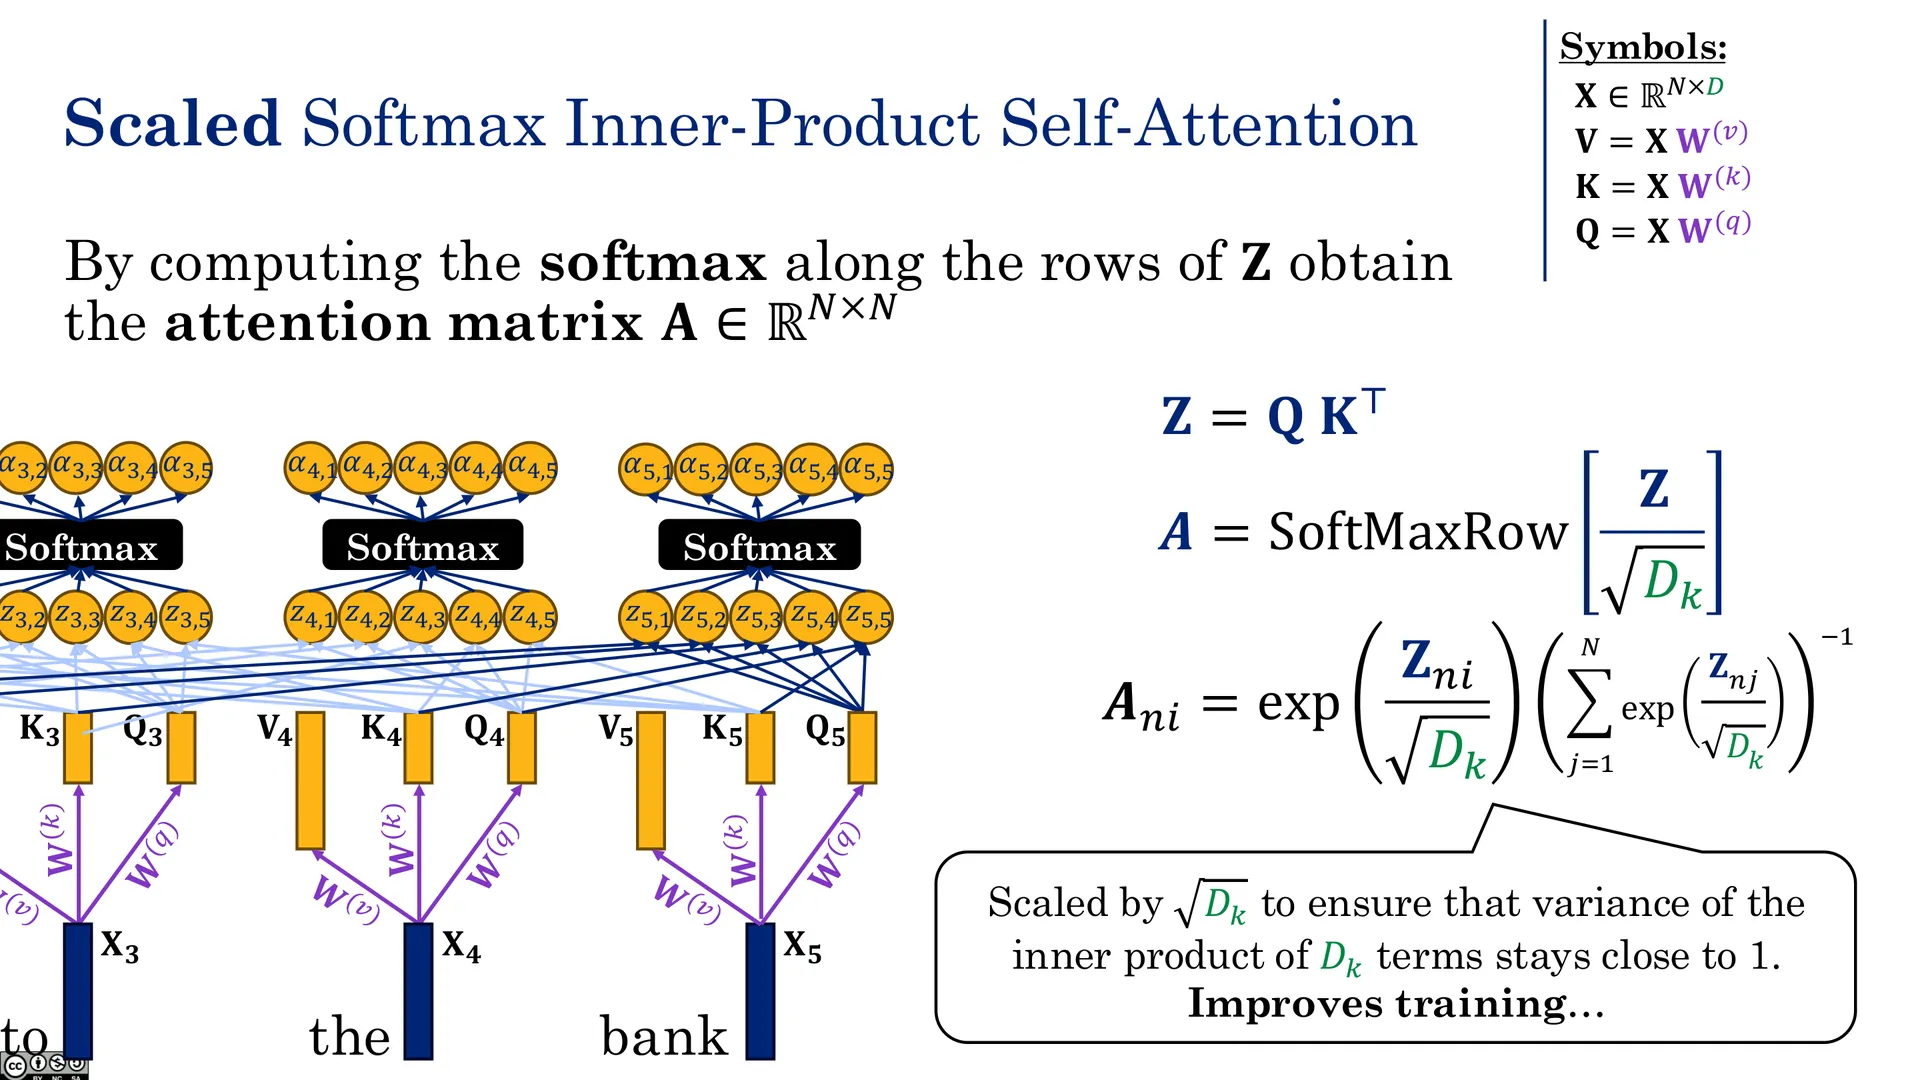
🖼️ $K_3$(三)
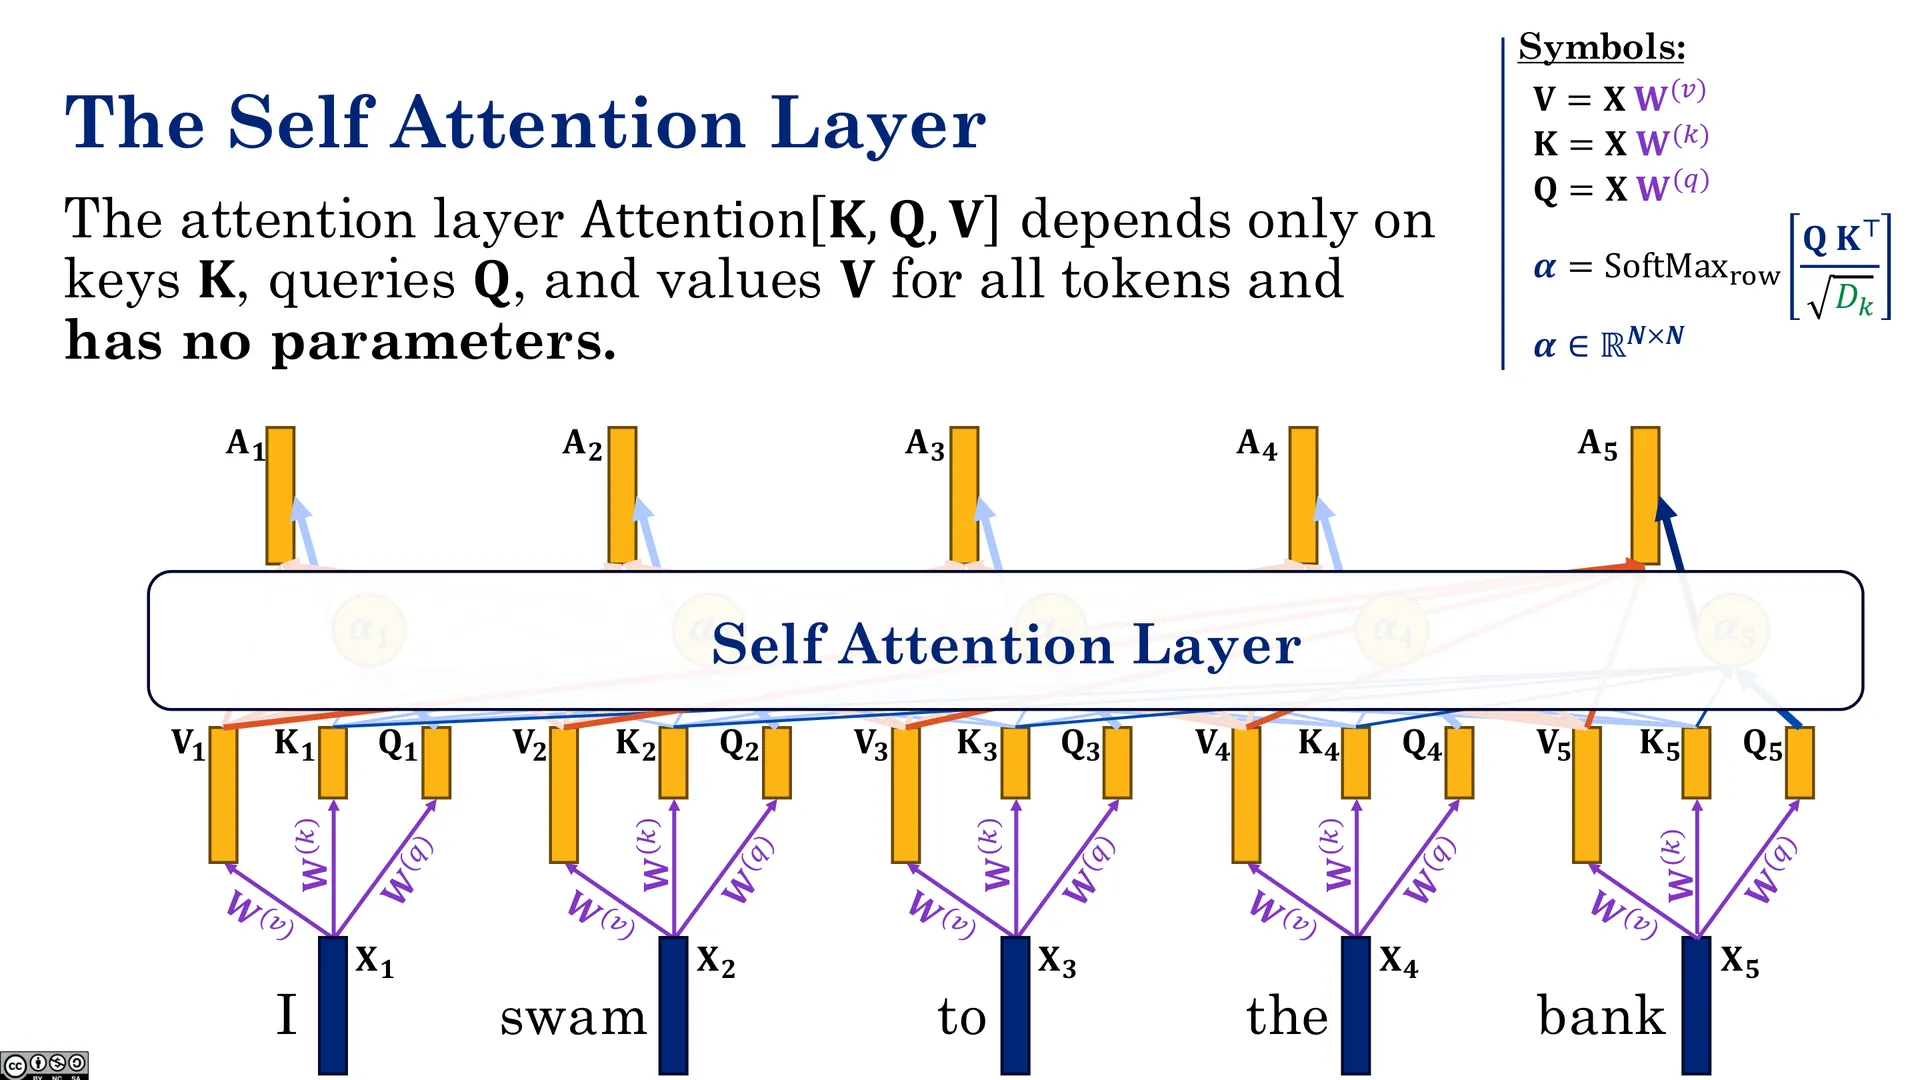
🖼️ 自注意力层
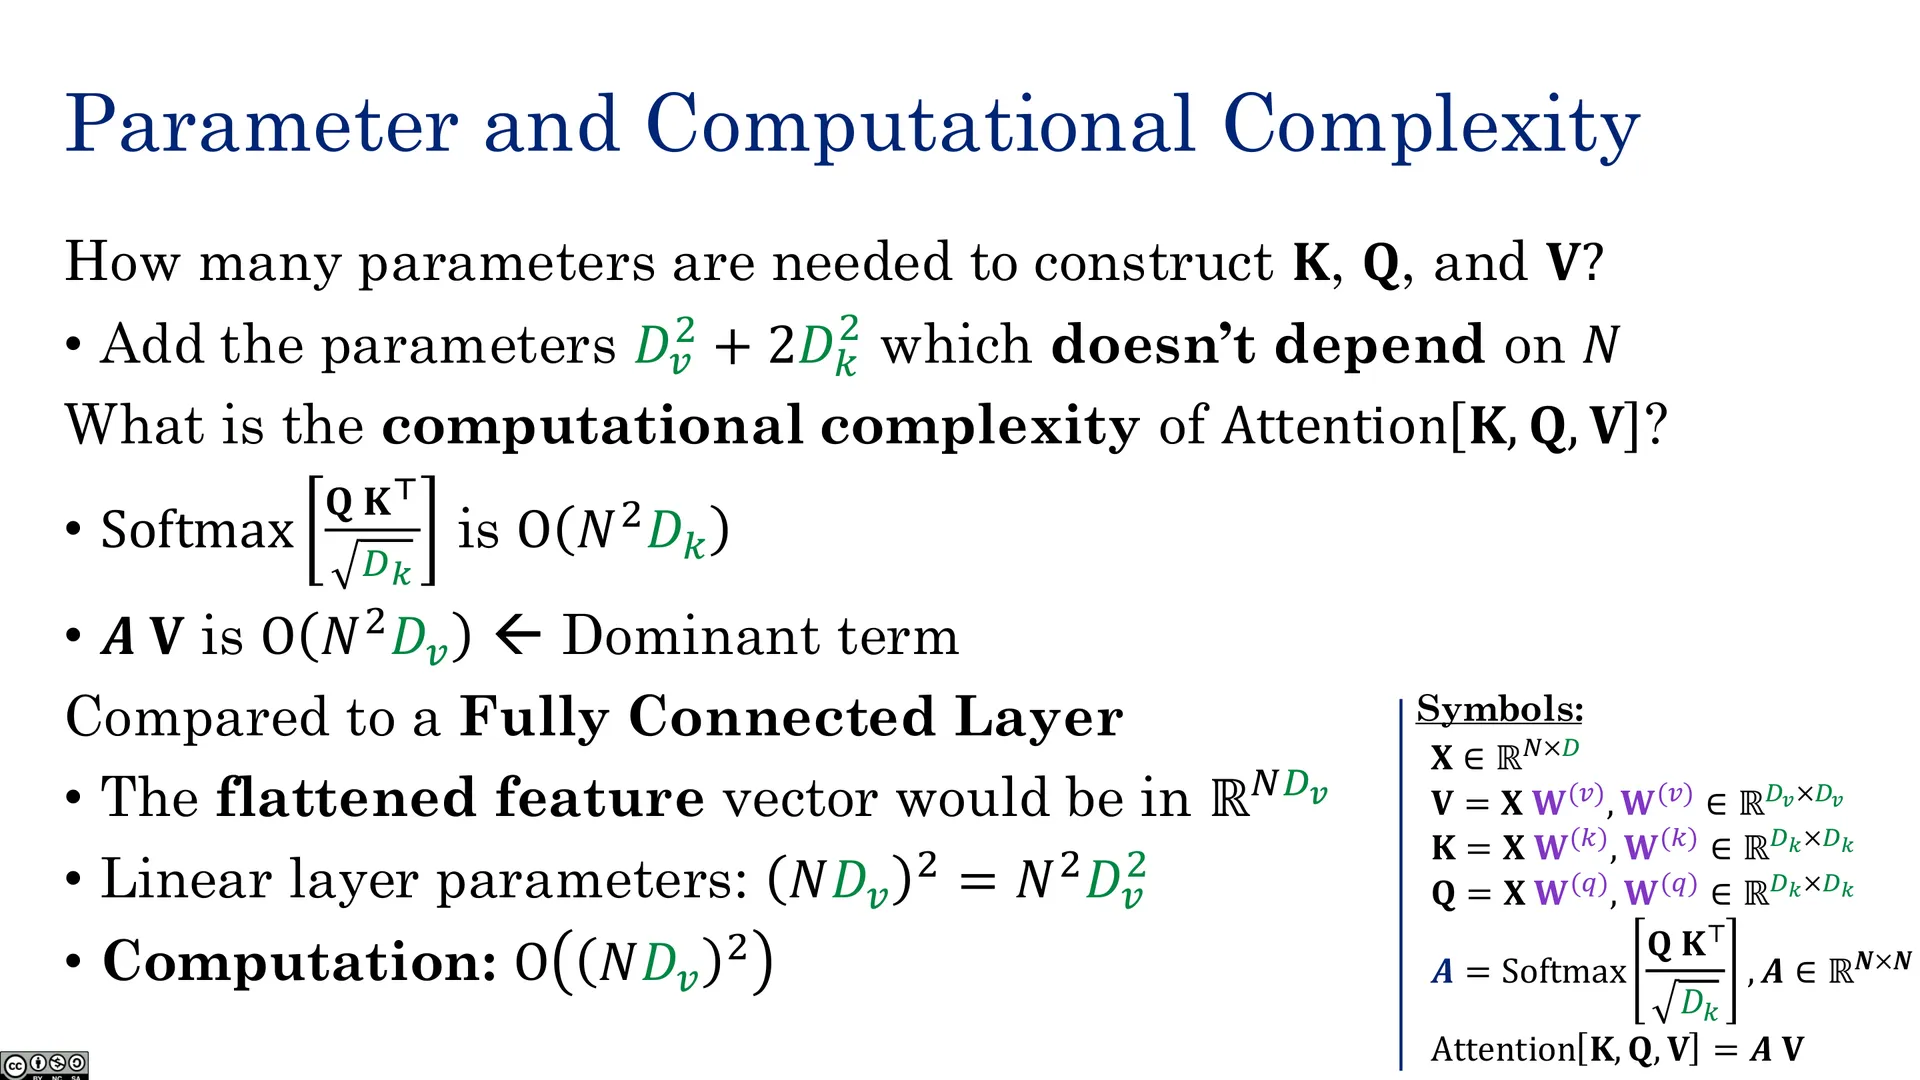
🖼️ 参数与计算复杂度
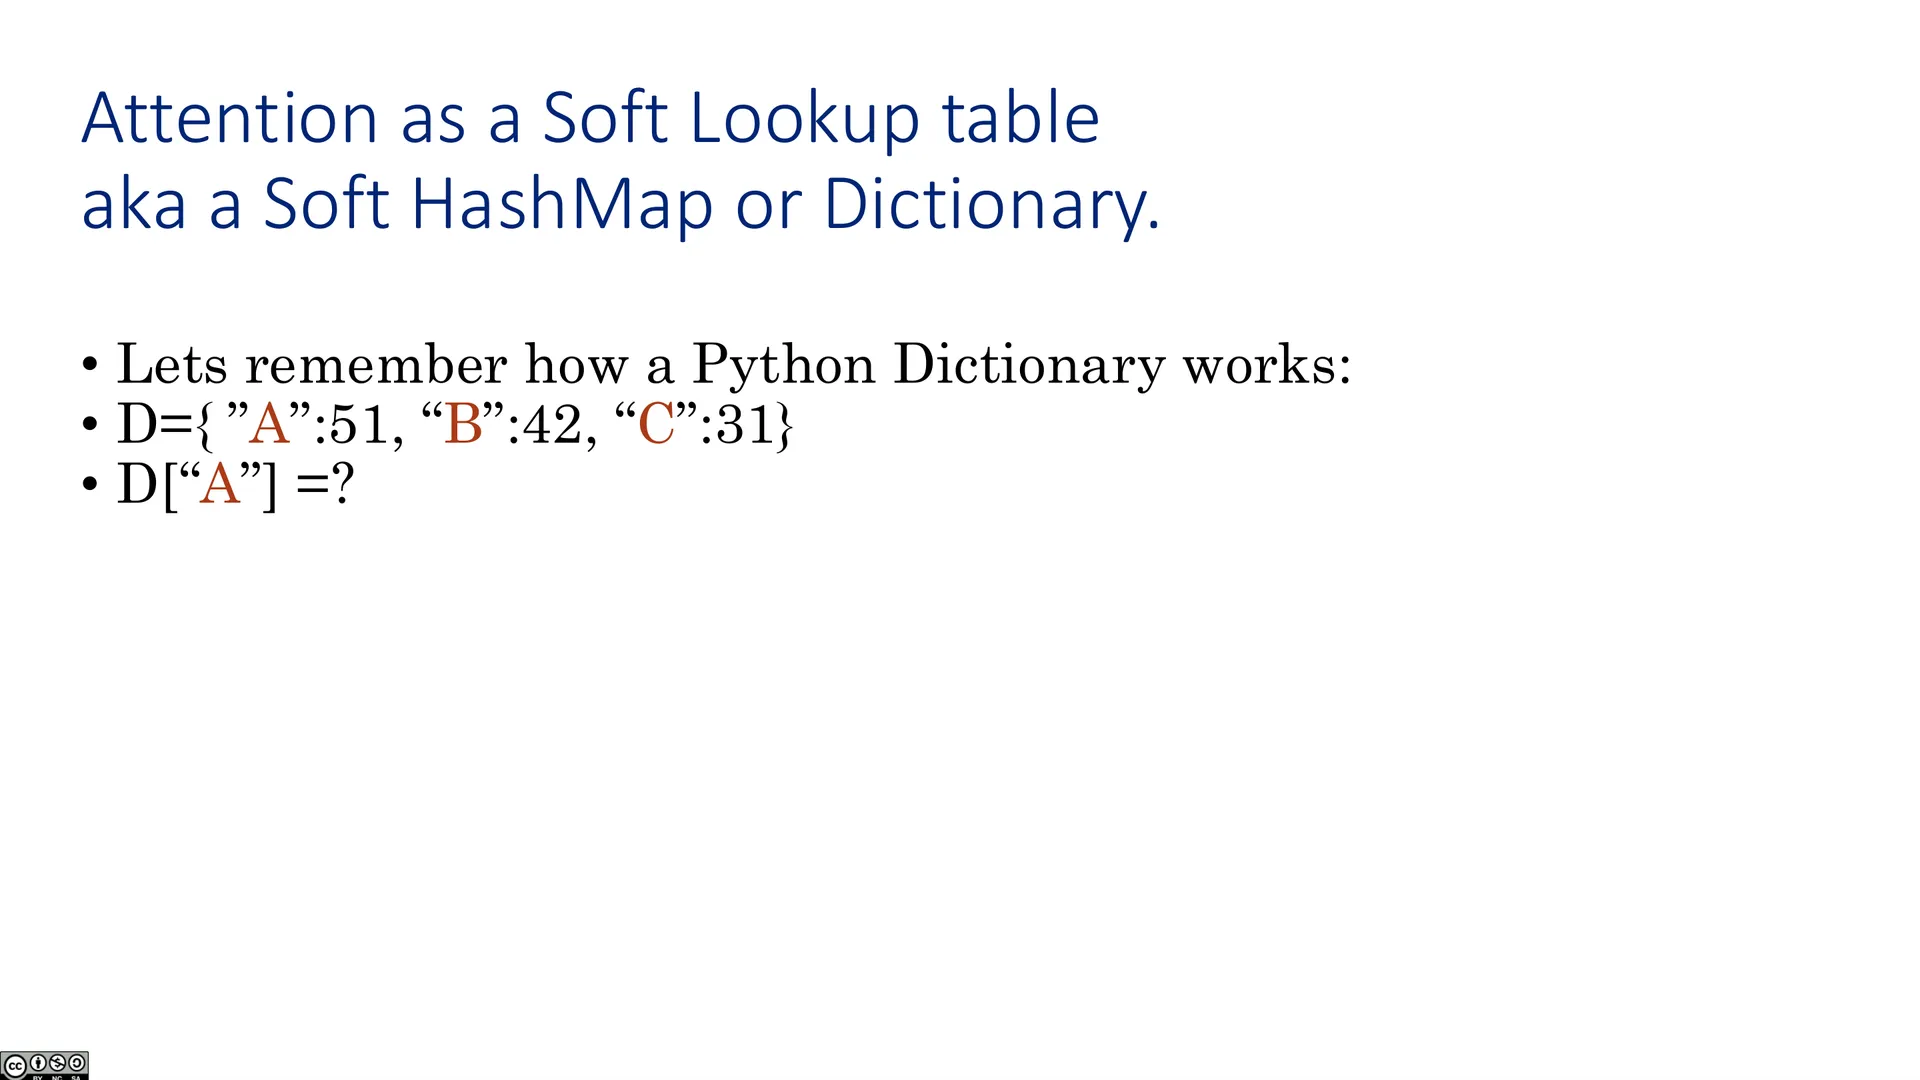
🖼️ 注意力作为软查找表(一)
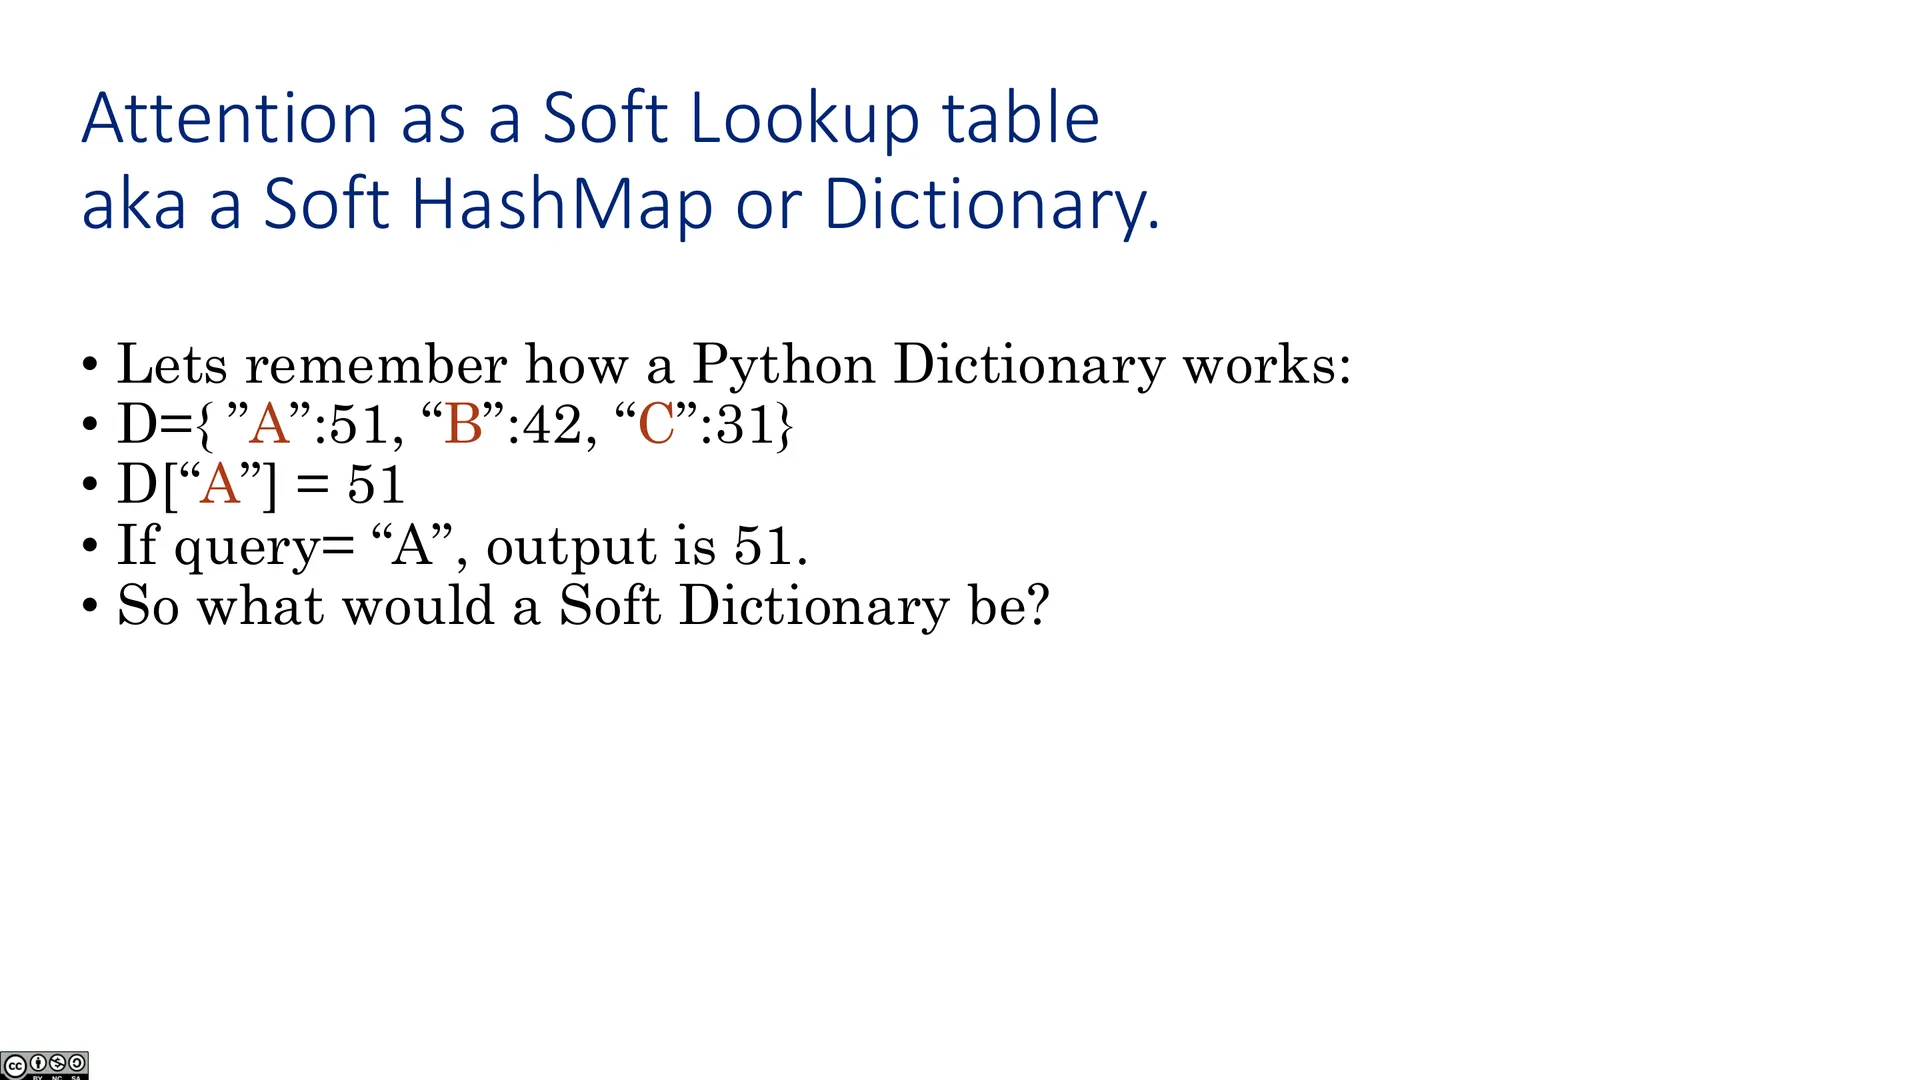
🖼️ 注意力作为软查找表(二)
🖼️ 注意力作为软查找表(三)
🖼️ 注意力作为软查找表(四)
🖼️ 多头注意力
🖼️ 多头注意力的替代方案
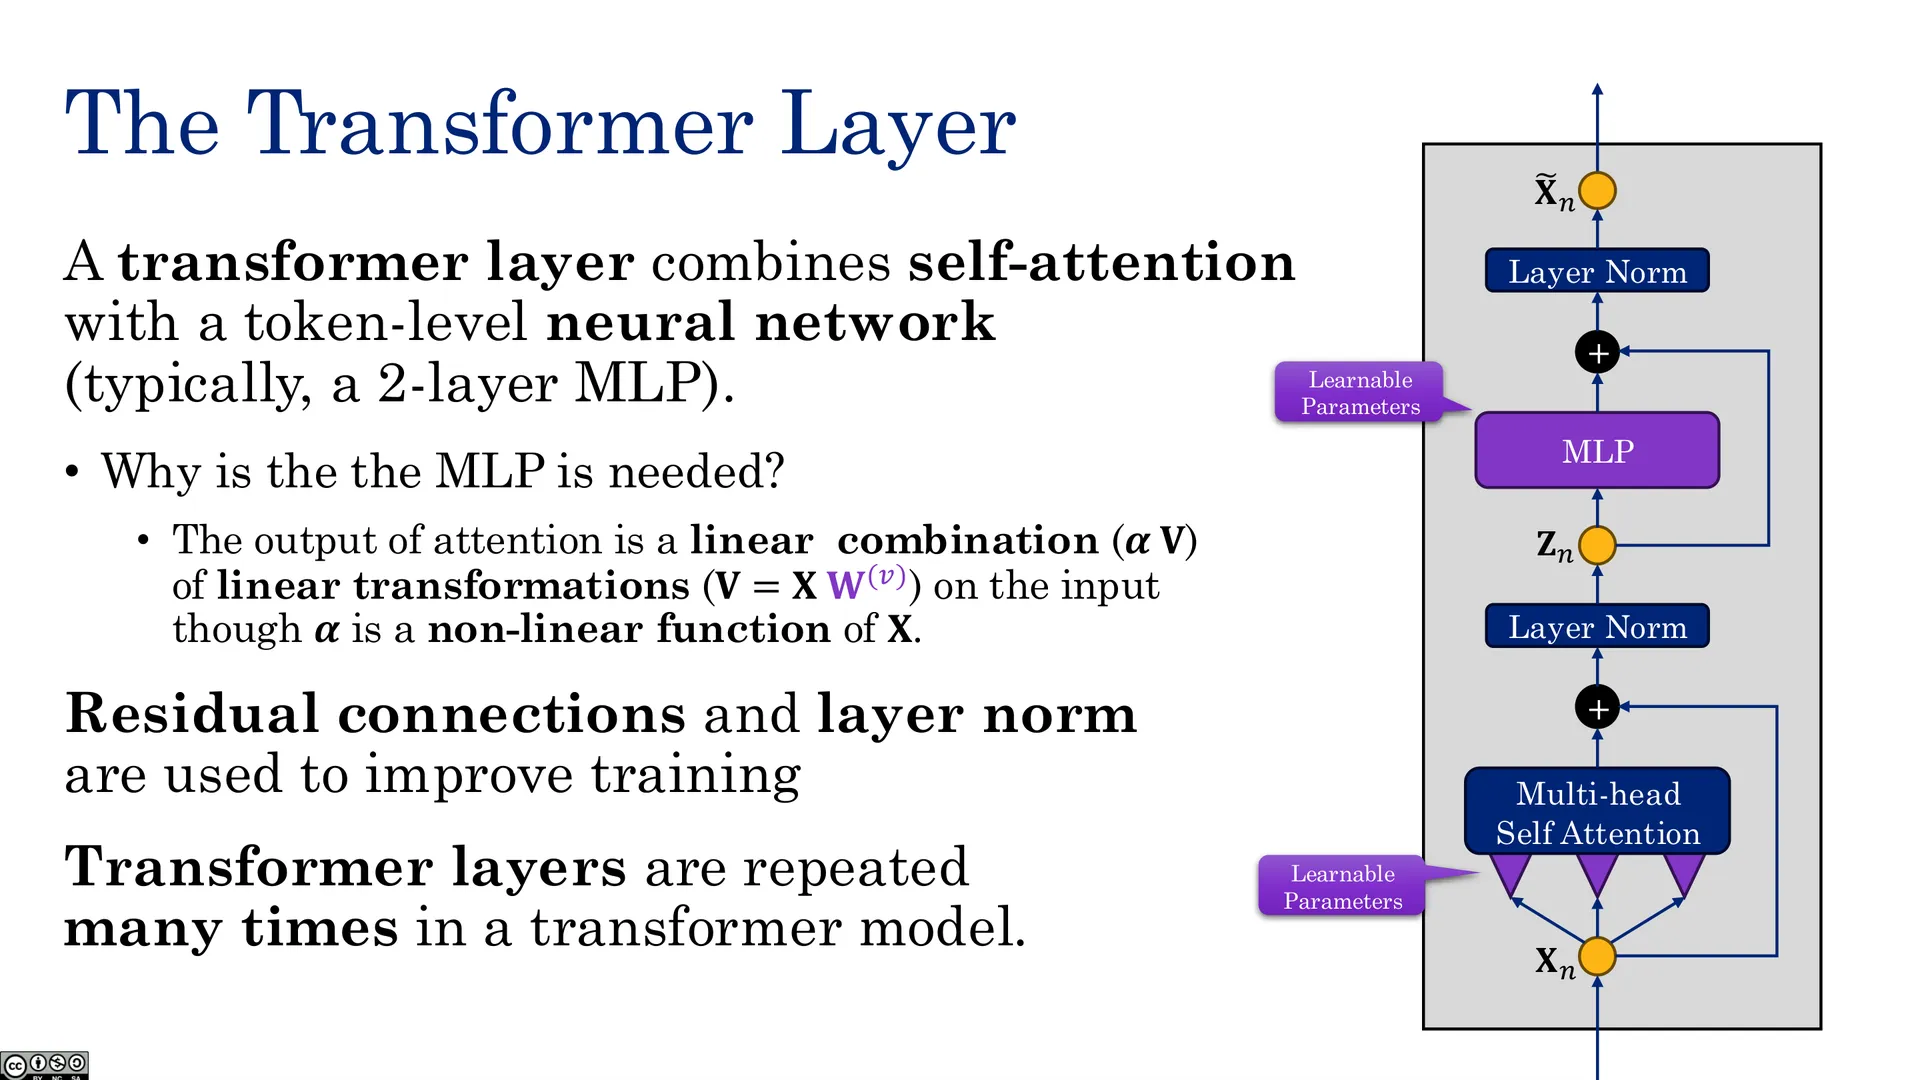
🖼️ Transformer 层
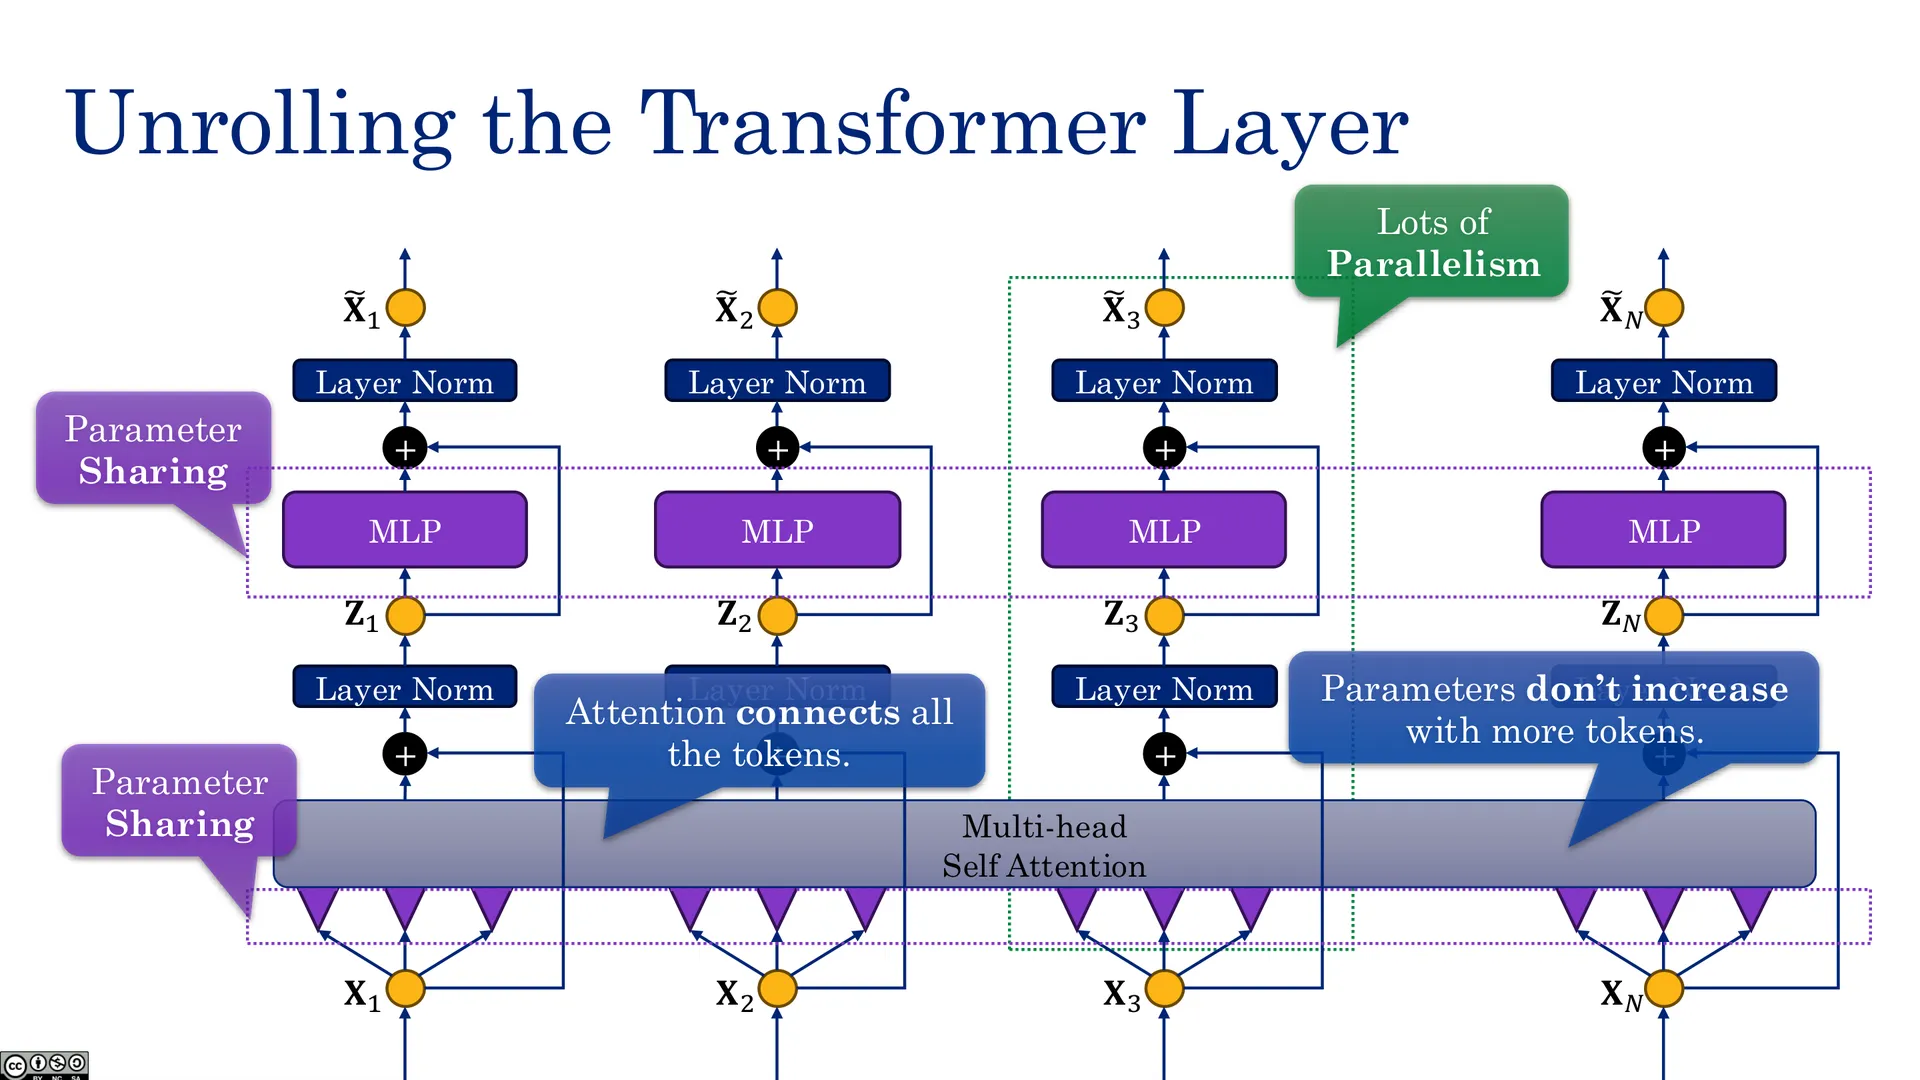
🖼️ 展开 Transformer 层
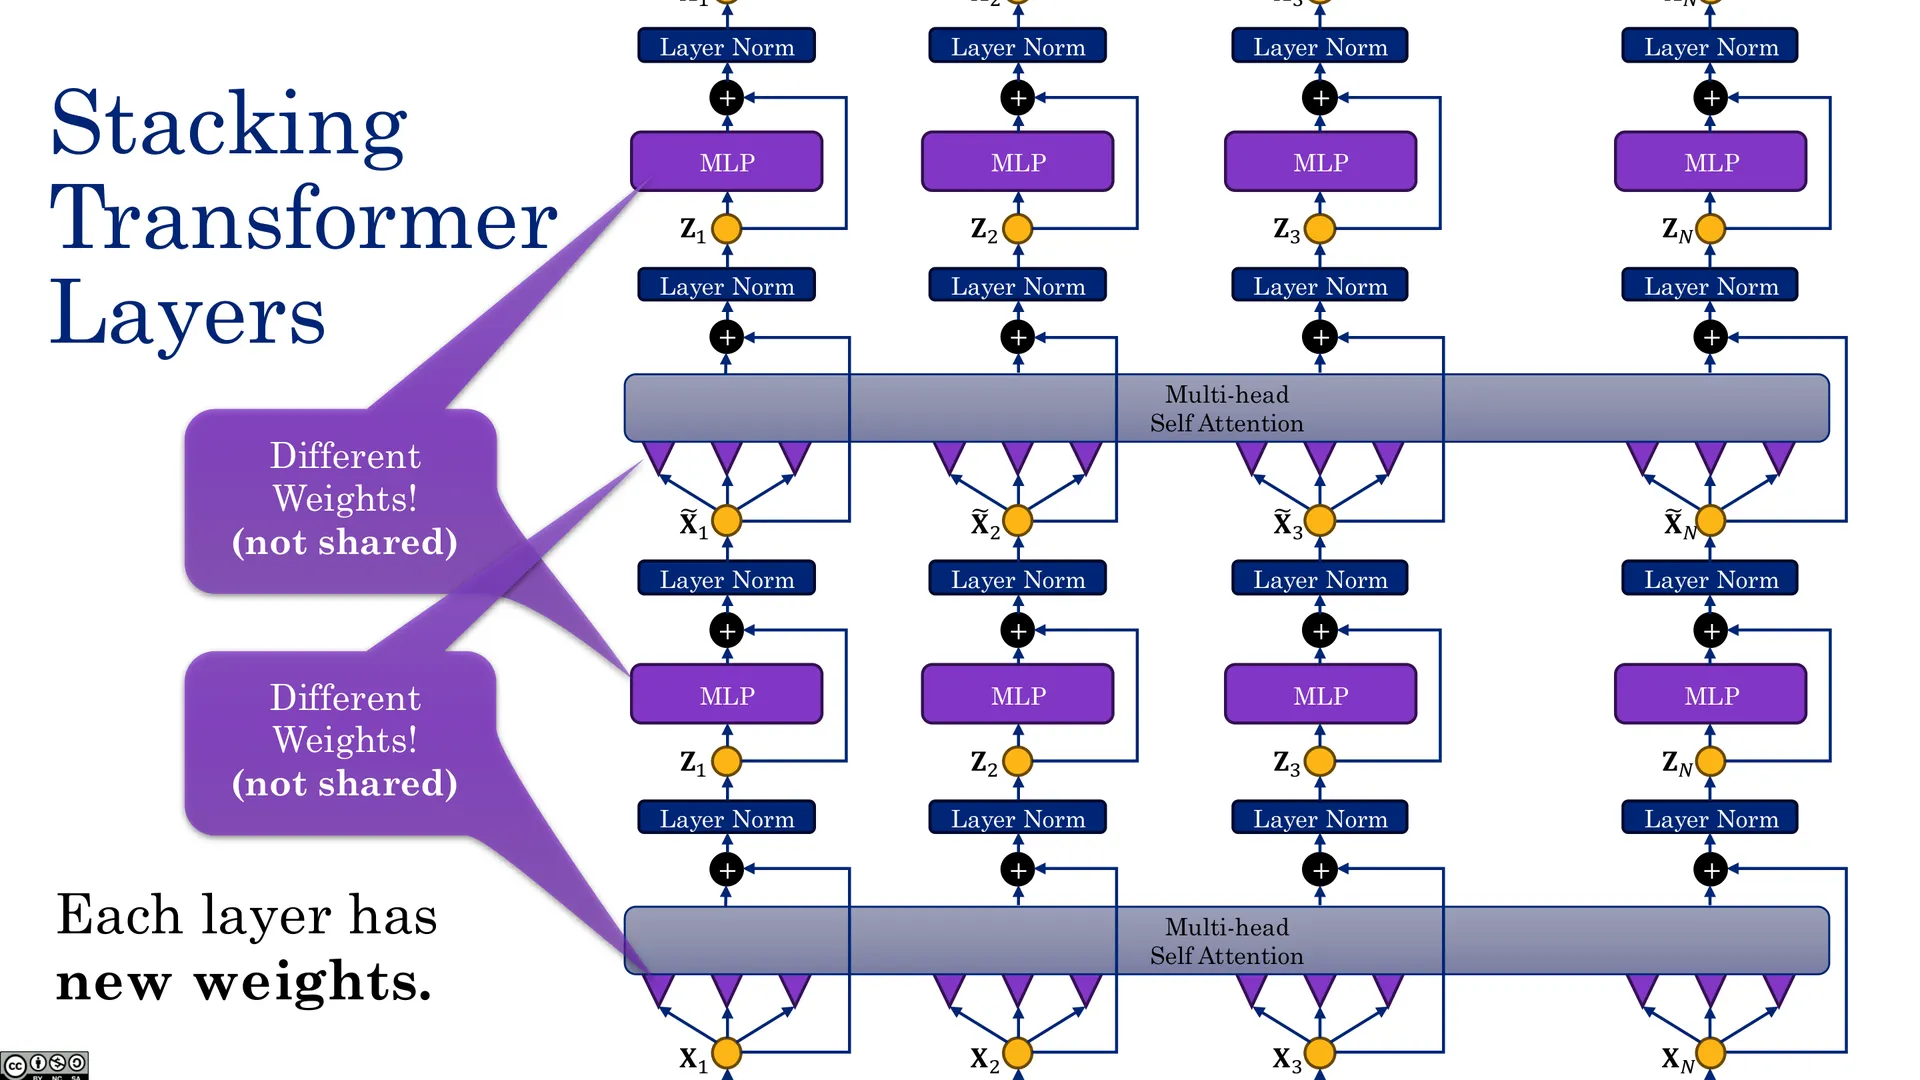
🖼️ 残差连接(+)
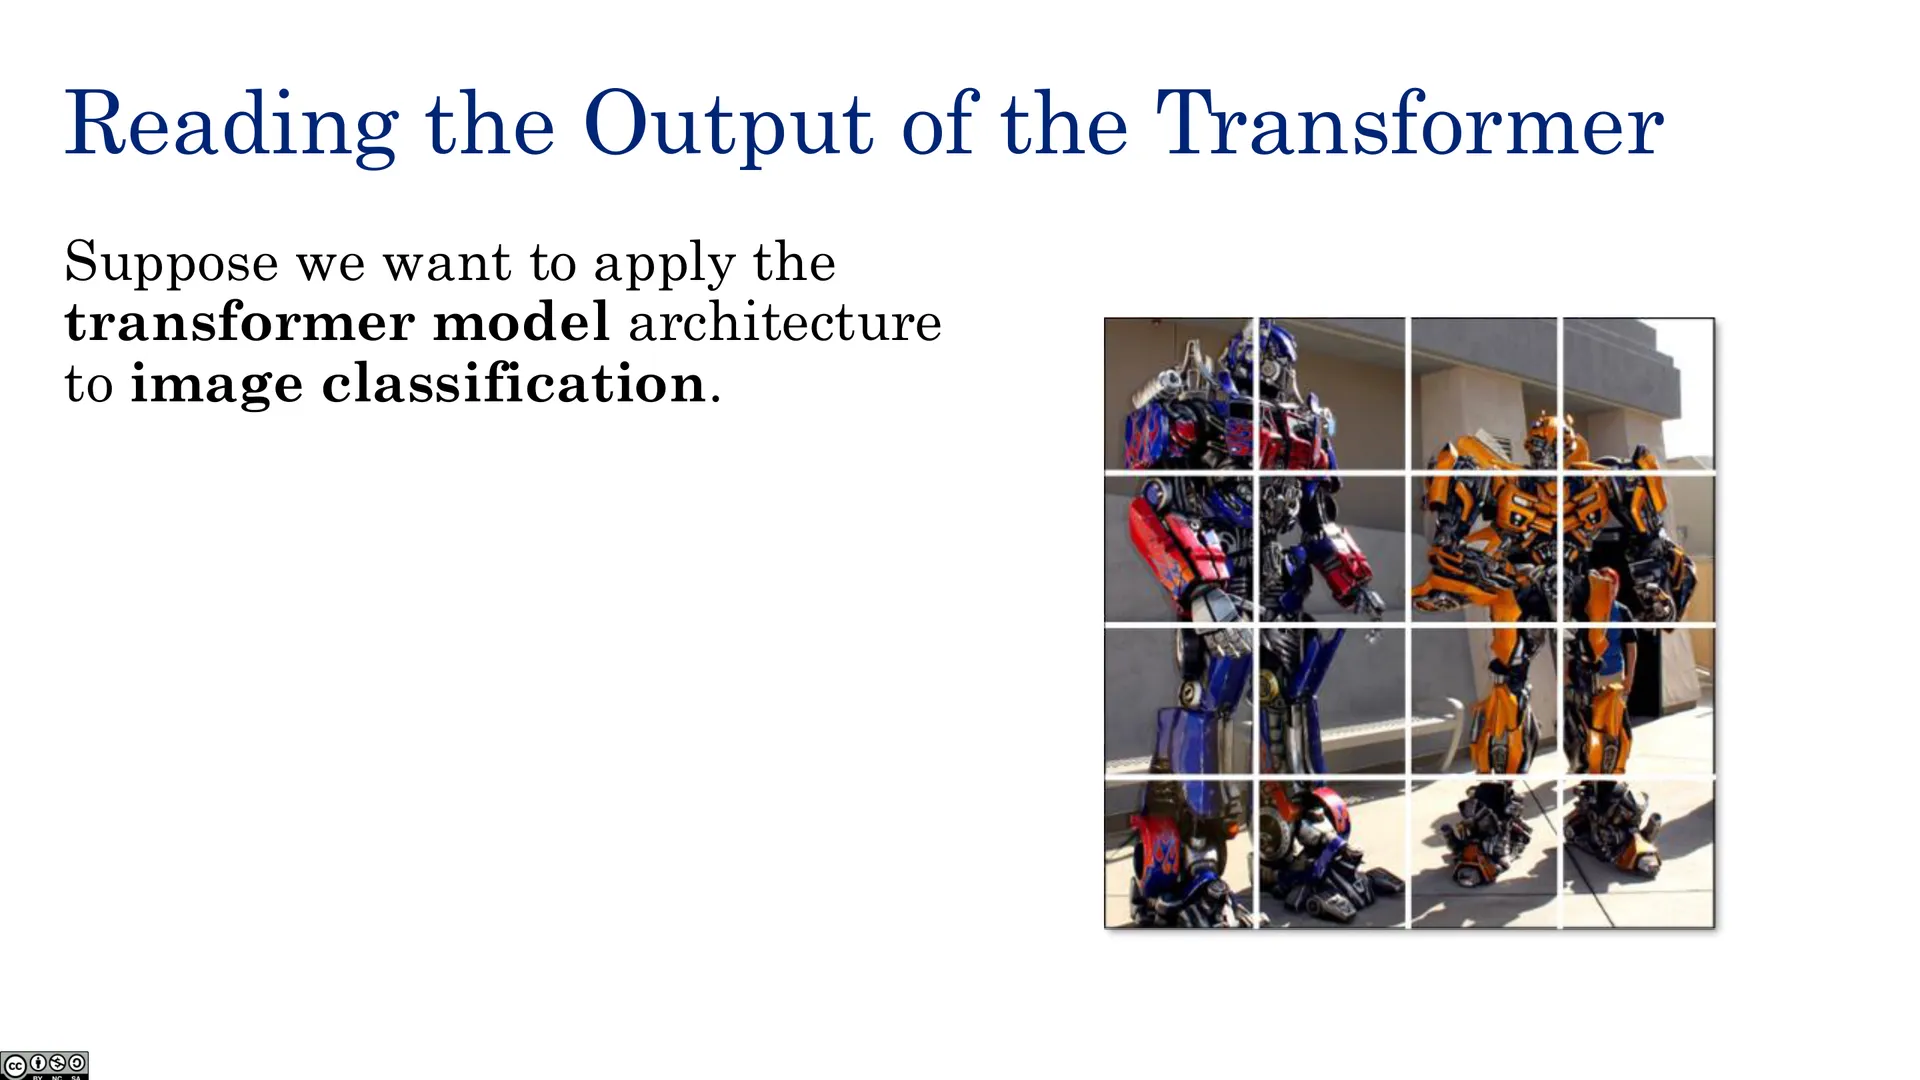
🖼️ 读取 Transformer 的输出(一)
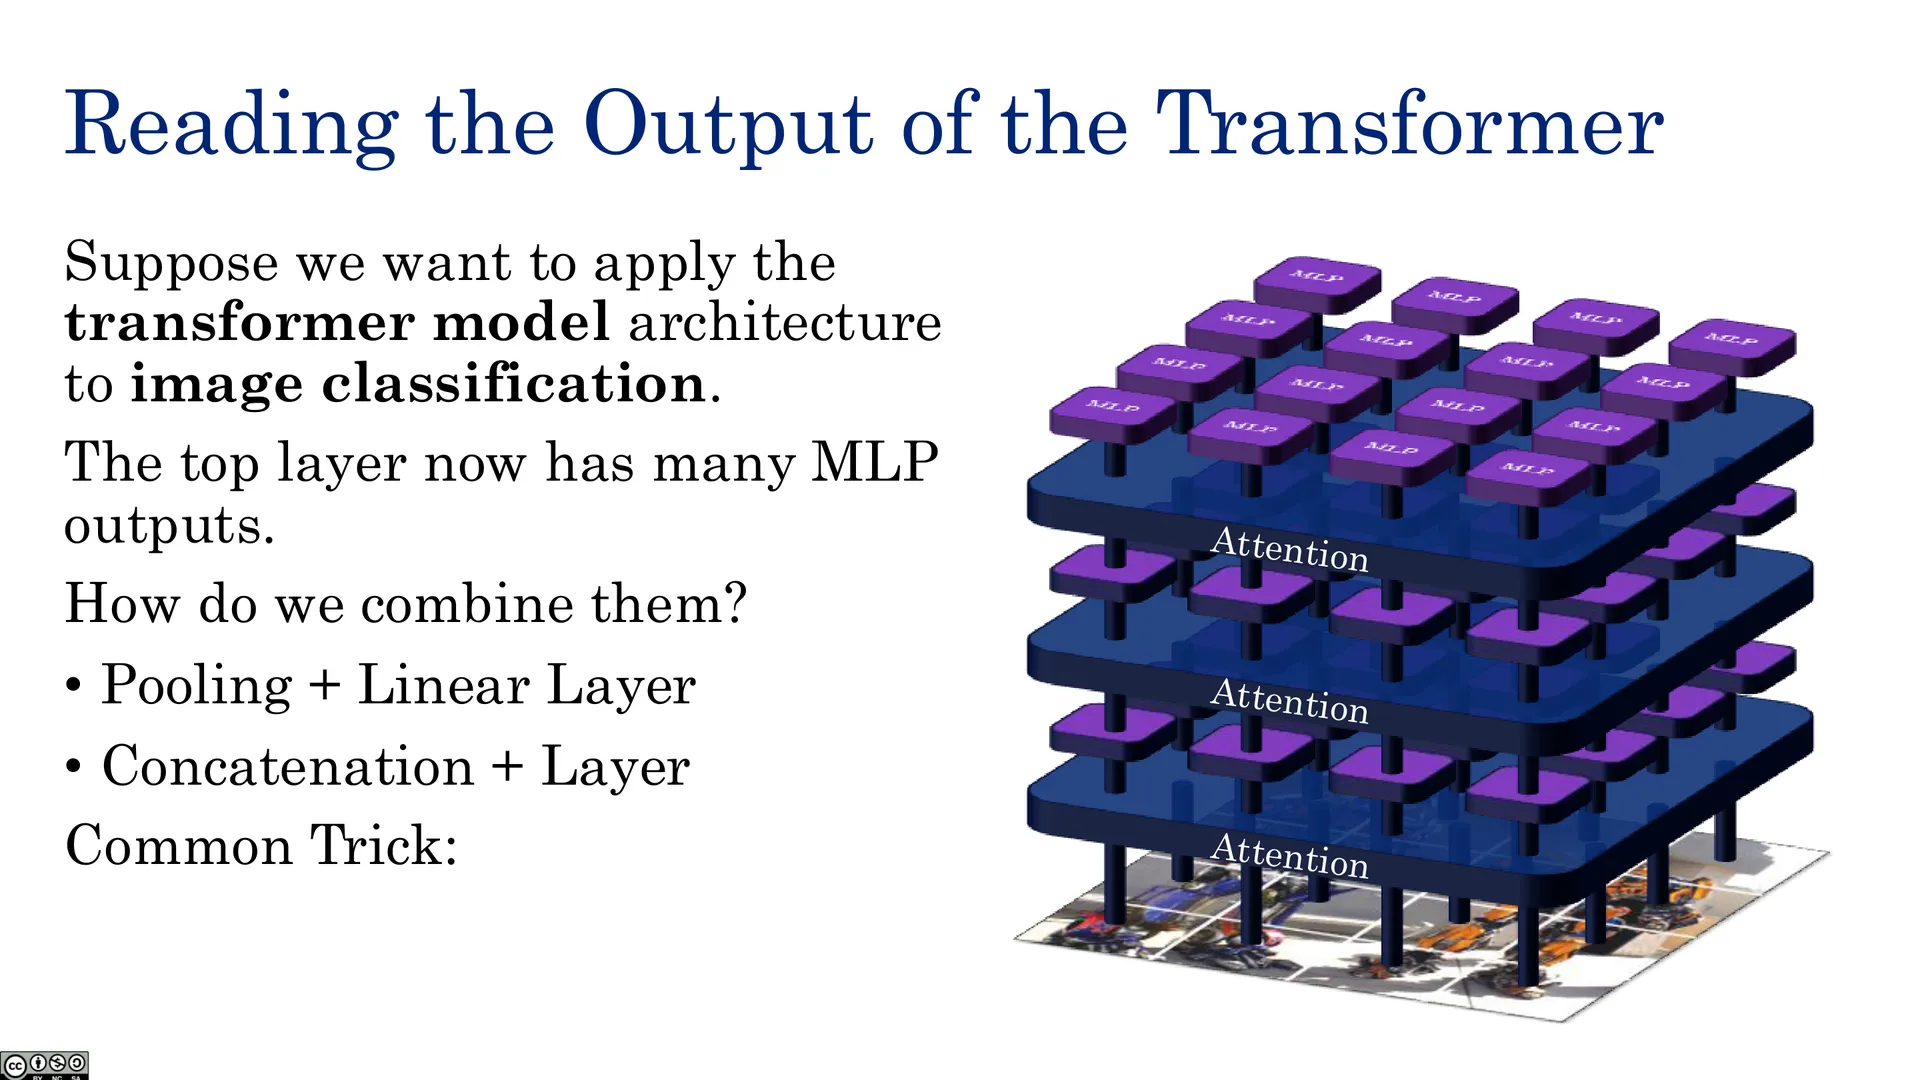
🖼️ 读取 Transformer 的输出(二)
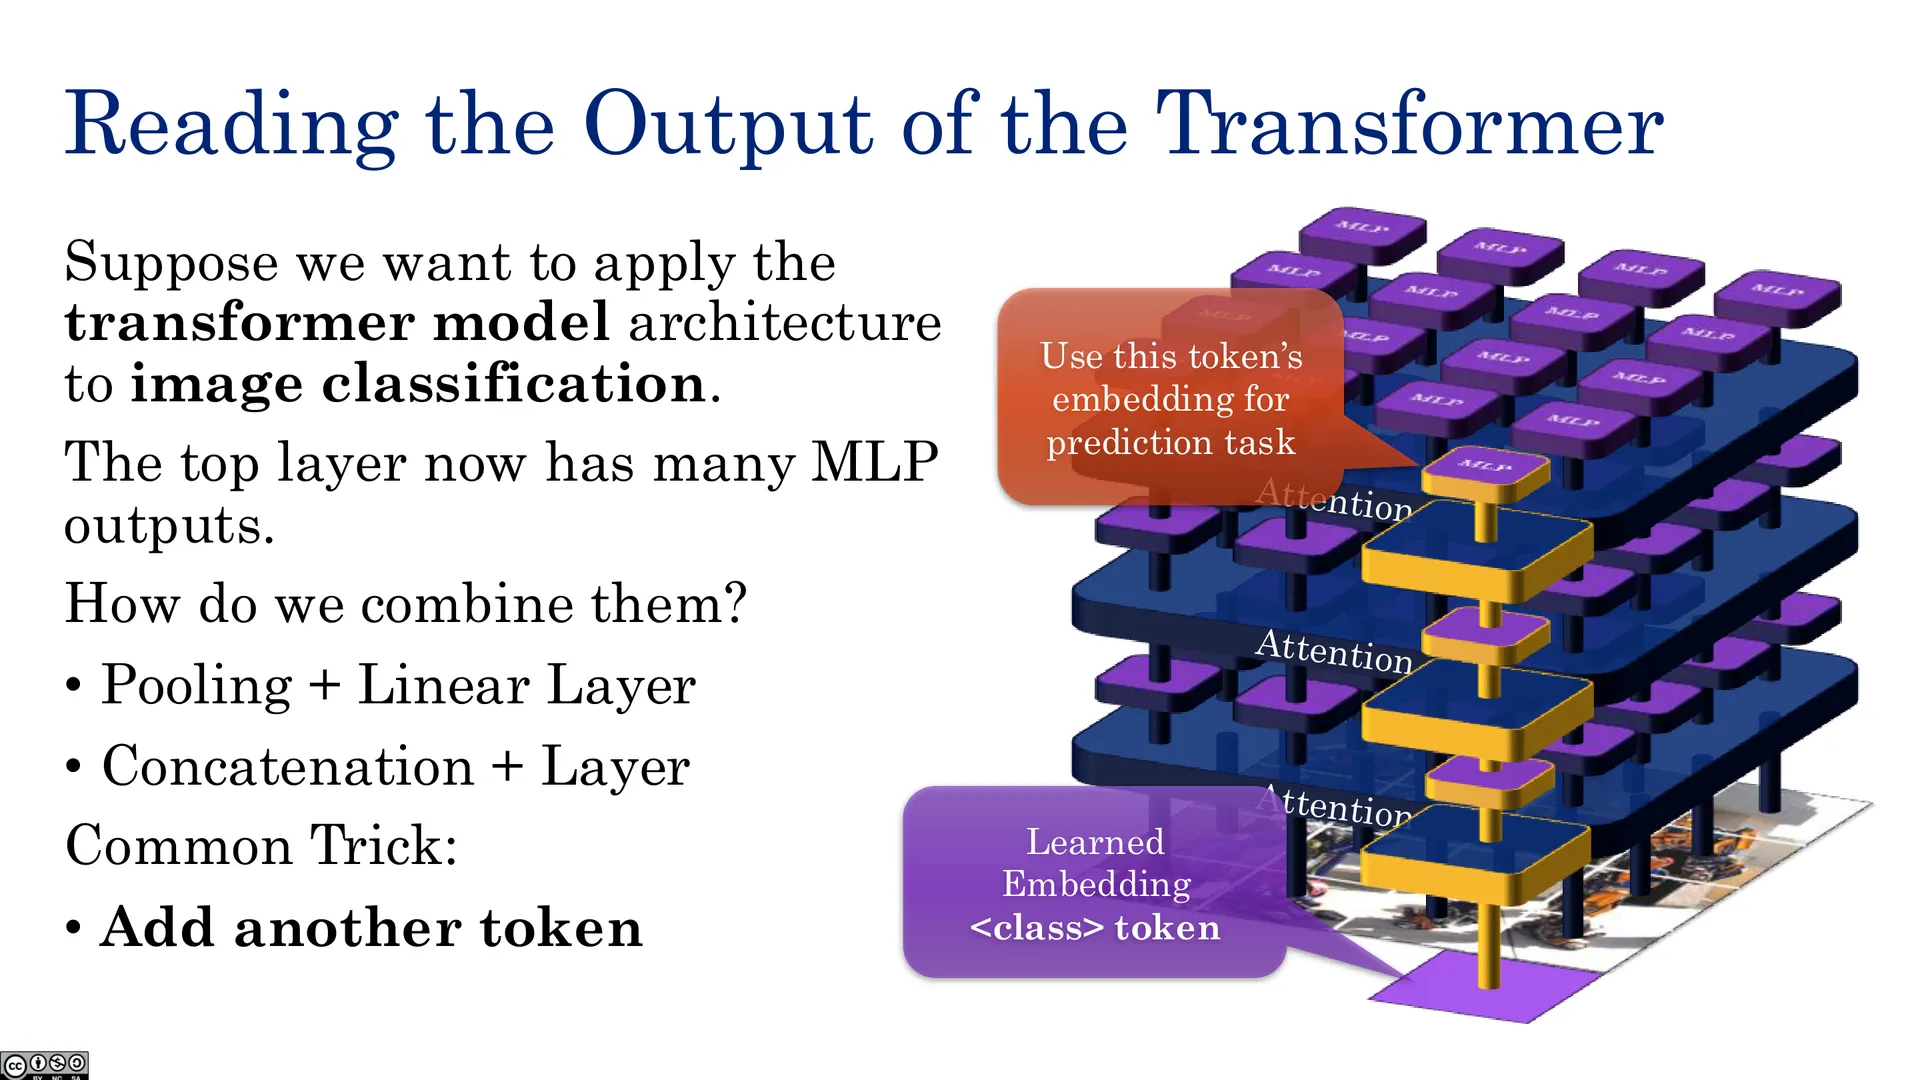
🖼️ 读取 Transformer 的输出(三)
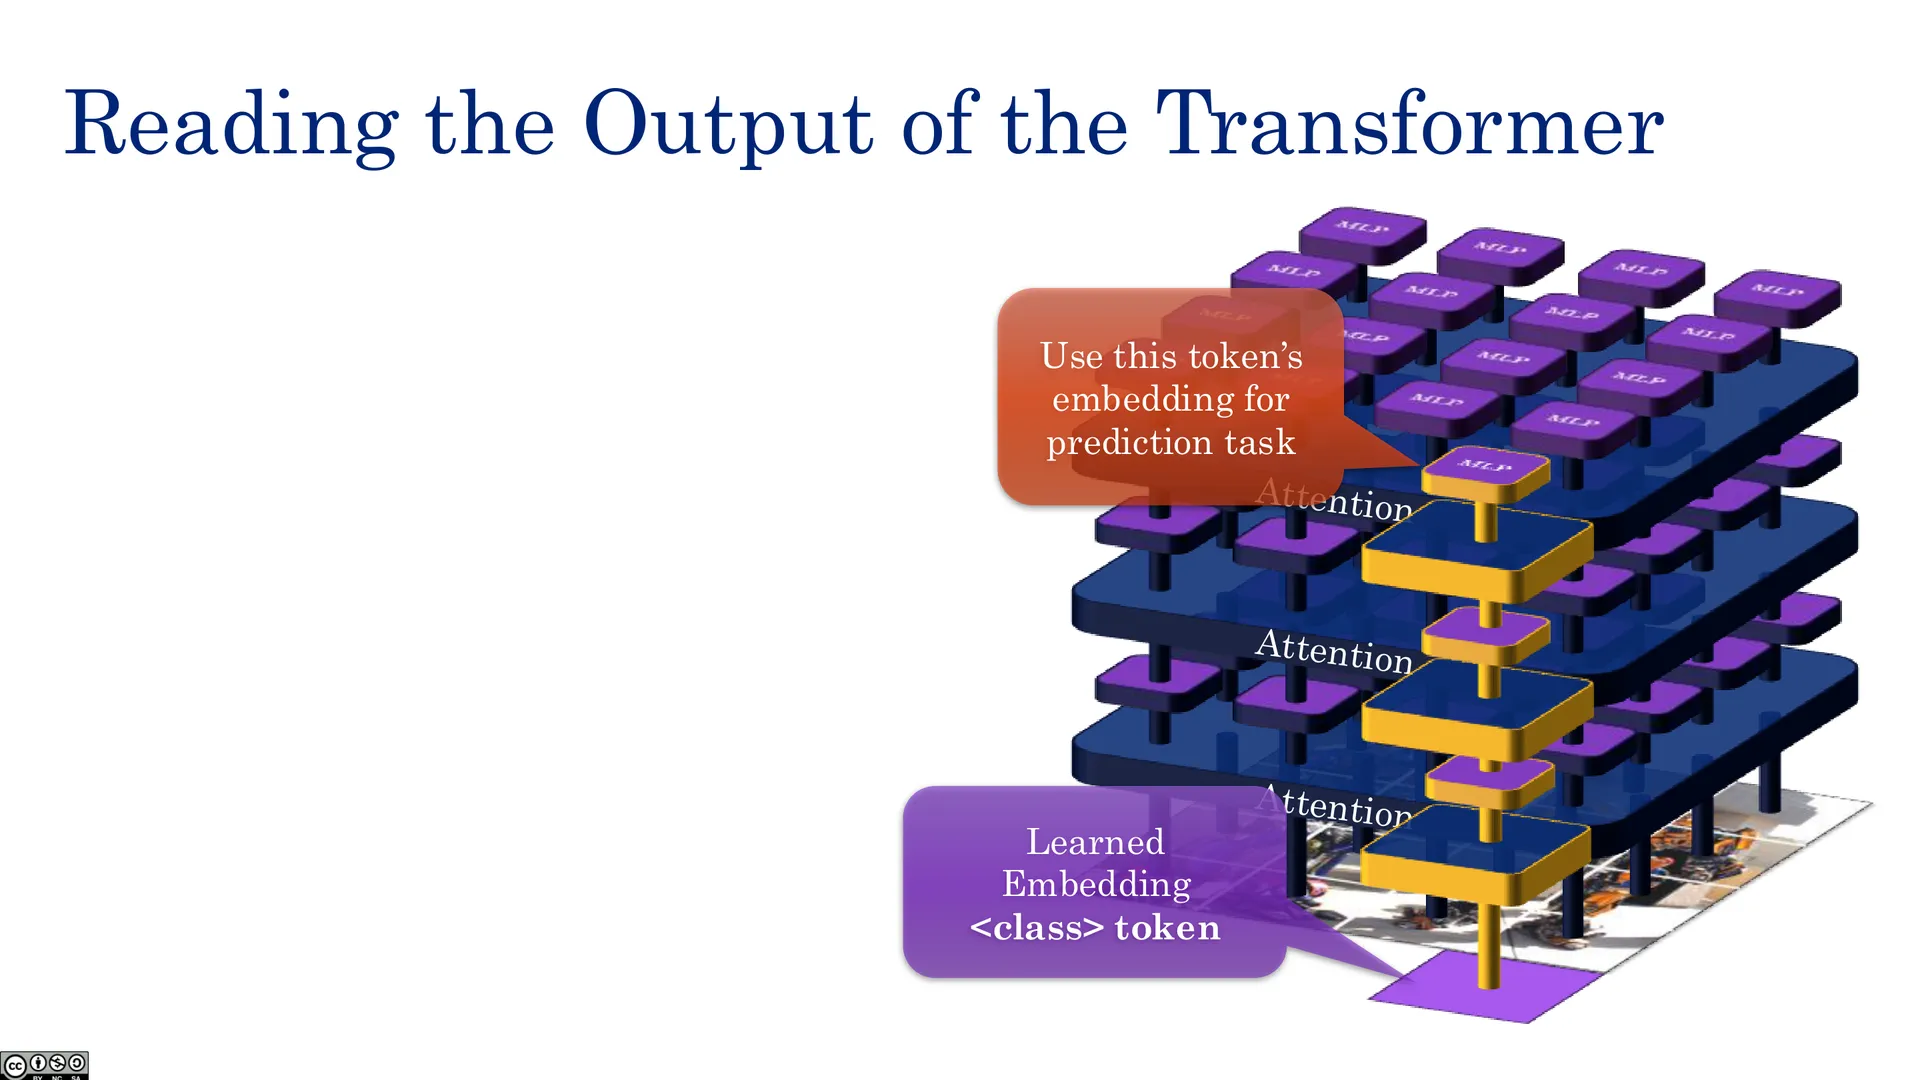
🖼️ 读取 Transformer 的输出(四)
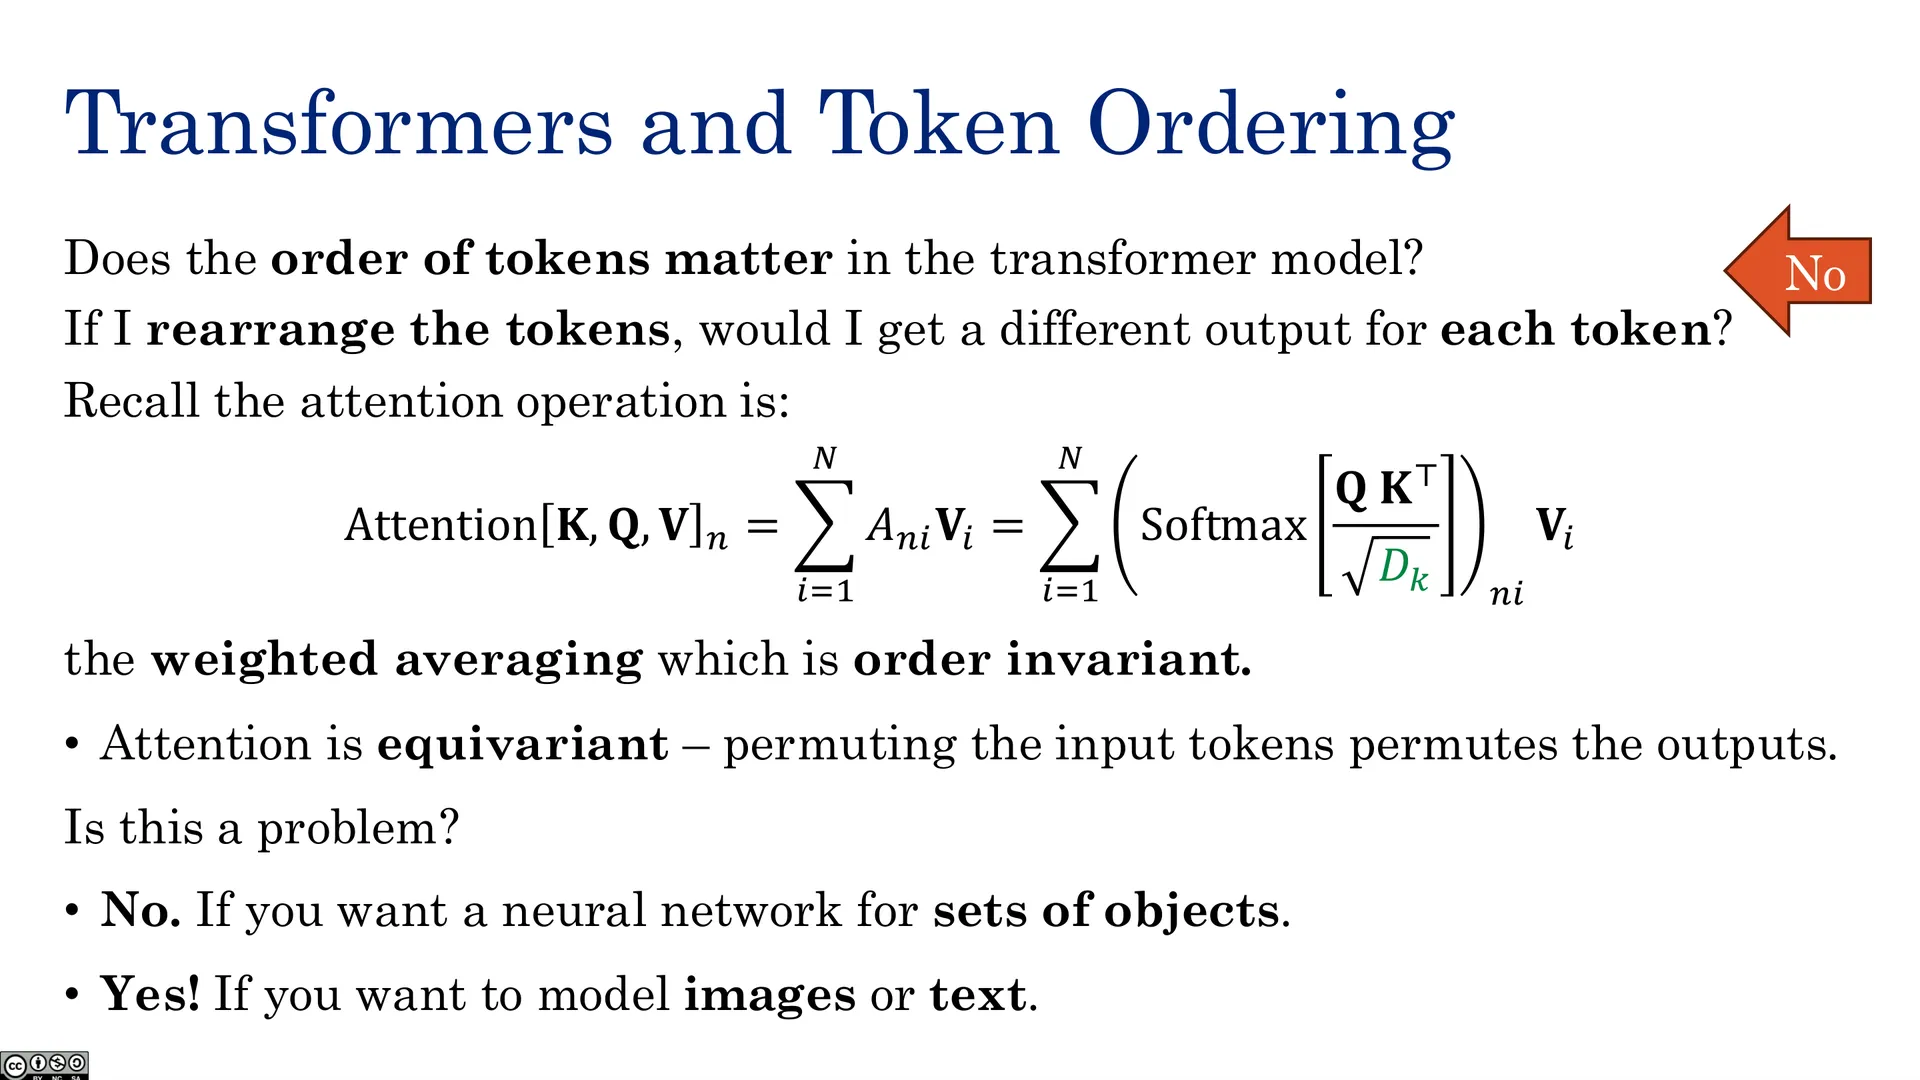
🖼️ Transformer 与 Token 顺序
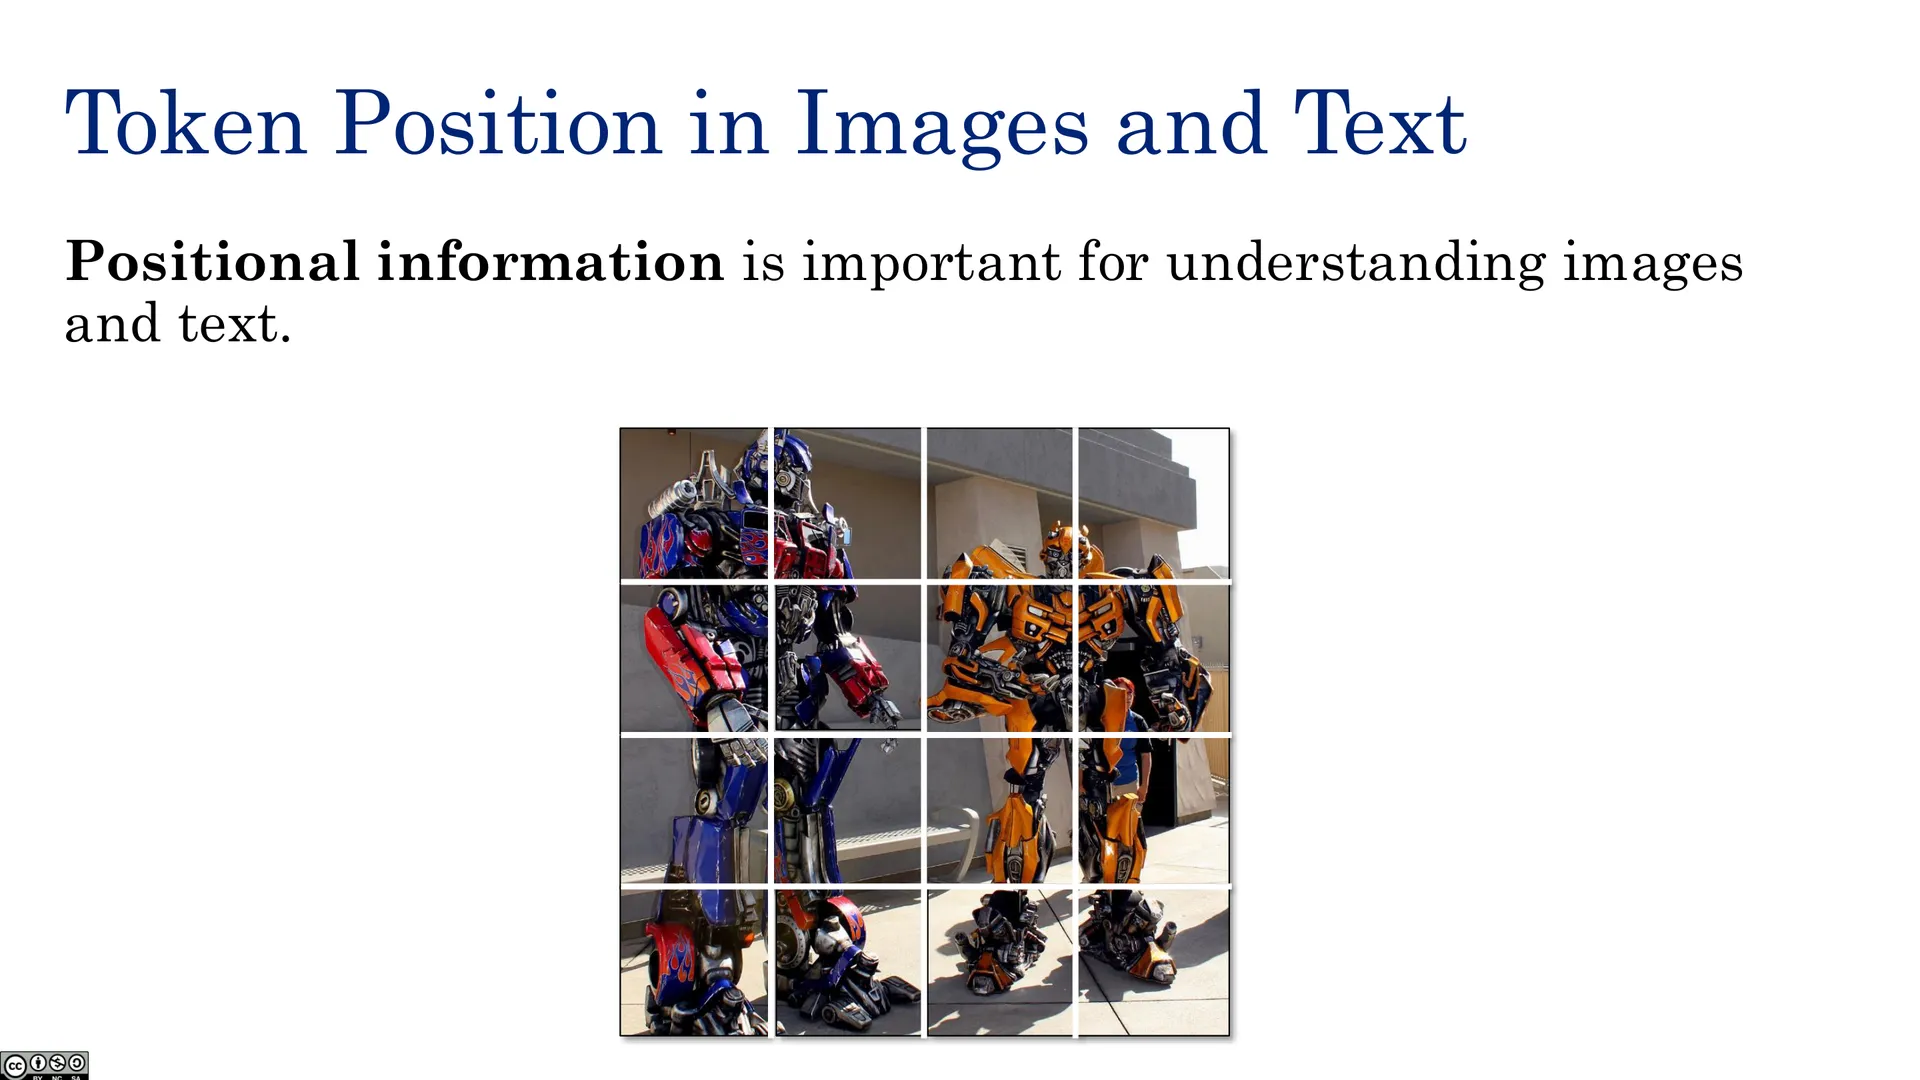
🖼️ 图像与文本中的 Token 位置
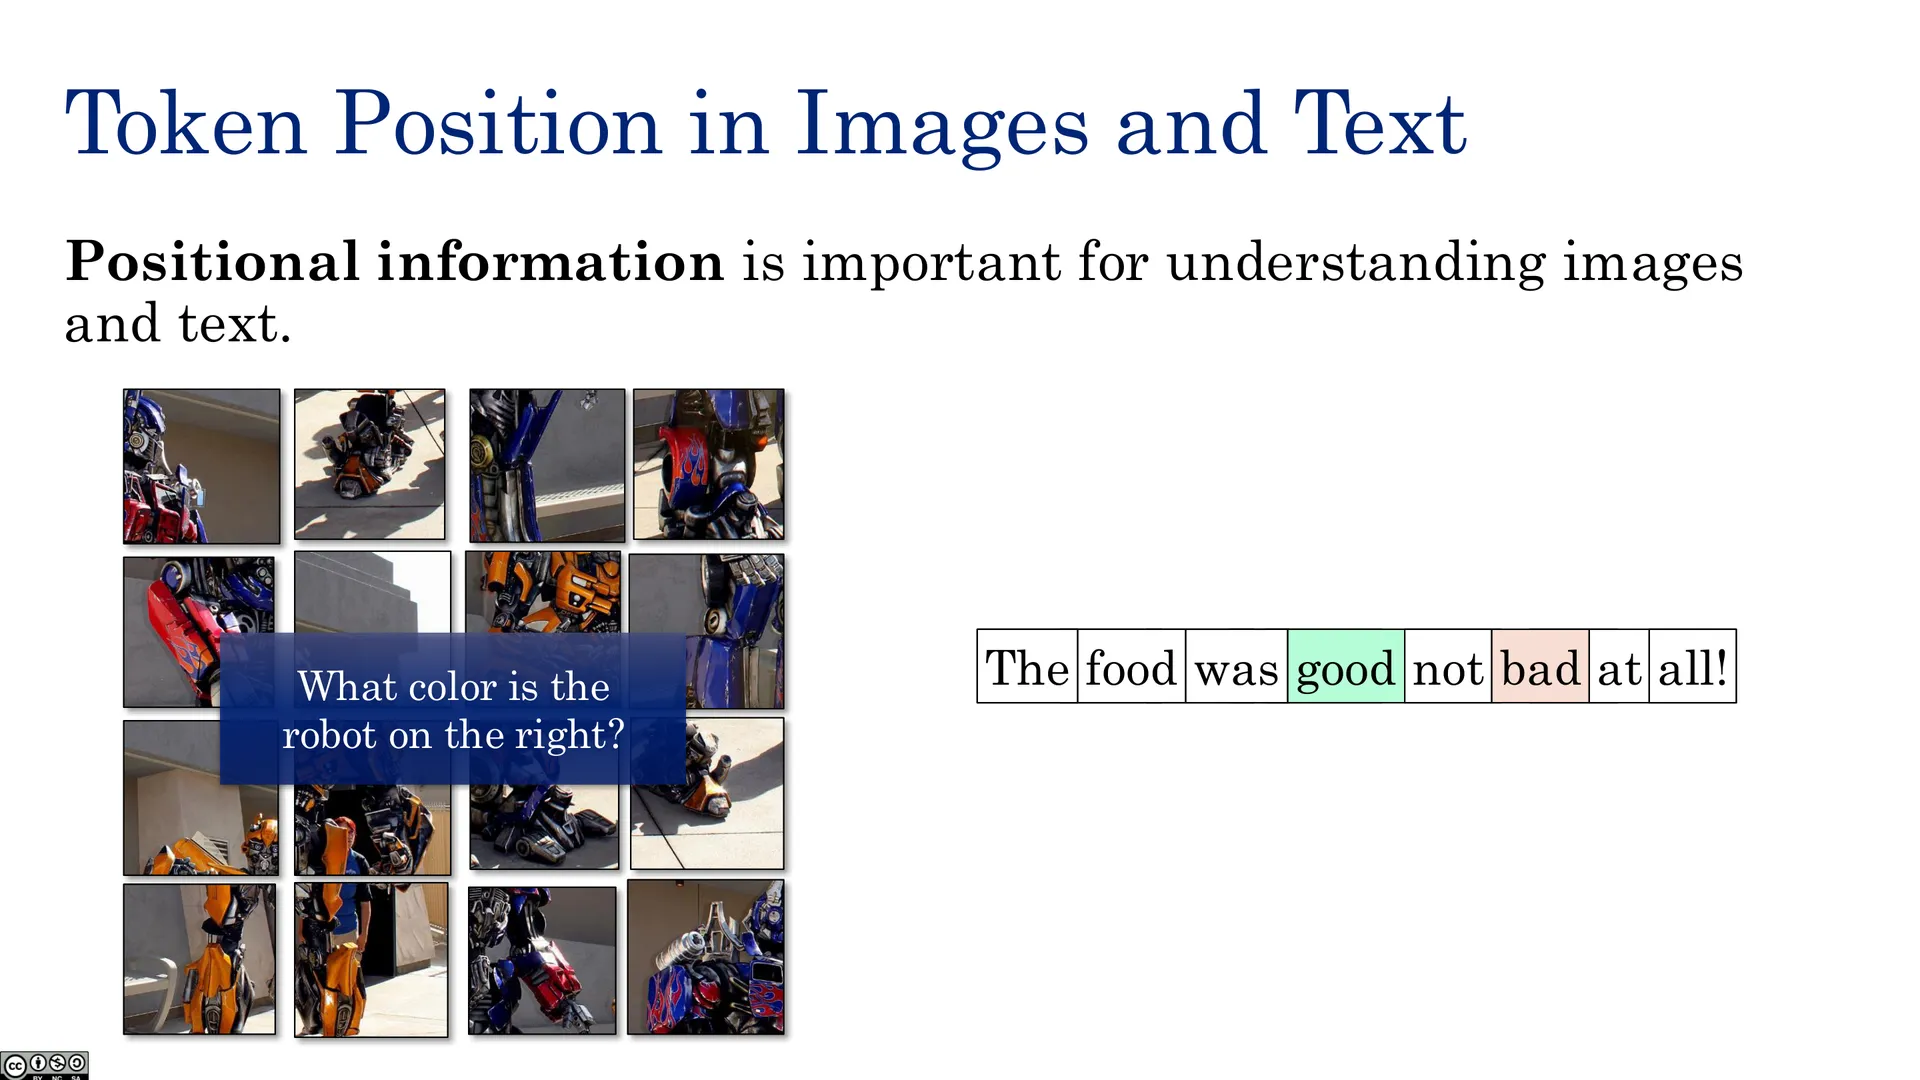
🖼️ 「The」
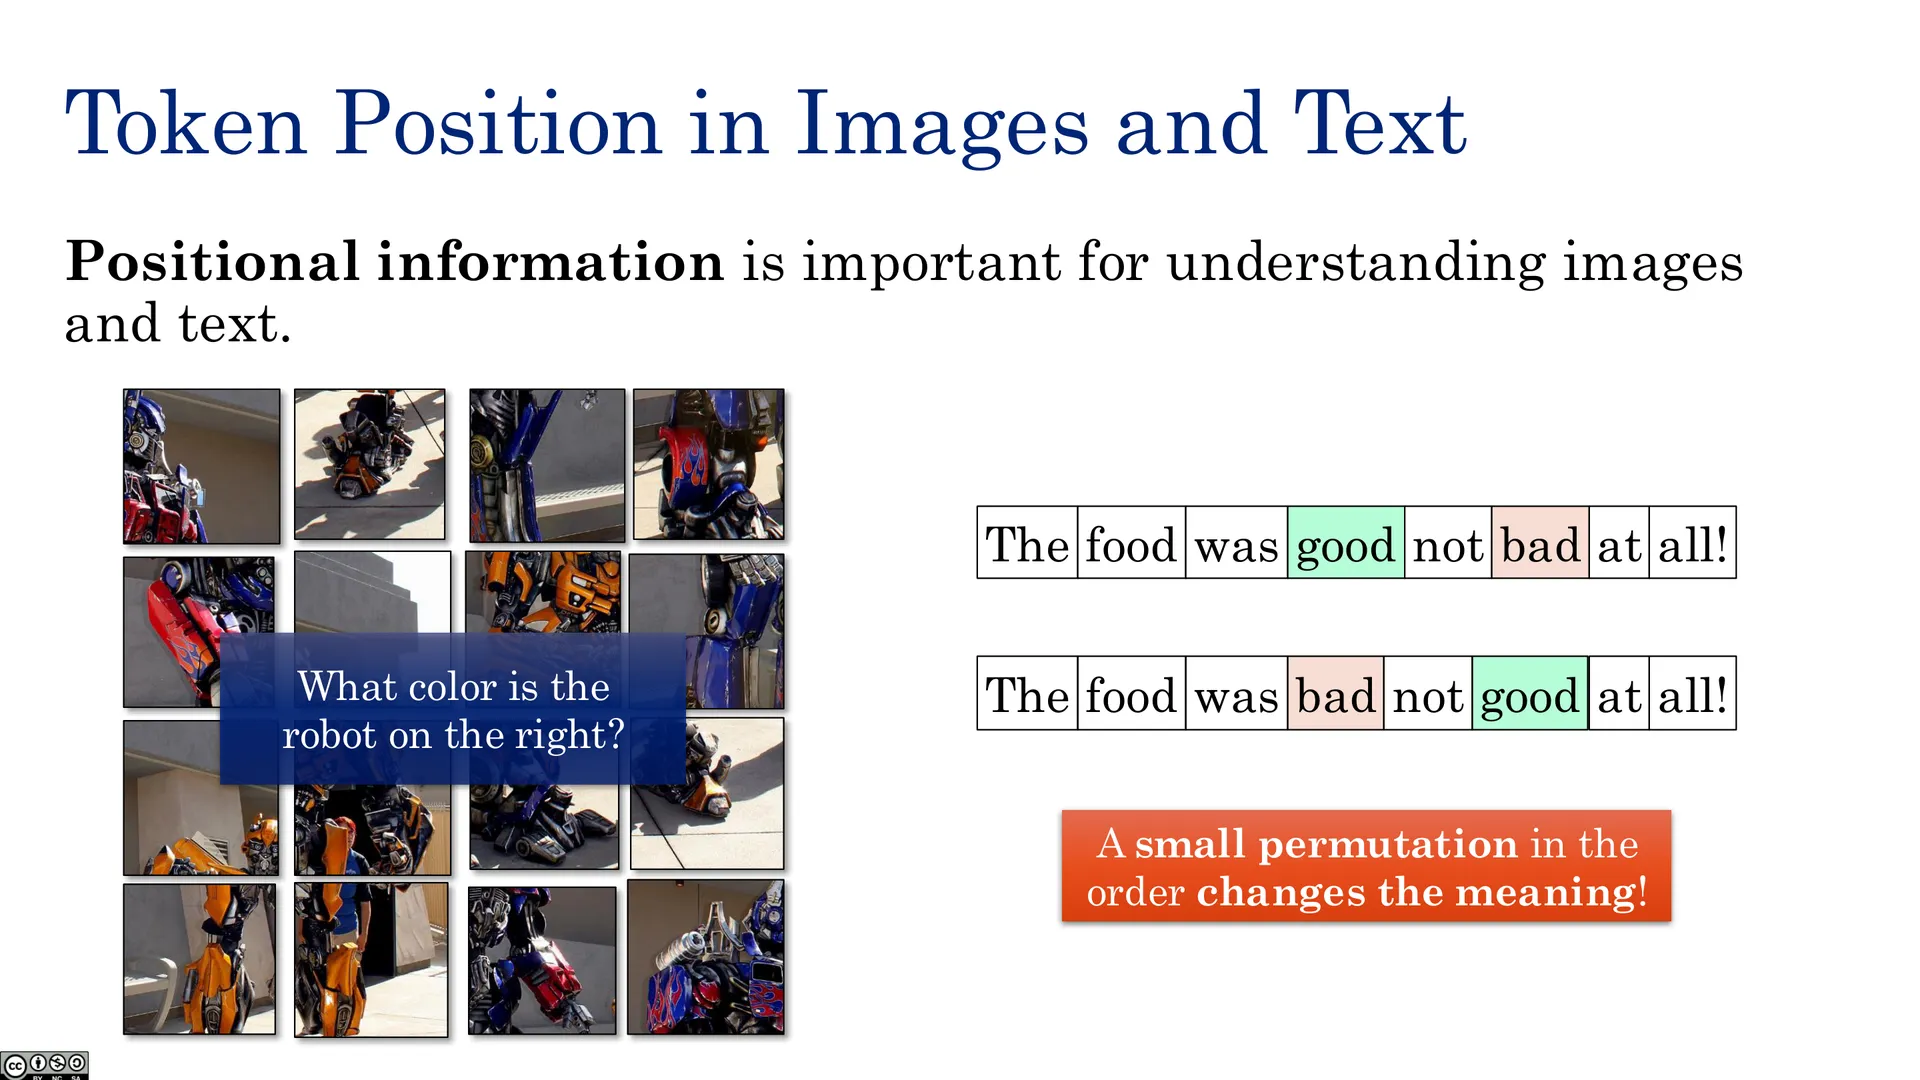
🖼️ 「The food was」
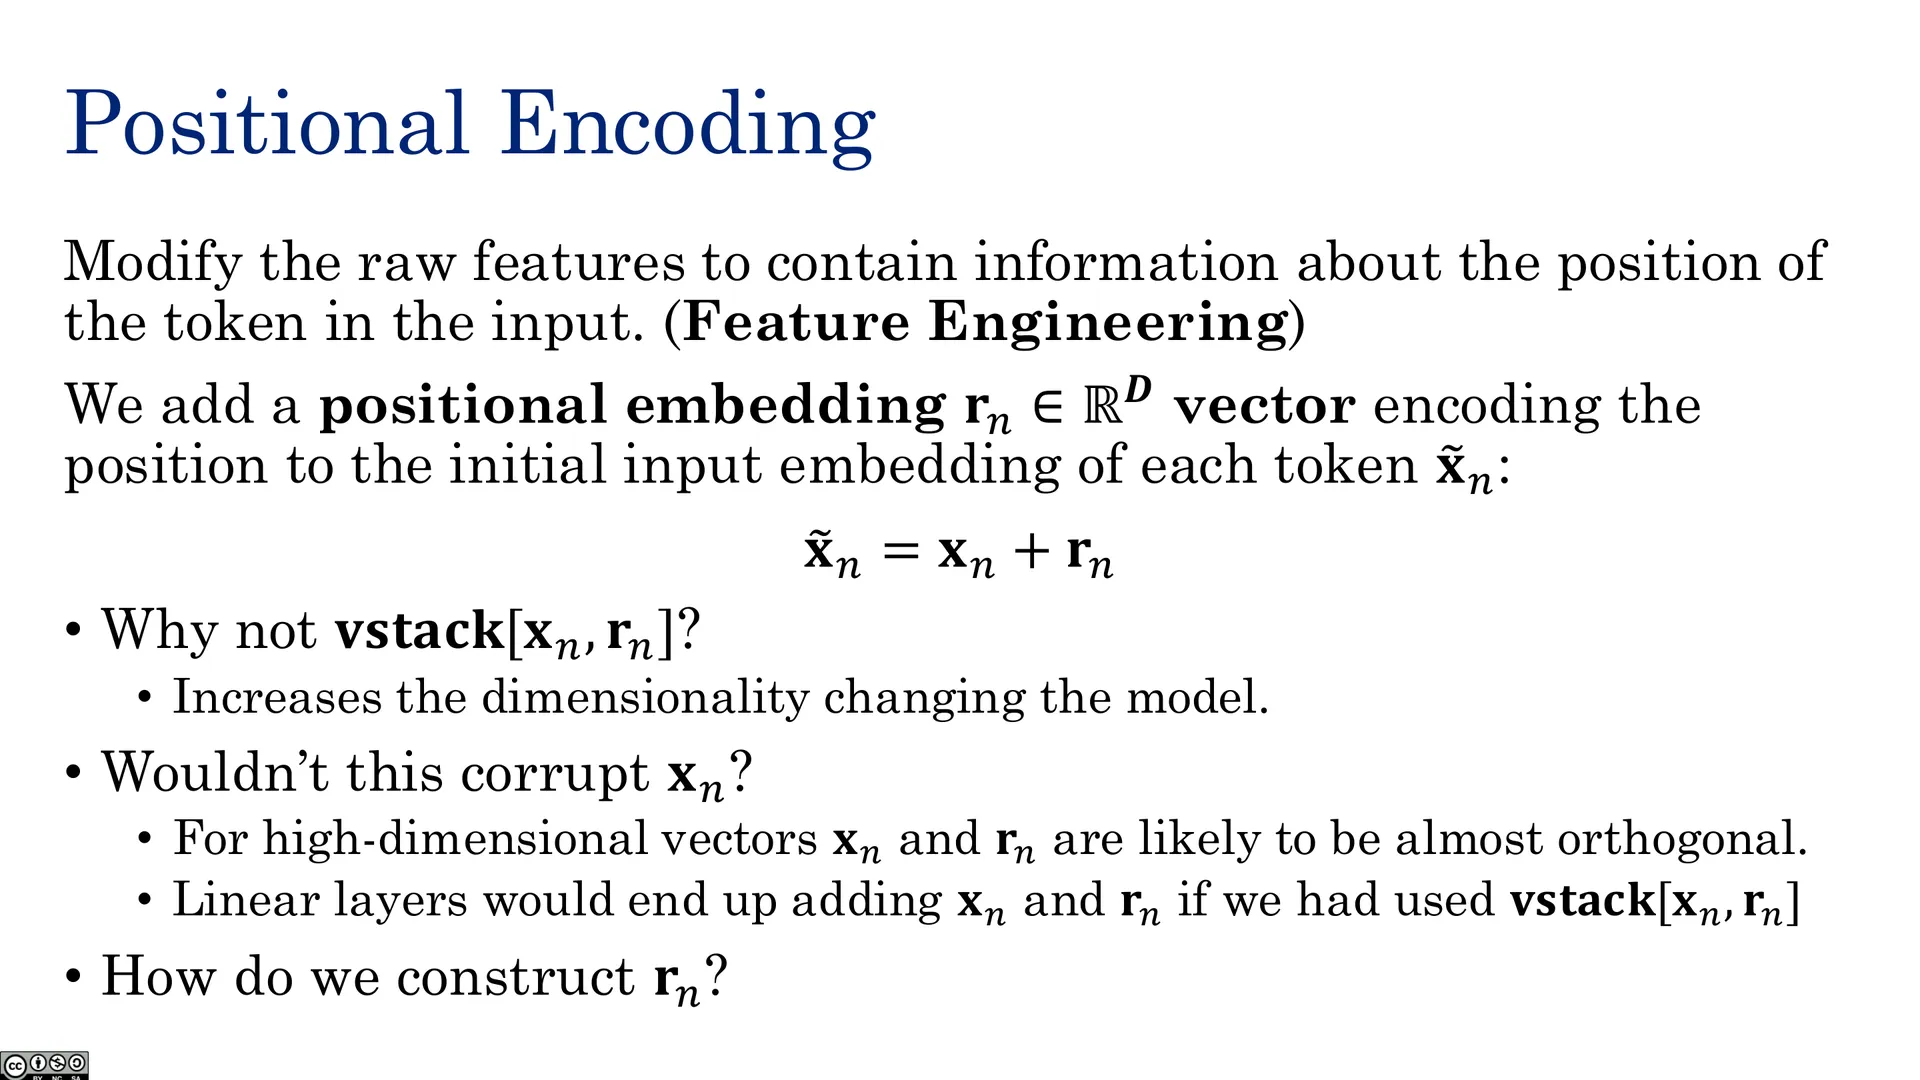
🖼️ 位置编码
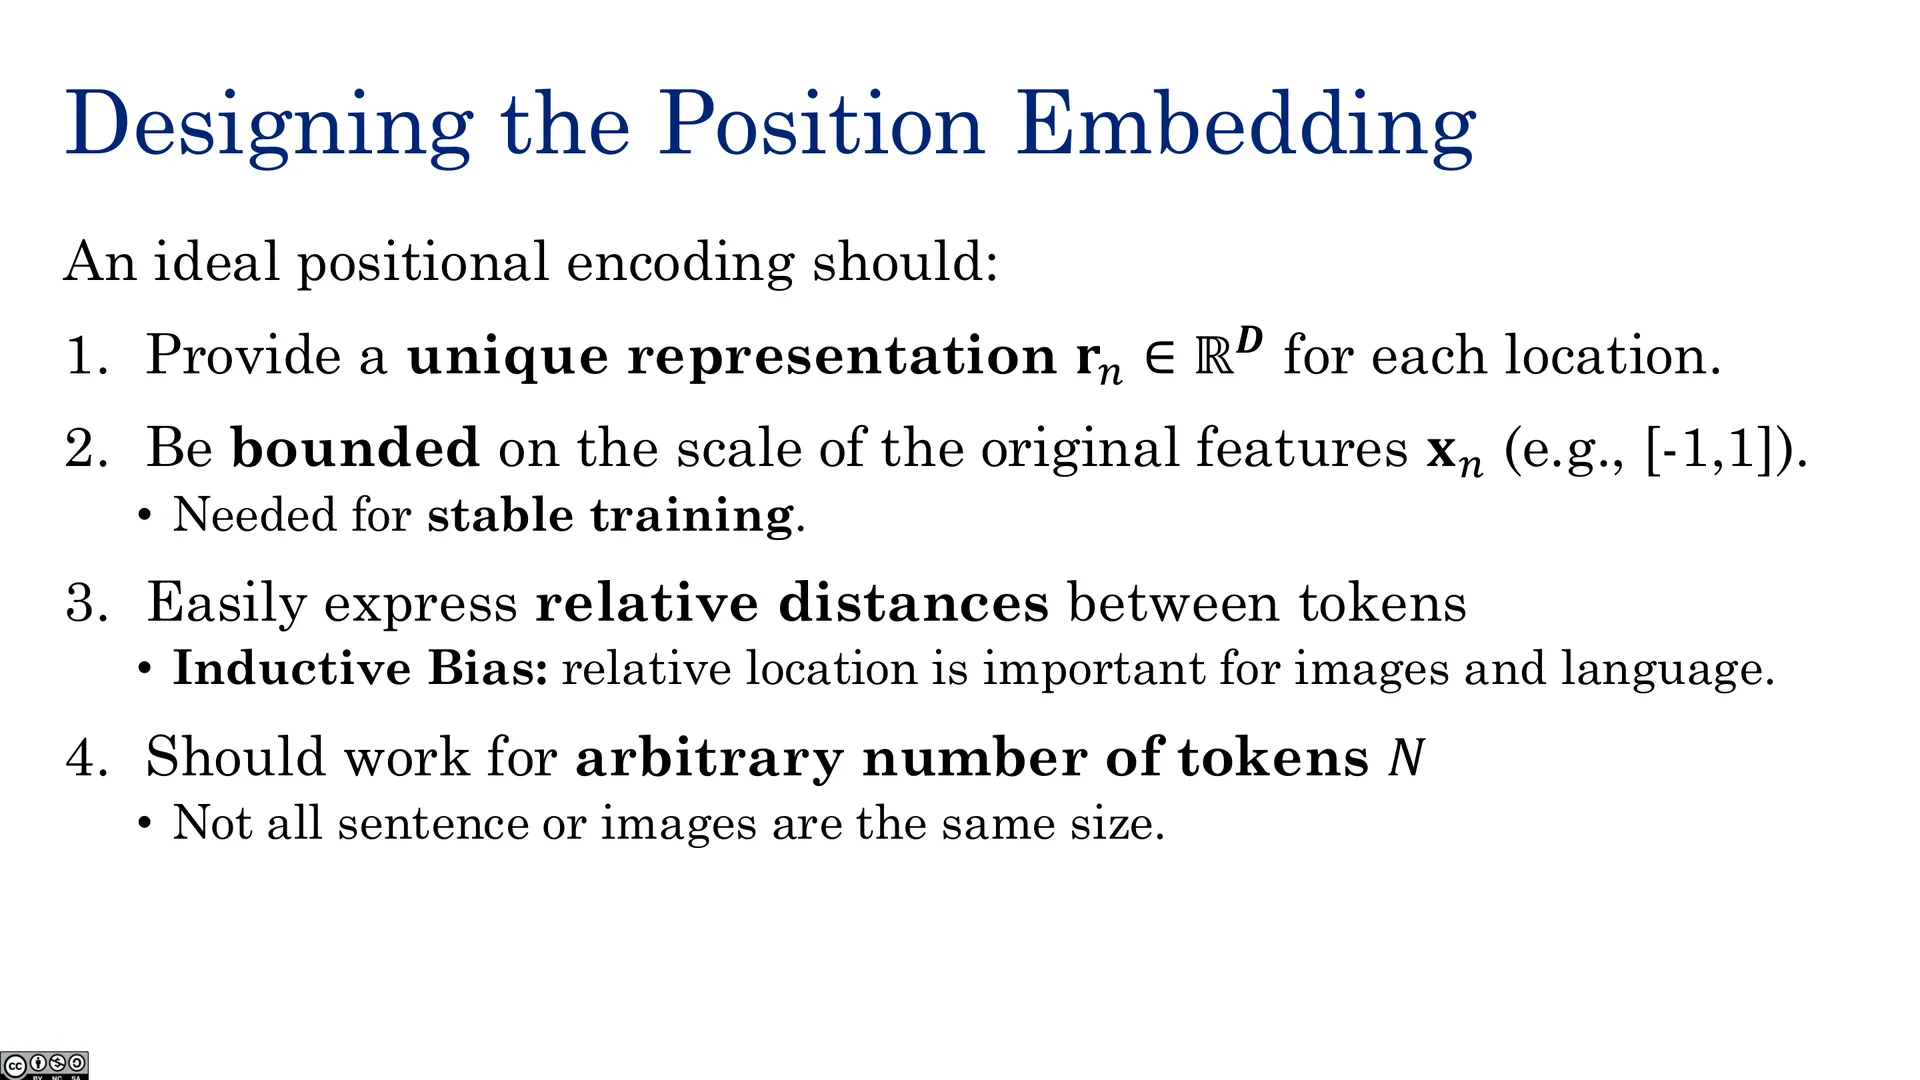
🖼️ 设计位置嵌入
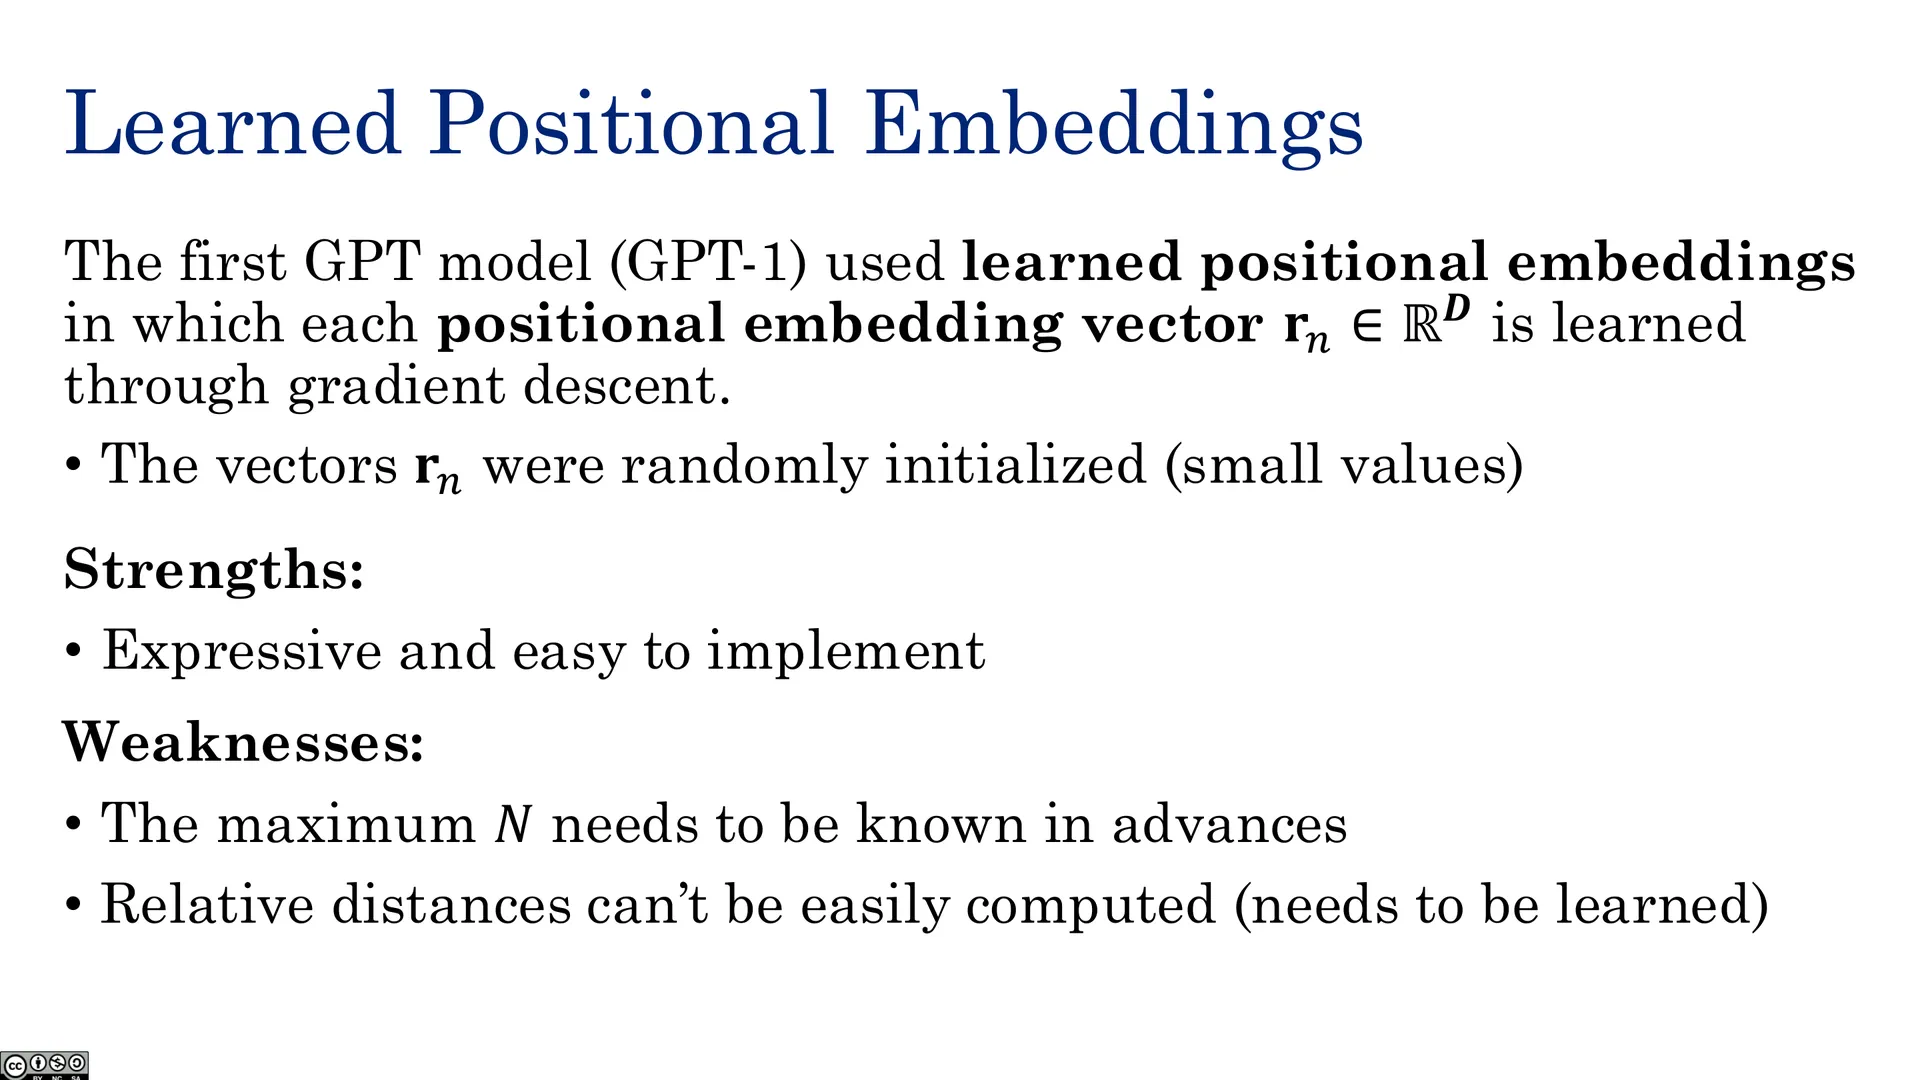
🖼️ 学习式位置嵌入
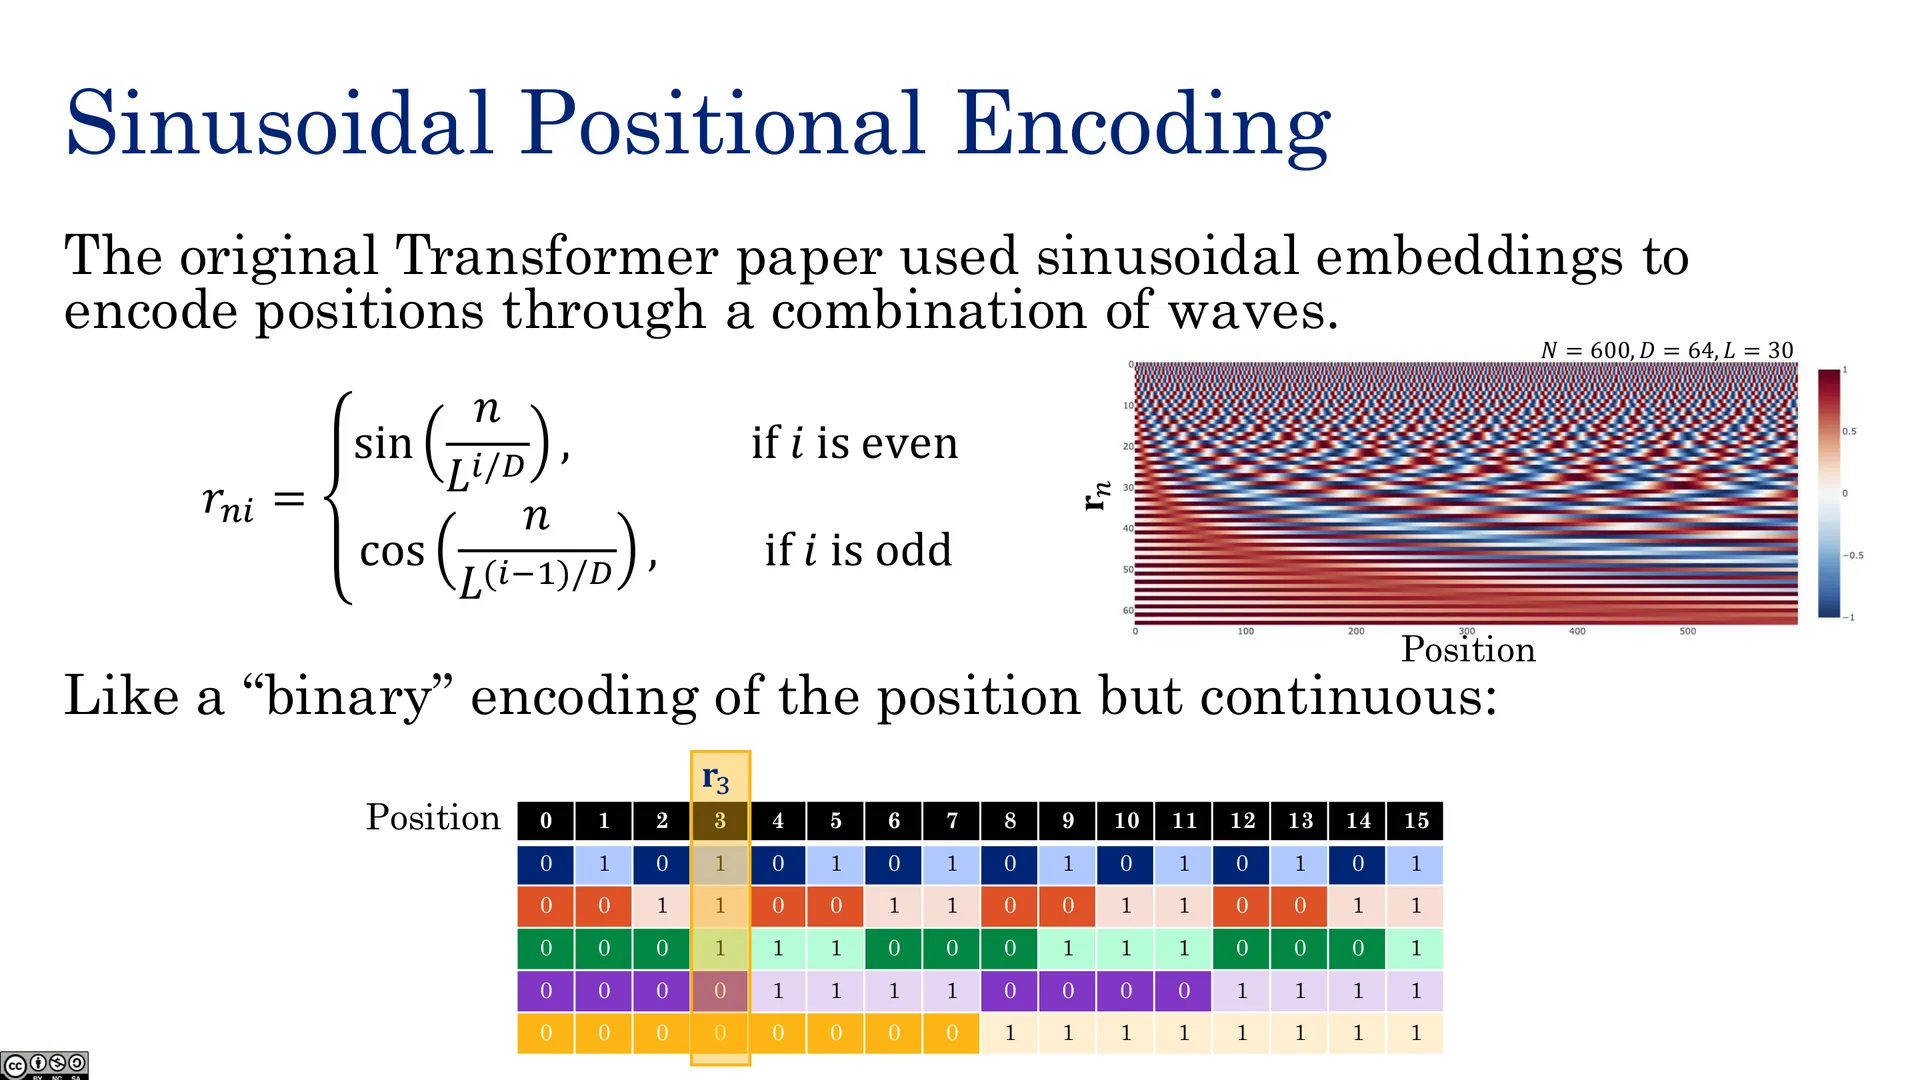
🖼️ 正弦位置编码
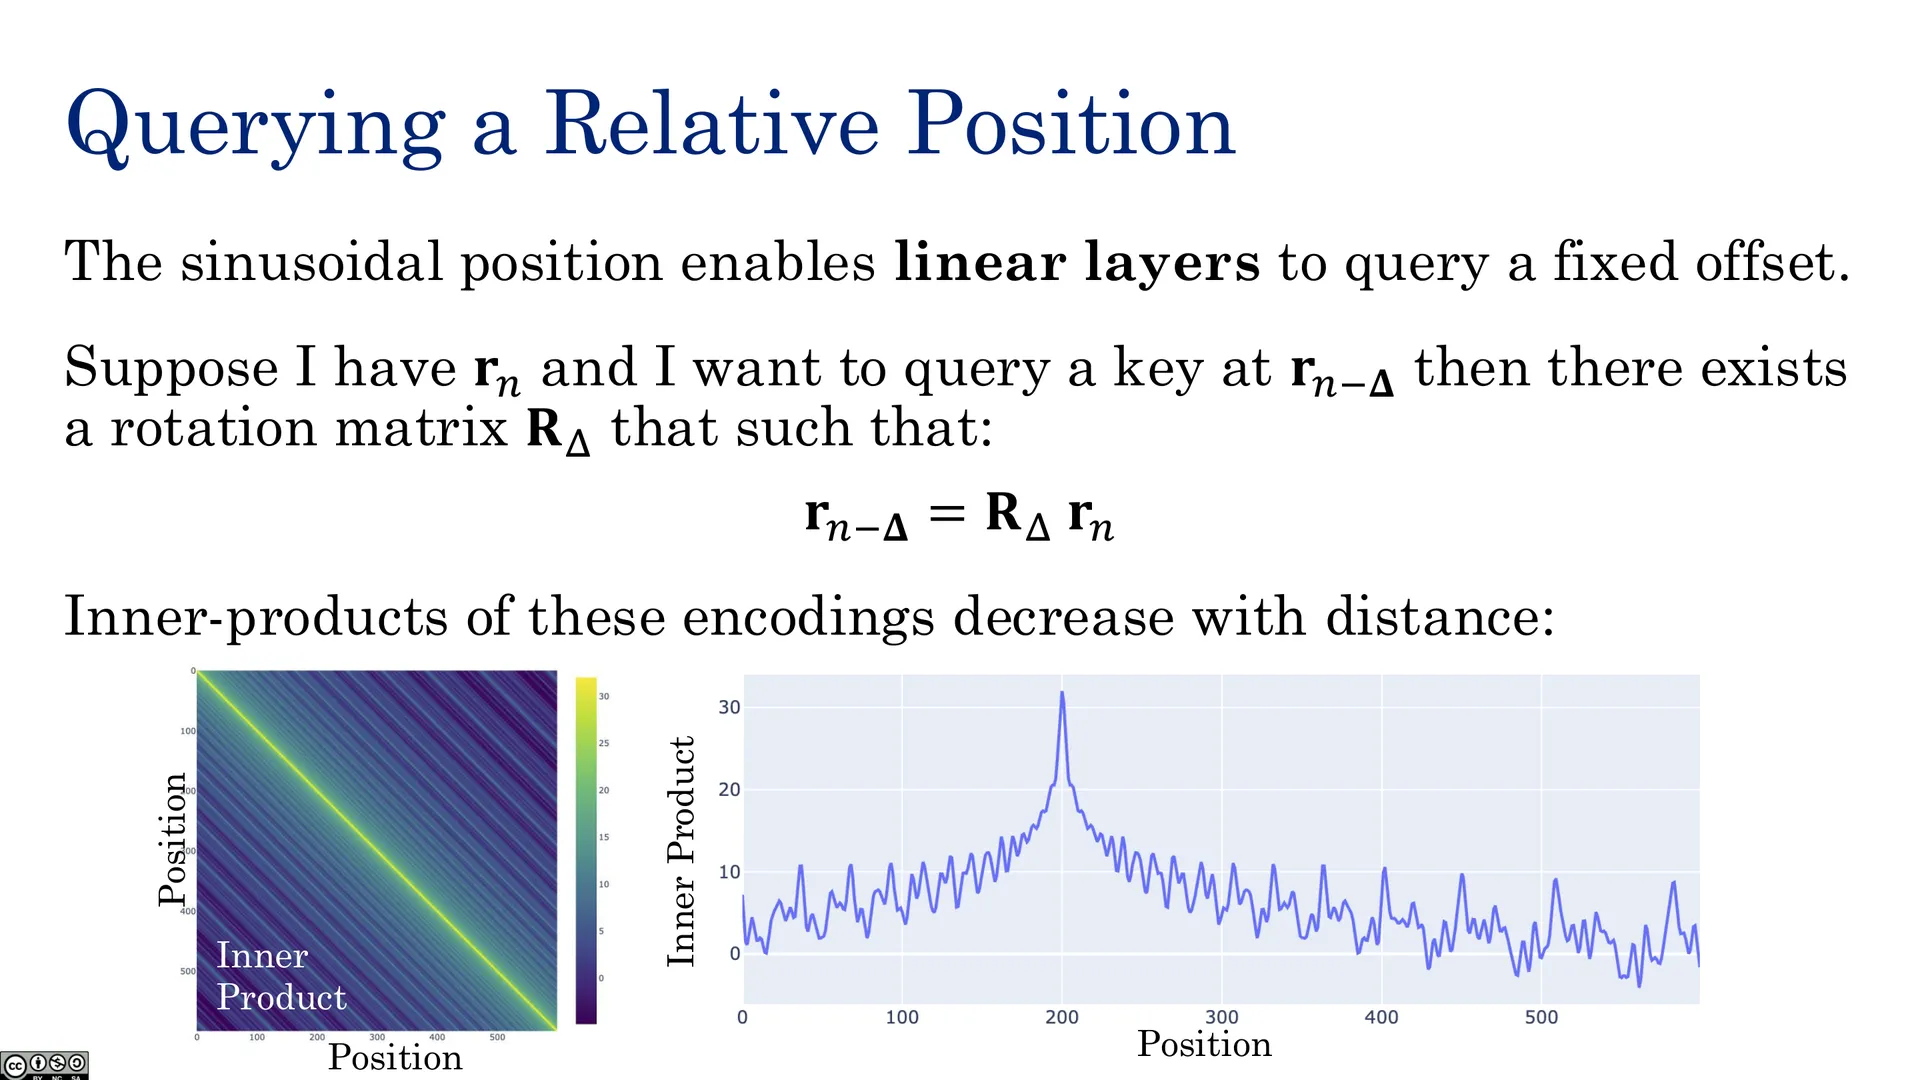
🖼️ 查询相对位置
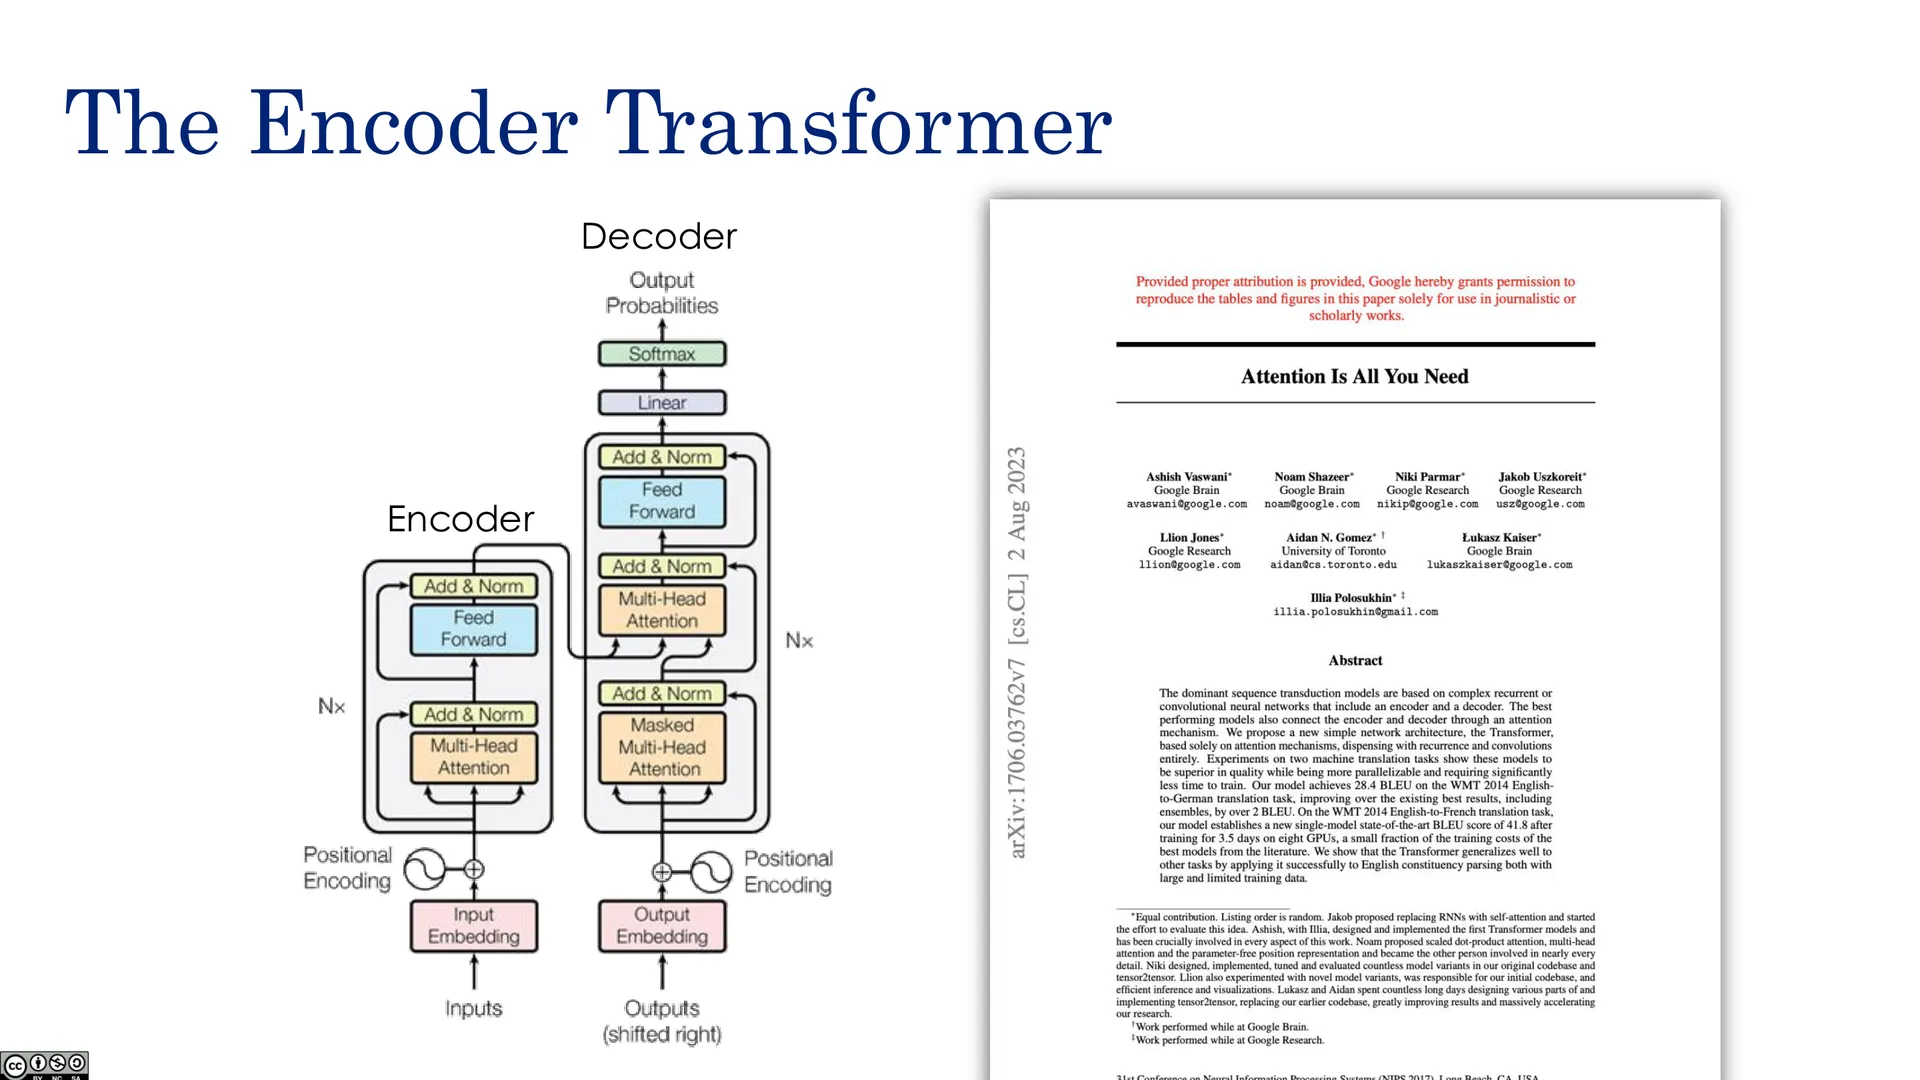
🖼️ 编码器 Transformer
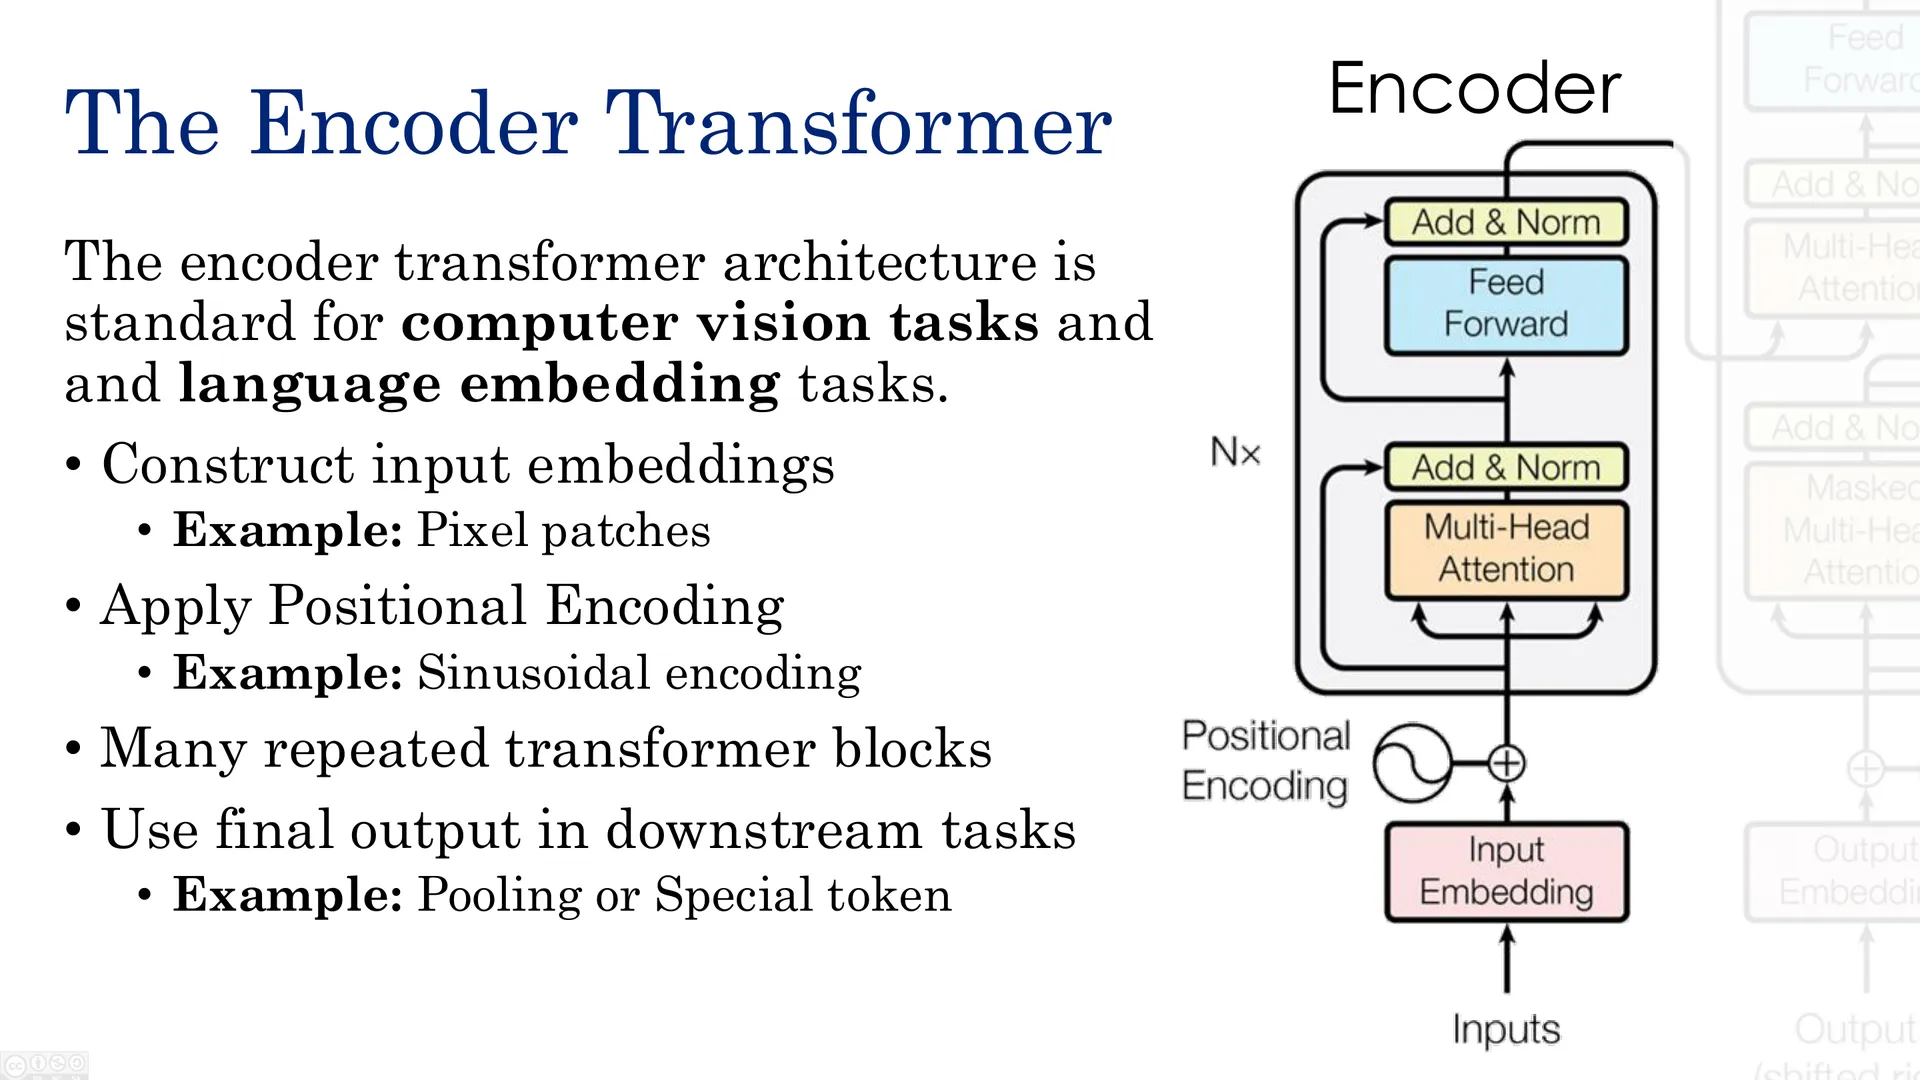
🖼️ 编码器
🖼️ 第二十一讲
总结(Takeaways)
- 所有现代大模型底层都是 Transformer + 注意力;其历史起点是「用注意力取代 RNN」。
- 所有架构都在做表示学习 / 特征变换,目标是更抽象、更上下文化的向量表示。
- MLP 表达力最强但参数爆炸、输入尺寸固定;CNN 参数高效、有空间不变性,但感受野有限、信息通道有损、缺乏长程相关。
- RNN 复用权重处理任意长度序列(如 MS COCO 图像描述),但受信息瓶颈限制。
- 注意力:从基于位置(soft/hard,可解释)到基于内容(query + 内积相似度 + softmax + 加权组合)——本质是软键值查找。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=mqaFEvi5rWE |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 21) | Google Drive PDF |
| Vaswani et al., Attention Is All You Need (2017) | https://arxiv.org/abs/1706.03762 |
| Bahdanau et al., Neural Machine Translation by Jointly Learning to Align and Translate (2015) | 注意力首次提出 · https://arxiv.org/abs/1409.0473 |
| Xu et al., Show, Attend and Tell (2015) | 图像描述注意力 · https://arxiv.org/abs/1502.03044 |
| Vinyals et al., Show and Tell (2015) | 图像描述基线 · https://arxiv.org/abs/1411.4555 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。