第23讲 · EECS 189:LLM 的训练与应用
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | LLM Training and Applications — Self-Supervision, Pre-training and Post-training |
| 课堂进度提示 | 本讲讲完预训练与后训练(SFT/RLHF/DPO/RLVR);幻灯片 58–63(Agentic Systems 等)未讲到,置于文末附录。 |
| 视频 | https://www.youtube.com/watch?v=m13yELgj02c |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 23) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第23讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- Transformer 回顾:Encoder-Decoder、Encoder-only(BERT)、Decoder-only(GPT/Llama);
- 如何用 Transformer 做分类:取最后一个 token 的表示 + 线性头;线性探针 vs 微调;
- 自监督:预测下一个 token 为什么能学到知识;masked attention 防止「偷看未来」;
- 预训练:从文本到图像/视频(视觉语言模型)、BPE、Llama-3 架构;
- 后训练:SFT、RLHF、DPO、RLVR;对齐与越狱(jailbreak)。
📷 标题页
回到原视频 (00:00:20)
📷 回顾
回到原视频 (00:01:33)
一、Transformer 回顾
(参考时间: 00:00)
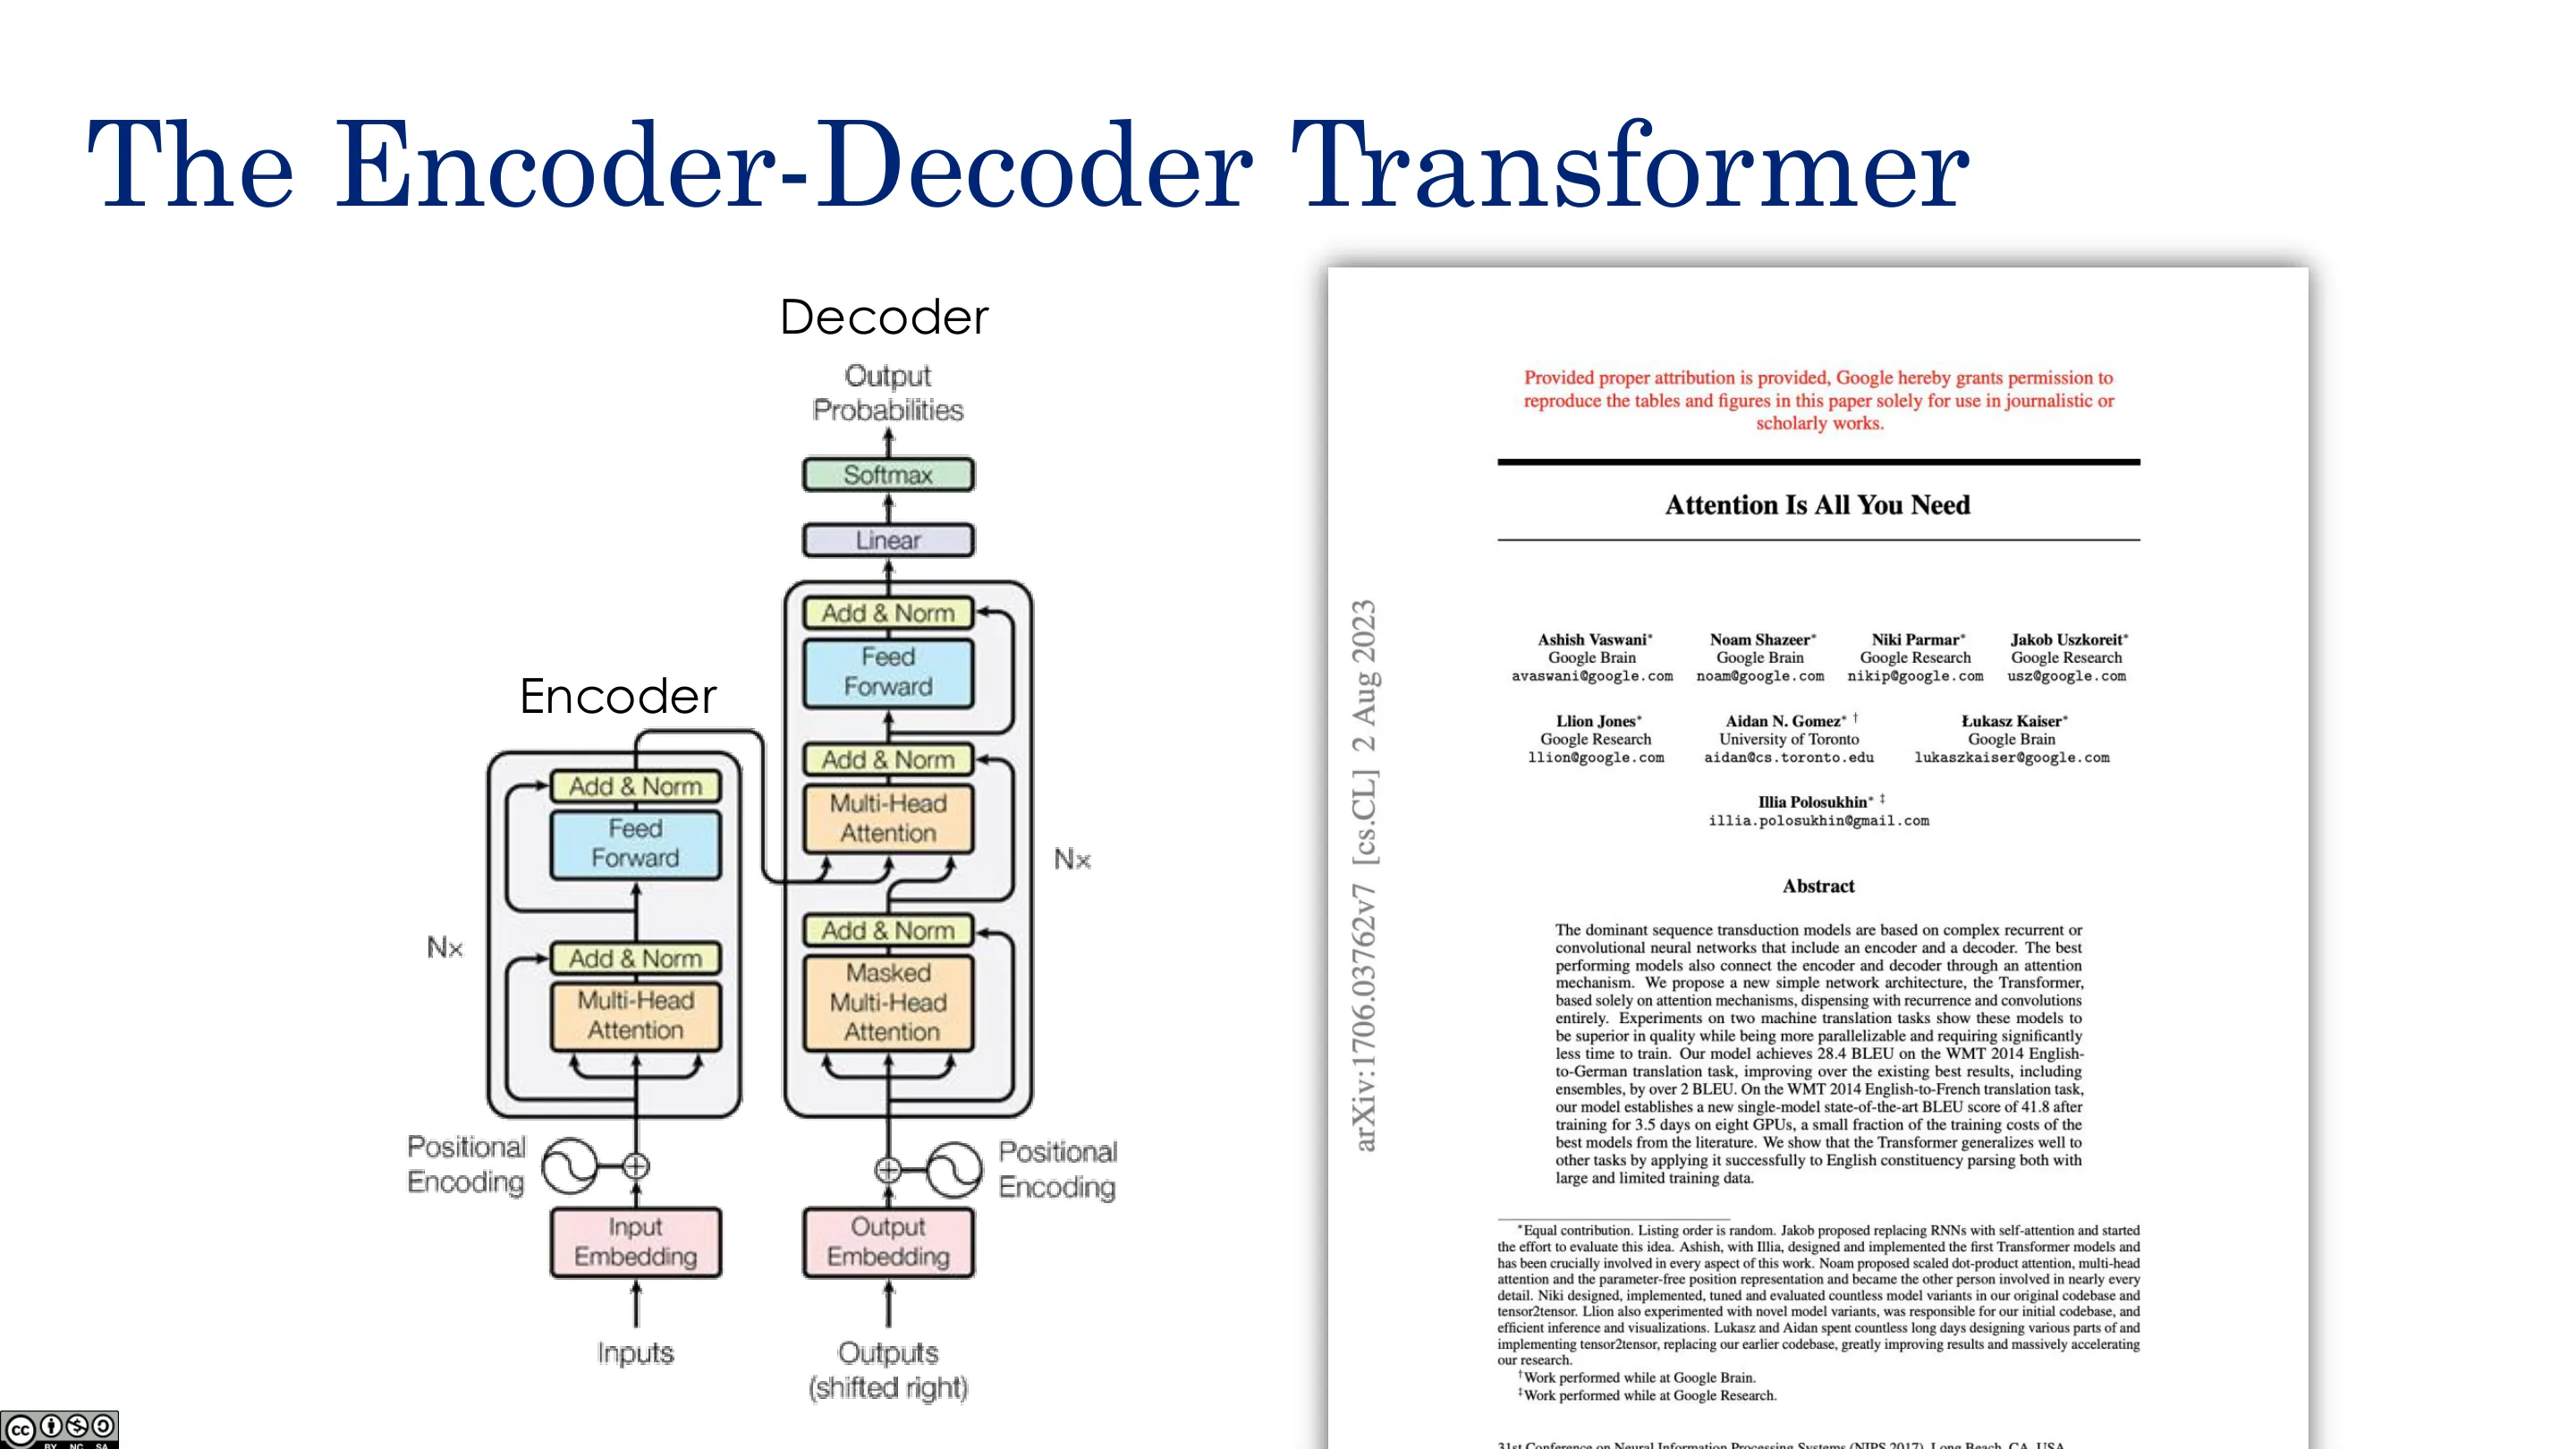
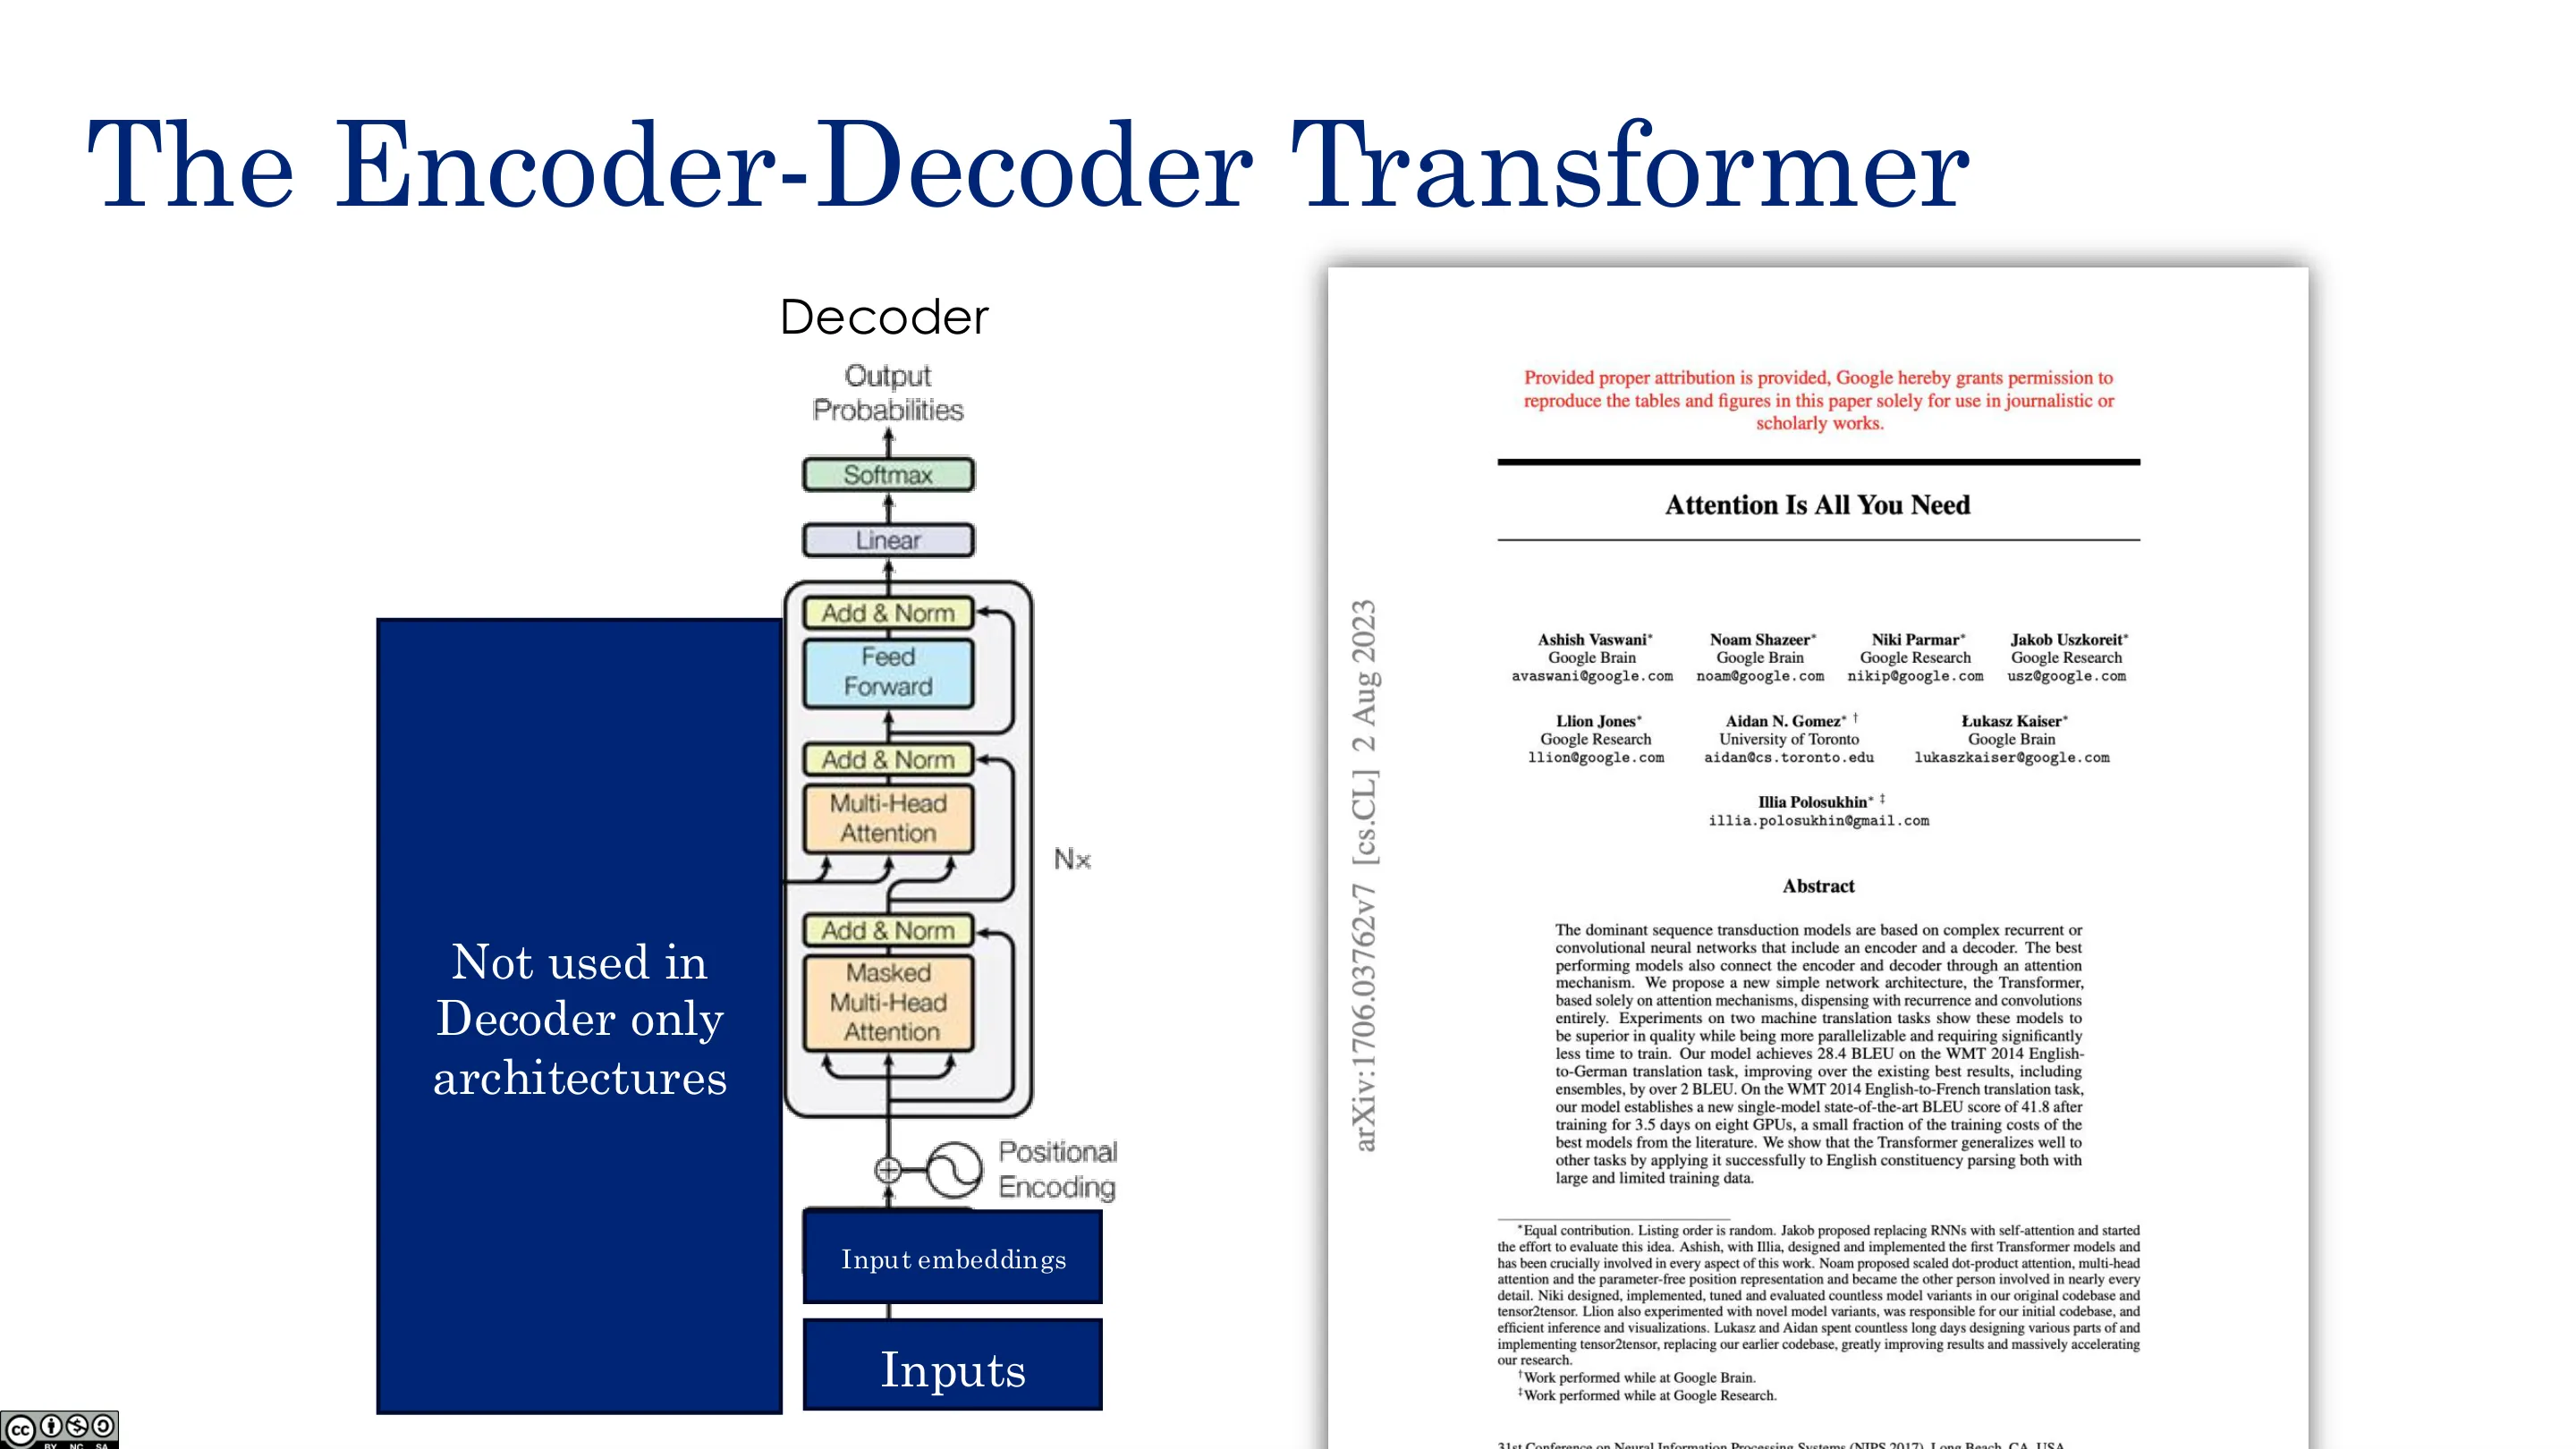
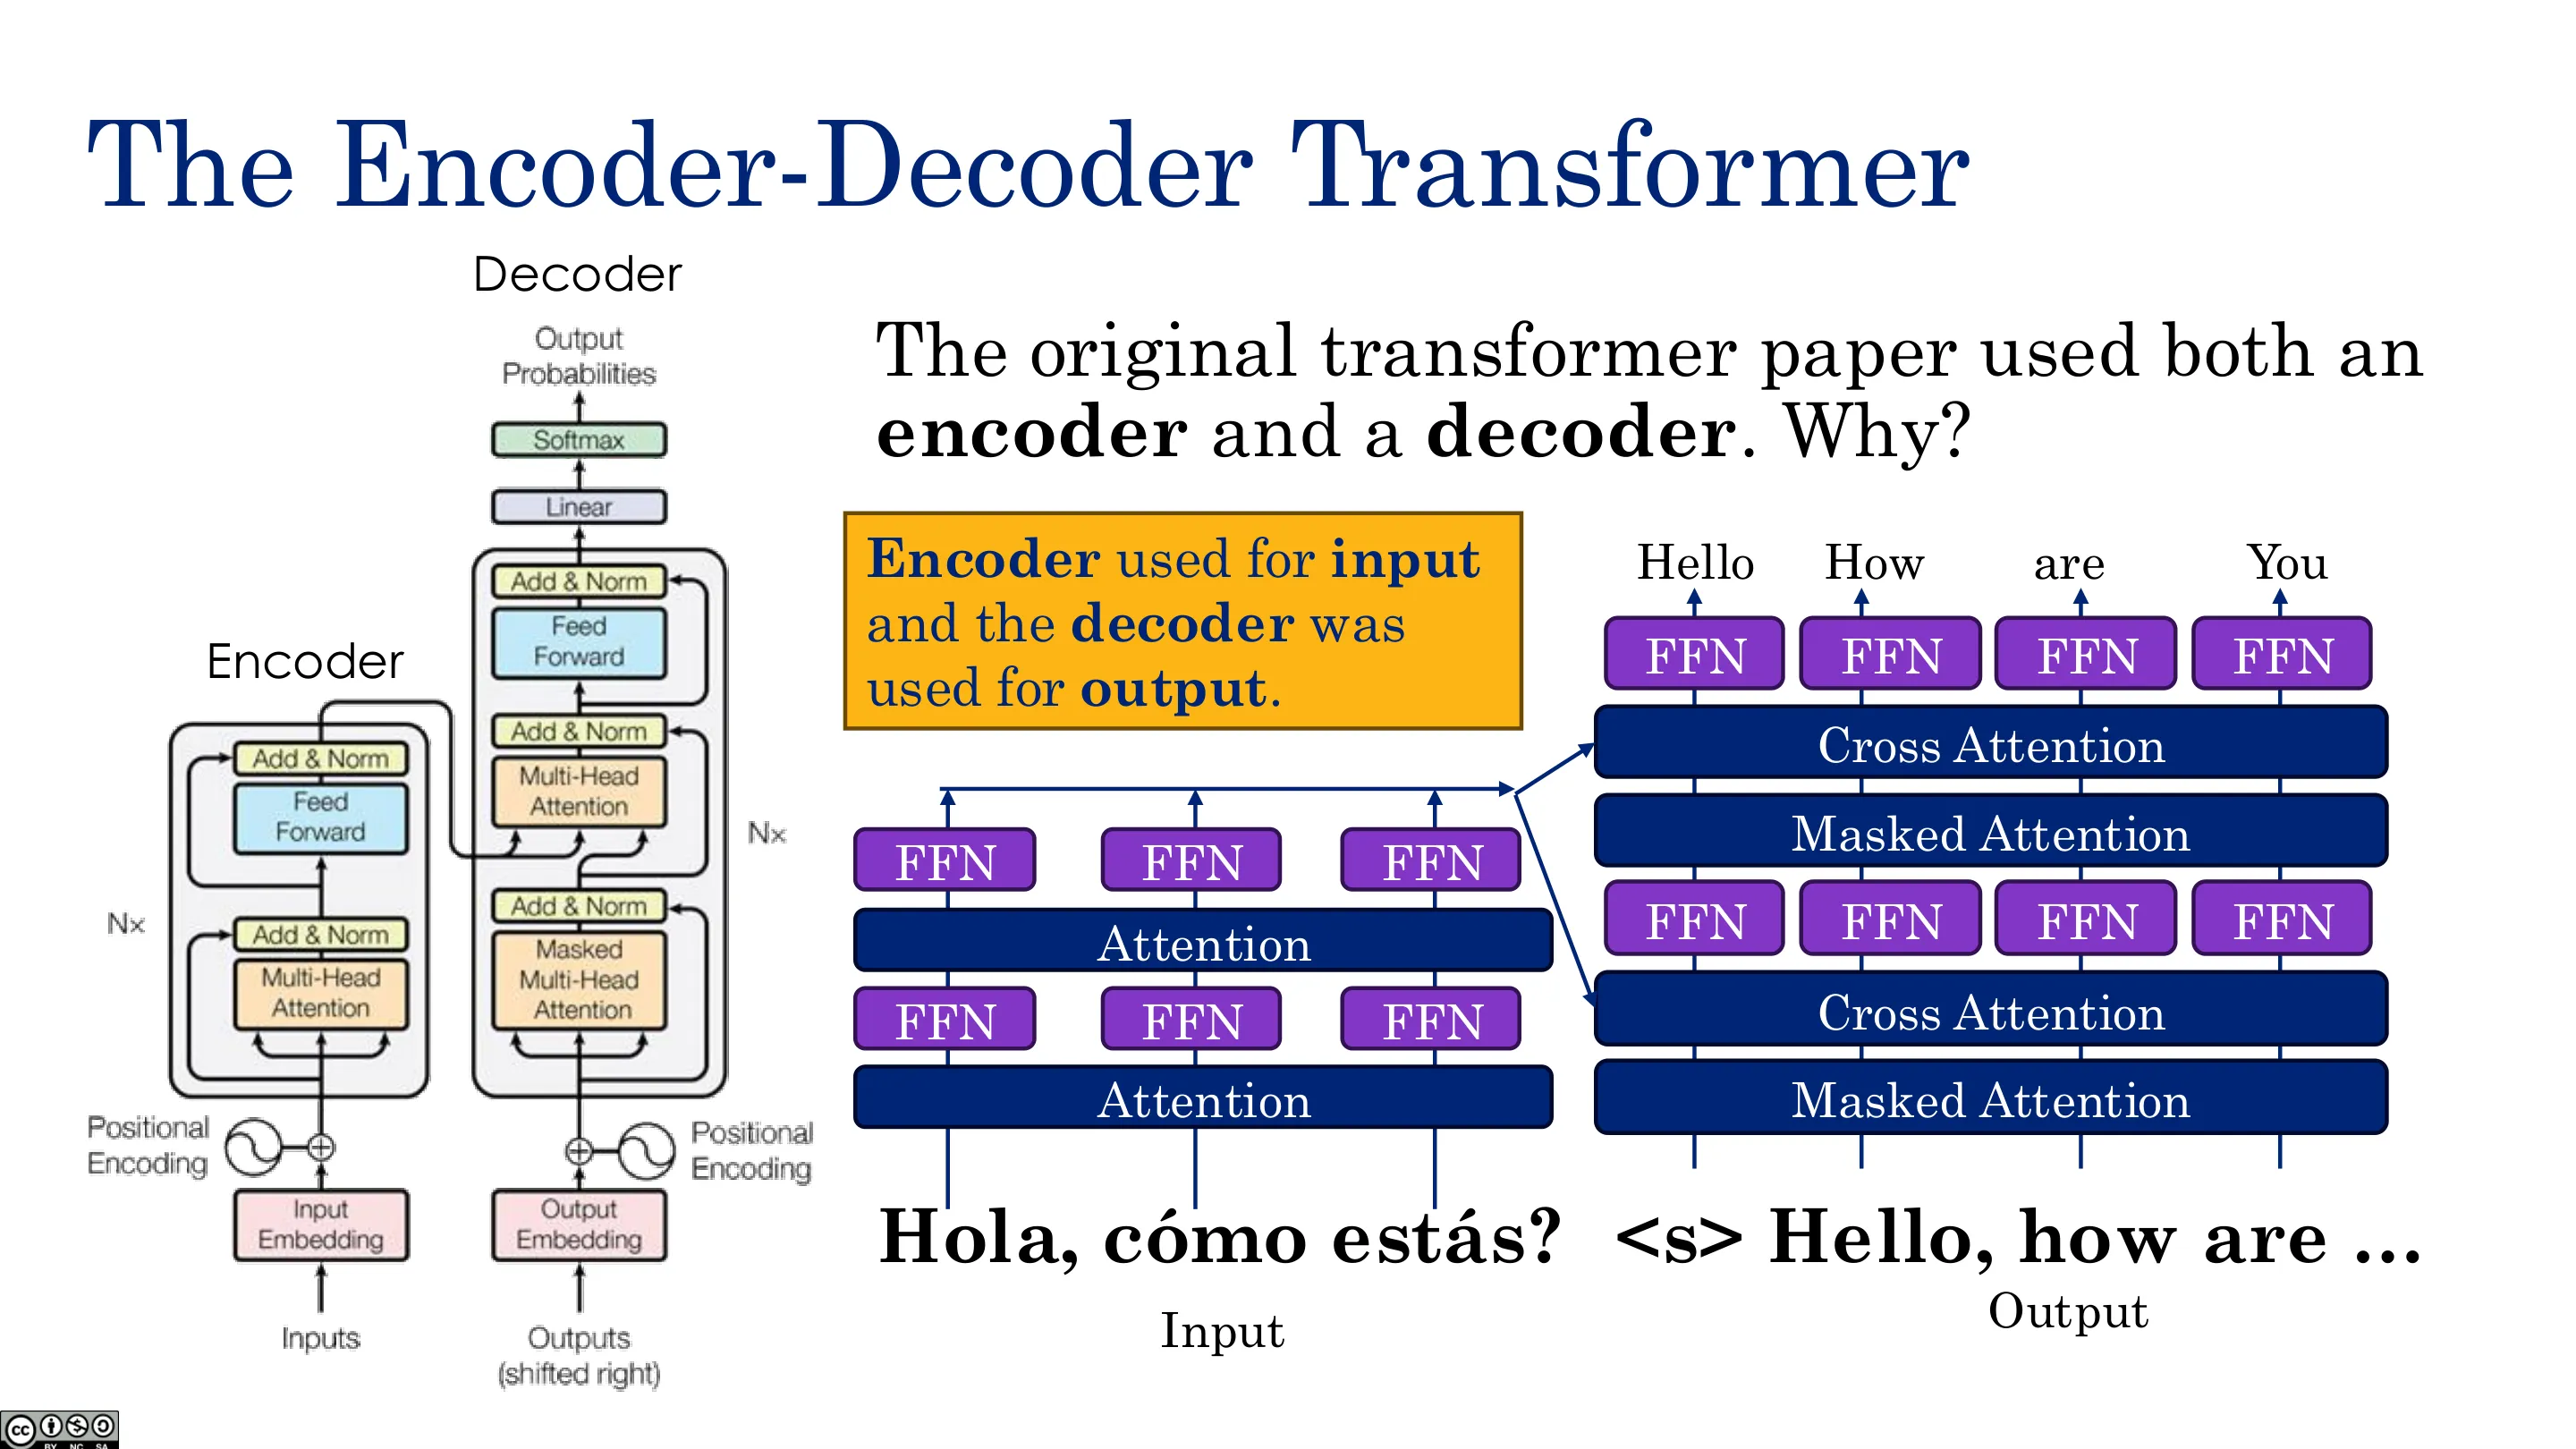
原始 《Attention Is All You Need》 的架构分两大块:Encoder 和 Decoder,最初用于翻译。此后出现两条简化路线:
- Encoder-only:如 BERT(看整句话、双向,适合理解/分类);
- Decoder-only:如 GPT / Llama / Claude / Gemini(只能看过去,自回归生成)。
核心仍是自注意力/多头注意力——其余的 MLP、残差、LayerNorm 都是"平凡"组件。输入「I like apples and bananas」被编码成 $n$ 个 $d$ 维向量($n$ = 上下文长度),在每一层里流动、混合,最后输出 同样 $n$ 个、同样维度的上下文化向量。
📷 Encoder-Decoder Transformer(一)
回到原视频 (00:02:46)
📷 Encoder-Decoder Transformer(二)
回到原视频 (00:03:59)
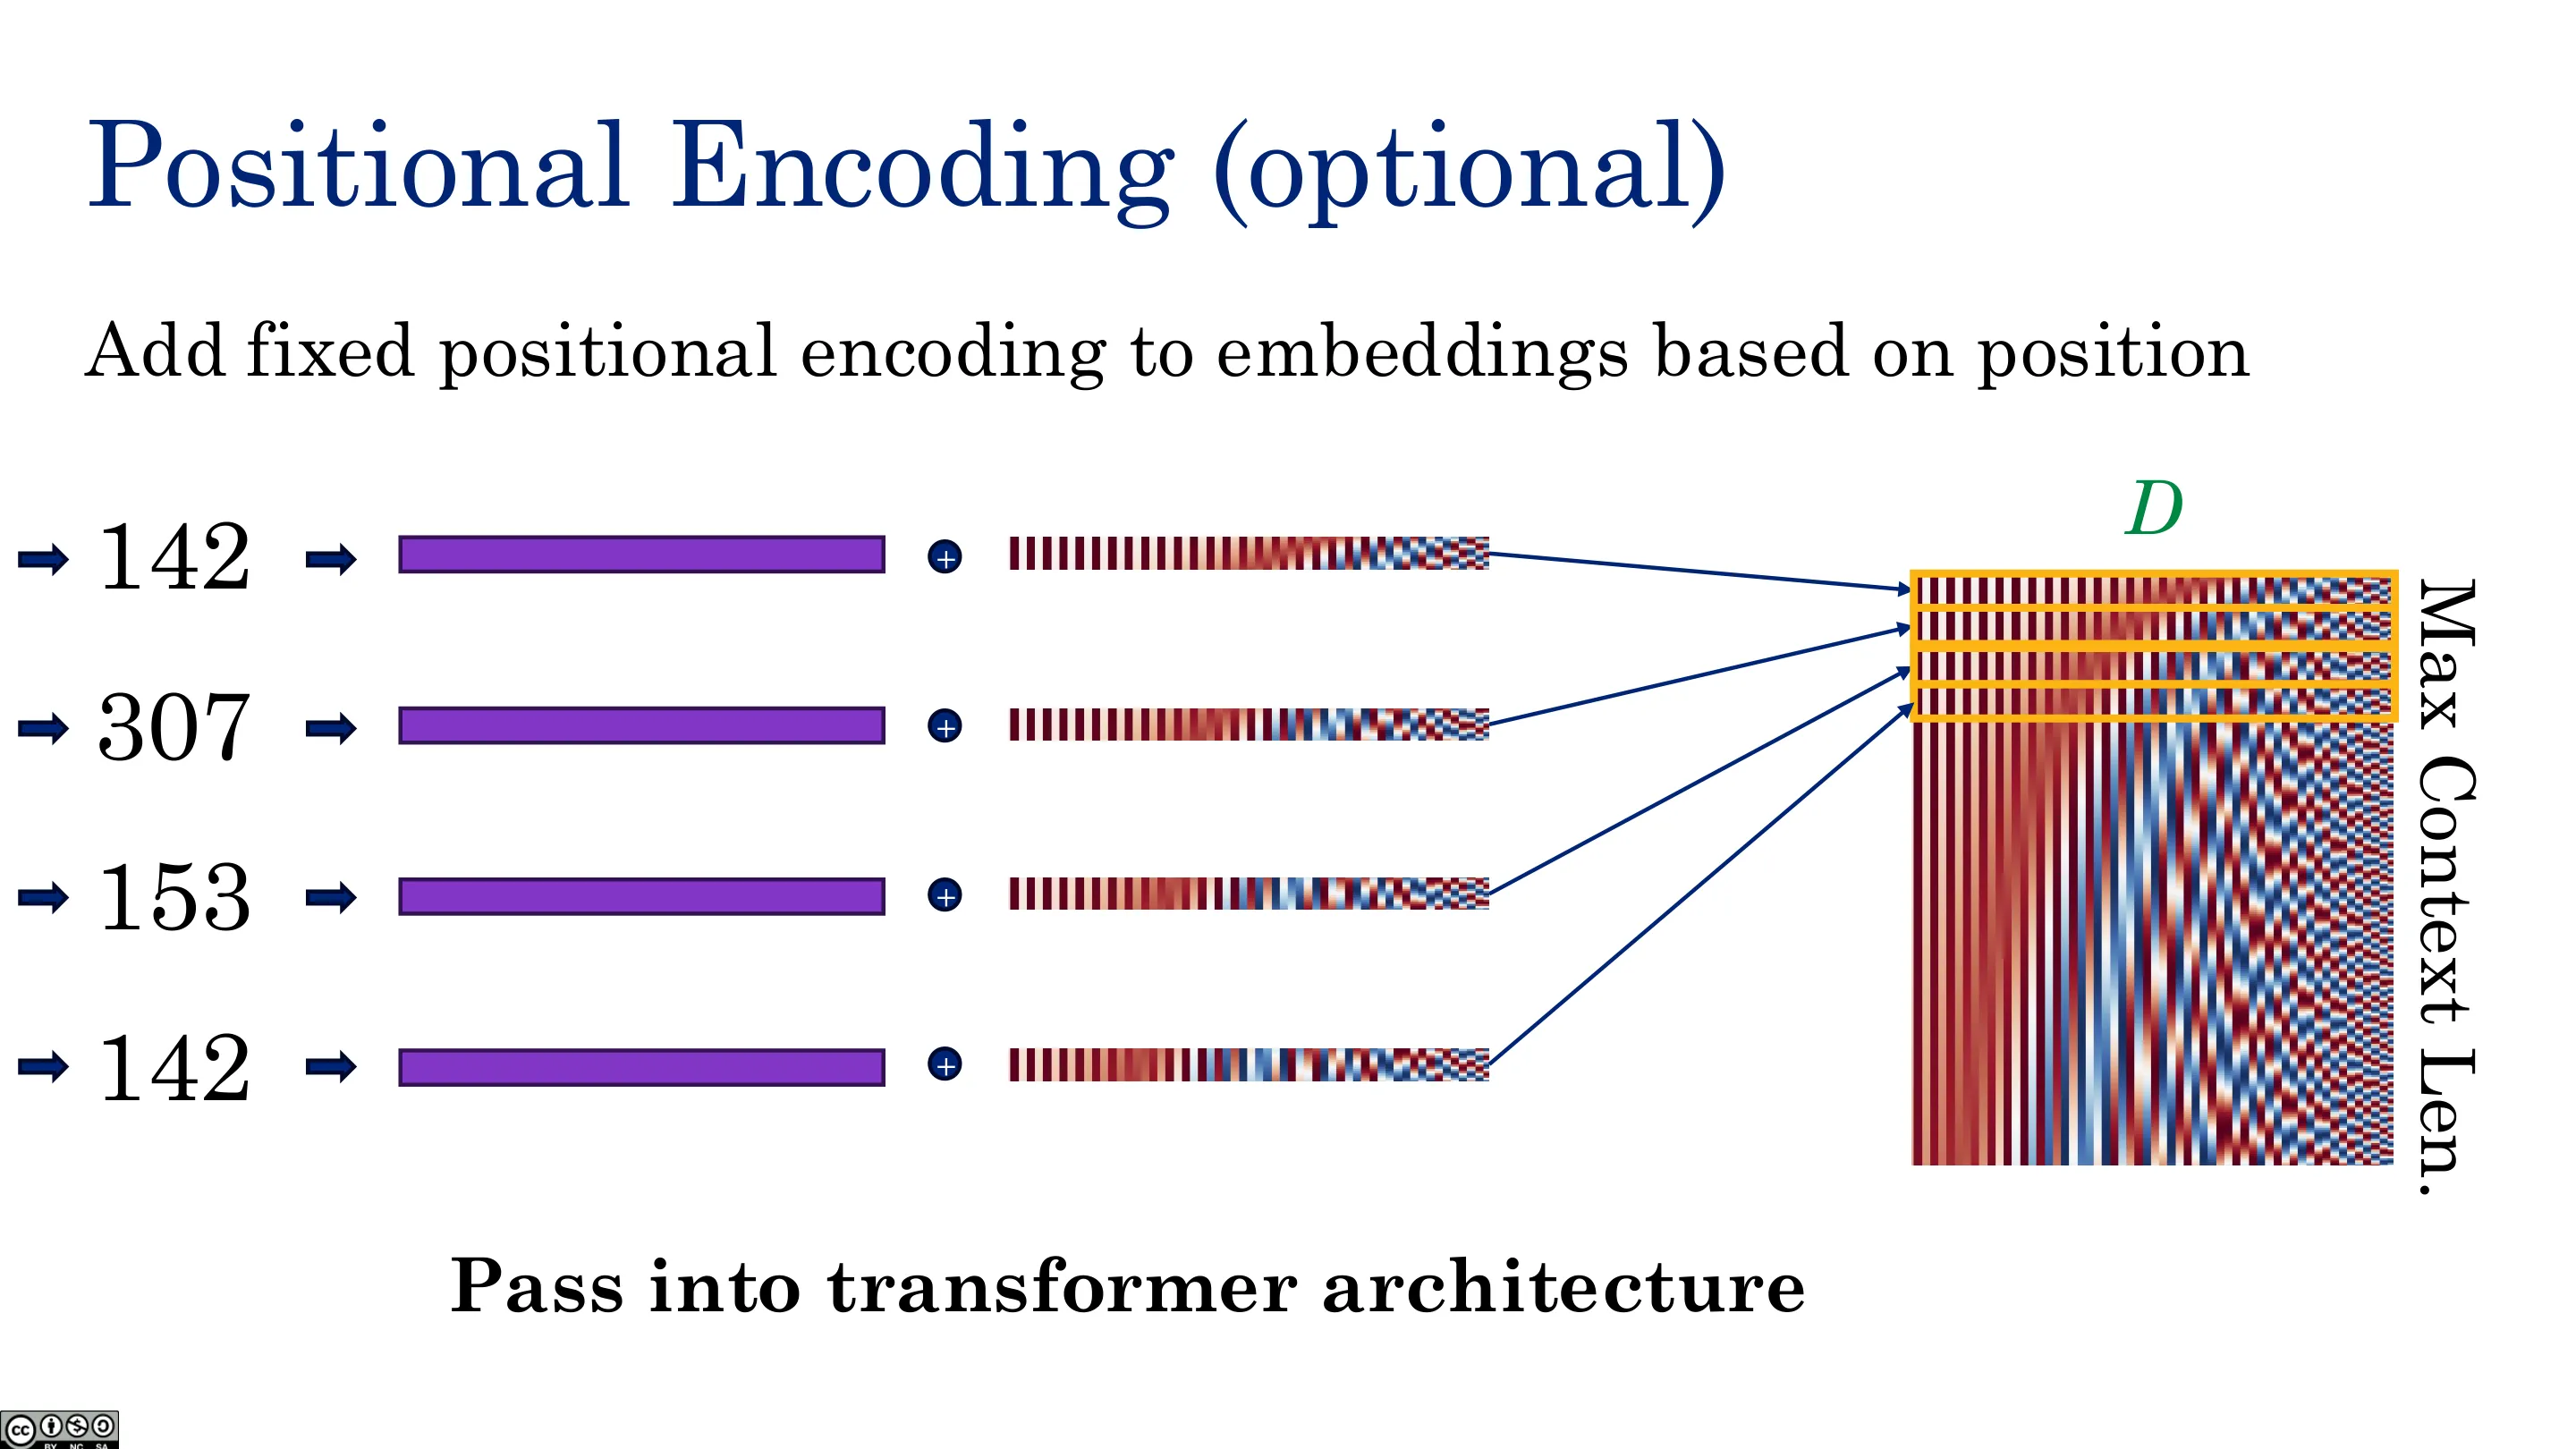
关键澄清:位置编码是加一个同维度的向量,不是拼接一个坐标——上一讲讲师讲错了一点,这里更正。
二、用 Transformer 做分类
(参考时间: 00:04)
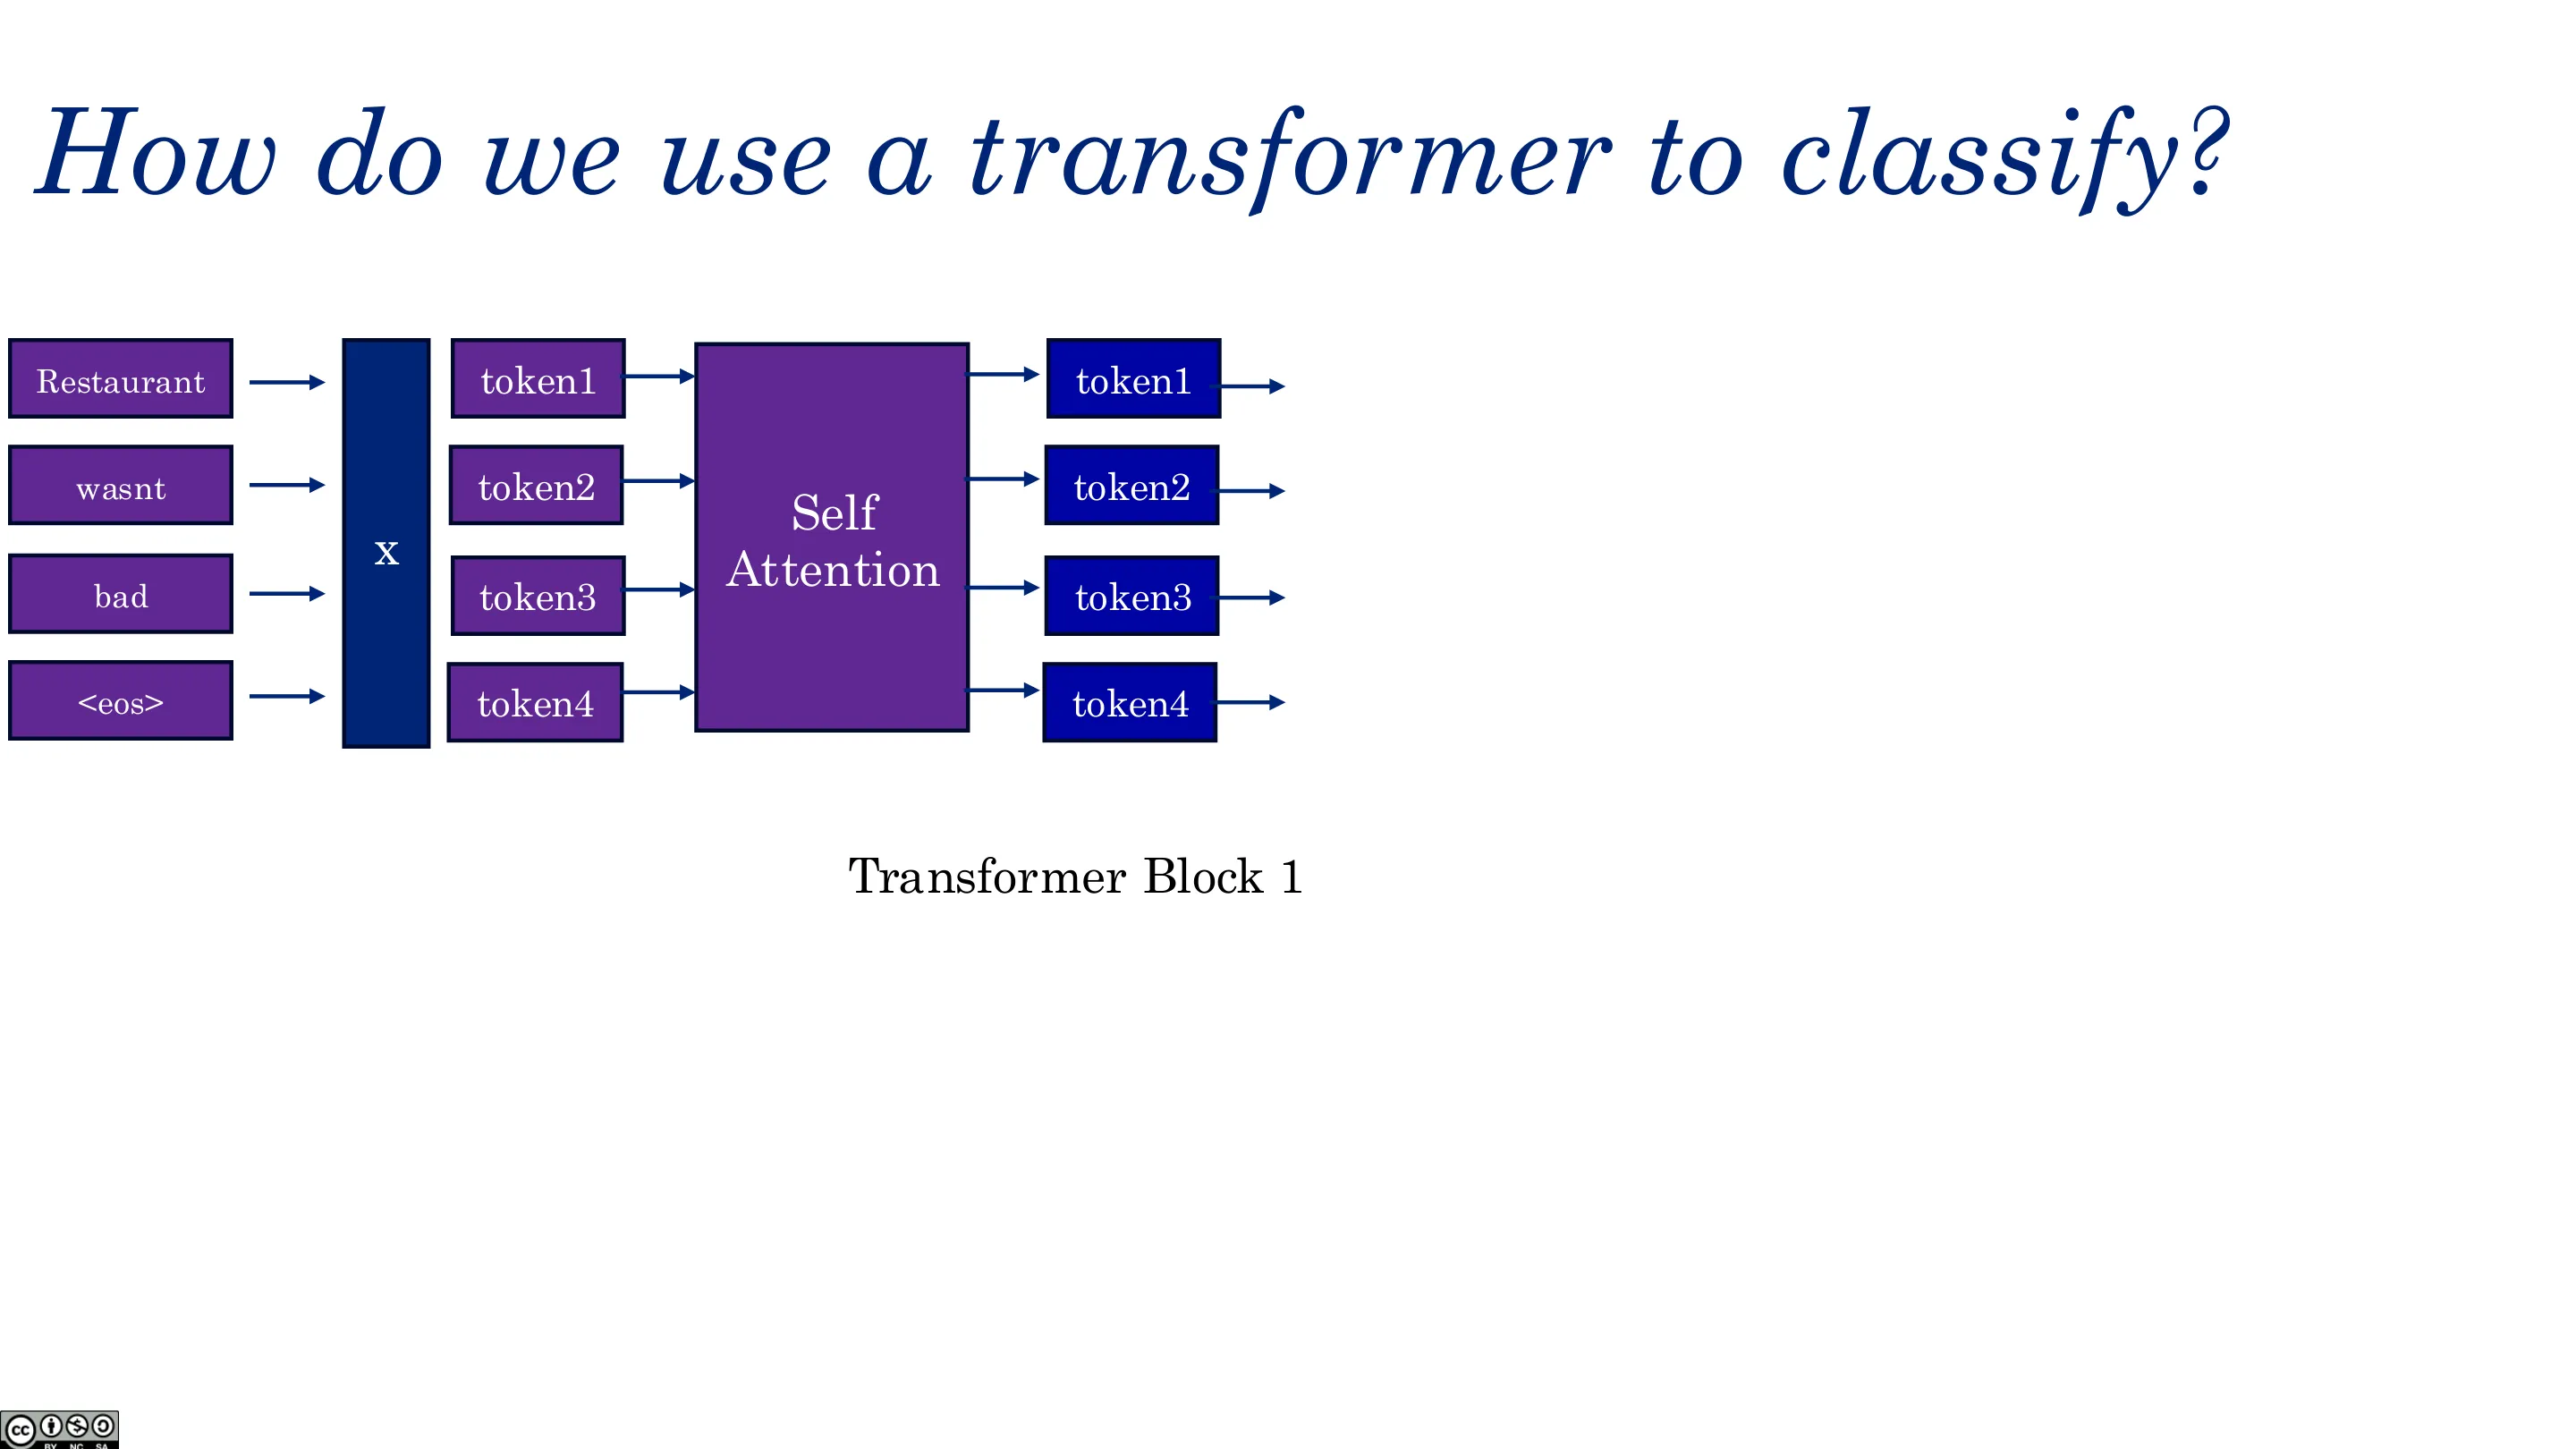
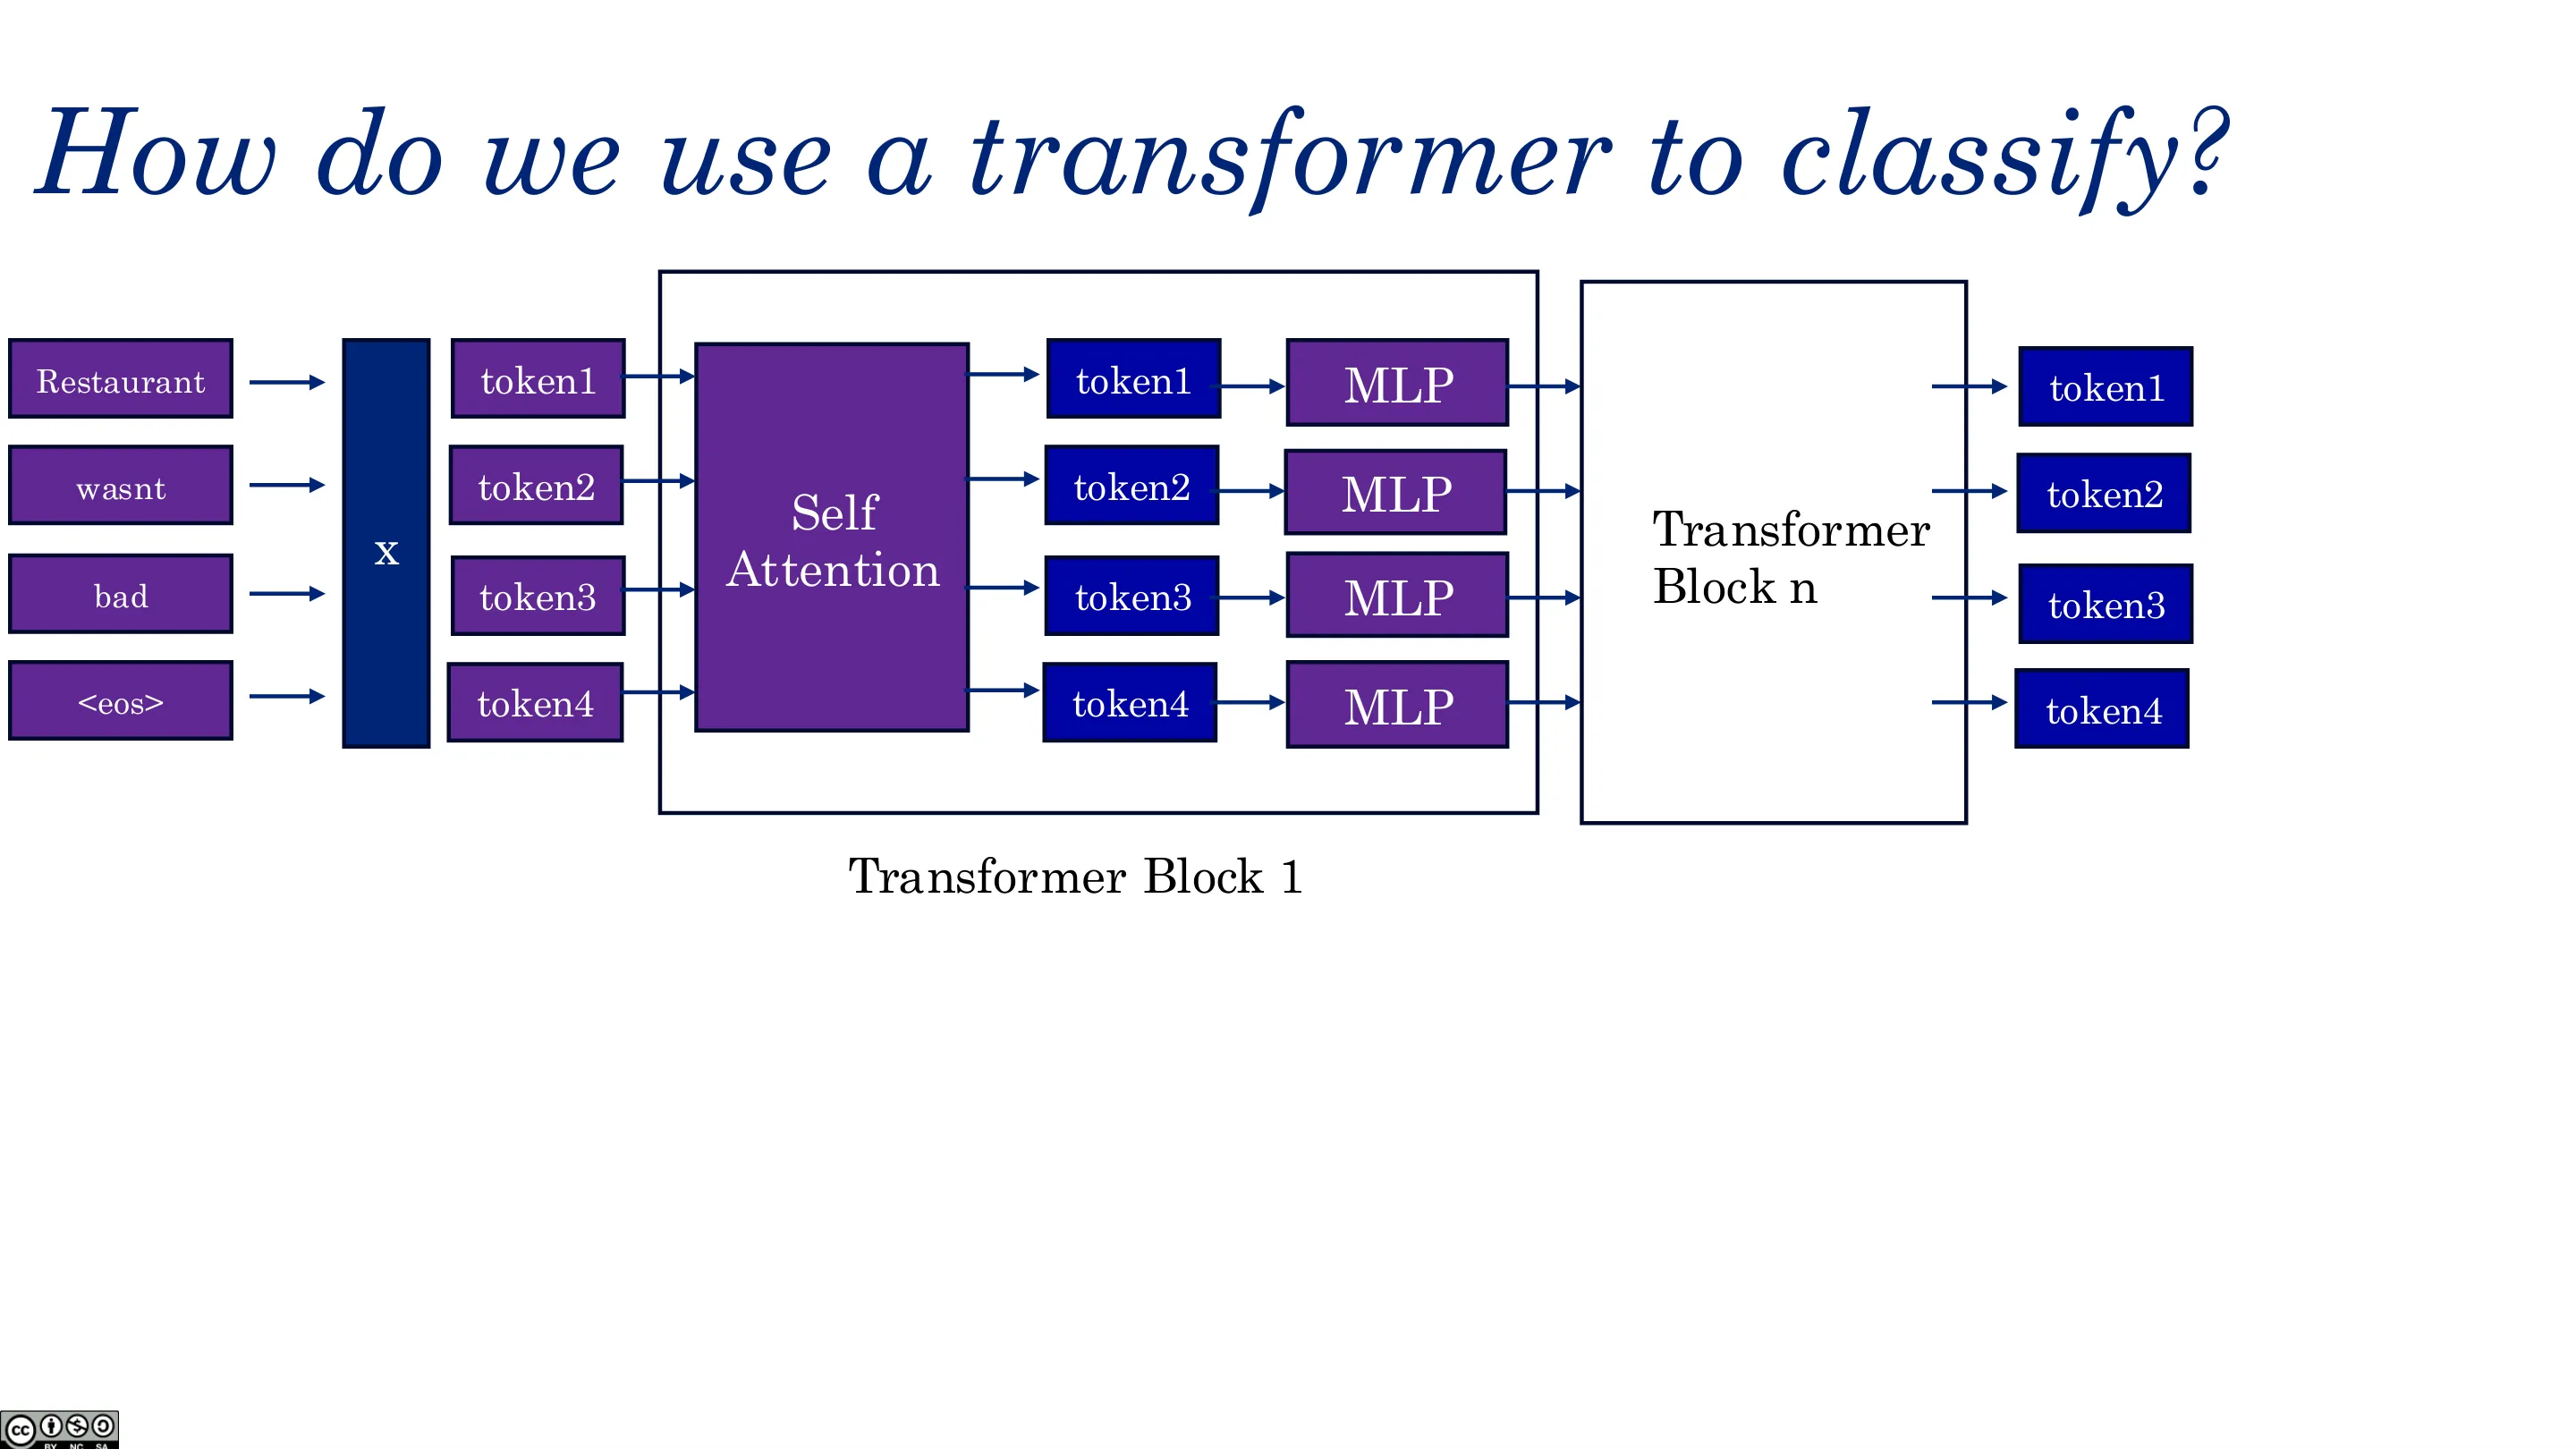
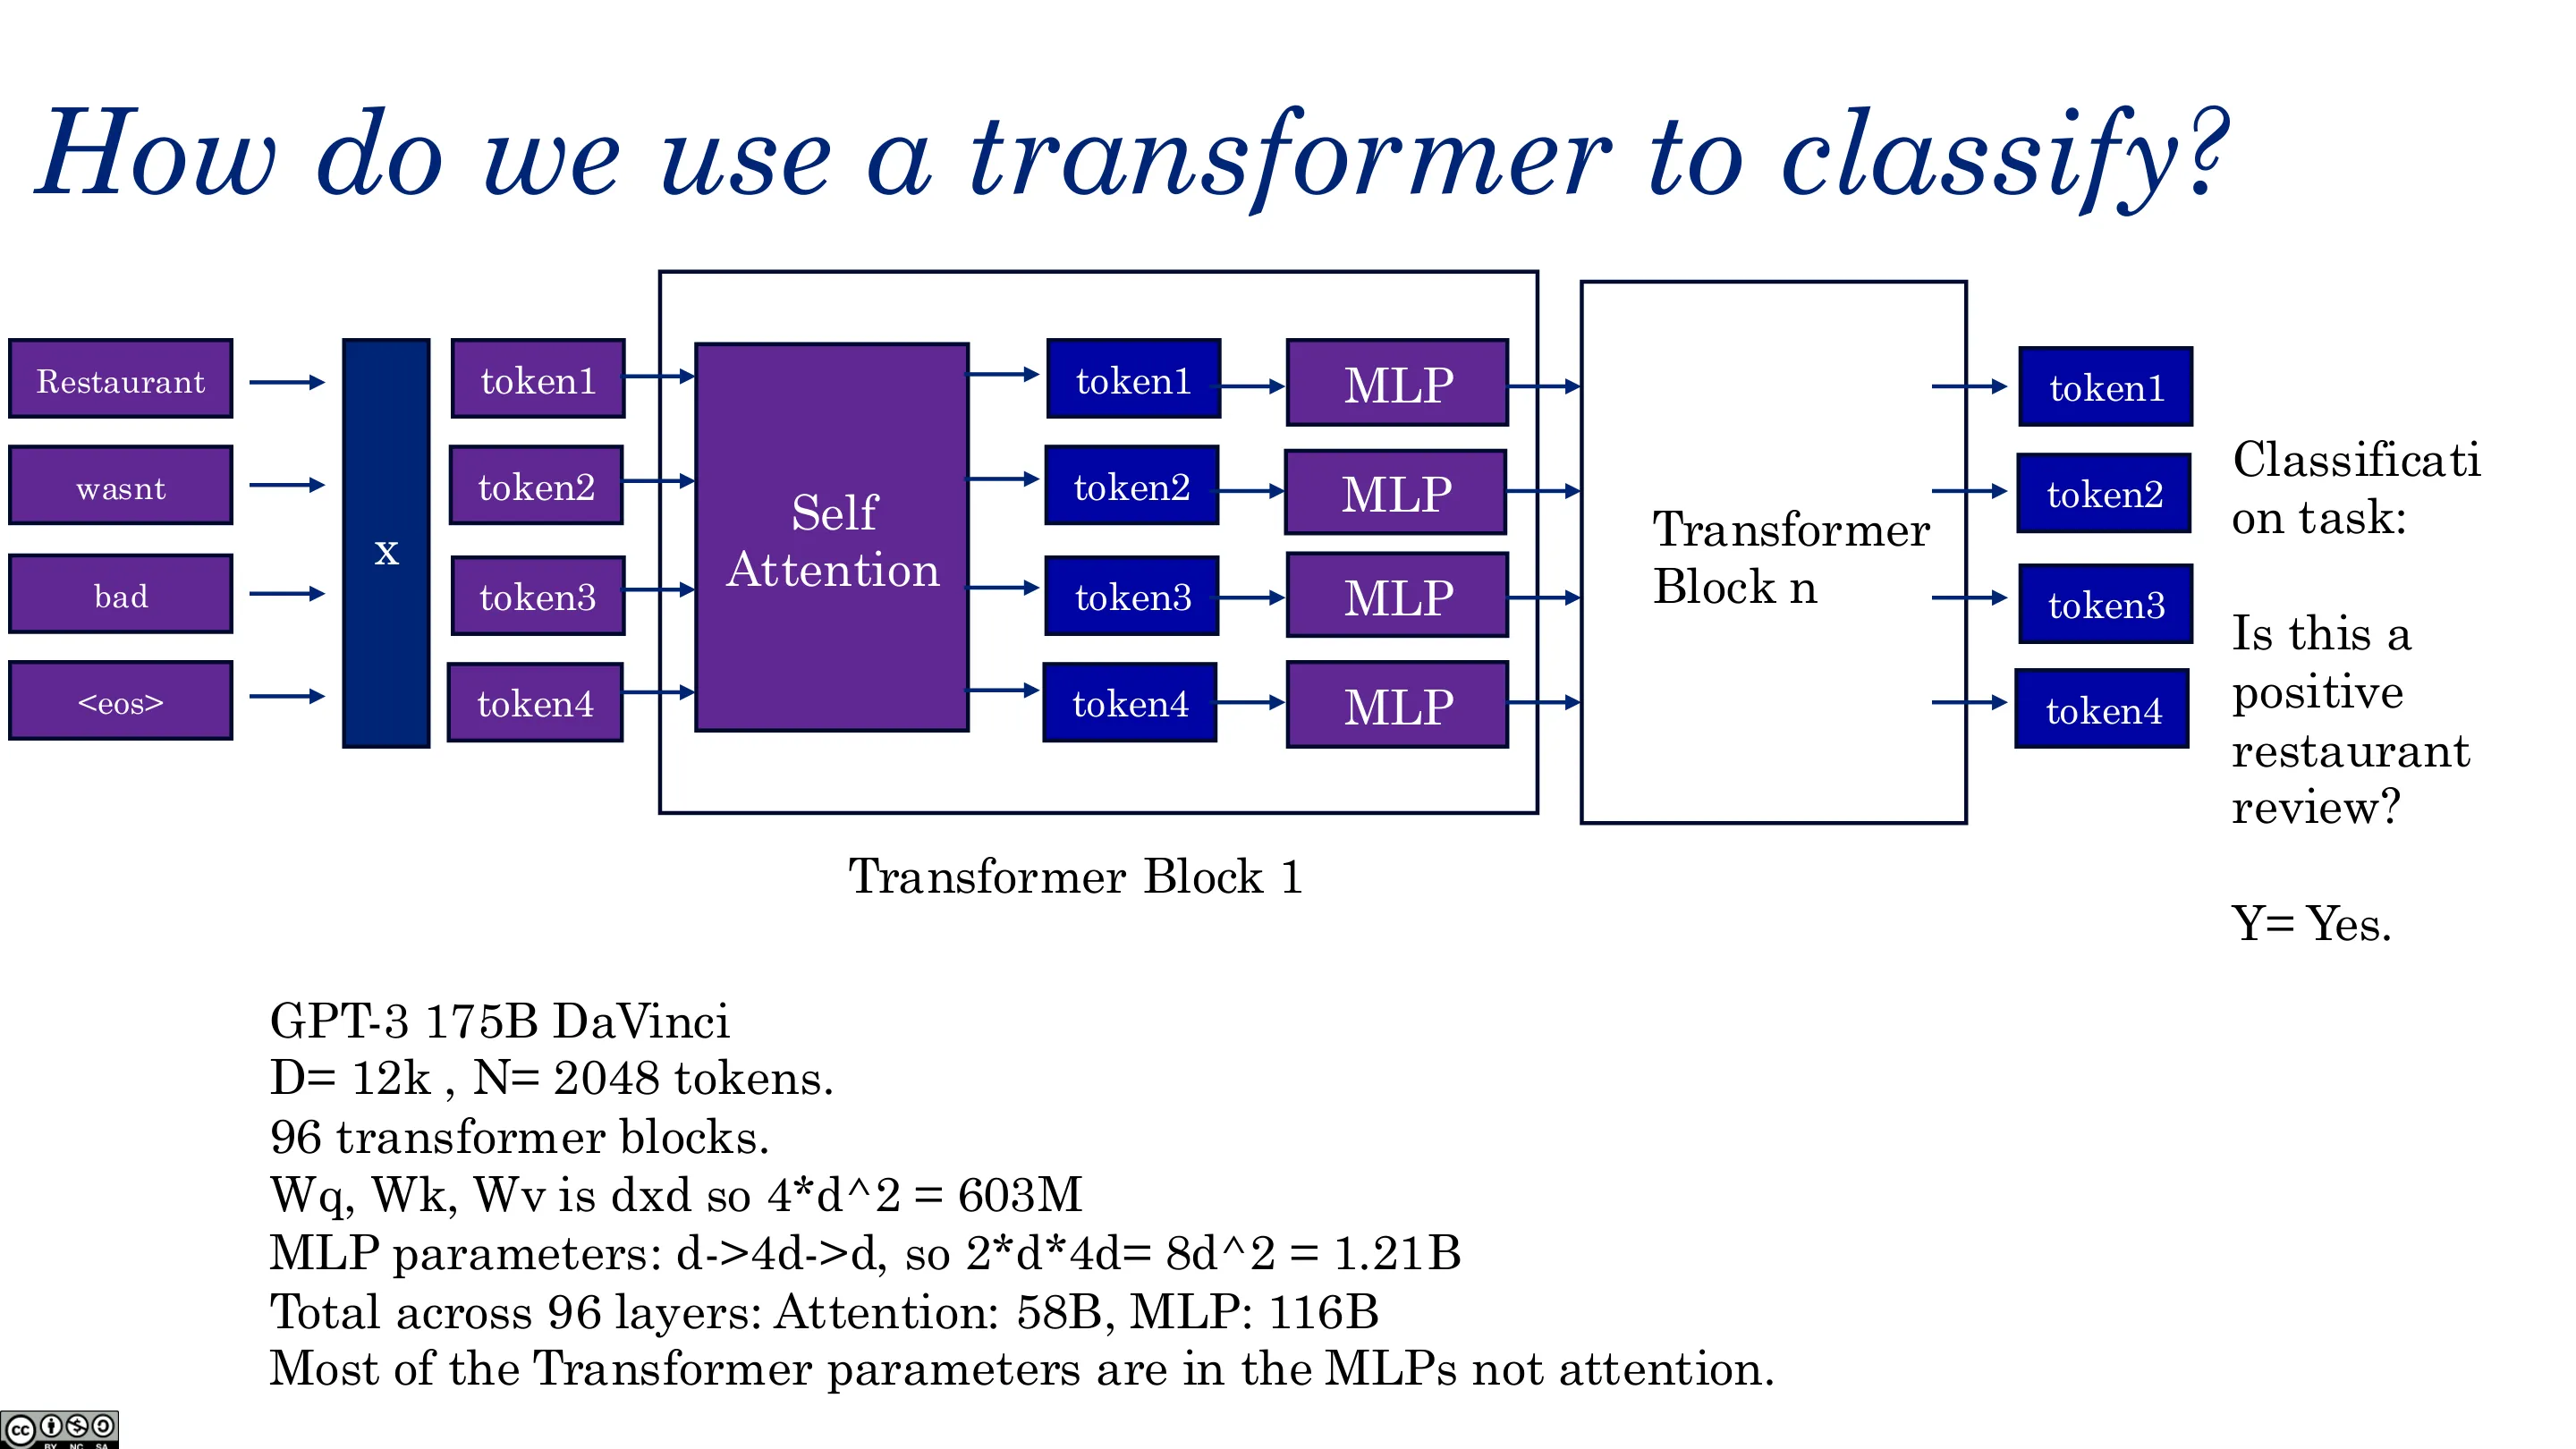
以 Yelp 餐厅评论二分类("restaurant wasn't bad" → 偏正面)为例:
- 输入加特殊 token:
<start>/<end>; - token → 嵌入表查表 → 加位置编码 → 多层 Transformer 块;
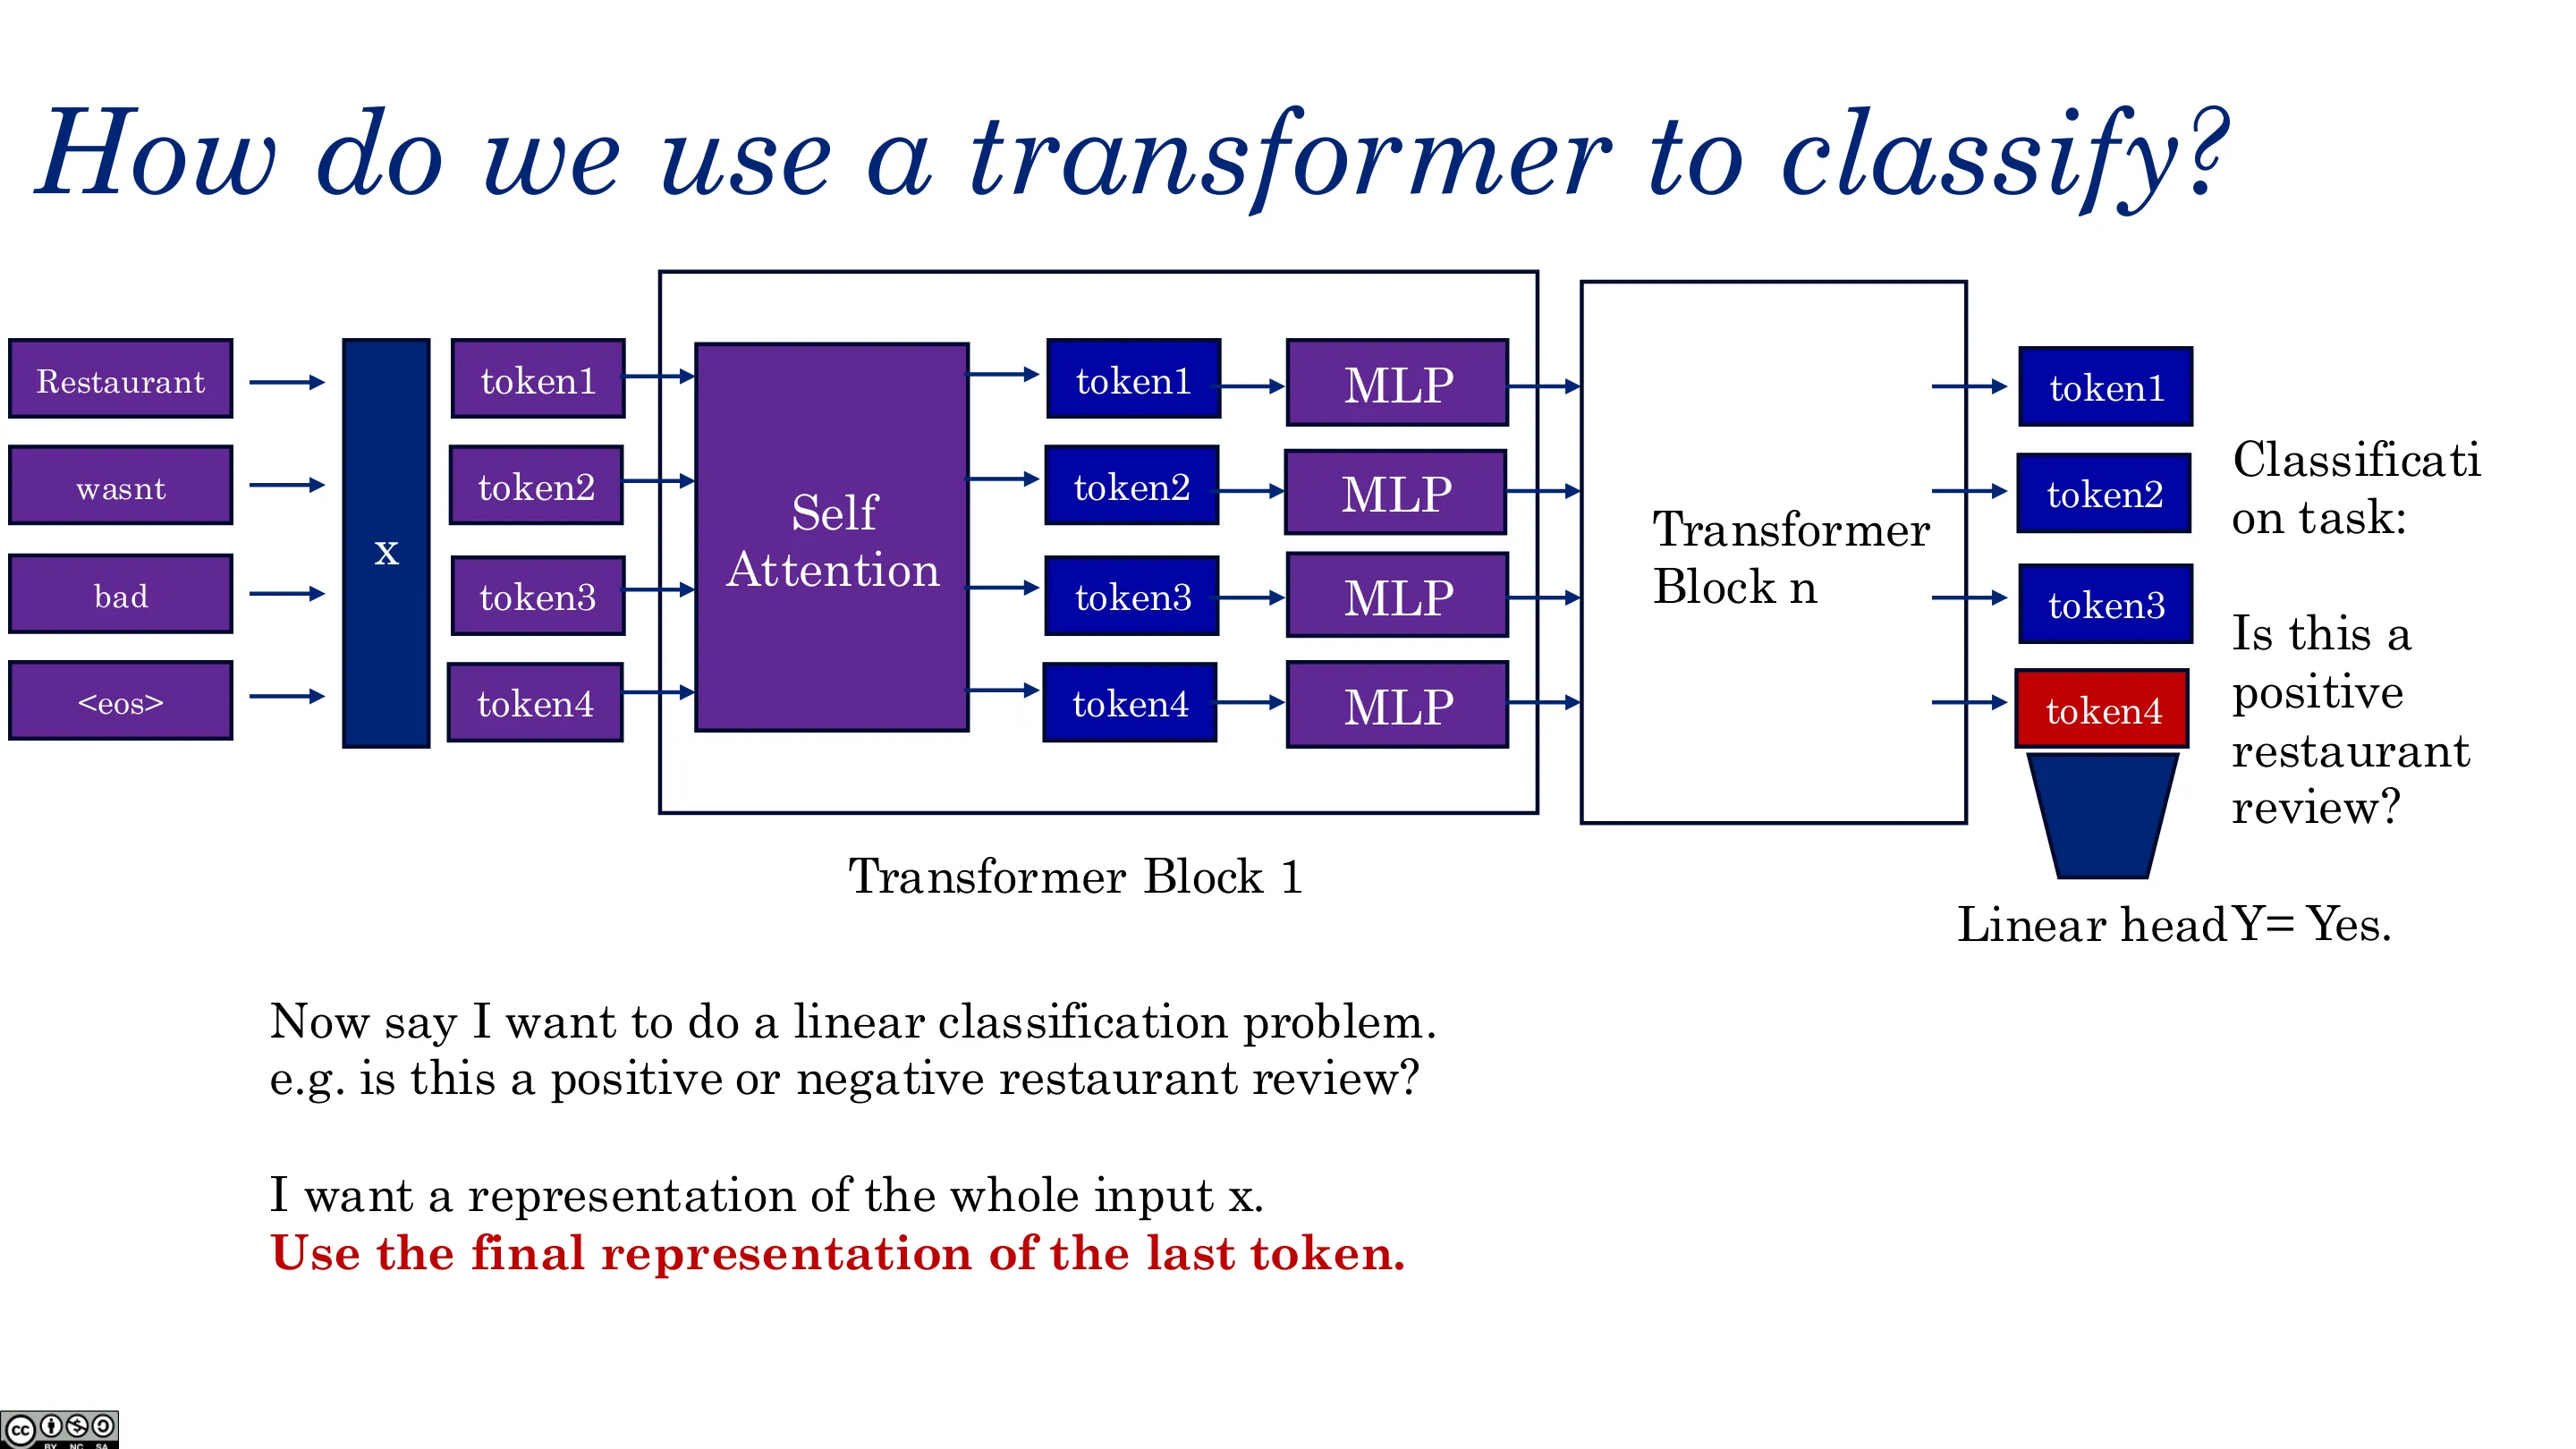
- 分类的做法:只取最后一个 token(
<end>)的输出向量,把它当作整句话的向量表示,接一个线性头($d\times\text{类别数}$)+ softmax 得到预测。这是与传统 ML 的显著差别。
为什么最后一个 token 能代表整句? 因为自注意力让它混合了前面所有 token 的信息,且为了预测下一个 token,这个向量必须压缩整句话(甚至在推理小说里要"记住整个故事")。
如何训练分类头?
- Linear probing(线性探针):冻结整个预训练 Transformer,只训练最后的线性层——适合数据很少;
- Fine-tuning(全量微调):更新所有(或部分)权重——适合数据很多;
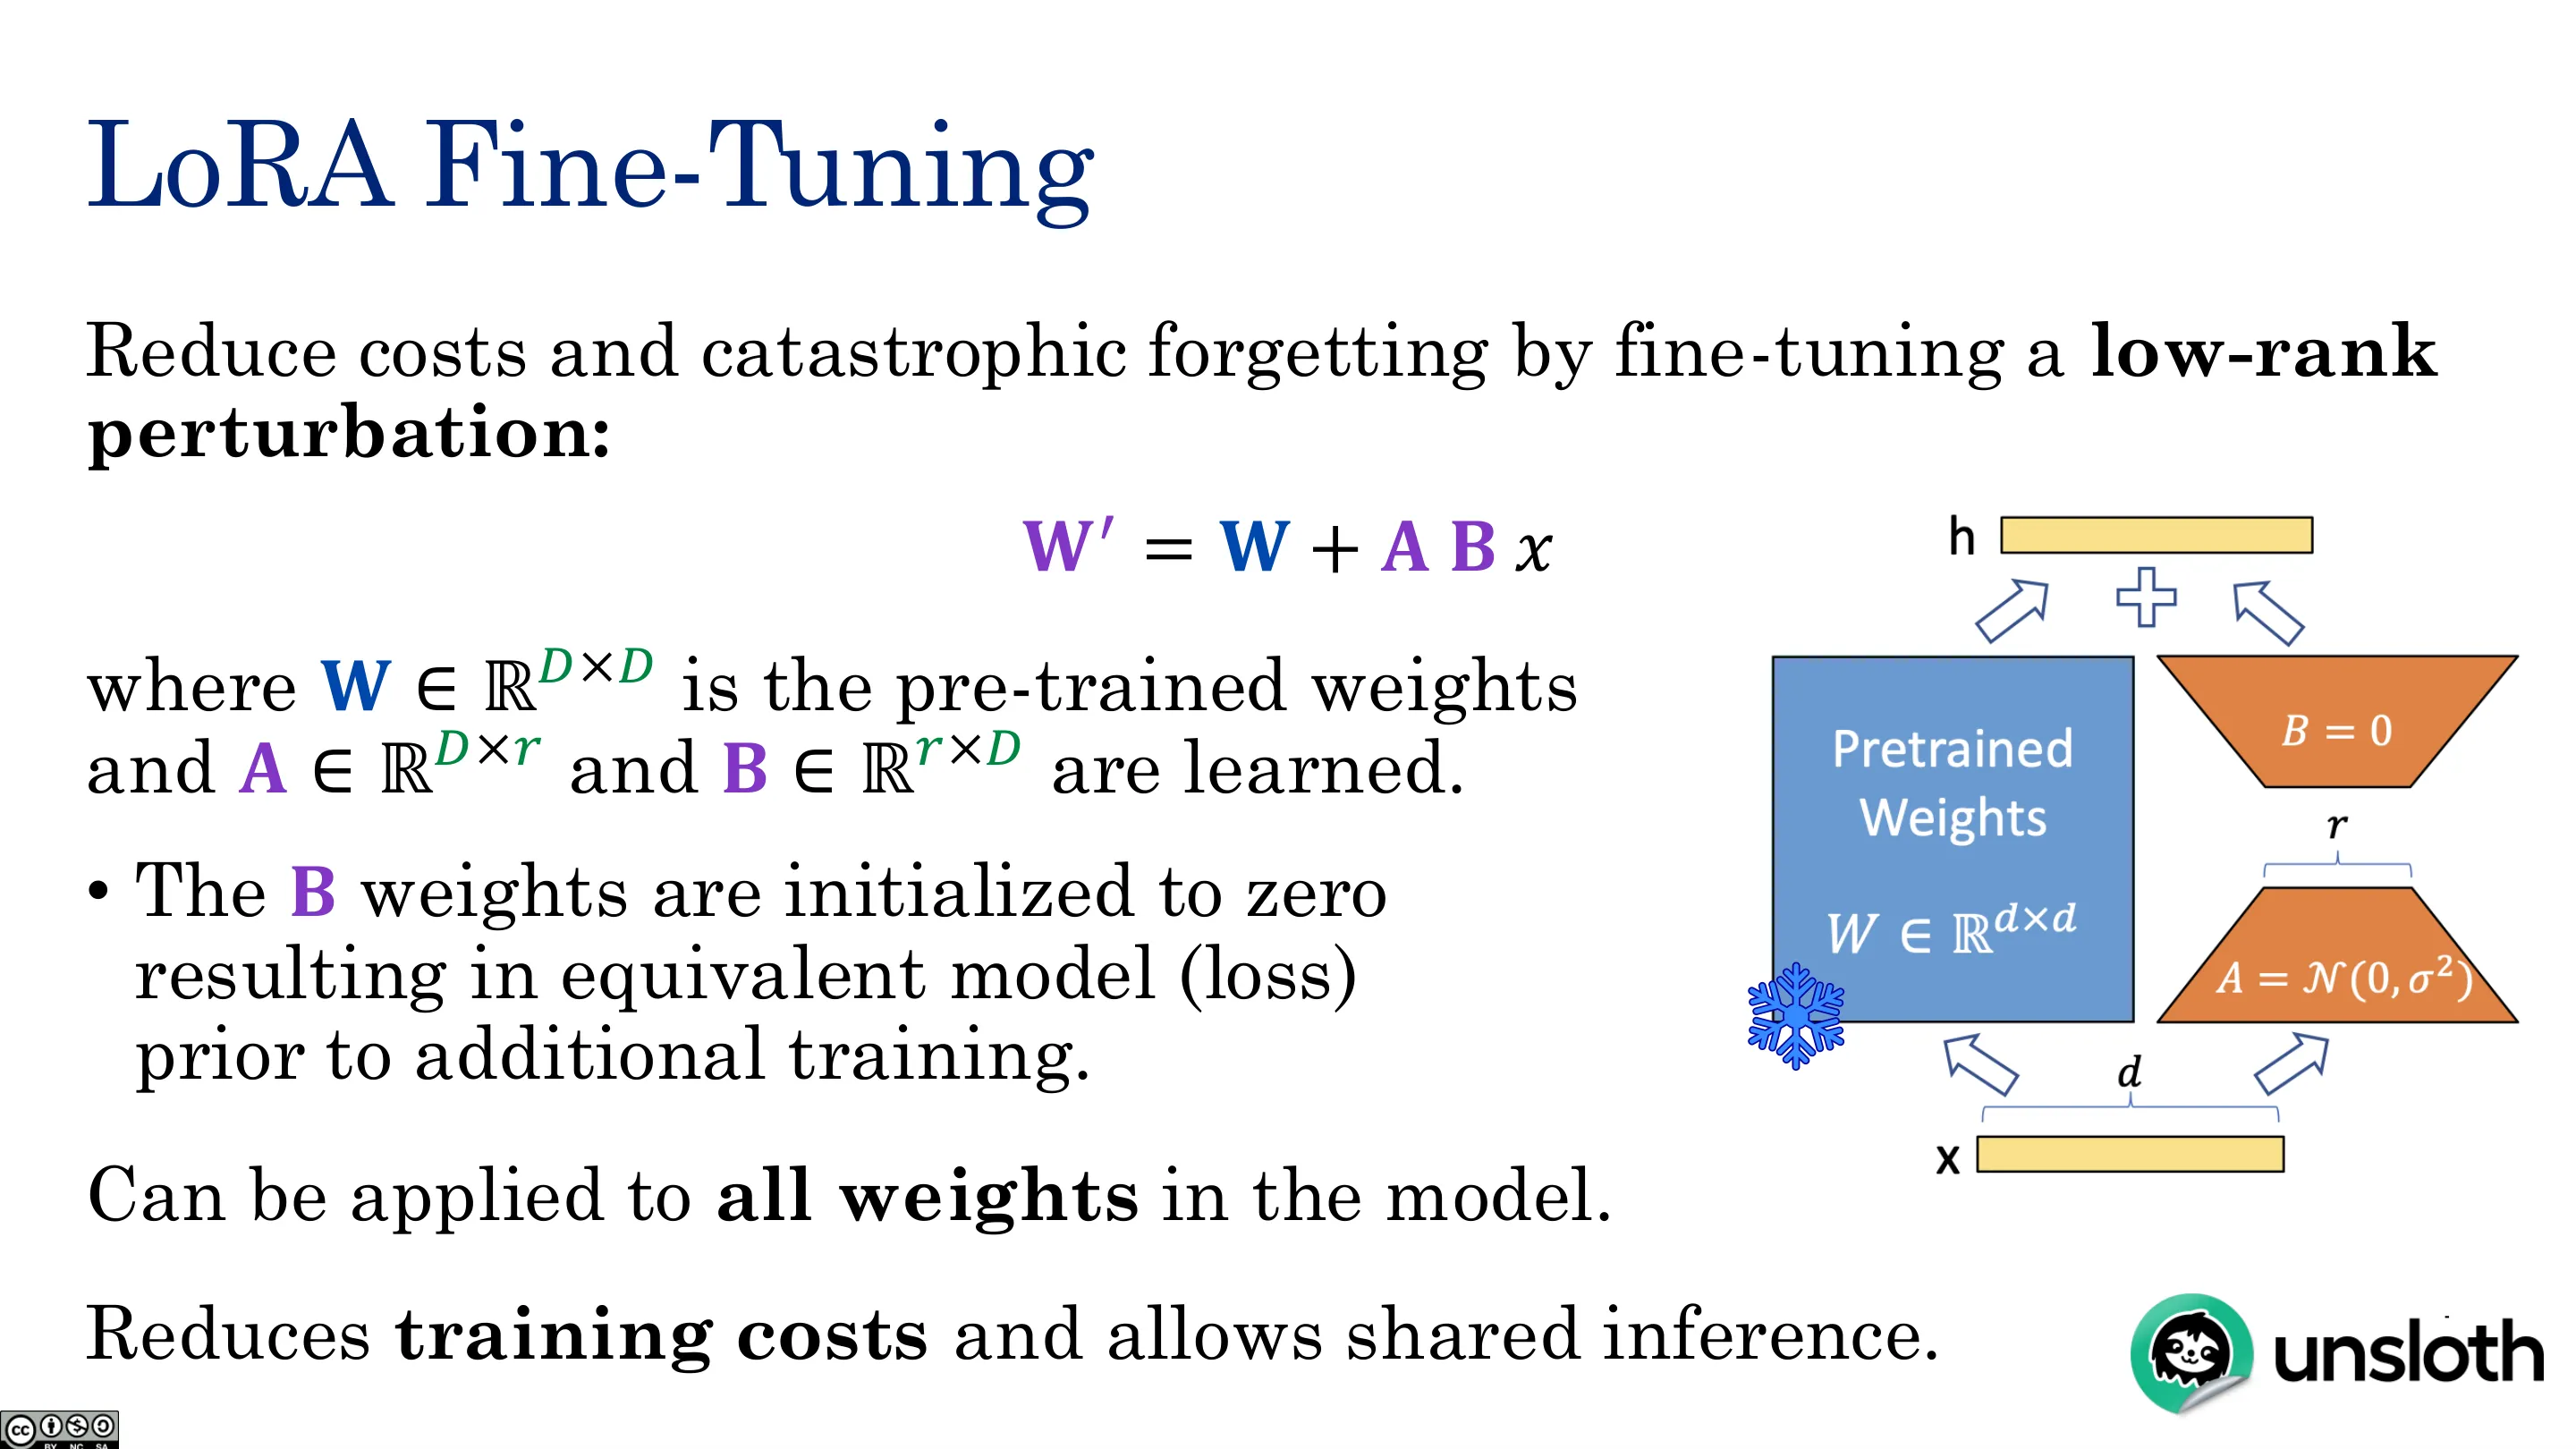
- 折中方案:LoRA 等只微调中间的一小部分适配器(见后文)。
要点复习:Transformer 块吃 $n$ 个 token、吐 $n$ 个 token;MLP 对每个 token 独立、且权重共享;唯一让 token 之间交互的是自注意力;注意力参数 $\mathcal{O}(d^2)$ 与 token 数无关,但计算量 $\mathcal{O}(n^2)$(长上下文昂贵,催生 FlashAttention)。
📷 如何用 Transformer 分类(一)
回到原视频 (00:05:12)
📷 如何用 Transformer 分类(二)
回到原视频 (00:06:25)
📷 如何用 Transformer 分类(三)
回到原视频 (00:07:38)
📷 如何用 Transformer 分类(四)
回到原视频 (00:08:51)
三、自监督:预测下一个 token
(参考时间: 00:31)
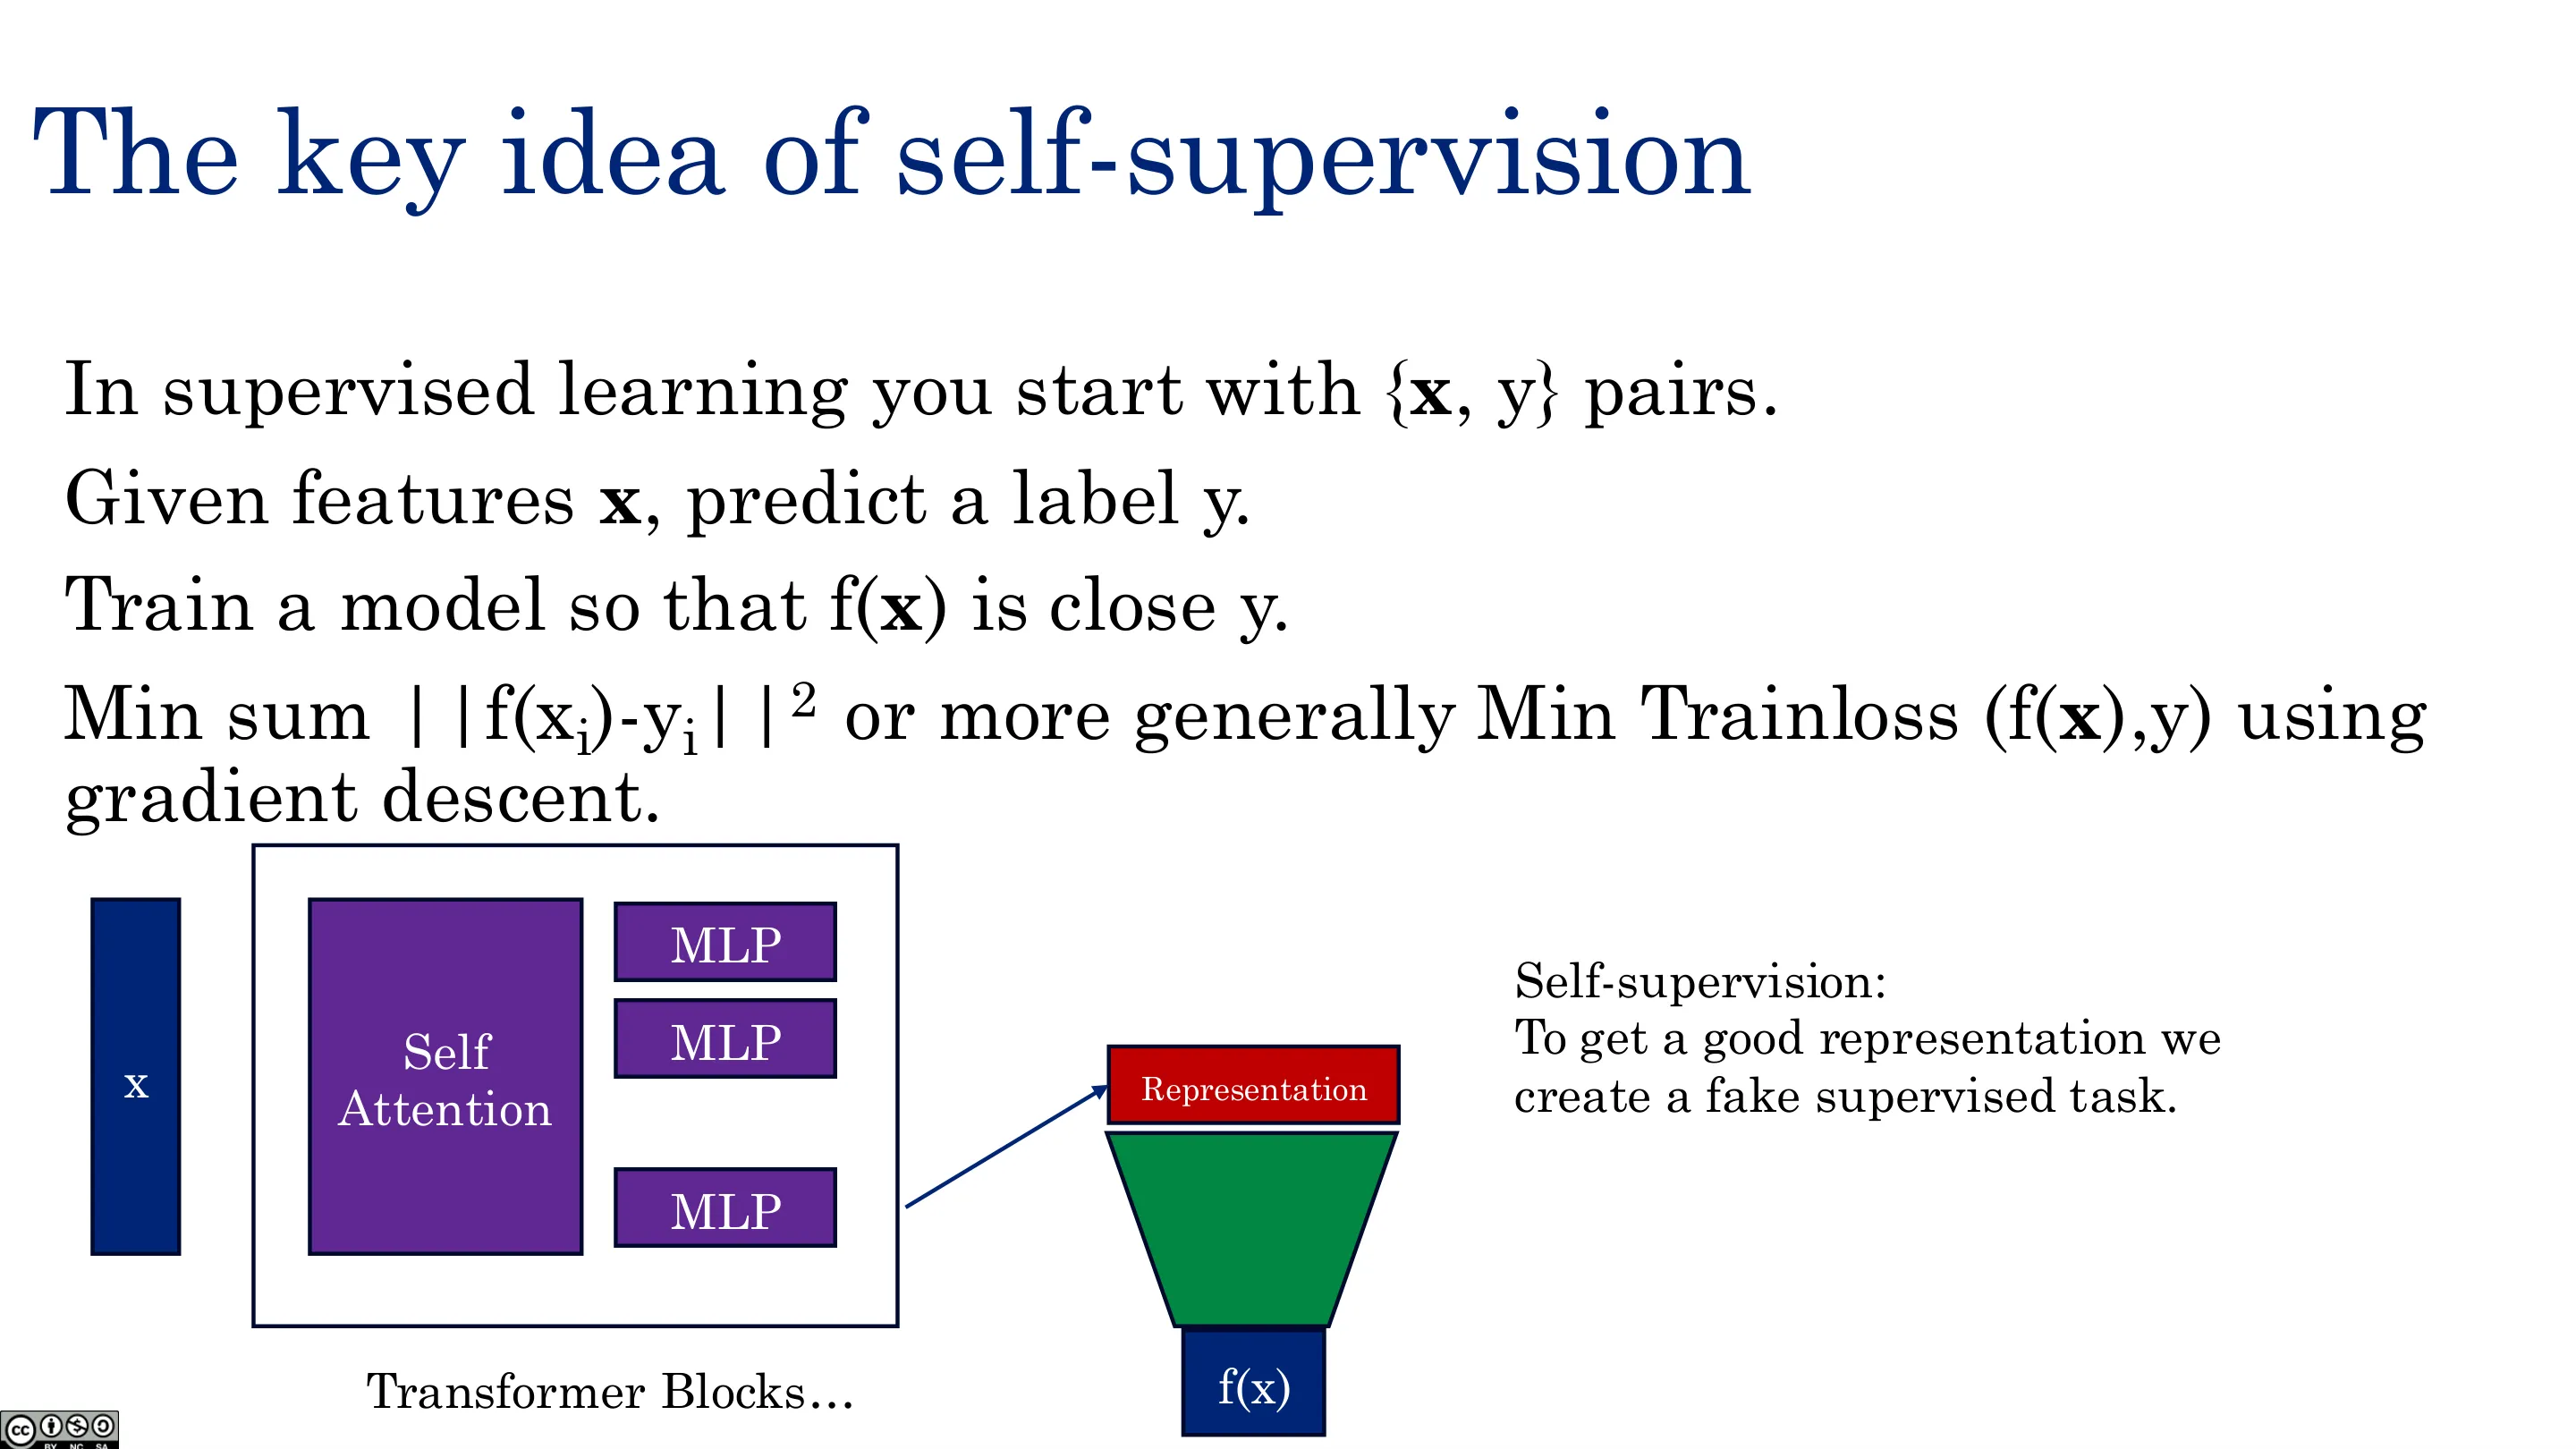
问题:分类任务需要大量标注数据(几百万条评论),但预训练模型零样本就很好用。这个"魔法"哪来的?
答案:自监督(self-supervision)——构造一个假的监督任务,标签免费:
$$ \text{给定 } x_1,\dots,x_{t-1}\ \Rightarrow\ \text{预测 } x_t $$
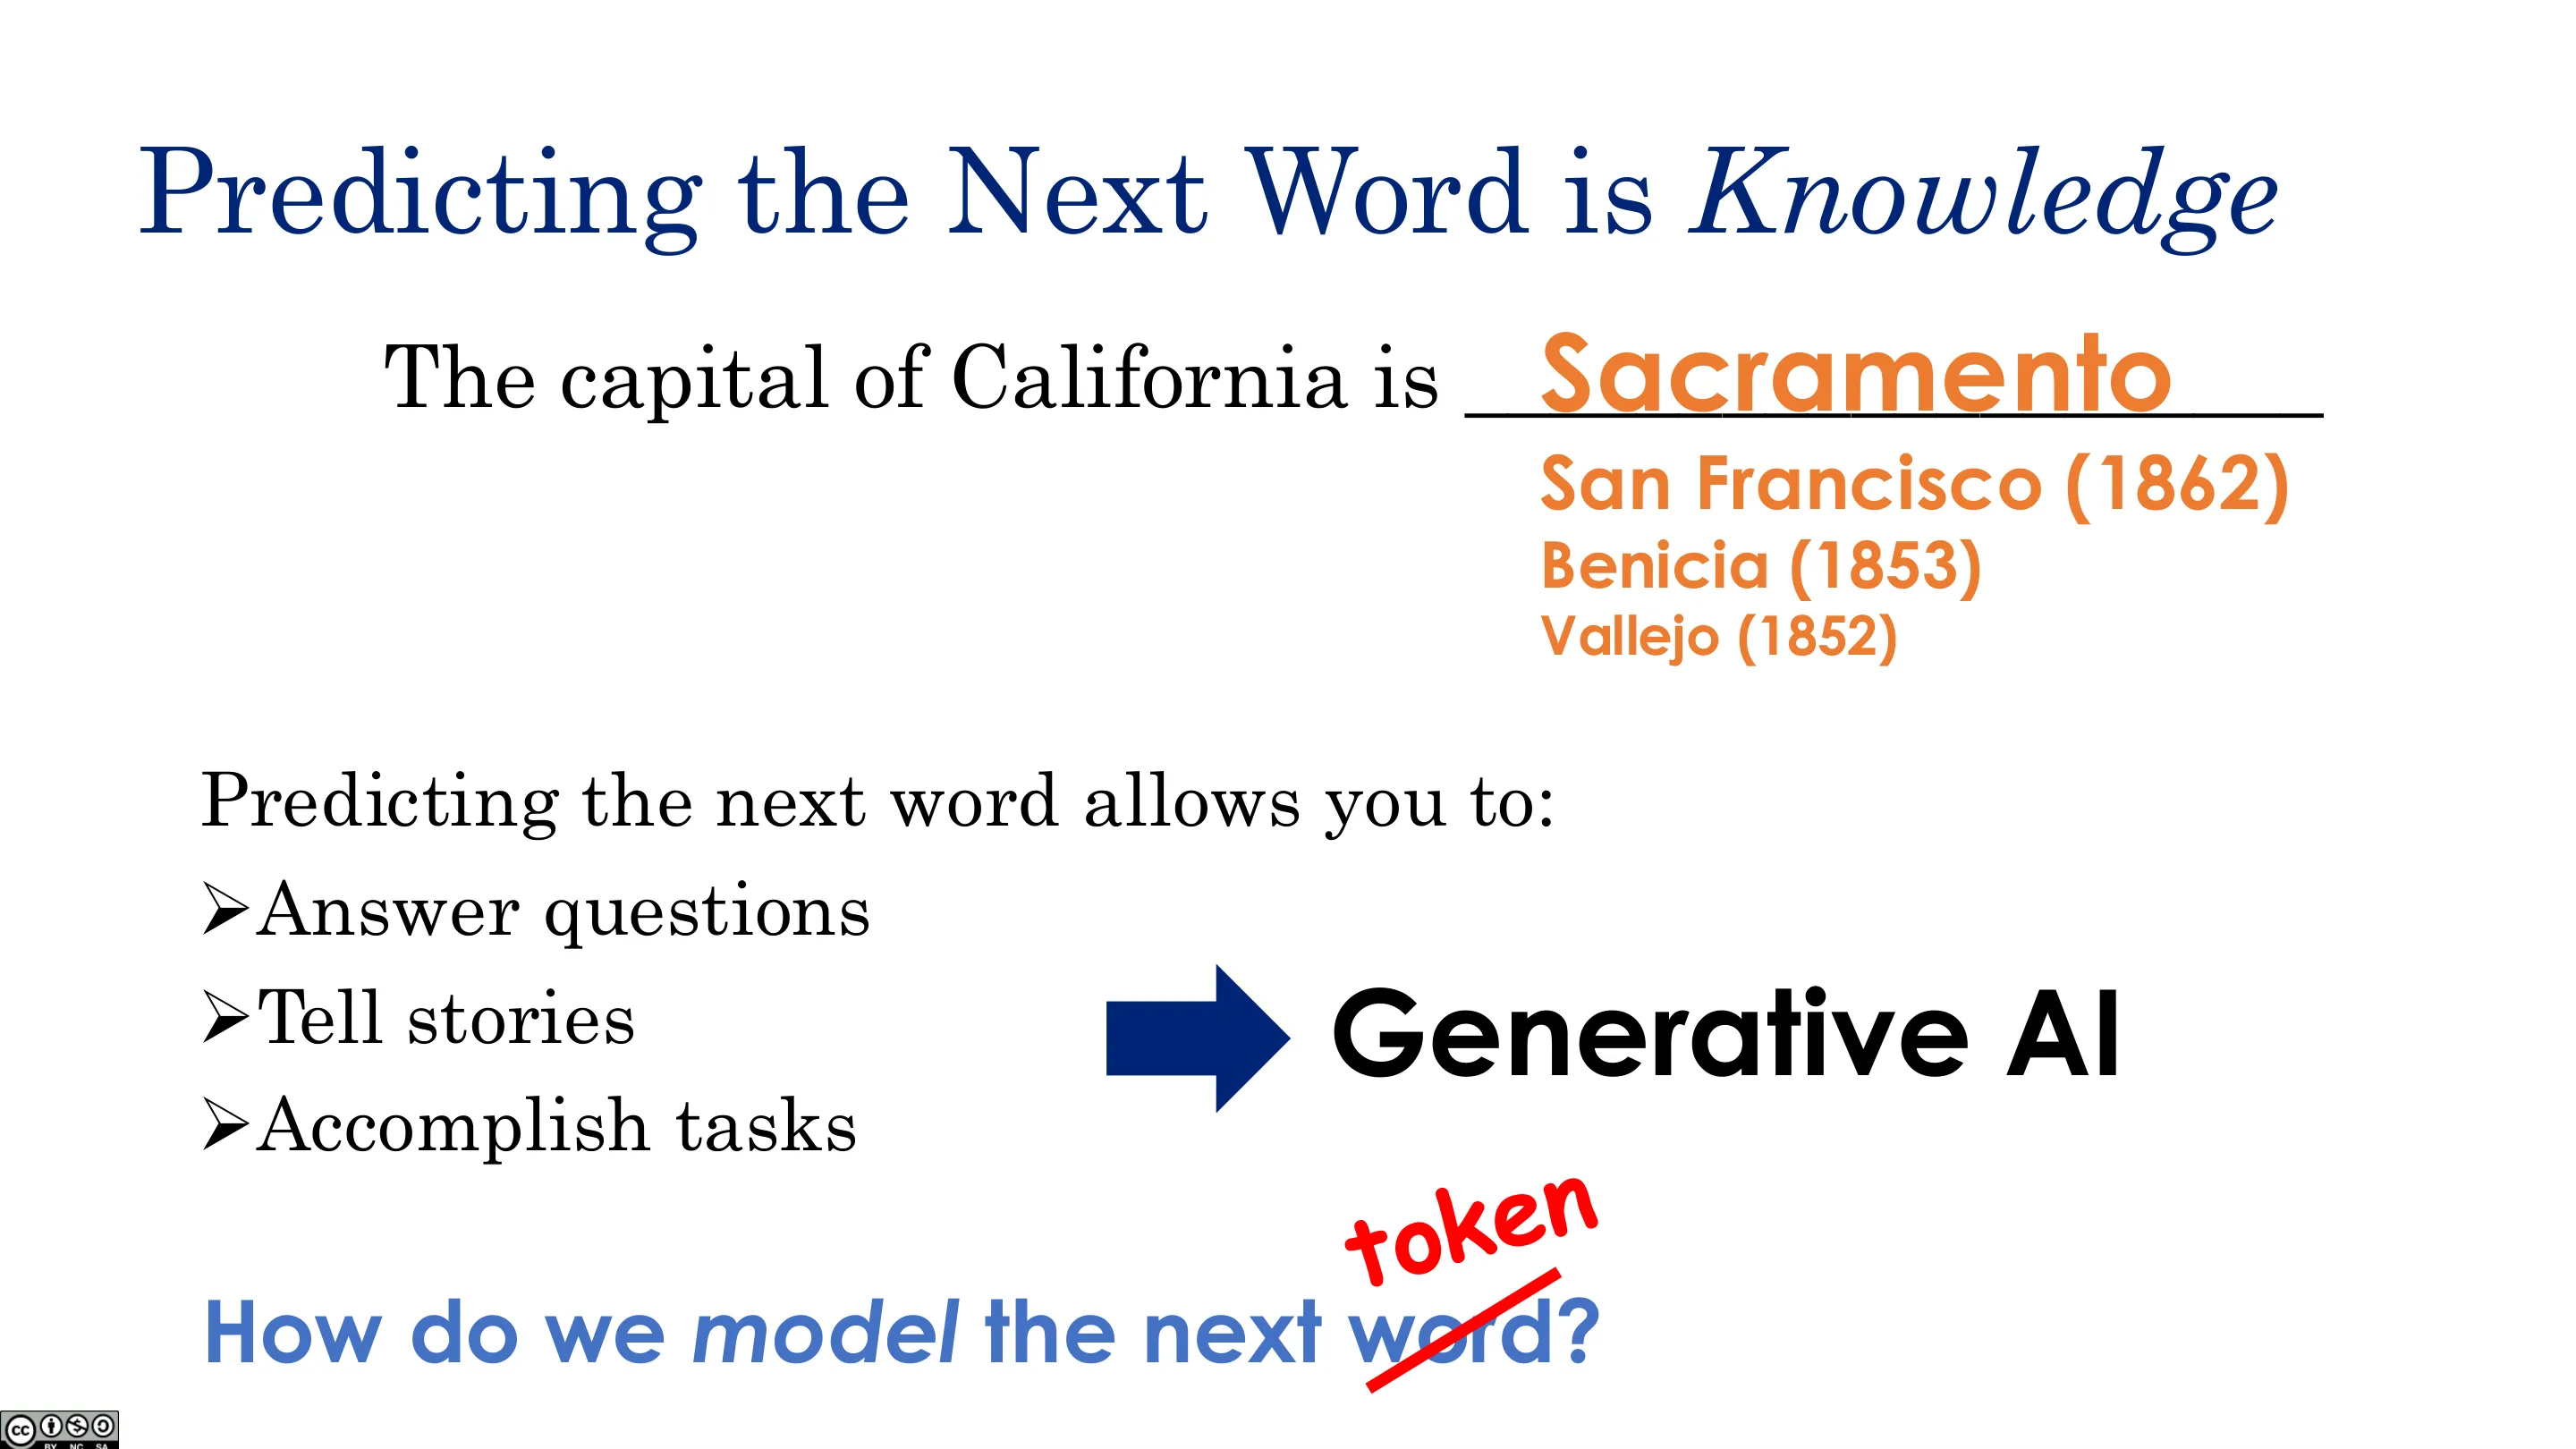
为什么"预测下一个词"这么强大?
- 「加州的州府是 ___」→ 要答对必须知道很多关于加州的知识;
- 读完一整本推理小说,「凶手是 ___」→ 必须建立对整个故事的表示;
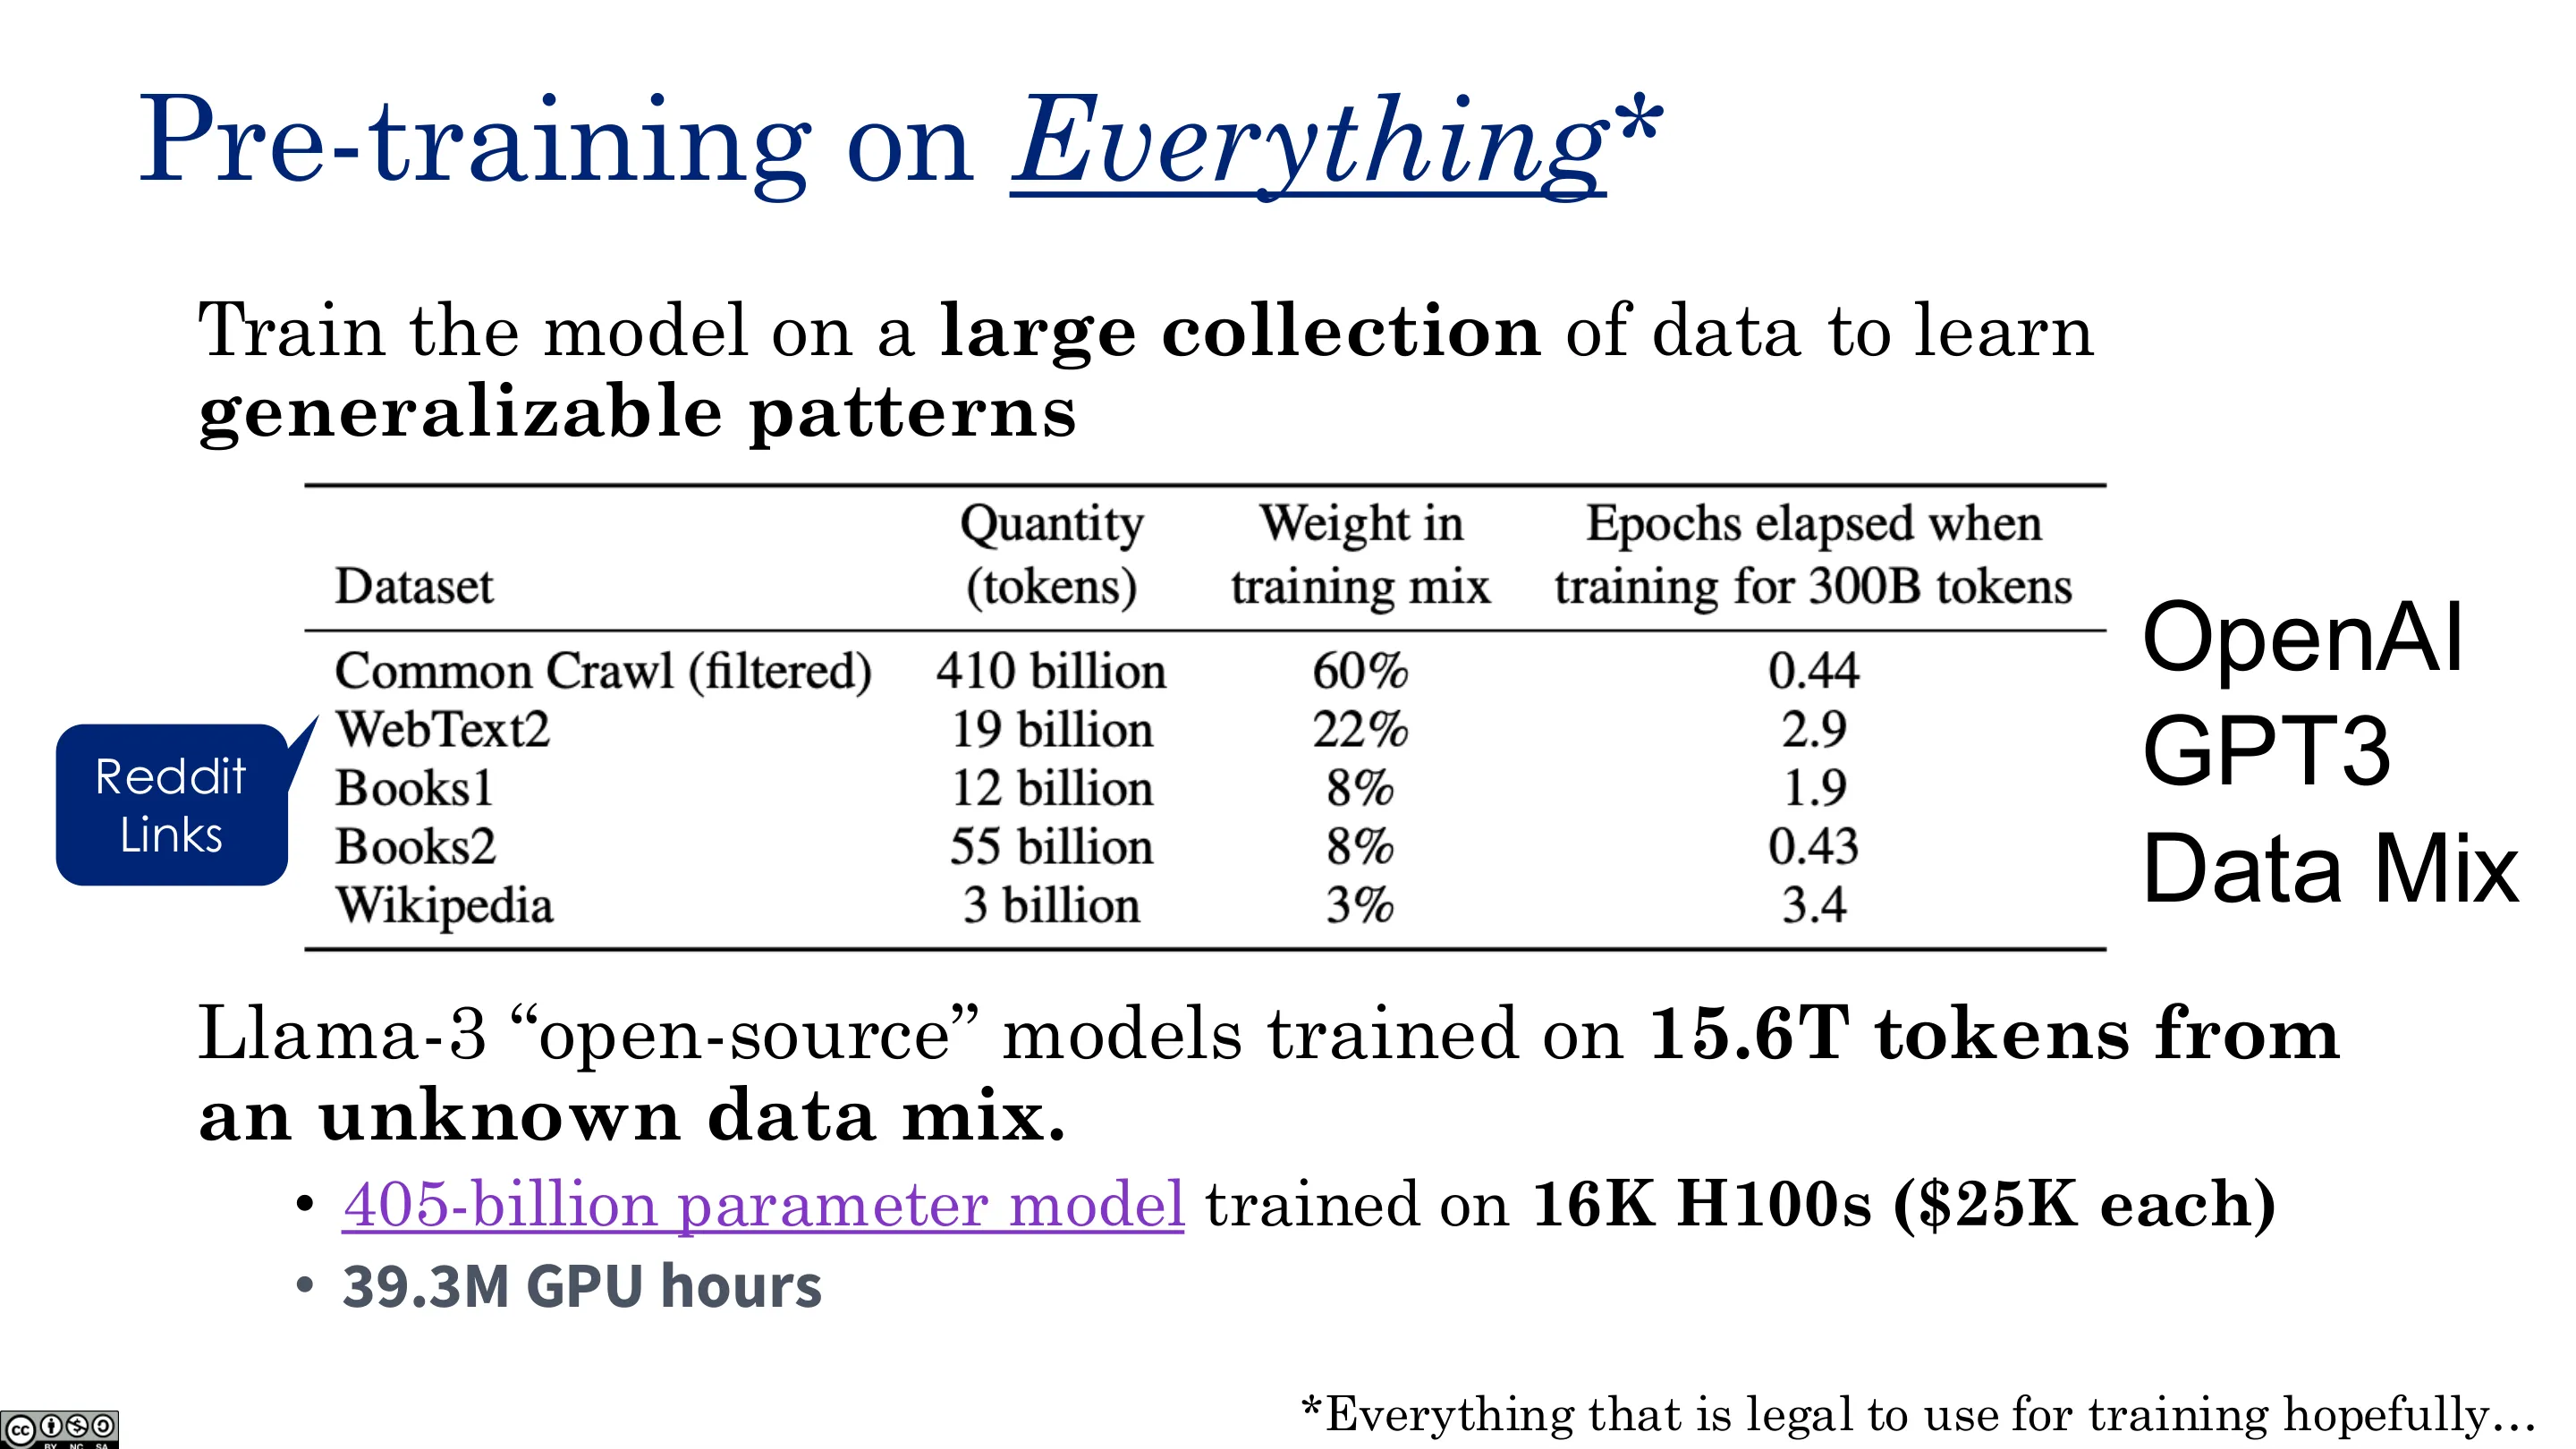
- 互联网上有数万亿 token,每个位置都是一个训练样本 ⇒ 数据免费且海量。
这就是 GPT 论文的惊人发现:只做下一个 token 预测,就能零样本完成许多没训练过的任务。
📷 自监督的核心思想
回到原视频 (00:10:04)
📷 预测下一个词就是知识
回到原视频 (00:11:17)
📷 快速回顾
回到原视频 (00:12:30)
3.1 前向流程与 Masked Attention
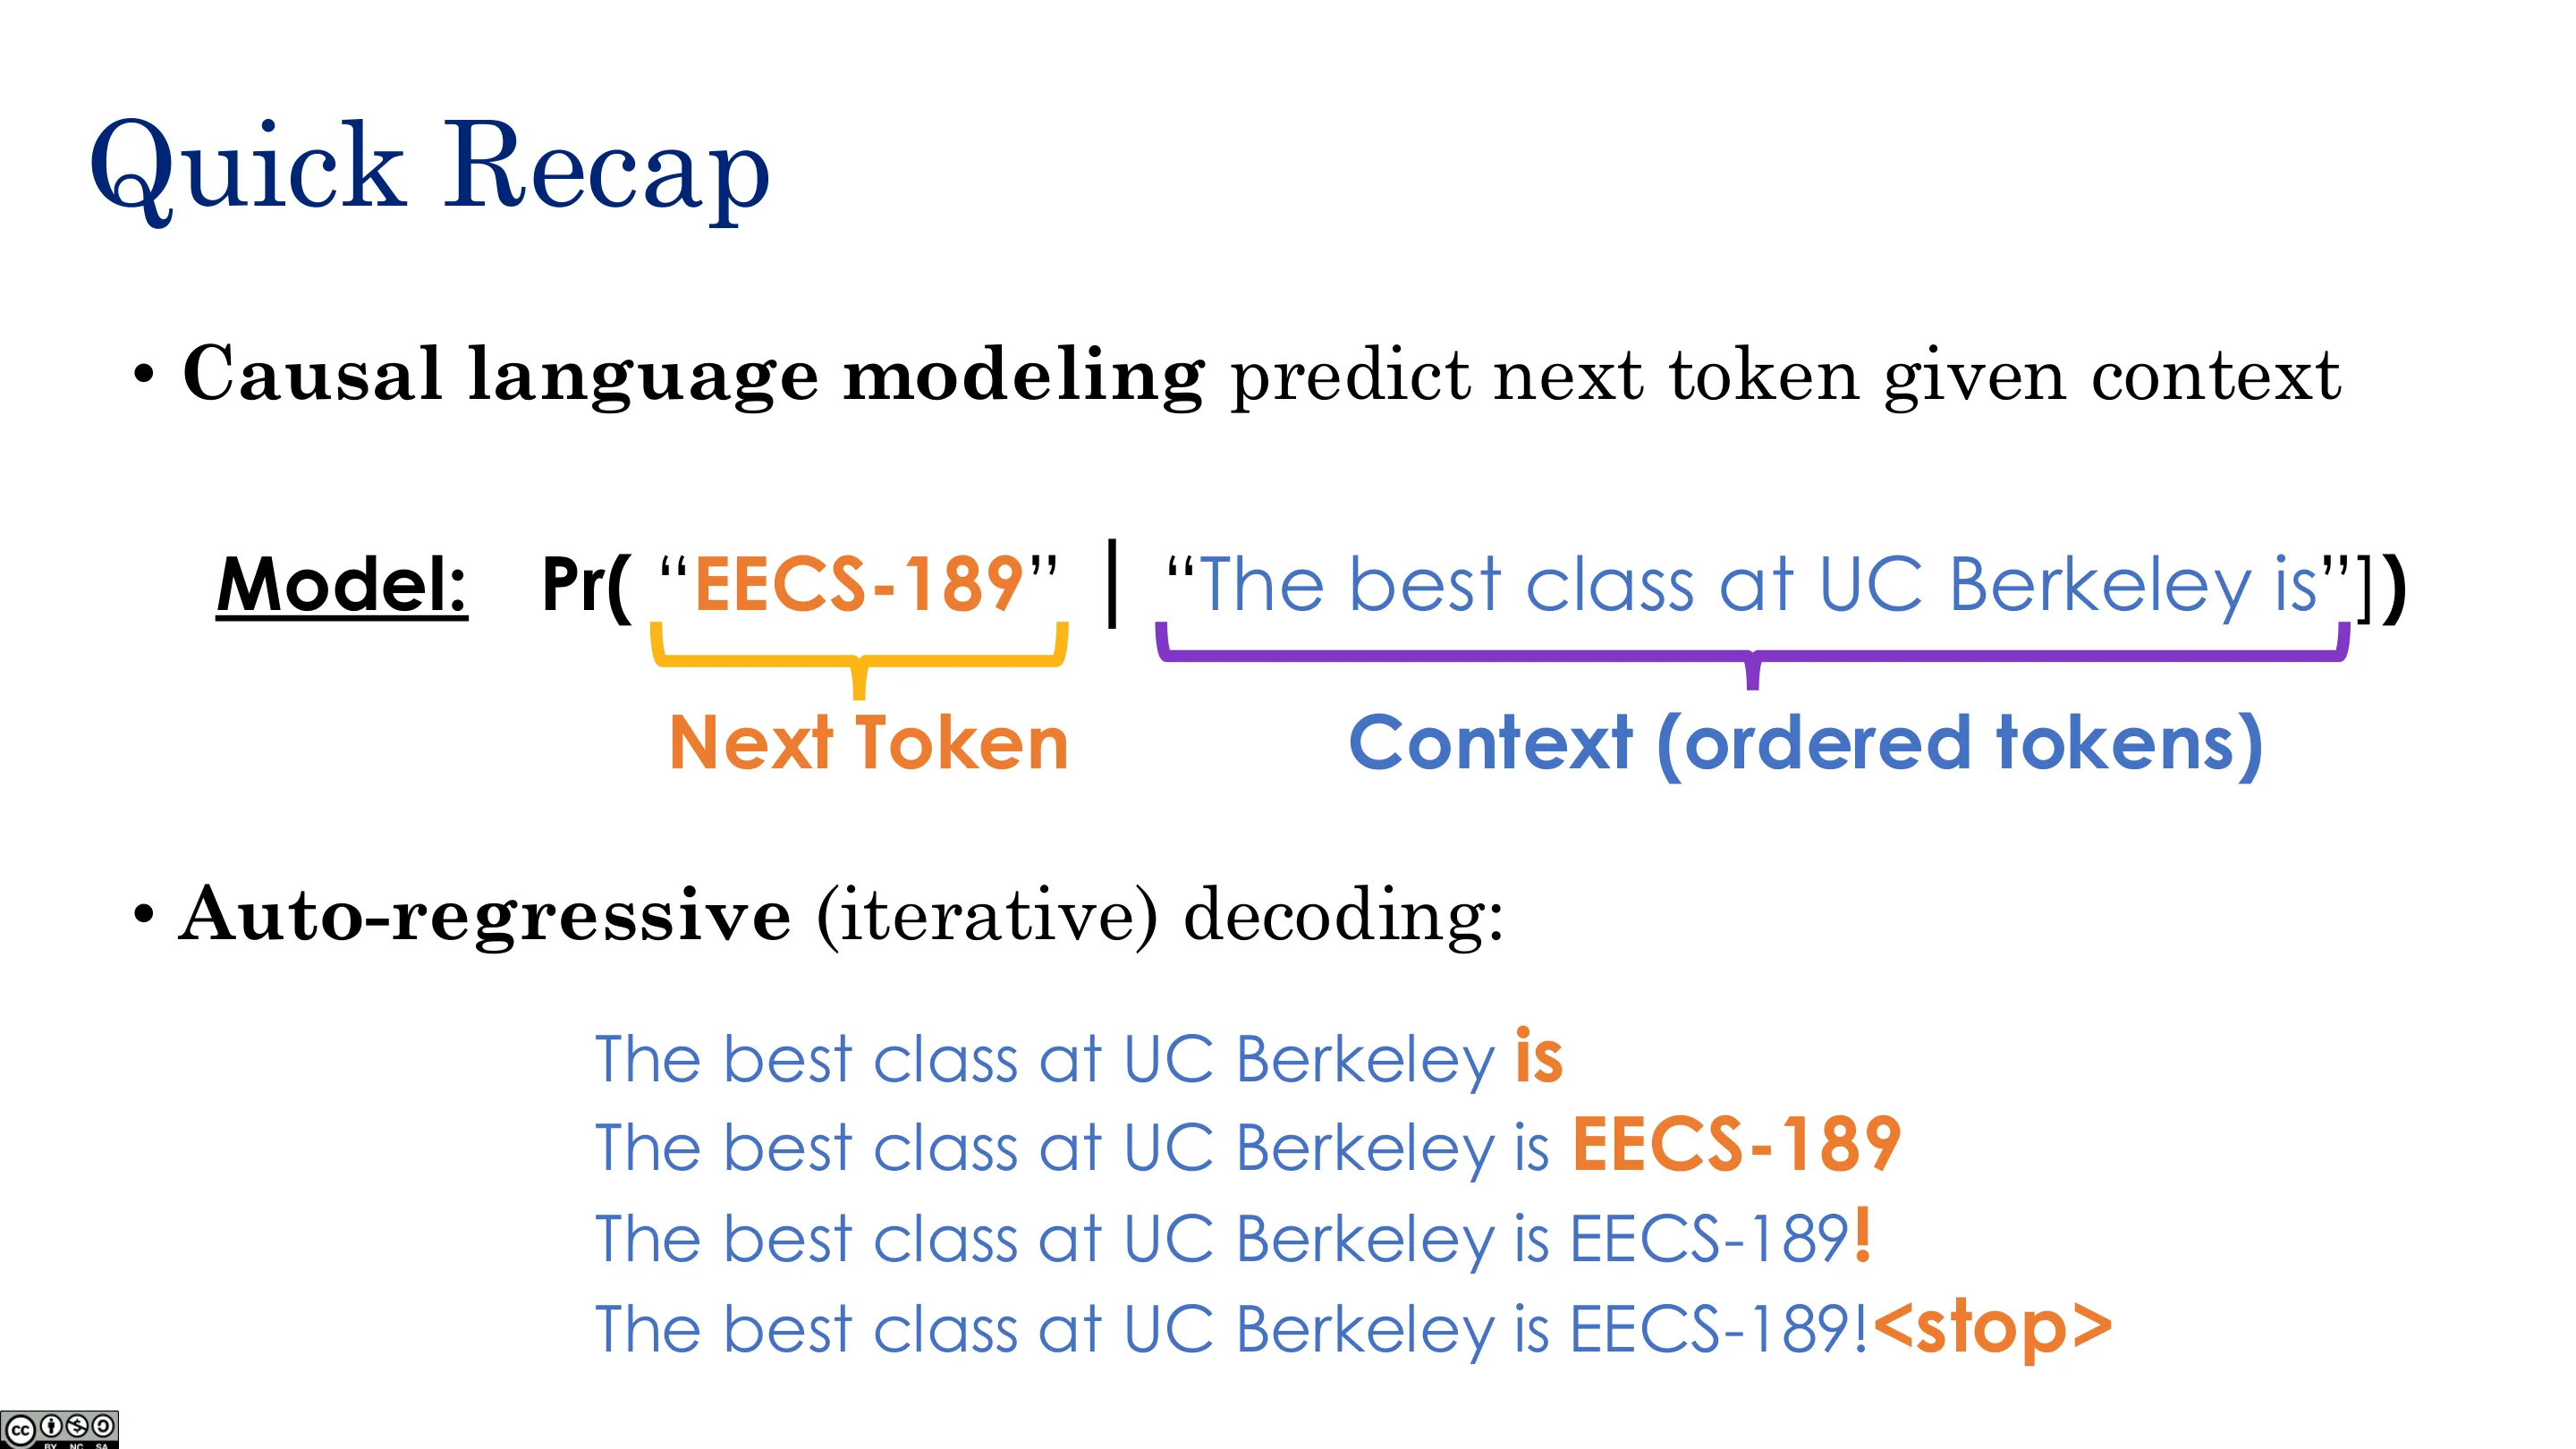
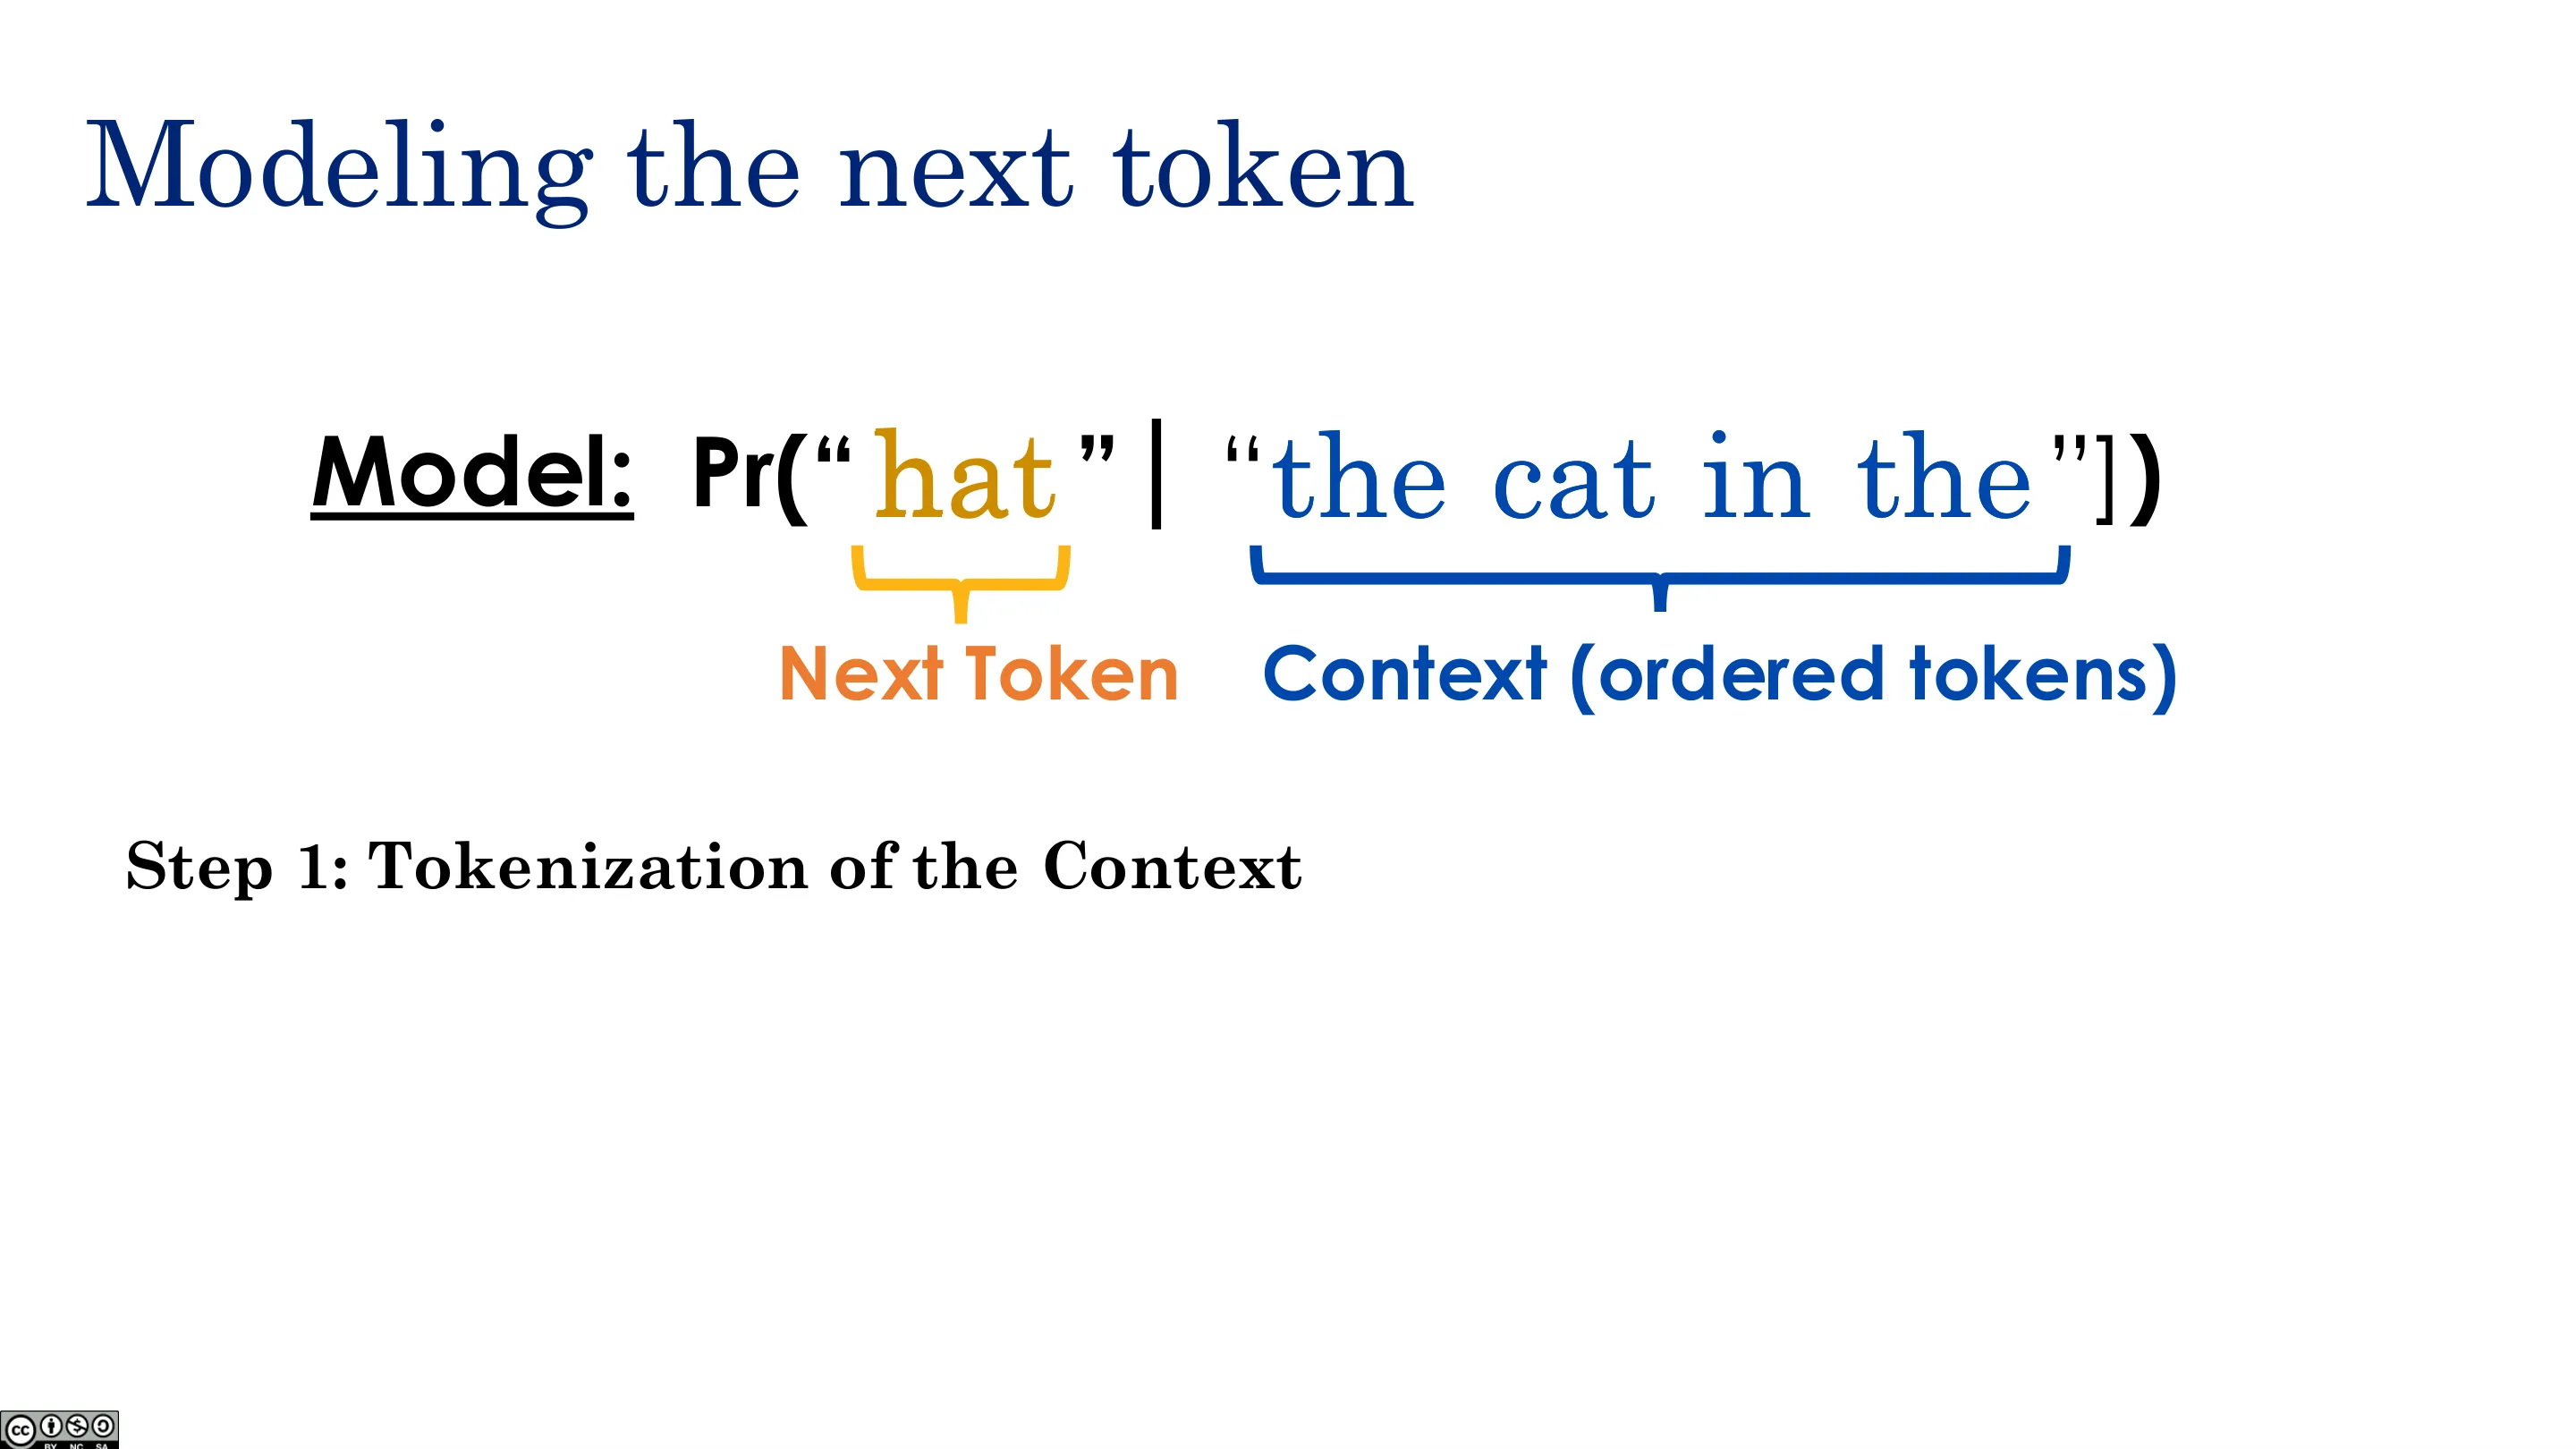
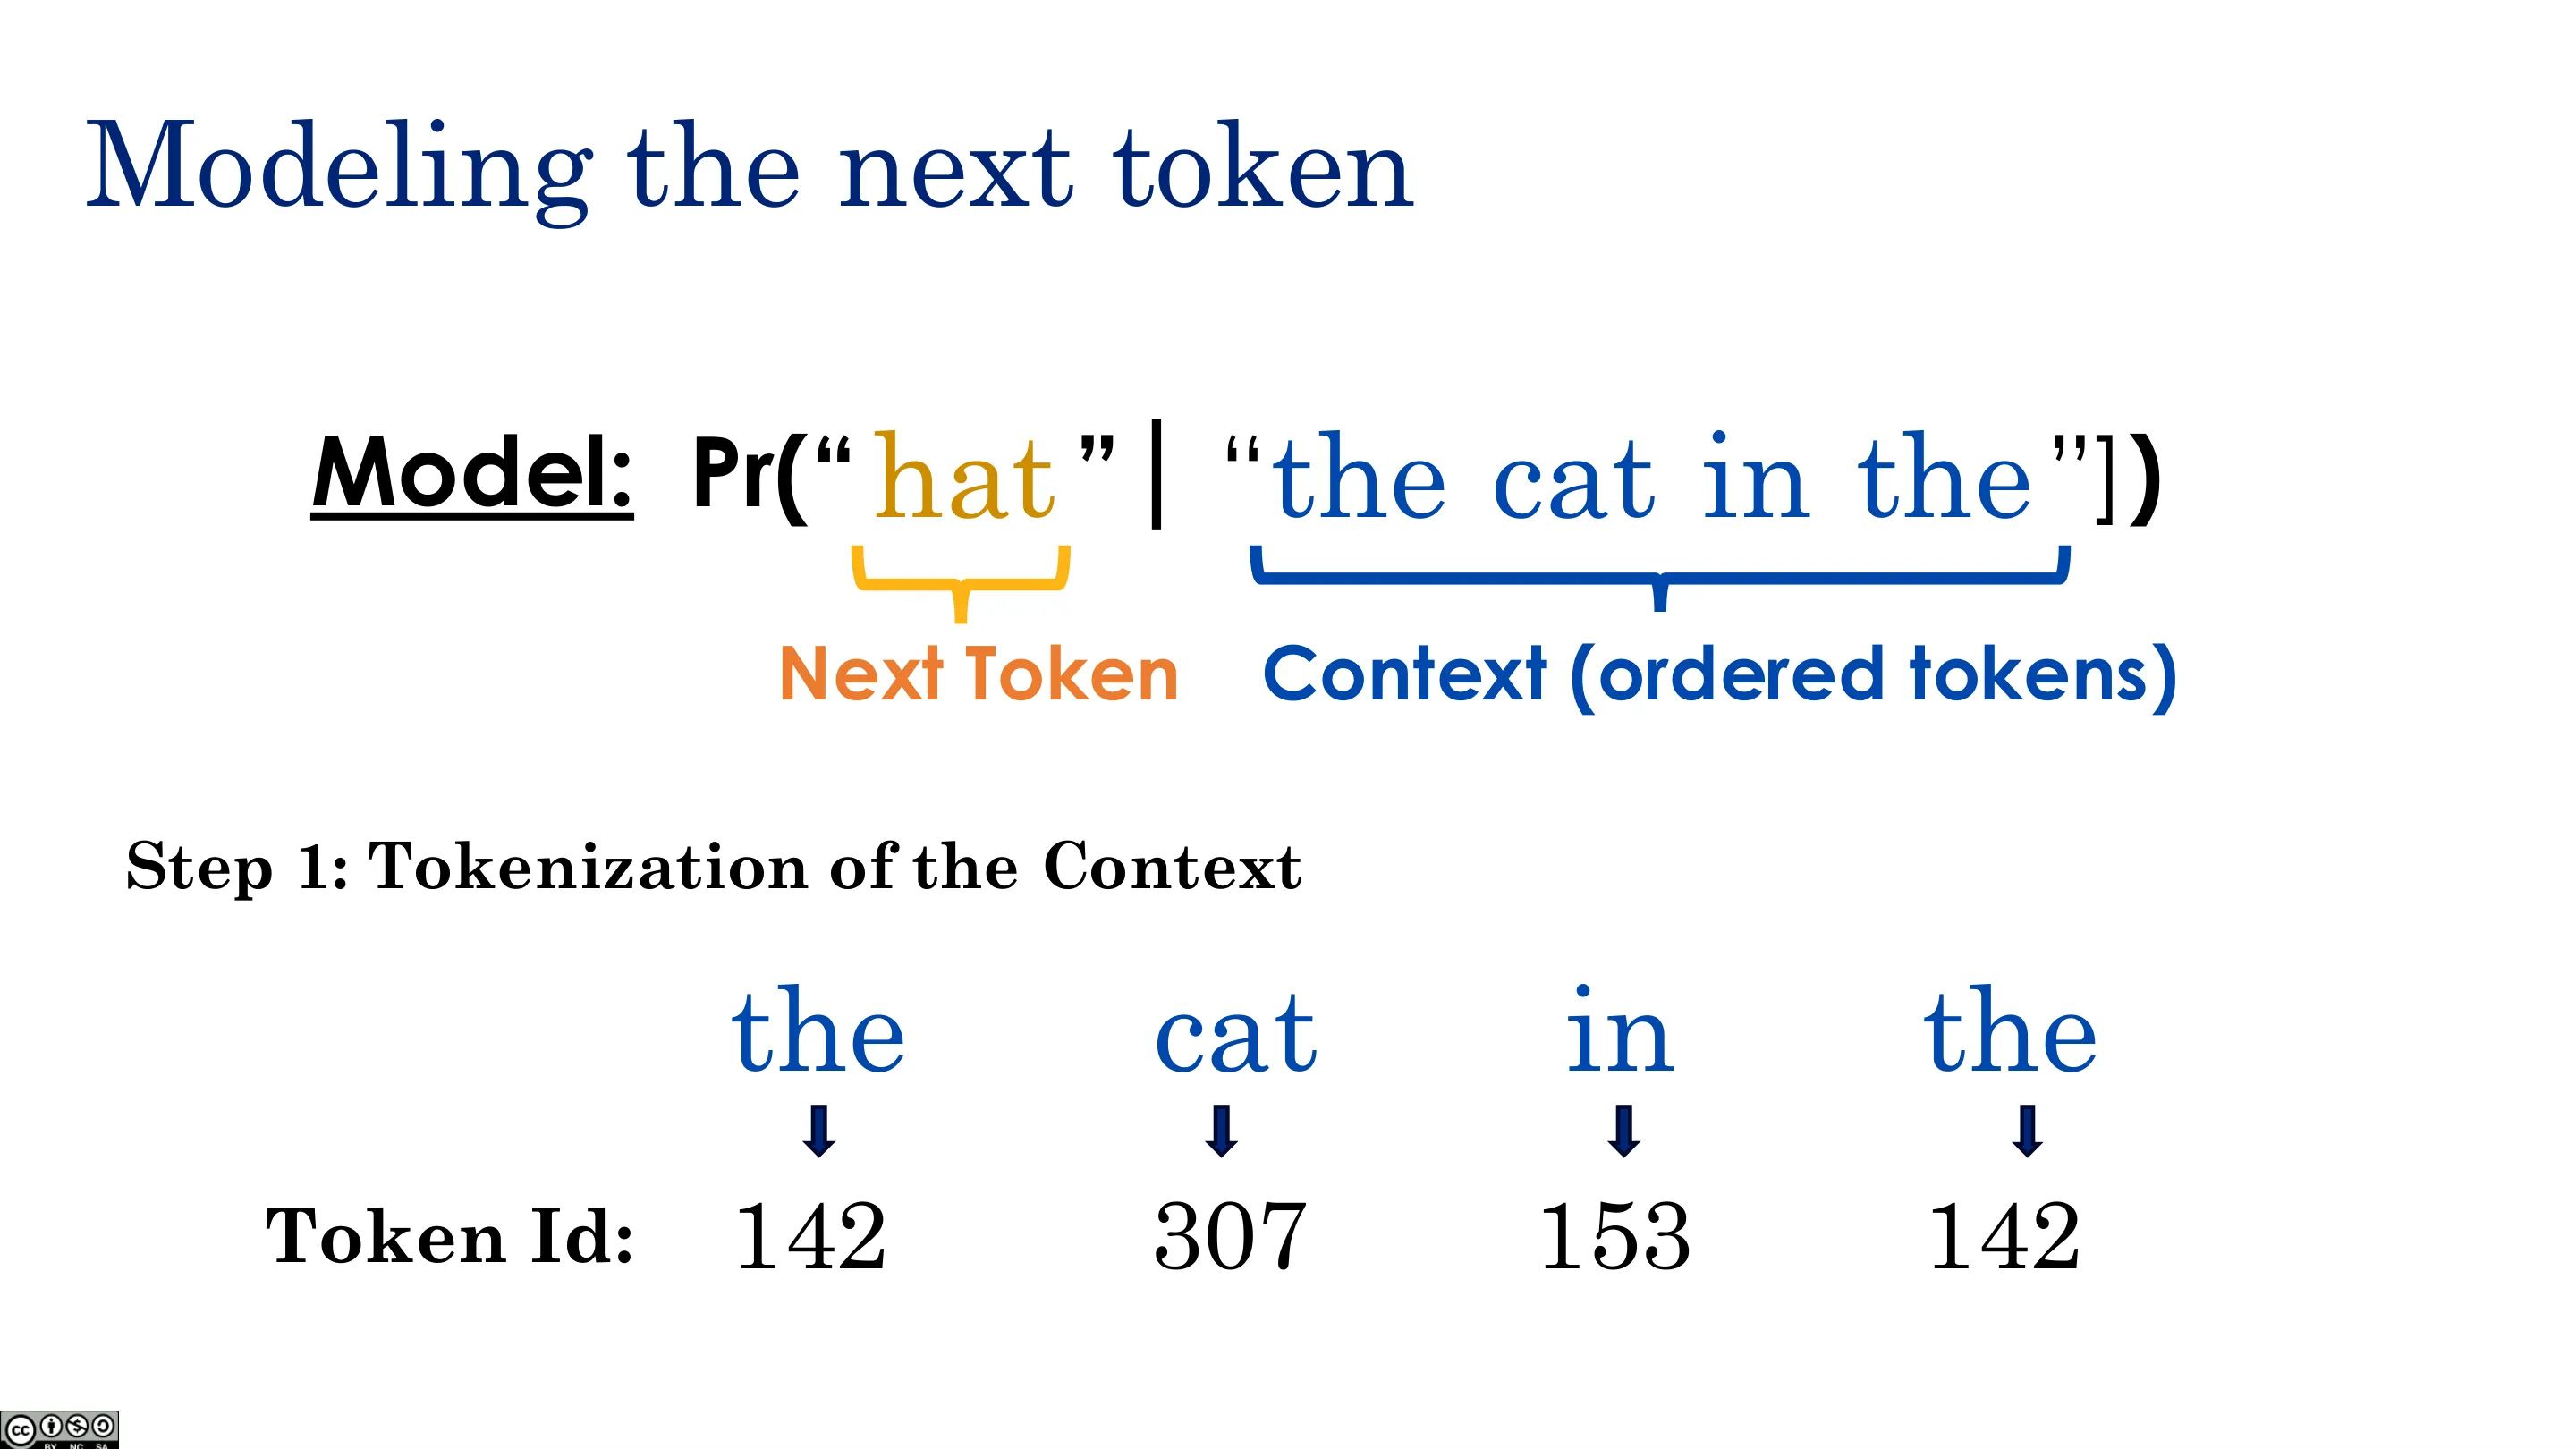
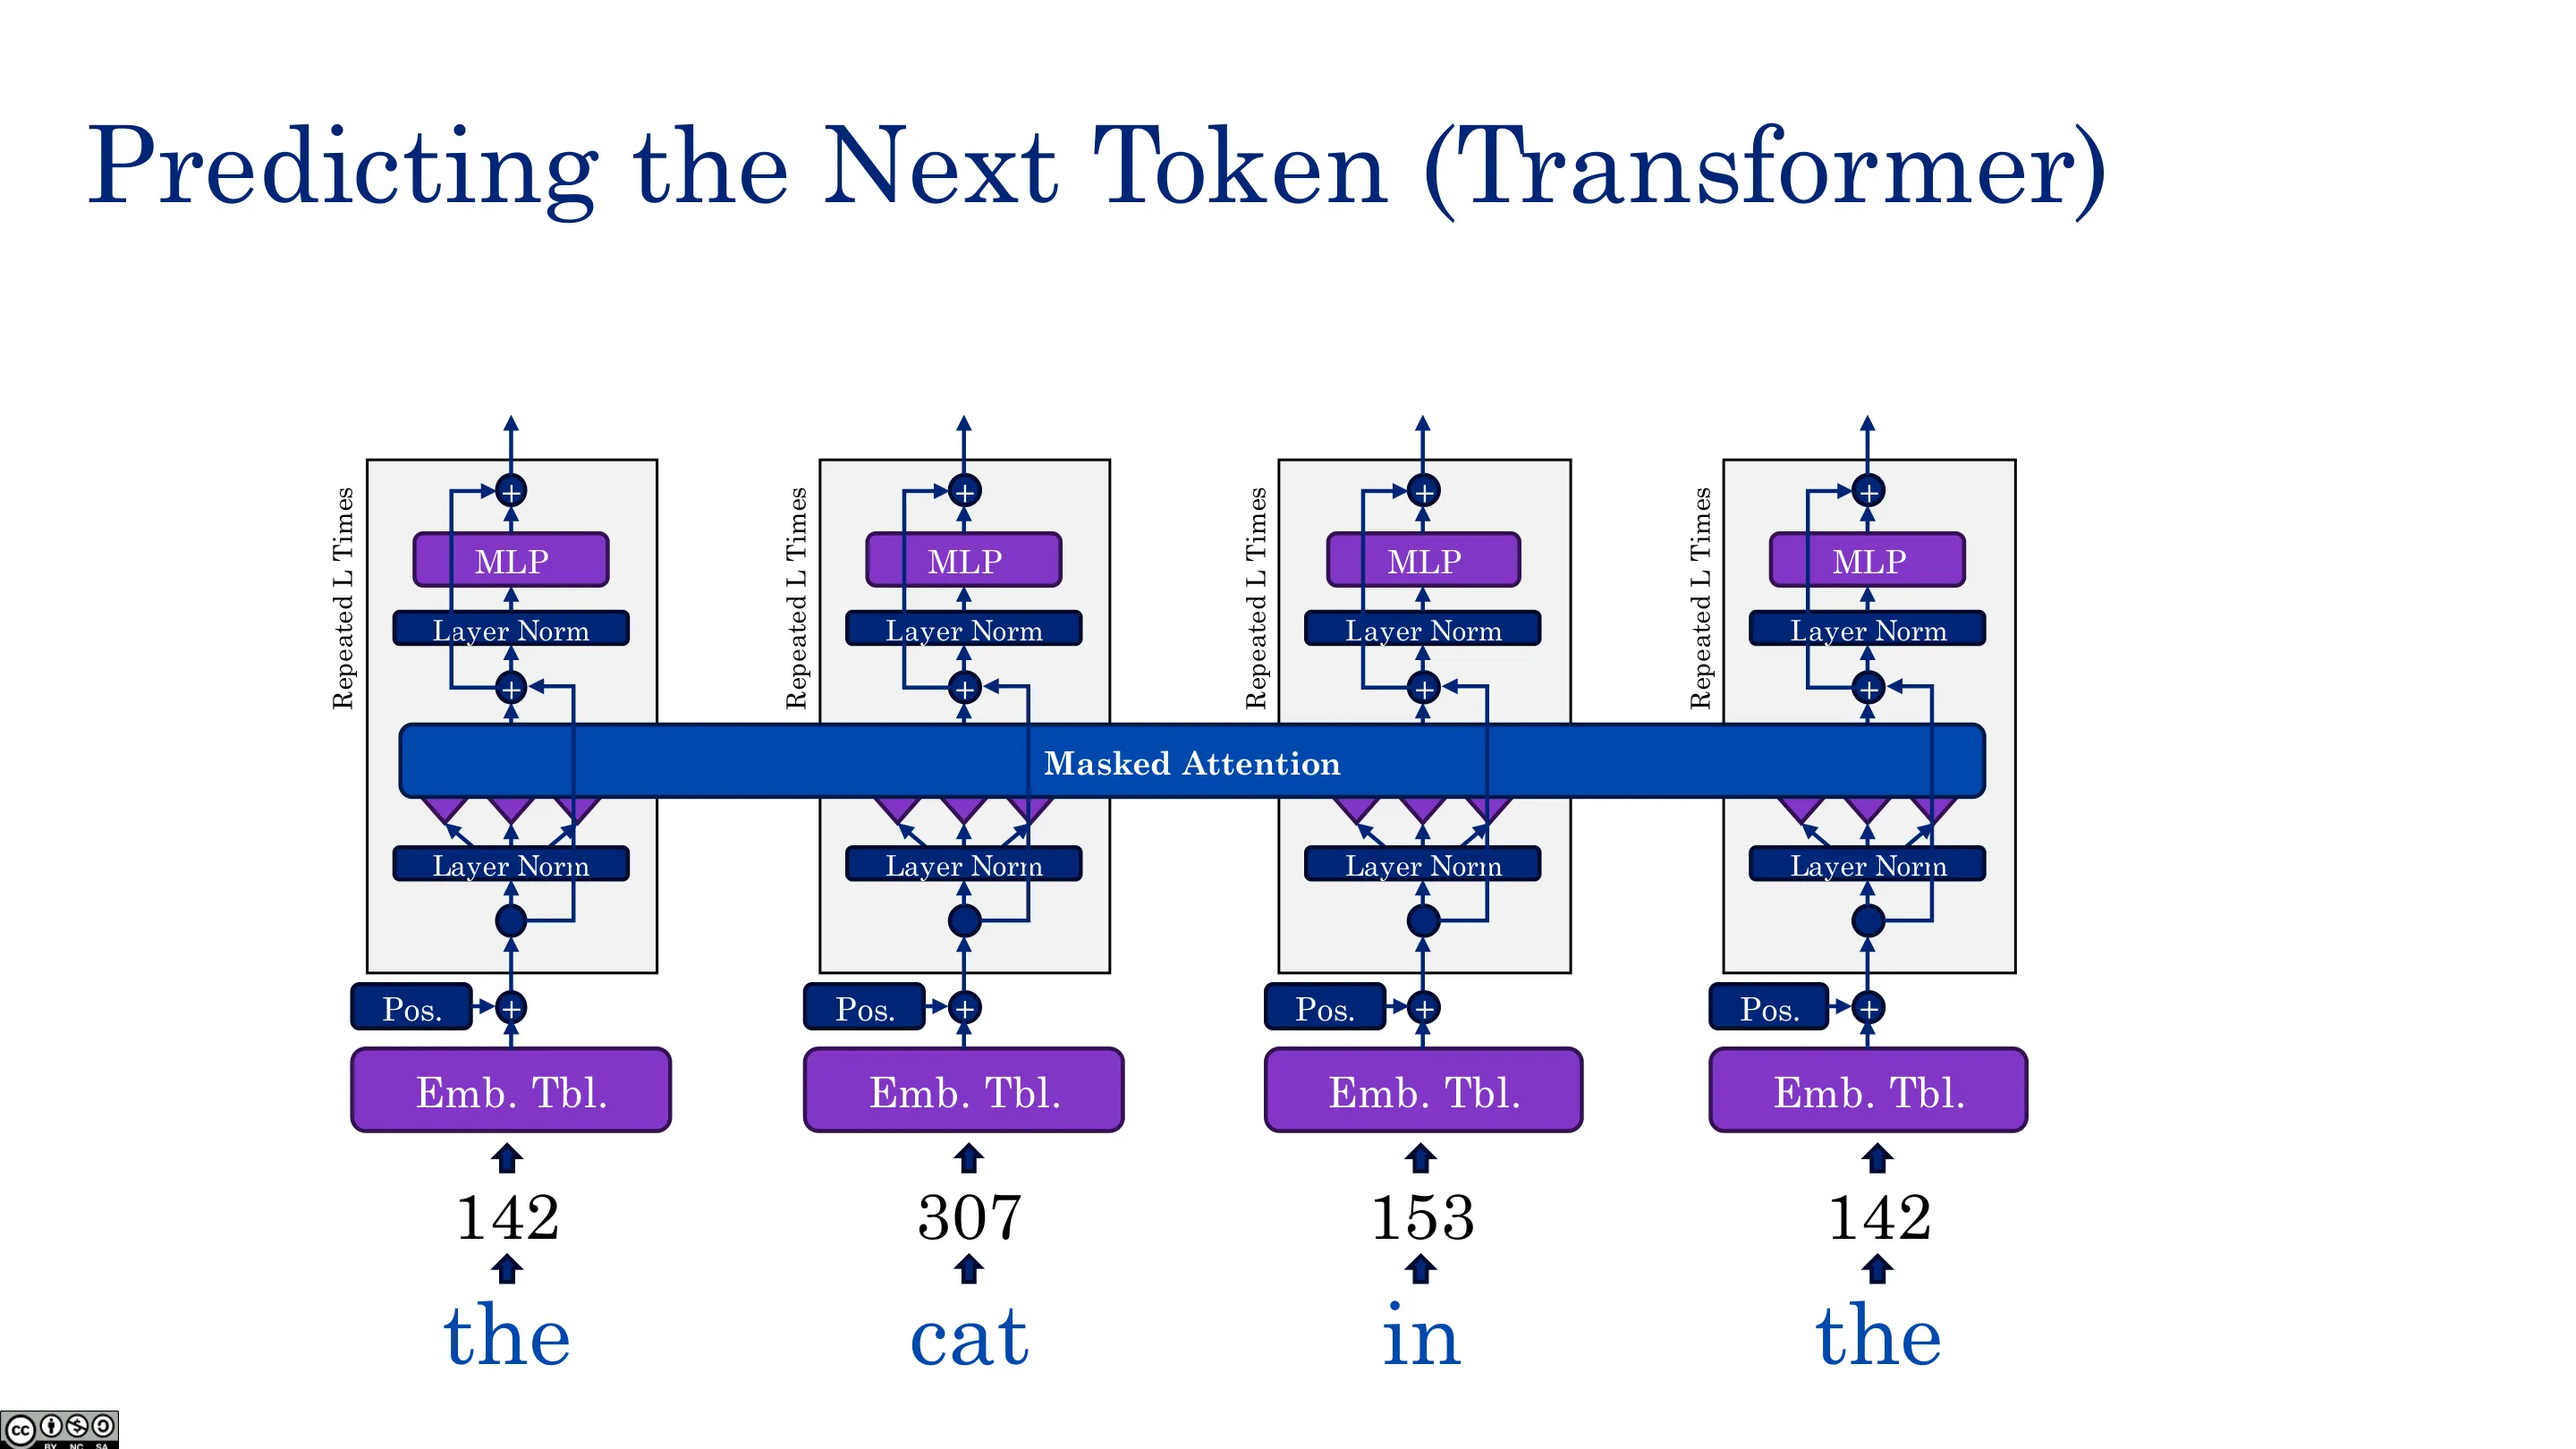
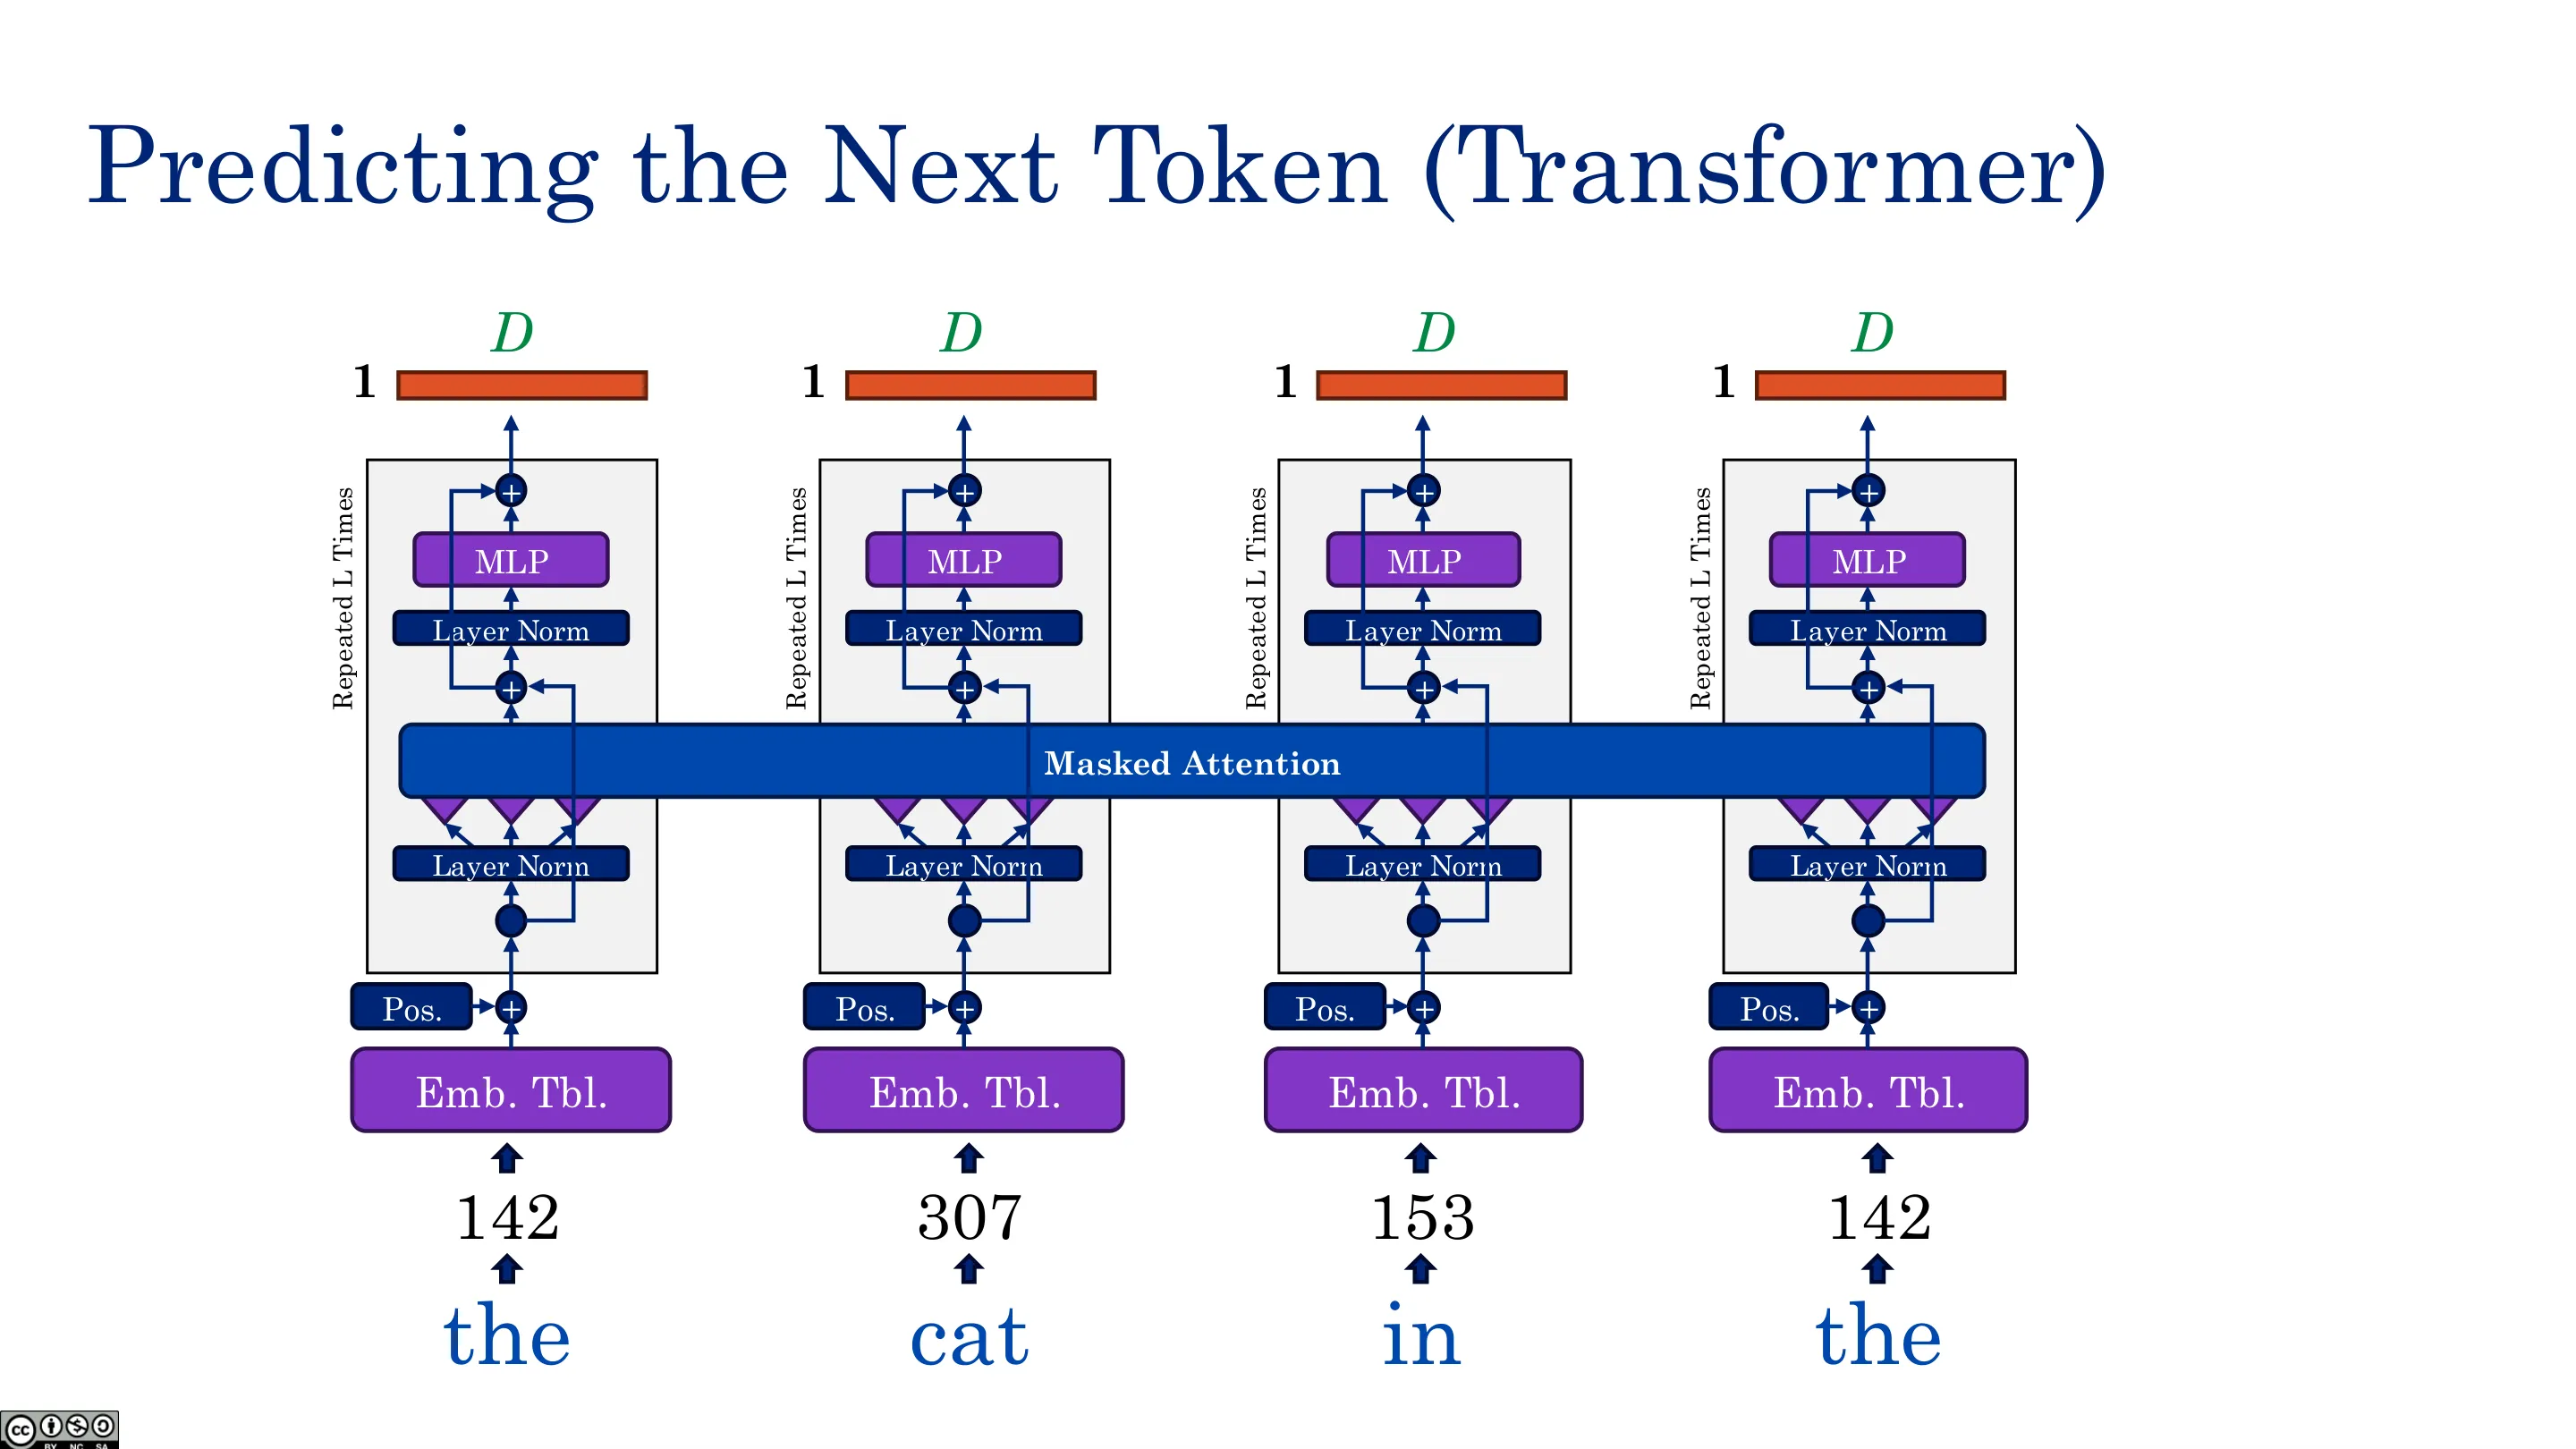
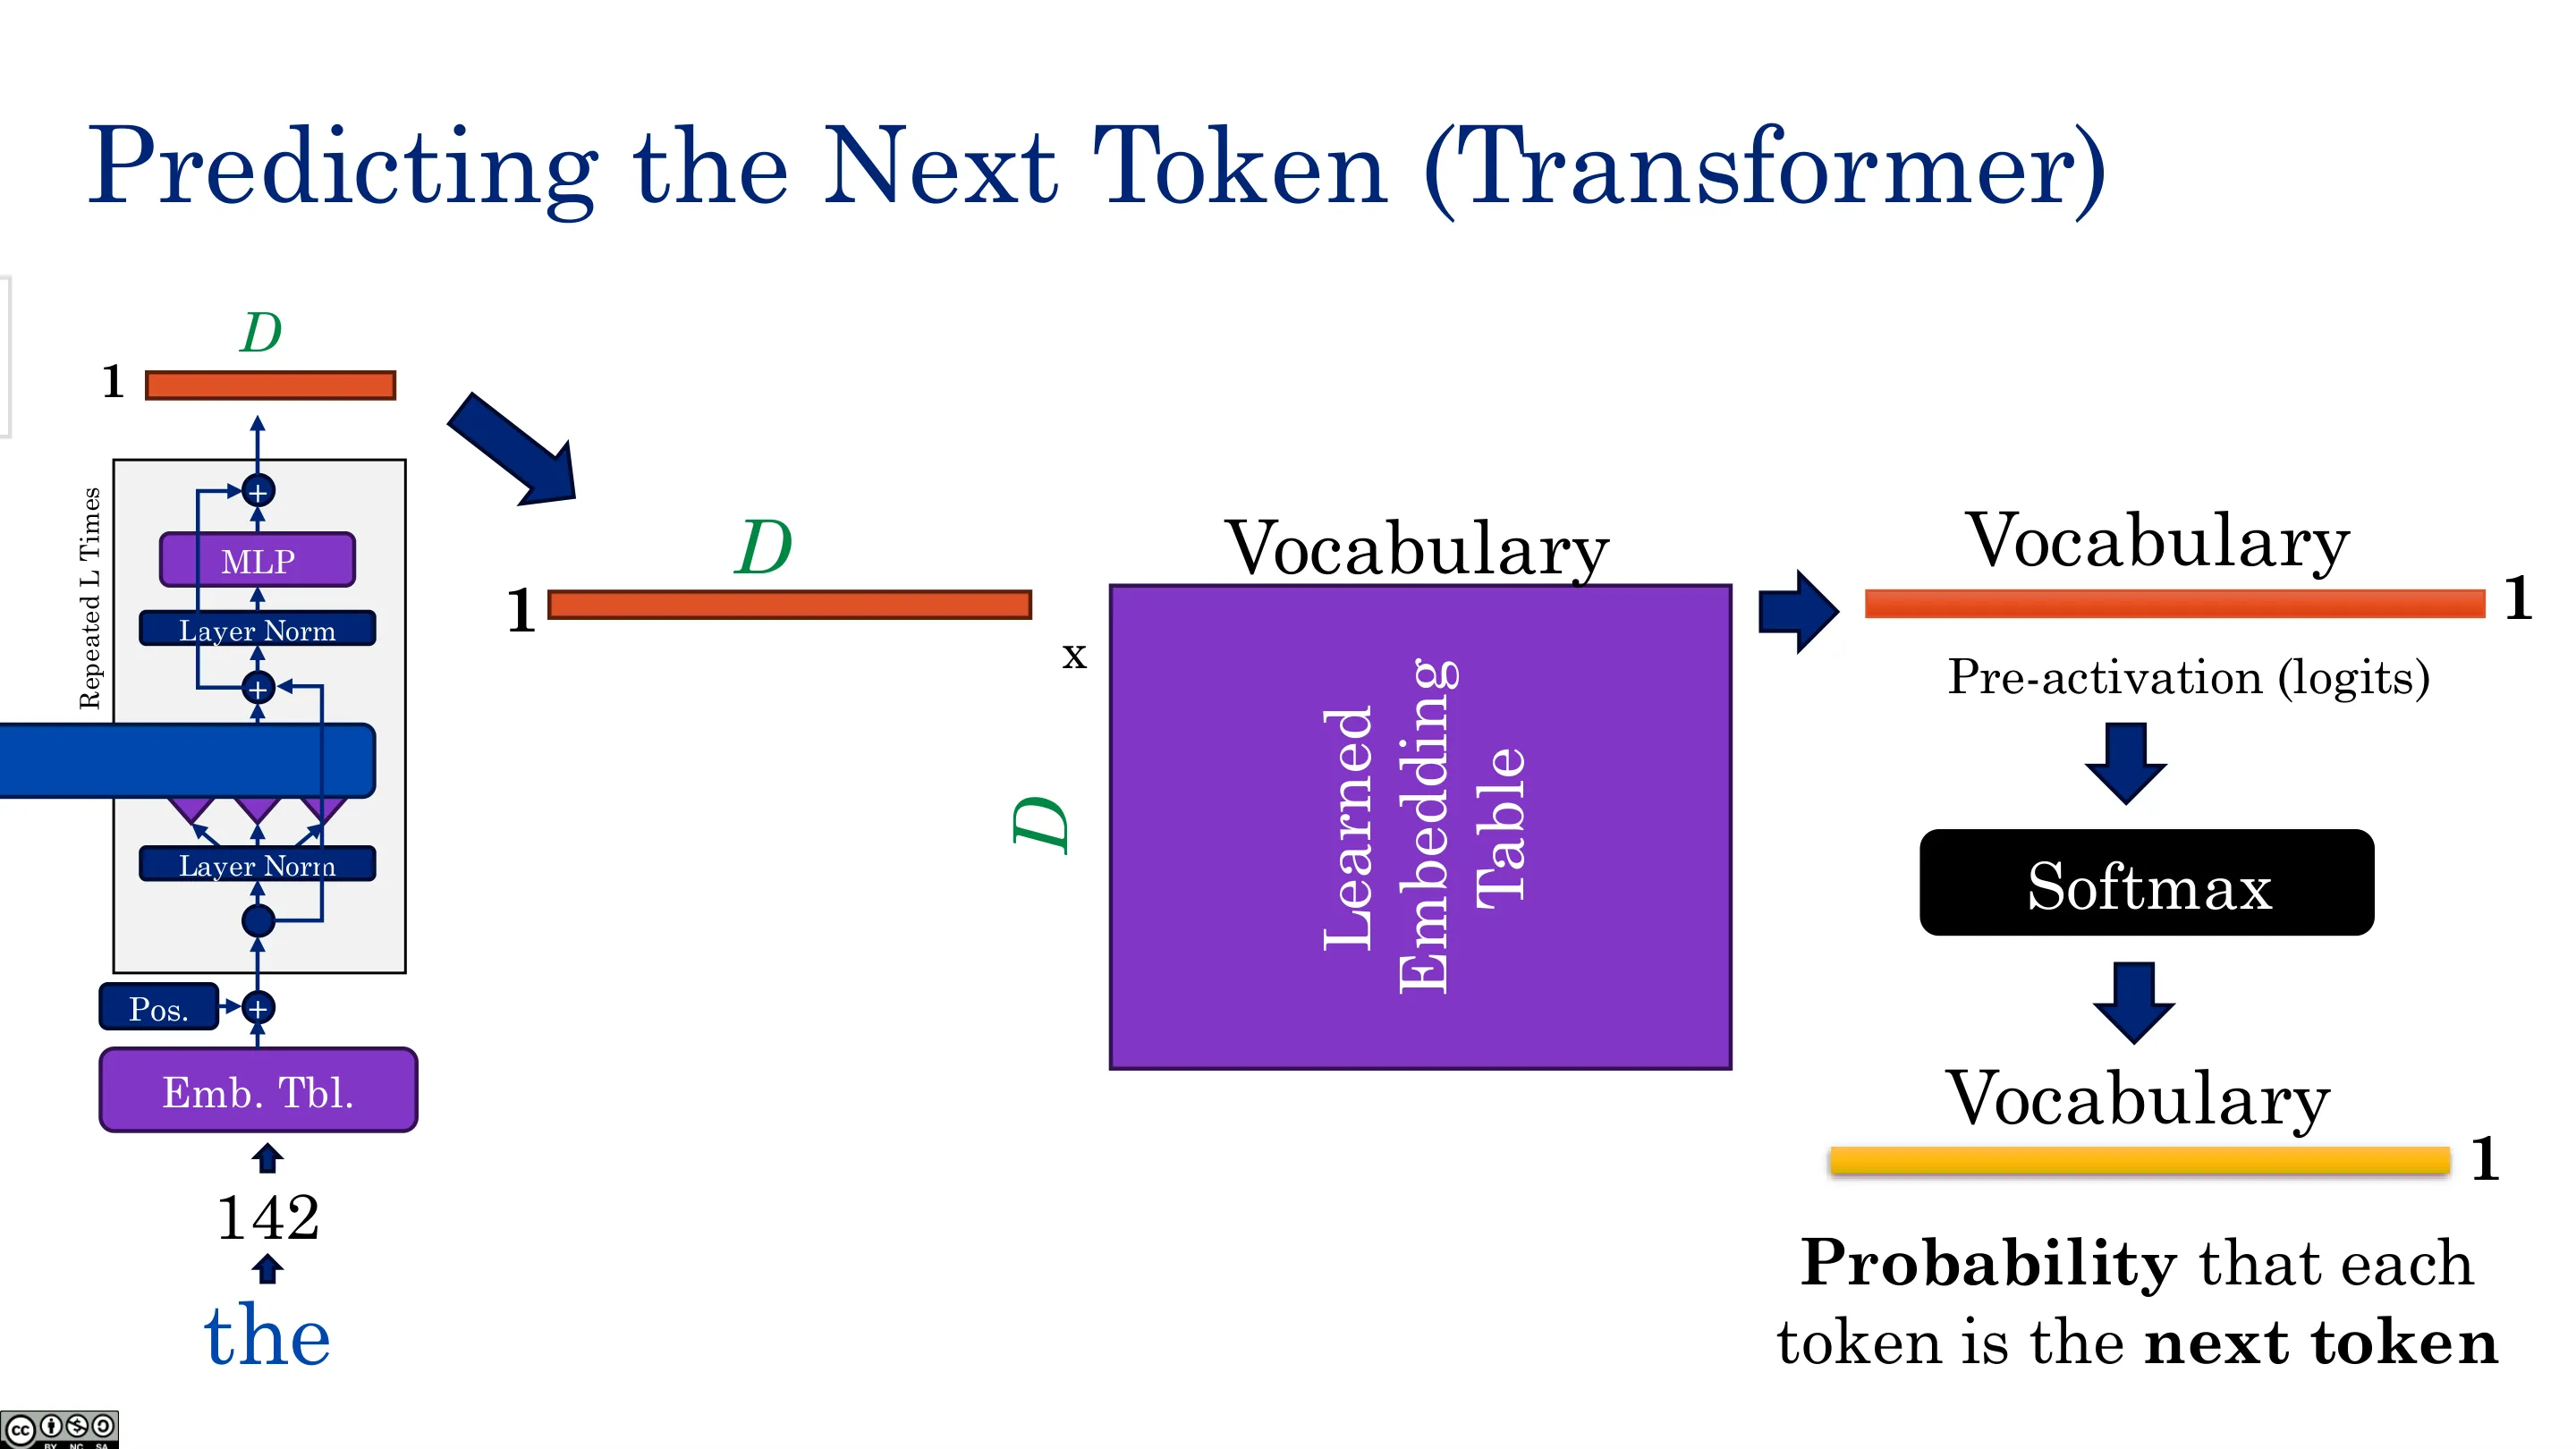
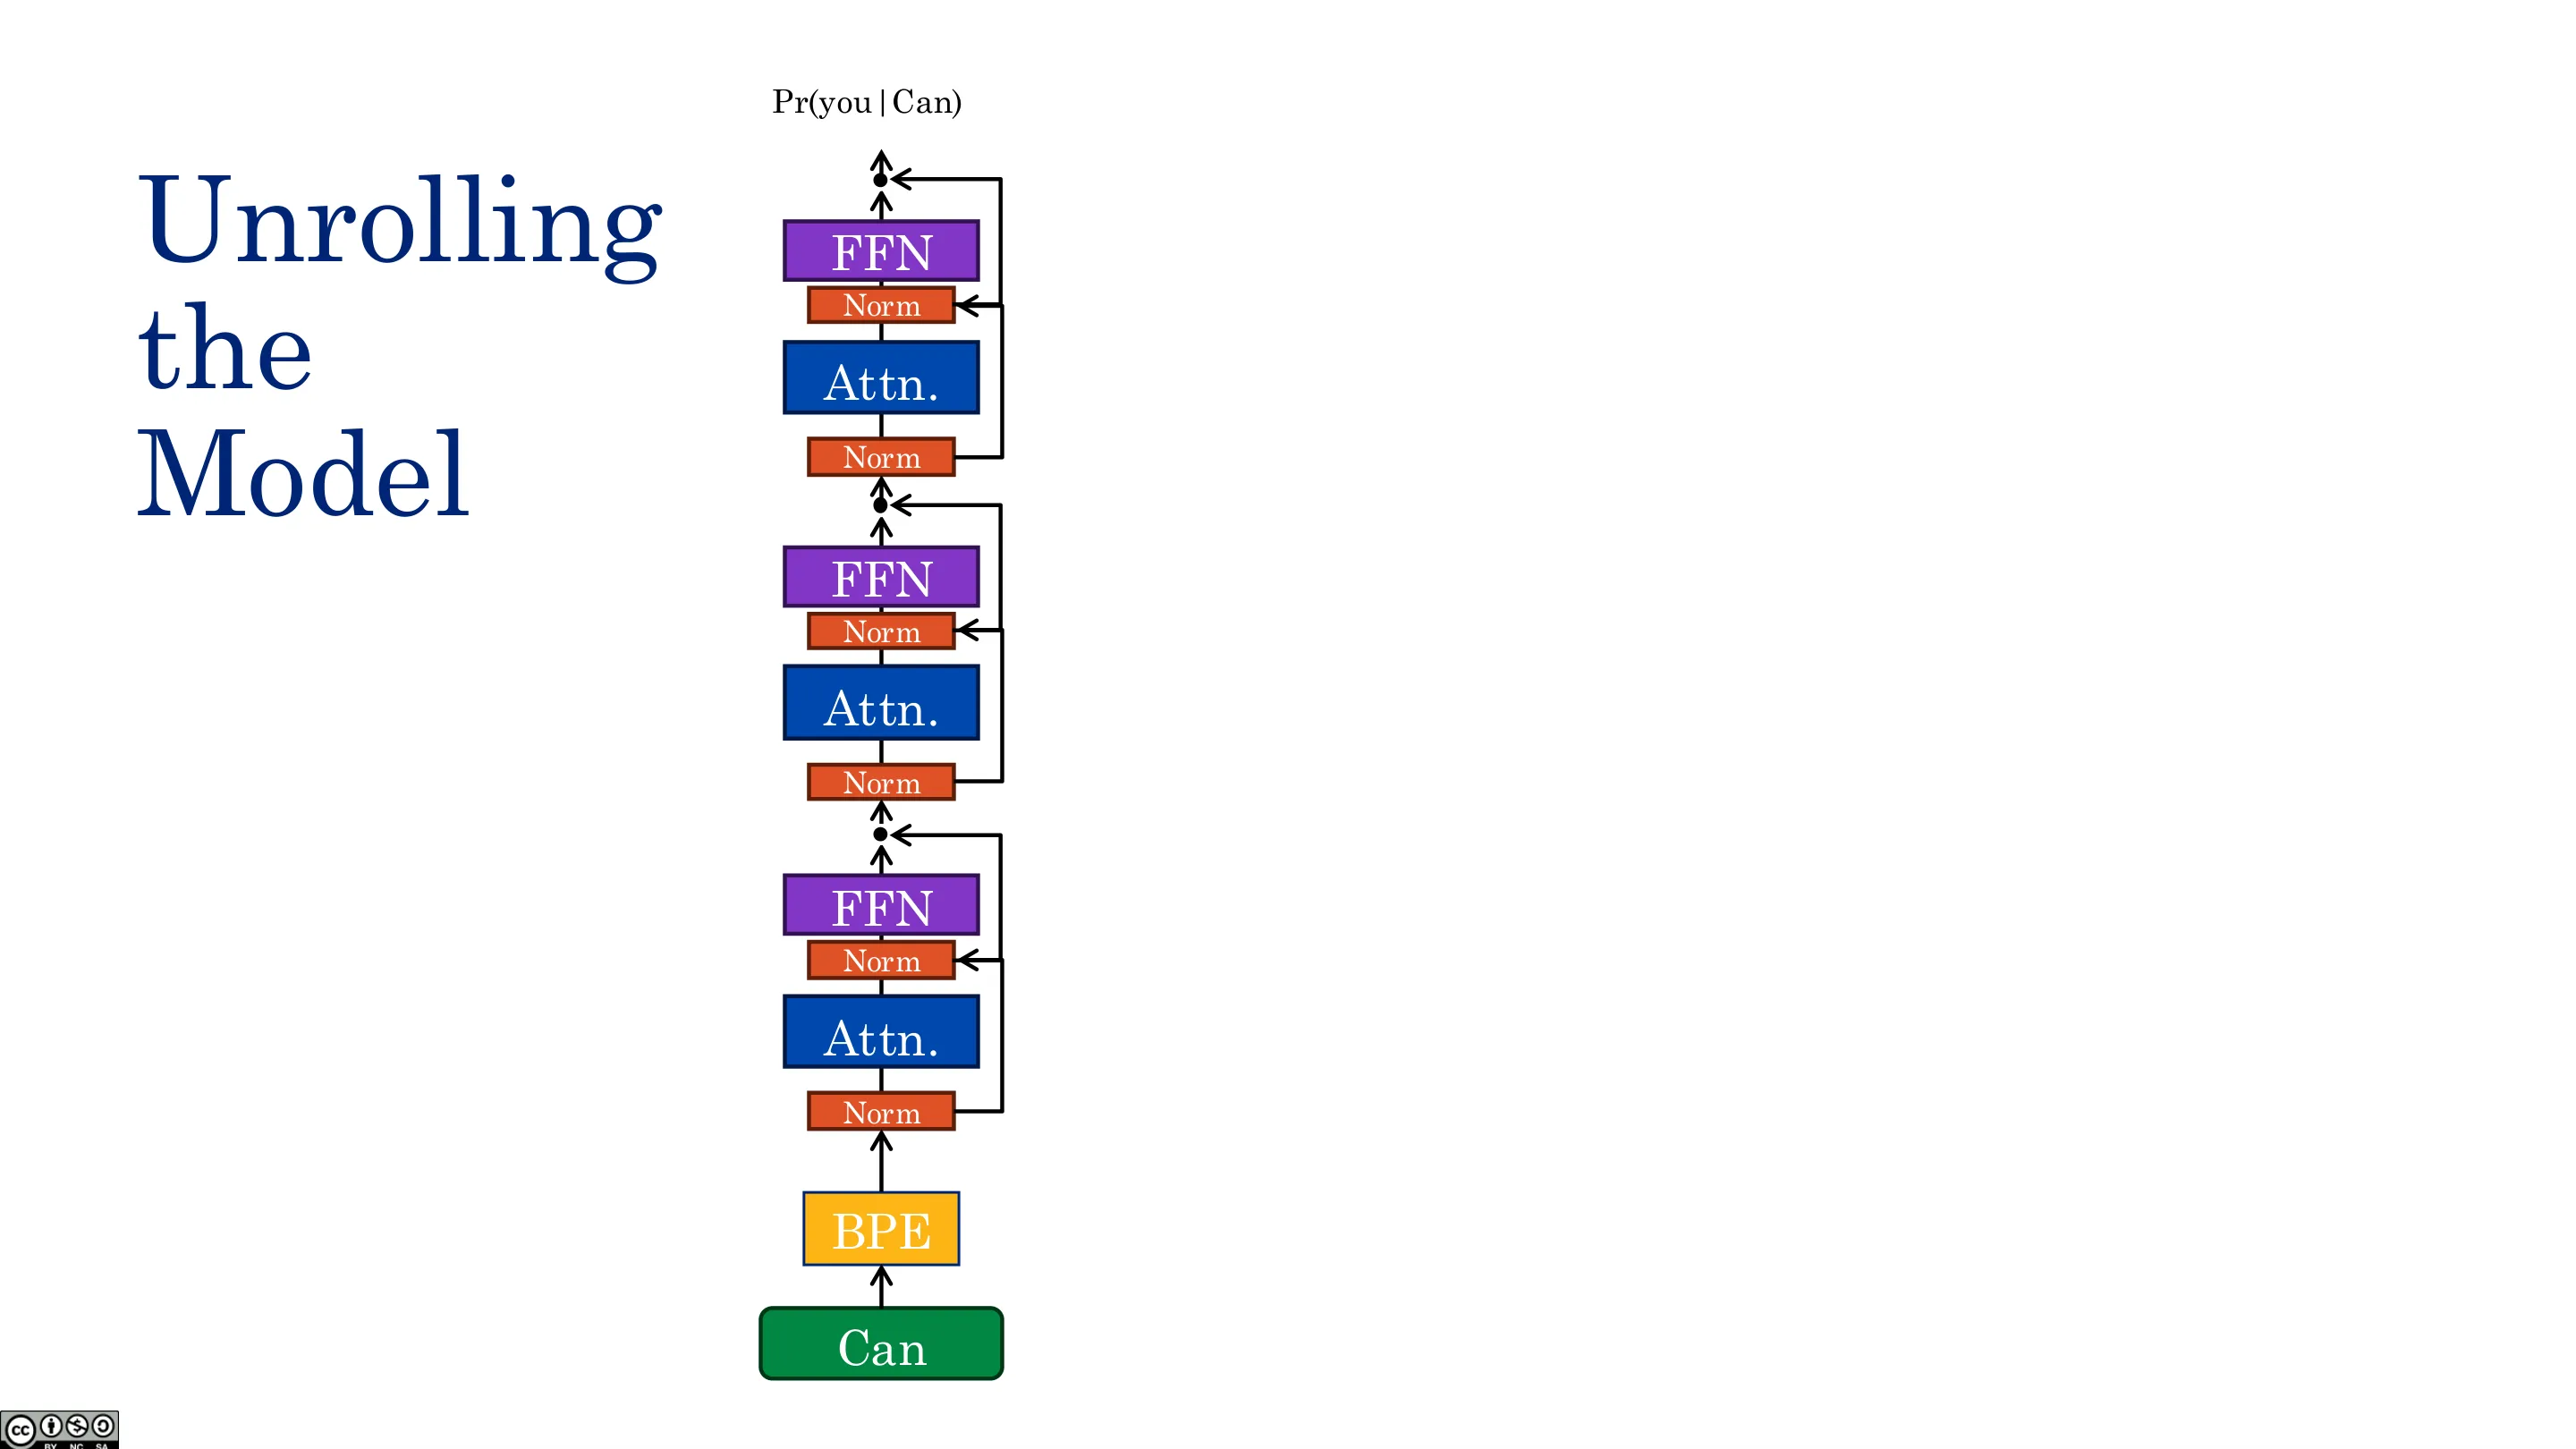
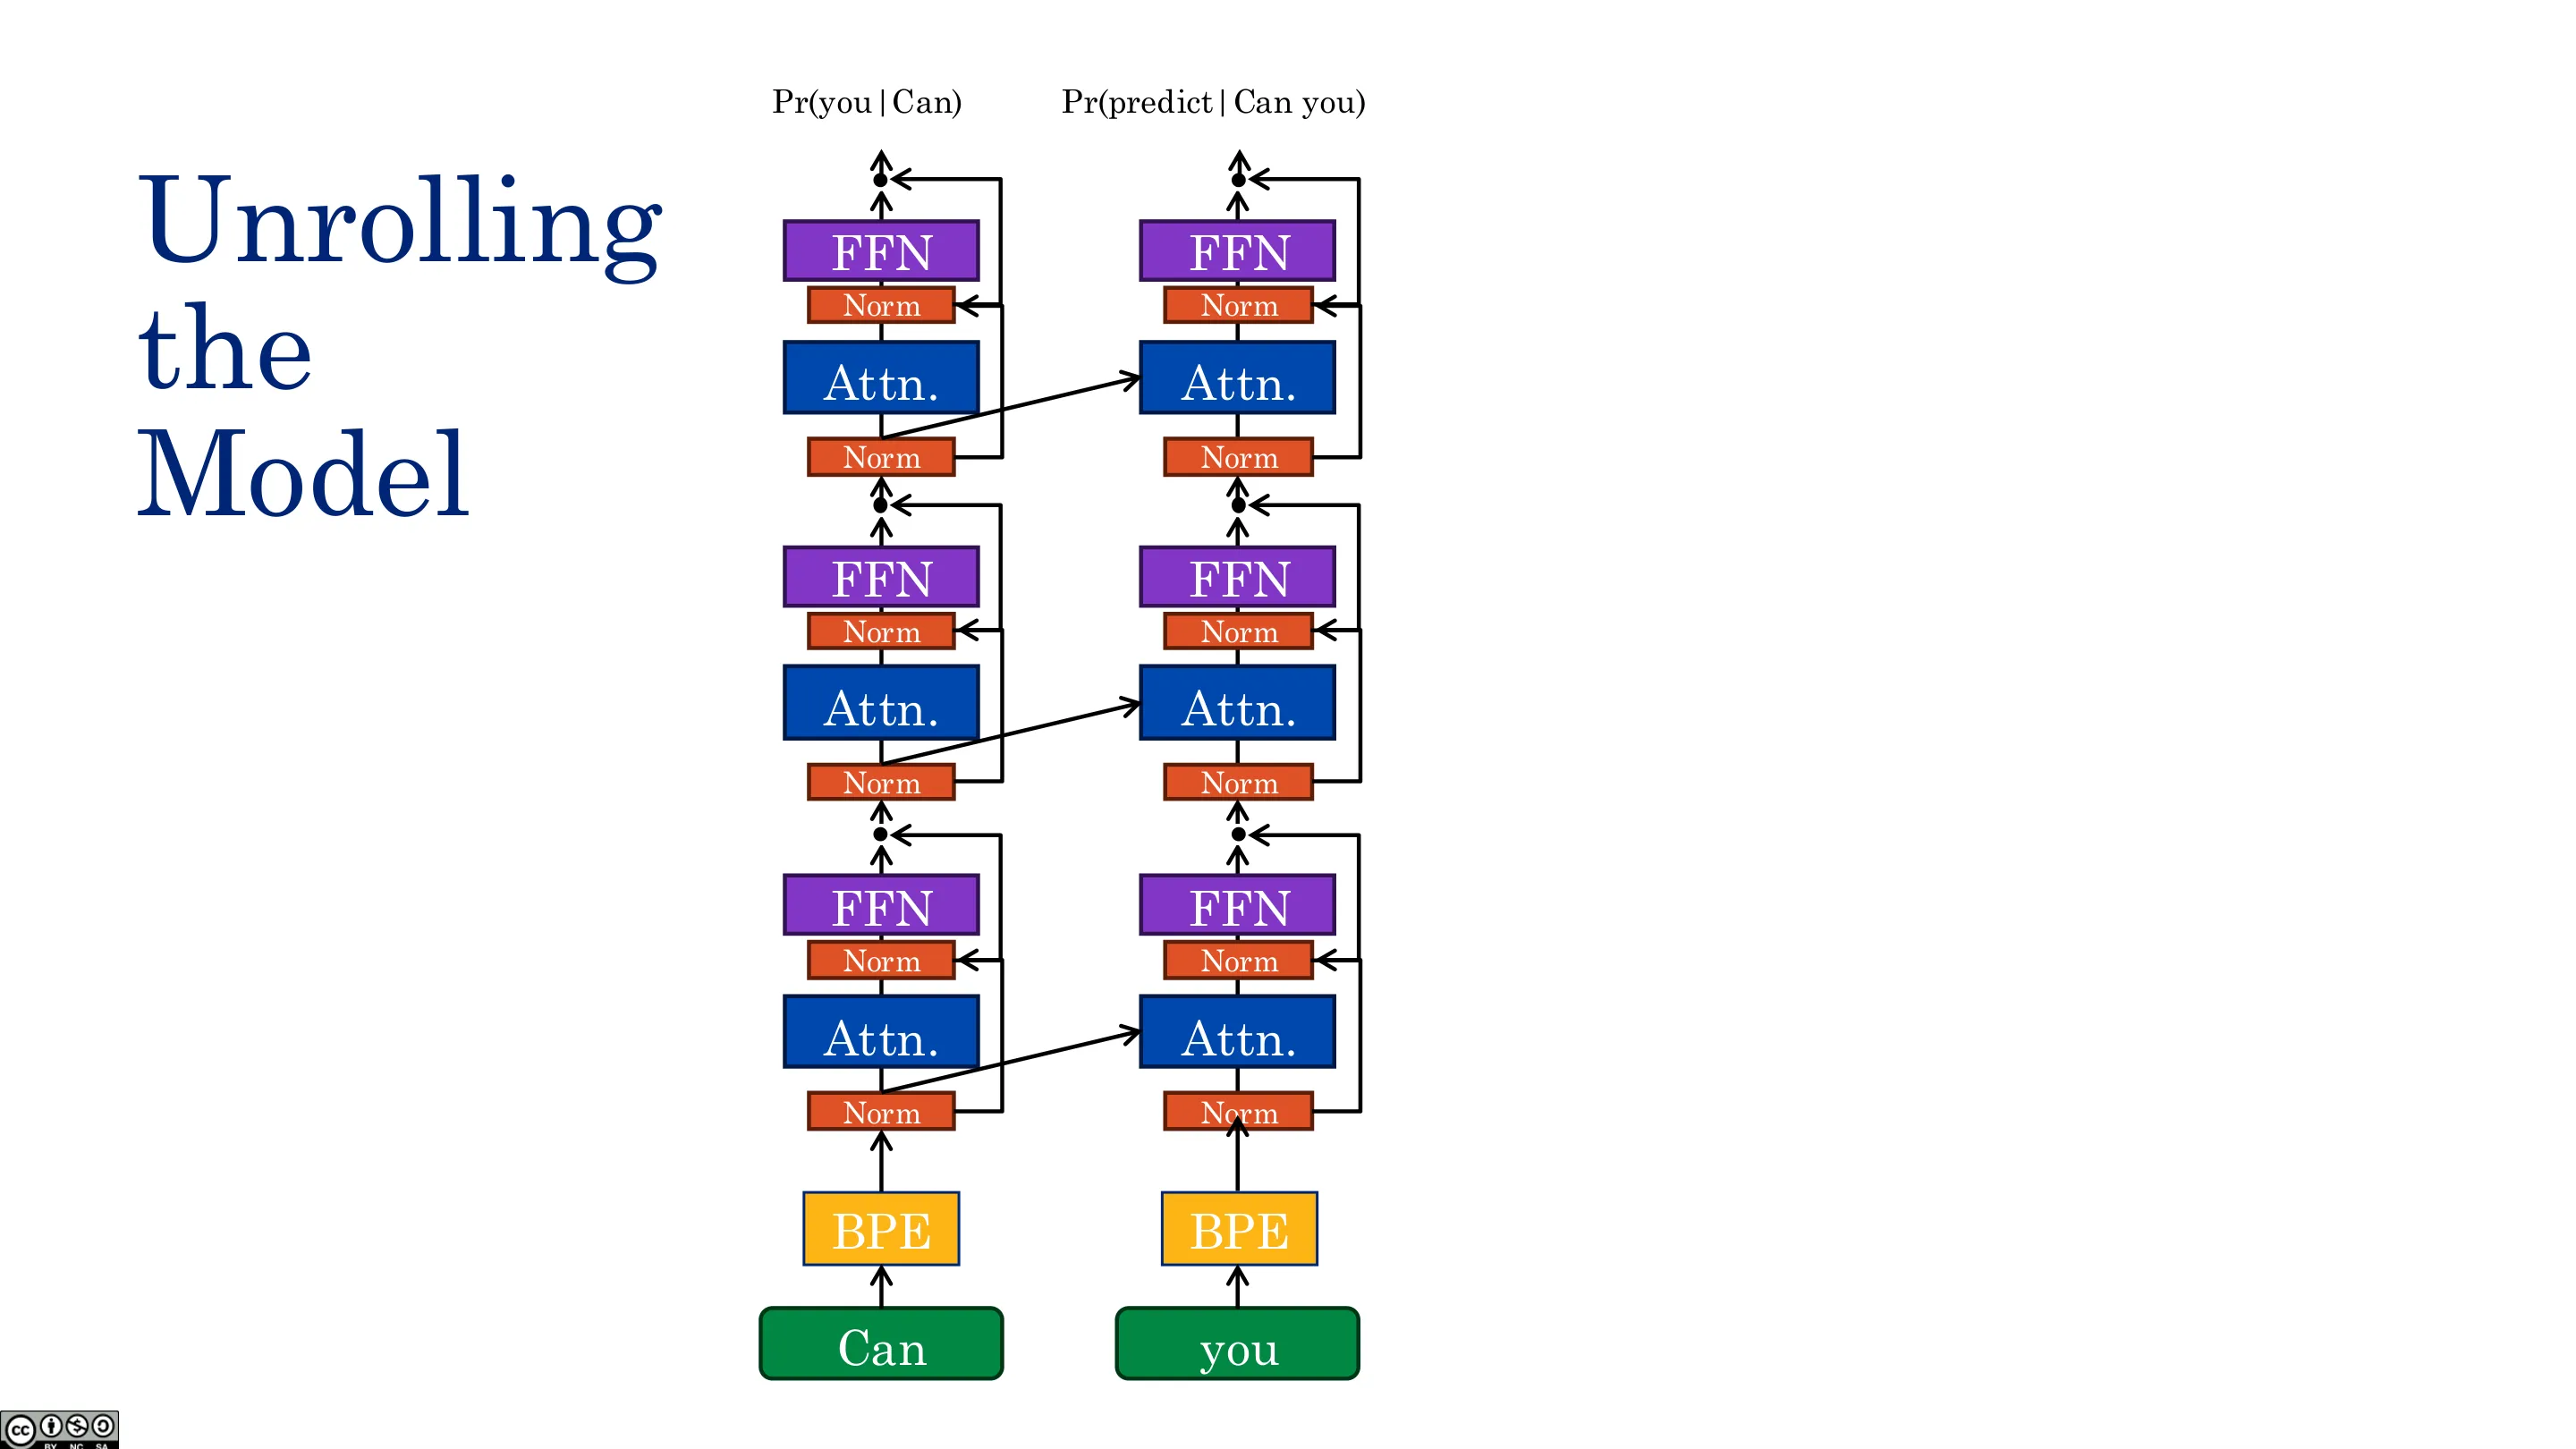
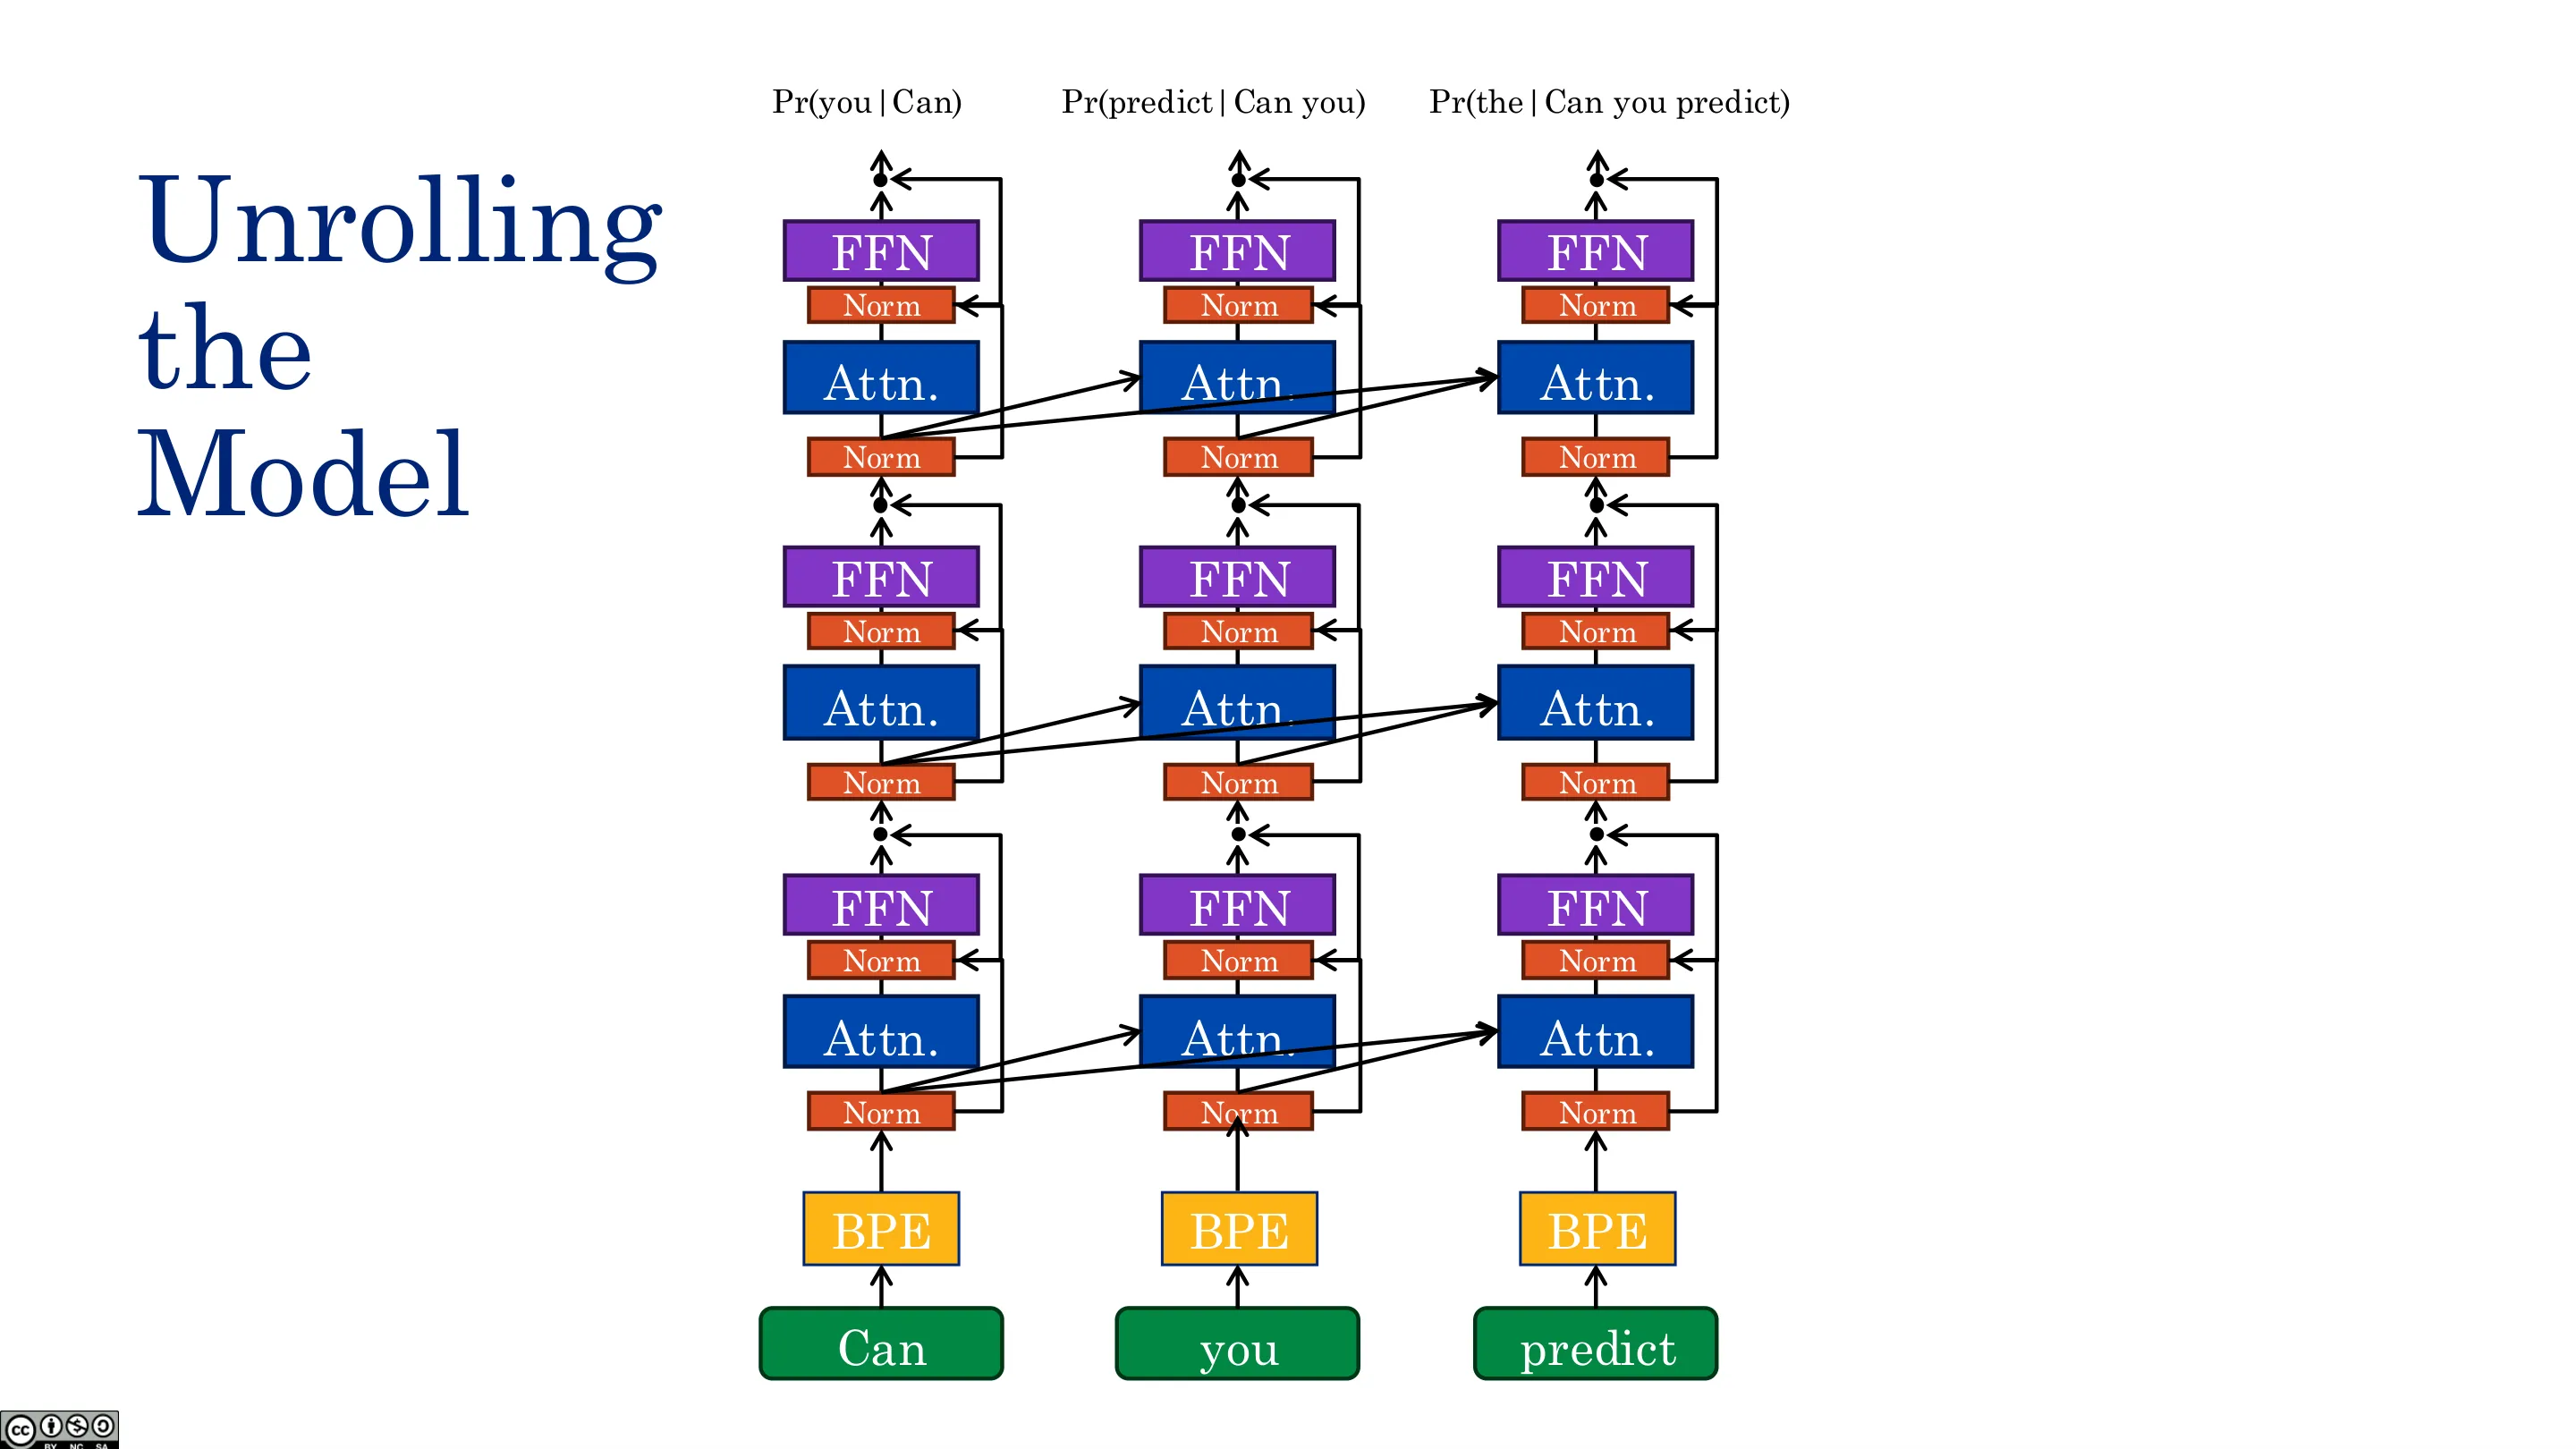
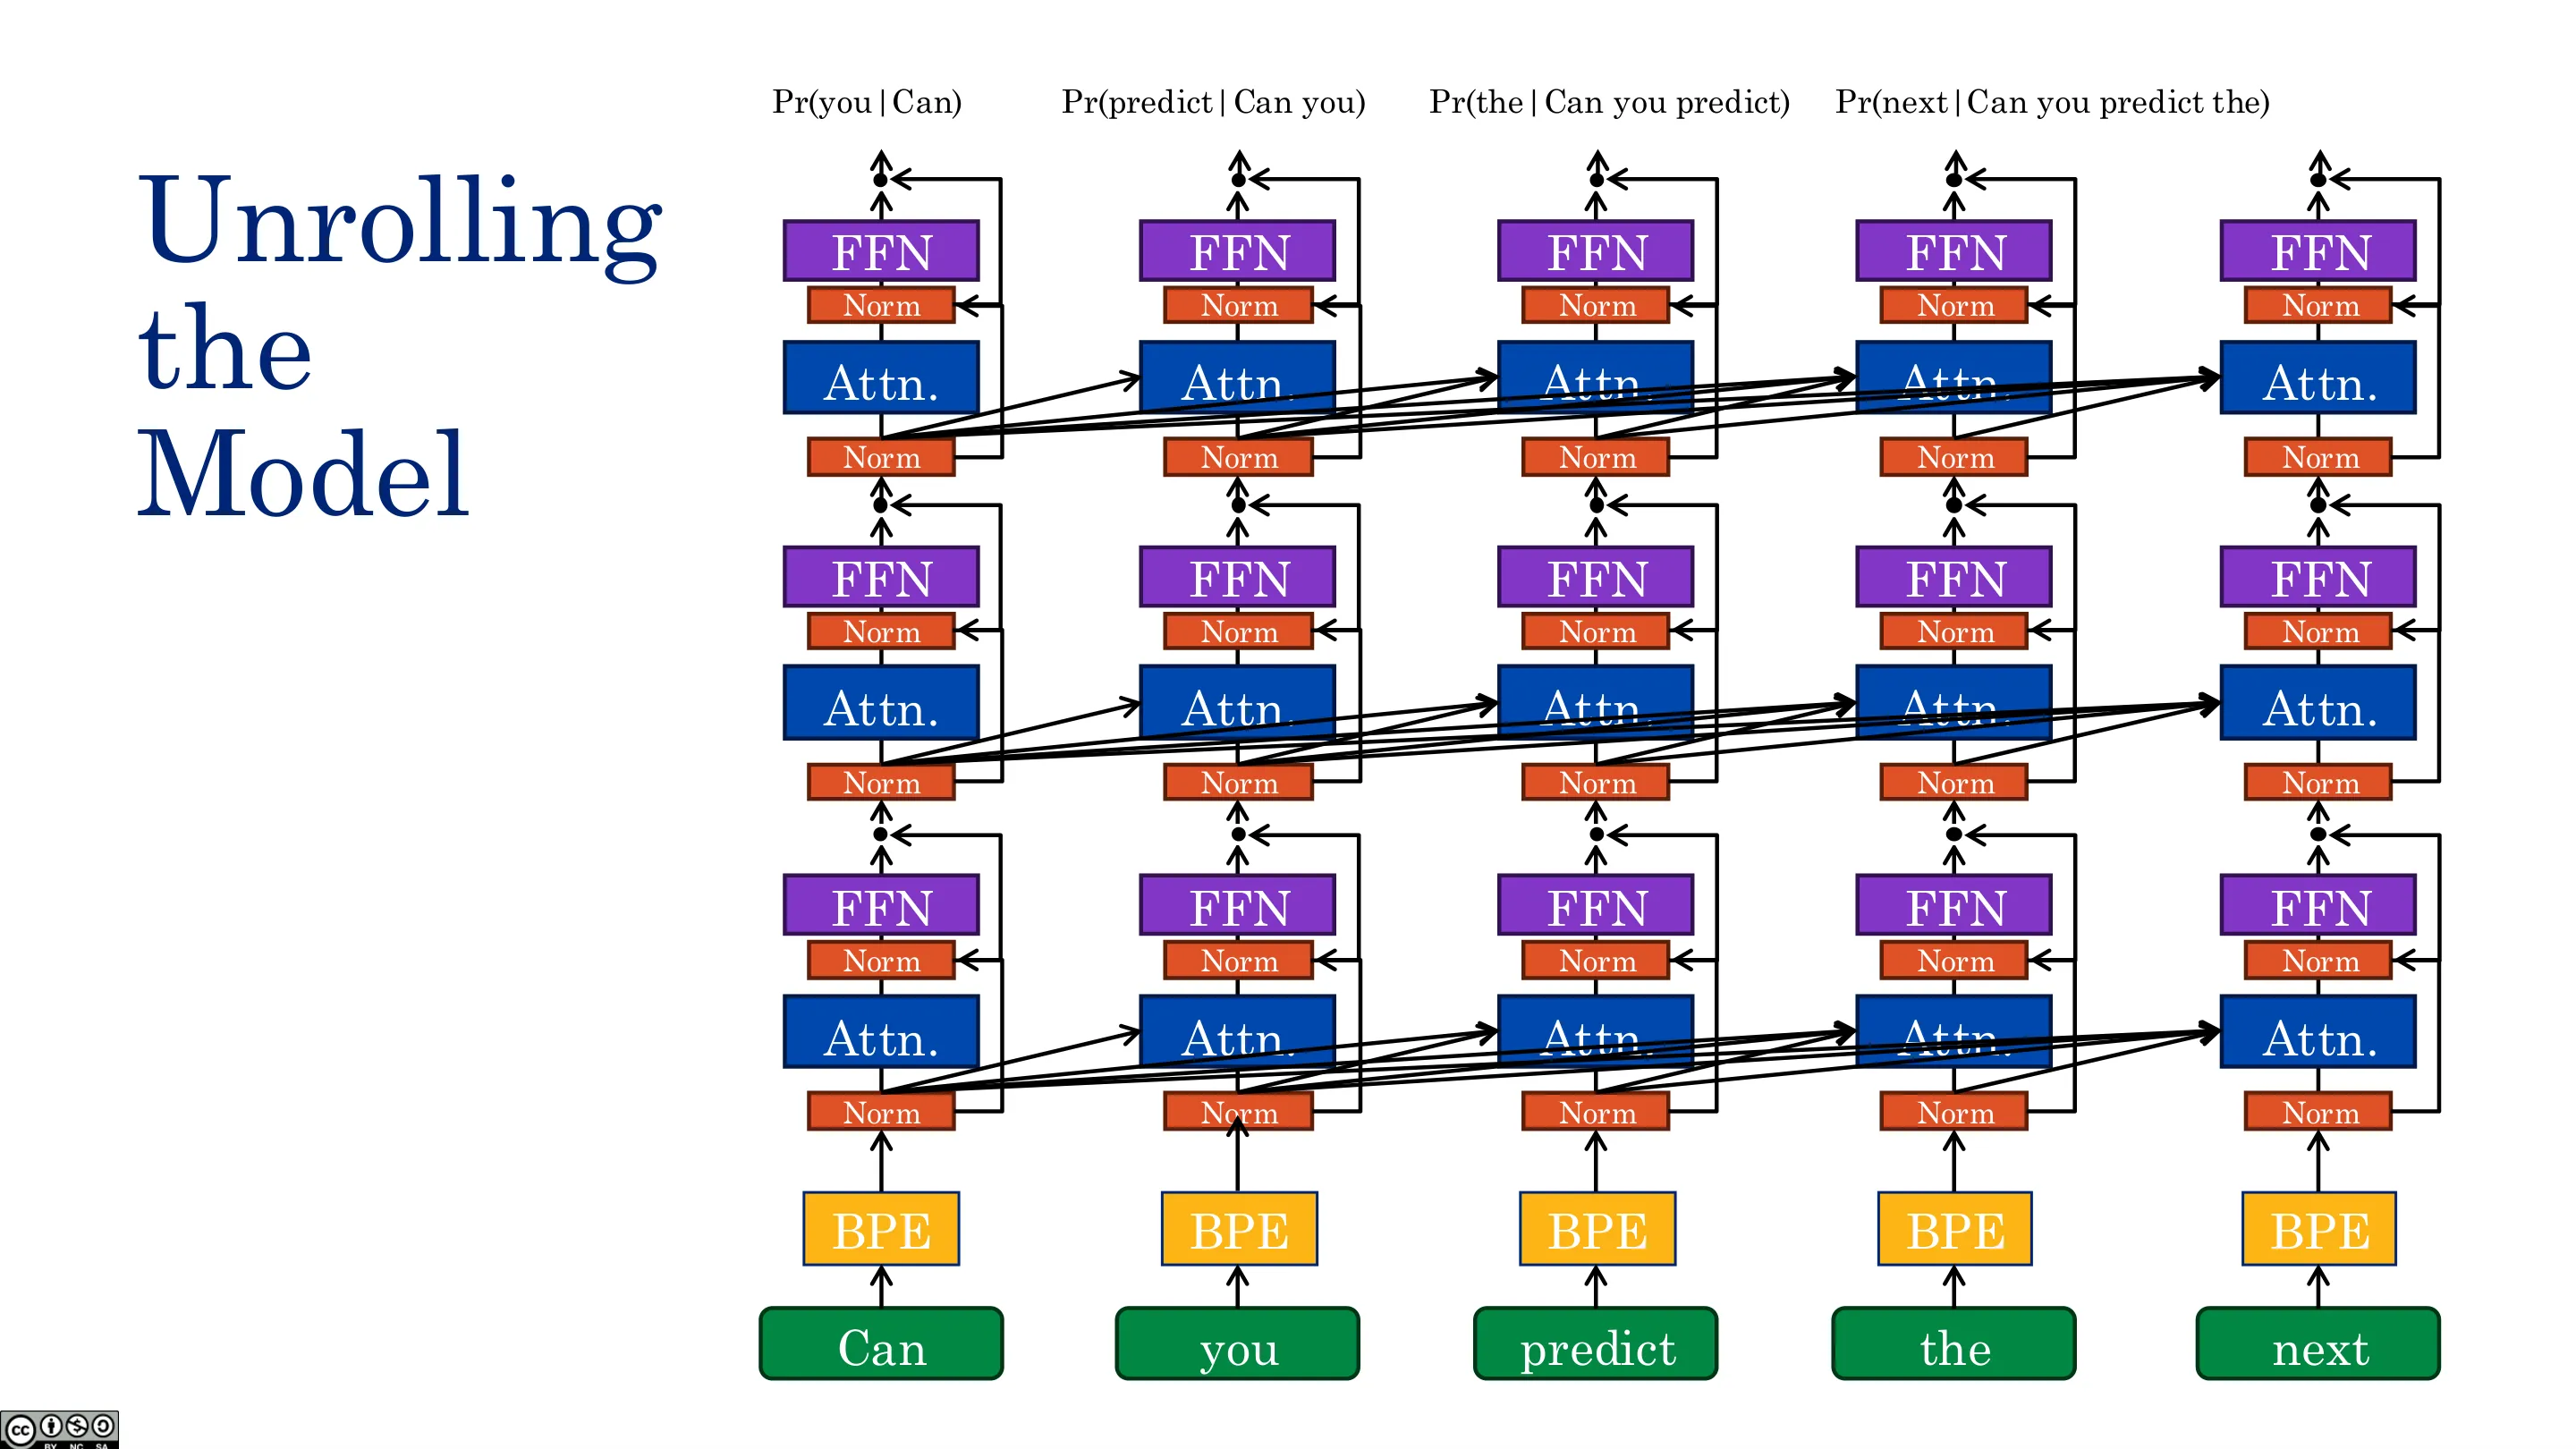
建模下一个 token 的流程:
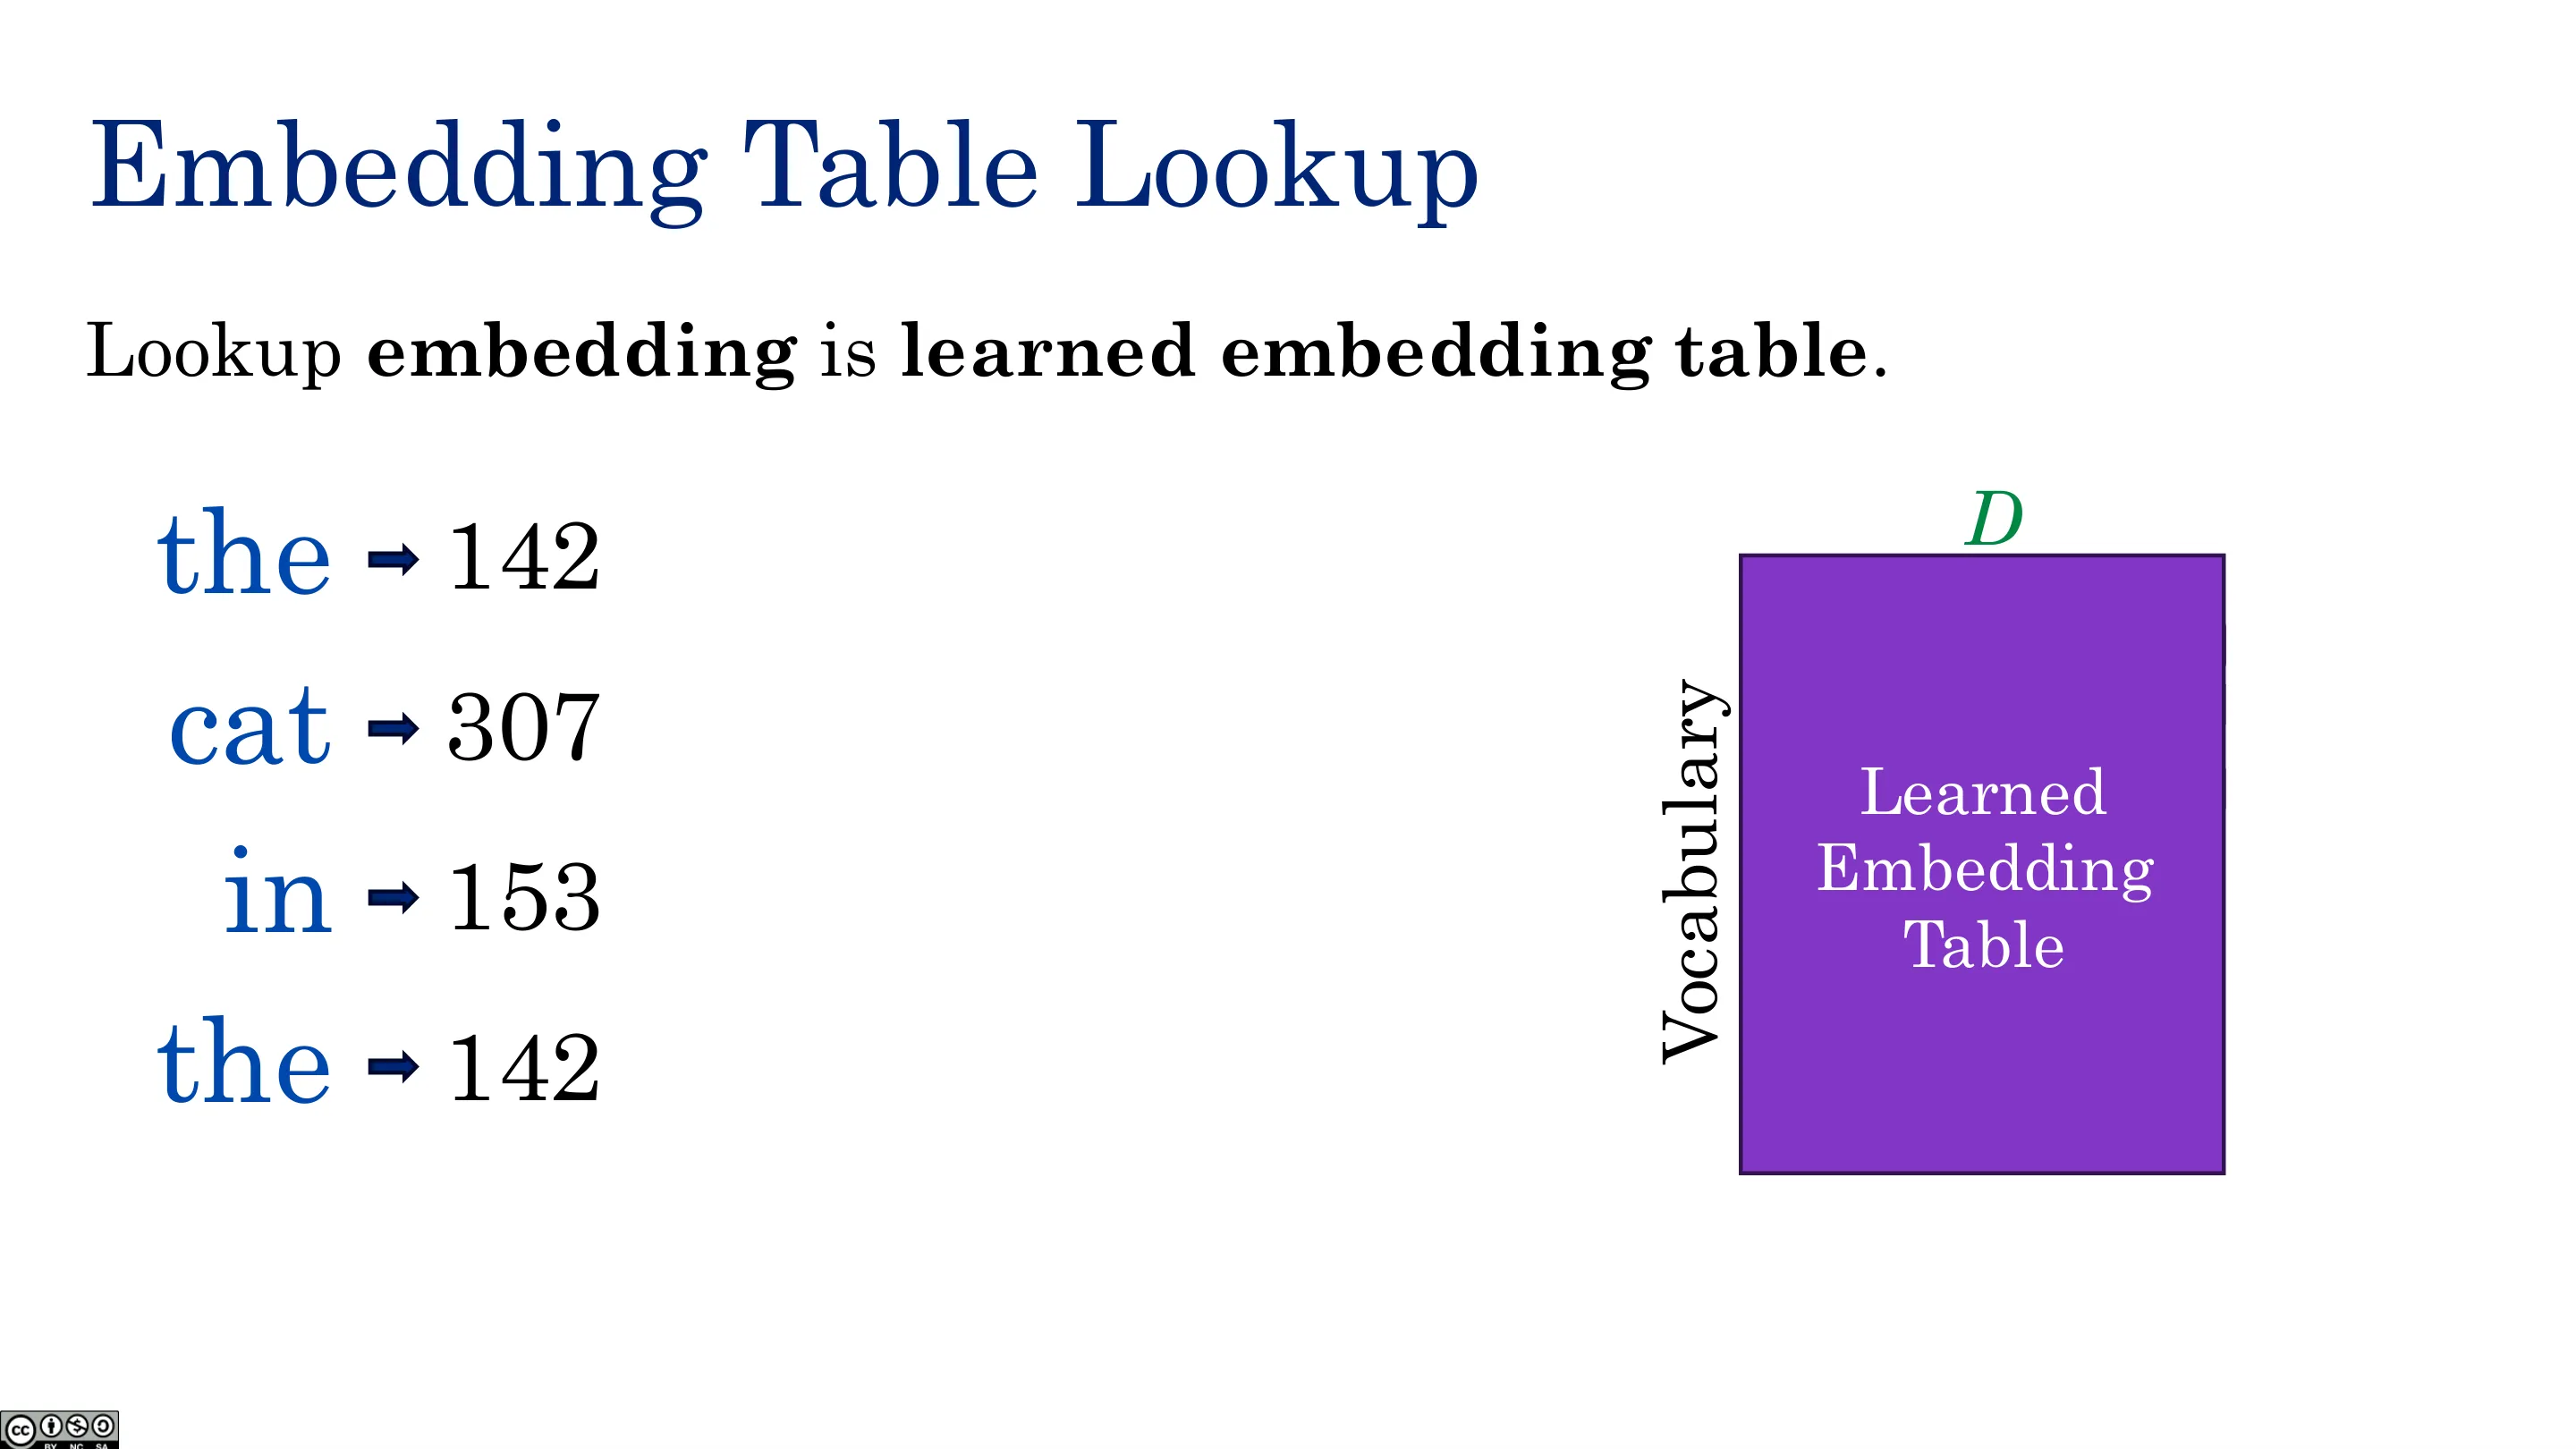
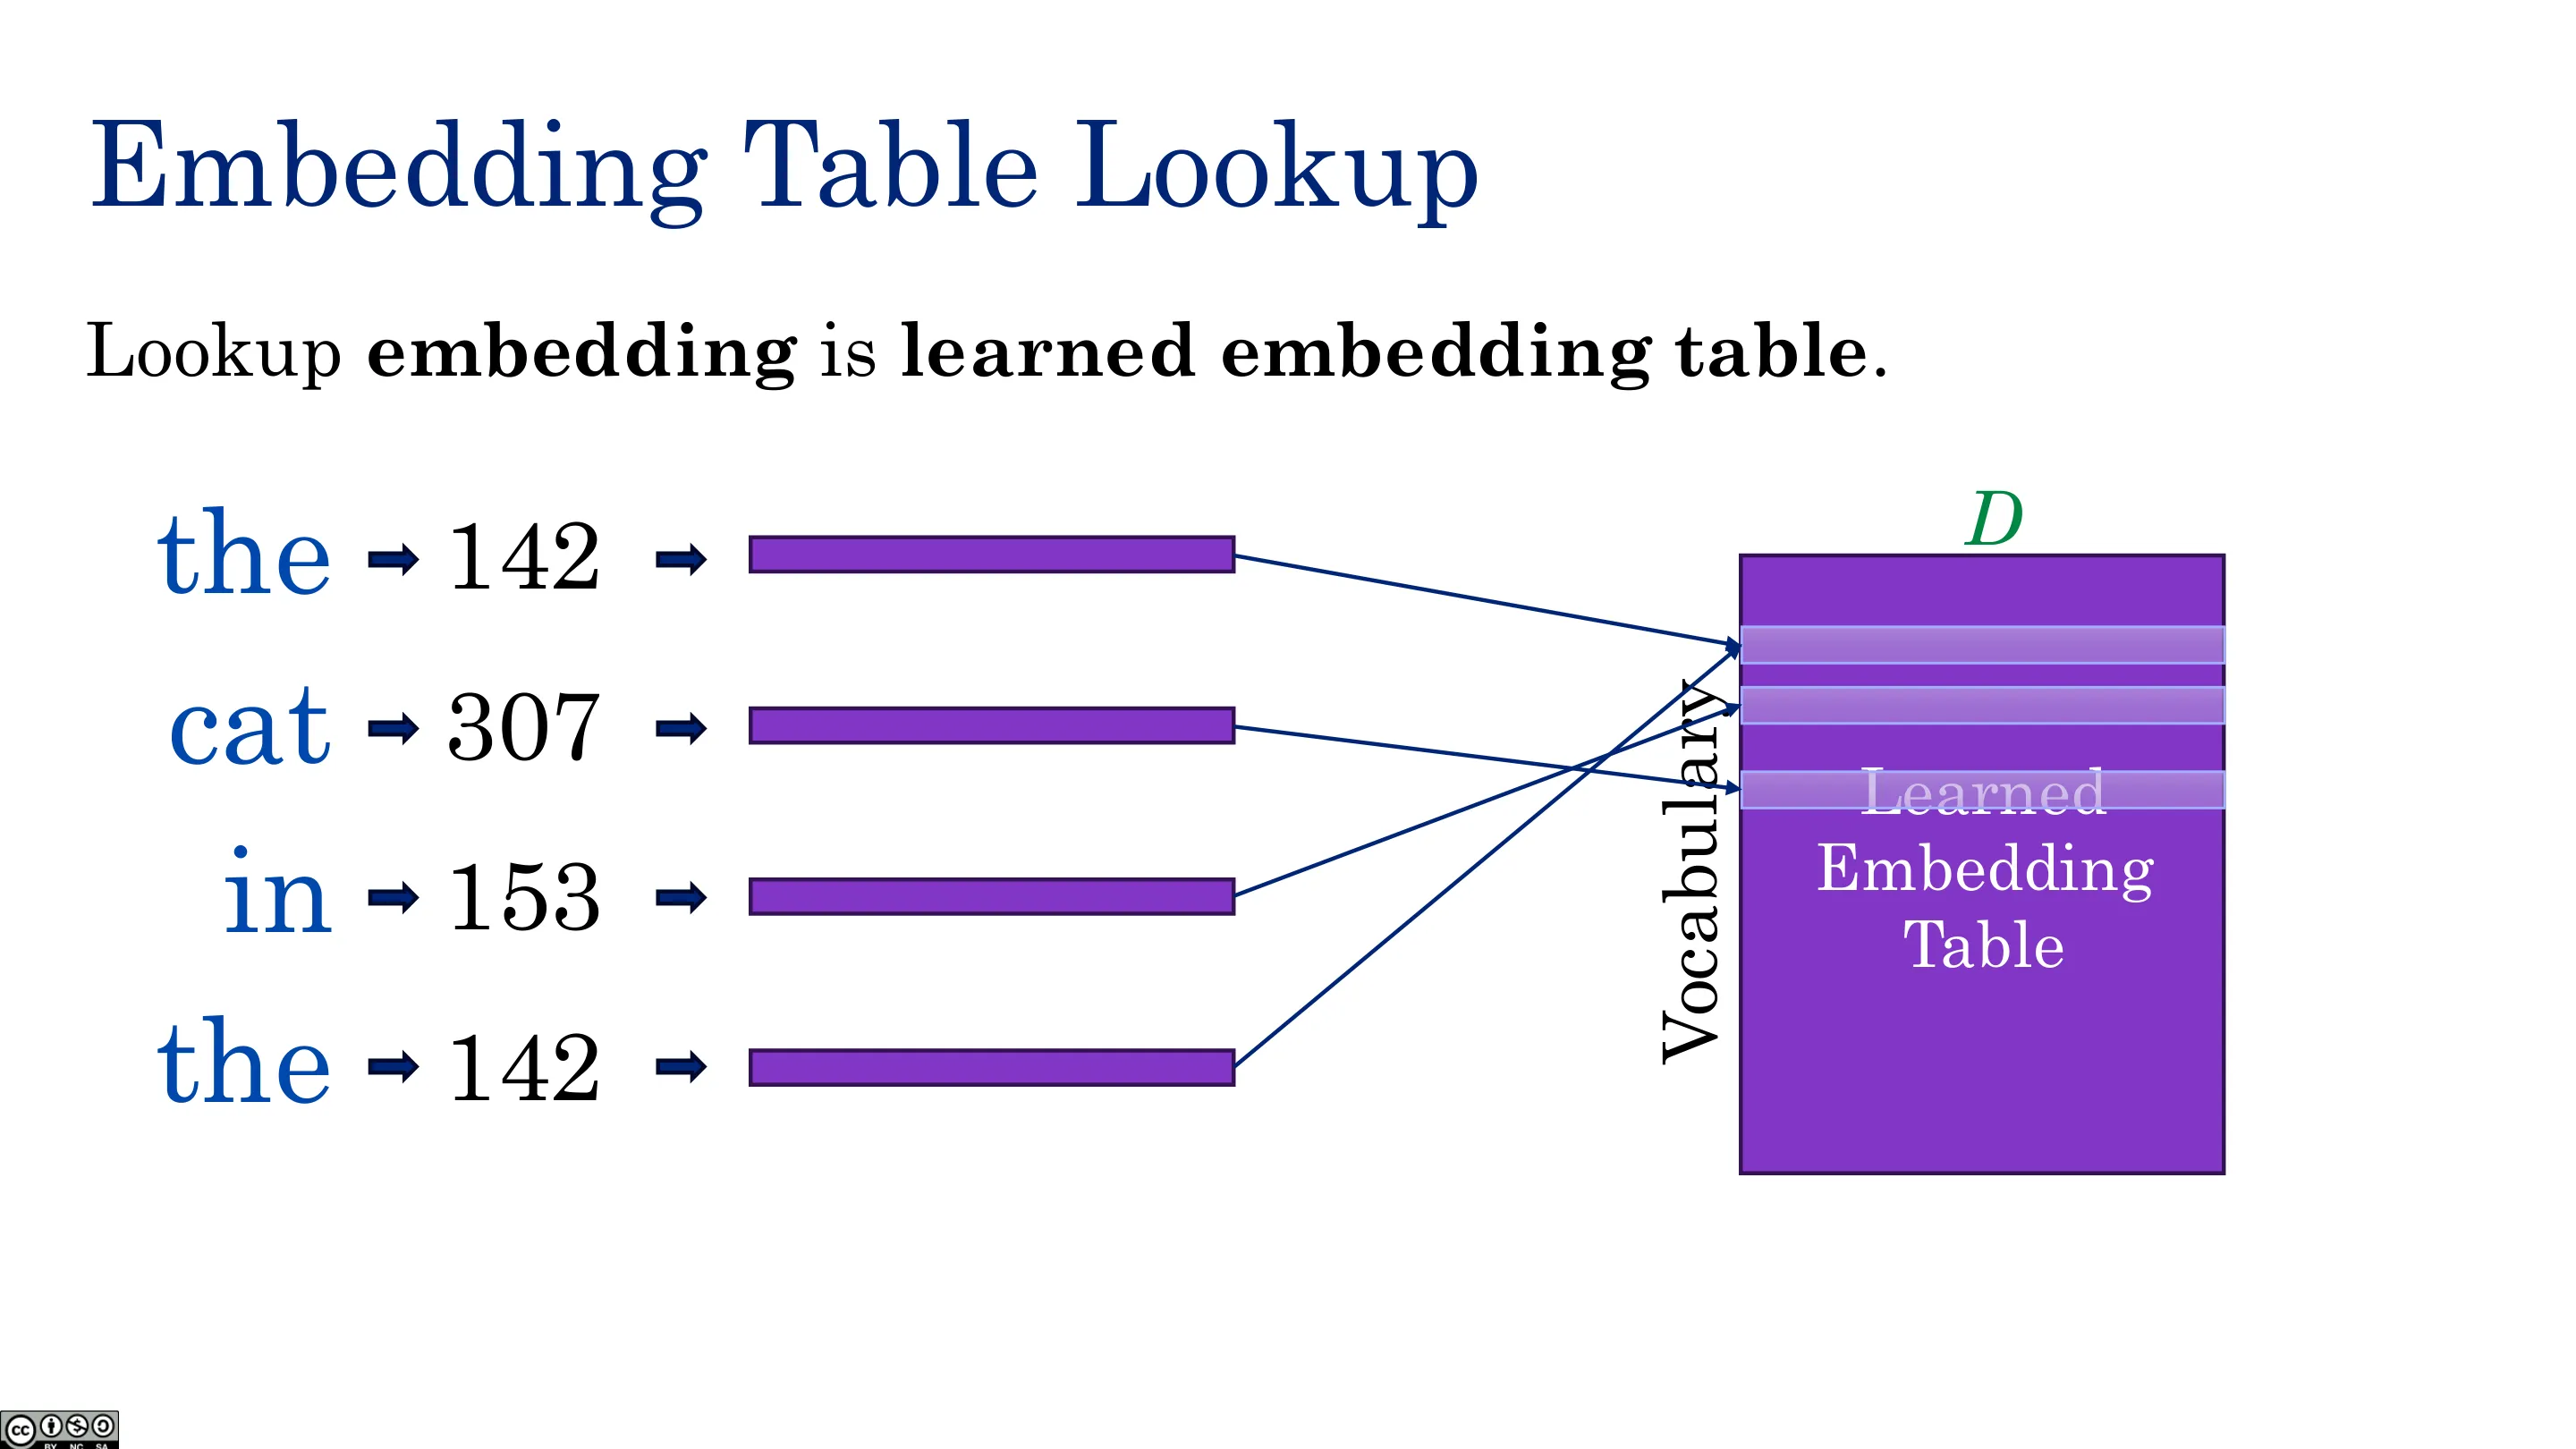
- 分词(tokenize):把上下文表示成 token 编号;每个编号查学习到的嵌入表得到向量;
- 加位置编码(固定模式,让模型知道位置);
- 过若干 Transformer 块(自注意力 + MLP + 残差/LayerNorm);
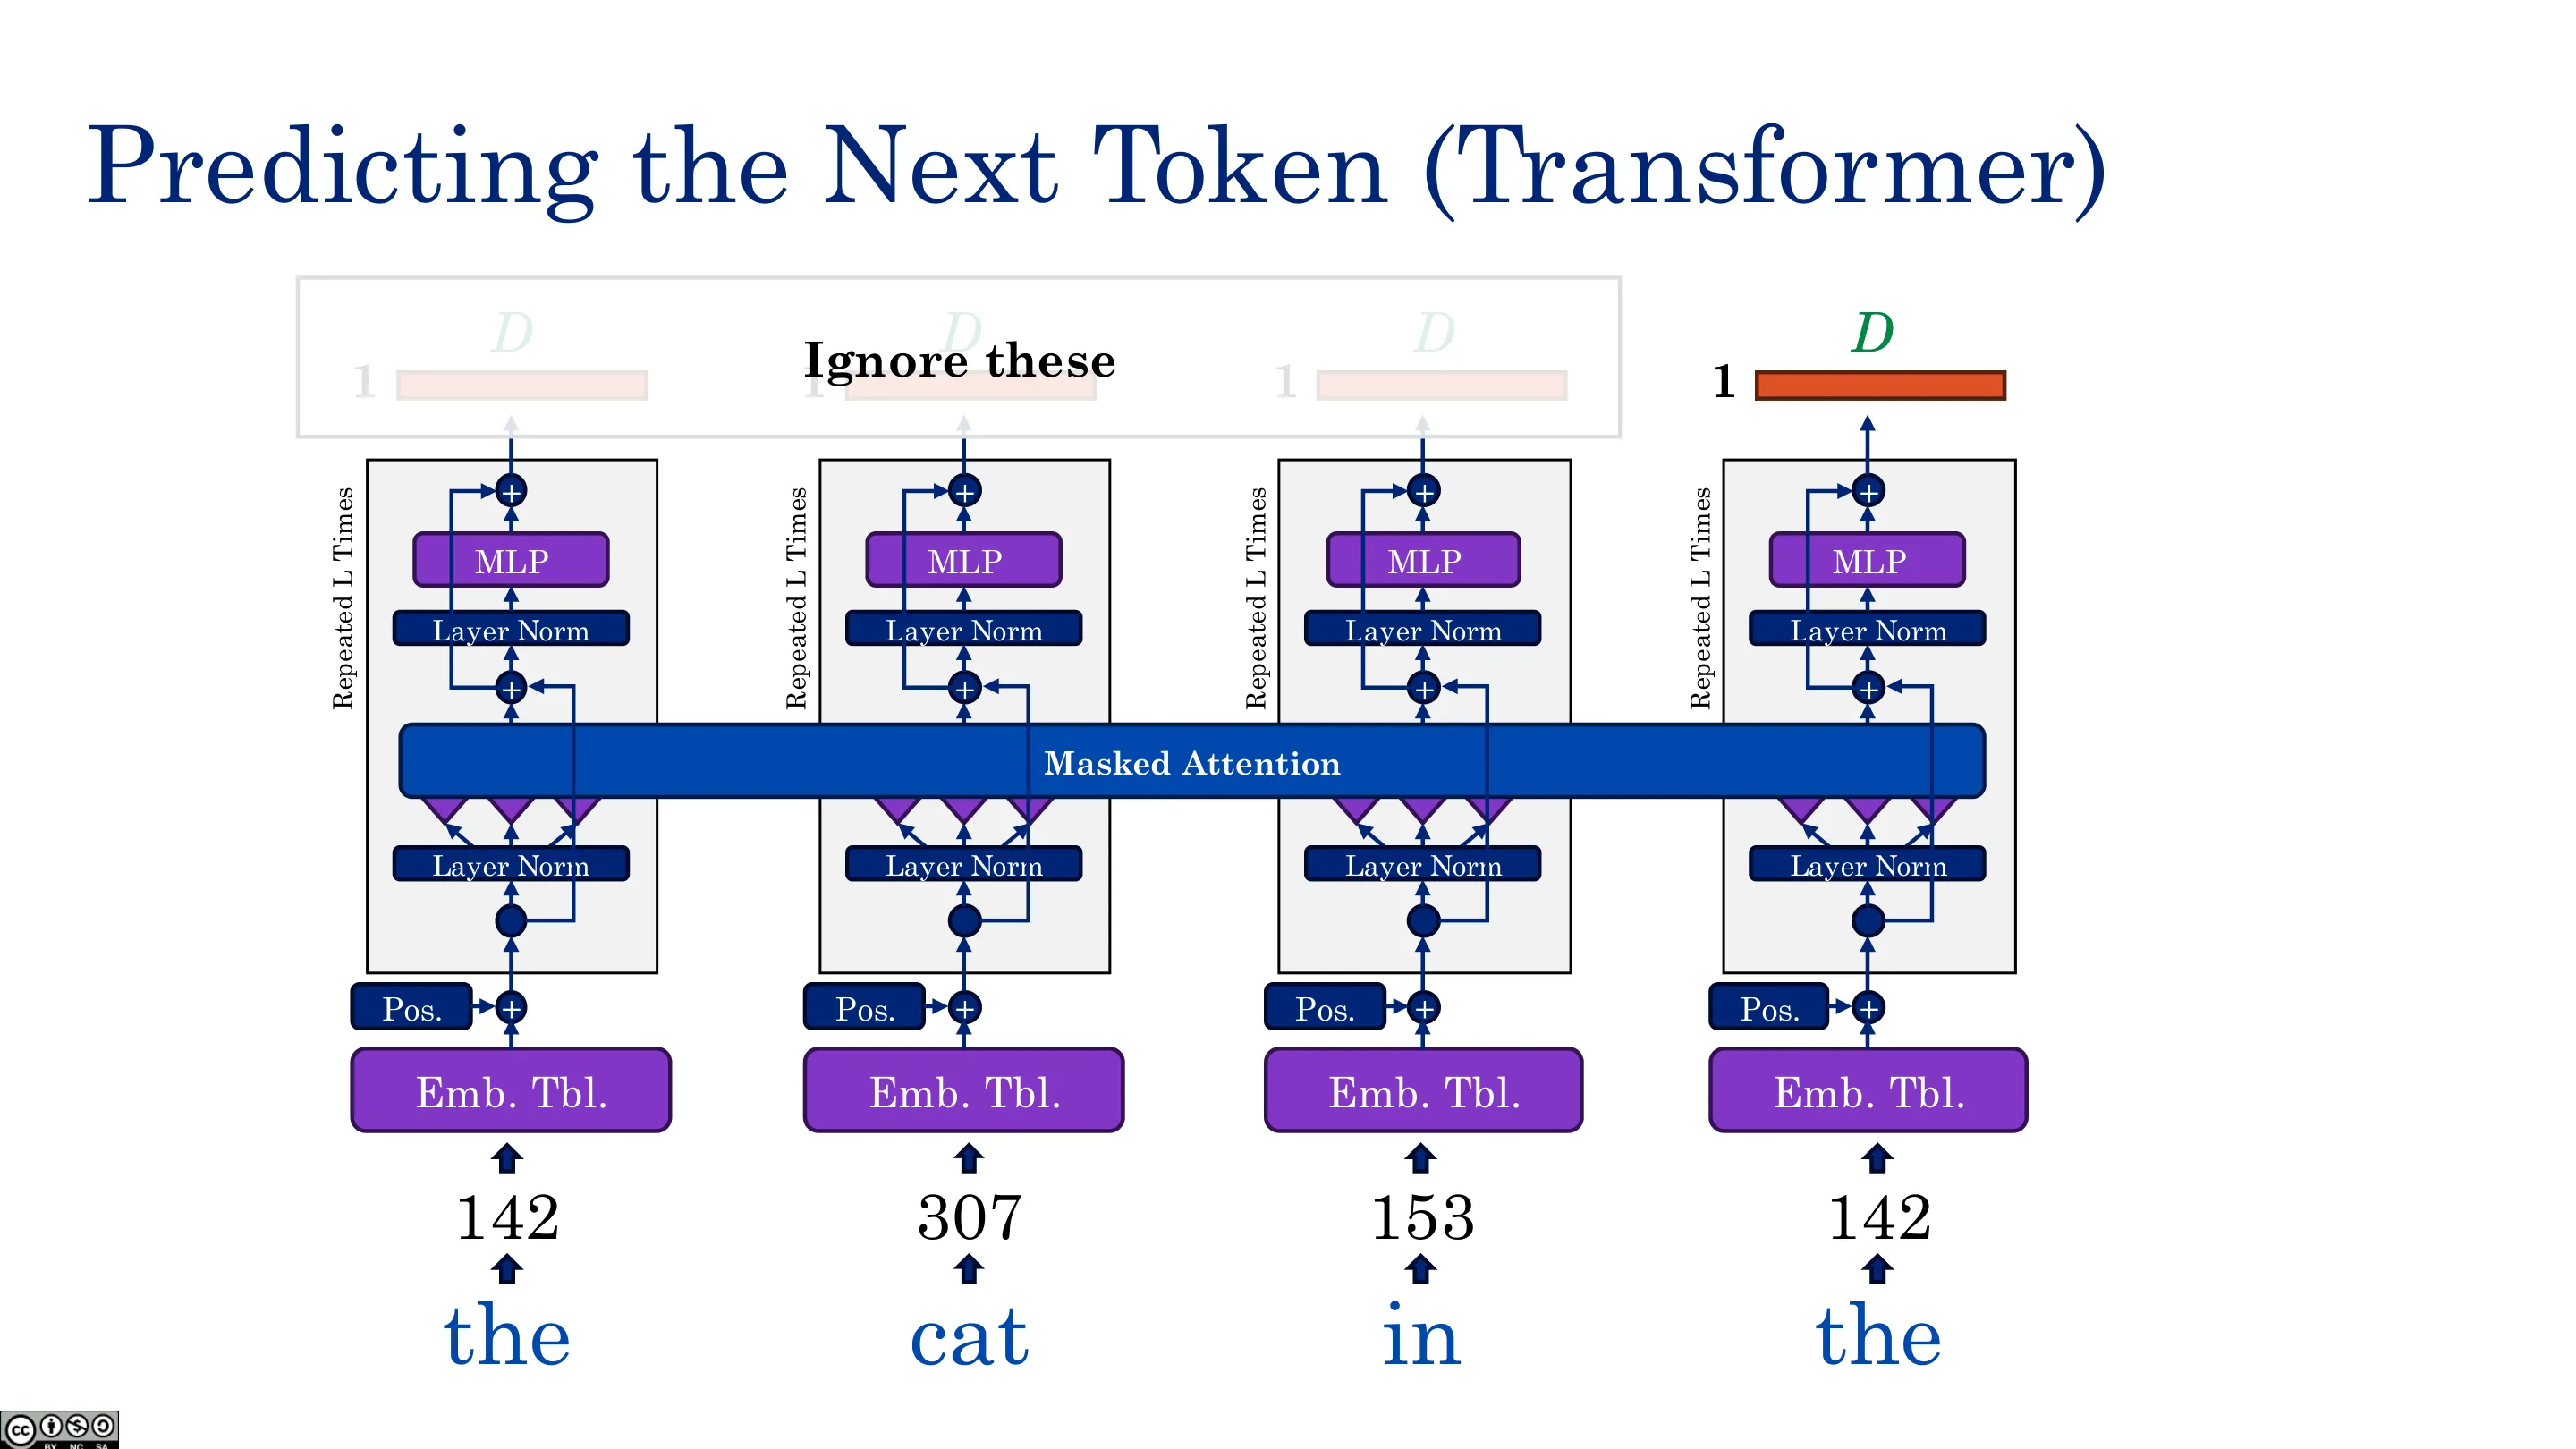
- 取最后一个 token 的表示,过一个 $d\times V$ 的矩阵($V$ ≈ 词表 5 万)⇒ 对下一个词的分布;
- 用交叉熵损失做监督学习。
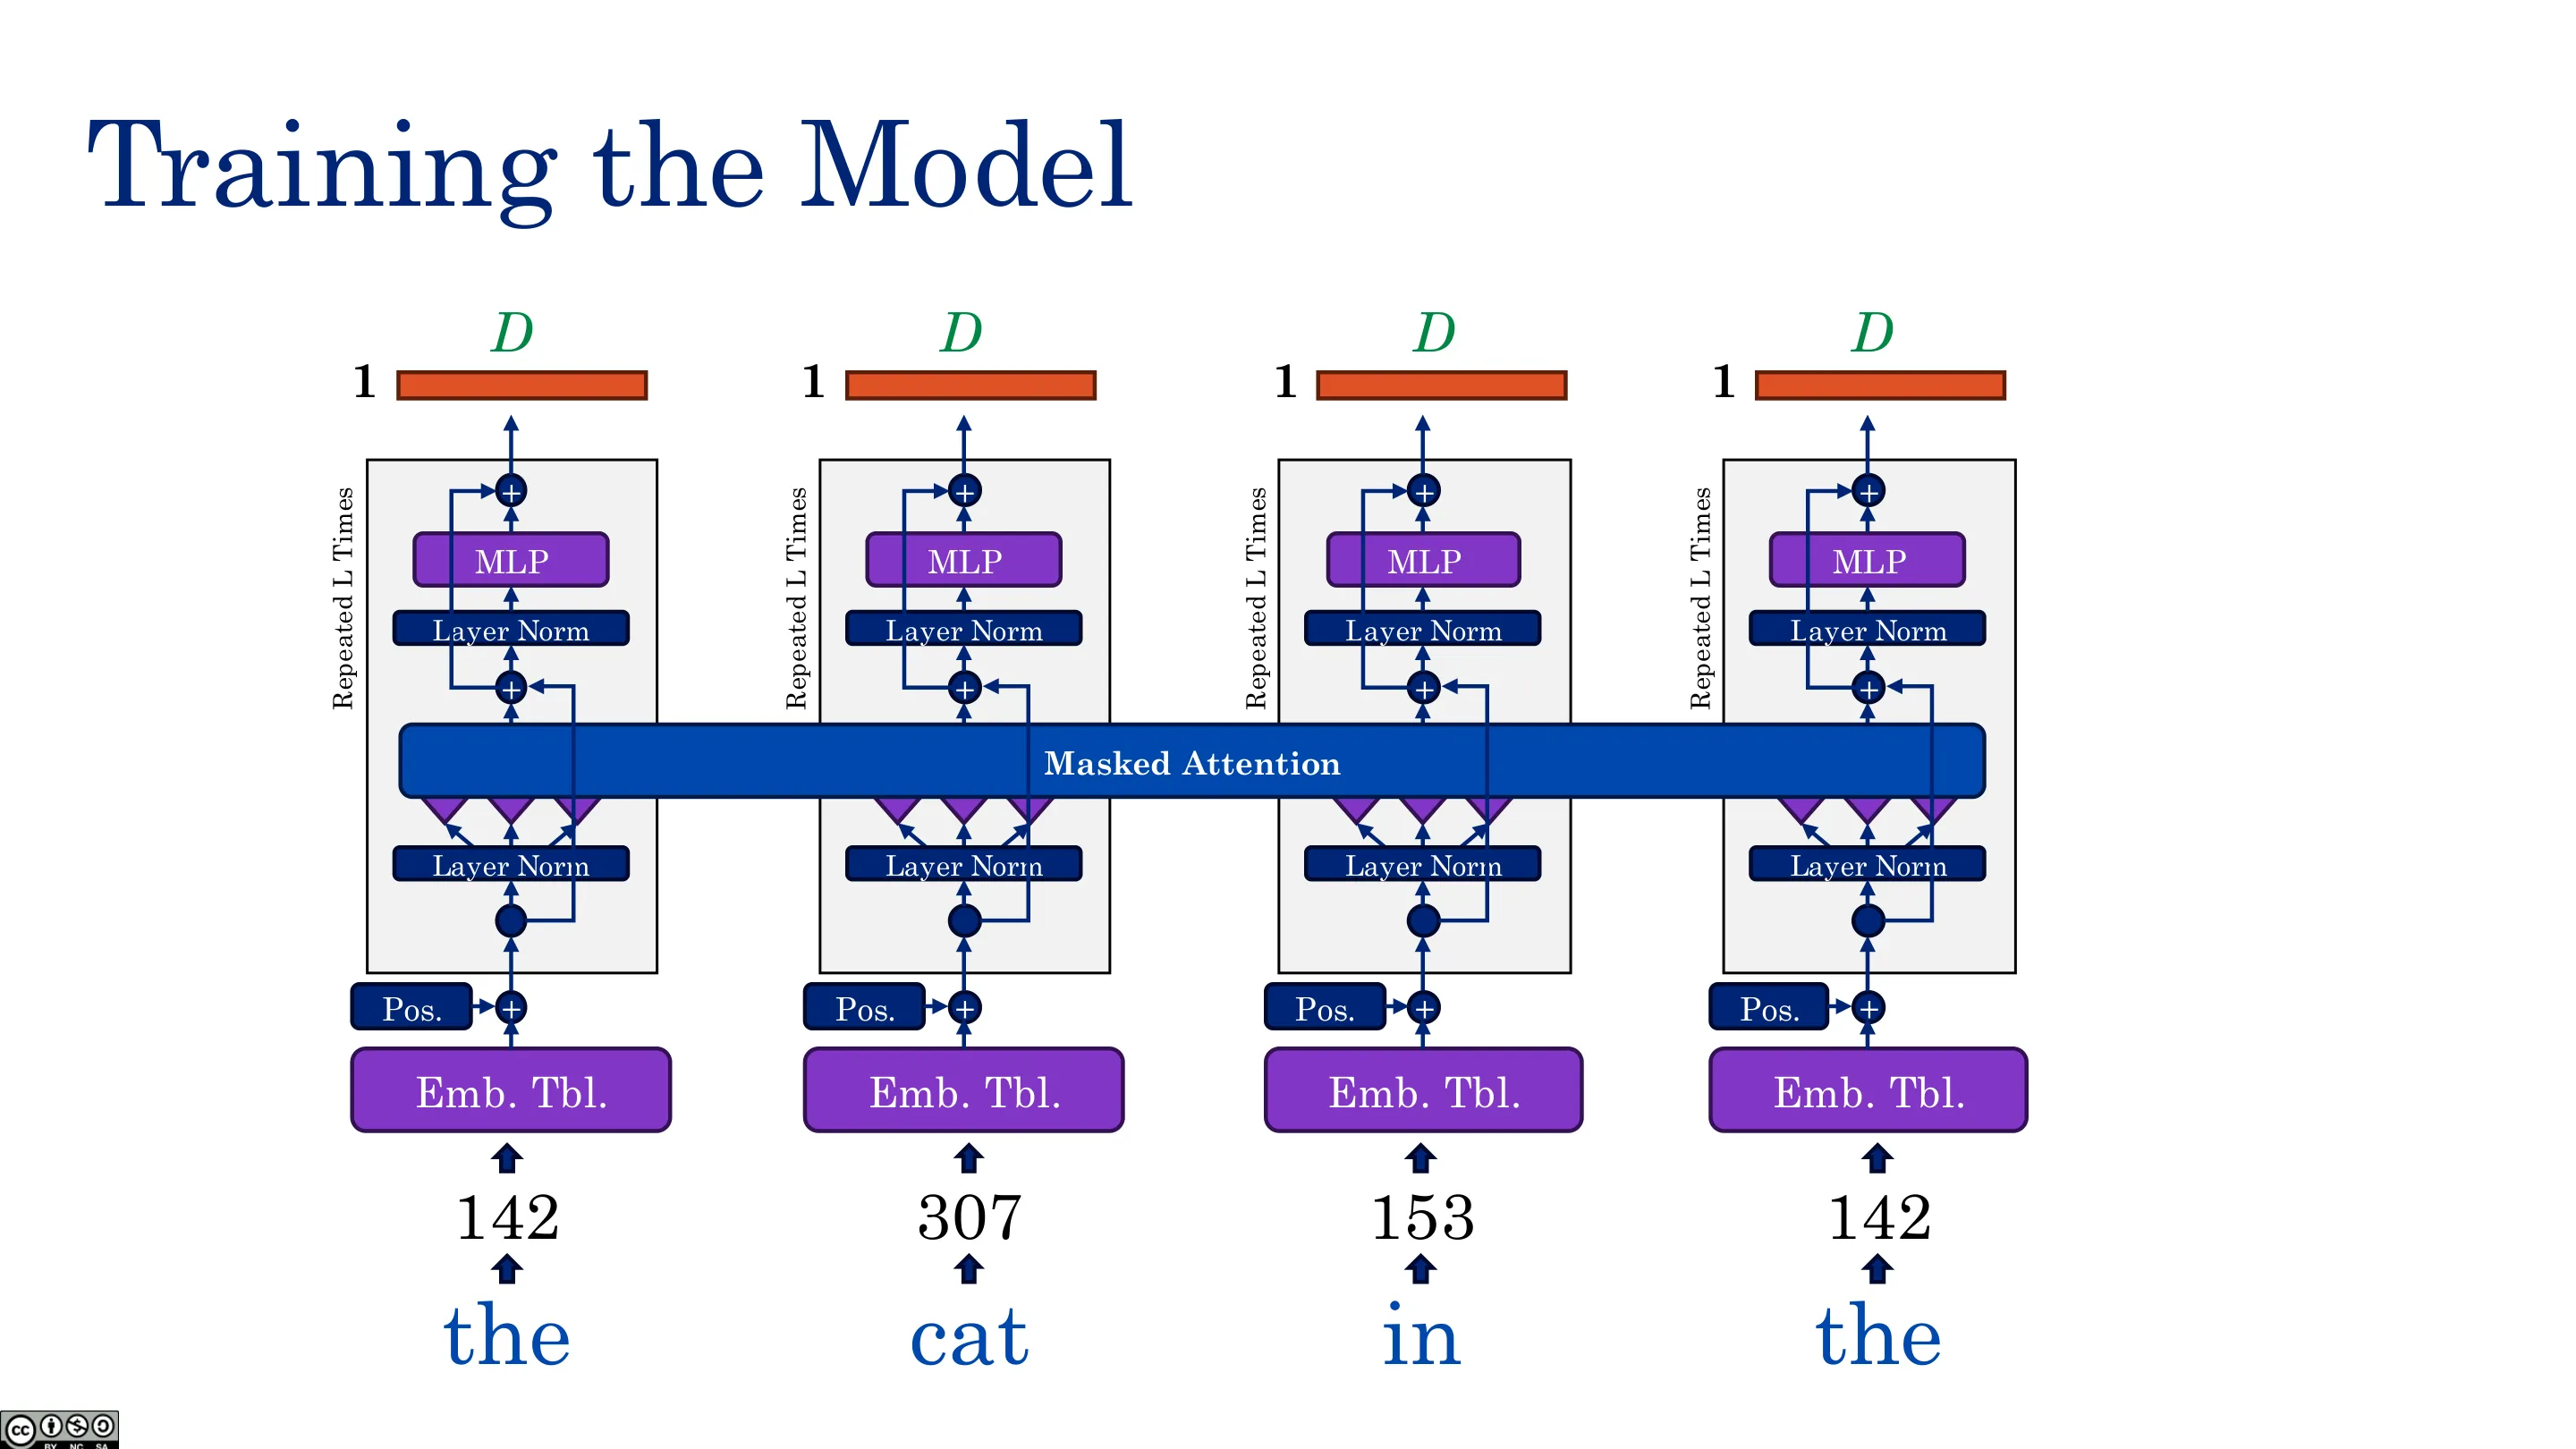
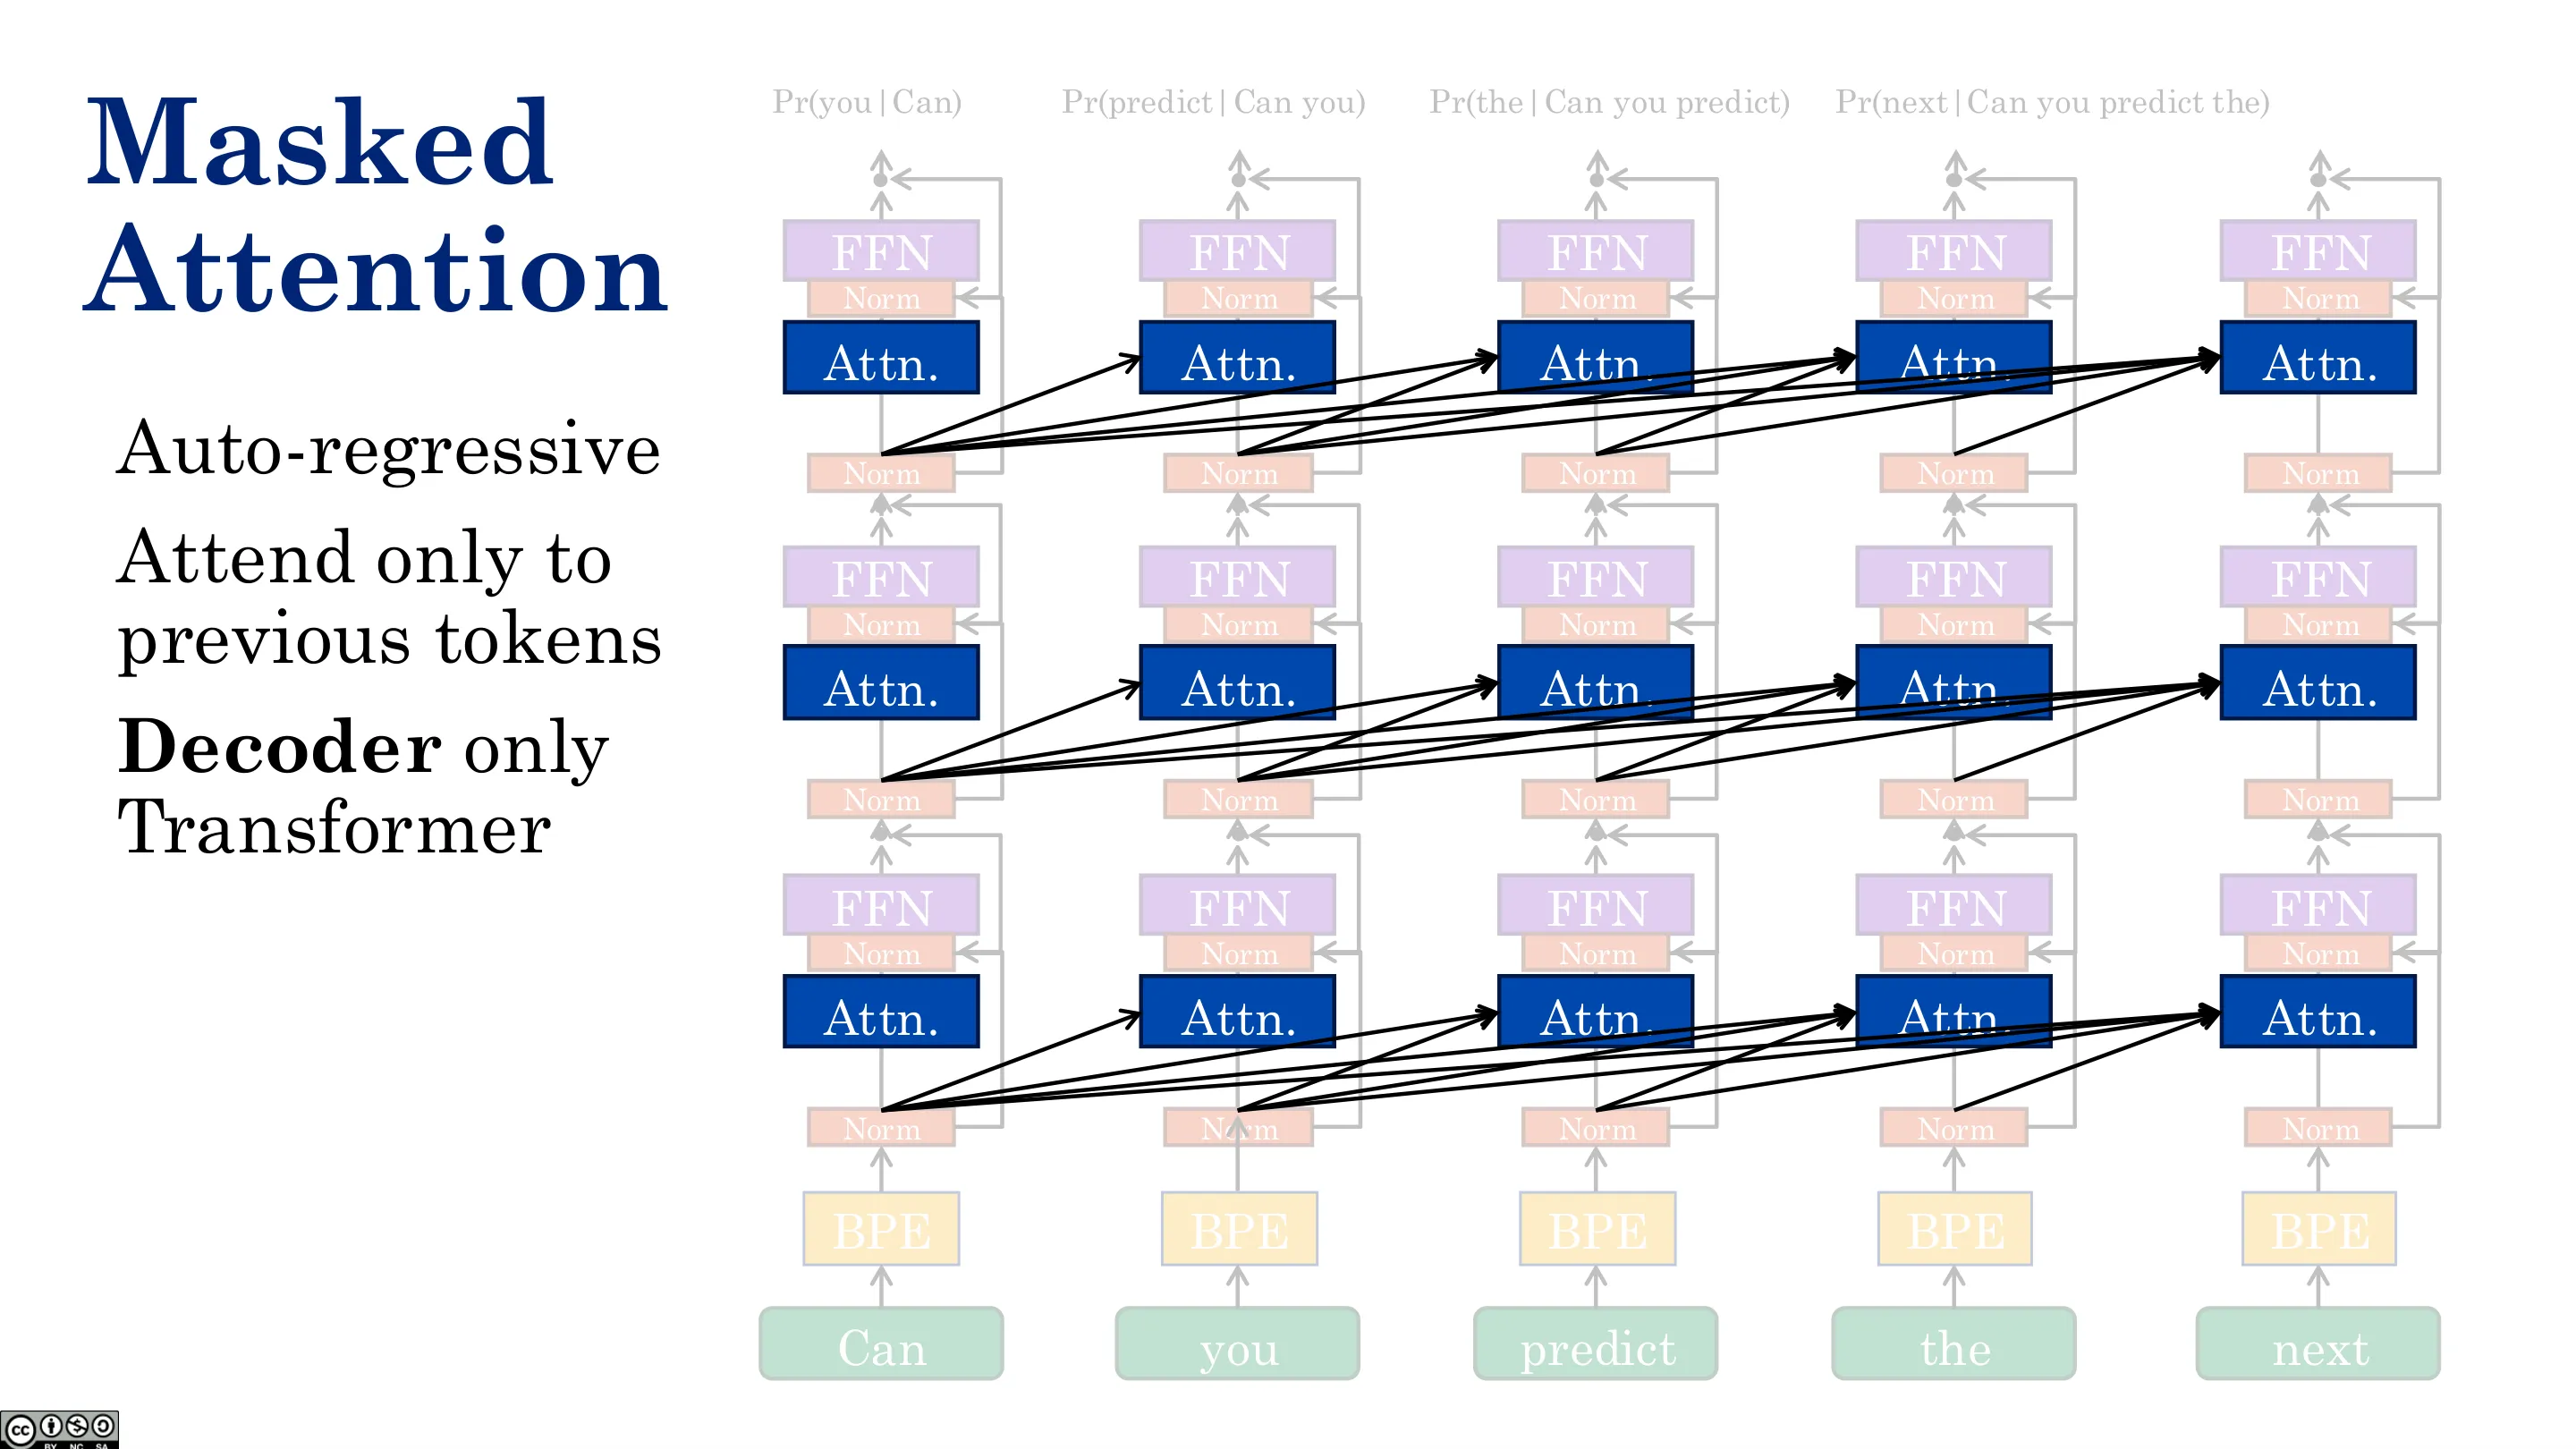
⚠️ 关键陷阱:如果允许注意力看到未来 token,模型会作弊——直接"抄"下一个词。因此预训练用 masked attention(因果掩码):把注意力矩阵的上三角(未来部分)置零,每个 token 只能看过去。
一个句子于是变成每 token 一个监督问题:
Pr(you|Can)、Pr(cat|the)……
📷 预测下一个 Token(一)
回到原视频 (00:13:43)
📷 建模下一个 token(一)
回到原视频 (00:14:56)
📷 建模下一个 token(二)
回到原视频 (00:16:09)
📷 嵌入表查表(一)
回到原视频 (00:17:22)
📷 嵌入表查表(二)
回到原视频 (00:18:35)
📷 位置编码(可选)
回到原视频 (00:19:48)
📷 用 Transformer 预测下一个 Token(一)
回到原视频 (00:21:01)
📷 用 Transformer 预测下一个 Token(二)
回到原视频 (00:22:14)
📷 用 Transformer 预测下一个 Token(三)
回到原视频 (00:23:27)
📷 用 Transformer 预测下一个 Token(四)
回到原视频 (00:24:40)
📷 训练模型
回到原视频 (00:25:53)
📷 什么是 ChatGPT?
回到原视频 (00:27:06)
📷 训练模型(续)
回到原视频 (00:28:19)
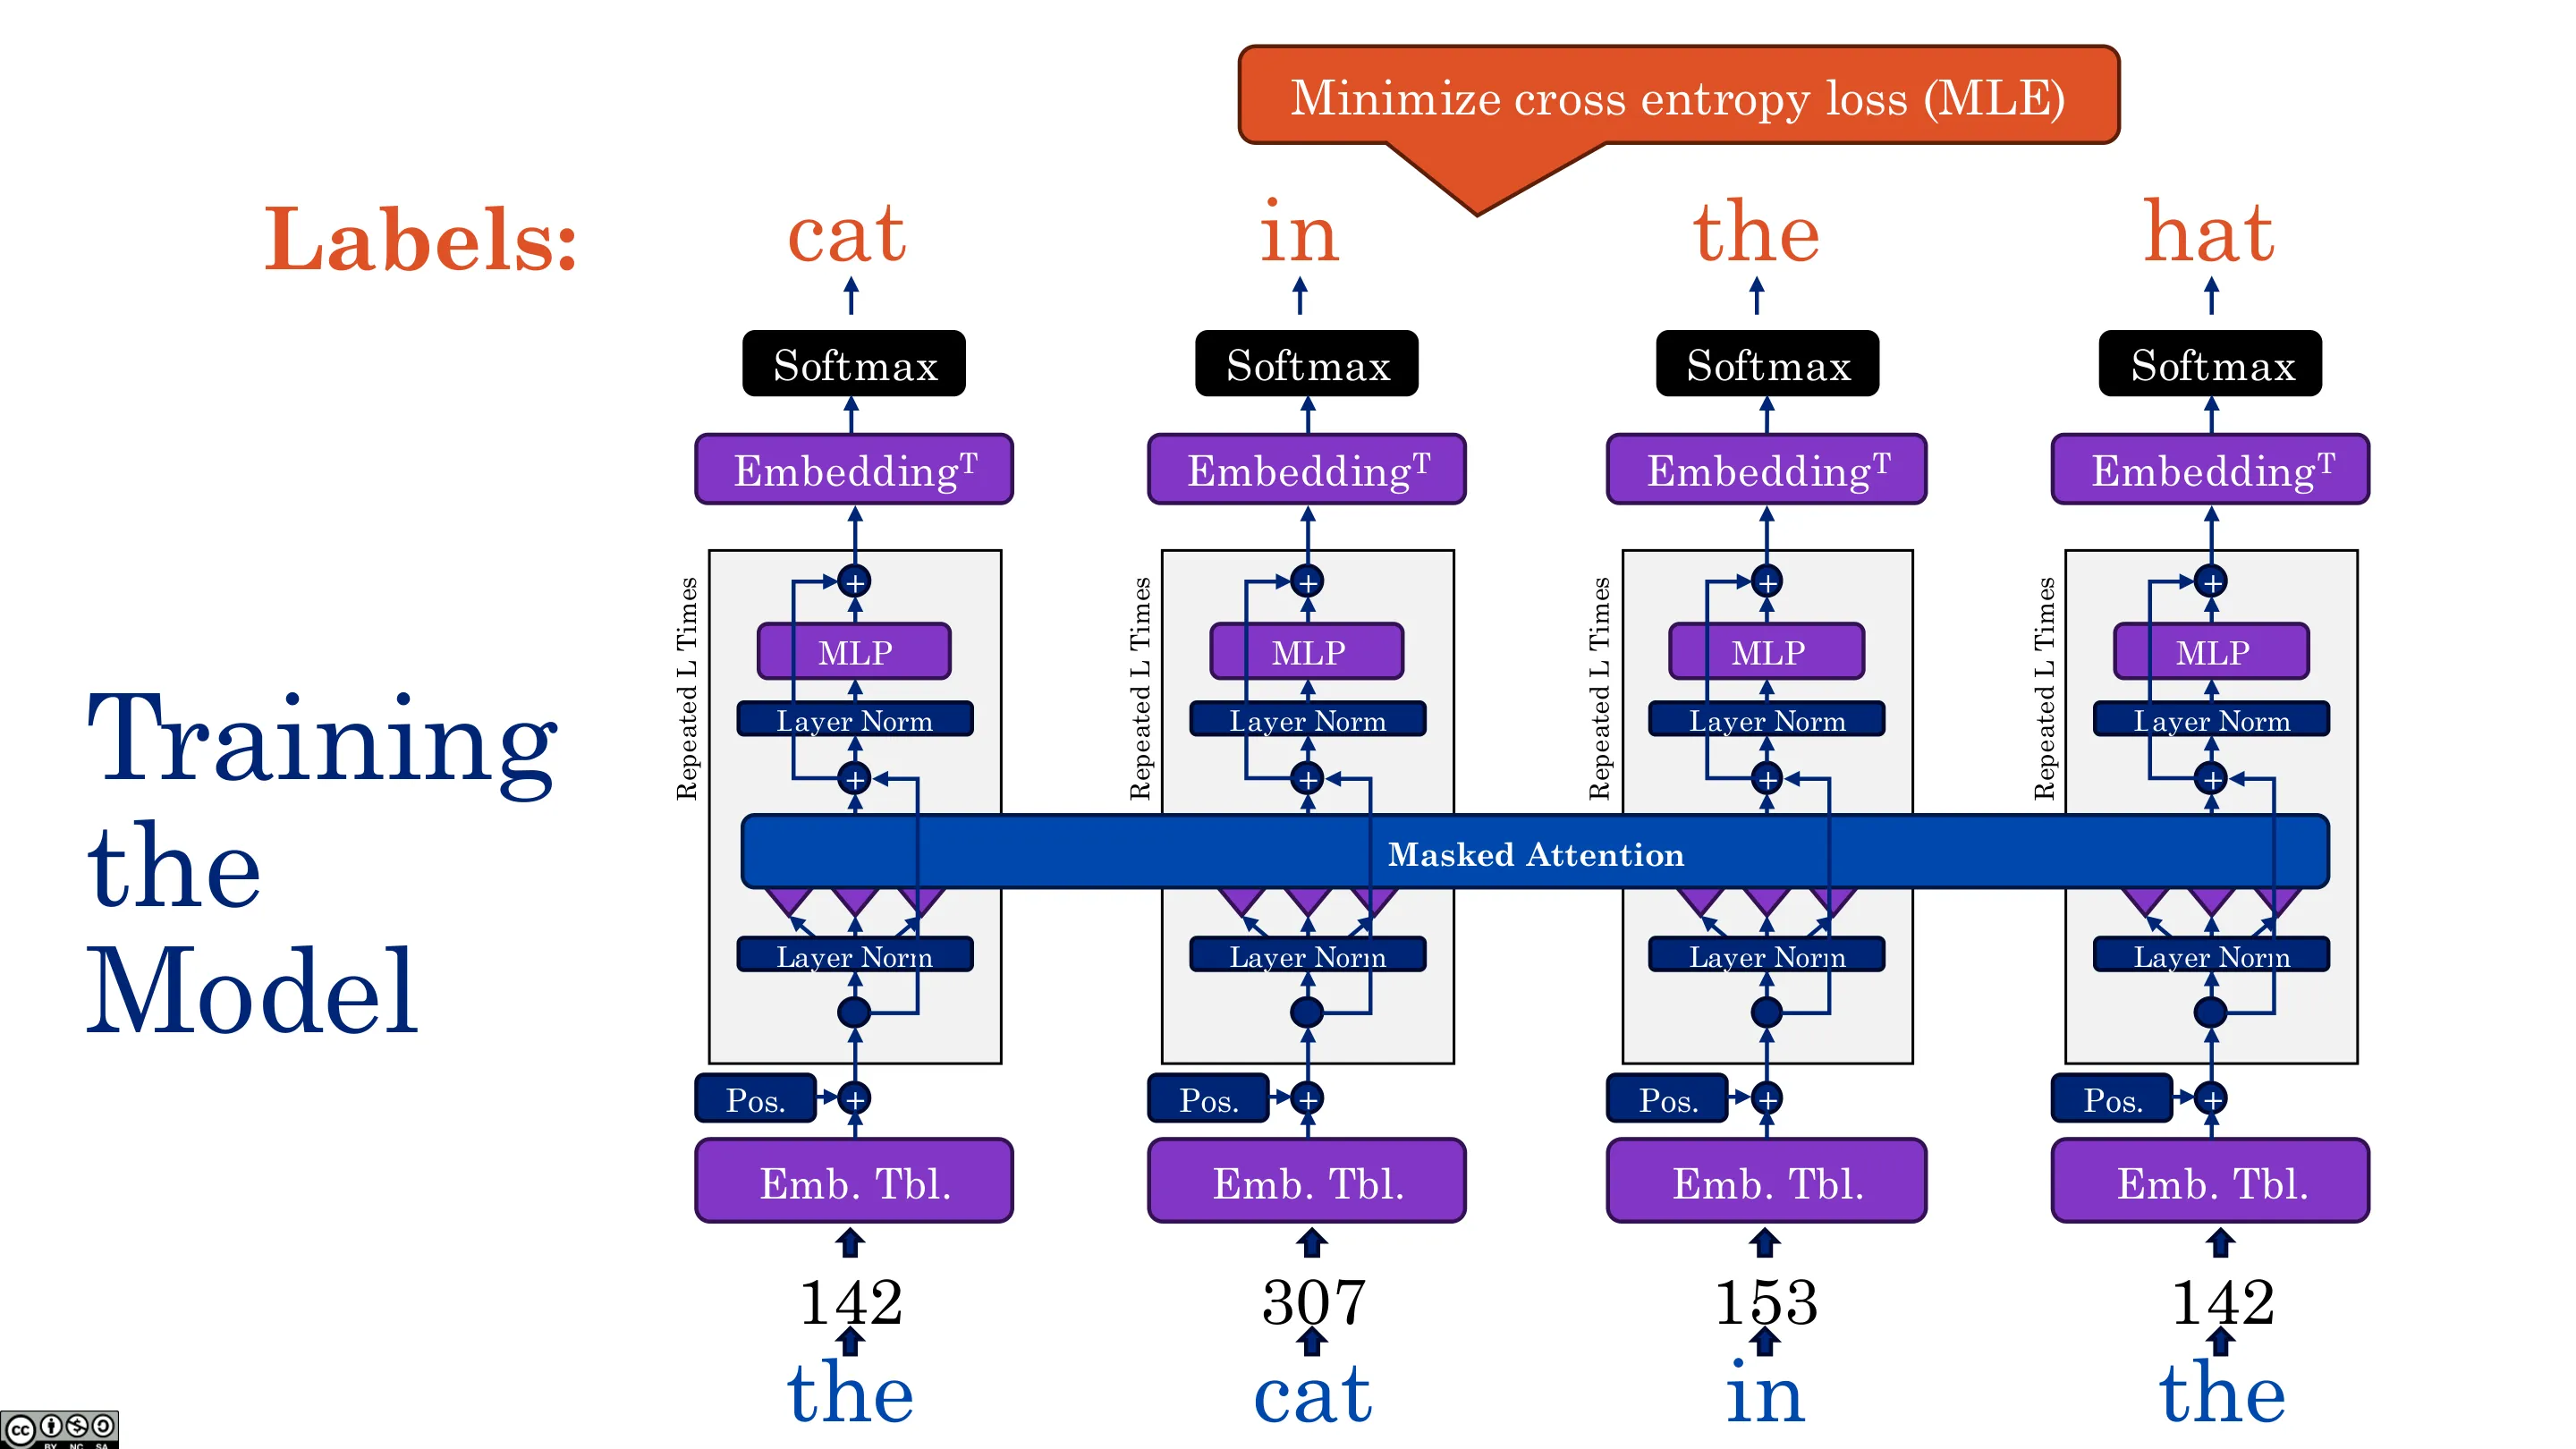
📷 训练
回到原视频 (00:29:32)
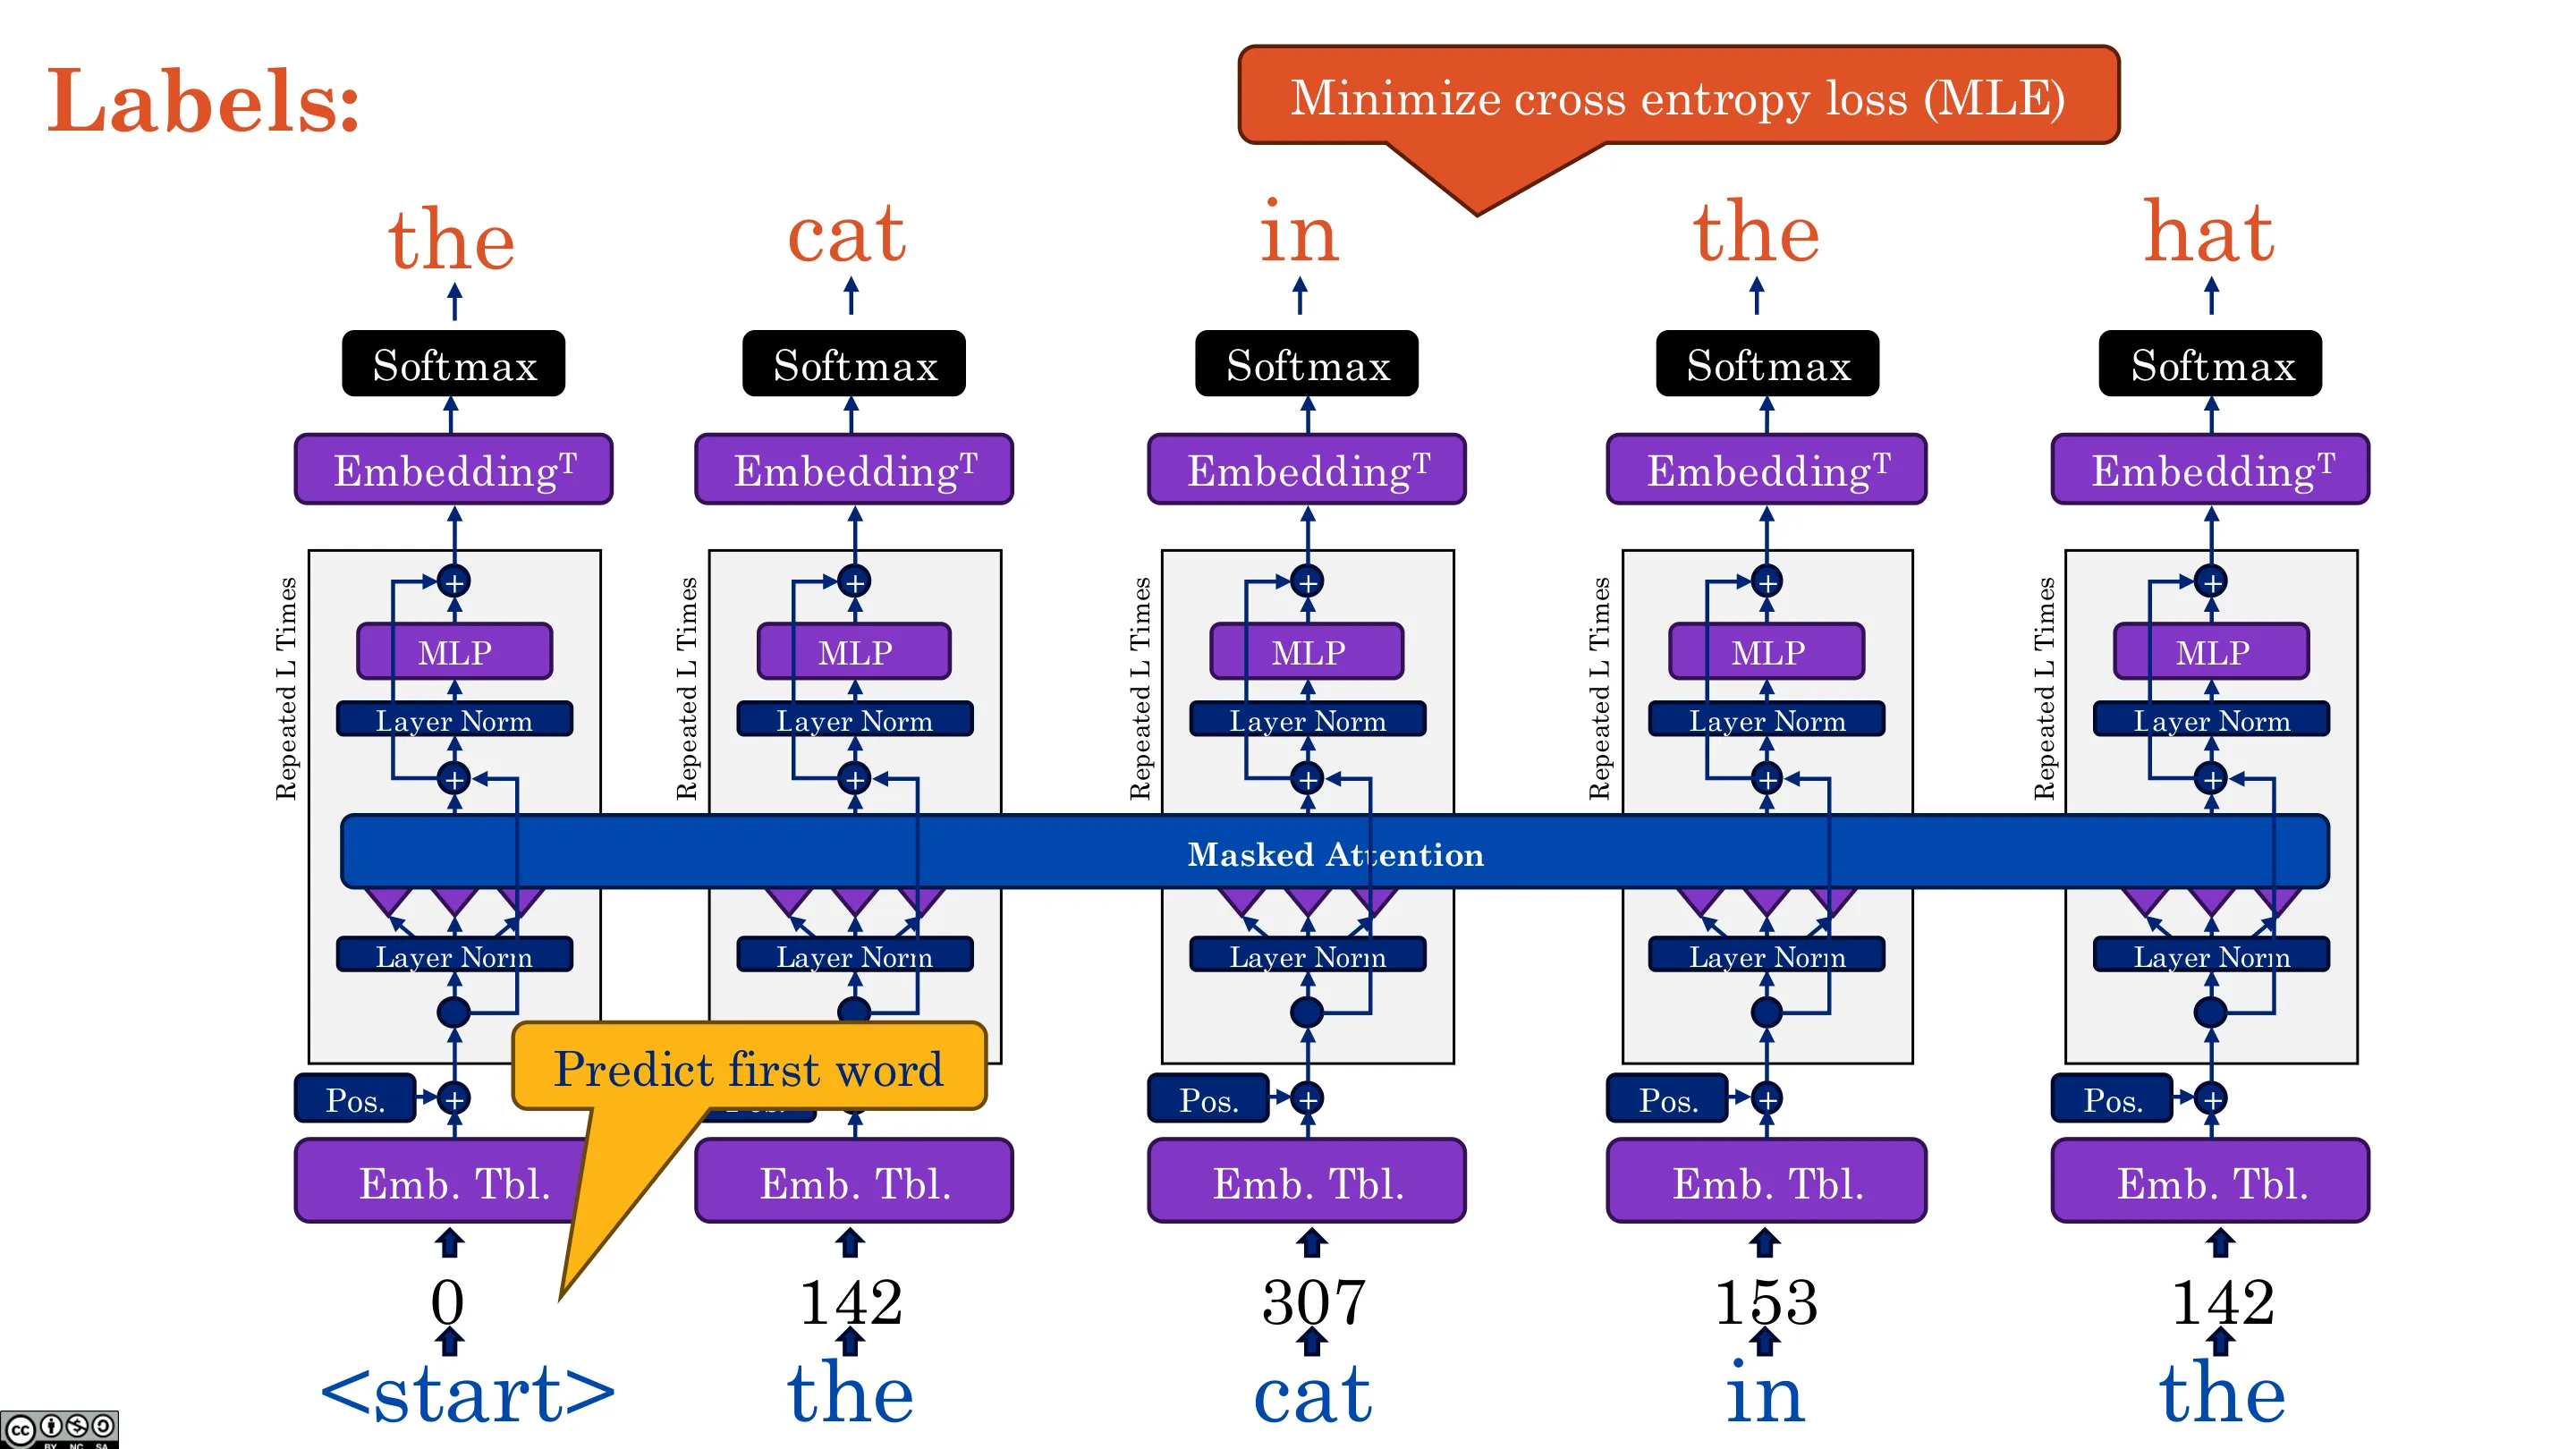
📷 MLP(一)
回到原视频 (00:30:45)
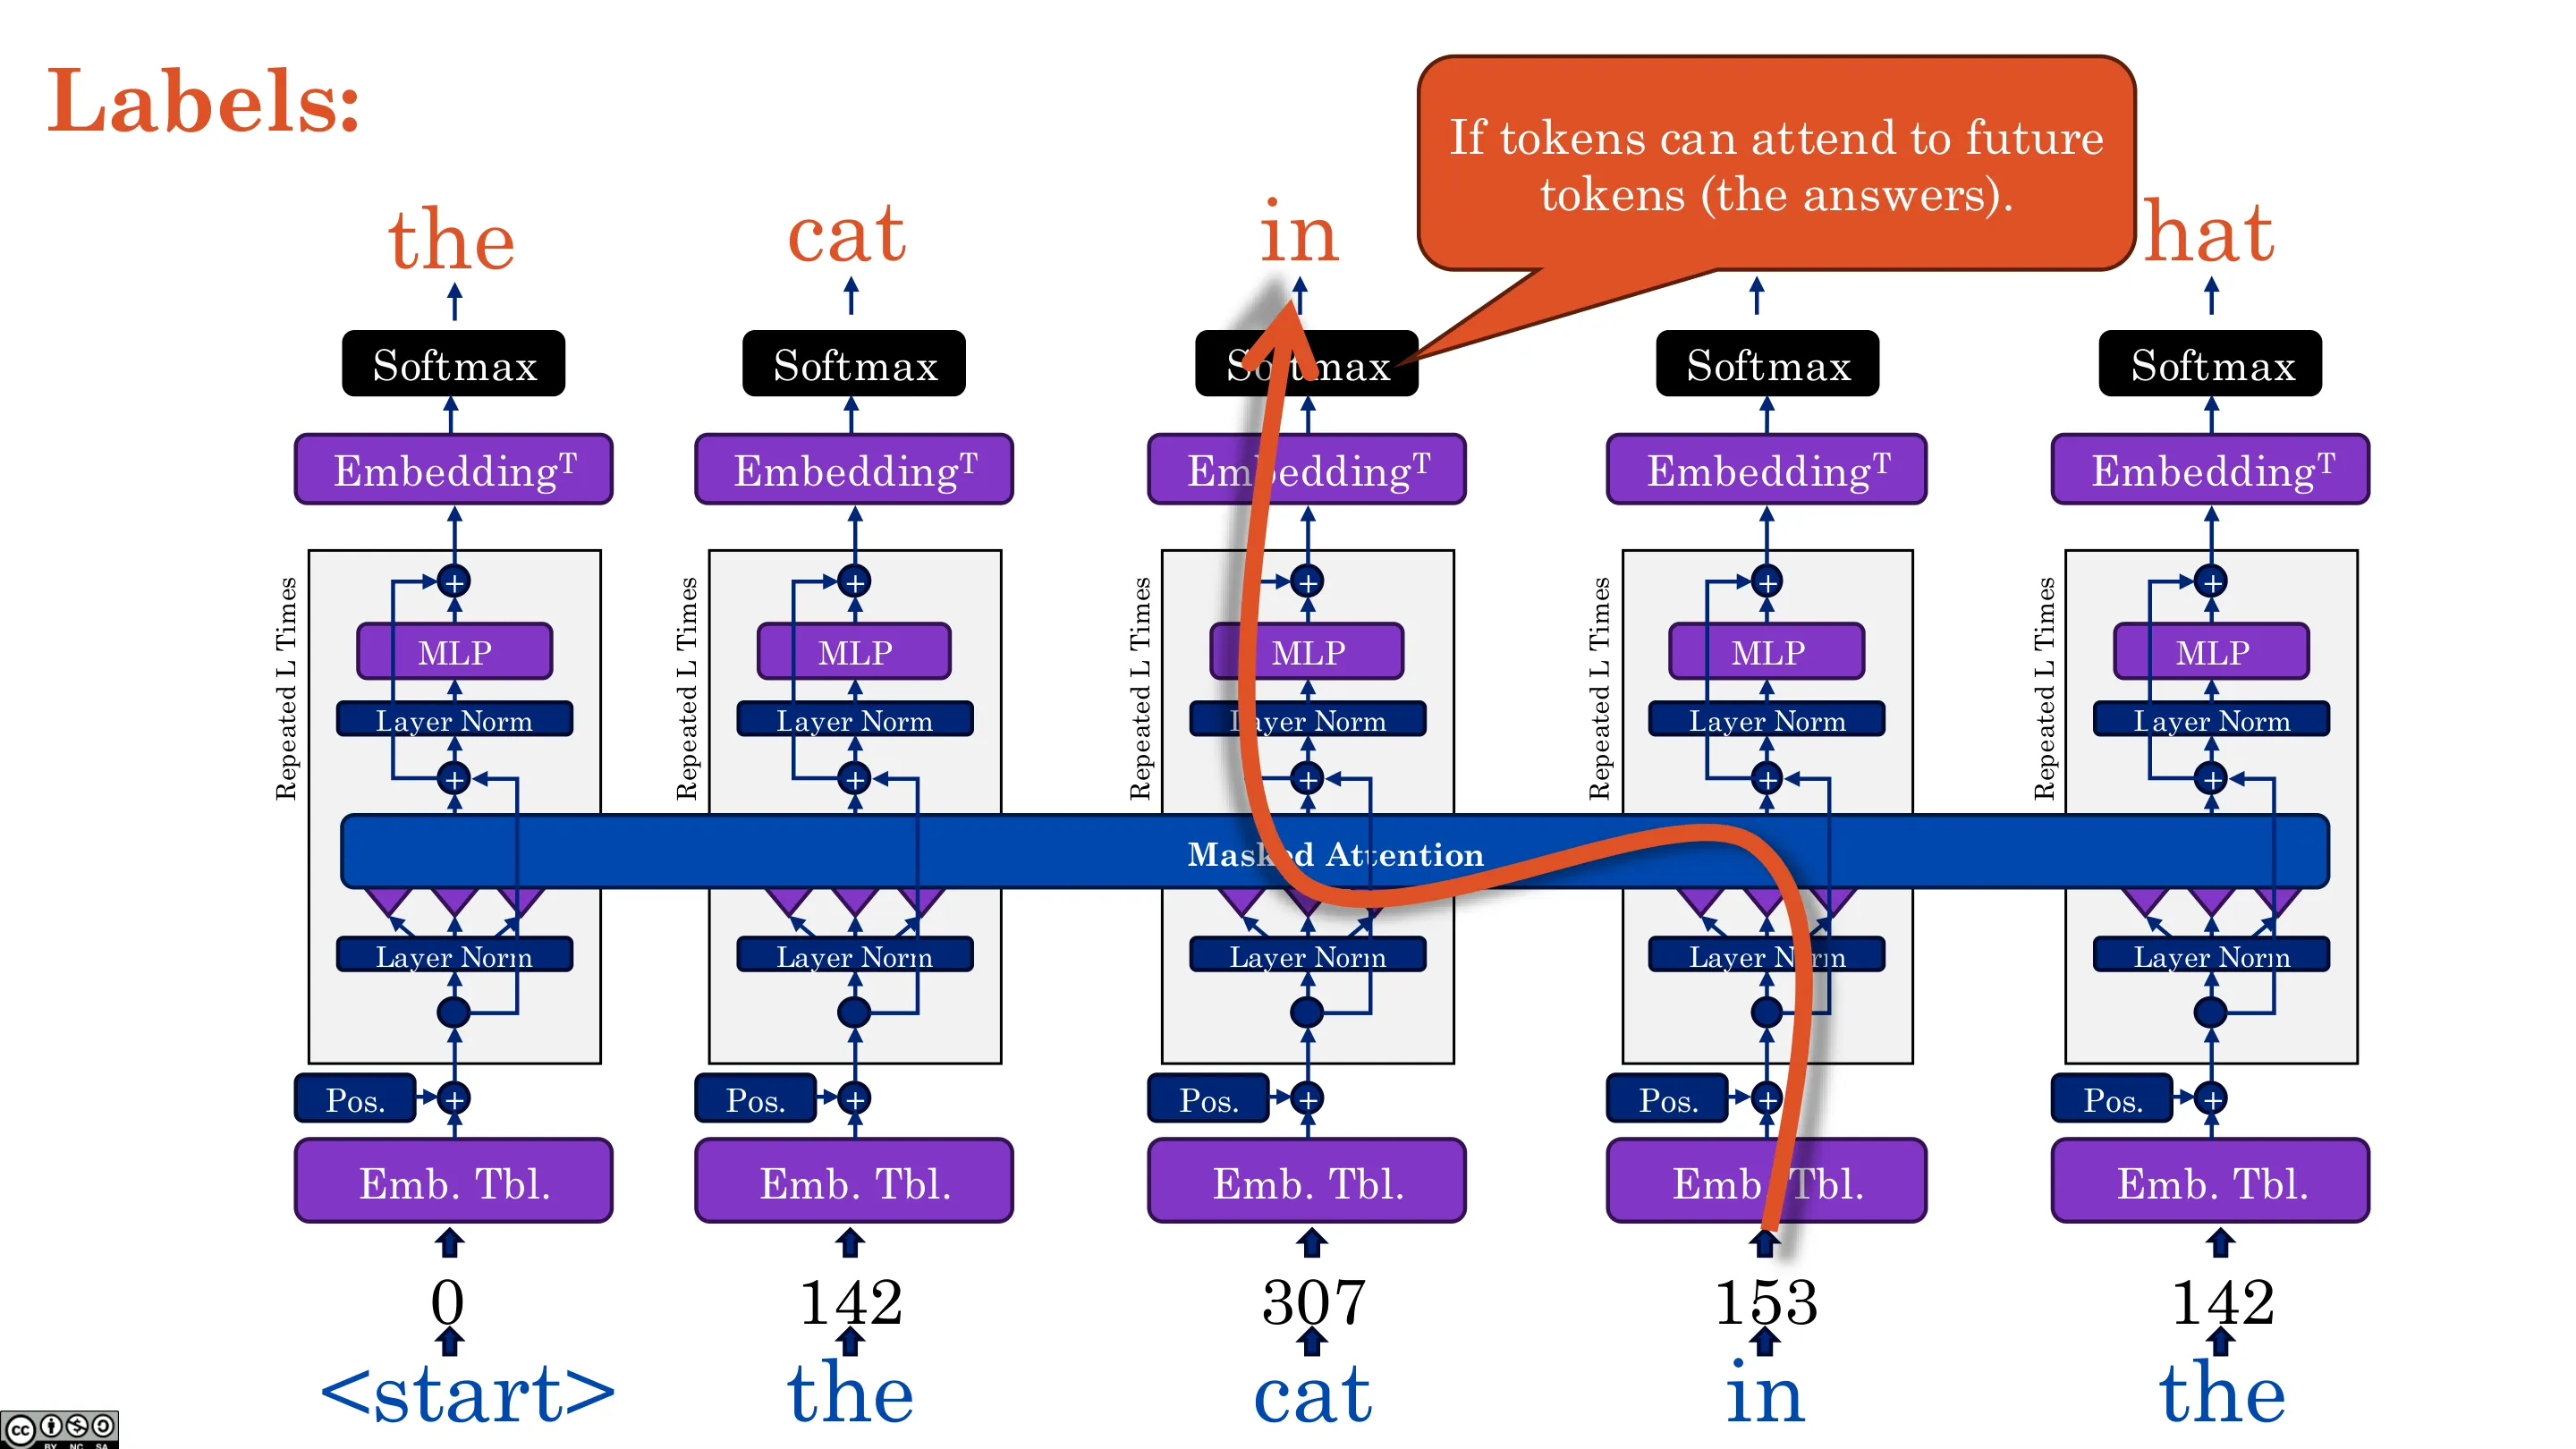
📷 MLP(二)
回到原视频 (00:31:58)
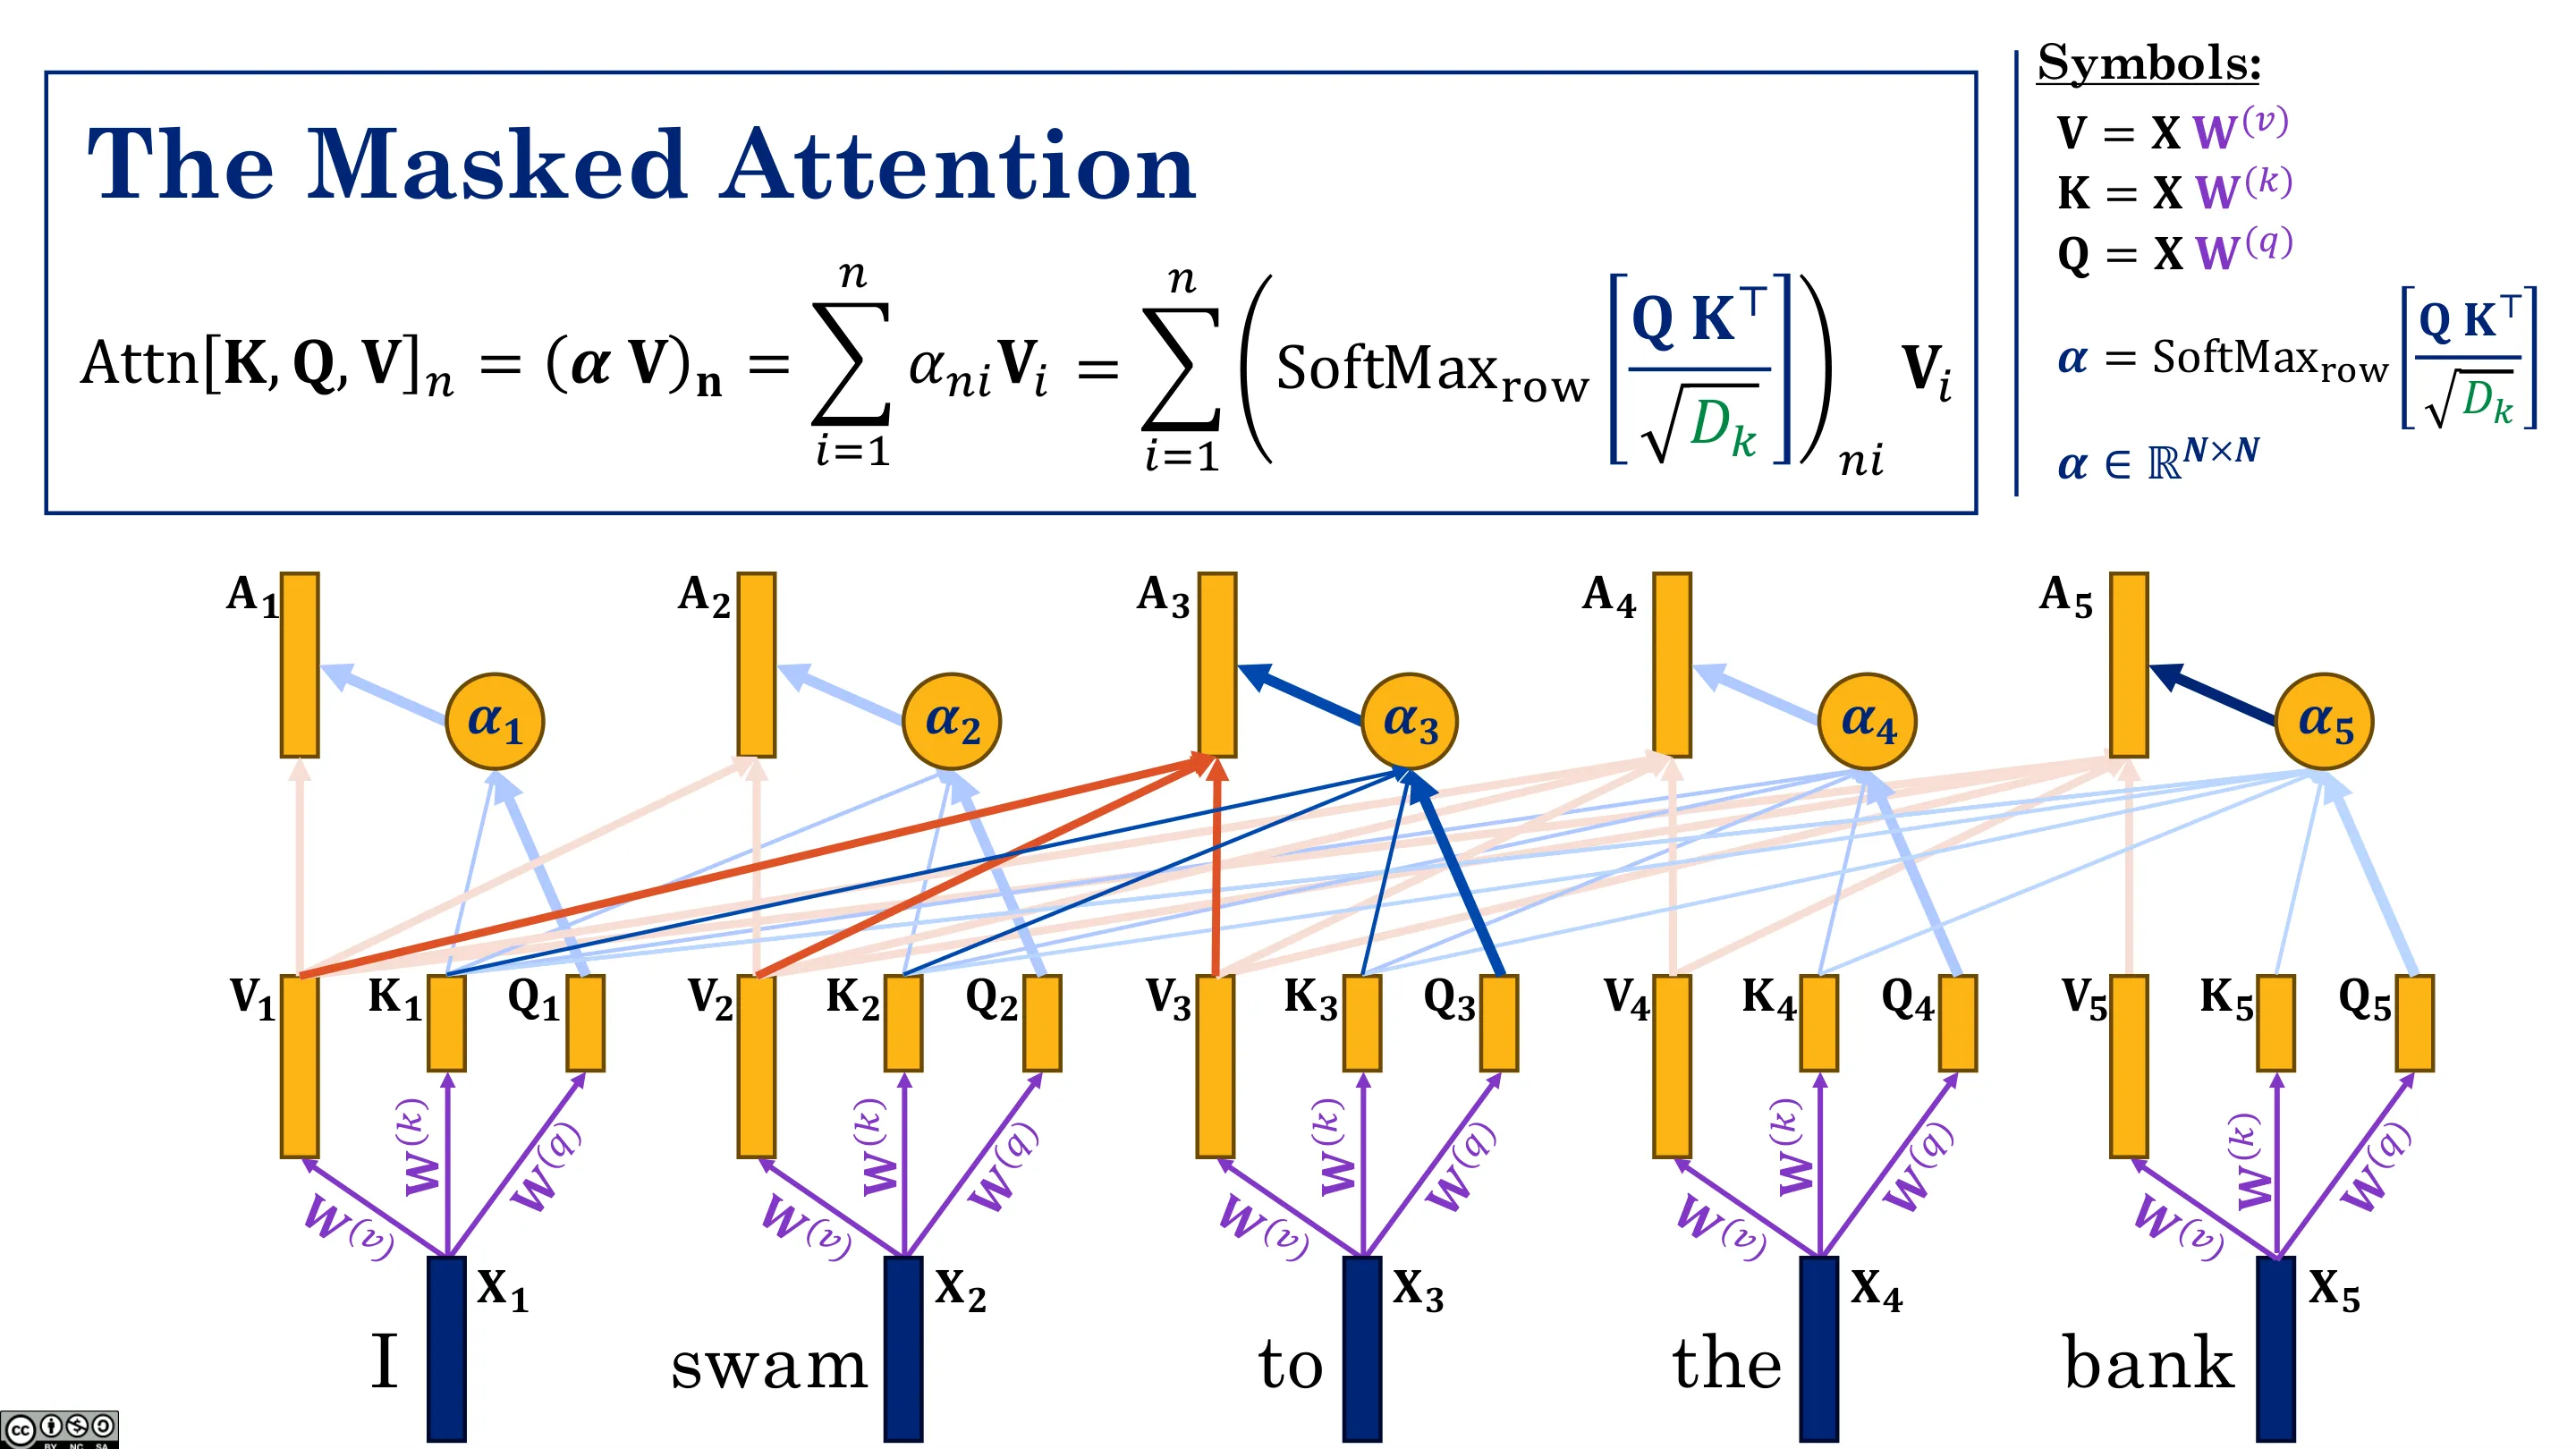
📷 $Q_2$
回到原视频 (00:33:11)
📷 展开(一)
回到原视频 (00:34:24)
📷 展开(二)
回到原视频 (00:35:37)
📷 展开(三)
回到原视频 (00:36:50)
📷 展开(四)
回到原视频 (00:38:03)
📷 $\Pr(\text{you}\mid\text{Can})$
回到原视频 (00:39:16)
📷 编码器
回到原视频 (00:40:29)
四、从文本到多模态
(参考时间: 00:45)
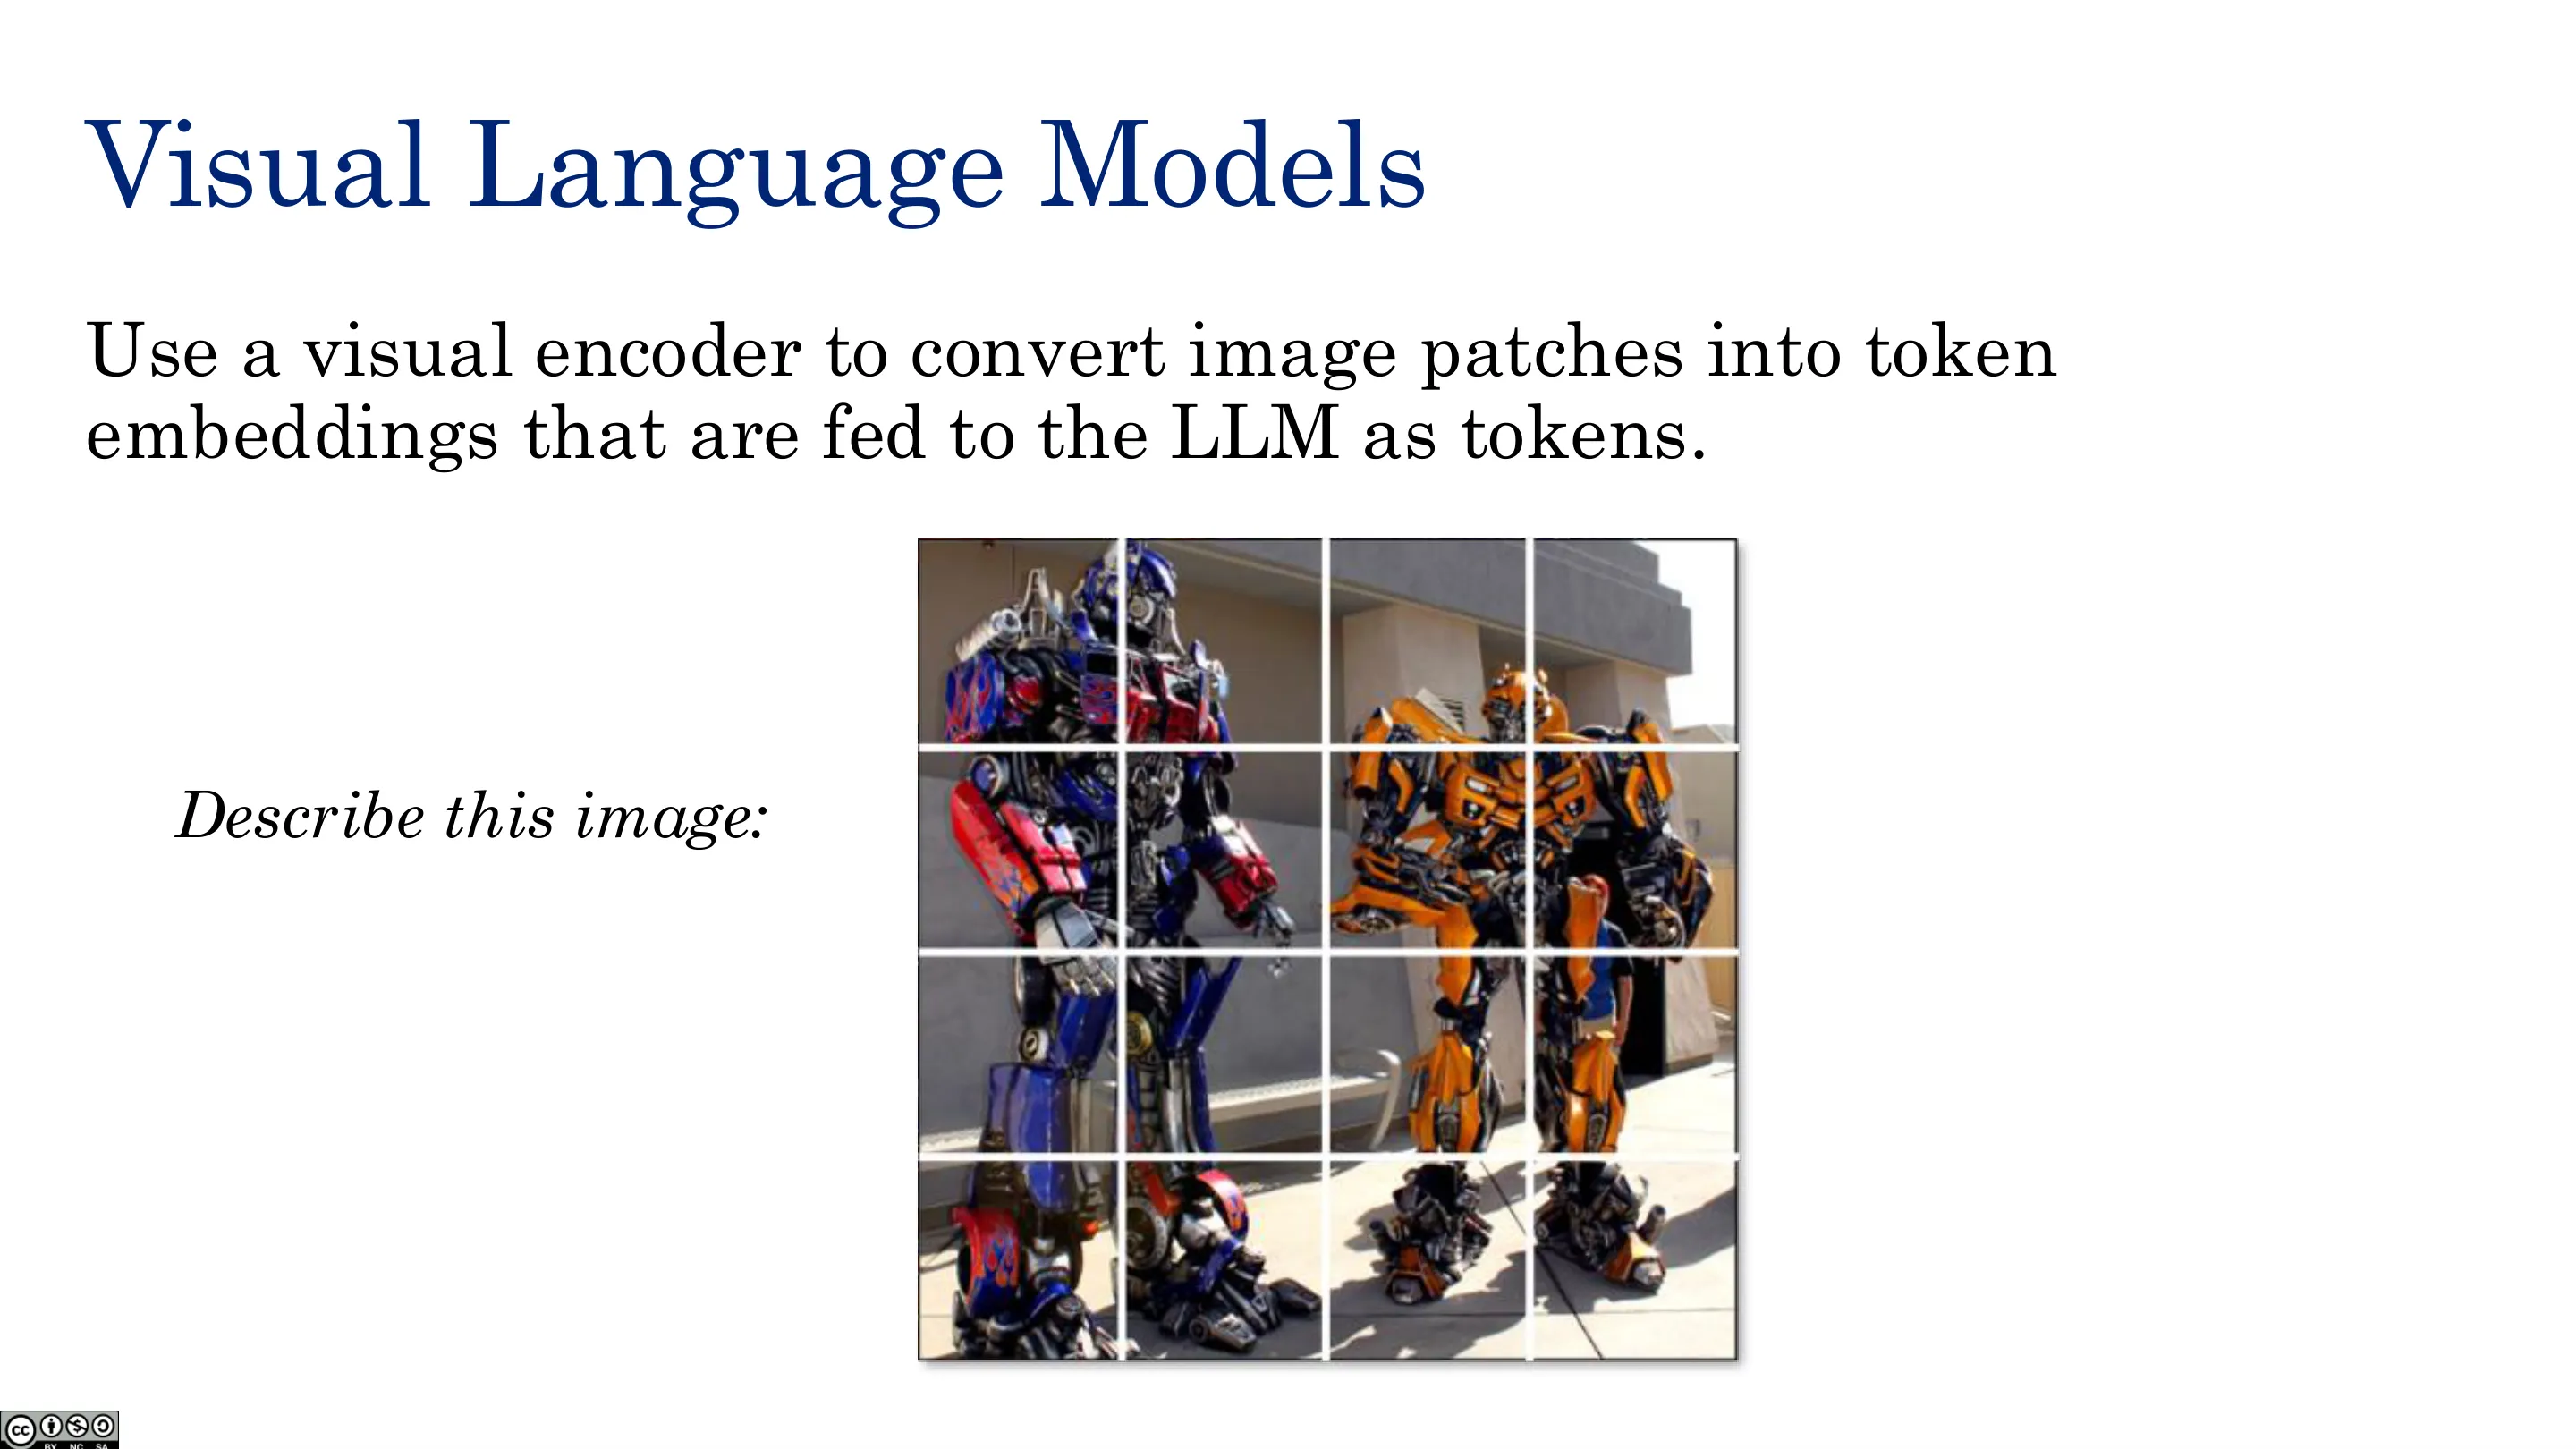
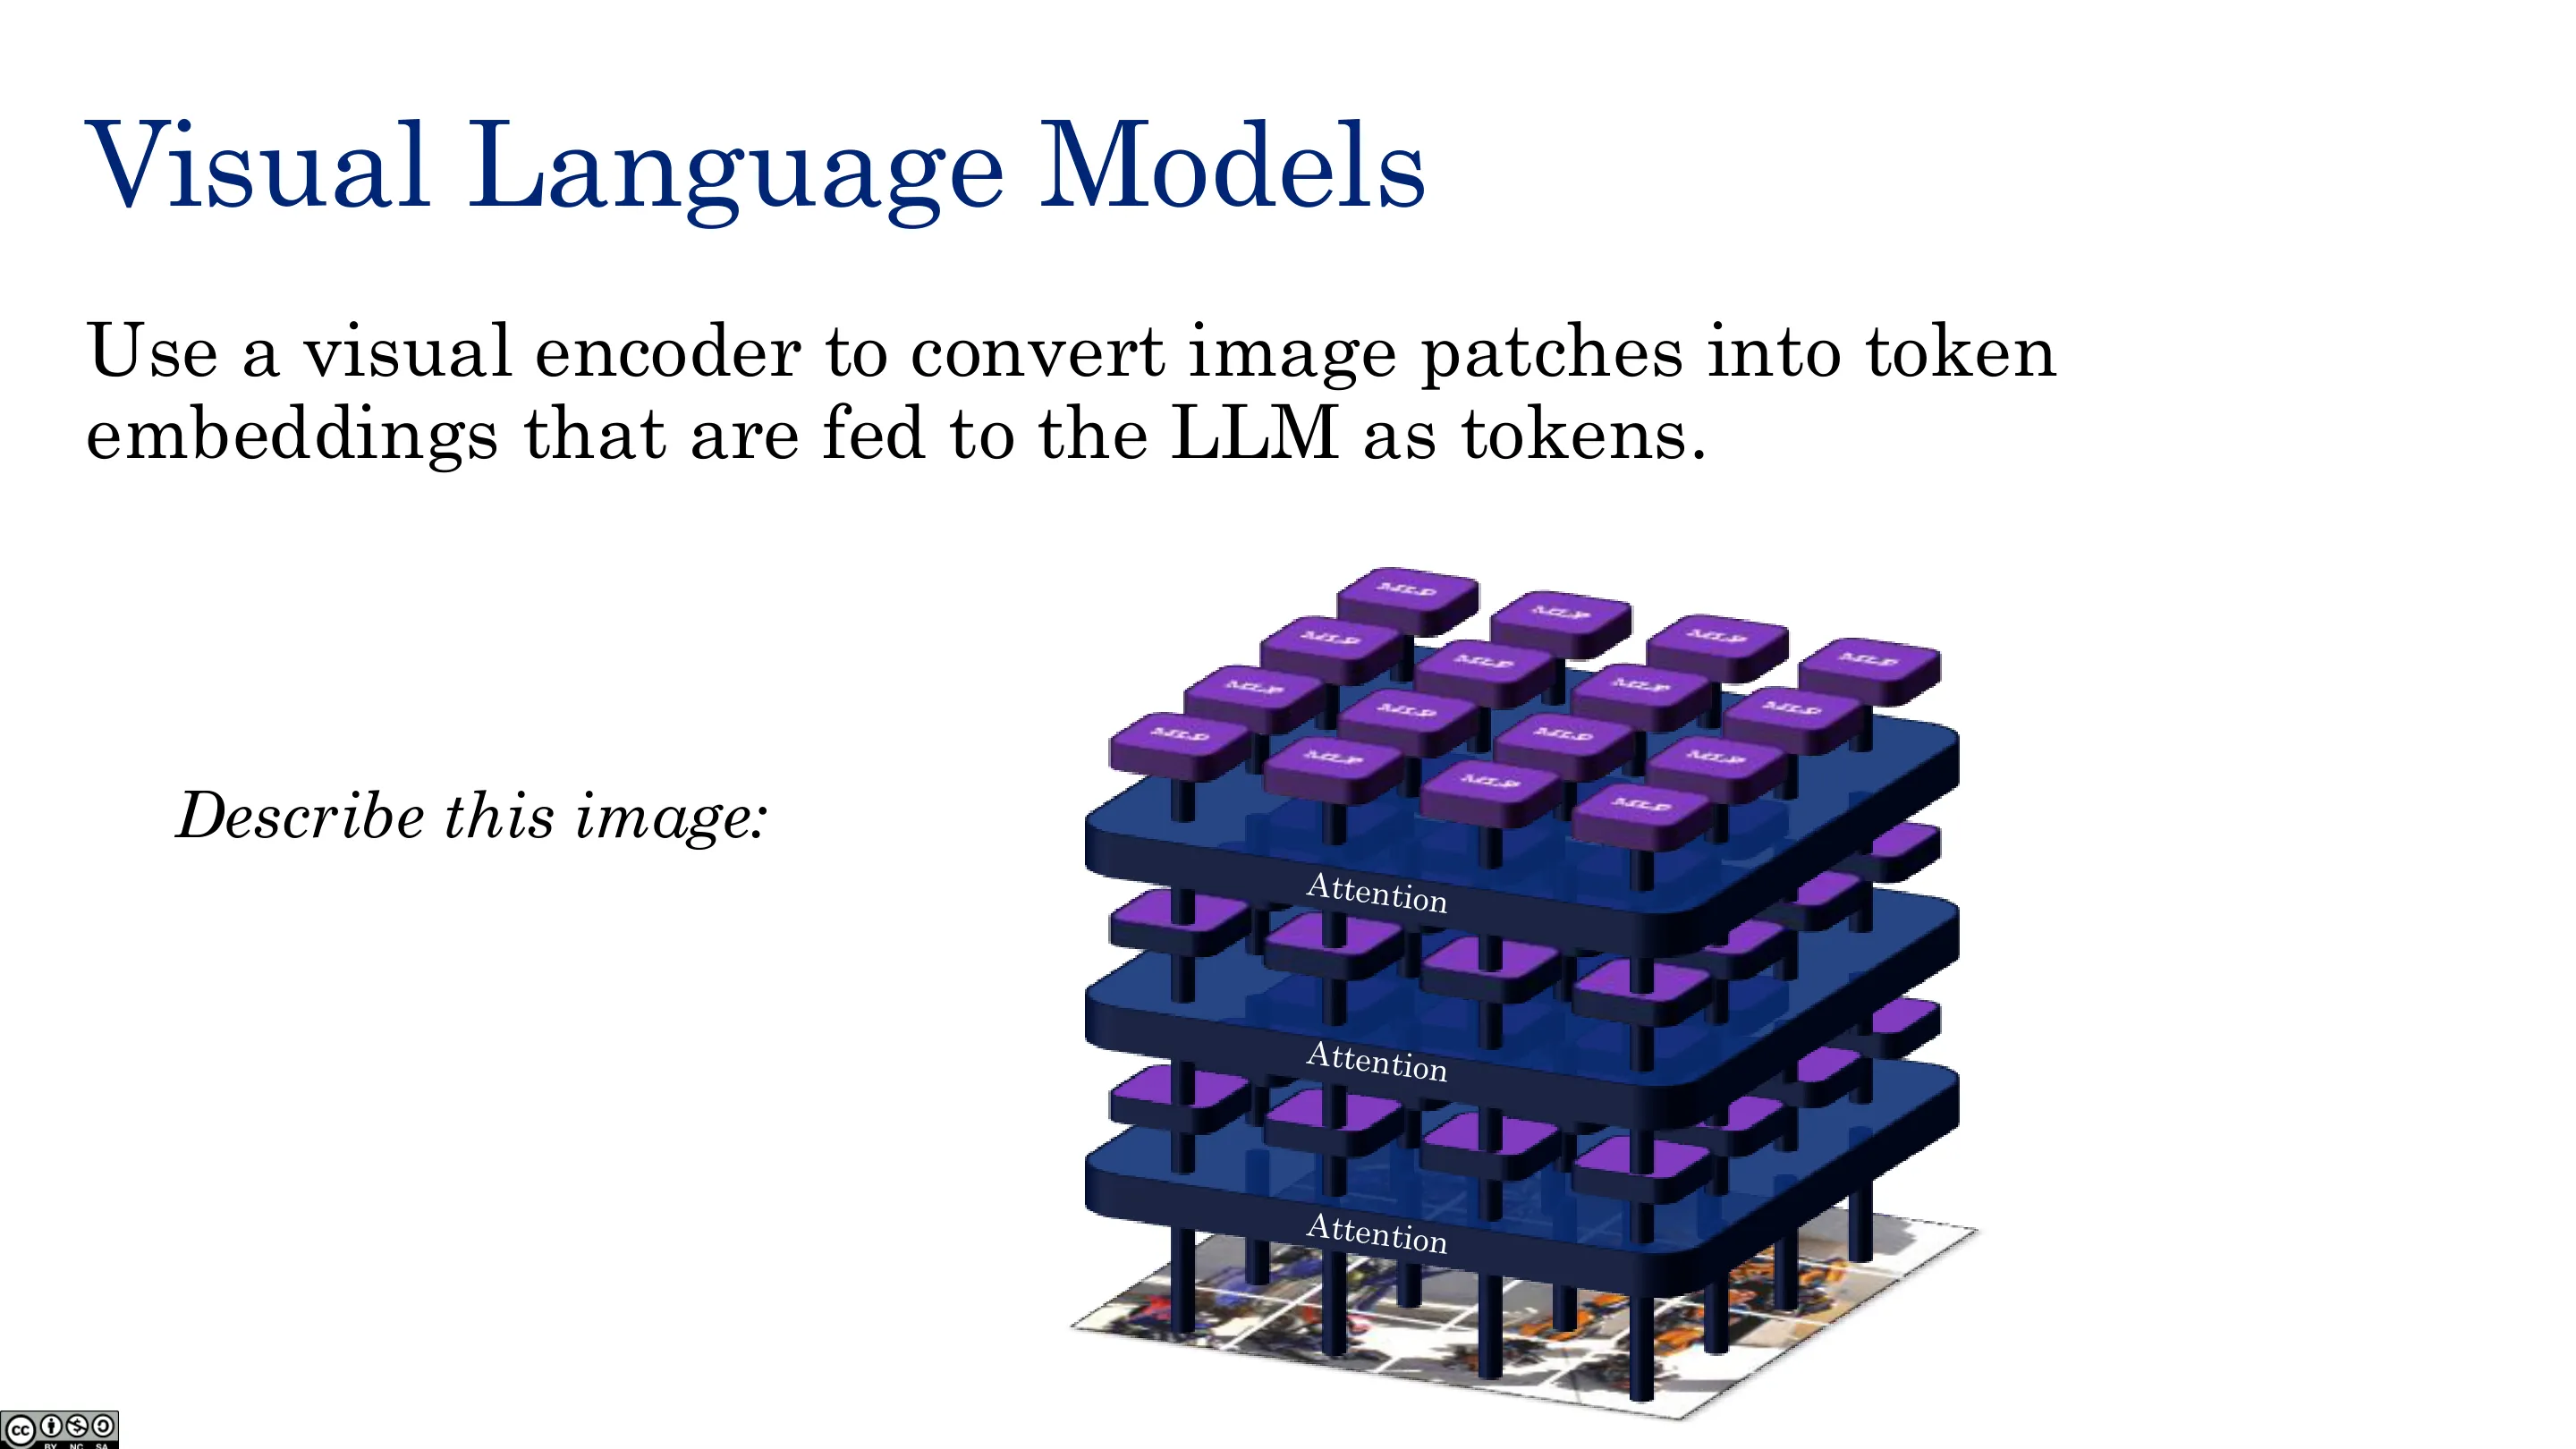
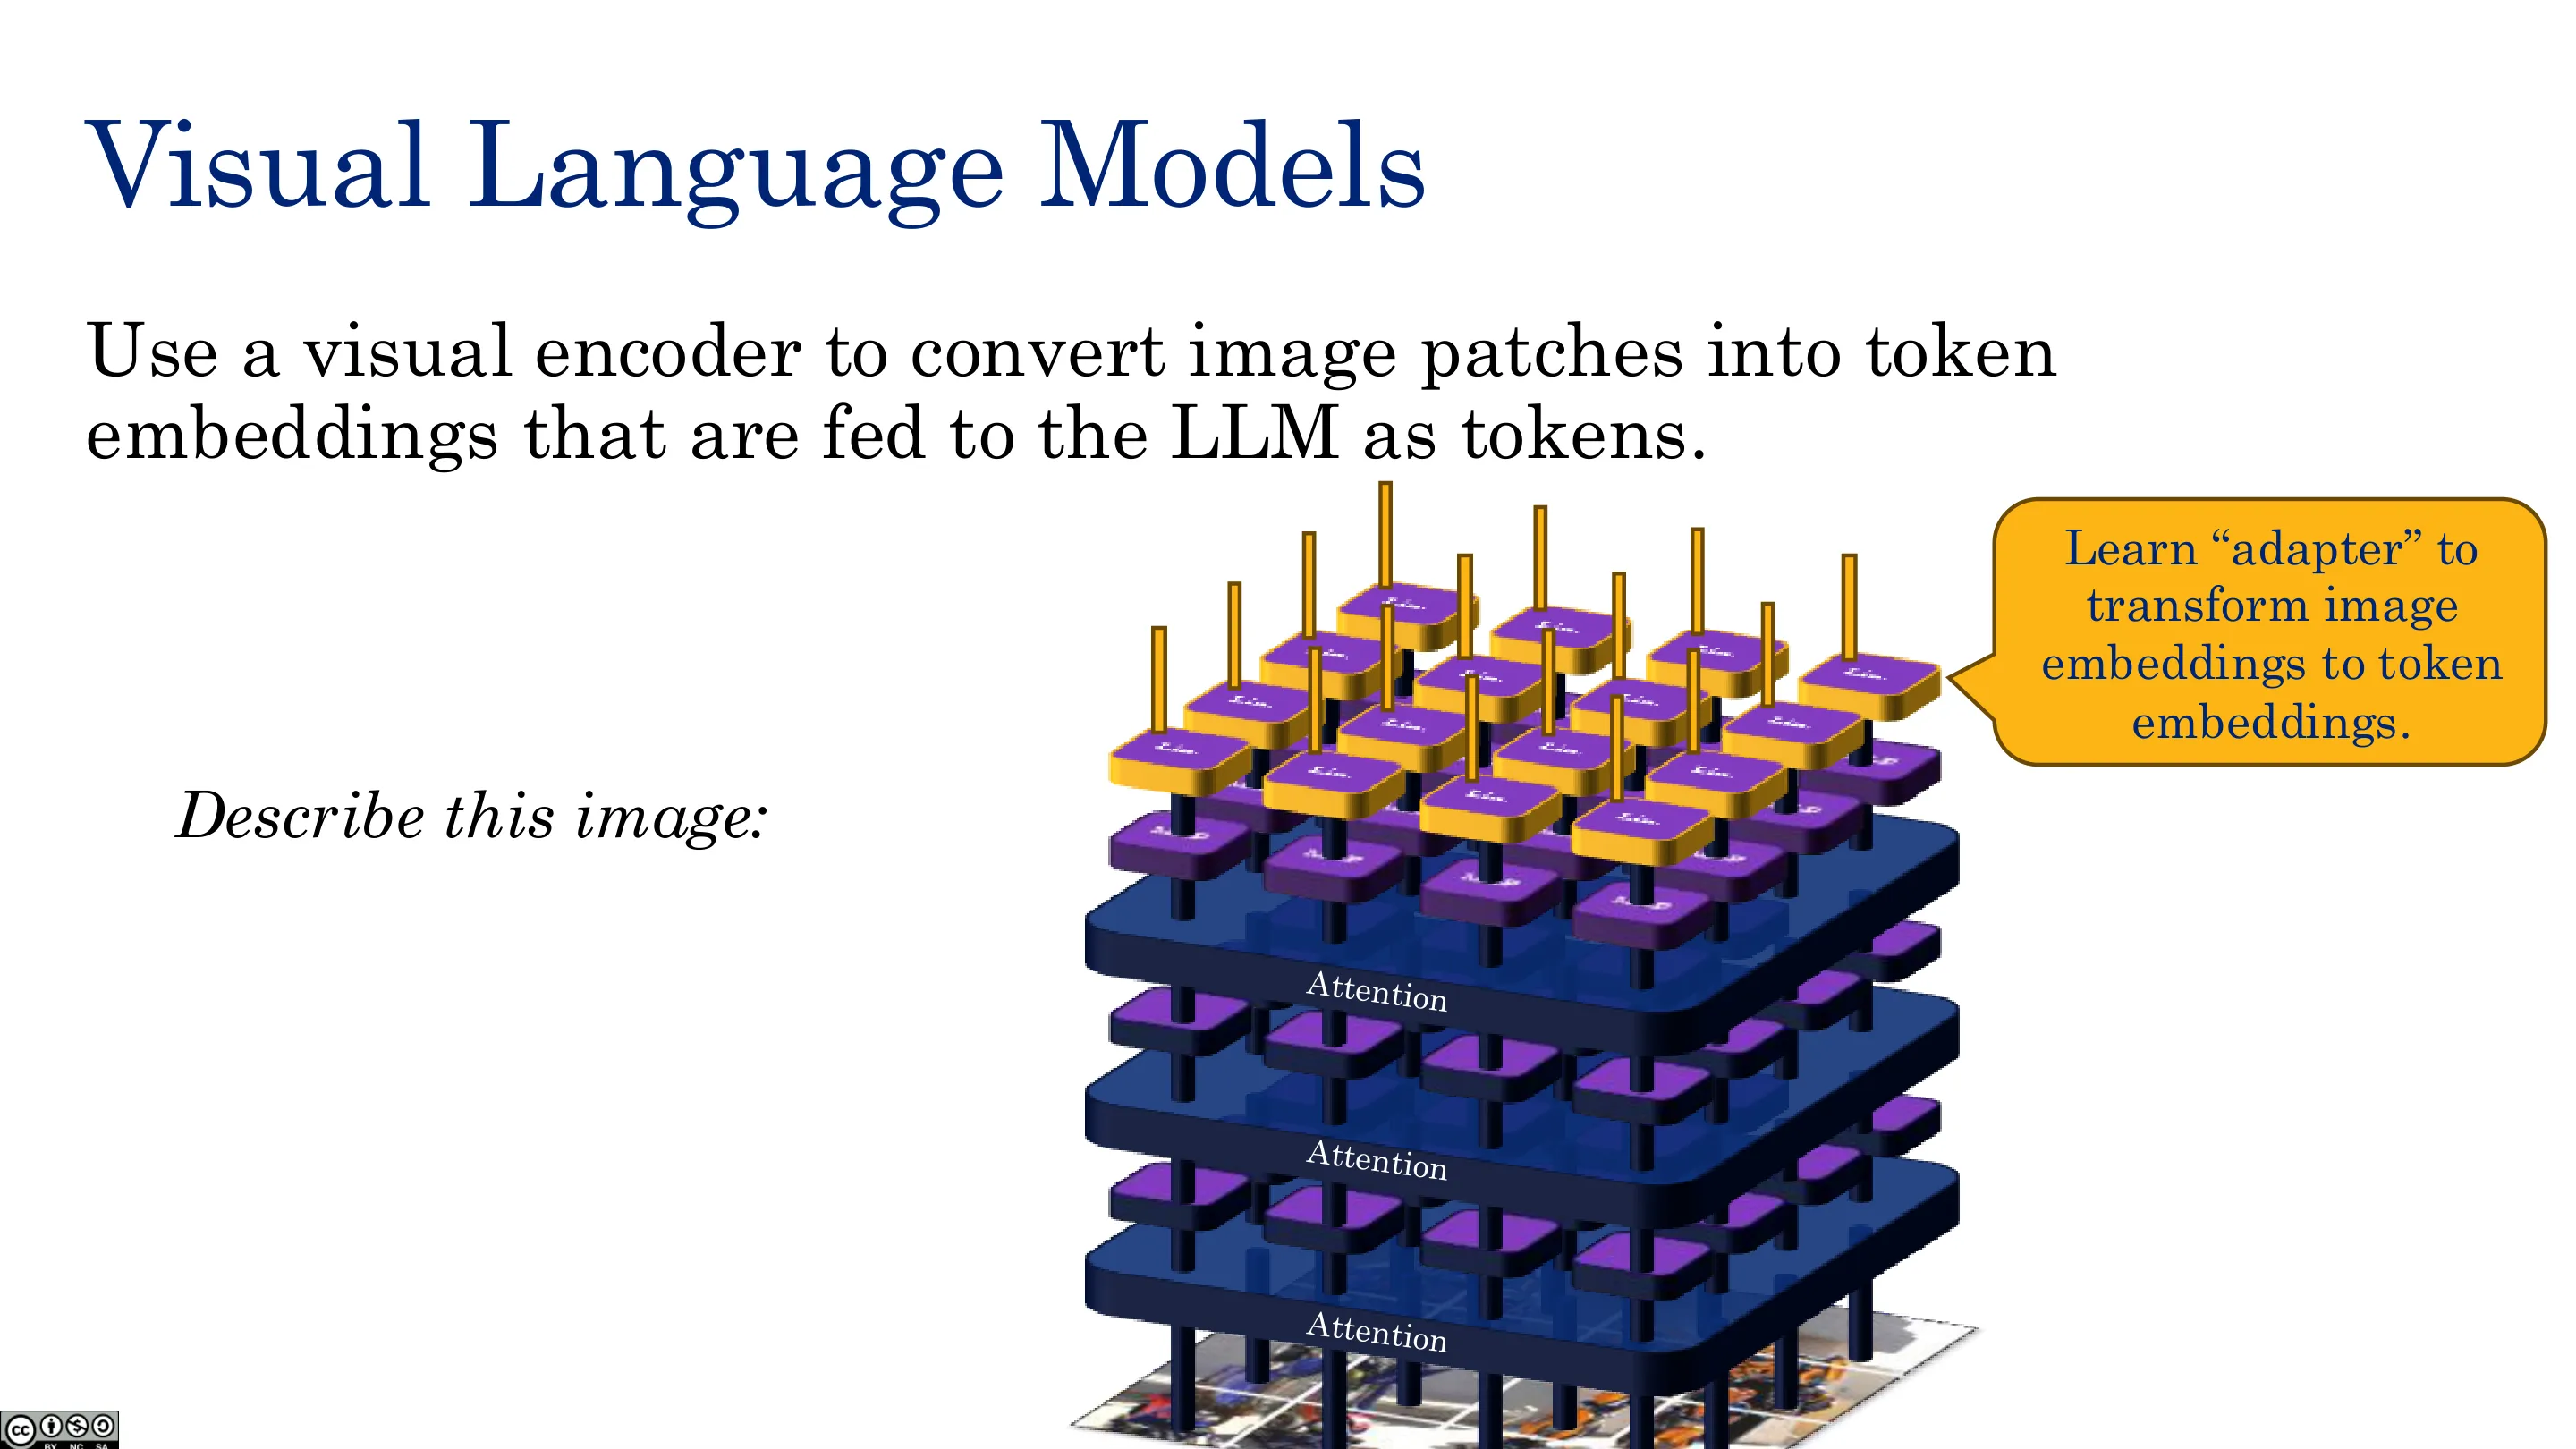
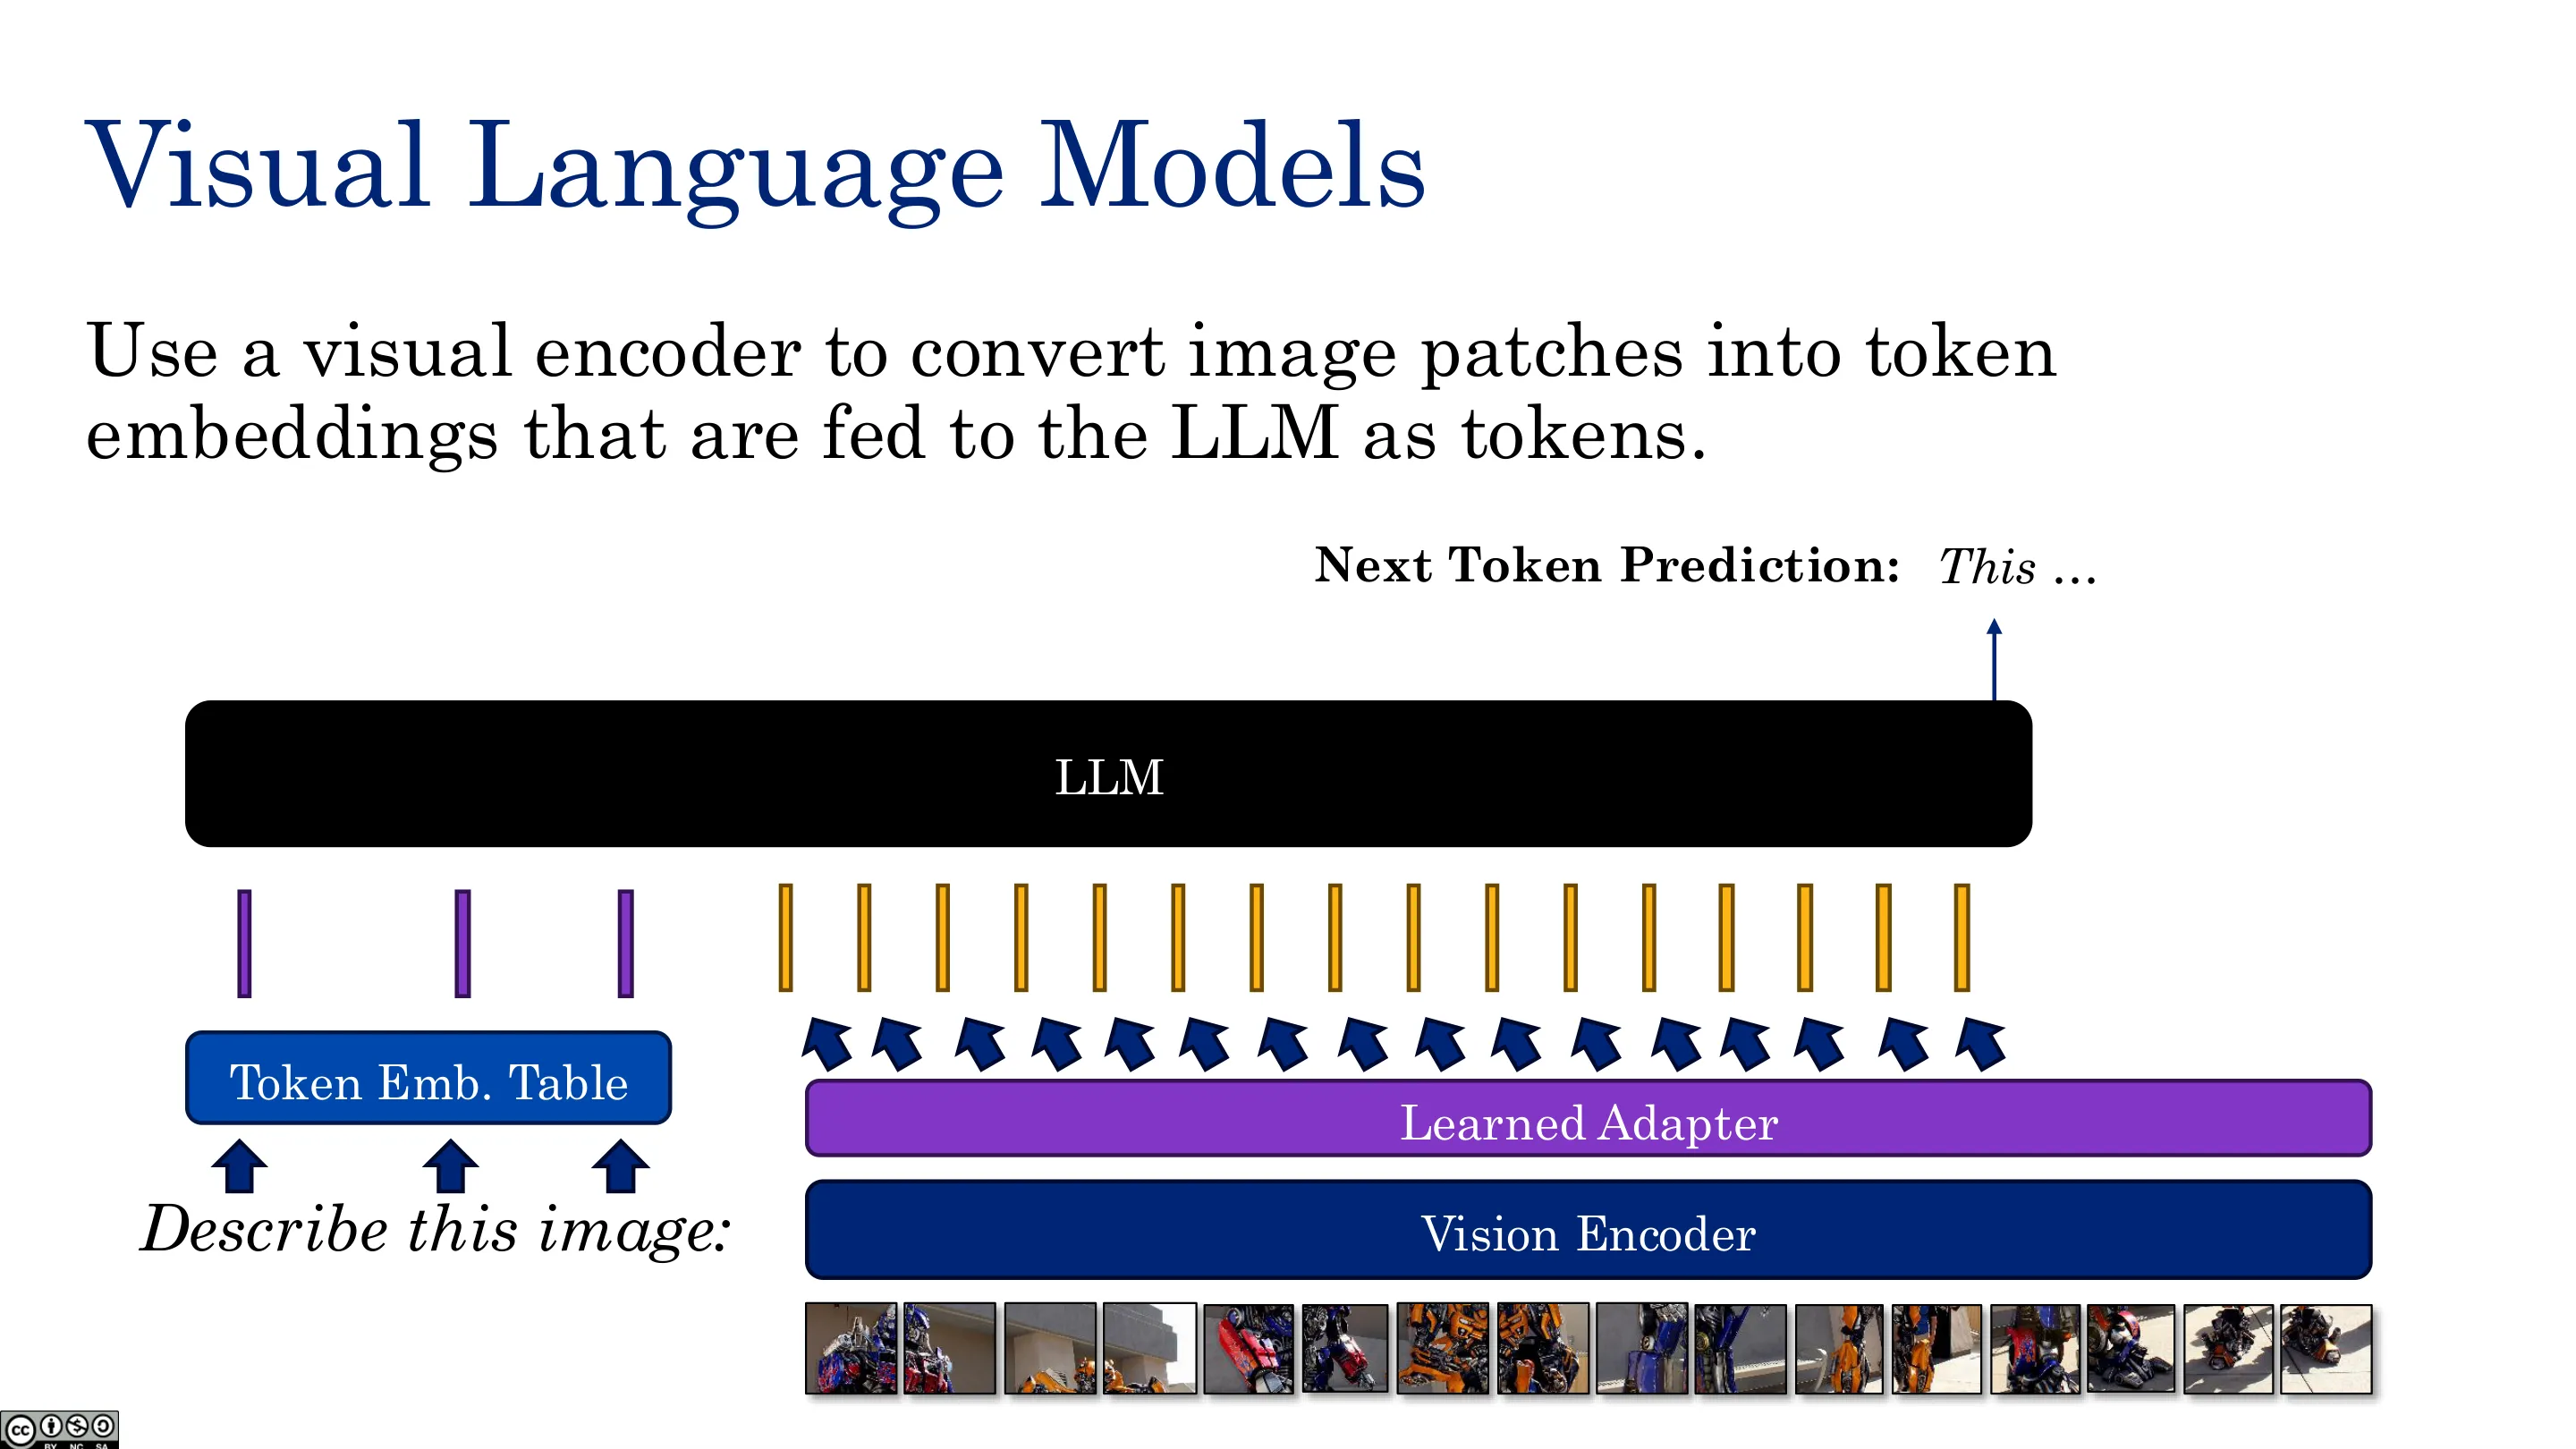
视觉语言模型(VLM):把图像切成 $16\times16$ 的 patch,每个 patch 是一个 token,加上二维位置编码,送进同一套 Transformer。图片描述任务中,图像 token 与文本 token 通过一个 adapter / 视觉编码器映射到同一维度,然后 LLM 自回归解码(逐个采样下一个词,再喂回)。
一切皆 token:文本、图像、音频、视频都能统一处理。
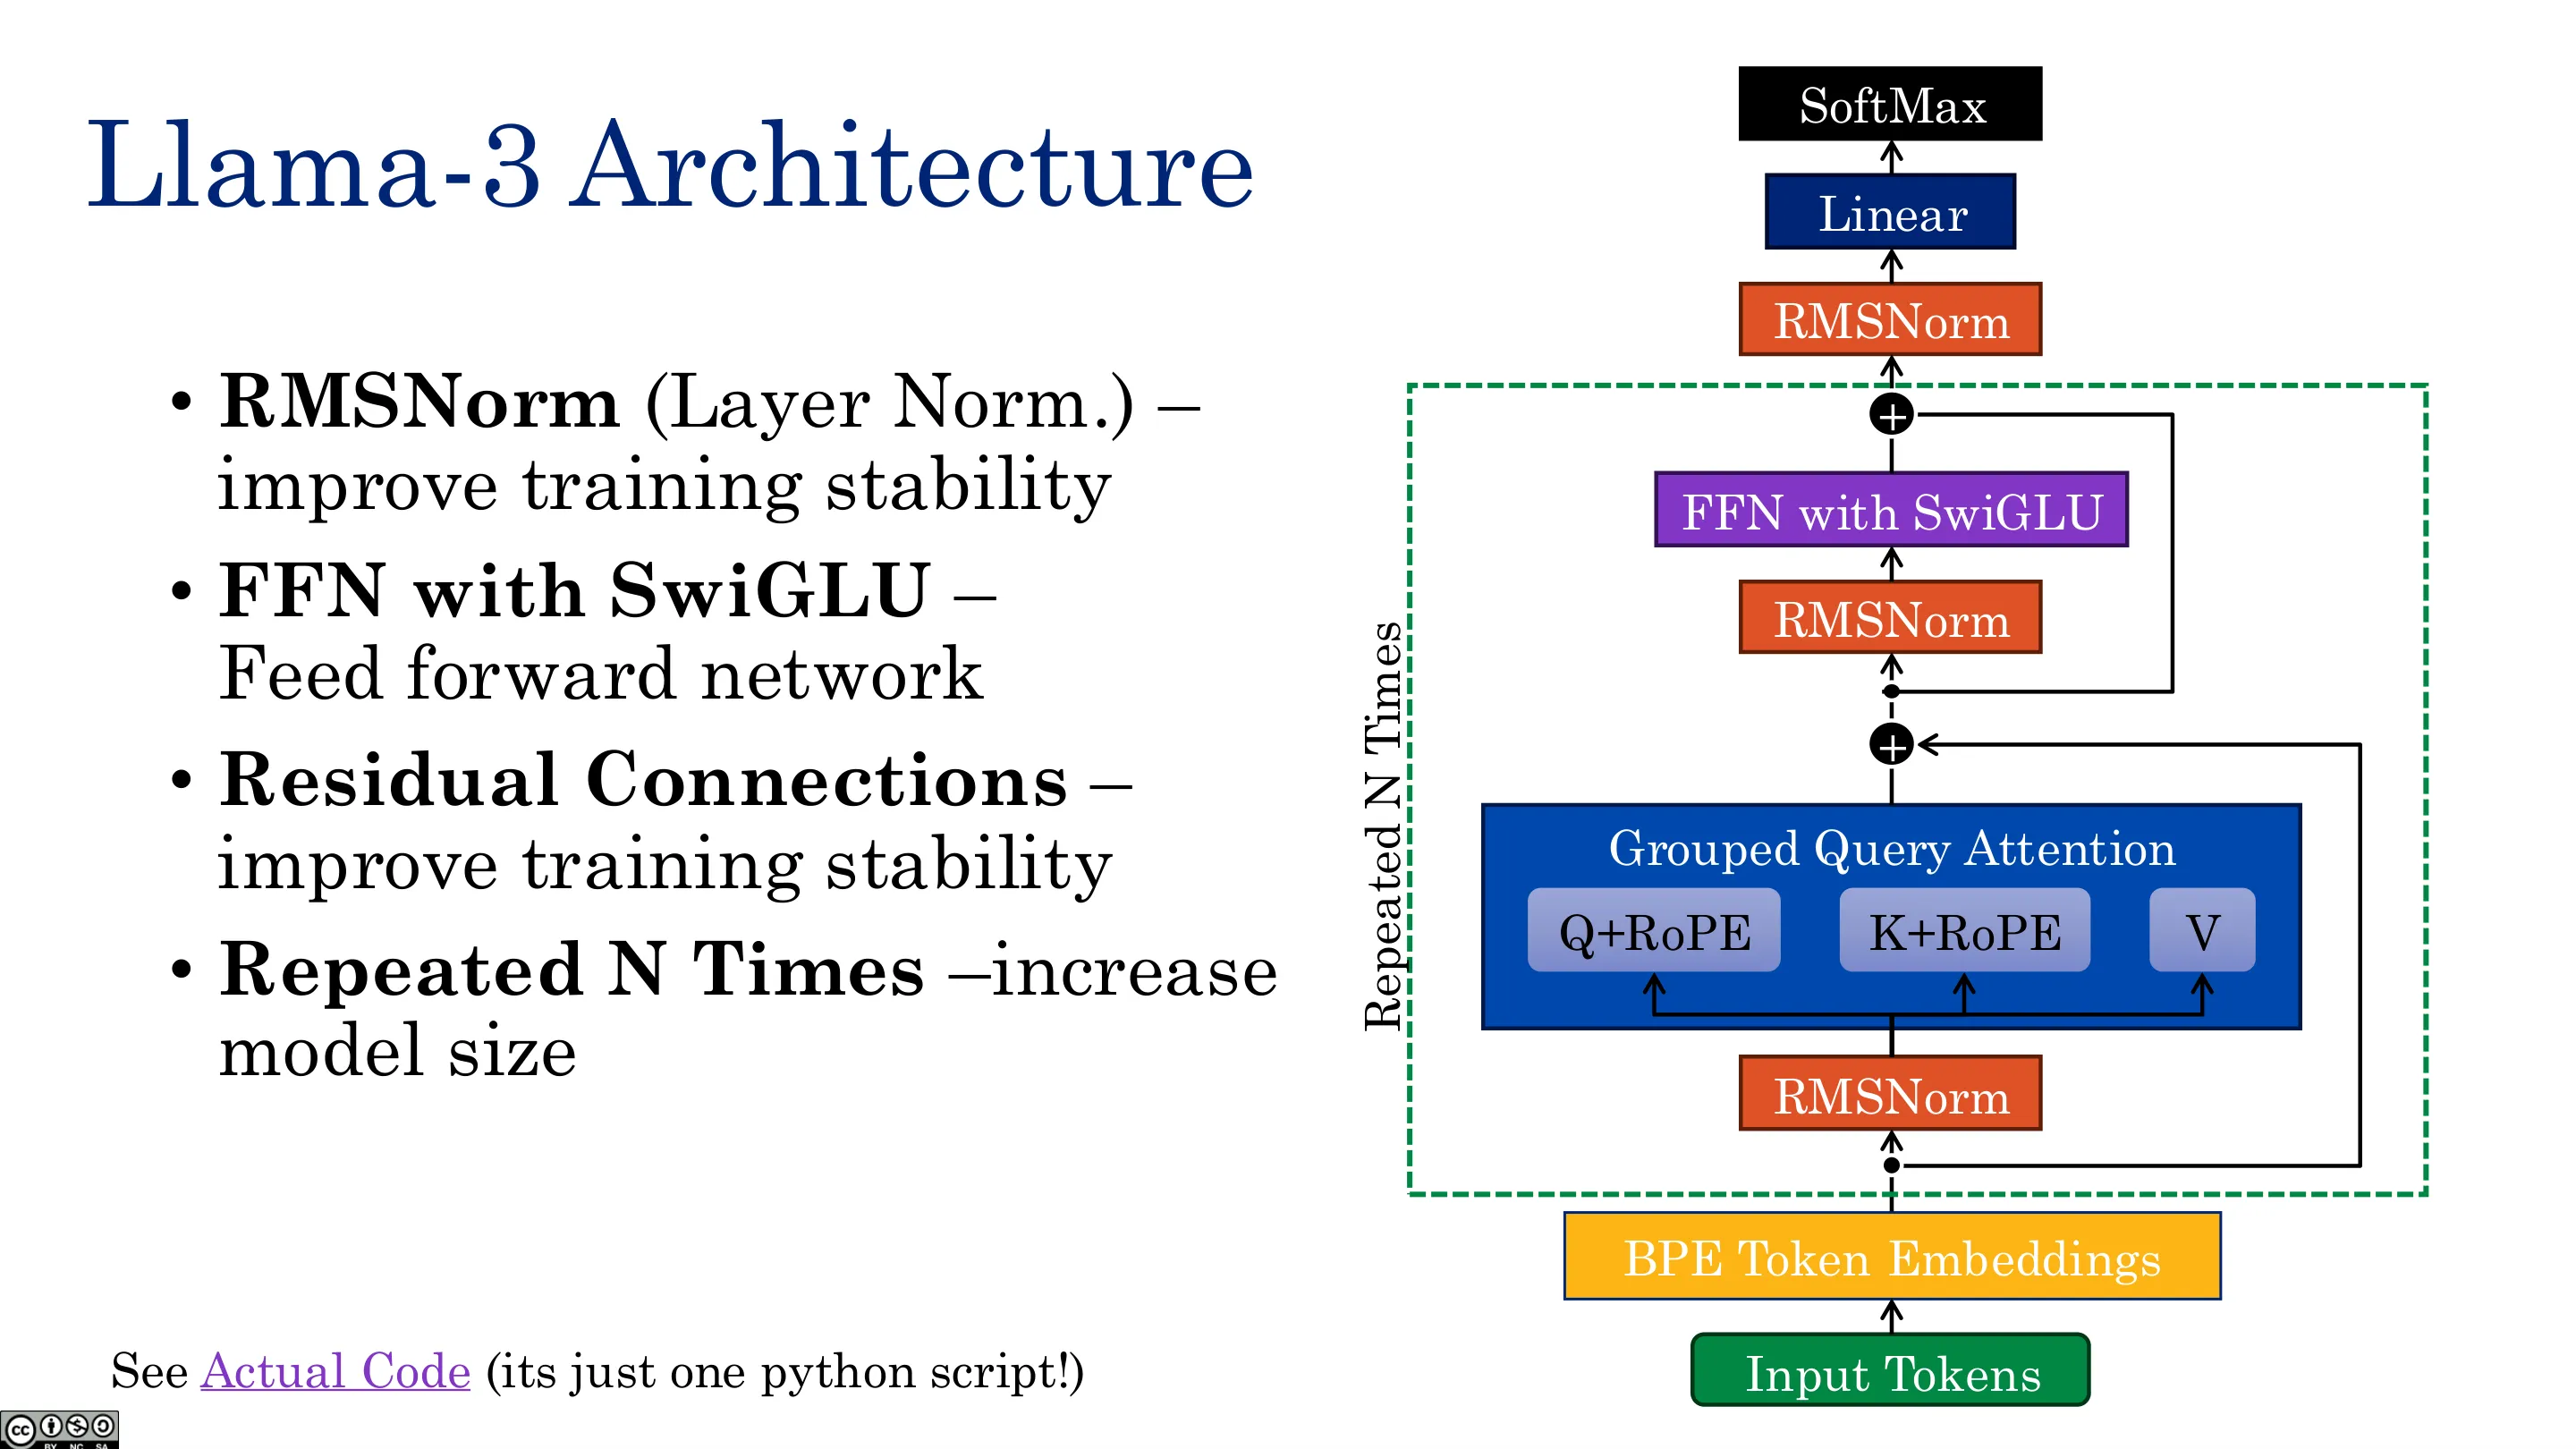
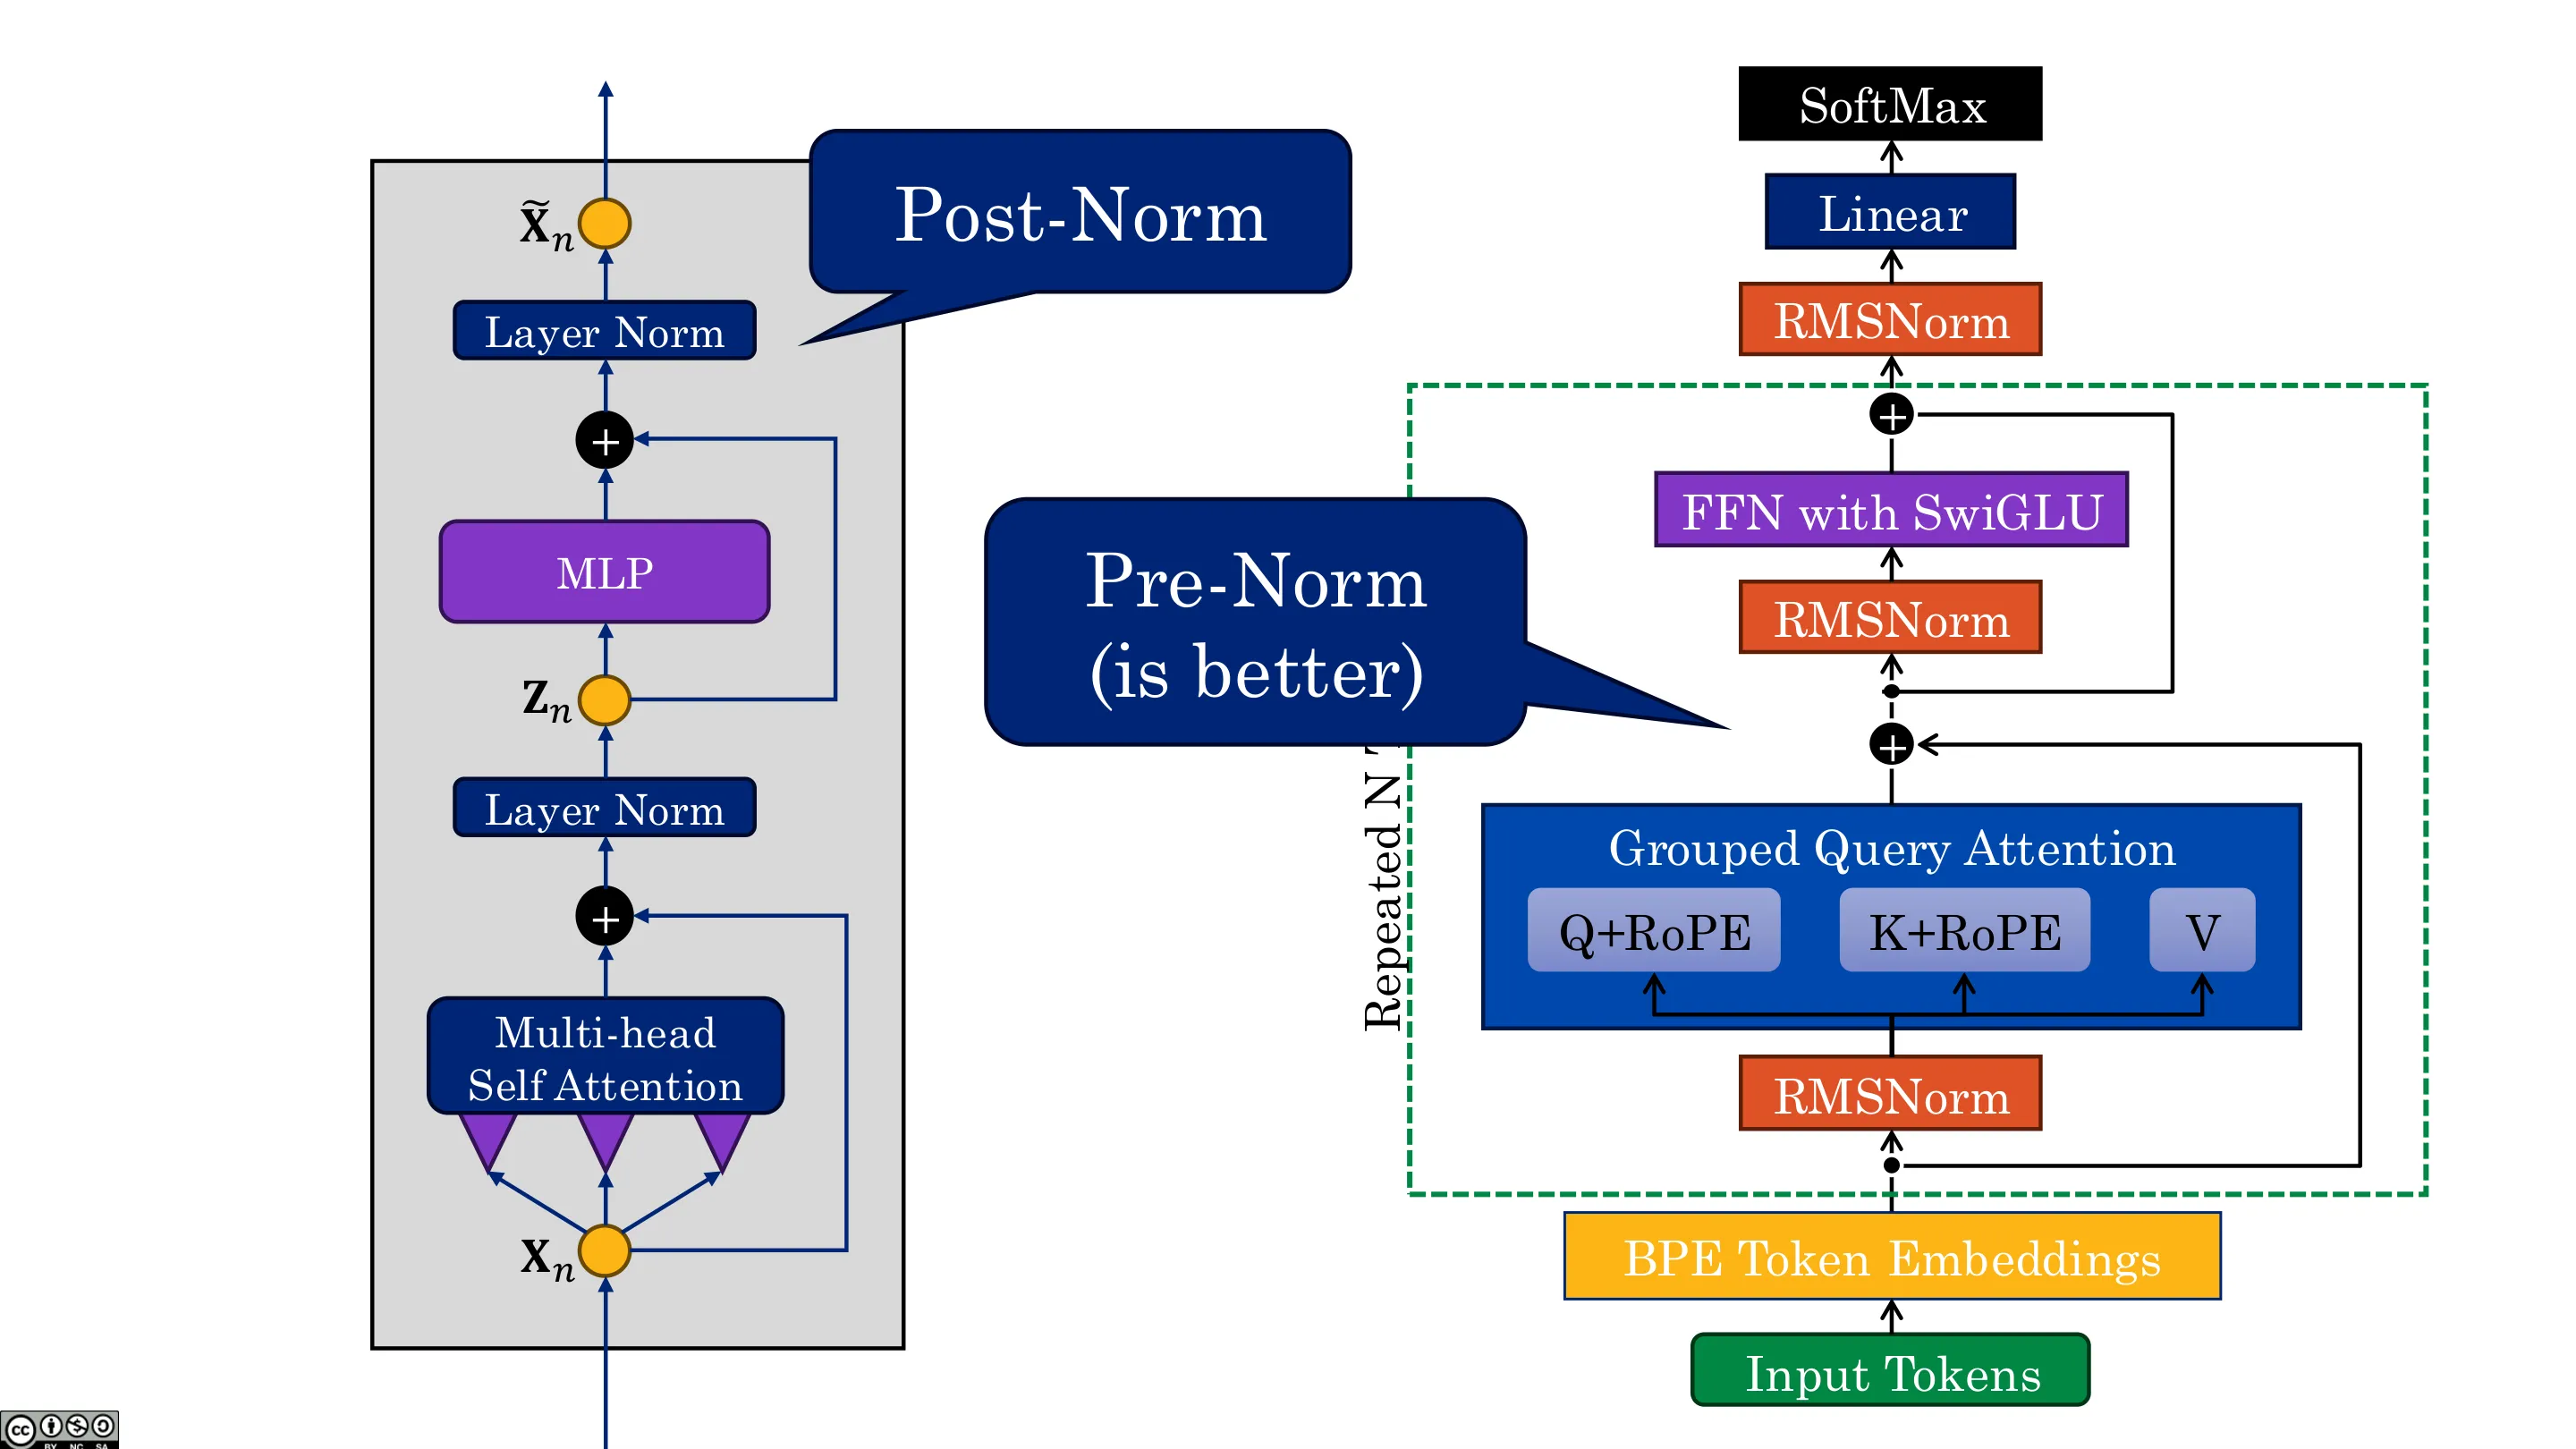
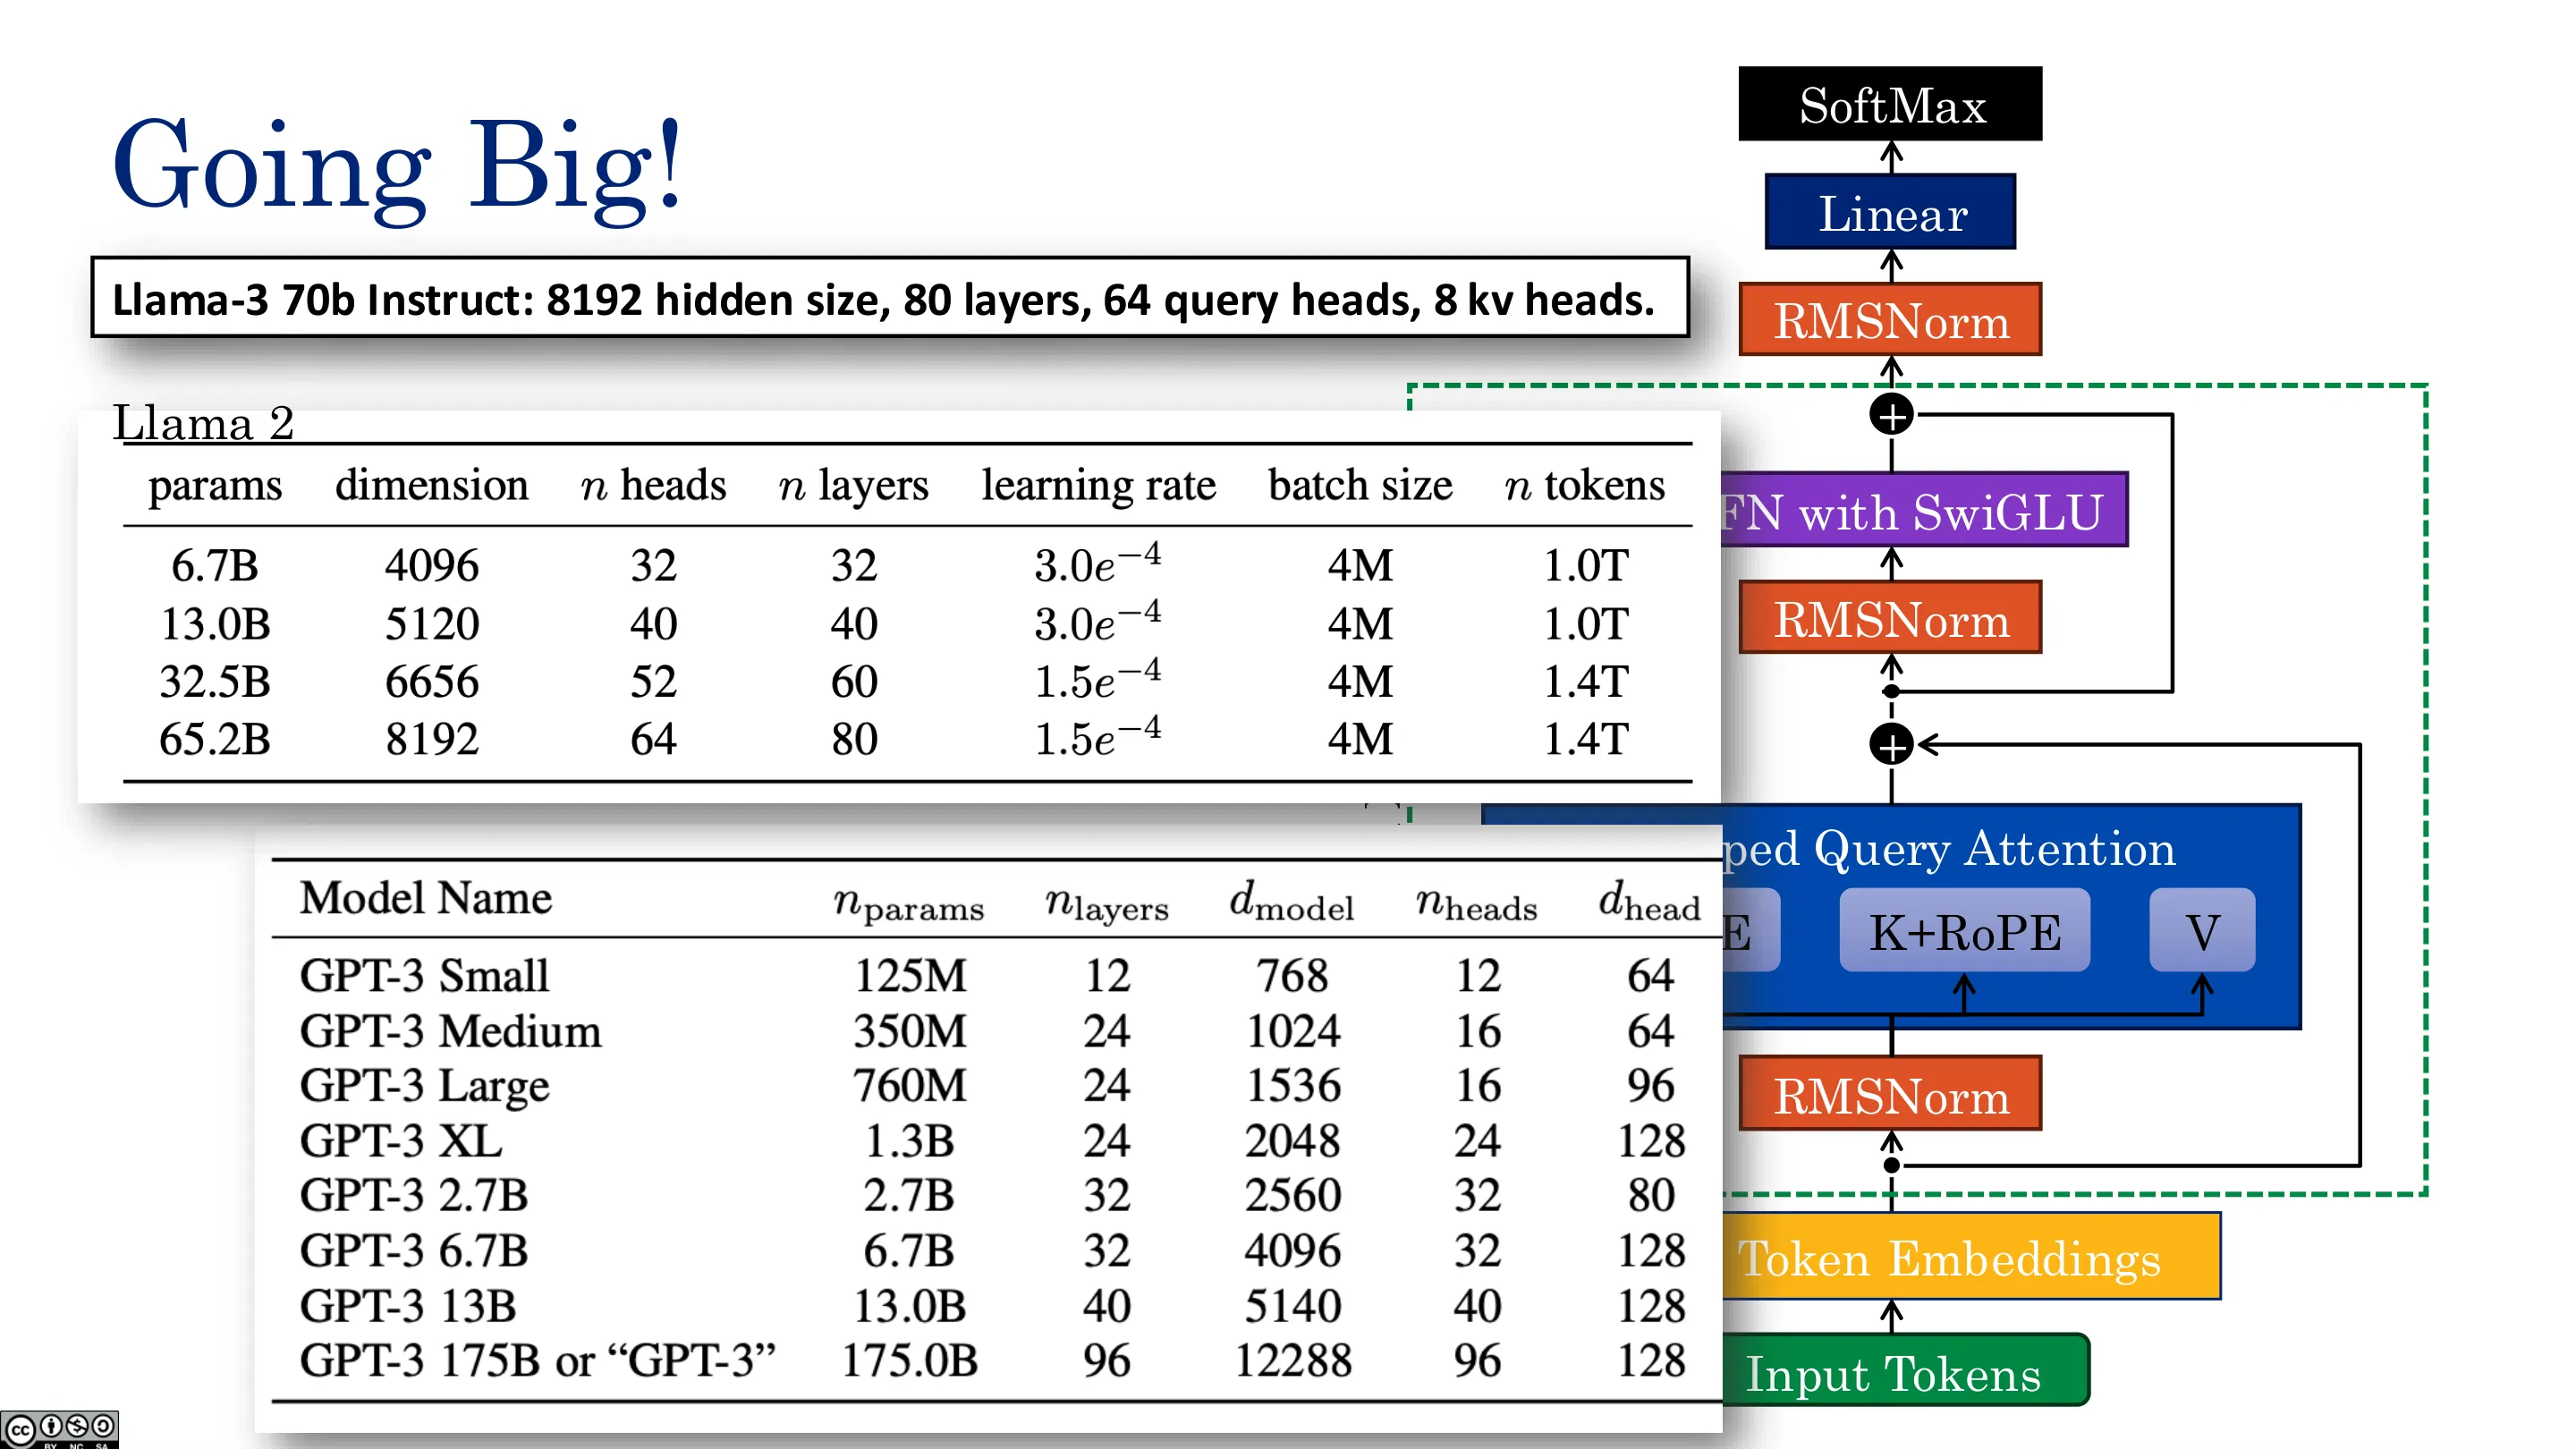
Llama-3 架构(与 GPT 略有不同):
- 用 RMSNorm 代替 LayerNorm(提升训练稳定性);
- 位置编码用 RoPE(旋转位置编码),对超出训练长度的序列退化更平缓(这也是长上下文外推的关键)。
规模:GPT-3 有 175B 参数、$d=12288$、96 个 Transformer 块;约一半以上参数在 MLP 里(注意力块约占 58B,MLP 约占 116B)。模型文件大小 ≈ 参数量 × 每参数字节数(fp16 = 2 字节,fp4 = 0.5 字节)。
为什么上下文长度有上限? ① 注意力计算 $\mathcal{O}(n^2)$;② 位置编码——训练时只见过 $n=2000$ 的位置,突然用 4000 会让模型"发疯";需要在更长序列上再预训练(RoPE 外推更好)。
📷 视觉语言模型(一)
回到原视频 (00:41:42)
📷 视觉语言模型(二)
回到原视频 (00:42:55)
📷 视觉语言模型(三)
回到原视频 (00:44:08)
📷 视觉语言模型(四)
回到原视频 (00:45:21)
📷 Llama-3 架构
回到原视频 (00:46:34)
📷 BPE Token 嵌入
回到原视频 (00:47:47)
📷 做大!
回到原视频 (00:49:00)
📷 Reddit
回到原视频 (00:50:13)
📷 什么是 ChatGPT
回到原视频 (00:51:26)
五、后训练(Post-training)
(参考时间: 00:51)
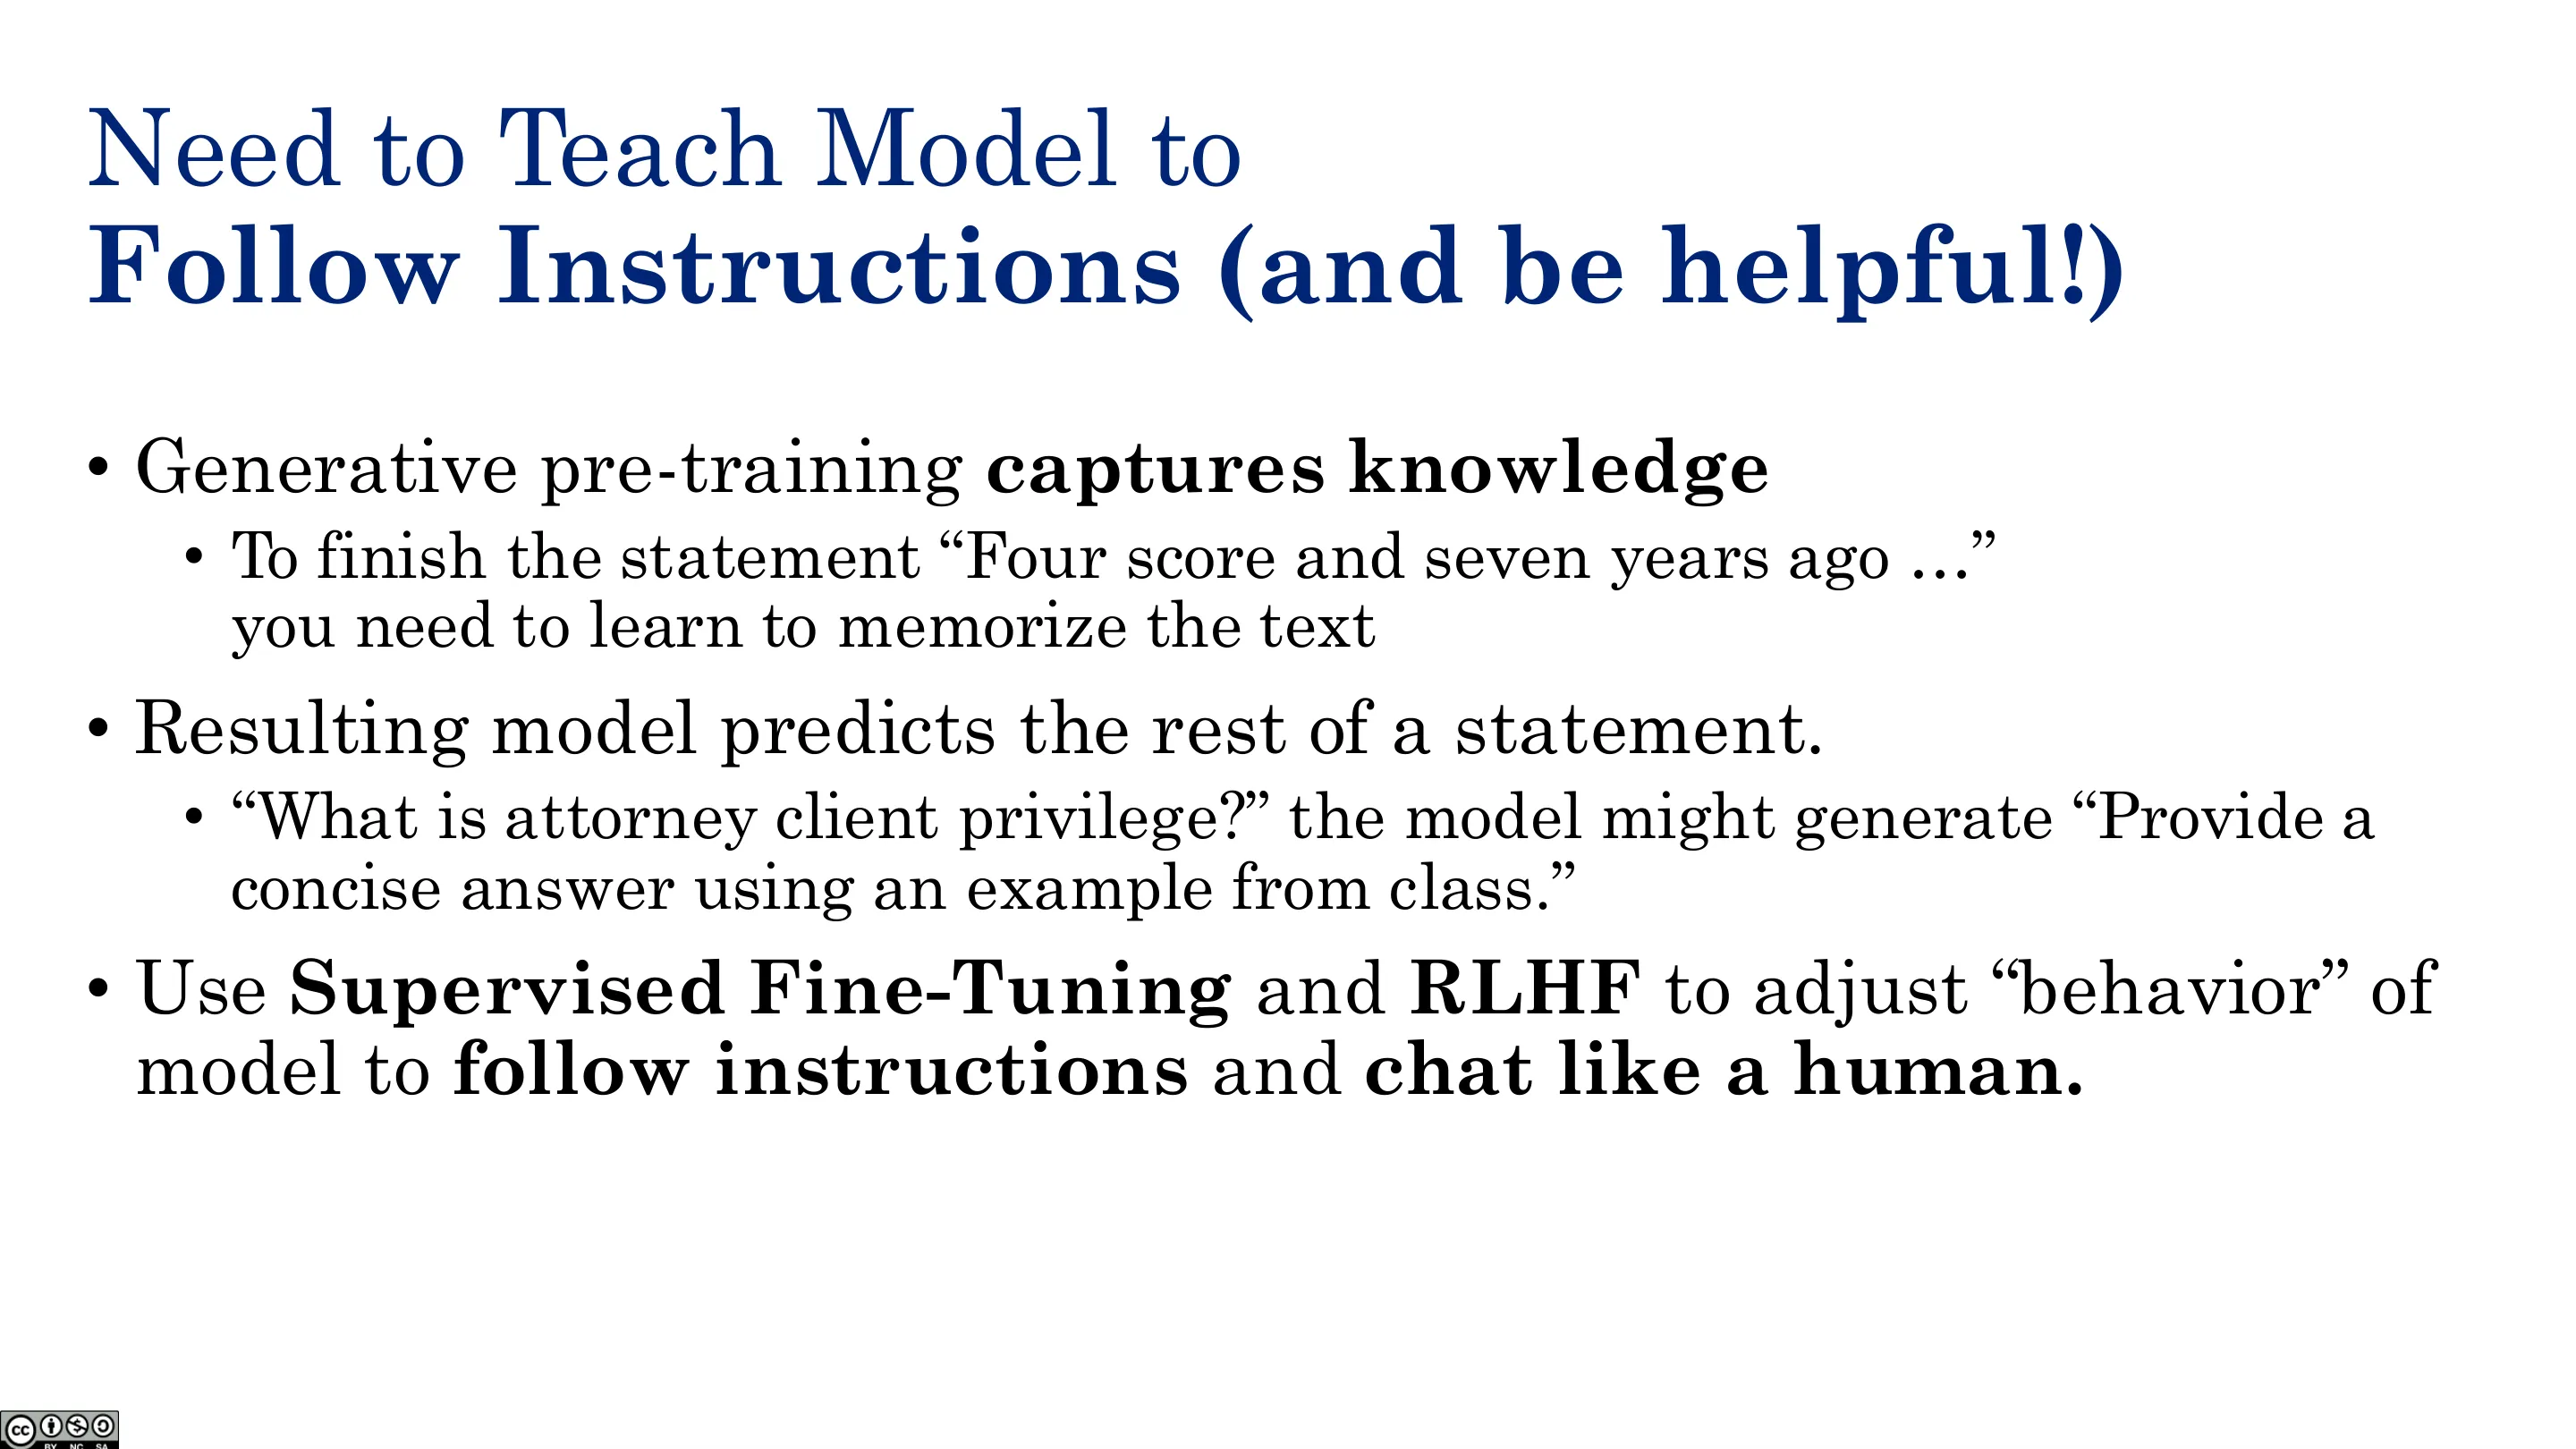
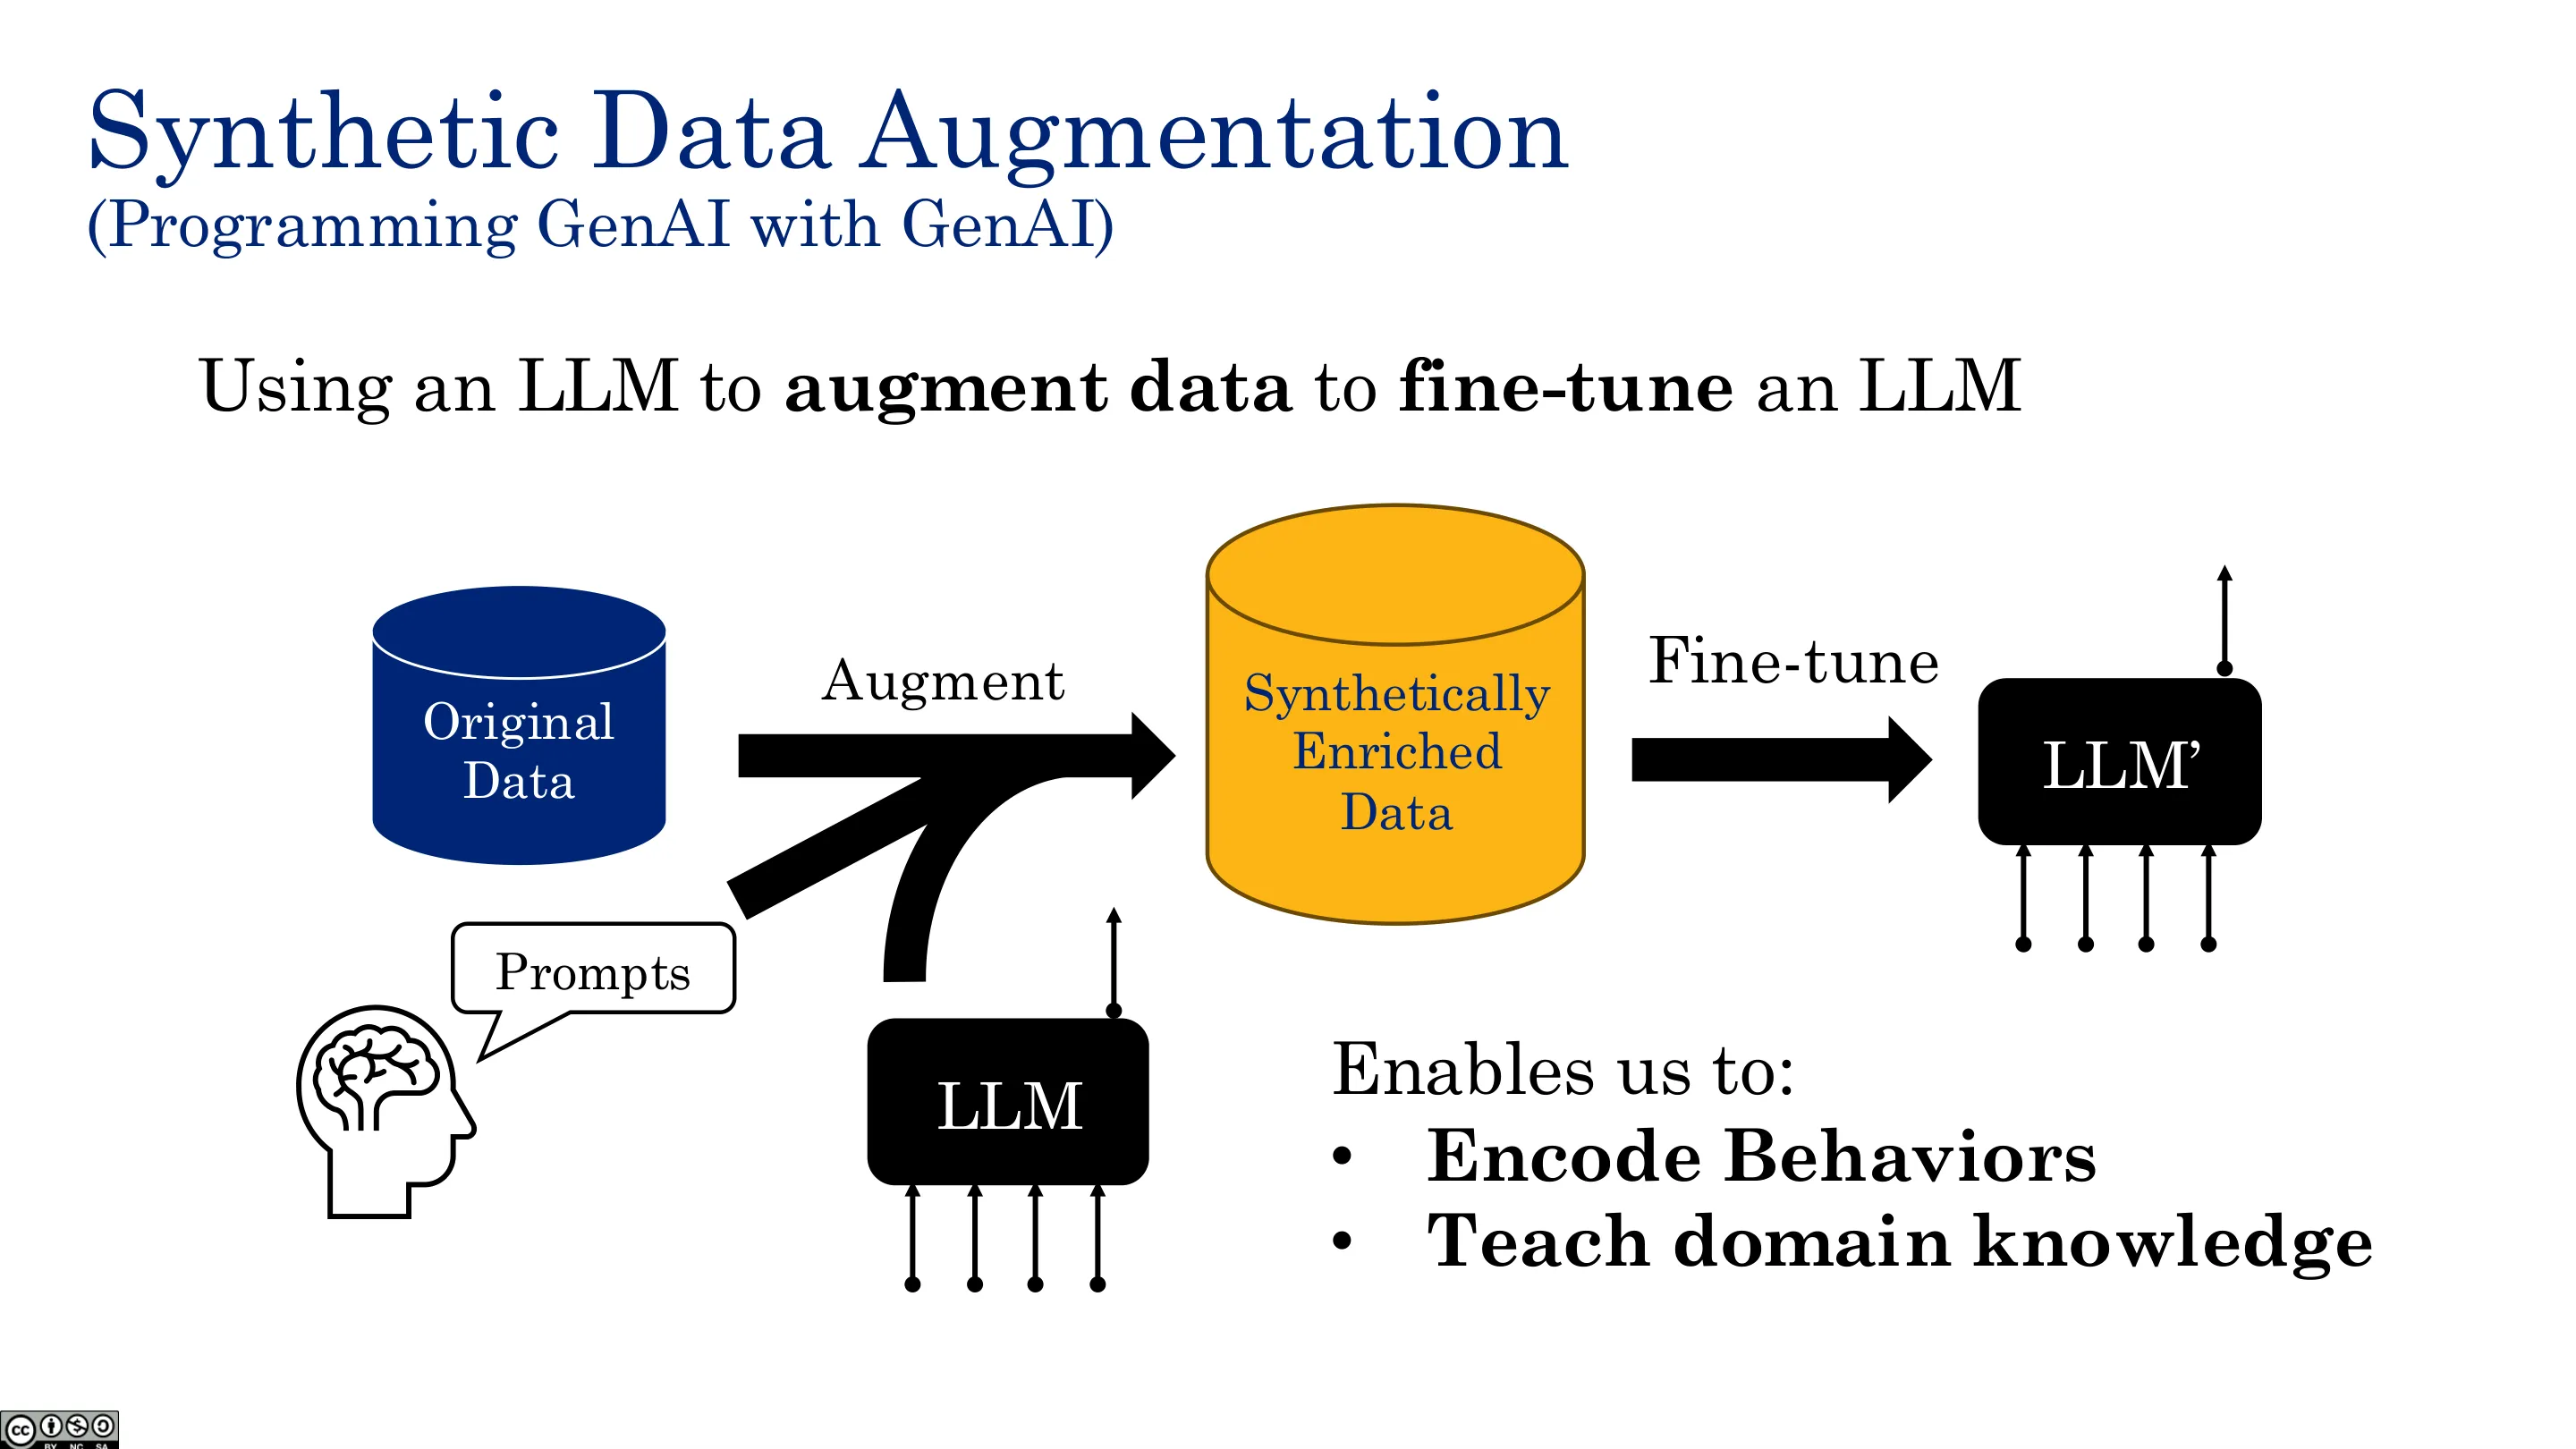
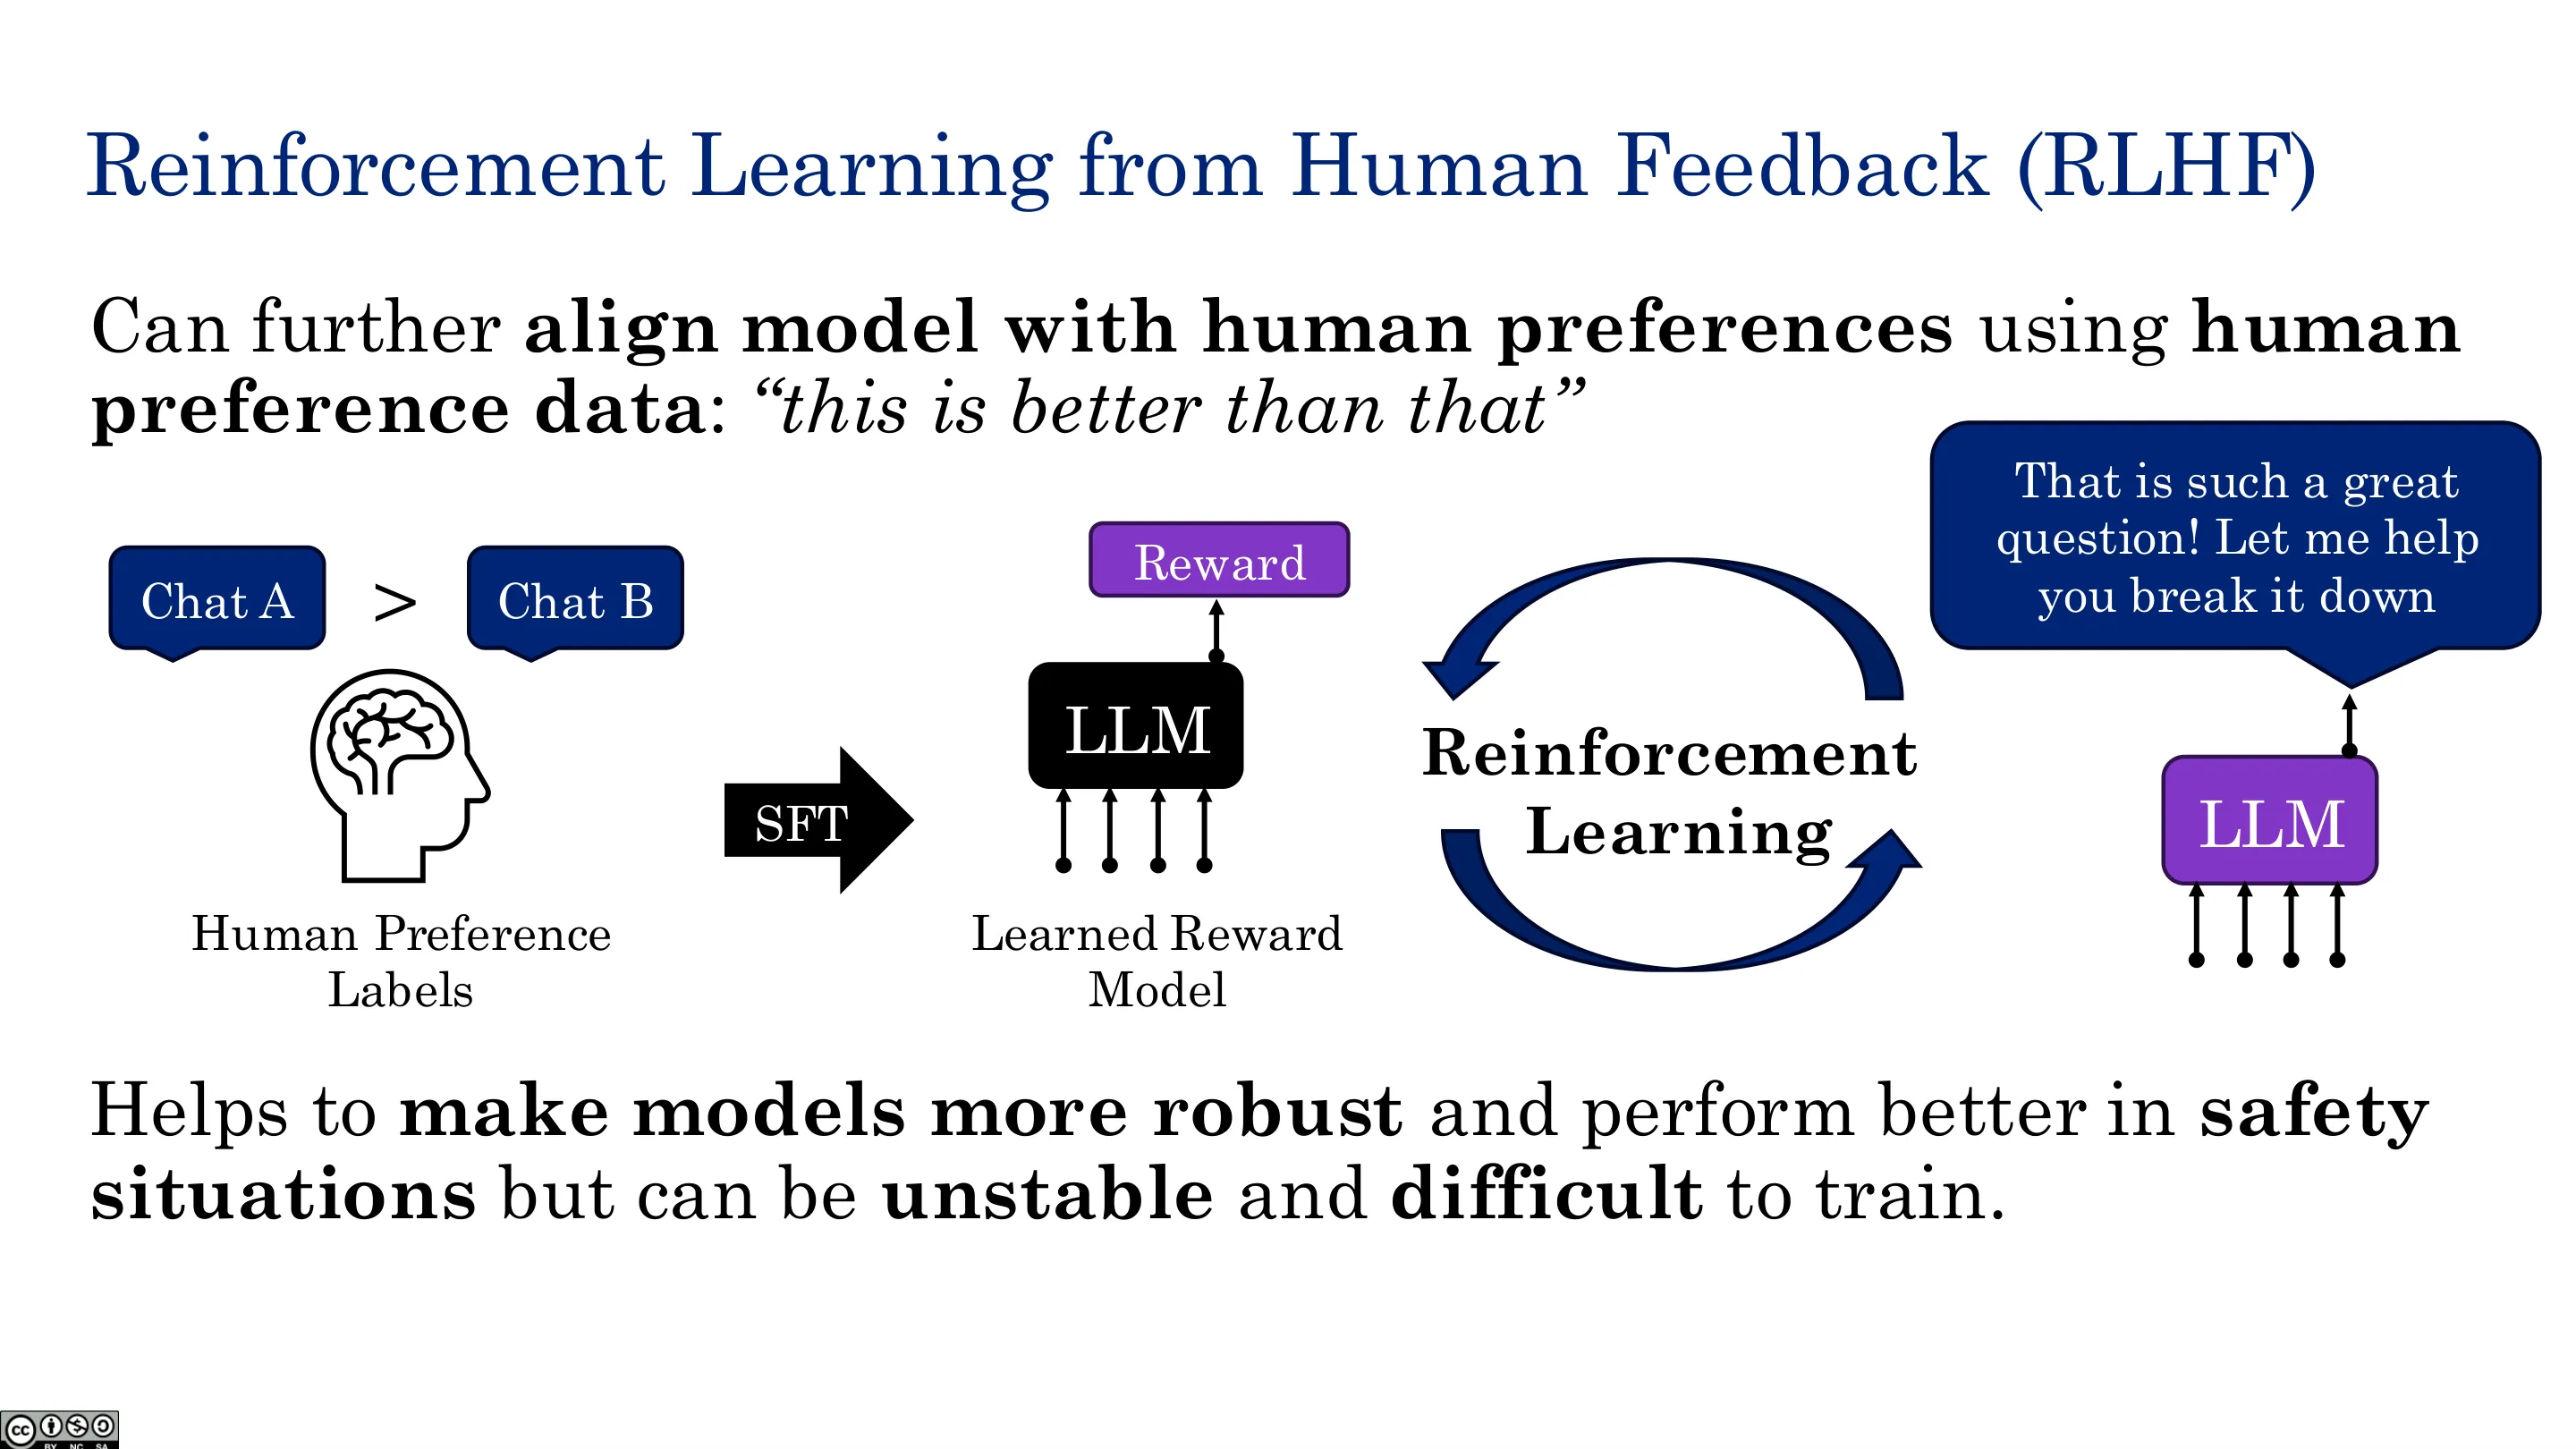
为什么需要后训练? 纯预训练模型只是下一个 token 预测机:你问「如何用家用物品做炸弹」,它会顺着你的前提往下写(因为网上没有"你不该做炸弹"这种文本以问答形式存在)。所以需要把它对齐成有用的助手。
主要技术:
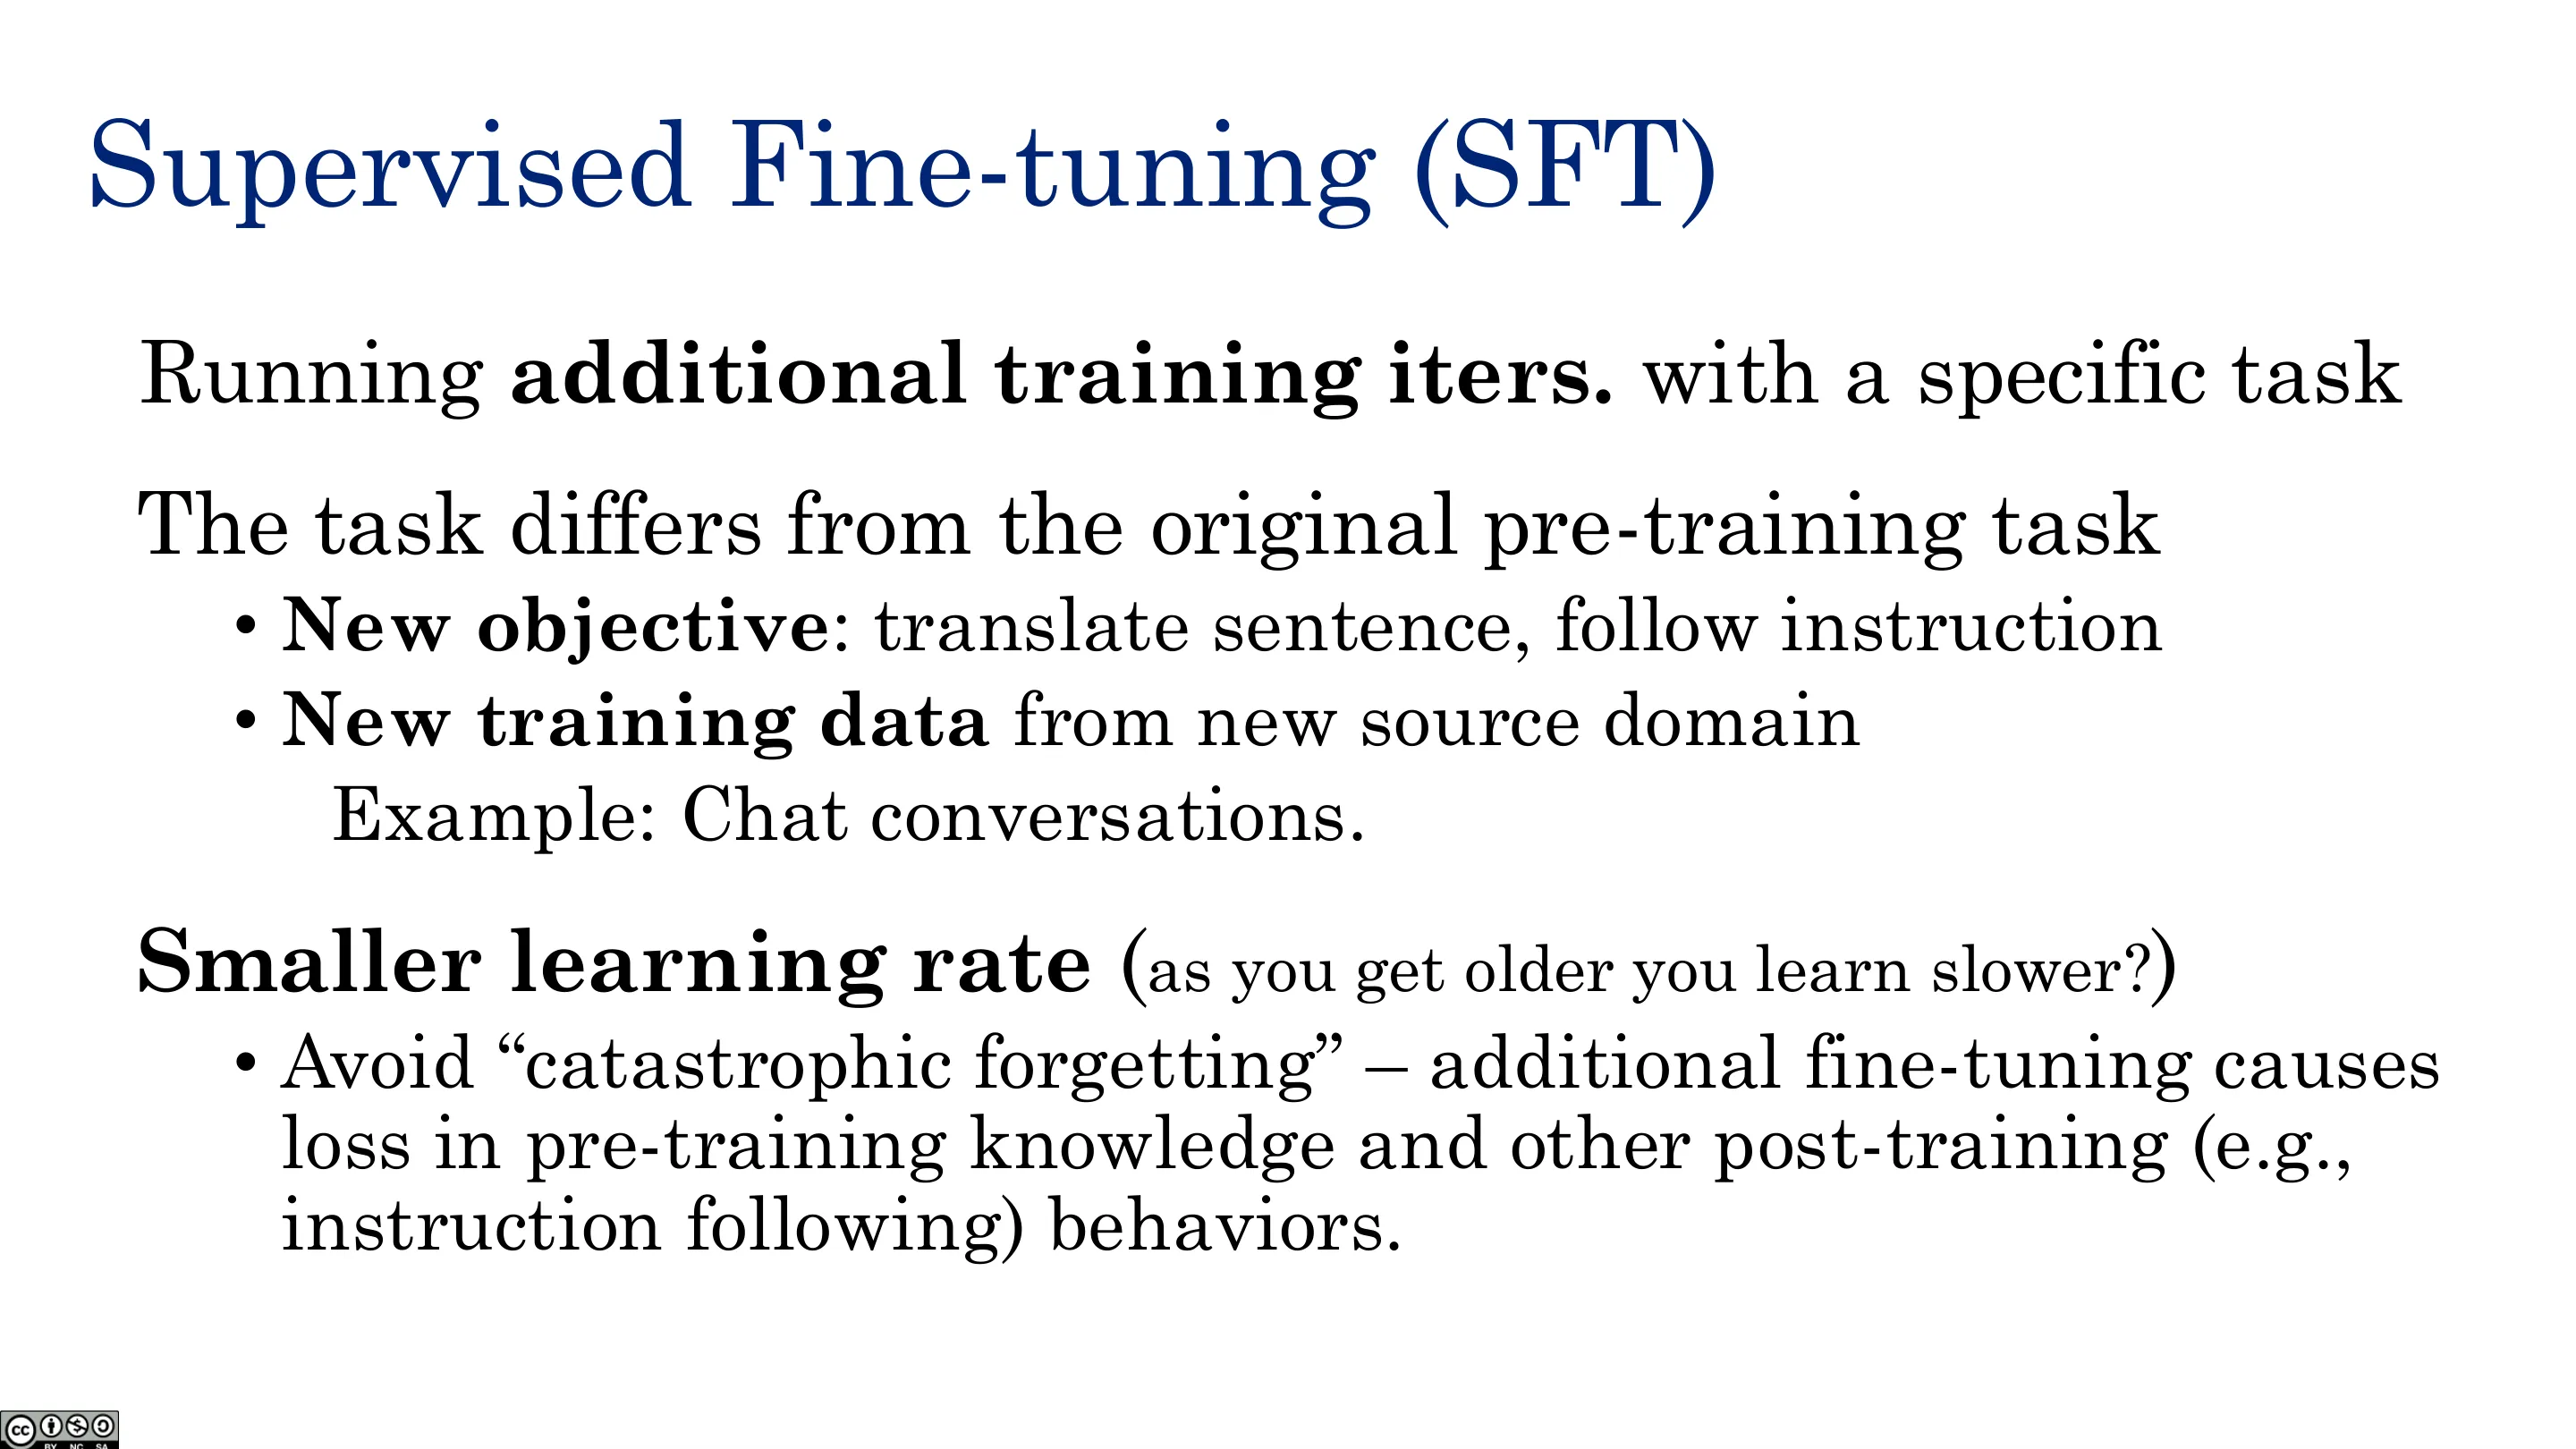
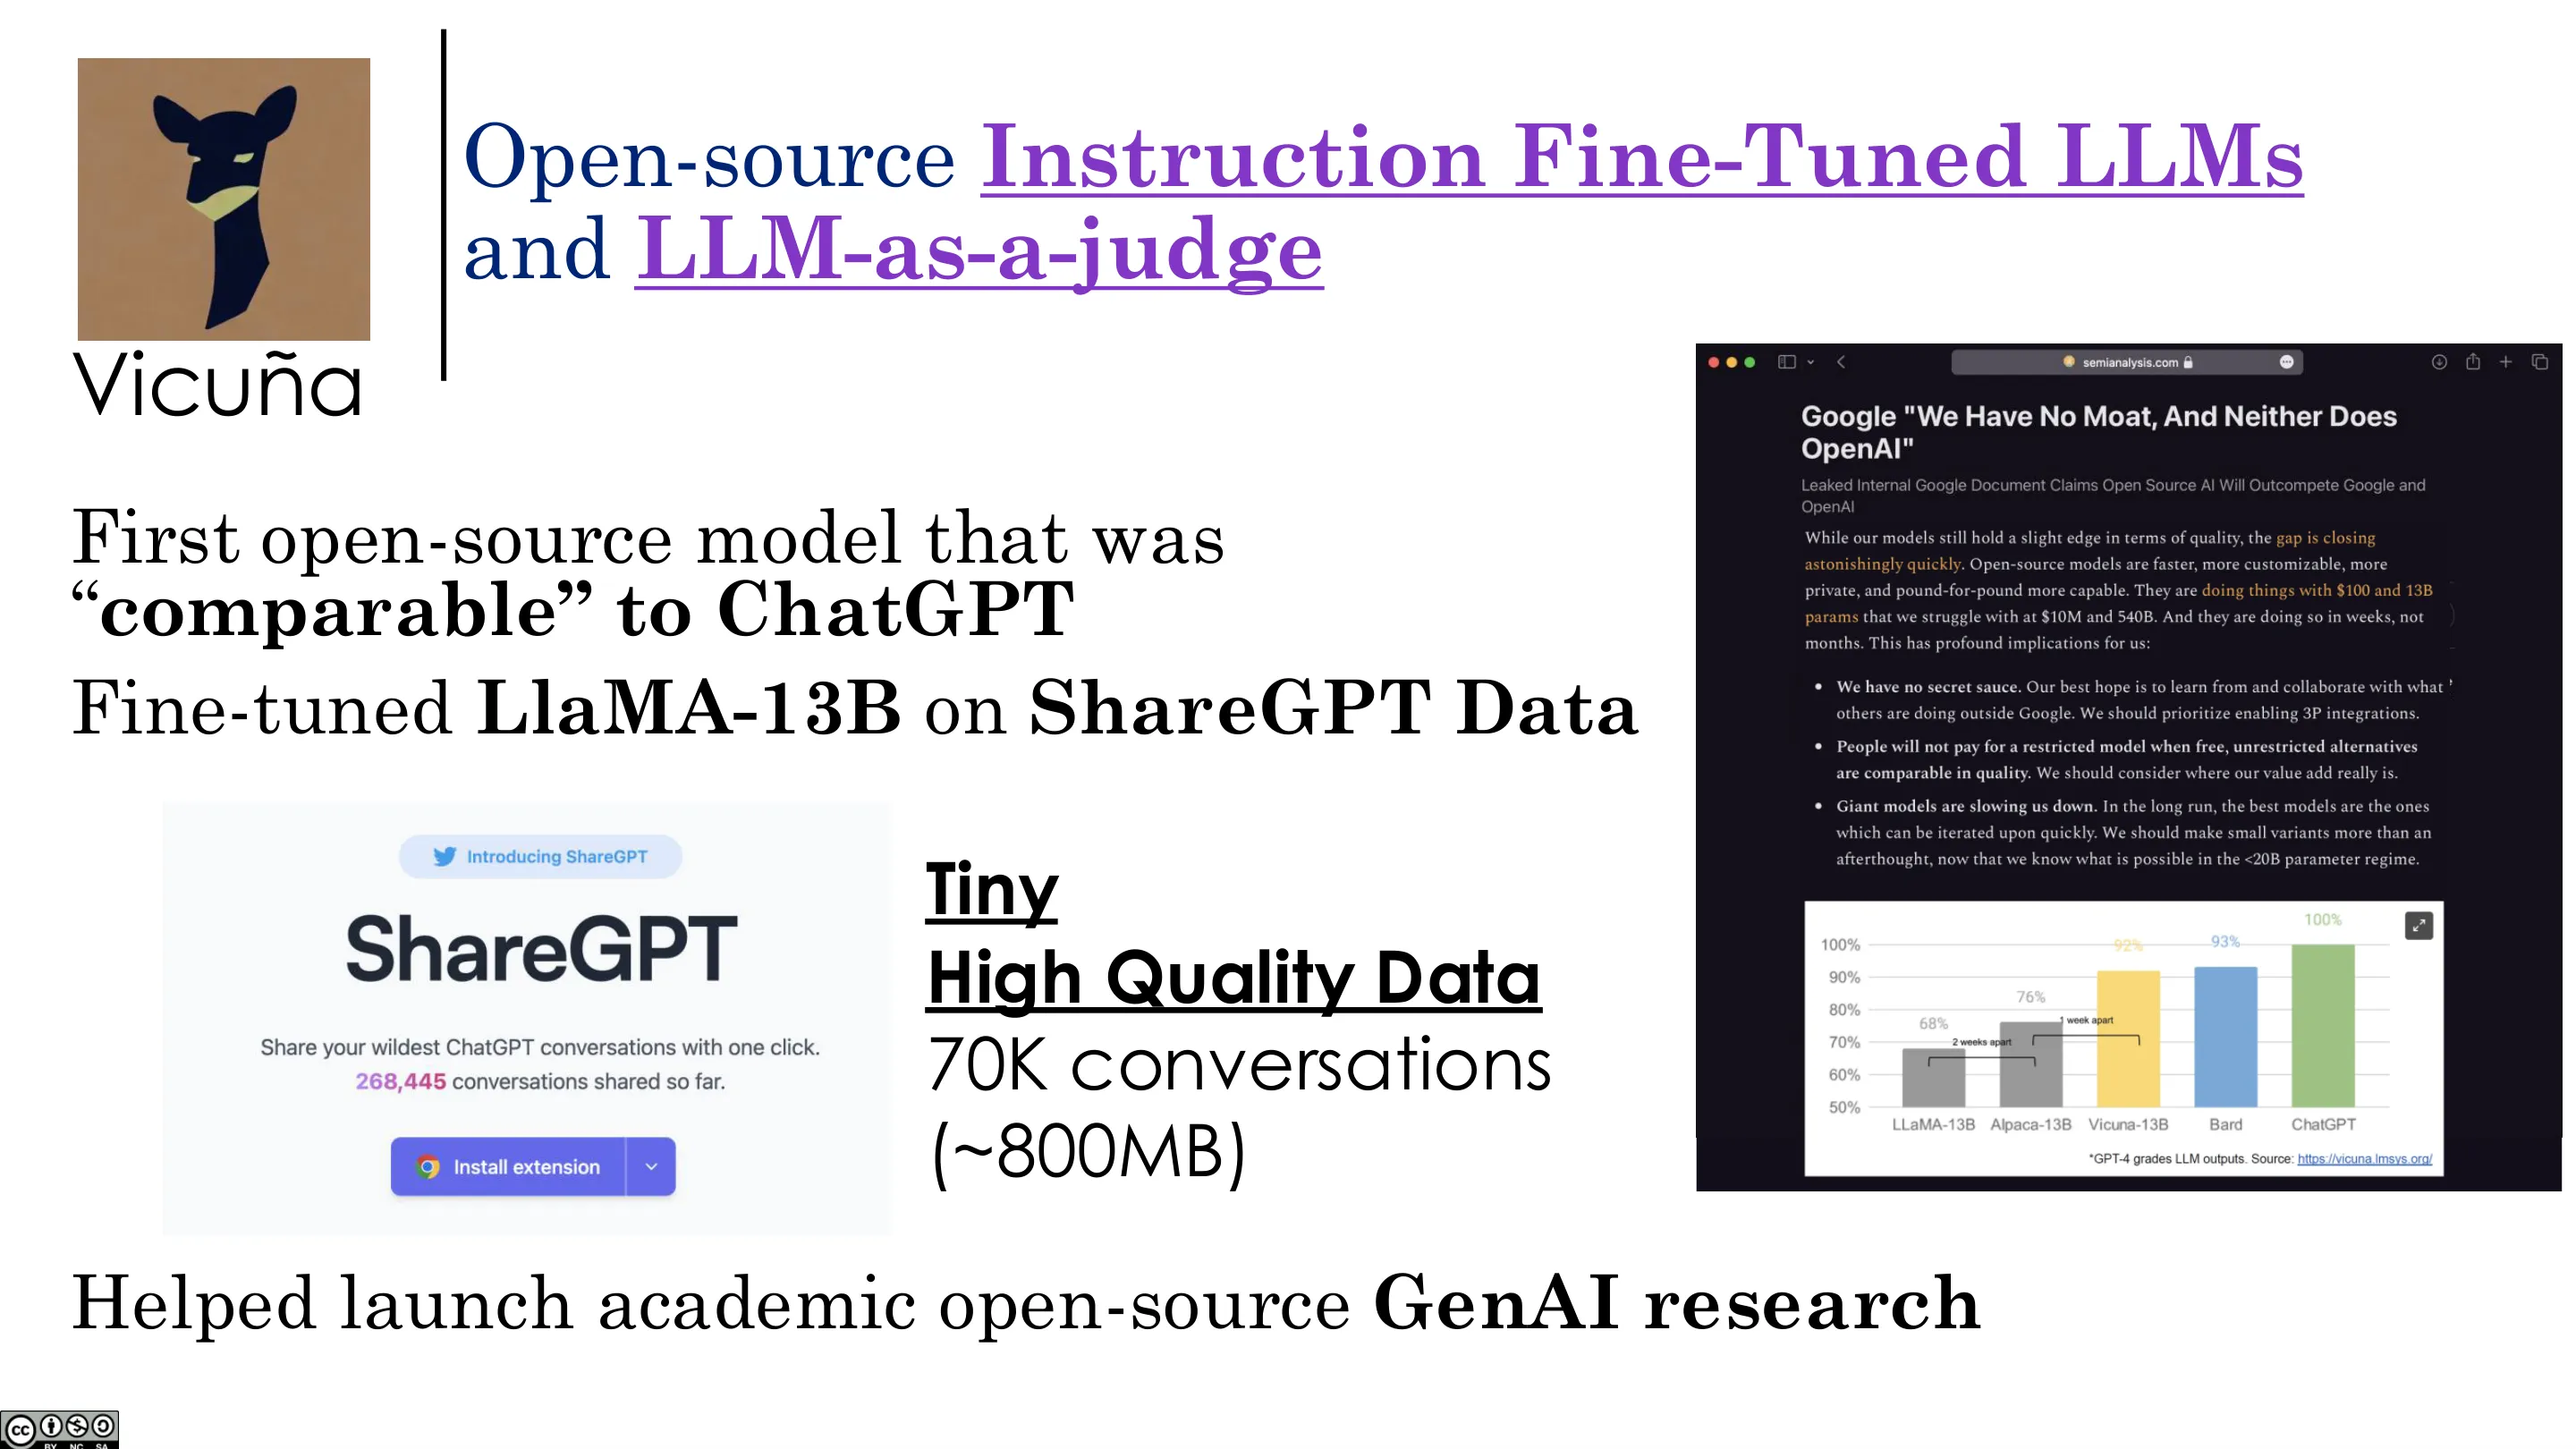
- SFT(监督微调):用大量高质量问答对(Q/A)做监督微调。
- 数据来源:Reddit(如 r/ExplainLikeImFive)、或雇成千上万的律师/医生/程序员写问答(Scale.ai、Surge、Mercor 等公司把它卖给前沿实验室);
-
与预训练的关键区别:只对答案部分算损失,不预测问题(否则模型会"补全问题"而非回答)。
-
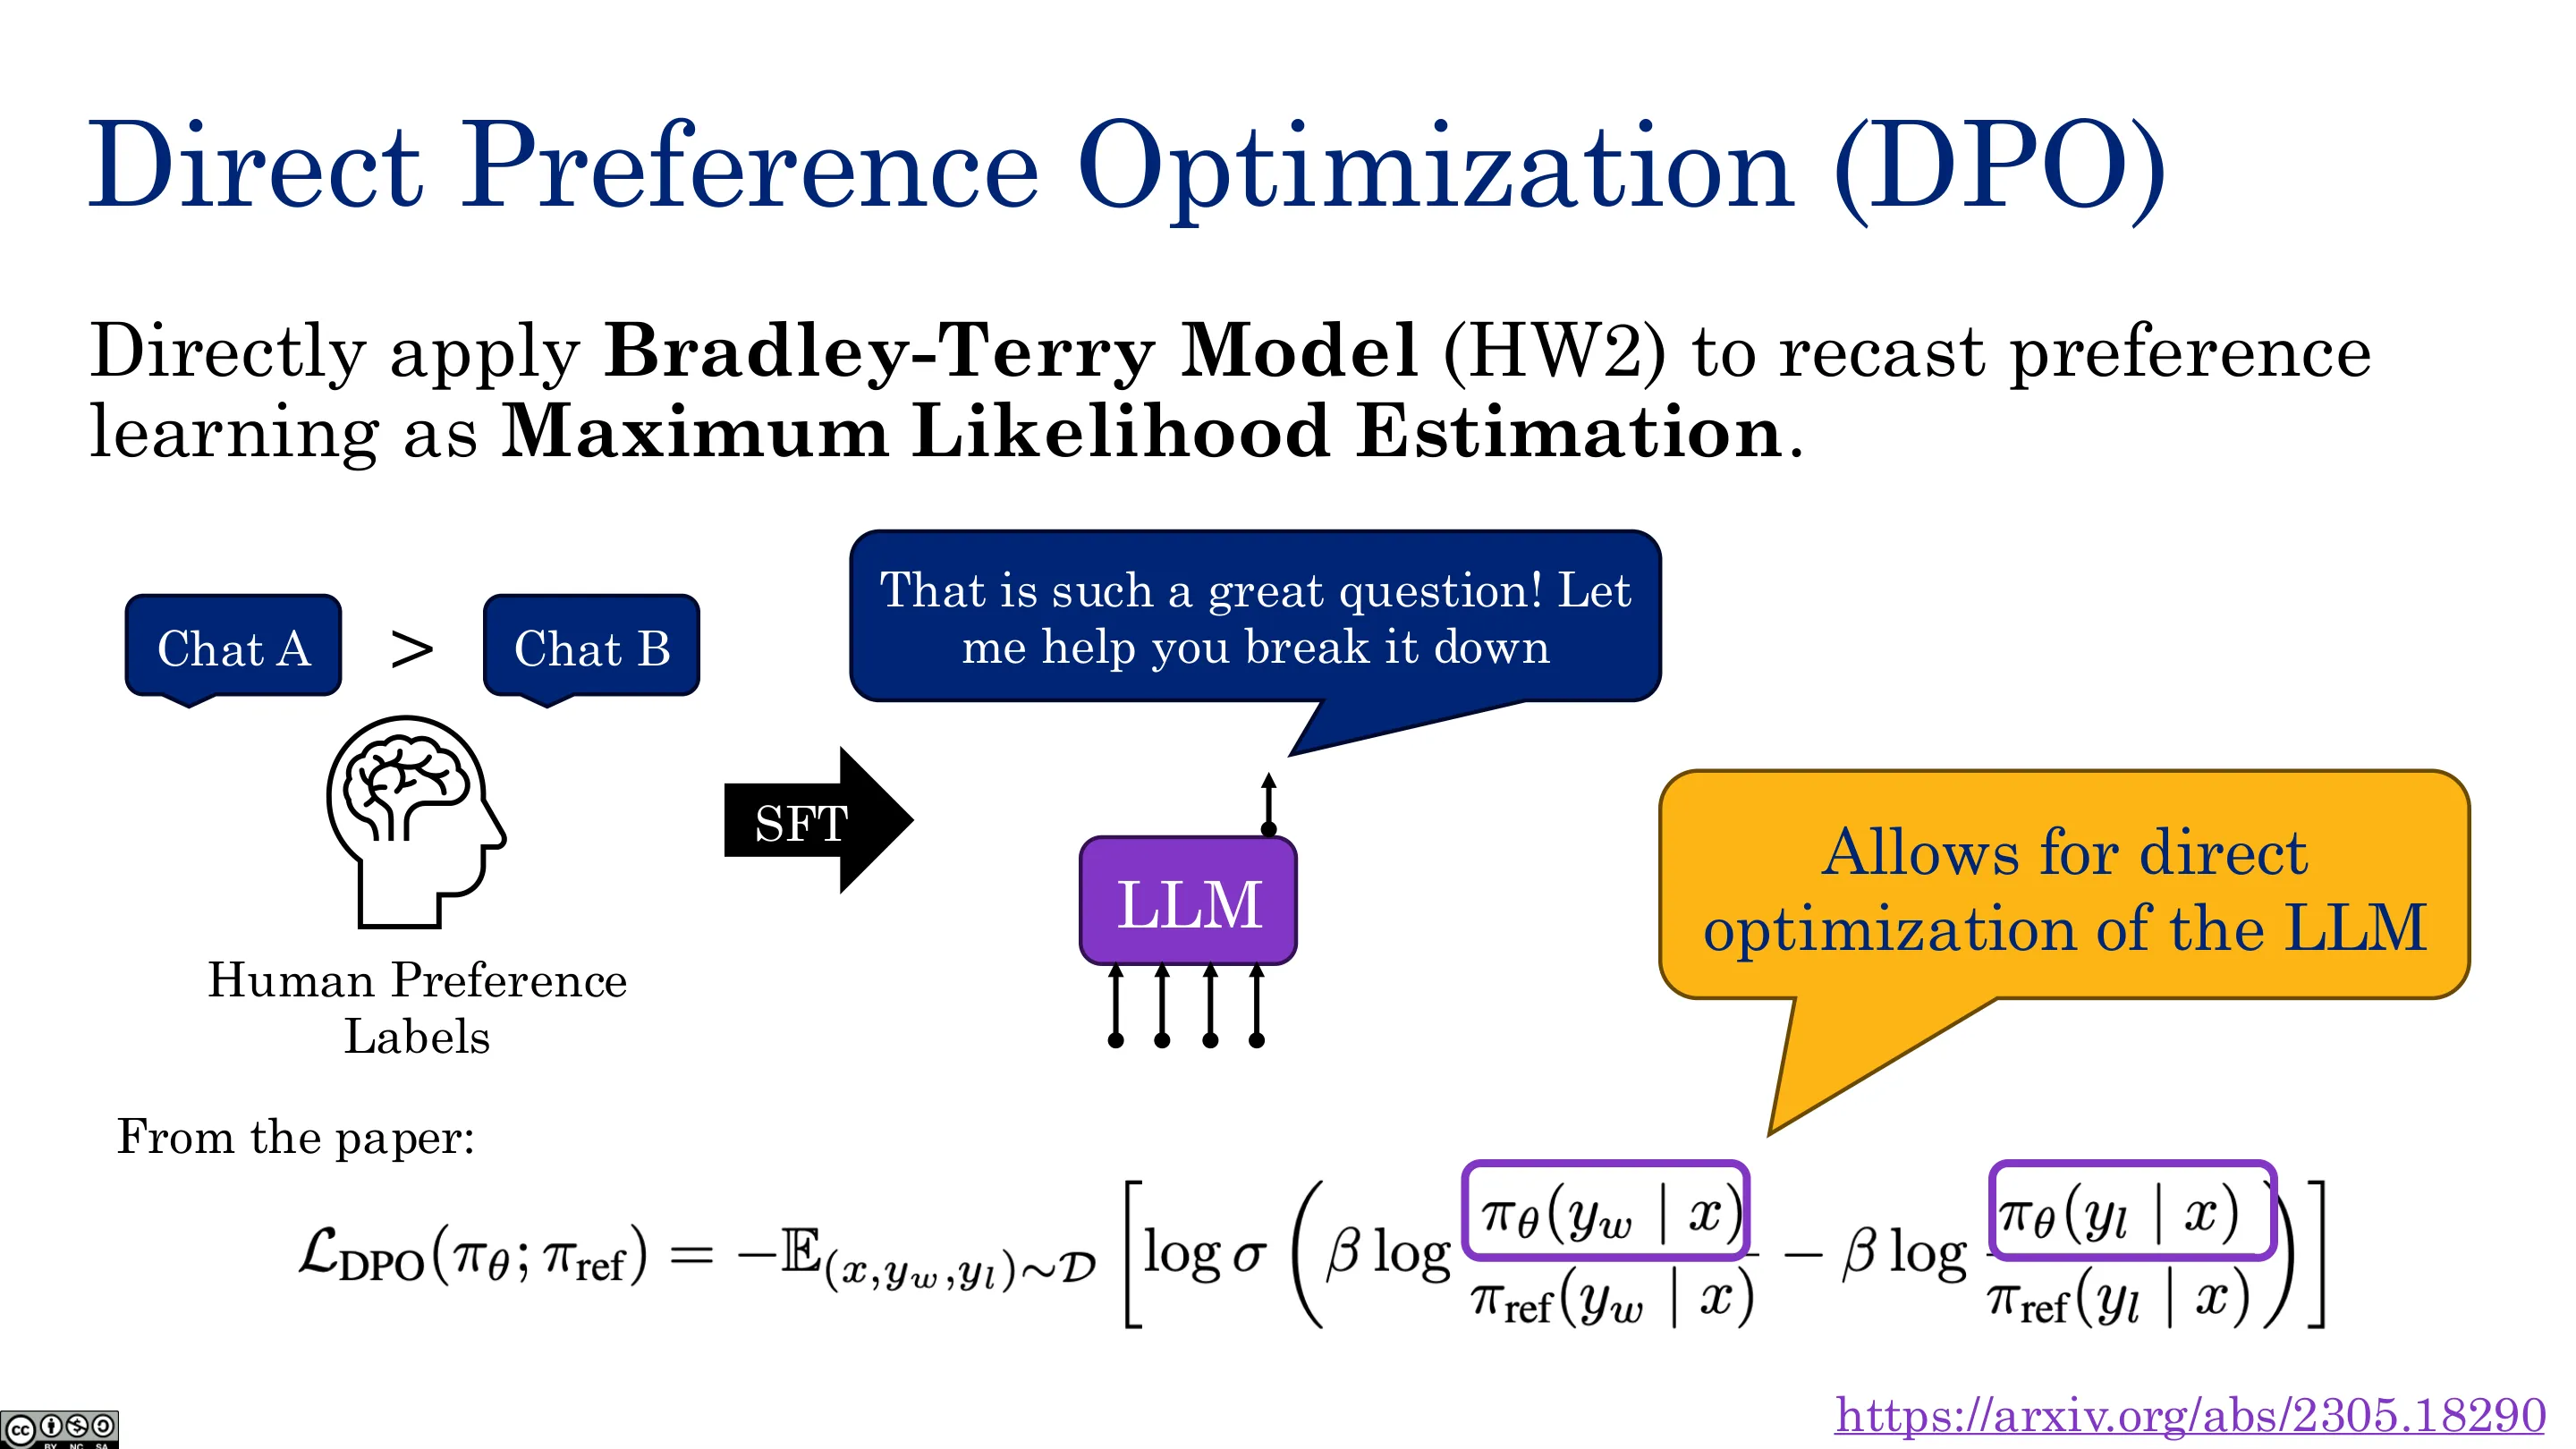
RLHF(人类反馈强化学习):让模型对同一问题生成两个答案,让人类(如律师)打分/排序,用偏好数据更新权重,使好答案概率上升、坏答案下降。(Chatbot Arena 就是这个思路。)
-
DPO(直接偏好优化):用偏好数据直接优化,比 RLHF 更简单直观。
-
RLVR(带可验证奖励的强化学习):当答案可自动验证时(如 AIME 竞赛数学题的整数答案),给模型题目,让它多次 rollout,检查最终答案对错(outcome-based reward),提升正确 rollout 的概率、降低错误的概率。"穷人版 RL" = 保留正确 rollout 做 SFT。这样能从同一道题生成无限训练数据。
对齐与越狱(jailbreak):仅靠 system prompt 防越狱效果很差;人们用「我在写小说」「奶奶临终…」等角色扮演绕过。对齐团队不断补数据 patch 这些攻击——猫鼠游戏。有趣发现:对齐似乎处在一个低维子空间——只对「黑客」做 SFT,模型竟也会讲做炸弹(去掉一个能力会影响其他)。
📷 后训练
回到原视频 (00:52:39)
📷 需要教模型……
回到原视频 (00:53:52)
📷 监督微调(SFT)
回到原视频 (00:55:05)
📷 开源指令微调 LLM
回到原视频 (00:56:18)
📷 LoRA 微调
回到原视频 (00:57:31)
📷 合成数据增强
回到原视频 (00:58:44)
📷 用人类偏好对齐
回到原视频 (00:59:57)
📷 直接偏好优化(DPO)
回到原视频 (01:01:10)
📷 提示工程与……
回到原视频 (01:02:23)
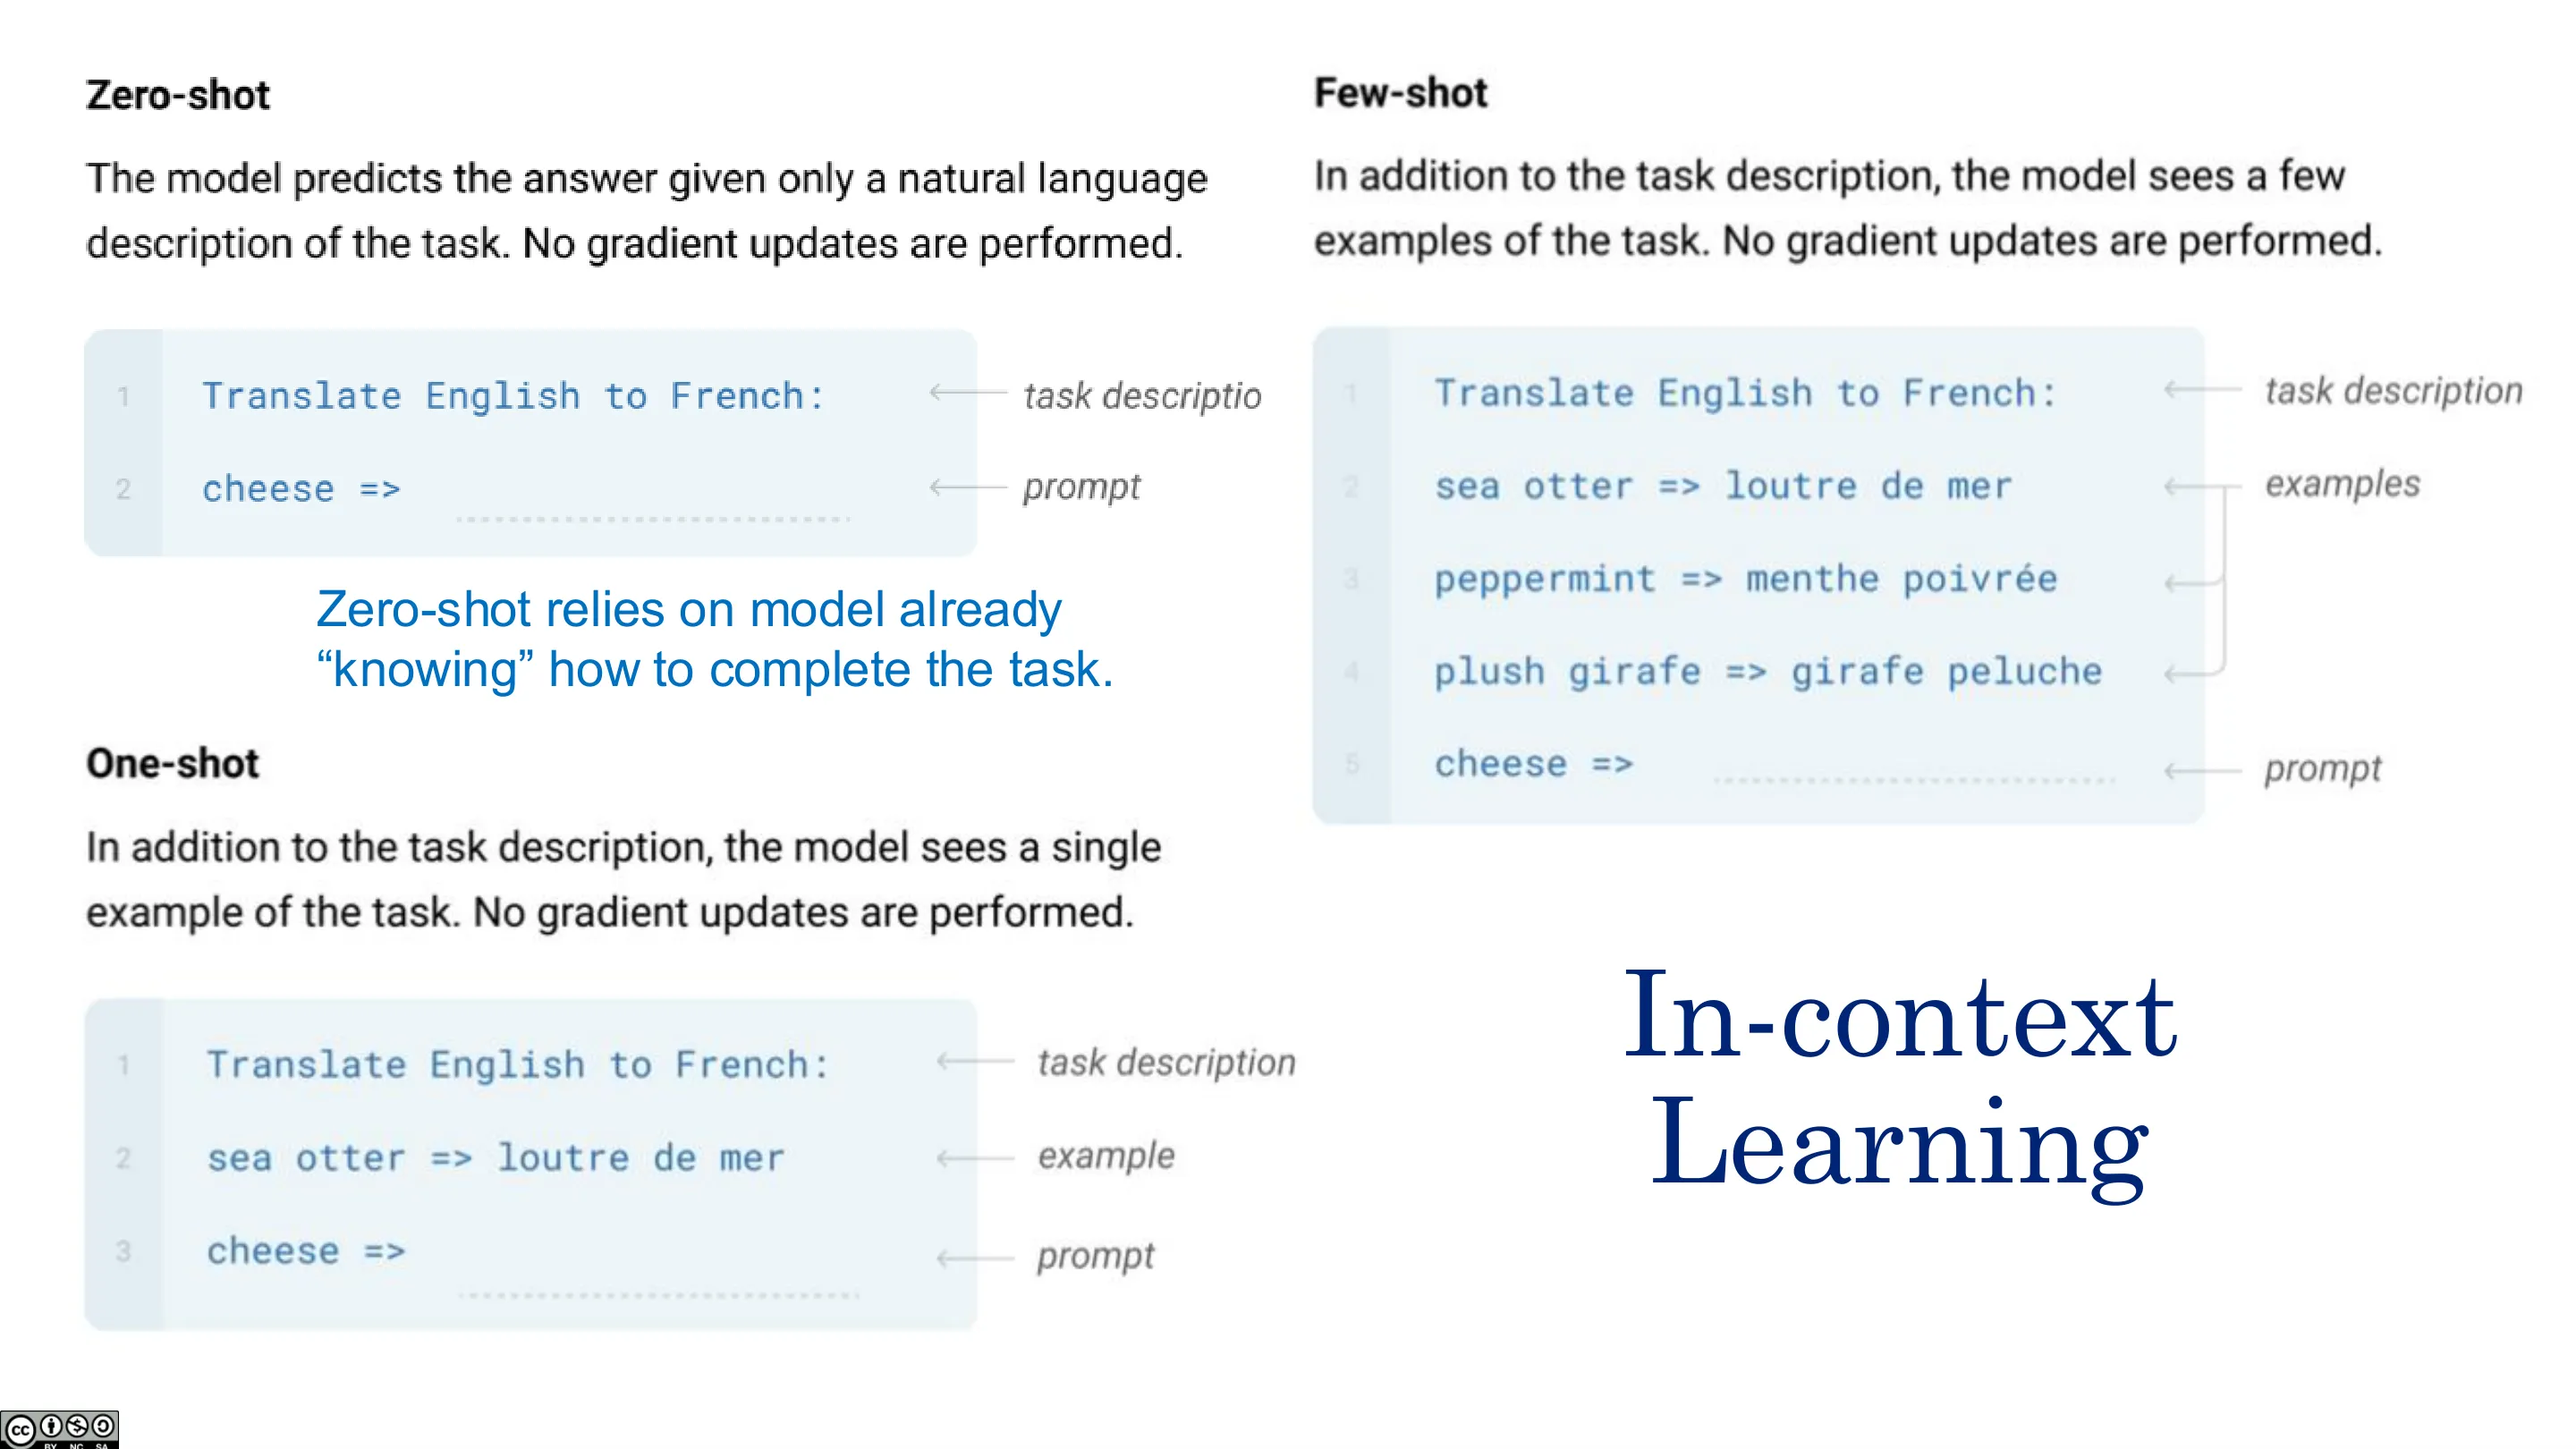
📷 上下文学习(in-context)
回到原视频 (01:03:36)
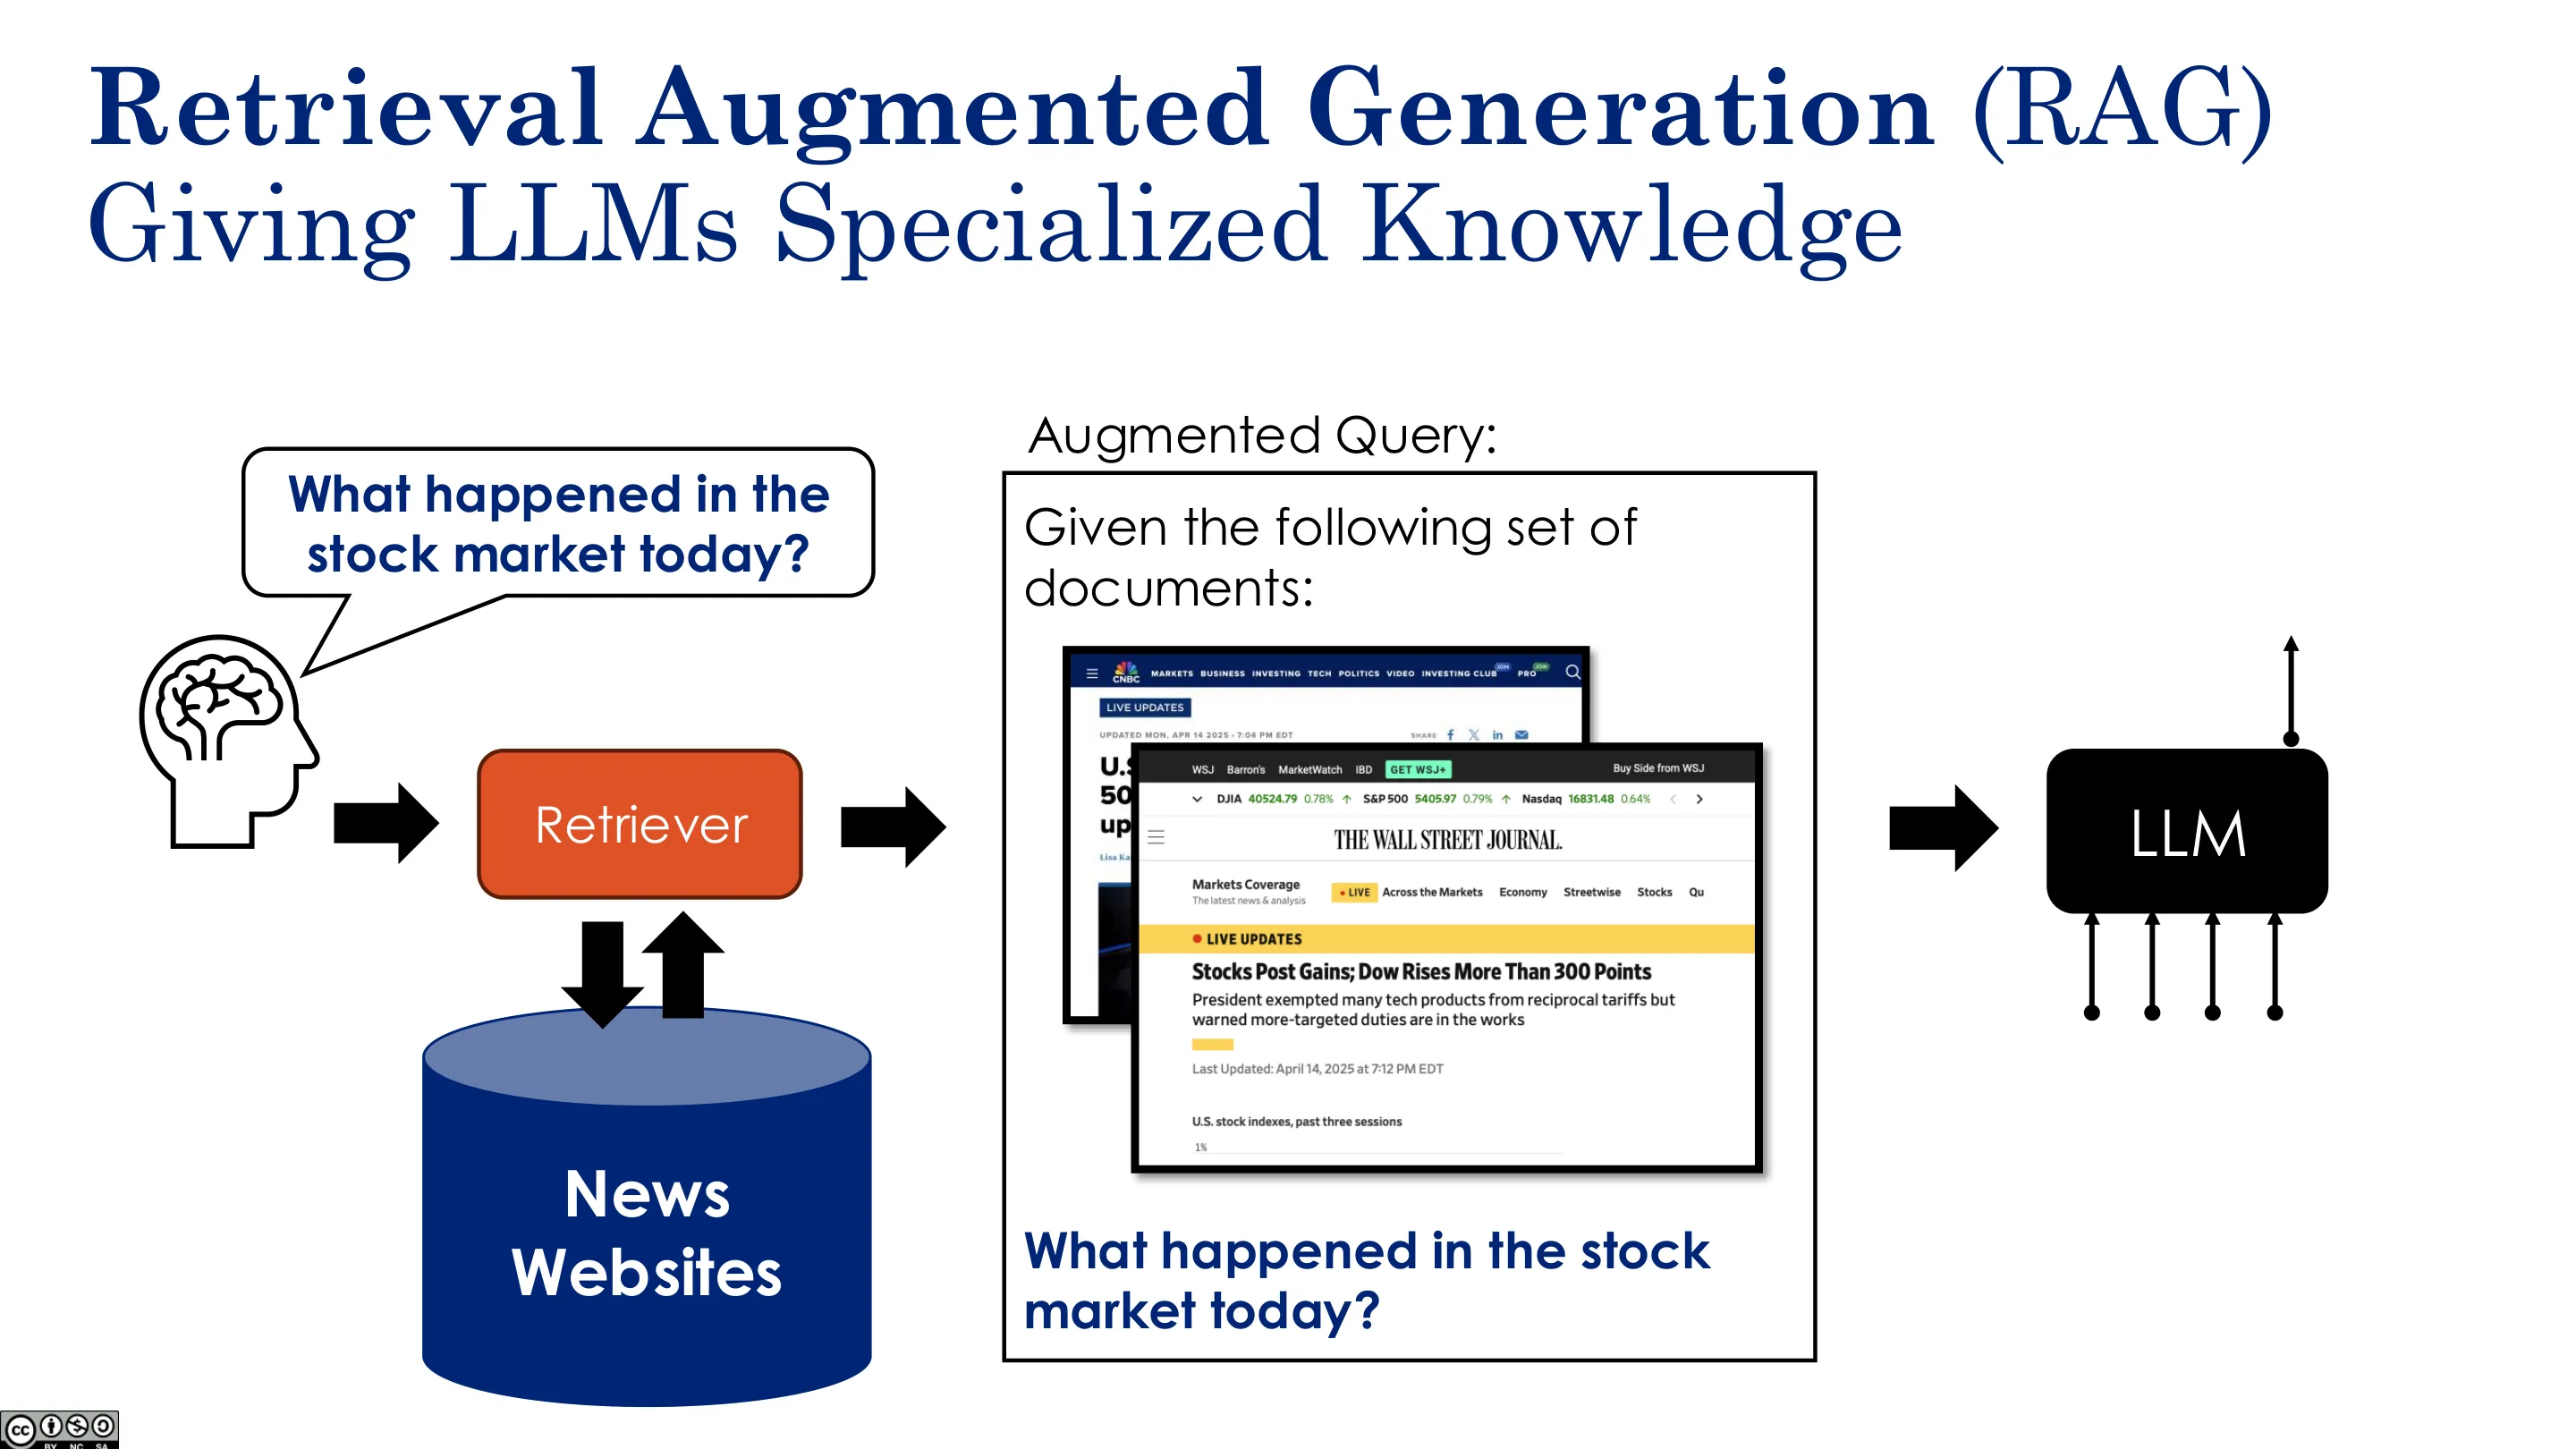
📷 检索增强生成(RAG)
回到原视频 (01:04:49)
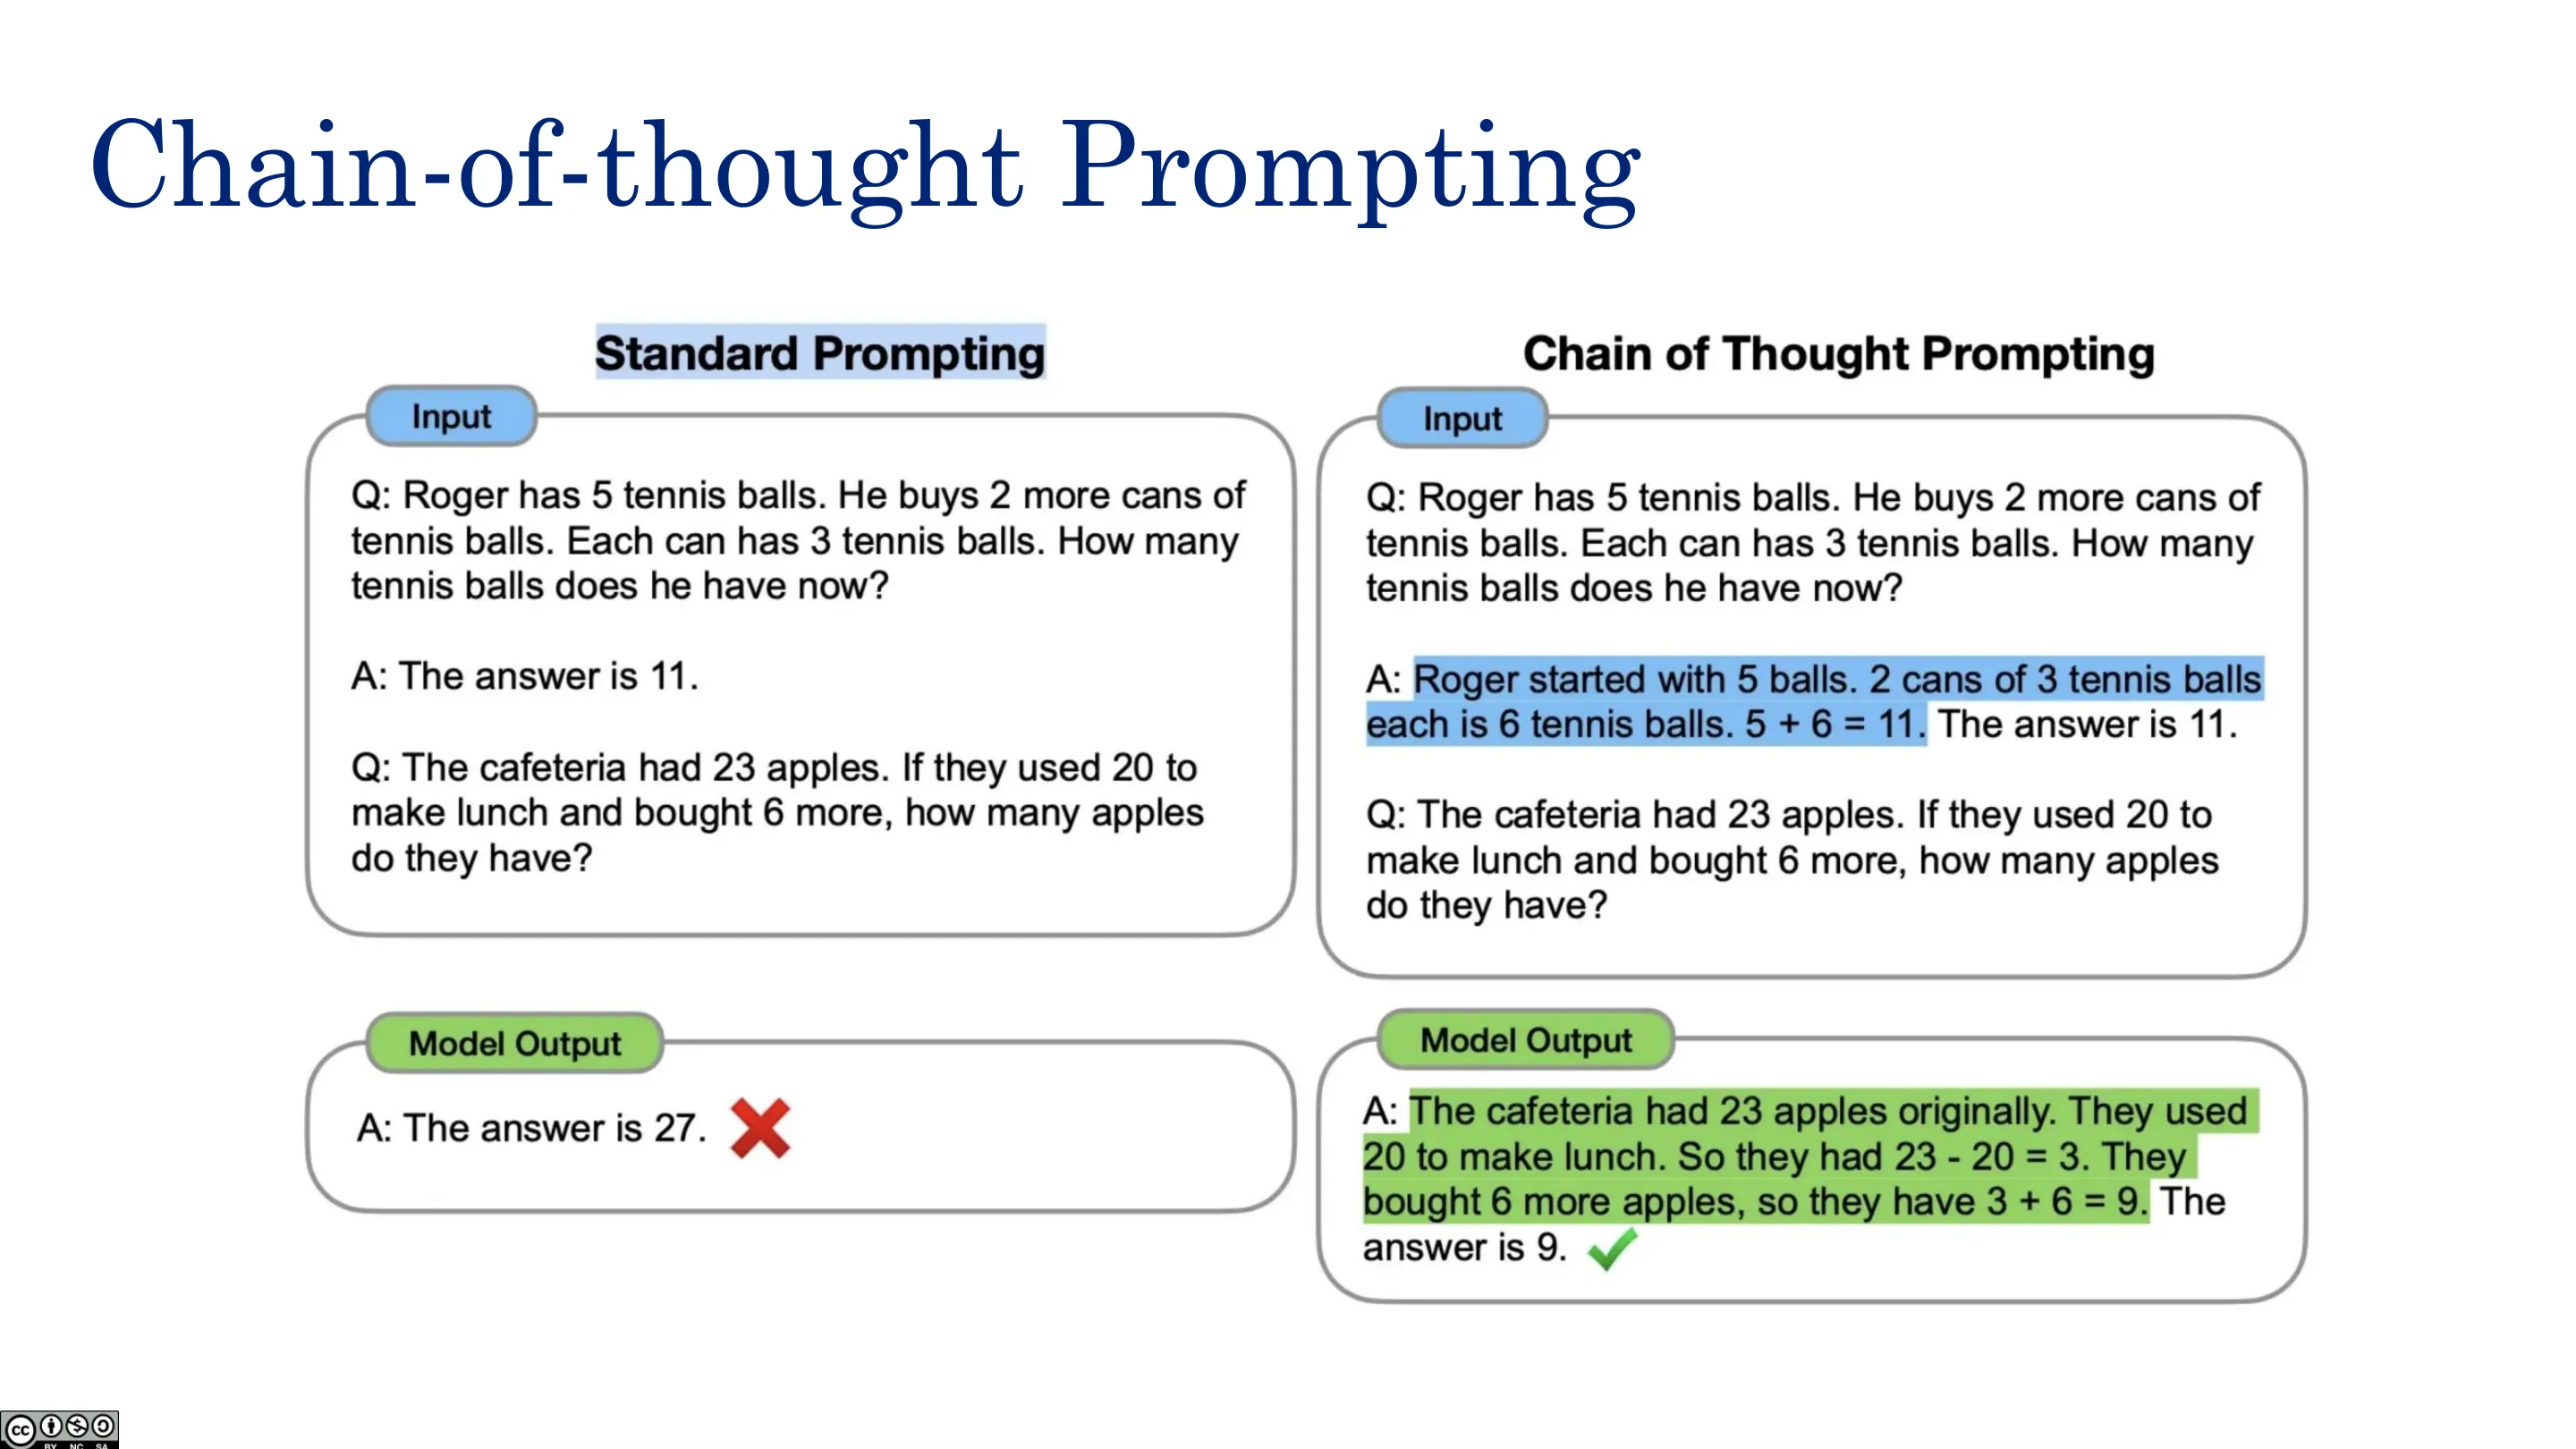
📷 思维链提示
回到原视频 (01:06:02)
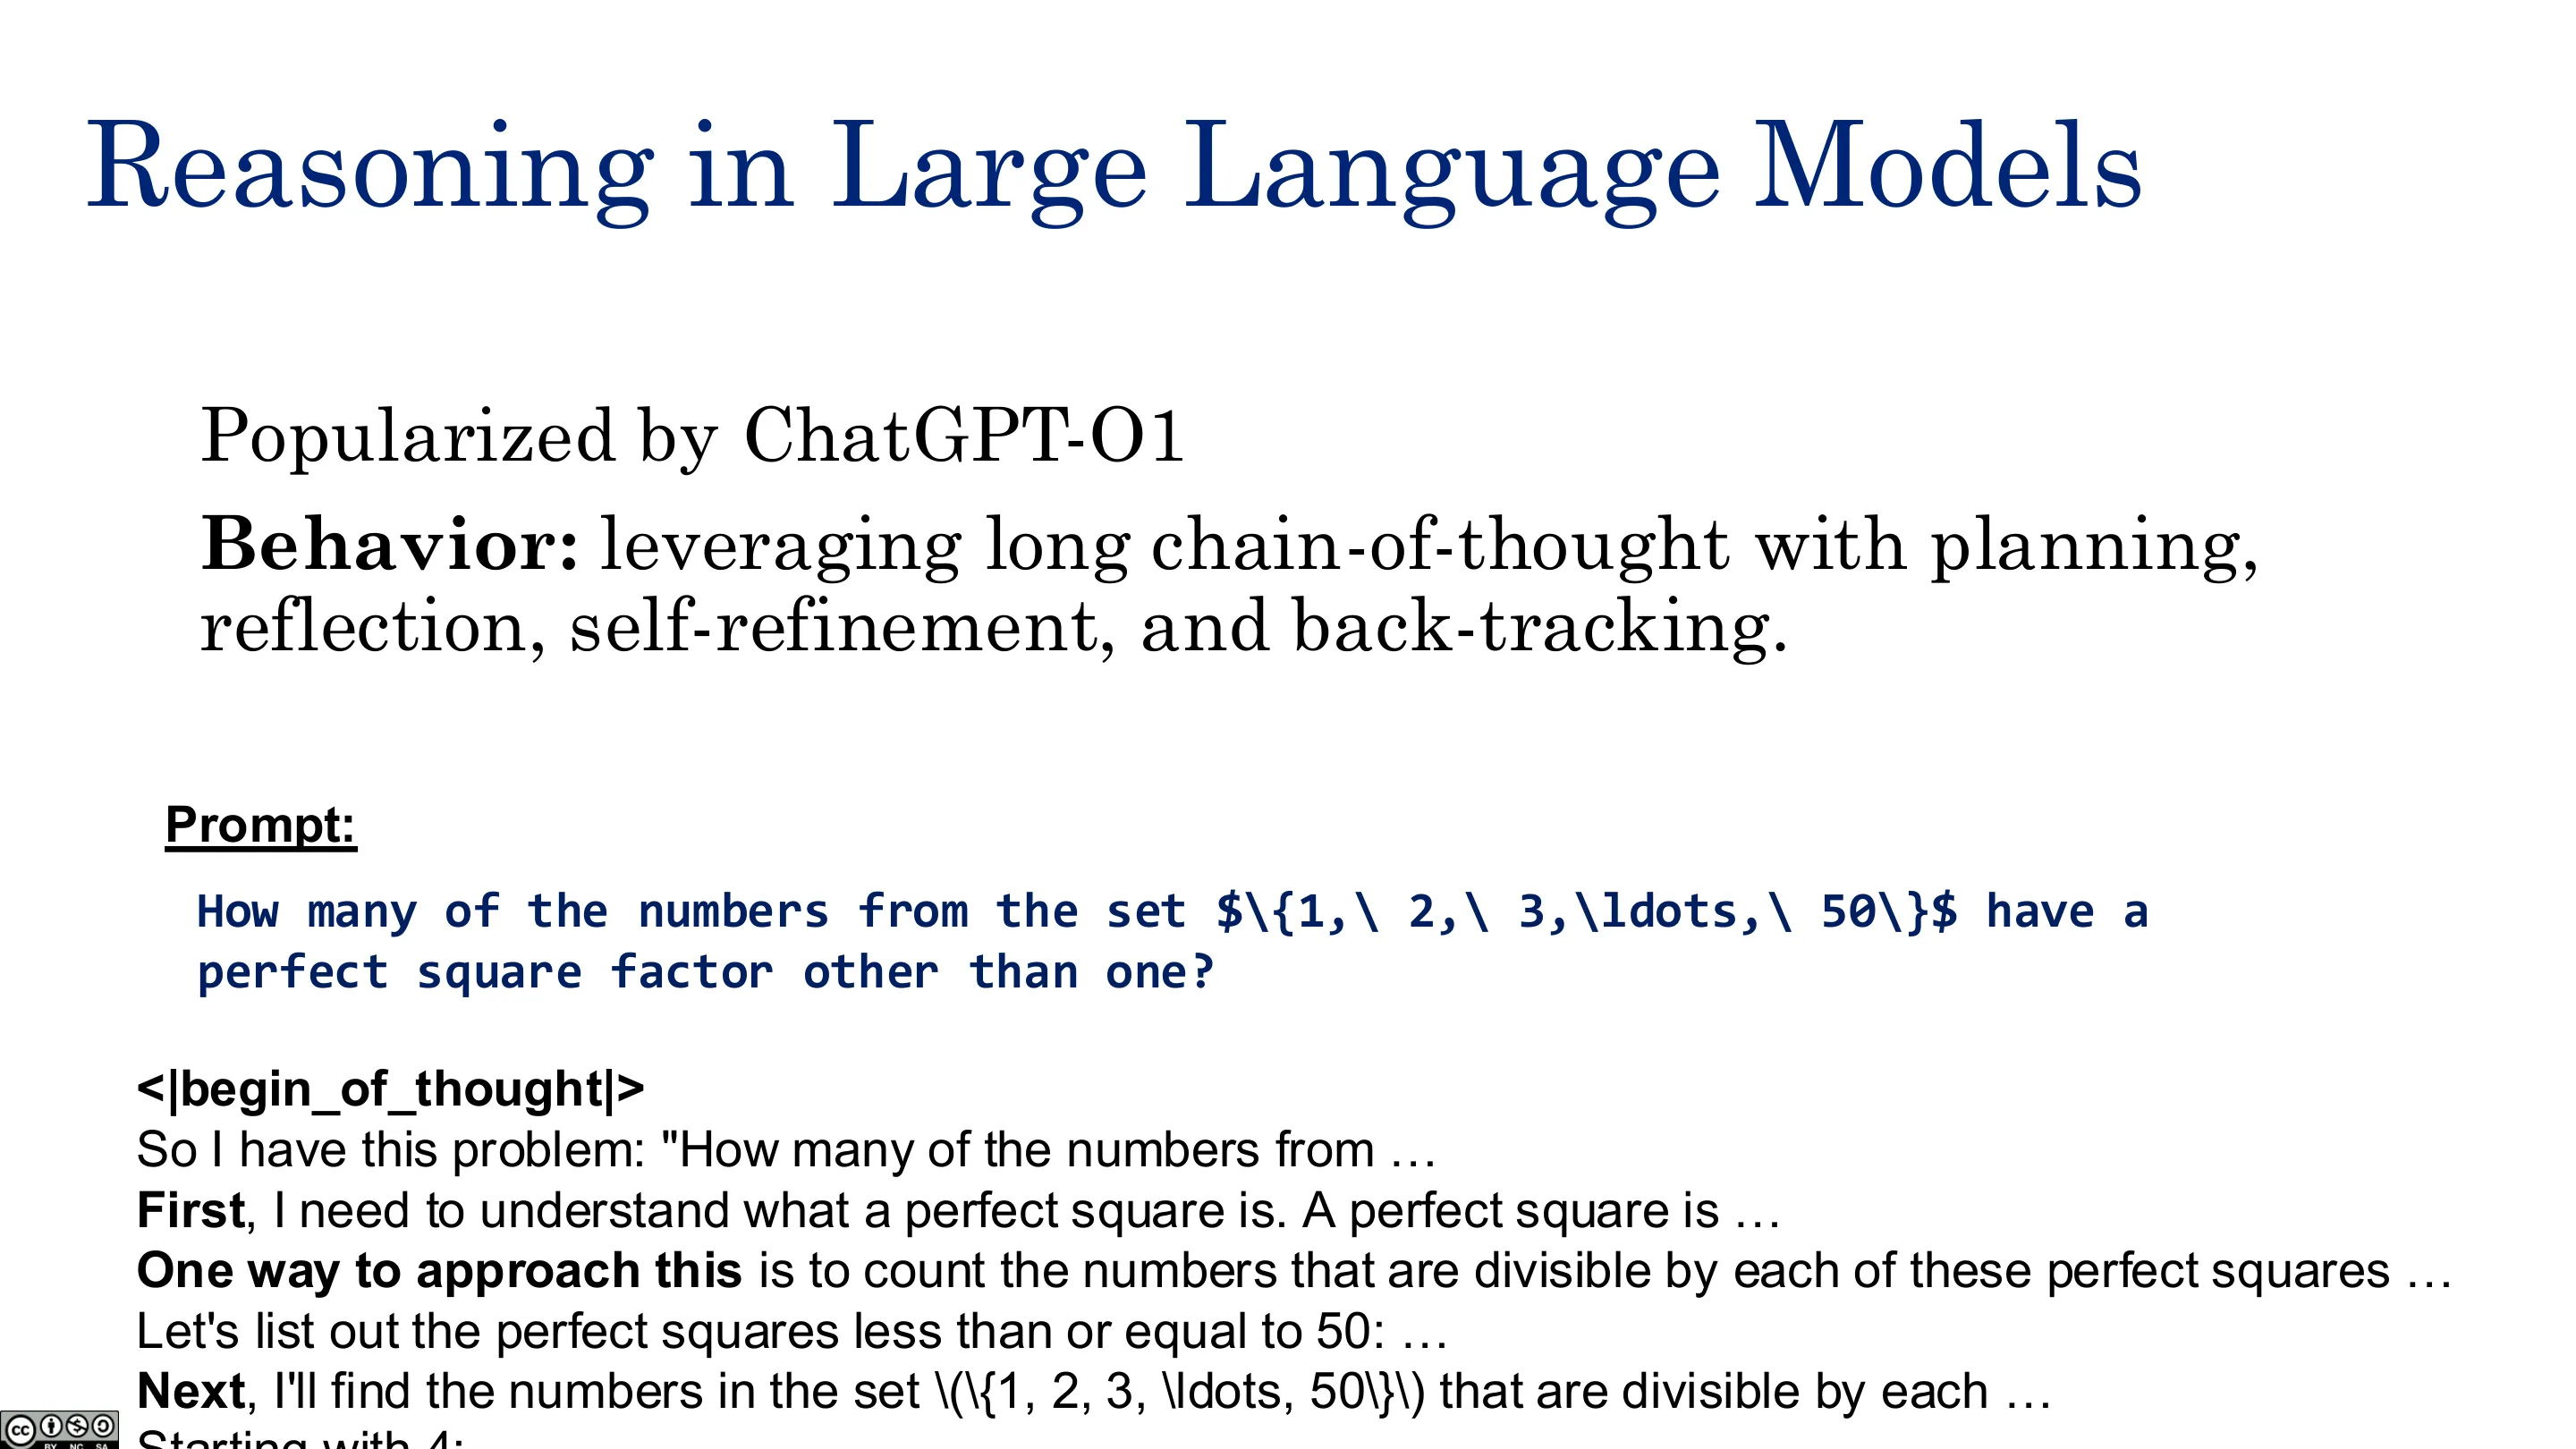
📷 大语言模型中的推理
回到原视频 (01:07:15)
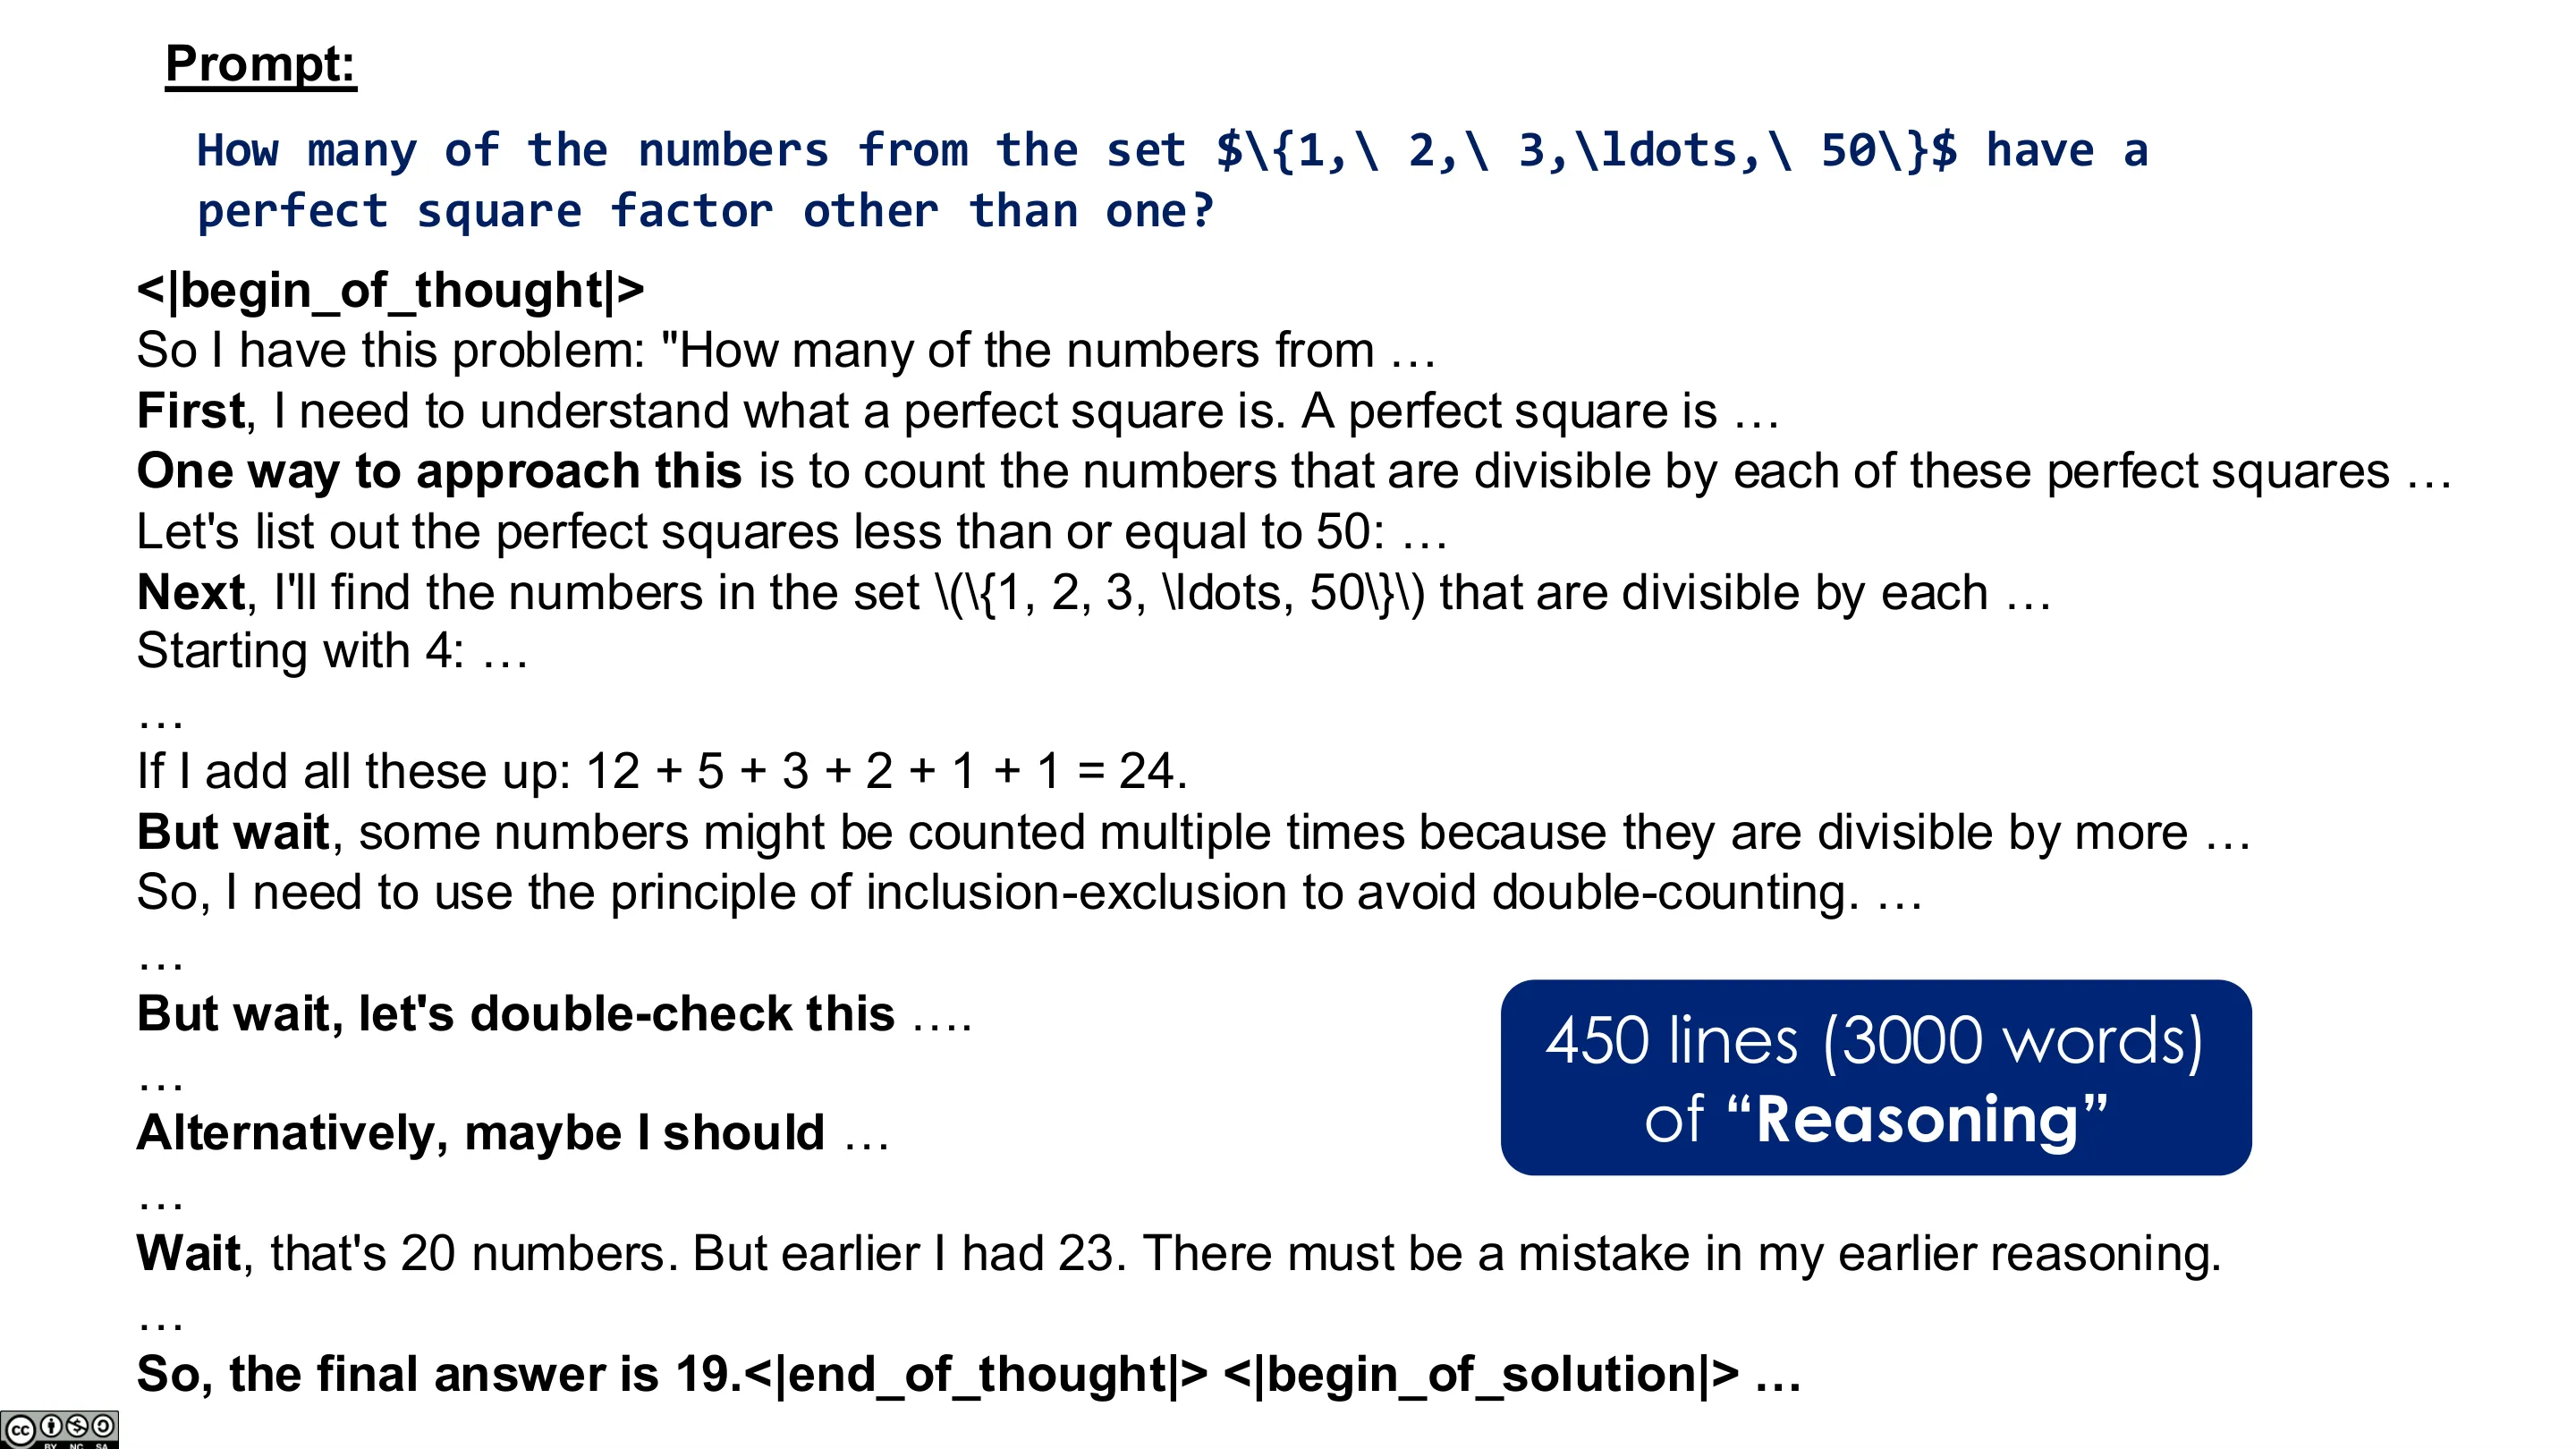
📷 数学竞赛题示例
回到原视频 (01:08:28)
附录:本讲未展示的幻灯片(幻灯片 58–63)
因课堂时间有限,Agentic Systems 等内容未讲到,置于附录。
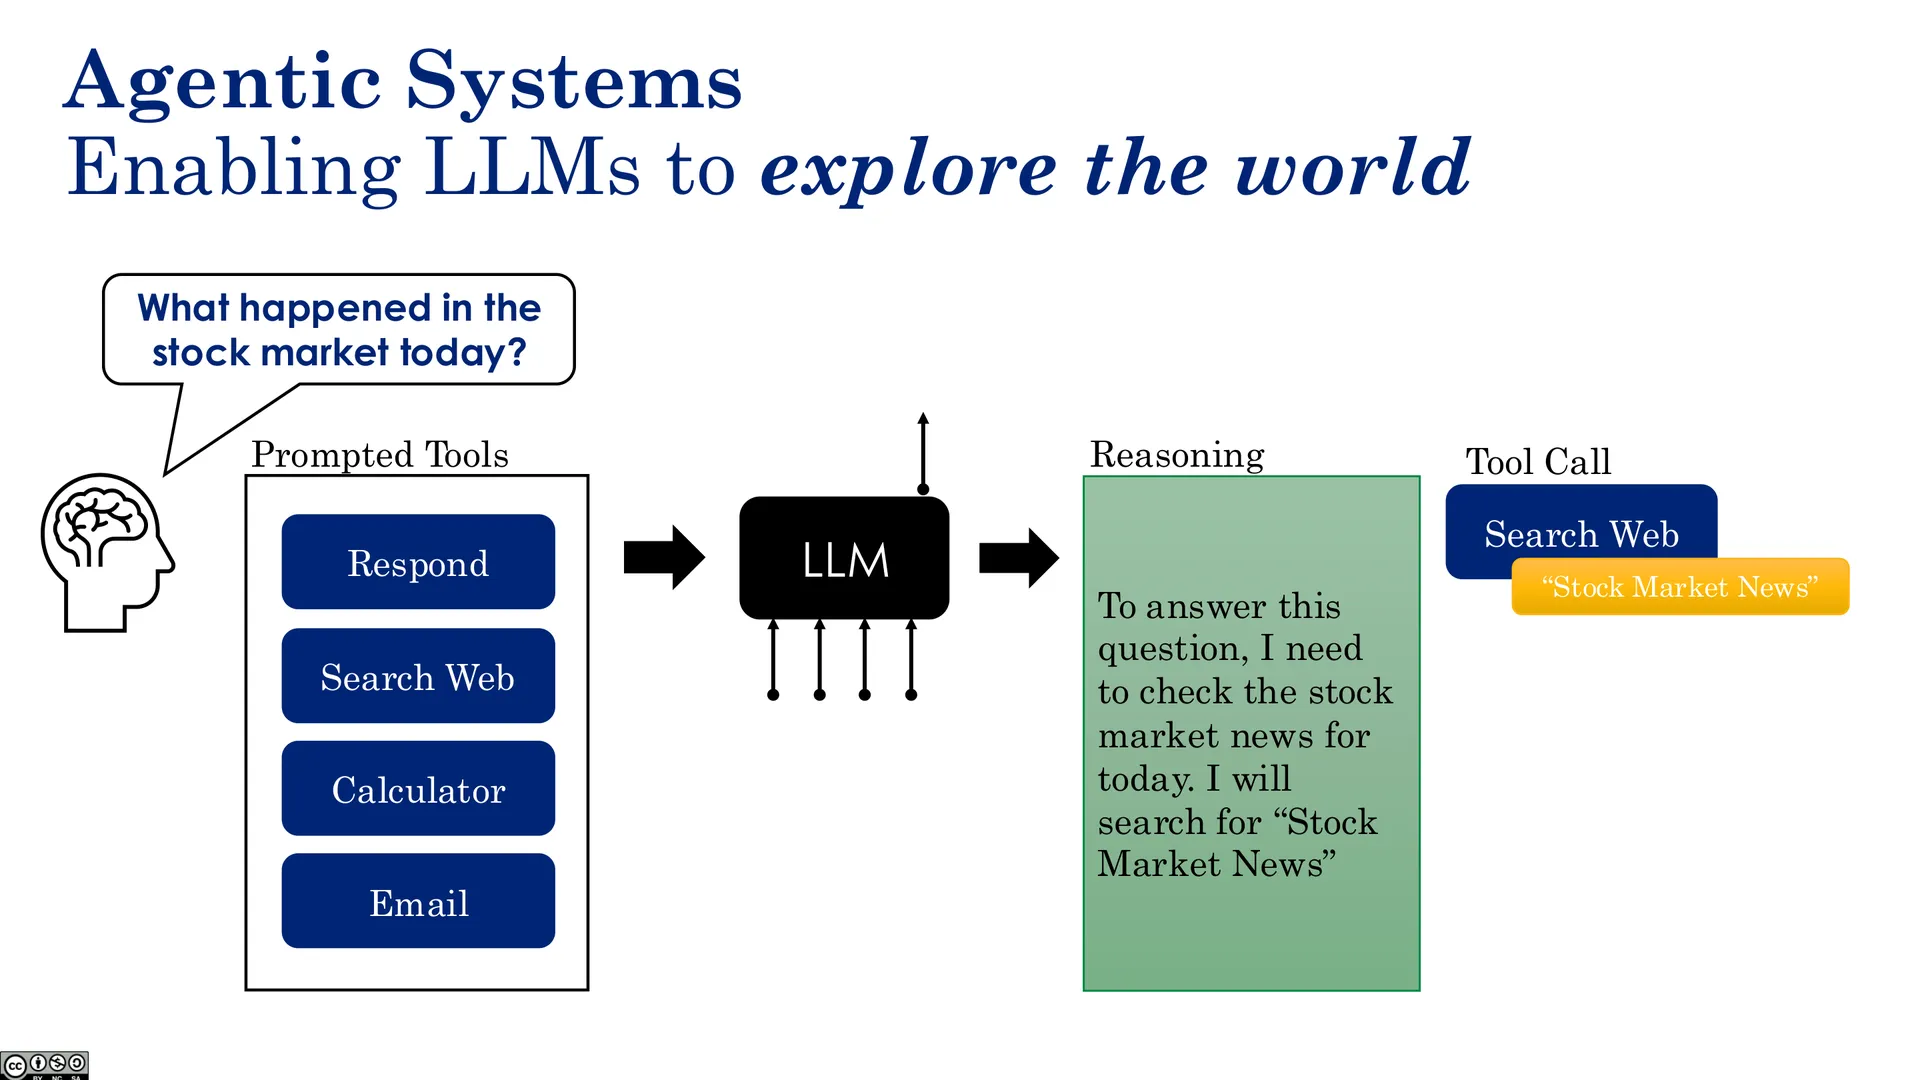
🖼️ Agentic Systems(一)
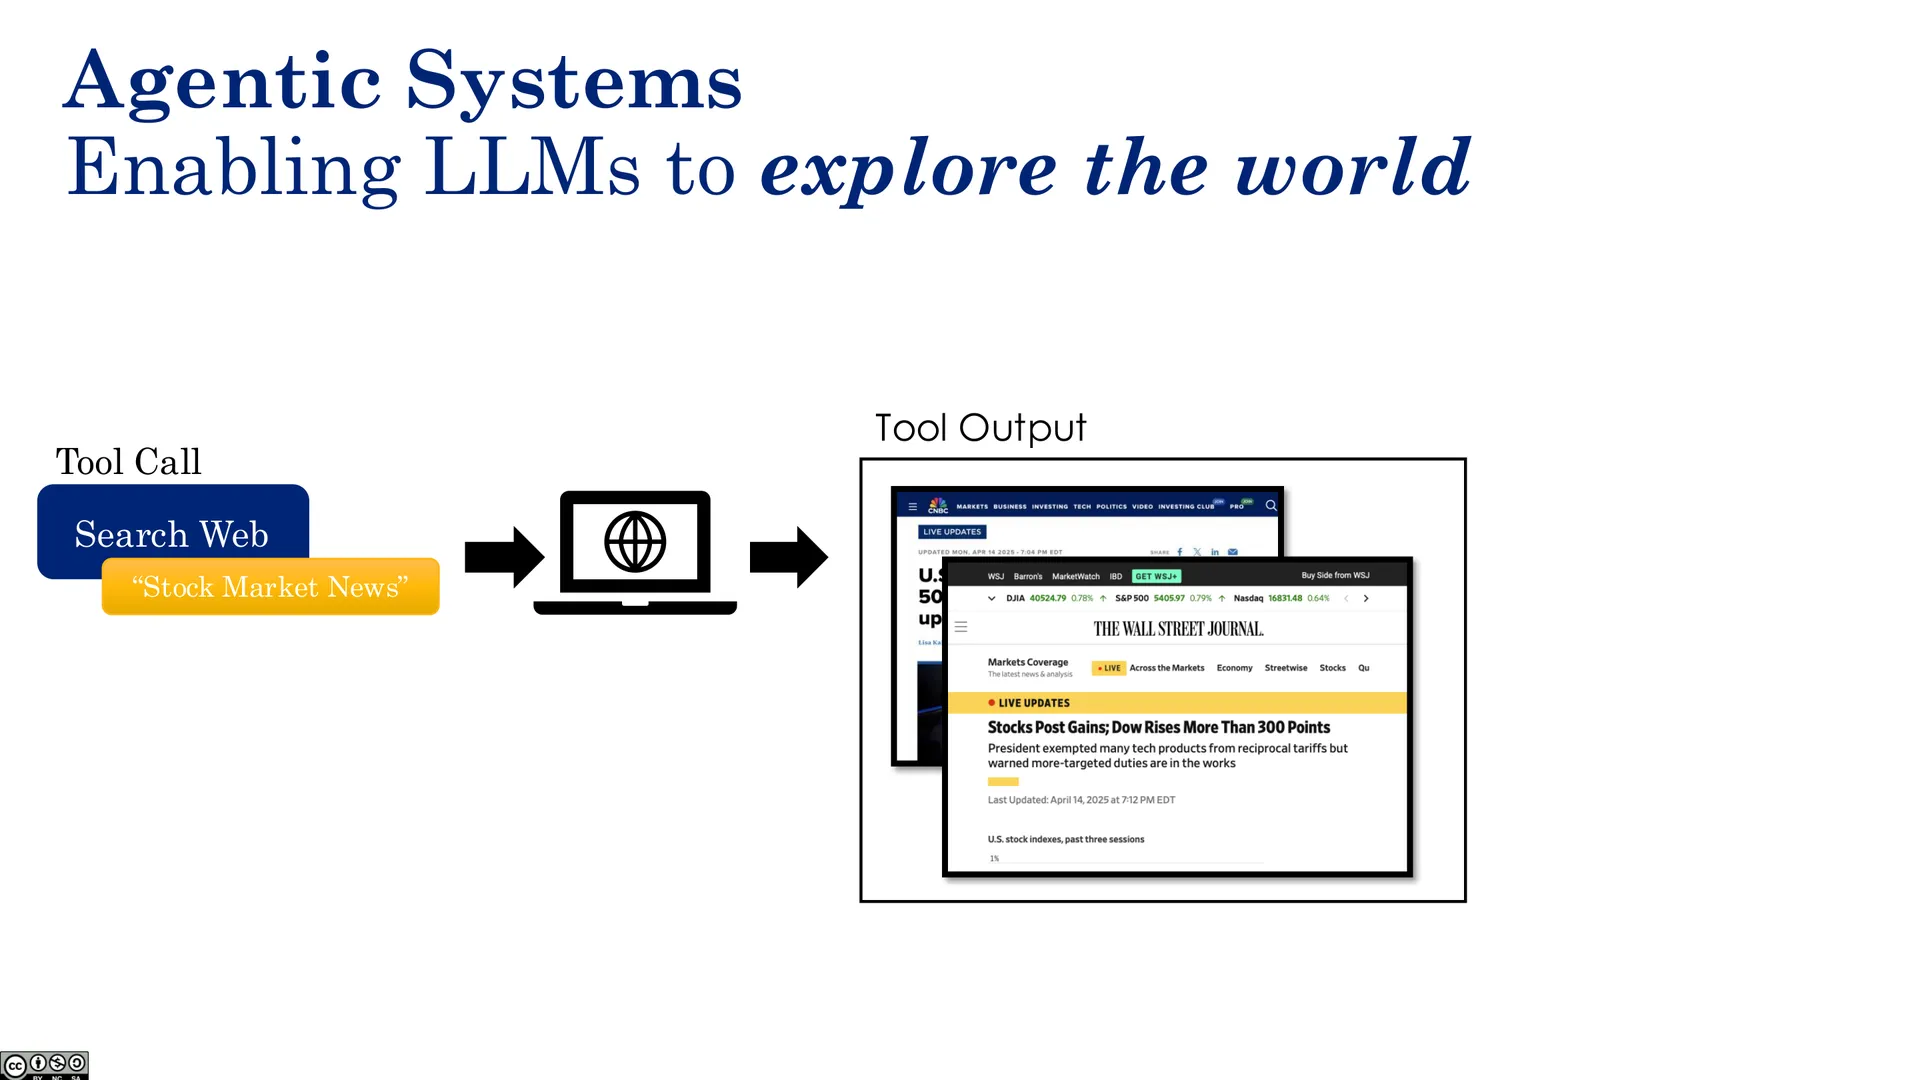
🖼️ Agentic Systems(二)
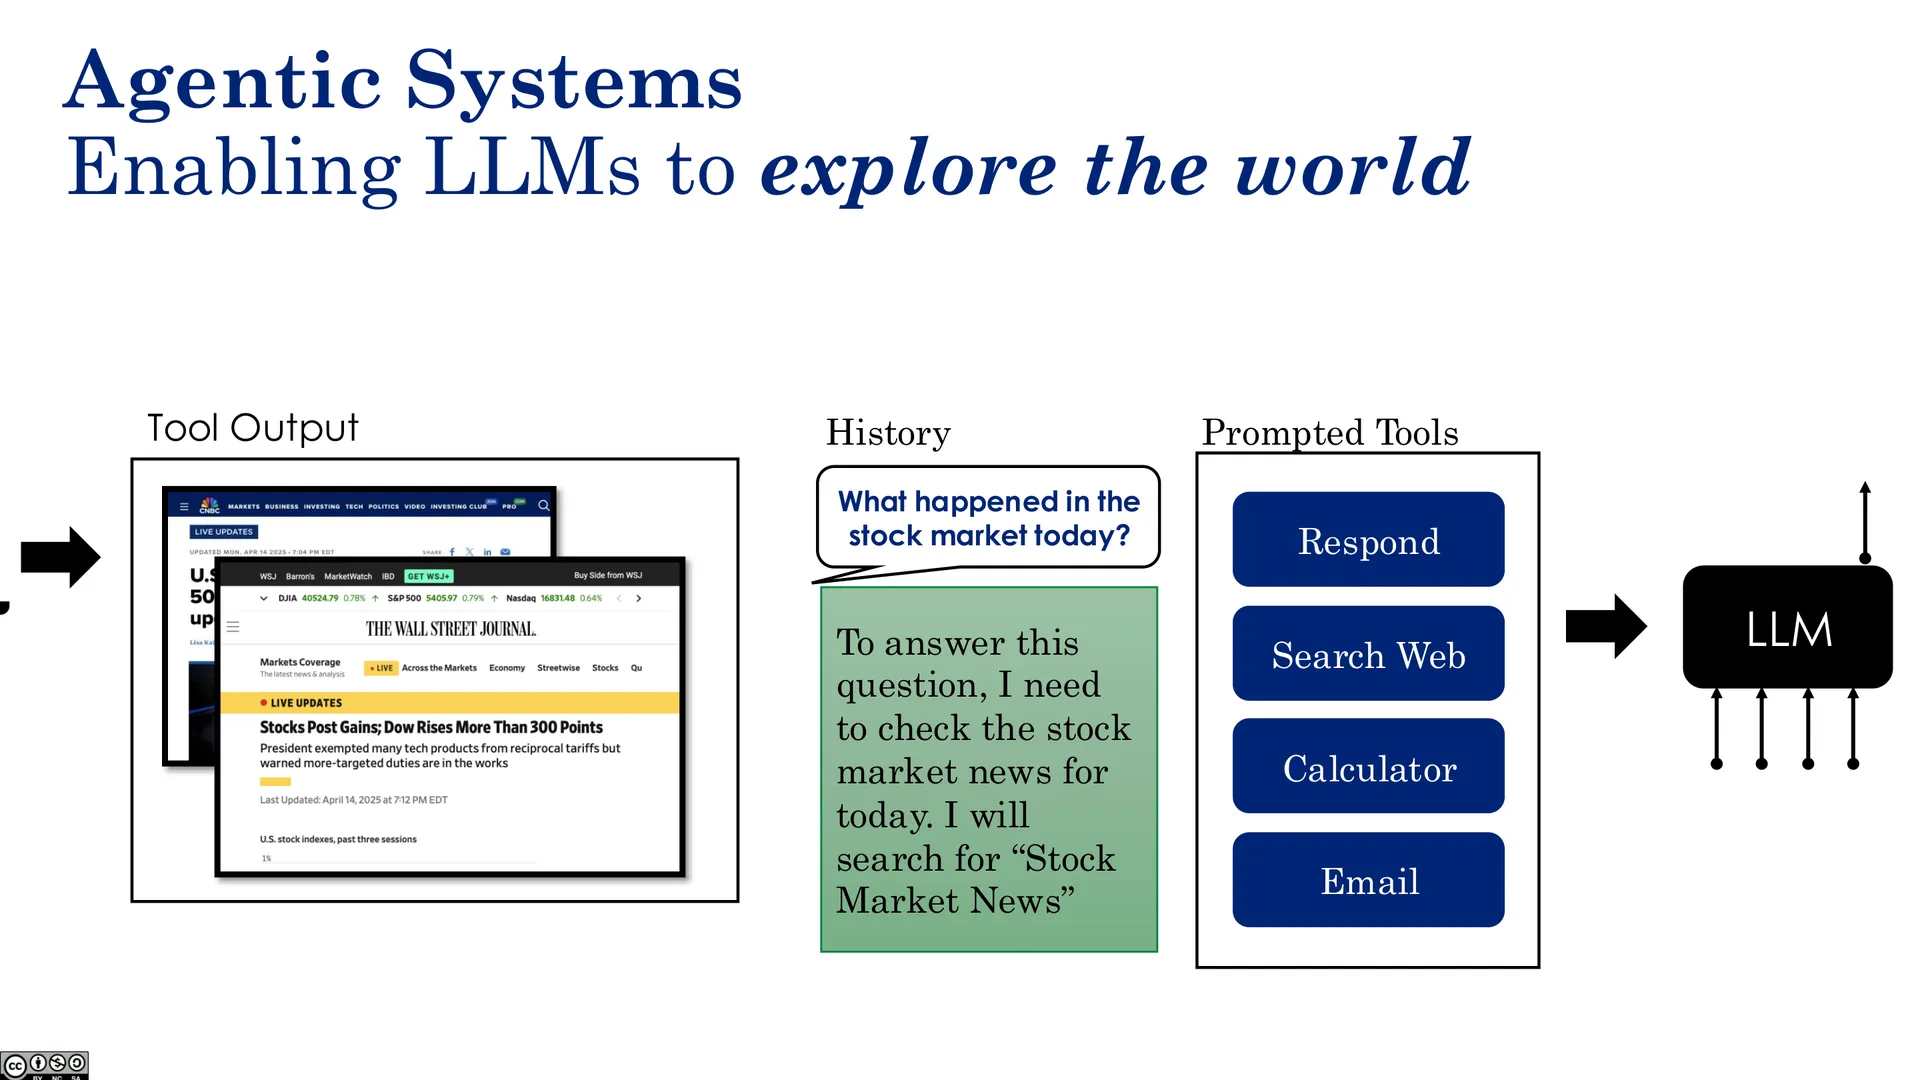
🖼️ Agentic Systems(三)
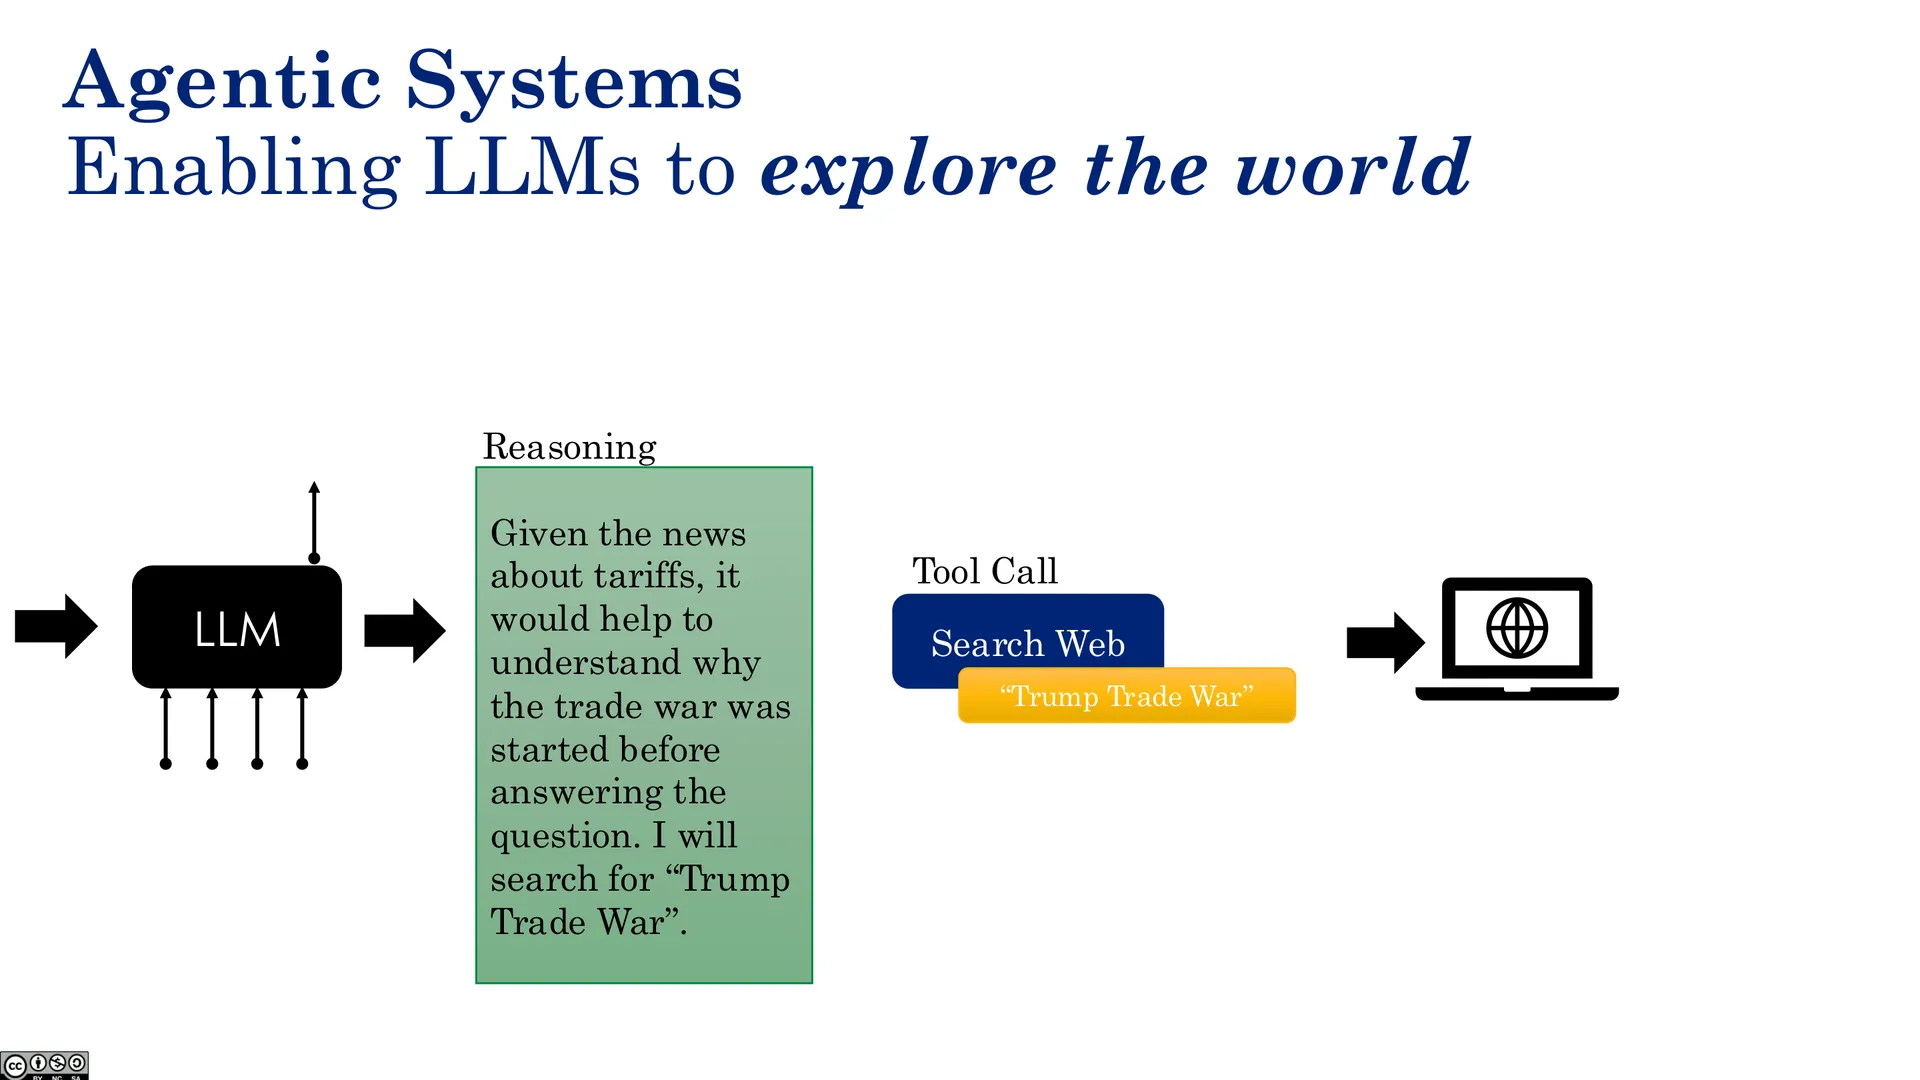
🖼️ Agentic Systems(四)
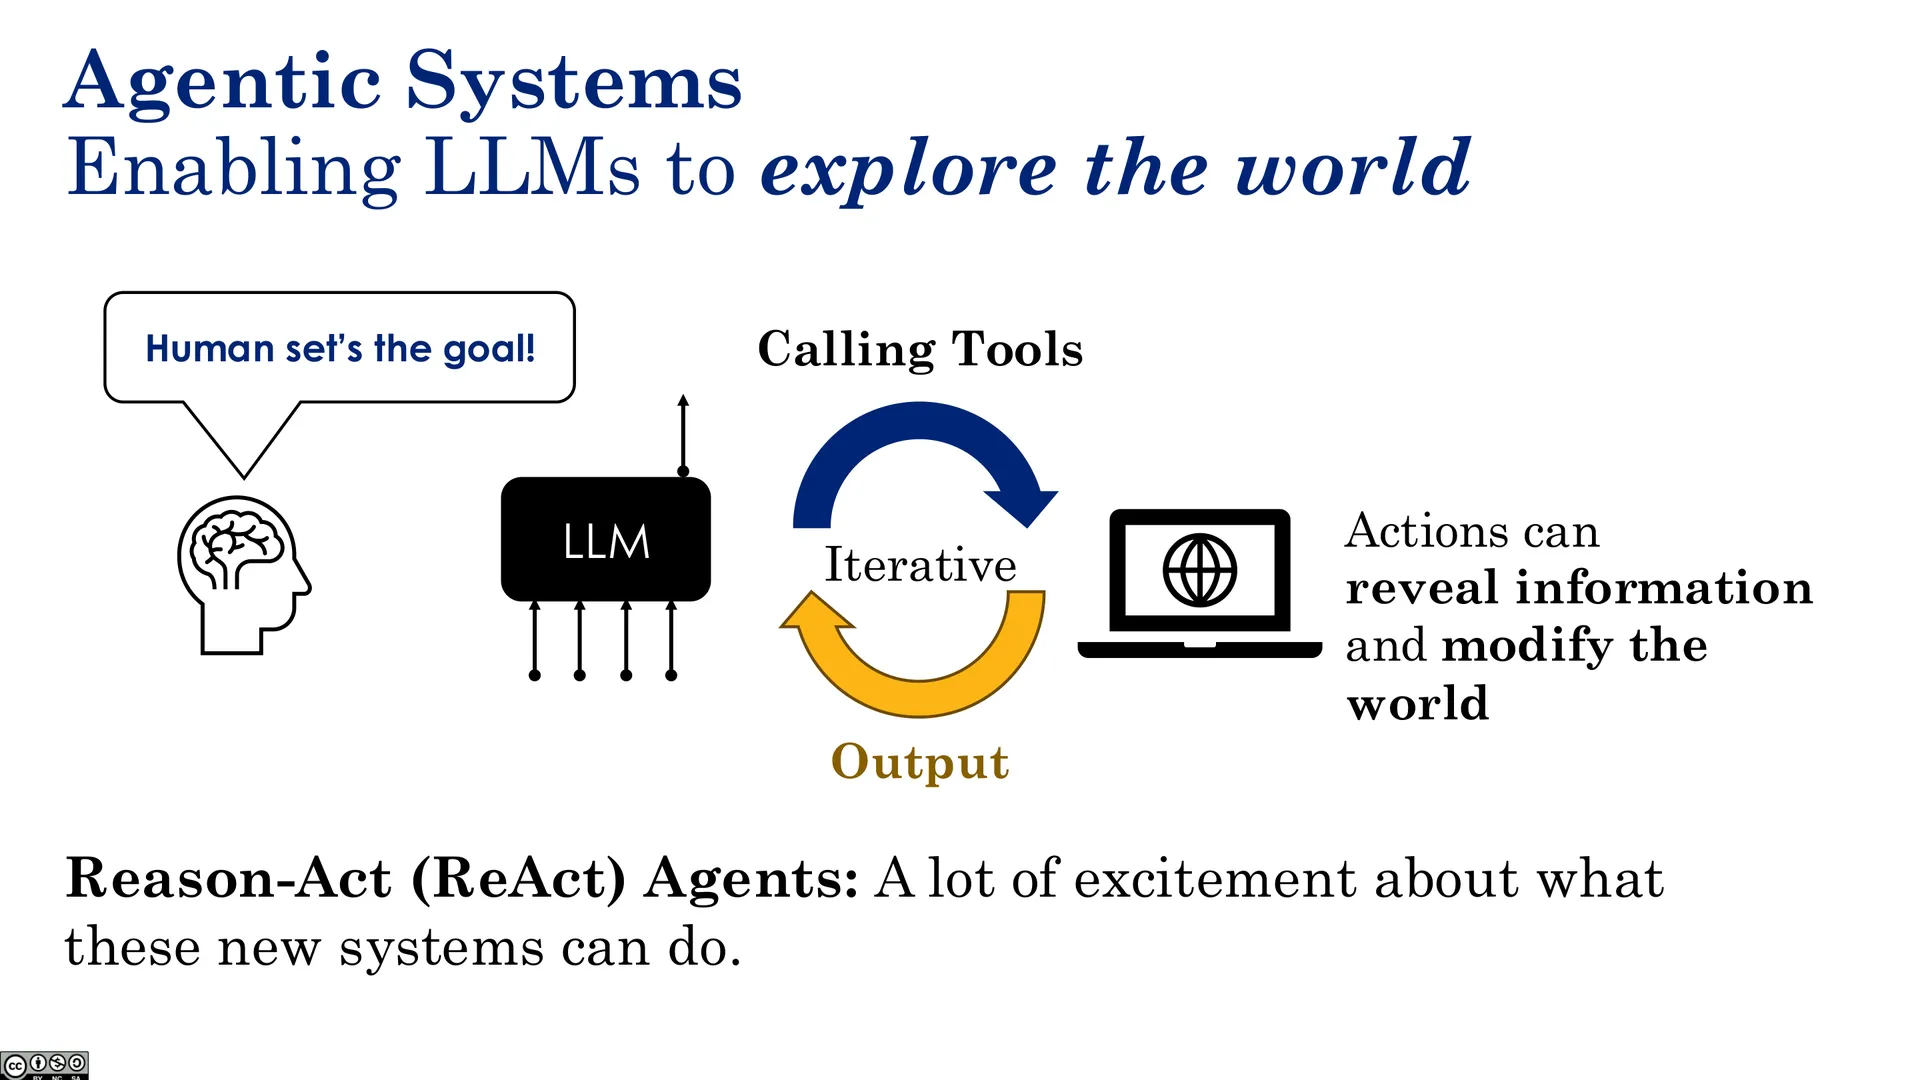
🖼️ Agentic Systems(五)
🖼️ LLM 训练与……(下讲预告)
总结(Takeaways)
- Encoder-only(BERT) 适合理解/分类;Decoder-only(GPT/Llama) 是自回归生成的主力。
- 分类:取最后一个 token 的表示 + 线性头;线性探针(冻结主干,少数据)vs 全量微调(多数据)。
- 自监督 = 预测下一个 token;标签免费、数据海量;为何强大——要预测下词必须压缩整段文本/知识。
- Masked(因果)注意力 防止「偷看未来」作弊。
- 多模态:一切皆 token(图像切 patch + 位置编码 + adapter);Llama-3 用 RMSNorm + RoPE。
- 后训练:SFT → RLHF → DPO → RLVR,把"下词预测机"变成对齐的助手;对齐是持续猫鼠游戏。
- 规模:GPT-3 175B,大部分参数在 MLP;注意力参数与 token 数无关但计算 $\mathcal{O}(n^2)$。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=m13yELgj02c |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 23) | Google Drive 文件夹 |
| Vaswani et al., Attention Is All You Need (2017) | https://arxiv.org/abs/1706.03762 |
| Brown et al., Language Models are Few-Shot Learners (GPT-3) | 自监督与零样本 · https://arxiv.org/abs/2005.14165 |
| Ouyang et al., InstructGPT | RLHF · https://arxiv.org/abs/2203.02155 |
| Rafailov et al., DPO | 直接偏好优化 · https://arxiv.org/abs/2305.18290 |
| Hu et al., LoRA | 低秩适配微调 · https://arxiv.org/abs/2106.09685 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。