第24讲 · EECS 189:自监督学习
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | Self-Supervised Learning — Pretext Tasks, Autoencoders, Contrastive Learning and CLIP |
| 视频 | https://www.youtube.com/watch?v=iGcer6b6mp8 |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 24) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第24讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
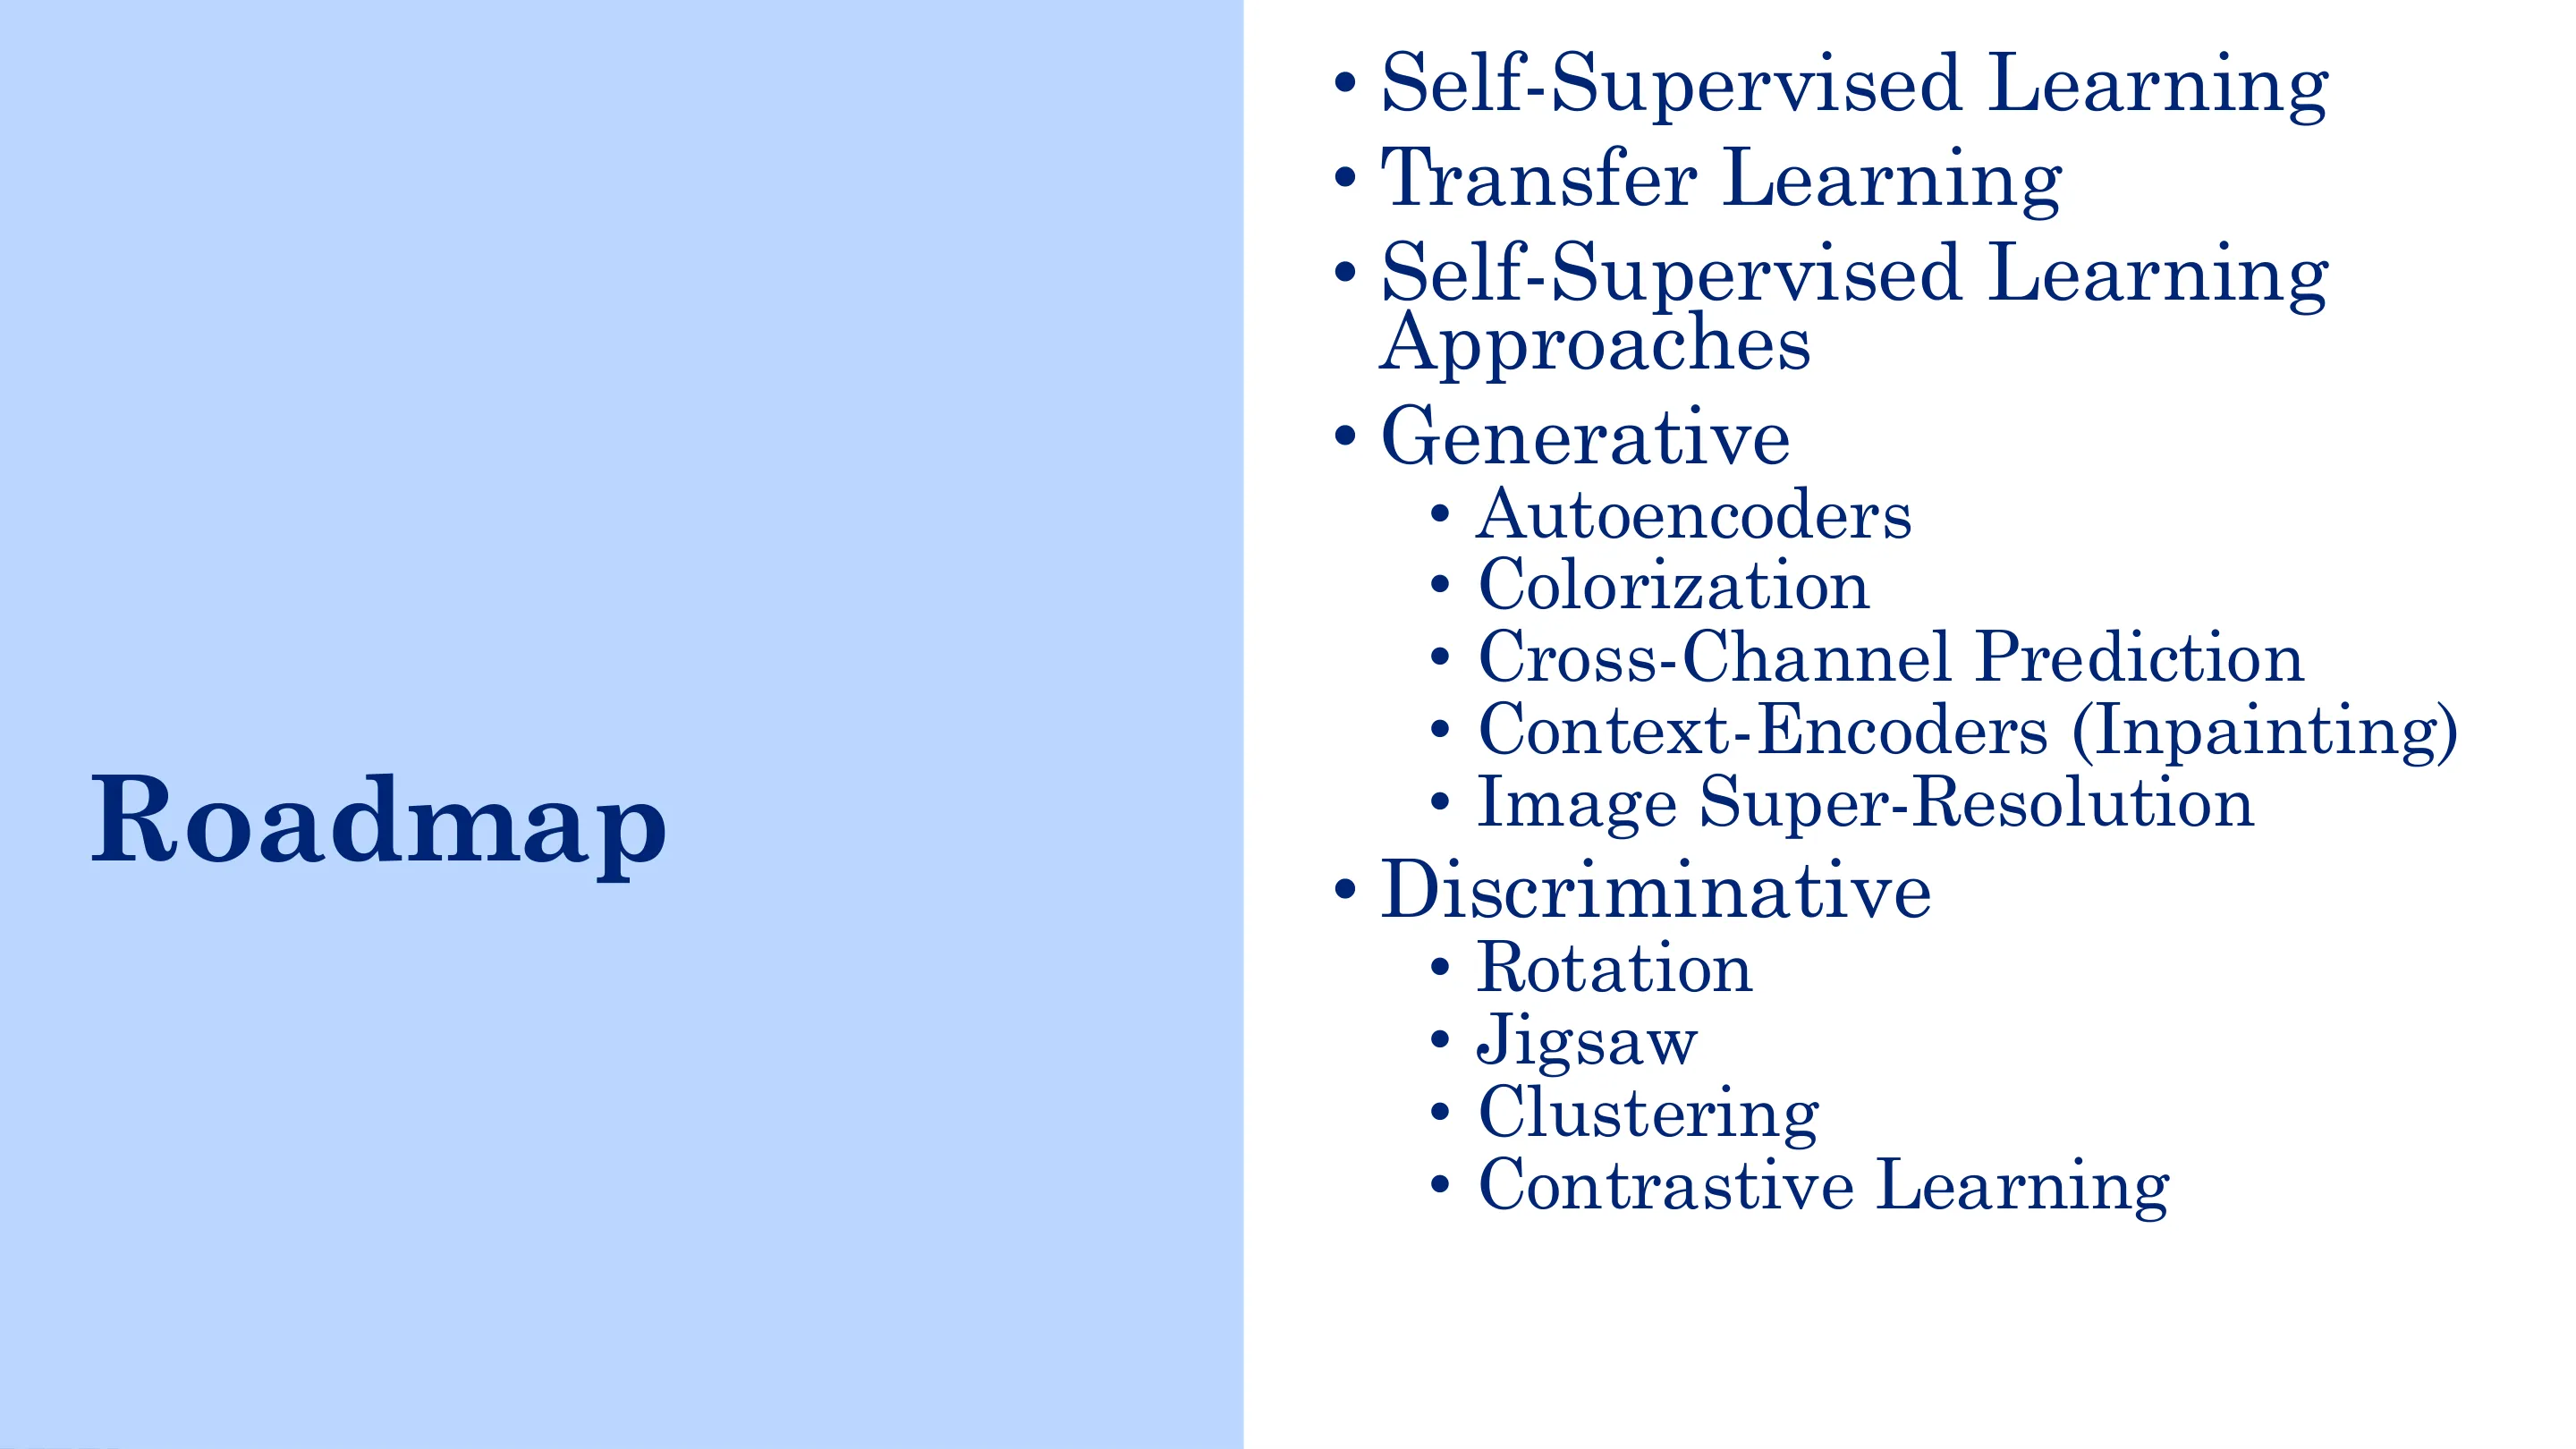
本讲路线图
(参考时间: 00:00)
本讲的主线:用自监督从原始数据中学到可迁移的表示。等价说法:
- 创建假的监督任务,却学到有用的东西;
-
预测你已经知道的东西,帮助预测以后的东西。
-
监督 vs 无监督 vs 自监督;迁移学习;
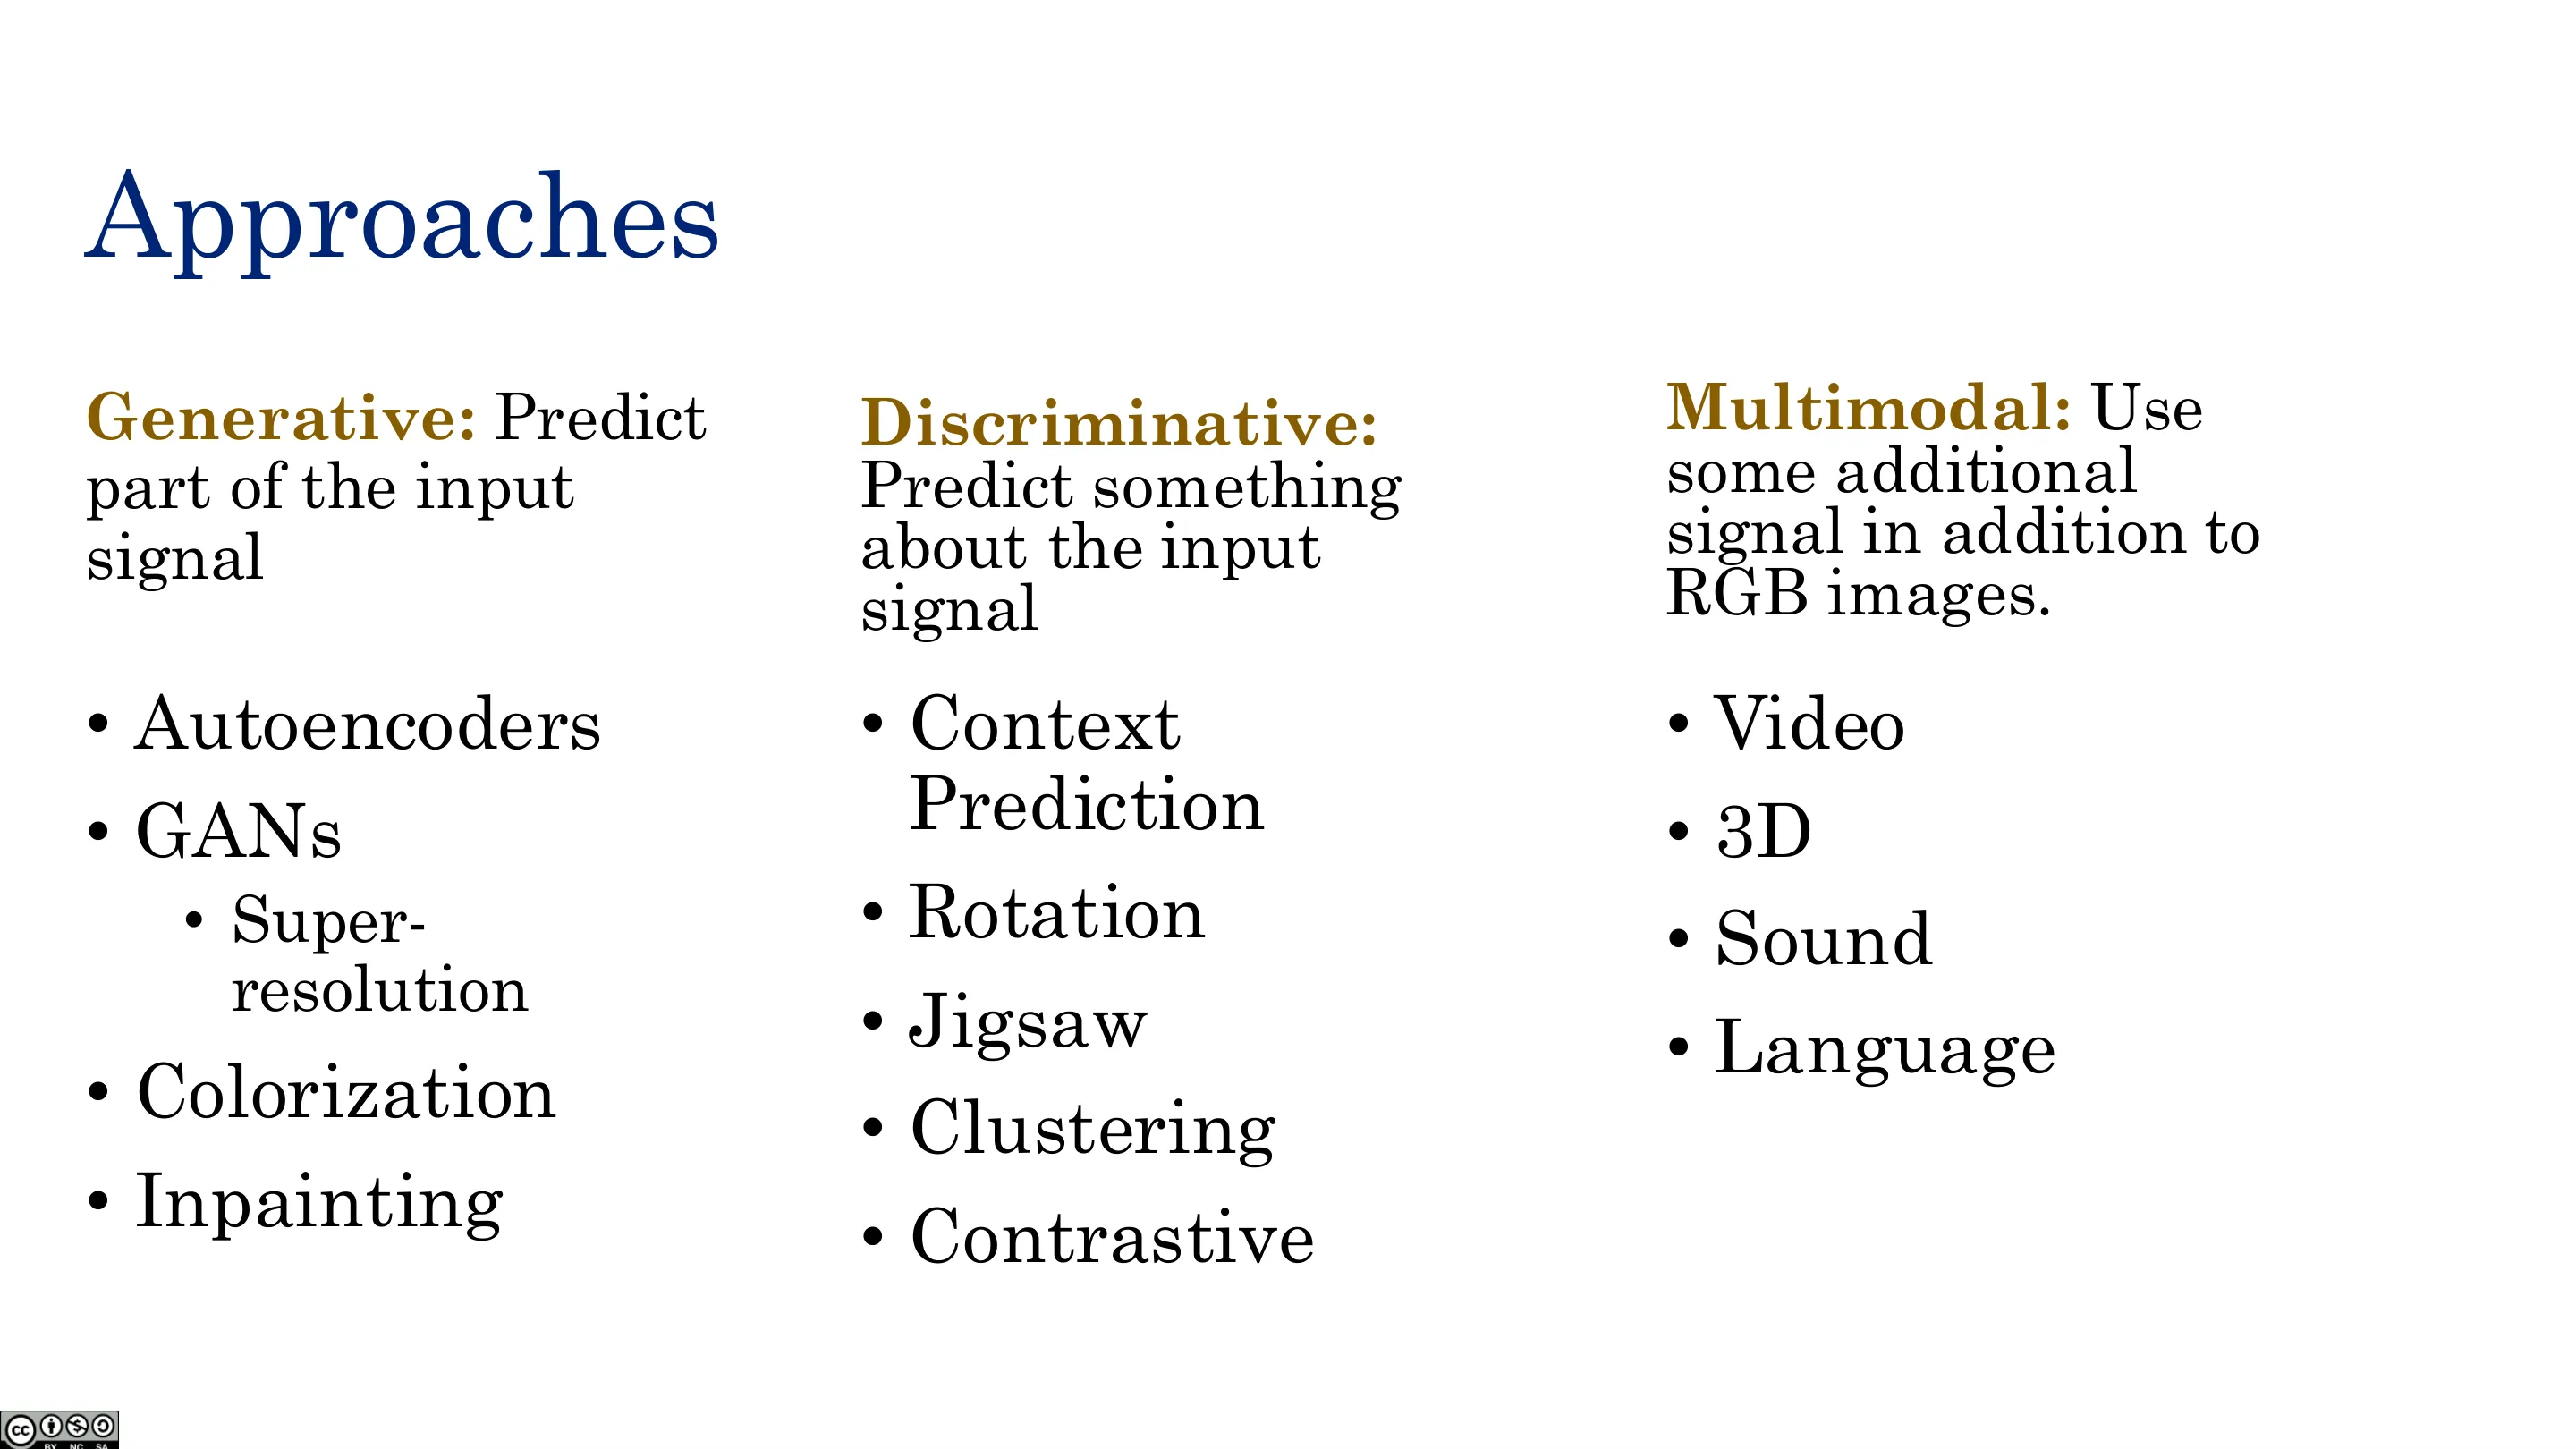
- 生成式 pretext 任务:自编码器、去噪、着色、跨通道、上下文编码、超分辨率;
- 判别式 pretext 任务:旋转预测、相对 patch 位置、拼图、深度聚类;
- 对比学习:SimCLR 与 OpenAI 的 CLIP(多模态图文对比)。
📷 标题页
回到原视频 (00:00:20)
📷 路线图
回到原视频 (00:01:33)
一、自监督与迁移学习
1.1 为什么需要自监督
(参考时间: 00:02)
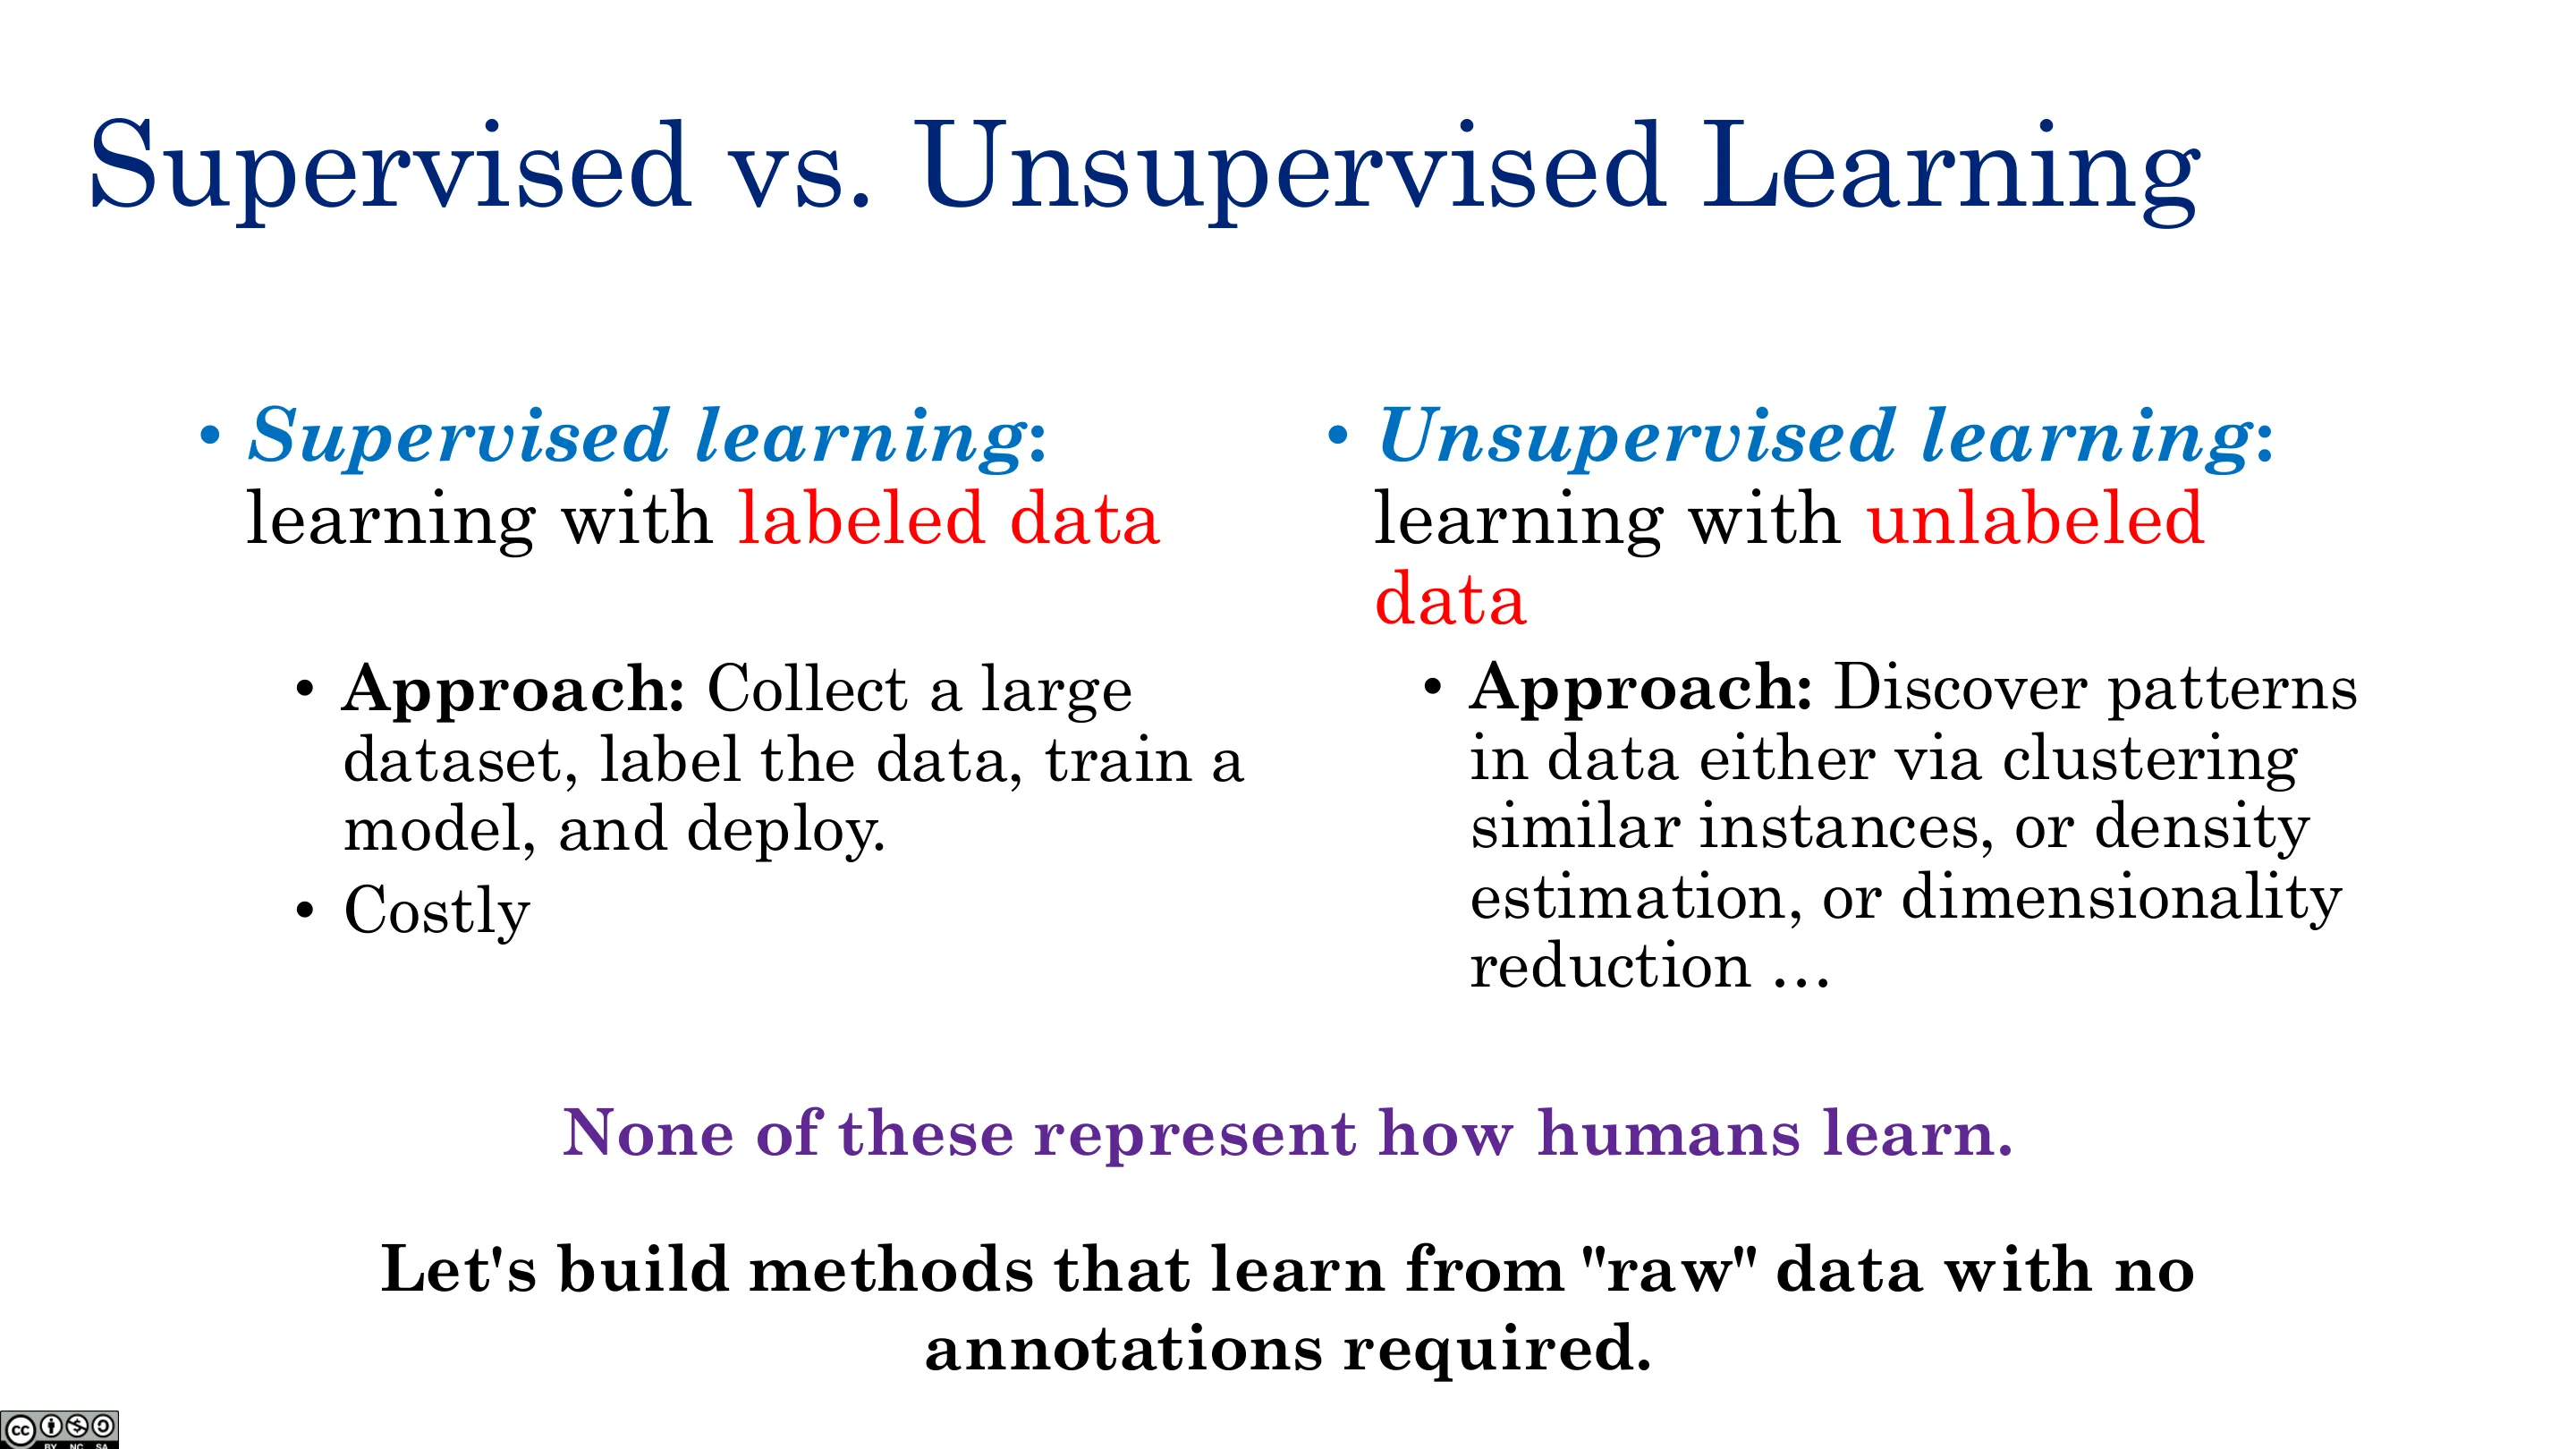
- 监督学习:有标注 $(X,Y)$(图像+标签、推文+情感、病人+是否患癌);
- 无监督学习:只有 $X$,没有 $Y$(但你不知道要预测什么——聚类可能按颜色也可能按形状)。
核心矛盾:原始数据(X)几乎无穷且便宜(网页文本、图片、蛋白质序列),但标注(Y)极其昂贵(雇人标注、做临床试验)。
自监督(self-supervision):从 $X$ 自己造标签,构造pretext(假)任务;训练中得到的表示向量会迁移到真正关心的下游任务上,于是只需很少甚至零标注。这就是旧的迁移学习(transfer learning)。
- Pre-train(预训练):在 pretext 任务上训练(数据可无限生成);
- Fine-tune(微调):在少量下游标注上微调;
- Zero-shot:连标注都不用;
- Few-shot:只用几张标注(人类能靠已有的表示一两张就区分新鸟种)。
📷 自监督
回到原视频 (00:02:46)
📷 监督 vs 无监督学习
回到原视频 (00:03:59)
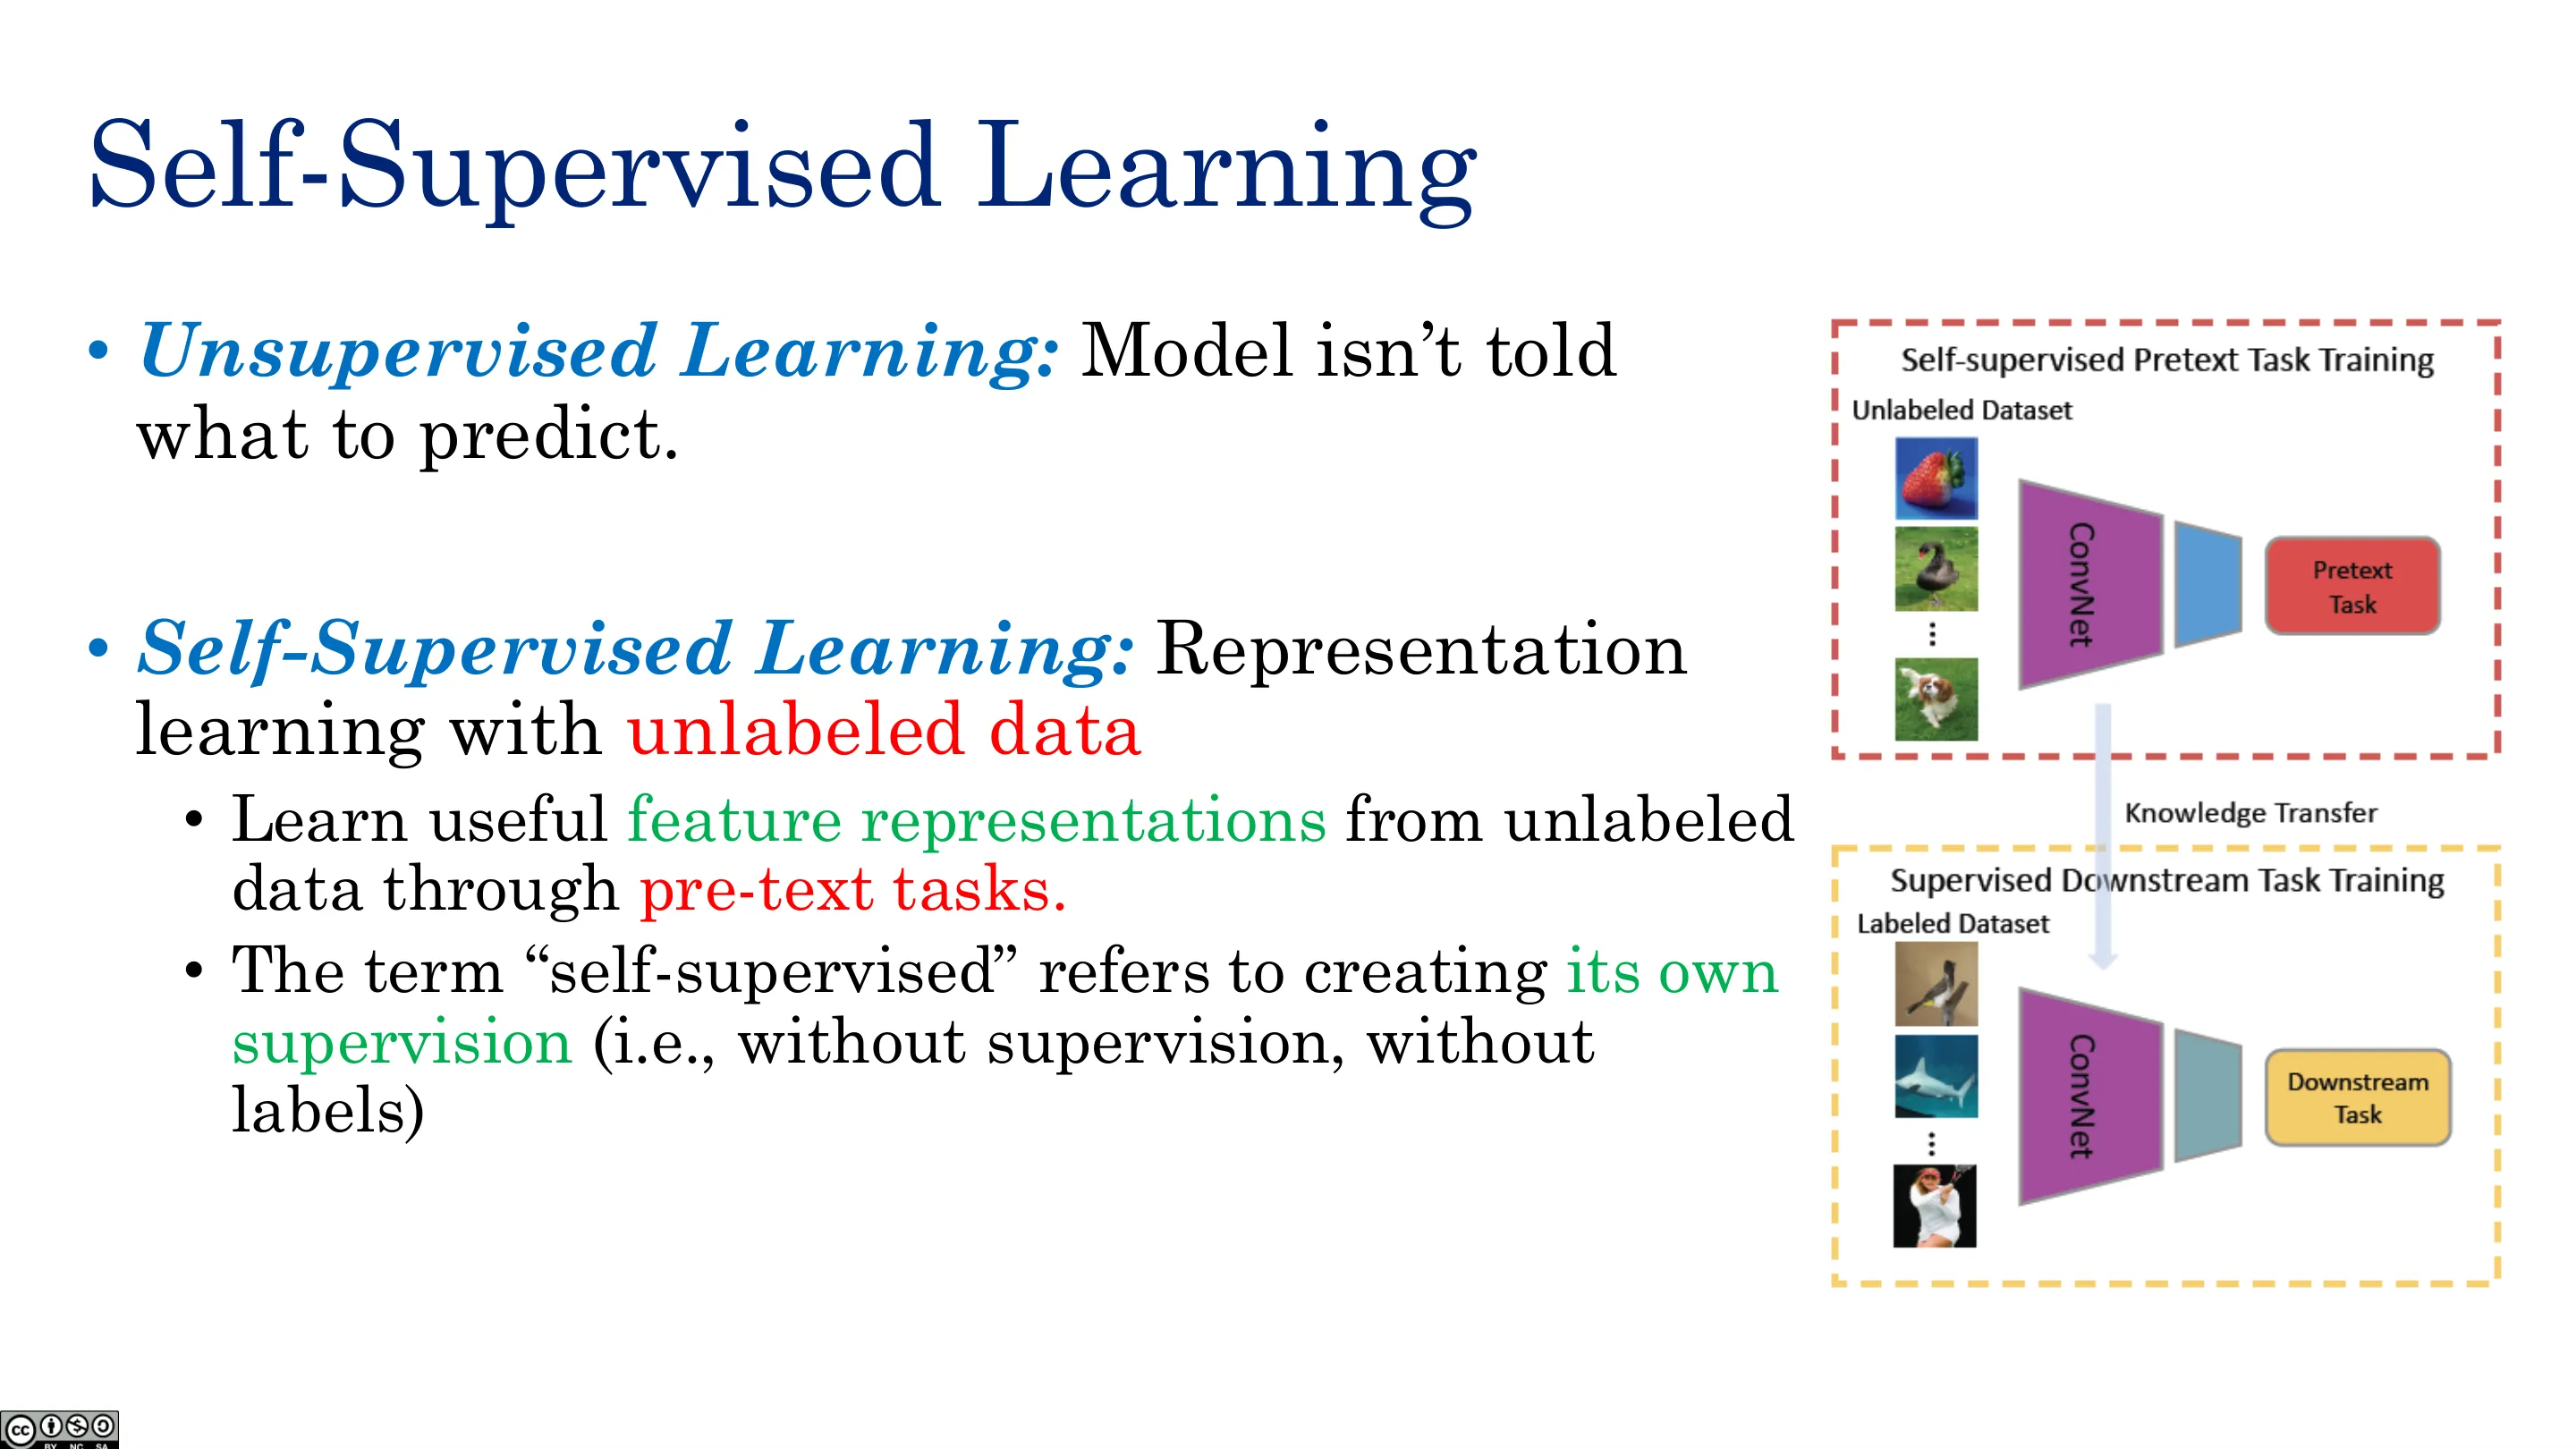
📷 自监督学习
回到原视频 (00:05:12)
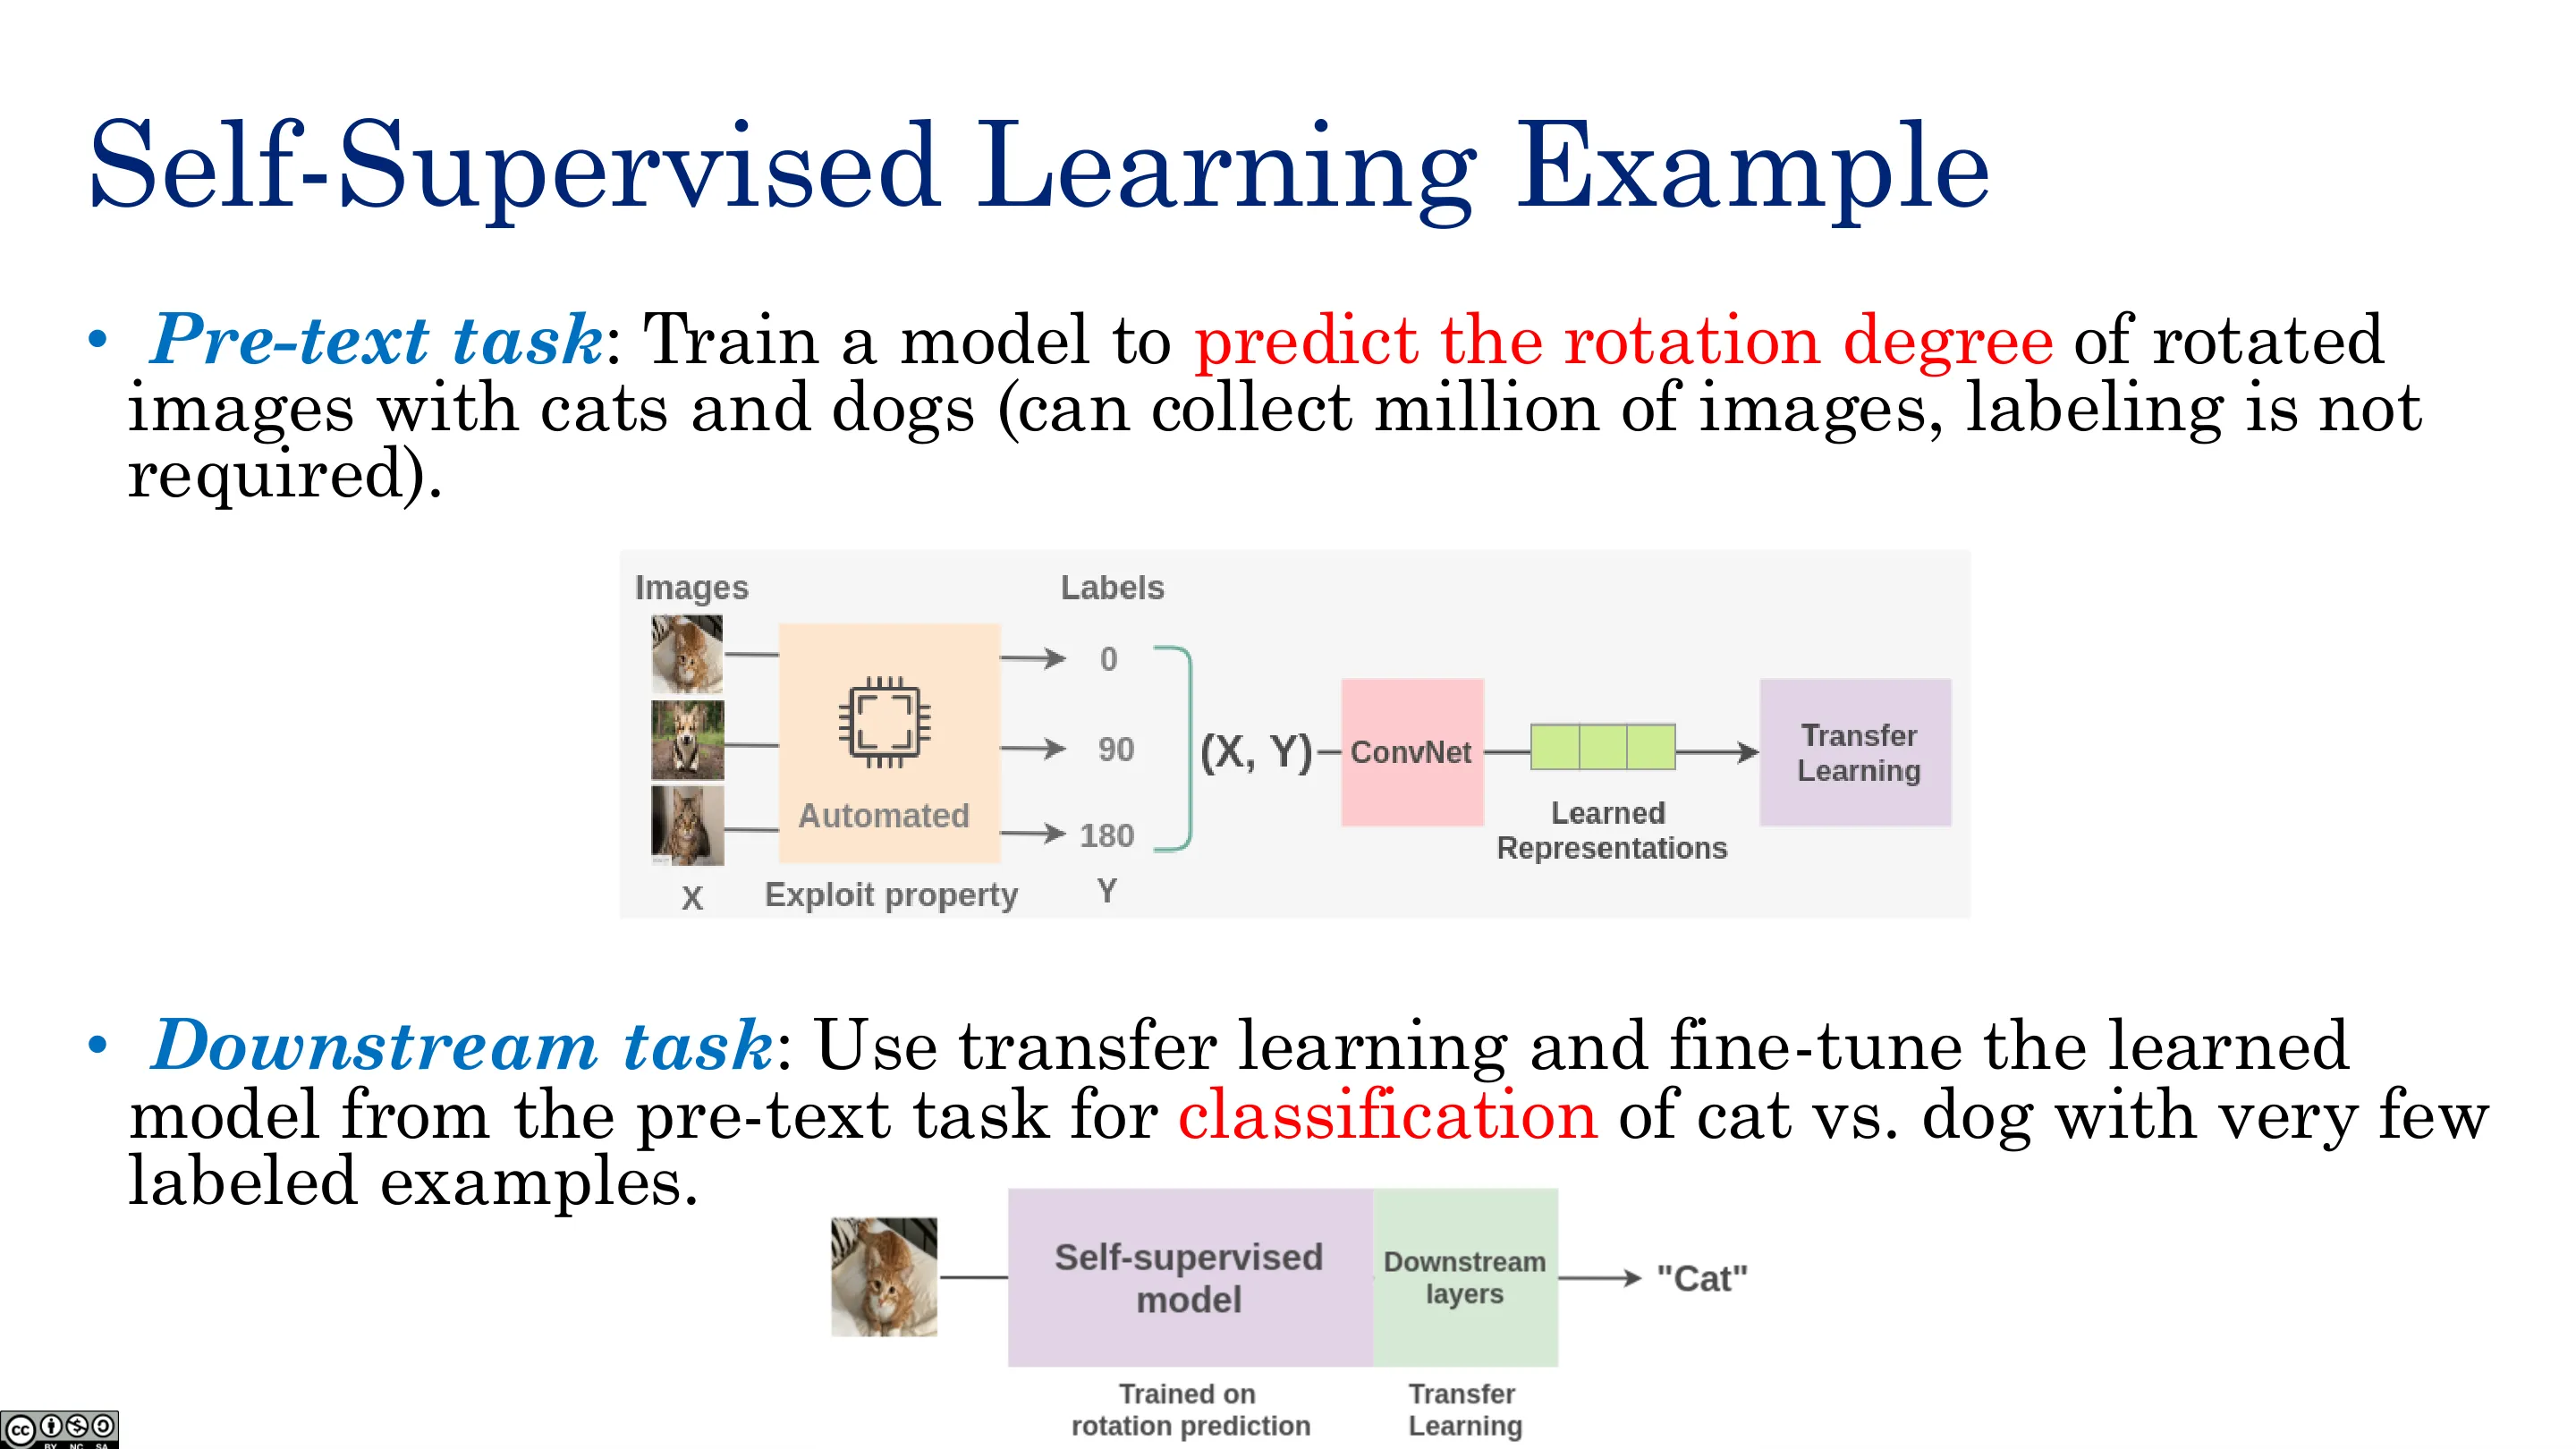
📷 自监督学习示例
回到原视频 (00:06:25)
📷 怎么做?
回到原视频 (00:07:38)
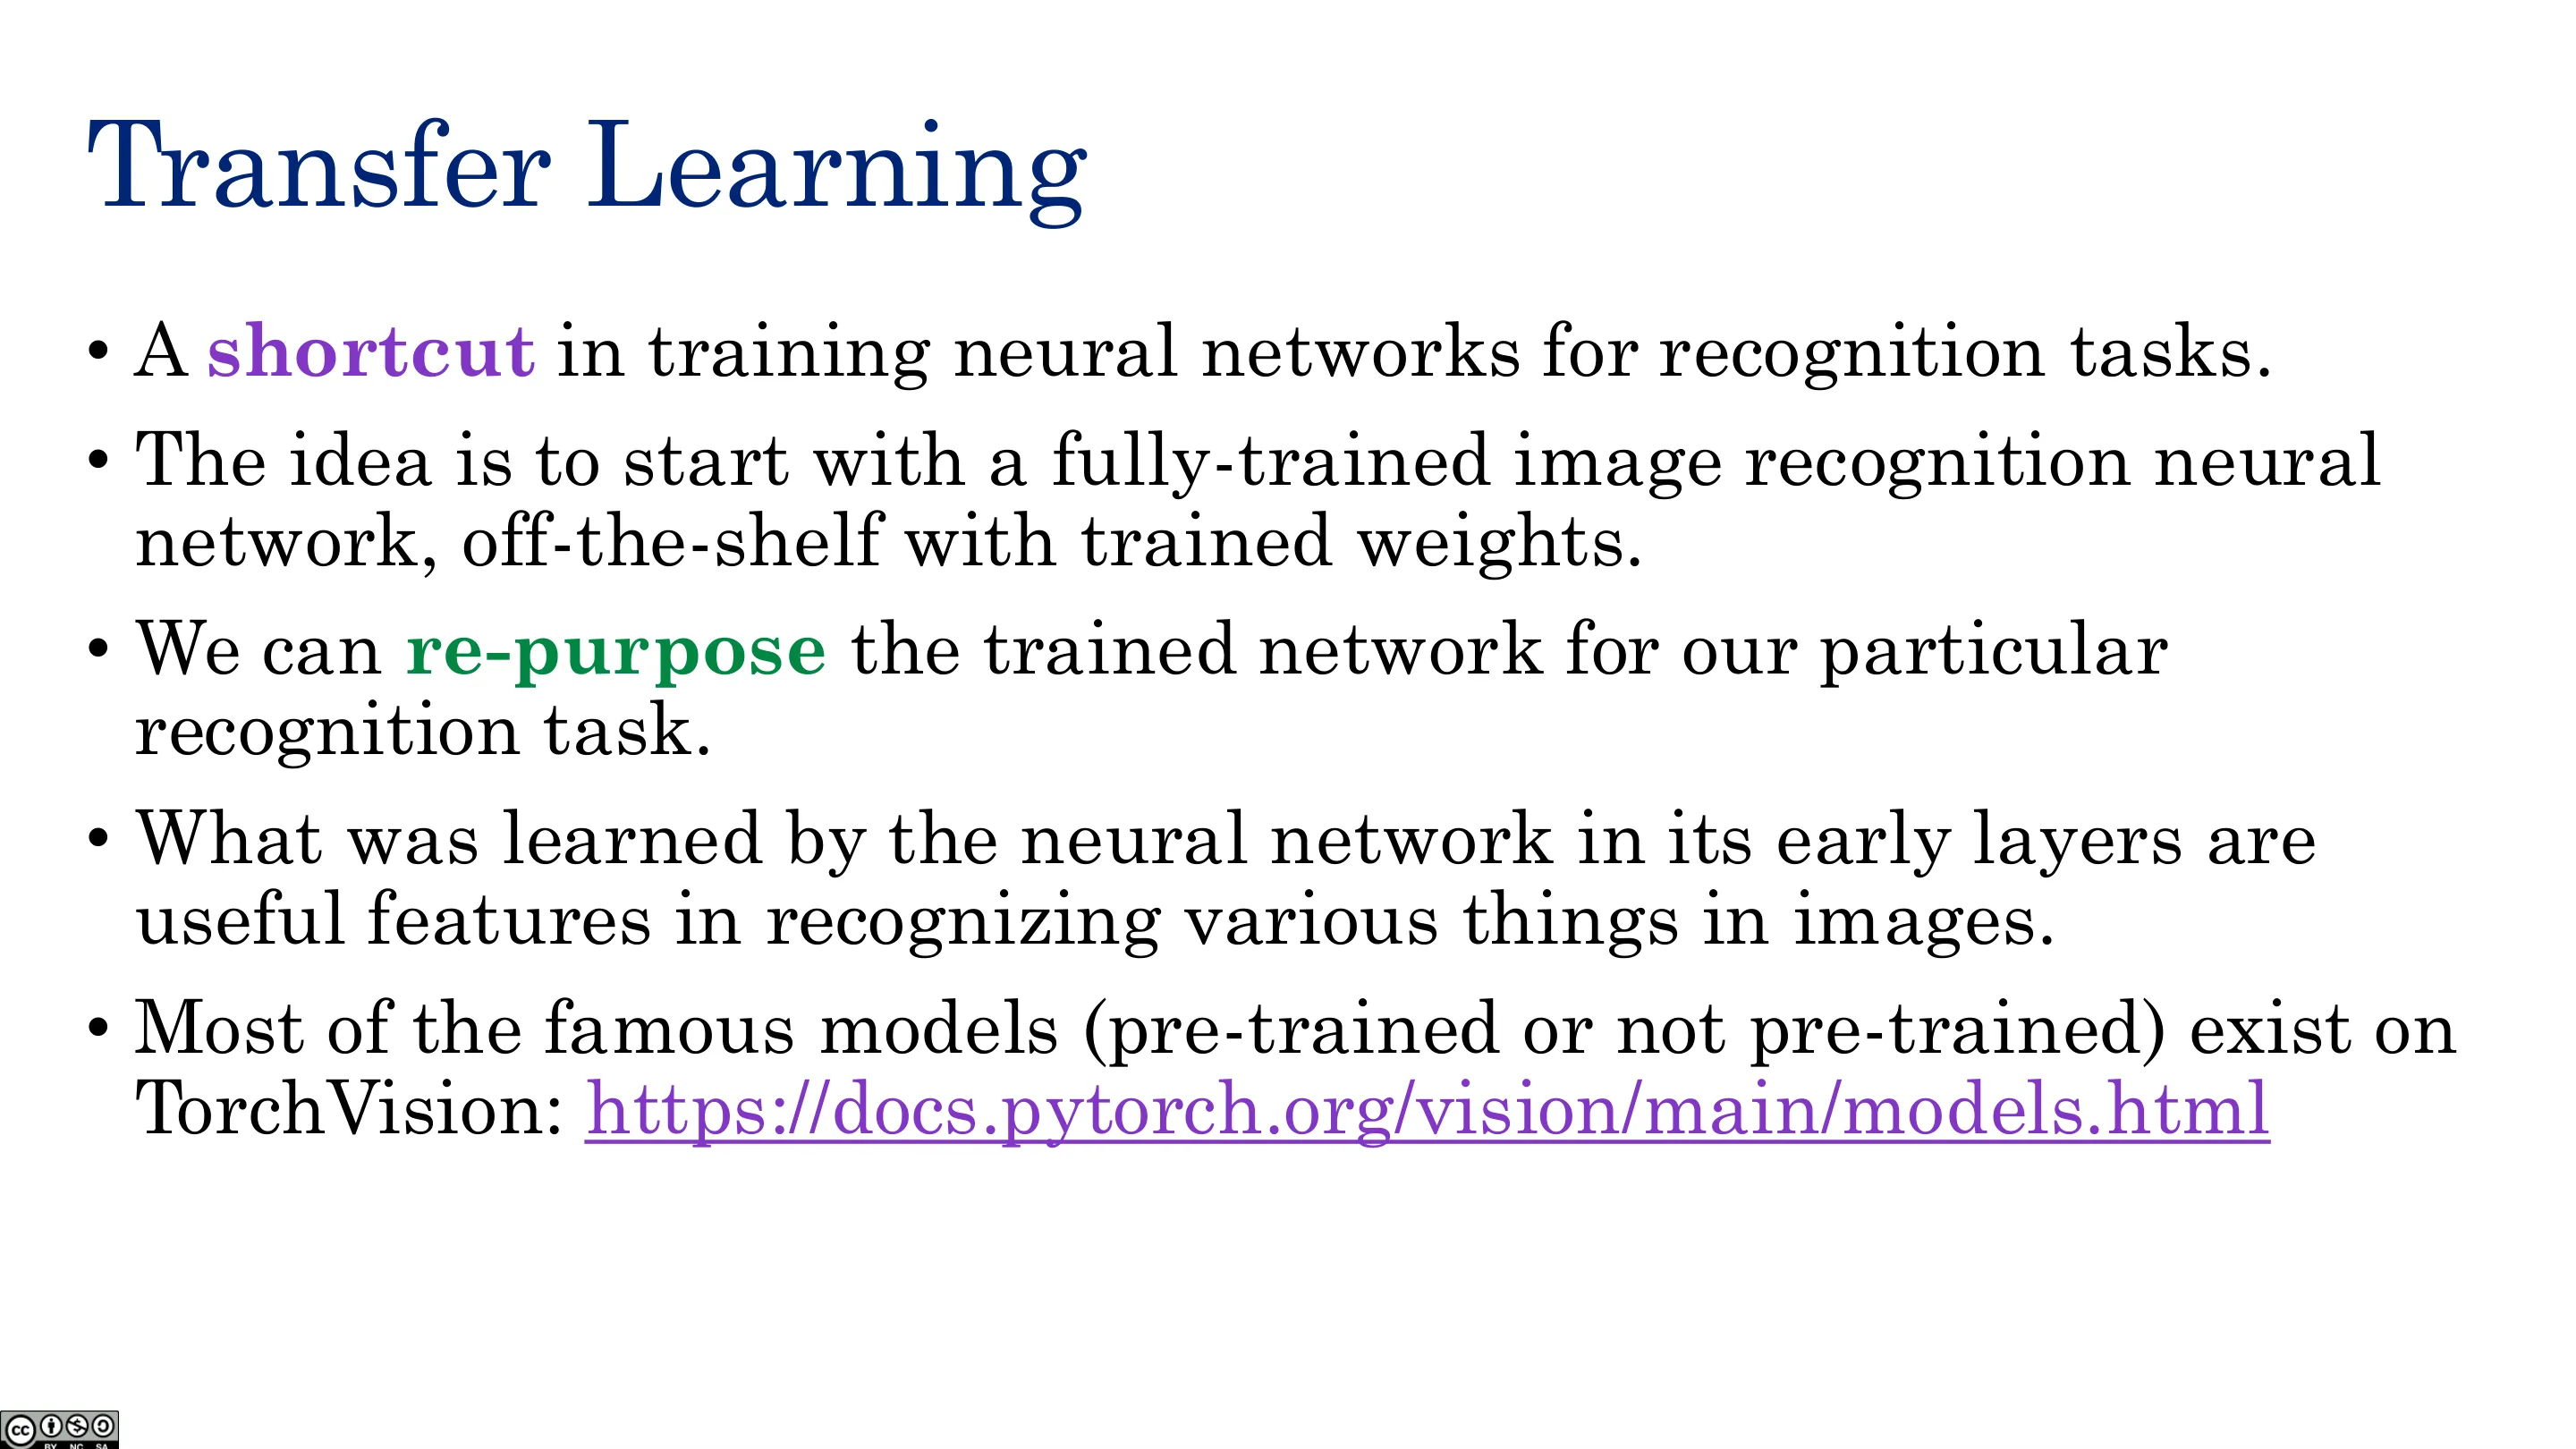
📷 迁移学习
回到原视频 (00:08:51)
1.2 迁移学习:以 CNN 为例
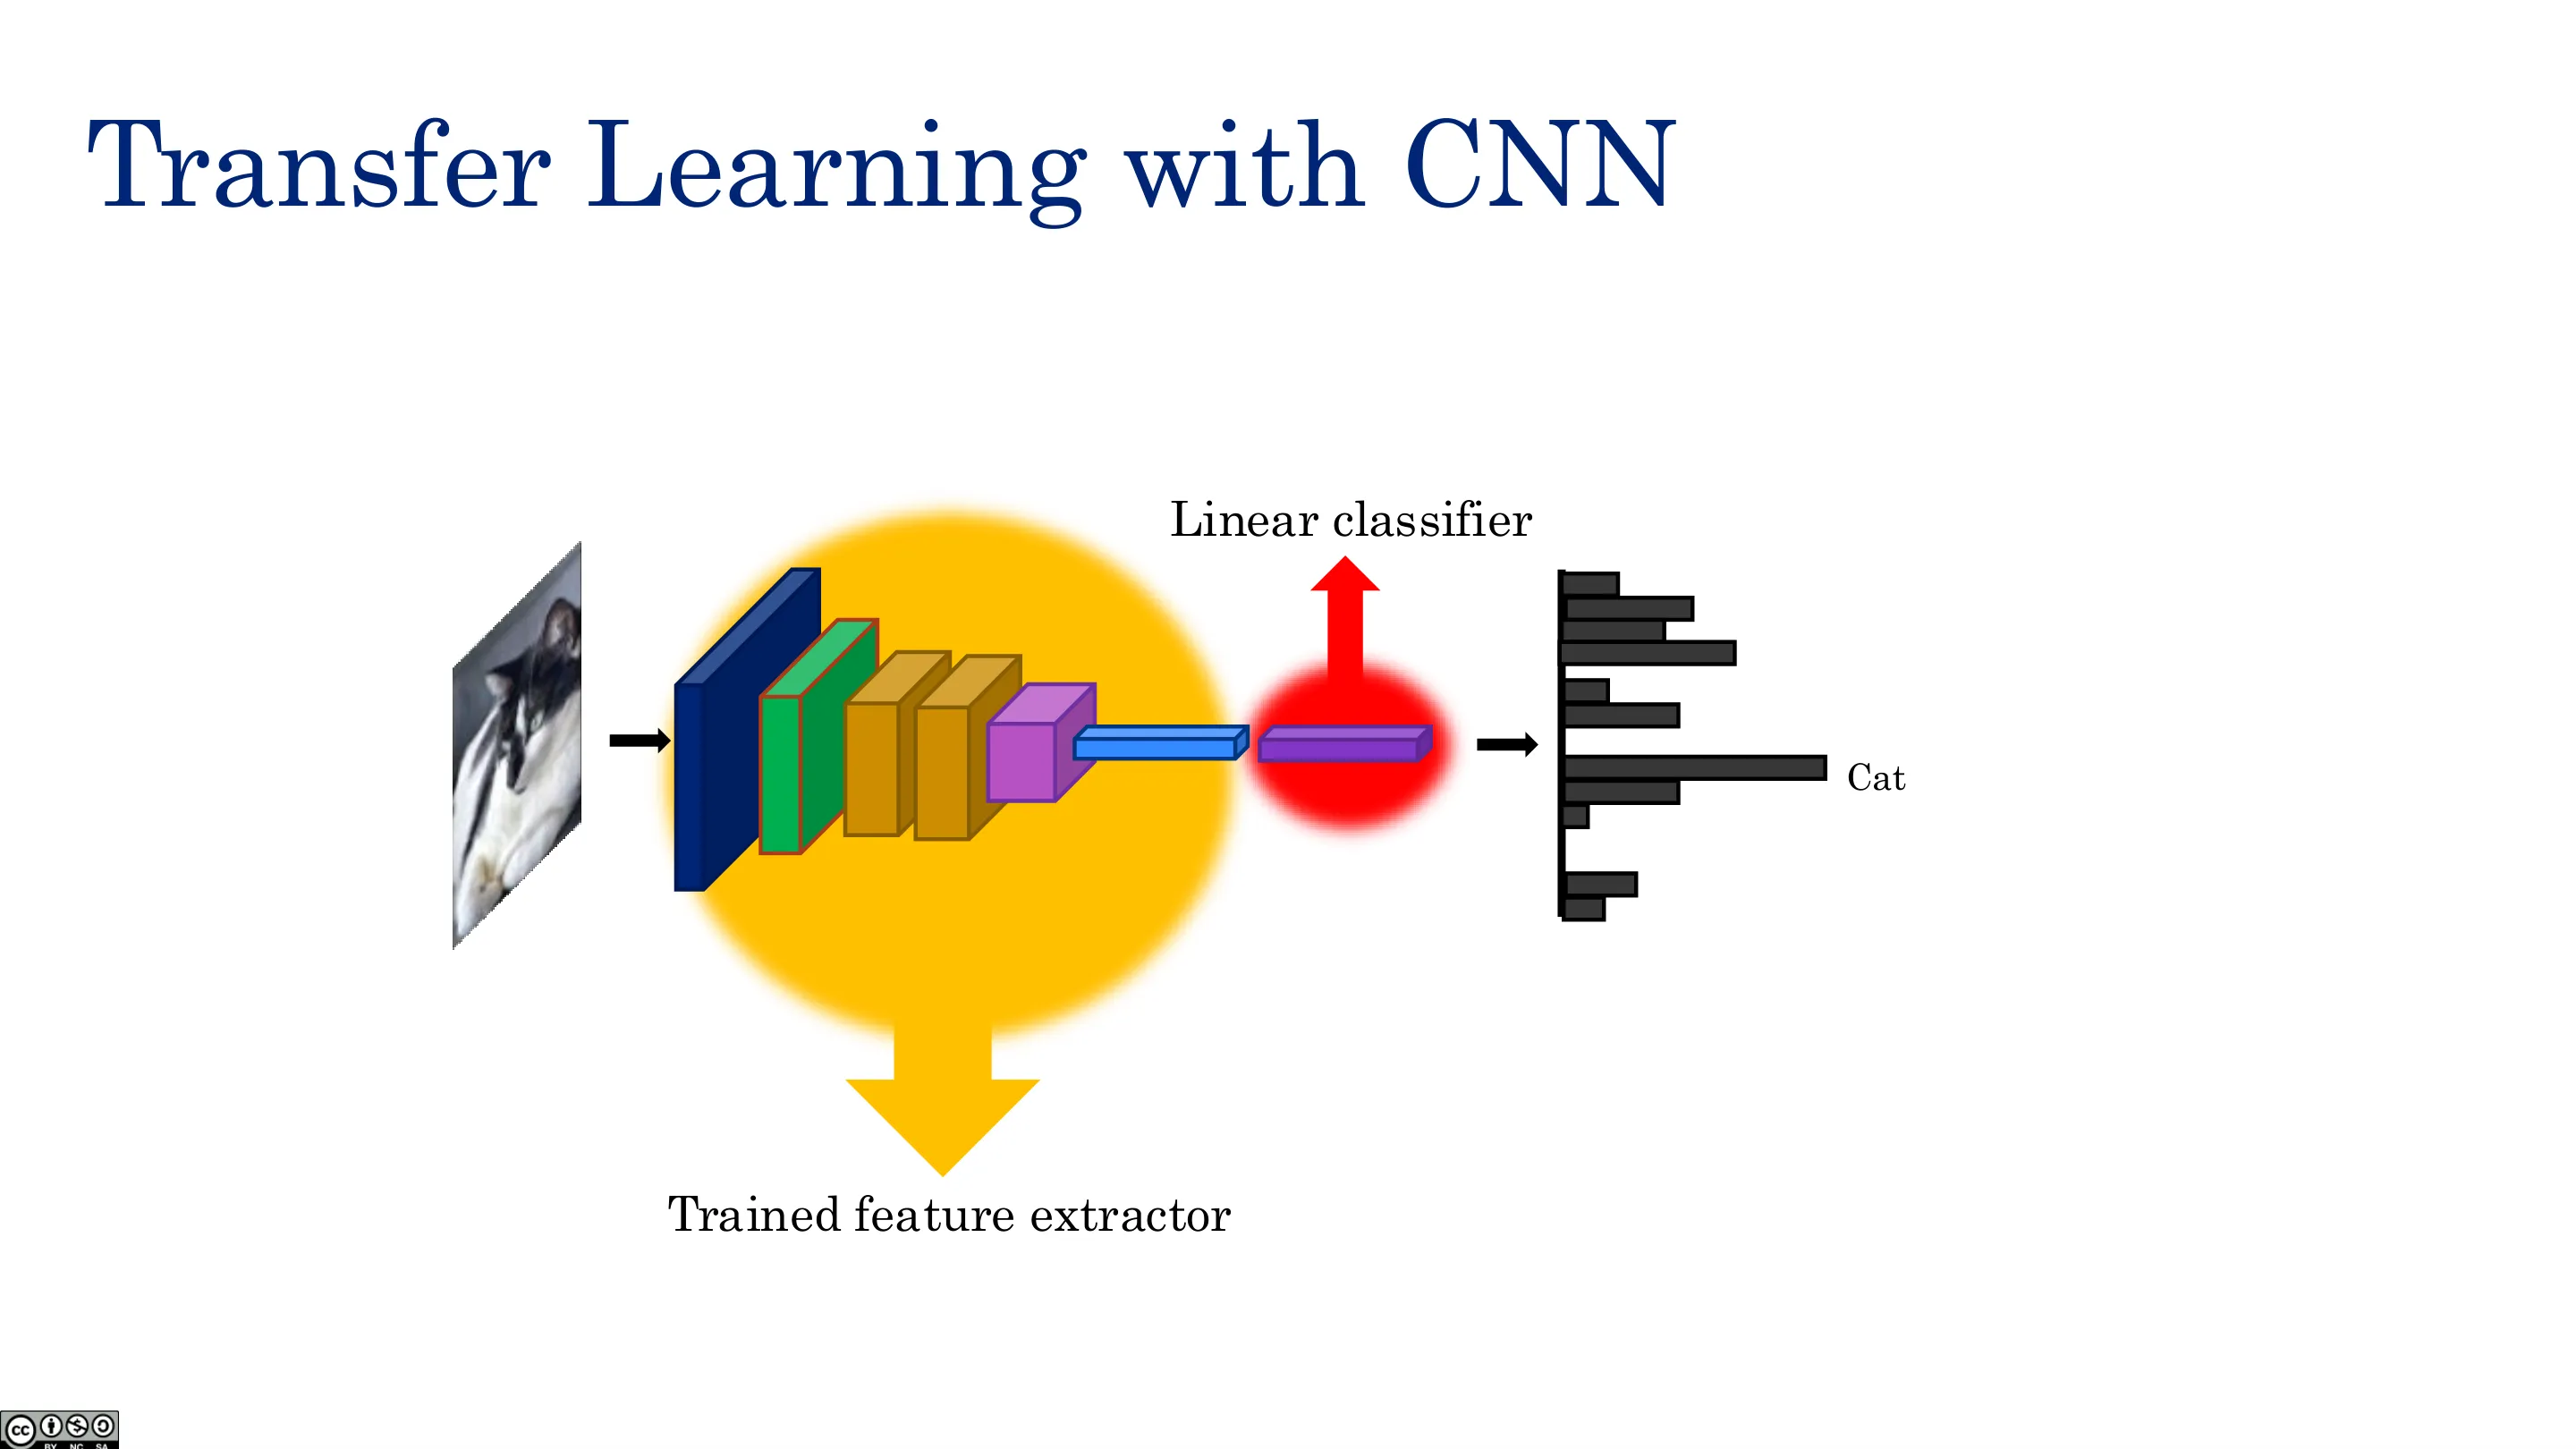
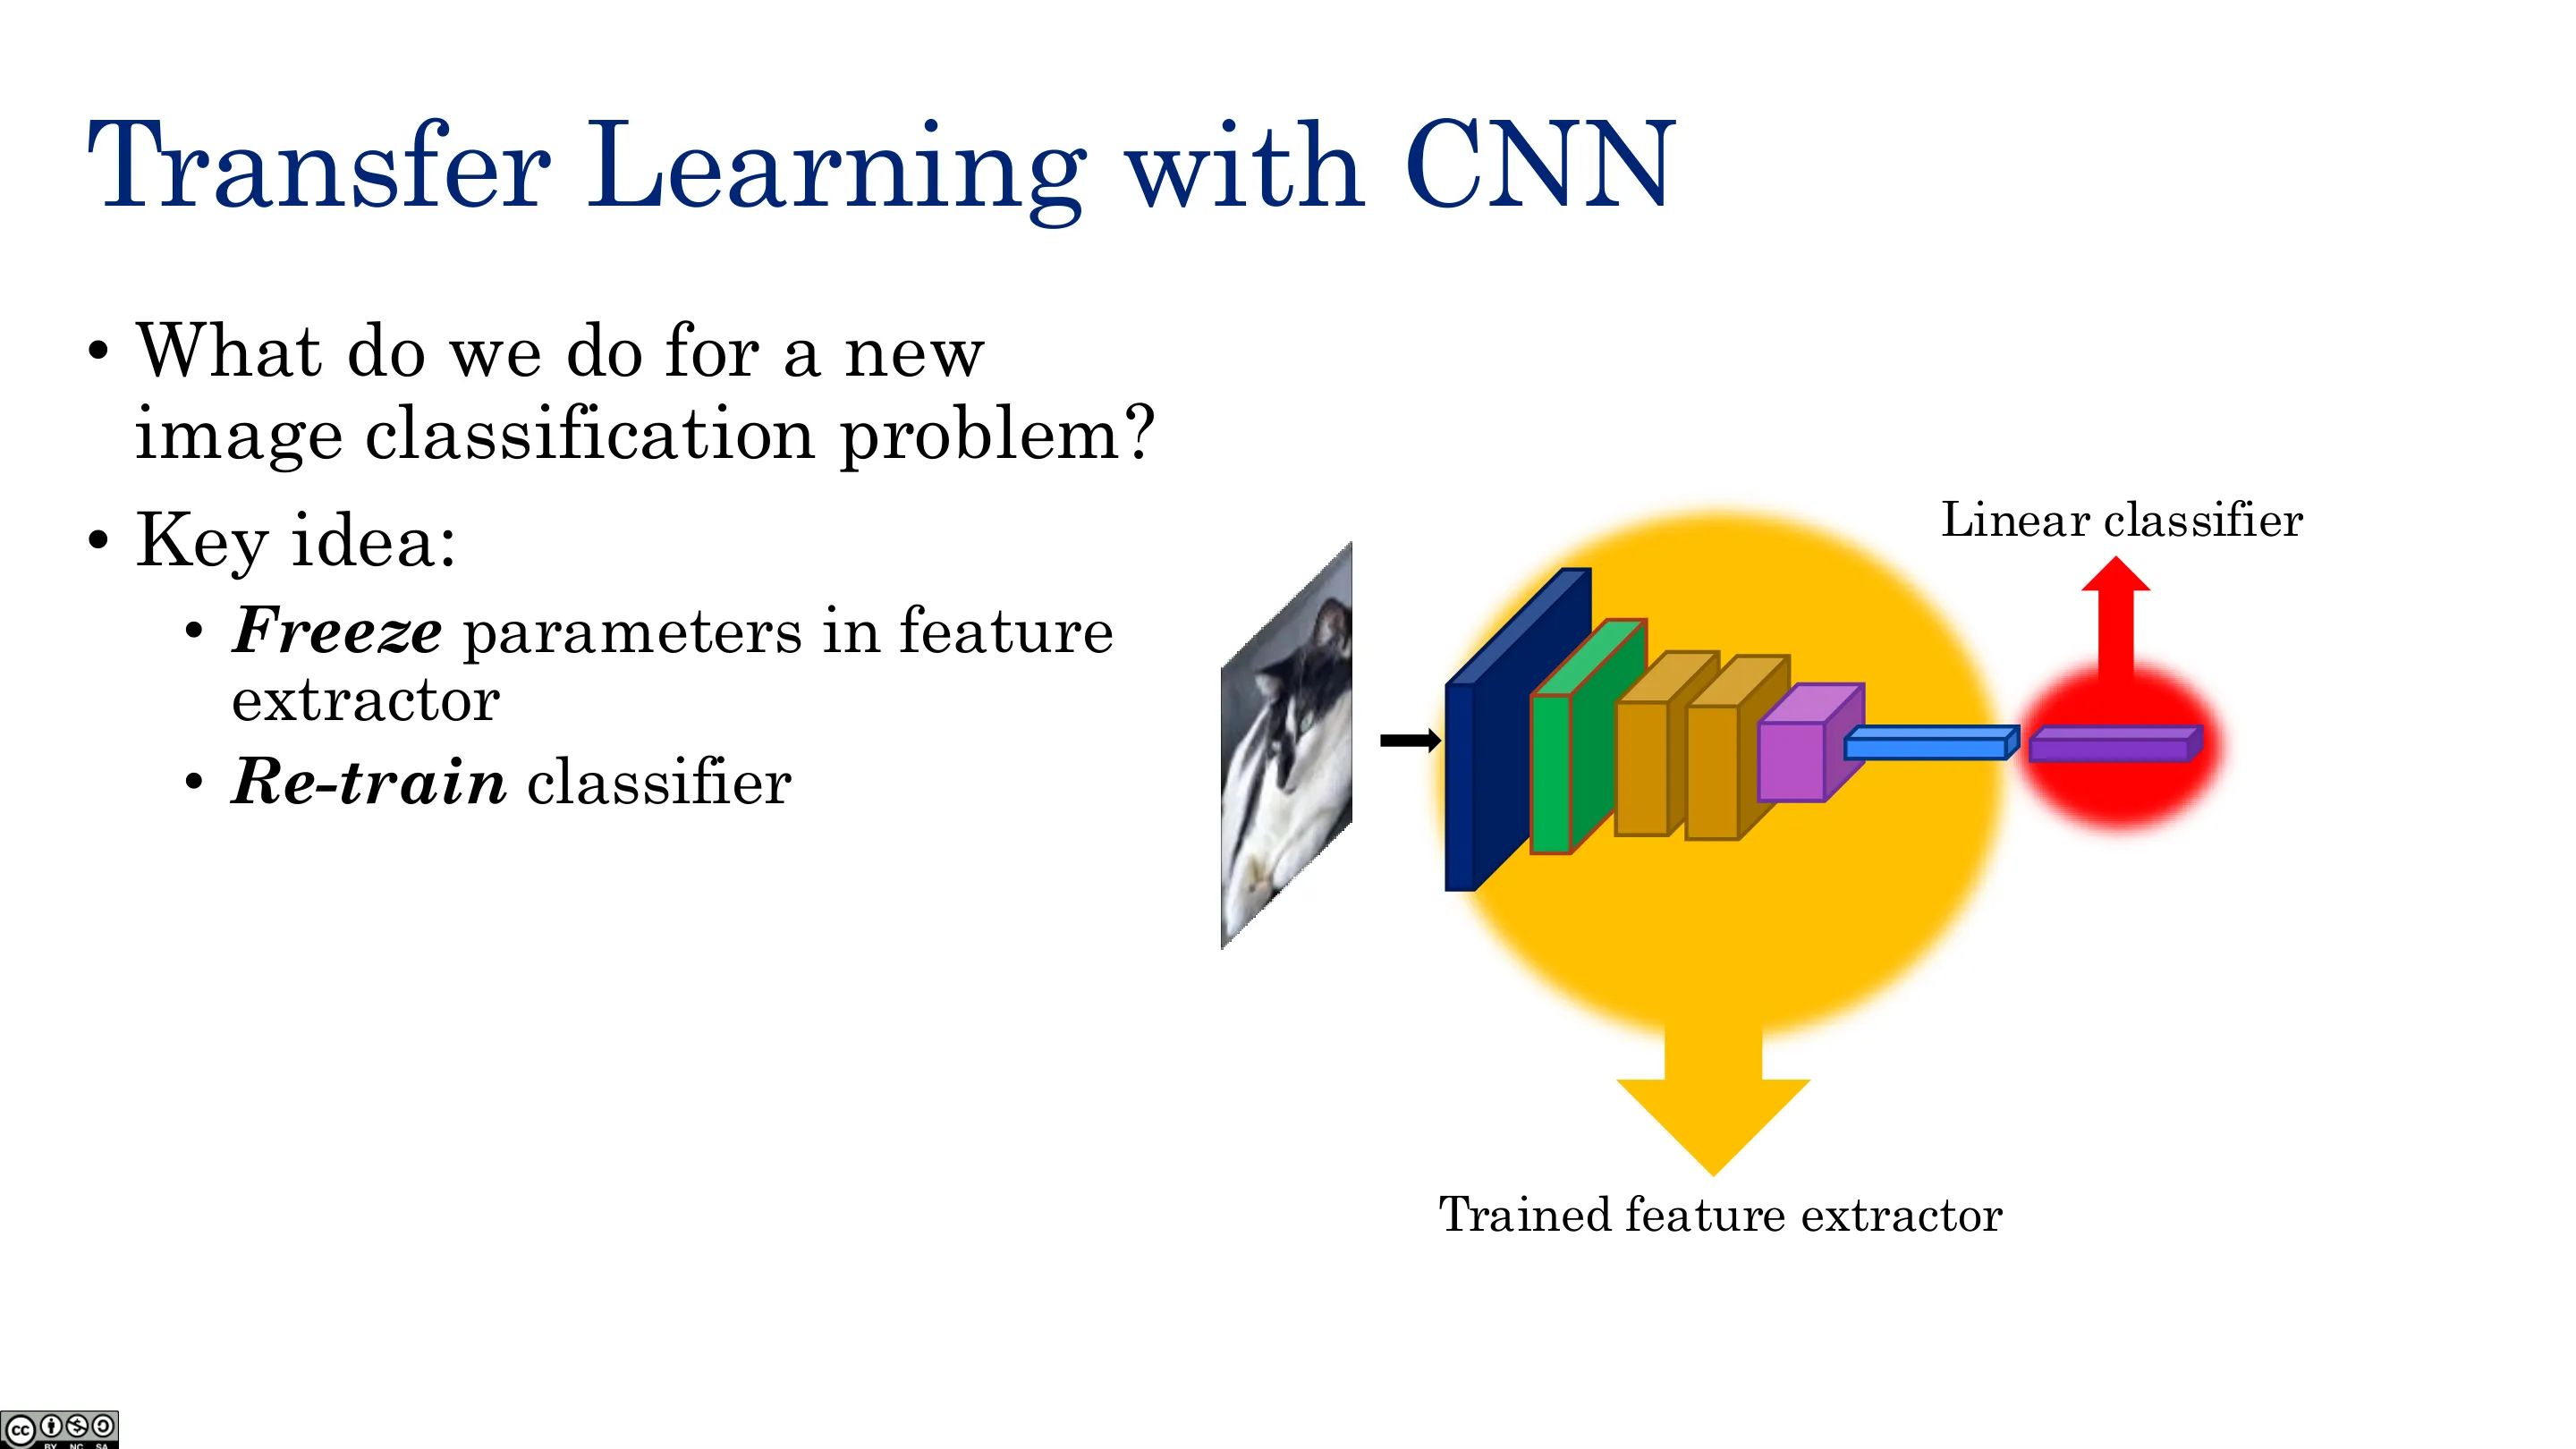
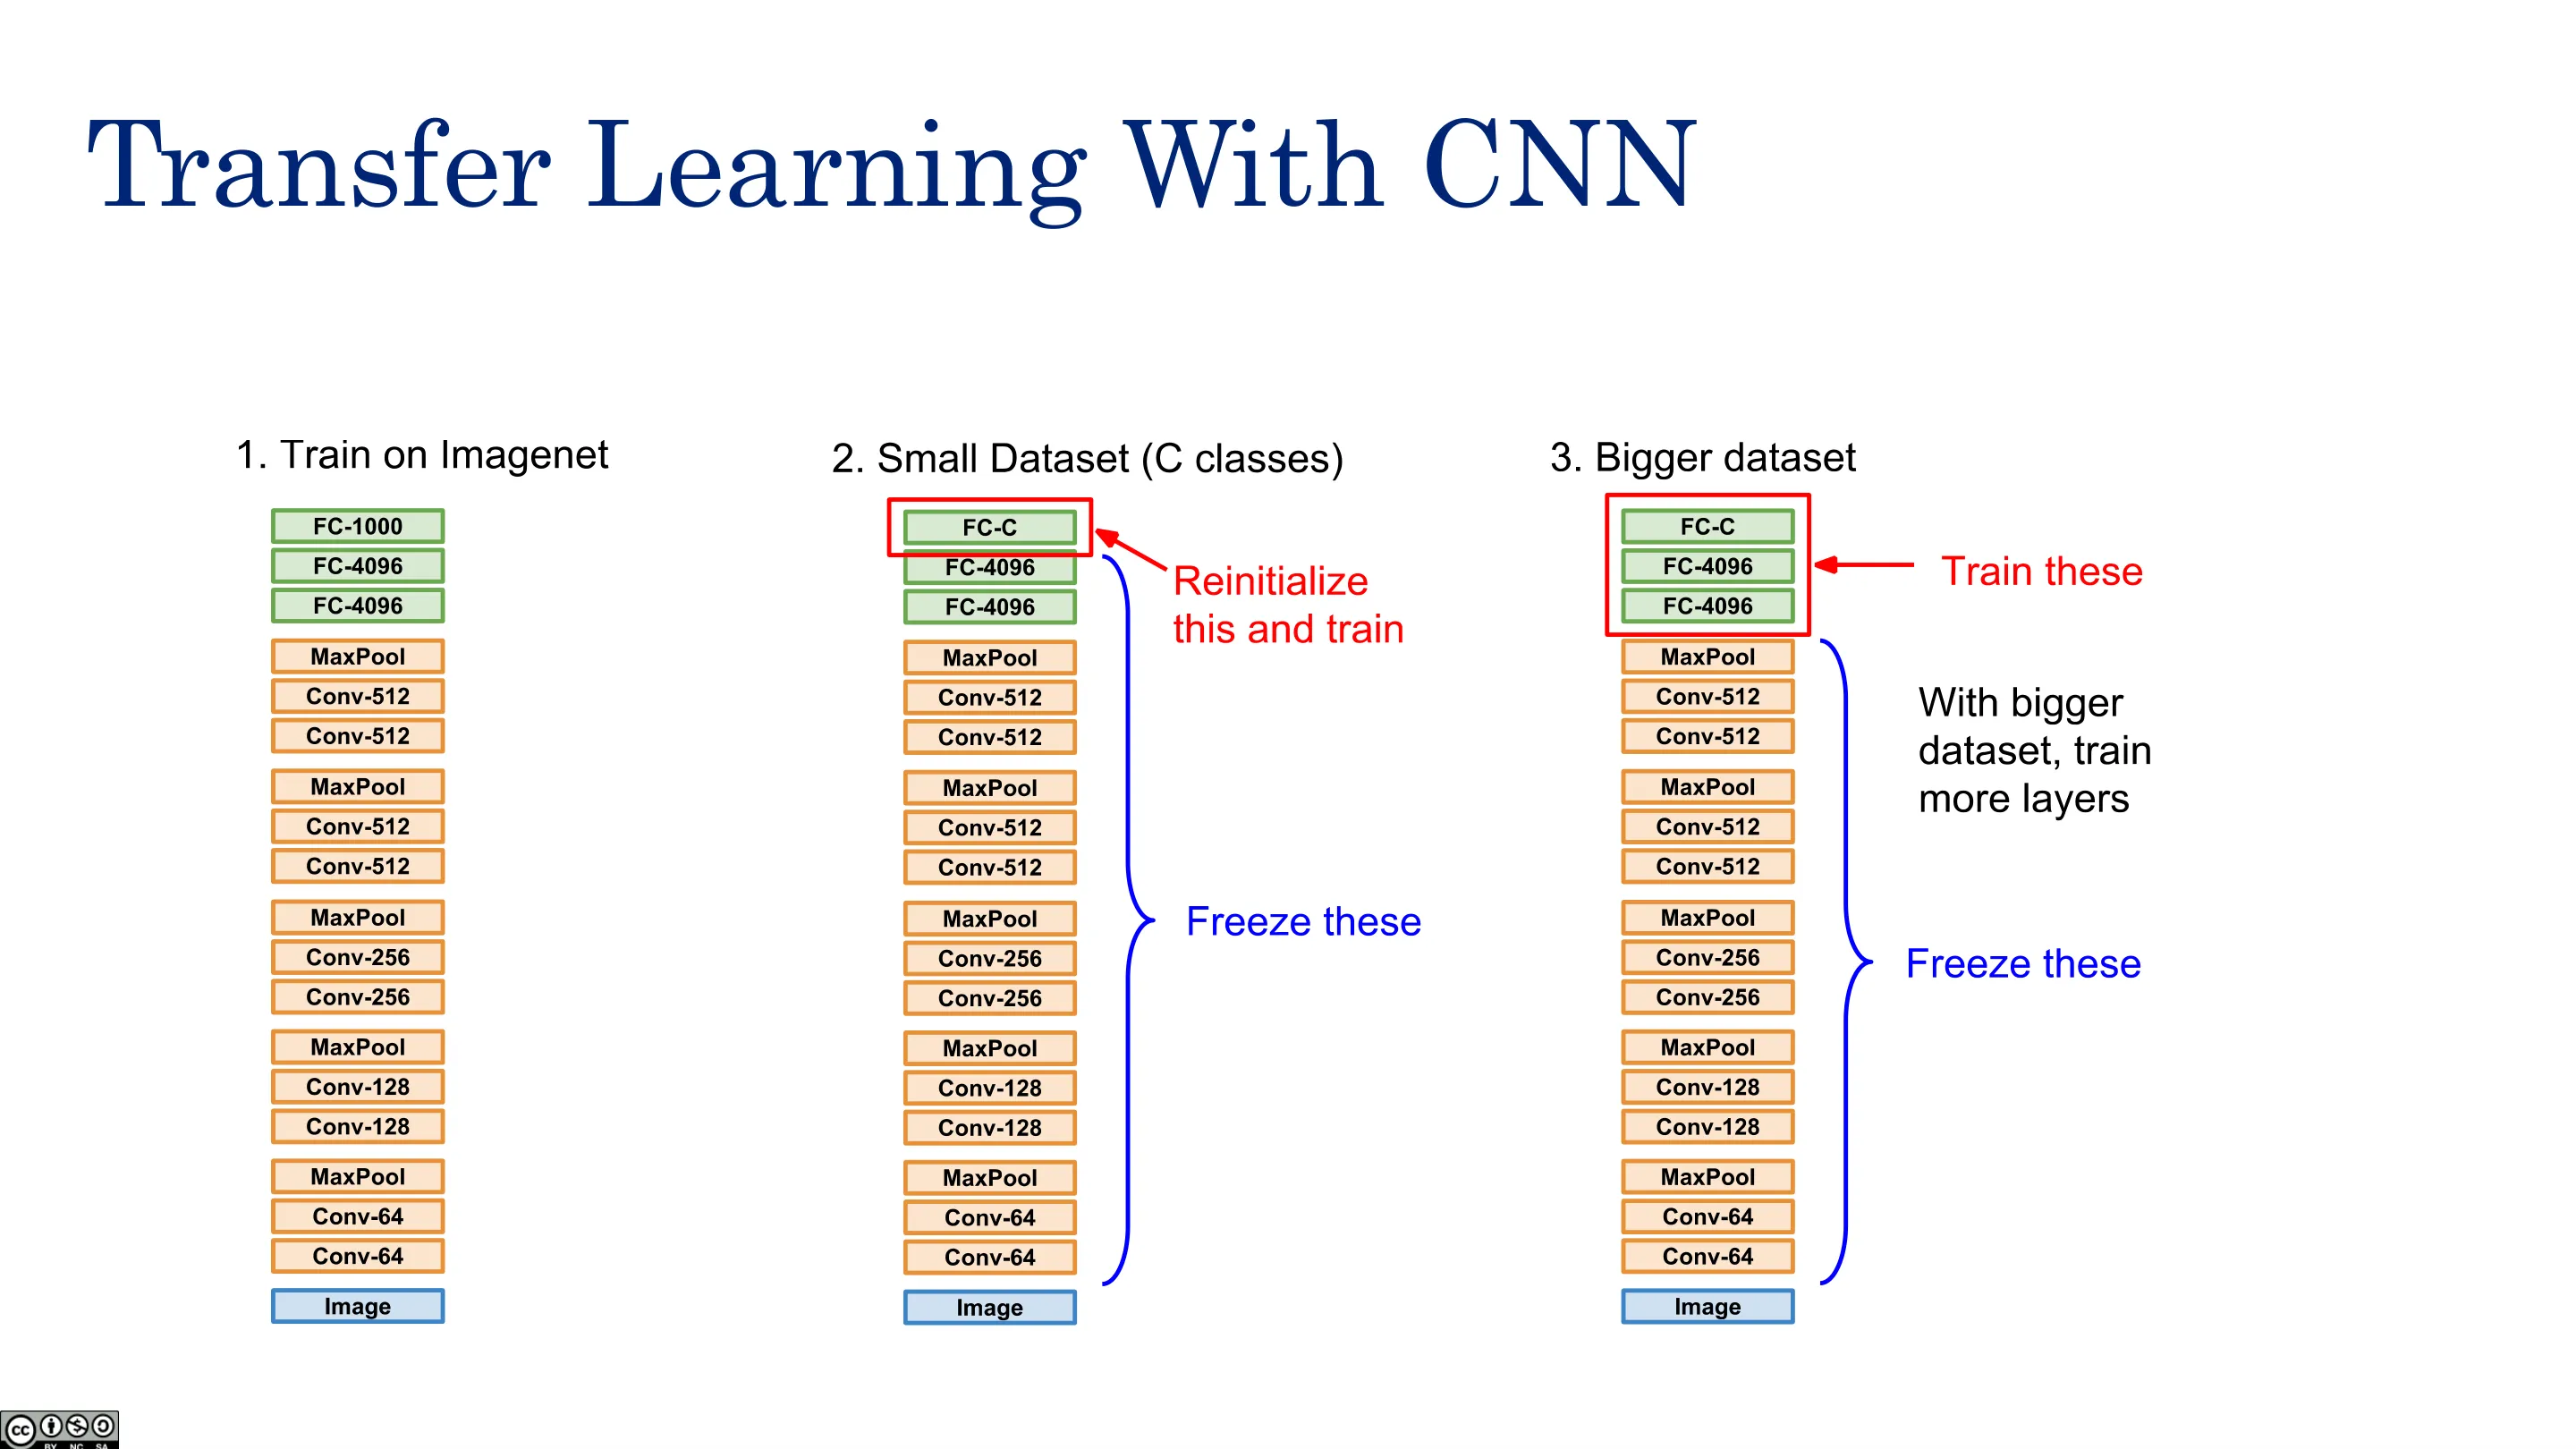
经典例子:下载预训练 ResNet(在 ImageNet 上训练过),冻结前面的层,只重训最后的线性头,用少量标注(如 100 张图)。
- 表示 $r(x)$ 从百万维像素压缩成 ~100–512 维,再在这个小空间上做逻辑回归;
- 关键规则:一旦更新某一层的权重,下游所有层都必须一起更新(下游层原本期望接收"线条/角",突然接到"火箭"就会崩);
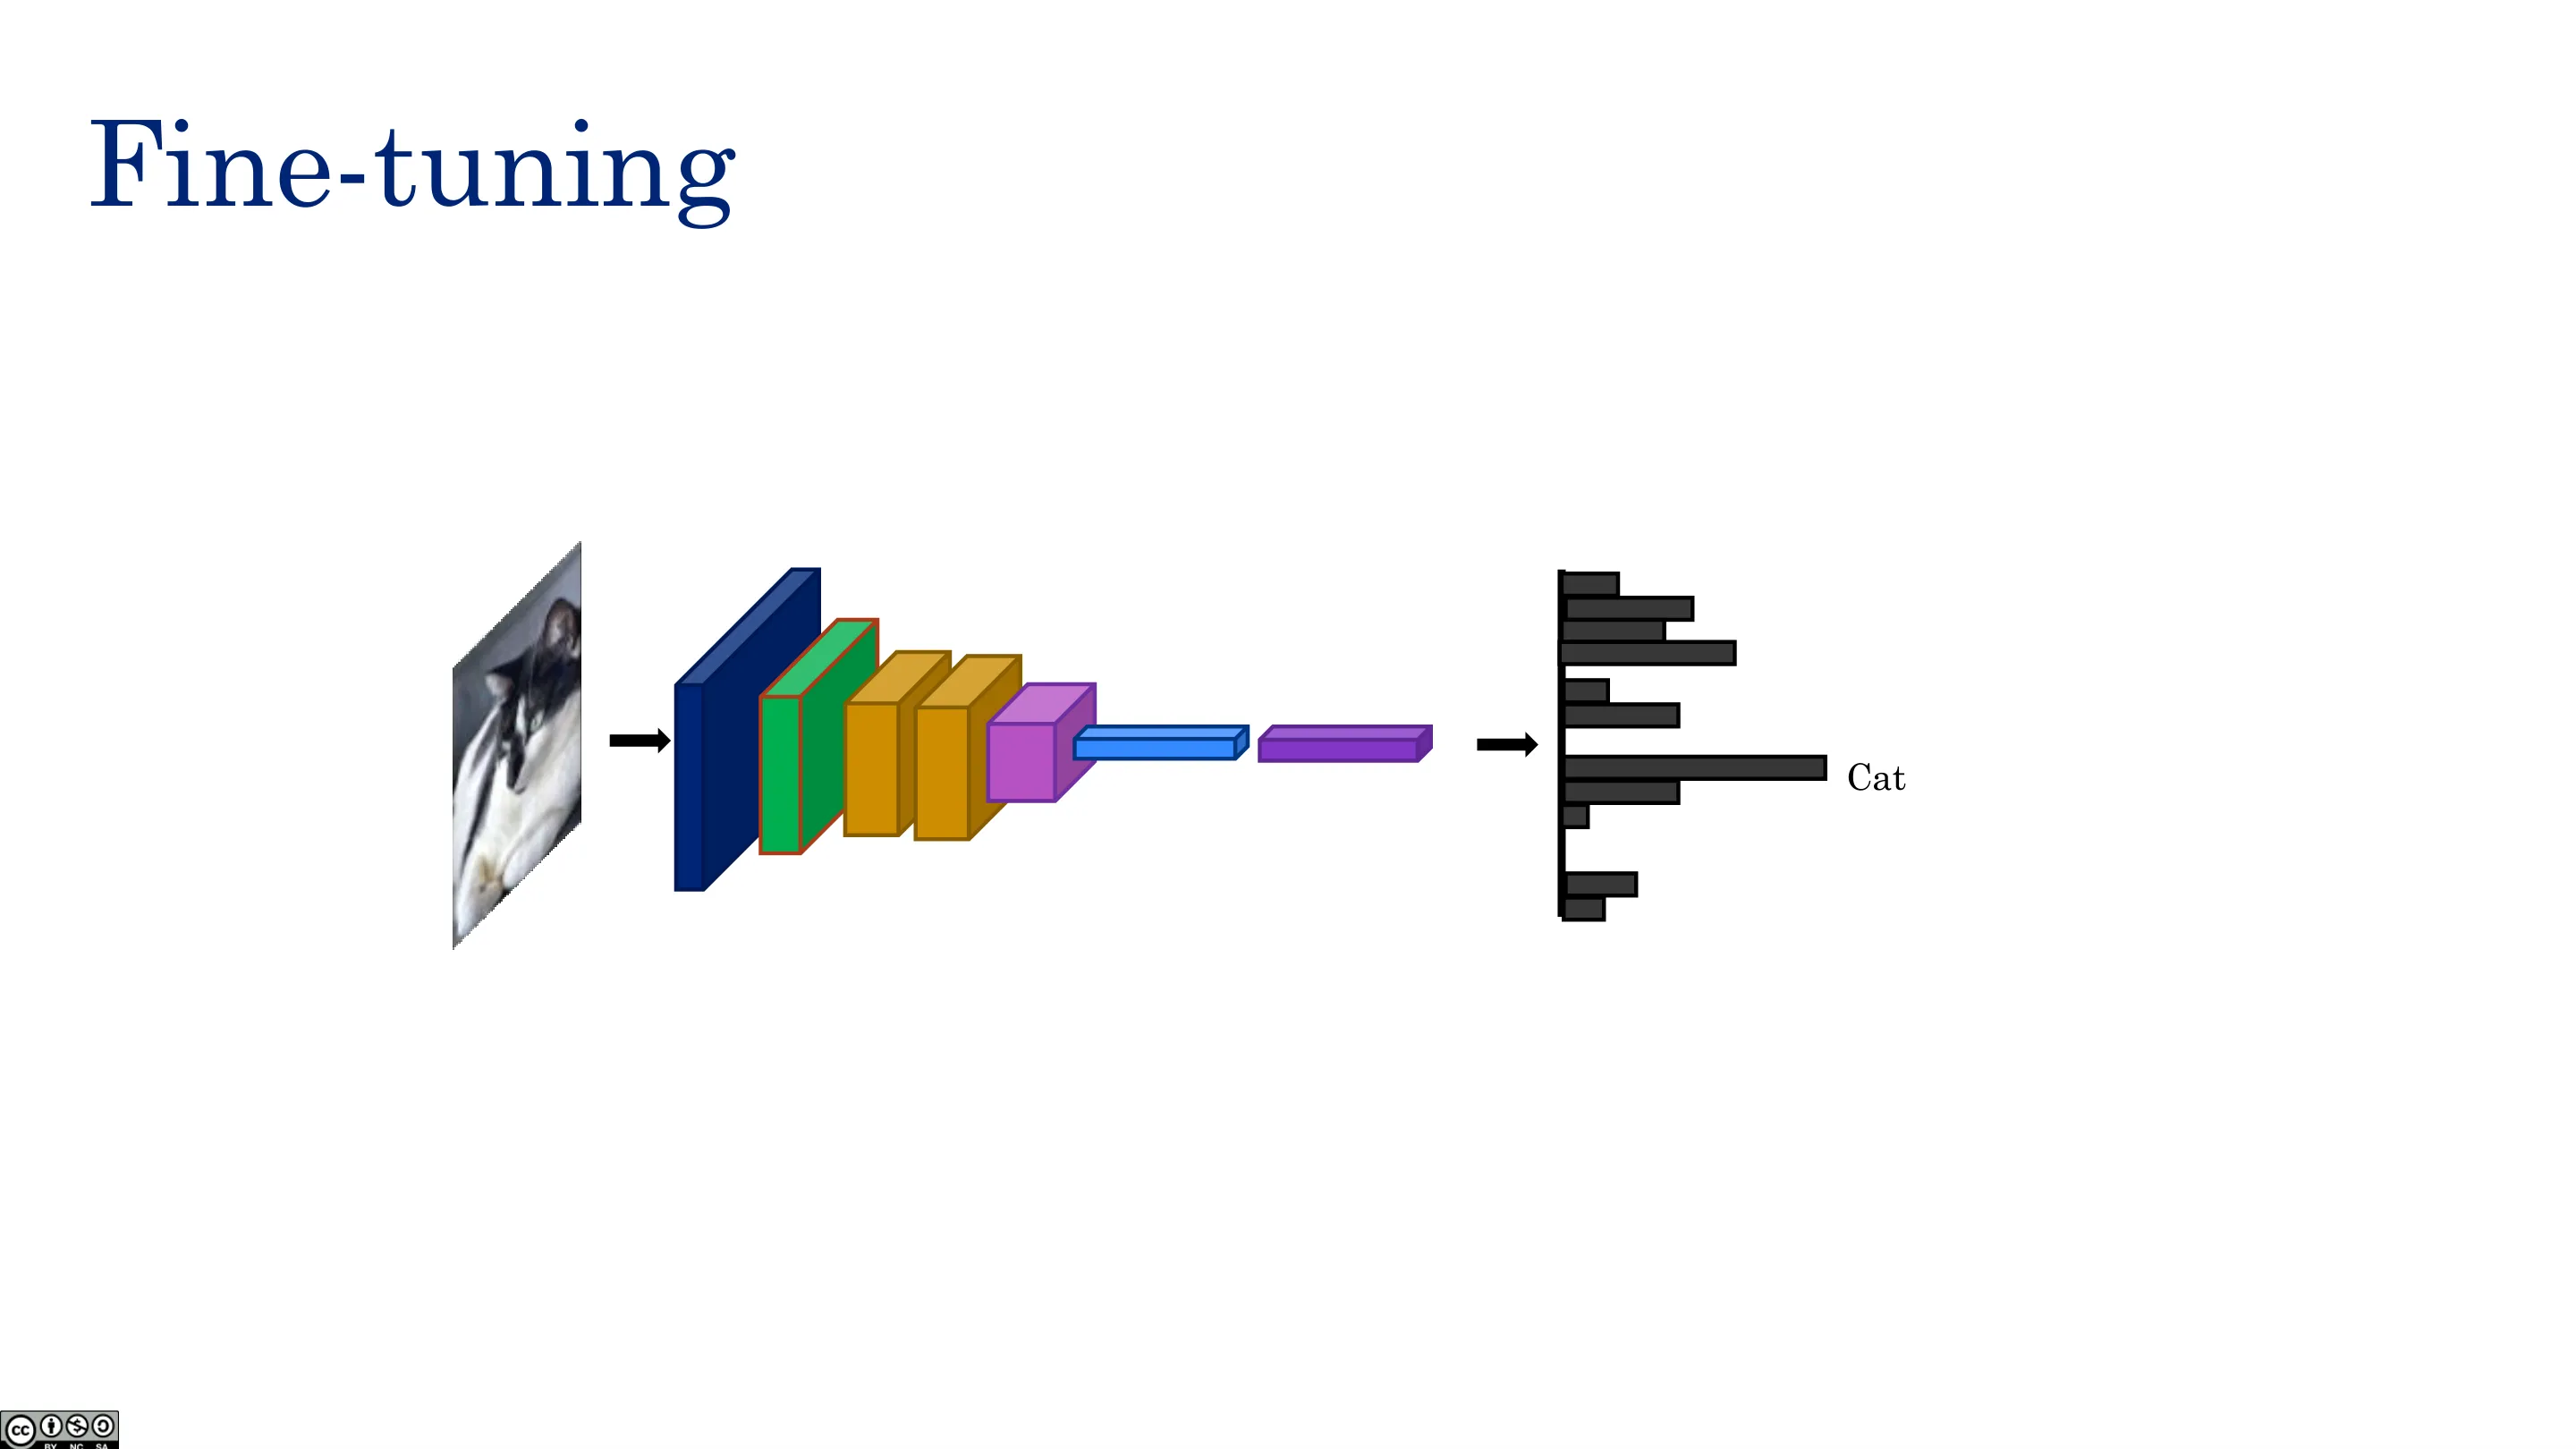
- 更新到多深取决于数据量:数据少 → 只训线性头(linear probing);数据多 → 全量微调(用较小学习率)。
真实成功故事:一位农夫用 PyTorch 预训练 ResNet + 几百张自建黄瓜图片,微调出"好黄瓜 vs 坏黄瓜"分类器,为家族生意省下大量分拣时间。
为什么预训练重要? 它把数据变换到更易分的坐标(原空间里圆和三角不可线性分离,变换后可分离),并大幅降维。但选什么 pretext 任务很关键:区分橙子和苹果时,颜色特征有用、形状特征没用 ⇒ 应设计对颜色敏感的自监督任务。
📷 用 CNN 做迁移学习(一)
回到原视频 (00:10:04)
📷 用 CNN 做迁移学习(二)
回到原视频 (00:11:17)
📷 用 CNN 做迁移学习(三)
回到原视频 (00:12:30)
📷 微调(一)
回到原视频 (00:13:43)
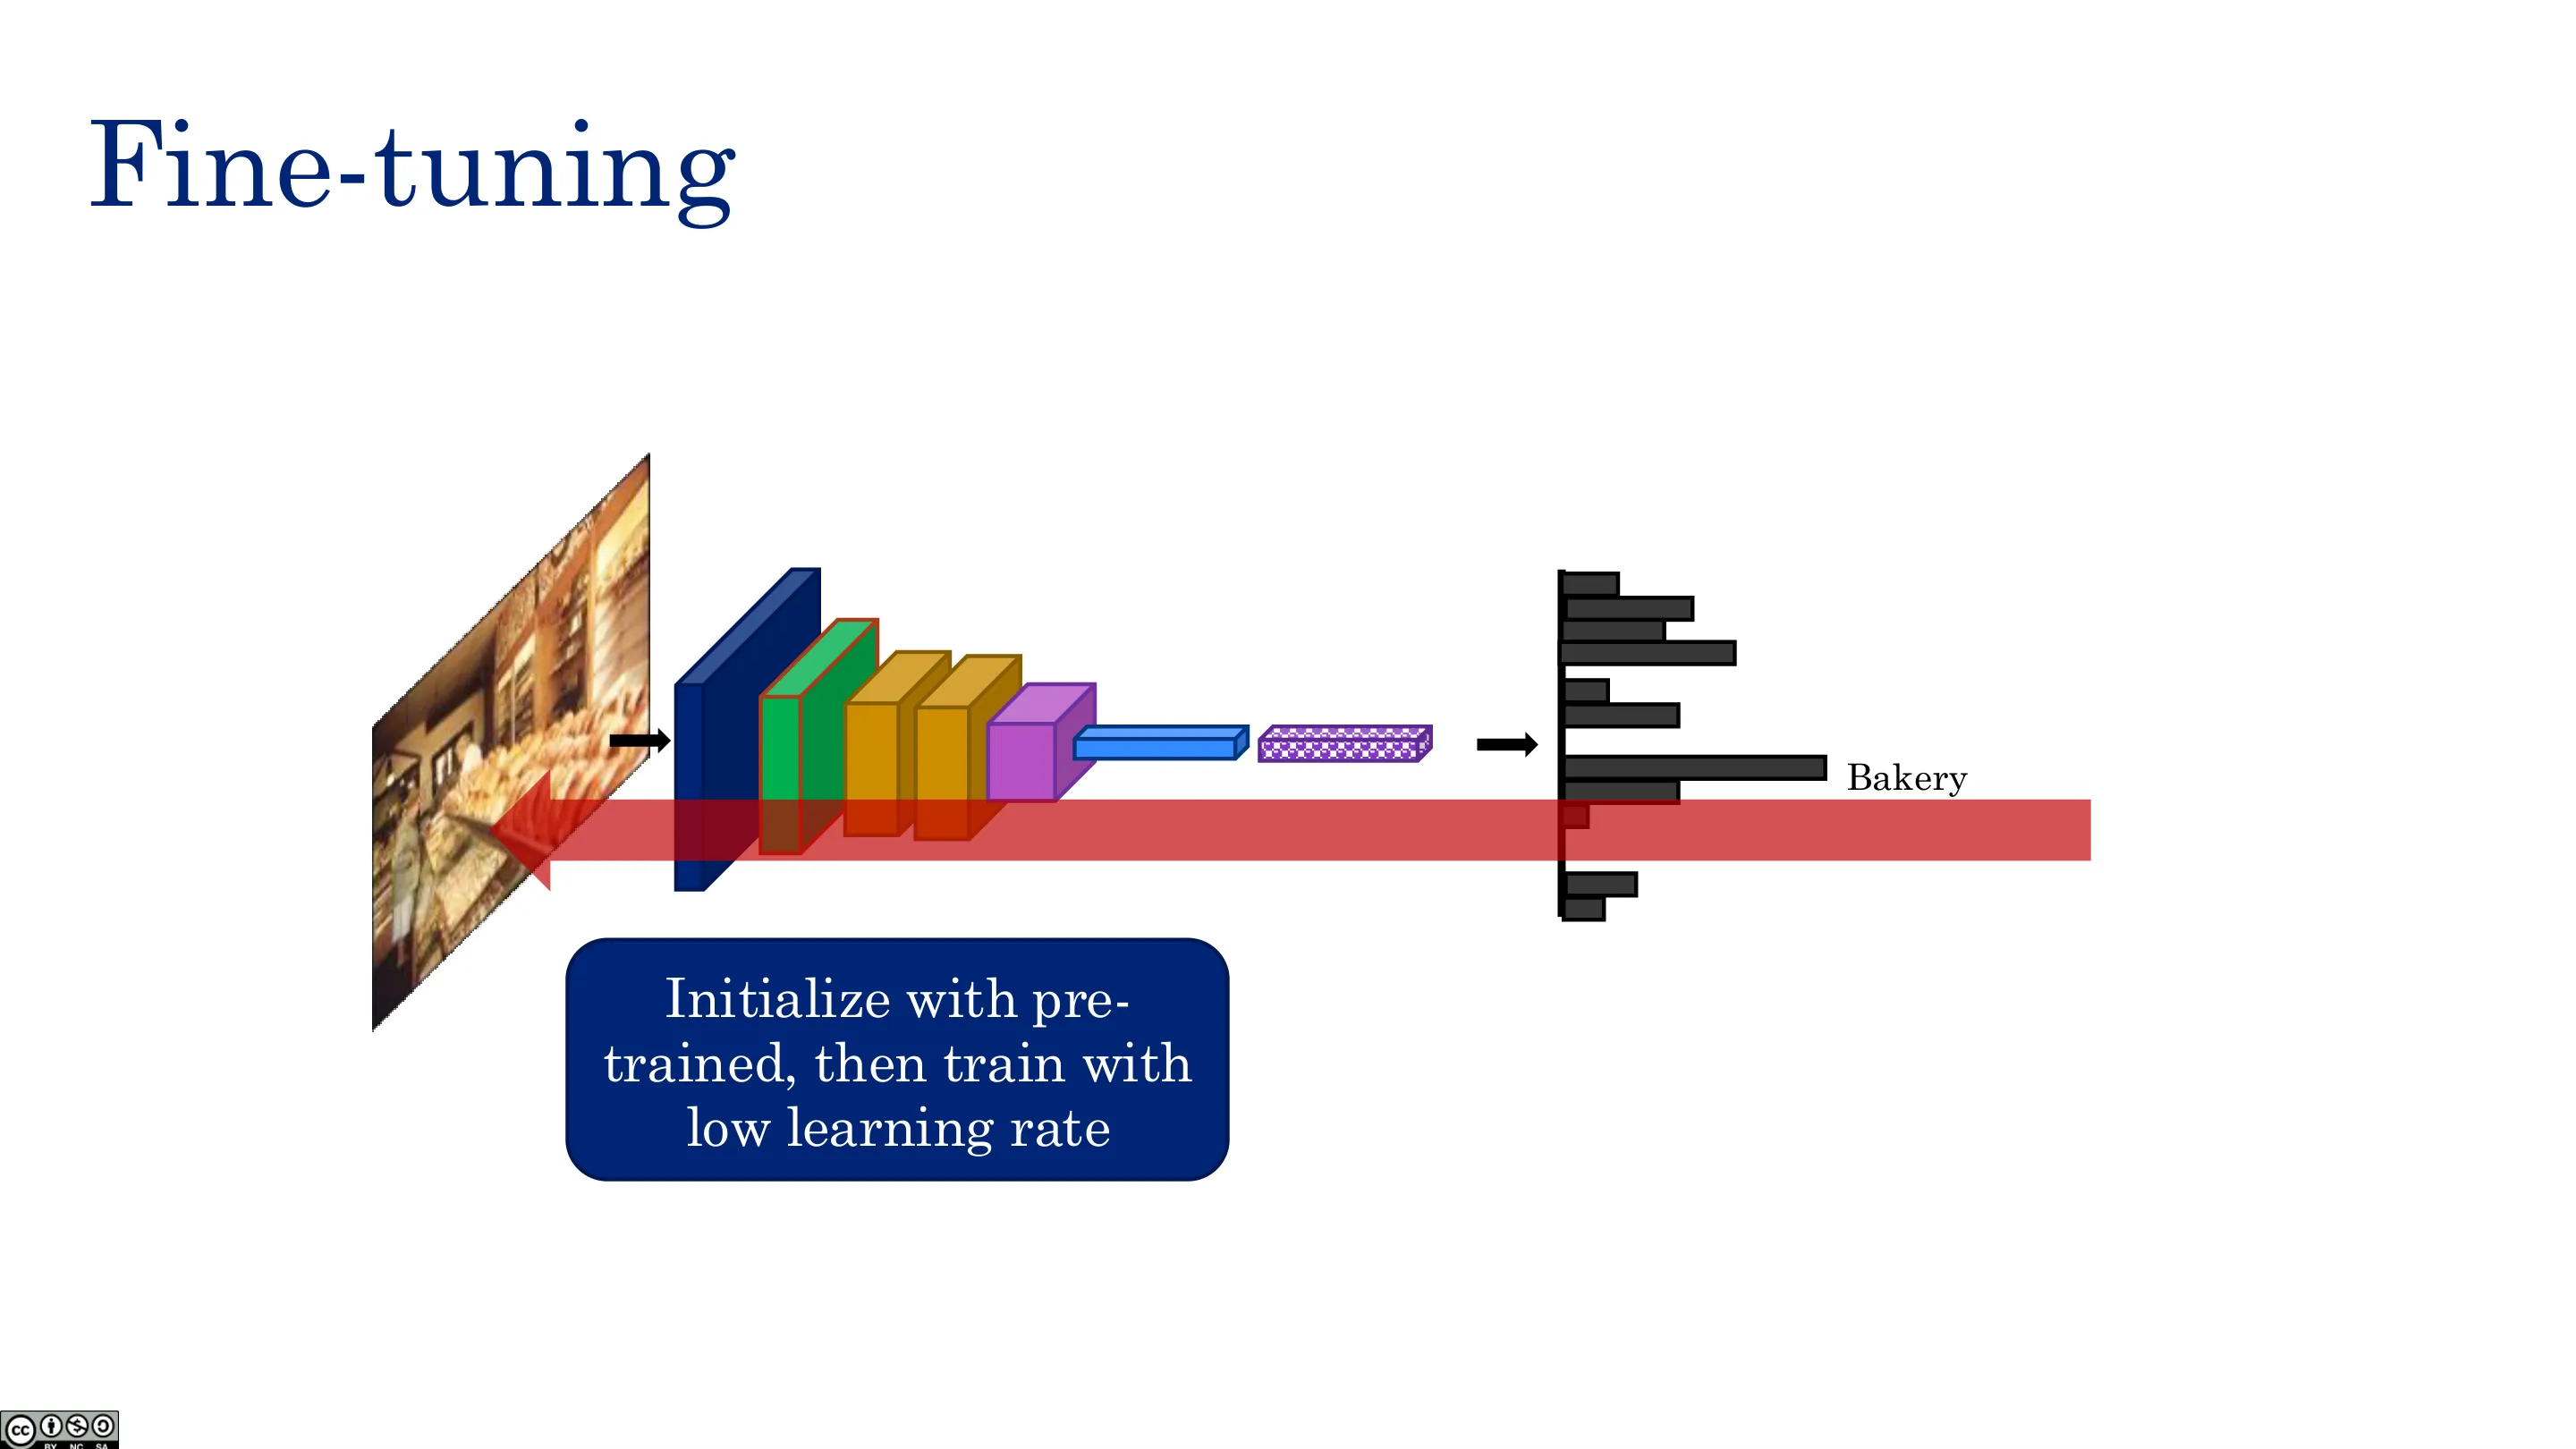
📷 微调(二)
回到原视频 (00:14:56)
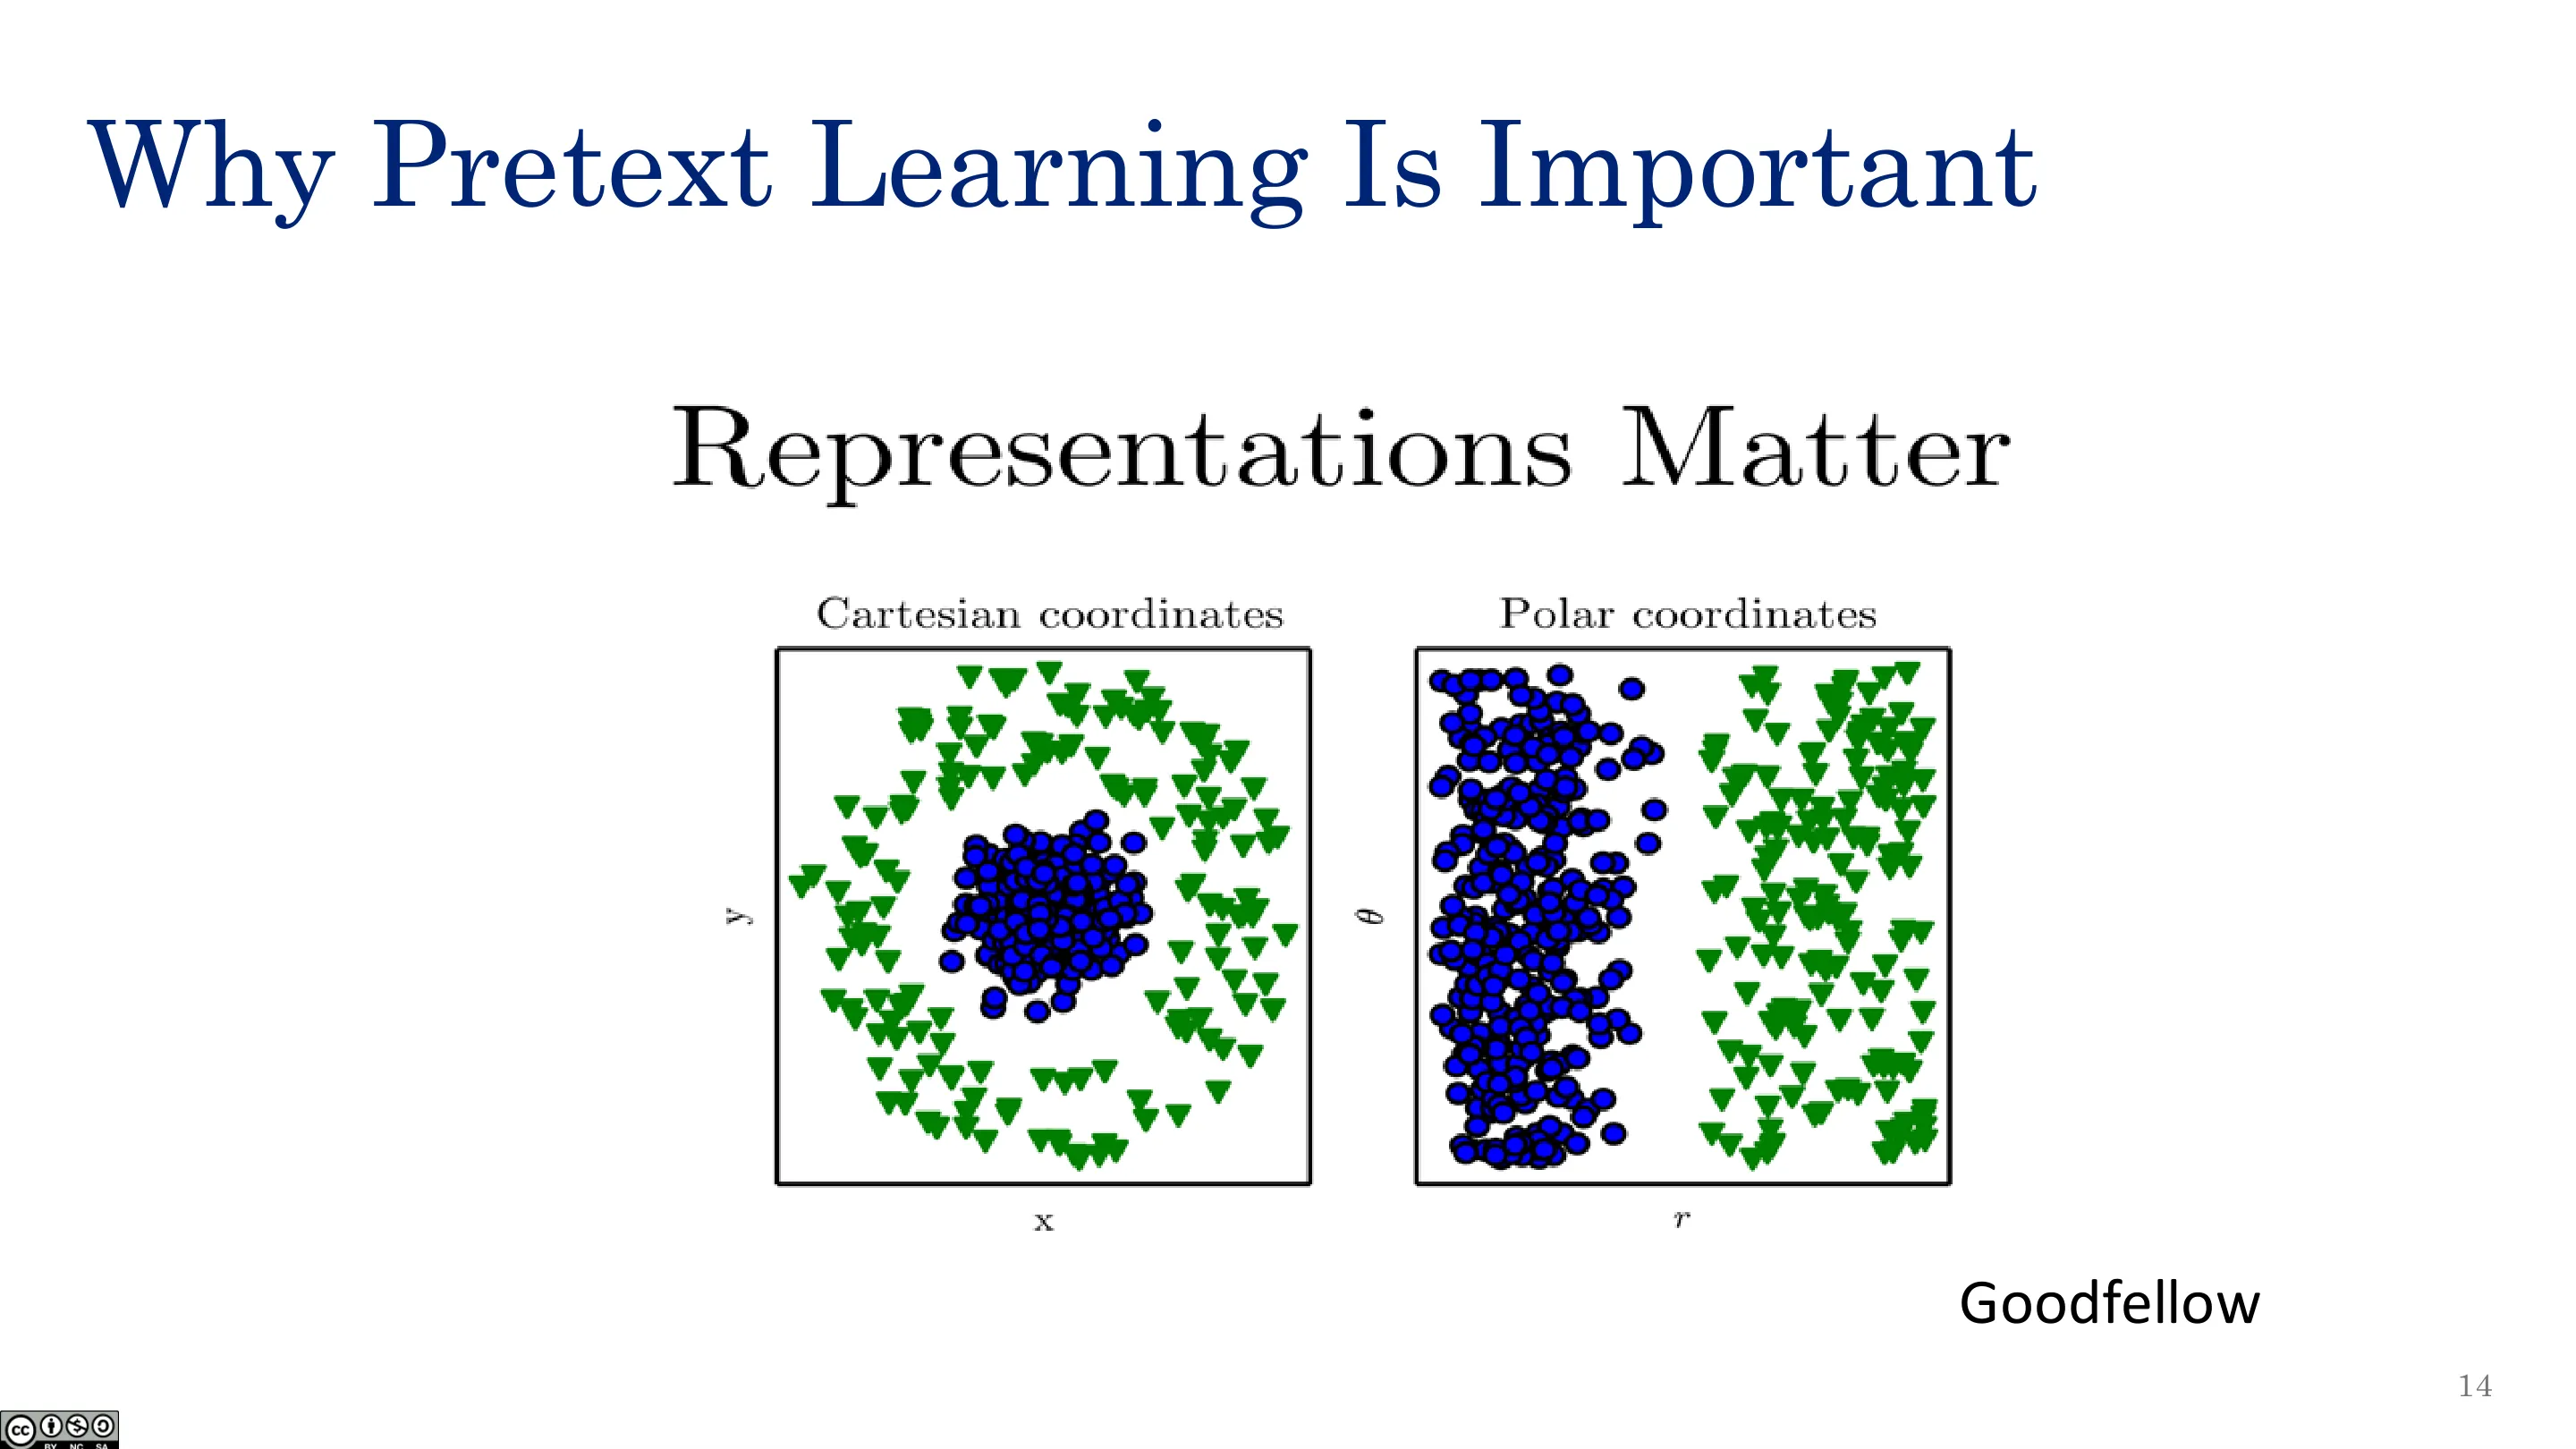
📷 为什么 pretext 学习很重要
回到原视频 (00:16:09)
📷 自监督学习的挑战
回到原视频 (00:17:22)
📷 自监督
回到原视频 (00:18:35)
📷 方法
回到原视频 (00:19:48)
二、生成式 Self-Supervision
📷 生成式
回到原视频 (00:21:01)
2.1 自编码器(Autoencoder)
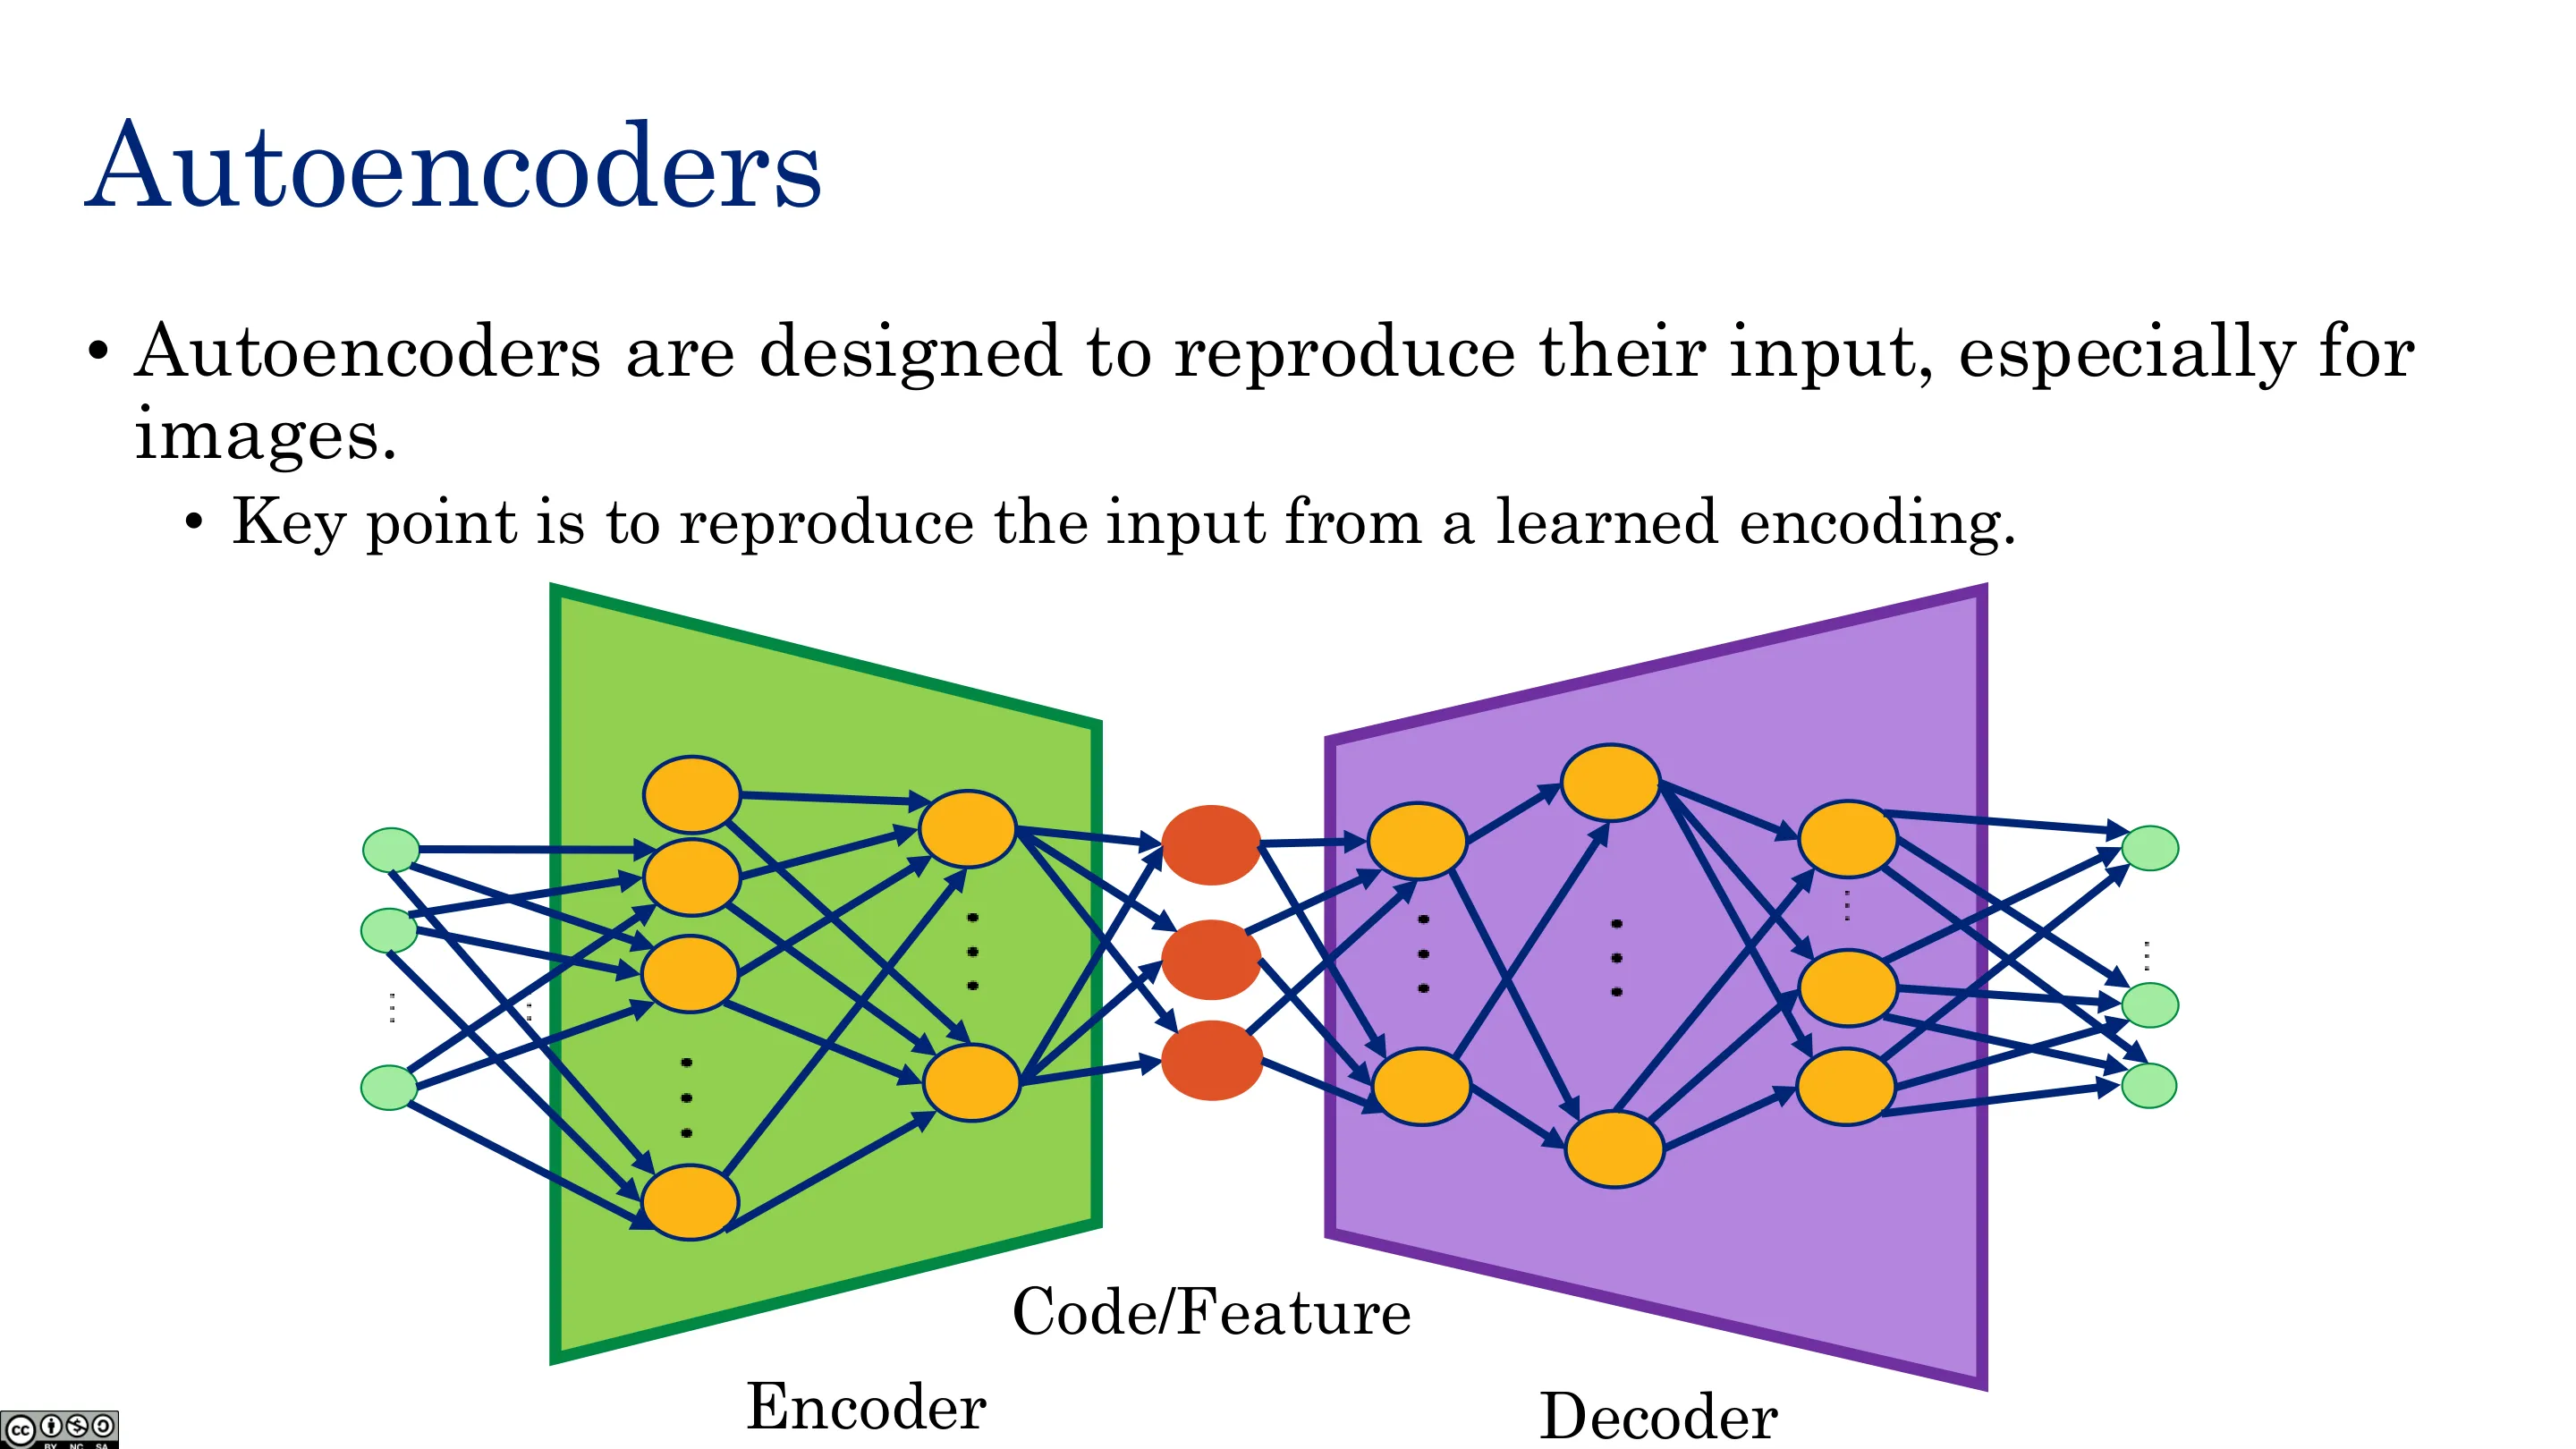
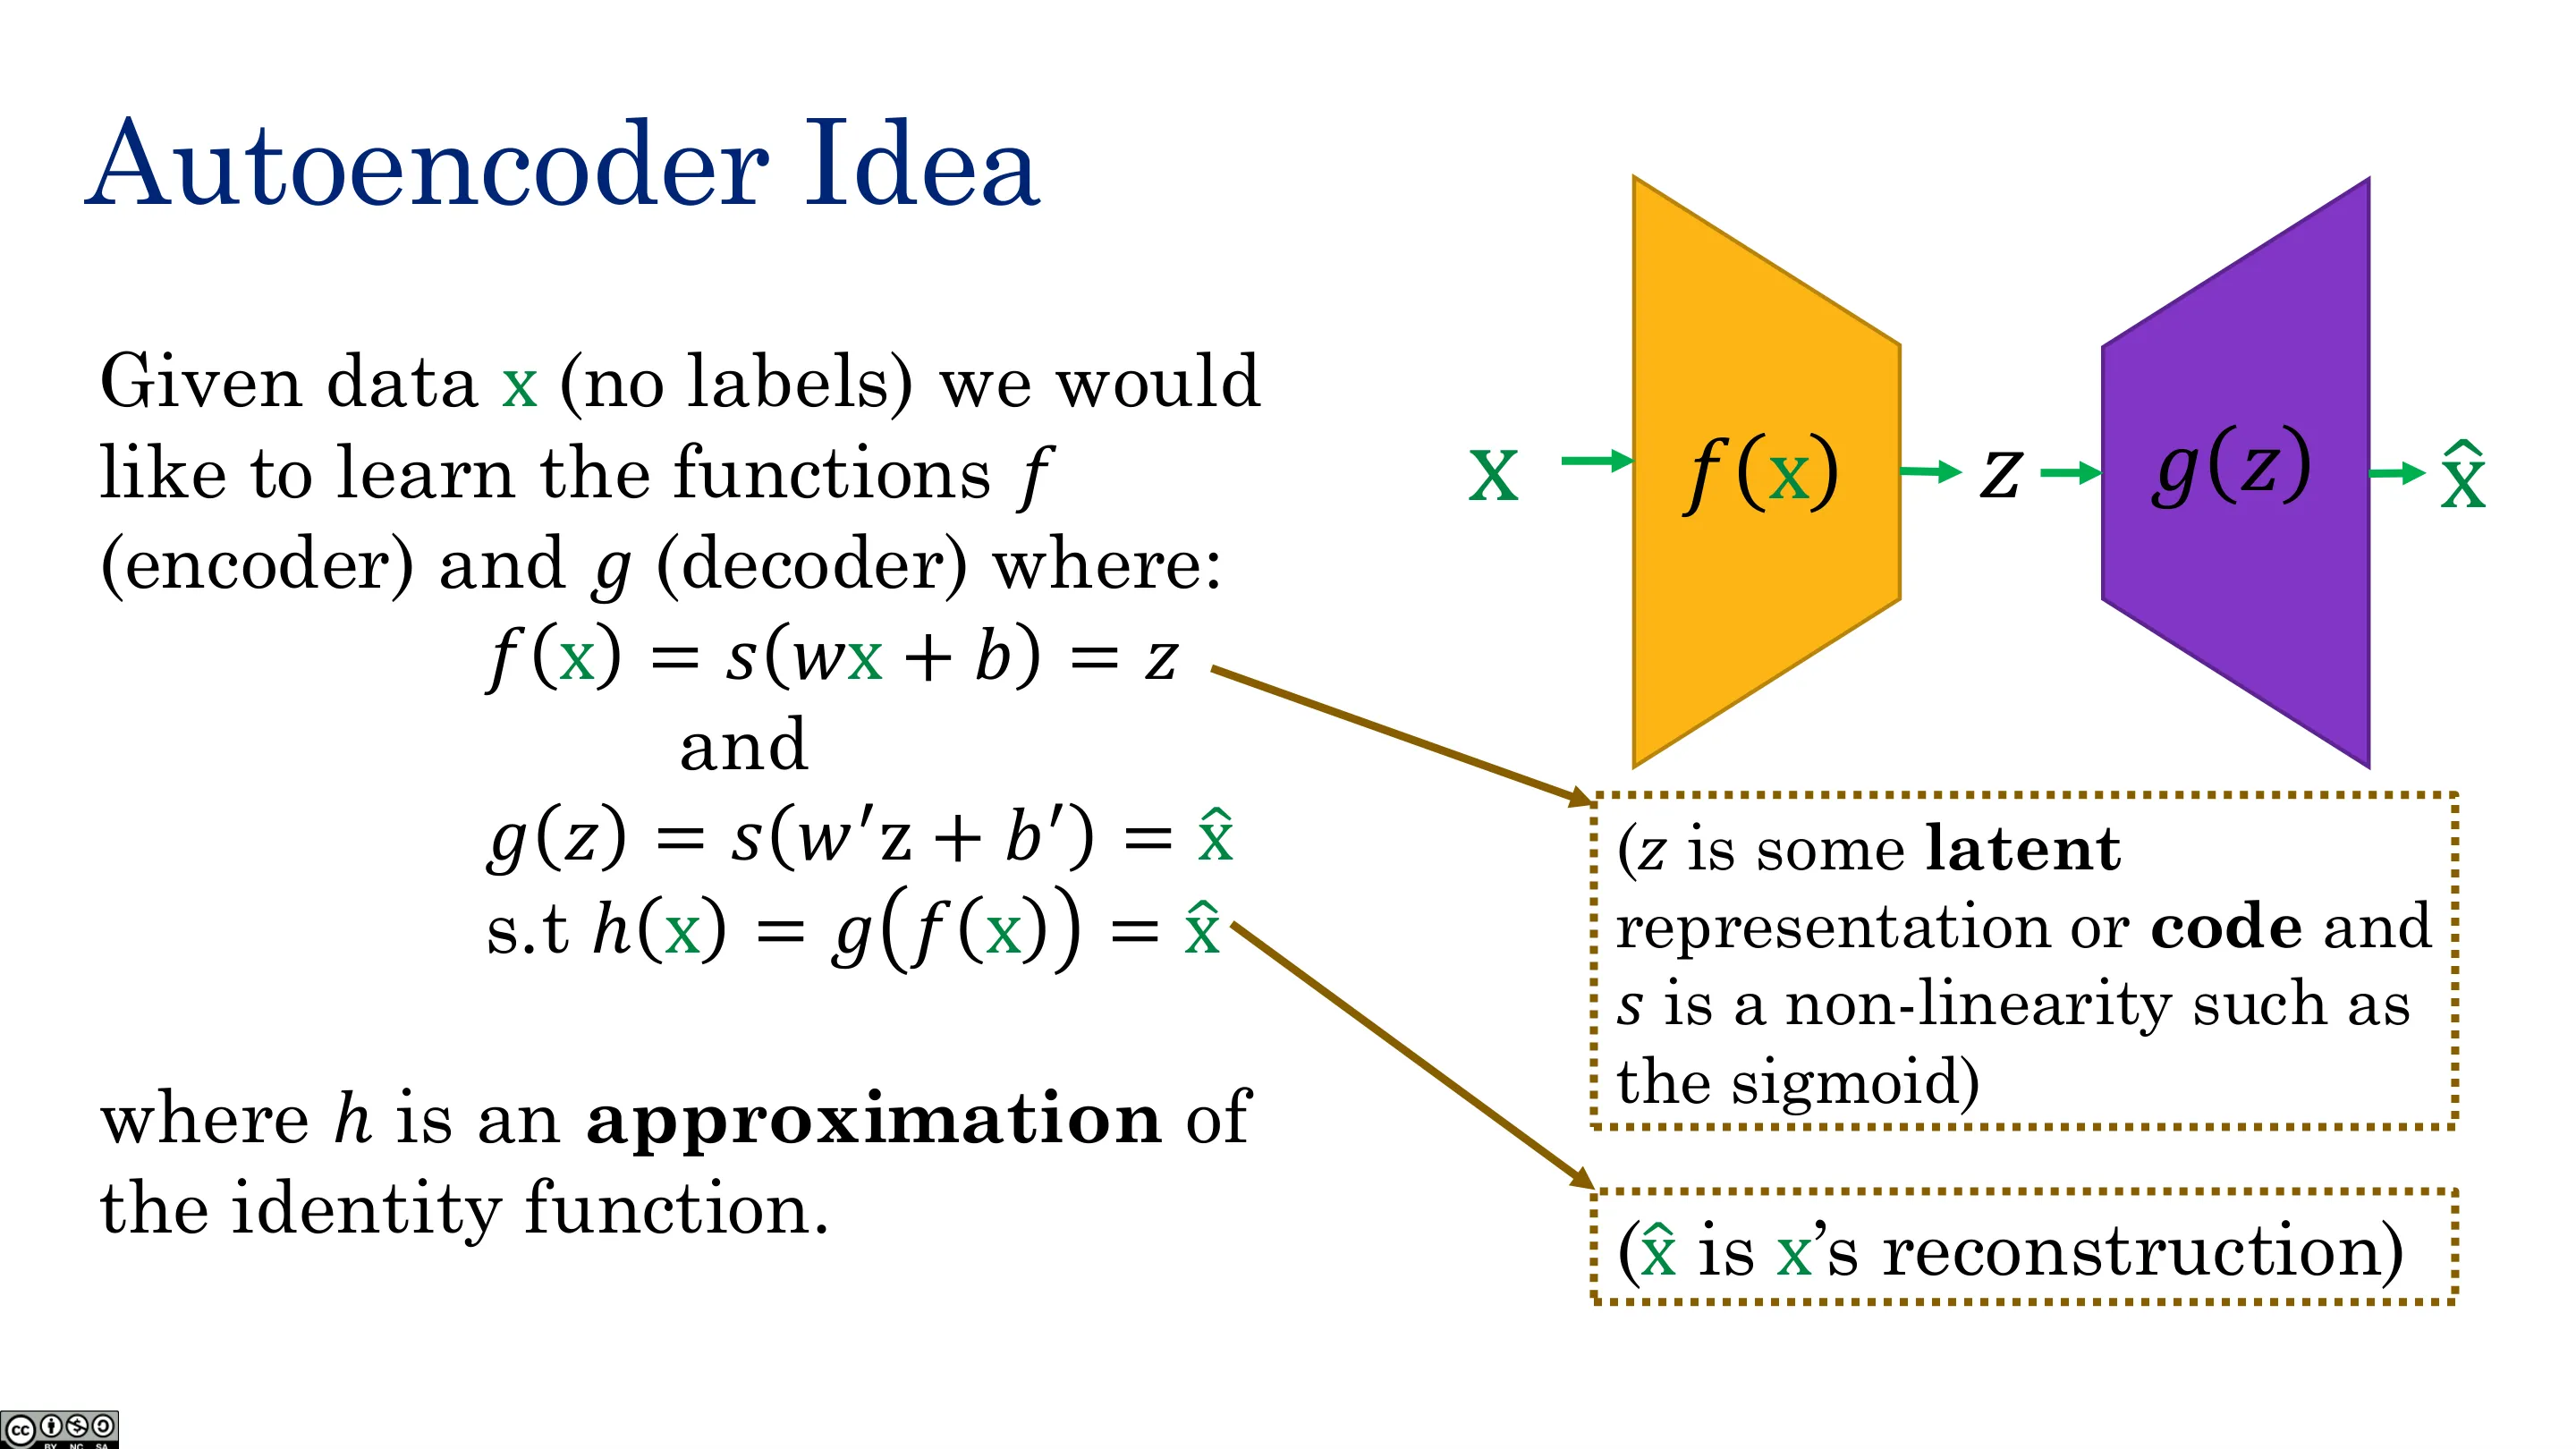
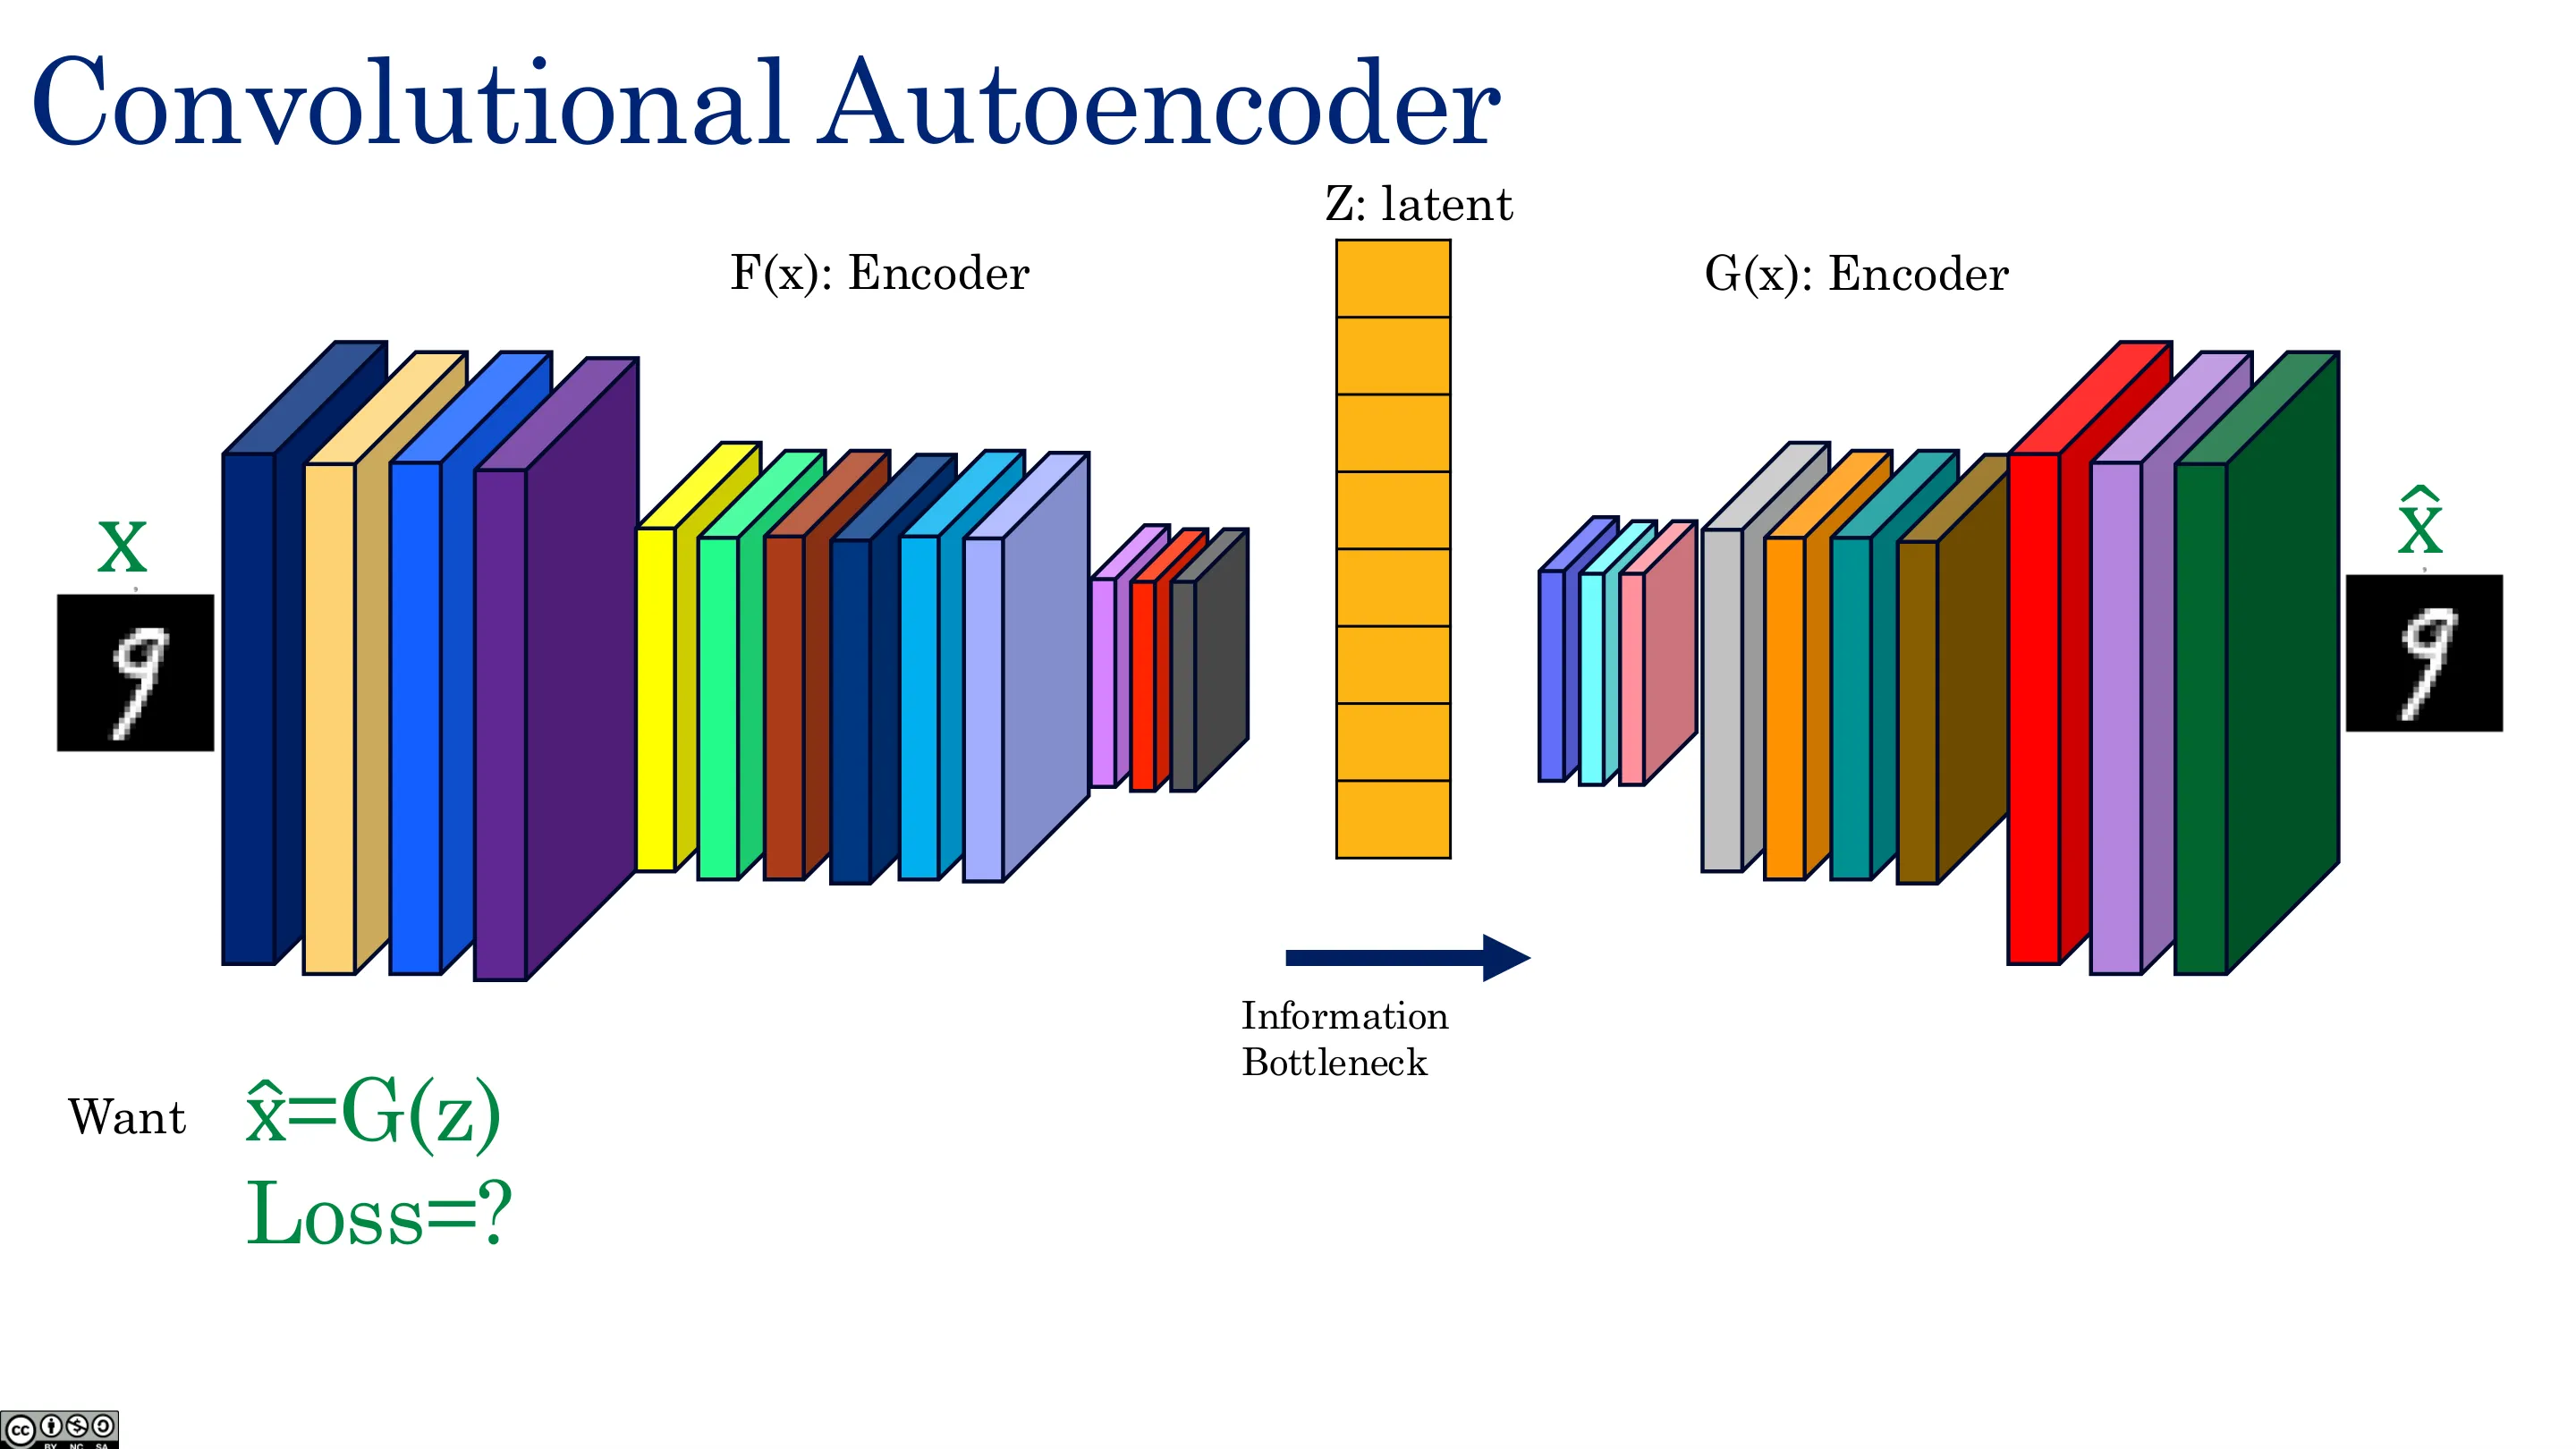
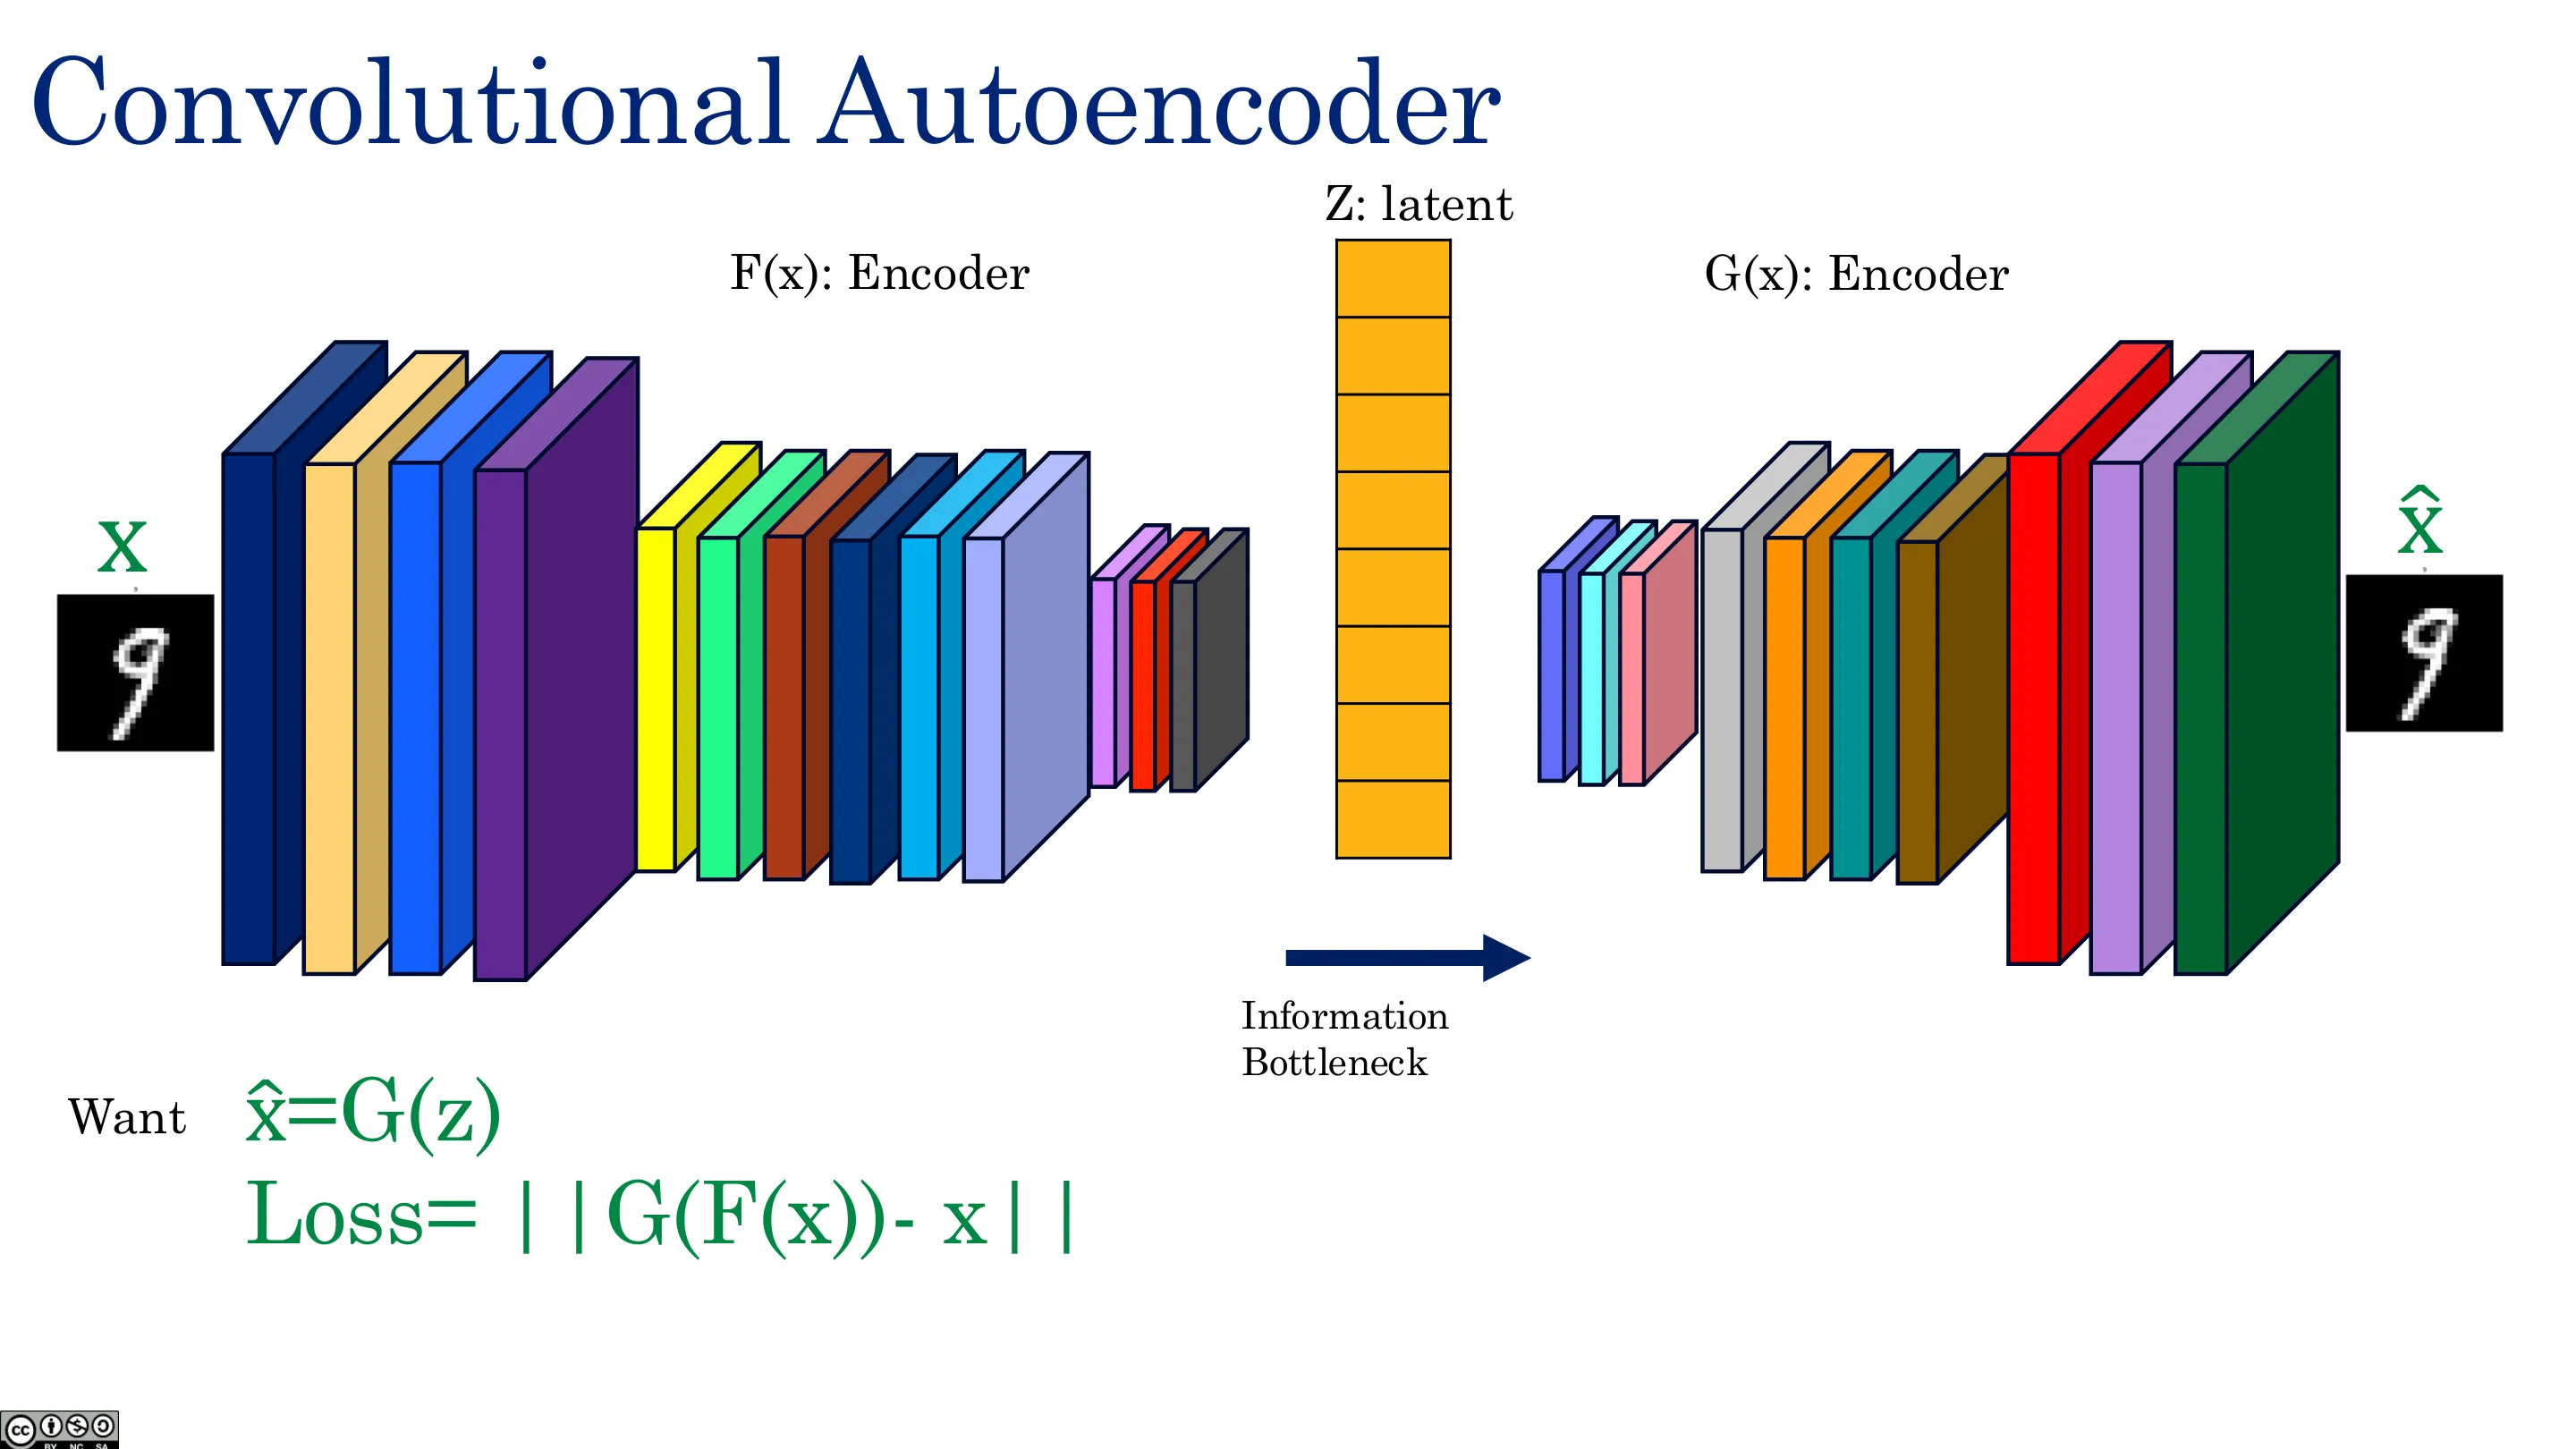
结构:编码器 $f$ 把大向量 $x$(如图像)压成小潜向量 $z=f(x)$,解码器 $g$ 从 $z$ 重建 $\hat x=g(z)$。
Pretext 任务 = 重建,损失:
$$ \mathcal{L}=\sum_i \lVert x_i-\hat x_i\rVert^2 \quad(\text{MSE}) $$
- 随机初始化时输出是垃圾;用梯度下降同时训练编码器和解码器(可 mini-batch/Adam);
- 关键:$z$ 的维度必须远小于 $x$。若同维,存在恒等映射的平凡解(零损失但没学到东西);
- 因此 $z$ 必须压缩——压缩即理解:能用 500 个数重建百万像素,说明学到了数据的结构(流形);
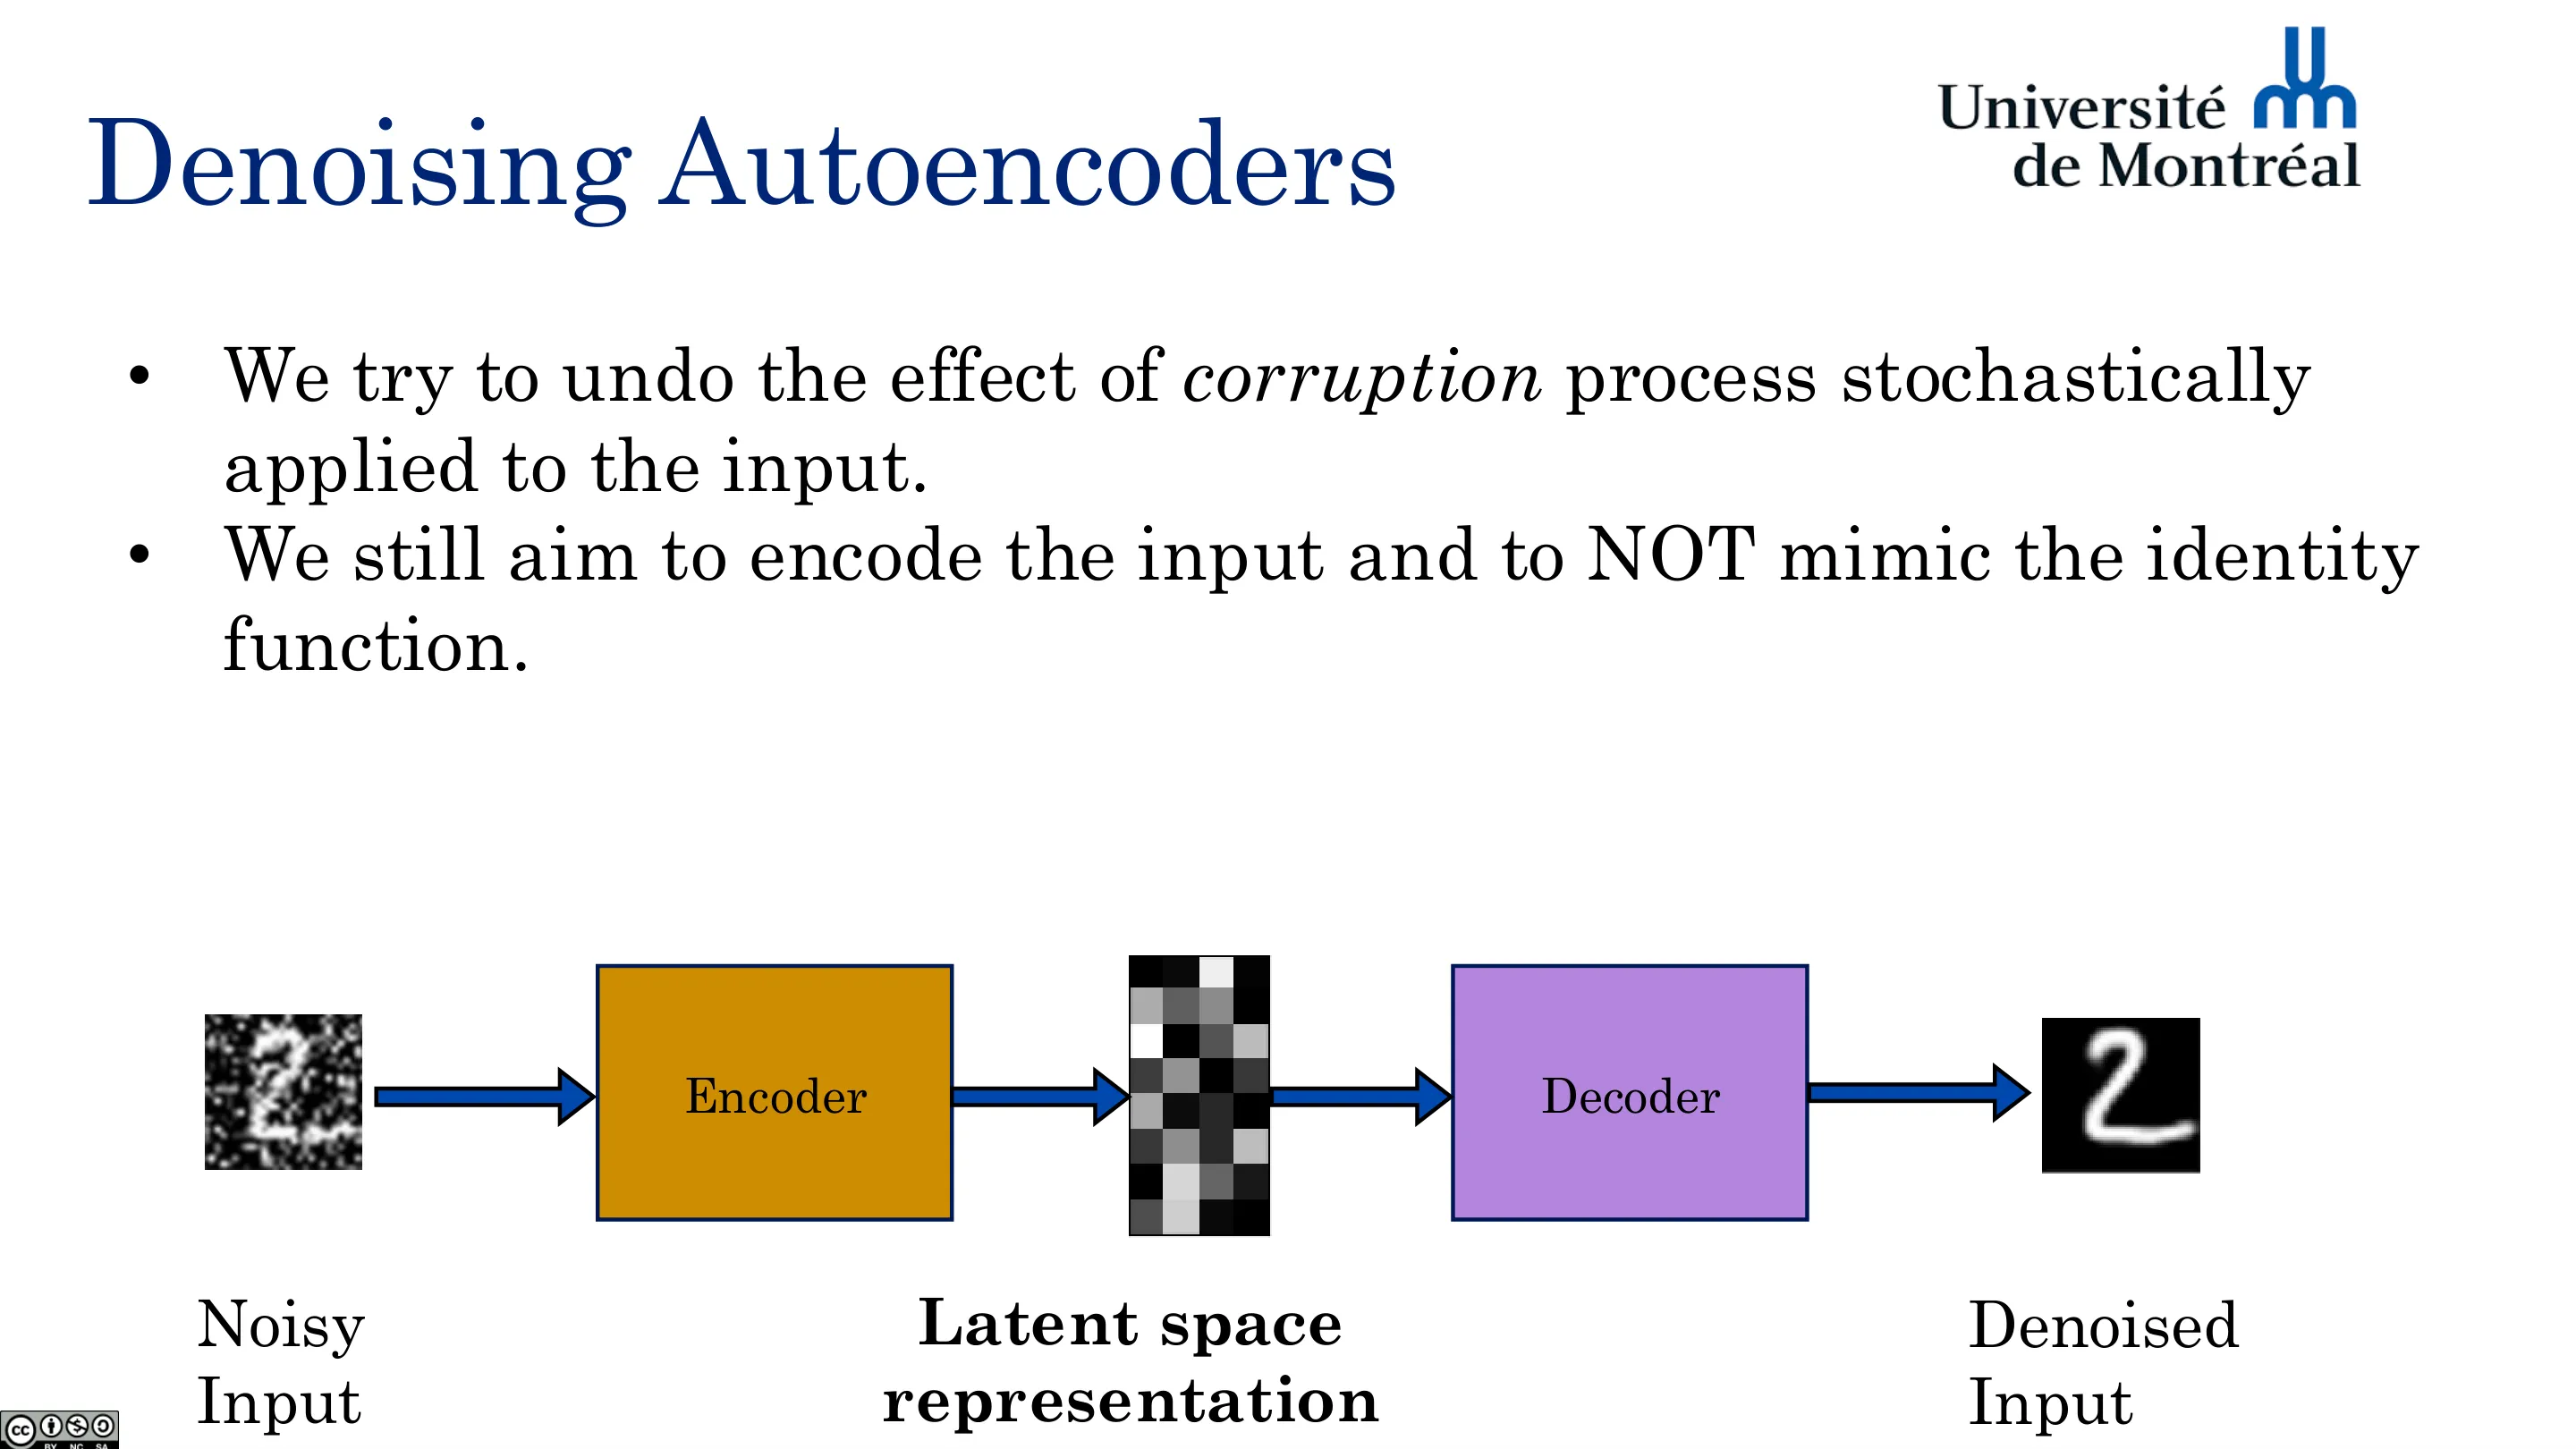
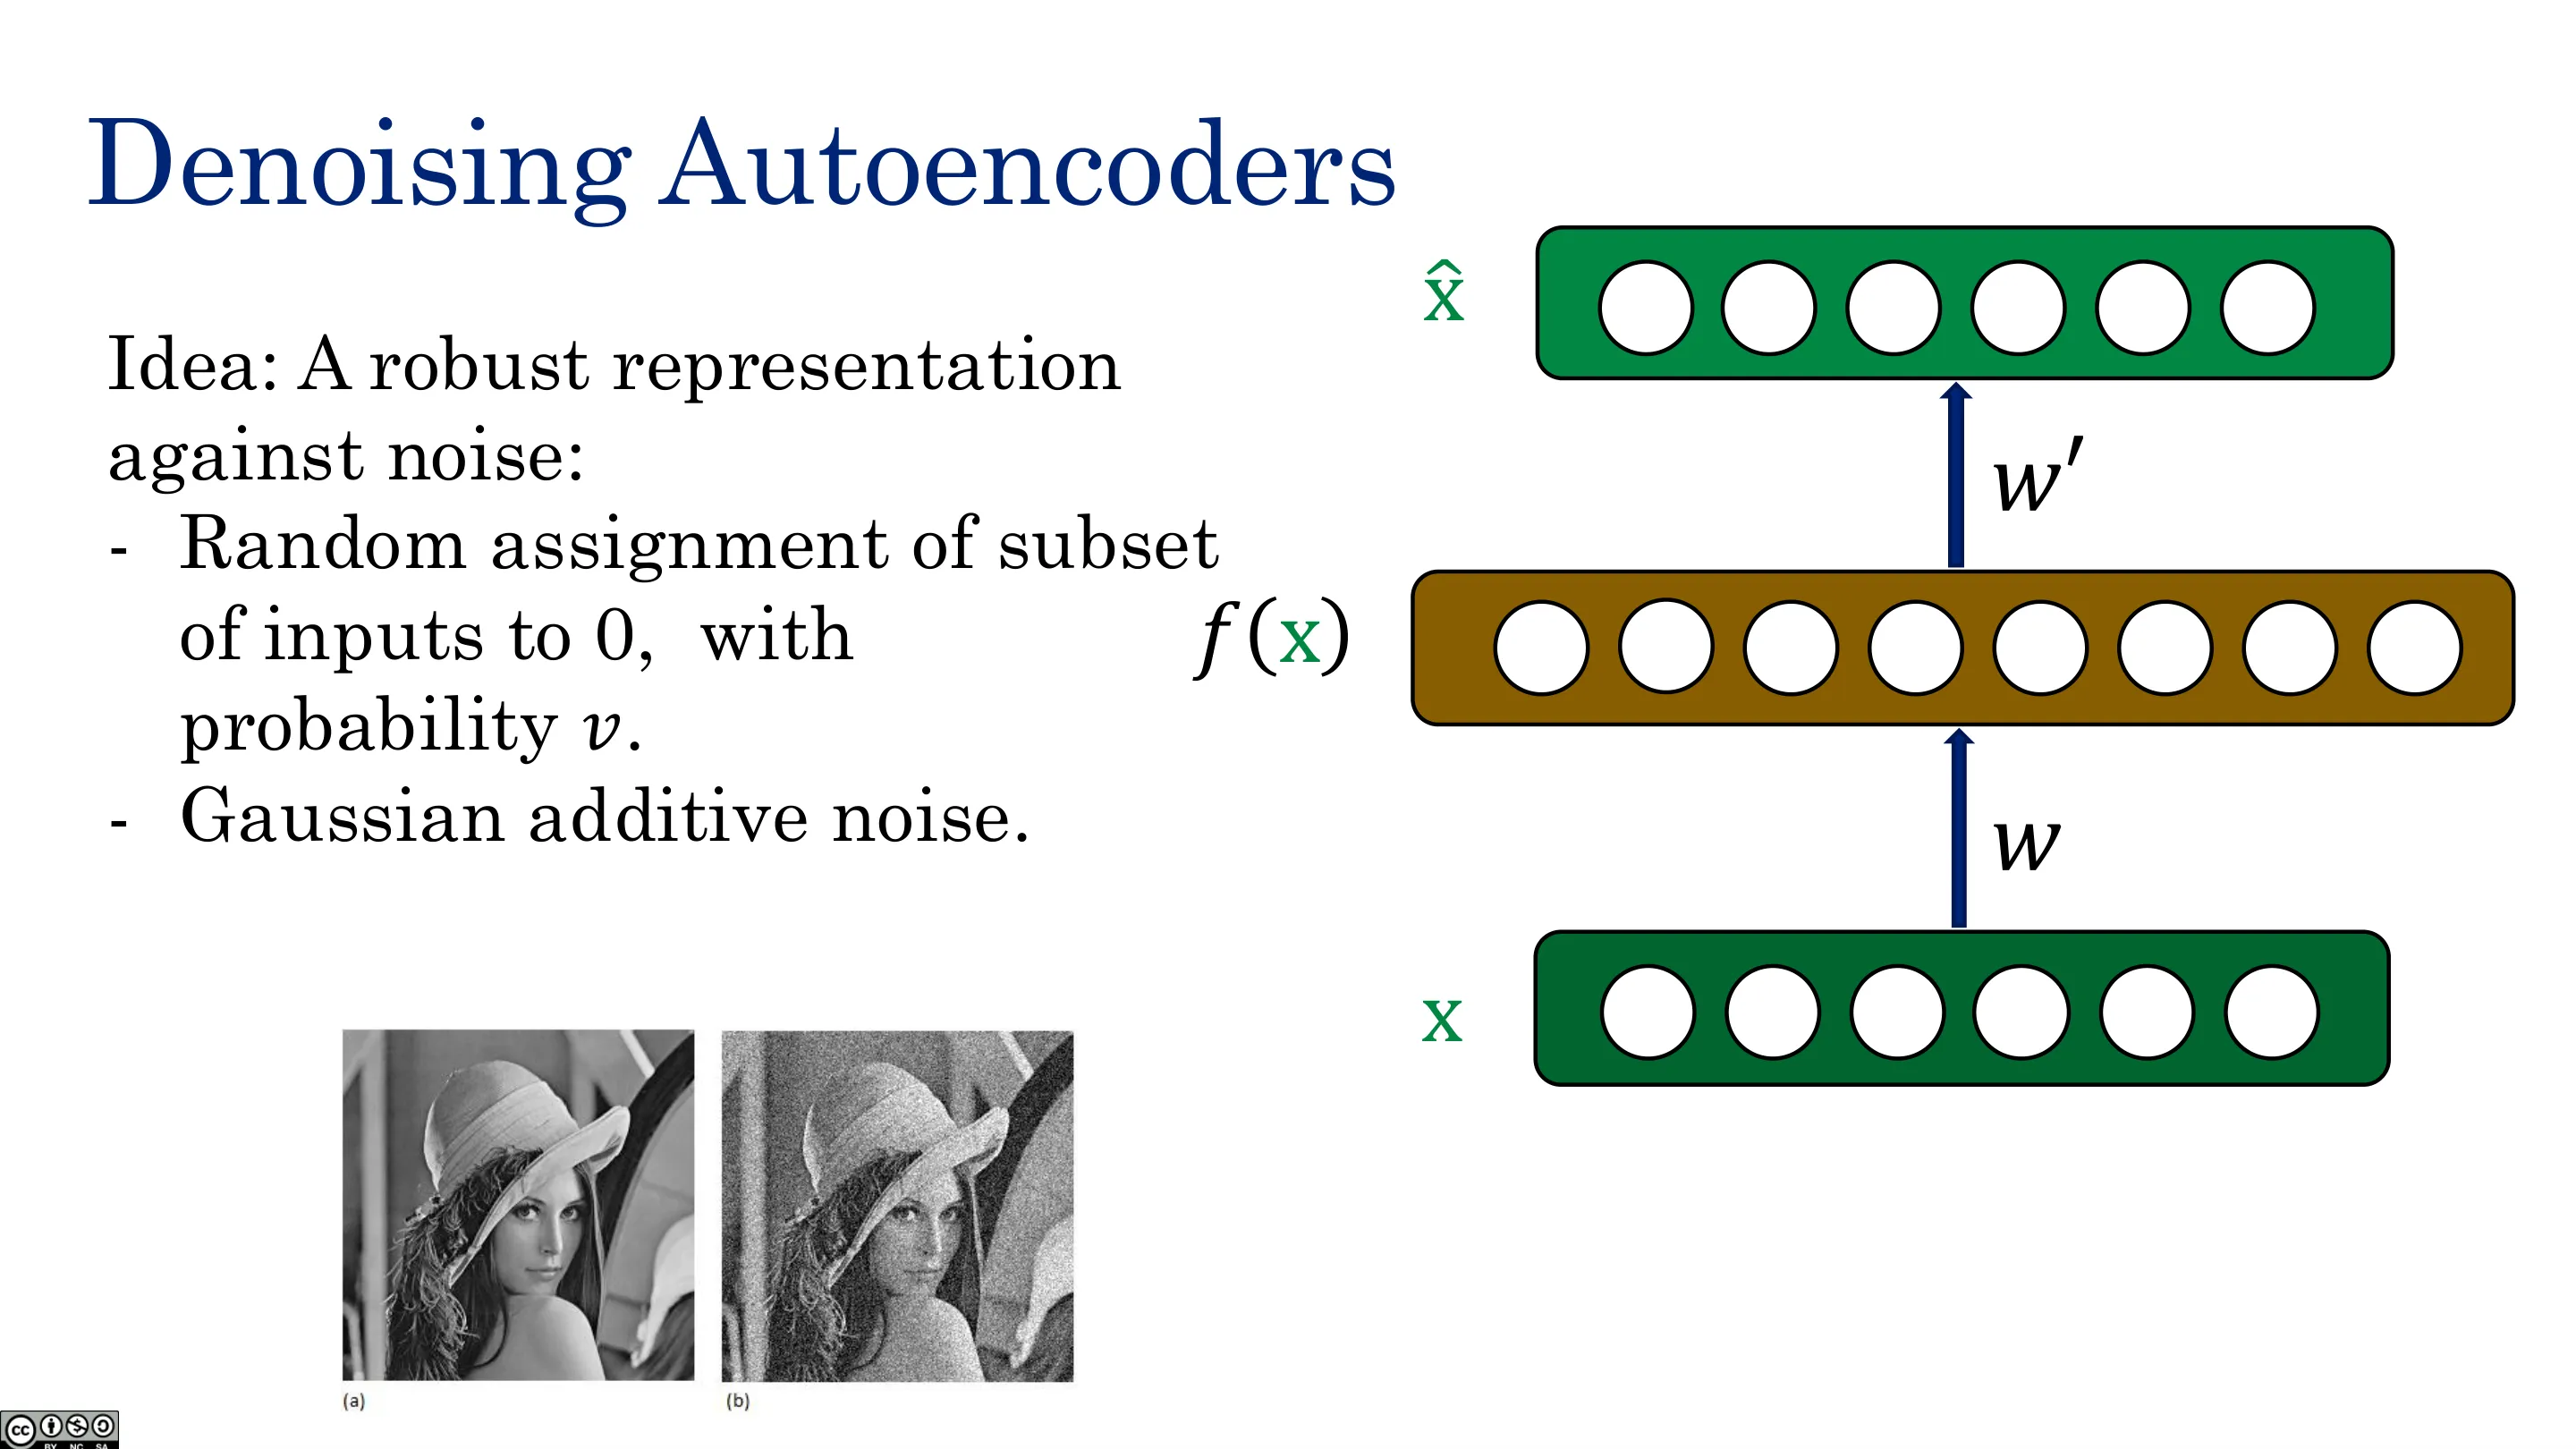
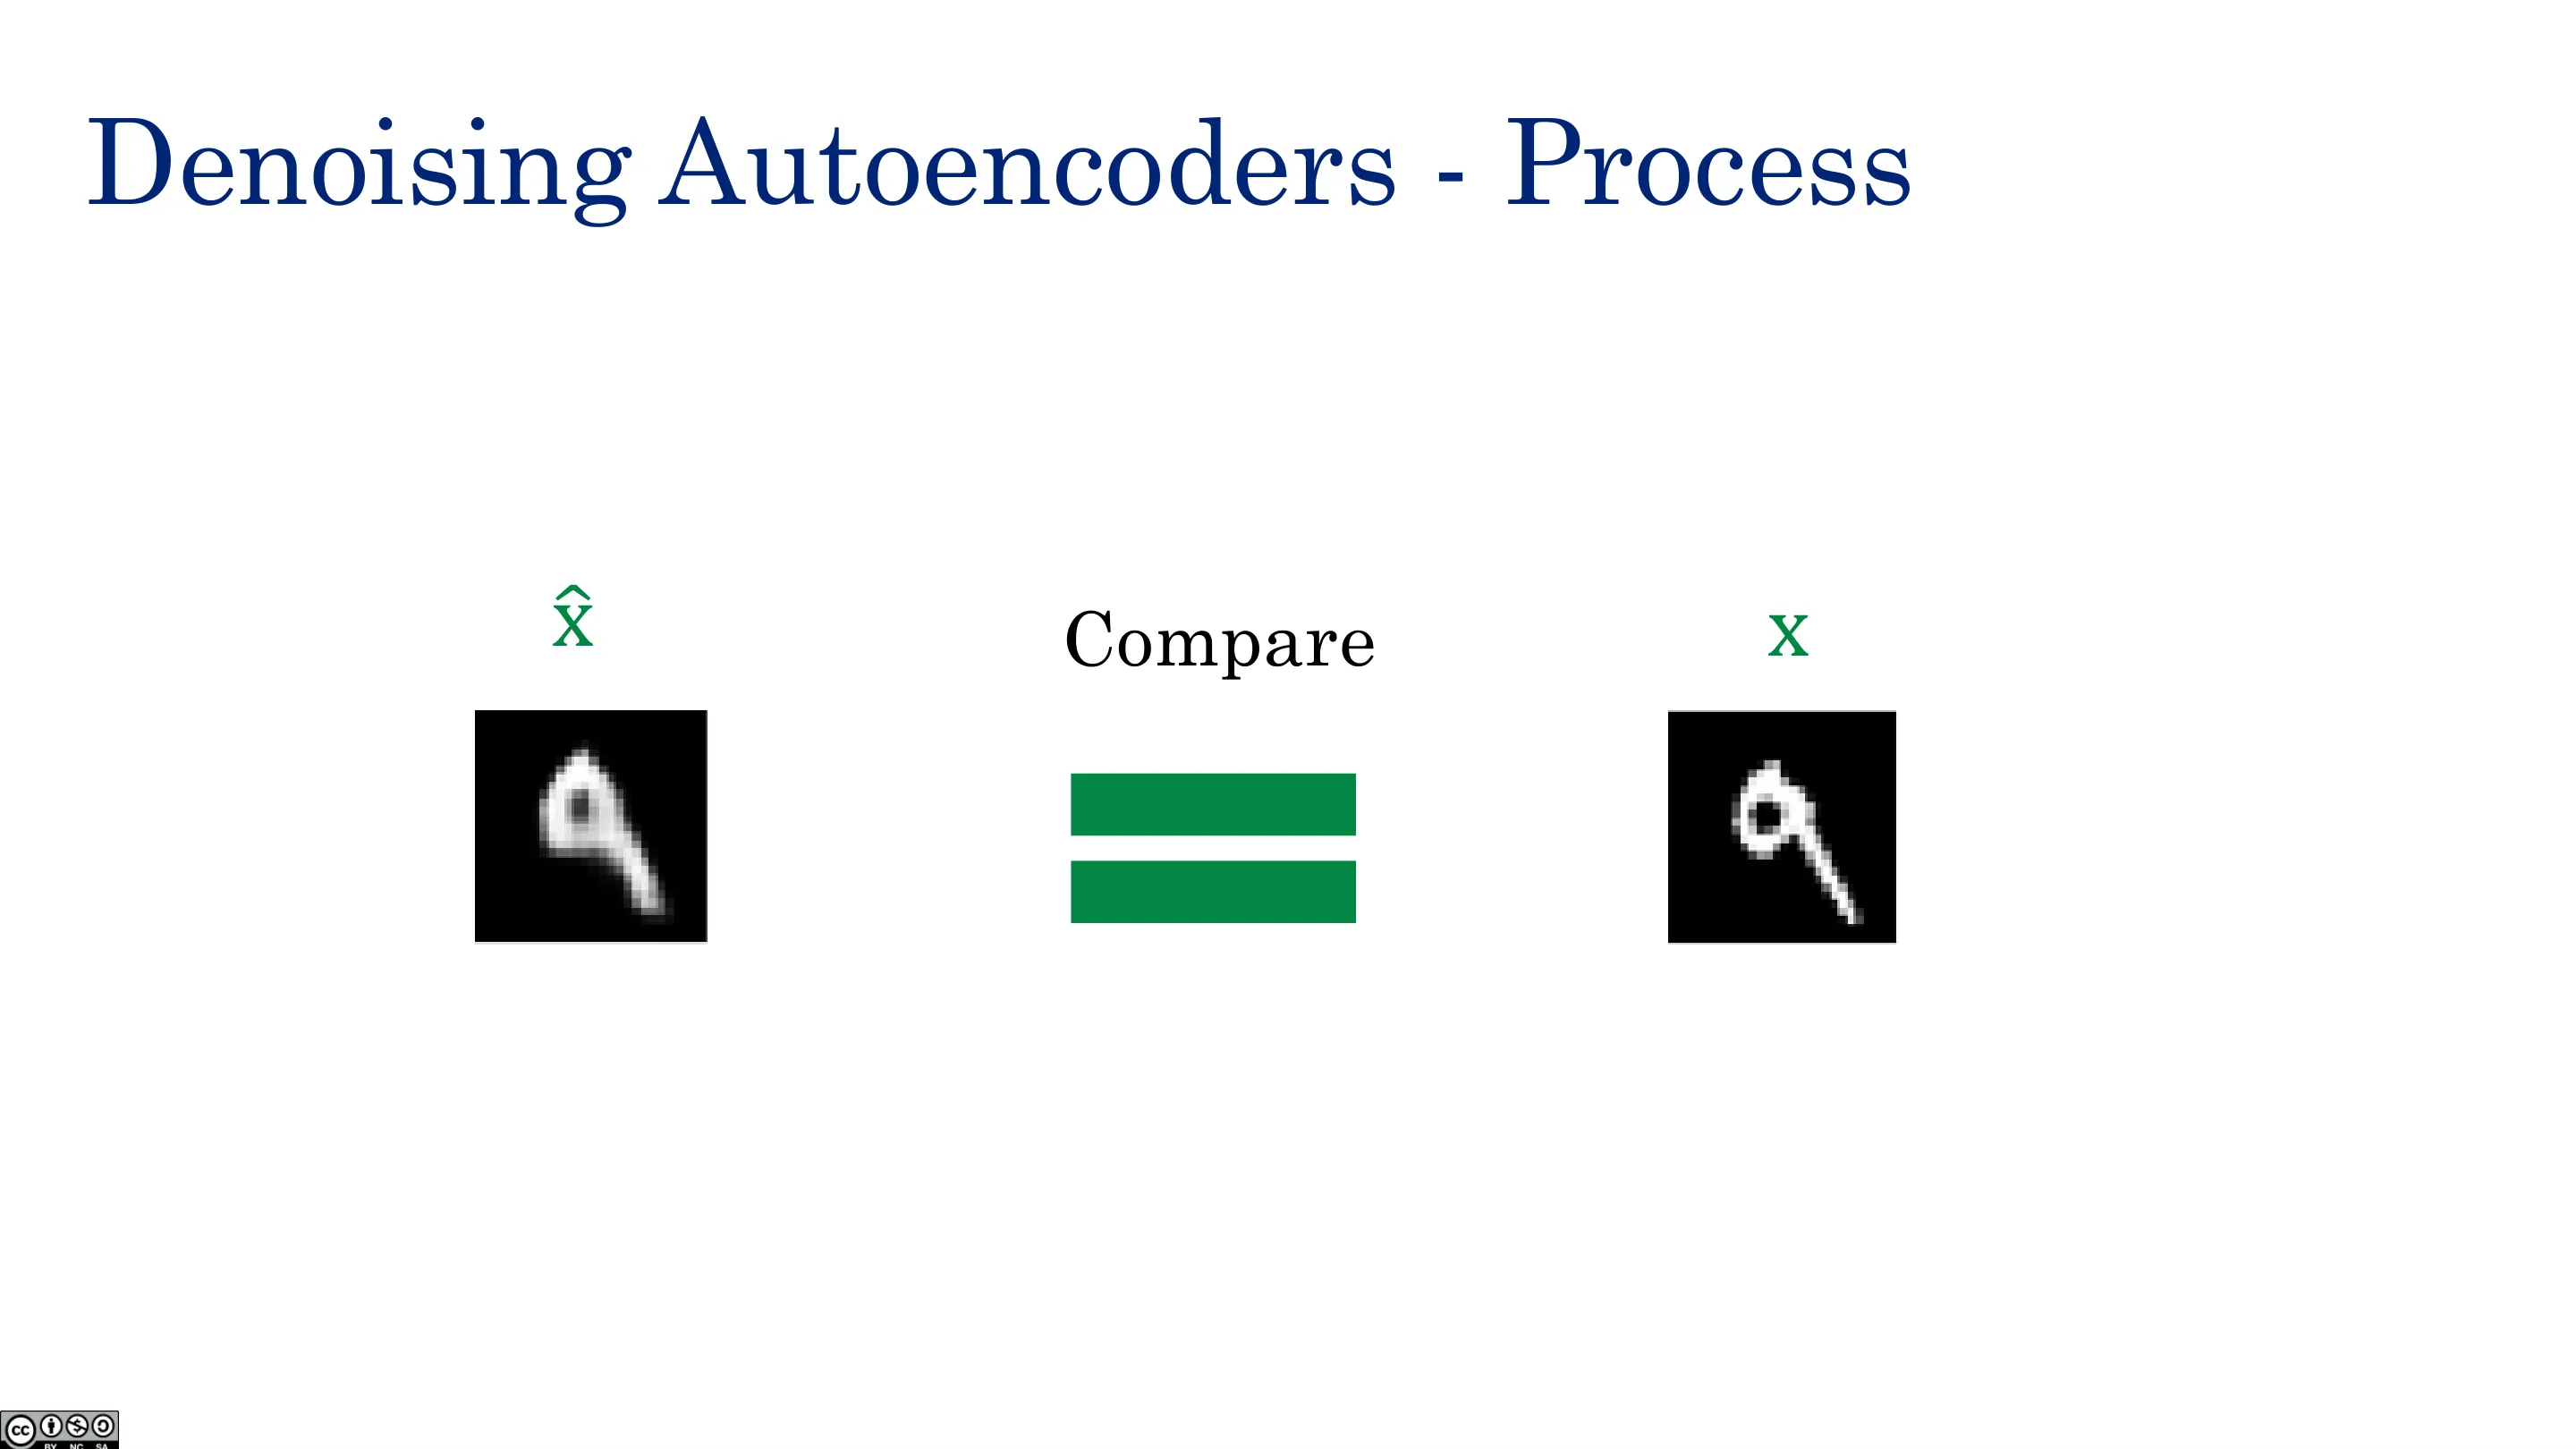
- 副产物:还能去噪(重建时忽略噪声)。
生成:训练后把随机 $z$ 送进解码器 $g$,会"梦"出一张黄瓜/人脸——最早的生成模型。把非黄瓜图像编码再解码,会得到它在黄瓜流形上的投影(模糊的黄瓜版)。$z$ 的分布理论上应是最大熵(高斯 iid)——这正是变分自编码器(VAE) 的思路。PCA 是自编码器的线性版。
📷 自编码器
回到原视频 (00:22:14)
📷 自编码器的思想
回到原视频 (00:23:27)
📷 卷积自编码器(一)
回到原视频 (00:24:40)
📷 卷积自编码器(二)
回到原视频 (00:25:53)
📷 去噪自编码器(一)
回到原视频 (00:27:06)
📷 去噪自编码器(二)
回到原视频 (00:28:19)
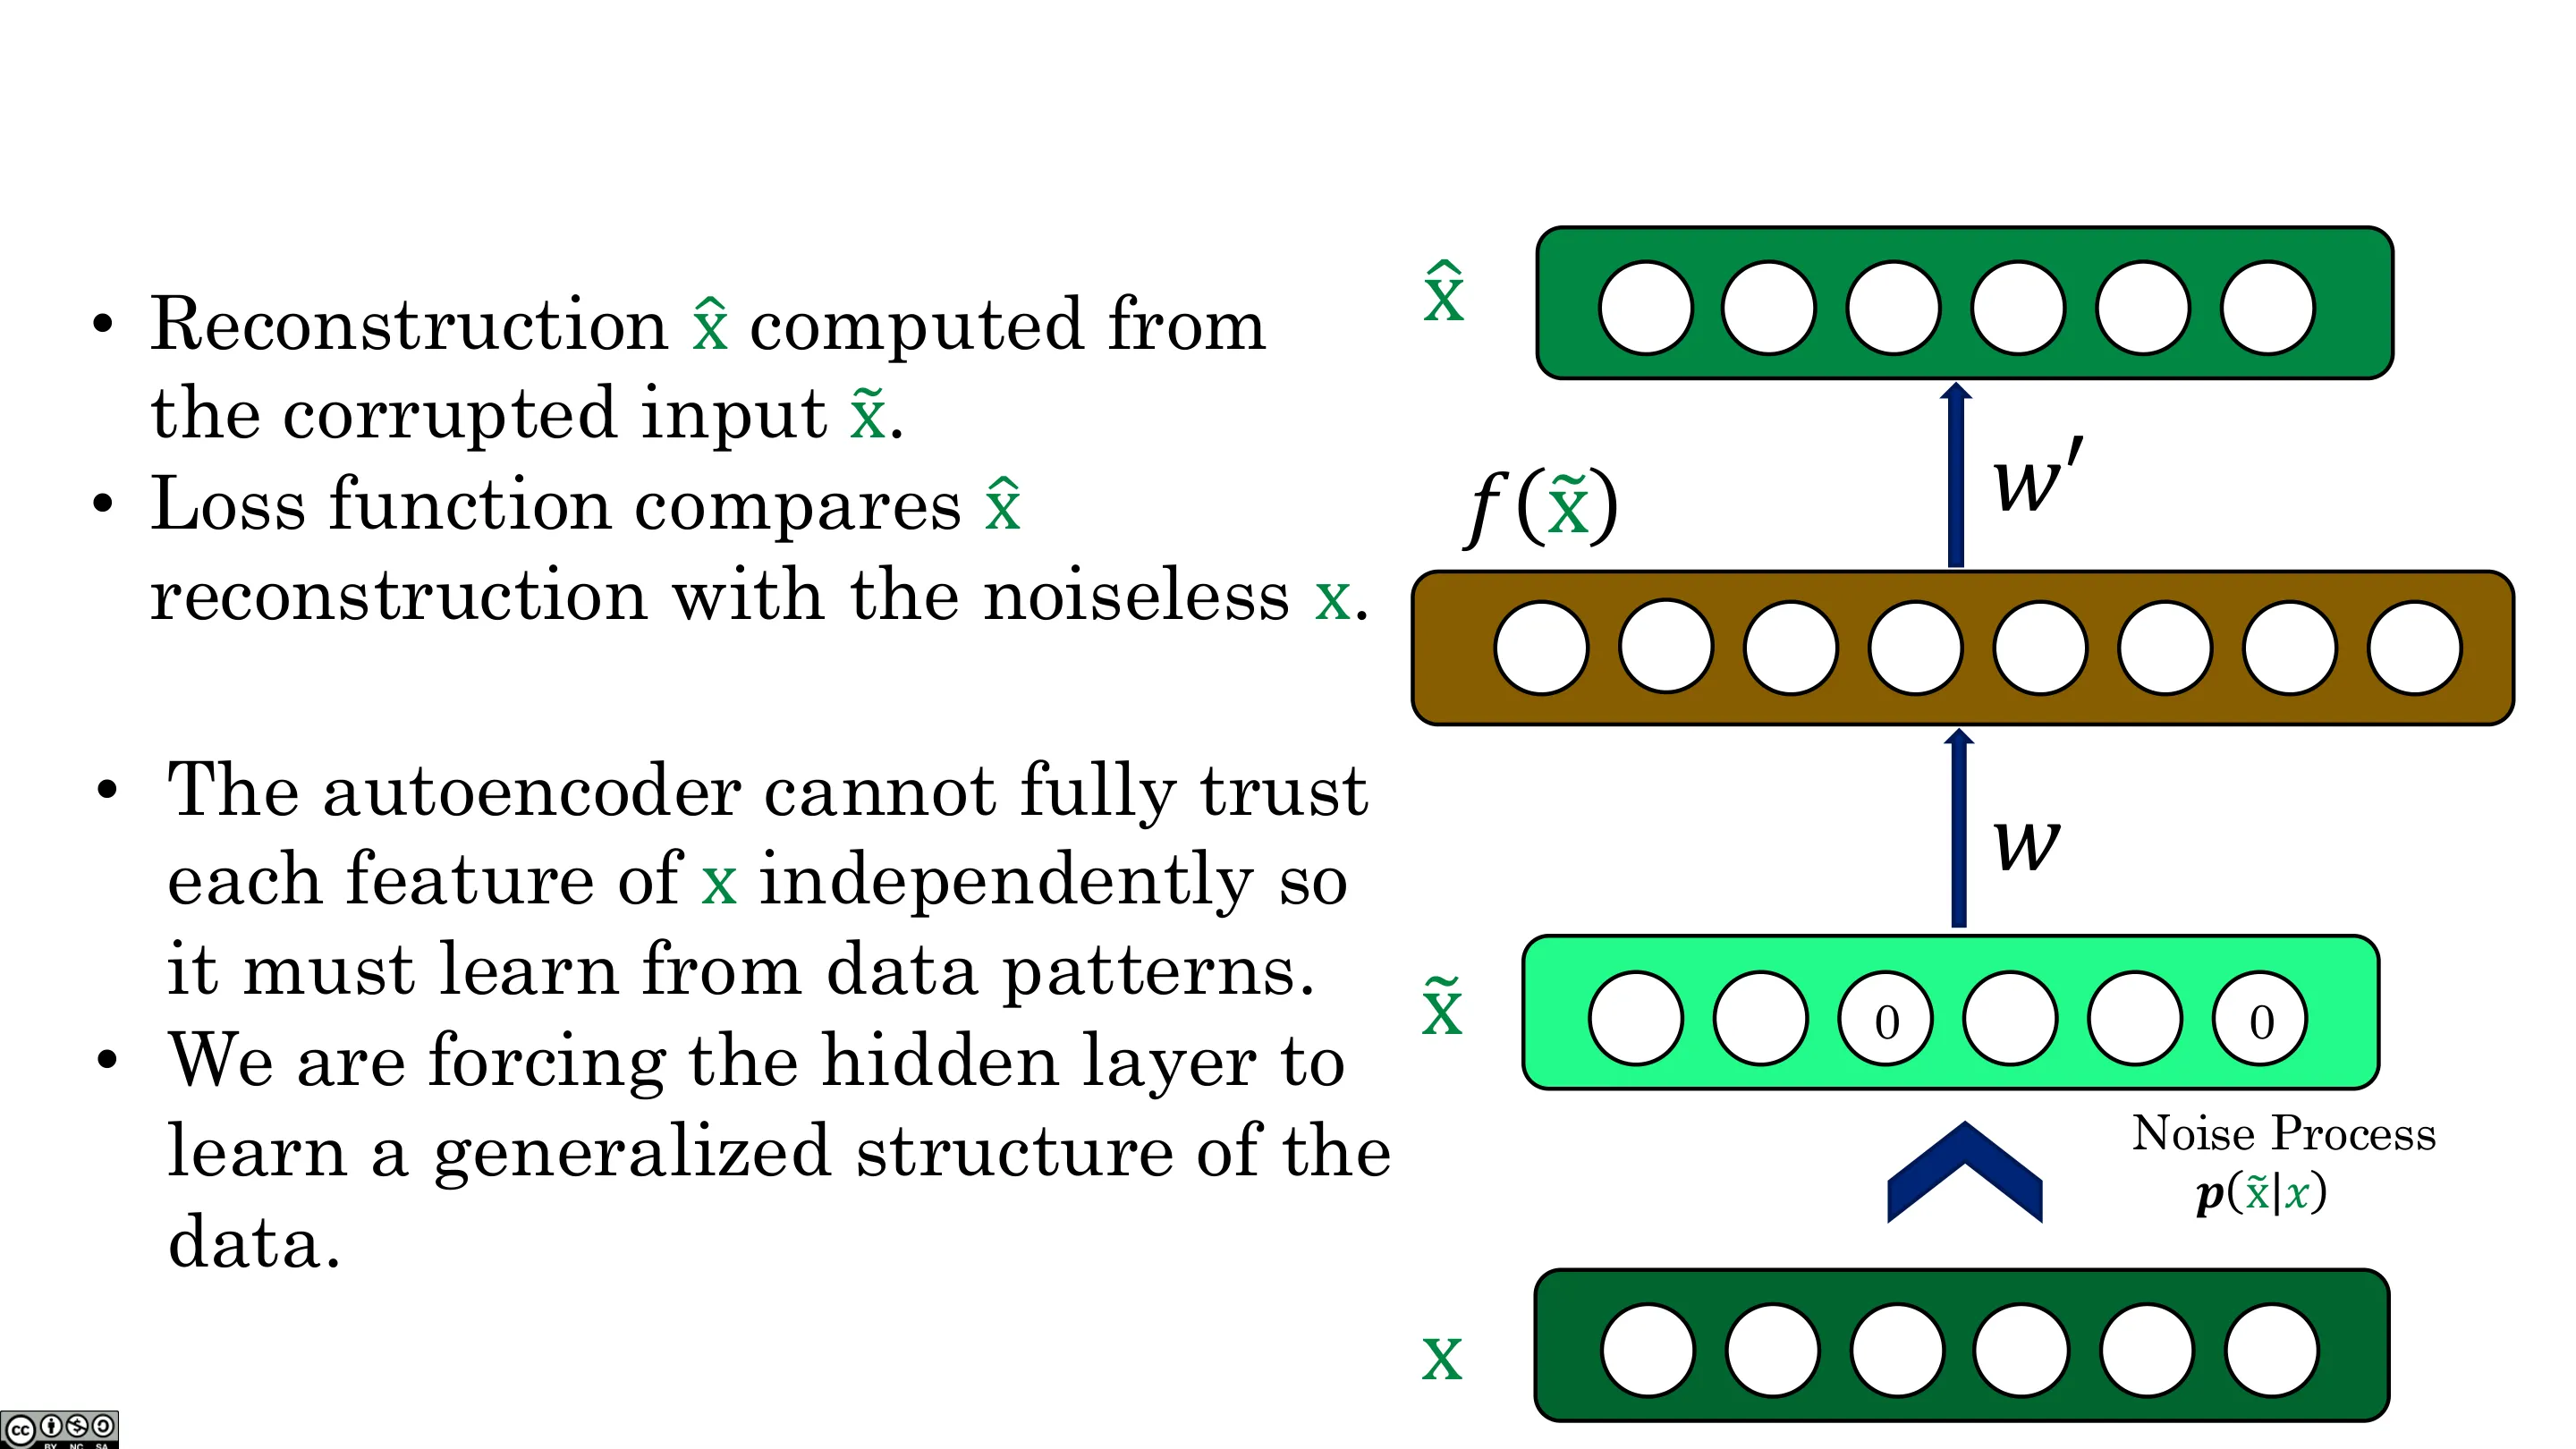
📷 重建 $\hat x$
回到原视频 (00:29:32)
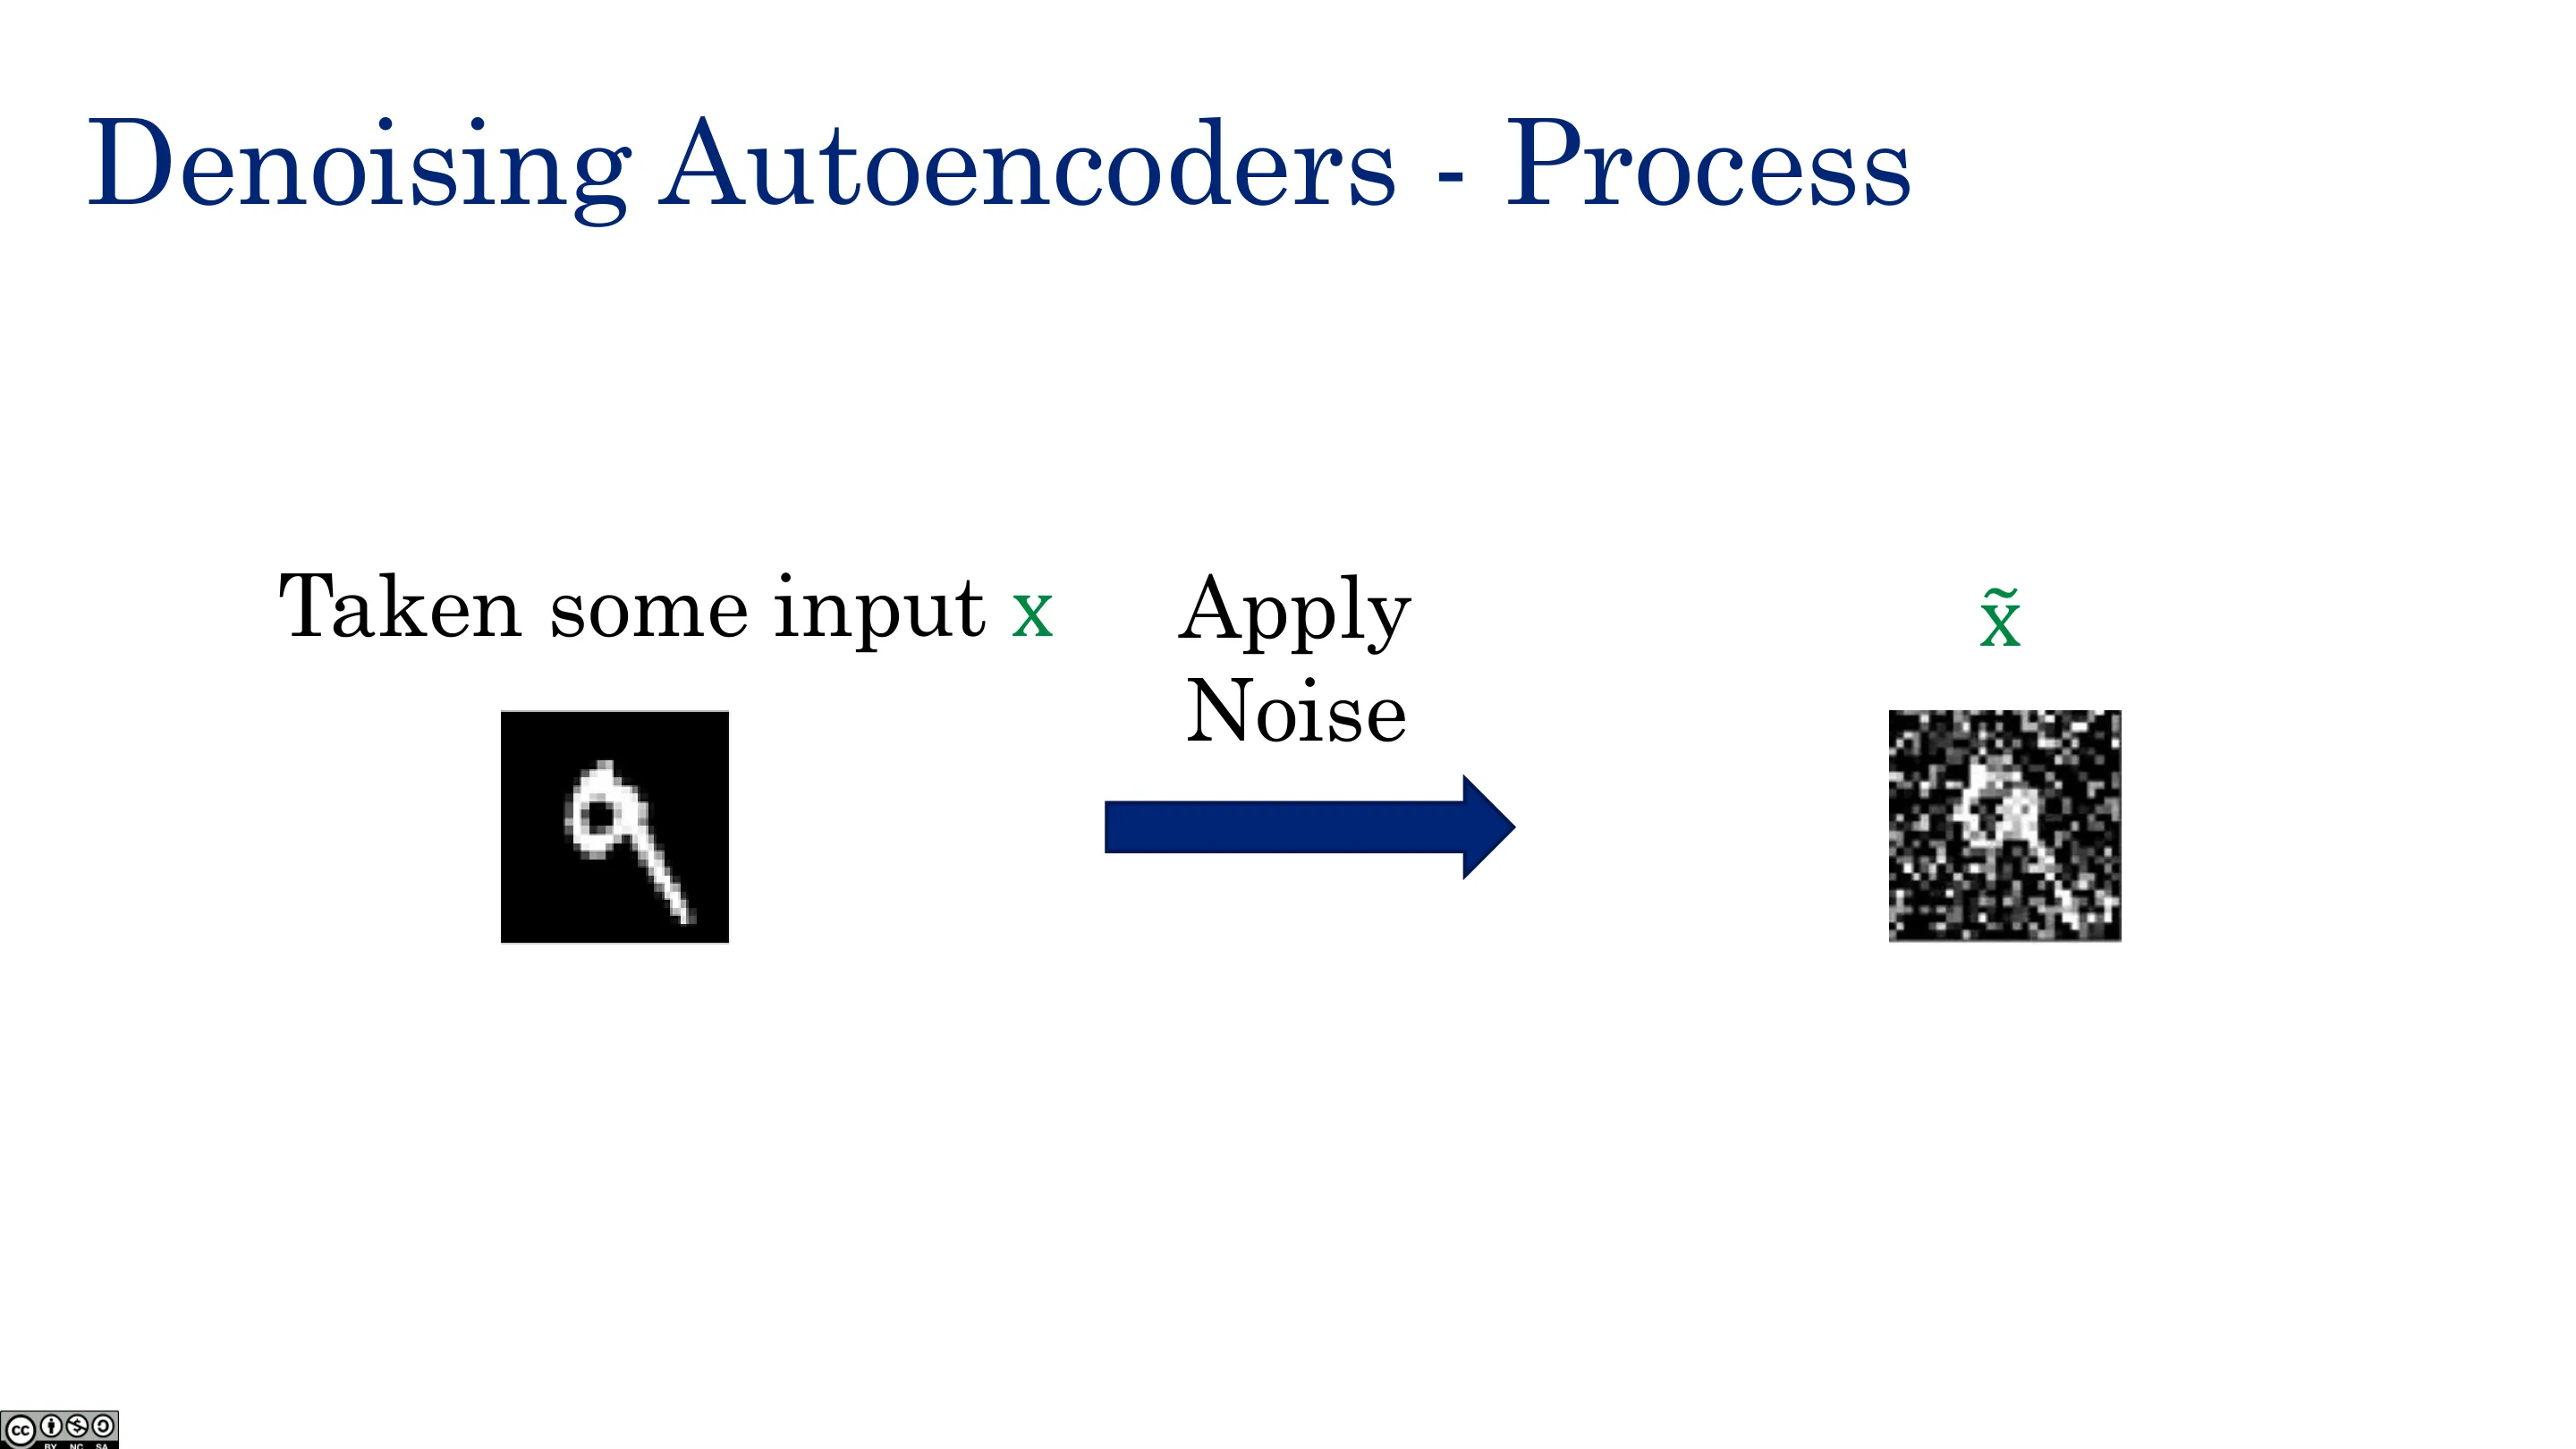
📷 去噪自编码器的流程(一)
回到原视频 (00:30:45)
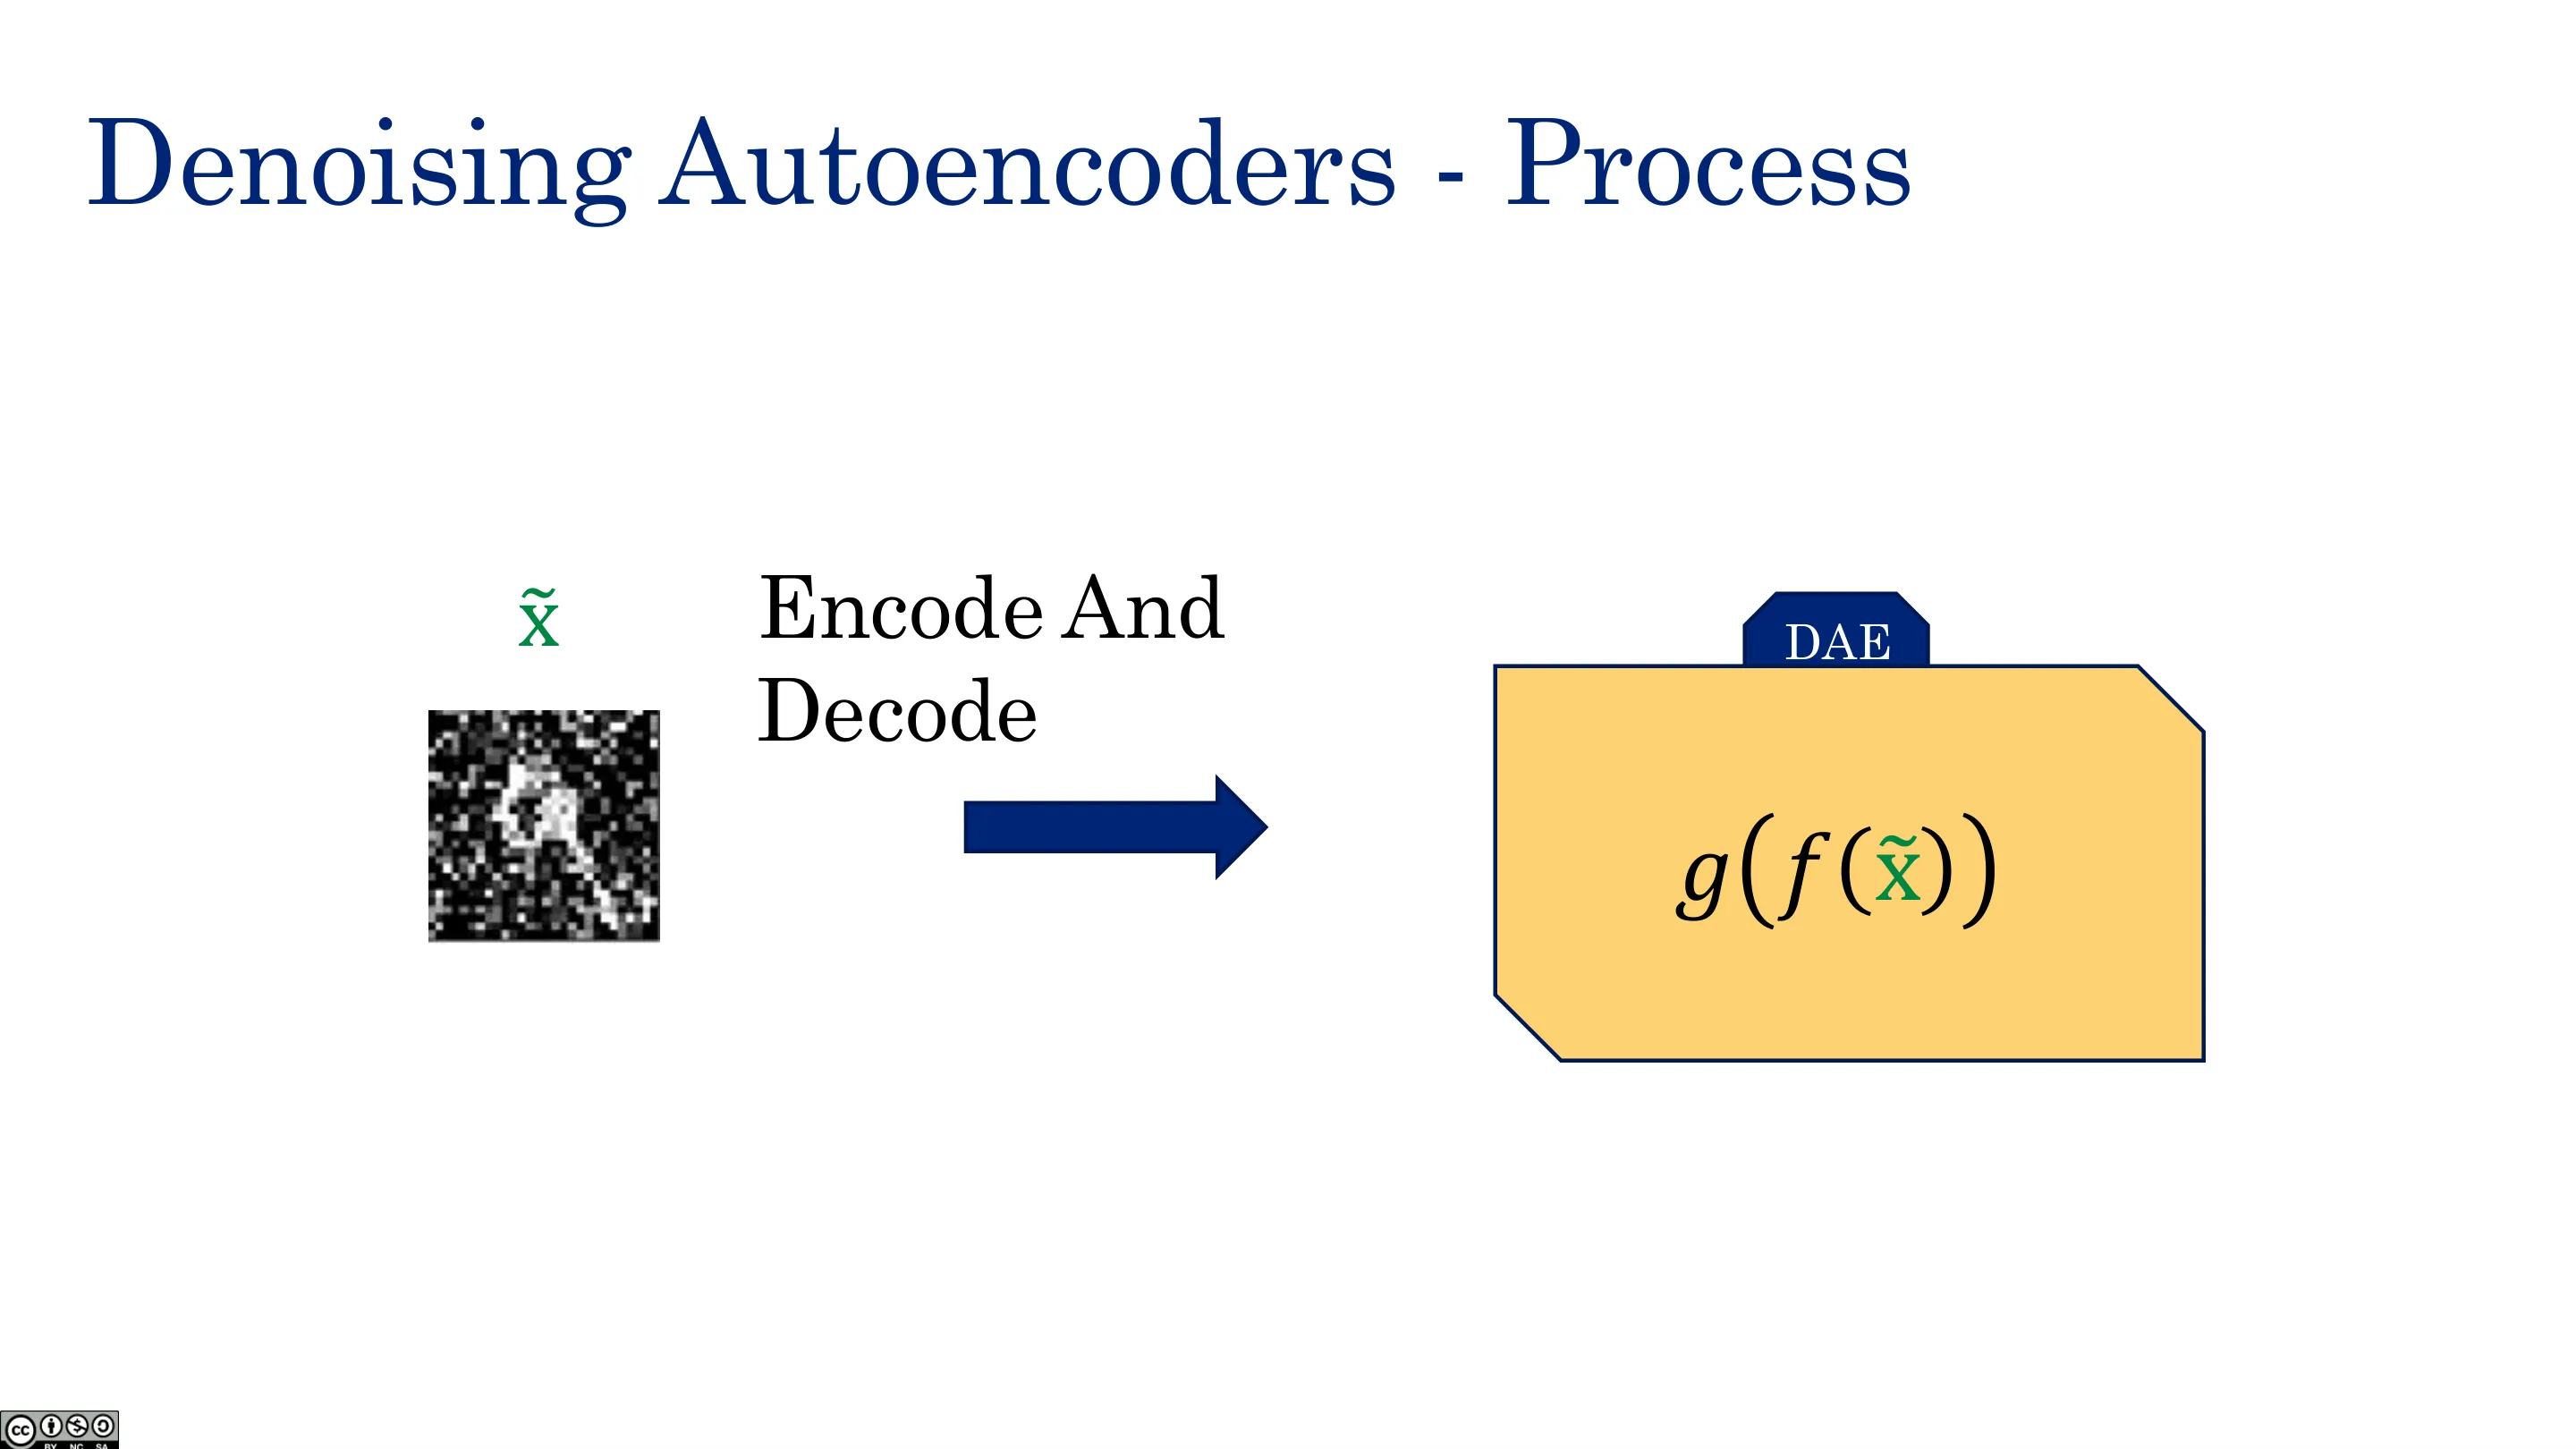
📷 去噪自编码器的流程(二)
回到原视频 (00:31:58)
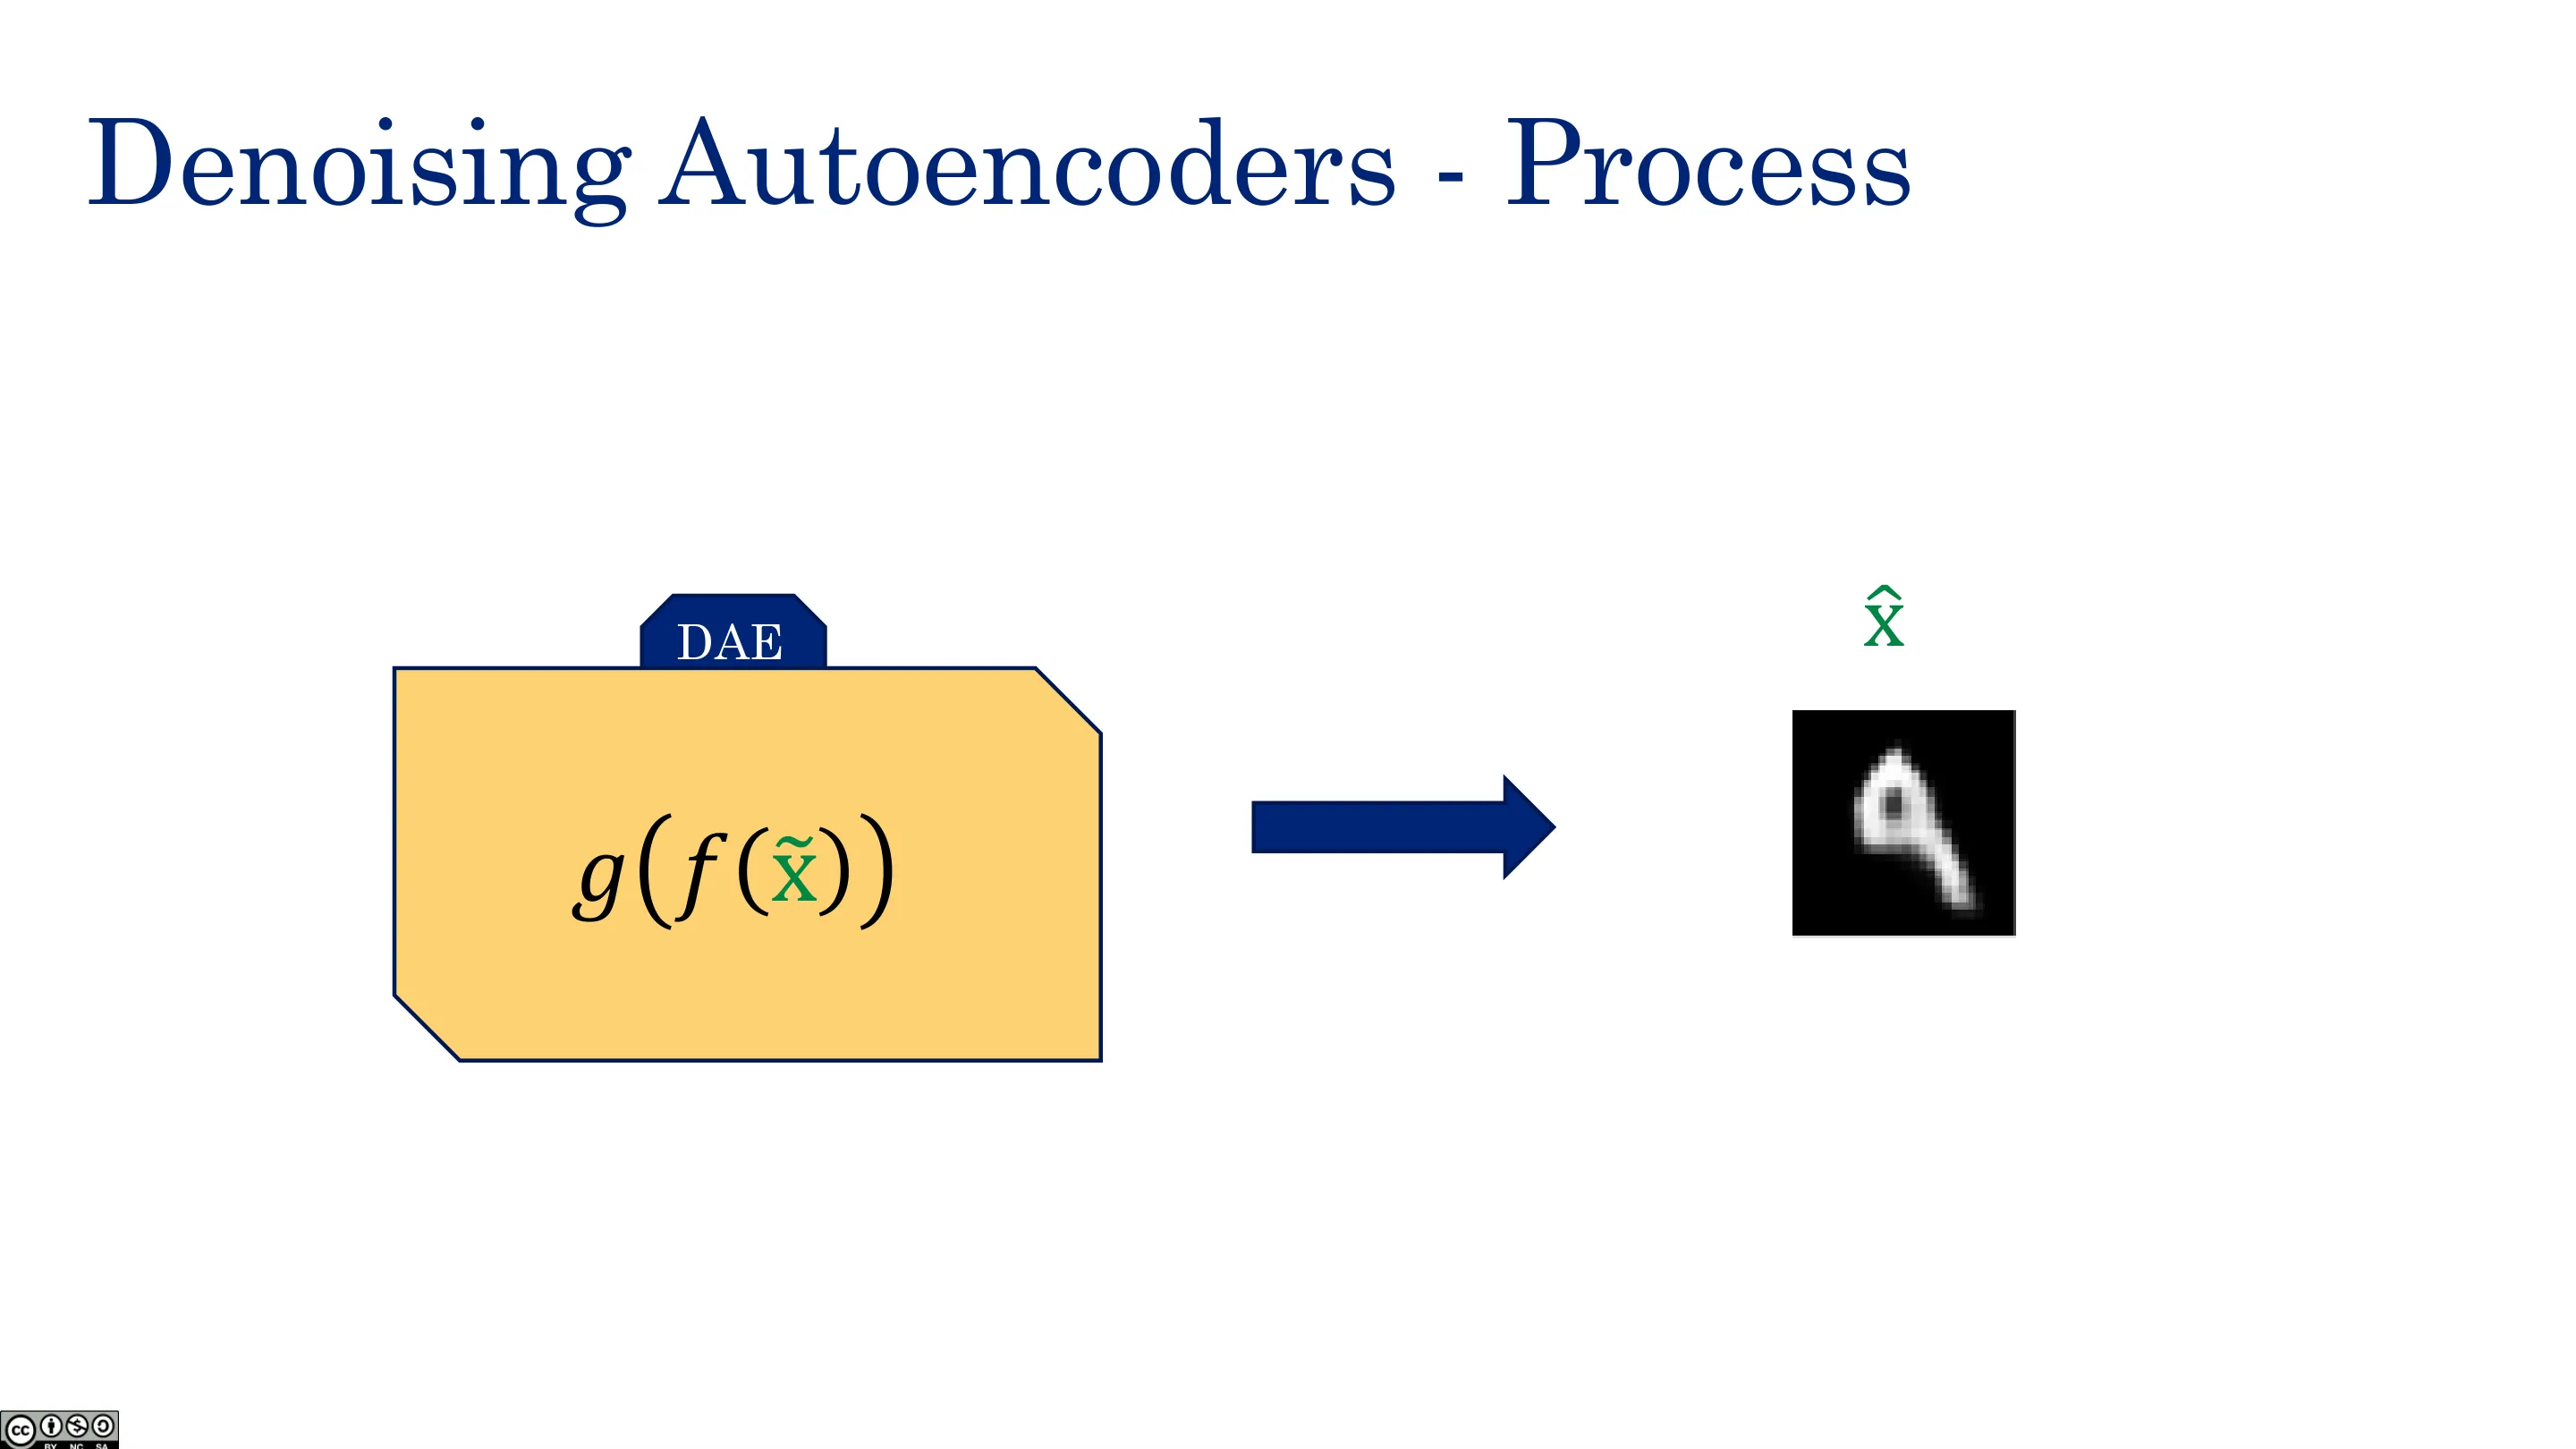
📷 $\hat x$(一)
回到原视频 (00:33:11)
📷 $\hat x$(二)
回到原视频 (00:34:24)
📷 生成式
回到原视频 (00:35:37)
2.2 图像着色(Colorization)
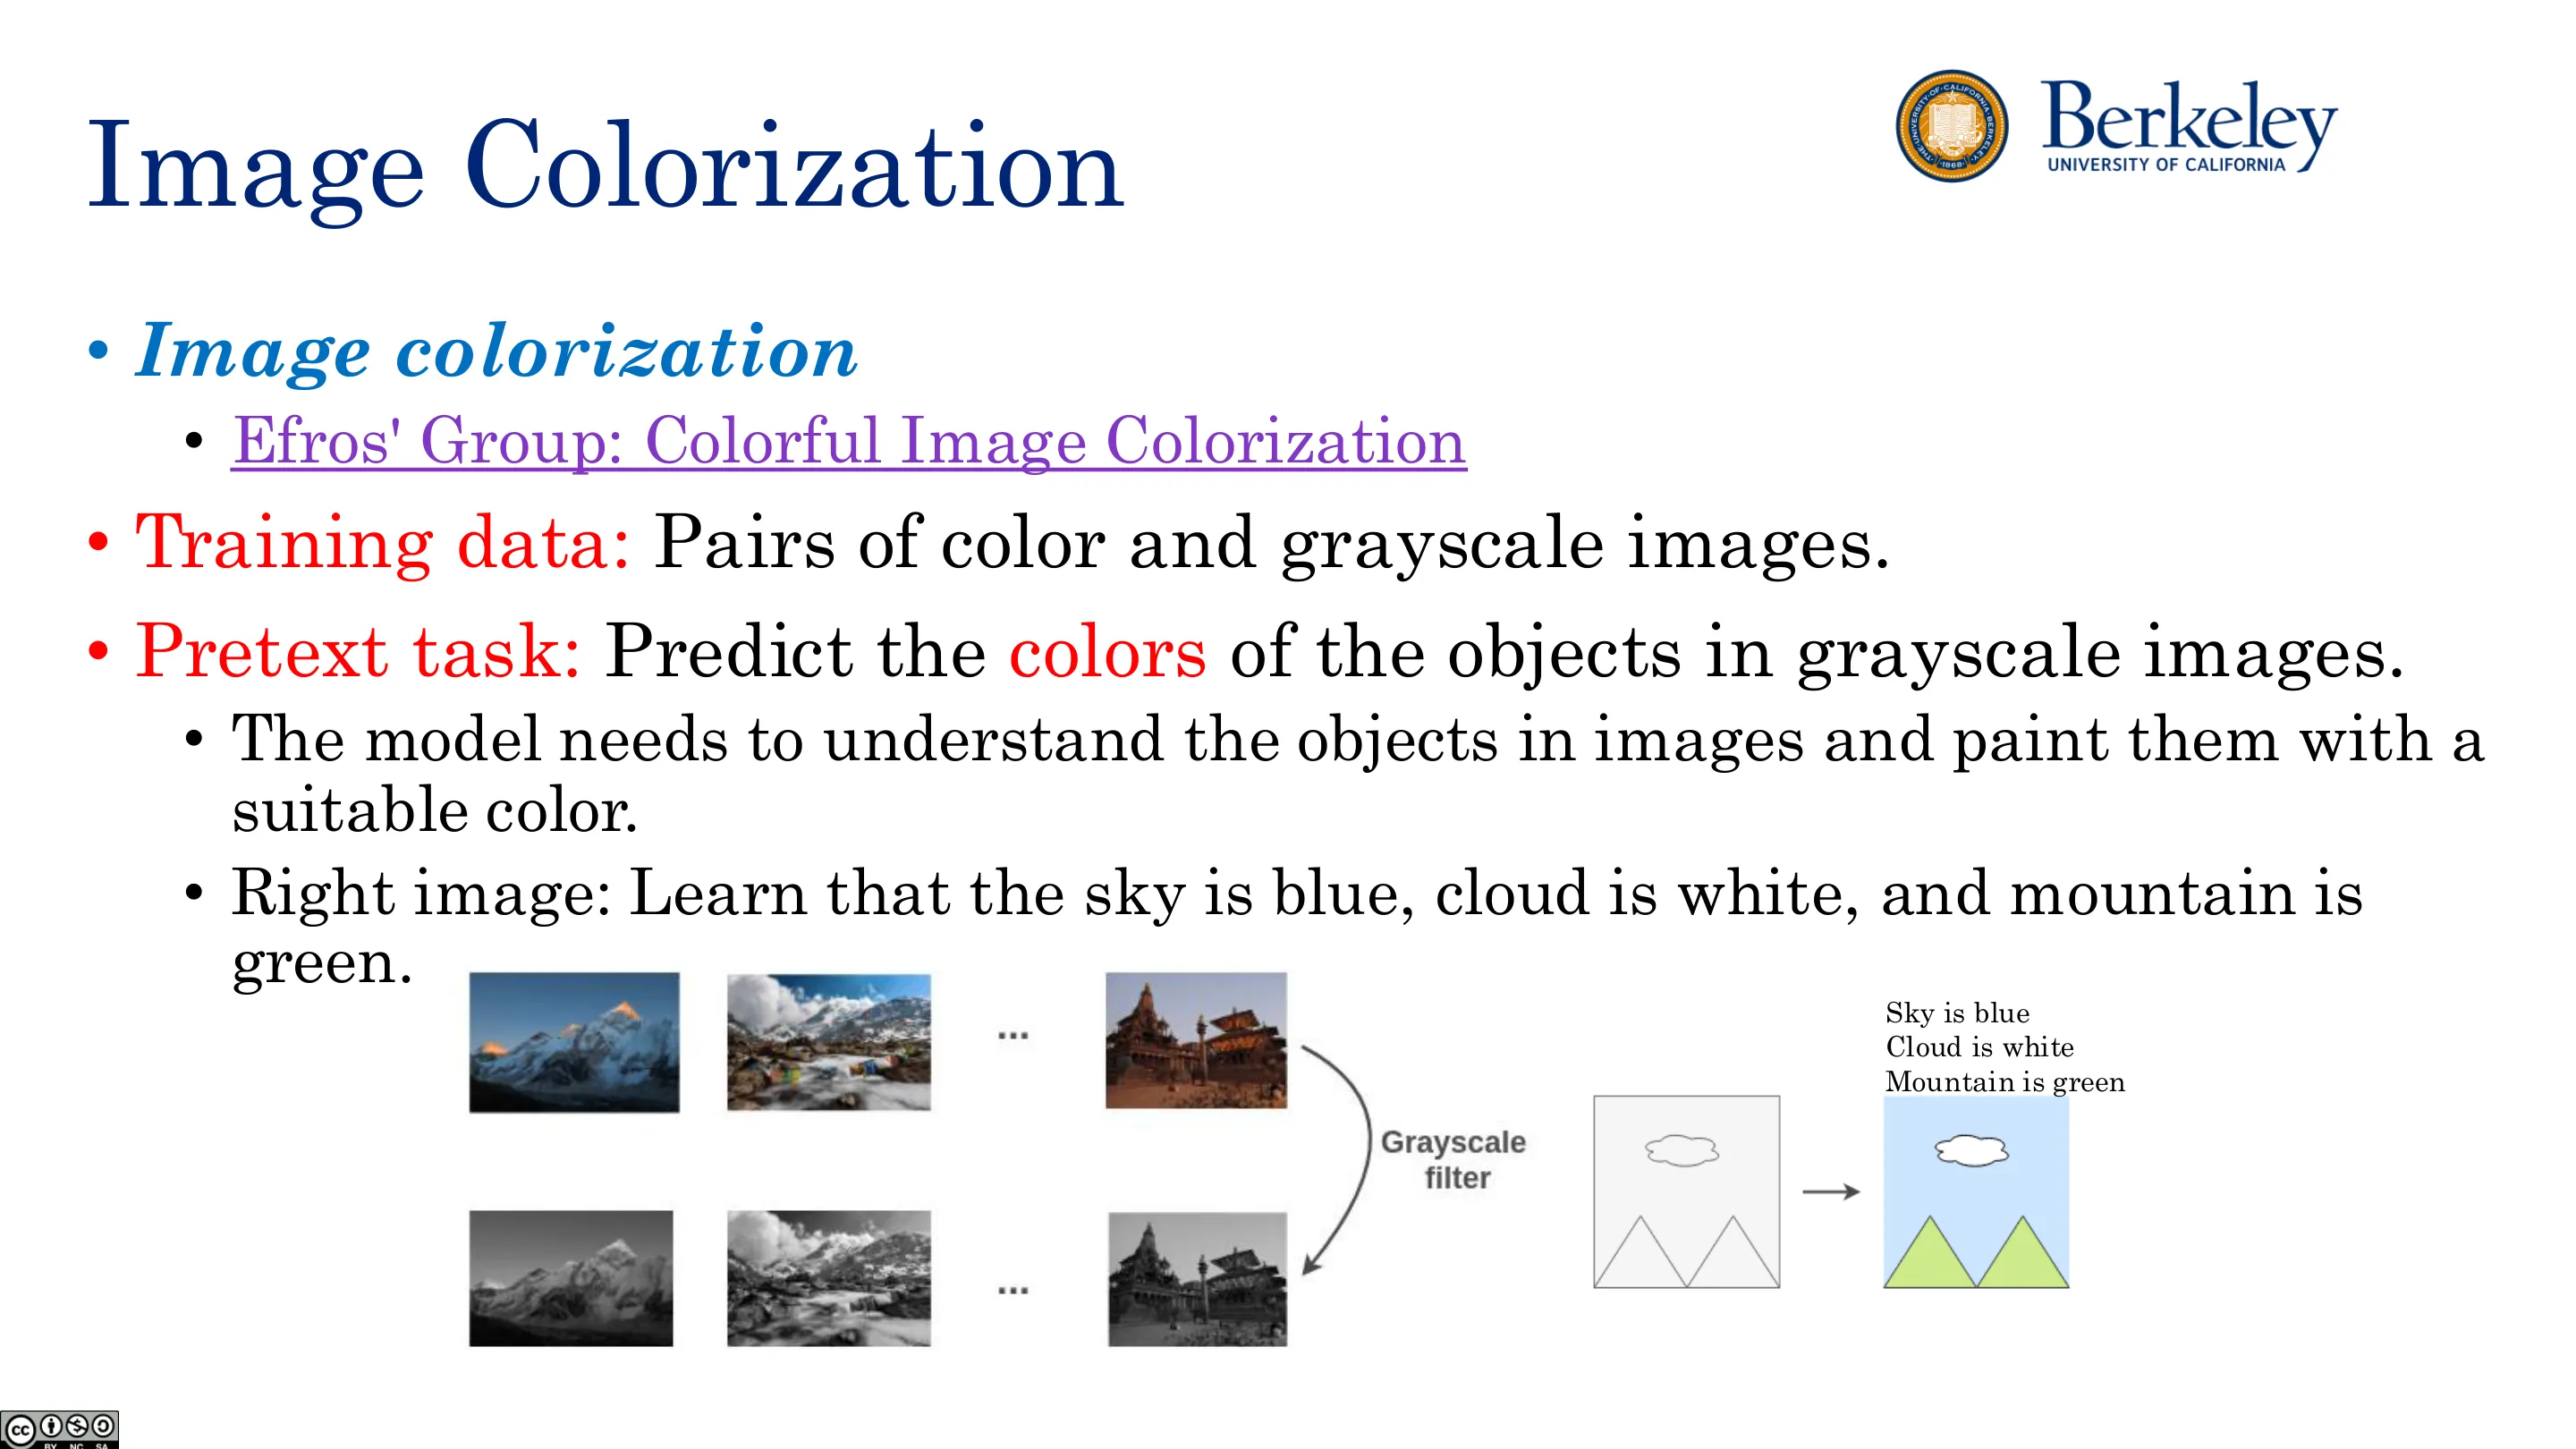
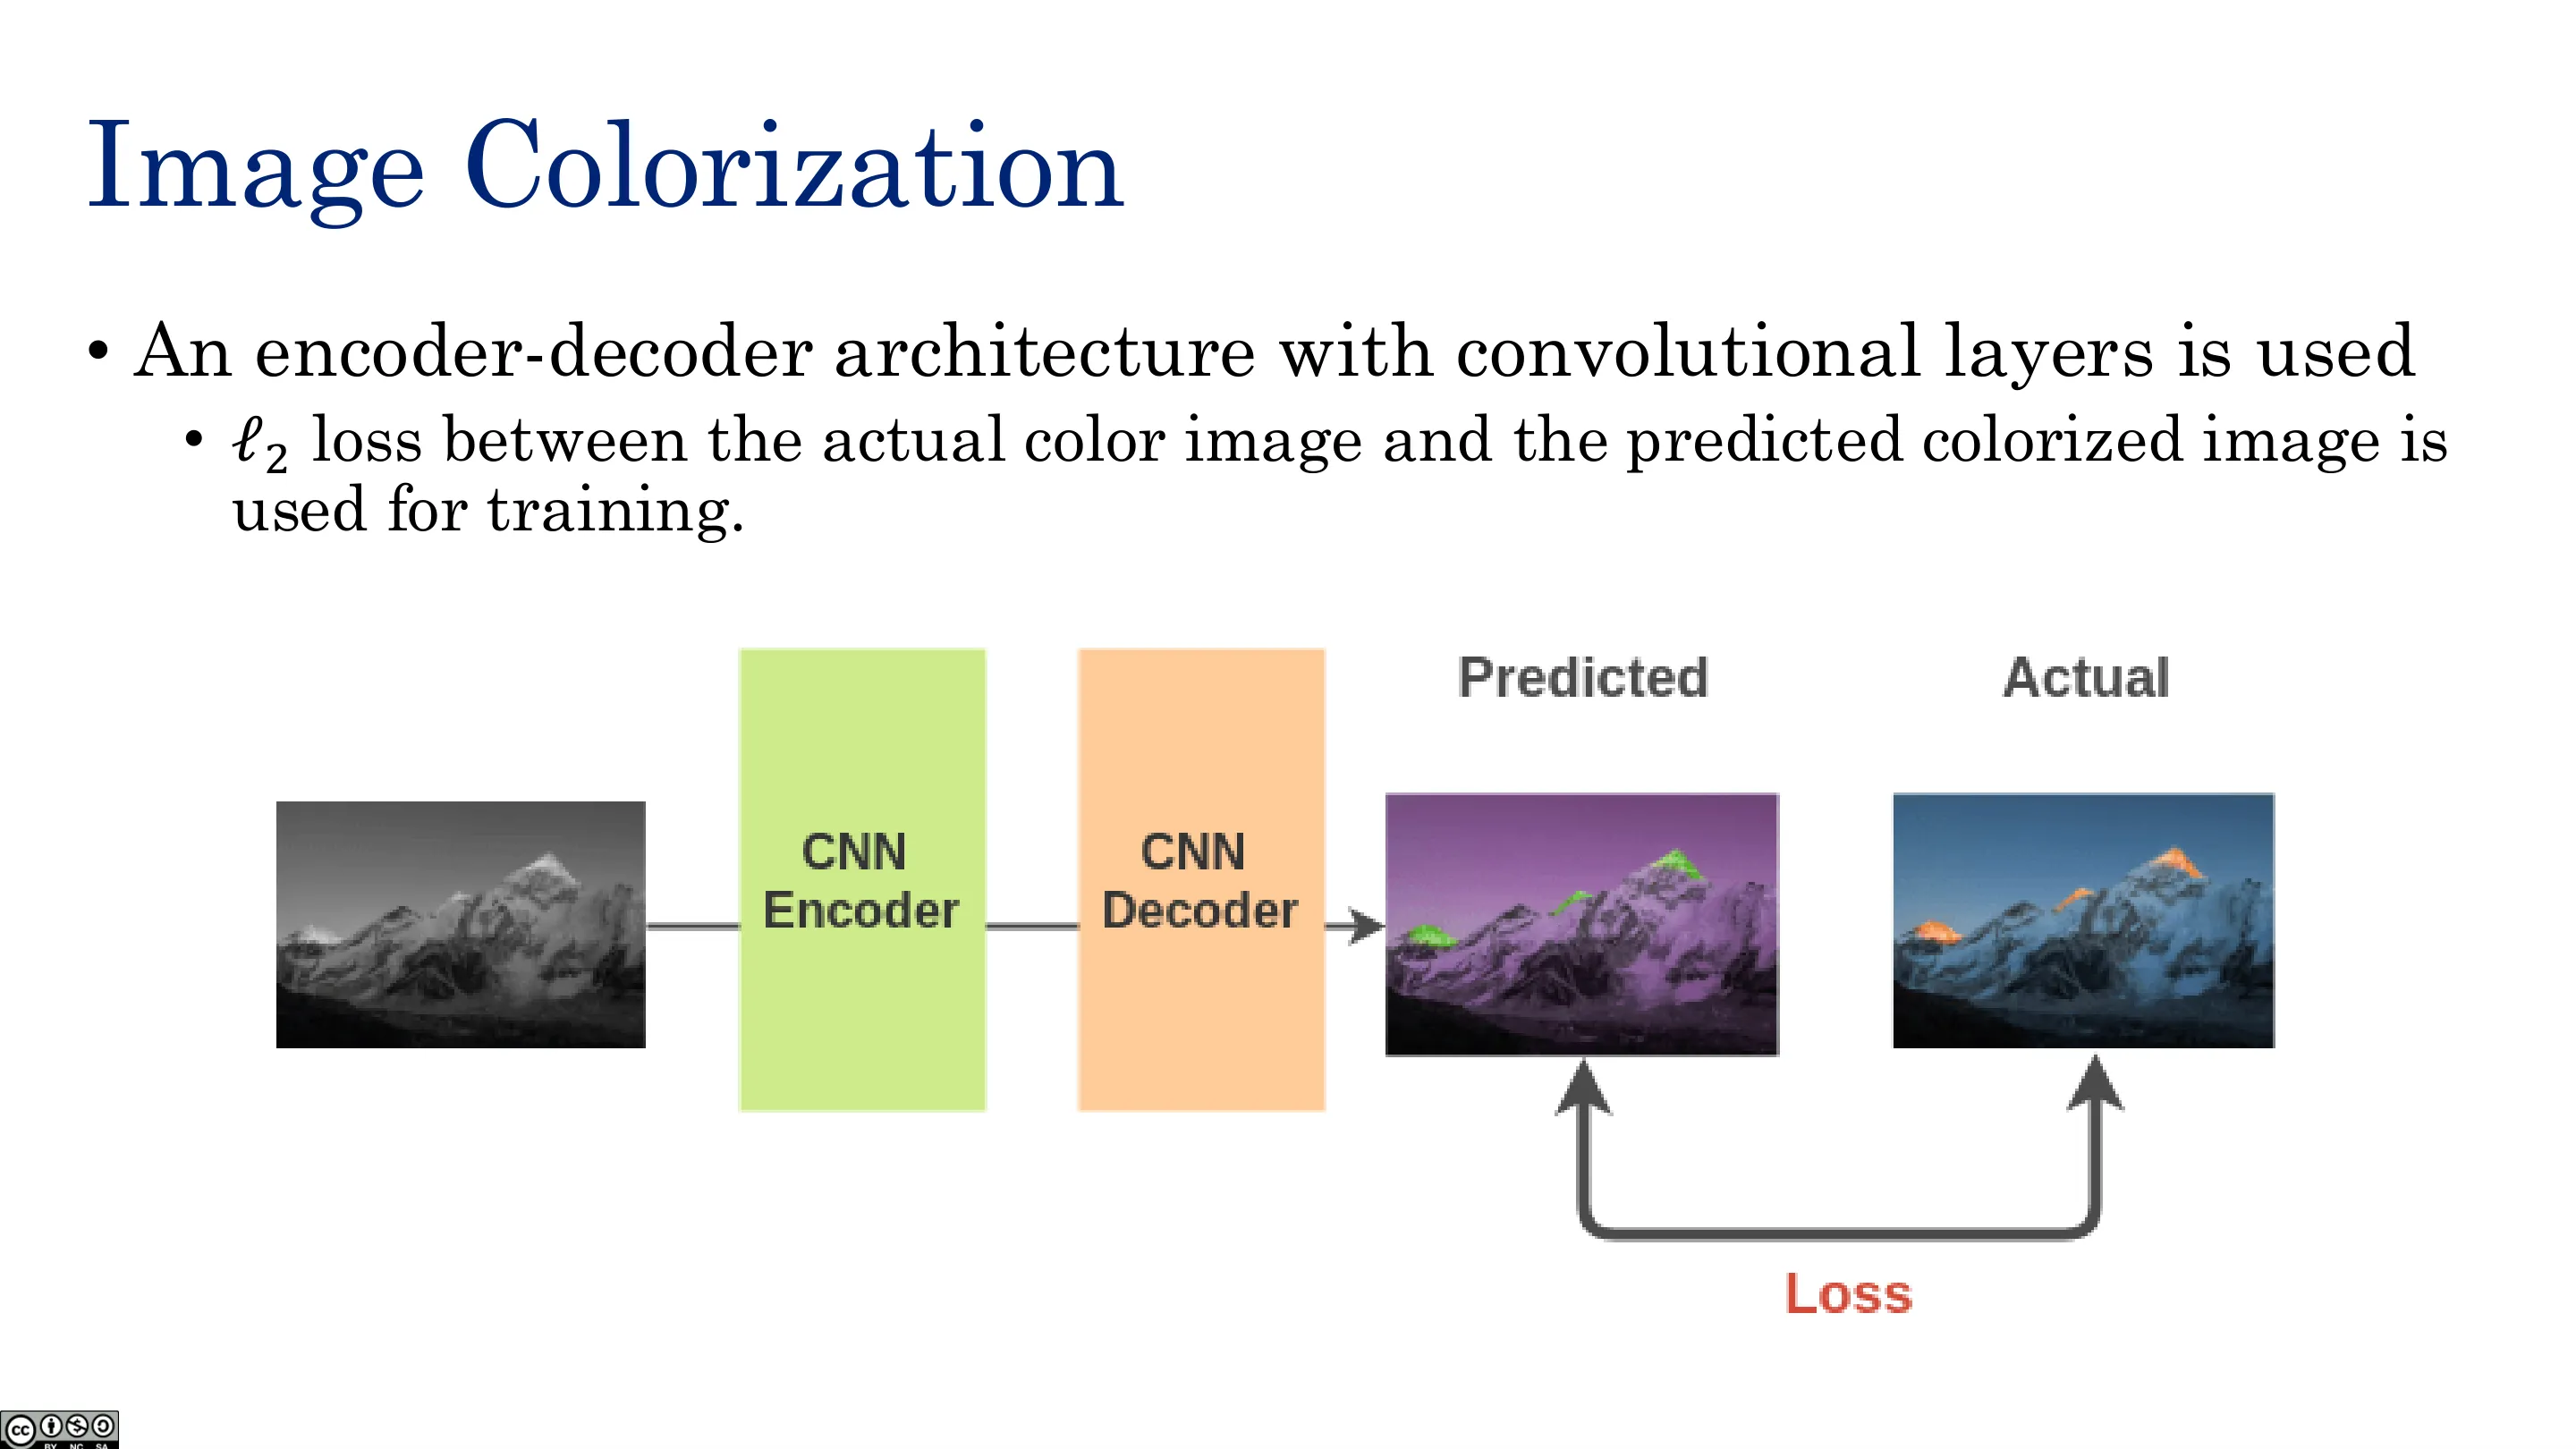
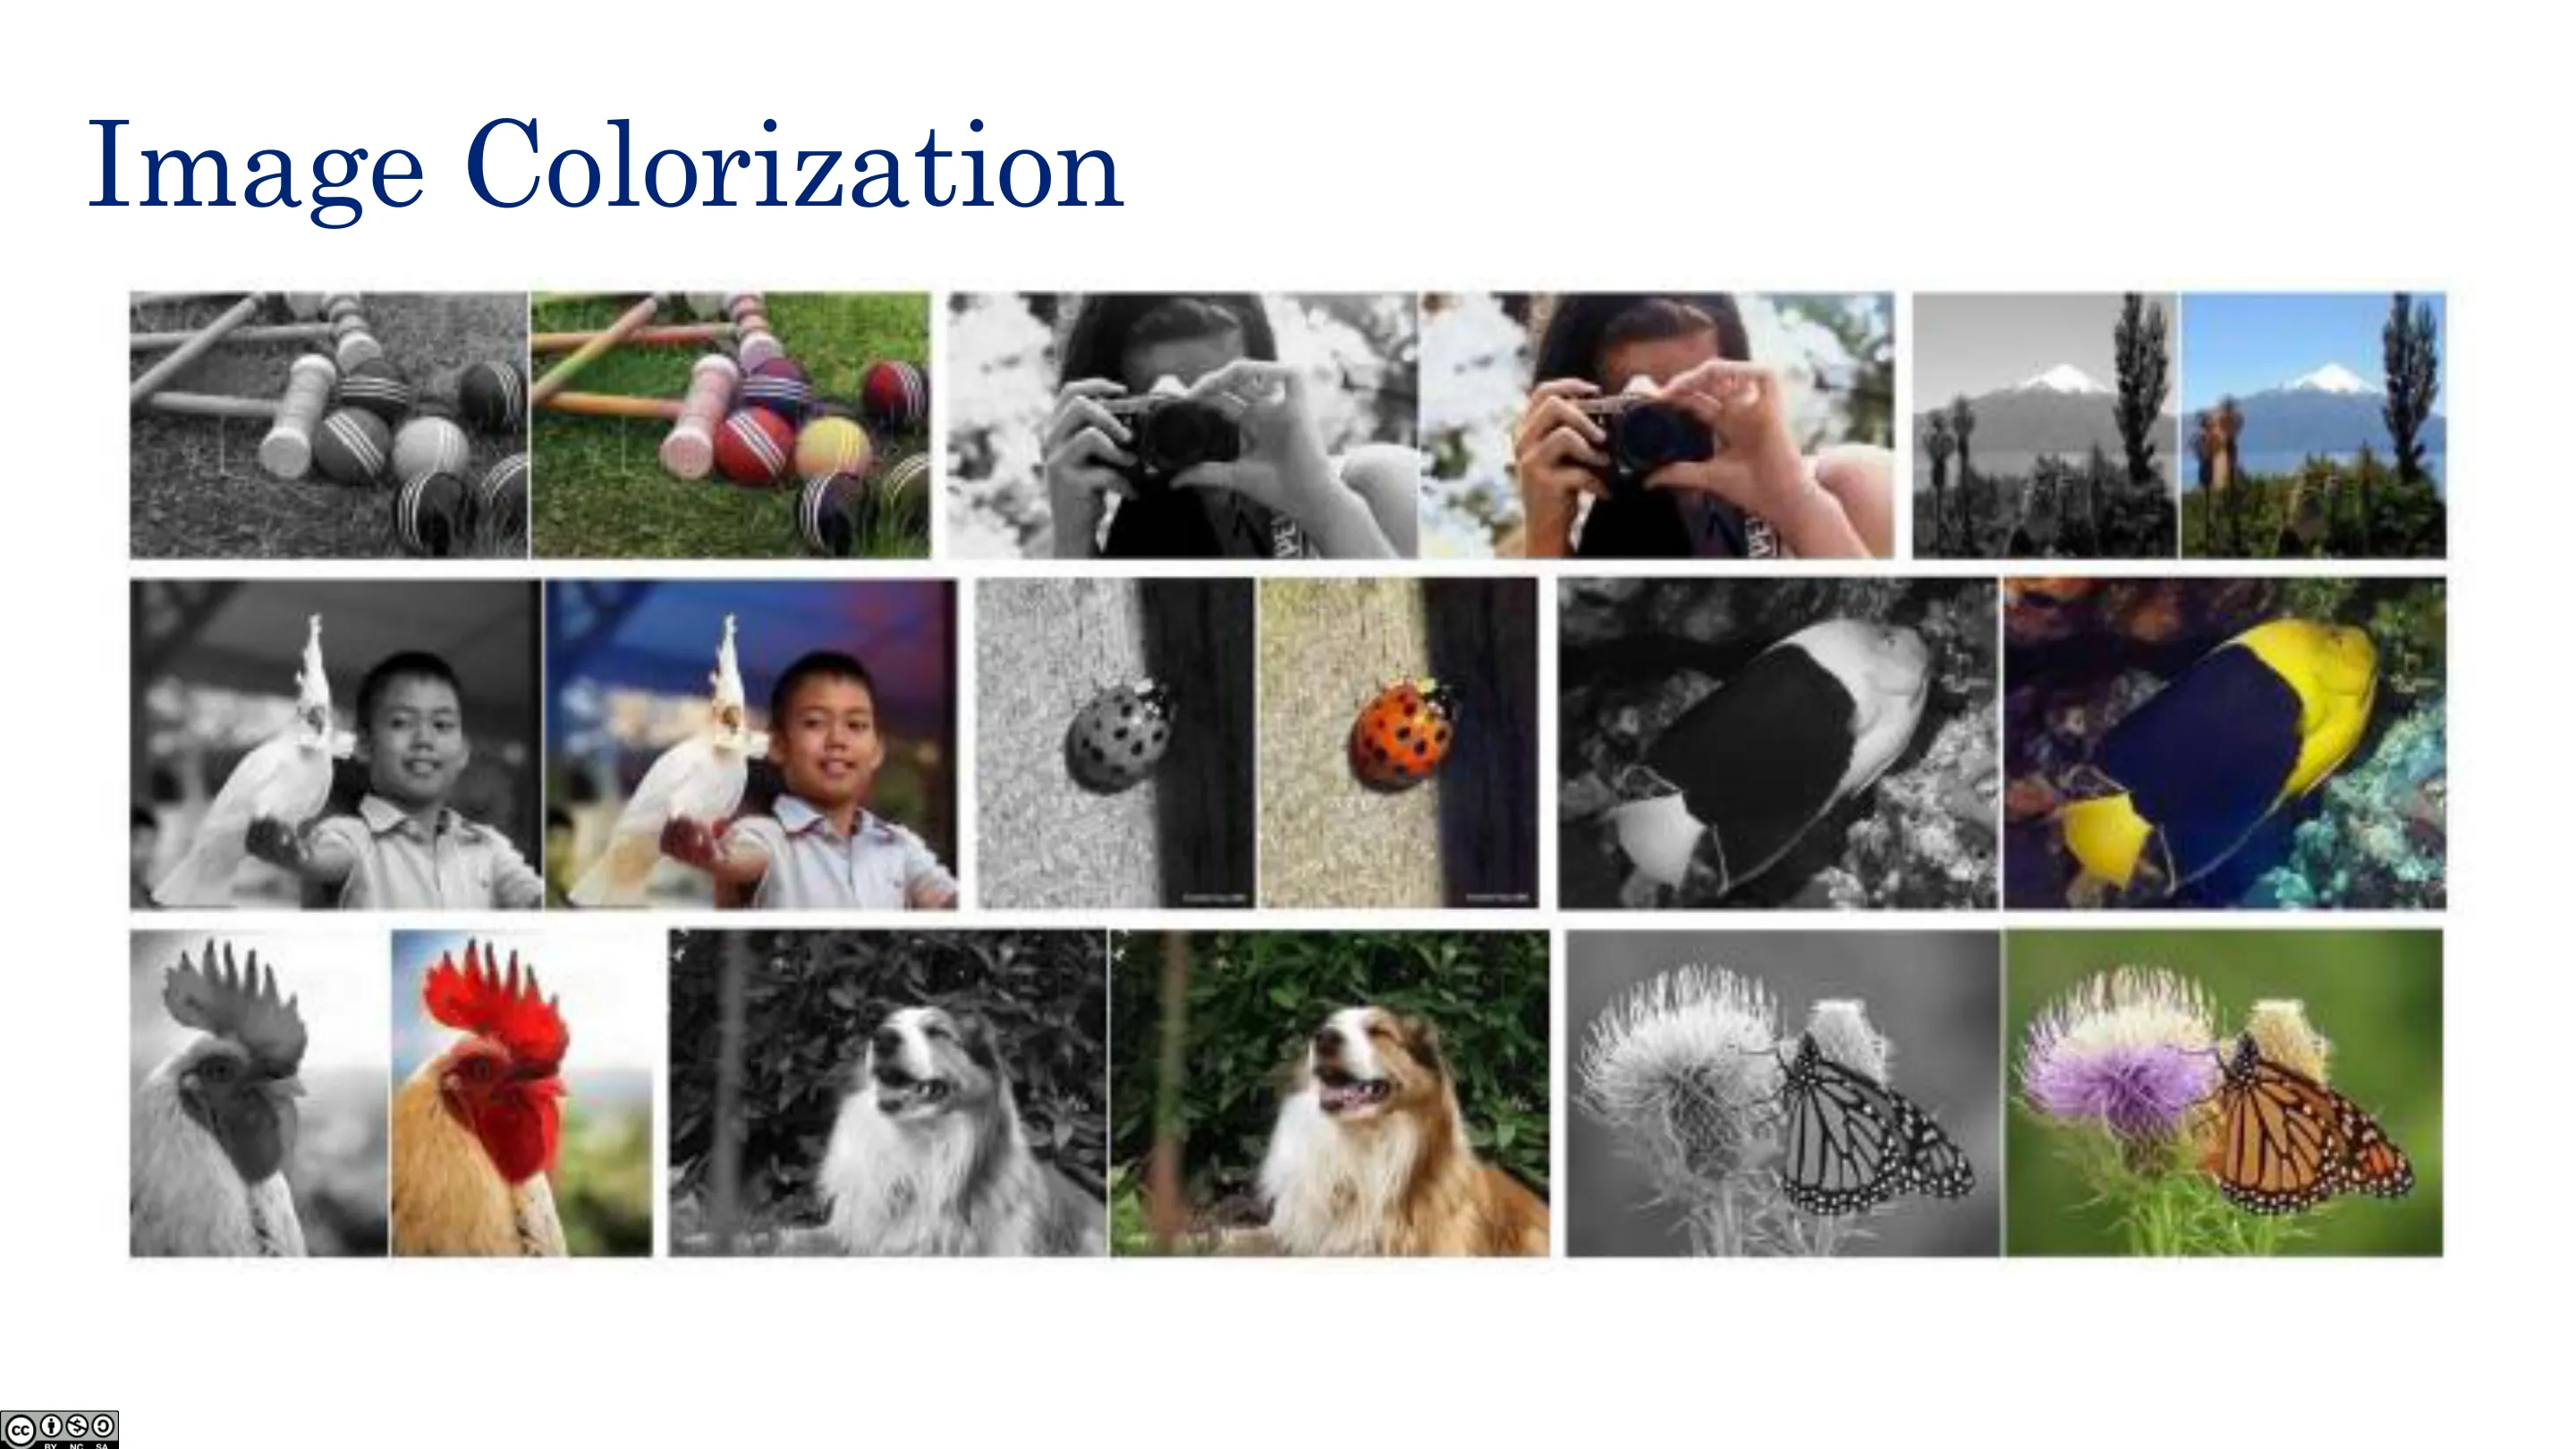
Pretext 任务:把黑白图变成彩色图。数据自动生成(把彩色图去色),损失 = 生成彩色与原彩色的距离。由 Berkeley 的 Alyosha Efros 组开创。若下游任务颜色重要,这个表示就有用。
📷 图像着色(一)
回到原视频 (00:36:50)
📷 图像着色(二)
回到原视频 (00:38:03)
📷 图像着色(三)
回到原视频 (00:39:16)
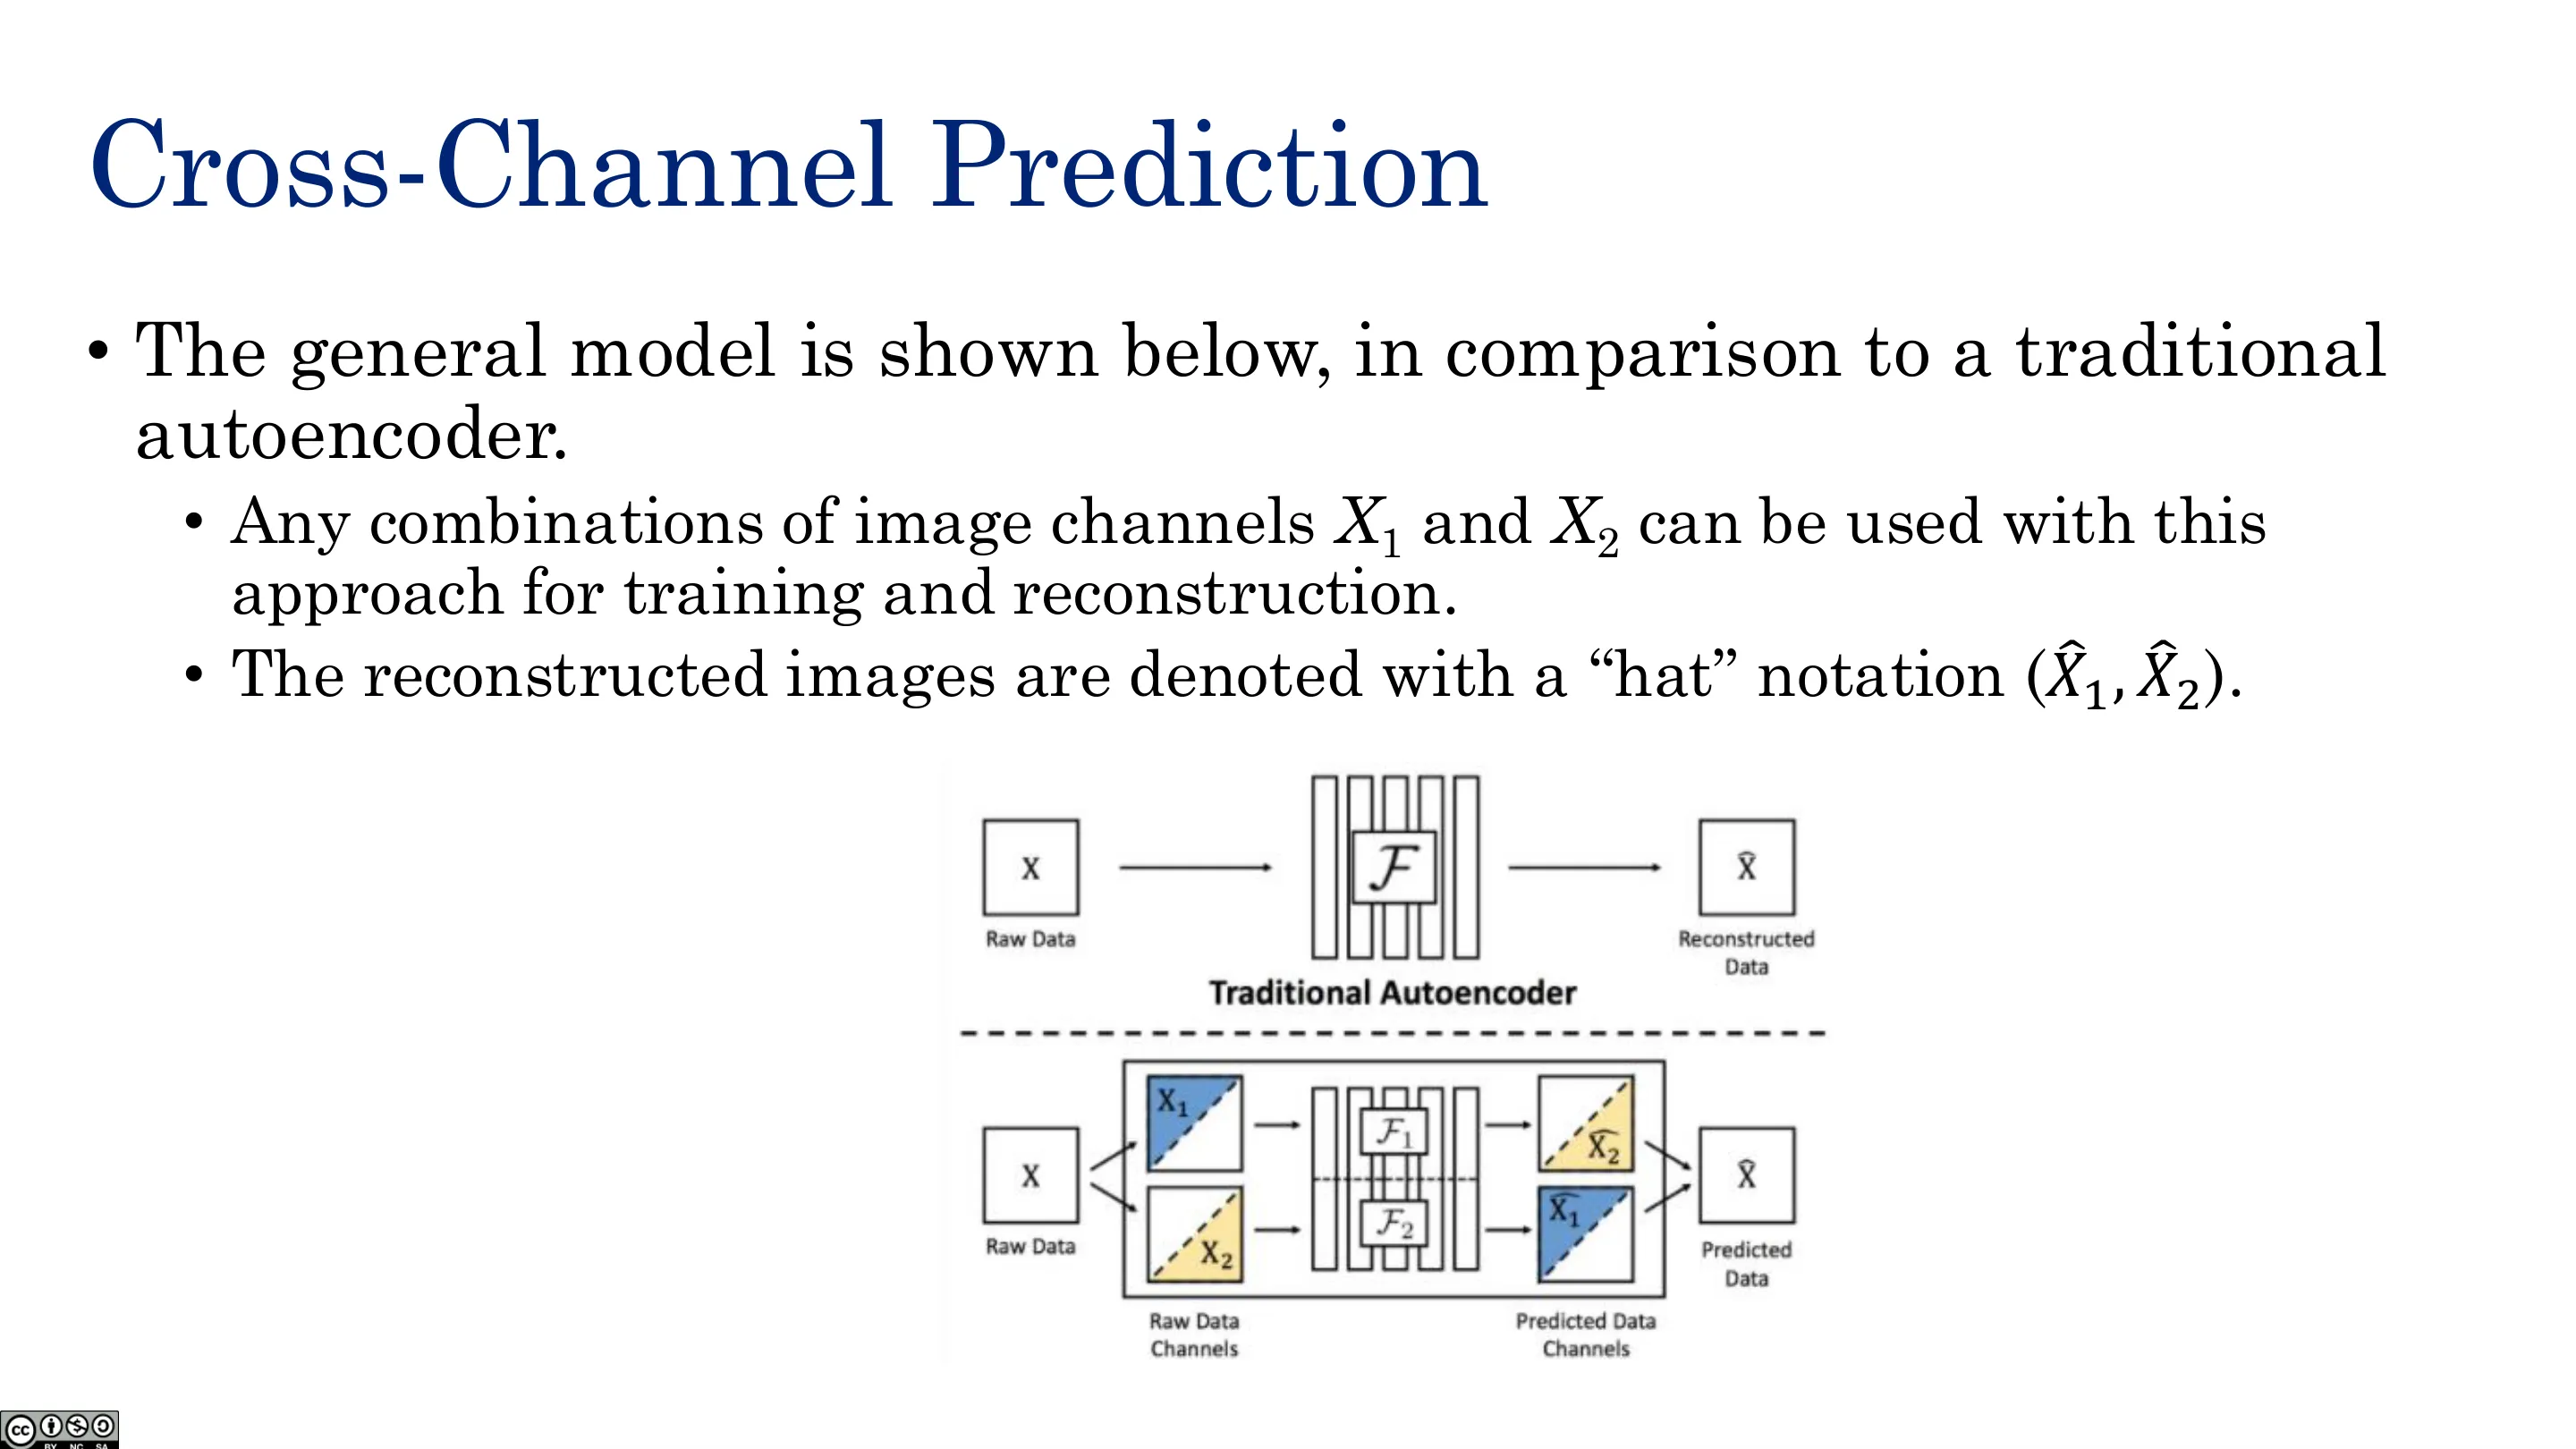
2.3 跨通道预测(Cross-Channel Prediction)
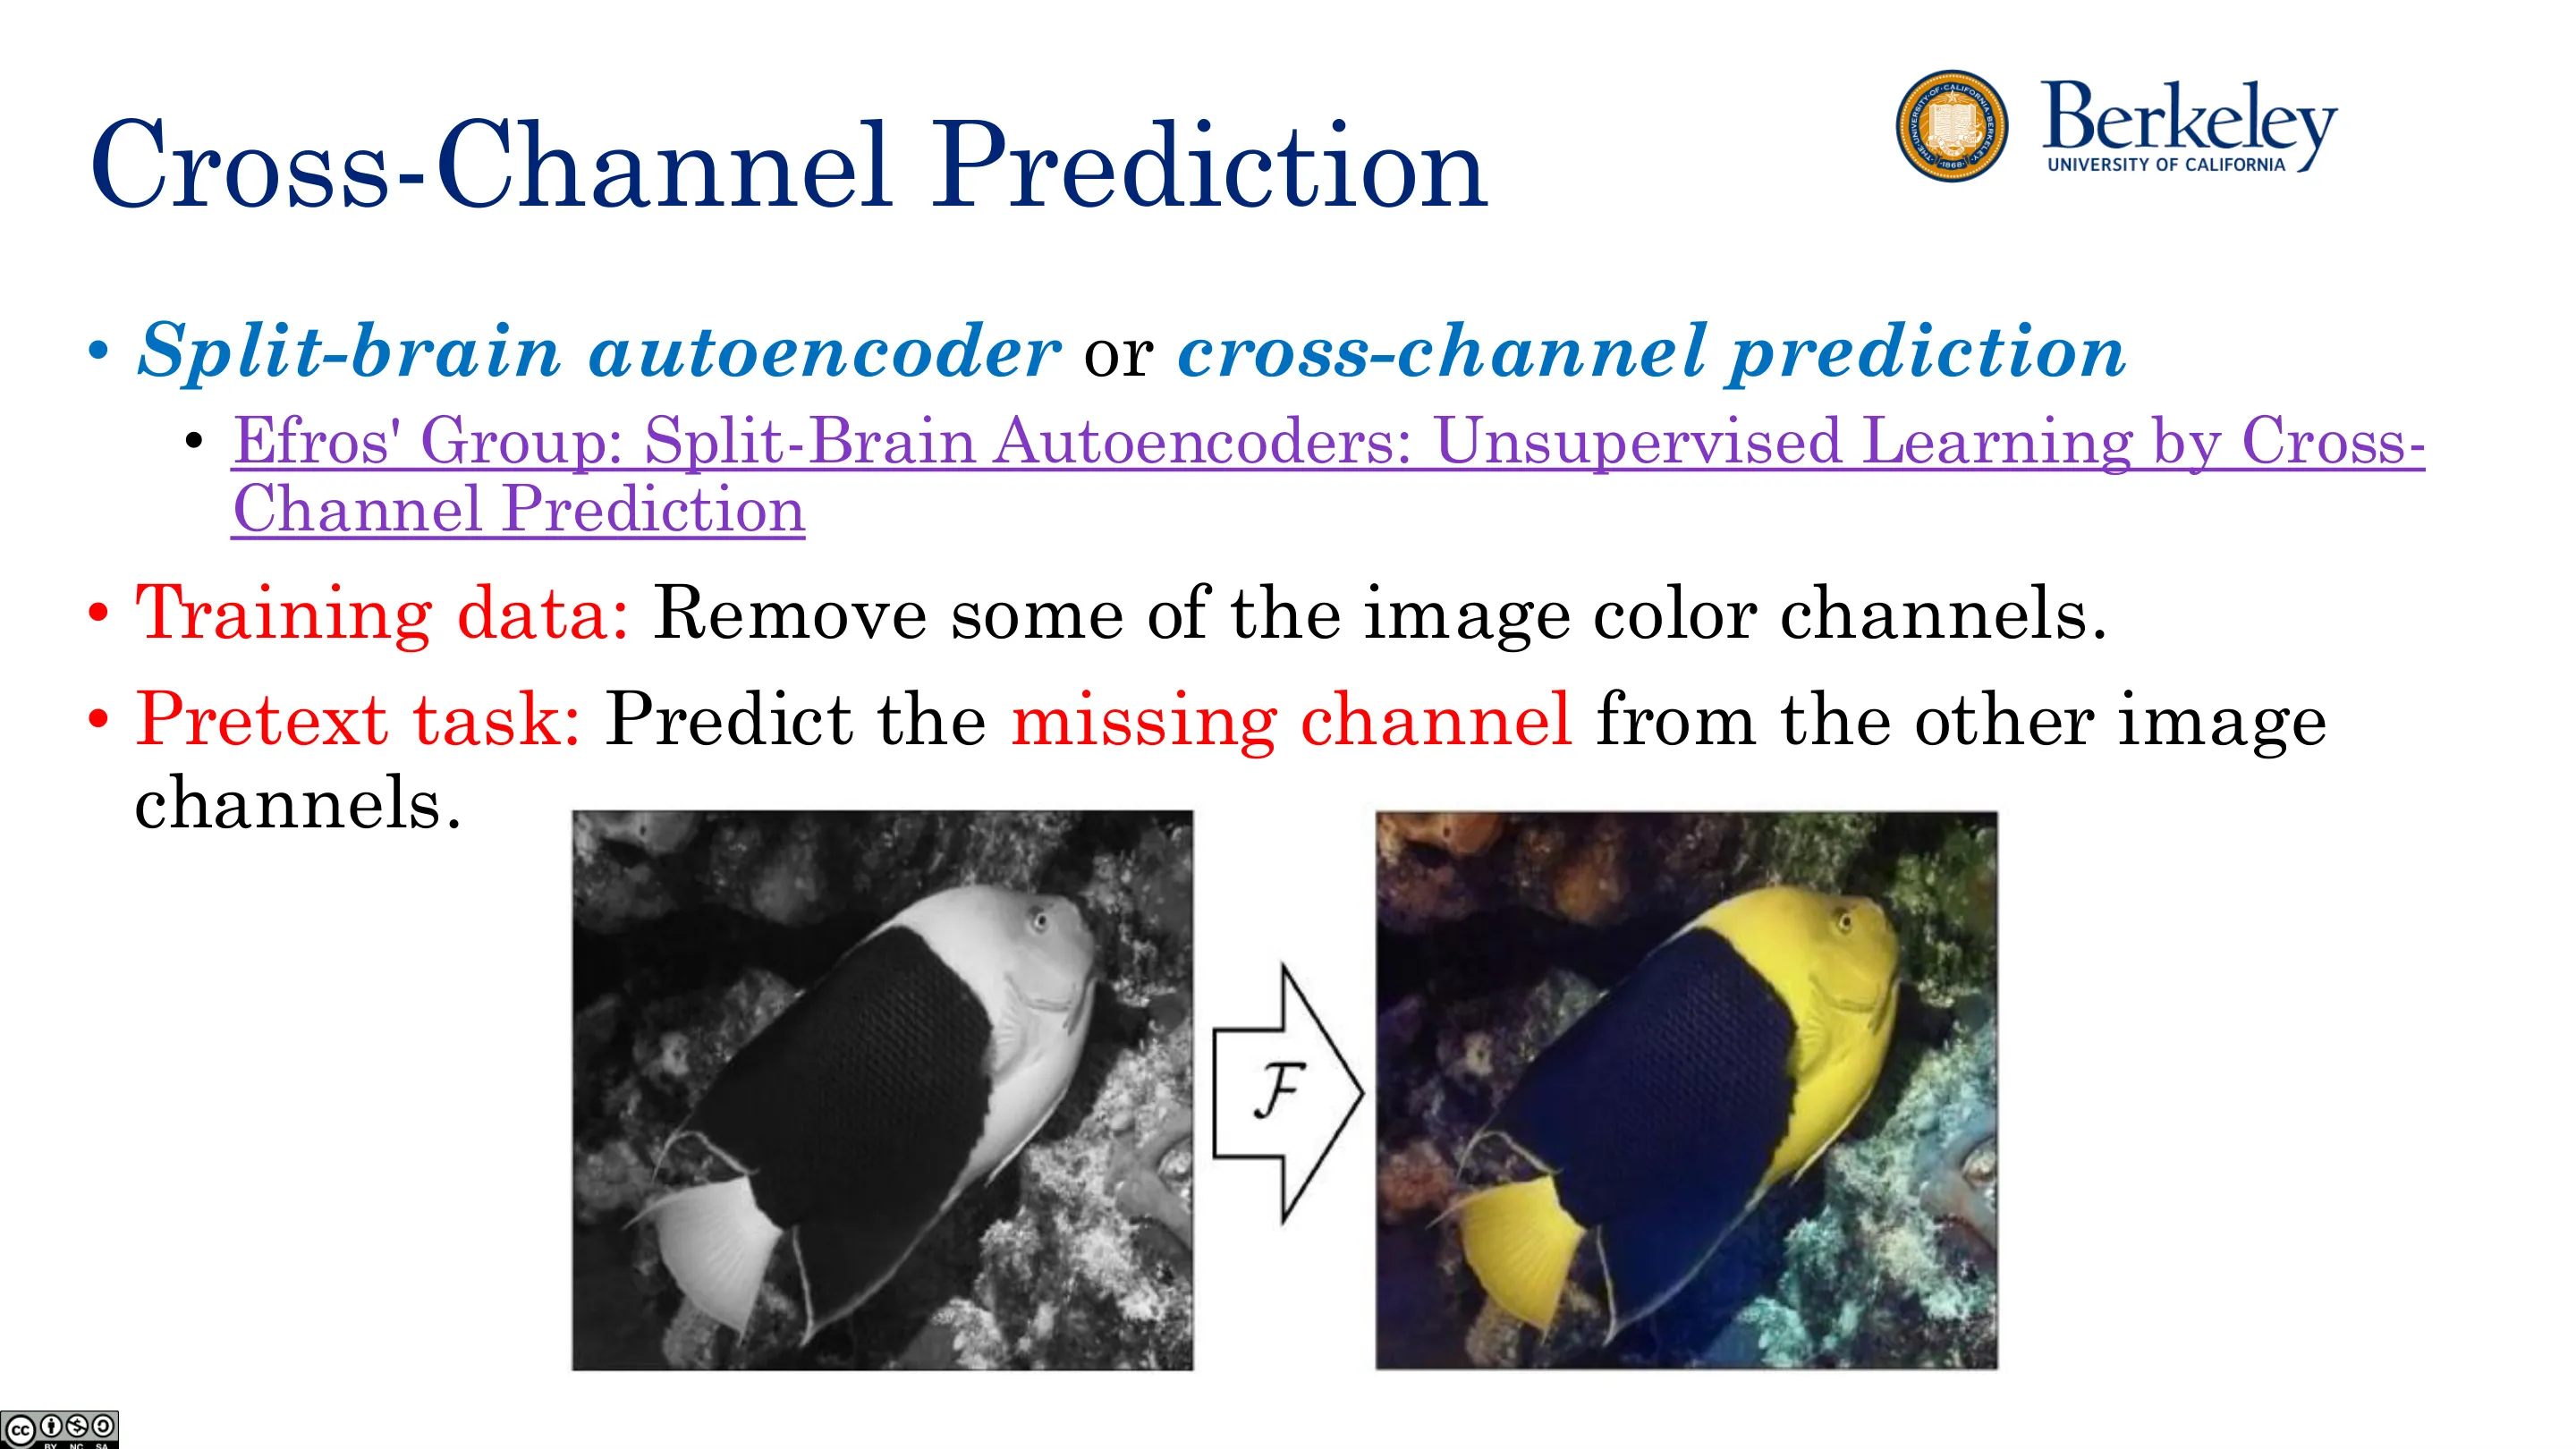
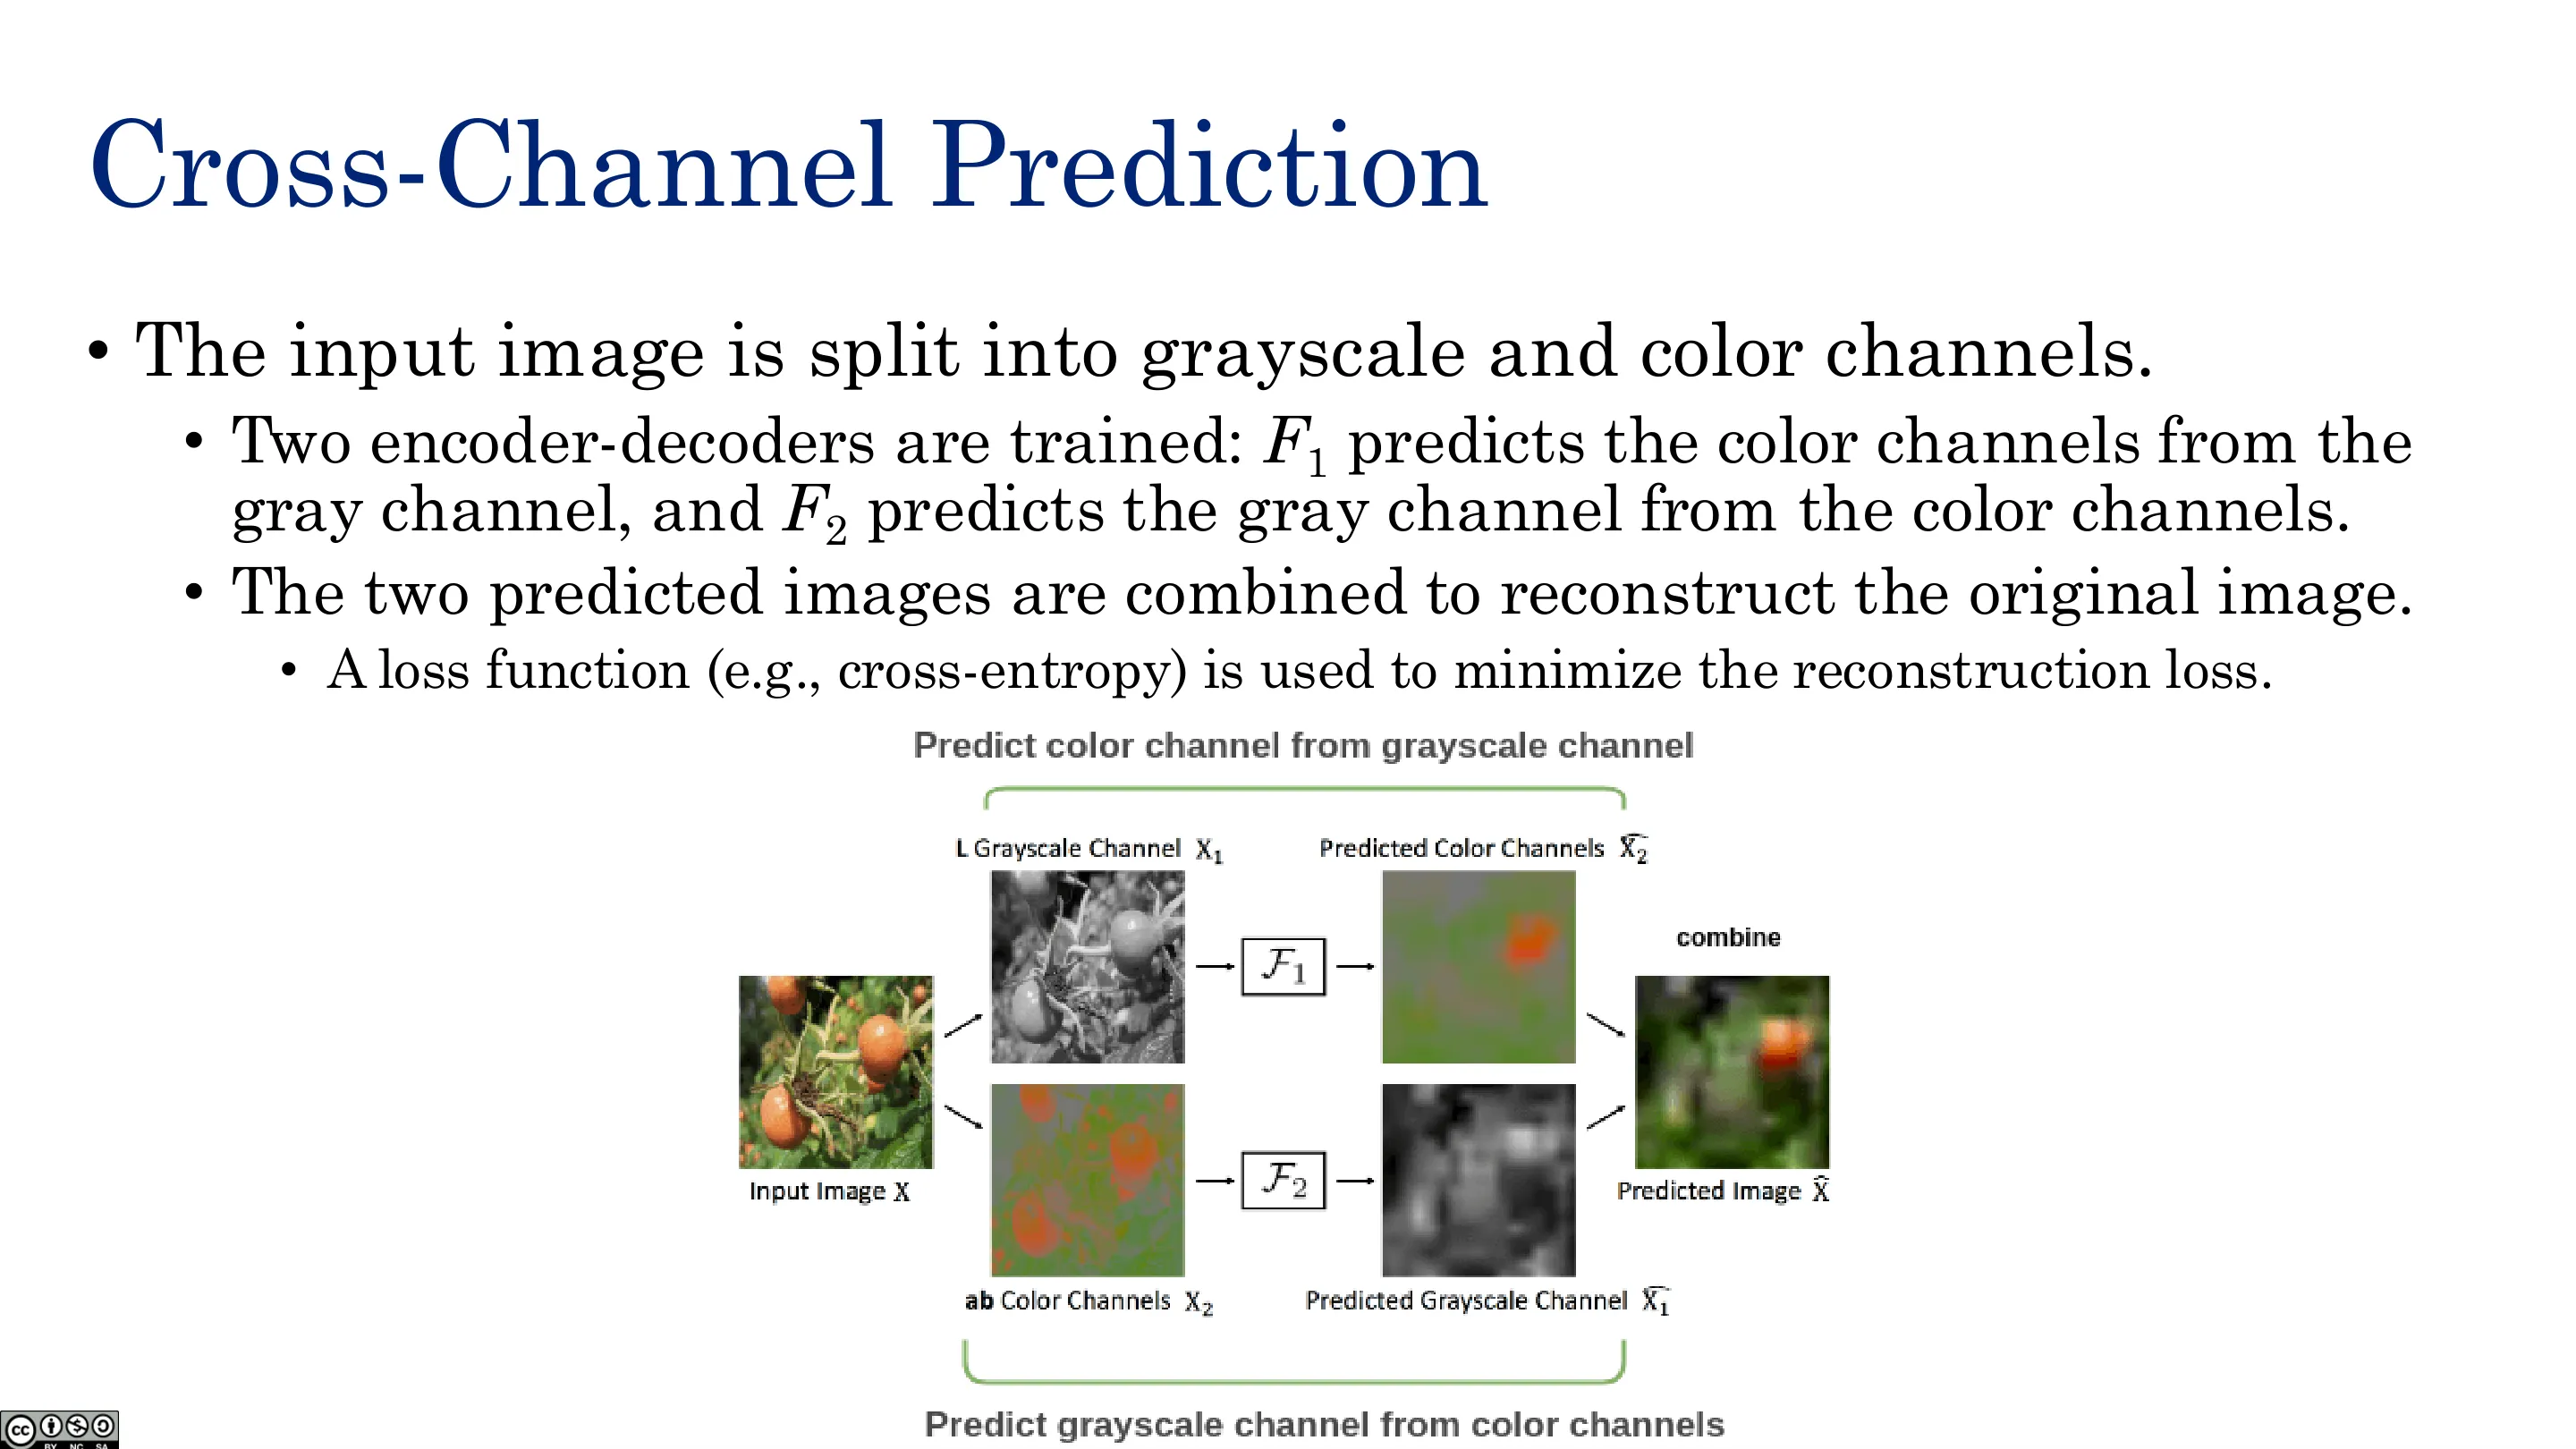
Pretext 任务:从部分通道(如灰度)预测其余通道(如 RGB 中的某通道)。
📷 生成式(二)
回到原视频 (00:40:29)
📷 跨通道预测(一)
回到原视频 (00:41:42)
📷 跨通道预测(二)
回到原视频 (00:42:55)
📷 跨通道预测(三)
回到原视频 (00:44:08)
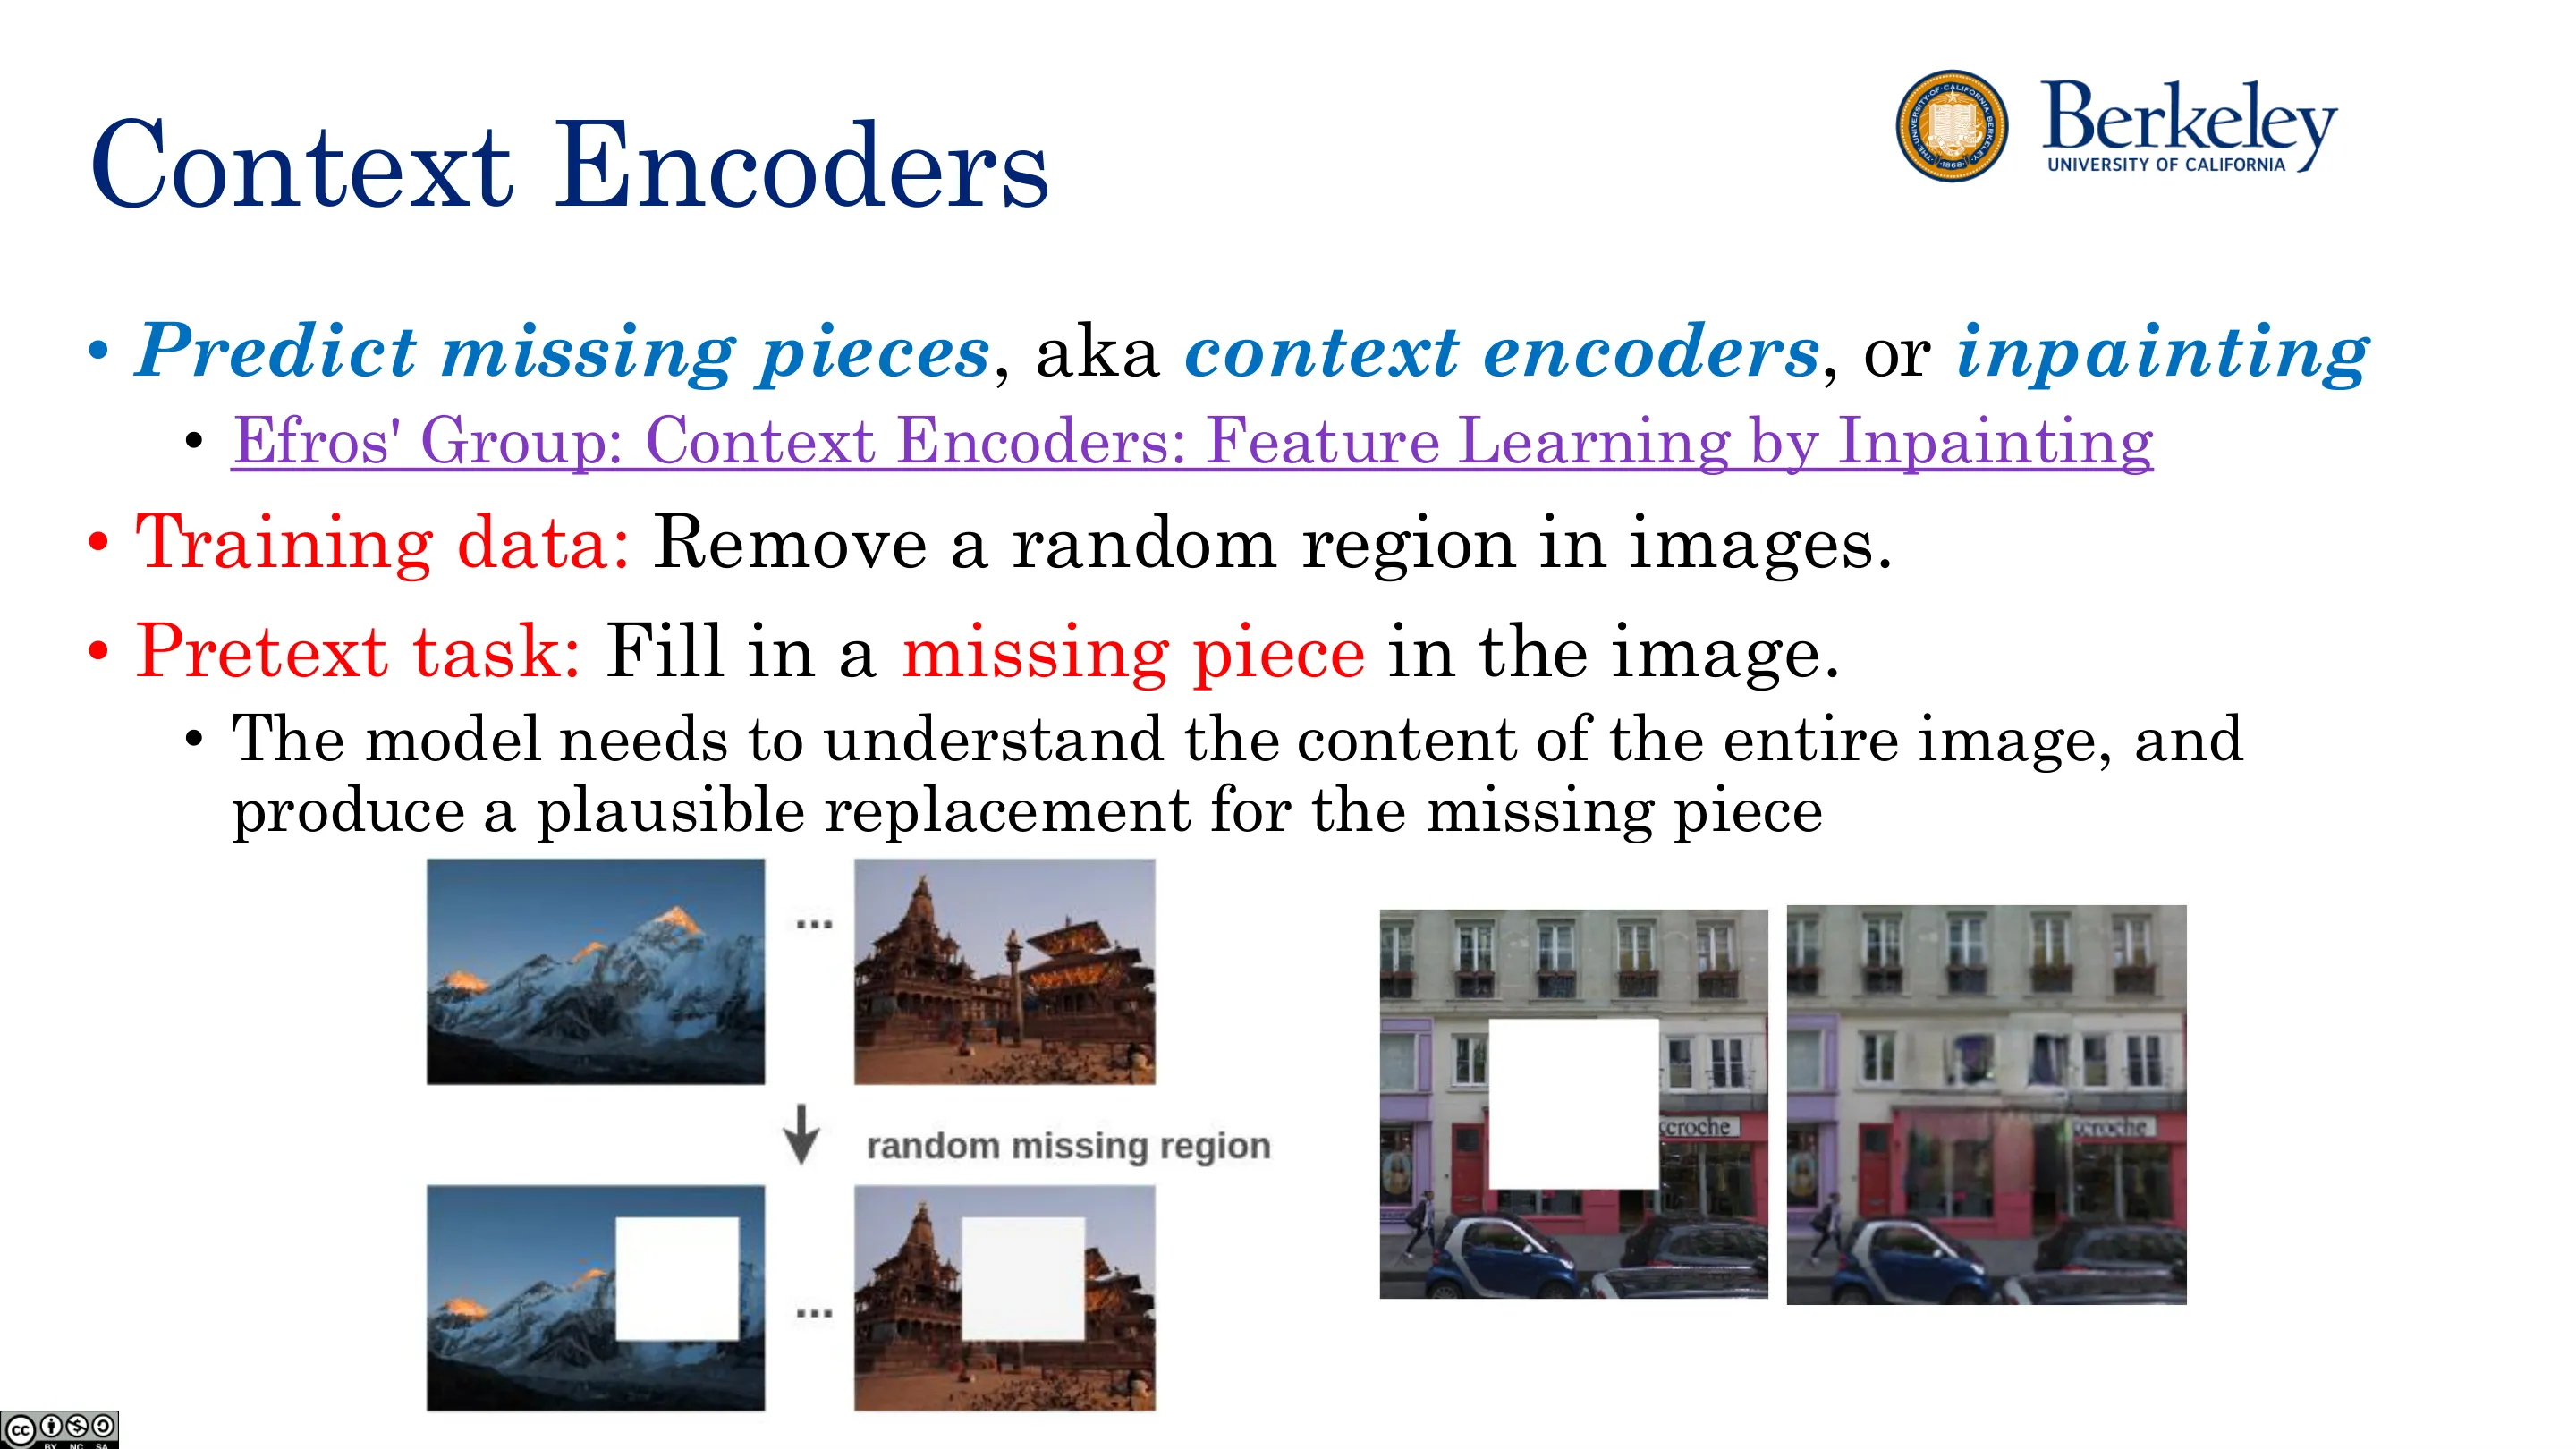
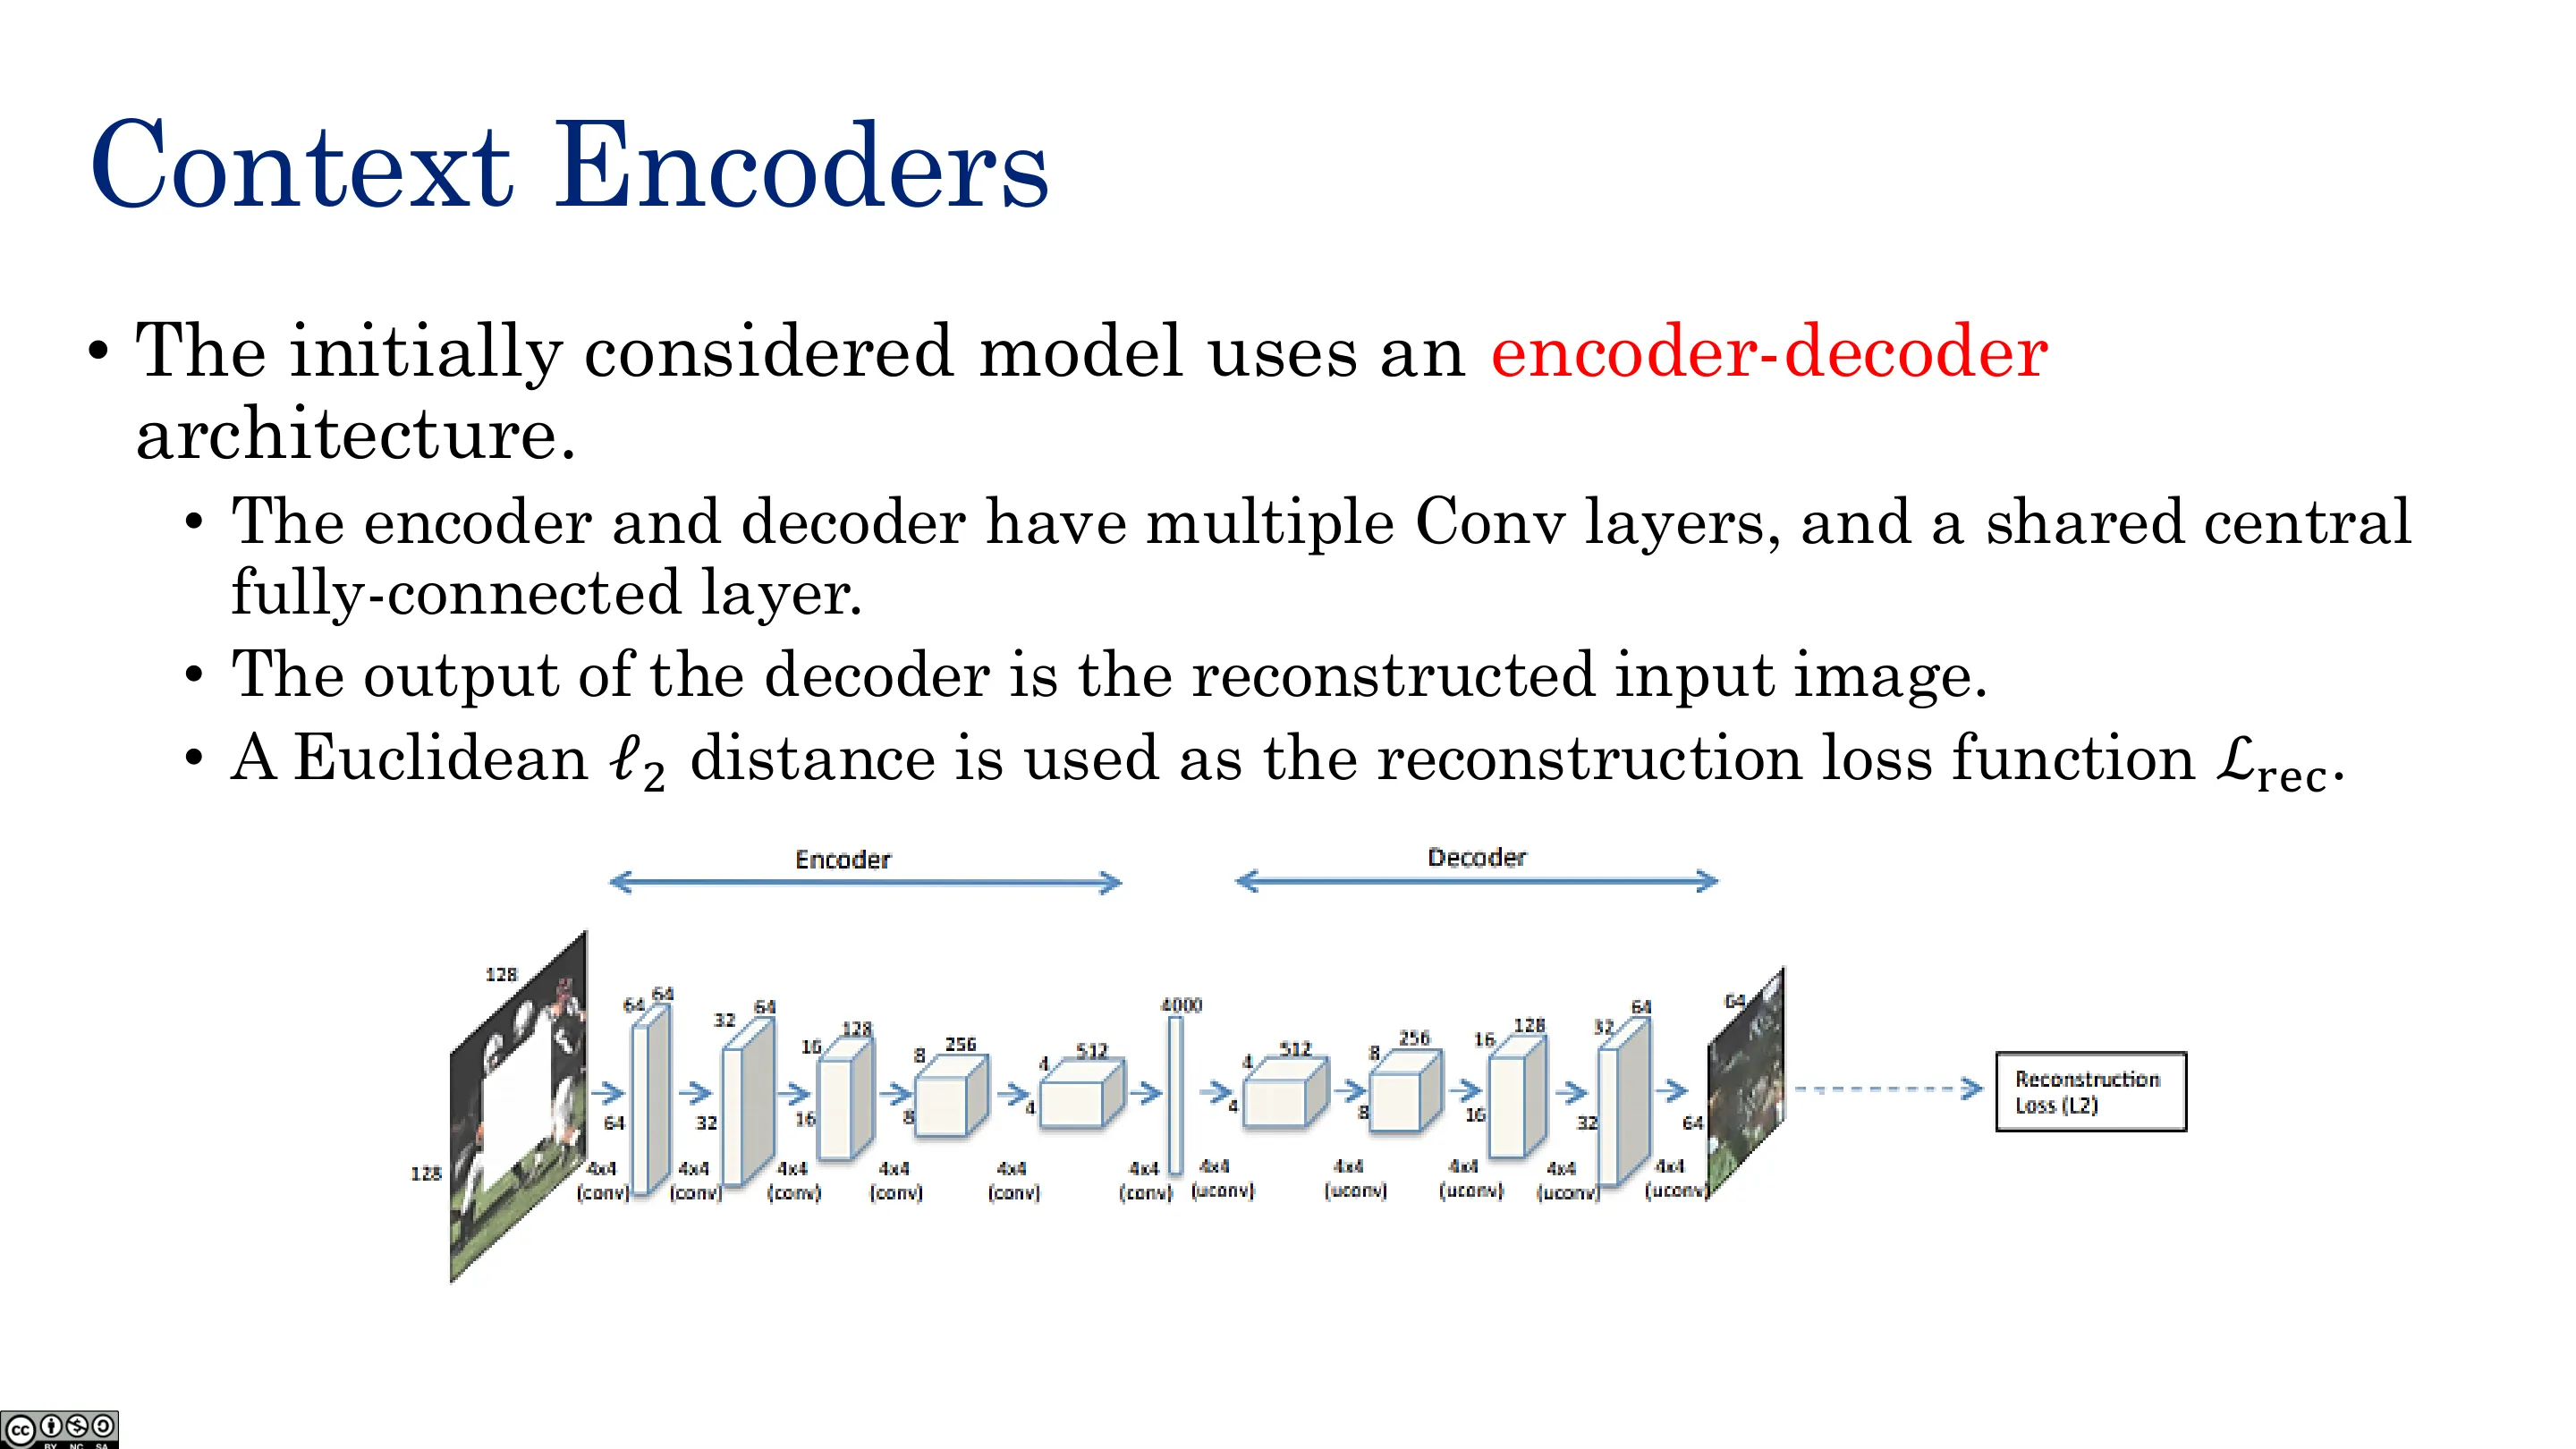
2.4 上下文编码器(Context Encoders)
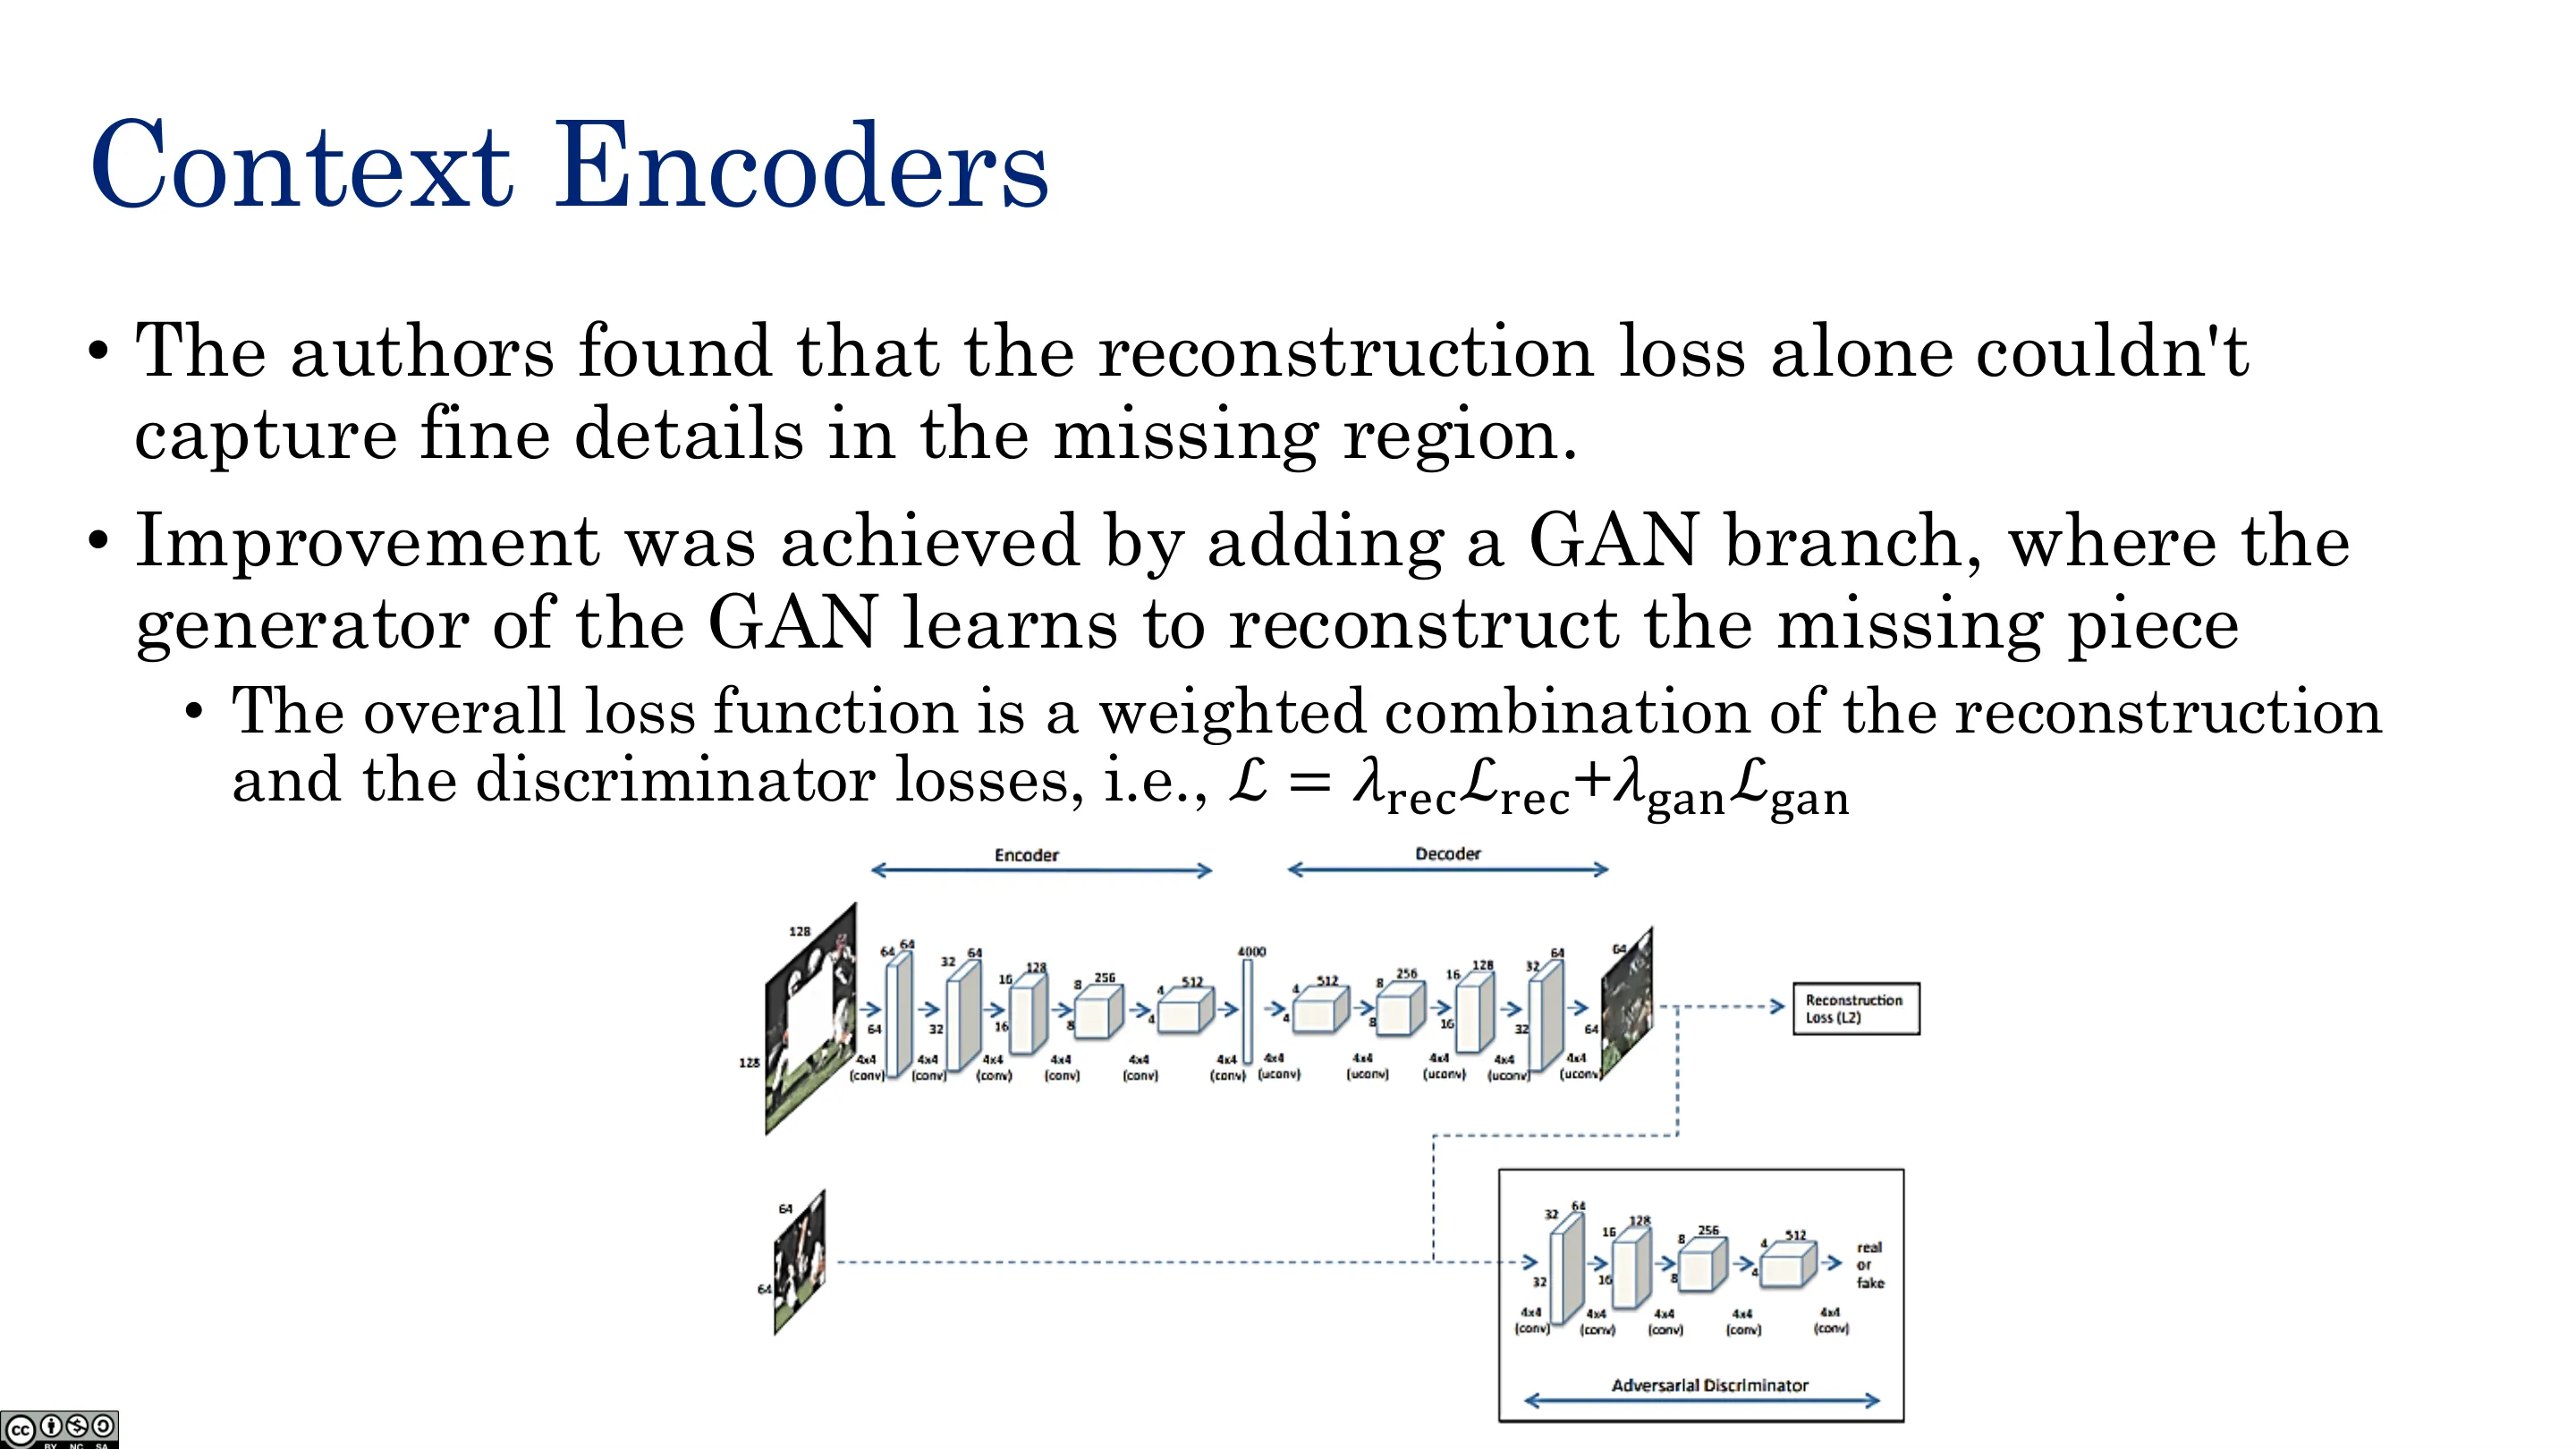
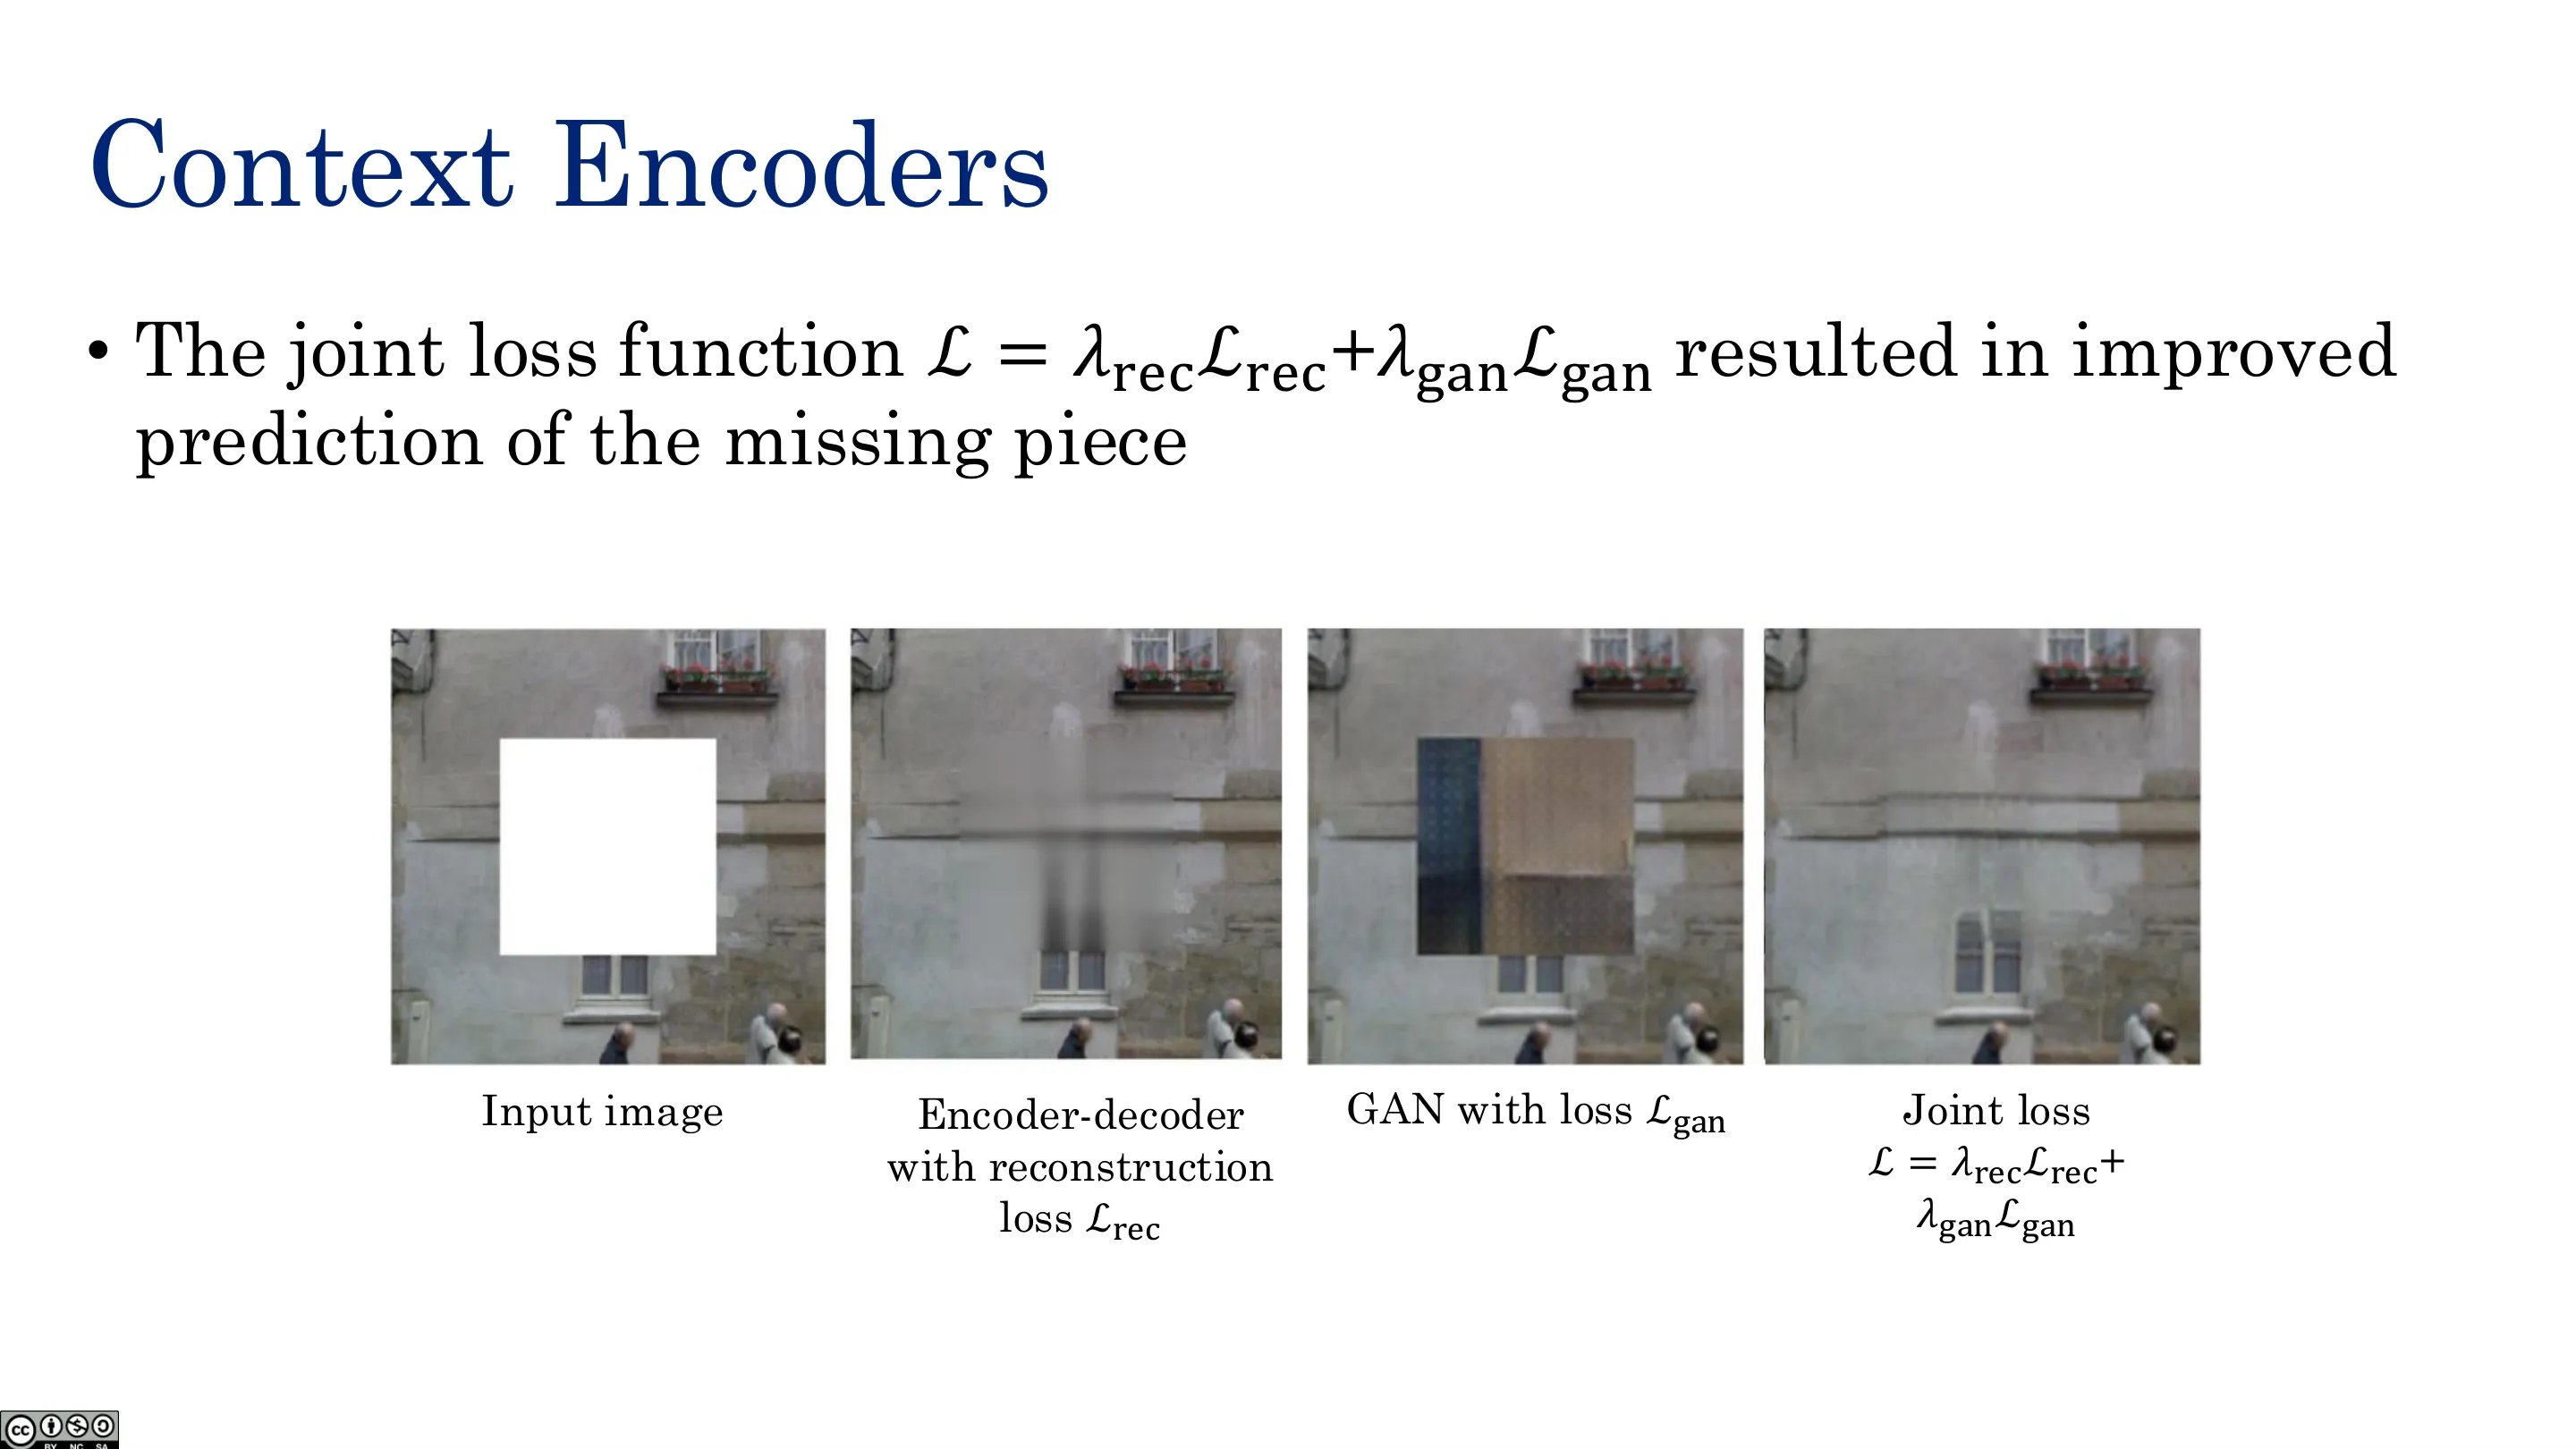
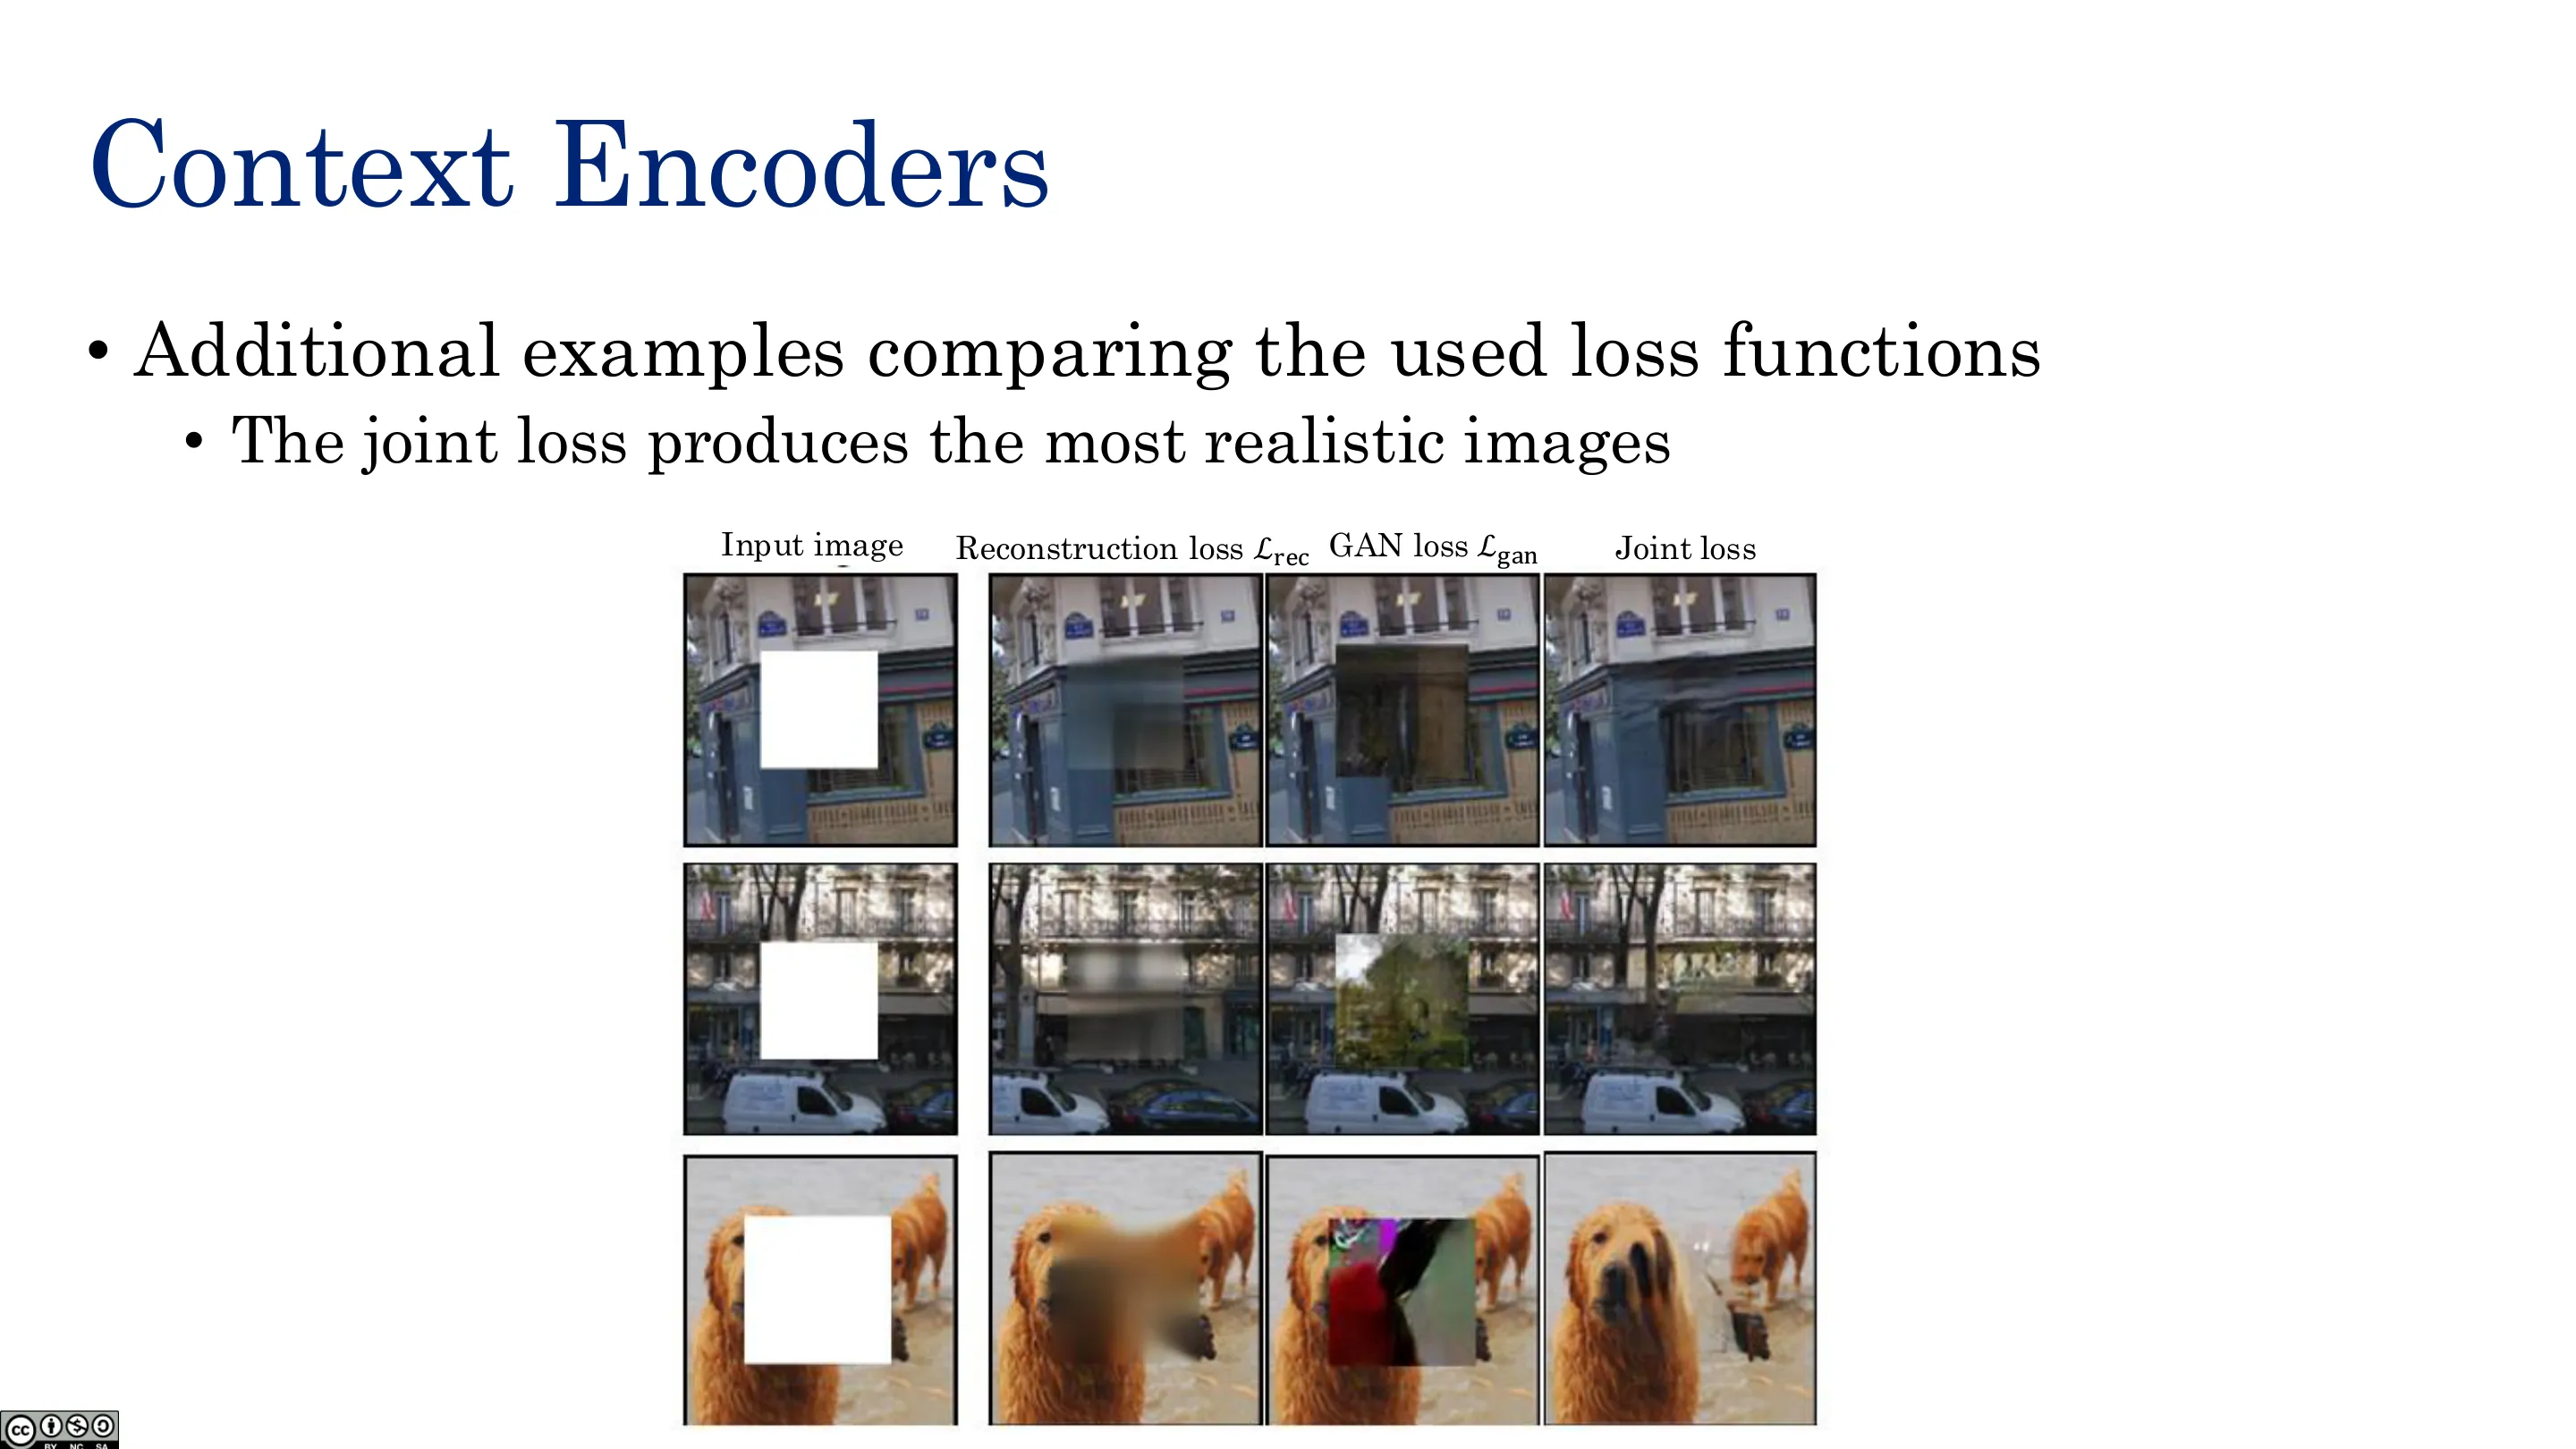
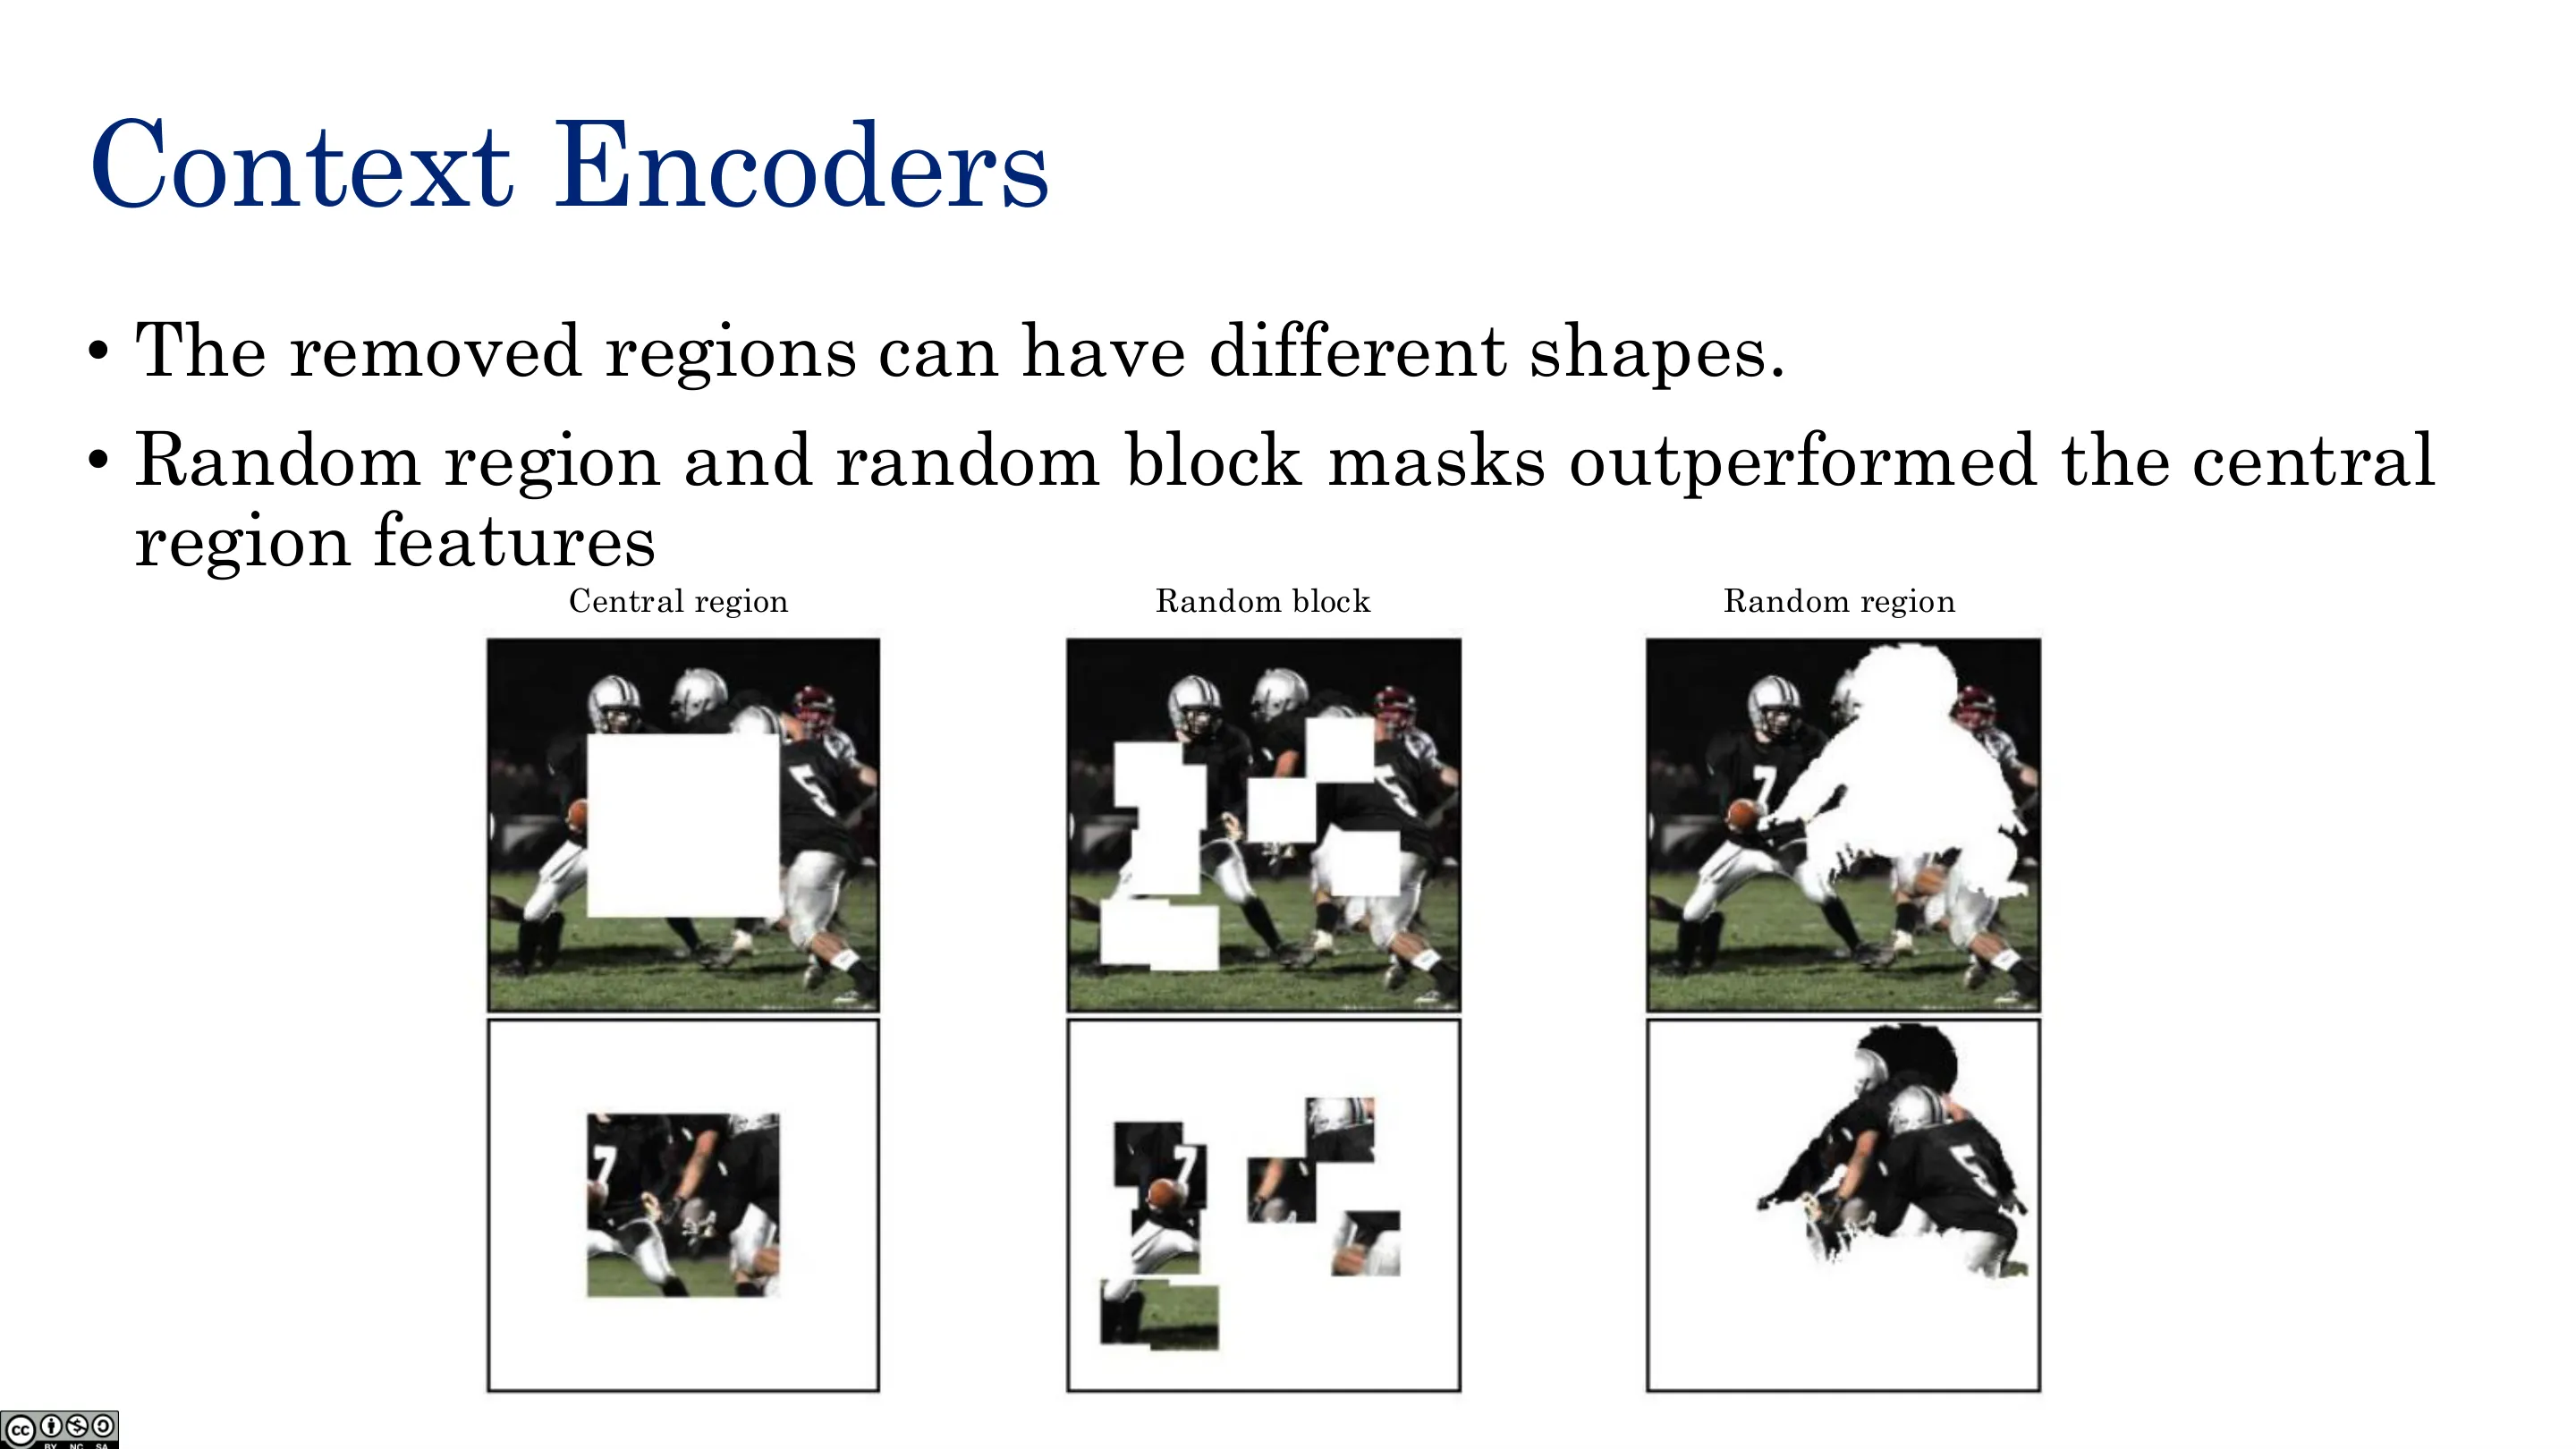
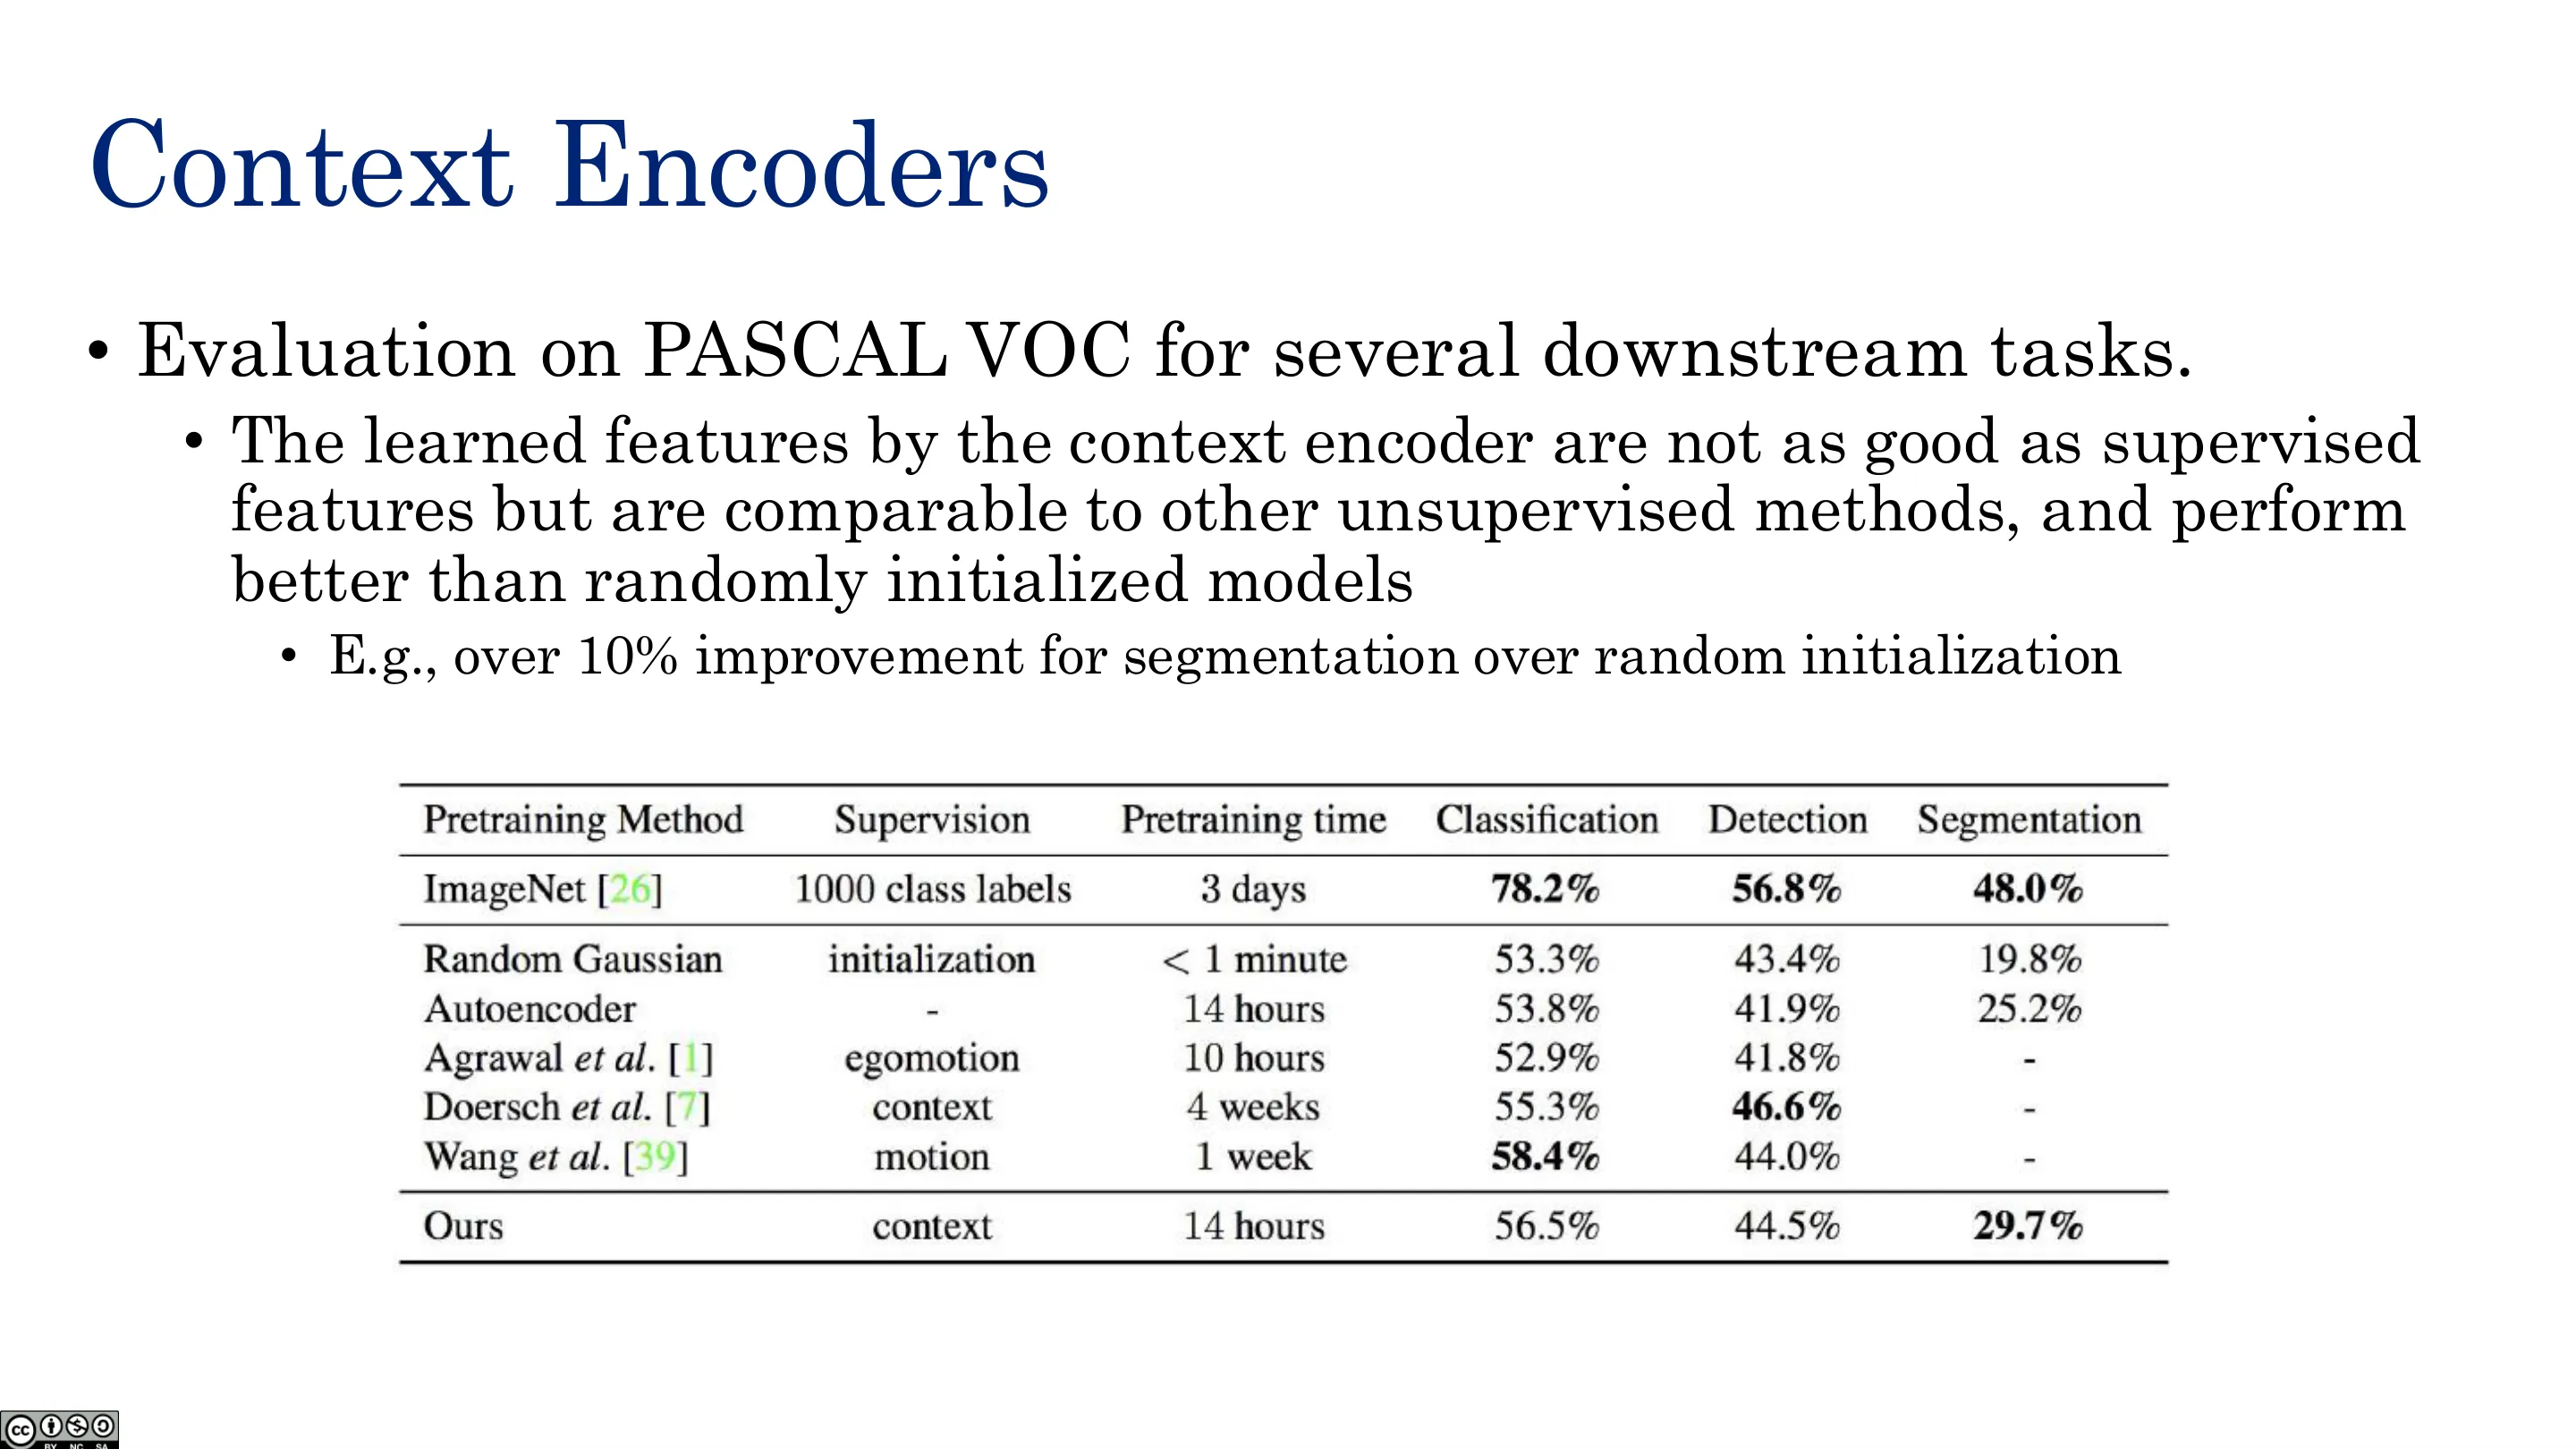
Pretext 任务:遮住图像的一块,让网络根据上下文填补缺失区域——学习语义与结构。
📷 生成式(三)
回到原视频 (00:45:21)
📷 上下文编码器(一)
回到原视频 (00:46:34)
📷 上下文编码器(二)
回到原视频 (00:47:47)
📷 上下文编码器(三)
回到原视频 (00:49:00)
📷 上下文编码器(四)
回到原视频 (00:50:13)
📷 上下文编码器(五)
回到原视频 (00:51:26)
📷 上下文编码器(六)
回到原视频 (00:52:39)
📷 上下文编码器(七)
回到原视频 (00:53:52)
2.5 图像超分辨率(Super-Resolution)
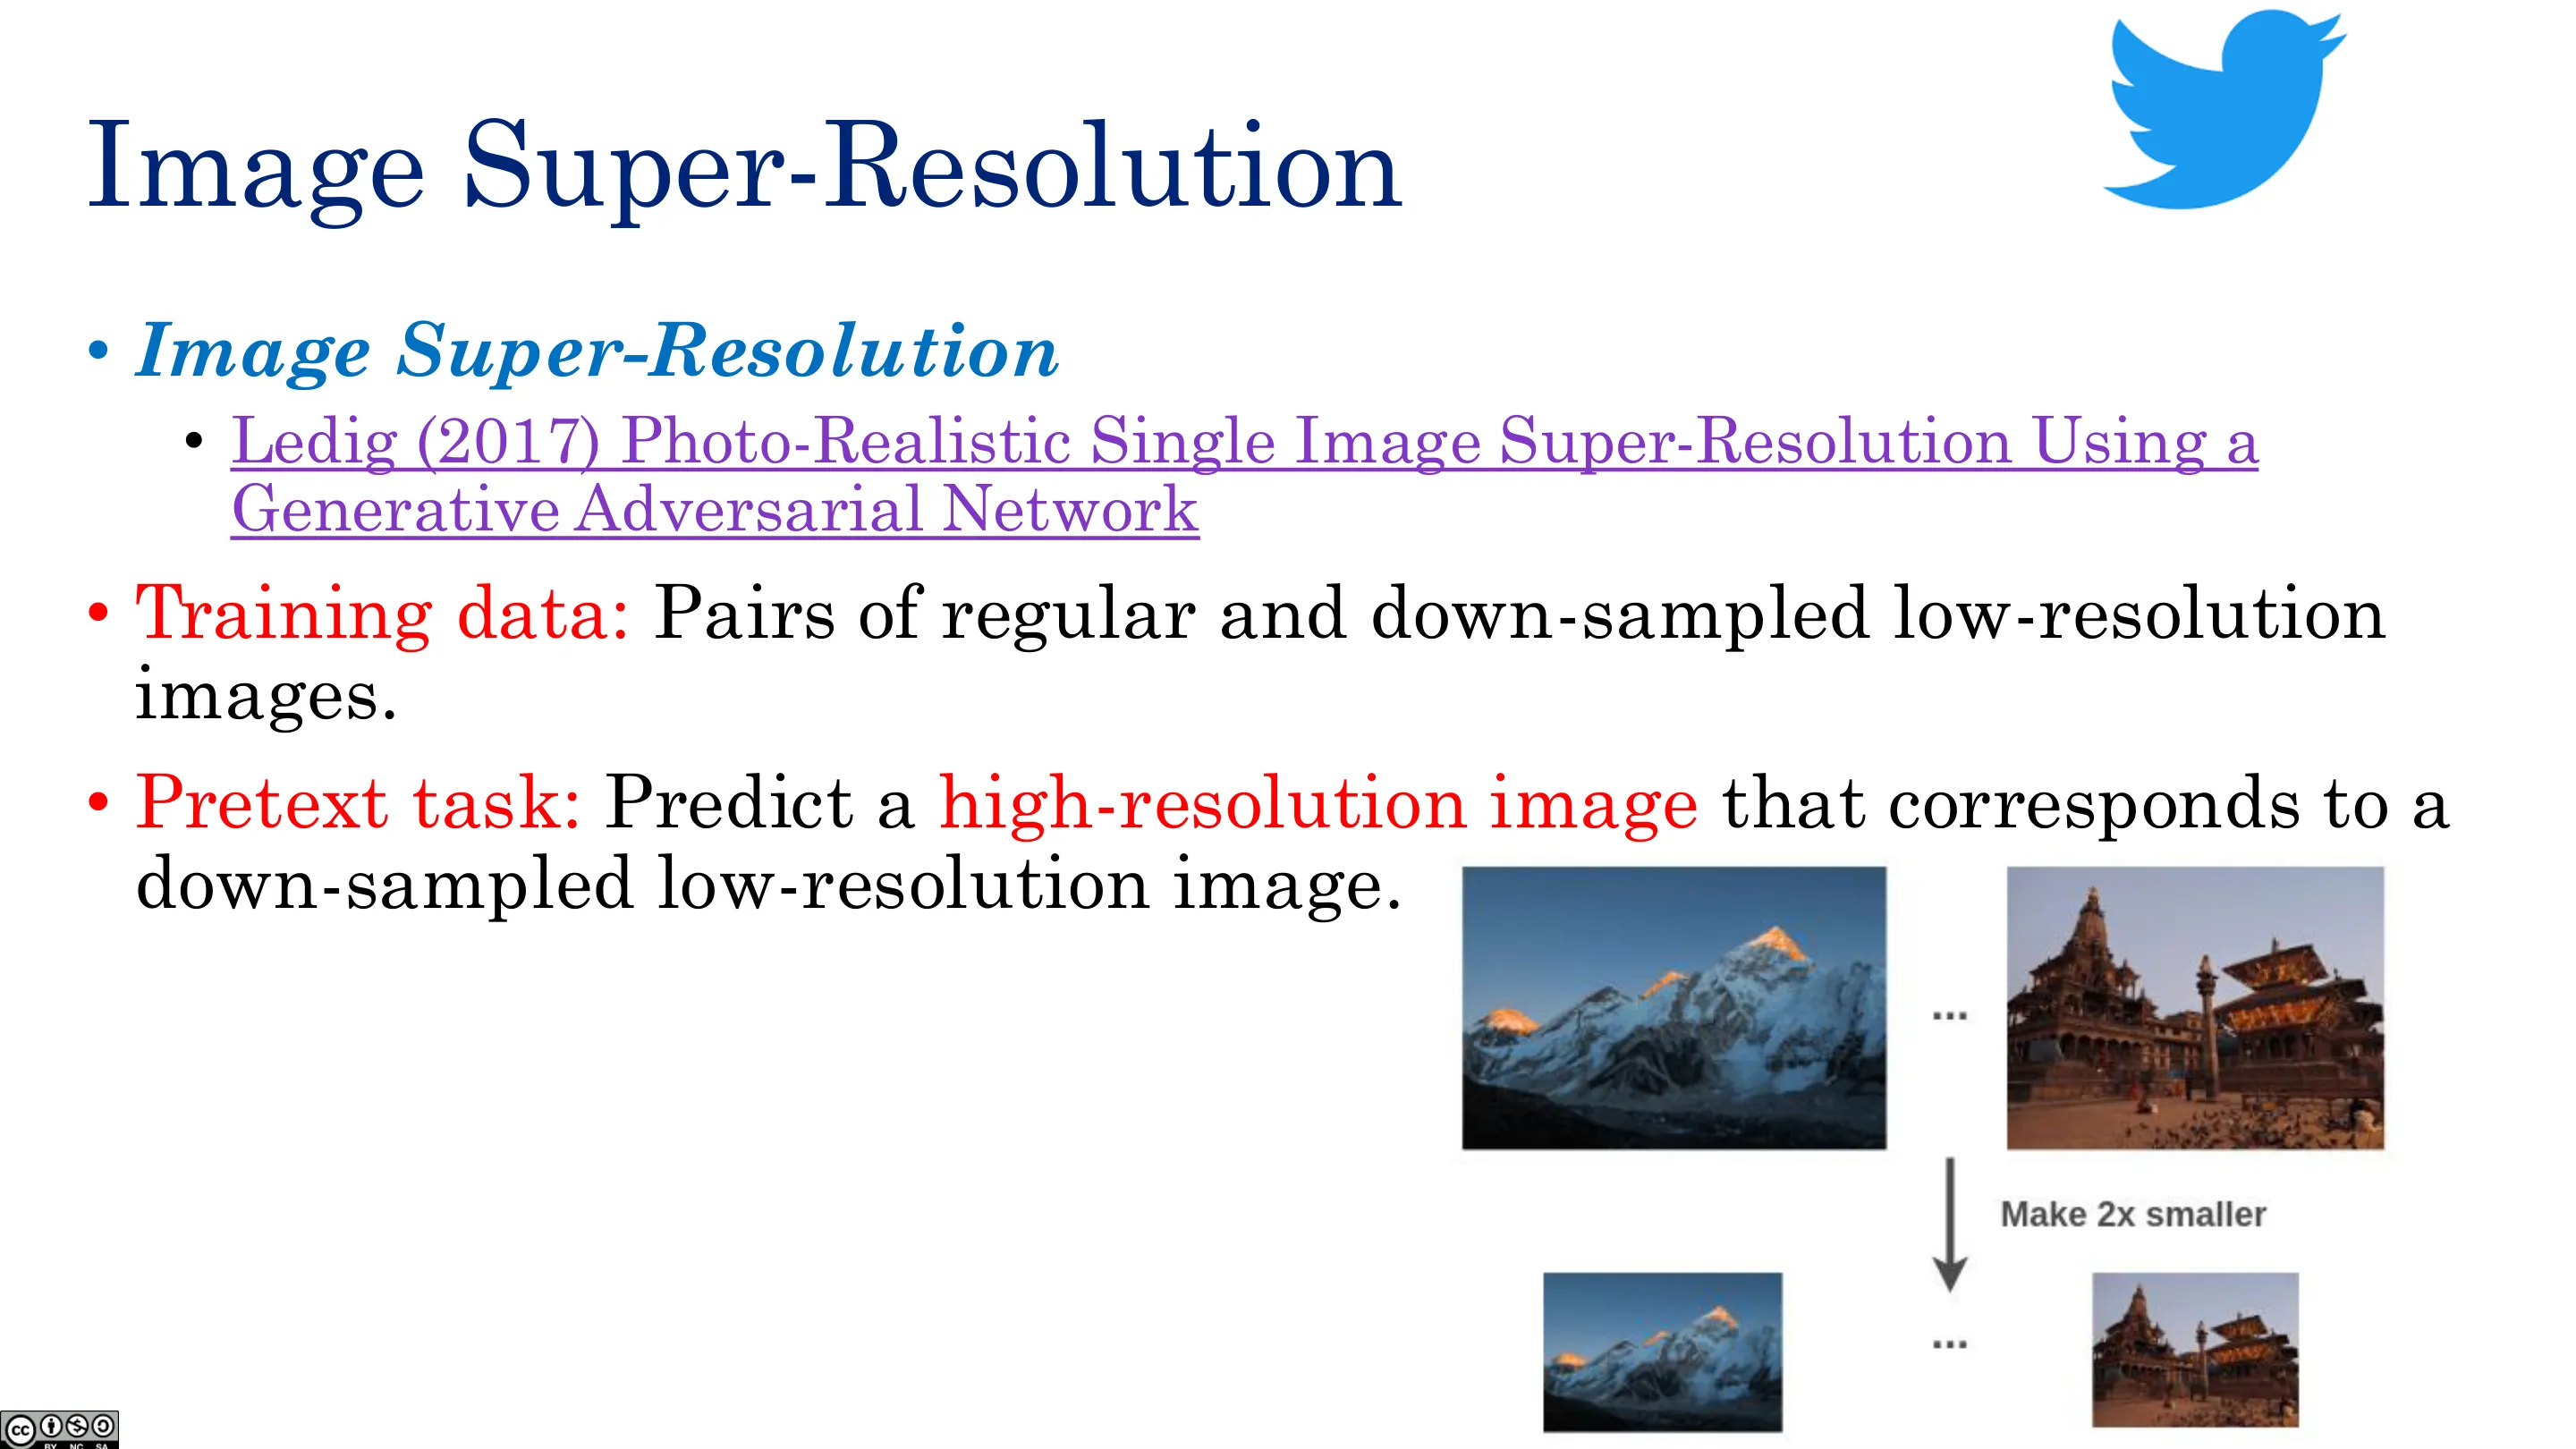
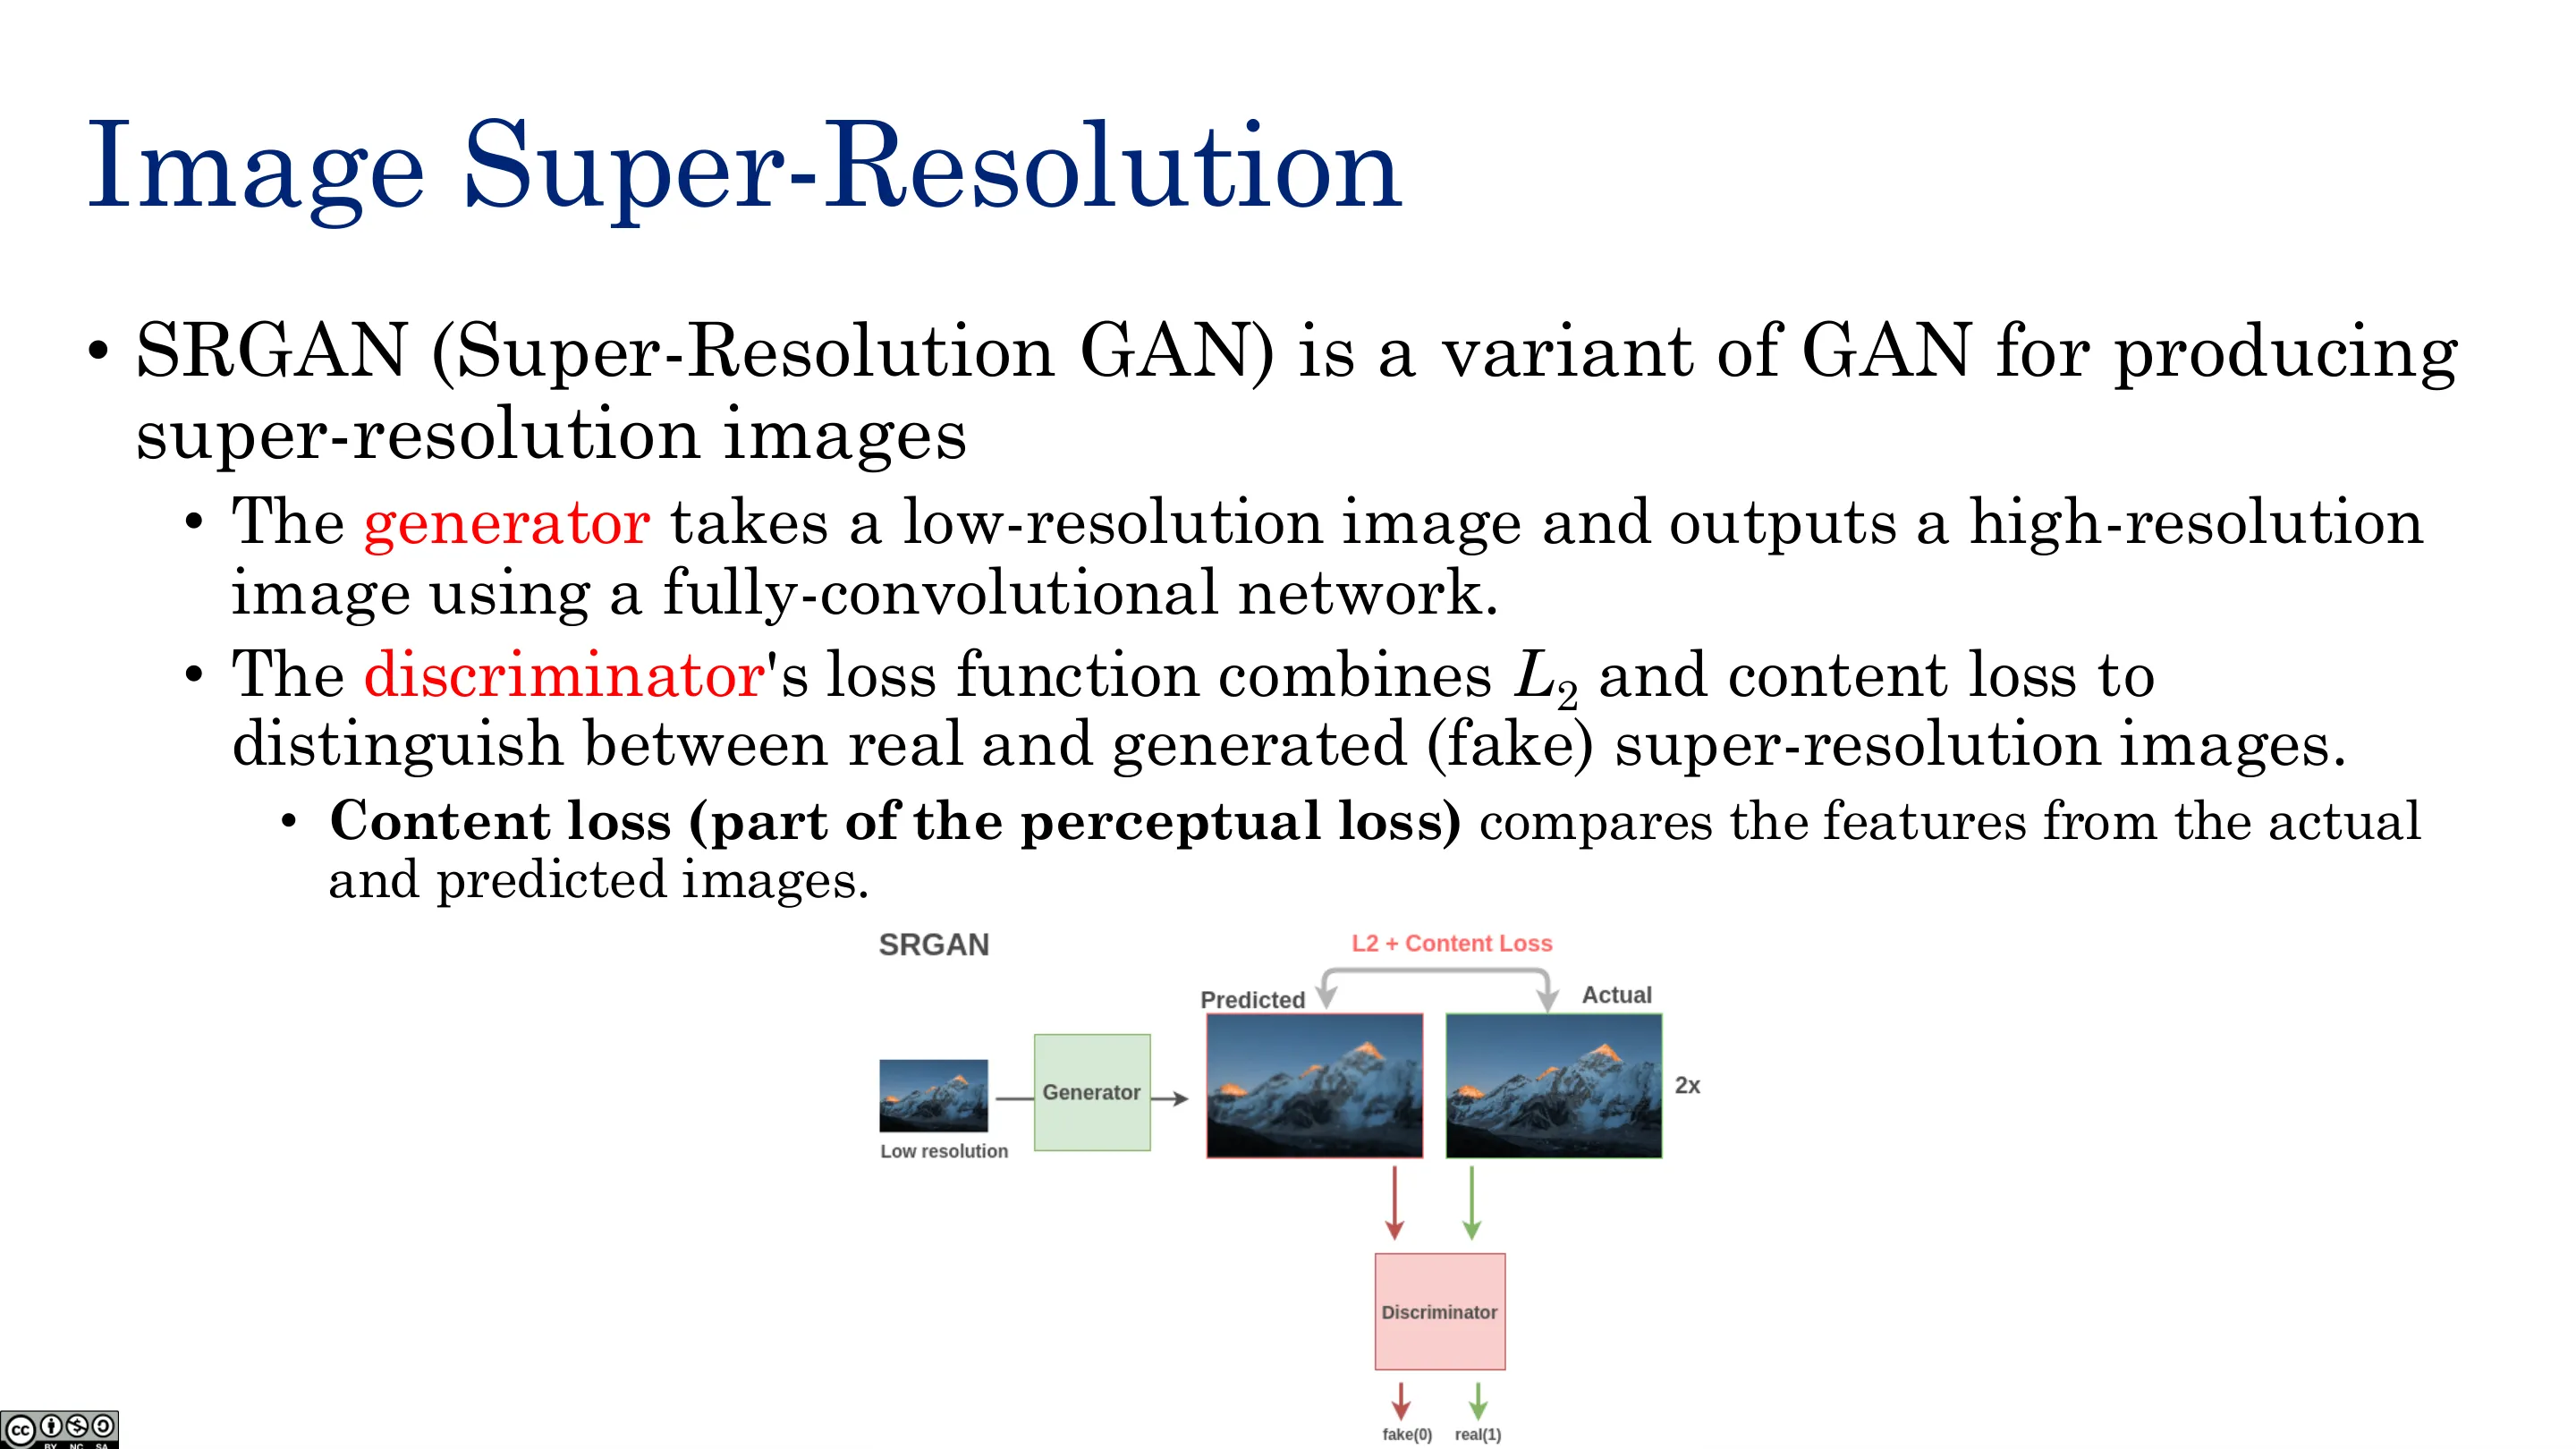
Pretext 任务:把低分辨率图(下采样)还原成高分辨率。数据自动生成,且本身就有实用价值(手机相机里的超分网络)。
📷 生成式(四)
回到原视频 (00:55:05)
📷 图像超分辨率(一)
回到原视频 (00:56:18)
📷 图像超分辨率(二)
回到原视频 (00:57:31)
三、判别式 Self-Supervision
📷 判别式
回到原视频 (00:58:44)
3.1 图像旋转预测(Image Rotation)
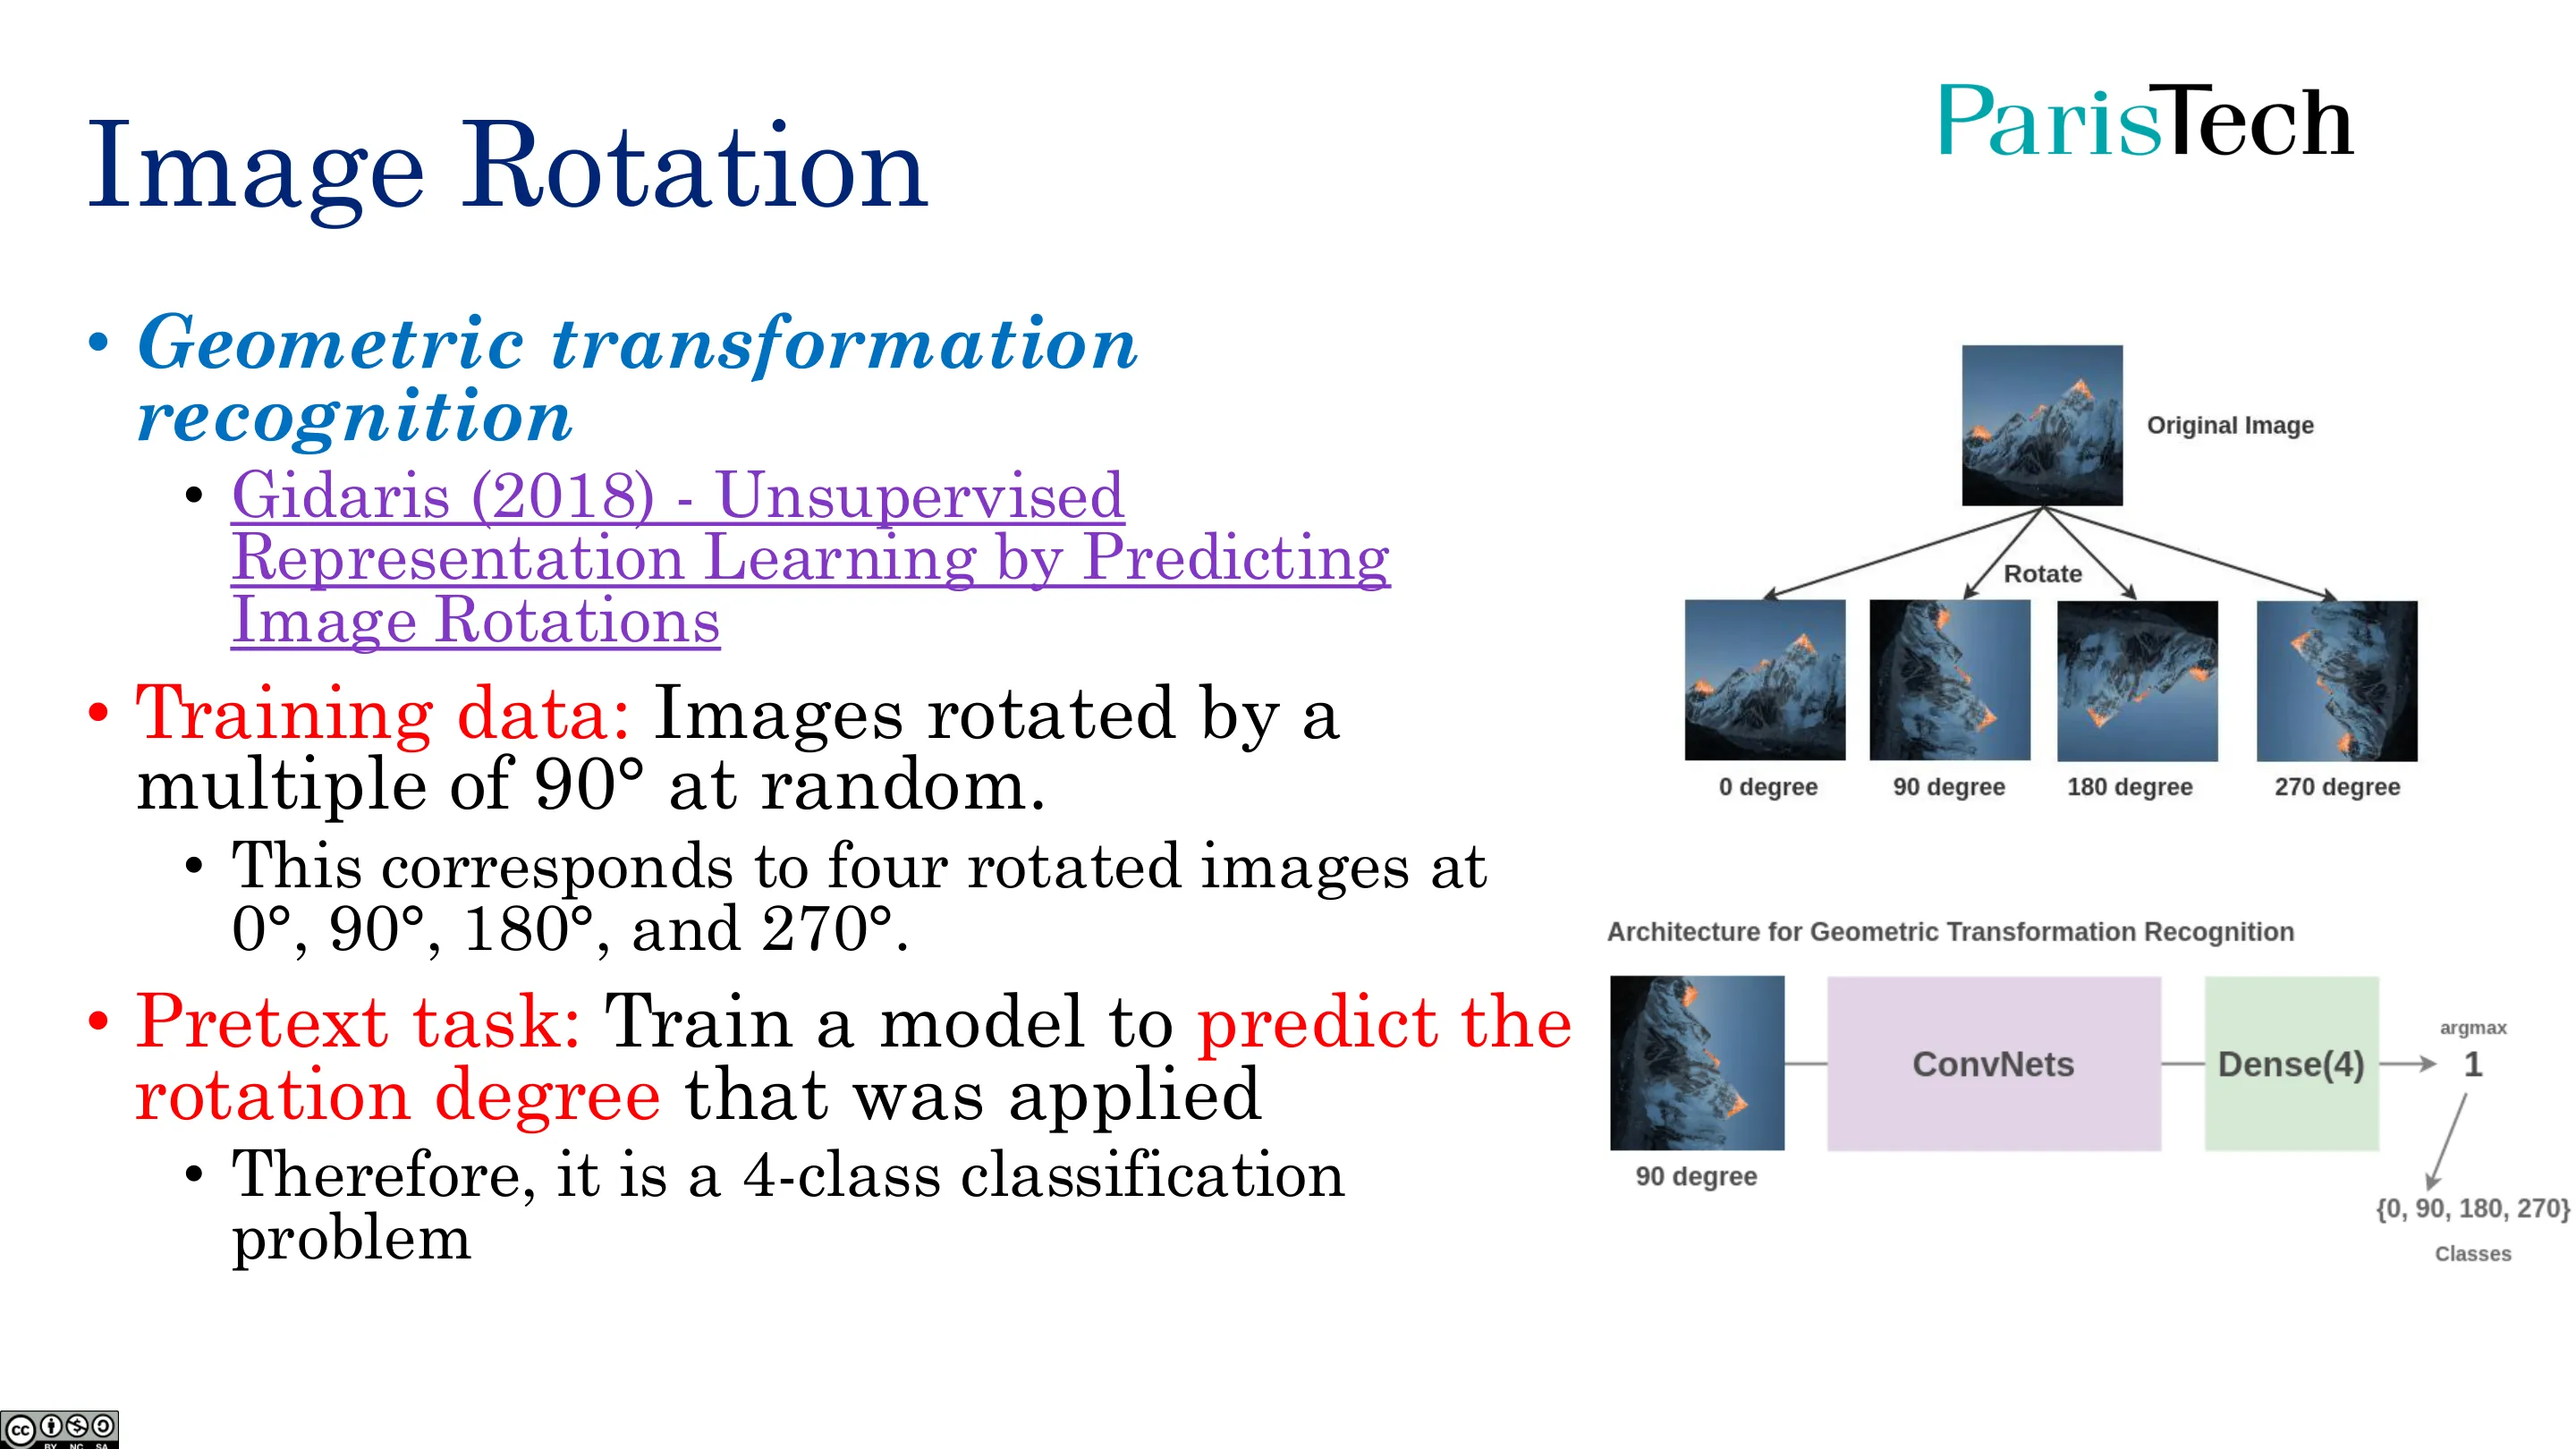
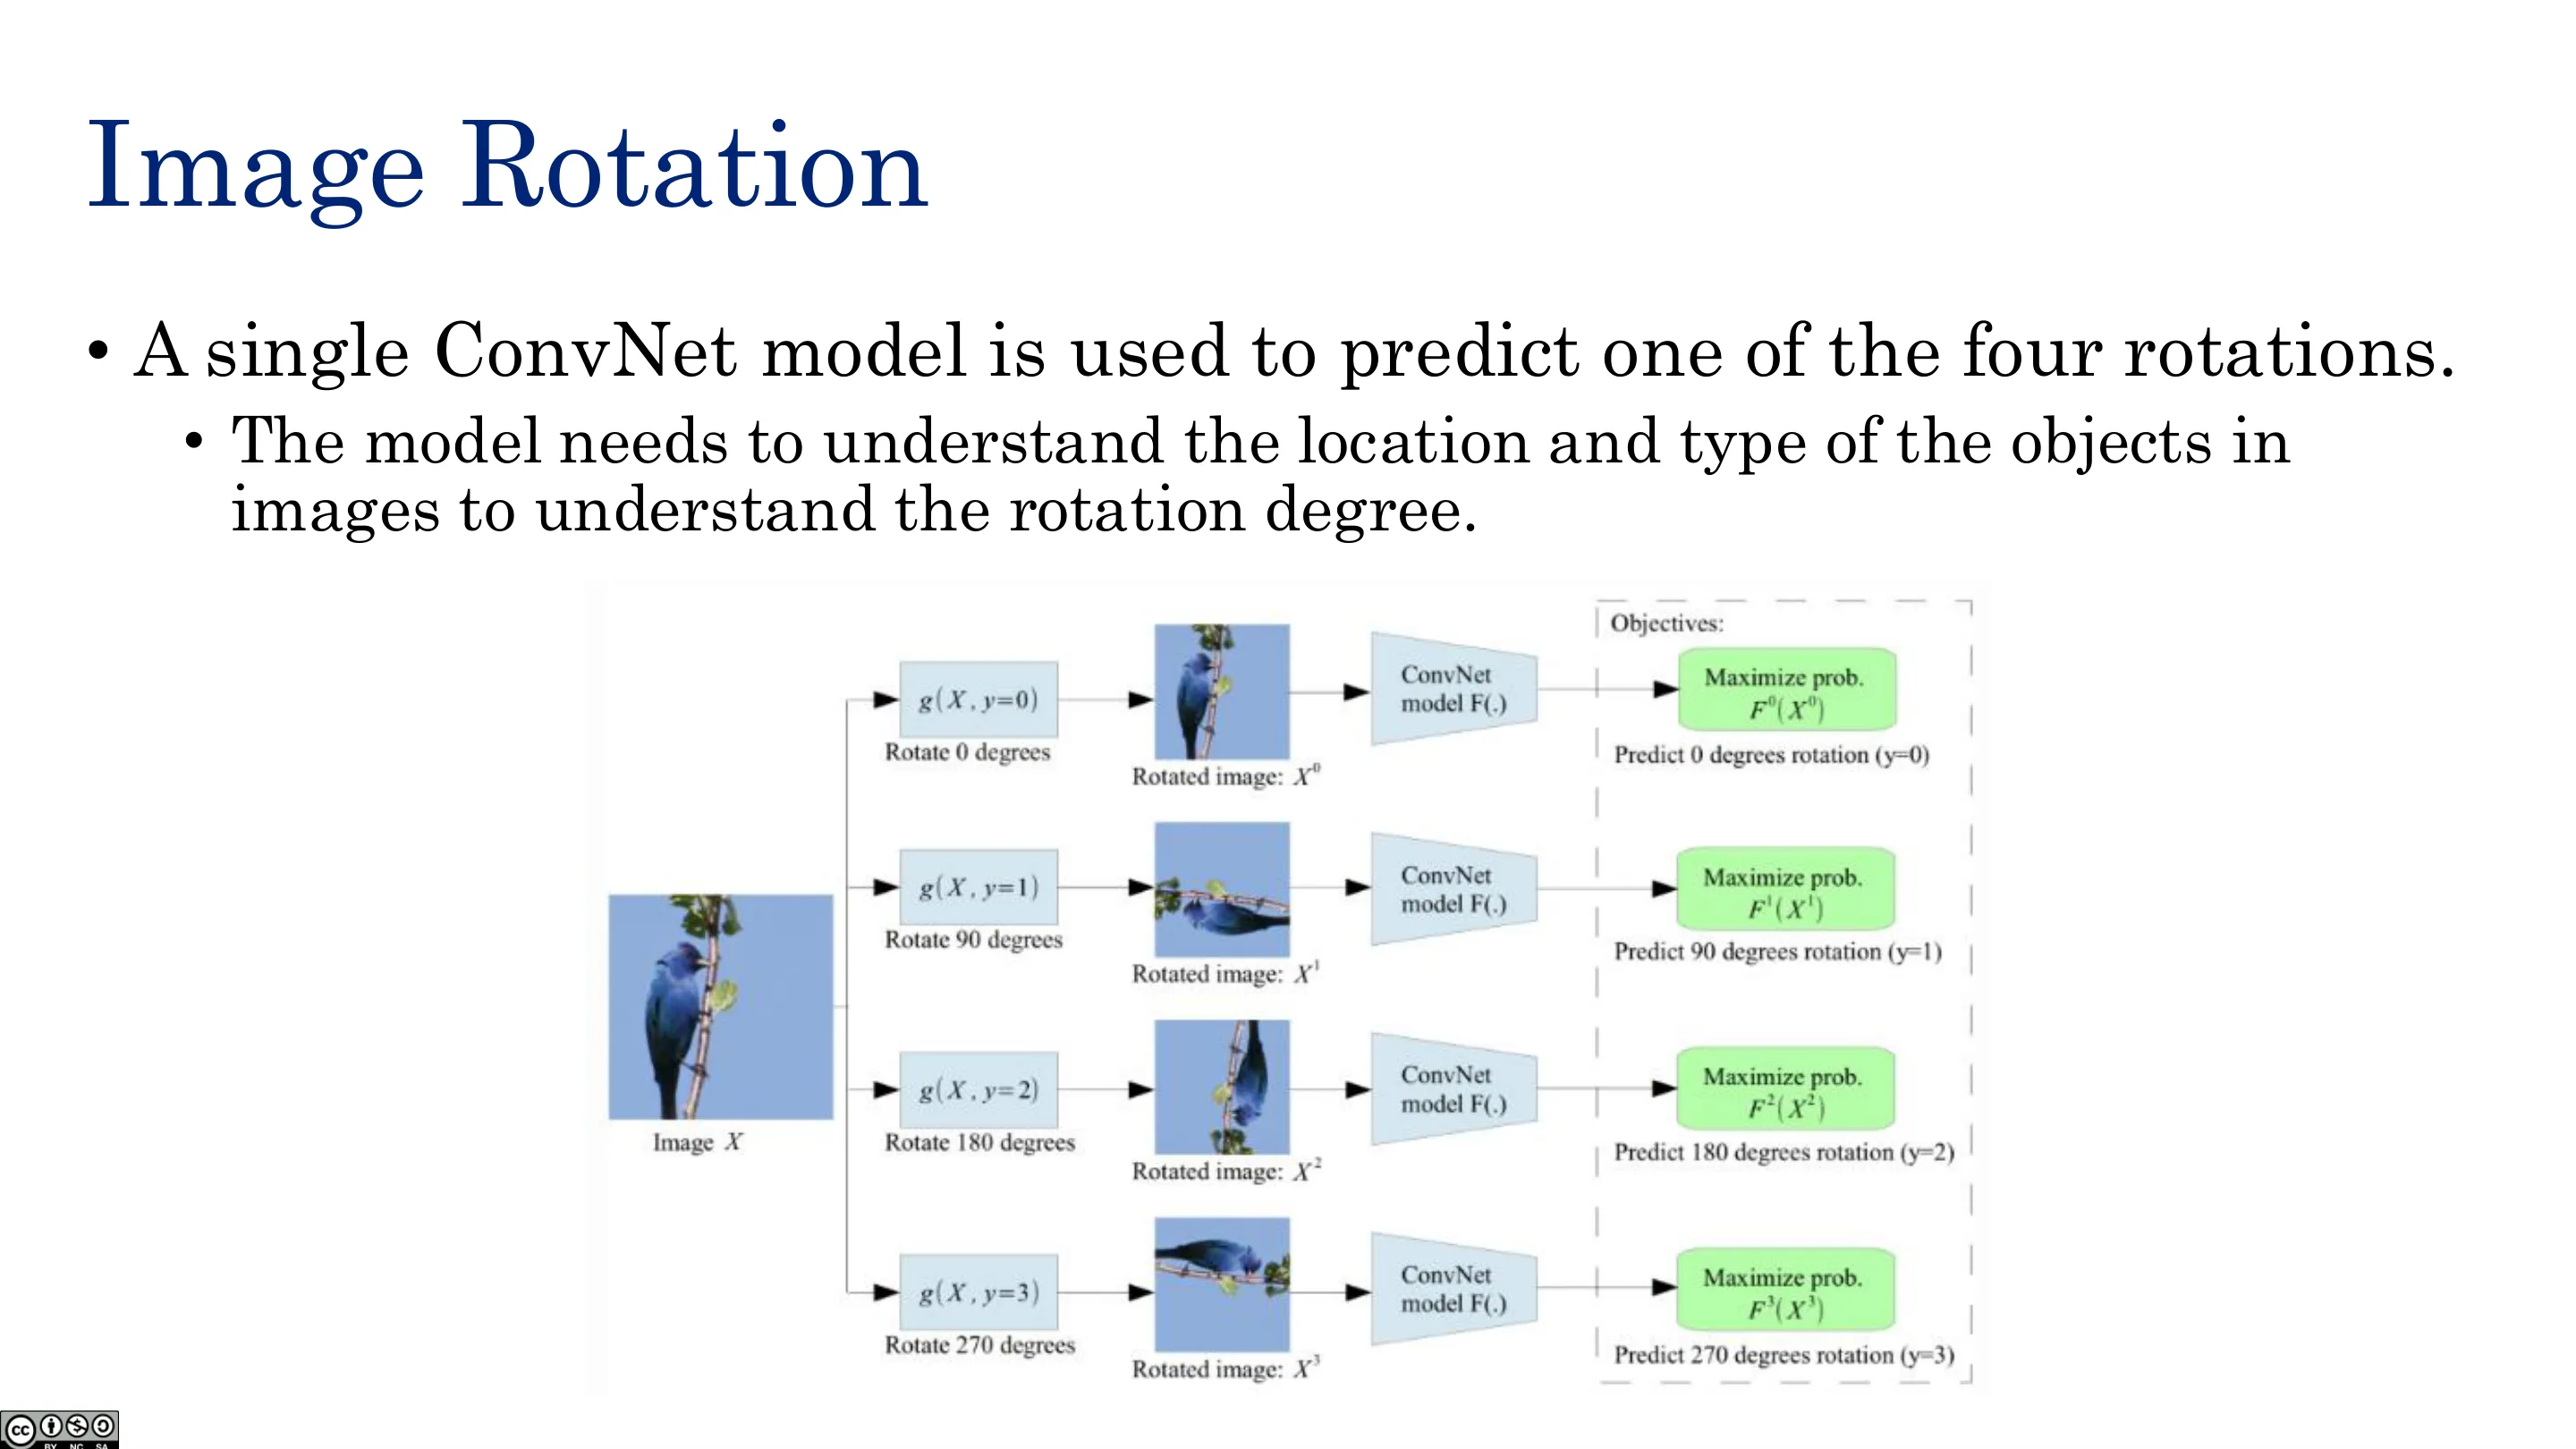
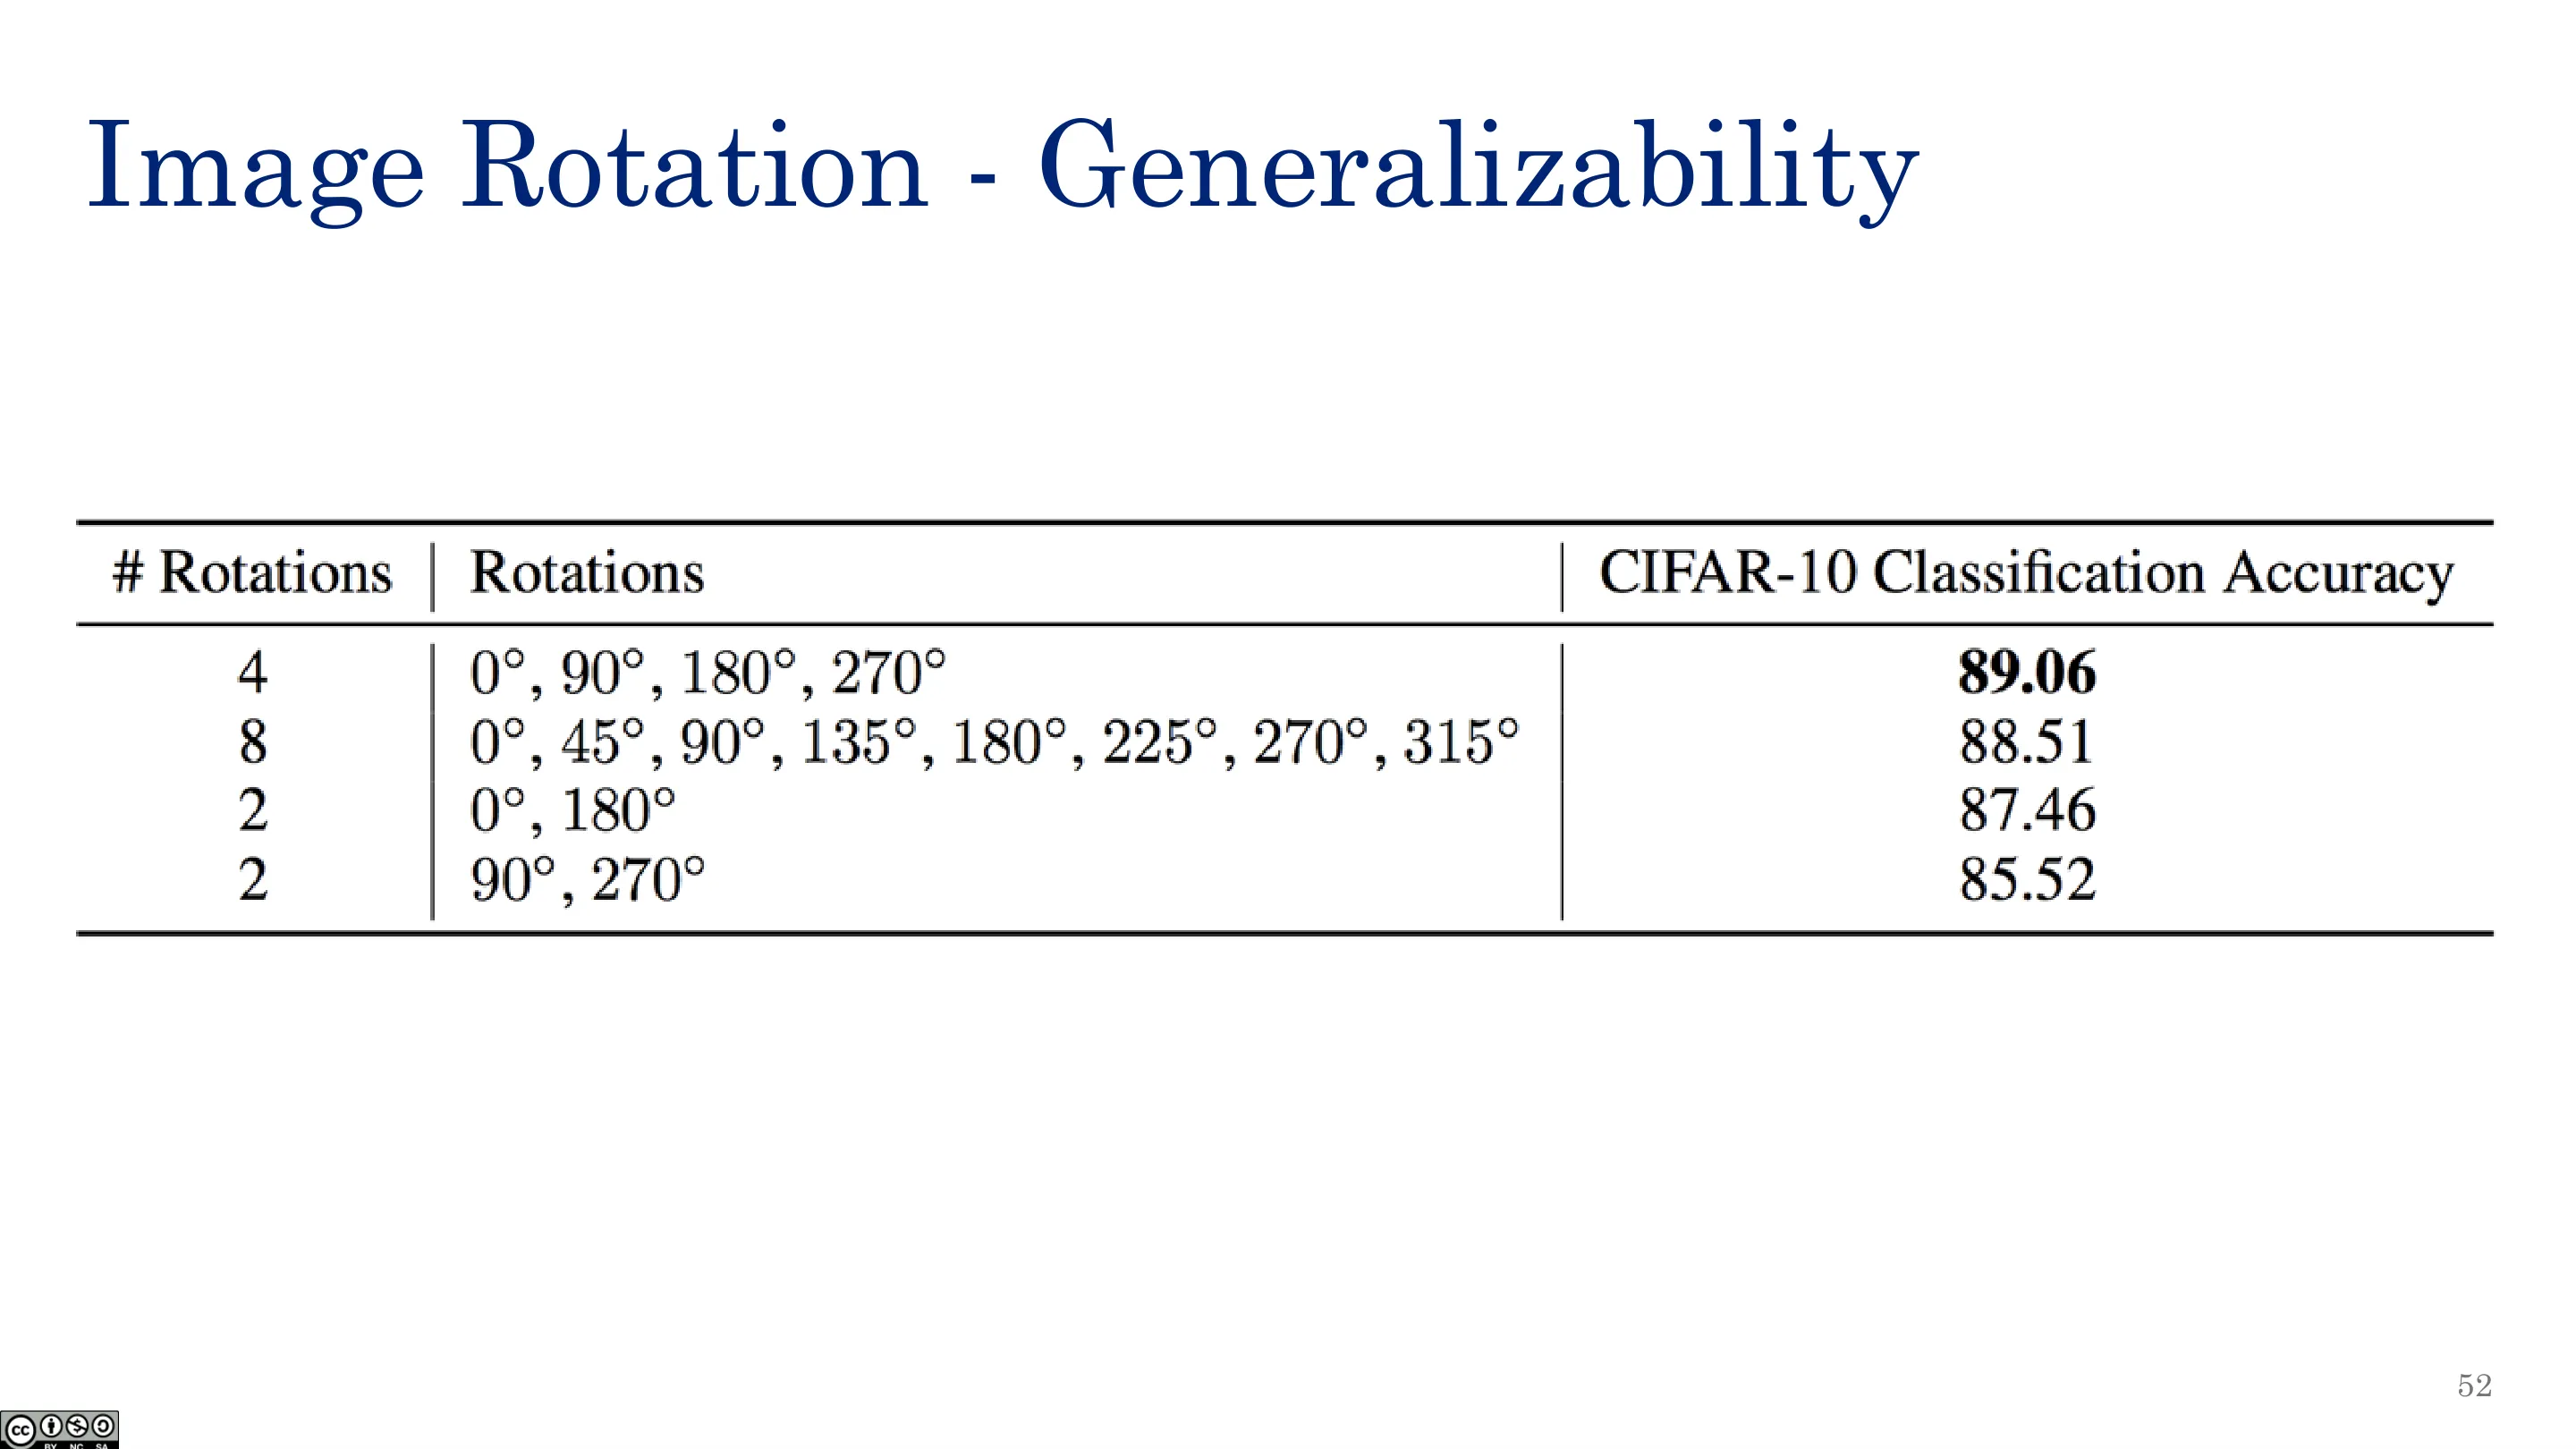
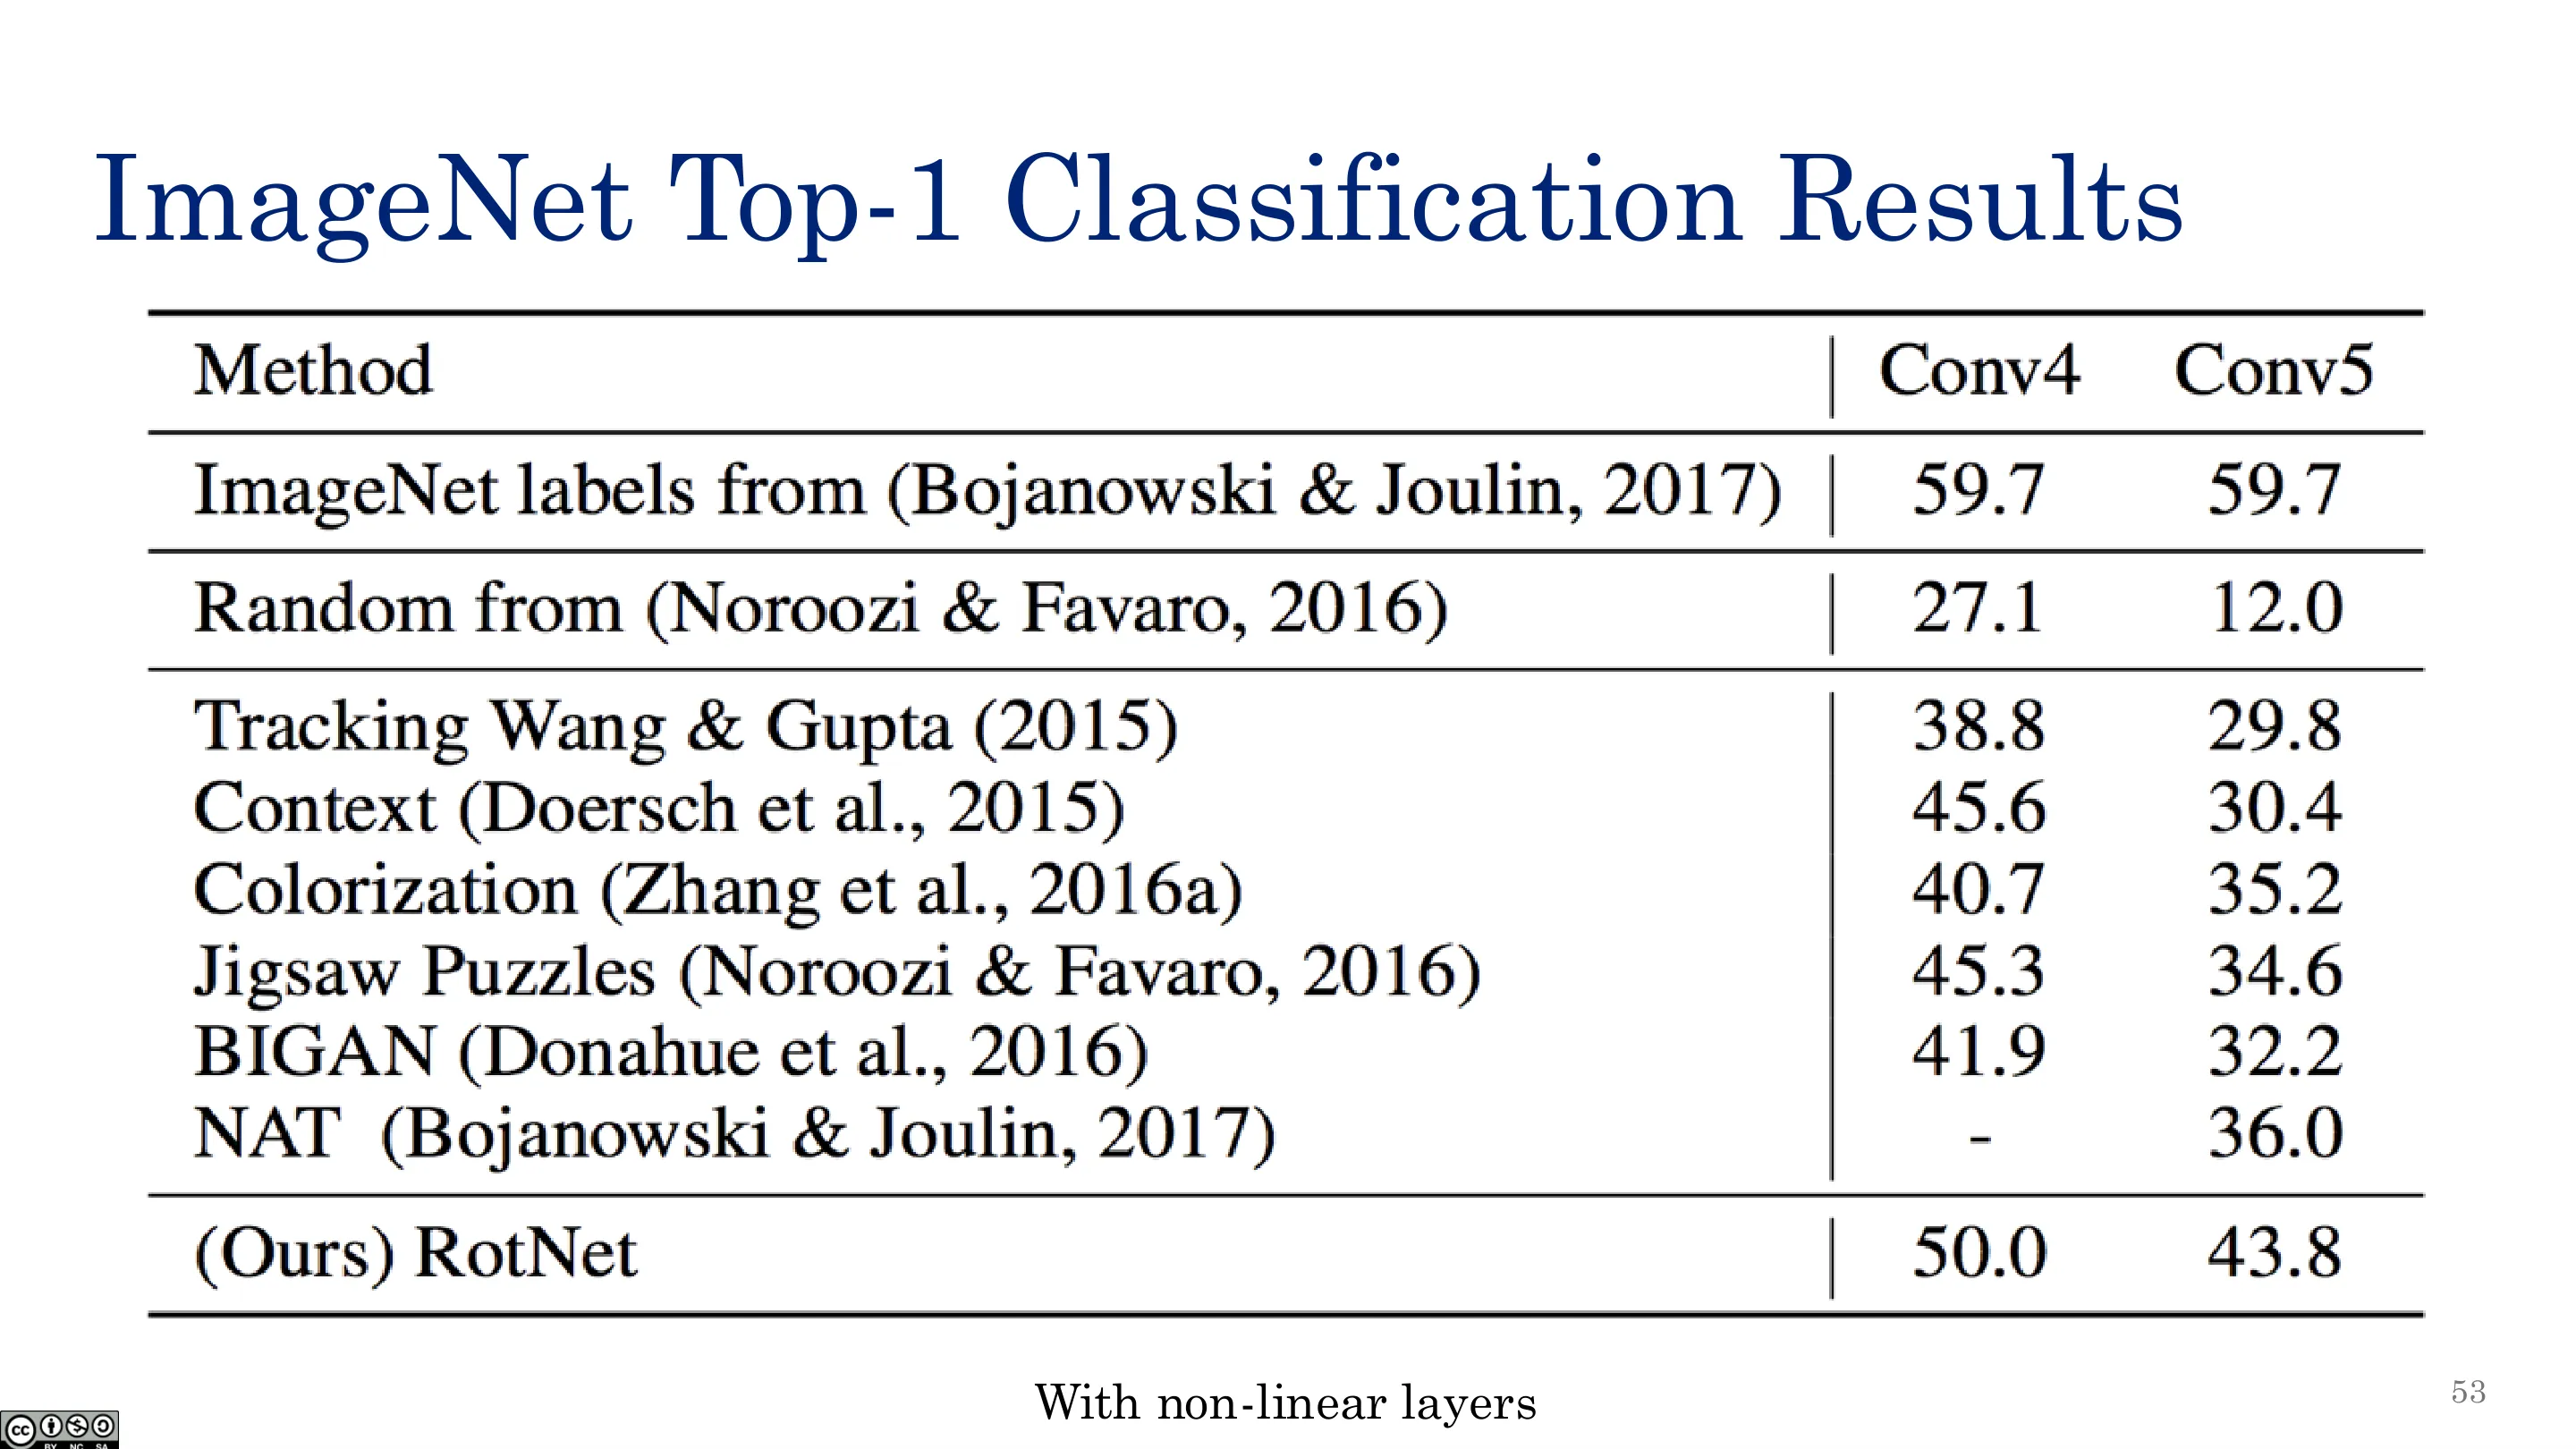
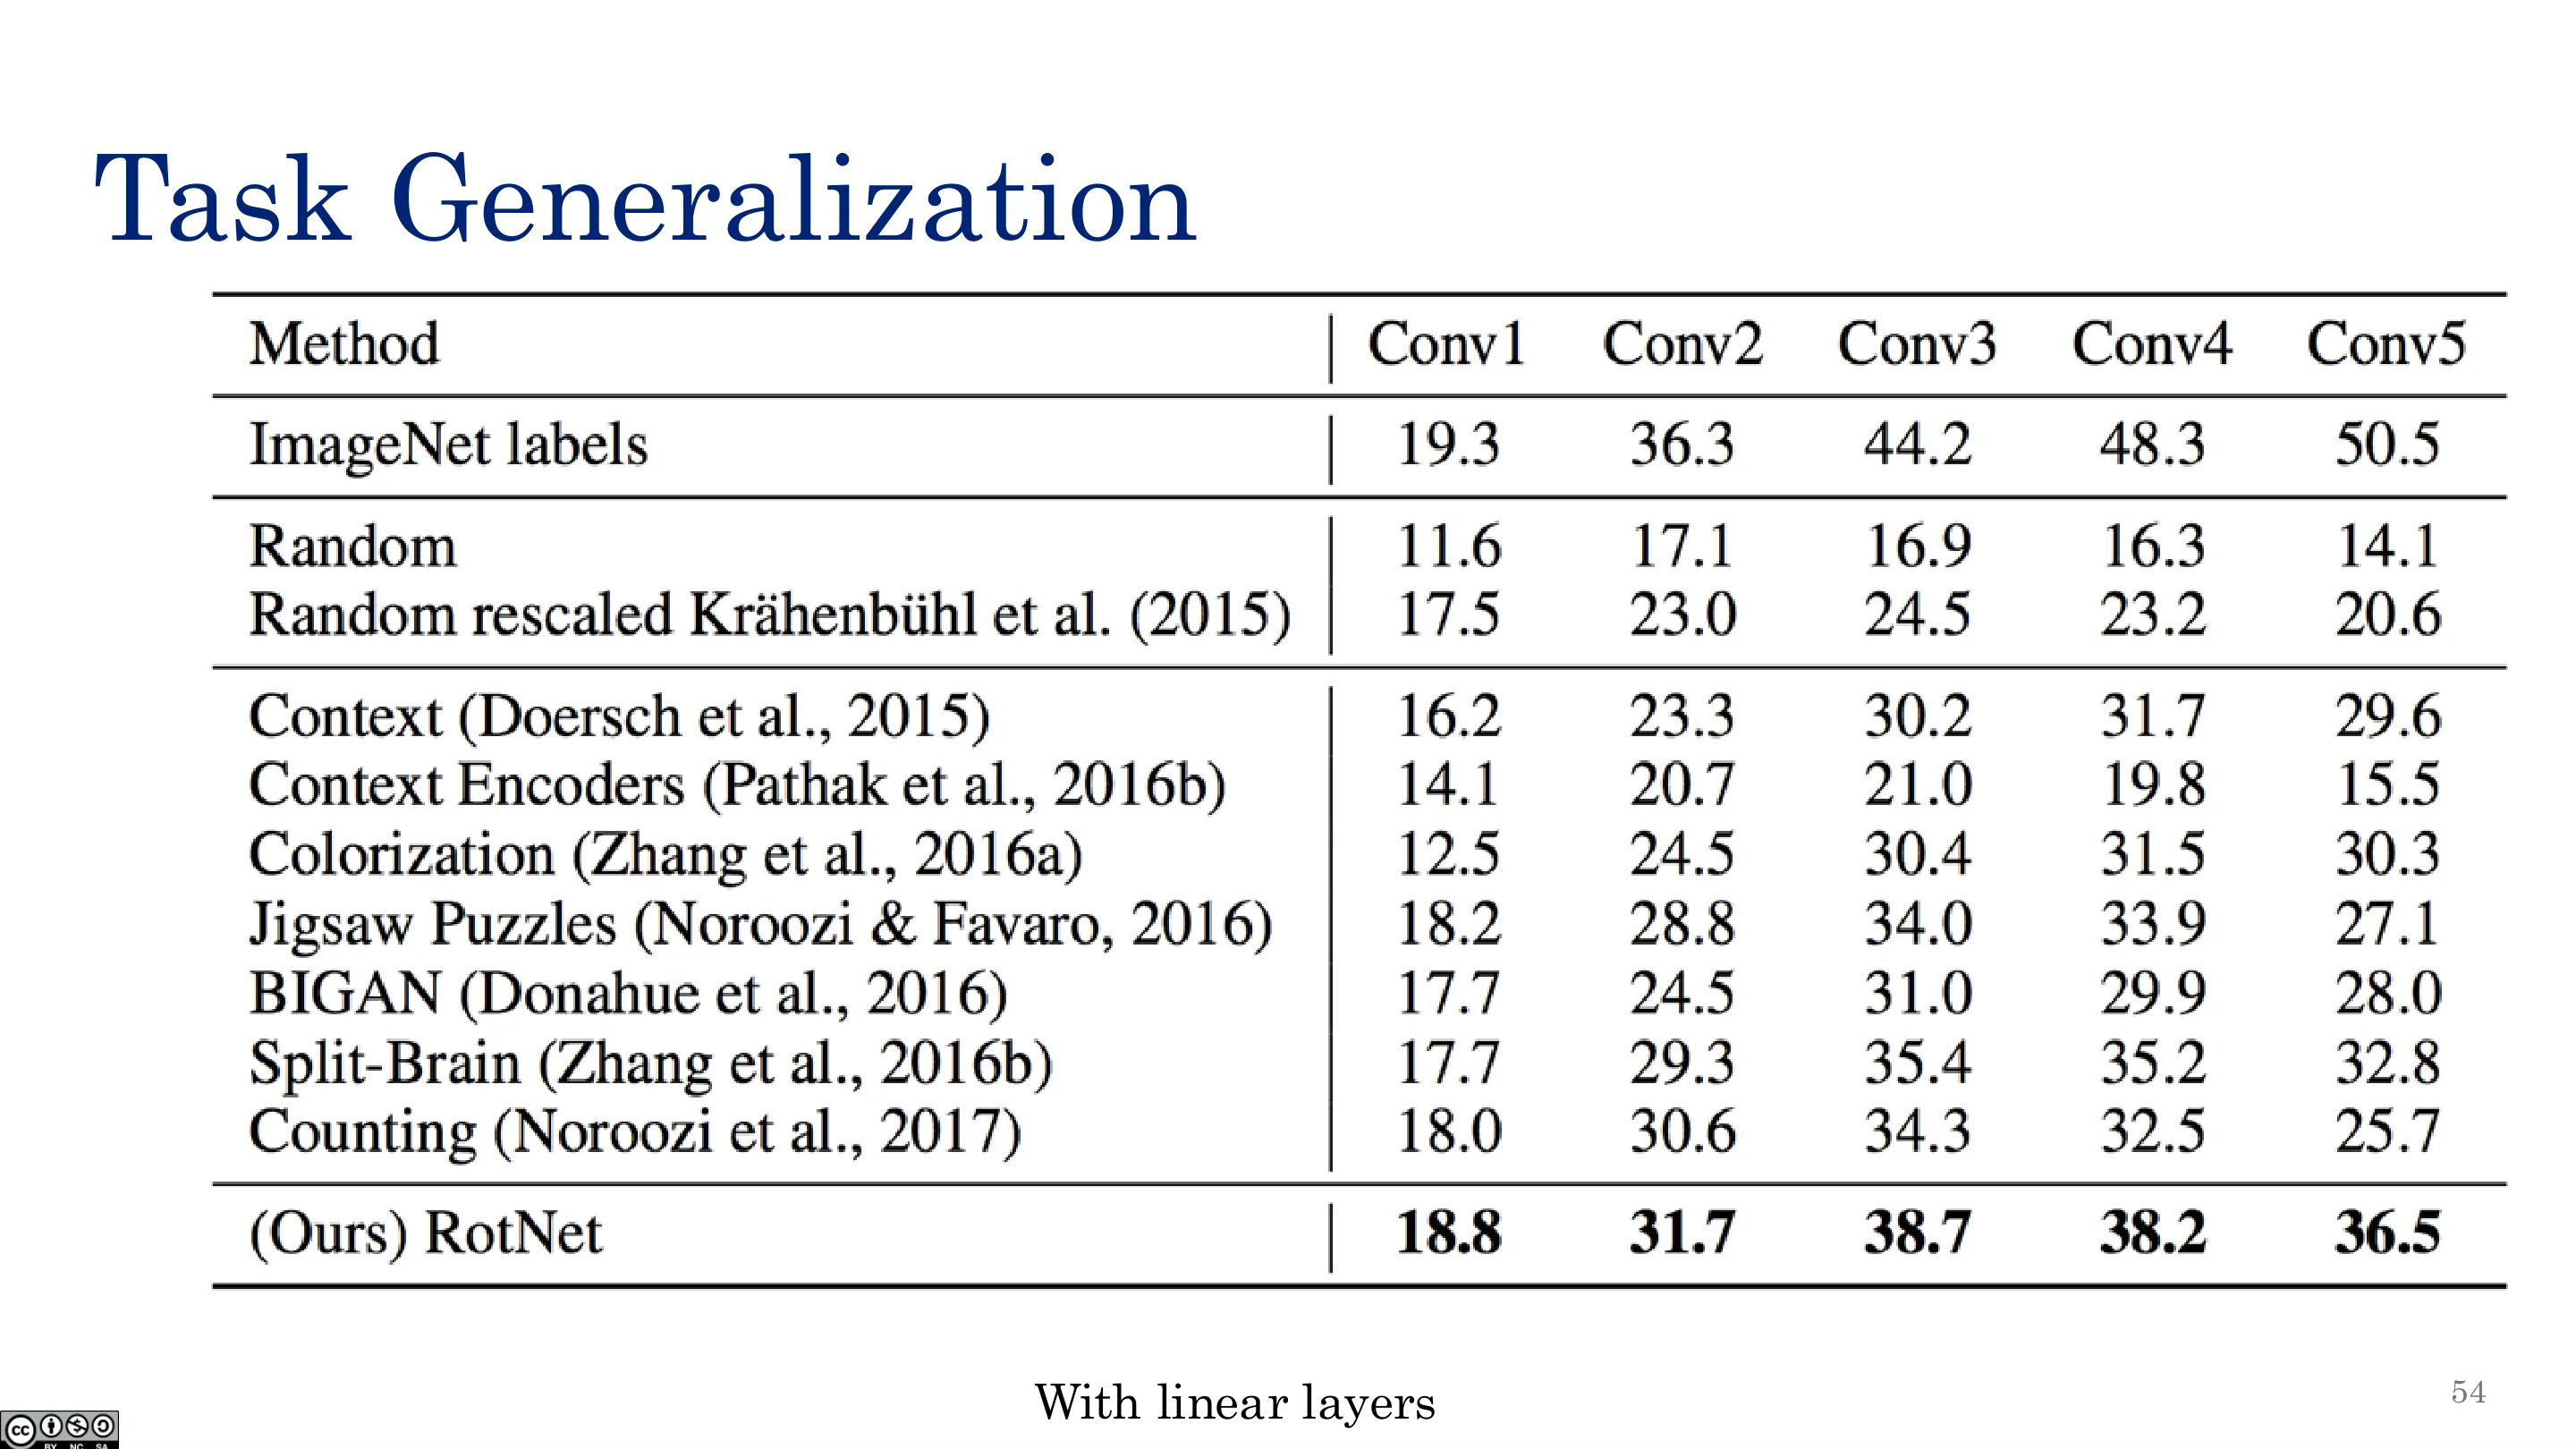
做法:对每张图随机做 $0°/90°/180°$ 旋转,标签就是旋转角度。用 CNN 提取表示 $r(x)$,与三个线性头 $w$ 做内积、softmax,用多类逻辑回归训练——可生成无限数据。
关键点:旋转任务本身无用,但训练出的 $r(x)$ 是好的图像表示;于是丢弃线性头,把 $r(x)$ 当特征做下游任务(如区分角鸮 vs 白头海雕)。这就是自监督的"魔法"。
📷 图像旋转(一)
回到原视频 (00:59:57)
📷 图像旋转(二)
回到原视频 (01:01:10)
📷 图像旋转:泛化性
回到原视频 (01:02:23)
📷 ImageNet Top-1 分类结果
回到原视频 (01:03:36)
📷 任务泛化
回到原视频 (01:04:49)
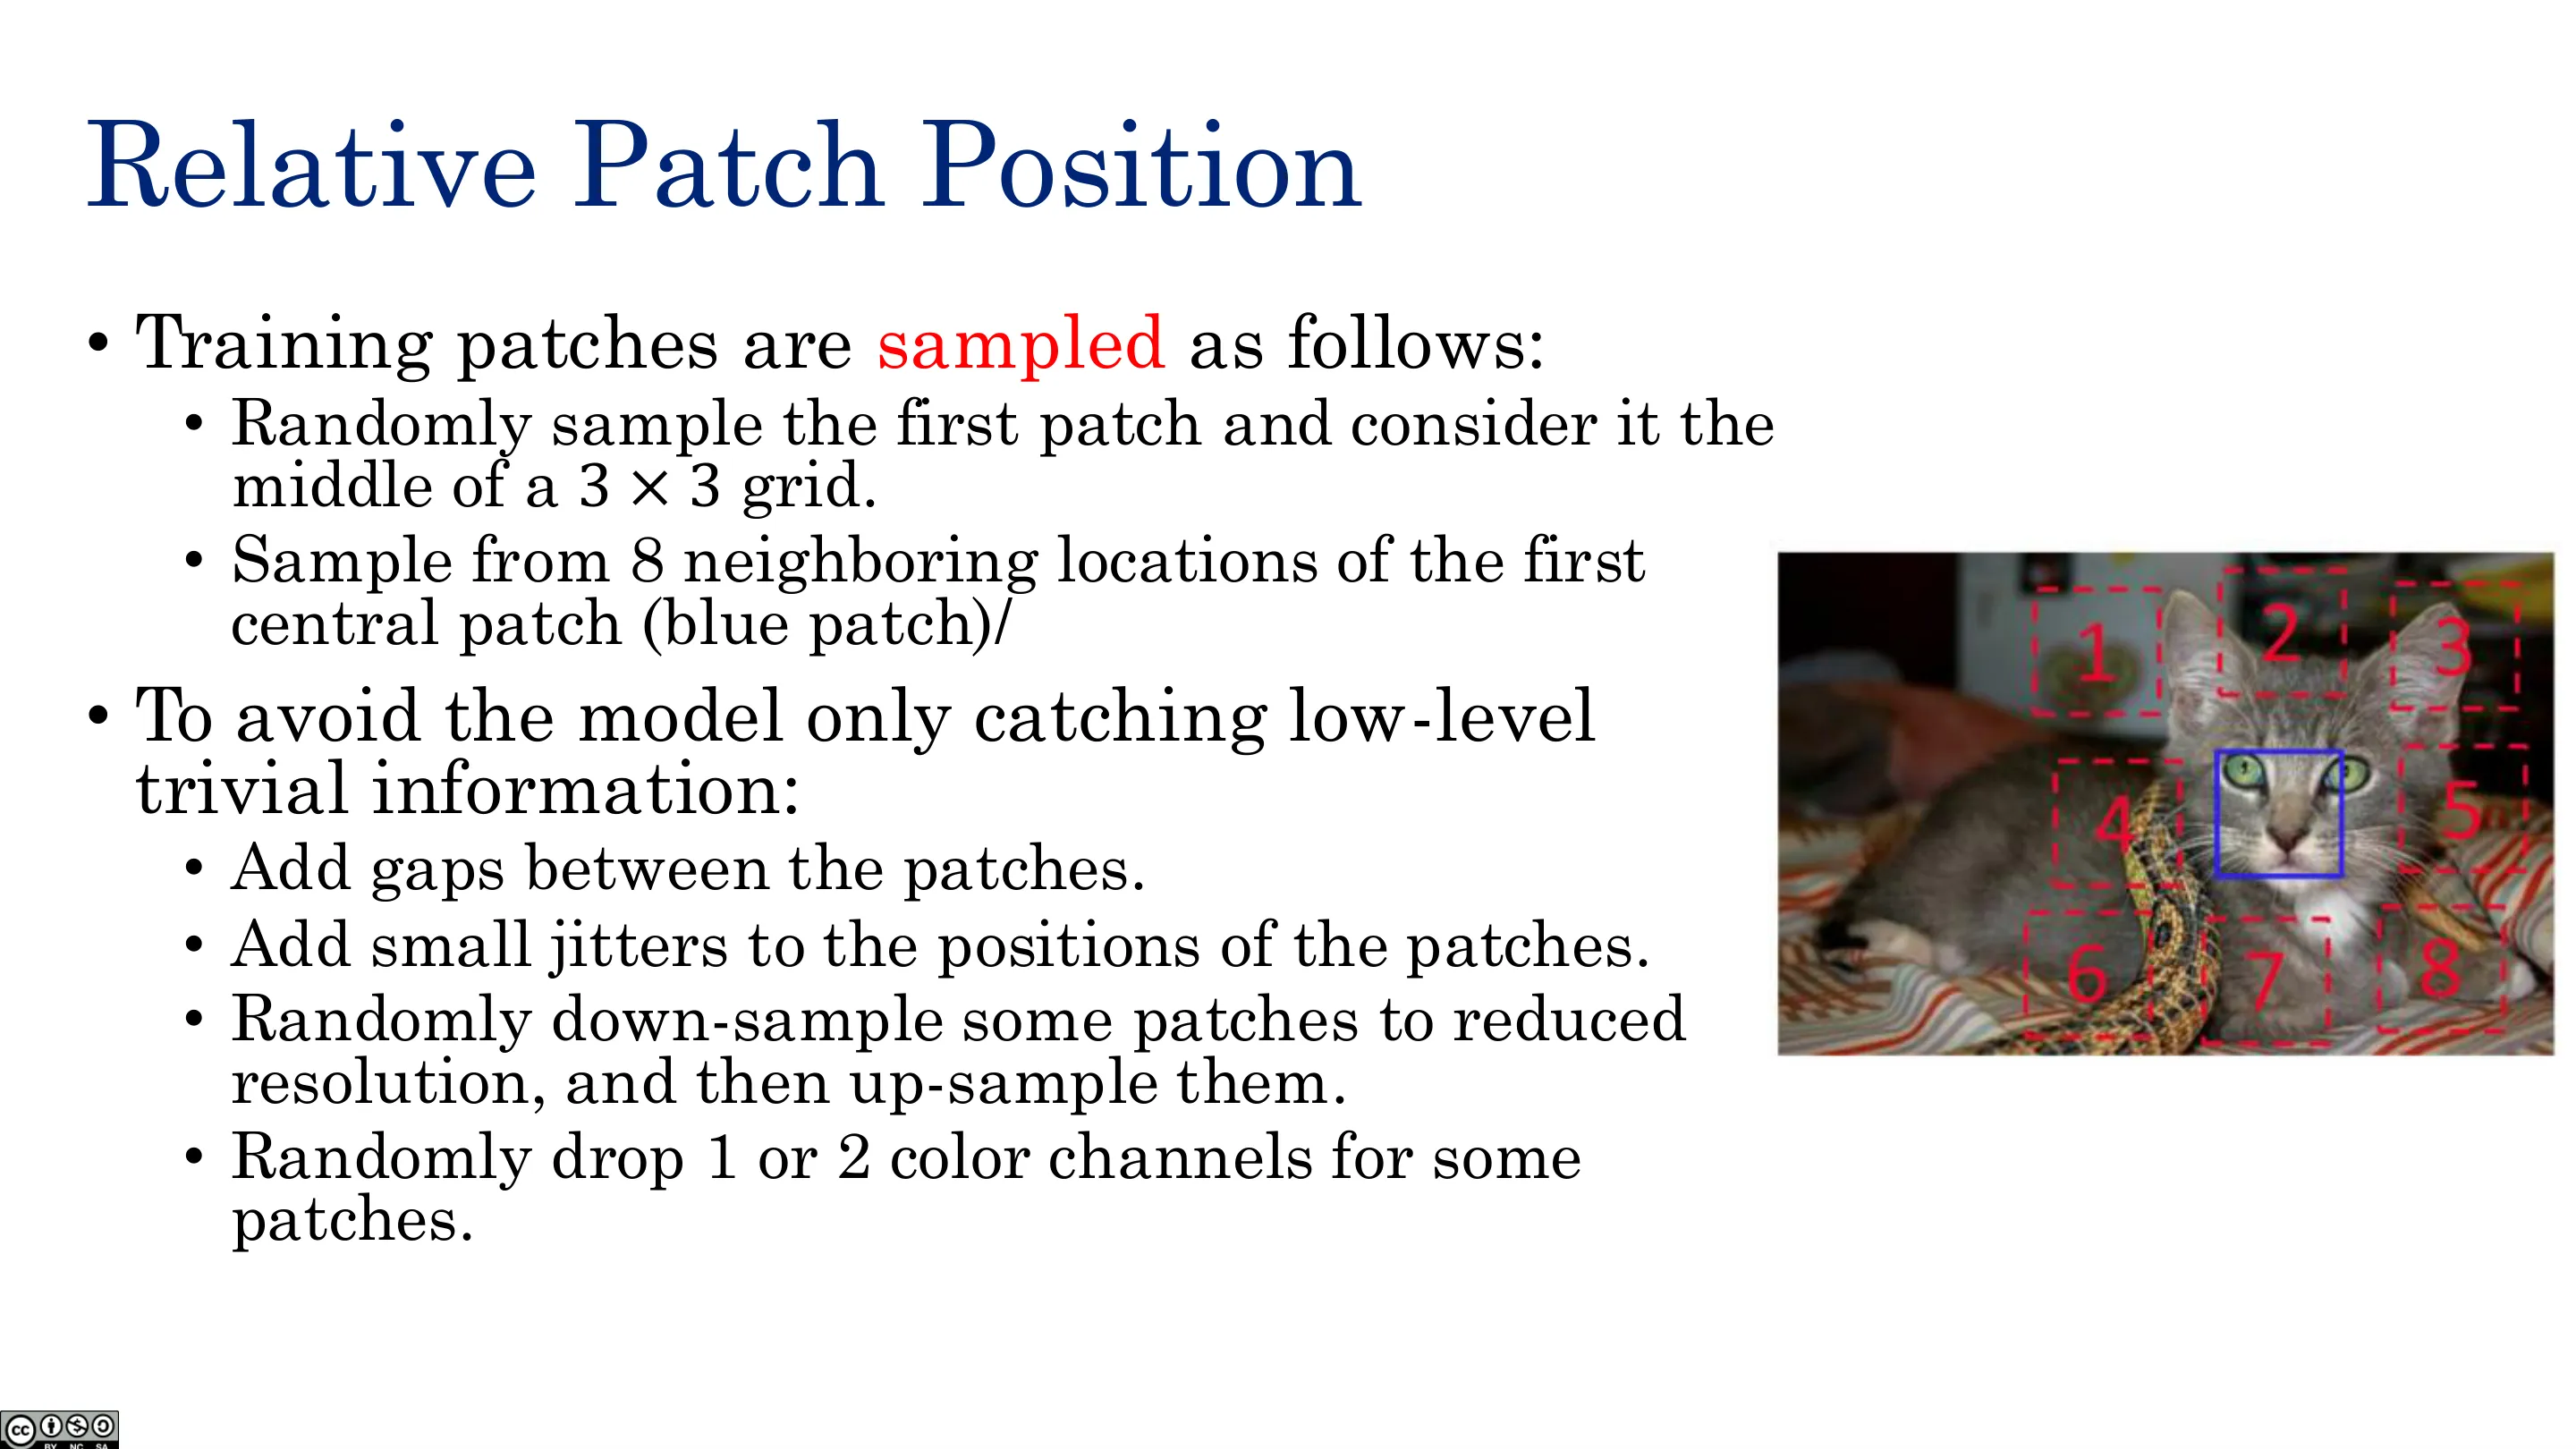
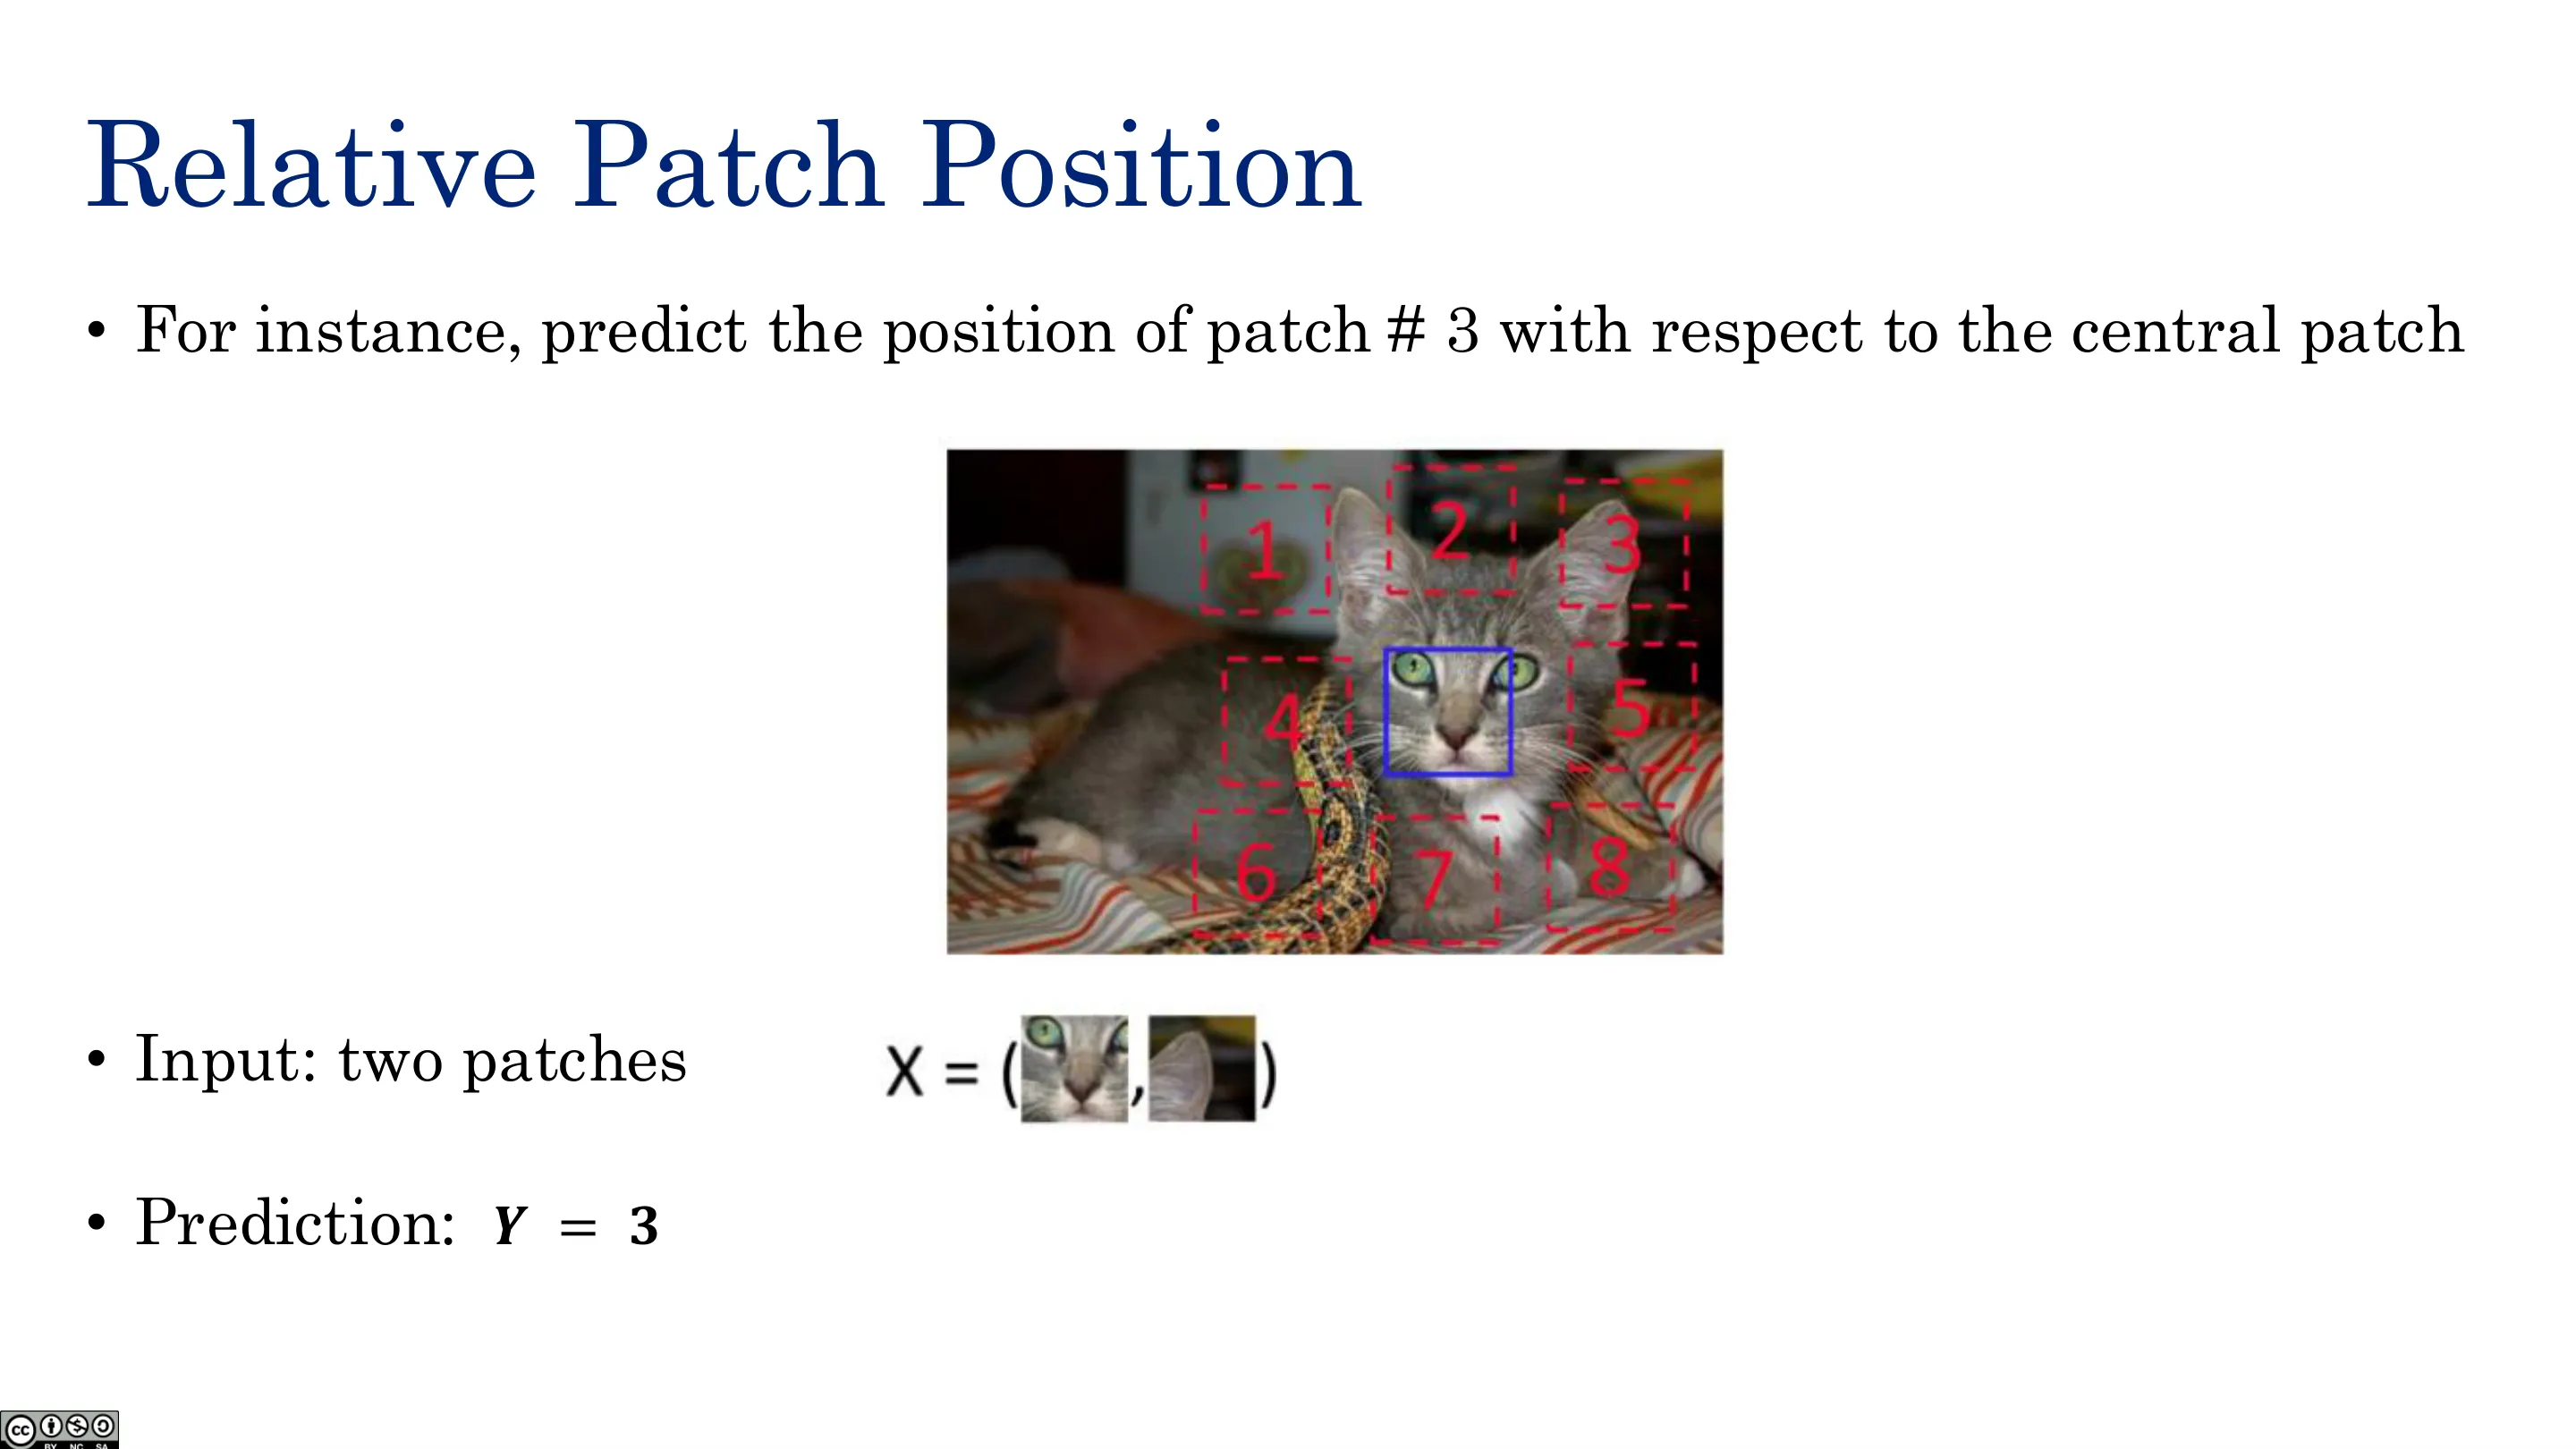
3.2 相对 Patch 位置(Relative Patch Position)
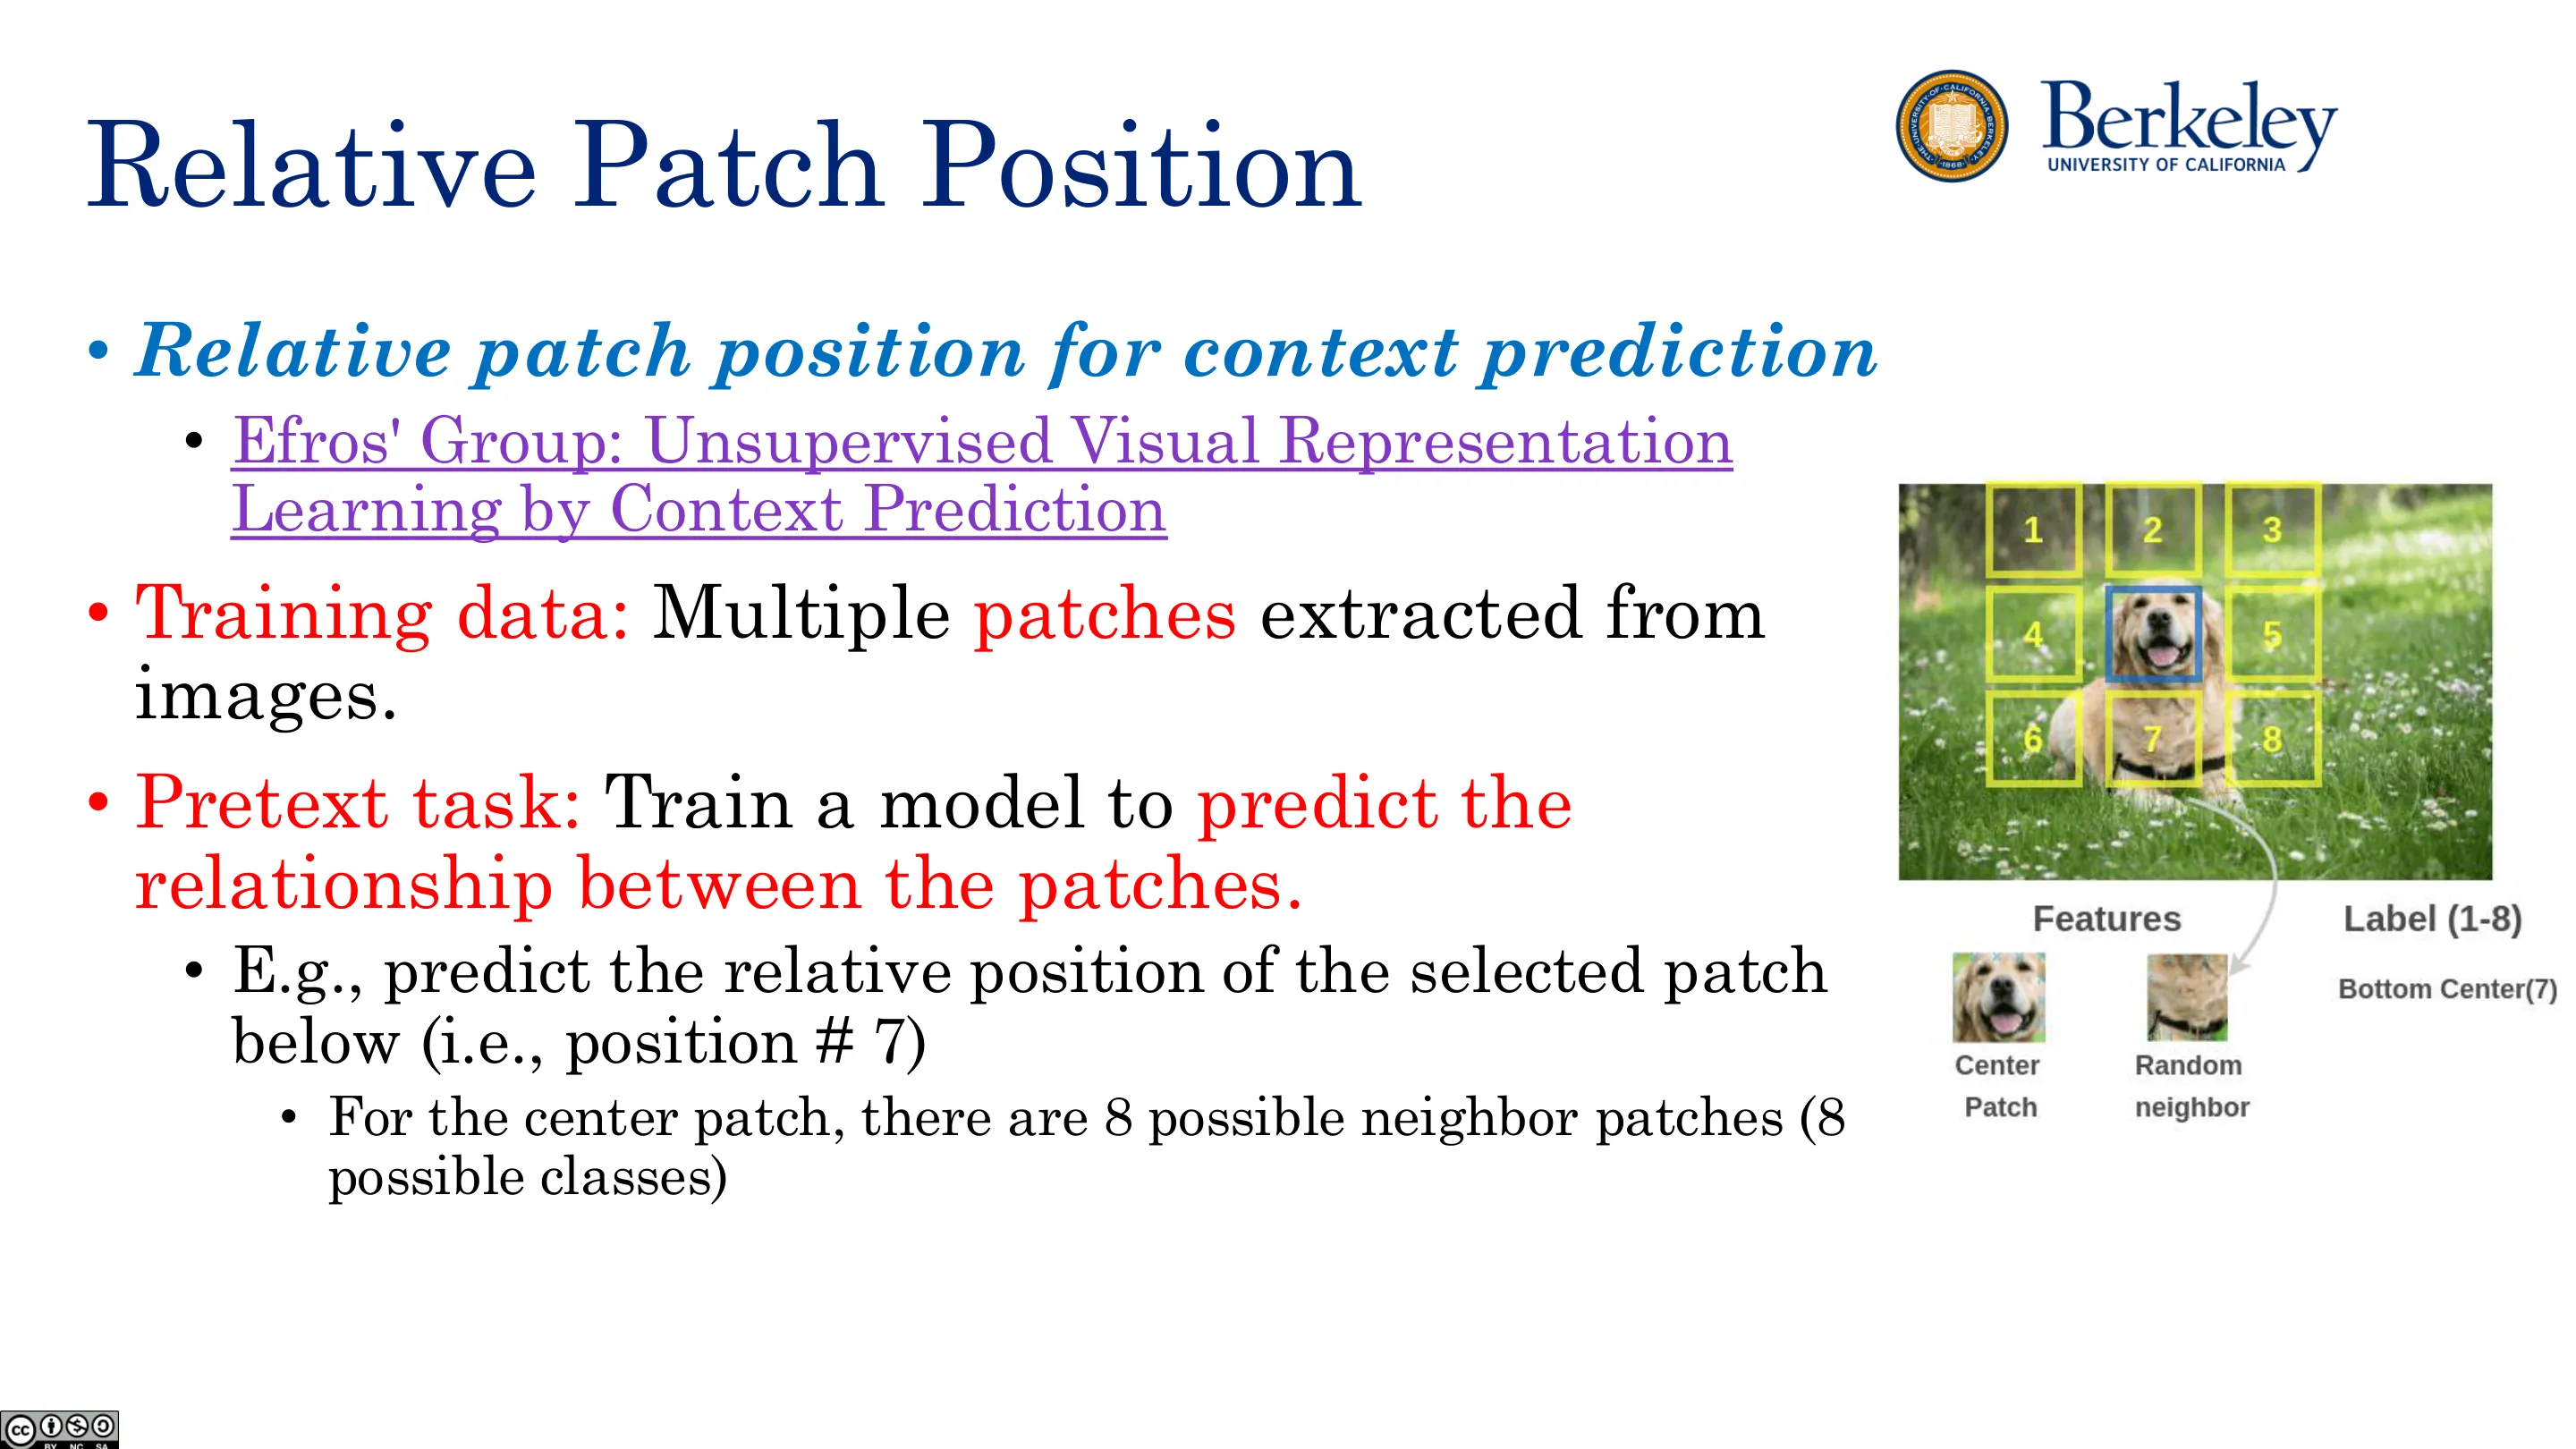
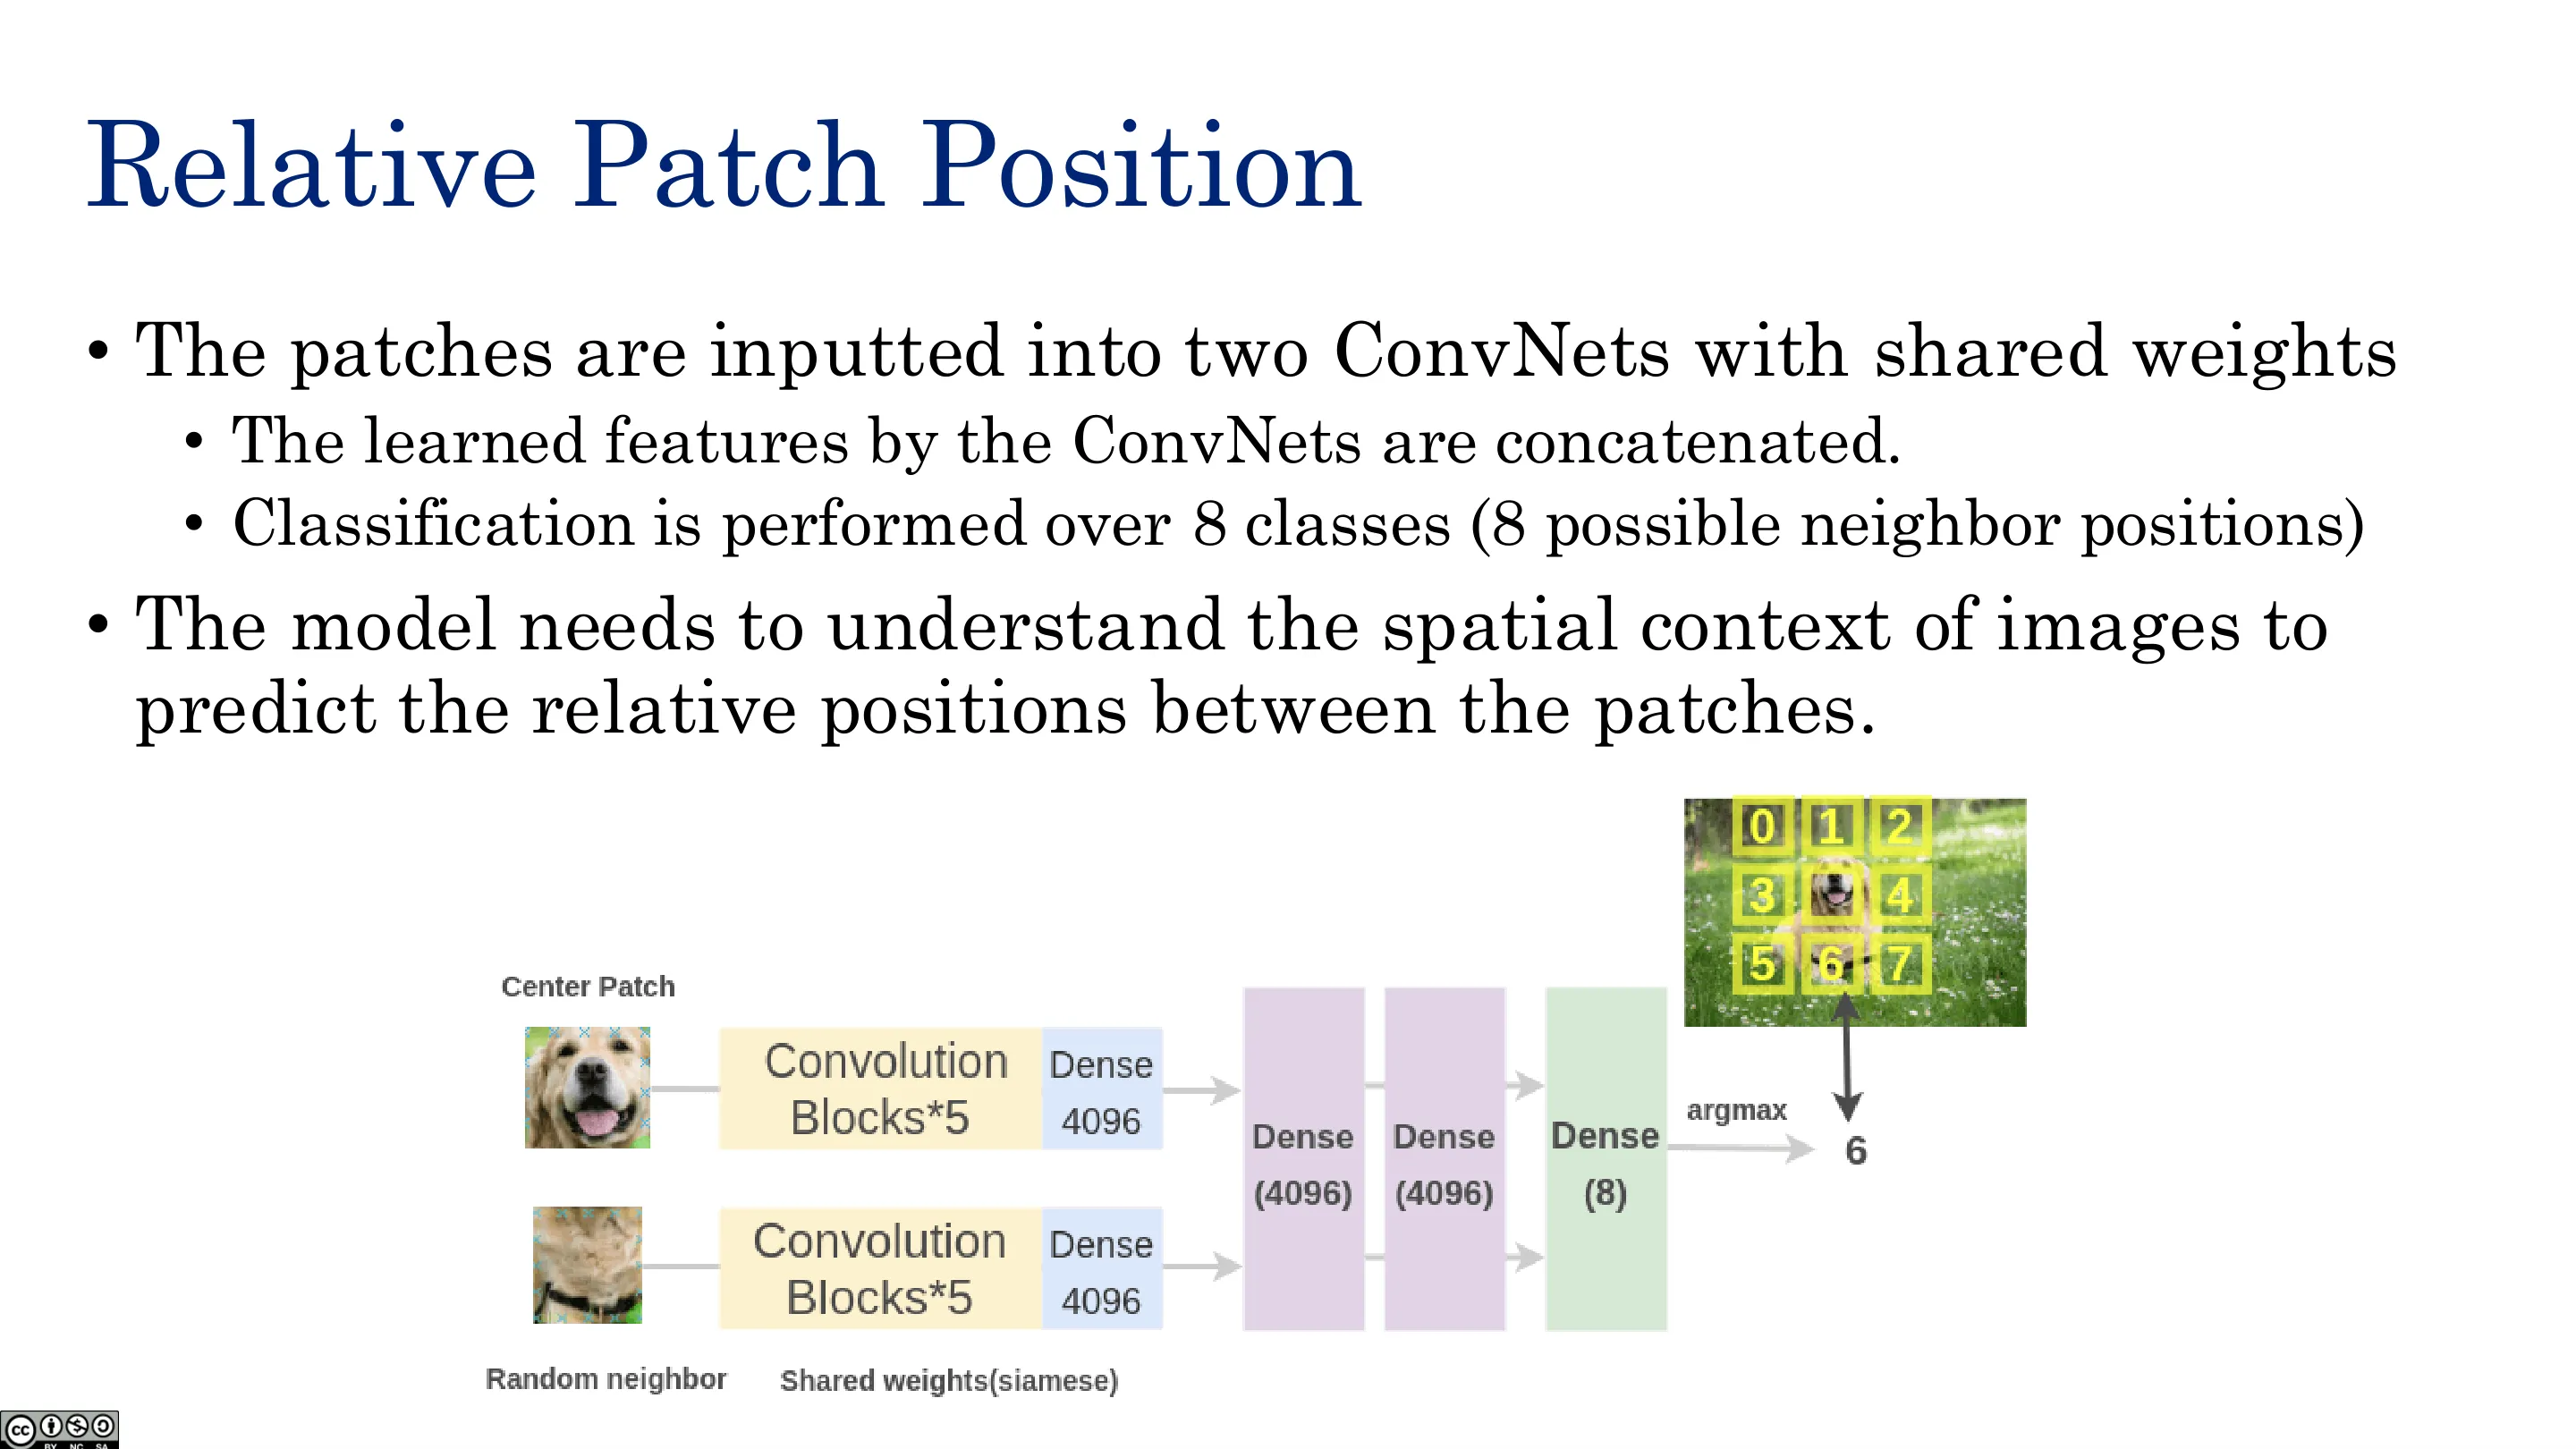
Pretext 任务:给两个图像块,预测第二个相对第一个的方位(上/下/左/右……)。
📷 相对 Patch 位置(一)
回到原视频 (01:06:02)
📷 相对 Patch 位置(二)
回到原视频 (01:07:15)
📷 相对 Patch 位置(三)
回到原视频 (01:08:28)
📷 相对 Patch 位置(四)
回到原视频 (01:09:41)
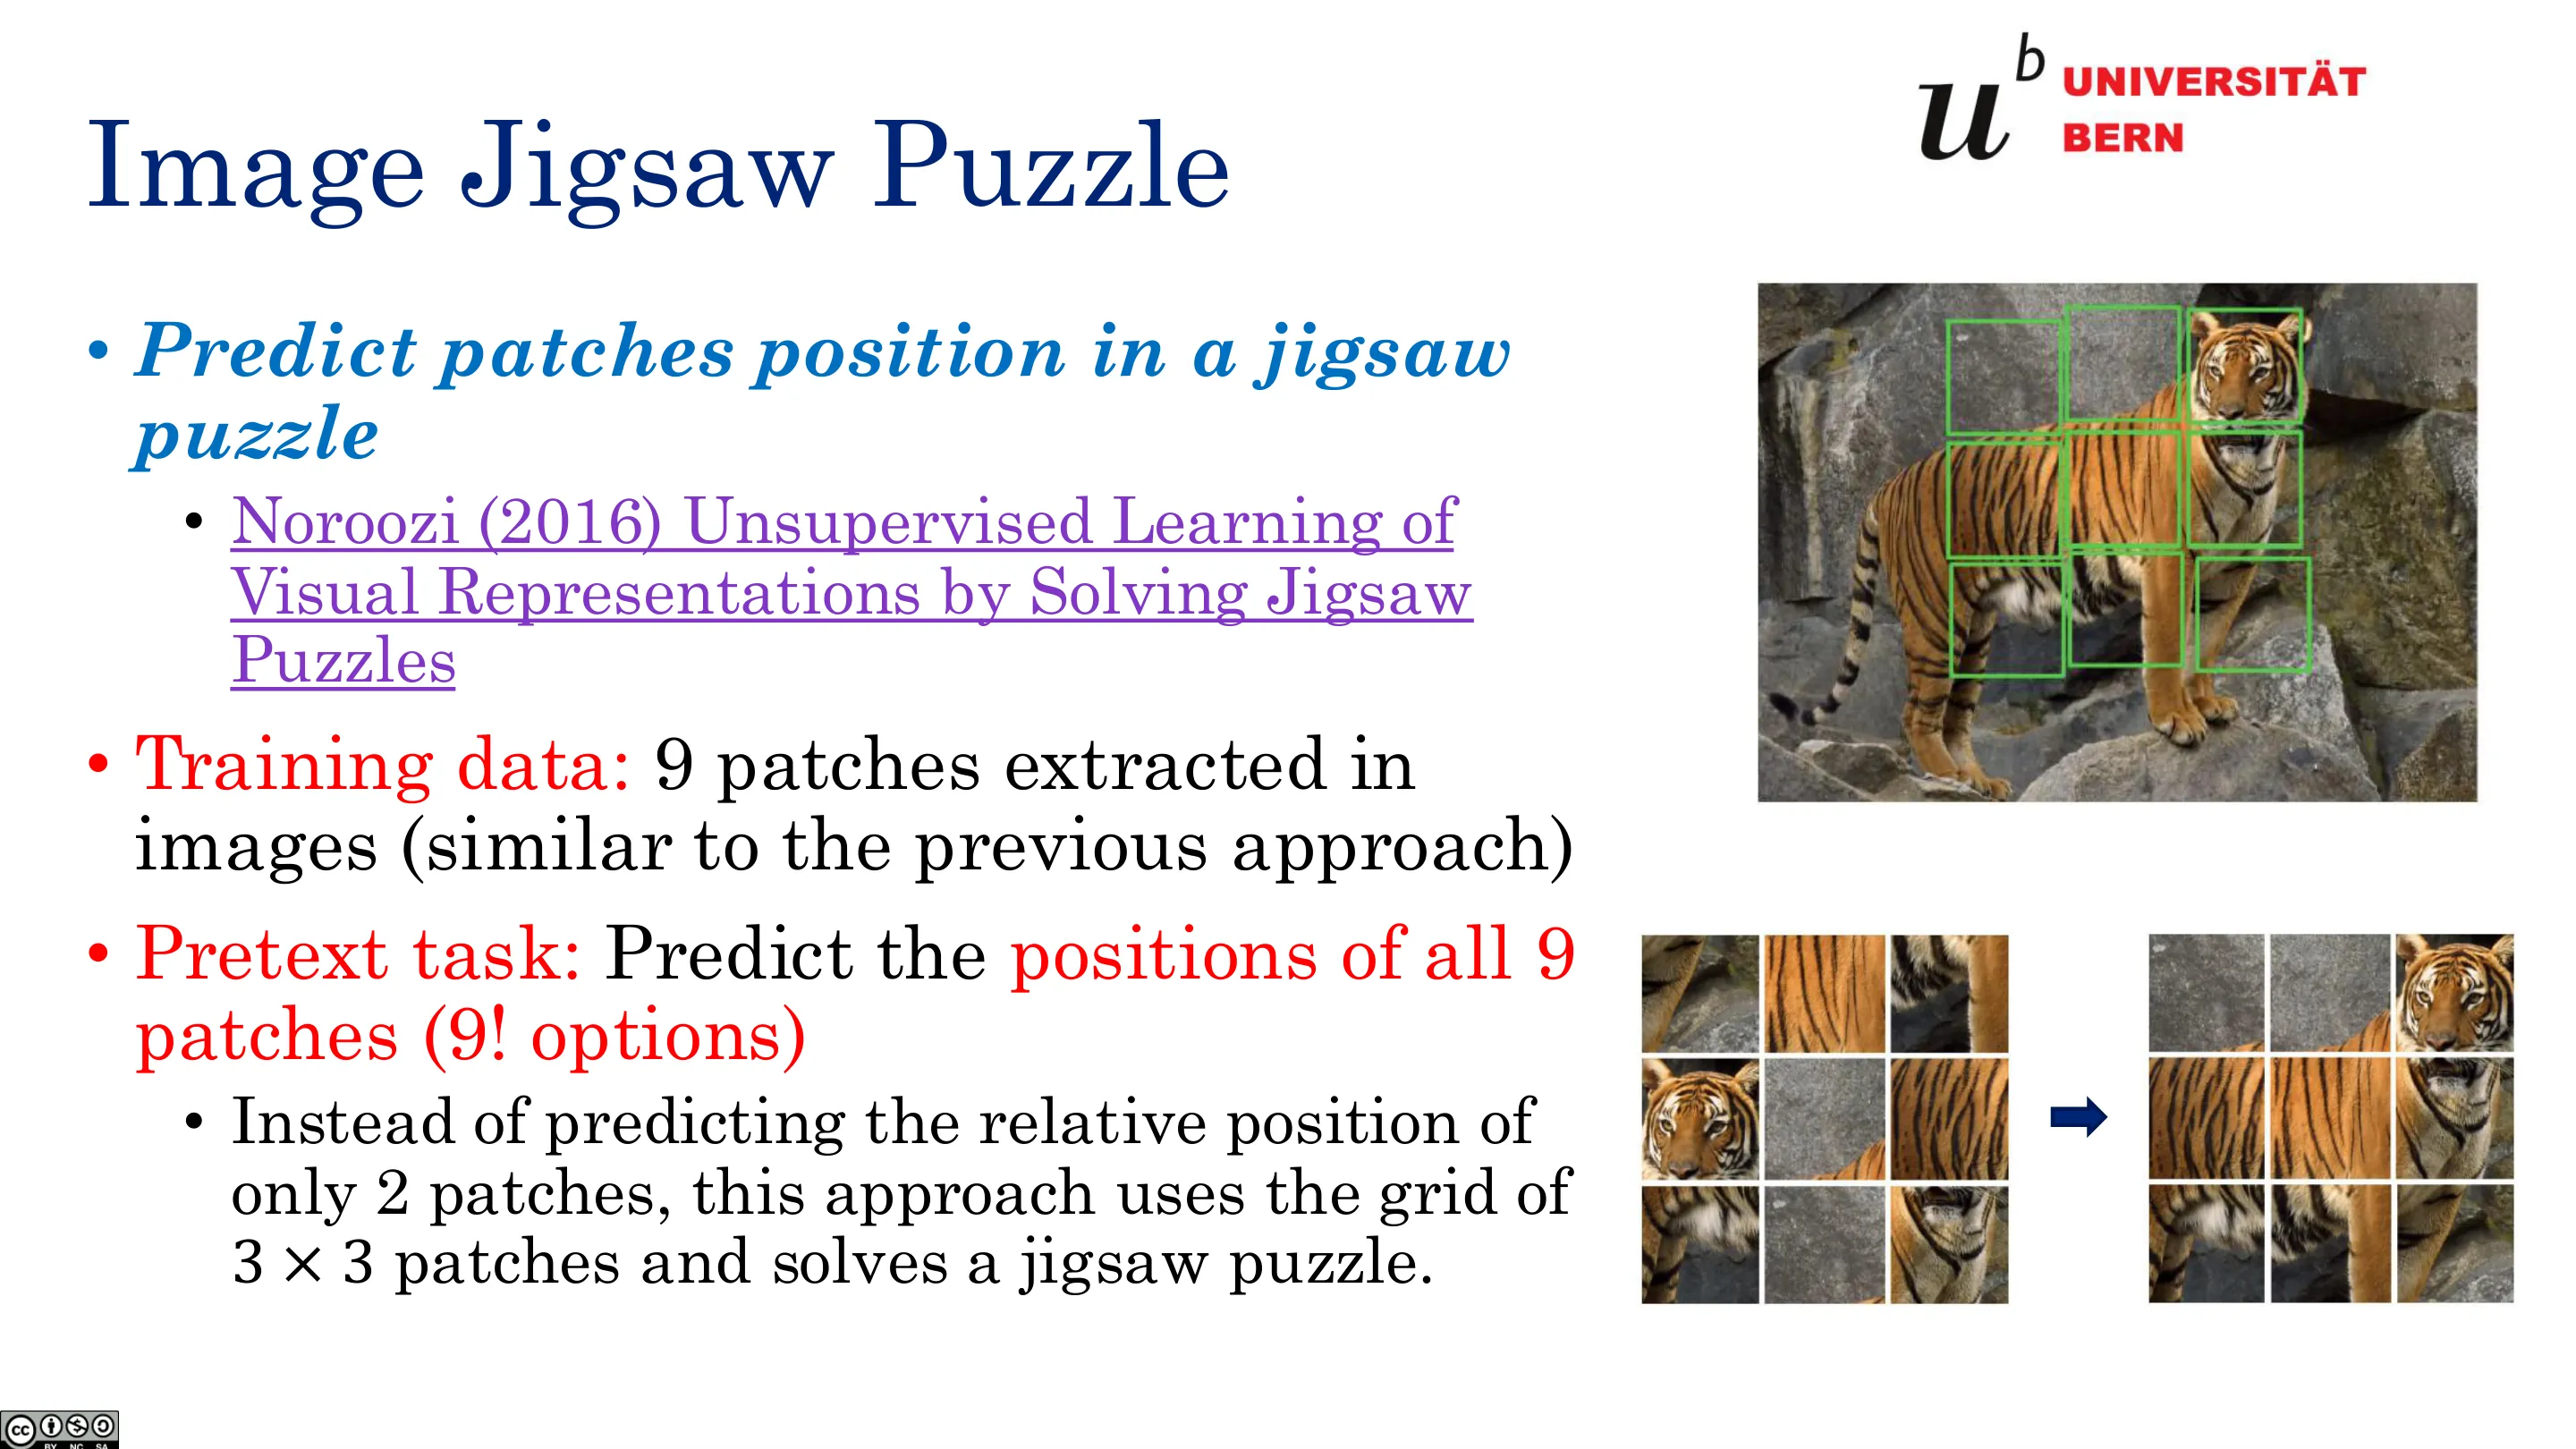
3.3 图像拼图(Jigsaw Puzzle)
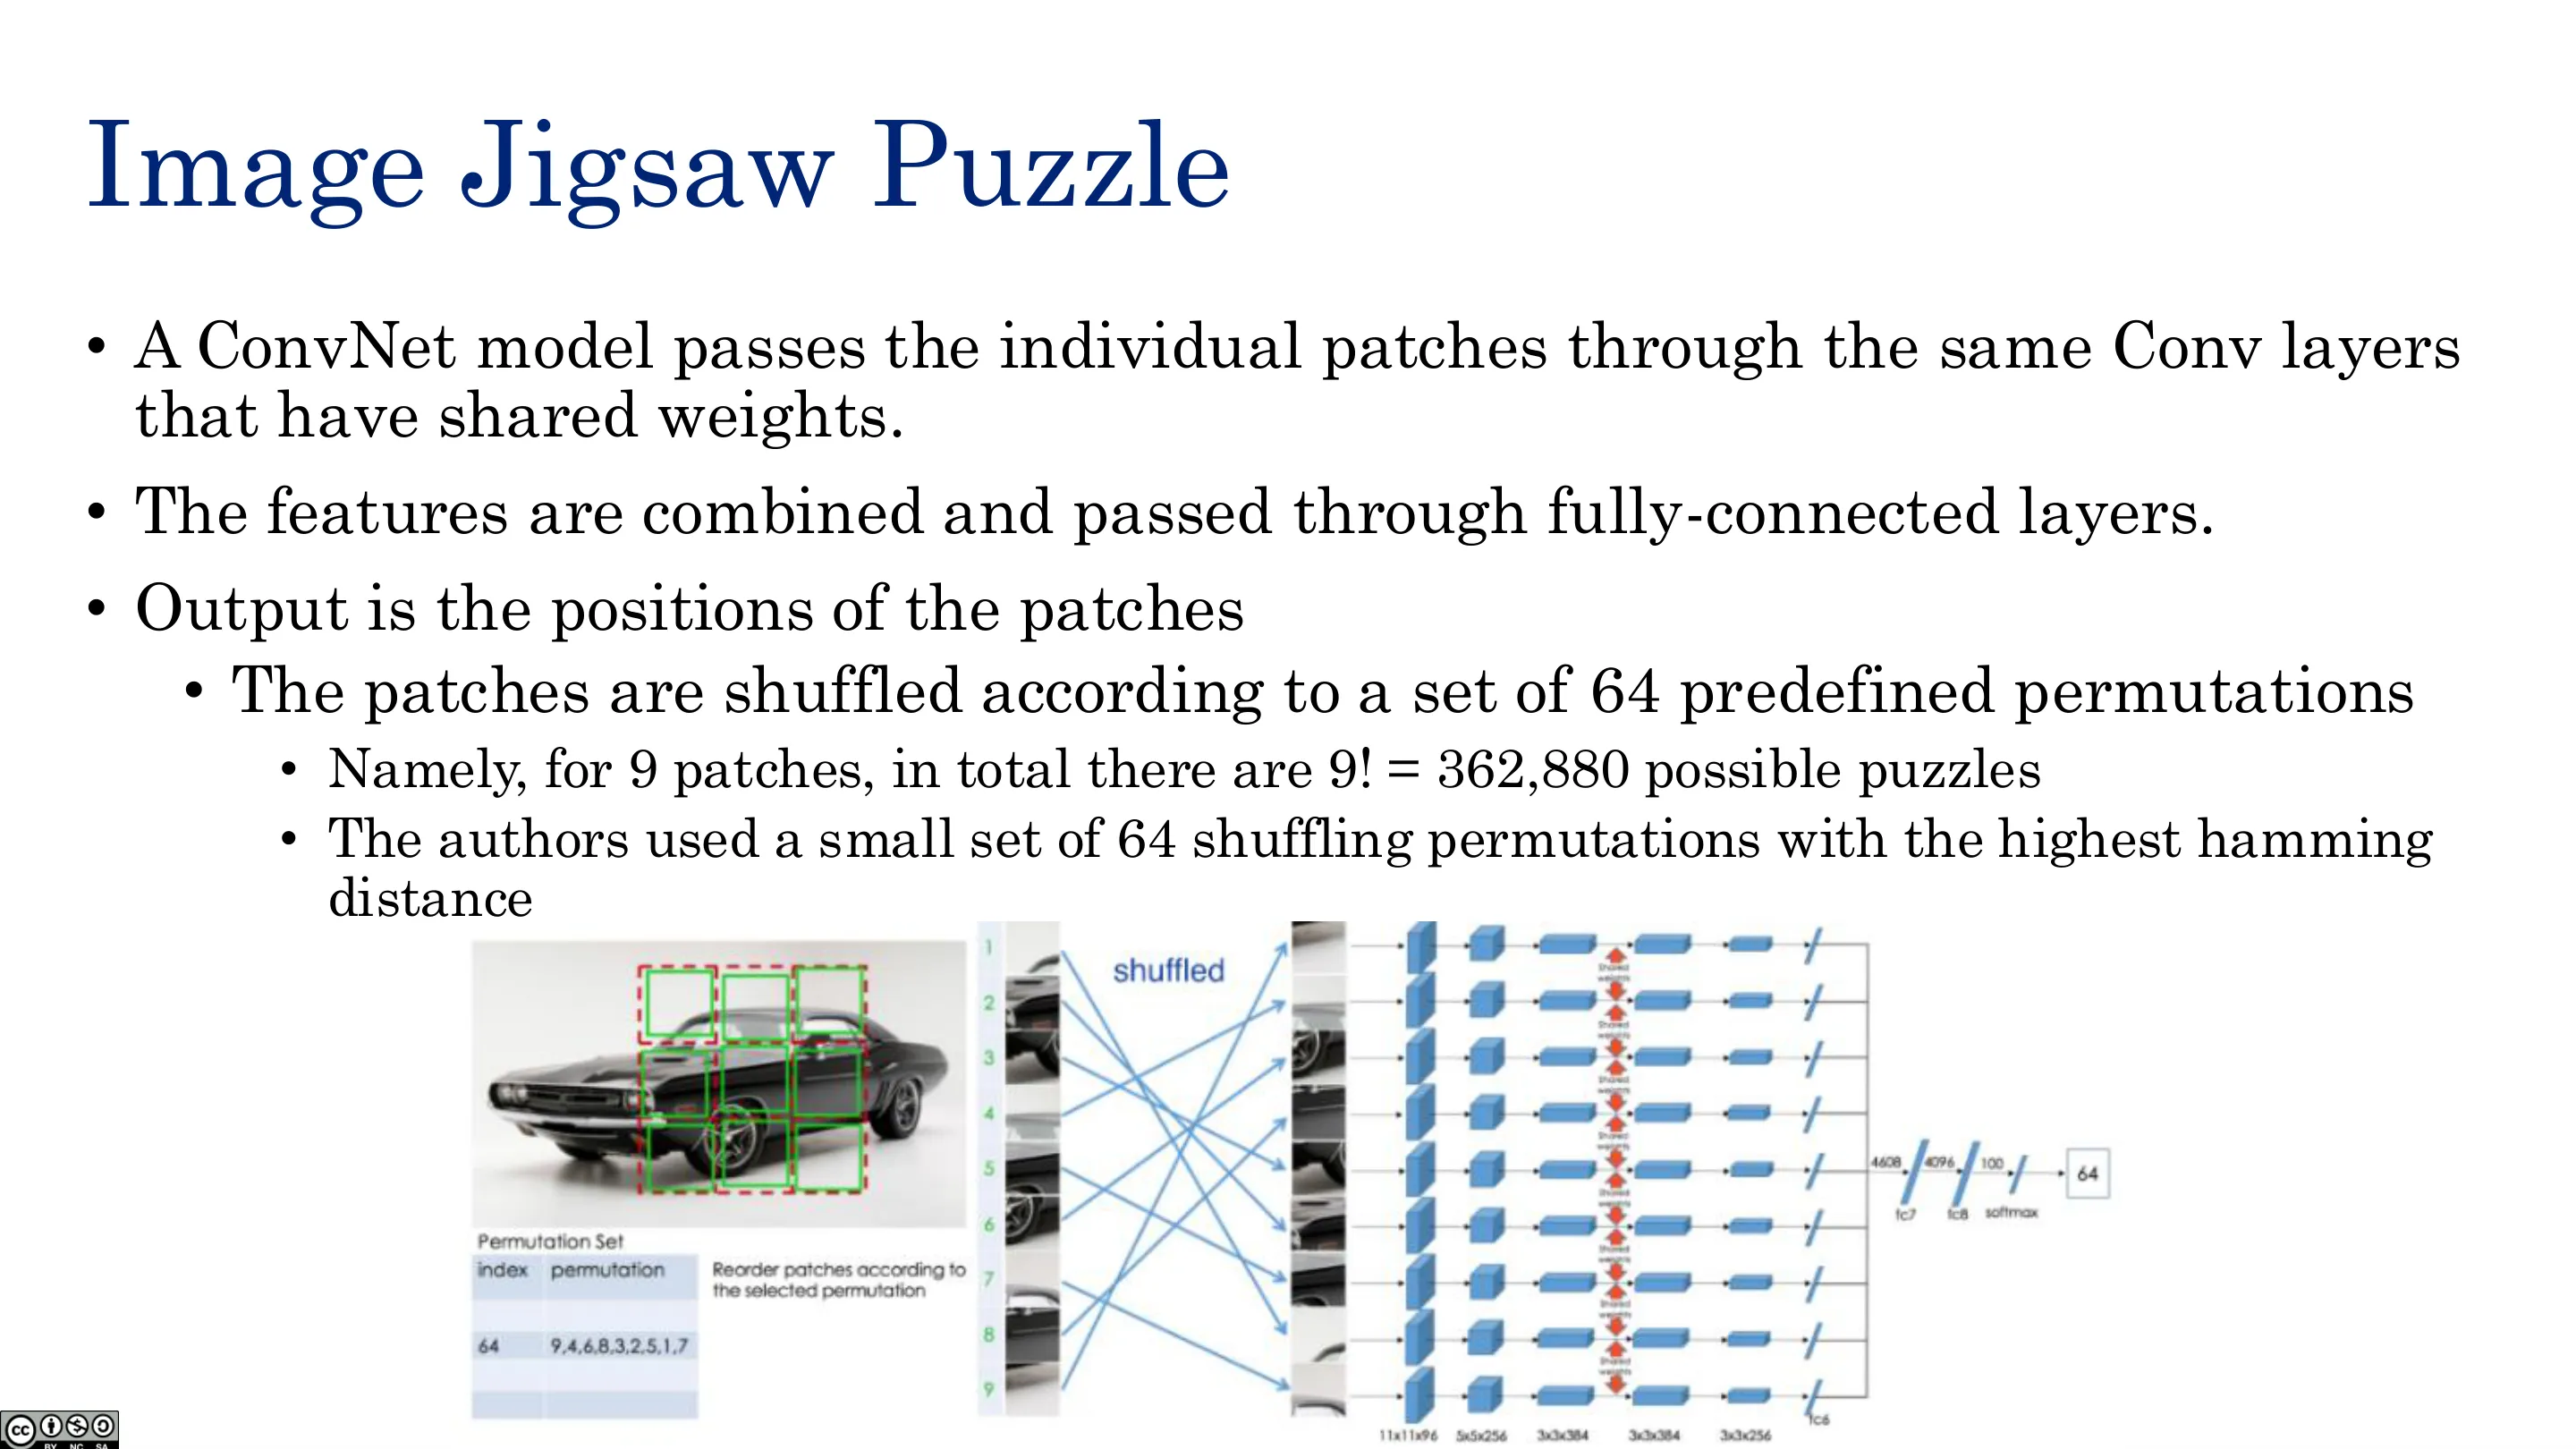
Pretext 任务:把图像切成若干块打乱,让网络还原正确顺序(本质是求解一个置换)。
📷 判别式(二)
回到原视频 (01:10:54)
📷 图像拼图(一)
回到原视频 (01:12:07)
📷 图像拼图(二)
回到原视频 (01:13:20)
3.4 深度聚类(Deep Clustering)
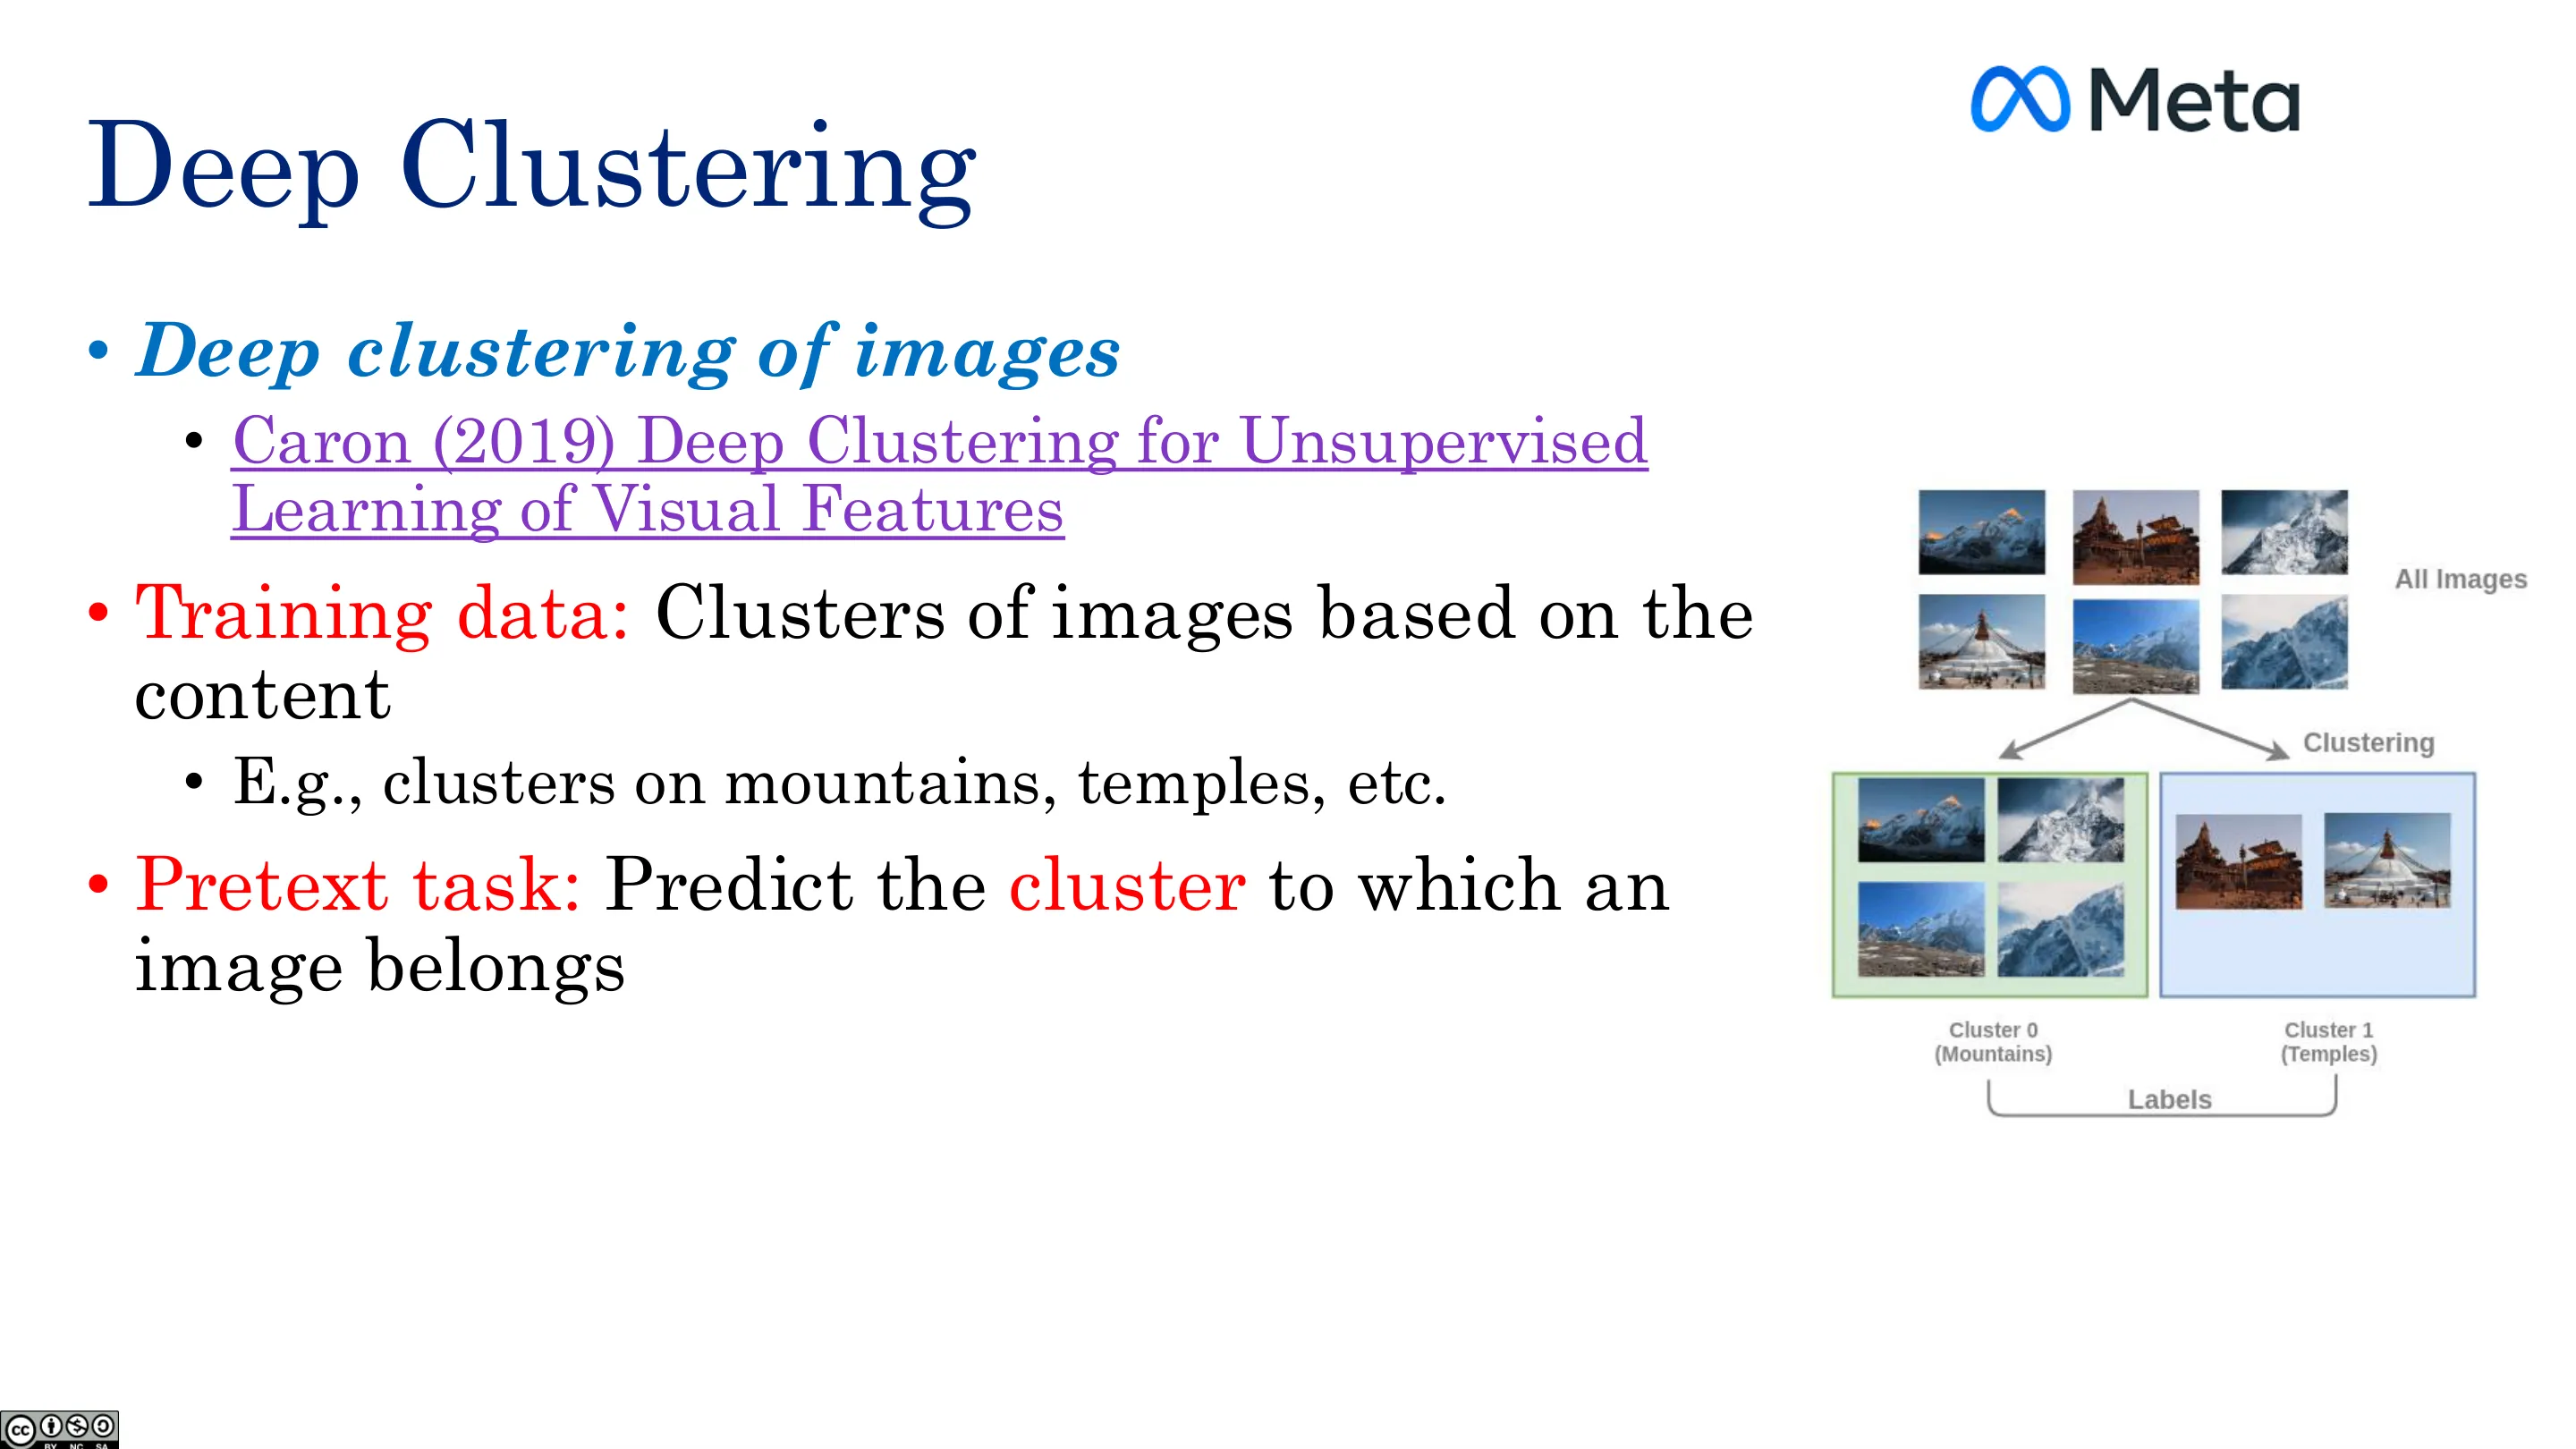
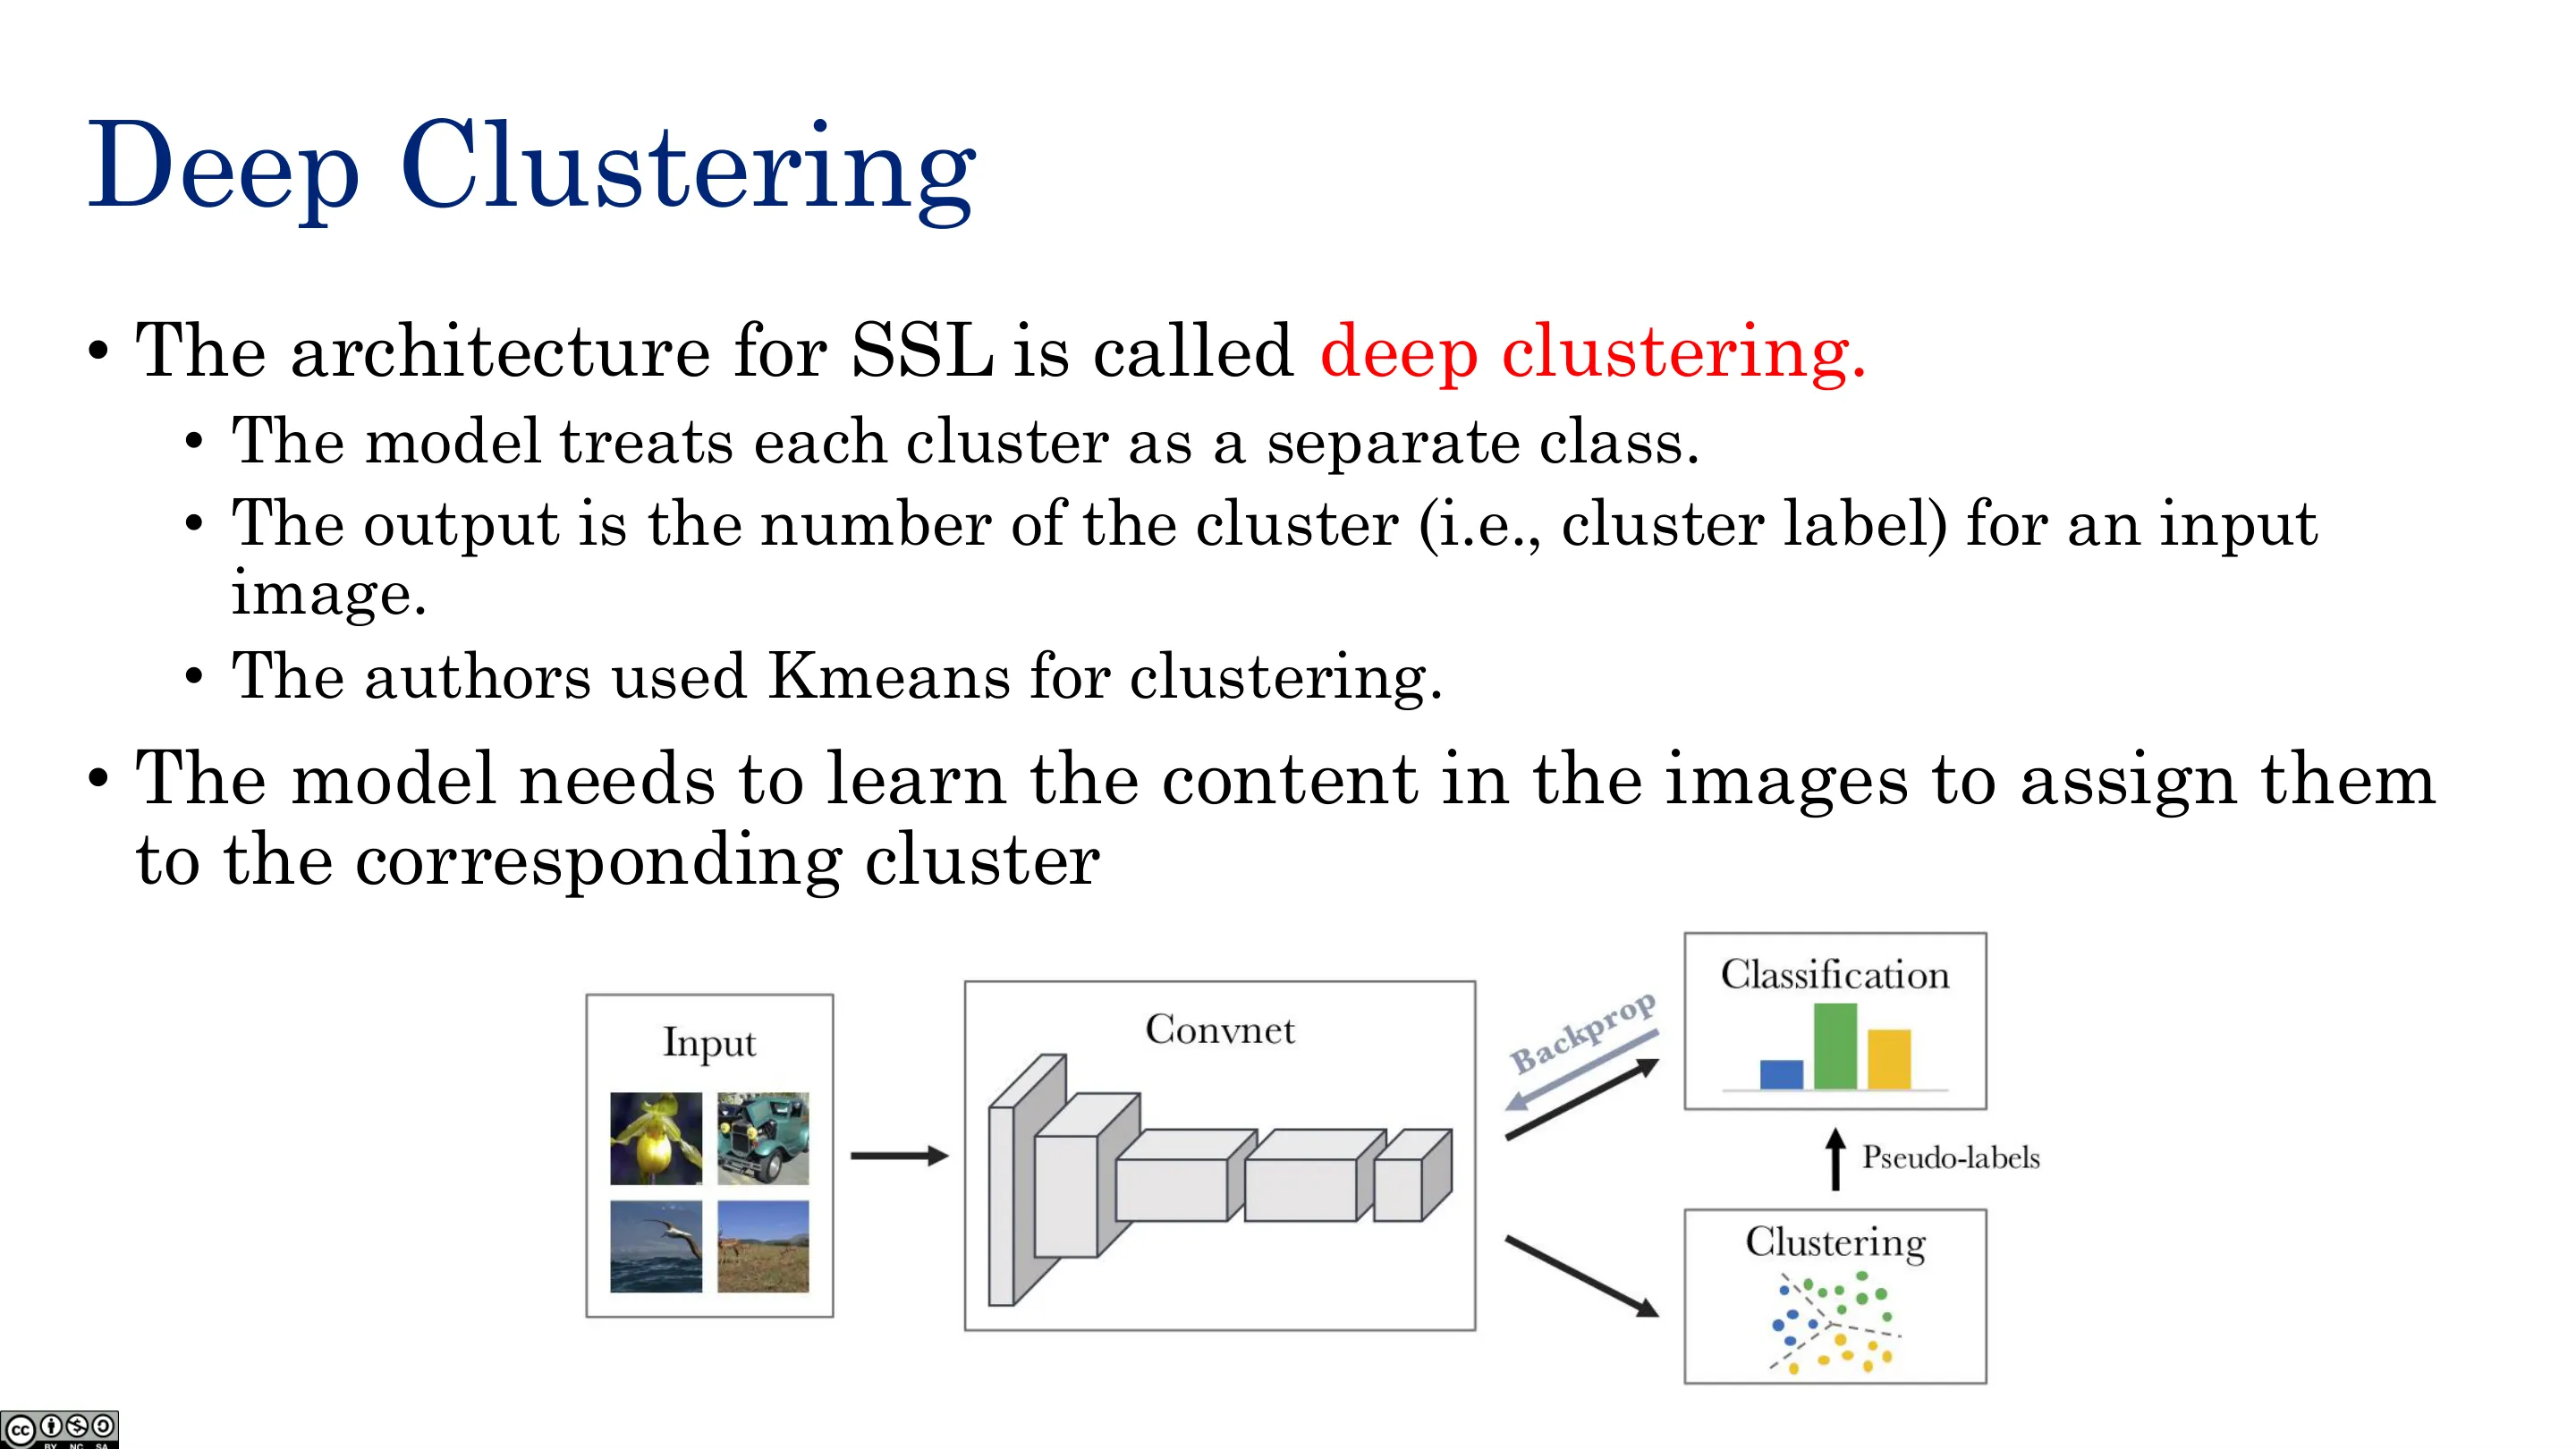
做法:联合学习表示与聚类分配(可迭代地"聚类 → 用簇标签当伪标签训练")。
📷 判别式(三)
回到原视频 (01:14:33)
📷 深度聚类(一)
回到原视频 (01:15:46)
📷 深度聚类(二)
回到原视频 (01:16:59)
四、对比学习(Contrastive Learning)
📷 对比
回到原视频 (01:18:12)
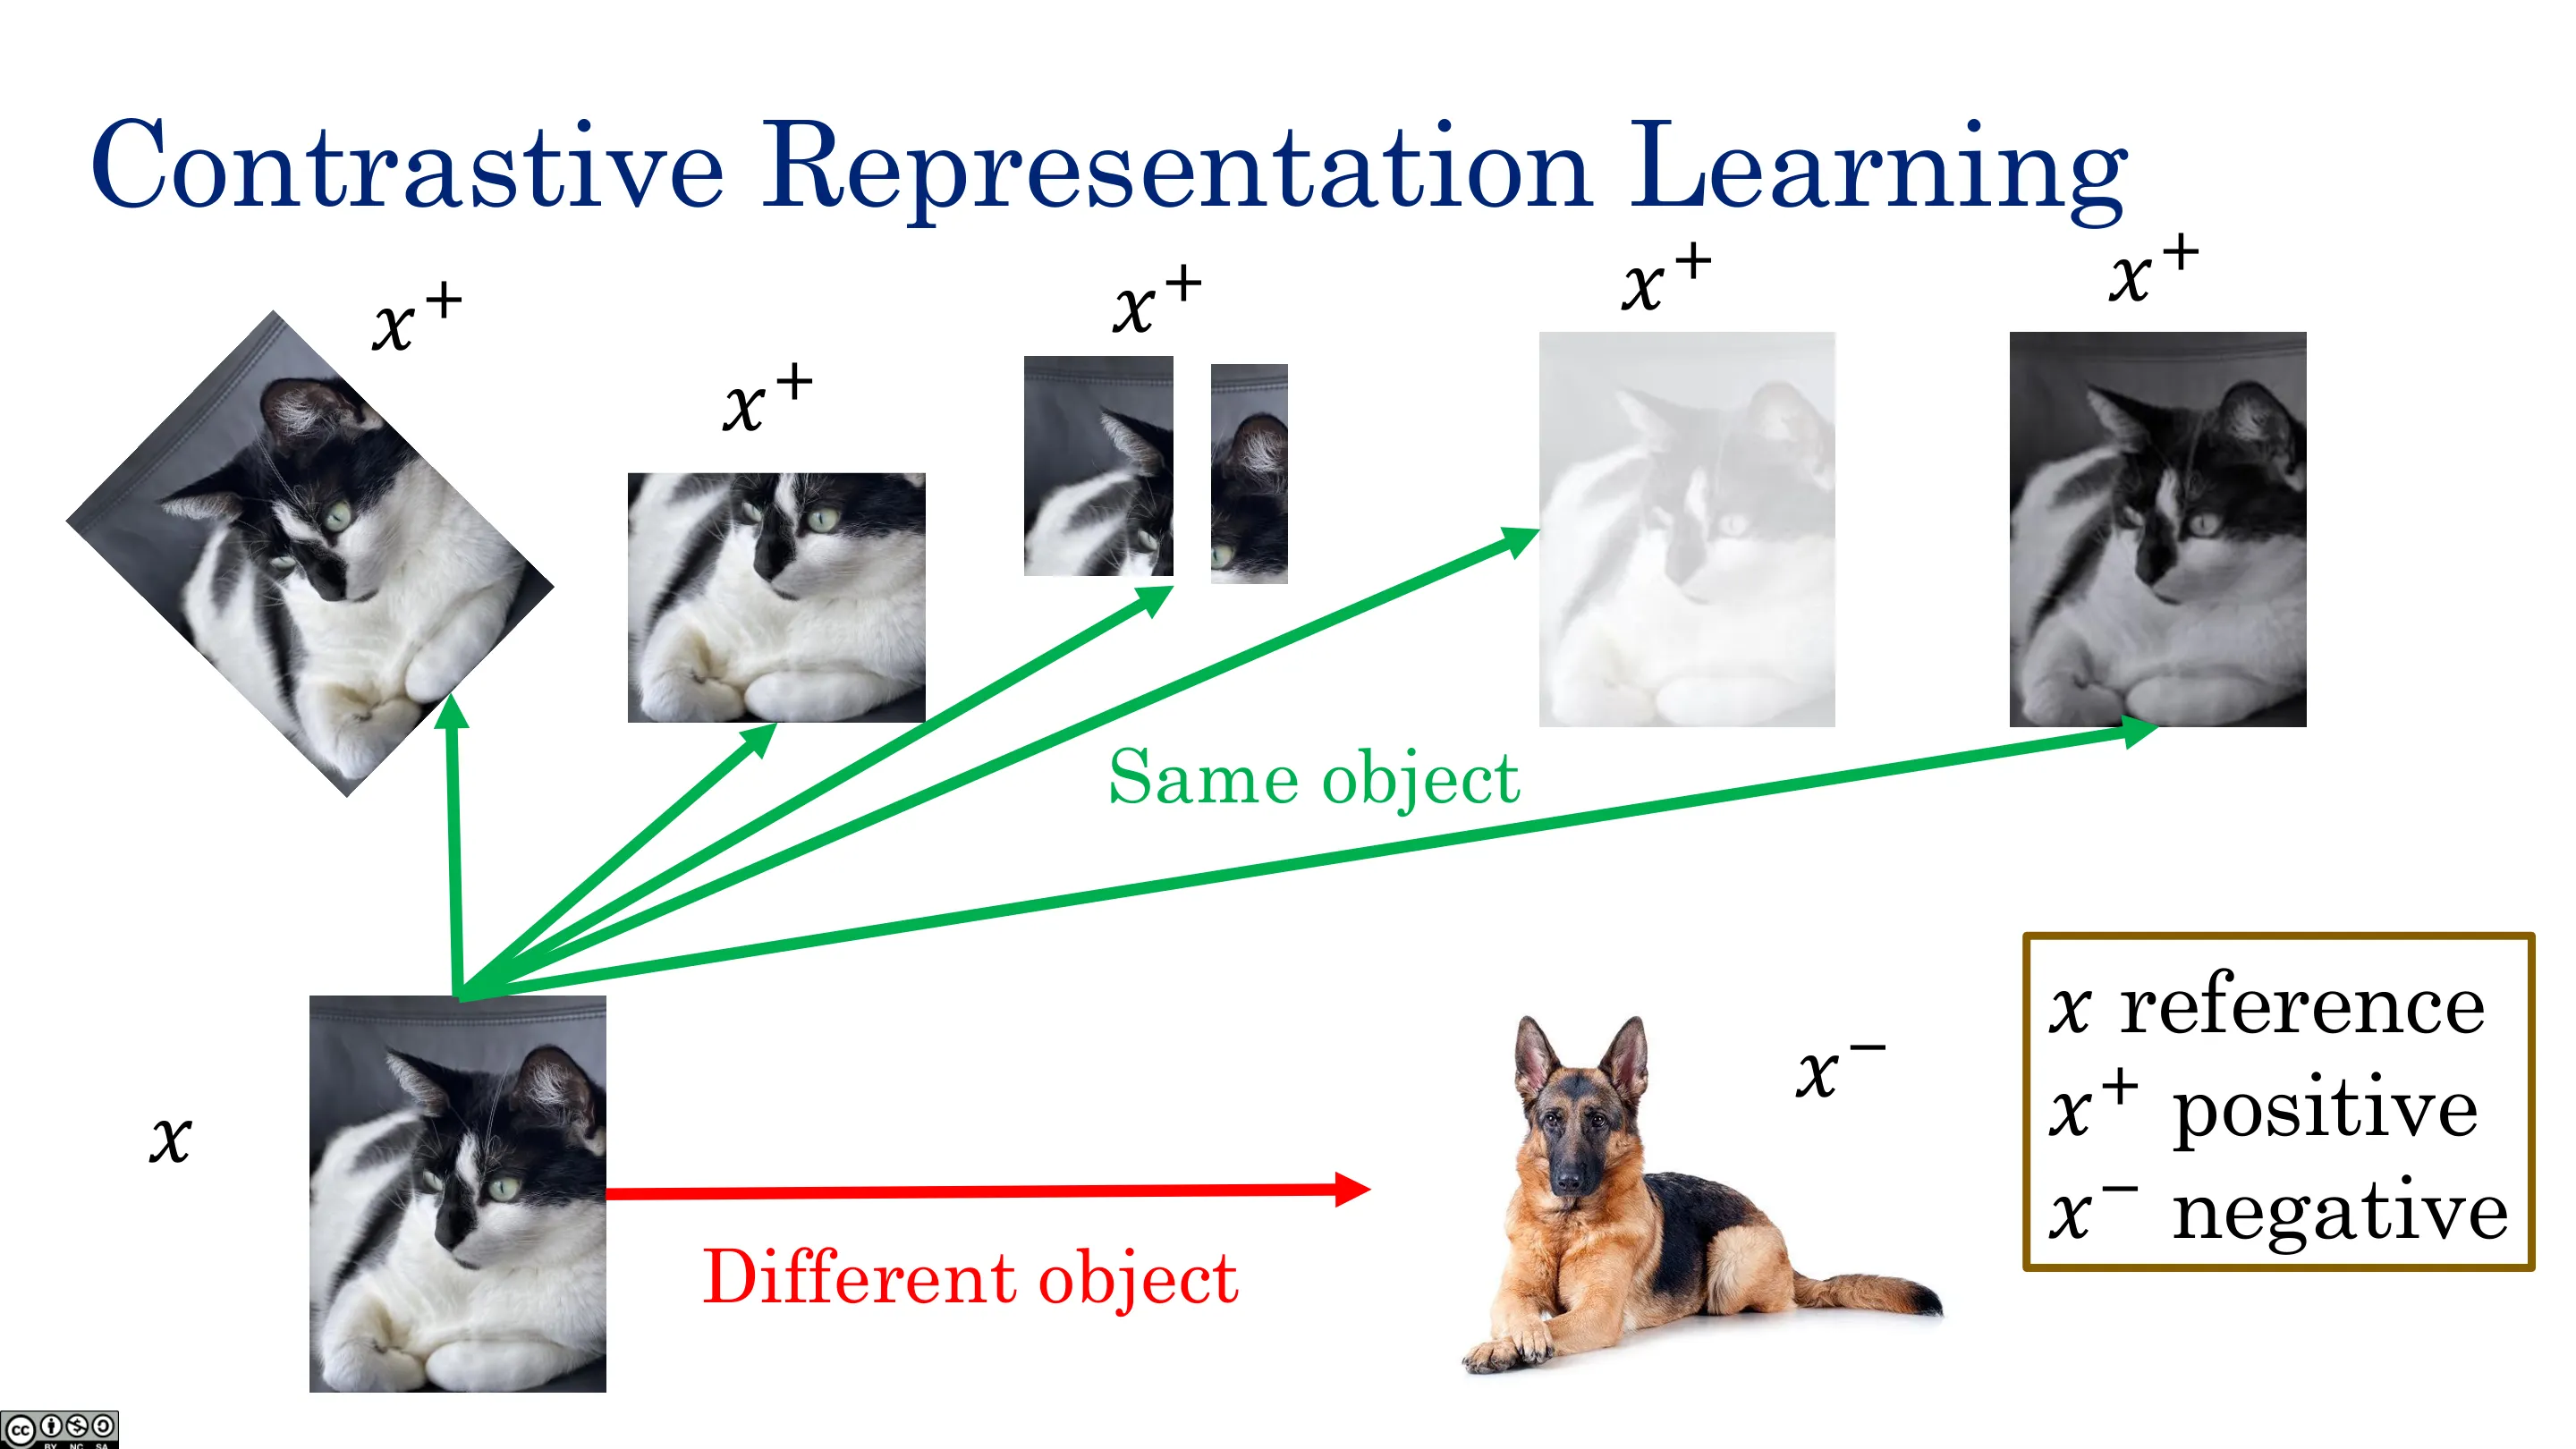
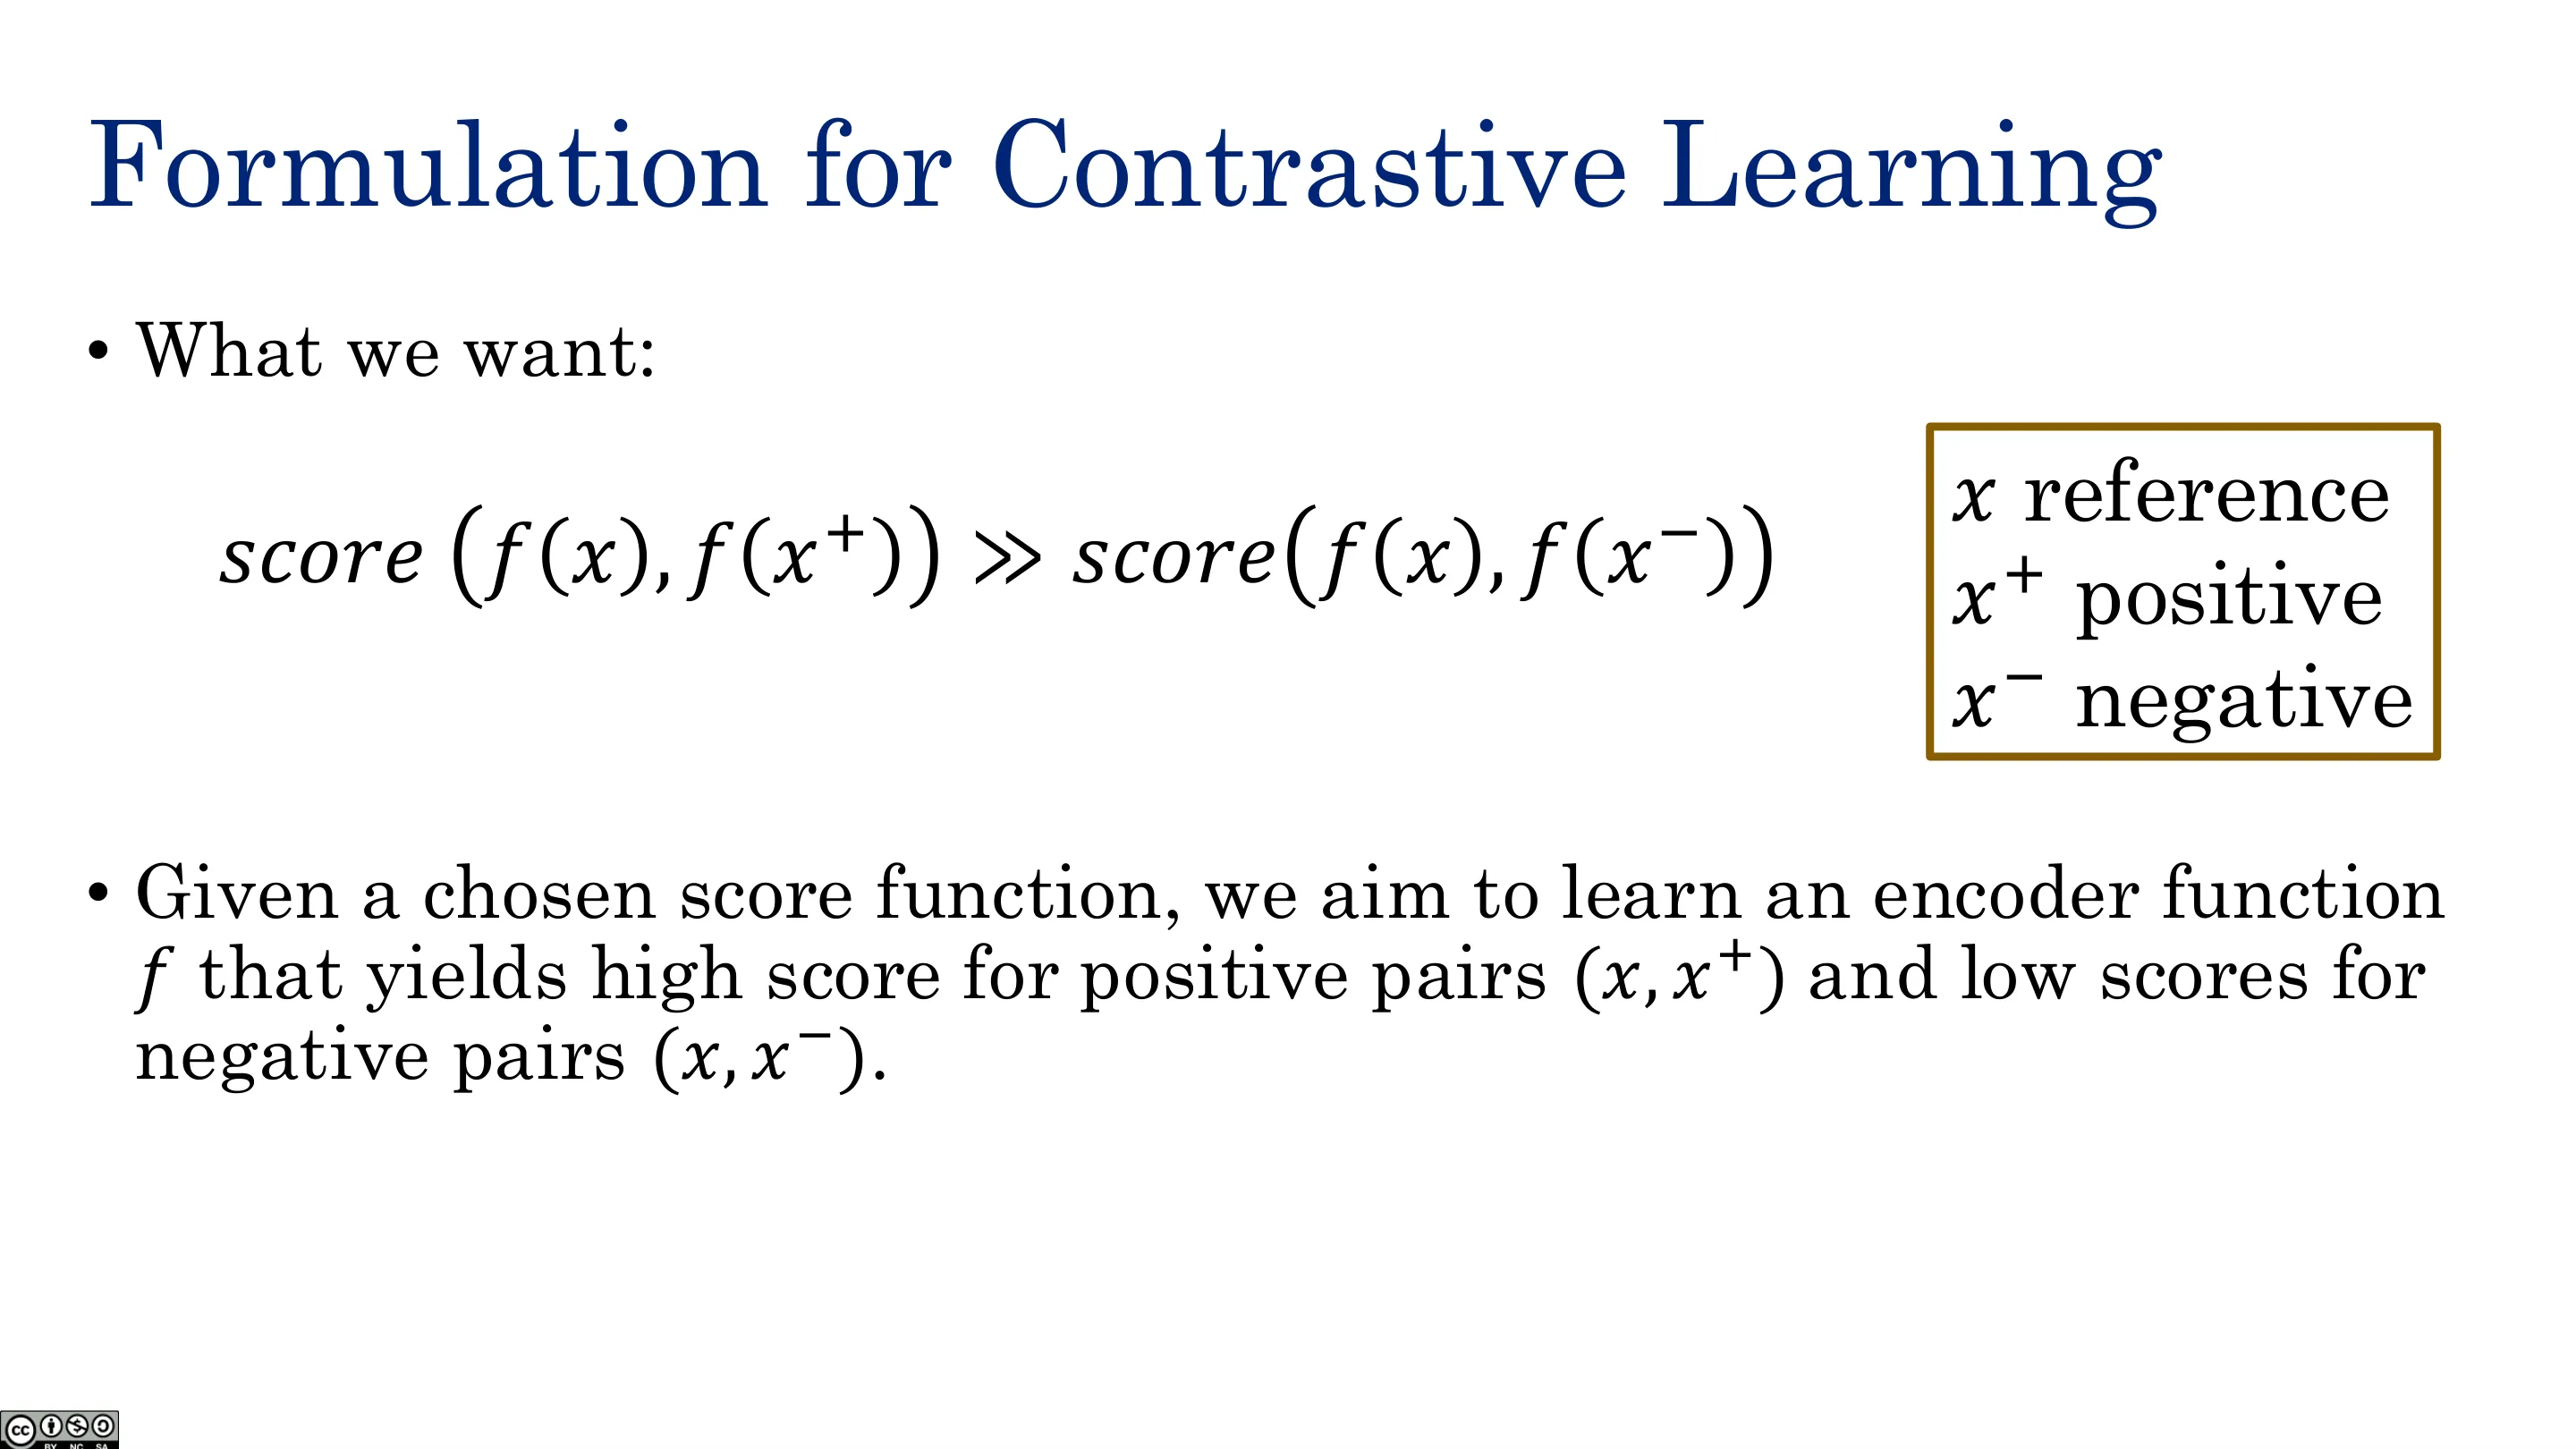
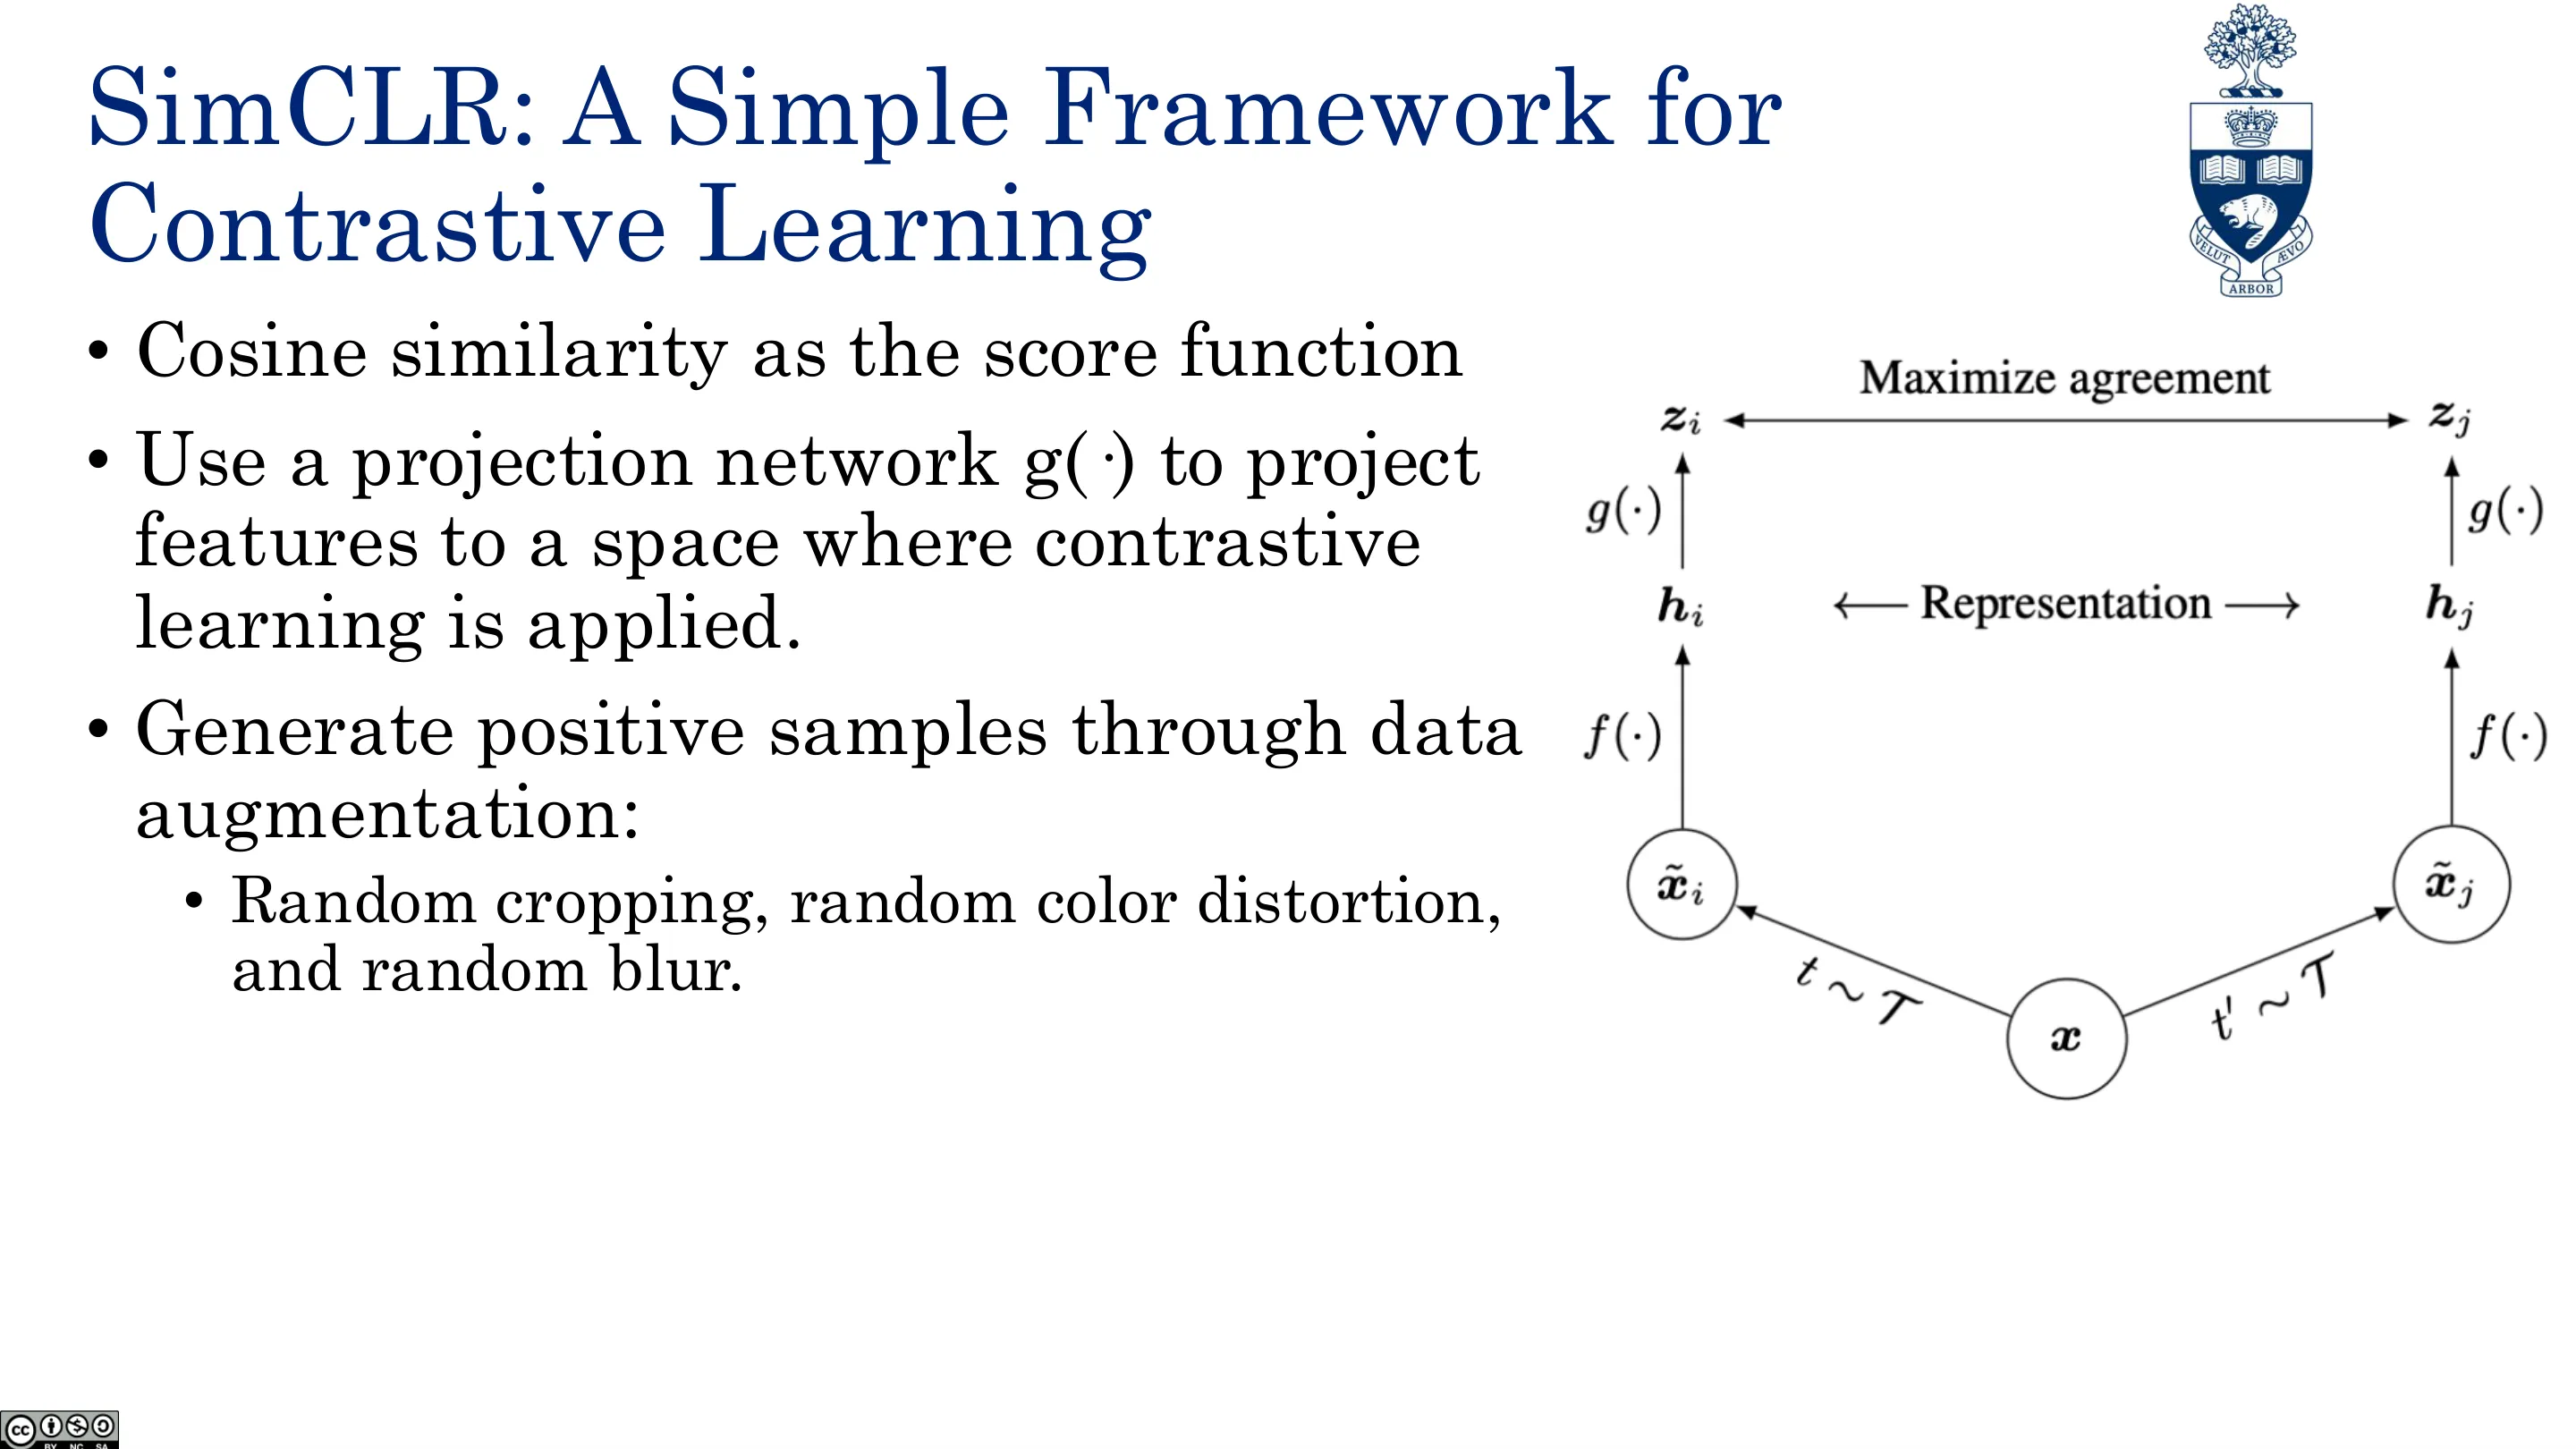
对比表示学习:让正样本对(同一样本的不同增强)在嵌入空间靠近,负样本对(不同样本)远离。
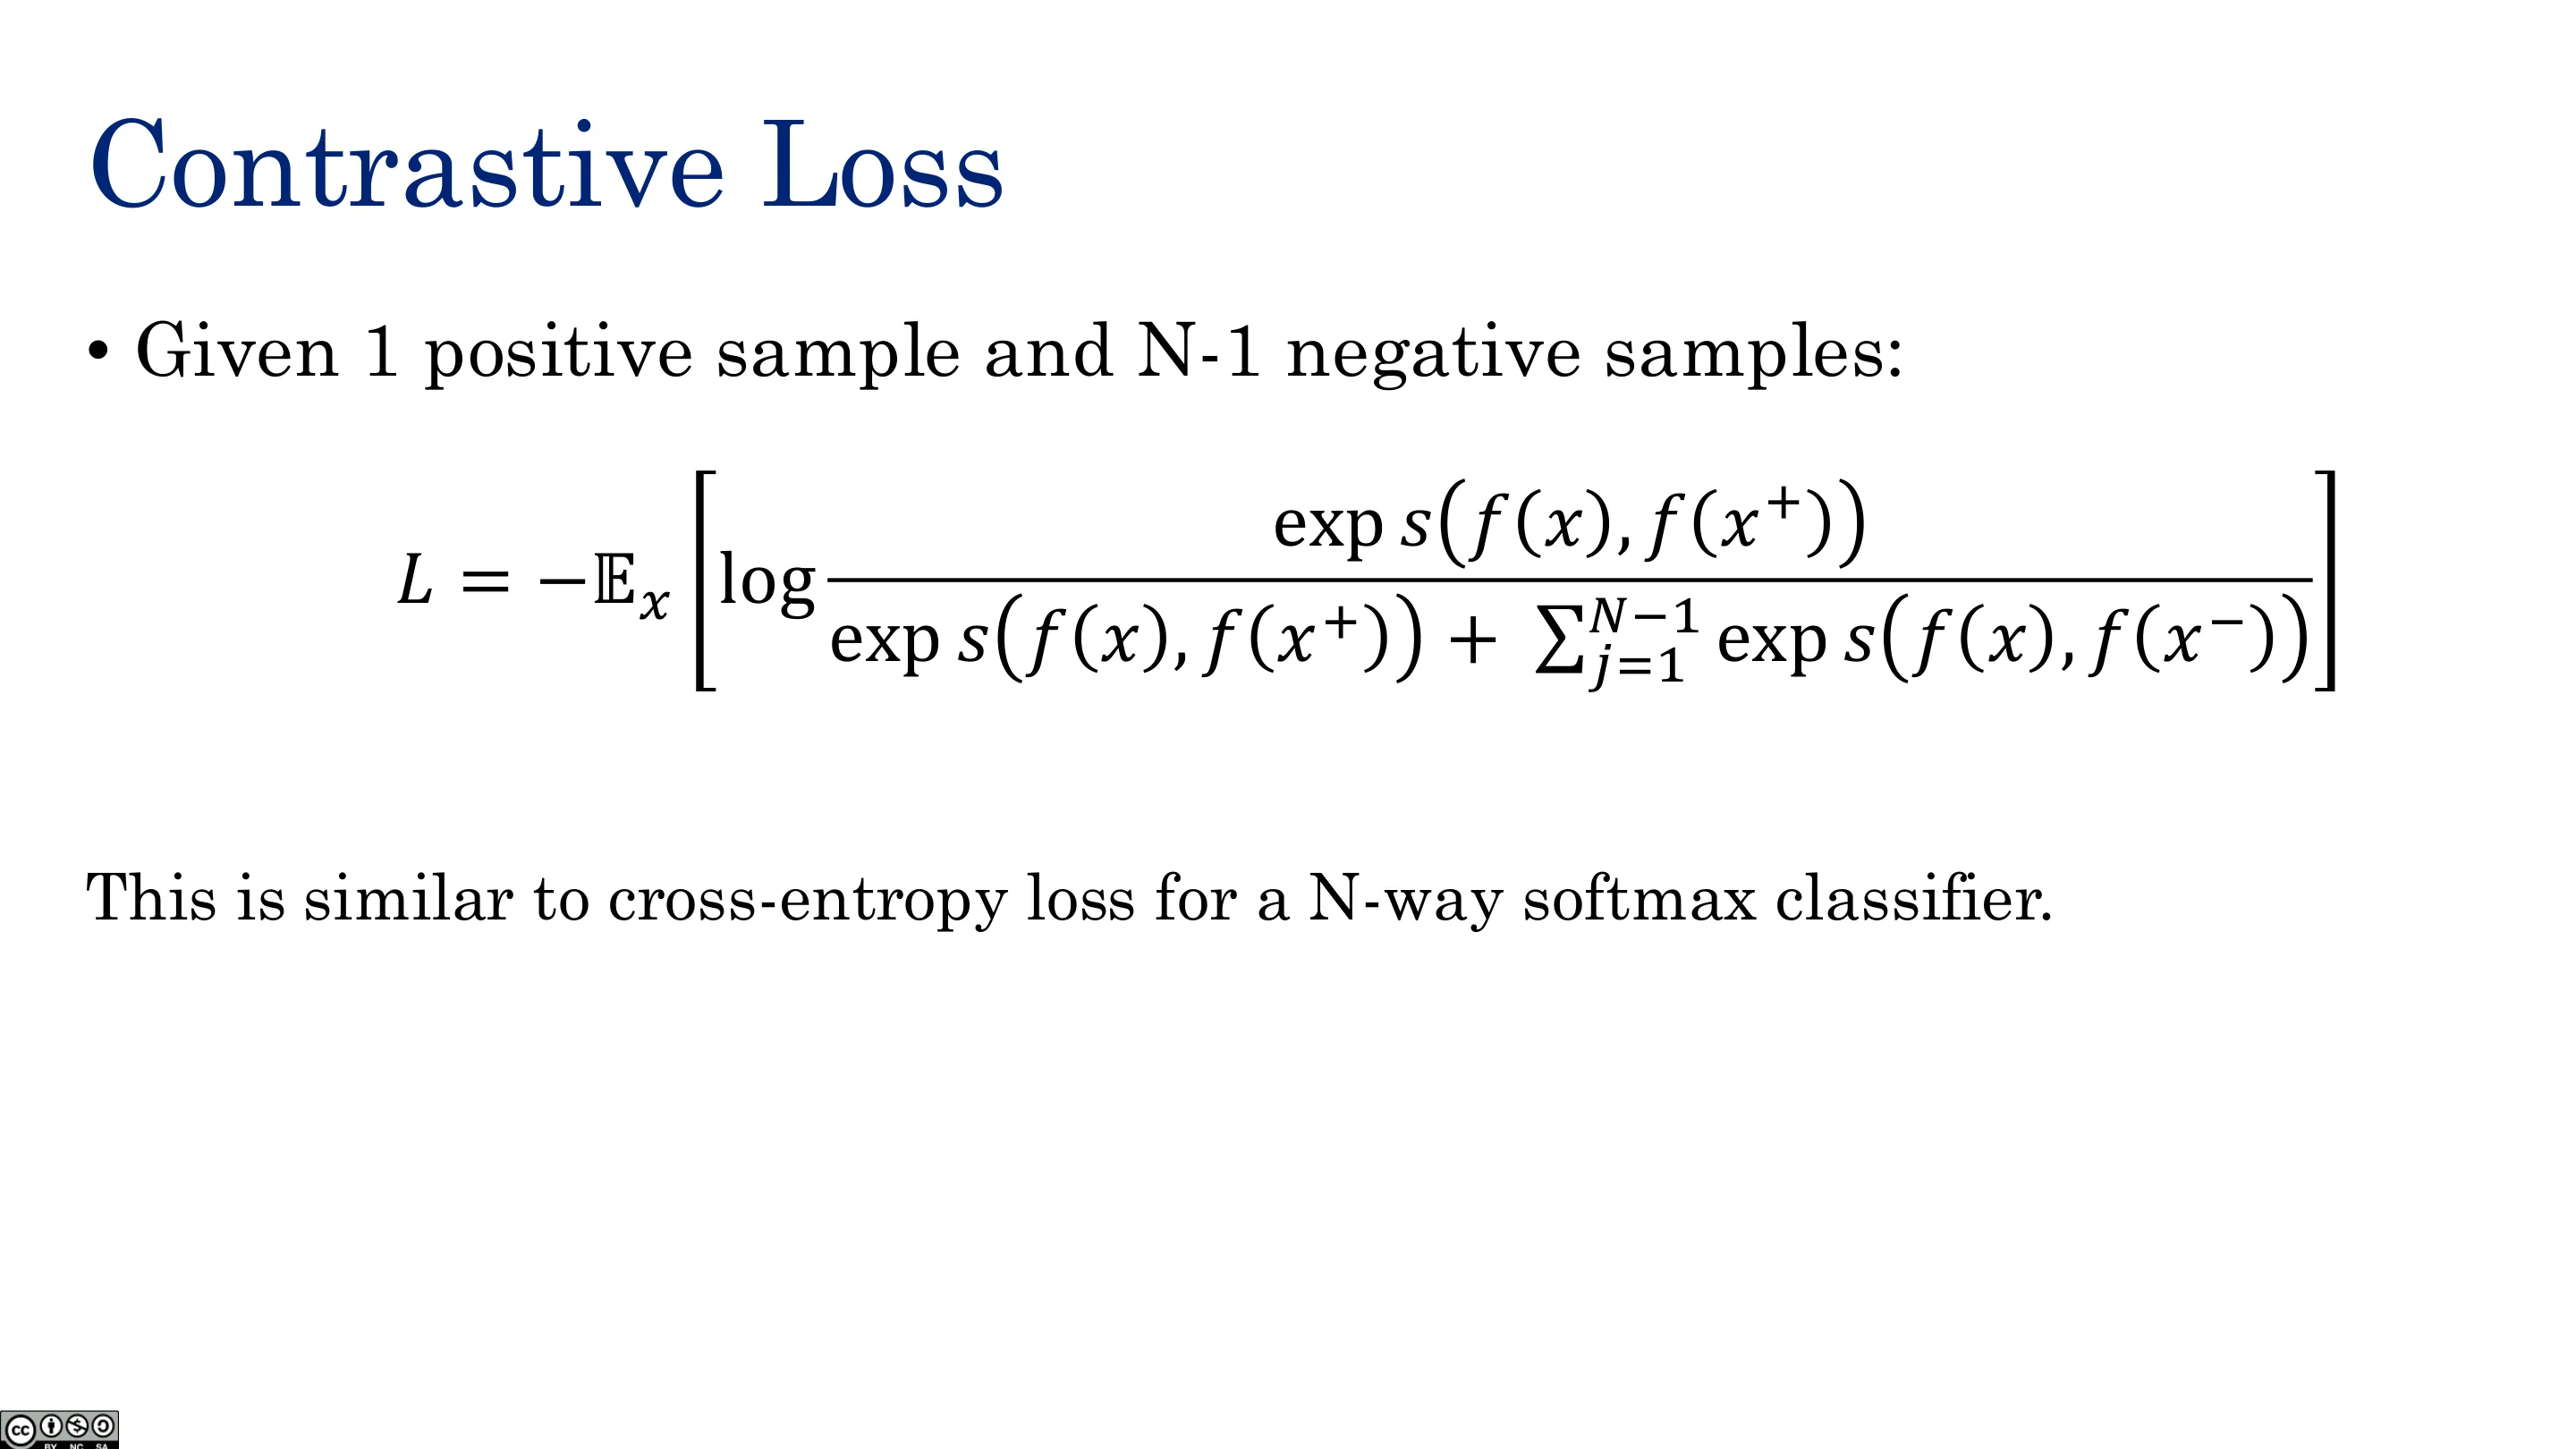
常见损失(InfoNCE / NT-Xent):对一个 batch 内的 $N$ 个样本,各自做两种增强得 $2N$ 个嵌入;对每个锚点,正例是它的另一个增强视图,负例是其余 $2N-2$ 个。
$$ \mathcal{L}=-\log\frac{\exp(\mathrm{sim}(z_i,z_j)/\tau)}{\sum_{k\neq i}\exp(\mathrm{sim}(z_i,z_k)/\tau)} $$
SimCLR:简洁框架——强数据增强 + 编码器 + 投影头 + 上述对比损失,无需记忆库也能达到很强效果。
📷 对比表示学习
回到原视频 (01:19:25)
📷 对比学习的公式化
回到原视频 (01:20:38)
📷 对比损失
回到原视频 (01:21:51)
📷 SimCLR:一个简单框架
回到原视频 (01:23:04)
📷 MLTrain(一)
回到原视频 (01:24:17)
📷 MLTrain(二)
回到原视频 (01:25:30)
4.1 CLIP:多模态对比学习
(参考时间: 01:00)
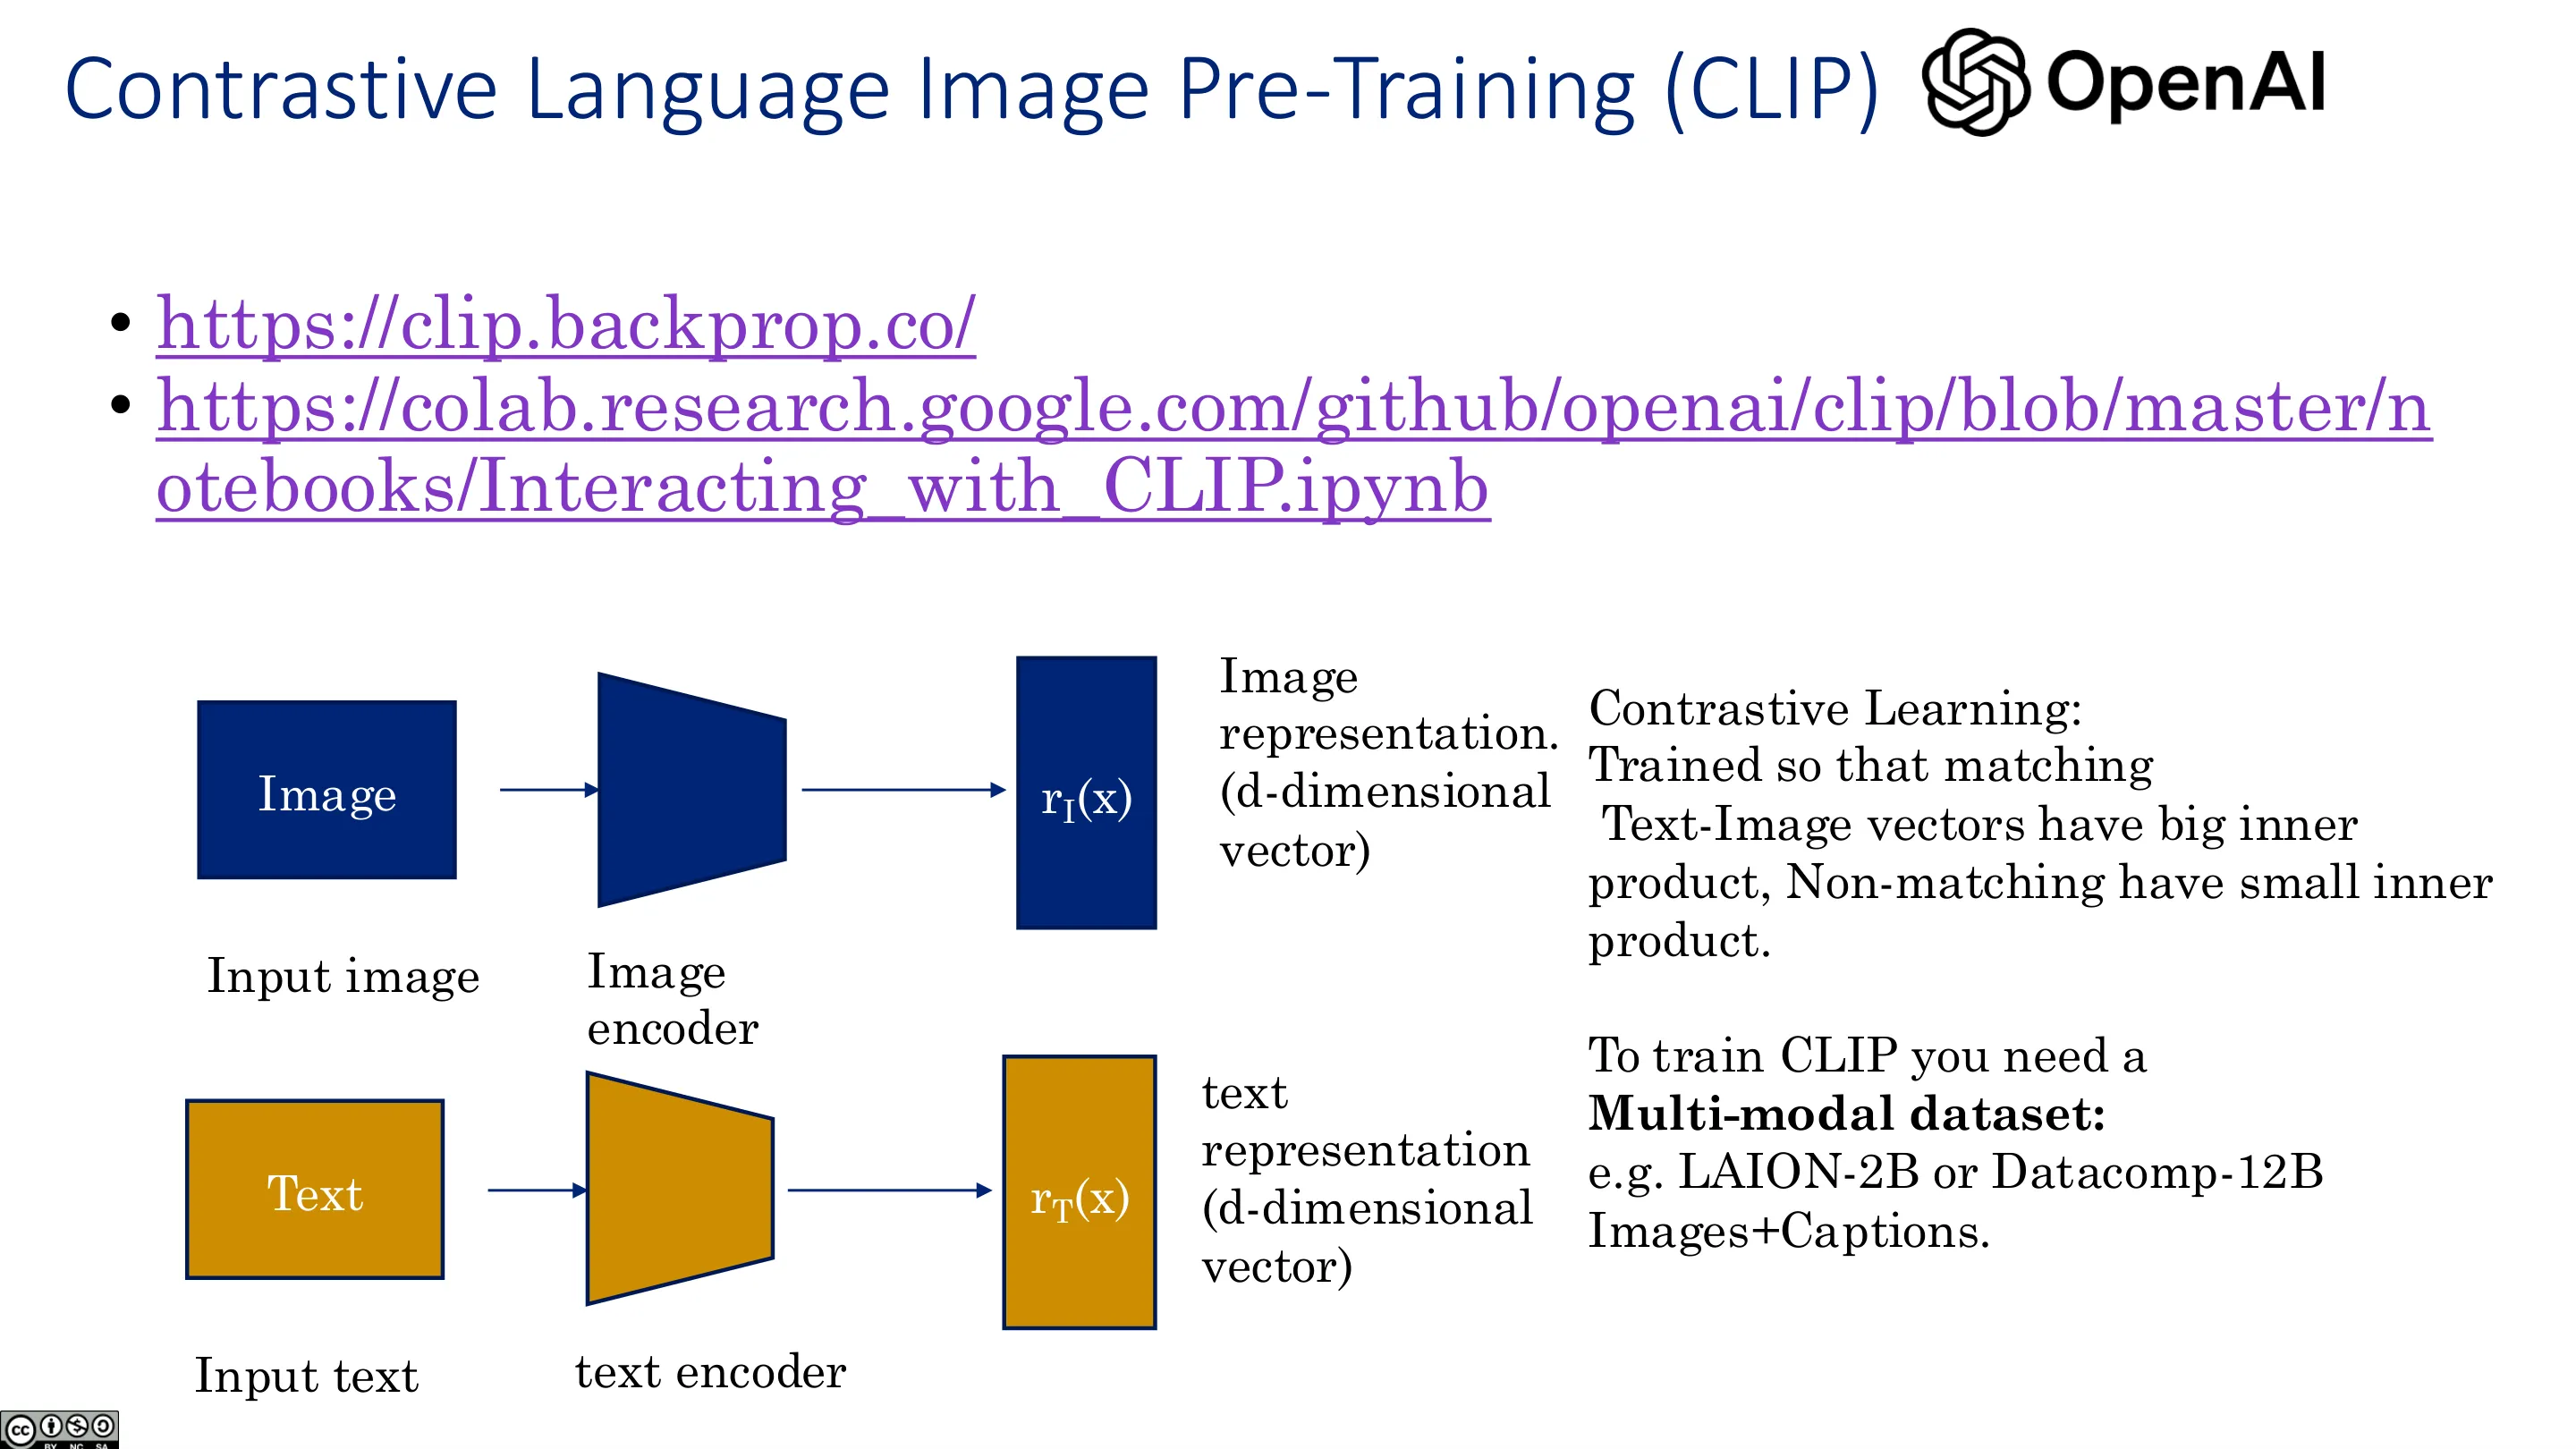
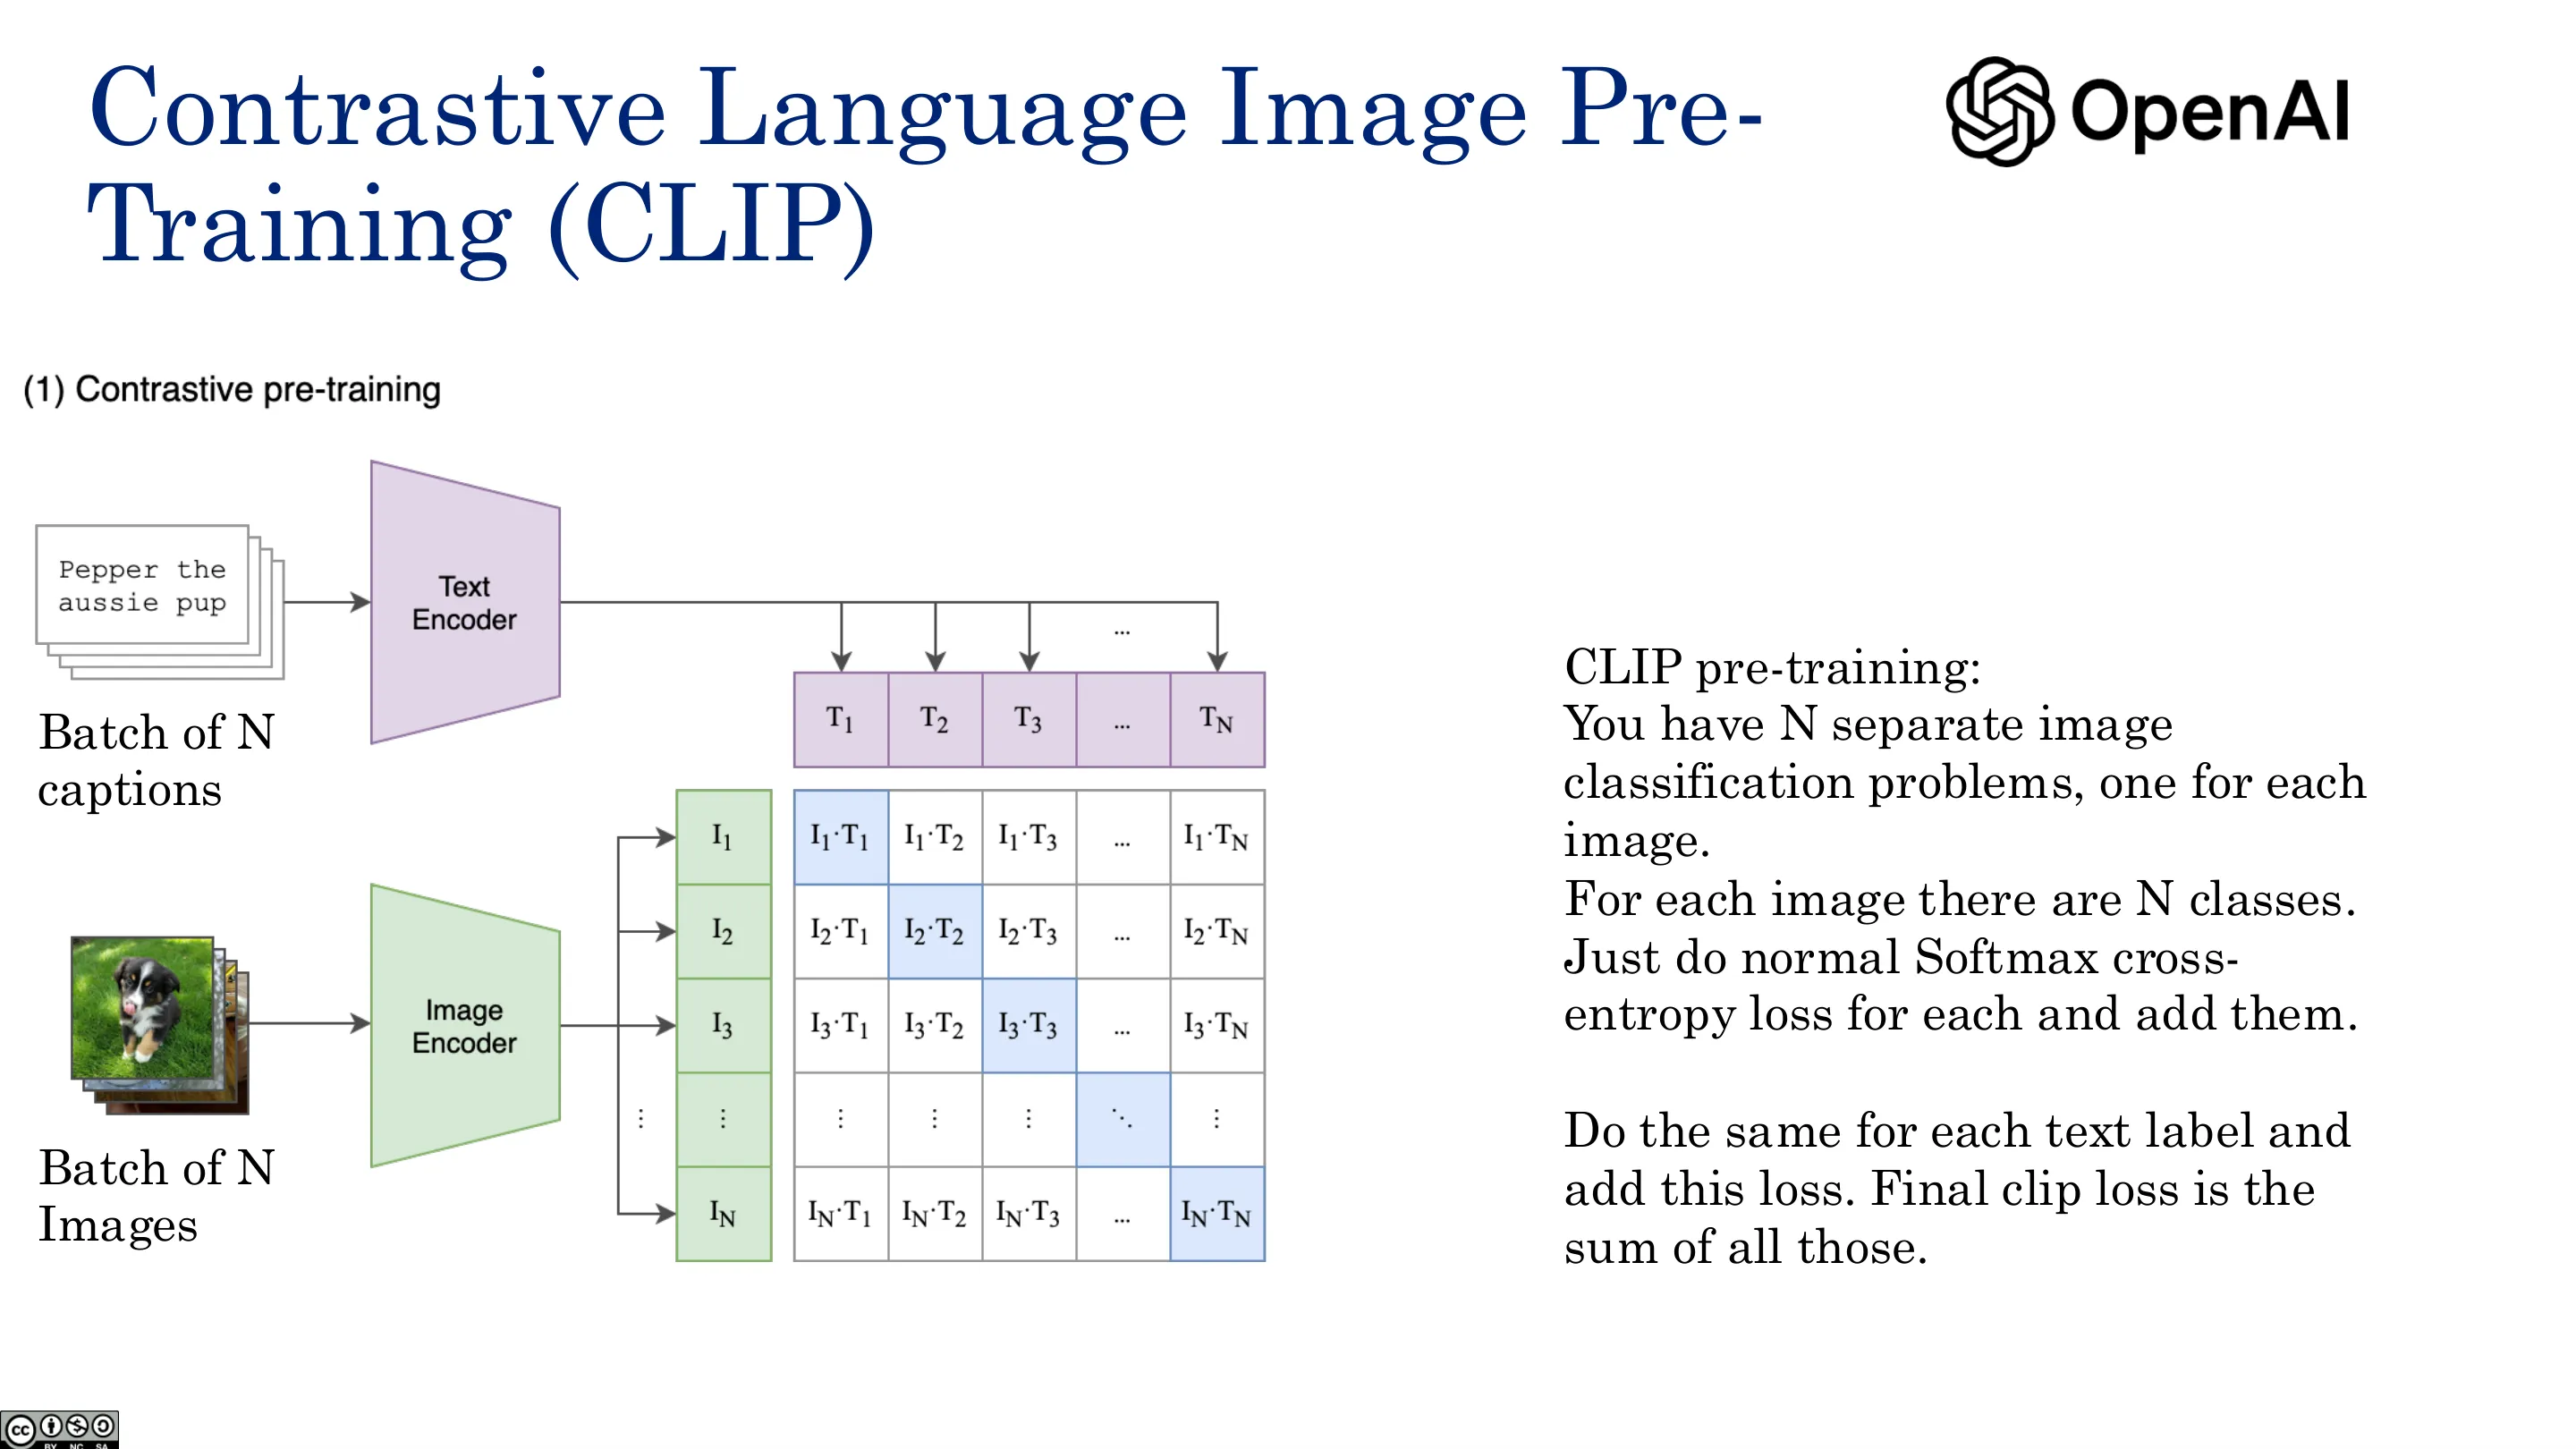
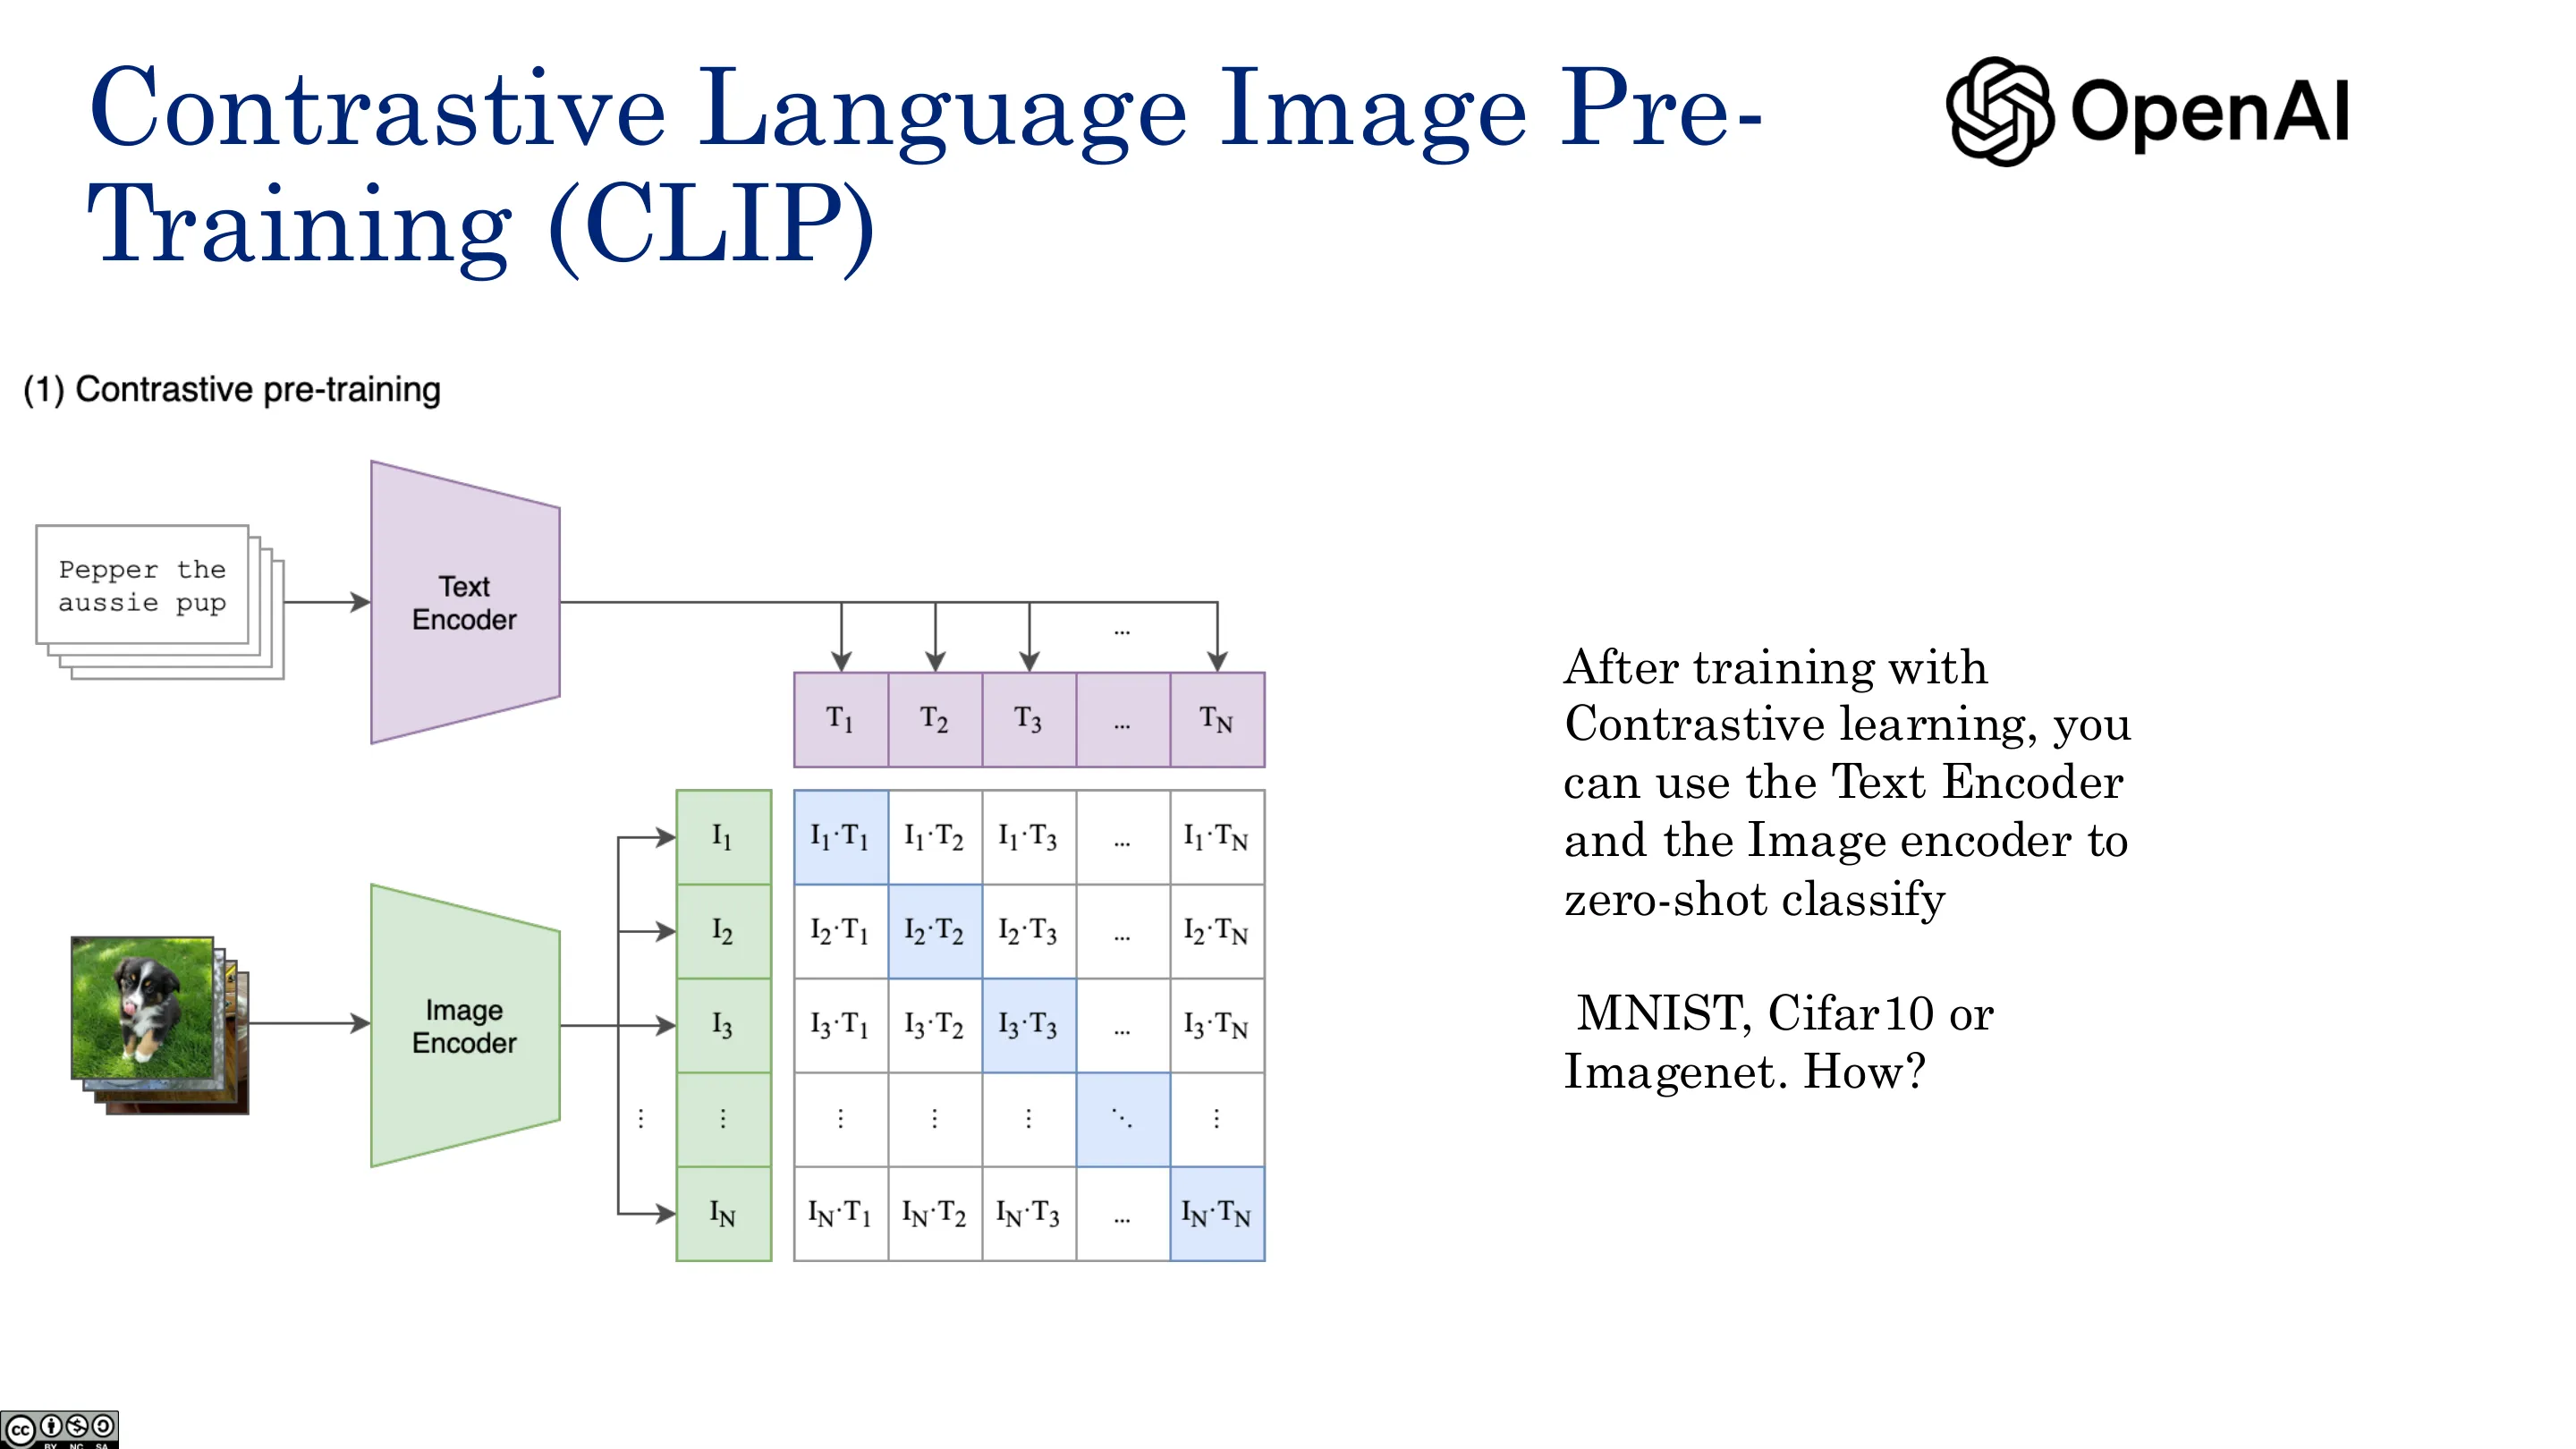
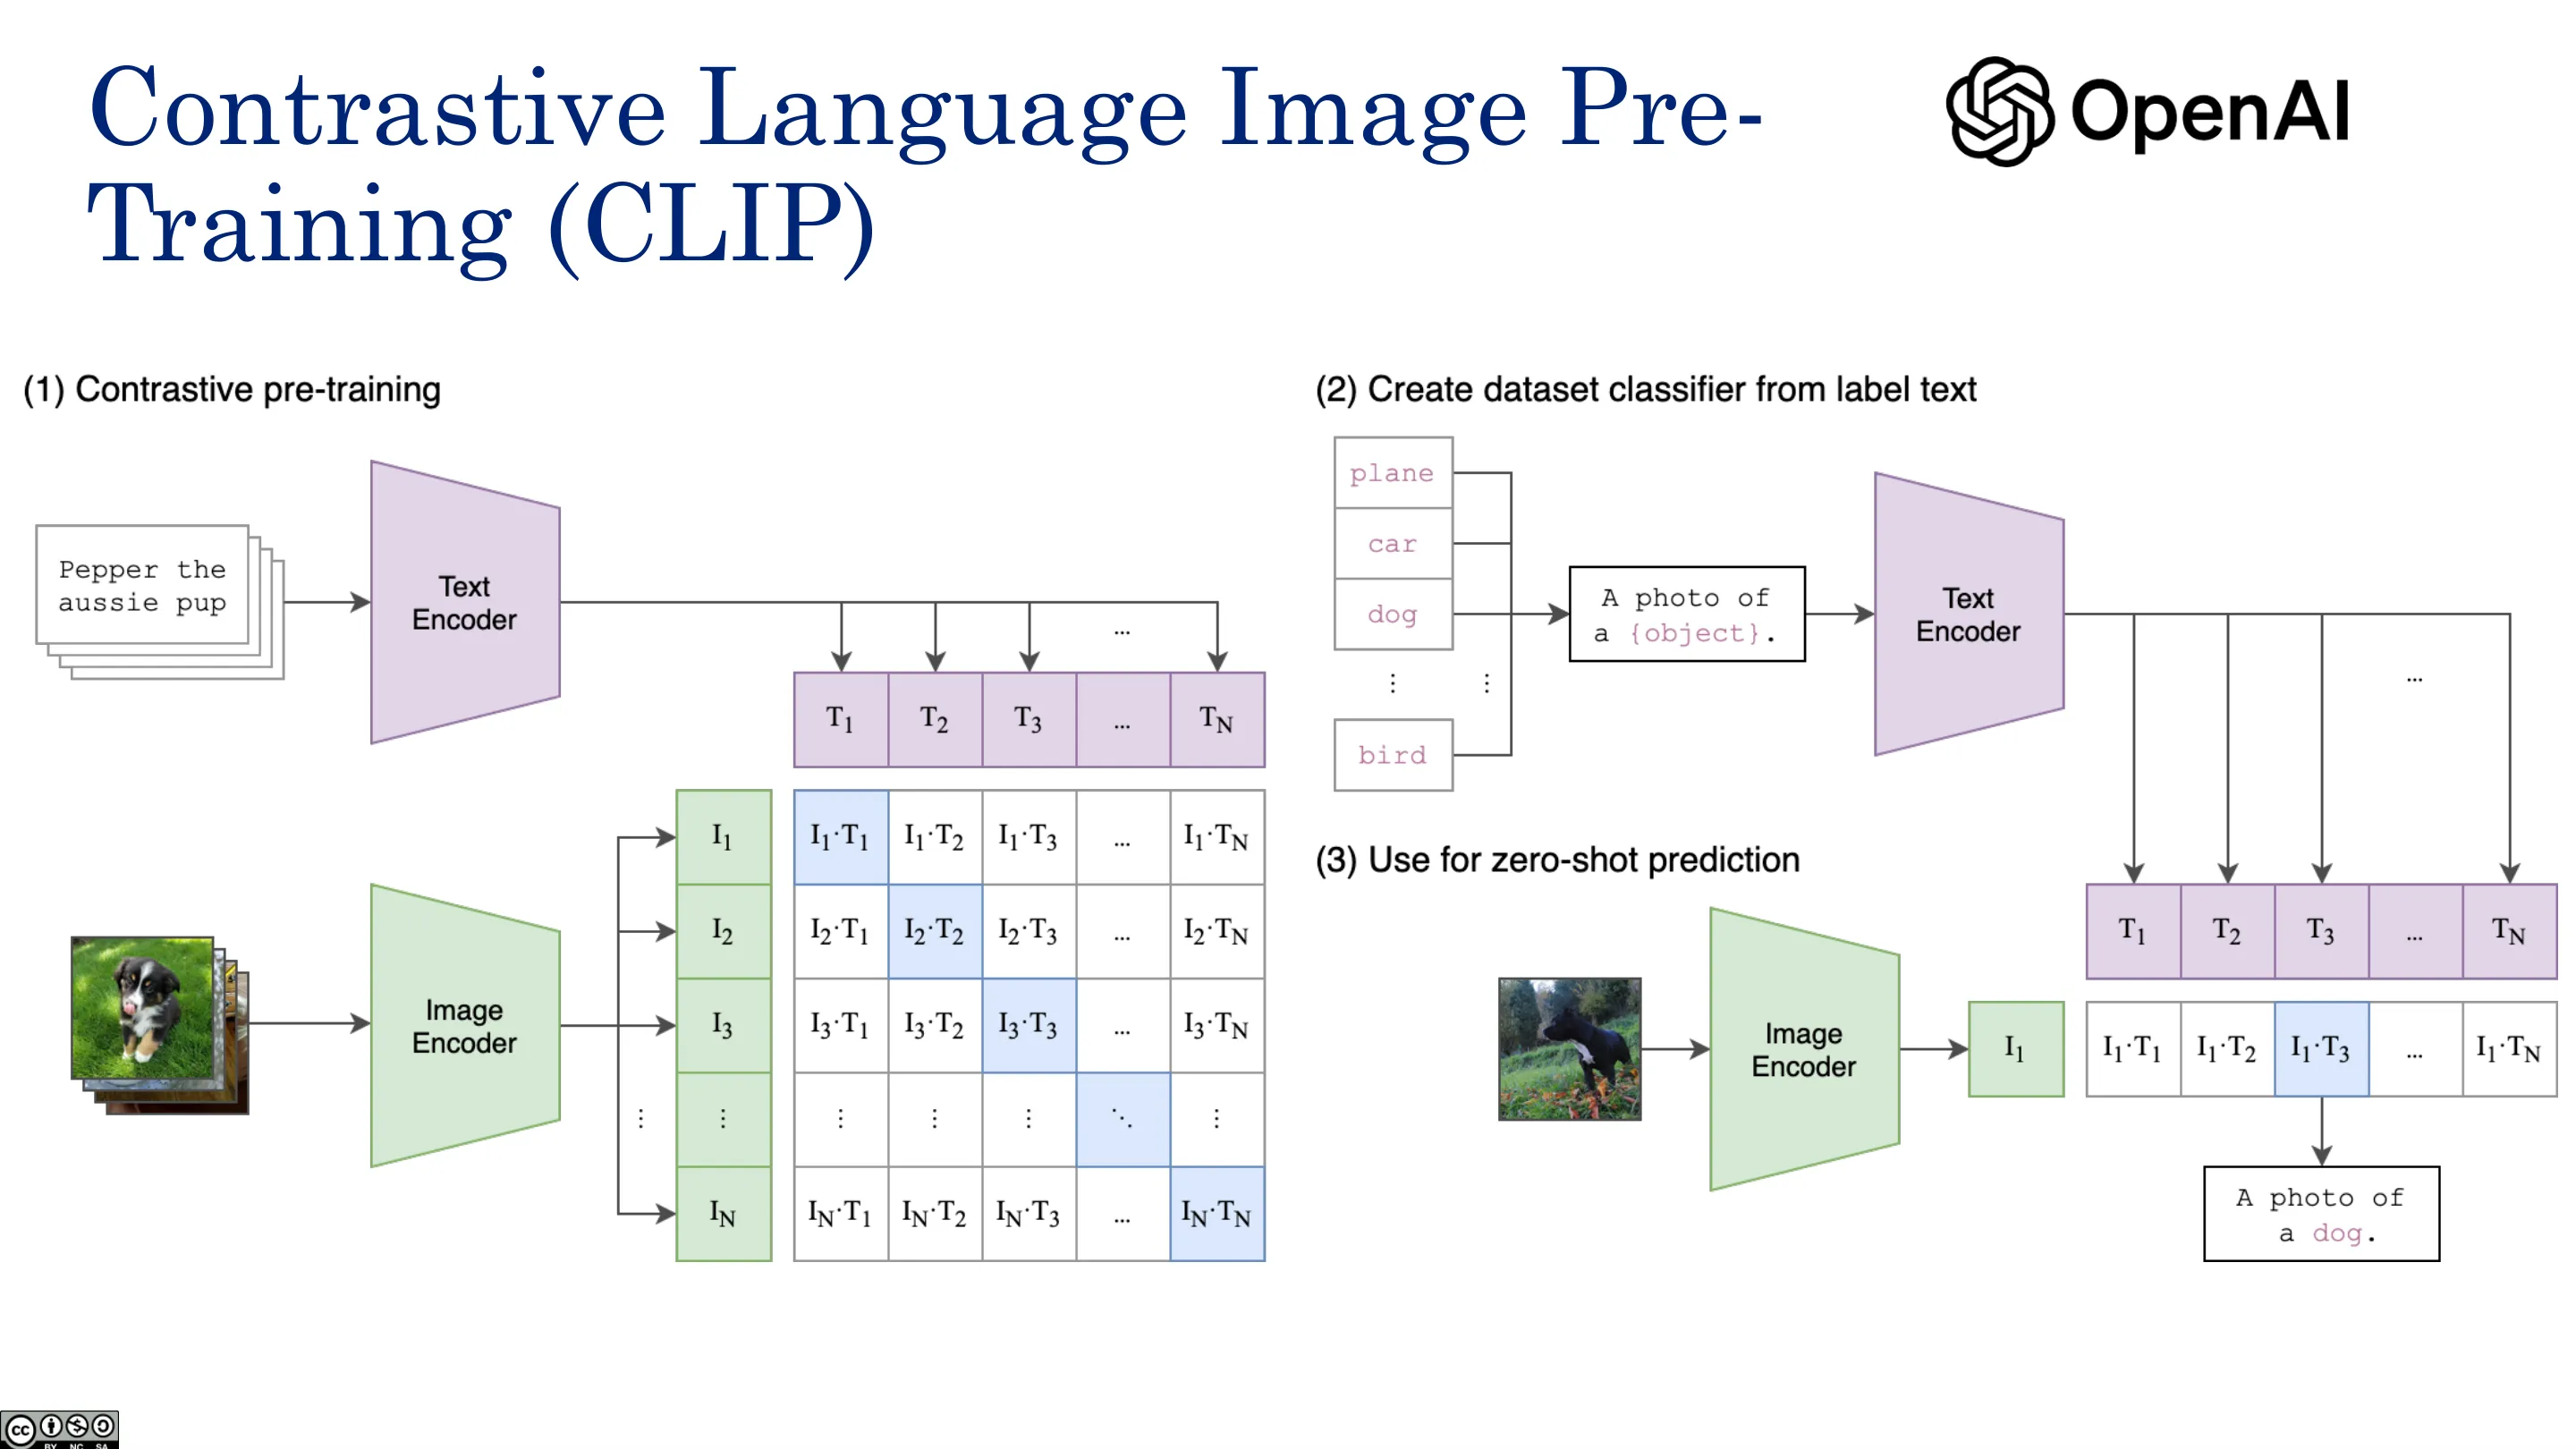
CLIP(Contrastive Language–Image Pre-training) 由 OpenAI 提出,训练两个编码器:
- 图像编码器(ViT/ResNet):图像 → 向量;
- 文本编码器(Transformer):描述 → 向量;
- 同一维度,且训练目标:匹配的图文对内积大,不匹配的对外积小。
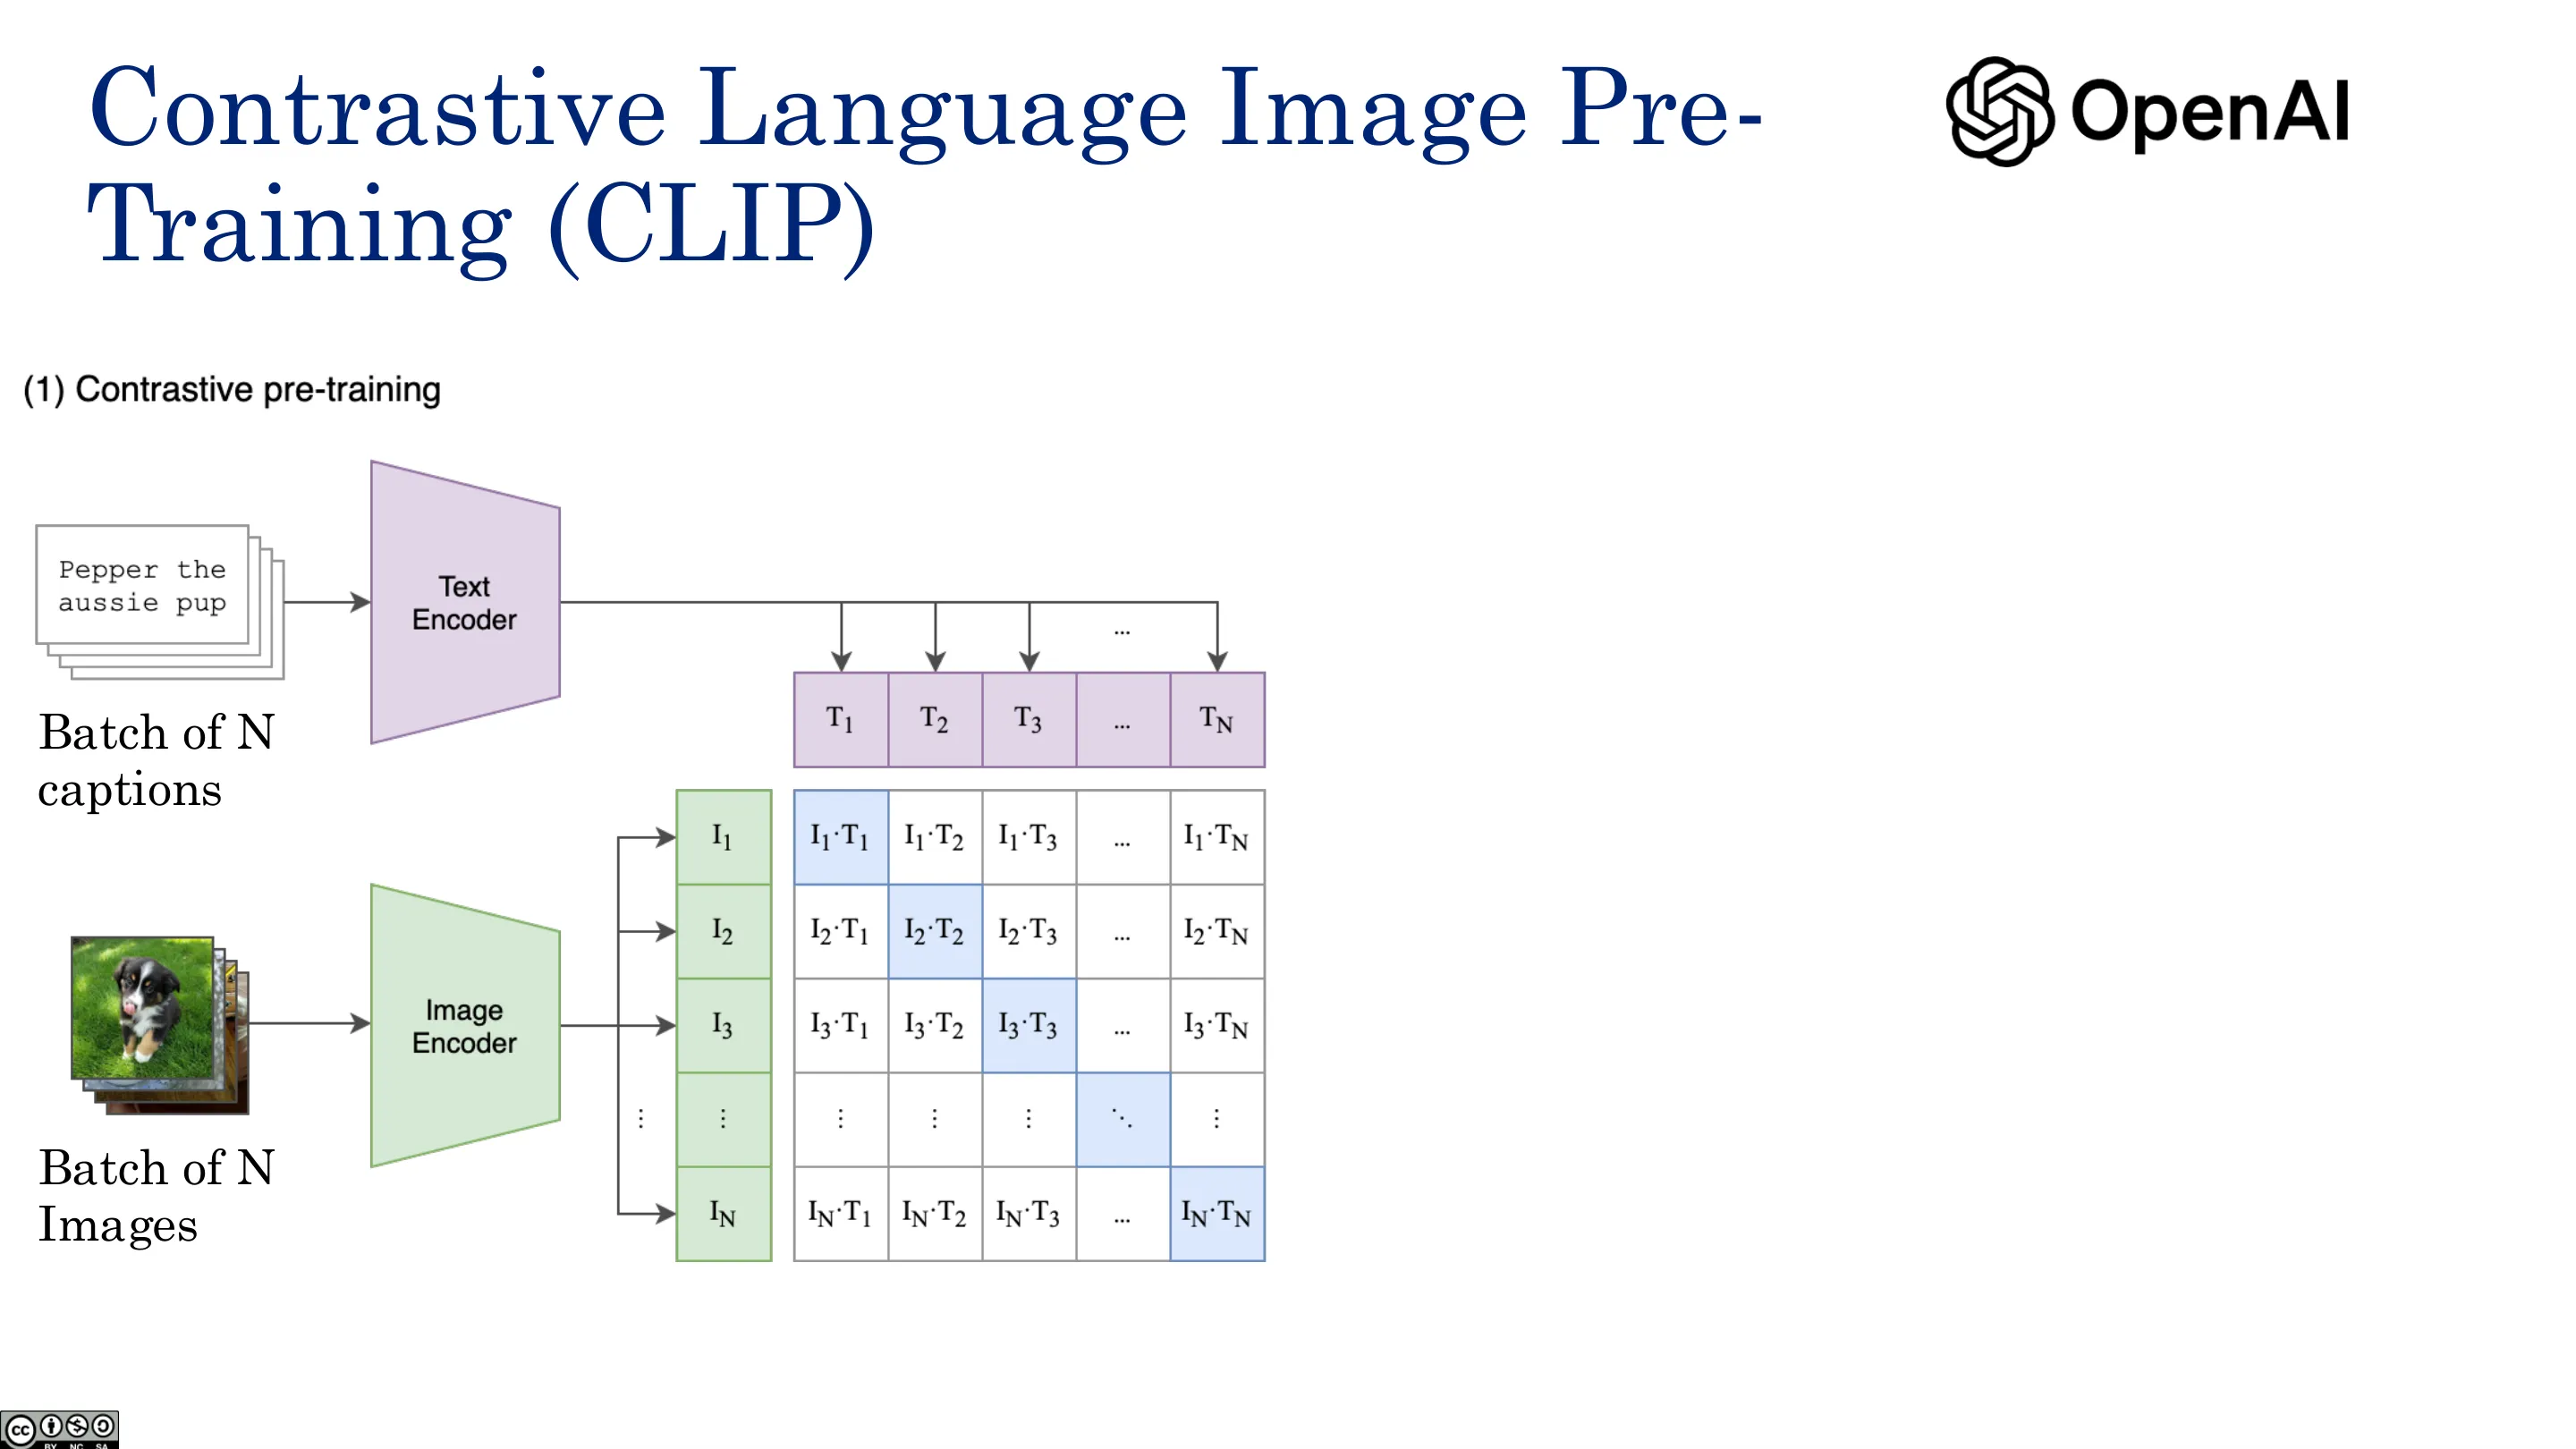
训练:从 4 亿(如 LAION / DataComp,12 亿对)图文对中取一个 $N\times N$ 的 batch(论文 $N=32000$,$d=512$):
- 每一行=「给定图像,哪个文本正确」⇒ 一个 $N$ 类分类问题(交叉熵);
- 每一列=「给定文本,检索哪张图」⇒ $N$ 个检索问题;
- 总损失 = 所有行列交叉熵之和,对两个编码器做梯度下降。
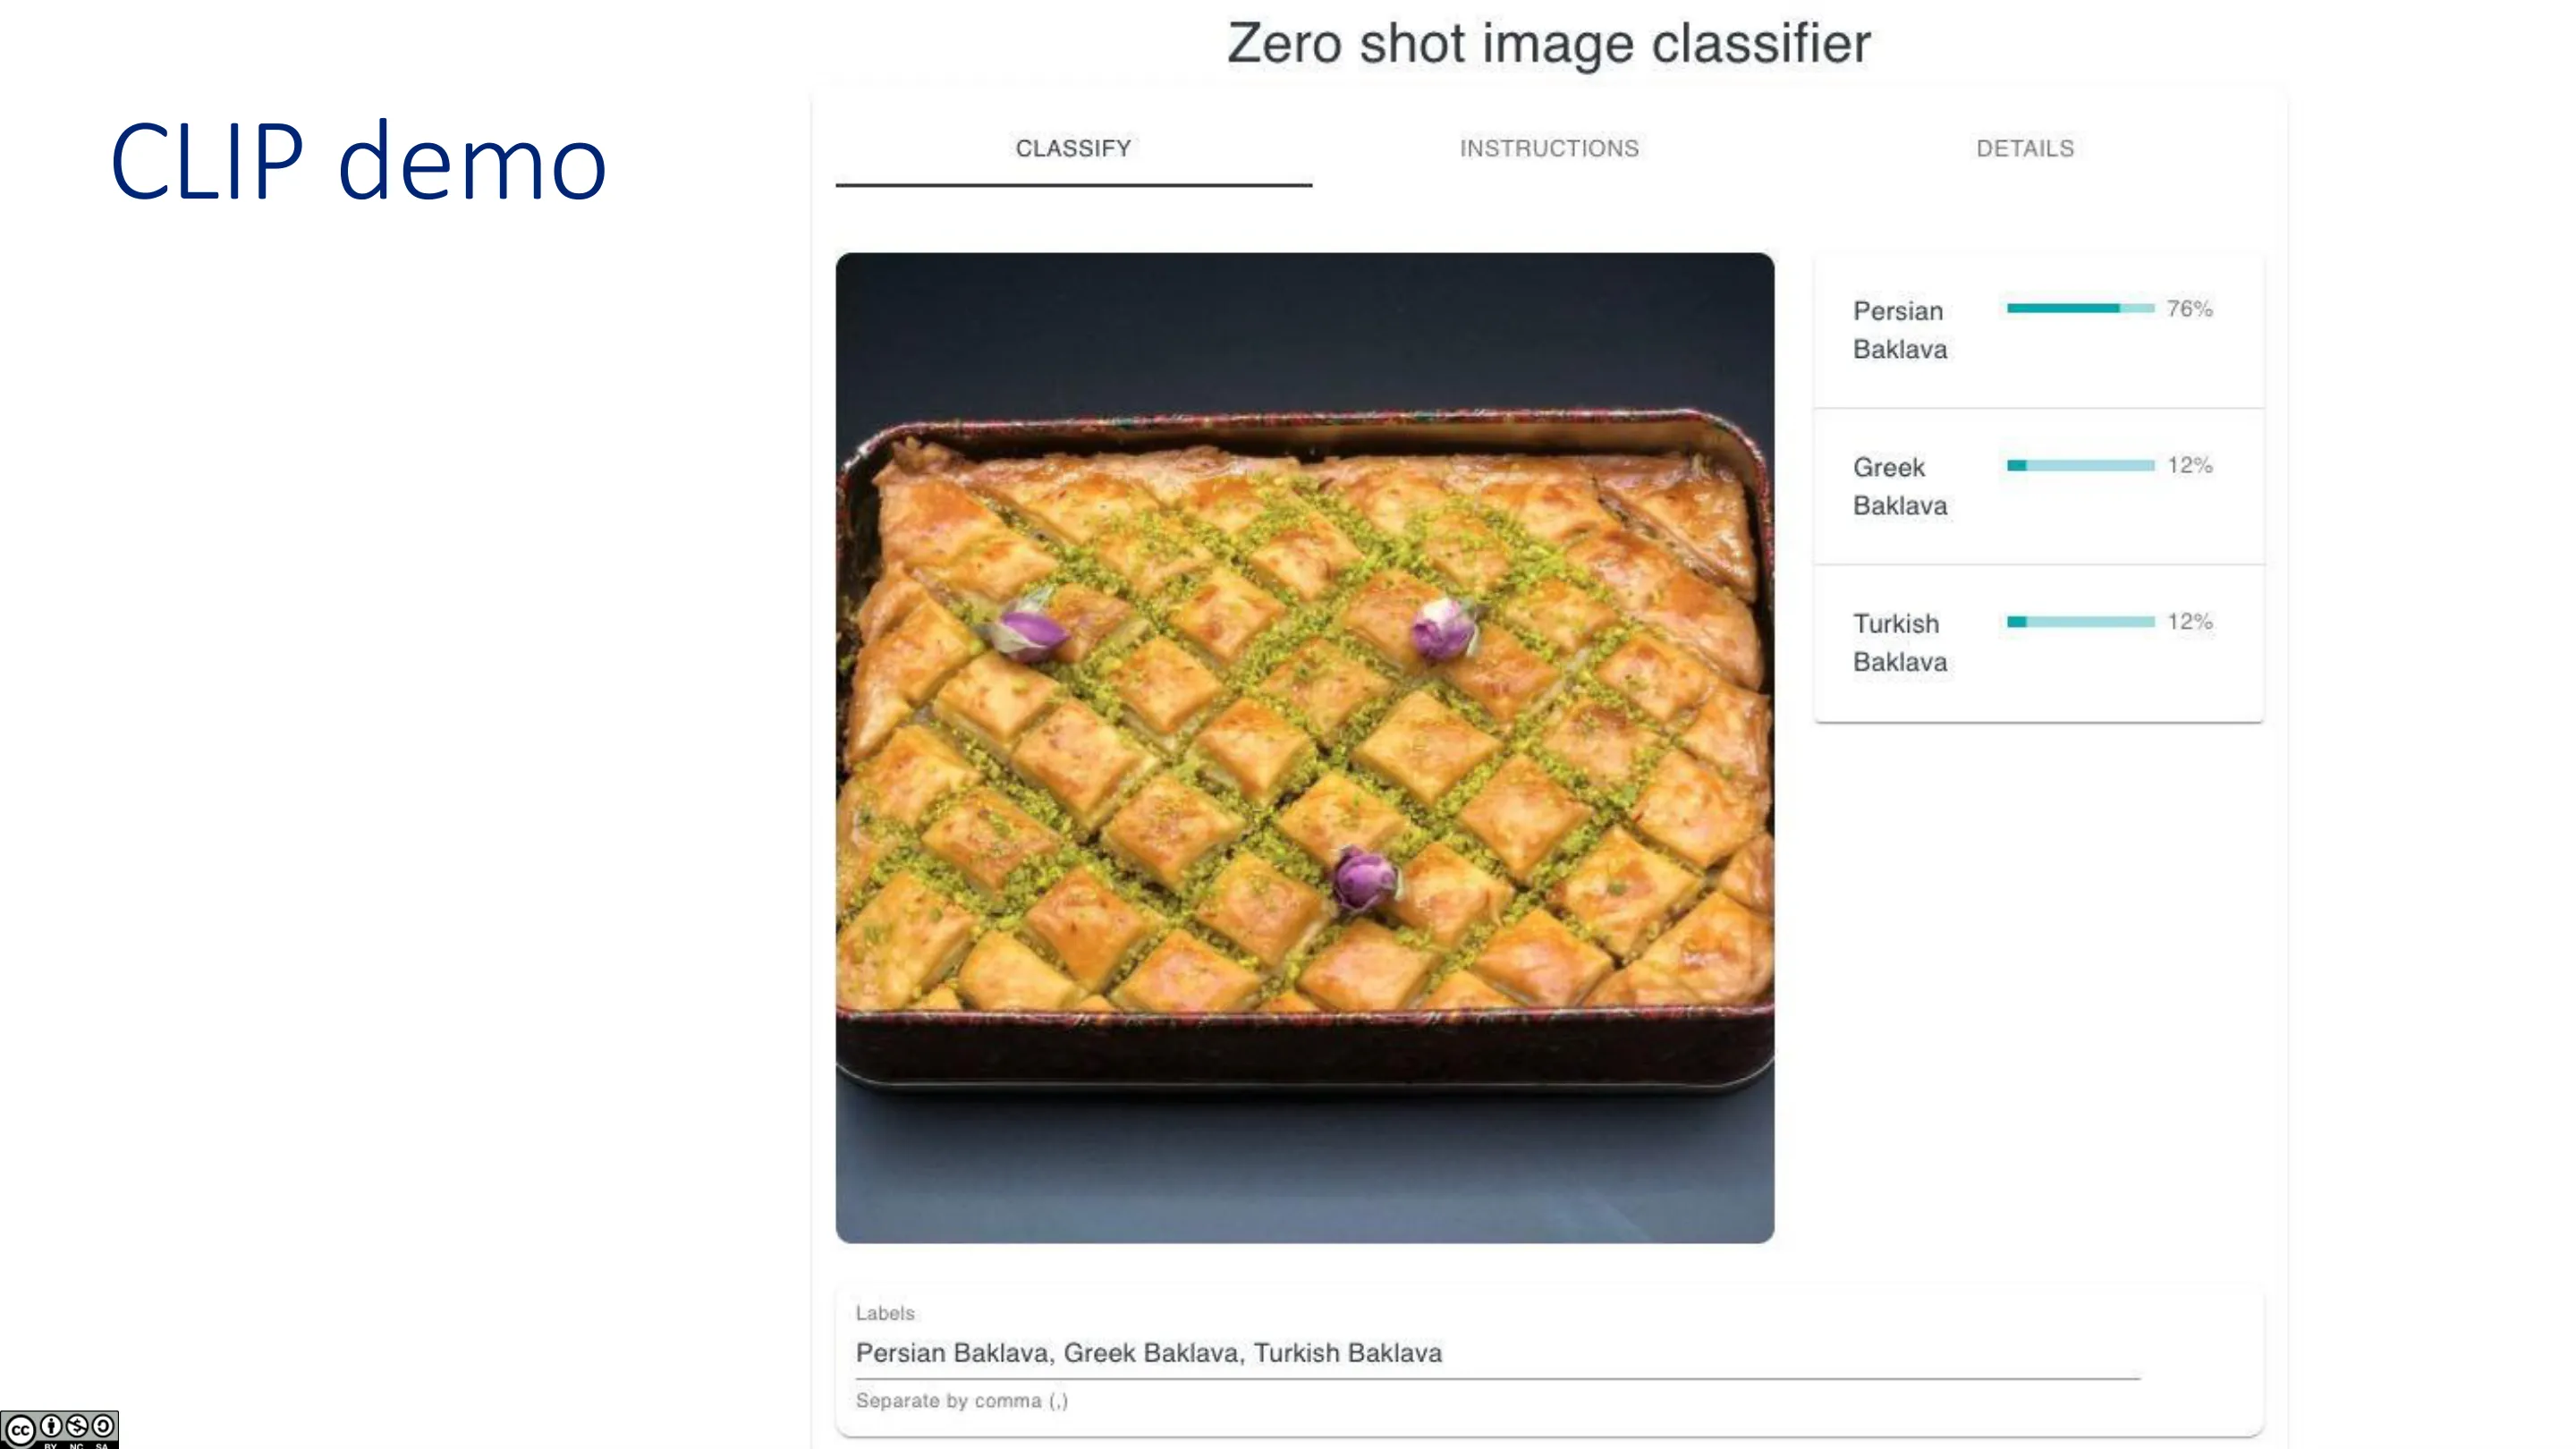
零样本分类:把每个类别名(如 "Persian baklava" / "Greek baklava" / "Turkish baklava")编码成文本向量,与图像向量做内积、取最大。可用于任意类别。
应用:图文检索、视频自由文本搜索(离线编码所有帧,在线用文本向量做内积检索);这类快速内积检索由 vector store 公司提供。若有第三模态(音频),可加一个音频编码器,用相同损失训练——任何"天然配对"的多模态数据都能提供免费监督。
batch 构造技巧:随机采样使任务容易;刻意把相似对象分到同一 batch(难负例)能提高区分力,但需训练更久。
📷 CLIP 对比语言-图像预训练(一)
回到原视频 (01:26:43)
📷 CLIP 对比语言-图像预训练(二)
回到原视频 (01:27:56)
📷 CLIP 对比语言-图像预训练(三)
回到原视频 (01:29:09)
📷 CLIP 对比语言-图像预训练(四)
回到原视频 (01:30:22)
📷 MLTrain(三)
回到原视频 (01:31:35)
📷 自监督学习
回到原视频 (01:32:48)
总结(Takeaways)
- 自监督 = 造假的监督任务,从海量无标注数据学到可迁移表示;下游只需少量标注(fine-tune / linear probing)甚至零标注(zero-shot)。
- 使用预训练的两种方式:冻结主干 + 线性头(数据少)vs 全量微调(数据多);更新某层必须连带更新下游所有层。
- 生成式 pretext:自编码器(重建/压缩/去噪/生成,VAE 让 $z$ 服从高斯)、着色、跨通道、上下文编码、超分。
- 判别式 pretext:旋转预测、相对 patch 位置、拼图、深度聚类。
- 对比学习:拉近正例、推远负例(InfoNCE);SimCLR 简洁有效。
- CLIP:图文对比预训练,实现零样本分类与检索;多模态配对数据提供免费监督。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=iGcer6b6mp8 |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 24) | Google Drive 文件夹 |
| Zhang et al., Colorful Image Colorization | 图像着色 · https://arxiv.org/abs/1603.08511 |
| Pathak et al., Context Encoders | 上下文编码 · https://arxiv.org/abs/1604.07379 |
| Gidaris et al., Unsupervised Representation Learning by Predicting Image Rotations | 旋转预测 · https://arxiv.org/abs/1803.07728 |
| Noroozi & Favaro, Unsupervised Learning of Visual Representations by Solving Jigsaw Puzzles | 拼图 · https://arxiv.org/abs/1603.09246 |
| Chen et al., SimCLR | 对比学习 · https://arxiv.org/abs/2002.05709 |
| Radford et al., CLIP | 多模态对比学习 · https://arxiv.org/abs/2103.00020 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。