第25讲 · EECS 189:AI 用于蛋白质工程
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | AI for Protein Engineering(客座讲座) |
| 视频 | https://www.youtube.com/watch?v=V-SJk4AJ-xc |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 25) | Google Drive 文件夹 |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第25讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:本讲为客座讲座,主题是蛋白质结构预测与机器学习驱动的蛋白质工程。
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:00)
- 蛋白质基础:氨基酸序列 → 三维结构;蛋白质为何无处不在;
- 蛋白质结构预测:证明原理、CASP 竞赛、AlphaFold2、MSA 与协方差、可信度校准;
- 蛋白质工程:近乎无穷的设计空间、两条诺奖路线(能量函数 vs 定向进化);
- ML 蛋白质工程的挑战:设计中的对抗性、「香蕉」类比、条件生成与贝叶斯法则;
- 案例:AAV 基因治疗载体文库设计、多样本随机选择模型、适应度景观。
📷 标题页
回到原视频 (00:00:20)
📷 CS 189/289
回到原视频 (00:01:33)
一、蛋白质基础
(参考时间: 00:00)
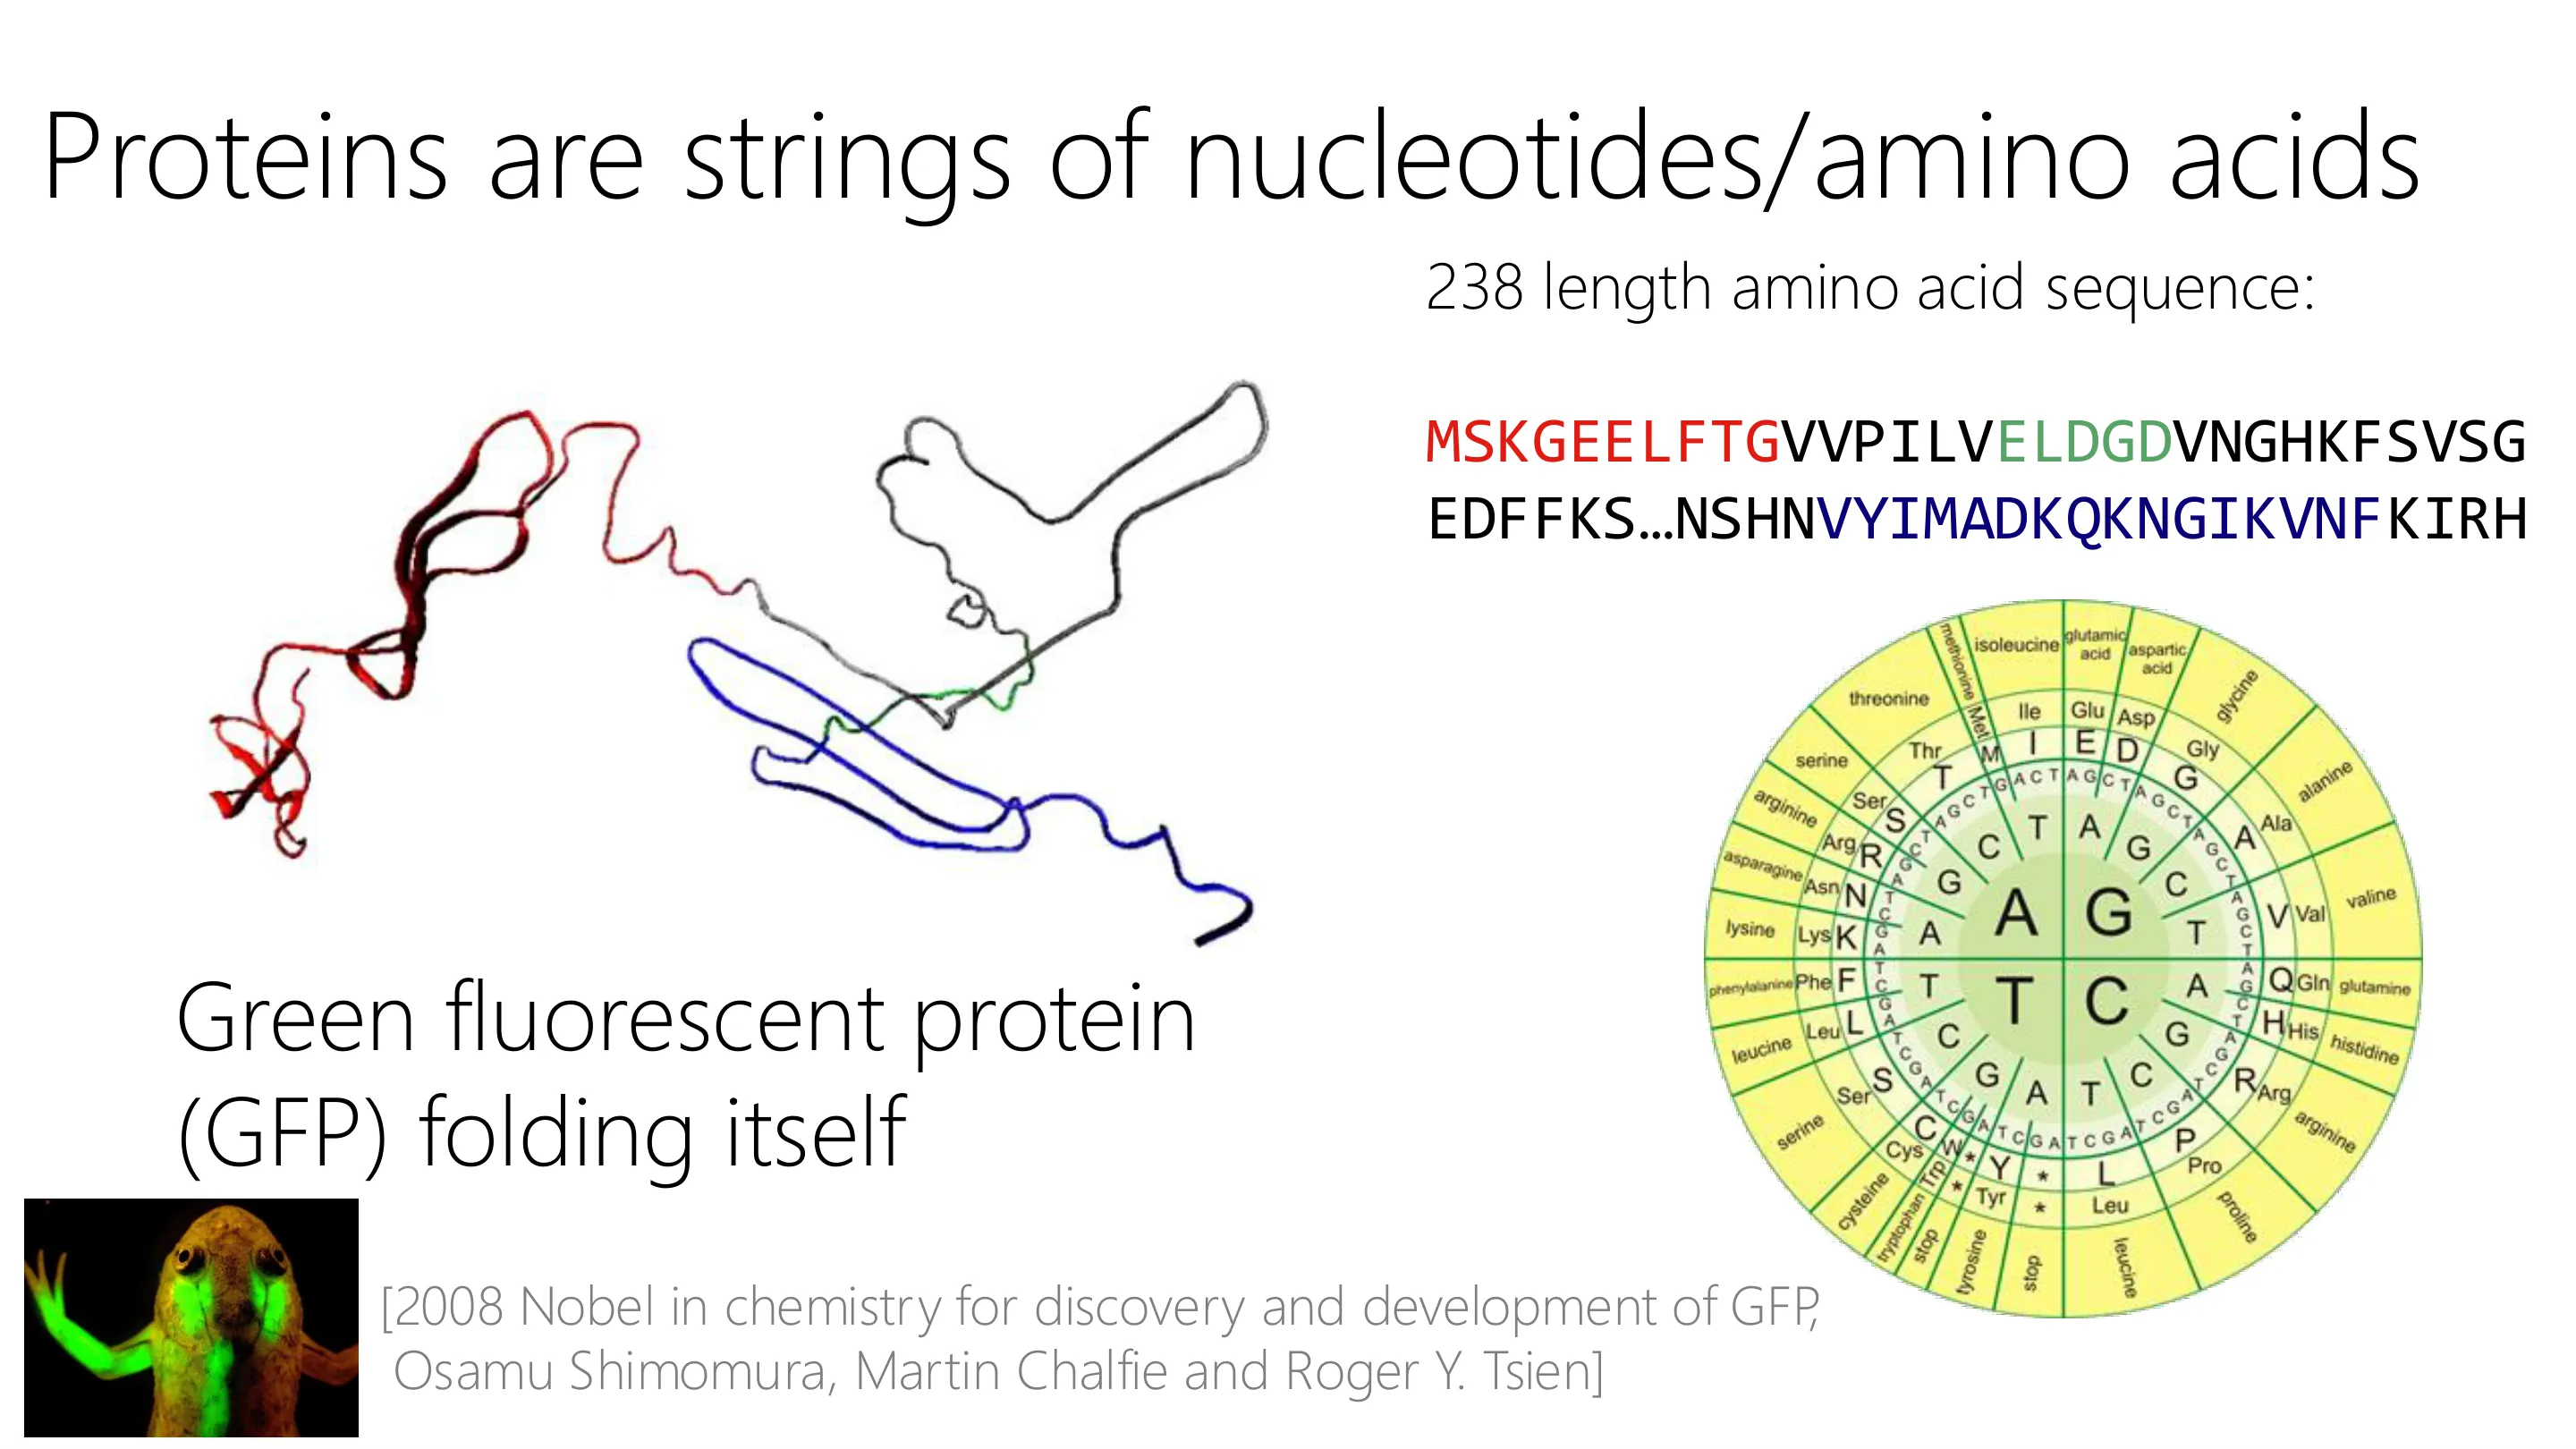
蛋白质是生命的主力分子。基因组由核苷酸(A/C/T/G)组成,三个核苷酸编码一个氨基酸;20 种标准氨基酸串成的序列(字母串)决定蛋白质。
绿色荧光蛋白(GFP):2008 年诺奖,是生物学的「标签」工具;序列是一维字符串,但在细胞中会自组装折叠成三维结构(视频演示)。
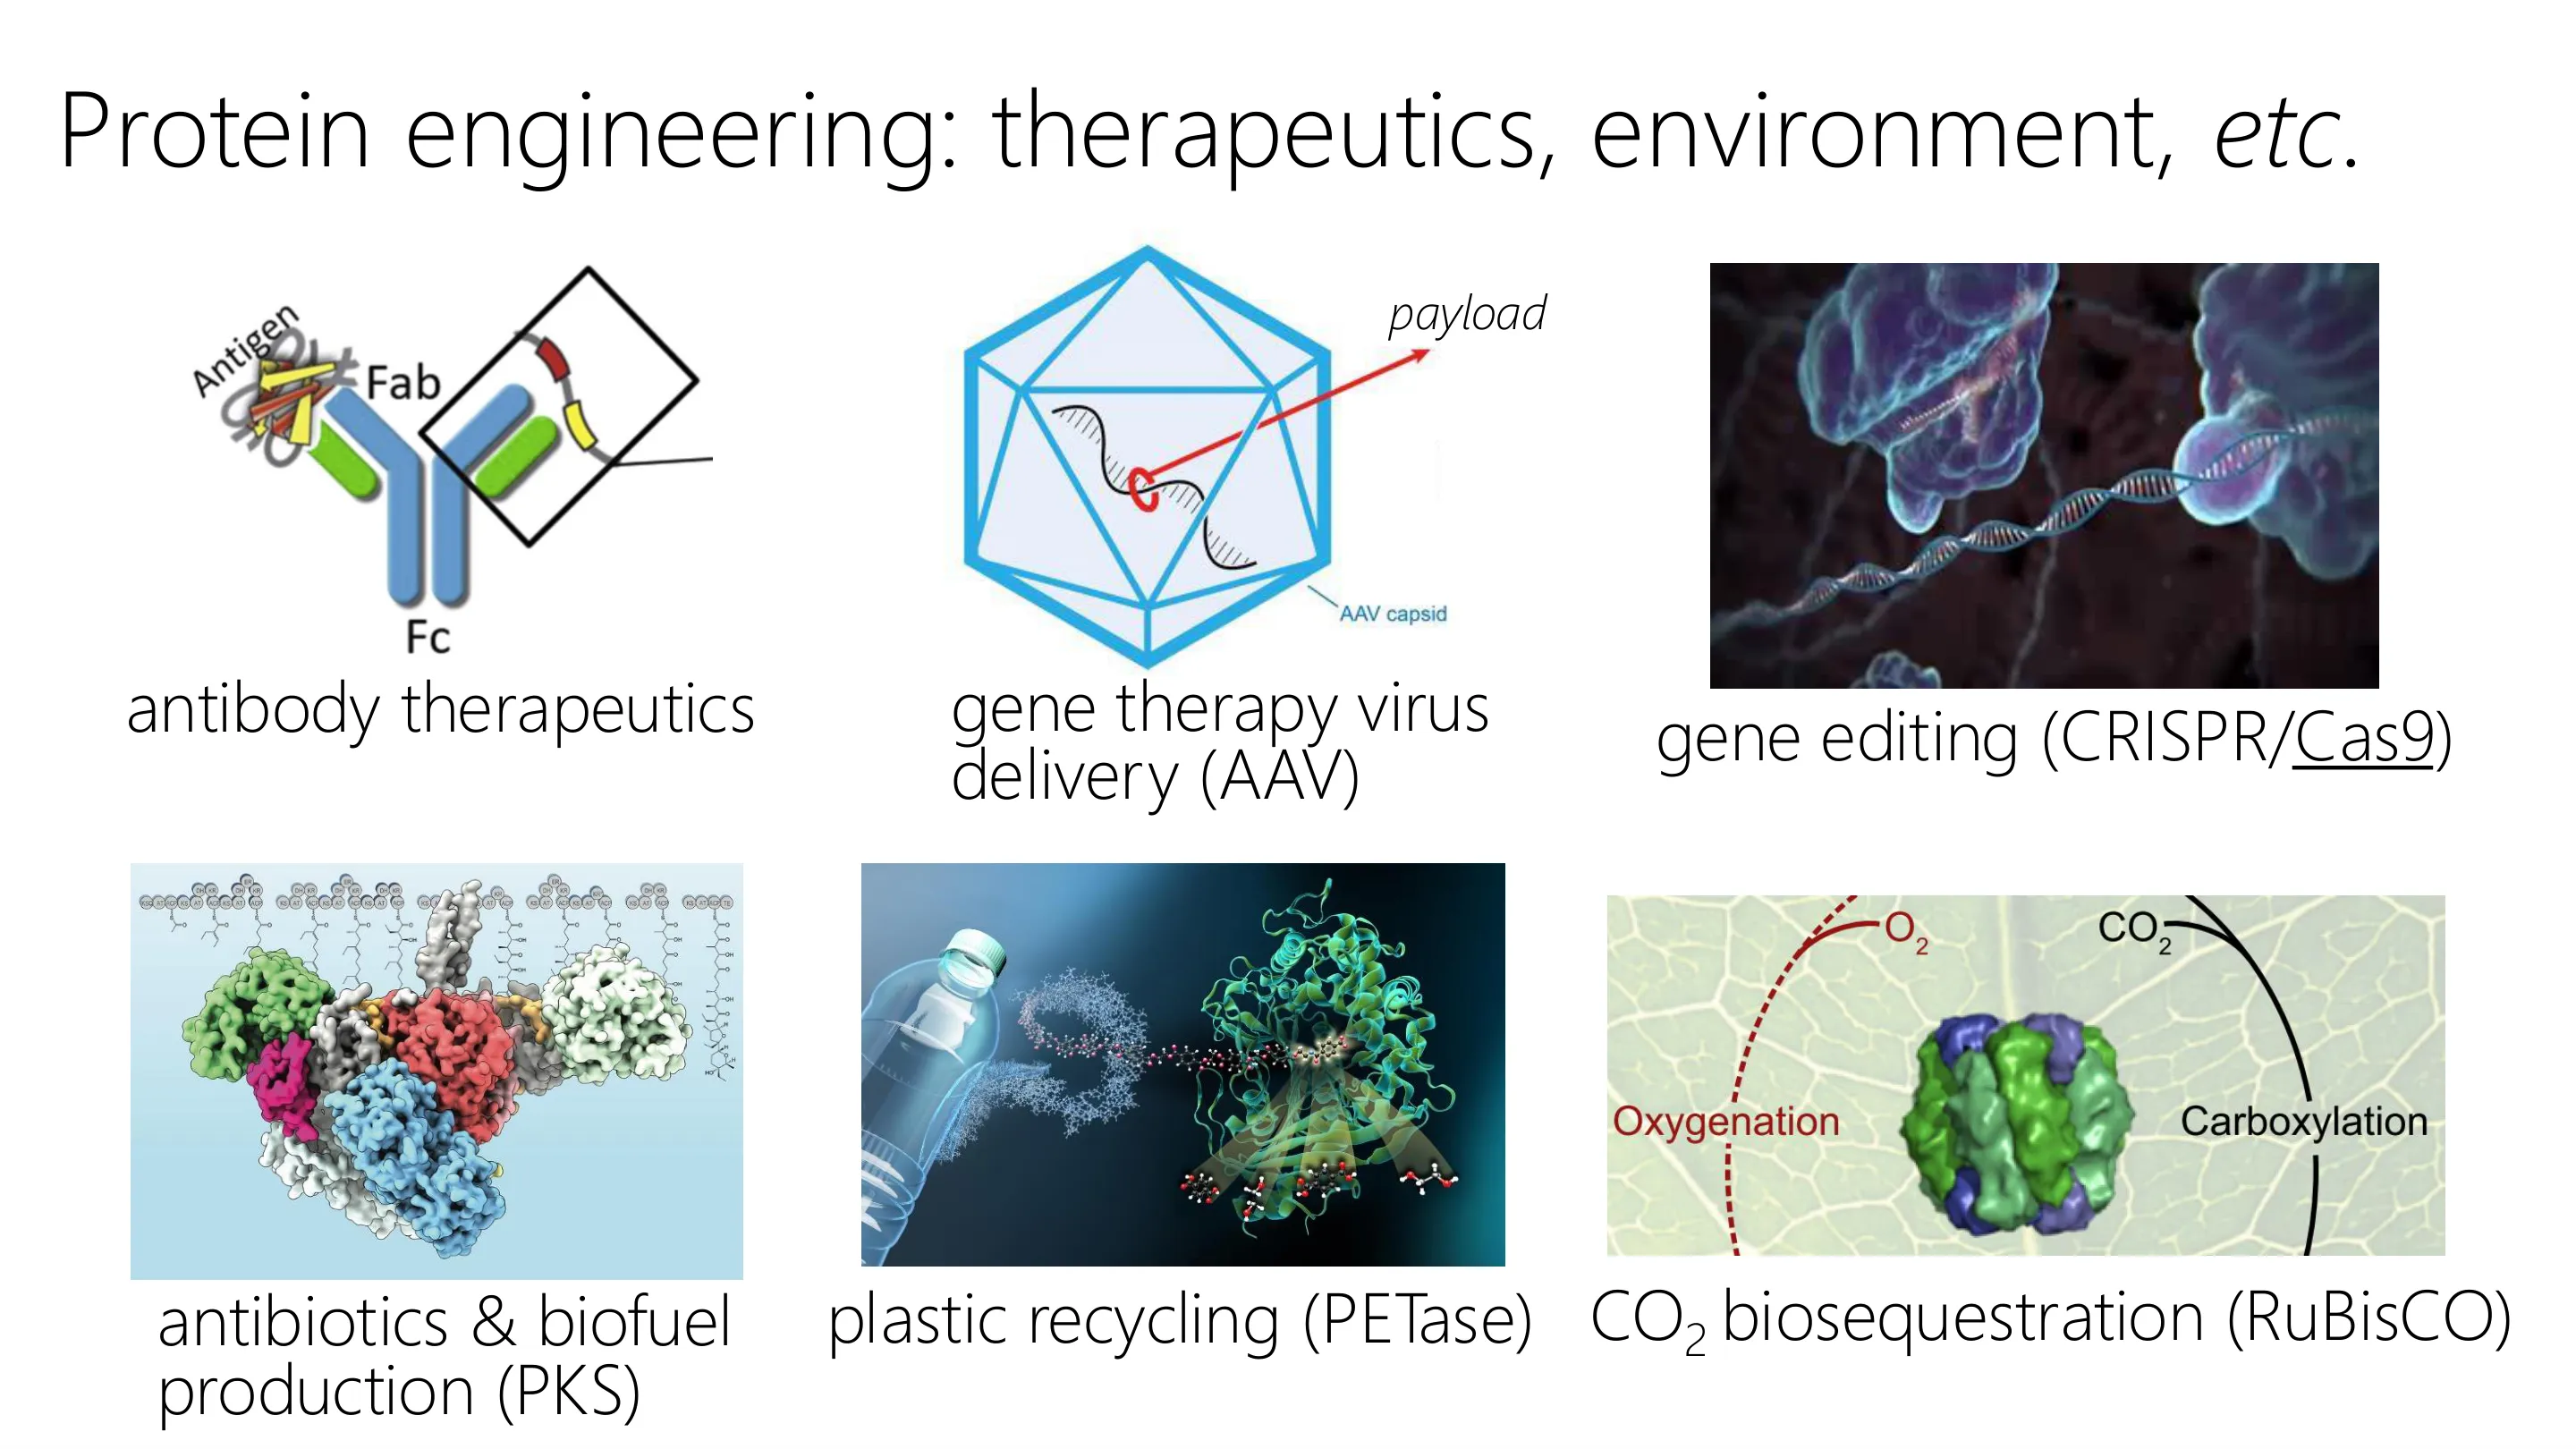
蛋白质无处不在:
- 抗体药物(对抗 COVID 等);
- 基因治疗:改造病毒外壳蛋白(如 AAV)把药物递送到目标细胞;
- CRISPR 基因编辑(Jennifer Doudna,2020 诺奖);
- 抗生素生产(Jay Keasling);
- 塑料回收:PETase 酶;
- CO₂ 生物封存:地球上最丰富的蛋白 RuBisCO。
📷 绿色荧光蛋白
回到原视频 (00:02:46)
📷 塑料回收(PETase)、CO₂ 生物封存(RuBisCO)
回到原视频 (00:03:59)
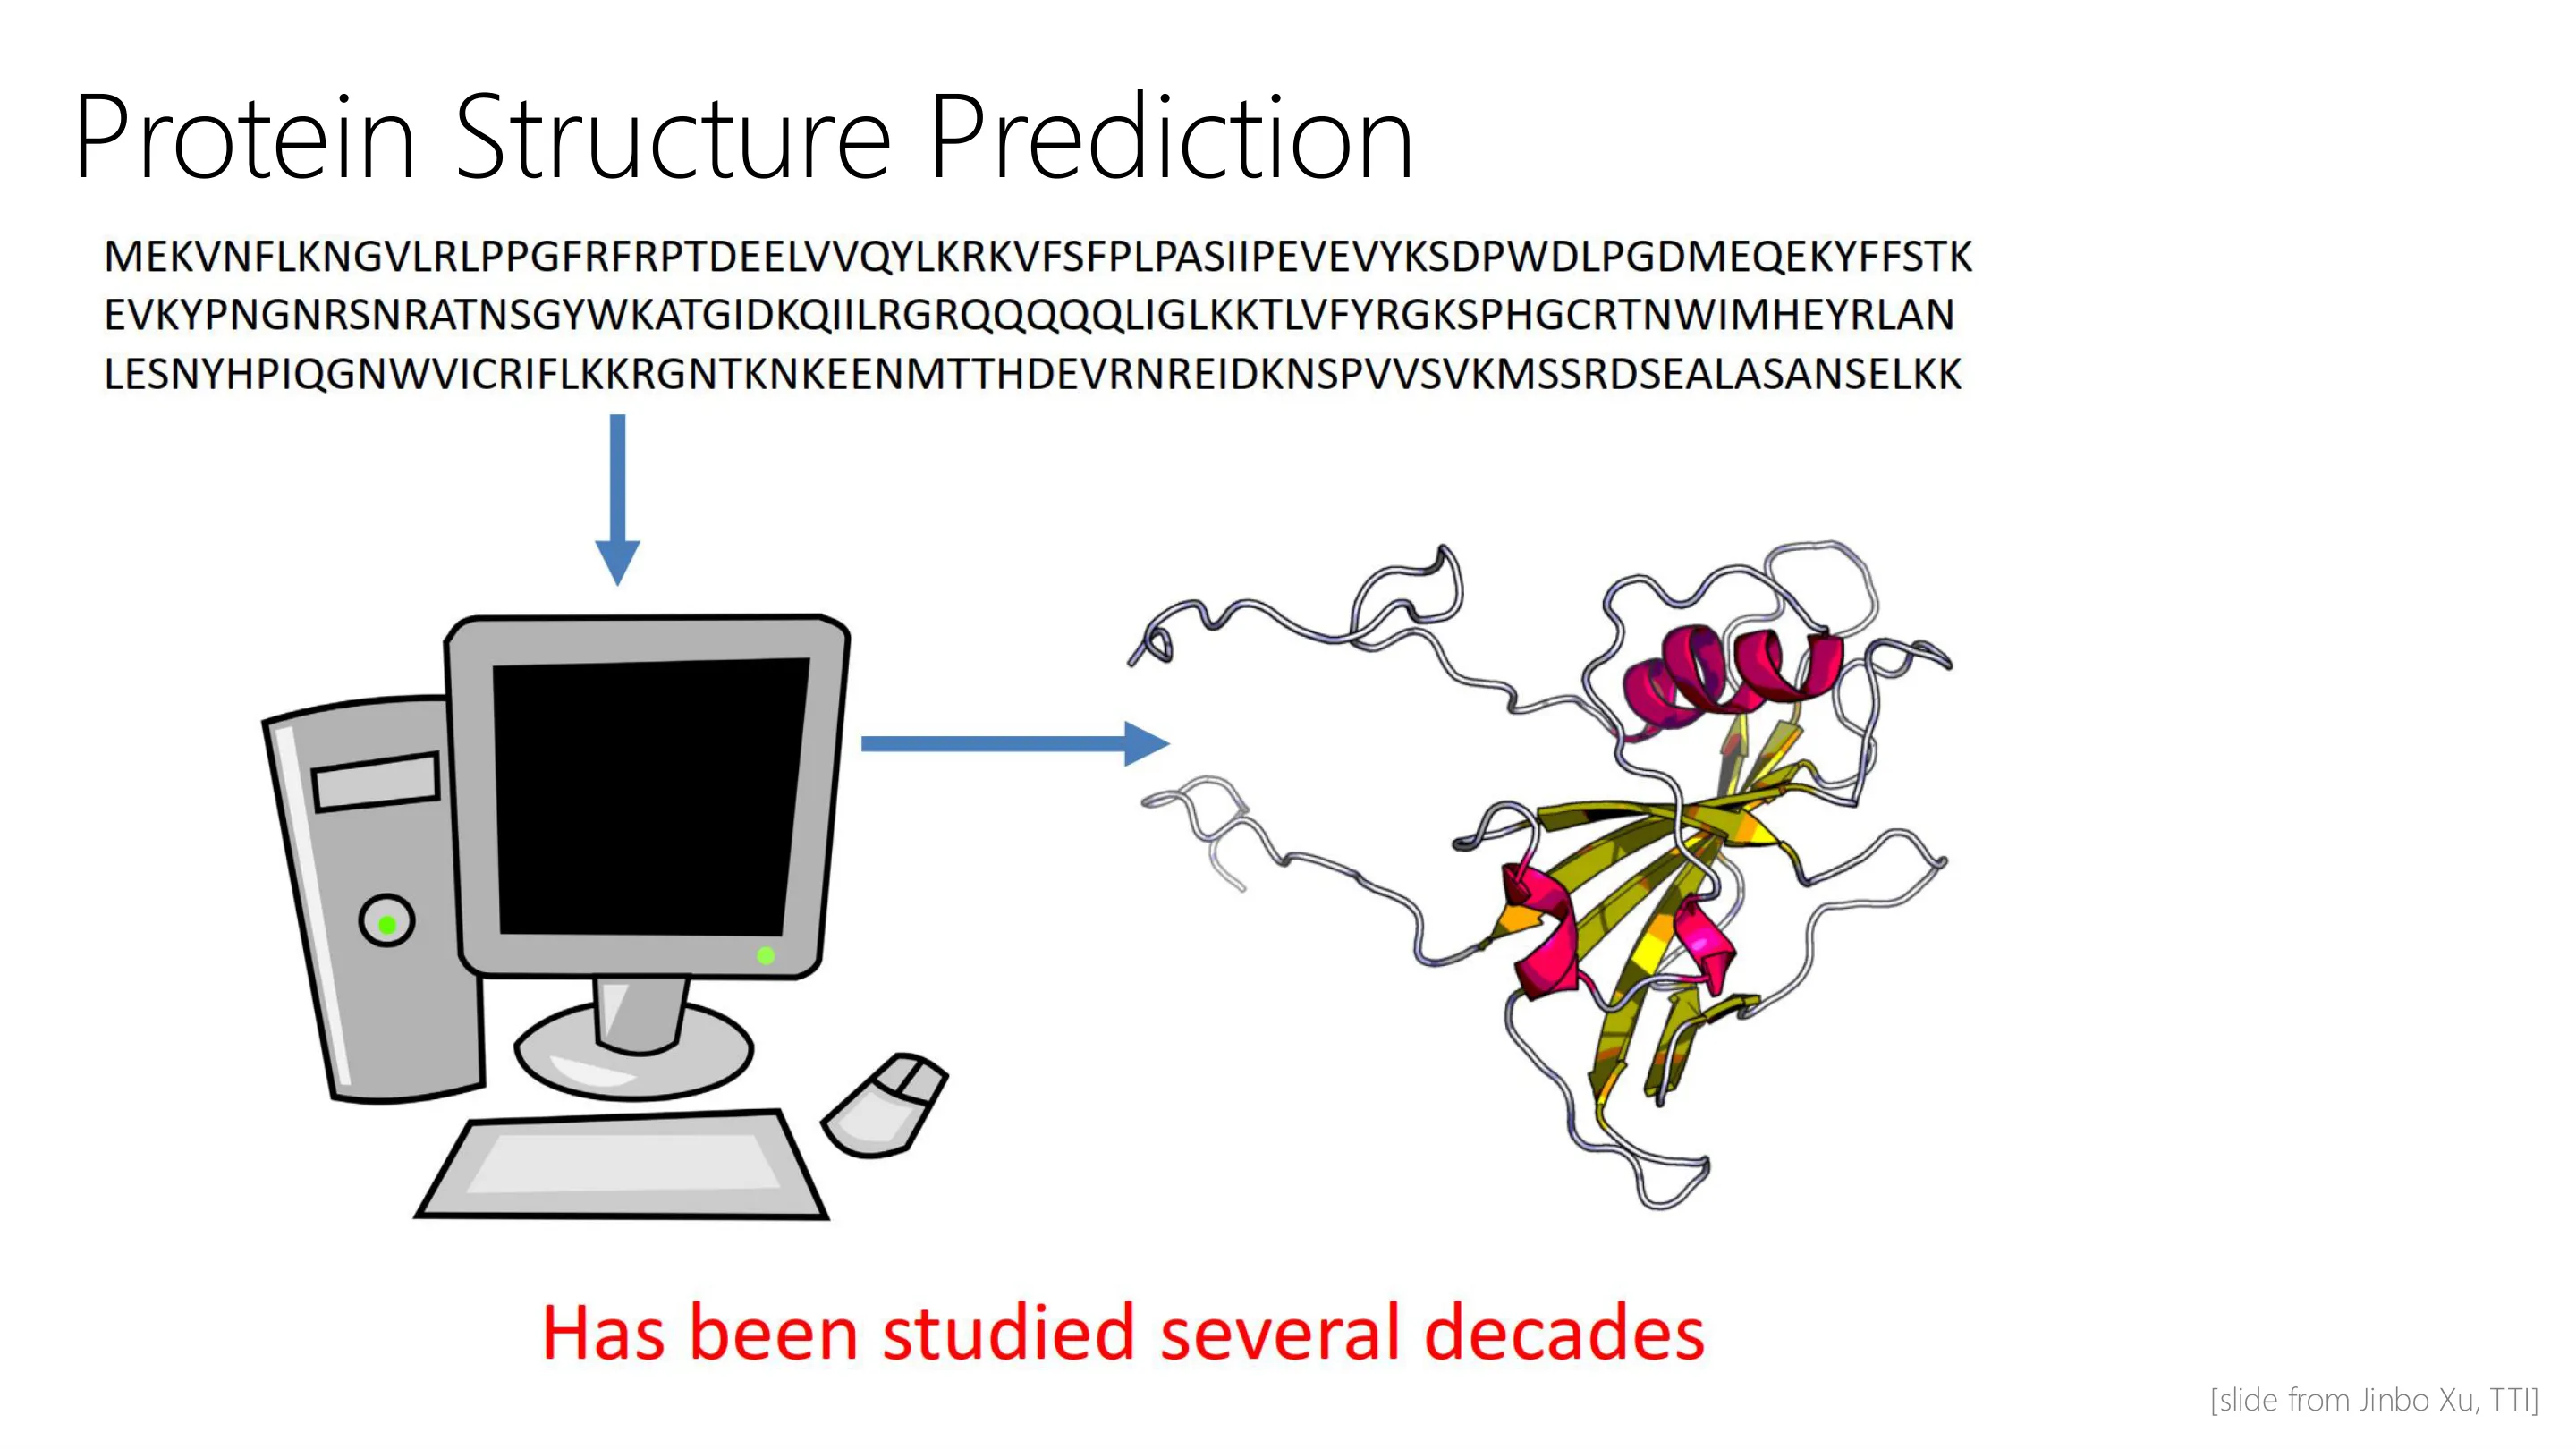
📷 蛋白质结构预测
回到原视频 (00:05:12)
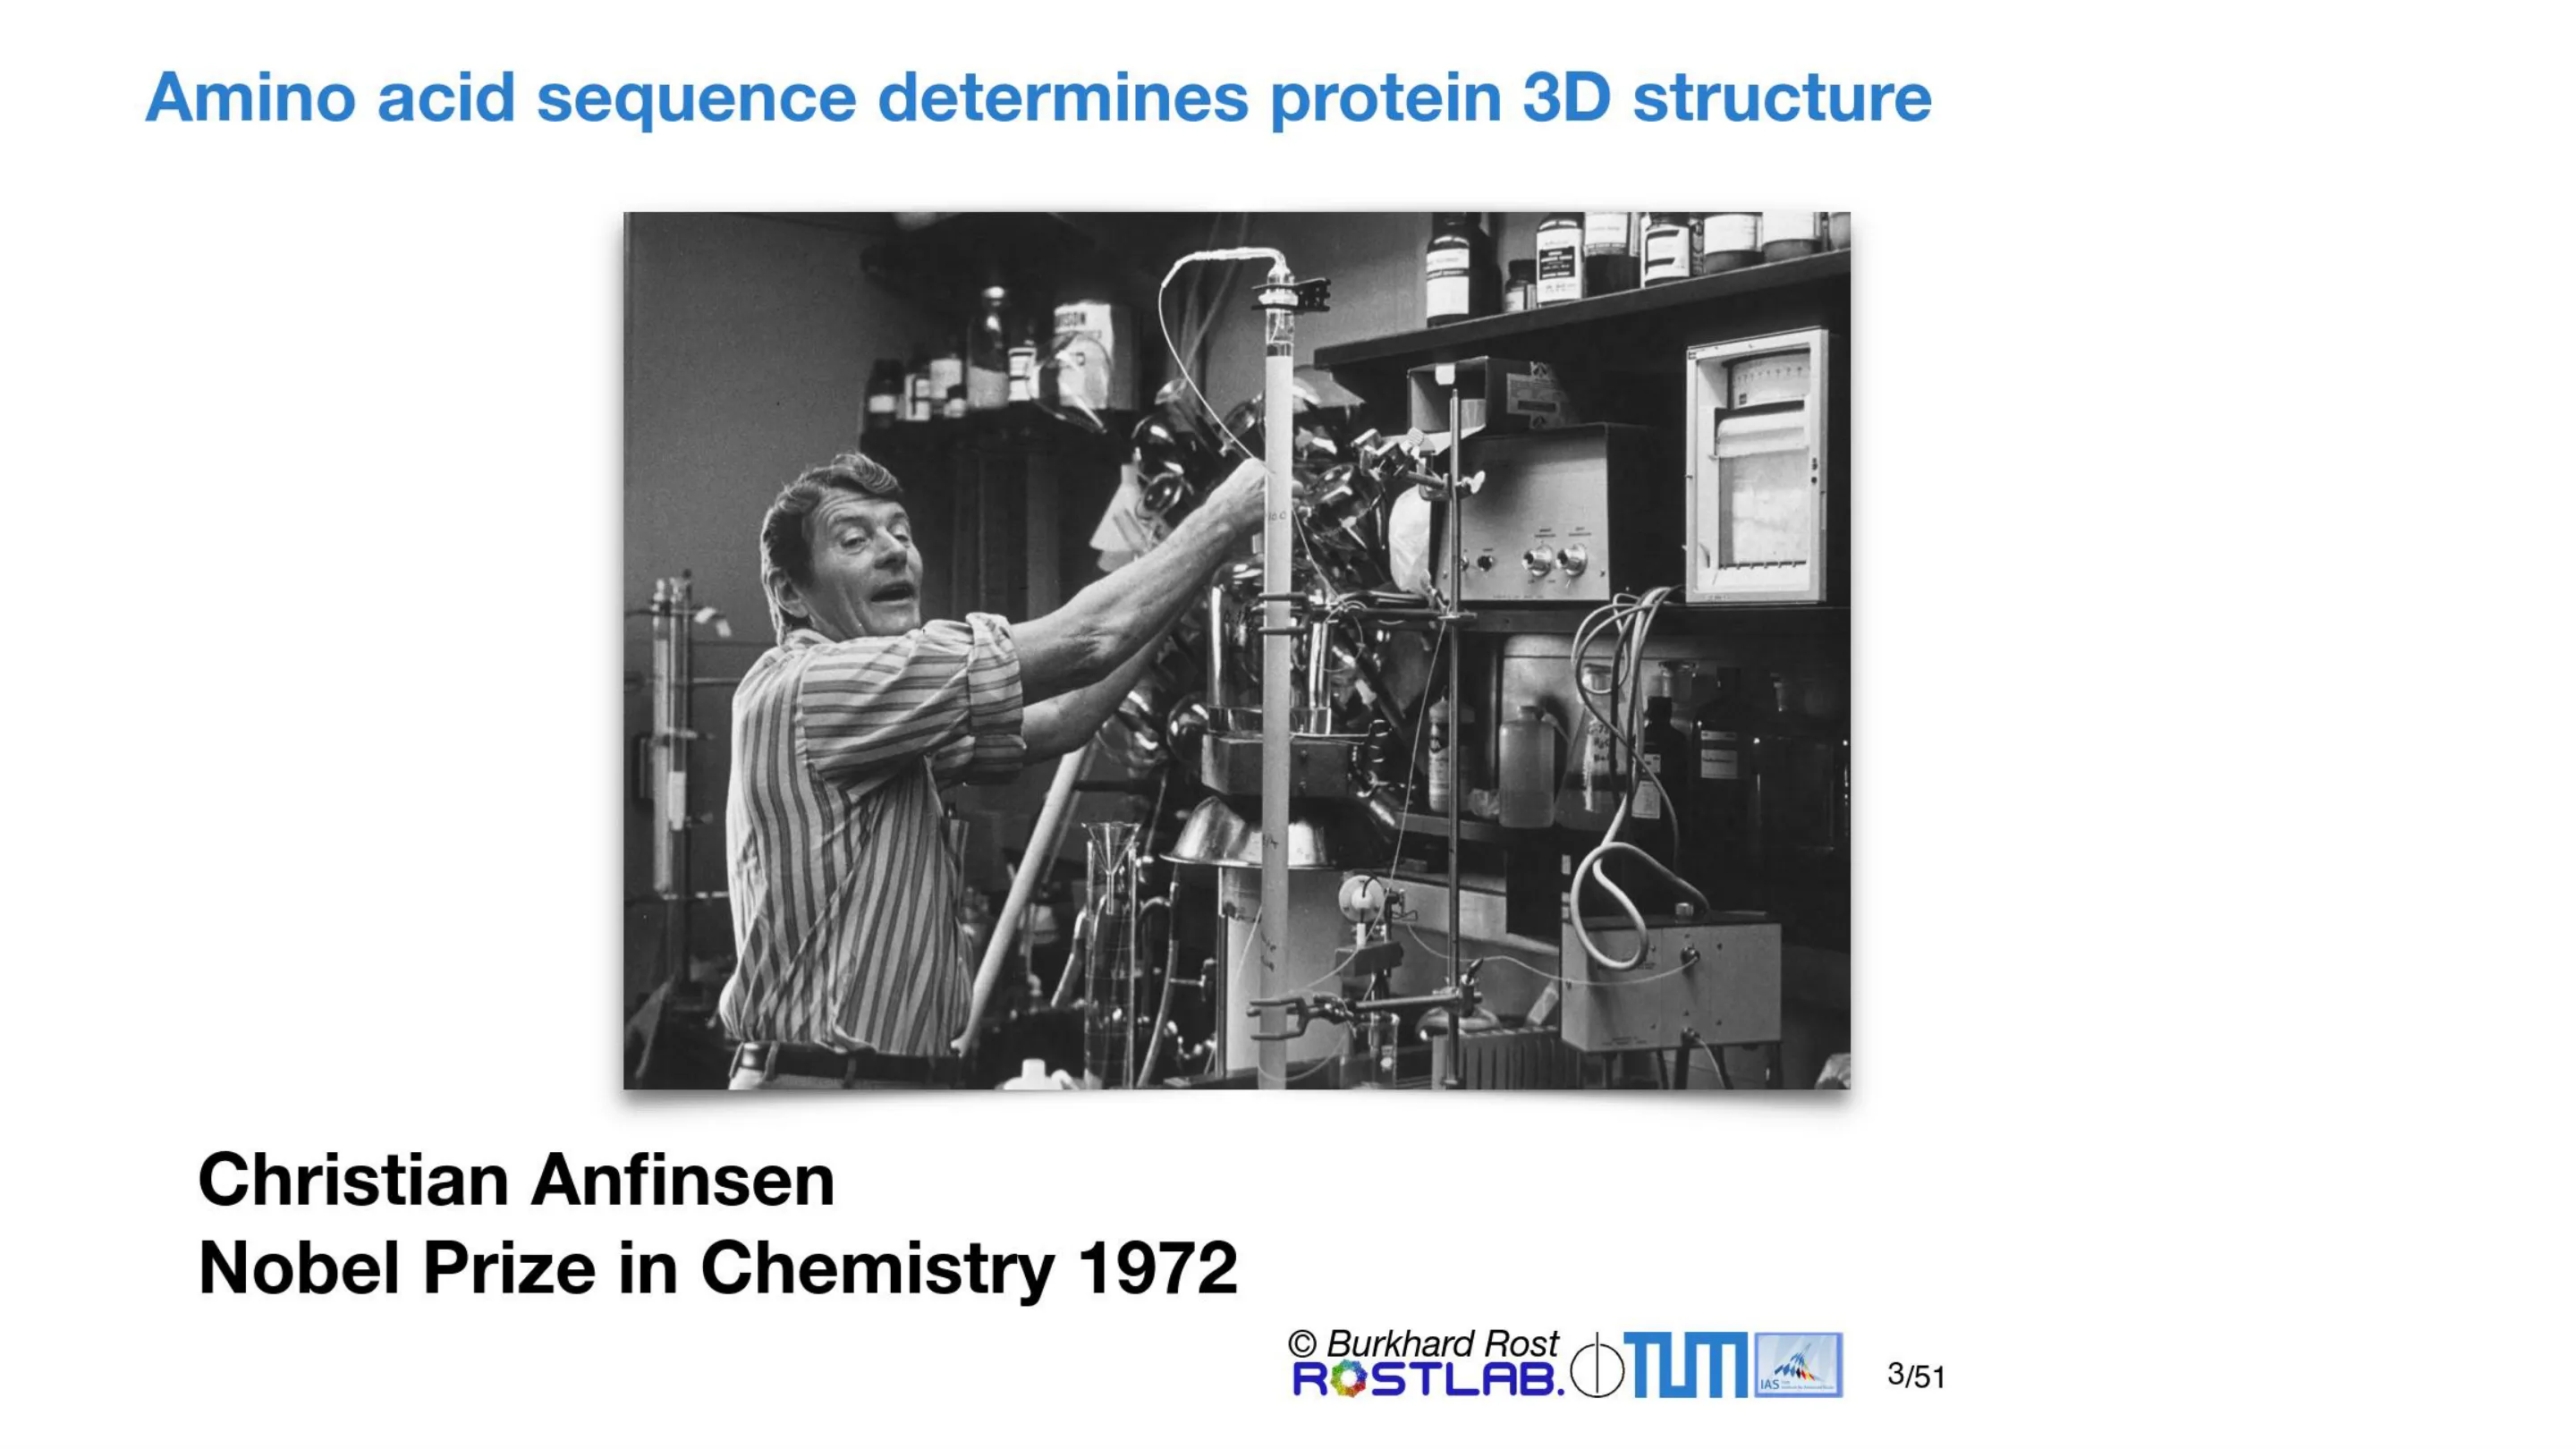
📷 (空白页)
回到原视频 (00:06:25)
二、蛋白质结构预测
2.1 问题与证明原理
(参考时间: 00:08)
蛋白质结构预测:给氨基酸序列,输出每个原子的三维坐标(以及相对取向)。
为什么相信它可能? Anfinsen 的湿实验证明:把纯序列放进空玻璃瓶(脱离细胞环境)它会自发折叠成正确结构——说明序列足以决定结构,所以应能造出计算机程序逼近这套物理。但进度缓慢,50 年后才有真正突破。
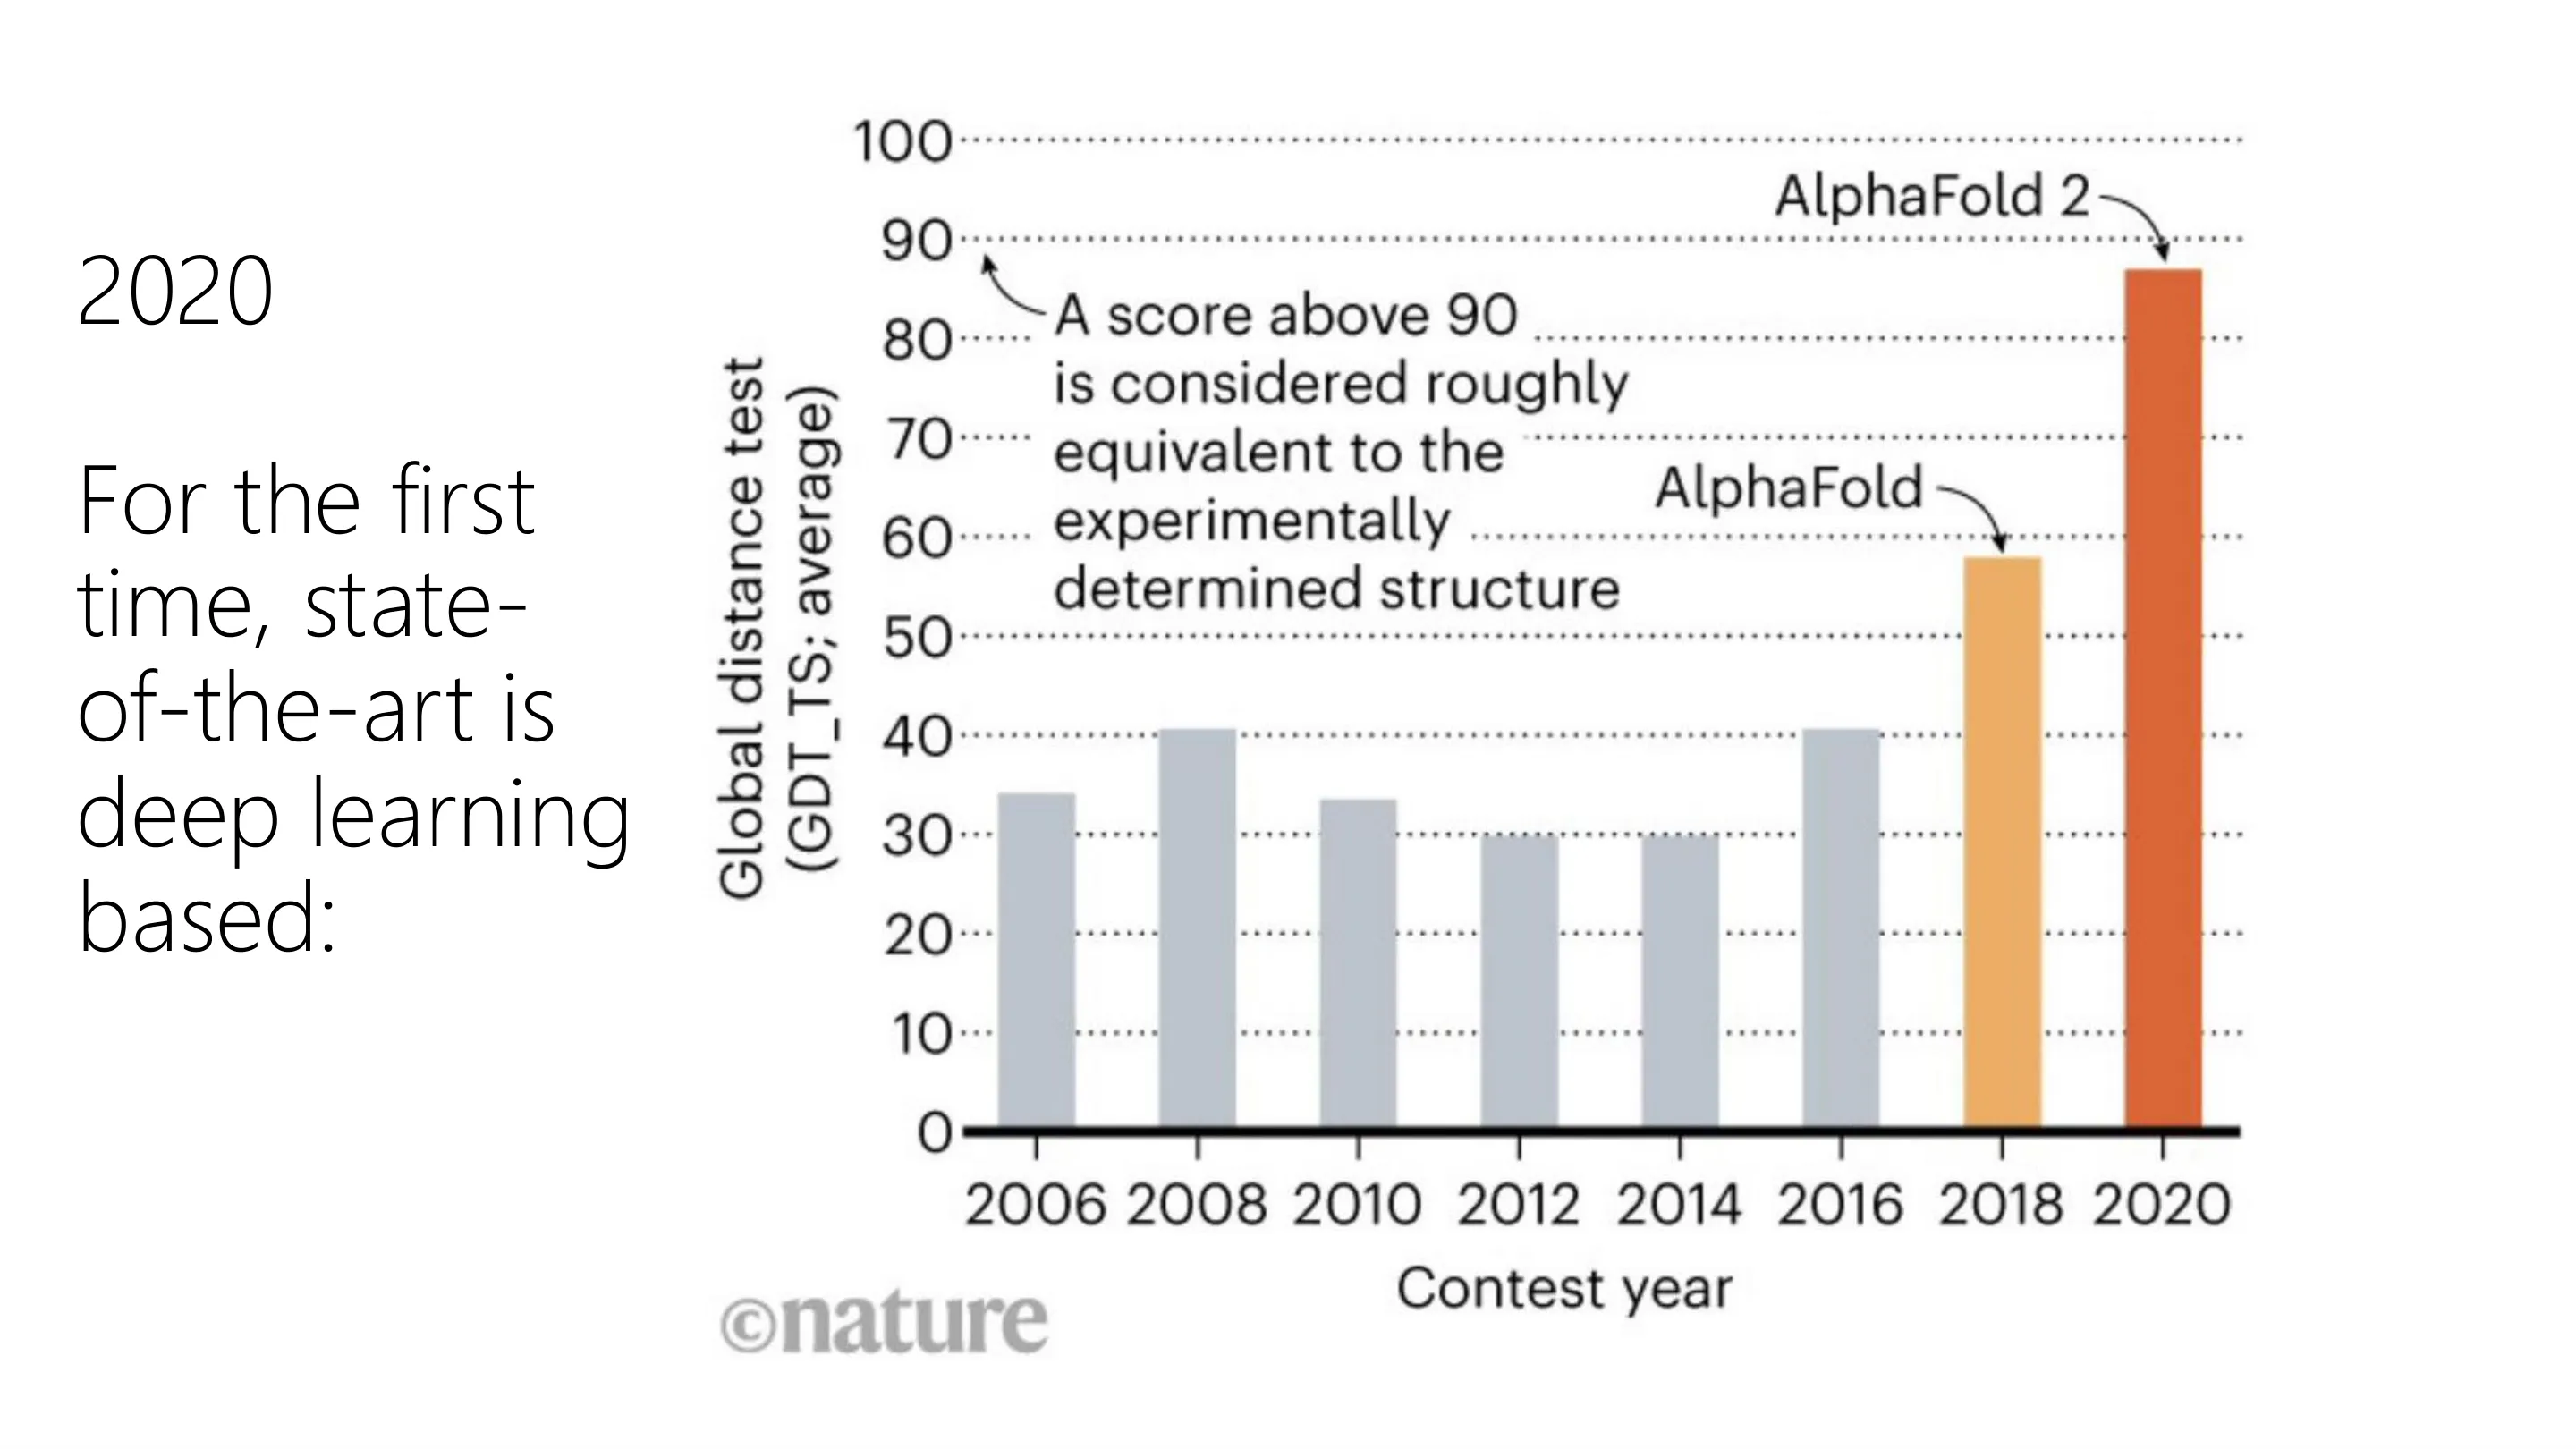
📷 首次……
回到原视频 (00:07:38)
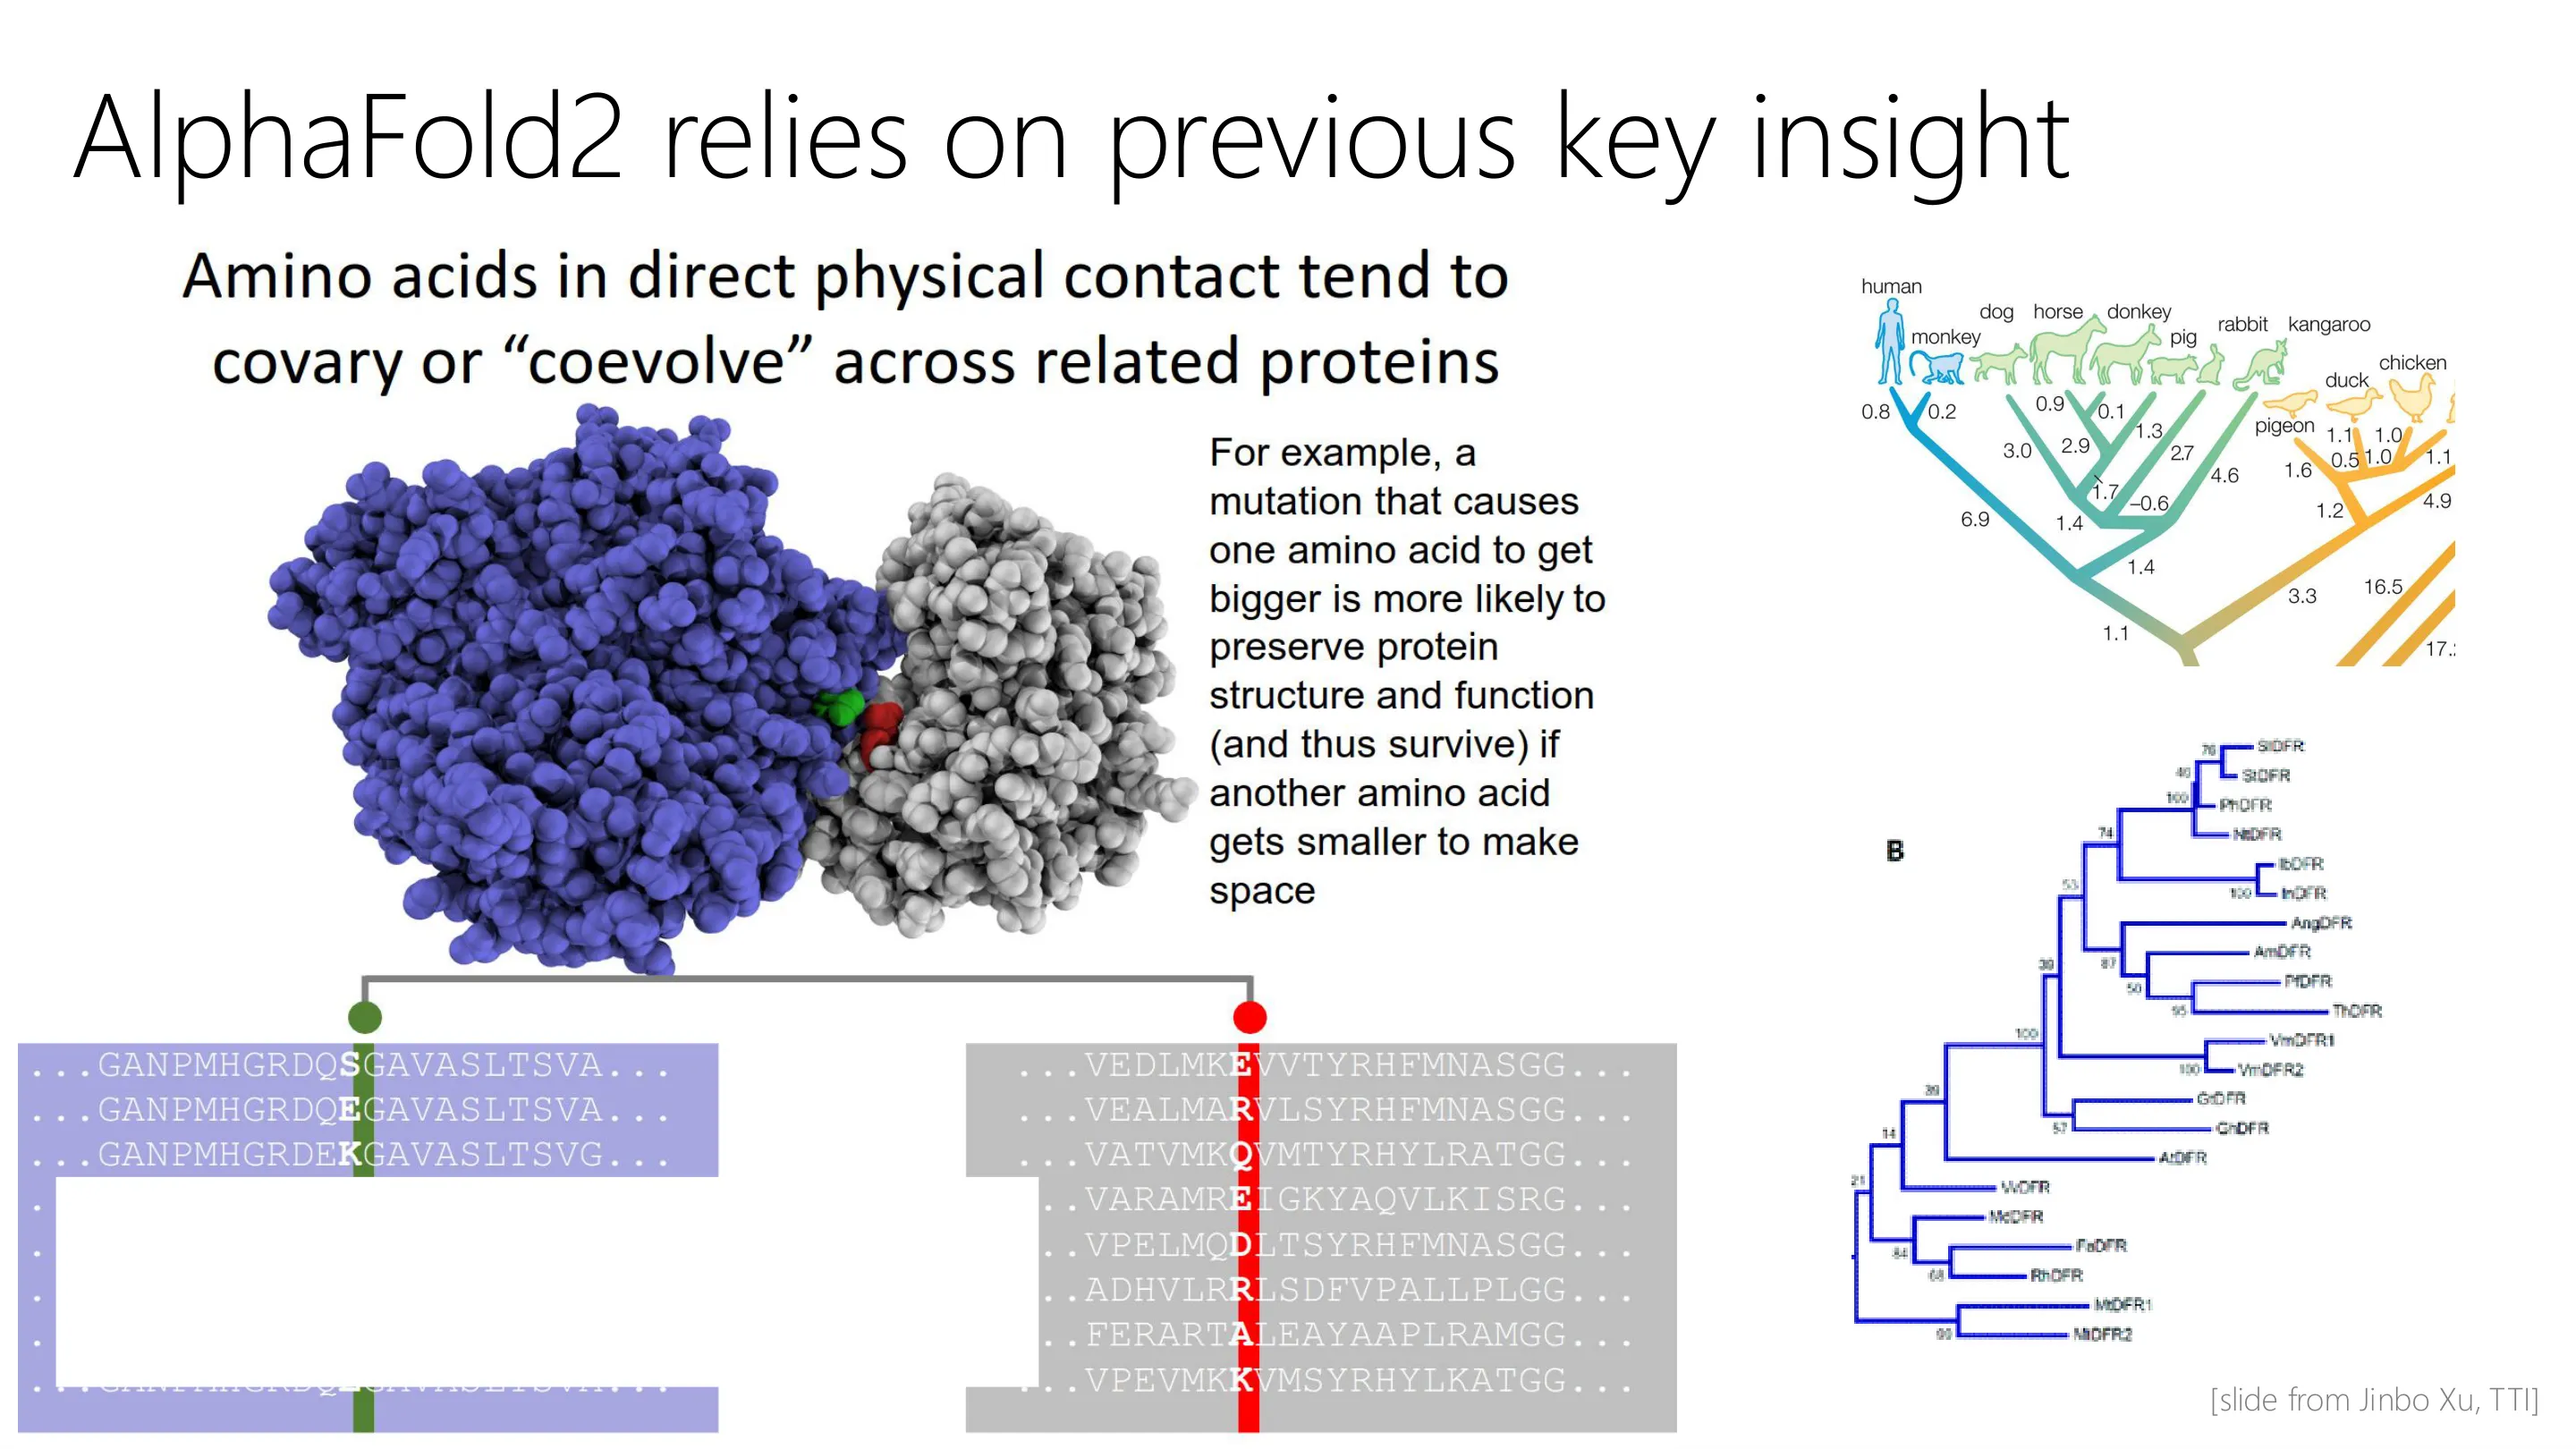
📷 (Jinbo Xu, TTI 的幻灯片)
回到原视频 (00:08:51)
CASP 竞赛是关键推动力:专家用X 射线晶体学测出结构(历史上一枚要 2 年、一位博后一个博士的时间),保留不公开用于盲测。评估指标大致是对齐后的原子 RMSD。2018 年 ML 首次成为主要竞争者,AlphaFold2 带来质的飞跃。
晶体学:把蛋白缓慢结晶成晶格,用 X 射线衍射,从衍射图反推结构(本身也是极难的数学问题,且有时分辨率不足)。如今可用 AlphaFold 辅助解读晶体学数据,形成良性循环。
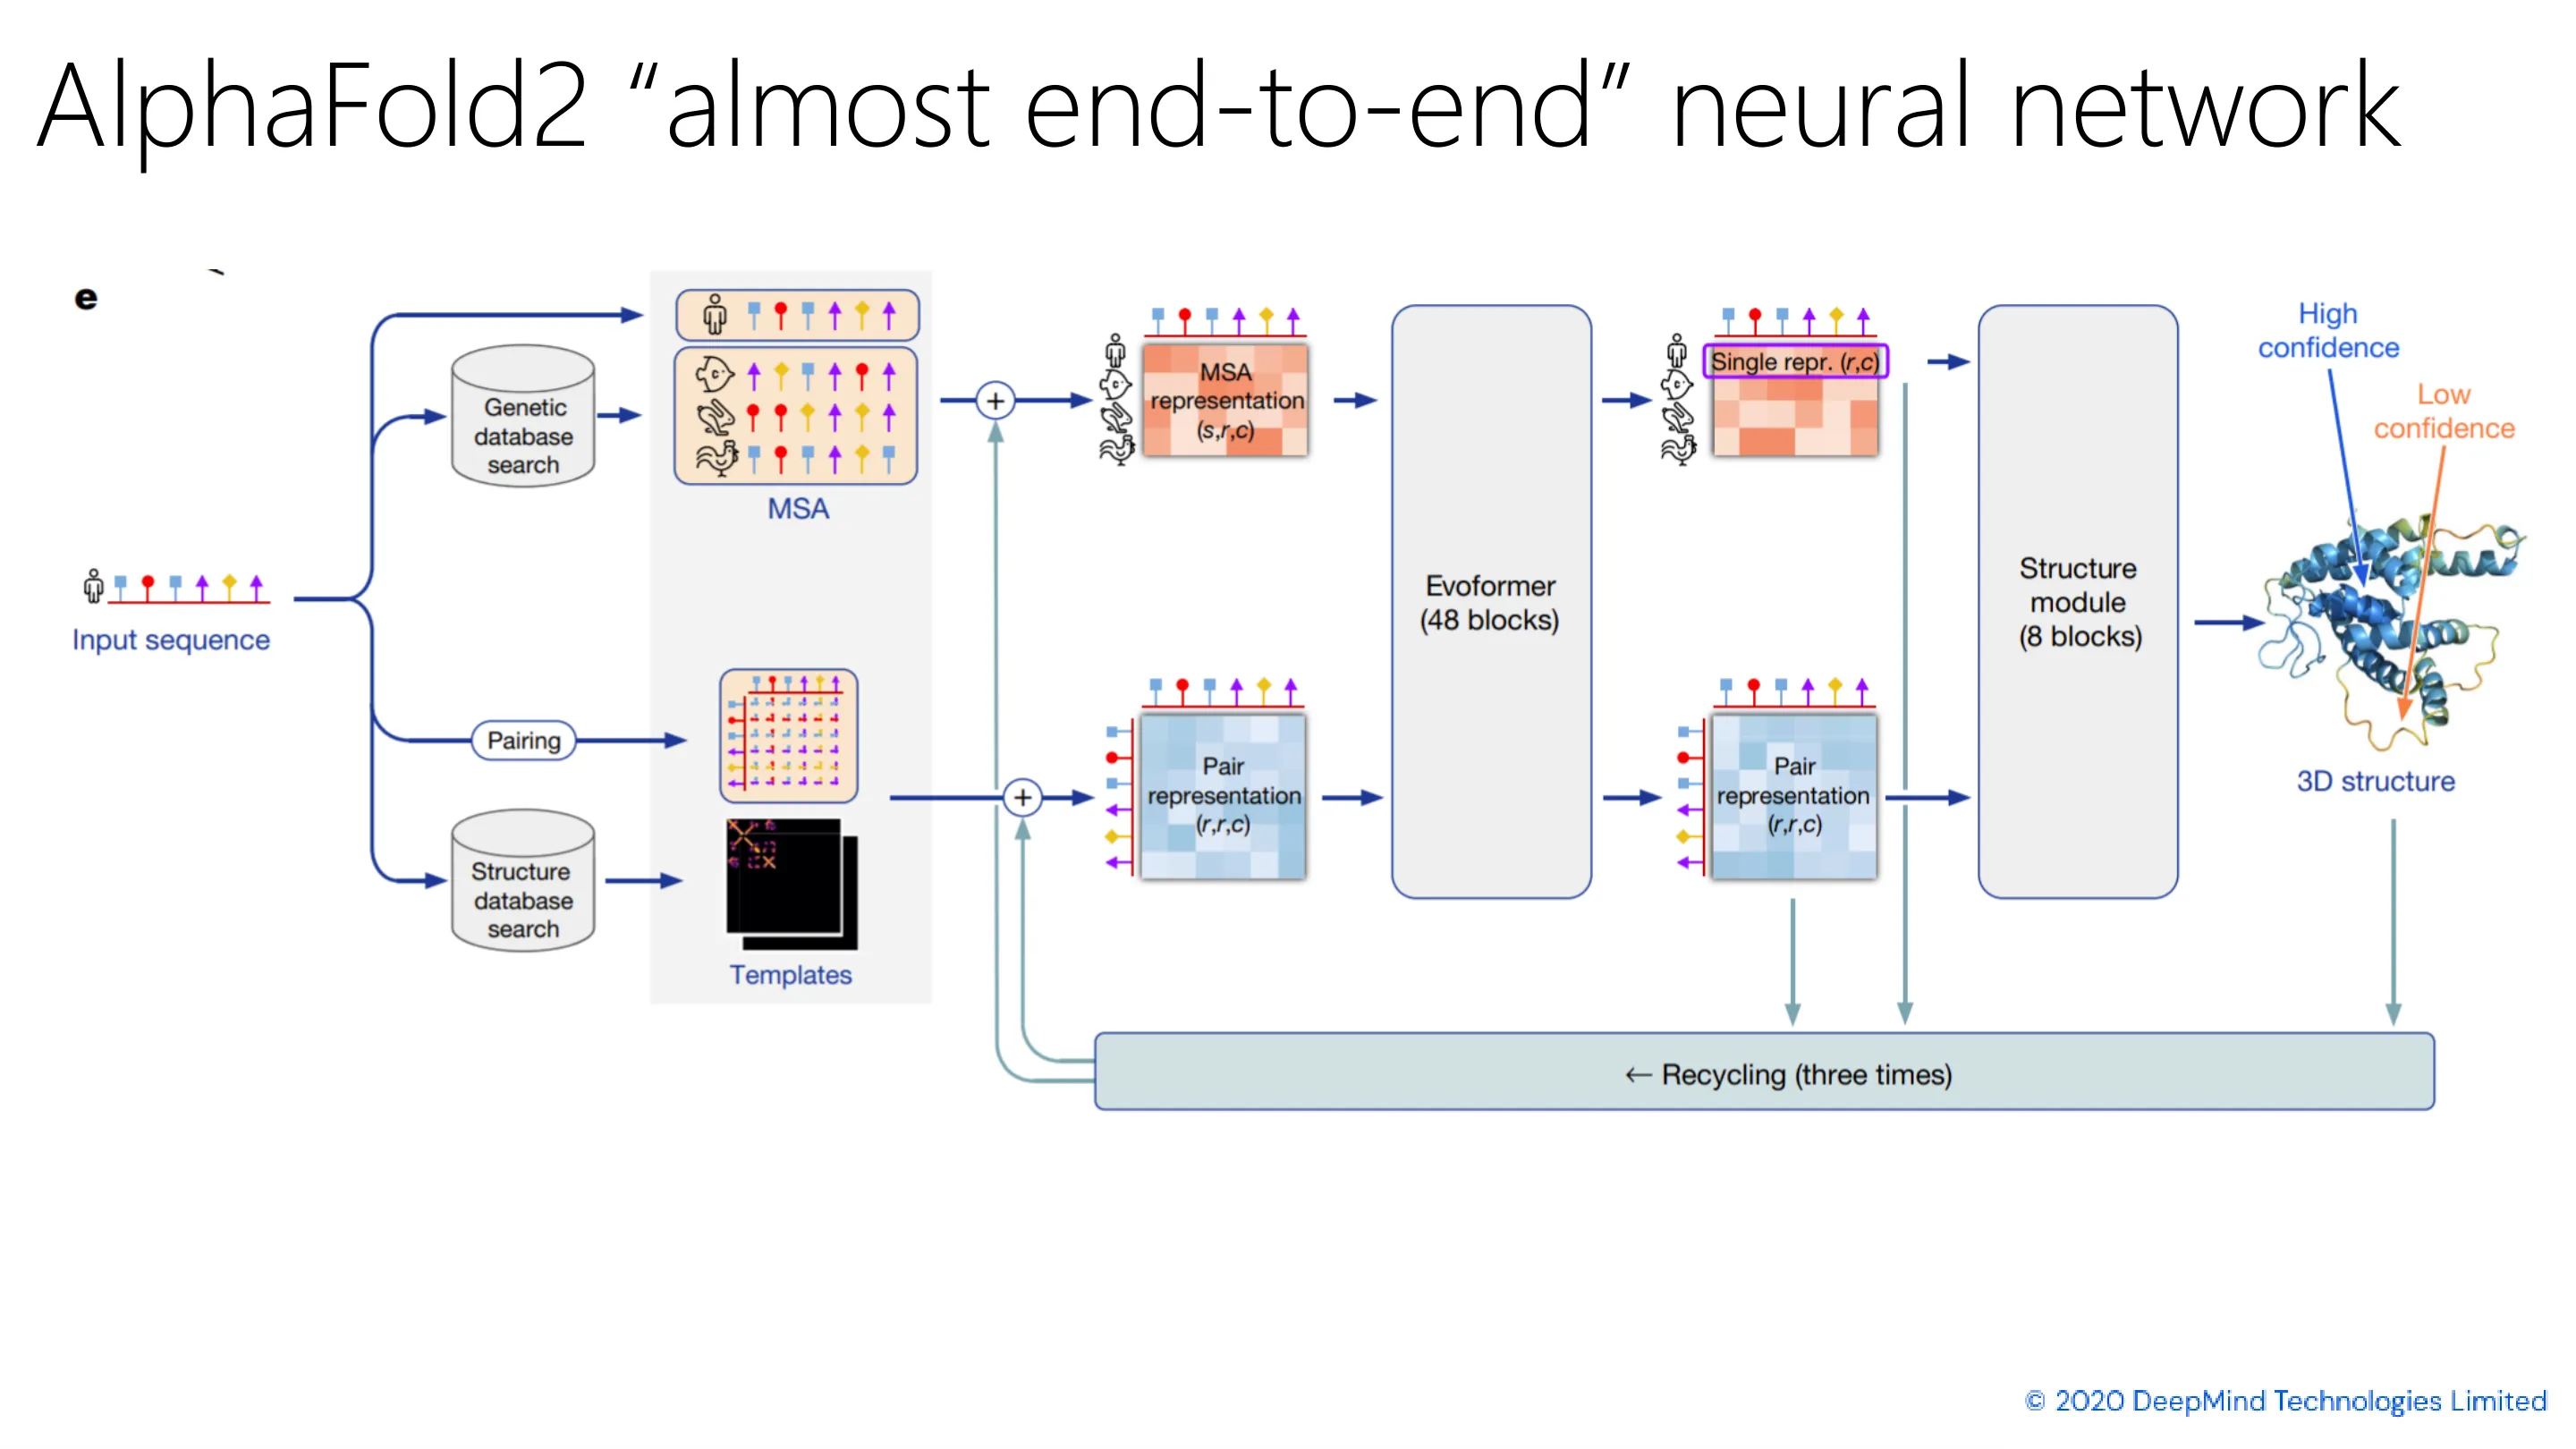
📷 AlphaFold2:「几乎端到端」的神经网络(一)
回到原视频 (00:10:04)
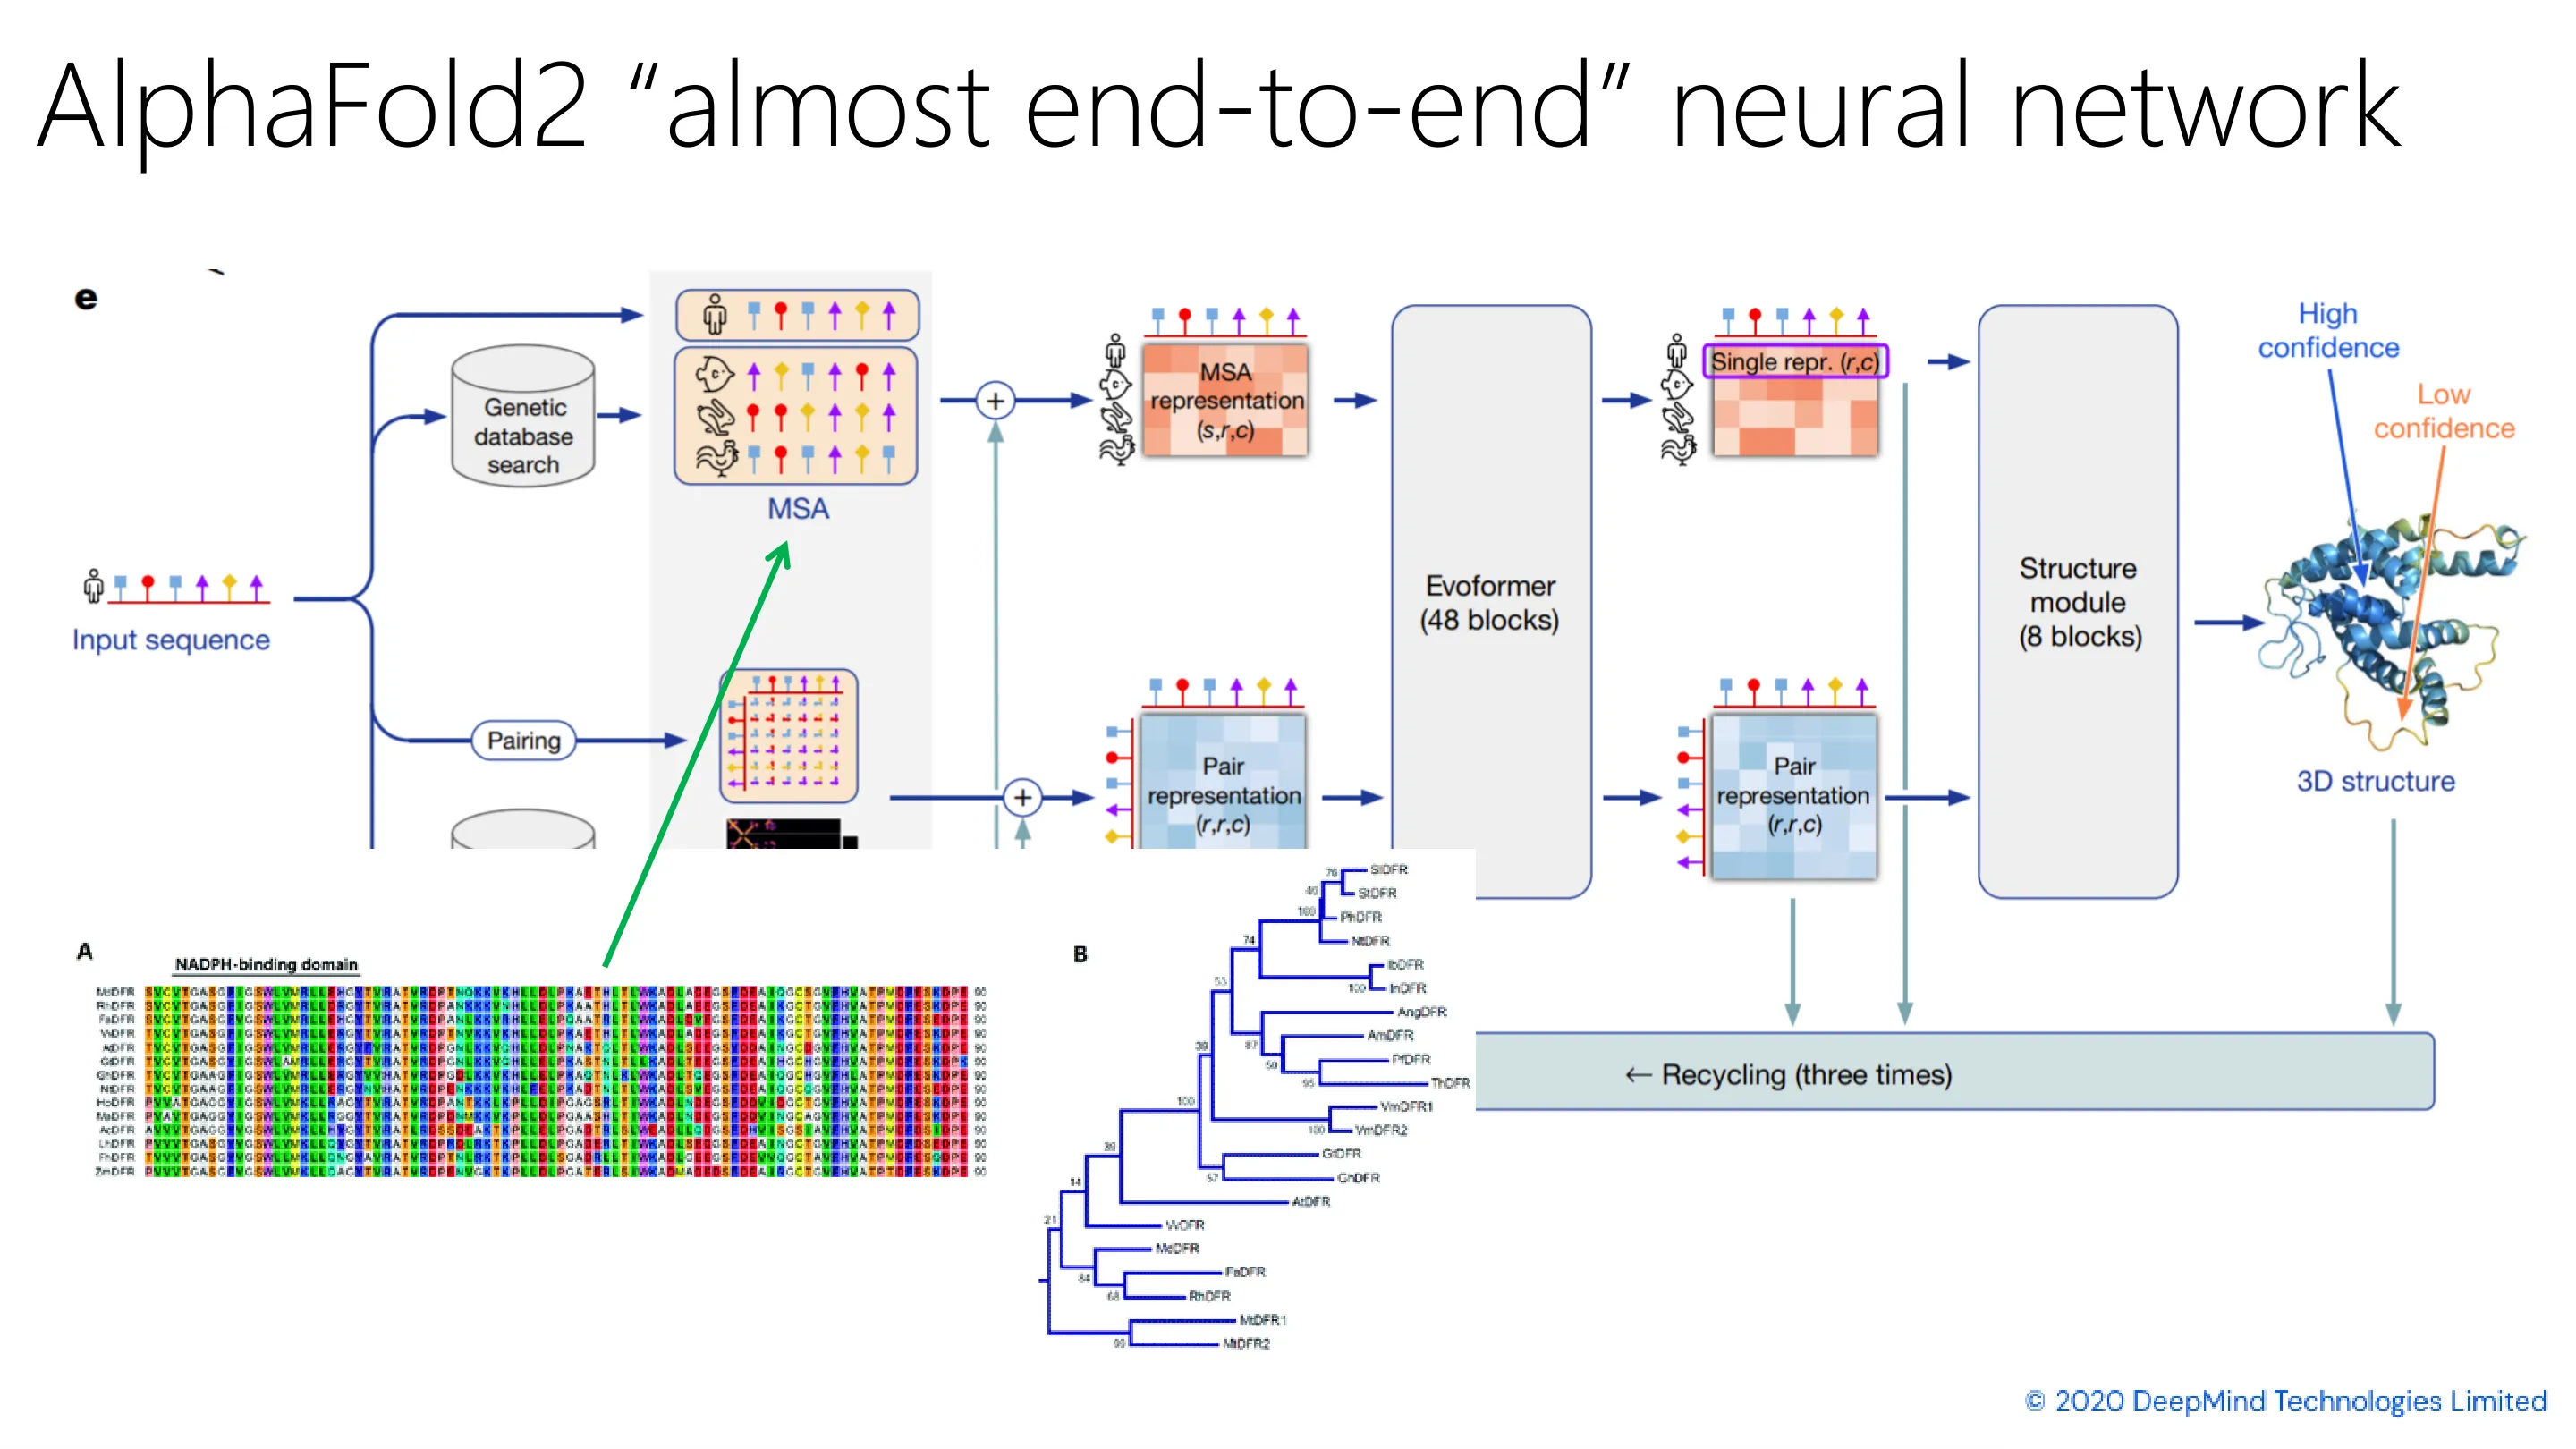
📷 AlphaFold2(二)
回到原视频 (00:11:17)
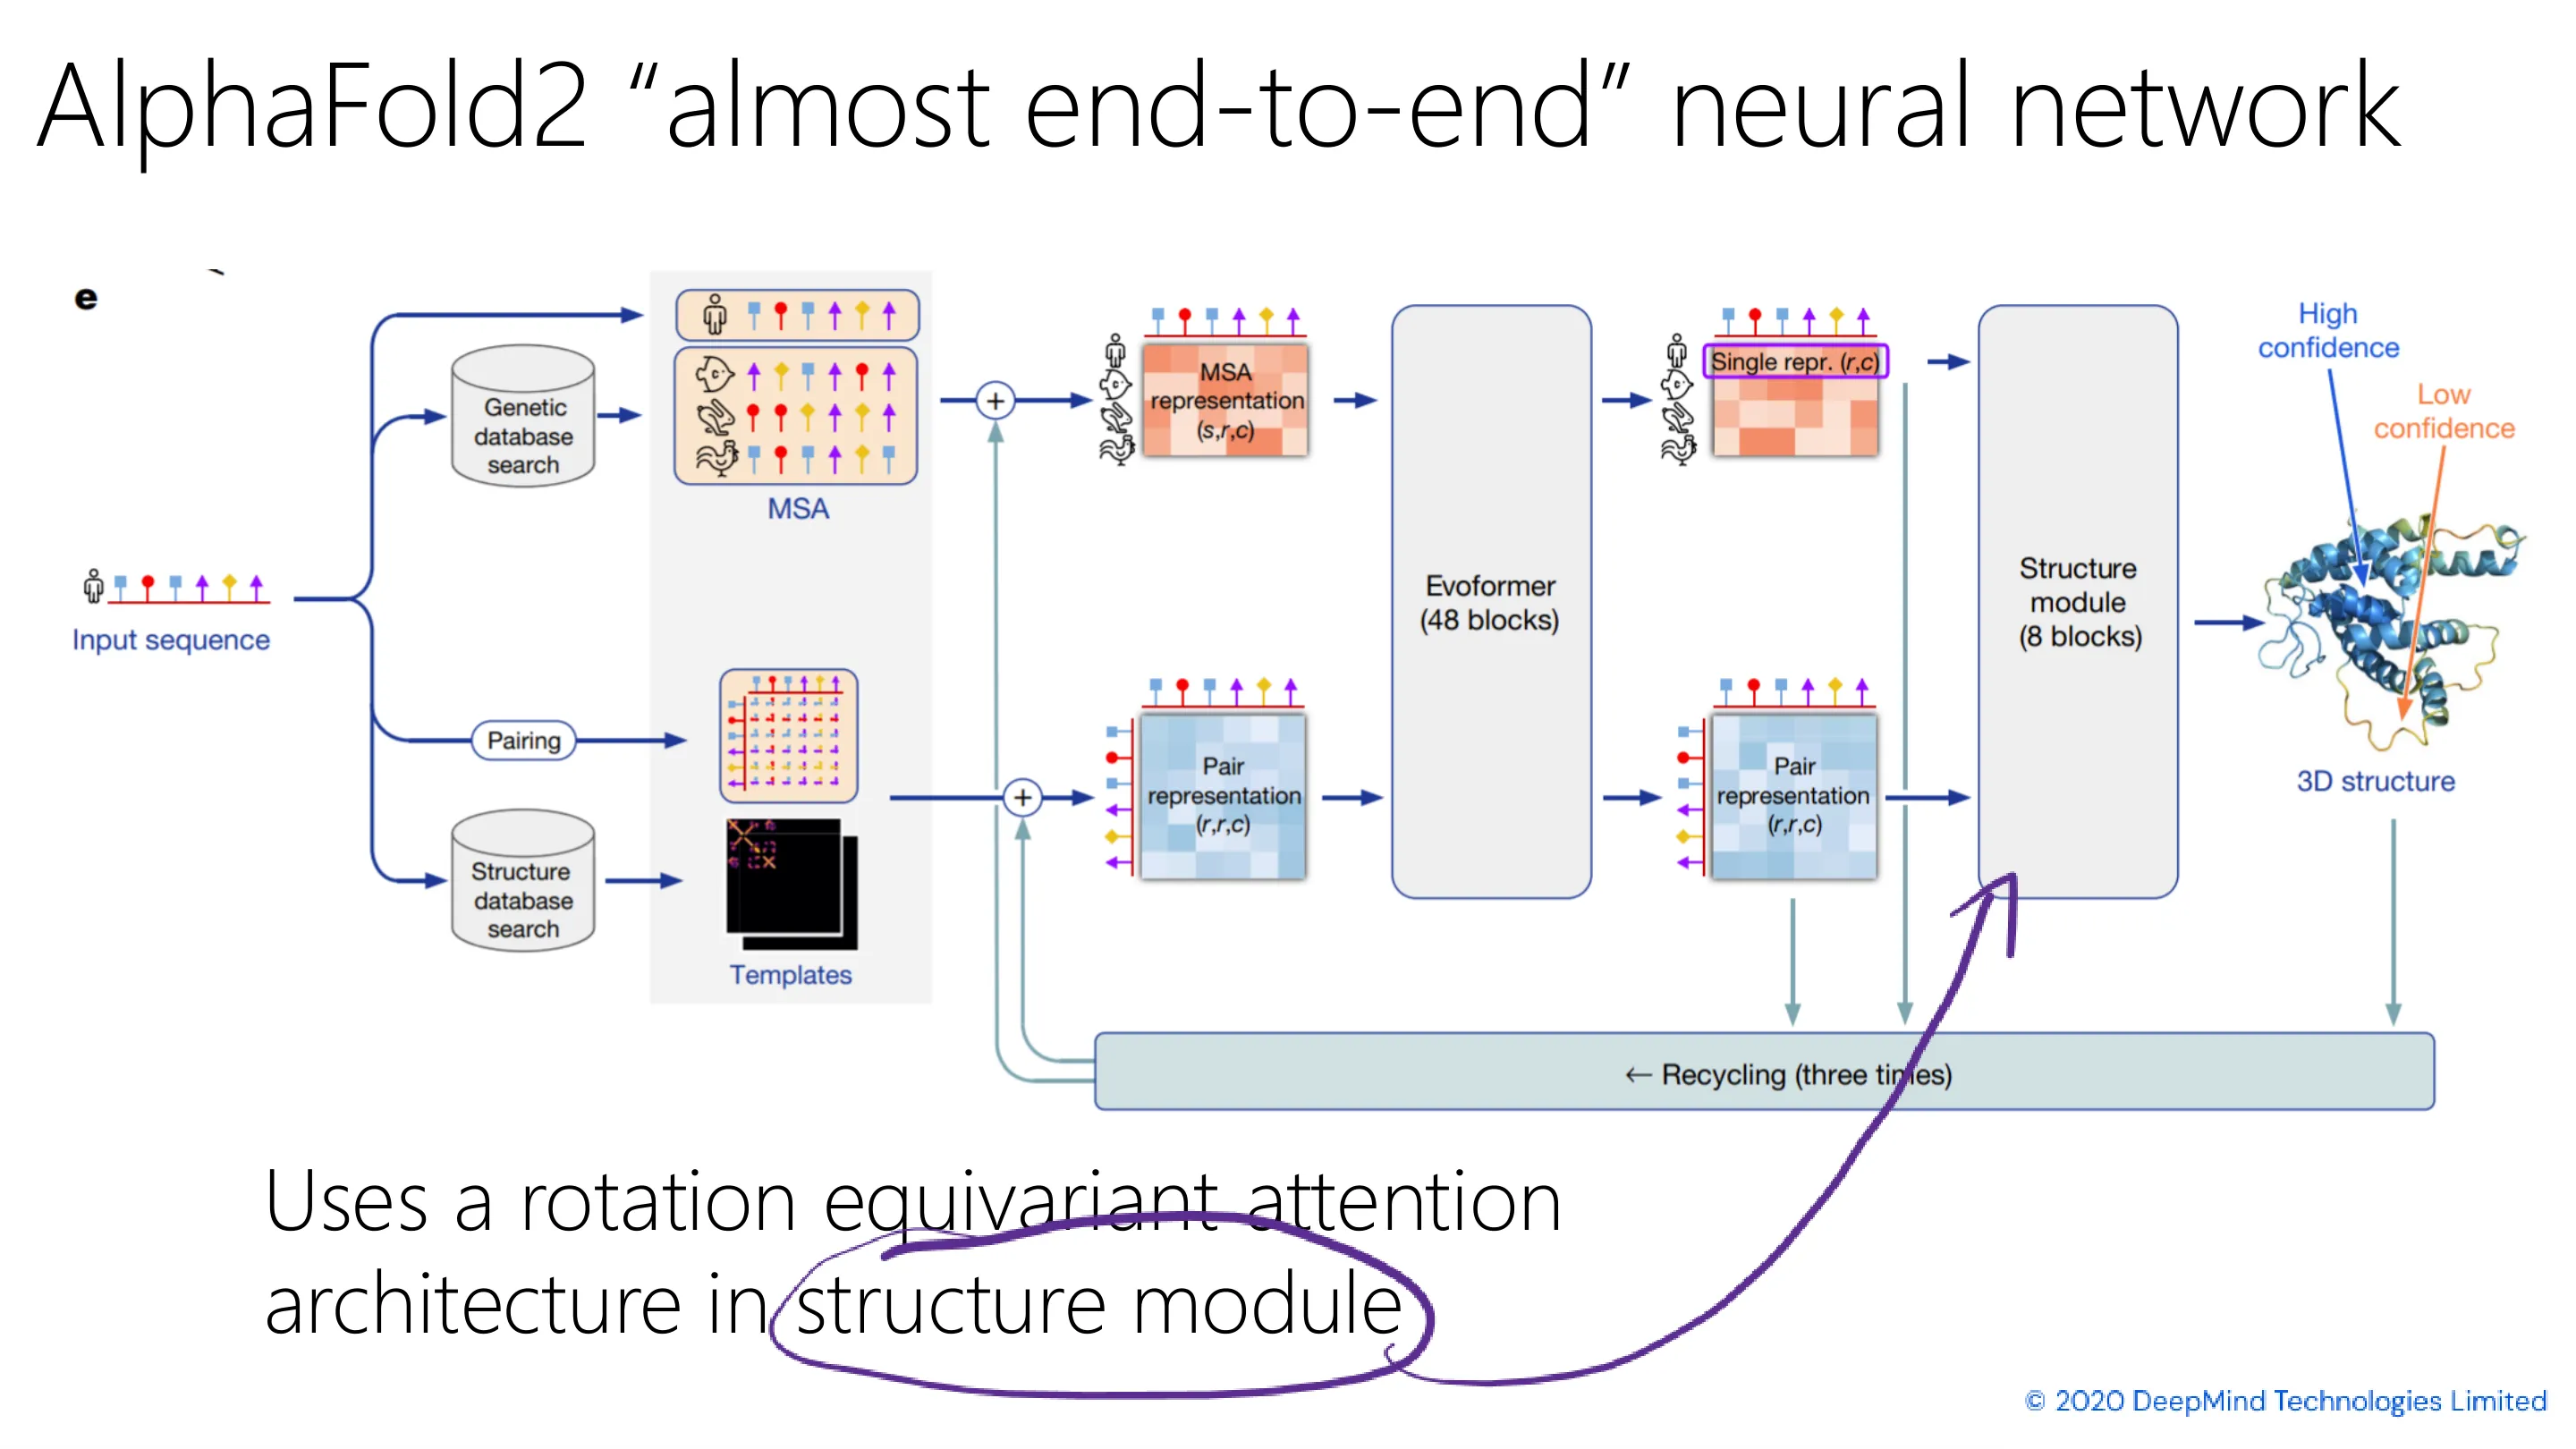
📷 AlphaFold2(三)
回到原视频 (00:12:30)
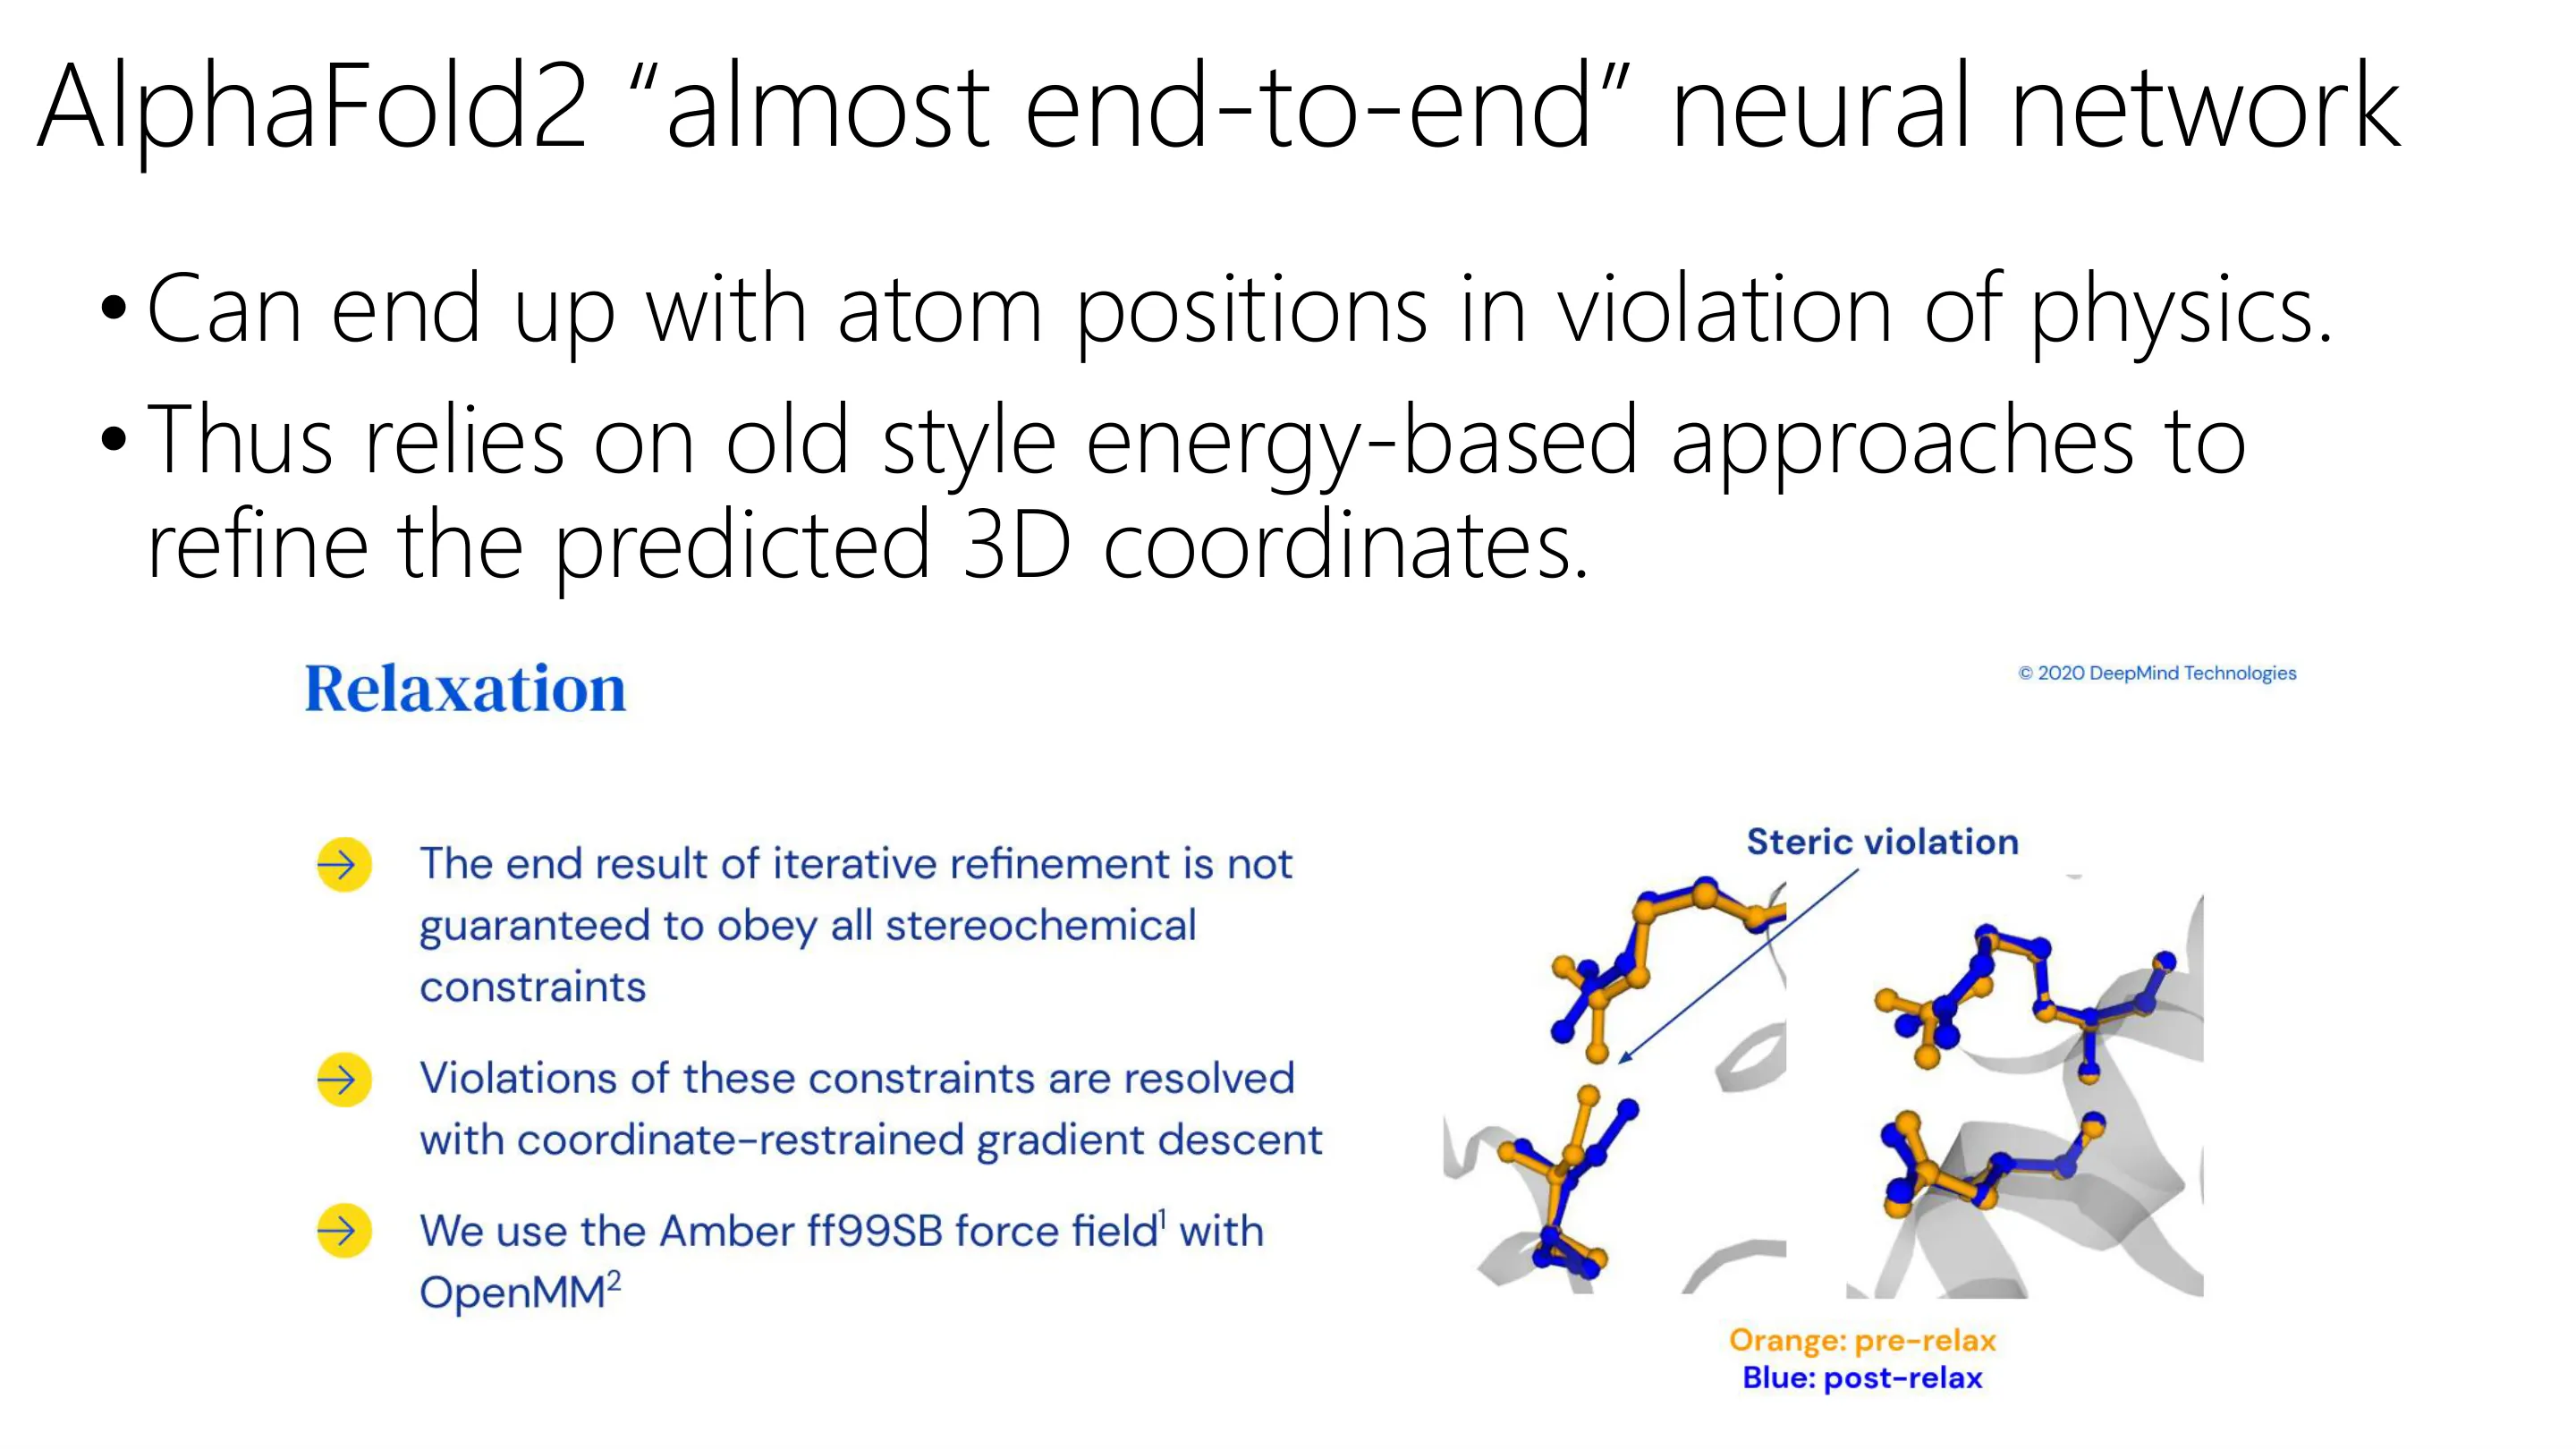
📷 AlphaFold2(四)
回到原视频 (00:13:43)
2.2 AlphaFold2 的关键
(参考时间: 00:13)
重要澄清:不是"AI 凭空解决了问题"——AlphaFold2 的成功建立在一个连续多年的关键概念上:多序列比对(MSA, Multiple Sequence Alignment)。
MSA 与协方差:
- 从序列数据库检索进化上相关的序列(本质是进化特化的字符串搜索);
- 把字母 one-hot 成数字,构造协方差矩阵;
- 在三维空间中靠近的残基,在进化中高度相关——因为若一处突变改变了结构,另一处必须共变才能维持结构/功能(否则该生物被淘汰);
- 因此协方差矩阵包含大量结构接触信息。
AlphaFold2 的要点:
- 输入序列 → 构造 MSA,并对每条序列查已知结构库作为模板;
- 特殊设计的隐藏层(含 48 个 attention block):MSA 表示 + pair 表示(协方差)相互交流;
- 末端 structure module 预测原子坐标;AlphaFold3 换成扩散模型;
- 损失不是单一似然,而是许多领域特定项的复合;
- 训练数据约 20 万条序列-结构对,重建这些数据的成本约 200 亿($2\times10^{10}$)美元。
两个深刻洞察:
- 置信度是良好校准的——AlphaFold「知道自己何时对、何时错」,对下游任务极有用;
- 去掉 MSA 就不工作 ⇒ 说明它不是在真正做物理,而是在利用进化信息"作弊";若真有好的物理模拟器,就不需要 MSA。
讲师盛赞 DeepMind 选对了一个恰好能被 AI 解锁的科学问题,而且它依赖约 200 亿美元的公版数据和多年蛋白质研究积累——不是"随便下载数据丢个神经网络"就行。AlphaFold2 之后仍需用传统方法做物理合法性校正(AI 会给出原子重叠等无意义结果)。物理归纳偏置(如旋转等变性)只被极少地纳入。
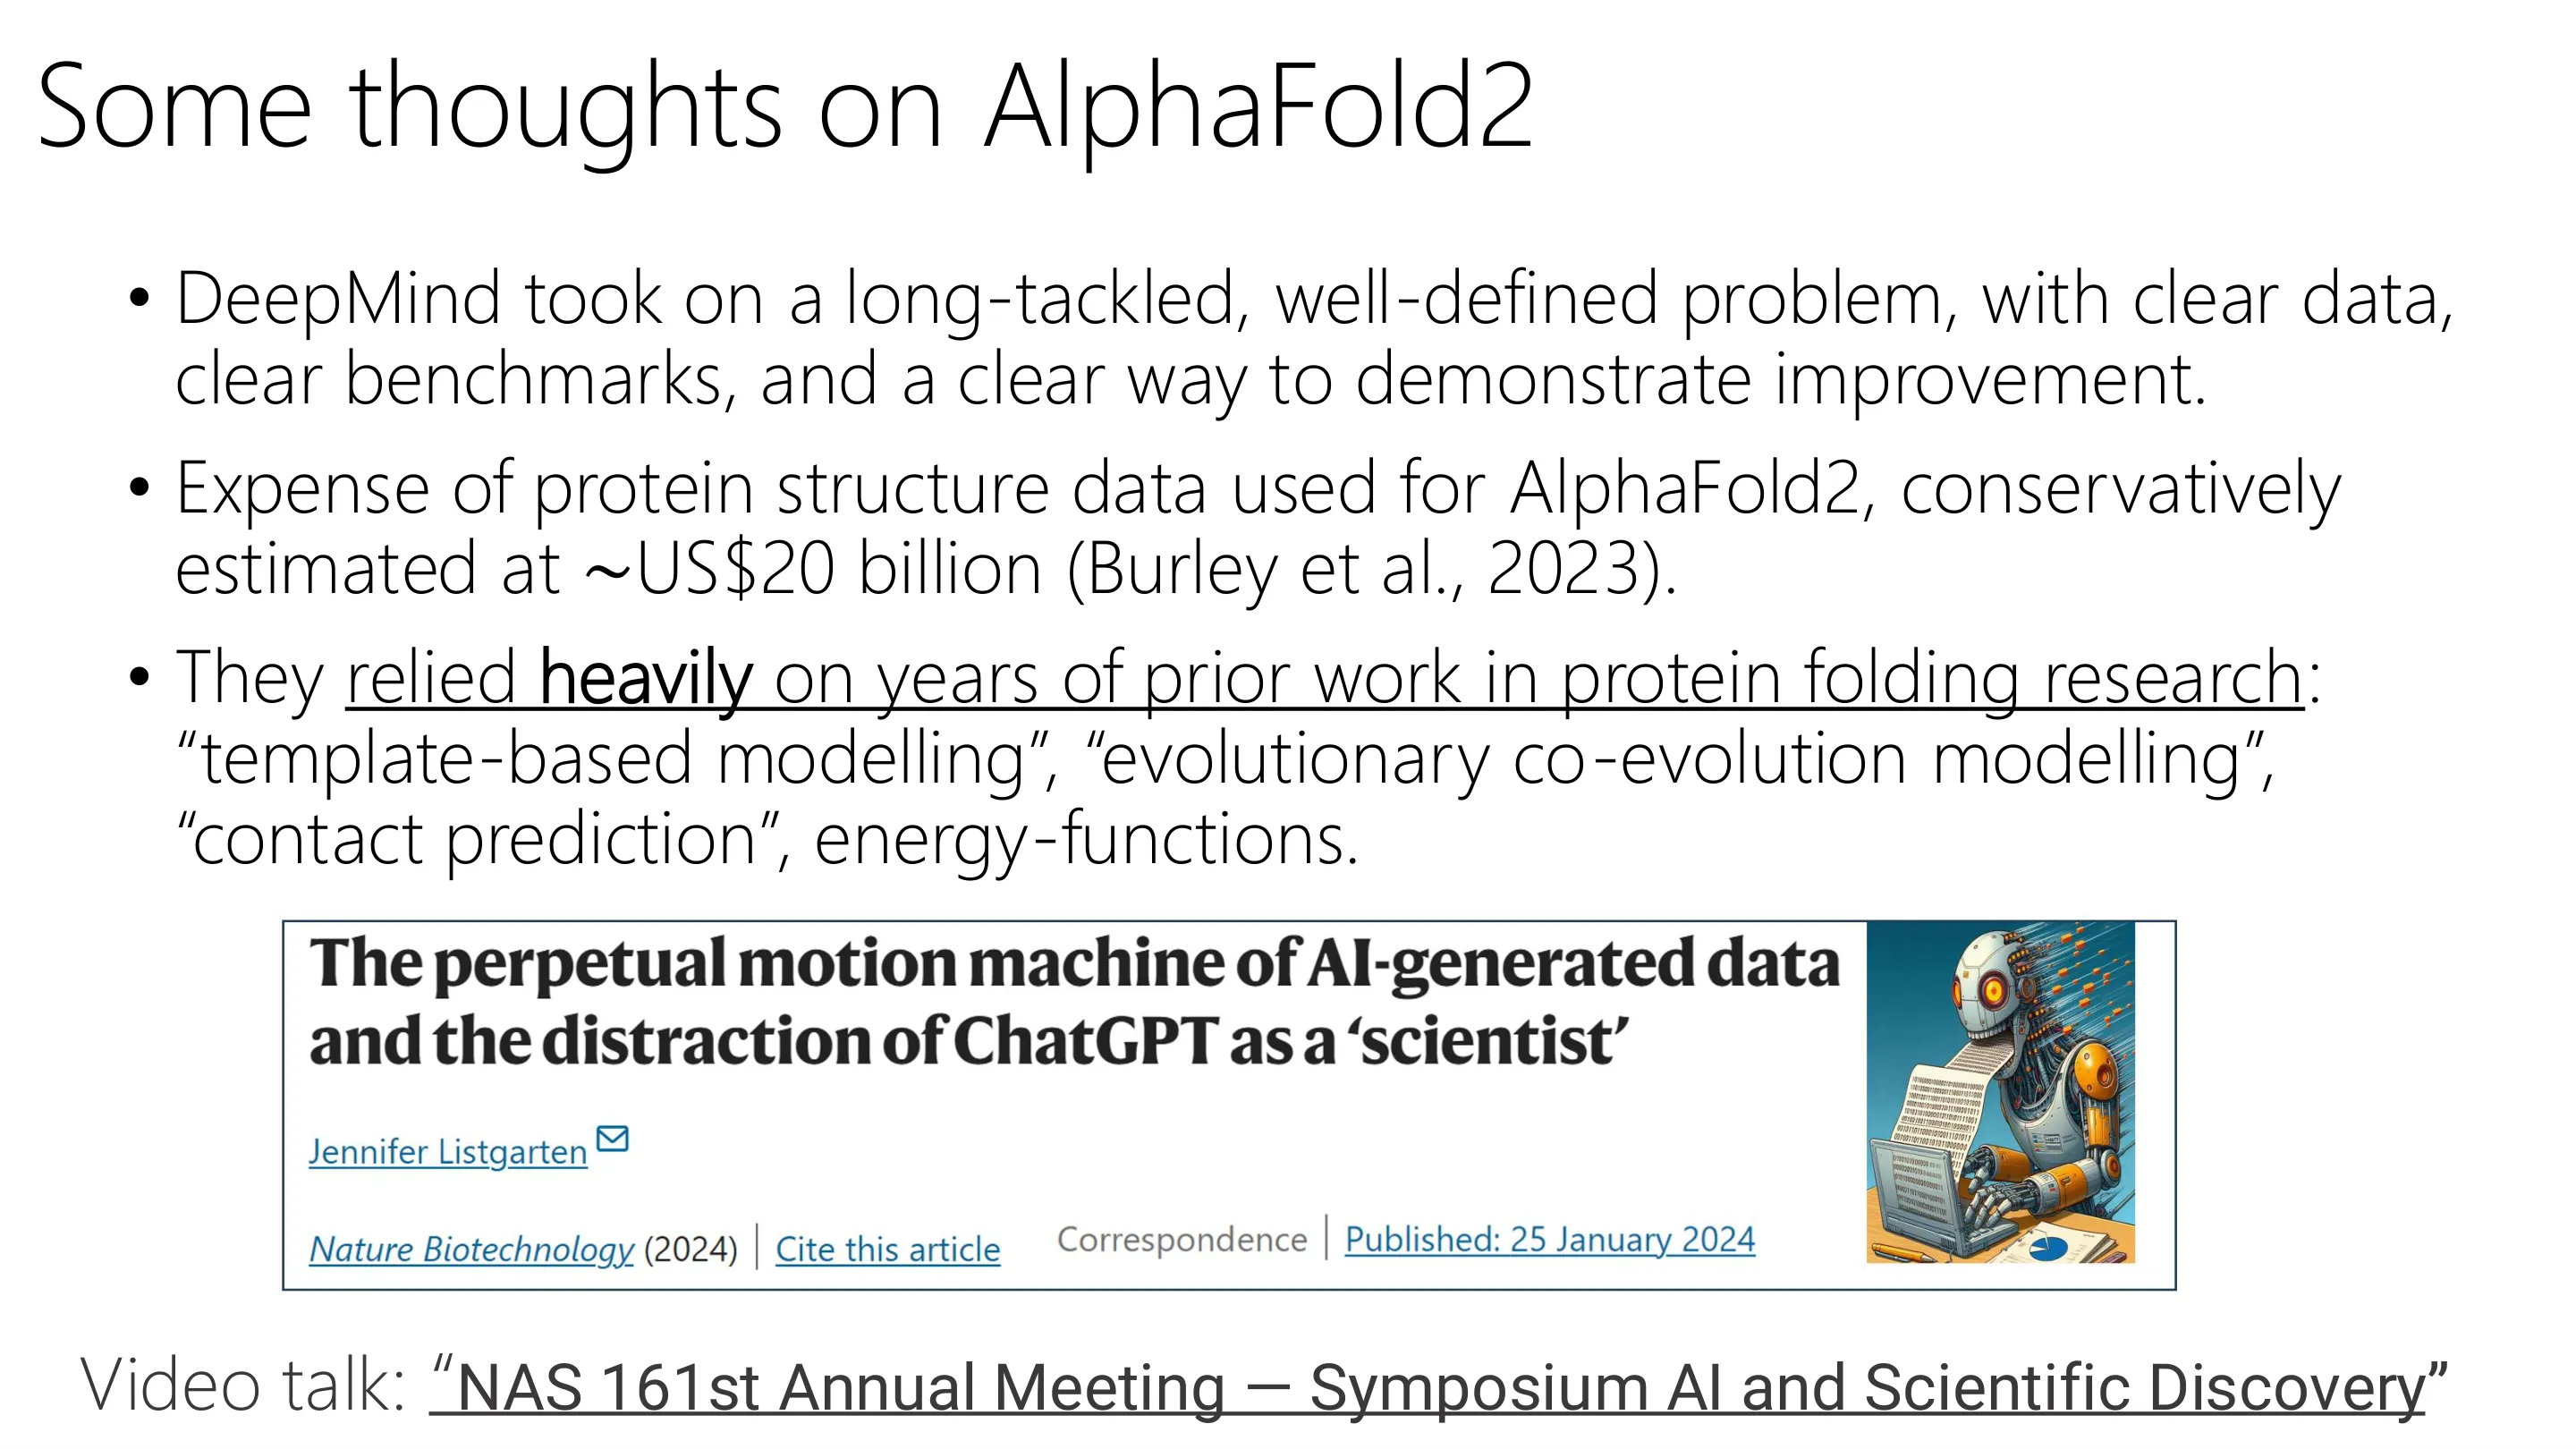
📷 关于 AlphaFold2 的一些思考
回到原视频 (00:14:56)
📷 CS 189/289
回到原视频 (00:16:09)
三、蛋白质工程
3.1 设计空间近乎无穷
(参考时间: 00:32)
蛋白质工程 = 指定氨基酸序列,使得蛋白具有我们想要的功能。
- 长度 $L$ 的序列有 $20^L$ 种可能;$L=100$ 就超过宇宙原子数;
- 更难的是:不能只在计算机里搜索,通常必须在湿实验中测量;
- 自然界的证明:进化造出了我们所需的所有蛋白——但花了数百万年,而我们想几周/几月完成。
历史上的两条路线(都在近十年获诺奖):
- 基于计算/能量函数(David Baker,2024 诺奖):用生物物理能量函数(粗粒化的薛定谔方程近似,含范德华力、共价键等)搜索使能量最小的结构,做结构预测与设计;不用数据驱动学习;
- 定向进化(directed evolution)(Frances Arnold,2018 诺奖):在实验室里随机突变 + 筛选 + 迭代——像贪婪优化:随机扰动 → 测量 → 保留最好的 → 再来。慢、贵、费力,但改变了世界。
如今 ML 正渗透这两条路线,使它们相互交织。
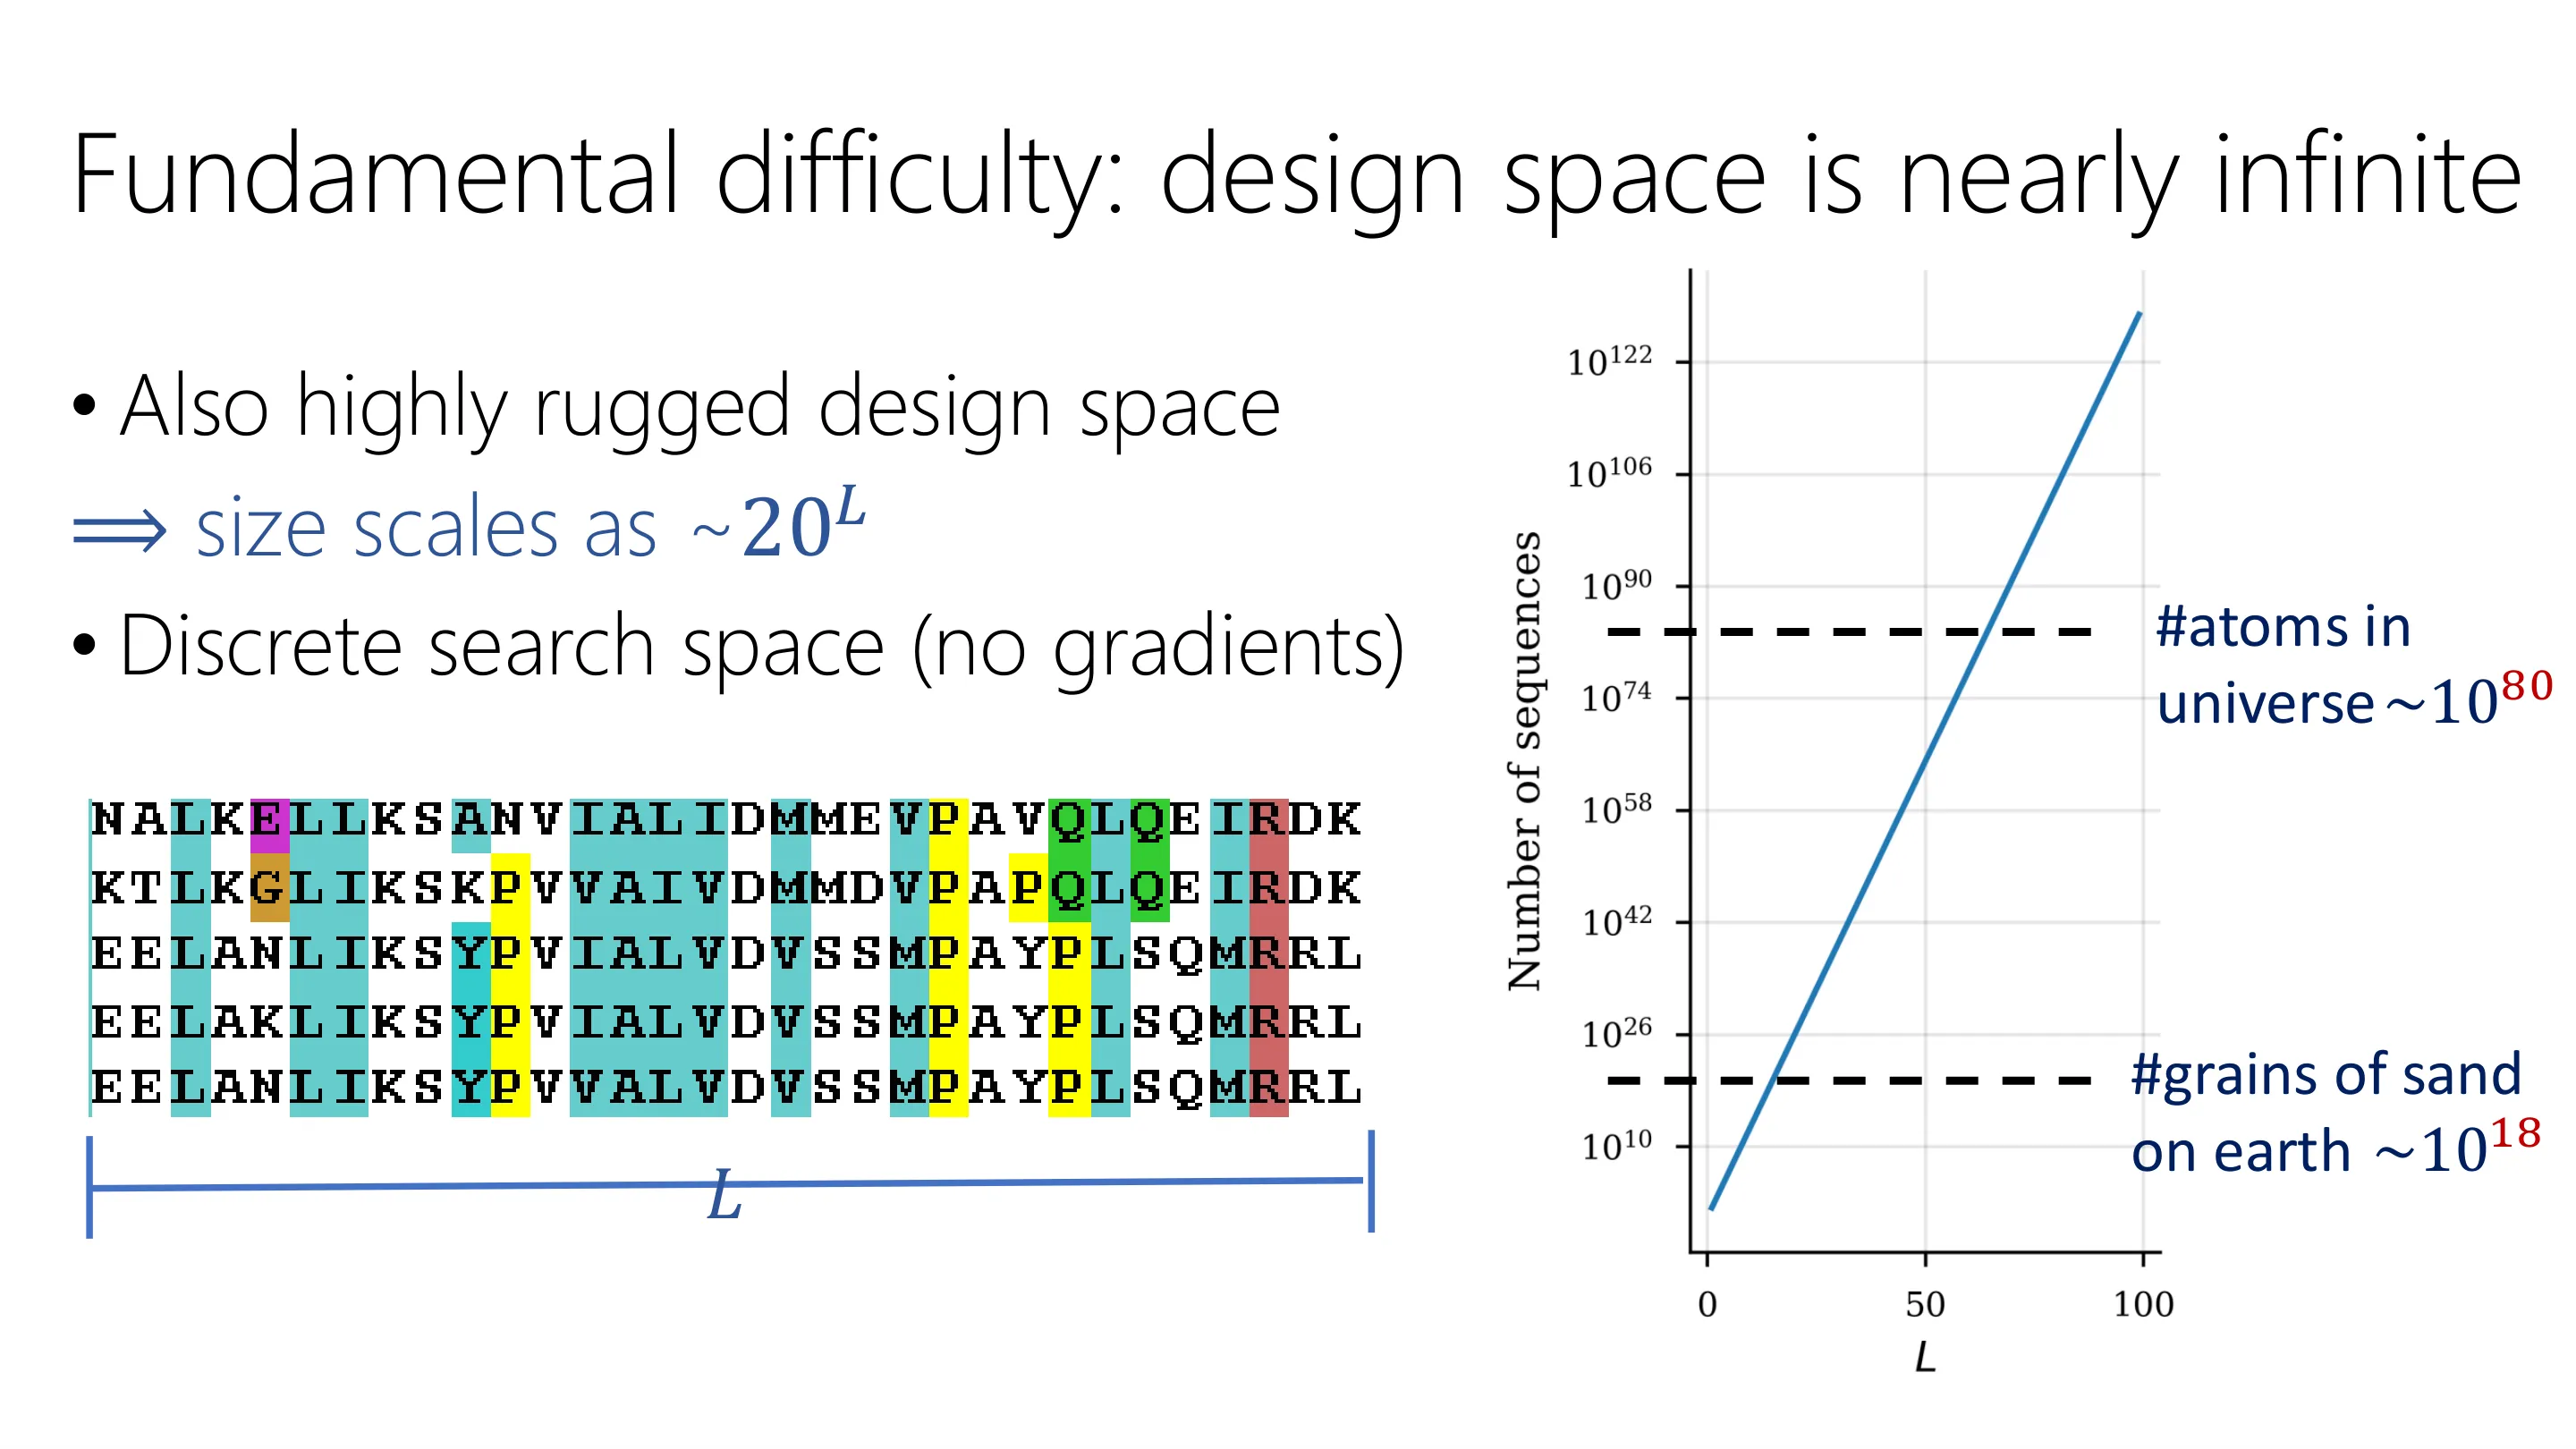
📷 近乎无穷的设计空间这一根本困难
回到原视频 (00:17:22)
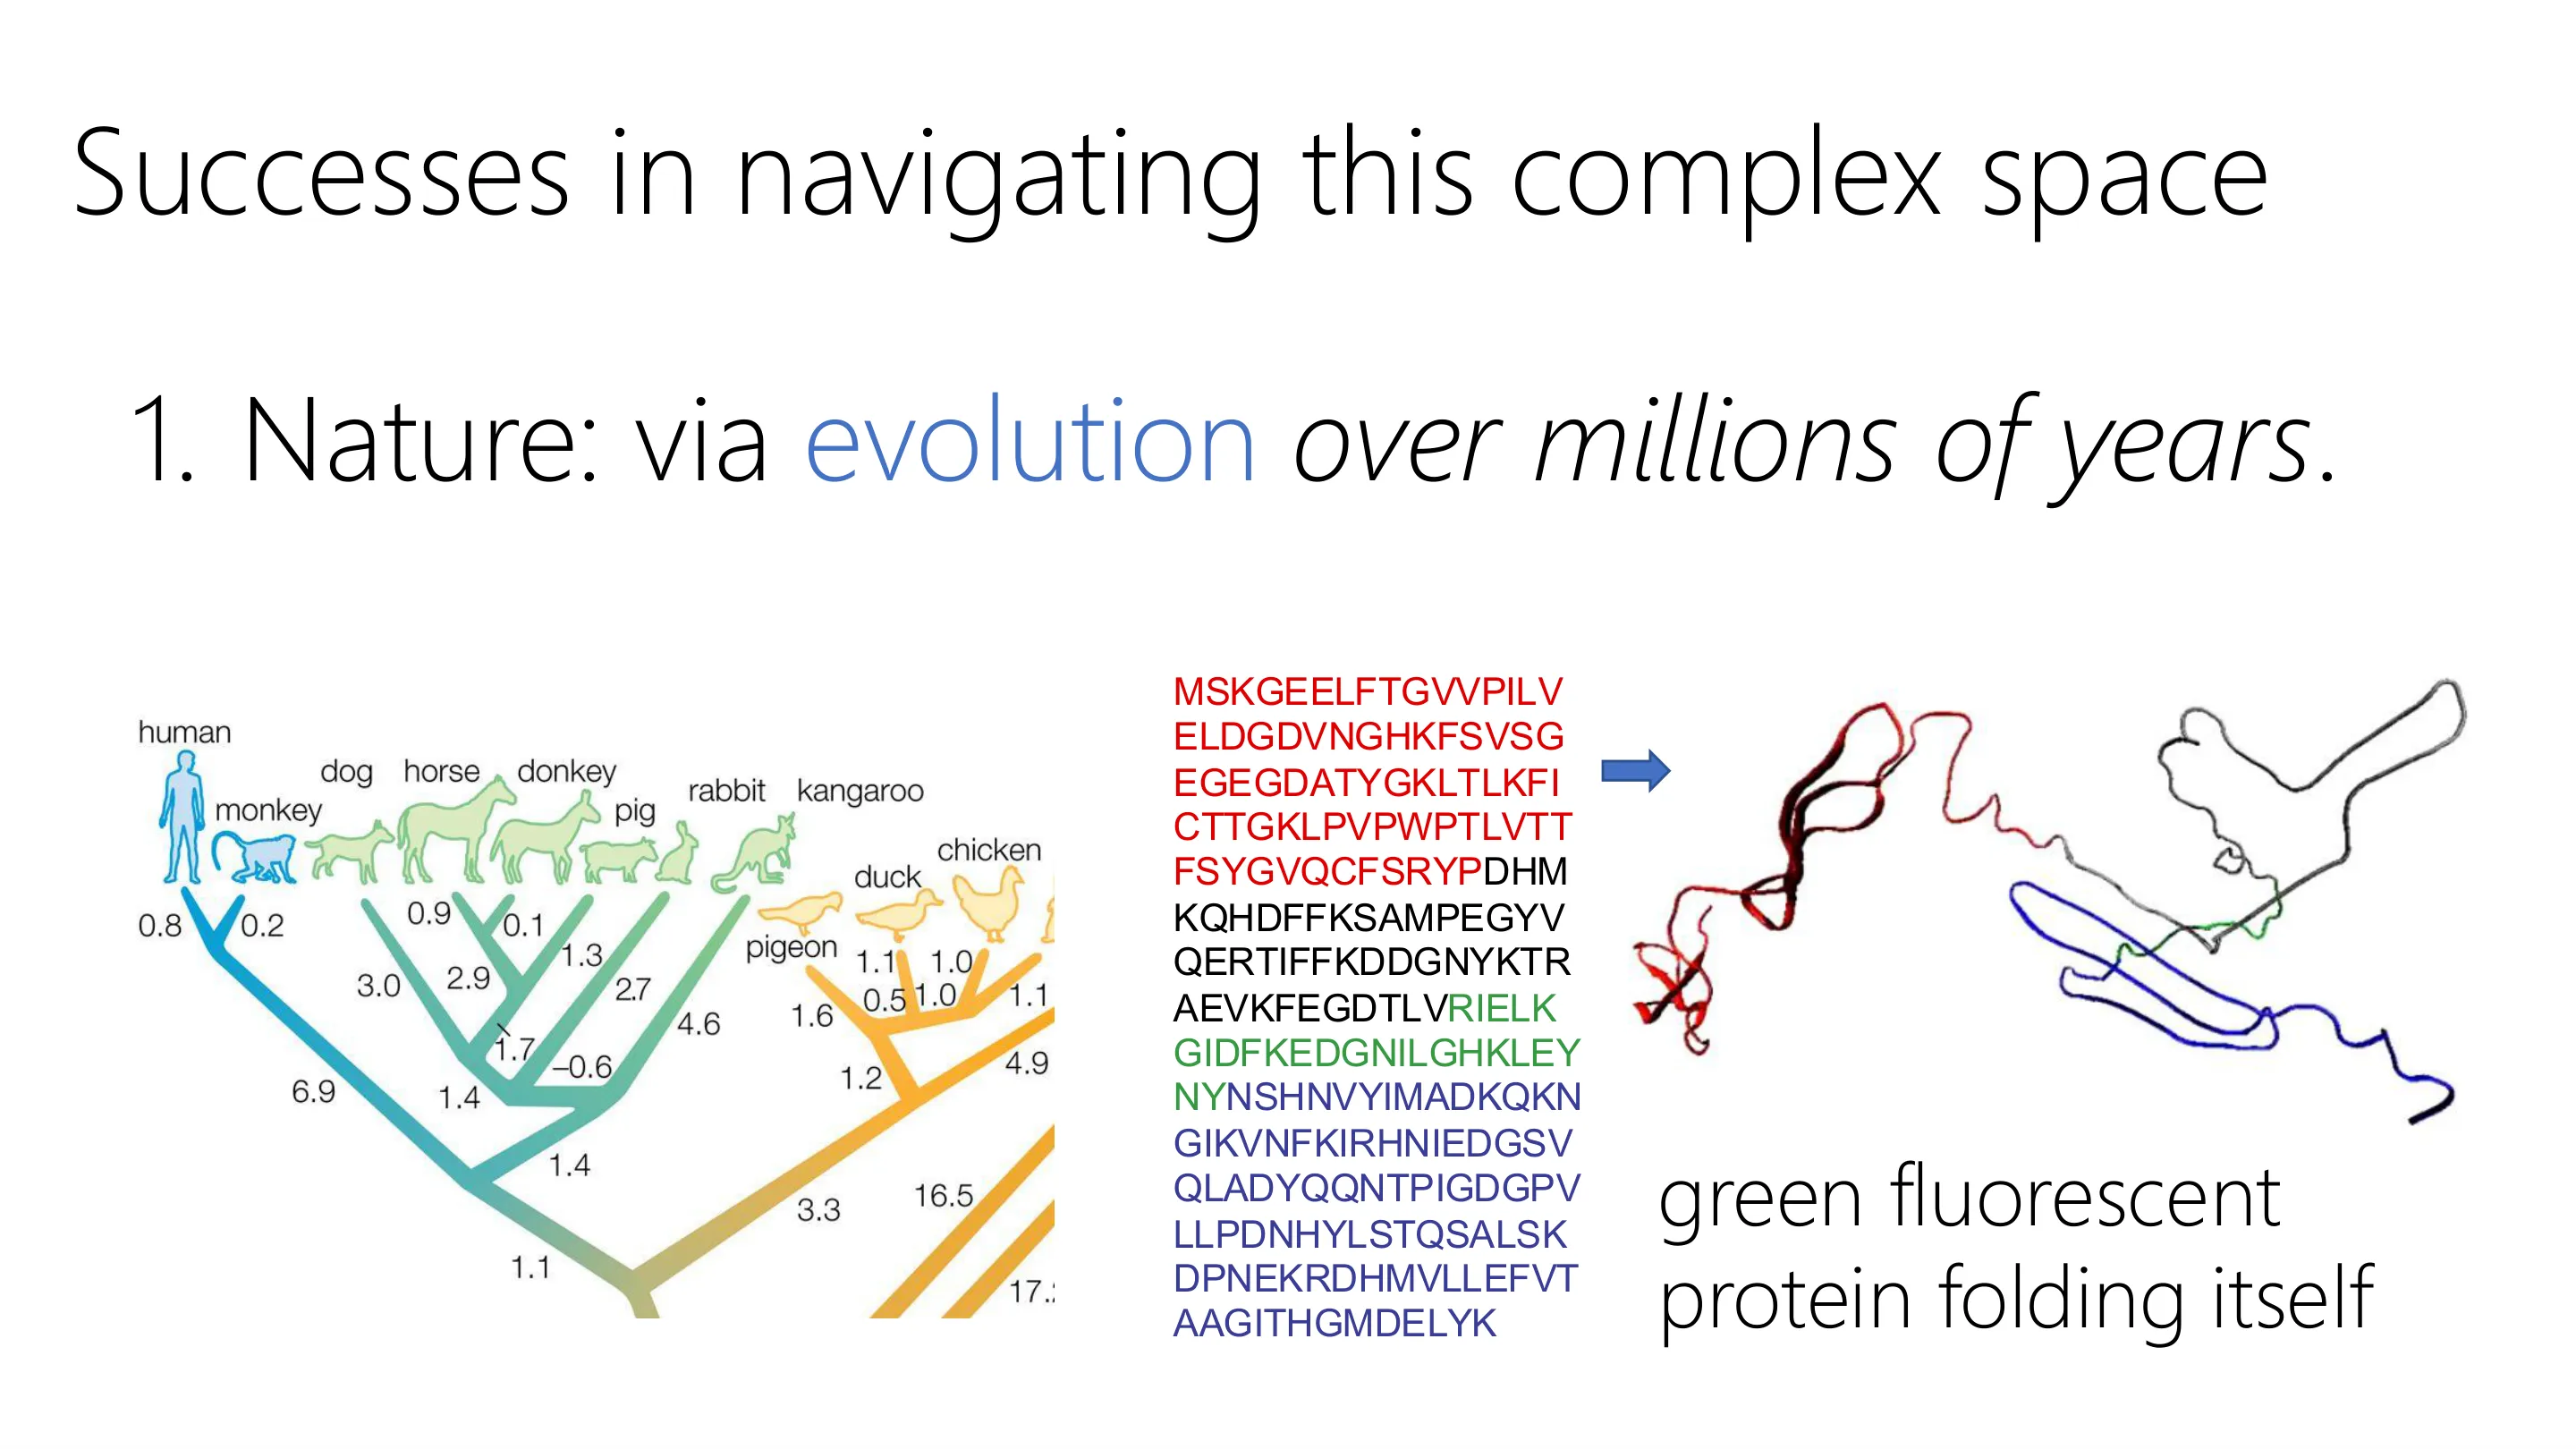
📷 在这个复杂空间中导航的成功案例
回到原视频 (00:18:35)
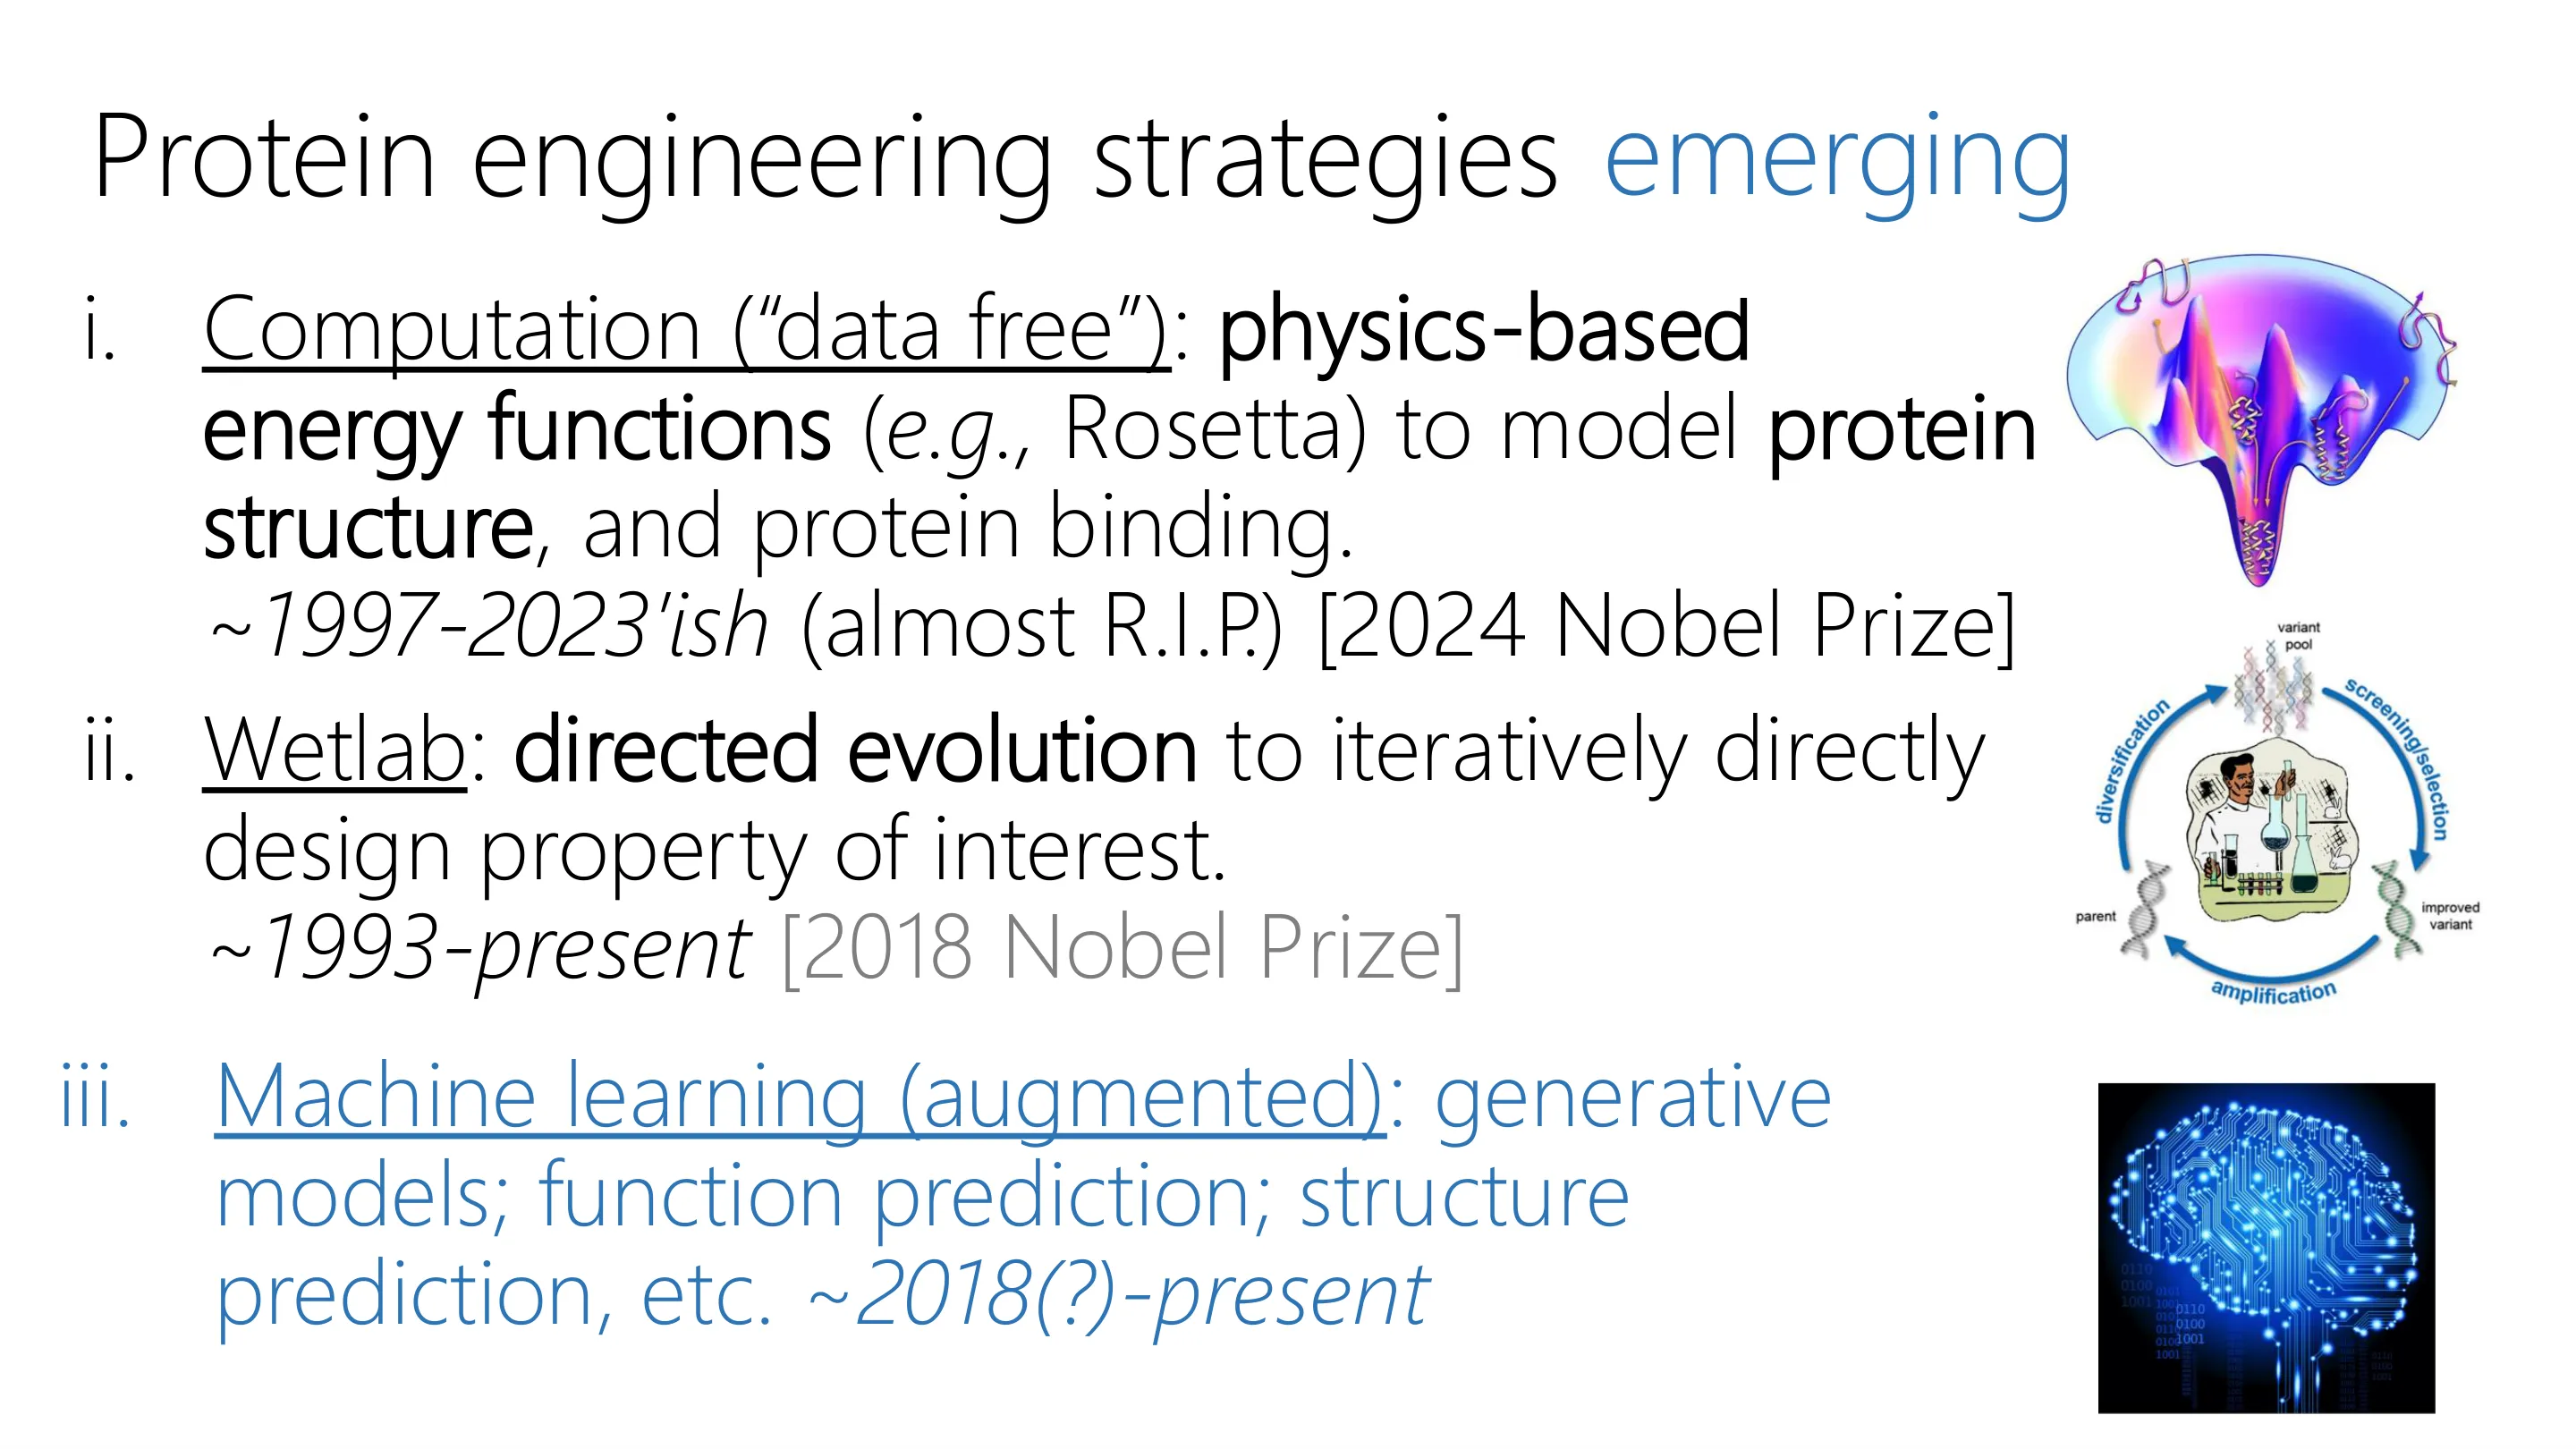
📷 迄今为止的蛋白质工程策略
回到原视频 (00:19:48)
3.2 AlphaFold 解决蛋白质工程了吗?
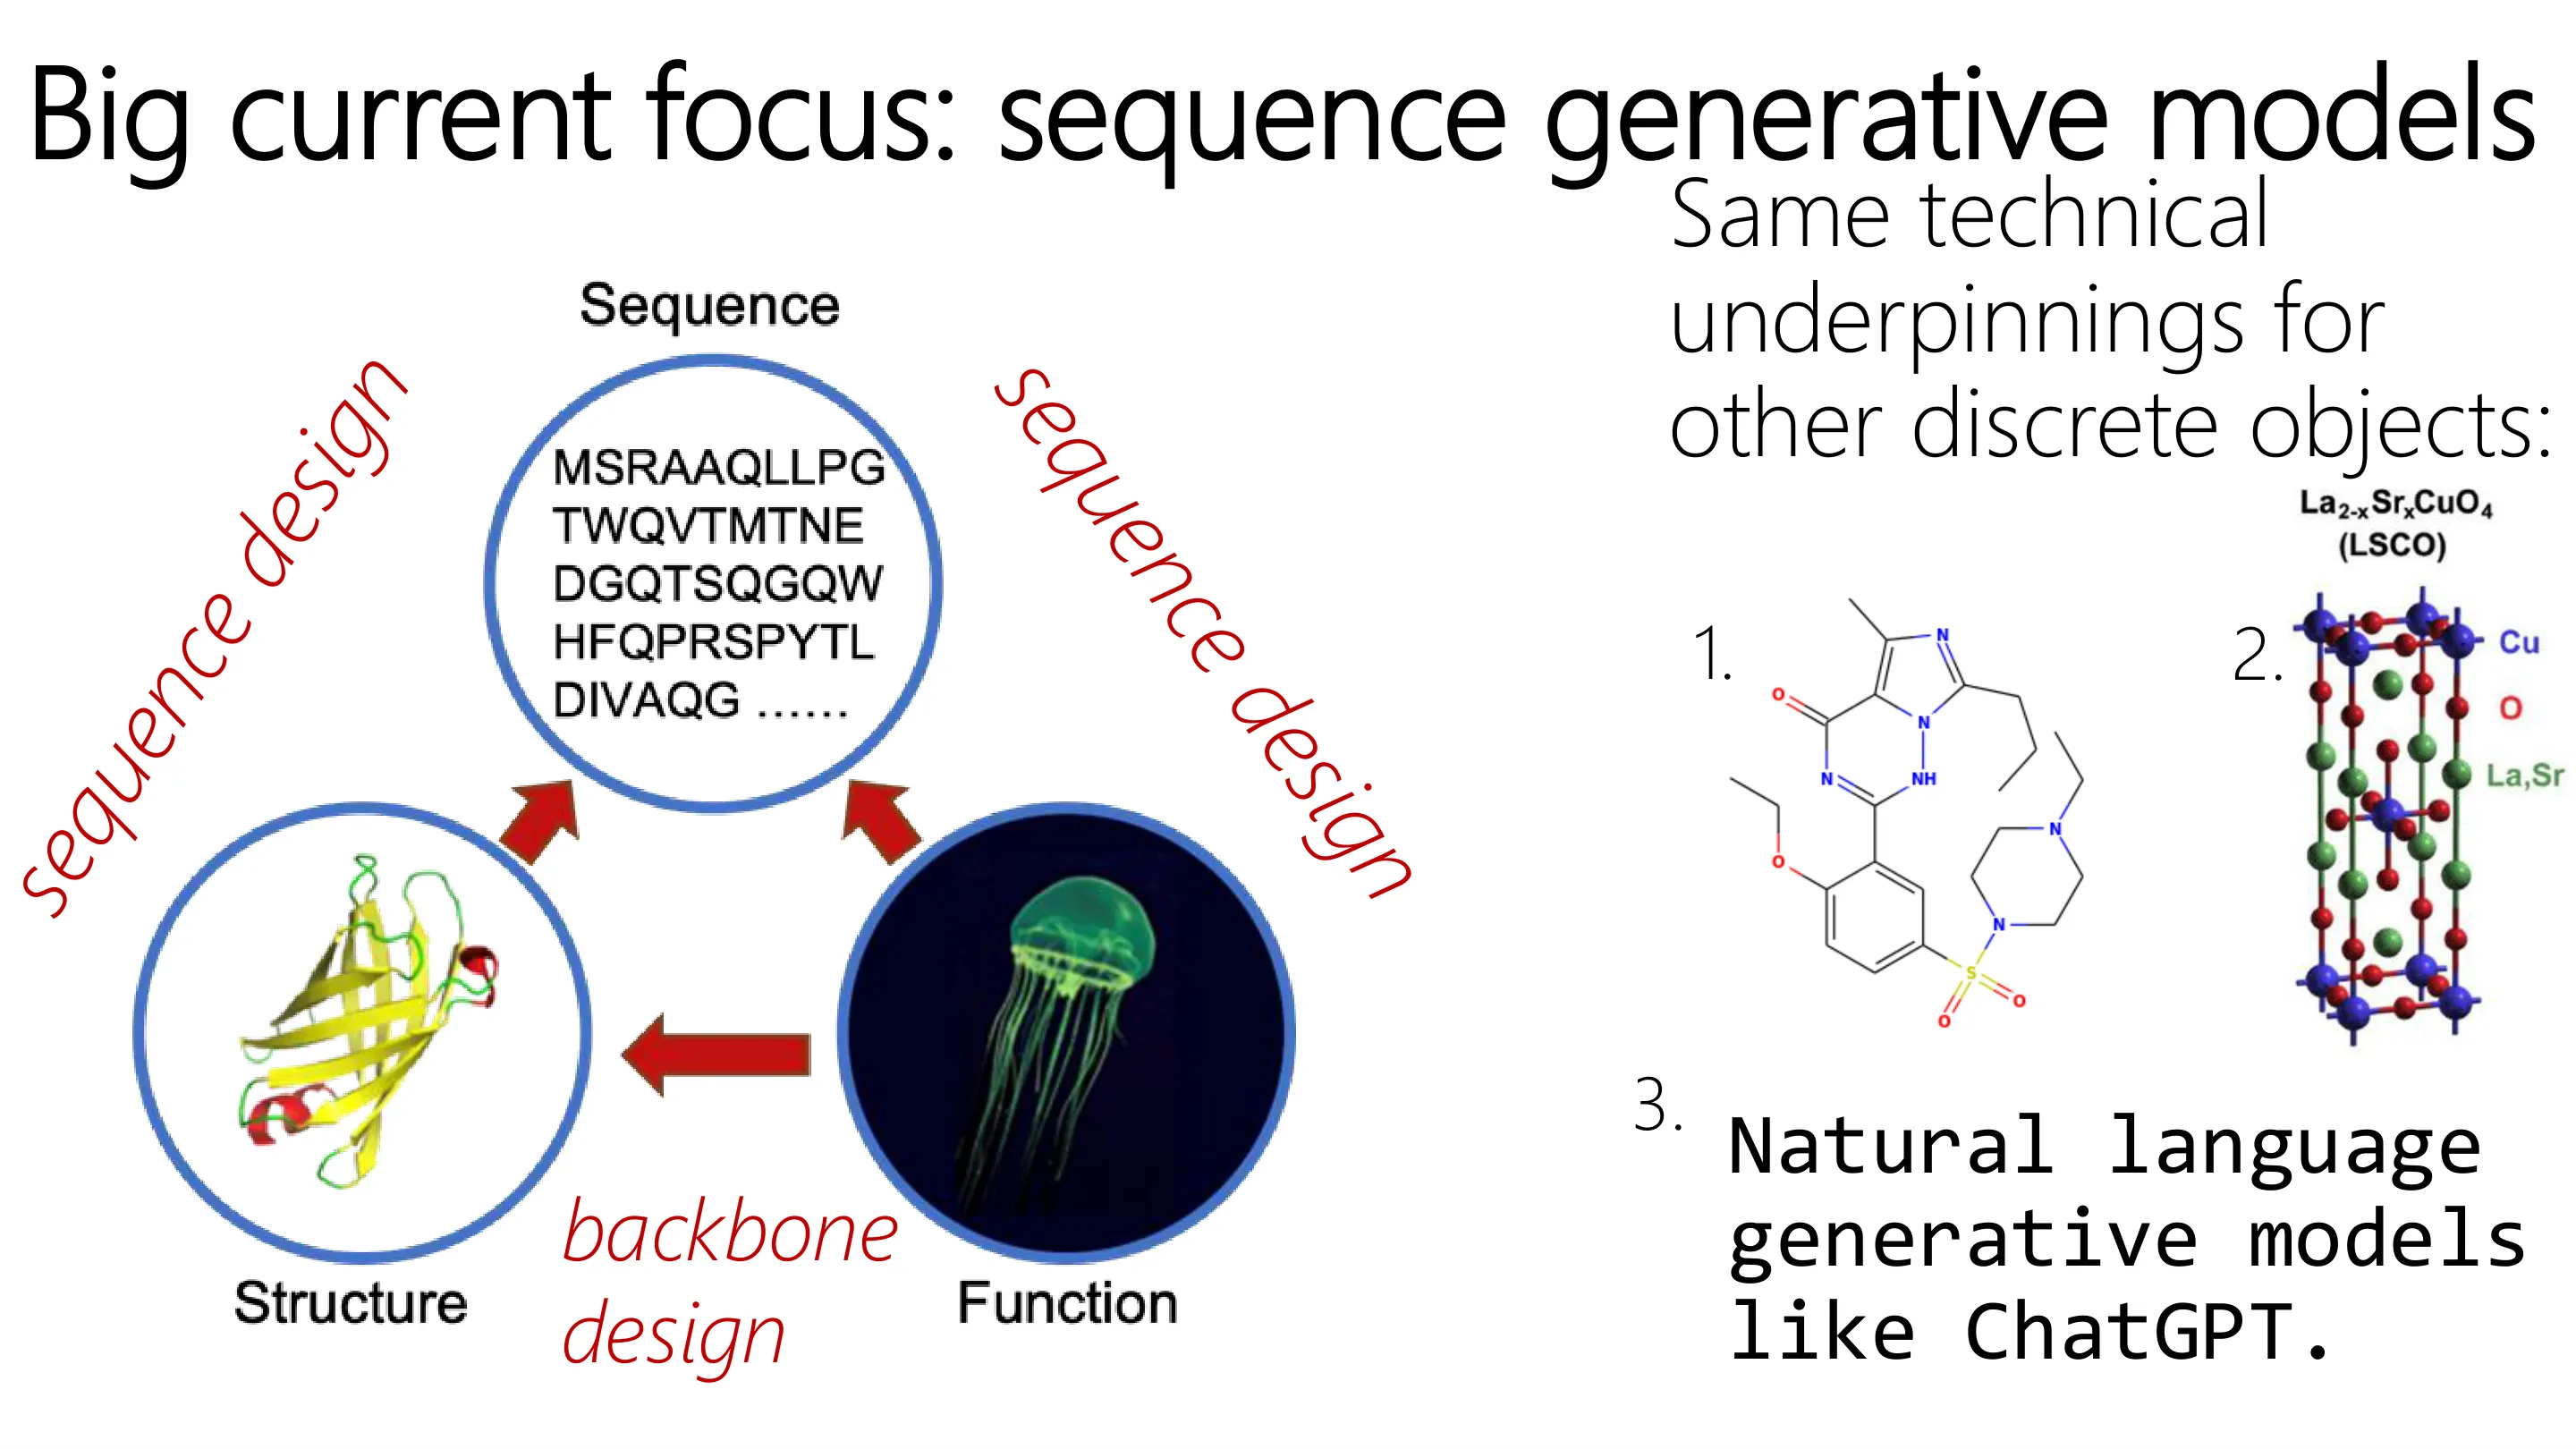
没有。AlphaFold 做的是 sequence → structure;而蛋白质工程需要输出序列。要借鉴 AlphaFold,得把它反过来:训练 structure → sequence 的 inverse folding(逆折叠) 模型。
- 给主链(backbone) 坐标(粗粒化,只给每个氨基酸的质心),预测氨基酸序列——这类模型效果不错;
- 但它不解决工程问题:如果你需要「结合 COVID 突刺」的蛋白,你并不知道那个结构,就无法作为输入;
- 真正被忽视的瓶颈:需要知道哪些序列/结构具有我们关心的功能。对结合而言结构几乎决定一切;但对酶催化,功能是细粒度的量子信息,不由结构决定,只能靠湿实验测量。
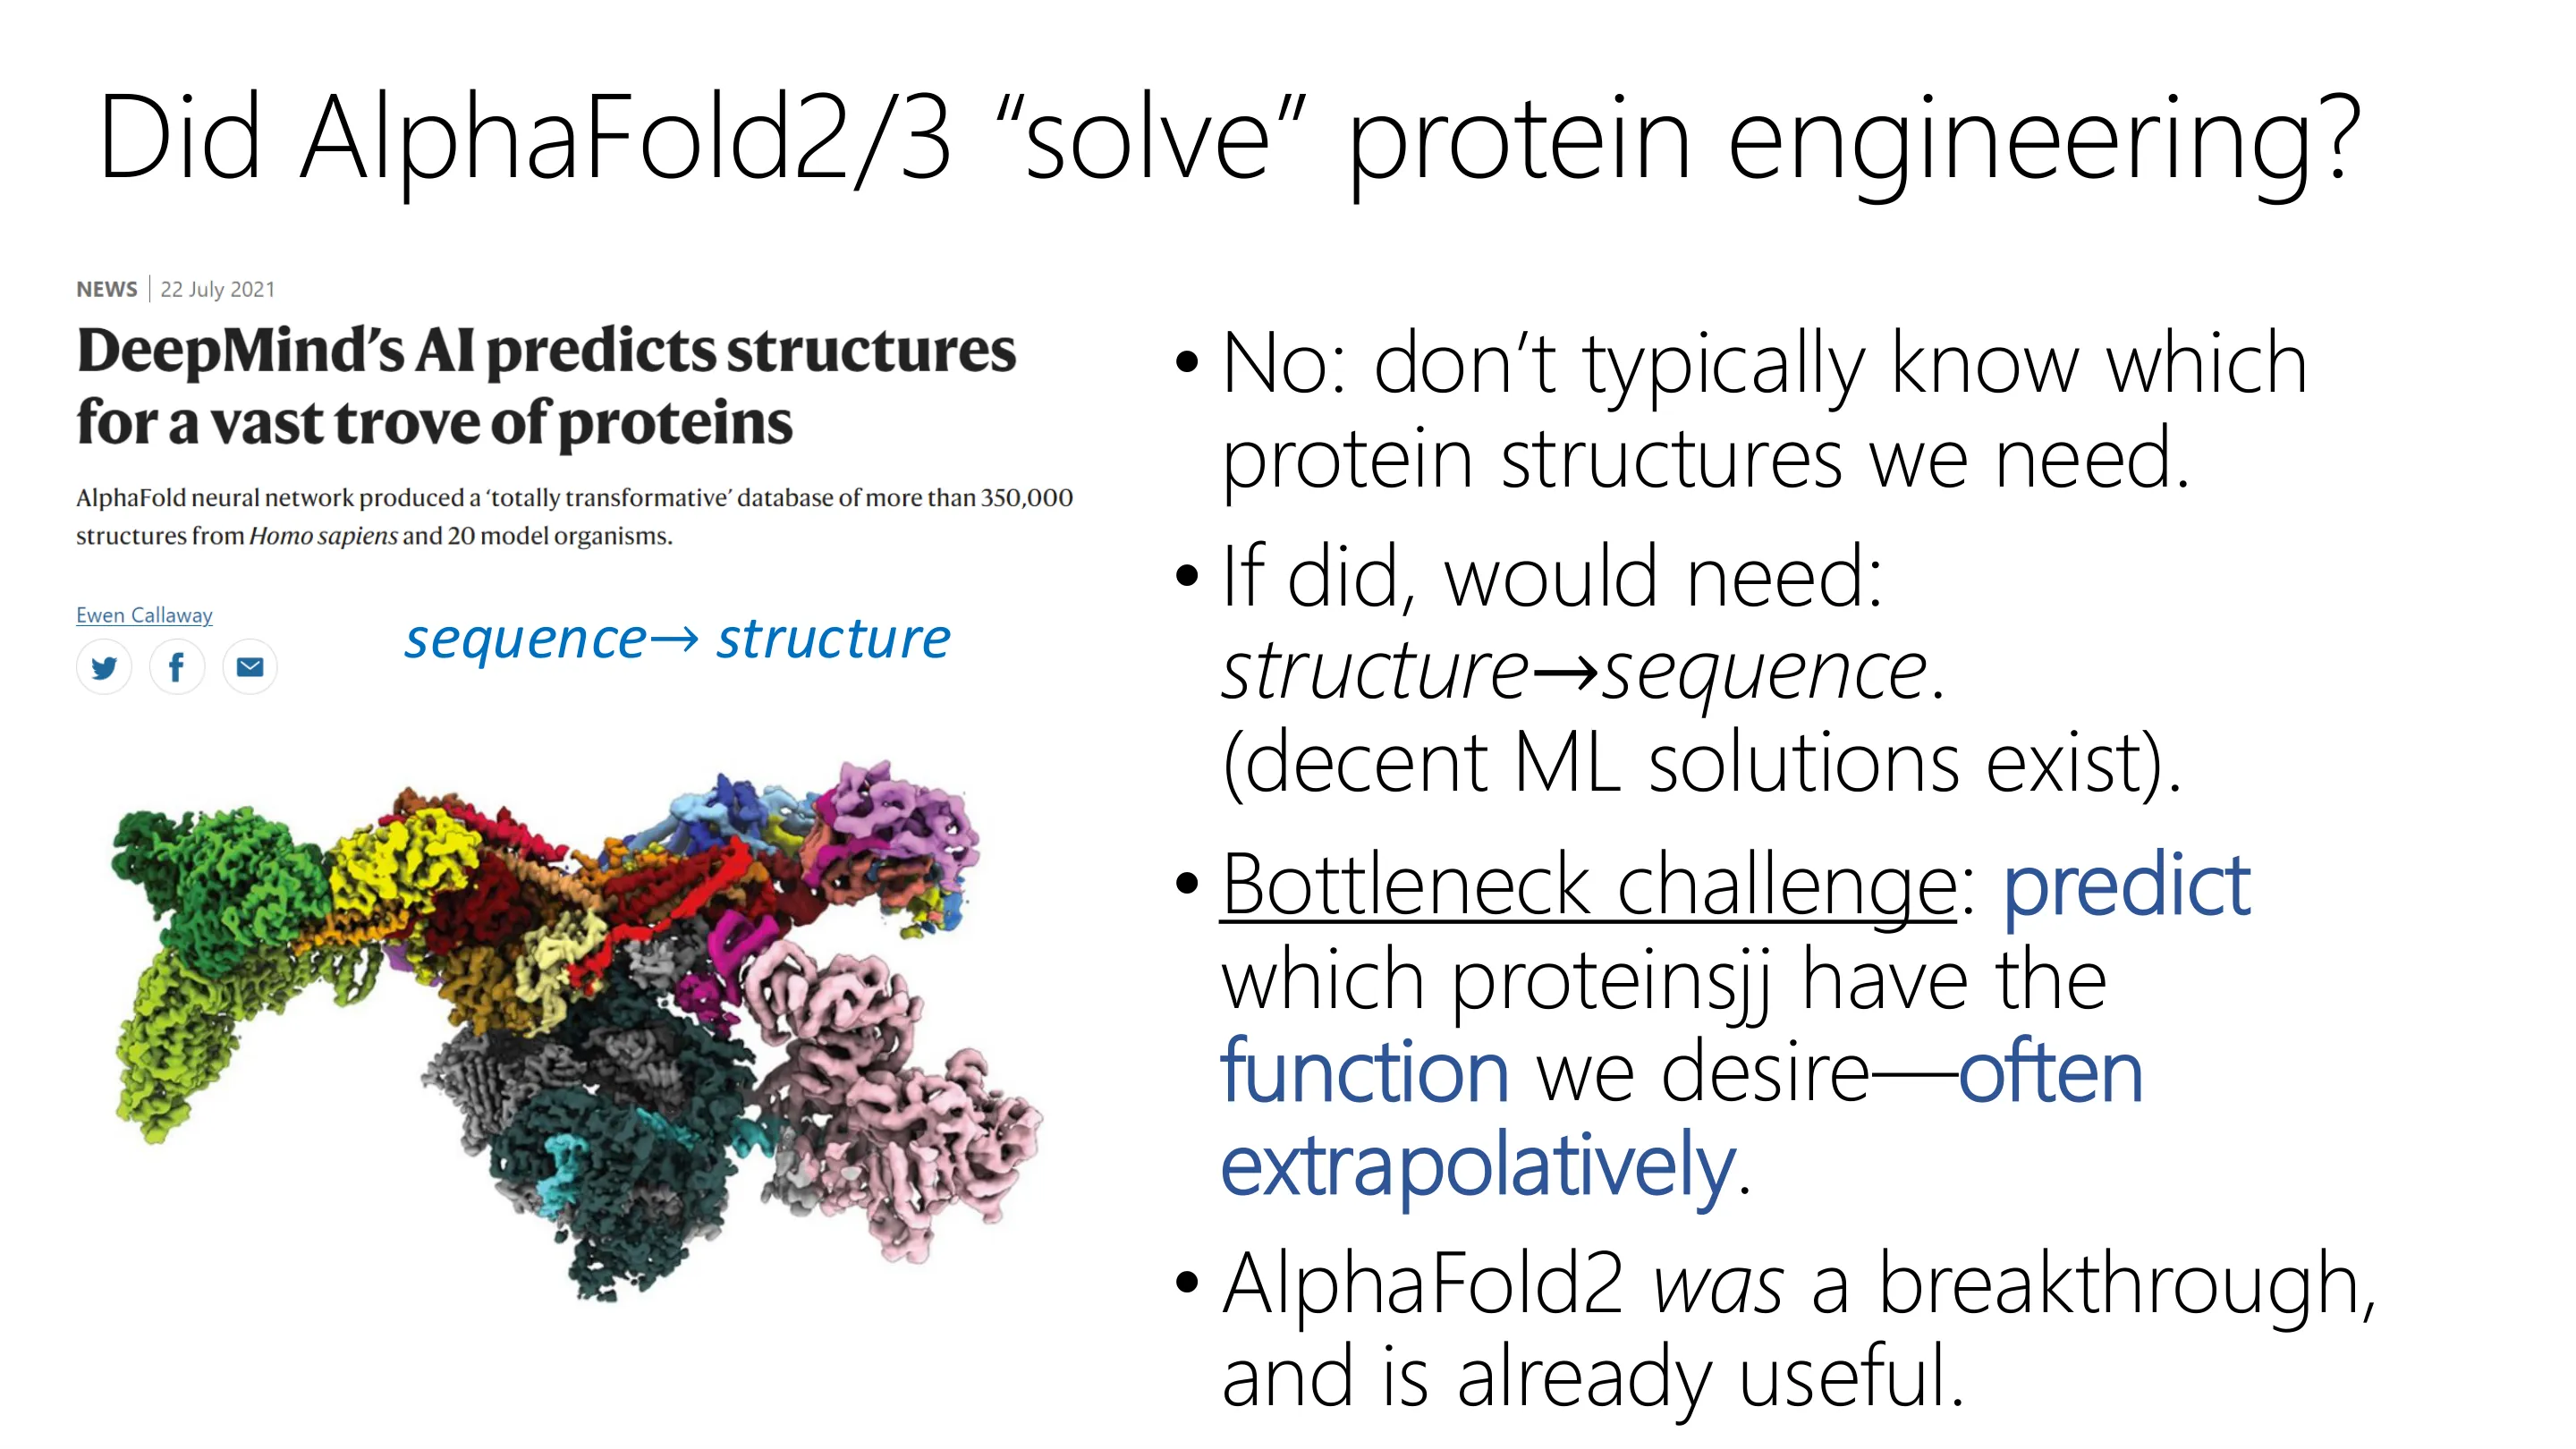
📷 AlphaFold2/3「解决」蛋白质工程了吗?
回到原视频 (00:21:01)
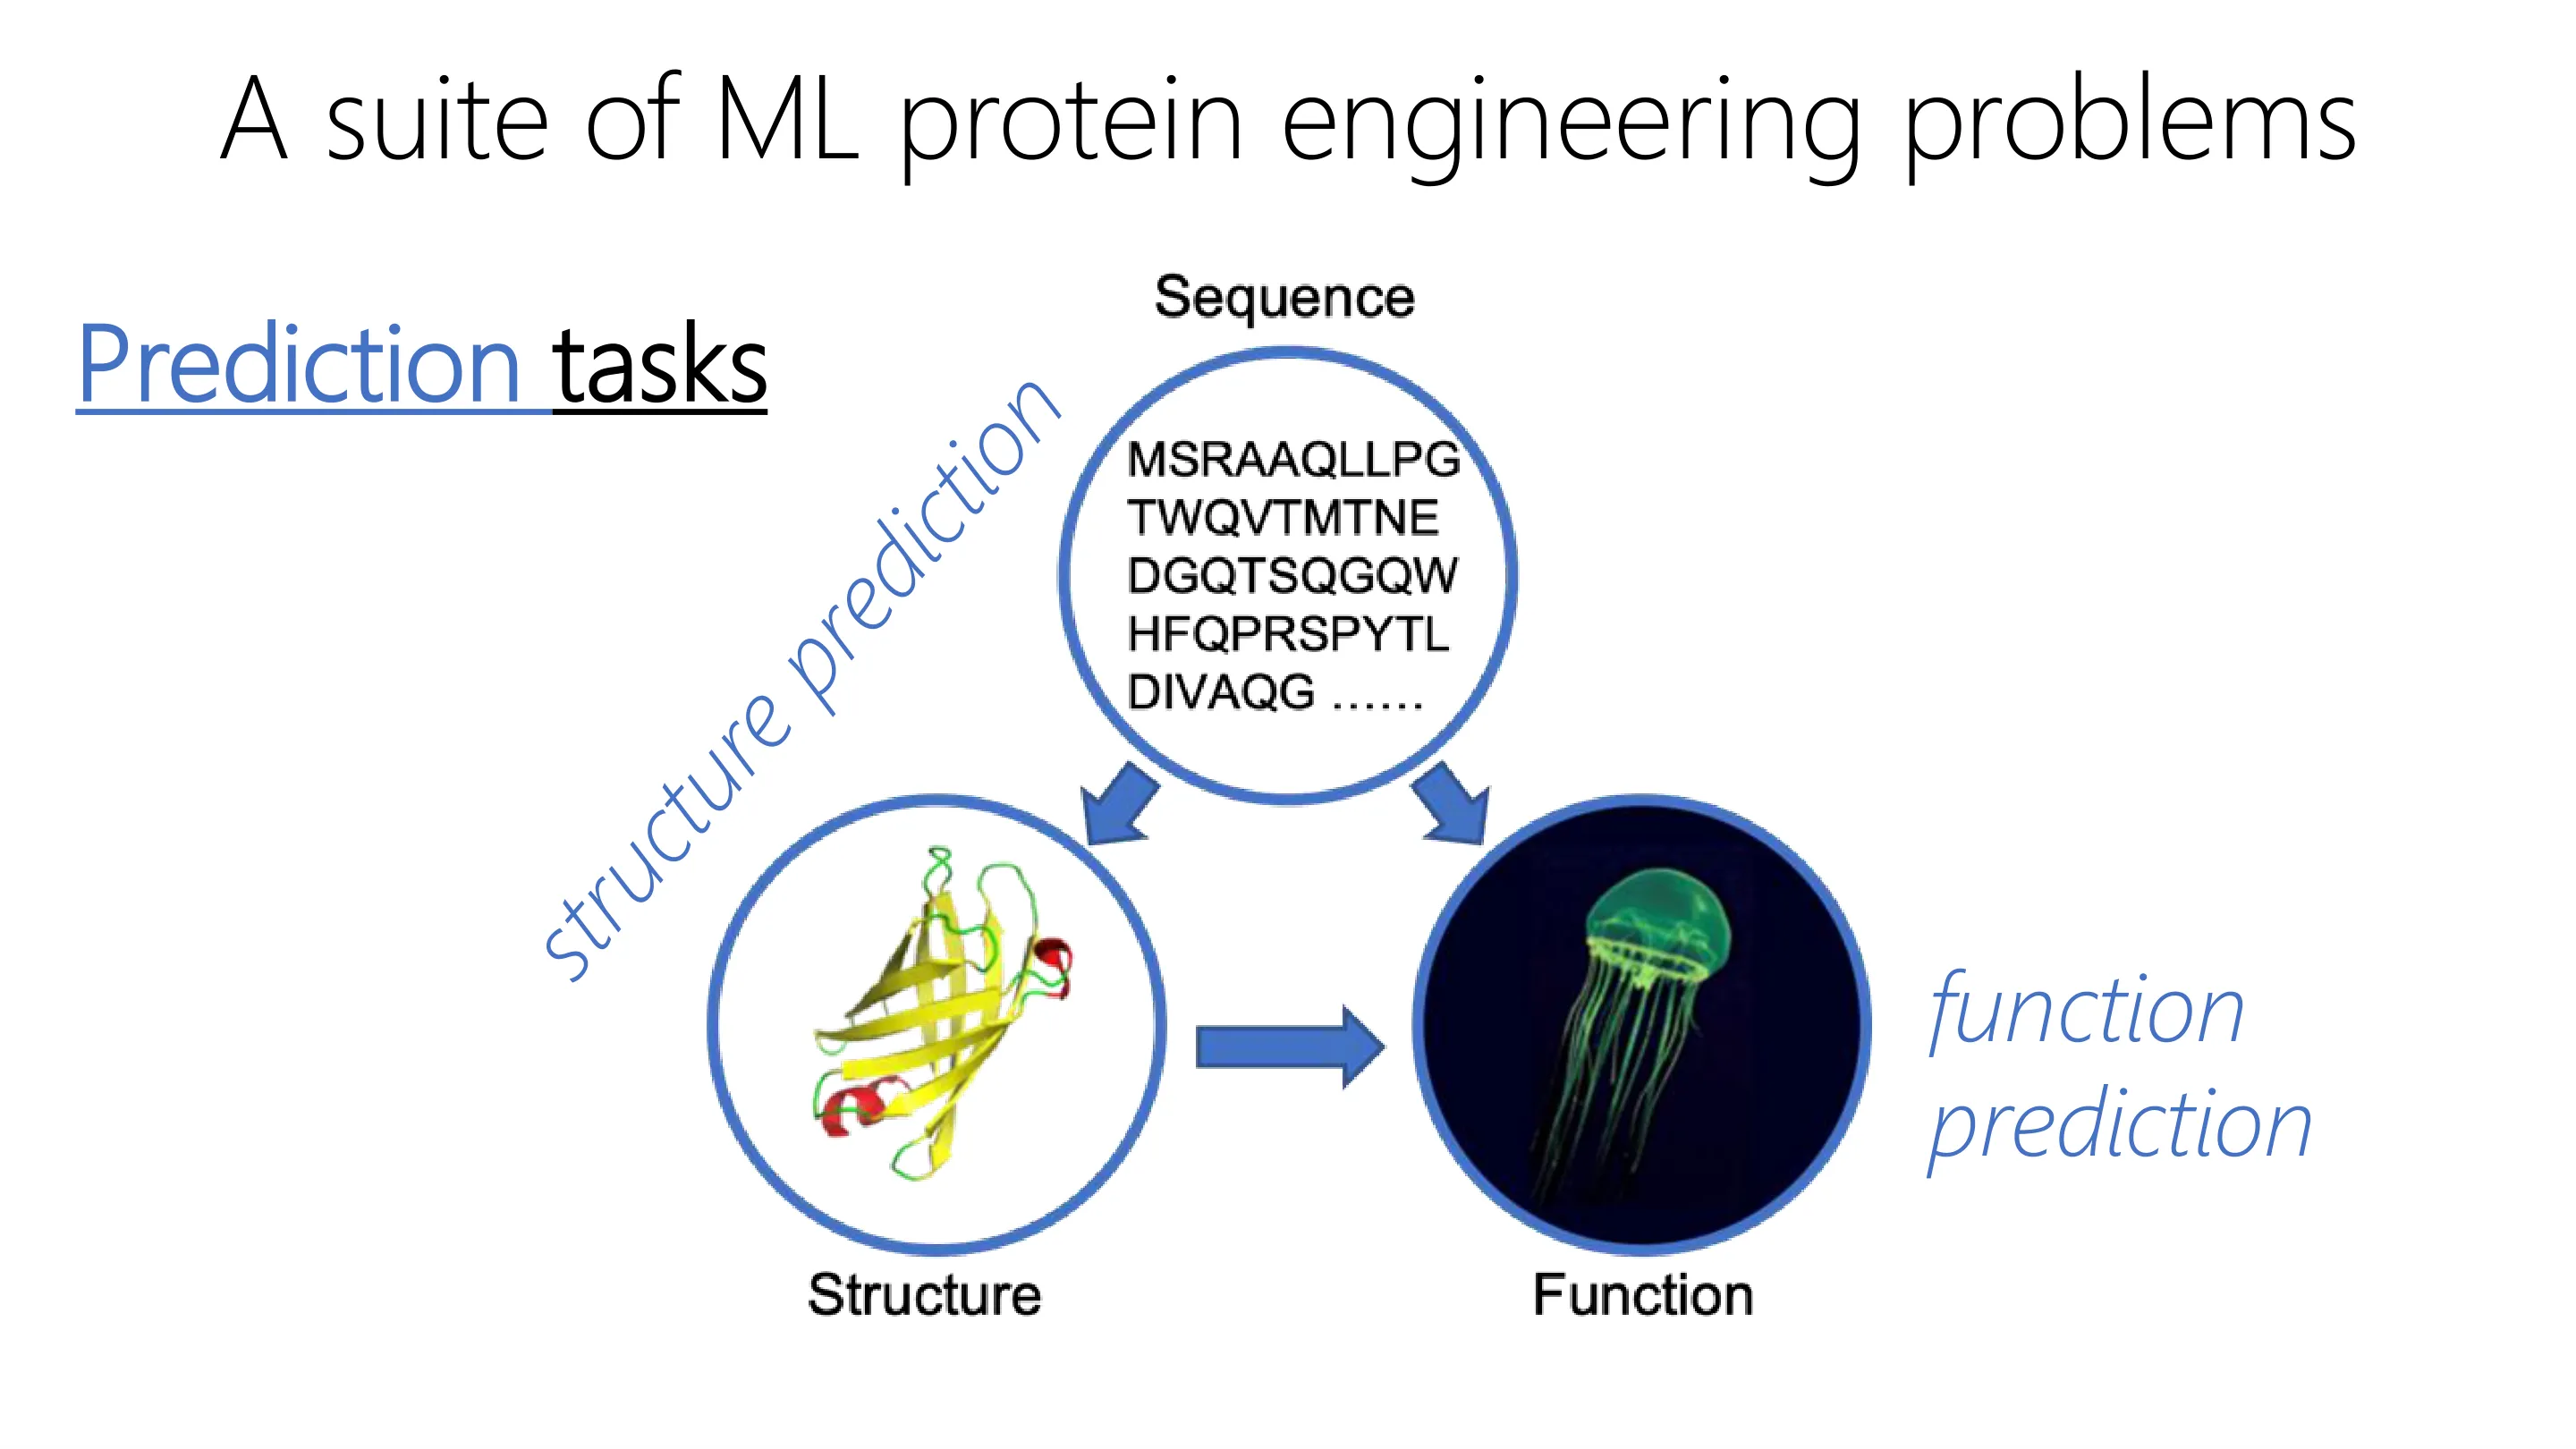
📷 一系列 ML 蛋白质工程问题
回到原视频 (00:22:14)
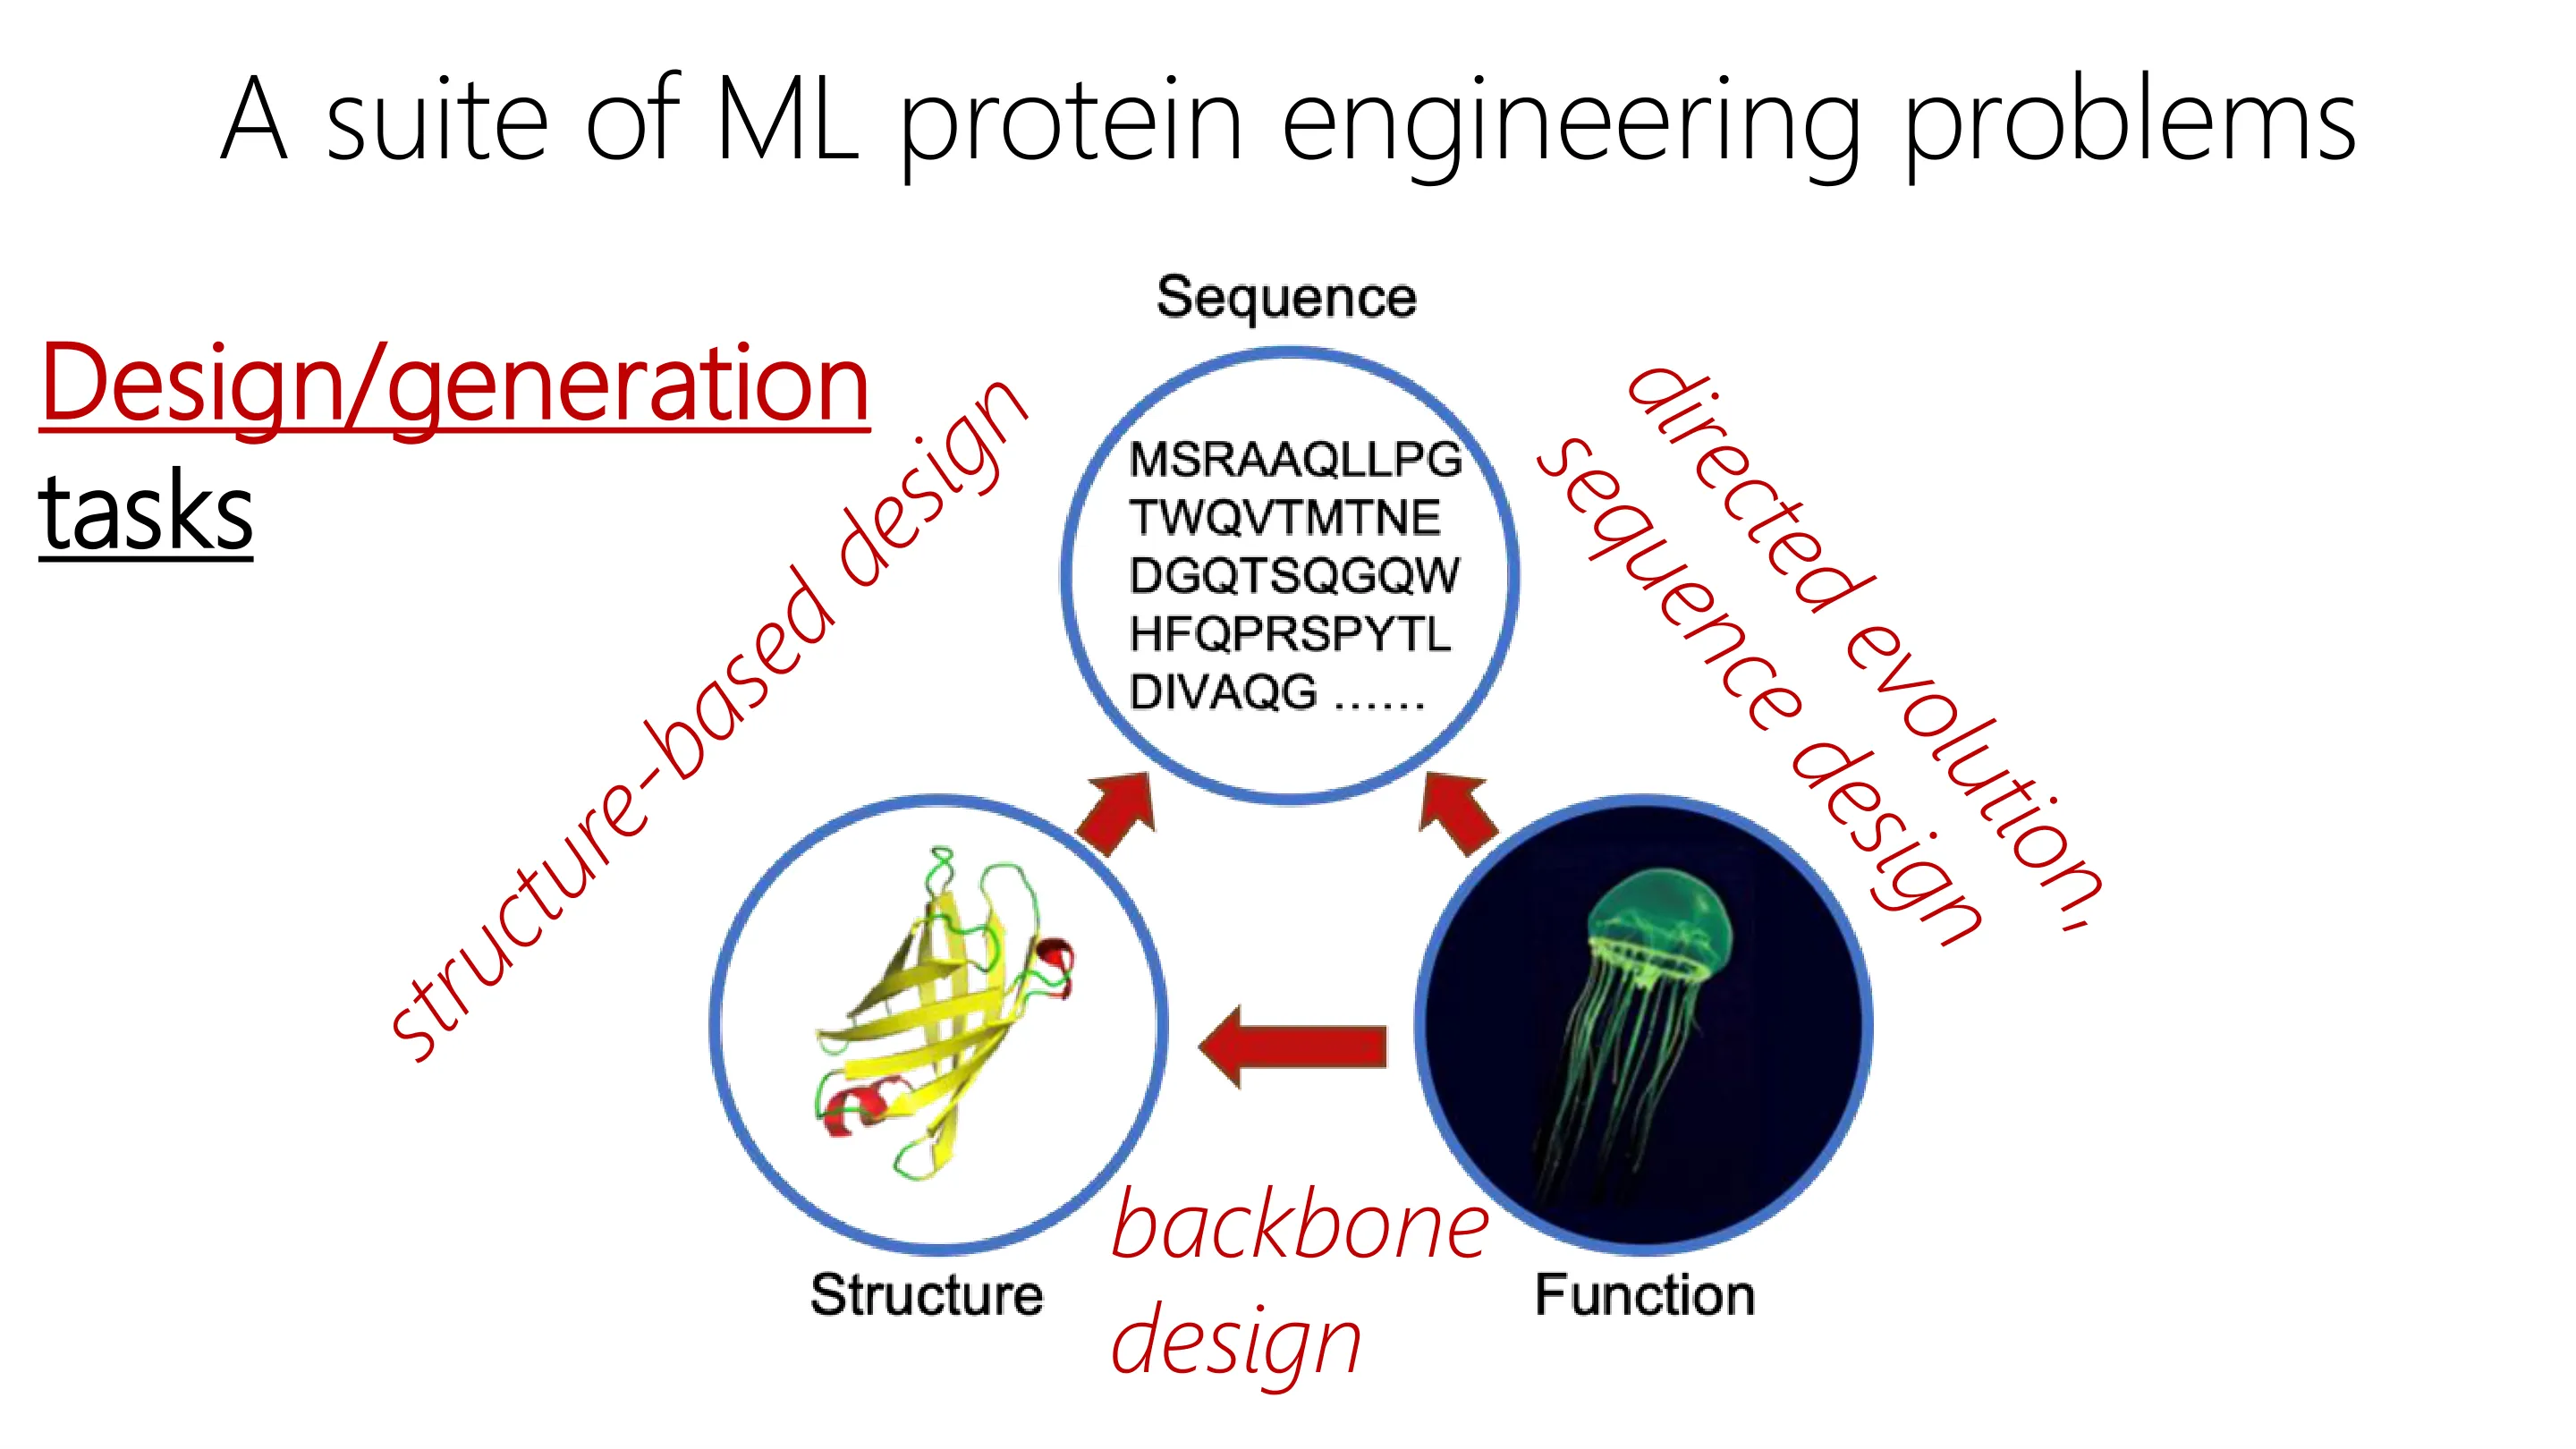
📷 主链
回到原视频 (00:23:27)
3.3 ML 蛋白质工程的趋势
- 表示学习:用自编码器等在大量序列上学潜表示(如 ESM2/ESM3 等「基础模型」),再用于下游监督任务。若不学表示,就只能 one-hot 或手工物理化学特征;
- 条件生成模型(本质是密度估计 / 采样):
- 序列的条件生成:给结构(backbone)生成序列分布(逆折叠),在工程流水线里很有用;
- 结构的条件生成:生成满足某性质(如结合突刺、催化某反应)的 backbone——这是当前极热的领域;
- ChatGPT 就是一个条件生成模型:以 prompt 为条件生成文本;
- 功能估计:在很少甚至没有标注时,估计序列 → 催化活性/亮度。可先用 zero-shot(利用 MSA/进化信息)设计初始文库(library),再用湿实验数据做监督学习,并巧妙融合两类信息。
在蛋白质工程里(不同于 CV/NLP),必须从一切可用信息中榨取价值:晶体结构、AlphaFold 预测(还要先判断它在这个蛋白上准不准)、湿实验数据、他人的数据……并聪明地融合。
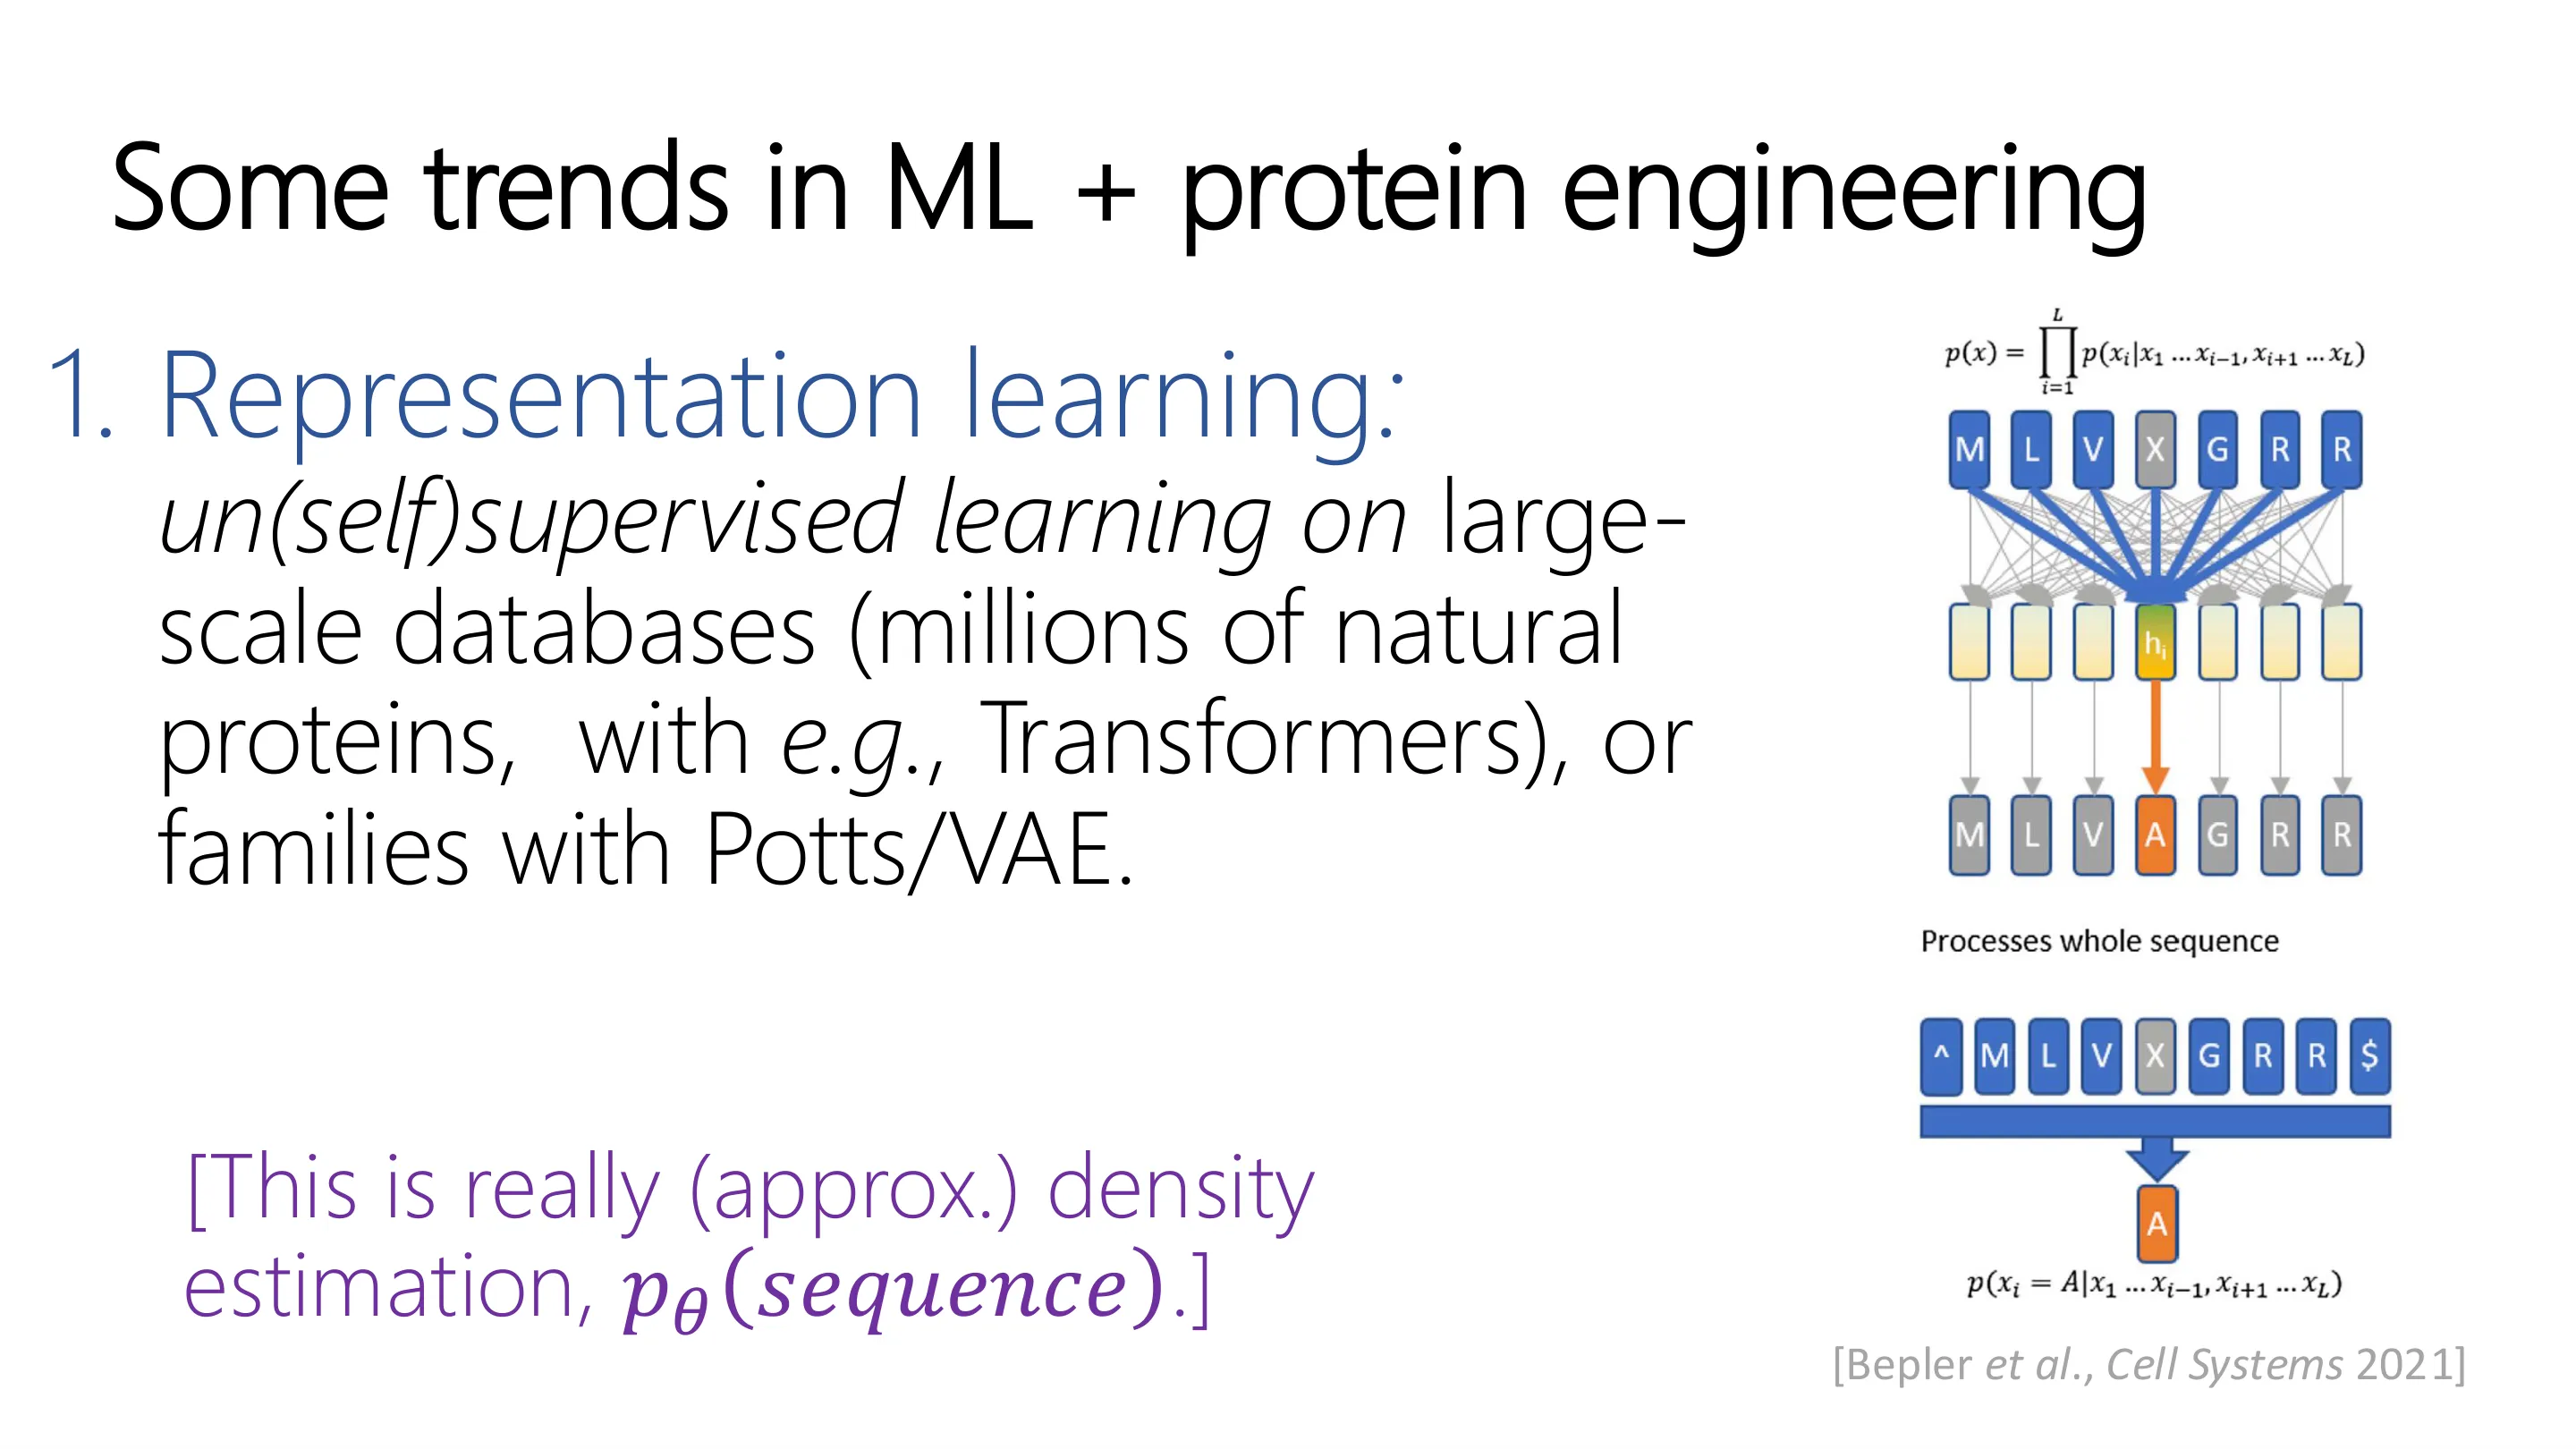
📷 ML + 蛋白质工程的一些趋势(一)
回到原视频 (00:24:40)
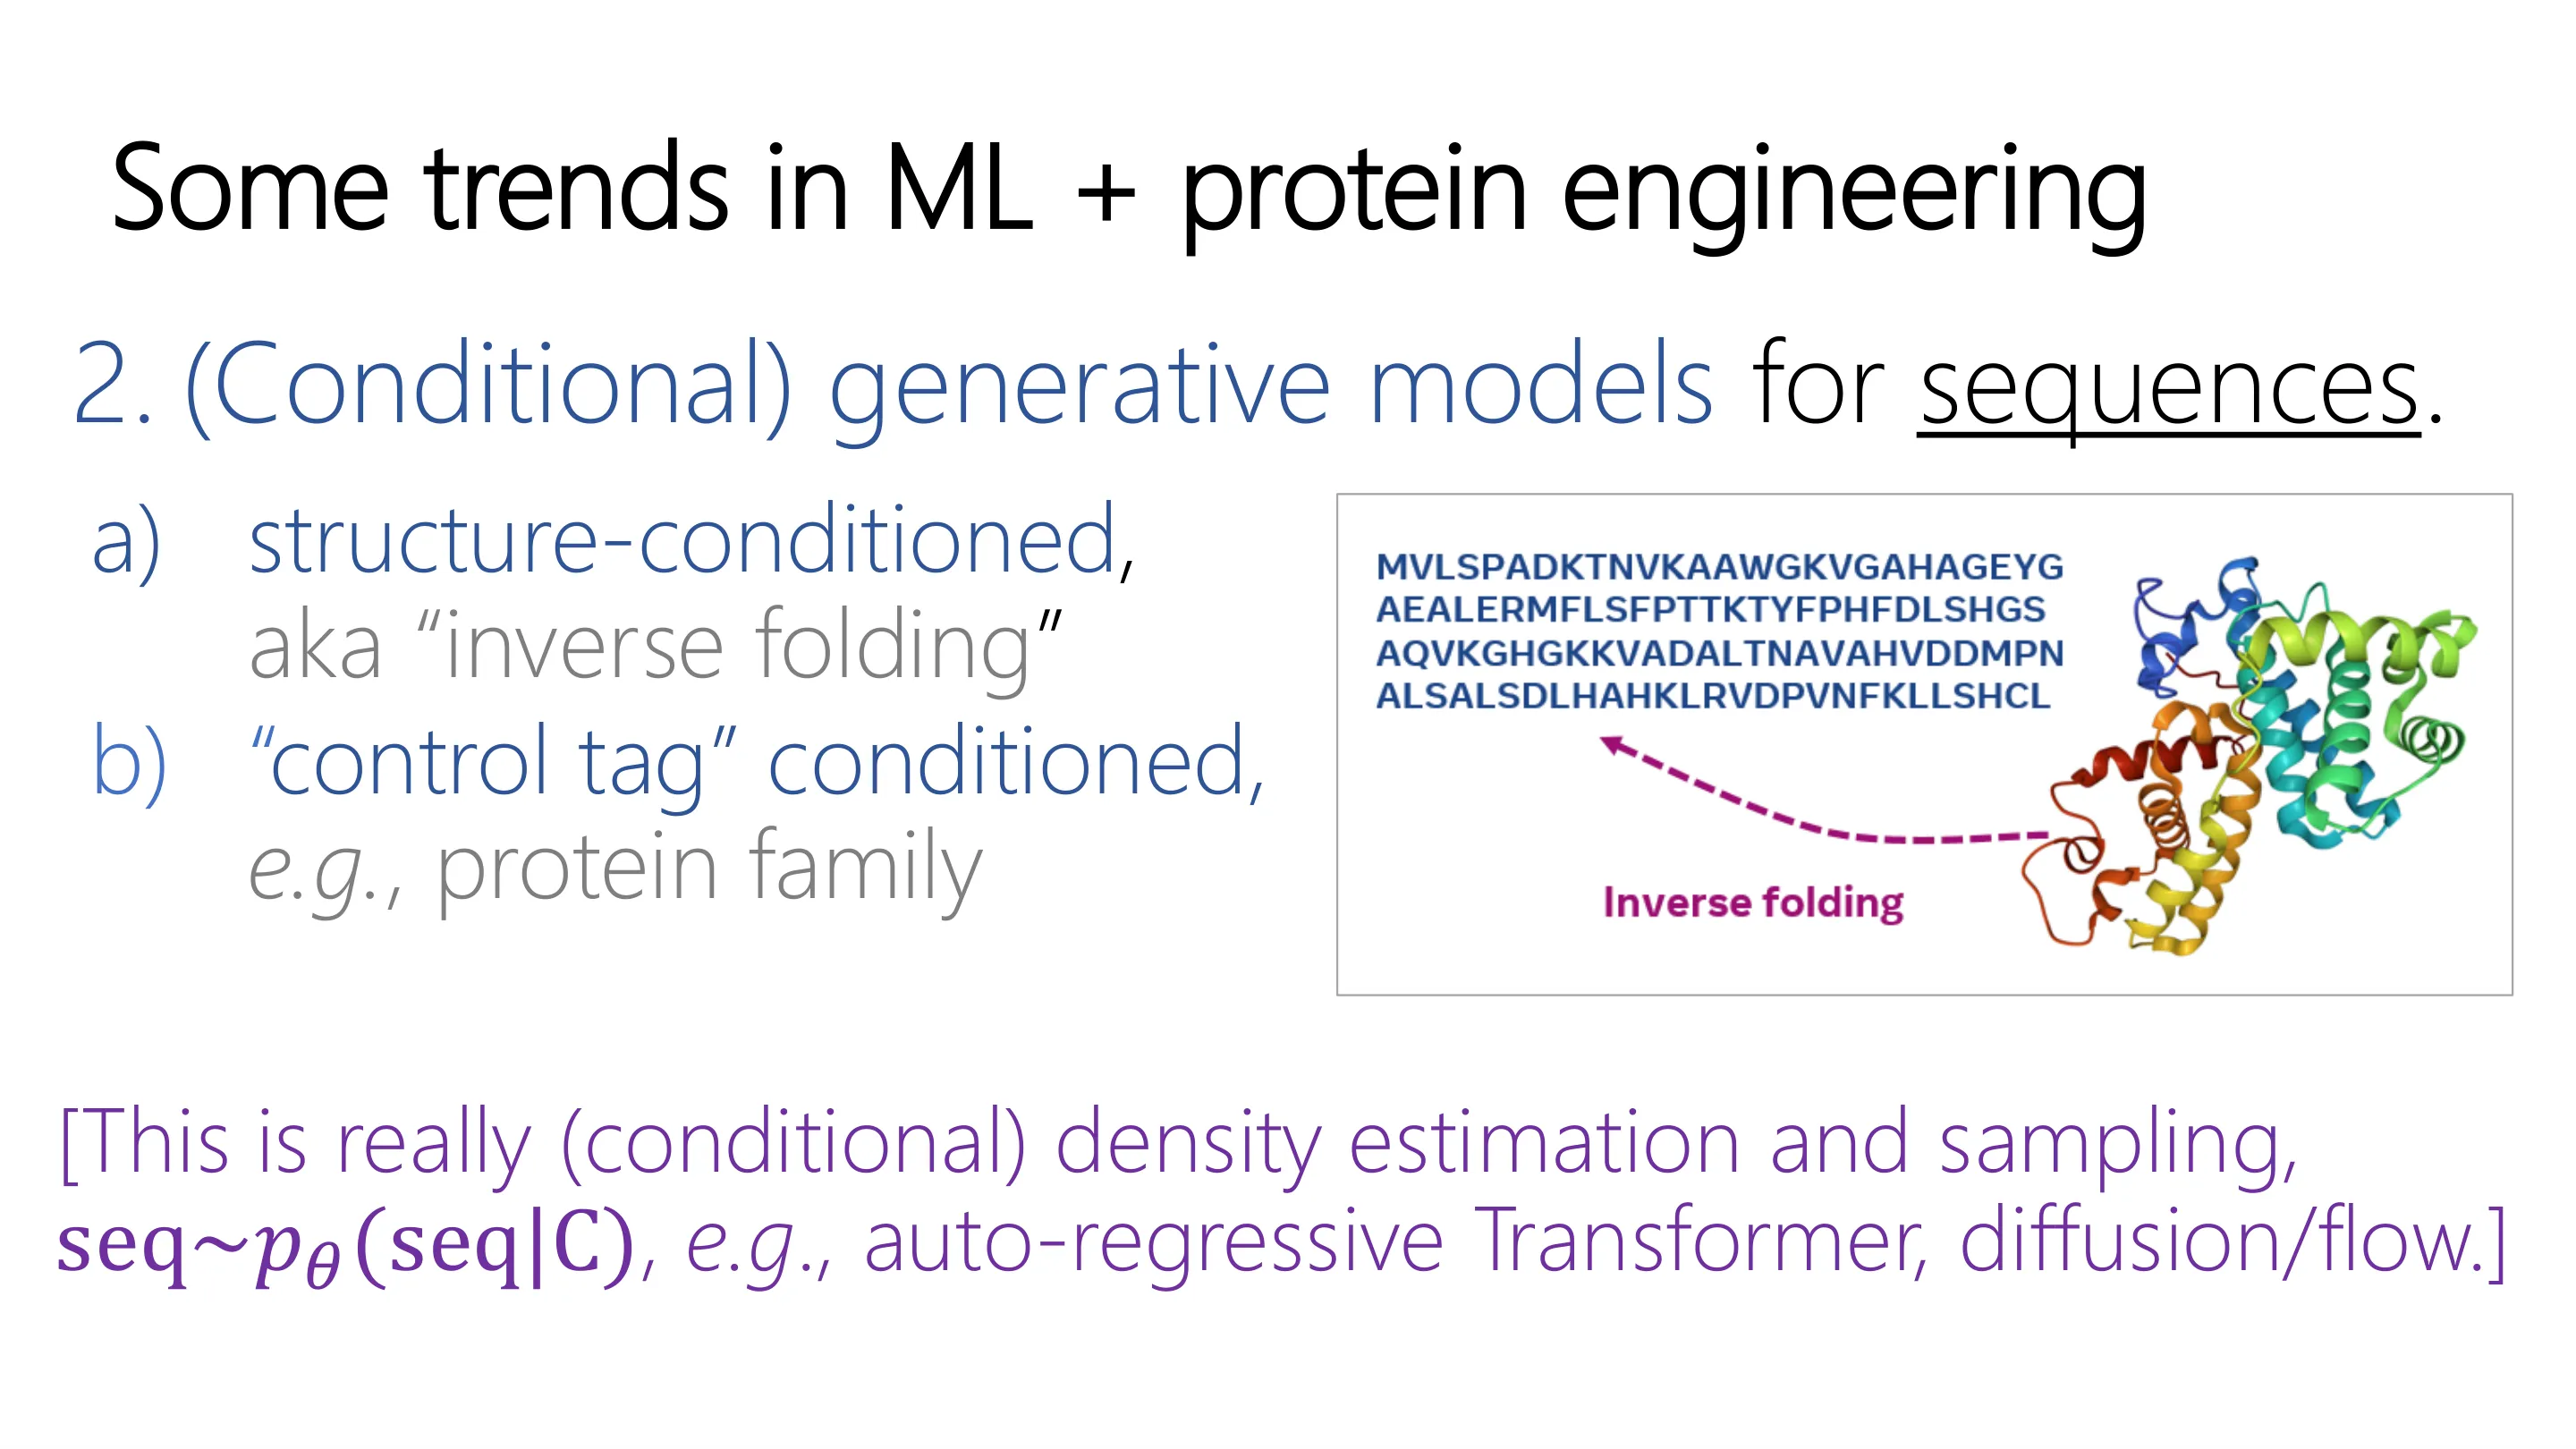
📷 ML + 蛋白质工程的一些趋势(二)
回到原视频 (00:25:53)
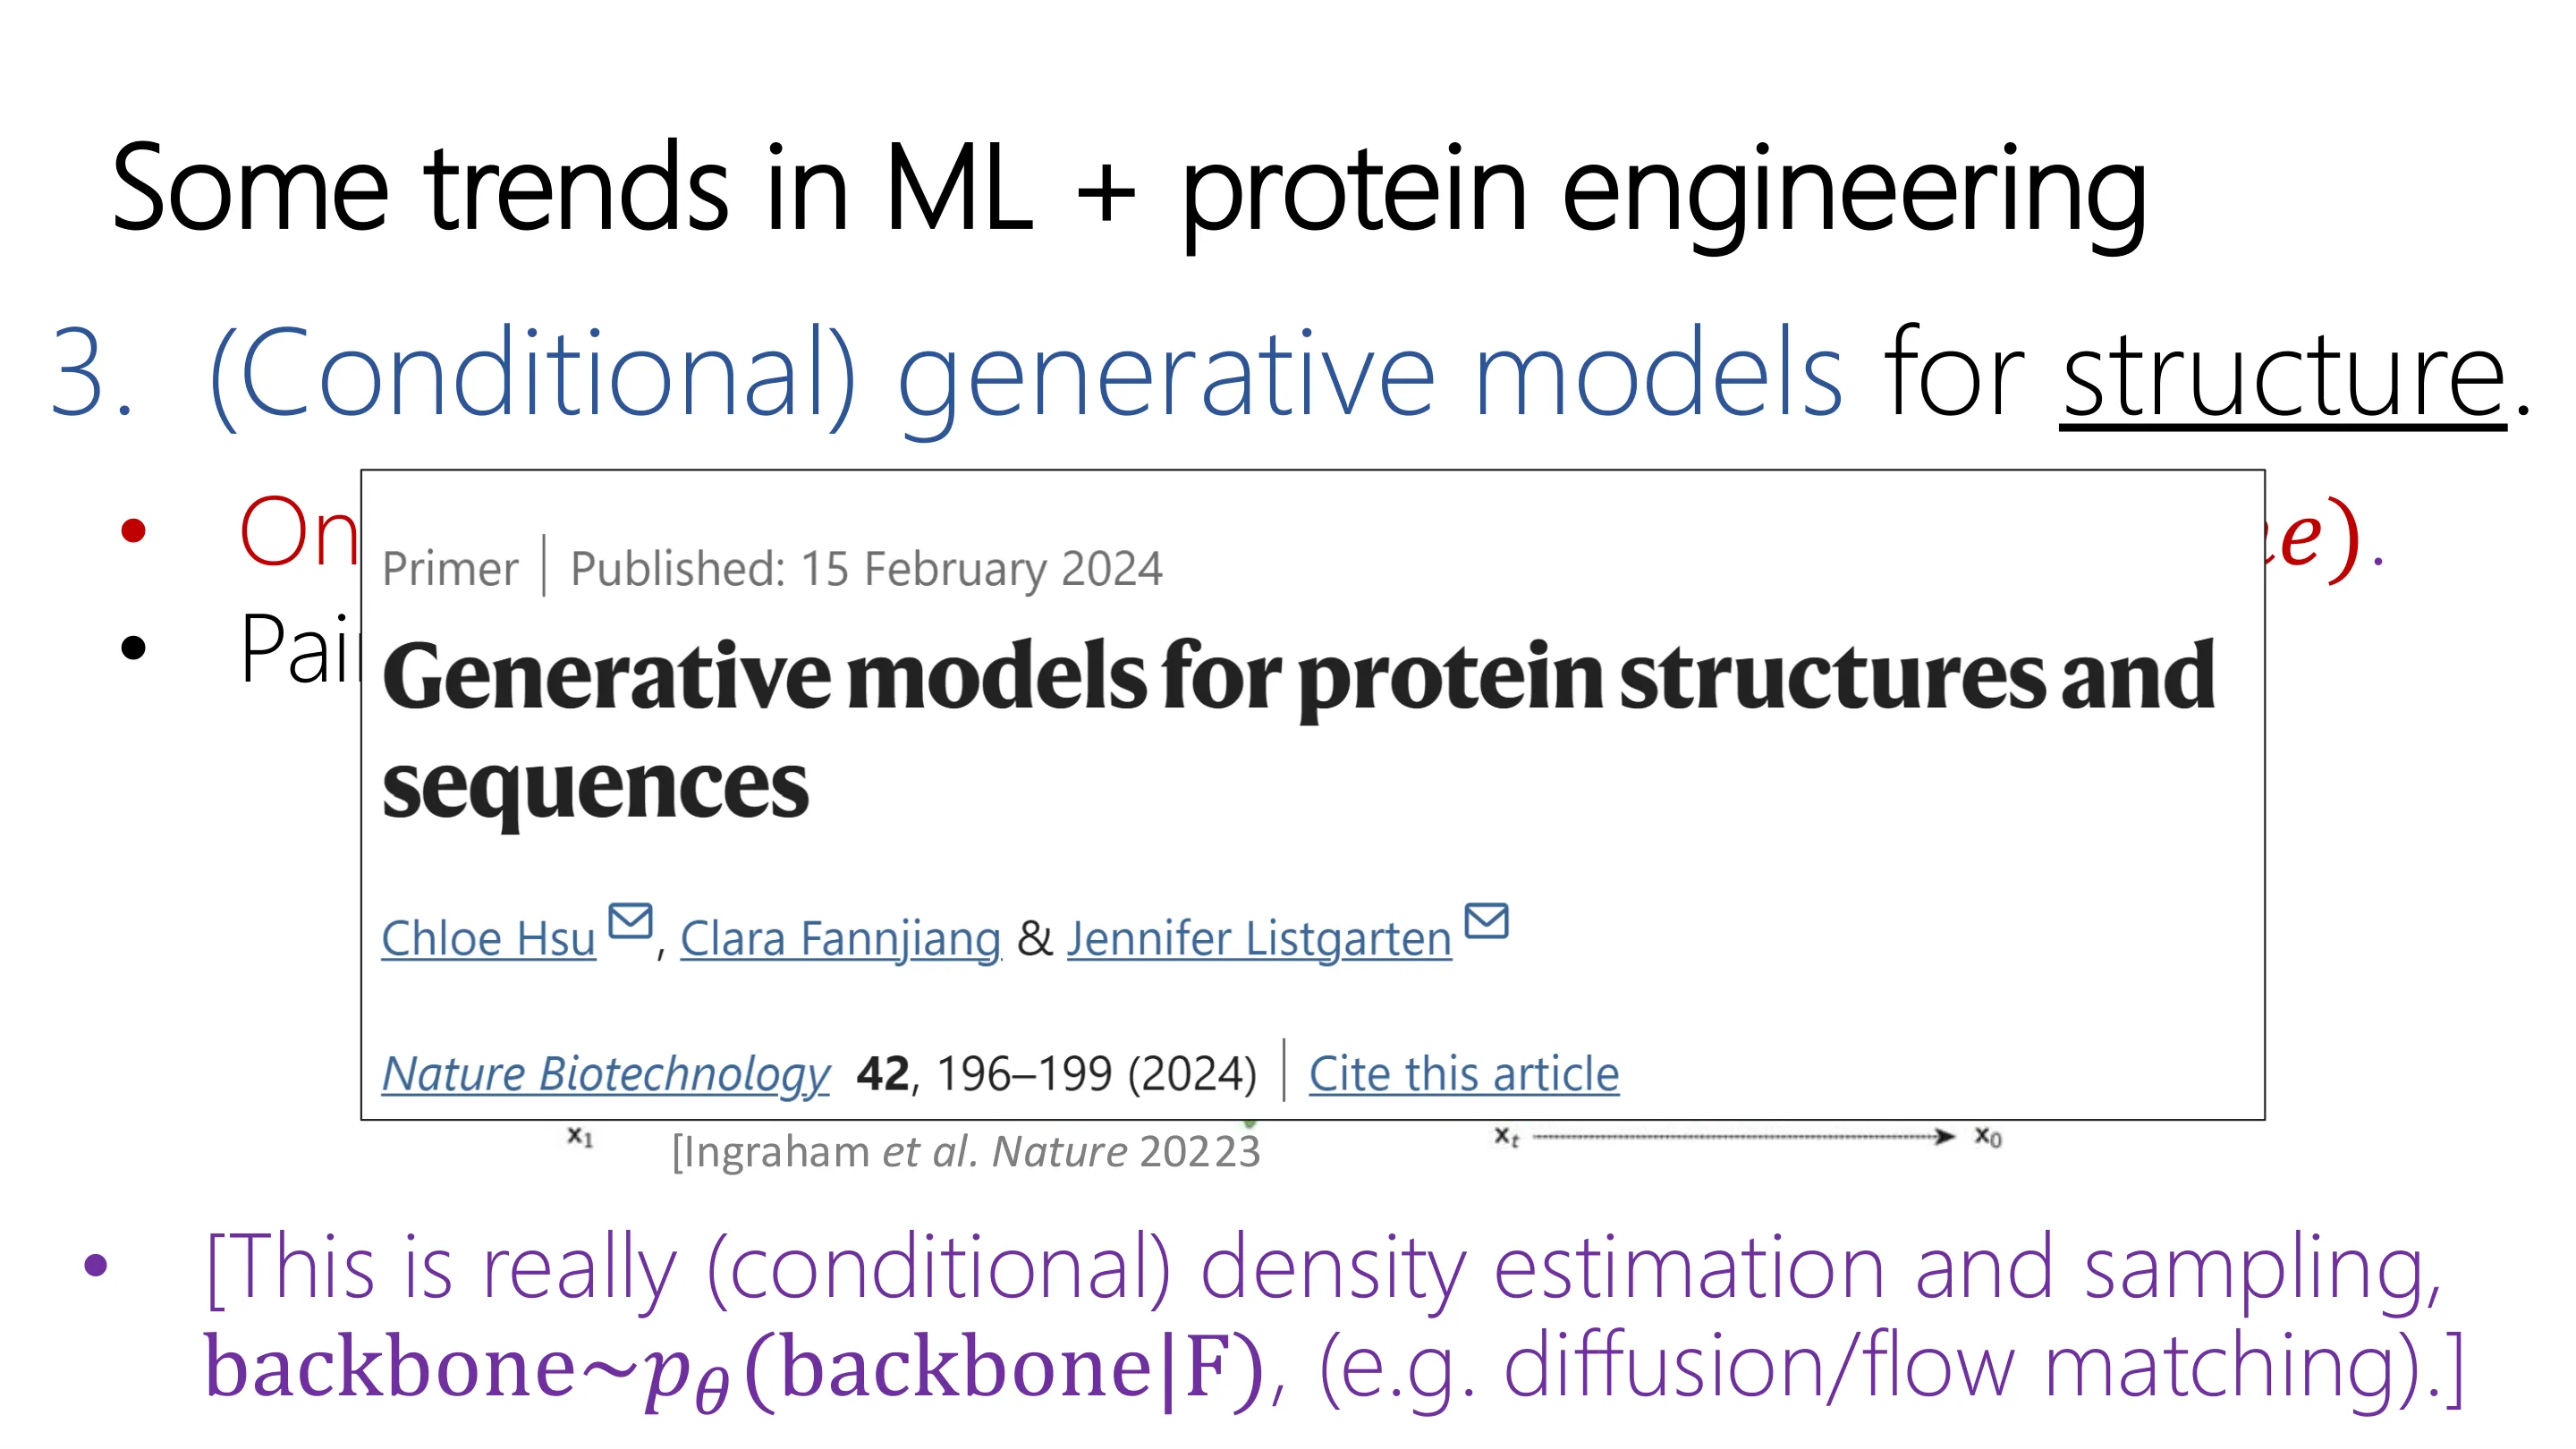
📷 ML + 蛋白质工程的一些趋势(三)
回到原视频 (00:27:06)
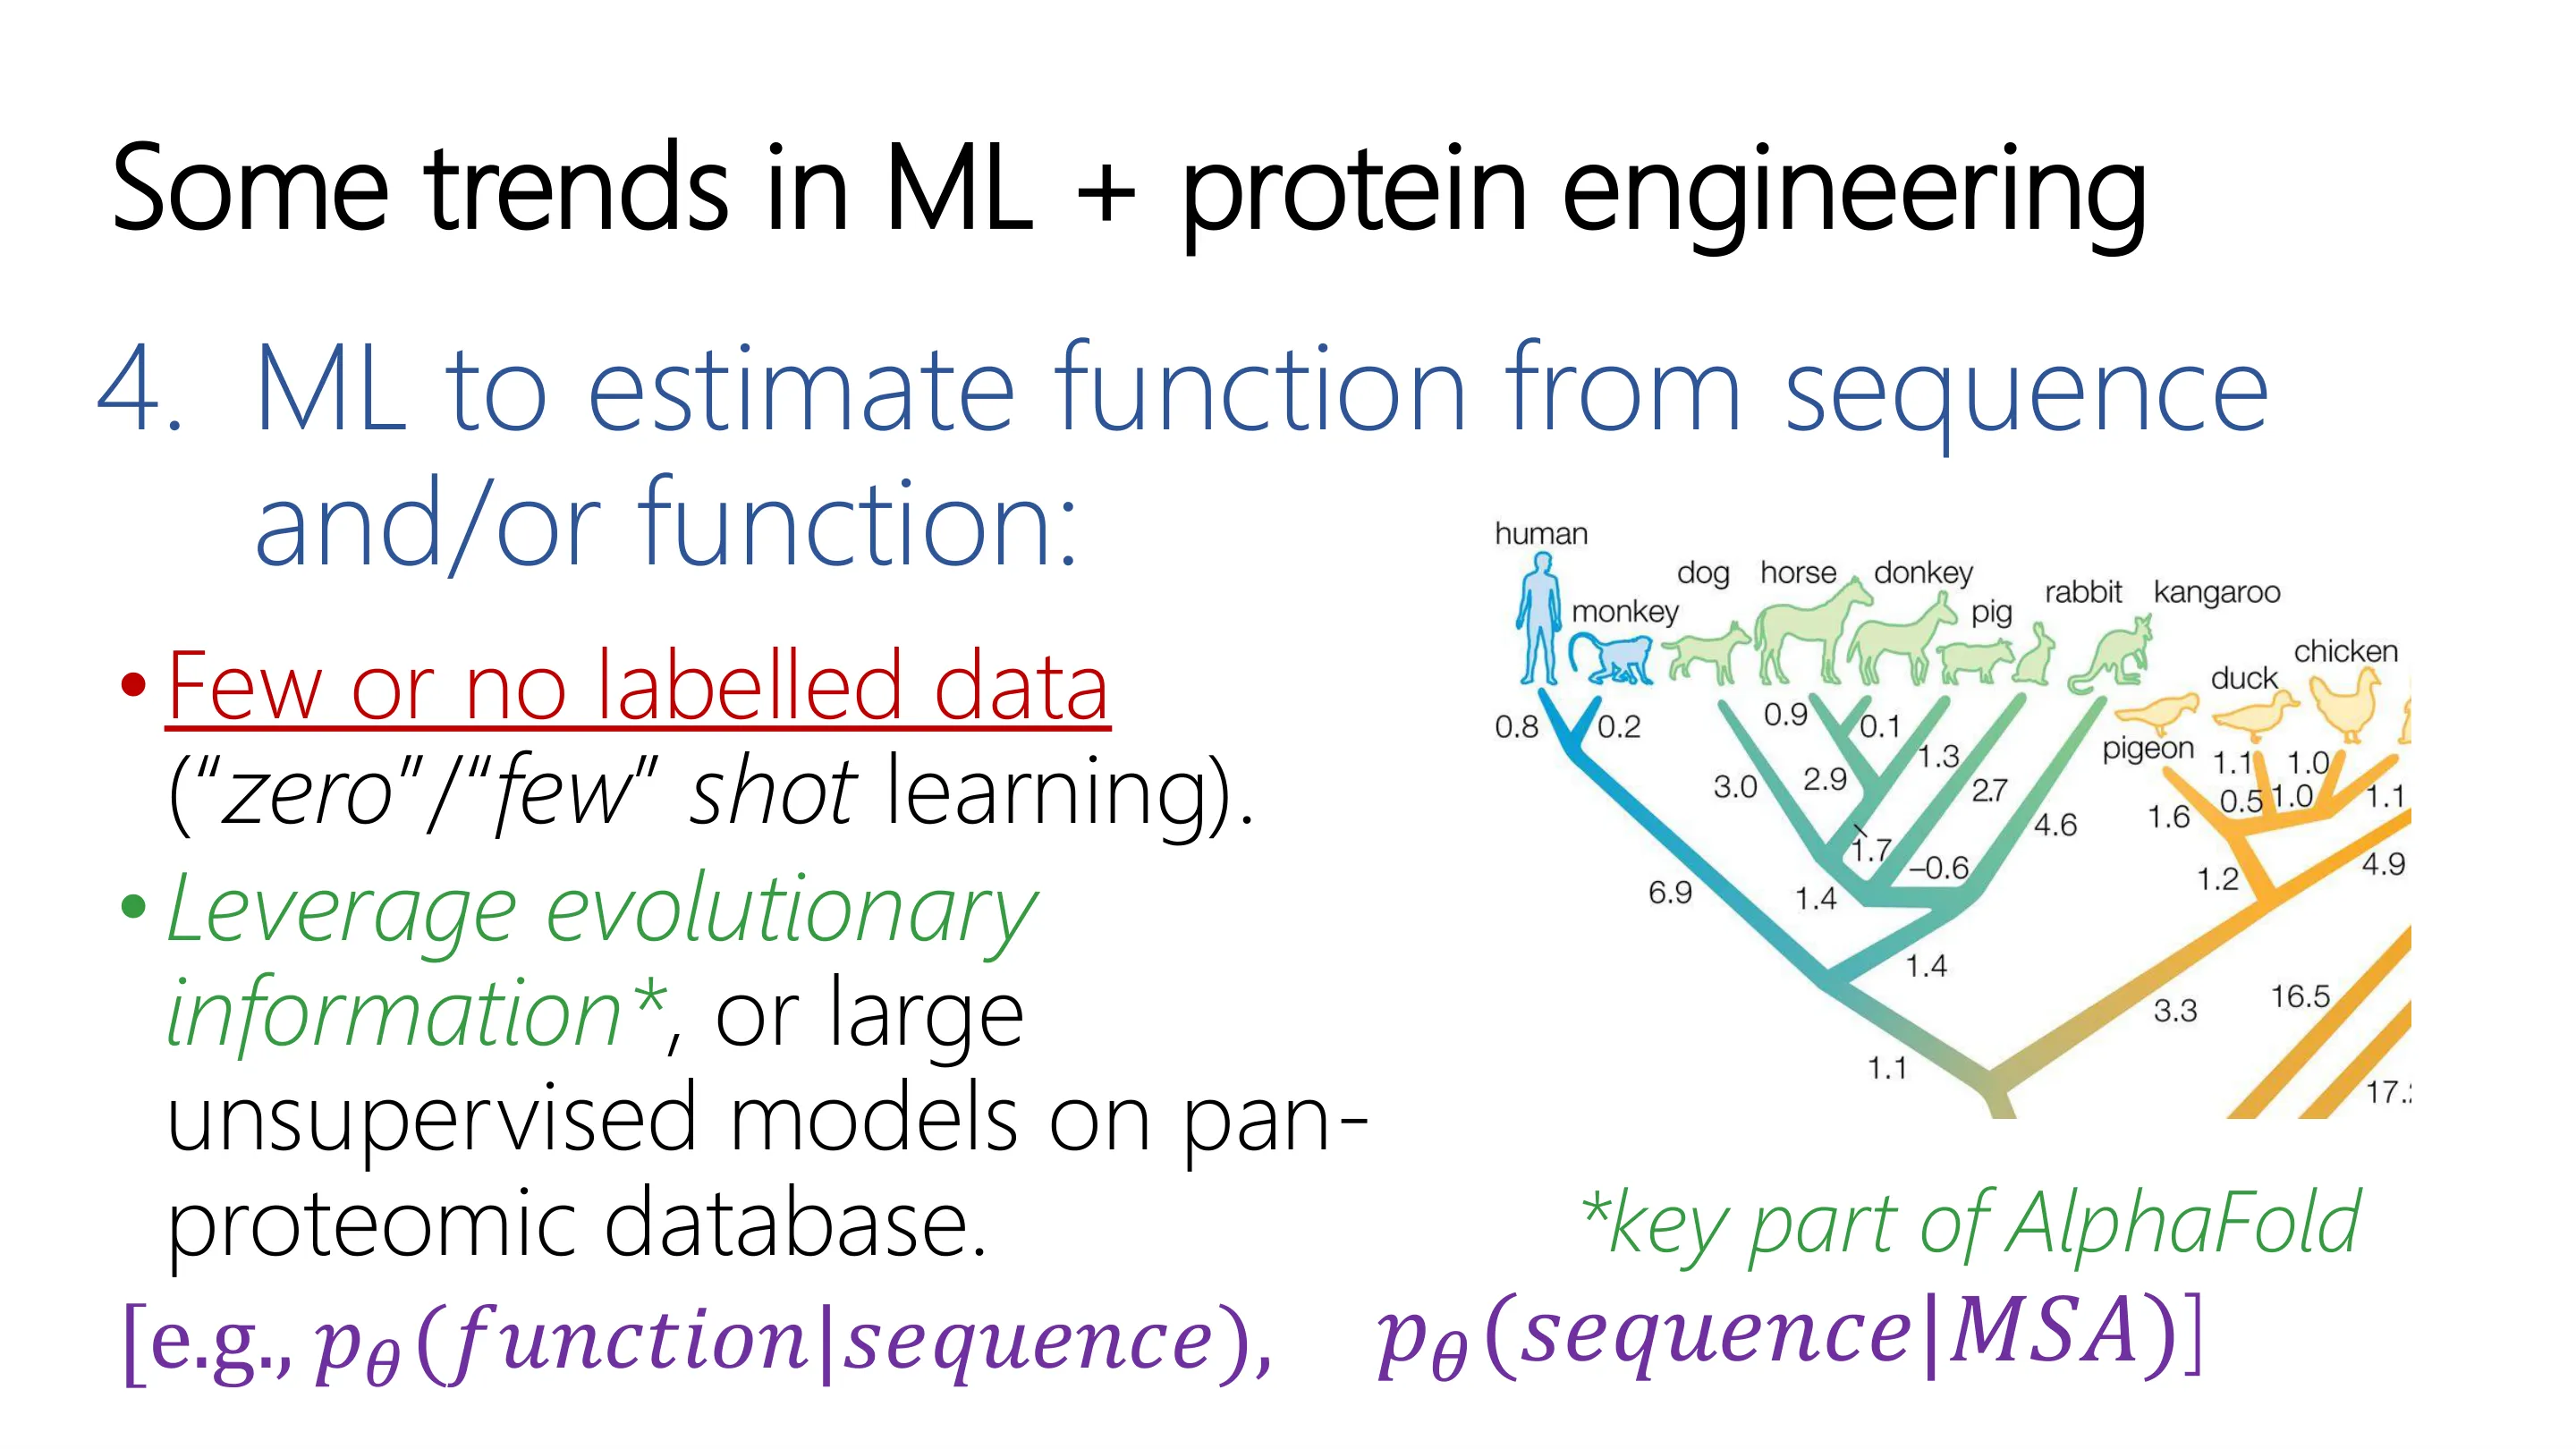
📷 ML + 蛋白质工程的一些趋势(四)
回到原视频 (00:28:19)
📷 ML + 蛋白质工程的一些趋势(五)
回到原视频 (00:29:32)
3.4 「香蕉」类比:设计中的对抗性
(参考时间: 00:58)
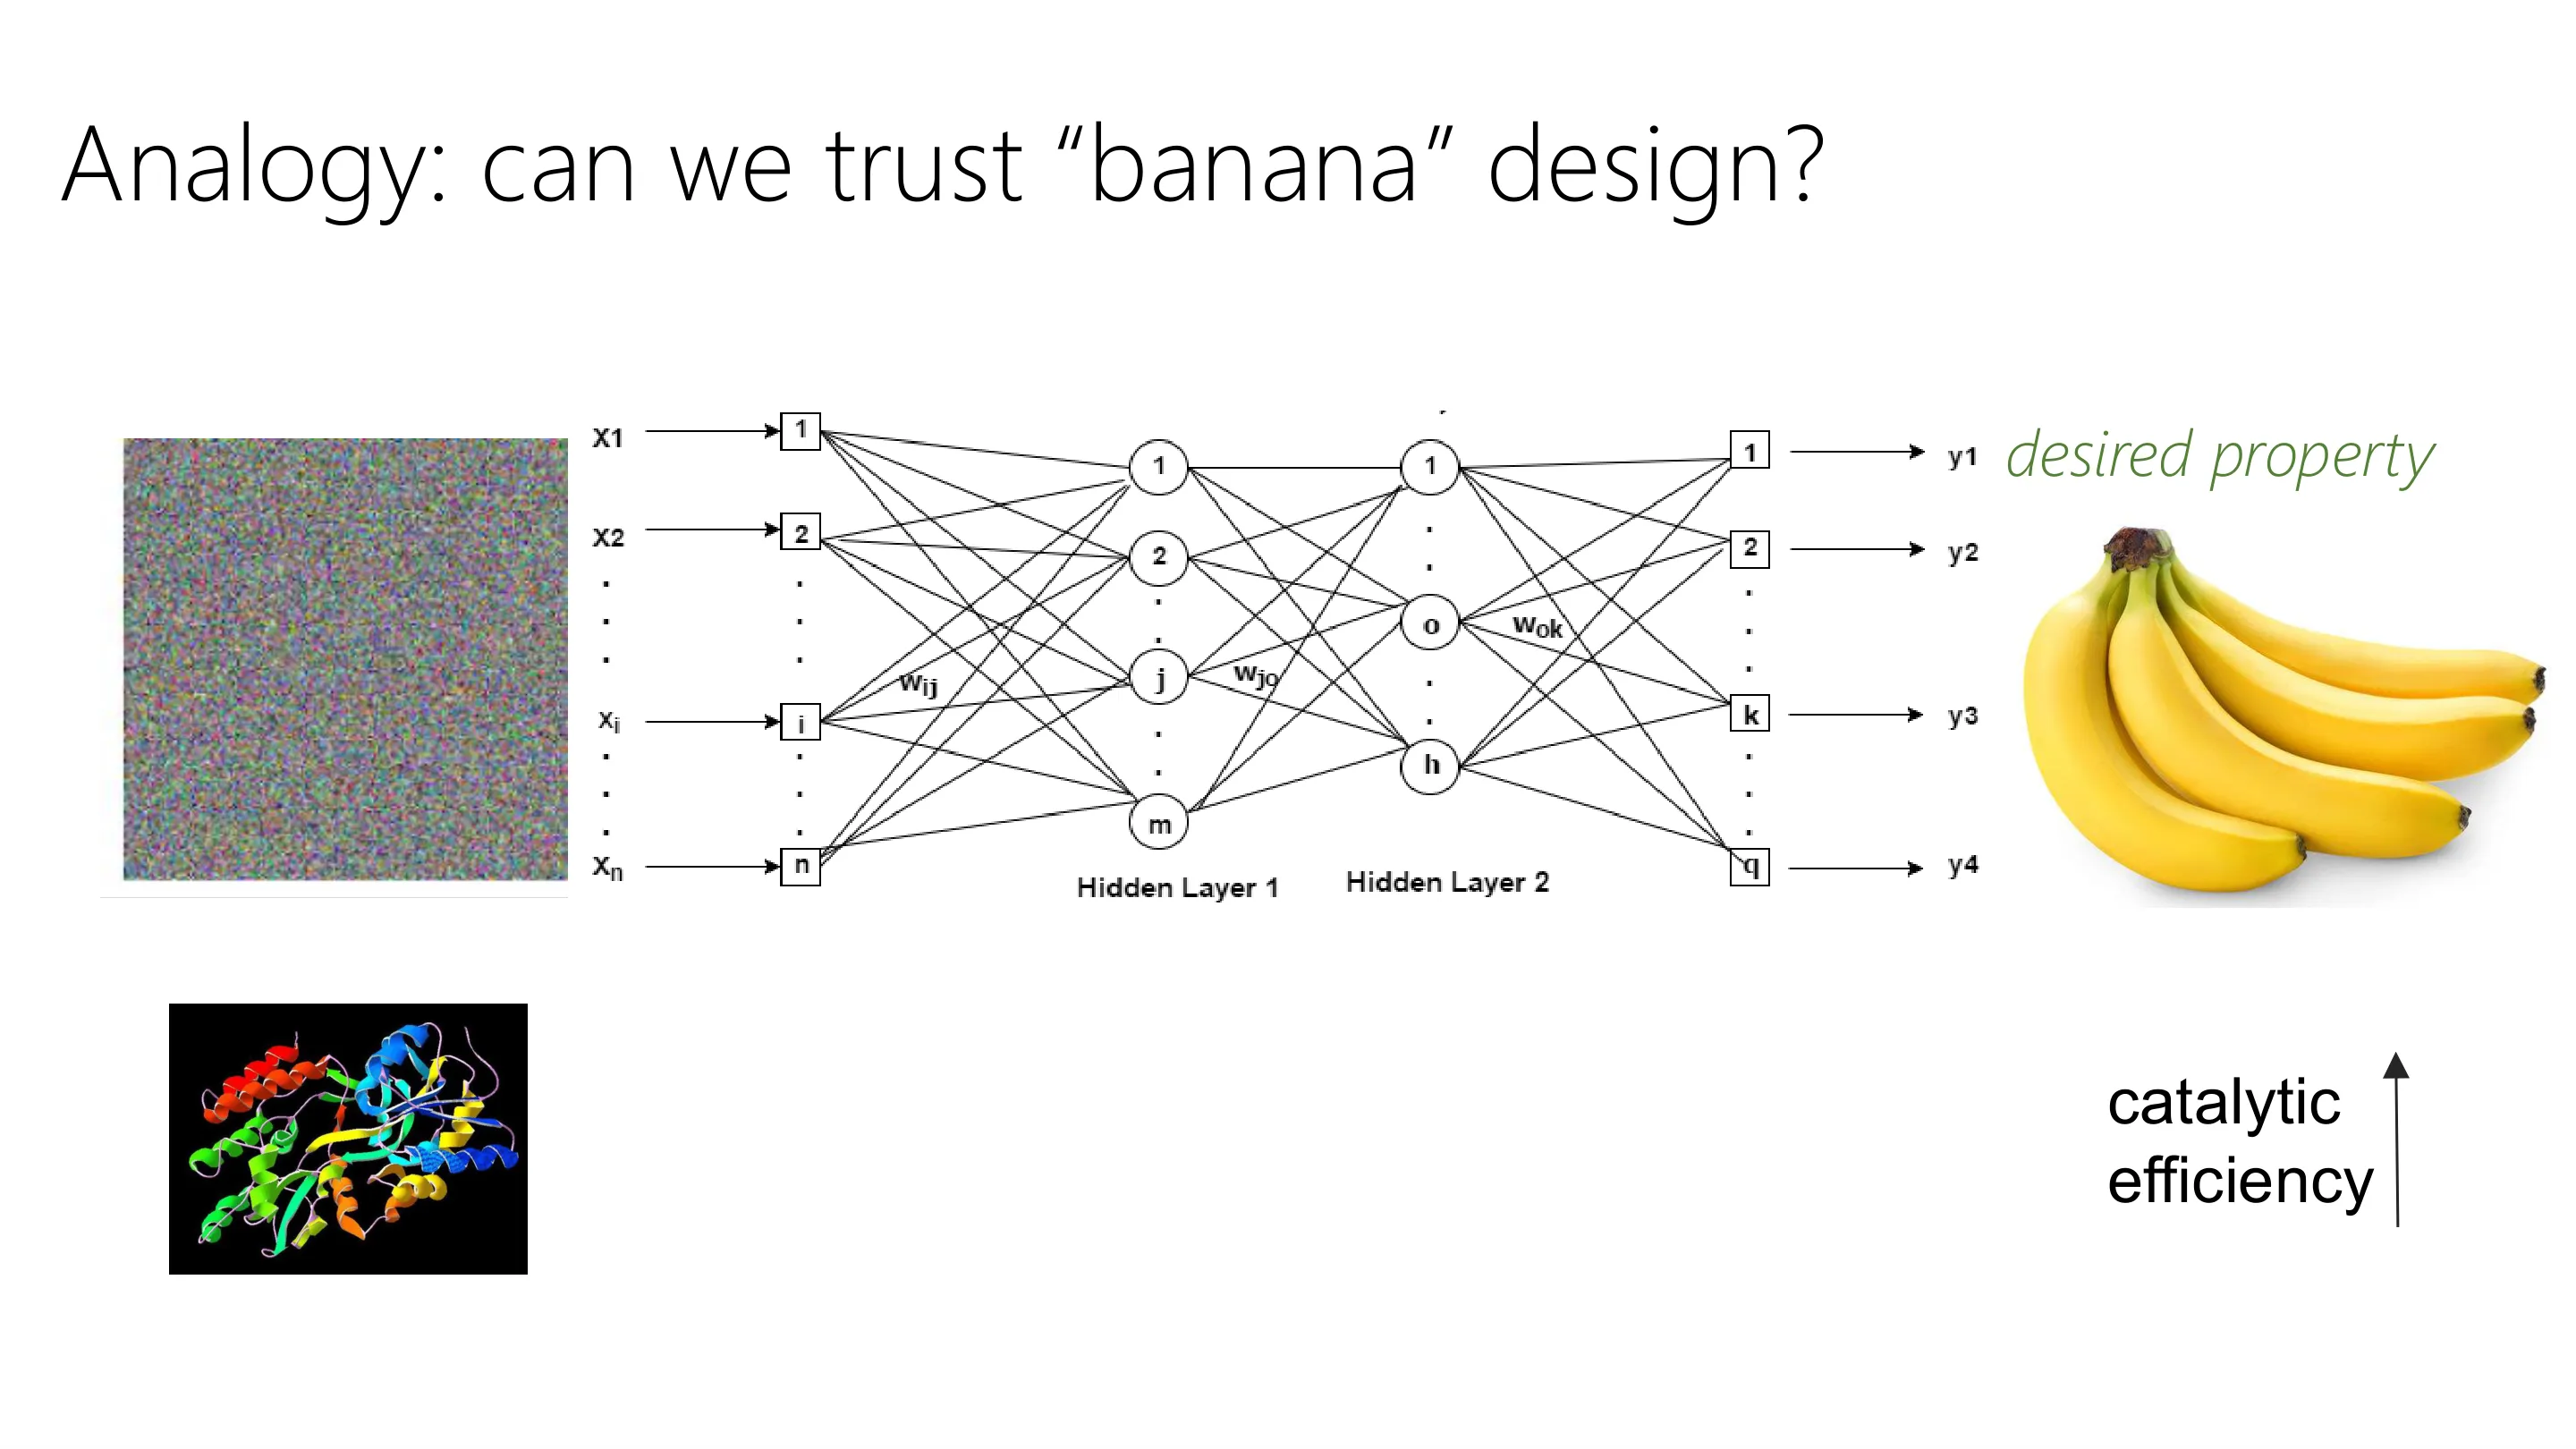
问题设定:假设有 10 万条序列及其催化效率标注,训练一个回归模型 $f$;然后不重训,而是反转它——固定参数,对输入做梯度下降,让输出(催化效率)尽可能高,得到一条序列。
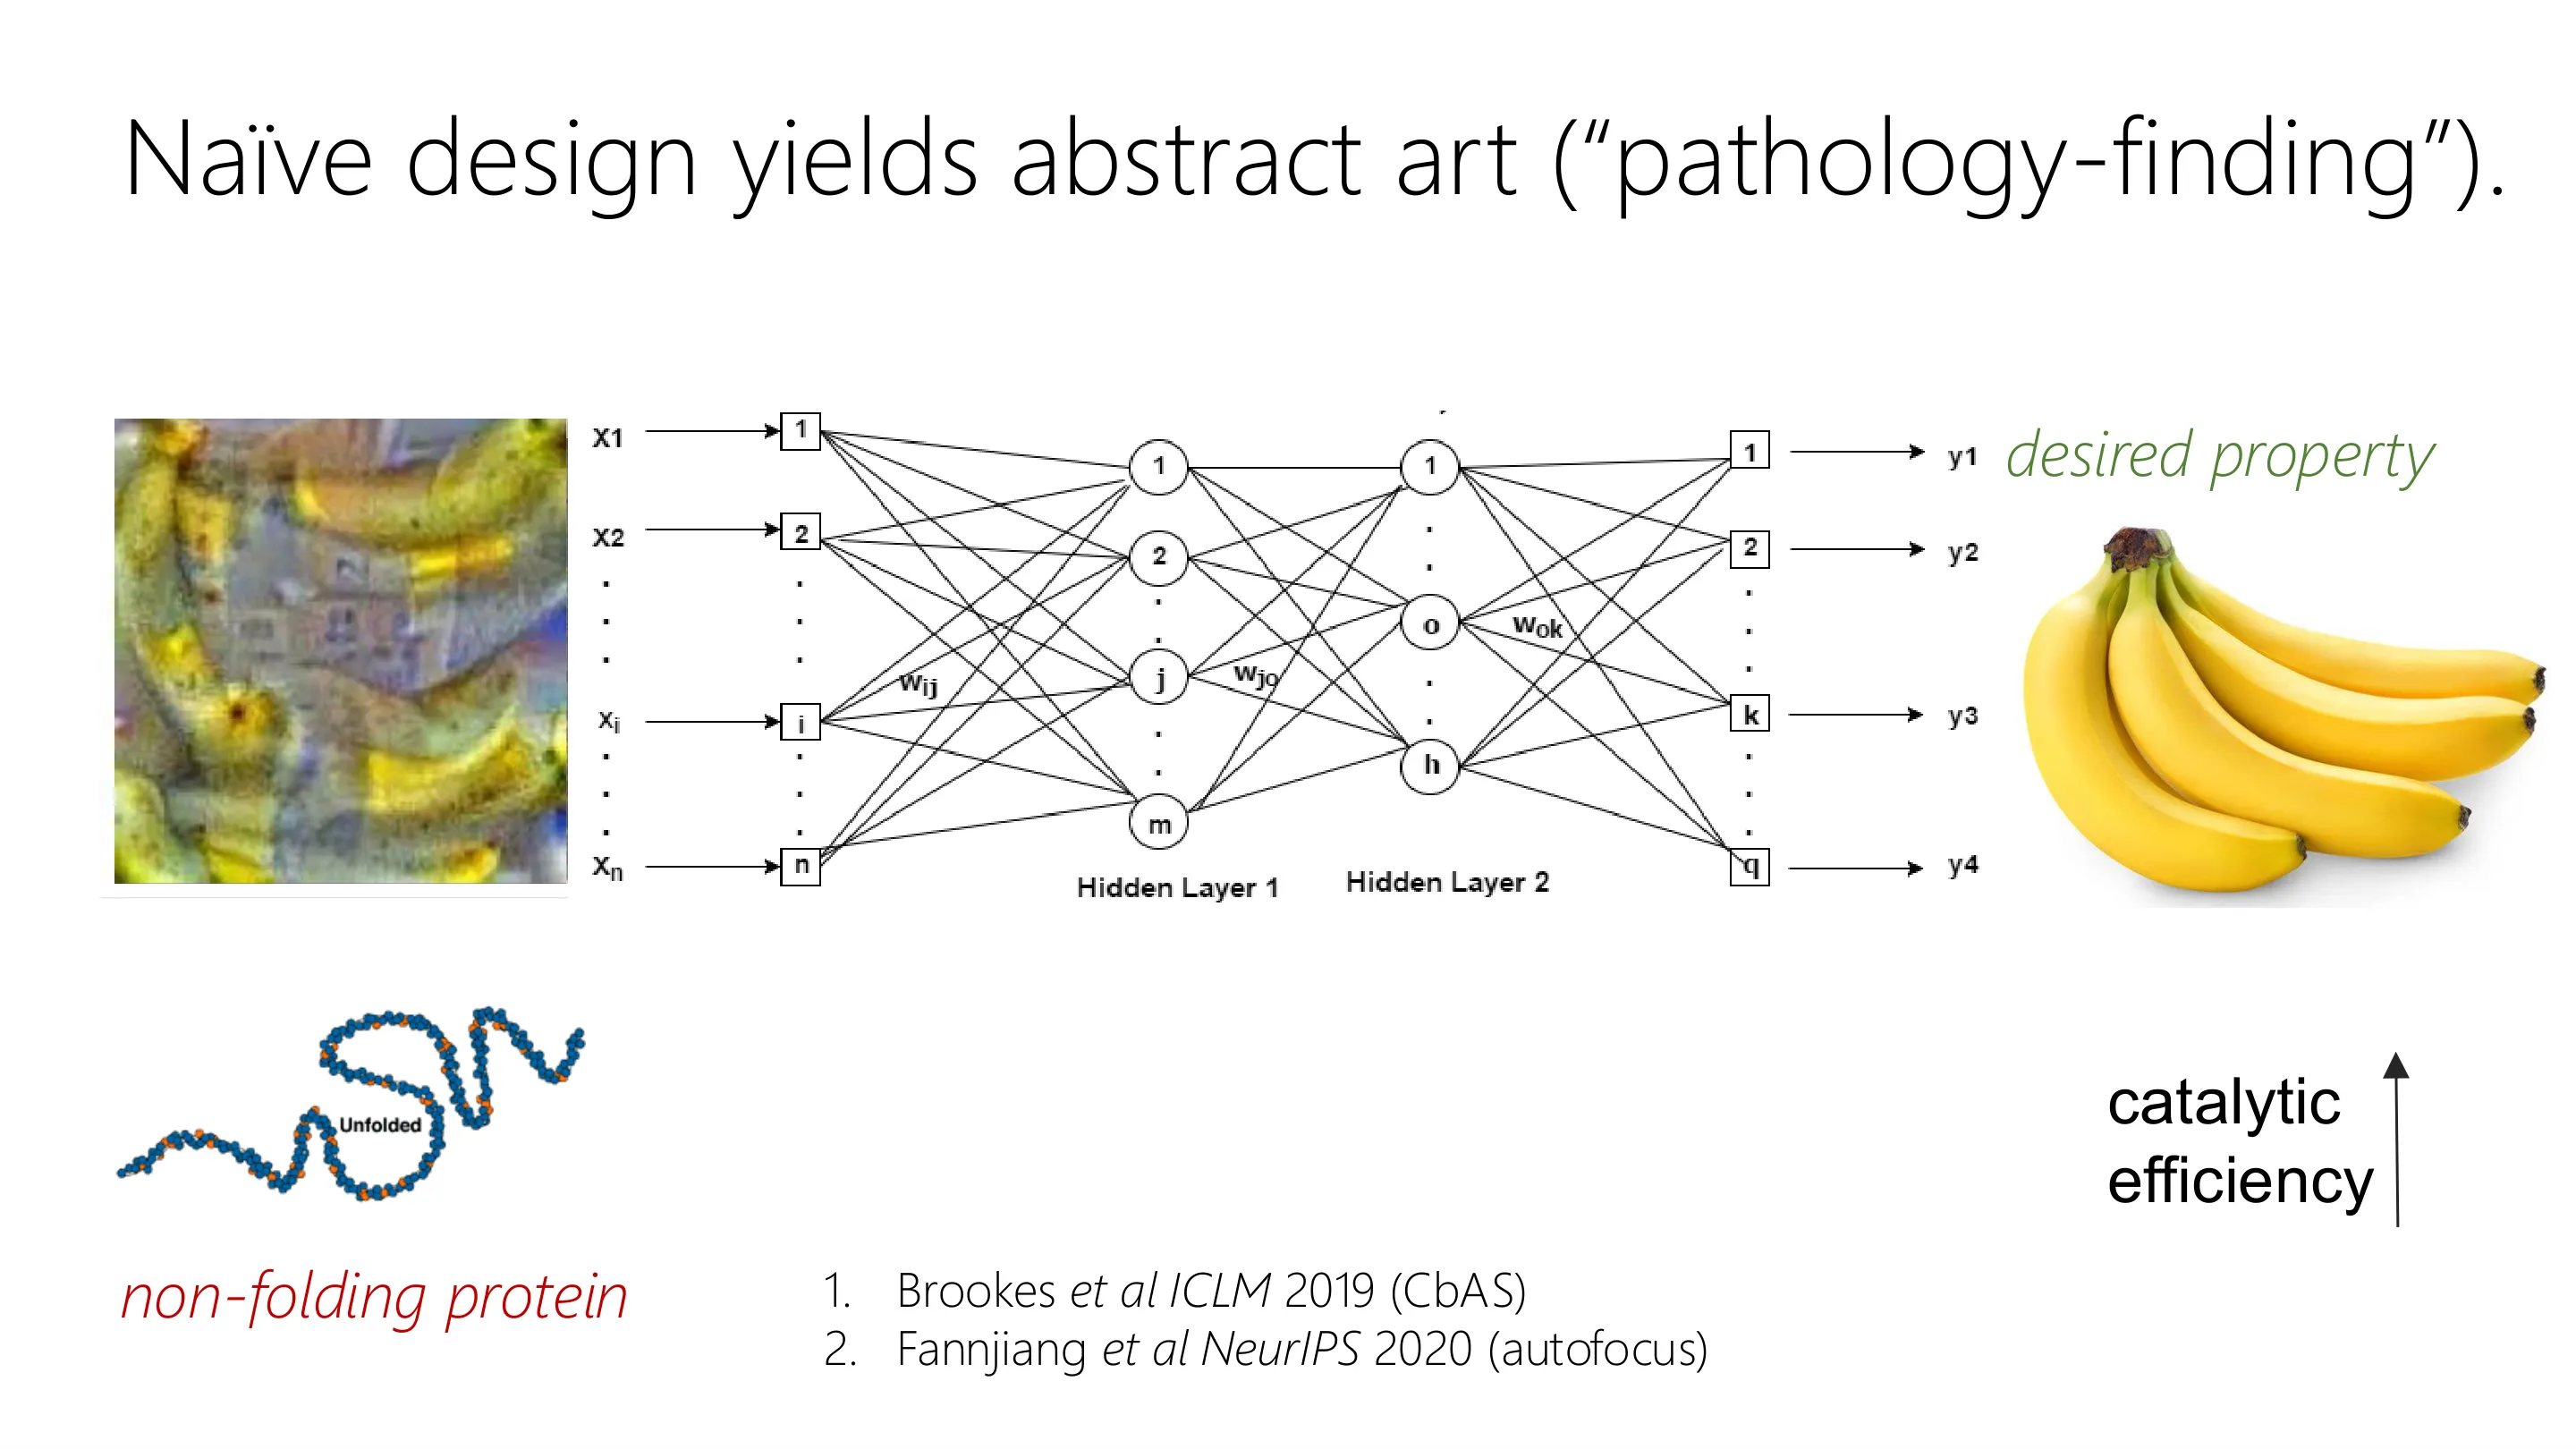
CV 类比:训练一个图像分类器,把「香蕉」节点设为 1,对其余设 0,对输入图像做梯度下降,问网络「心中的标准香蕉」是什么。结果得到的是抽象画——颜色和轮廓对,但完全不像真的香蕉。
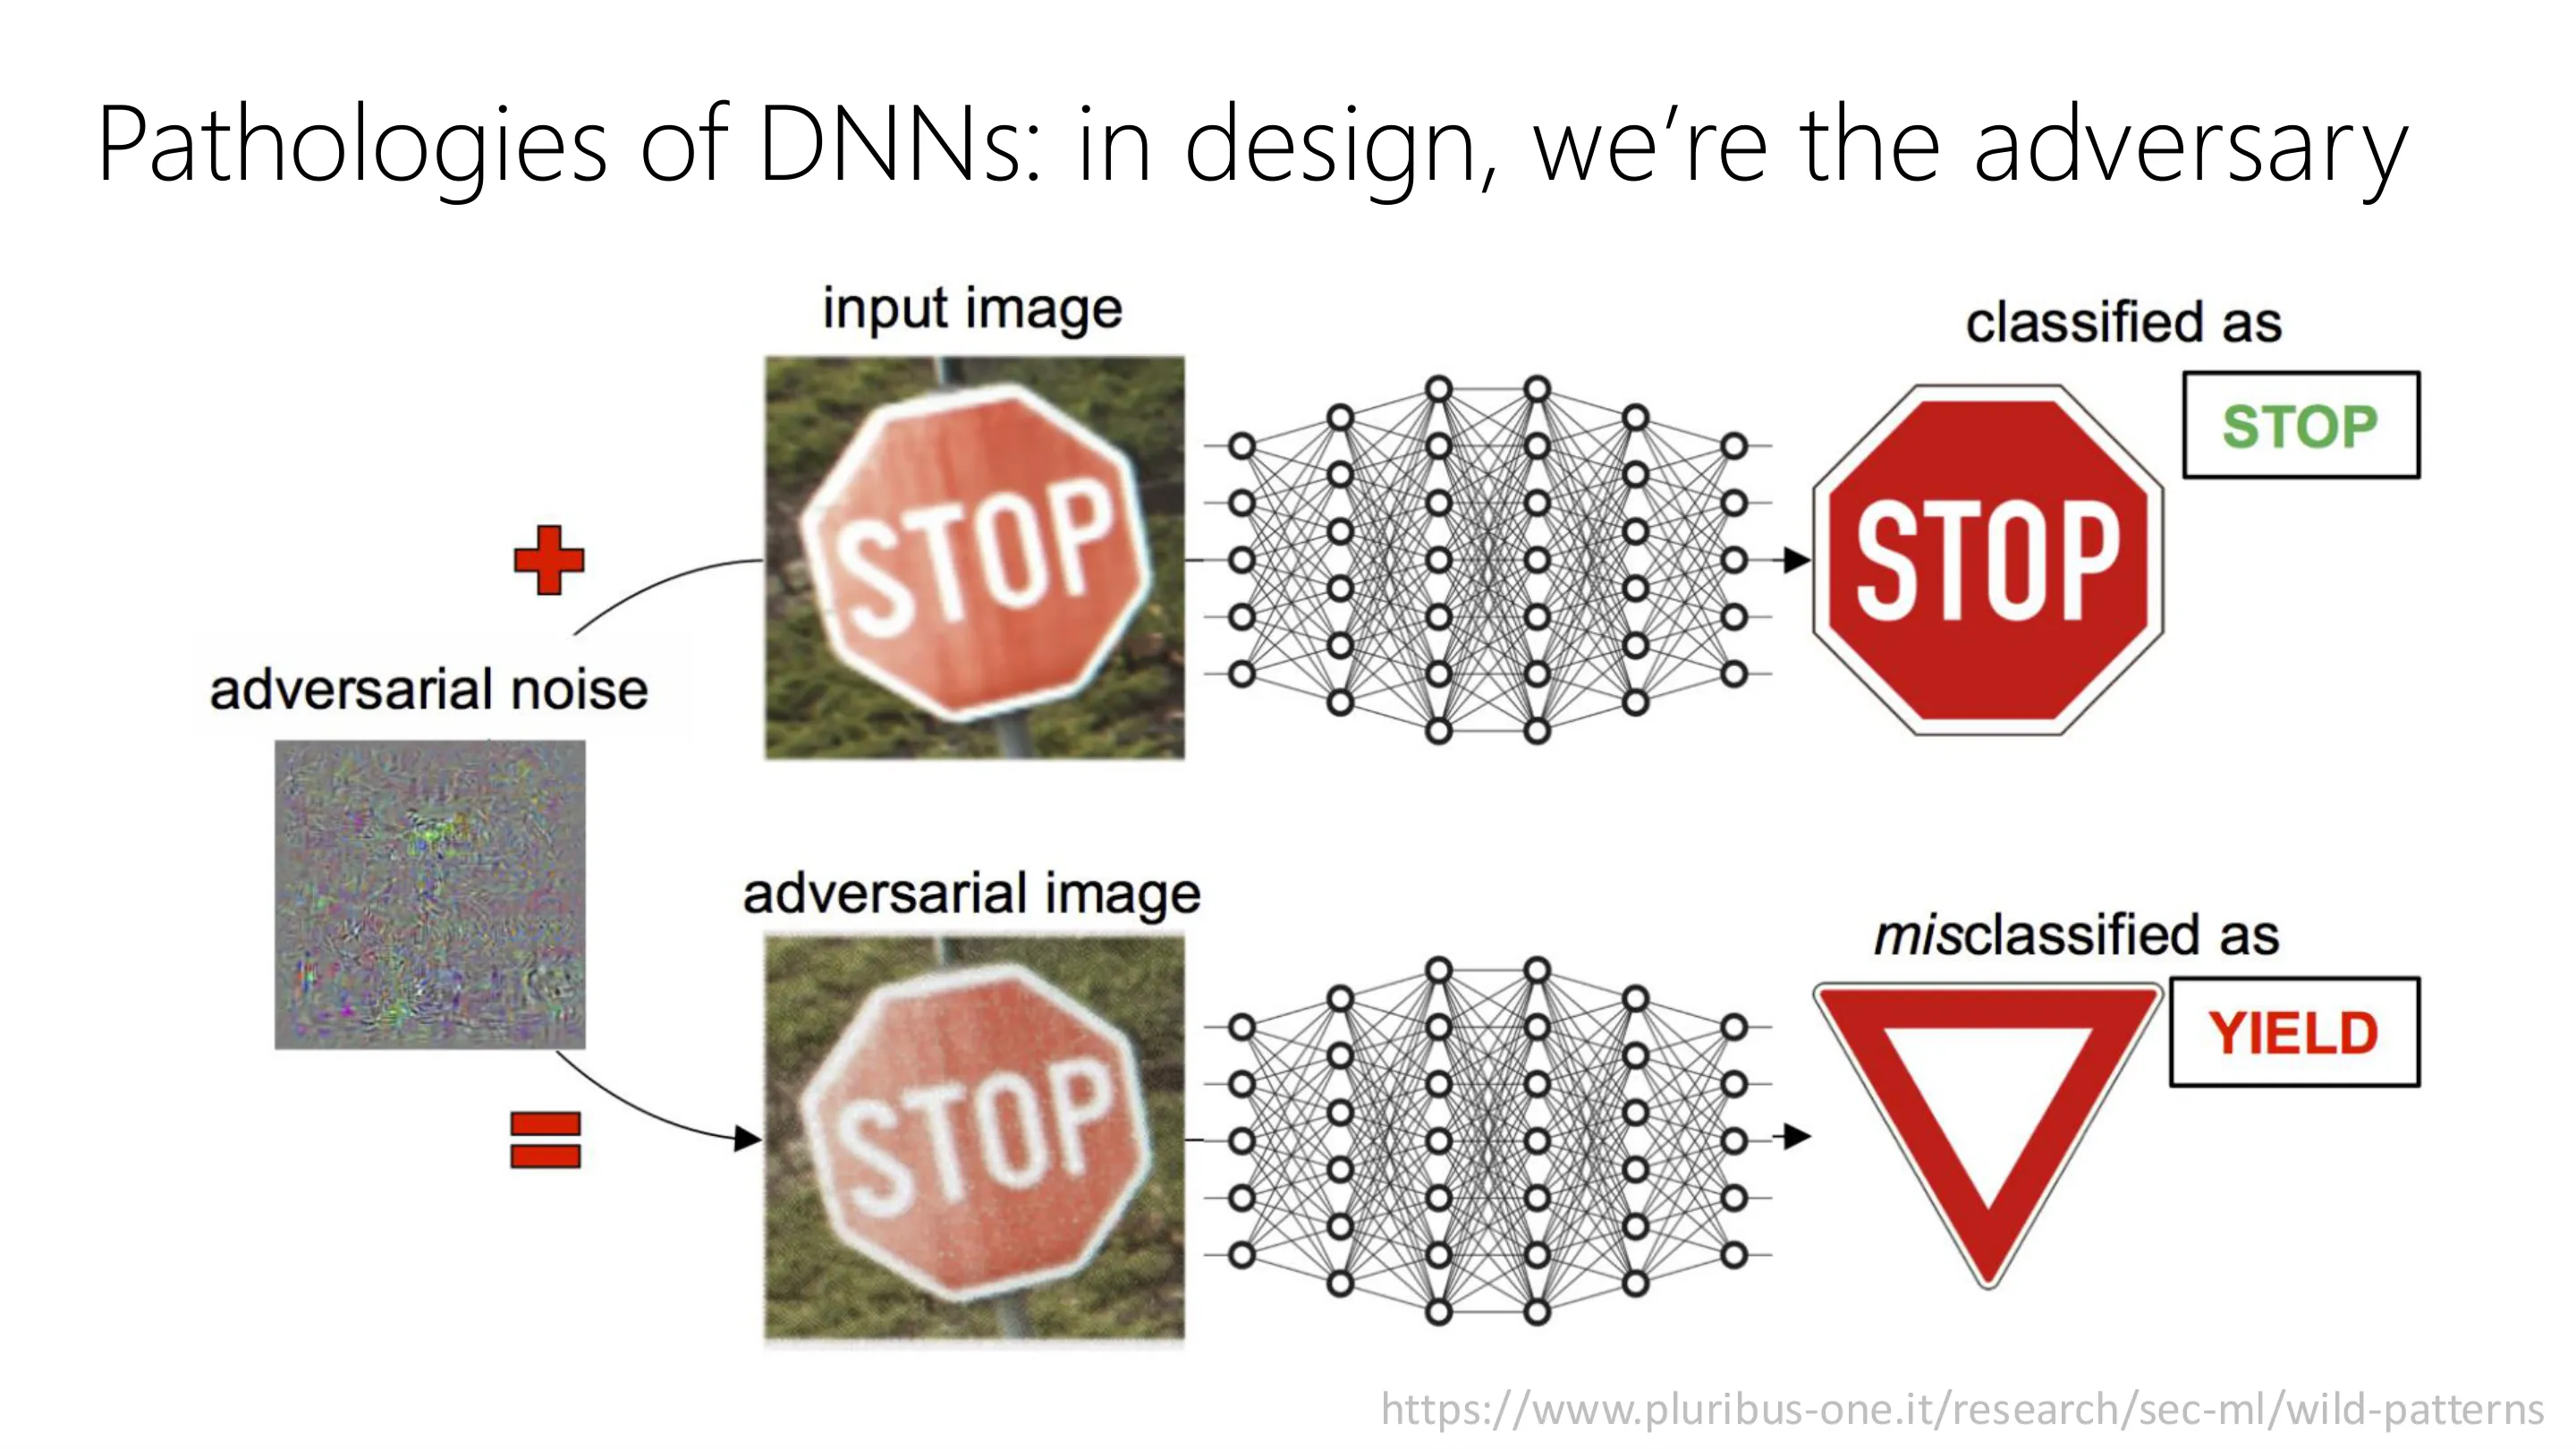
原因:设计时我们是模型的对手(adversary)——把模型压榨到极限,会把我们带到训练数据从未涉及的区域,只是空间的某个「怪癖」恰好让预测值高。对蛋白而言,很可能得到一条根本不折叠的死蛋白。这是神经网络「在训练流形之外,一切都没有保证」的一般现象,也是对抗样本(adversarial examples)(如对停车标志做难以察觉的扰动,却被预测为让行标志)的同一根源。
结论:直接反转 NN 做设计,很可能落入病态区域。
📷 类比:我们能信任「香蕉」设计吗?
回到原视频 (00:30:45)
📷 目标性质
回到原视频 (00:31:58)
📷 DNN 的病态:设计中我们是对手
回到原视频 (00:33:11)
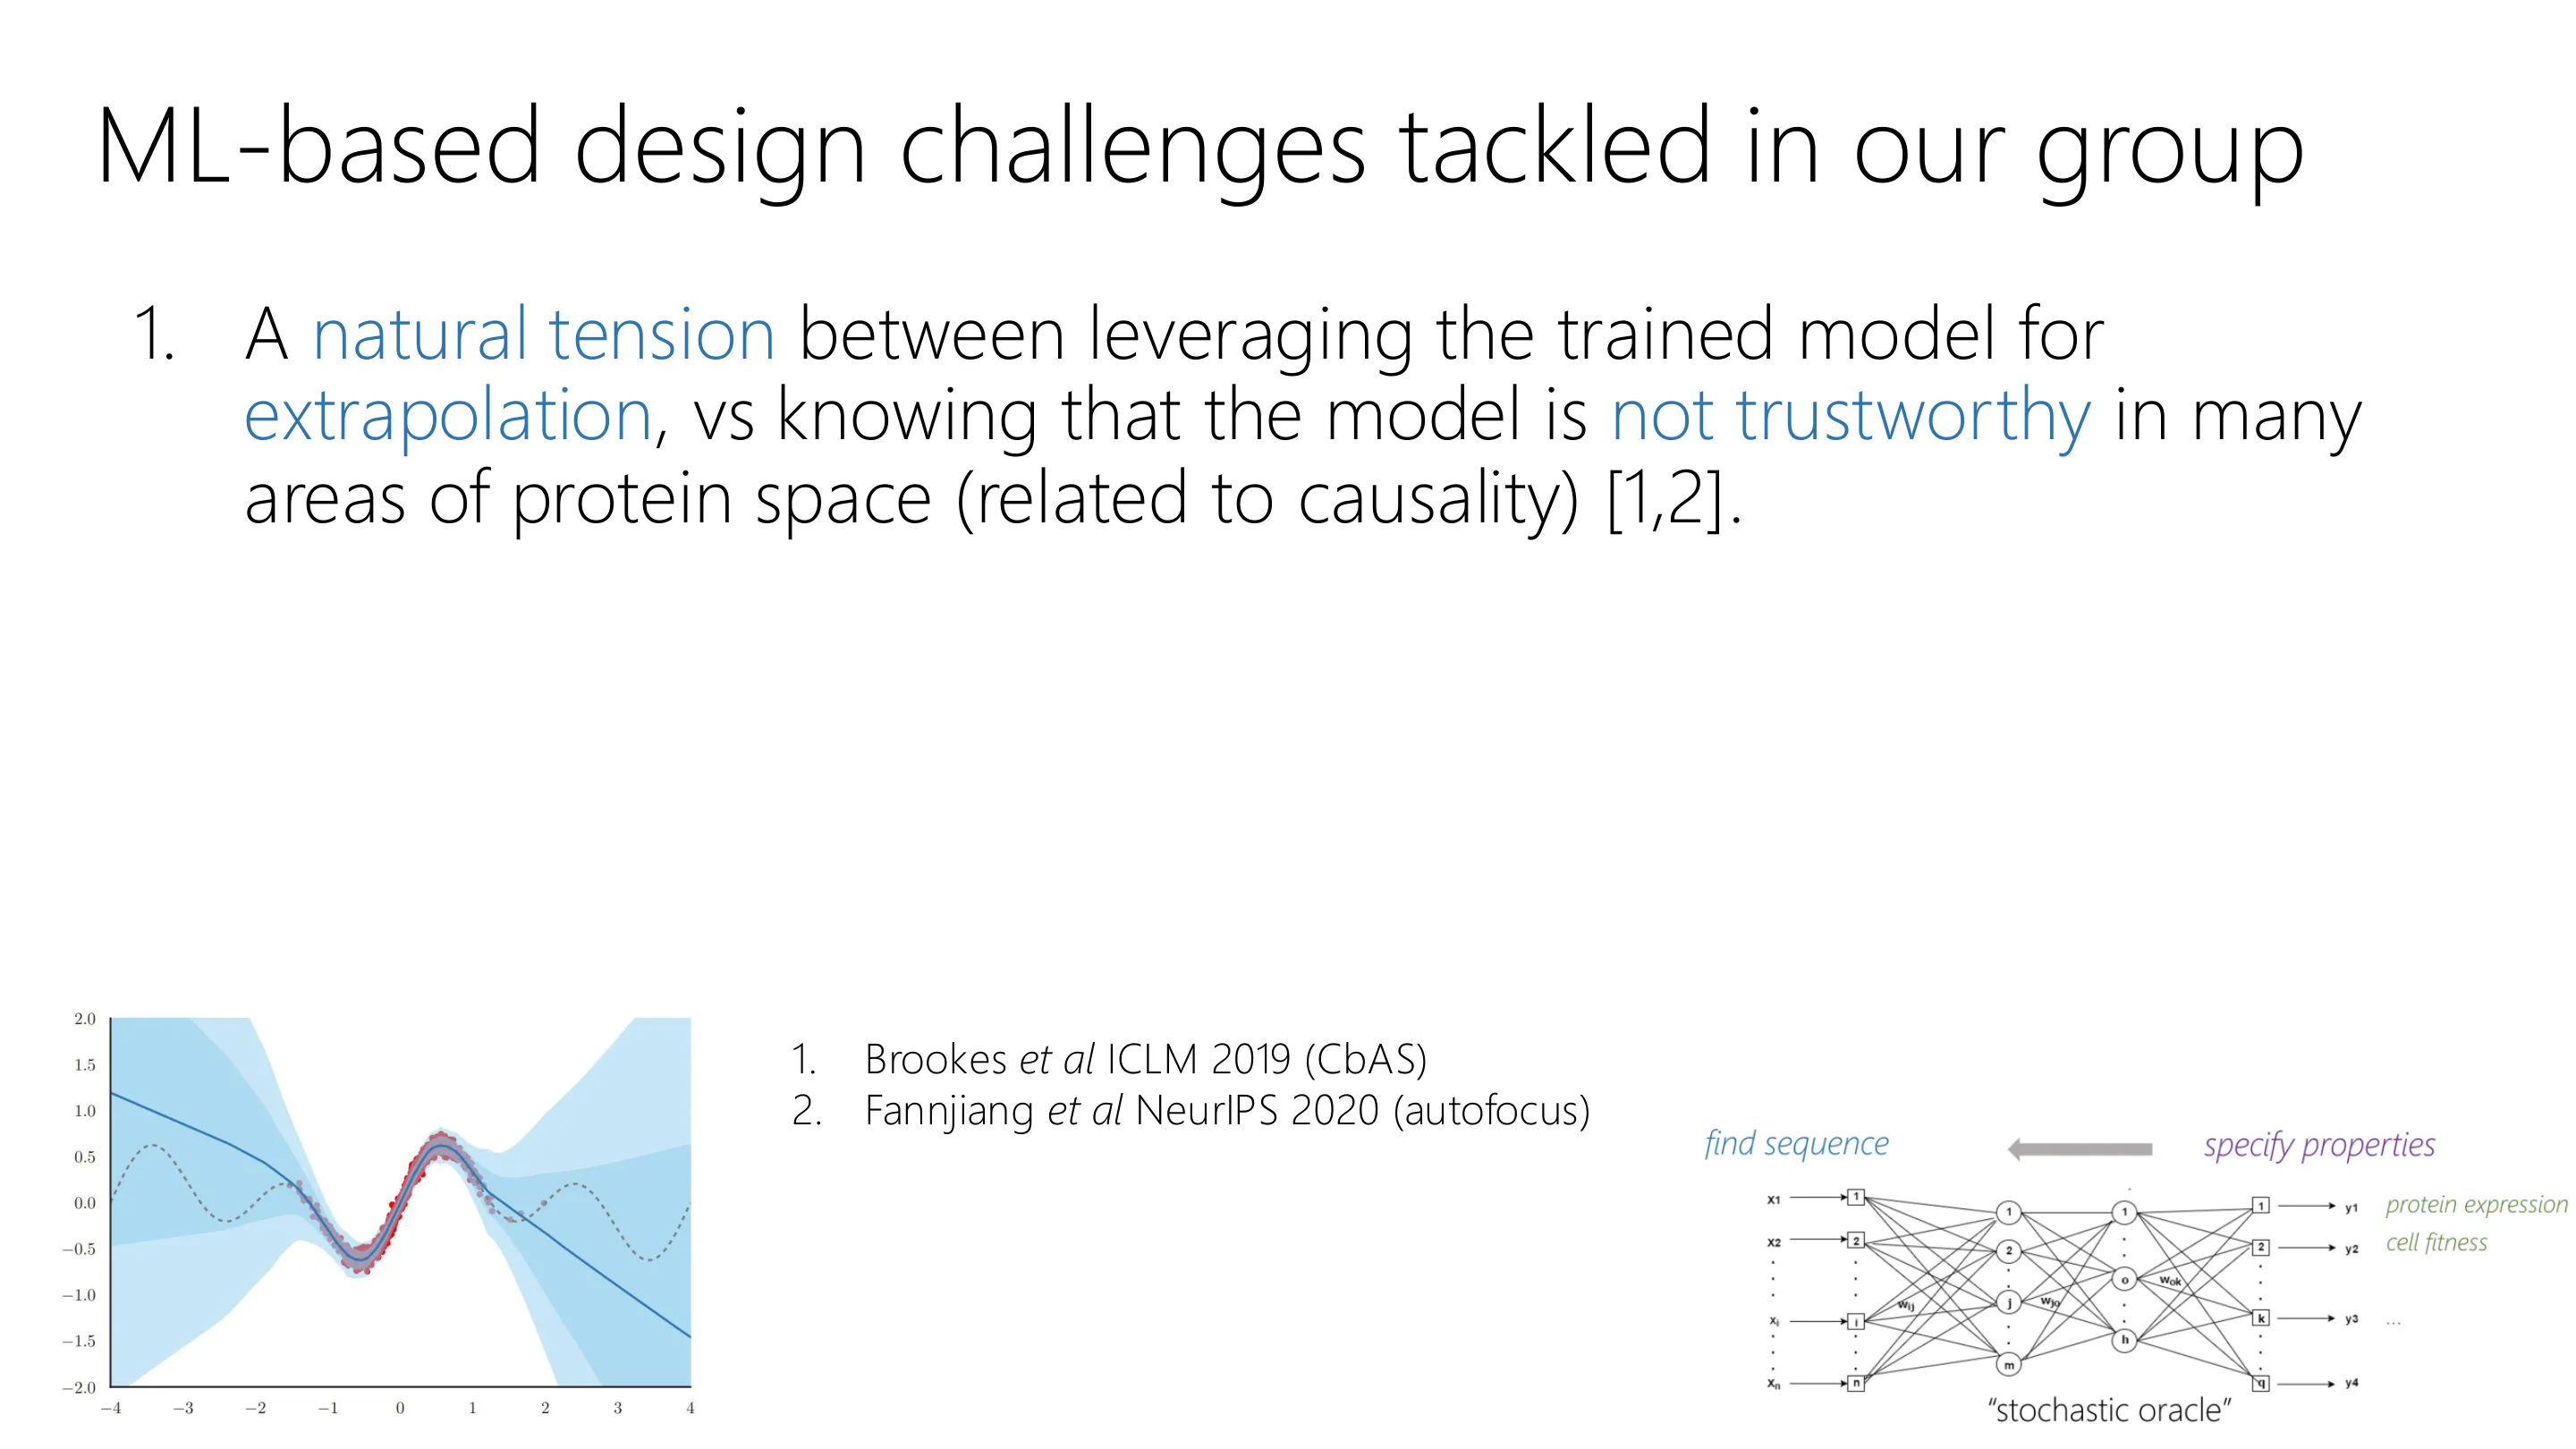
📷 我们组攻克的基于 ML 的设计挑战(一)
回到原视频 (00:34:24)
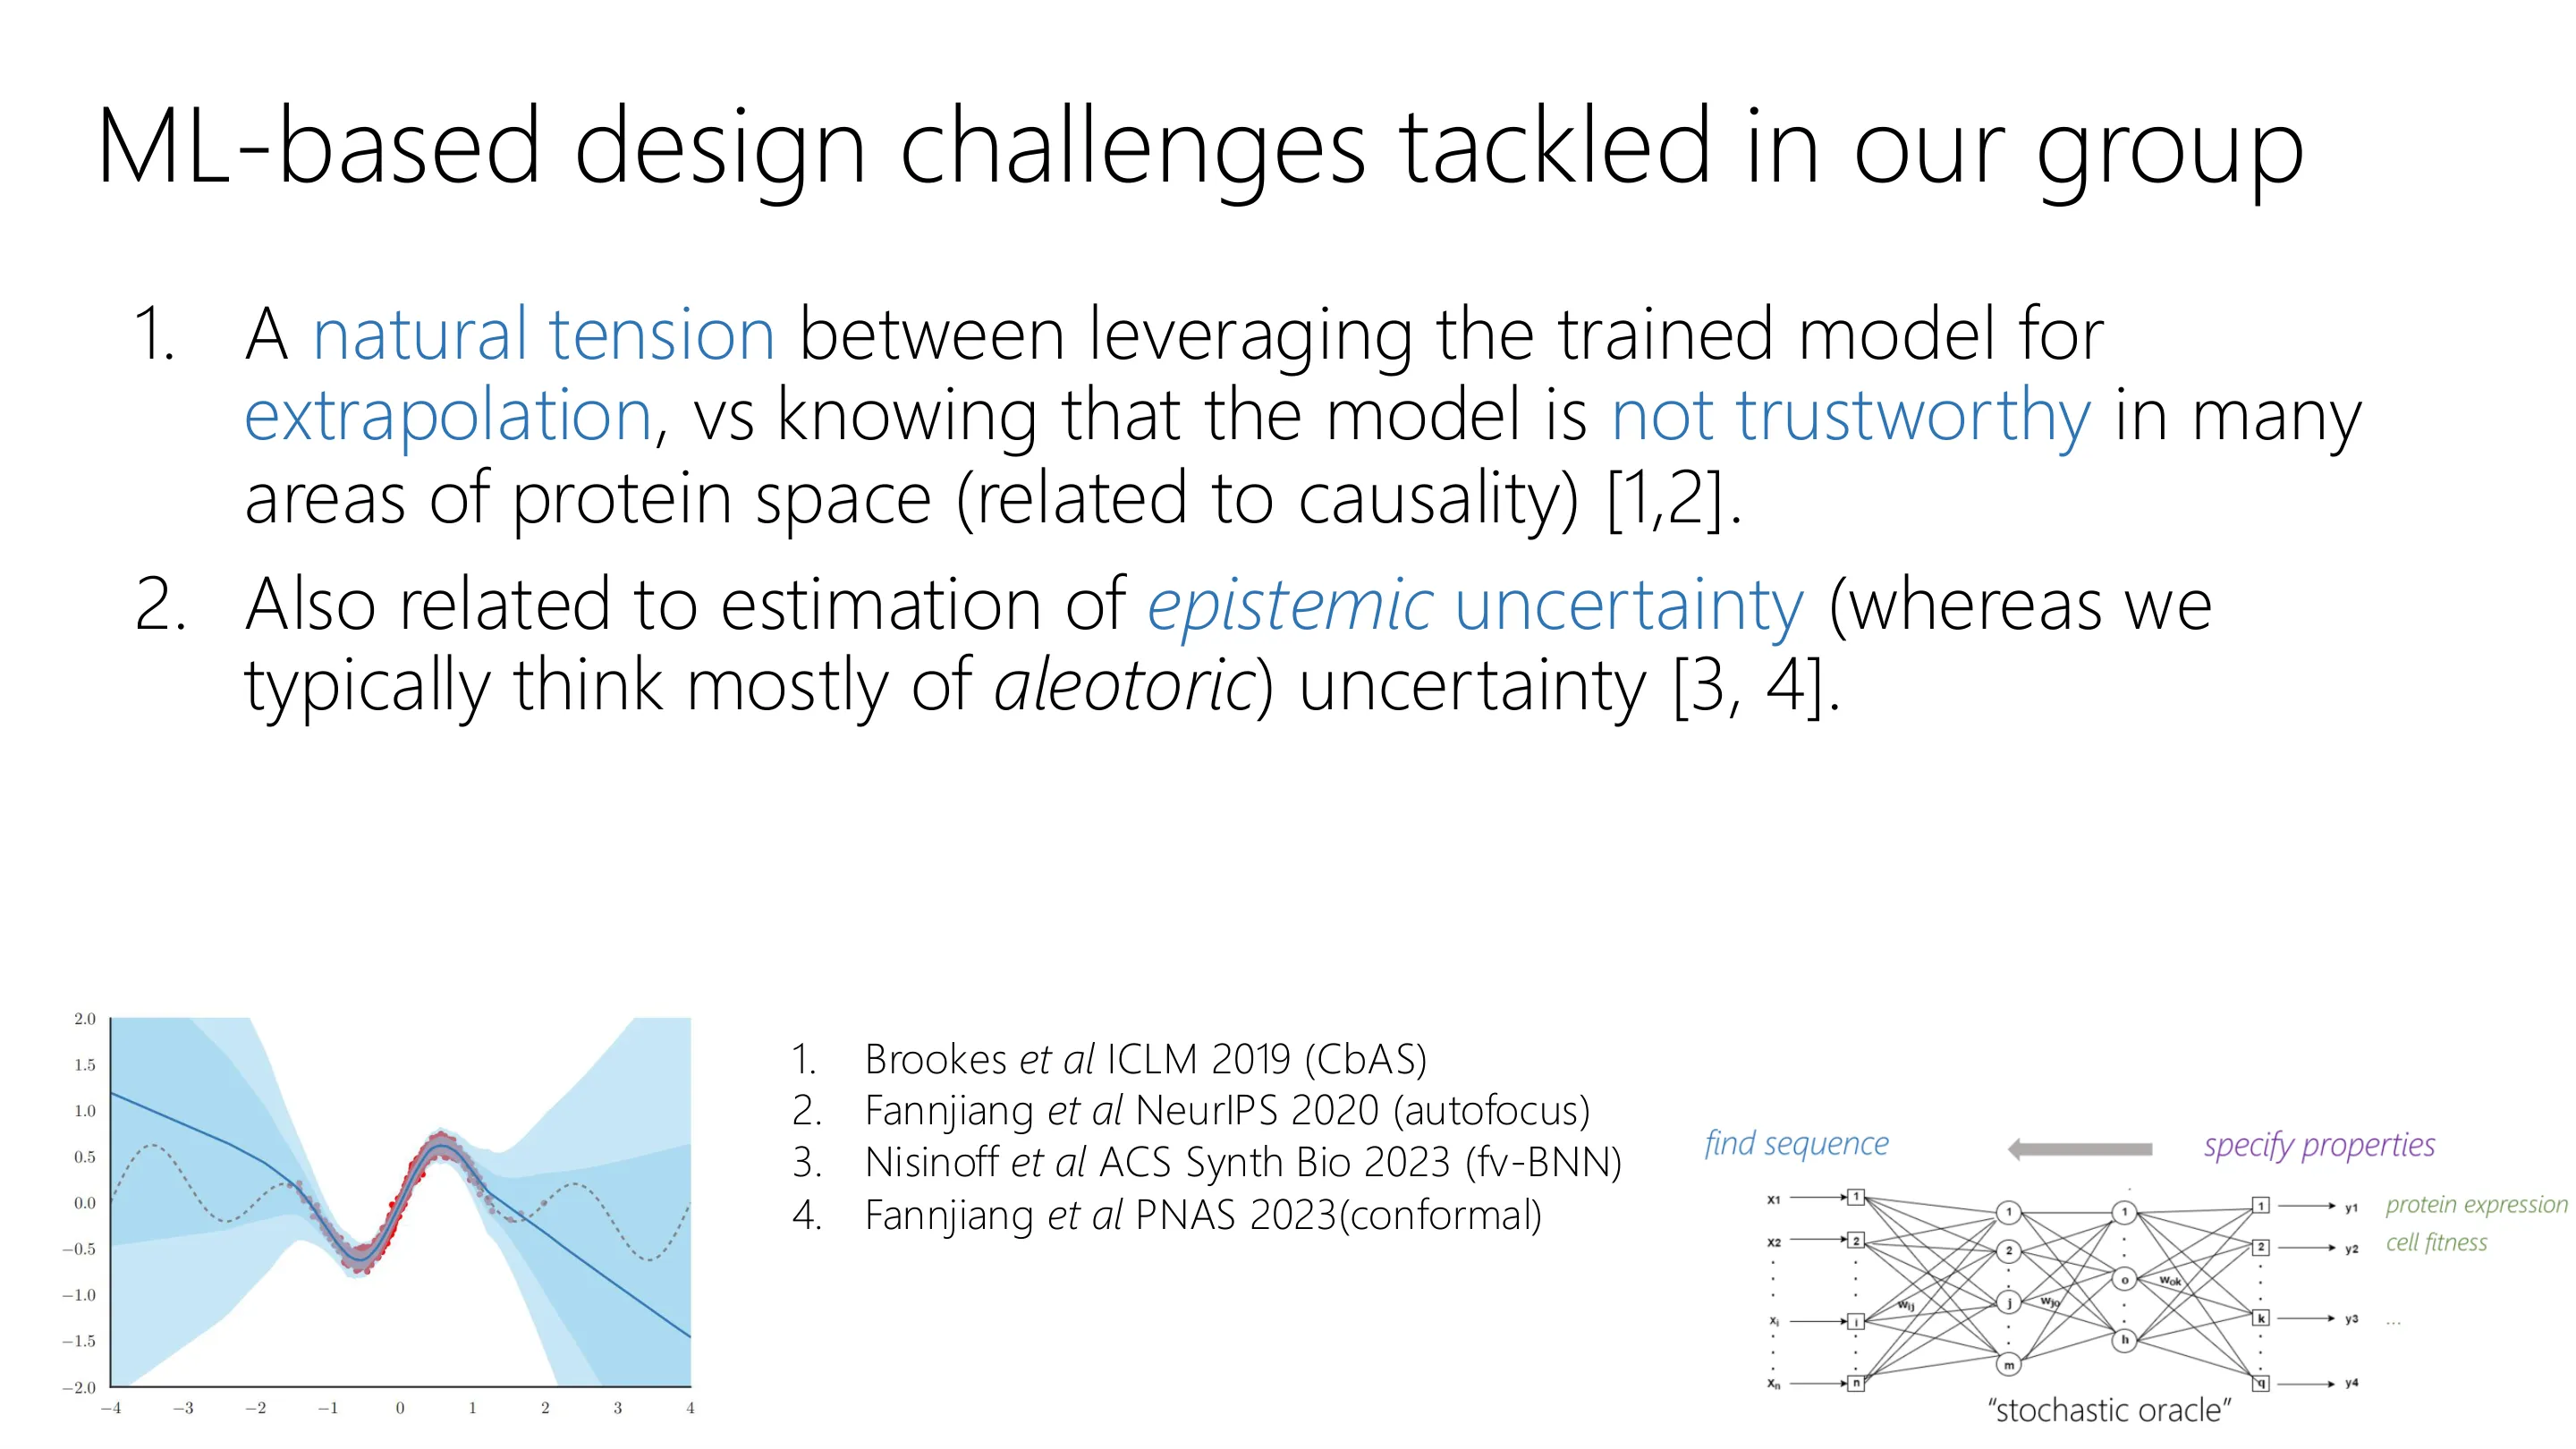
📷 基于 ML 的设计挑战(二)
回到原视频 (00:35:37)
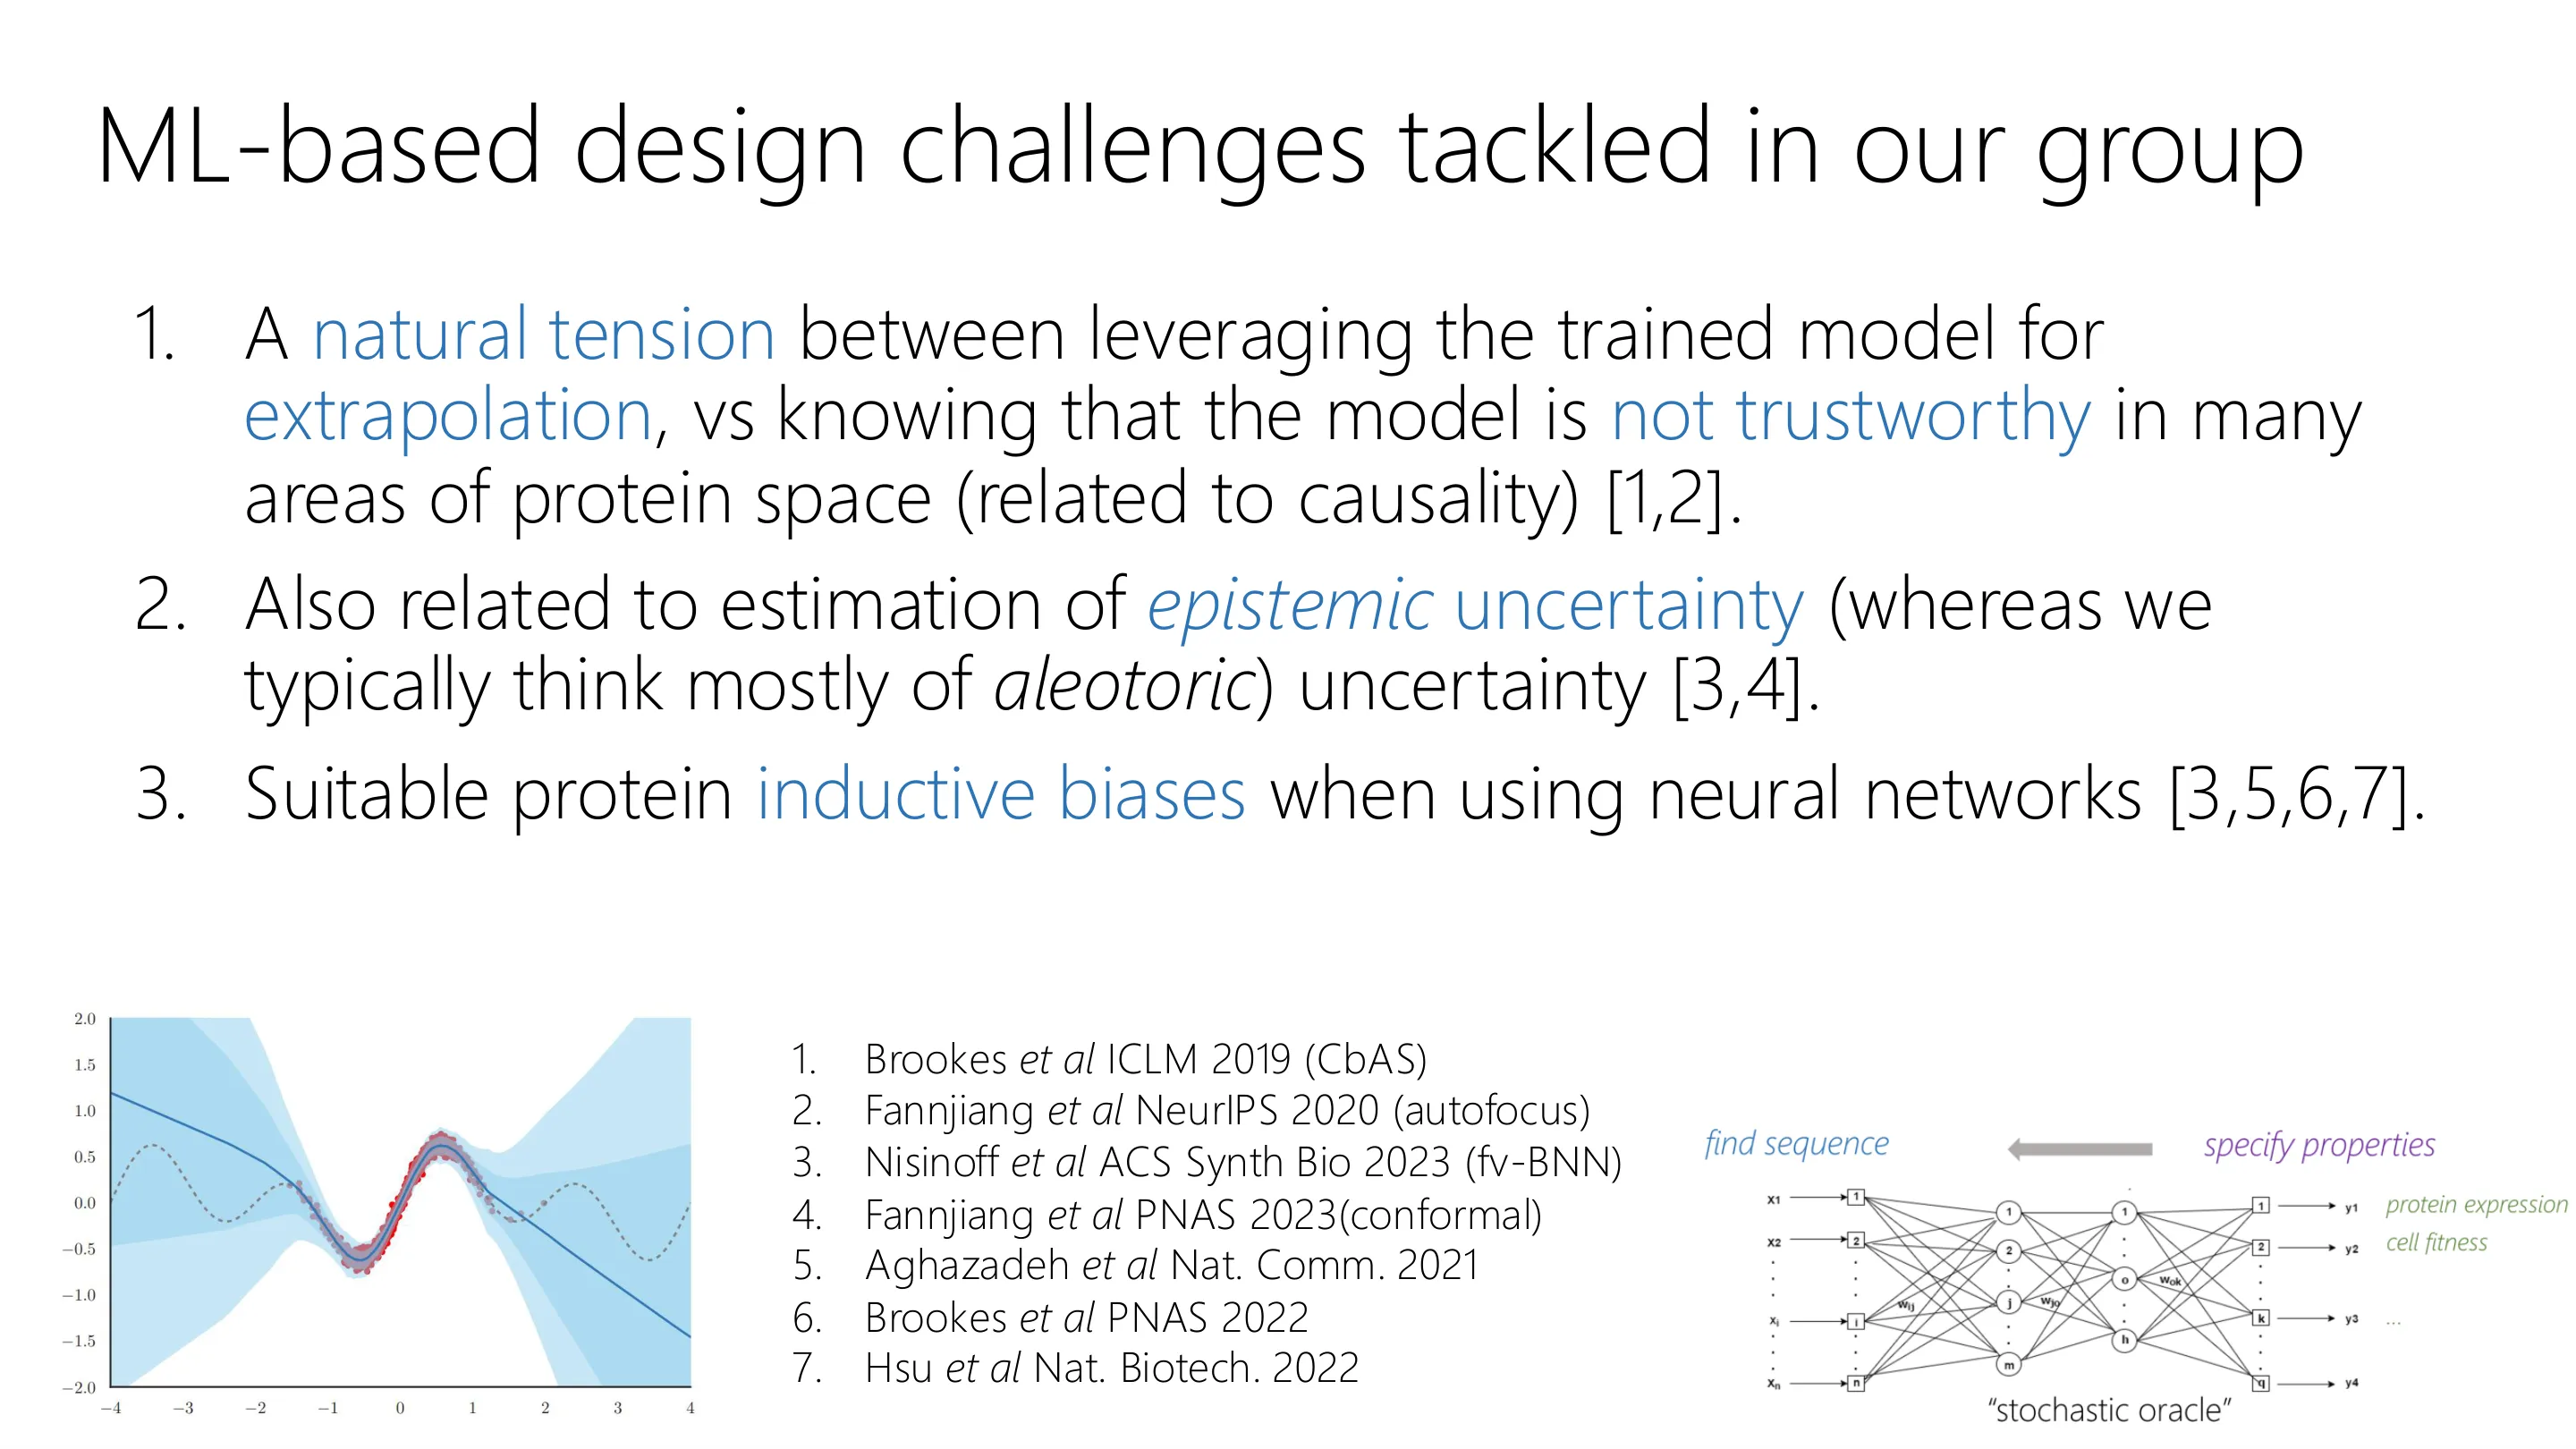
📷 基于 ML 的设计挑战(三)
回到原视频 (00:36:50)
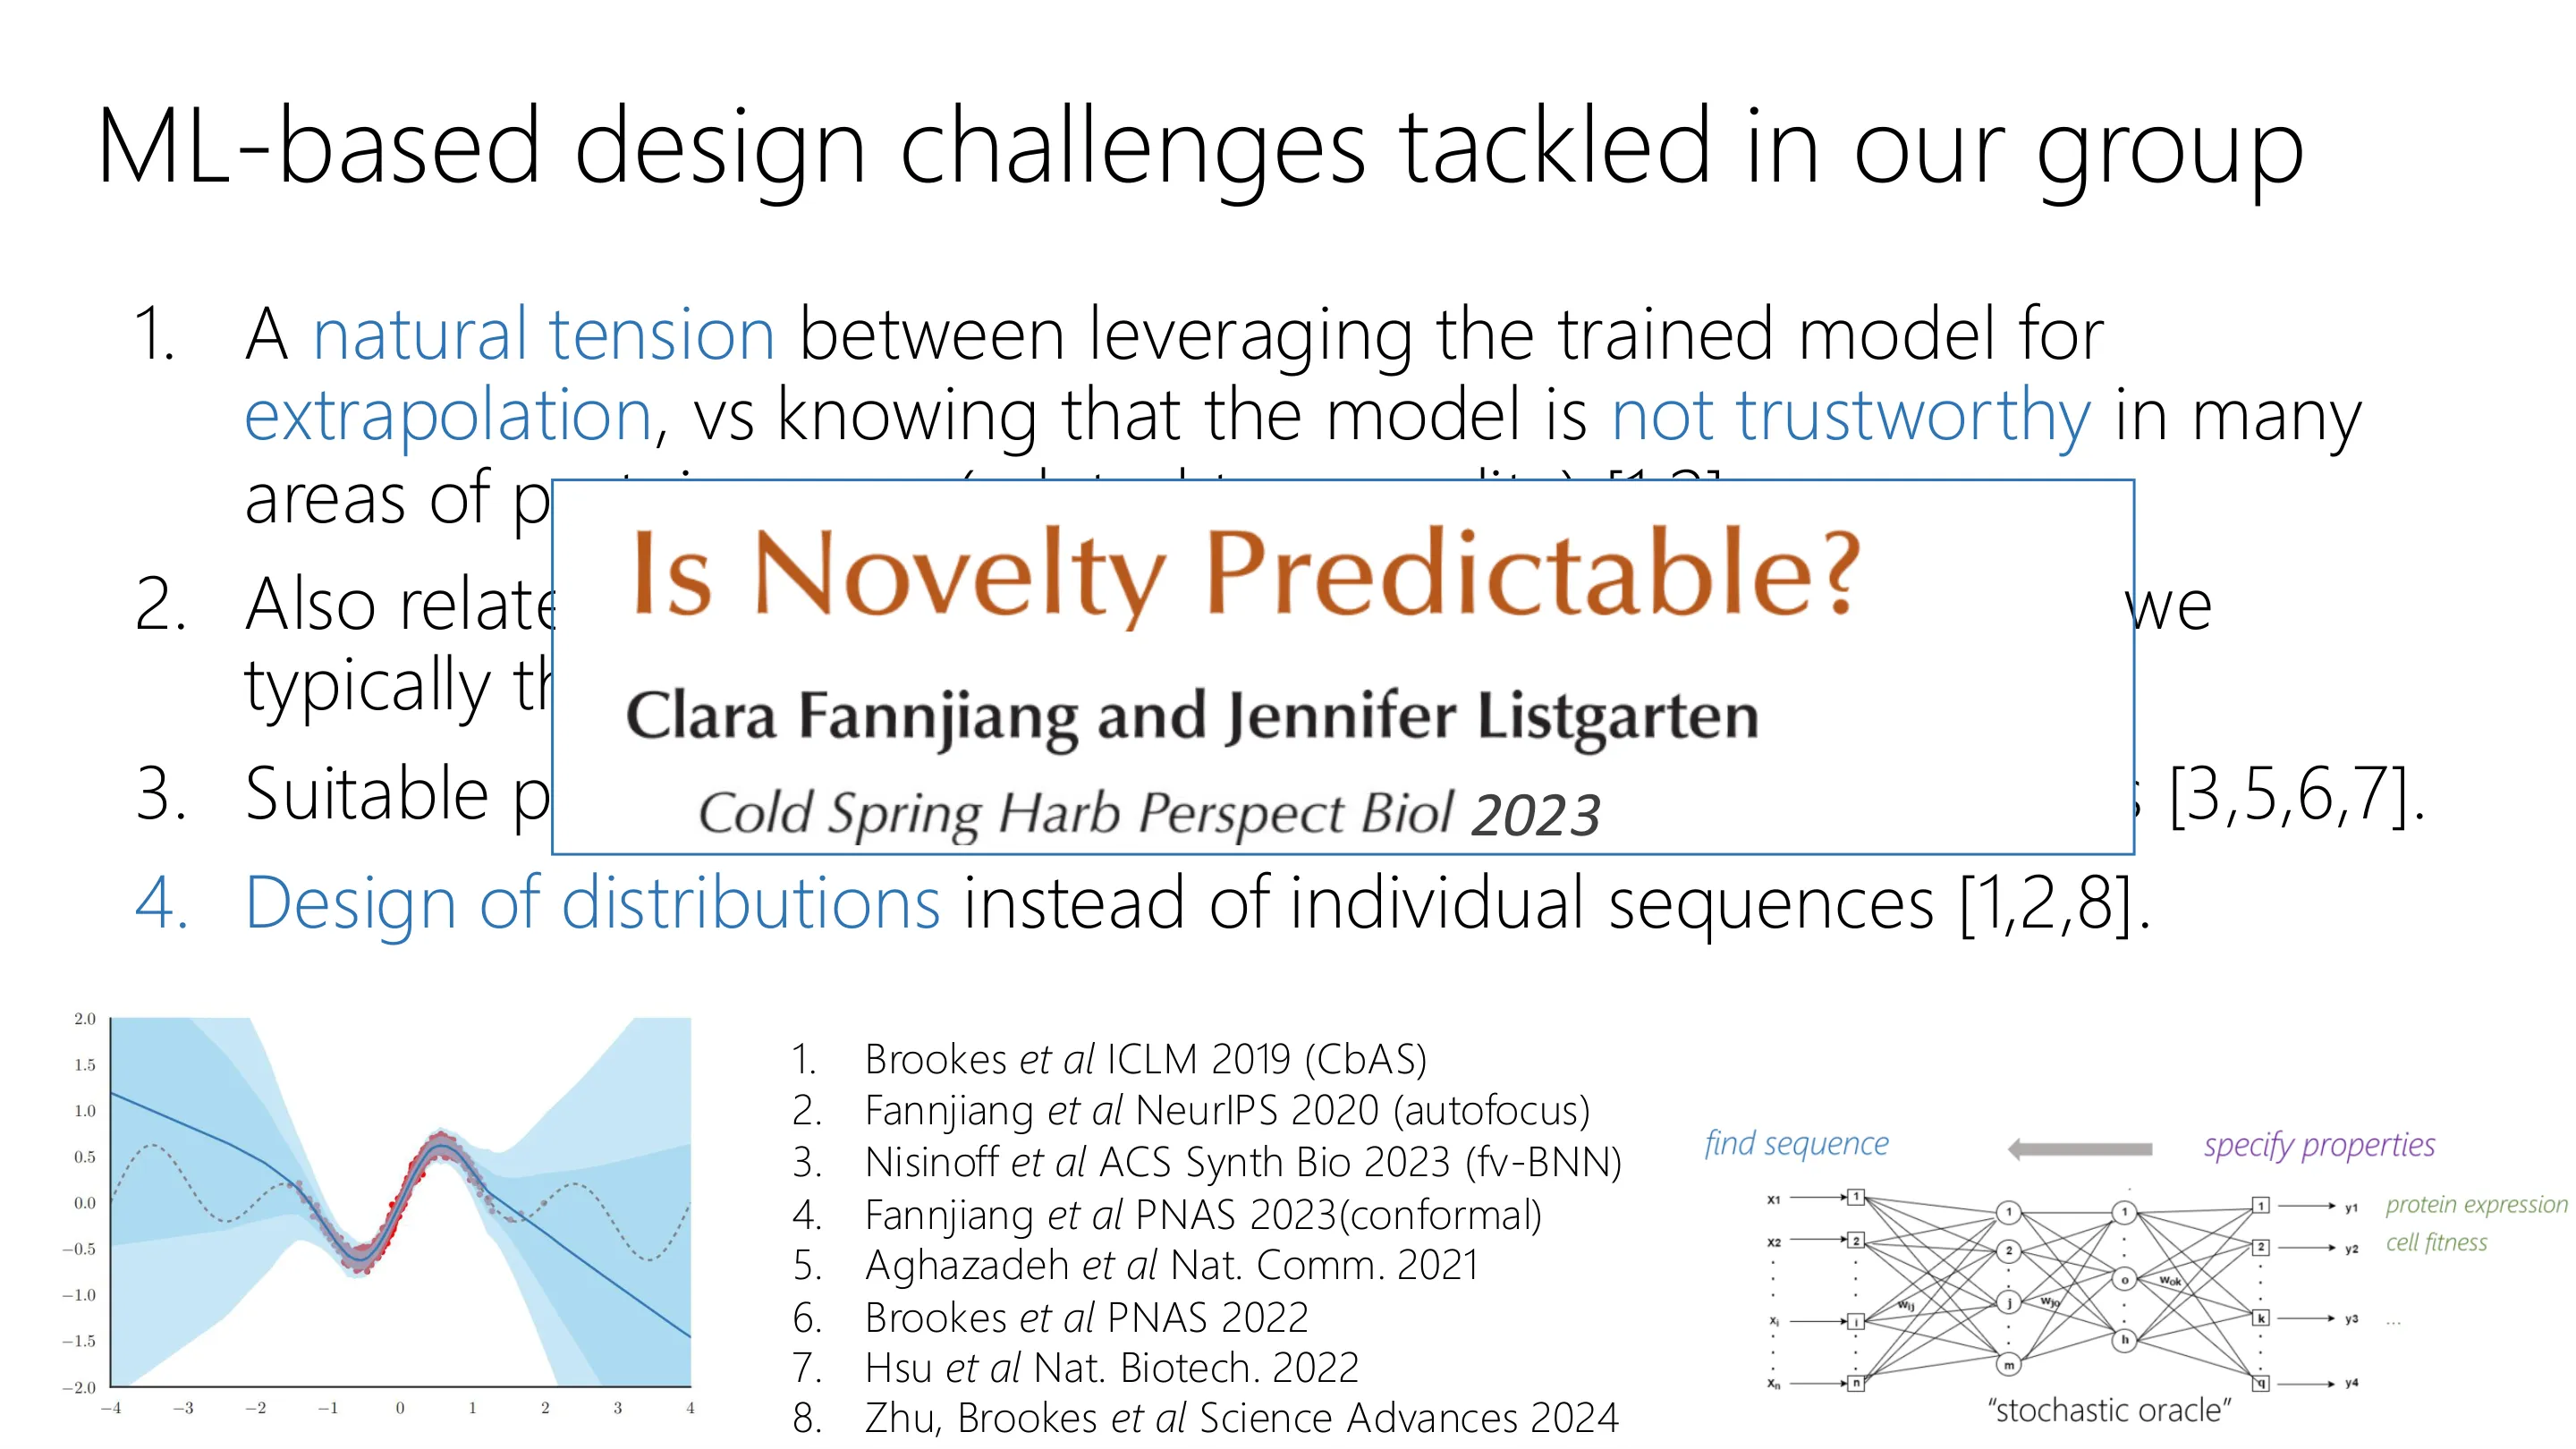
📷 基于 ML 的设计挑战(四)
回到原视频 (00:38:03)
📷 主链
回到原视频 (00:39:16)
3.5 条件设计:贝叶斯法则与扩散/流模型
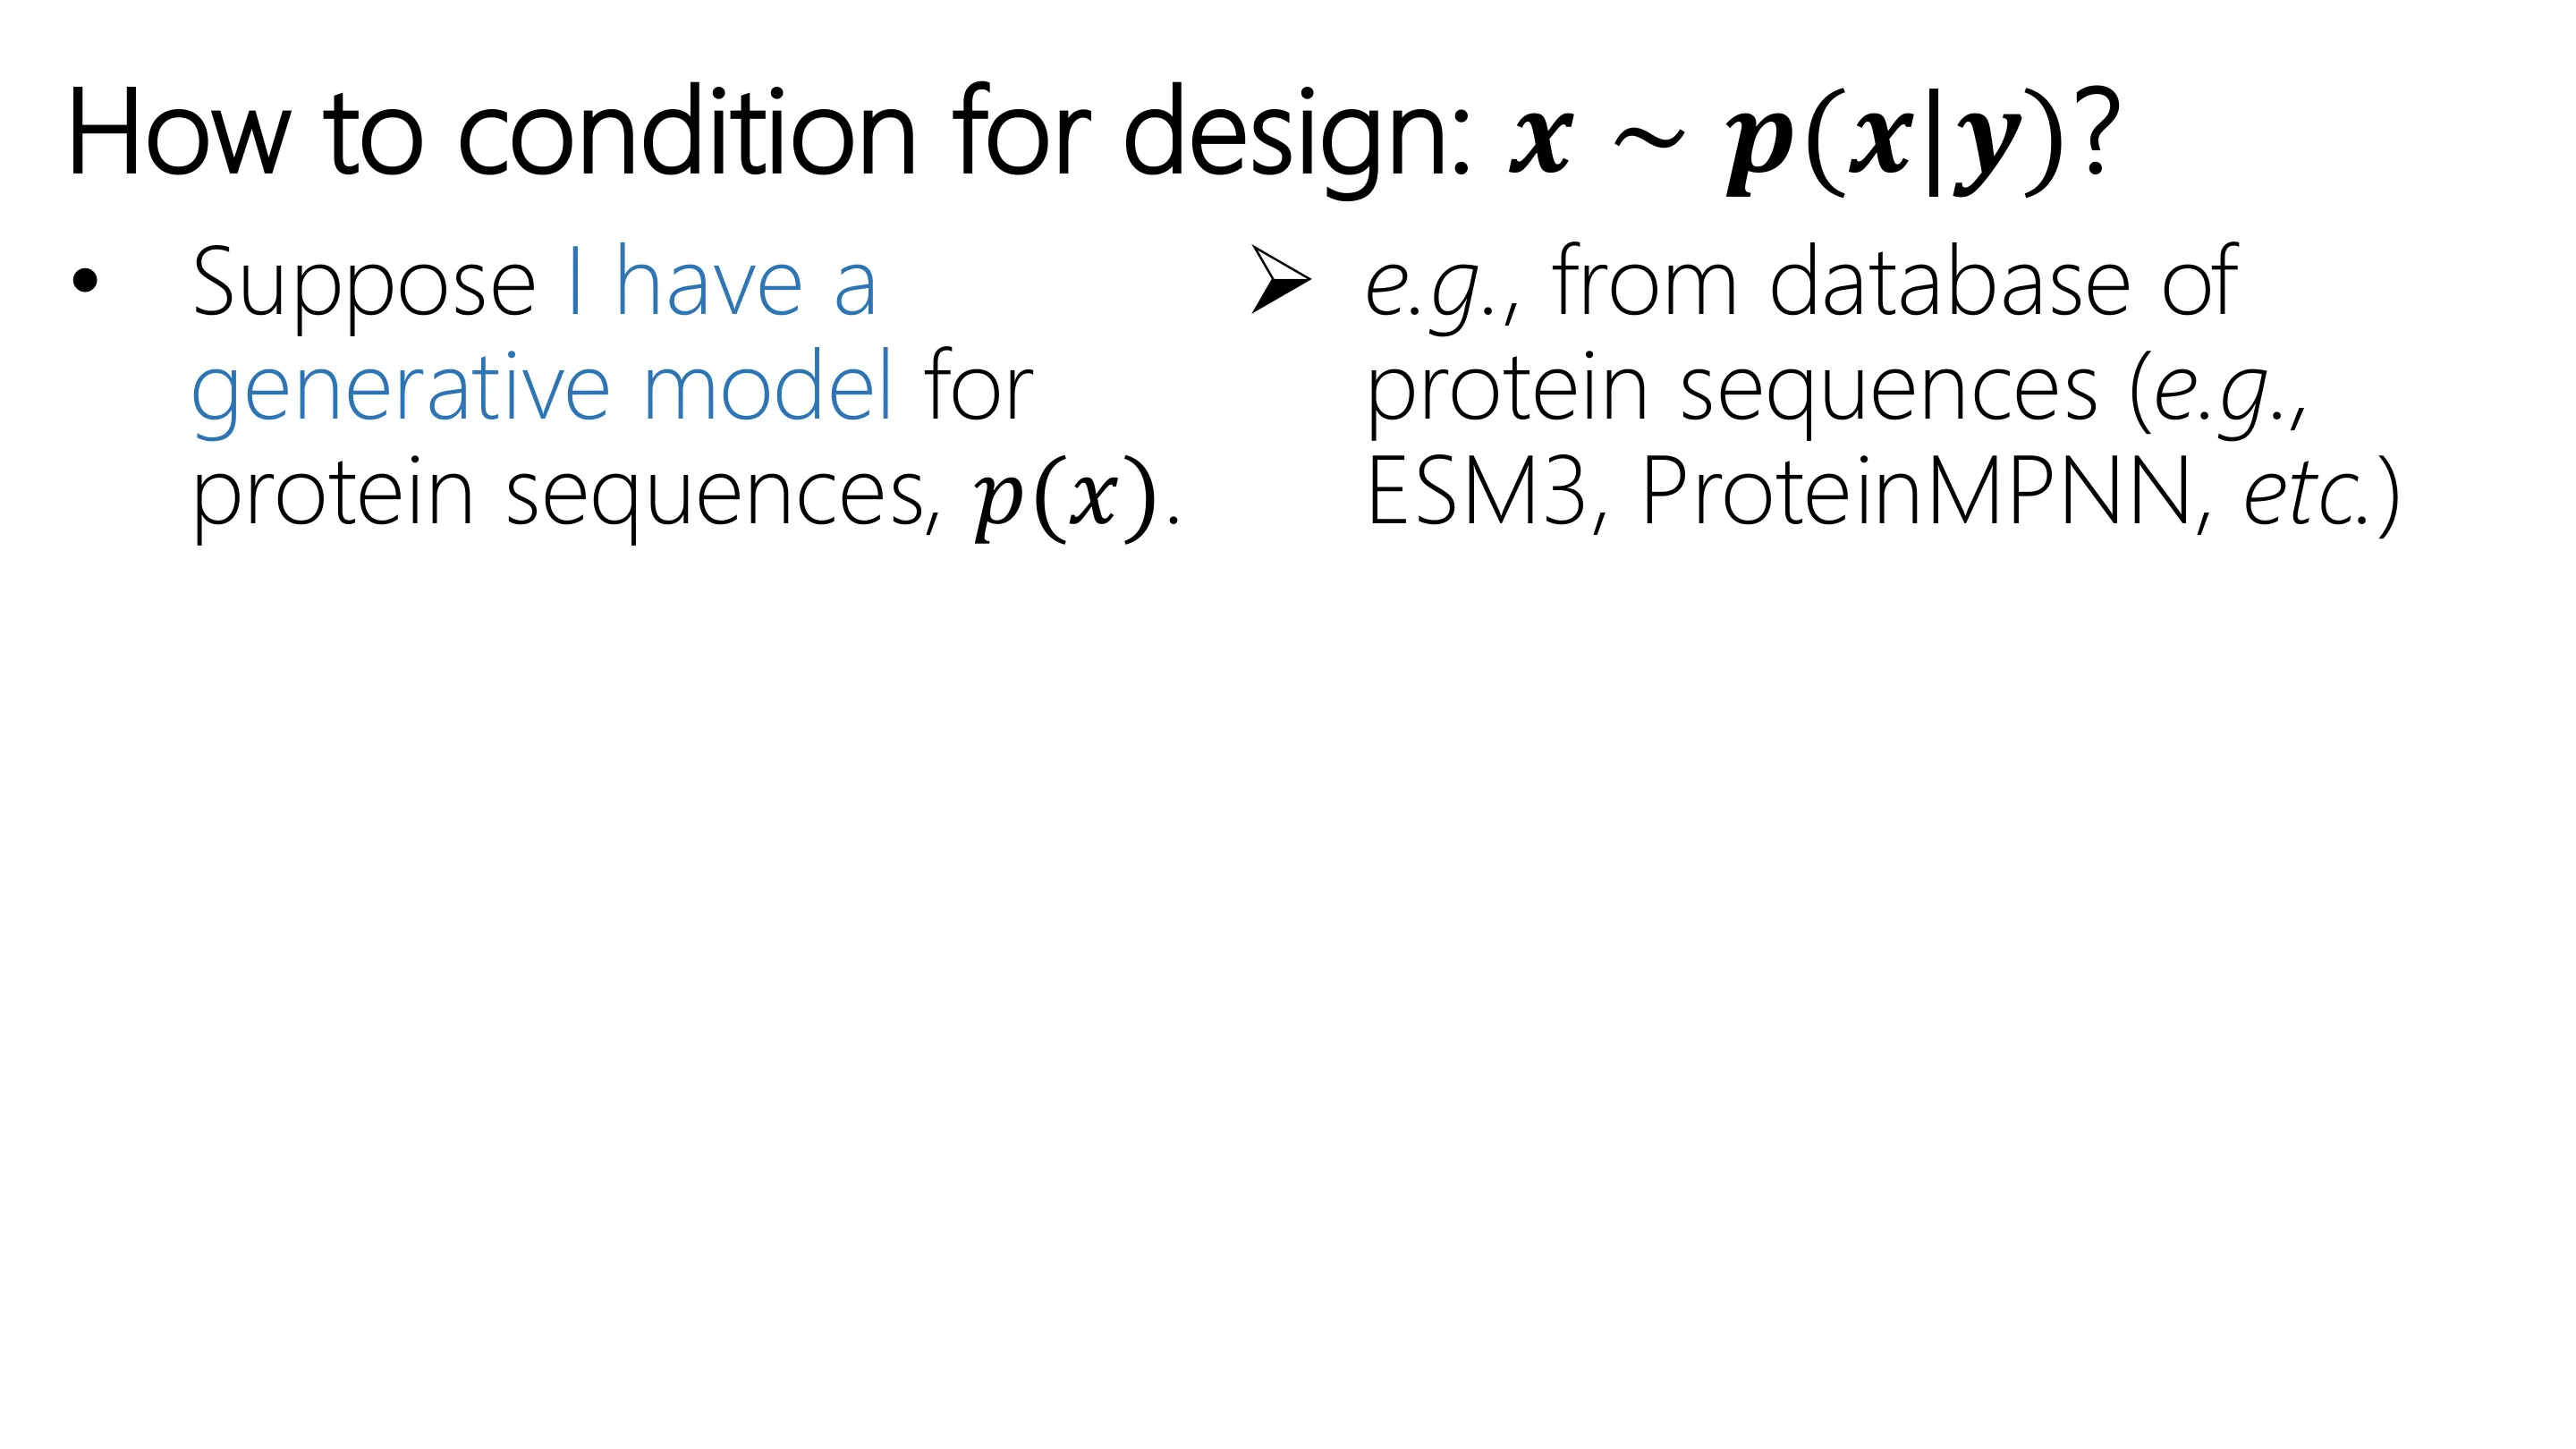
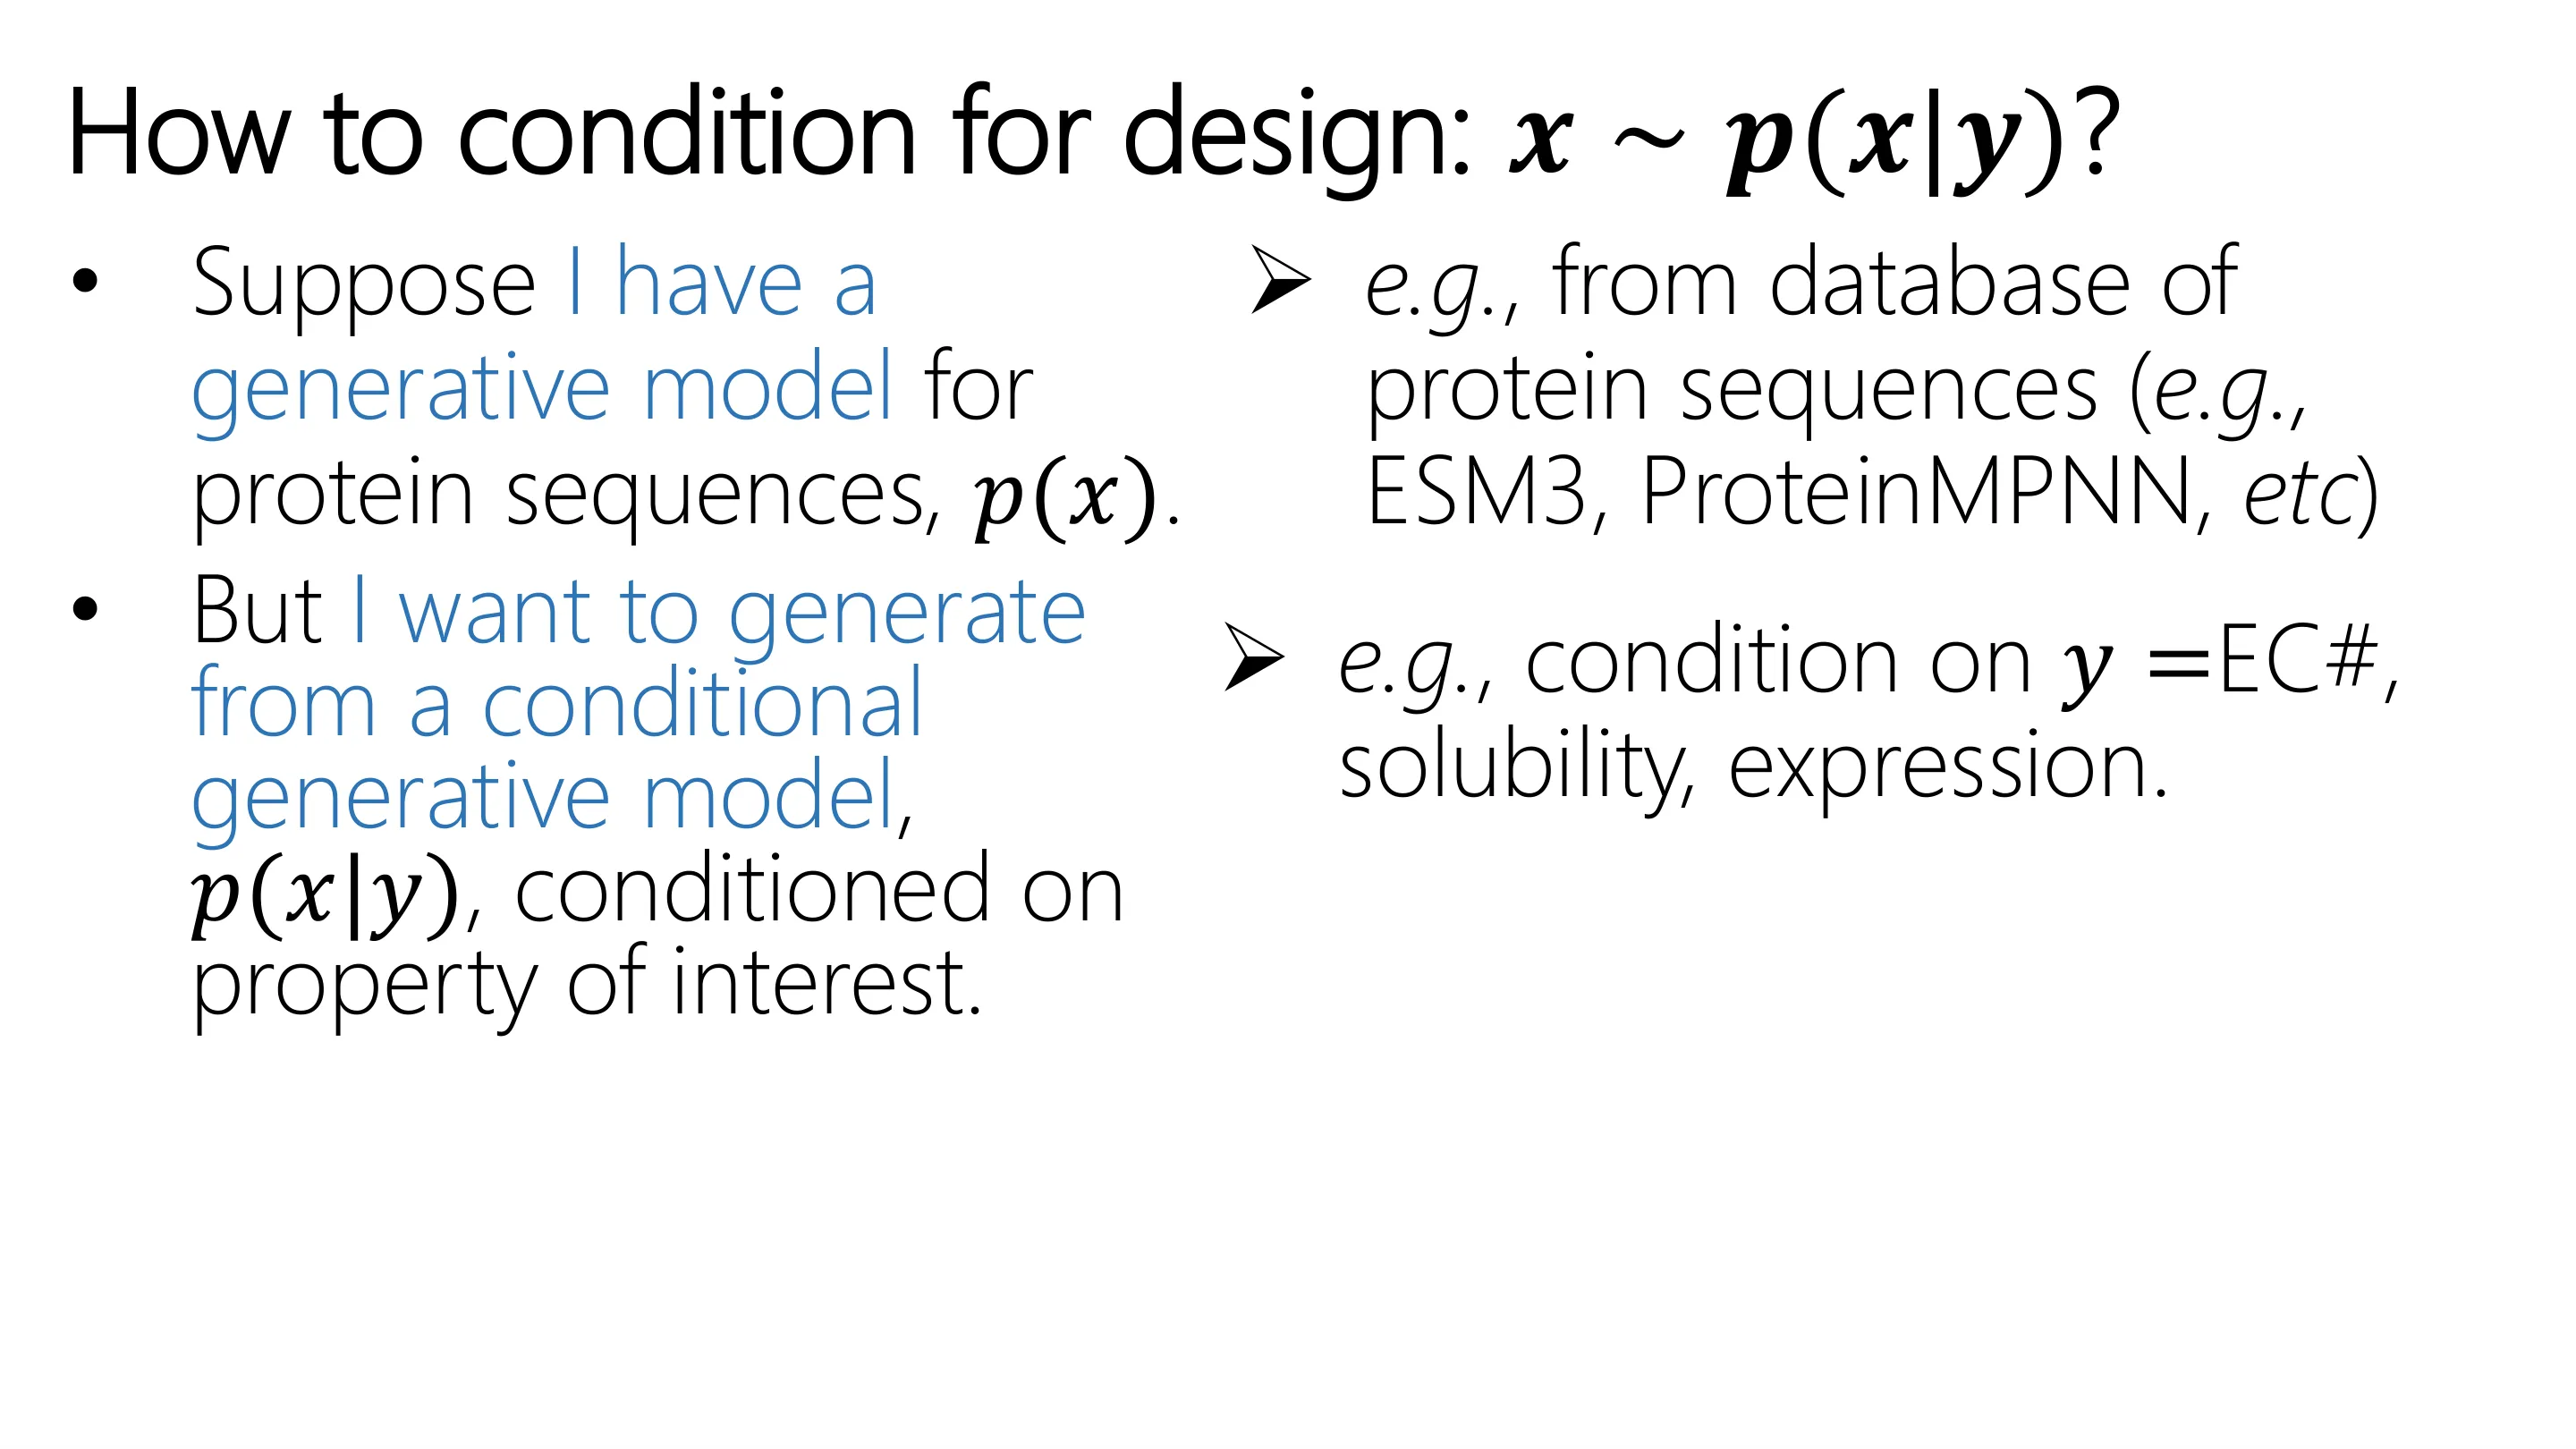
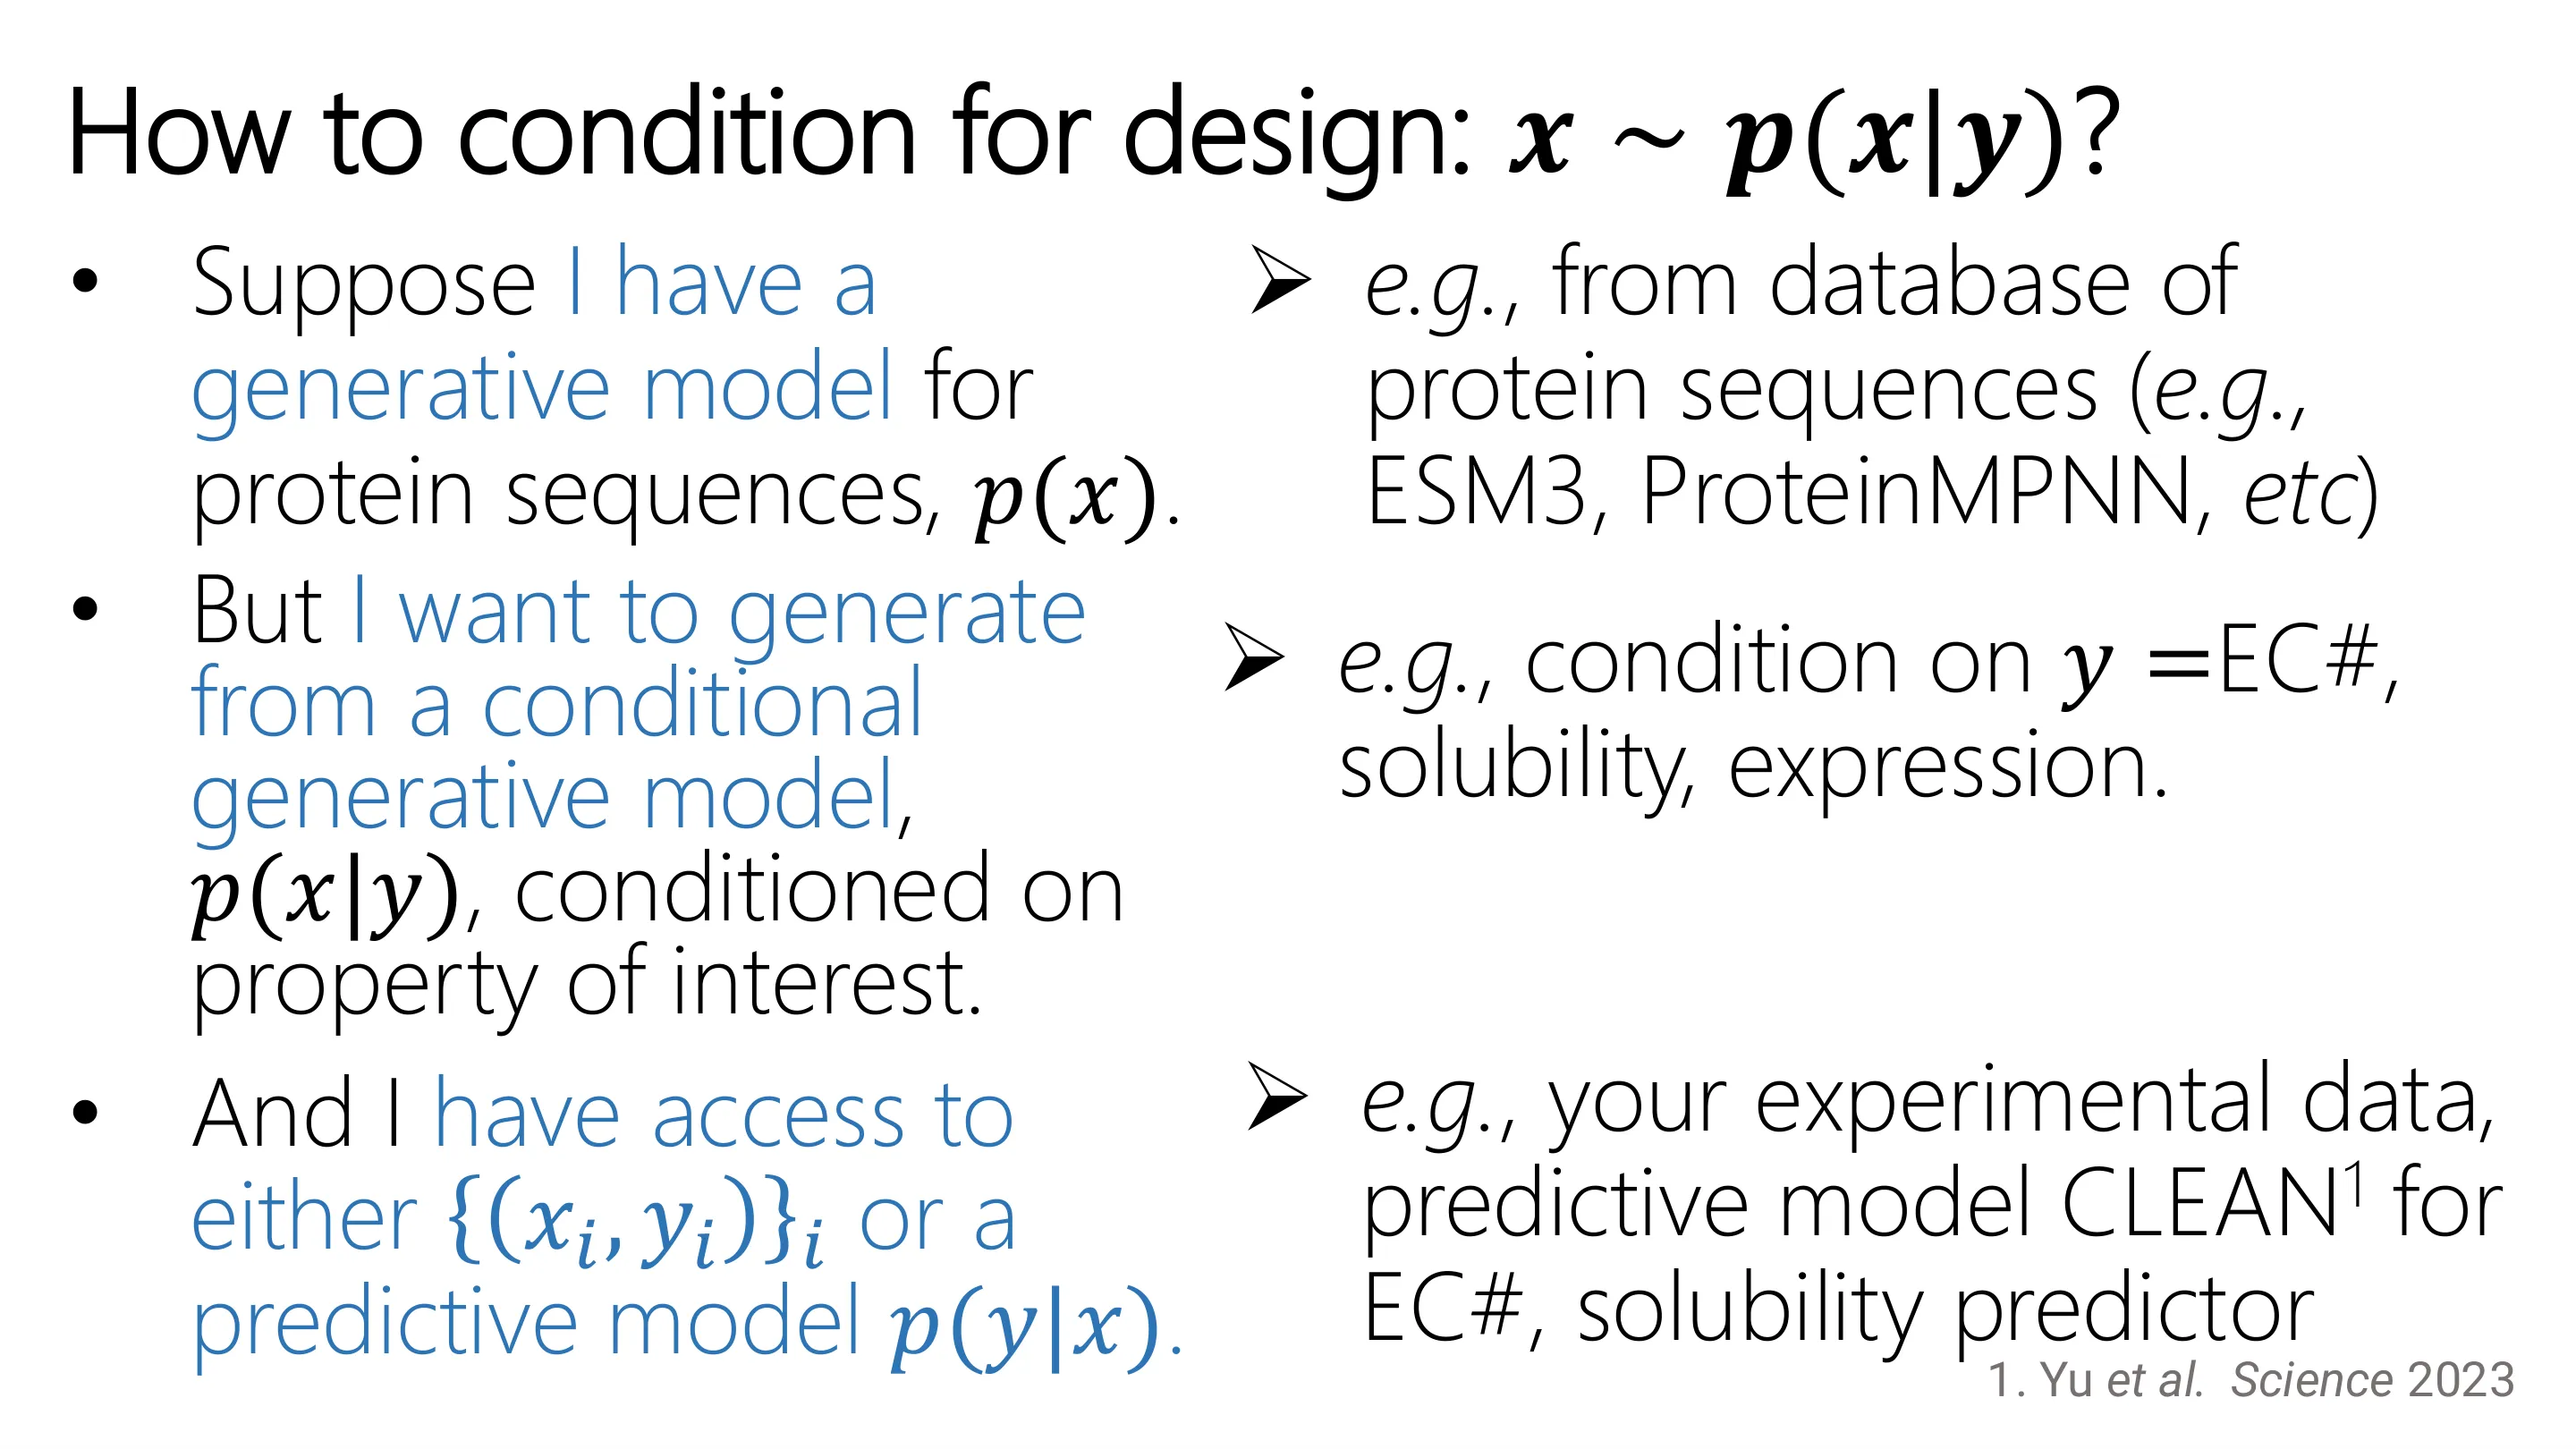
目标:从条件密度 $p(x\mid y)$ 采样($x$ = 序列/结构,$y$ = 我们想要的性质)。
三种(统计上正确的)做法,核心是贝叶斯法则:
$$ p(x\mid y)=\frac{p(y\mid x)\,p(x)}{p(y)} $$
- $p(x)$:在全部已知蛋白序列上训练的大模型——包含「蛋白质世界」的信息;
- $p(y\mid x)$:用湿实验数据训练的性质预测回归模型——包含我们真正关心的信息;
- 二者相乘再归一化 ⇒ 兼具两者的条件生成模型。
难点:归一化常数 $p(y)=\int p(y\mid x)p(x)\,dx$ 通常不可计算。
扩散 / 流匹配 / score 模型的妙处:不估计密度 $p(x)$ 本身,而是估计密度对 $x$ 的梯度(score)$\nabla_x\log p(x)$。把它代入贝叶斯法则:
$$ \nabla_x\log p(x\mid y)=\nabla_x\log p(y\mid x)+\nabla_x\log p(x) $$
因为 $p(y)$ 不含 $x$,其梯度为 0——归一化常数自动消失!代价是:要采样必须对梯度做积分(比自回归模型直接采样复杂得多),这正是扩散模型的核心。
这套「大无条件模型 + 小预测模型 → 贝叶斯」的思路也适用于 NLP(prompt 就是条件)和机器人控制。幻灯片里的 Taylor Swift 彩蛋就是调侃归一化常数 $p(y)$「down bad」(难算)。
📷 如何为设计设置条件:$x\sim p(x\mid y)$?(一)
回到原视频 (00:40:29)
📷 如何为设计设置条件(二)
回到原视频 (00:41:42)
📷 如何为设计设置条件(三)
回到原视频 (00:42:55)
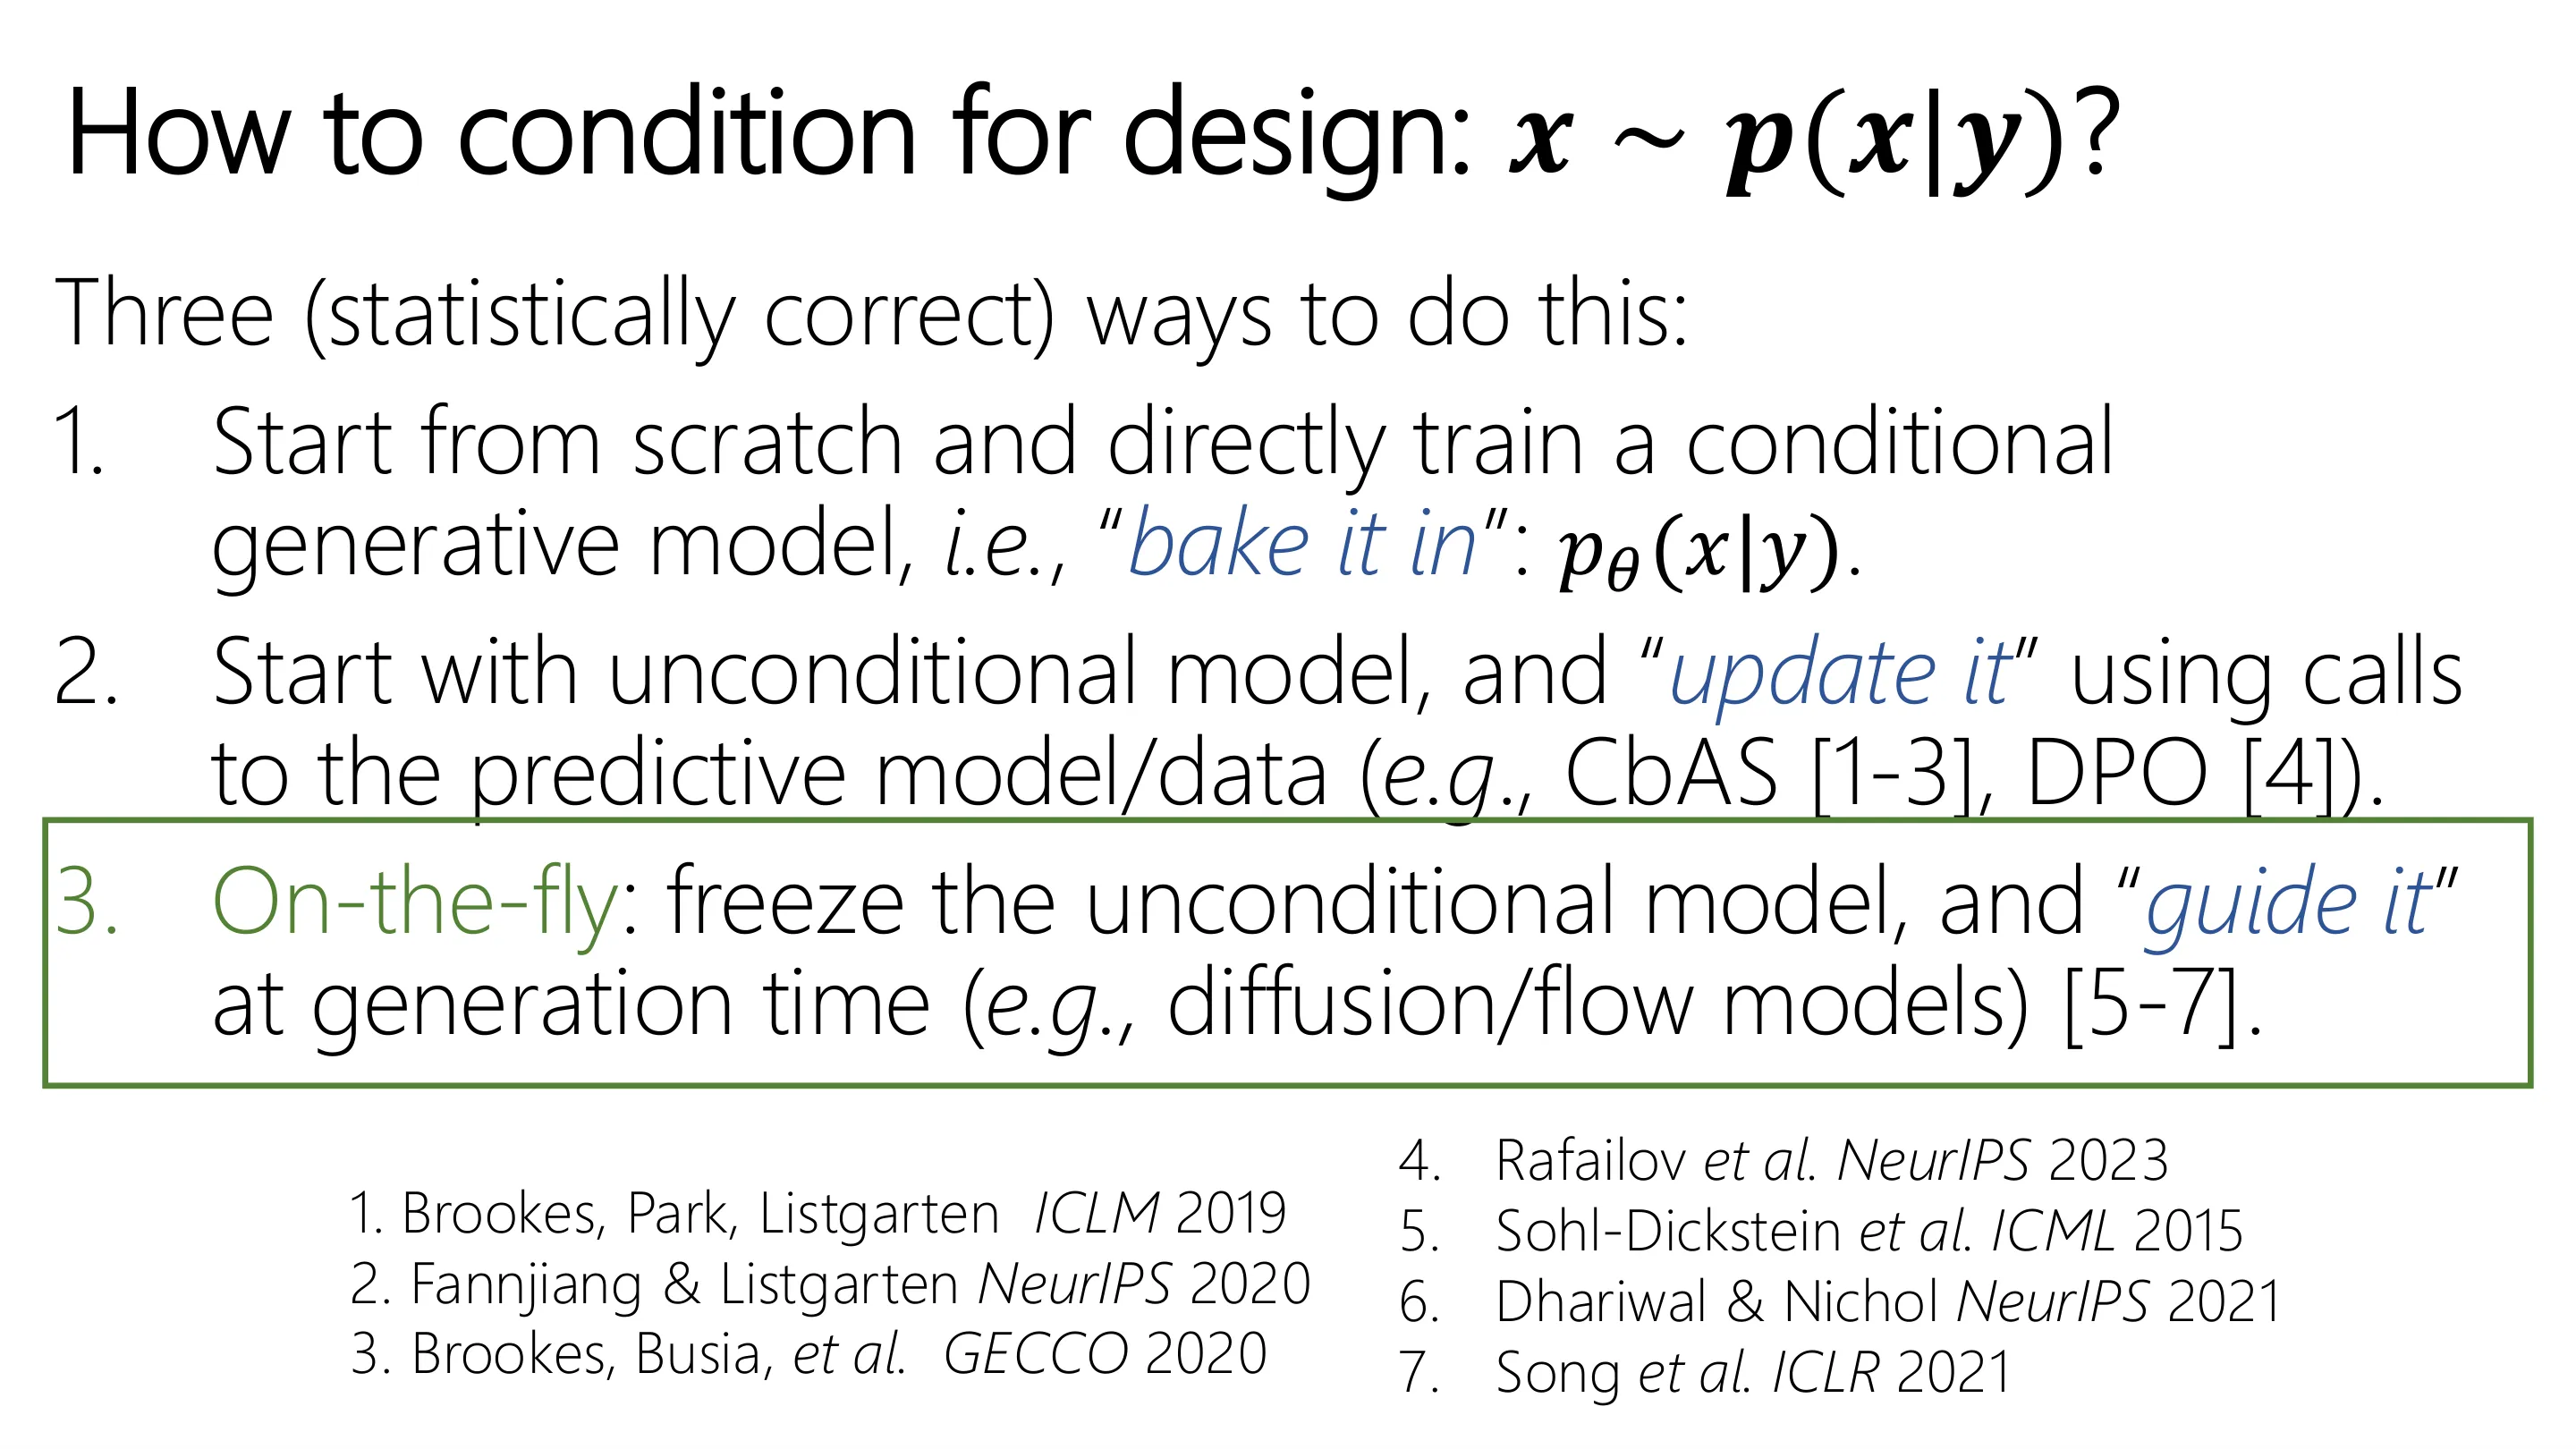
📷 三种(统计上正确的)做法
回到原视频 (00:44:08)
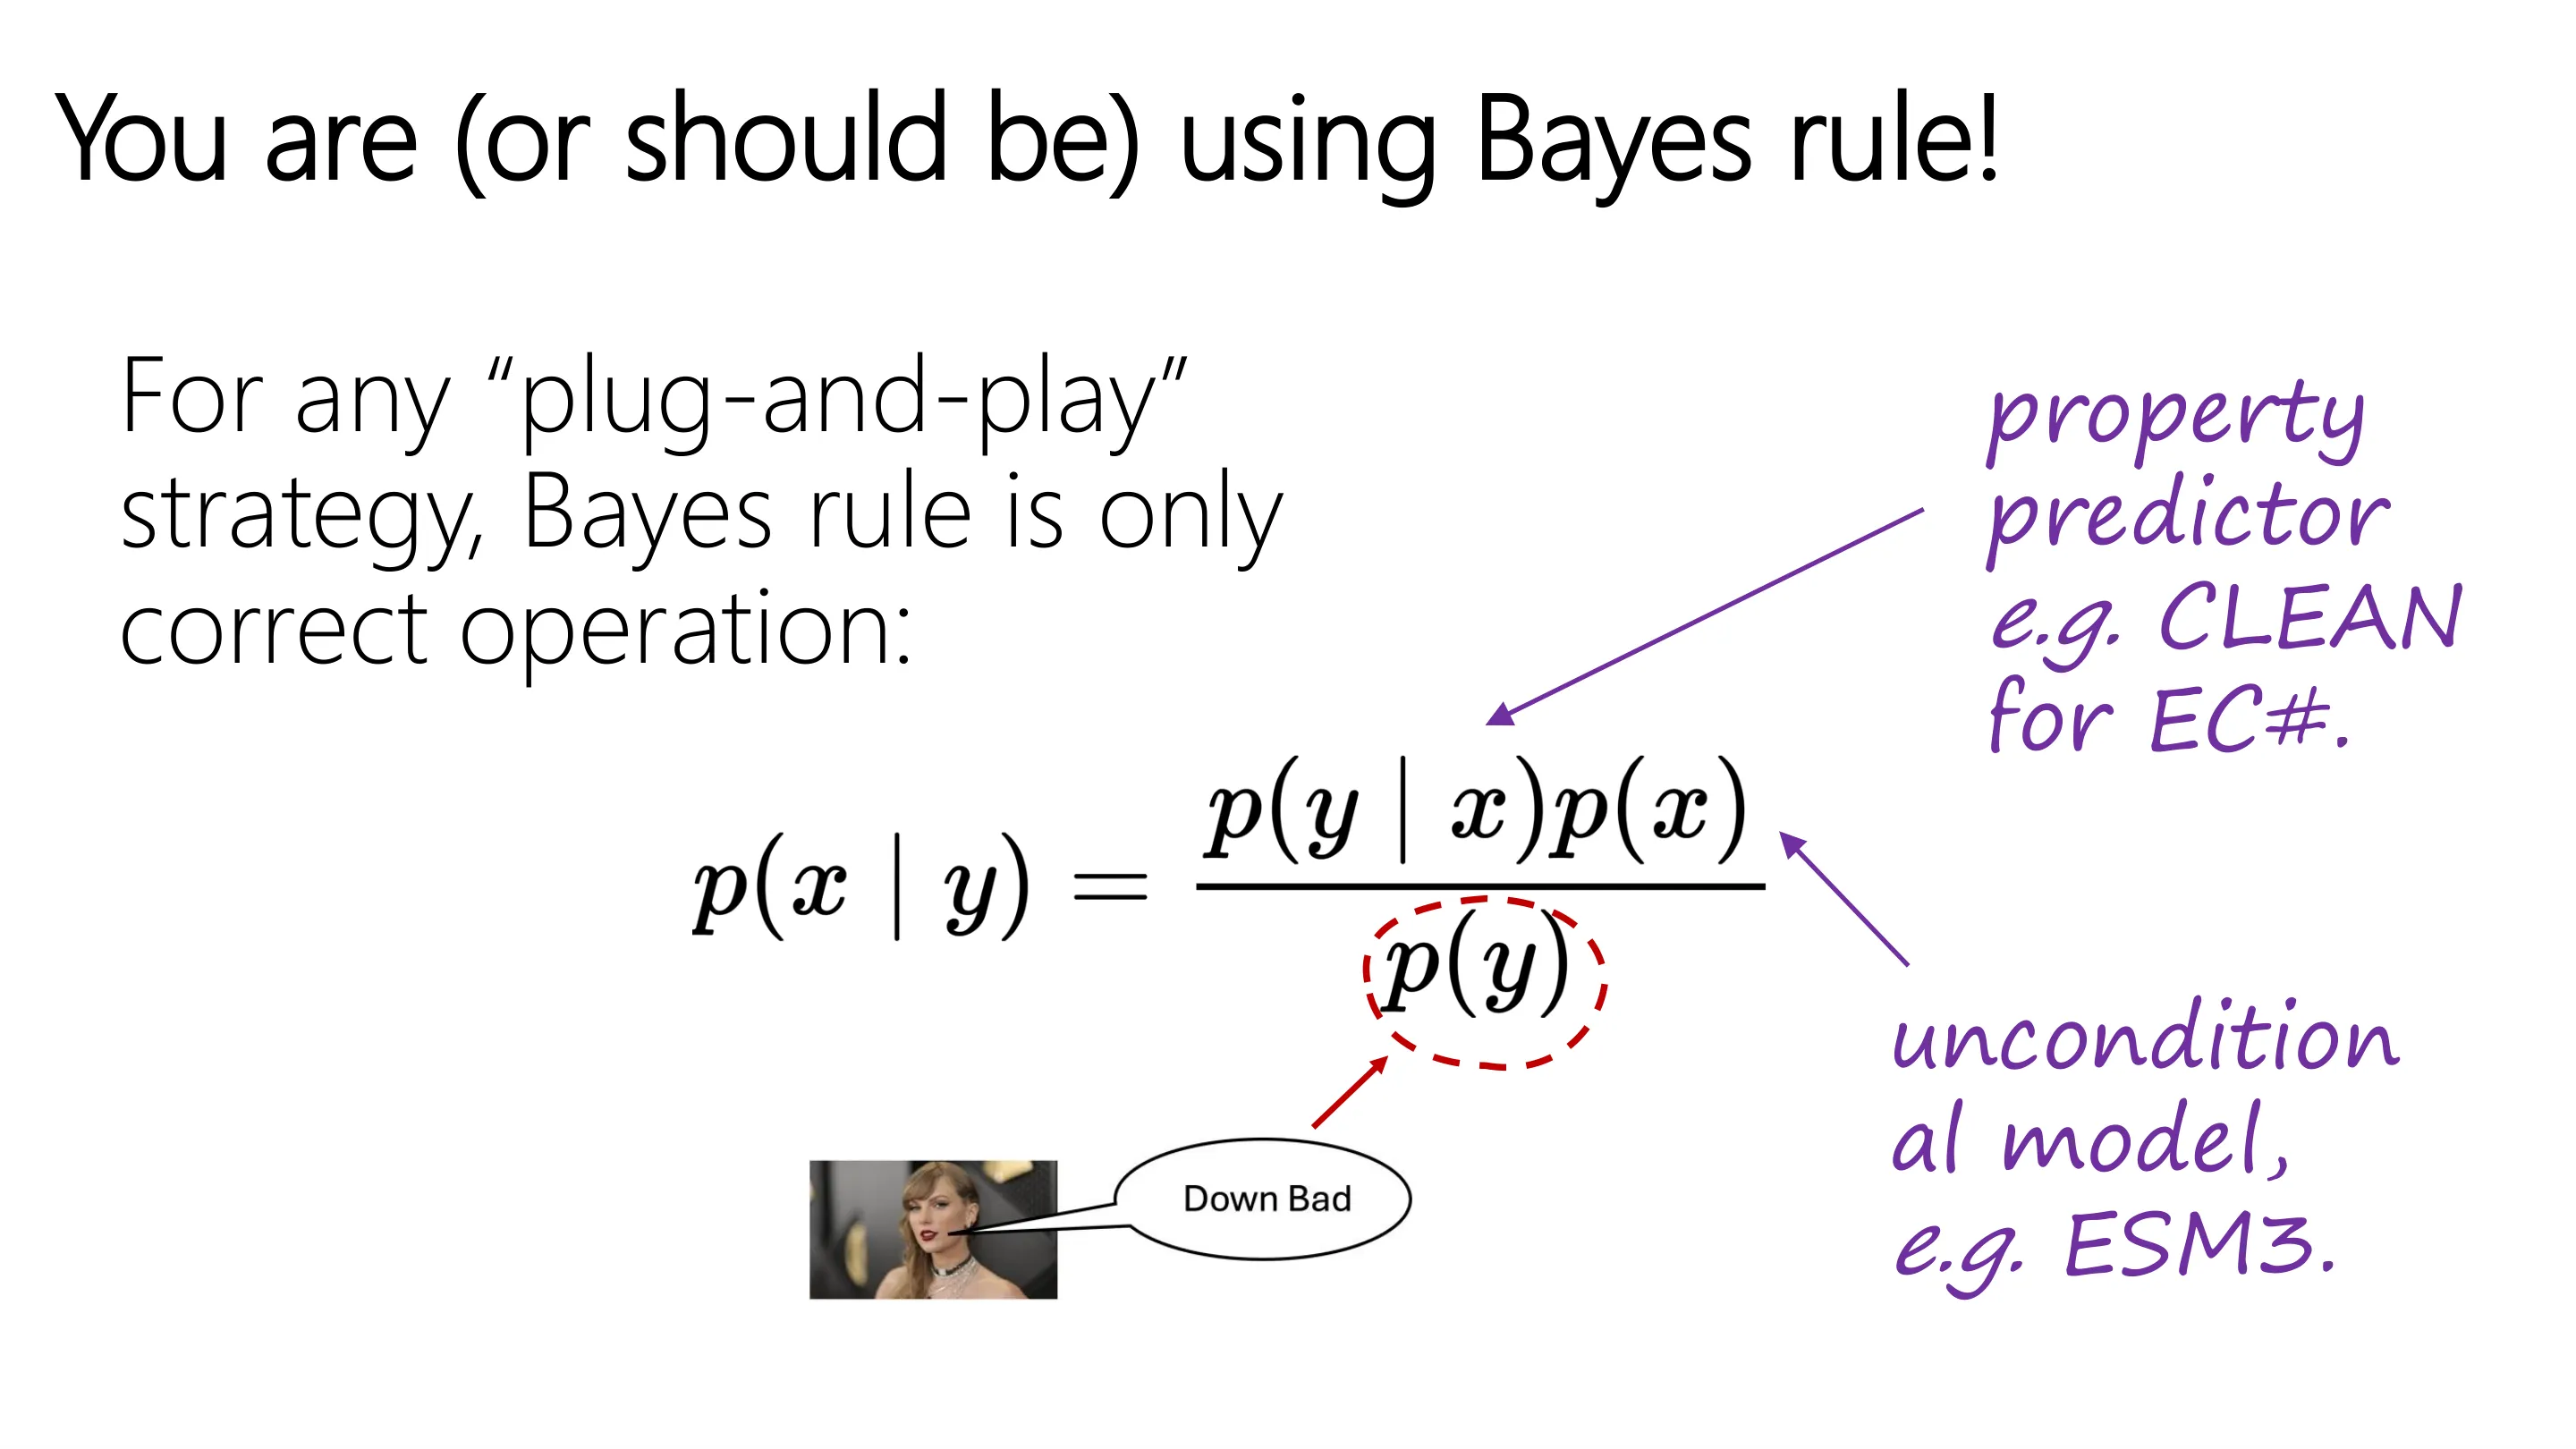
📷 你(应该)在用贝叶斯法则!
回到原视频 (00:45:21)
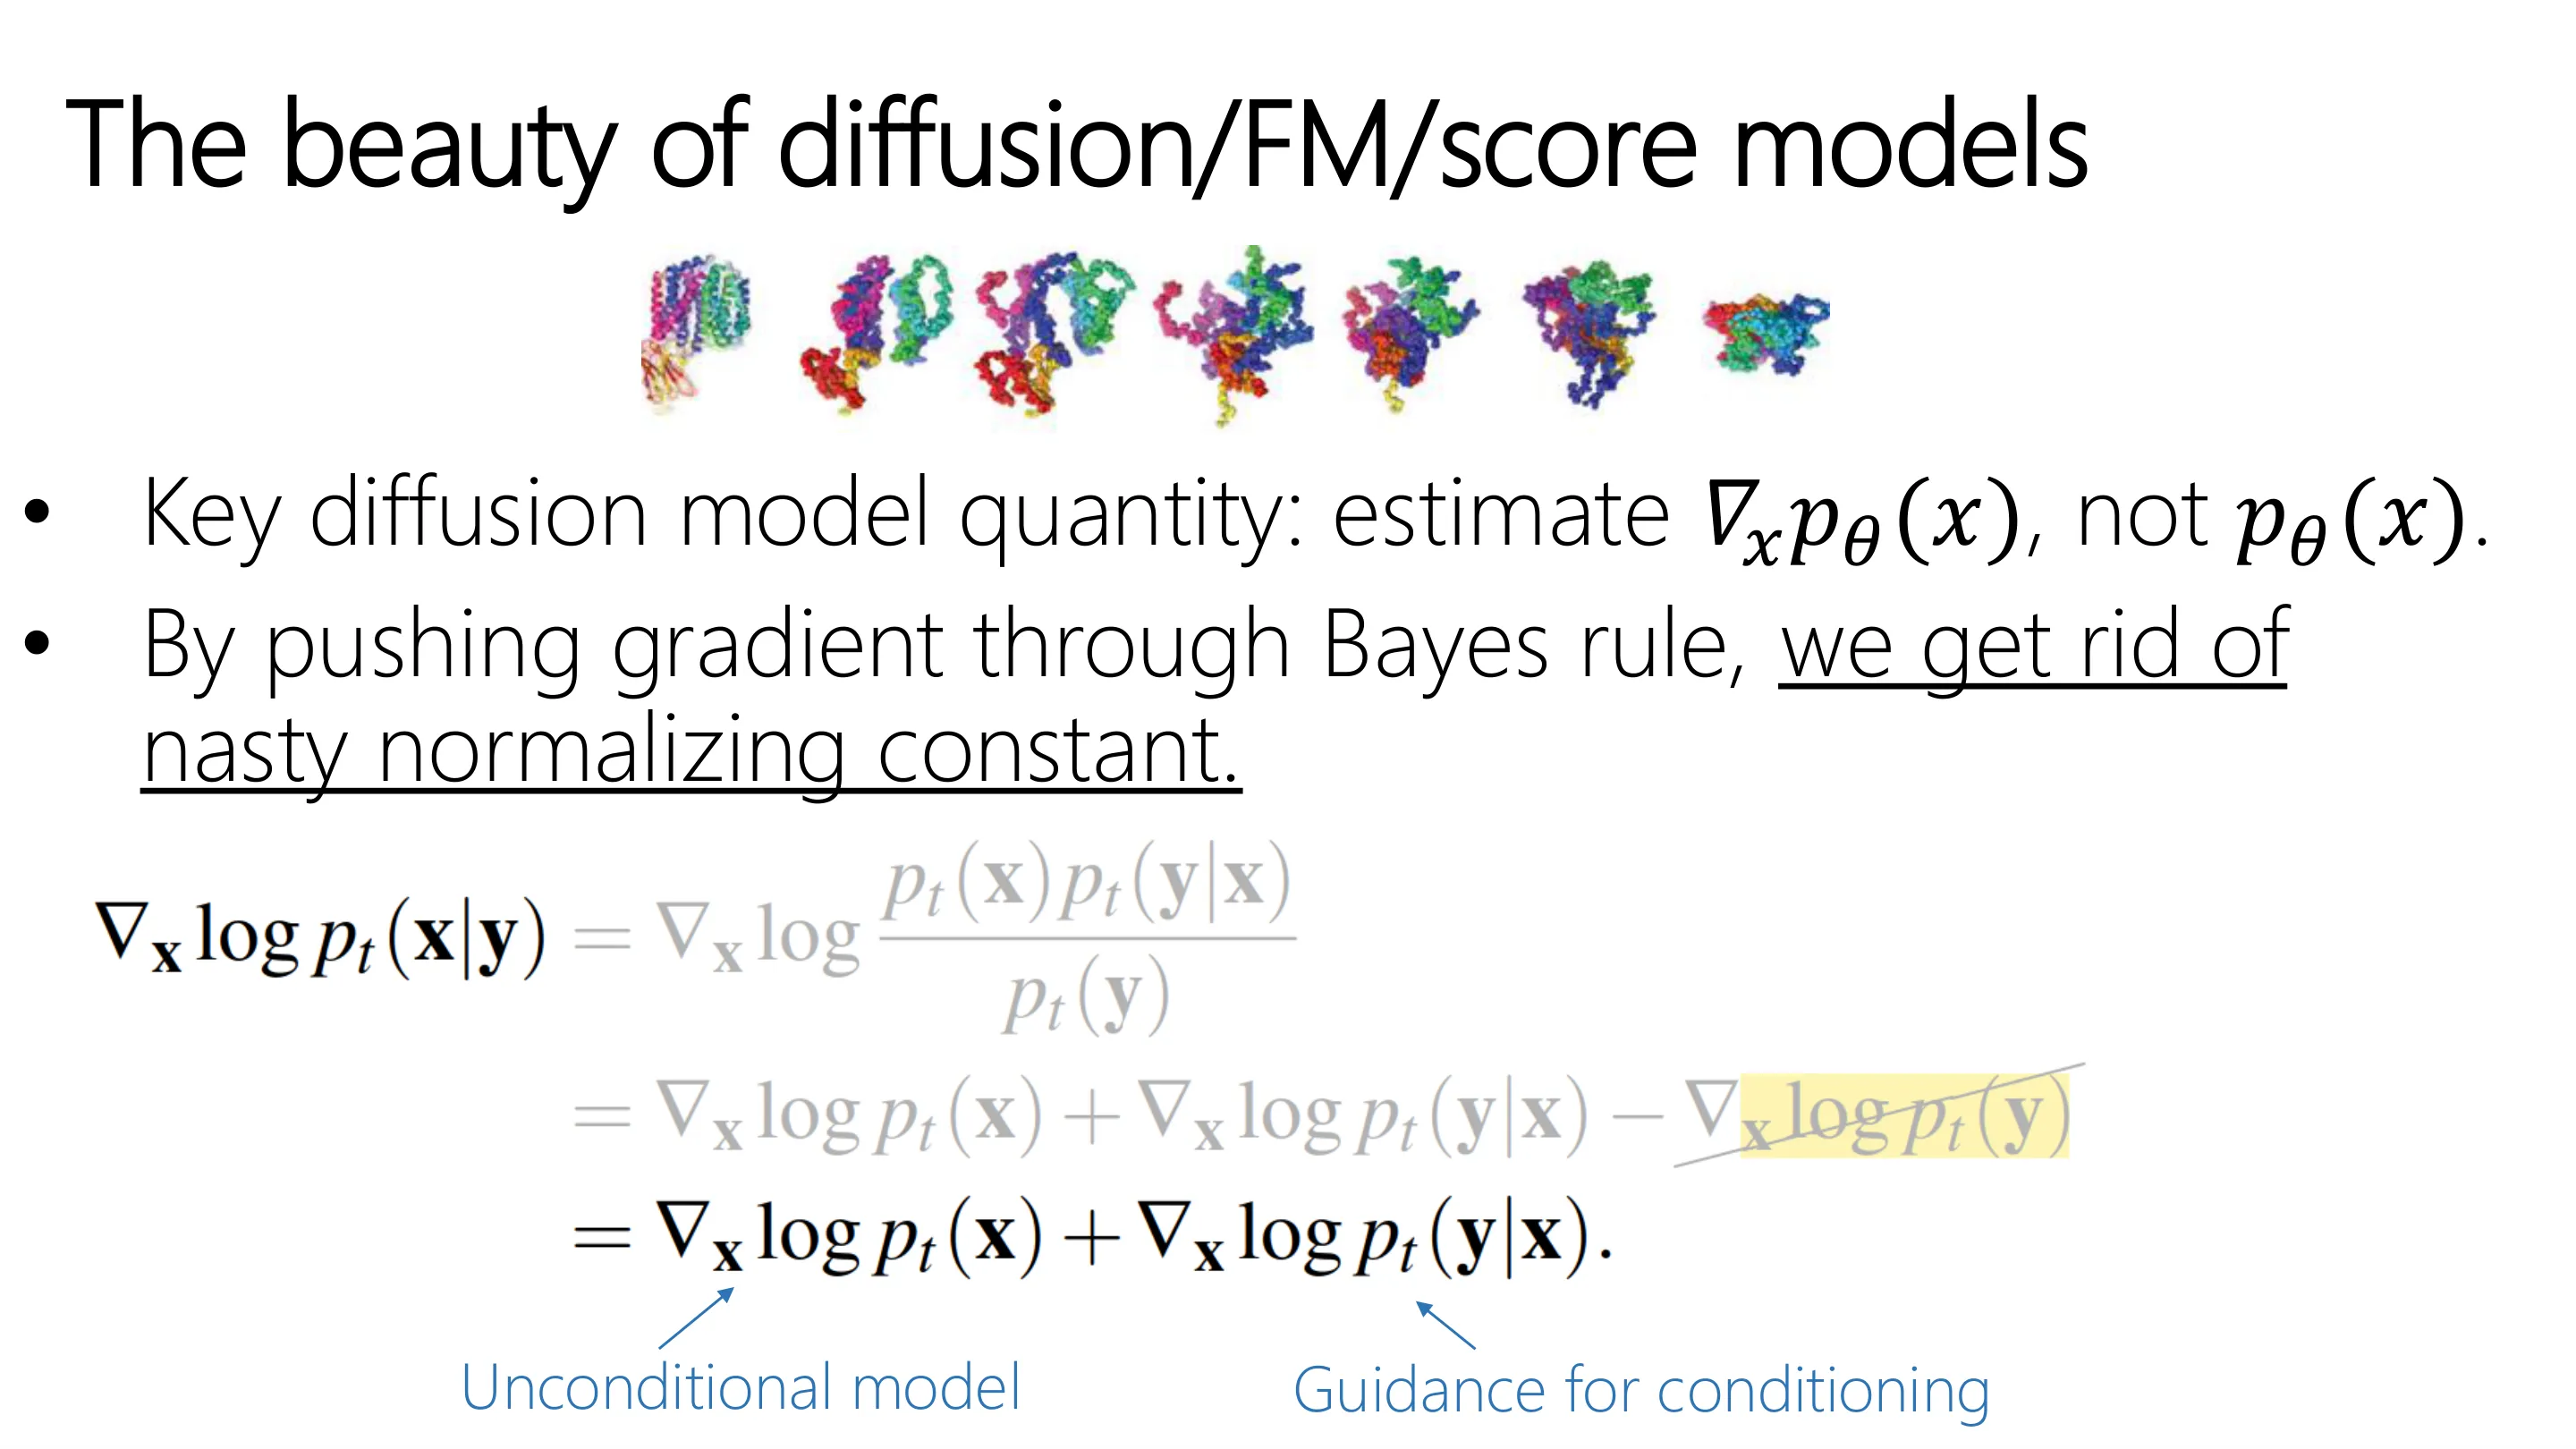
📷 扩散/流匹配/score 模型之美
回到原视频 (00:46:34)
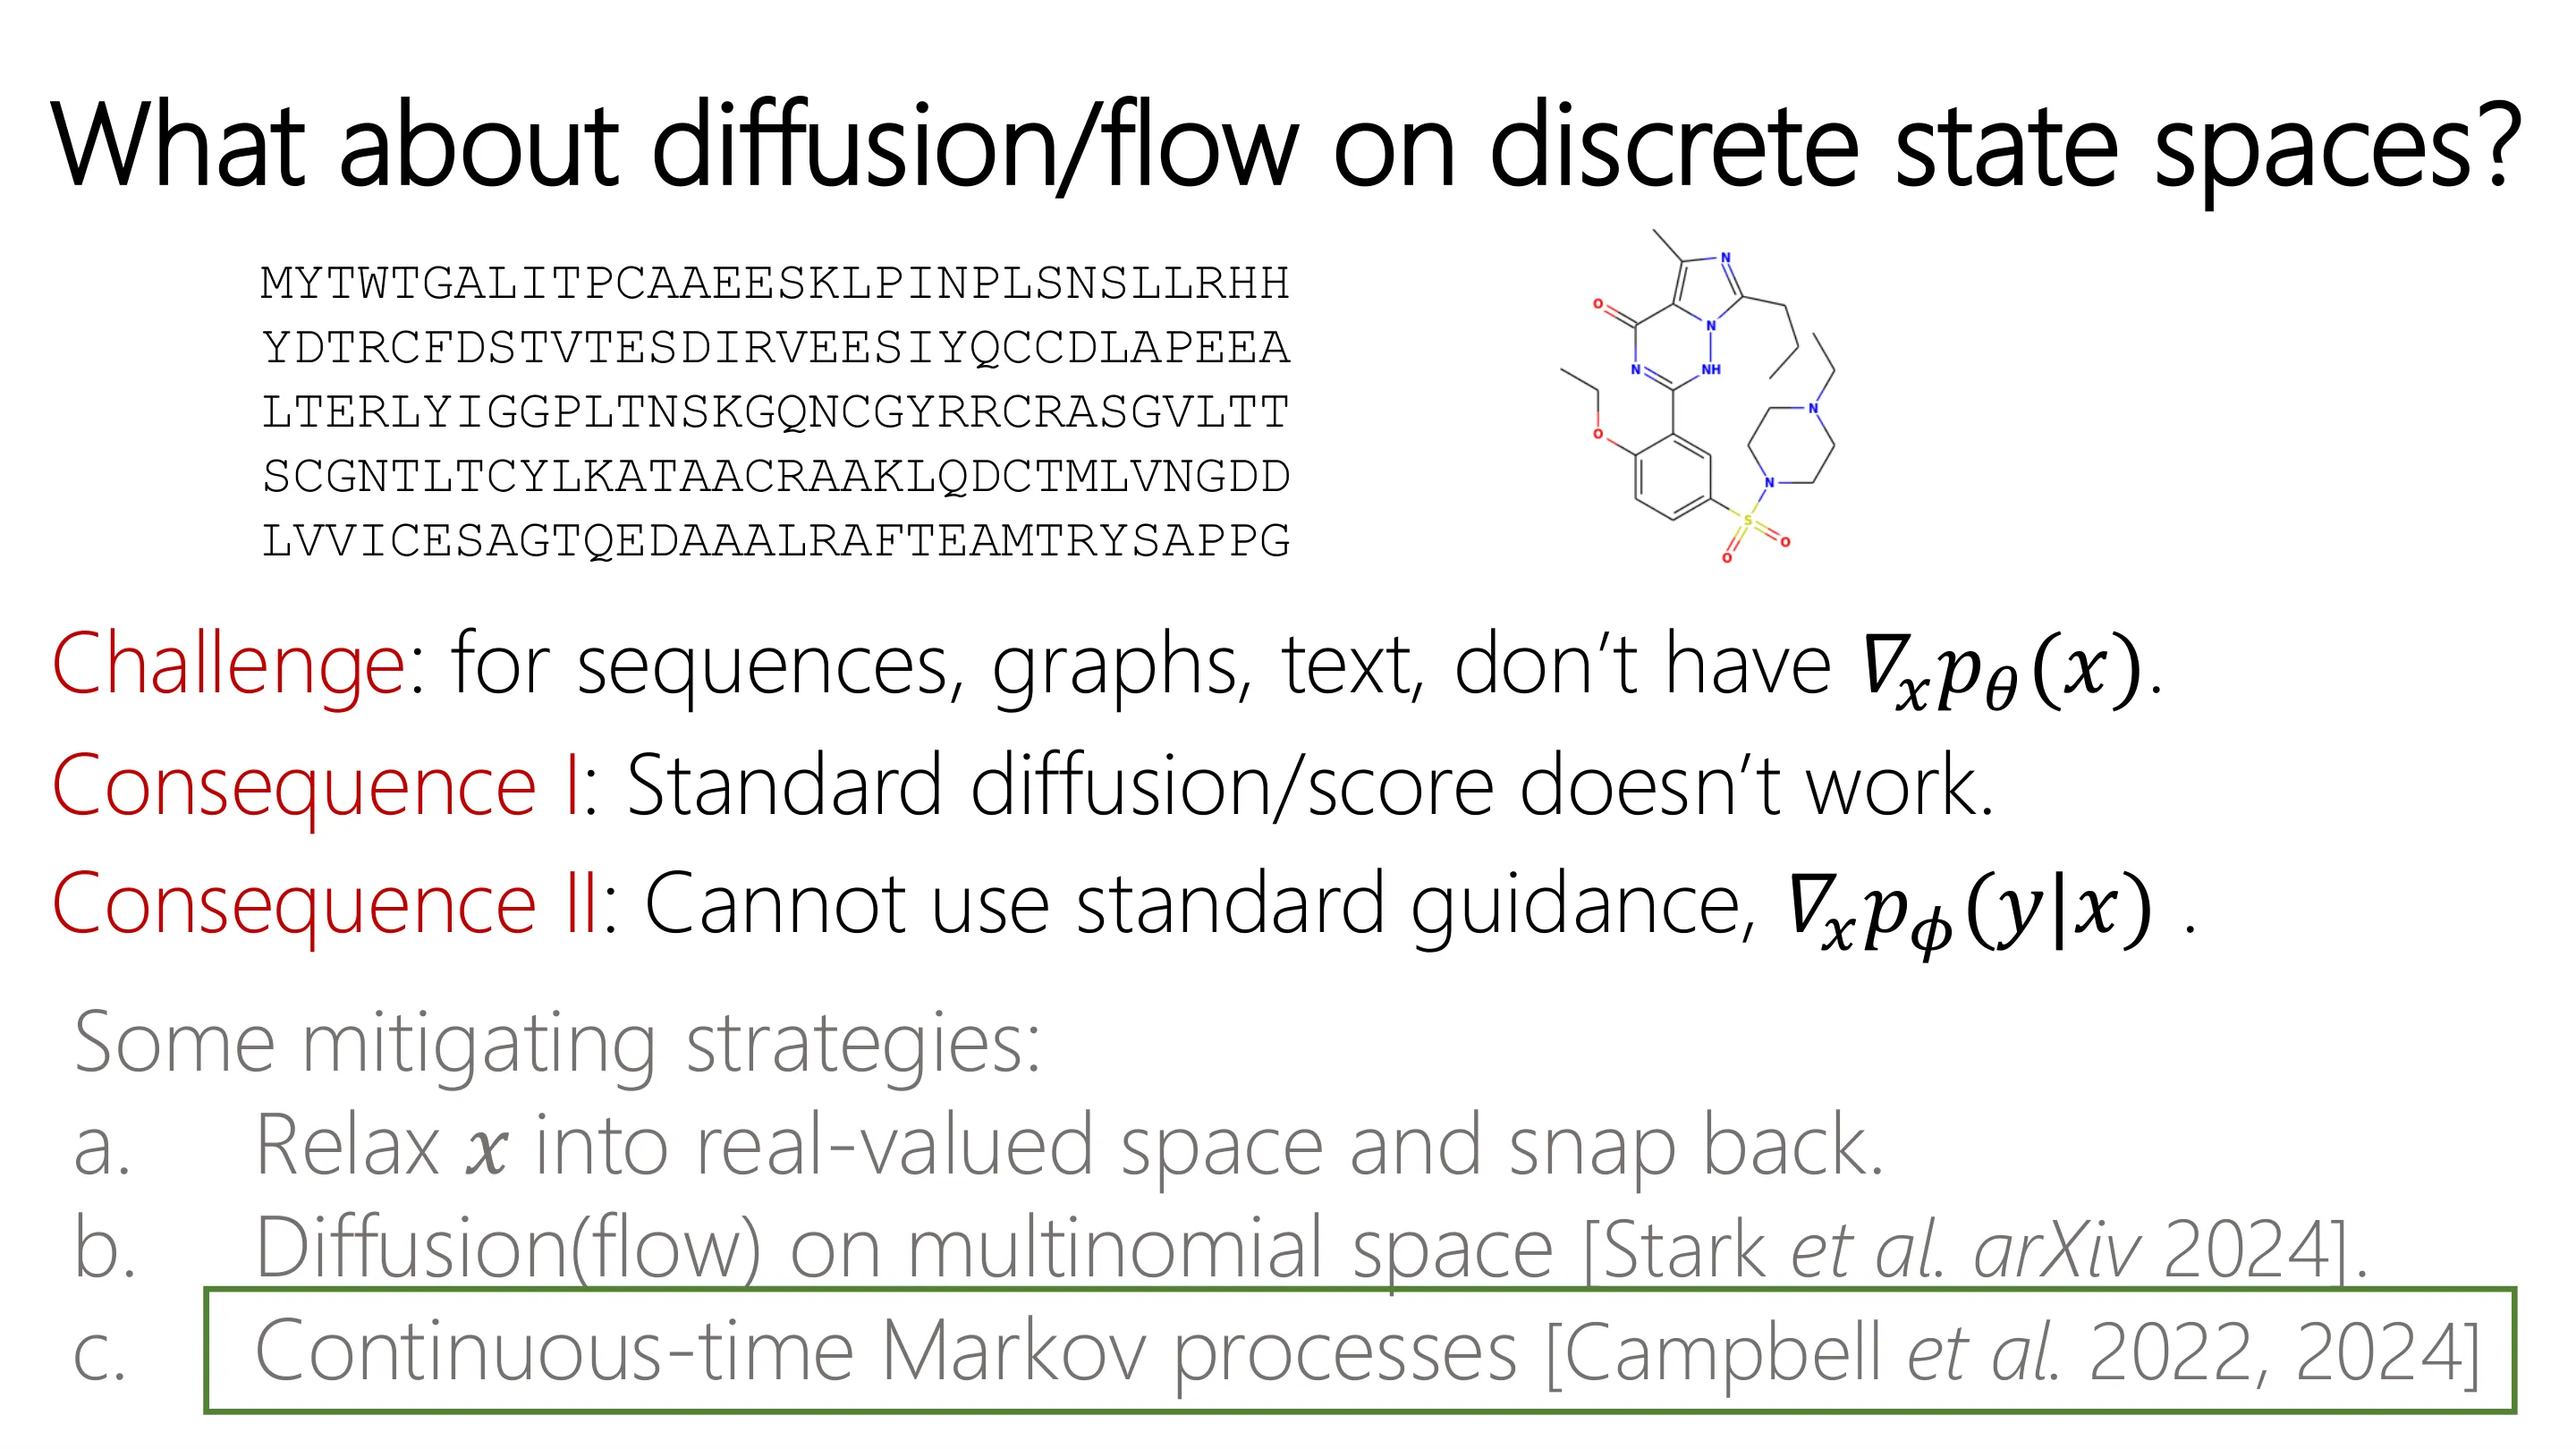
📷 离散状态空间上的扩散/流?
回到原视频 (00:47:47)
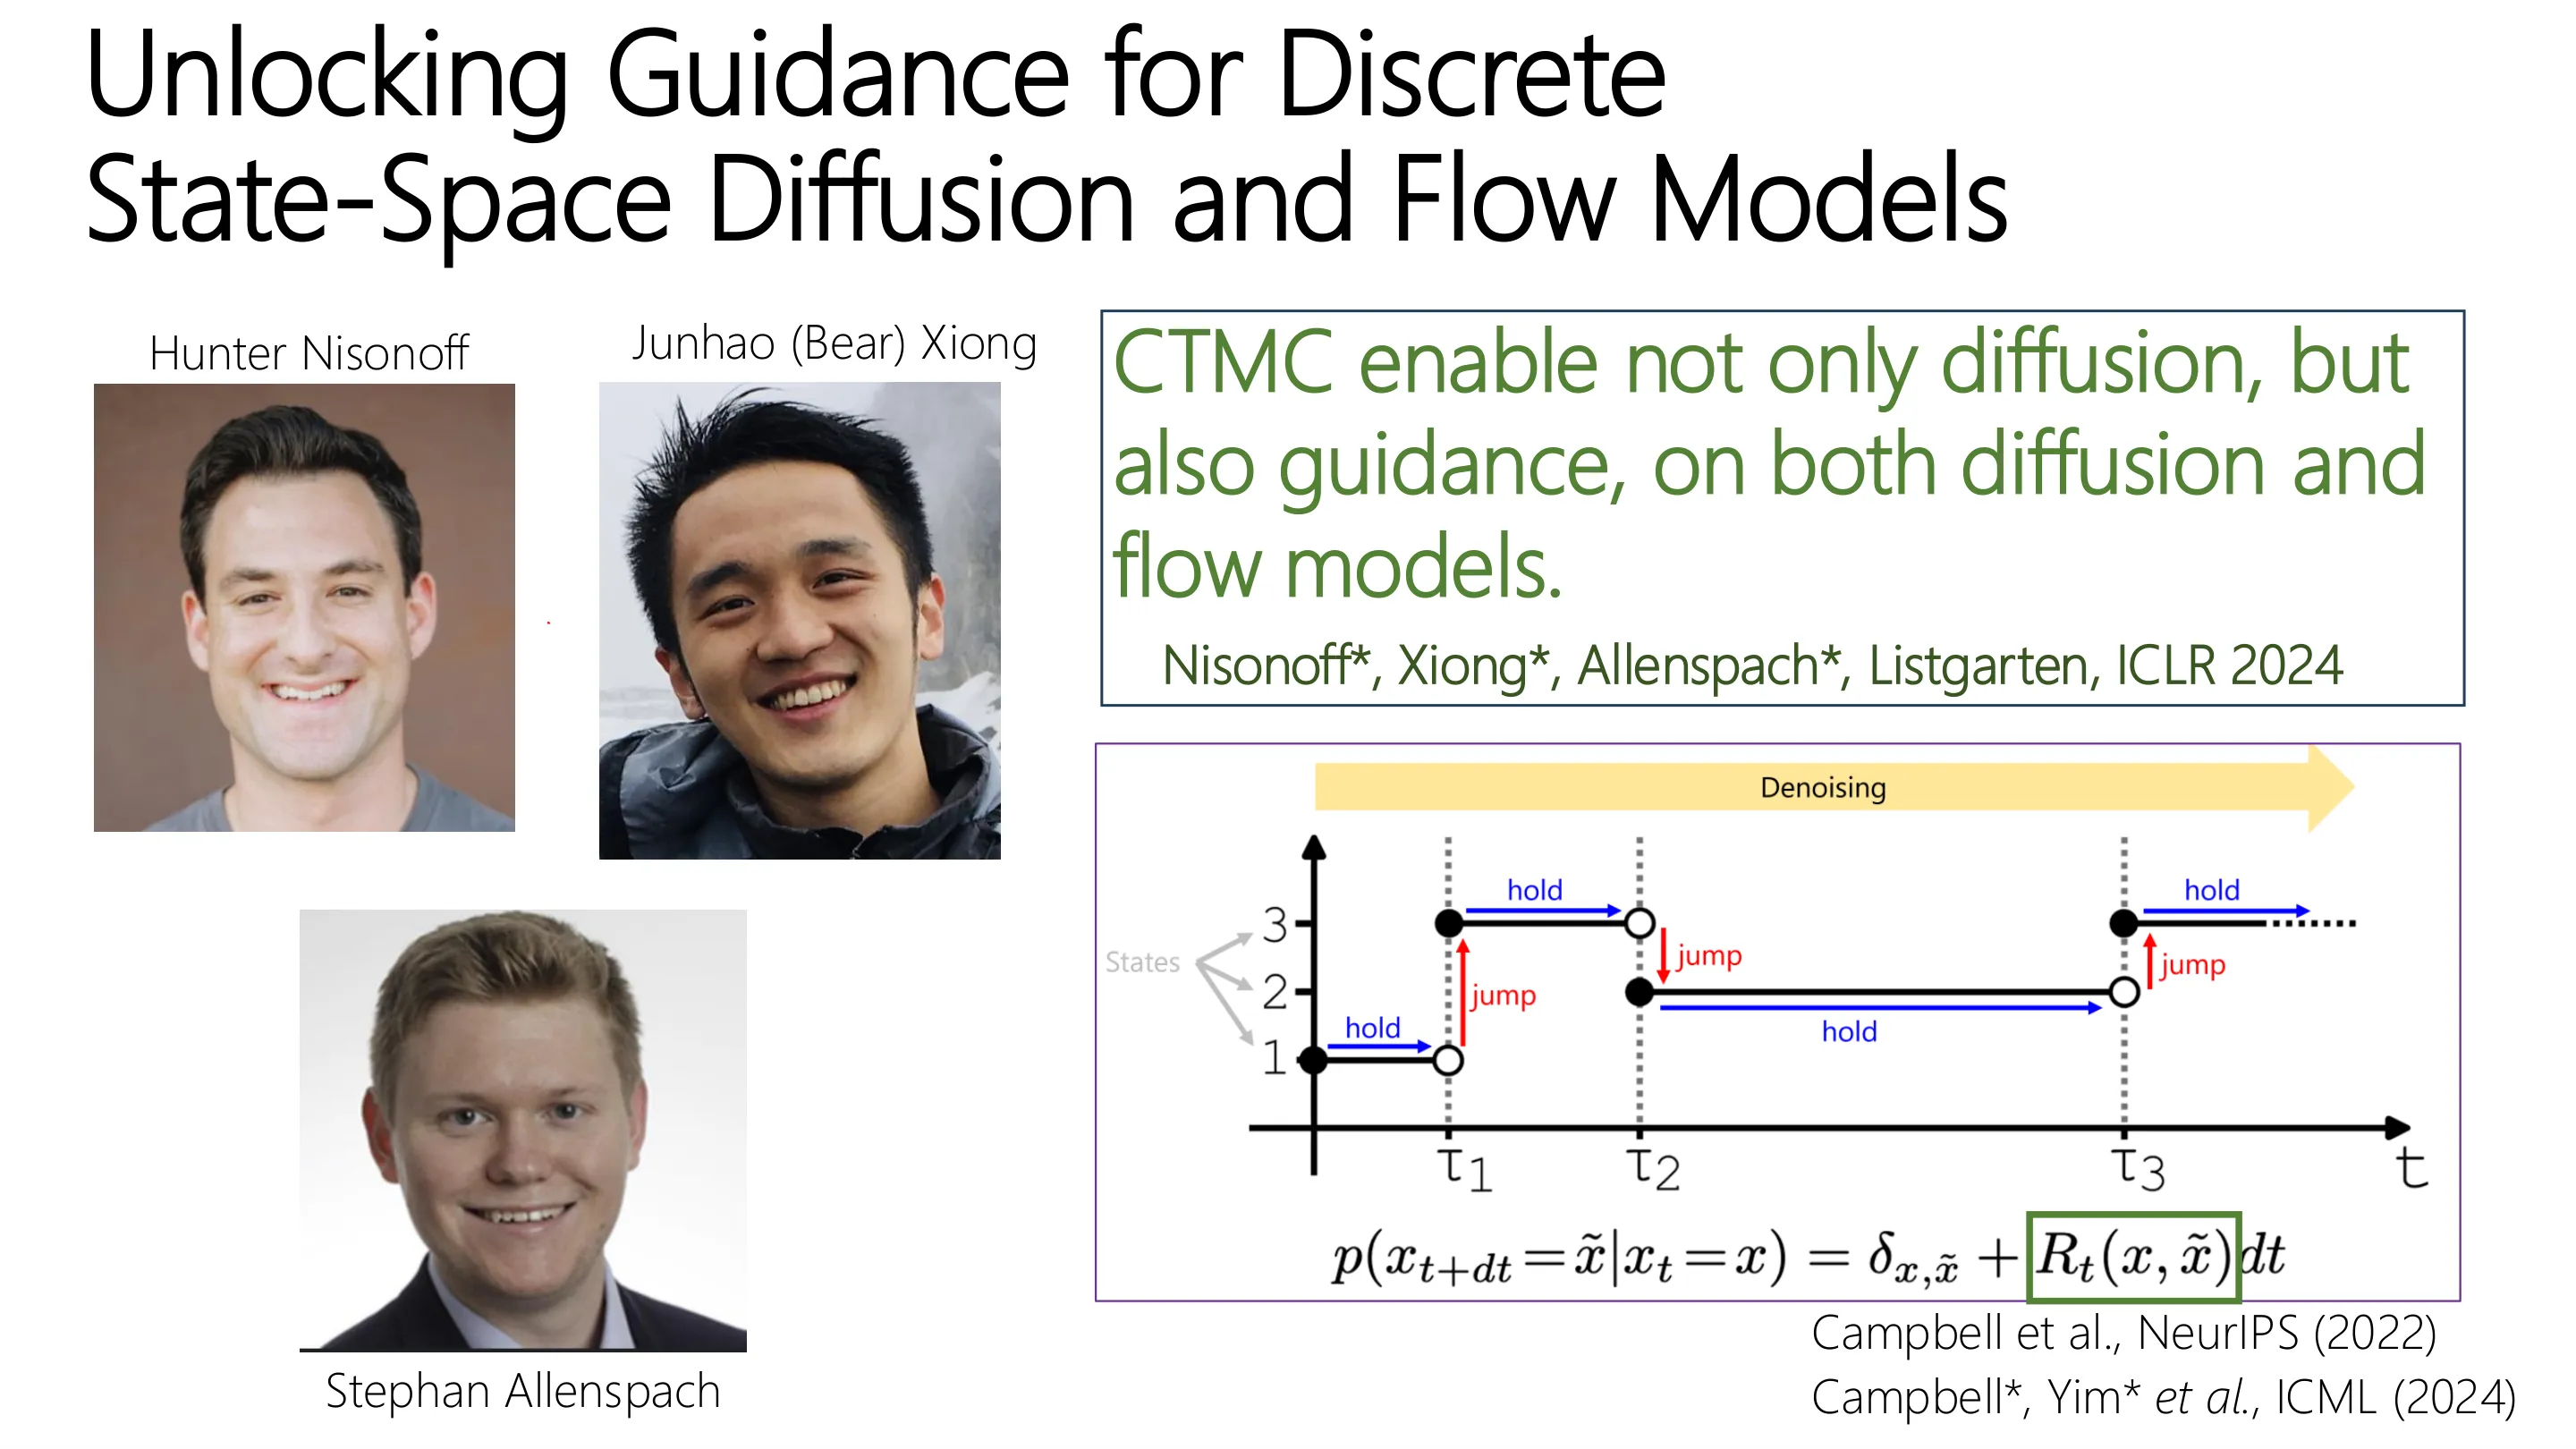
📷 为离散……解锁引导
回到原视频 (00:49:00)
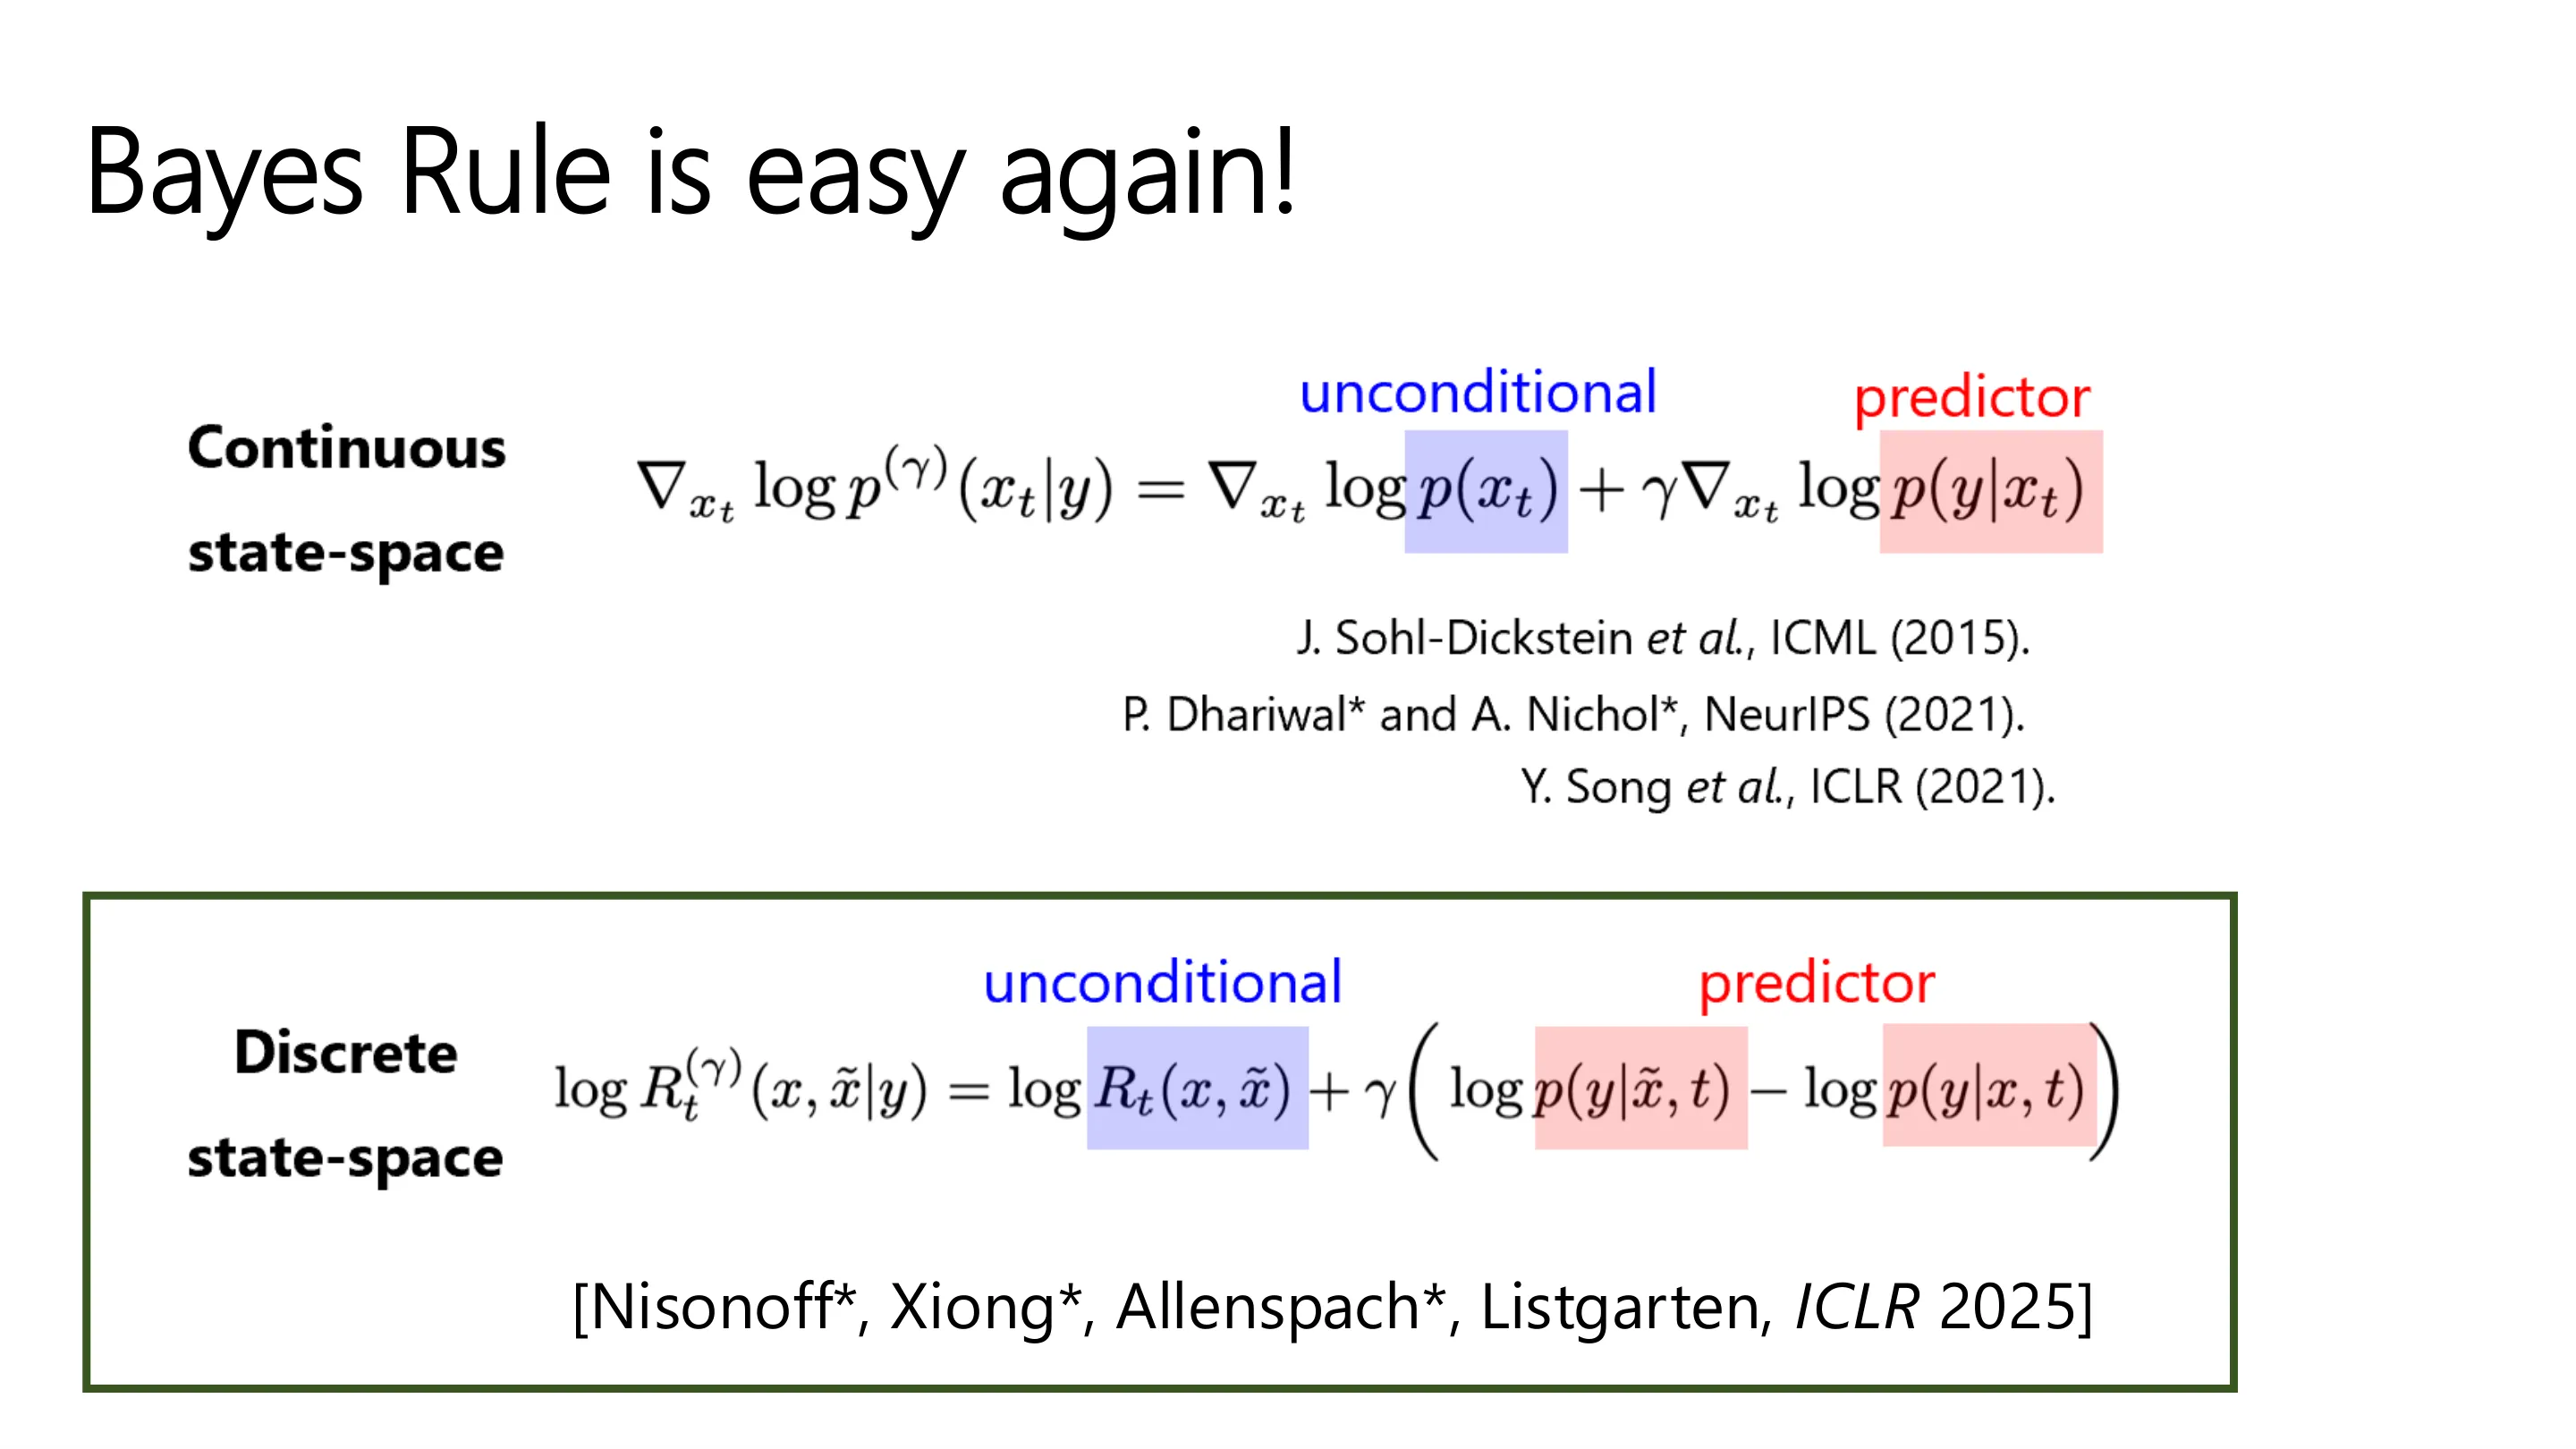
📷 贝叶斯法则又变简单了!
回到原视频 (00:50:13)
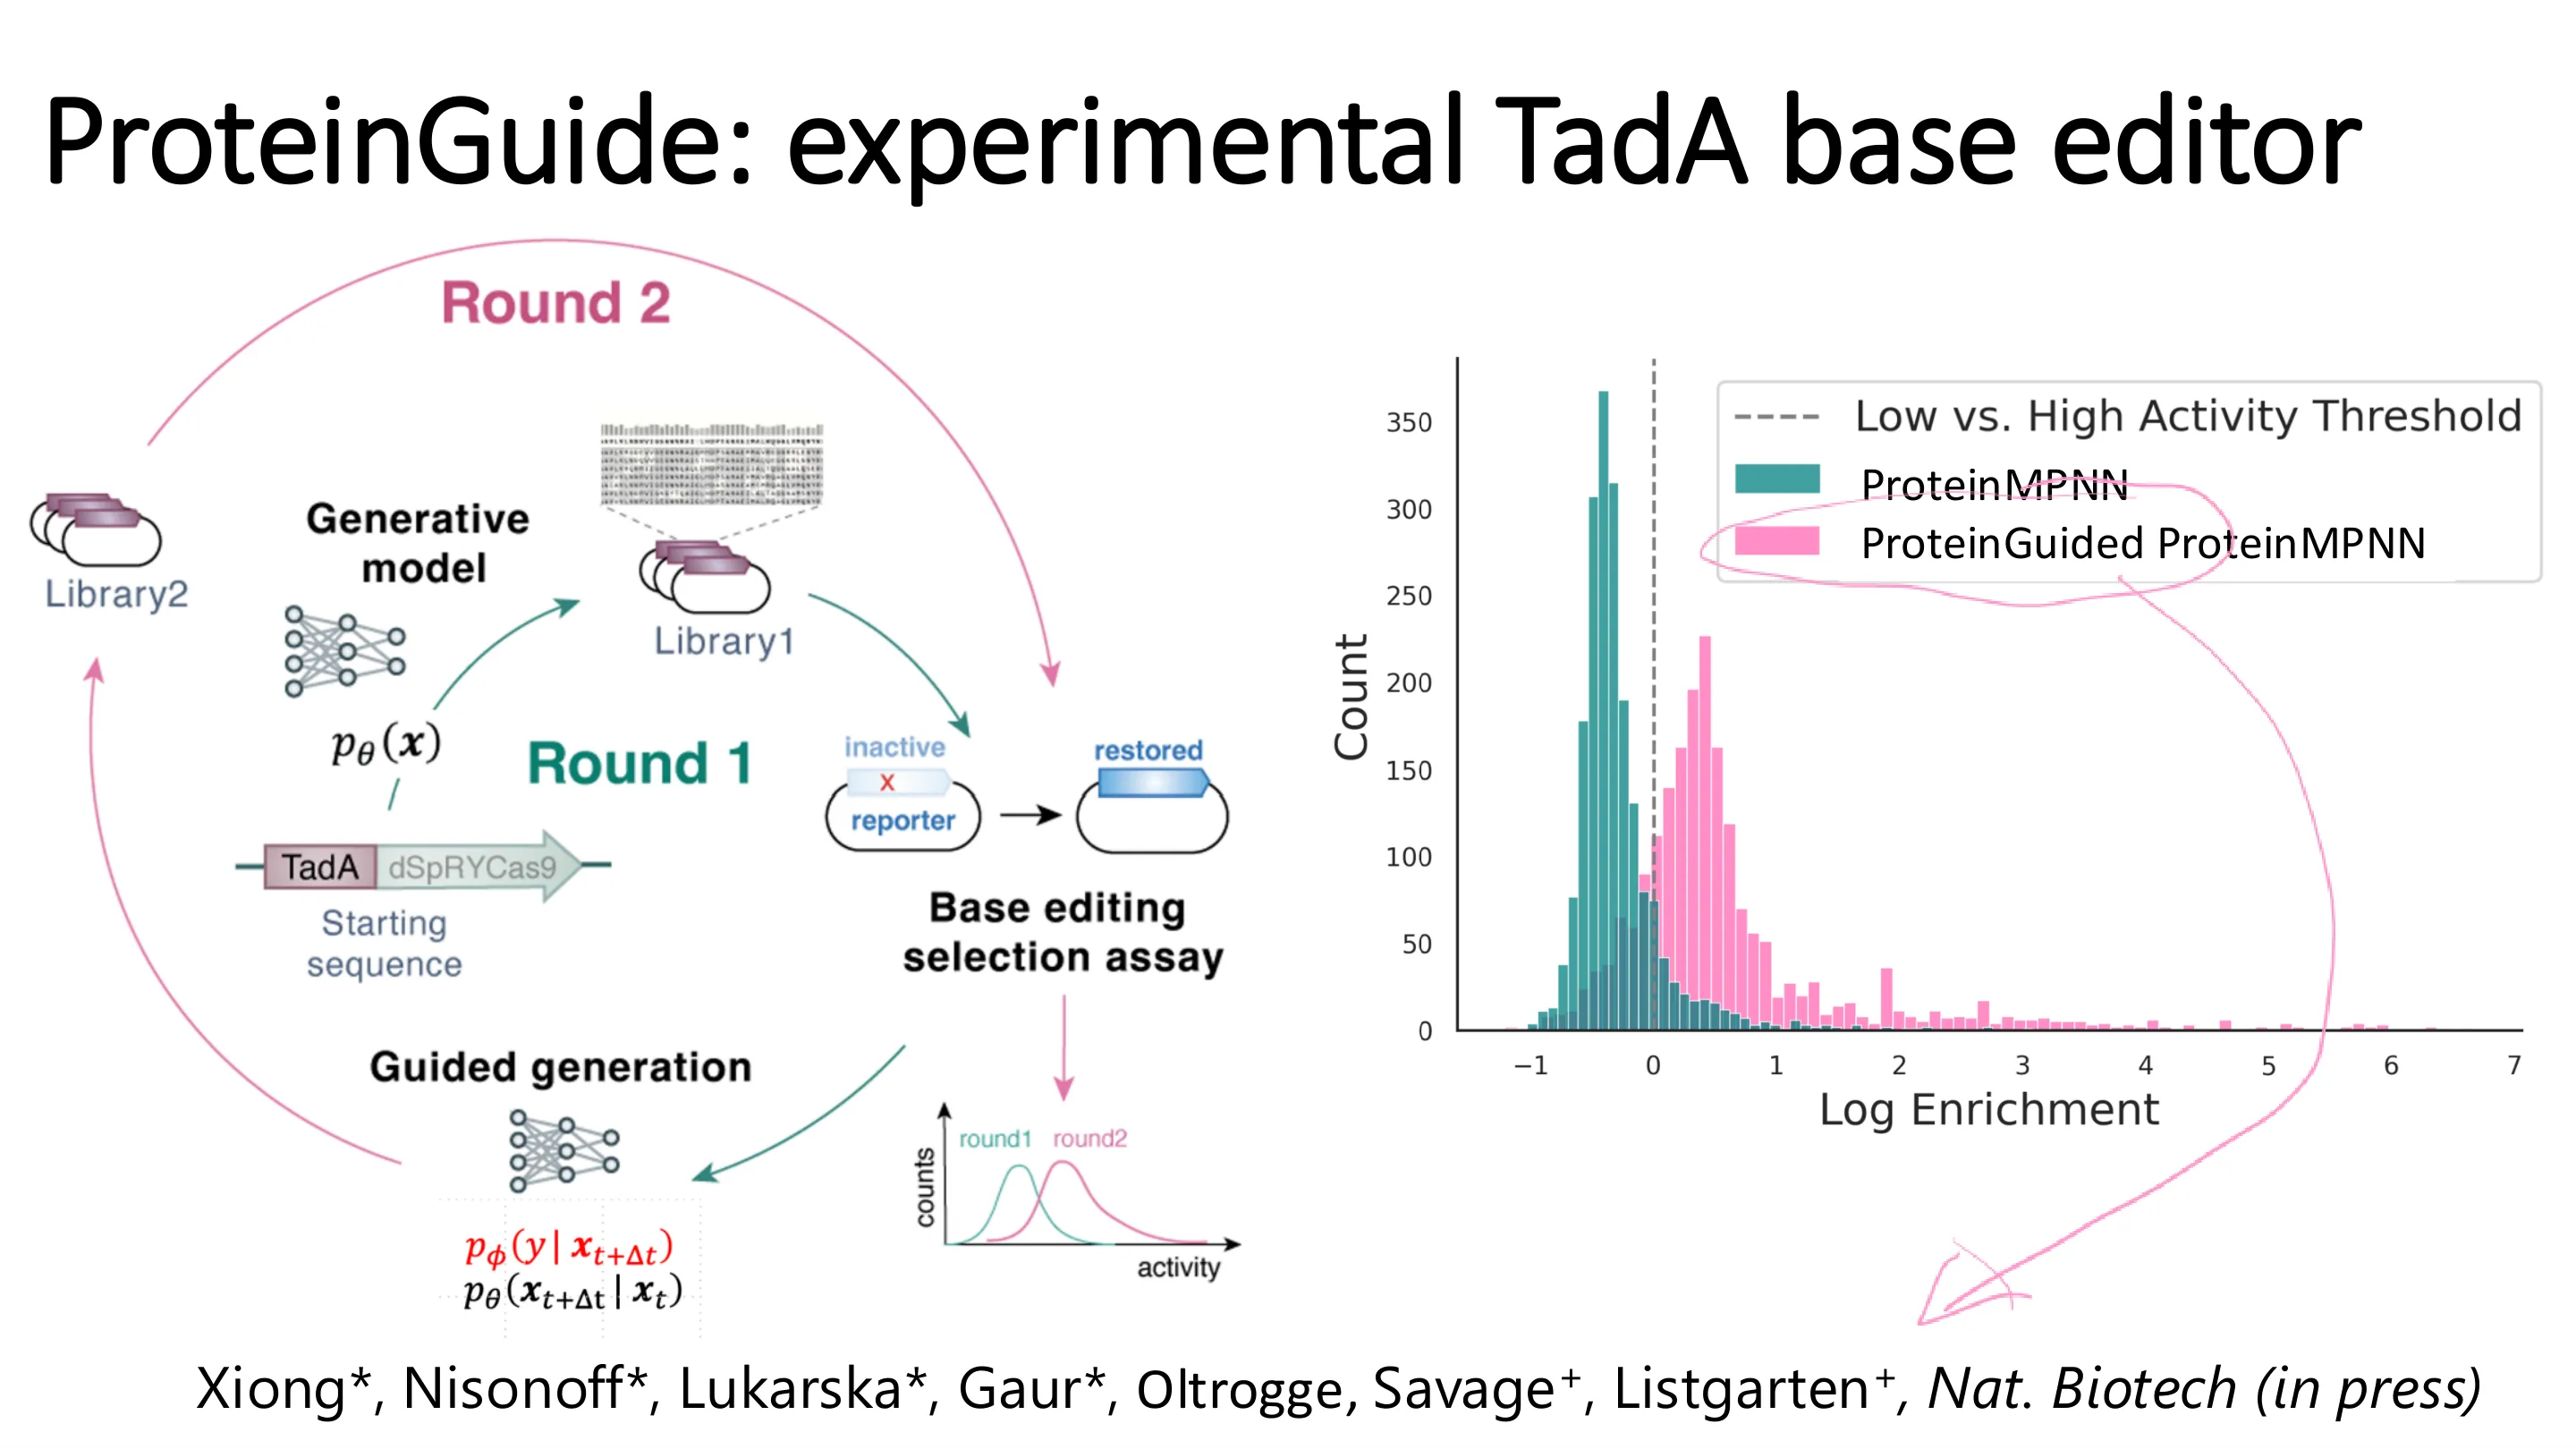
📷 (引文)
回到原视频 (00:51:26)
四、案例:AAV 载体文库设计
(参考时间: 00:44)
背景:AAV(腺相关病毒) 是基因治疗的热门载体,已有多个临床试验成功;但递送到目标组织/细胞效率低。我们对 AAV 外壳蛋白做工程以提升递送。
AAV 文库设计流程:
- 设计候选序列文库;
- 建立机器学习预测模型(从小规模实验数据学习多样性与适应度的关系);
- 反向利用 ML 预测模型,得到多样性-适应度最优曲线;
- 湿实验验证。
结果:预测与实验的 Pearson 相关 = 0.96(p=0.001)。
统计视角:所有花哨名称的生成模型,本质都是估计条件密度并采样——只是「用 AI 语言包装的现代统计学」。本讲的模型框架可迁移到其他离散对象领域(小分子、材料、自然语言)。
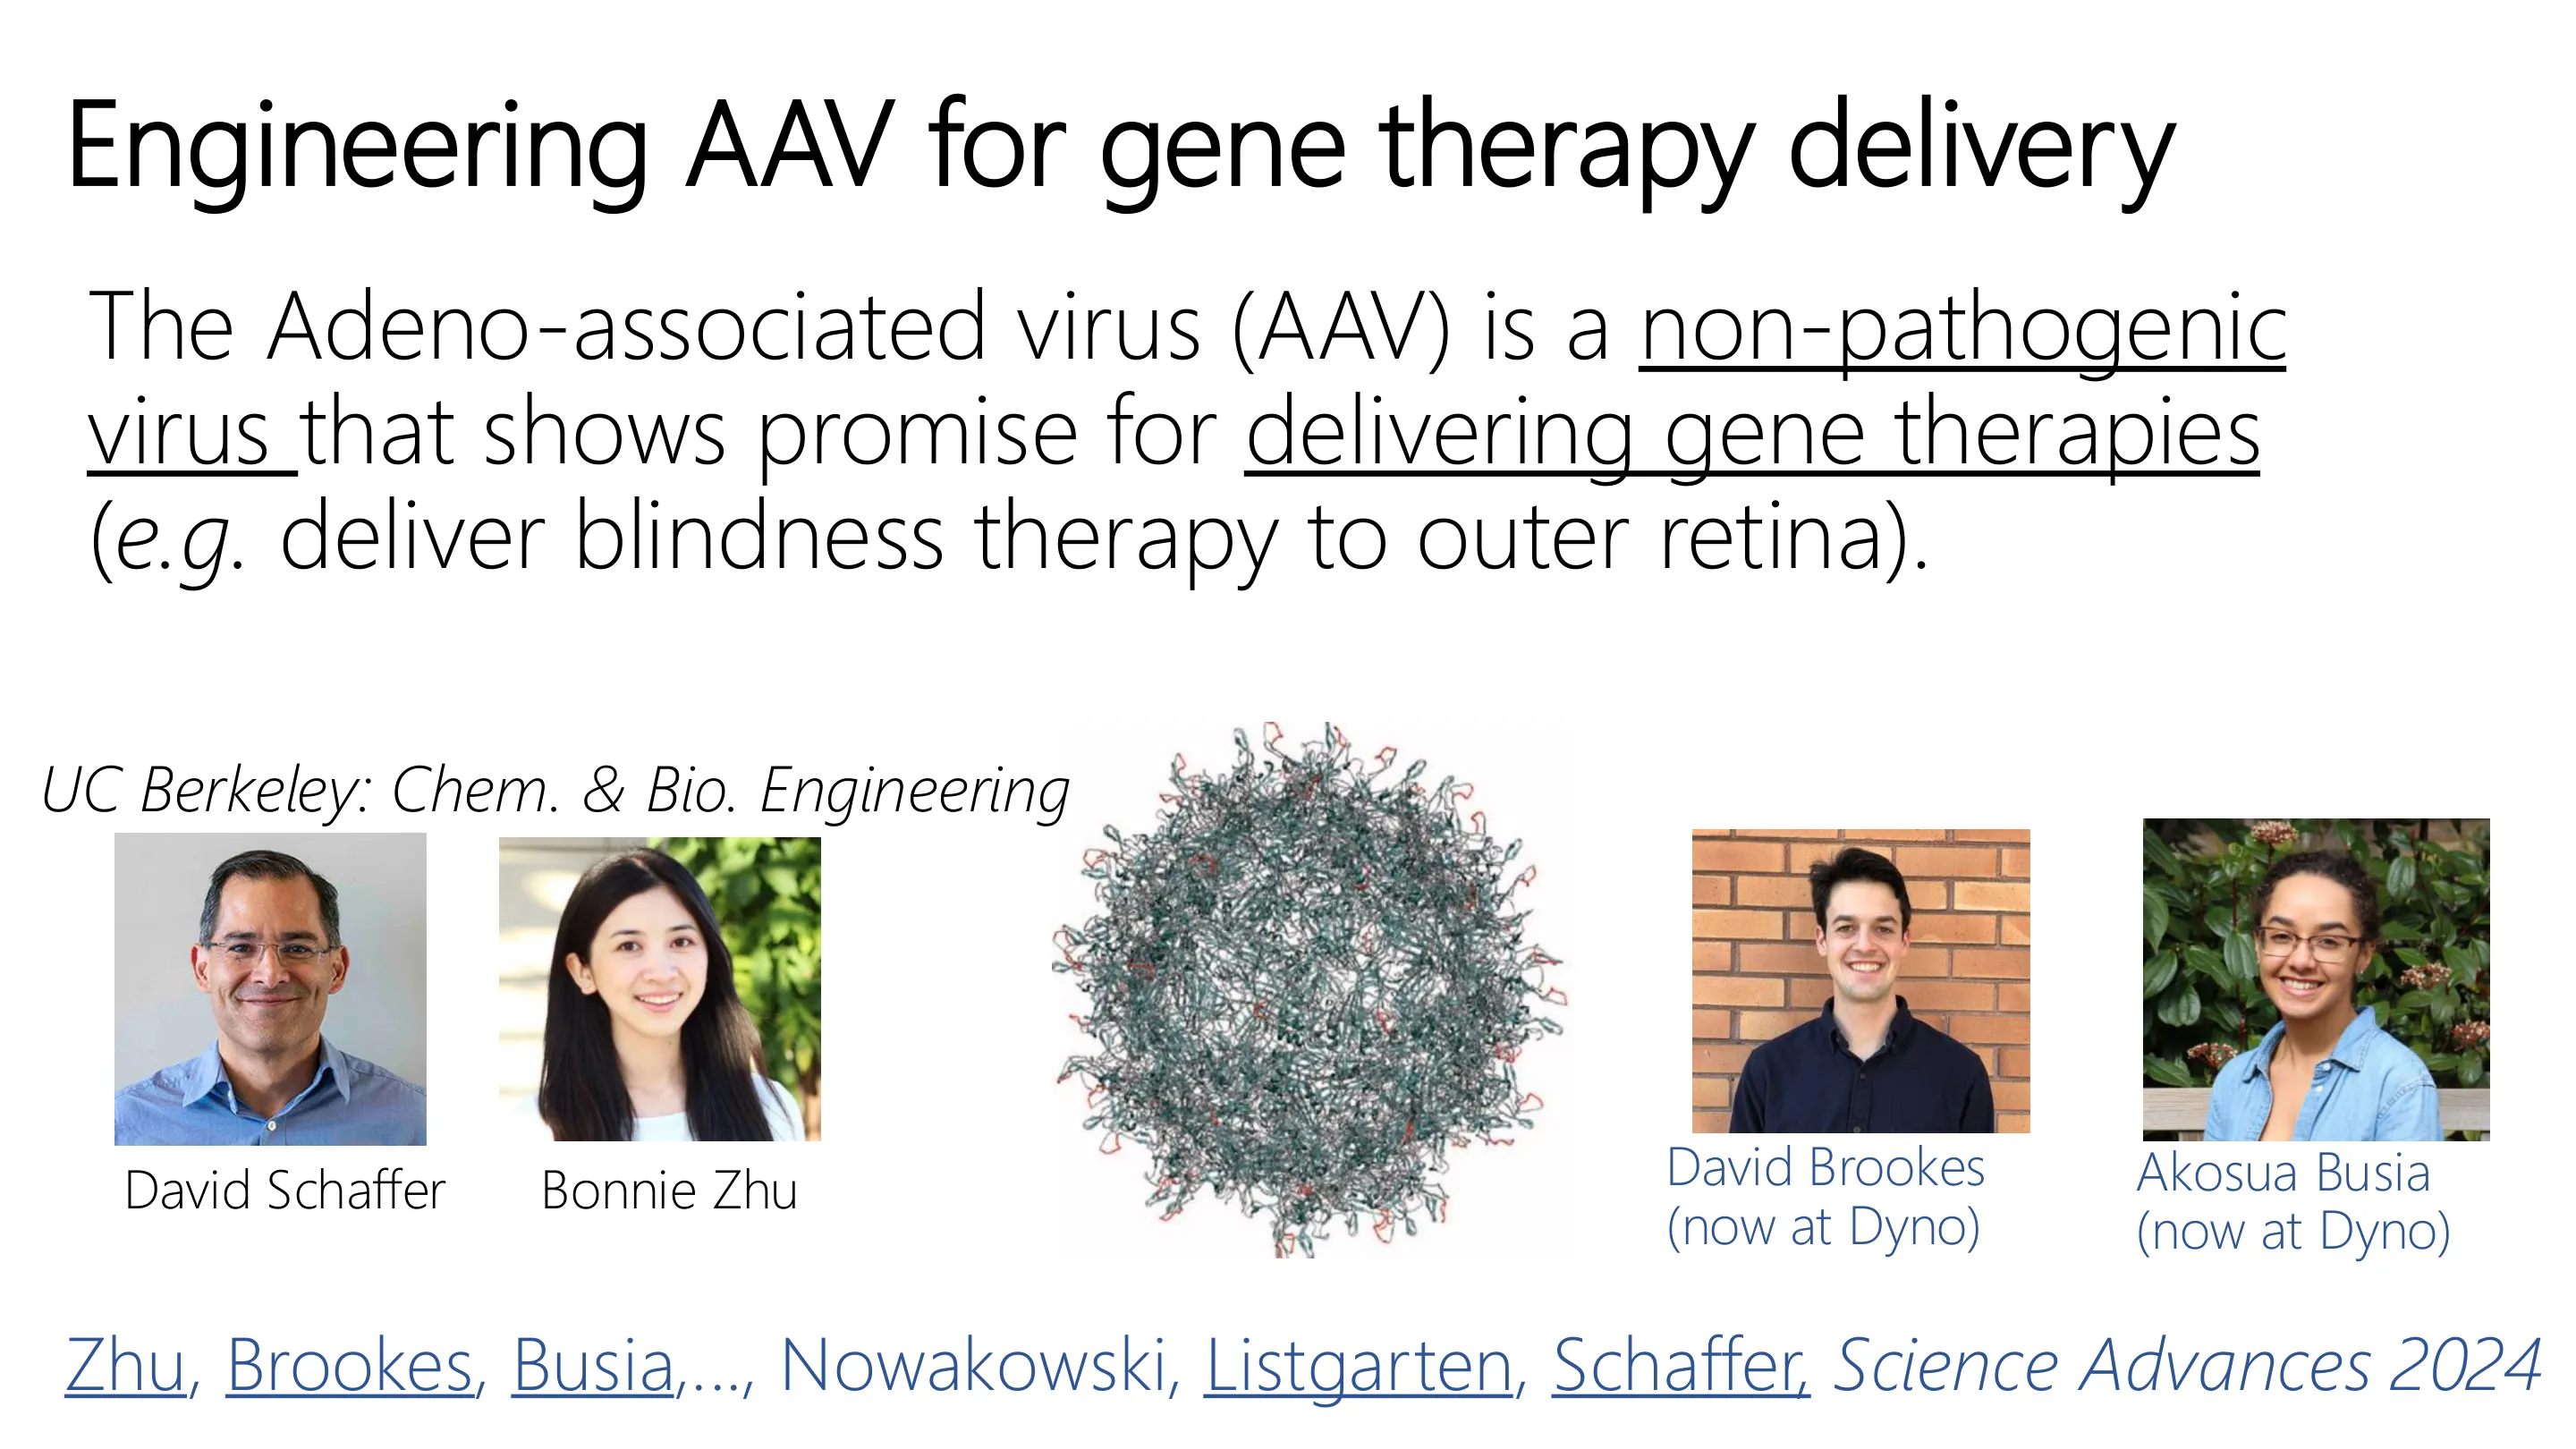
📷 为基因治疗递送工程化 AAV
回到原视频 (00:52:39)
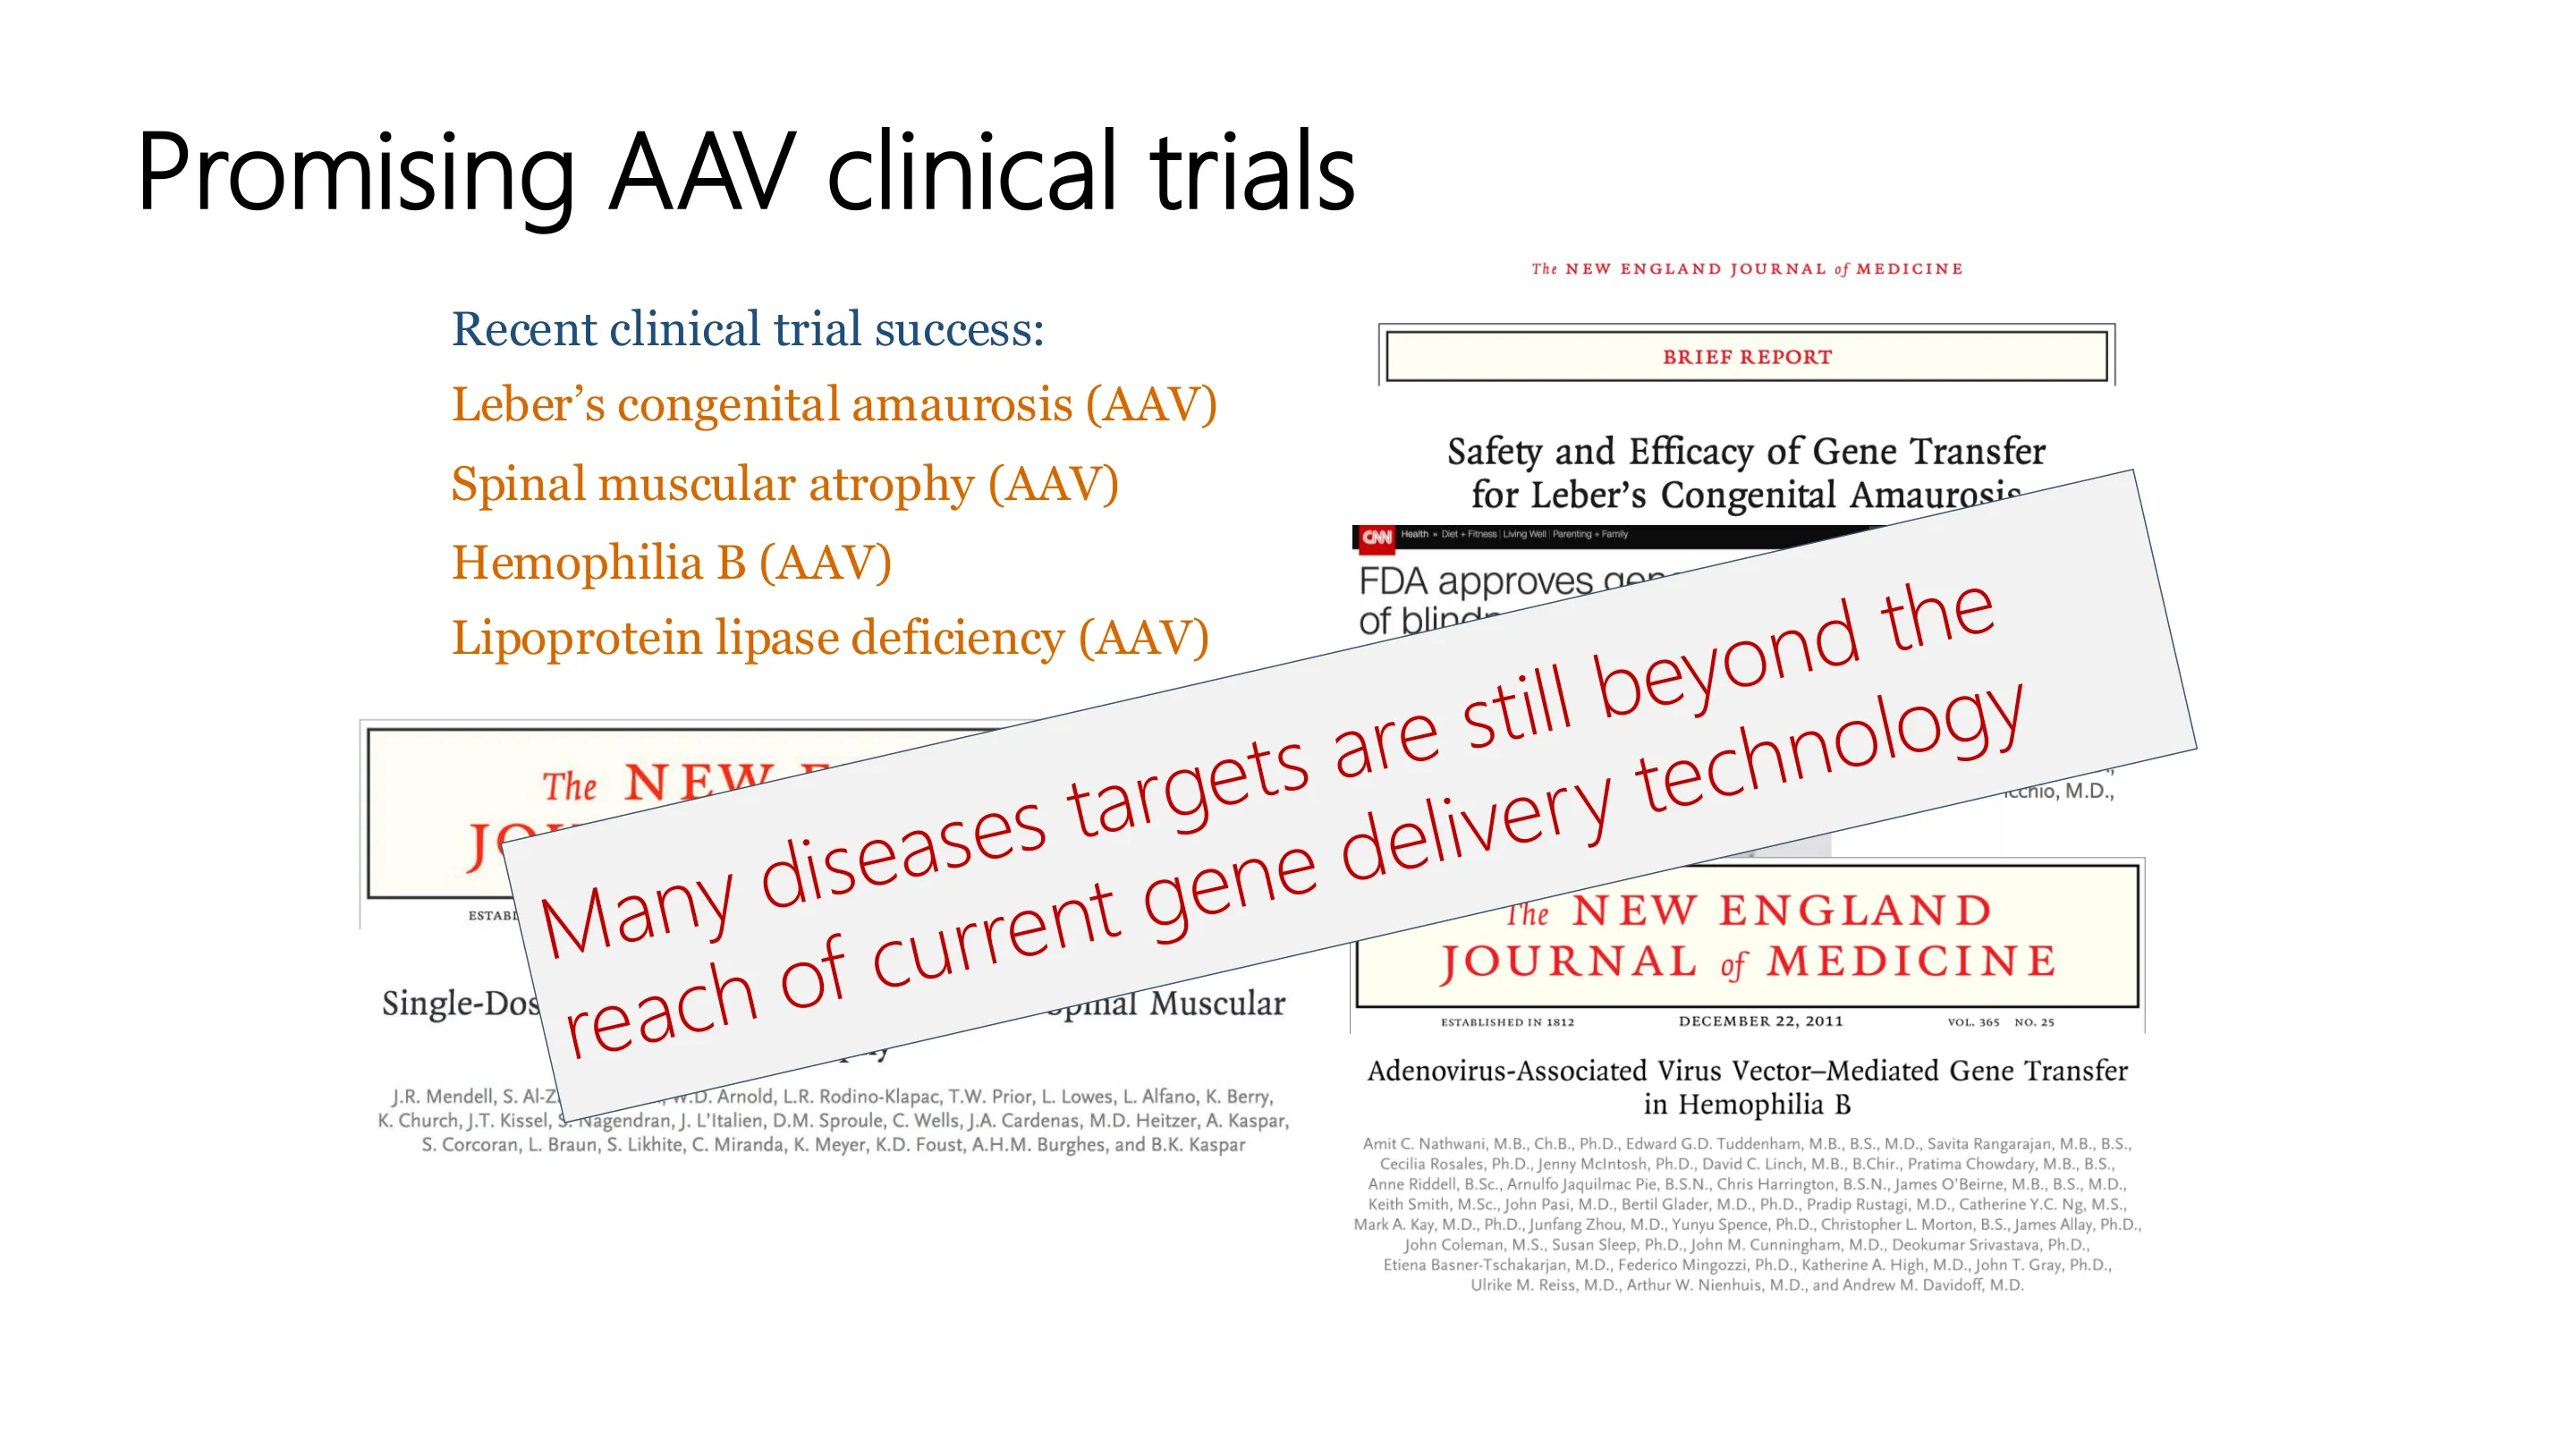
📷 有前景的 AAV 临床试验
回到原视频 (00:53:52)
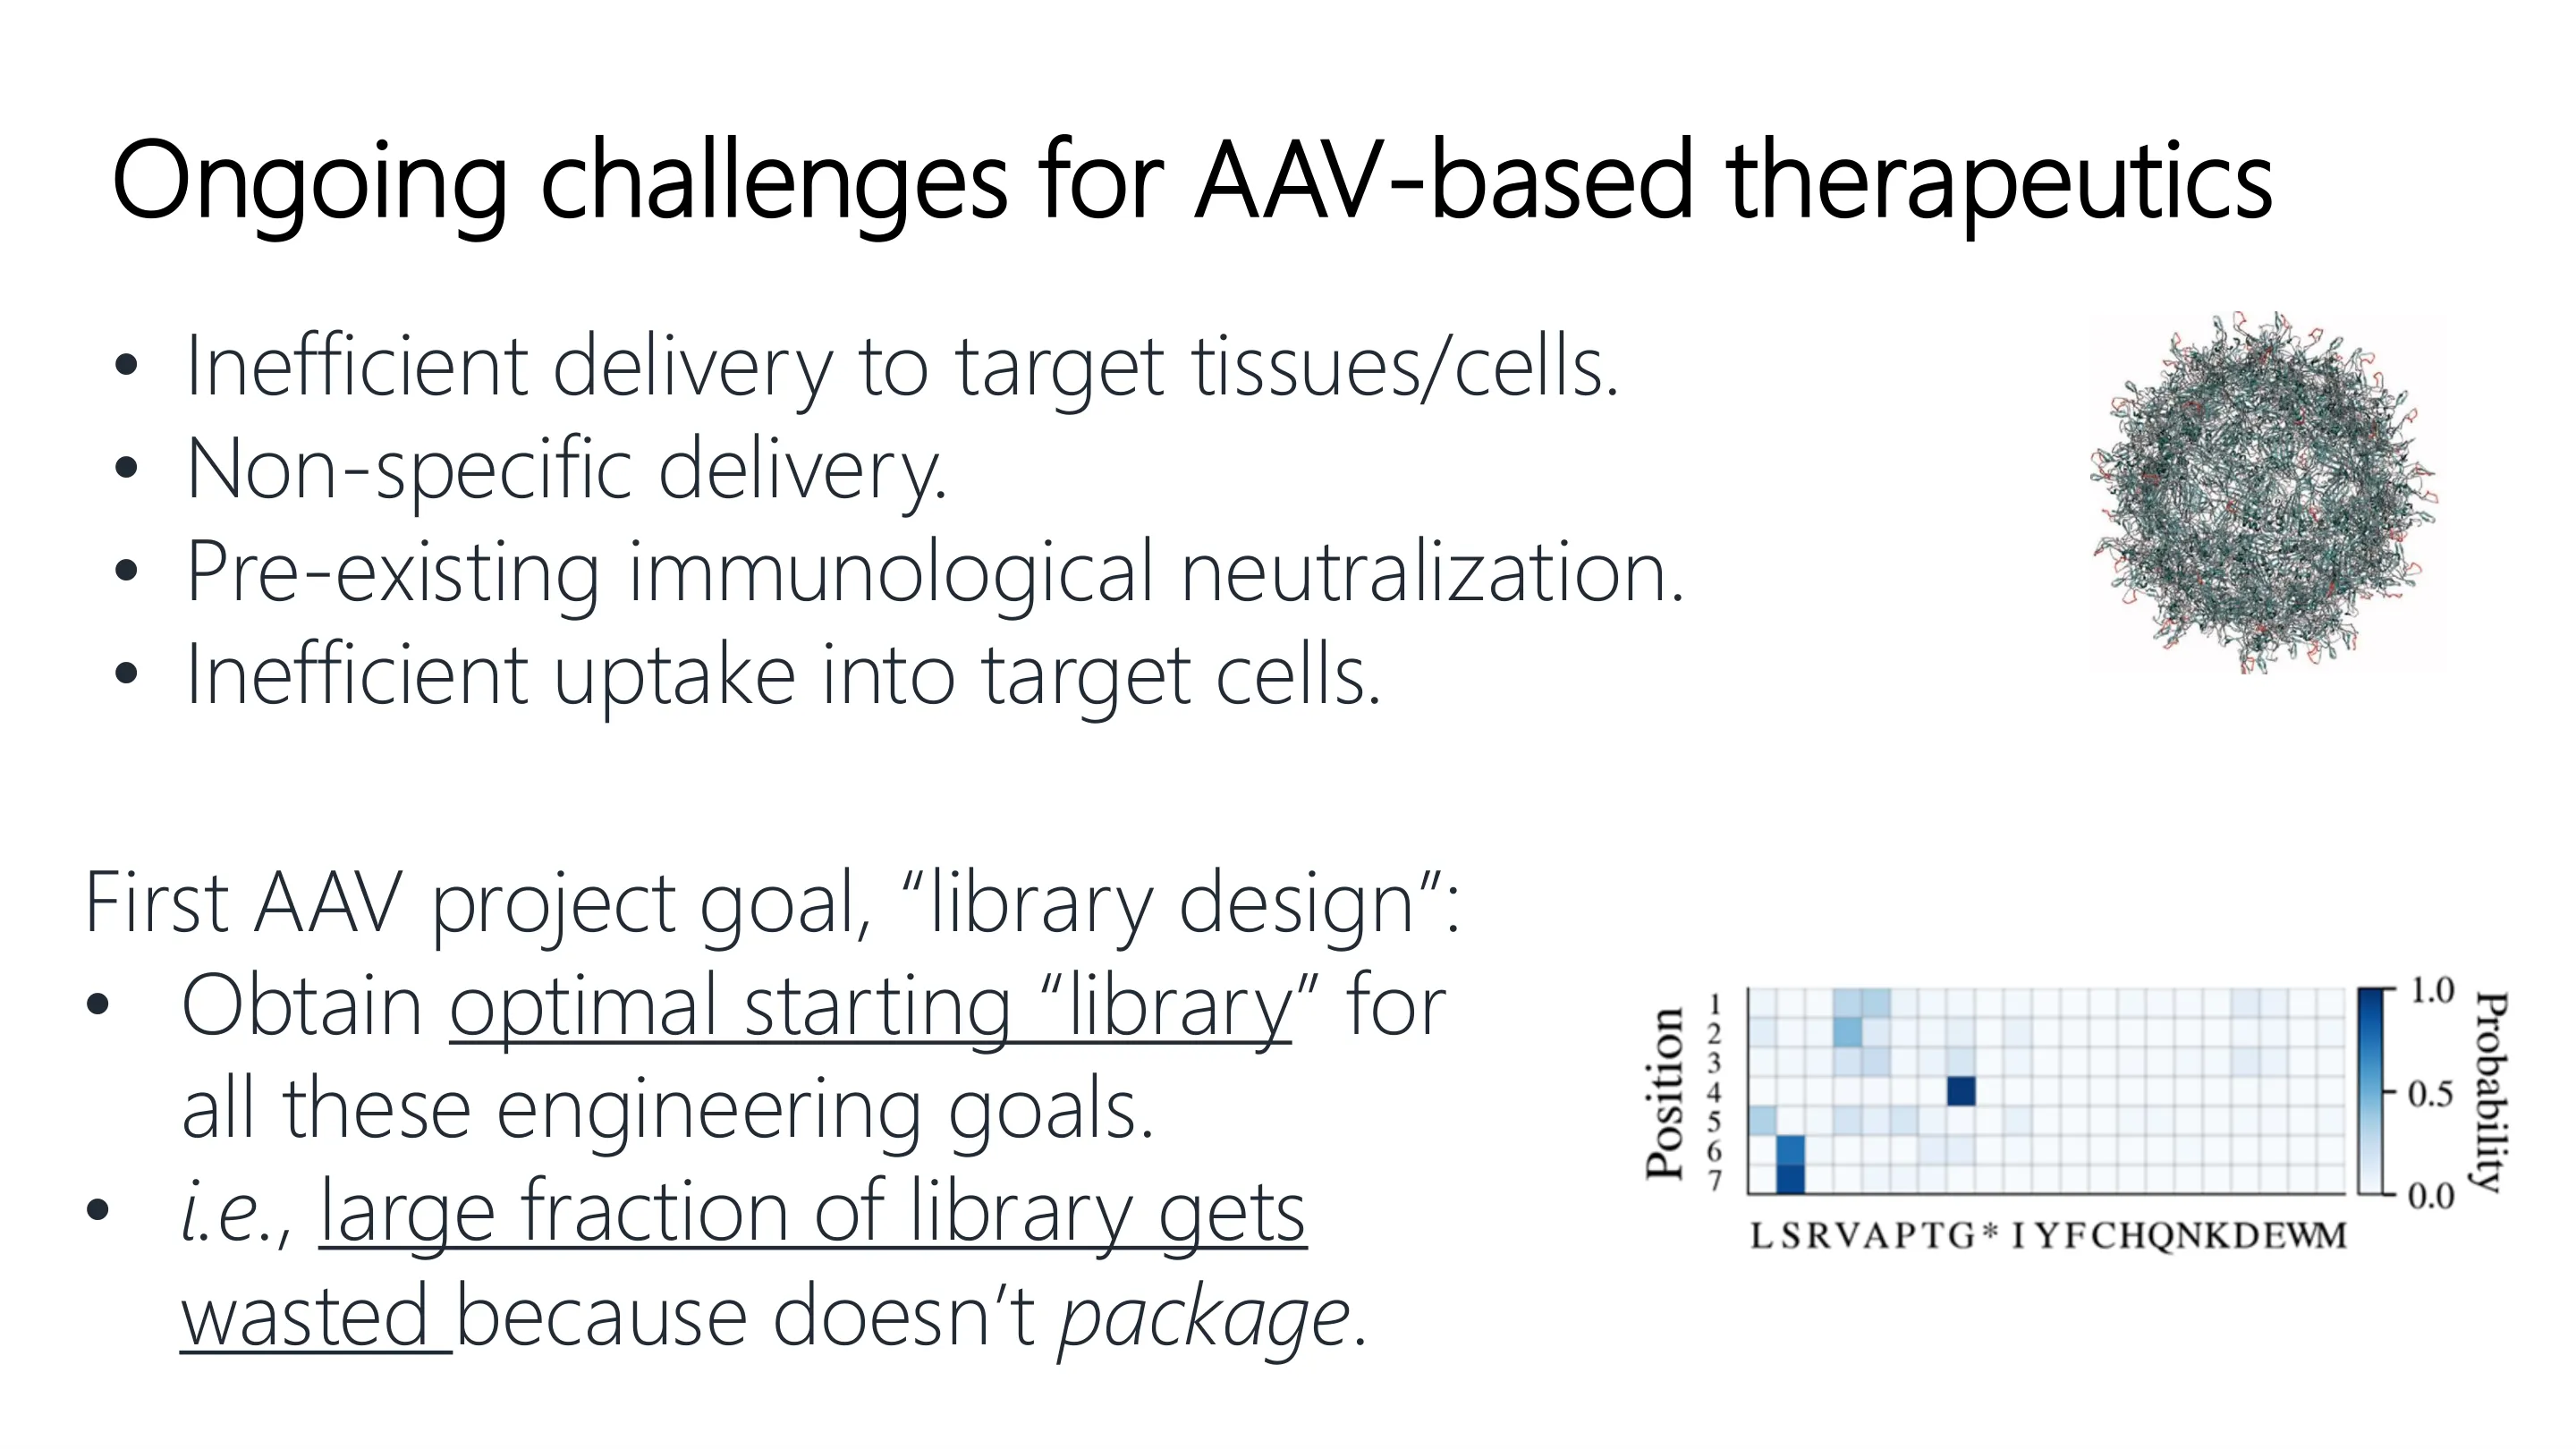
📷 递送到目标组织/细胞效率低
回到原视频 (00:55:05)
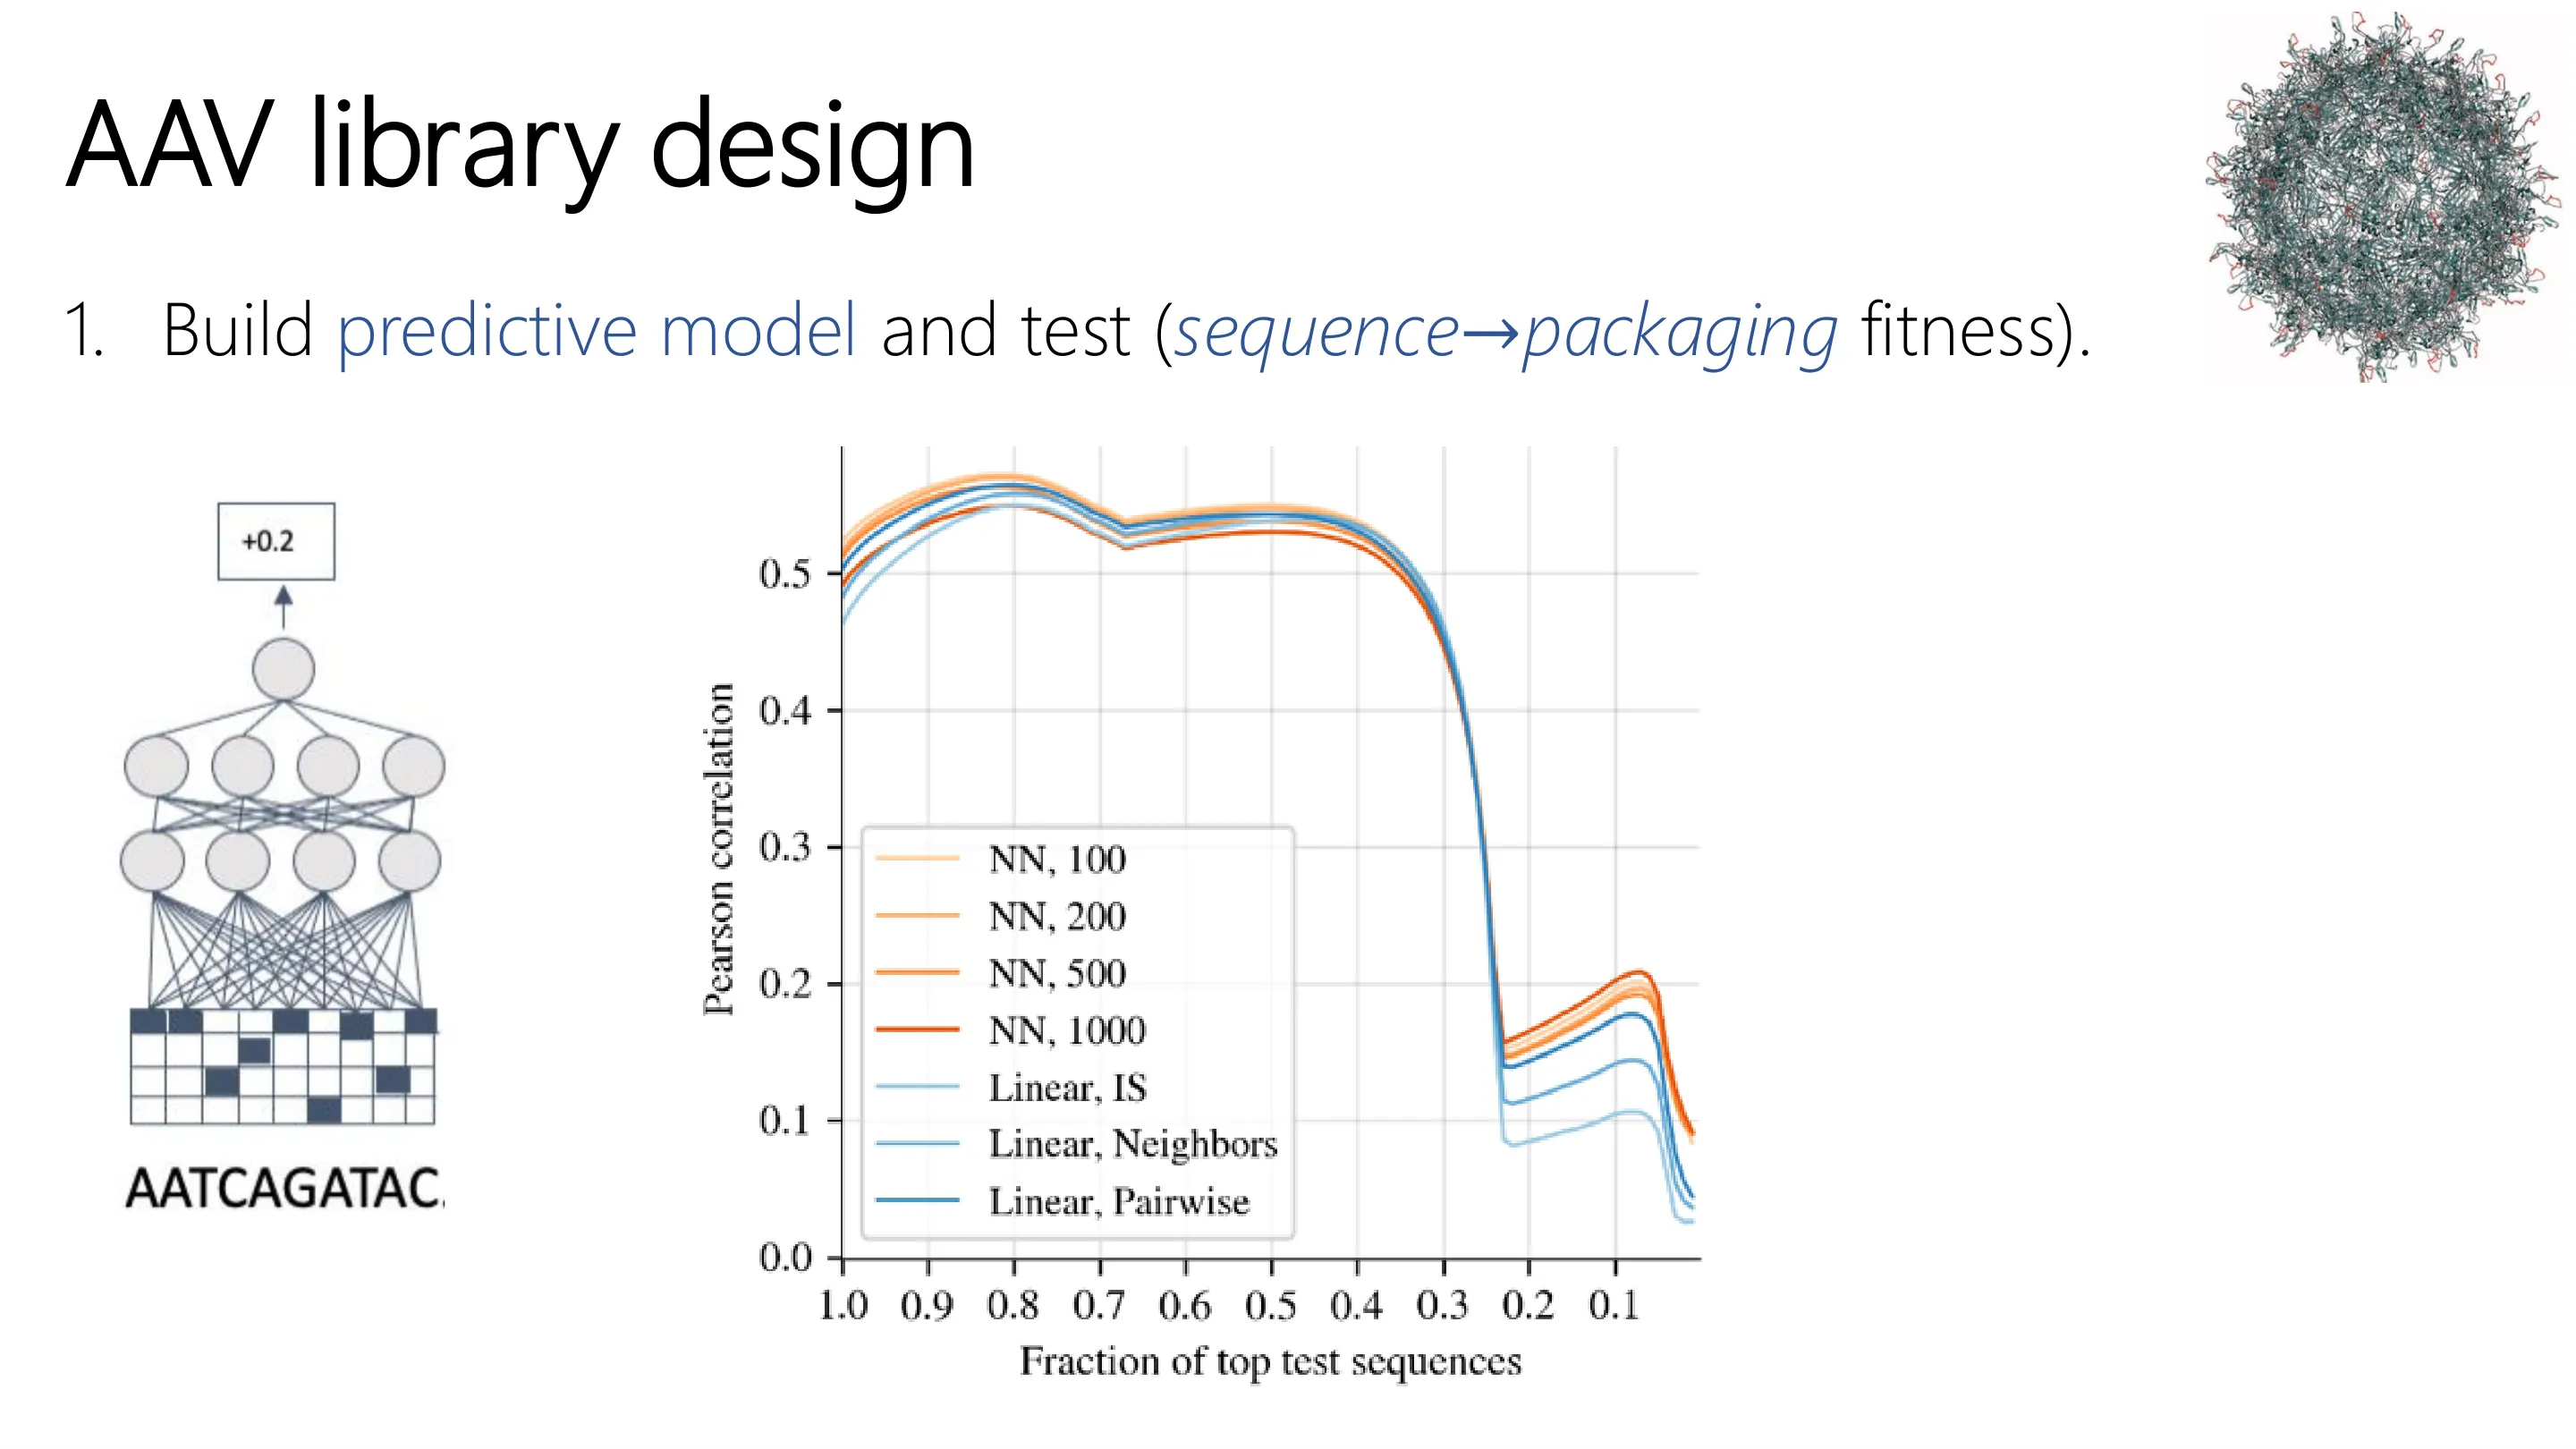
📷 AAV 文库设计(一)
回到原视频 (00:56:18)
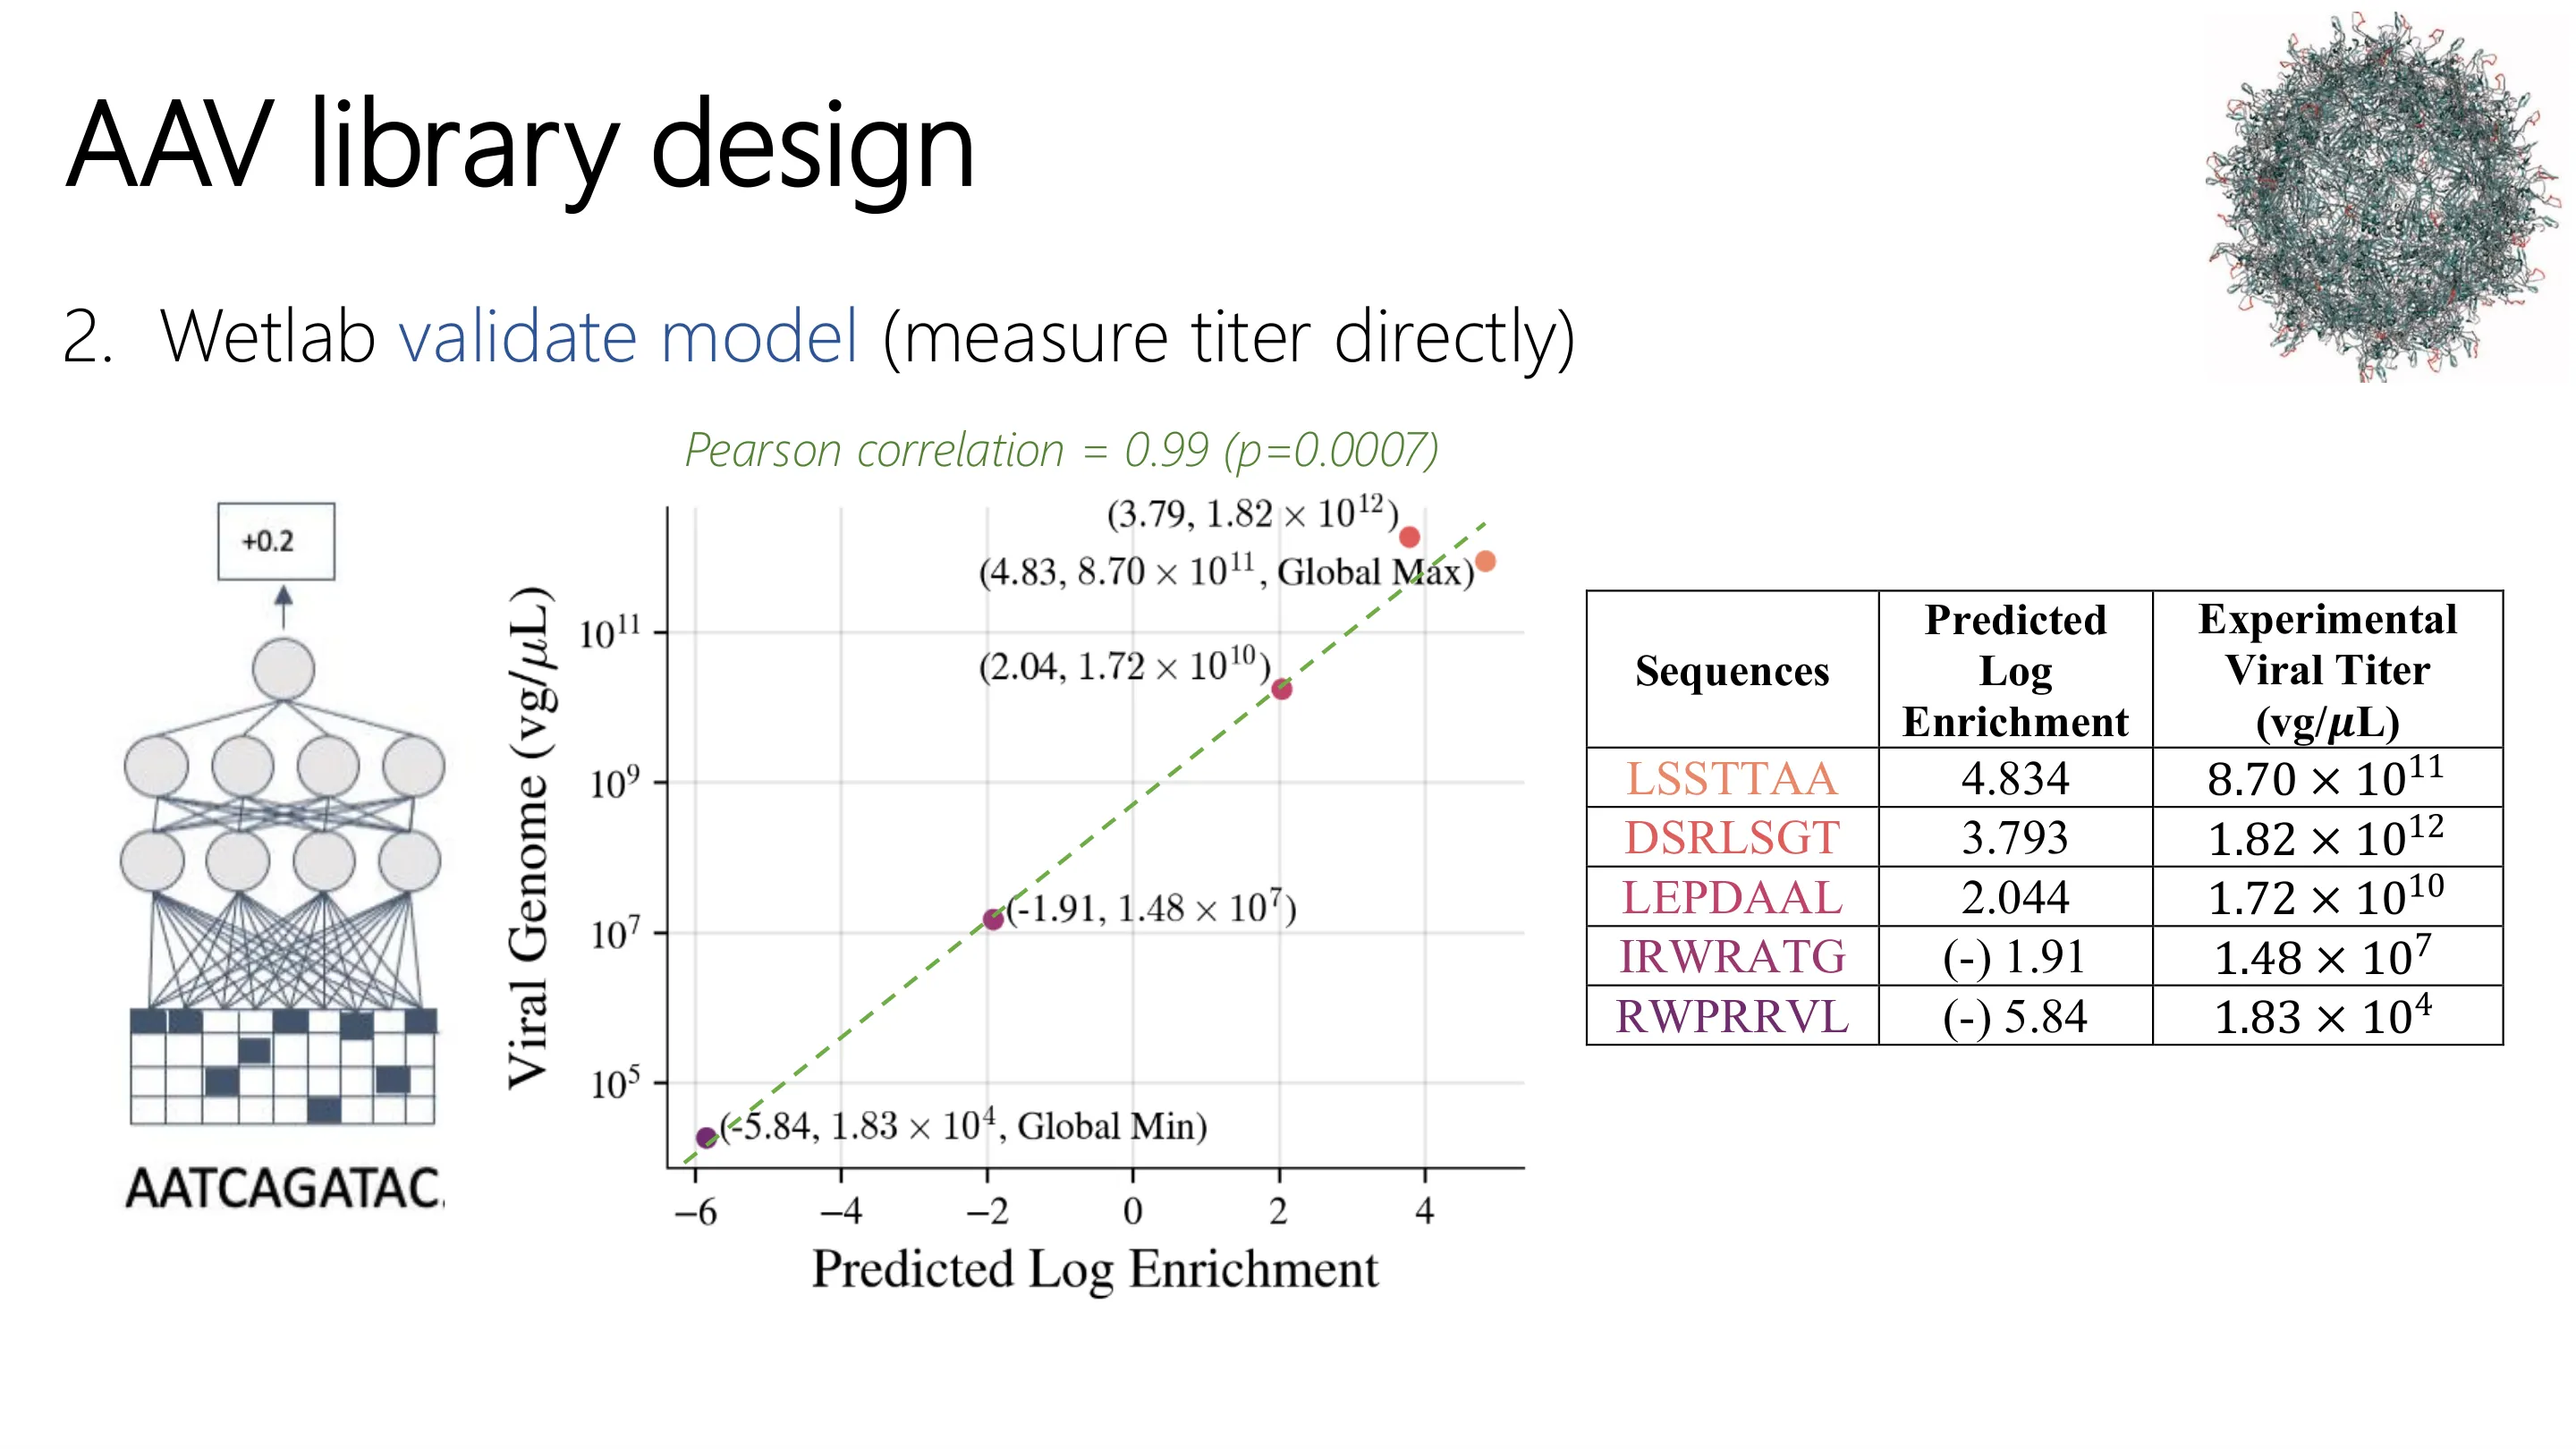
📷 AAV 文库设计(二)
回到原视频 (00:57:31)
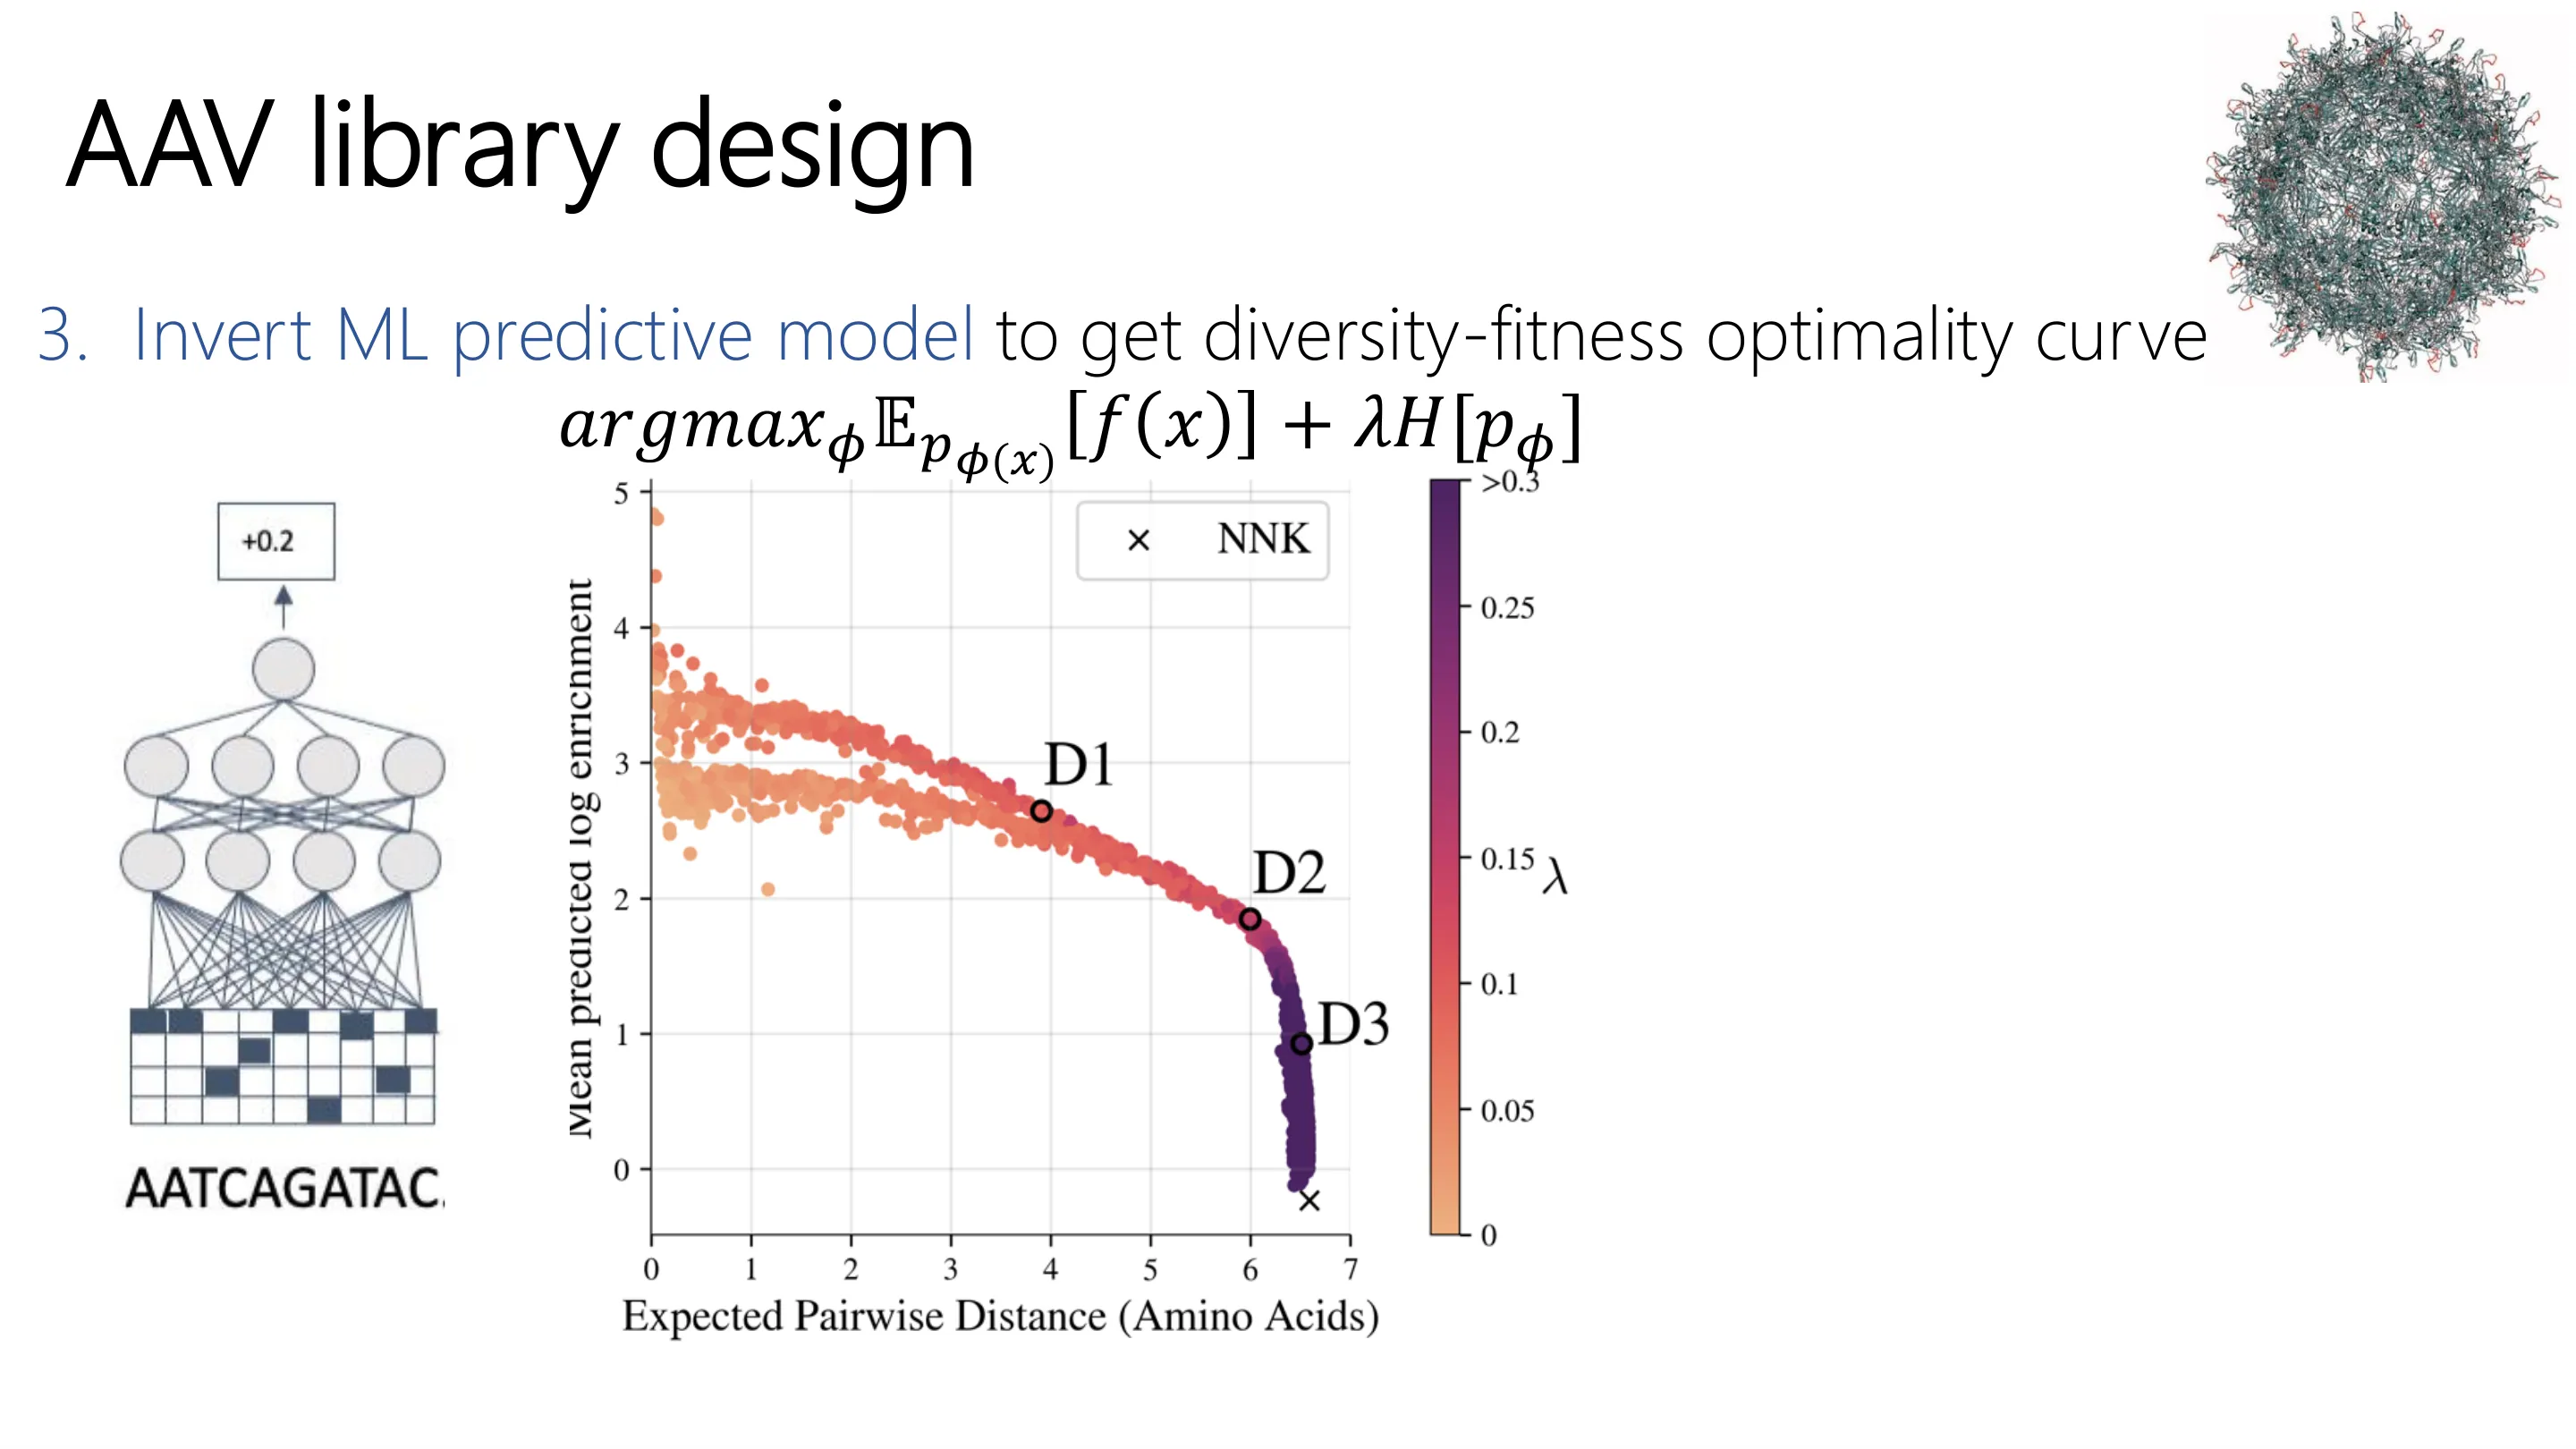
📷 反转 ML 预测模型以得到多样性-适应度最优曲线
回到原视频 (00:58:44)
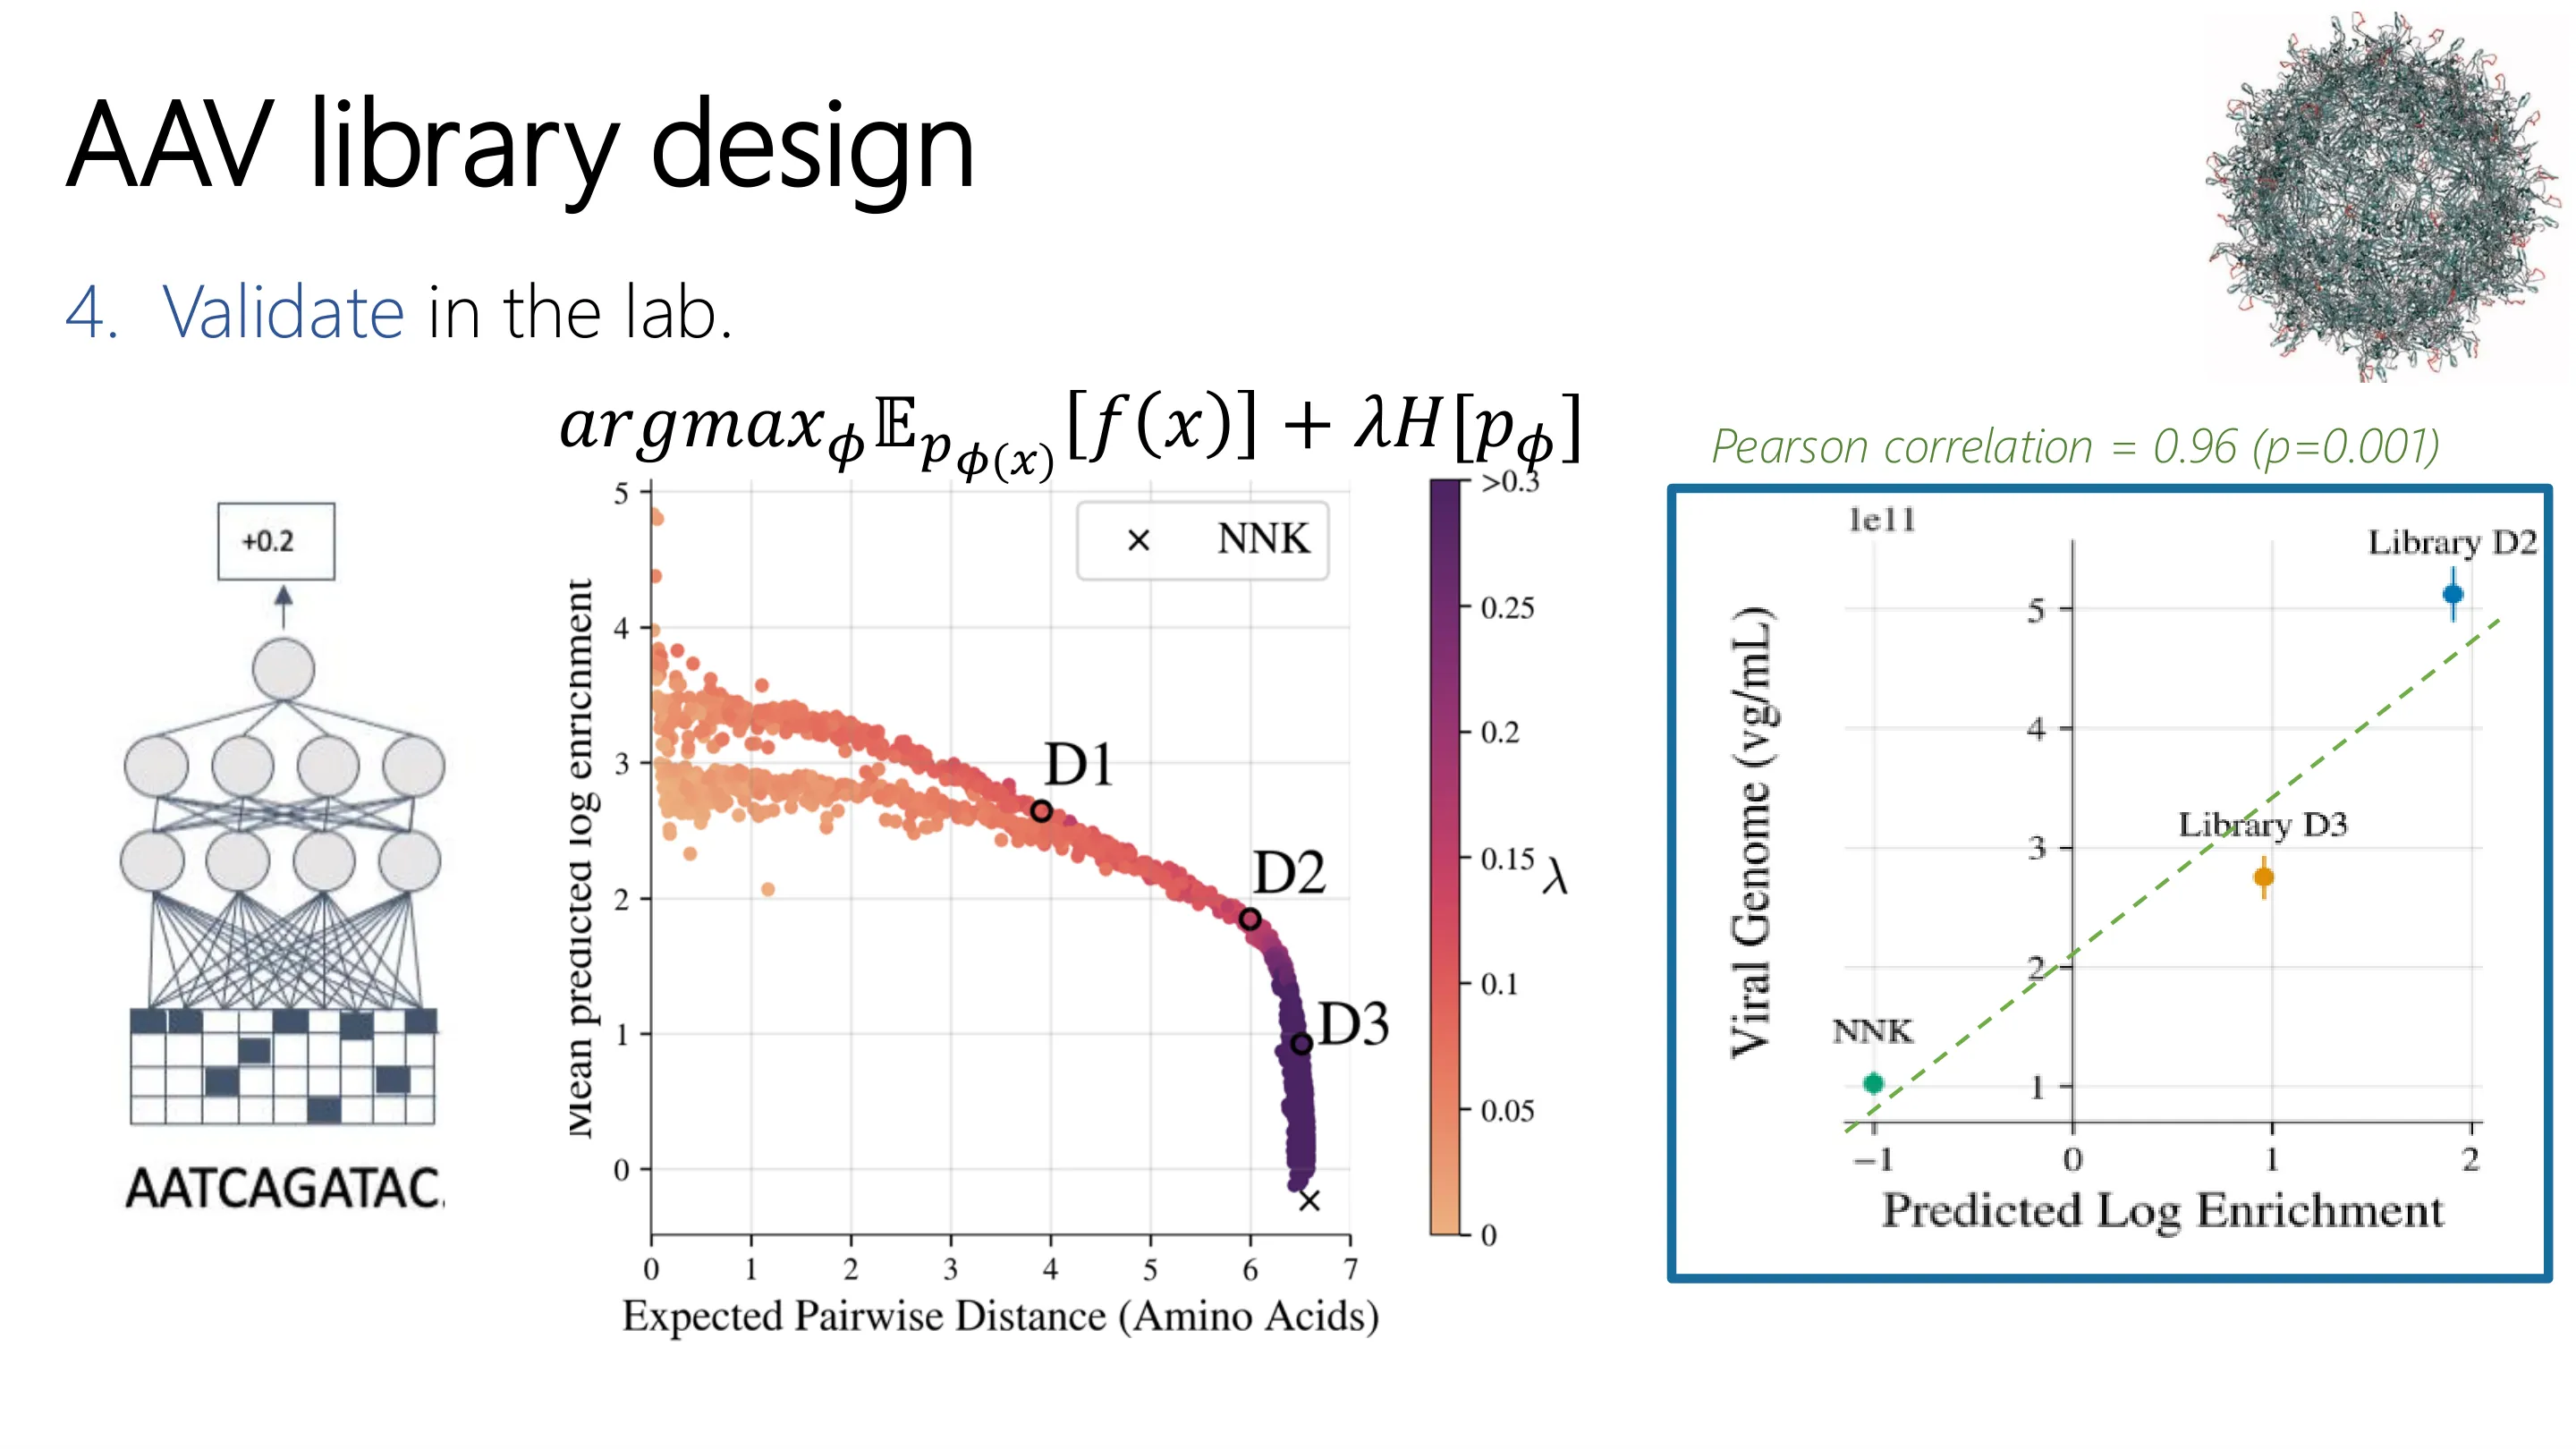
📷 在实验室中验证
回到原视频 (00:59:57)
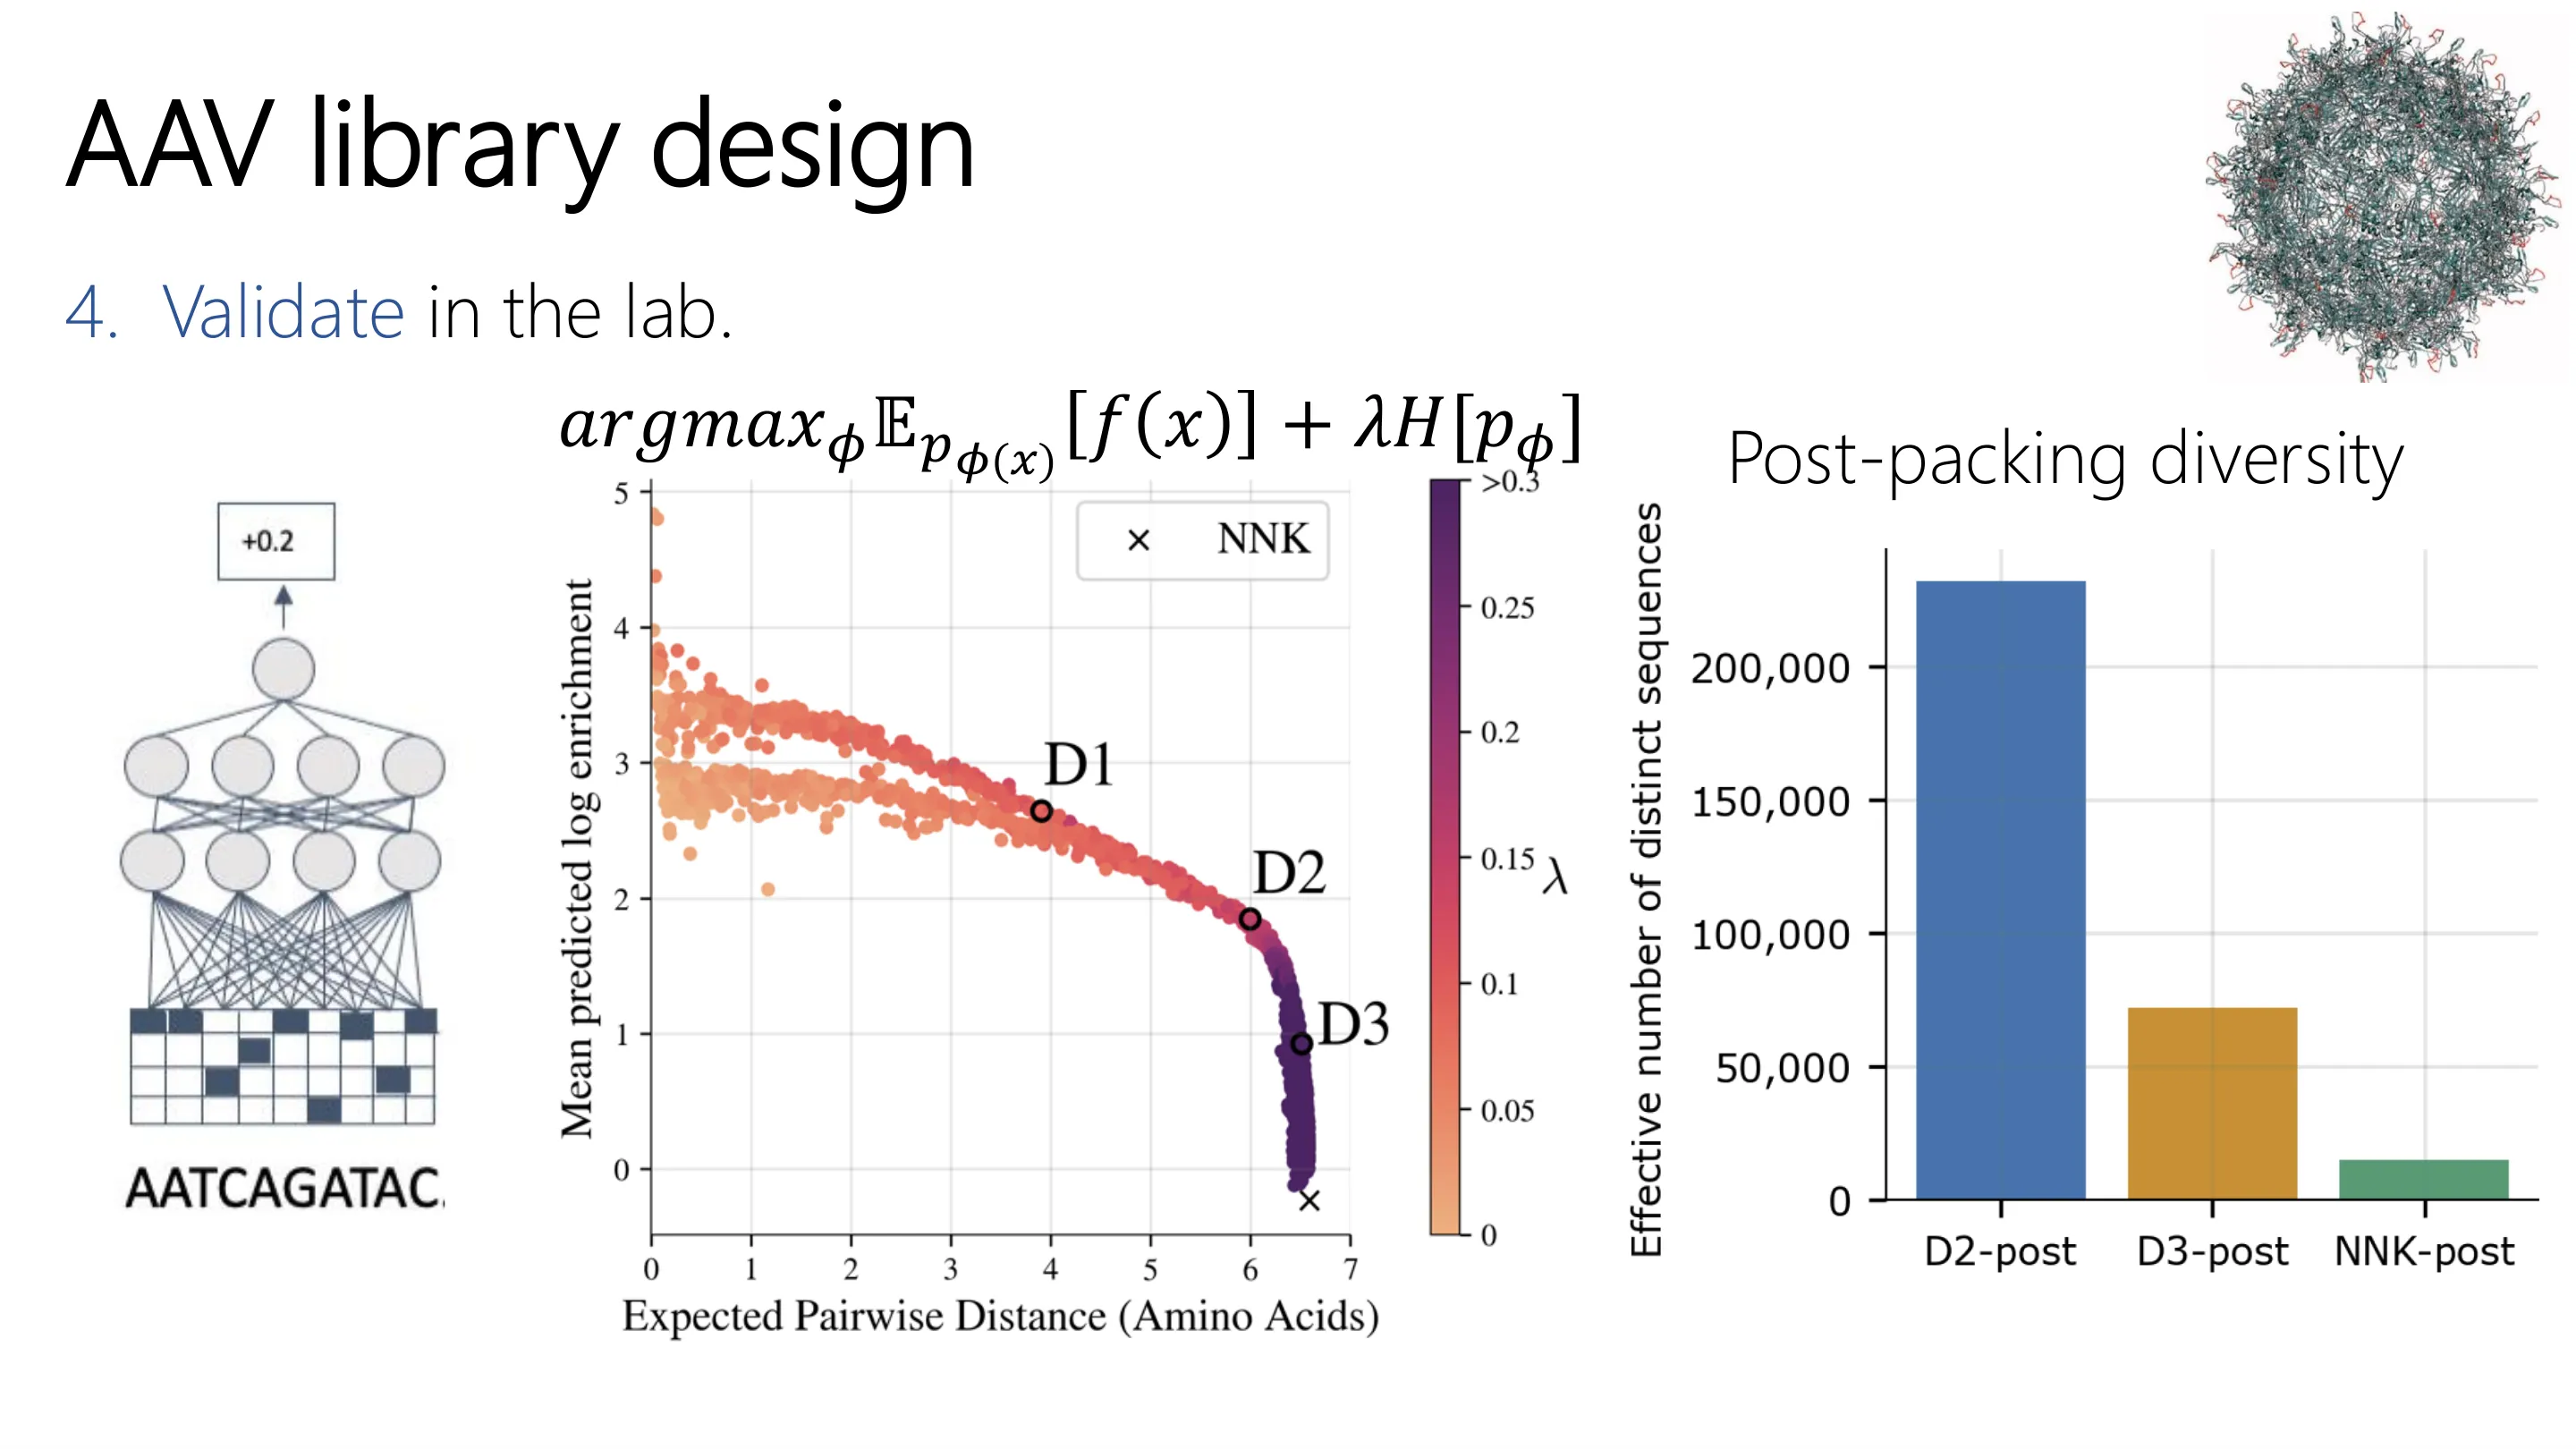
📷 Pearson 相关 = 0.96(p=0.001)
回到原视频 (01:01:10)
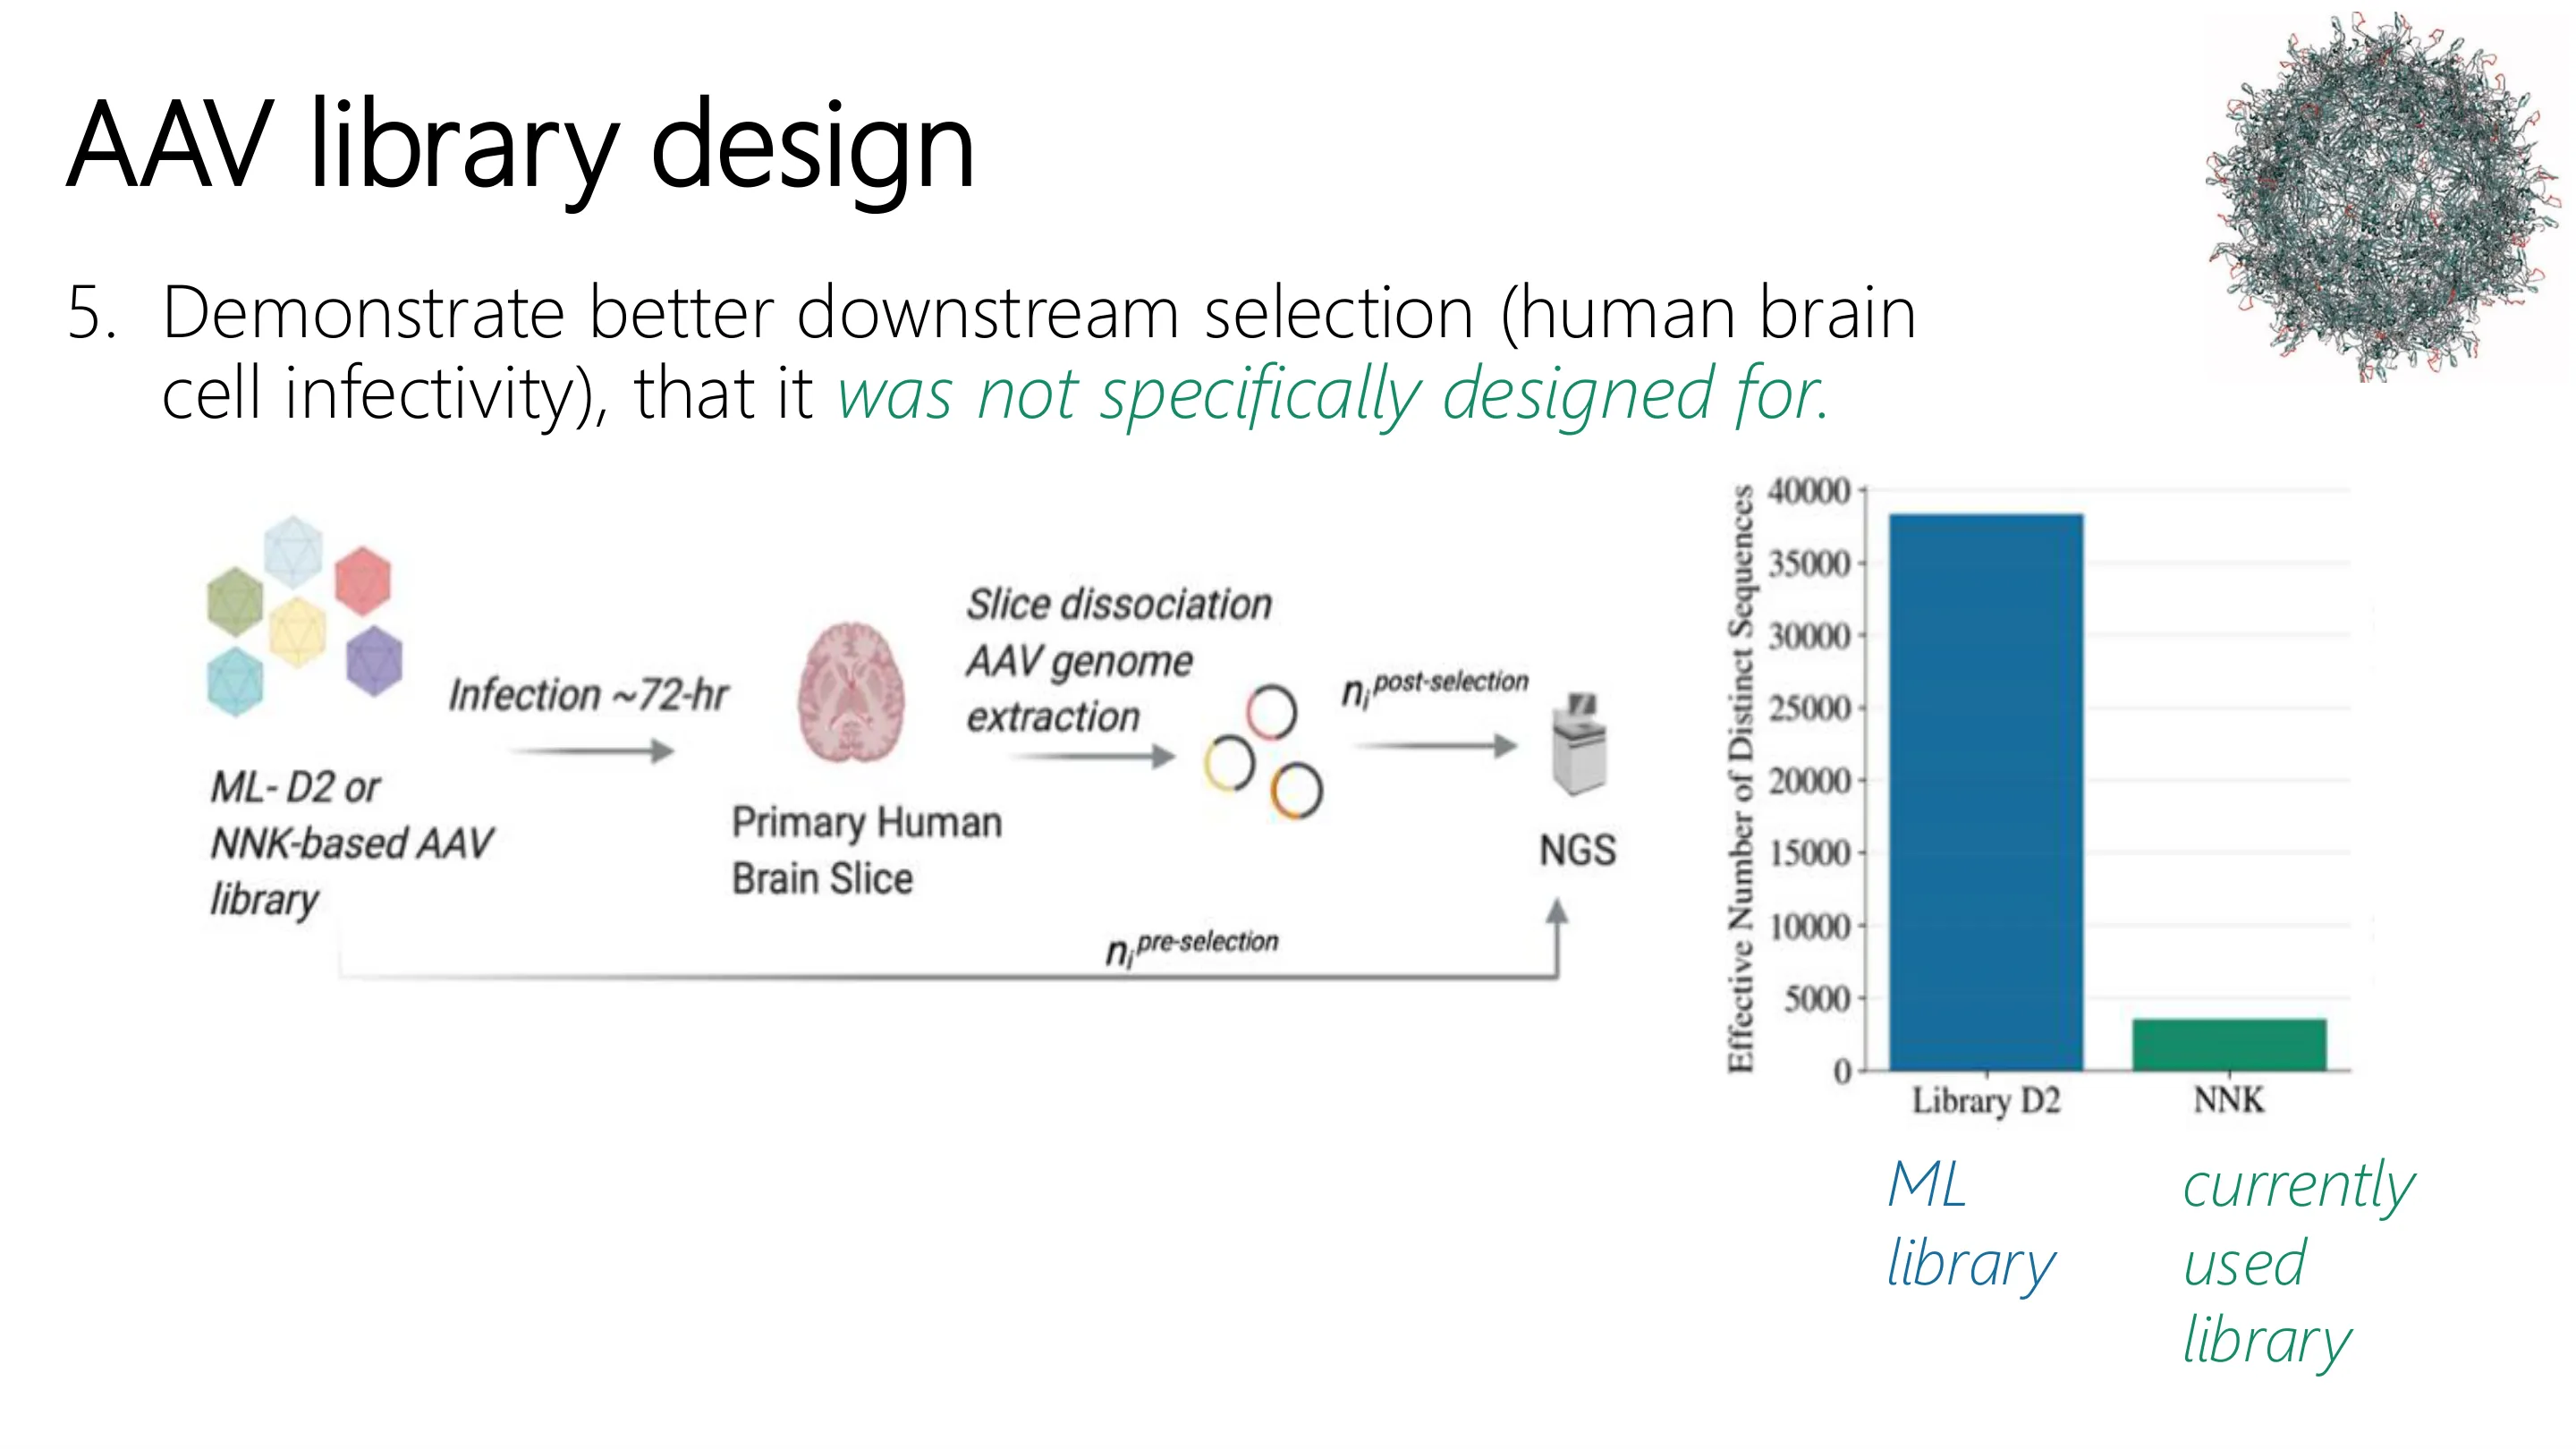
📷 AAV 文库设计(三)
回到原视频 (01:02:23)
📷 团队
回到原视频 (01:03:36)
4.1 多样本随机选择模型
筛选平台:在天然界面(natural interface) 上做蛋白质文库的高通量筛选,提出新的科学问题。
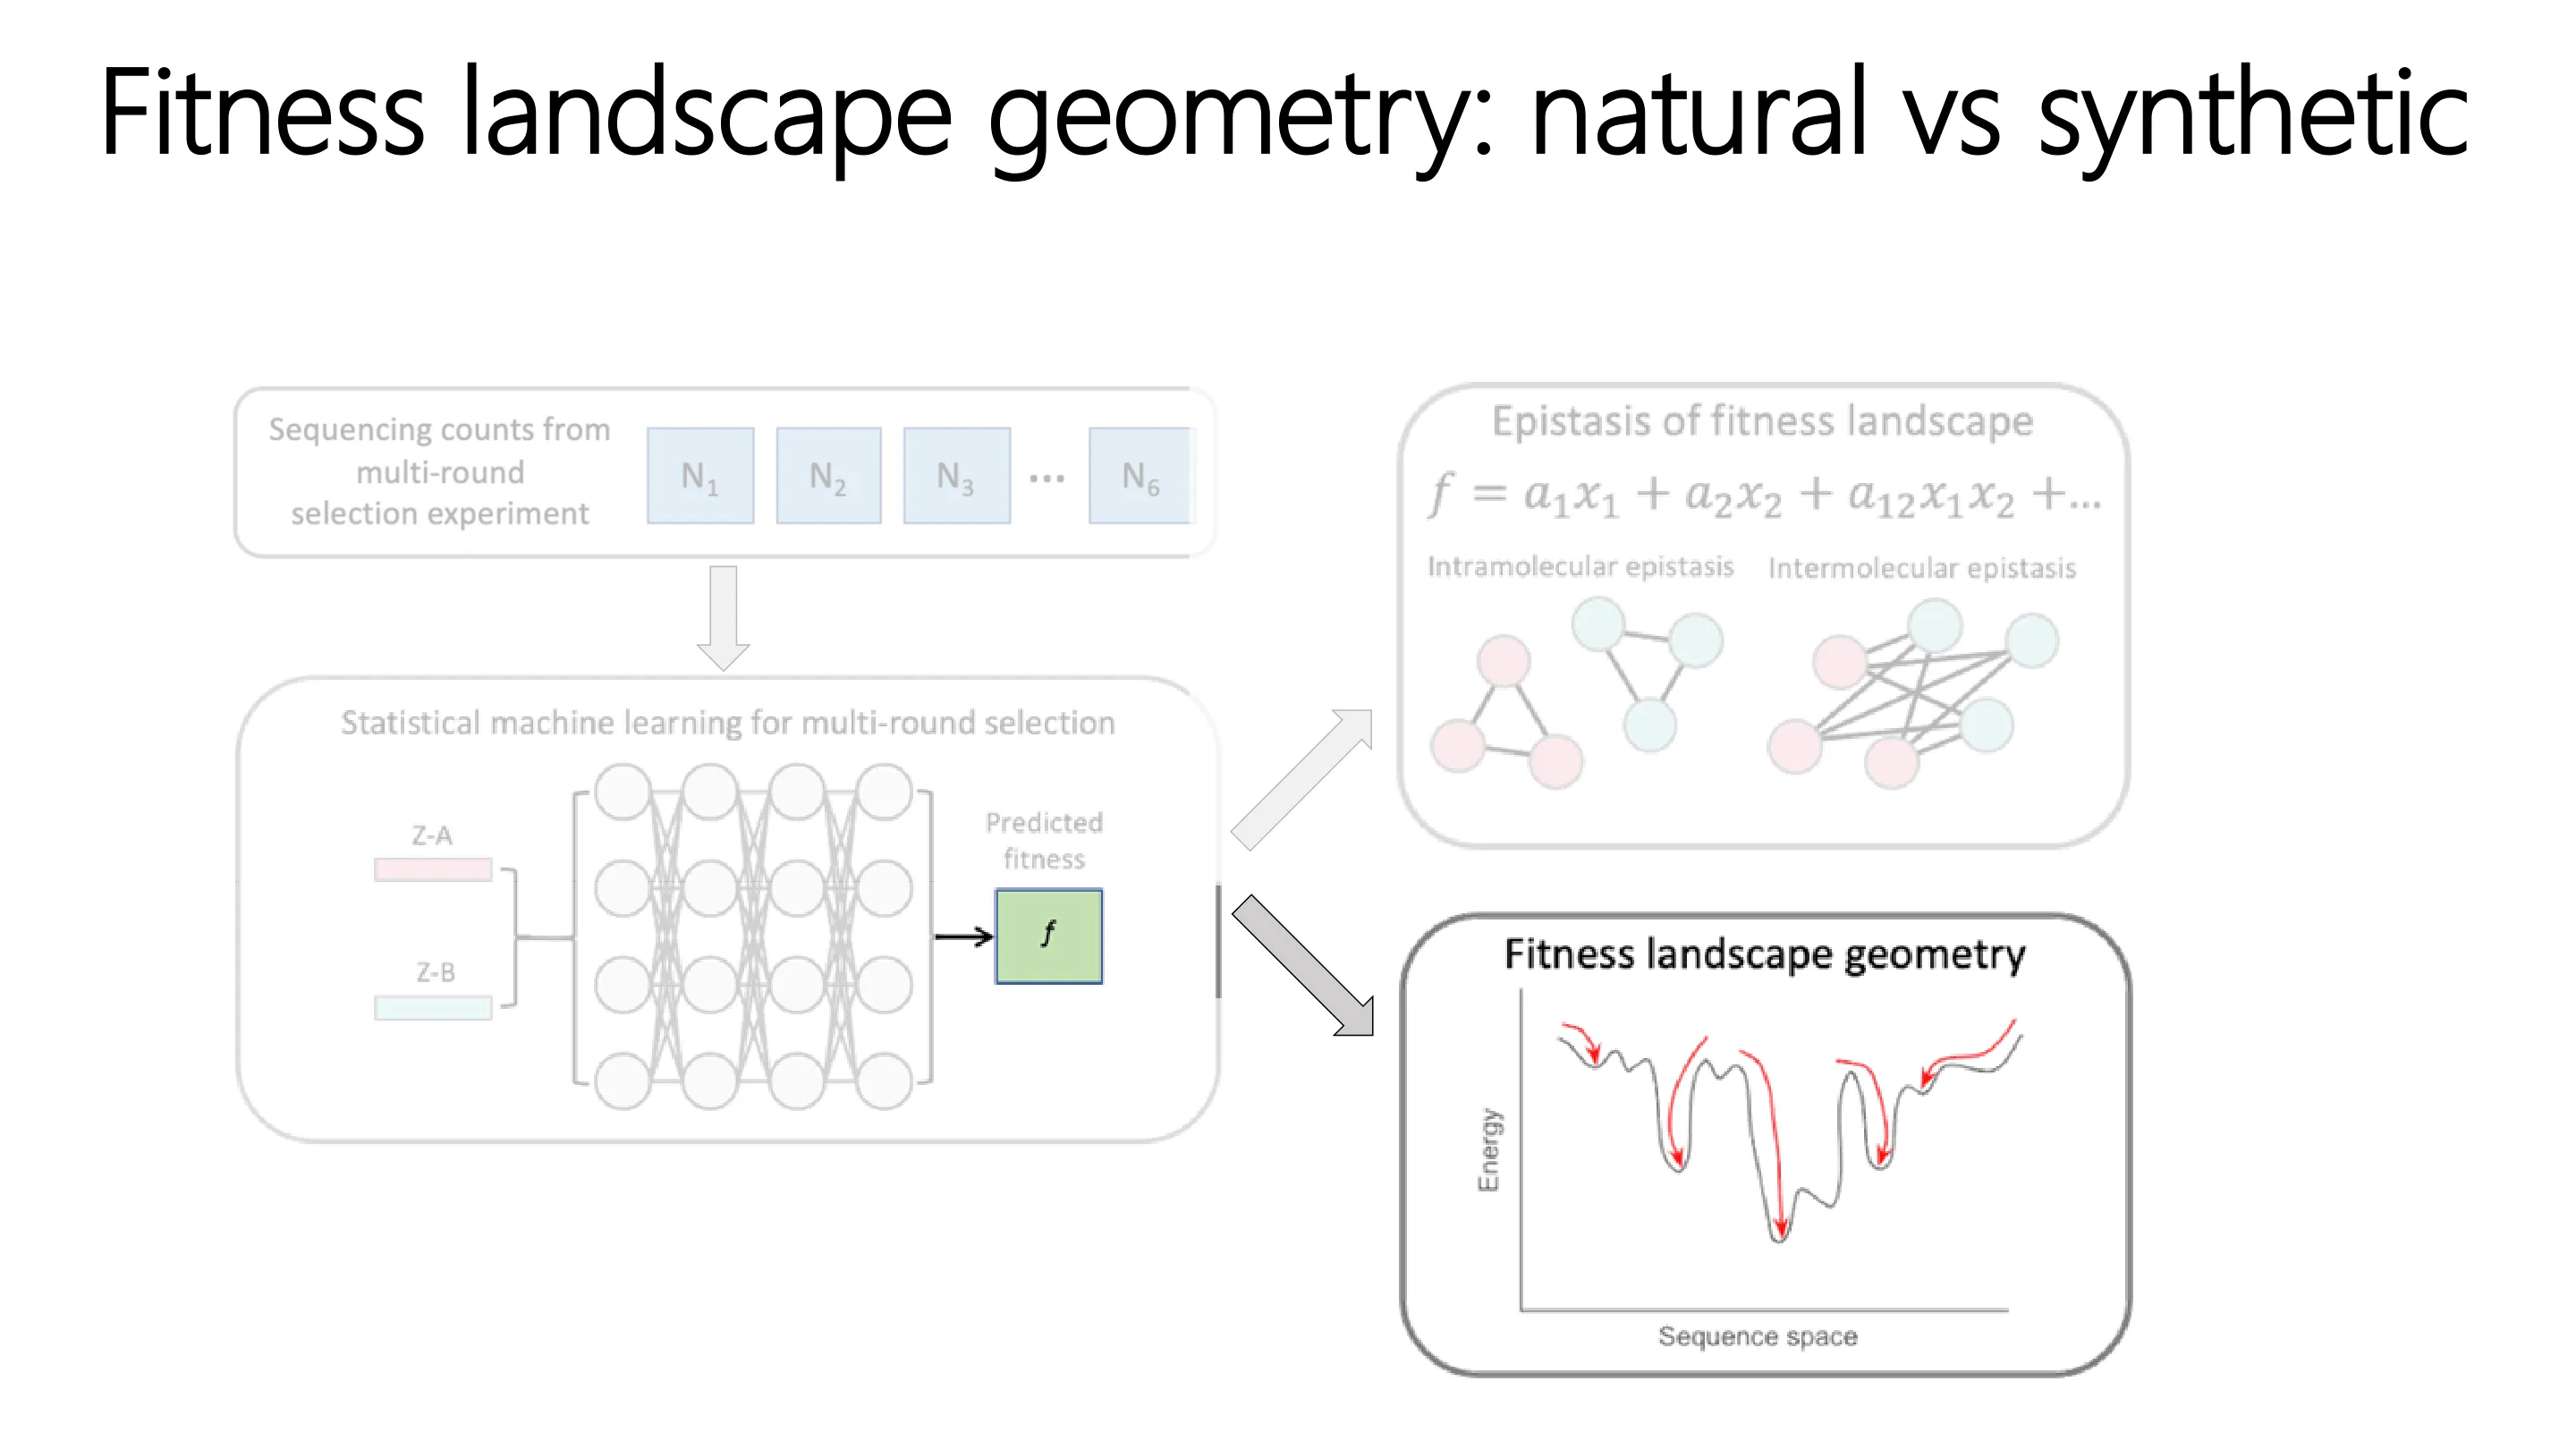
统计 ML 方法:多轮概率选择模型——模拟每一轮「结合 → 洗脱 → 扩增」的筛选过程,从多轮数据中 jointly 推断每个变体的结合适应度。
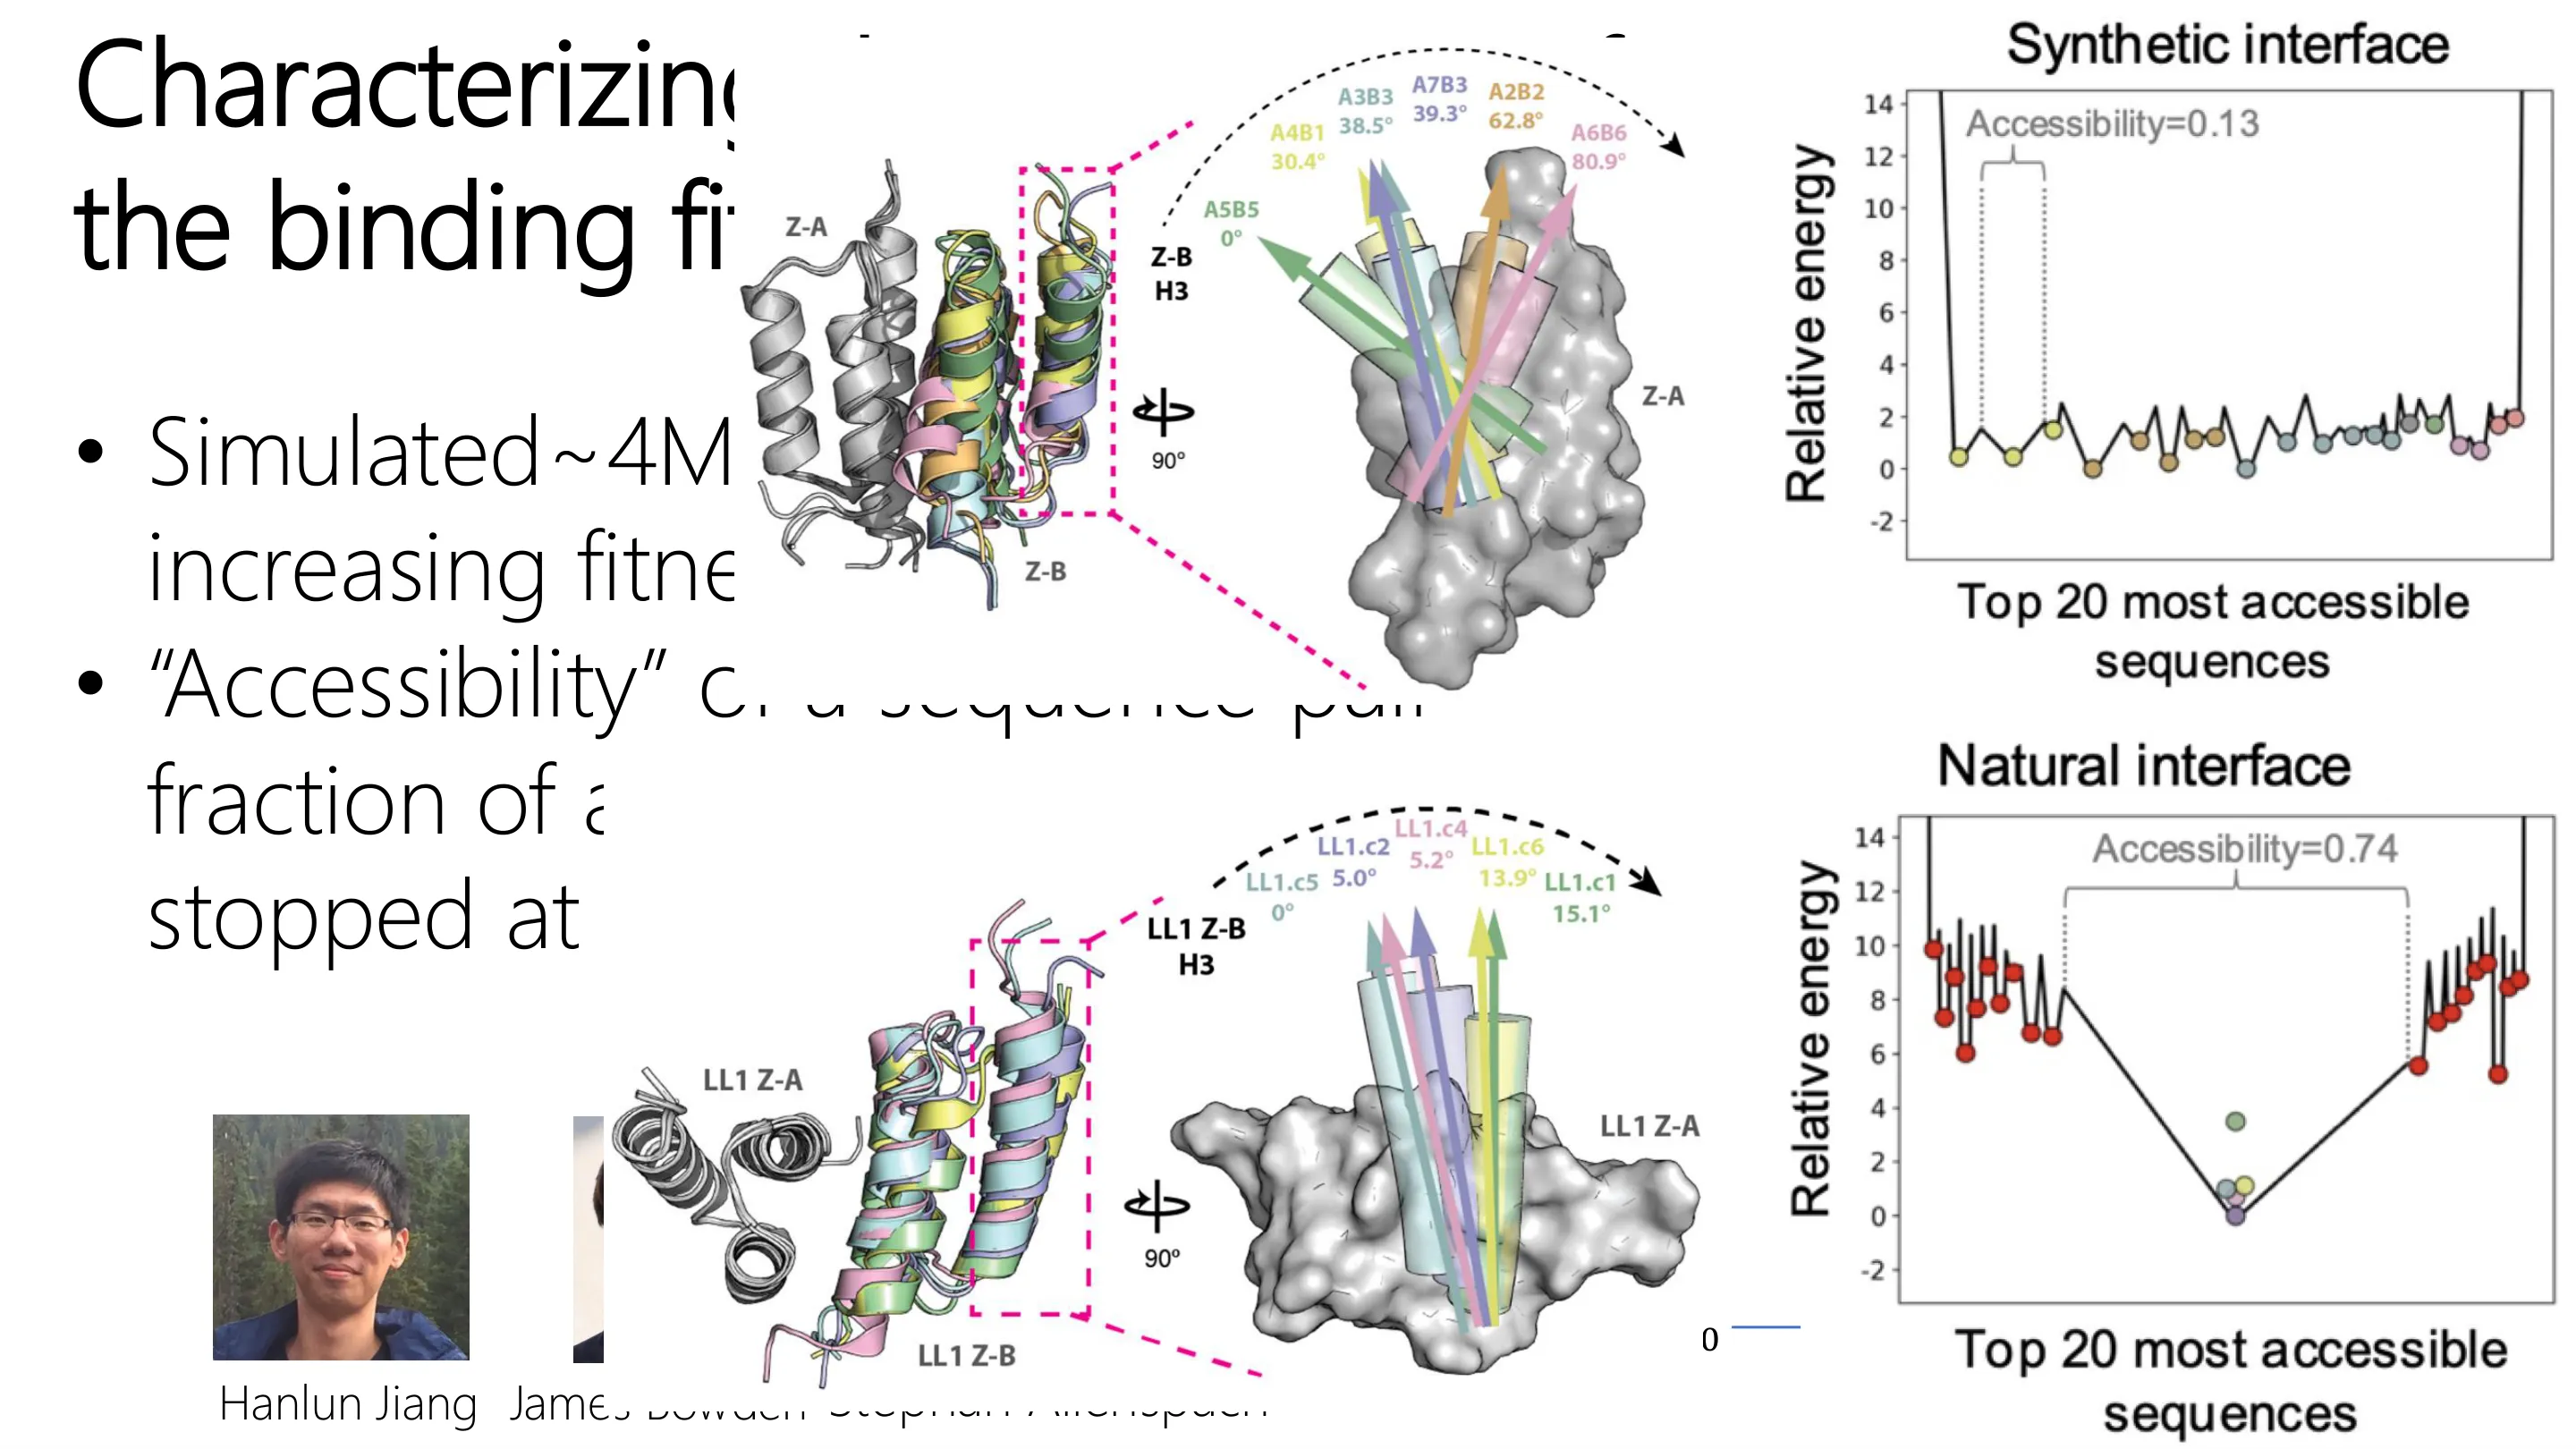
上位性(epistasis)分析:分析结合适应度景观(fitness landscape) 中的成对上位性;发现成对上位性的强度与……成反比;对比天然 vs 合成景观的几何结构(模拟约 400 万条进化序列)。
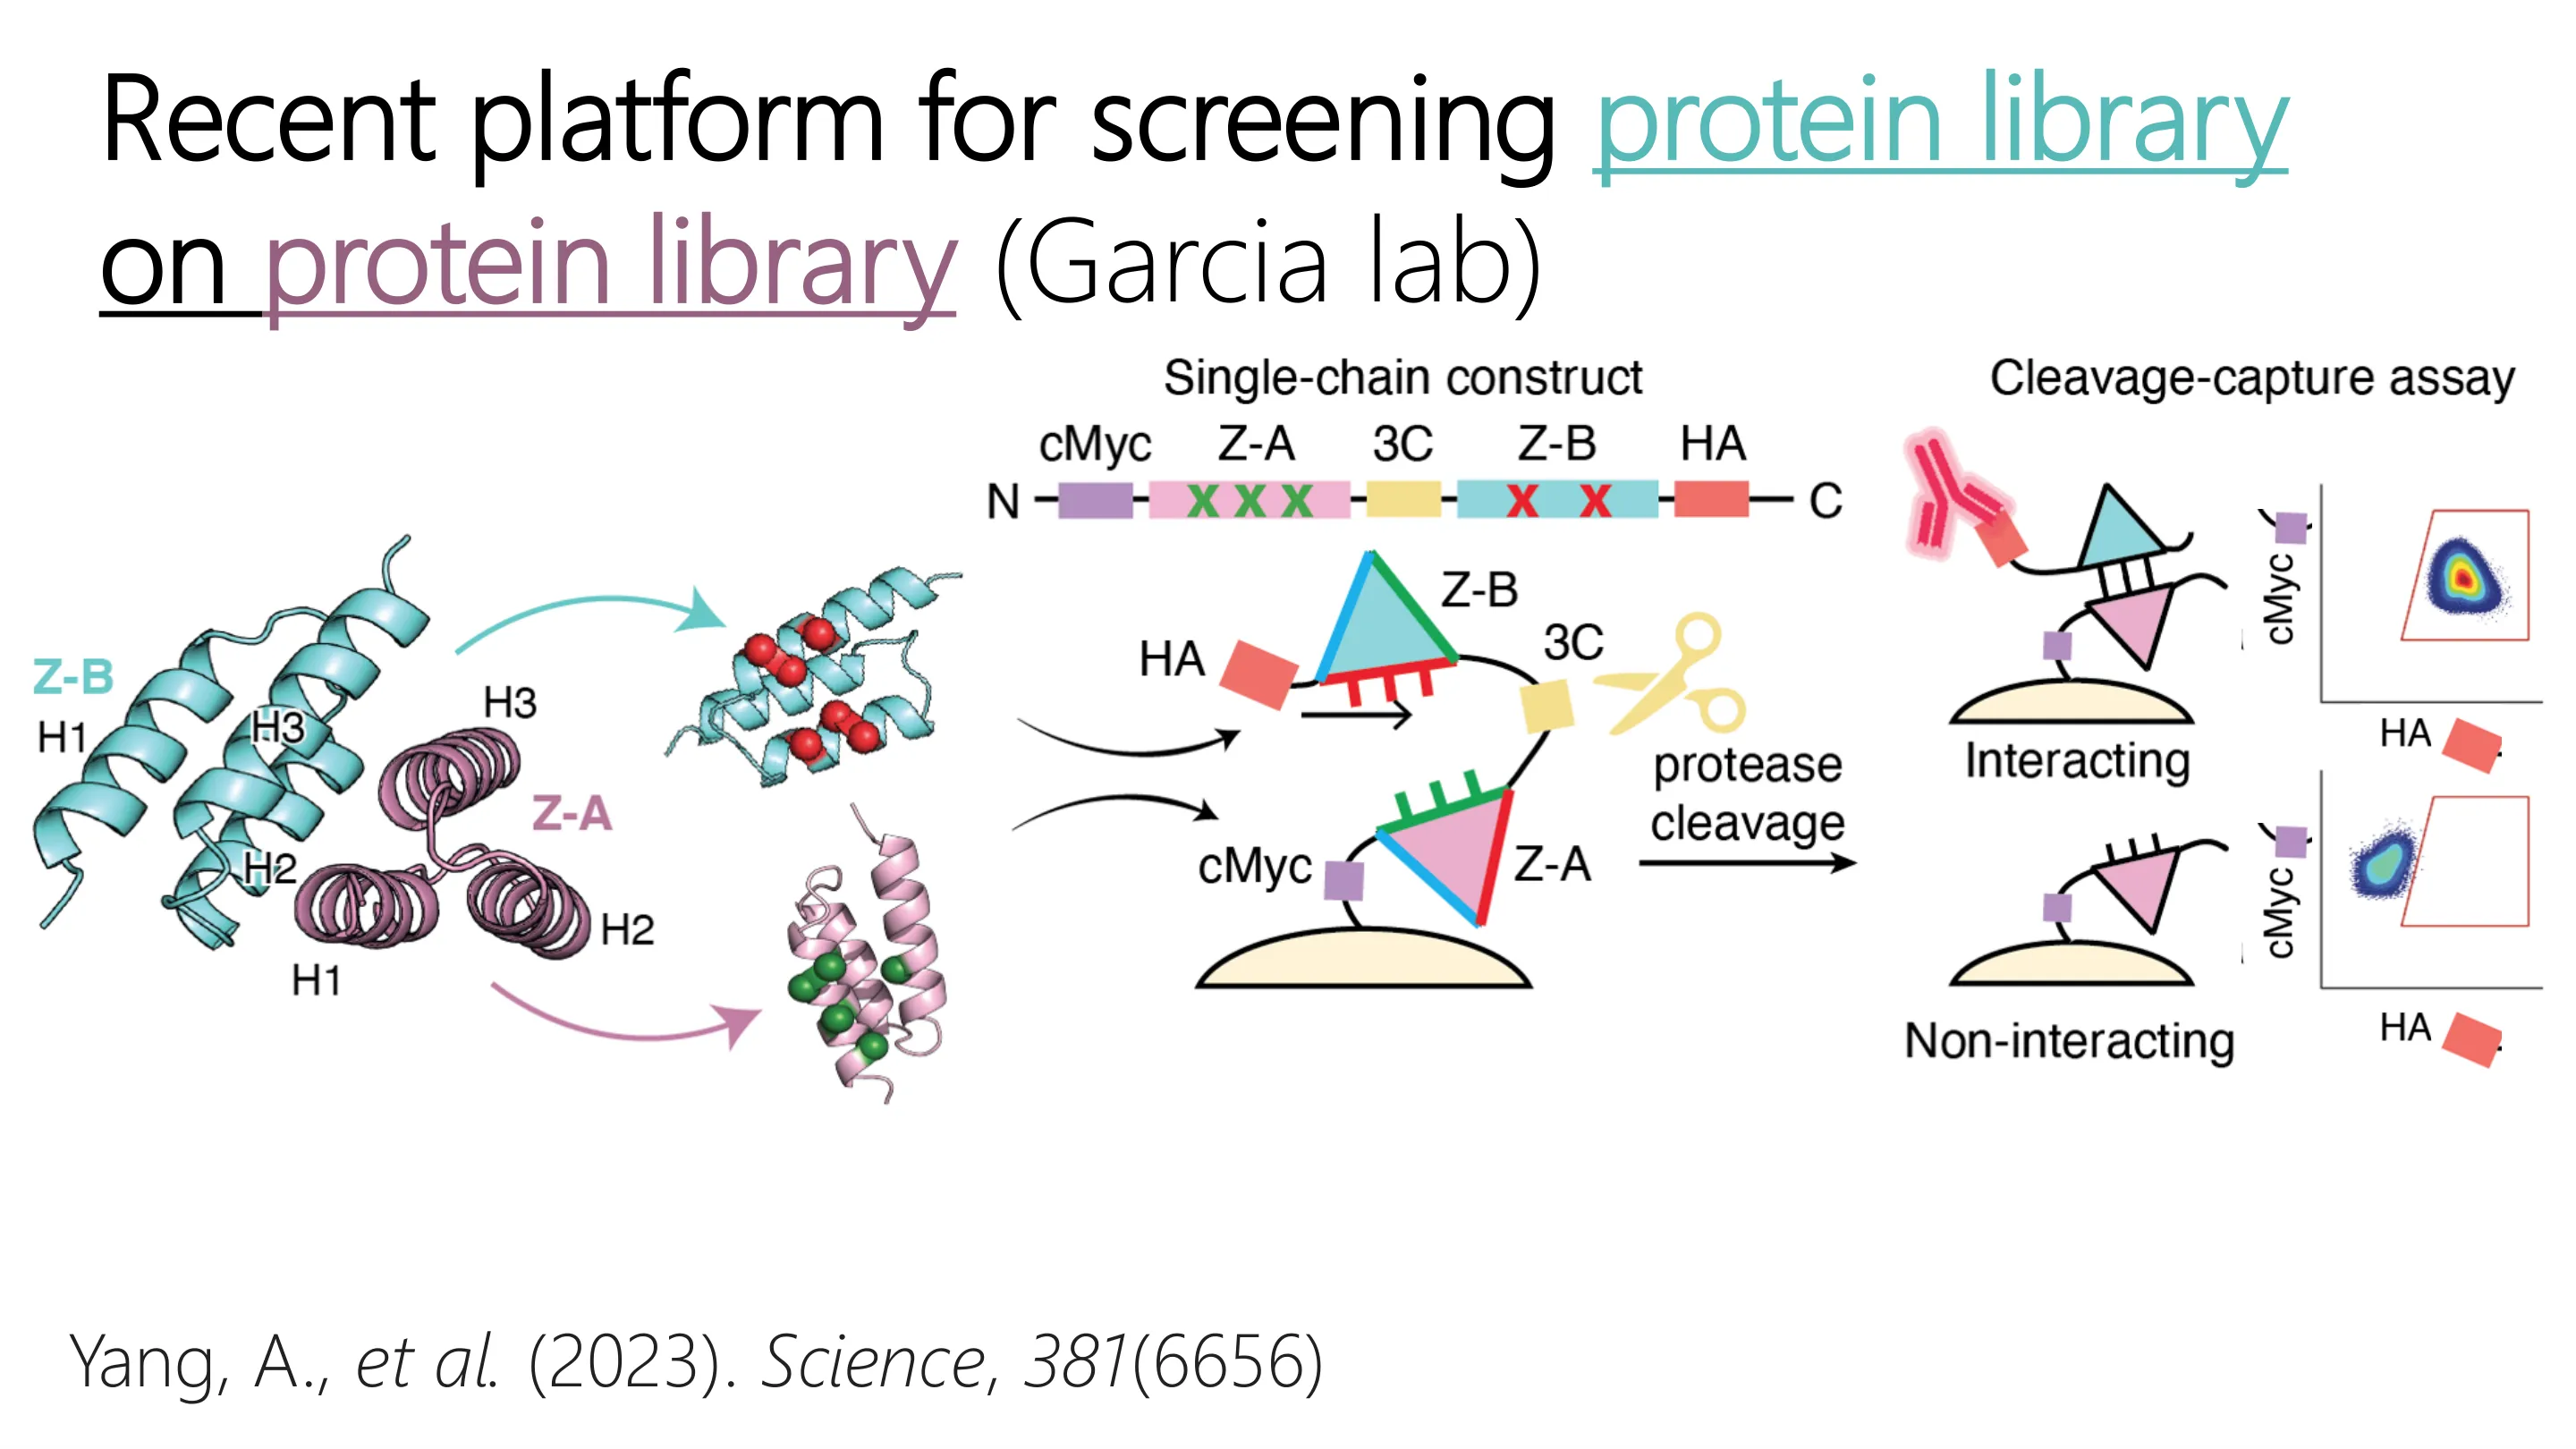
📷 近来用于筛选蛋白质文库的平台
回到原视频 (01:04:49)
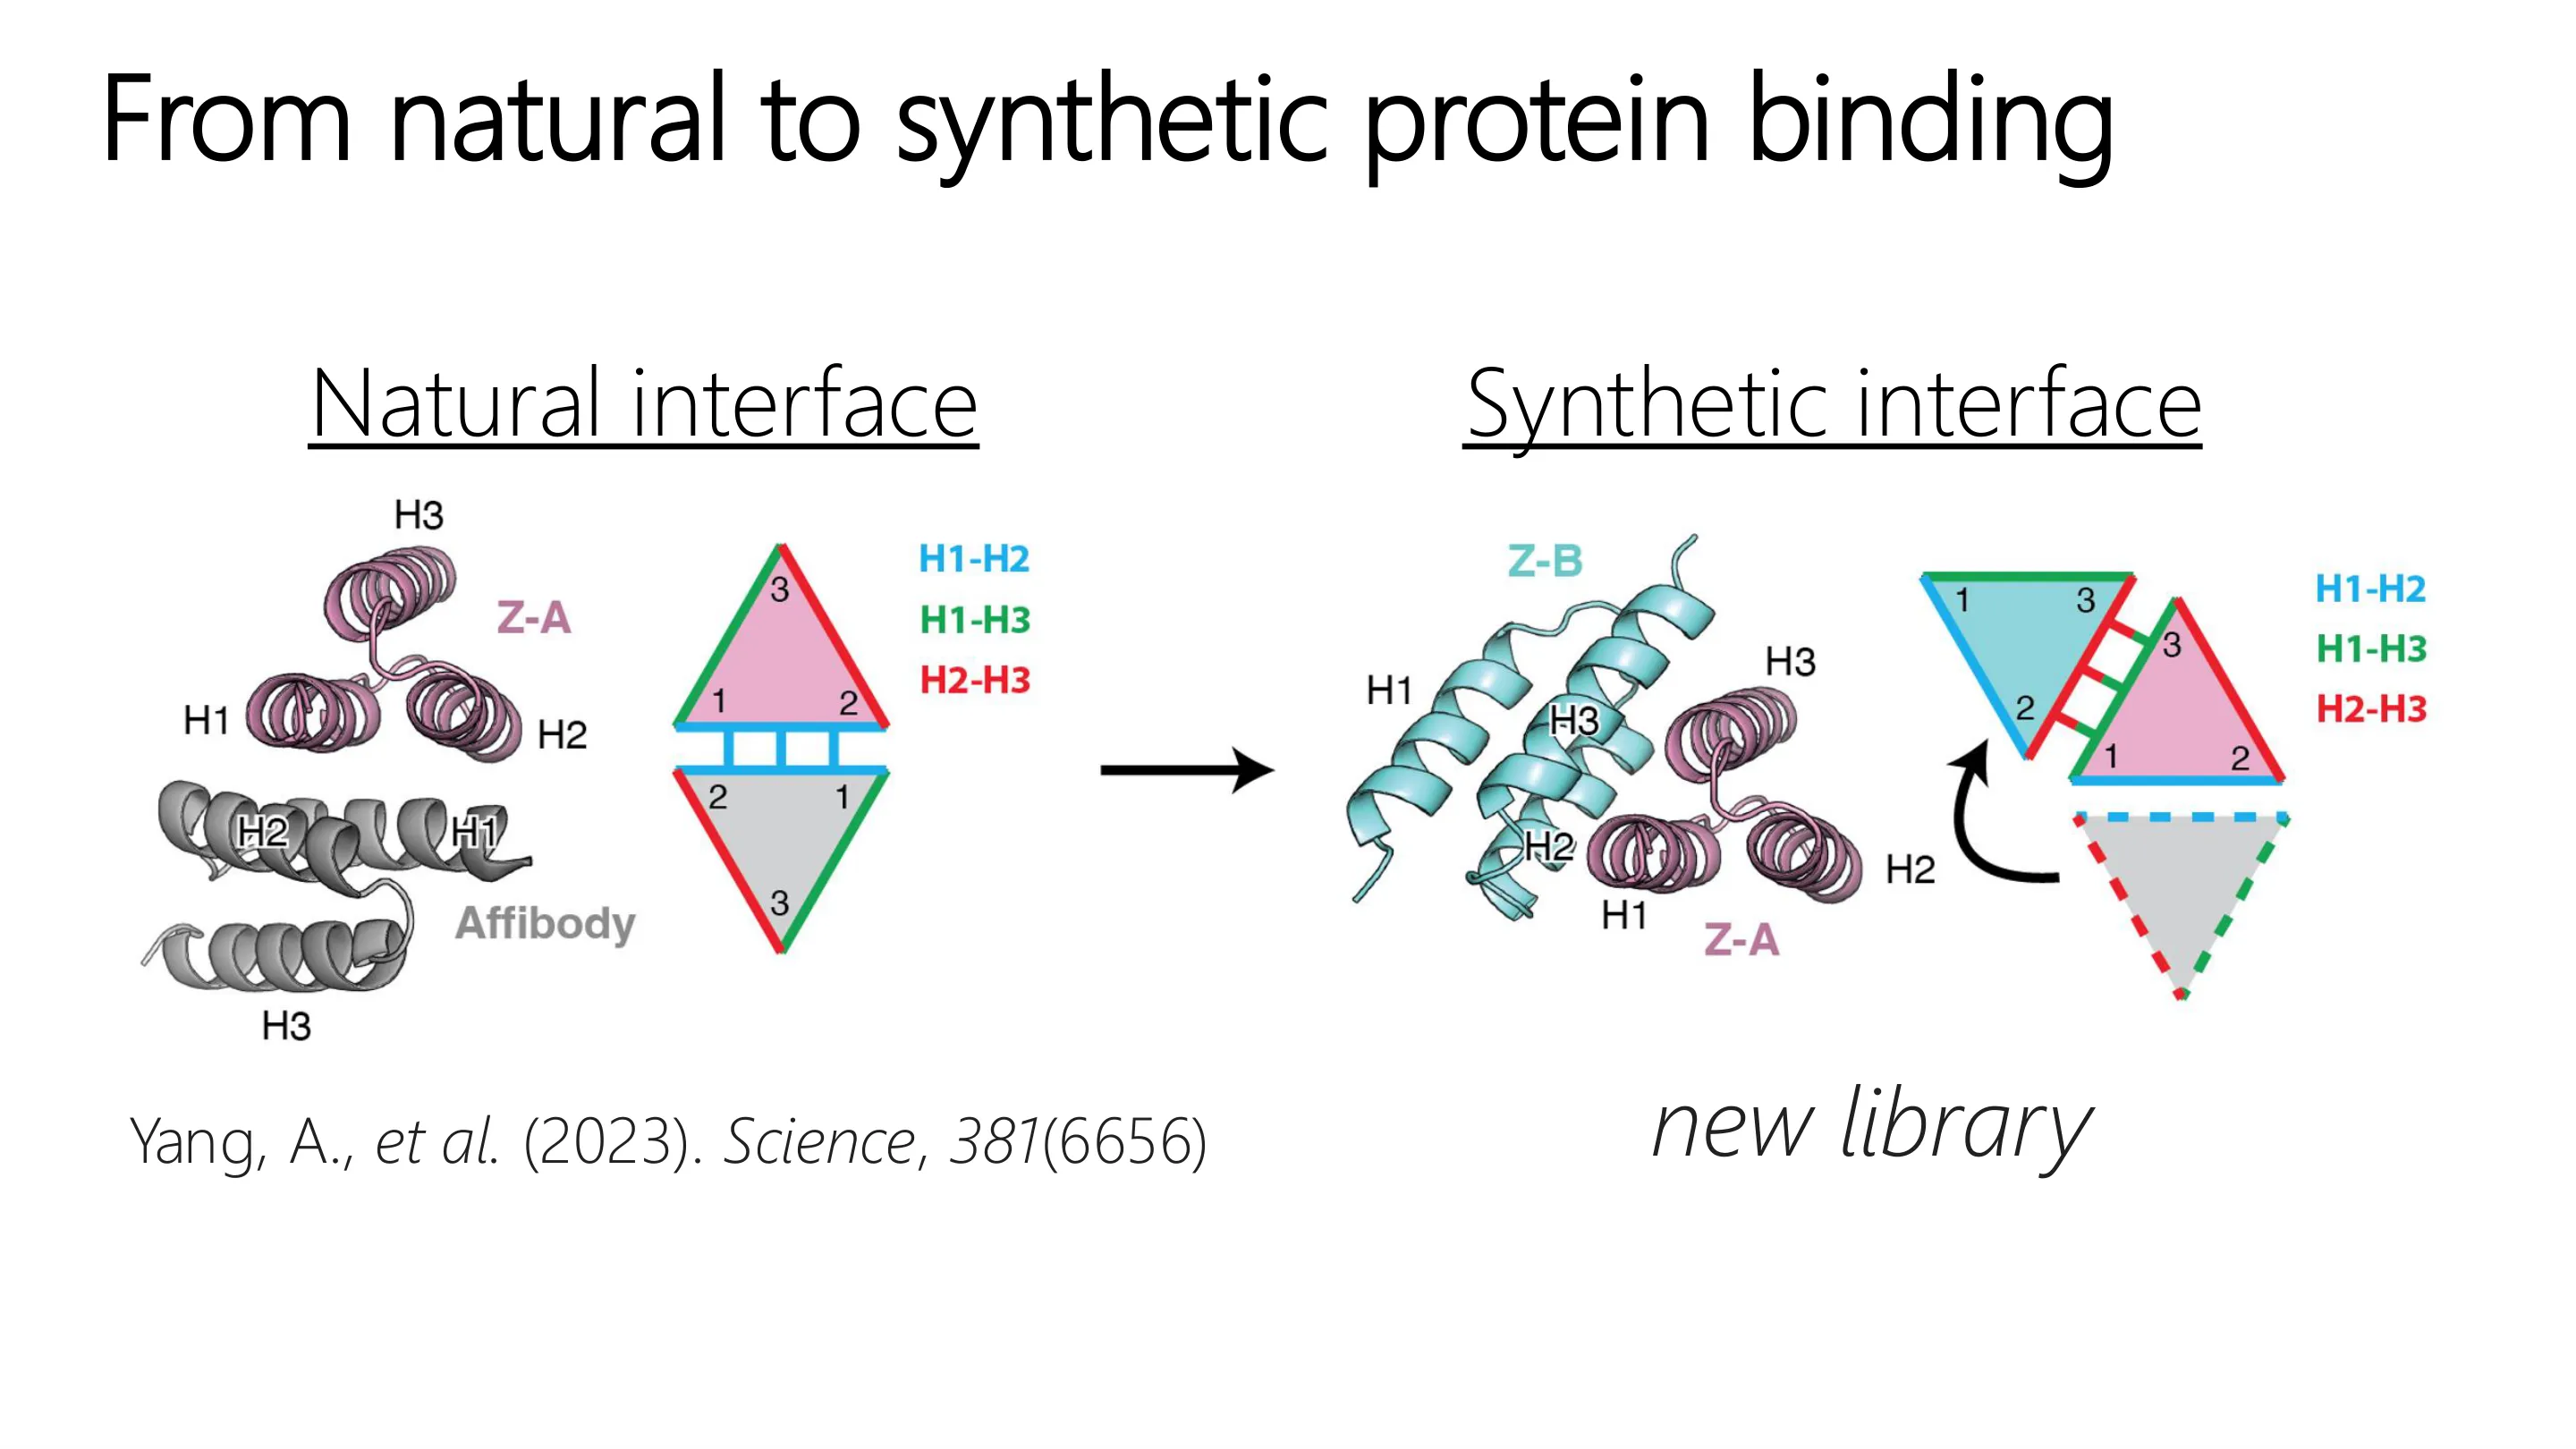
📷 天然界面
回到原视频 (01:06:02)
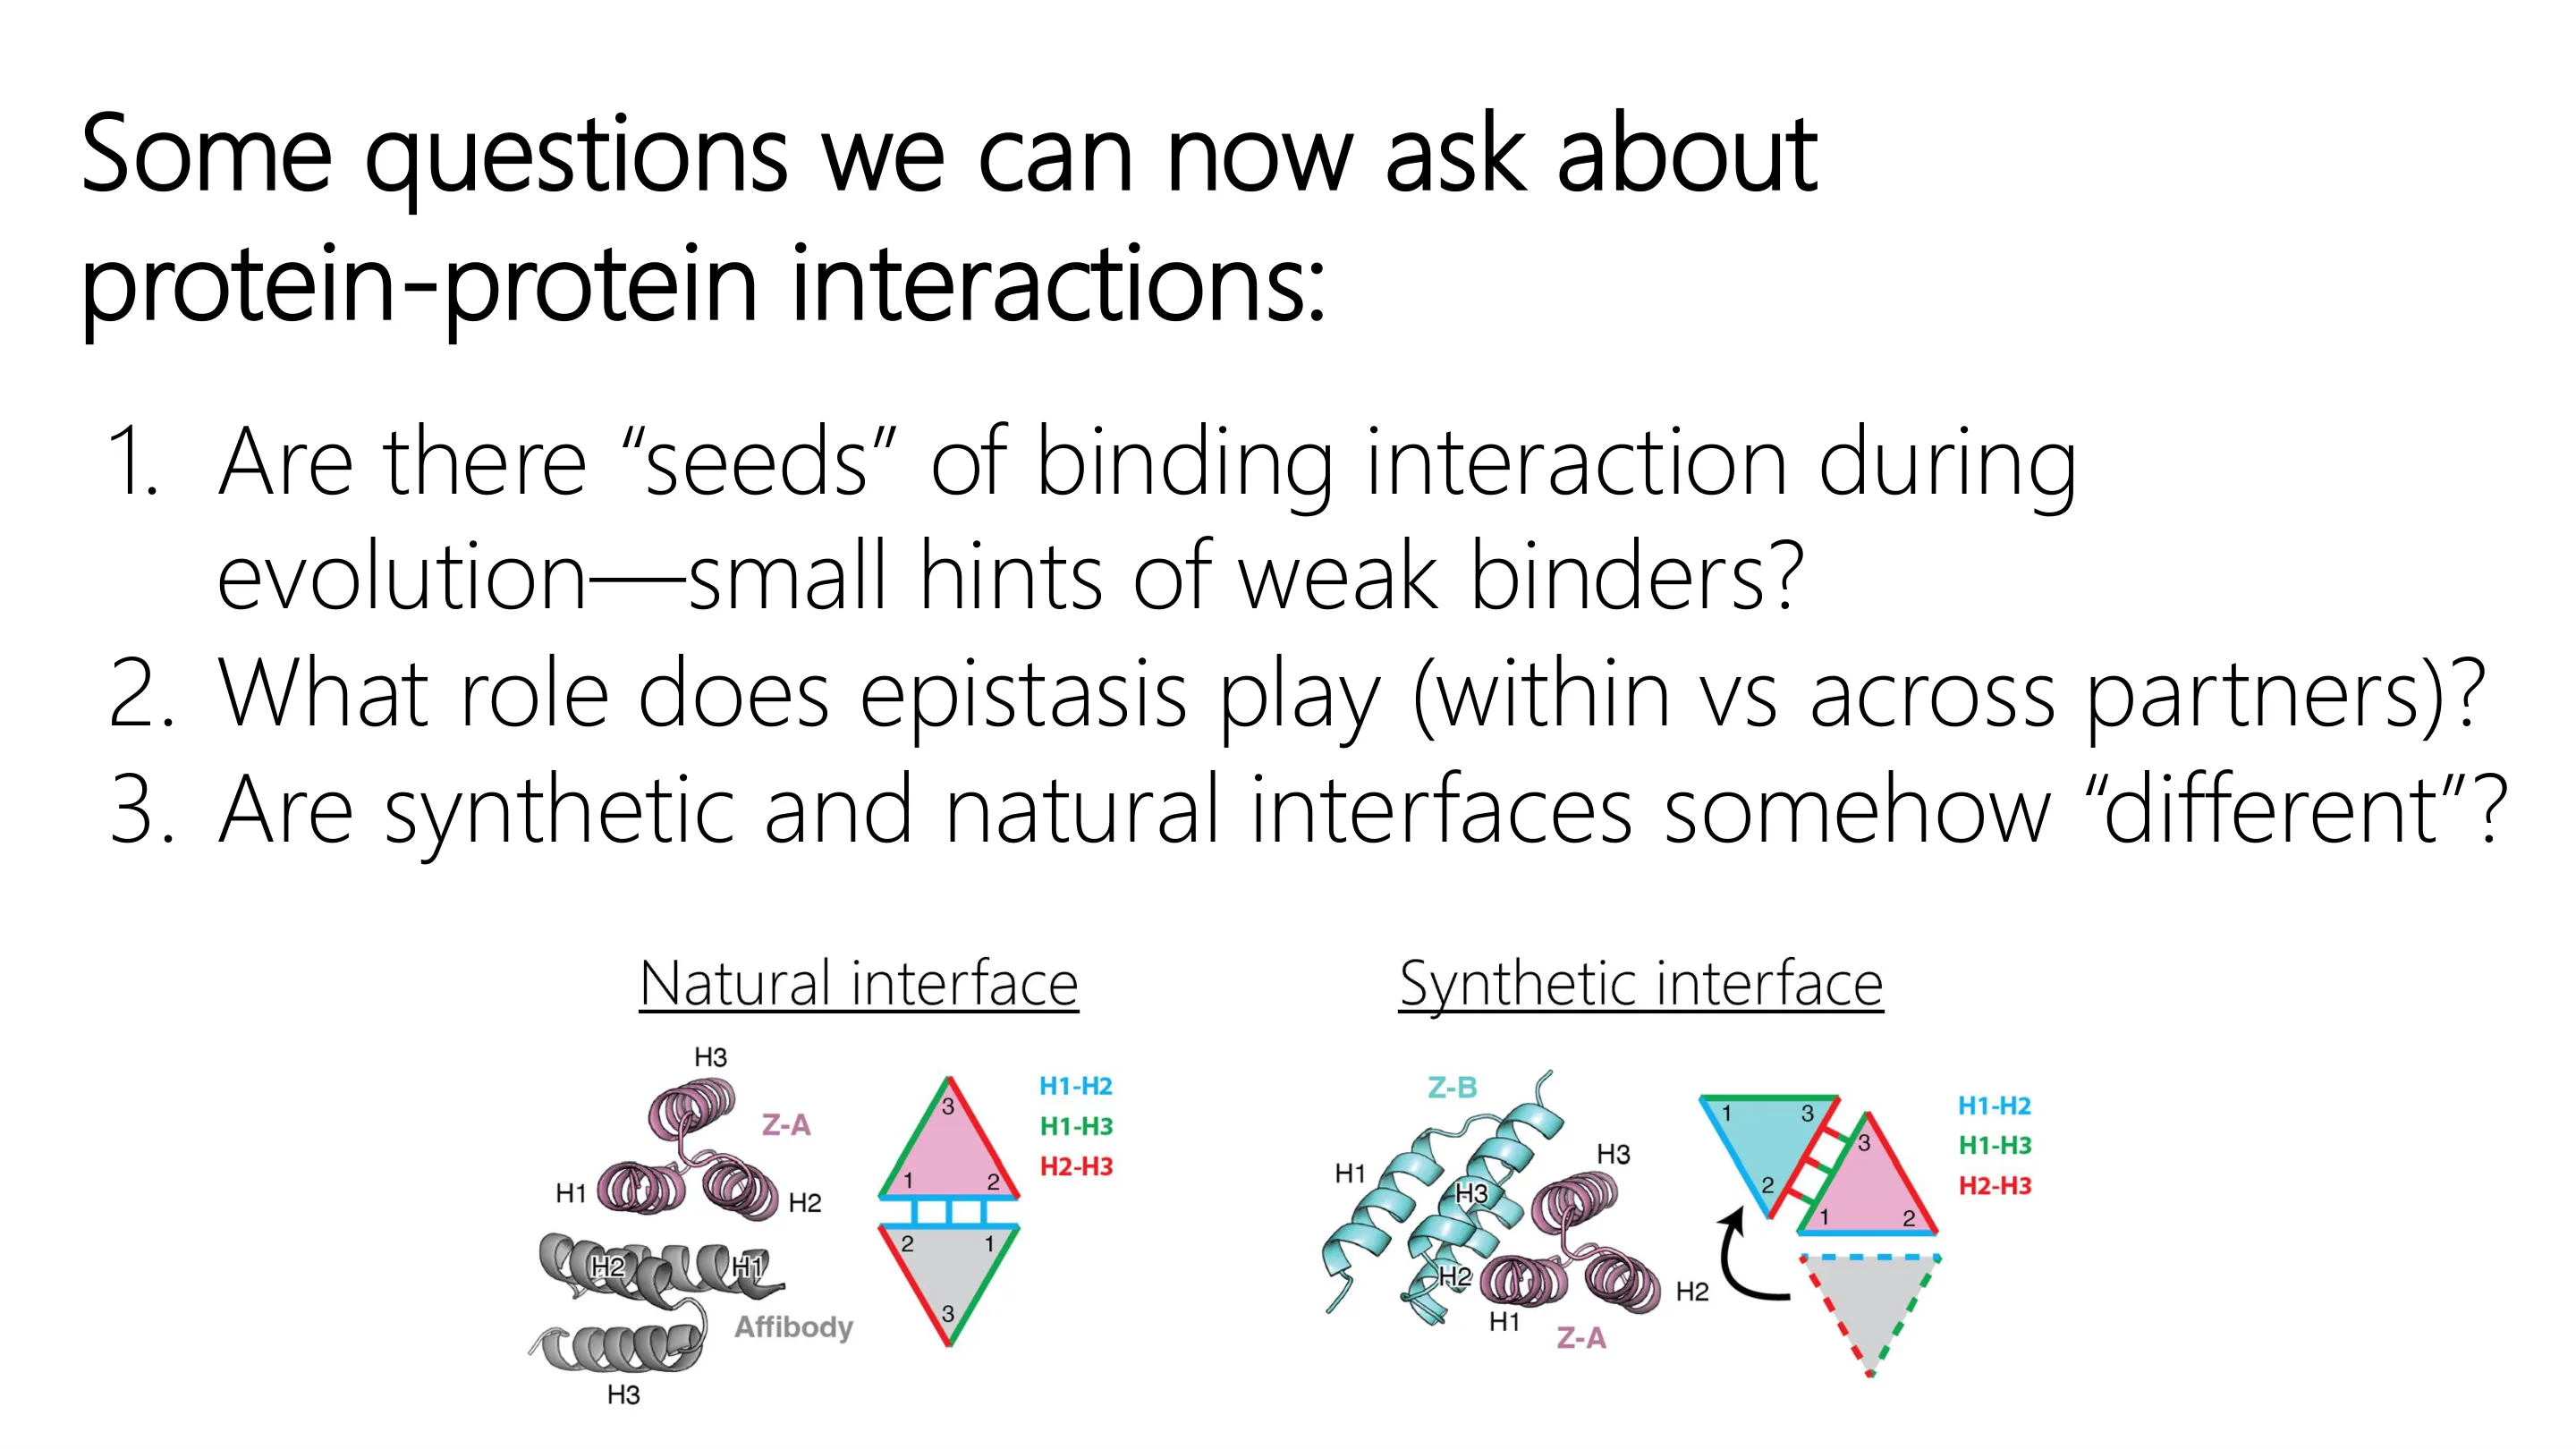
📷 我们现在能问的一些问题
回到原视频 (01:07:15)
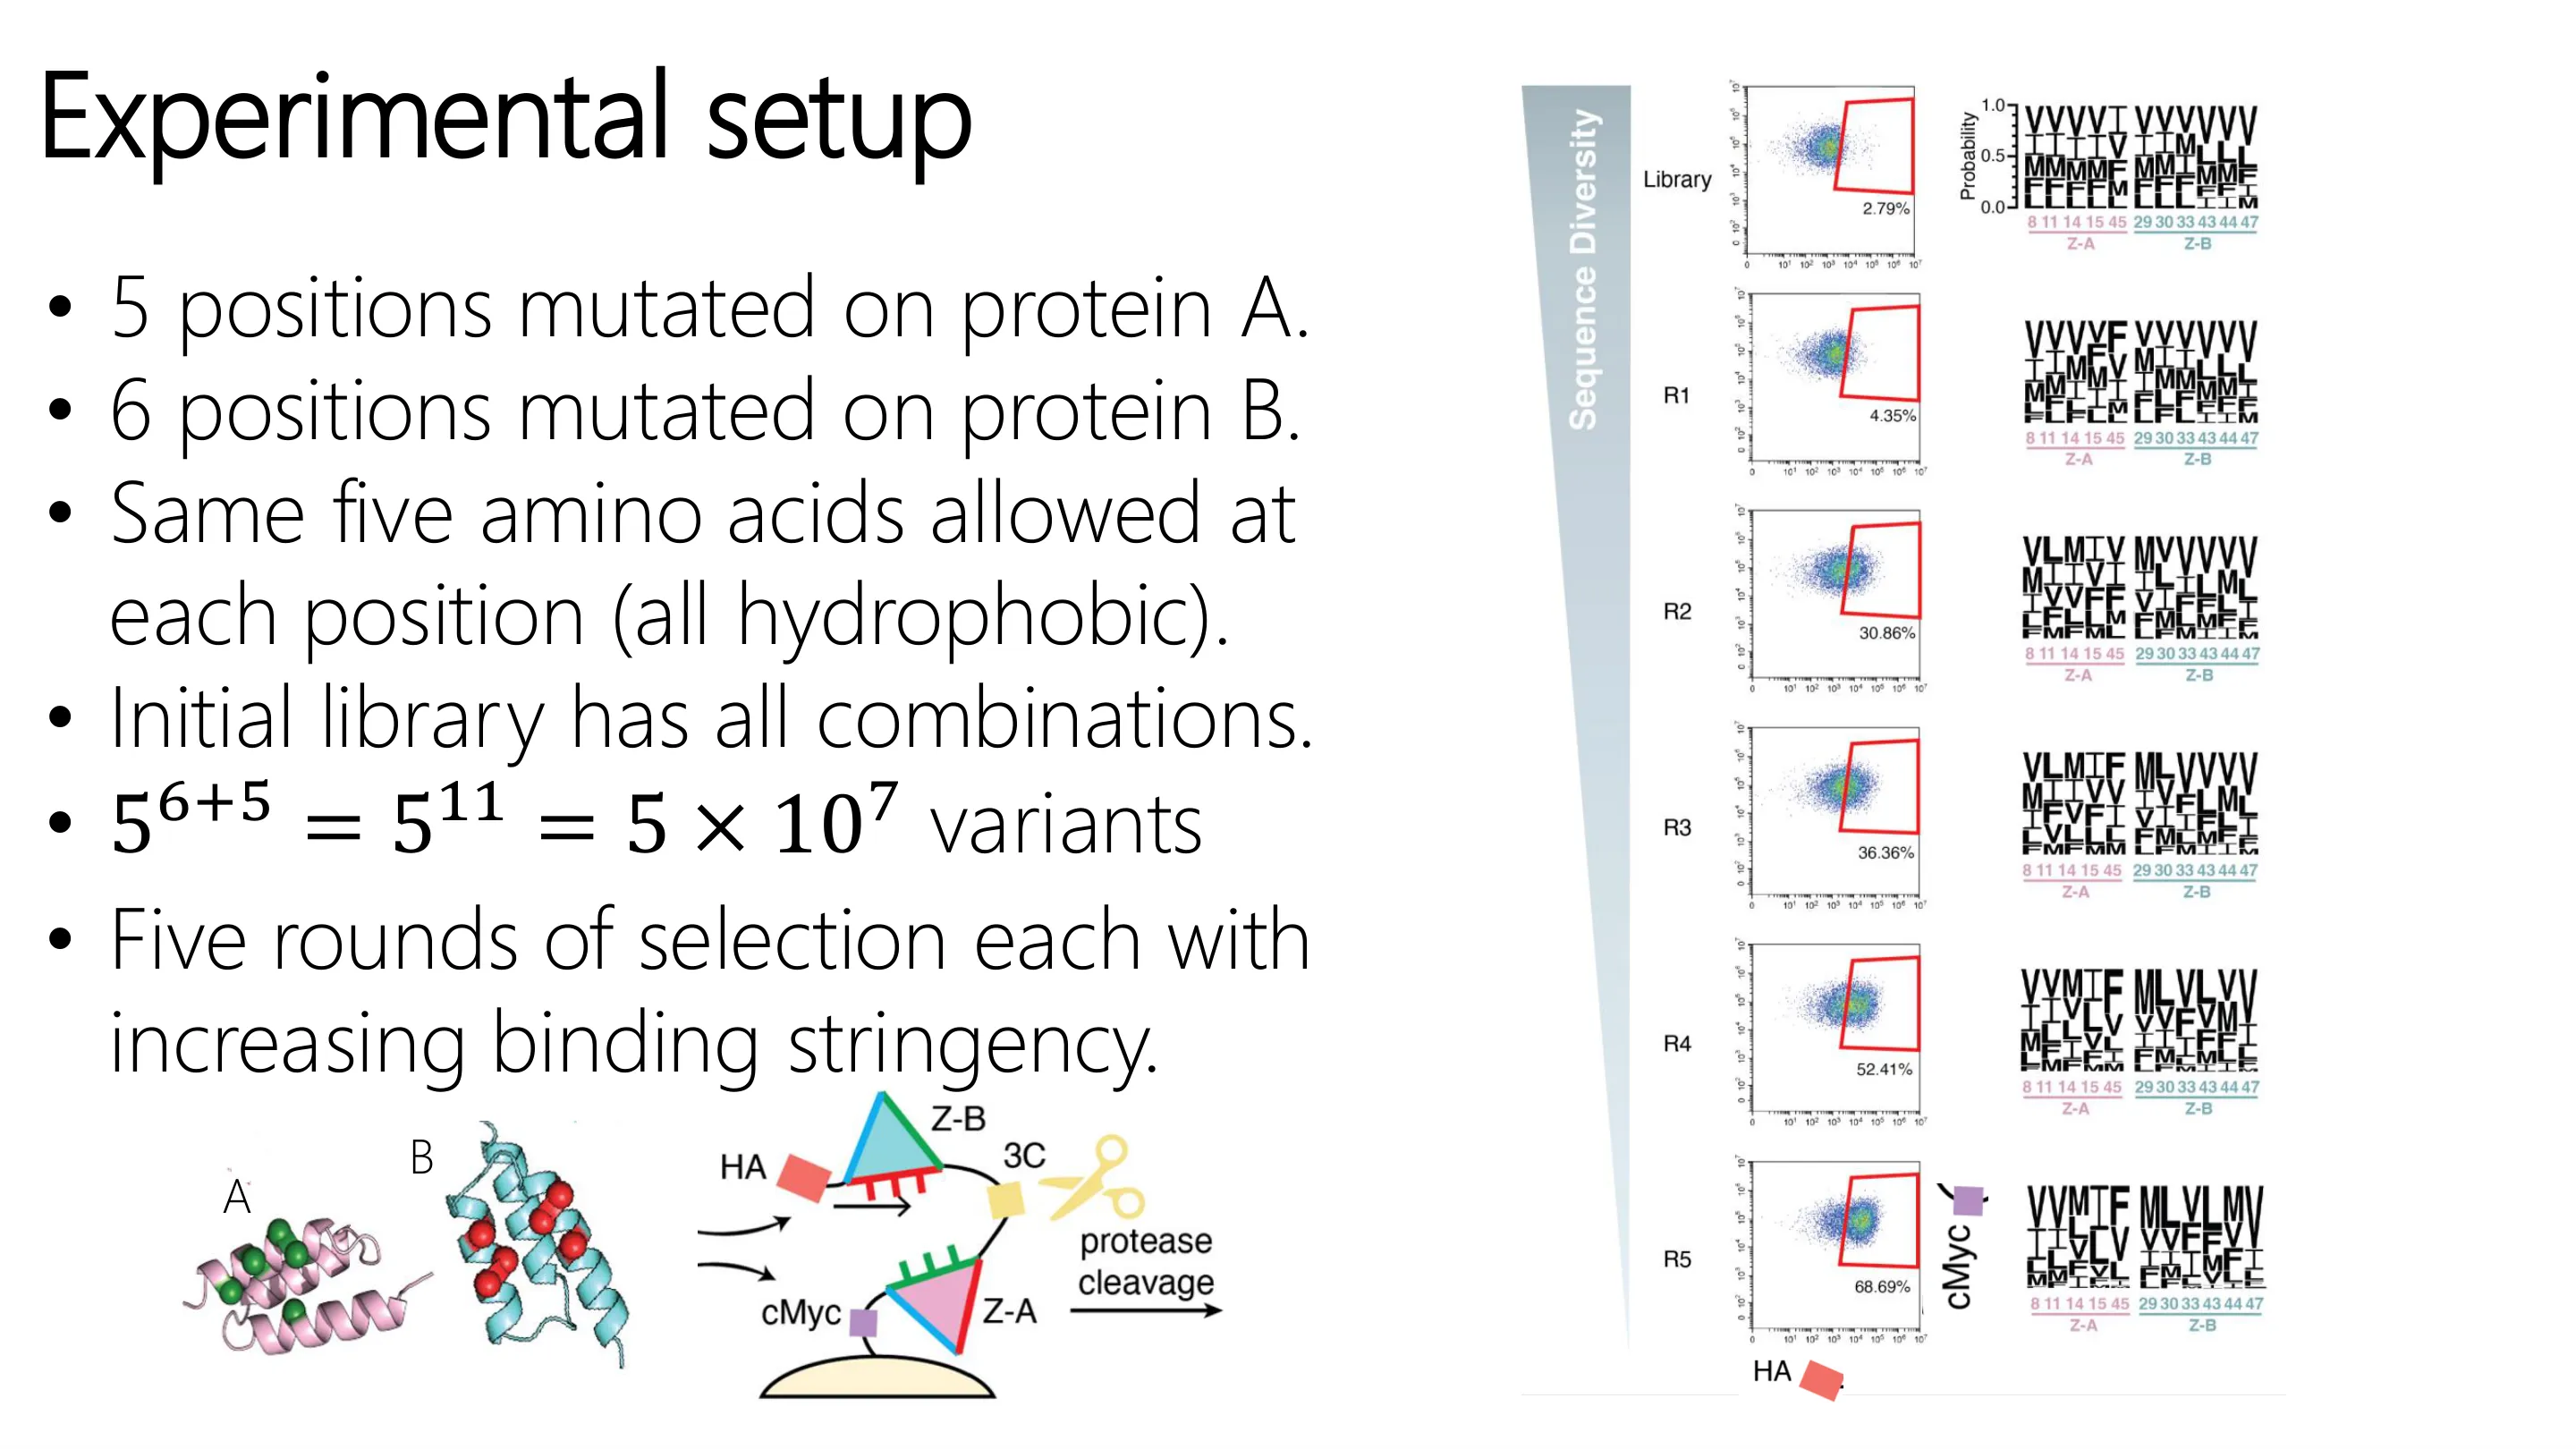
📷 实验设置
回到原视频 (01:08:28)
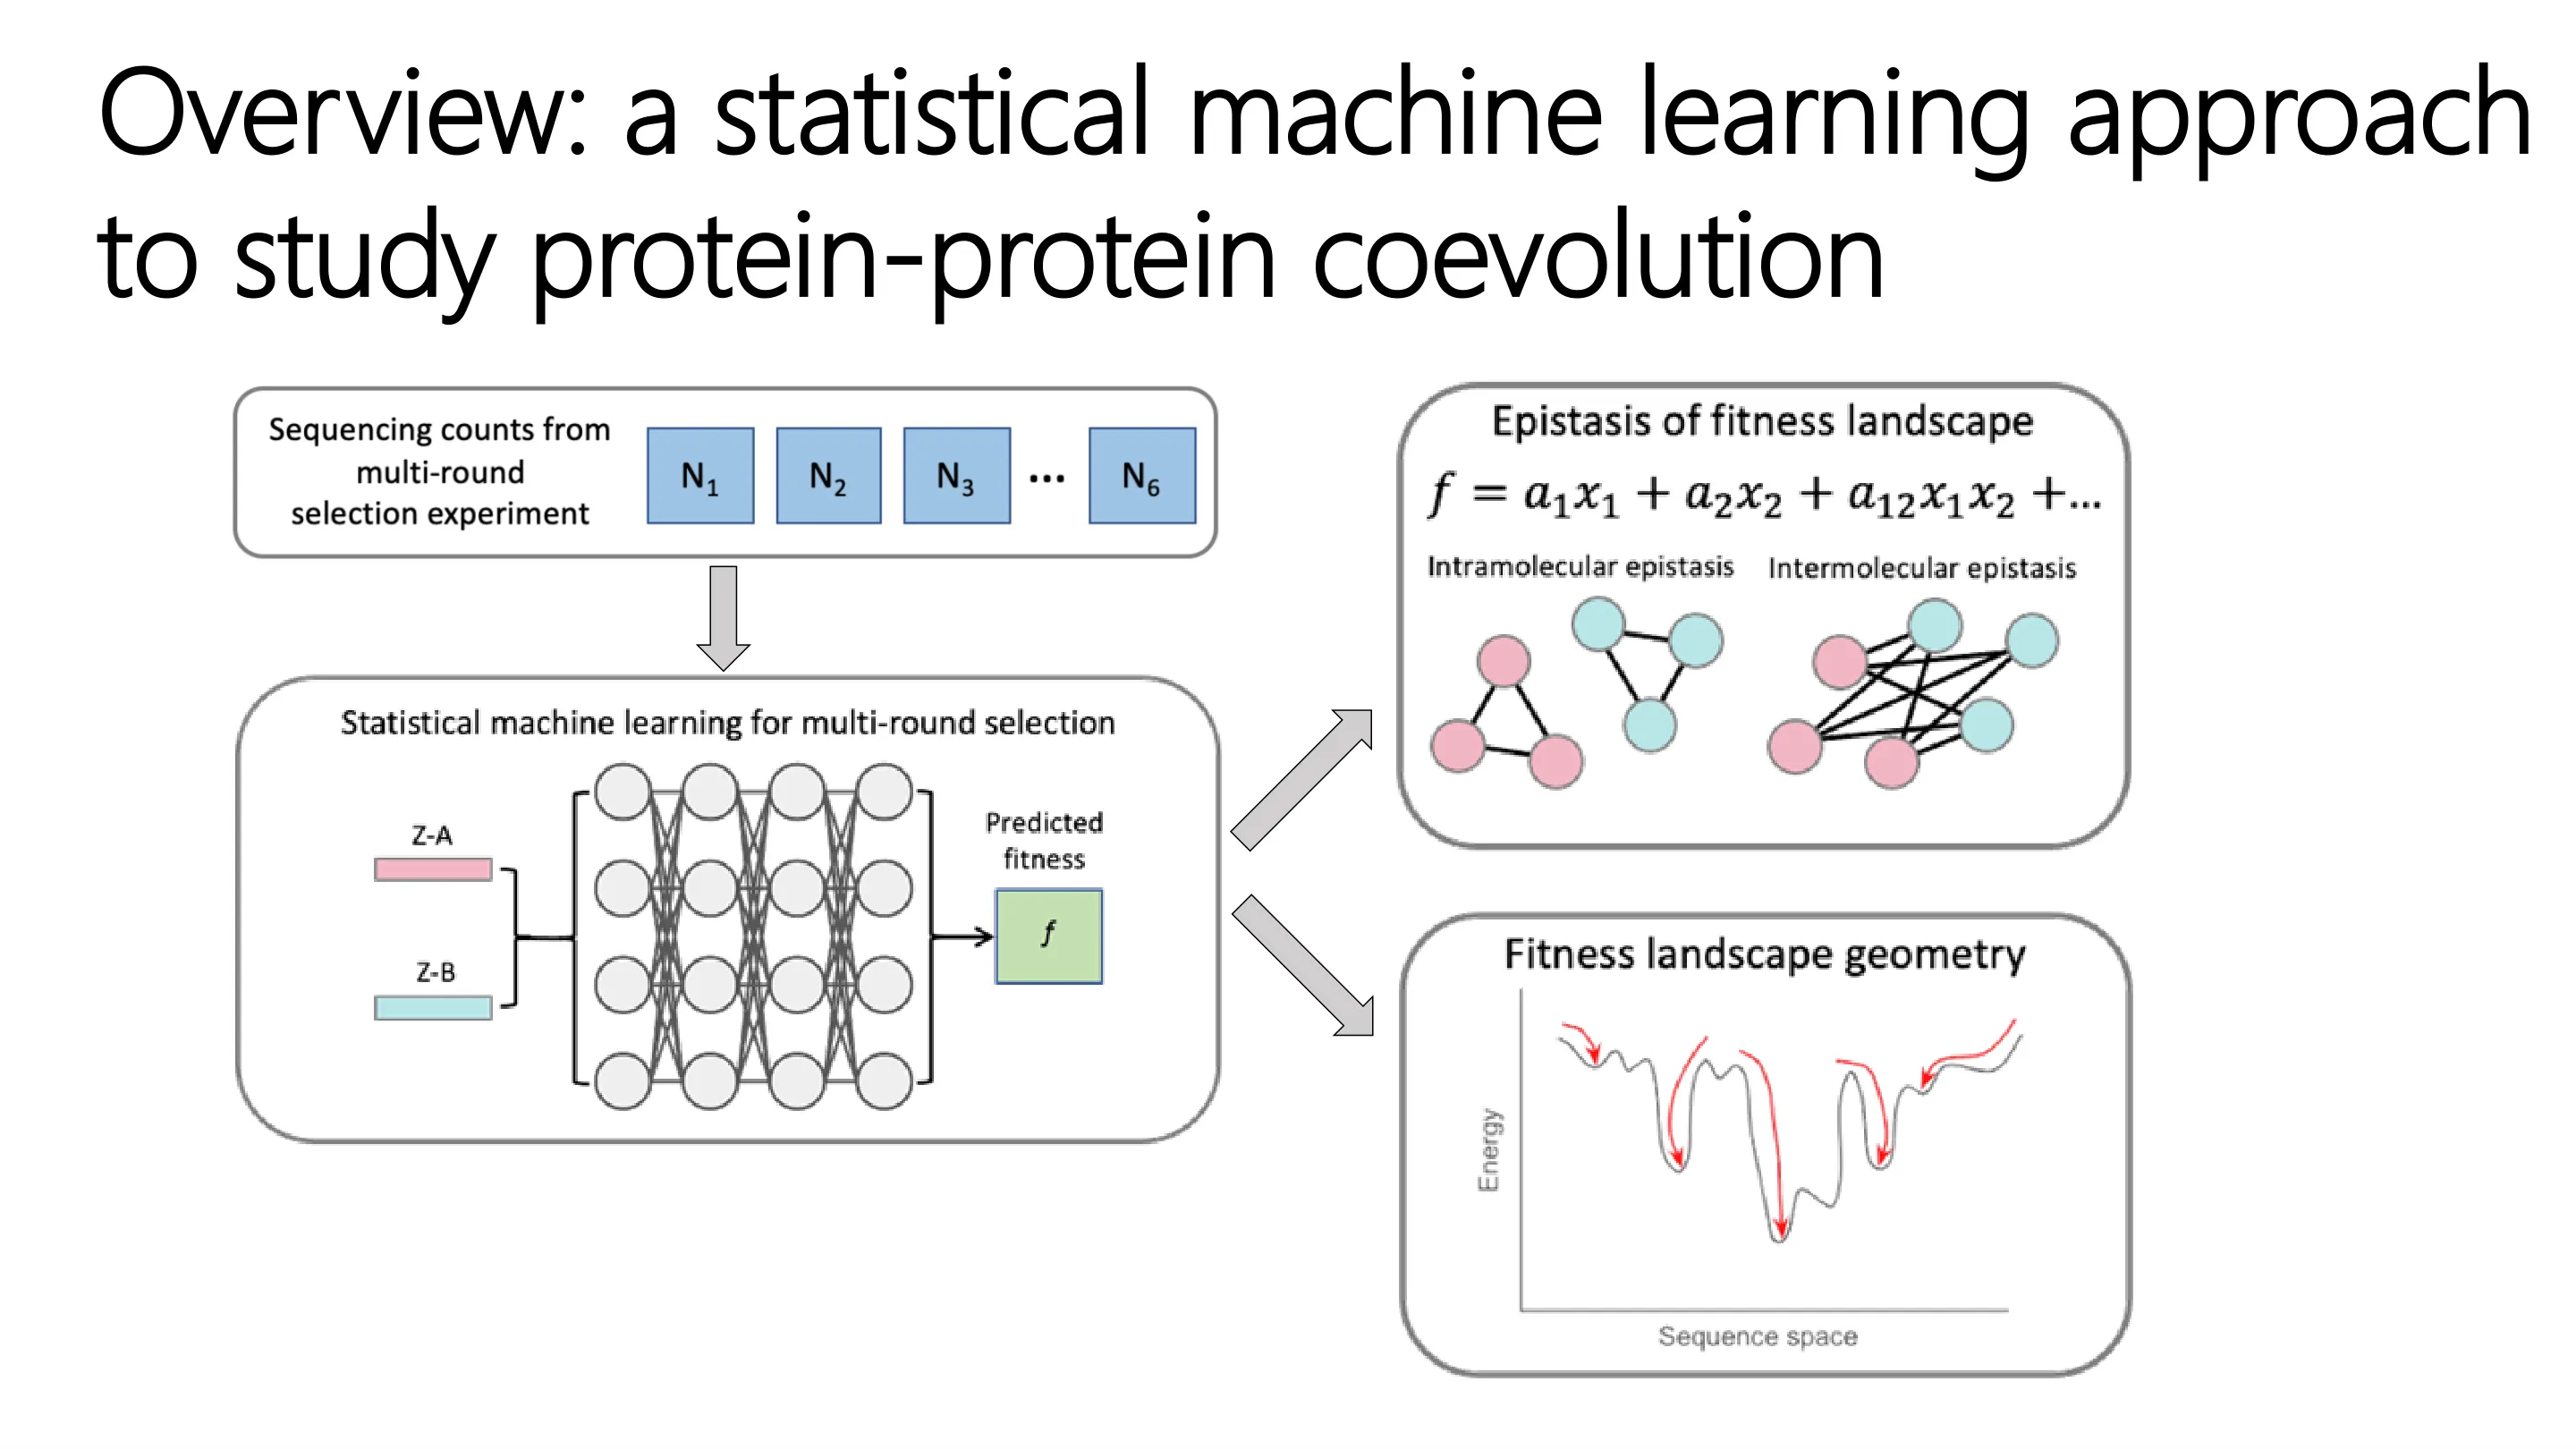
📷 概览:一种统计机器学习方法
回到原视频 (01:09:41)
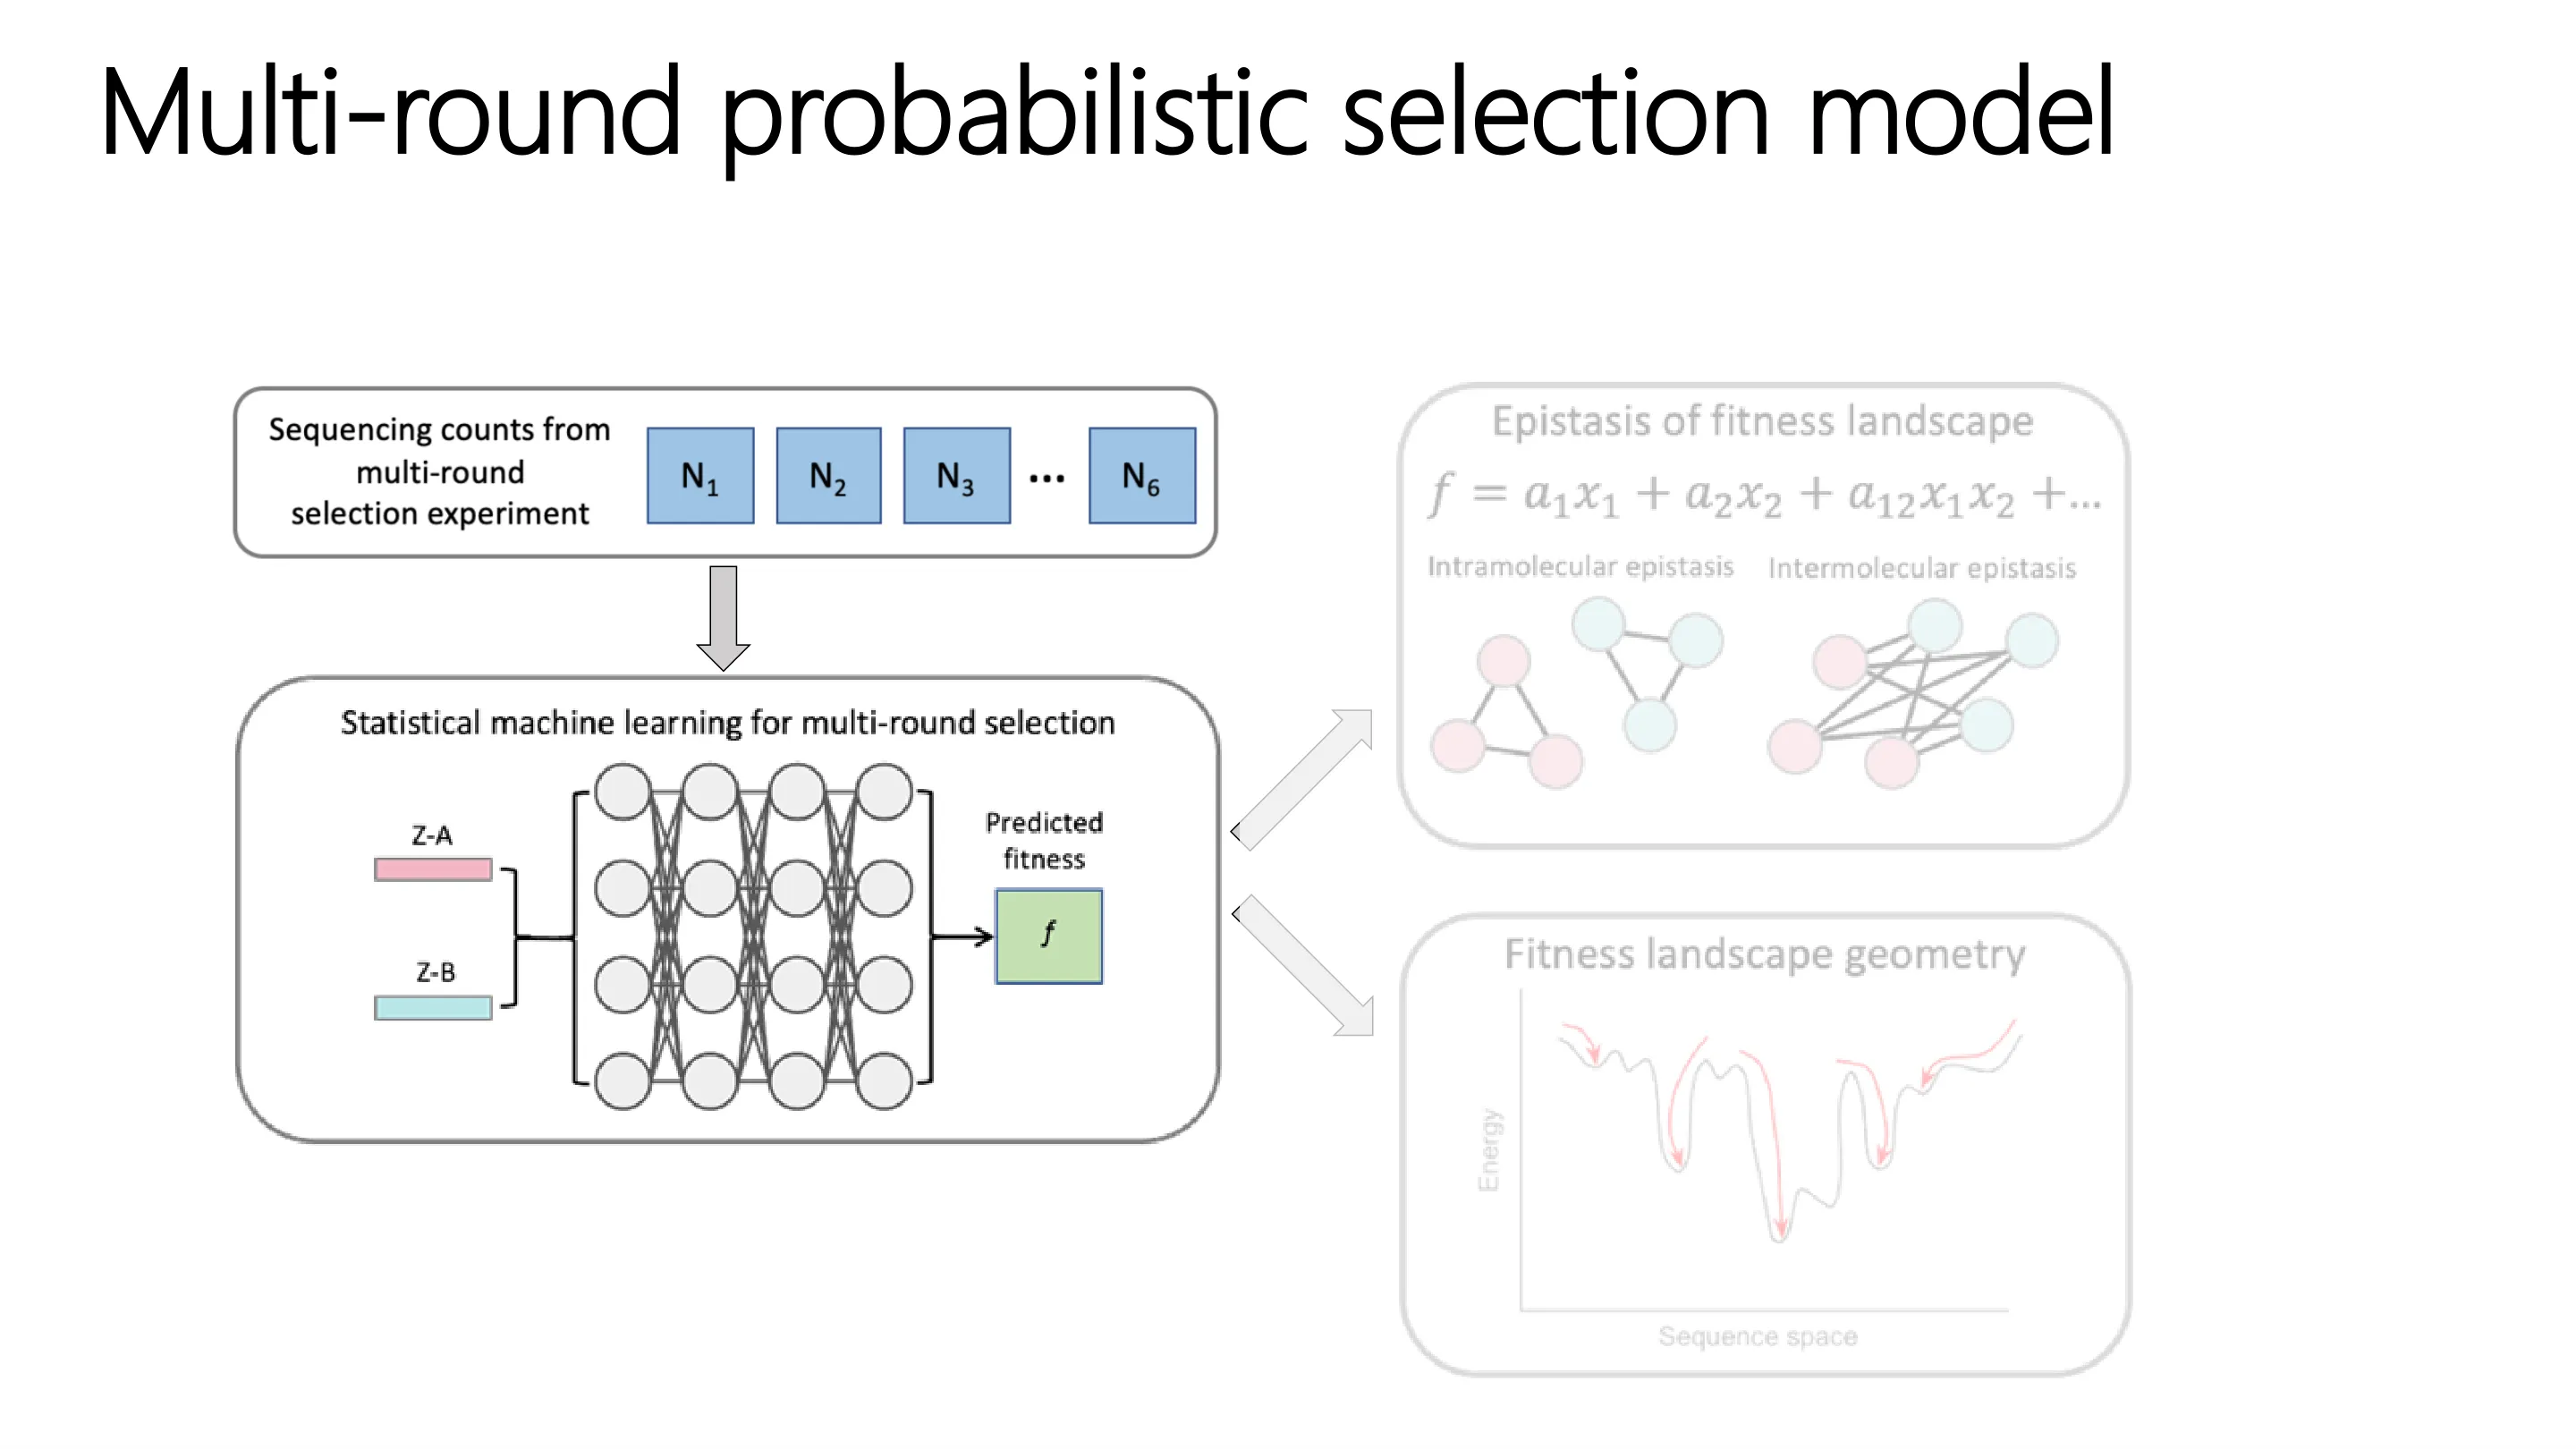
📷 多轮概率选择模型(一)
回到原视频 (01:10:54)
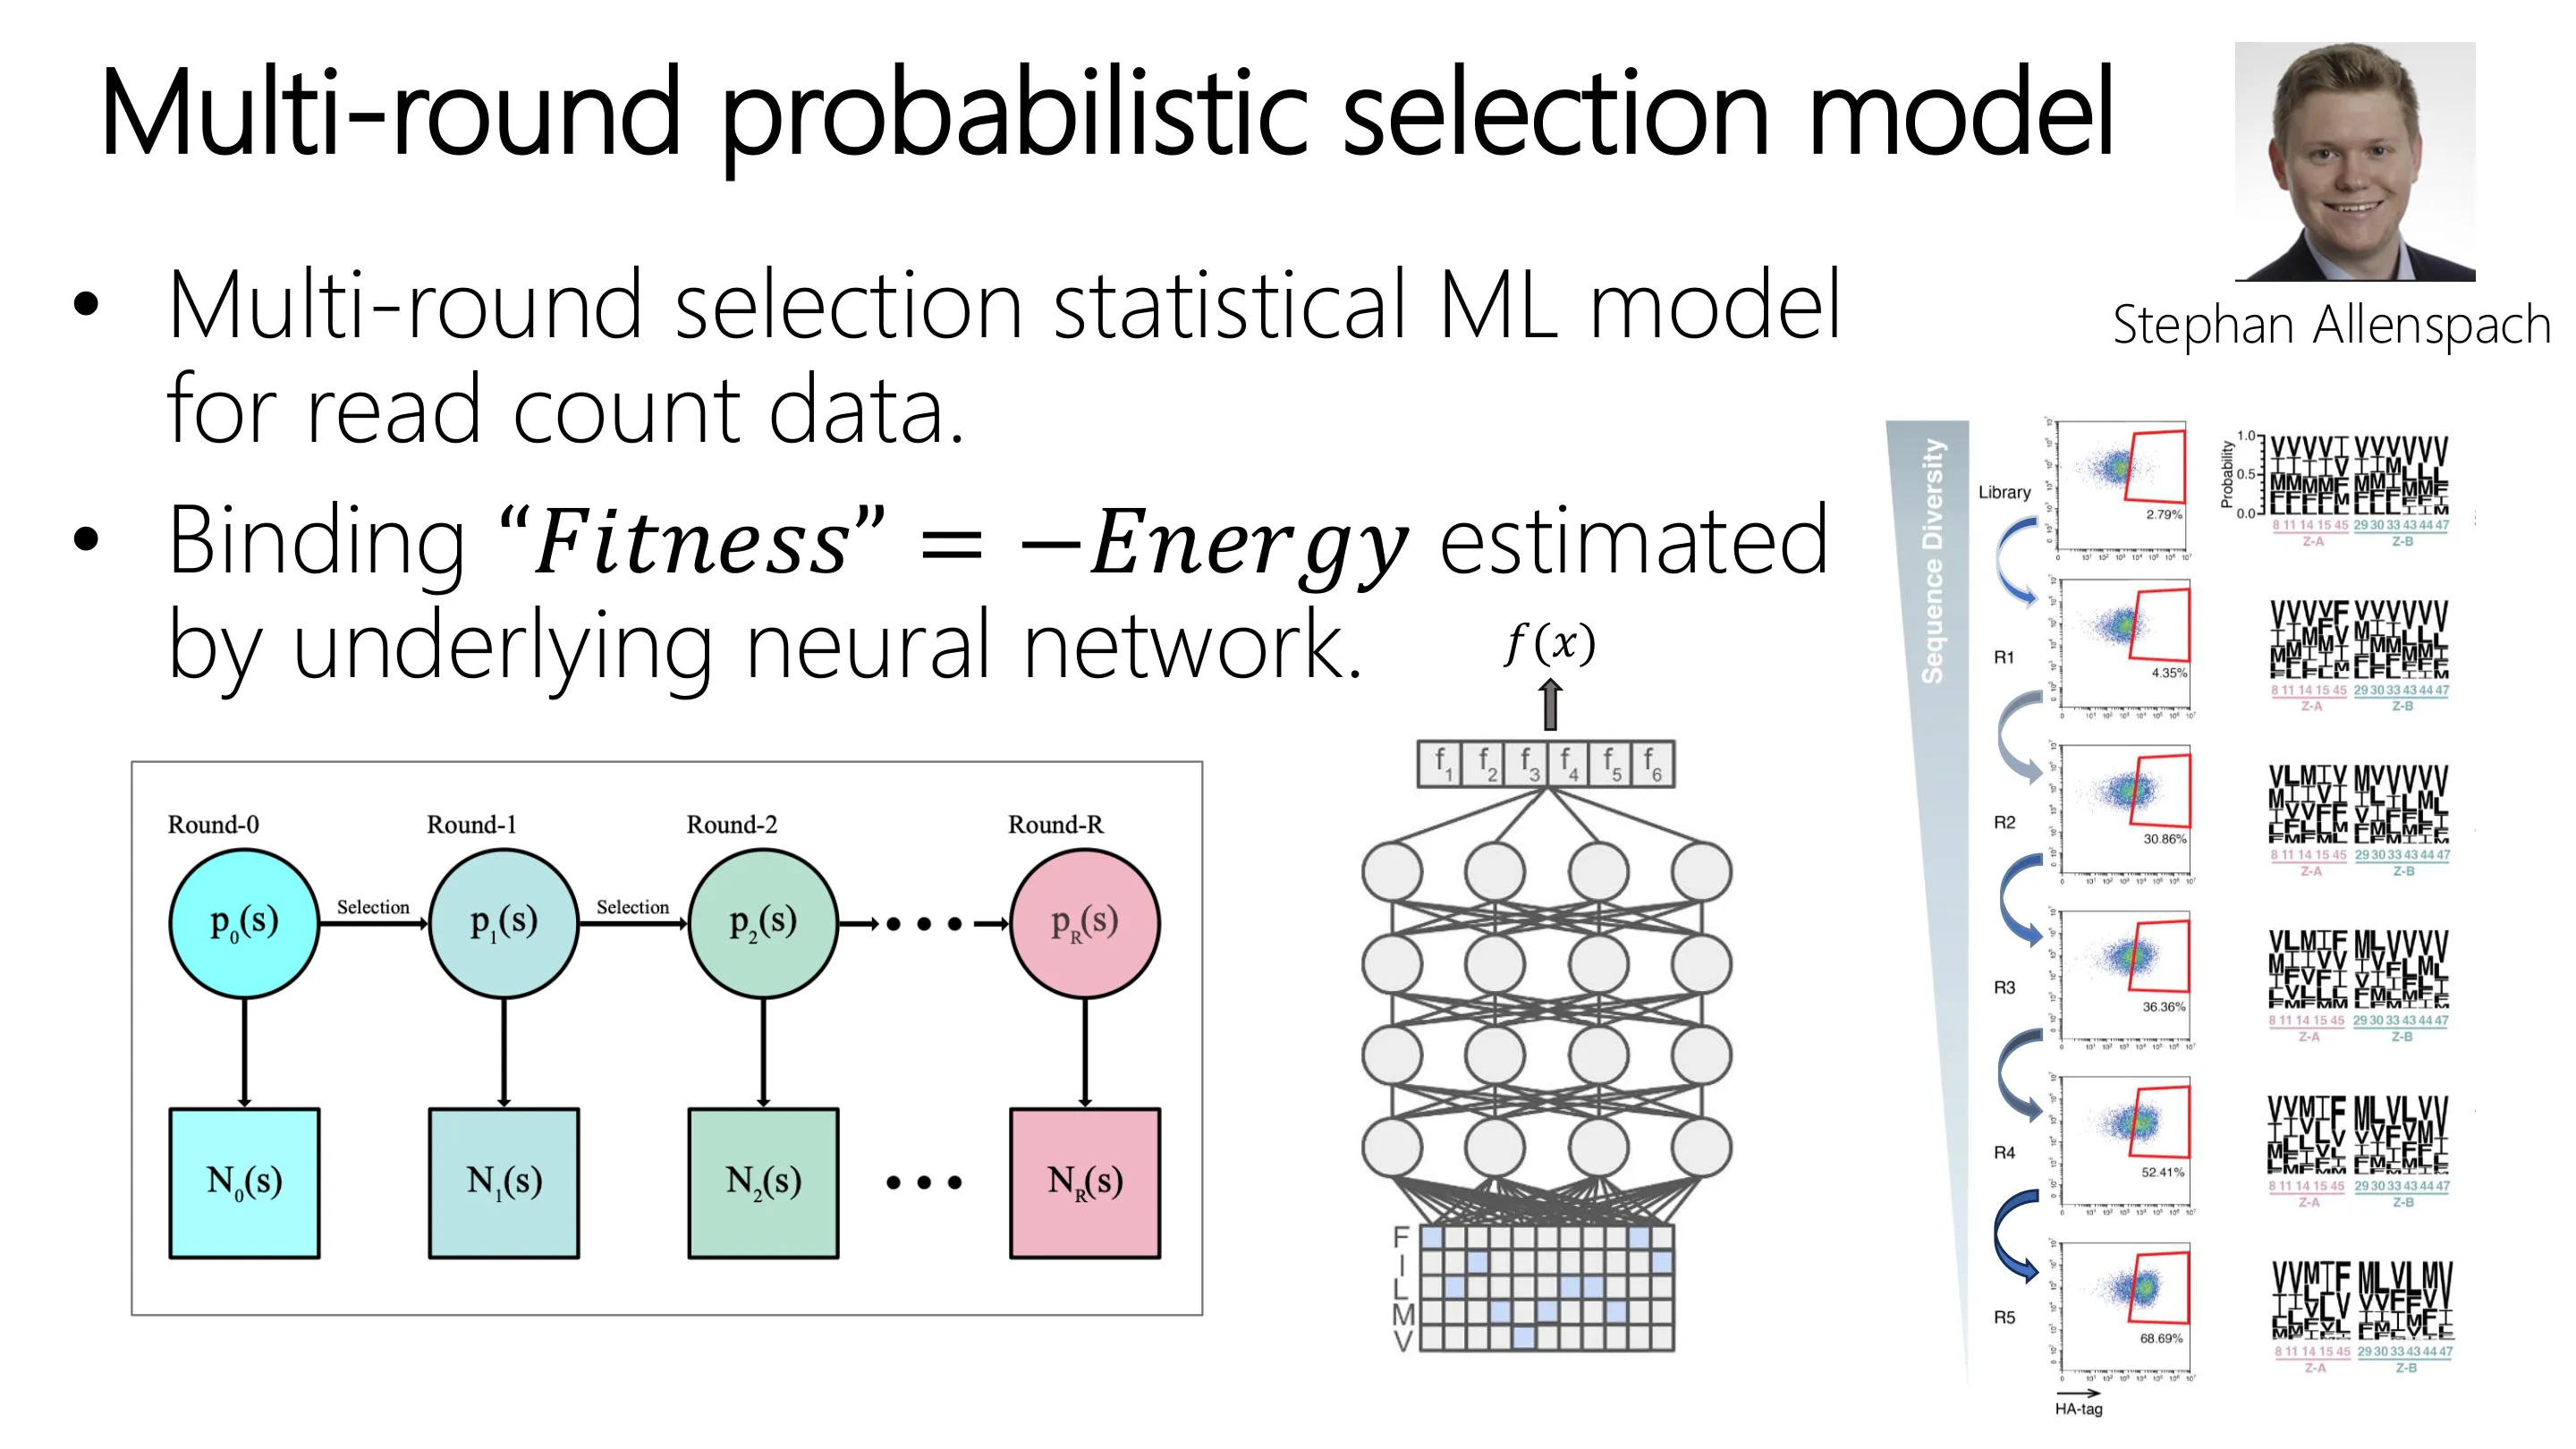
📷 多轮概率选择模型(二)
回到原视频 (01:12:07)
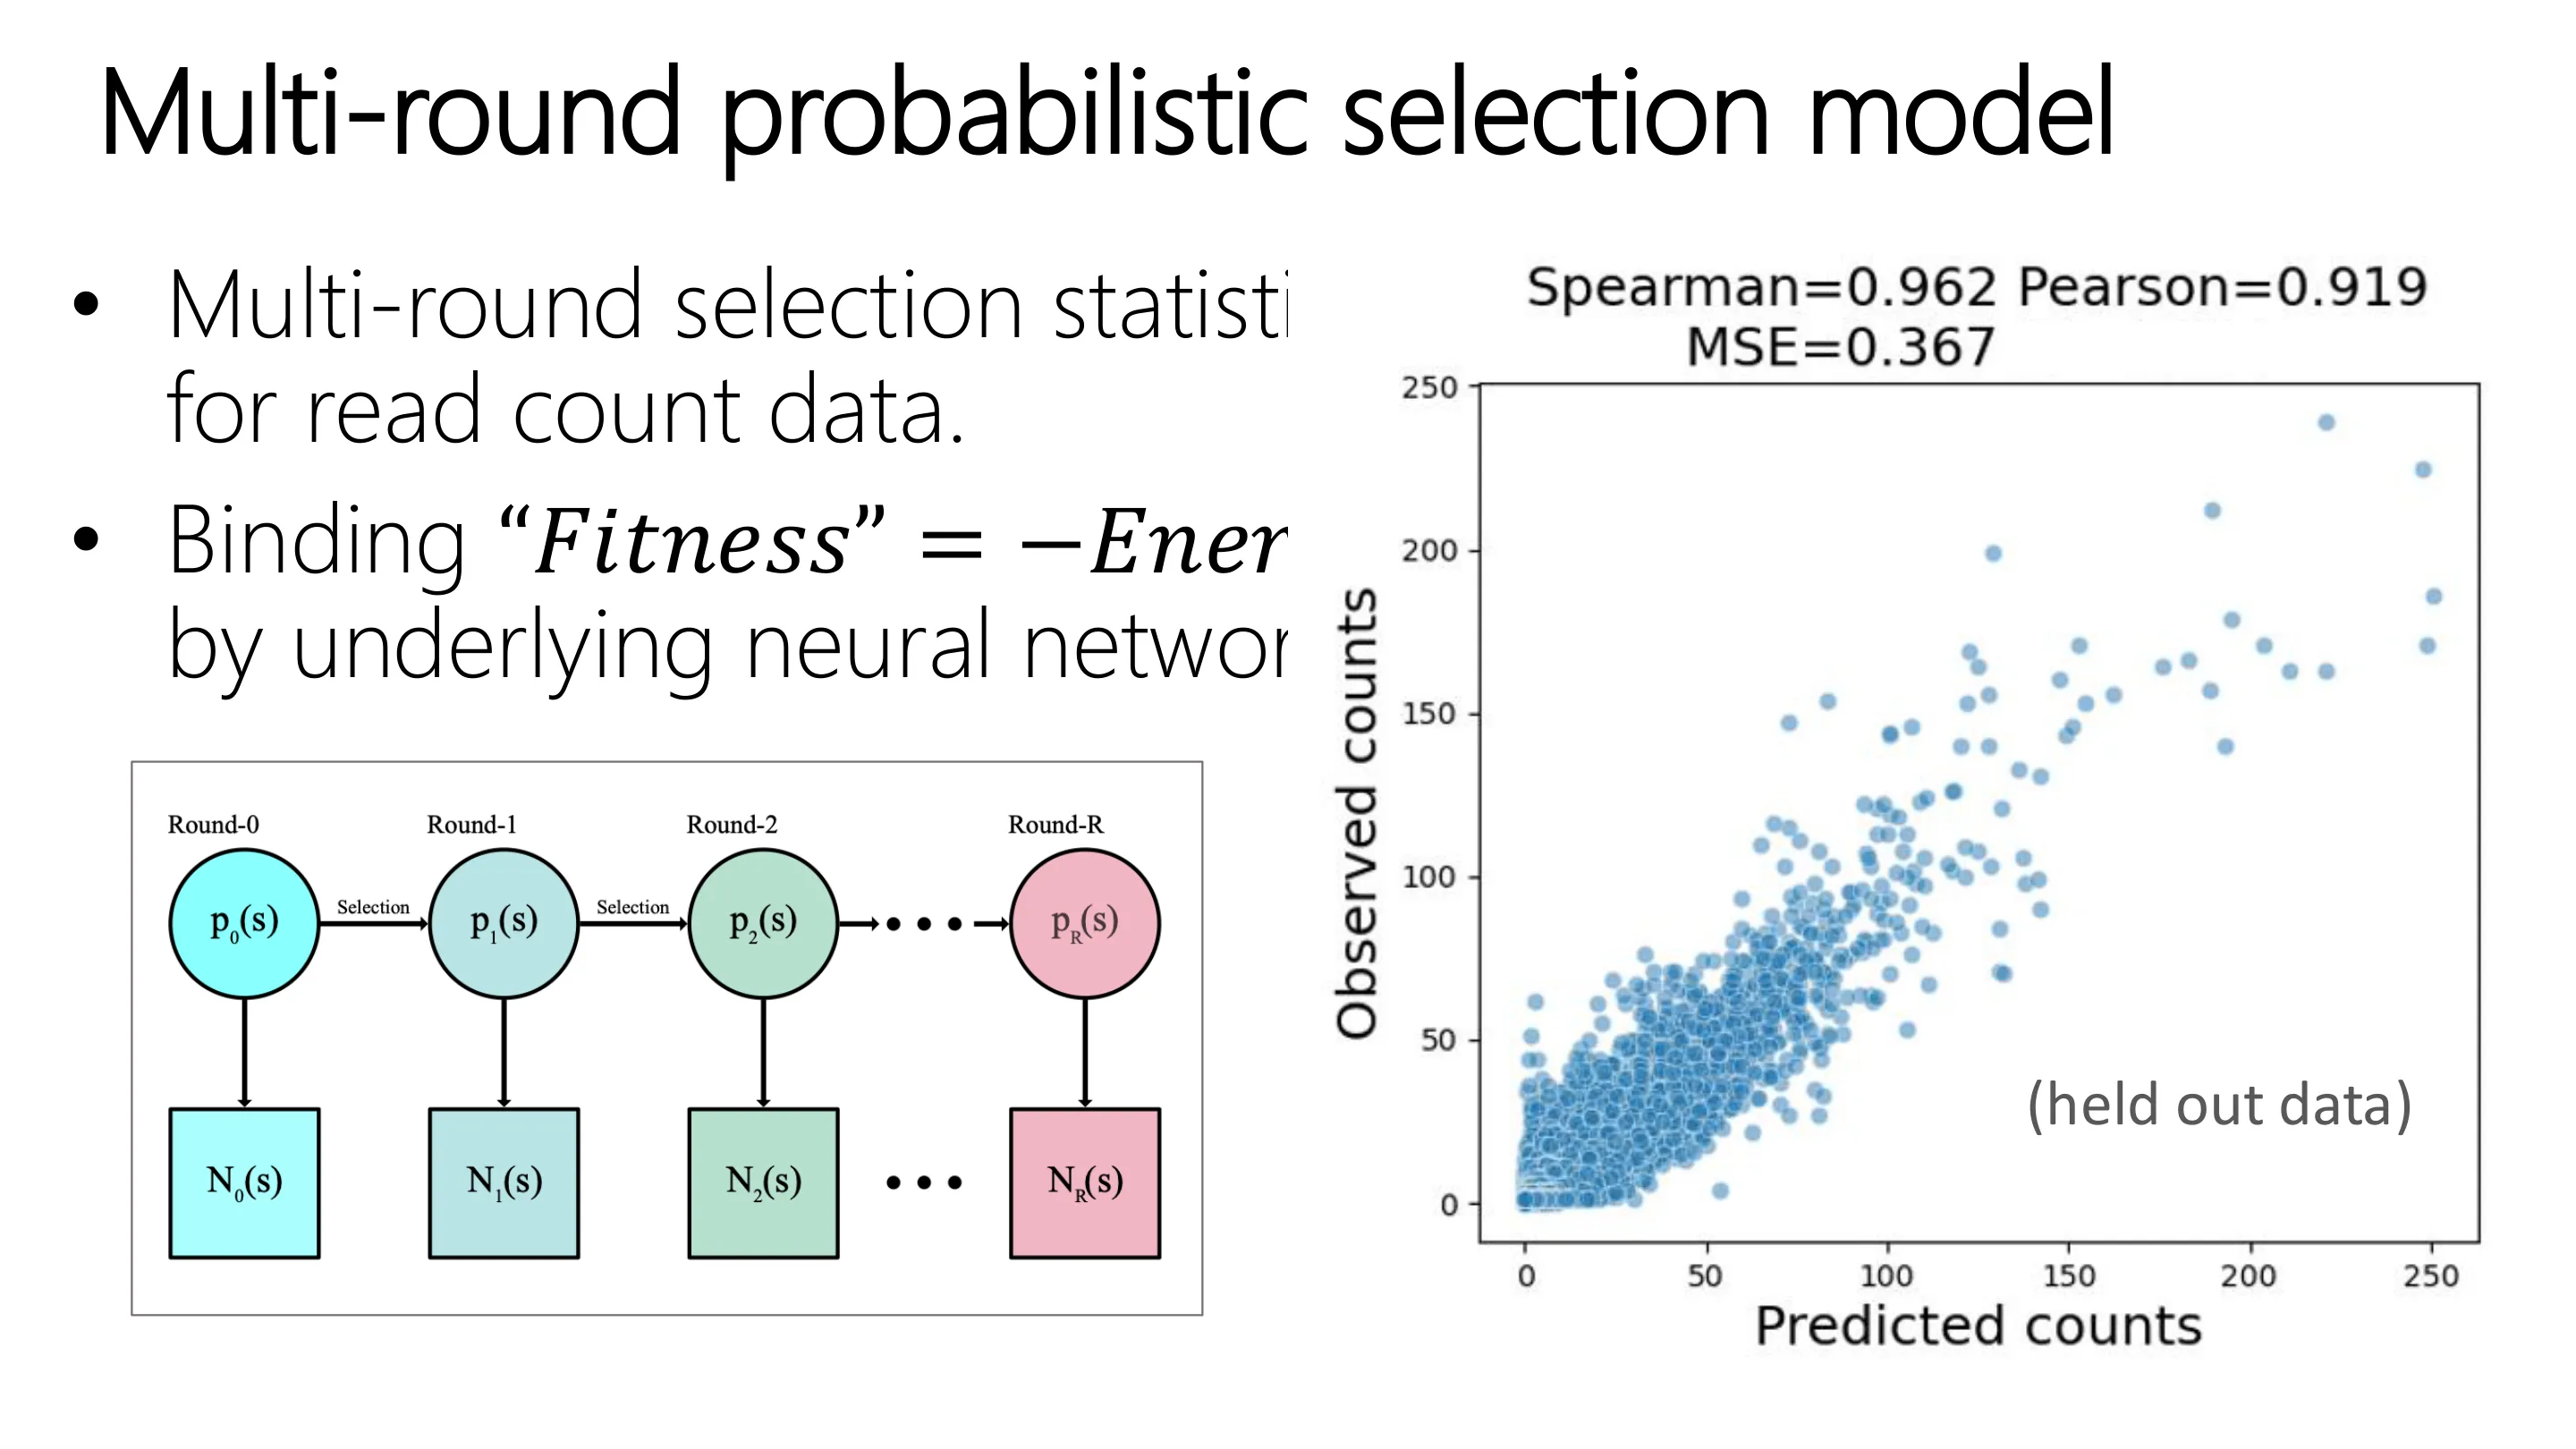
📷 多轮概率选择模型(三)
回到原视频 (01:13:20)
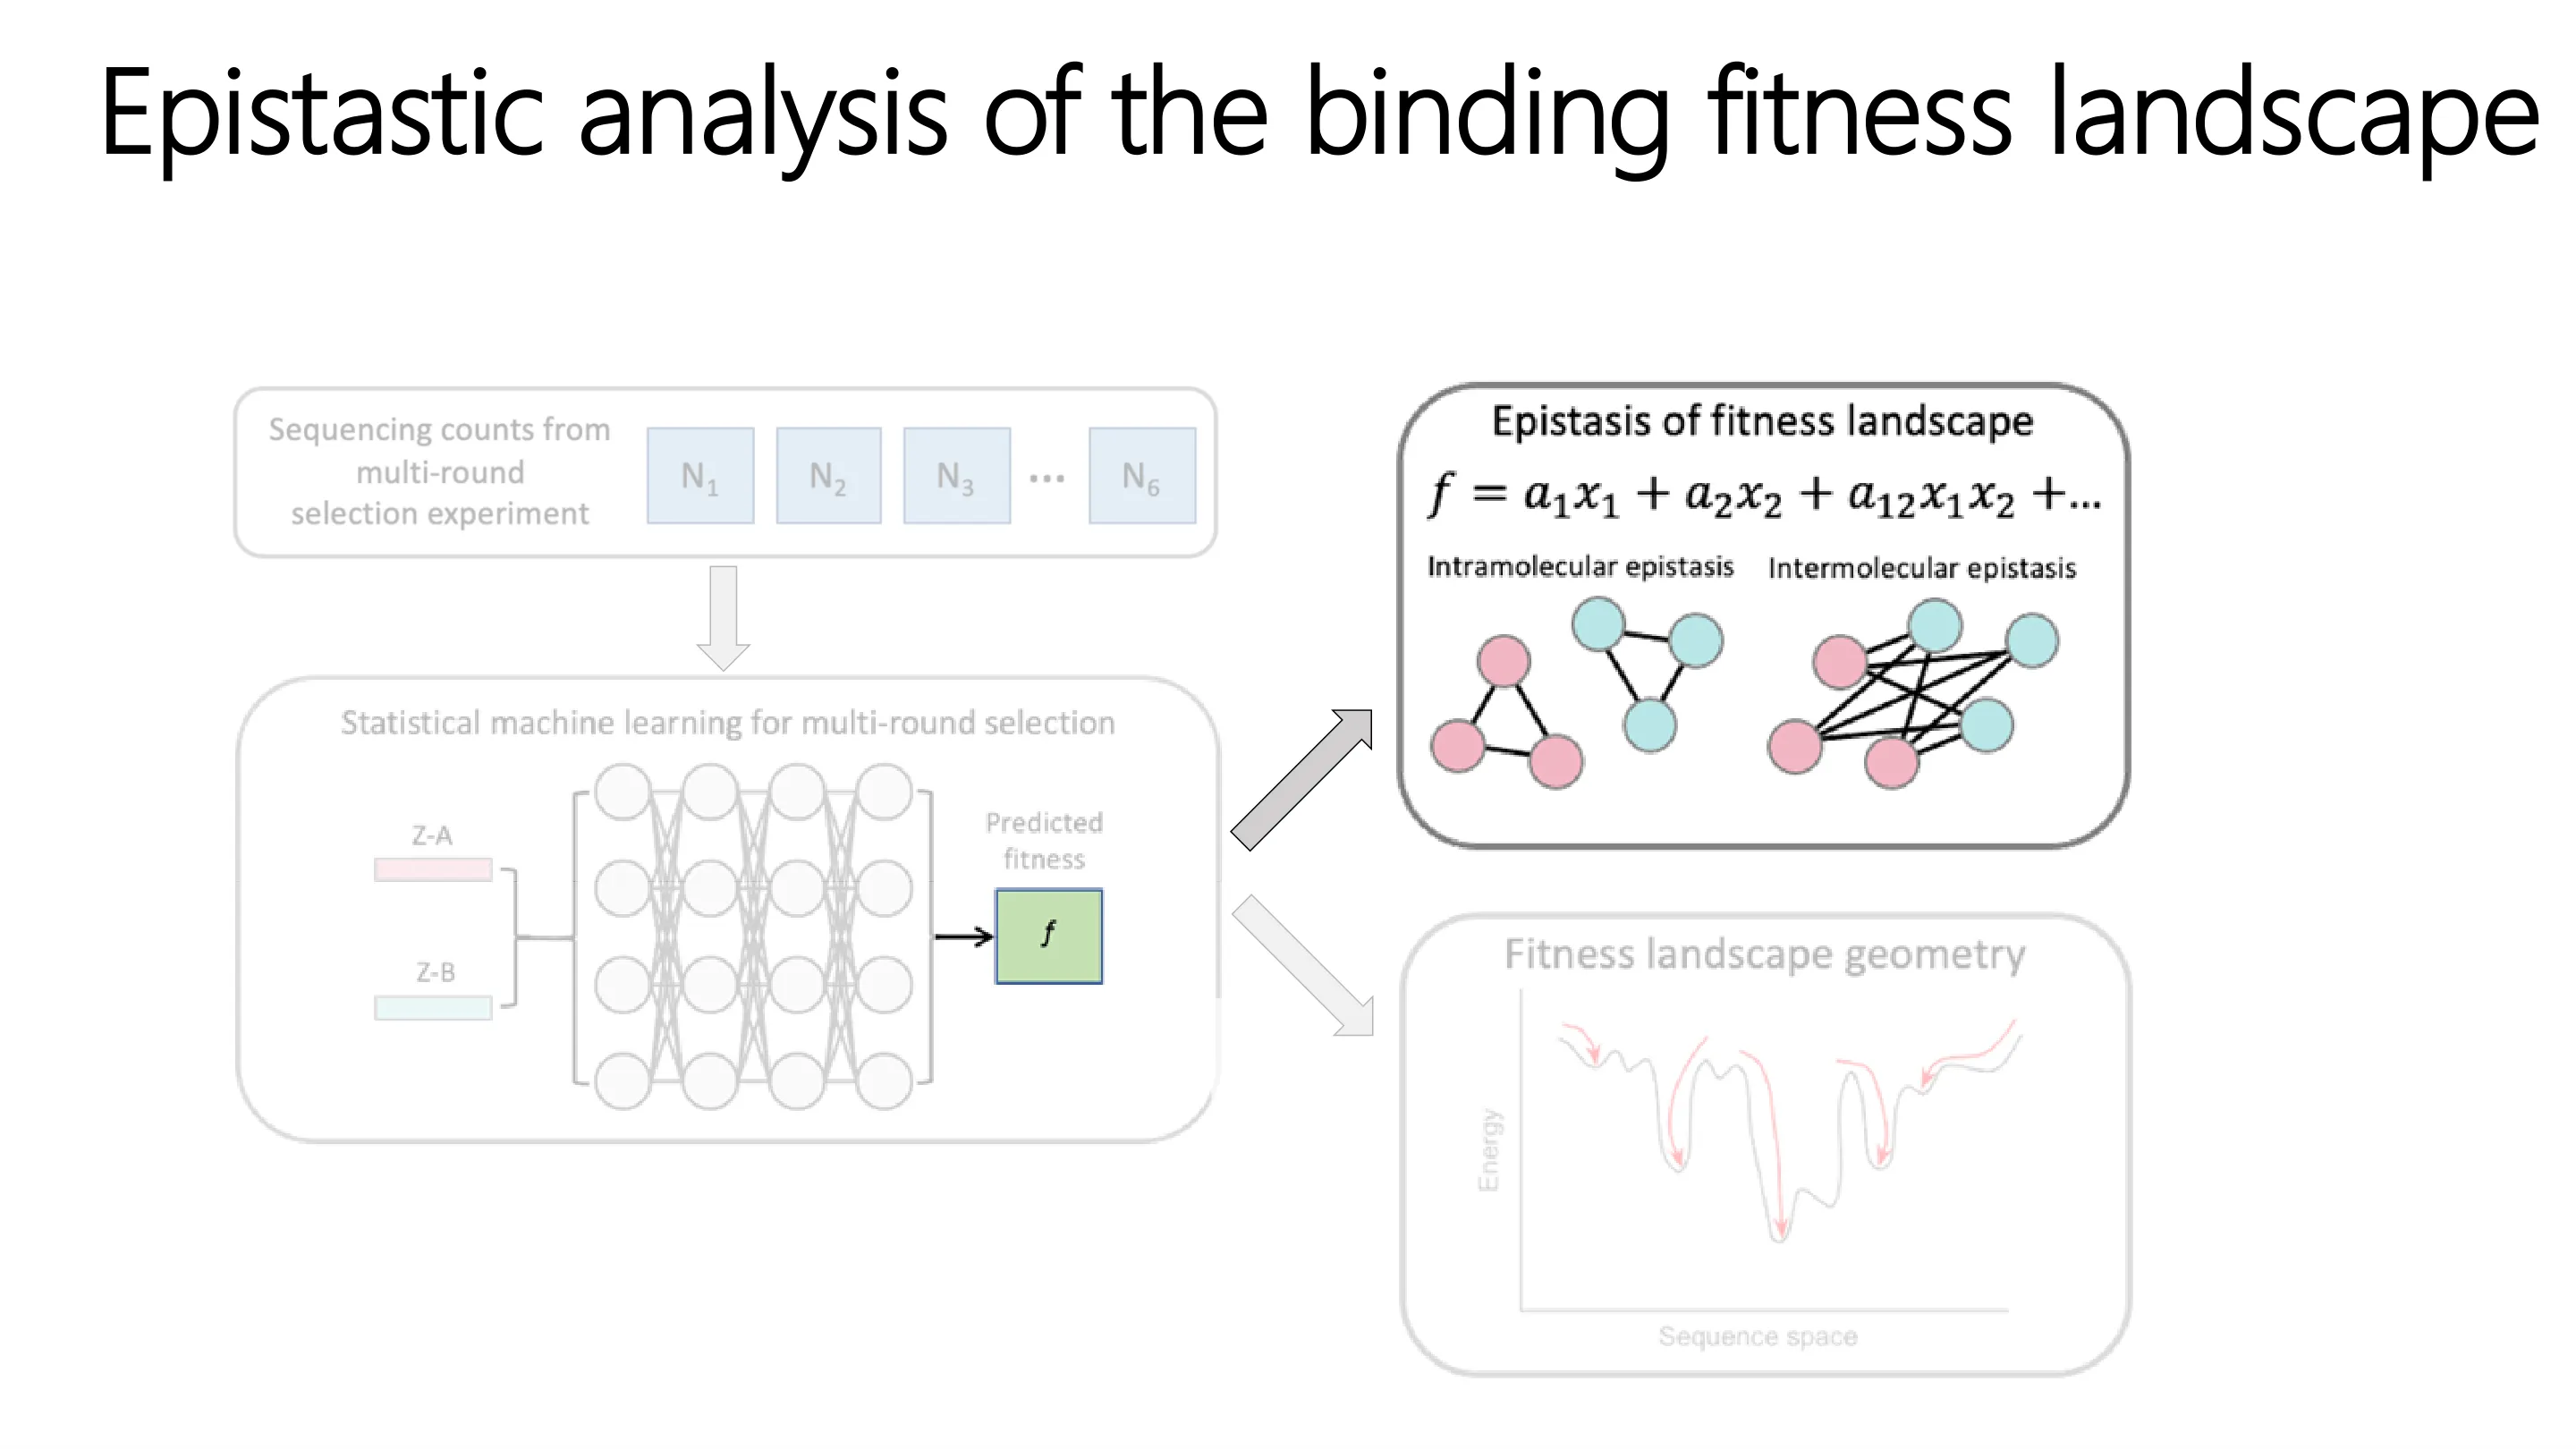
📷 结合适应度景观的上位性分析(一)
回到原视频 (01:14:33)
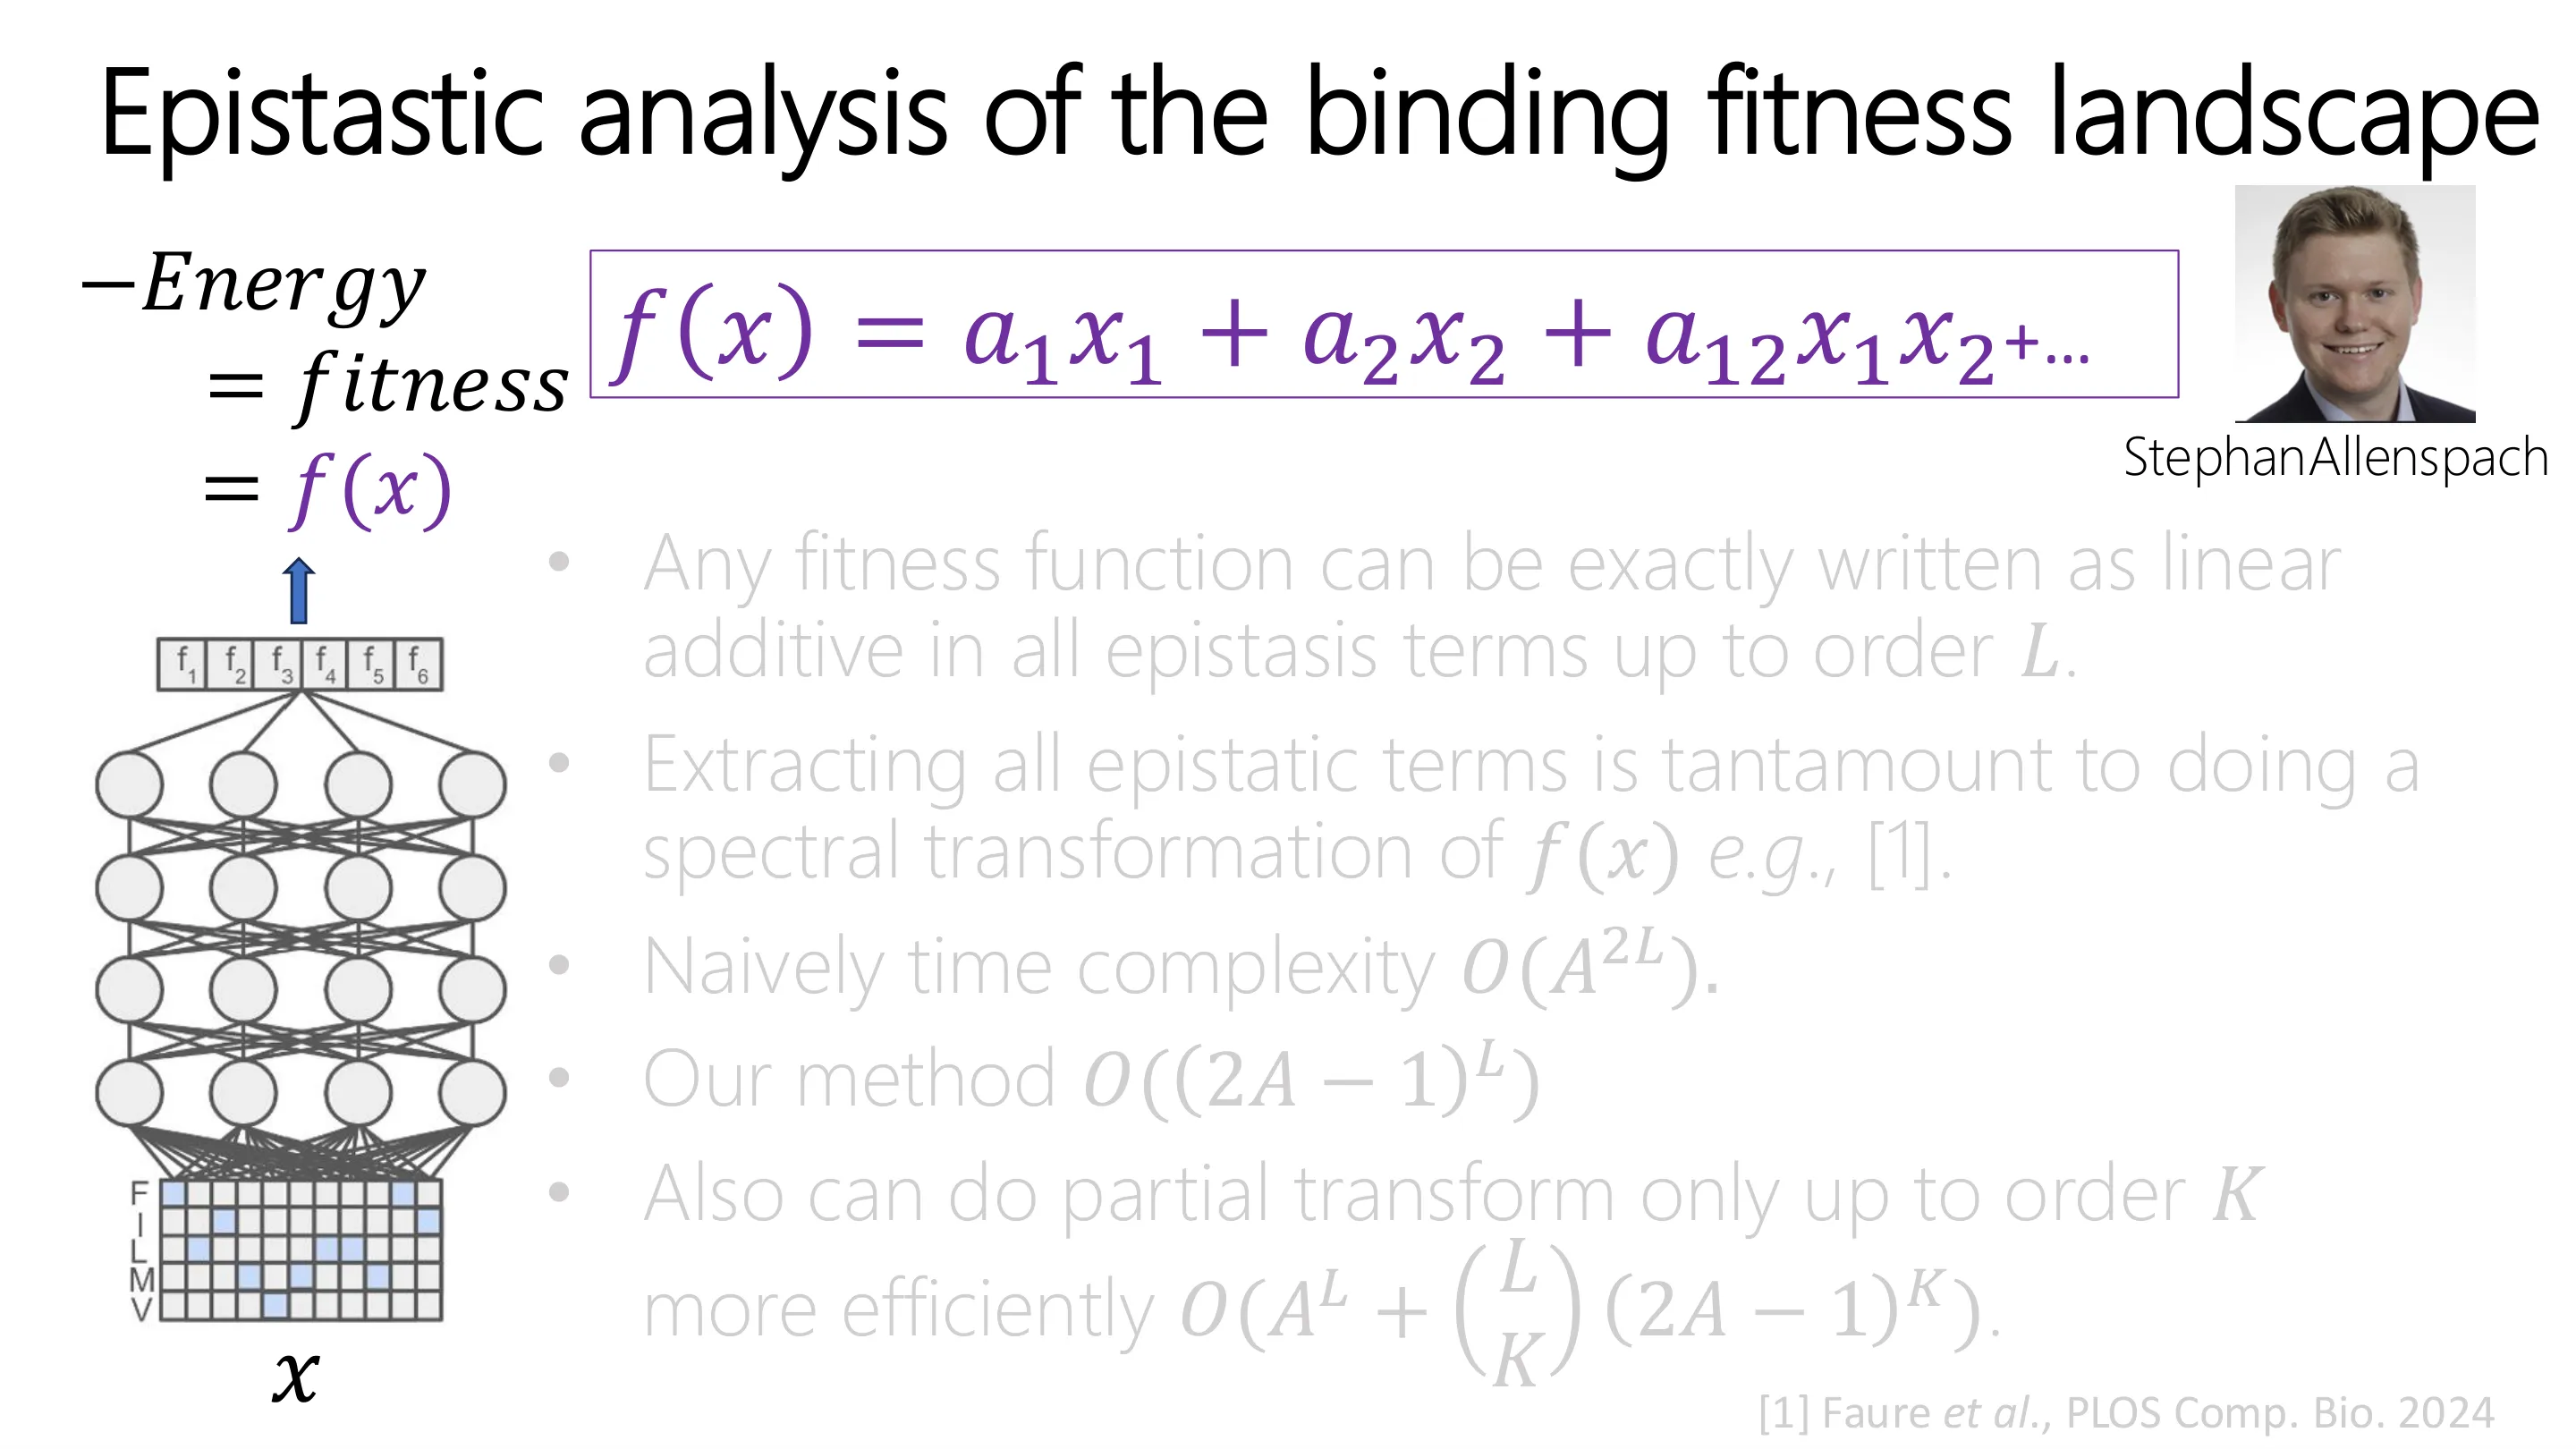
📷 结合适应度景观的上位性分析(二)
回到原视频 (01:15:46)
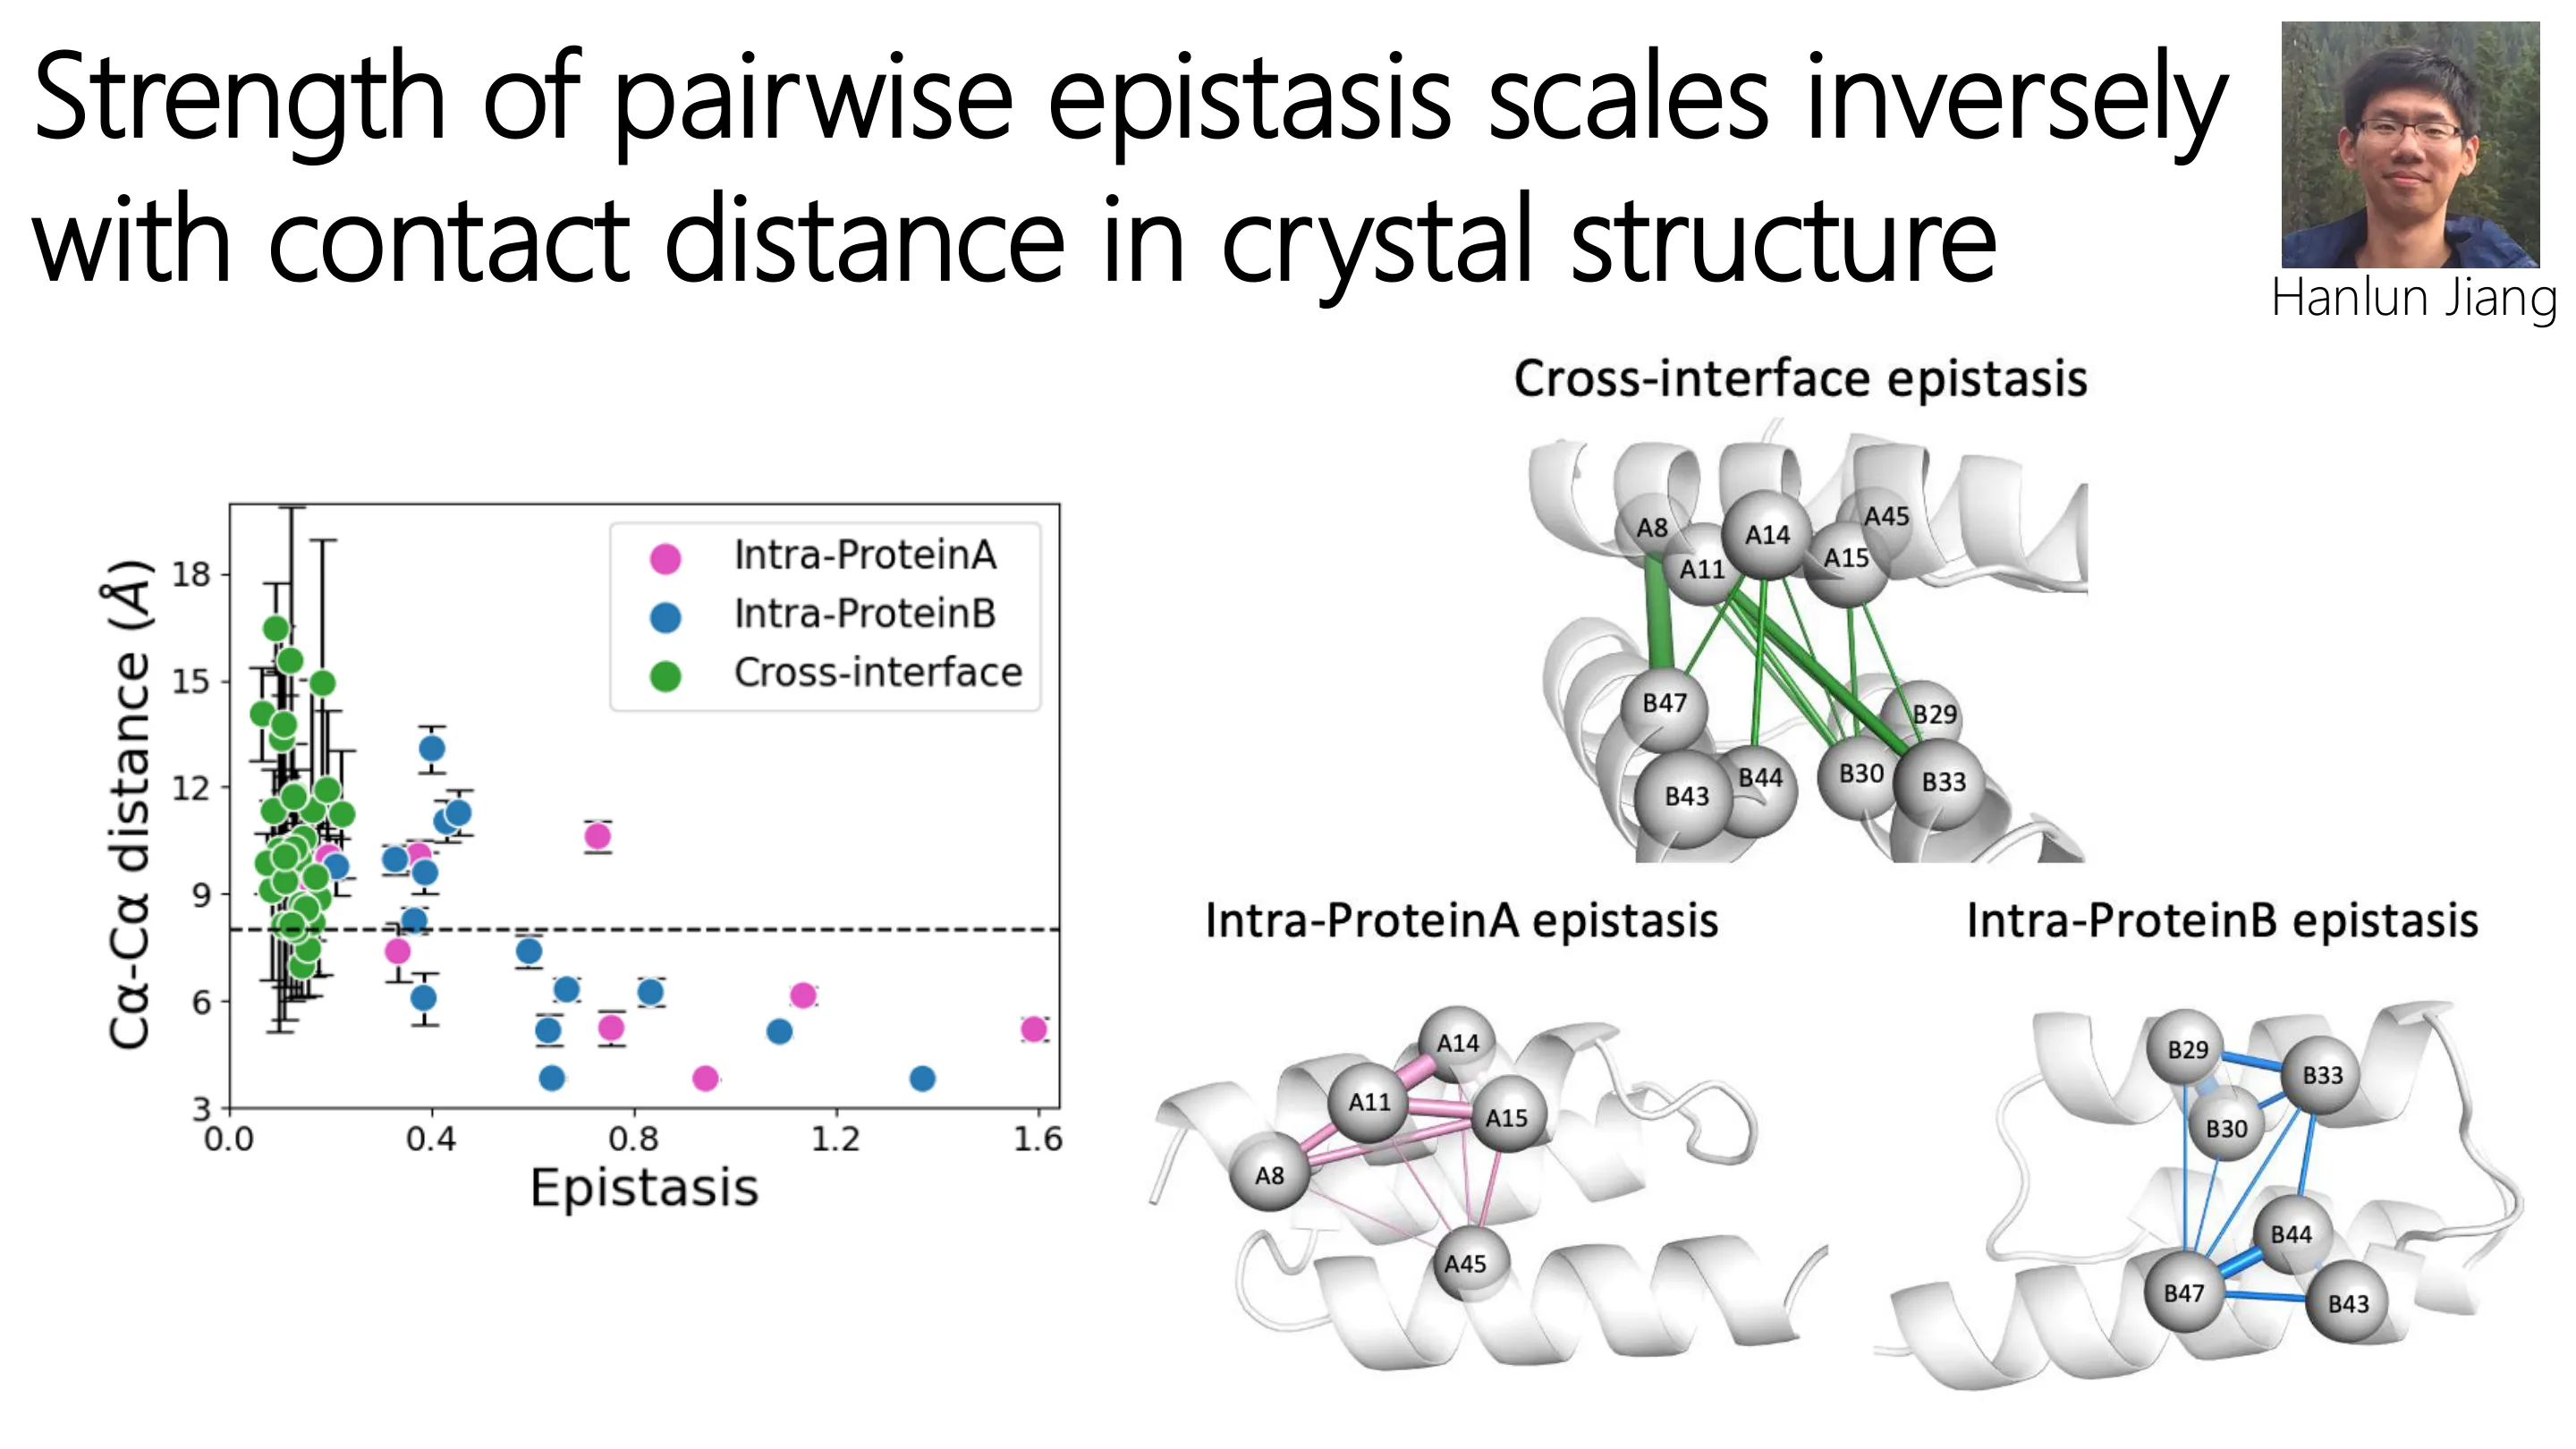
📷 成对上位性的强度与……成反比
回到原视频 (01:16:59)
📷 适应度景观几何:天然 vs 合成
回到原视频 (01:18:12)
📷 模拟约 400 万条进化序列
回到原视频 (01:19:25)
总结(Takeaways)
- 蛋白质 = 20 种氨基酸的序列,序列决定三维结构(Anfinsen 证明原理);结构大体决定结合,但酶催化等功能不由结构决定。
- AlphaFold2 依赖 MSA / 协方差、模板、特殊架构与领域特定损失;训练数据成本约 200 亿美元;置信度校准良好;去掉 MSA 就失效 ⇒ 它并非在做物理。
- 蛋白质工程是在近乎无限的设计空间中找序列;历史两条路线(能量函数 vs 定向进化)都已获诺奖,如今被 ML 融合。
- 设计 = 反转模型 → 对抗性:直接反转 NN 会落入训练流形之外的病态区域(「香蕉」类比、对抗样本)。
- 条件生成:用贝叶斯法则融合「大蛋白模型 $p(x)$」与「湿实验预测模型 $p(y\mid x)$」;扩散/score 模型因对 $x$ 求梯度而消去归一化常数,代价是采样需积分。
- 案例:AAV 载体文库设计(预测-实验相关 0.96)、多轮概率选择模型与适应度景观、上位性分析。
- 统计视角:许多「AI」蛋白质方法本质是现代统计学(密度估计 + 采样),并需湿实验紧密配合。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=V-SJk4AJ-xc |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 25) | Google Drive 文件夹 |
| Jumper et al., Highly accurate protein structure prediction with AlphaFold (2021) | AlphaFold2 · https://www.nature.com/articles/s41586-021-03819-2 |
| Abramson et al., Accurate structure prediction of biomolecular interactions with AlphaFold 3 (2024) | AlphaFold3 · https://www.nature.com/articles/s41586-024-07487-w |
| Arnold, Directed Evolution | 定向进化(2018 诺奖) |
| Baker 等,蛋白质设计 | 计算蛋白设计(2024 诺奖) |
| 蛋白质工程的生成模型综述(Nature Biotechnology primer) | 序列/结构生成模型 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。