第27讲 · EECS 189:LLM、智能体与环境
UC Berkeley EECS 189/289A《机器学习导论》2026 春季 · 课堂实录重构
| 原始标题 | LLMs, Agents, and Environments |
| 视频 | https://www.youtube.com/watch?v=yRgSQCXr8M0 |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 27) | Google Drive PDF |
| 图片来源 | 书中幻灯片插图为官方 PDF 高清渲染图 |
对应讲次:第27讲(UC Berkeley EECS 189 机器学习导论)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
说明:课程材料版权归 UC Berkeley 及授课教师所有,本书仅供学习
本讲路线图
(参考时间: 00:04)
本讲是本学期最后一讲,主题是智能体(agents)与环境(environments):
- 什么是 LLM、什么是 agent:一步一步排除「不是 agent」的东西(tool use、RAG、硬编码 workflow);
- 如何造 agent:多智能体系统的长程问题,前沿实验室的自主 agent + 终端;
- 环境:从「问答评测」到「环境评测」,Agent 的历史三阶段;
- Terminal-Bench:Harbor 框架、任务三要素(任务描述 / Dockerfile / 验证器)、reward hacking;
- 用环境训练 agent:SFT vs RL(GRPO)、GEPA(自动提示优化 / 遗传-Pareto)。
📷 标题页
回到原视频 (00:00:20)
📷 路线图
回到原视频 (00:01:33)
一、什么是 Agent?
1.1 先回顾 LLM
(参考时间: 00:04)
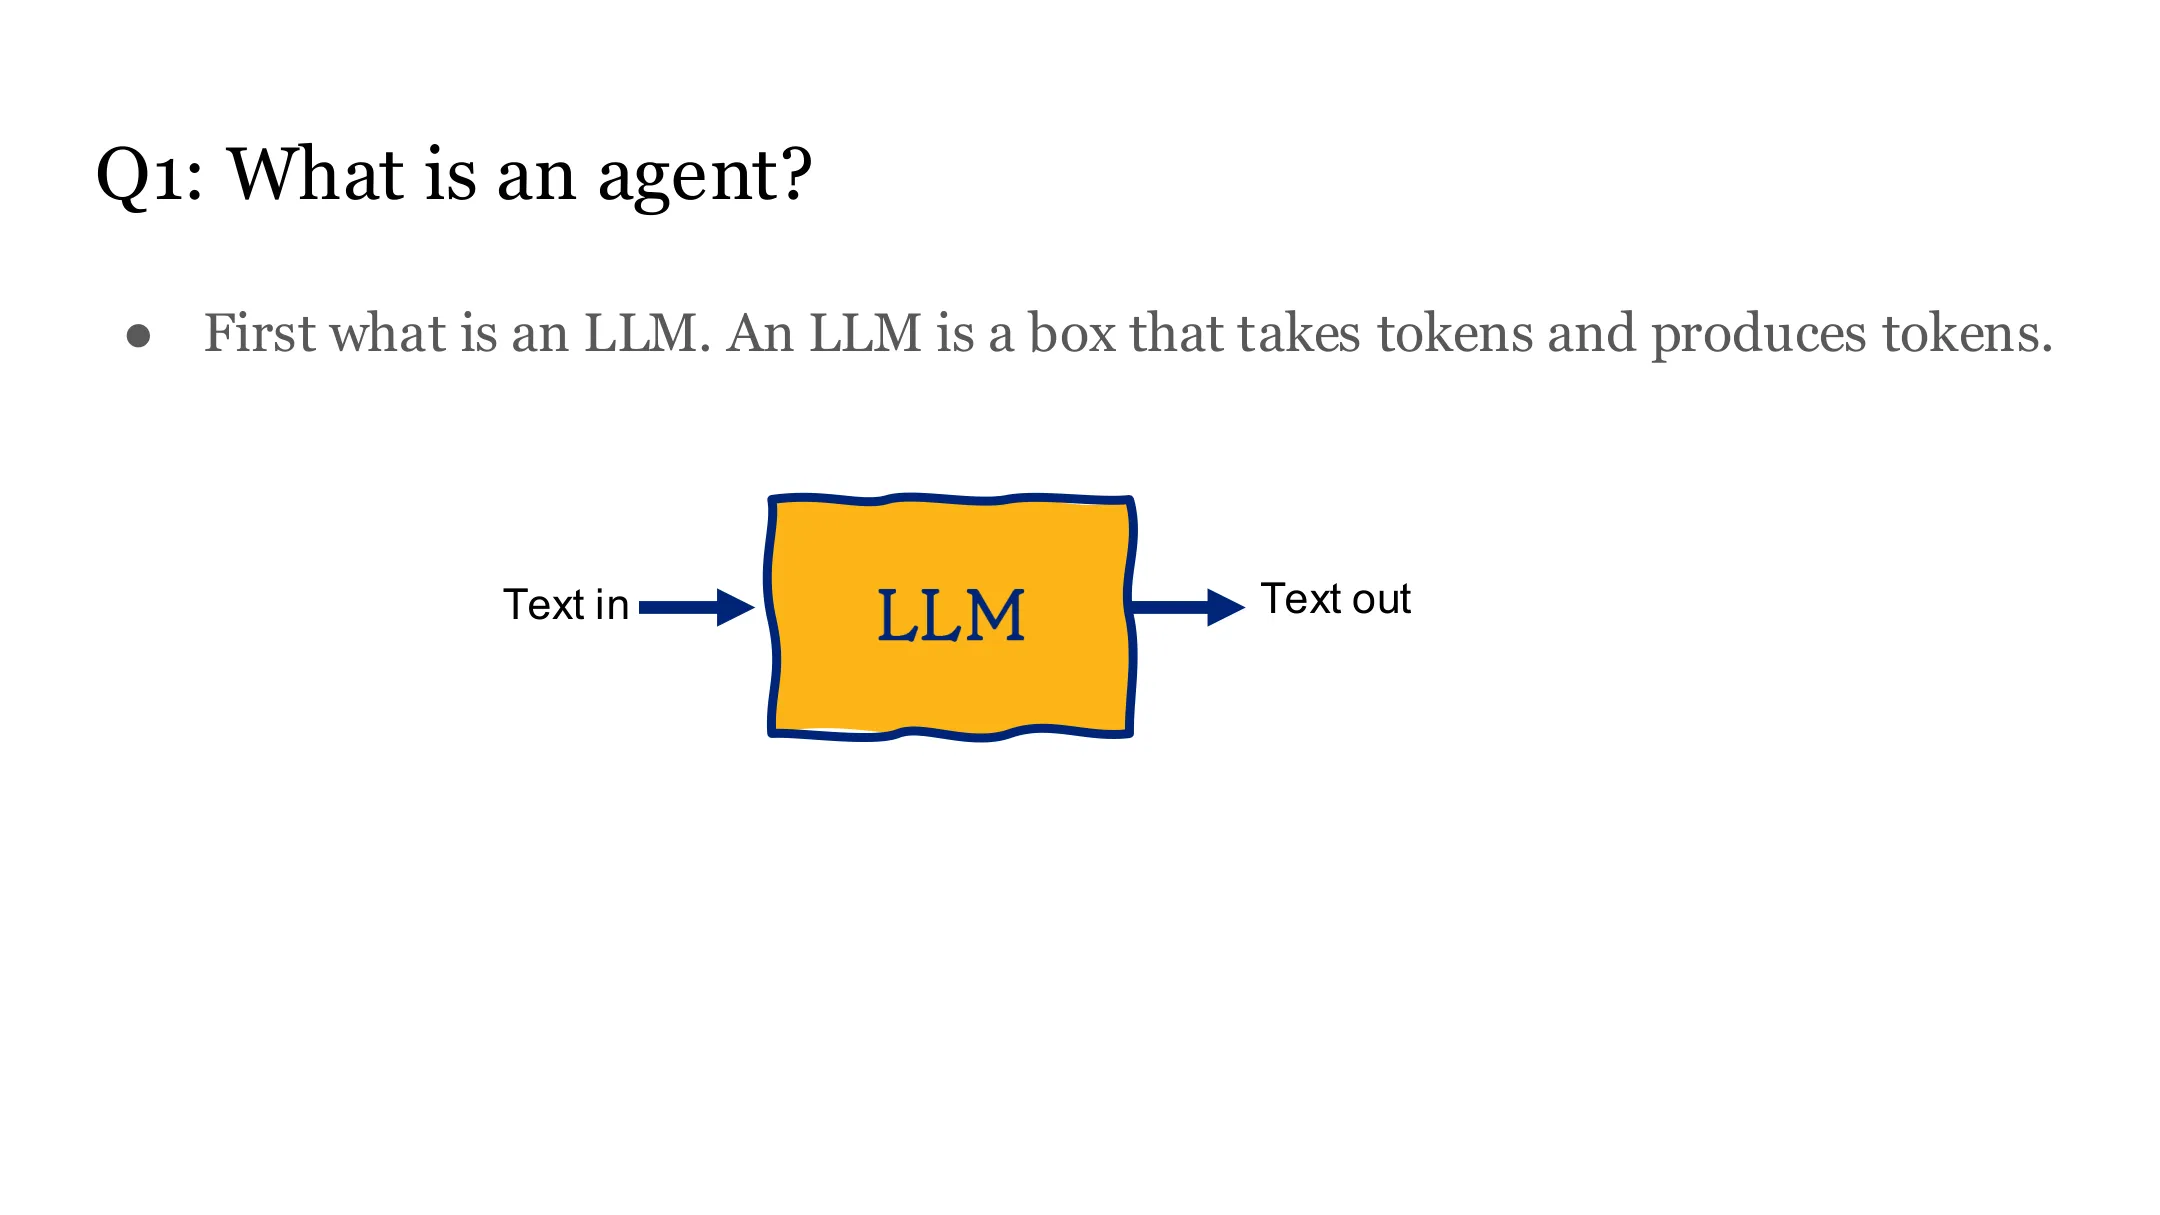
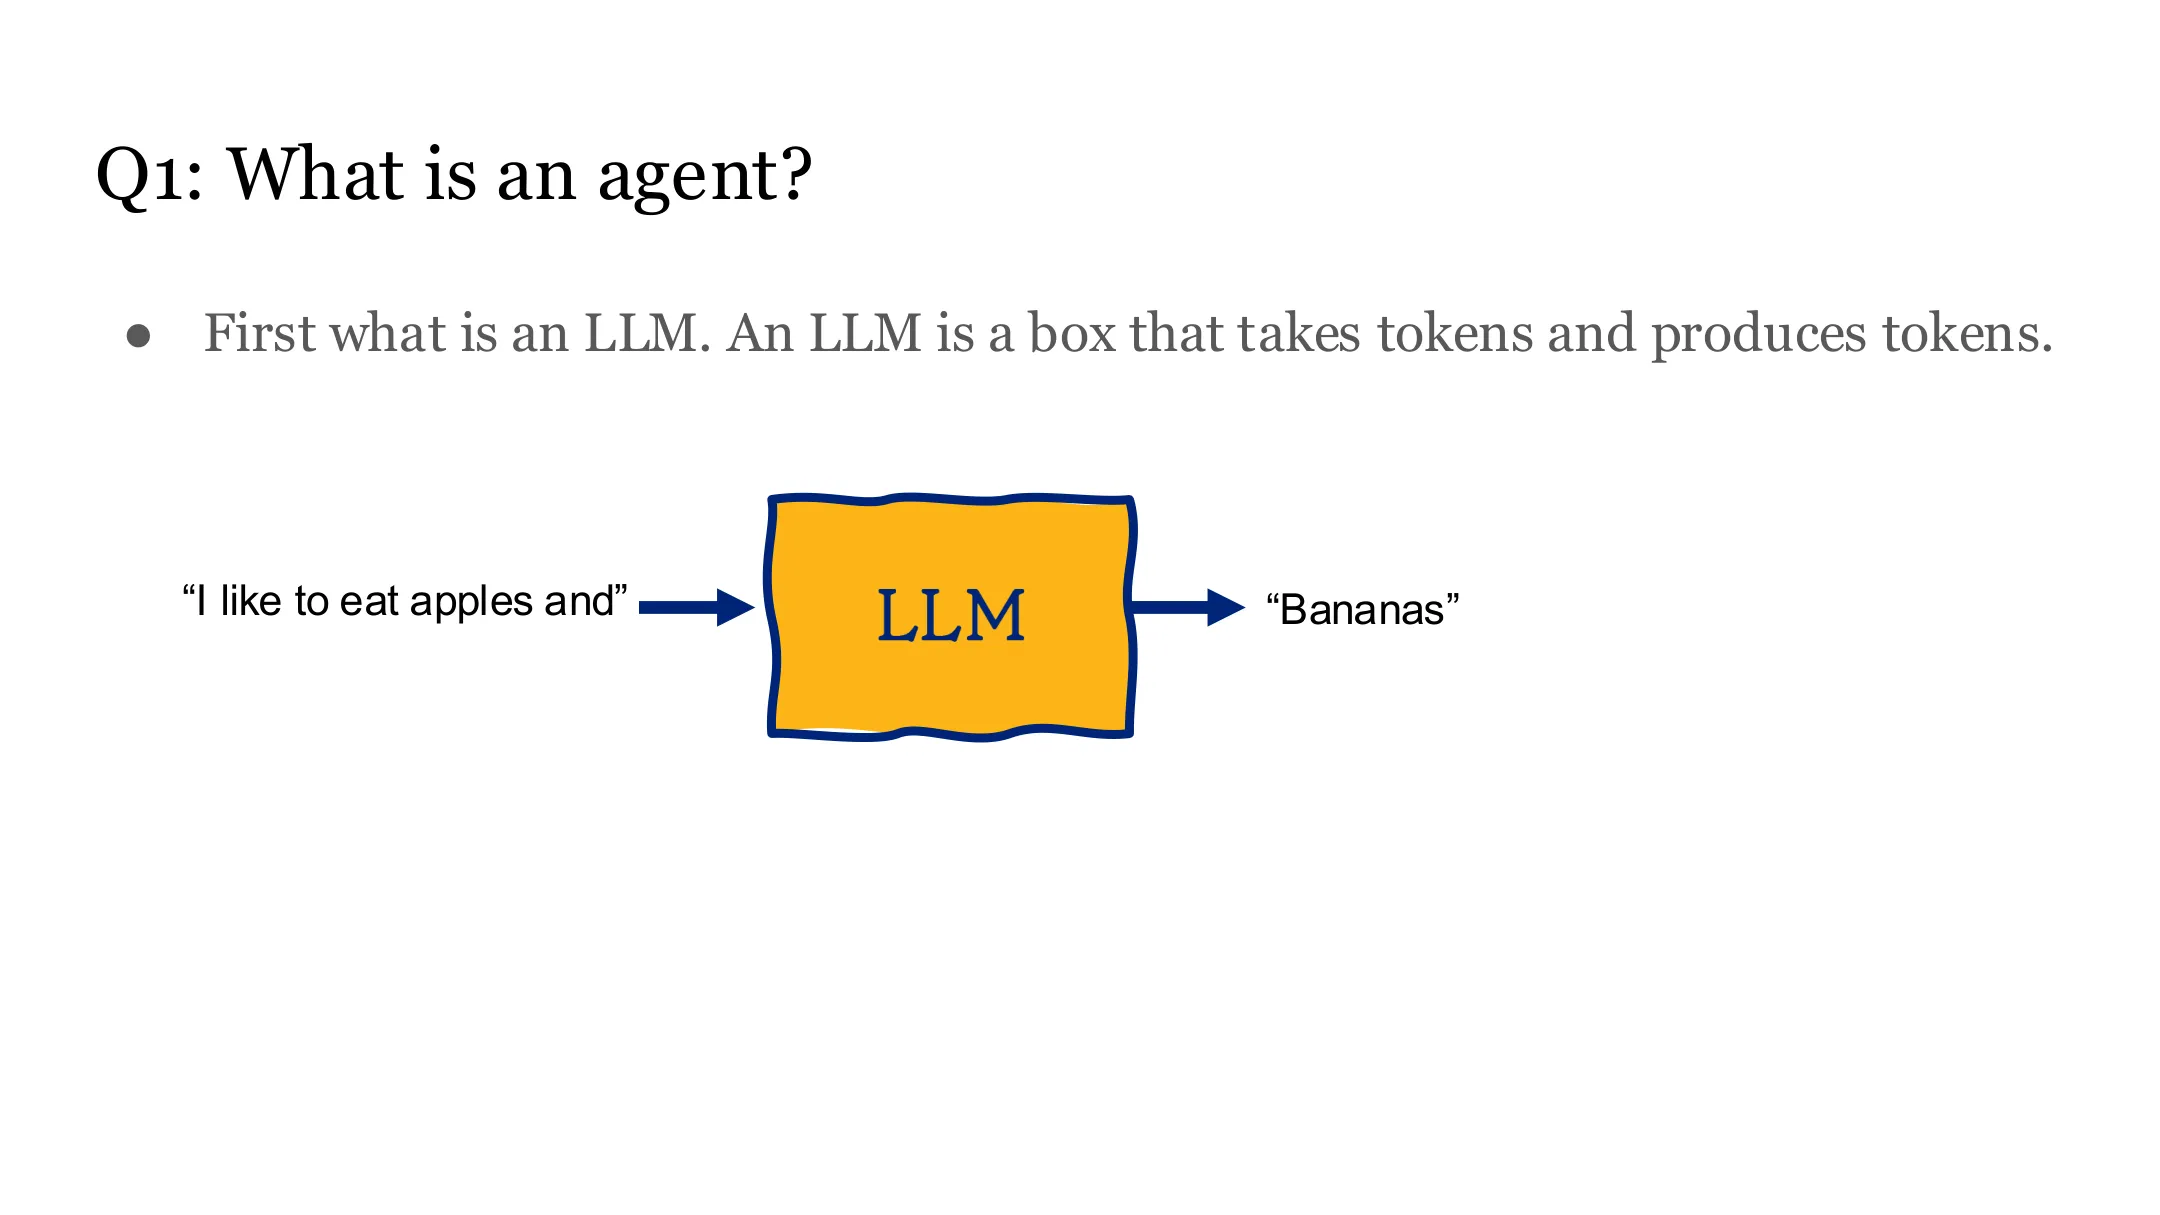
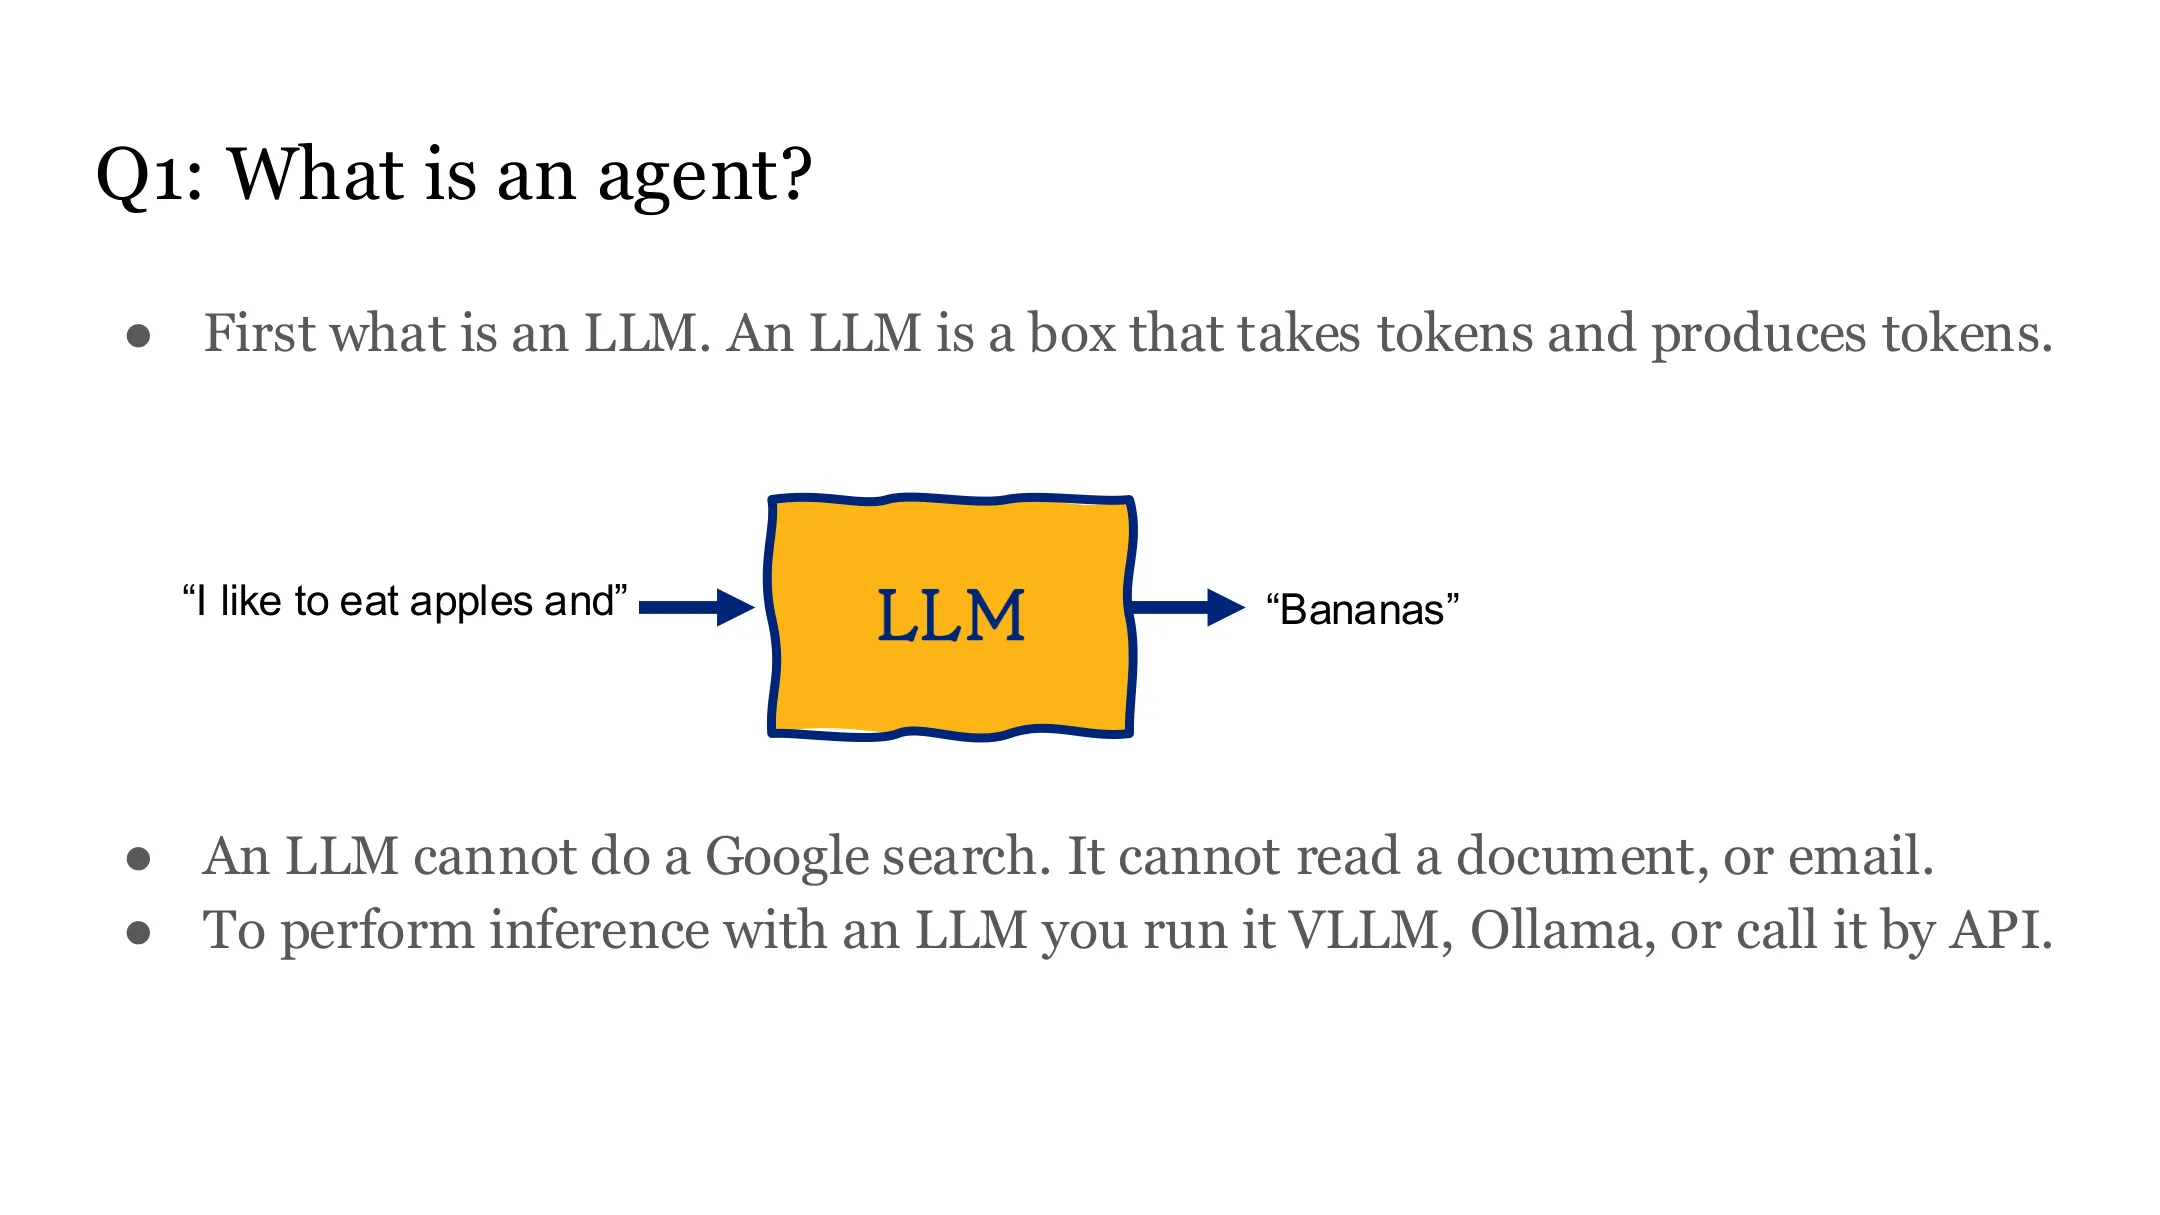
LLM 是一个模型:吃 token,吐 token。它把输入分词、过若干 Transformer 块、取最后向量过一个线性头,得到下一个 token 的分布并采样;自回归地循环即可生成文本。训练方式是自监督的下一个 token 预测(海量文本,如 Common Crawl,需要大量清洗工作,如 DCLM / DataComp-LM)。
运行:把权重放进推理库,如 vLLM(伯克利起源)、SGLang。
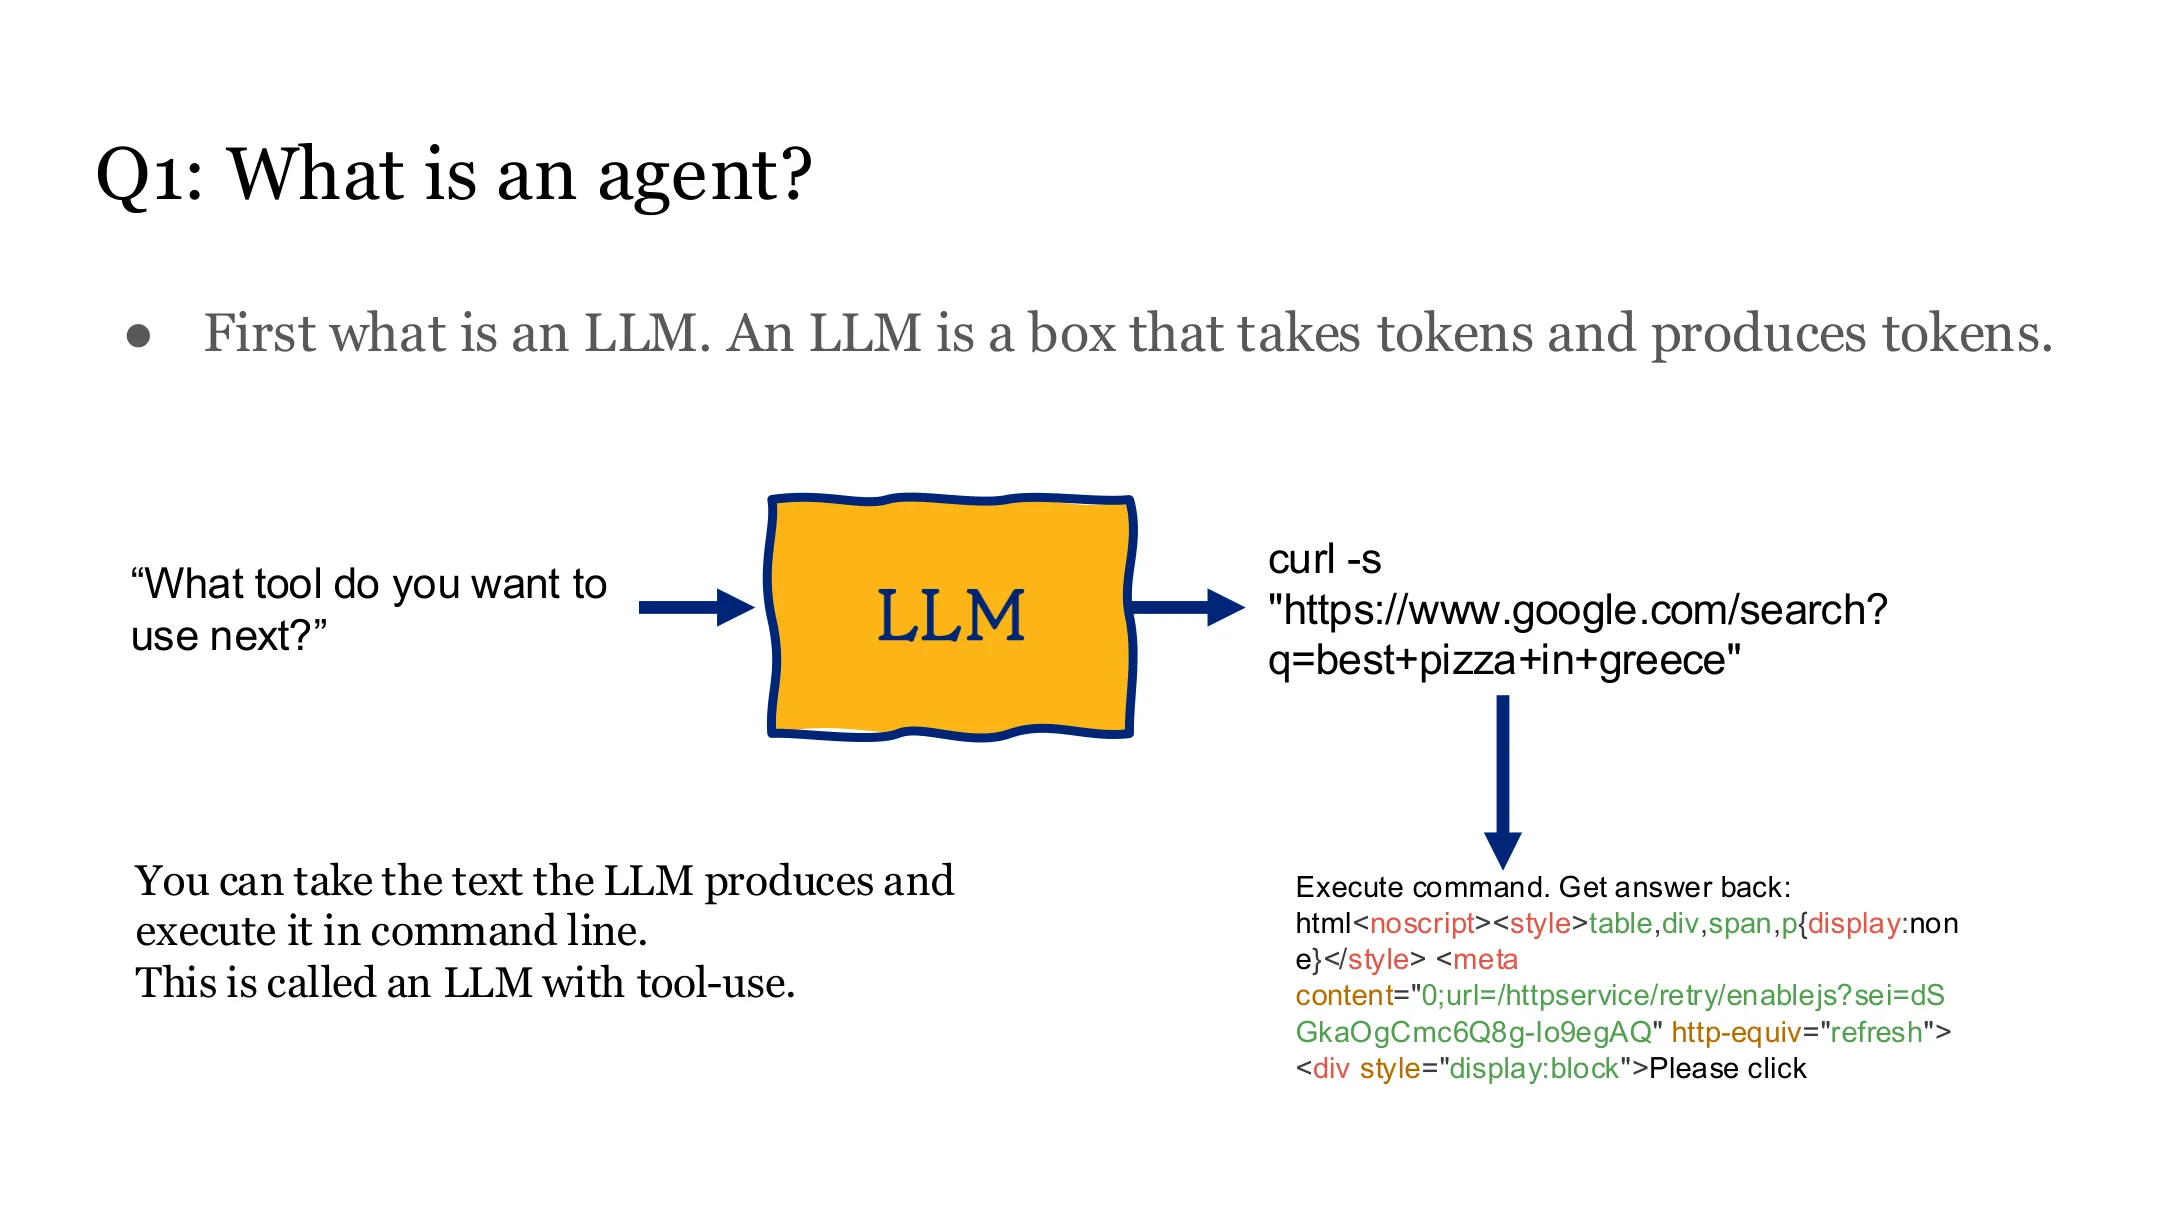
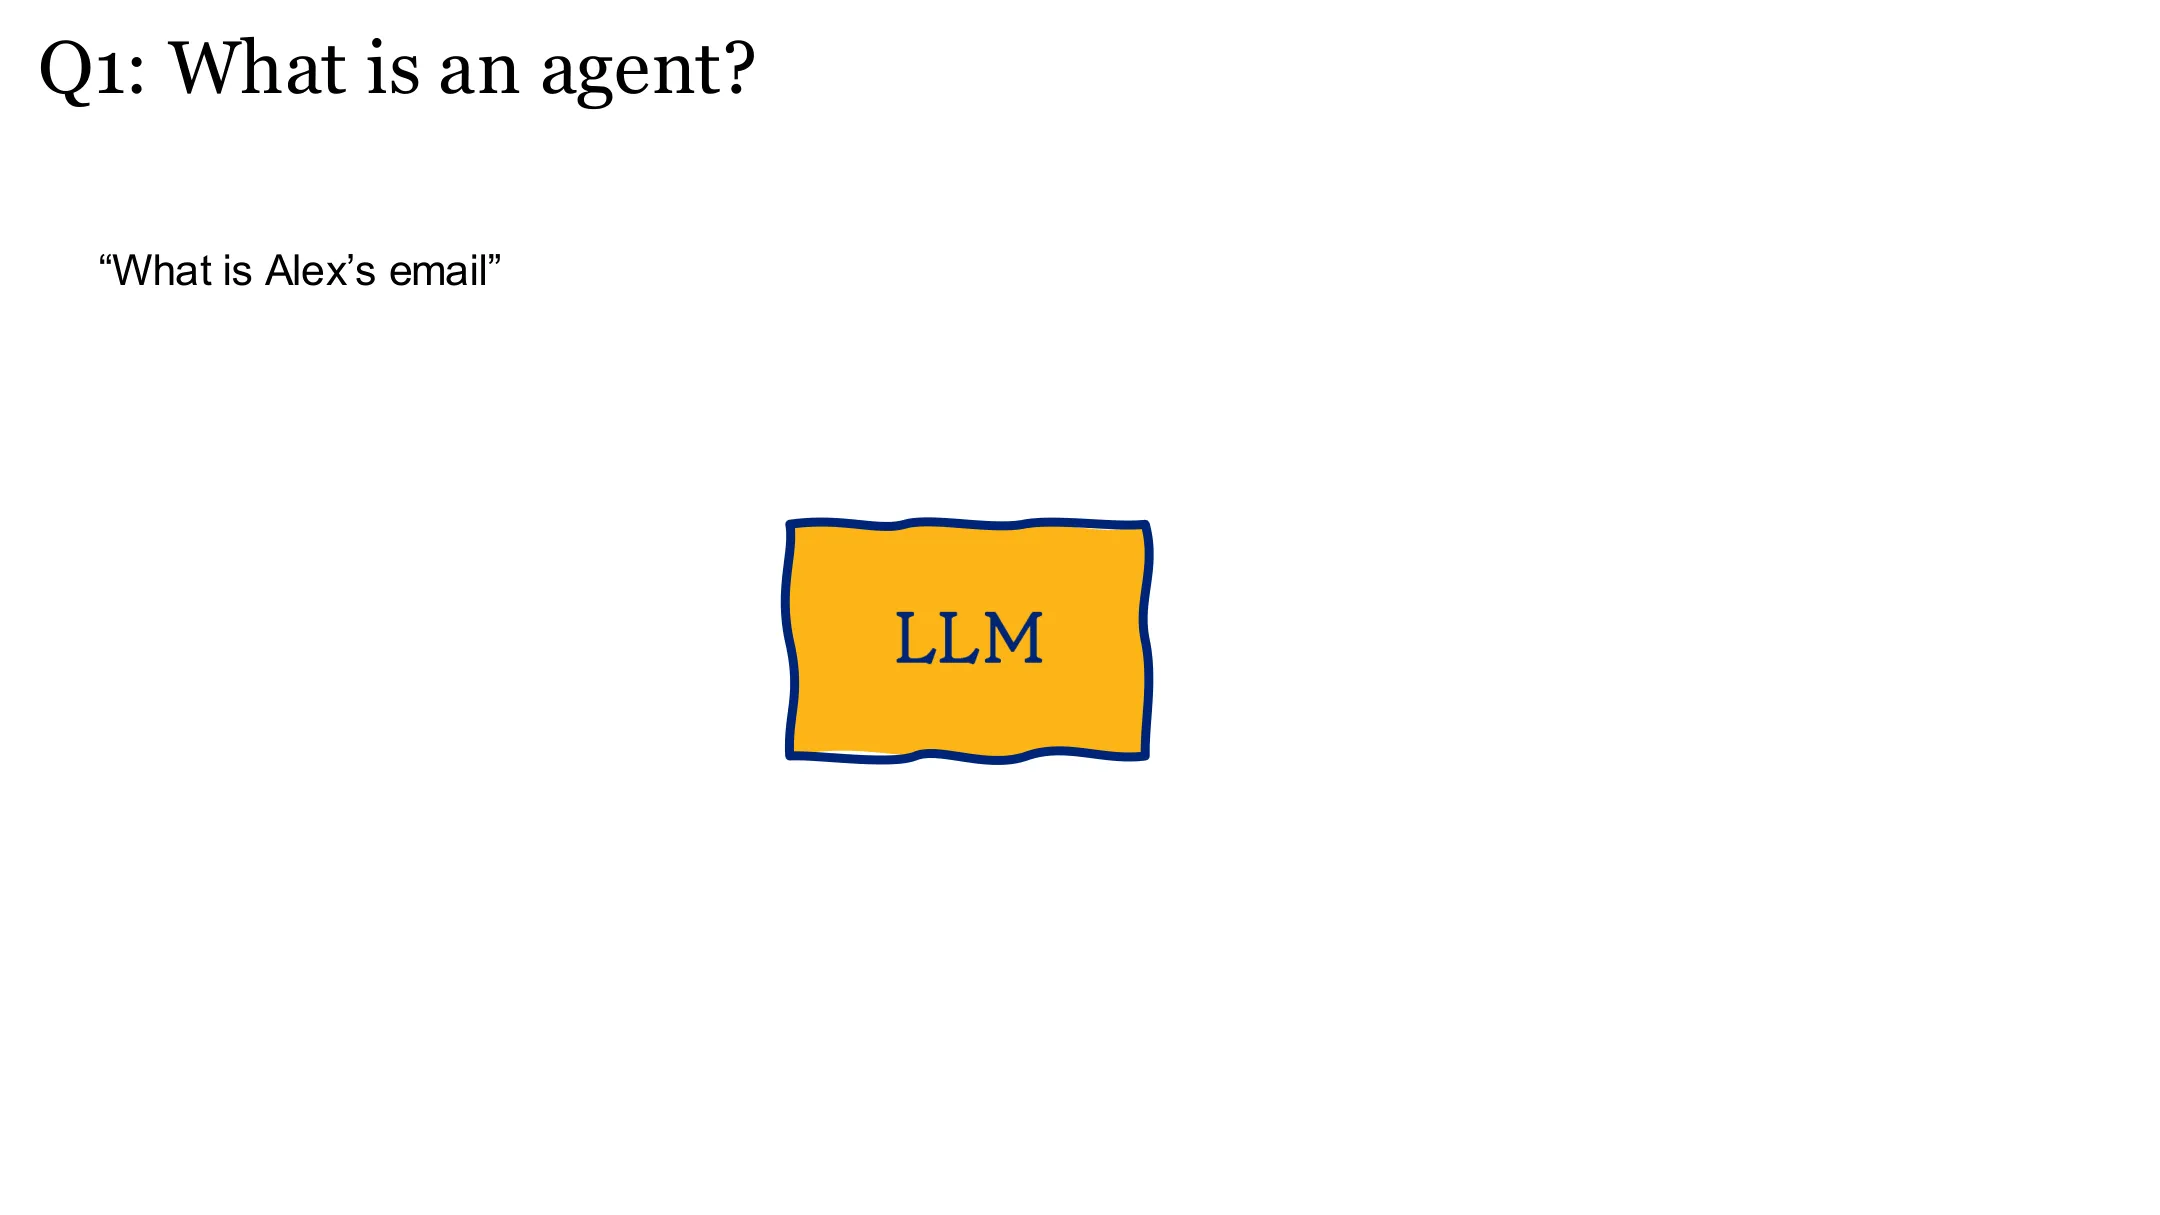
LLM 不是 agent:它不能 搜索、读文档、发邮件、订机票、pip install——它只会「字符串进、字符串出」。
📷 什么是 agent?(一)
回到原视频 (00:02:46)
📷 什么是 agent?(二)
回到原视频 (00:03:59)
📷 什么是 agent?(三)
回到原视频 (00:05:12)
📷 什么是 agent?(四)
回到原视频 (00:06:25)
📷 什么是 agent?(五)
回到原视频 (00:07:38)
📷 什么是 agent?(六)
回到原视频 (00:08:51)
📷 什么是 agent?(七)
回到原视频 (00:10:04)
📷 什么是 agent?(八)
回到原视频 (00:11:17)
📷 什么是 agent?(九)
回到原视频 (00:12:30)
📷 什么是 agent?(十)
回到原视频 (00:13:43)
📷 什么是 agent?(十一)
回到原视频 (00:14:56)
1.2 一步一步排除「不是 agent」
(参考时间: 00:08)
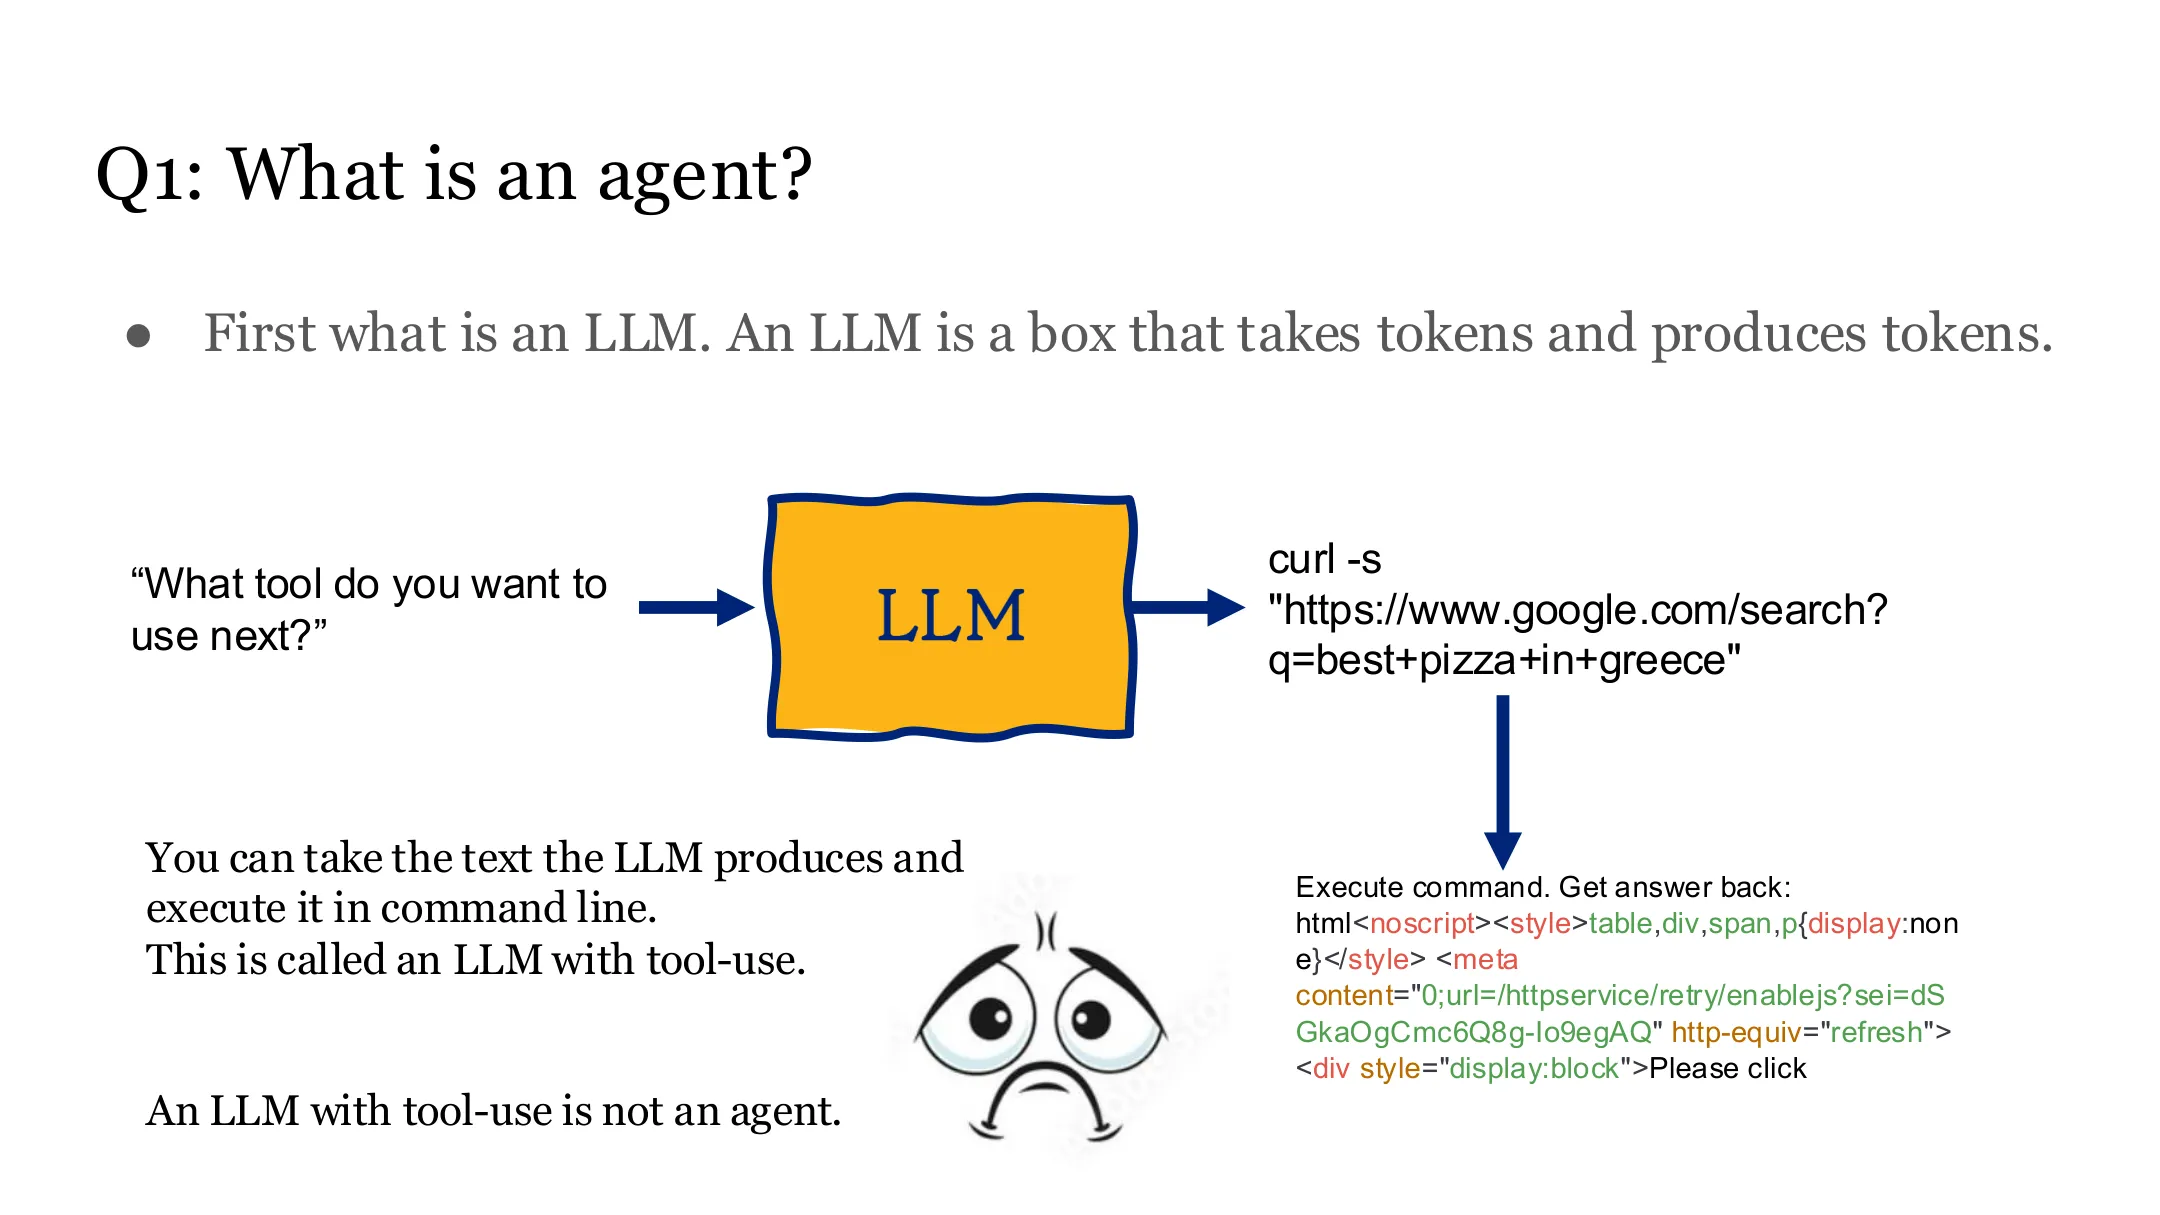
- Harness(外壳 / 脚手架):LLM 有时会输出看起来像命令的字符串;外面写一个程序把它执行、把输出喂回 LLM——这种「运行在 LLM 之外的程序」旧称 harness,现在有时也被叫作 agent(容易混淆)。
- Tool use:用 CLI 命令或 MCP 协议调用工具——LLM + 工具 ≠ agent。
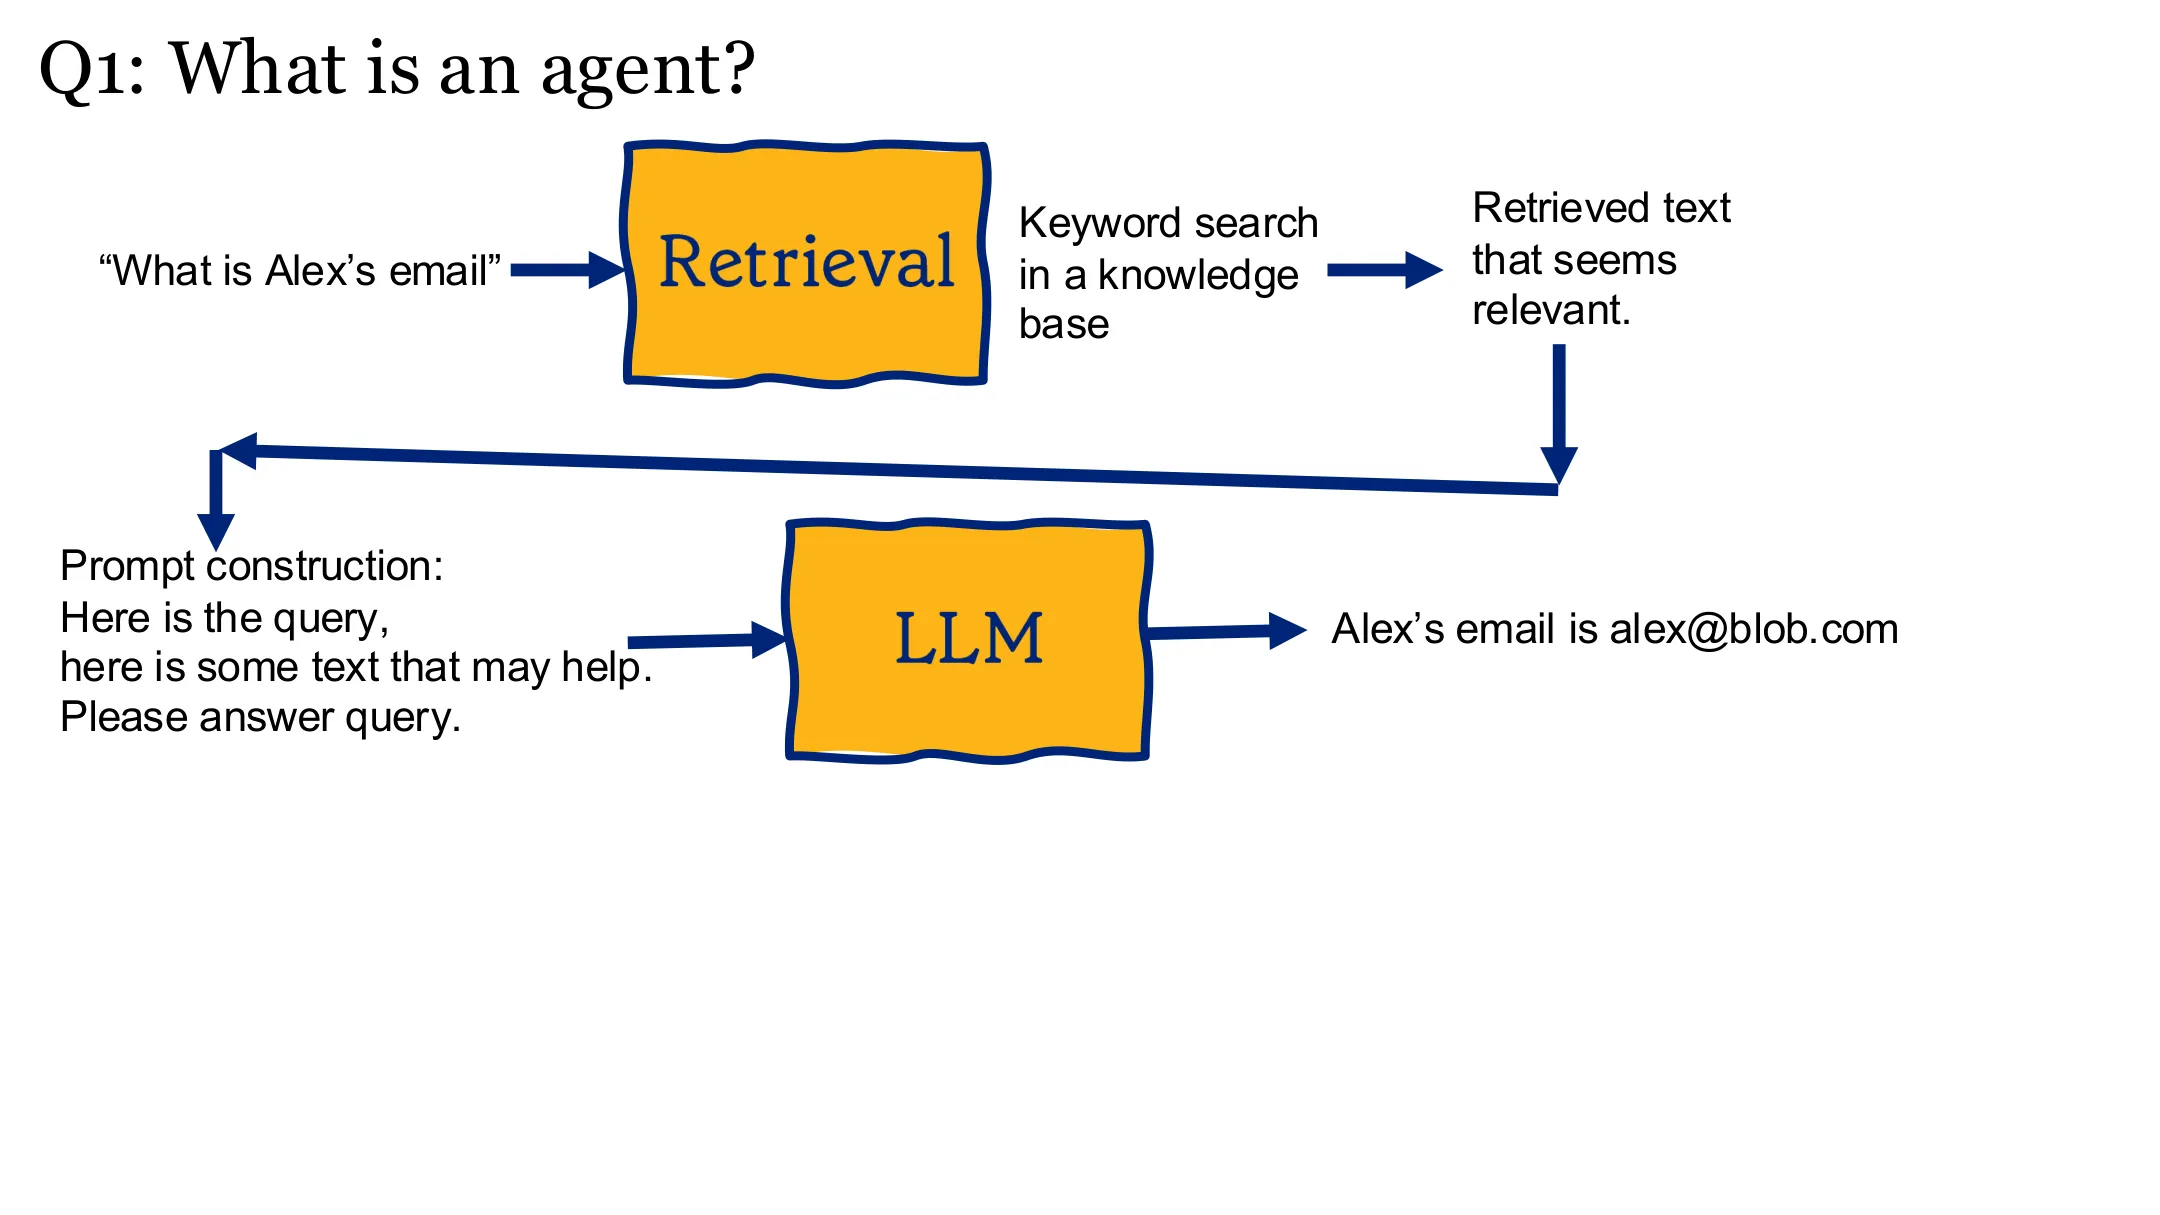
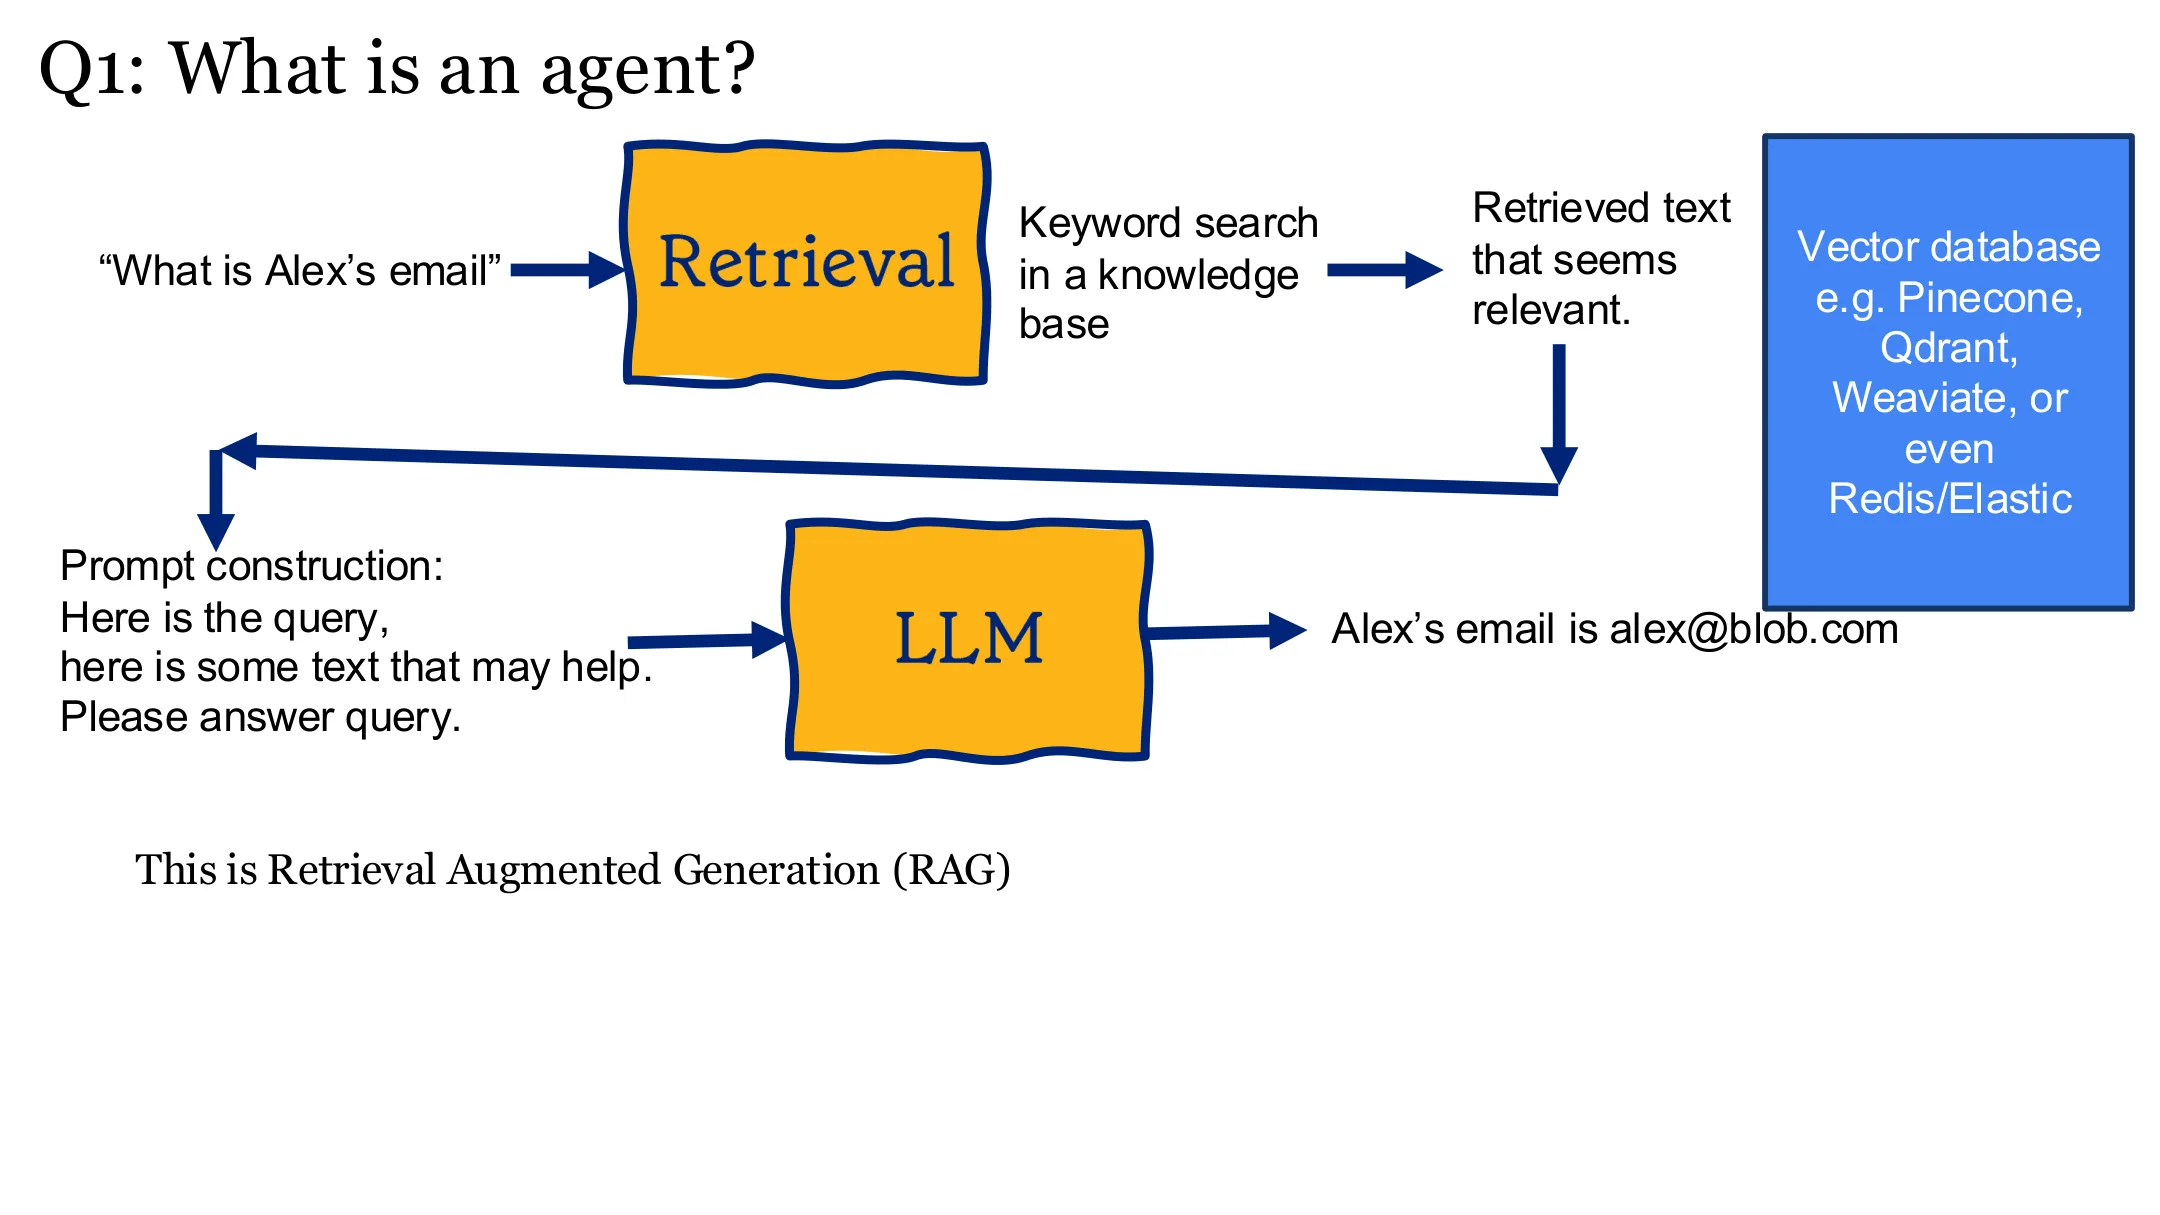
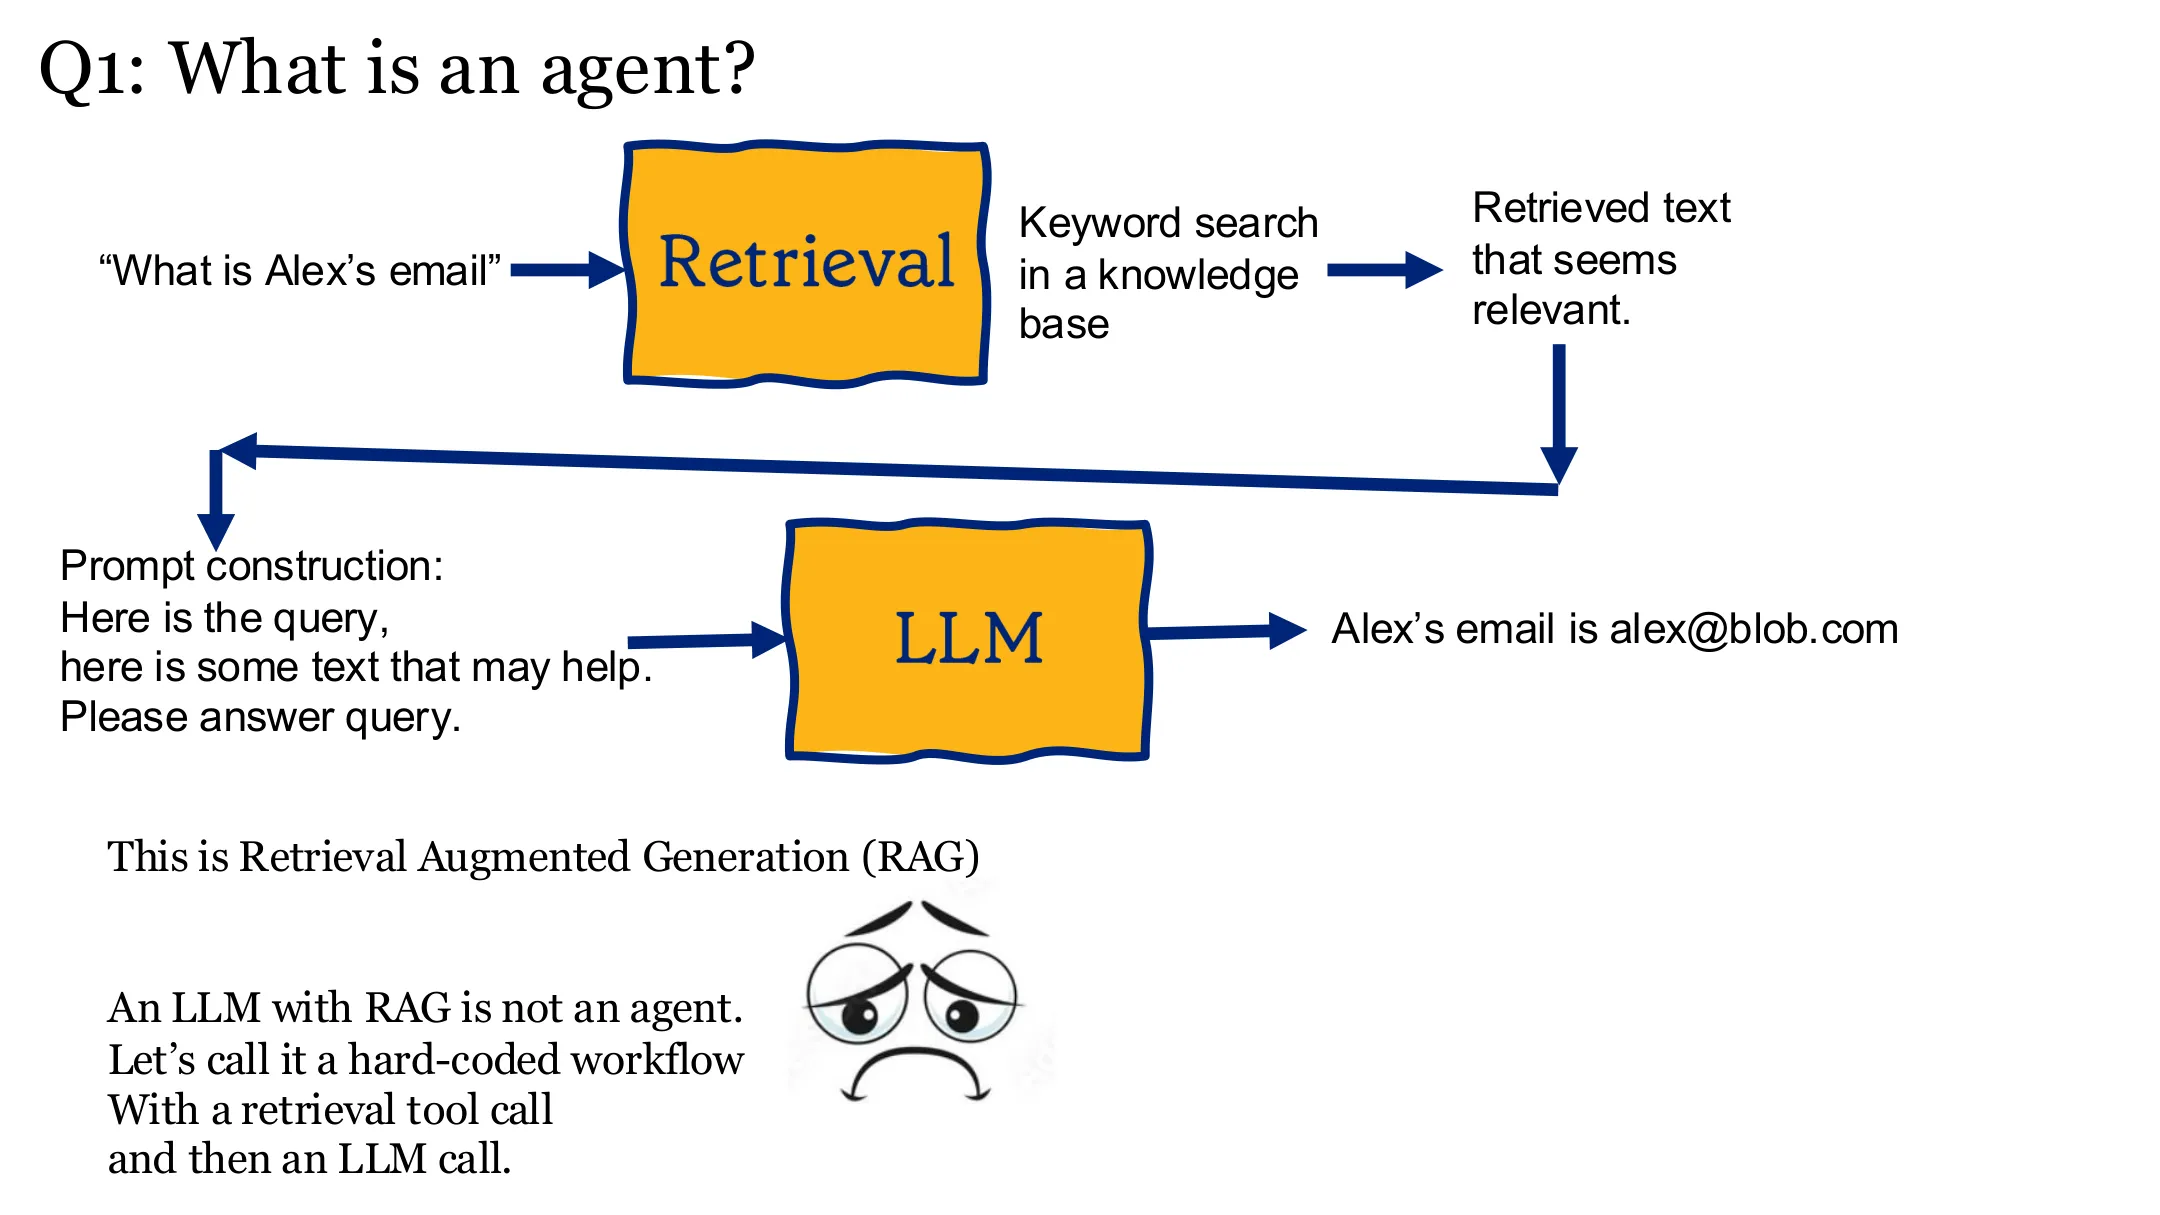
- RAG(检索增强生成):一个硬编码的 workflow——一次检索(向量库 / Pinecone、Quadrant、Weaviate、Elasticsearch),一次 prompt 构造,一次 LLM 调用。这是「我的解题方式」,而非 agent 自己解题——正是 bitter lesson(苦涩教训) 的体现。
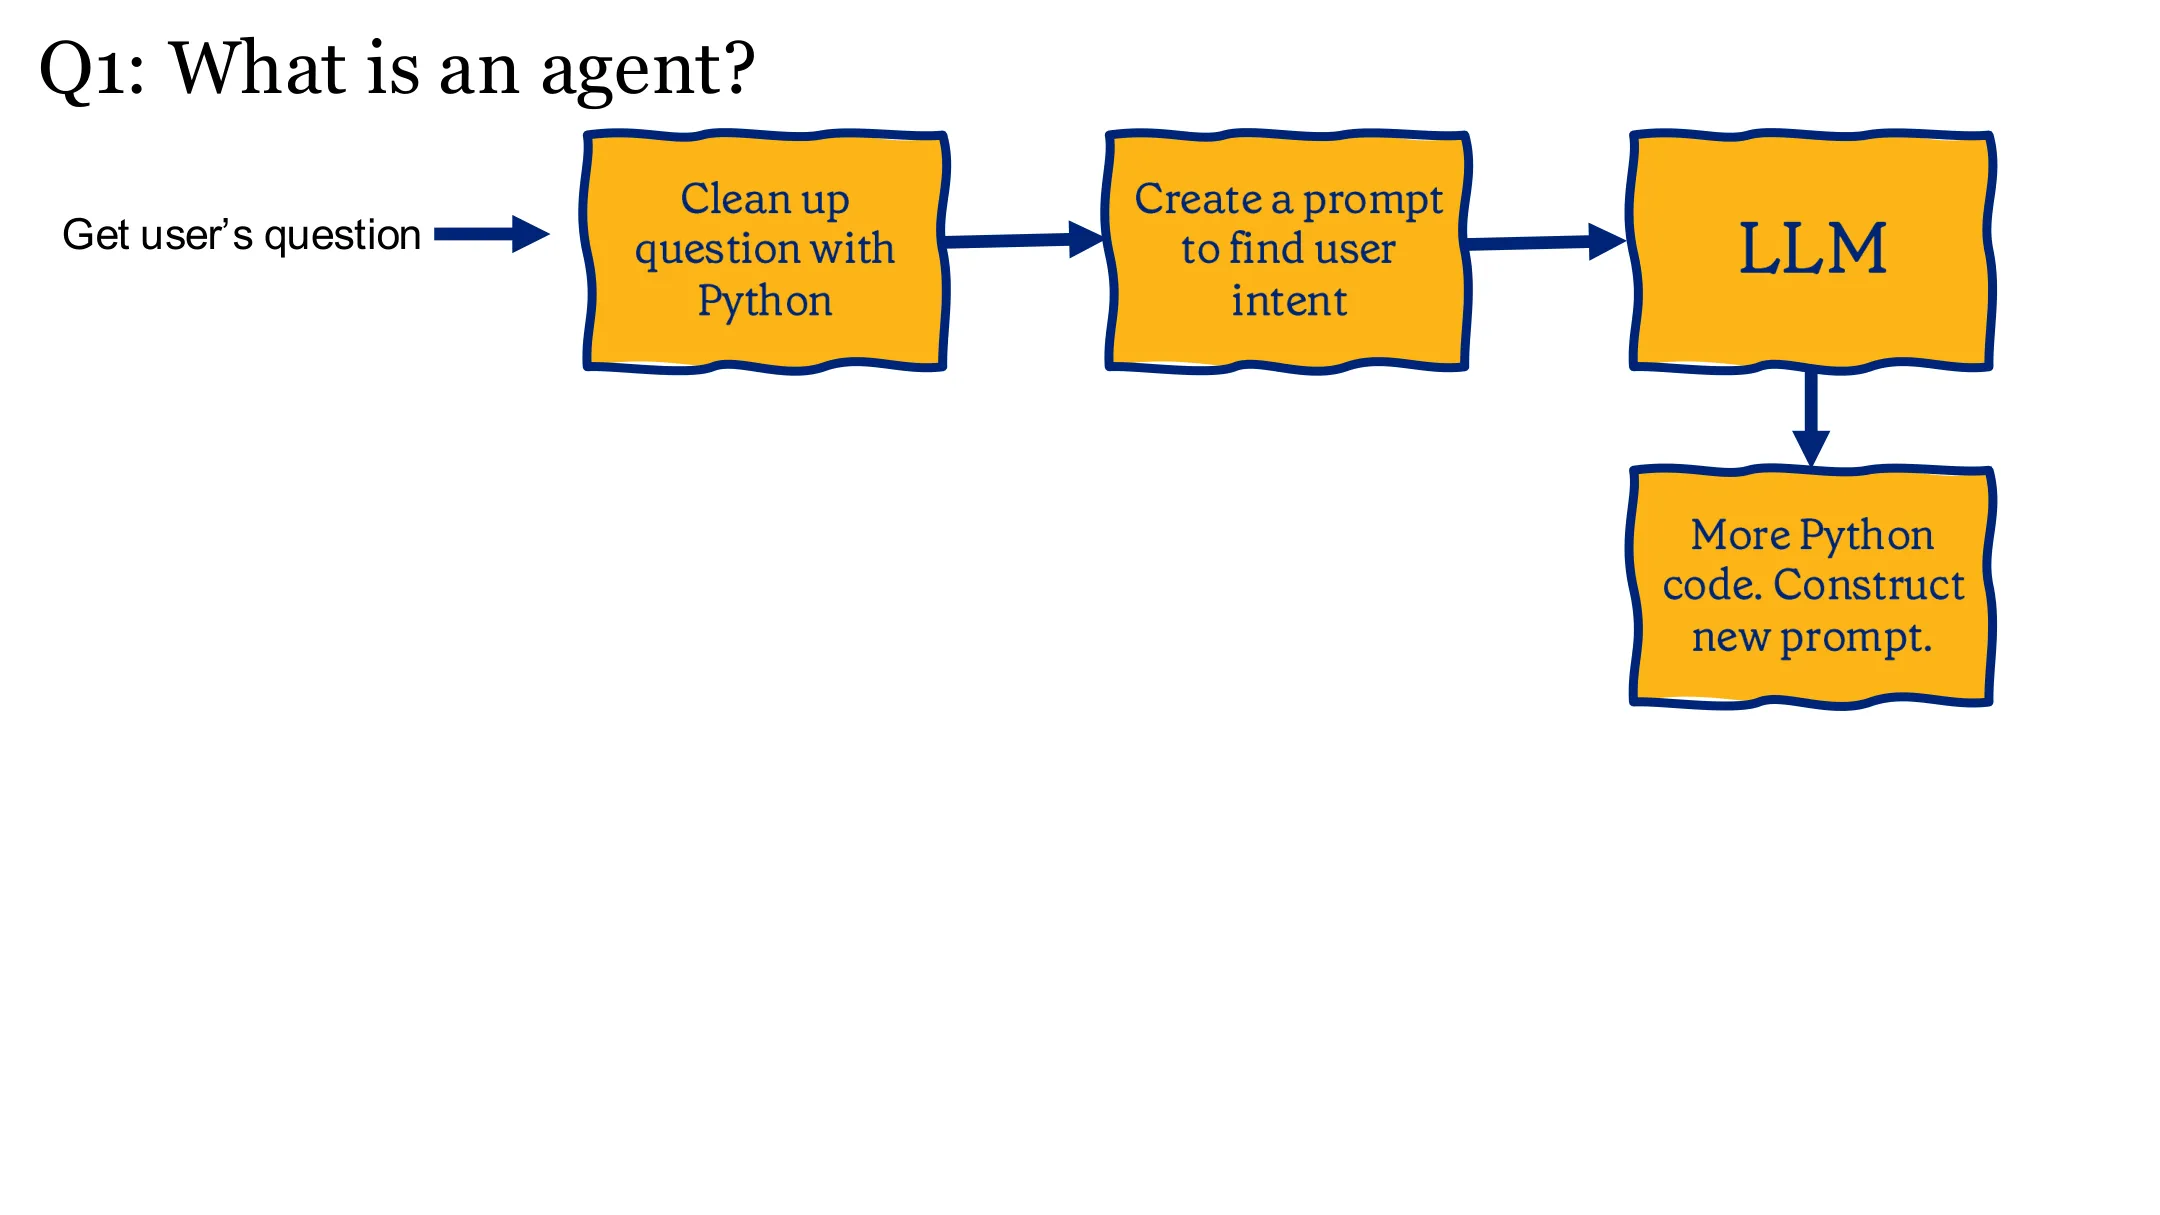
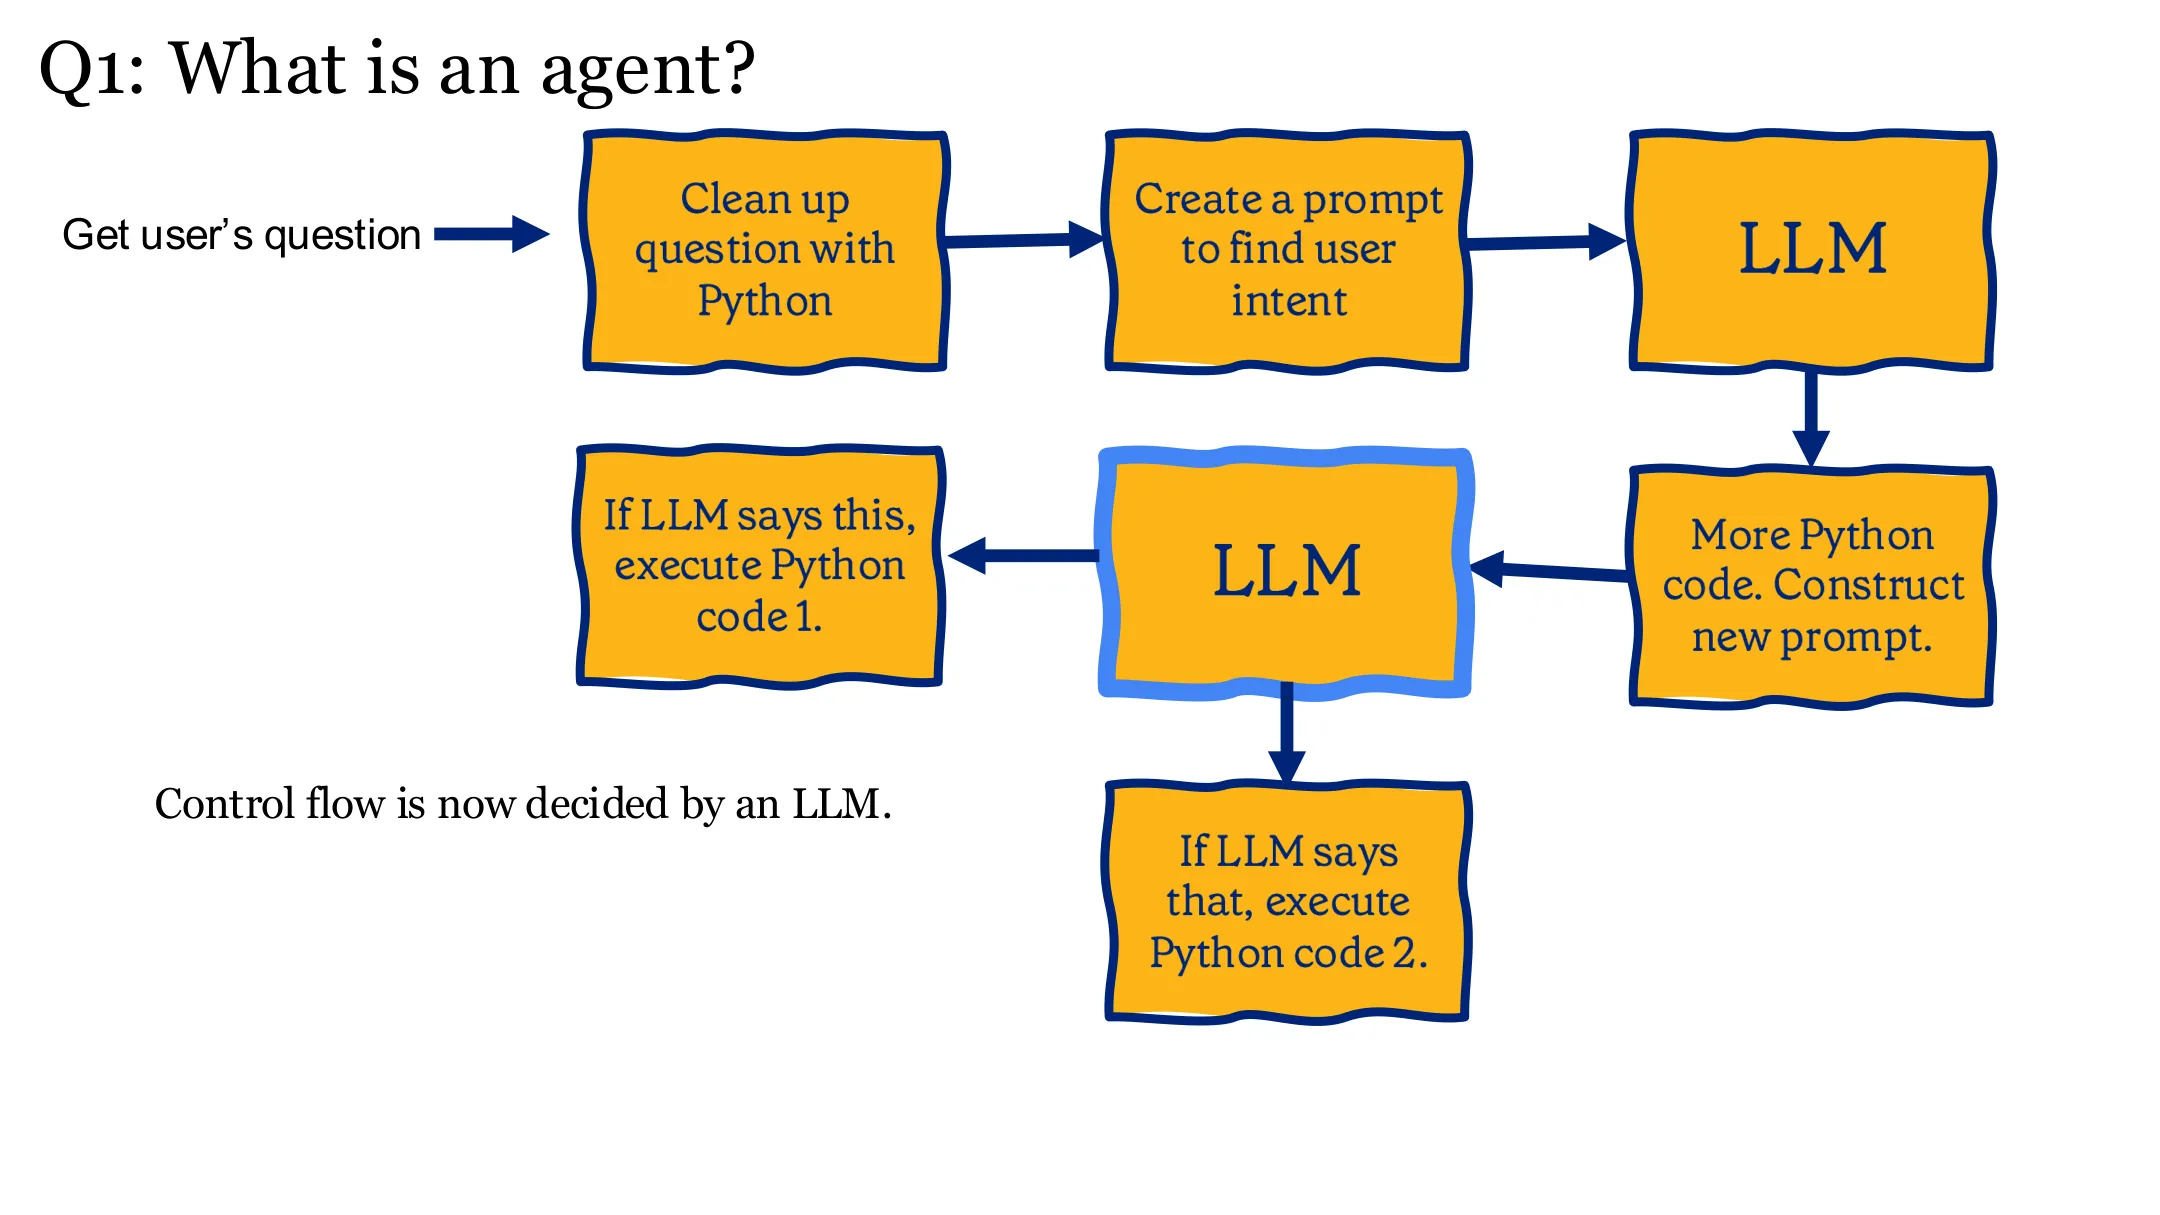
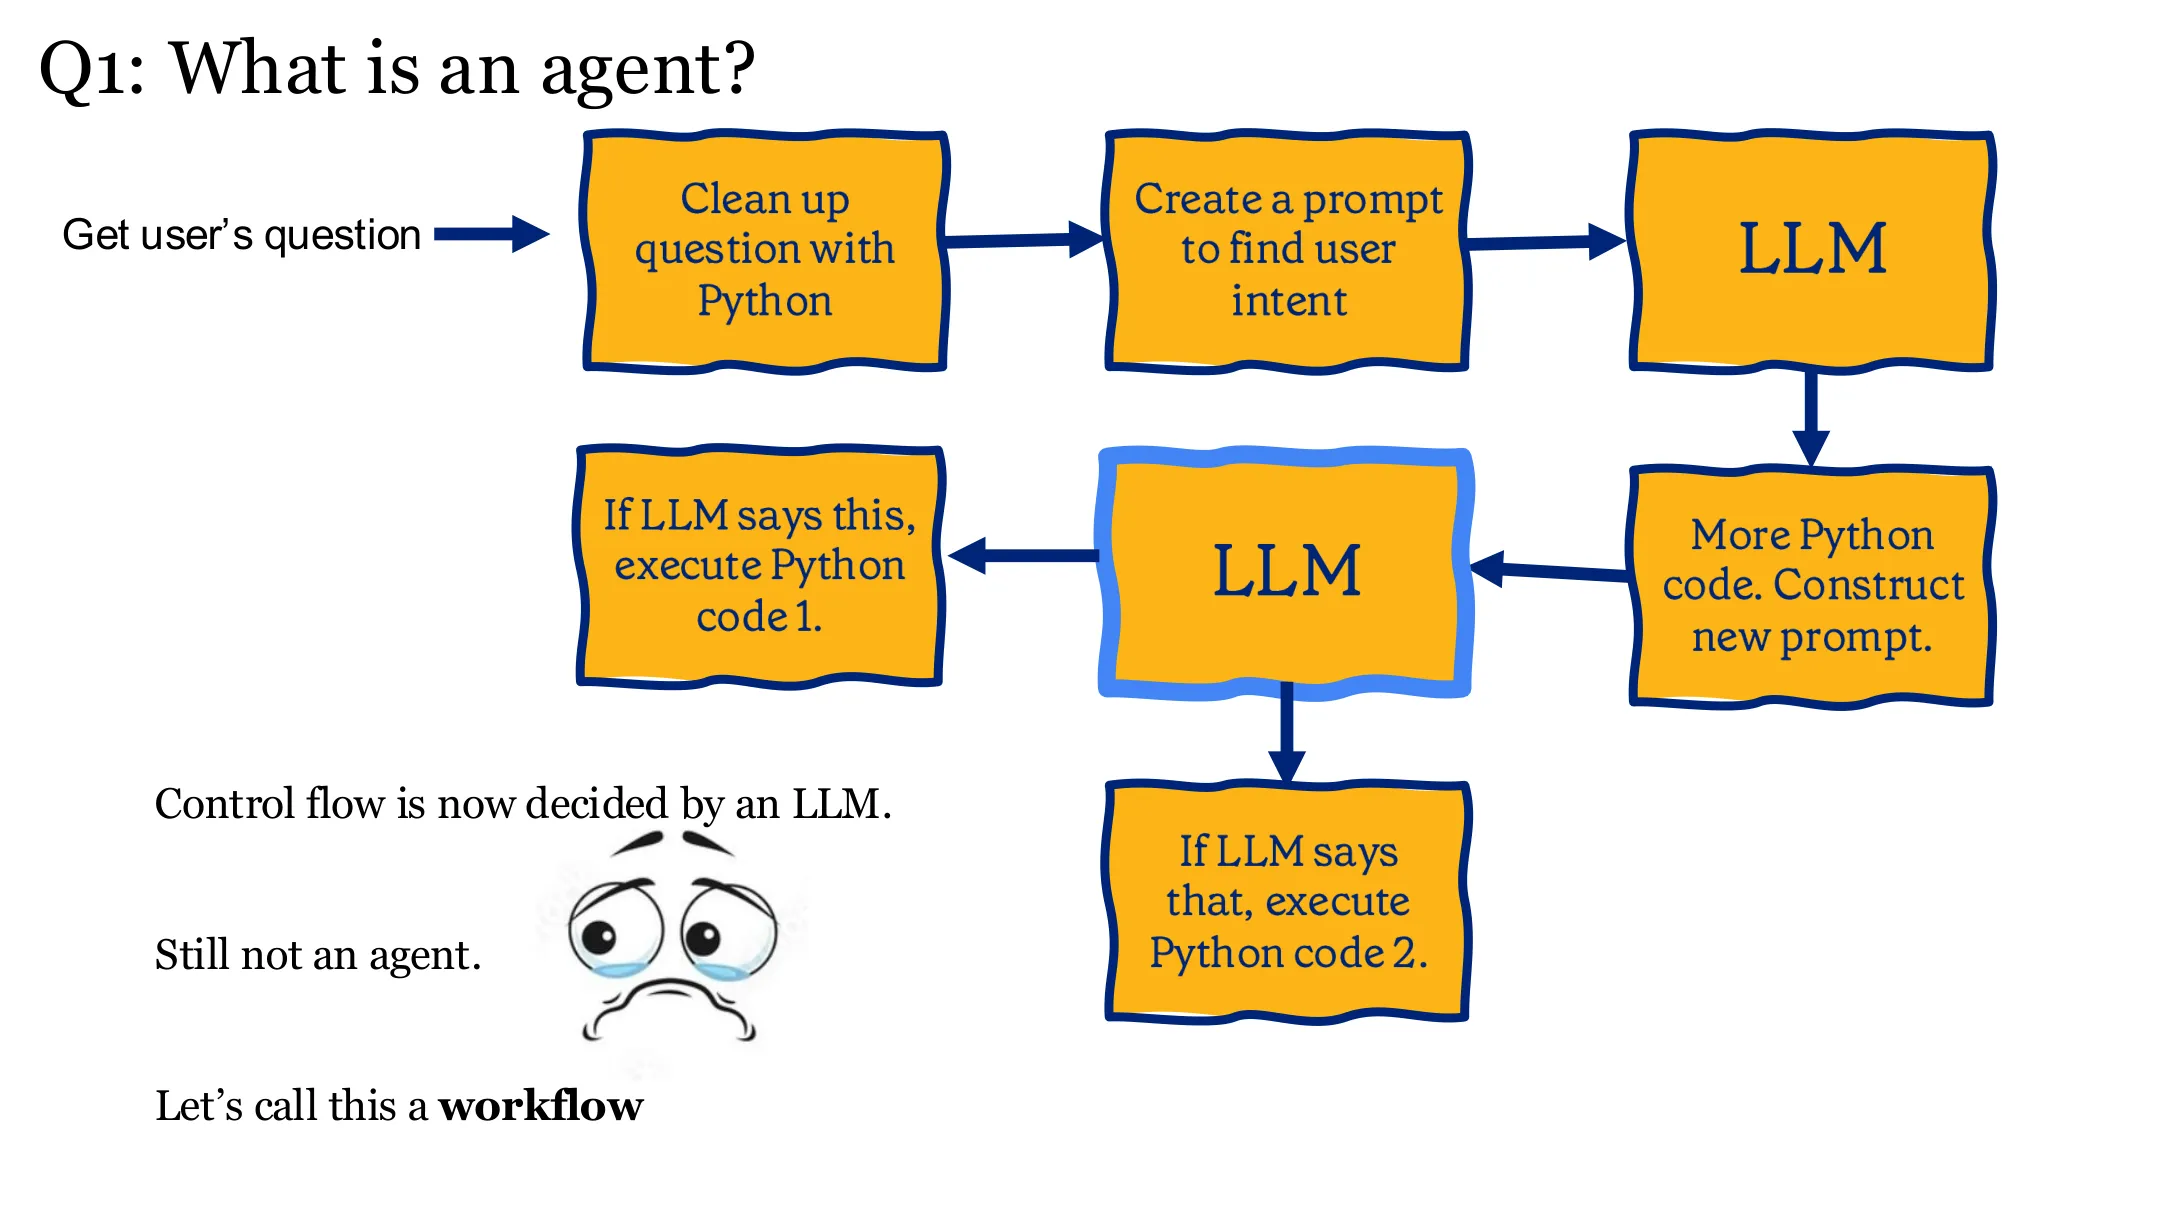
- 硬编码 workflow:用 LLM 调用 + Python
if搭出的固定流程(如航空客服意图识别),用 LangChain/LangGraph 写——简单场景可用,但不是真正的 agent。
📷 什么是 agent?(十二)
回到原视频 (00:16:09)
📷 什么是 agent?(十三)
回到原视频 (00:17:22)
📷 什么是 agent?(十四)
回到原视频 (00:18:35)
1.3 什么才是真正的 agent
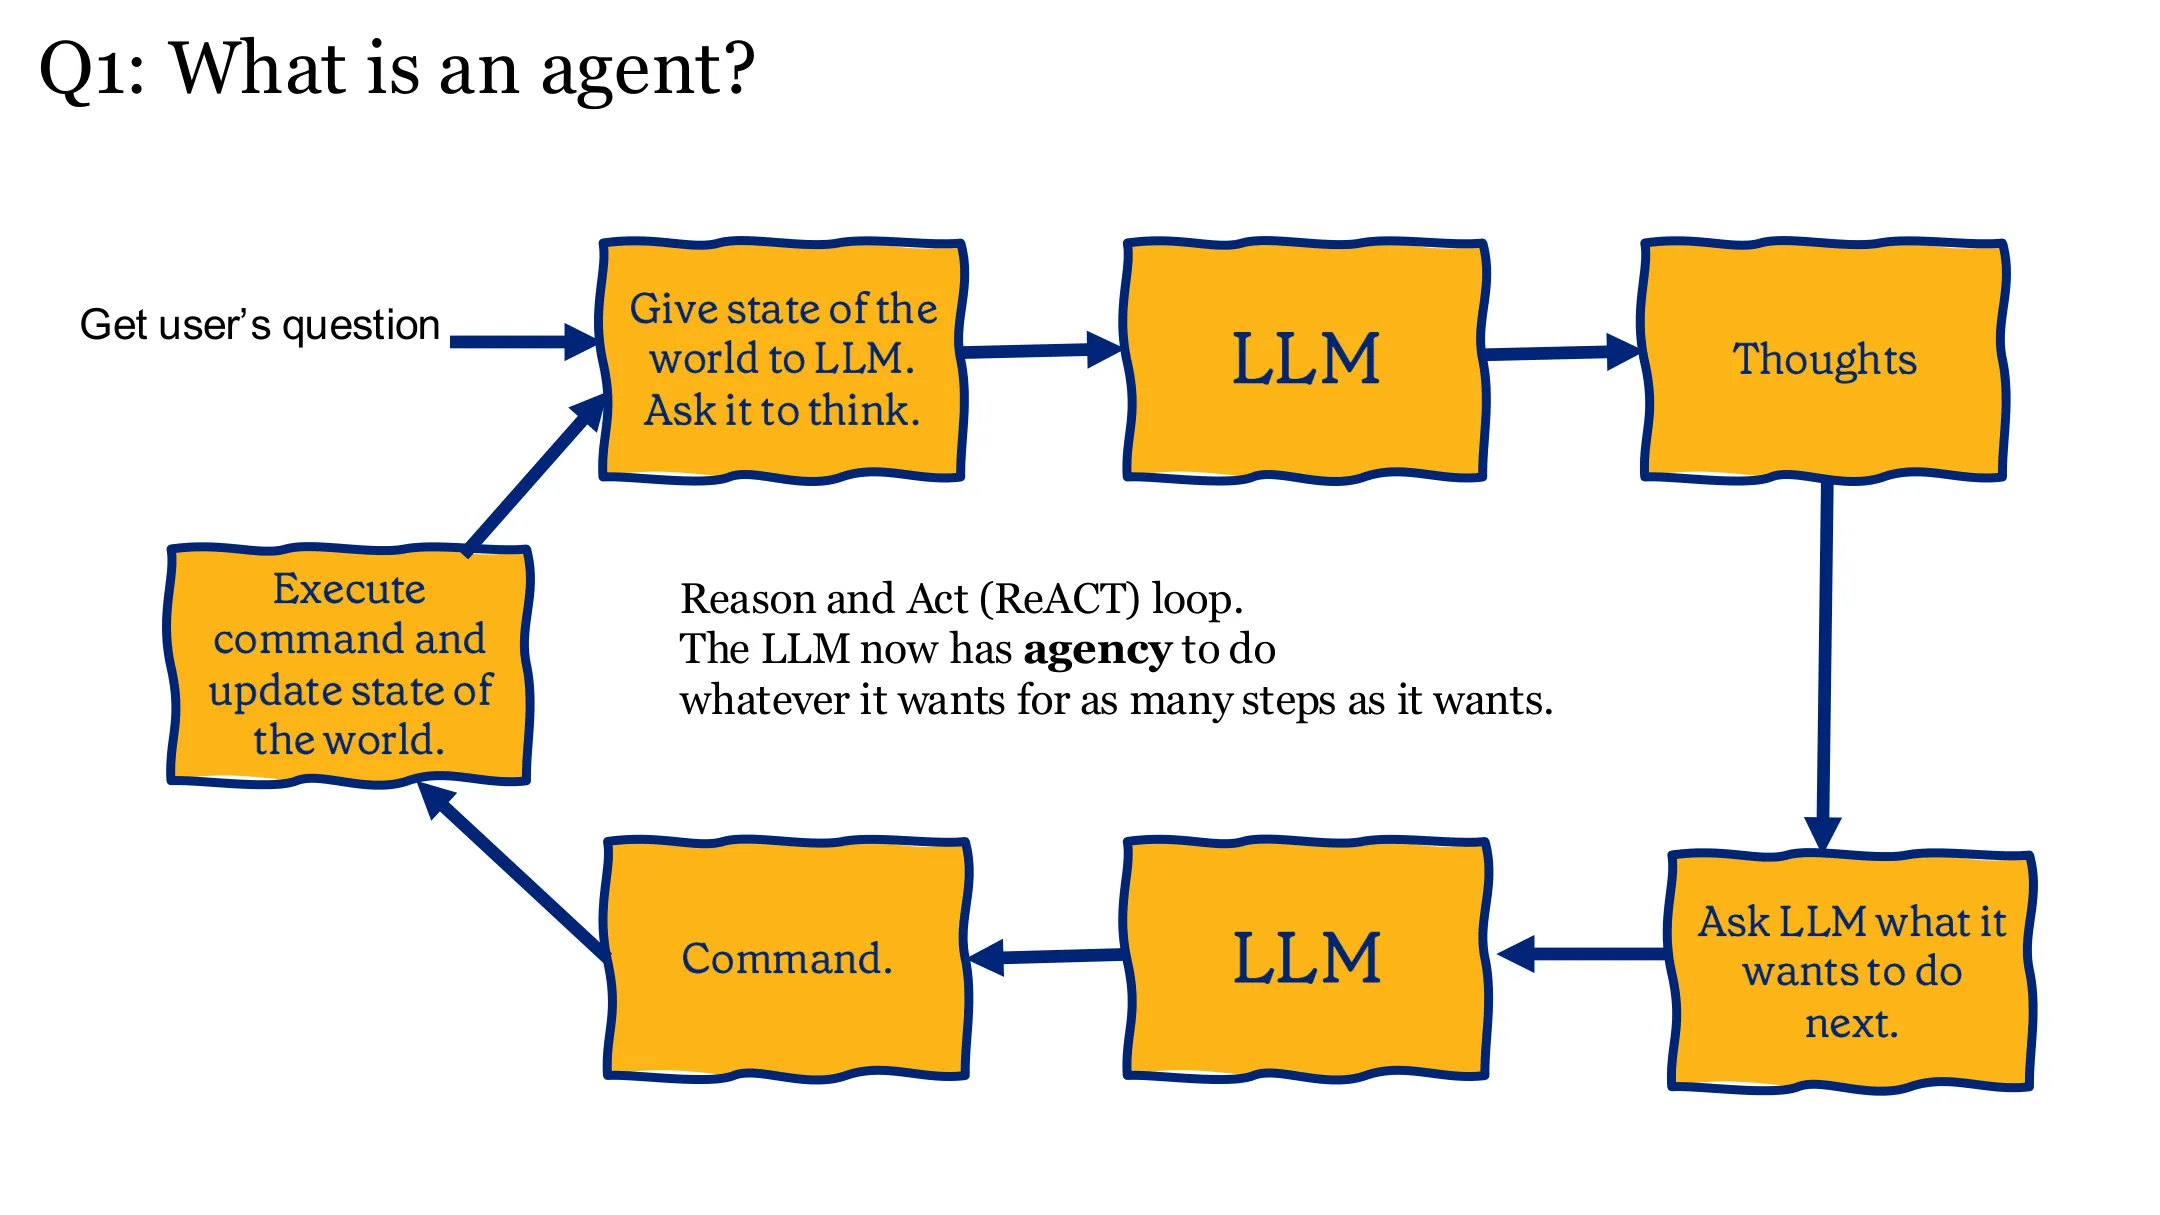
真正的 agent = LLM 在循环里 +(理想地)一个真终端:
- 把世界状态给 LLM,让它「思考」(输出一些文本);
- 问它下一步想做什么 → 输出一条命令(CLI/终端命令);
- harness 执行命令、更新世界状态、把输出返回给 LLM;
- 循环 —— 就是 Reason + Act(ReAct)。
区别:LLM 拥有自主权(agency)——想做 5 次检索就做 5 次,甚至可以无限循环,而不是预先规定好的 5 条路径。
📷 人们如何造 agent?(一)
回到原视频 (00:19:48)
📷 人们如何造 agent?(二)
回到原视频 (00:21:01)
📷 人们如何造 agent?(三)
回到原视频 (00:22:14)
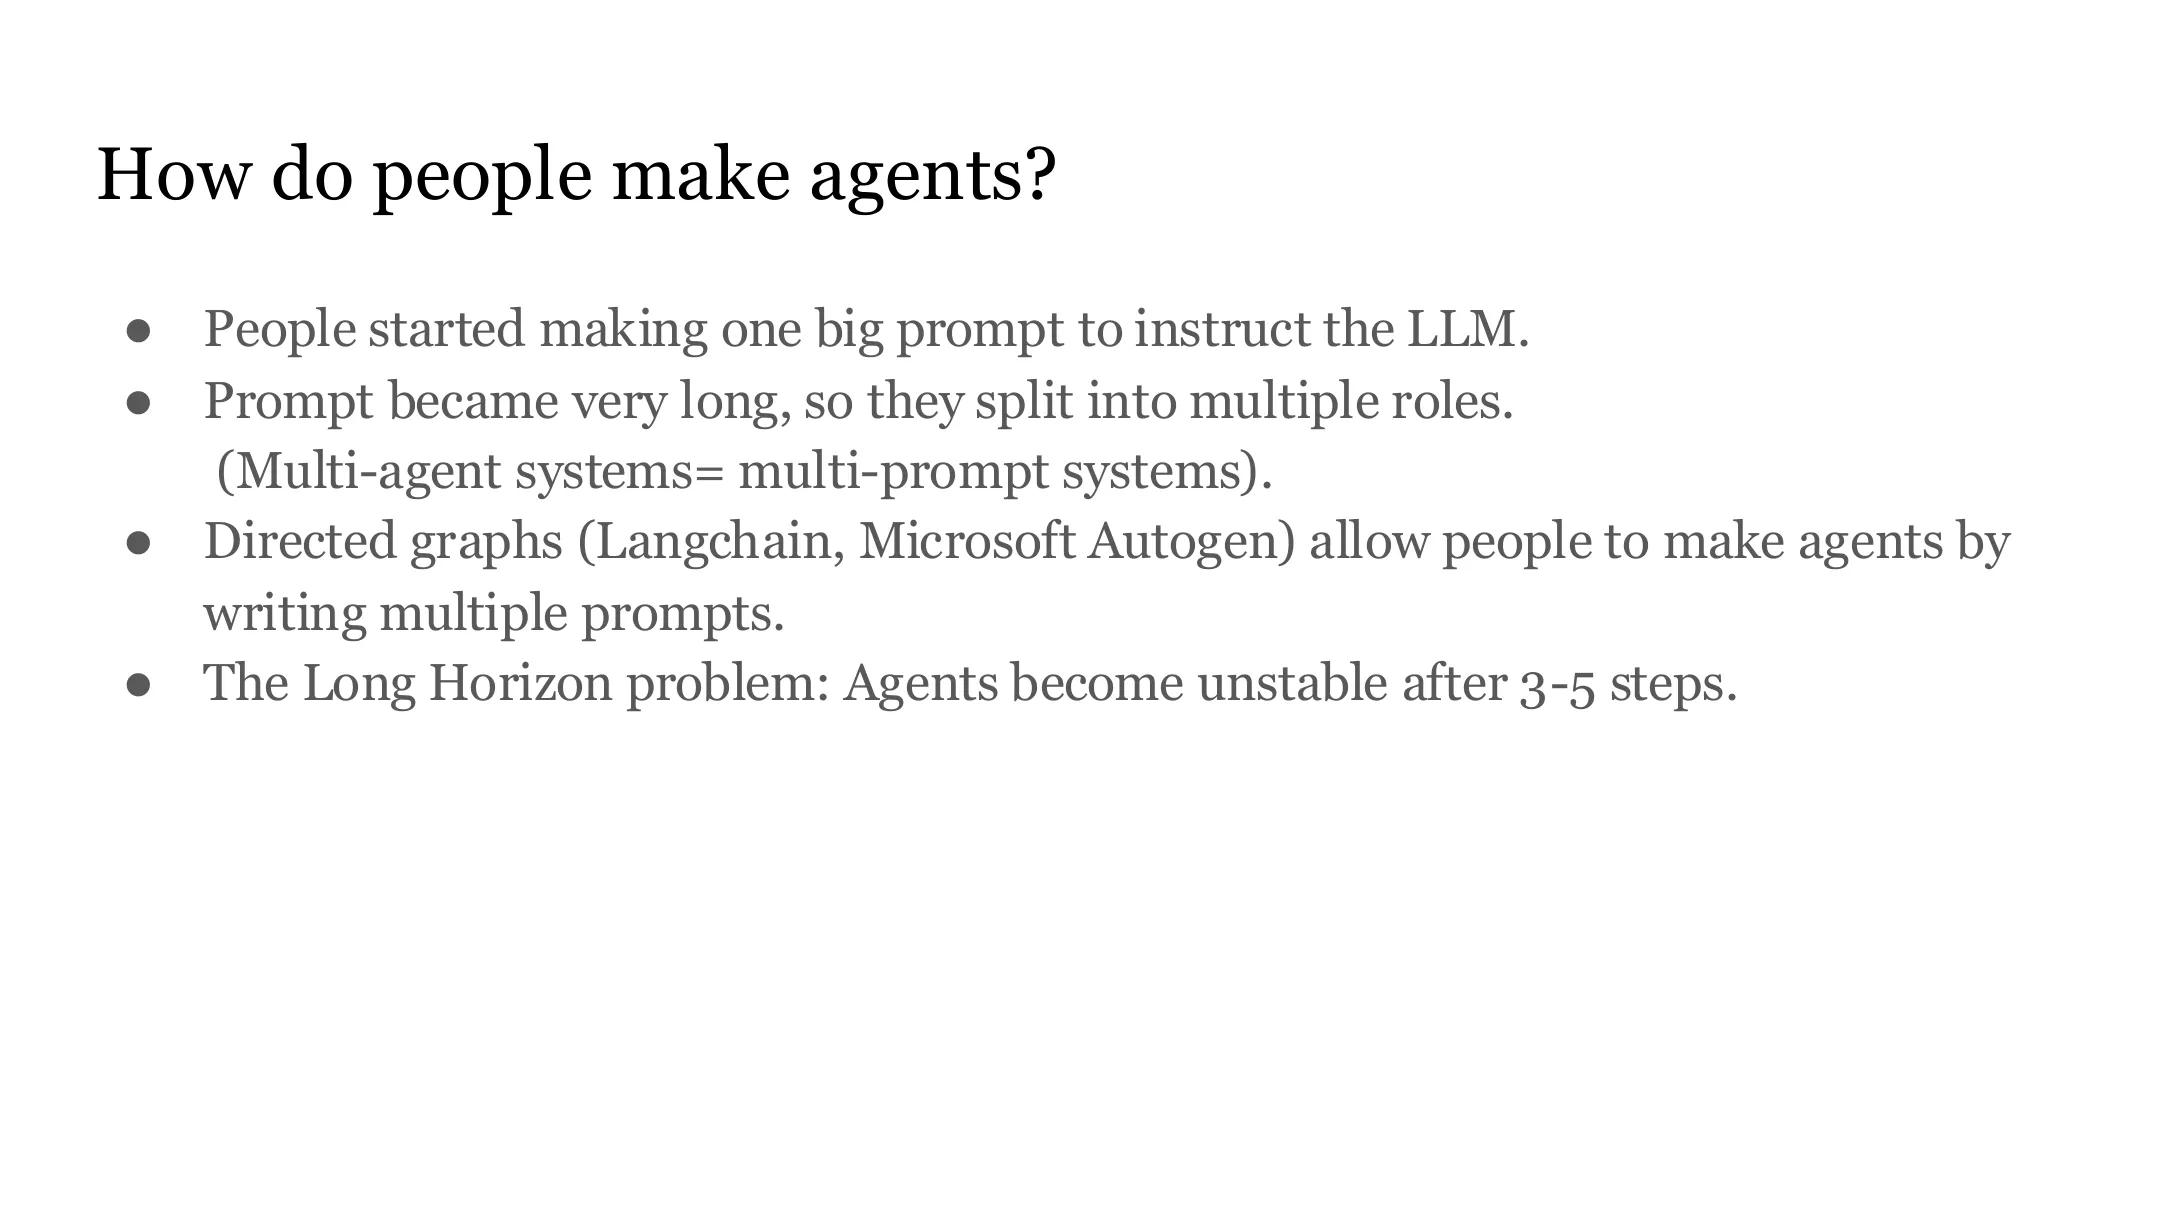
造 agent 的两种方式:
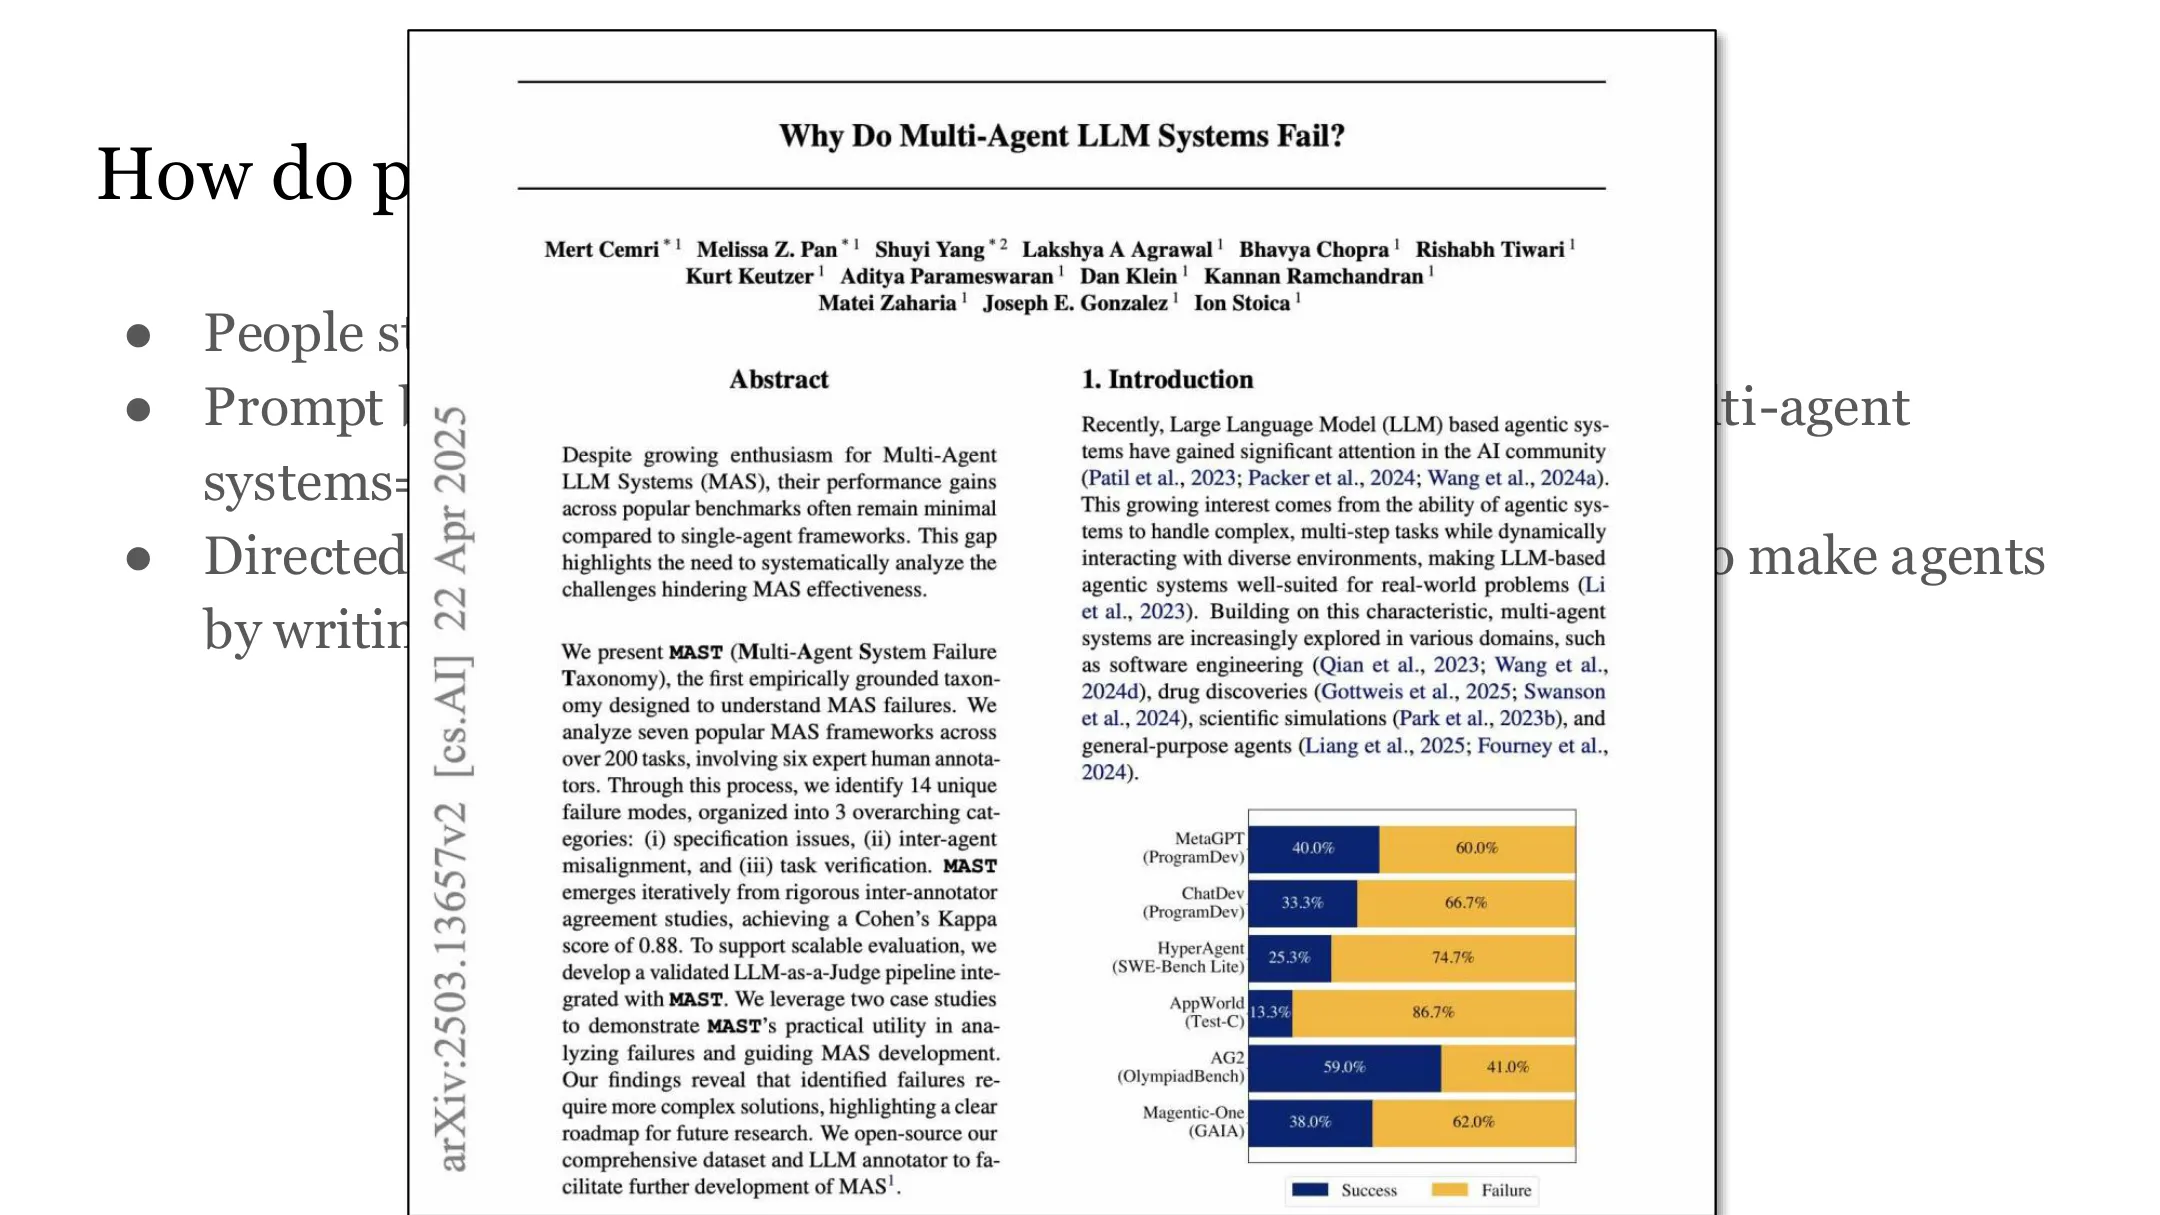
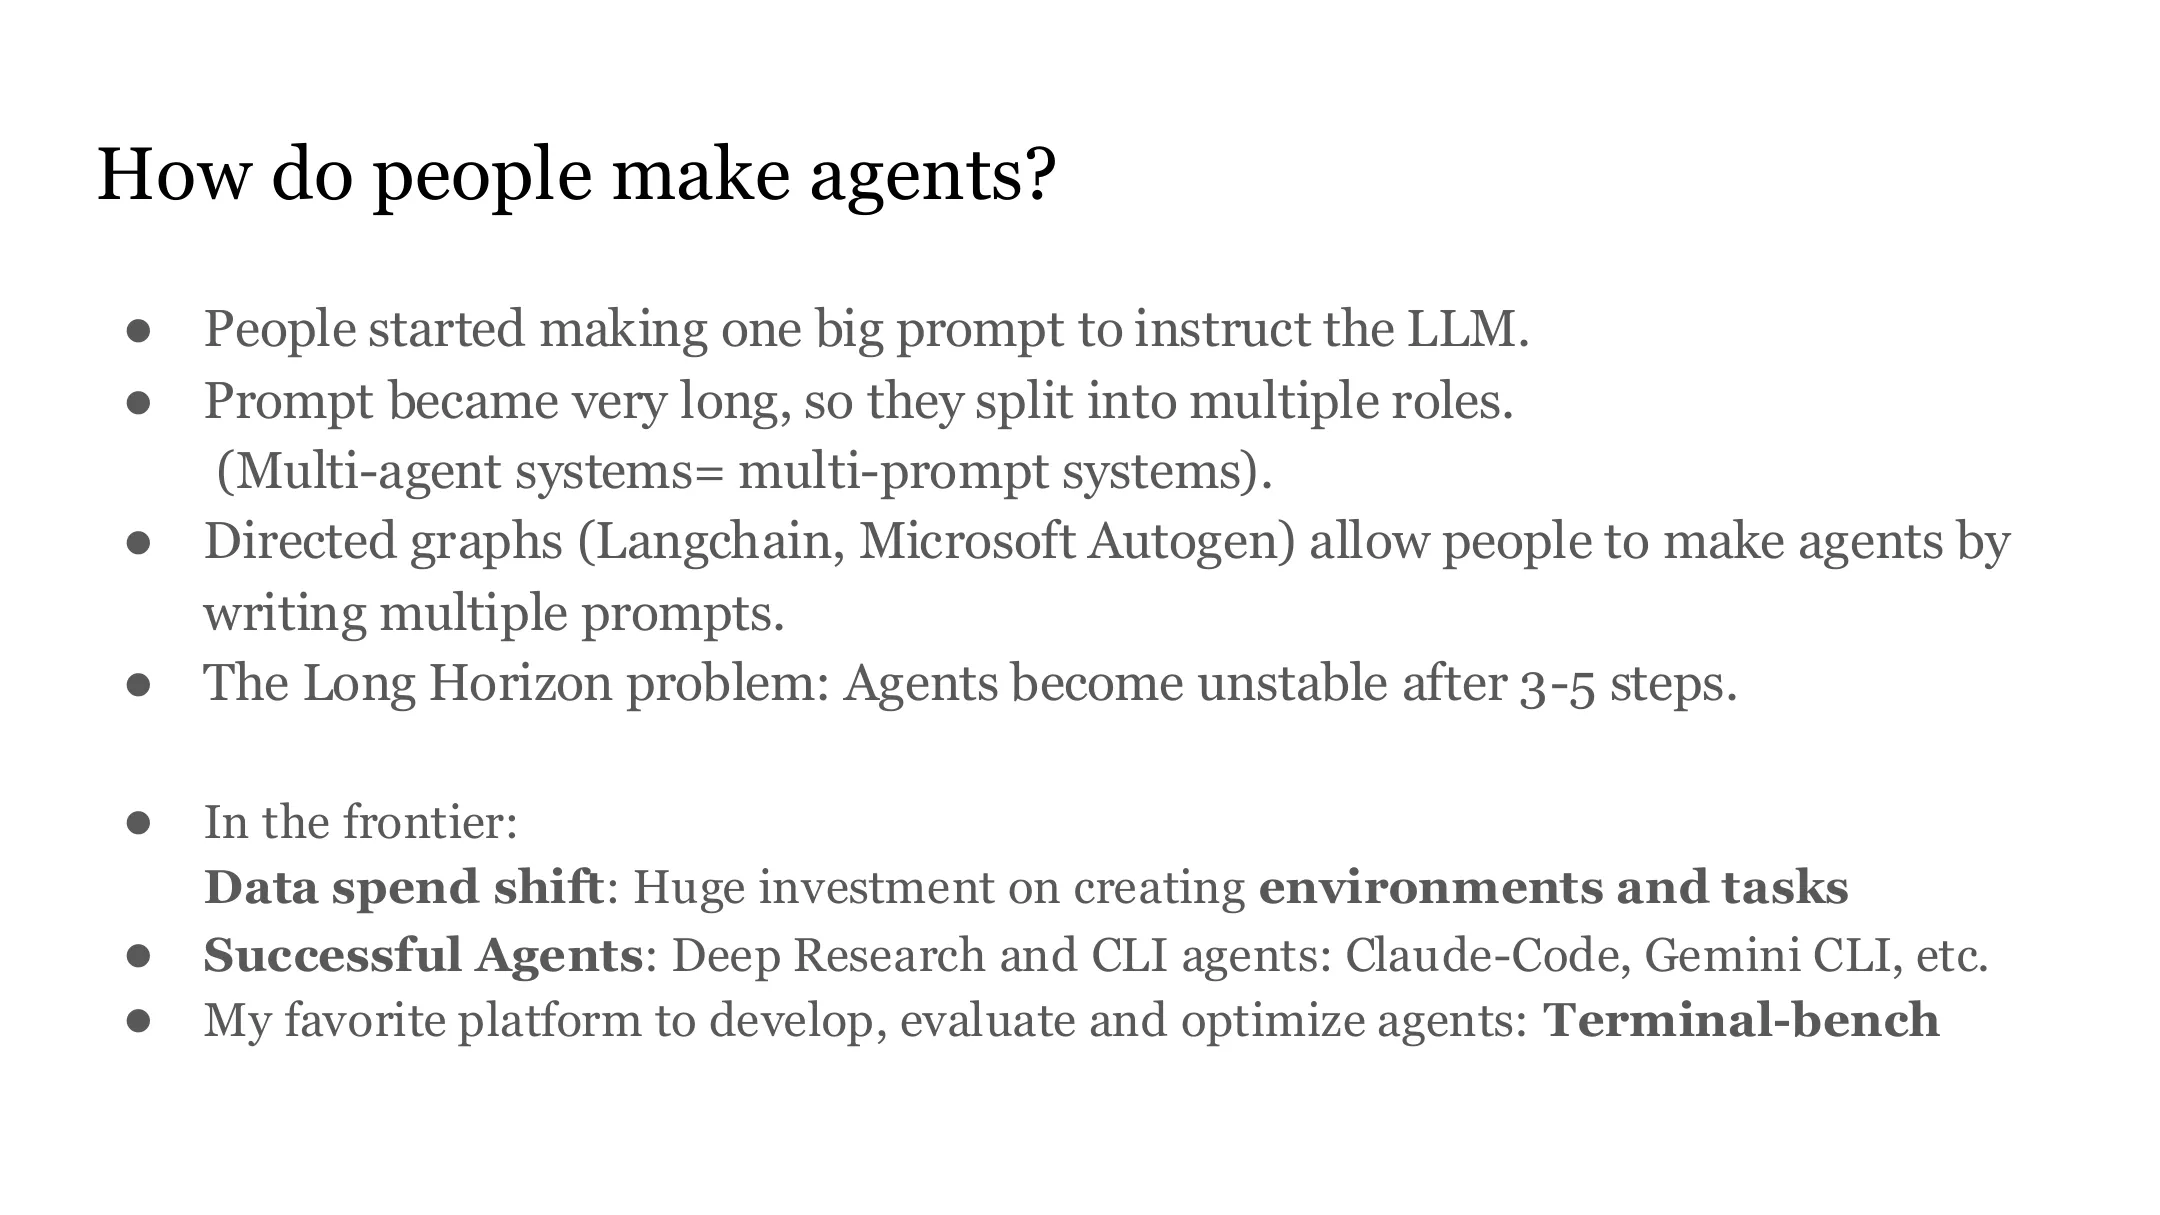
- 多智能体系统(multi-agent):每个「agent」其实只是一段 prompt,用 LangChain/LangGraph/AutoGen 管理多个 prompt 的图或并行——工业界主流。核心难题是 long-horizon problem(长程问题):若每步有 5% 出错概率,且训练中从没出错,一旦出错就永远无法恢复。伯克利有论文专门为多智能体系统的失败做了分类学。
- 前沿实验室:不写固定流程,而是让 agent 完全自主 + 给一个终端,并大量投资于环境和任务。稳定性来自「让它自己失败,再从错误中恢复」。
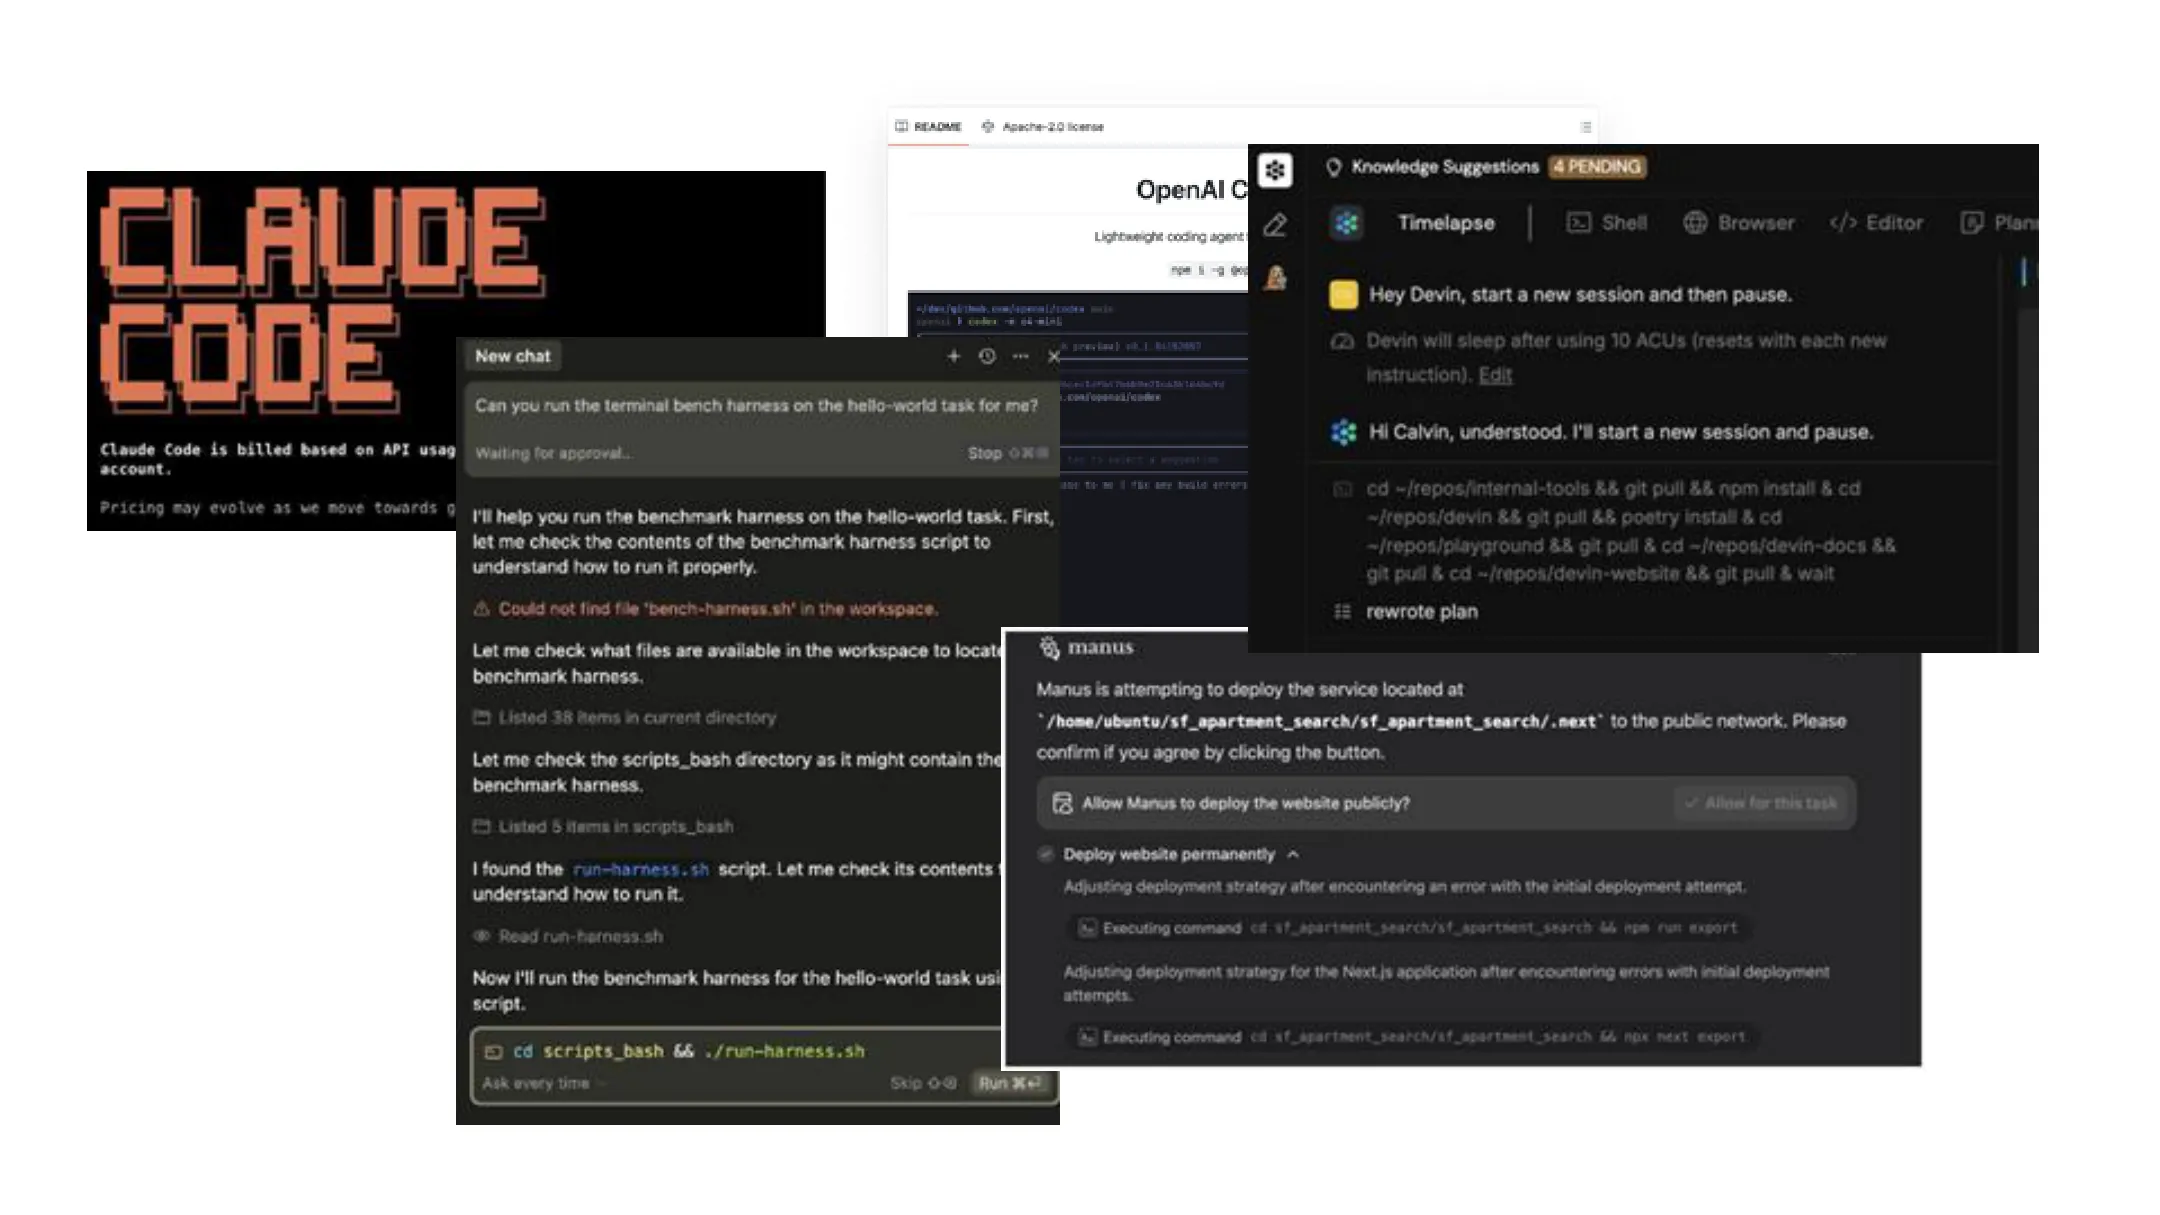
成功的 agent:Claude Code、Codex(OpenAI)、Gemini CLI(Google)、deep research 等。
📷 从 LLM 到自主智能体
回到原视频 (00:23:27)
📷 2021 年 AI 知道什么?
回到原视频 (00:24:40)
📷 (空白页)
回到原视频 (00:25:53)
📷 (空白页)
回到原视频 (00:27:06)
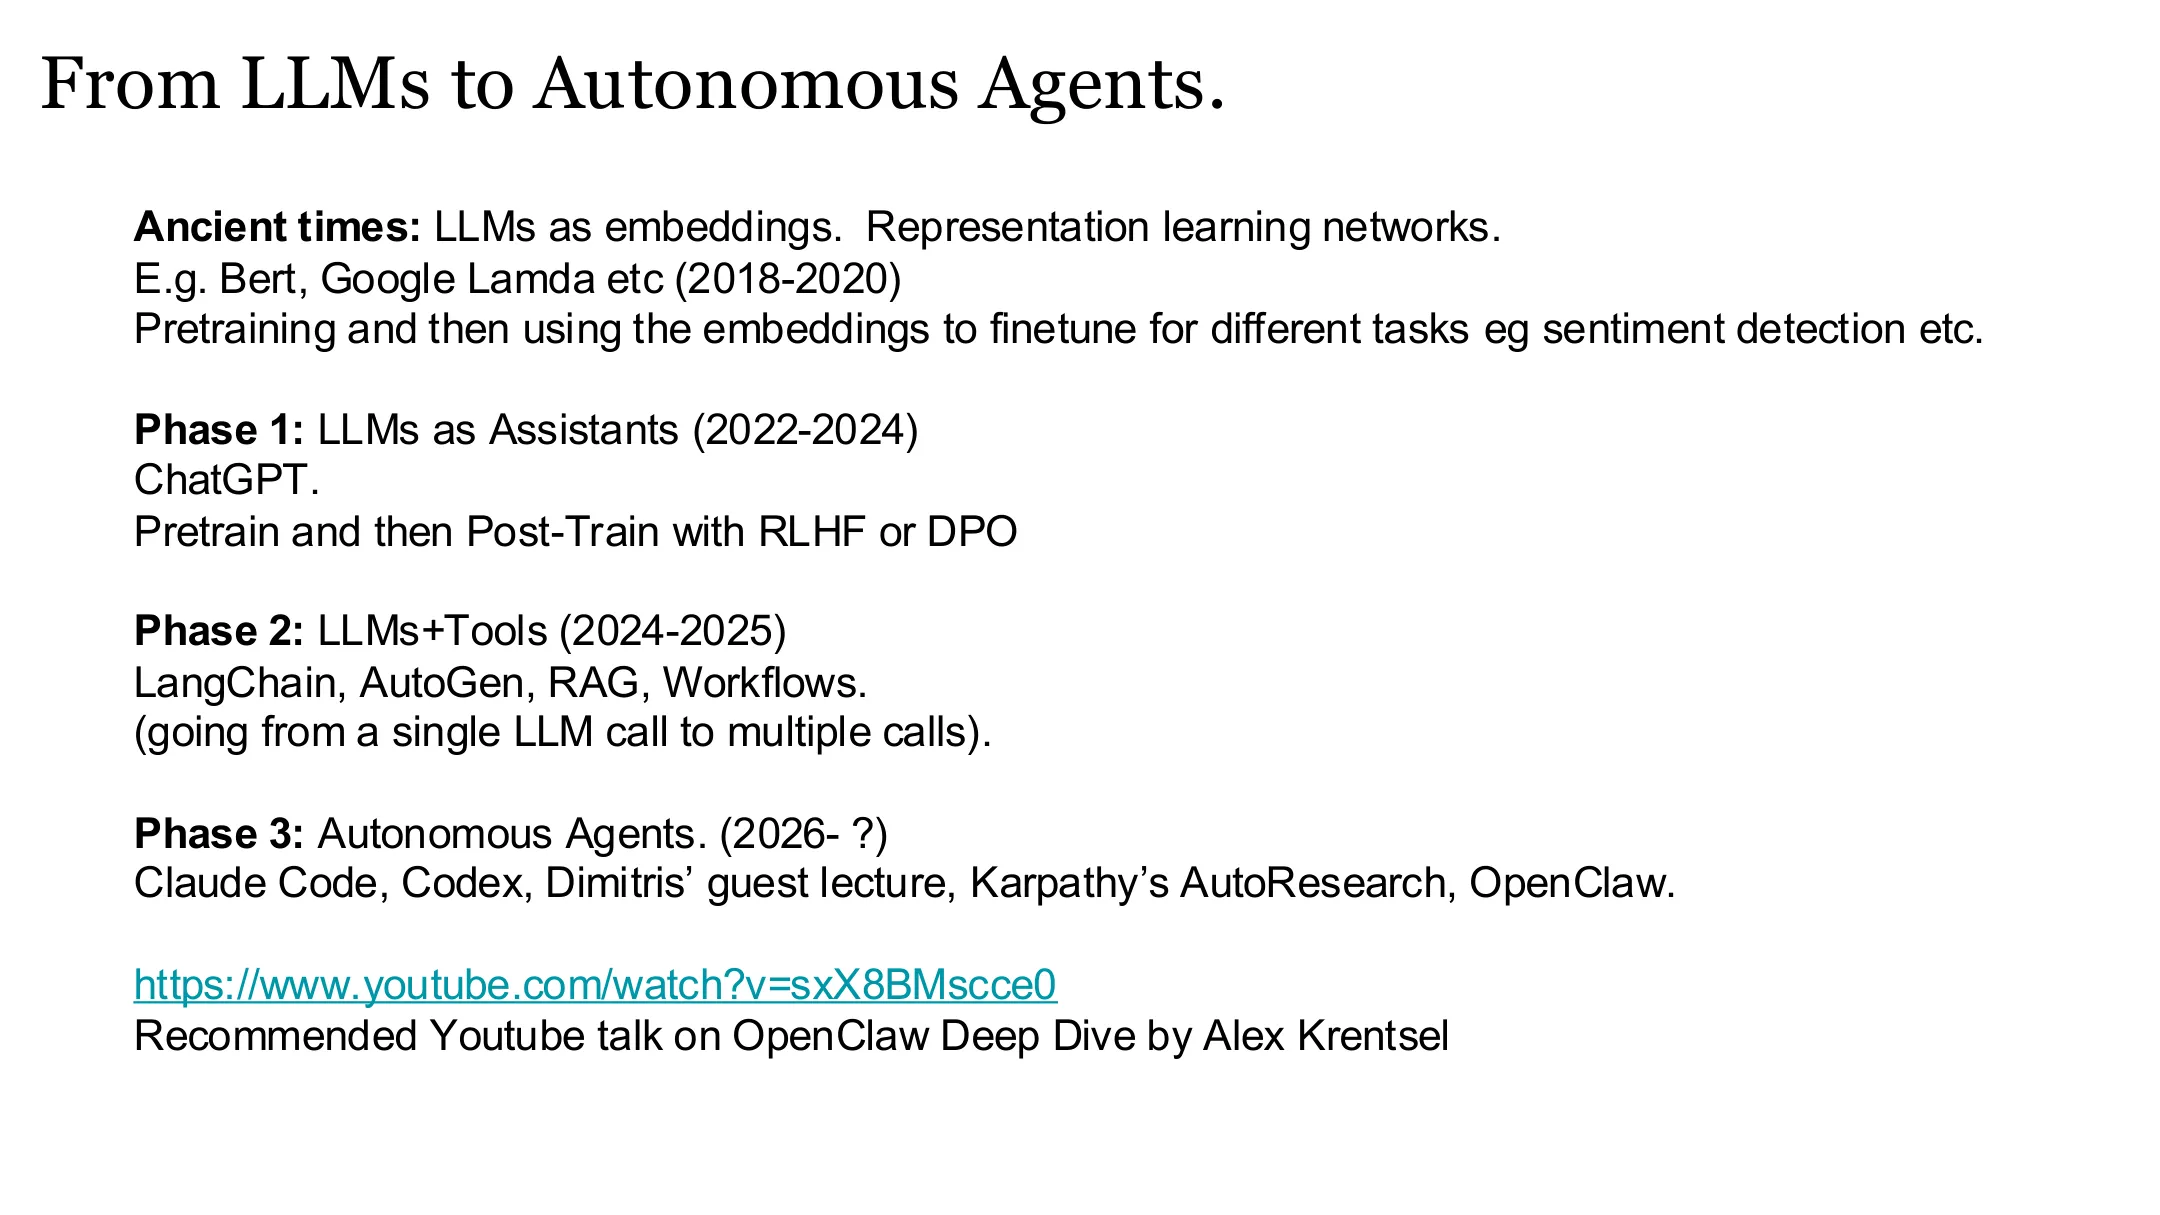
二、Agent 的历史三阶段
(参考时间: 00:24)
- 阶段 1(2020,上古时期):LLM 被认为只是「文本 → 嵌入」的工具,如 BERT 预训练 + 线性头做情感分类。没人会把模型直接放到用户面前——就像不会把 CPU 的导线暴露给用户去加电压。
- 阶段 2(2022,ChatGPT):把模型本身作为产品,后训练成助手。预训练模型只会「顺着前提往下写」(让它续写「Harry Potter met Mozart…」它就顺着编,或问「如何做炸弹」它就接着教);要用专家标注的偏好数据(RLHF/DPO)把它变成有帮助、对齐的助手。
- 阶段 3(~2025 到现在):自主 agent。从「LLM + 工具(LangChain/AutoGen/RAG,硬编码)」走向 Claude Code 式:在终端上自主运行、无限轮。最新形态是 Open Claw——一个常驻的外部循环(有自己电脑和数据库,可主动给你发消息)。这是当前前沿。
📷 论文刚刚……
回到原视频 (00:28:19)
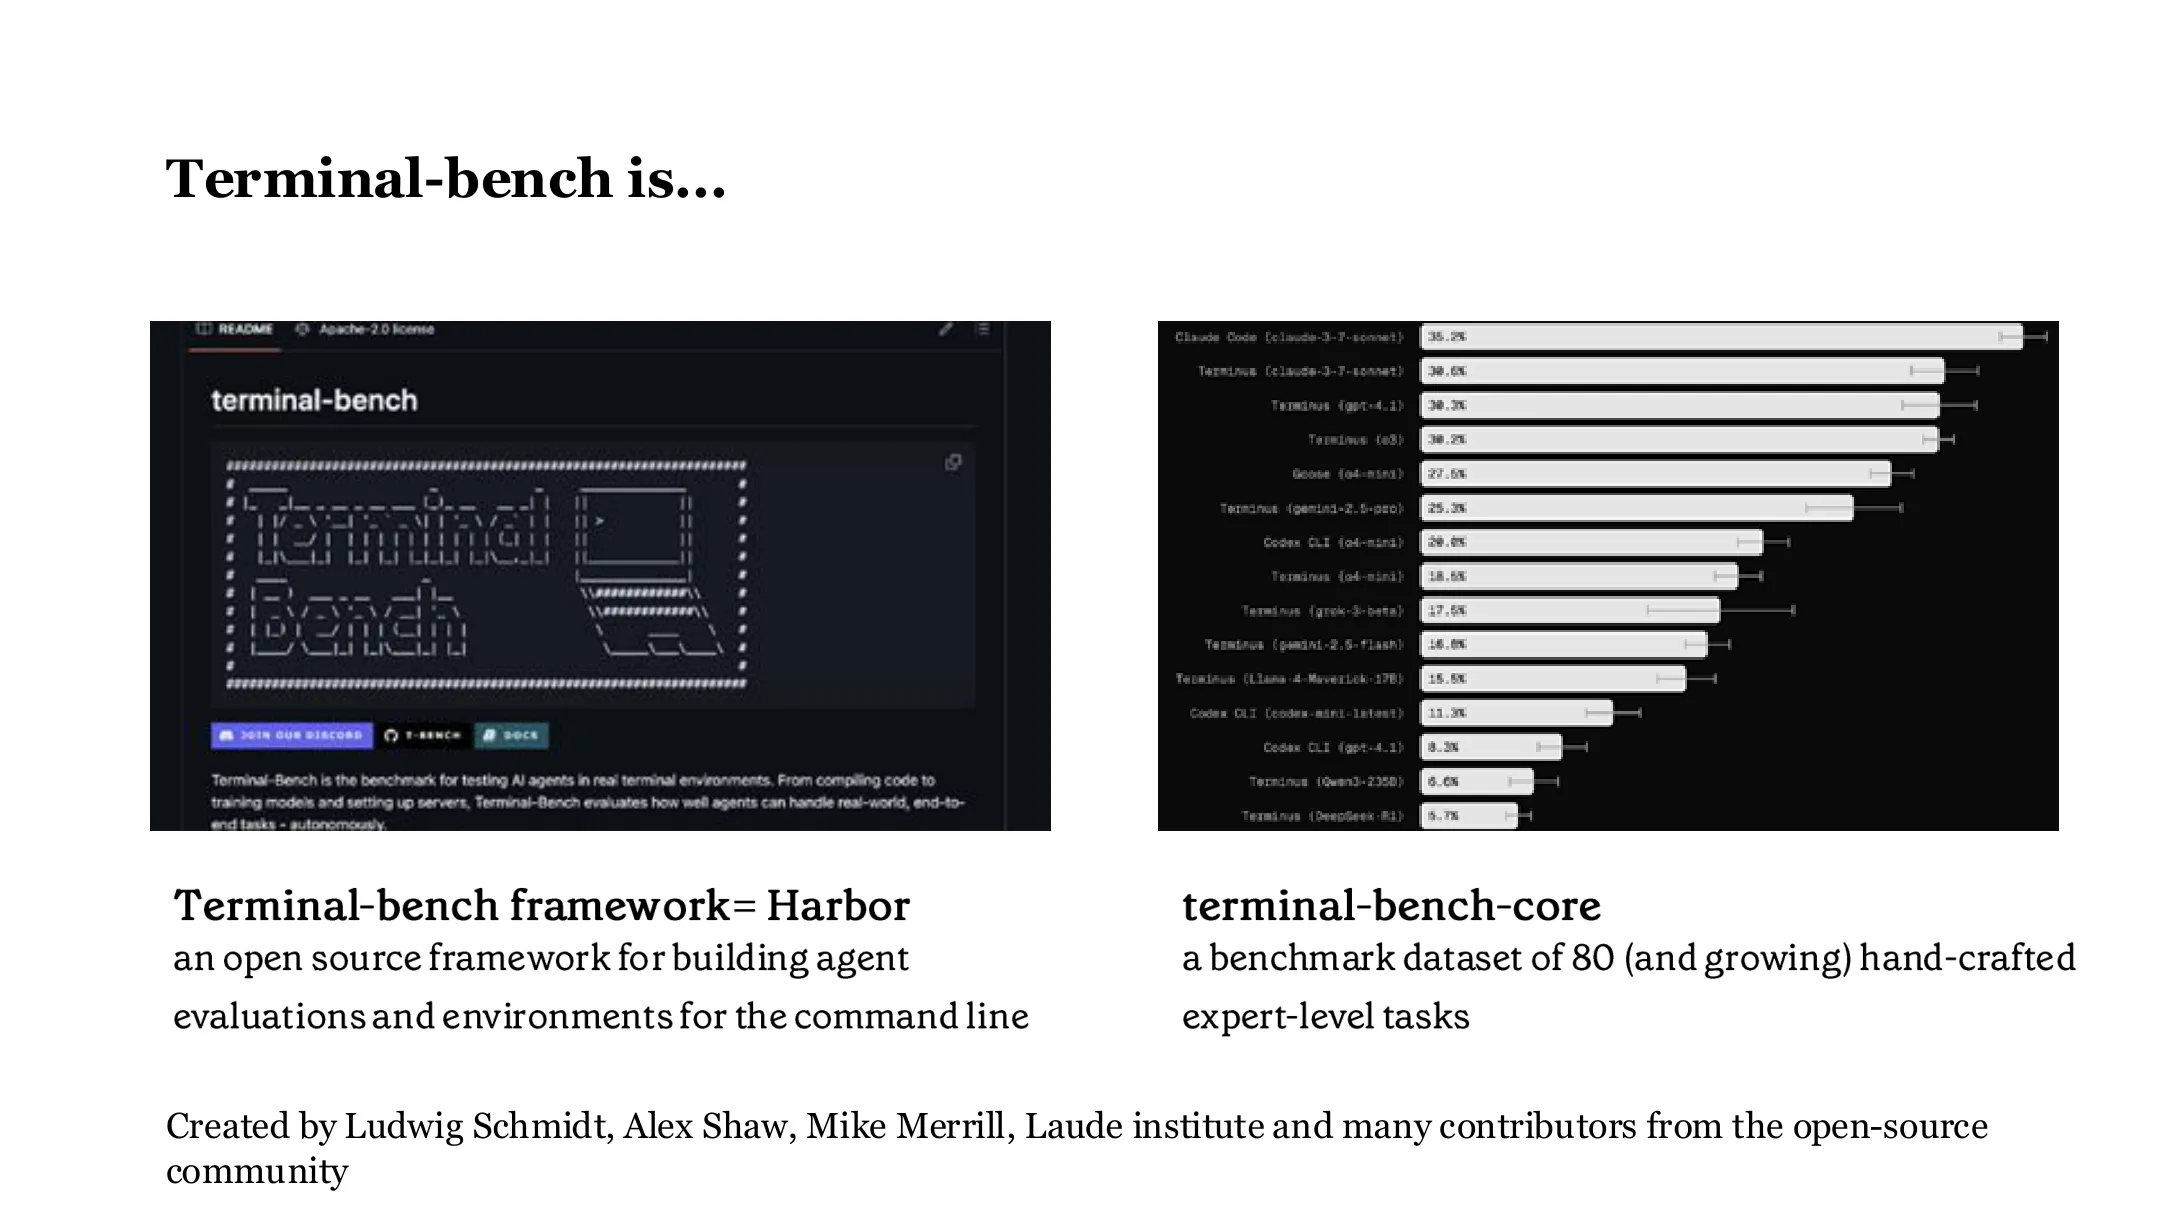
📷 Terminal-Bench 是……
回到原视频 (00:29:32)
为什么 workflow 会失败? 因为多步任务中任何一步出错都致命,而 LLM 从没在训练中经历过错误。每个 agent 的失败方式都独特(就像每个学生对 PCA 的误解都不同),只有自己动手犯错并修正才能学会。SFT = 读别人解好的题;RL = 自己解题、只在真正解出时才得奖励。所以环境通过让 agent 以自己独特的方式失败来稳定它。
三、从问答评测到环境评测
(参考时间: 00:35)
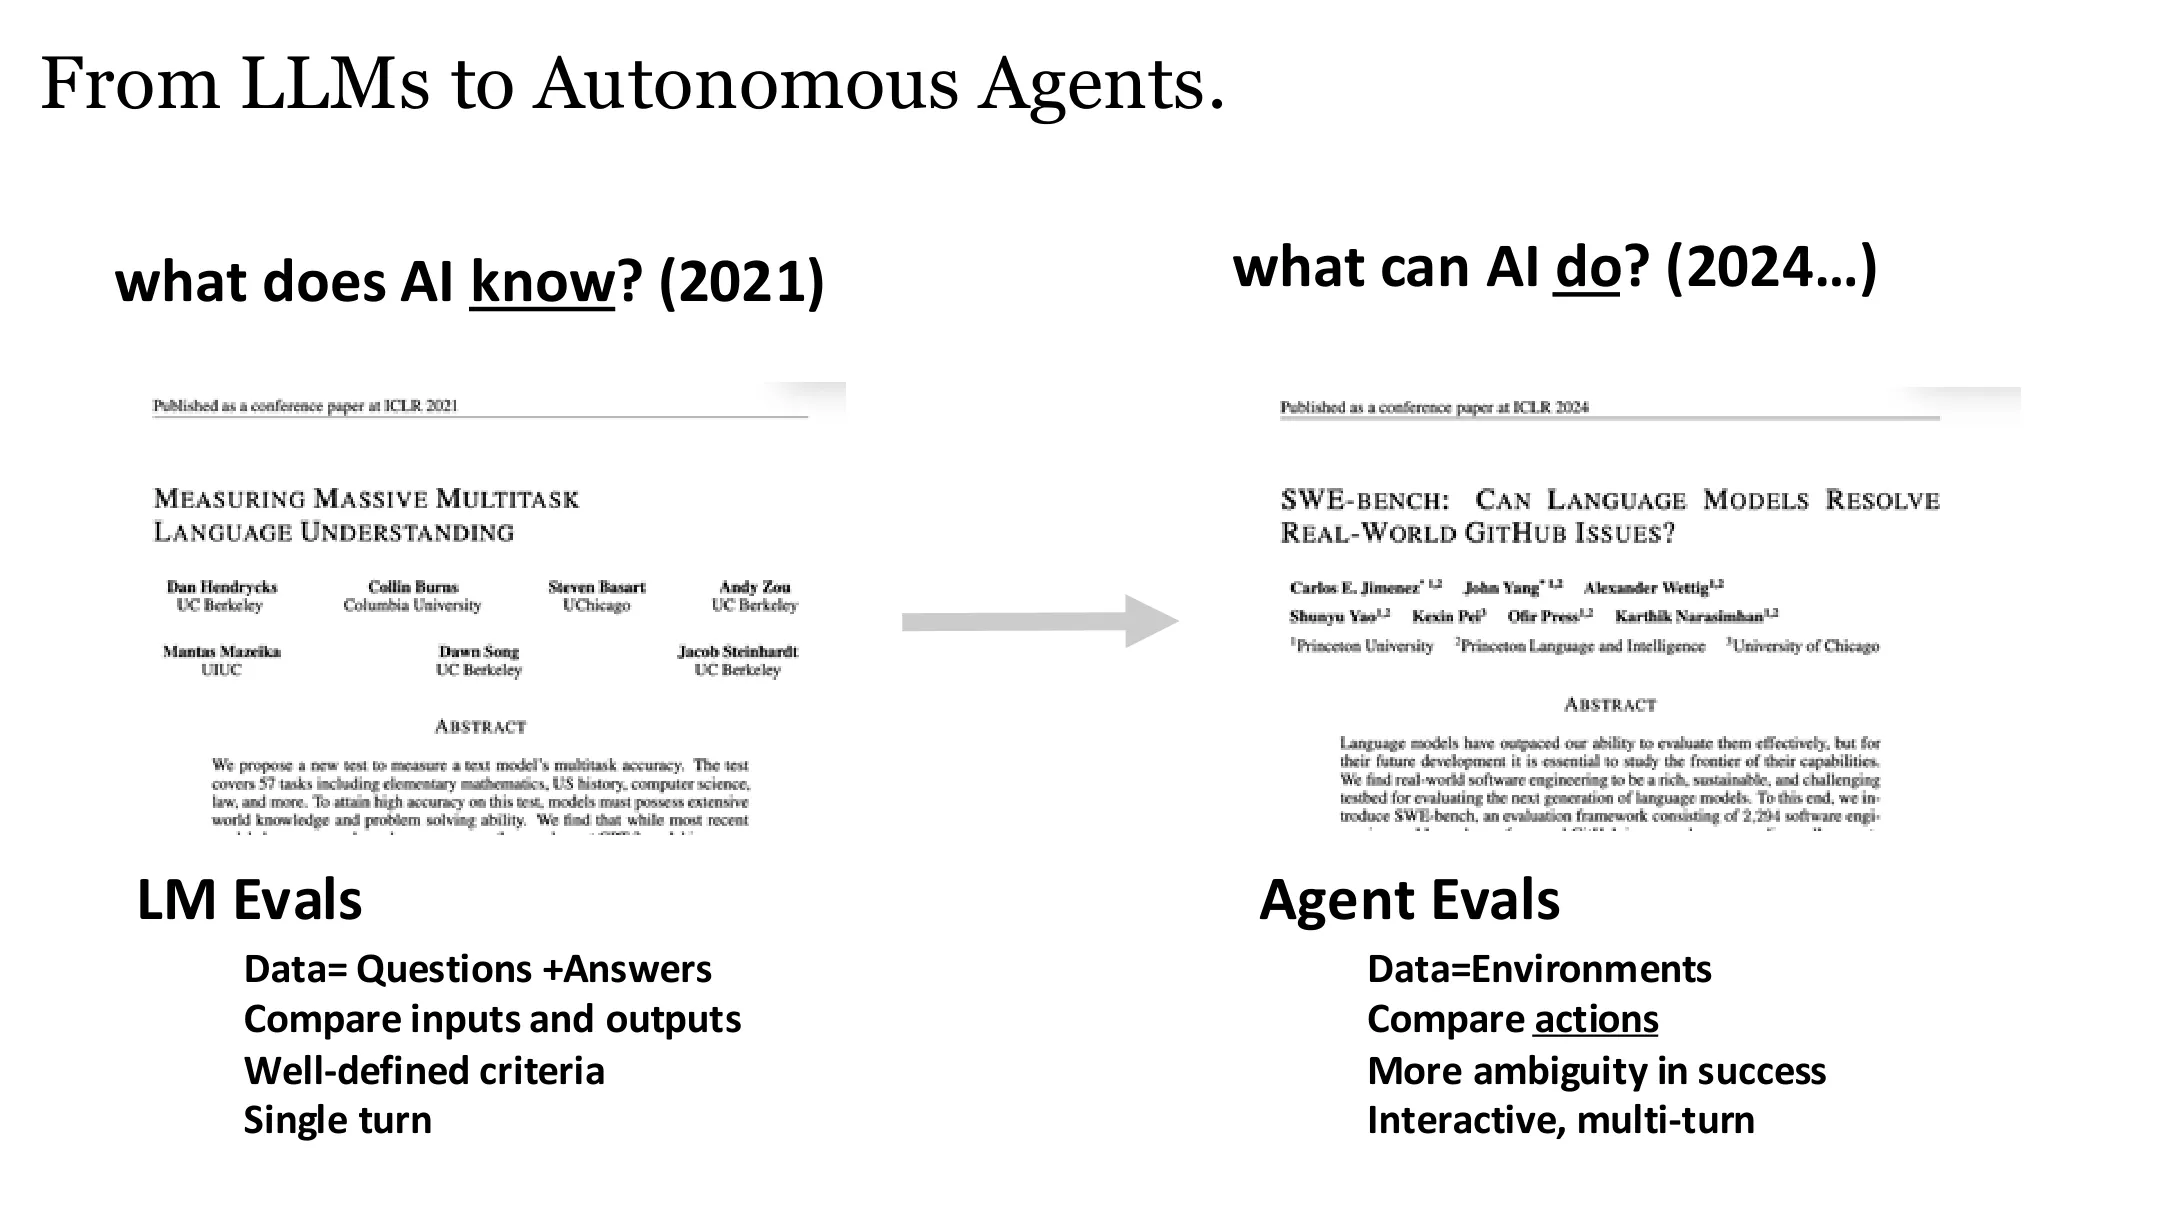
旧世界(问答):评测就是问题 + 标准答案(如 MMLU,Massive Multitask Language Understanding,含博士级题目)。比较答案即可,必要时用 LLM-as-judge。
新世界(能力):现在要问「agent 能做什么」(如「用 Rust 重写 Linux 内核」)。这无法用问答评测 ⇒ 评测对象变成 environments(环境):
- 构造一个虚拟世界(playground),把 agent 放进去;
- agent 做完说「我完成了」,你要自动检验它是否真的解决了问题;
- 这就是 RL with Verifiable Rewards(RLVR):不关心怎么做,只关心结果;本质是多轮、可交互,且成功判定常有歧义。
数据从「问答对」变成了「环境」。
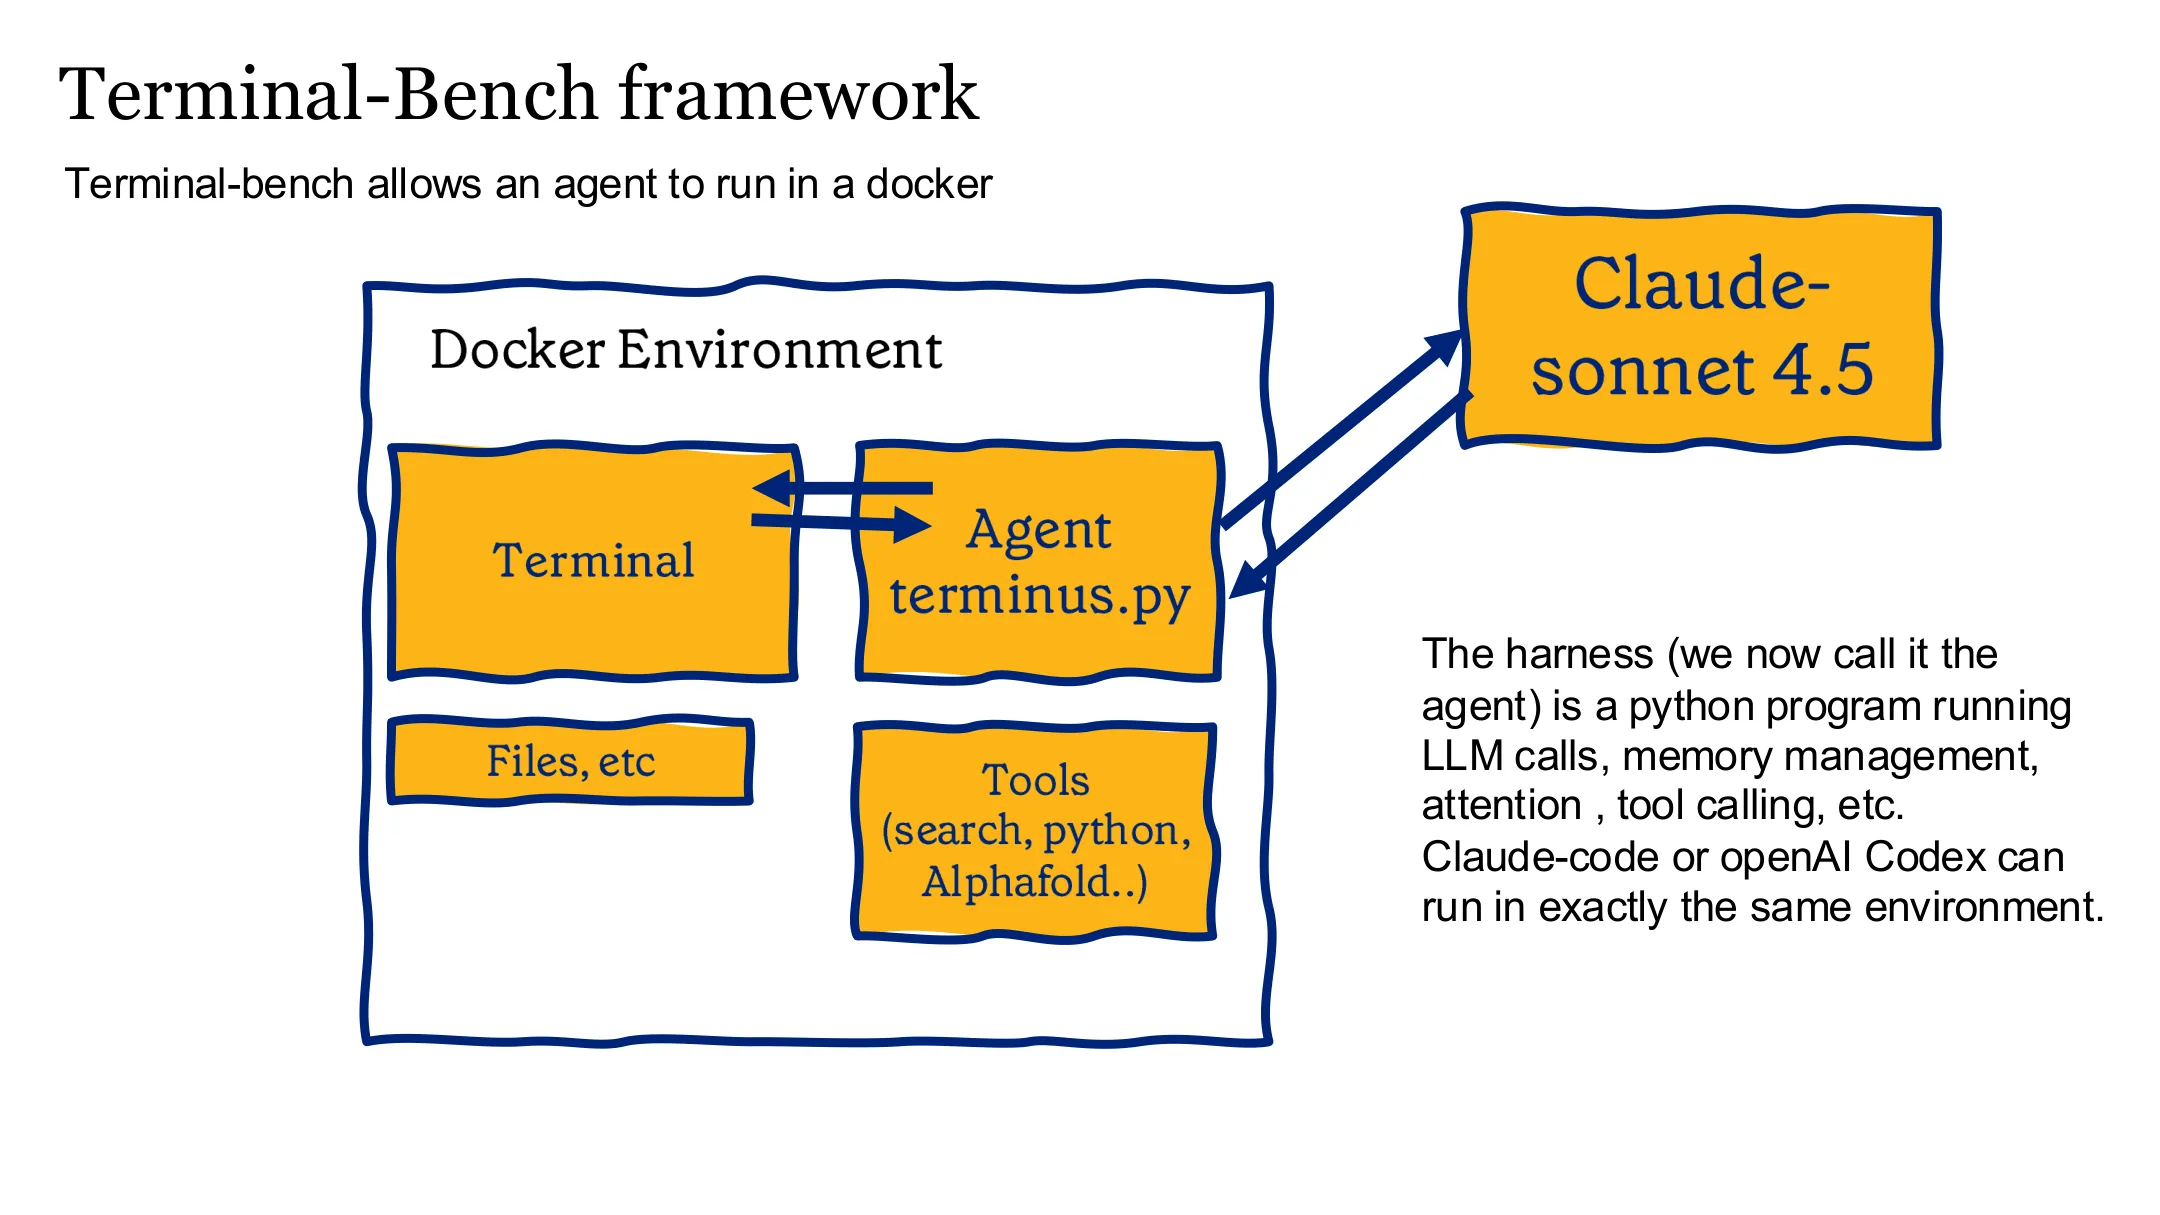
📷 Terminal-Bench 框架
回到原视频 (00:30:45)
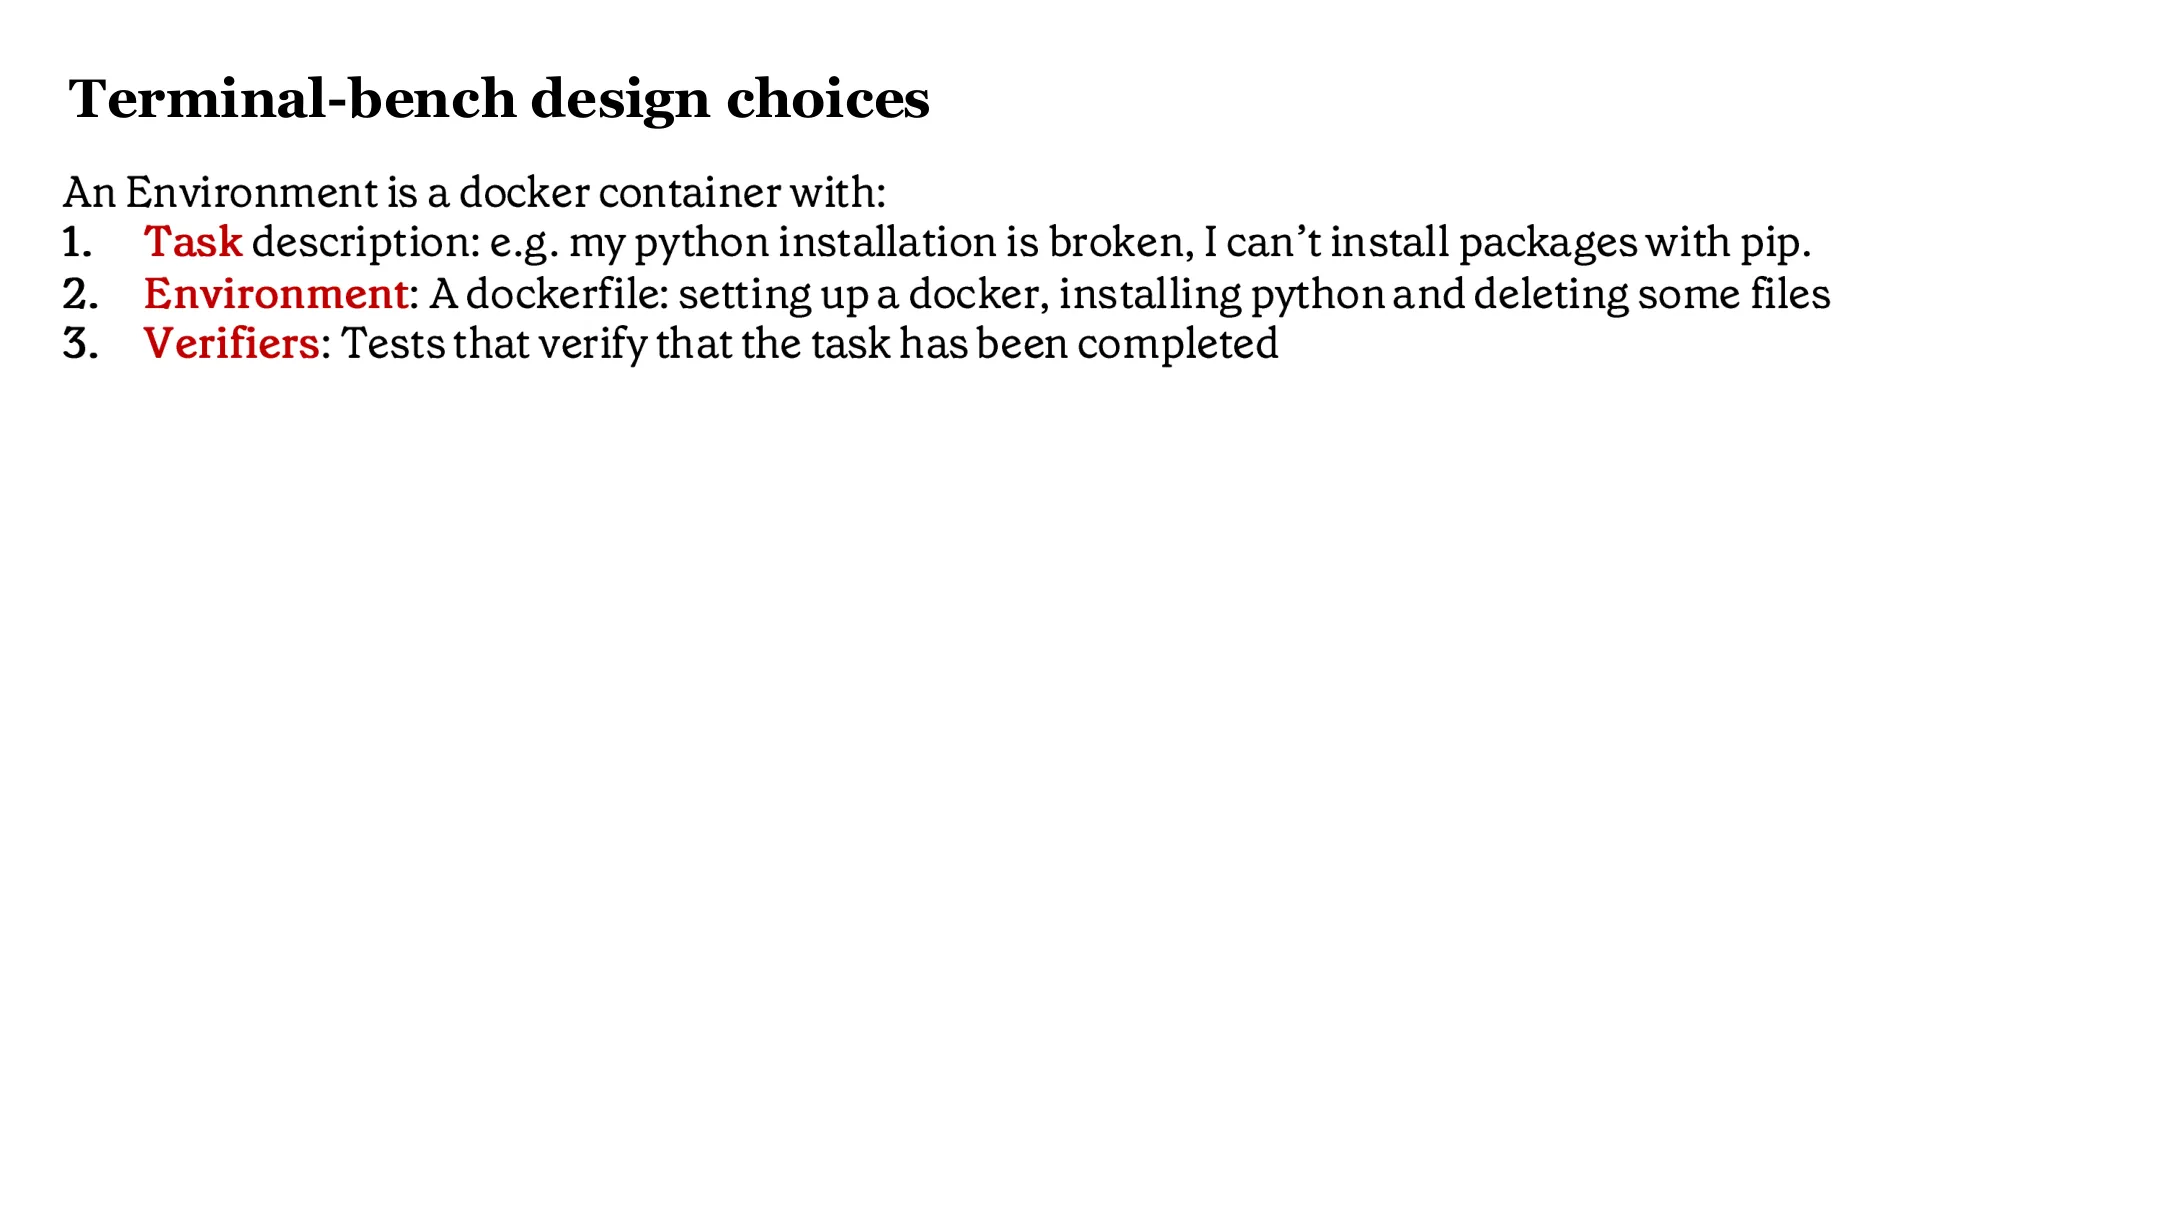
📷 Terminal-Bench 的设计选择(一)
回到原视频 (00:31:58)
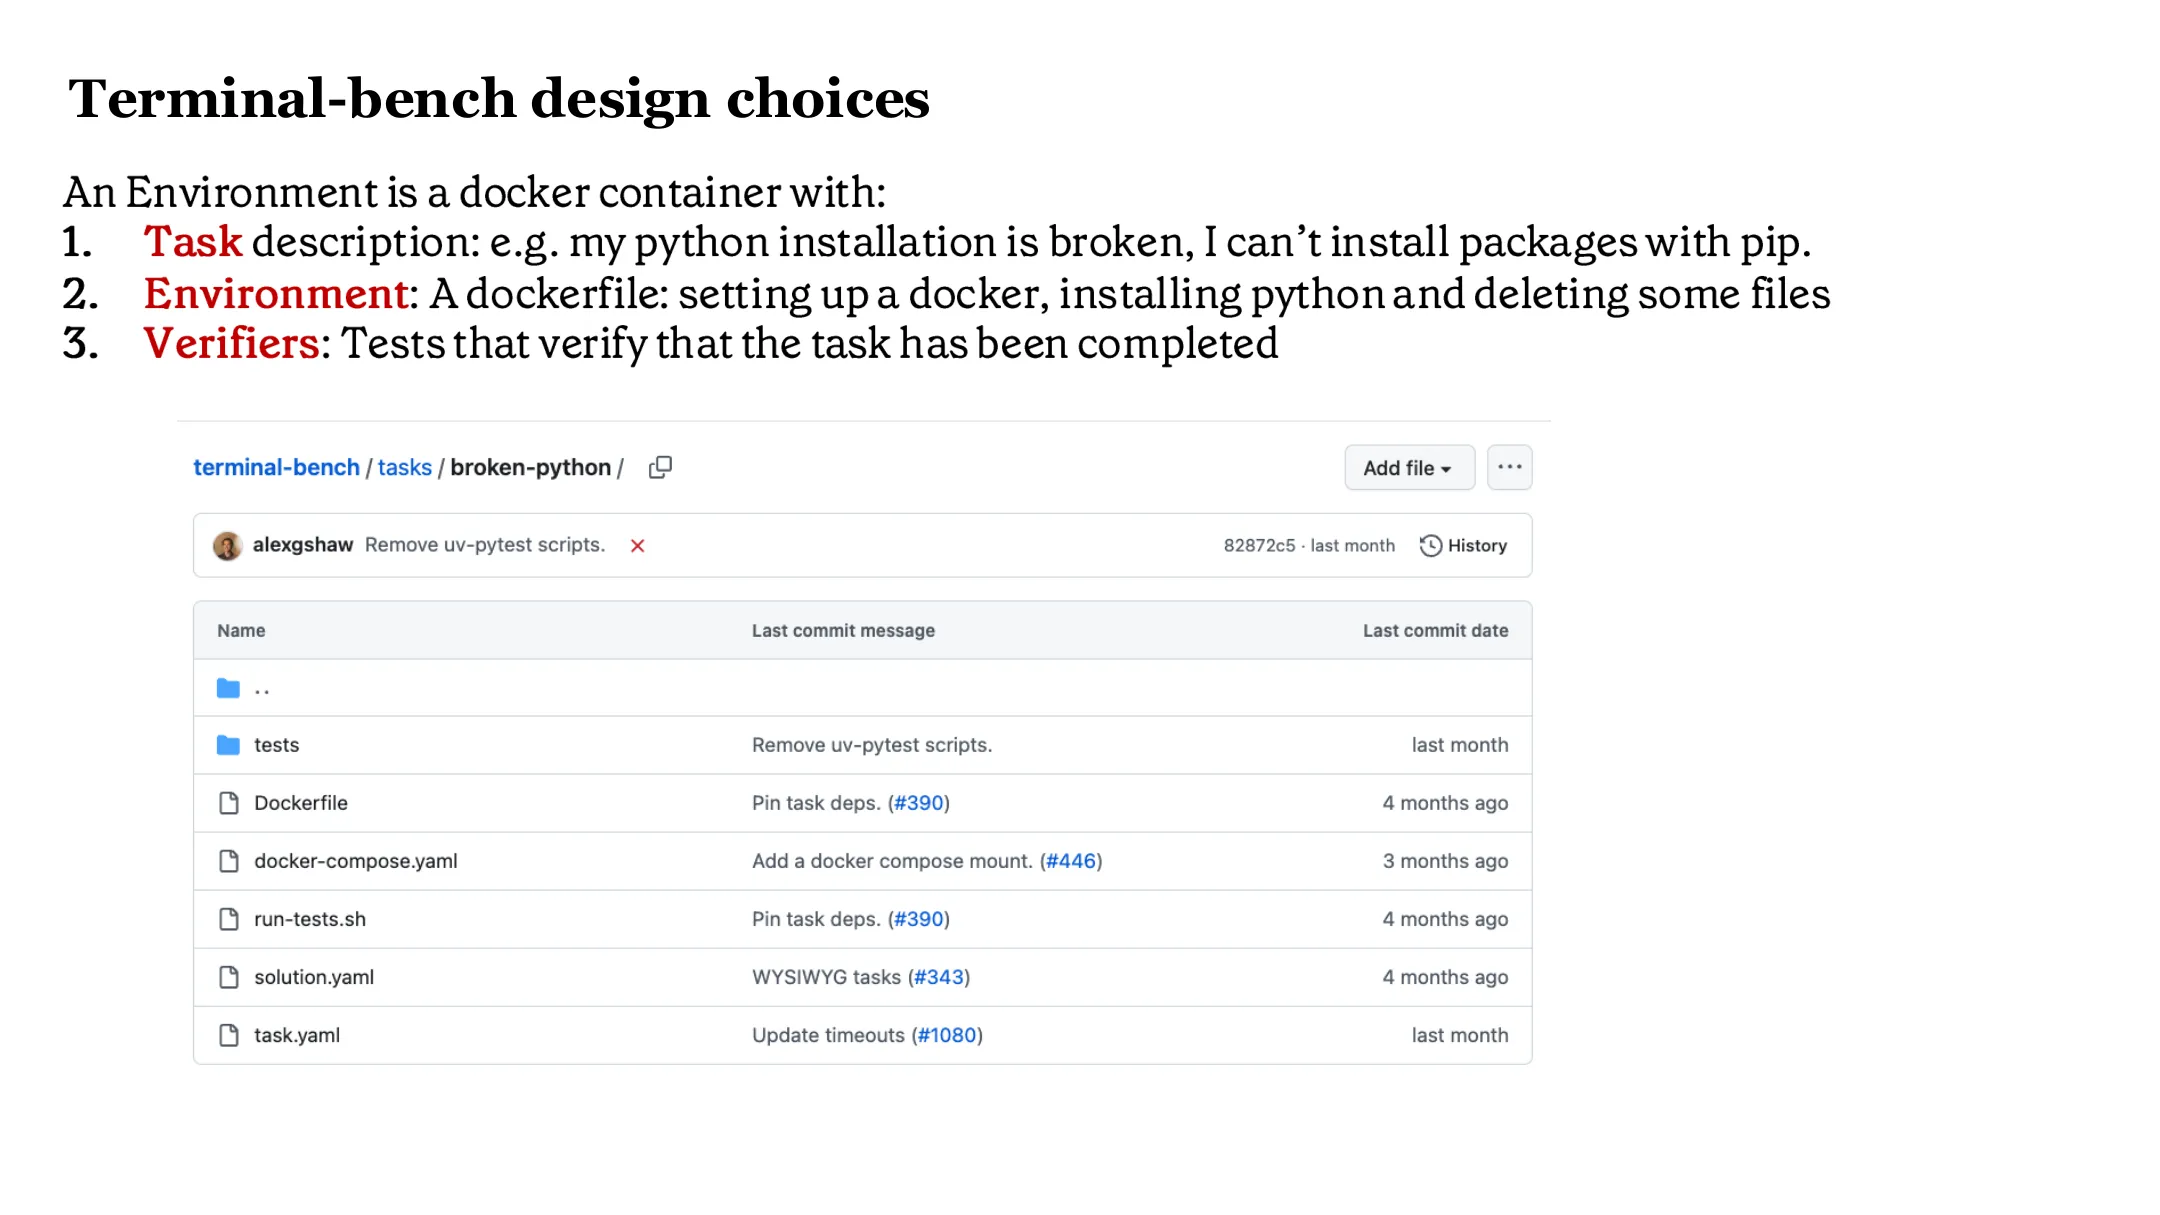
📷 Terminal-Bench 的设计选择(二)
回到原视频 (00:33:11)
📷 例子包括:
回到原视频 (00:34:24)
📷 Terminal-Bench 示例任务
回到原视频 (00:35:37)
📷 编码 Agent(CLI agent)能做很多事
回到原视频 (00:36:50)
📷 Terminal-Bench 的影响(一)
回到原视频 (00:38:03)
📷 Terminal-Bench 的影响(二)
回到原视频 (00:39:16)
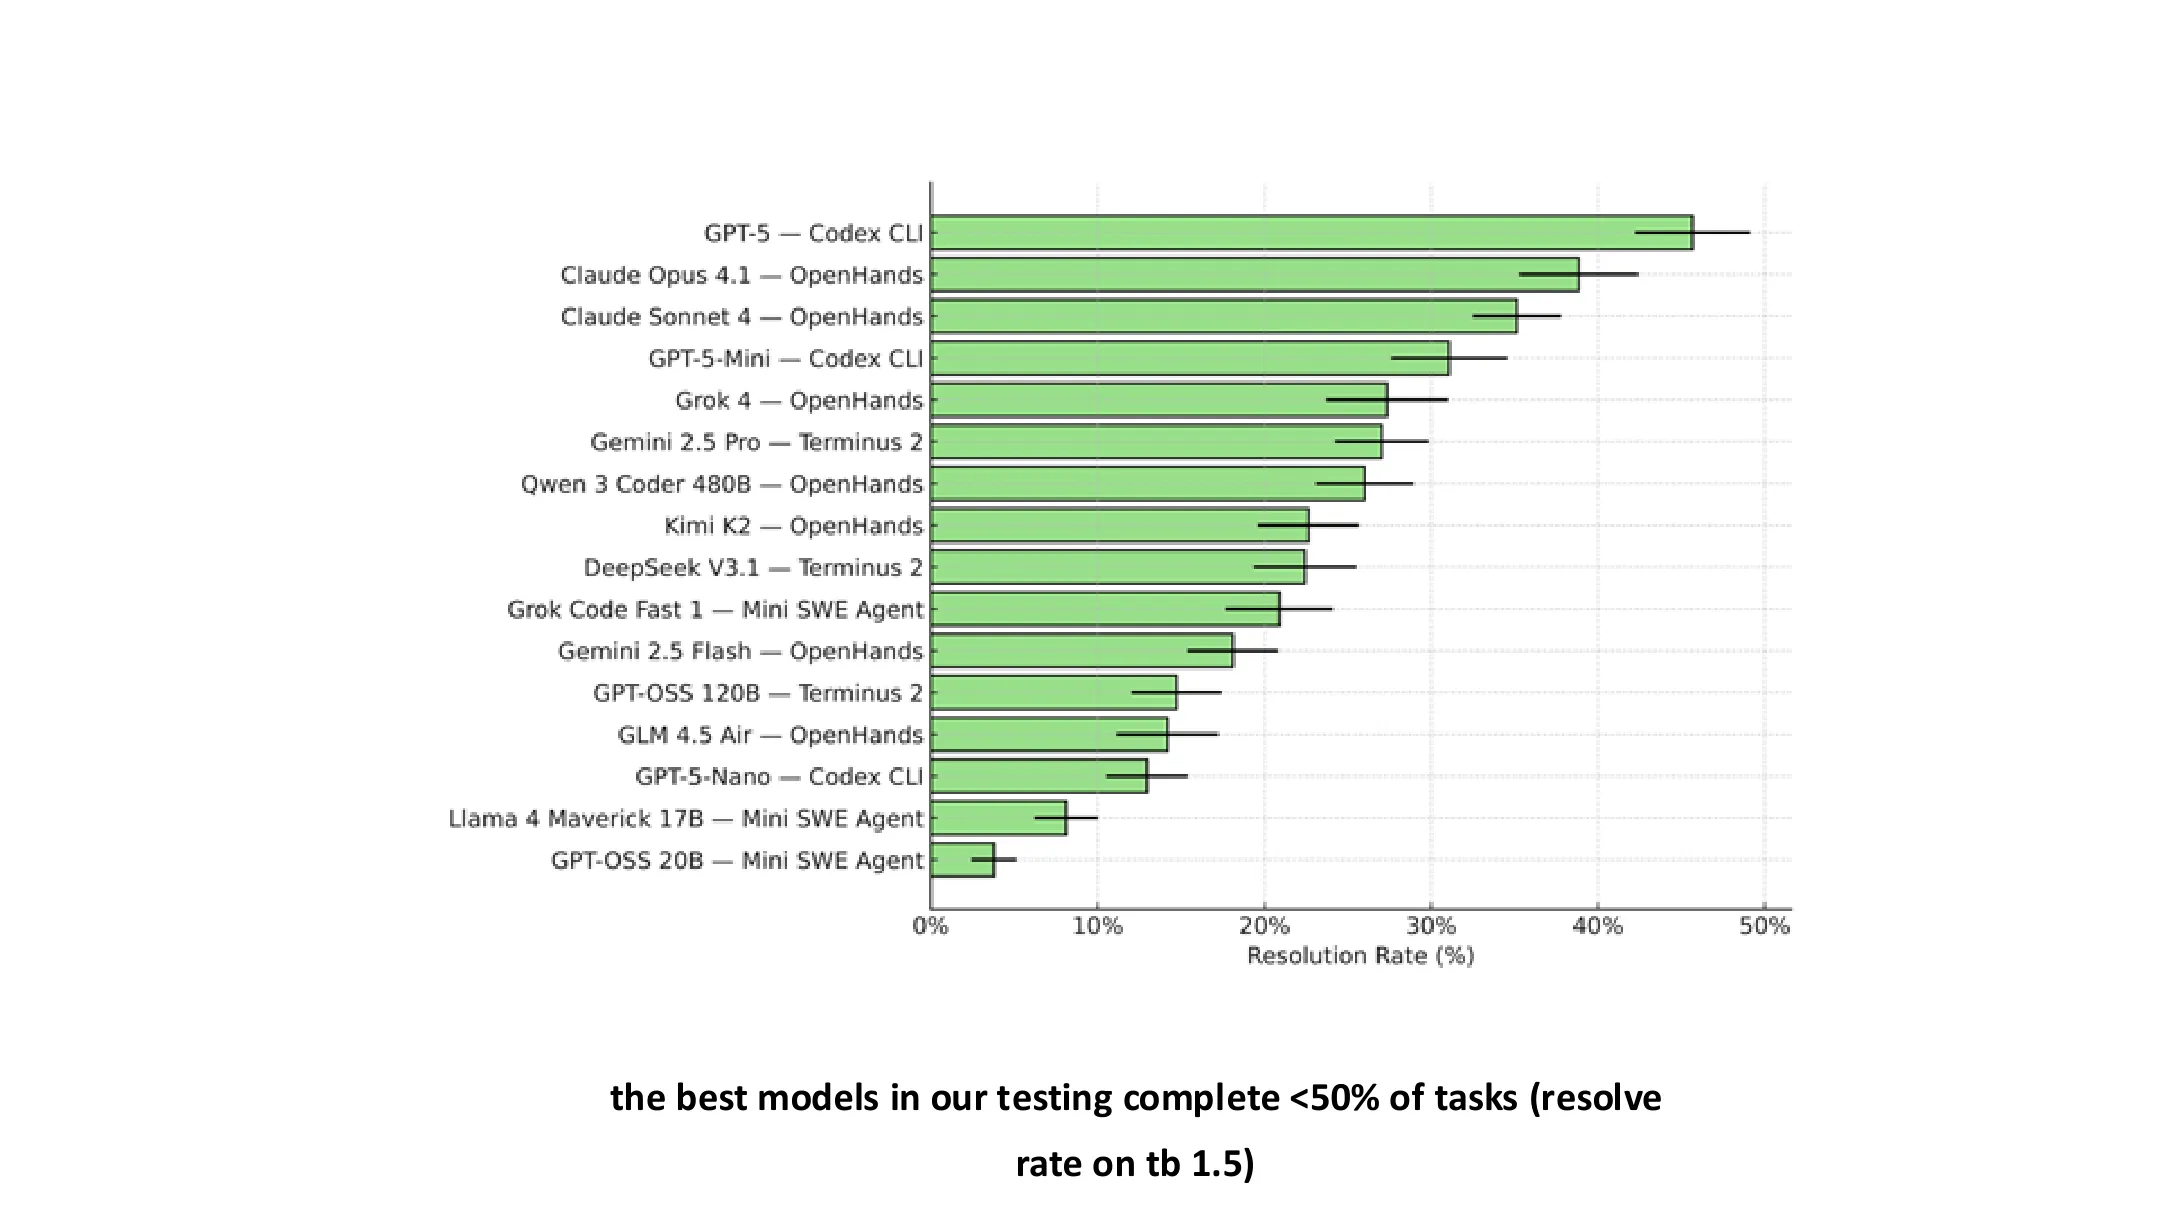
📷 测试中最好的模型完成 <50% 任务
回到原视频 (00:40:29)
3.1 Terminal-Bench
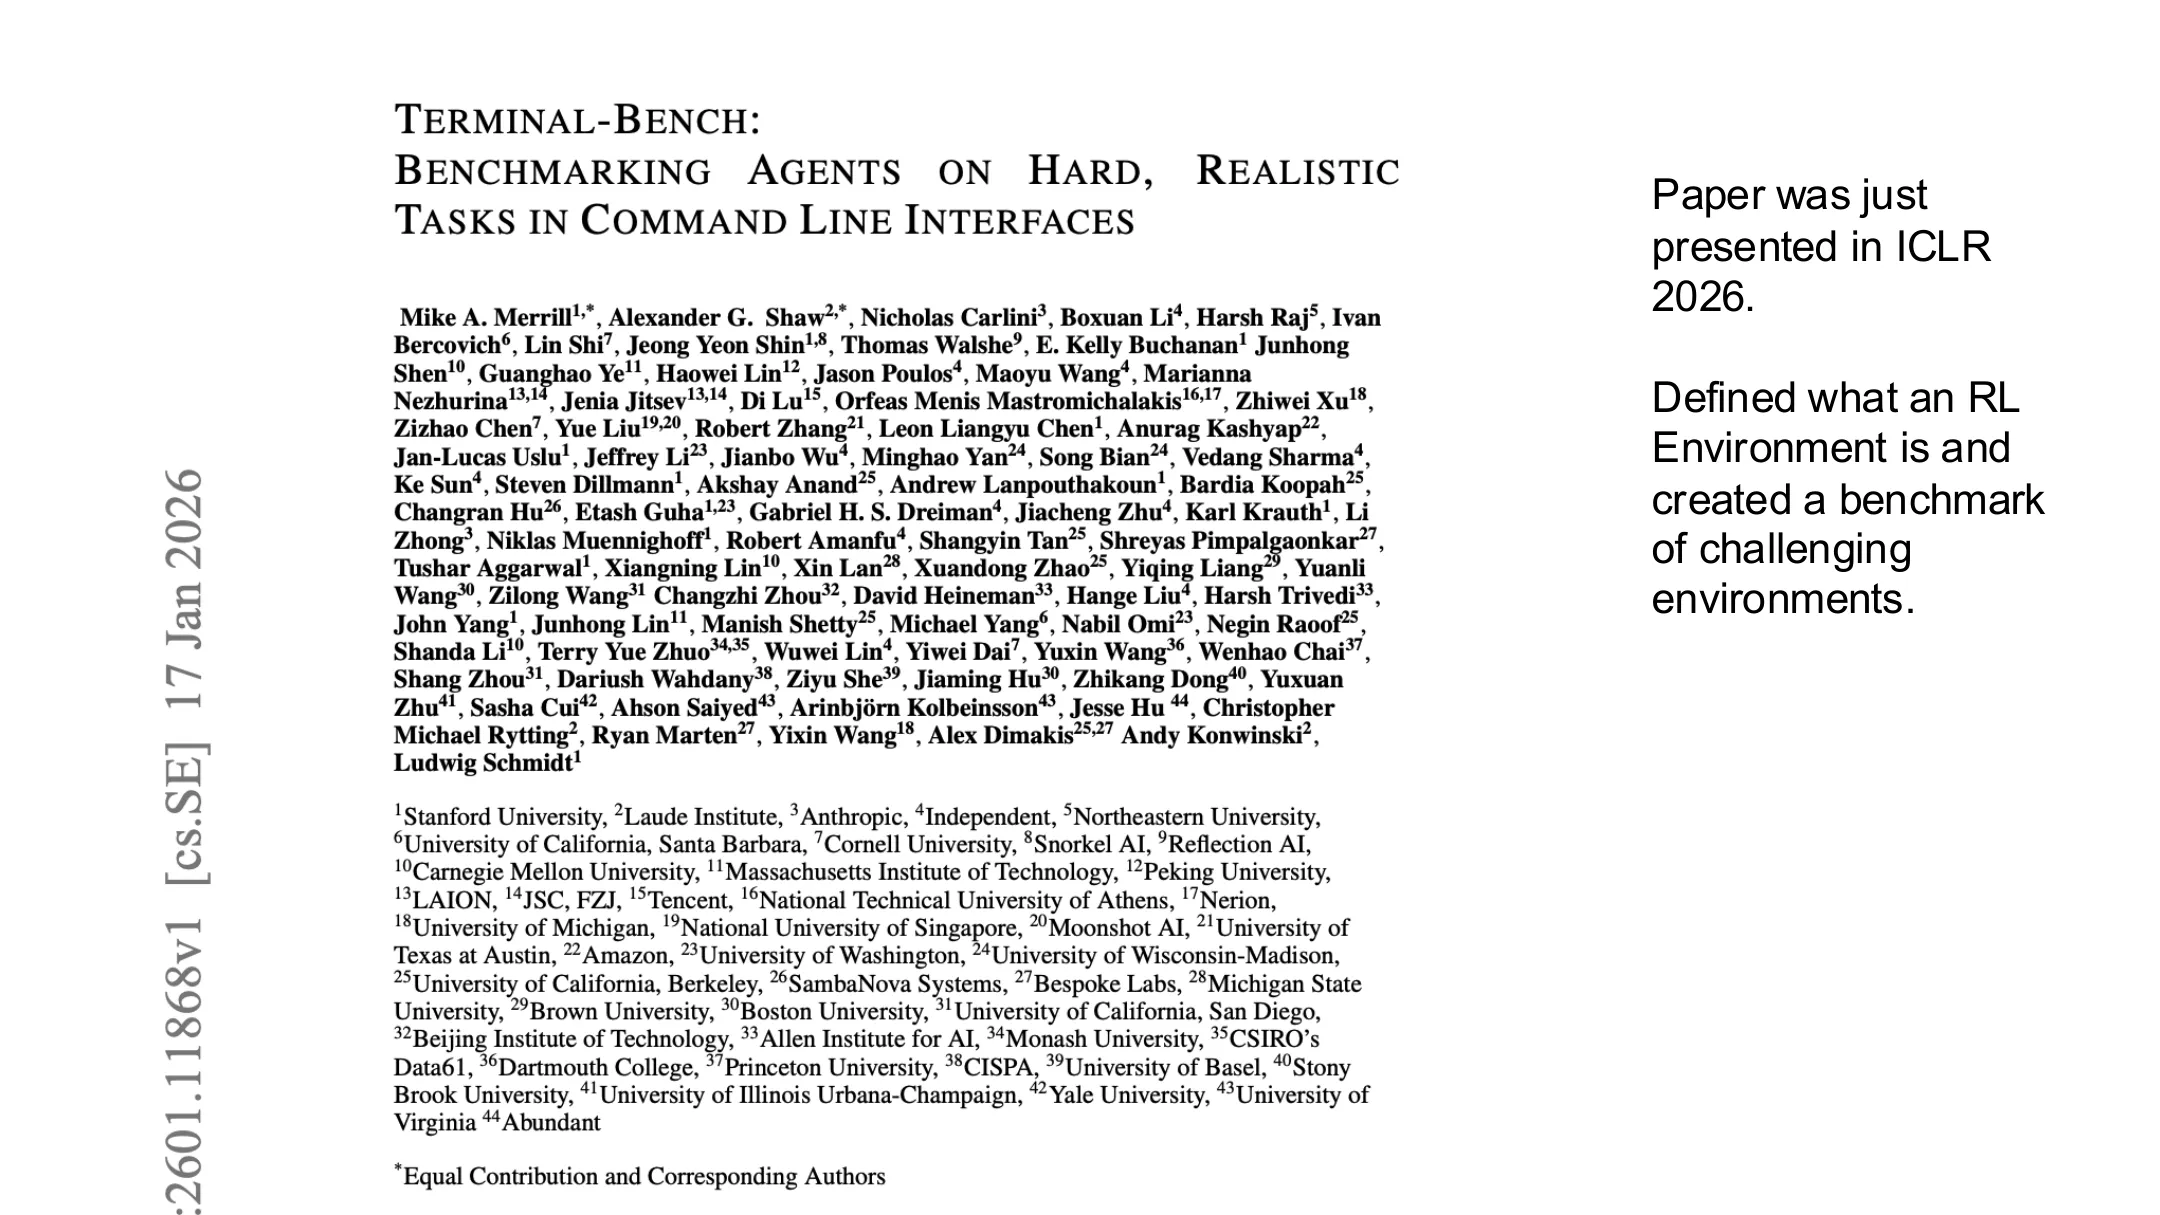
Terminal-Bench(ICLR 2026 报告)定义了什么是一个 RL 环境,并构造了高难度环境基准:
- Harbor:开源框架,用于为命令行构建 agent 评测与环境(TB1 约 80 个任务、TB2 100 个、TB3 正在做);
- 目标是让前沿实验室统一评测 Claude Code / Codex 等 agent。
框架结构:
- agent 运行在一个 Docker 容器(想象成你的电脑/终端)里,能敲键盘、
pip install、甚至rm -rf; - agent 通过 API 调用 LLM——LLM 与 harness 分离:可换 Sonnet/Opus/GPT/Gemini,或自建 vLLM;
- harness(如开源 Terminus、OpenHands、Codex)就是一个 Python 程序:循环调用 LLM、执行命令、返回输出。最「笨」的 harness 就是「LLM 给你命令、你人肉执行、把输出贴回去」;
- harness 逐渐加入:上下文压缩(不要把
ls的海量 token 每轮都塞回去)、待办清单、额外工具(grep、正则在 LLM 手里「超人级」)、文件系统(agent 像人一样动态按需读取文件,而不是把整个 PDF 塞进上下文)。
3.2 环境的形状:Harbor 任务
一个 Harbor 任务由三部分组成:
- 任务描述(
task.yaml):如「我的 Python 装坏了,pip不能装包」; - 环境(Dockerfile):搭建虚拟机(装 Python、再删掉某些文件,制造「坏掉的 pip」);
- 验证器(verifiers / auto-grader):测试任务是否真的完成(如运行
pip看是否报错)。
两个关键陷阱:
- reward hacking:agent 会改测试让自己「通过」(真的会!)⇒ 运行时不给它读测试目录的权限;
- 测试覆盖:测试可能被「没真正解决」的方式通过 ⇒ 要设计足够强的测试覆盖。
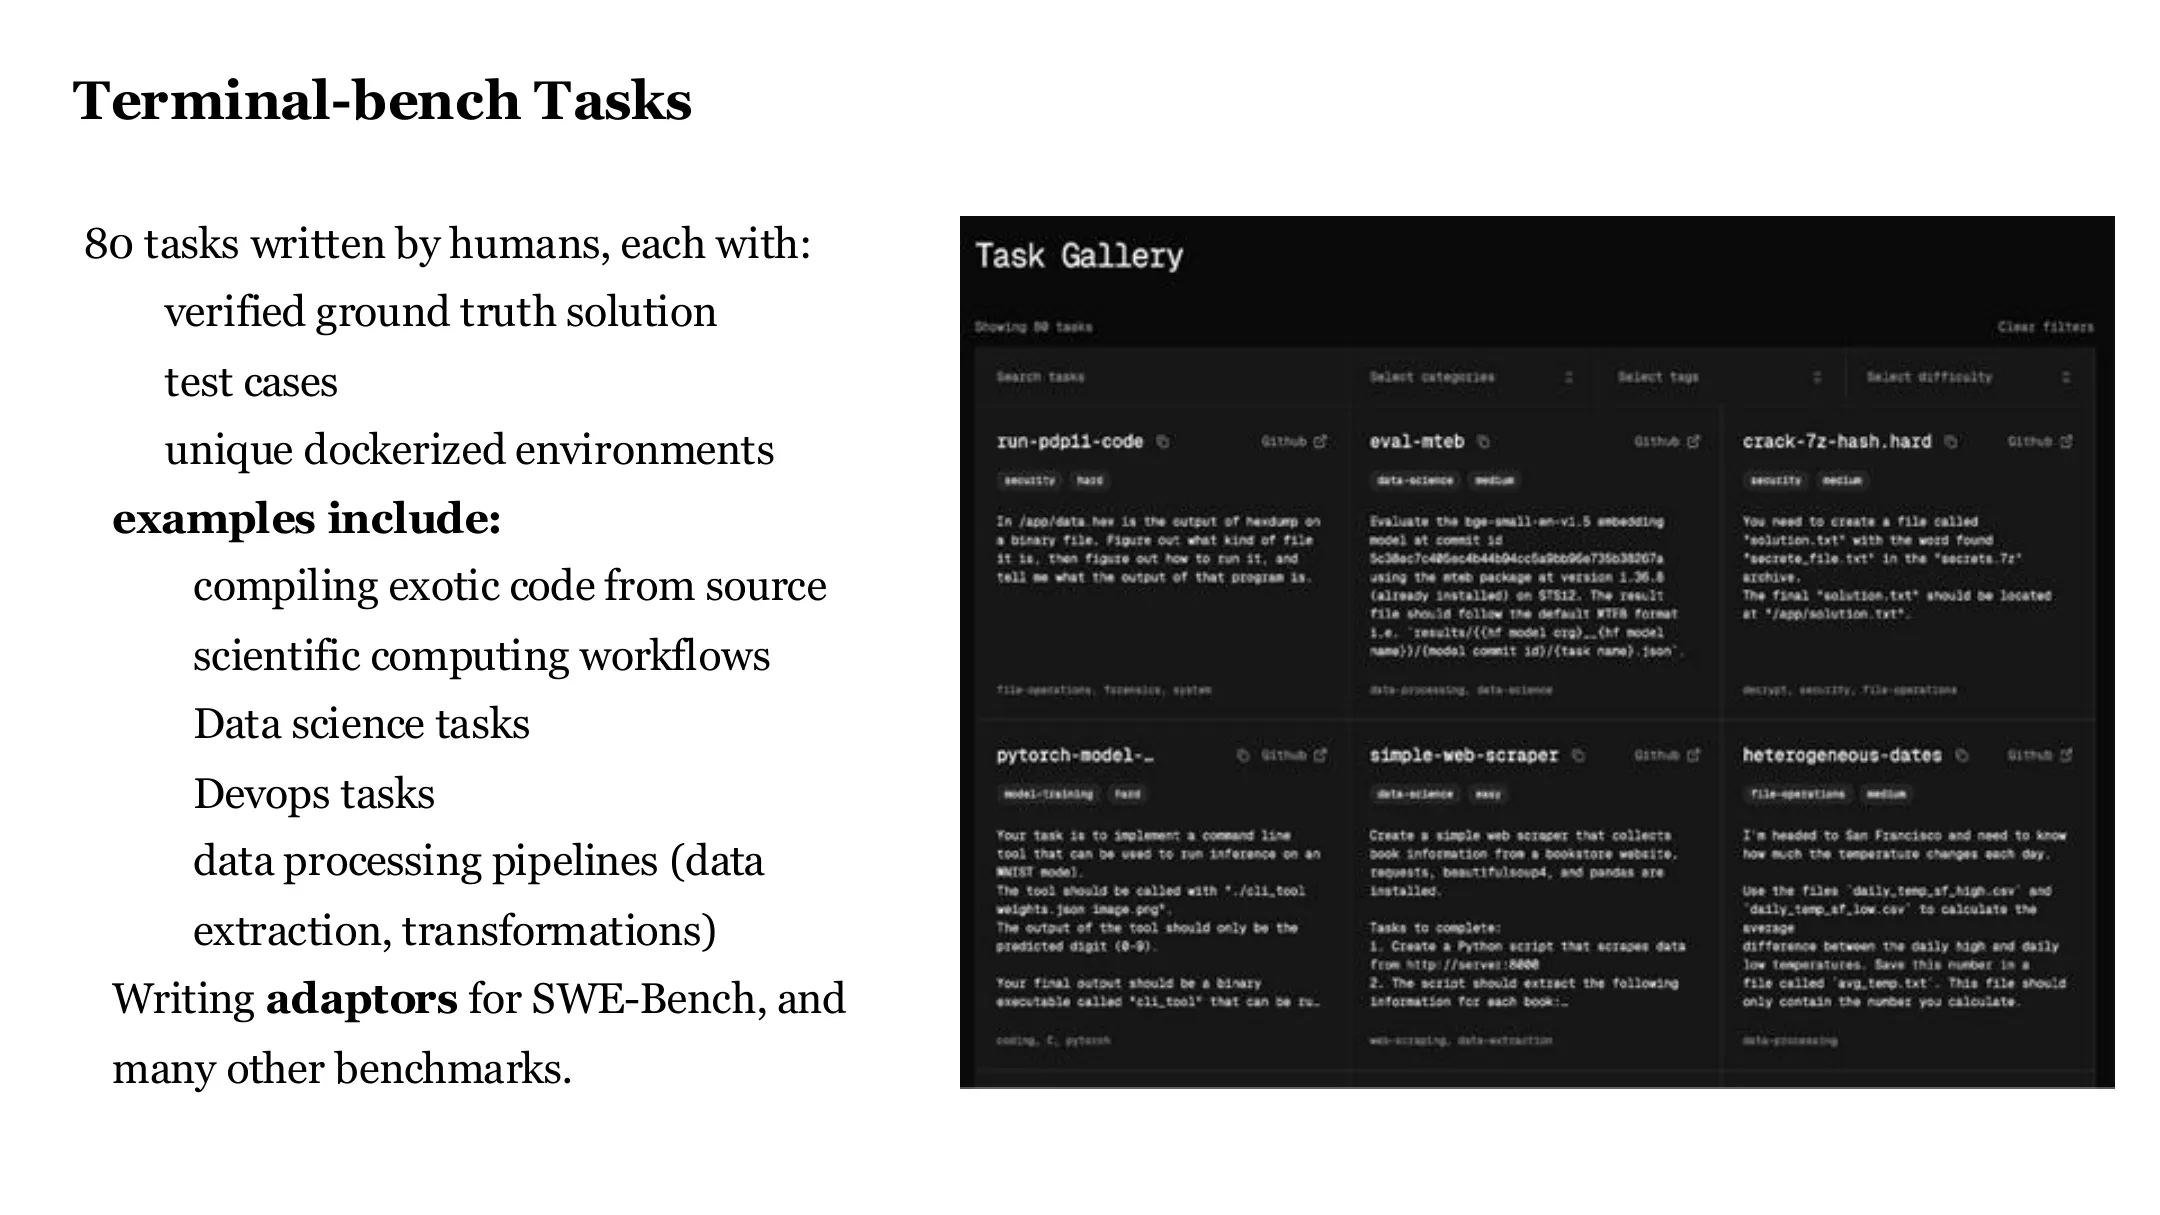
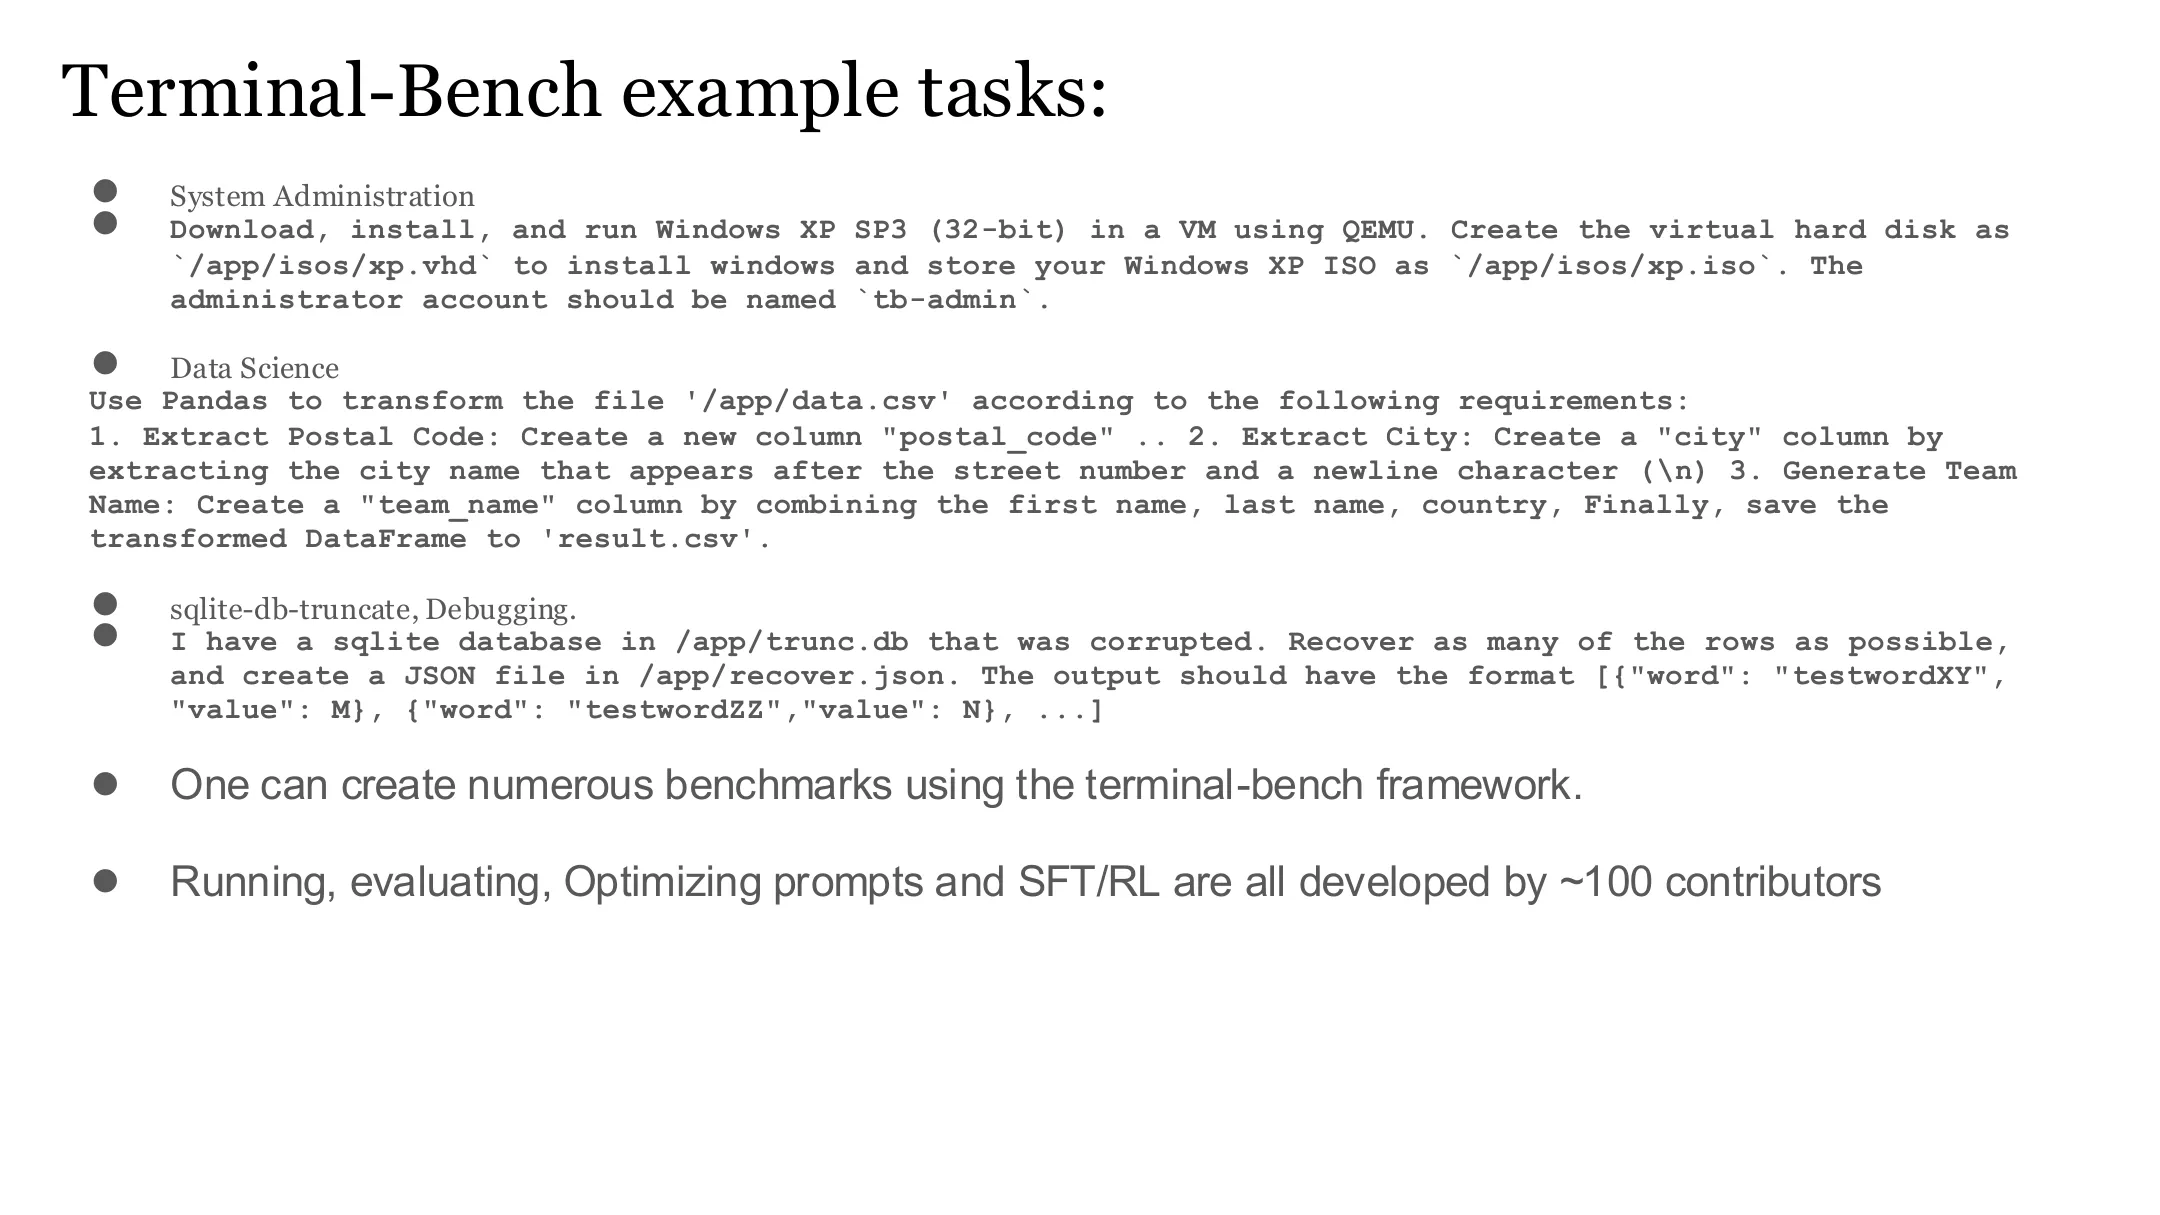
任务示例:识别二进制文件并运行;破解加密哈希;用 Pandas 清洗数据(提取邮编/城市、生成队名、存成 CSV);修复损坏的 SQLite 数据库导出 JSON;用 QEMU 下载安装并运行 Windows XP SP3。
任务由人工(博士生、Anthropic 研究员等)编写,约一周一个,经审阅、并跑 agent 检查不会 reward hacking;每个任务还有ground-truth 解。TB3 的标准是「一个博士生要花一周」,本科作业太简单。只要能作弊,agent 就会作弊——所以环境必须「刀枪不入」。
📷 如何使用环境(一)
回到原视频 (00:41:42)
📷 如何使用环境(二)
回到原视频 (00:42:55)
📷 如何使用环境(三)
回到原视频 (00:44:08)
📷 如何使用环境(四)
回到原视频 (00:45:21)
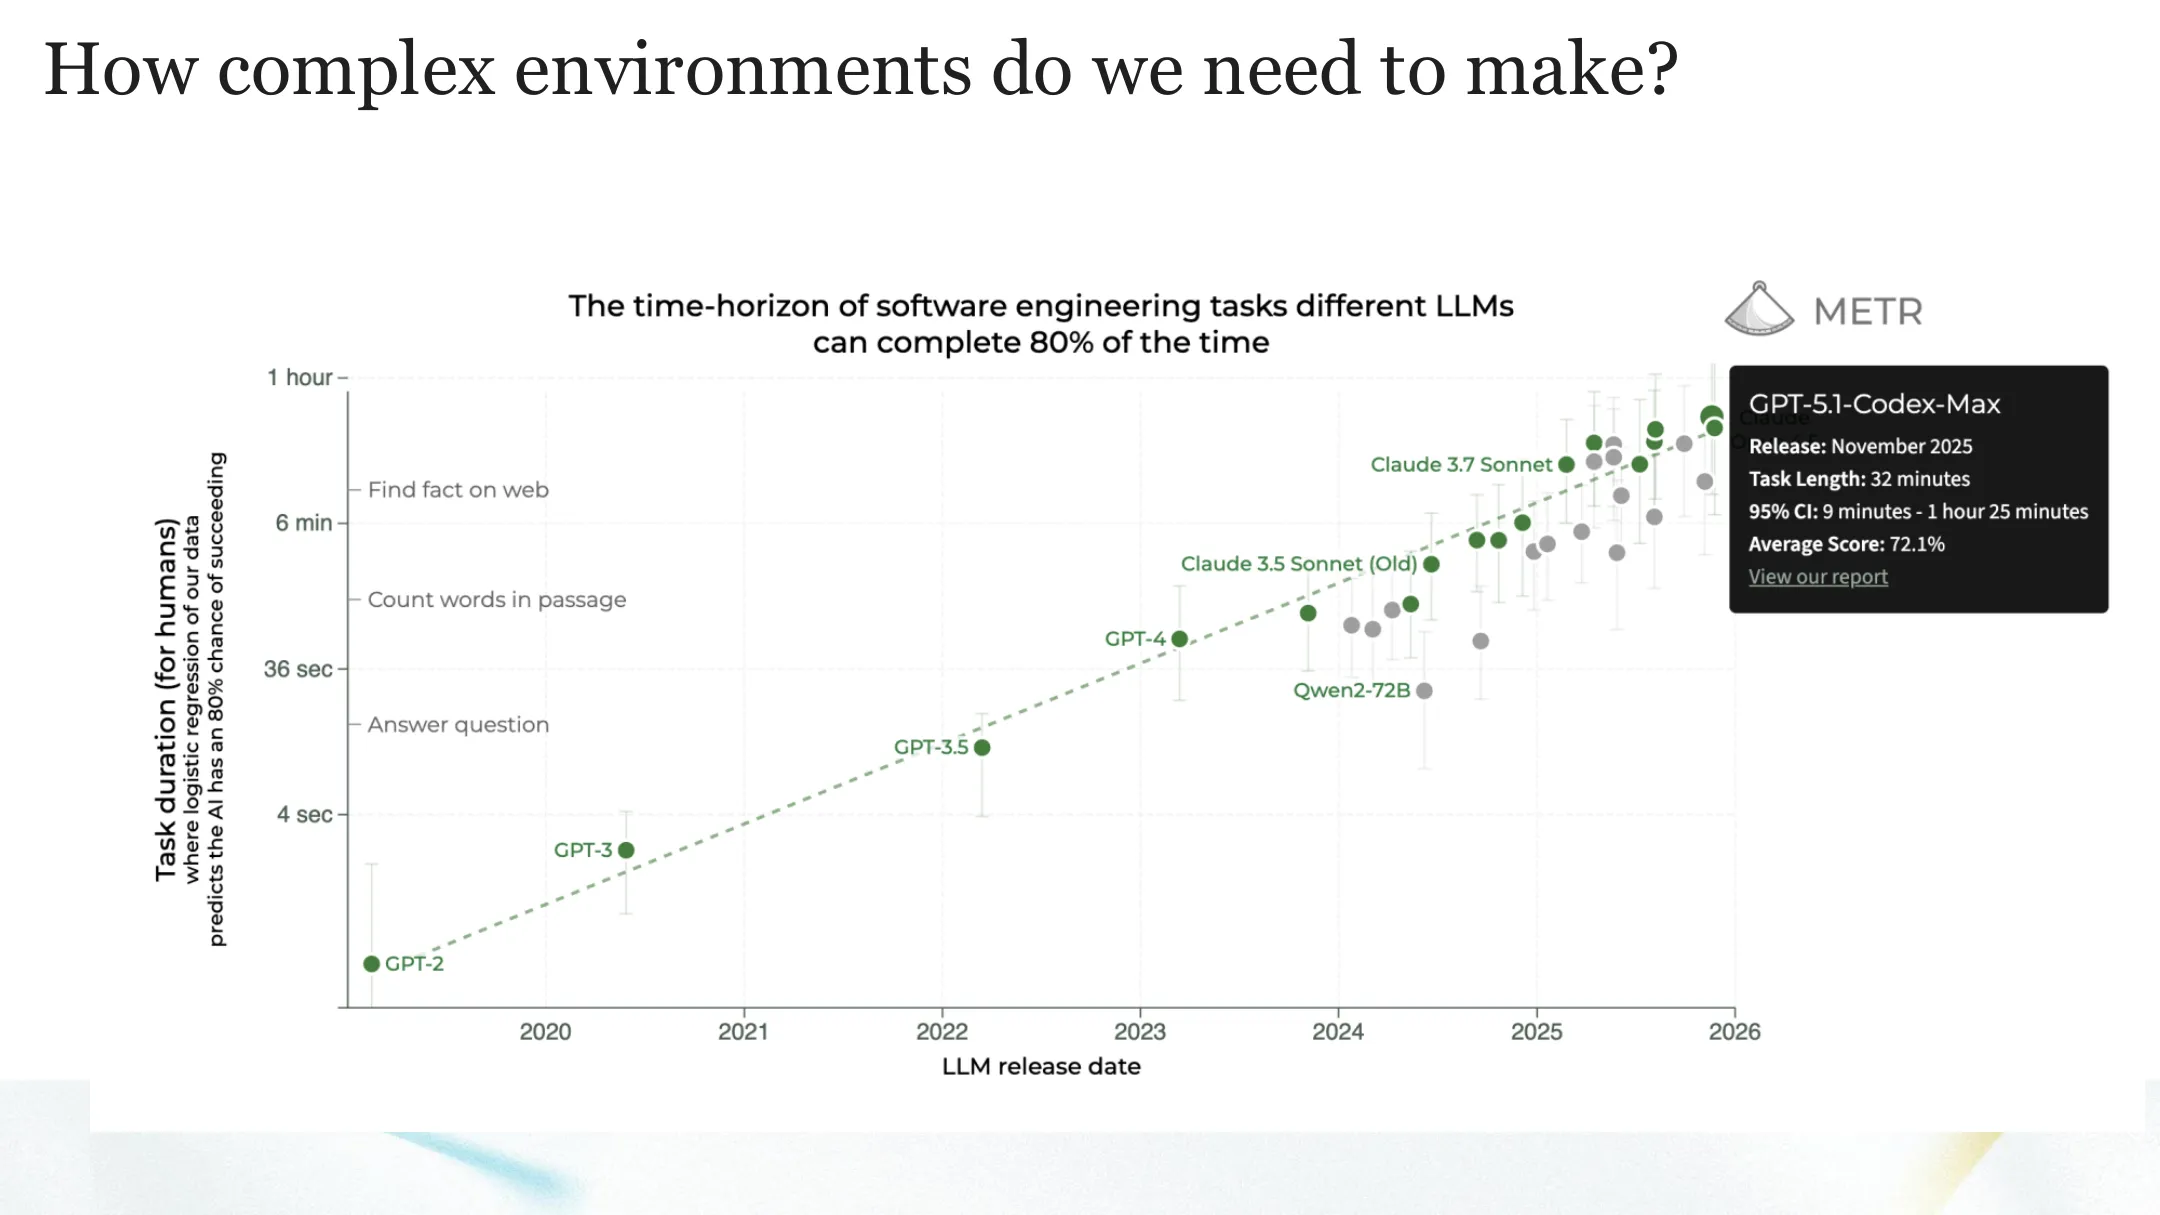
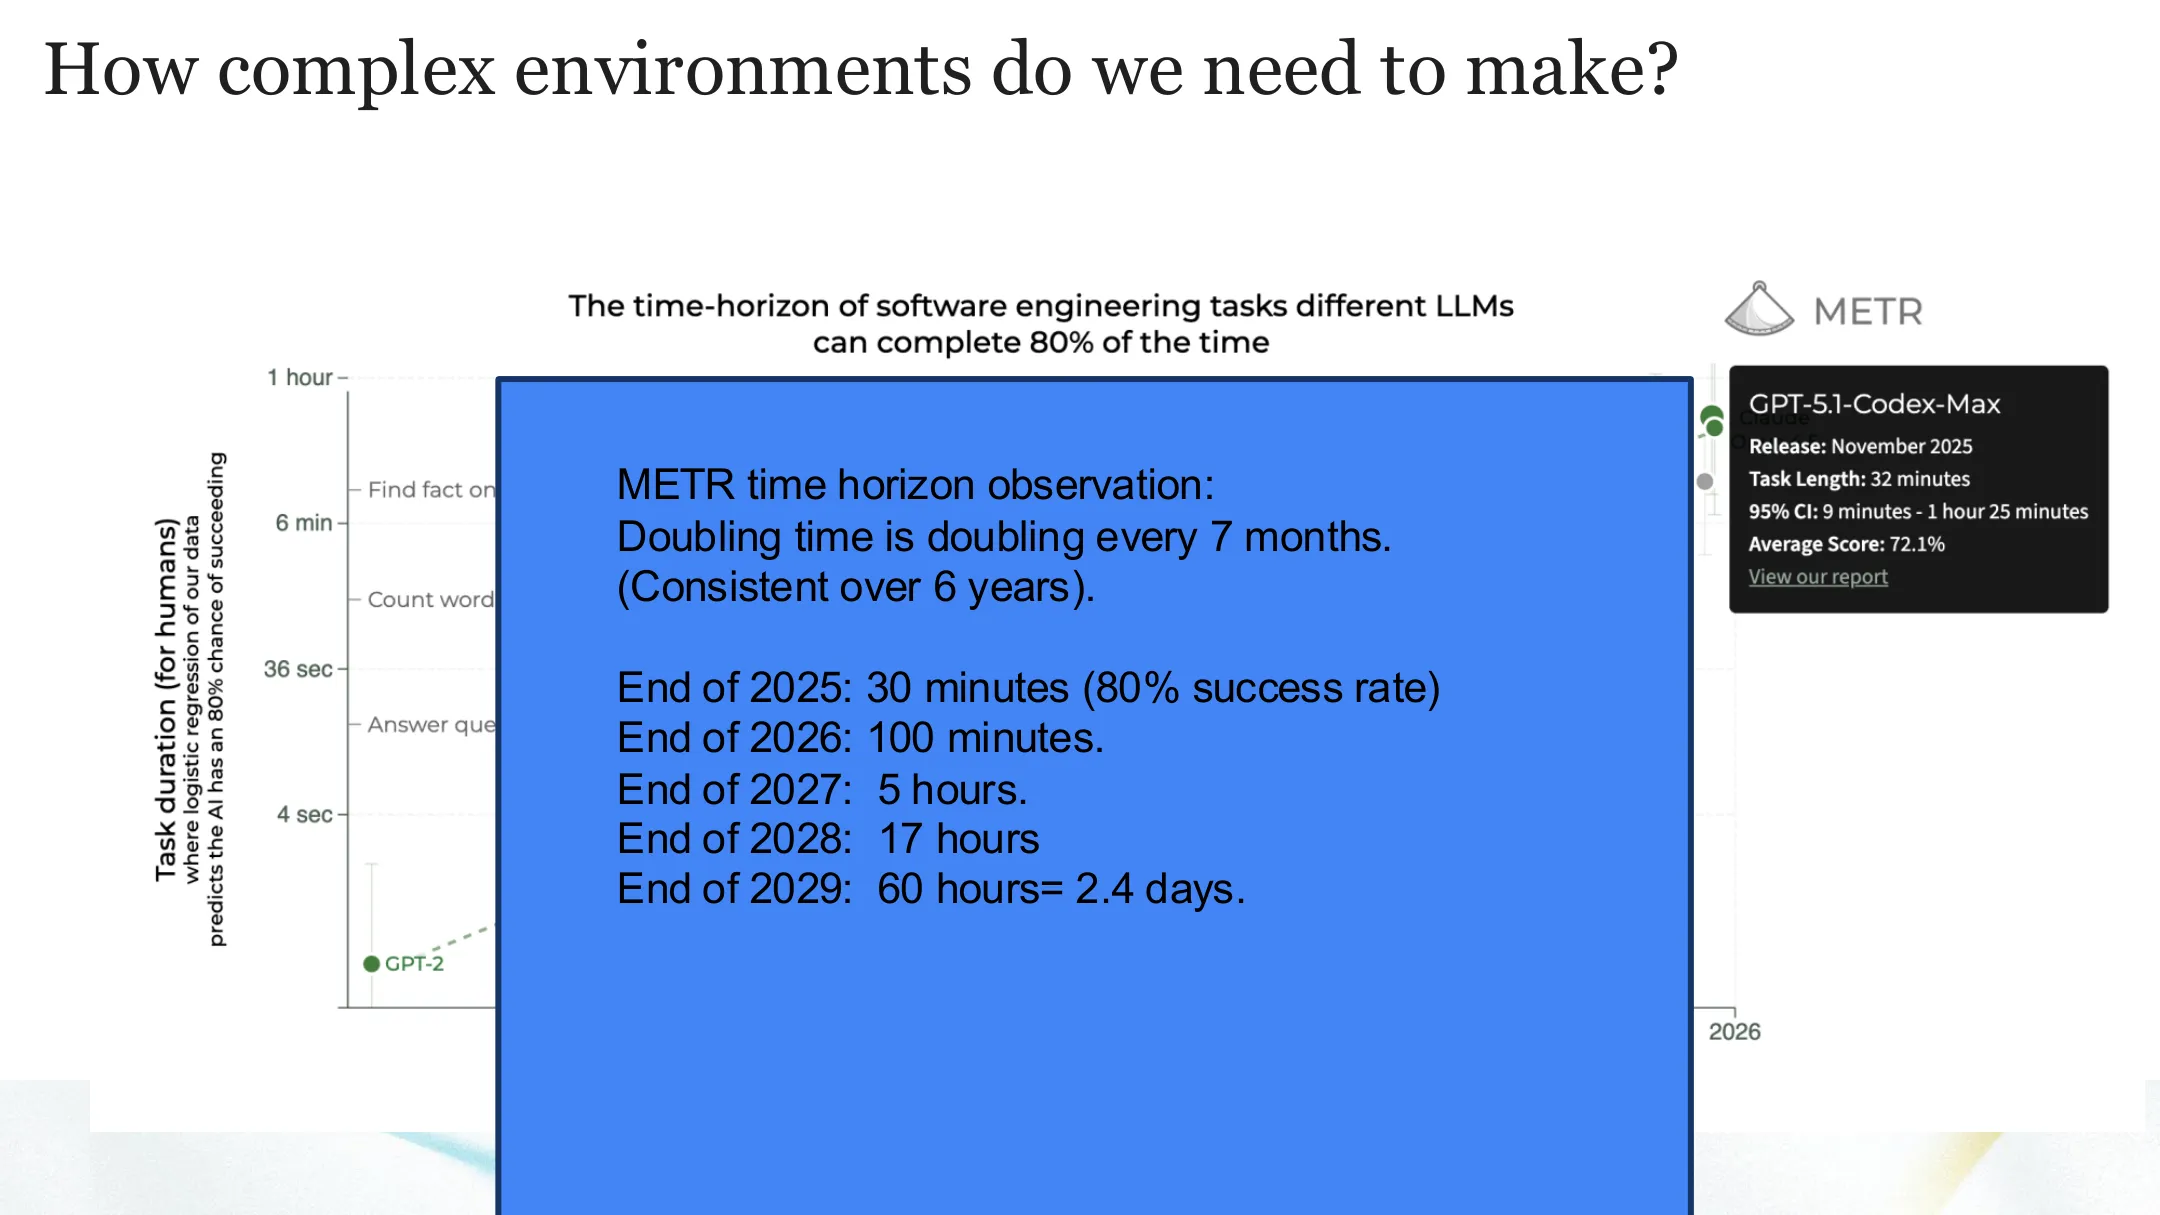
3.3 环境要造多复杂?
📷 我们需要把环境造得多复杂?(一)
回到原视频 (00:46:34)
📷 我们需要把环境造得多复杂?(二)
回到原视频 (00:47:47)
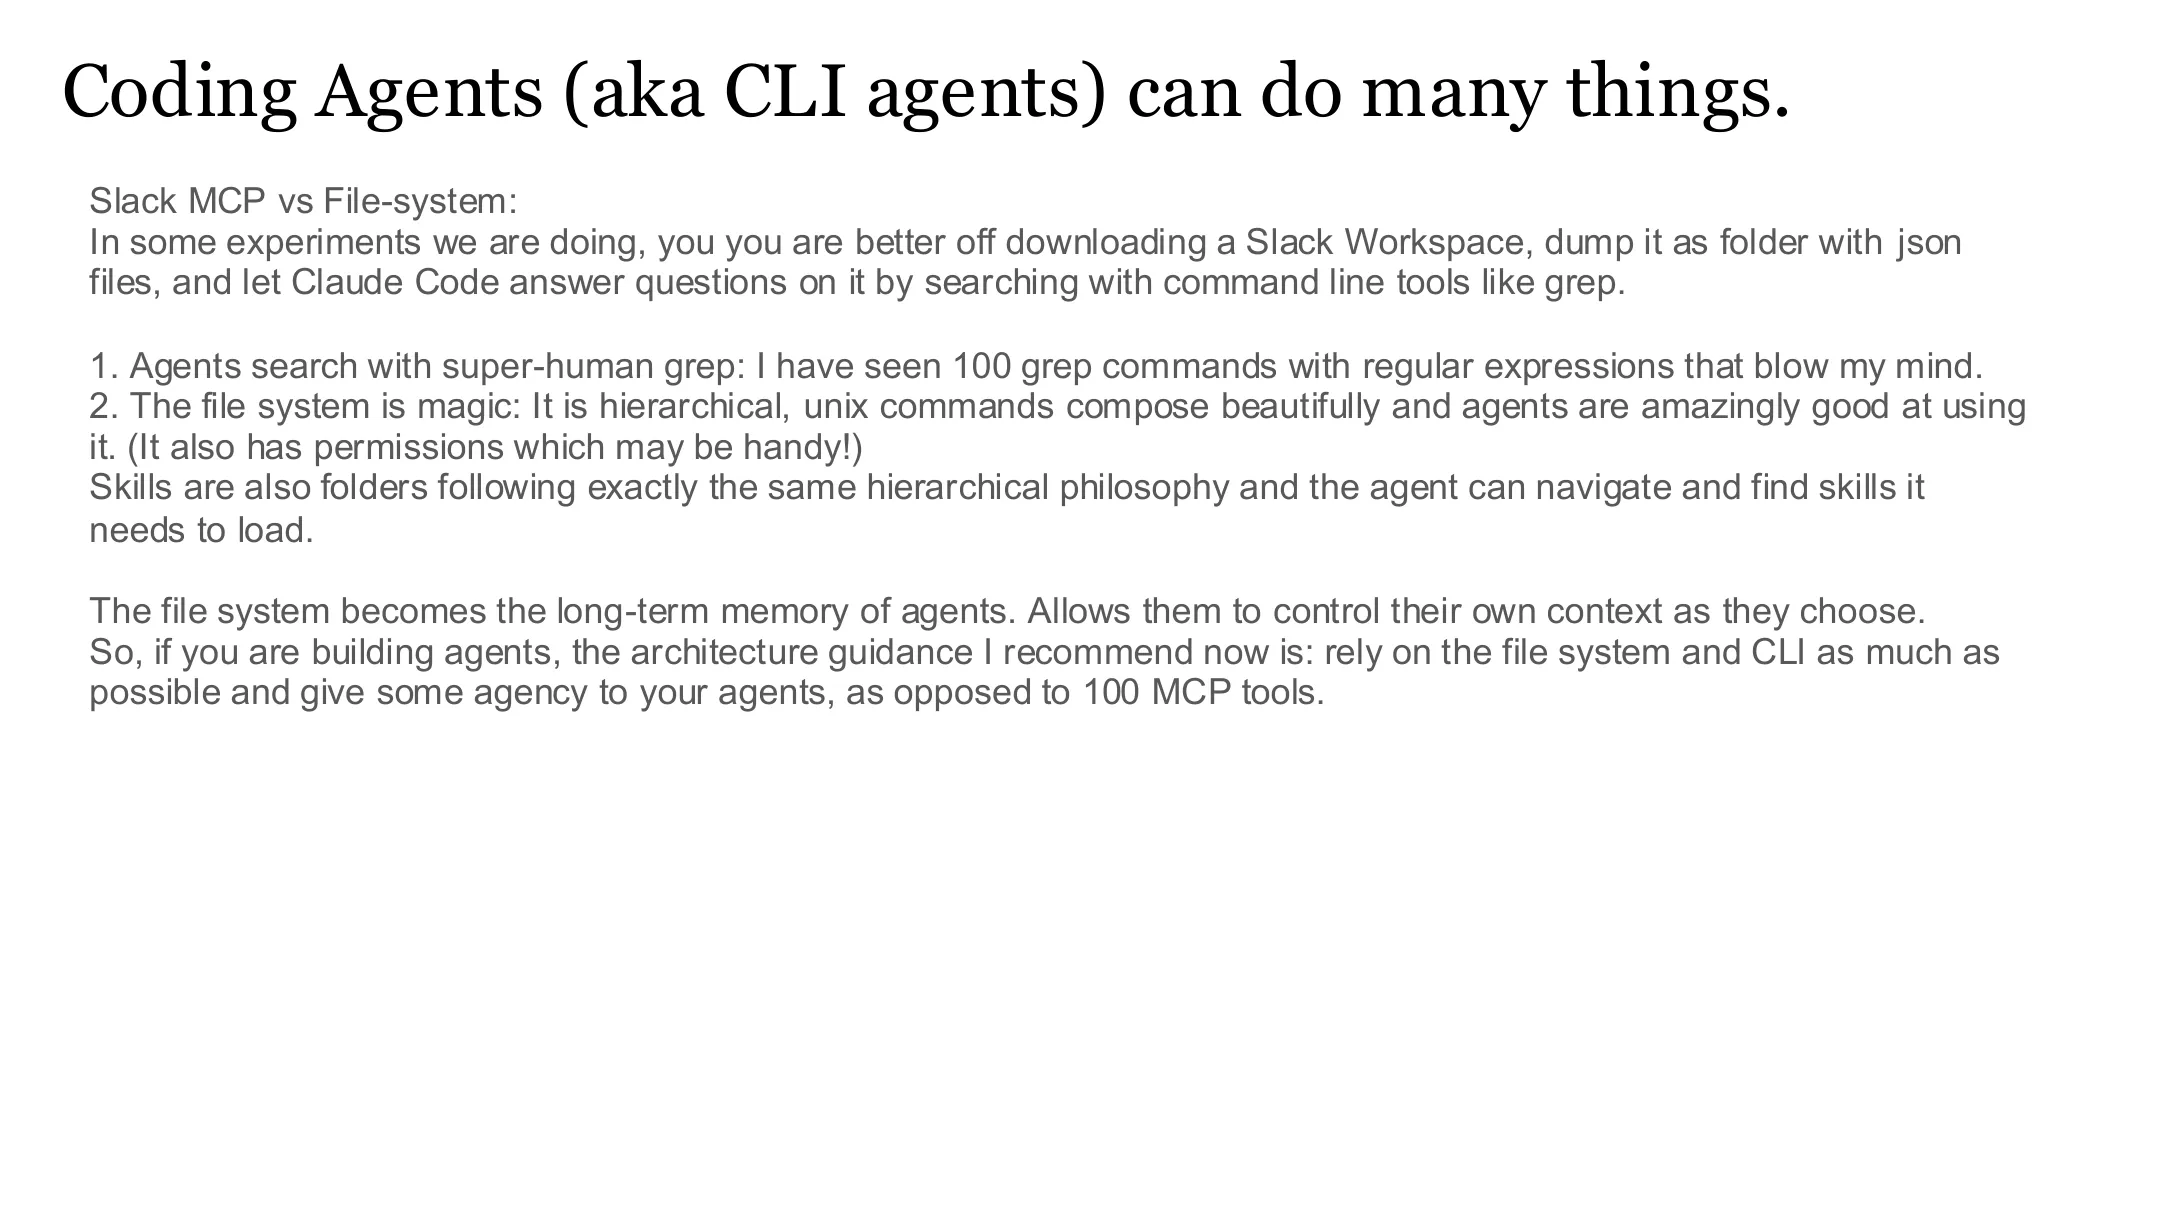
案例:一个 Slack 工作区,学生和 agent 一起修真实科研代码库的问题(BFCL,Berkeley Function Calling)。问题如「Bob 在做什么」「谁贡献最多」「哪两个学生闹矛盾、互相不帮忙」。如何把 Slack 给 agent? 可以用 Slack MCP;但一个「笨」办法竟出奇地好——把整个 Slack 导出成 JSON 文件夹,让 agent 用 grep 等命令行工具搜索。
核心理念:文件系统成为 agent 的长期记忆,它自己控制上下文、只按需取每个文件需要的部分(不必同时记住所有文件)。构建 agent 时,尽量依赖文件系统和命令行工具,把决策权交给 agent。UNIX 工具组合优雅、层级文件系统像一棵树,agent 用起来「超人级」——Anthropic 的 skills 就是文件夹。这就是命令行 agent 能做远超「编码」的事情(报税、销售预测、市场)的原因。
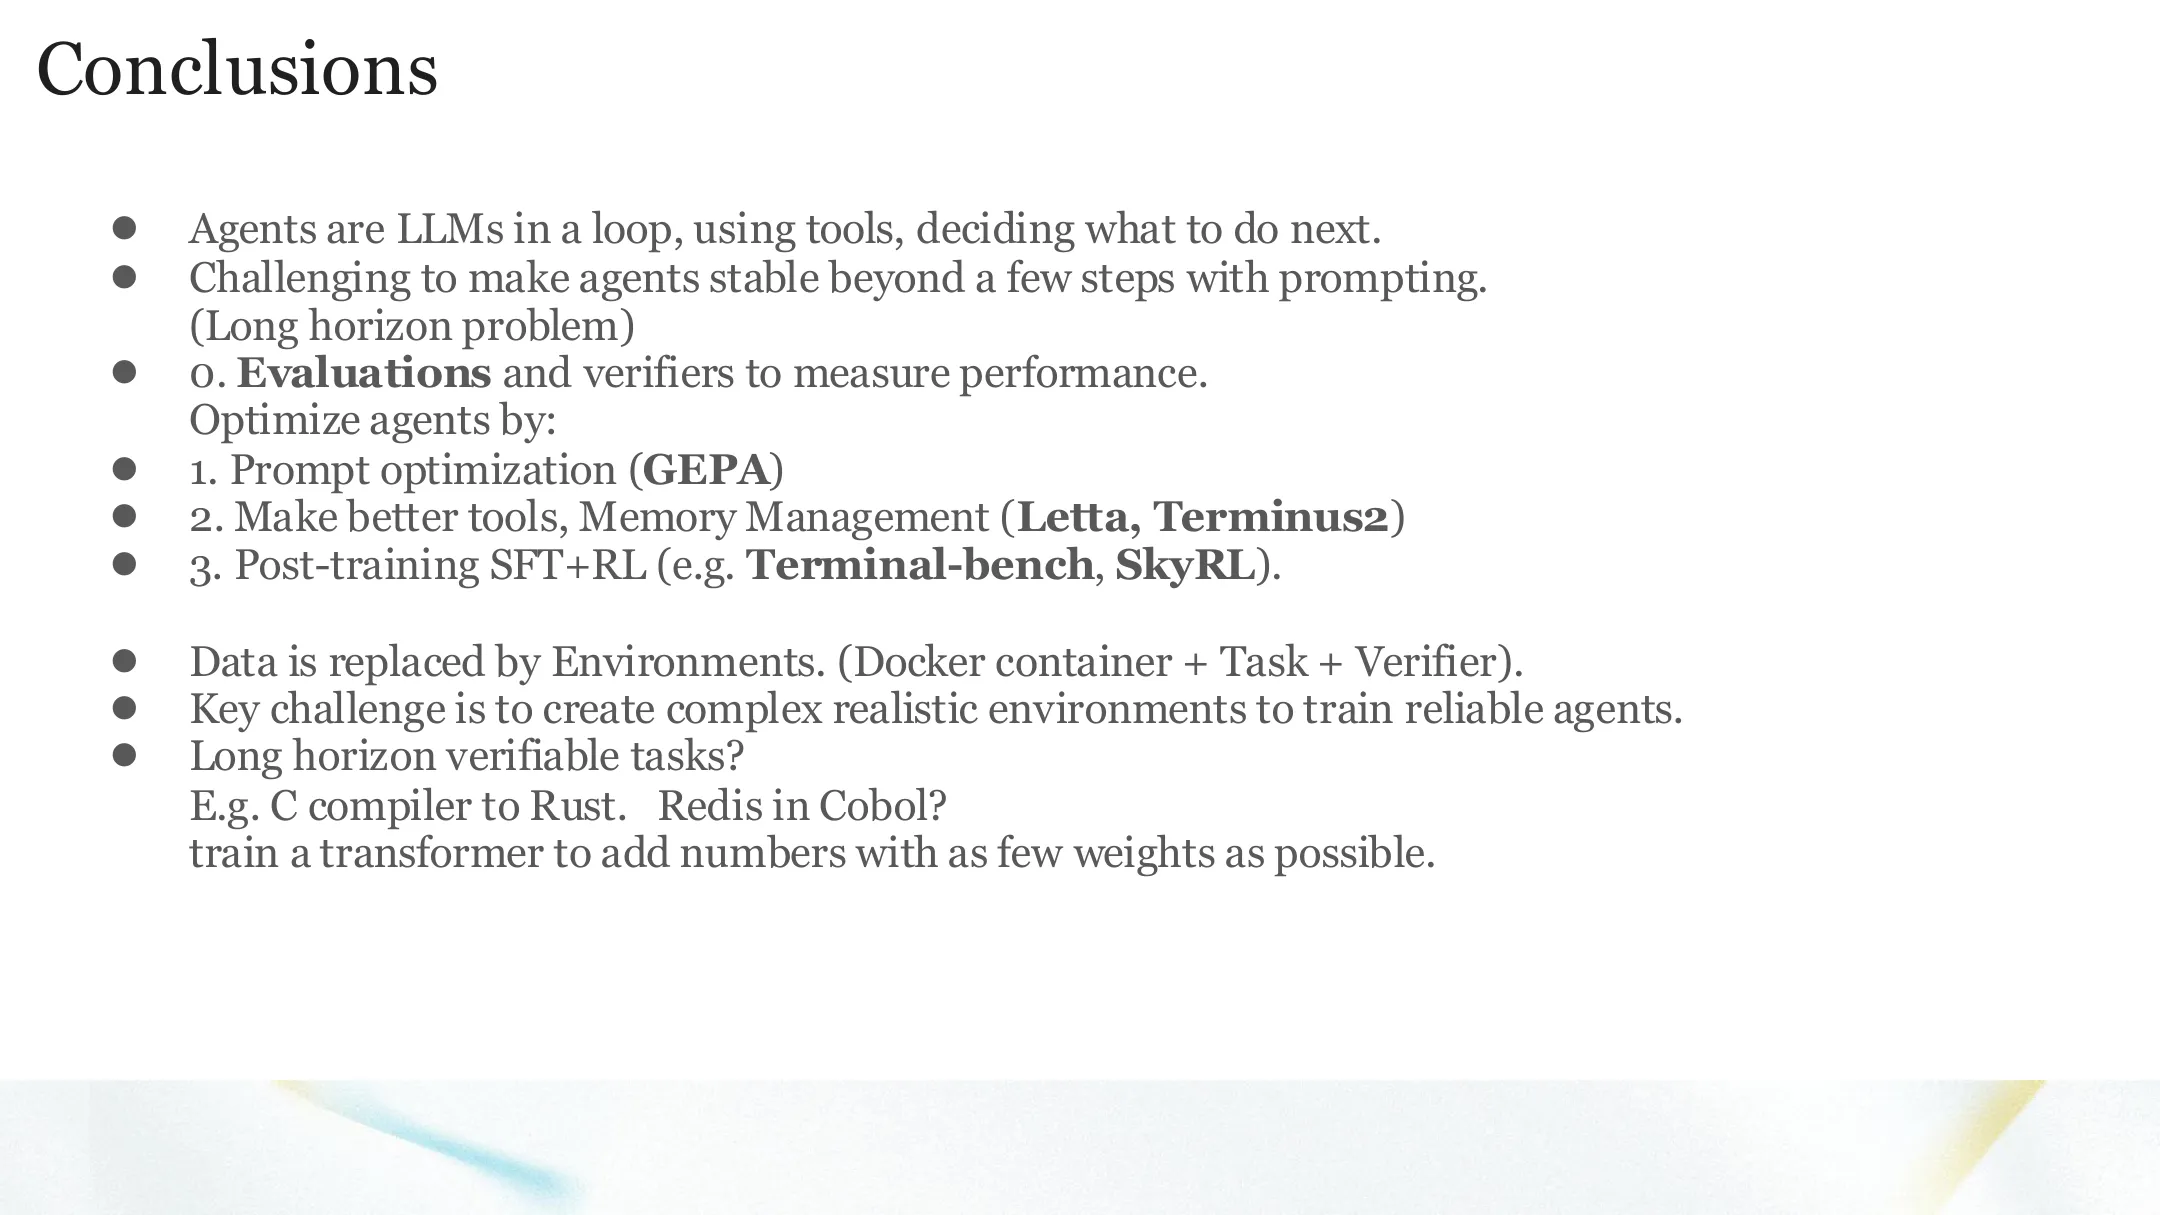
📷 结论
回到原视频 (00:49:00)
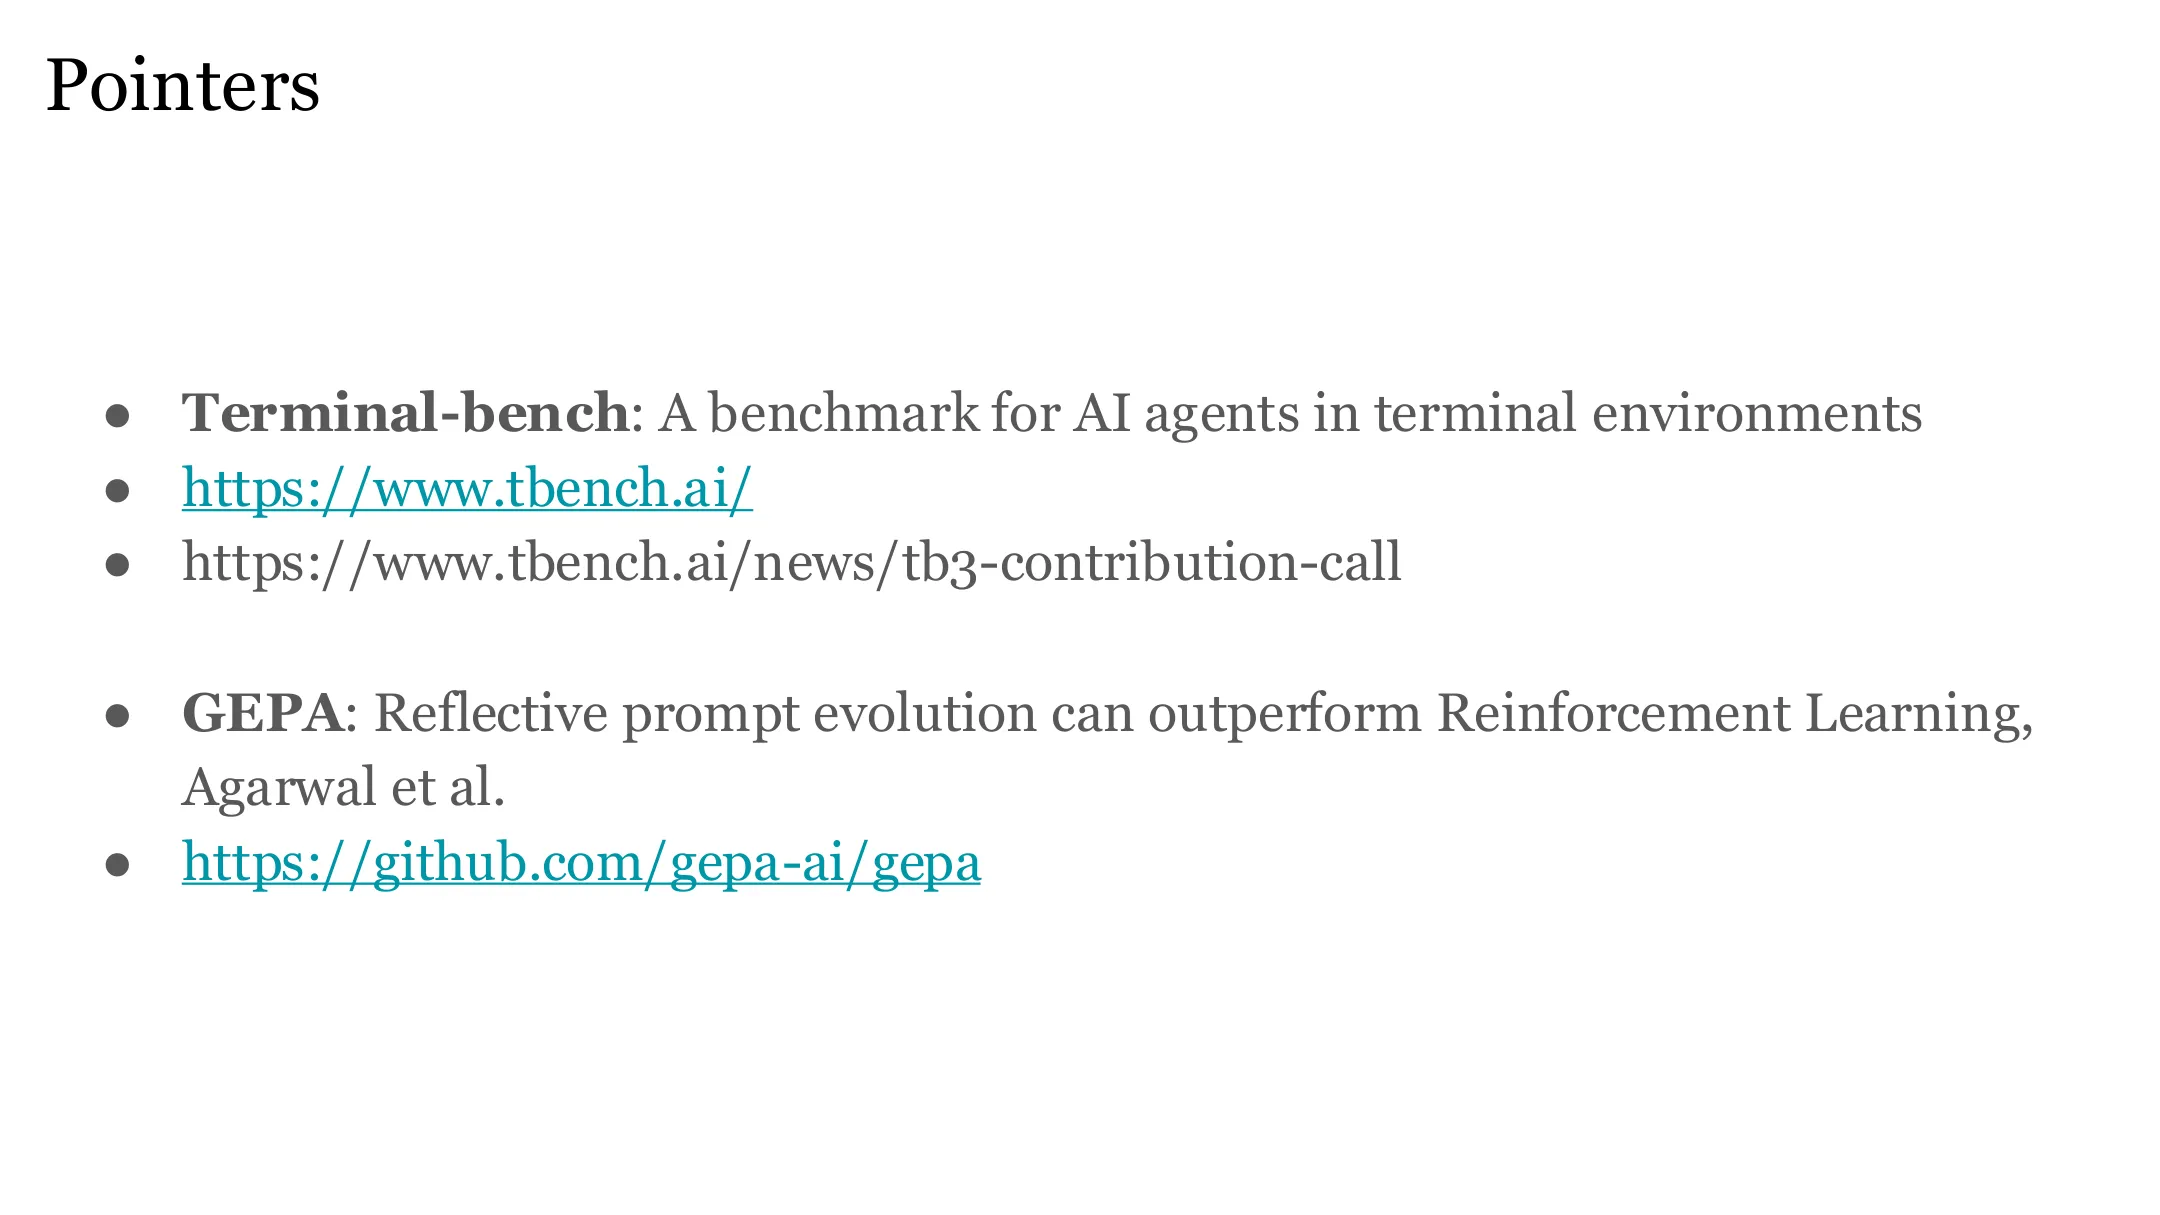
📷 延伸阅读
回到原视频 (00:50:13)
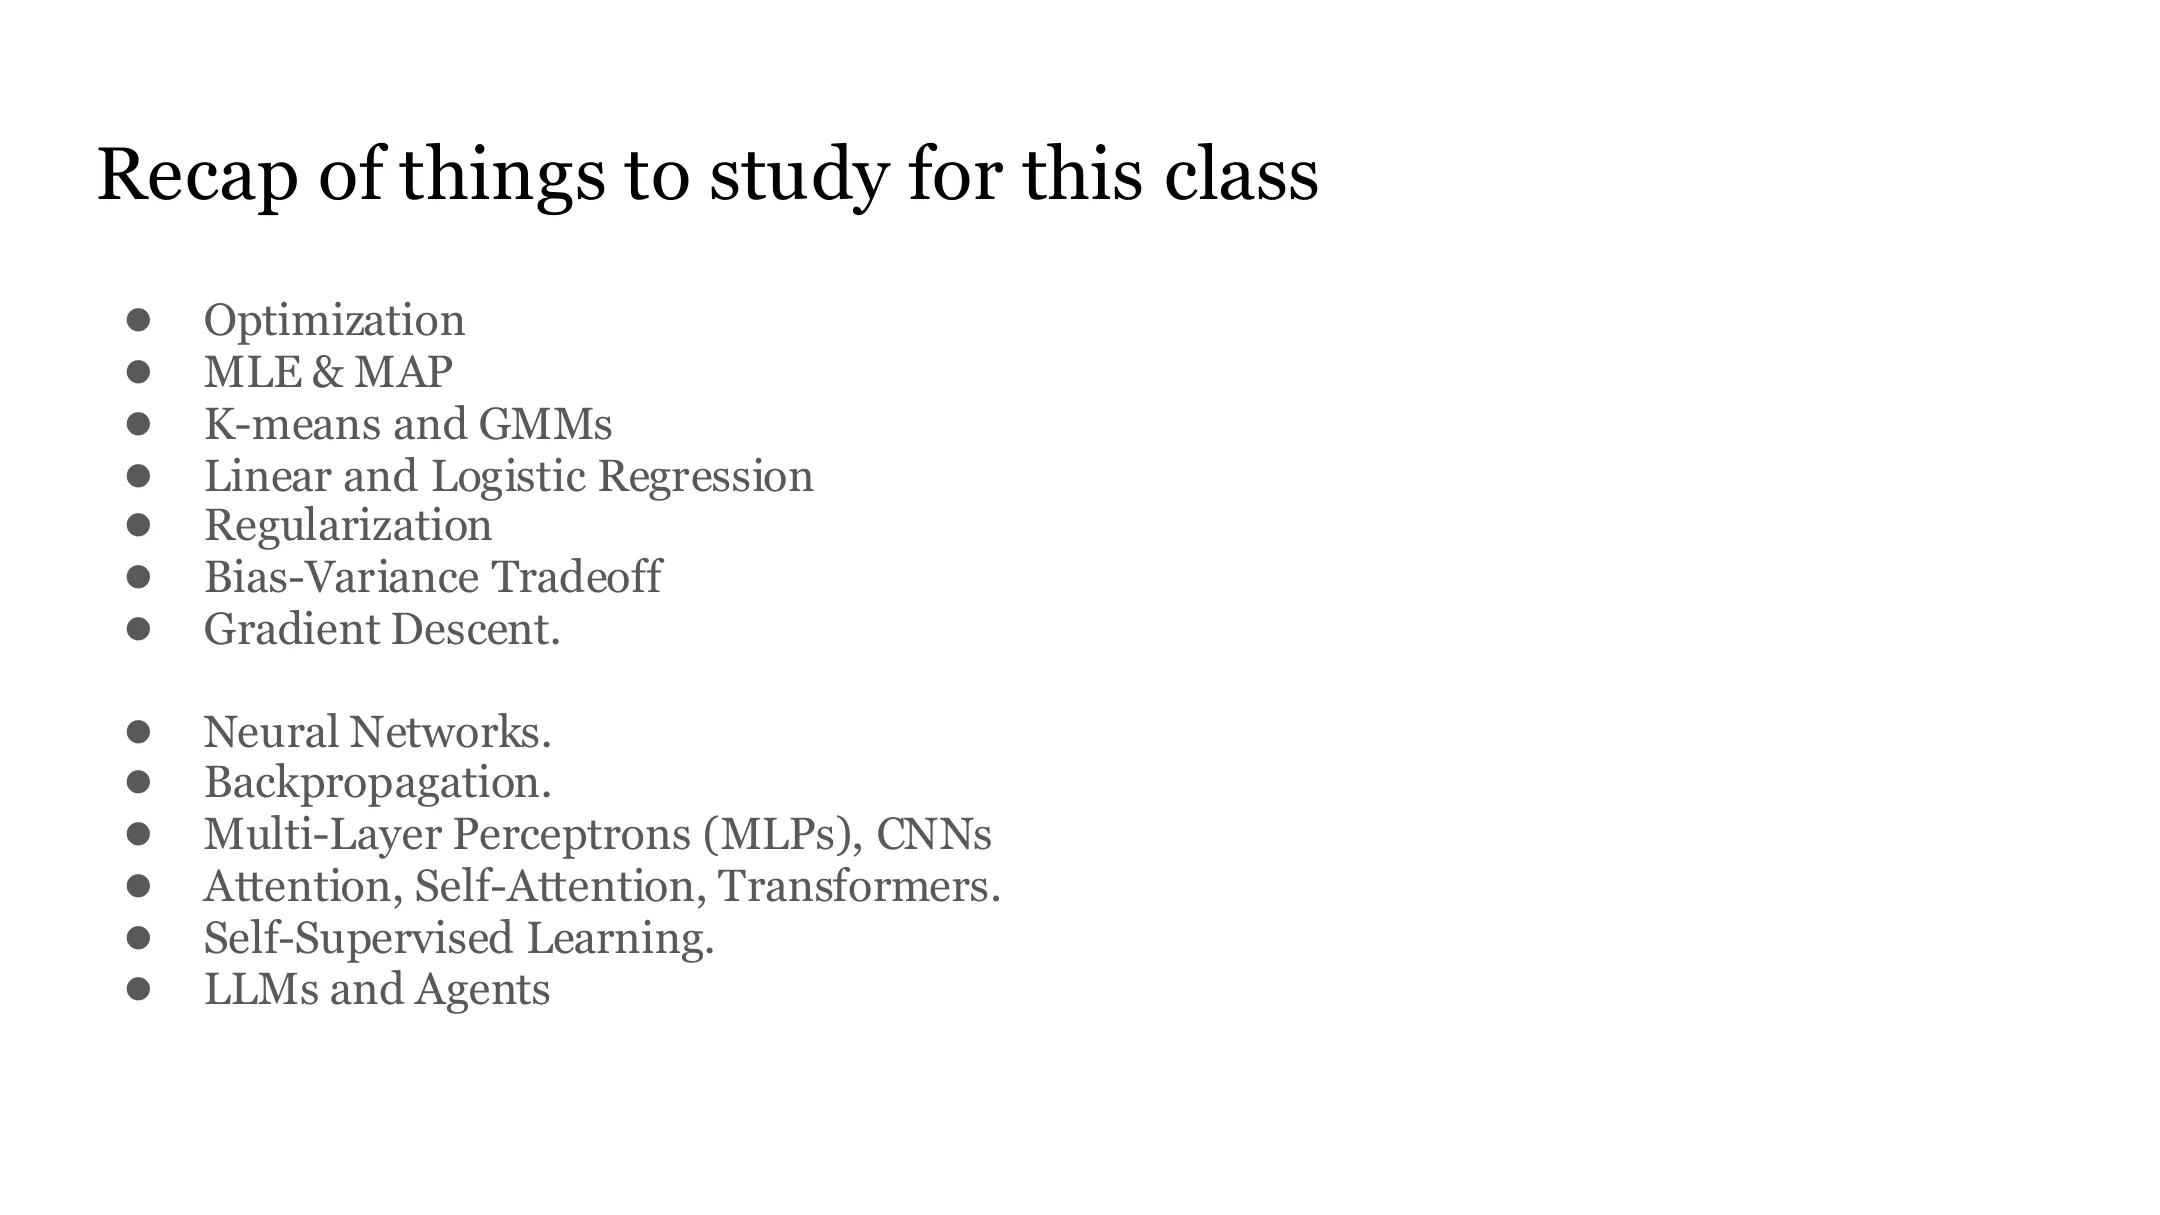
📷 本课程学习内容回顾
回到原视频 (00:51:26)
四、用环境训练 Agent
(参考时间: 01:03)
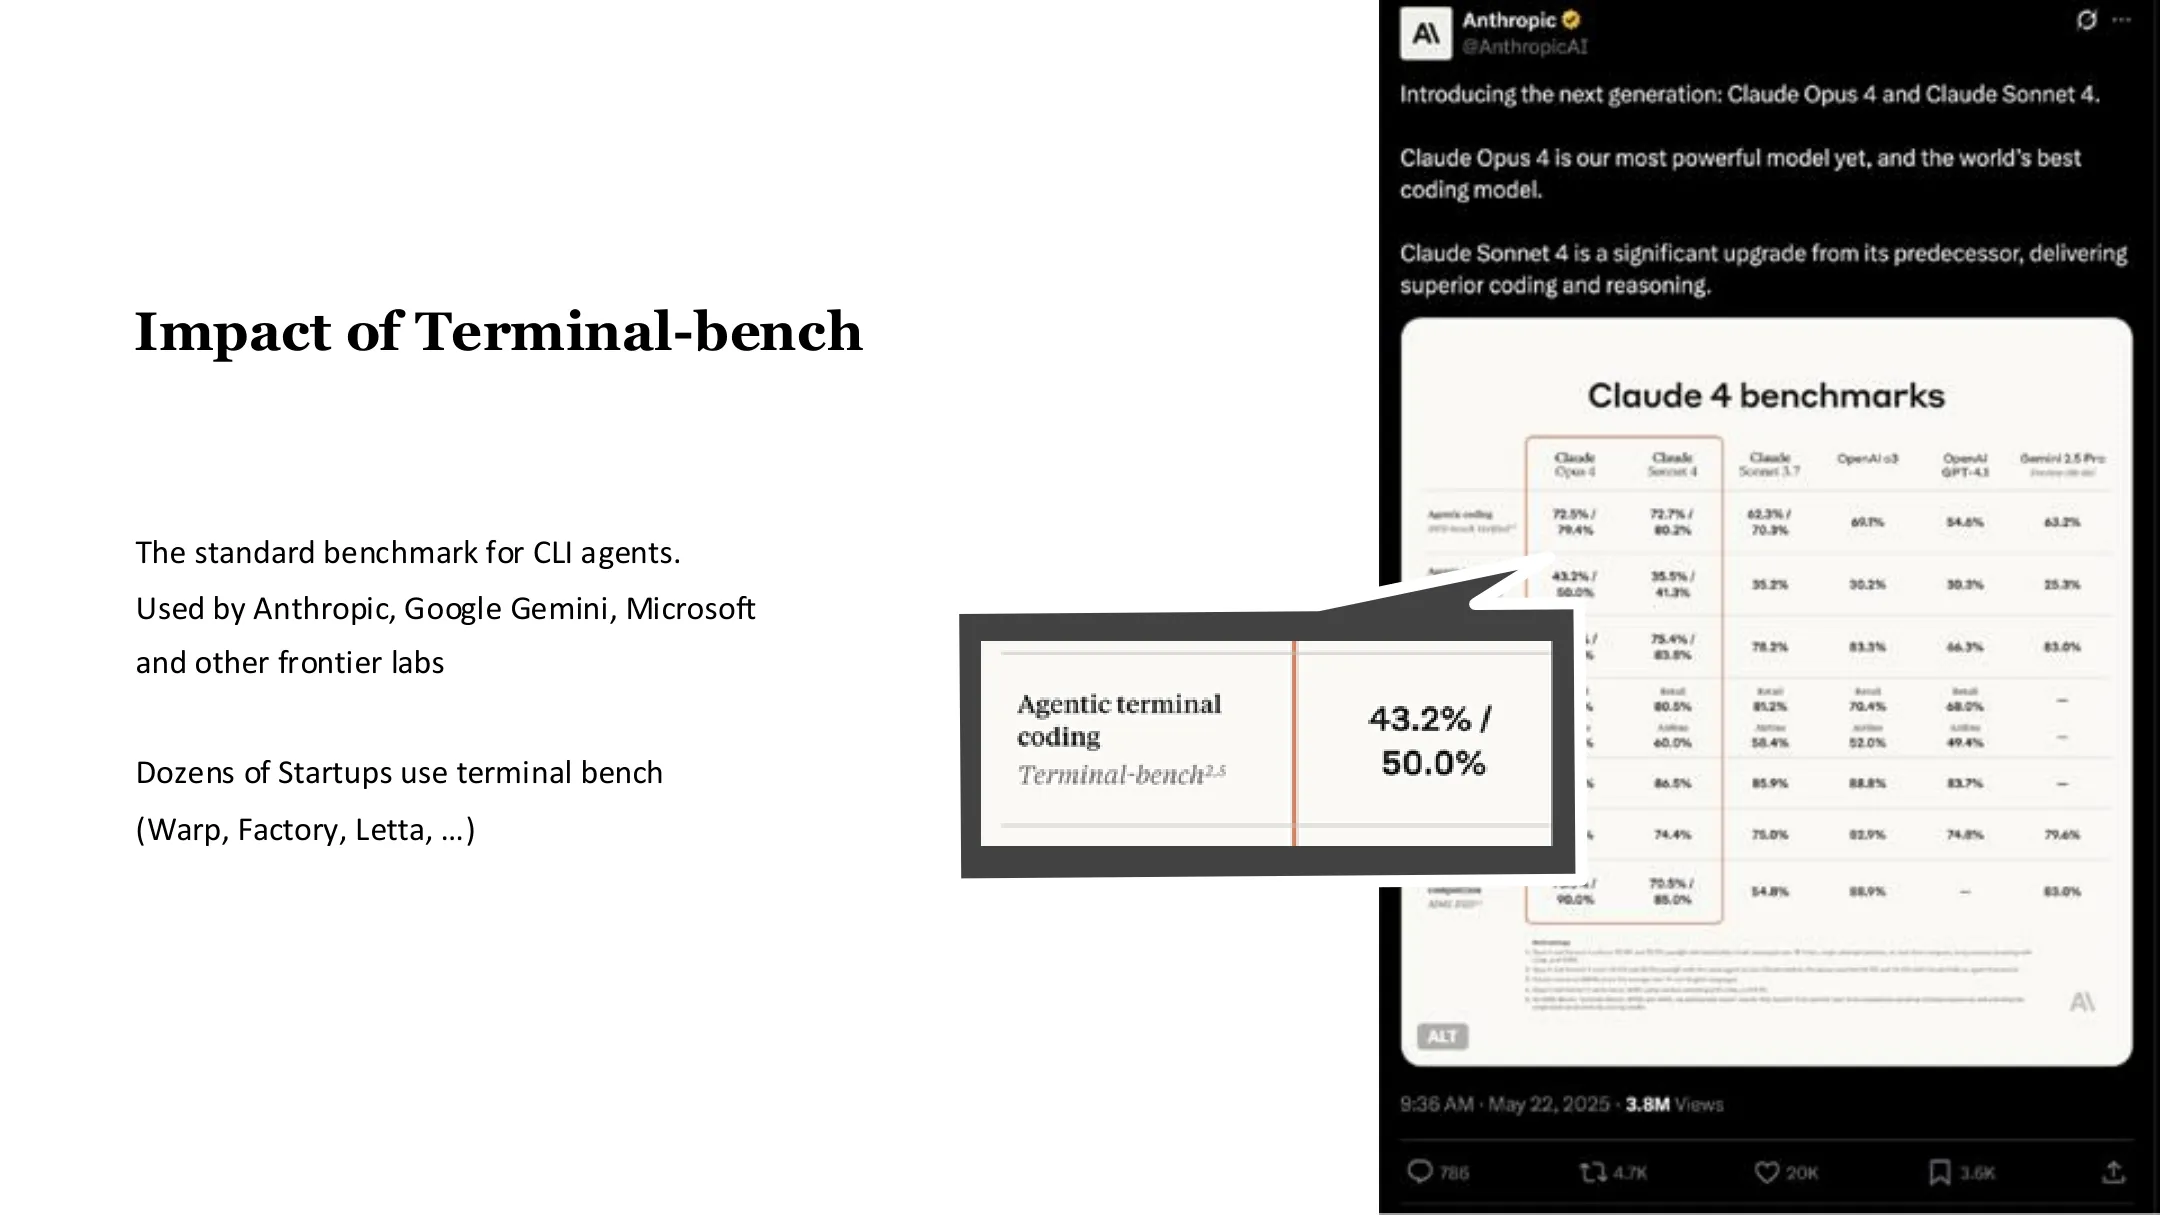
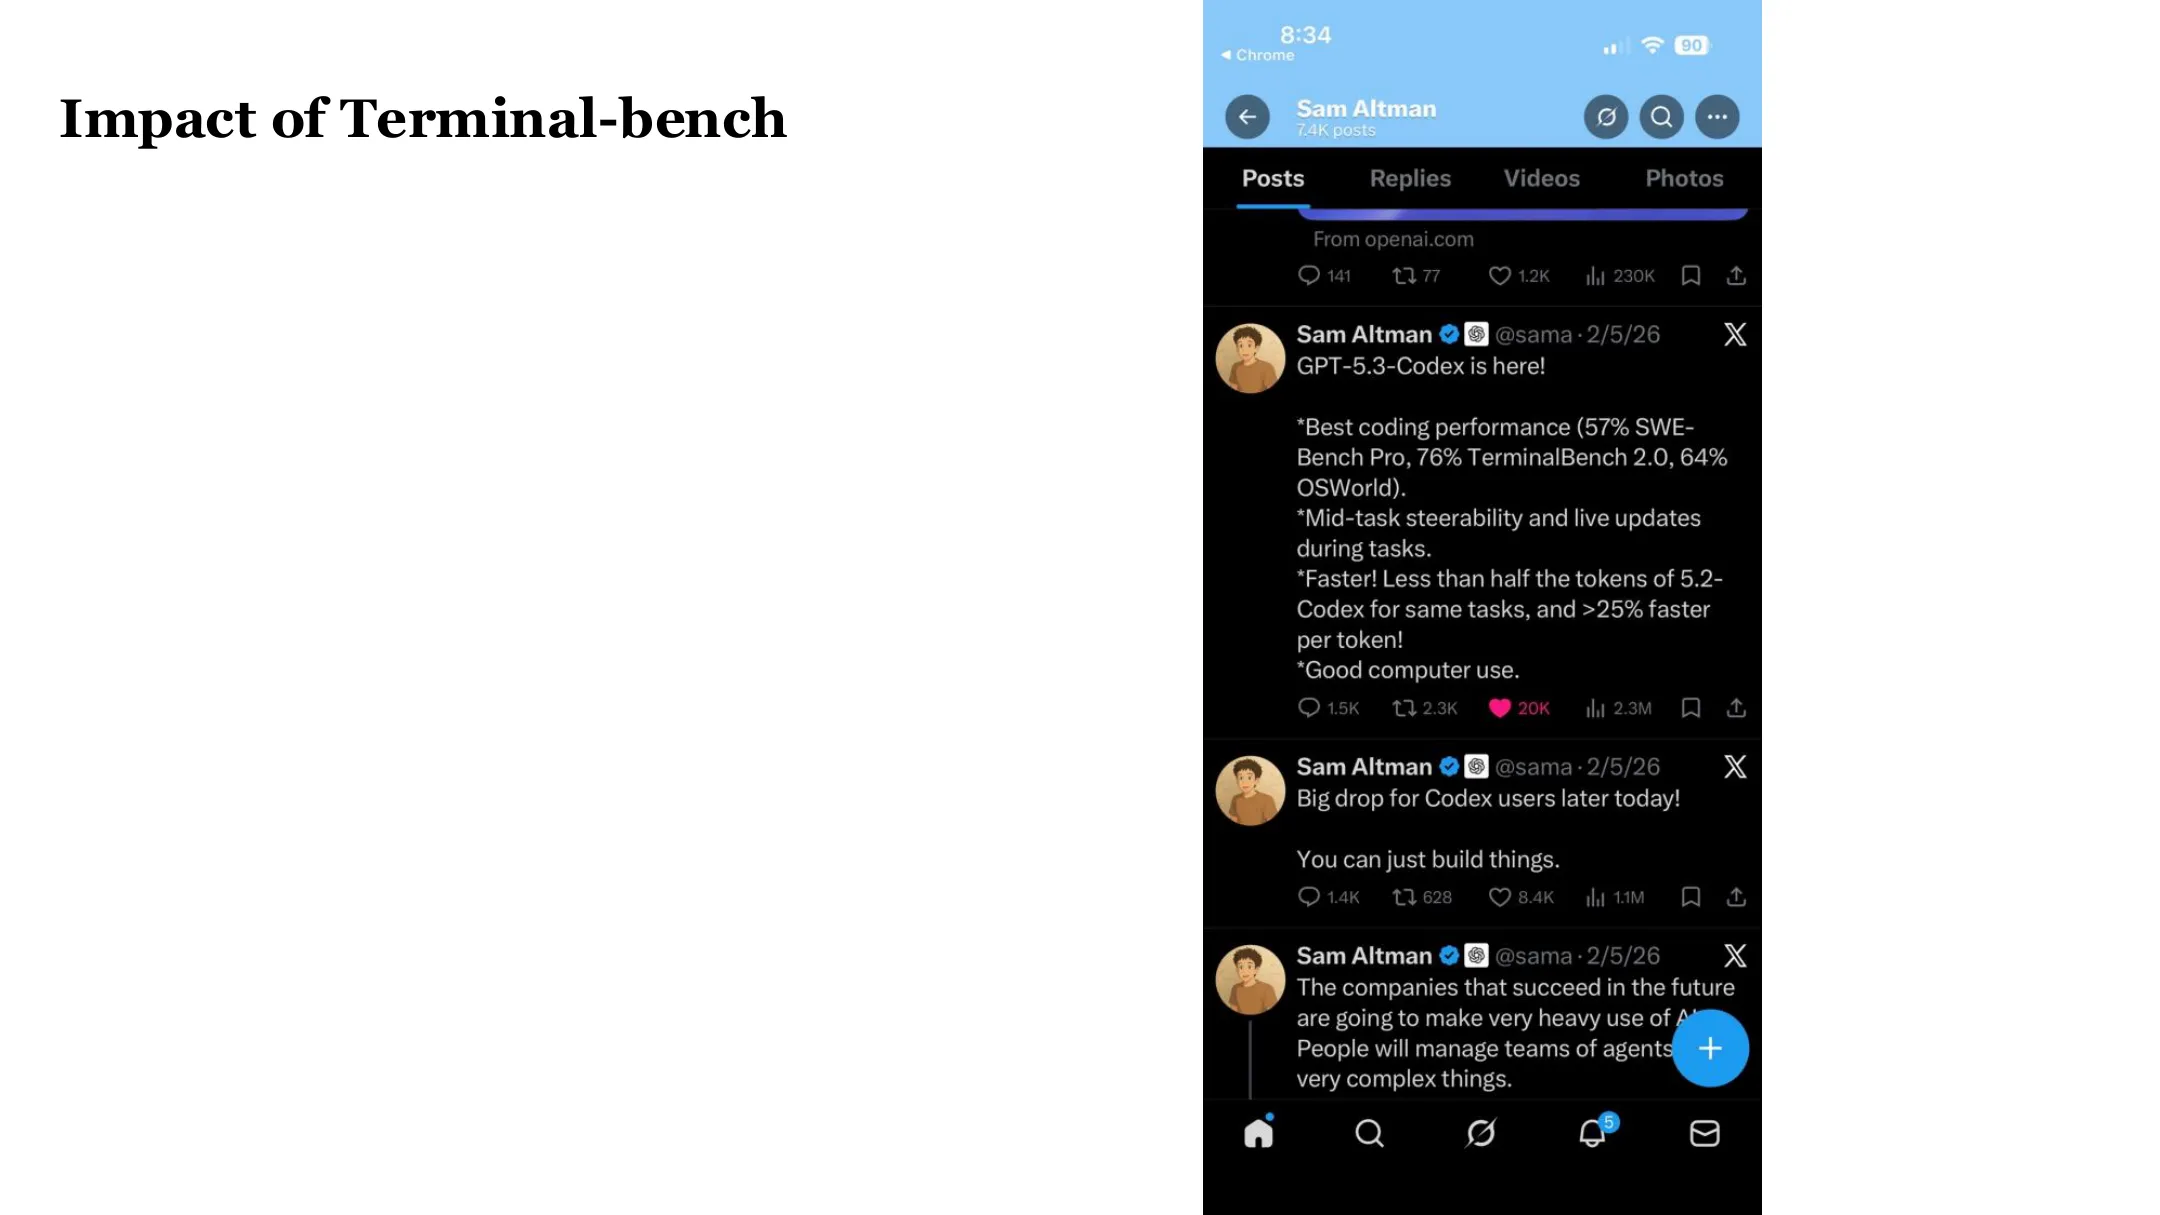
评测 vs 训练:一次 rollout 可以迭代很多轮(甚至 100 轮)、直到 agent 说「完成」或超时(如 1 小时);评测通常跑 1 次或 5 次(看预算)。若用于训练,pass rate 最好在 10%–30%。前沿实验室会把 Terminal-Bench 写进系统卡(如 Claude 4 报 43%、Codex 53 报 76%)。
两种训练方式:
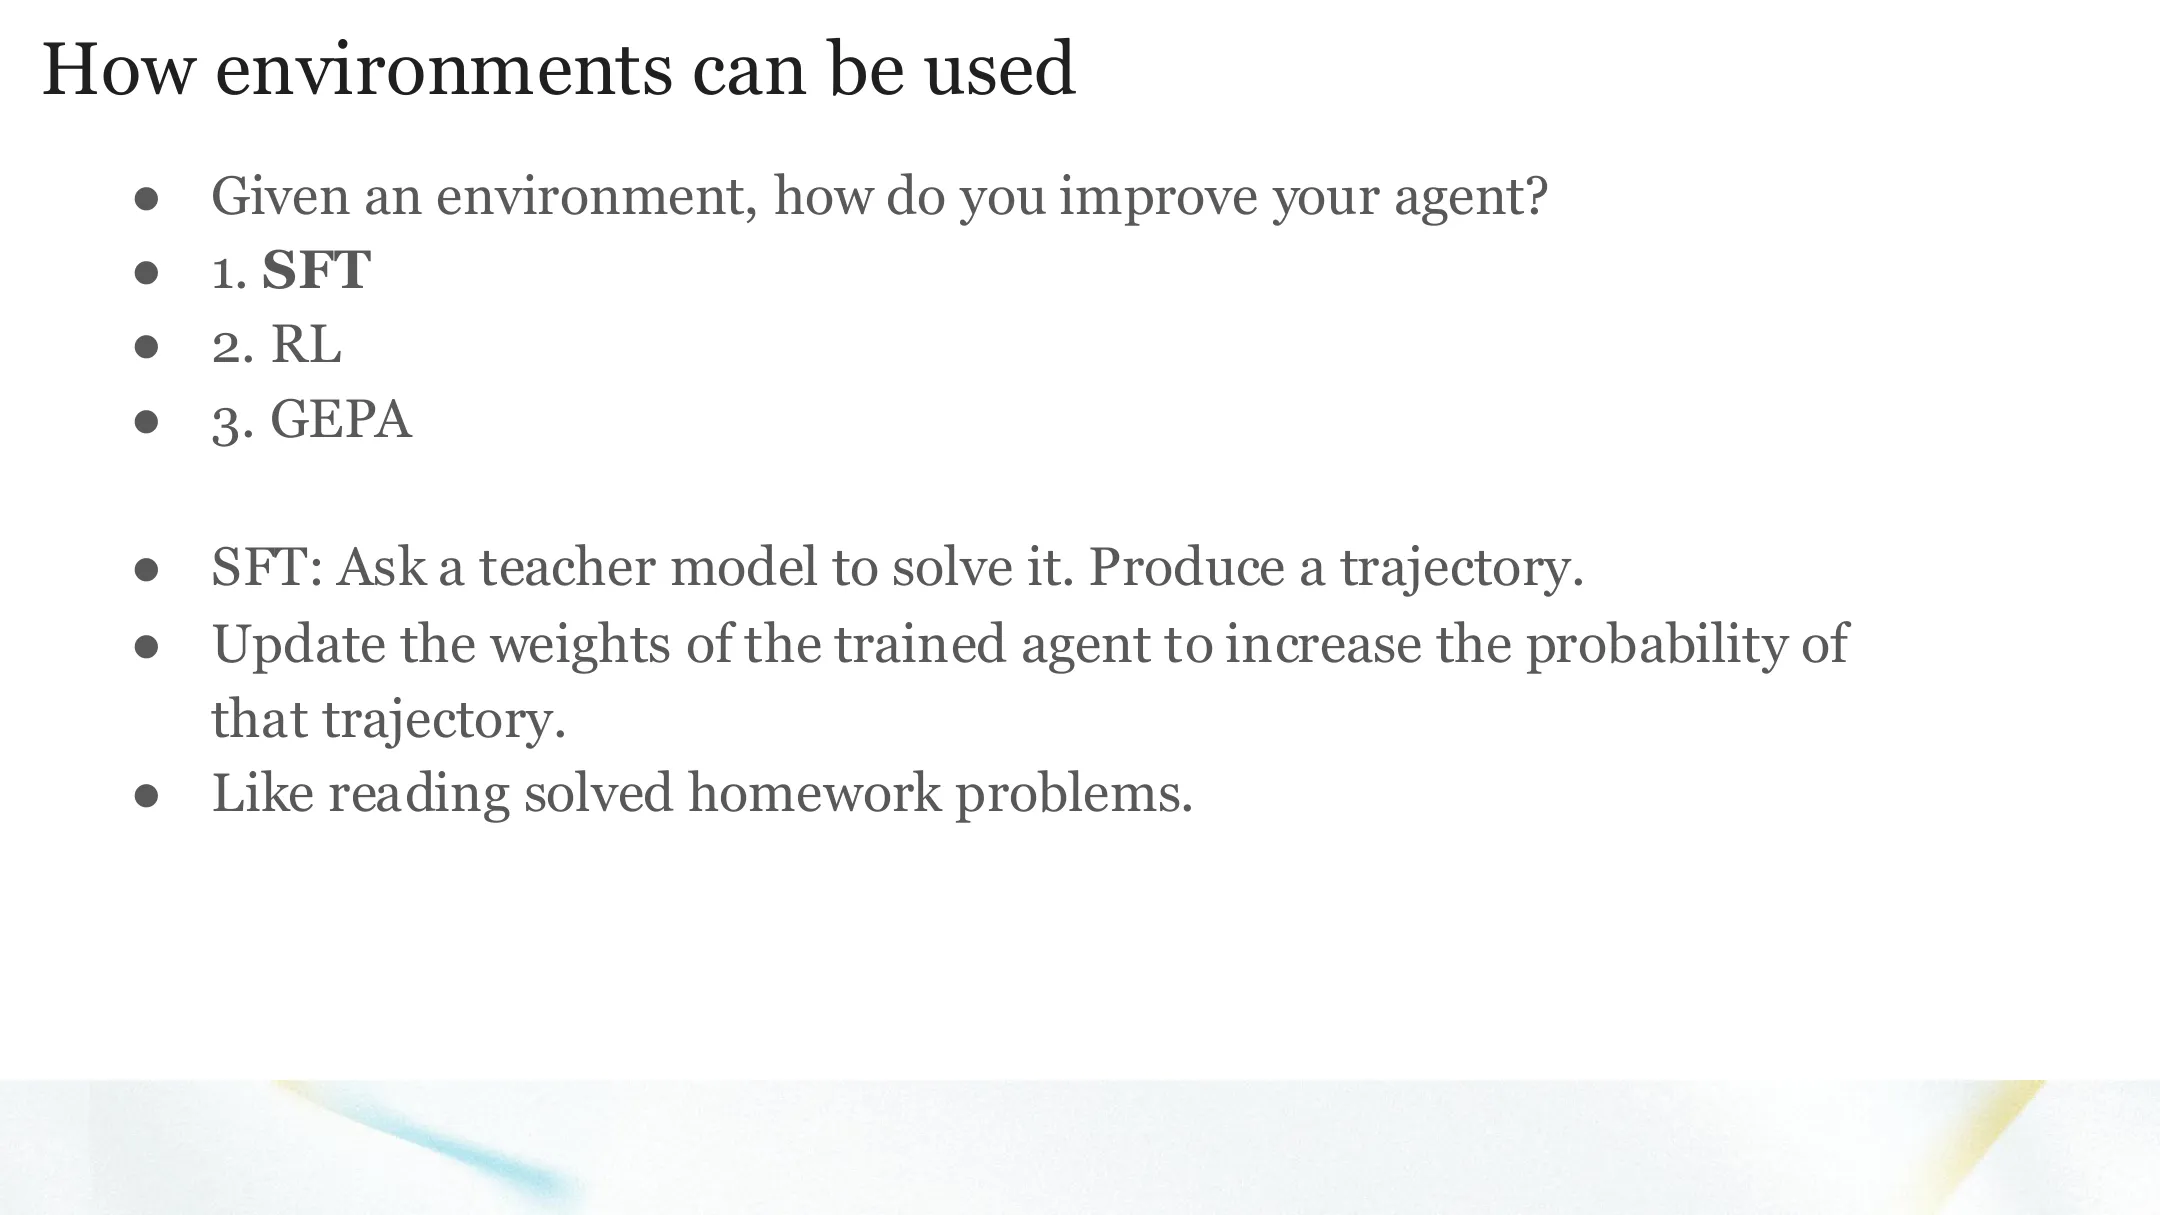
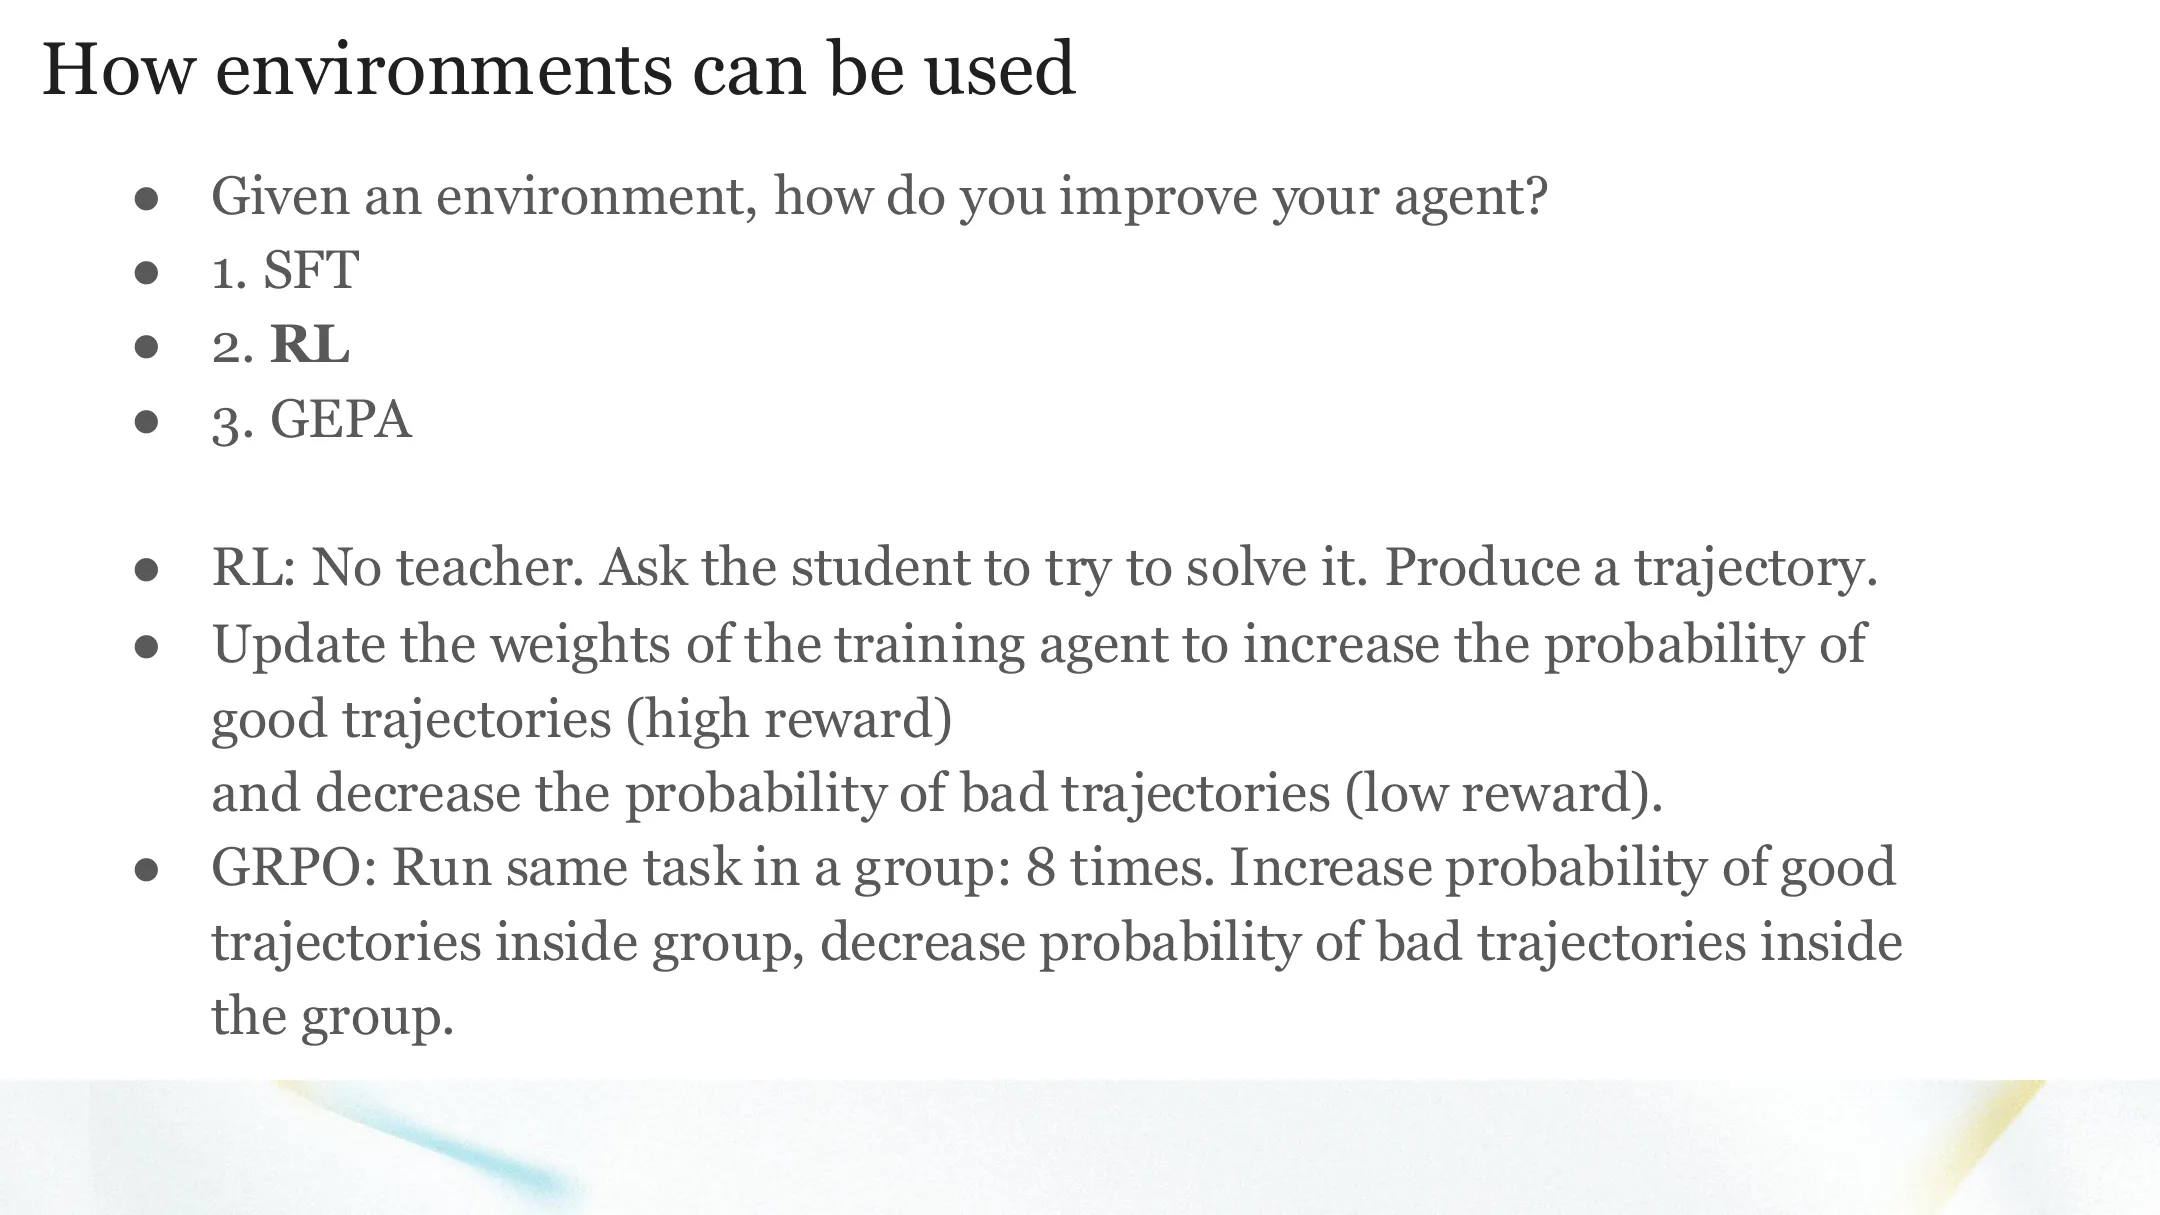
- SFT(监督微调):让教师模型或人类解决任务、产出正确轨迹(trajectory),然后提高该轨迹的概率(= 对正确 token 做监督学习)。若模型完全解不出,可给提示得到解、再去掉提示做 SFT。类比:通过读「解好的题」学数学。
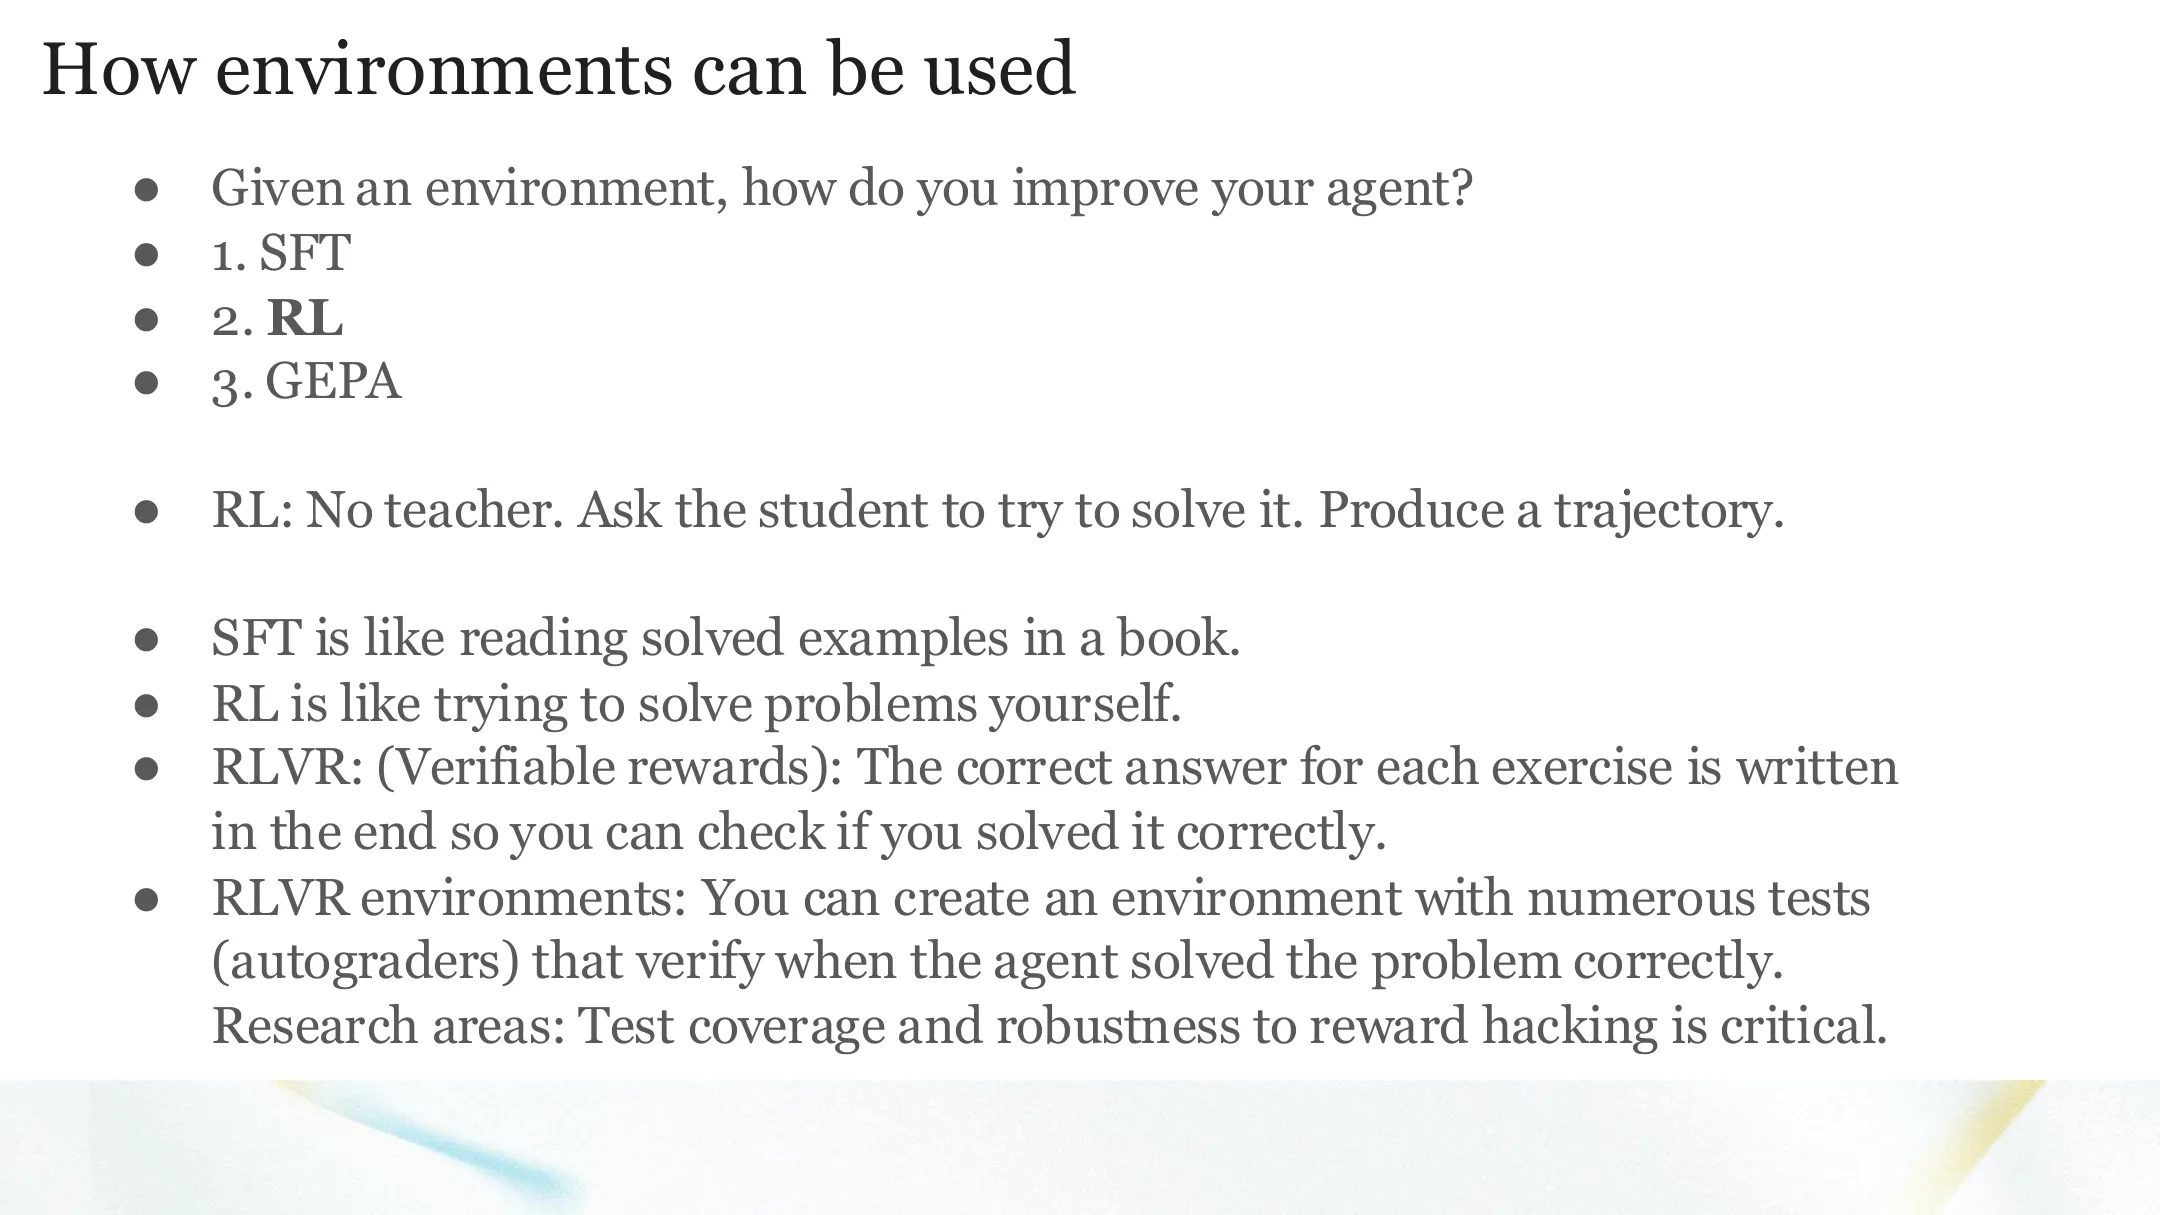
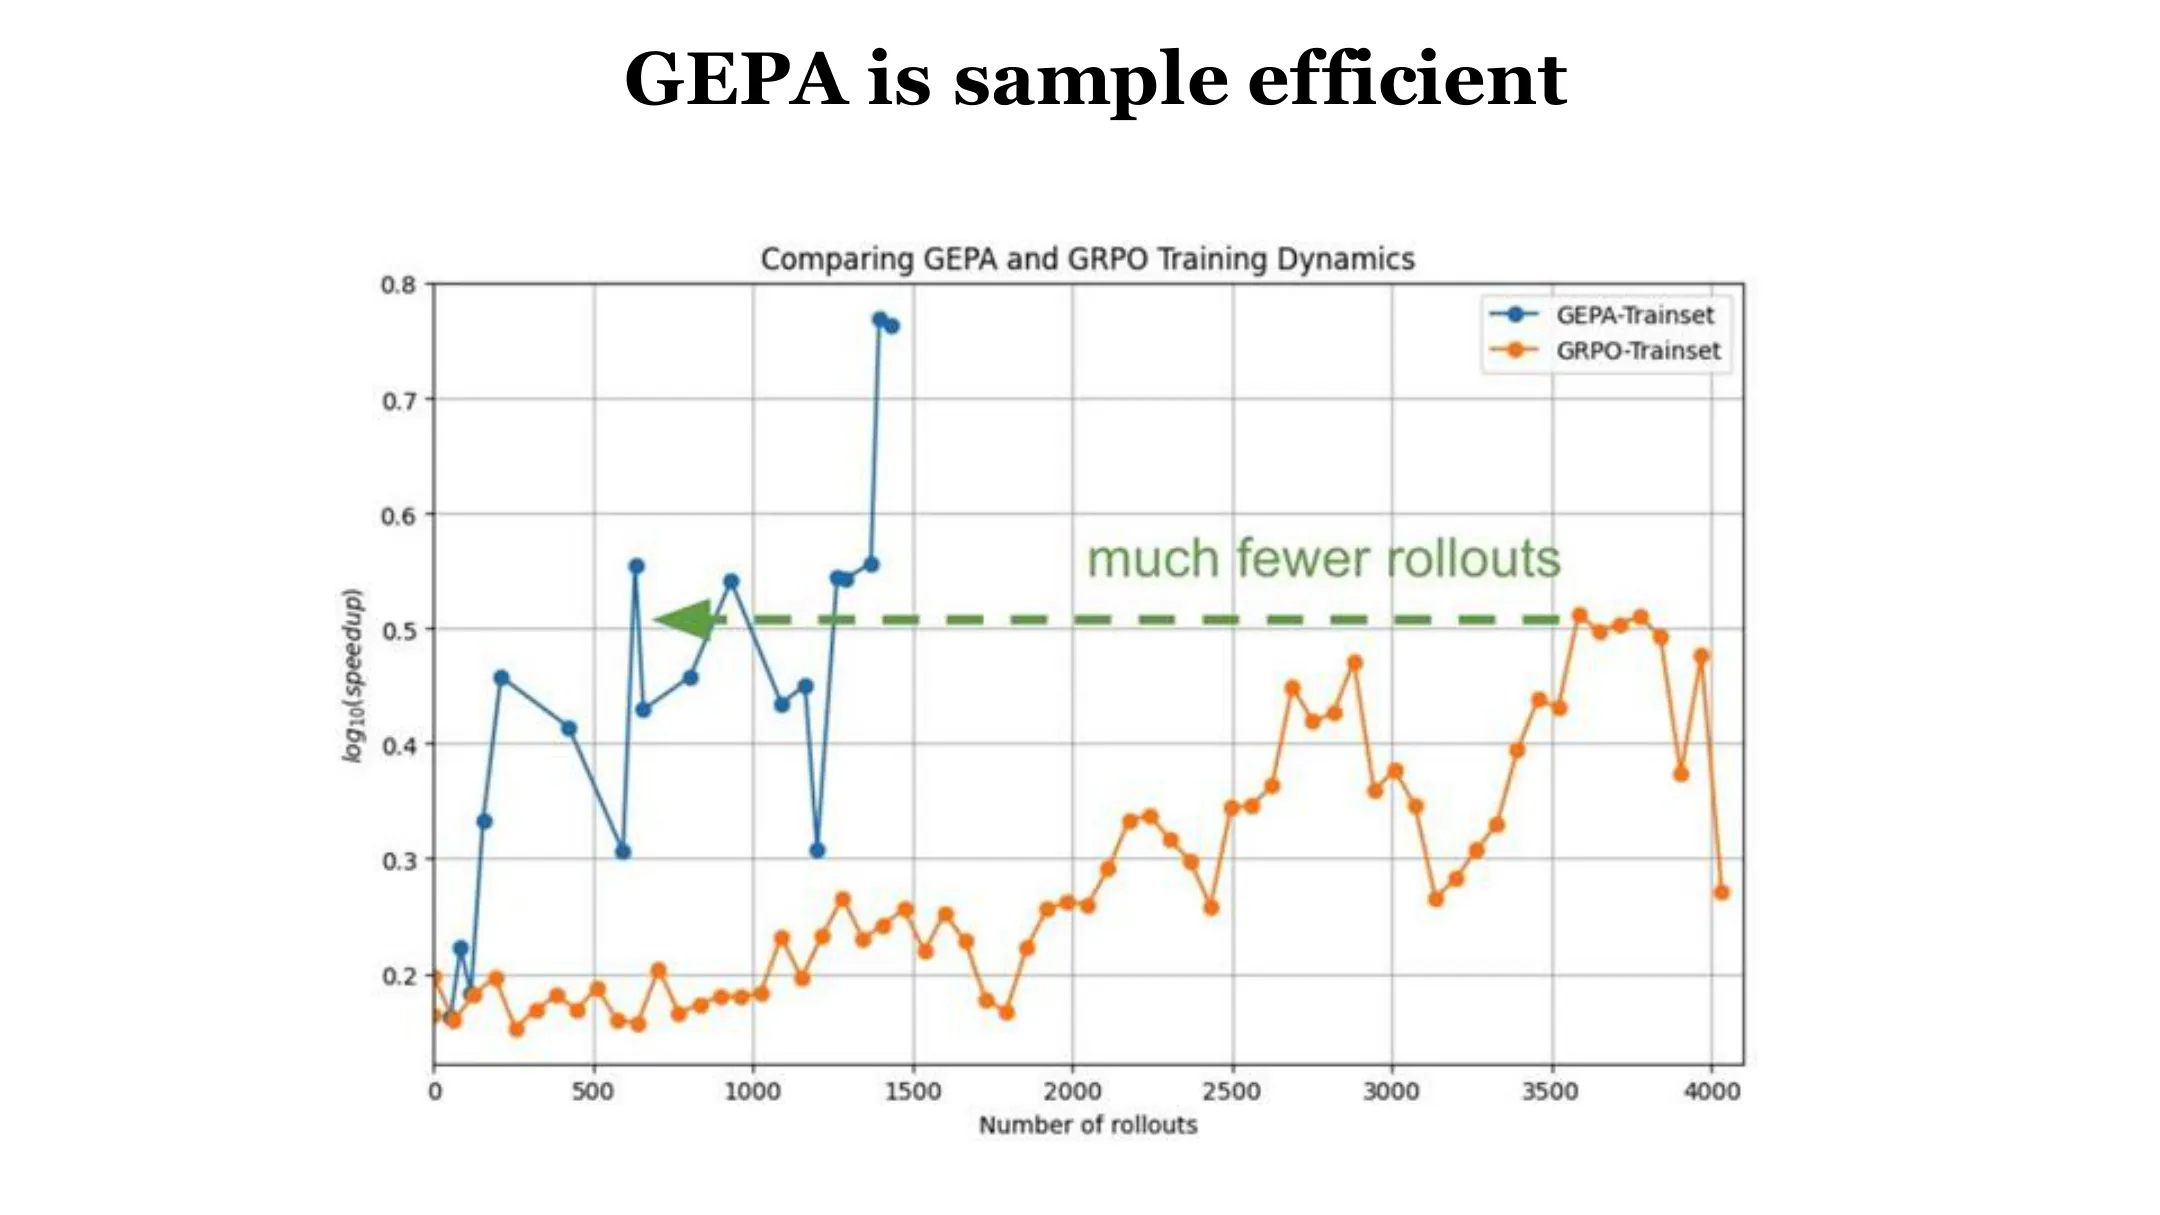
- RL(强化学习,如 GRPO):没有教师、没有解。让模型多次尝试得到一批成功/失败的轨迹,提高正确轨迹的概率、降低错误轨迹的概率。最简单近似 = 只保留正确轨迹做 SFT。关键是可验证奖励——你有测试、知道何时成功。类比:自己动手解题,只在真正解出时得奖励。
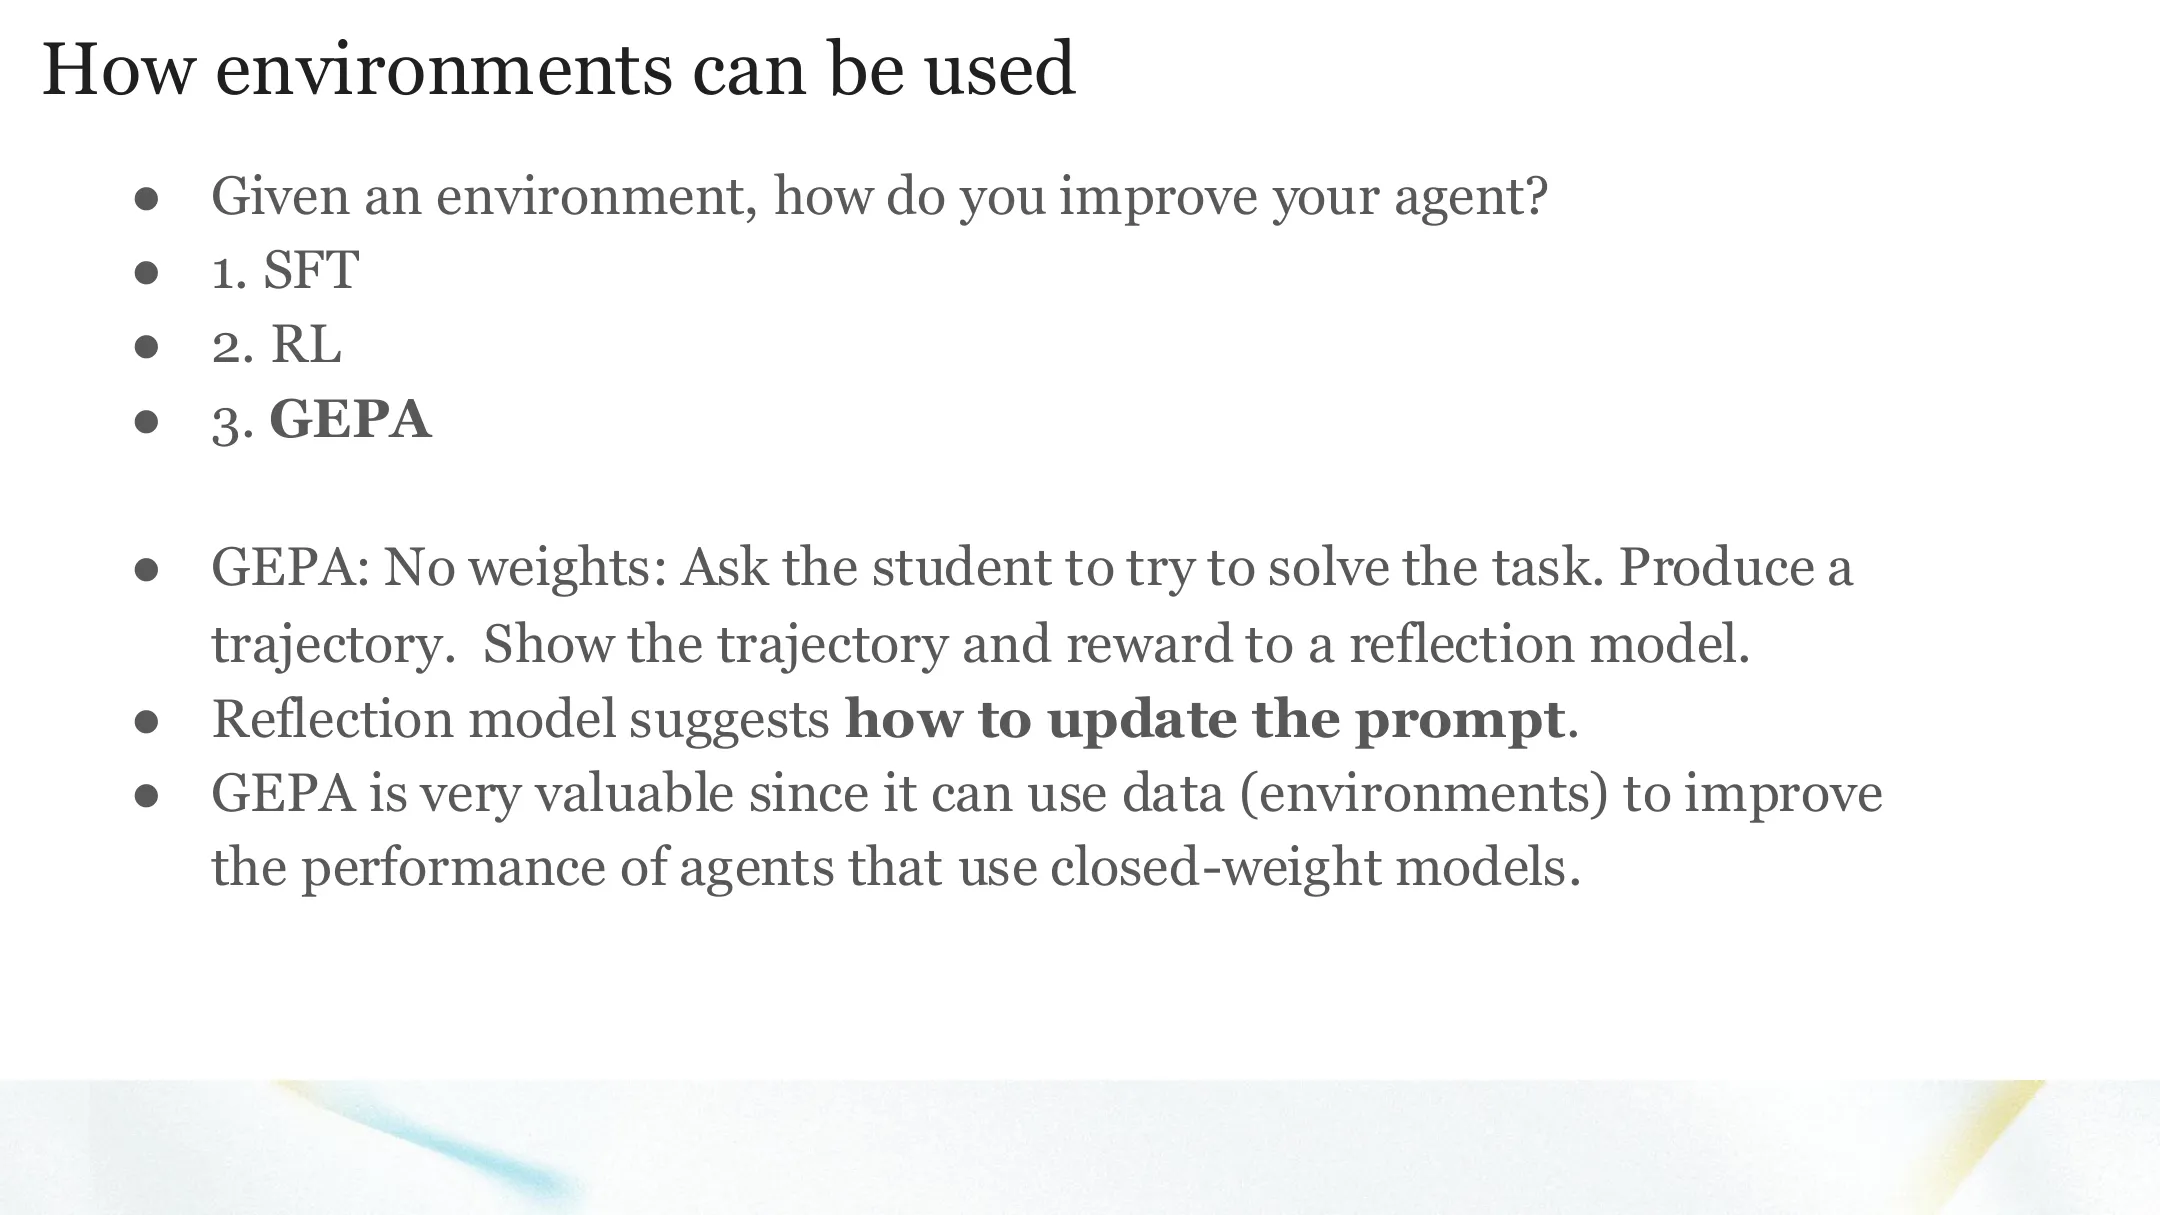
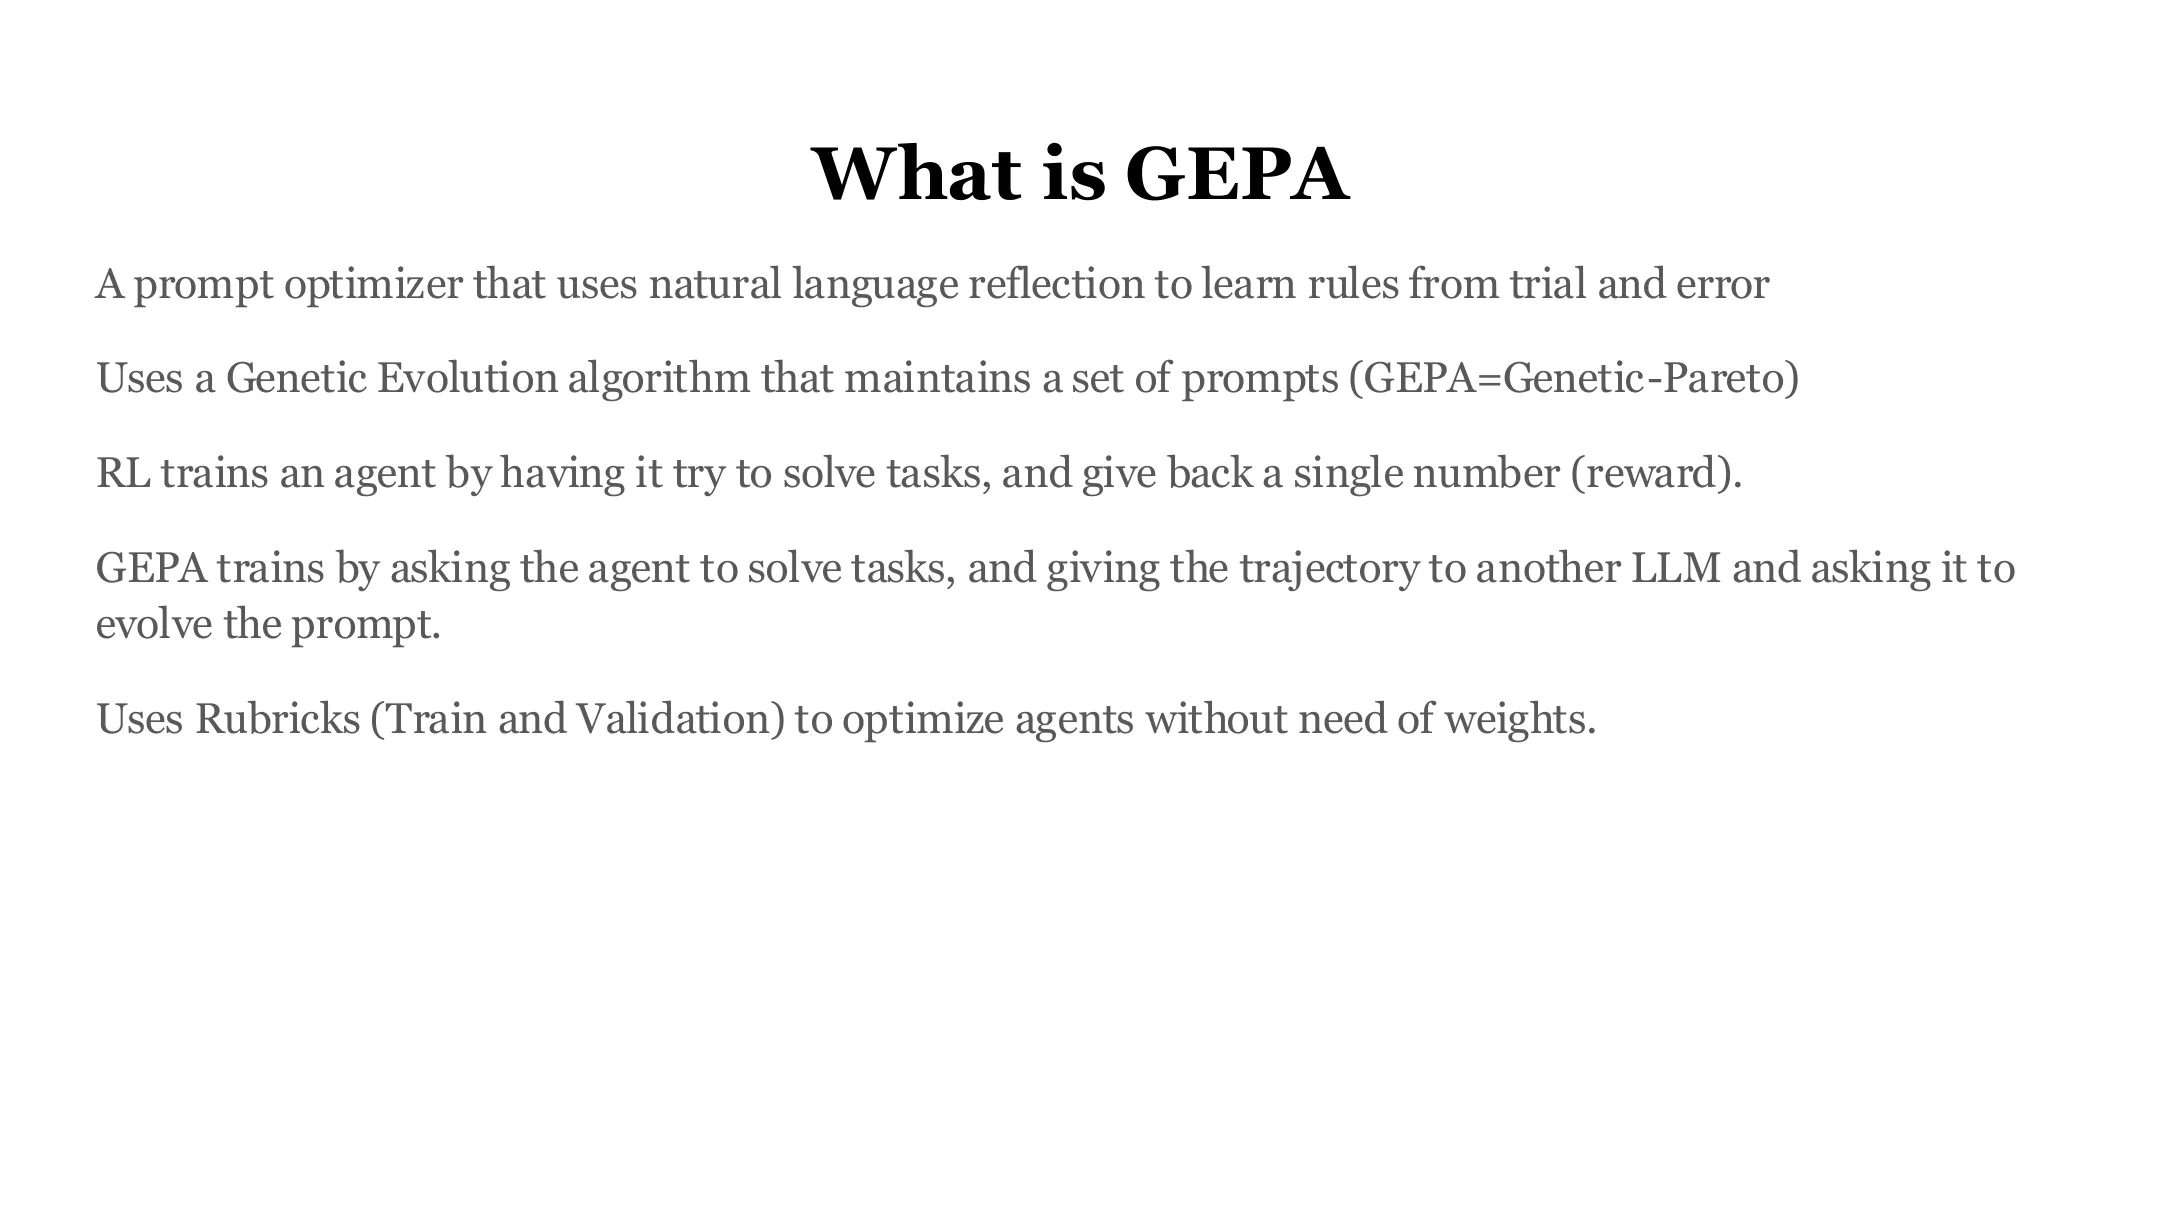
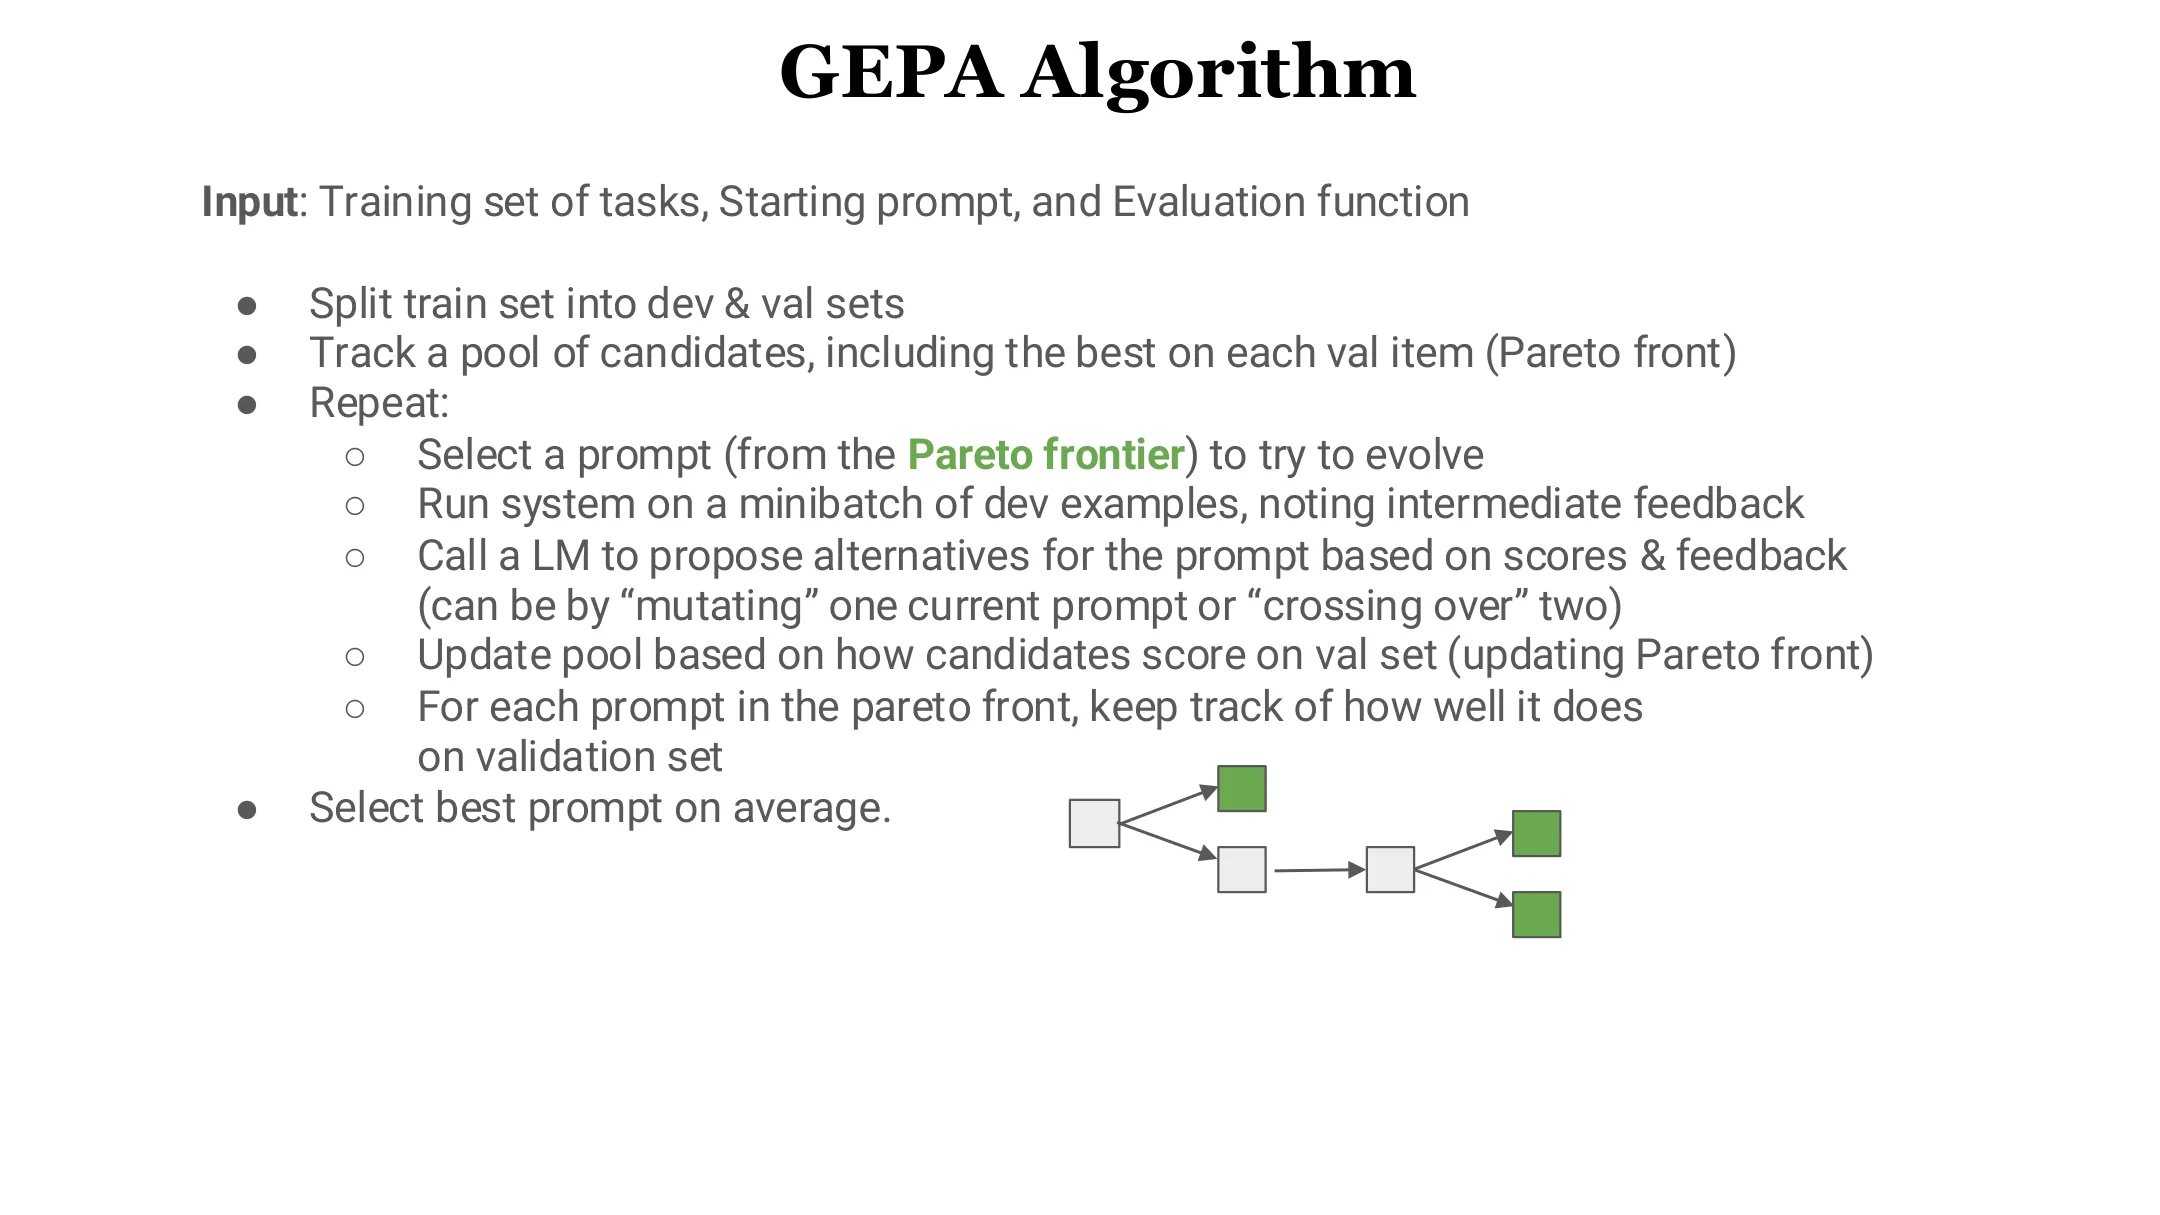
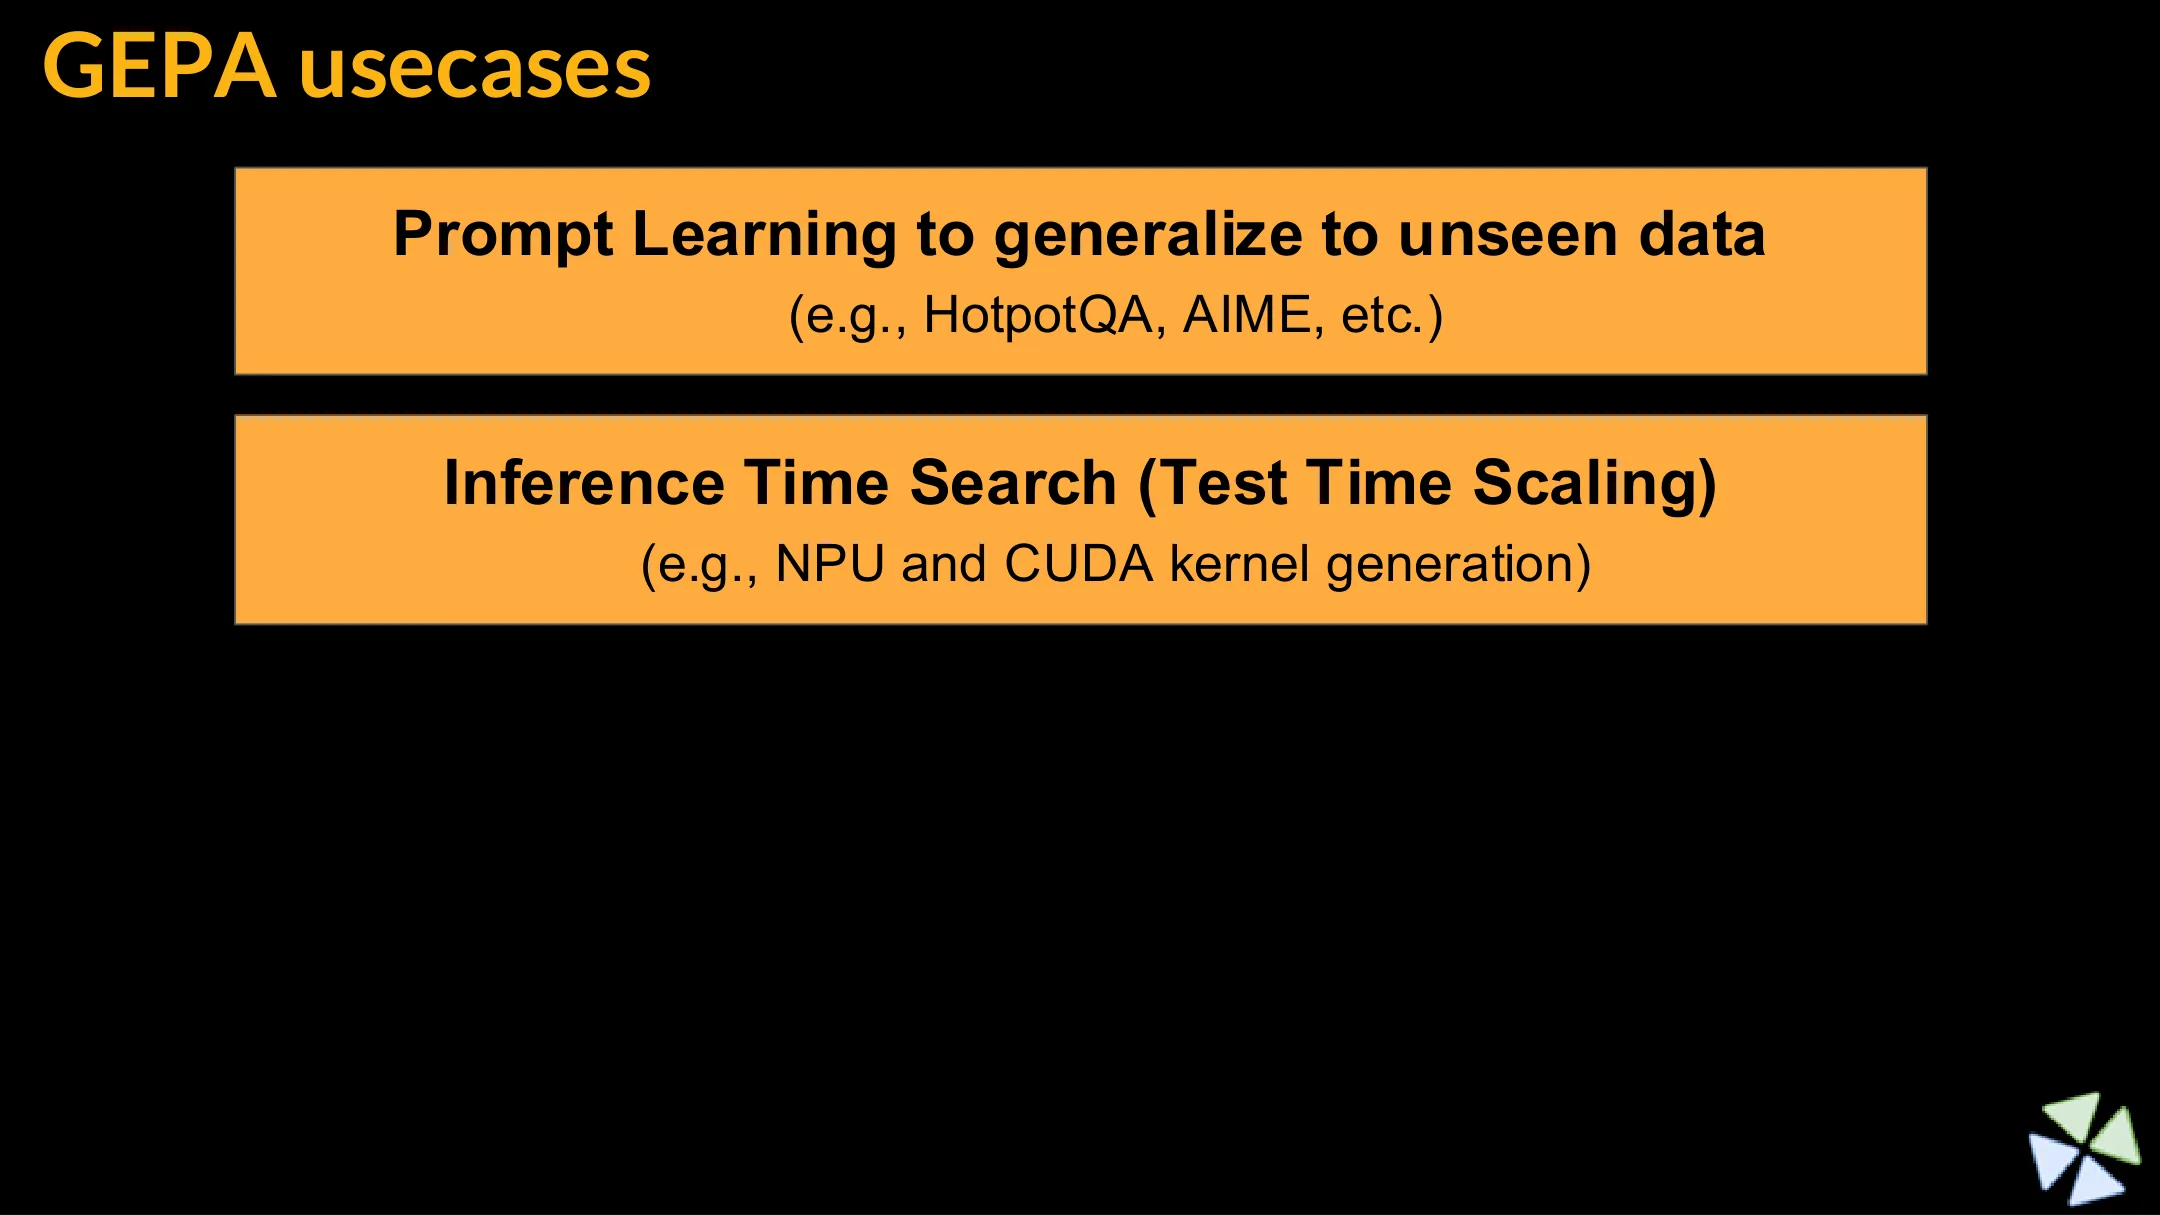
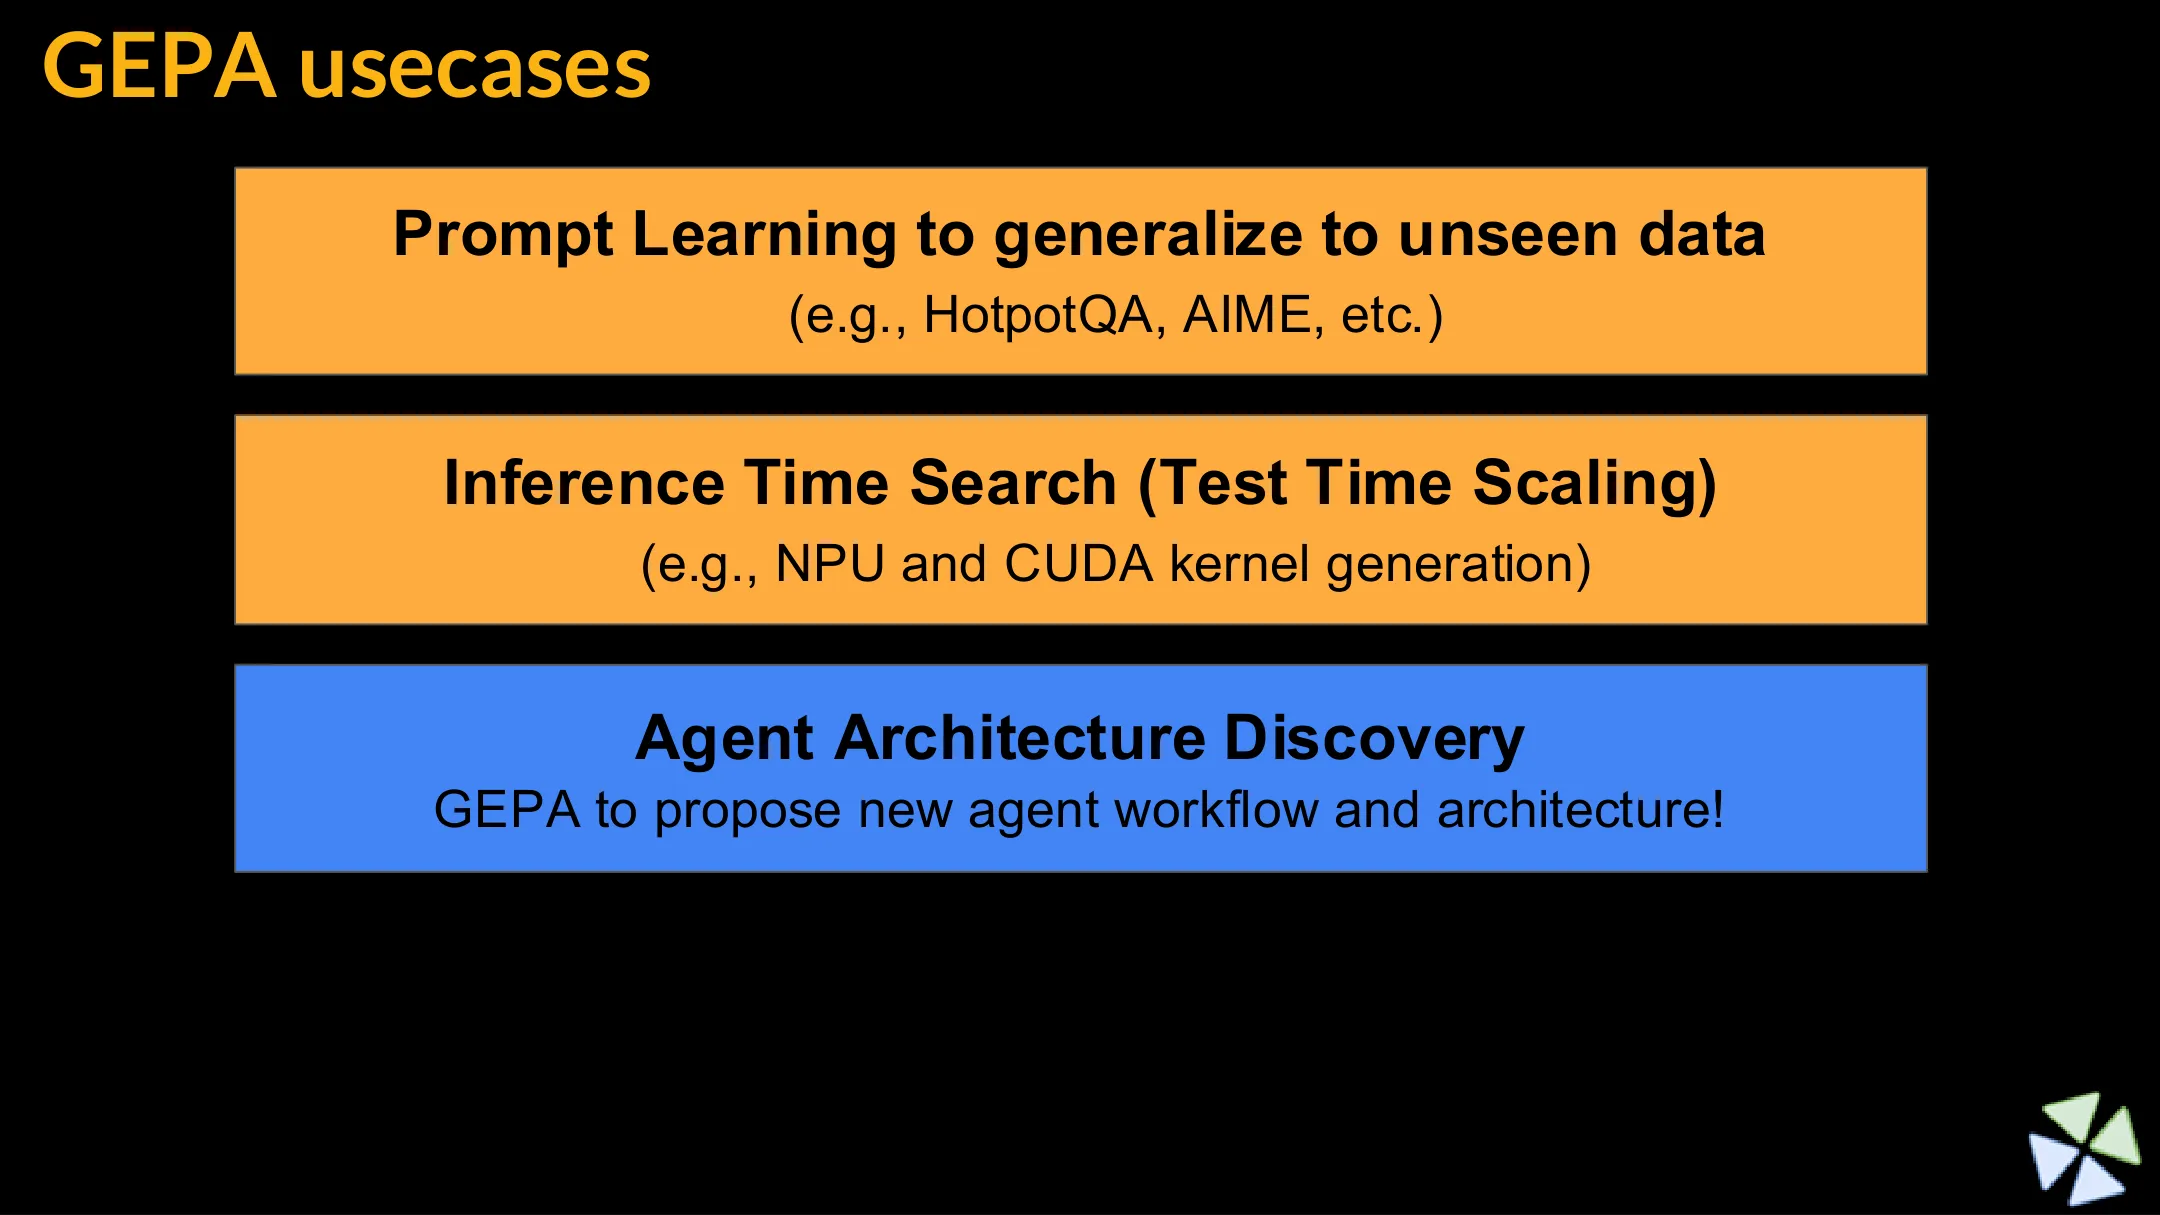
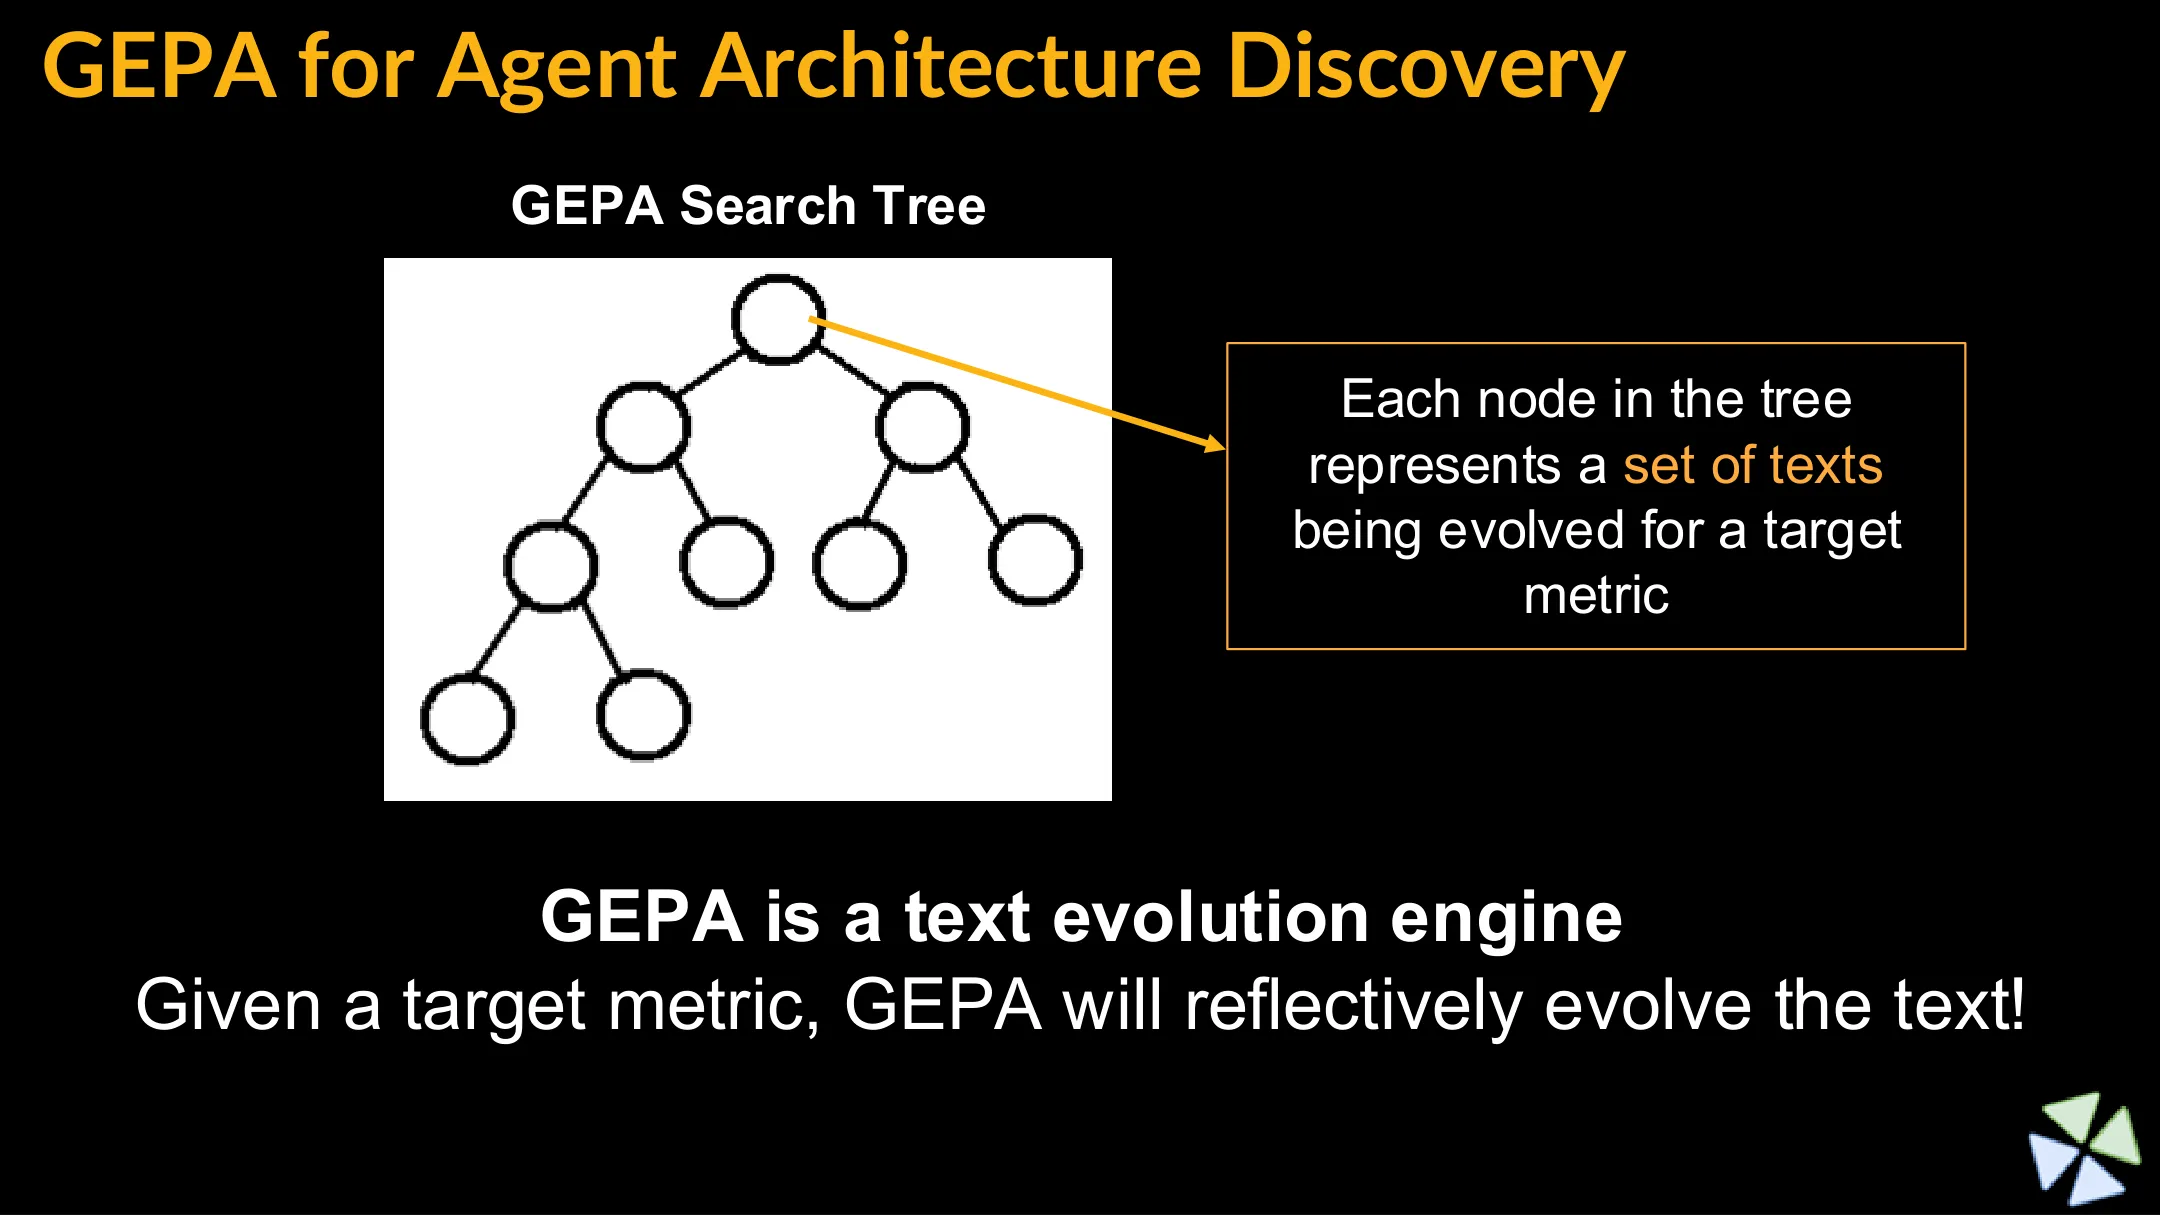
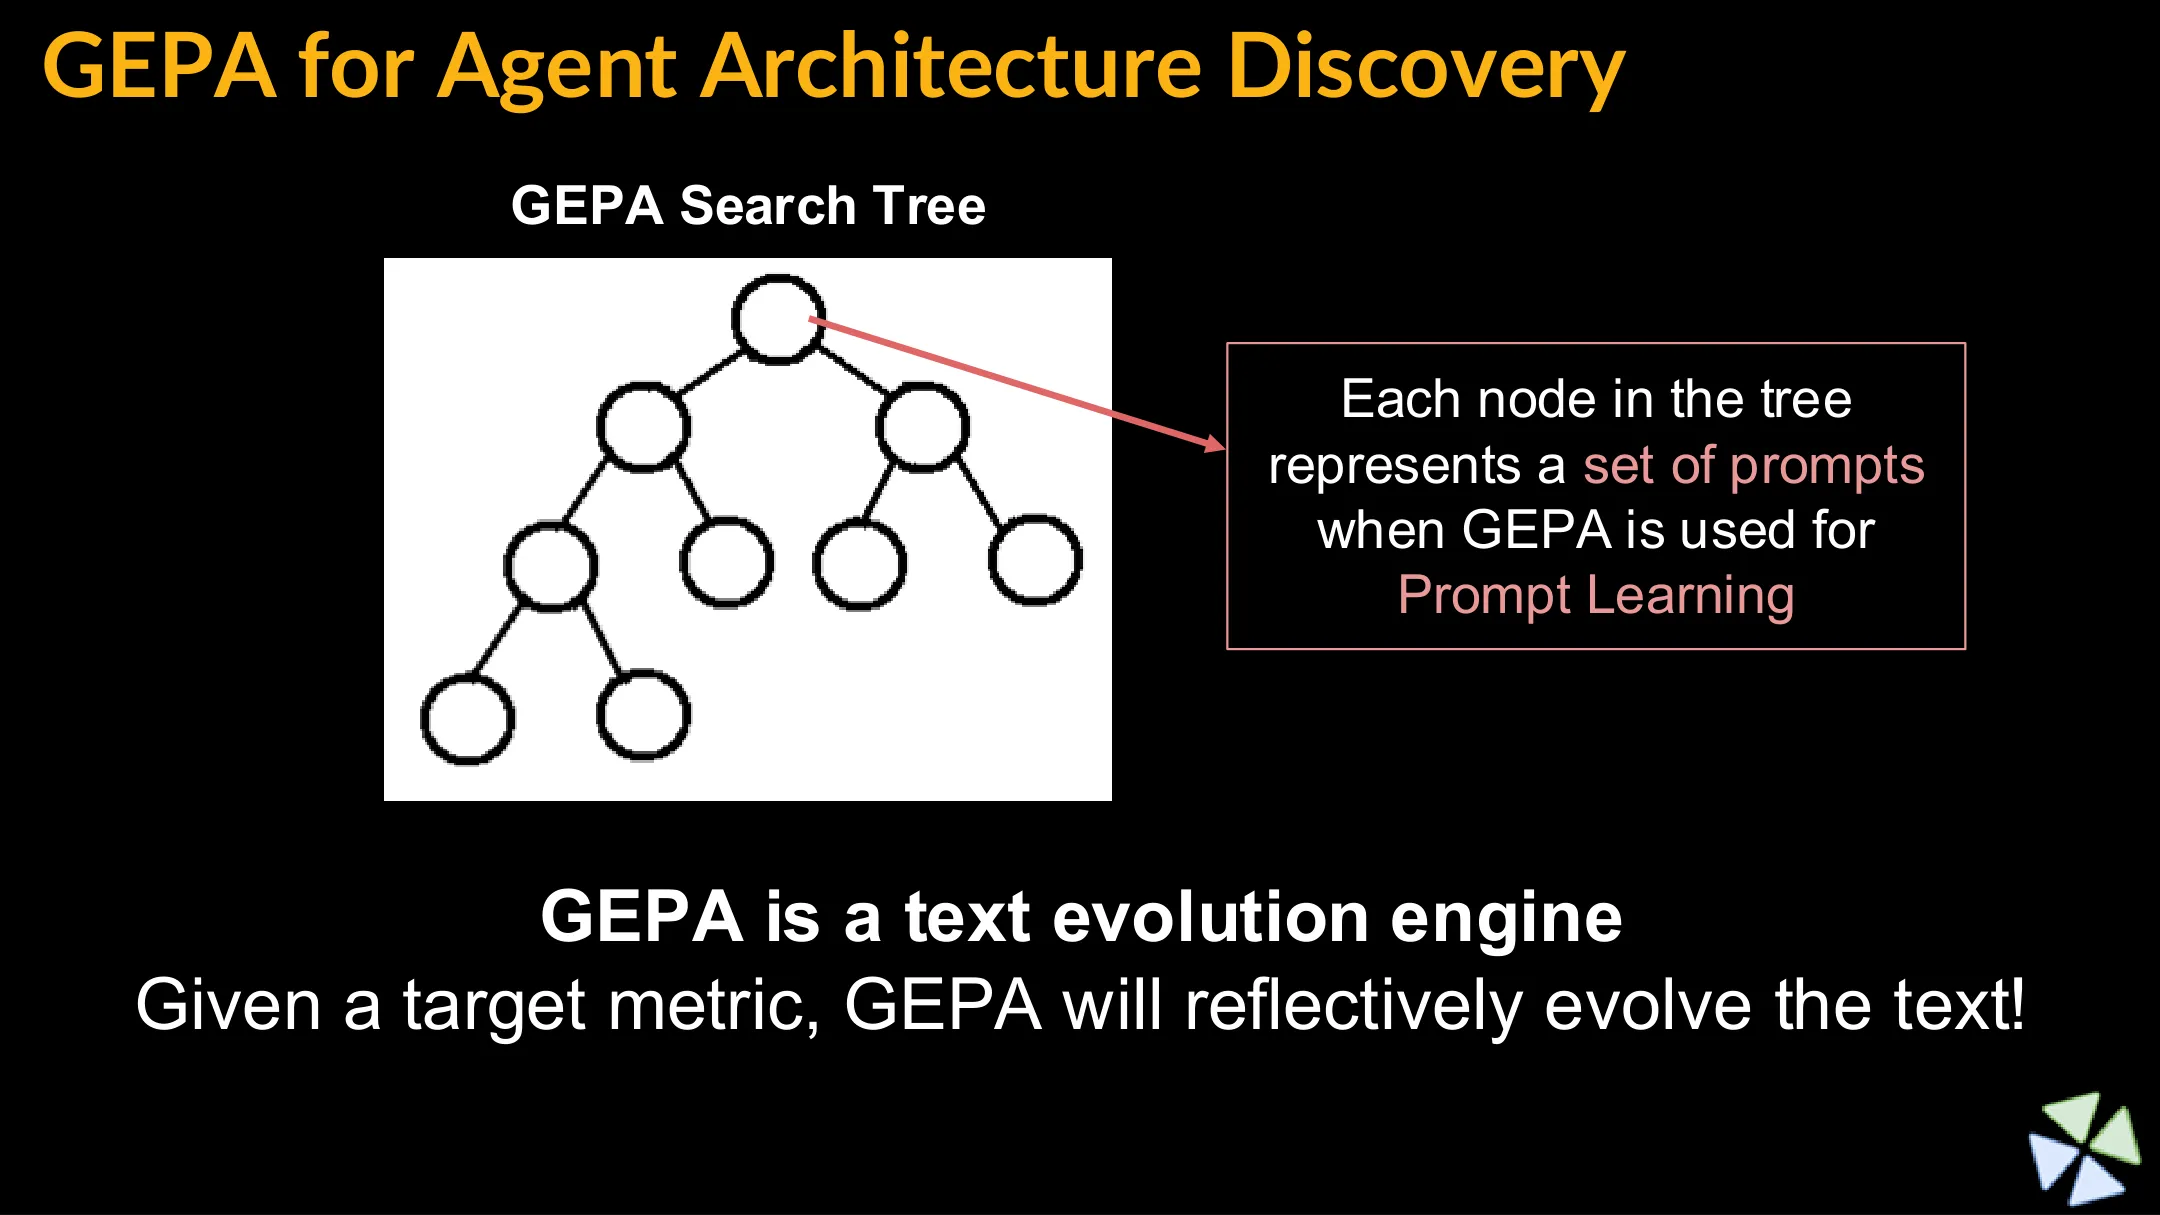
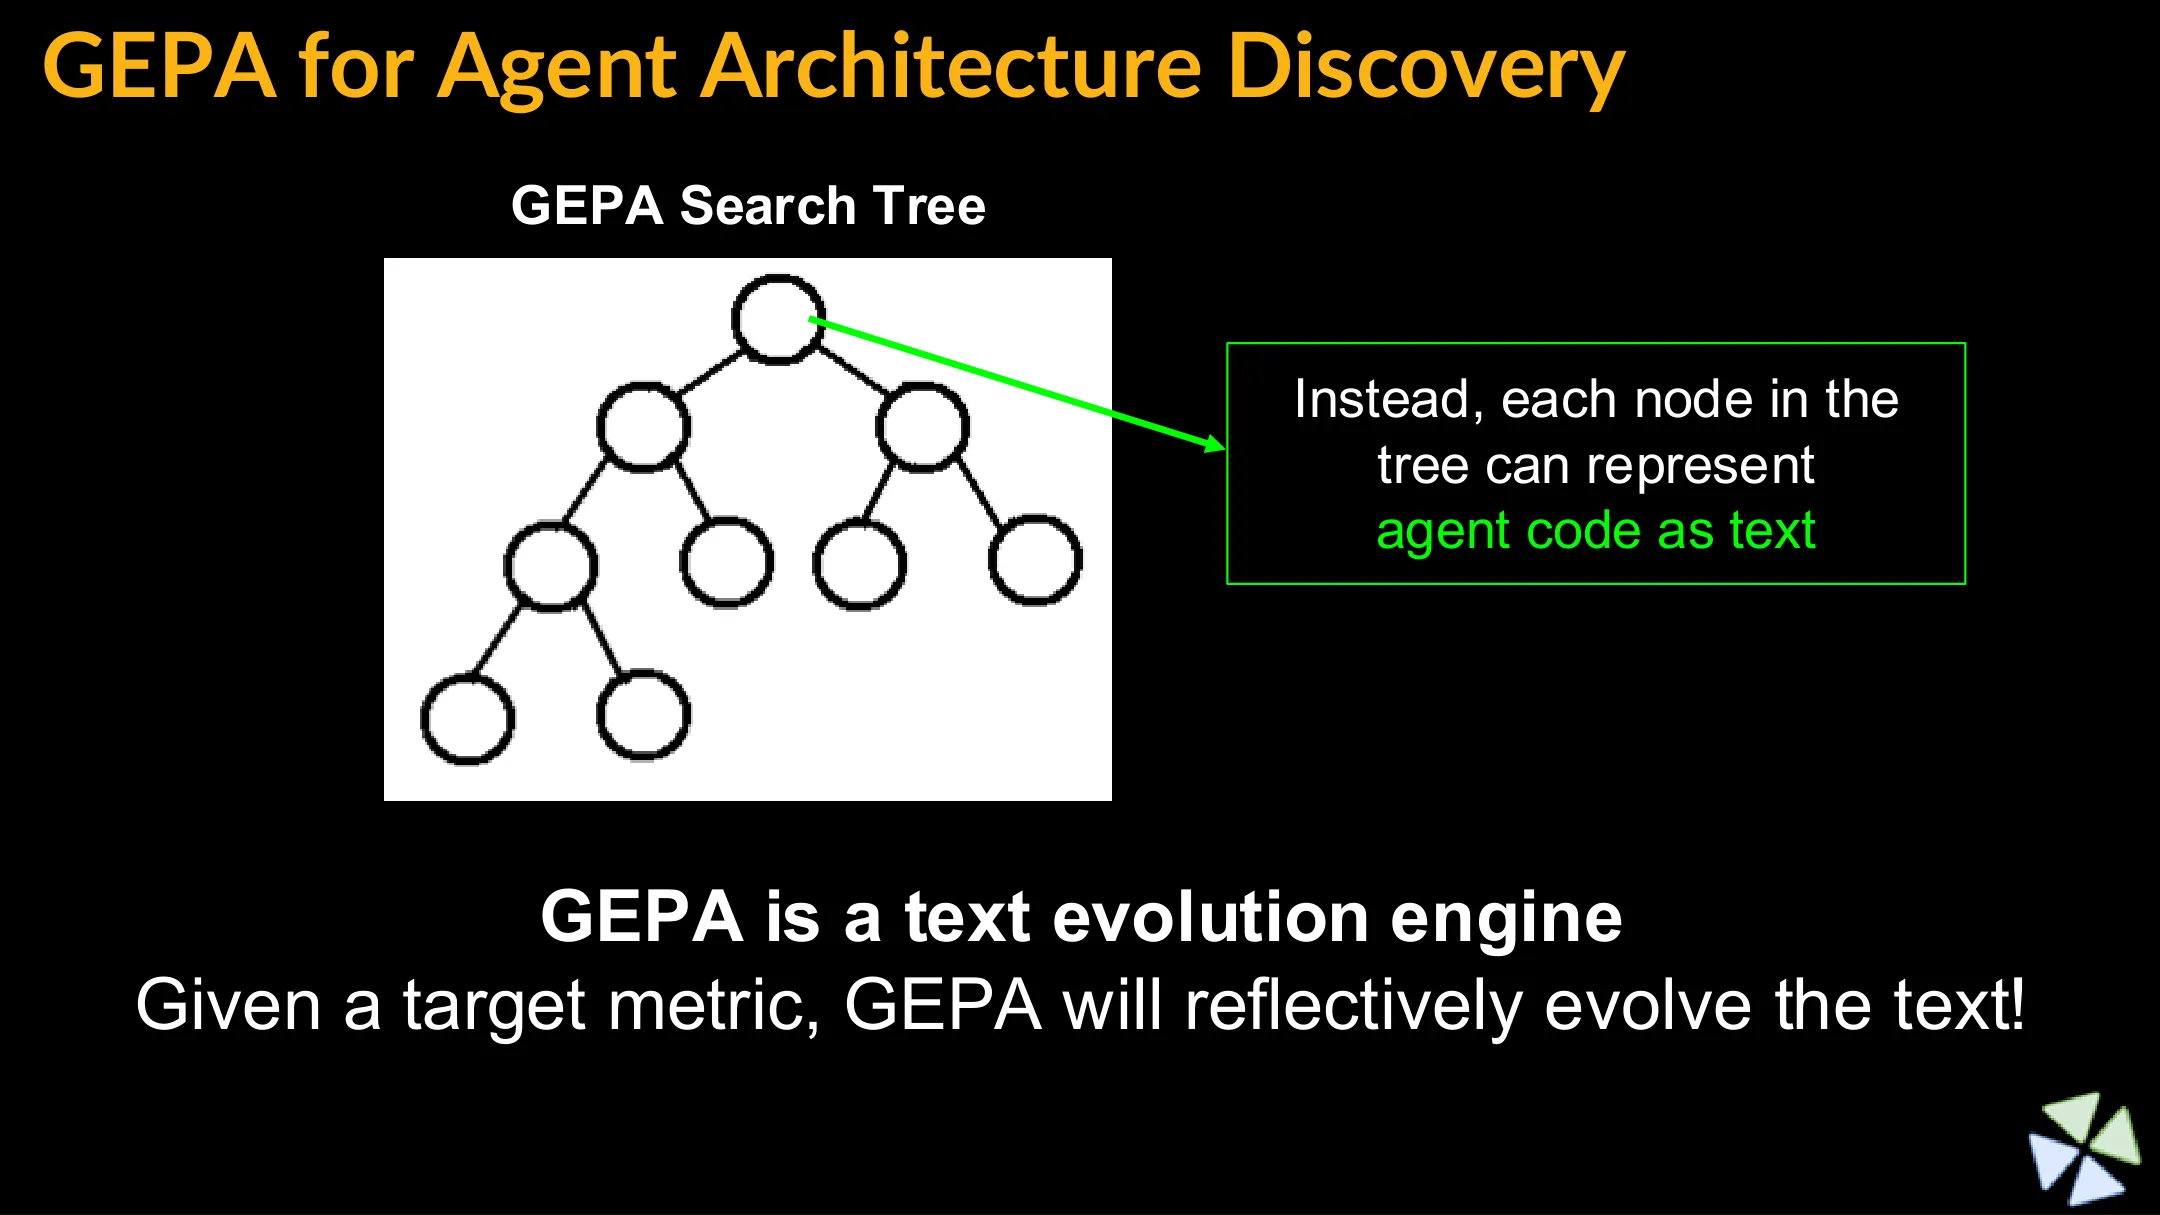
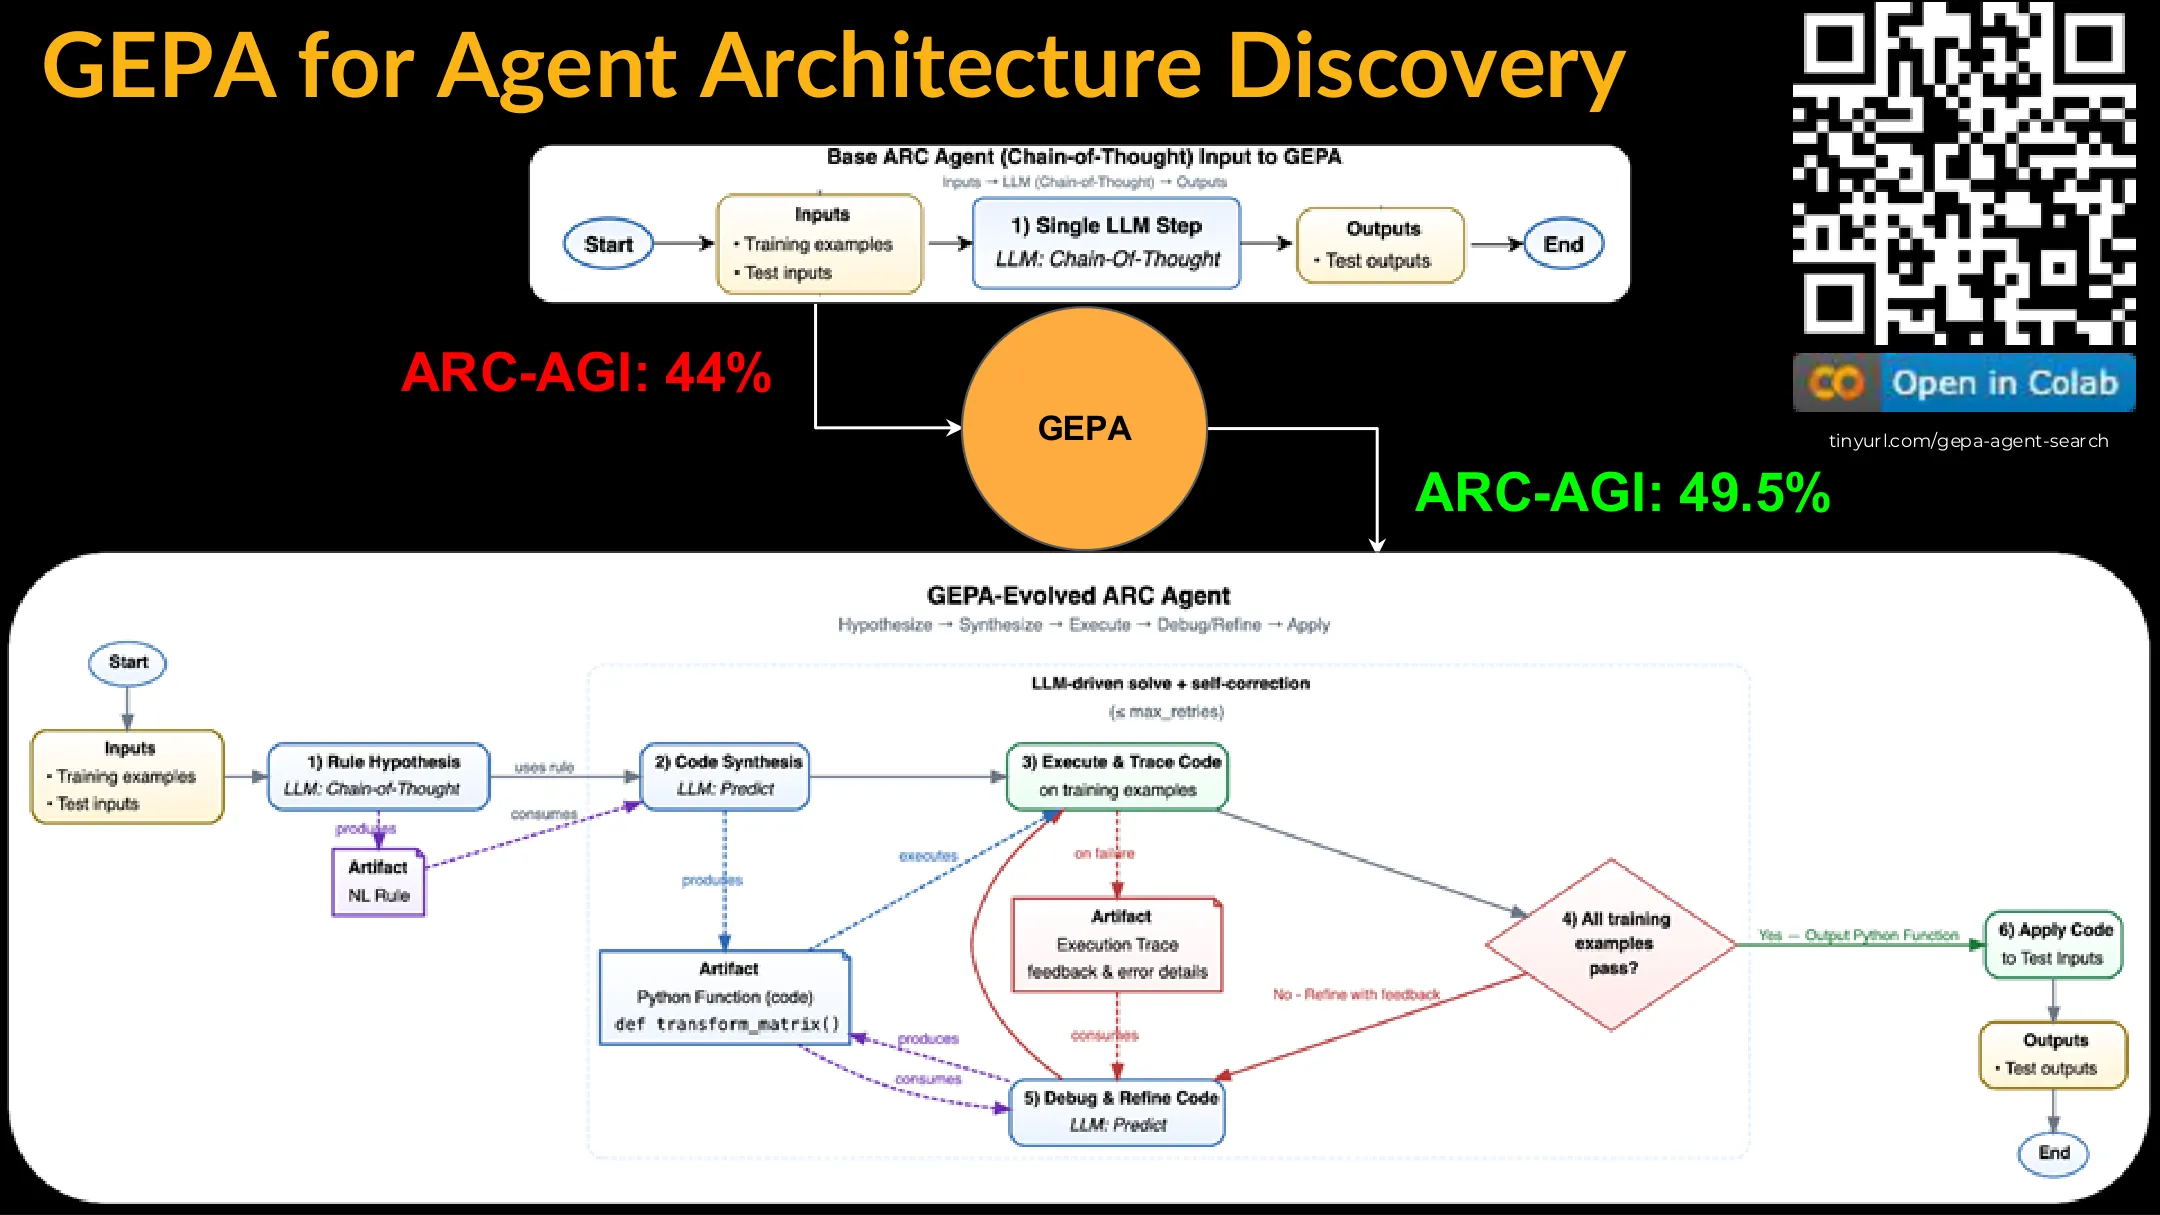
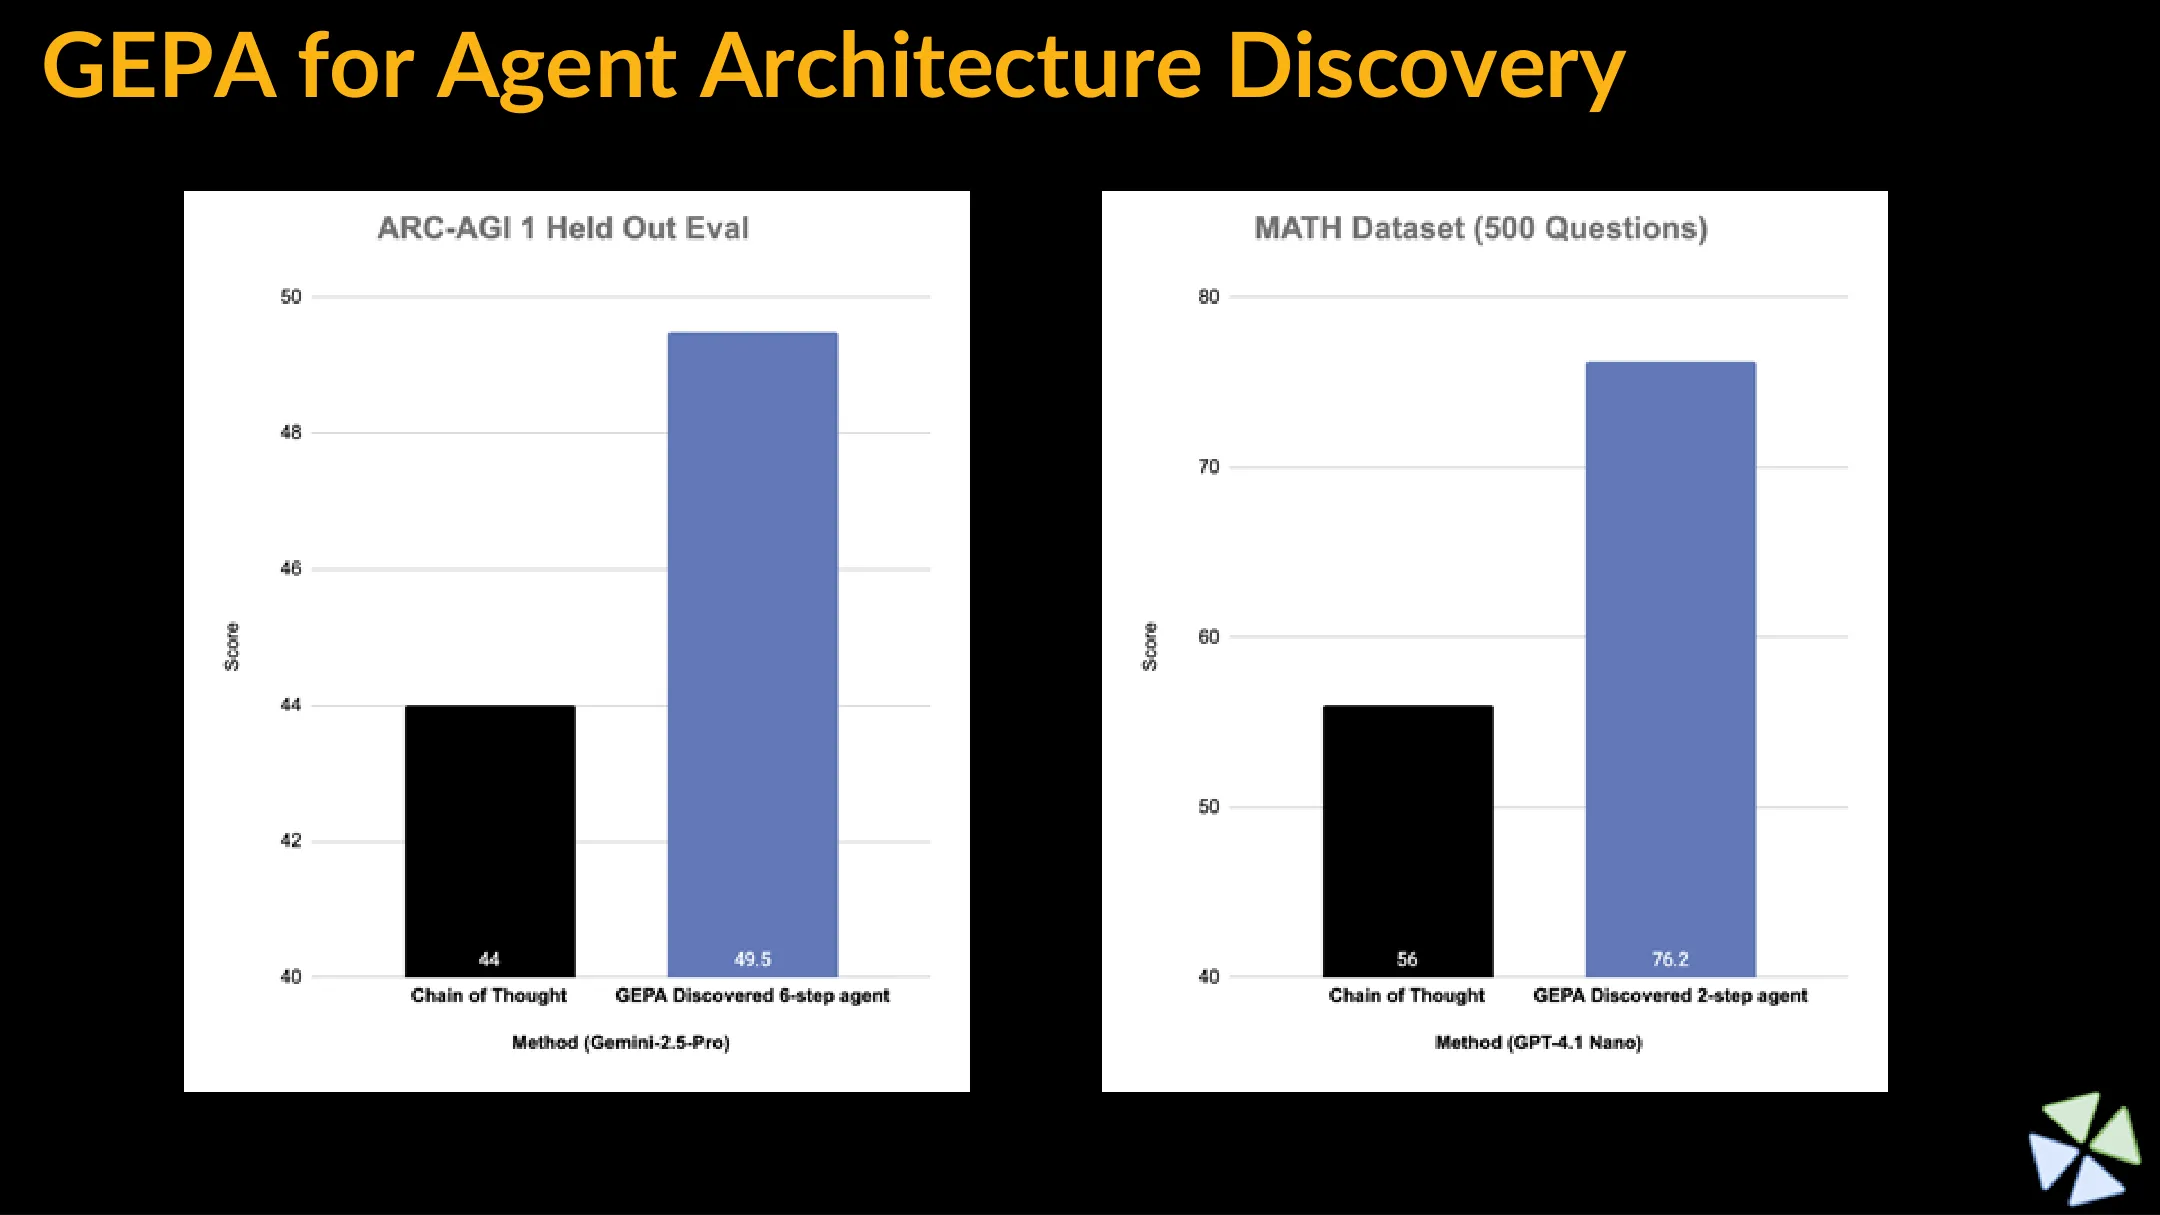
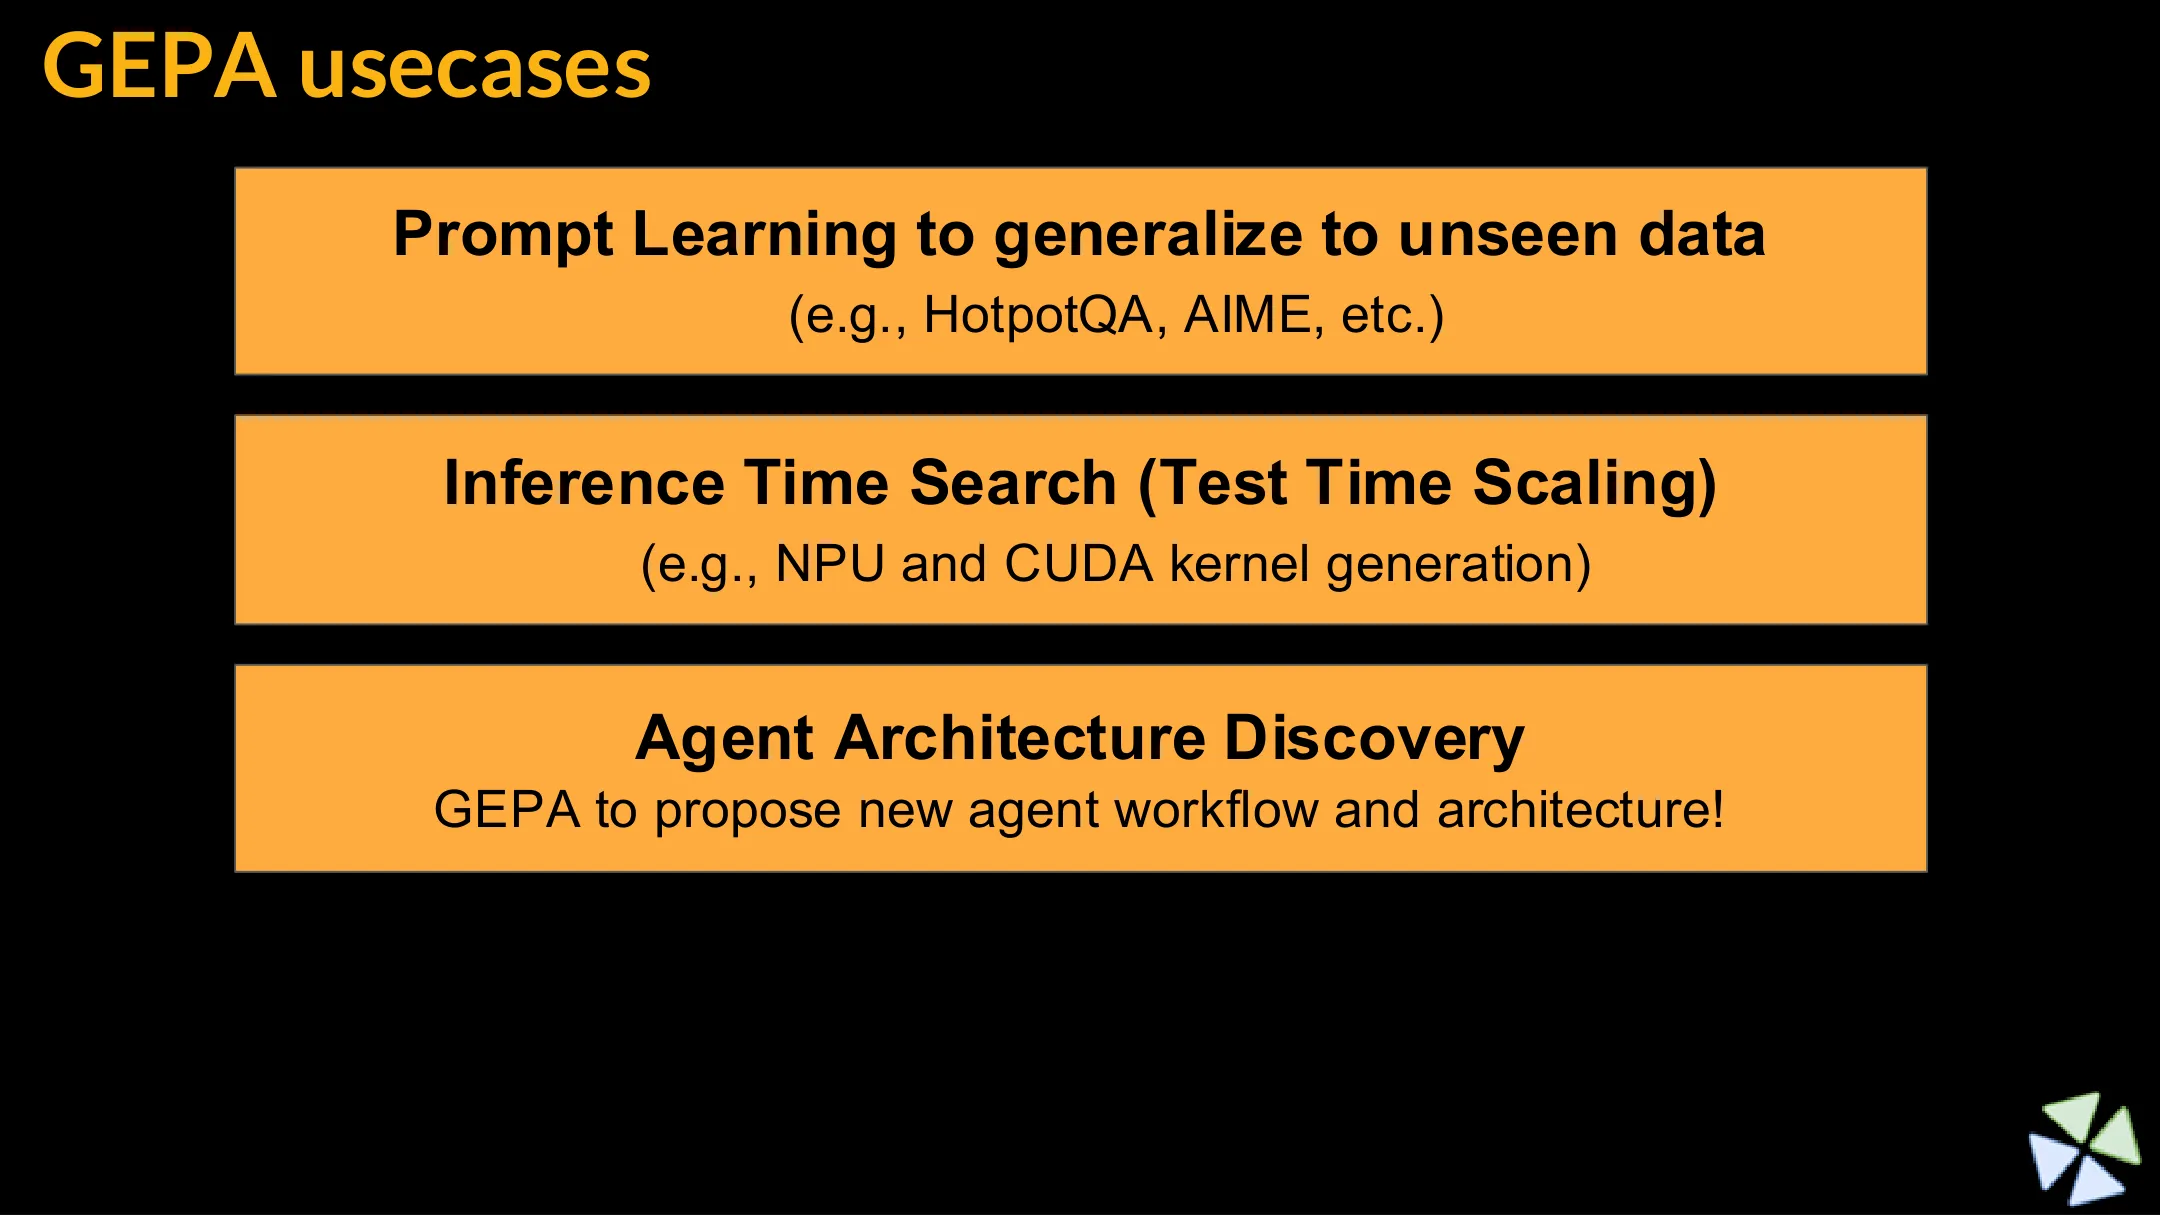
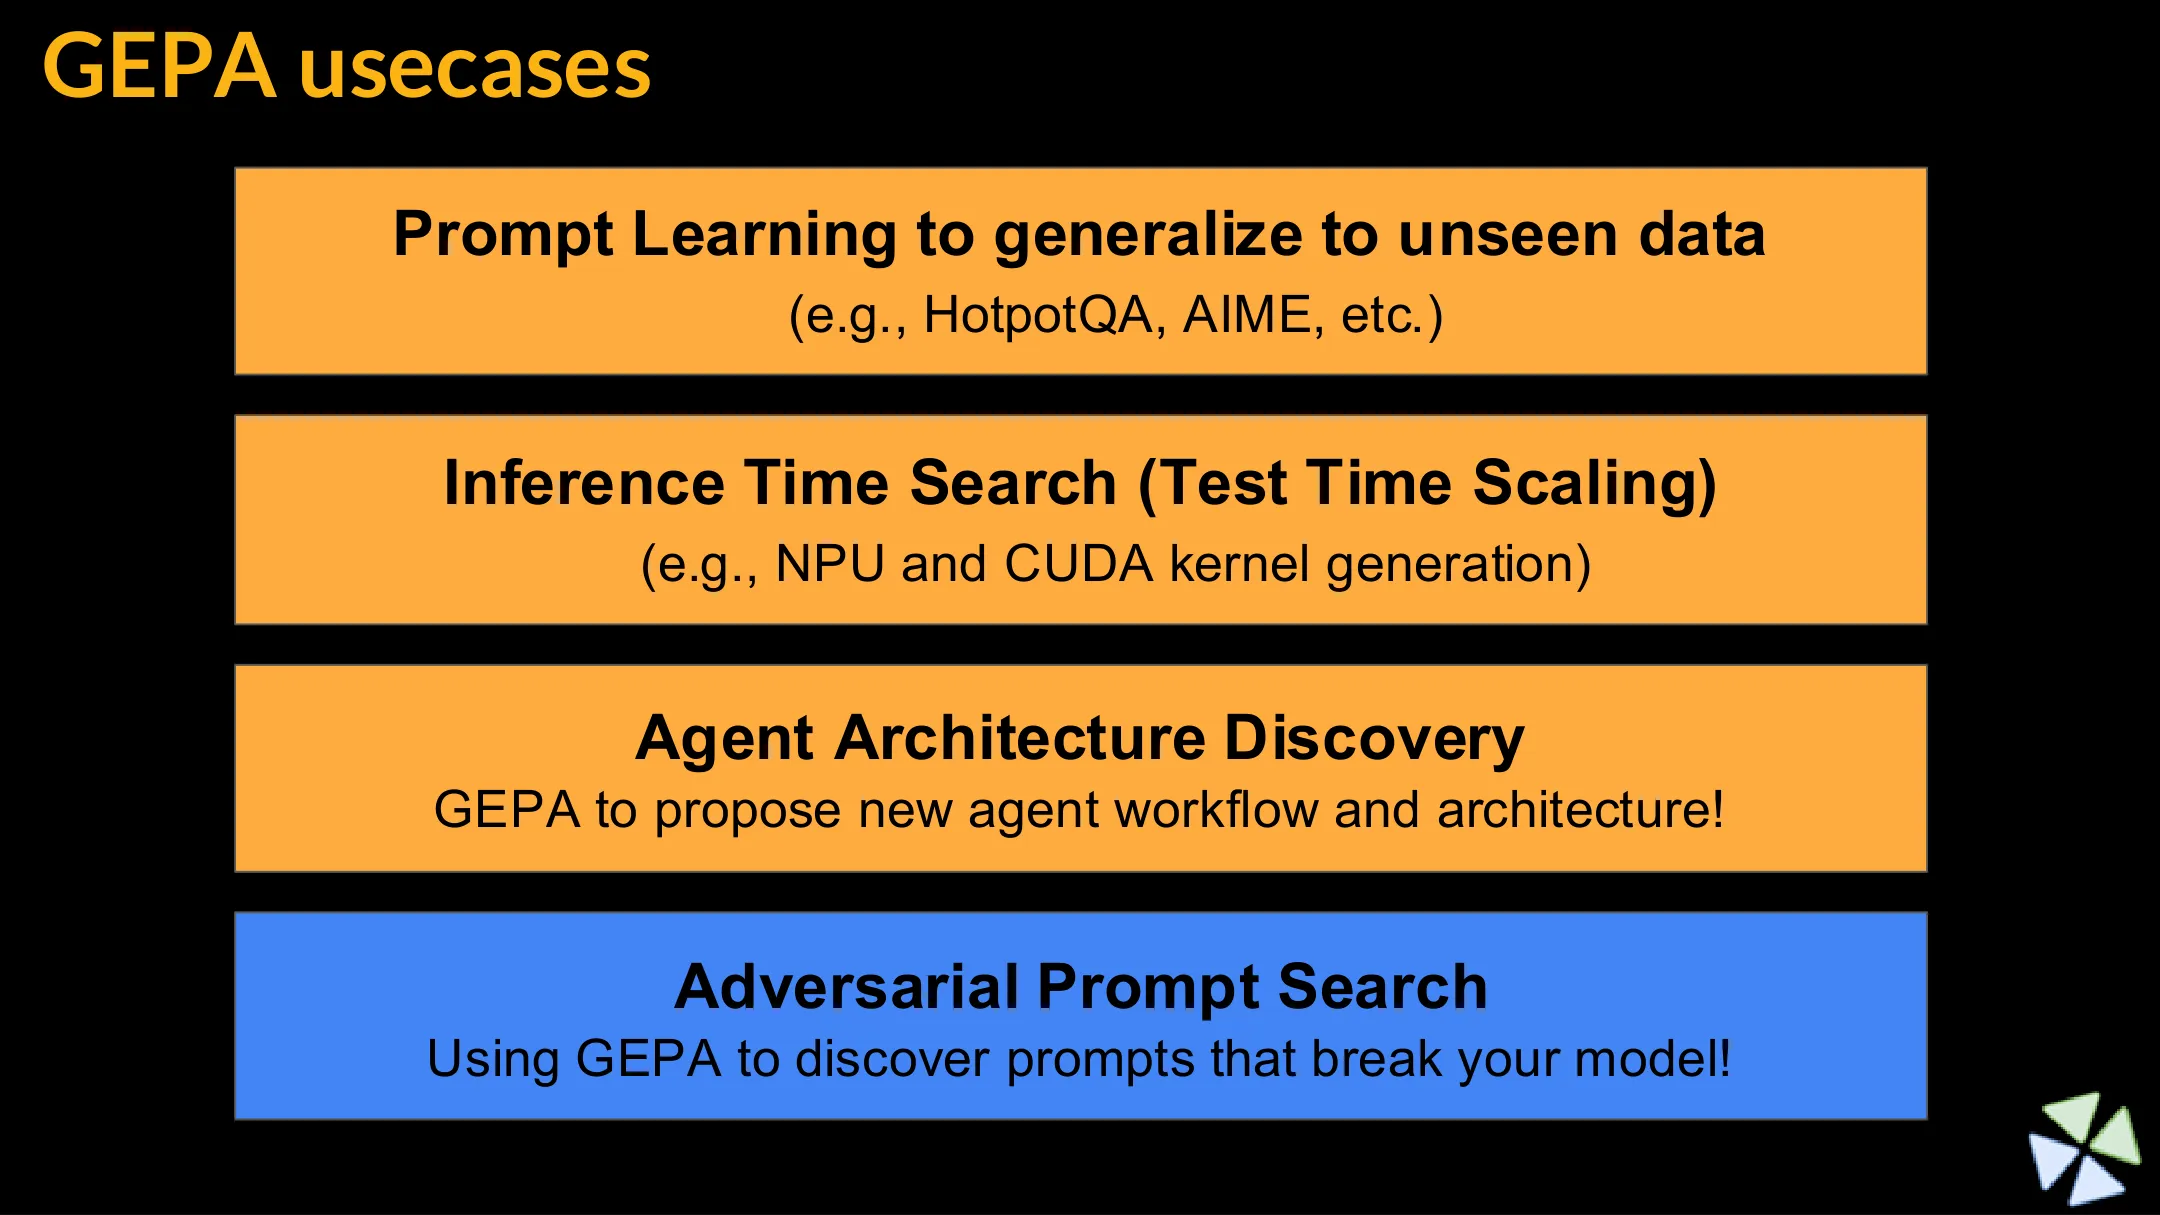
GEPA(Genetic-Pareto,幻灯片名;讲师口头称 JEPA):不更新权重,只优化提示(prompt):
- 让 agent 去解任务、得到轨迹;
- 把轨迹展示给一个 LLM(「这个 agent 想装 Windows,做了……然后失败了,有什么建议?」);
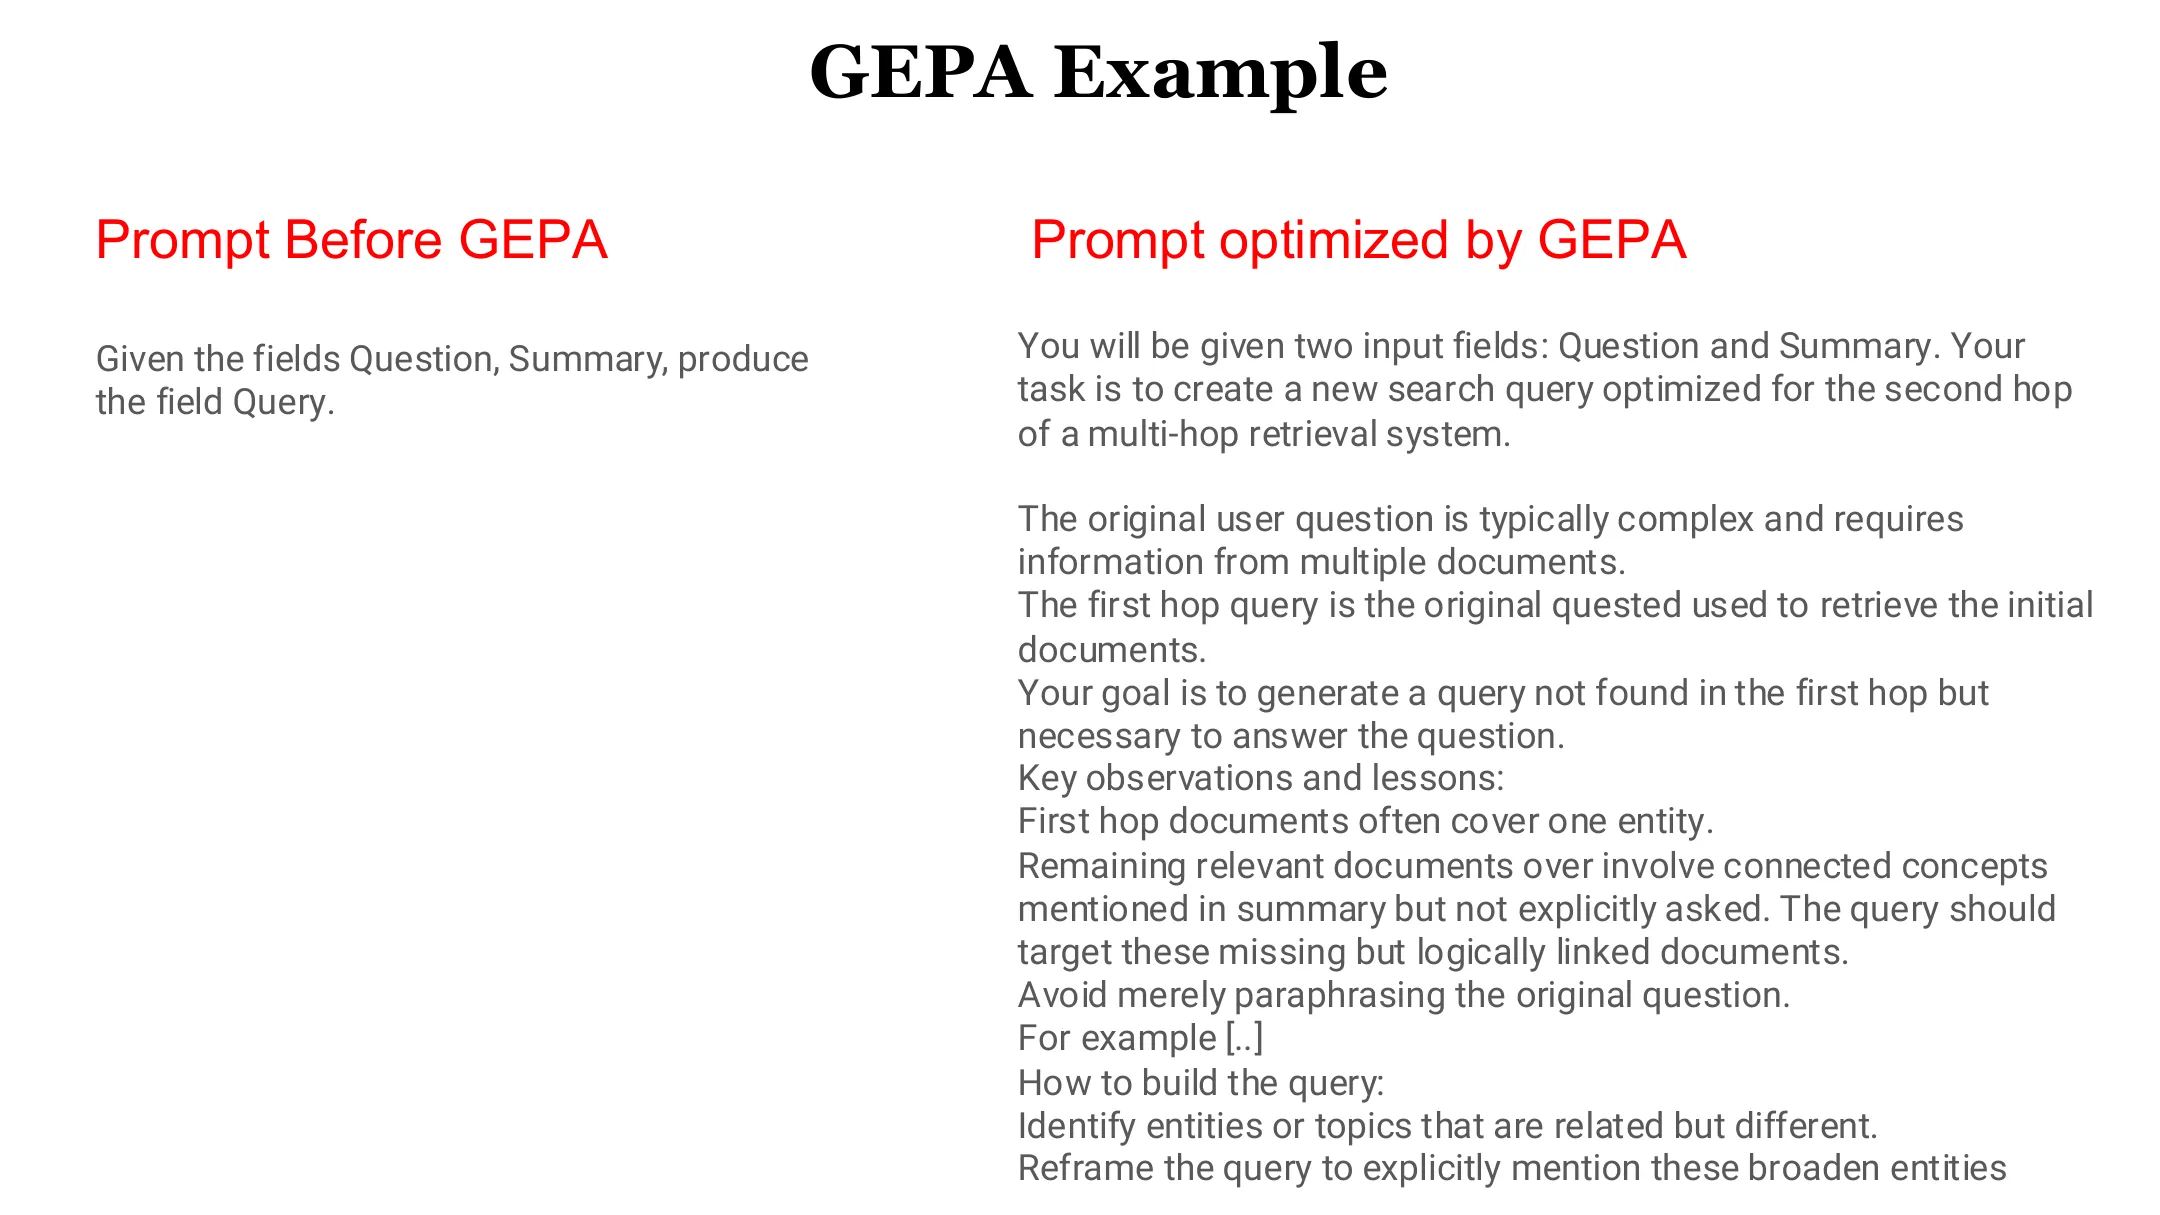
- LLM 产出经验教训,写回系统提示或技能(skill);
- 迭代进行。它是自动化的提示工程(evolutionary-Pareto 策略),可在拿不到权重(如用 Opus)时提升 agent,工业界广泛使用。
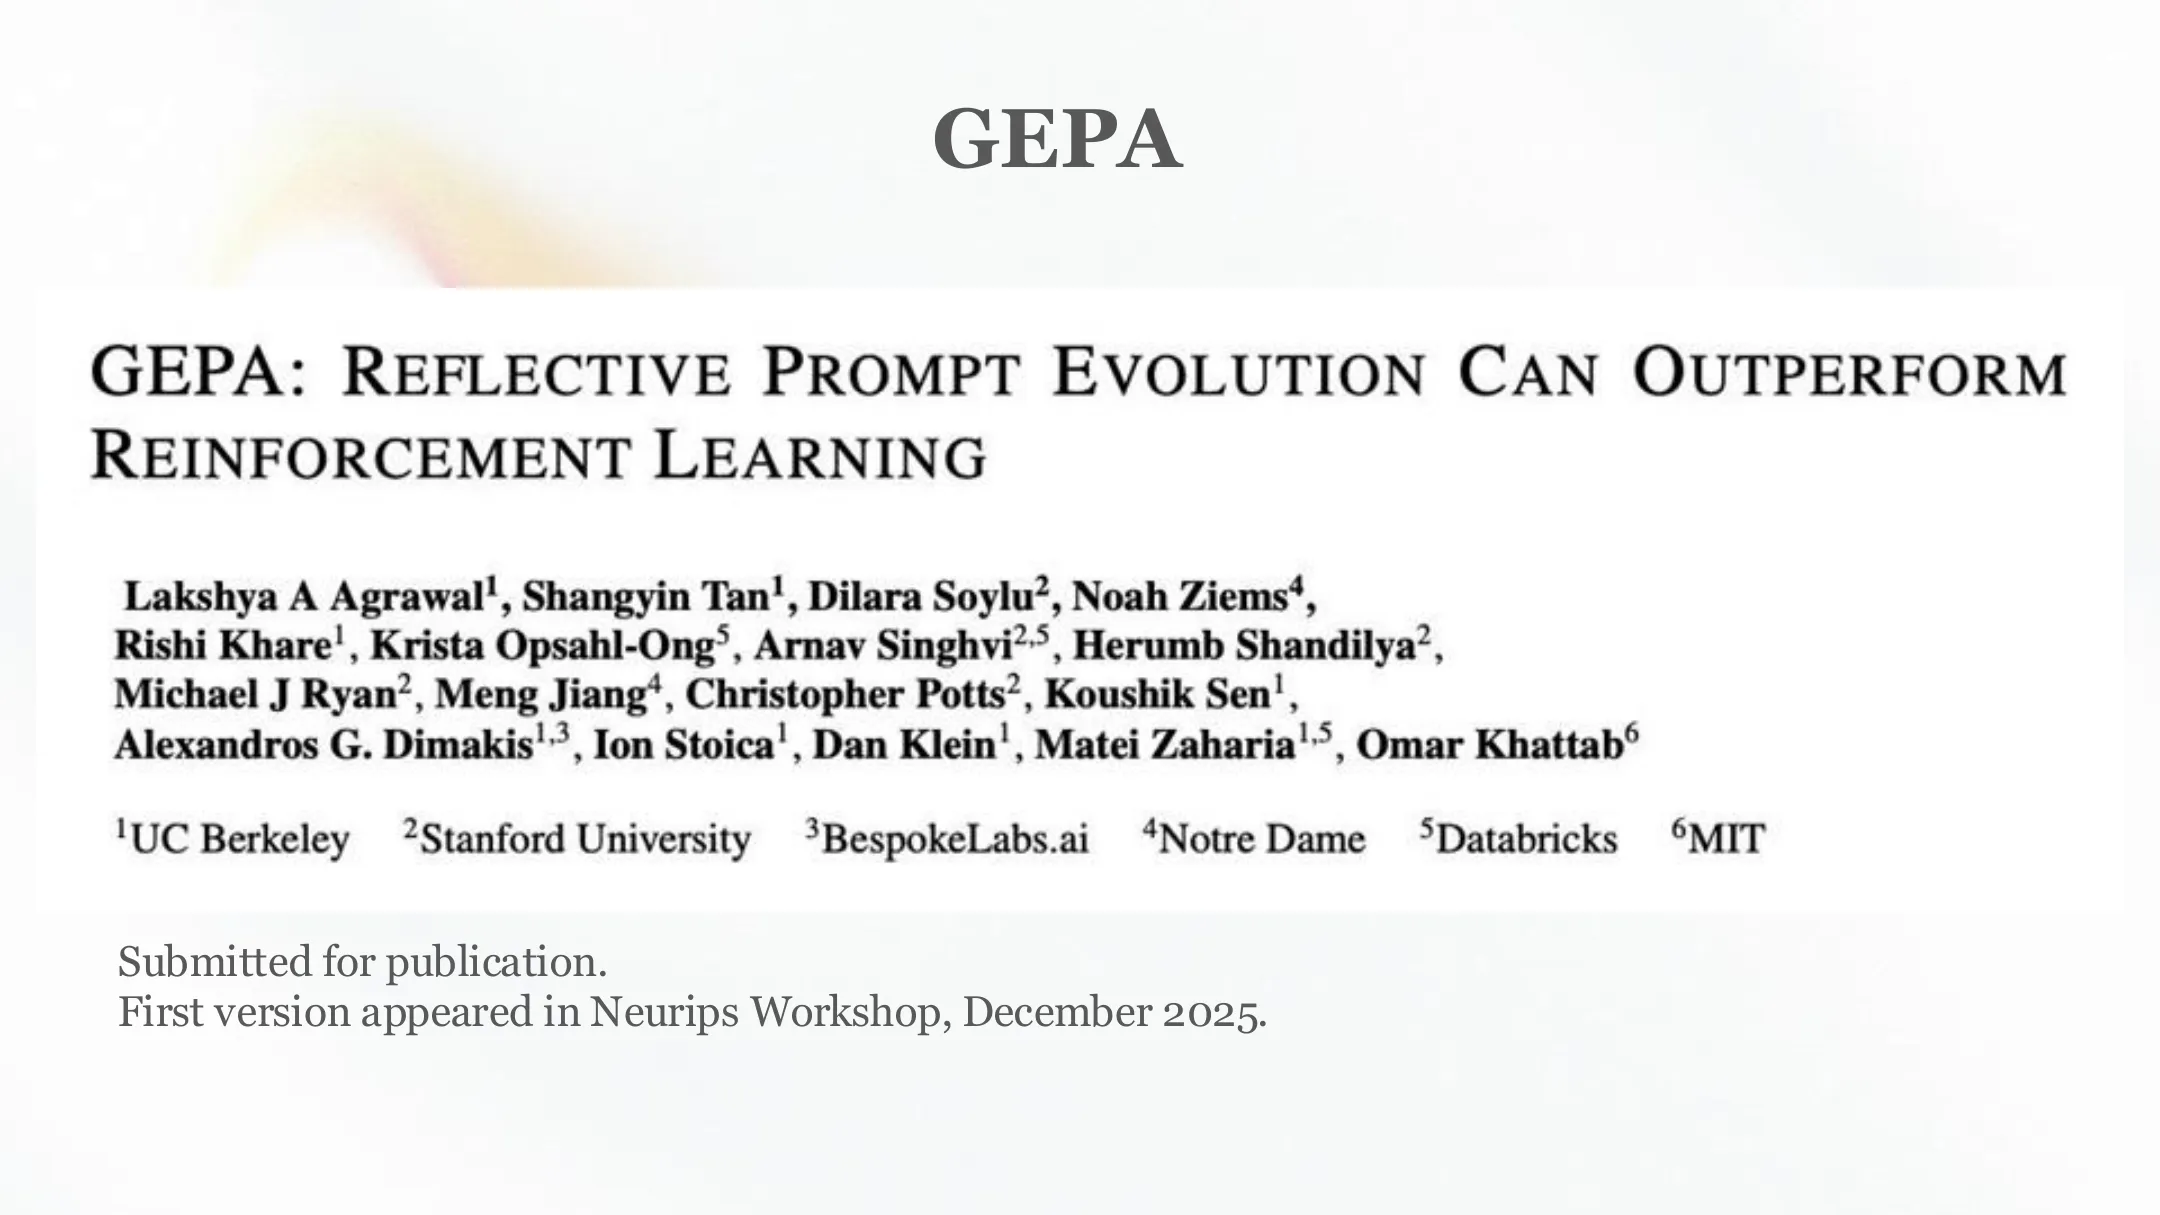
📷 GEPA
回到原视频 (00:52:39)
📷 什么是 GEPA
回到原视频 (00:53:52)
📷 GEPA 样本高效
回到原视频 (00:55:05)
📷 GEPA 示例
回到原视频 (00:56:18)
📷 GEPA 算法
回到原视频 (00:57:31)
📷 GEPA 用例(一)
回到原视频 (00:58:44)
📷 GEPA 用例(二)
回到原视频 (00:59:57)
📷 用 GEPA 发现 Agent 架构(一)
回到原视频 (01:01:10)
📷 用 GEPA 发现 Agent 架构(二)
回到原视频 (01:02:23)
📷 用 GEPA 发现 Agent 架构(三)
回到原视频 (01:03:36)
📷 用 GEPA 发现 Agent 架构(四)
回到原视频 (01:04:49)
📷 用 GEPA 发现 Agent 架构(五)
回到原视频 (01:06:02)
📷 GEPA 用例(三)
回到原视频 (01:07:15)
📷 GEPA 用例(四)
回到原视频 (01:08:28)
📷 用 GEPA 做对抗性提示搜索(一)
回到原视频 (01:09:41)
📷 用 GEPA 做对抗性提示搜索(二)
回到原视频 (01:10:54)
📷 用 GEPA 做对抗性提示搜索(三)
回到原视频 (01:12:07)
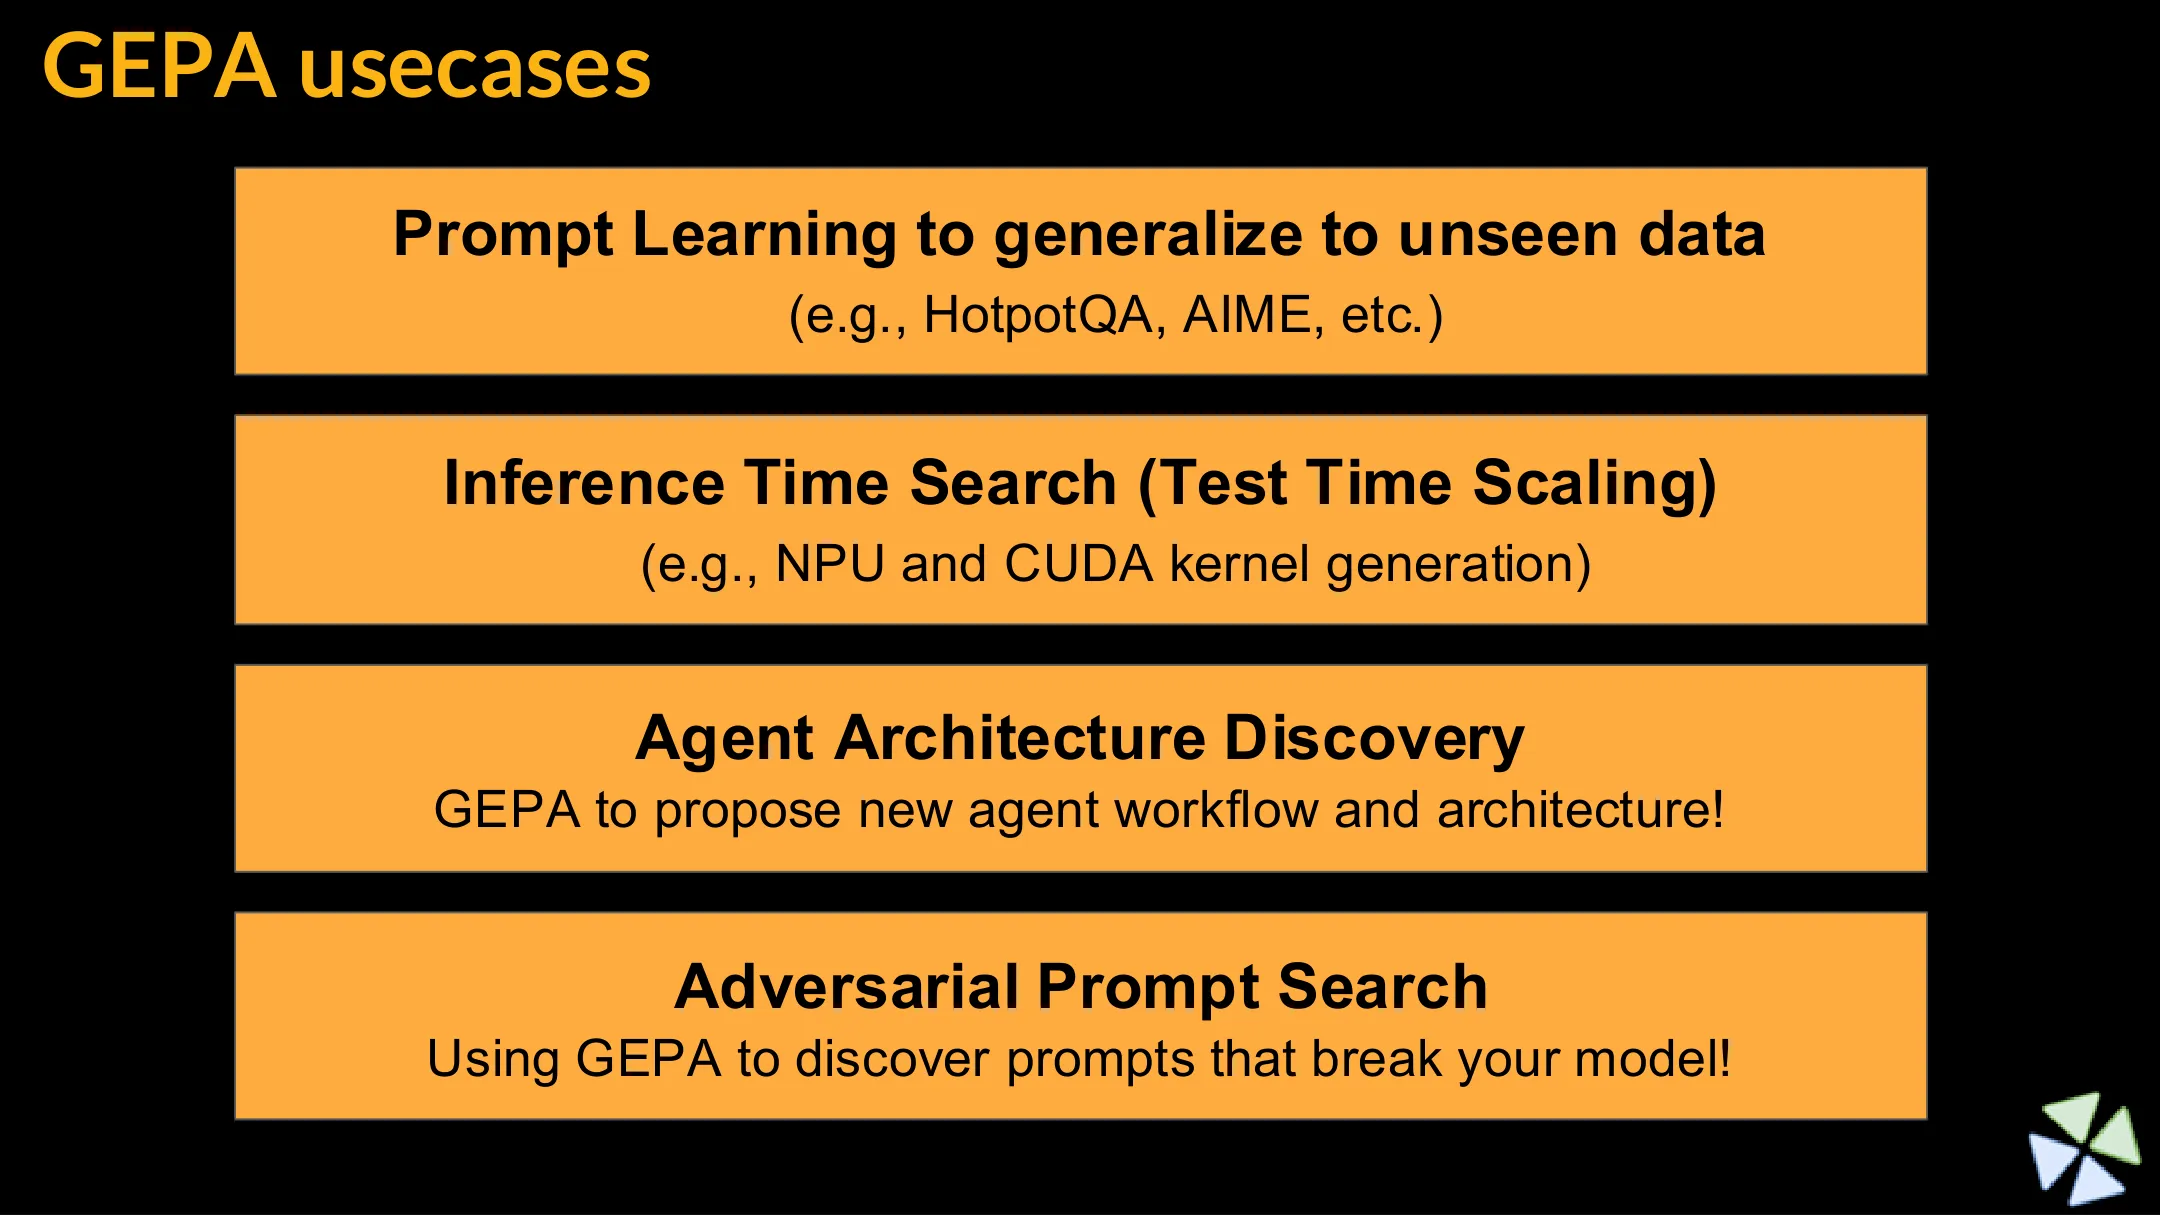
📷 GEPA 用例(五)
回到原视频 (01:13:20)
总结(Takeaways)
- LLM 只吃 token 吐 token;tool use、RAG、硬编码 workflow 都不是 agent。
- 真正的 agent = LLM 在循环里 + 终端(ReAct):自主决定调用、处理返回、持续运行。
- 多智能体系统本质是「多个 prompt」,受长程问题困扰;前沿做法是自主 agent + 环境,稳定性来自让 agent 自己失败并恢复。
- Agent 三阶段:嵌入工具(2020)→ ChatGPT 助手(2022)→ 自主 agent(2025+,如 Claude Code、Open Claw)。
- 评测从「问答」变成「环境」:环境 = 任务描述 + Dockerfile + 可验证的测试;要防 reward hacking 与测试覆盖不足。
- 训练 agent:SFT(学正确轨迹)vs RL/GRPO(自己试,提高正确、降低错误),依赖可验证奖励。
- 文件系统 = agent 的长期记忆;命令行工具(grep/正则)组合优雅,让 agent 能做远超编码的任务。
- GEPA:不更新权重,用 LLM 反思轨迹来自动优化提示(遗传-Pareto / 进化策略)。
附:参考与延伸阅读
| 主题 | 链接 |
|---|---|
| 本讲视频 | https://www.youtube.com/watch?v=yRgSQCXr8M0 |
| 课程主页 | https://eecs189.org/sp26/ |
| 官方讲义/笔记(Lecture 27) | Google Drive PDF |
| Terminal-Bench(ICLR 2026)与 Harbor 框架 | agent 环境基准 |
| Yao et al., ReAct: Synergizing Reasoning and Acting | Reason+Act 循环 · https://arxiv.org/abs/2210.03629 |
| GEPA(Genetic-Pareto) | 自动提示优化 |
| MMLU | LLM 问答评测 · https://arxiv.org/abs/2009.03300 |
| DCLM / DataComp-LM | 预训练语料清洗 · https://arxiv.org/abs/2406.11794 |
版权说明:本讲视频、幻灯片与课程材料版权归 UC Berkeley EECS 189/289A 课程团队所有。本书为课堂内容的学习性中文重构,仅供学习交流。
全书完。本讲是 EECS 189(2026 春季)课堂重构系列的最后一册。感谢阅读!