第1讲 · 手把手入门神经网络与反向传播:从零构建 micrograd
本电子书由教学视频重构而成。 视频原标题:The spelled-out intro to neural networks and backpropagation: building micrograd 书中代码、数据集与图片版权归原作者 Andrej Karpathy 所有。本文为课堂讲解的中文书面重构,仅供学习交流。
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=VMj-3S1tku0 |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 本讲课件 Notebook | https://github.com/karpathy/nn-zero-to-hero/tree/master/lectures/micrograd |
| 完整实现(micrograd 仓库) | https://github.com/karpathy/micrograd |
| 📝 练习(Exercises) | Karpathy 亲自出的配套习题,一个 Google Colab:https://colab.research.google.com/drive/1FPTx1RXtBfc4MaTkf7viZZD4U2F9gtKN?usp=sharing |
| 讨论区 | 官方 Discord:https://discord.gg/3zy8kqD9Cp(也可用视频评论区) |
| 后续讲次 | makemore 系列、GPT from scratch、Tokenizer、GPT-2 复现 |
对应讲次:第1讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者拓展|为什么这一讲值得"动手做练习":看视频是输入,做练习才是输出。Karpathy 在这一讲的描述里专门放了一个 Colab 习题集——它们不会太难,但会逼你把「看懂」变成「写出来」。强烈建议在看完每一节后,切到那个 Colab 把对应的练习题做掉;做不出来再回来看书。这个系列后续每一讲基本都有配套练习,请养成习惯。
引子:训练神经网络,底下到底发生了什么?
(参考时间: 00:00)
讲师(Andrej Karpathy)说,他训练深度神经网络已经十多年了;这一讲要从一张空白的 Jupyter Notebook 开始,到结尾定义并训练一个神经网络,并且把底下发生的每一件事都摊开给你看。
具体来说,我们要一层层搭出 micrograd——他两年前发布在 GitHub 上的一个库,当时只上传了源码,需要读者自己去啃。这一讲会带着你一步一步把它写出来。
编者拓展|micrograd 是什么:micrograd 是一个「自动求导引擎」(autograd engine)——它的全部工作就是实现反向传播。它只支持标量(scalar)运算,不能用来训练真正的生产模型(真正的库用 tensor),但它把「反向传播 + 链式法则 + 神经网络训练」的数学内核用 ~150 行 Python 讲得清清楚楚。
它为什么重要:PyTorch、JAX 这些库的核心,就是同一个东西——只不过它们把成千上万个标量打包成张量、用并行硬件跑得飞快。「除了效率之外,别无新事」(everything else is just efficiency)。
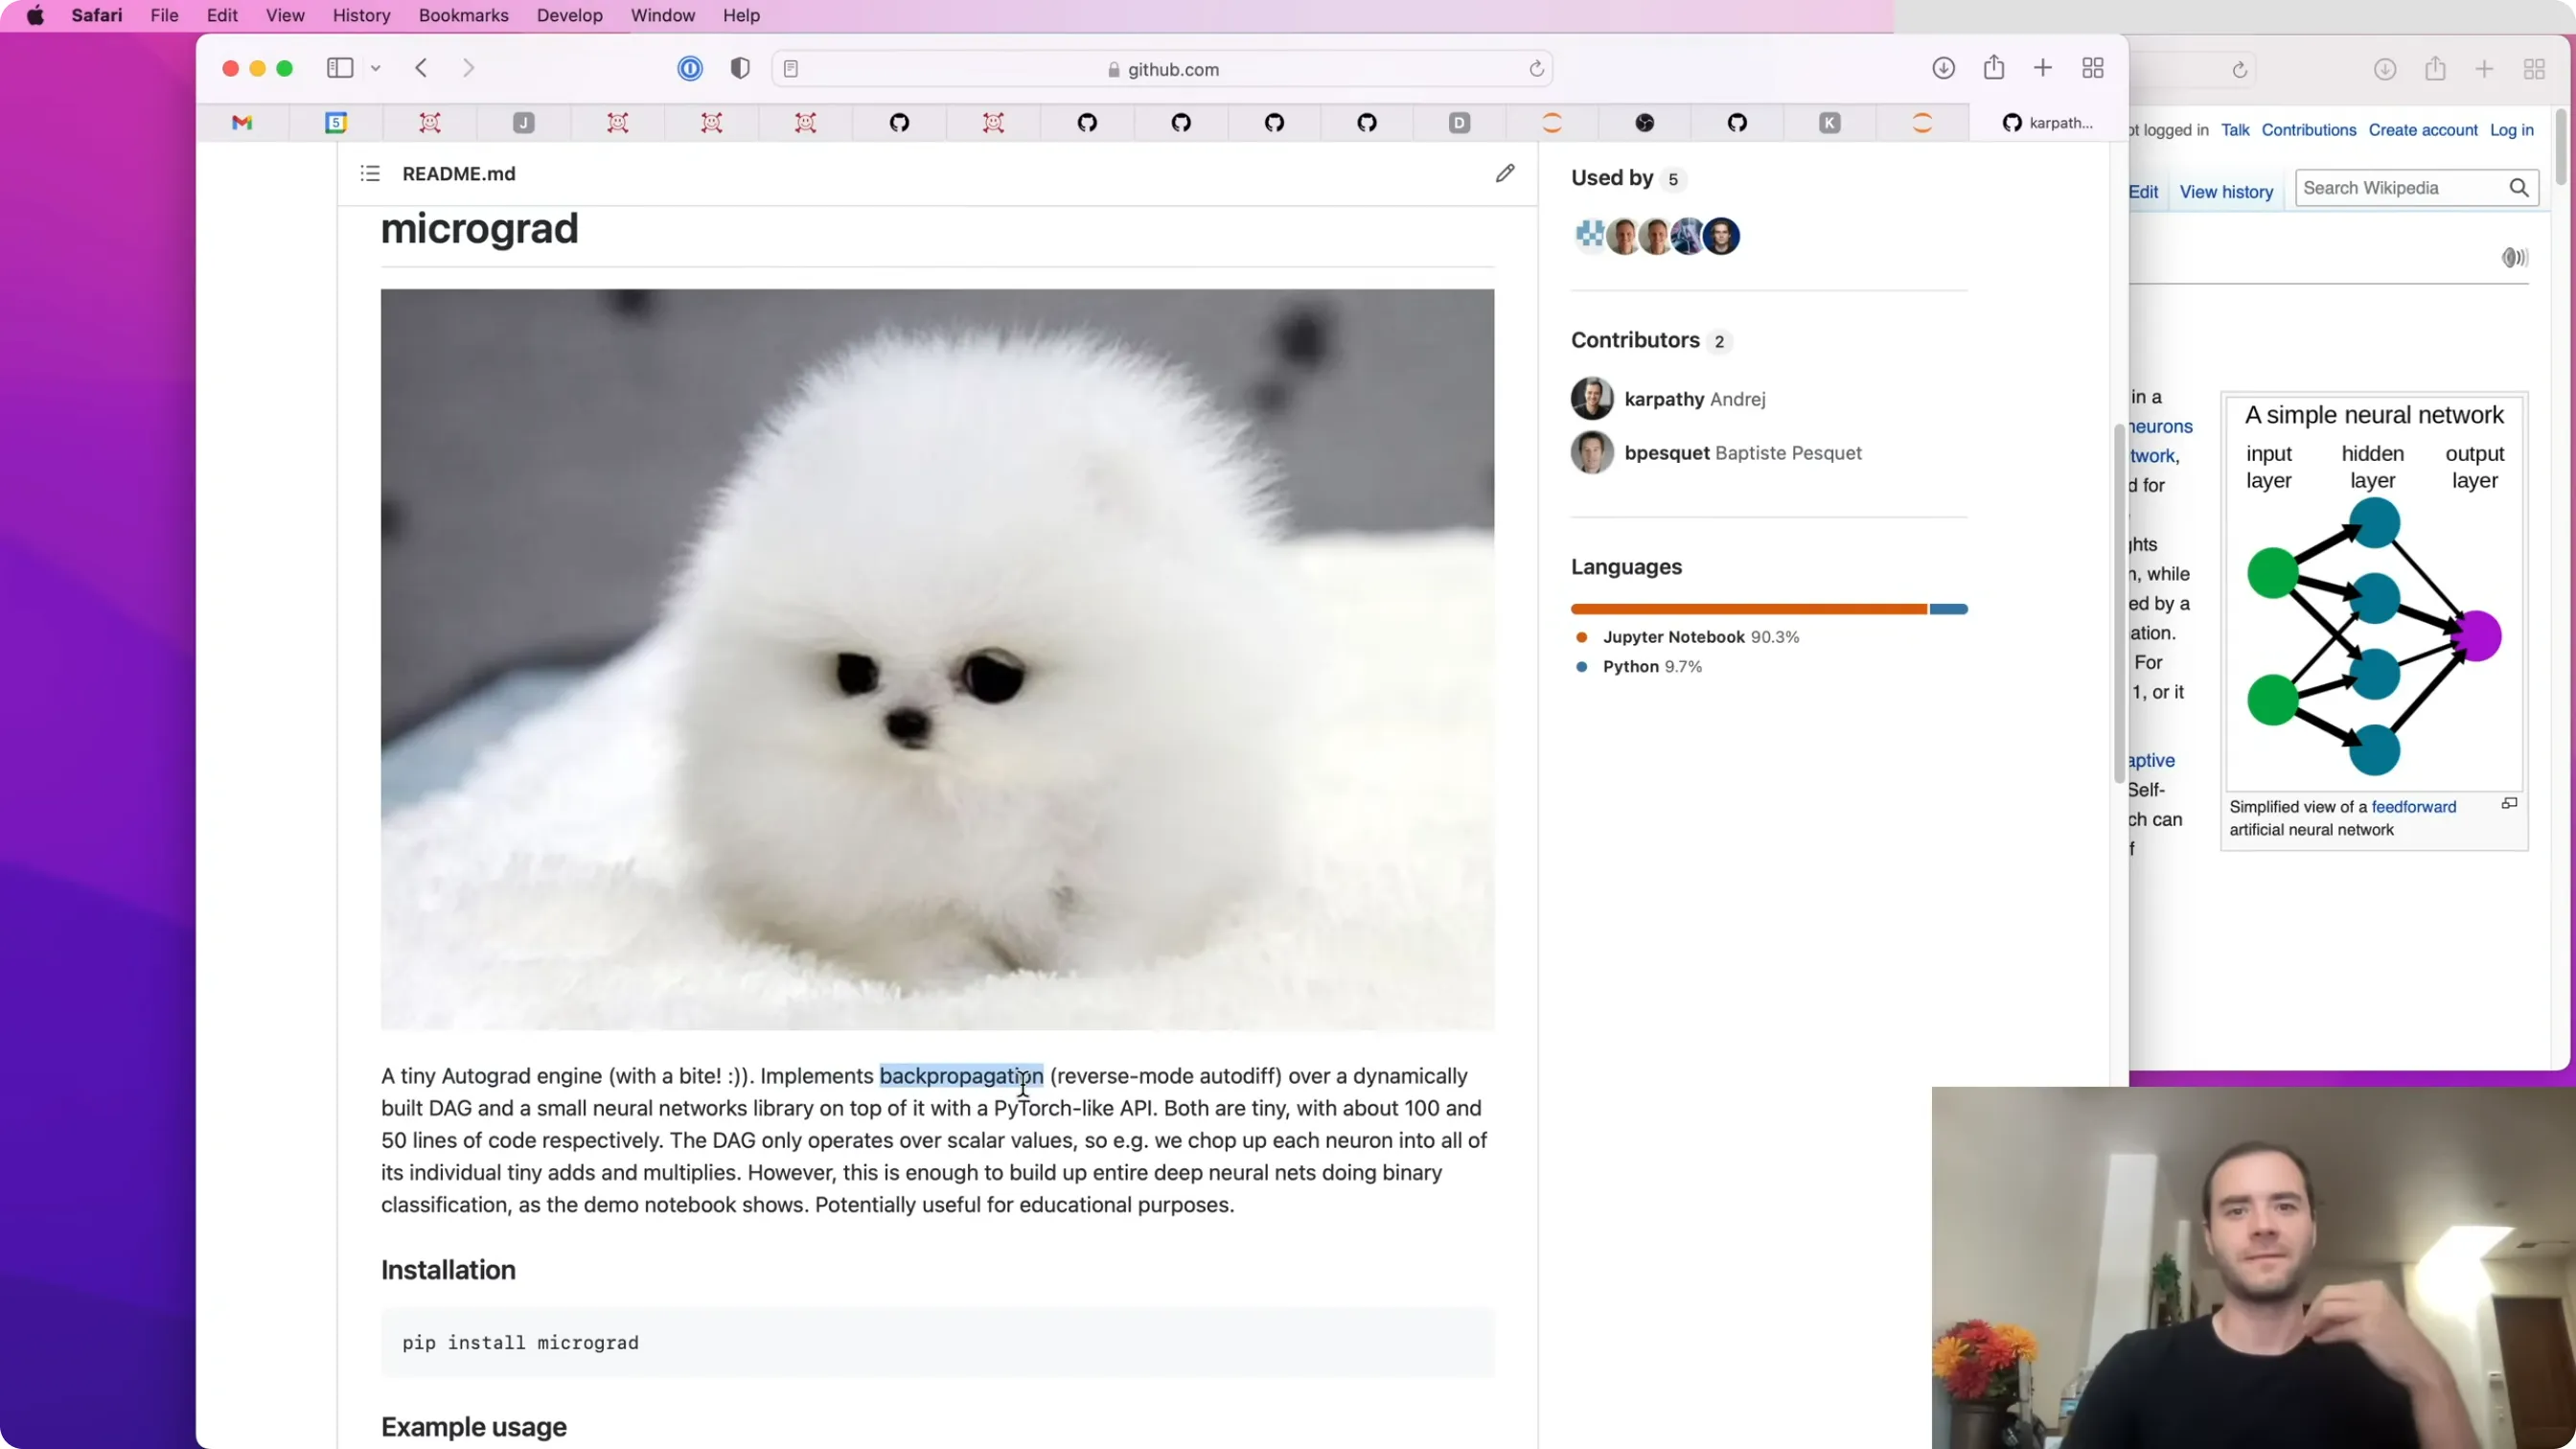
📷 micrograd 的示例表达式图:两个输入 a、b 经过一串运算得到输出
回到原视频 (00:01:00)
micrograd 长什么样
(参考时间: 00:25)
看一个例子:给两个输入 a = -4、b = 2,把它们的值包进一个 Value 对象,然后写一段表达式:a、b 先算出 c、d,再算 e、f,最后得到 g。micrograd 会在背后记录整张表达式图:它知道 c 是「一次加法」的结果、它的子节点是 a 和 b,并持有指向它们的指针。
- 前向传播:读
g.data,得到结果(这个例子是 24.7); - 反向传播:调用
g.backward(),它从g出发,沿着表达式图反向走,递归地应用微积分里的链式法则,算出g对每一个中间节点(e、d、c)以及对输入a、b的导数。
你可以查询 a.grad(这个例子是 138)和 b.grad(645)。这些导数是关键信息:a.grad = 138 说明「把 a 稍微调大一点,g 会增大,增大的斜率是 138」。
编者拓展|这一讲的地基:「导数」到底在说什么:整个深度学习只依赖一件事——梯度告诉你"往哪个方向动参数,损失会变大/变小,以及变化多快"。
a.grad = 138的完整含义是:$g$ 对 $a$ 的偏导数是 138,即 $\partial g/\partial a = 138$。于是「想让 $g$ 变大」就该让 $a$ 朝正方向动一小步;「想让损失变小」就该让参数朝梯度的反方向动(这就是梯度下降)。
两个要点:
- 神经网络只是"一类"数学表达式(甚至比上面这个例子还简单),它把输入数据和权重都当作输入,输出预测(或损失)。但反向传播本身更通用——它根本不在乎"神经网络",它作用于任意数学表达式;
- micrograd 是标量引擎,把神经网络拆到「一个个标量、一个个加号乘号」的原子级别。生产环境当然不会这么做——「纯粹出于教学目的」,让我们不必一开始就面对 N 维张量。
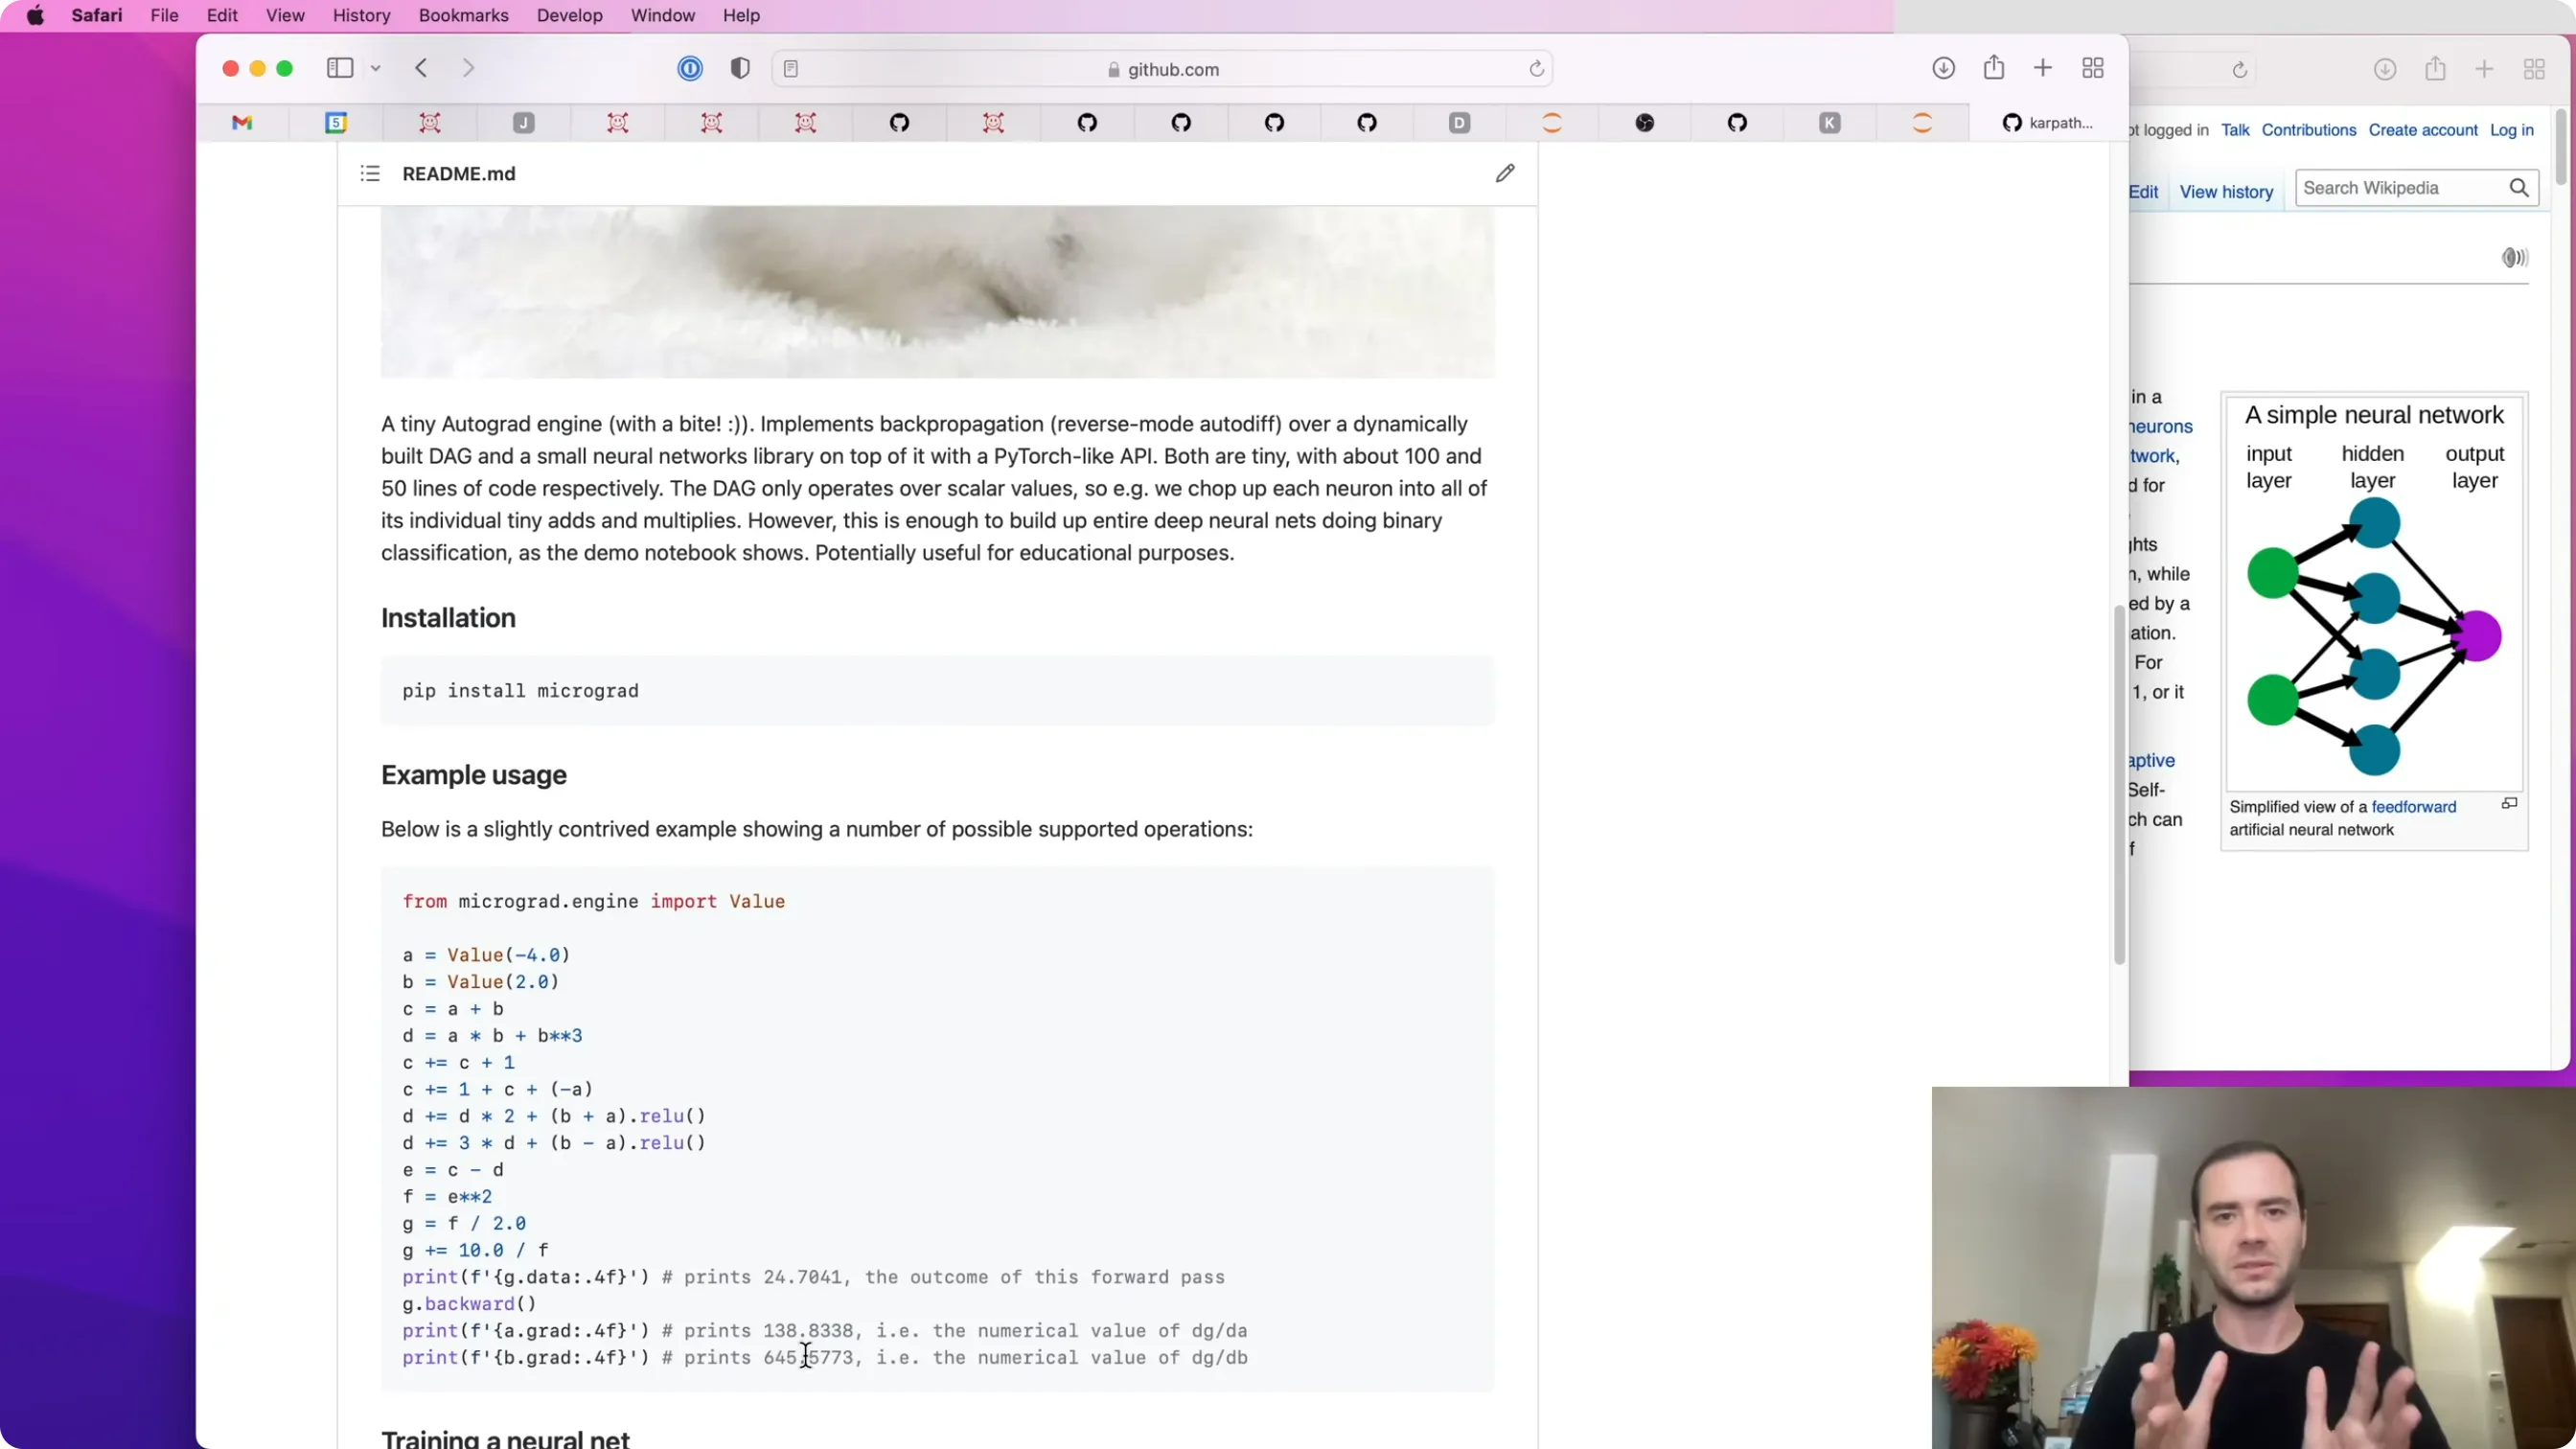
📷 micrograd 的 README 示例:a、b 经过 c/d/e/f 得到 g,并可查询 grad
回到原视频 (00:04:00)
一、什么是导数:先建立直觉
1.1 单输入函数
(参考时间: 00:08)
先定义一个单变量标量函数 $f(x)$(讲师随手写了一个,其实是条抛物线 $3x^2 - 4x + 5$):
def f(x):
    return 3*x**2 - 4*x + 5

f(3.0)   # 20.0
用 numpy 取 $-5$ 到 $5$ 的点、画出来,得到一条抛物线。
传统的做法是「符号求导」:在纸上用求导法则把 $f'(x)$ 推导出来,再代点进去。但神经网络里没人这么做——因为真实网络的表达式有成千上万项,没人真的把它求导出来。
所以我们换一种方式:看导数的定义。
$$f'(x) = \lim_{h\to 0}\frac{f(x+h) - f(x)}{h}$$
它的意思是:在 $x$ 处把输入轻轻增加一点点 $h$,函数会怎么响应?响应的斜率是多少?
我们取一个很小的 $h = 0.001$ 来数值近似导数:
h = 0.001
x = 3.0
(f(x + h) - f(x)) / h     # ≈ 14.0
在 $x=3$ 处,$f(x+h)$ 比 20 略大(因为抛物线在这里在上升),算出来斜率约 14。手算验证:$f'(x) = 6x - 4$,代入 $x=3$ 得 $18-4=14$ ✅。
再看几个点:
- $x = -3$:往正方向动一点,函数会下降(斜率为负),约 $-22$;
- $x = 2/3$:这里是抛物线的最低点,斜率恰为 0。
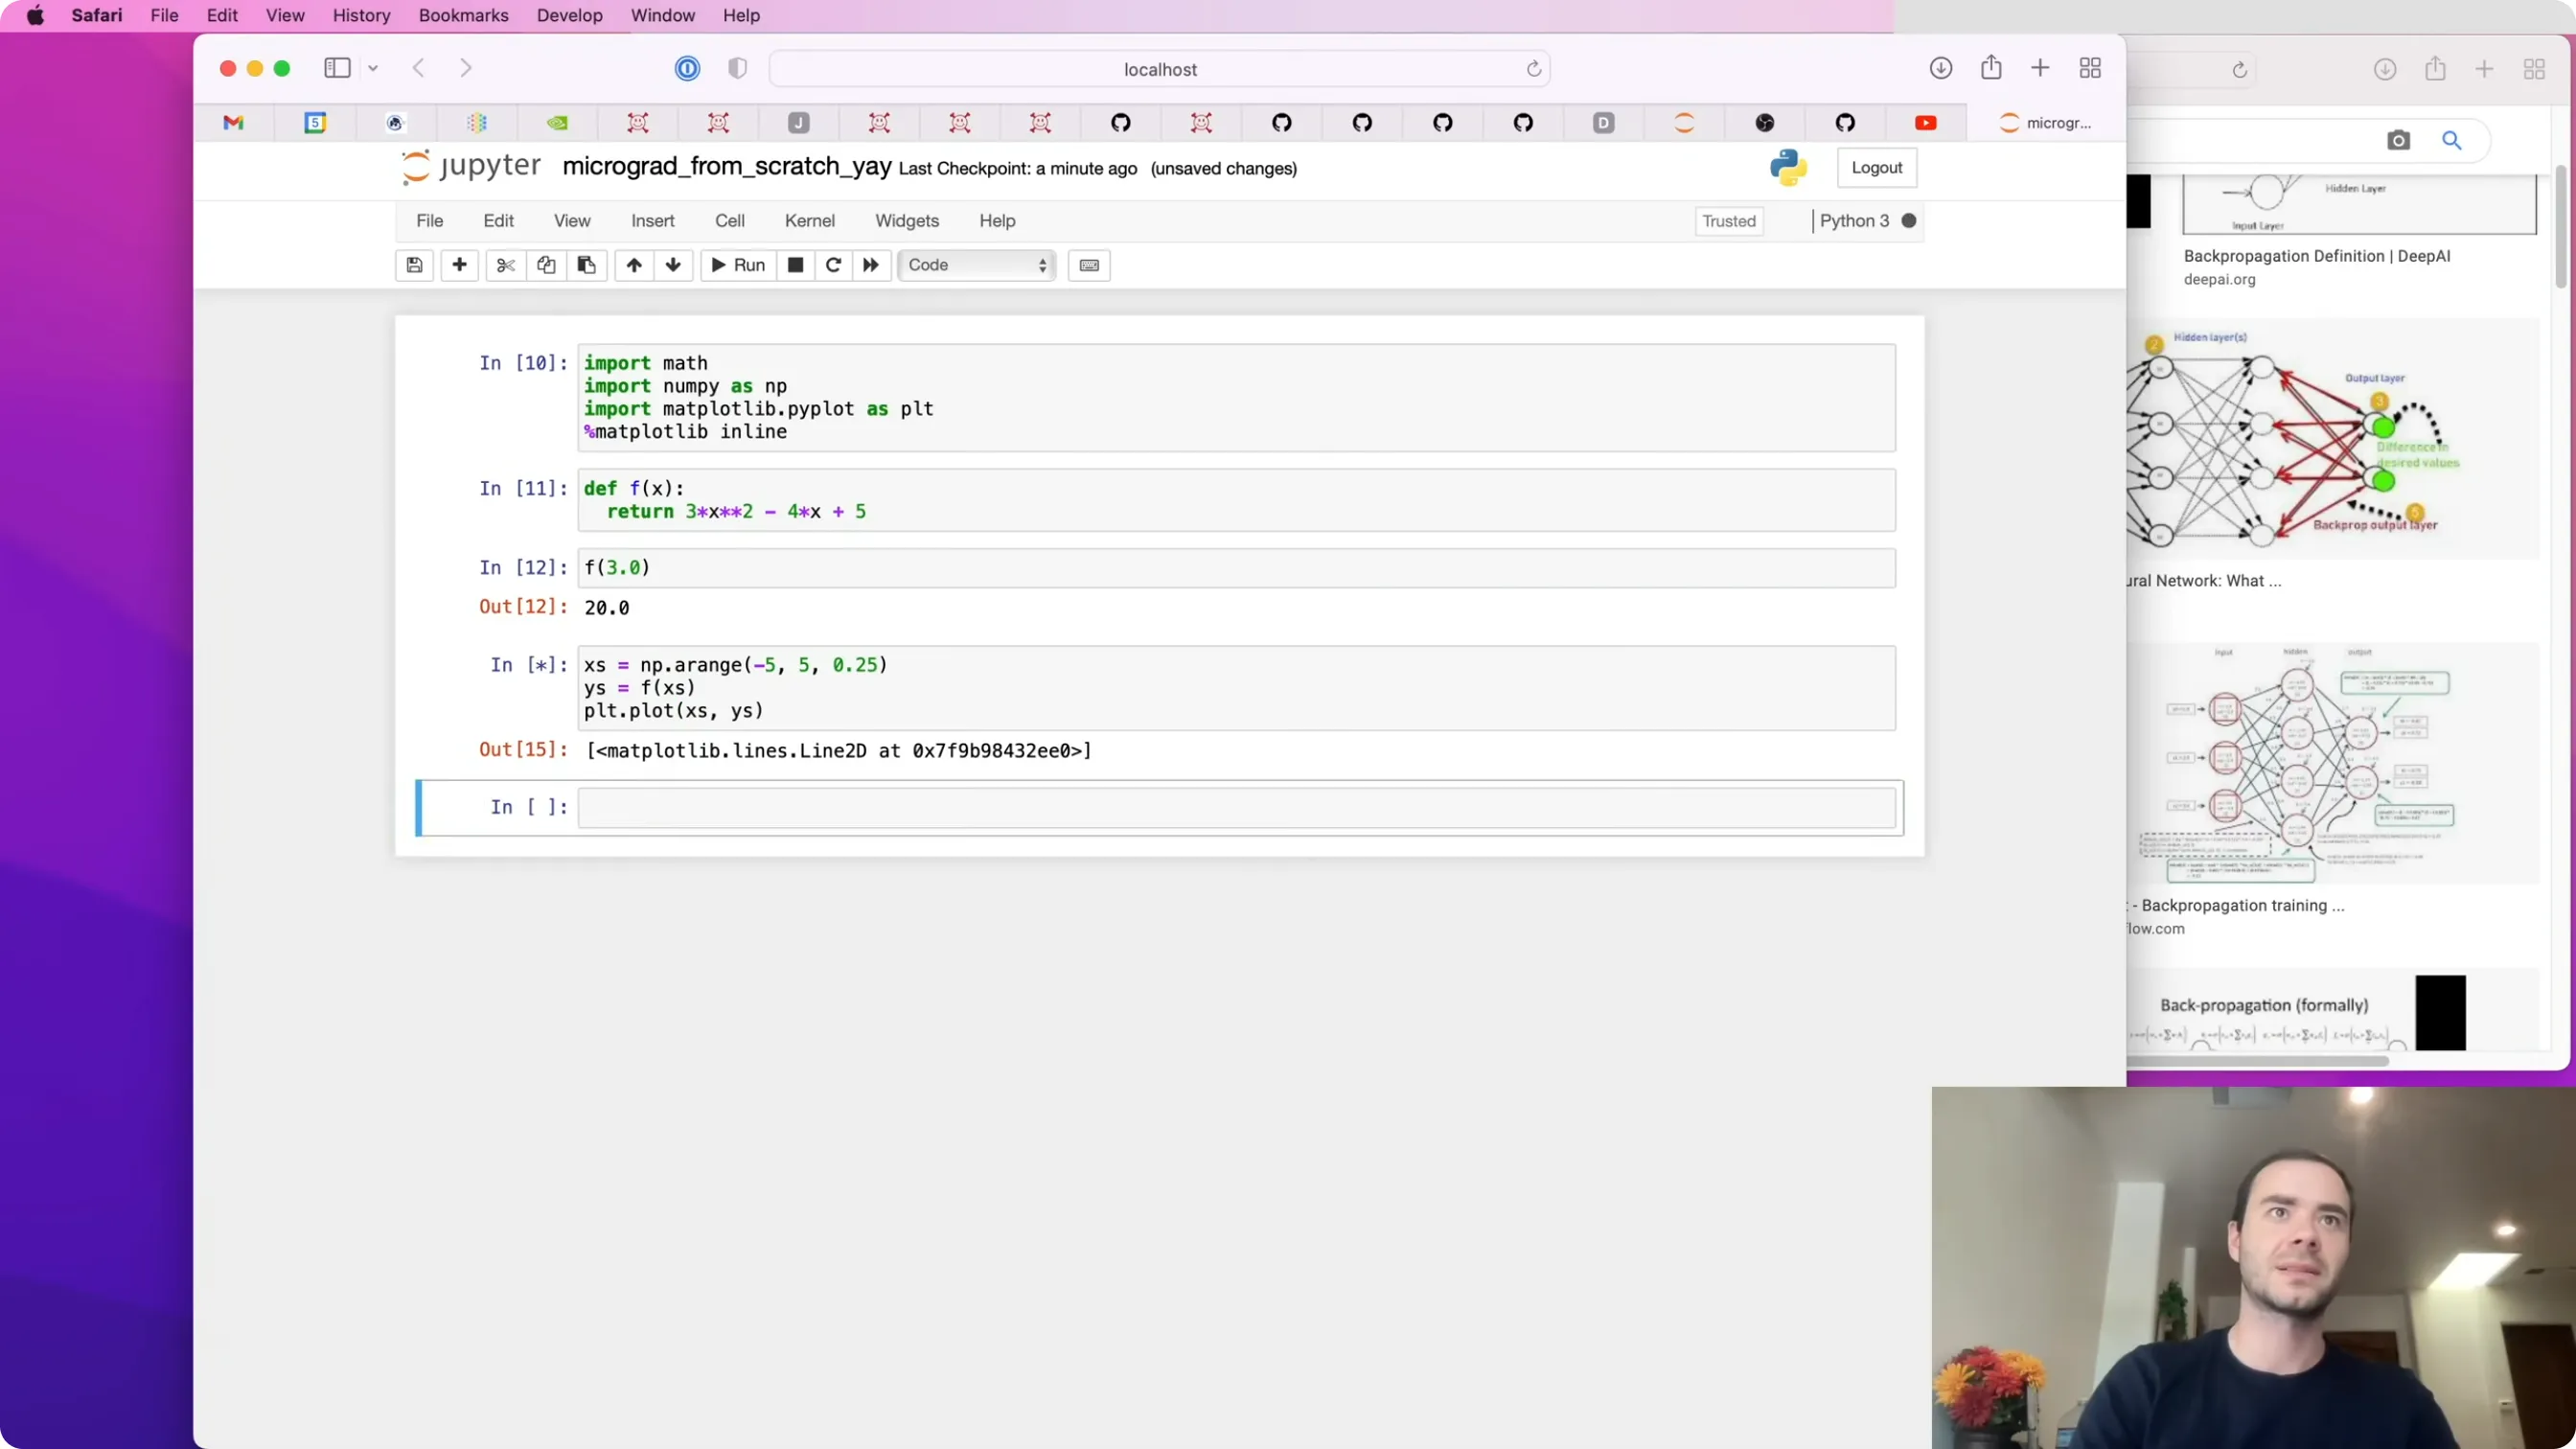
📷 抛物线 f(x) = 3x² − 4x + 5 与它的斜率
回到原视频 (00:09:30)
编者拓展|数值求导 vs 符号求导 vs 自动求导:这里有三种"求导"。 - 数值求导(上面用的):$f'(x) \approx (f(x+h)-f(x))/h$。好写、好验证,但有浮点误差($h$ 太小会因相减相消而失真),而且慢(每个参数要正反算两次); - 符号求导:像数学课那样推导出公式。表达式会爆炸; - 自动求导(autograd):就是本讲要造的——用链式法则在计算图上一路回传,既精确又快。PyTorch/JAX/micrograd 都是这个。
顺带一提:数值求导虽然慢,却是"检查反向传播写没写对"的黄金标准——后面你会看到讲师反复用它来 gradient check(梯度检查)。
1.2 多输入函数
(参考时间: 00:14)
现在换成三个输入、一个输出:
a, b, c = 2.0, -3.0, 10.0
d = a*b + c          # 4.0
要算 $\partial d/\partial a$、$\partial d/\partial b$、$\partial d/\partial c$:把待求的那个输入加一个 $h$,其余固定,看 $d$ 变多少,再除以 $h$:
def dd_a():
    a = 2.0; b = -3.0; c = 10.0
    d1 = a*b + c
    a += h
    d2 = a*b + c
    print((d2 - d1)/h)
先用直觉想:a 稍微变大,因为 b = -3 是负数,a*b 其实会变小,所以 $d$ 会下降——斜率应为负。结果约 −3。手算验证:$\partial(a b + c)/\partial a = b = -3$ ✅。
- $\partial d/\partial b = a = 2$;
- $\partial d/\partial c = 1$($c$ 直接相加,加多少就涨多少)。
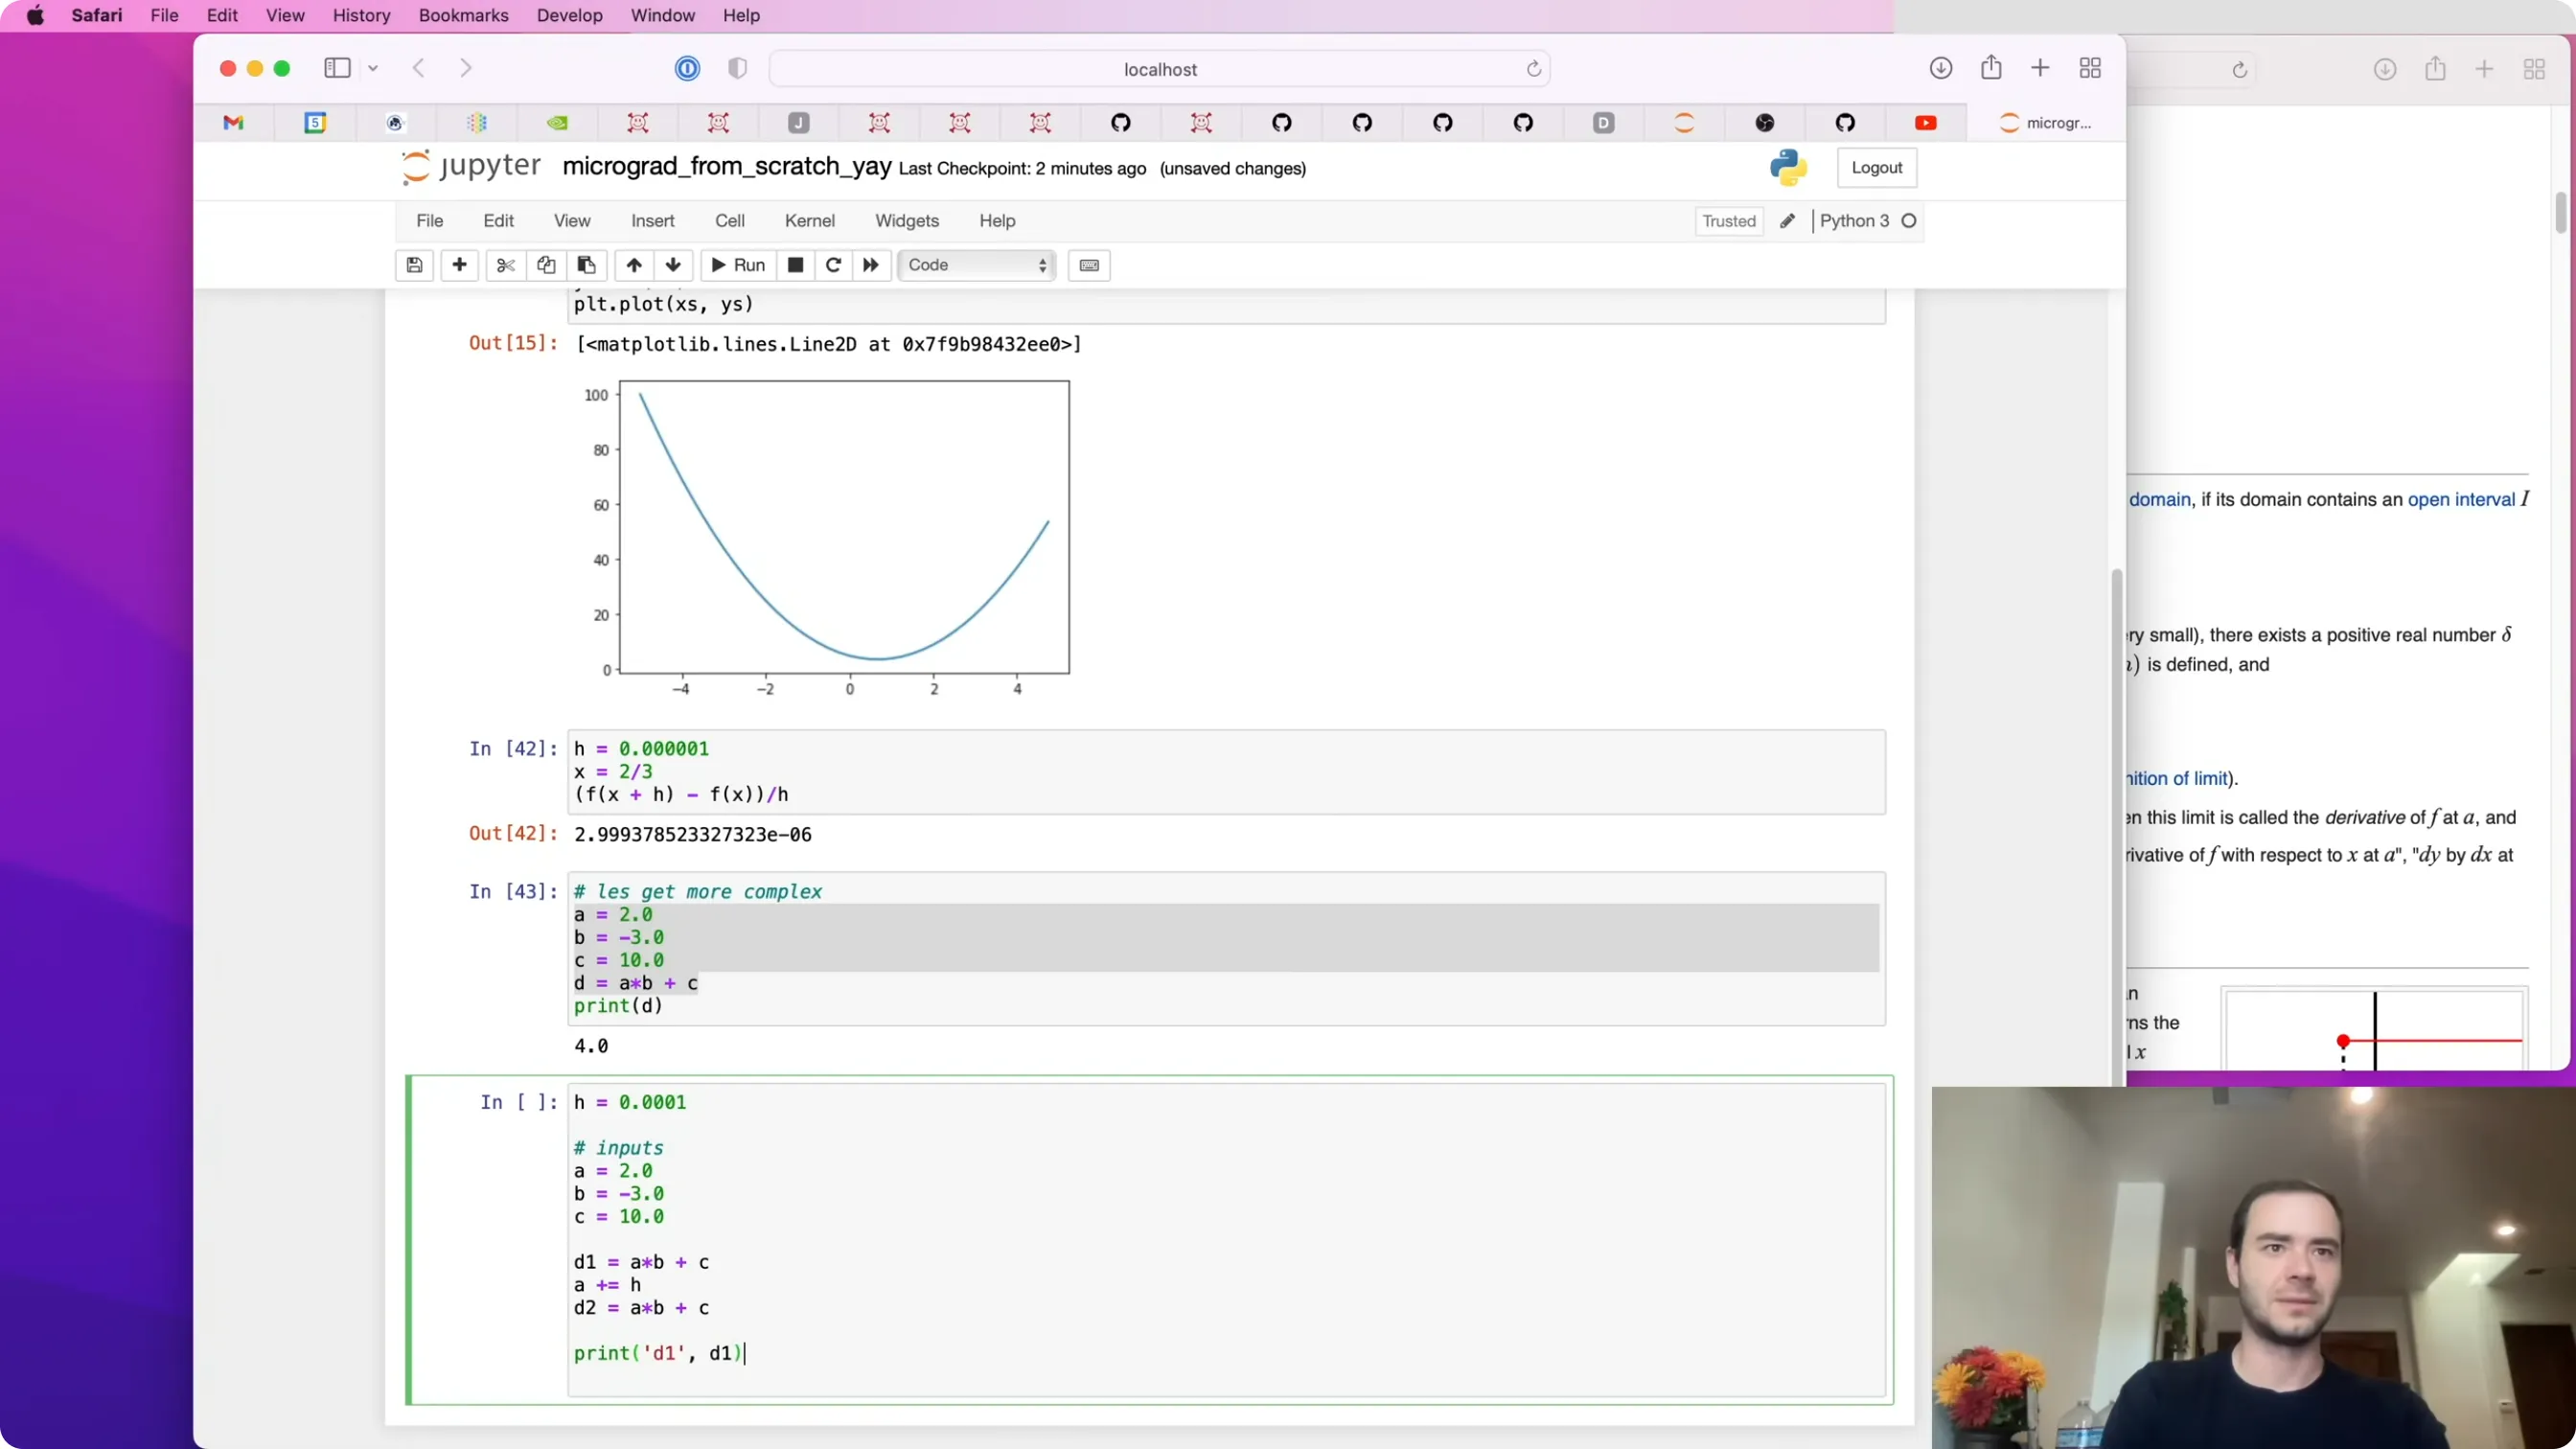
📷 多输入函数 d = a·b + c 的三个偏导数
回到原视频 (00:15:30)
编者拓展|为什么
a变大,d反而变小?:这是初学者最容易卡住的地方——导数的"符号"和"数值"都很重要。这里 $b=-3$,所以a增大 1,乘积 $a\cdot b$ 减少 3,$d$ 净减 3,于是 $\partial d/\partial a<0$。梯度是"带符号的敏感度",不是"变化量"。
二、从零构建 Value 对象
2.1 一个能"记住来源"的标量
(参考时间: 00:19)
神经网络是巨大的表达式,需要一种数据结构来维护这些表达式。于是我们定义 Value 类:它包住一个标量,并且记住它是怎么来的。
第一步,只需要包住 data 和漂亮的打印:
class Value:
    def __init__(self, data):
        self.data = data

    def __repr__(self):
        return f"Value(data={self.data})"

Value(2.0)      # Value(data=2.0)
但 Value(2.0) + Value(-3.0) 会报错——Python 不知道两个 Value 怎么相加。于是要实现运算符重载(Python 的双下划线方法):
class Value:
    ...
    def __add__(self, other):
        out = Value(self.data + other.data, (self, other), '+')
        return out
a + b 会内部调用 a.__add__(b),返回一个新的 Value,其 data 是两个数字的浮点加法结果。
同样地实现 __mul__:a * b → Value(a.data * b.data)。
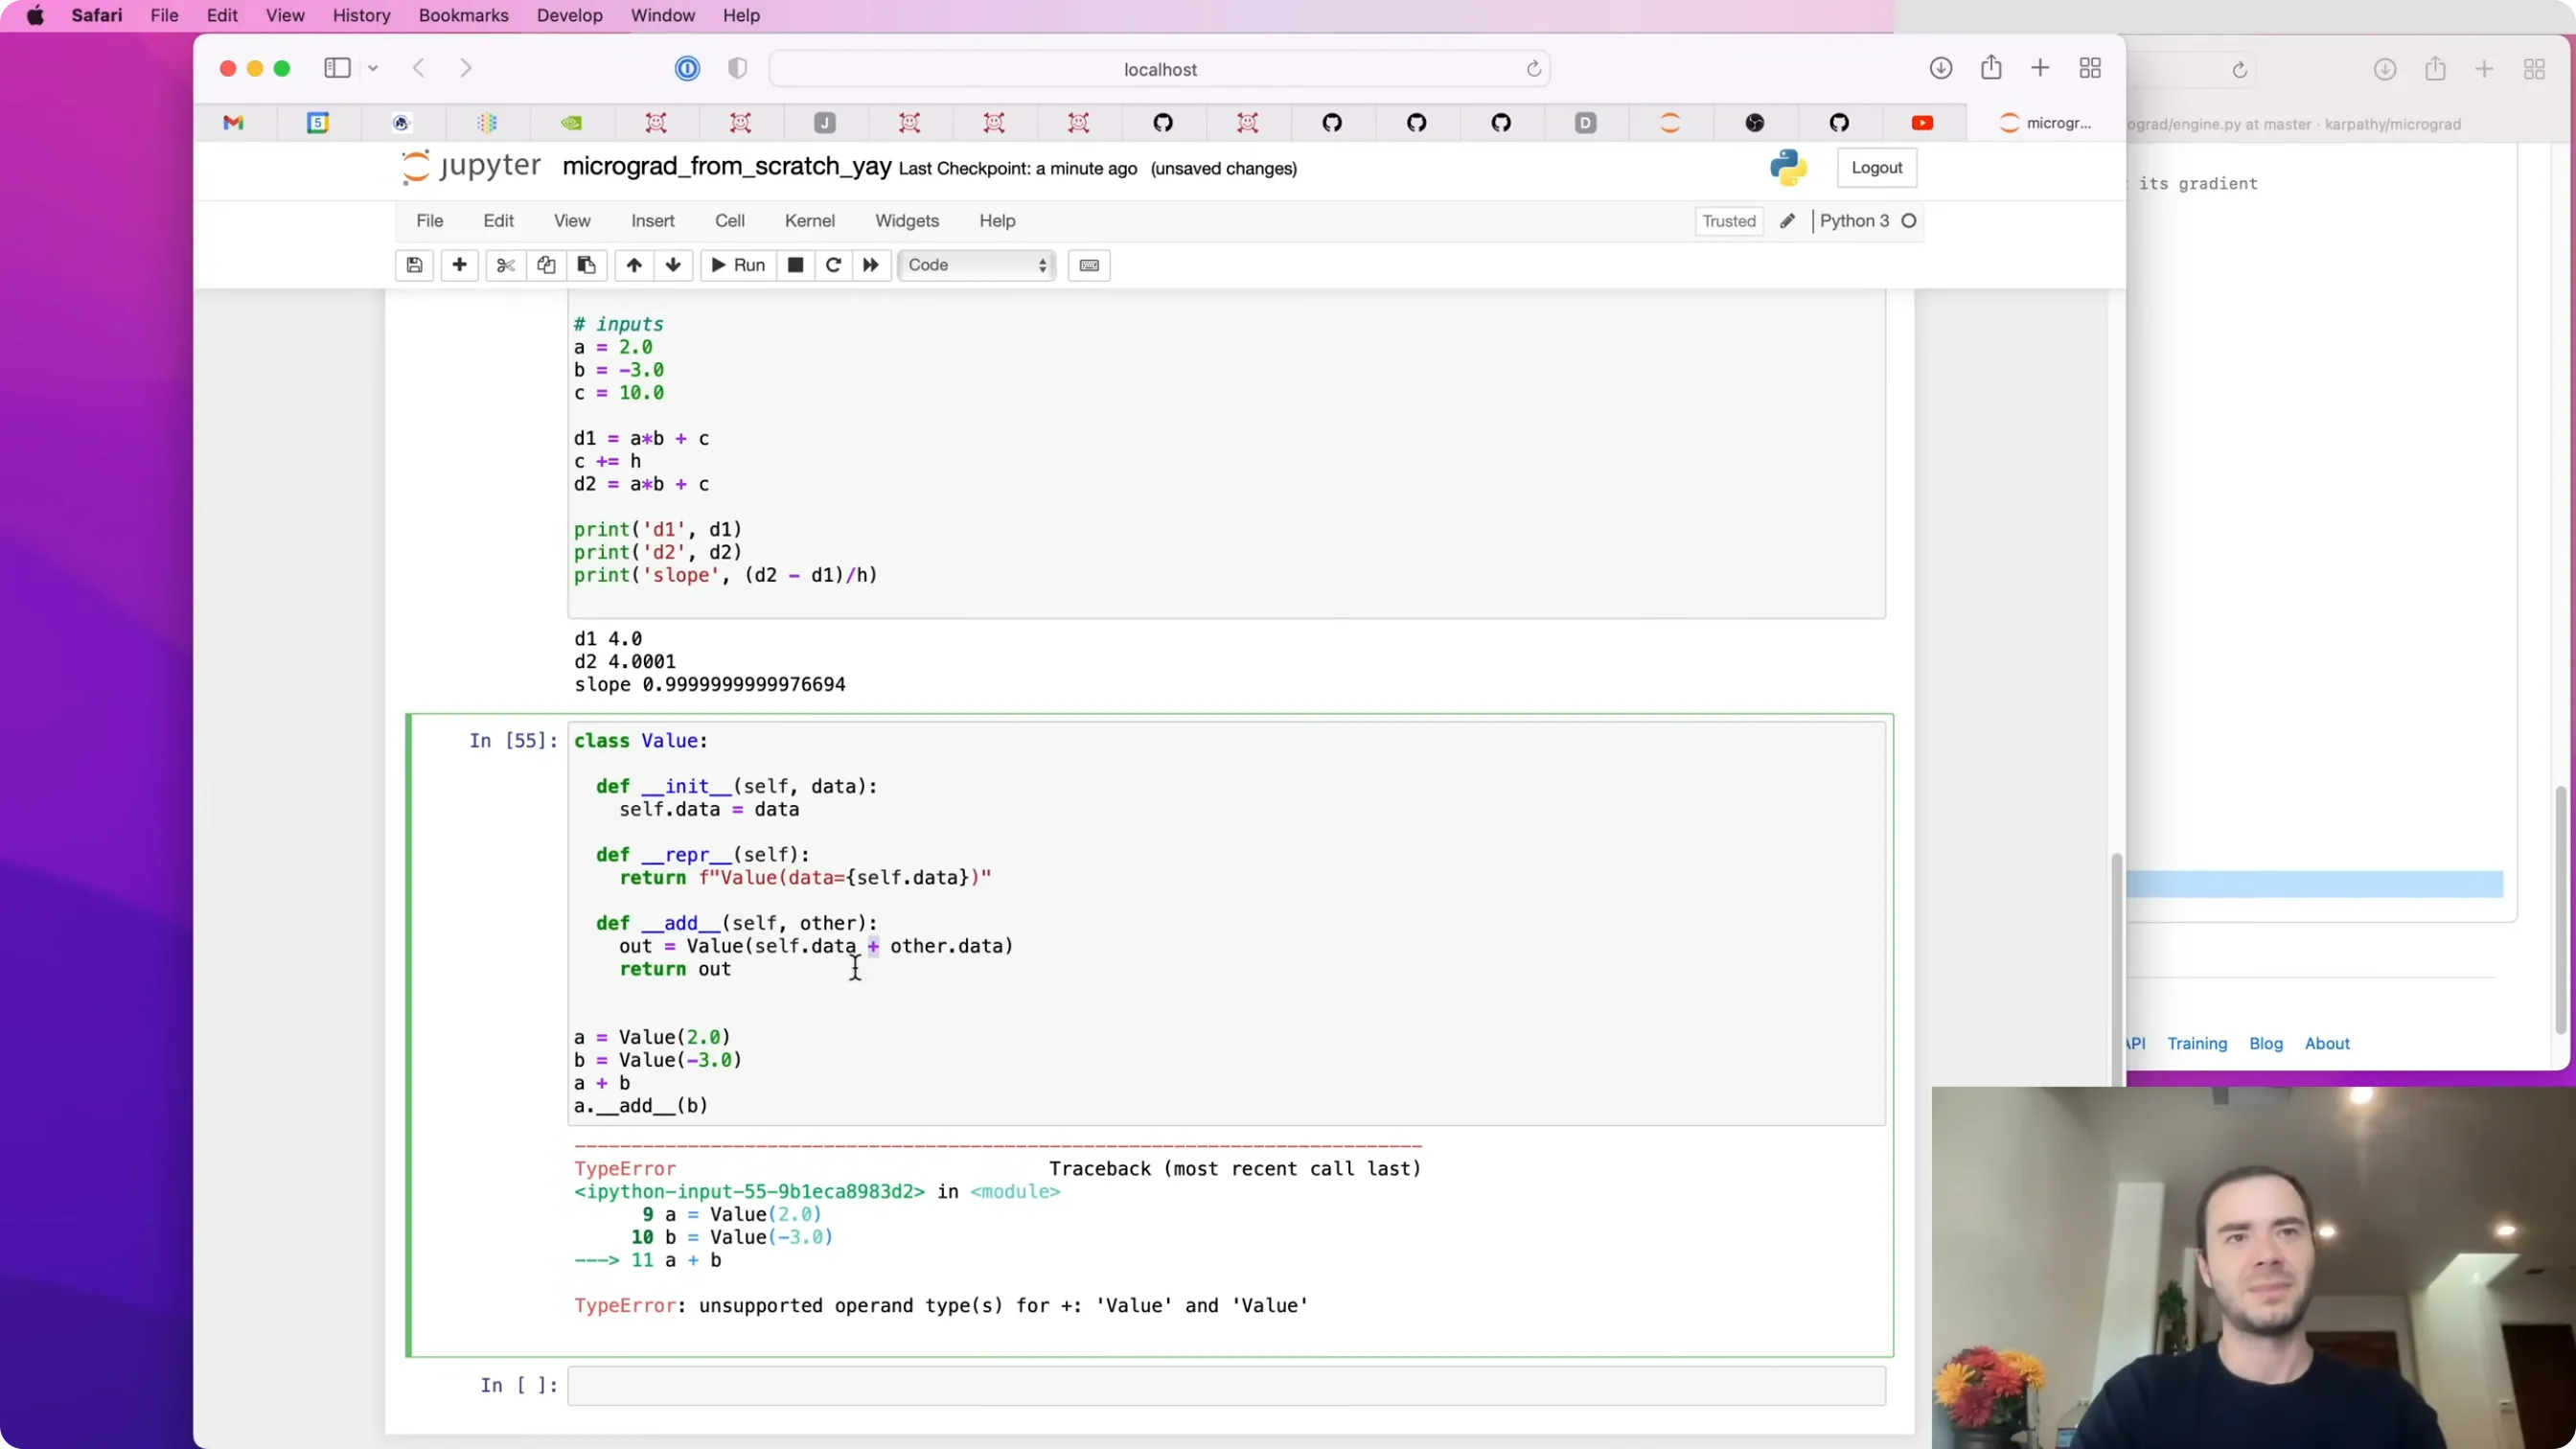
📷 从零实现 Value 对象与 __add__/__mul__
回到原视频 (00:21:00)
2.2 记录表达式图:children 与 op
(参考时间: 00:22)
只有数值还不够——我们要维护表达式图的"连接组织":谁产生了谁。于是 Value 里再加两样东西:
_prev:产生本节点的子节点集合(用set存,是为了效率);_op:产生本节点的运算名('+'、'*',叶子节点为空)。
class Value:
    def __init__(self, data, _children=(), _op=''):
        self.data = data
        self._prev = set(_children)
        self._op = _op
这样 d._prev 就告诉我们「d 是由哪两个值相加来的」,d._op 告诉我们「是一次加法」。我们现在拥有完整的数学表达式与它的构造历史。
2.3 把表达式画出来
(参考时间: 00:24)
为了直观,讲师贴了一段(看起来有点吓人的)可视化代码 draw_dot(root):它用 graphviz 遍历整张图,为每个 Value 画一个节点、为每条依赖画一条边,还额外插入一些假的"运算节点"(比如一个 + 小圆圈)让图更好看。
def draw_dot(root):
    ...
给节点加 label,就能看出 a、b 经 * 得到 e,e 与 c 经 + 得到 d,d 再乘 f 得到 l。这就是"前向传播"的可视化——输出 l = -8。
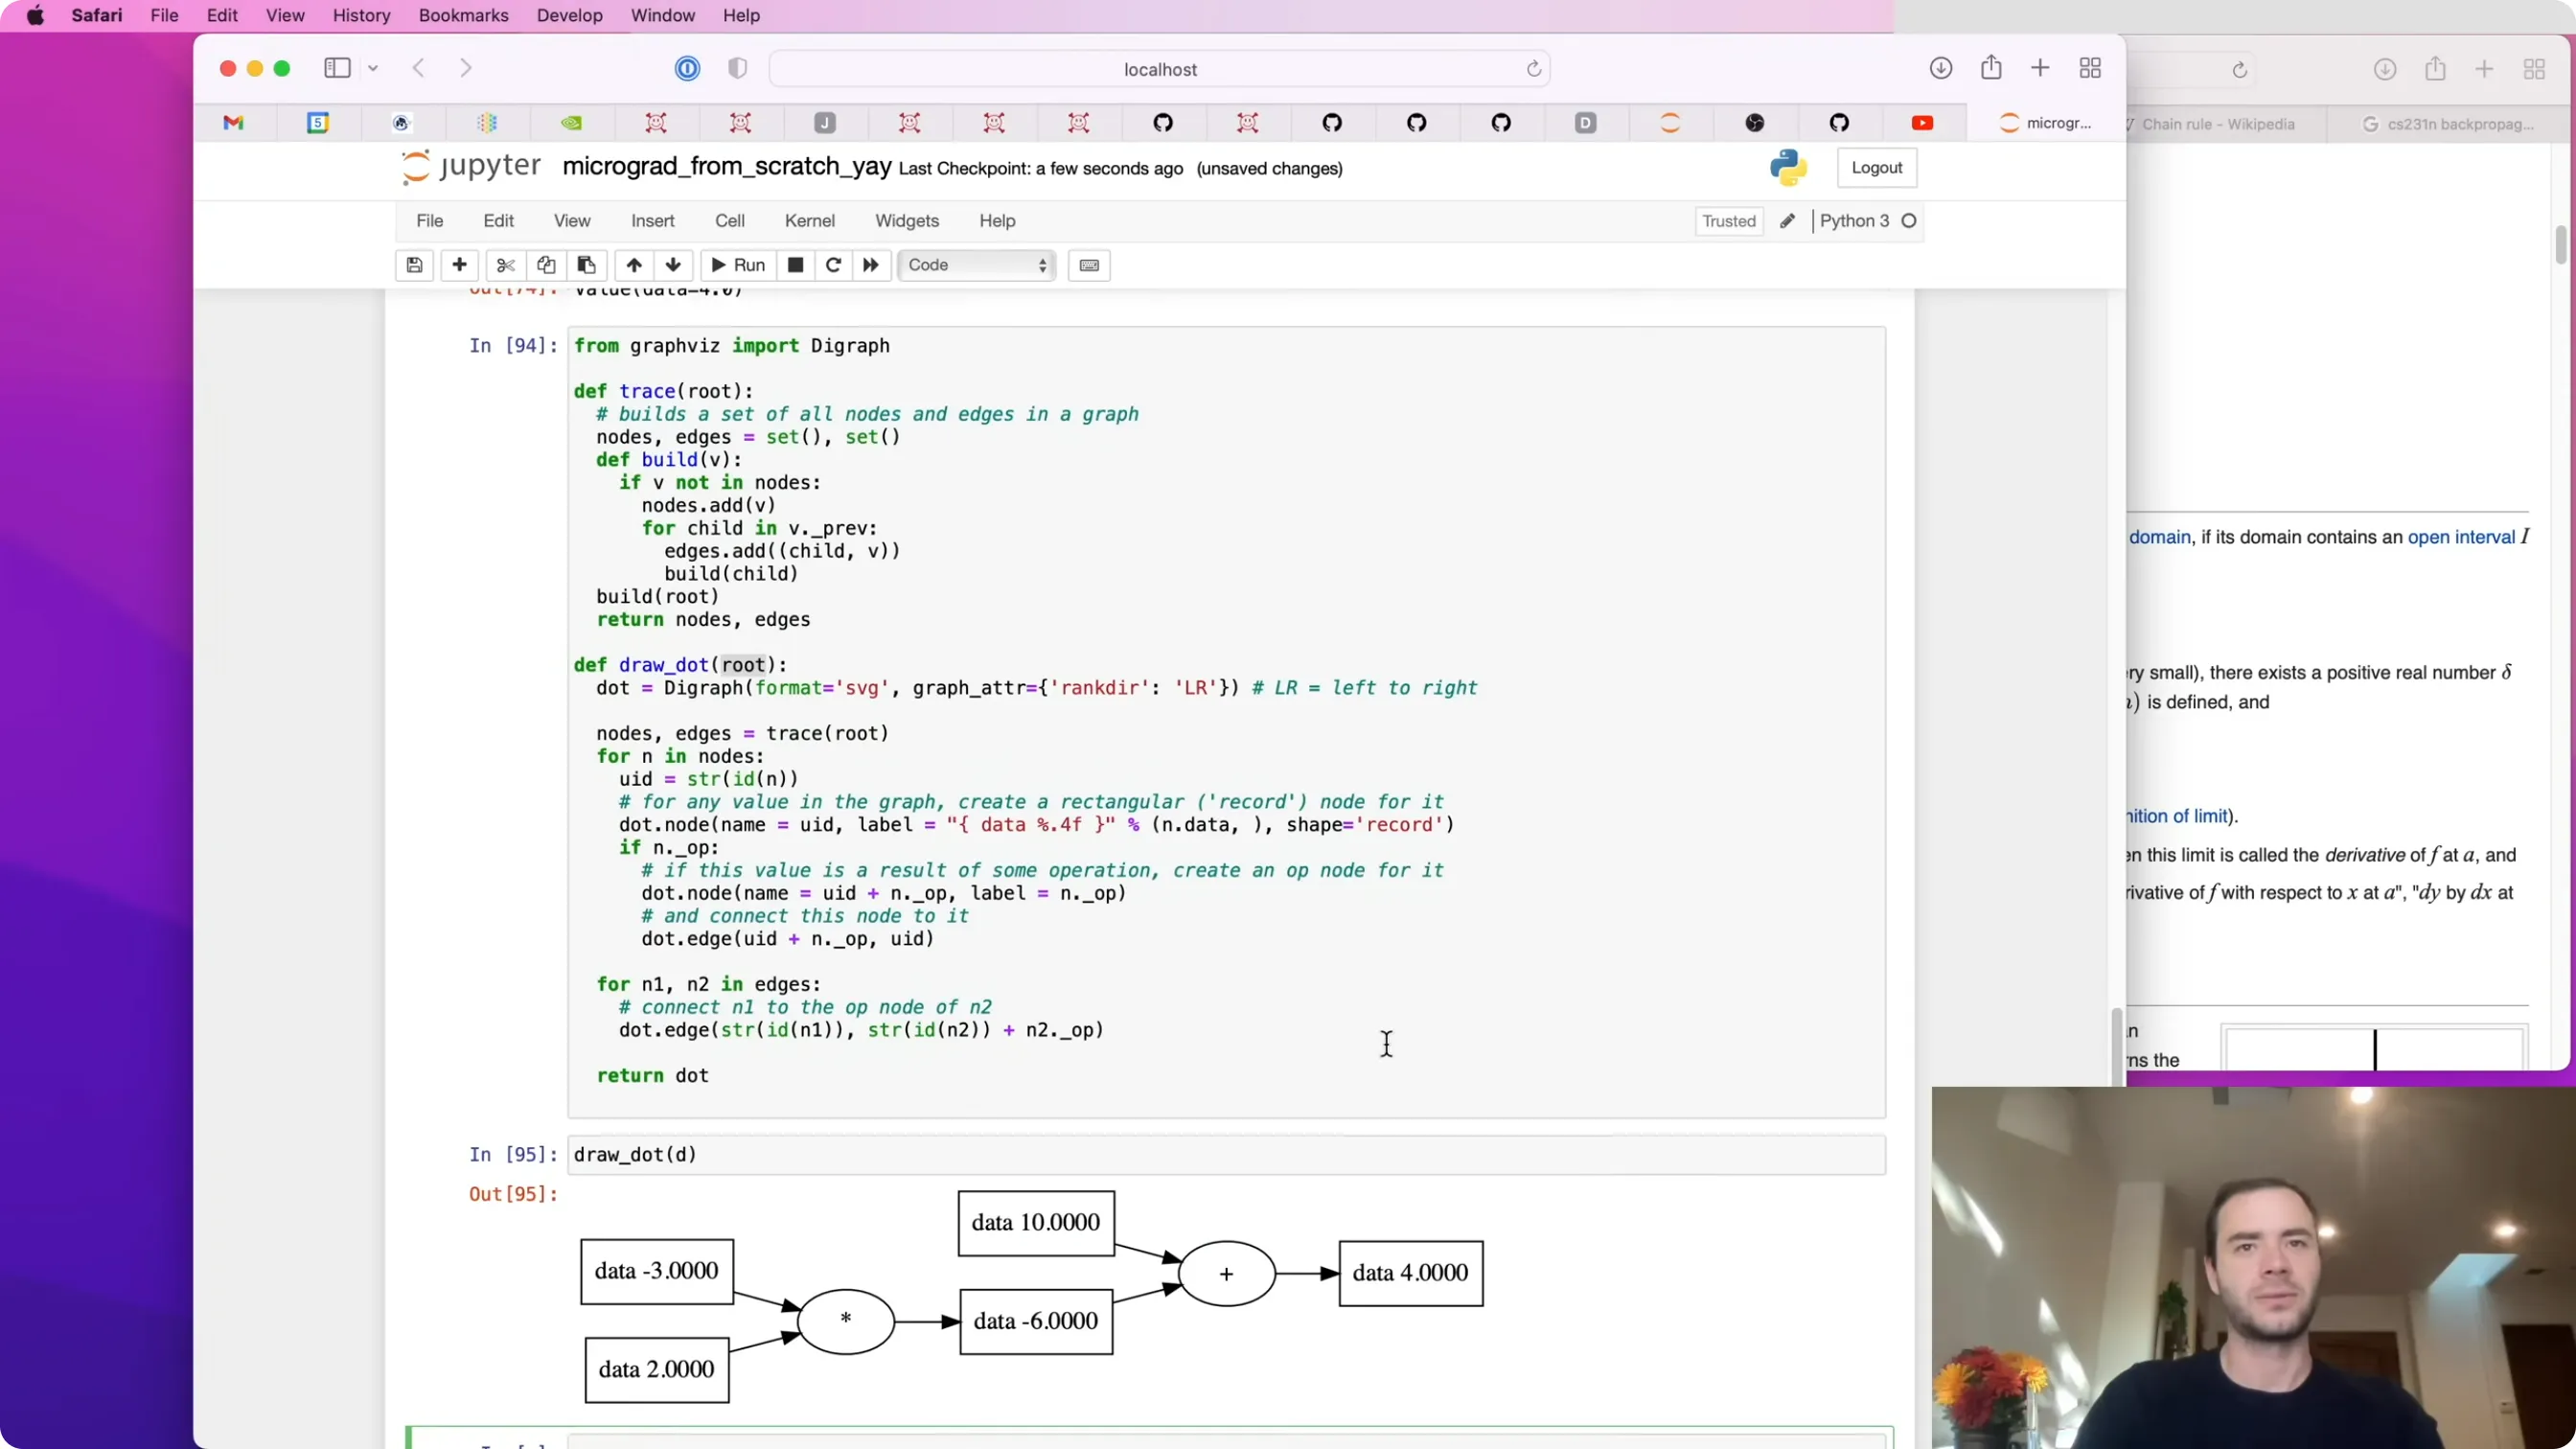
📷 用 graphviz 画出表达式图(每个节点显示 data)
回到原视频 (00:25:30)
编者拓展|为什么"画图"在学反向传播时特别有用:反向传播的难点不在公式,而在"一张图上有哪些节点、梯度的流向是什么"。把图可视化之后,"链式法则"就变成了「沿着边,把上游梯度乘上本地的局部导数,传下去」——一个可以在图上用手比划的过程。强烈建议你自己跑一遍
draw_dot,比看十遍公式都管用。
2.4 给每个节点加一个 grad
(参考时间: 00:30)
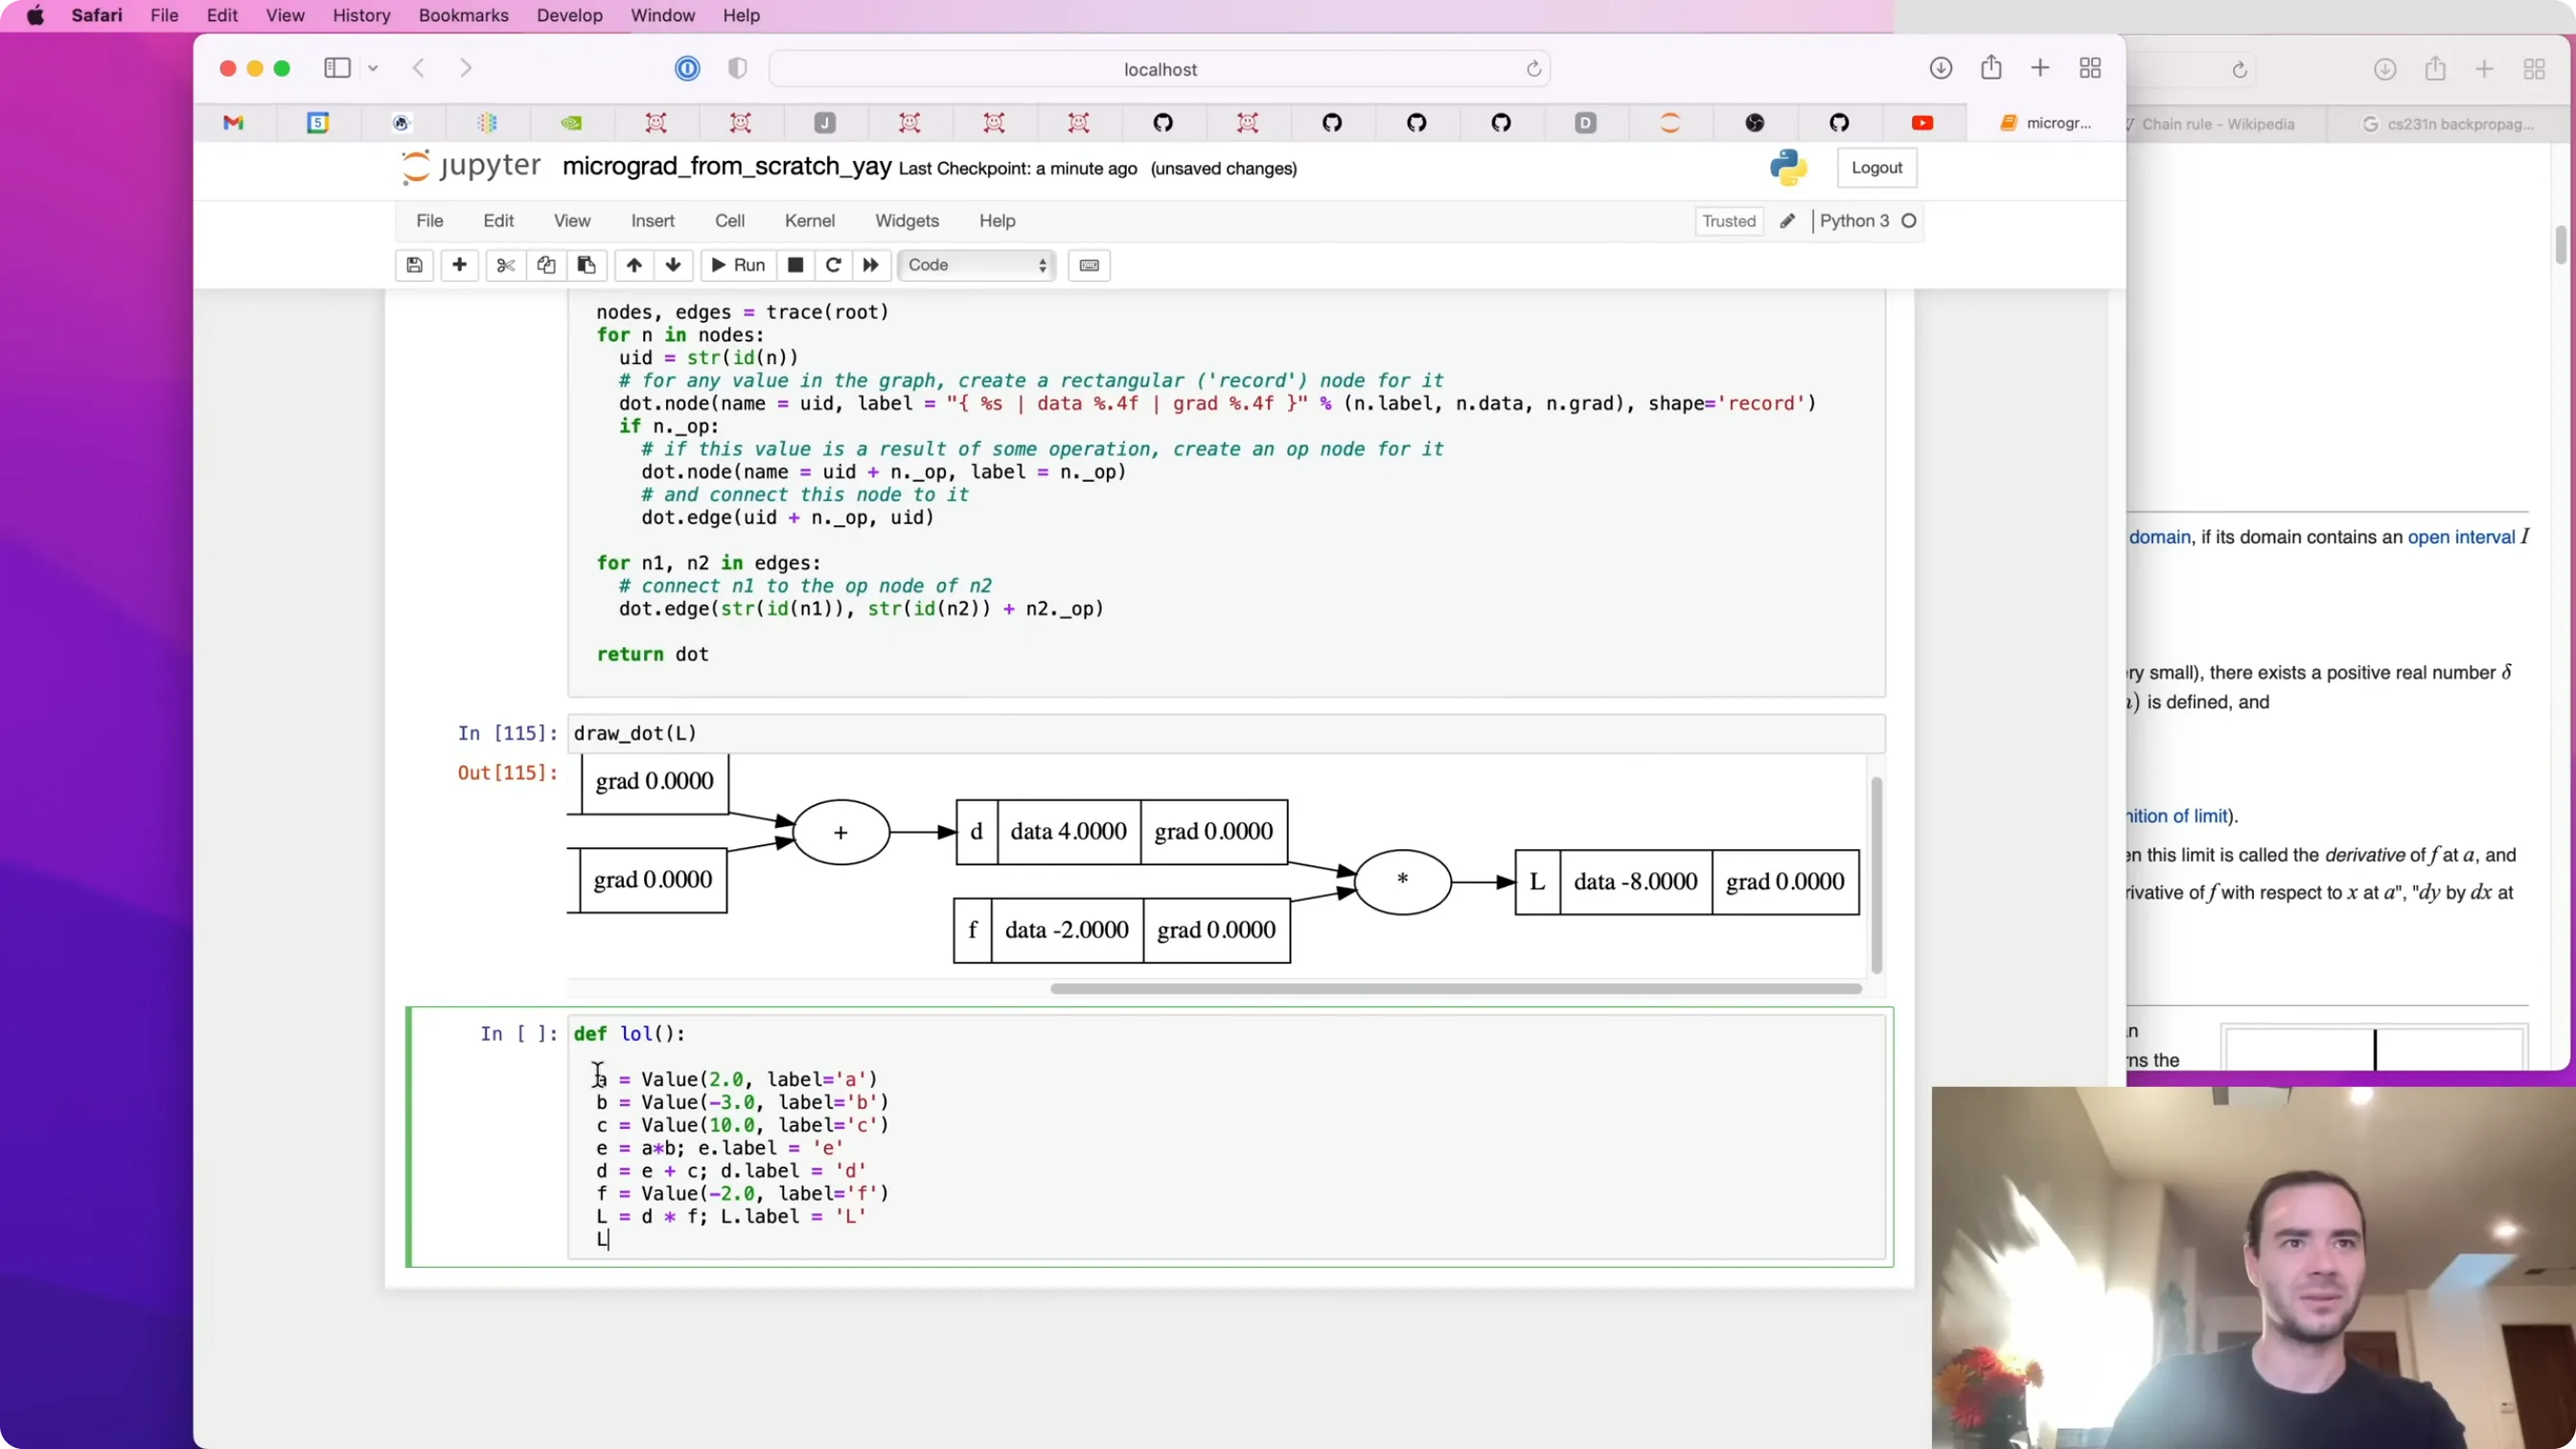
反向传播要算的是:输出 $l$ 对每个节点的导数。于是在 Value 里再加一个 grad,初始化为 0:
self.grad = 0.0
为什么初始是 0:
grad的含义是「这个值对输出的影响」。一开始我们假设每个值都不影响输出——如果梯度是 0,意味着"改动这个变量不会改变损失函数"。0 是"还没算"时的合理默认值。
现在每个节点就同时显示 data 和 grad(都为 0),准备开始反向传播。
三、手动反向传播(例 1:简单表达式)
(参考时间: 00:32)
我们要从输出 l 出发,一路往回填每个节点的 grad。这次先用手算,把每一步都想清楚。
① 基准情形:$\partial l/\partial l = 1$。 把 l 增加 $h$,l 就增加 $h$——比例是 1。
l.grad = 1.0
② 再看 $l = d \times f$。 乘法节点:
$$\frac{\partial l}{\partial d} = f = -2, \qquad \frac{\partial l}{\partial f} = d = 4$$
(讲师用定义推导了一遍:$(d+h)f - df = hf$,除以 $h$ 得 $f$。对称地得到 $d$。)
d.grad = -2.0
f.grad = 4.0
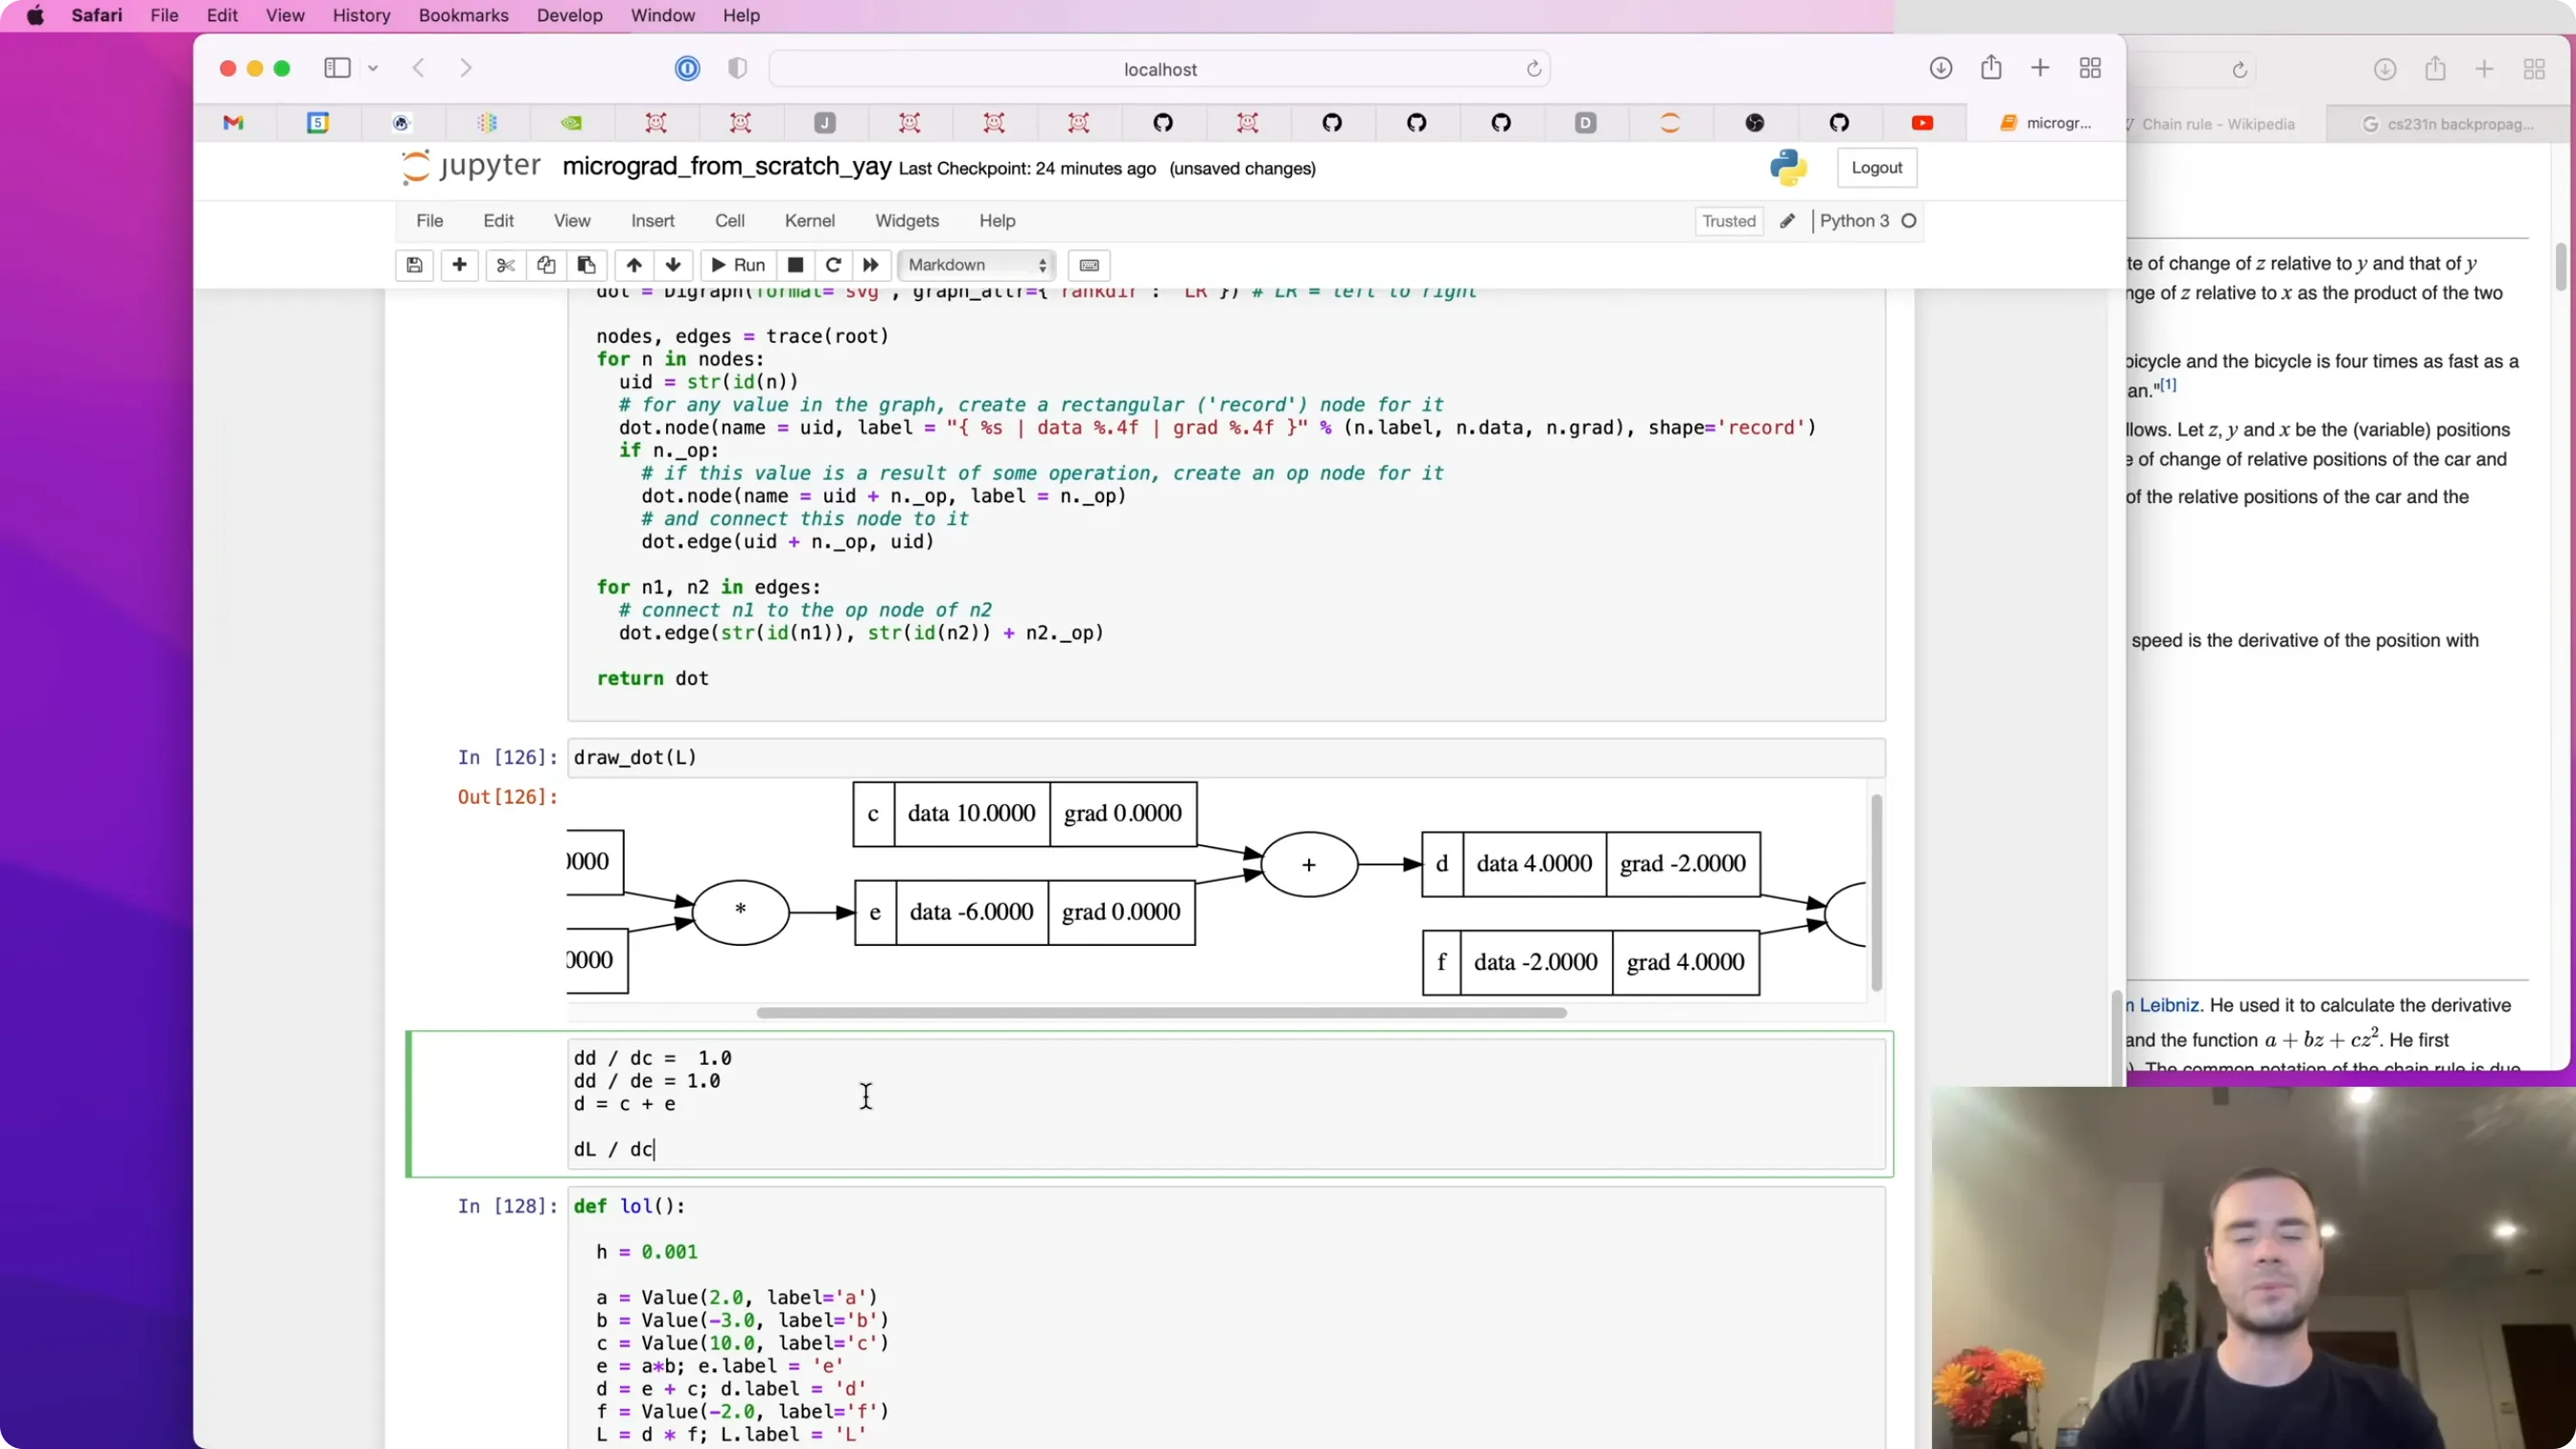
③ 关键的一步:$\partial l/\partial c$ 怎么求? 我们已经知道 $\partial l/\partial d$,而 $d = c + e$。我们需要 $\partial d/\partial c$——这是局部导数:
「局部导数」是这一讲最重要的概念:这个小小的「加号节点」不知道自己嵌在一张多大的图里,它只知道"我把
c和e相加得到了d",以及"c对d的影响是 1"。
加法节点的局部导数是 1:$\partial d/\partial c = \partial d/\partial e = 1$。于是由链式法则:
$$\frac{\partial l}{\partial c} = \frac{\partial l}{\partial d}\cdot\frac{\partial d}{\partial c} = (-2)\times 1 = -2$$
同理 $\partial l/\partial e = -2$。
📷 手动反向传播:从 l=1 出发,逐节点应用链式法则
回到原视频 (00:33:00)
编者拓展|链式法则,一句话版本:维基百科上的写法很吓人,讲师给了个更好记的表述——「若 $z$ 依赖 $y$、$y$ 又依赖 $x$,那么 $\dfrac{dz}{dx} = \dfrac{dz}{dy}\cdot\dfrac{dy}{dx}$」。
把导数"链"起来,就是相乘。 讲师还给了个绝妙的类比:「汽车速度是自行车的 2 倍,自行车是步行的 4 倍,那么汽车就是步行的 8 倍」——这就是链式法则。
📷 链式法则的直观解释(Wikipedia)
回到原视频 (00:44:00)
编者说明:加法节点是"梯度的分发器"——因为它的局部导数恒为 1,所以它只是把上游梯度原样复制给每一个子节点。这是反向传播里最简单也最常见的一种节点。
④ 继续递归:$\partial l/\partial a$ 与 $\partial l/\partial b$。 现在 $e = a\times b$:
$$\frac{\partial l}{\partial a} = \frac{\partial l}{\partial e}\cdot\frac{\partial e}{\partial a} = (-2)\times b = (-2)\times(-3) = 6$$
$$\frac{\partial l}{\partial b} = \frac{\partial l}{\partial e}\cdot\frac{\partial e}{\partial b} = (-2)\times a = (-2)\times 2 = -4$$
每一步都用手算的数值梯度验证过(6 和 −4 都对上了)。这就是完整的、从输出到叶子的手动反向传播。
⑤ 用梯度做一次优化。 既然有了梯度,就可以让 $l$ 变大:把每个叶节点沿梯度方向走一小步:
a.data += 0.01 * a.grad
b.data += 0.01 * b.grad
c.data += 0.01 * c.grad
f.data += 0.01 * f.grad
# 重新前向传播
l.data     # 从 -8 变成了 -7(确实"上升"了)
这就是一次优化步骤的雏形。
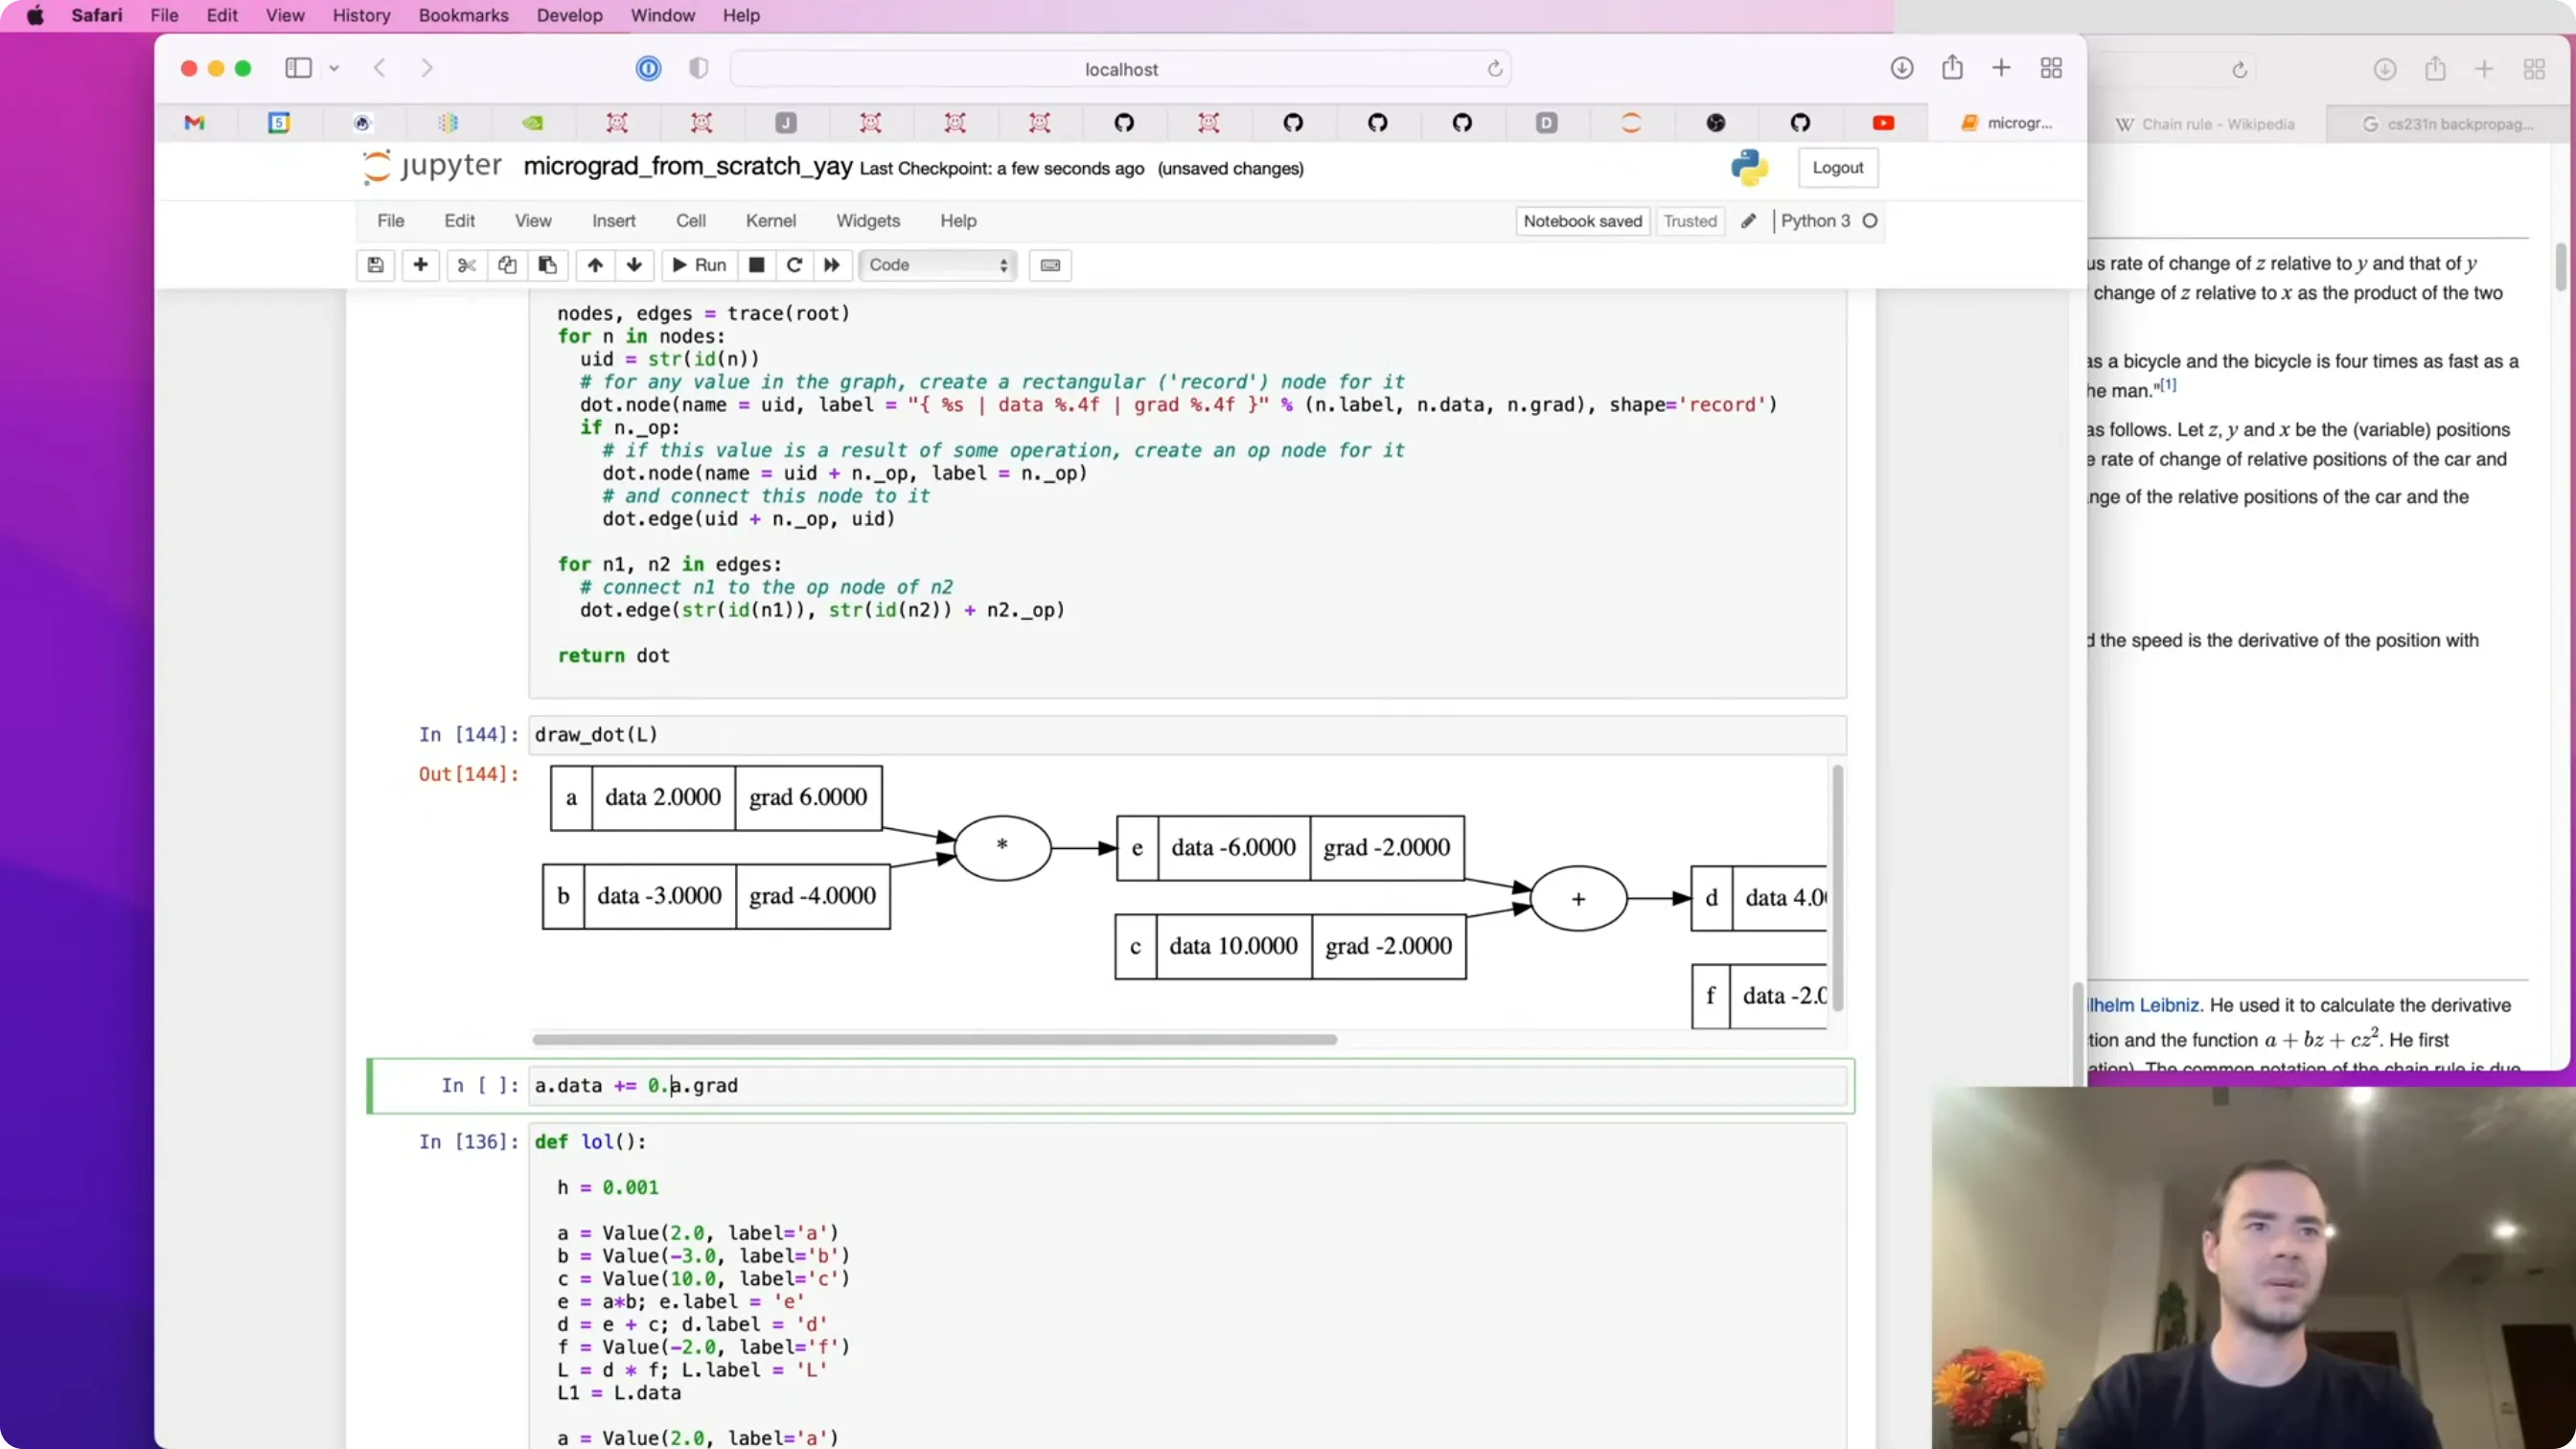
📷 用梯度"推"输入,让 l 上升(一次优化步骤)
回到原视频 (00:51:30)
四、手动反向传播(例 2:一个神经元)
(参考时间: 00:53)
现在把反向传播用在更有用的结构上:一个神经元。
神经元的数学模型(生物版很复杂,数学版极简):
$$n = \sum_i w_i x_i + b, \qquad o = \tanh(n)$$
- $x_i$ 是输入;$w_i$ 是权重("突触强度",与输入相乘后流入细胞体);
- $b$ 是偏置(决定这个神经元"天生的触发倾向");
- 最后过一层激活函数——常用压缩函数(squash),比如 tanh、sigmoid。tanh 把任意实数平滑地压到 $[-1, 1]$。
x1, x2 = Value(2.0), Value(0.0)
w1, w2 = Value(-3.0), Value(1.0)
b = Value(6.8813735870195432)

x1w1 = x1*w1;  x2w2 = x2*w2
n = x1w1 + x2w2 + b
o = n.tanh()
编者拓展|tanh 长什么样、为什么用它:$\tanh(x)=\dfrac{e^{2x}-1}{e^{2x}+1}$,图像是一条过原点、在 $[-1,1]$ 之间平滑饱和的 S 形曲线。它和 sigmoid 形状一样,只是关于原点对称(输出可正可负)。关键性质是它的导数非常漂亮:$\dfrac{d}{dx}\tanh(x) = 1 - \tanh(x)^2$——只需要输出值就能算出导数。
⚠️ 但我们现在实现不了 tanh:因为我们只实现了 + 和 *,而 tanh 需要指数运算($e^x$)。
于是引出一个重要的设计思想:
我们不必把运算拆到最原子。
Value可以支持任意粒度的运算——只要知道它的局部导数,就能反向传播。所以我们可以直接实现一个tanh节点,而不是把它拆成 exp/add/div。
def tanh(self):
    x = self.data
    t = (math.exp(2*x) - 1) / (math.exp(2*x) + 1)
    out = Value(t, (self,), 'tanh')
    return out
于是 n.tanh() 得到 o ≈ 0.7071。现在图的末尾多了一个 tanh 节点。
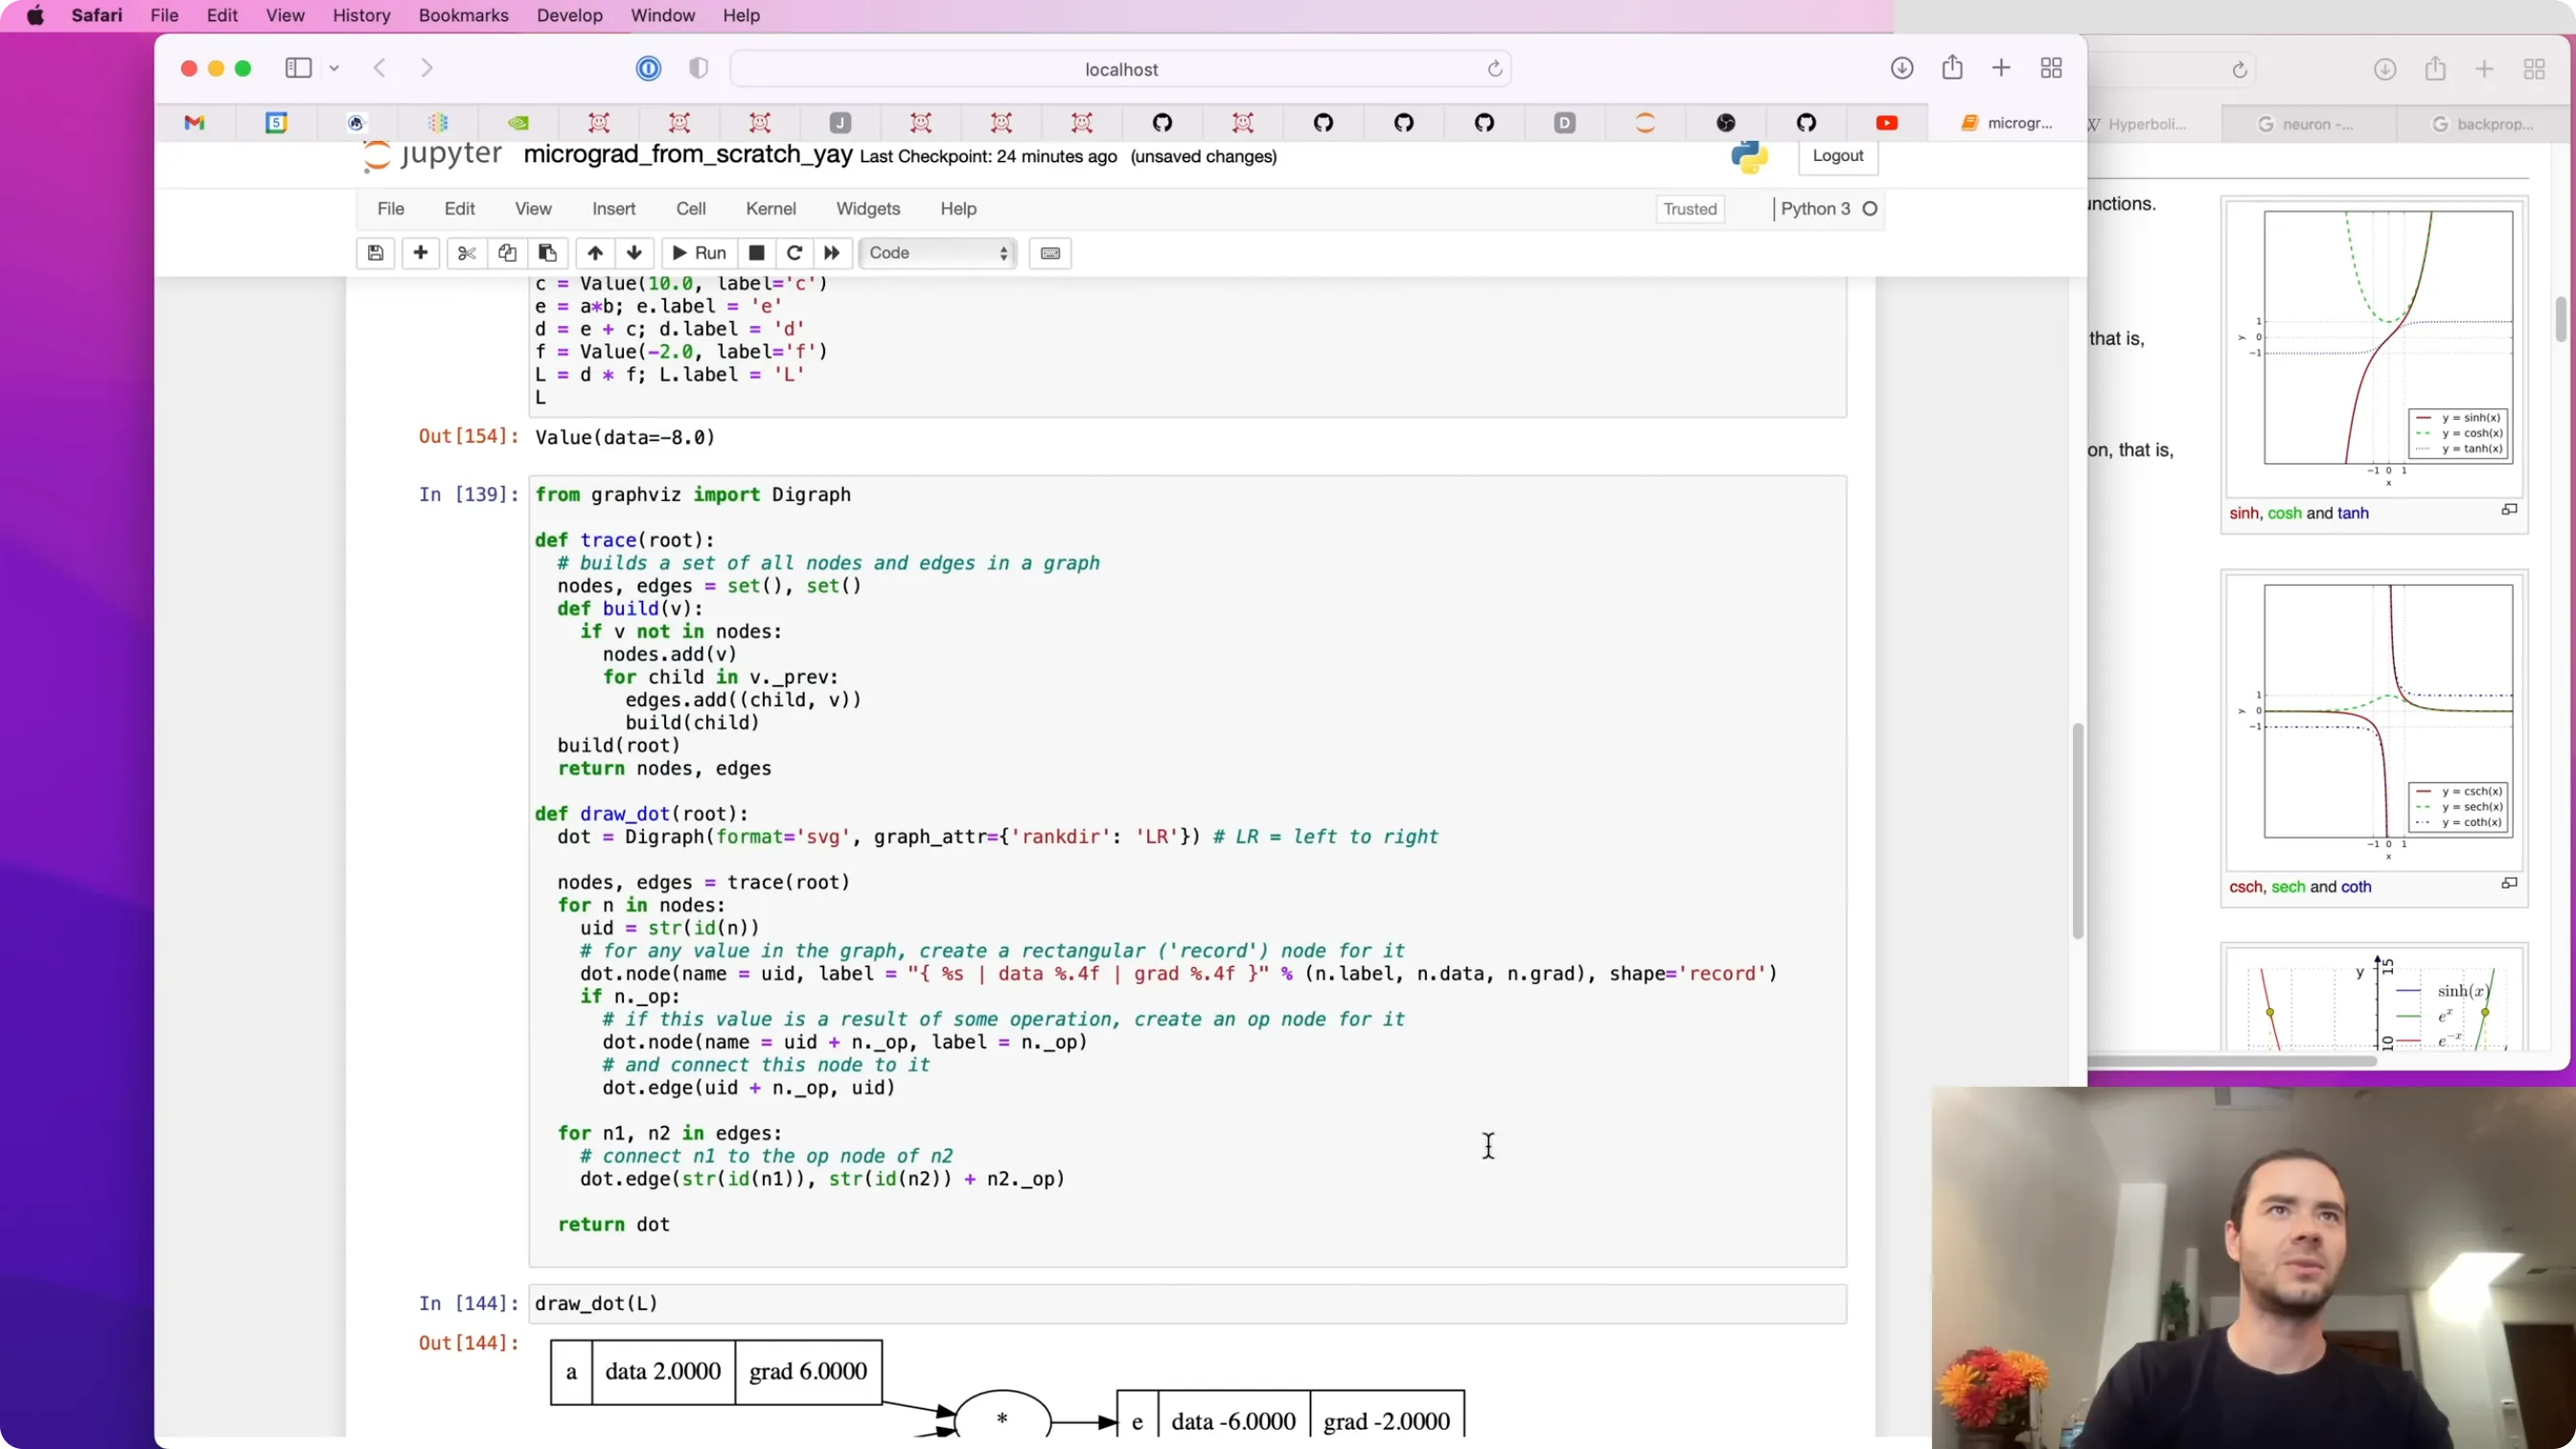
📷 一个二维神经元:x1w1 + x2w2 + b 经过 tanh 得到输出
回到原视频 (01:00:30)
手动反向传播这个神经元(讲师把 bias 特意调成一个怪数字,好让结果"是漂亮的数"):
- $\partial o/\partial o = 1$(基准);
- $\partial o/\partial n = 1 - o^2 = 1 - 0.7071^2 = 0.5$(tanh 的局部导数);
- 加法节点分发:
b.grad = 0.5,x1w1.grad = x2w2.grad = 0.5; - 乘法节点:
x2.grad = w2 = 1 × 0.5 = 0.5,w2.grad = x2 = 0 × 0.5 = 0; - 同理
x1.grad = w1 × 0.5 = -1.5,w1.grad = x1 × 0.5 = 1。
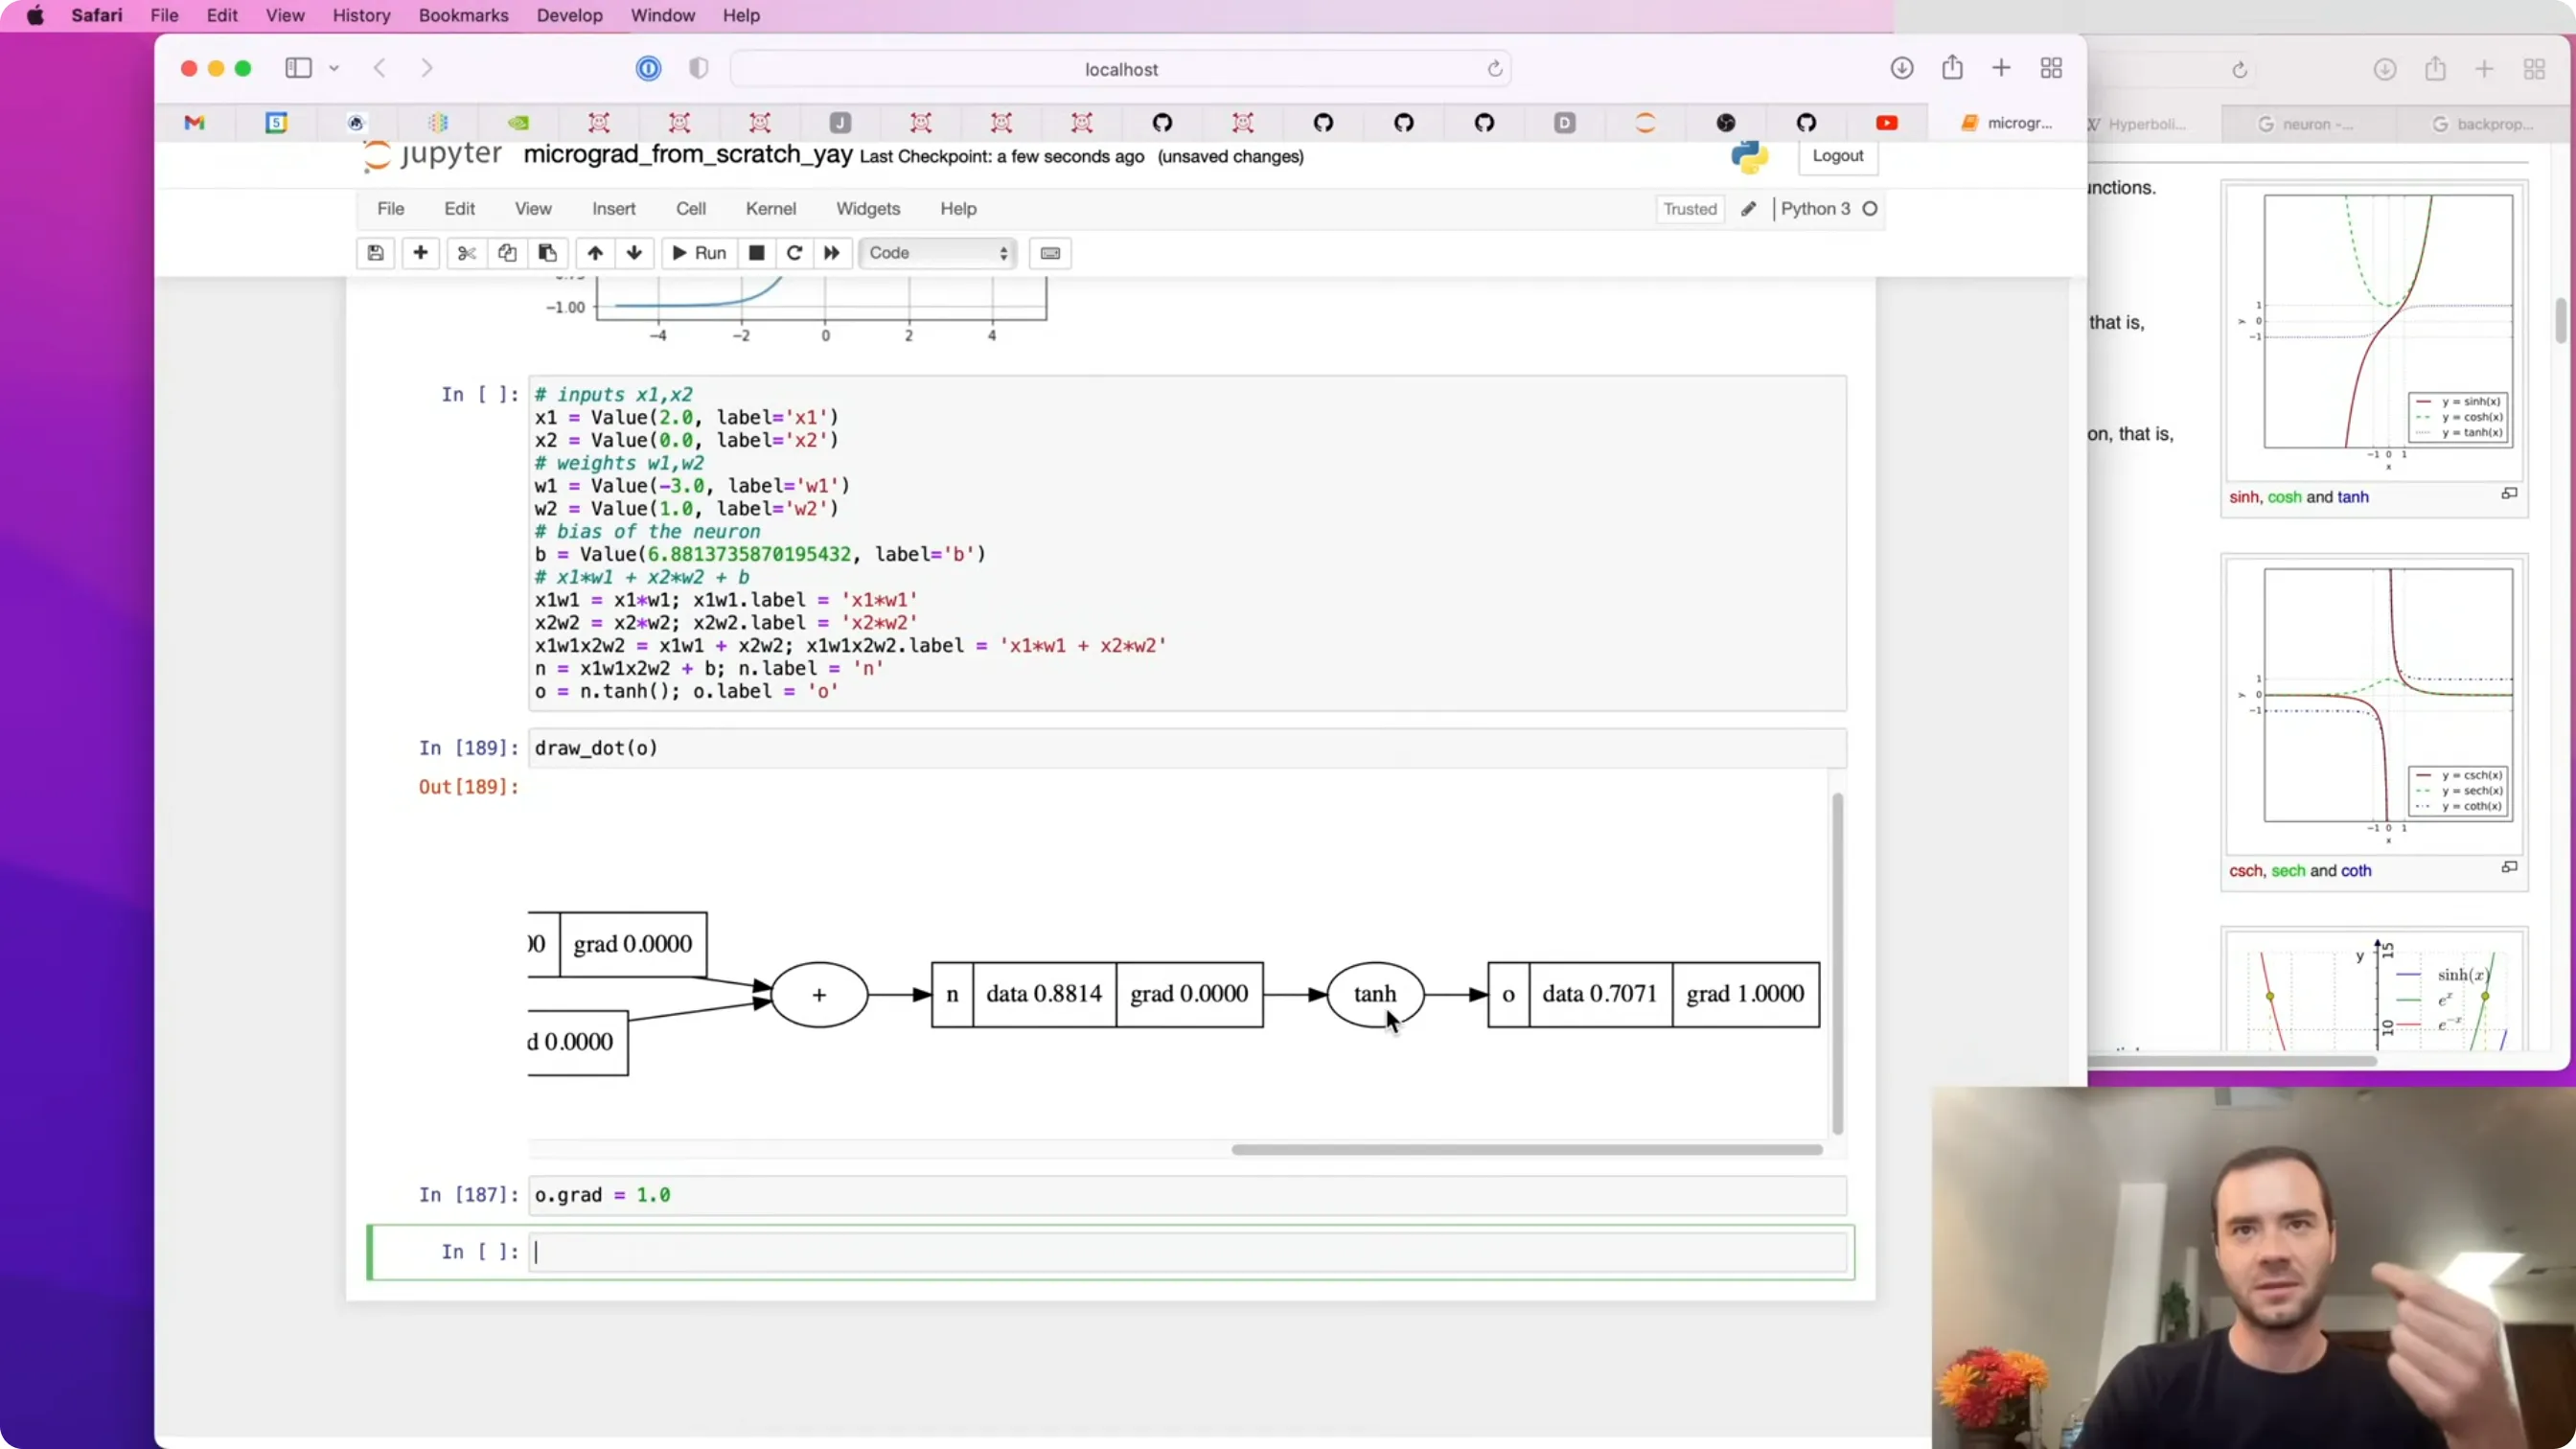
📷 神经元的手动反向传播:各叶节点的梯度
回到原视频 (01:03:00)
编者拓展|
w2.grad = 0说明了什么:因为输入x2 = 0,所以"改w2不会改变输出"(无论w2多大,$w_2 \cdot 0 = 0$),于是它的梯度就是 0——梯度精确地反映了"这个参数现在有没有影响"。这是一个很好的"用直觉理解梯度"的练习。
手动反向传播显然太荒唐了("doing the back propagation manually is obviously ridiculous")。接下来我们让机器来做。
五、为每个运算实现 backward
(参考时间: 01:09)
思路:让每个 Value 存一个函数 _backward,它负责把上游梯度链到自己的子节点。默认是空函数(叶子节点不需要做任何事)。
class Value:
    ...
    def _backward(self):
        pass
加法(局部导数都是 1,所以只是把 out.grad 分发下去):
def __add__(self, other):
    out = Value(self.data + other.data, (self, other), '+')
    def _backward():
        self.grad  += 1.0 * out.grad
        other.grad += 1.0 * out.grad
    out._backward = _backward
    return out
乘法(局部导数是"对方的值"):
def __mul__(self, other):
    out = Value(self.data * other.data, (self, other), '*')
    def _backward():
        self.grad  += other.data * out.grad
        other.grad += self.data  * out.grad
    out._backward = _backward
    return out
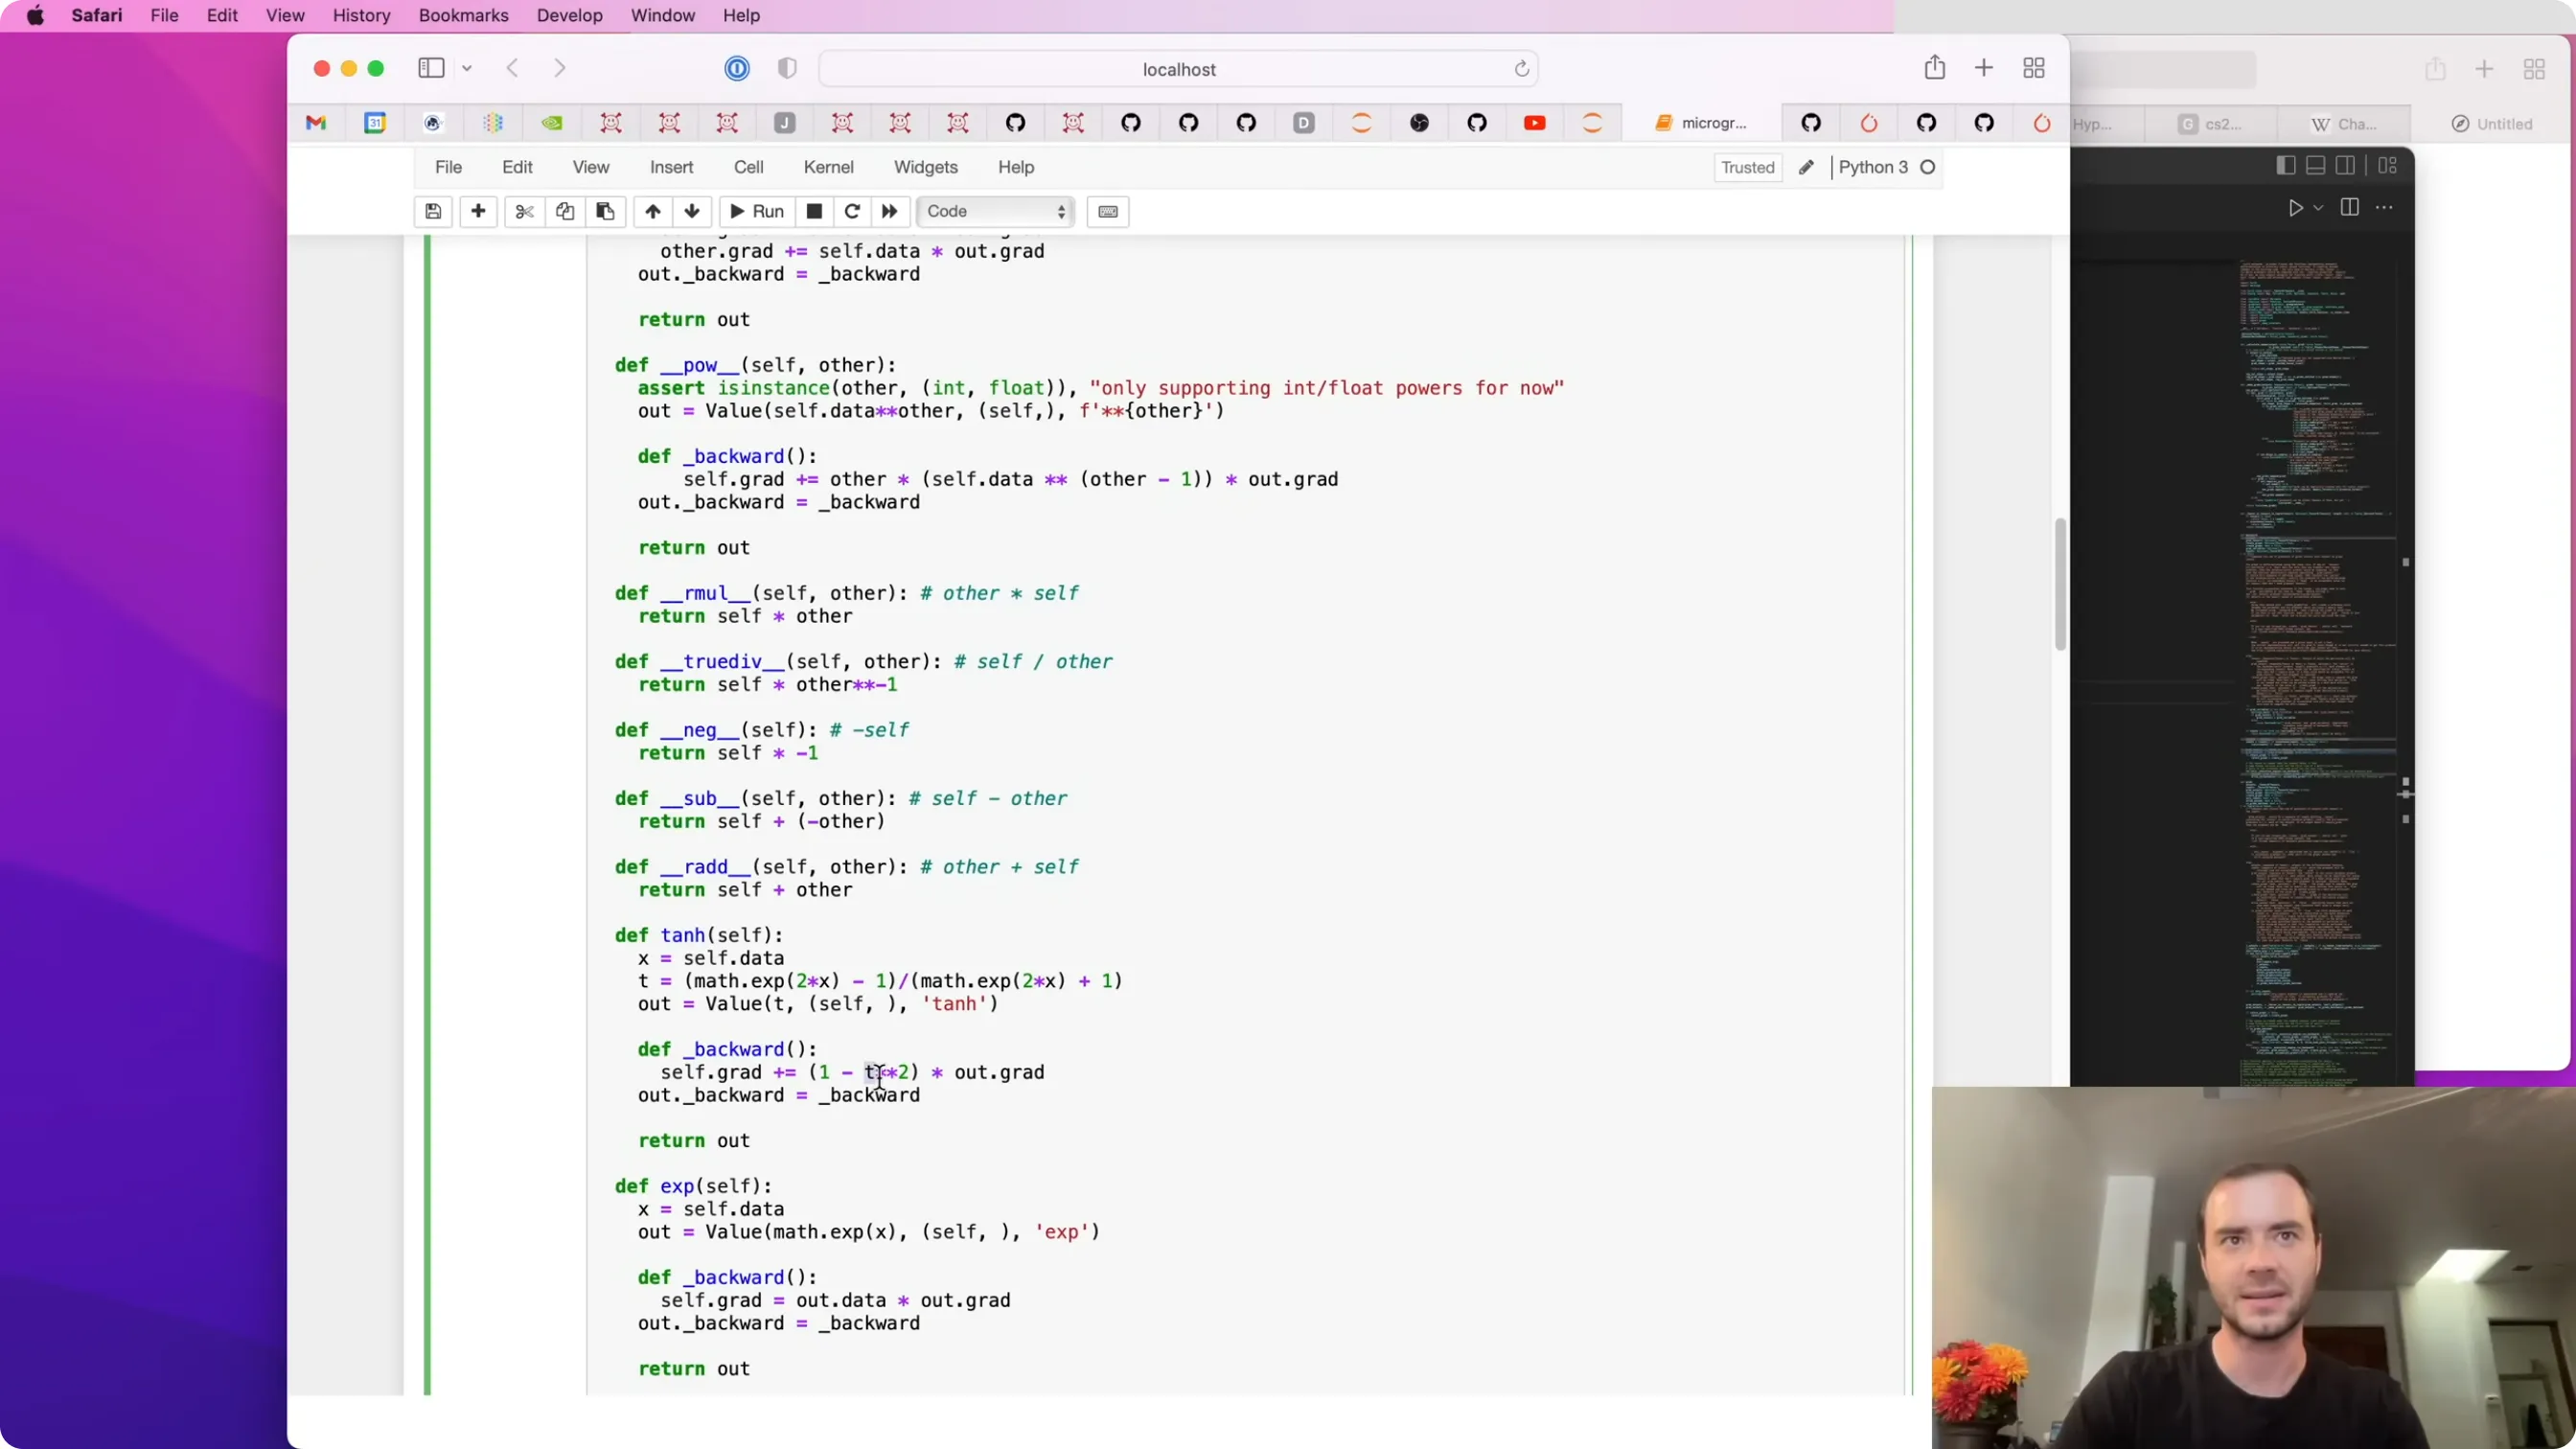
tanh(局部导数是 $1 - t^2$):
def tanh(self):
    ...
    def _backward():
        self.grad += (1 - t**2) * out.grad
    out._backward = _backward
    return out
编者说明:
+=而不是=—— 为什么?先记住这里用了累加,第 7 节会解释(这是后面那个"bug"的解药)。
重要的坑:要存函数本身,而不是调用函数。讲师现场就踩了这个坑('NoneType' object is not callable),把错误留在视频里:"我本想重录,但觉得挺好笑"。
于是给 out.grad = 1.0 之后,按正确的顺序依次调用各节点的 _backward,就能得到和手算完全一致的结果(0.5、0、−1.5、1)。
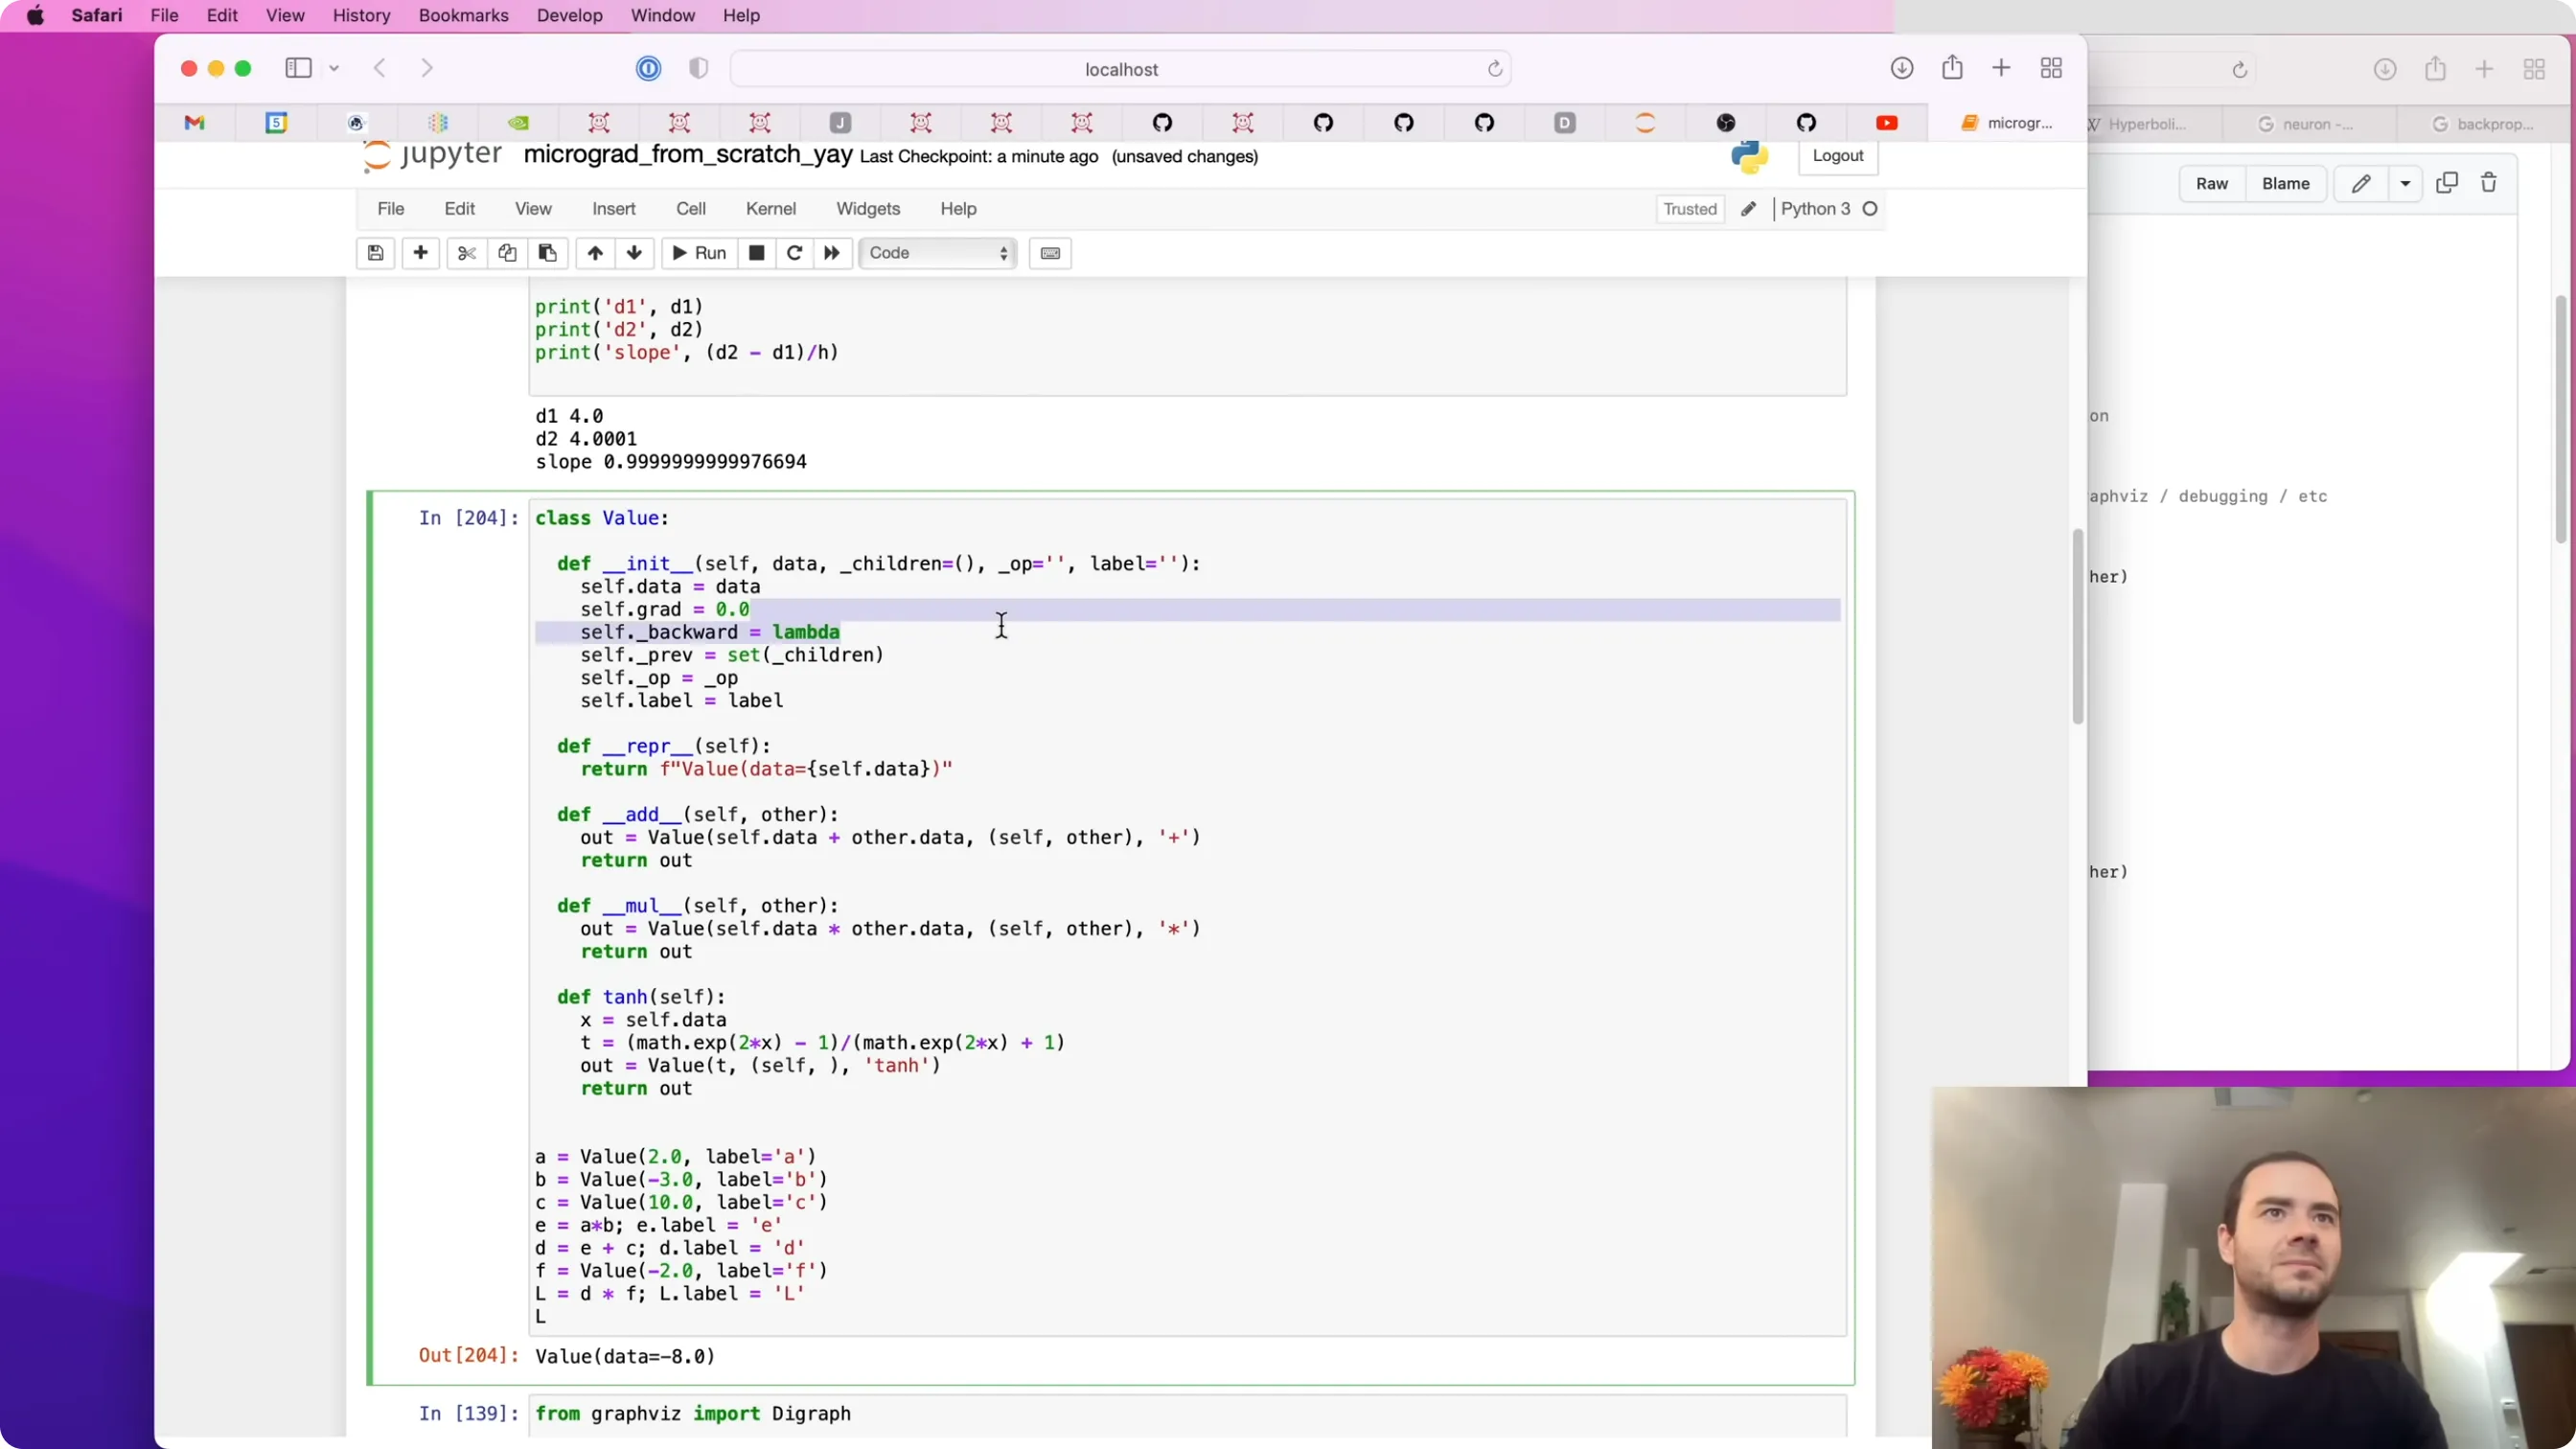
📷 为每个运算实现 backward:加法、乘法、tanh 的局部导数
回到原视频 (01:10:00)
六、为整张图实现 backward:拓扑排序
(参考时间: 01:17)
还剩最后一件"丢人"的事:我们不能手工排顺序调用 _backward。正确的规则是:
一个节点的
_backward,必须在"所有依赖它的节点"都处理完之后才能调用——也就是要按拓扑序的逆序。
拓扑排序(topological sort) 把有向无环图(DAG)的节点排成一列,使得所有边都从左指向右。做法(递归):
topo, visited = [], set()
def build_topo(v):
    if v not in visited:
        visited.add(v)
        for child in v._prev:
            build_topo(child)
        topo.append(v)          # 孩子都处理完,才把自己加进去
不变式:一个节点只有当它的所有子节点都已进入列表后,才会被加进去。对输出 o 调用它,得到的列表最后一个就是 o。
于是整个反向传播就三行:
def backward(self):
    topo, visited = [], set()
    build_topo(self)            # 从 self 出发建拓扑序

    self.grad = 1.0             # 基准情形
    for node in reversed(topo):
        node._backward()        # 从输出往叶子走
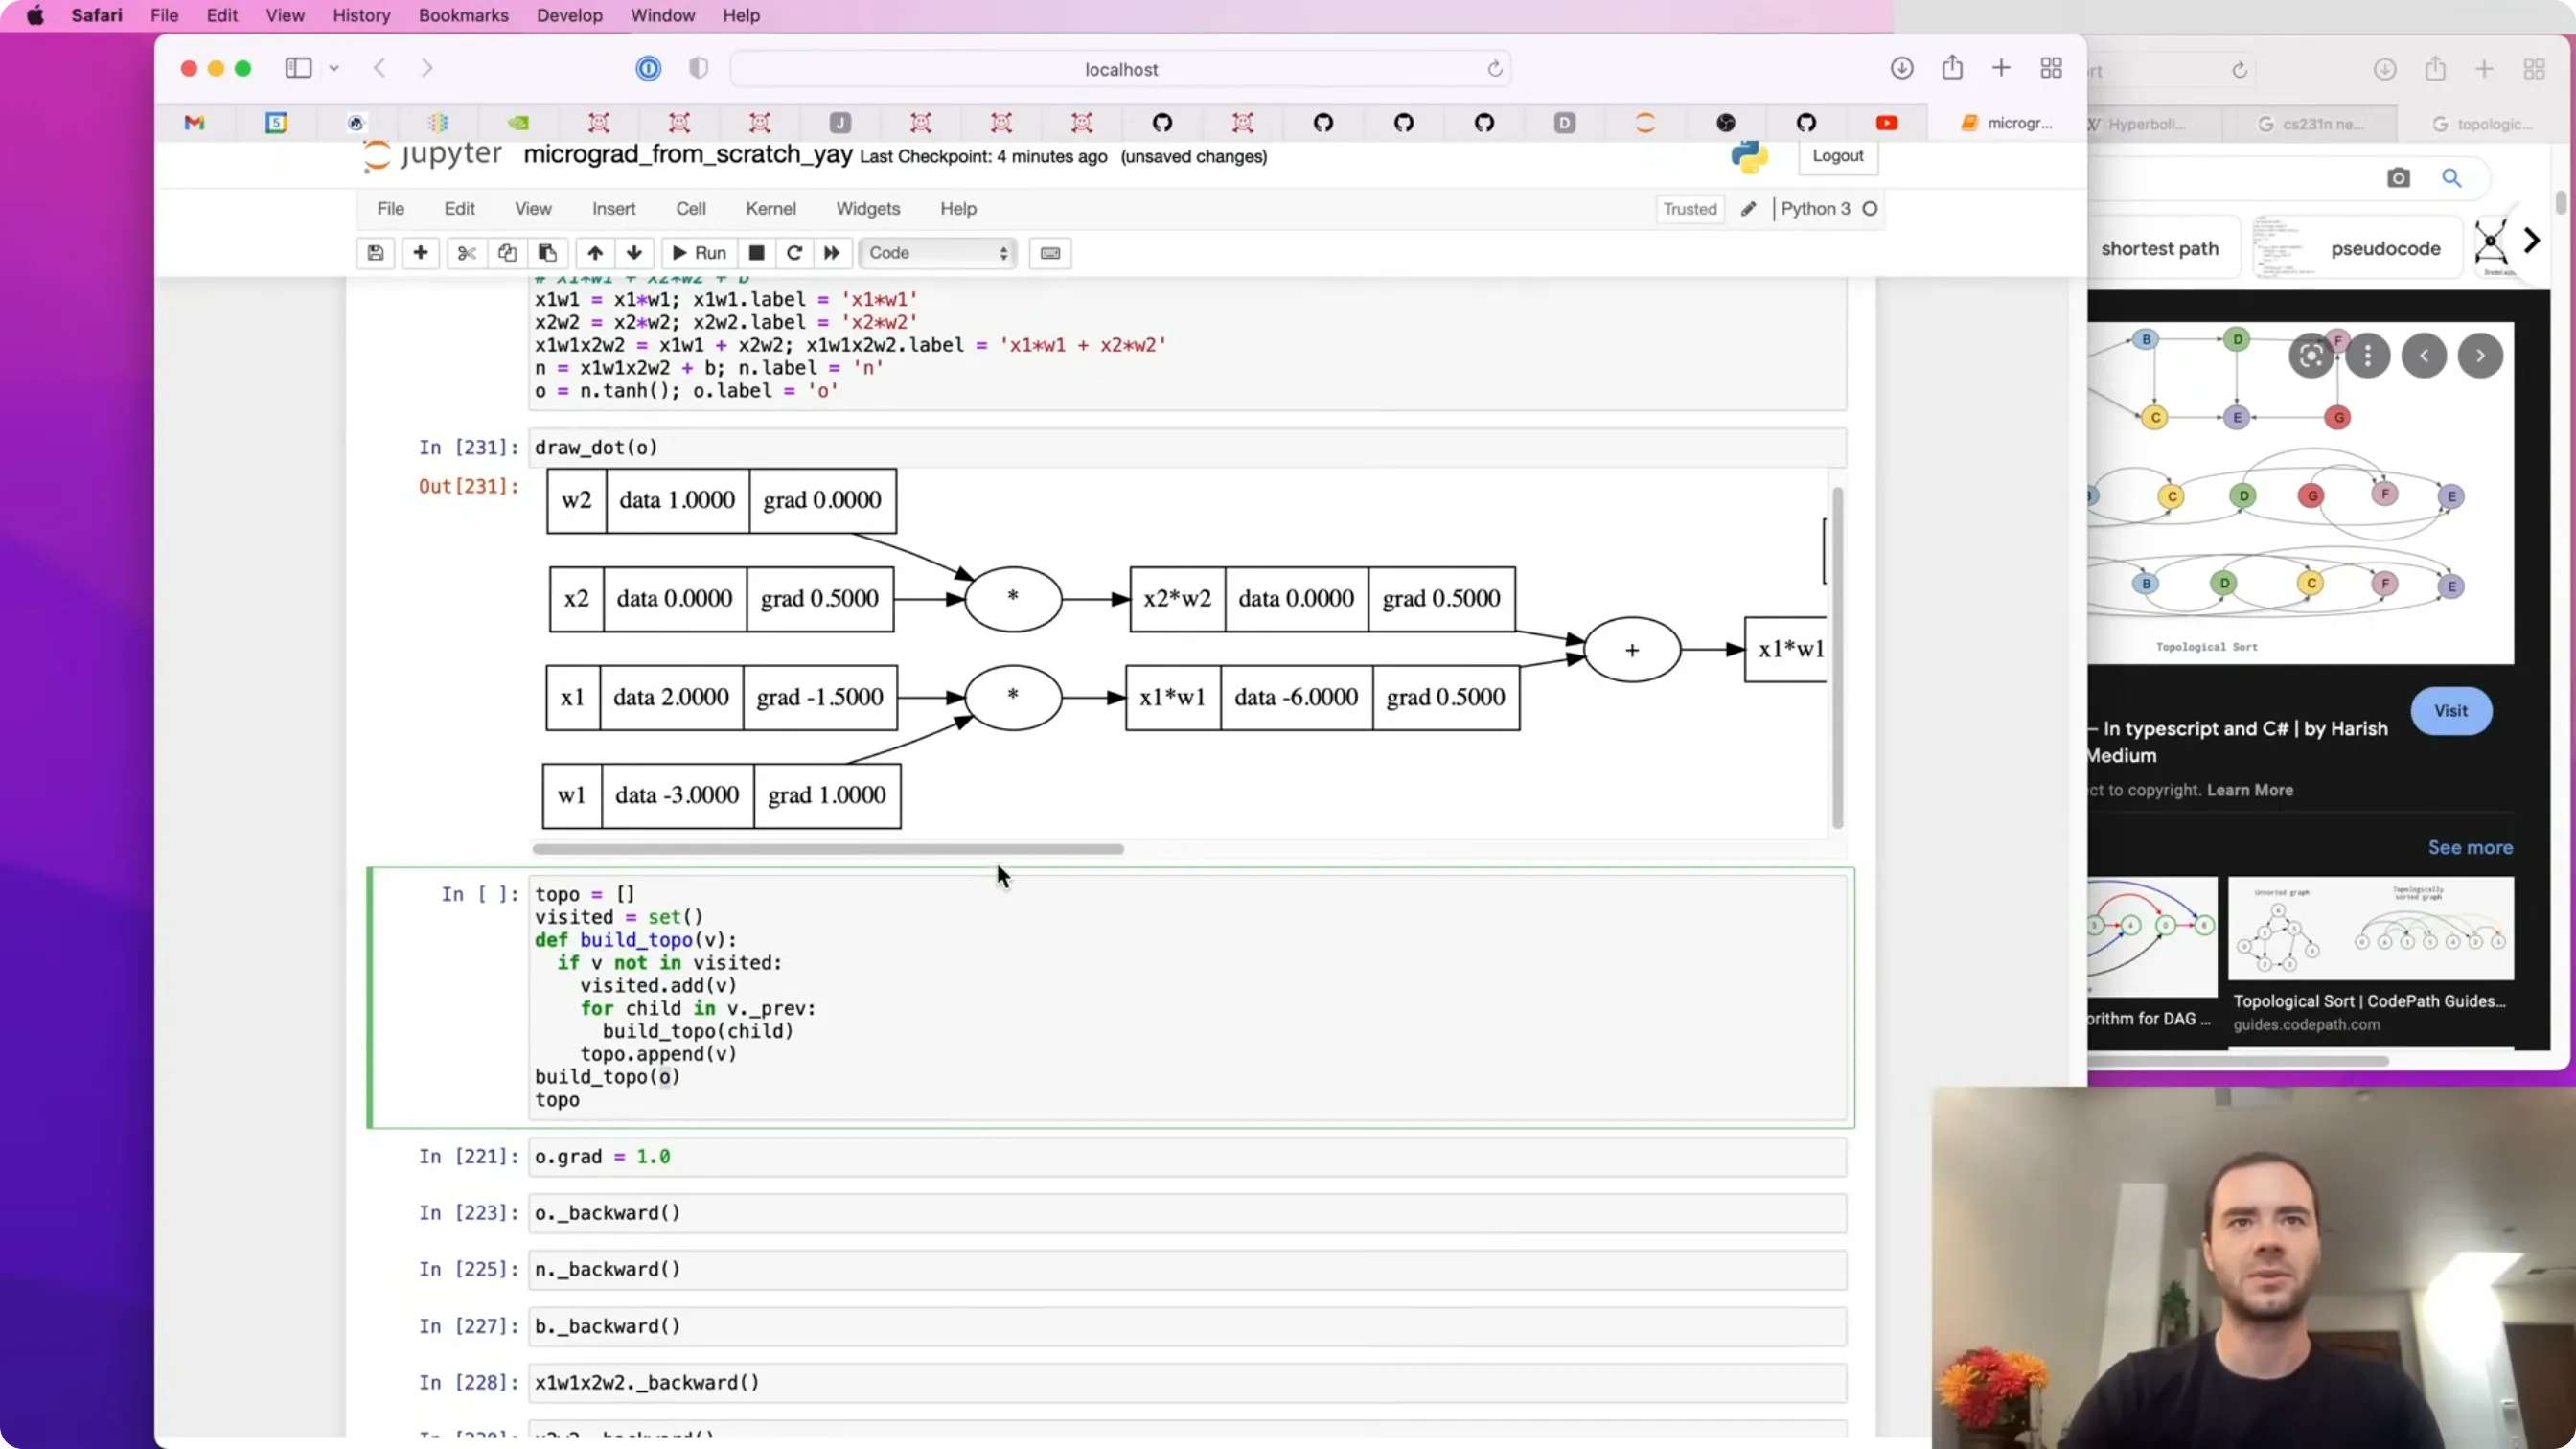
📷 拓扑排序 + 逆序调用 _backward:完整的反向传播
回到原视频 (01:19:00)
编者拓展|为什么非要"拓扑序"?:因为梯度是"累加"来的(
+=)。要算某个节点的最终梯度,必须等所有从它流出的路径都贡献过之后。如果顺序错了,你可能在梯度还不完整时就往下传,结果就错了。拓扑序保证了"轮到某个节点时,它的上游已经全部到齐"。一个直观类比:先修课。要修「机器学习」,得先修「线性代数」和「概率论」。拓扑序就是一张合法的选课顺序表;反向传播则是倒着把学分(梯度)退回去。
七、修复 bug:同一个节点被用多次
(参考时间: 01:22)
先别高兴太早——这里有一个 bug。
a = Value(3.0)
b = a + a       # b = a 与 a 相加
b.backward()
a.grad          # 得到 1.0 —— 但正确答案应该是 2!
为什么错了:a + a 中,self 和 other 是同一个对象。加法节点的 _backward 里:
self.grad  += 1.0 * out.grad     # a.grad: 0 -> 1
other.grad += 1.0 * out.grad     # 还是同一个 a!但它此时已写上别的值
顺序执行下来,a.grad 被写了两次——第二次覆盖了第一次(因为我们当时用的是 = 就会这样;即便用了 +=,如果是同一个对象也要小心)。真值 $db/da = 1+1 = 2$。
更一般的例子:$f = e \cdot d$,其中 $d = a\cdot b$、$e = a + b$。反向传播时,a、b 会被两条路径分别"存款"。只要一个变量被用多次,就会出问题。
解法:梯度要"累加"(这正是多元链式法则的一般形式)。把所有 = 改成 +=(我们前面实现时已经这么写了!)。
a.grad = 1.0          # 第一次
a.grad = 1.0          # 覆盖 → 错
# 改成
a.grad += 1.0         # 0 + 1
a.grad += 1.0         # 1 + 1 = 2  ✅
编者拓展|一图流总结这个 bug:反向传播里每个节点的梯度,是"所有从它出发、流向输出的路径"的贡献之和。所以它天然是累加的。 - 新创建节点时
grad从 0 出发; - 每次回传都+=; - 每一轮训练前必须清零(第 10 节会看到这个坑)。这三条合起来,就是"梯度正确性"的全部纪律。
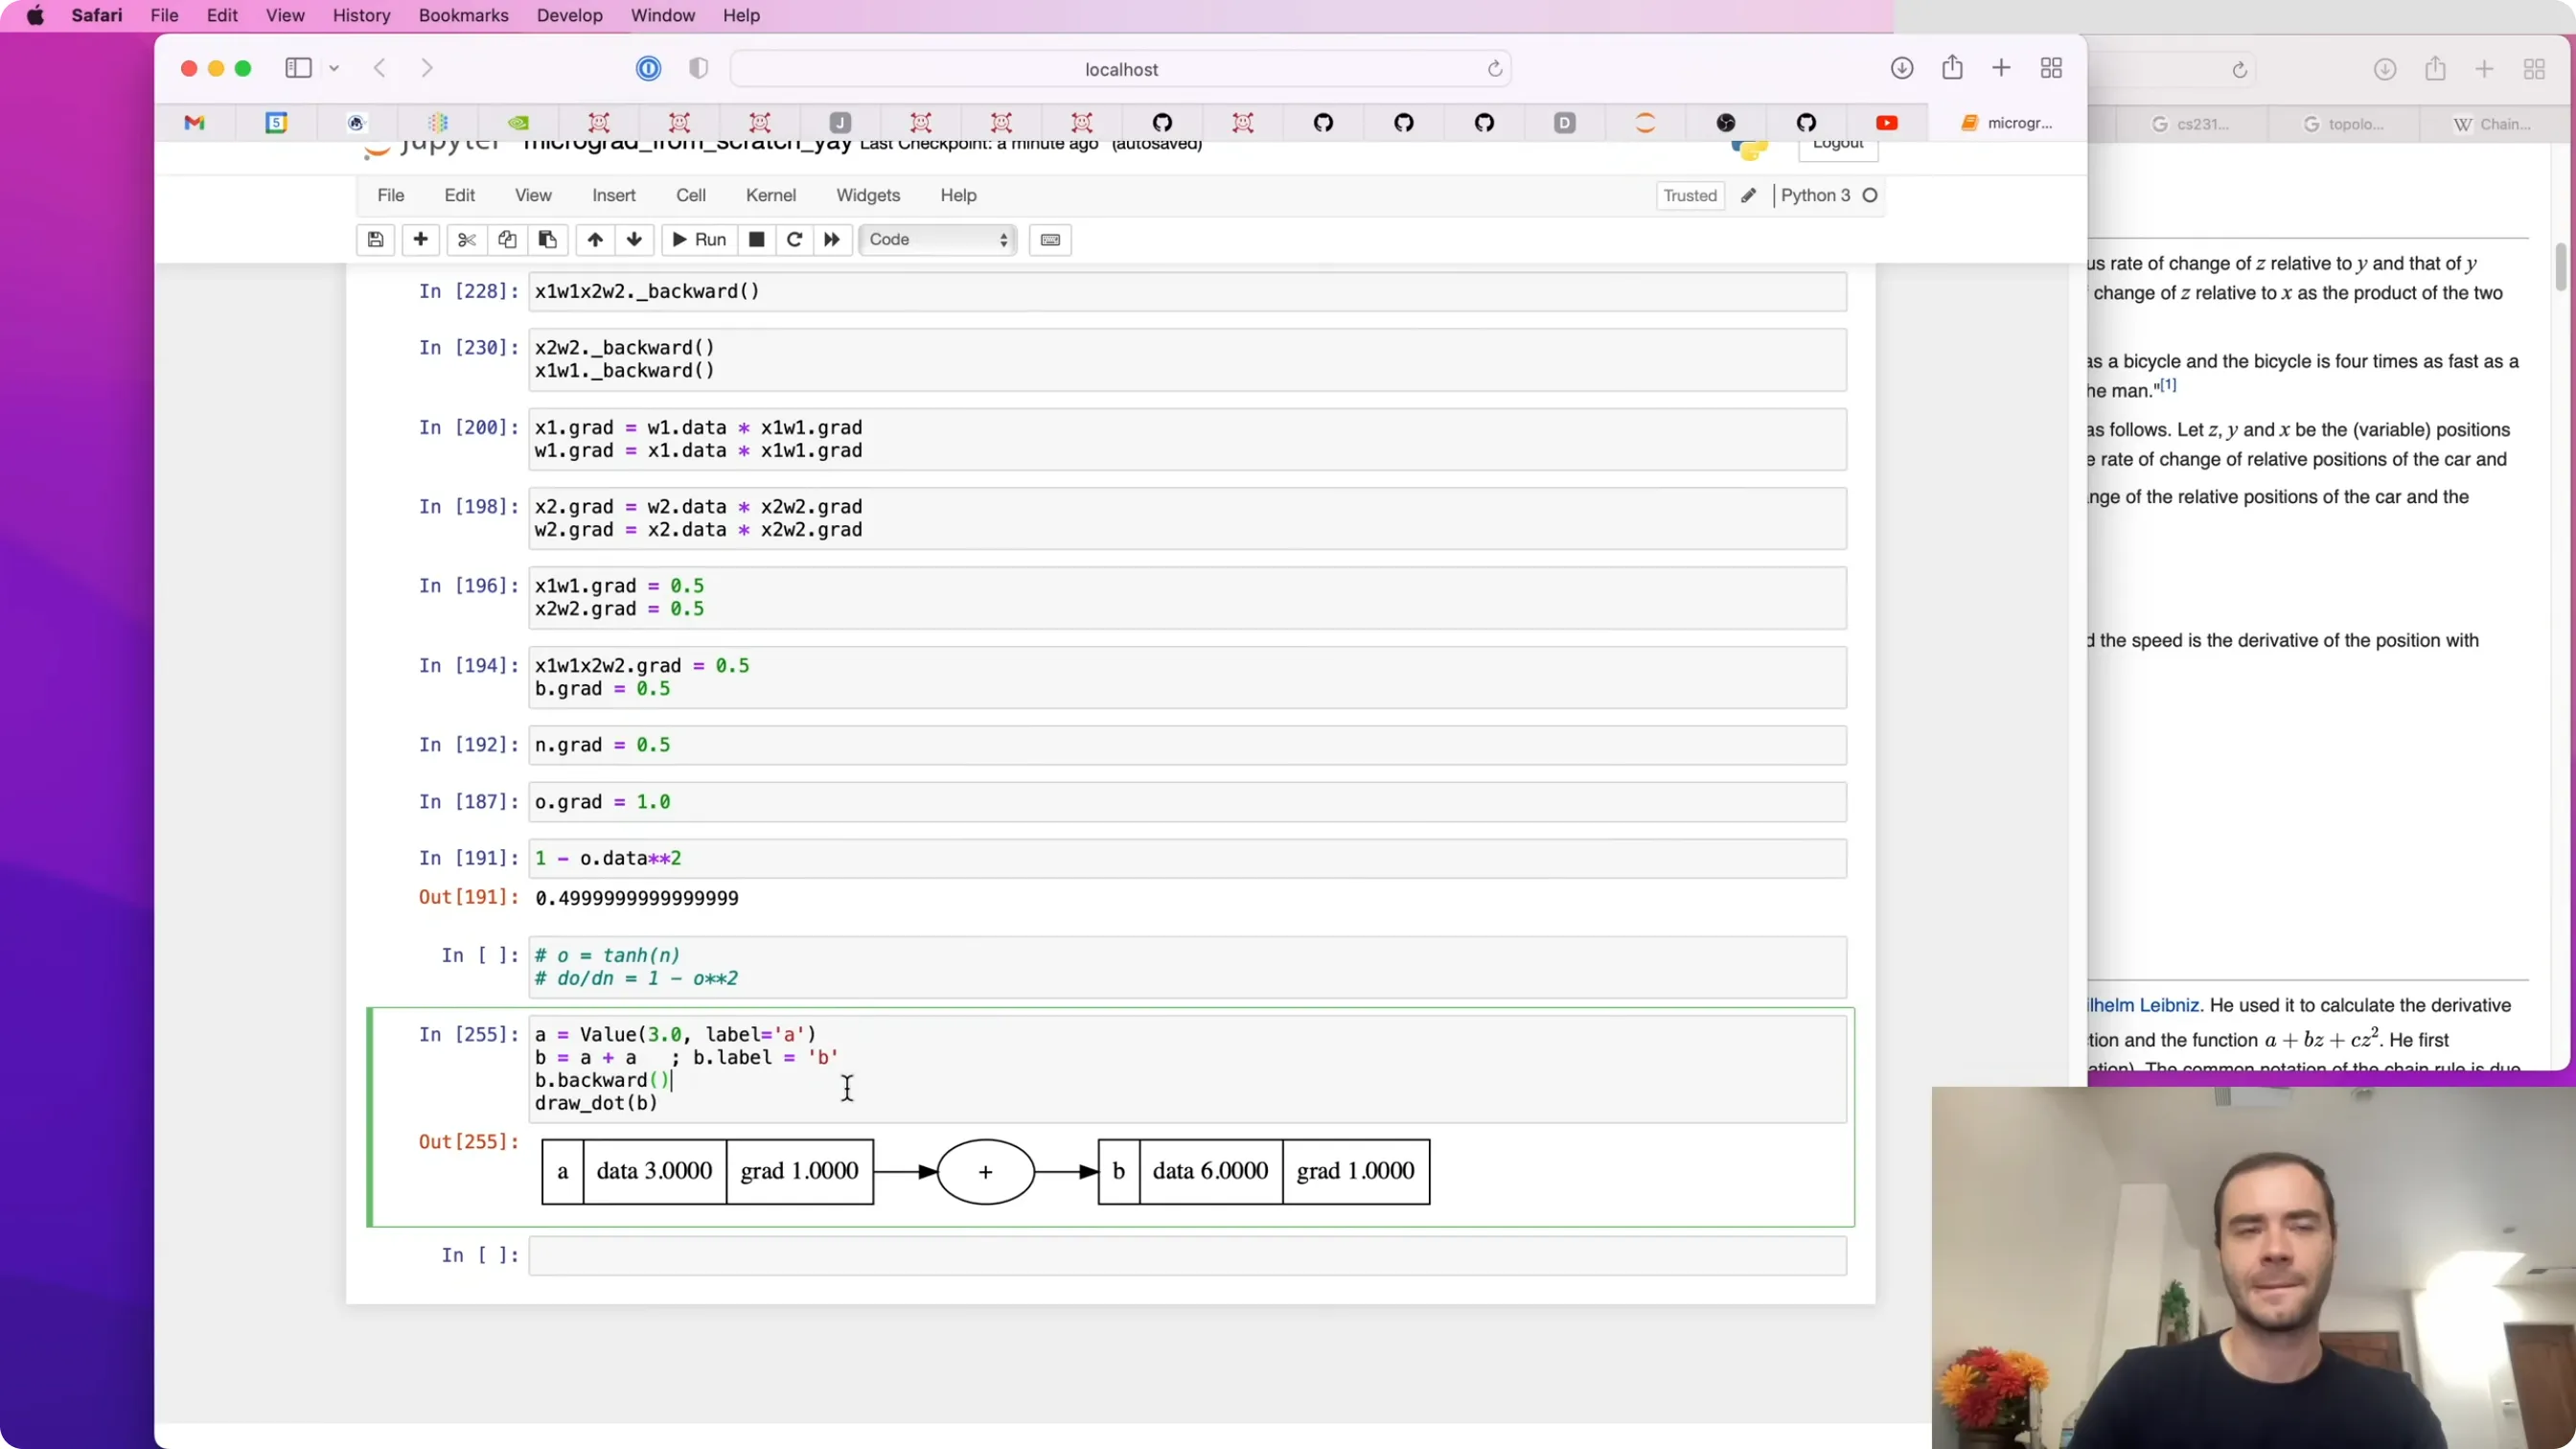
📷 bug 与修复:同一节点被多次使用,梯度必须"累加"
回到原视频 (01:23:30)
八、拆解 tanh:把运算粒度交给你自己
(参考时间: 01:27)
现在把之前那个"整体实现"的 tanh 拆成原子运算,借此实现更多算子,并验证结果一致。
先让常量能用:
def __add__(self, other):
    other = other if isinstance(other, Value) else Value(other)
    ...
这样 a + 1 就能工作了。
还有一个坑:2 * a 不工作。 因为 Python 会先试 2.__mul__(a)(失败),于是回退到 a.__rmul__(2)。实现 __rmul__ 即可:
def __rmul__(self, other):
    return self * other      # 交换顺序,再走 __mul__
实现 exp:局部导数 famously 就是它自己。
def exp(self):
    x = self.data
    out = Value(math.exp(x), (self,), 'exp')
    def _backward():
        self.grad += out.data * out.grad
    out._backward = _backward
    return out
实现 pow(幂,指数是常量):由幂法则 $\dfrac{d}{dx}x^n = n x^{n-1}$:
def __pow__(self, other):
    assert isinstance(other, (int, float))
    out = Value(self.data**other, (self,), f'**{other}')
    def _backward():
        self.grad += other * (self.data ** (other - 1)) * out.grad
    out._backward = _backward
    return out
除法则"顺水推舟":$a / b = a \cdot b^{-1}$。
def __truediv__(self, other):
    return self * other**-1
减法:$a - b = a + (-b)$,而 $-b = b \times (-1)$。
最后,用 exp 把 tanh 拆开:$\tanh(x) = \dfrac{e^{2x}-1}{e^{2x}+1}$:
o = (e - 1) / (e + 1) # e = (2*n).exp()
运行后:前向传播结果不变(同一个 0.7071),反向传播得到的四个叶子梯度也完全一致(0、0.5、1、−1.5)。
编者拓展|这一节的"元信息":运算的粒度完全由你决定。「单加的 plus、单乘的 times」可以,「tanh 这样的复合操作」也可以——唯一重要的是:你能写出这个操作的局部导数。能写局部导数,就能链式回传,就能继续反向传播。
这也解释了 PyTorch 的
autograd.Function:它就是让你"注册一个新的 lego 积木",你只要告诉它前向怎么算、反向局部导数是什么,剩下的 PyTorch 全包。(视频末尾 Karpathy 演示了这个。)
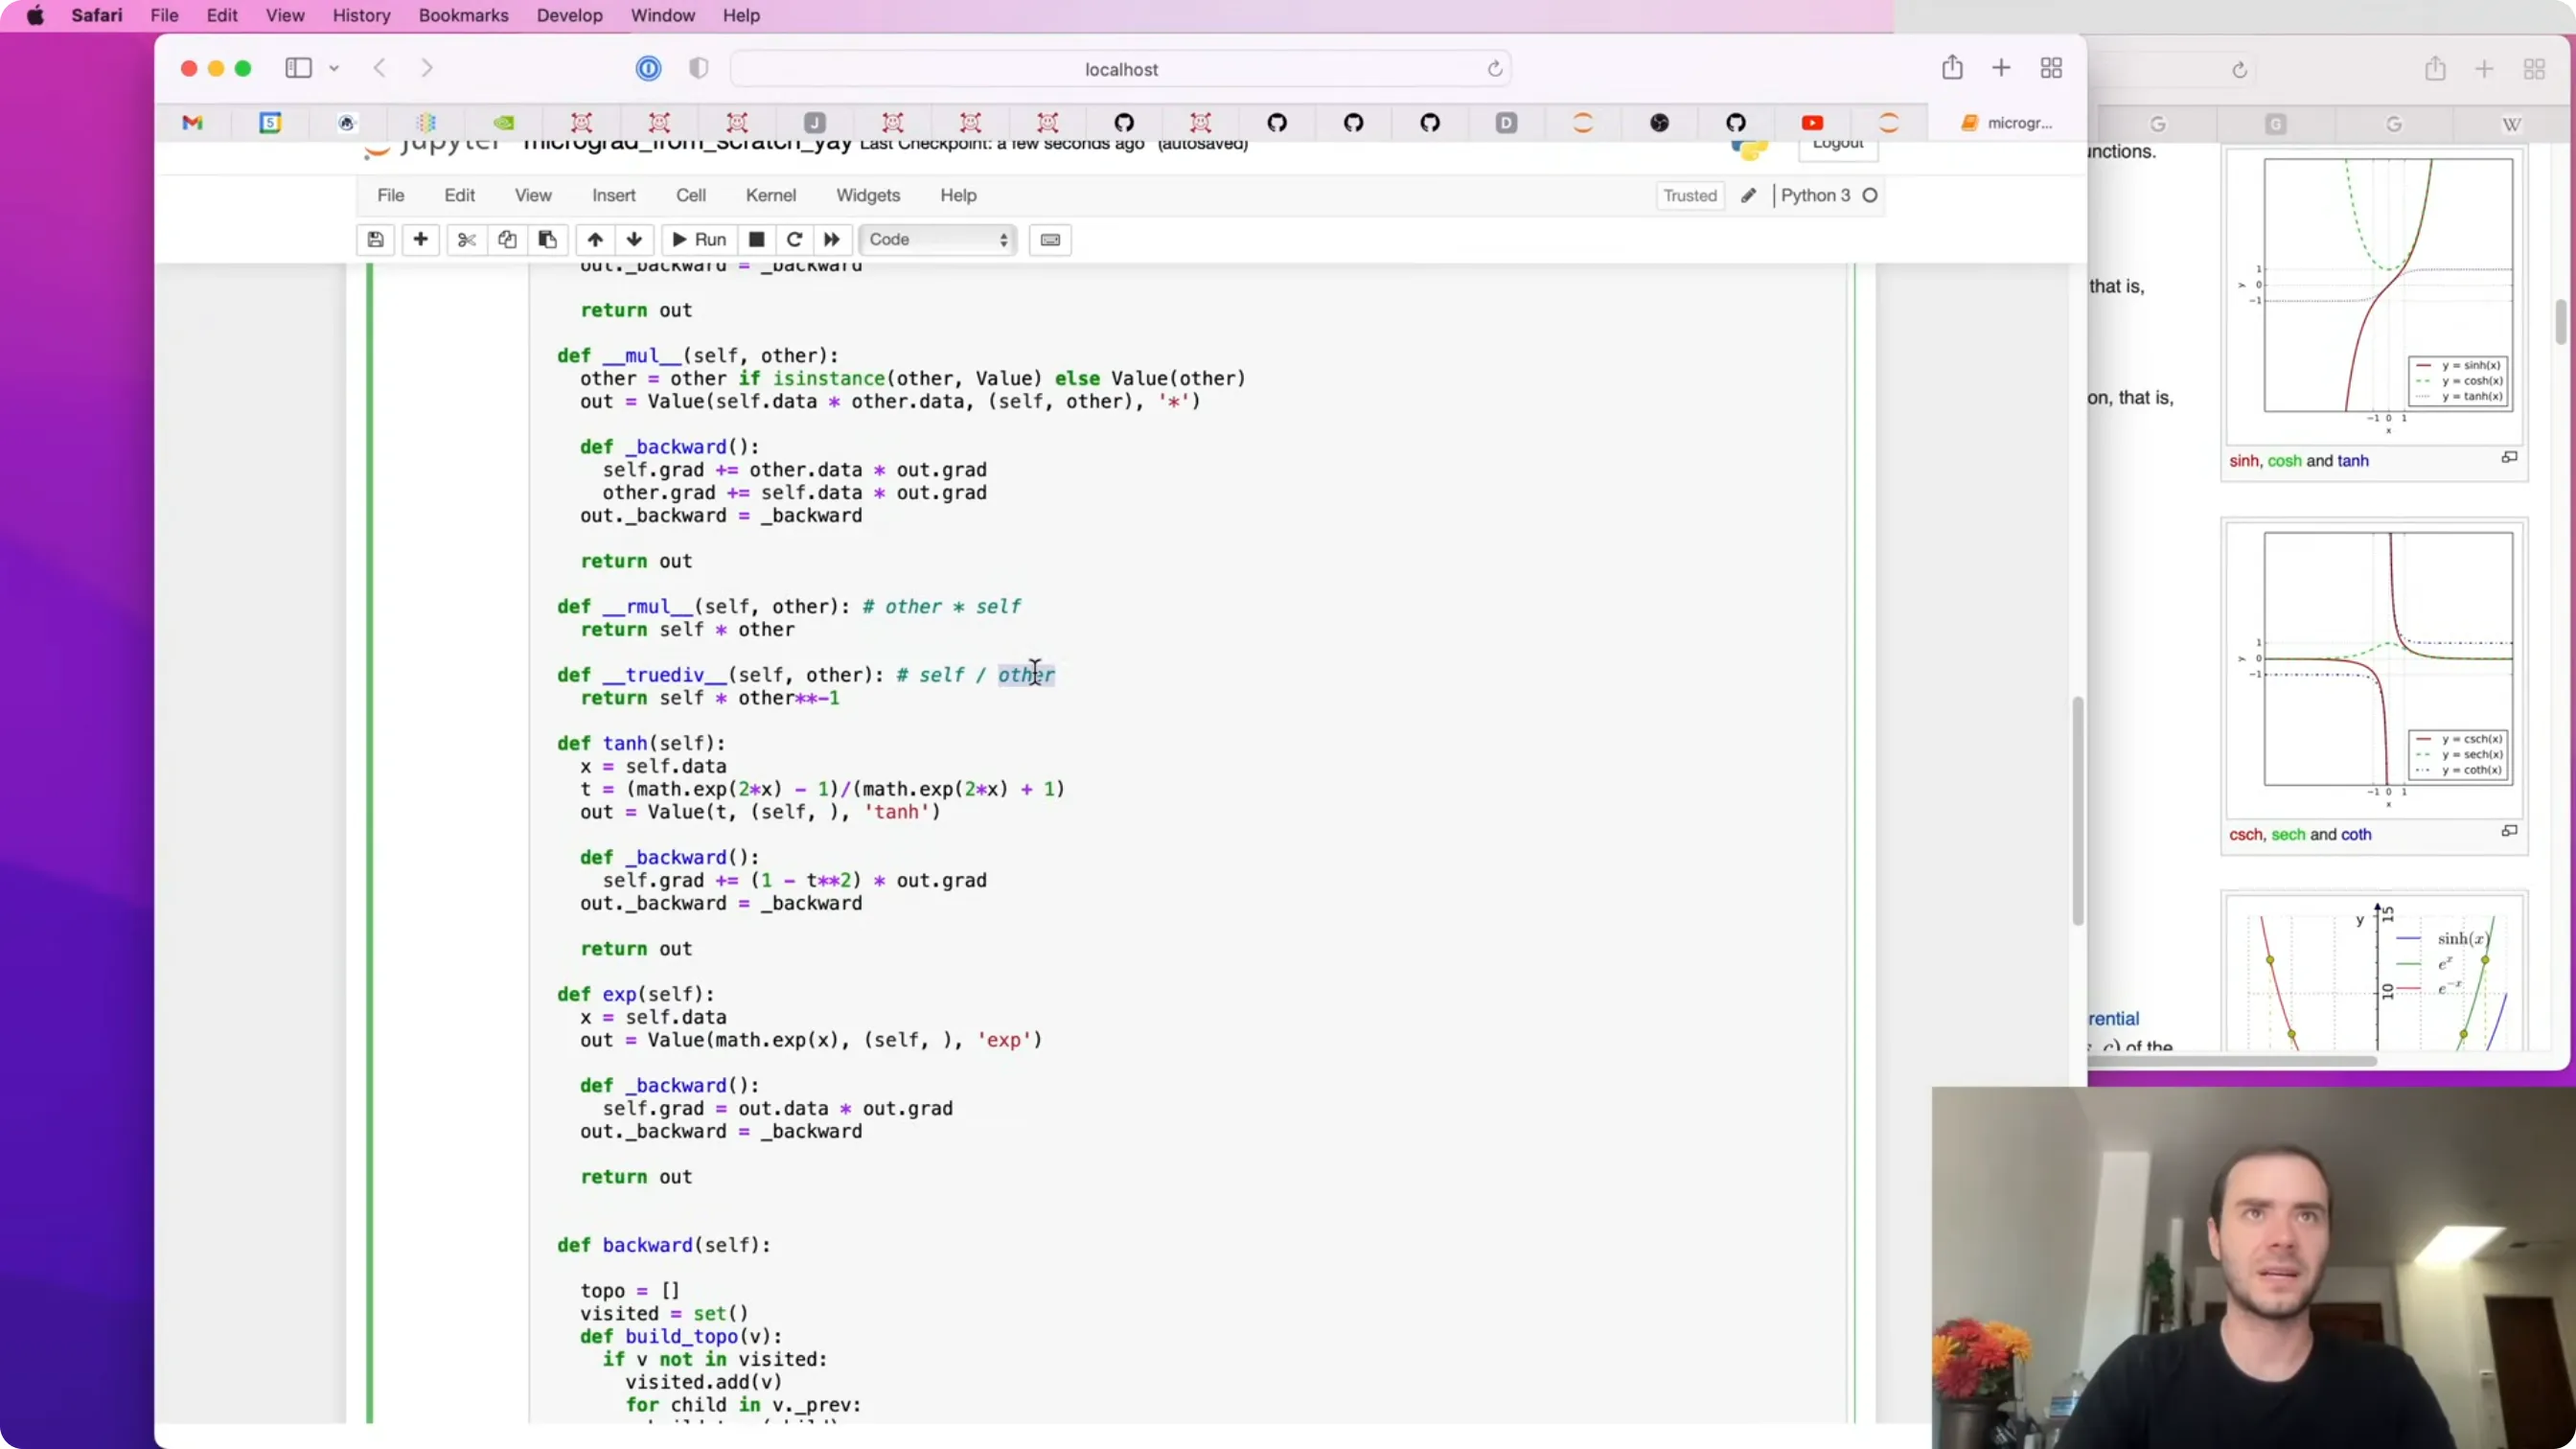
📷 用 exp/pow/div/sub 拆解 tanh,前向与反向结果完全一致
回到原视频 (01:33:00)
九、与 PyTorch 对照
(参考时间: 01:39)
同一件事,用 PyTorch 写长这样:
import torch
x1 = torch.Tensor([2.0]).double();  x1.requires_grad = True
# ... 其余输入同理
n = x1*w1 + x2*w2 + b
o = torch.tanh(n)
print(o.data.item())        # 0.7071...
o.backward()
print(x2.grad.item(), w2.grad.item(), x1.grad.item(), w1.grad.item())
得到 完全相同的前向值与梯度(0.5、0、−1.5、1)。
几个区别:
- PyTorch 里一切都是张量(tensor)——"标量"只是单元素张量;而 micrograd 是标量引擎;
- 张量默认是
float32(单精度),Python 浮点是float64(双精度),所以这里显式转成.double()以便逐位对齐; - 叶子节点默认
requires_grad=False(出于效率——通常你不想对"数据"求梯度),要手动打开; .item()把单元素张量取成一个普通 Python 数。
编者拓展|micrograd 是 PyTorch 的"特例":把张量限制成"只有一个元素",PyTorch 干的事就和 micrograd 一模一样(
data、grad、backward、运算图)。PyTorch 的全部额外价值,就是"张量 + 并行 + 效率"——它能把成千上万次标量运算同时做掉(CPU 的 SIMD、GPU 的成千上万核心)。所以:你现在理解了 PyTorch 的"数学内核"。 后面所有的框架,都只是在这个内核外面加效率。
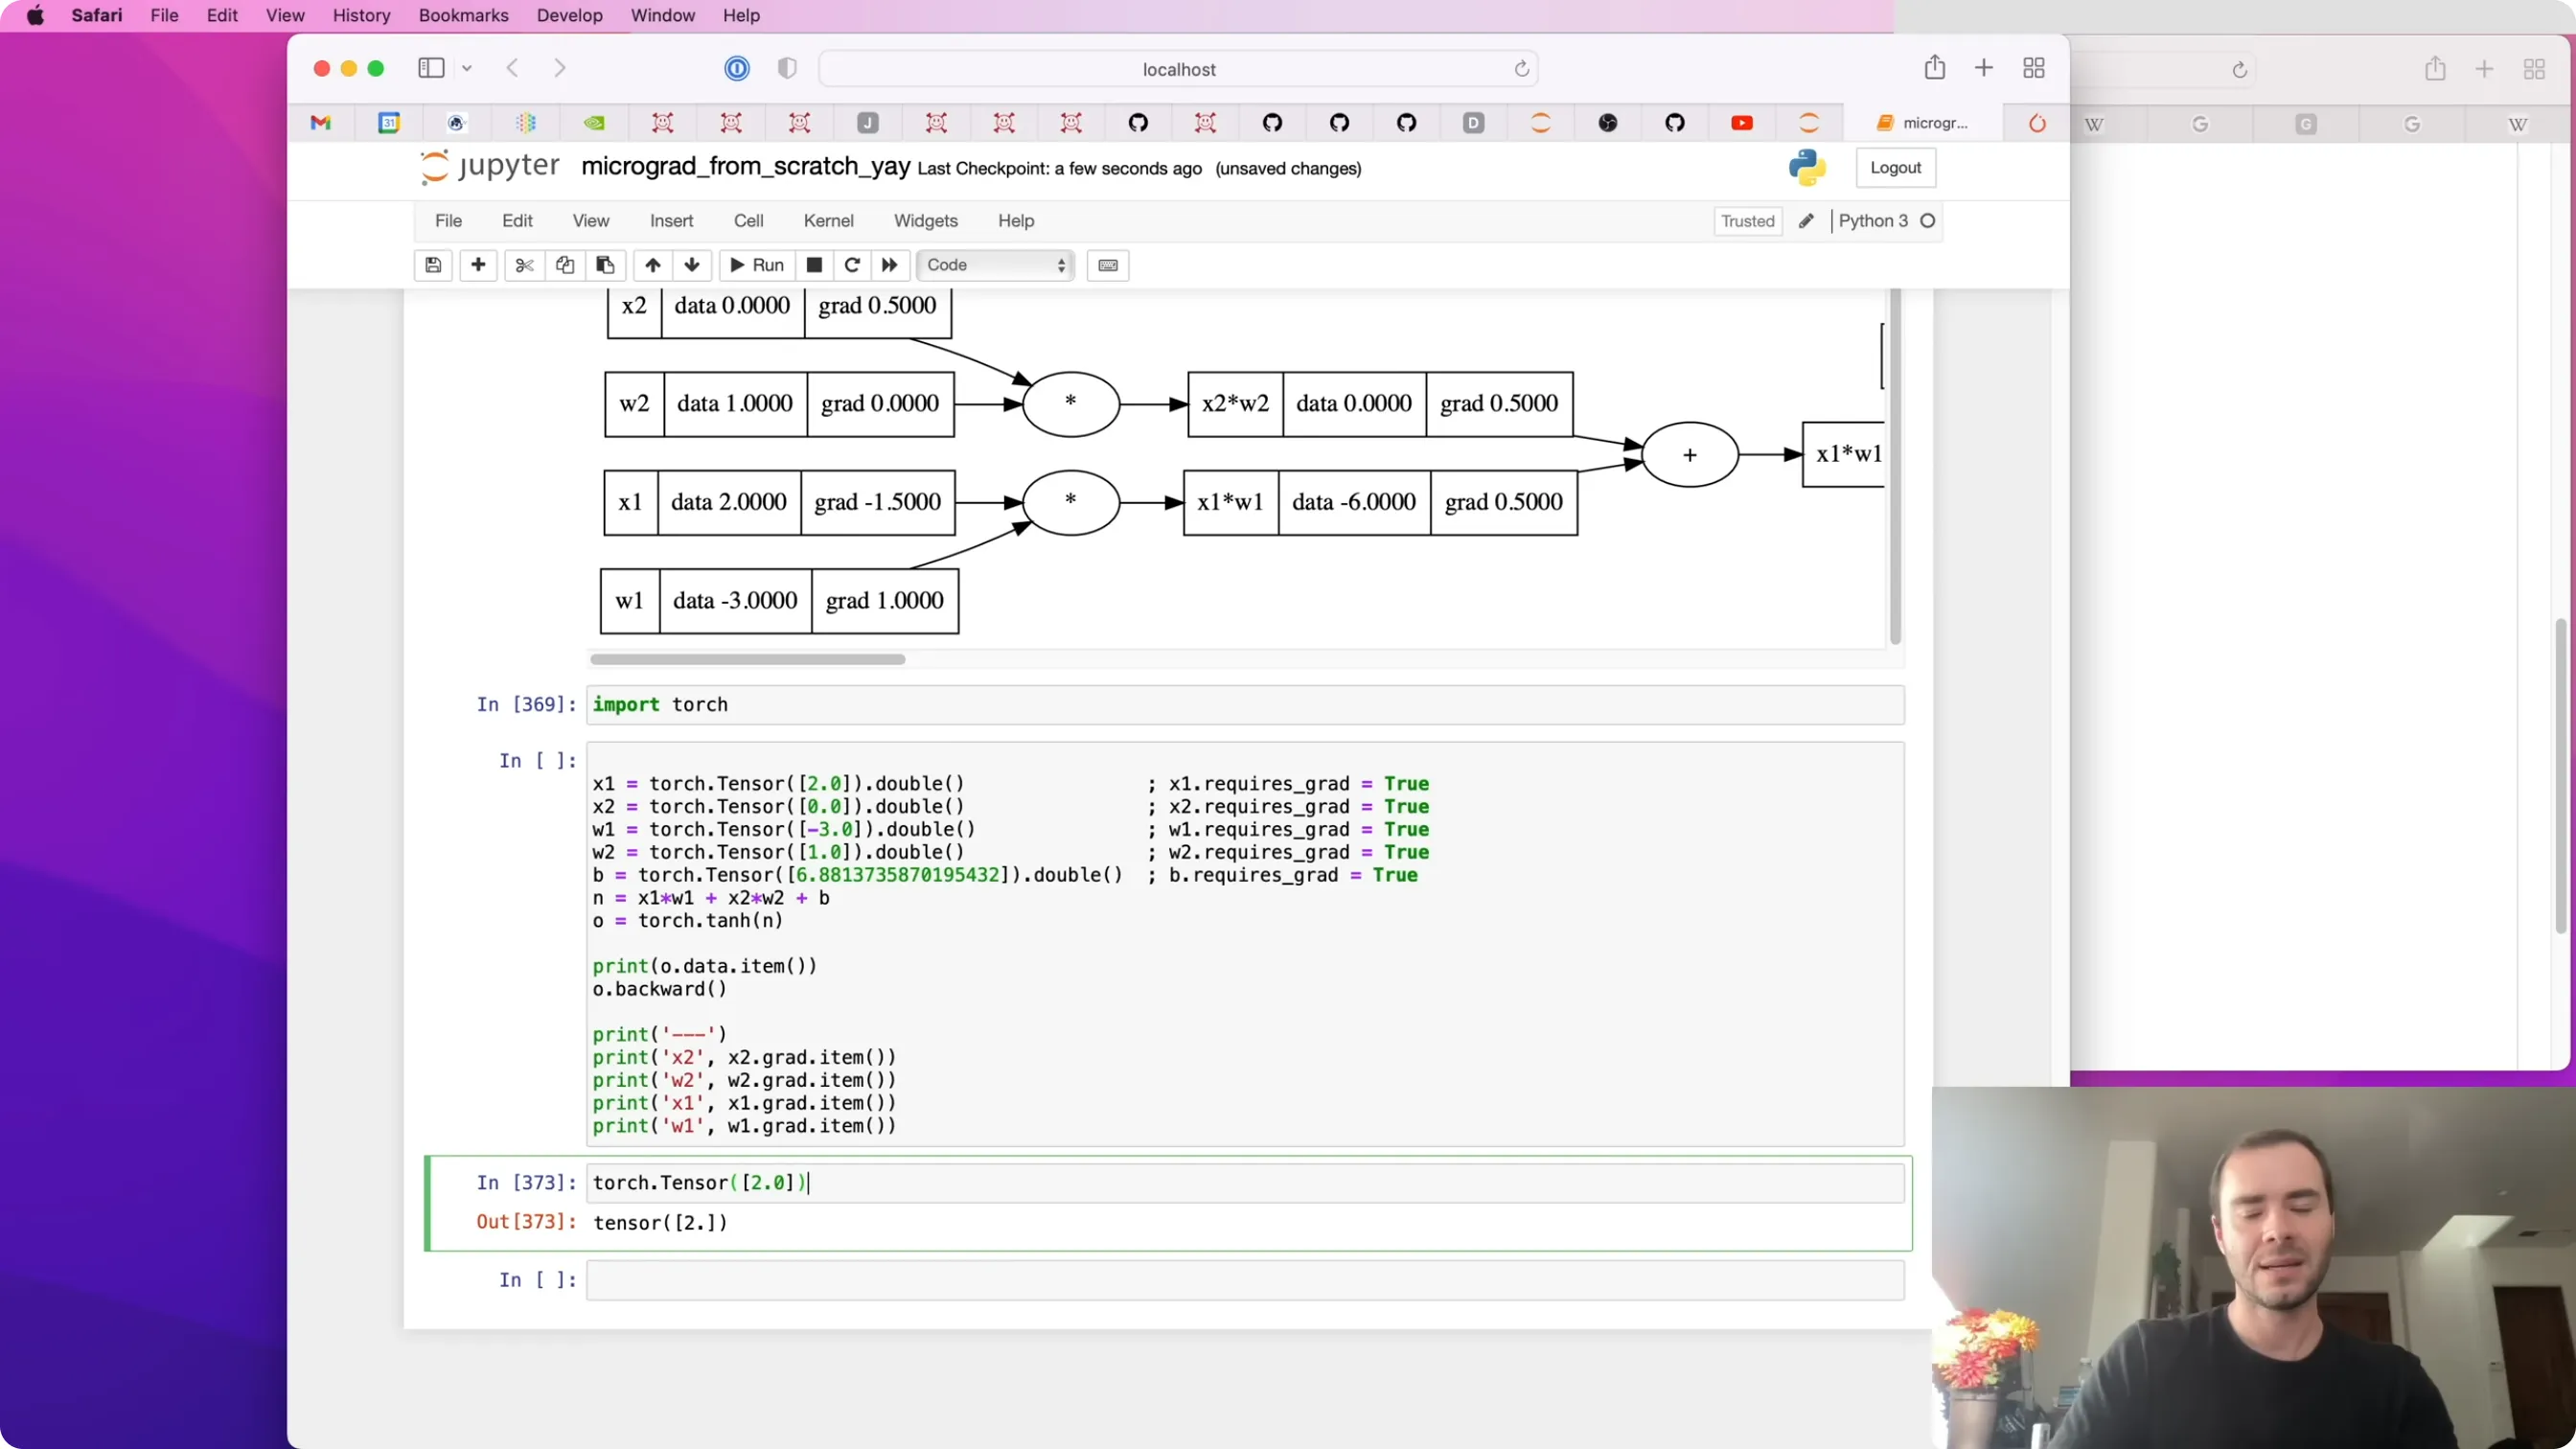
📷 PyTorch 对照:同样的表达式,同样的梯度
回到原视频 (01:41:00)
十、构建神经网络库:Neuron / Layer / MLP
(参考时间: 01:44)
现在我们有了自动求导,就可以搭神经网络了(神经网络 = 一类特定的数学表达式)。
Neuron(神经元):接收 nin 个输入,初始化 nin 个随机权重($[-1,1]$)和一个偏置:
class Neuron:
    def __init__(self, nin):
        self.w = [Value(random.uniform(-1,1)) for _ in range(nin)]
        self.b = Value(random.uniform(-1,1))

    def __call__(self, x):
        act = sum((wi*xi for wi, xi in zip(self.w, x)), self.b)
        return act.tanh()

    def parameters(self):
        return self.w + [self.b]
Layer(层):一"层"就是一组互不连接的神经元,它们各自独立地看同样的输入:
class Layer:
    def __init__(self, nin, nout):
        self.neurons = [Neuron(nin) for _ in range(nout)]

    def __call__(self, x):
        outs = [n(x) for n in self.neurons]
        return outs[0] if len(outs) == 1 else outs

    def parameters(self):
        return [p for n in self.neurons for p in n.parameters()]
MLP(多层感知机):把若干层顺序串起来:
class MLP:
    def __init__(self, nin, nouts):
        sz = [nin] + nouts
        self.layers = [Layer(sz[i], sz[i+1]) for i in range(len(nouts))]

    def __call__(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

    def parameters(self):
        return [p for layer in self.layers for p in layer.parameters()]
n = MLP(3, [4, 4, 1])          # 3 个输入 → 两个各 4 个神经元的隐藏层 → 1 个输出
n([2.0, 3.0, -1.0])            # 前向传播
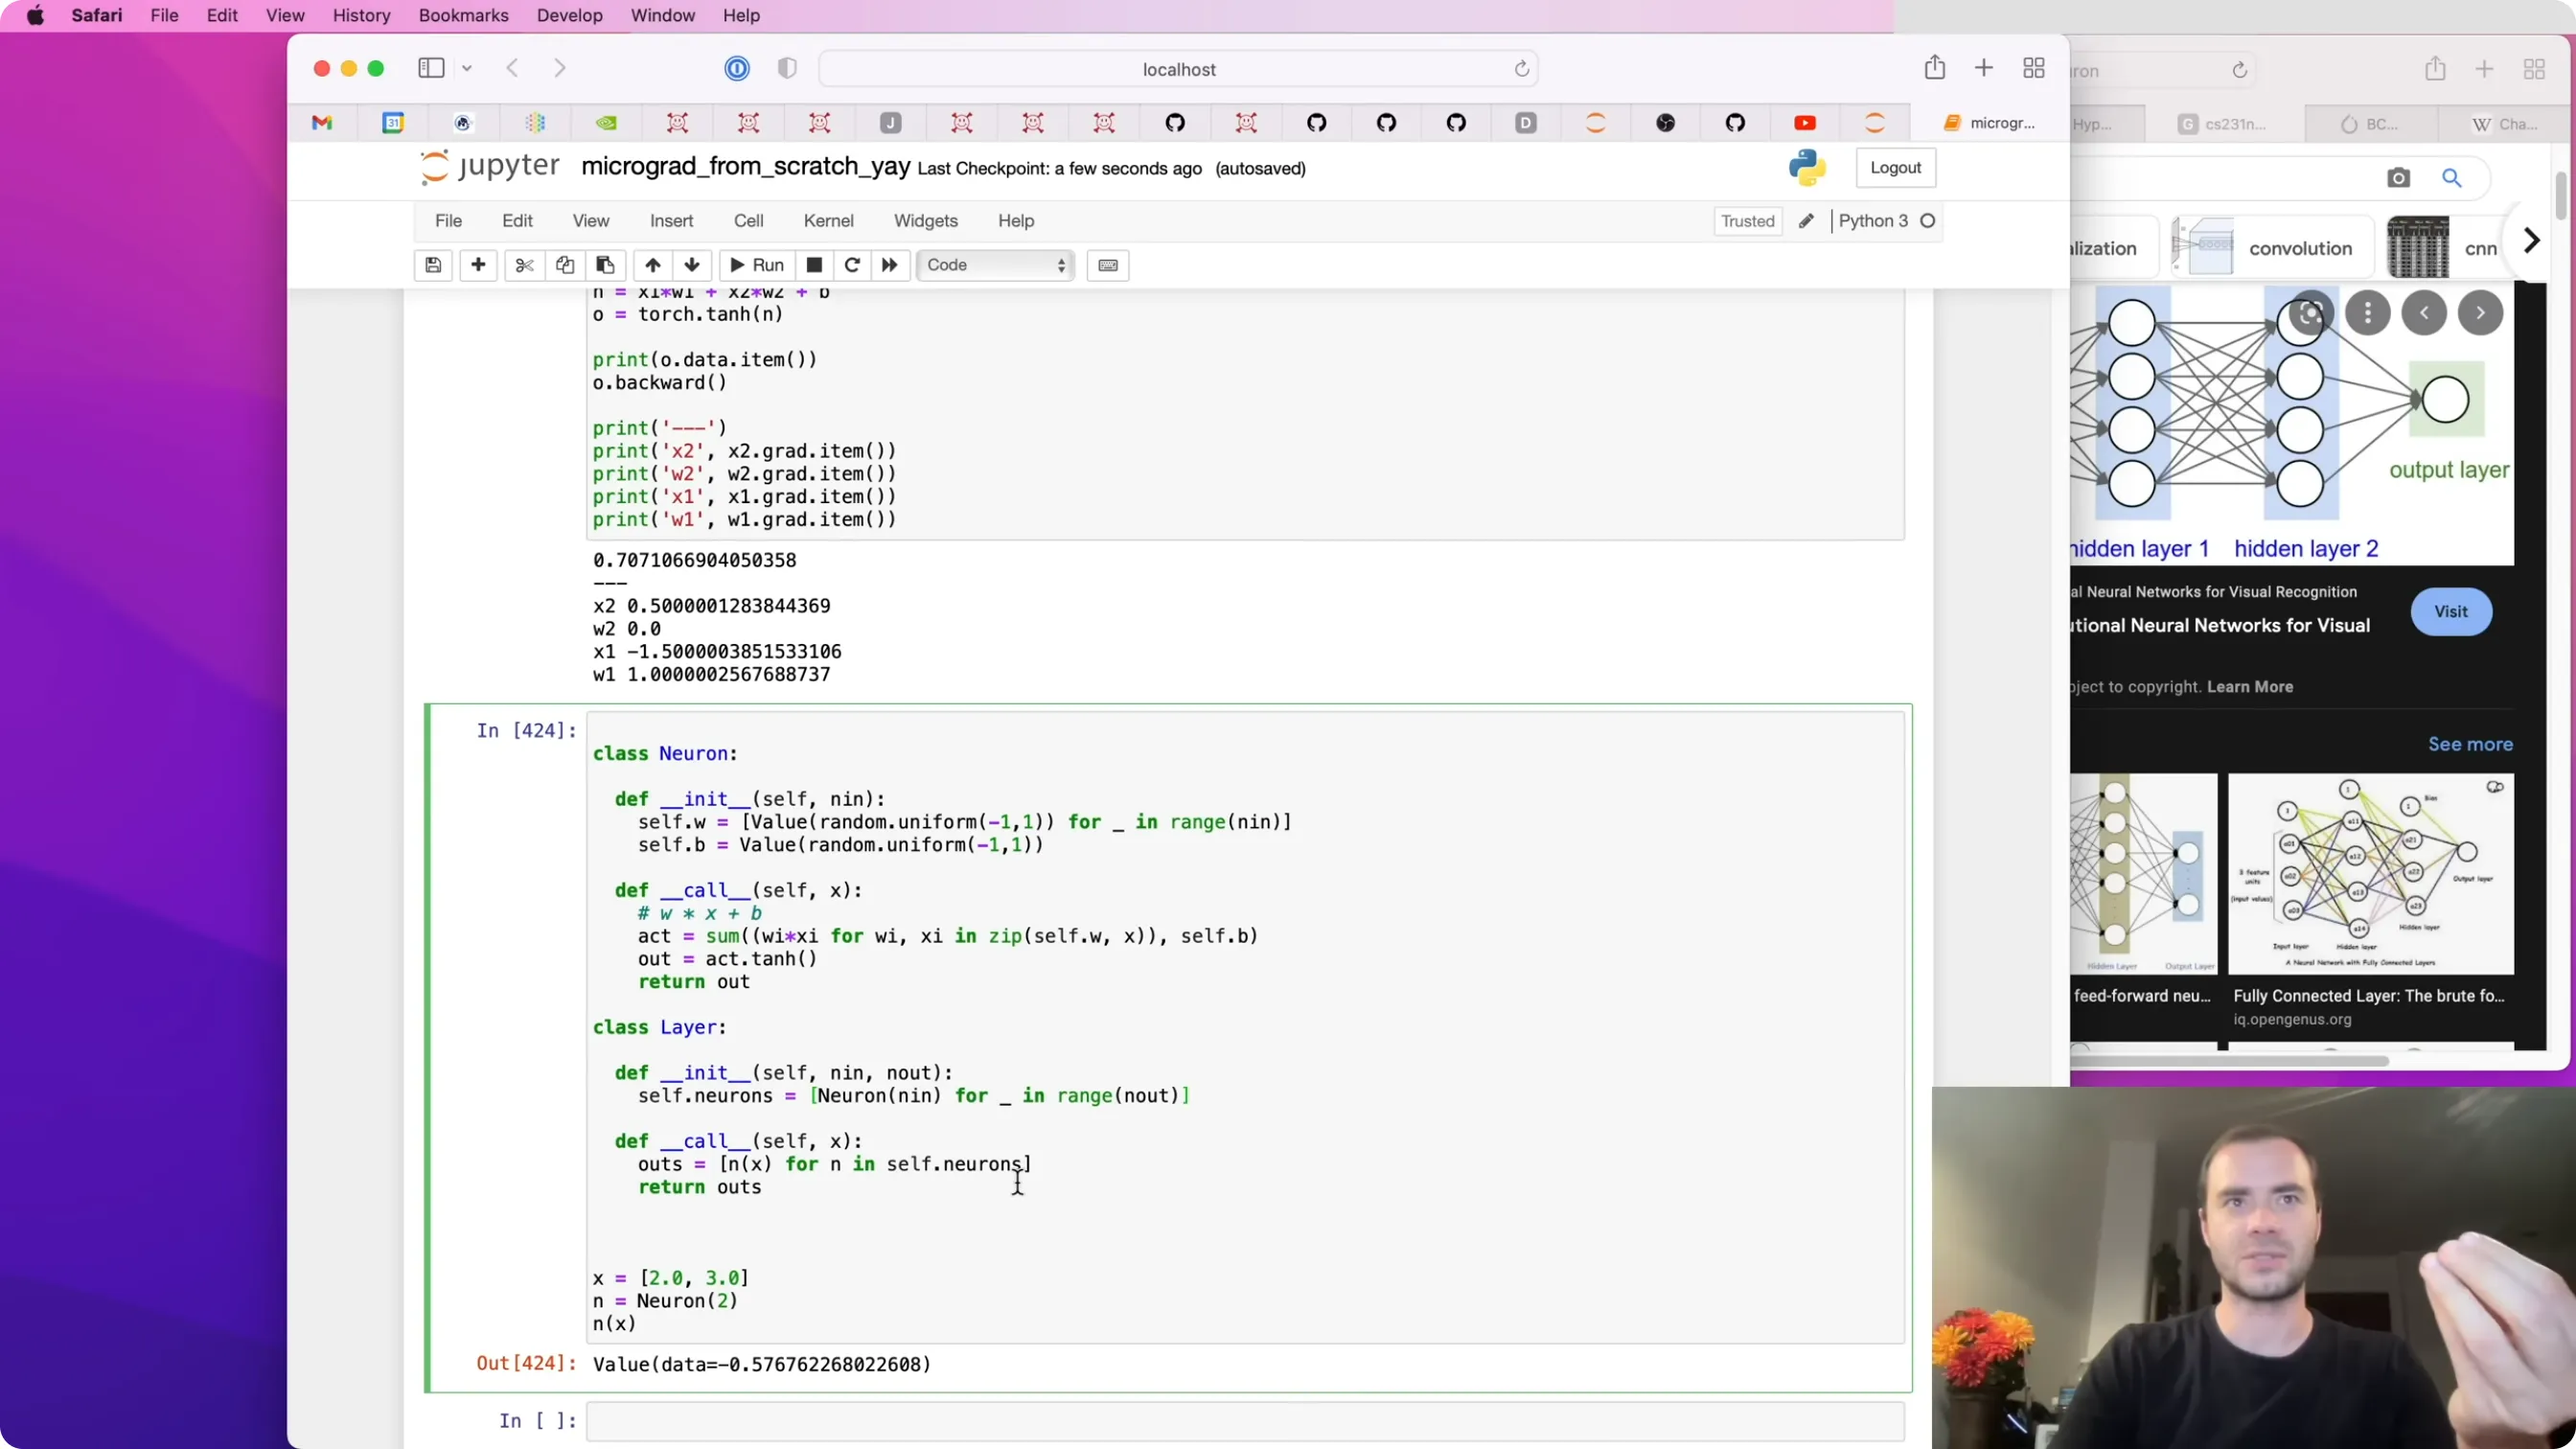
📷 用 Neuron/Layer/MLP 三个类搭出一个多层感知机
回到原视频 (01:48:30)
编者拓展|"神经网络库"只是"积木积木再积木":这就是 PyTorch
nn.Module的 API——Neuron、Layer、MLP都是模块,都有自己的parameters()。视频里 Karpathy 把它们的共同父类抽成Module,正是为了和 PyTorch 的nn.Module对齐。请注意:这个"神经网络库"的核心逻辑不到 30 行——剩下的复杂度全在训练和工程上。
十一、数据集与损失函数
(参考时间: 01:51)
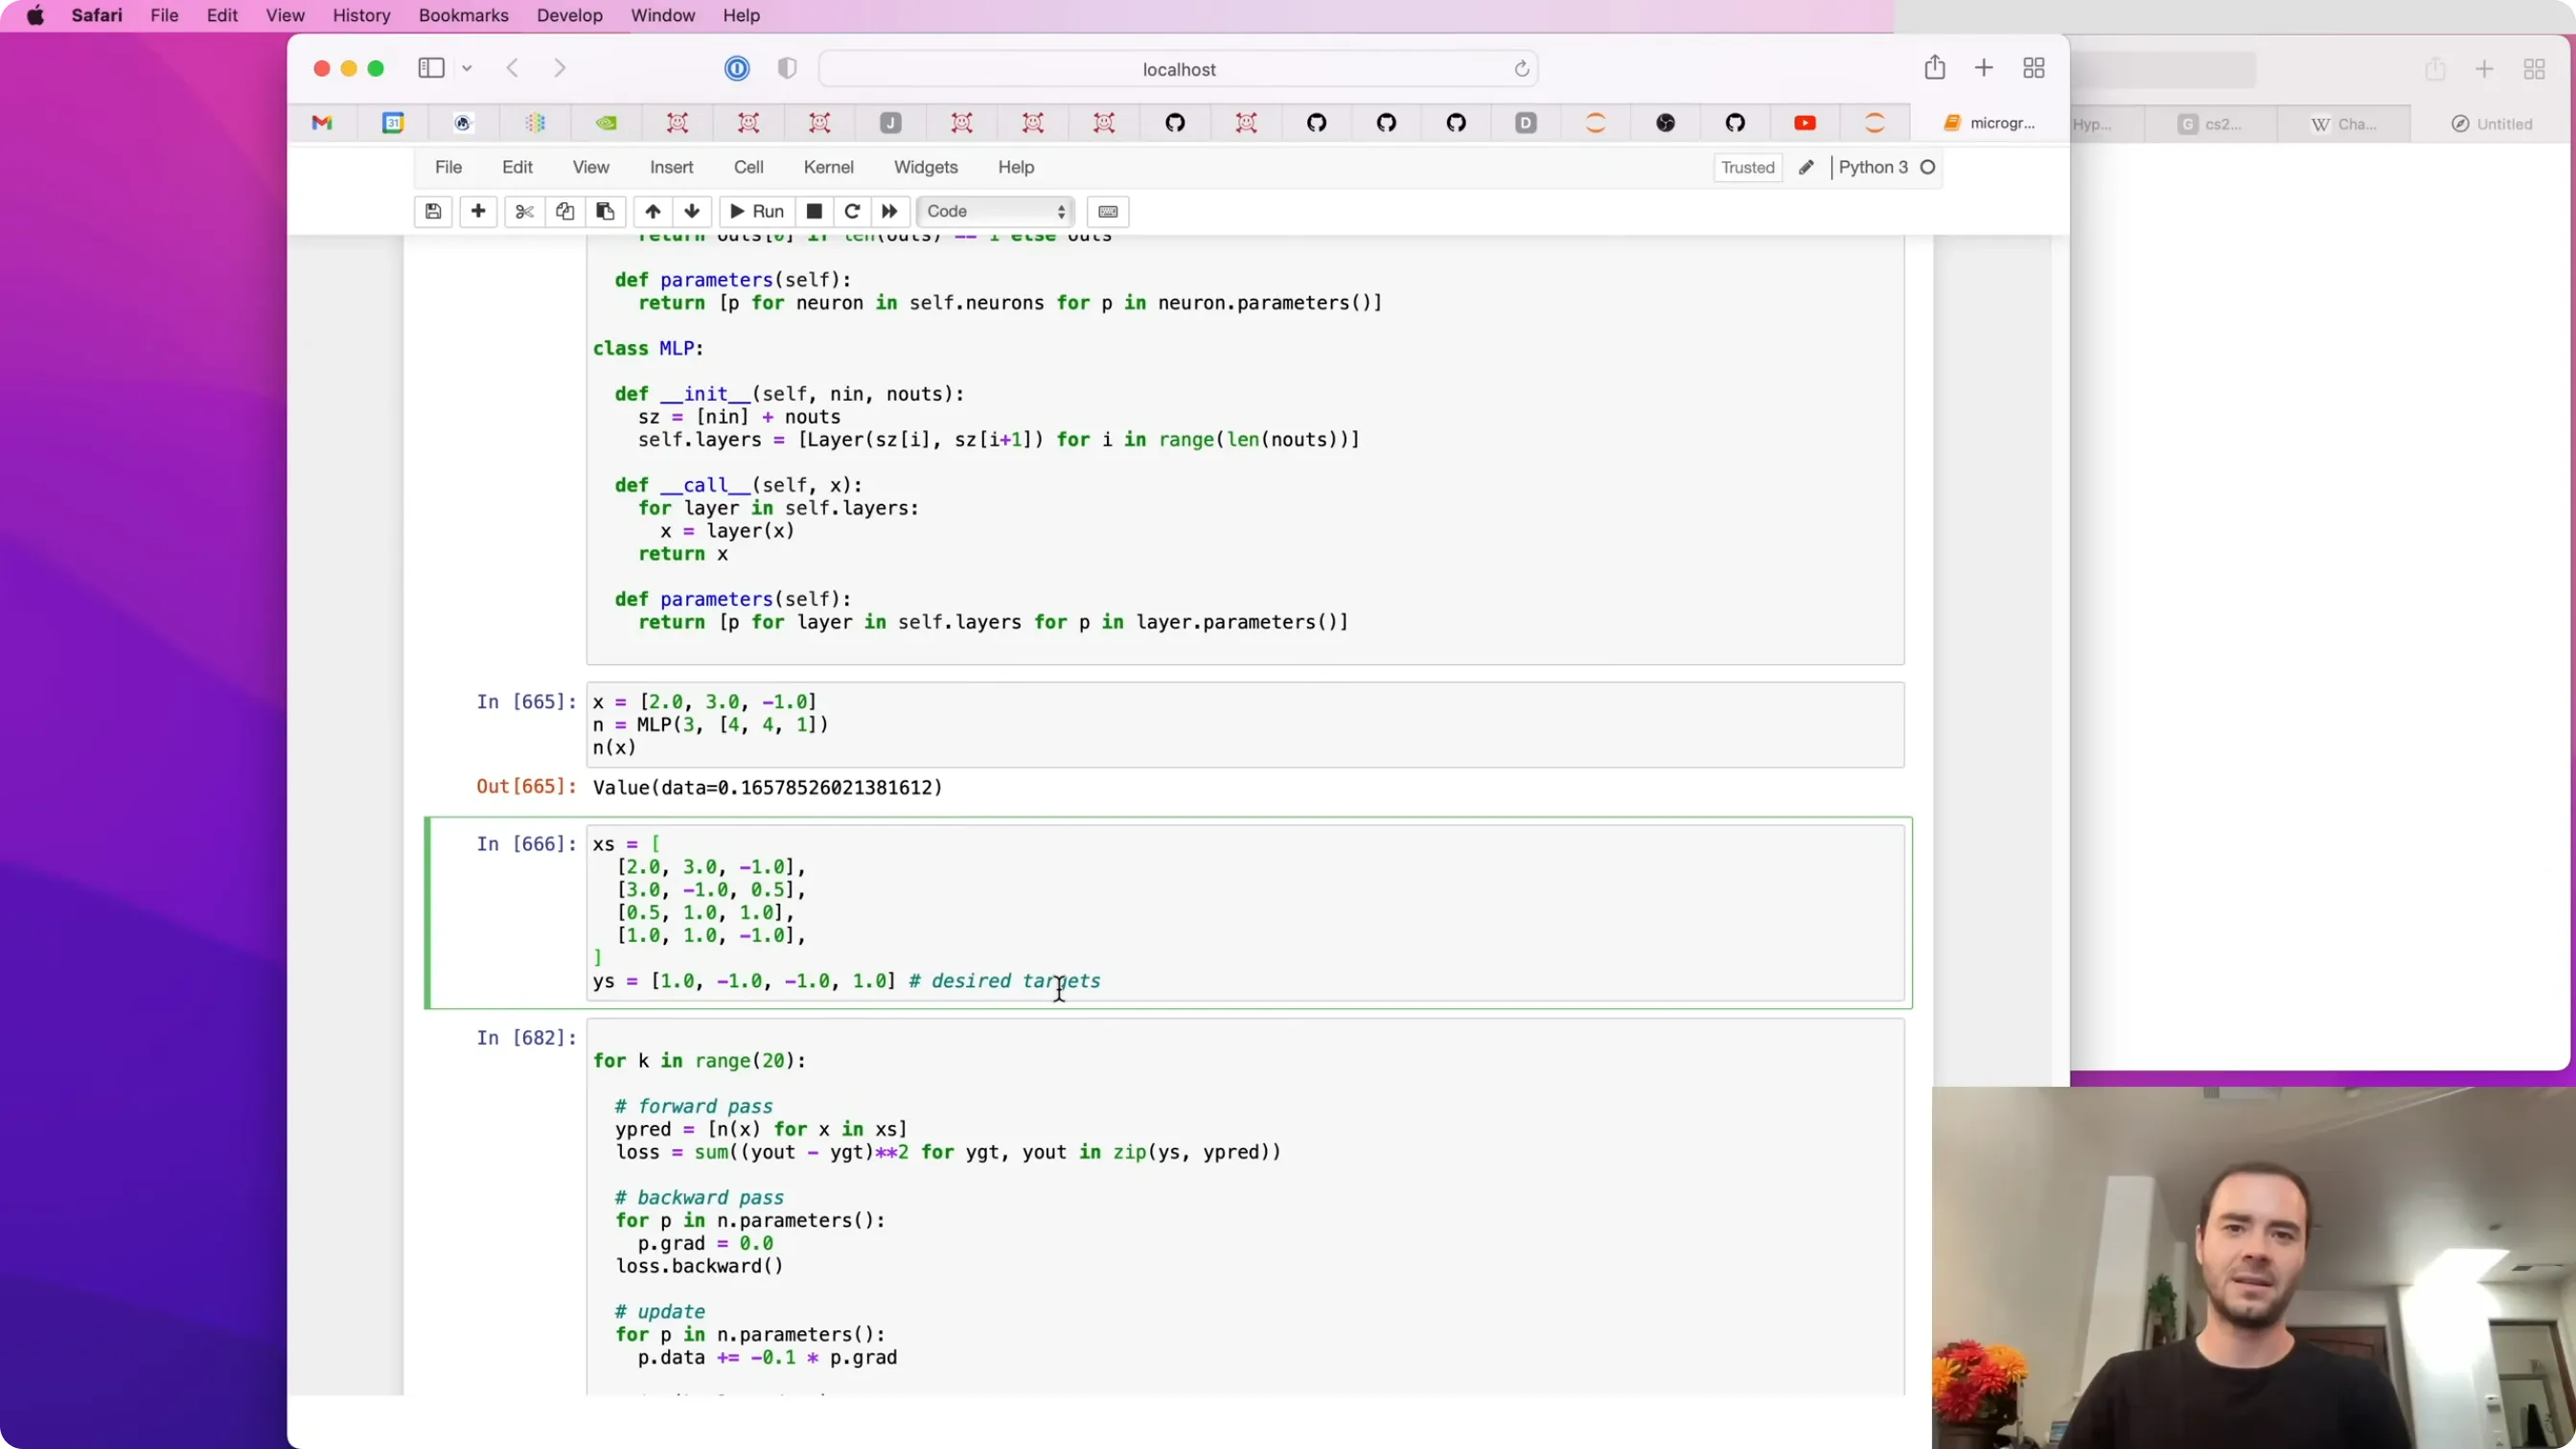
构造一个 4 个样本的小数据集(一个二分类问题):
xs = [[2.0, 3.0, -1.0], [3.0, -1.0, 0.5], [0.5, 1.0, 1.0], [1.0, 1.0, -1.0]]
ys = [1.0, -1.0, -1.0, 1.0]
现在的网络输出的预测和期望差得很远,我们需要一个能衡量"网络现在有多差"的单一数字——这就是损失(loss)。
均方误差(MSE):
def loss(y_pred, y_true):
    return sum((y_true_i - y_pred_i)**2 for y_true_i, y_pred_i in zip(y_true, y_pred)) / len(y_pred)
- 平方保证正数(无论偏差是正还是负),且只有预测恰好等于目标时才为 0;
- 偏差越大损失越大;
- 损失越低越好,目标是最小化它。
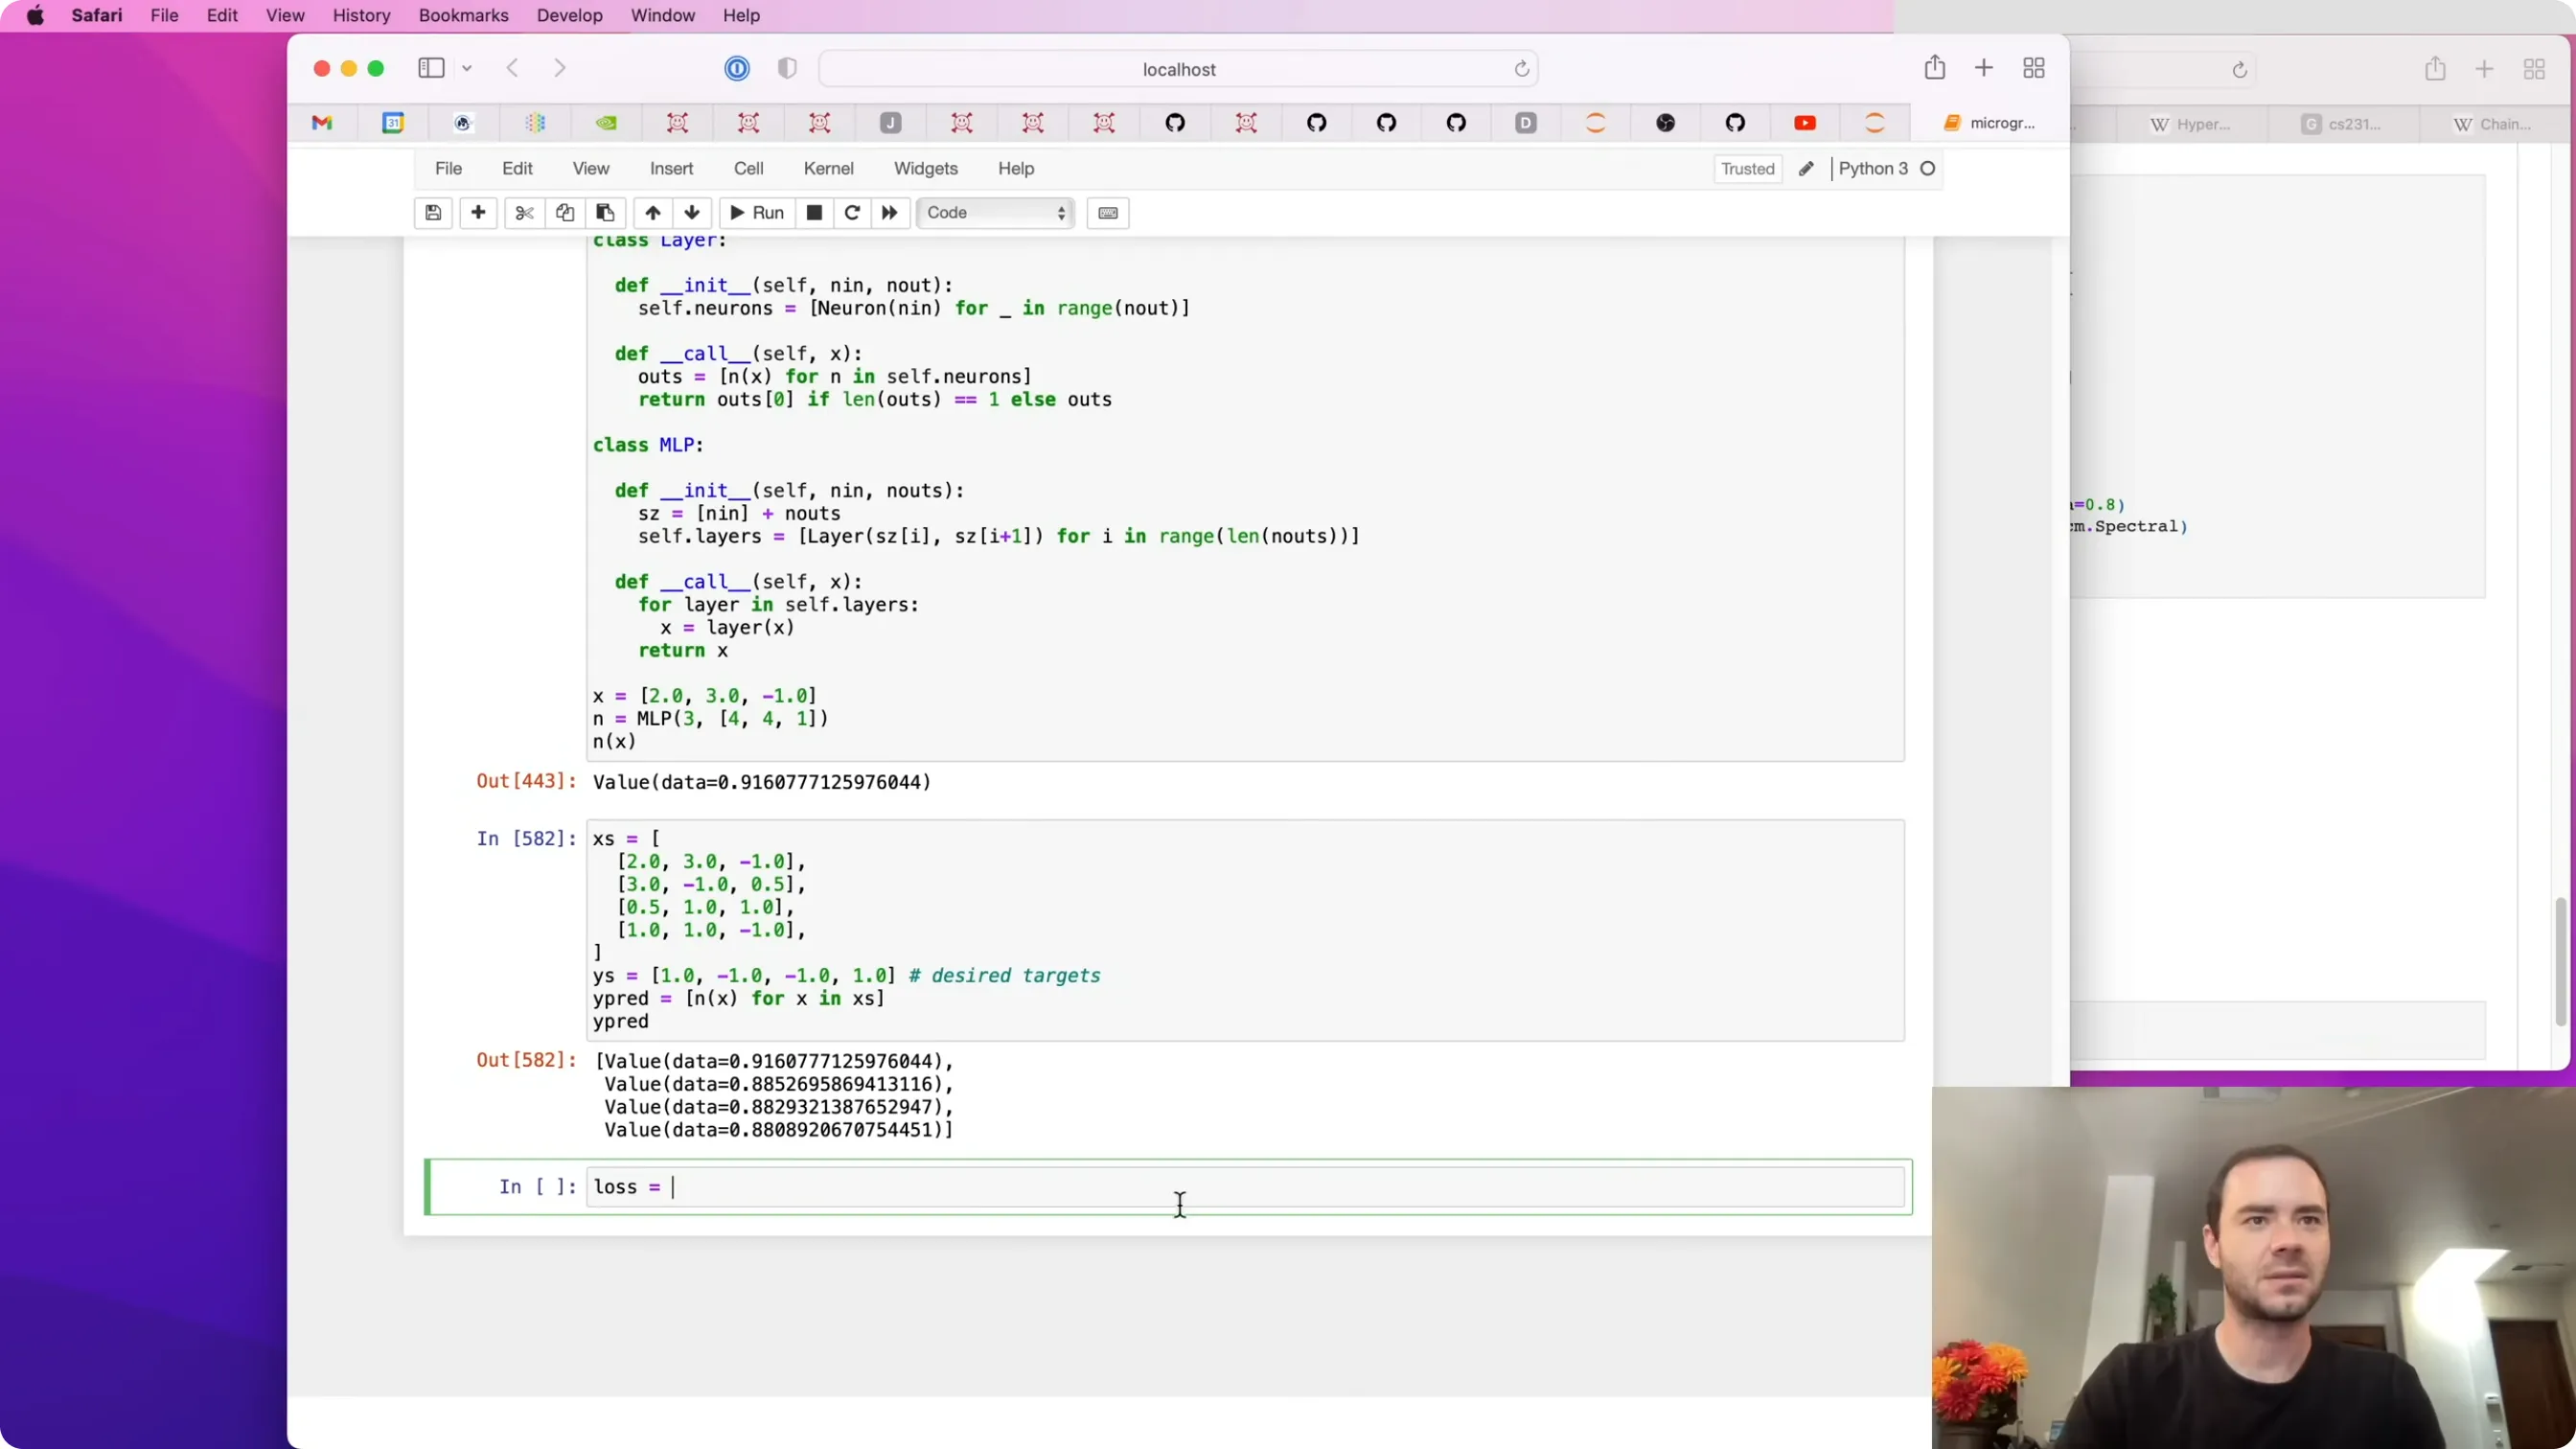
📷 小数据集 + 均方误差损失
回到原视频 (01:52:30)
训练循环:
for k in range(20):
    # 前向
    y_pred = [n(x) for x in xs]
    loss_value = loss(y_pred, ys)

    # 反向
    # ... 要先 zero_grad
    loss_value.backward()

    # 更新:沿着梯度的反方向走一小步
    for p in n.parameters():
        p.data += -0.05 * p.grad

    print(k, loss_value.data)
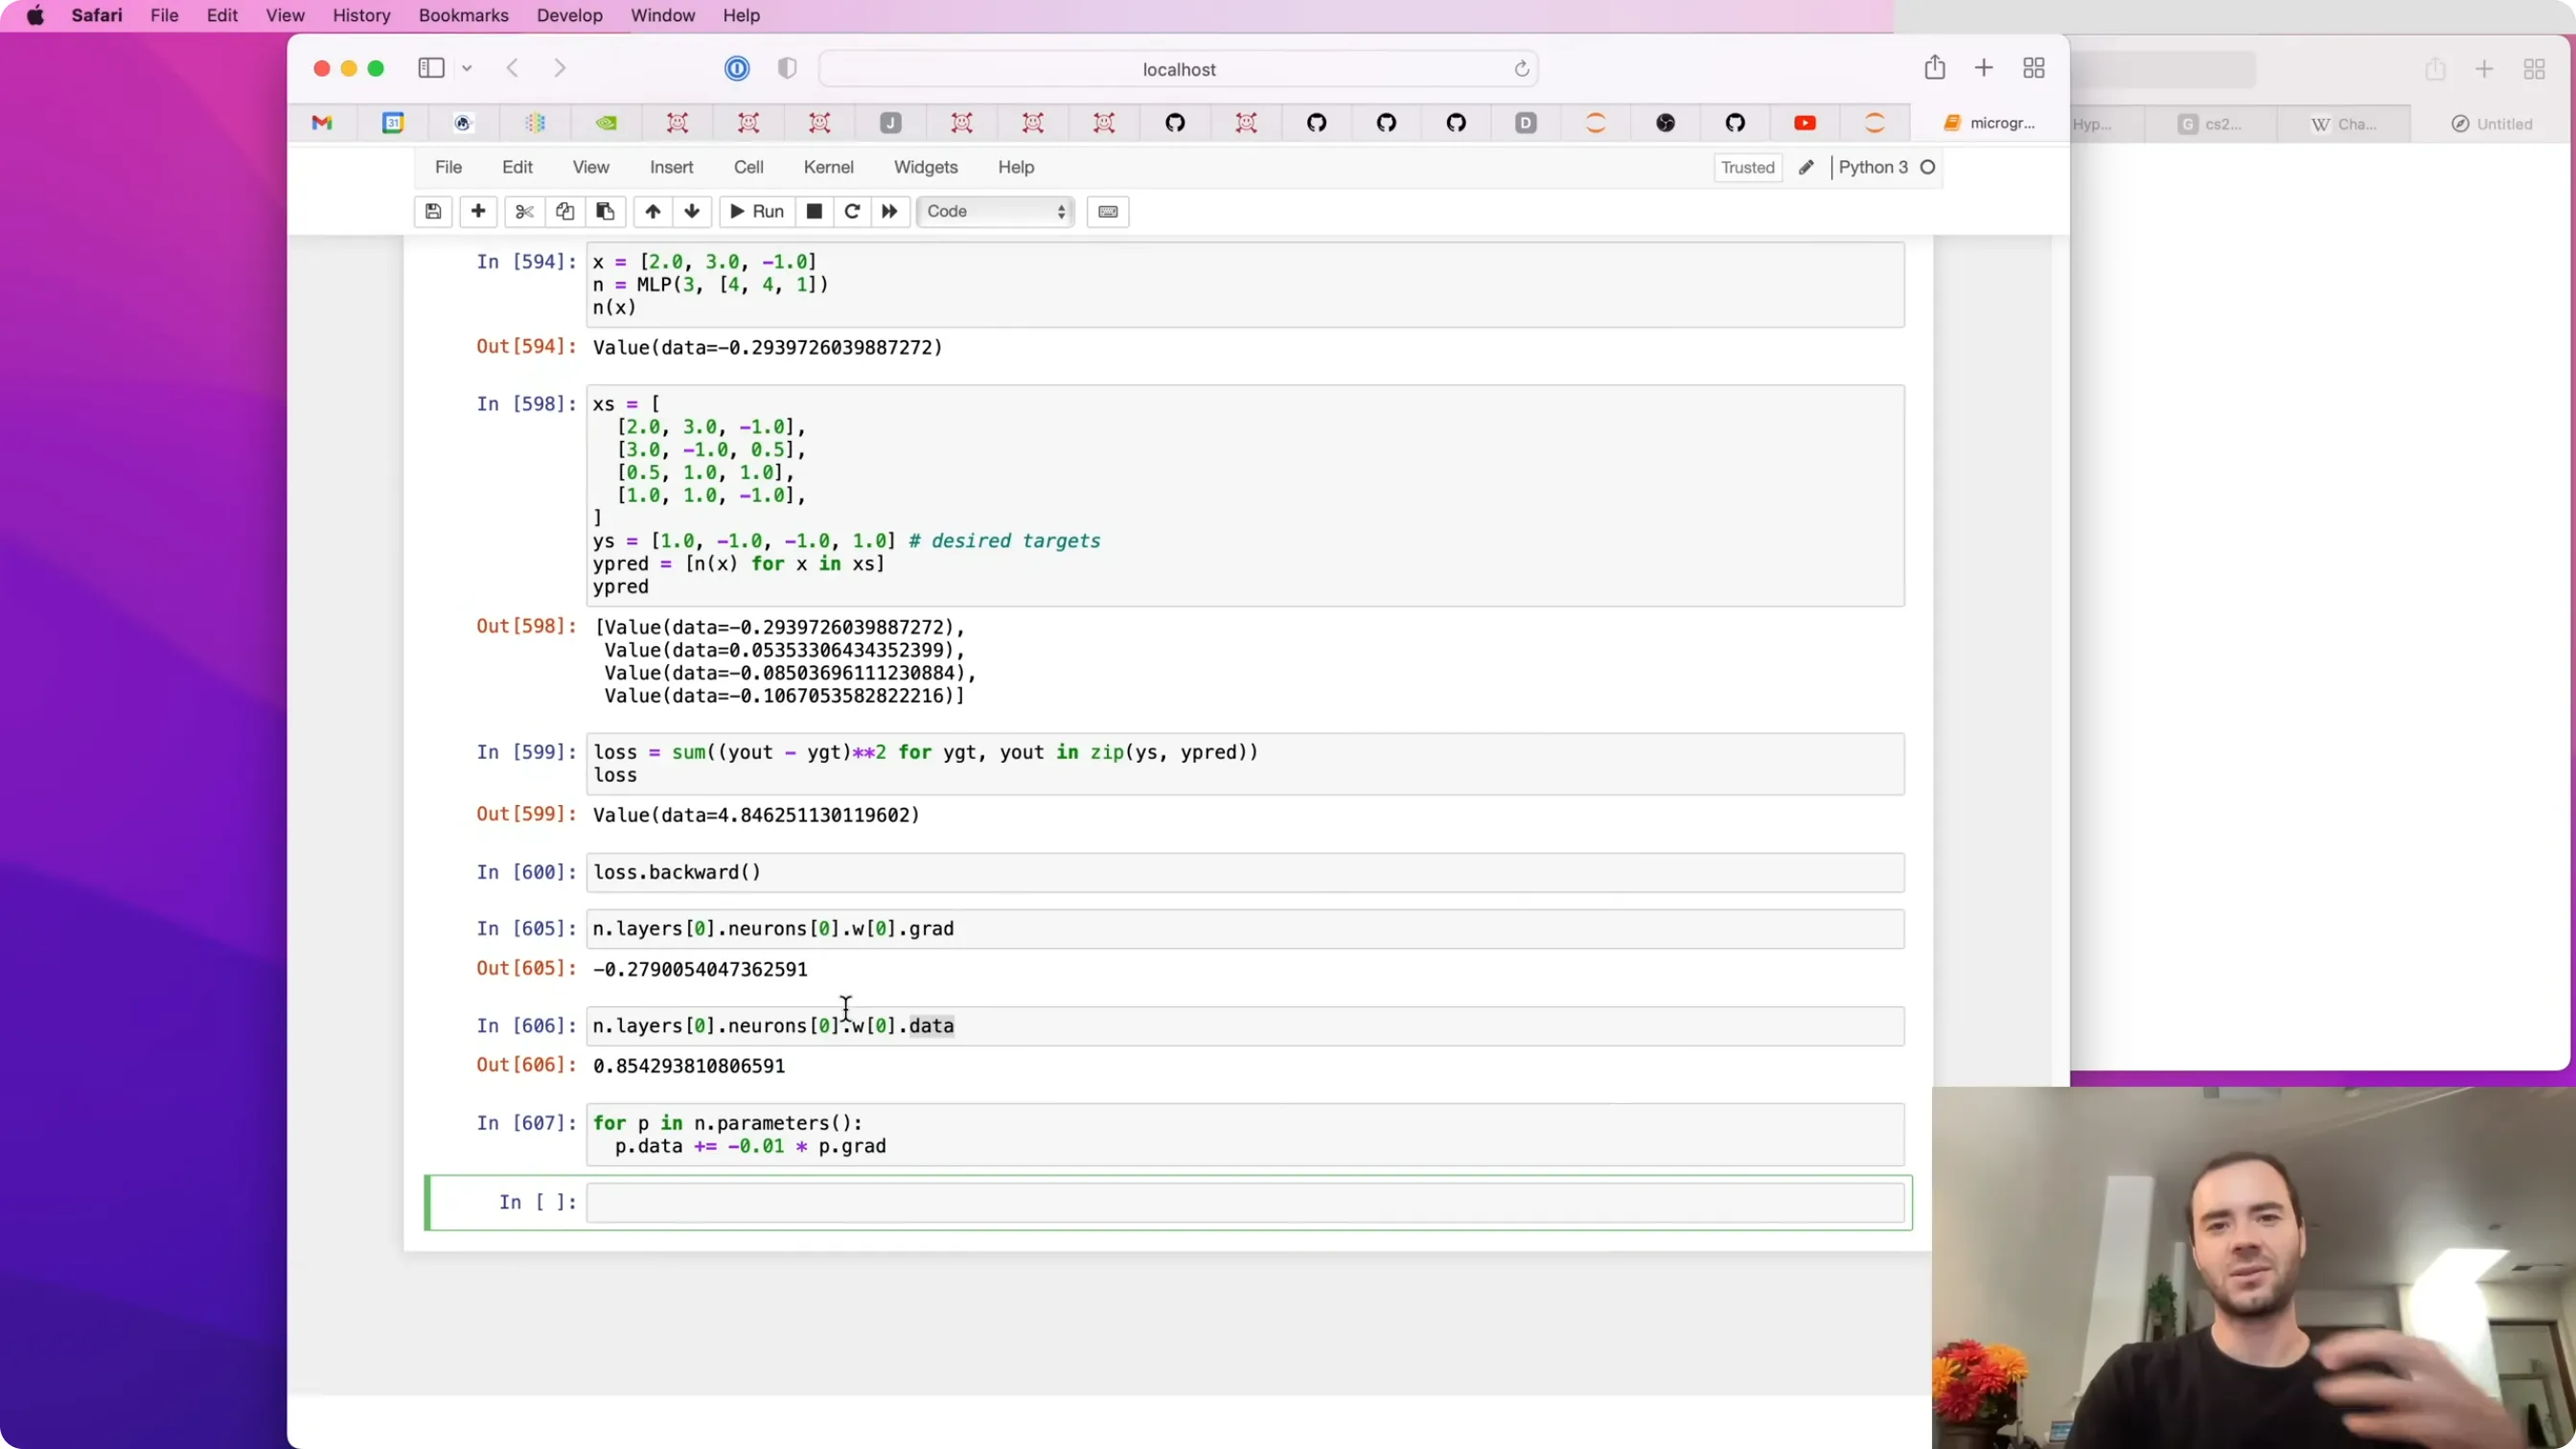
📷 梯度下降训练循环:前向 → 反向 → 更新
回到原视频 (02:04:30)
编者拓展|学习率:太小太慢、太大爆炸:这个
-0.05就是学习率(learning rate)。 - 太小 → 收敛太慢; - 太大 → 每次跨得太远,"冲过头",损失可能先剧烈震荡甚至爆炸。视频里 Karpathy 用了 0.1 时,"走得太快、甚至短暂爆炸,但碰巧落到了很好的地方";随后用更小的步长得到可控、平稳的下降。调学习率是一门"微妙的艺术"。
一个"著名"的 bug:忘了 zero_grad
(参考时间: 02:10)
跑完第一版训练后发现:损失降得飞快,效果好得可疑。原因是个超常见错误——每个参数的 grad 从来没有被清零。
因为每次 backward() 用的是 +=,上一轮的梯度会累加到这一轮。所以实际步长等价于越滚越大:
for p in n.parameters():
    p.grad = 0.0        # ← 必须在每次 backward 前清零!
加了这个以后,训练变成更慢但正确的下降。
编者拓展|Karpathy 的"最常见的神经网络错误 Top N":他多年前发过一条著名的推文,列出初学者最常犯的神经网络错误。第 3 条正是「backward 之前忘了 zero_grad」。
为什么这个 bug 特别阴险?因为它在这份小数据上"碰巧也能工作"(网络太容易拟合了),但如果问题复杂一点,它就会让你怎么都训不好。它的危险性不在"错",而在"错得看起来对"。
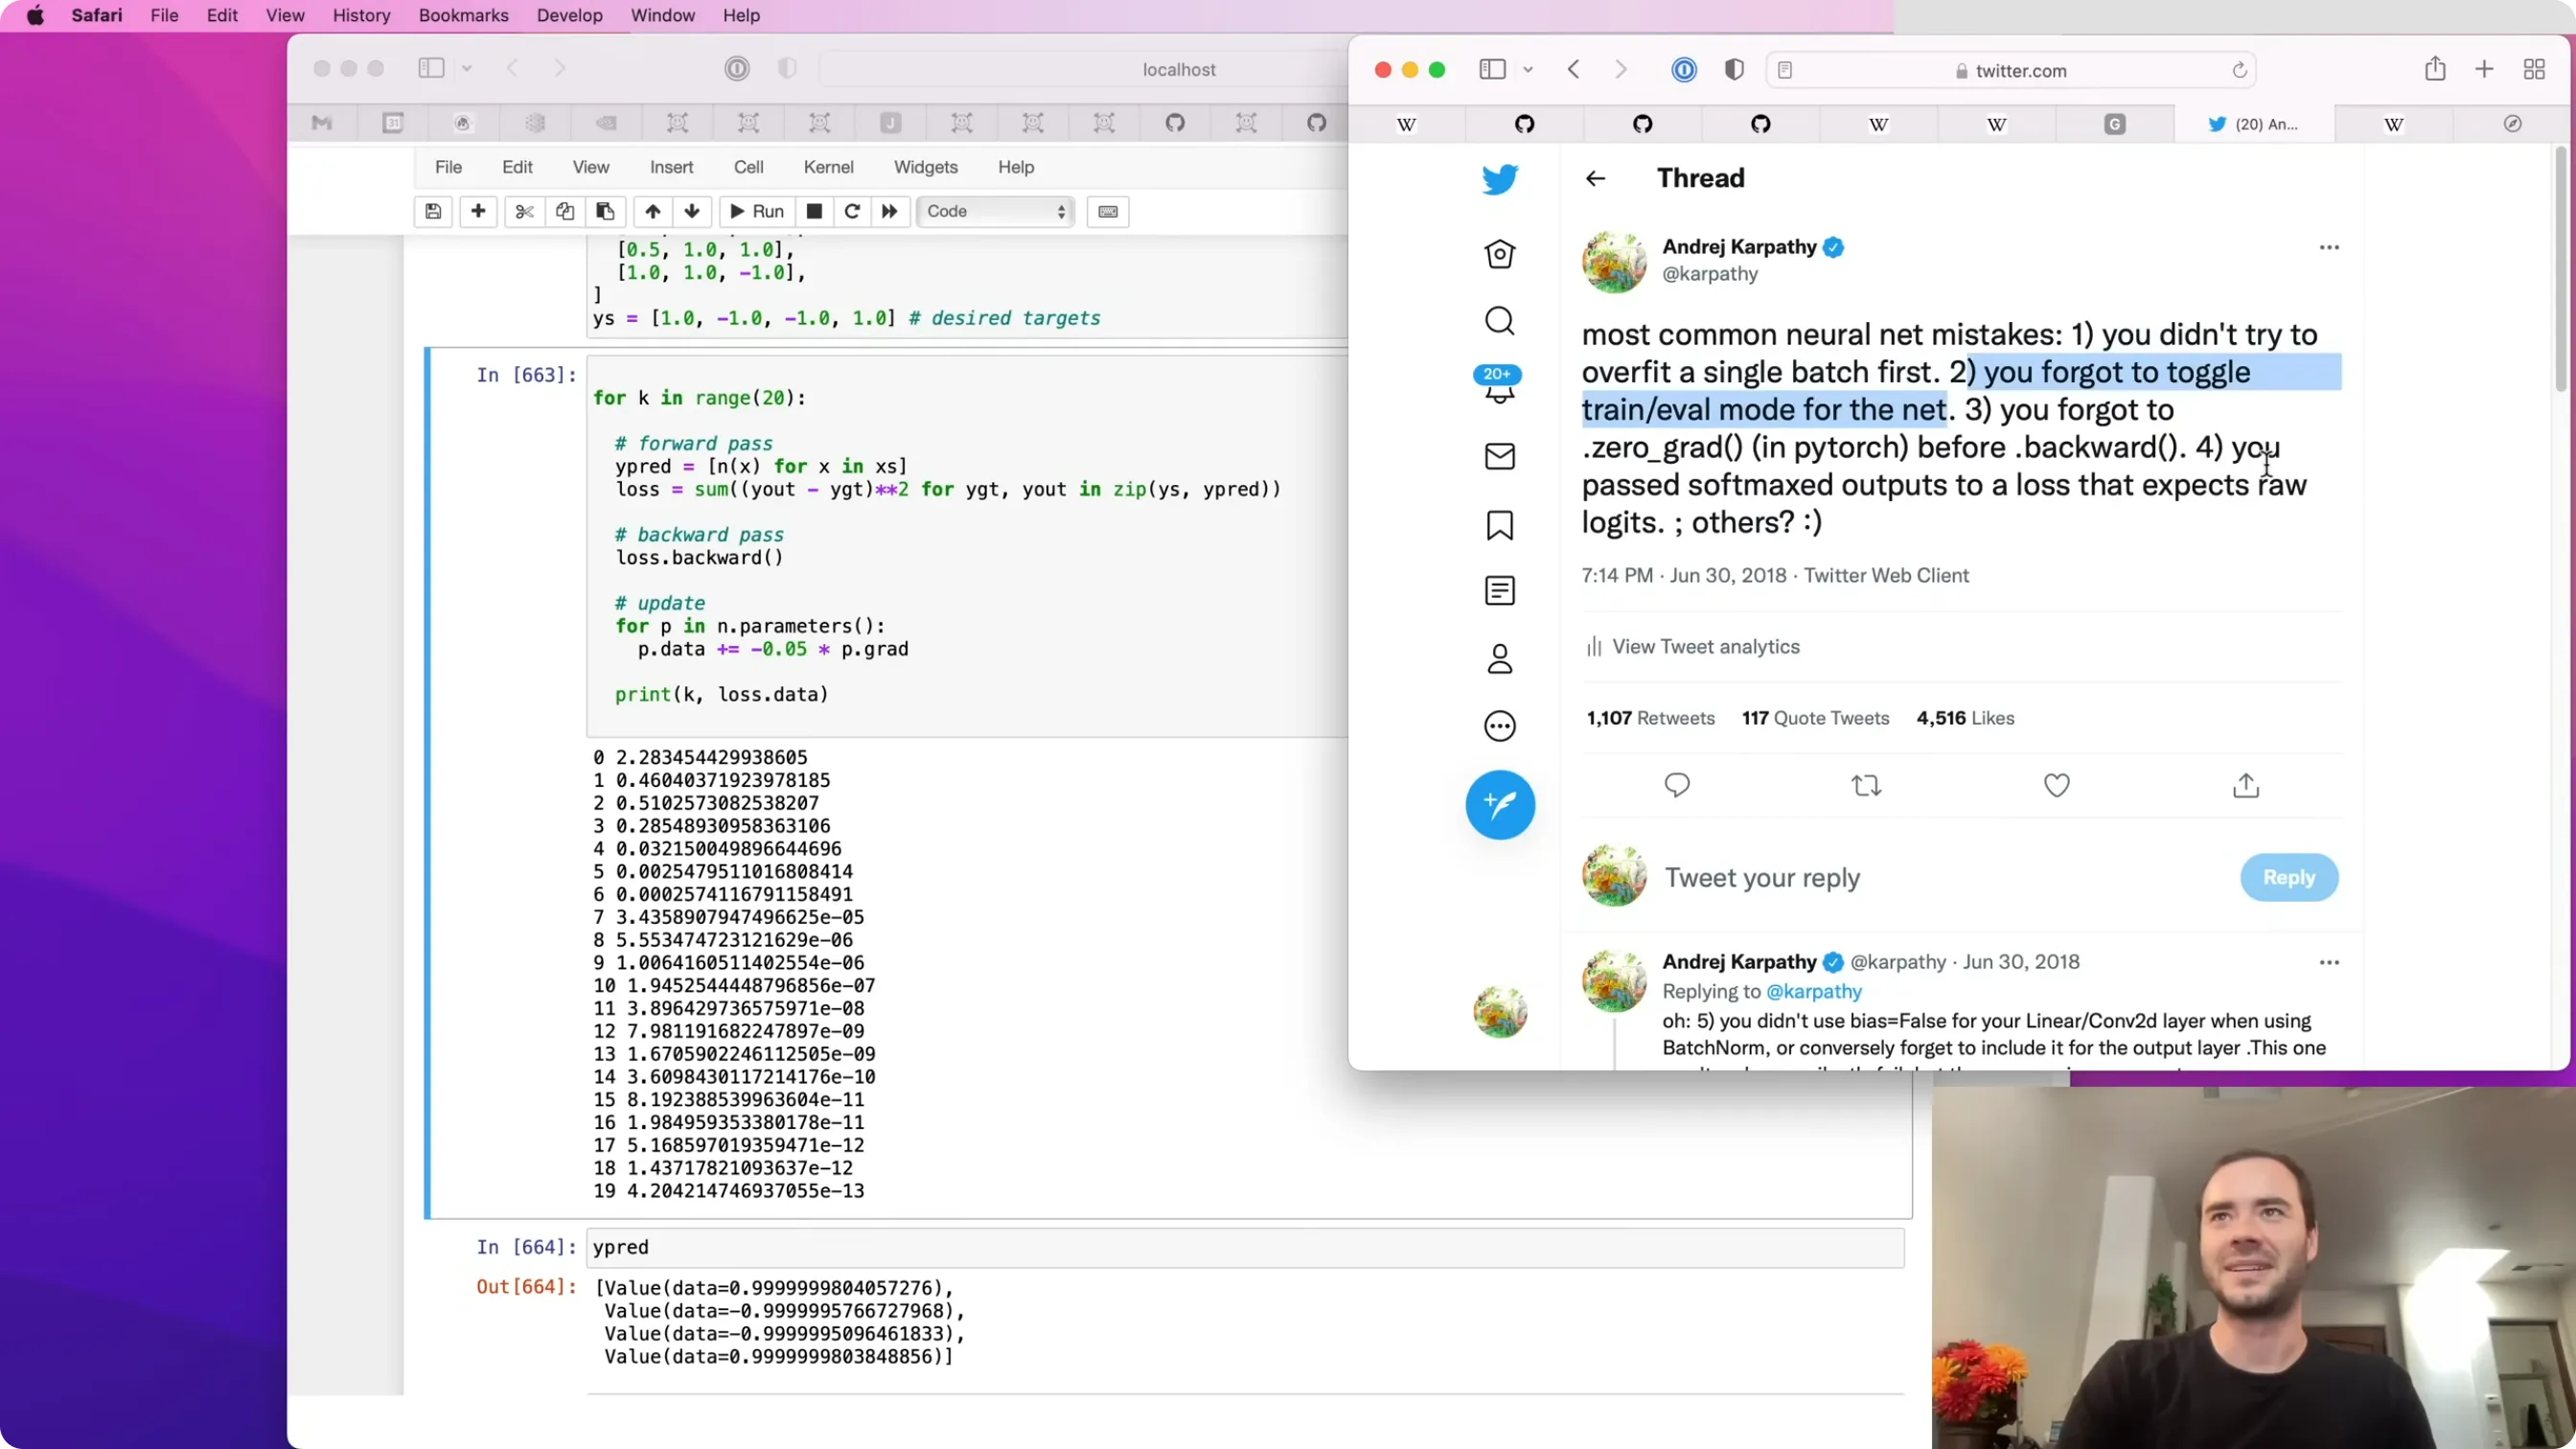
📷 忘了 zero_grad:梯度会累加,步长越滚越大
回到原视频 (02:11:00)
十二、总结:从 bigram 到 GPT,外壳不变
(参考时间: 02:14)
回顾我们学到的东西:
- 神经网络是数学表达式:它接收数据和参数(权重)作为输入,前向传播算出预测,再用一个损失函数衡量预测的好坏;
- 反向传播给出"每个参数如何影响损失"——也就是梯度;
- 梯度下降反复按梯度反方向微调参数,最小化损失;而损失被设计成"损失小 = 网络在做你想让它做的事"。
「这是一个只有 41 个参数的小网络。但你可以构建几十亿、乃至上万亿参数的网络——本质上是一团"模拟出来的神经组织",能做极其复杂的事情,并涌现出各种惊人的能力。」
以 GPT 为例:给它海量互联网文本,让它预测下一个词。它的参数可能是几千亿,但原理完全相同——同样有梯度、同样做梯度下降。区别只在细节:
| 组件 | micrograd | GPT |
|---|---|---|
| 表达式规模 | 41 个参数 | 千亿级参数 |
| 更新方式 | 朴素梯度下降 | 略有不同的更新(如 Adam) |
| 损失函数 | 均方误差 | 交叉熵(预测下一个 token) |
| 核心原理 | value + grad + backward + 梯度下降 | 完全相同 |
📷 总结:神经网络 = 数学表达式 + 损失 + 反向传播 + 梯度下降
回到原视频 (02:16:00)
十三、源码走读与「看真的 PyTorch」
13.1 走一遍 micrograd 源码
(参考时间: 02:16)
回到 GitHub 上的 micrograd,你会几乎认识每一行:
engine.py:全部是Value——data/grad/backward/_prev/_op,以及+、*、幂、ReLU(另一种非线性)等运算;_backward的实现和你写的一模一样(tanh 当时还没加进去,Karpathy 打算后来补);nn.py:Neuron/Layer/MLP,外加一个Module父类(对应 PyTorch 的nn.Module)和zero_grad;test_engine.py:同时用 micrograd 和 PyTorch 跑同一段表达式,断言两边的前向、反向完全一致;demo.ipynb:一个更完整的二分类 demo——更复杂的数据集、支持 batch(随机取一个子集做前向/反向/更新,因为百万样本不可能一次全跑)、max-margin loss / 二元交叉熵、L2 正则化、以及 学习率衰减(前期大、后期小,便于收敛到细节)。
编者拓展|从这一讲出发的"下一步":你已经掌握了这套框架,接下来可以做两件事—— 1. 做那个 Exercises Colab(本讲 front matter 里的链接):它专门为"刚看完这讲"设计; 2. 接着看下一讲
makemore:同一套"表达式 + 反向传播"的框架,但模型开始变复杂。
13.2 钻进 PyTorch 找 tanh 的 backward
(参考时间: 02:21)
最后一个彩蛋:真正的工业级库,tant 的 backward 长什么样?
Karpathy 承认自己在 PyTorch 仓库里翻了十五分钟才找到——「搜 tanh 有 2800 个结果、406 个文件」。最终在 CPU kernel / CUDA kernel 里找到了那个熟悉的式子:
// 简化后的核心:b * (1 - a * a)
g = a * (1 - b * b) …
其中 b 是 tanh 的输出,g 是上游梯度——和我们在 micrograd 里写的一模一样。
他还演示了 PyTorch 的 autograd.Function:你可以注册一个新的"积木"——只要告诉它前向怎么算、反向的局部导数是什么,PyTorch 就能把它接进整张大图。这正是 micrograd 的"运算粒度由你决定"的工业版。
📷 在 PyTorch 源码里找到 tanh 的 backward kernel
回到原视频 (02:21:30)
编者说明:这一讲到此结束。你现在已经从零手搓了一个自动求导引擎,而且和 PyTorch 逐位一致——这不是"玩具",而是理解 PyTorch / JAX / 一切深度学习框架的钥匙。
附:官方参考与延伸阅读
- 课程主页(Neural Networks: Zero to Hero):https://karpathy.ai/zero-to-hero.html
- 本讲课件 Notebook:https://github.com/karpathy/nn-zero-to-hero/tree/master/lectures/micrograd
- 📝 练习(Exercises,Google Colab):https://colab.research.google.com/drive/1FPTx1RXtBfc4MaTkf7viZZD4U2F9gtKN?usp=sharing
- micrograd 仓库:https://github.com/karpathy/micrograd
- 讨论 Discord:https://discord.gg/3zy8kqD9Cp
- graphviz(可视化表达式图):https://graphviz.org/
- 链式法则(Wikipedia):https://en.wikipedia.org/wiki/Chain_rule
- PyTorch
autograd教程:https://pytorch.org/tutorials/beginner/blitz/autograd_tutorial.html - Karpathy, A Recipe for Training Neural Networks:http://karpathy.github.io/2019/04/25/recipe/
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 The spelled-out intro to neural networks and backpropagation: building micrograd 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。