第4讲 · 手把手语言建模(激活、梯度与 BatchNorm 篇)
本电子书由教学视频重构而成。 视频原标题:Building makemore Part 3: Activations & Gradients, BatchNorm 书中代码、数据集与图片版权归原作者 Andrej Karpathy 所有。本文为课堂讲解的中文书面重构,仅供学习交流。
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=P6sfmUTpUmc |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 本讲课件 Notebook | https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part3_bn.ipynb |
| 🟢 Google Colab(免安装) | https://colab.research.google.com/drive/1H5CSy-OnisagUgDUXhHwo1ng2pjKHYSN?usp=sharing |
| 完整实现(makemore 仓库) | https://github.com/karpathy/makemore |
| 📄 "Kaiming init" 论文 | https://arxiv.org/abs/1502.01852(Delving Deep into Rectifiers) |
| 📄 BatchNorm 论文 | https://arxiv.org/abs/1502.03167(Batch Normalization, 2015) |
| 📄 BatchNorm 实践问题的论文 | https://arxiv.org/abs/2105.07576 |
| 📄 Bengio et al. 2003 | https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf |
| 讨论区 | 官方 Discord:https://discord.gg/3zy8kqD9Cp |
| E01(全零初始化) | 把所有权重和偏置都初始化成 0,然后训练。你可能会猜 (1) 照常训练 or (2) 完全训不动——但实际上是 (3):能训,但只训了一部分,最终效果很差。请检查梯度和激活,搞清楚到底哪一部分在被训练、为什么只训了一部分。 |
| E02(把 BatchNorm「折叠」进 Linear) | BatchNorm 相比 LayerNorm/GroupNorm 的一大优势是——训练完之后,BN 的 gamma/beta 可以"折叠"进前一层的 W、b,从而推理时完全不需要跑 BN。请搭一个带 BN 的 3 层 MLP,训练,然后构造新的 W2/b2 抹掉 BN,验证推理时前向传播完全一致。👉「BN 只为稳定训练而生,训练完就可以扔掉。很酷。」 |
对应讲次:第4讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
编者拓展|📝 本讲的官方练习(Exercises):Karpathy 在这一讲的描述里给了 2 道(都很有意思,强烈建议动手):
引子:先别急着上 RNN
(参考时间: 00:00)
上一讲我们用 MLP(Bengio 2003 的方式)做字符级语言模型。接下来自然要走向更复杂的网络——RNN、GRU、LSTM……但在此之前,Karpathy 说要在 MLP 上多停留一会儿,因为:
我们要非常直观地理解神经网络训练中的激活(activations),尤其是反向流动的梯度——它们的行为、它们的分布、它们长什么样。
为什么这很重要? 因为 RNN 虽然表达力极强(是通用逼近器,原则上能实现任何算法),但很难用一阶梯度方法优化。而理解"为什么难优化"的关键,就是理解激活与梯度的统计分布。历史上 RNN 的绝大多数变体,都是在试图改善这个问题。
一、起点代码
(参考时间: 01:22)
和上一讲基本相同,只做了清理:
- 去掉了所有魔法数字,改成命名变量:
n_embd(嵌入维度)、n_hidden(隐藏层神经元数); - 训练 11,000 参数、200,000 步、batch size 32;
- 评估函数支持
'train' / 'val' / 'test'三种划分; - 用了
@torch.no_grad()装饰器。
编者拓展|
torch.no_grad()在做什么:它告诉 PyTorch「这段代码里不会调用backward」——于是 PyTorch 不再为这些张量维护计算图(相当于所有张量都requires_grad=False)。这省内存、省时间。等价写法是上下文管理器:with torch.no_grad(): ...。规律:评估 / 采样时一律用
no_grad;训练时才需要建图。
采样出来的名字已经比 bigram 好多了,但仍不够像人名。这就是我们的起点。
二、修复一:初始损失不该那么高
(参考时间: 04:19)
看训练的第 0 步:损失是 27,然后迅速掉到 1~2。「这明显说明初始化配错了。」
怎么知道该期望多少? 训练神经网络时,几乎总能对初始损失有个合理的预期:
- 有 27 个字符可能出现在下一位;
- 初始化时,我们没有任何理由认为某个字符更可能——所以理想的预测分布应该是均匀分布,每个字符约 $1/27$;
- 损失是负对数概率:$-\log(1/27) = \log 27 \approx \mathbf{3.29}$。
「我期望的是 3.29,不是 27。」
为什么实际是 27? 因为初始化时 logits 取值太极端——网络对某些错误答案非常自信。「它在非常自信地犯错。」
一个小例子(4 个字符):如果所有 logits 都≈0,softmax 后是均匀分布,损失 $=\log 4 \approx 1.39$;但如果某些 logits 变成 5、10,网络就会"猜中正确桶的概率很低",损失飙升;如果 logits 极端到一定程度,初始化时的损失就能是 inf。
修法(两步):
- 输出层的 bias
b2置零(乘 0)——「我们想让它约等于 0,就不该加一个随机的偏置」; - 把
W2缩小(乘 0.1)——让 logits 更接近 0。
试 0.1 后损失约 4.2,再小一点就接近 3.29 了。
编者拓展|为什么不用"正好等于 0":把
W或b精确置零会导致权重完全对称——同层的每个神经元算出的东西一模一样,永远学不出差异(这叫对称性问题)。所以实践中我们用非常小的随机数(如×0.01),保留一点熵,用于对称性破缺(symmetry breaking)。E01 会带你亲手看到"全零初始化"的后果。
效果:修复后,损失曲线不再有那个"曲棍球杆"(hockey stick)形状——因为前几千步原本只是在把过大的权重压小,那是"免费的收益",学不到真正的东西。修好之后,从一开始就在做有意义的训练。验证损失也从 2.17 → 2.13。
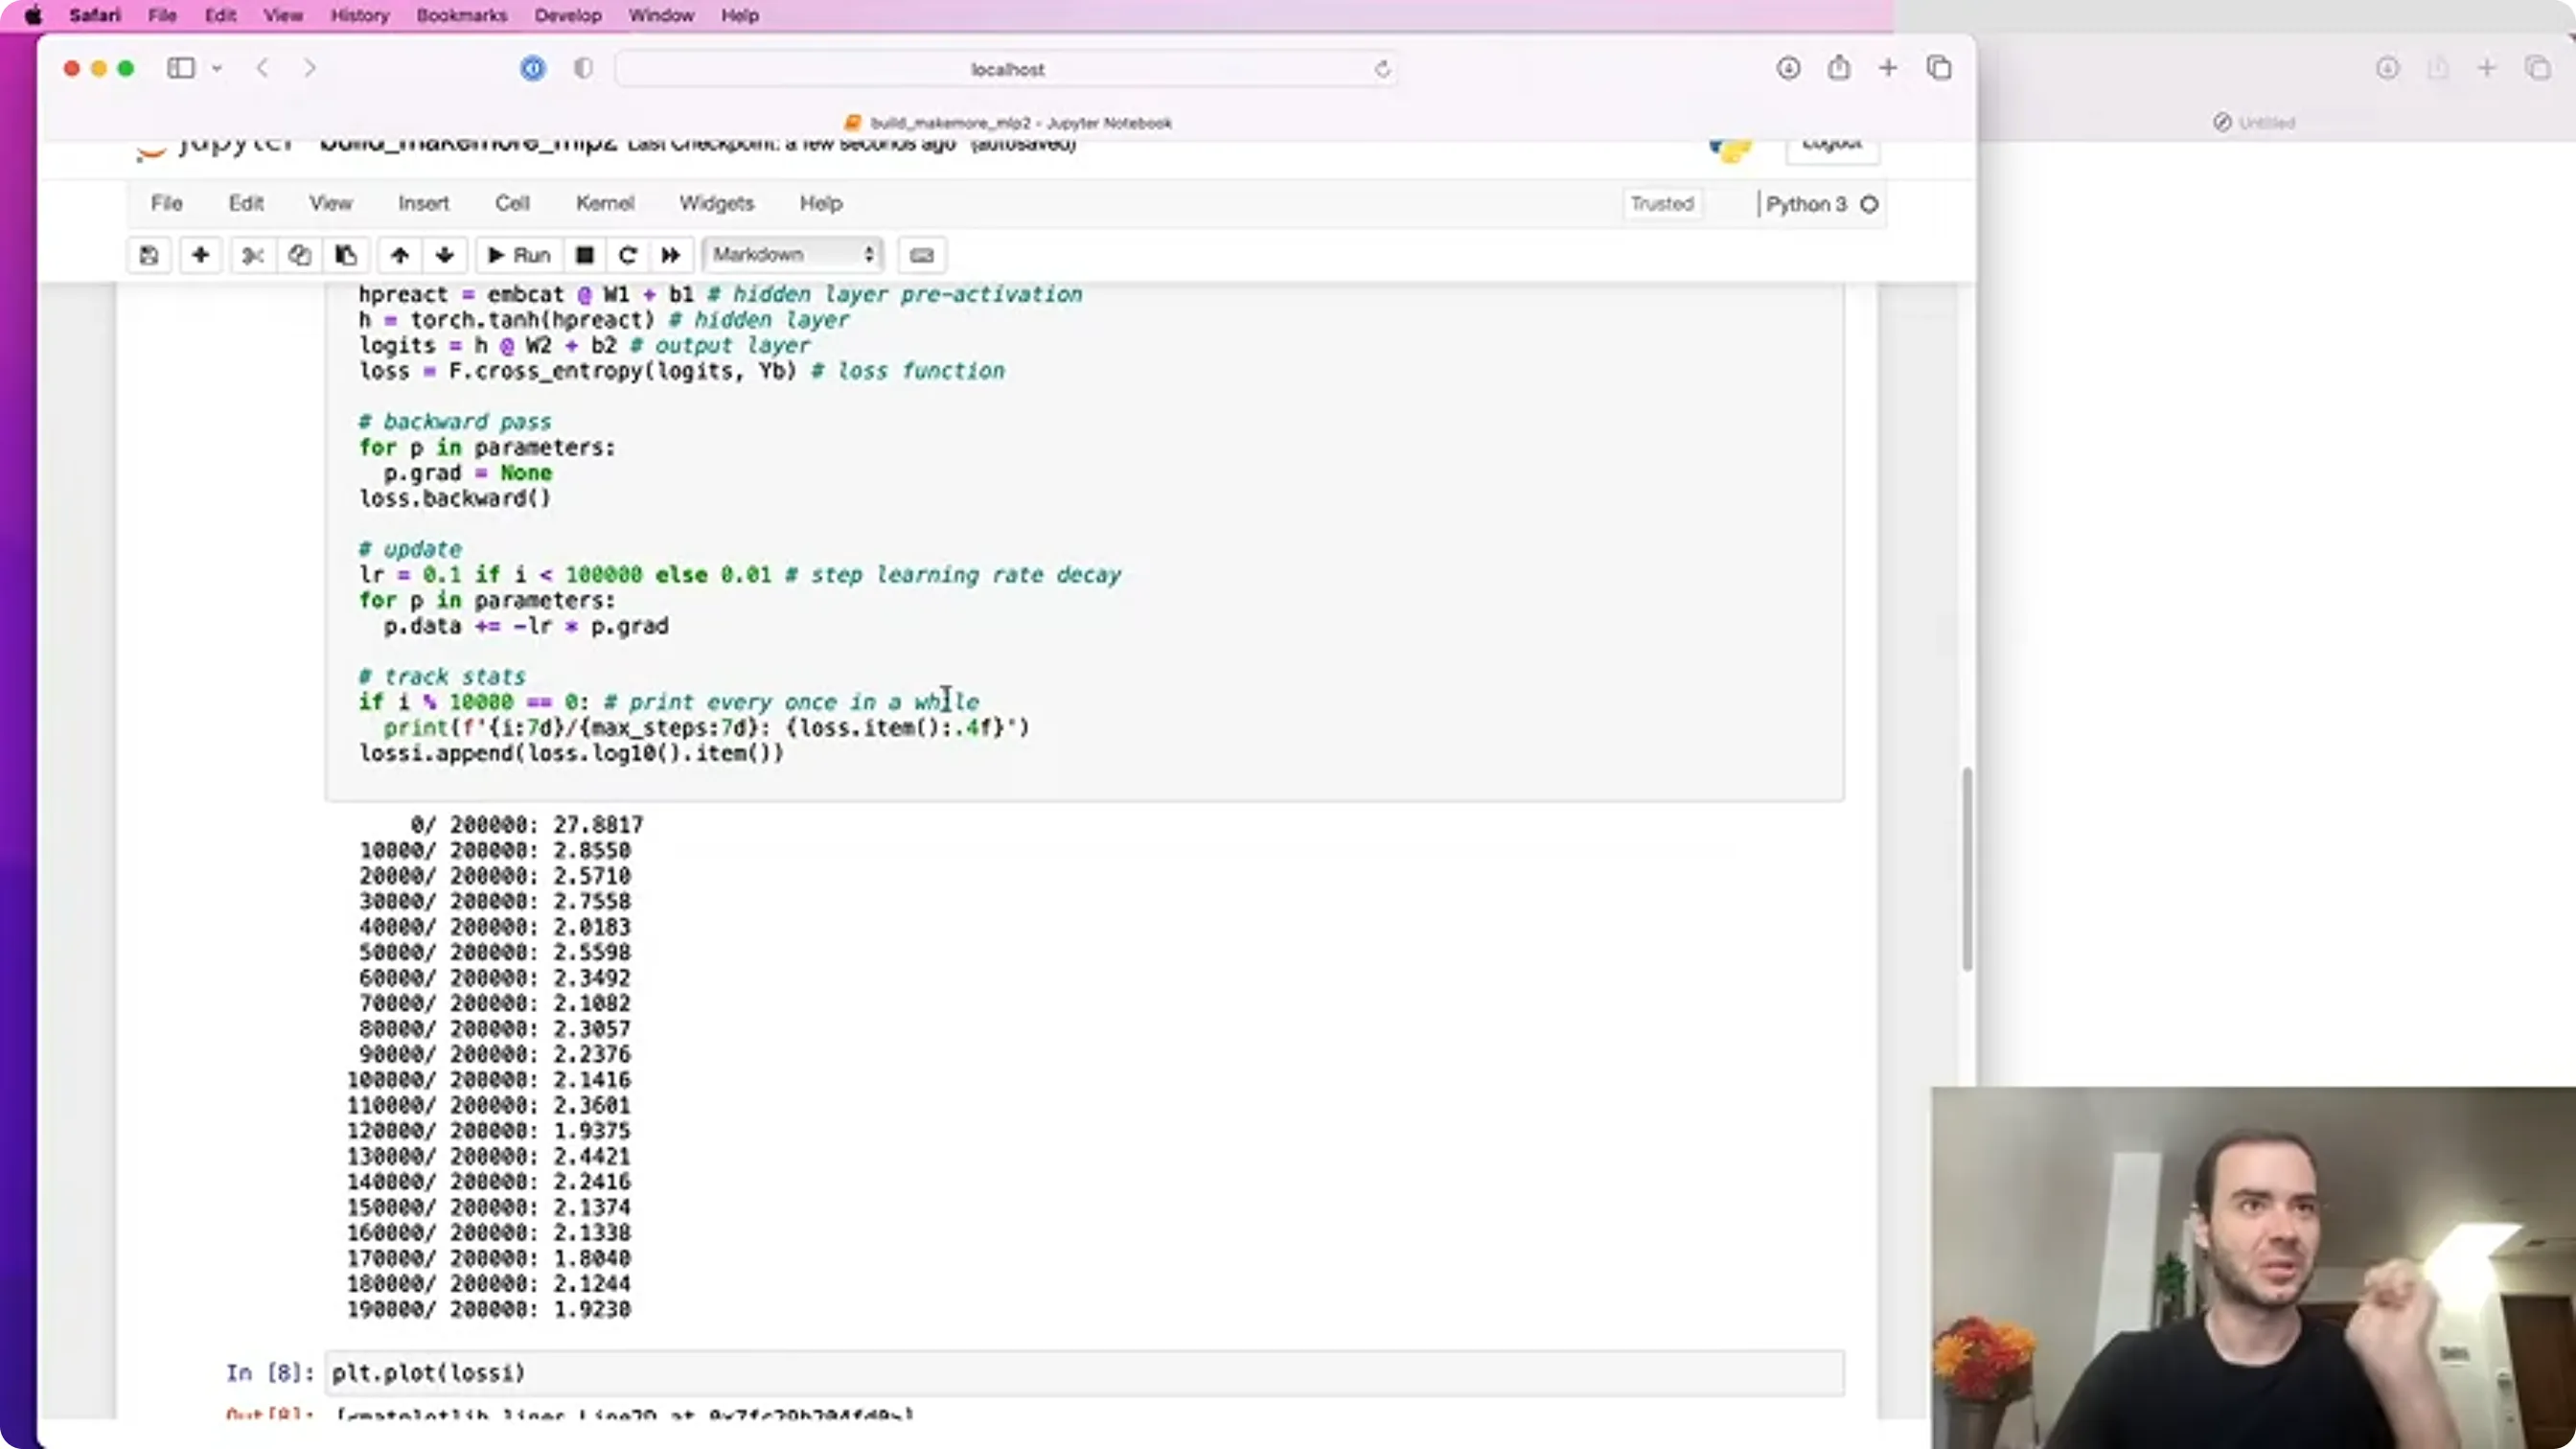
📷 初始损失 27:logits 太极端,网络"非常自信地犯错"
回到原视频 (00:04:30)
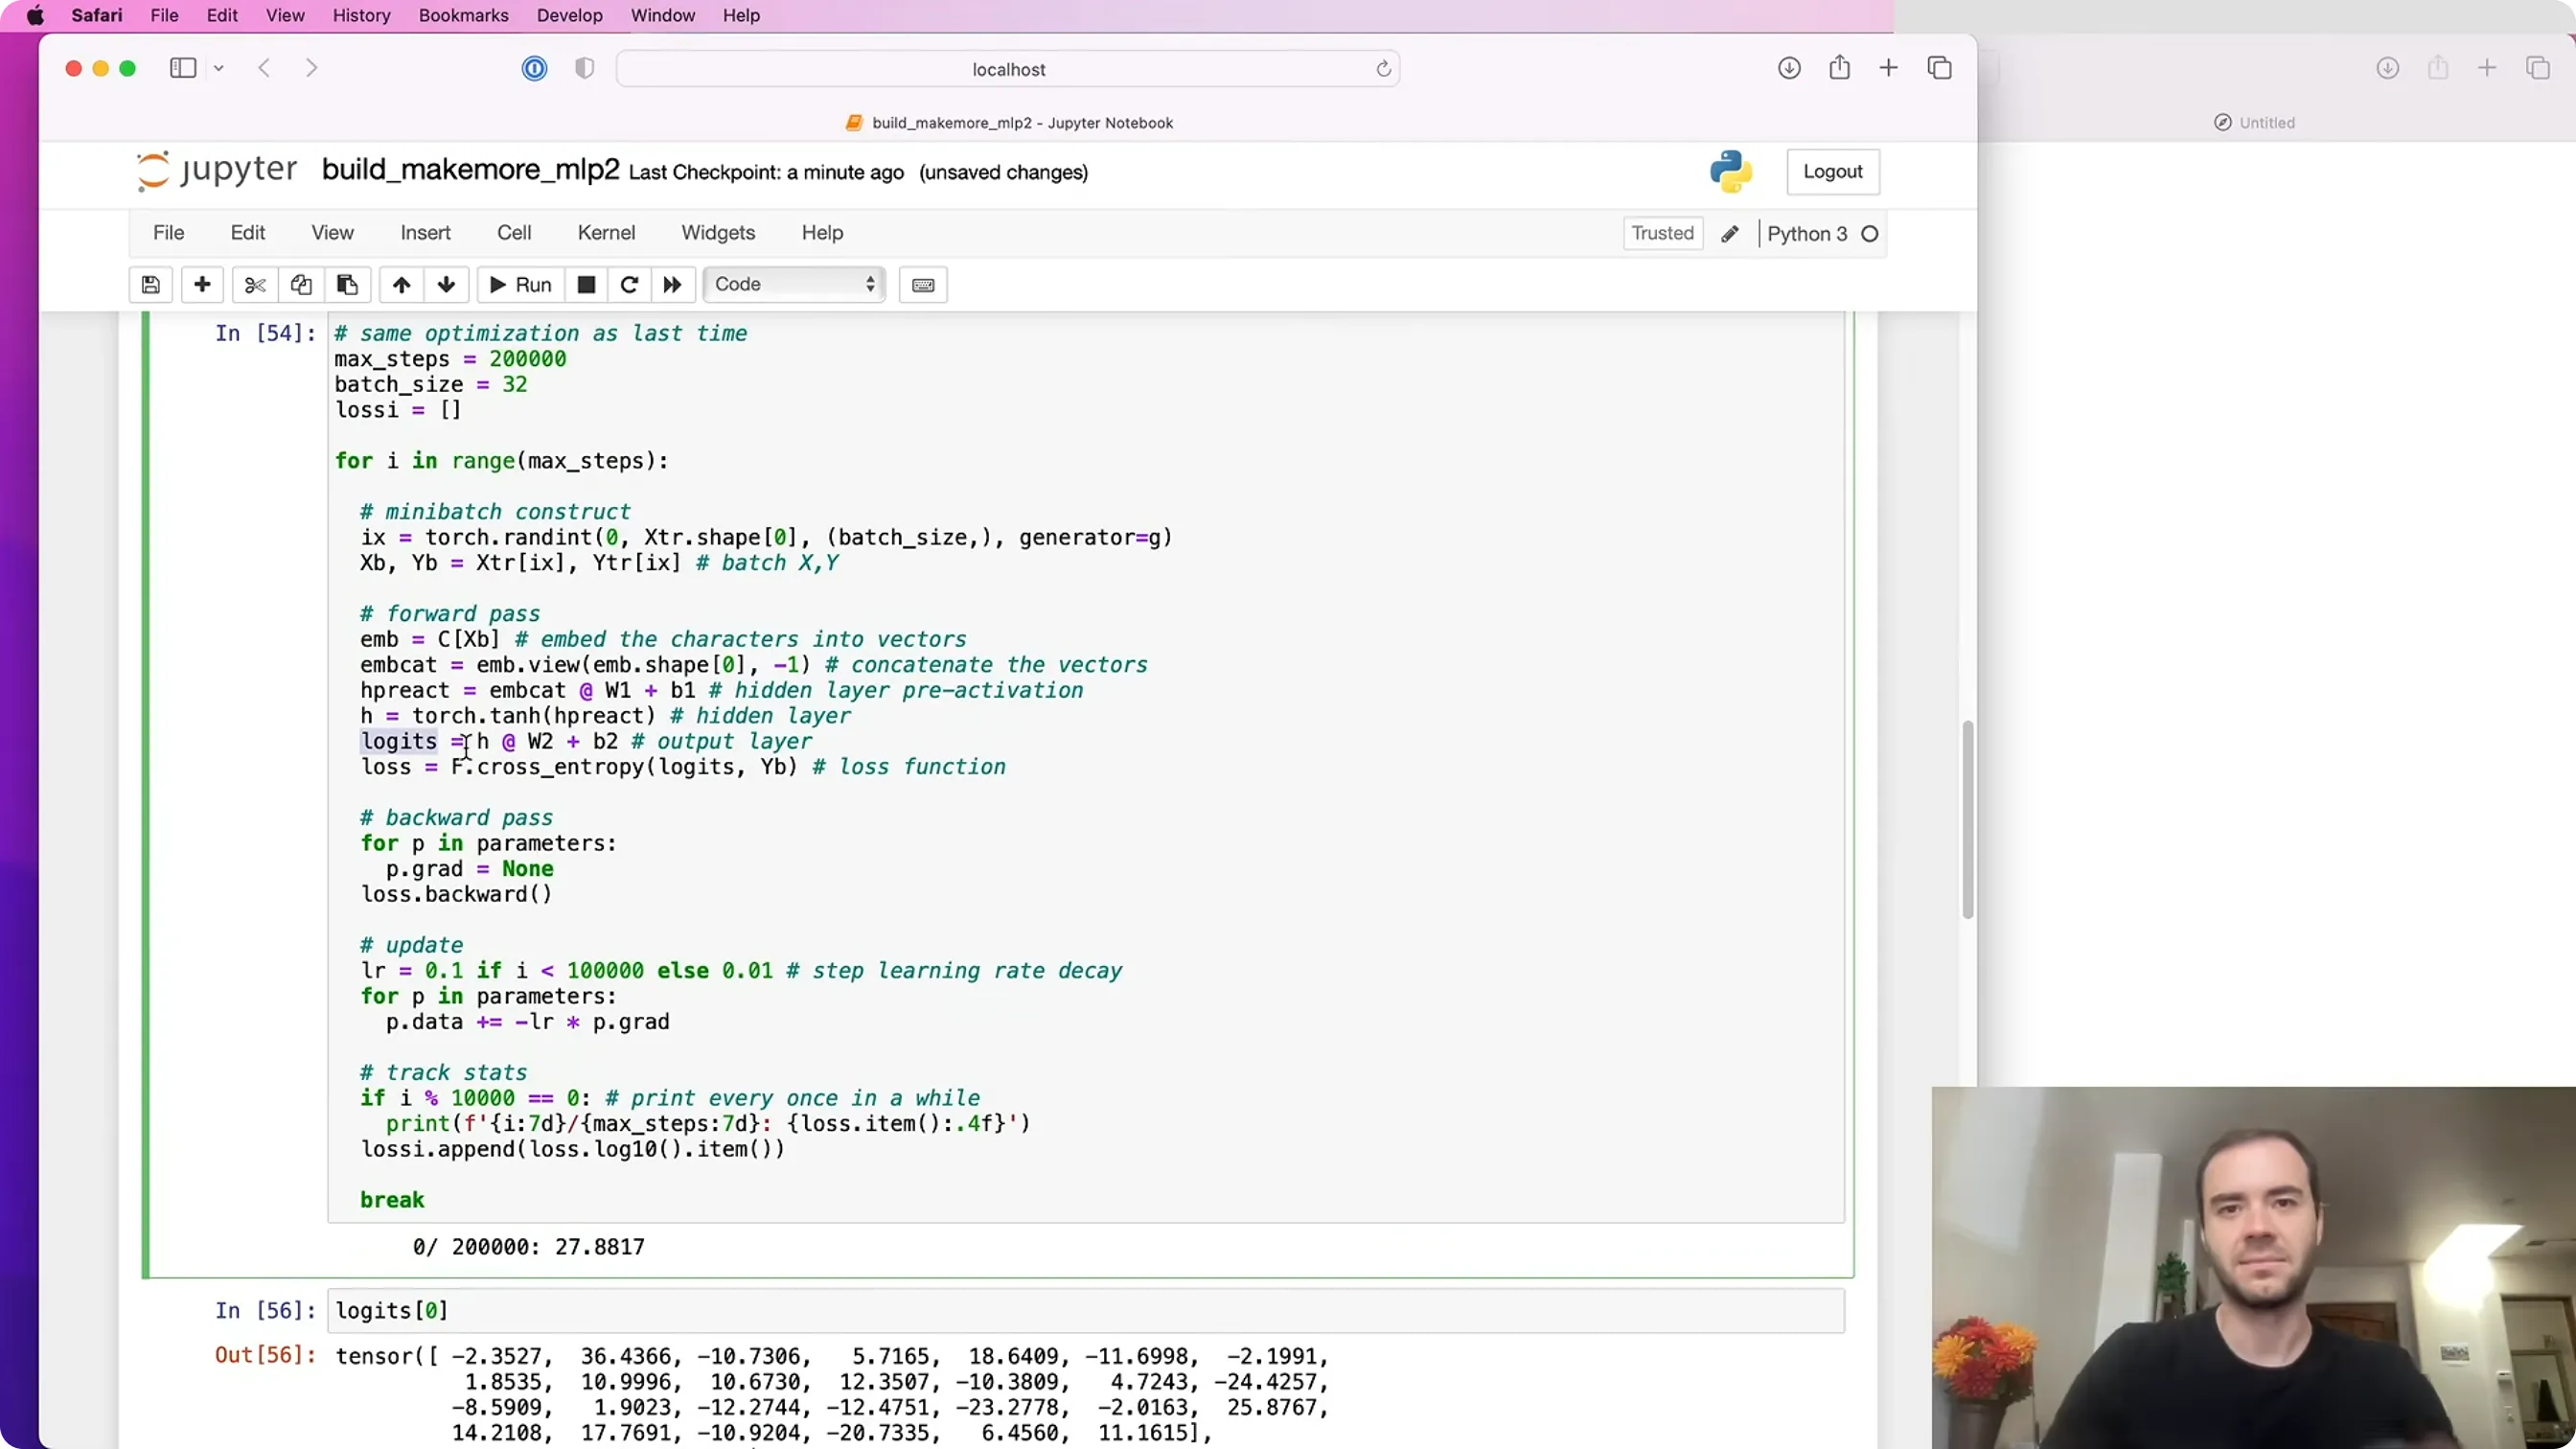
📷 把 W2 缩小、b2 置零后,logits 接近 0、损失接近 log 27 ≈ 3.29
回到原视频 (00:09:30)
三、修复二:tanh 饱和了
(参考时间: 12:59)
损失看起来正常了,但网络内部还有更深的问题——看隐藏层激活 h:大量元素是 1 或 −1。
画 h 的直方图:绝大多数值都在 ±1 两端。再看进入 tanh 之前的 pre-activation:分布非常宽(大约 −5 到 15),「所以 tanh 把它们全压到了 ±1」。
"如果你熟悉反向传播的'黑魔法',看到这个分布你会冒冷汗。"
为什么? 回忆 micrograd 里 tanh 的反向:
$$\frac{\partial \tanh}{\partial x} = 1 - t^2$$
如果输出 $t$ 接近 ±1,那么 $1-t^2 \to 0$,把上游梯度乘成了 0——「无论 out.grad 是什么,梯度都被杀死了。」直觉上也对:tanh 在两端是平的,改输入几乎不改变输出,所以对损失没有影响。
后果:h 里几乎所有神经元都"饱和"了,梯度传不下去。
- 死神经元(dead neuron):如果某一列全是饱和的(对所有样本都落在平坦区),这个神经元永远学不到东西。检查矩阵里"$|h|>0.99$"的布尔图,这次没有整列全白——所以还能训,但效率被严重拖慢。
- 这个问题不只属于 tanh:sigmoid 一样;ReLU 在负半轴是完全平的,会精确地把梯度置 0,也会出现死 ReLU。「有时候学习率太大,某次梯度把神经元踢出数据流形,从此没有任何样本能激活它——这是网络里的永久性脑损伤。」
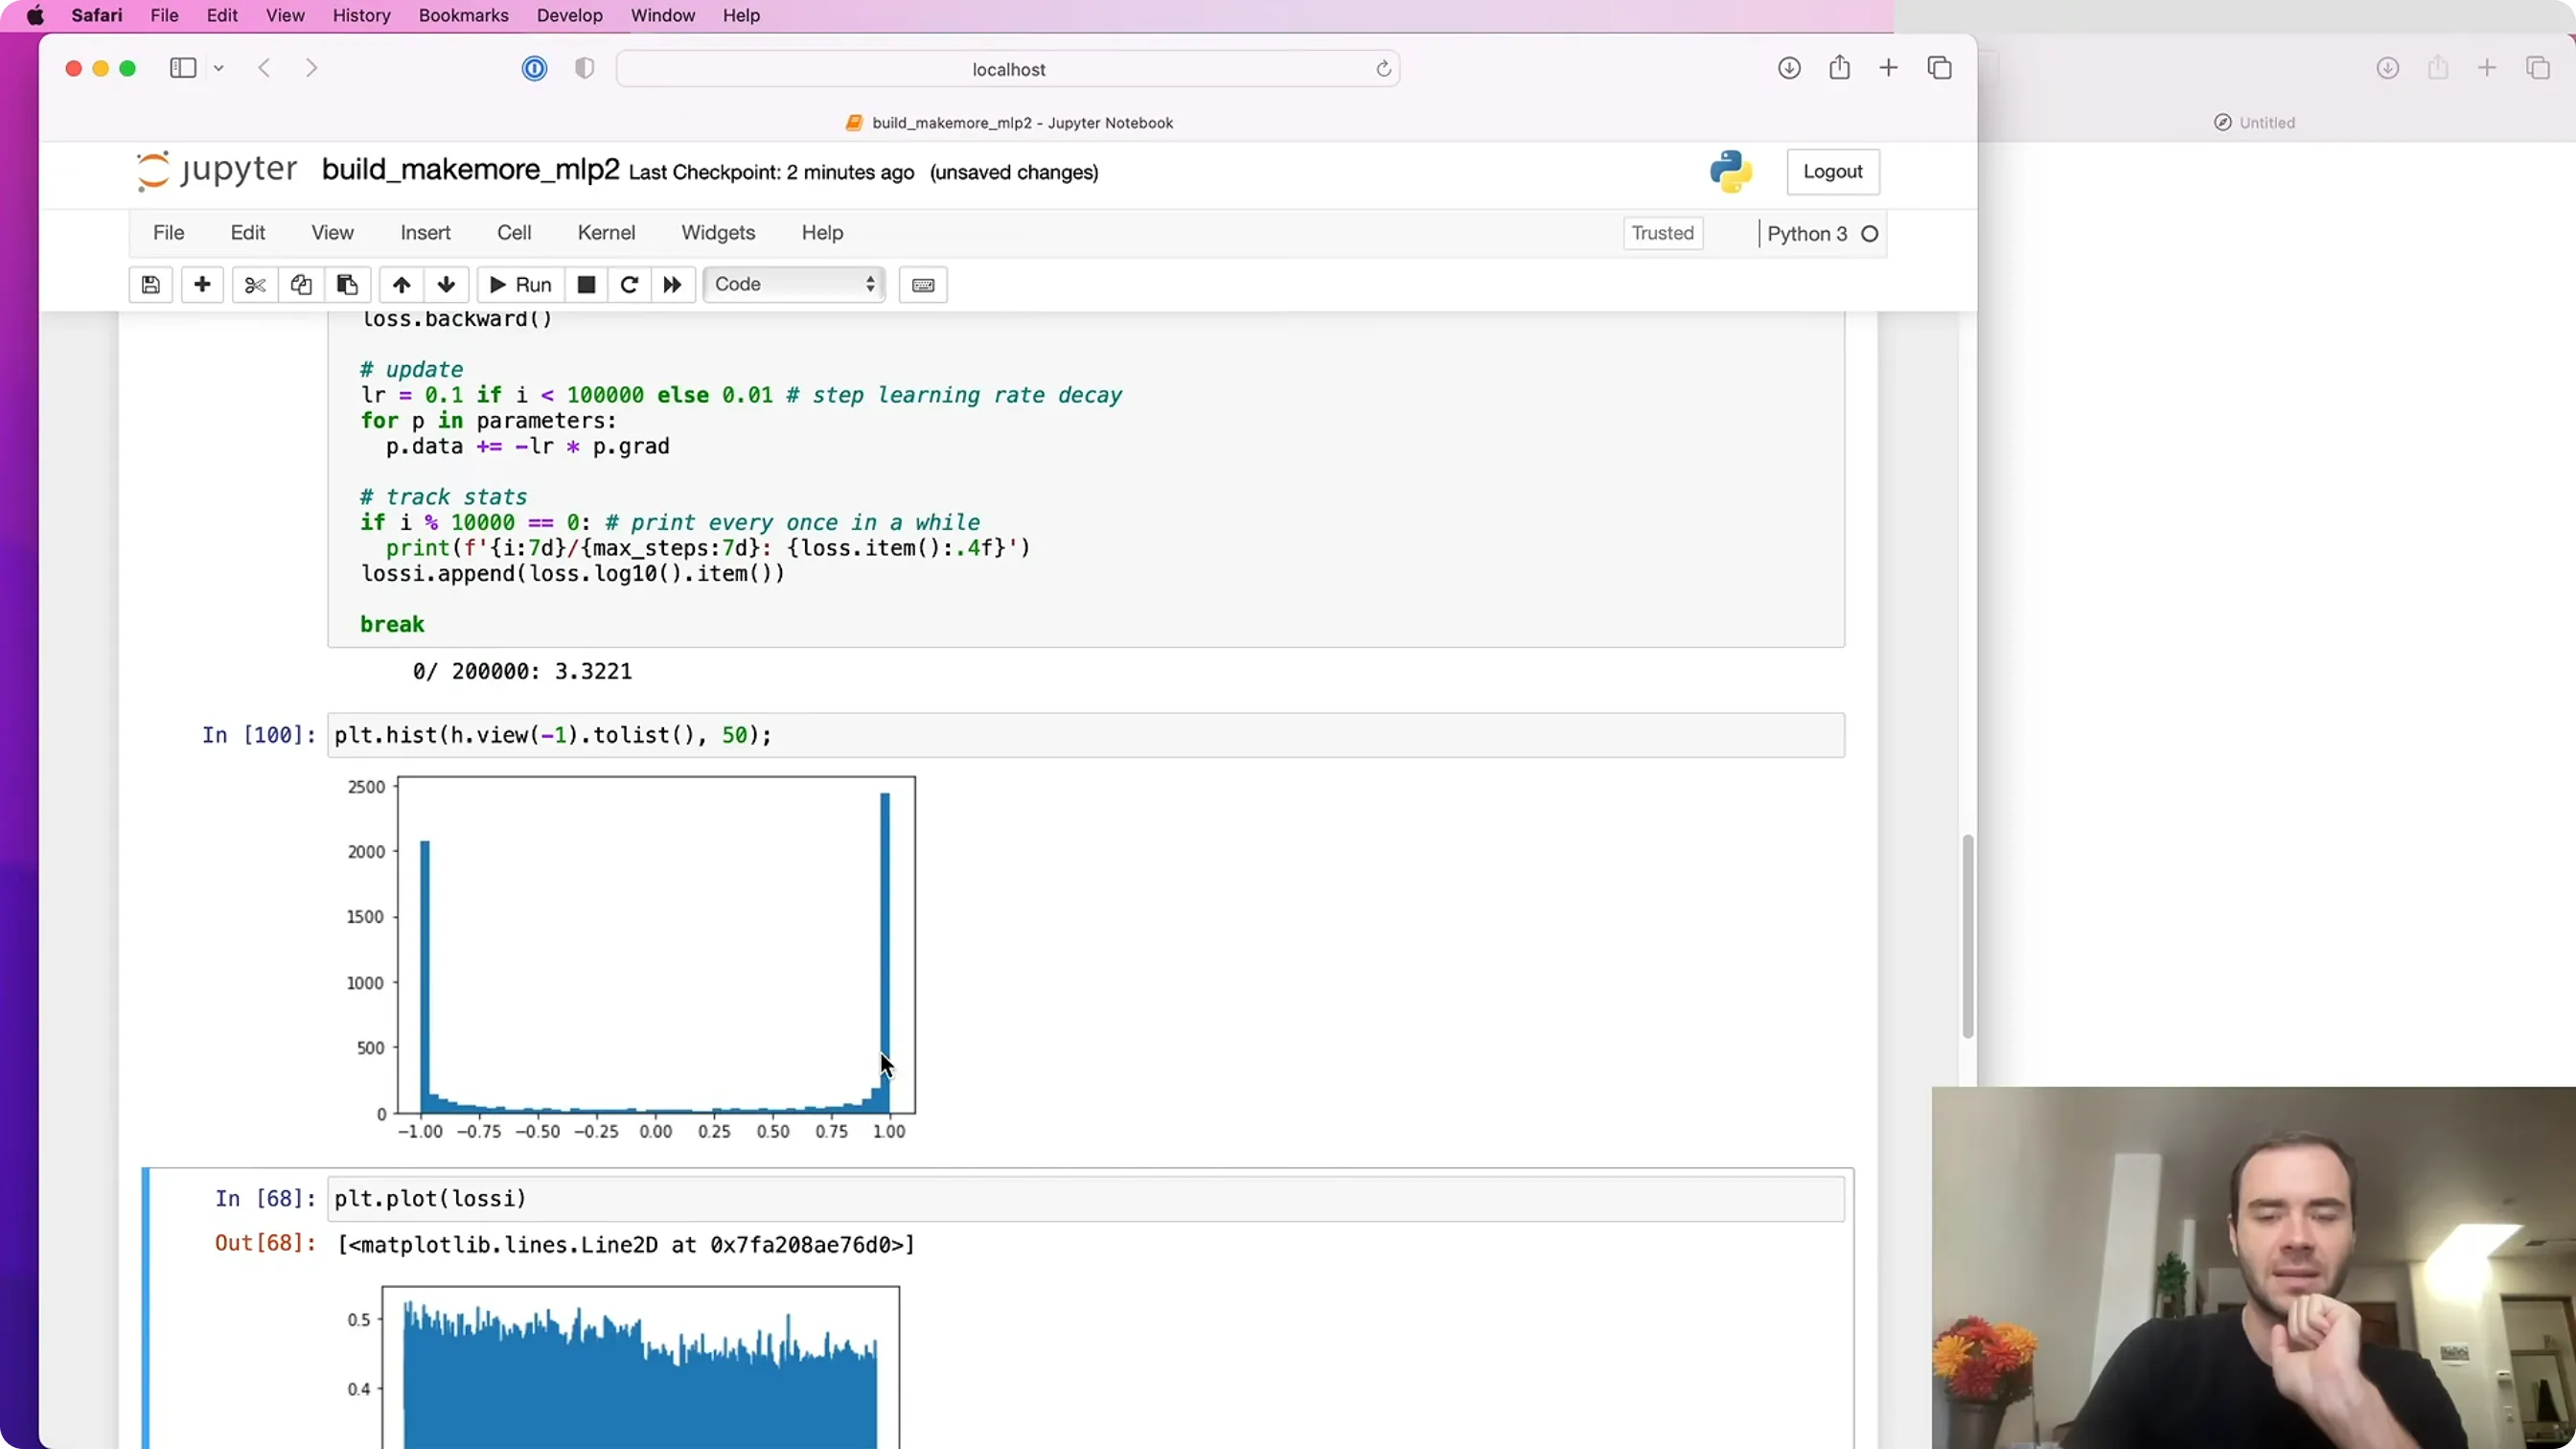
📷 h 的直方图:值大量堆在 ±1(tanh 饱和)
回到原视频 (00:14:30)
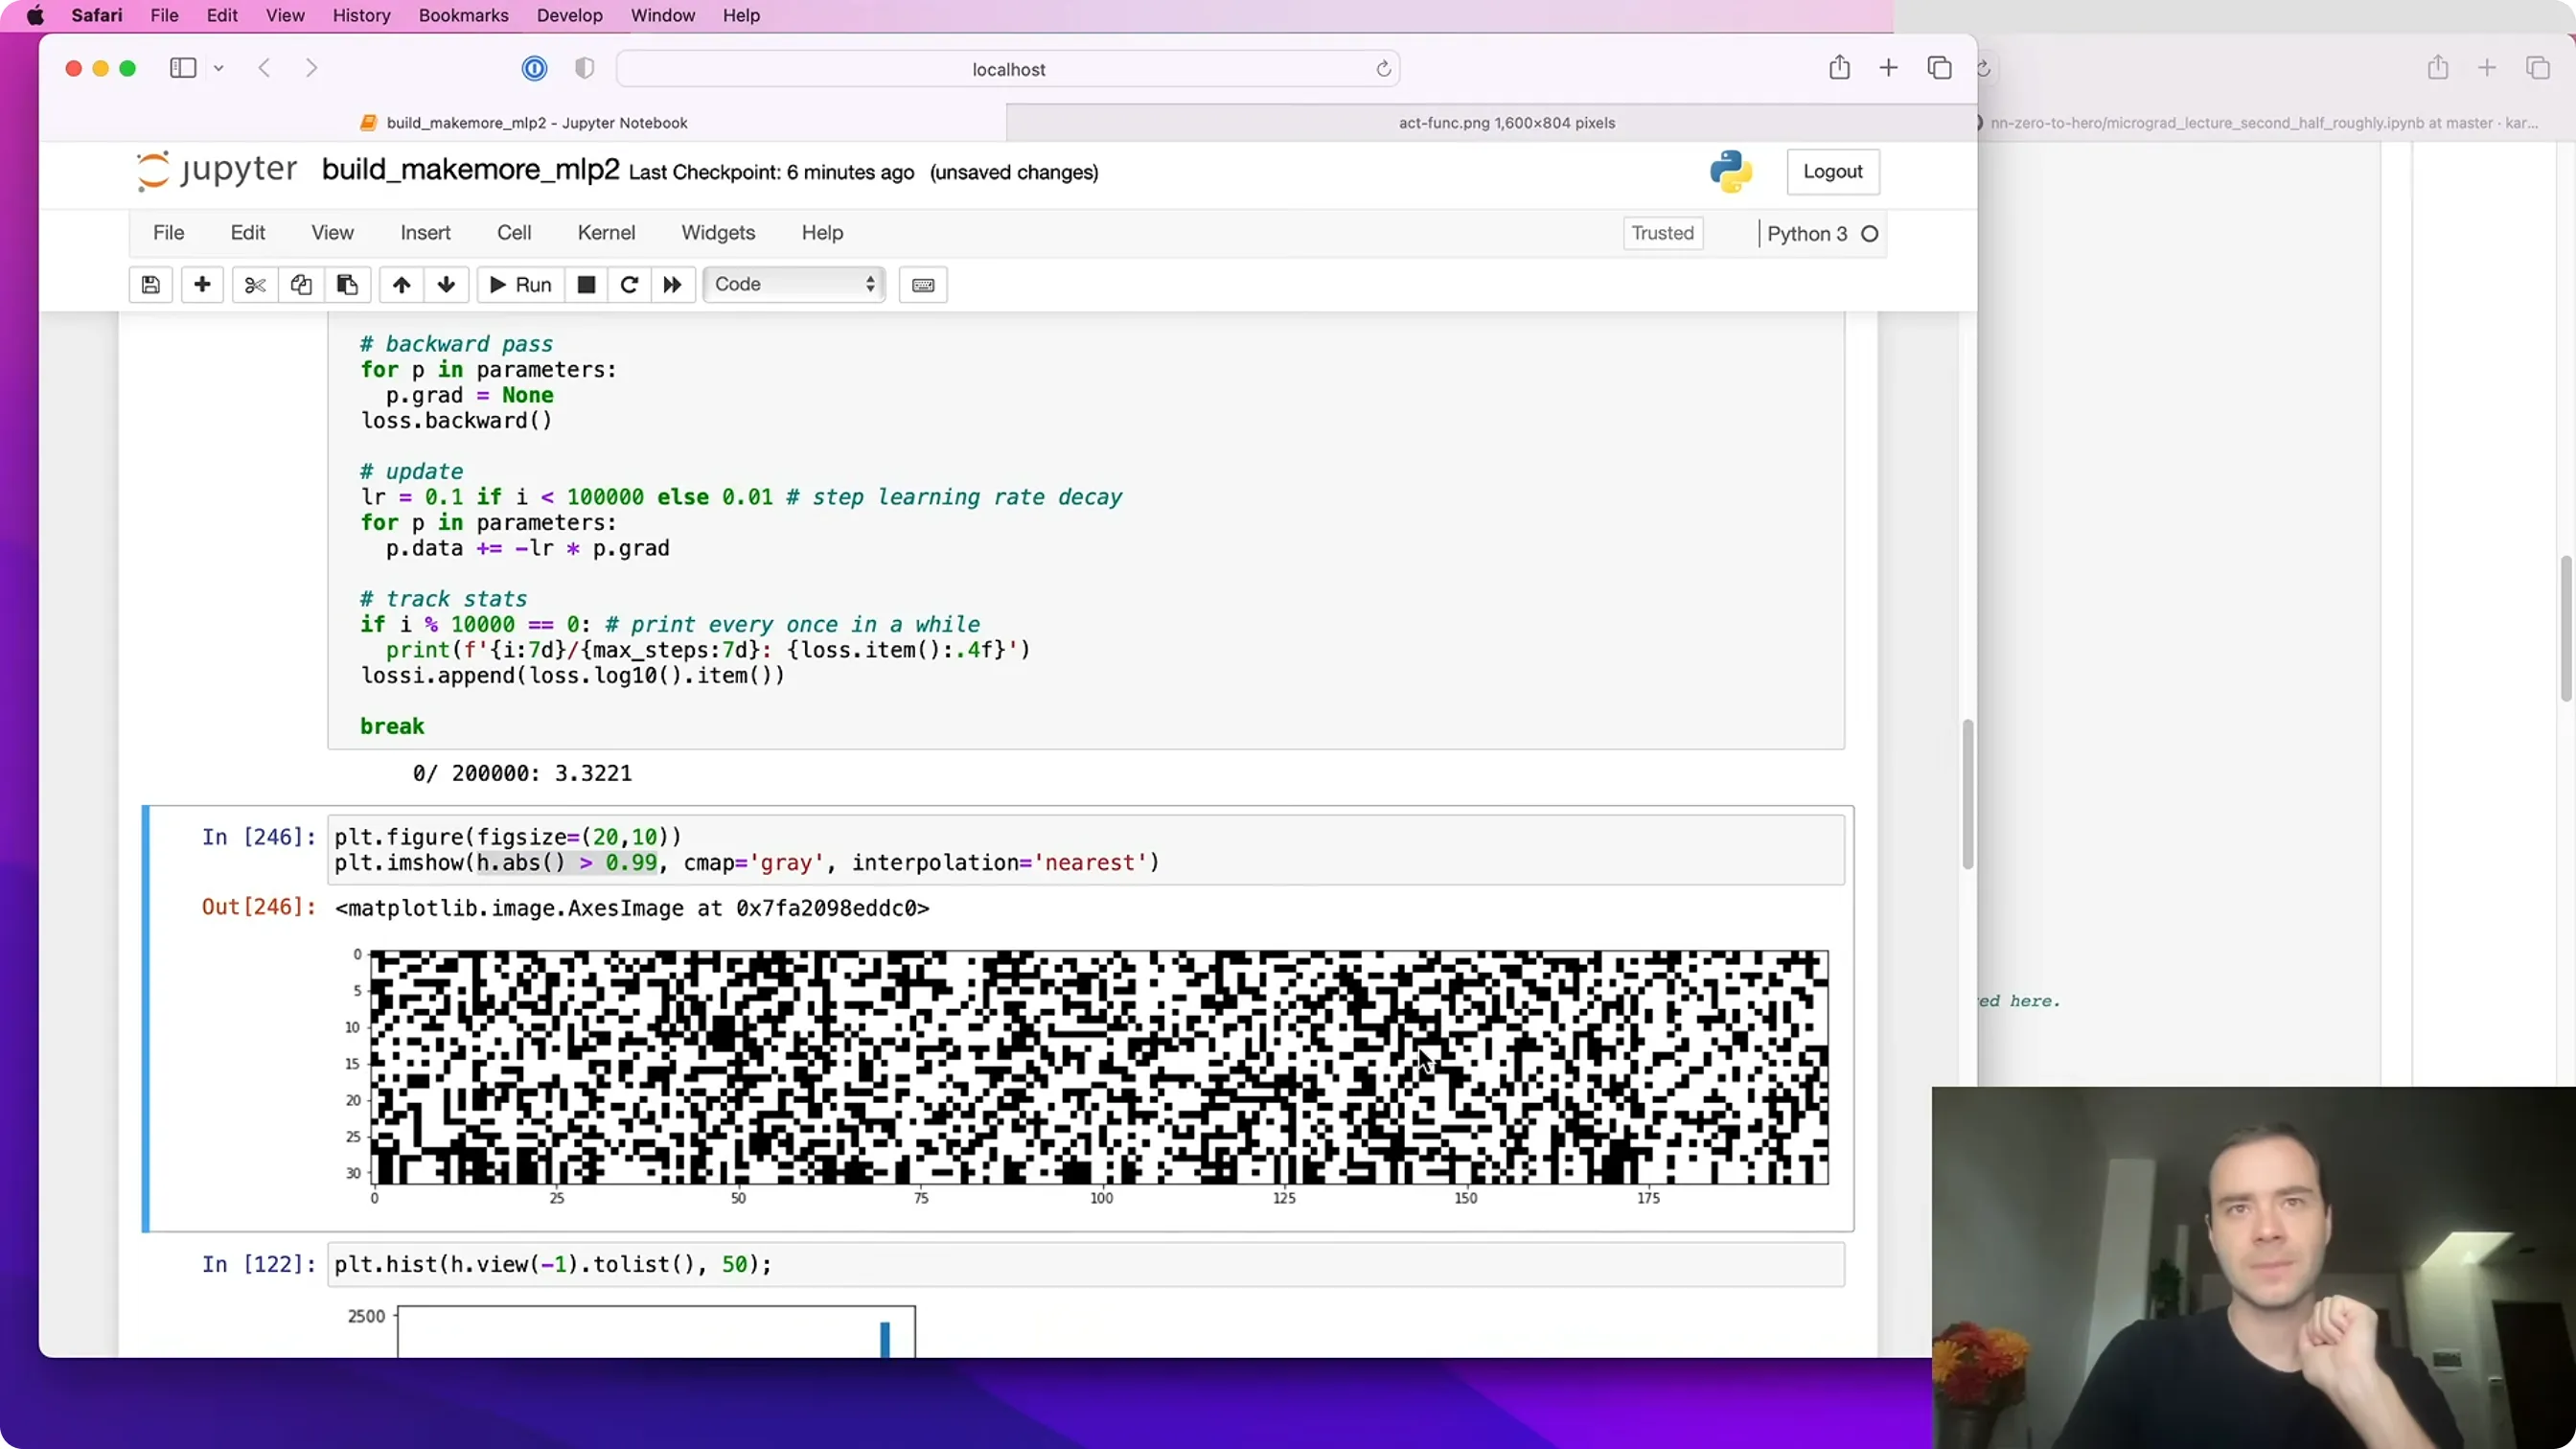
📷 饱和度检查:布尔矩阵里大片"白"= 大量神经元落在平坦区
回到原视频 (00:19:00)
修法与前面同构:
b1乘 0.01(保留一点熵,利于对称性破缺);W1乘 0.1(或 0.2),压小 pre-activation。
修好后,pre-activation 落在约 ±1.5,没有白色区域,激活分布很健康。验证损失 2.13 → 2.10。
四、Kaiming 初始化:把"魔法数字"变成公式
(参考时间: 27:53)
我们用了 0.1、0.2 这种魔法数字——「这些数是哪来的?如果我有一百层,我该怎么设?」显然没人手调。
先做一个分析:设输入 $x \sim \mathcal N(0,1)$(1000 个样本 × 10 维),权重也是高斯,看 y = x @ W:
- 均值仍约为 0(对称);
- 但标准差会膨胀:从 1 涨到 3。乘
5又变成 15;乘0.2又缩到 0.6。
「我们不想让分布一直膨胀或缩小——我们希望整个网络里大致保持单位高斯。」那该乘多少?
答案是:除以 fan-in 的平方根。
$$\text{std} = \frac{1}{\sqrt{\text{fan\_in}}}$$
这里 fan-in = 10,除以 $\sqrt{10}$ 后标准差恰好回到 1。
更一般的结论来自 Kingma & He 的论文 Delving Deep into Rectifiers(常被称为 "Kaiming init"):
- 对 ReLU:因为丢掉了一半分布(负半轴截断),需要增益 $g = \sqrt 2$;
- 对 线性:$g = 1$;
- 对 tanh:推荐 $g = 5/3$。
为什么需要增益? 因为 ReLU 和 tanh 都是"收缩性"变换——它们把分布往中间挤,所以你得把权重稍微放大去"对抗挤压"。
PyTorch 里对应 torch.nn.init.kaiming_normal_(mode 默认 fan_in,再传 nonlinearity)。
在本讲里:W1 的 fan-in 是 n_embd * block_size = 10 × 3 = 30,所以标准差应为 $\frac{5/3}{\sqrt{30}} \approx 0.3$——正好接近我们手调出来的那个量级。
W1 = torch.randn((n_embd*block_size, n_hidden)) * (5/3) / (n_embd*block_size)**0.5
结果:验证损失同样是 2.10——「我们到达了同一个地方,但没有引入任何魔法数字,而是用了一个半原理化、能扩展到更大网络的规则。」
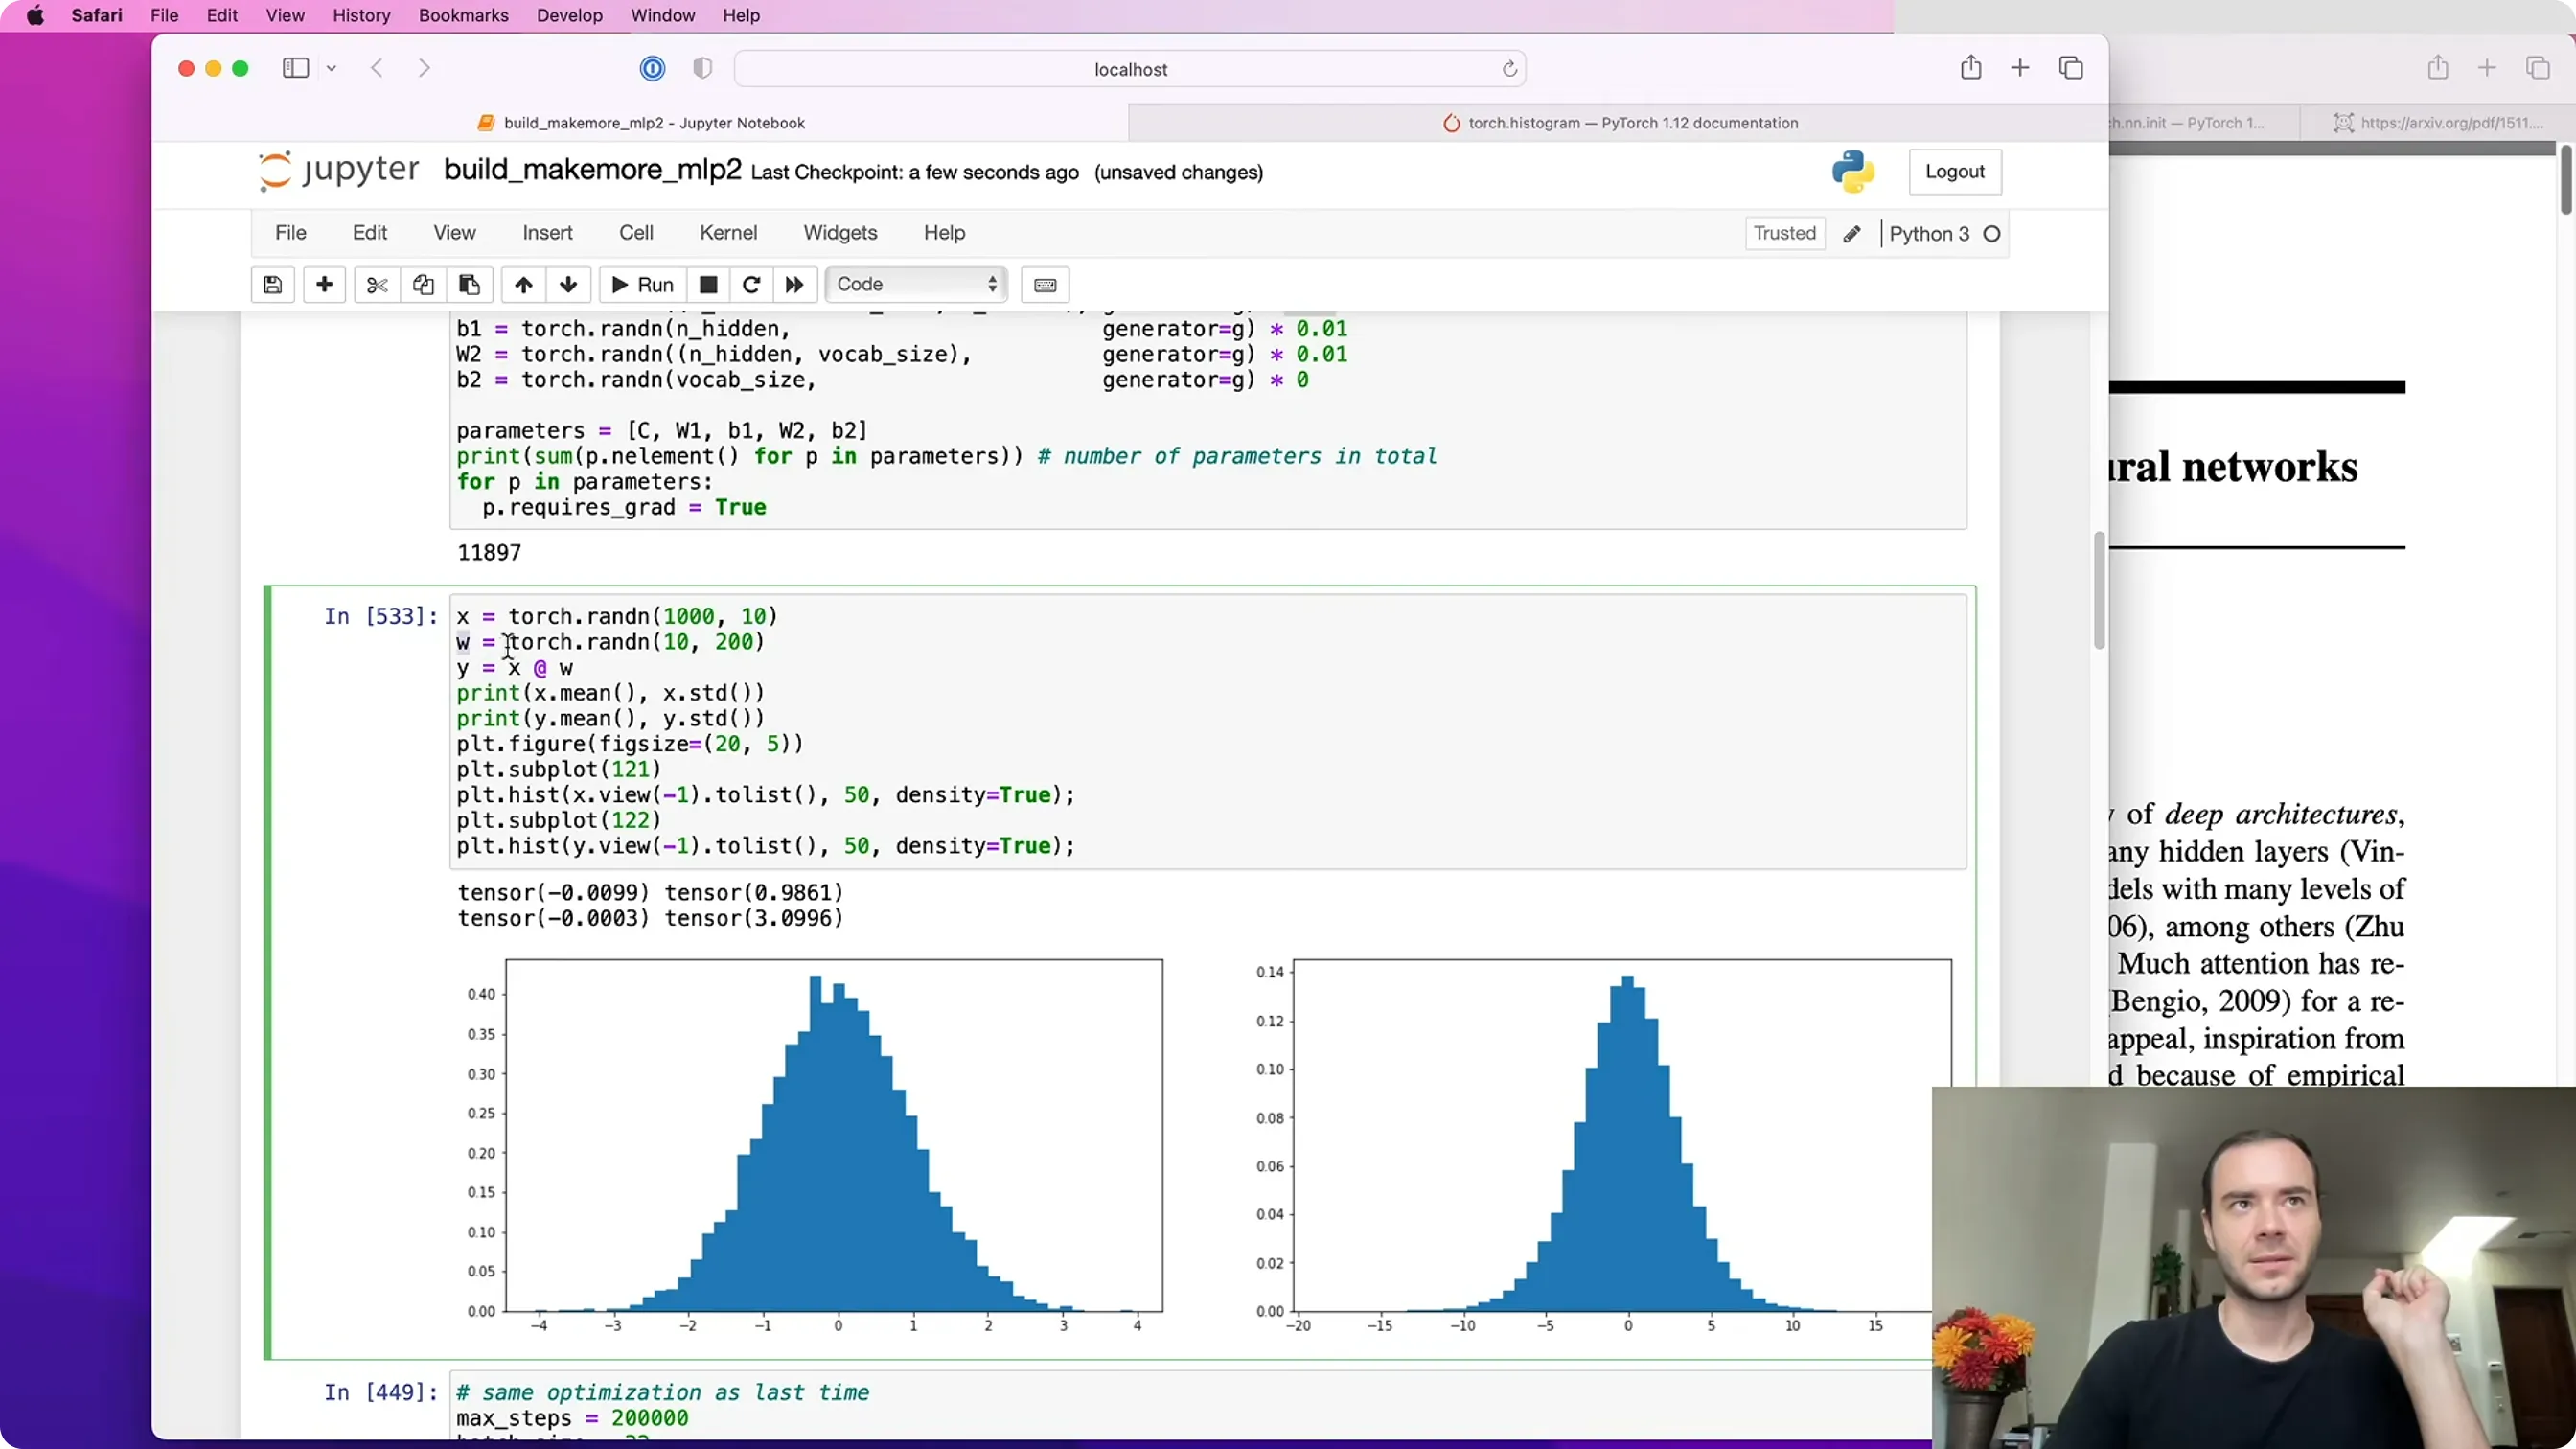
📷 Kaiming init 的分析:x@W 会让标准差膨胀,除以 √fan_in 恰好保持
回到原视频 (00:28:30)
编者拓展|$\sqrt{\text{fan\_in}}$ 的直觉:$y_j=\sum_{i=1}^{n} w_i x_i$ 是 $n$ 个独立项之和。若 $x_i$、$w_i$ 方差分别为 $\sigma_x^2,\sigma_w^2$,则 $\mathrm{Var}(y_j)=n\,\sigma_x^2\sigma_w^2$——方差随 fan-in 线性增长。要让 $\mathrm{Var}(y)\approx\sigma_x^2$,就要 $\sigma_w\propto 1/\sqrt n$。这就是"除以 $\sqrt{\text{fan\_in}}$"的由来(也是 Xavier/Glorot 初始化的同一思路)。
编者说明:Karpathy 强调,今天初始化已经没那么"要命"了,因为有三样现代发明:残差连接、各种归一化层(BatchNorm/LayerNorm/GroupNorm)、更好的优化器(RMSProp/Adam)。「但在 7 年前,这些都是要非常精细地调的,很脆弱。」
五、Batch Normalization
(参考时间: 40:40)
核心洞察(2015,Google):
你希望隐藏层的激活大致是单位高斯——那为什么不直接"标准化"它们? 标准化(减均值、除标准差)是完全可微的,所以可以放进网络里一起训练。
「我第一次读这篇论文时惊为天人」——「你居然可以直接把隐藏状态归一化。」
实现(pre-activation 形状 (32, 200),即 32 个样本 × 200 个神经元):
# 沿 batch 维度(dim=0)统计每个神经元的均值/方差
bnmean = hpreact.mean(0, keepdim=True)         # (1, 200)
bnstd  = hpreact.std(0, keepdim=True)          # (1, 200)
hpreact = (hpreact - bnmean) / bnstd           # 标准化:每个神经元在 batch 上恰为单位高斯
但只有标准化是不够的——那会强行让分布永远是单位高斯,网络就失去了调整分布的自由(比如让某个 tanh 神经元更"敏感"或更"迟钝")。所以要加上可训练的 scale 和 shift:
bngain = torch.ones((1, n_hidden))     # γ(gain),乘
bnbias = torch.zeros((1, n_hidden))    # β(bias),加
hpreact = bngain * ((hpreact - bnmean)/bnstd) + bnbias
初始化 γ=1、β=0 时,每个神经元的输出在 batch 上恰为单位高斯——正是我们想要的。而 γ、β 是参数,会被反向传播训练,「网络想怎么调就怎么调」。
(γ、β 必须加进 parameters 列表。)
这一版没有带来损失提升(依然 2.10),因为只有一层的网络,我们已经能用 Kaiming 精确算出合适的缩放。BN 的价值在深网络——「一层层手工调缩放很快就行不通了,而"在每个线性层后面撒一个 BN"要容易得多。」
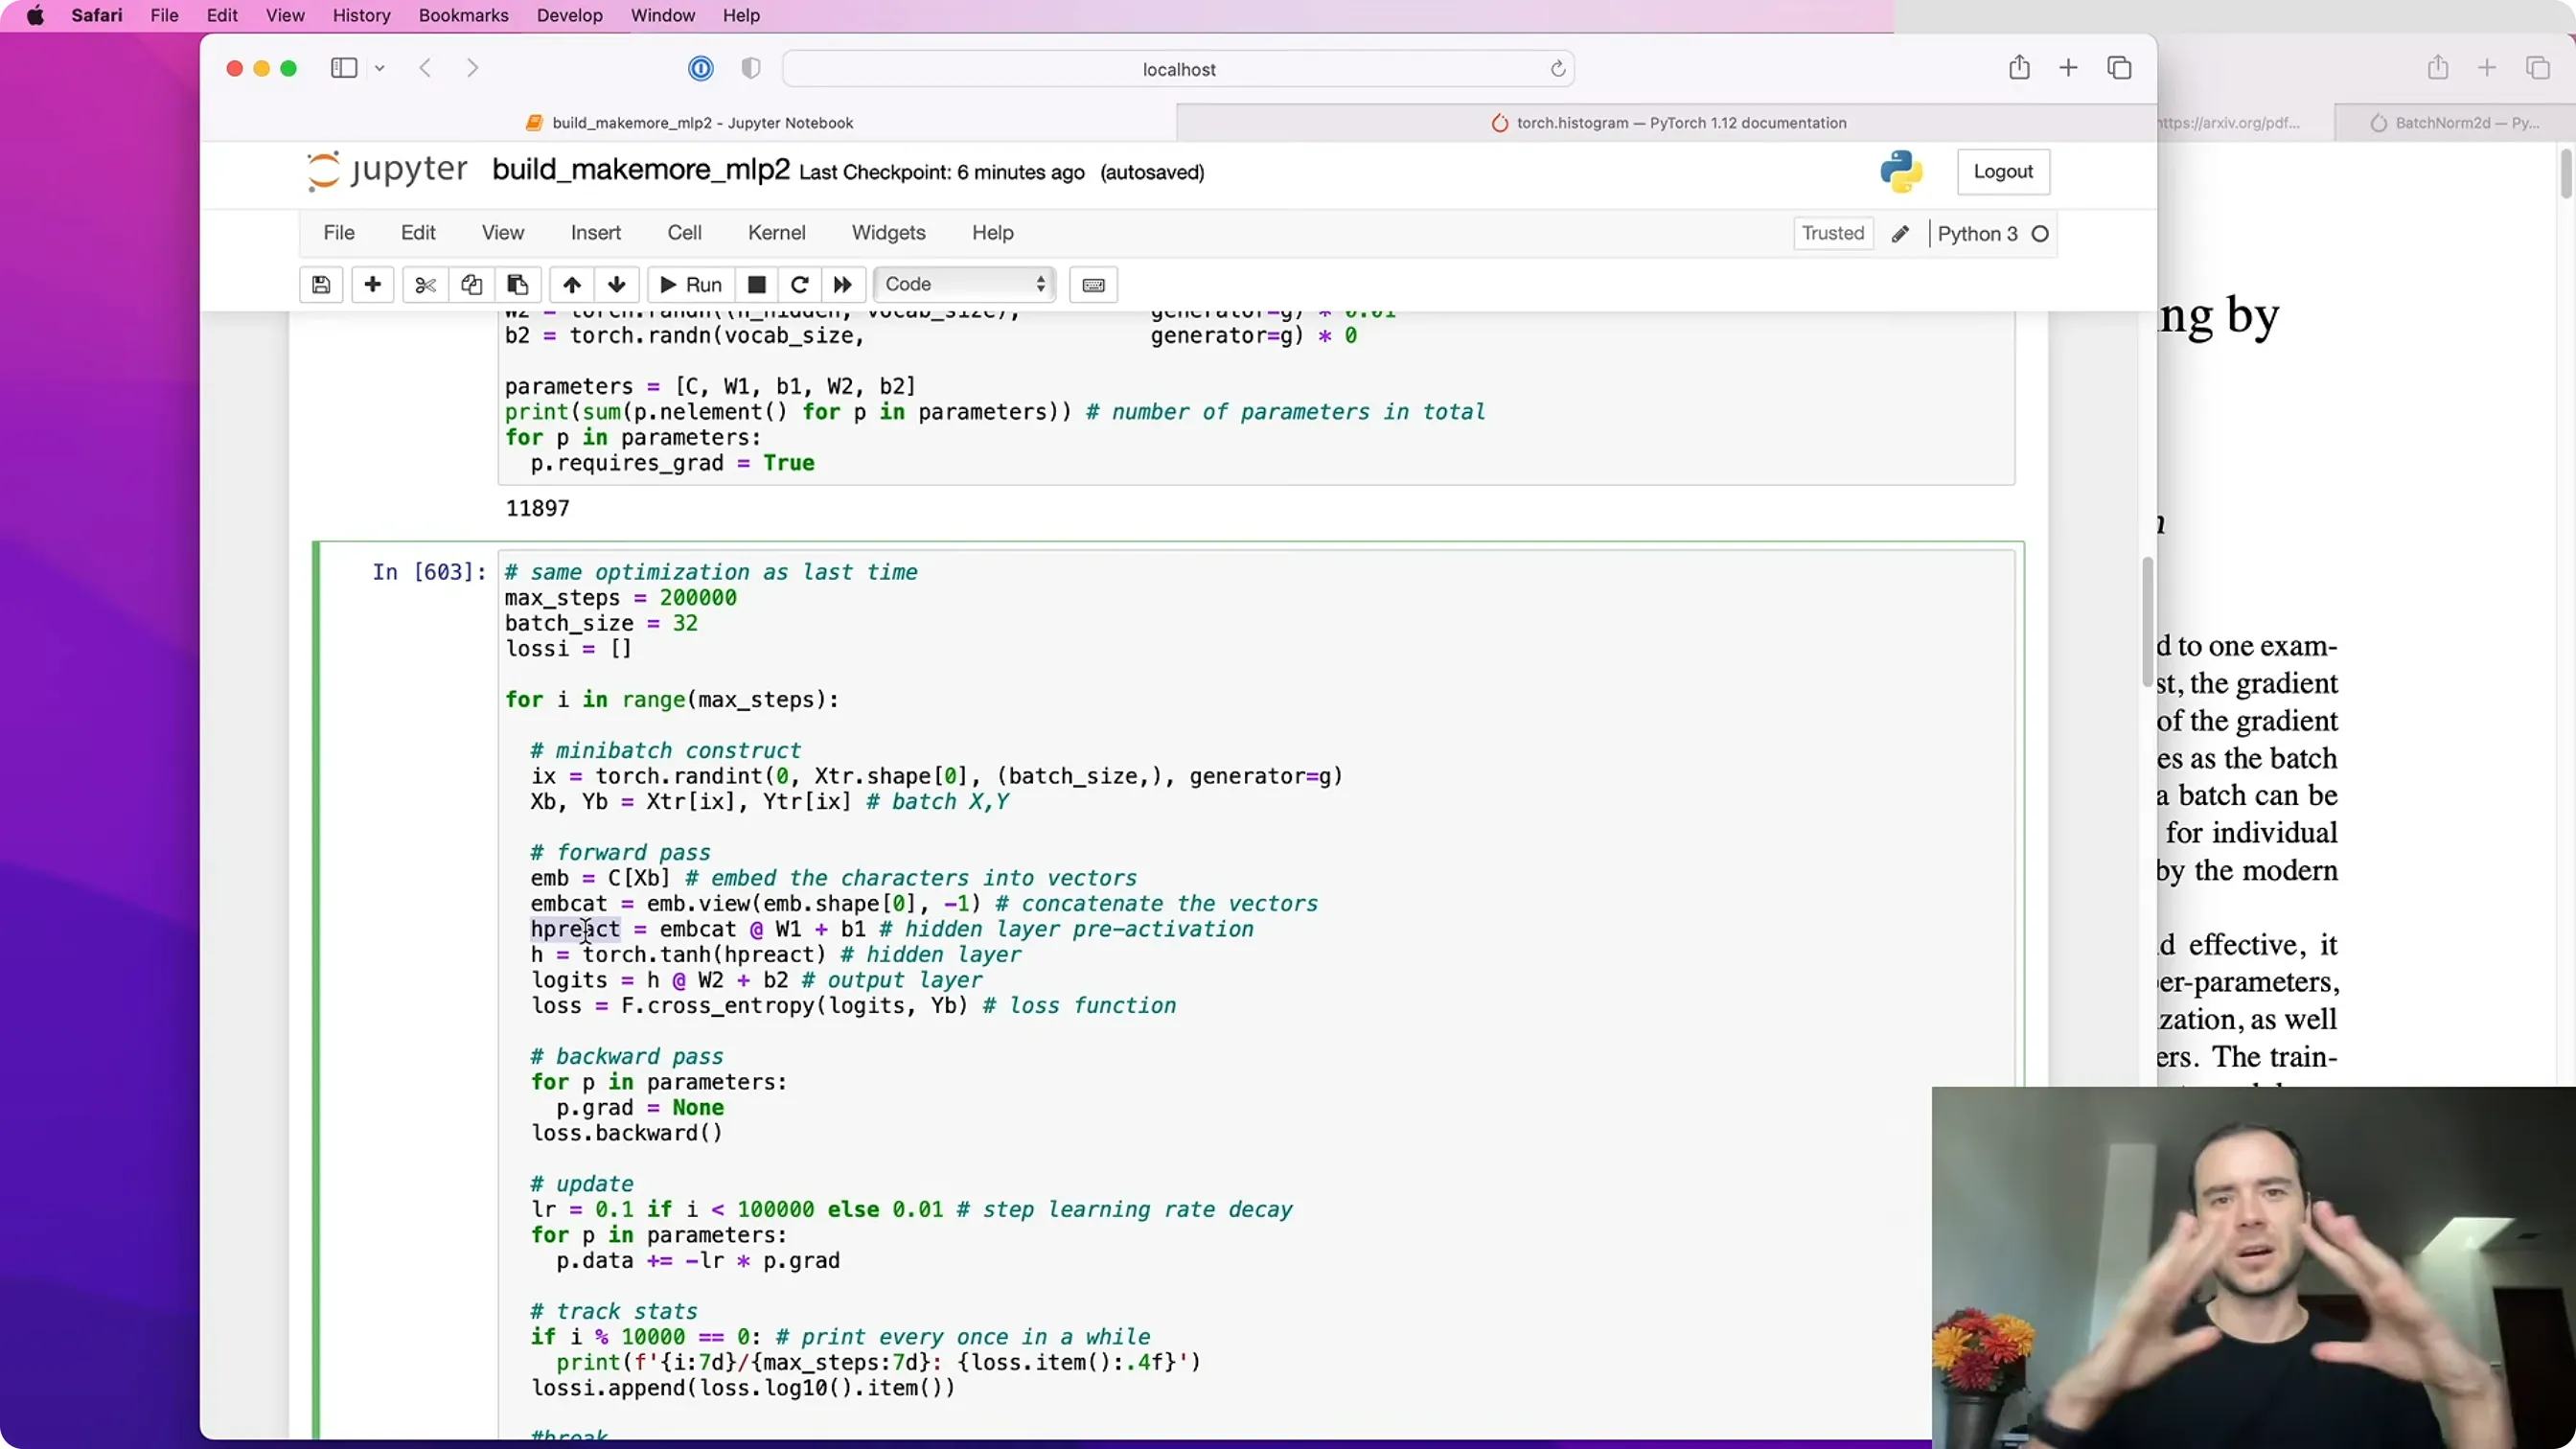
📷 BatchNorm:标准化 + 可训练的 scale/shift(γ, β)
回到原视频 (00:41:30)
5.1 代价:batch 内的样本被「耦合」了
(参考时间: 50:00)
但稳定性的代价是"可怕"的:
- 原本每个样本独立地流过网络(batch 只是出于效率);
- 现在,归一化让同一个 batch 里的样本在数学上相互耦合——某个样本的
h与 logits 会随同 batch 里其他样本而"抖动"。
「你会以为这是个 bug……但很奇怪,它居然是好事」:
这是个正则化器。 因为每个样本都被"加噪",等价于一种数据增强——「让网络更难去死记具体的样本」,降低过拟合。
「也正因为这个副作用,人们想移除 BN 一直很难:没人喜欢样本耦合,它带来大量 bug,但它确实好用。」后来出现了 LayerNorm / InstanceNorm / GroupNorm 等不耦合 batch 的替代方案,但在当时,BN 是第一个让"可靠地训练很深的网络"成为可能的层。
编者拓展|BatchNorm 的另一个"怪"后果:推理怎么办?:BN 的训练前向传播依赖当前 batch 的统计量,但部署时你可能只喂一个样本——一个样本的"均值/方差"没有意义。论文的解法: 1. 训练后在训练集上统计一次全局的均值/方差("calibrate"),推理时用固定值; 2. 但没人喜欢跑第二阶段,所以更常用的是在训练过程中用"滑动平均"(running mean/variance)边训边估:
$$ \mu_{\text{run}} \leftarrow 0.999\,\mu_{\text{run}} + 0.001\,\mu_{\text{batch}} $$
(用
torch.no_grad()更新,不参与反向传播——它是 buffer,不是 parameter。)推理时用
mu_run、std_run,于是也能对单个样本前向。这正是nn.BatchNorm1d内部做的事。
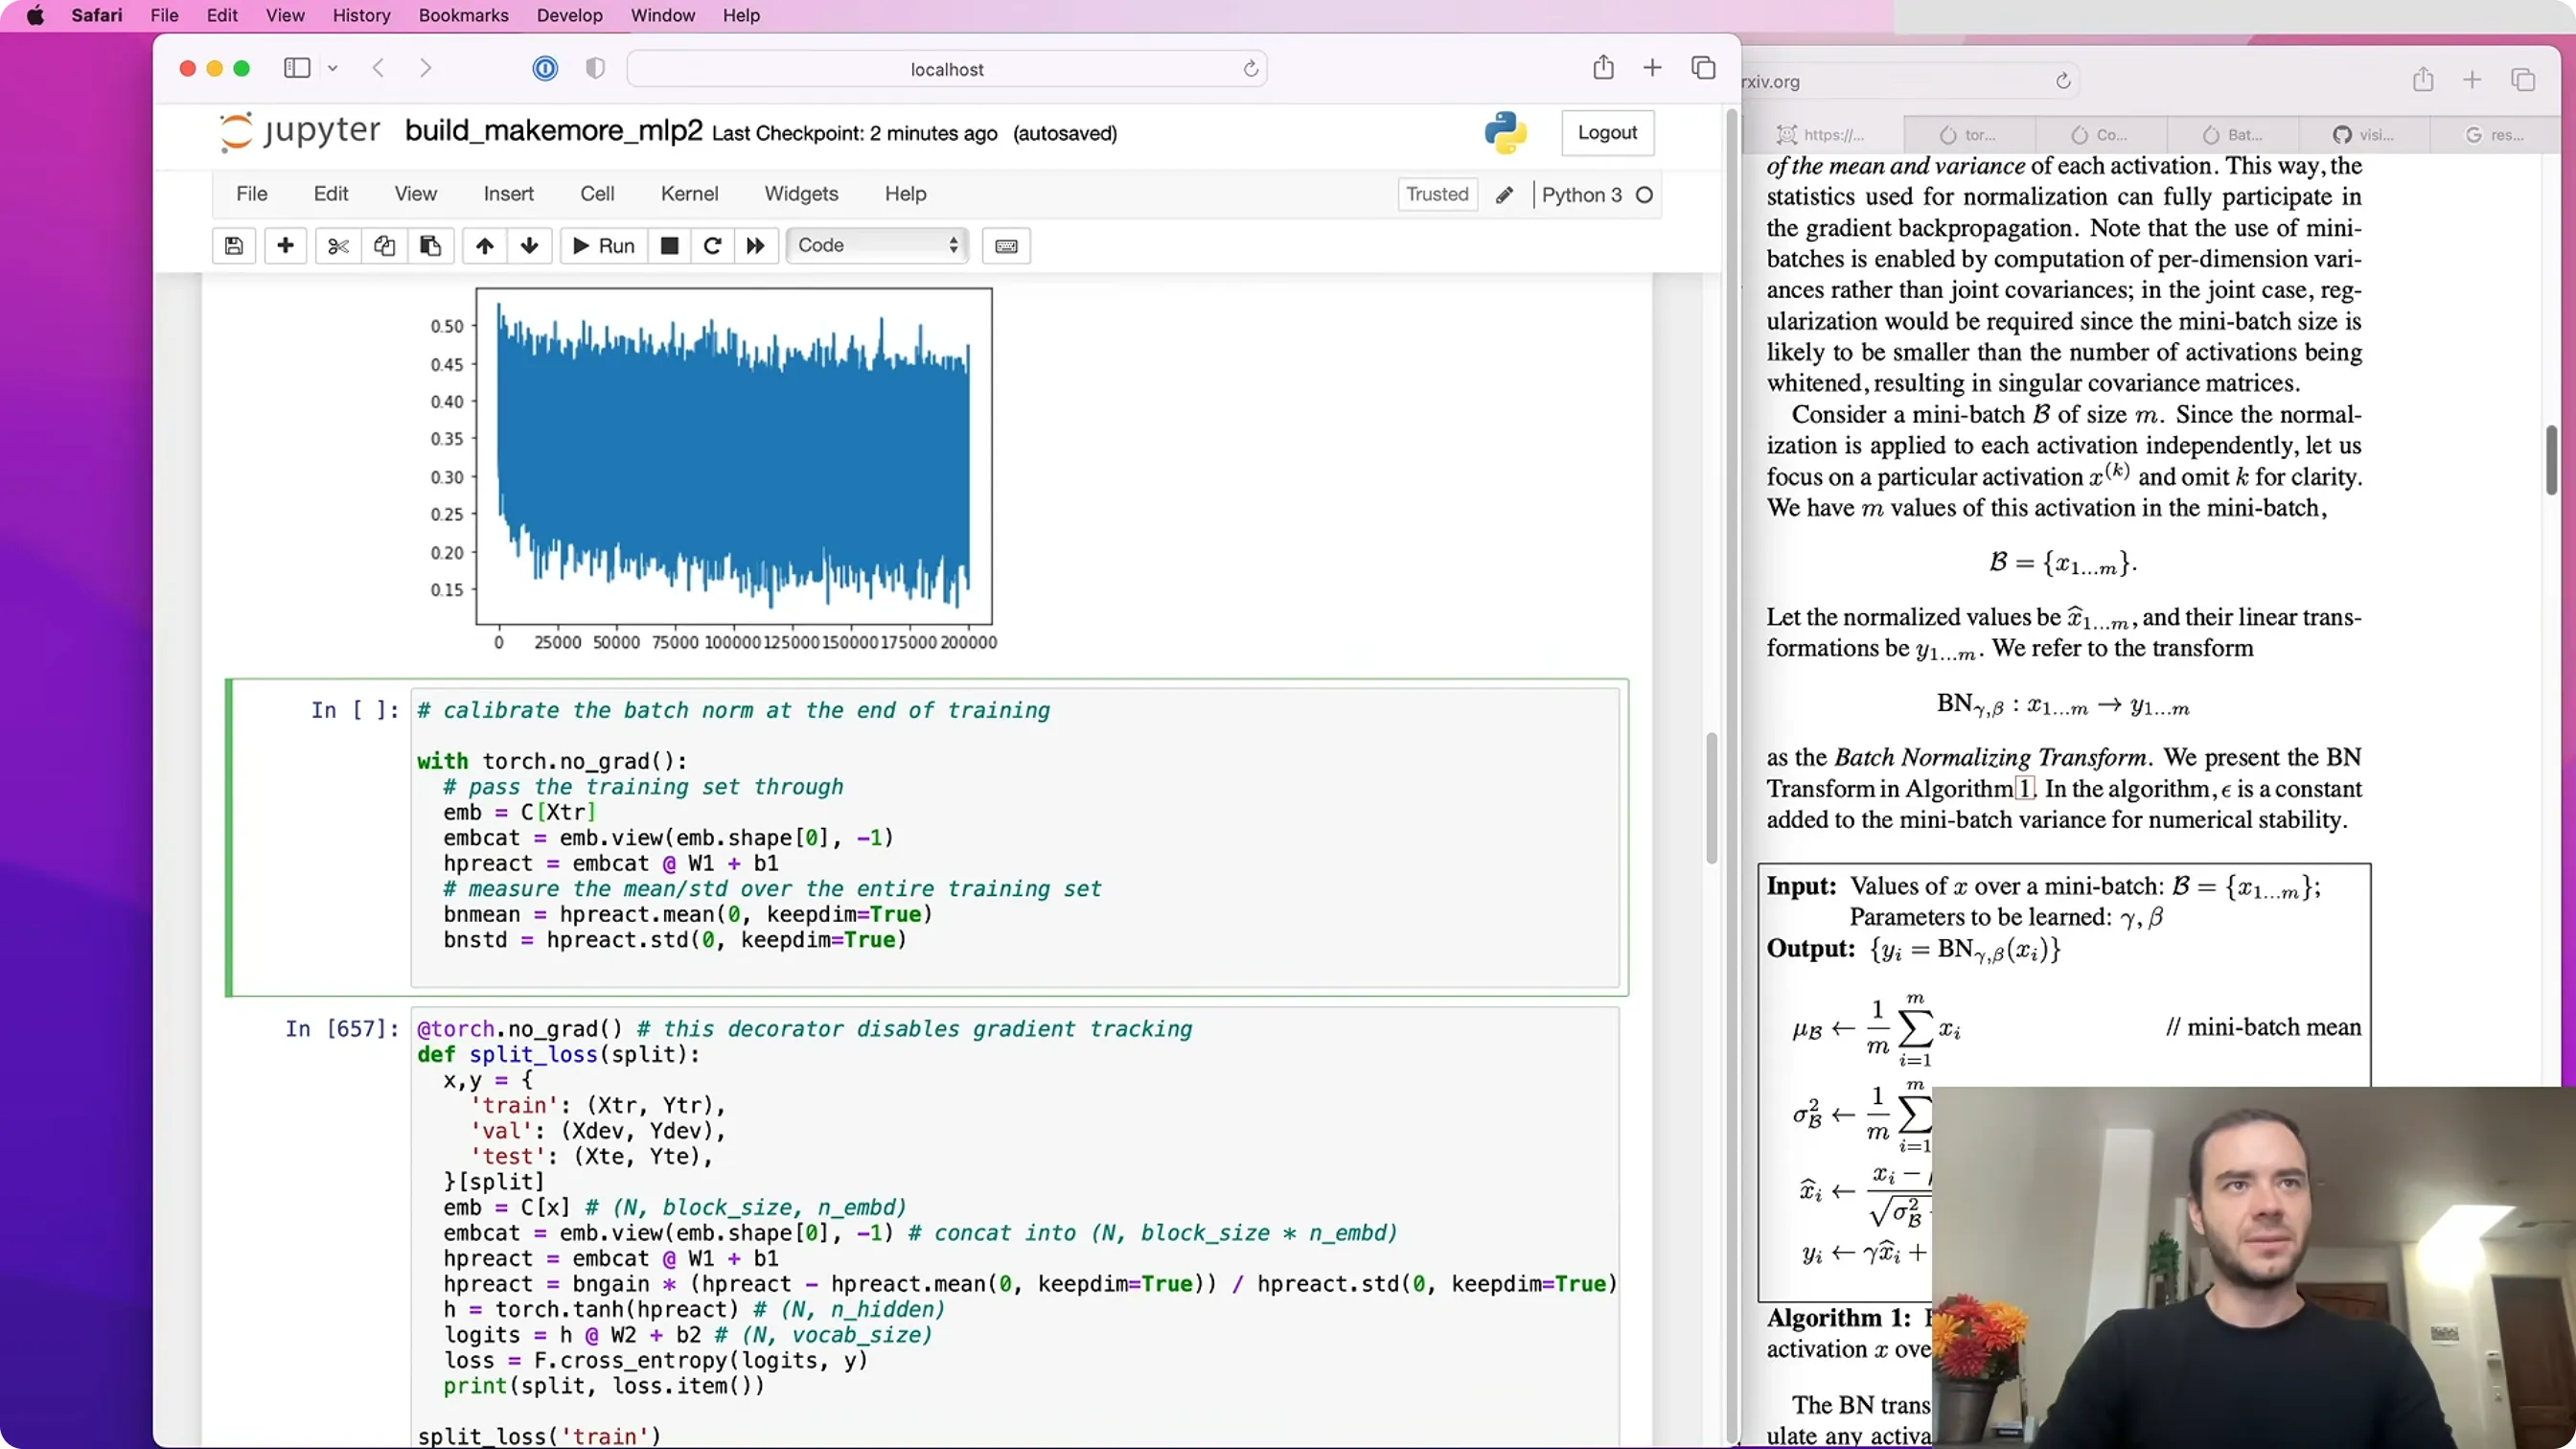
📷 推理:用训练中滑动平均得到的 running mean / std,从而能对单样本前向
回到原视频 (00:55:00)
5.2 两个小细节:eps 与「多余的 bias」
(参考时间: 1:01)
eps:分母加一个极小数(默认1e-5),防止方差恰为 0 时除零;b1是多余的:因为 BN 会减掉均值,你在线性层里加的 bias 会被减掉,b1.grad恒为 0——所以线性层可以bias=False,把"偏置"这件事交给 BN 自己的β。「不致命,只是浪费。」
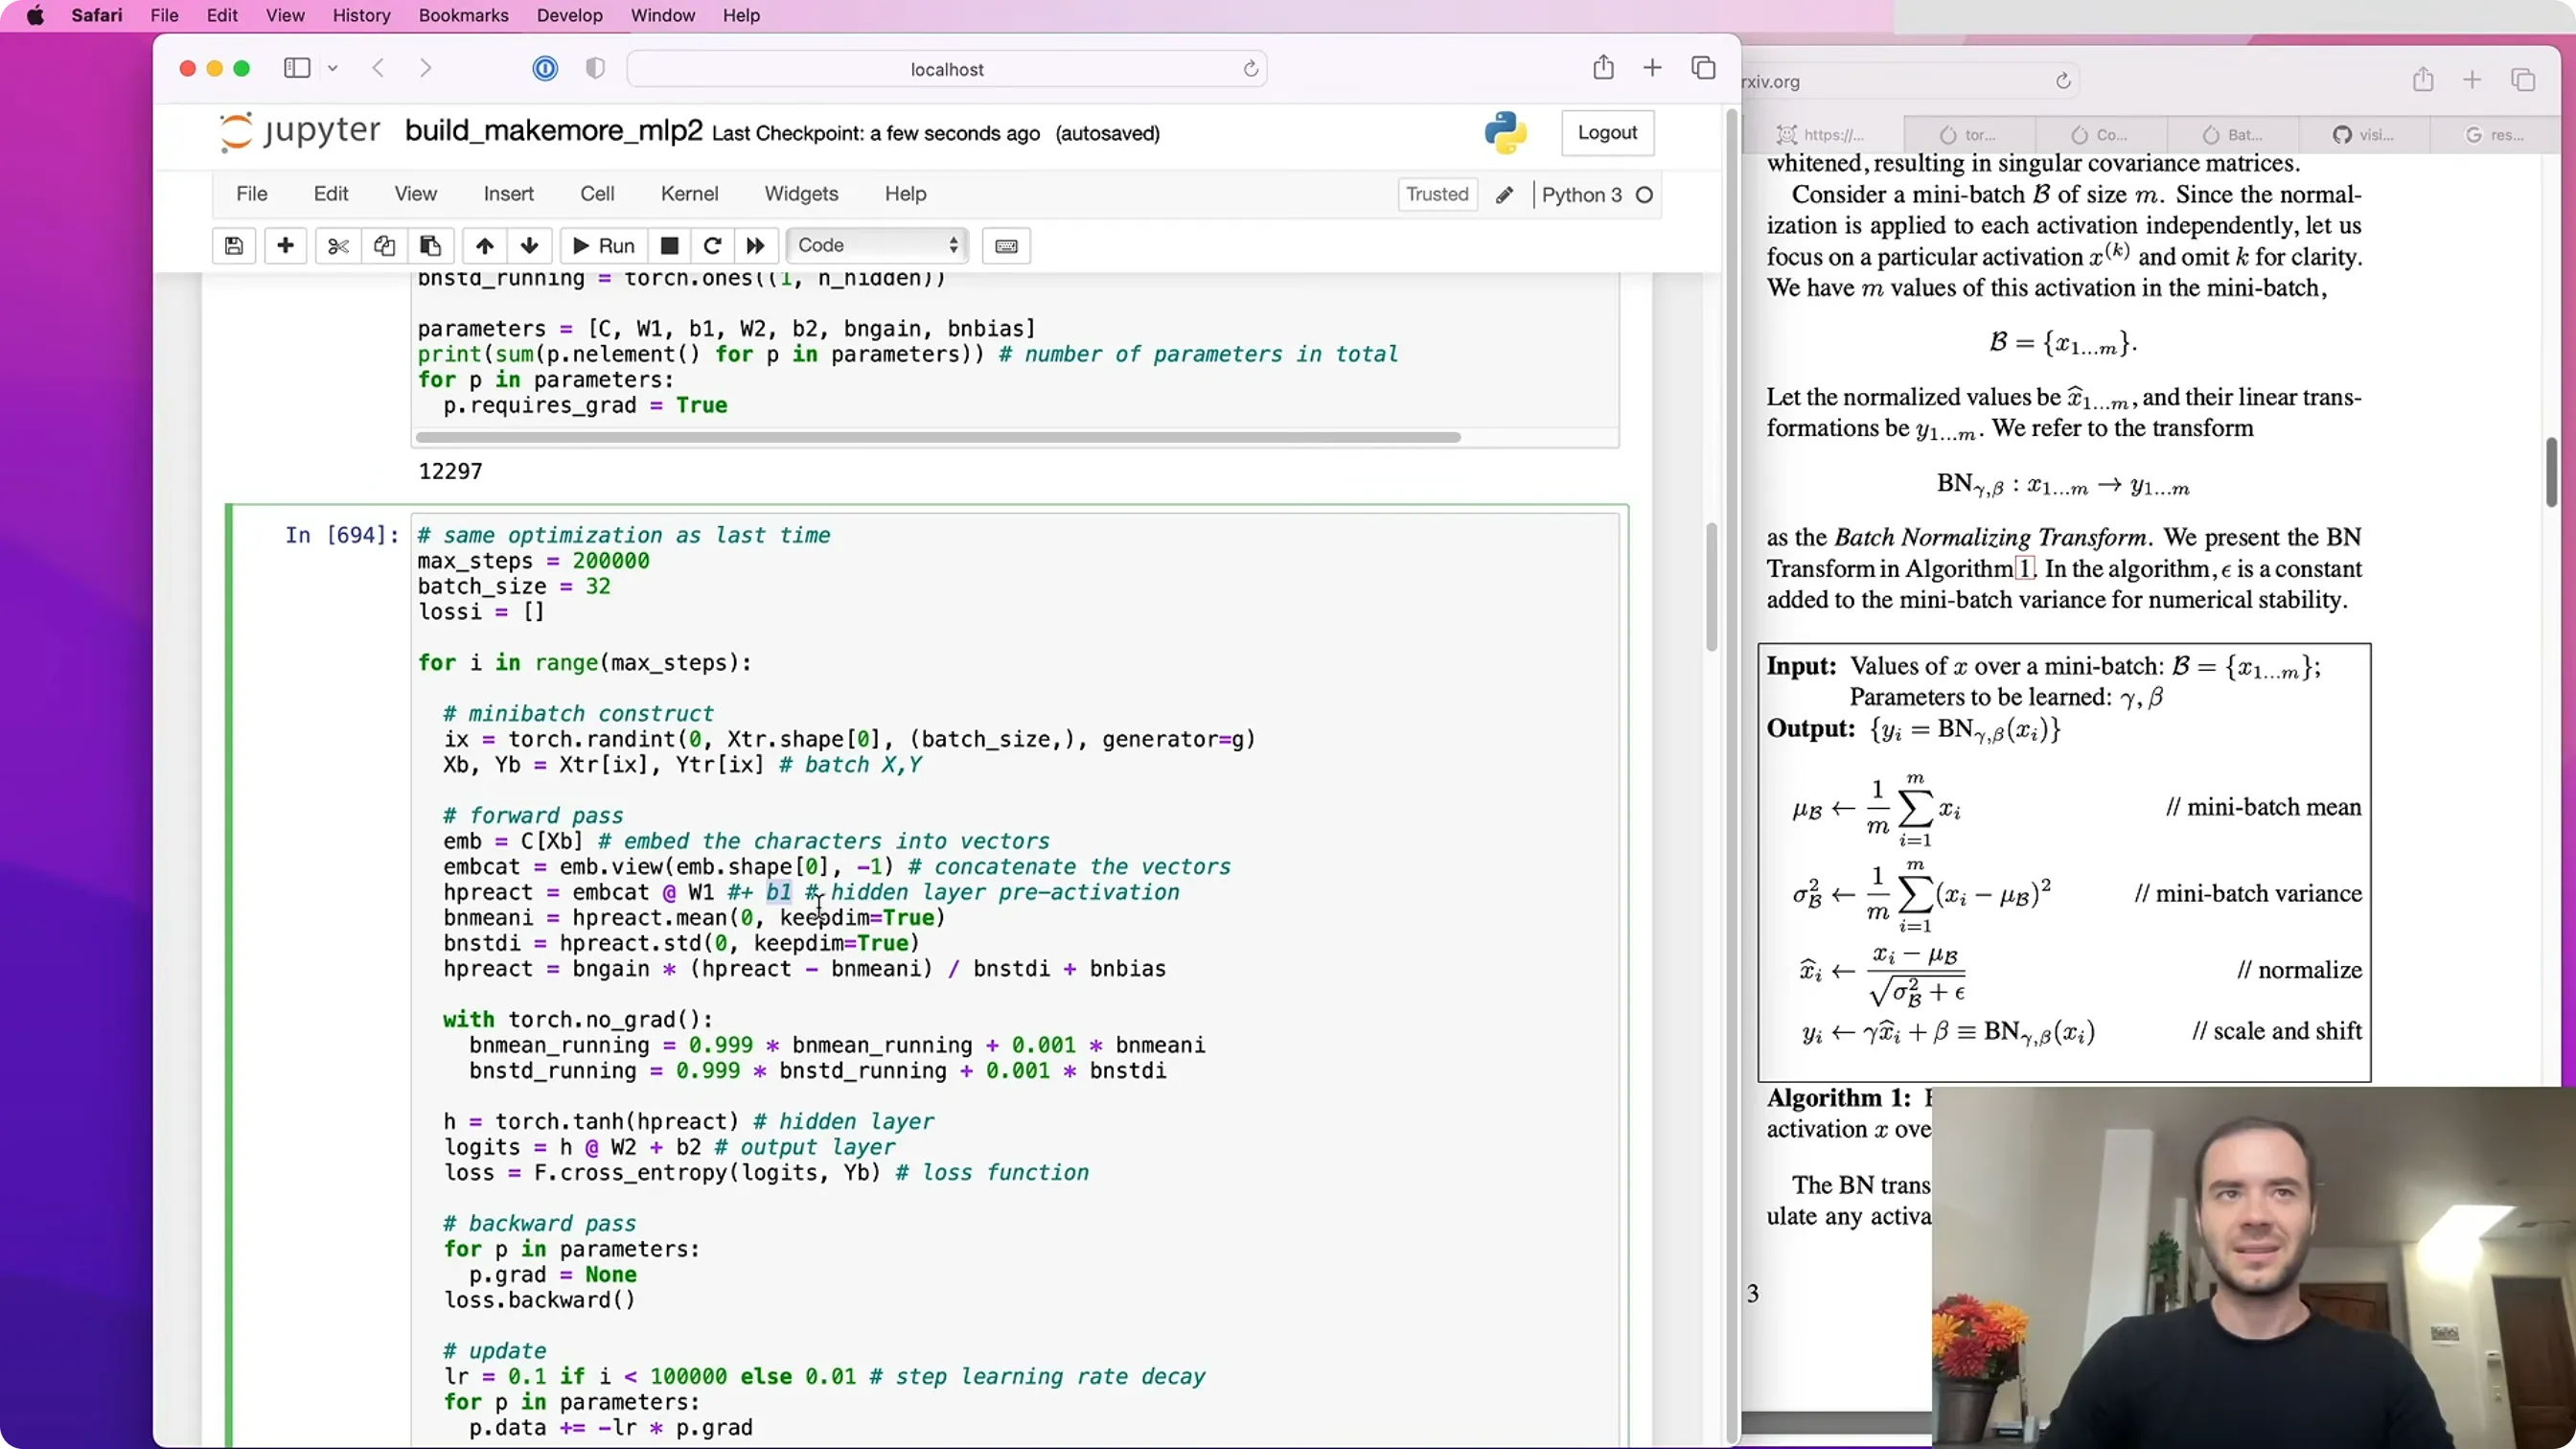
📷 BN 的两个细节:加 eps 防除零;前一层的 bias 会被减掉,应设为 False
回到原视频 (01:03:00)
5.3 真实例子:ResNet50
(参考时间: 1:04)
搜索 resnet 就能在 PyTorch 里找到 torchvision 的 ResNet 实现。看它的 Bottleneck block:
__init__里初始化各层(这正是我们前面做的事);forward定义数据怎么流动(这正是我们的前向传播);- 反复出现的母题(motif)是:
Conv → BatchNorm → ReLU,再重复; - 卷积层写成
bias=False——「和我们去掉b1是同一个原因」。
「就是"权重层 + 归一化层 + 非线性",一遍一遍地堆。」
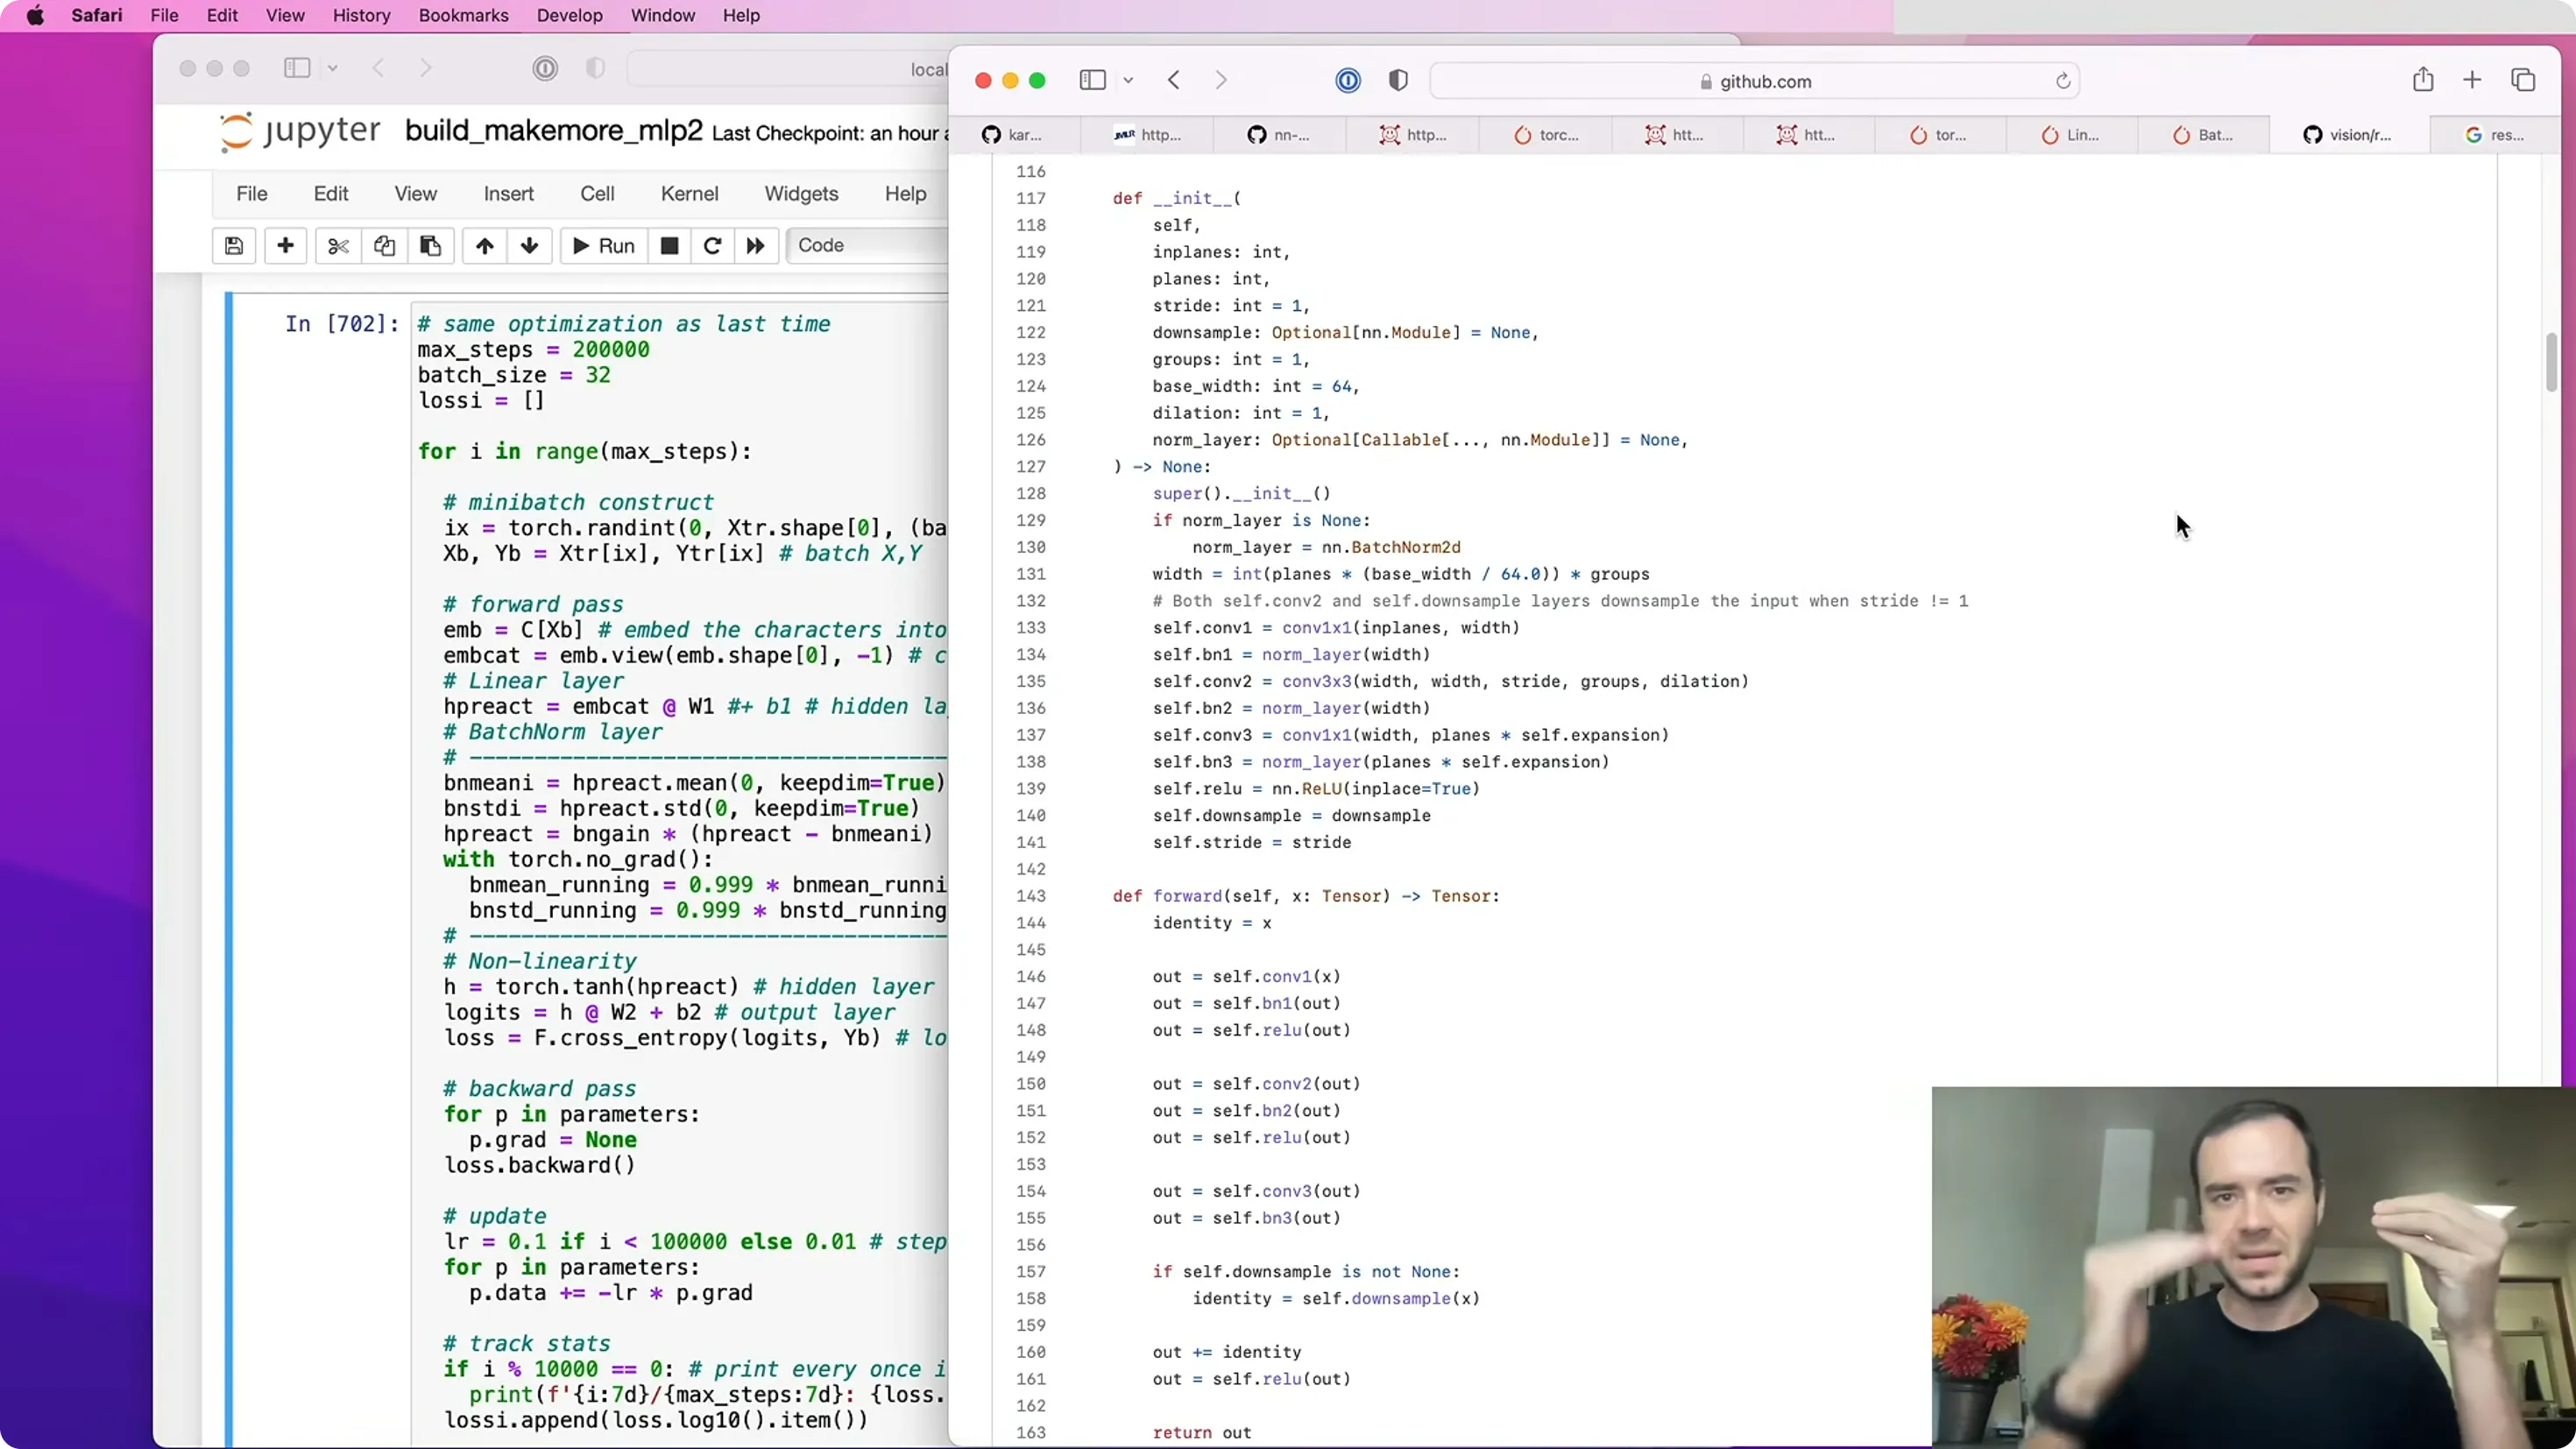
📷 ResNet50 的 Bottleneck block:Conv → BN → ReLU,且 conv 层 bias=False
回到原视频 (01:05:30)
编者拓展|
nn.Linear与nn.BatchNorm1d的接口:视频里 Karpathy 也顺带把这两个层翻了一遍(不用记,知道去哪查即可): -nn.Linear(in, out, bias=True):内部有weight、bias;默认初始化就是 Kaiming 的 $\frac{1}{\sqrt{\text{fan\_in}}}$(只是用均匀分布而非正态);bias=False正是为了搭配后面的归一化层。 -nn.BatchNorm1d(num_features):参数是γ/β(affine=True);buffers 是running_mean/running_var(track_running_stats=True);还有eps、momentum。注意:momentum=0.1默认值对大 batch 合适,而小 batch(如 32)下一般要调小(本讲用了 0.001),否则 running stats 会"抖"得厉害。
六、PyTorch-ifying:把代码变成"层"
(参考时间: 1:18:35)
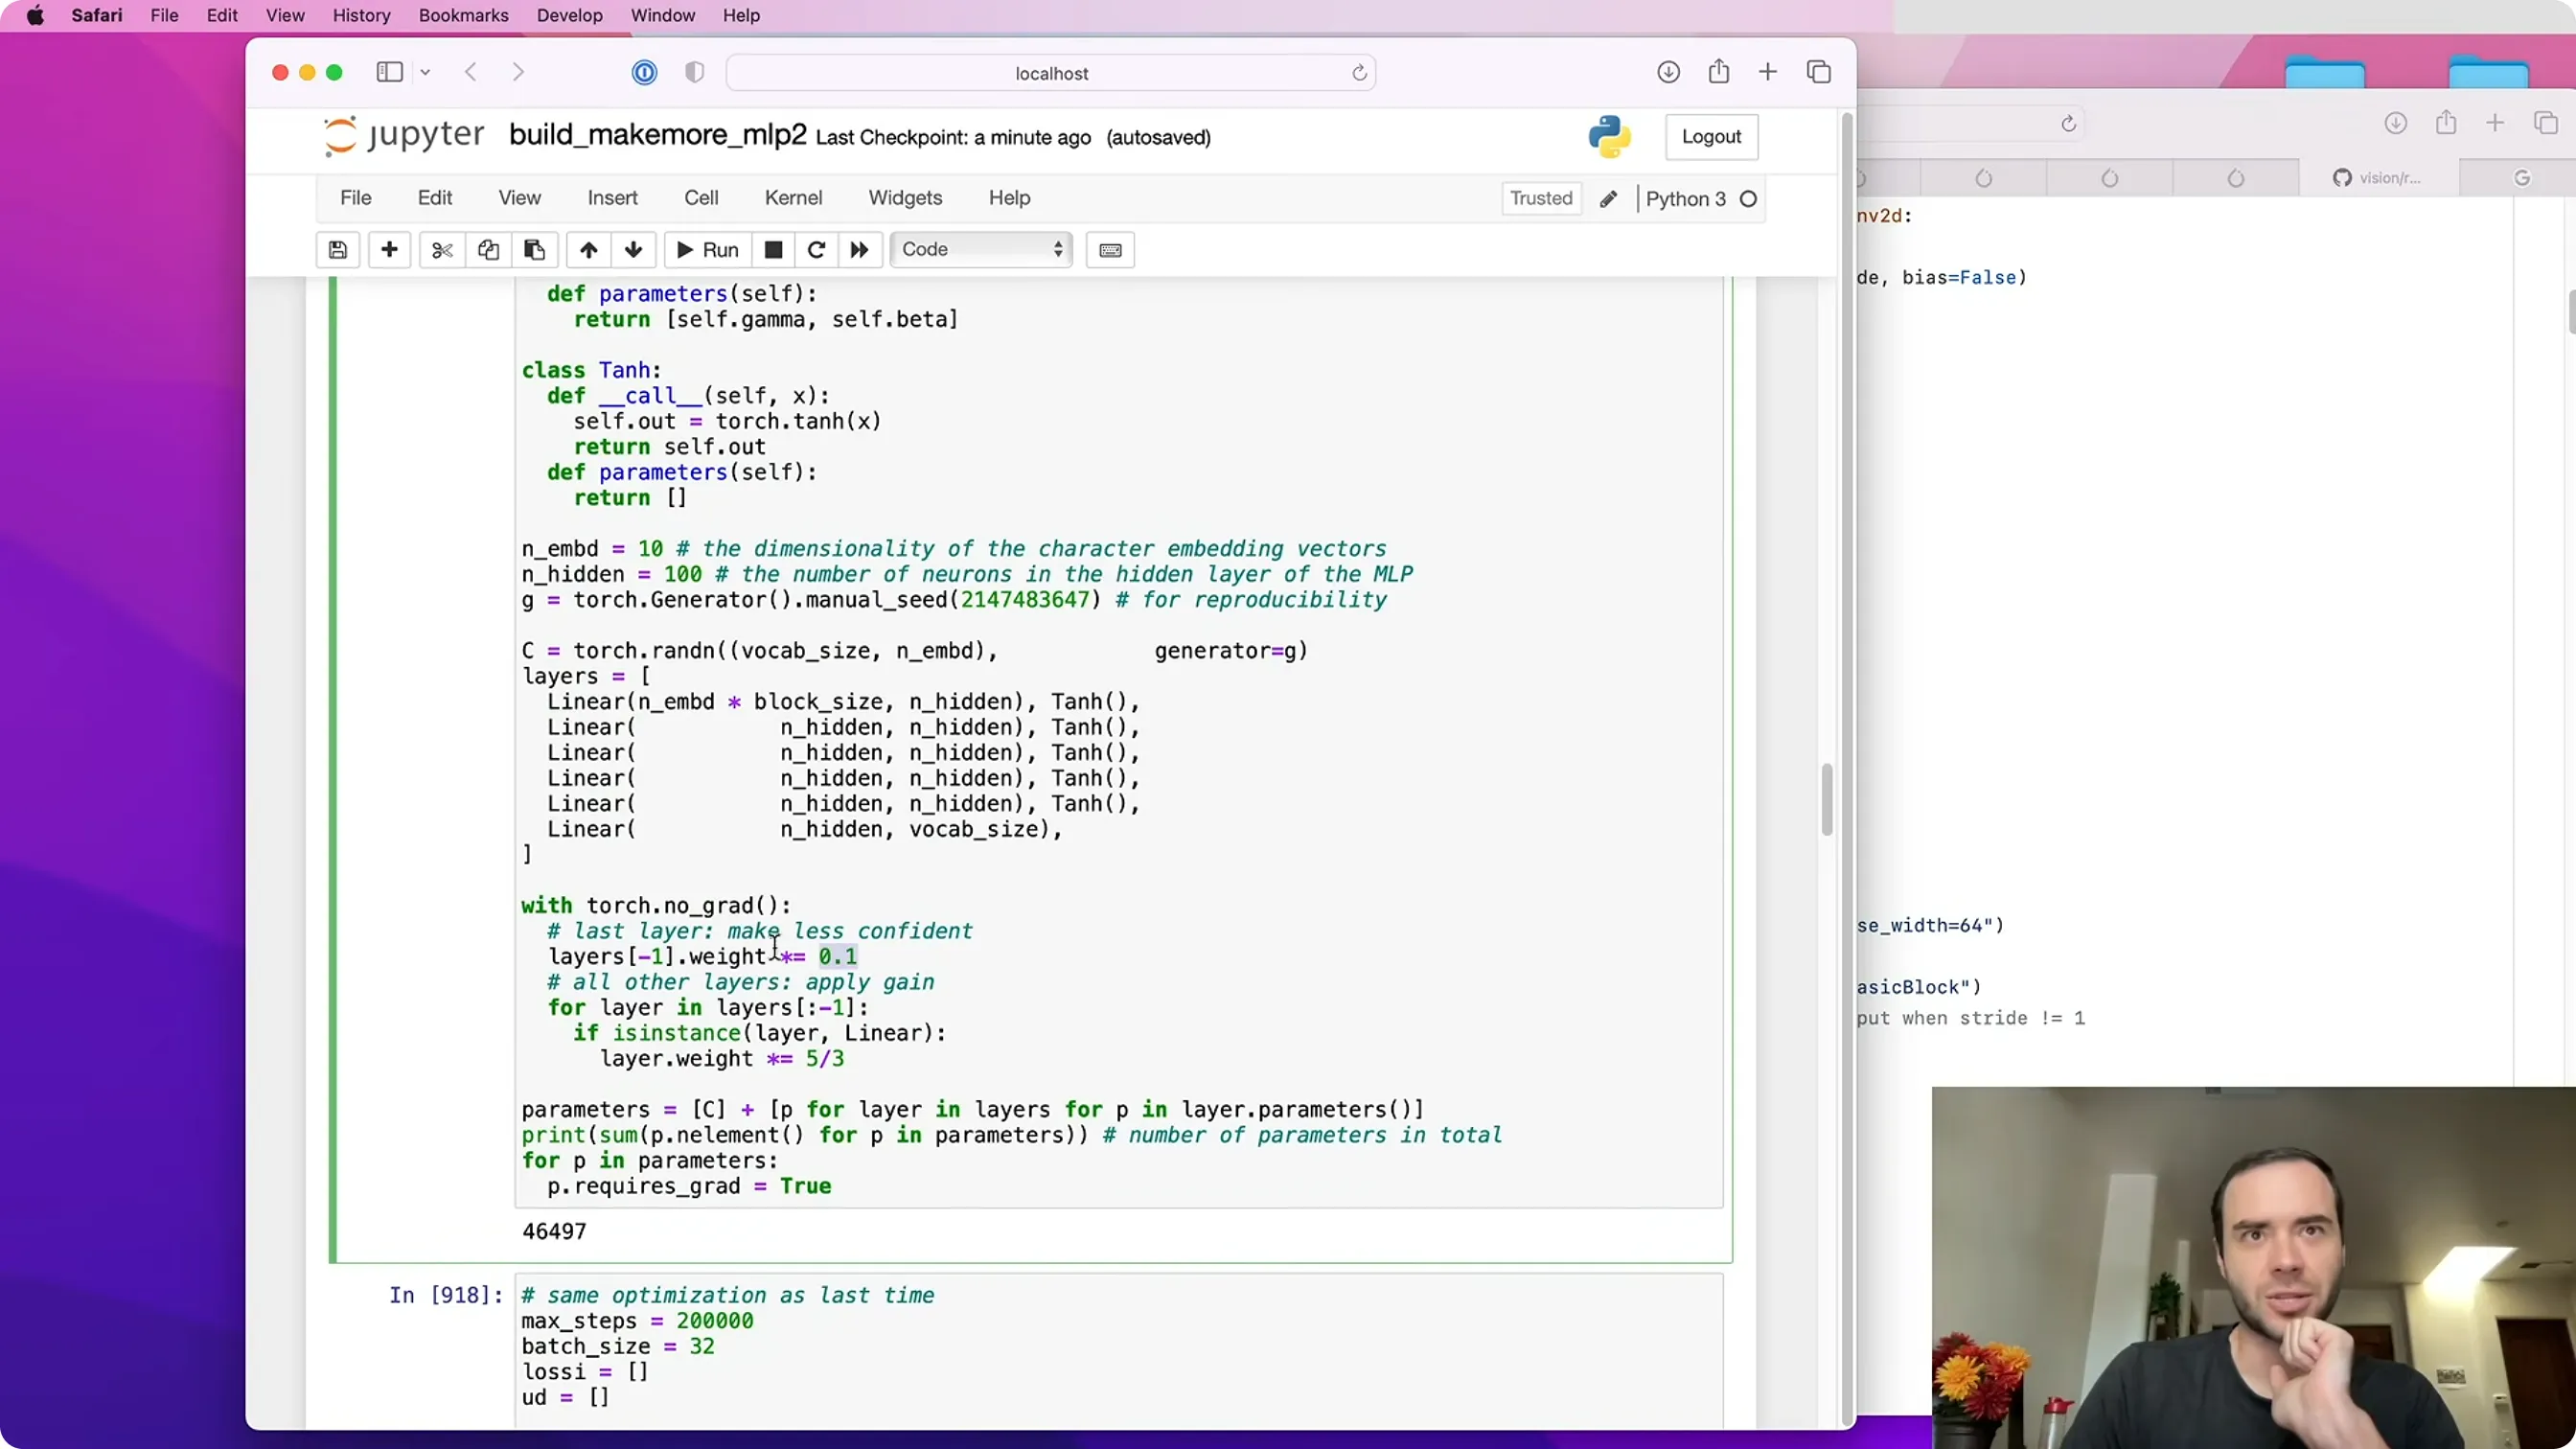
「其实我撒了个谎——还有第二部分。」Karpathy 把代码重构成模块,让它和 PyTorch 的 API 一模一样:
class Linear:
    def __init__(self, fan_in, fan_out, bias=True): ...
    def __call__(self, x): return x @ self.W + self.b if self.b is not None else x @ self.W
    def parameters(self): ...

class BatchNorm1d:
    def __init__(self, dim, eps=1e-5, momentum=0.1):
        self.training = True          # 训练/推理行为不同!
        self.gamma = torch.ones(dim); self.beta = torch.zeros(dim)
        self.running_mean = torch.zeros(dim)
        self.running_var  = torch.ones(dim)
    def __call__(self, x):
        if self.training:
            mean, var = x.mean(0, keepdim=True), x.var(0, keepdim=True)
            with torch.no_grad():     # buffer 更新不建图
                self.running_mean = (1-self.momentum)*self.running_mean + self.momentum*mean
                self.running_var  = (1-self.momentum)*self.running_var  + self.momentum*var
        else:
            mean, var = self.running_mean, self.running_var   # 推理用 running
        xhat = (x - mean) / torch.sqrt(var + self.eps)
        self.out = self.gamma * xhat + self.beta
        return self.out
    def parameters(self): return [self.gamma, self.beta]

class Tanh:
    def __call__(self, x):
        self.out = torch.tanh(x)
        return self.out
    def parameters(self): return []
注意 self.training 这个开关——「PyTorch 的 module 也有这个属性」,因为 BatchNorm 在训练和推理时行为不同(训练用 batch 统计 + 更新 running stats;推理用 running stats 且不更新)。
于是网络就变成一串层的列表,顺序调用即可:
layers = [Linear(30, 200), BatchNorm1d(200), Tanh(),
          Linear(200, 200), BatchNorm1d(200), Tanh(), ...]
总参数 46,000。而且——「你只要把这些类的前面加上 nn.,它们就是 PyTorch 的层,代码直接能跑。」
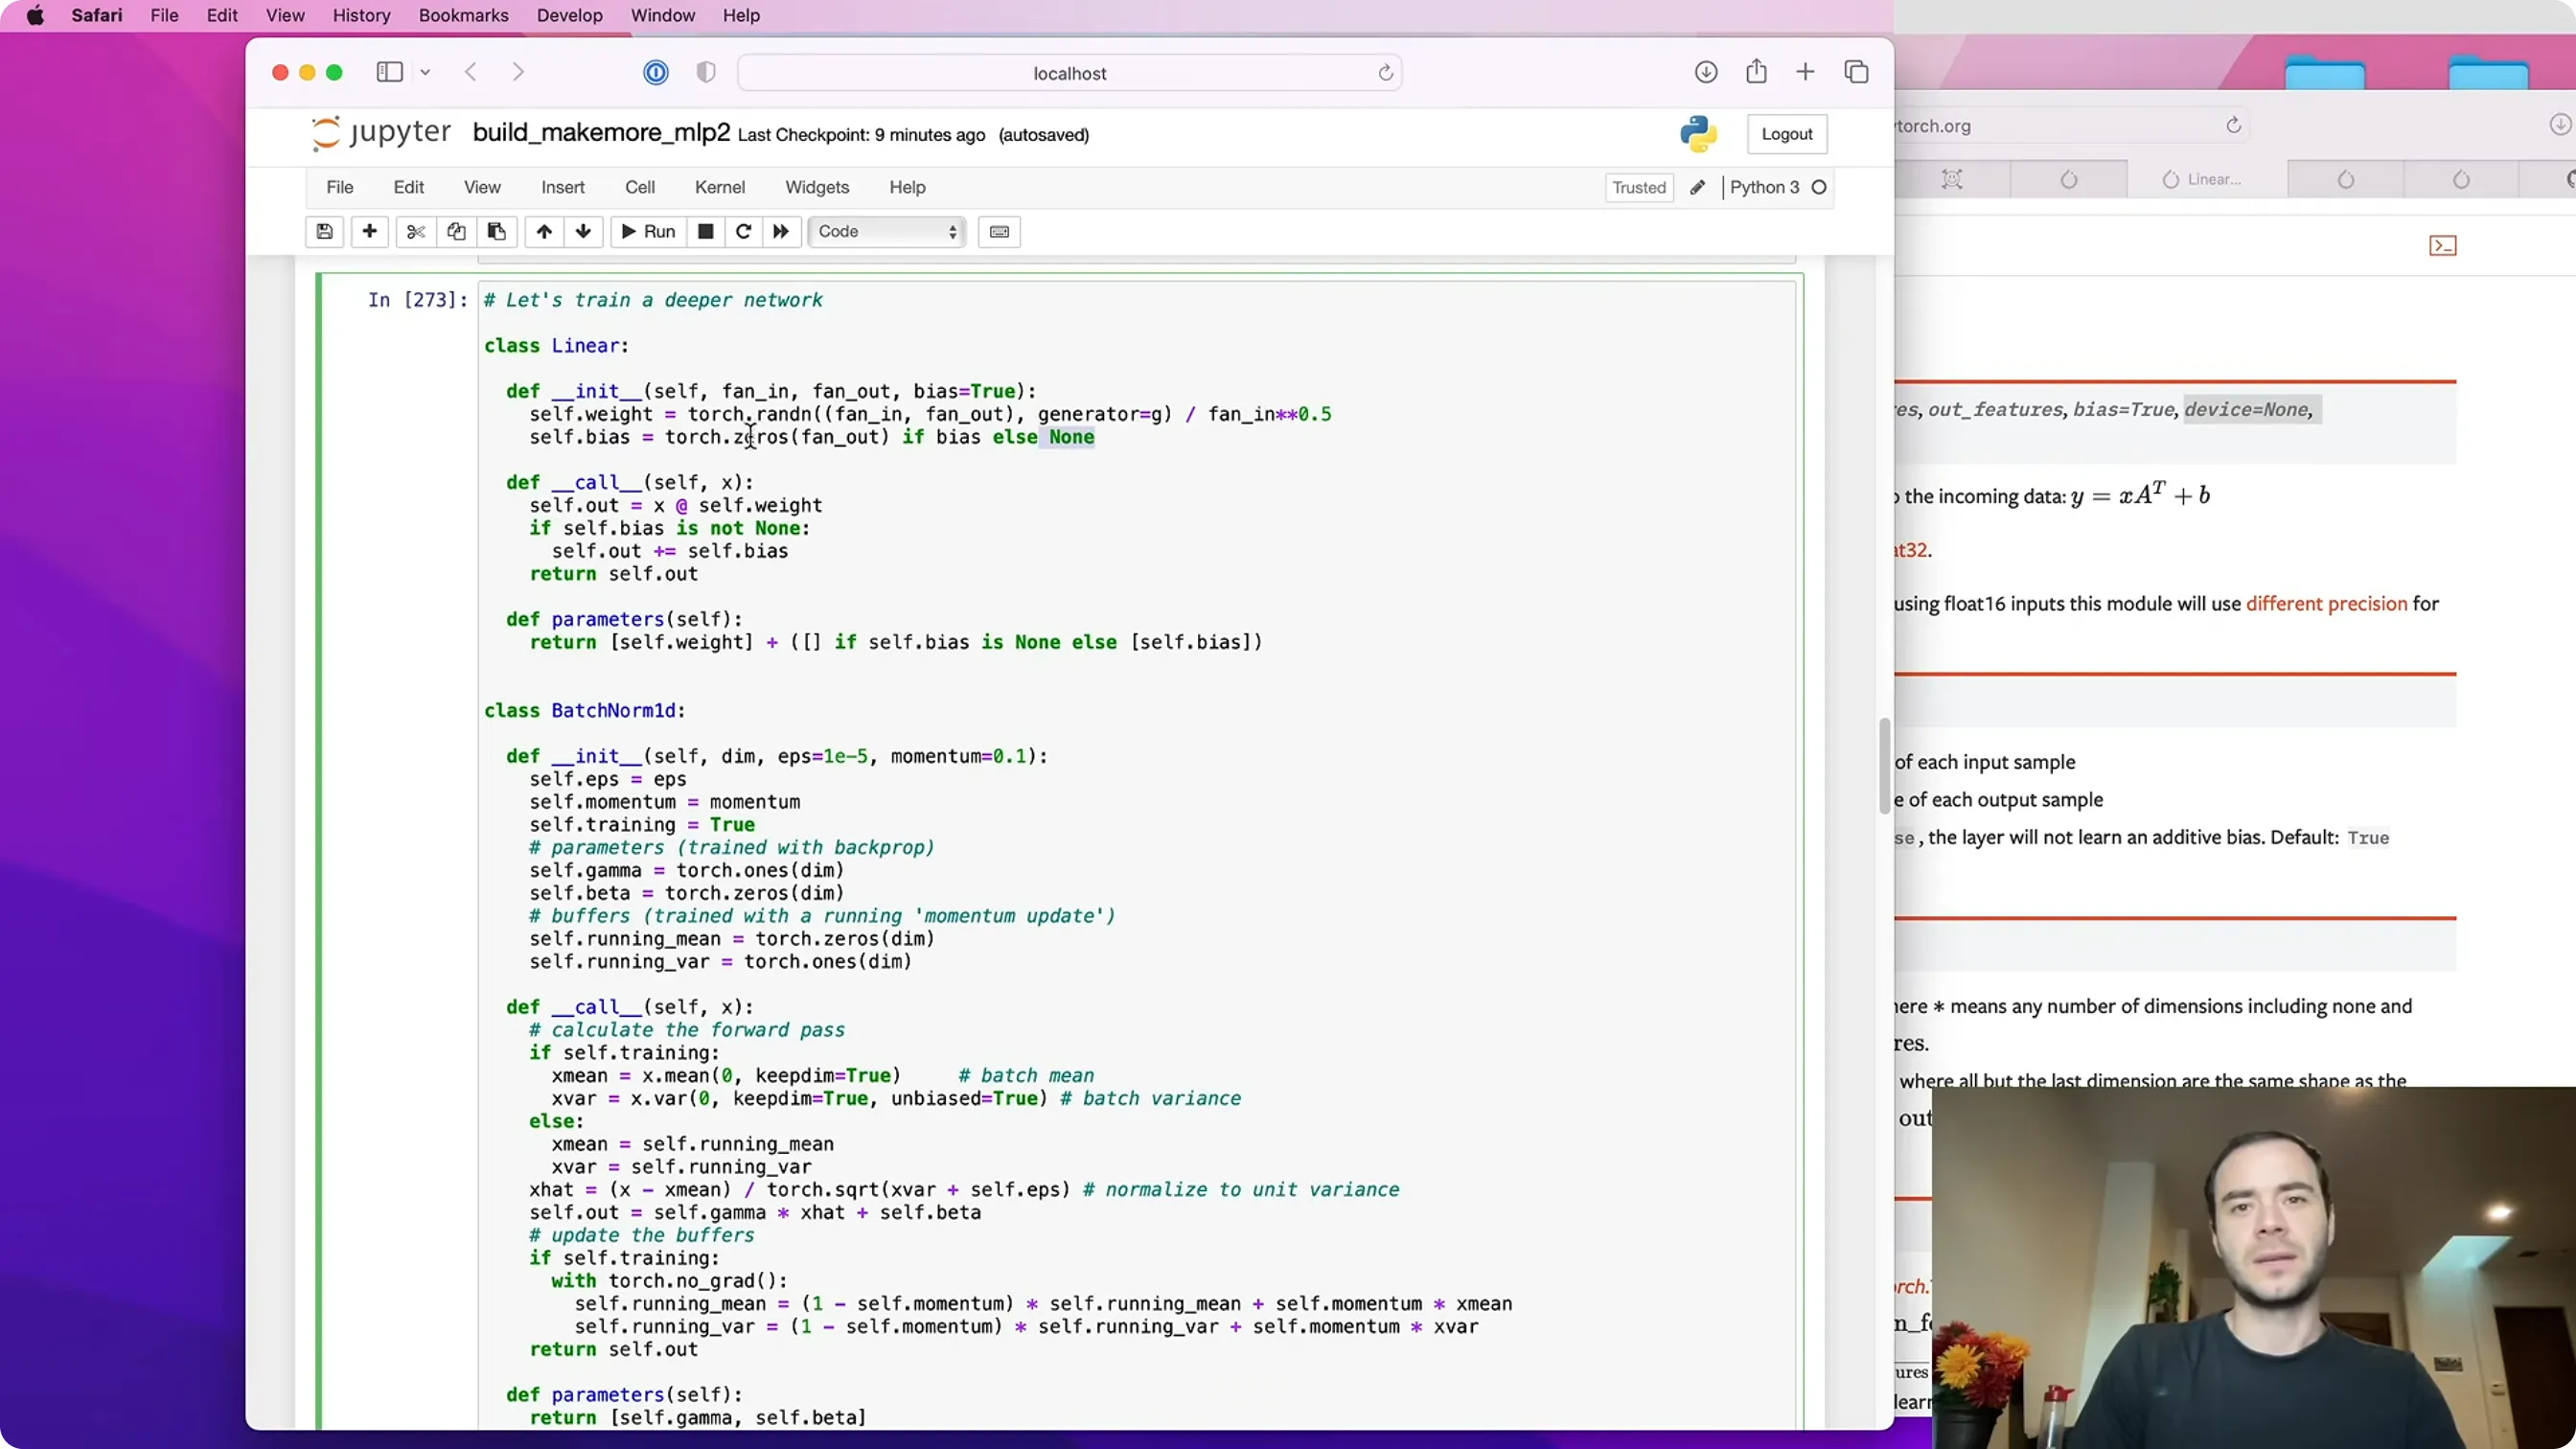
📷 把代码重构成 Linear / BatchNorm1d / Tanh 模块,API 与 PyTorch 一致
回到原视频 (01:20:00)
编者说明:
self.out是 Karpathy 自己加的(PyTorch 没有),纯粹为了后面统计各层输出。他还提醒:训练时要对每层输出retain_grad(),否则中间层的.grad拿不到。
七、诊断可视化:四张"体检图"
(参考时间: 1:26:51)
这是本讲最有价值的部分——这些图,是你判断"网络健不健康"的工具。
图 1:前向传播的激活统计
(参考时间: 1:26:51)
对每个 Tanh 层,统计其输出的均值、标准差、饱和百分比(定义为 $|t| > 0.97$):
print(f"{layer_idx}: mean {t.mean():+.2f} std {t.std():.2f} saturation {sat:.2f}%")
- 第 1 层饱和约 20%(还有尾巴);
- 之后稳定下来:标准差约 0.65、饱和约 5%——「这是 gain = 5/3 的功劳」。
把 gain 换成 1(不使用):标准差逐层缩小、饱和趋近 0——因为 tanh 是收缩的,一层层把分布挤没了。
把 gain 换成 3(太大):饱和率爆表。
结论:「$5/3$ 是"线性 + tanh 三明治"的一个很好的 setting」——但 Karpathy 也坦白:「我其实不知道 PyTorch 里的 $5/3$ 是怎么来的,我搜过没找到出处,只是经验上它让分布的饱和落在 5% 左右这个不错的范围。」
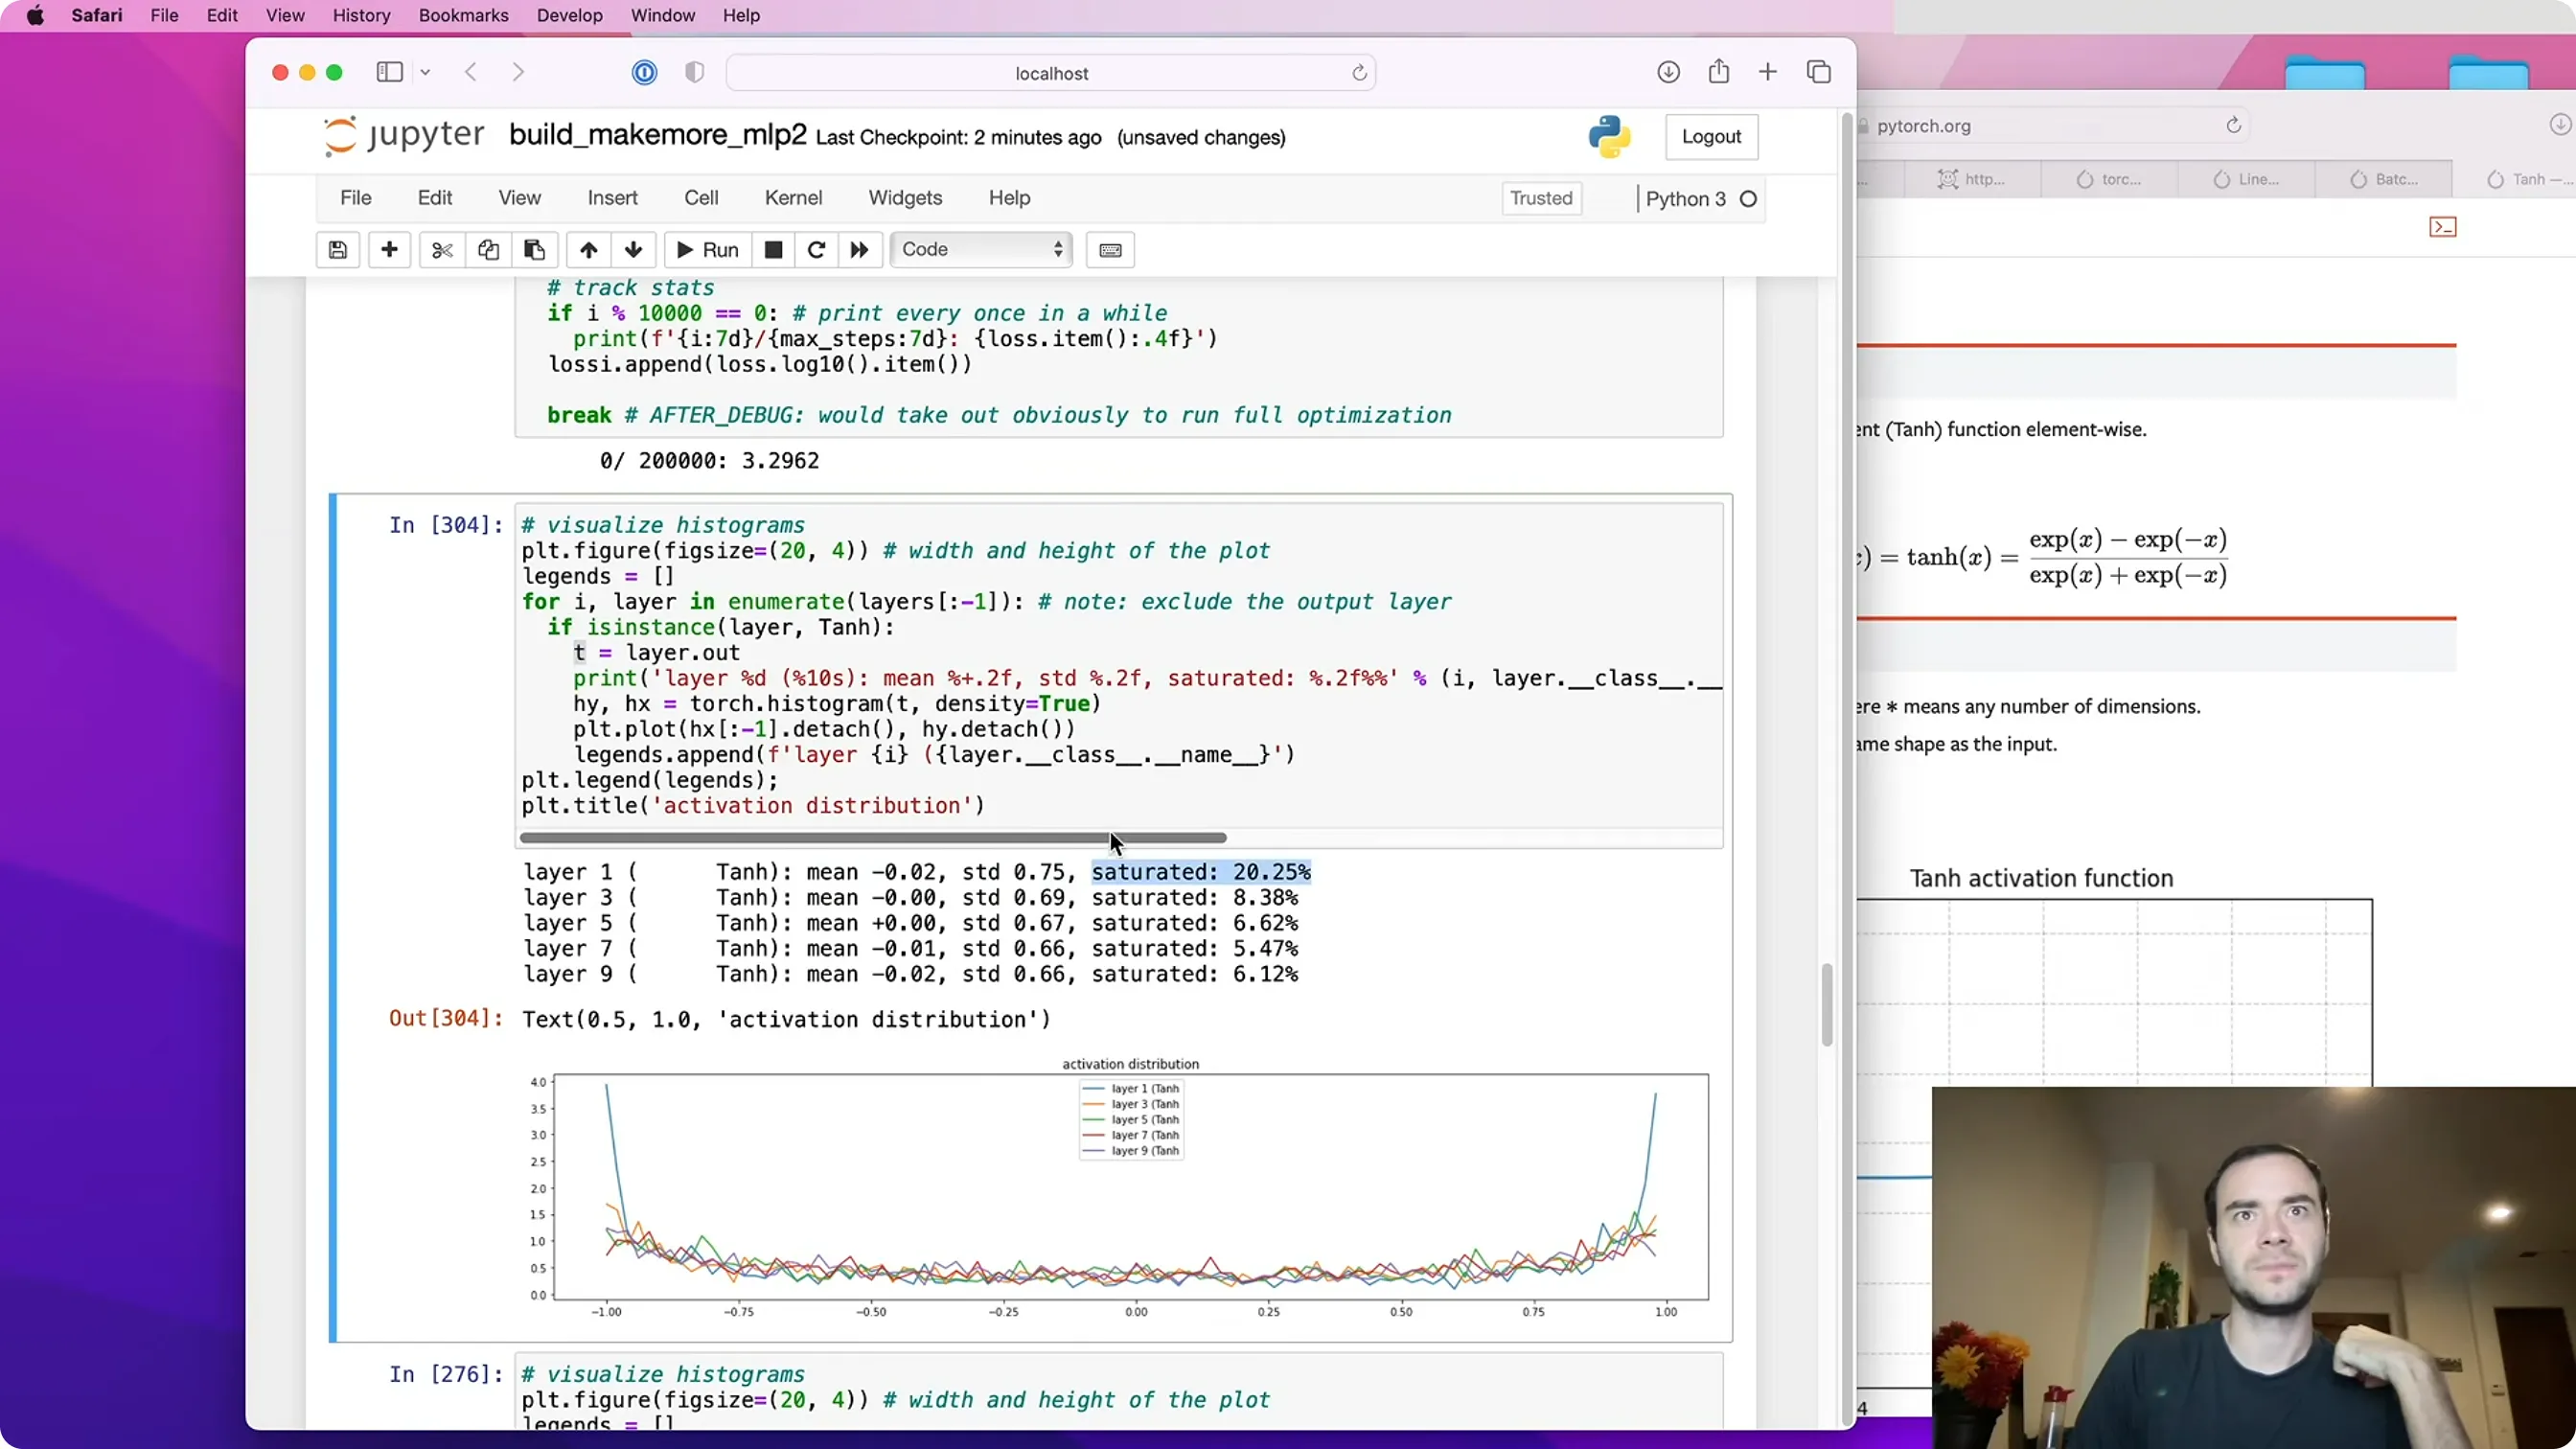
📷 图 1:前向激活直方图(各层不同颜色);gain=5/3 时稳定在 std≈0.65、饱和≈5%
回到原视频 (01:27:30)
图 2:反向传播的梯度统计
(参考时间: 1:30:54)
对每层的 .grad 做同样的统计与直方图。我们要看的是:各层的梯度大致同量级——不缩小、不爆炸。
- gain 太小(0.5):激活在缩小、梯度反而在放大;
- gain 太大(3):越深的层越不对称。
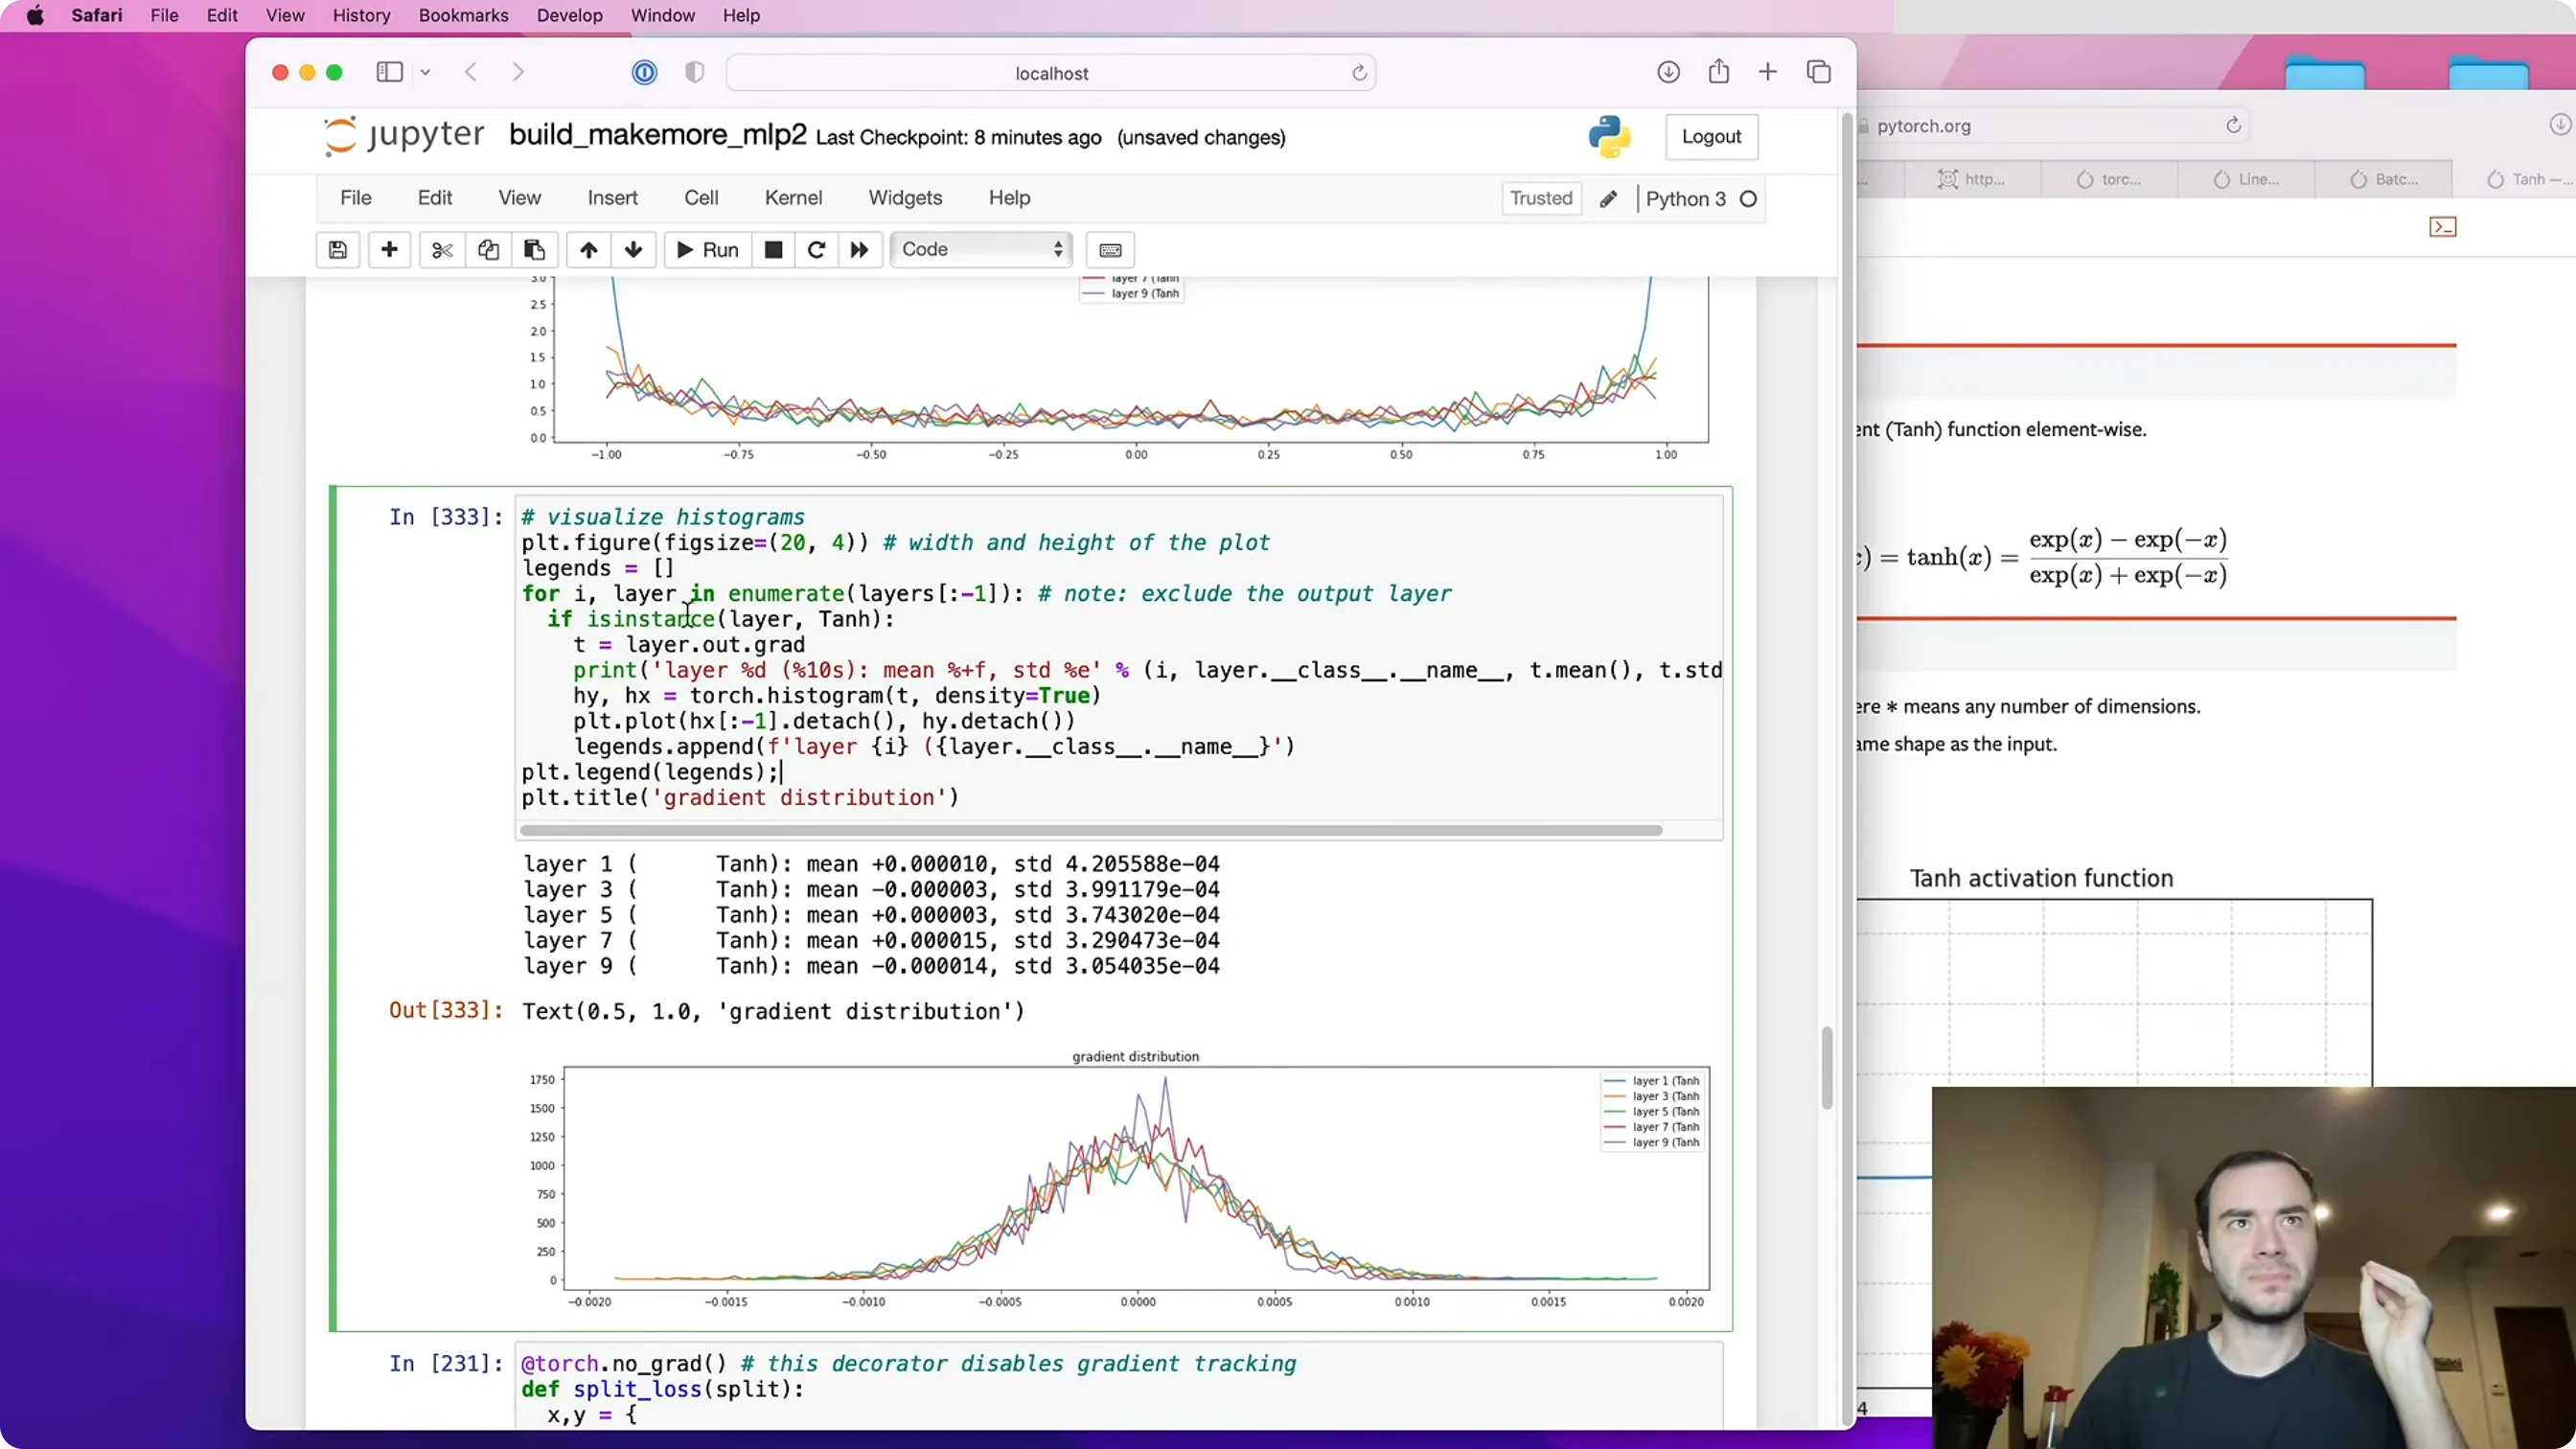
📷 图 2:反向梯度直方图;目标是各层量级一致,不缩不爆
回到原视频 (01:31:00)
图 3(插曲):如果完全没有非线性
(参考时间: 1:32)
把 tanh 全换成线性(gain 保持 5/3)——这是一个巨大的"线性三明治":
- 激活逐层扩散(到第 4 层已经非常散);
- 梯度逐层衰减;出现明显不对称。
「如果你有 50 层,这绝对不是你想待的地方。」这正是 BN 出现之前"极难调"的原因。
编者拓展|但"纯线性"并非完全没用:Karpathy 提了一句很有意思的现象——前向传播塌缩成单个线性变换($Wx+b$),但反向传播的训练动力学并不相同:优化"一个线性层"和优化"十个线性层"在梯度层面是不一样的,甚至有论文专门分析无限层线性网络。「这是个很值得玩的题目。」
而这也是为什么必须有非线性:没有它,再深也只是线性函数;有了它,网络才可能逼近任意函数。
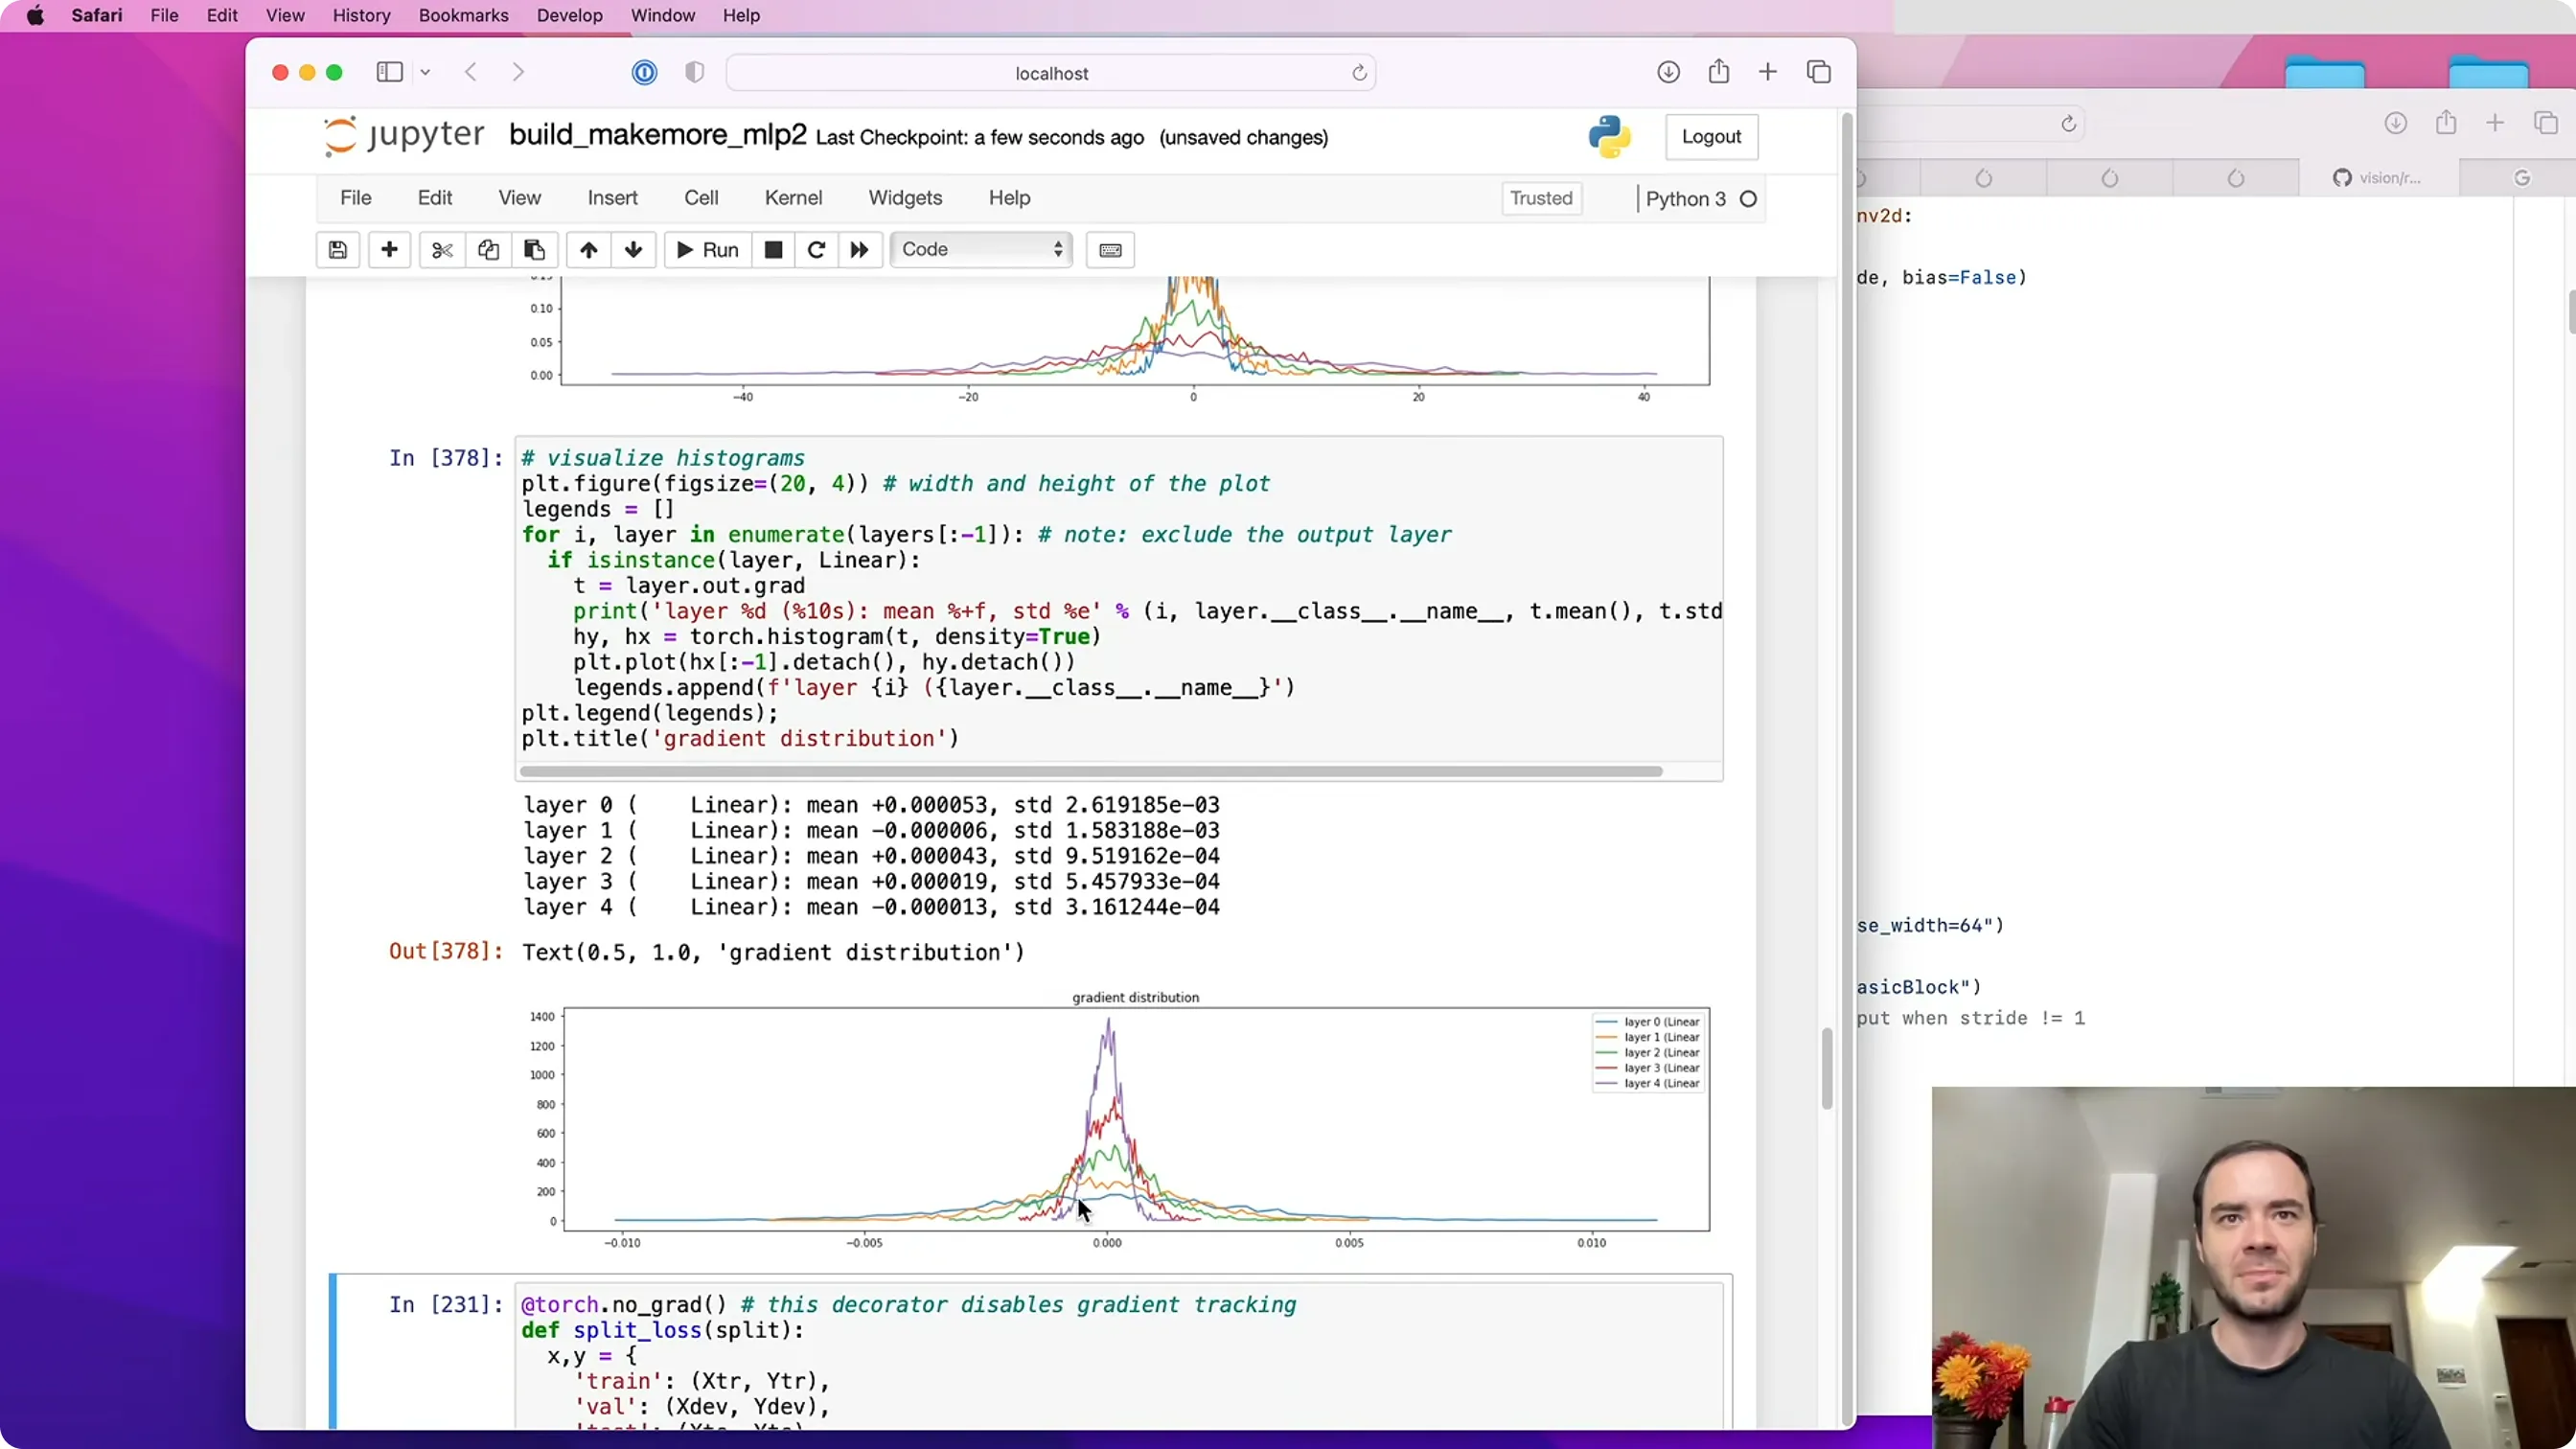
📷 图 3:纯线性三明治——激活扩散、梯度衰减
回到原视频 (01:33:00)
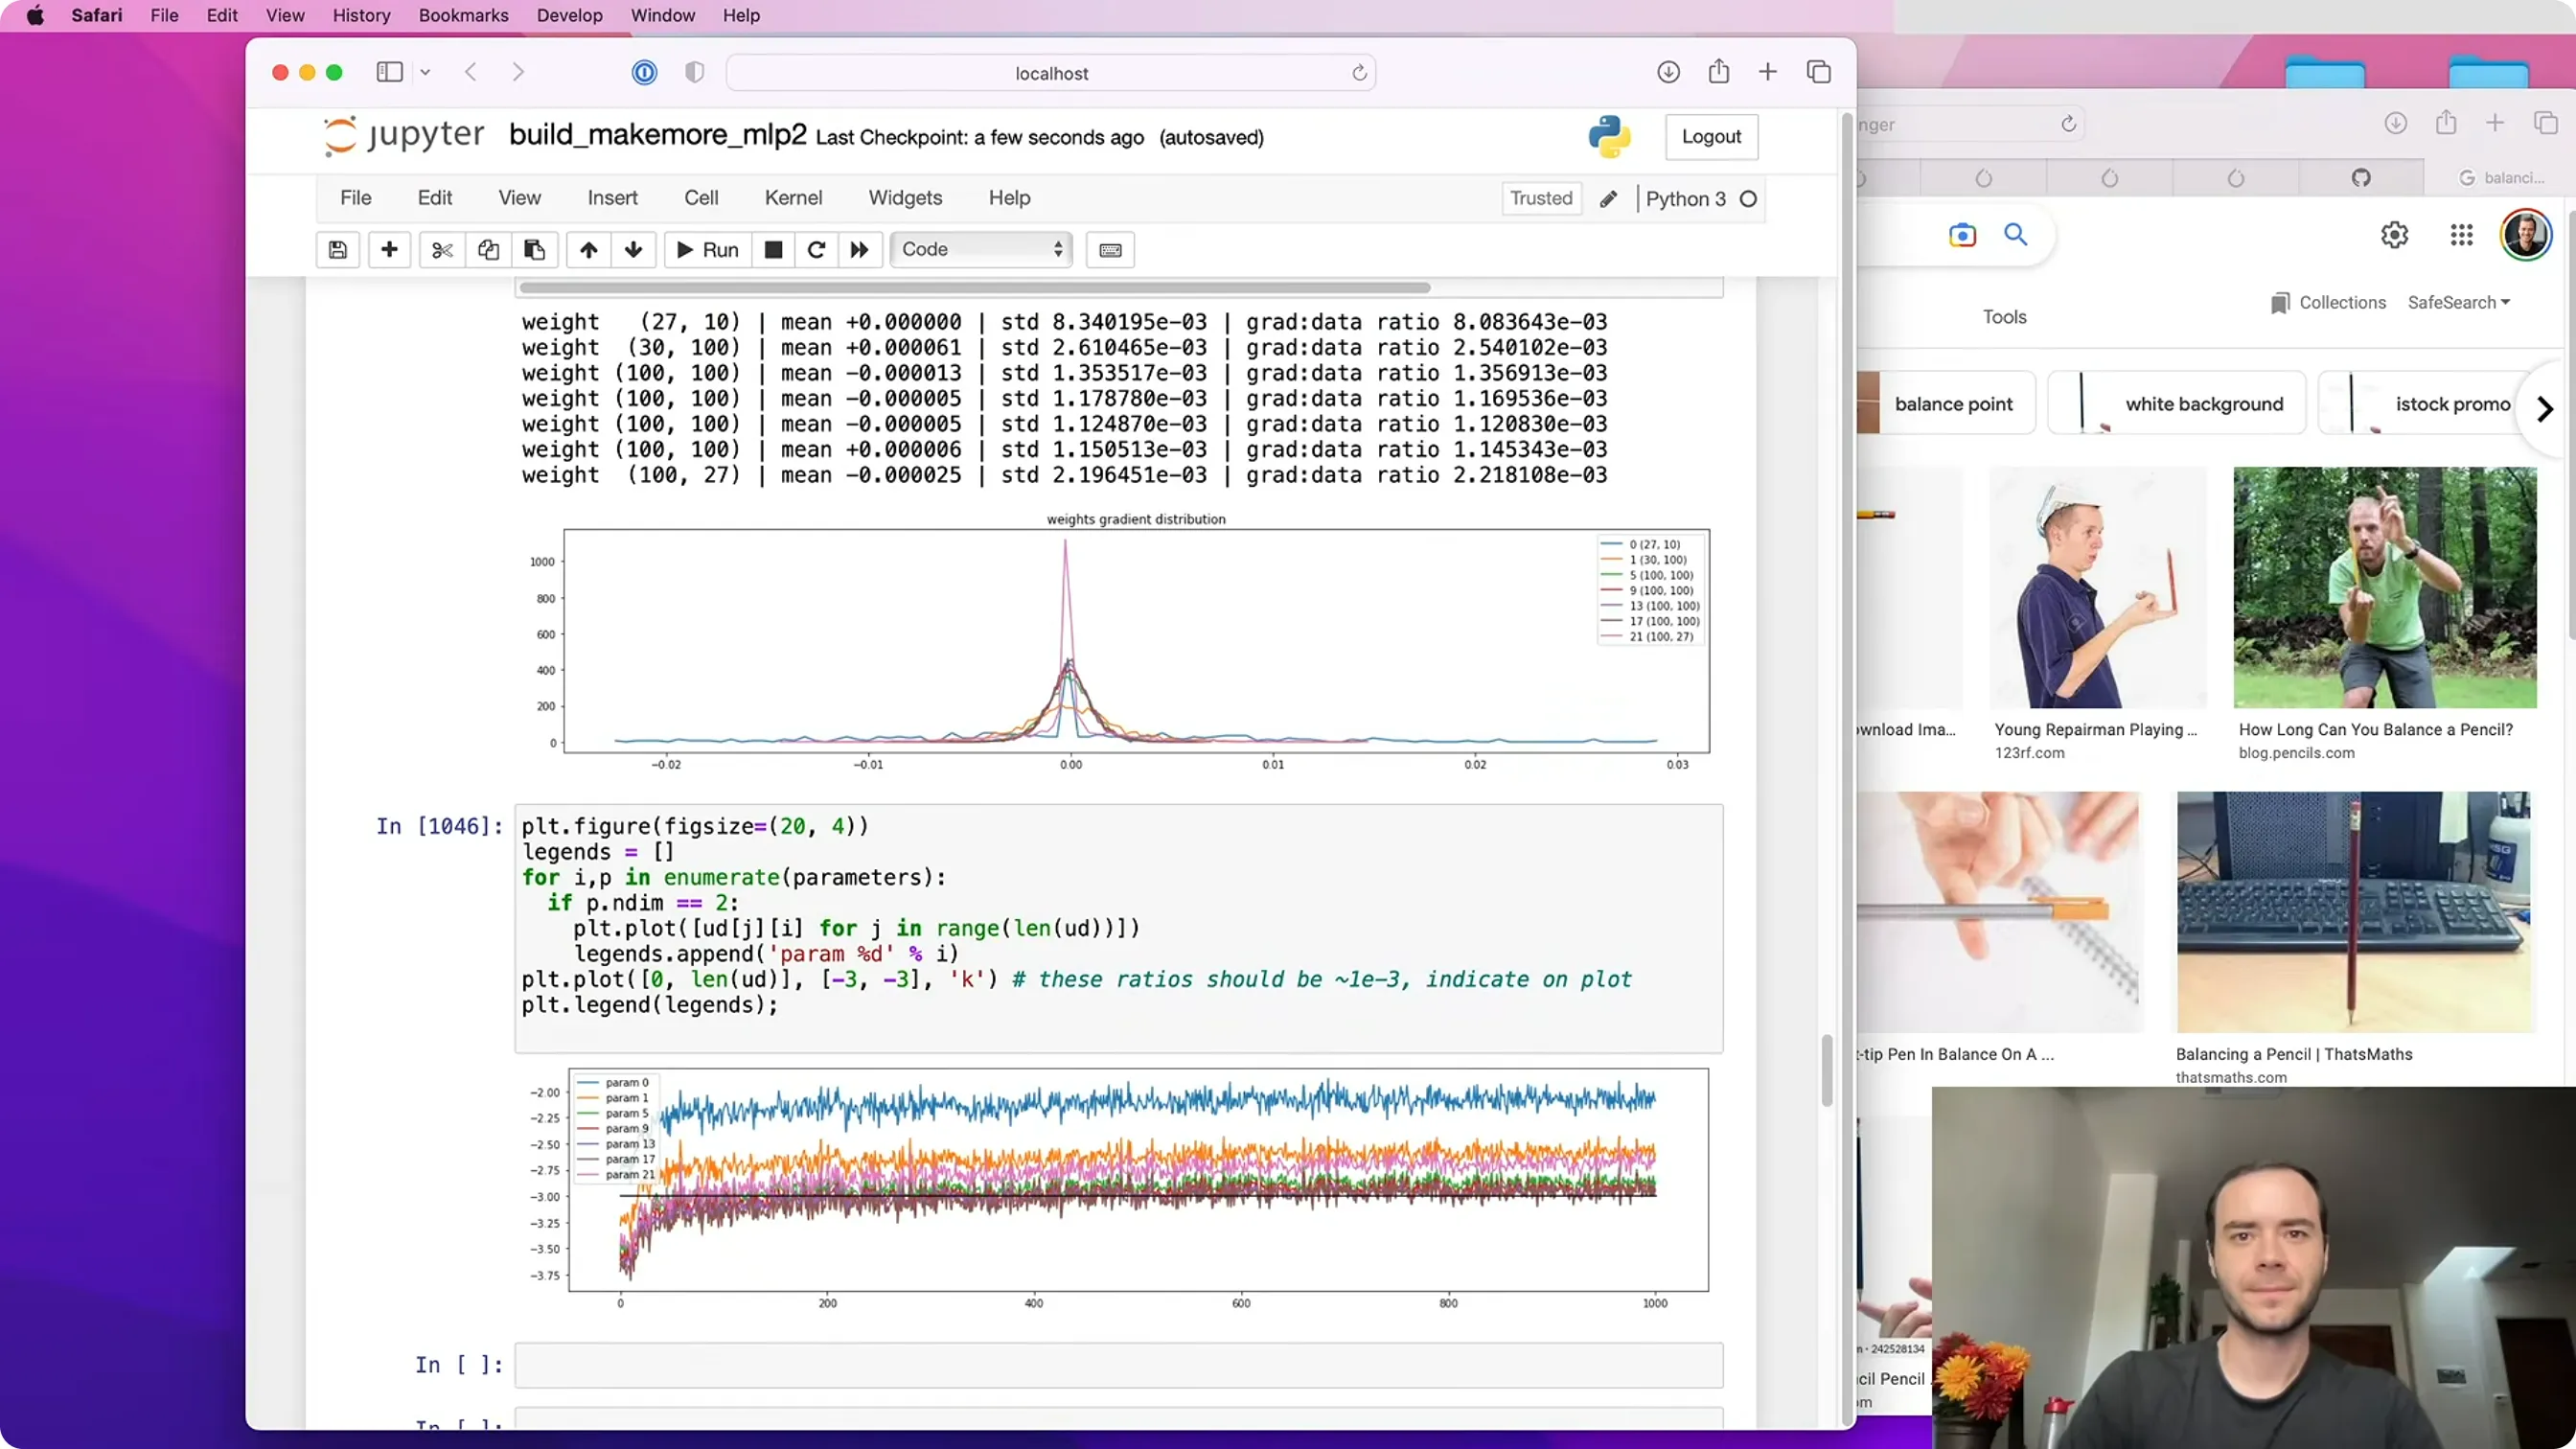
图 4:参数本身与「更新 : 数据」比值
(参考时间: 1:36)
只看激活/梯度还不够——最终被更新的是"参数"。所以:
- 遍历所有二维参数(即线性层的权重,跳过 bias 与
γ/β); - 画它们的均值、标准差、直方图;
- 再算一个非常实用的量——
update : data比值:
$$\frac{\text{std}(\text{lr} \cdot \text{grad})}{\text{std}(\text{data})}$$
为什么要看它? 因为更新量就是 lr × grad。如果更新的量级和参数本身相差太远,训练就会出问题。
- 健康的量级:约 $10^{-3}$,即"每次更新不超过参数大小的千分之一";
- 太大了(如 $10^{-1}$):更新过猛;
- 太小了:学习率太小,参数根本没被有效训练——「这个图能一眼看出学习率调小了」。视频里用
lr = 1e-3做实验,比值直接掉到 $10^{-4}$ 量级,一眼暴露。
另一个有意思的发现:最后一层的更新比值是"离群点"——因为它的权重被人为乘了 0.1(为了压低 softmax 置信度),把参数数值压得太小了。不过随着训练会慢慢稳定。
📷 图 4:各参数随时间演化的 update:data 比值(黑线 = 1e-3 的经验参考)
回到原视频 (01:43:00)
编者拓展|这四张图请务必记牢:它们构成了一套通用的"网络体检"流程——激活(前向)→ 梯度(反向)→ 参数(权重)→ 更新/数据比(优化)。 出问题时你会立刻看出:激活饱和 / 梯度消失或爆炸 / 各层学习速度不均 / 学习率过大或过小。这比盯着 loss 曲线有用得多。
带回 BatchNorm 看这些图
(参考时间: 1:46:04)
把 BN 加回每一层(Linear → BN → Tanh 的母题),再跑同样的体检:
- 激活:必然很健康(因为每层前面都有归一化);
- 梯度、权重、更新:都均匀、同量级;
- 而且更"抗造":把 gain 改成 2(甚至去掉 fan-in 归一化、直接用随机高斯权重),前向/反向统计依然健康——代价是更新比值变了,需要重新调学习率(视频里发现要把 lr 乘 10 才能回到 $10^{-3}$)。
「长话短说:BN 让我们对线性层的 gain、是否需要 fan-in 归一化,都显著更鲁棒;我们只需要关注全局的更新尺度(学习率)。」
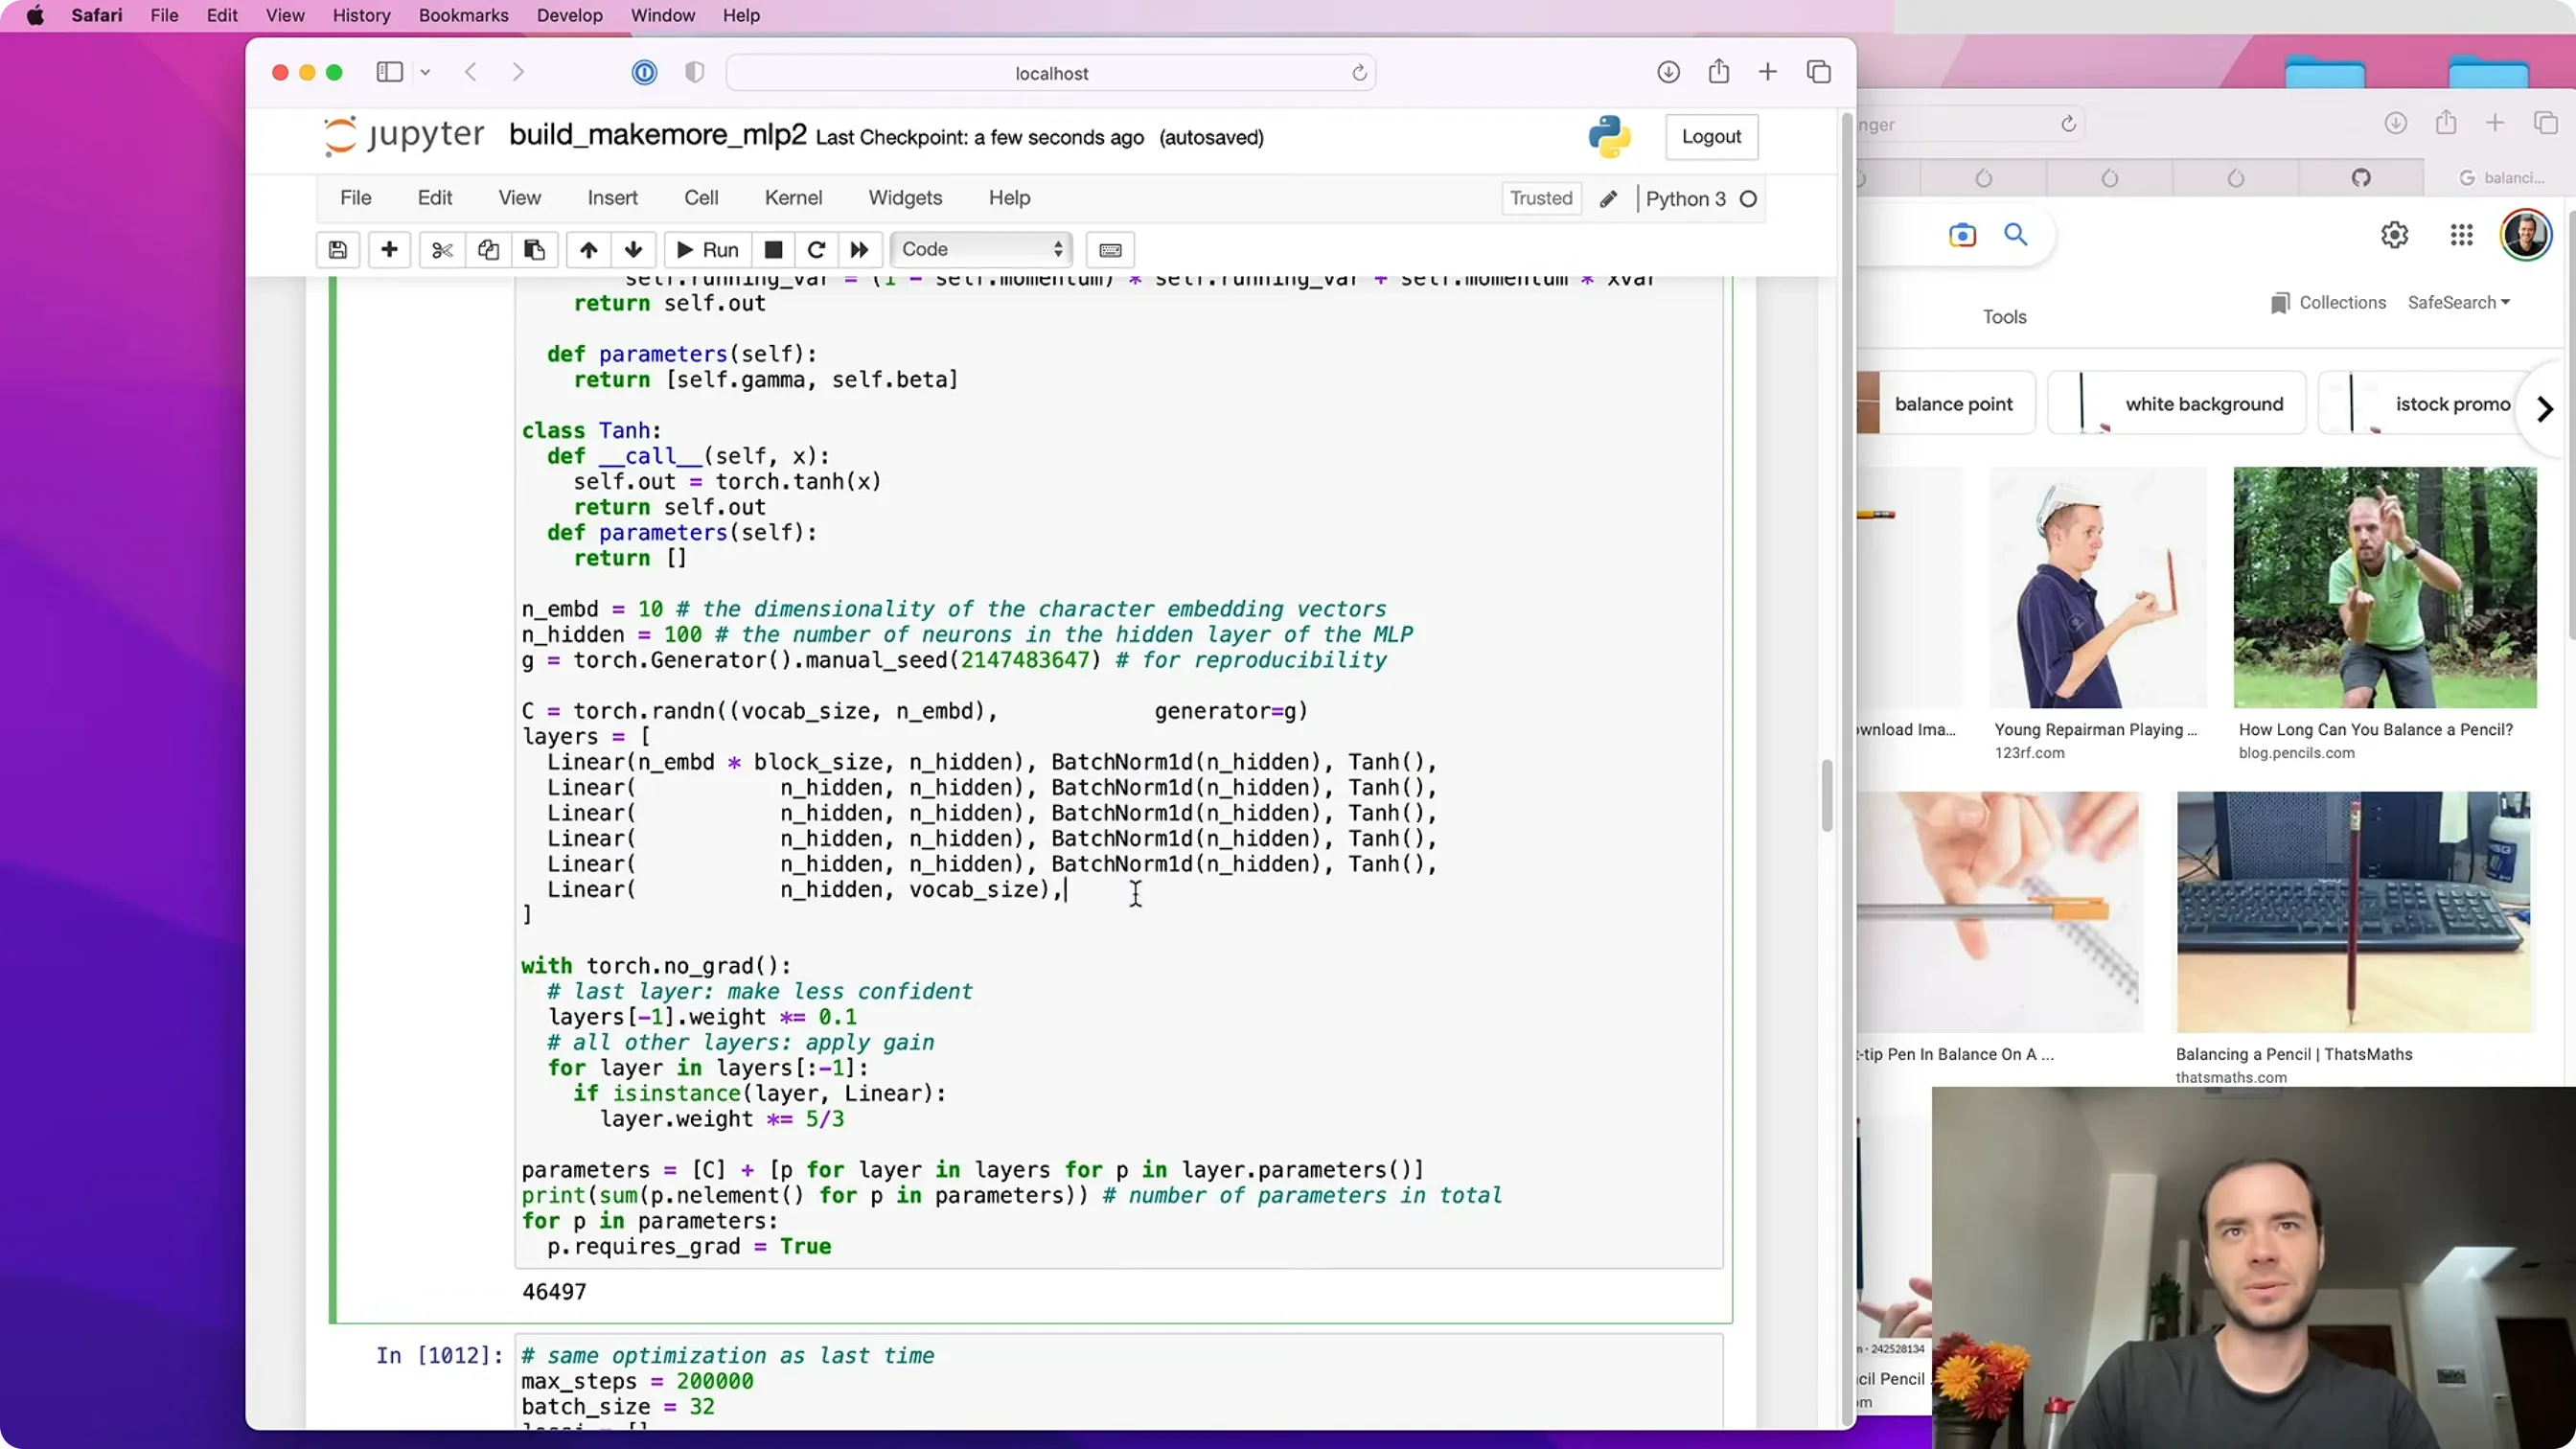
📷 带回 BatchNorm:激活/梯度/权重/更新全都整齐划一
回到原视频 (01:47:00)
八、总结
(参考时间: 1:51:34)
本讲想达成三件事:
- 引入 BatchNorm——它是让很深的网络能被稳定训练的第一批现代发明之一;
- 把代码 PyTorch 化——
Linear/BatchNorm1d/Tanh作为积木(lego blocks),可以像搭乐高一样堆出网络;而且接口与 PyTorch 一致(前面加nn.就能用); - 引入诊断工具——看前向激活、反向梯度、参数、以及 update:data 比值的统计与直方图;并且通常要看它们的"时间演化"而不是单张快照。
两个"没做到"(也很有启发):
- BN 并没有提升本讲的性能:因为现在的瓶颈不是优化,而是上下文长度(只看 3 个字符)。「要真正提升,得看更多上下文,需要 RNN / Transformer 这样的架构。」
- 没有把"梯度/初始化的直观理解"讲透:「如果你对'改了 gain 为什么就要改学习率'仍感到困惑,很正常——那需要对每一层的反向传播有更细的直觉。我们其实站在了这个领域的前沿:初始化、反向传播,至今都还没有被"解决",仍是活跃的研究方向。」
📷 总结:BatchNorm 是"稳定训练"的第一批现代发明之一
回到原视频 (01:51:34)
附:官方参考与延伸阅读
- 课程主页:https://karpathy.ai/zero-to-hero.html
- 本讲 Notebook:https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part3_bn.ipynb
- 🟢 本讲 Colab:https://colab.research.google.com/drive/1H5CSy-OnisagUgDUXhHwo1ng2pjKHYSN?usp=sharing
- 📄 Kaiming init:https://arxiv.org/abs/1502.01852
- 📄 Batch Normalization(2015):https://arxiv.org/abs/1502.03167
- 📄 BatchNorm 的实践问题:https://arxiv.org/abs/2105.07576
- makemore 仓库:https://github.com/karpathy/makemore
- PyTorch
nn.Linear:https://pytorch.org/docs/stable/generated/torch.nn.Linear.html - PyTorch
nn.BatchNorm1d:https://pytorch.org/docs/stable/generated/torch.nn.BatchNorm1d.html torch.nn.init.kaiming_normal_:https://pytorch.org/docs/stable/nn.init.html- ResNet(torchvision):https://github.com/pytorch/vision/blob/main/torchvision/models/resnet.py
- PyTorch internals:http://blog.ezyang.com/2019/05/pytorch-internals/
- 讨论 Discord:https://discord.gg/3zy8kqD9Cp
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 Building makemore Part 3: Activations & Gradients, BatchNorm 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。