第5讲 · 手把手语言建模(反向传播忍者篇)
本电子书由教学视频重构而成。 视频原标题:Building makemore Part 4: Becoming a Backprop Ninja ⚠️ 本讲是一道大题,不是一段可以"看过去"的视频。 Karpathy 原话(视频描述里用一排感叹号强调): "I recommend you work through the exercise yourself but work with it in tandem and whenever you are stuck unpause the video and see me give away the answer. This video is not super intended to be simply watched." 👉 先自己动手,卡住了再看讲解。 配套的空白练习本在 Colab 上,点开就能做,不用装任何东西。 编者拓展|📝 本讲的"官方练习"就是全片的四个 Exercise(这也是它和其他几讲最大的不同): 本讲的全部代码变量名在书中与官方 Notebook 保持一致,方便对照。
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=q8SA3rM6ckI |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 🎯 练习本(空白 · Colab,从这里开始) | https://colab.research.google.com/drive/1WV2oi2fh9XXyldh02wupFQX0wh5ZC-z-?usp=sharing |
| 参考答案 Notebook | https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part4_backprop.ipynb |
| 完整实现(makemore 仓库) | https://github.com/karpathy/makemore |
| 📄 Yes you should understand backprop | https://karpathy.medium.com/yes-you-should-understand-backprop-e2f06eab496b |
| 📄 BatchNorm 论文 | https://arxiv.org/abs/1502.03167 |
| 📄 Bessel's Correction 讲解 | http://math.oxford.emory.edu/site/math117/besselCorrection/ |
| 📄 Bengio et al. 2003 MLP LM | https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf |
| 讨论区 | 官方 Discord:https://discord.gg/3zy8kqD9Cp |
| E1|反向传播"原子计算图" | 把 forward pass 拆成最细的原子操作(max / exp / sum / log / matmul / tanh / BN 的每一步 / embedding 索引),逐行手写每个 d*,用 cmp() 与 PyTorch autograd 逐张量比对。 |
| E2|交叉熵损失的解析反向 | 不再逐原子回传,而是用纸笔把 $\partial L/\partial \text{logits}$ 推导出来——结果短得惊人:dlogits = probs; dlogits[range(n), Yb] -= 1; dlogits /= n。 |
| E3|BatchNorm 层的解析反向 | 同样用纸笔推导 BN 的反向公式(忽略 $\gamma,\beta$ 的情形),实现成一行,并验证与 PyTorch 一致。 |
| E4|全部拼起来 | 把这些手写梯度拼成完整反向传播,注释掉 loss.backward(),用 with torch.no_grad() 跑完整训练,得到与原来完全一样的损失和样本。 |
对应讲次:第5讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
一、引子:为什么要手写反向传播?
(参考时间: 00:00)
大家可能已经迫不及待想进入 RNN 及其各种变体了,但 Karpathy 说「很遗憾,我们还得在这里再待一讲」。原因在这行代码:
loss.backward()
「我对这行代码有意见。 我们正在用 PyTorch 的 autograd 替我们算所有梯度,我想把这行删掉,让我们自己在"张量层级"上手写反向传播。」
1.1 反向传播是一个"有漏洞的抽象"
Karpathy 有一篇著名的博文 Yes you should understand backprop,核心比喻是:
反向传播是一个"有漏洞的抽象"(leaky abstraction)。
它并不是"把一堆可微乐高积木随便堆起来、闭着眼睛反向传播、一切就好了"。恰恰相反——如果你不理解它的内部机制,很容易把自己打伤:
- 饱和的激活(flat tails)→ 梯度死掉;
- 死神经元(dead neurons);
- 梯度爆炸 / 消失(尤其在 RNN 里);
- 以及真实代码里那些"看起来很微妙、其实很致命"的 bug。
Karpathy 举了一个从网上随便找来的代码片段为例:作者本意是"把损失截断(clip the loss)",但实际写成了"把梯度截断(clip the gradients)"。
为什么这是 bug? 因为当你截断一个 outlier 的 loss 时,你实际上把它的梯度设成了 0——于是这个本应被认真学习的"难样本",被彻底忽略了。
👉 结论:「不要因为 PyTorch 提供了 autograd,就觉得可以不去理解它。」
1.2 但 micrograd 还不够
我们上一轮已经从零写过 micrograd——那是一个 autograd 引擎,但它的"原子"是单个标量。
「我觉得那不够。 我想让我们在 tensor 层级 上思考反向传播。」
1.3 一段有趣的历史
(参考时间: 00:03:40)
「今天手写反向传播只在练习时有意义,没人真的这么做。但大约十年前,这在深度学习里是标准做法、而且非常普遍——包括我自己。 那时候大家都手写反向传播,现在大家都只调
loss.backward()。我们丢掉了一些东西。」
- 2006 年 Hinton & Salakhutdinov 在 Science 上的论文,训练 受限玻尔兹曼机(RBM);
- 约 2010 年,Karpathy 自己写过一个训练 RBM 的库,用 Matlab(那会儿 Python 还没统治深度学习)。Matlab 有很方便的 tensor 类、漂亮的绘图、内置调试器;
- 2010 年那份代码今天看仍然眼熟:造
XYbatch、初始化带权重和偏置的网络、写训练循环、做参数更新。但那时人们直接在代码里"摆弄梯度"——而且当时训练 RBM 甚至不一定用反向传播,而是 对比散度(contrastive divergence) 来估计梯度。 - 2014 年他自己的论文代码(Fragmented Embeddings,一个"对象级 CLIP")已经用 numpy + Python,但仍然是:先手写 cost function,再手写 backward pass,最后用 gradient checker 数值校验自己的解析梯度。
编者说明:这一小段历史很有价值——它说明「先手推、再用梯度检验验证」曾经是日常工作流,而不只是教学练习。今天我们正是用同样的方法学它。
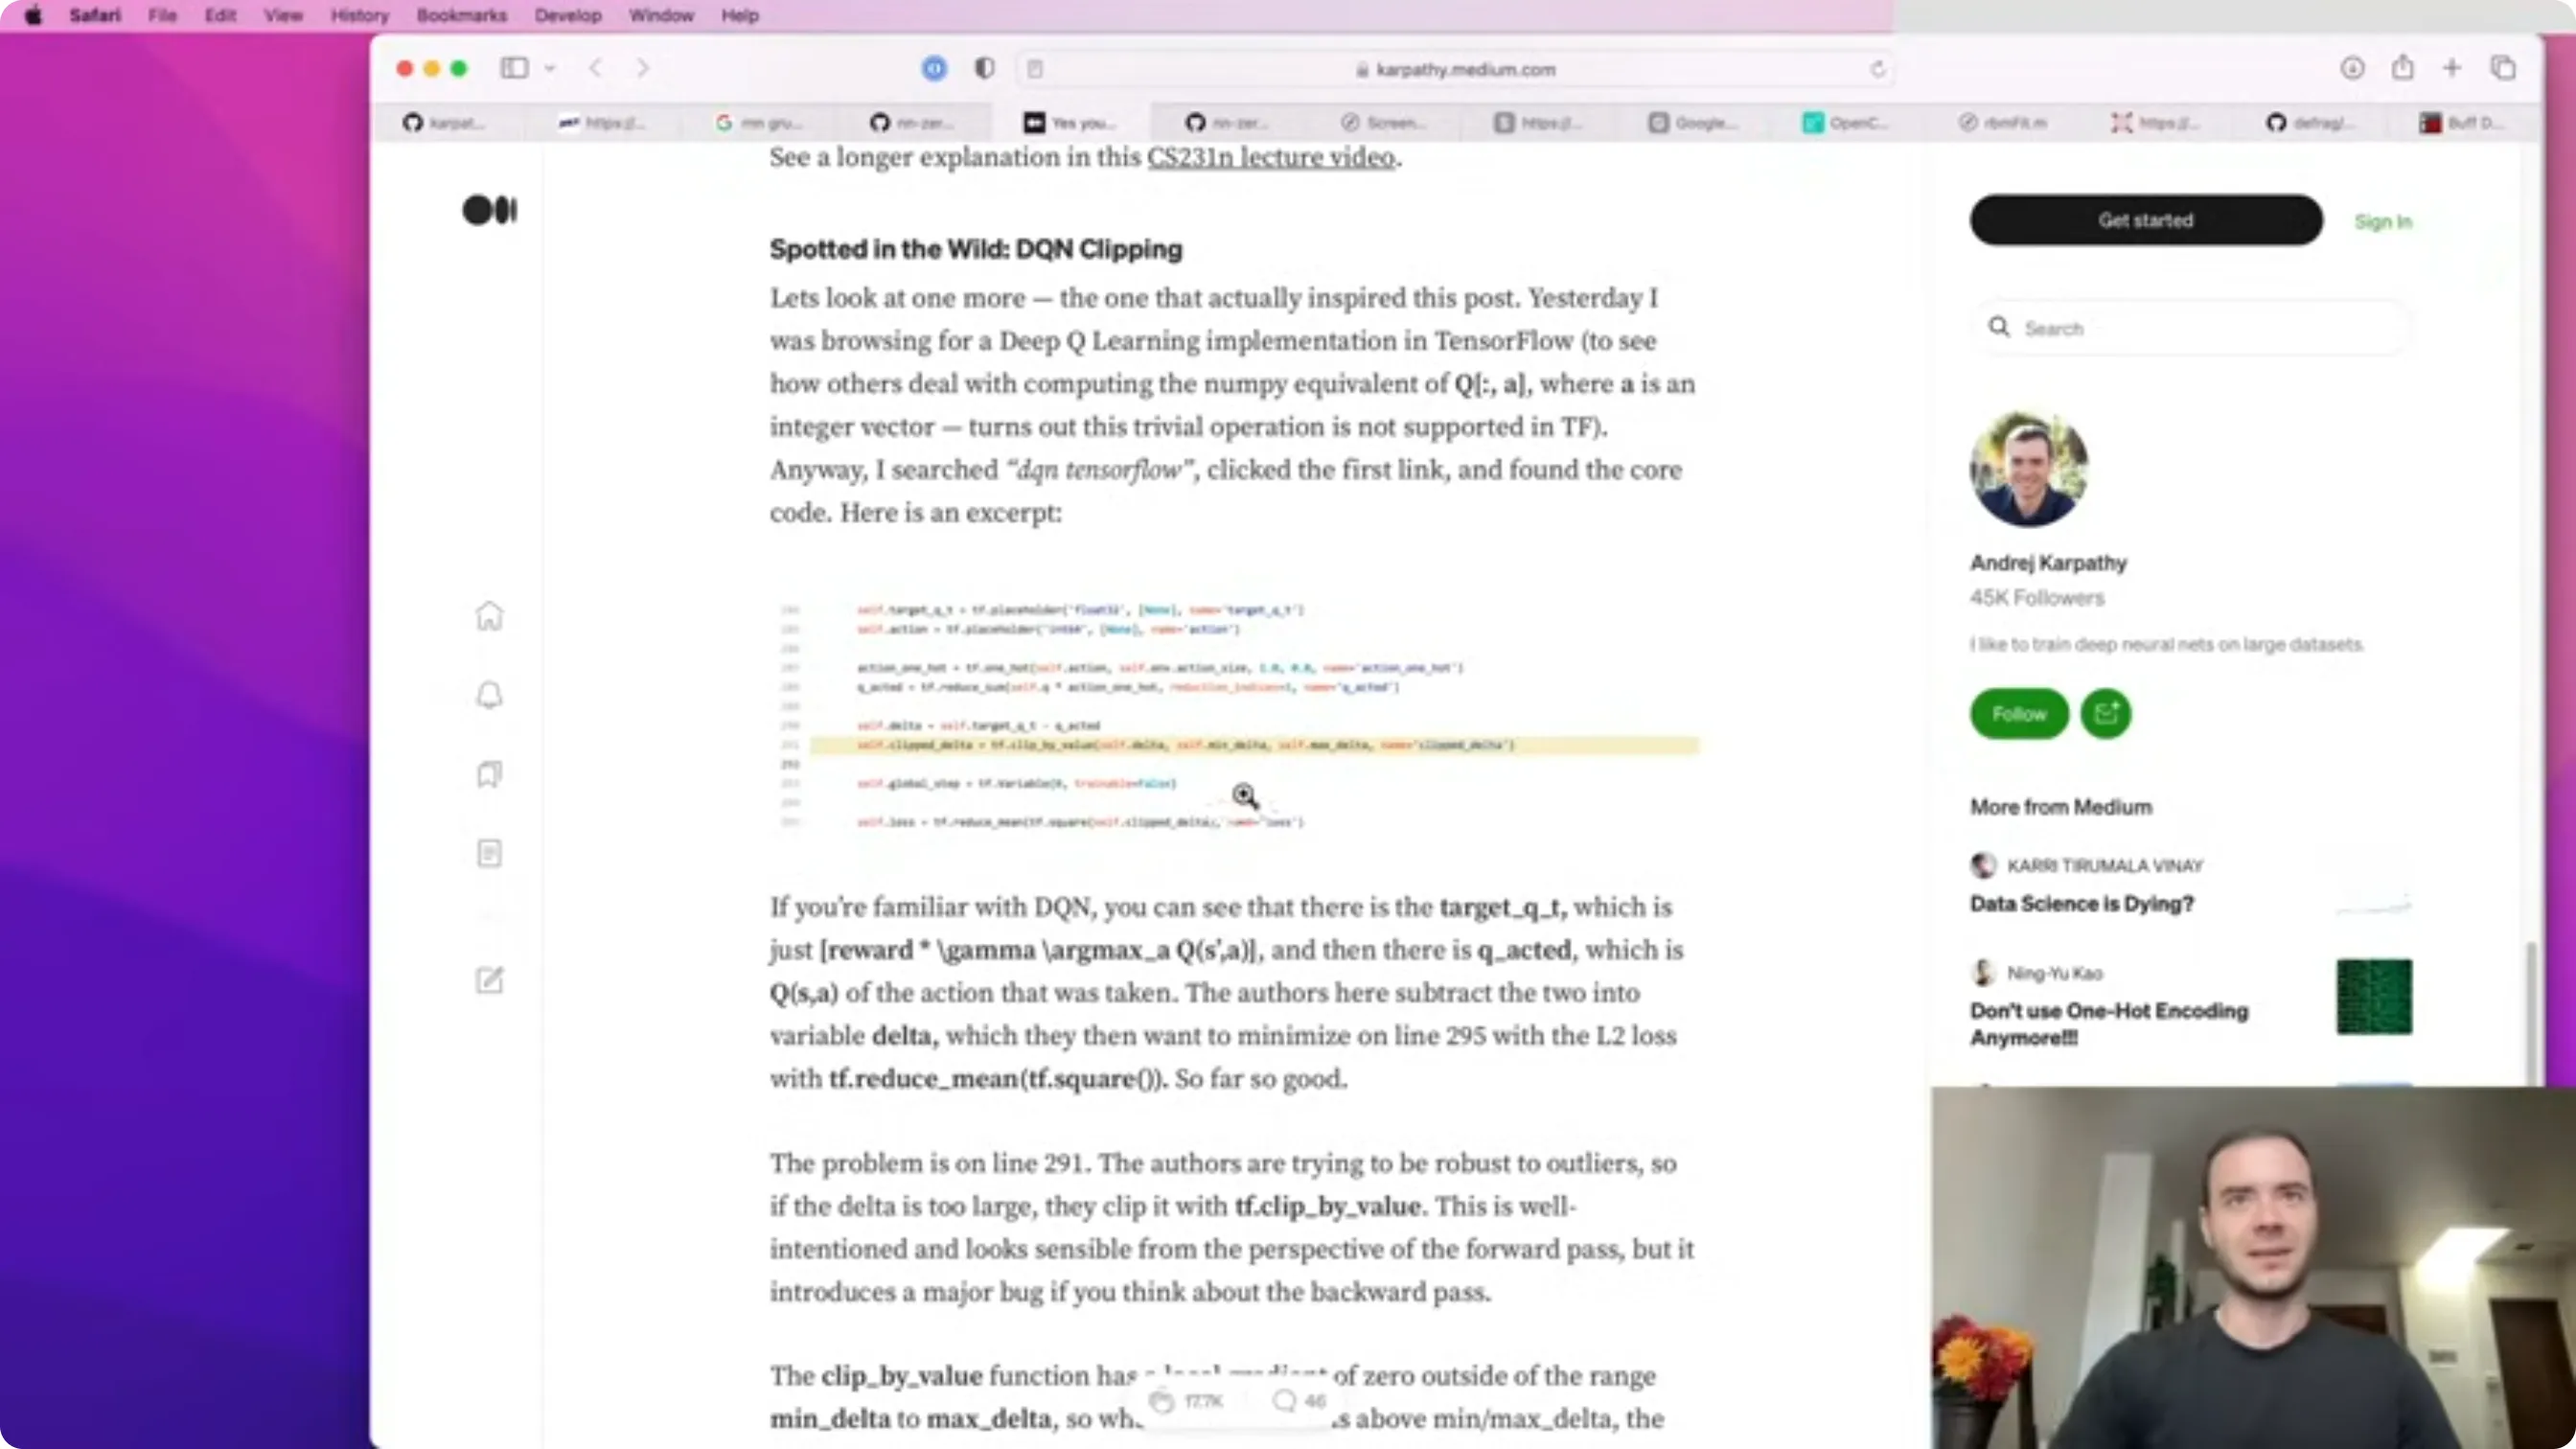
📷 被截断的 loss 与 exploding/vanishing gradients 等"真实世界里的坑"
回到原视频 (00:02:40)
📷 约 2010 年的 Matlab RBM 代码:训练循环里直接手写梯度更新
回到原视频 (00:04:40)
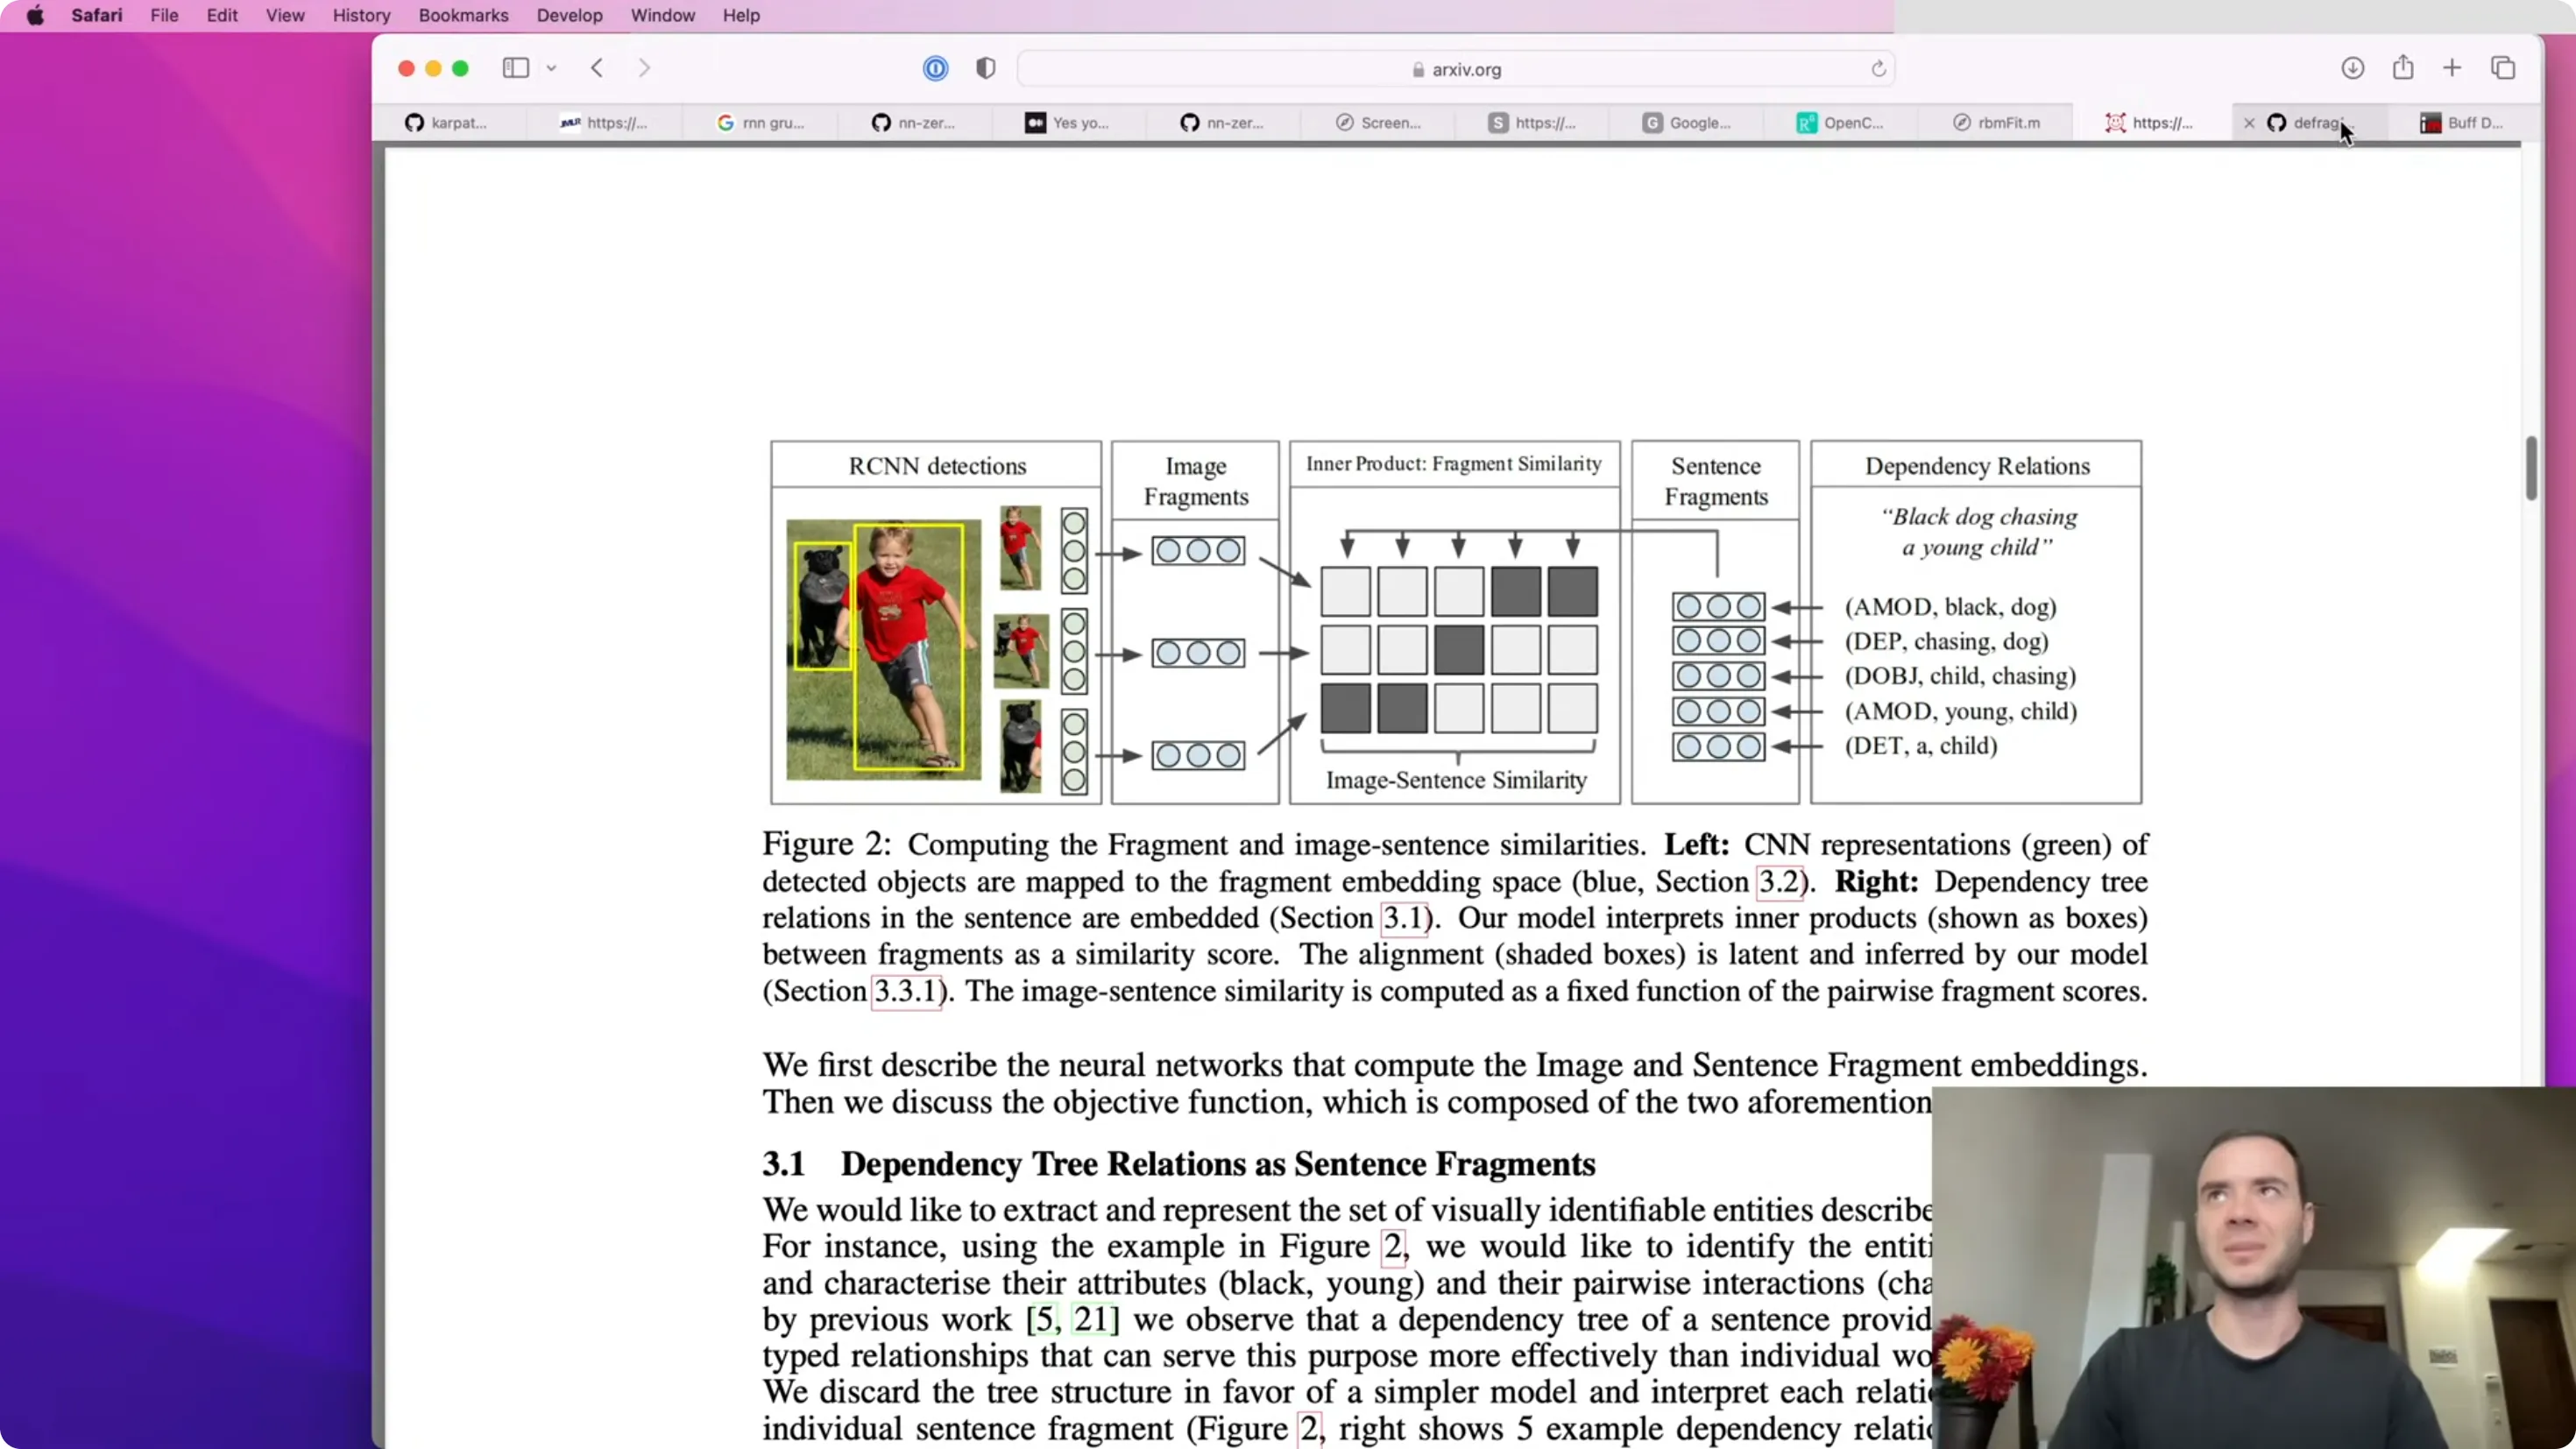
📷 2014 年的 numpy 代码:手写 cost + 手写 backward + gradient checker
回到原视频 (00:06:10)
二、起手式:把 forward 拆成原子
(参考时间: 00:07:26)
上一讲的 notebook 原样保留:
仍然是 两层 MLP + BatchNorm,forward pass 和上一讲完全一样。唯一的区别是:删掉
loss.backward(),改我们自己写。
2.1 新工具:cmp()
def cmp(s, dt, t):
    # dt: 我们手算的梯度; t: 对应的 tensor(t.grad 是 autograd 算的)
    ex = torch.all(dt == t.grad).item()          # 是否逐位相等
    app = torch.allclose(dt, t.grad)             # 是否足够接近
    maxdiff = (dt - t.grad).abs().max().item()   # 最大绝对差
    print(f'{s:15s} | exact: {str(ex):5s} | approximate: {str(app):5s} | maxdiff: {maxdiff}')
编者拓展|
all与allclose的分工:浮点运算不满足结合律,所以"数学上等价的两个公式"算出来常常不是逐位相等。因此cmp同时报告: *exact:逐位相等(用==)——能相等当然最好; *approximate(torch.allclose,默认rtol=1e-5, atol=1e-8)——稍微不一样但很接近也算对; *maxdiff:最大绝对差,判断"是不是只差浮点噪声(~1e-9)还是真的错了(~1e0)"。这叫"梯度检验"(gradient check),是深度学习工程里最实用的技能之一。更严格的做法还有
torch.autograd.gradcheck(有限差分法)。注意:allclose不是万能判据——绝对量级大的张量即使maxdiff不小,也可能是纯粹的浮点误差。
2.2 两个刻意为之的"防作弊"设计
(参考时间: 00:08:00)
- 偏置不再是 0,而是小随机数
「如果你的变量恰好初始化成 0,有时会掩盖掉错误的梯度实现——因为一切都为 0 时,梯度表达式会大大简化,你写错了也看不出来。用小随机数是为了"揭穿"这些潜在错误。」
- 第一个线性层保留
b1(尽管后面紧跟 BatchNorm)上一讲说过:BN 会把
b1的贡献减掉,b1.grad恒为 0,所以它是"多余的"。「但这里我故意留着——因为这样我们就有一个梯度应当为 0 的参数,正好可以验证我们连"应该为零的梯度"都算对了。」
2.3 forward pass 被"拆开"了
(参考时间: 00:09:07)
相比上一讲,forward 变长了很多,原因有二:
F.cross_entropy被换回显式实现(max/exp/sum/div/log/ 索引 /mean);- 把每一步拆成独立的中间张量——因为我们要从下往上(从 loss 往输入)逐张量回传。
命名约定:forward 里叫
logits,反向里就叫dlogits("loss 对 logits 的导数")。这次不建Value图,而是给每个 tensor 造一个d版本。
另外要加 retain_grad()(对每个中间张量),否则非叶子节点的 .grad 拿不到,就没法和我们的手算结果比对。
# ---- forward(原子版)----
logit_maxes  = logits.max(1, keepdim=True).values   # 每行最大值(数值稳定用)
norm_logits  = logits - logit_maxes
counts       = norm_logits.exp()
counts_sum   = counts.sum(1, keepdims=True)
counts_sum_inv = counts_sum**-1
probs        = counts * counts_sum_inv
logprobs     = probs.log()
loss         = -logprobs[range(n), Yb].mean()
编者说明:为什么用
counts_sum**-1而不用1.0 / counts_sum?Karpathy 说得很实在:当时 PyTorch 里除法(/)的 backward 实现有问题(会给出实数结果,而不是正确的梯度),而**-1没这个问题。「数学上完全等价,我只是绕开了那个实现问题。」
2.4 全局路线图
E1:从 loss 出发,逐个原子往回传(练手,但实践里不会这么做)。
E2:把 cross-entropy 那一堆原子折叠回一个数学表达式,用纸笔求导——结果短得多、也快得多。
E3:对 BatchNorm 做同样的事(纸笔求导 → 一行代码)。
E4:全部拼起来,彻底删掉
loss.backward(),完整训练。
graph LR
    C["C(嵌入表)"] --> emb["emb = C[Xb]"]
    emb --> embcat["embcat(view)"]
    embcat --> hprebn["hprebn = embcat@W1 + b1"]
    hprebn --> bnraw["bnraw(标准化的 x̂)"]
    bnraw --> hpreact["hpreact = γ·bnraw + β"]
    hpreact --> h["h = tanh(hpreact)"]
    h --> logits["logits = h@W2 + b2"]
    logits --> loss["loss(cross entropy)"]
    loss -.->|"反向:逐原子 d*(E1)"| C
    loss -.->|"反向:解析式(E2/E3)"| C
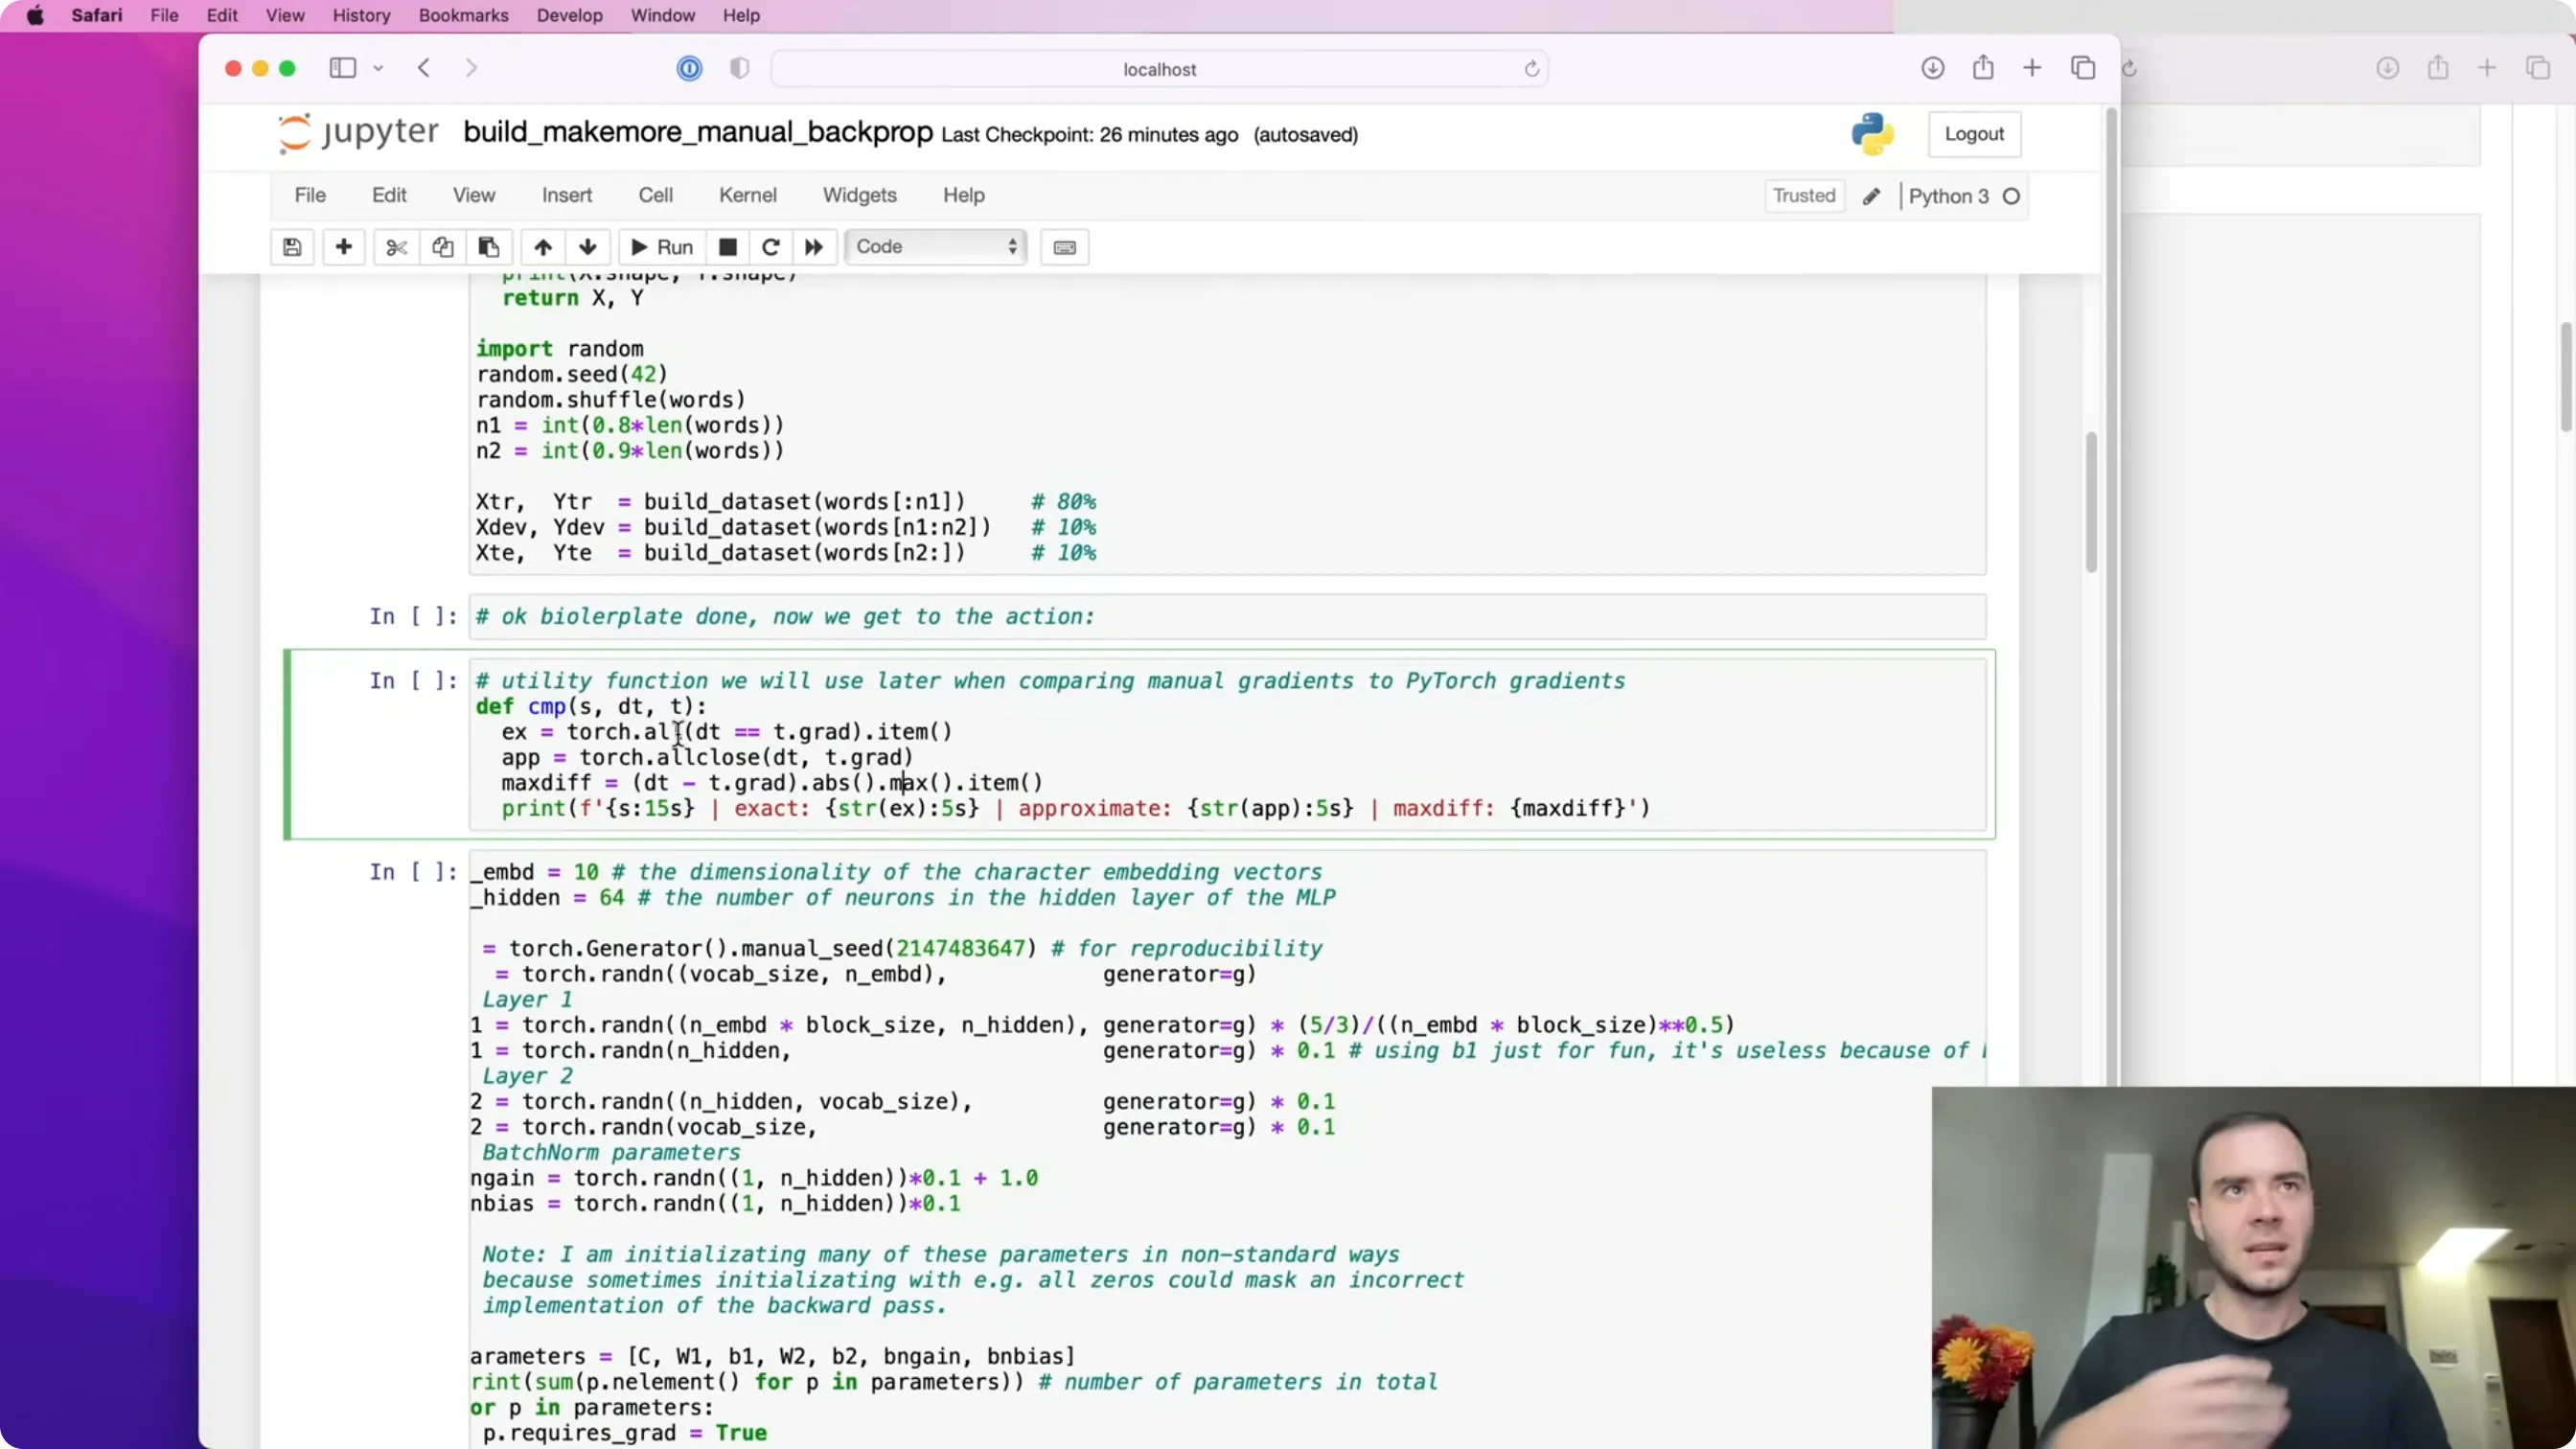
📷 starter code:cmp 工具 + 小随机初始化(用于"揭穿"错误的梯度)
回到原视频 (00:07:50)
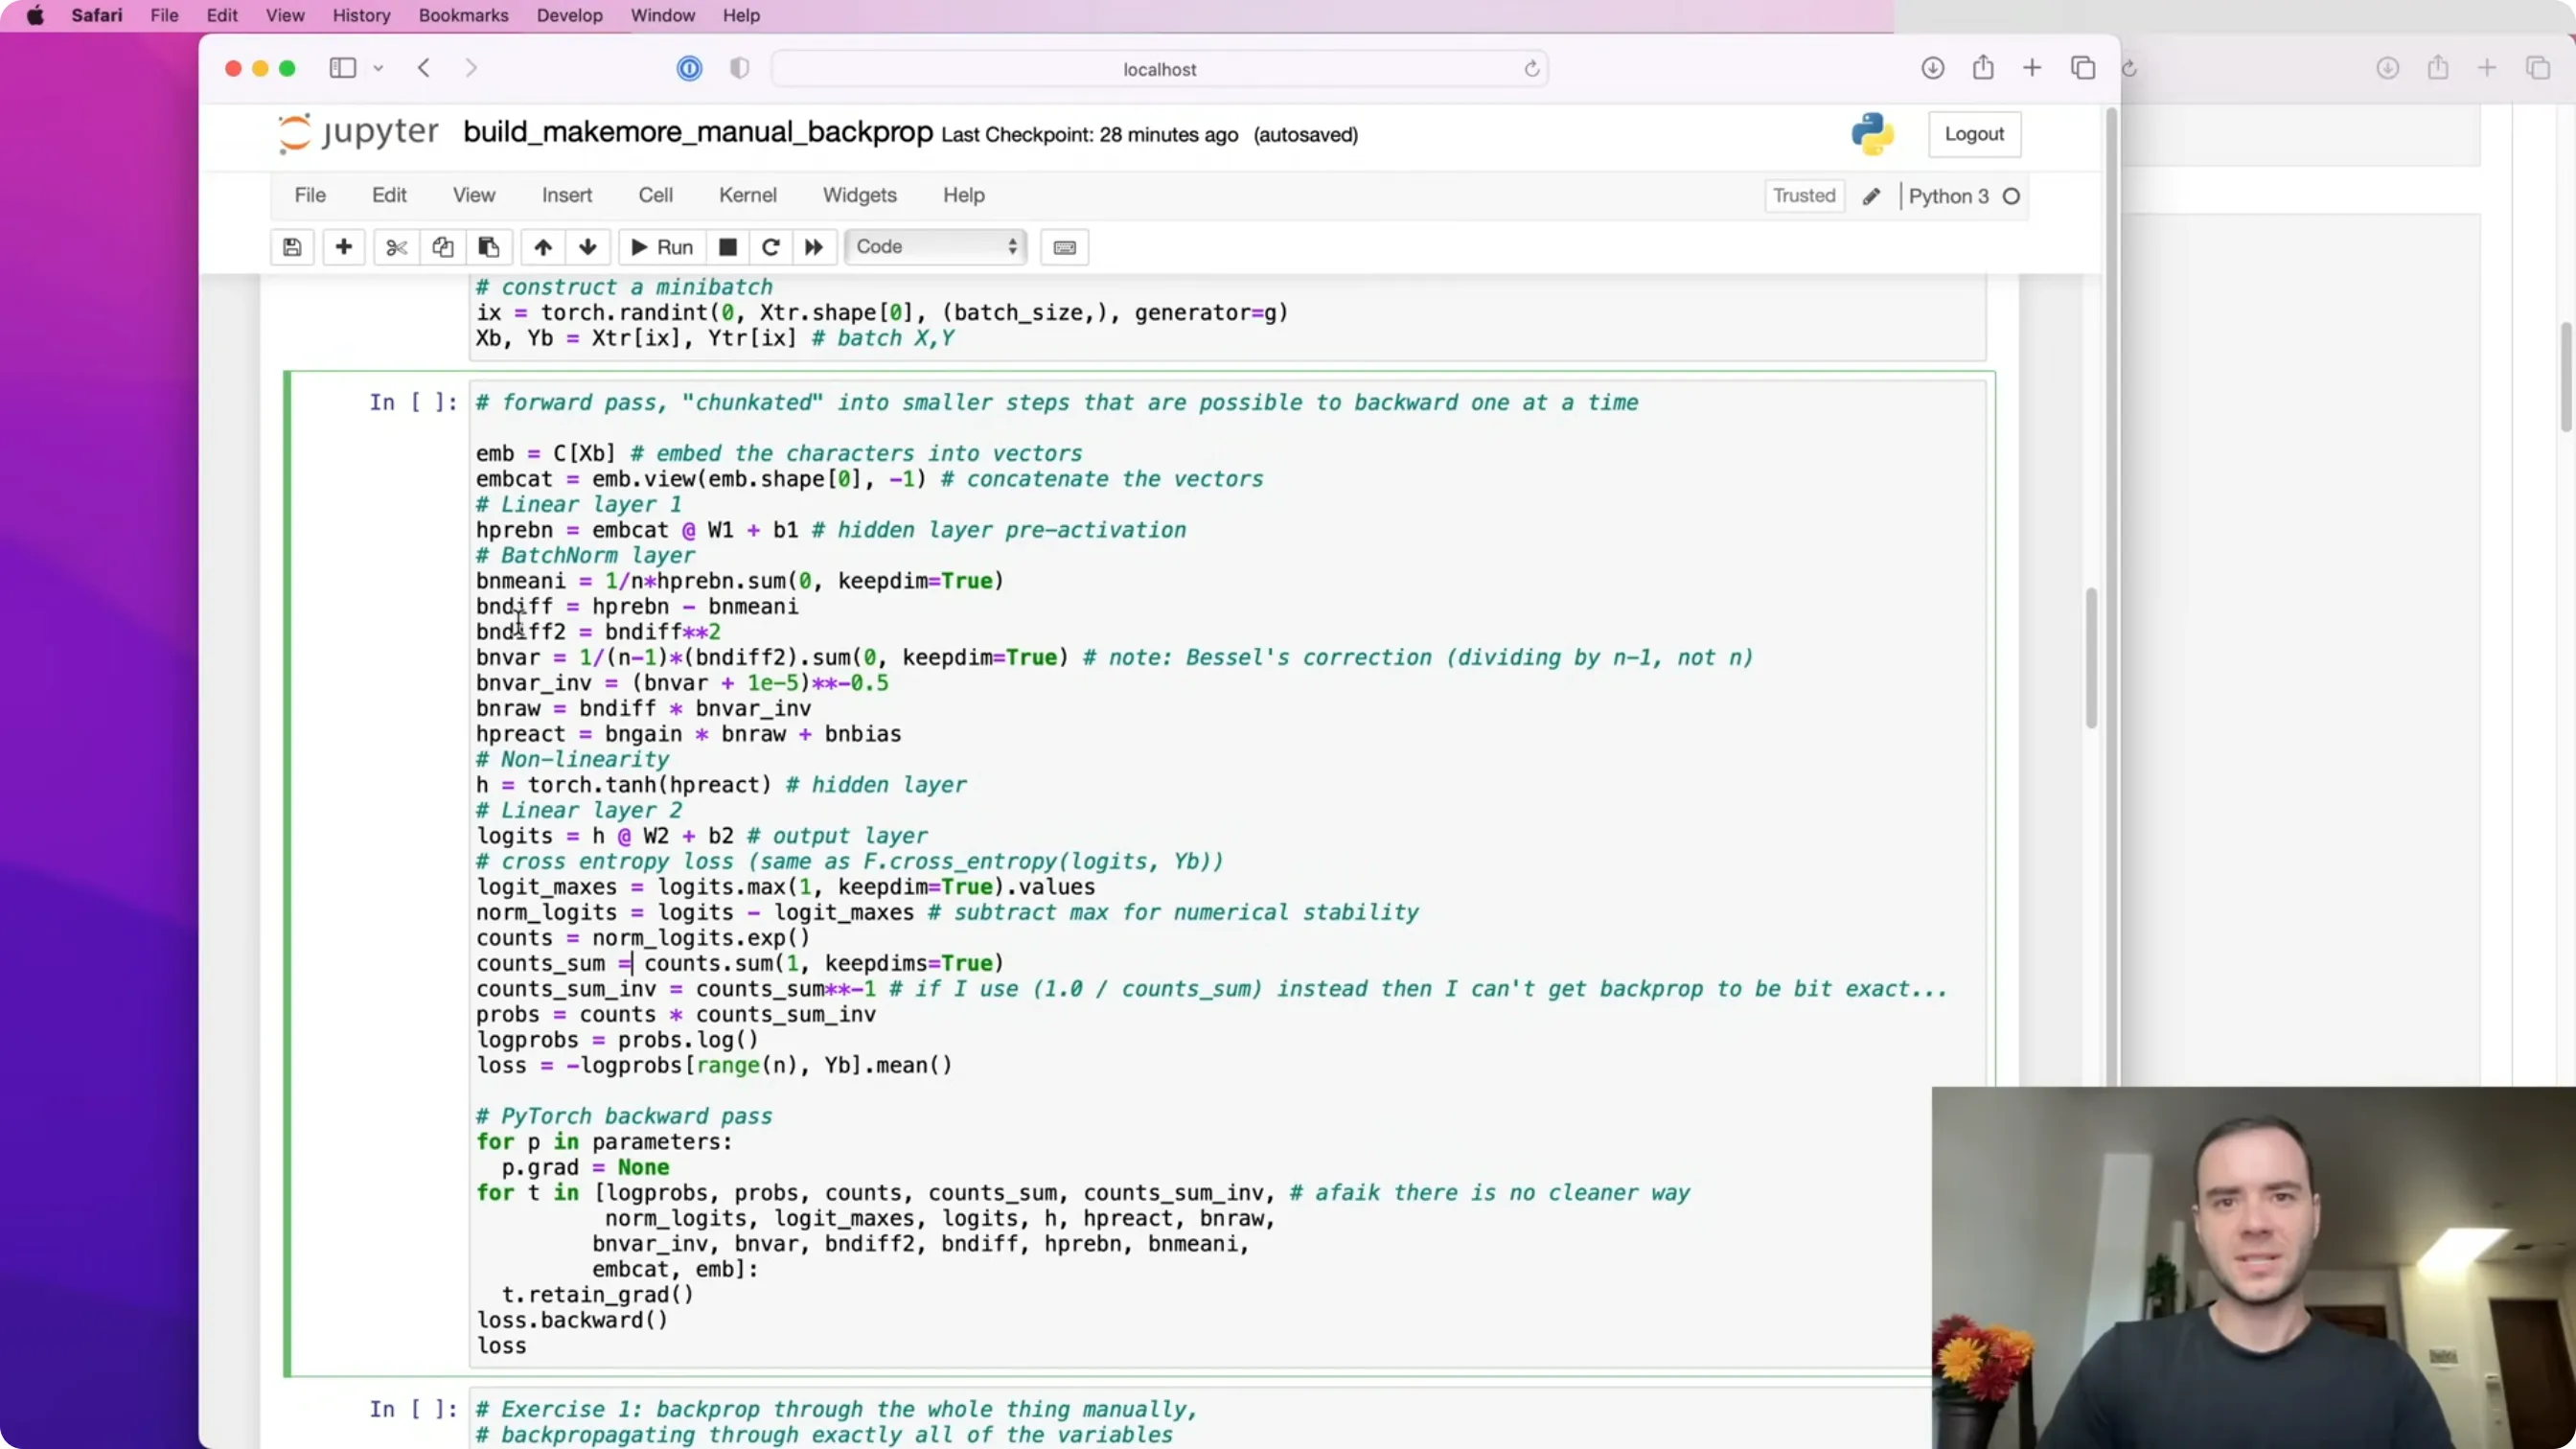
📷 被拆成原子的 forward pass:每一步都有名字,方便逐个回传
回到原视频 (00:09:40)
三、Exercise 1:反向传播"原子计算图"
(参考时间: 00:13:01)
「我先把答案剧透一下,但我更建议你先去描述里的 Colab 链接自己试一遍,卡住了再回来看我揭晓答案。边做边看,这才是最有价值的学法。」
3.1 dlogprobs:标量损失的最简一步
(参考时间: 00:13:03)
logprobs 形状 (32, 27),dlogprobs 形状必然相同("导数与变量形状永远一致")。
先化到最简:loss 本质是「挑出 32 个数,取平均,再取负」:
$$L = -\frac{1}{n}\sum_{k=1}^{n} a_k \quad\Longrightarrow\quad \frac{\partial L}{\partial a_k} = -\frac{1}{n}$$
- 被挑中的位置:导数是 $-1/n$;
- 其余所有位置(
27-1列的绝大部分):根本没参与 loss,所以导数为 0。
dlogprobs = torch.zeros_like(logprobs)
dlogprobs[range(n), Yb] = -1.0 / n
✅ cmp 结果:exact 相等,maxdiff = 0。
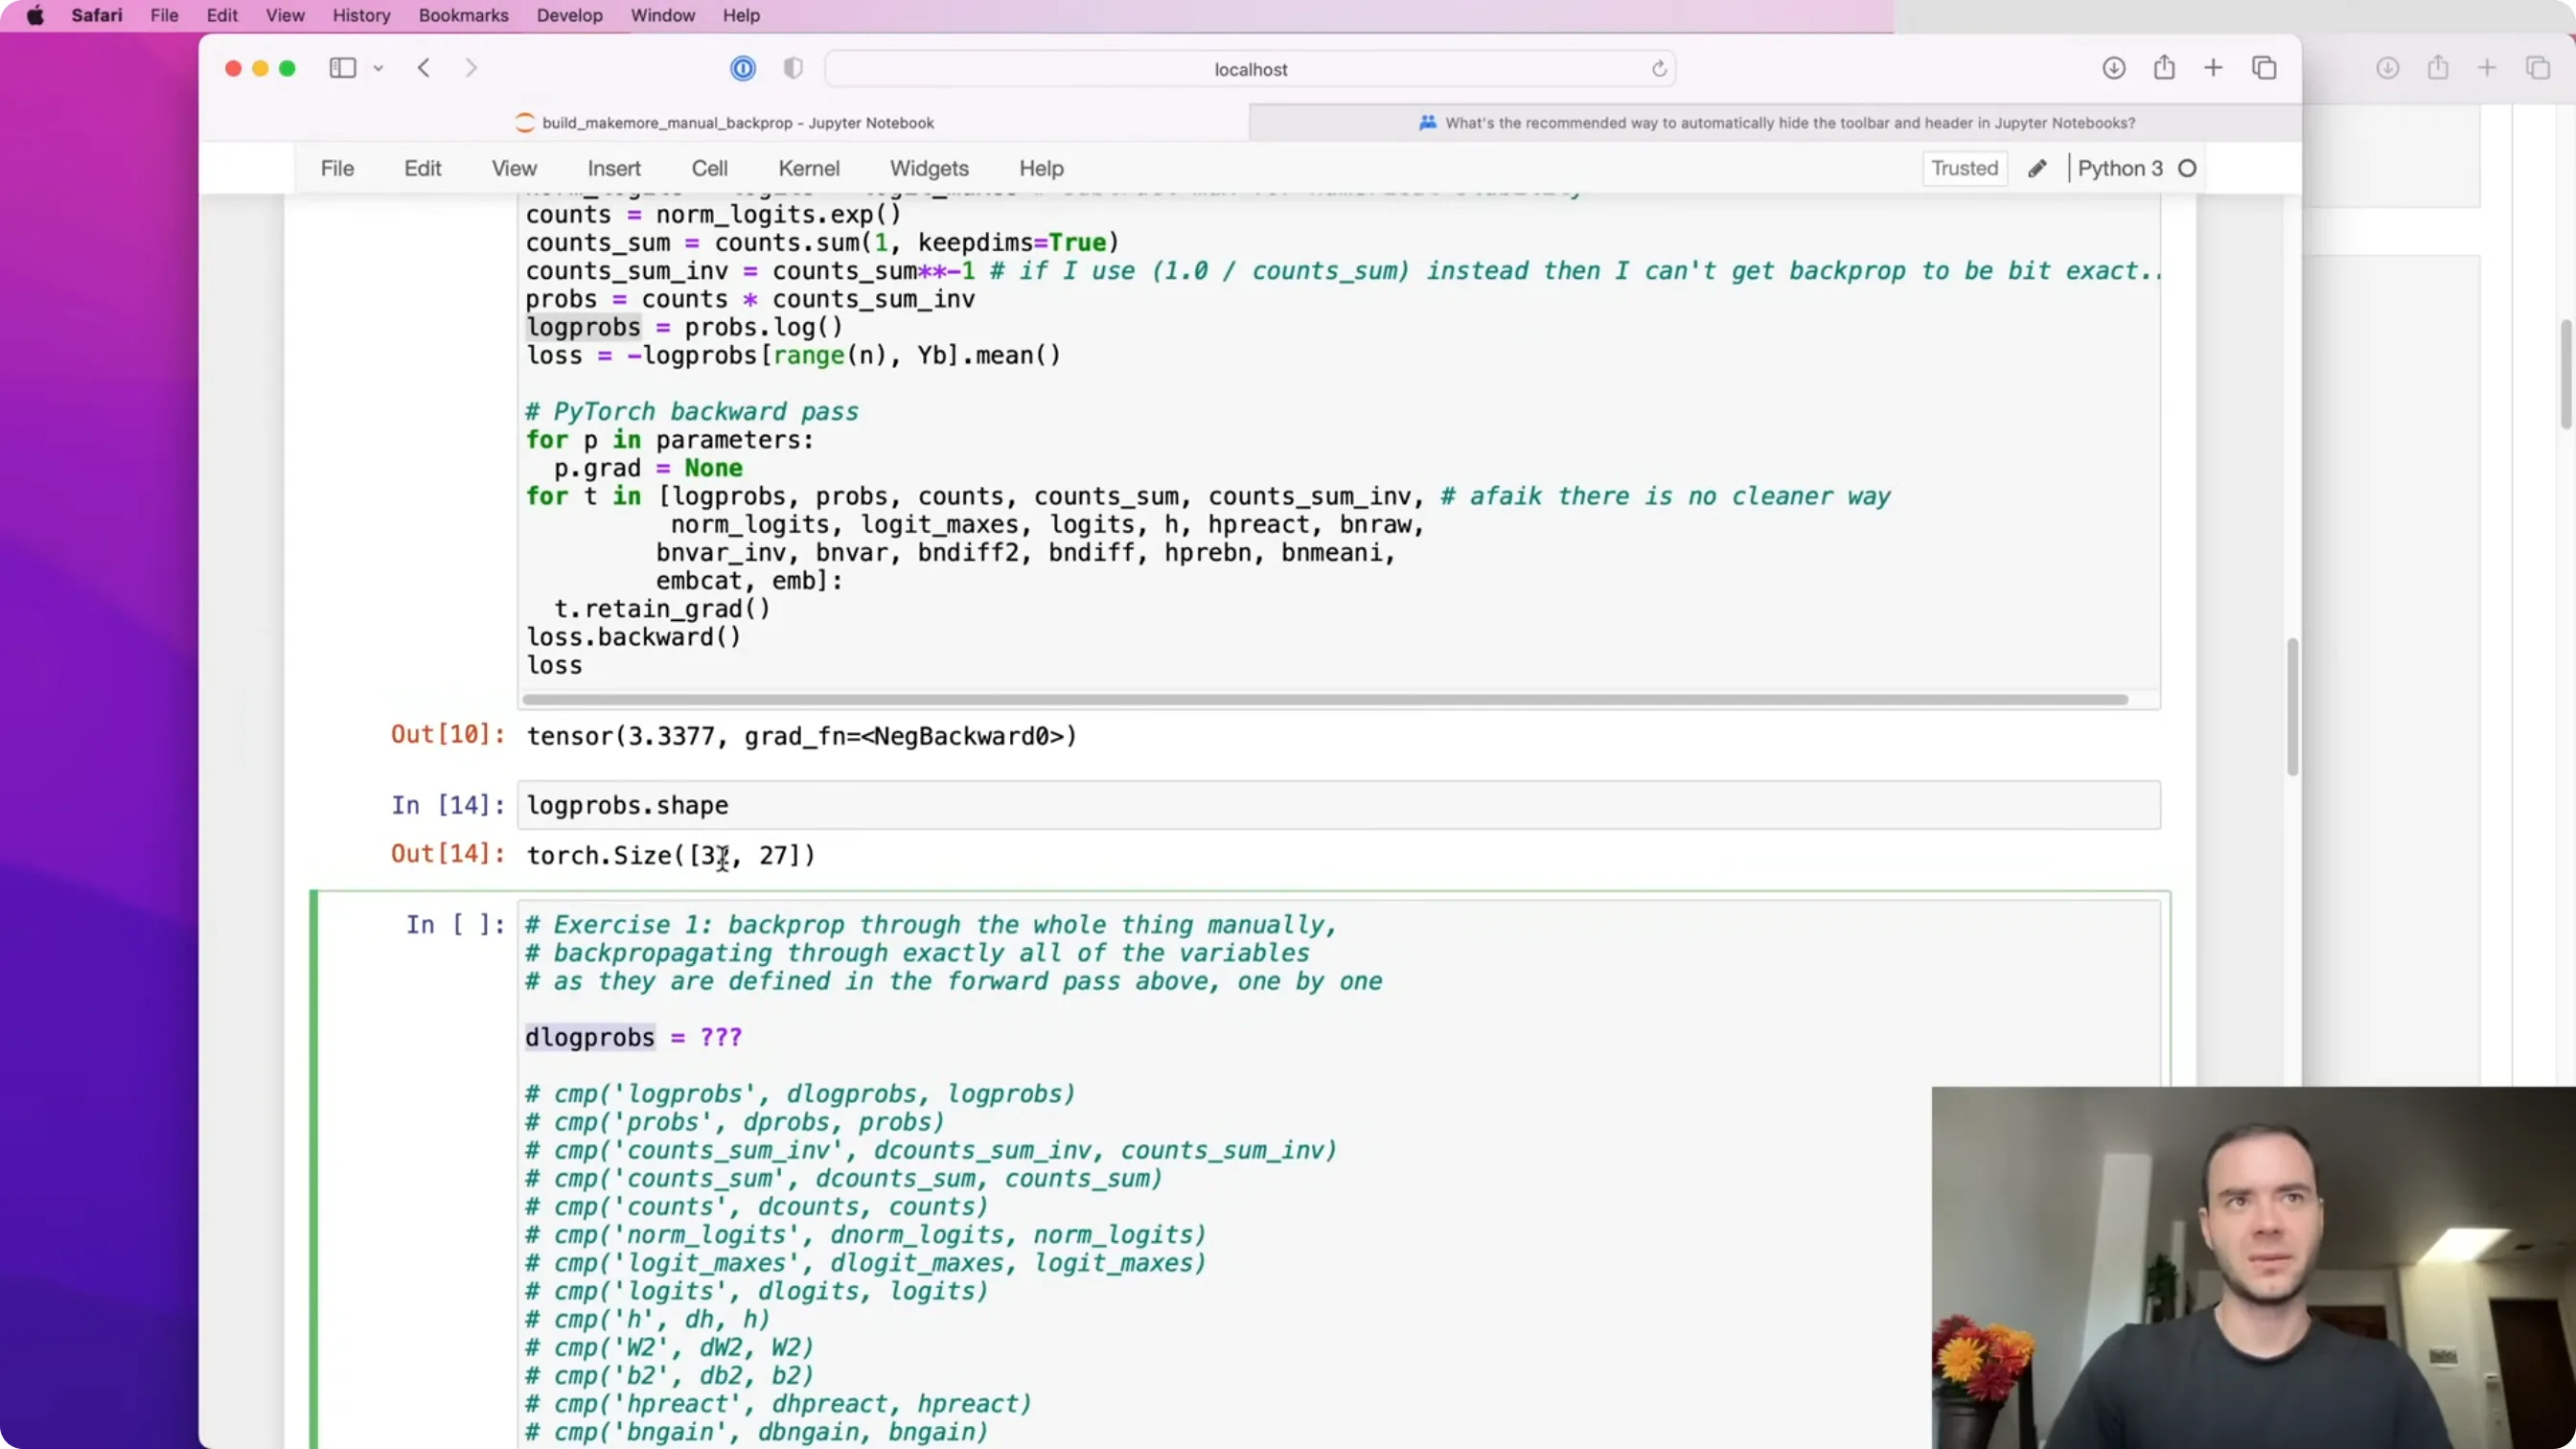
📷 dlogprobs:只有被"挑中"的 32 个位置是 -1/n,其余全 0
回到原视频 (00:13:20)
3.2 dprobs:$\log$ 的局部导数
(参考时间: 00:19:17)
链式法则 = 局部导数 × 上游梯度。$\frac{d}{dx}\log x = \frac{1}{x}$,所以:
dprobs = (1.0 / probs) * dlogprobs
直觉(Karpathy 特意点出):如果一个字符当前被赋予的概率很低(网络预测错了),那么 $1/p$ 很大,它的梯度会被放大——「这一行在做的事,就是把那些"当前概率很低的样本"的梯度放大。」
3.3 dcounts_sum_inv 与 dcounts:广播的反向是求和
(参考时间: 00:21:02)
这一段是本讲最重要的技术点。probs = counts * counts_sum_inv 看着像一个元素级乘法,但两个操作数形状不同:
counts:(32, 27)counts_sum_inv:(32, **1**)
这实际上是两步操作:
- 广播(replication):把
(32,1)横向复制 27 次 →(32,27); - 元素级相乘。
逐层回传:
- 先穿乘法:$c = a\cdot b \Rightarrow \partial c/\partial a = b$,所以局部导数是
counts_sum_inv; - 再穿广播:那个
(32,1)变量被复用了 27 次——这正是 micrograd 里"一个节点分叉成多条支路"的情况。
🔑 铁律:如果一个变量在前向里被复用(或广播),它的梯度在所有副本上要"加回来"。
dcounts_sum_inv = (counts * dprobs).sum(1, keepdim=True)   # 横向求和,keepdim 保住 (32,1)
dcounts        = counts_sum_inv * dprobs                   # 乘法那一支
dcounts_sum    = (-counts_sum**-2) * dcounts_sum_inv       # x⁻¹ 的导数是 -x⁻²
dcounts       += torch.ones_like(counts) * dcounts_sum     # sum 的反向:复制回去(+=!)
最后一行用 torch.ones_like(counts)「让广播替我们做复制」,并且必须 +=——因为 counts 有两条支路(一路去 probs,一路经 counts_sum)。
编者拓展|前向-反向的"对偶性"(本讲的点睛之笔):Karpathy 在 01:09:45 明确总结过这条规律—— | 前向传播 | 反向传播 | |---|---| | 广播 / 复制(变量被复用) | 求和(沿被复制的维度) | | 求和(信息被聚合) | 广播(把梯度等分送回各贡献者) | | 元素级乘法 | 元素级乘法(用另一侧的值) | | 重排 /
view| 反向重排(view回原形状) |记住这张表,你就能"推出"绝大多数层的反向传播,而不用背公式。
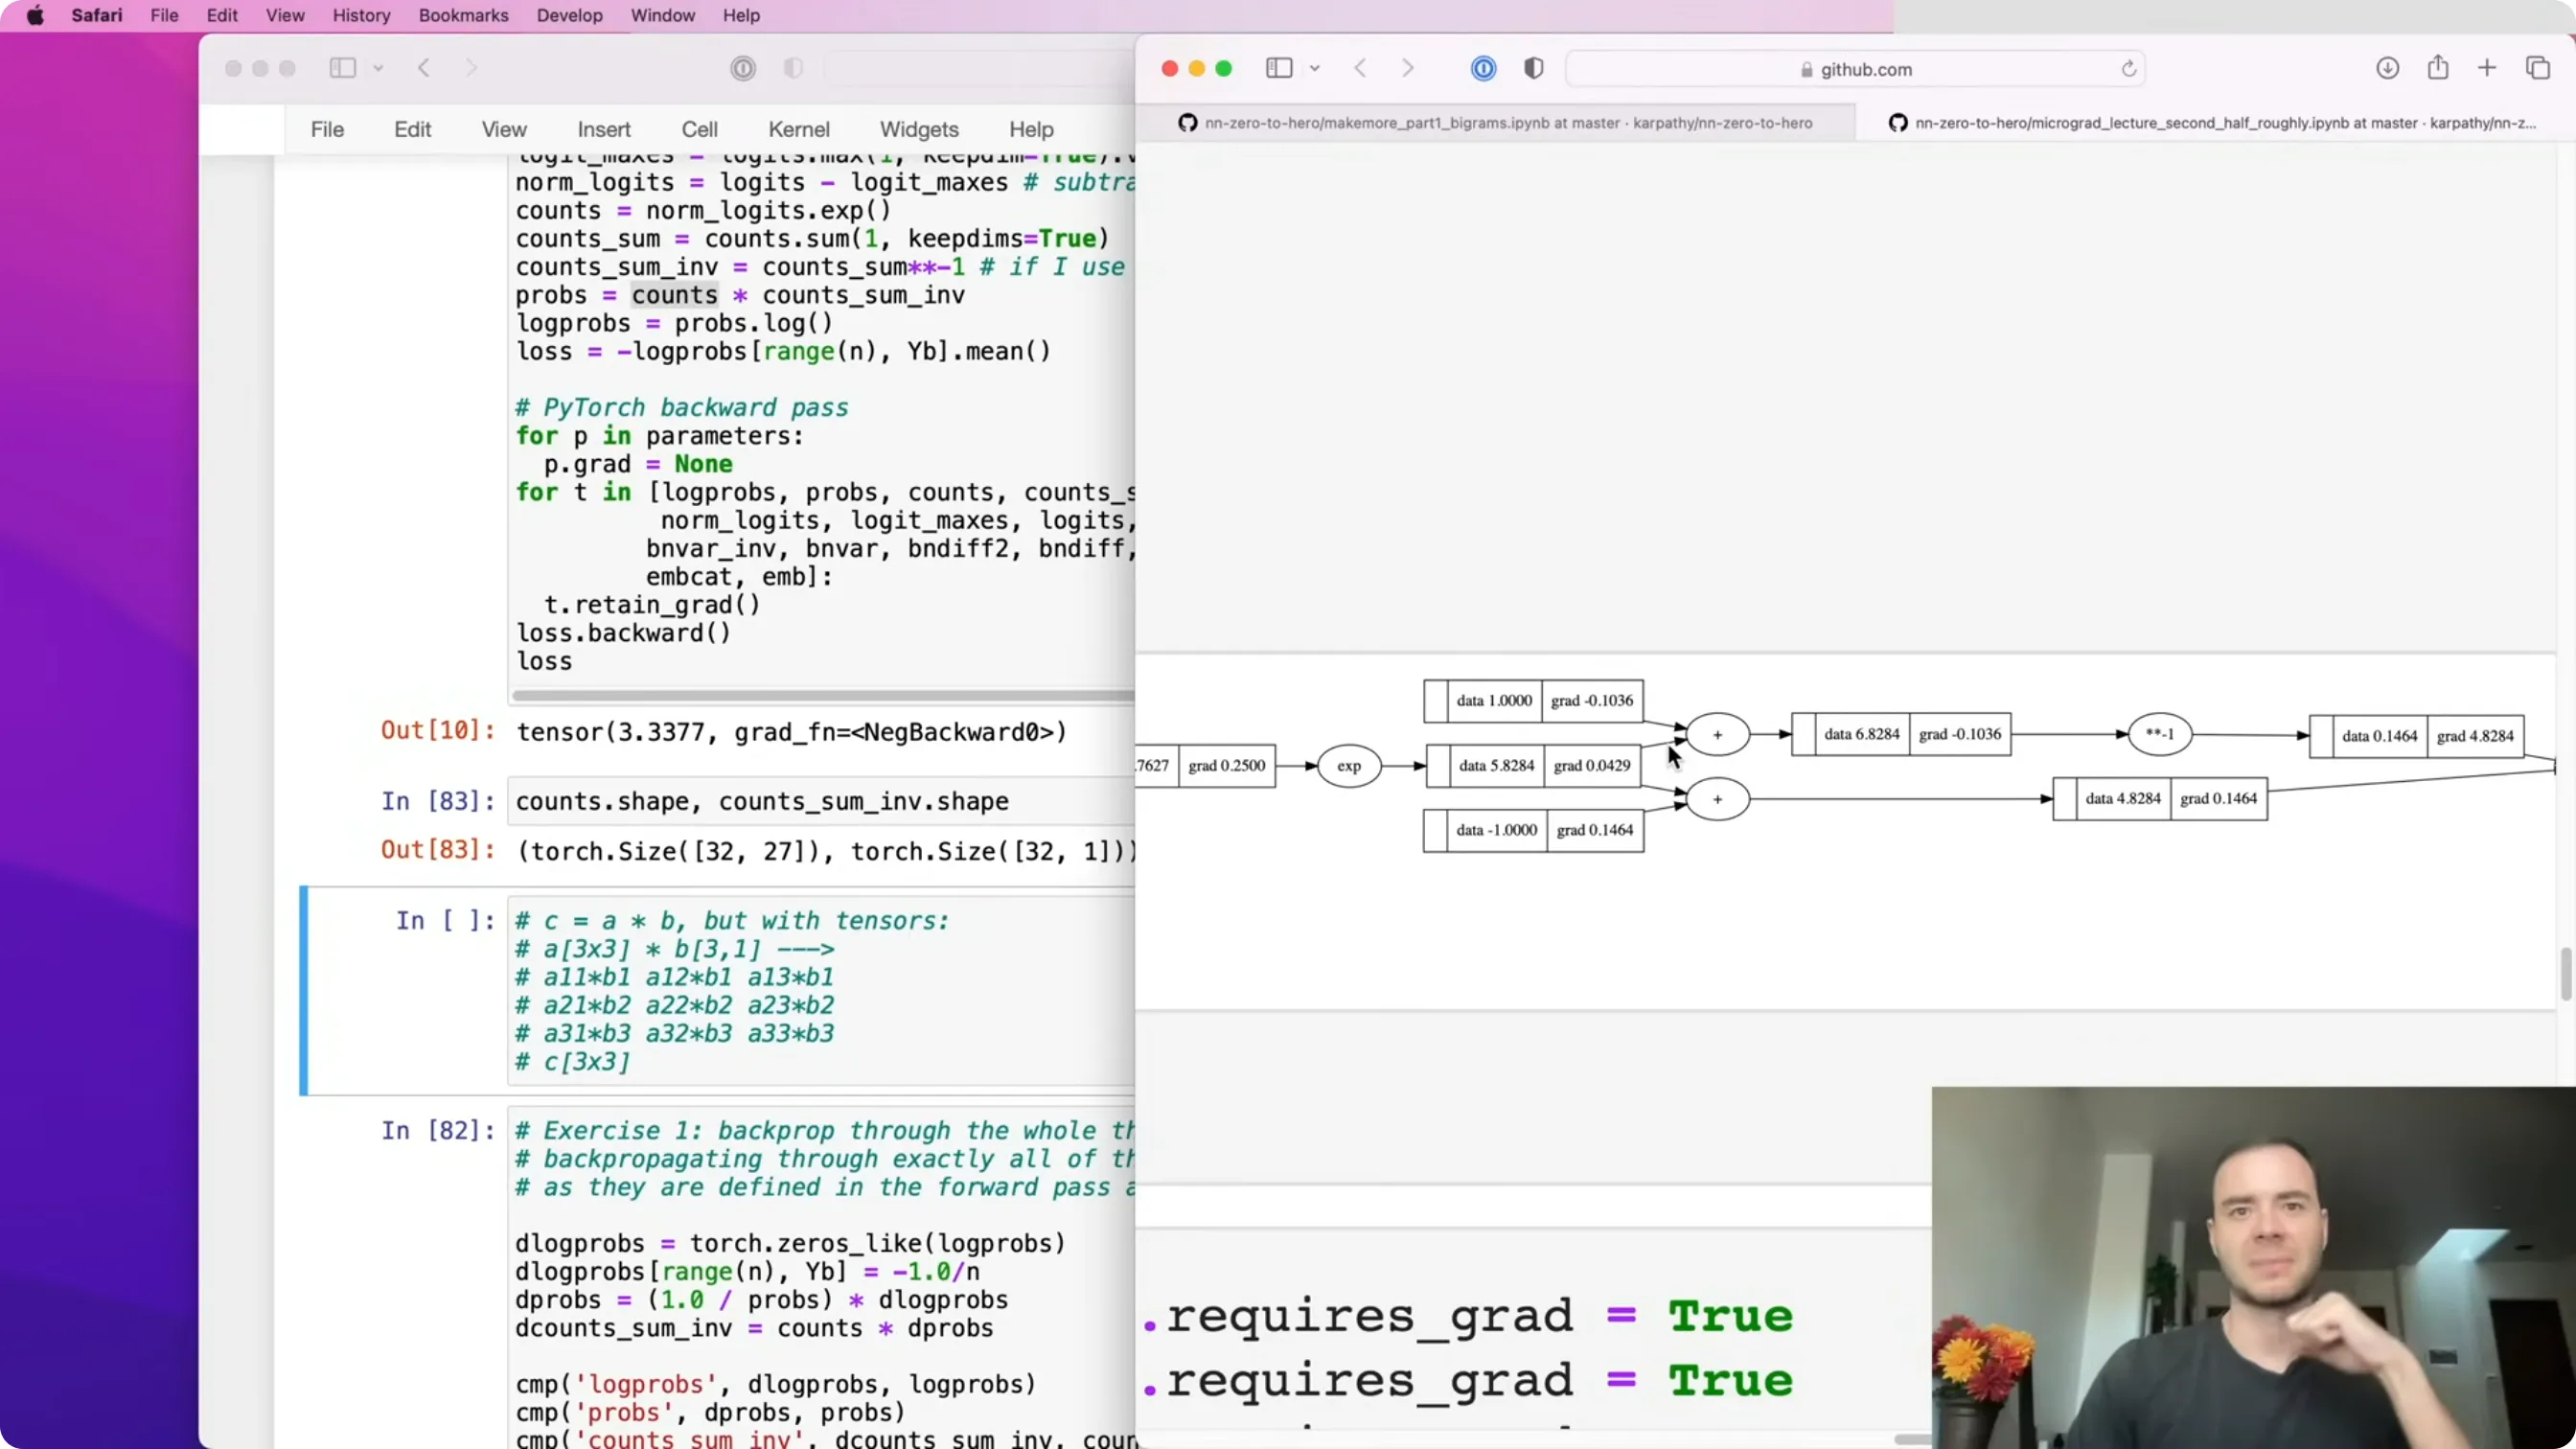
📷 广播的反向 = 求和:一个被复用 27 次的变量,梯度必须加起来
回到原视频 (00:25:40)
3.4 走到 dlogits:max 的散射
经过 counts = norm_logits.exp()($\frac{d}{dx}e^x = e^x$,正好可以复用 counts)、以及 norm_logits = logits - logit_maxes(减法的局部导数是 $+1$ 和 $-1$,再对广播做一次求和),我们得到 dlogit_maxes。
然后还有第二条支路:logit_maxes 本身就是 logits.max(1) 出来的——它是从 logits 里"挑"出来的。
$$\text{反向} = \text{把上游梯度"散落"回那些被挑中的位置}$$
dlogits += F.one_hot(logits.max(1).indices, num_classes=logits.shape[1]) * dlogit_maxes
为什么可以近似忽略这条支路? 因为
logit_maxes对 loss 没有影响——softmax 对"每行同时加减同一个常数"是不变的。所以 $d\text{logit\_maxes}$ 理论上应当恰好为 0。实测由于浮点误差,它是 ~1e-9 量级。「即使把 softmax 彻底拆成原子、老老实实回传,它也会自动告诉你"这一支的梯度是 0"——这个正确的结果会自己浮现出来。」
但要注意:在广播求和得到
dlogit_maxes之前,logits上真正非零的那部分梯度不能丢——所以上面这行用的是+=。
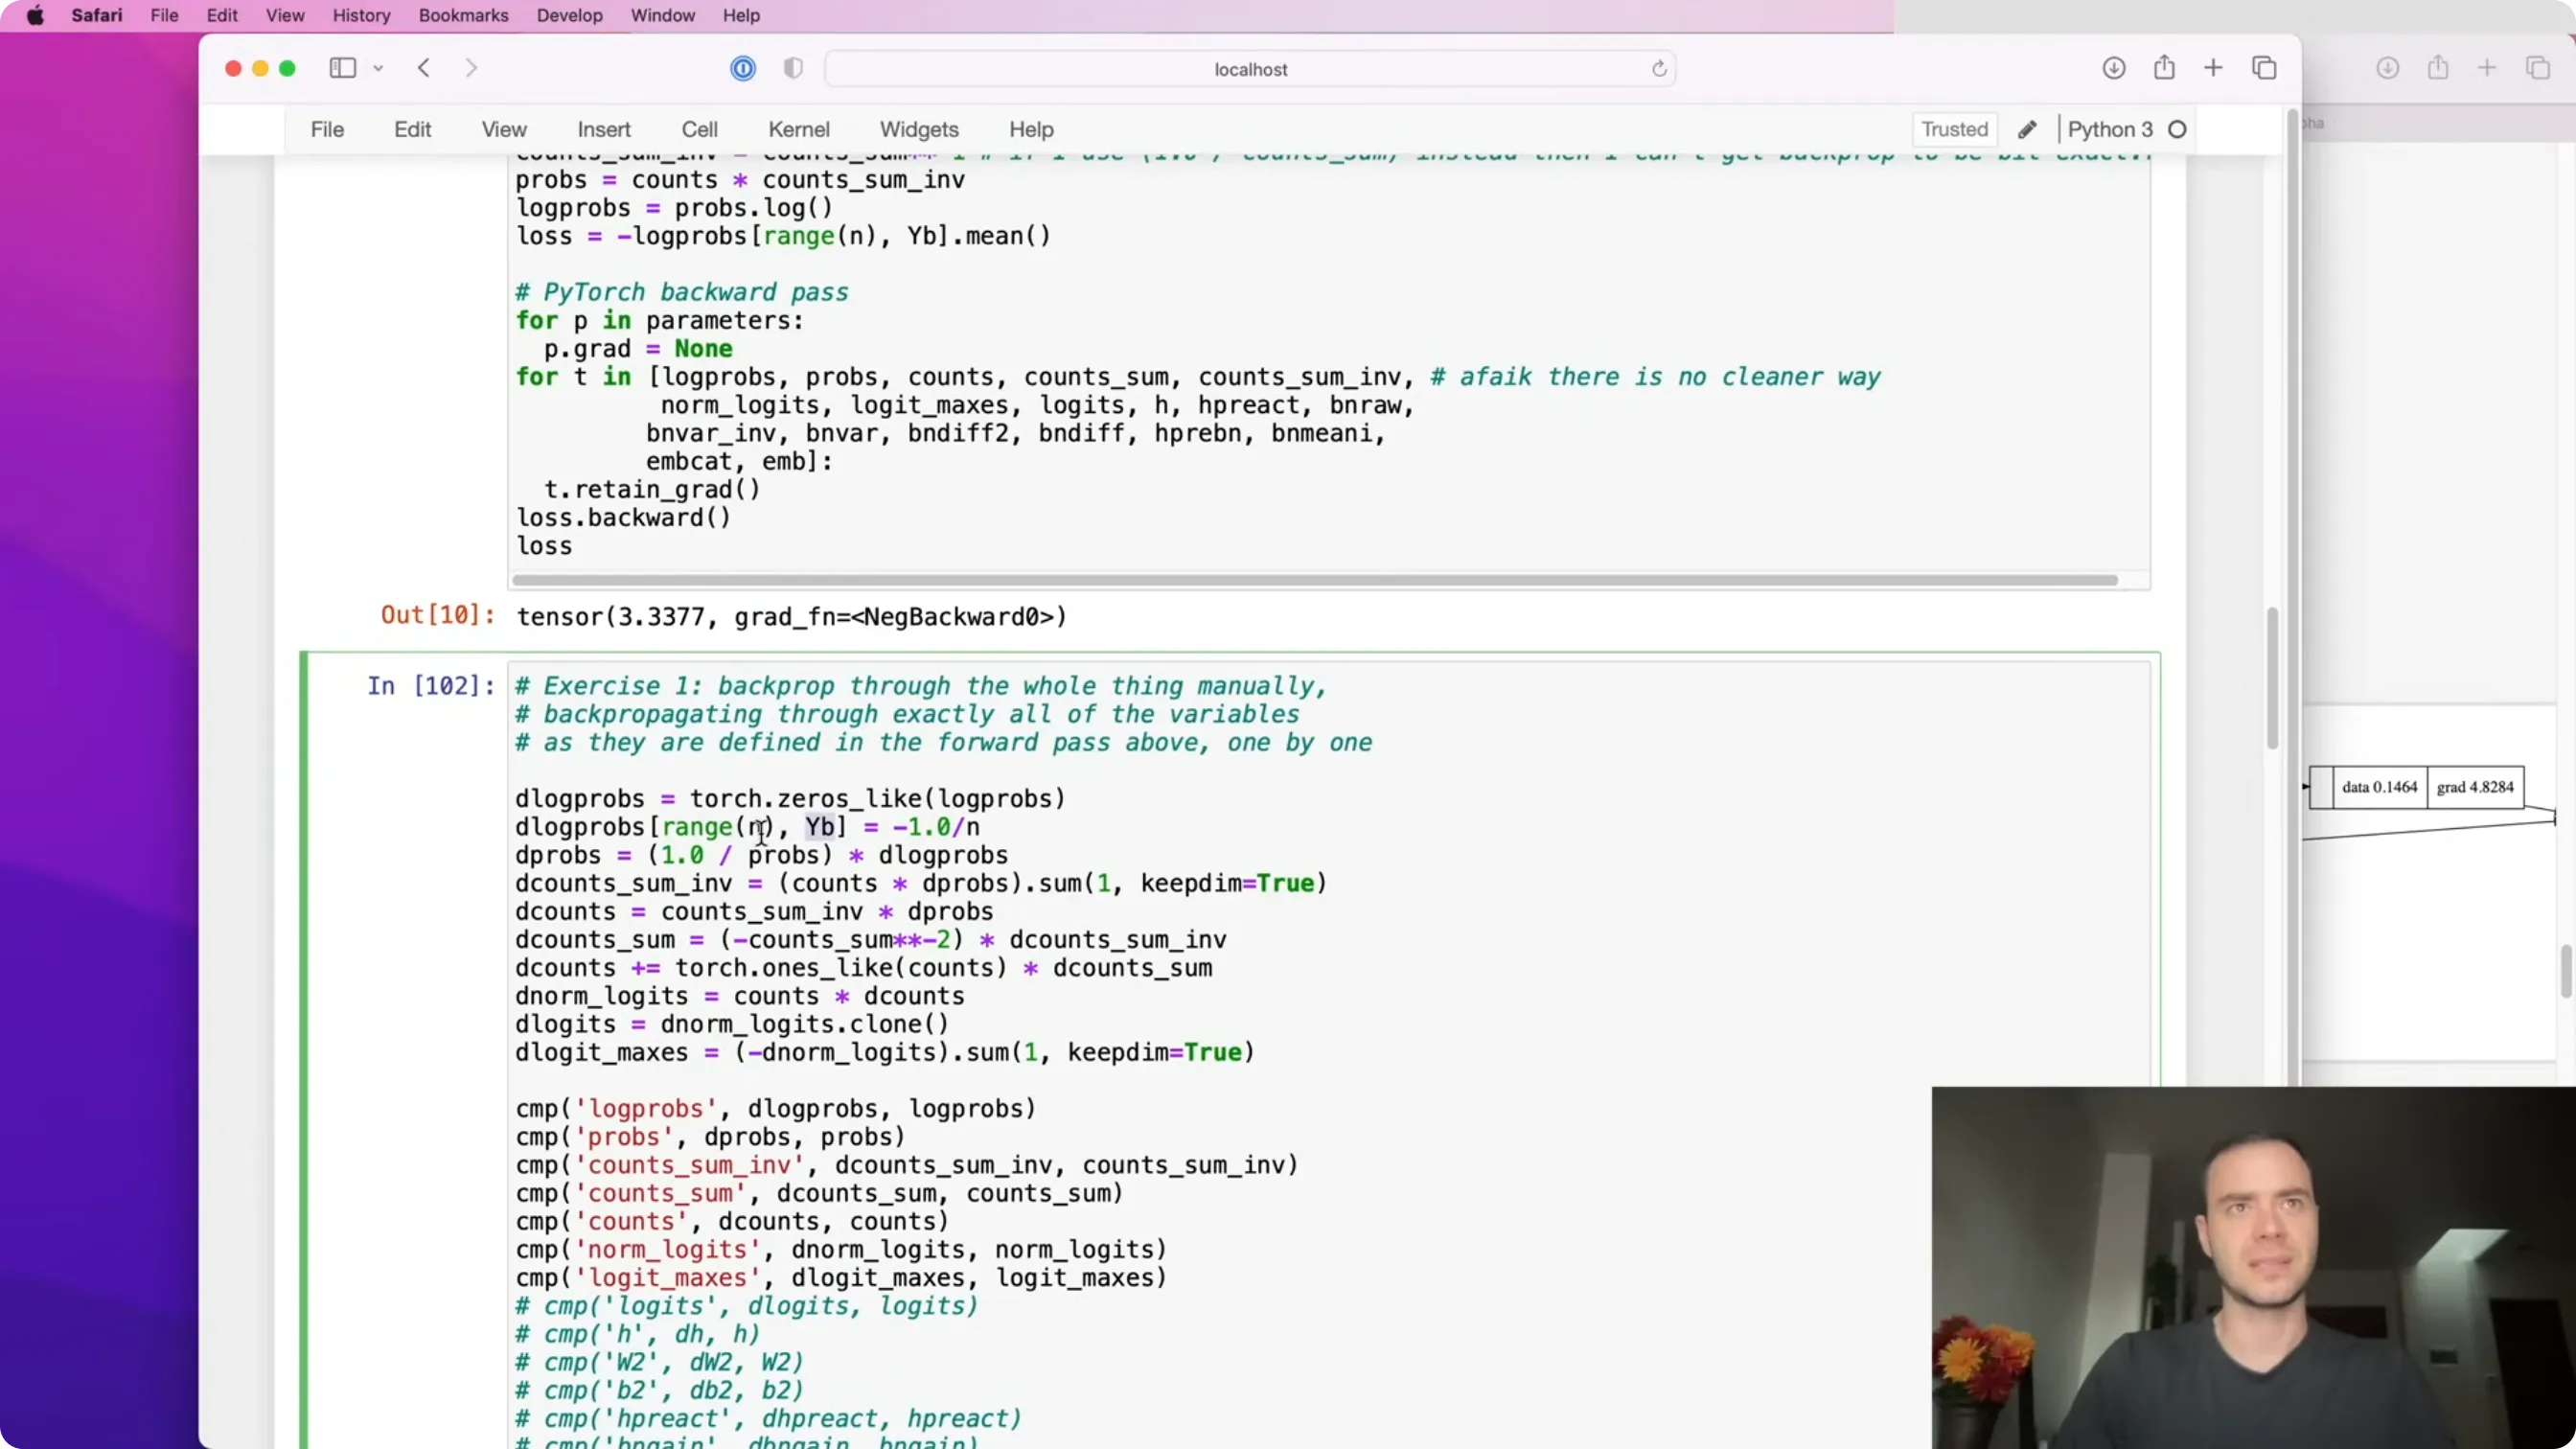
📷 `logit_maxes` 的反向:用 one-hot 把梯度散射回每行最大值的位置
回到原视频 (00:40:10)
3.5 线性层反向:不用背公式,用 shape 推
(参考时间: 00:41:51)
形状:h (32,64)、W2 (64,27)、b2 (27,) → logits (32,27)。
Karpathy 的方法论:先写一个 2×2 的小例子在纸上全展开,你会看到 $d_{11} = a_{11}b_{11} + a_{12}b_{21} + c_1$——不过是一堆乘法和加法,micrograd 早就教过你怎么求导了。只是"繁琐",并不"可怕"。
推导结果($\partial L/\partial A = (\partial L/\partial D)\,B^\top$ 等),但更实用的技巧是:
🔑 "我从来记不住矩阵乘法反向的公式。我用 shape 推。"
已知 $\partial L/\partial \text{logits}$ 是
(32,27)、W2是(64,27),而 $\partial L/\partial h$ 必须是(32,64)。只有一种乘法能让形状对上:python dh = dlogits @ W2.T # (32,27) @ (27,64) = (32,64) ✅ dW2 = h.T @ dlogits # (64,32) @ (32,27) = (64,27) ✅ db2 = dlogits.sum(0) # (27,) —— 只能沿 dim 0 求和,否则形状对不上 ✅「形状是唯一的向导,而它给出的正好就是正确答案。」编者拓展|为什么
db2是.sum(0):前向里+ b2把(27,)广播到了(32,27)(复制),所以反向要沿 dim 0 求和——又是"广播 ↔ 求和"的对偶性。sum的方向不用记,形状会告诉你。
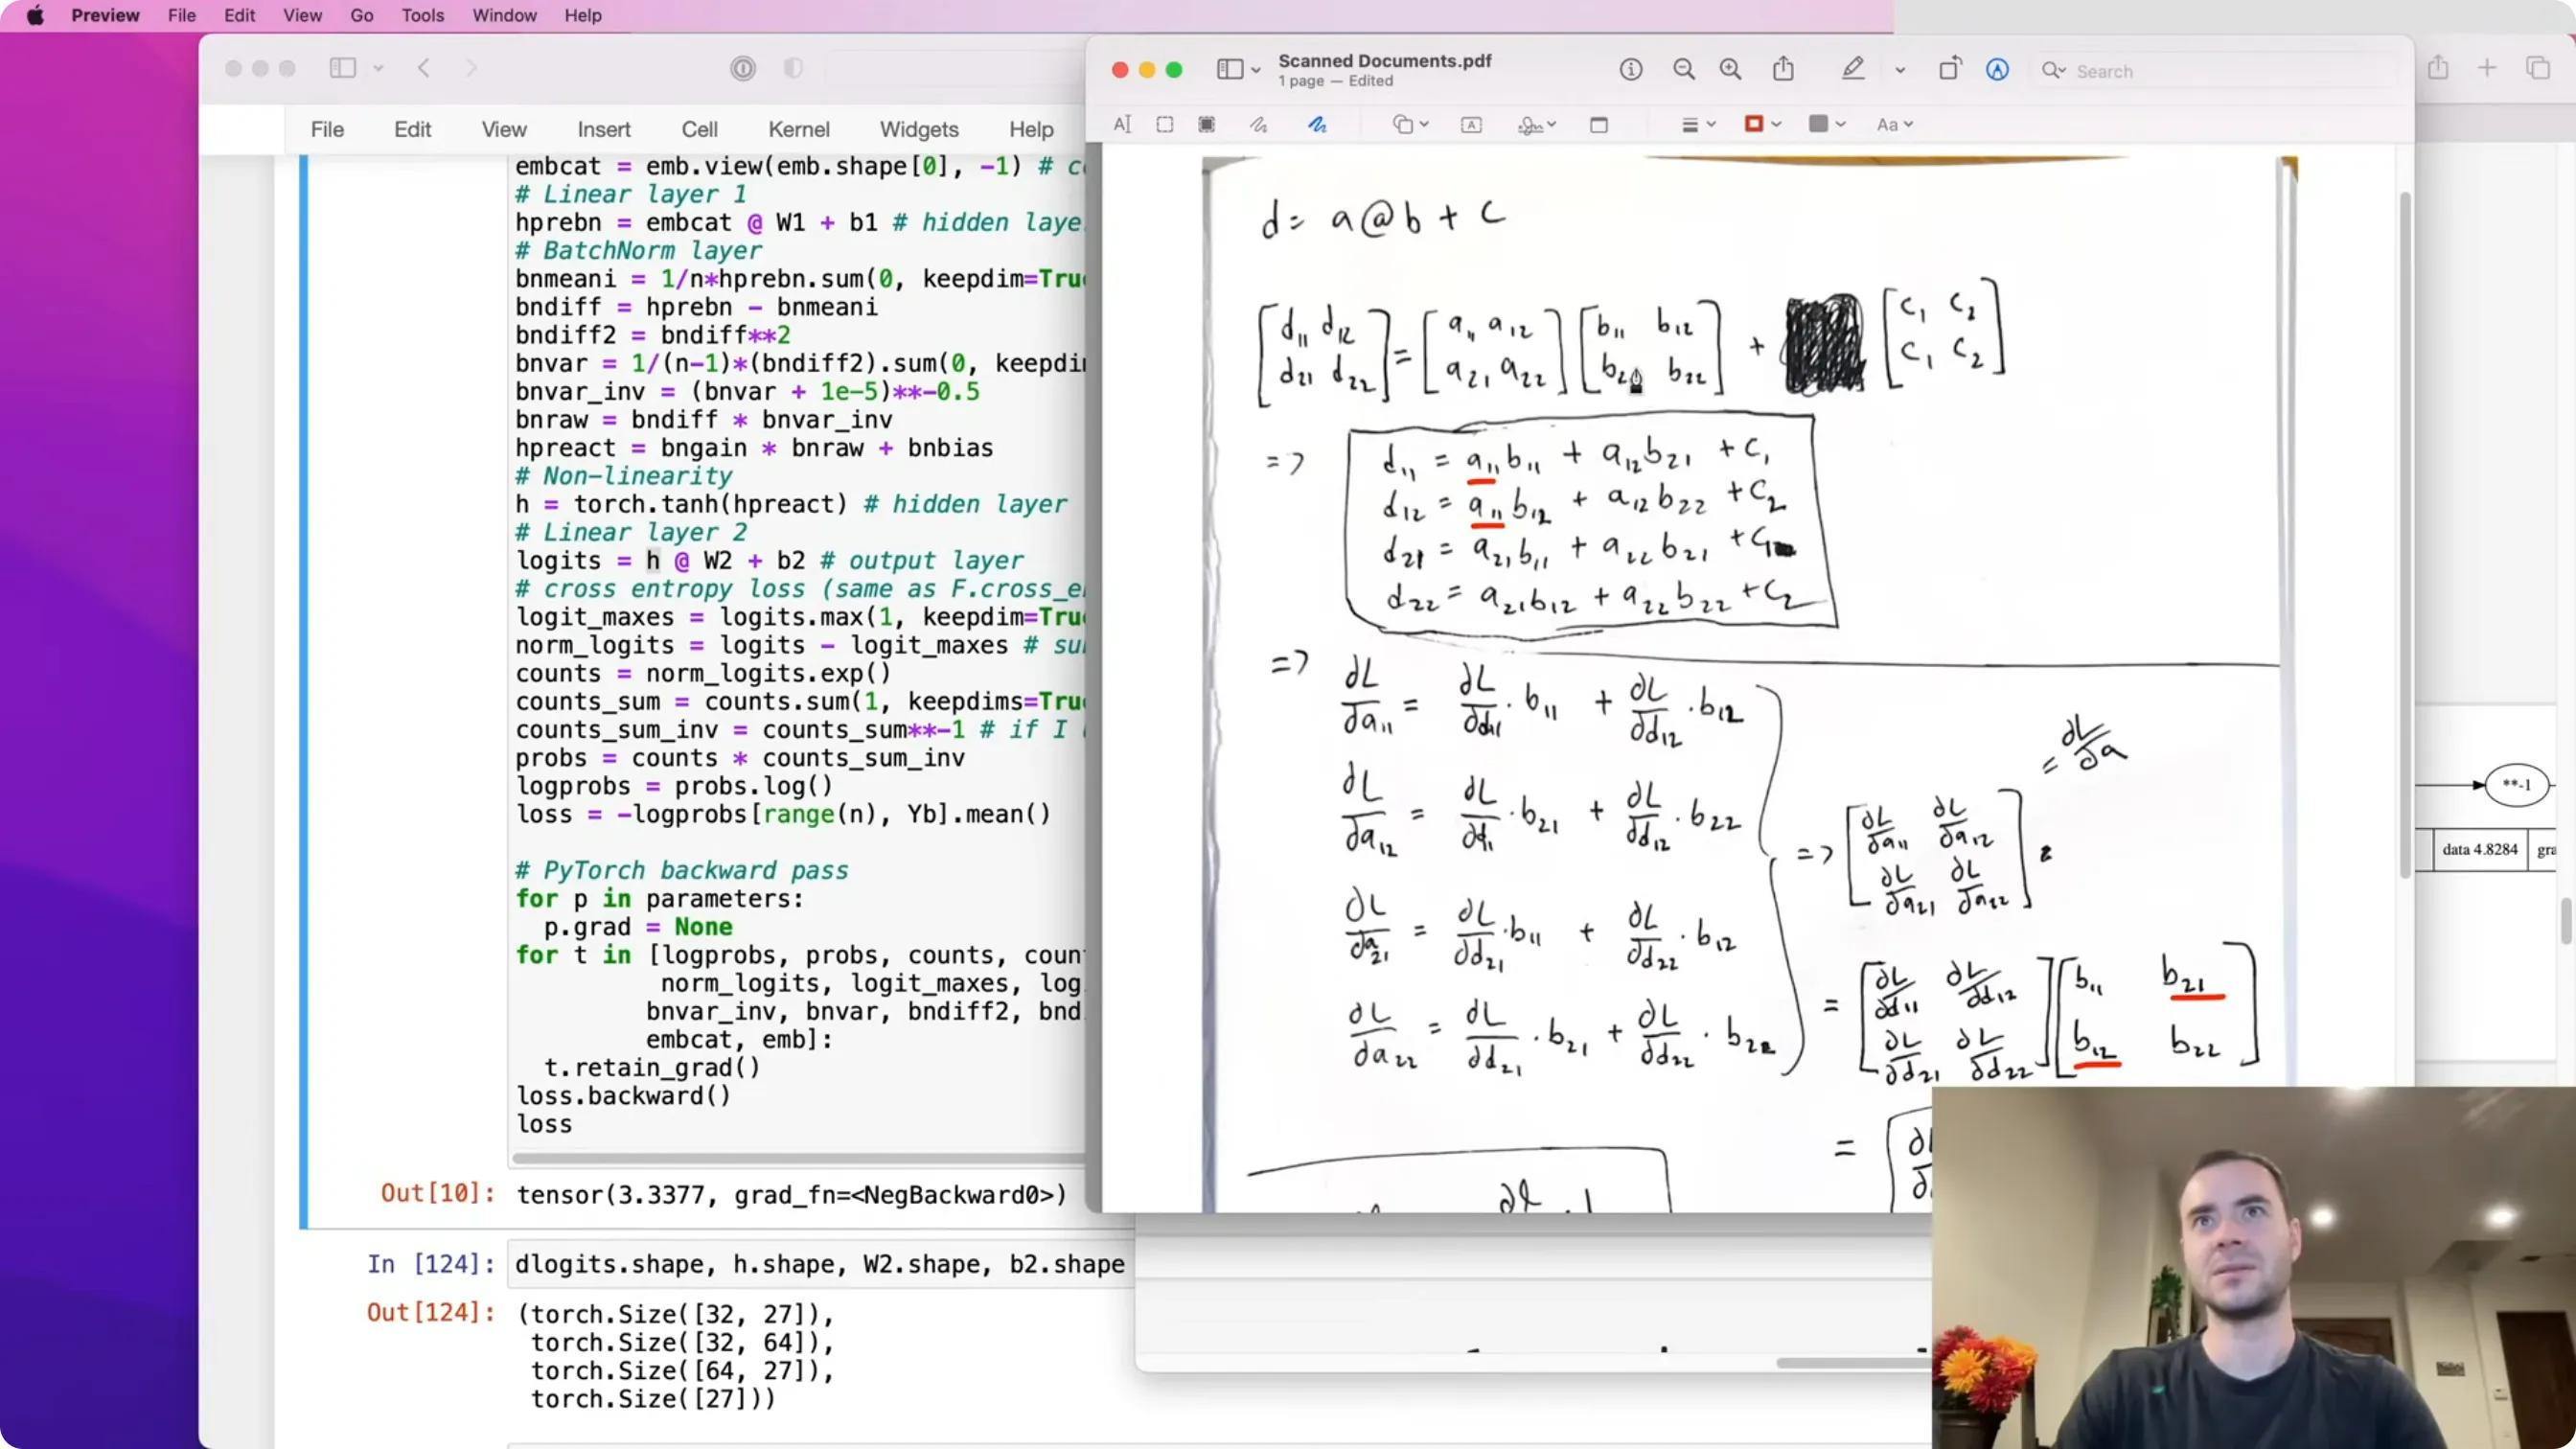
📷 矩阵乘法的反向:用纸笔写开 2×2 小例子,再"用形状推公式"
回到原视频 (00:47:40)
3.6 tanh 反向
(参考时间: 00:53:47)
$$\frac{d}{dx}\tanh(x) = 1 - \tanh^2(x)$$
注意:这个公式用的是 tanh 的"输出",不是"输入"。
dhpreact = (1.0 - h**2) * dh
编者说明:Wolfram Alpha 会给你 $\text{sech}^2(x)$——不好用。「但幸好 Google 图片搜索不会让我们失望」,它给出的是 $1-a^2$($a=\tanh z$)这个更好用的形式。(这也呼应上一讲:饱和时 $h\to\pm1$,$1-h^2\to0$,梯度被杀死。)
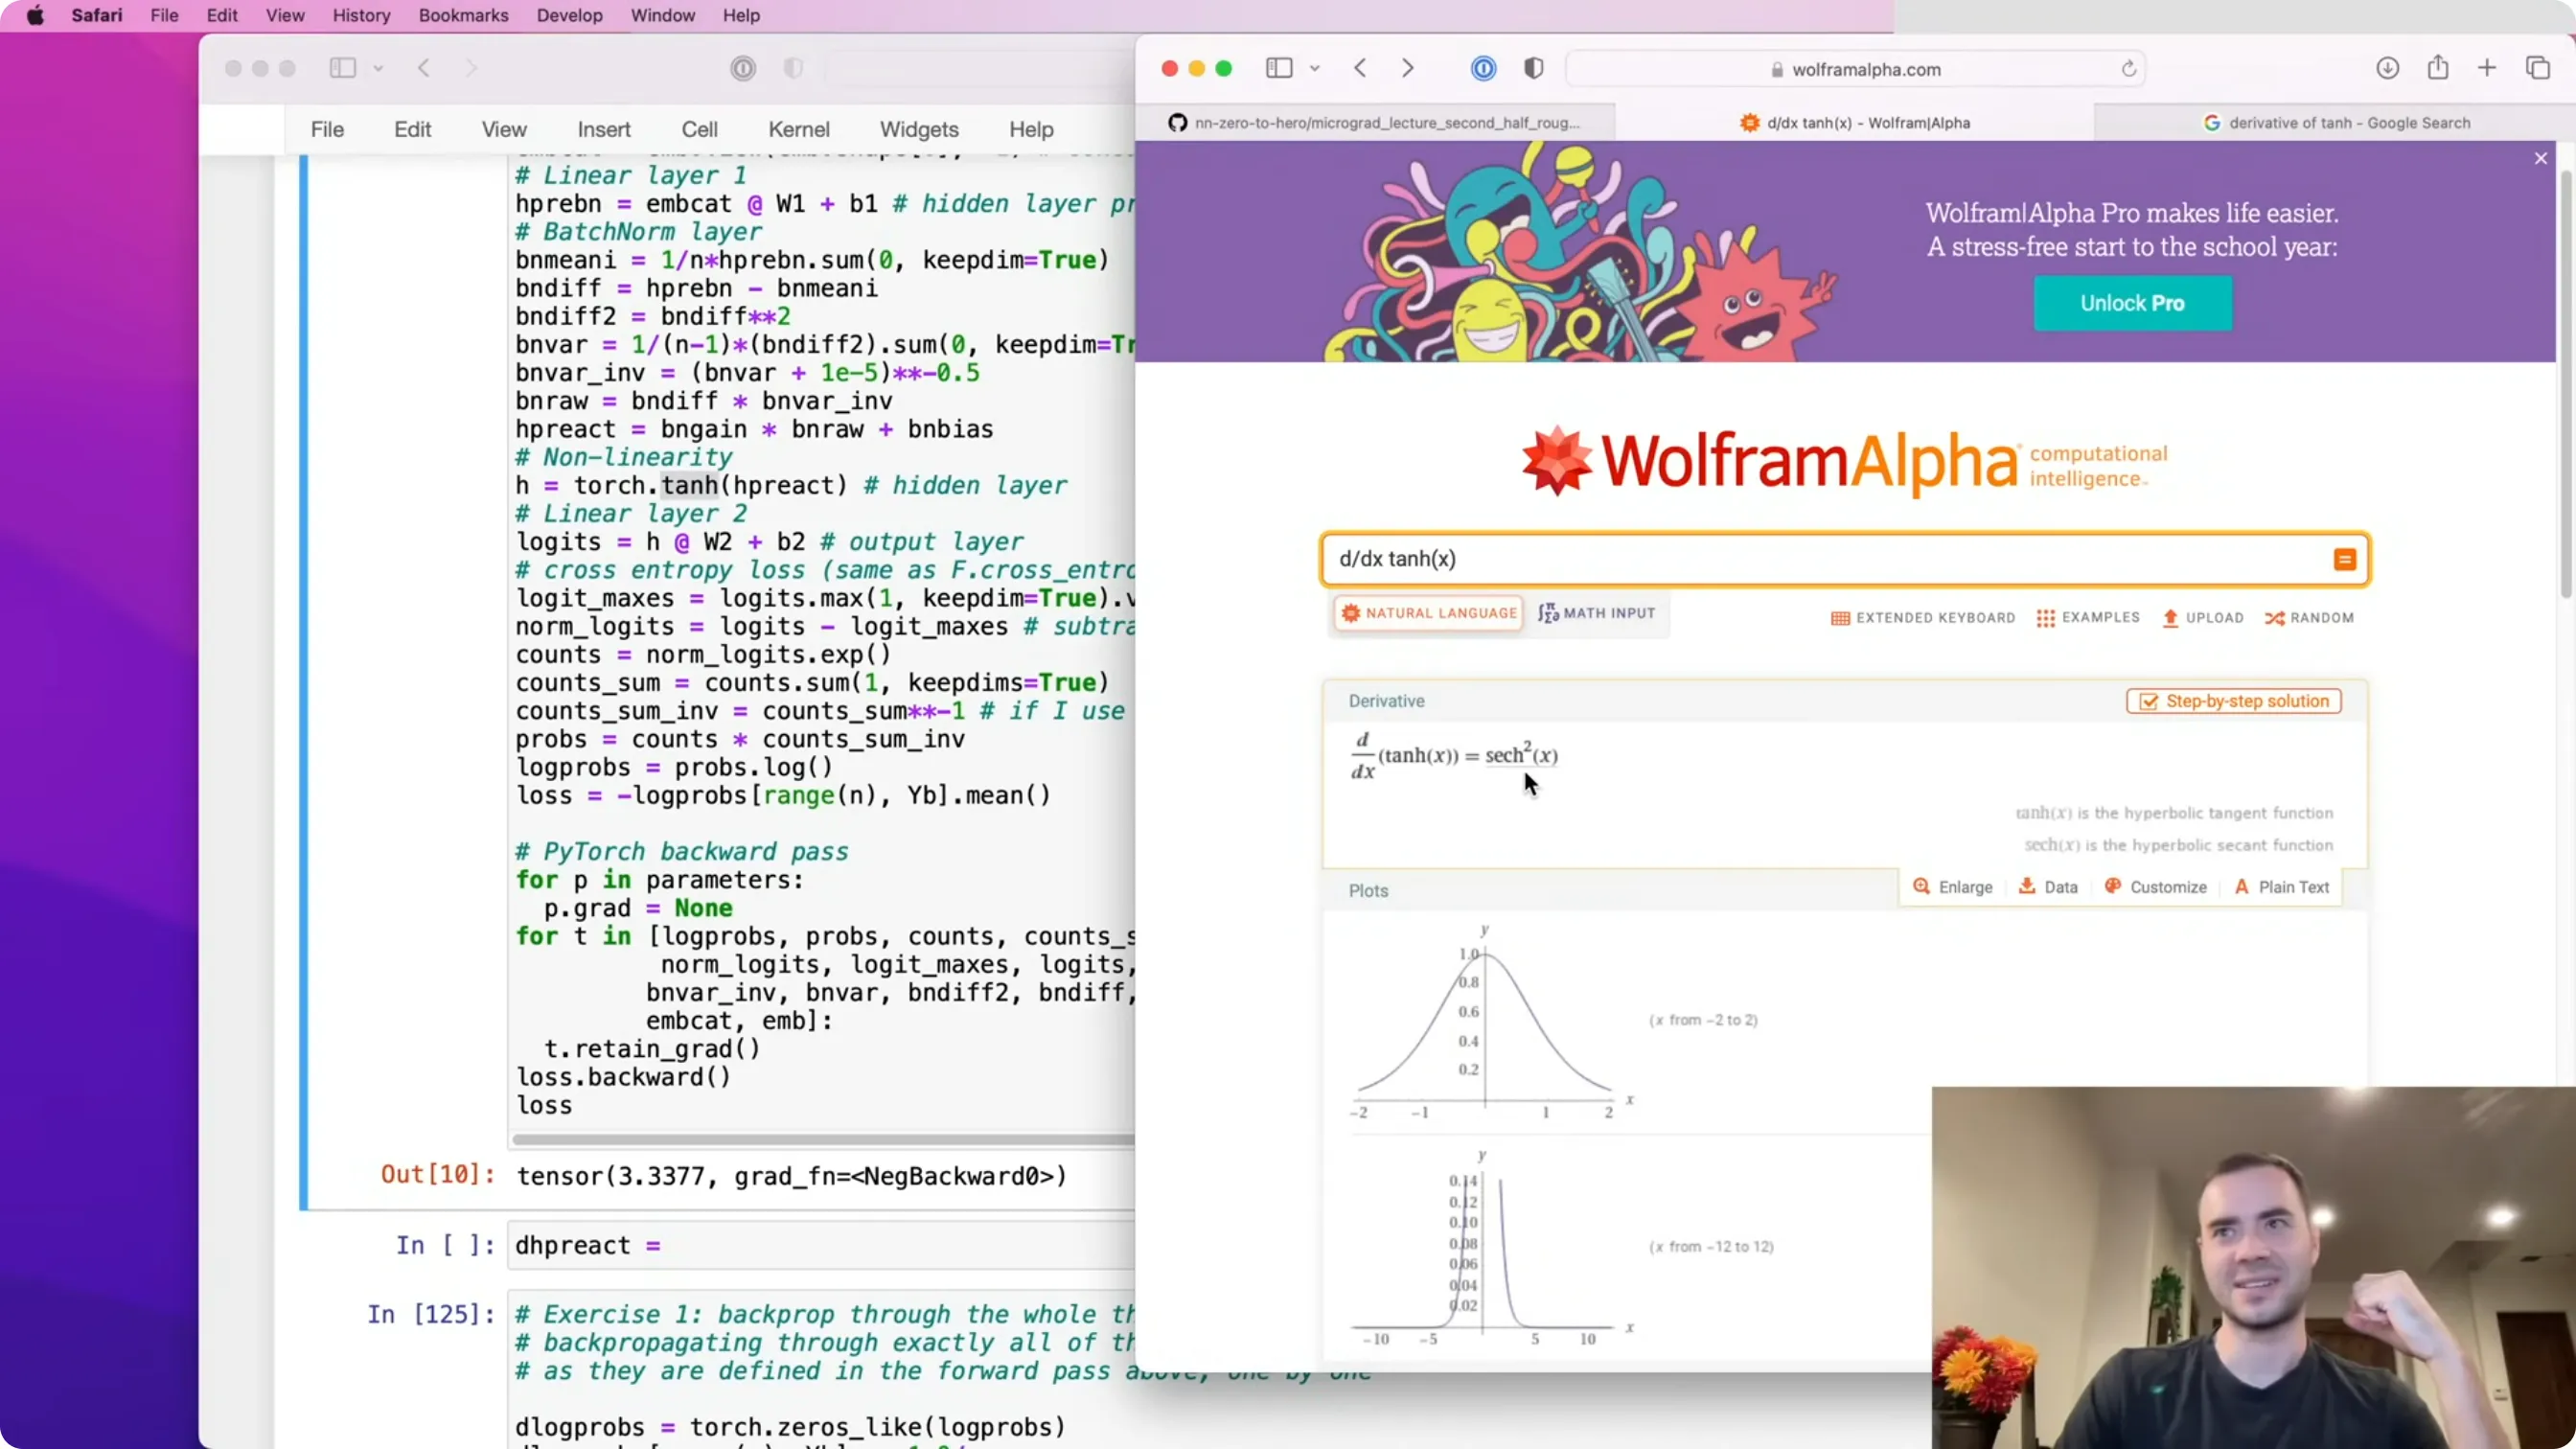
📷 tanh 的反向:$1-h^2$,用的是输出而不是输入
回到原视频 (00:54:00)
3.7 BatchNorm 的 γ、β 与内部
(参考时间: 00:55:15)
hpreact = bngain * bnraw + bnbias——元素级乘法,简单,但 bngain (1,64) 会被广播到 (32,64):
dbngain = (bnraw * dhpreact).sum(0, keepdim=True)   # 广播 → 求和;keepdim 保持 (1,64)
dbnraw  = bngain * dhpreact                          # 乘法支路
dbnbias = dhpreact.sum(0, keepdim=True)              # 广播 → 求和
keepdim=True是必须的——否则形状从(1,64)变成(64,),后面的广播就不对了。「我不记得当初为什么把bngain/bnbias做成二维……但只要你自始至终保持一致,就没问题。」
接着进 BN 内部(bnmeani → bndiff → bndiff2 → bnvar → bnvar_inv → bnraw),逐步回传,每一步都遵循同样的对偶性:
dbndiff     = bnvar_inv * dbnraw
dbnvar_inv  = (bndiff * dbnraw).sum(0, keepdim=True)
dbnvar      = (-0.5 * (bnvar + 1e-5)**-1.5) * dbnvar_inv     # x^(-1/2) 的导数
dbndiff2    = (1.0/(n-1)) * torch.ones_like(bndiff2) * dbnvar # sum 的反向 = 复制
dbndiff    += 2 * bndiff * dbndiff2                           # 第二条支路 → +=
dbnmeani    = (-dbndiff).sum(0, keepdim=True)
dhprebn     = dbndiff.clone()
dhprebn    += 1.0/n * (torch.ones_like(hprebn) * dbnmeani)
bndiff有两条支路(一路直接去bnraw,一路经bndiff2 → bnvar → bnvar_inv),所以必须等两支都算完再+=。Karpathy 特意在中途跑了一次cmp,故意让你看到它"报错"—— 「cmp不会总是骗你说"对了",它真的能检测出梯度是错的。 这本身也是个好现象。」编者说明|
n-1的来历:代码里用1/(n-1)而不是论文的1/n——这是 Bessel's correction,下一节专门讲。
3.8 剩下两层:view 与 embedding
(参考时间: 01:18:44)
- Linear1:和 Linear2 完全一样,照 shape 推:
python dembcat = dhprebn @ W1.T; dW1 = embcat.T @ dhprebn; db1 = dhprebn.sum(0) view:反向就是"再看回去"(view 只是同一块内存的逻辑解释,不是数据搬运):python demb = dembcat.view(emb.shape) # (32,30) → (32,3,10)- embedding(最有意思的一个):
emb = C[Xb]是「按索引从查找表里"挑行"」。
反向因此是"路由 + 累加":每个挑出来的 10 维向量,它的梯度要还回它来自的那一行;而同一行被用多次时,梯度要相加(又是"复用 → 求和")。
python
  dC = torch.zeros_like(C)
  for k in range(Xb.shape[0]):
      for j in range(Xb.shape[1]):
          ix = Xb[k, j]
          dC[ix] += demb[k, j]      # += !同一行可能被多次引用
「用 Python 的 for 循环确实不优雅,也许有人能想到更好的向量化写法。」
编者拓展|向量化写法:这正是
index_add_/scatter_add_的用武之地——python dC.index_add_(0, Xb.view(-1), demb.view(-1, C.shape[1]))效果与双重循环完全一致,但在 GPU 上快几个数量级。这个"挑行的反向是 scatter-add"的模式,后来在 Transformer 的 embedding、MoE 路由、以及各种 gather/scatter 操作里反复出现,值得记住。
✅ cmp('C', dC, C) → exact!「我们把这个庞然大物整个反向传播完了。」
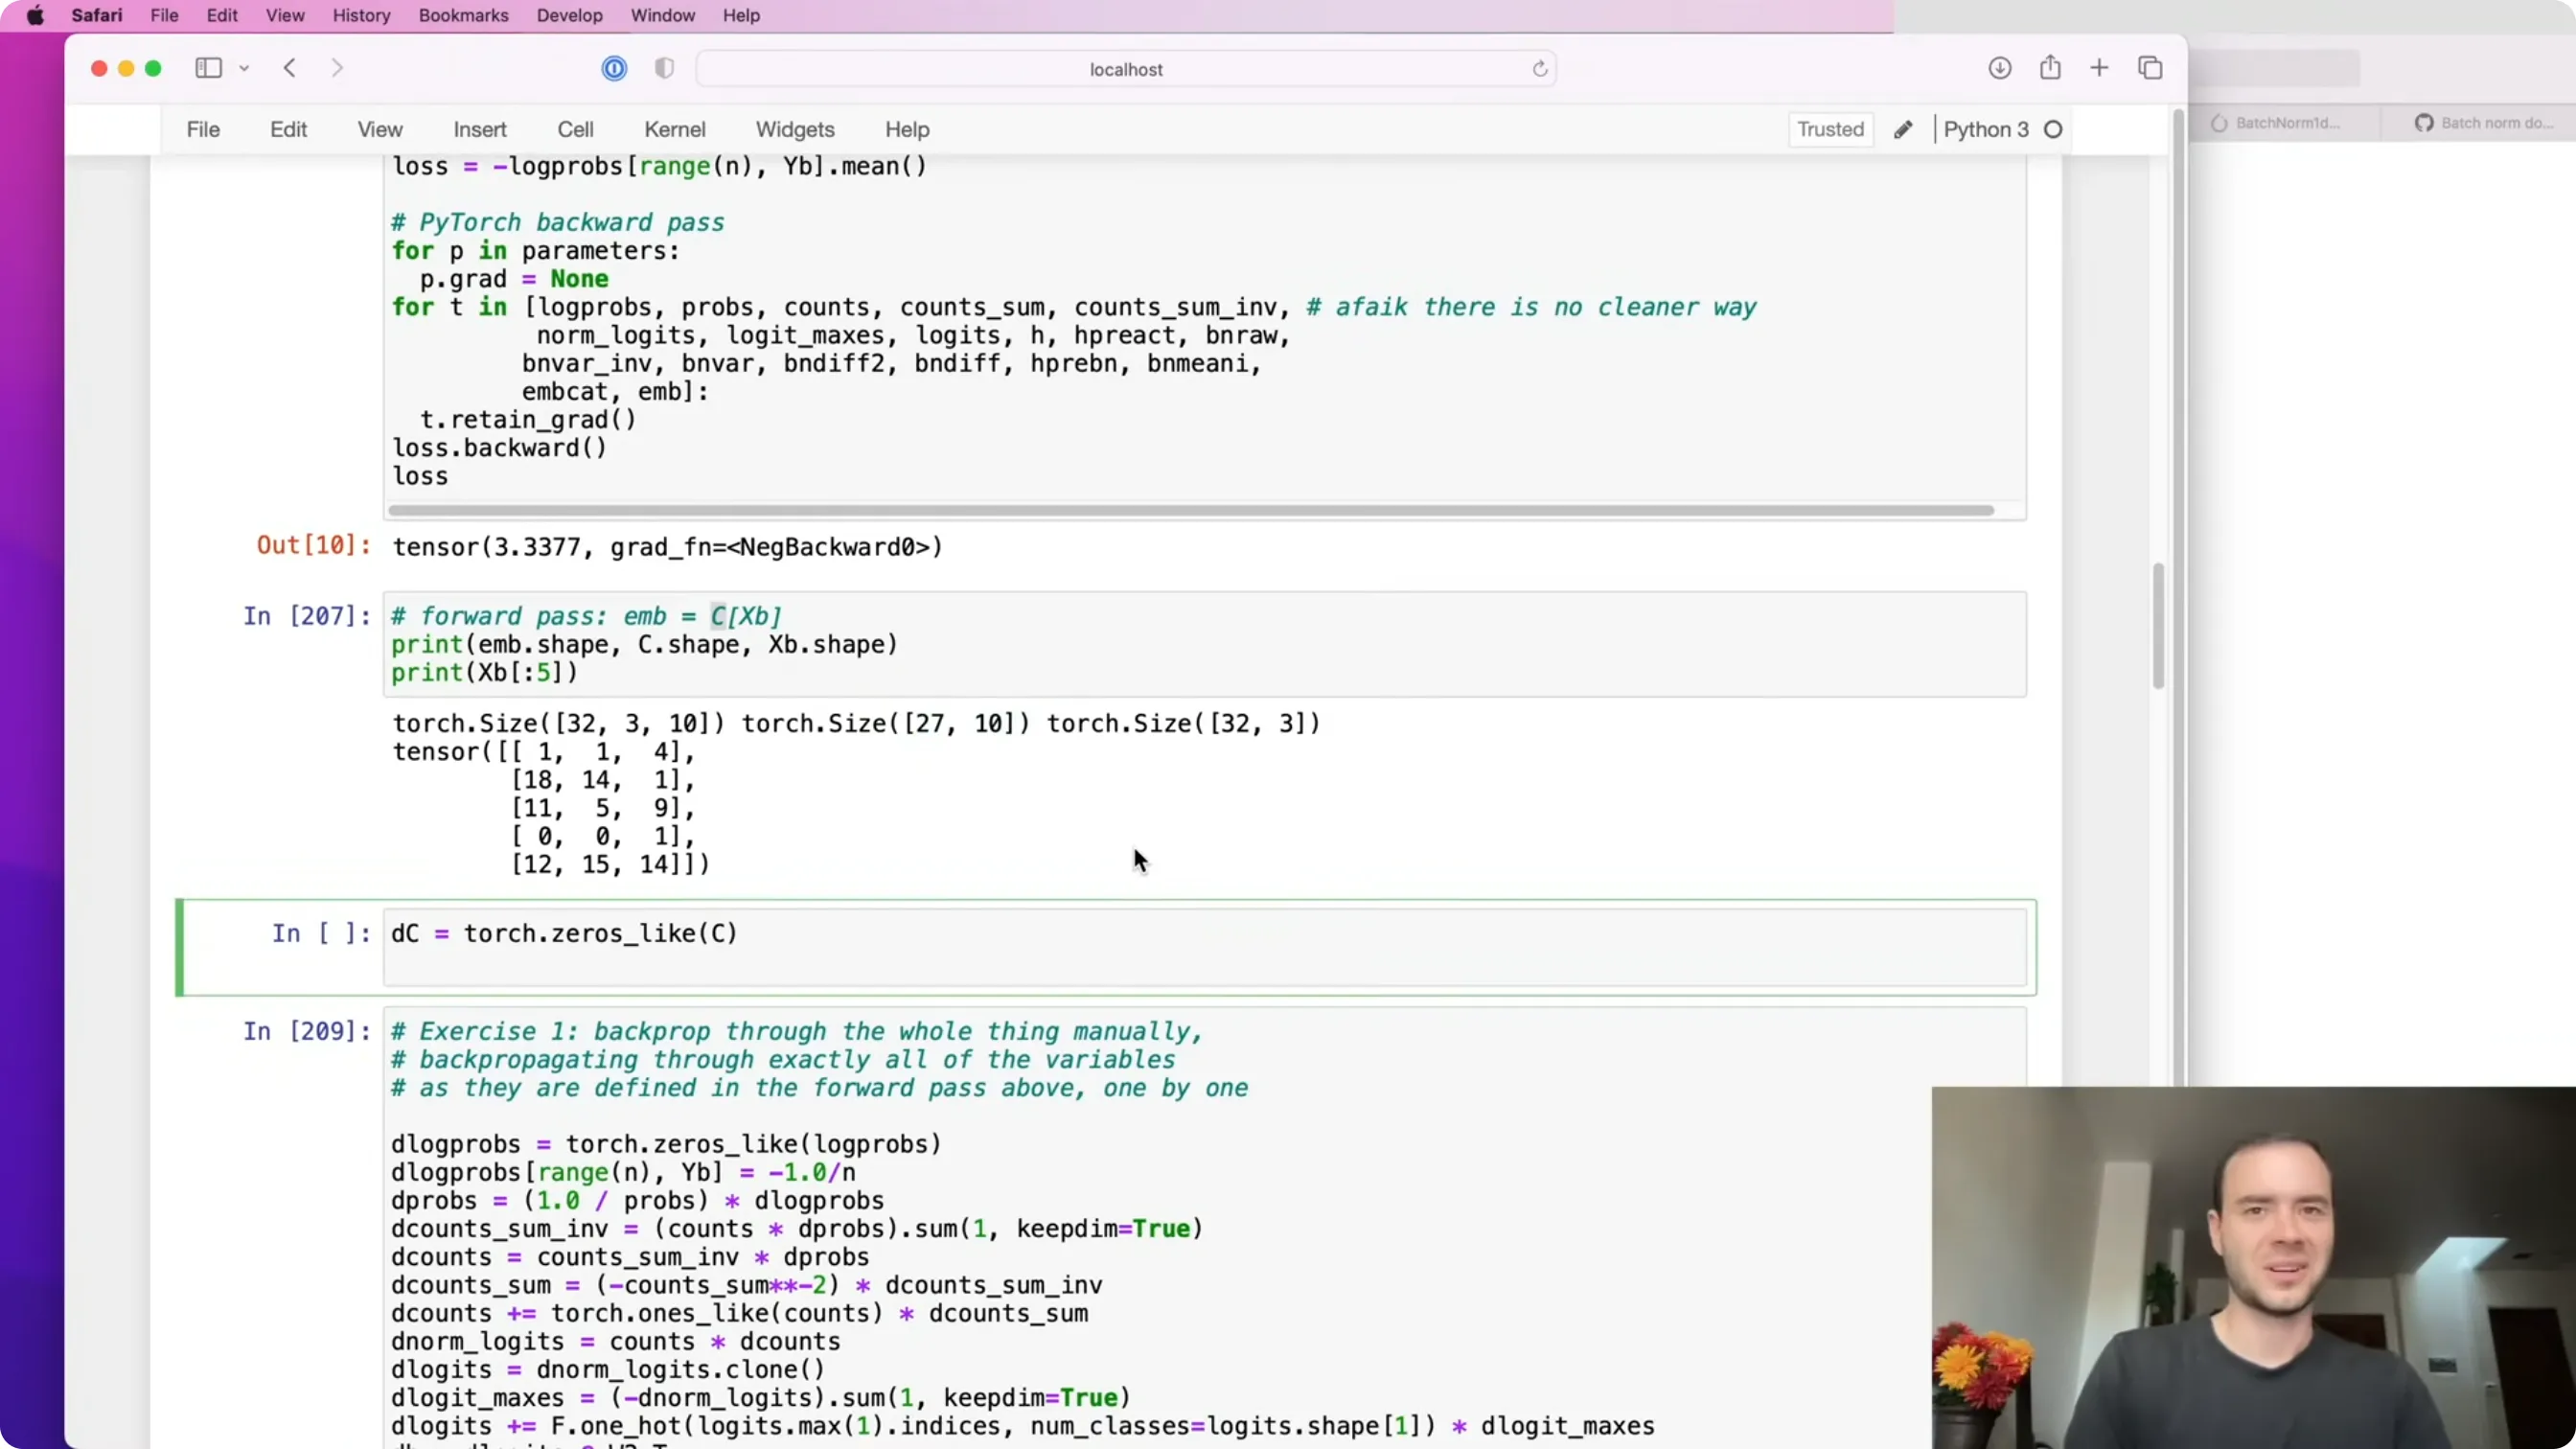
📷 embedding 的反向:把梯度"路由"回它来自的那一行,同行的梯度相加
回到原视频 (01:24:40)
四、插曲:BatchNorm 里的 Bessel 校正
(参考时间: 01:05:17)
前向里有一行别有用心的偏离:
bnvar = 1.0/(n-1) * (bndiff2).sum(0, keepdim=True) # 注意是 n-1,不是 n
估计方差有两种方式:
| 公式 | 名称 | |
|---|---|---|
| 有偏估计(biased) | $\frac{1}{n}\sum (x_i-\mu)^2$ | 论文里训练时用的 |
| 无偏估计(unbiased) | $\frac{1}{n-1}\sum (x_i-\mu)^2$ | Bessel's correction |
为什么除以 $n-1$? 因为 $\mu$ 是用同一批数据估出来的,样本越多、$\mu$ 越"贴合"这批数据,从而系统性地低估真实方差。除以 $n-1$ 恰好能补偿这个偏差。当 $n$ 很小(比如 minibatch 32)时,这个偏差不可忽略。
而论文里有一个令人困惑的不一致:
训练时用有偏(
1/n),推理时(估计 running mean/variance)用无偏(1/(n-1))——这是一个"训练-测试不匹配"(train/test mismatch)。
PyTorch 忠实地沿用了论文这个行为,于是:
torch.var()的unbiased参数默认是True,但文档里没明说;BatchNorm1d的文档说"标准差用有偏估计"——这其实不完全对(社区已在 issue 里指出):训练用有偏,但更新running_var时用无偏。
Karpathy 的立场: 「我不喜欢训练-测试不一致。我认为这是一个 bug,论文里也没给出理由。所以我倾向于在自己的工作里统一使用无偏估计(训练和推理都用
n-1)。」 「遗憾的是BatchNorm没有提供开关让你统一选有偏/无偏——所以任何用 BatchNorm 的人,代码里都带着这个我认为的 bug。」 「好在 minibatch 一大,这个问题就基本消失了……也许有人能解释为什么这样是 OK 的,但至少目前我觉得难以接受。」
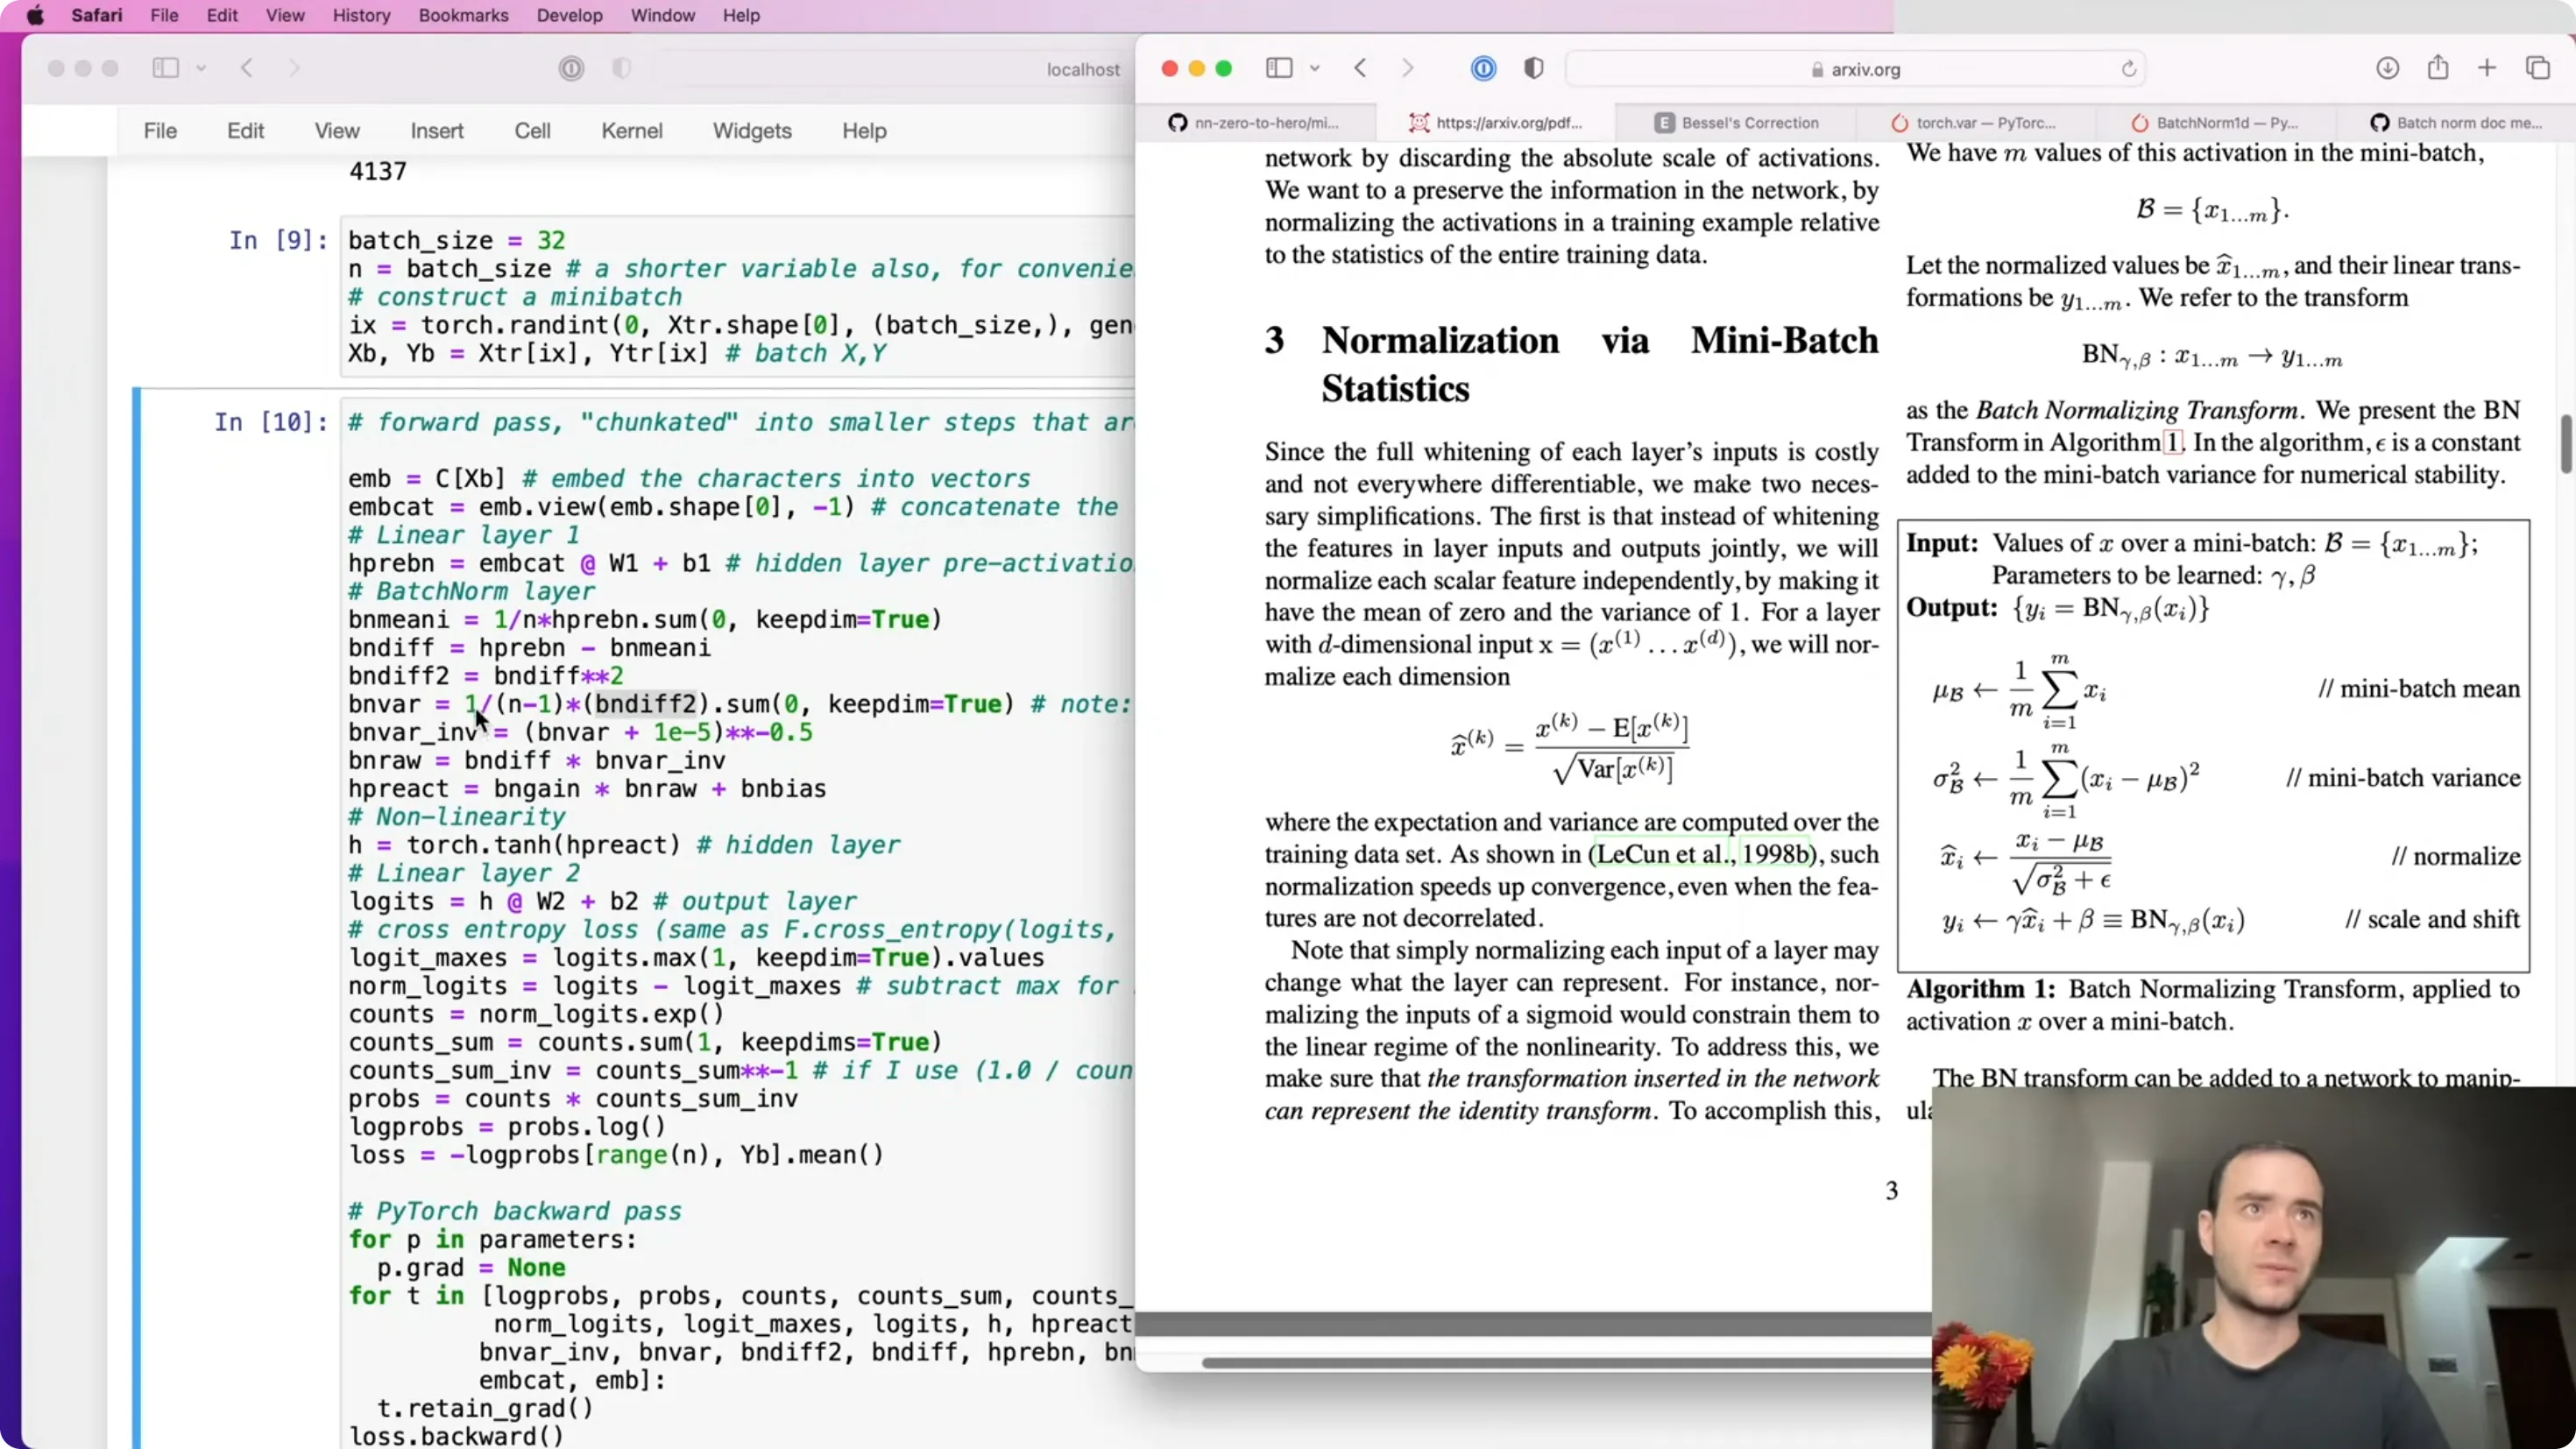
📷 Bessel's correction:训练用有偏、推理用无偏,是论文留下的"训练-测试不一致"
回到原视频 (01:05:50)
五、Exercise 2:交叉熵损失的解析反向
(参考时间: 01:26:31)
「E1 我们其实做了太多无用功。 它当然是极好的练习,但实践中不会那么做——因为我把 loss 拆成了最细的原子、逐一回传。」
真相是:如果把 loss 看成一个数学表达式,在纸上求导,很多项会相消、表达式会大幅简化——又快又好实现。
5.1 纸笔推导
对单个样本,设 $p = \text{softmax}(l)$,$y$ 是正确类别:
$$L = -\log p_y = -\log\frac{e^{l_y}}{\sum_j e^{l_j}} = -l_y + \log\sum_j e^{l_j}$$
对第 $i$ 个 logit 求导,分成 $i=y$ 与 $i\neq y$ 两种情况讨论,最终惊人地简洁:
$$\frac{\partial L}{\partial l_i} = p_i - \mathbf{1}[i = y]$$
($\mathbf{1}[\cdot]$ 是指示函数:条件成立取 1,否则取 0。)
对整个 batch:loss 是各样本 loss 的平均,所以还要除以 $n$。
5.2 实现(三行)
dlogits = F.softmax(logits, 1)          # (1) 那个 p
dlogits[range(n), Yb] -= 1              # (2) 正确位置减 1(one-hot 减法)
dlogits /= n                            # (3) 平均的反向:除以 n
✅ 结果:不是逐位相等(
maxdiff ~5e-9)——纯浮点误差,公式是对的。为什么不能逐位相等? 因为我们的路径是
softmax(logits) - onehot,而 PyTorch 的F.cross_entropy内部走的是logsumexp那一套数值稳定的路径,代数上等价、浮点上不同。
5.3 这个梯度的"力学直觉"
(参考时间: 01:32:33)
Karpathy 把 dlogits 可视化:
- 每一行(一个样本)的内容就是
probs本身; - 正确类别那个位置被减掉了 1;
- 每行求和恰好为 0。
🔑 把每个格子想象成一个"力": * 对错误字符:往下压(降低它们的概率); * 对正确字符:往上拉(提高它的概率); * 而"下压力"的总量 = "上拉力"的总量(因为求和为 0)——斥力与引力严格平衡。
「把神经网络想成一个巨大的滑轮系统:你在 logits 上往上拉、往下压,这股张力通过一层层传动机构传递下去,最后在权重和偏置上"拽"一下;参数一点点地屈服于这个拉力——这就是训练在高层面上的样子。」
而且力度正比于"错得有多离谱":如果一个样本的预测恰好完全正确($p$ 在正确位置是 1、其余为 0),那么该行梯度全是 0——没有力,也就没有更新。「你预测得有多不准,你受到的拉力就有多大。」
这就是交叉熵损失在反向传播里的"魔法"。
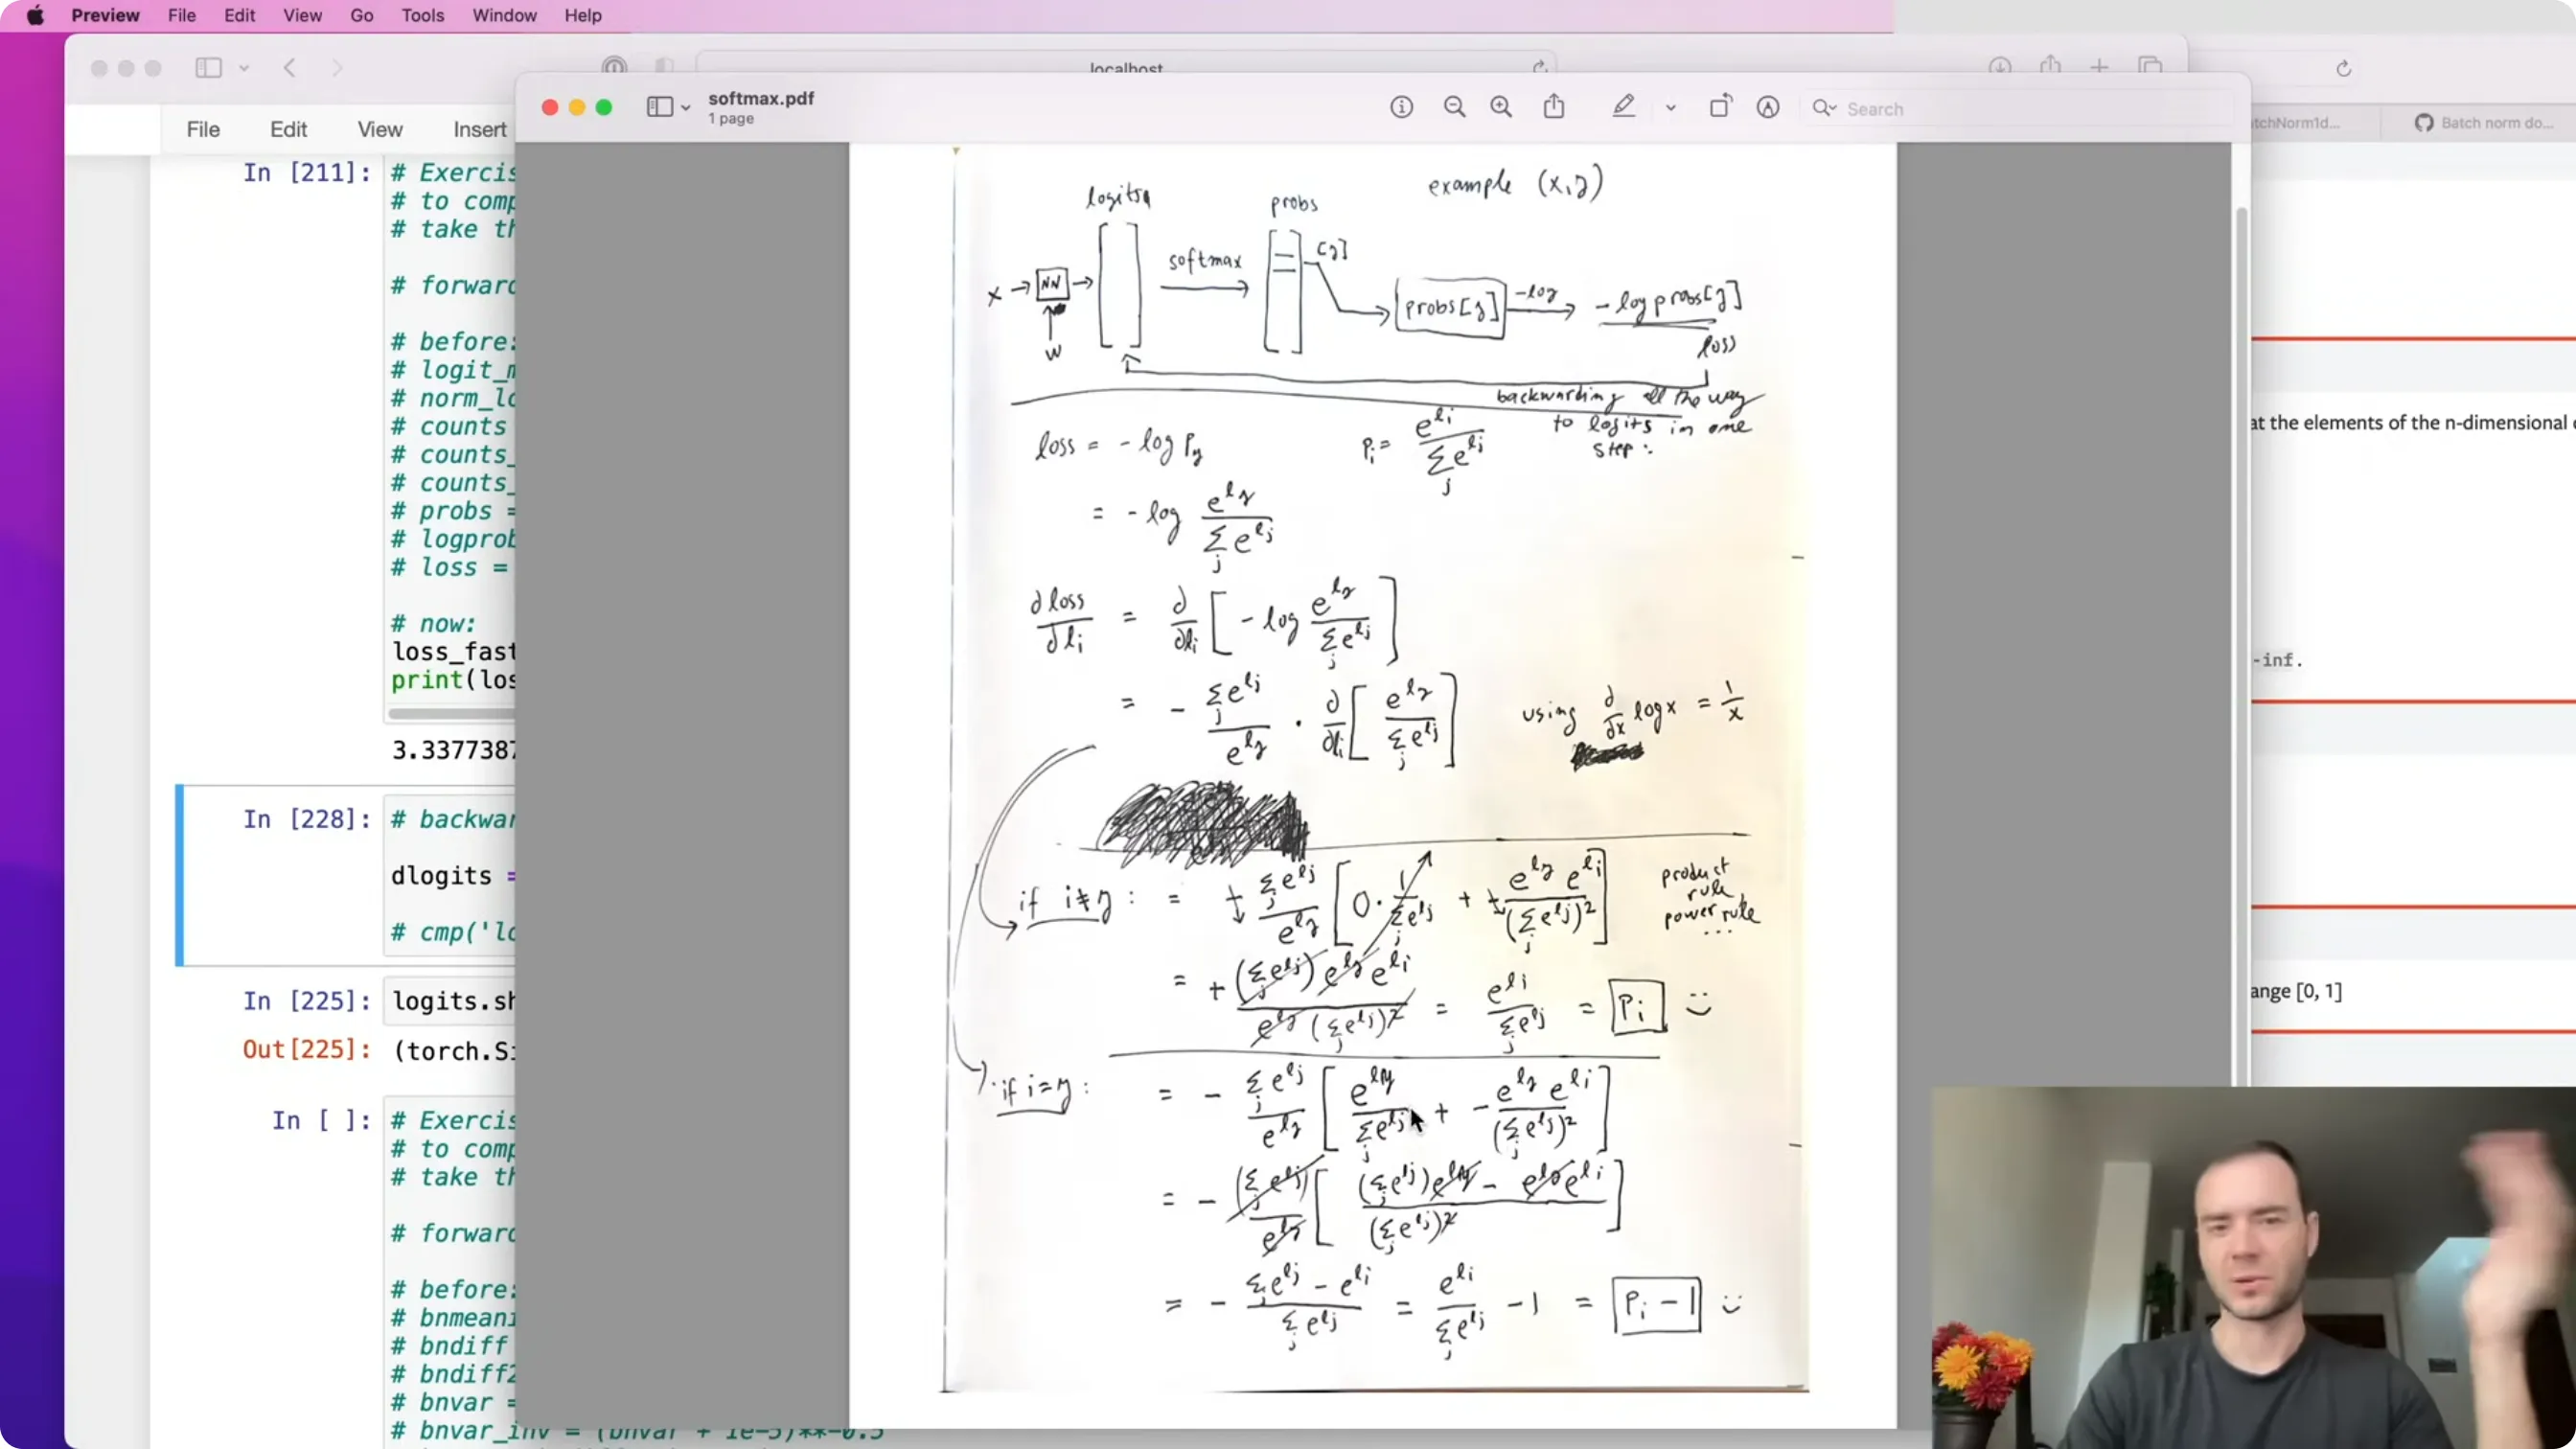
📷 交叉熵解析梯度:$p - \text{one-hot}$,黑方块是减了 1 的正确位置
回到原视频 (01:30:20)
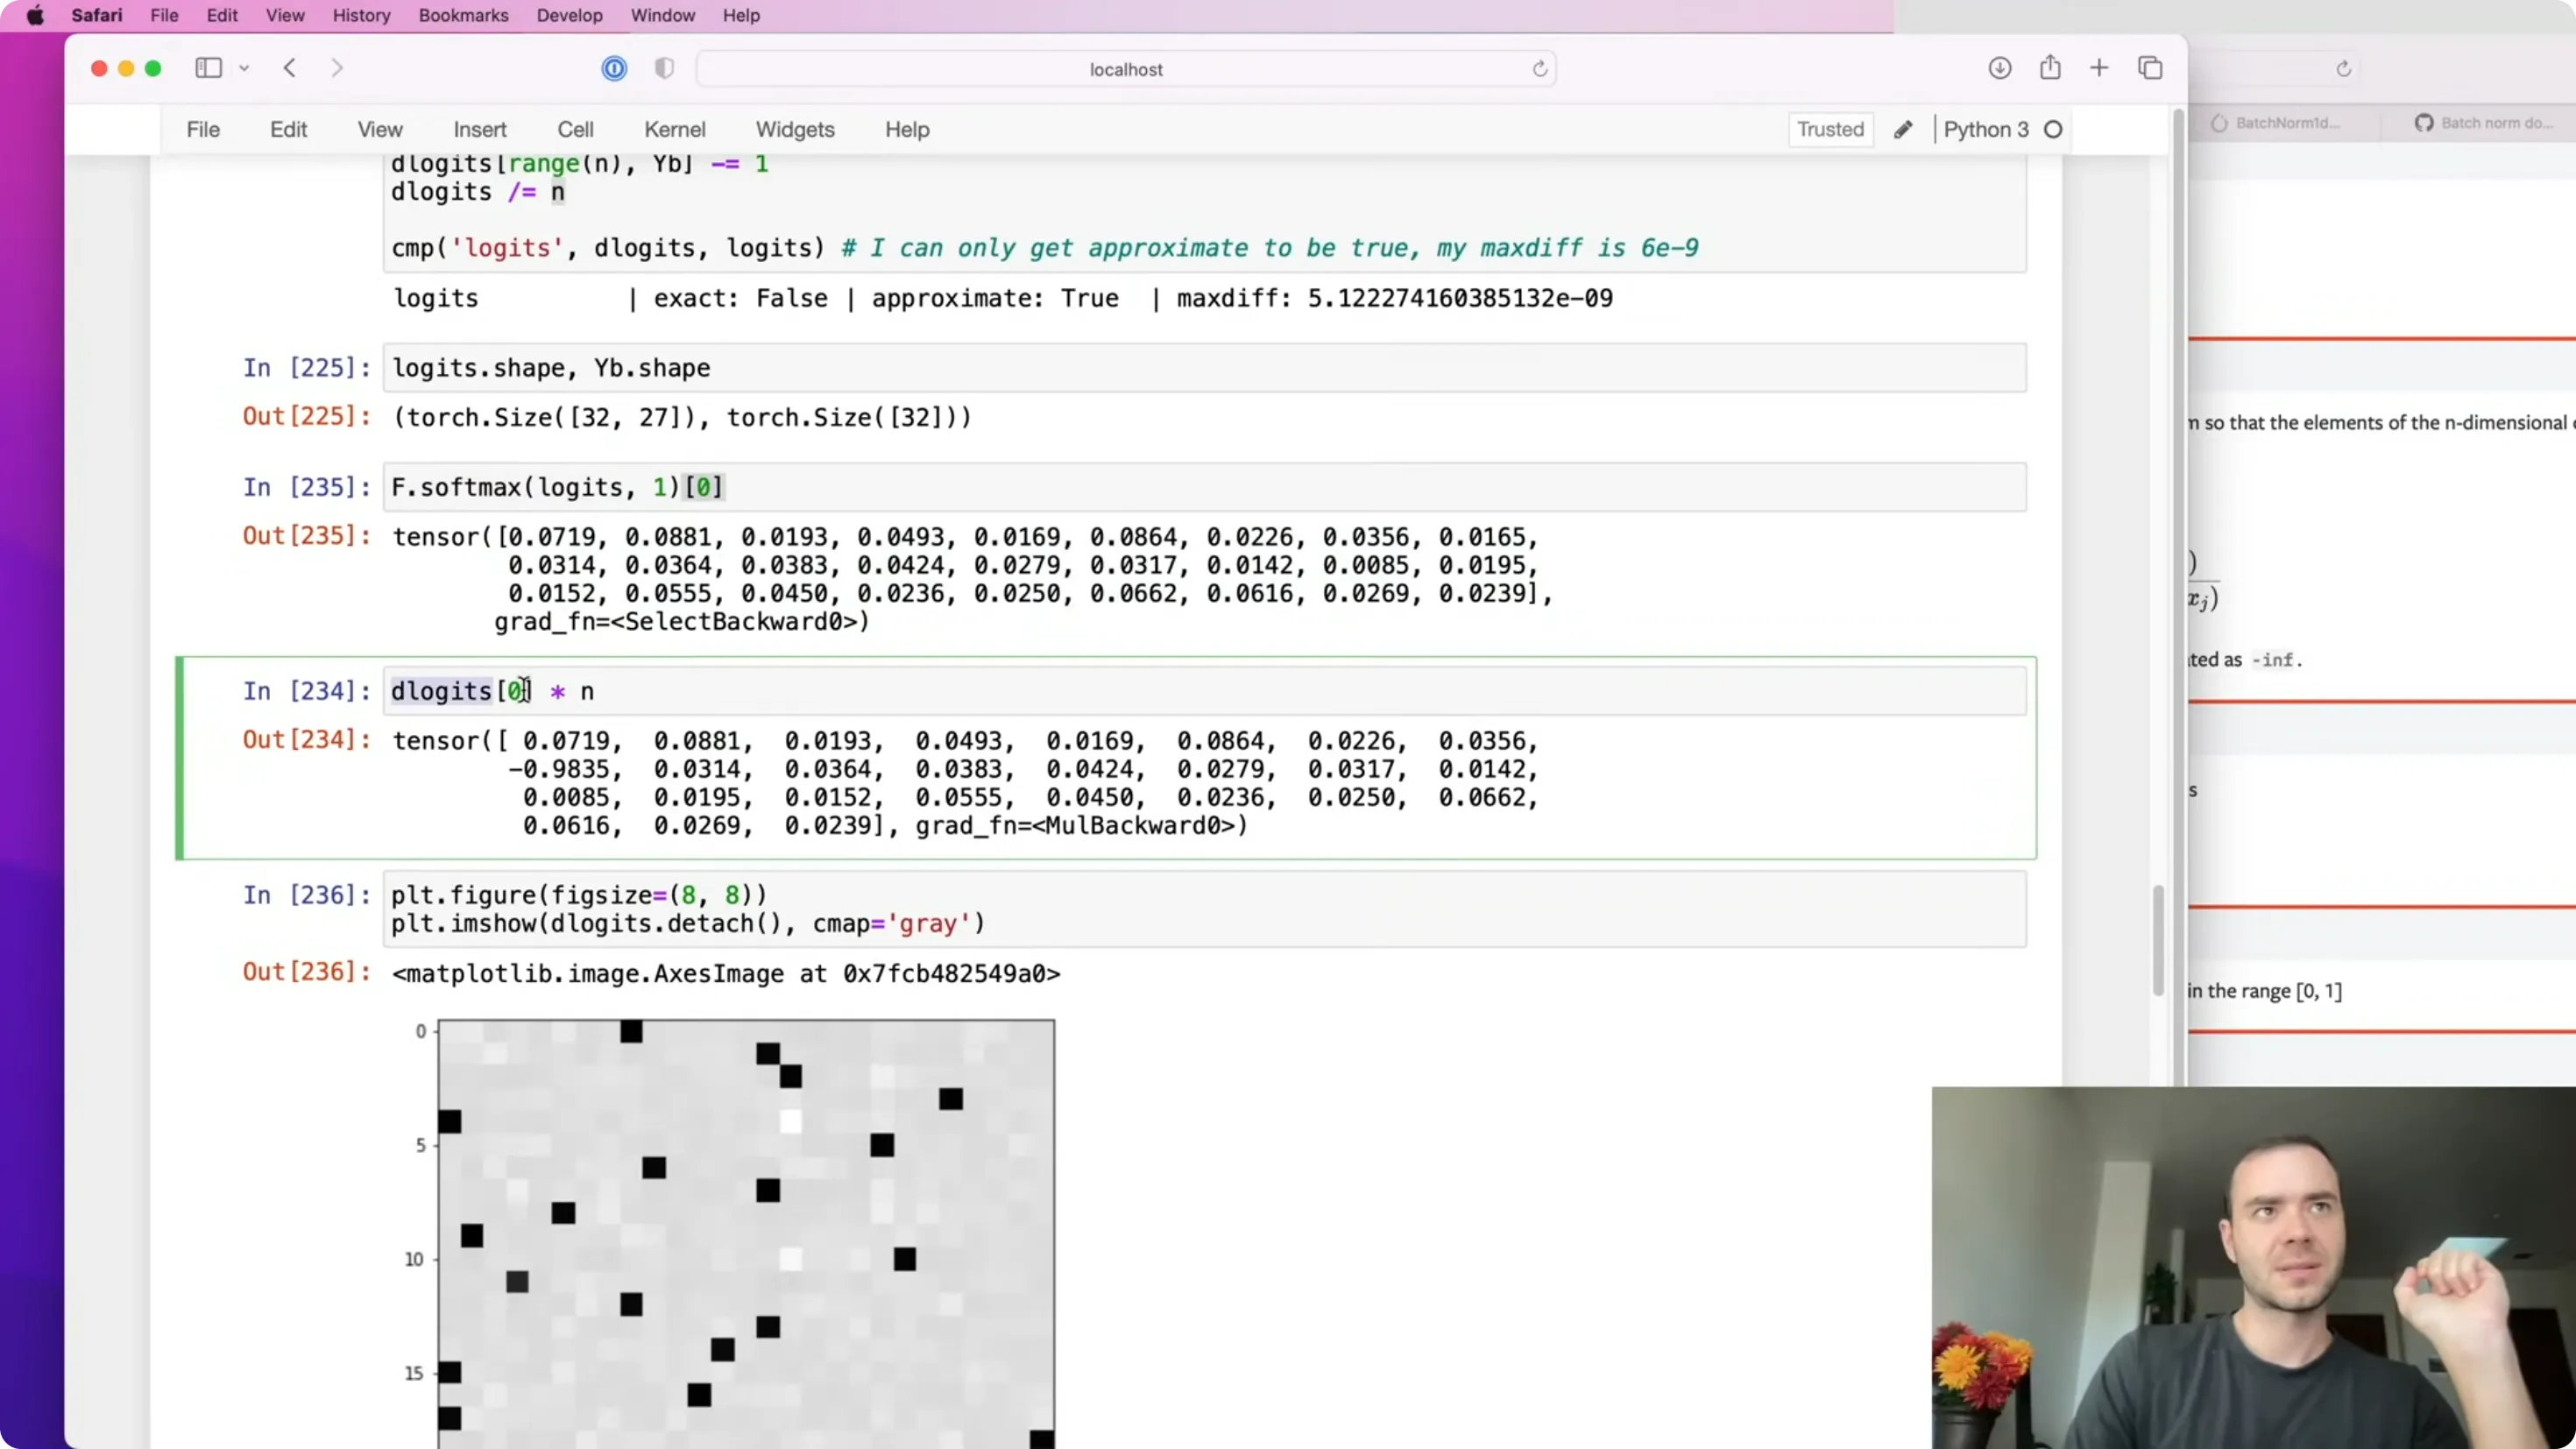
📷 dlogits 的"推拉"直觉:错误往下压、正确往上拉,且总量相等
回到原视频 (01:33:40)
六、Exercise 3:BatchNorm 层的解析反向
(参考时间: 01:36:37)
「这是一个非常好玩的练习——取决于你对"好玩"的定义。」
我们要对 BN 做和交叉熵完全一样的事:不再逐原子回传,而是推导出整层的解析反向公式。
符号(与论文一致):pre-BN 的输入叫 $x$(代码里 hprebn),输出叫 $y$(hpreact)。
$$x̂_i = \frac{x_i - \mu}{\sqrt{\sigma^2 + \epsilon}}, \qquad \mu = \frac{1}{n}\sum_j x_j, \qquad \sigma^2 = \frac{1}{n-1}\sum_j (x_j-\mu)^2$$
本练习先忽略 $\gamma$、$\beta$ 的导数(它们的反向和前面一样简单)。目标是:给定 $\partial L/\partial y_i$,求 $\partial L/\partial x_i$。
6.1 计算图与拓扑顺序
关键提醒:$x$、$x̂$、$y$ 都是向量(32 个节点);而 $\mu$、$\sigma^2$ 只是单个标量。搞混了数学就会错。
推荐的回传顺序(就像 micrograd 的拓扑排序,只不过这次是在纸上用符号):
$$y \to x̂ \to \sigma^2 \to \mu \to x$$
第 1 步(热身):$y_i = \gamma x̂_i + \beta \Rightarrow \dfrac{\partial L}{\partial x̂_i} = \gamma \cdot \dfrac{\partial L}{\partial y_i}$
6.2 第 2 步:$\partial L/\partial\sigma^2$
$\sigma^2$ 是标量,但扇出到所有 32 个 $x̂_i$——所以必须求和:
$$\frac{\partial L}{\partial \sigma^2} = \sum_{i=1}^{m} \frac{\partial L}{\partial x̂_i}\cdot\frac{\partial x̂_i}{\partial \sigma^2}$$
6.3 第 3 步:$\partial L/\partial\mu$——一个漂亮的相消
$\mu$ 有 33 条出边:32 条通向各个 $x̂_i$,1 条通向 $\sigma^2$:
$$\frac{\partial L}{\partial \mu} = \sum_i \frac{\partial L}{\partial x̂_i}\frac{\partial x̂_i}{\partial\mu} + \frac{\partial L}{\partial\sigma^2}\frac{\partial\sigma^2}{\partial\mu}$$
🔑 神奇的地方:因为 $\mu$ 恰好就是这批数据的均值,可以证明
$$\frac{\partial \sigma^2}{\partial \mu} = 0$$
——第二项整个消失!
「如果你只看数学公式,会以为 $\mu$ 对 $\sigma^2$ 有影响;但在"$\mu$ 就是均值"这个特殊情形下,这个梯度恰好恒等于零。」
6.4 第 4 步:$\partial L/\partial x_i$——"最疯狂的部分"
每个 $x_i$ 有 3 条出边:→ $\mu$、→ $\sigma^2$、→ $x̂_i$(这一条只依赖 $x_i$ 自己,是"平行"的 32 条路,互不干扰)。
$$\frac{\partial L}{\partial x_i} = \underbrace{\frac{\partial L}{\partial x̂_i}\frac{\partial x̂_i}{\partial x_i}}_{\text{直接支路}} + \underbrace{\frac{\partial L}{\partial \mu}\frac{\partial \mu}{\partial x_i}}_{\text{经 }\mu} + \underbrace{\frac{\partial L}{\partial \sigma^2}\frac{\partial \sigma^2}{\partial x_i}}_{\text{经 }\sigma^2}$$
代入并化简。两个容易出错的细节:
- 哑变量重命名:$\partial L/\partial\sigma^2$ 里已经有一个遍历 32 项的求和指标,代入时必须把它改名(比如 $i\to j$),否则会和当前的 $i$ 混淆——「哪些是 $i$、哪些是 $j$,必须非常小心。」
- 因式提取:整理时会冒出一堆 $(\sigma^2+\epsilon)^{-3/2}$,可以拆成三个 $(\sigma^2+\epsilon)^{-1/2}$ 分给三项;而其中一部分恰好就是 $x̂$ 本身,还能继续化简。
最终形式(不能再化简)只用到了 $\partial L/\partial y_i$、$x̂_i$、$x̂_j$——后两个都是前向传播里已经算好的值。
6.5 实现:把它写成"一行"
dhprebn = (
    bngain * bnvar_inv / n * (
        n * dhpreact
        - dhpreact.sum(0, keepdim=True)
        - n / (n-1) * bnraw * (dhpreact * bnraw).sum(0, keepdim=True)
    )
)
✅ 与 PyTorch 的最大差 ~1e-9——公式和广播都对了。
但 Karpathy 特别强调这个实现有多难:
「这个公式一点都不 trivial,里面塞了非常多的东西。 第一,这个公式是为单个神经元、对一个 32 样本的 batch 写的,而我们实际有 64 个神经元——所以这个表达式要在 64 列上并行地各算一遍; 第二,式子里有好几个求和,必须确保它们的广播能正确地作用到其它每一项上。 所以"把这个数学表达式变成这一行代码"本身就是一整个练习。」
编者说明:PyTorch 的
BatchNorm内部其实用的是 $\frac{\gamma}{\sqrt{\sigma^2+\epsilon}}$ 记作invstd,再对(dhpreact - mean(dhpreact) - x̂ * mean(dhpreact*x̂))做缩放——形式不同、代数等价。上面的写法是 Karpathy 从零推出来的版本。
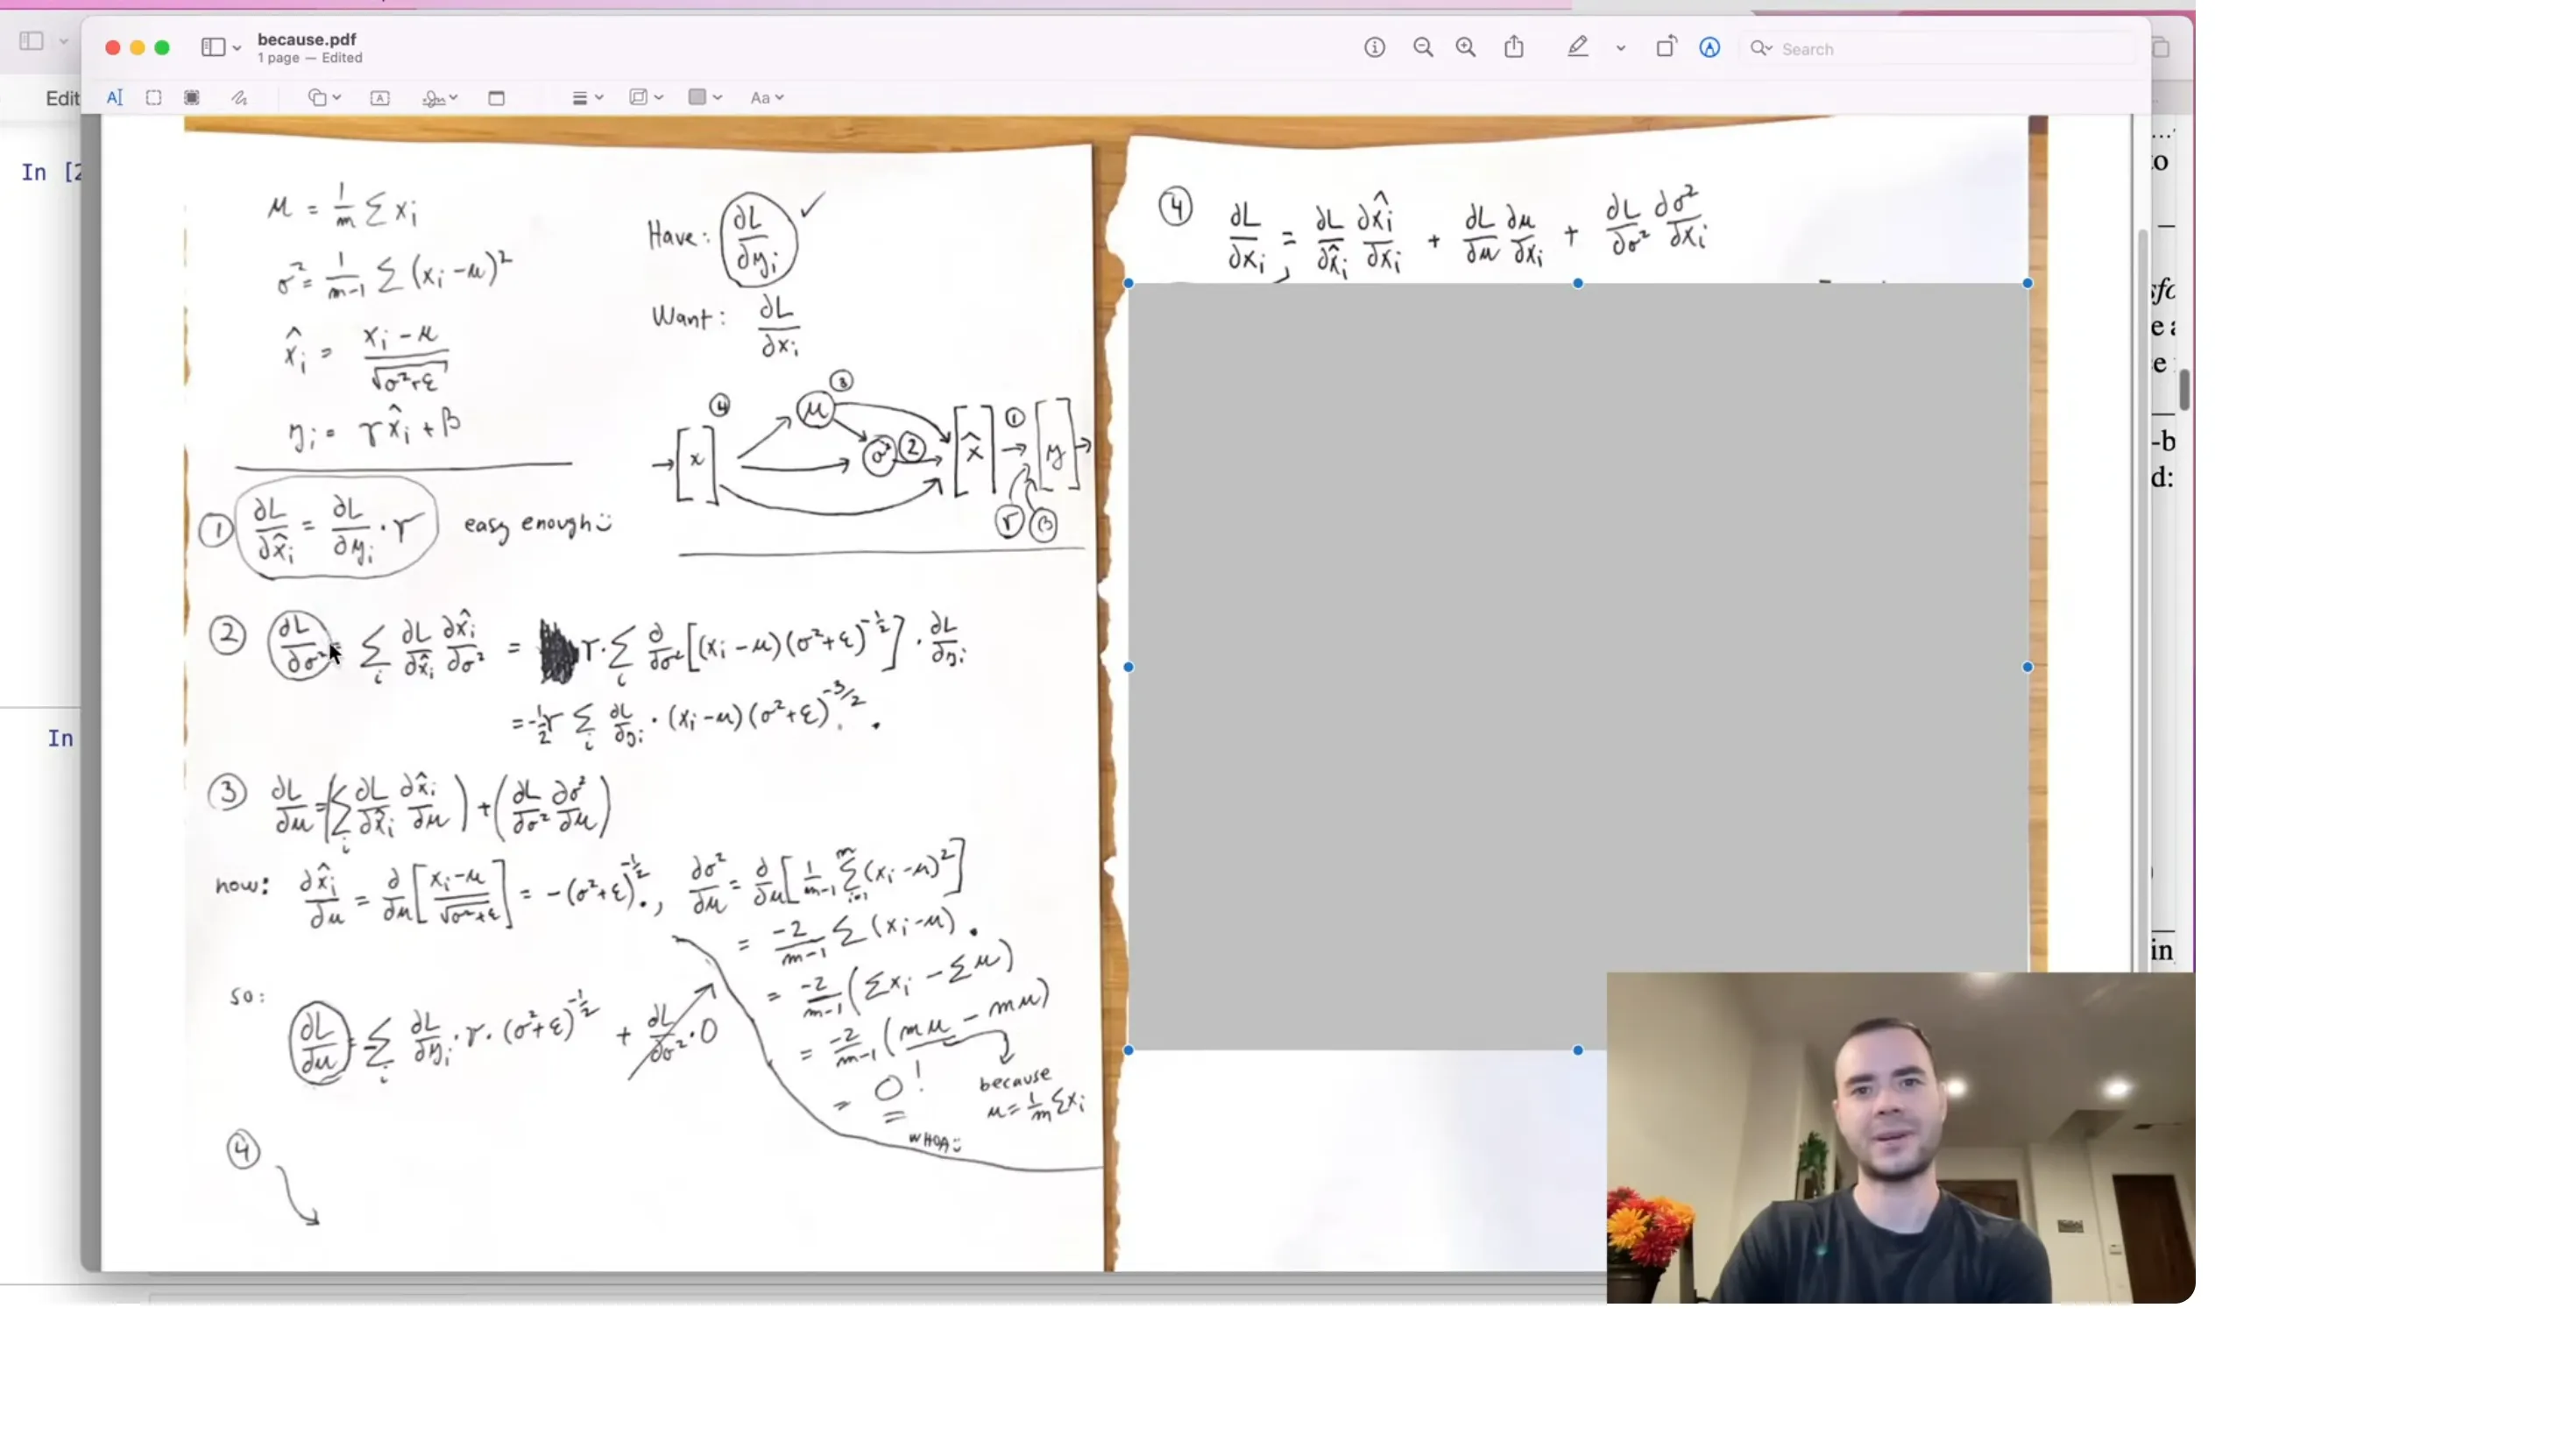
📷 BN 反向的纸笔推导:$\sigma^2$ 扇出要"求和",$\partial\sigma^2/\partial\mu$ 恰好为零
回到原视频 (01:45:20)
七、Exercise 4:全部拼起来
(参考时间: 01:50:02)
重新初始化网络,把上面所有手写梯度拼成完整反向传播:
# ---- 手工反向传播(全程不使用 loss.backward())----
dlogits  = F.softmax(logits, 1); dlogits[range(n), Yb] -= 1; dlogits /= n   # E2
dh       = dlogits @ W2.T;  dW2 = h.T @ dlogits;  db2 = dlogits.sum(0)
dhpreact = (1.0 - h**2) * dh
dbngain  = (bnraw * dhpreact).sum(0, keepdim=True)
dbnbias  = dhpreact.sum(0, keepdim=True)
dhprebn  = bngain * bnvar_inv / n * (                                       # E3
    n * dhpreact
    - dhpreact.sum(0, keepdim=True)
    - n/(n-1) * bnraw * (dhpreact * bnraw).sum(0, keepdim=True)
)
dembcat  = dhprebn @ W1.T;  dW1 = embcat.T @ dhprebn;  db1 = dhprebn.sum(0)
demb     = dembcat.view(emb.shape)
dC       = torch.zeros_like(C)
for k in range(Xb.shape[0]):
    for j in range(Xb.shape[1]):
        dC[Xb[k, j]] += demb[k, j]
然后:
cmp校验 → 近似相等,差异 ~1e-9(「说实话我也不完全确定这些微小差异从哪来」);- 关掉
loss.backward()——「说出这句话的感觉真是太棒了」; - 用手写梯度更新参数(不再用
p.grad):python grads = [dC, dW1, db1, dbngain, dbnbias, dW2, db2] for p, grad in zip(parameters, grads): p.data += -lr * grad - 用
with torch.no_grad():把整段包起来——「告诉 PyTorch:我不会对这里的任何东西调backward」,于是 PyTorch 可以更省内存、更快; - 训练完成后校准 BN 的 running statistics(因为训练循环里没跟踪它们),再评估 loss、采样名字。
结果:损失和样本质量与"用 autograd"时几乎一样——这毫不意外,因为我们只是把
loss.backward()里的东西原样搬了出来,梯度完全相同。 唯一变了的,是我们对"引擎盖下面到底发生了什么"拥有了完全的可见性——以及 20 行代码。
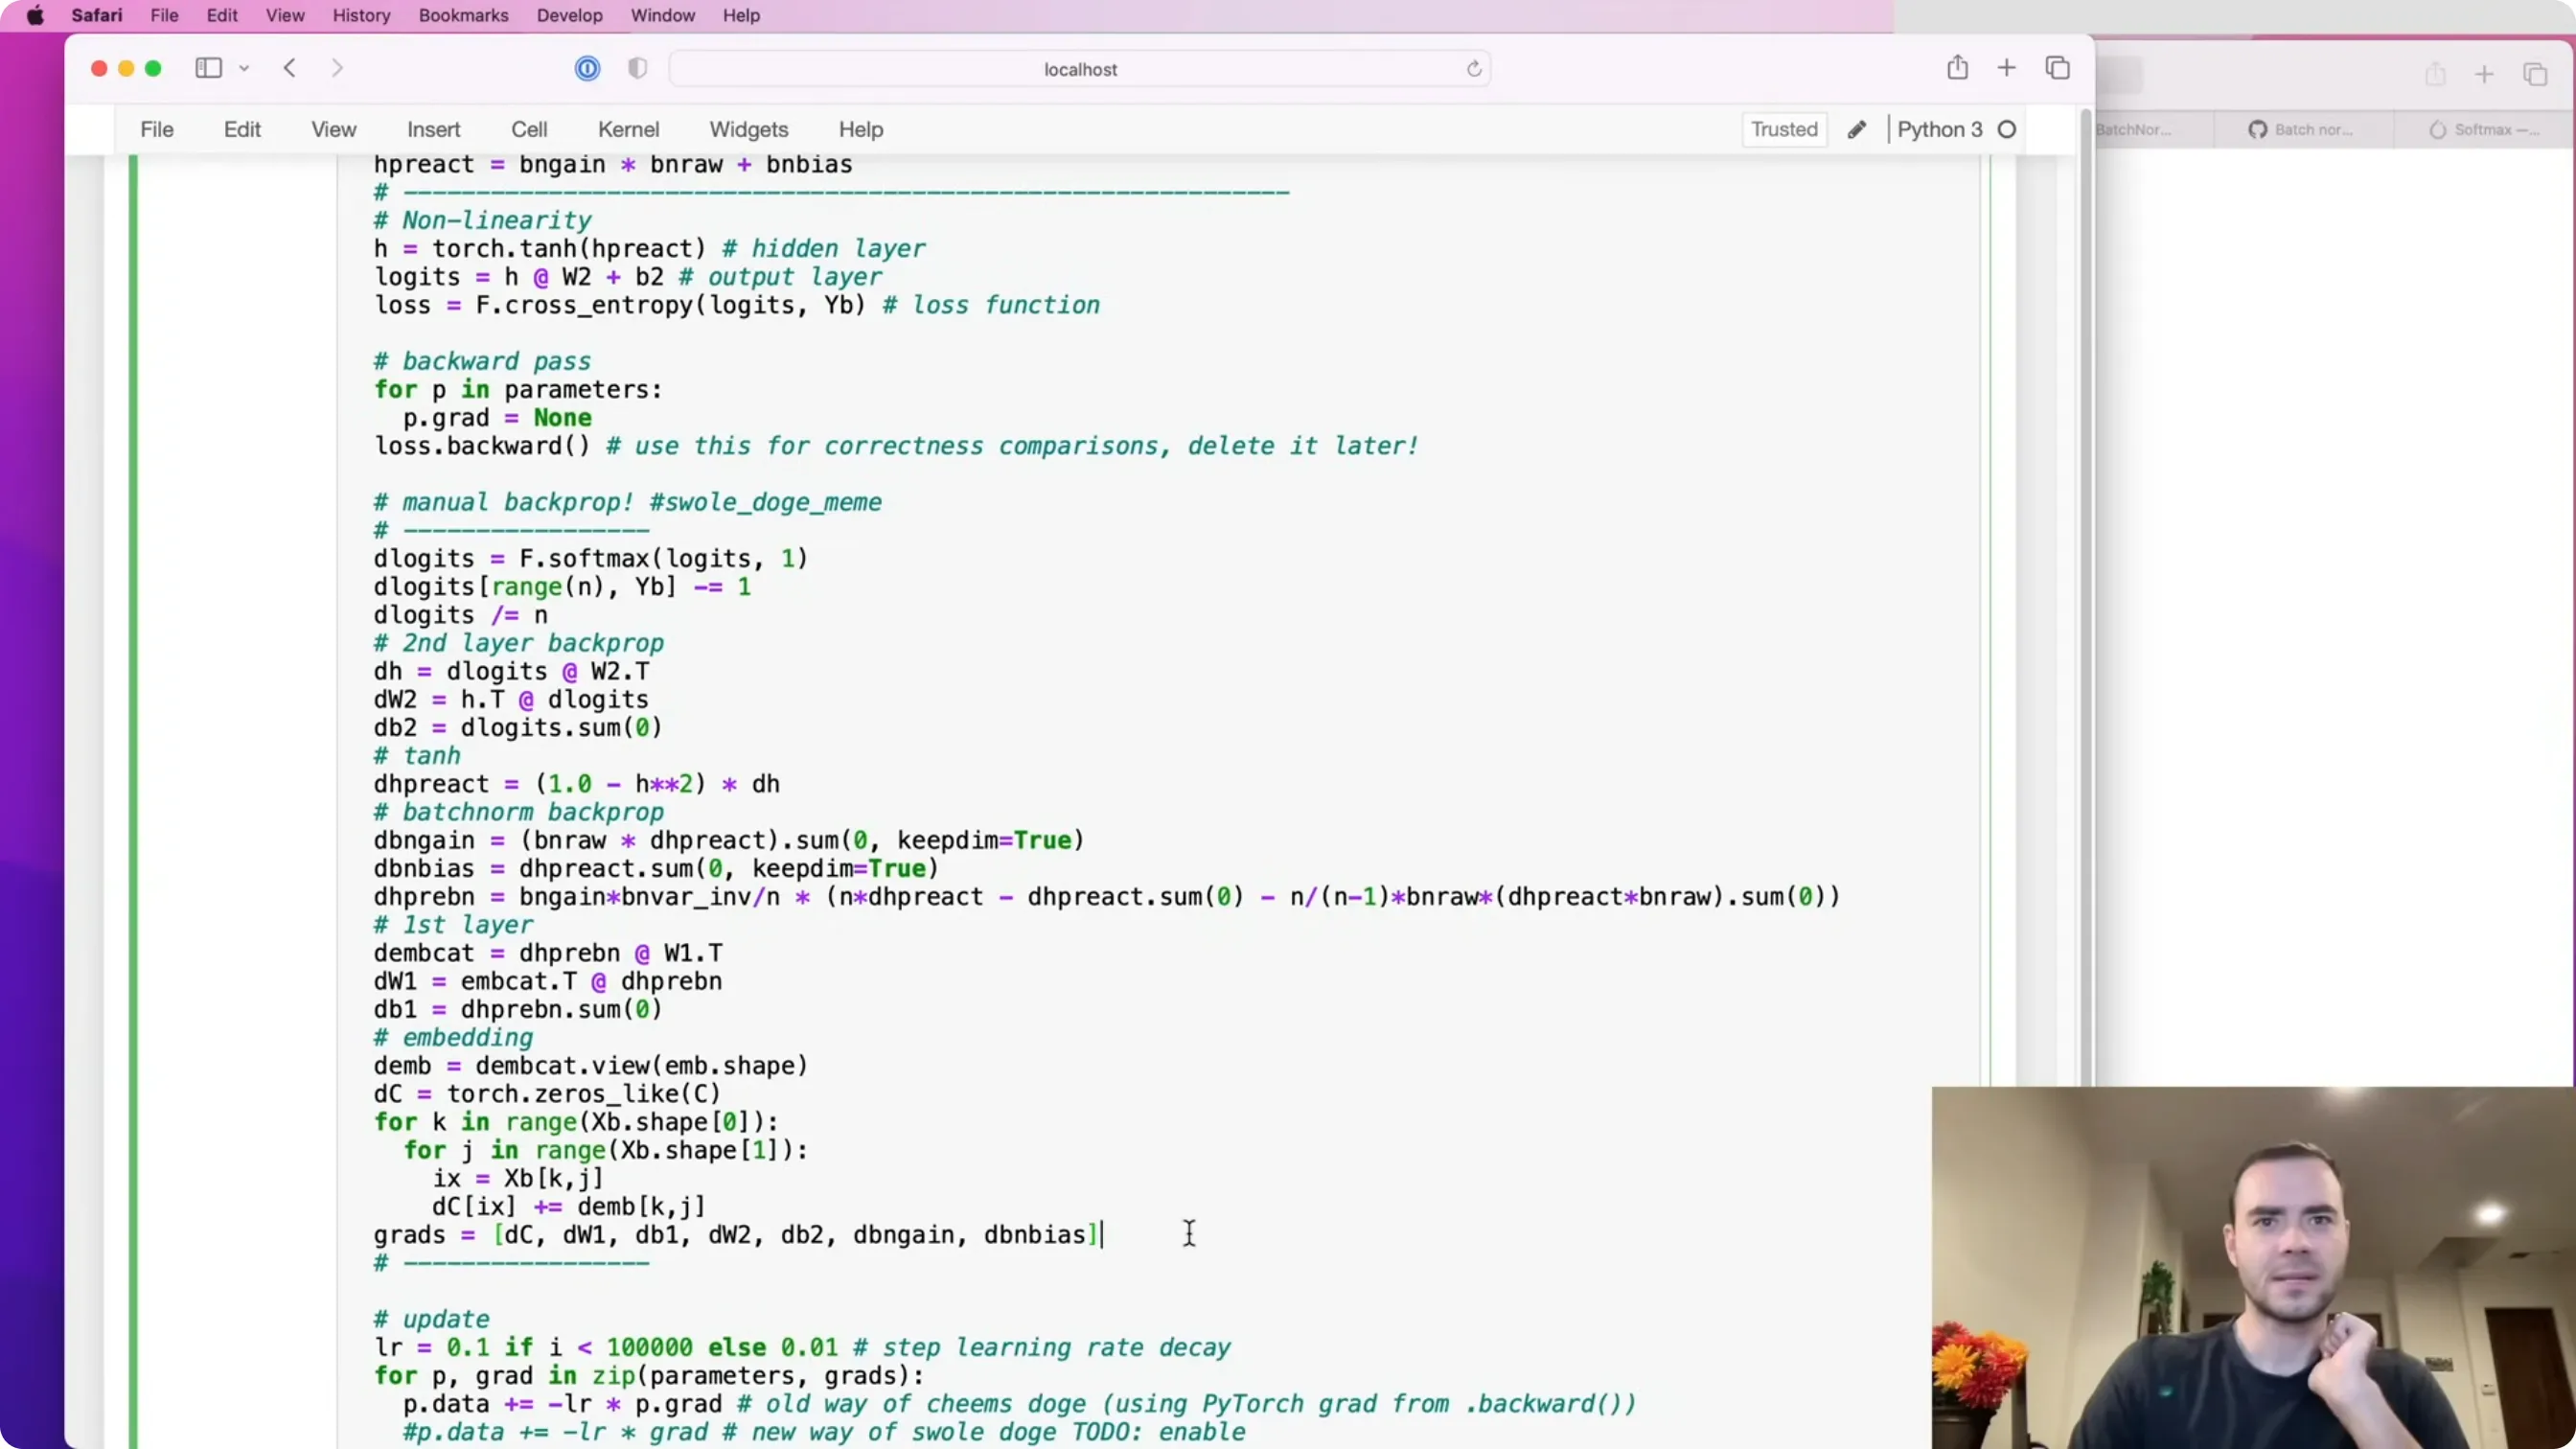
📷 把手工反向拼起来:整段用 `with torch.no_grad()` 包住,彻底告别 `loss.backward()`
回到原视频 (01:51:00)
八、结语
(参考时间: 01:54:24)
「这堂课让我最喜欢的,是它给了我们非常多样化的一组层去反向传播:交叉熵、第二个线性层、tanh、BatchNorm、第一个线性层、嵌入表——这套组合相当全面。」
回头看那个"20 行"的反向传播,你会发现:
- 每一层大概只有三行代码;
- 大部分都很直白;
- 唯一的例外是 BatchNorm 的反向——那确实是本讲最难的部分。
「你现在当然有能力自己推这些公式,但实践中你大概不想这么做——你会用 PyTorch 的 autograd。」
「但希望你已经有了一些直觉:梯度是如何从 loss 出发,沿着神经网络向后流,流过每一个变量和每一个中间结果的。」
「如果你理解了其中相当一部分,那你可以把自己算作左边这些"功夫熊猫"之一,而不是右边这些。」
下一讲:正式进入 RNN、LSTM 及其它变体——把架构复杂起来,去追求更好的对数似然。
附:官方参考与延伸阅读
- 课程主页:https://karpathy.ai/zero-to-hero.html
- 🎯 练习本(Colab):https://colab.research.google.com/drive/1WV2oi2fh9XXyldh02wupFQX0wh5ZC-z-?usp=sharing
- 参考答案 Notebook:https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part4_backprop.ipynb
- 📄 Yes you should understand backprop:https://karpathy.medium.com/yes-you-should-understand-backprop-e2f06eab496b
- 📄 Batch Normalization(2015):https://arxiv.org/abs/1502.03167
- 📄 Bessel's Correction:http://math.oxford.emory.edu/site/math117/besselCorrection/
- 📄 Bengio et al. 2003:https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf
- makemore 仓库:https://github.com/karpathy/makemore
- PyTorch
torch.autograd.gradcheck:https://pytorch.org/docs/stable/generated/torch.autograd.gradcheck.html torch.Tensor.index_add_:https://pytorch.org/docs/stable/generated/torch.Tensor.index_add_.htmltorch.nn.BatchNorm1d:https://pytorch.org/docs/stable/generated/torch.nn.BatchNorm1d.html- 讨论 Discord:https://discord.gg/3zy8kqD9Cp
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 Building makemore Part 4: Becoming a Backprop Ninja 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。