第6讲 · 手把手语言建模(WaveNet 篇)
本电子书由教学视频重构而成。 视频原标题:Building makemore Part 5: Building a WaveNet 编者拓展|📝 本讲的「官方练习」是一个公开挑战(Karpathy 在片尾亲口说的,也是视频最后一章的标题):
「improve on my loss! how far can we improve a WaveNet on this data?」 他在本讲把验证损失做到了 1.993,并强调自己并没有认真调过,所以"果实"还挂在树上: - 试试不同的通道数分配(每层给多少 hidden units); - embedding 维度(本讲用的是 10 / 24)可能并不合适; - 也许用原始的单隐层 MLP,只要把它堆得足够大,就能打败我这个花哨的层级网络——「如果它做不到,那还挺尴尬的」; - 读 WaveNet 论文,自己实现那些更复杂的层(gated linear unit、residual / skip connections); - 调初始化或优化器(learning rate schedule 等)。 另外,本讲的 Notebook 里就有练习位:Colab 打开就能做。
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=t3YJ5hKiMQ0 |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 本讲课件 Notebook | https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part5_cnn1.ipynb |
| 🟢 Google Colab(免安装) | https://colab.research.google.com/drive/1CXVEmCO_7r7WYZGb5qnjfyxTvQa13g5X?usp=sharing |
| 完整实现(makemore 仓库) | https://github.com/karpathy/makemore |
| 📄 WaveNet 论文(DeepMind, 2016) | https://arxiv.org/abs/1609.03499 |
| 📄 Bengio et al. 2003 MLP LM | https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf |
| 讨论区 | 官方 Discord:https://discord.gg/3zy8kqD9Cp |
对应讲次:第6讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
一、引子:为什么要更深的架构?
(参考时间: 00:00)
「你会注意到我背后的背景变了,因为我在京都,这里太棒了。」Karpathy 在酒店房间里开讲。
回顾我们已经搭出来的东西:多层感知机(MLP)字符级语言模型——
它接收前面 3 个字符,用一层隐层(10 维)、带 tanh 非线性,预测第 4 个字符。
本讲要做两件事:
- 吃进更长的上下文——不只是 3 个字符;
- 不要把所有信息一次性塞进同一个隐层——「那会把太多信息压扁得太快(squashes too much information too quickly)」。我们要一个更深的模型,逐层、渐进地融合信息。
而当我们这么做了之后——会得到非常像 WaveNet 的东西。
WaveNet 是 DeepMind 在 2016 年发表的论文。它本质上也是一个语言模型,只不过预测的是音频序列(而不是字符或词)。但建模的框架完全相同:都是一个自回归模型(autoregressive),都在预测序列中的下一个元素。它的架构采用了一种很有意思的层级式(hierarchical)、树状结构来预测下一个字符。
本讲就把这个架构实现出来。
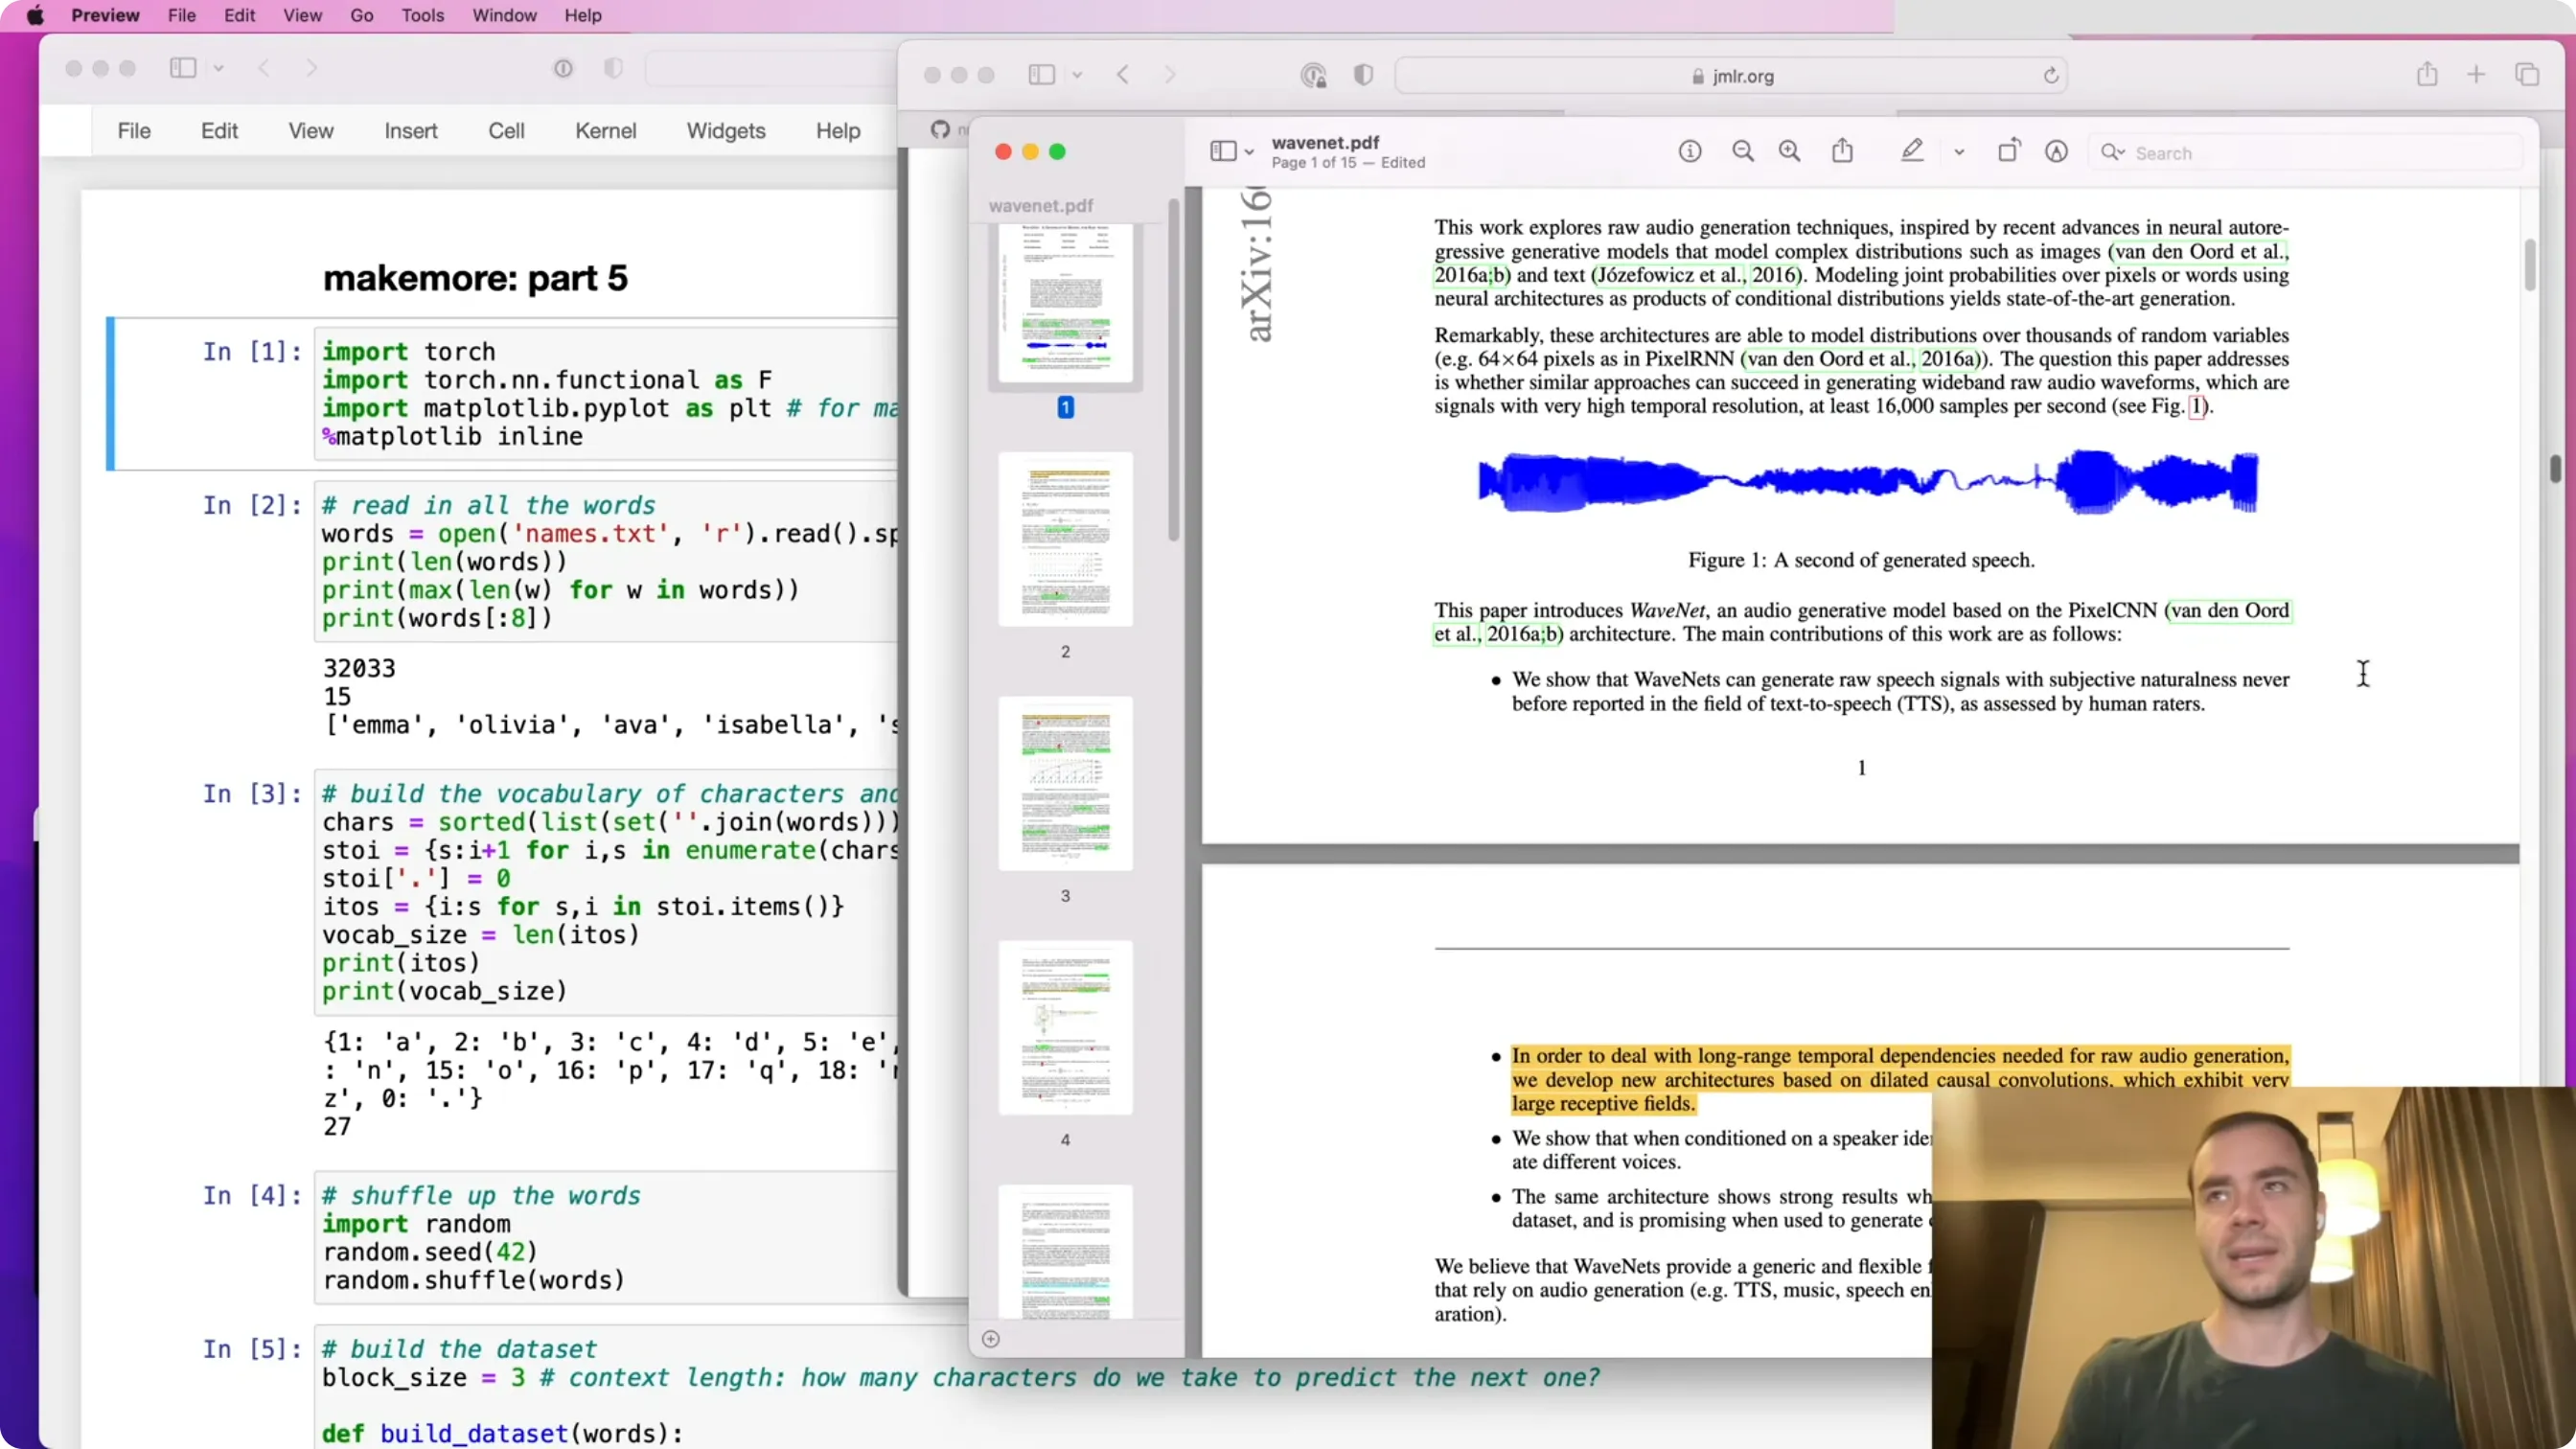
📷 WaveNet 论文里的层级式架构:逐层"渐进融合"上一层的相邻元素
回到原视频 (00:01:09)
二、起点代码
(参考时间: 01:41)
注意:起点是 Part 3 结束时的状态——因为 Part 4 只是"手写反向传播"的插曲,做完就回来了。所以本讲是把 Part 3 的代码复制粘贴过来,改动极少。
没变的部分:
- 读词表、切数据。182,000 个「给 3 个字符、预测第 4 个」的样本。
- 我们在 Part 3 里发展出来的层模块(
Linear/BatchNorm1d/Tanh)——把它们当乐高积木,互相堆叠、传递数据、组成图。 - 这些层的 API 刻意模仿
torch.nn:nn.Linear、nn.BatchNorm1d……
BatchNorm 这个层,Karpathy 忍不住吐槽了一番:
「BatchNorm 是个很疯狂的层。 疯狂在哪? 1. 它有 running mean / variance,是在反向传播之外训练的——用指数滑动平均(EMA)在 forward 里更新; 2. 它有 training 开关——训练和评估时行为不同,你必须时刻小心它处在哪个状态,这经常引入 bug(忘了切换模式); 3. 它把同一个 batch 内不同样本的激活耦合在一起——我们本来以为 batch 只是个效率手段,现在它在计算上是耦合的; 4. 你必须等 mean/variance 收敛。
一句话:这个层里有状态,而状态通常是有害的。」
其他小改动:不再在每个层里持有 generator,改成全局只用一次 torch RNG,图个简单。
网络:C 嵌入表 + layers = [Linear → BatchNorm1d → Tanh → Linear],最后一层权重乘 0.1 缩小(避免"自信地犯错")。约 12,000 个参数。优化器和损失函数都和以前一样。
但损失曲线惨不忍睹:
「这条损失曲线太难看了,我们得修一修。 因为 batch size 只有 32 太小了,任何一批都可能很"幸运"或很"不幸",于是损失噪声极大、糊成一片。」
当前验证损失 2.10。采样出来的名字已经有点样子了(Yvonne、Kilo、Pros、Alaia……),但「还不能说很好,还有很大提升空间。」
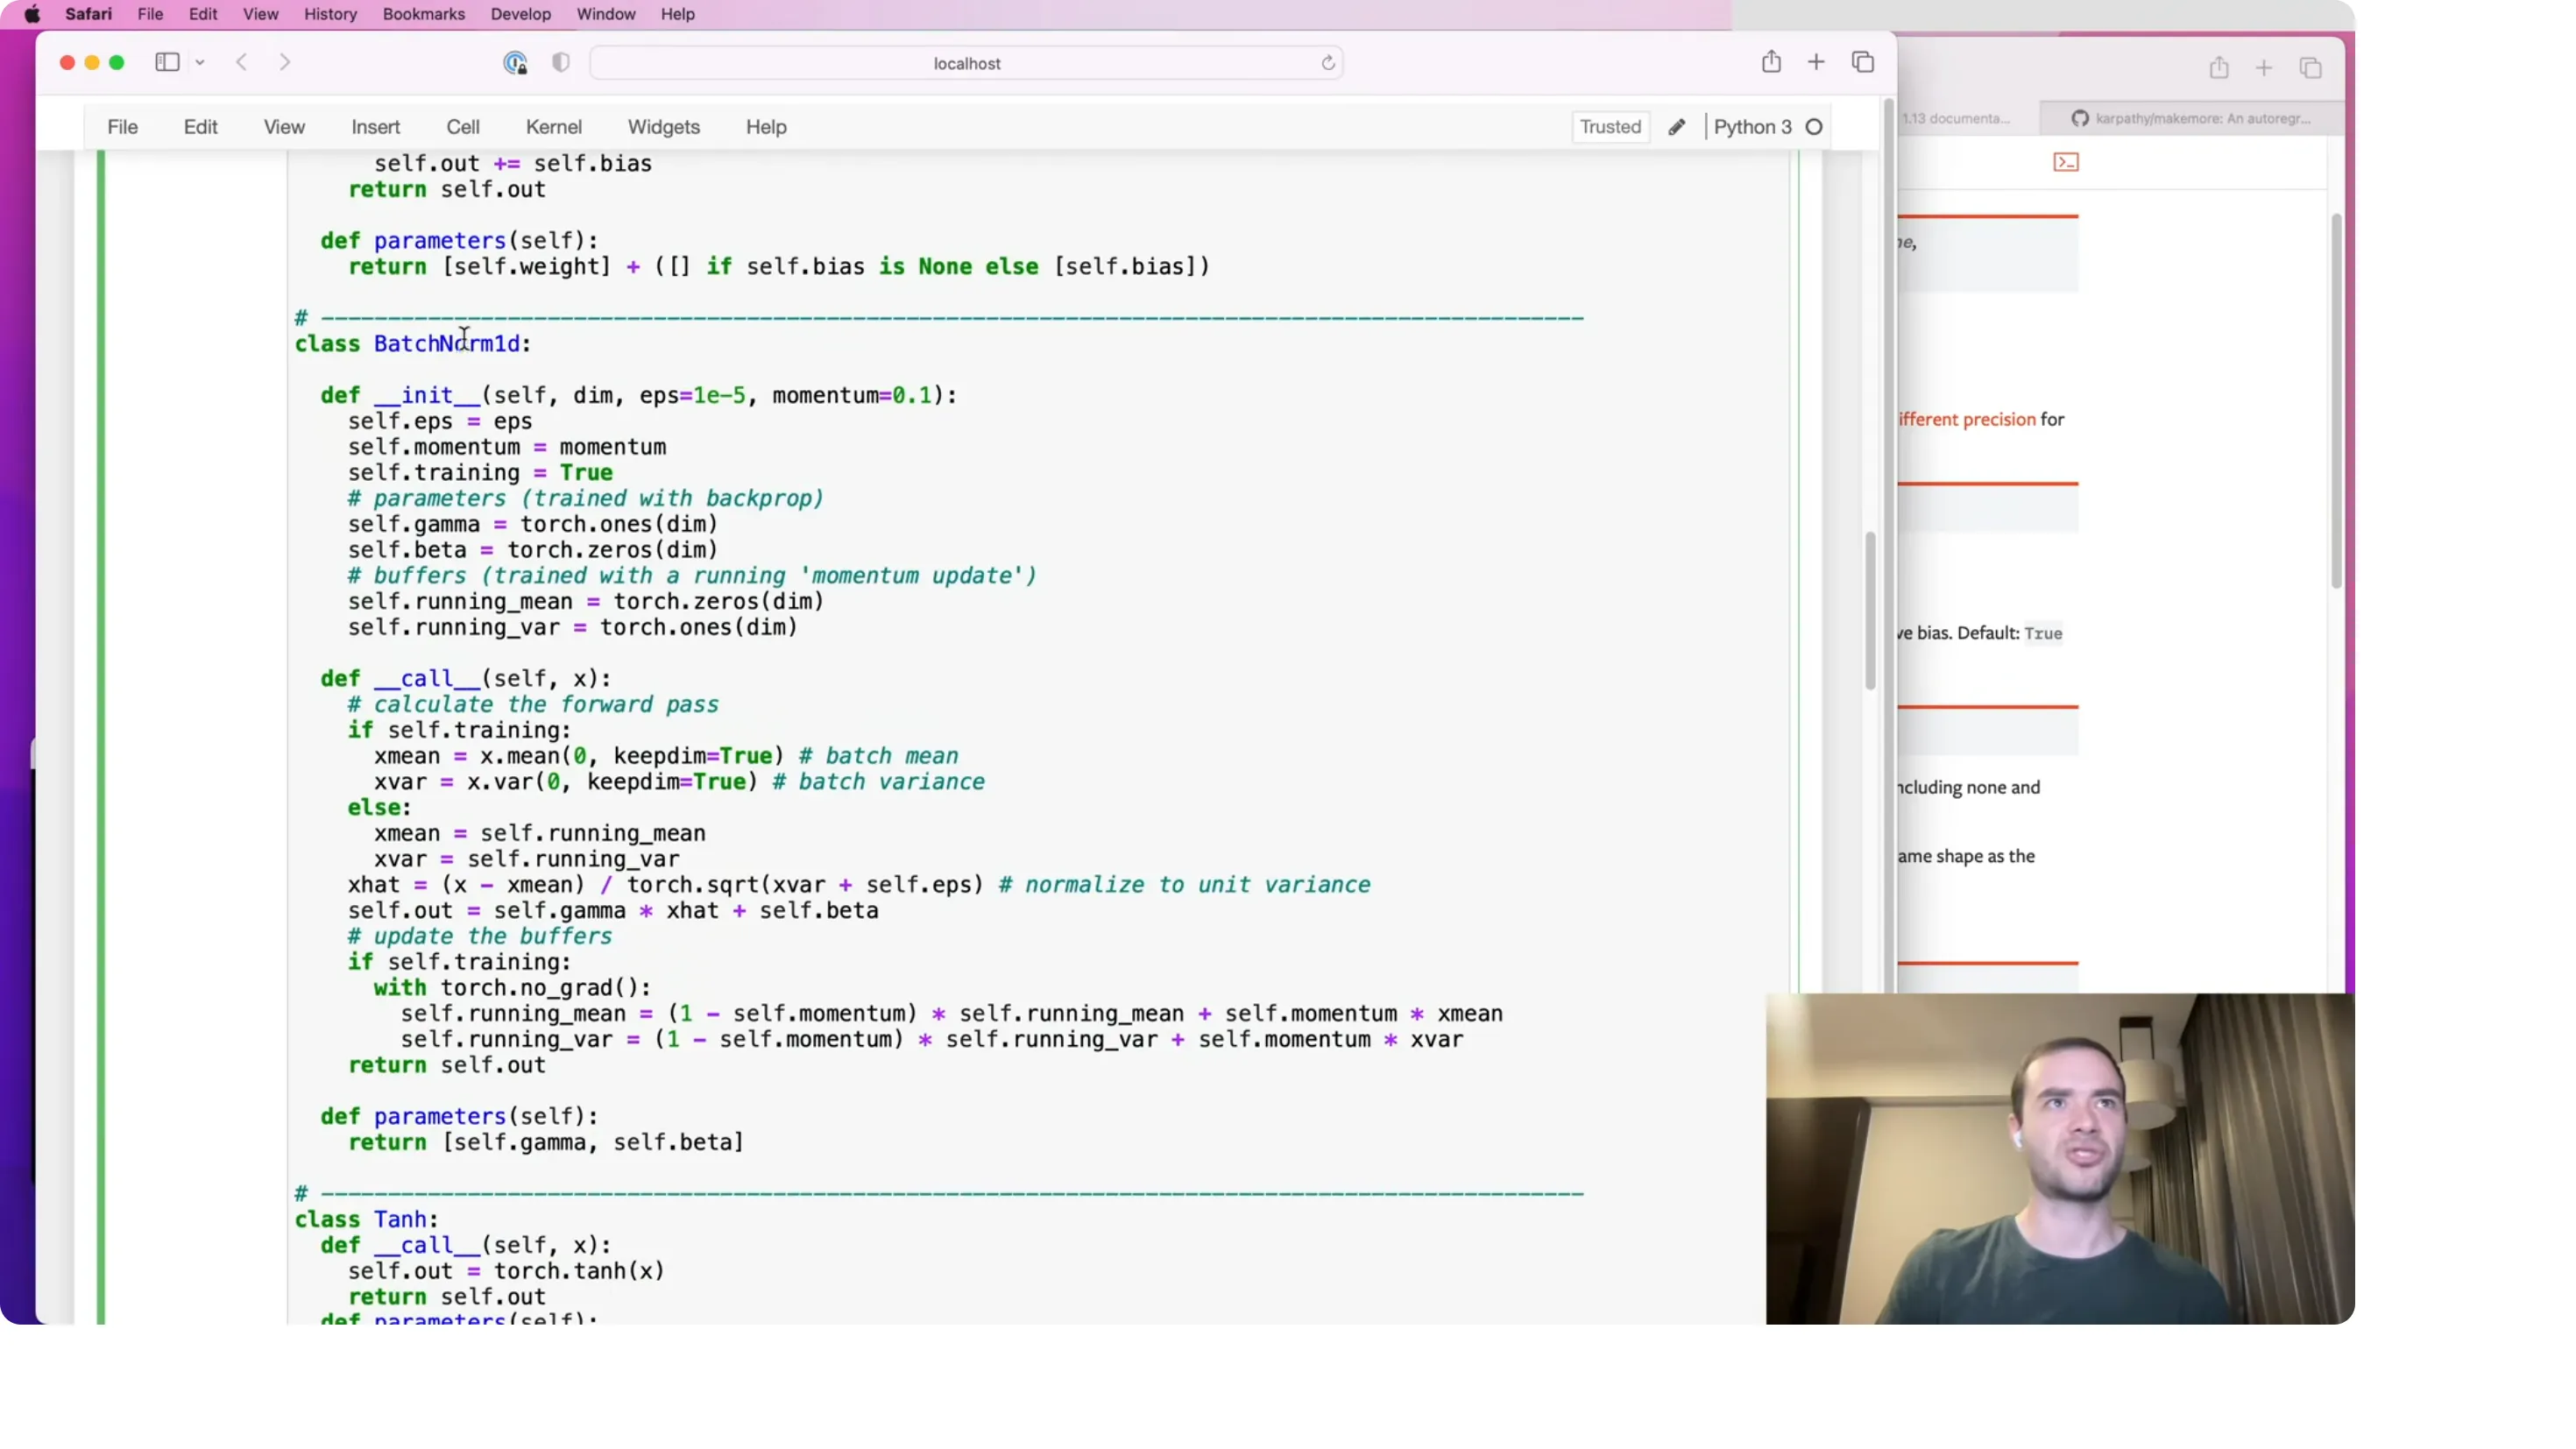
📷 Part 3 留下的层模块:Linear / BatchNorm1d / Tanh,API 刻意对齐 torch.nn
回到原视频 (00:03:35)
三、先修一修那张图
(参考时间: 06:56)
「这个图简直是在我眼睛里扎刀子,我受不了了。」
lossi 是一个一维的 float 列表。想让它平滑,不需要移动平均——只要把它重排成若干行、对每行取平均:
x = torch.tensor(lossi).view(-1, 1000)   # 200 行 × 1000 个连续元素
plt.plot(x.mean(1))                      # 每行取均值 → 形状 (200,)
编者拓展|这里的
view用法值得记住:一维(N,)张量view(A, B)时,第 0 行是前 B 个元素、第 1 行是接着的 B 个——它是"按顺序切段",不是"转置"。所以view(-1, 1000)天然就是"把每 1000 个连续 step 分成一段"。-1让 PyTorch 自己算那一维(这里是 200)。顺便记住这个通用技巧:
x.view(-1, k).mean(1)就是"按 k 个一组的滑动平均"的廉价版本(不重叠)。
修完之后曲线立刻好看多了,并且暴露出一个有用的信息:
学习率衰减(lr decay)从系统里抽走了大量能量,让我们沉降到了局部极小值。
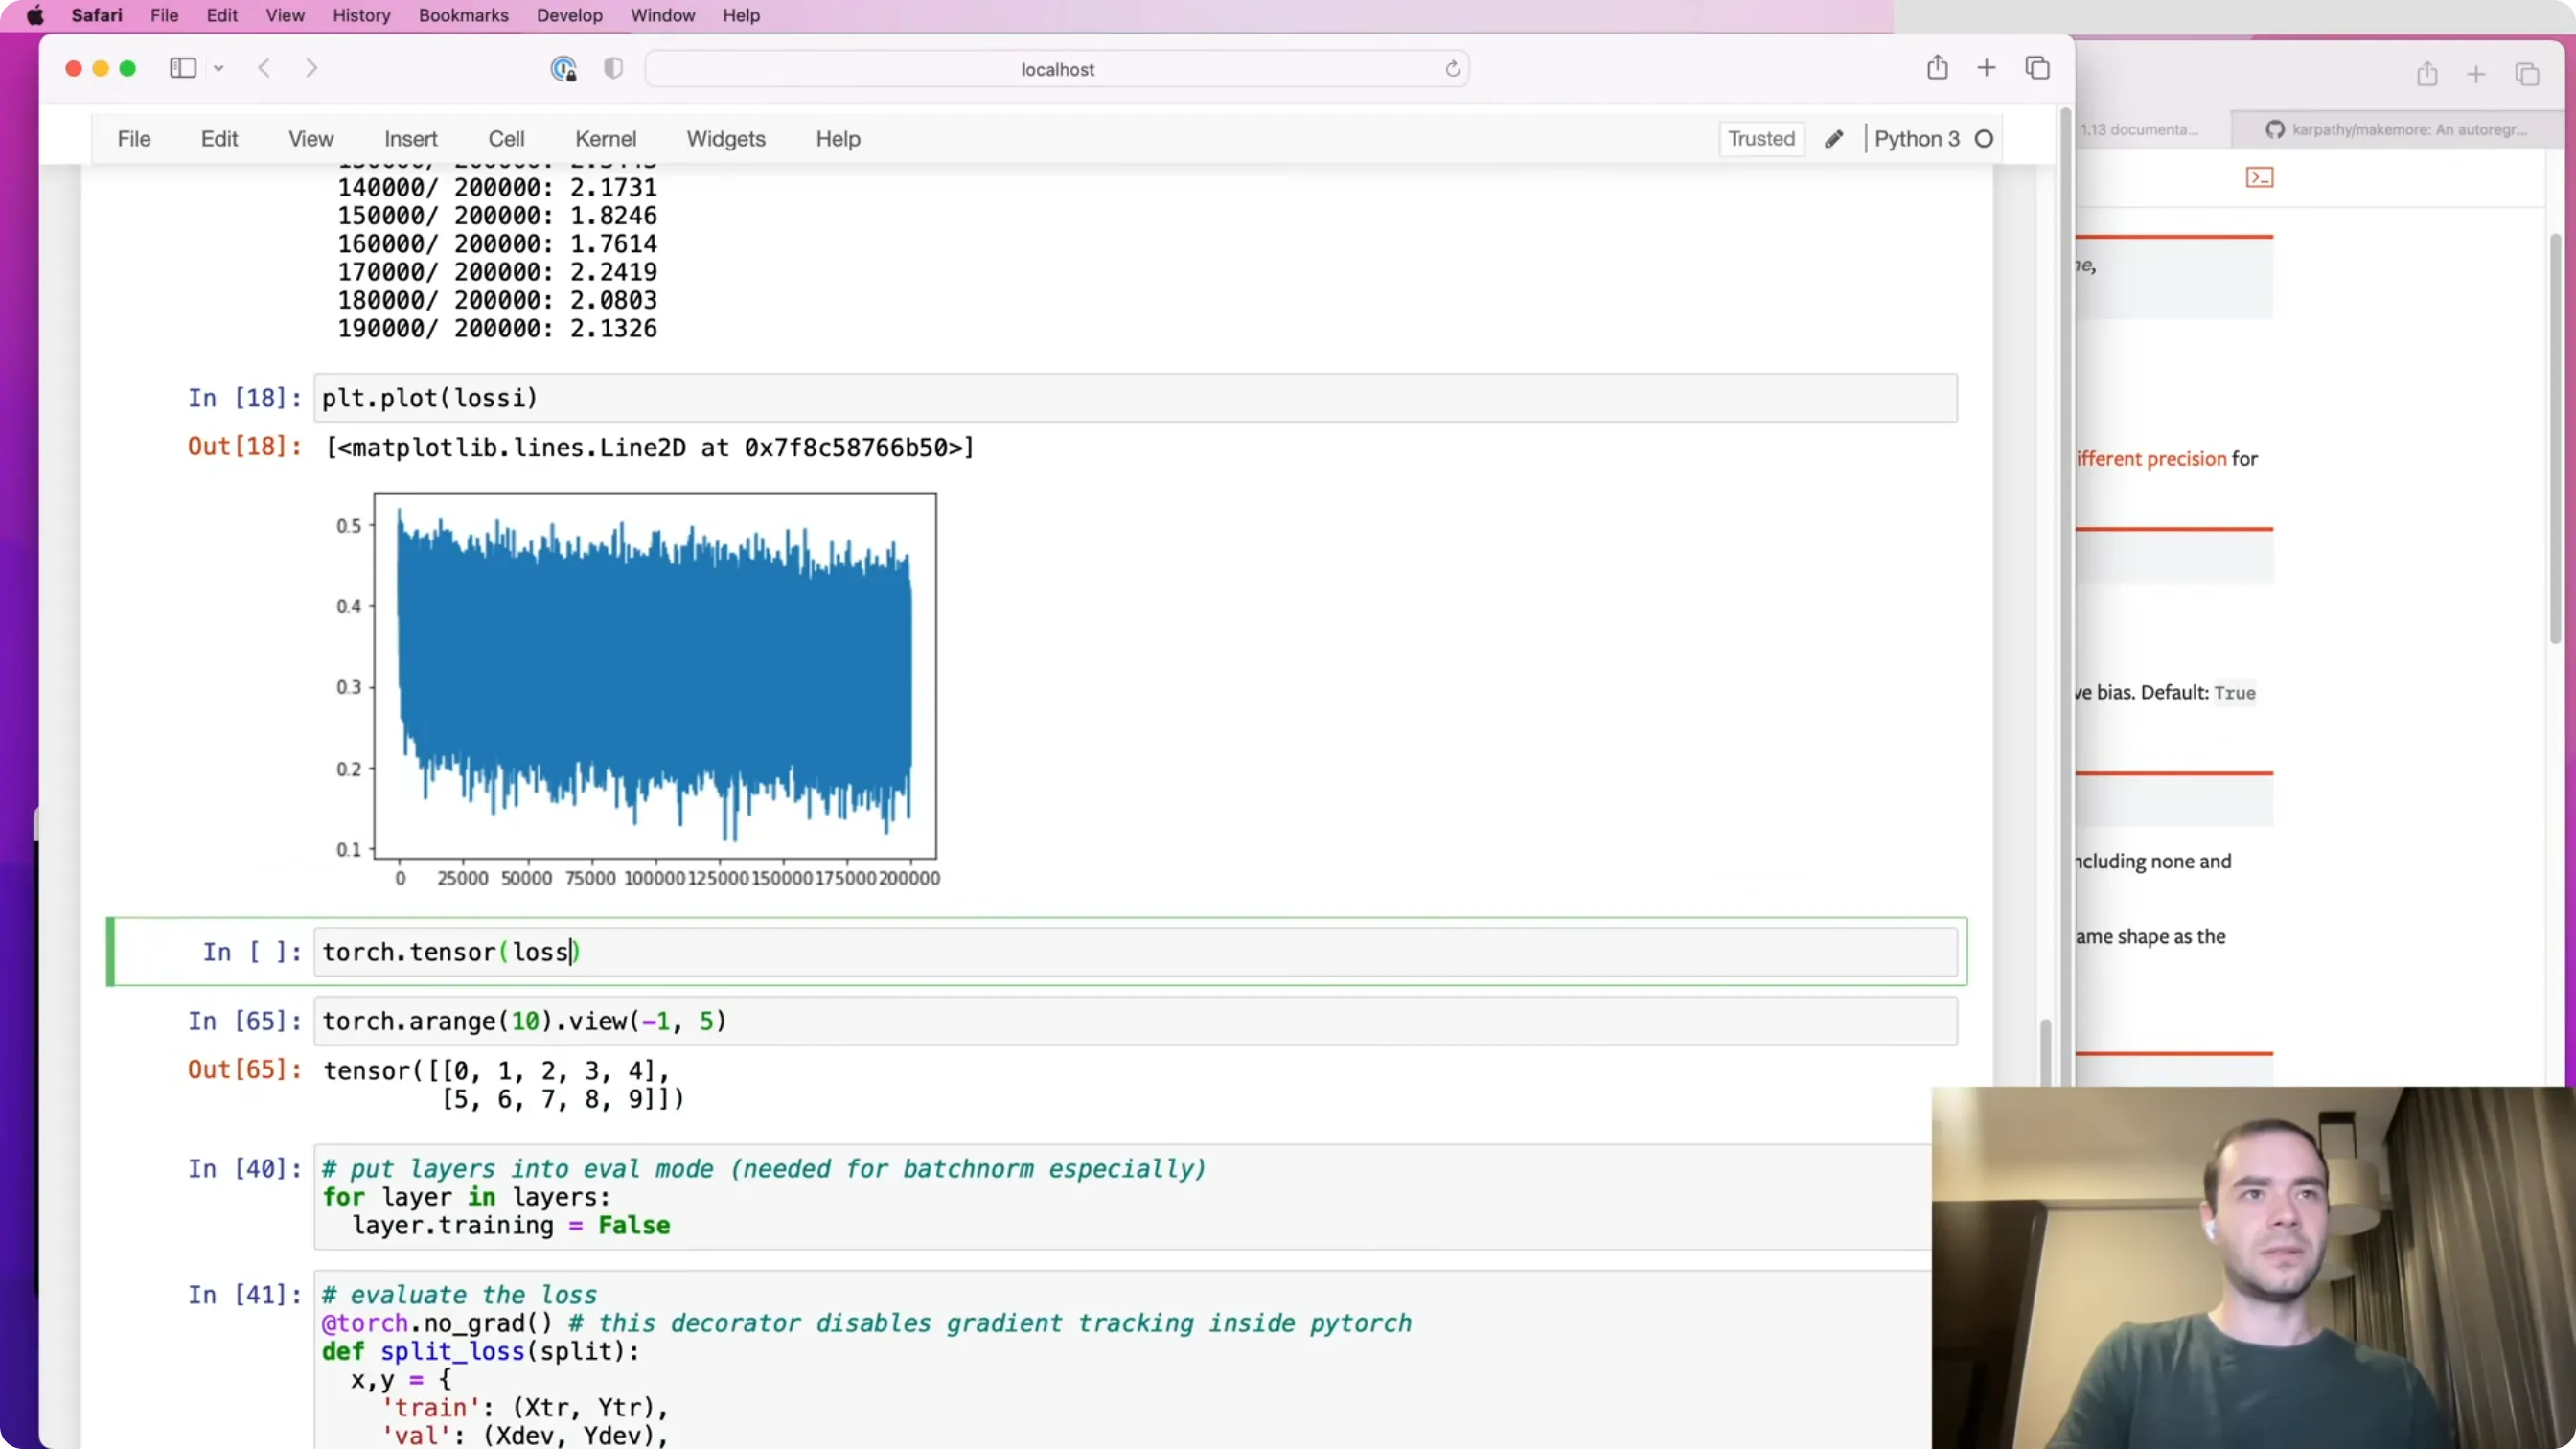
📷 把一维 loss 列表 view 成 (200,1000) 再对每行求均值,曲线立刻平滑
回到原视频 (00:08:20)
四、PyTorch-ifying:层(layers)与容器(containers)
(参考时间: 09:16)
4.1 补上缺失的两层
我们的 forward pass 还是有点"狰狞"——因为有几件事没被放进 layers:嵌入表和那个 view 操作。
嵌入表其实就是一个用索引做的查表;而那个 view——
「它本质上就是拼接(concatenation)操作,但它免费——因为 view 在 PyTorch 里非常便宜,没有任何内存被拷贝,我们只是重新解释了这块张量。」
于是补上两个模块:Embedding(forward 里做索引)和 Flatten(forward 里做重排),并把 C 收进 Embedding.weight。它们在 PyTorch 里都有对应物:nn.Embedding、nn.Flatten(都还有更多我们暂不使用的关键字参数)。
现在 forward 变得非常干净:
x = self.embedding(x)     # (B,T) ints → (B,T,C)
x = self.flatten(x)       # (B,T,C) → (B, T*C)
logits = self.model(x)
4.2 引入 Sequential 容器
(参考时间: 12:45)
「我们一直在用一个"裸列表"维护所有模块。 在
torch.nn里有一个概念叫容器(containers)——用来把层组织成 list 或 dict。」
于是自己写一个 Sequential:
class Sequential:
    def __init__(self, layers):
        self.layers = layers
    def __call__(self, x):
        for layer in self.layers:
            x = layer(x)
        return x
    def parameters(self):
        return [p for layer in self.layers for p in layer.parameters()]
现在:
model = Sequential([...])
parameters = model.parameters()
logits = model(Xb)
代码又短了一大截。
4.3 一个真实 bug:忘了重跑那个 cell
(参考时间: 15:42)
Karpathy 现场踩了一个坑,而且他特意停下来讲了它:
「我把这个 cell 改成
model.layers之后,没有真的重新运行它——于是 BatchNorm 还留在 training 模式。 而采样时我们传进去的是单个样本(一条 context)。在 training 模式下往 BatchNorm 里塞单个样本,它会用这个输入去估计方差——而"一个数的方差"根本不是一个数。」
# variance of a single number?
torch.tensor([5.0]).var()   # → nan(分母 n-1 = 0)
结果:nan 污染了后面所有的处理。讽刺的是——
「我们甚至没有从损失上看出来问题。 它照样给你一个数,只是那个数是错的——因为它用的是 batch 的样本统计量,而我们想要的是 running mean/variance。」
又一次因为"没有正确维护 training/eval 状态"而在线引入 bug。这正是 BatchNorm 那个"状态"的代价。
编者说明:这正是后来 PyTorch 引入
model.eval()/model.train()的原因——递归地把整个模型(含所有子模块与子子模块)切到正确的模式,而不是靠人肉一个个改。本讲还是手写的training标志,所以特别容易踩。
修好之后,训练损失 2.05、验证损失 2.10。
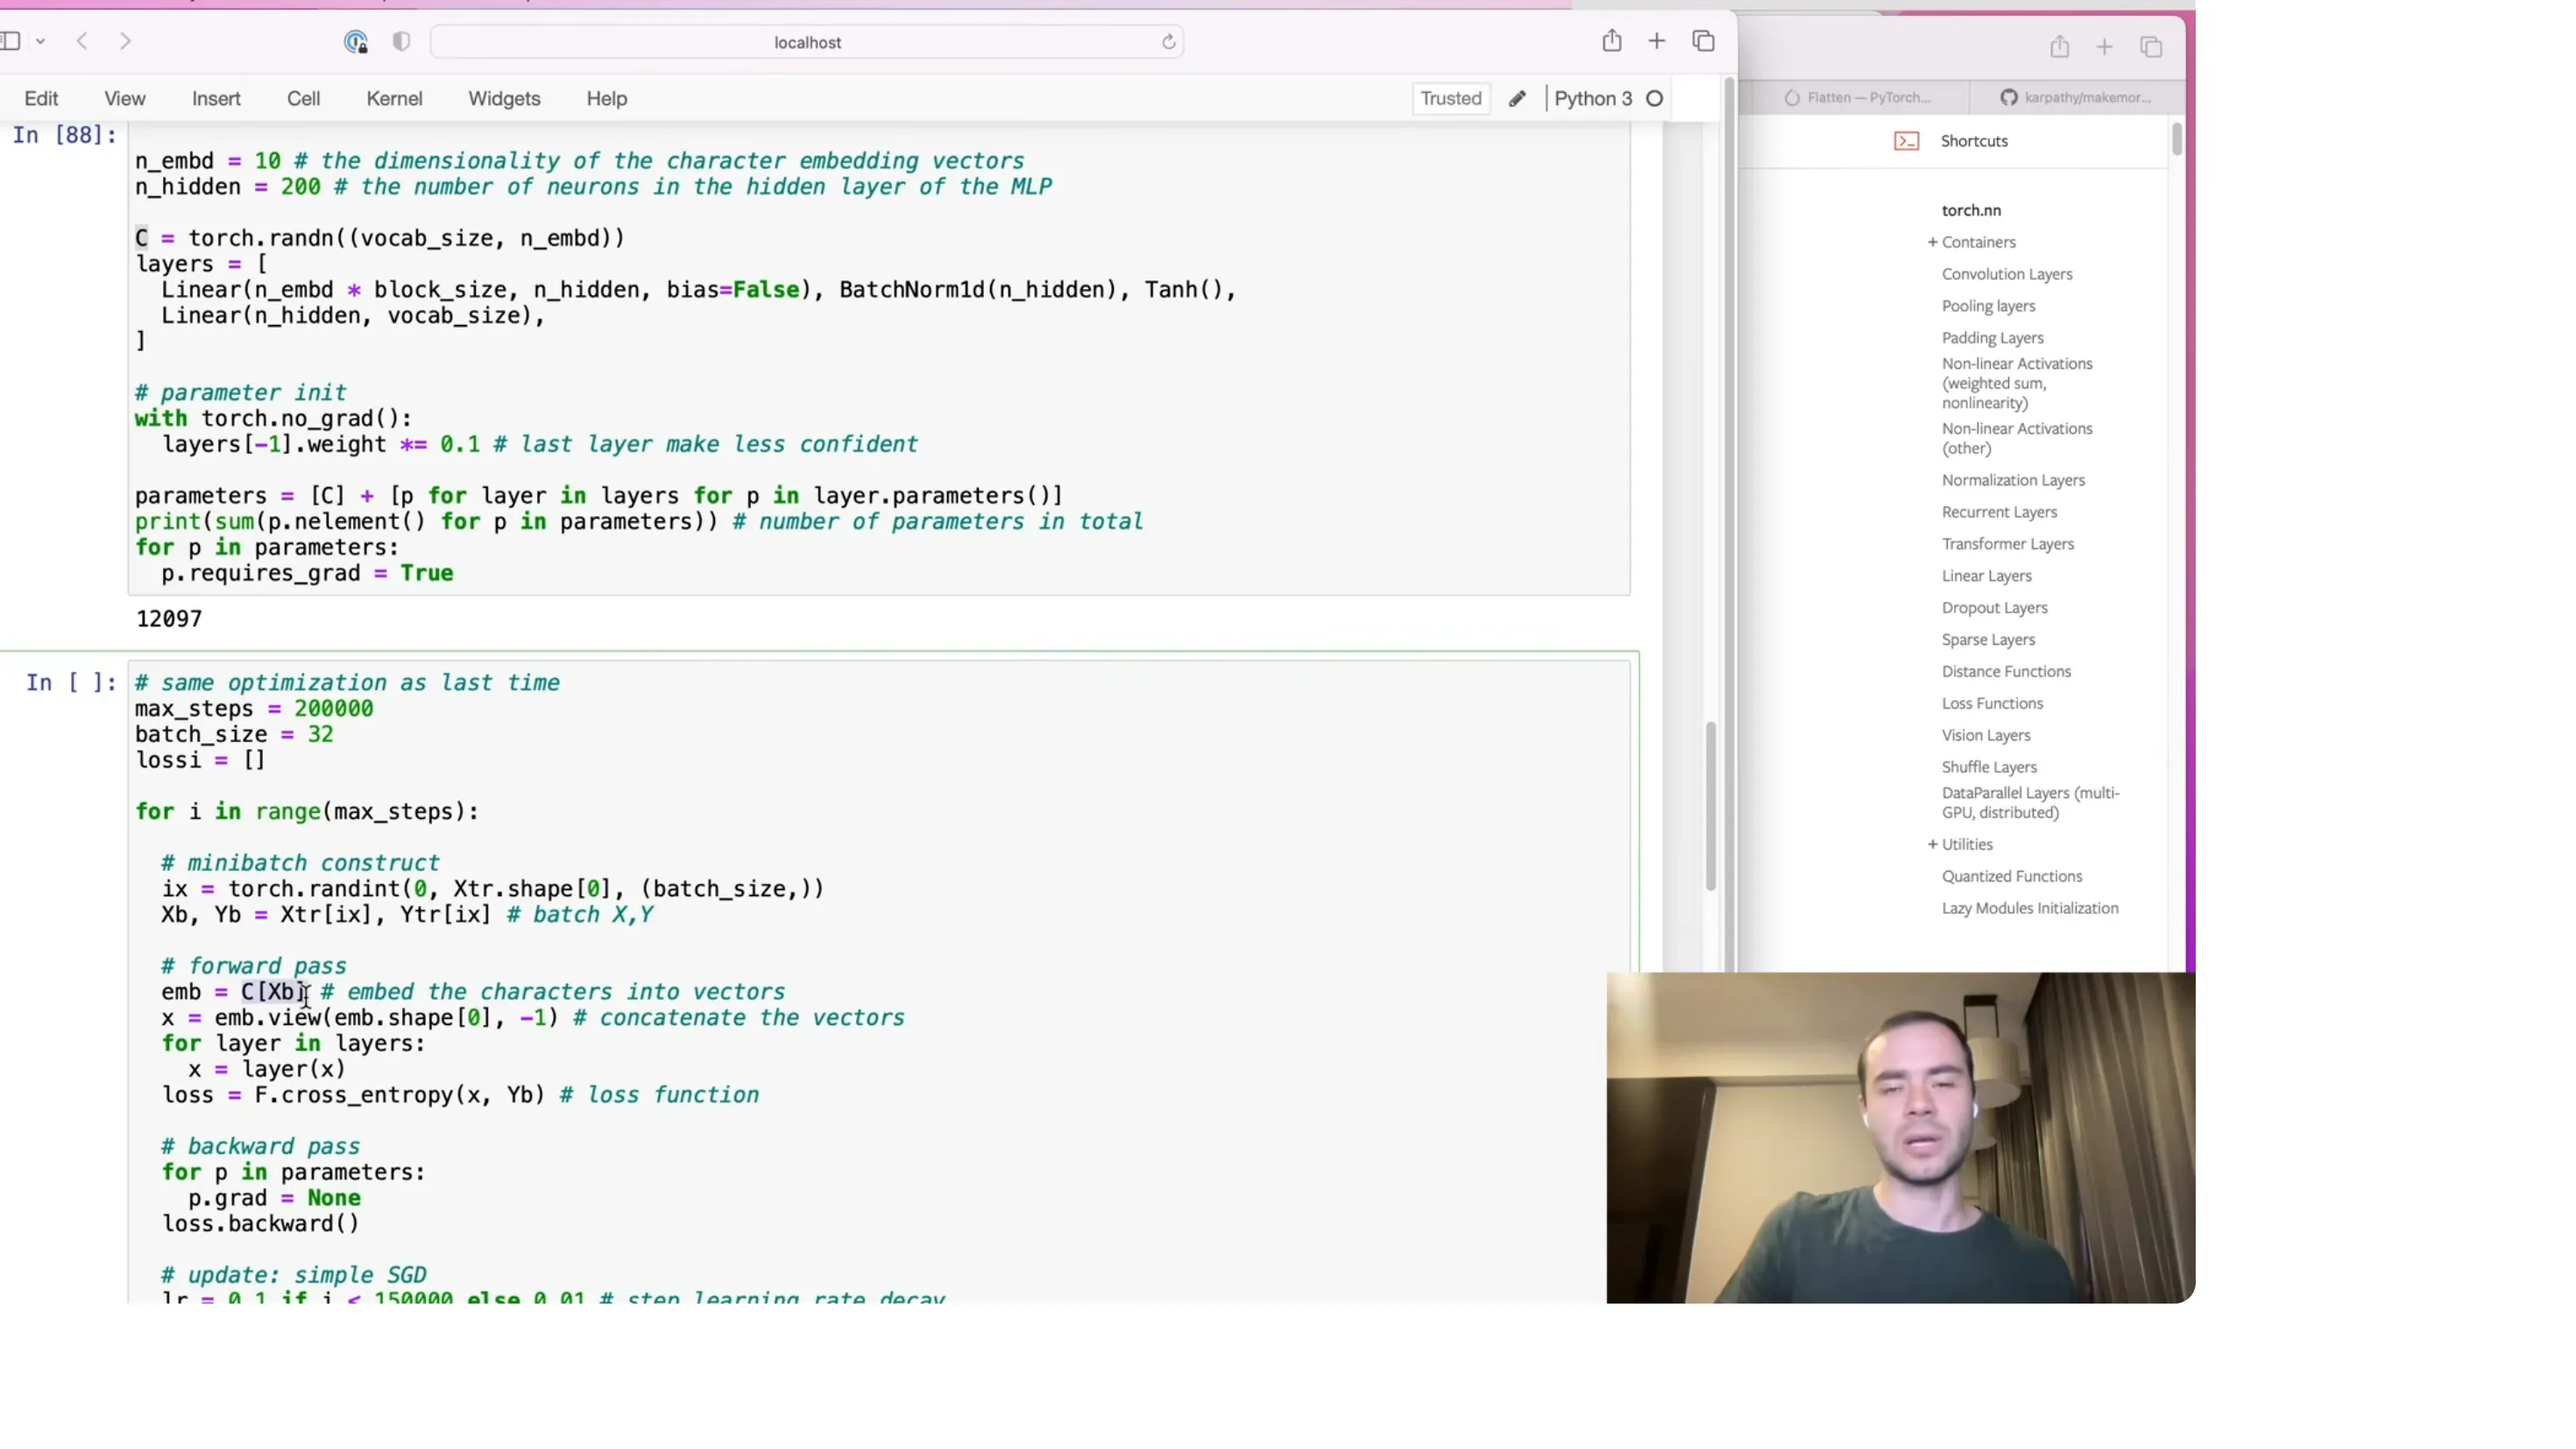
📷 Embedding / Flatten 模块:view 是"免费"的拼接,不拷贝任何内存
回到原视频 (00:10:00)
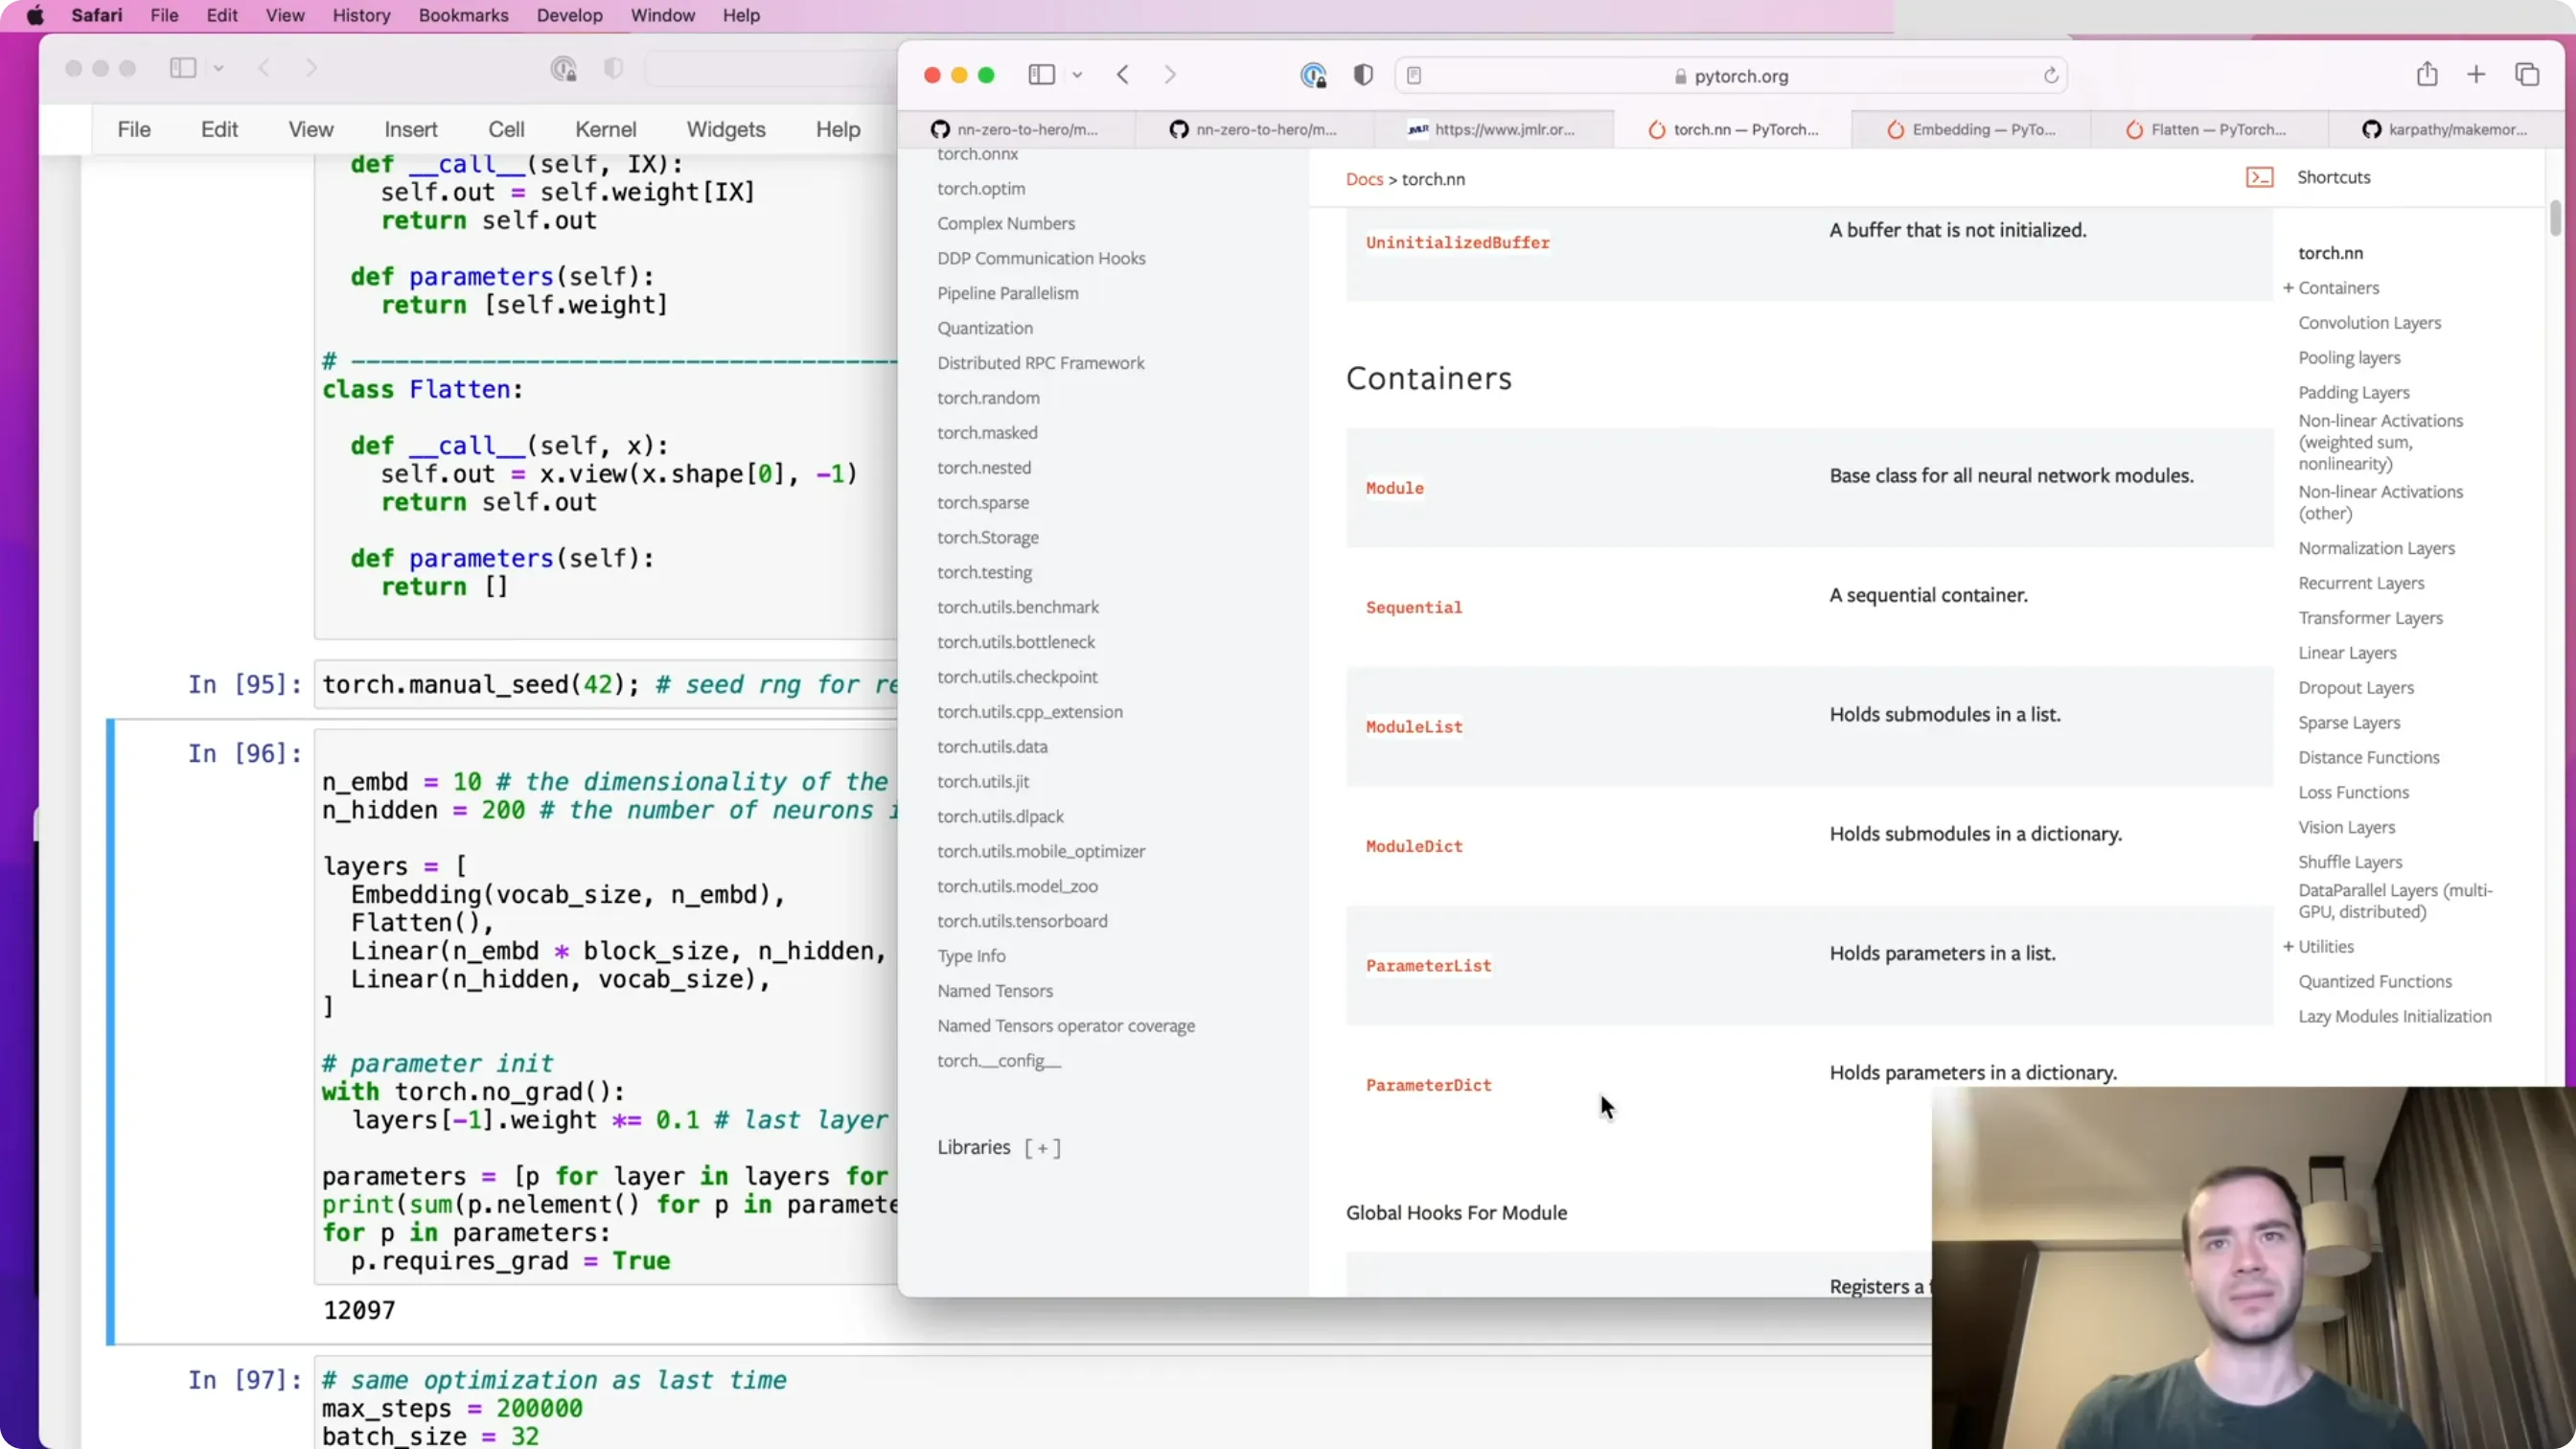
📷 Sequential 容器:把裸列表换成"模型",forward 与 parameters 都大幅简化
回到原视频 (00:13:15)
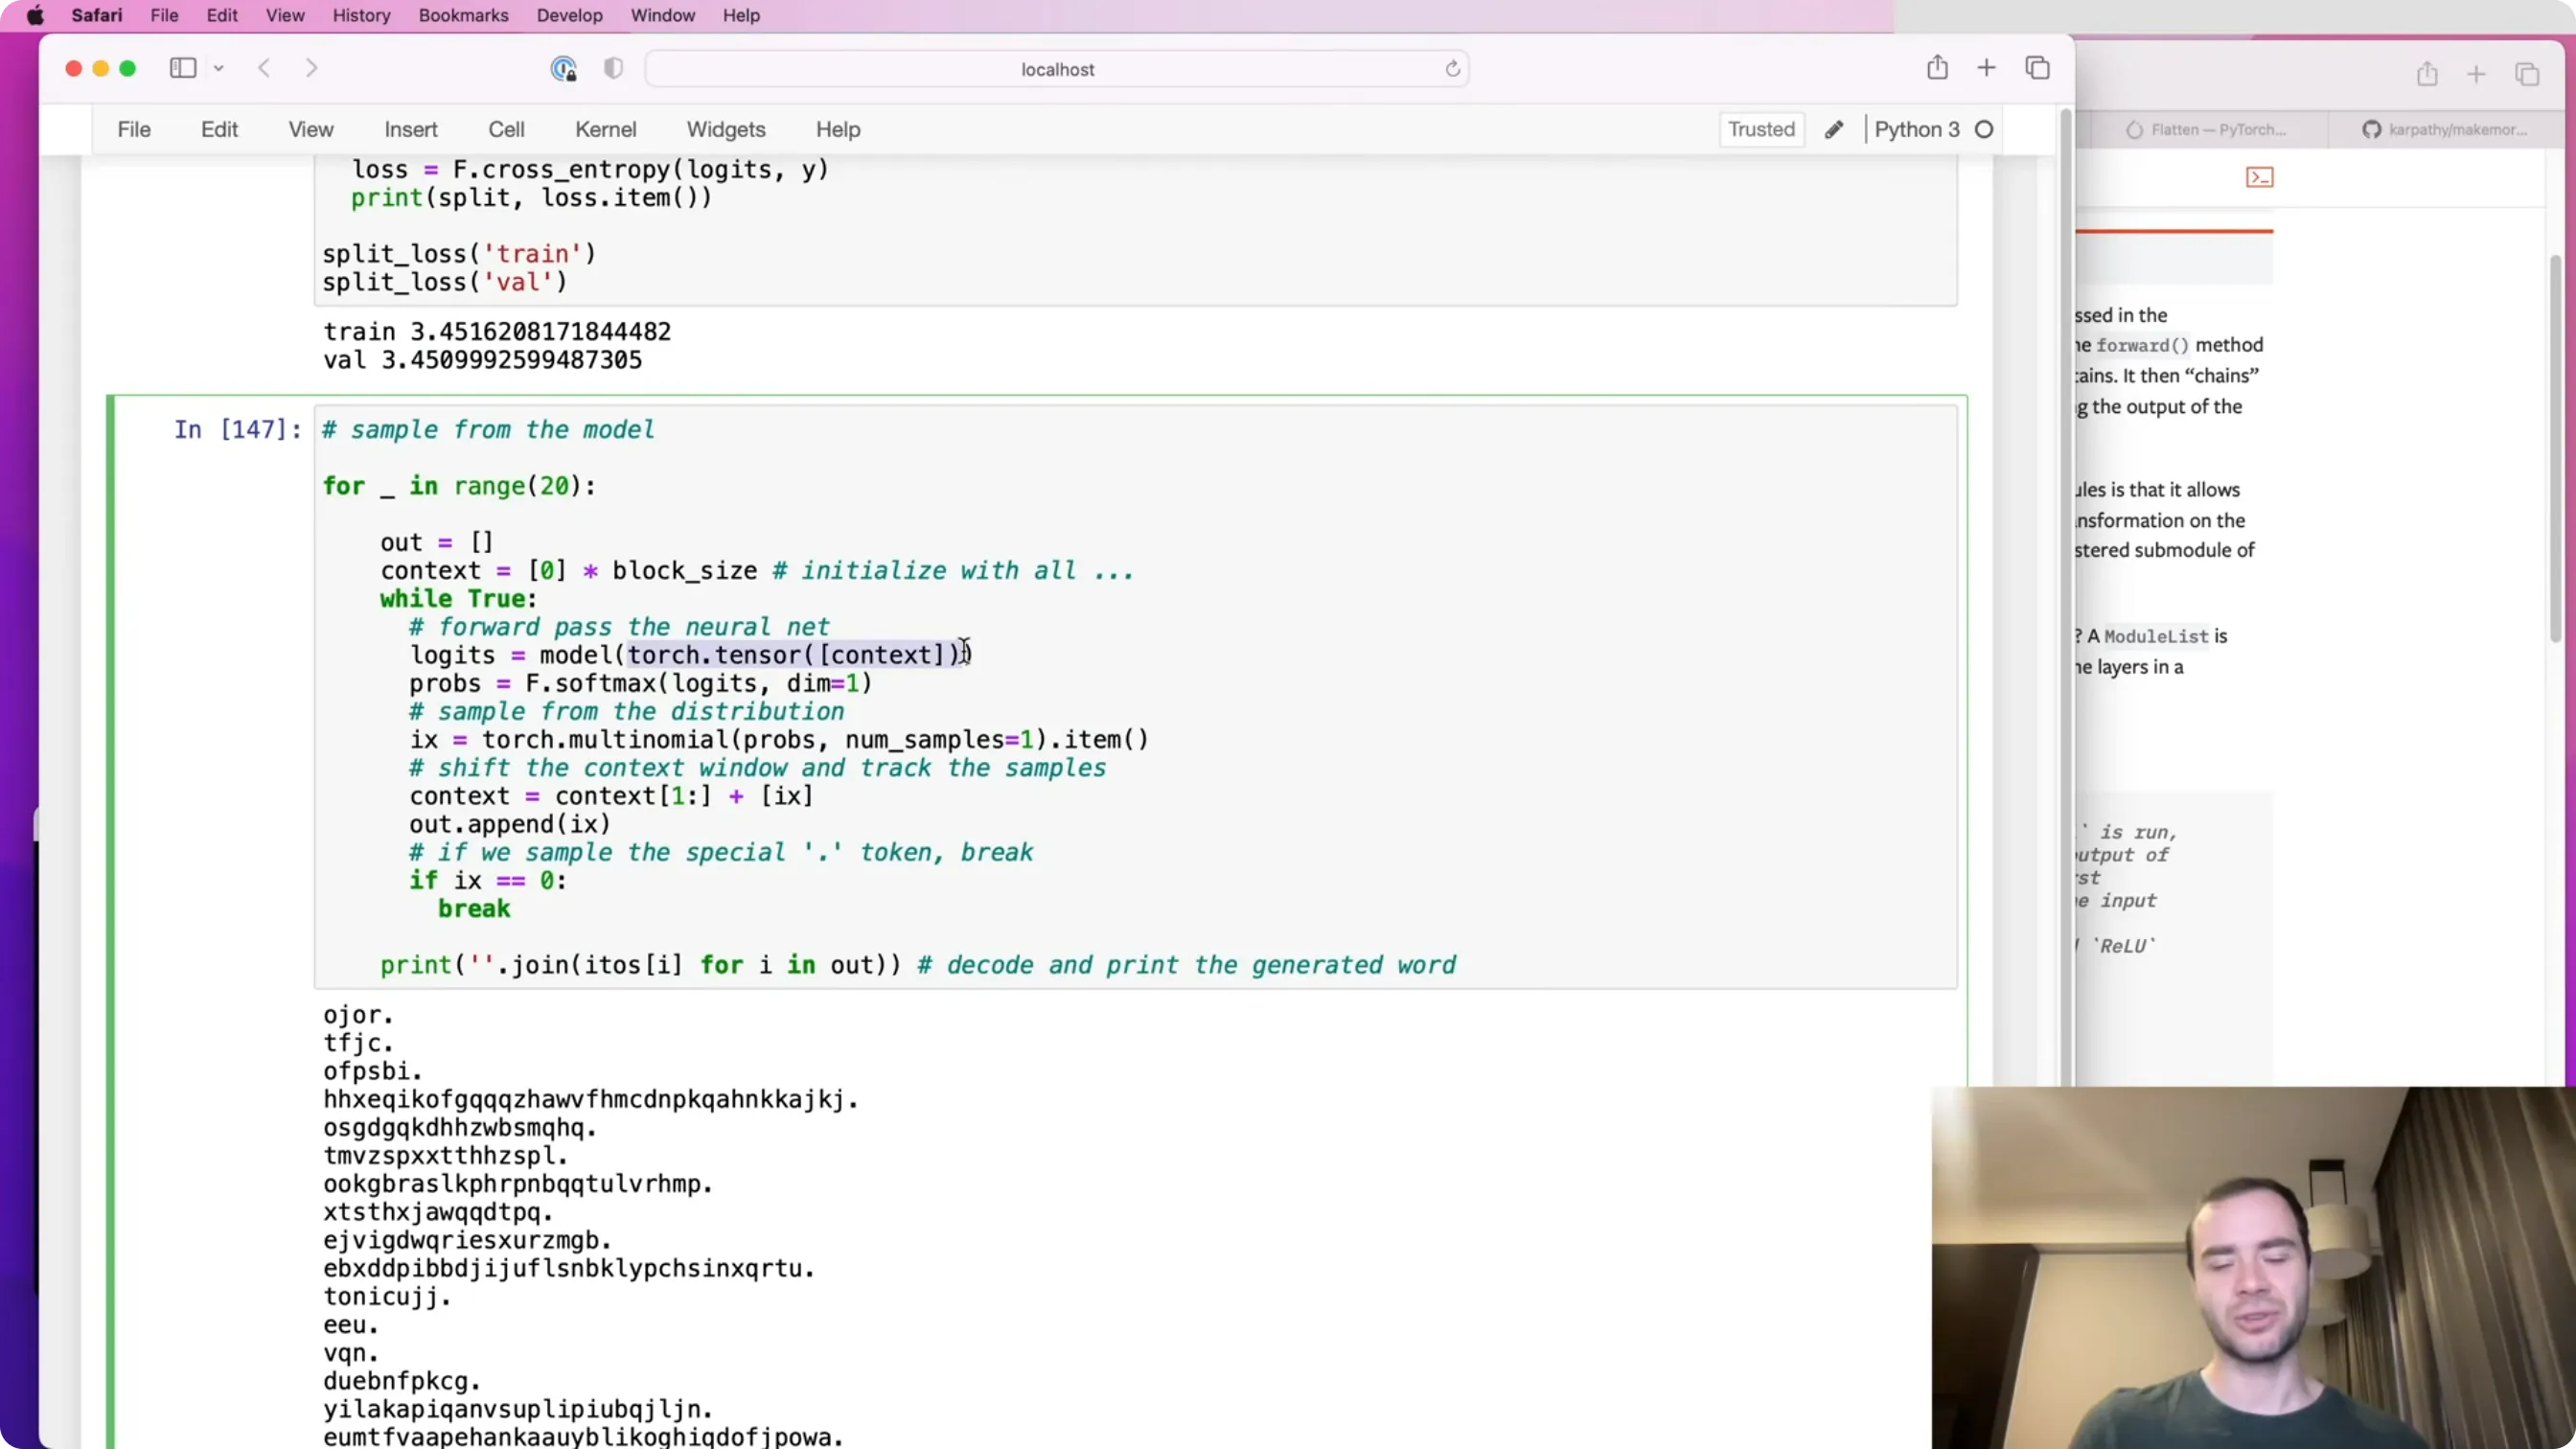
📷 踩坑现场:BatchNorm 处在 training 模式时喂单个样本 → 方差是 nan
回到原视频 (00:16:10)
五、WaveNet 总览
(参考时间: 17:11)
当前架构的问题:
「我们把所有字符在最开始就一次性压进同一个隐层。 就算把这个层加宽、加深,"一步就把信息压扁"这件事本身仍然很傻。」
WaveNet 的做法:让网络逐层、成对地融合——
graph BT
    c1["c₁"] --> b1["bigram"]
    c2["c₂"] --> b1
    c3["c₃"] --> b2["bigram"]
    c4["c₄"] --> b2
    b1 --> q1["4-gram"]
    b2 --> q1
    q1 --> out["下一个字符"]
先两两融合成 bigram,再把 bigram 两两融合成 4-gram……像树一样往上长。 「我们把上下文里的信息,随着网络变深而慢慢地融合进去。」
关于"dilated causal convolution"(膨胀因果卷积):
「这个名字听起来很吓人,但其实想法很简单——"dilated causal convolution"只是个让一切变快的实现细节(我们后面才讲)。现在只要记住核心想法:渐进融合(progressive fusion)。」
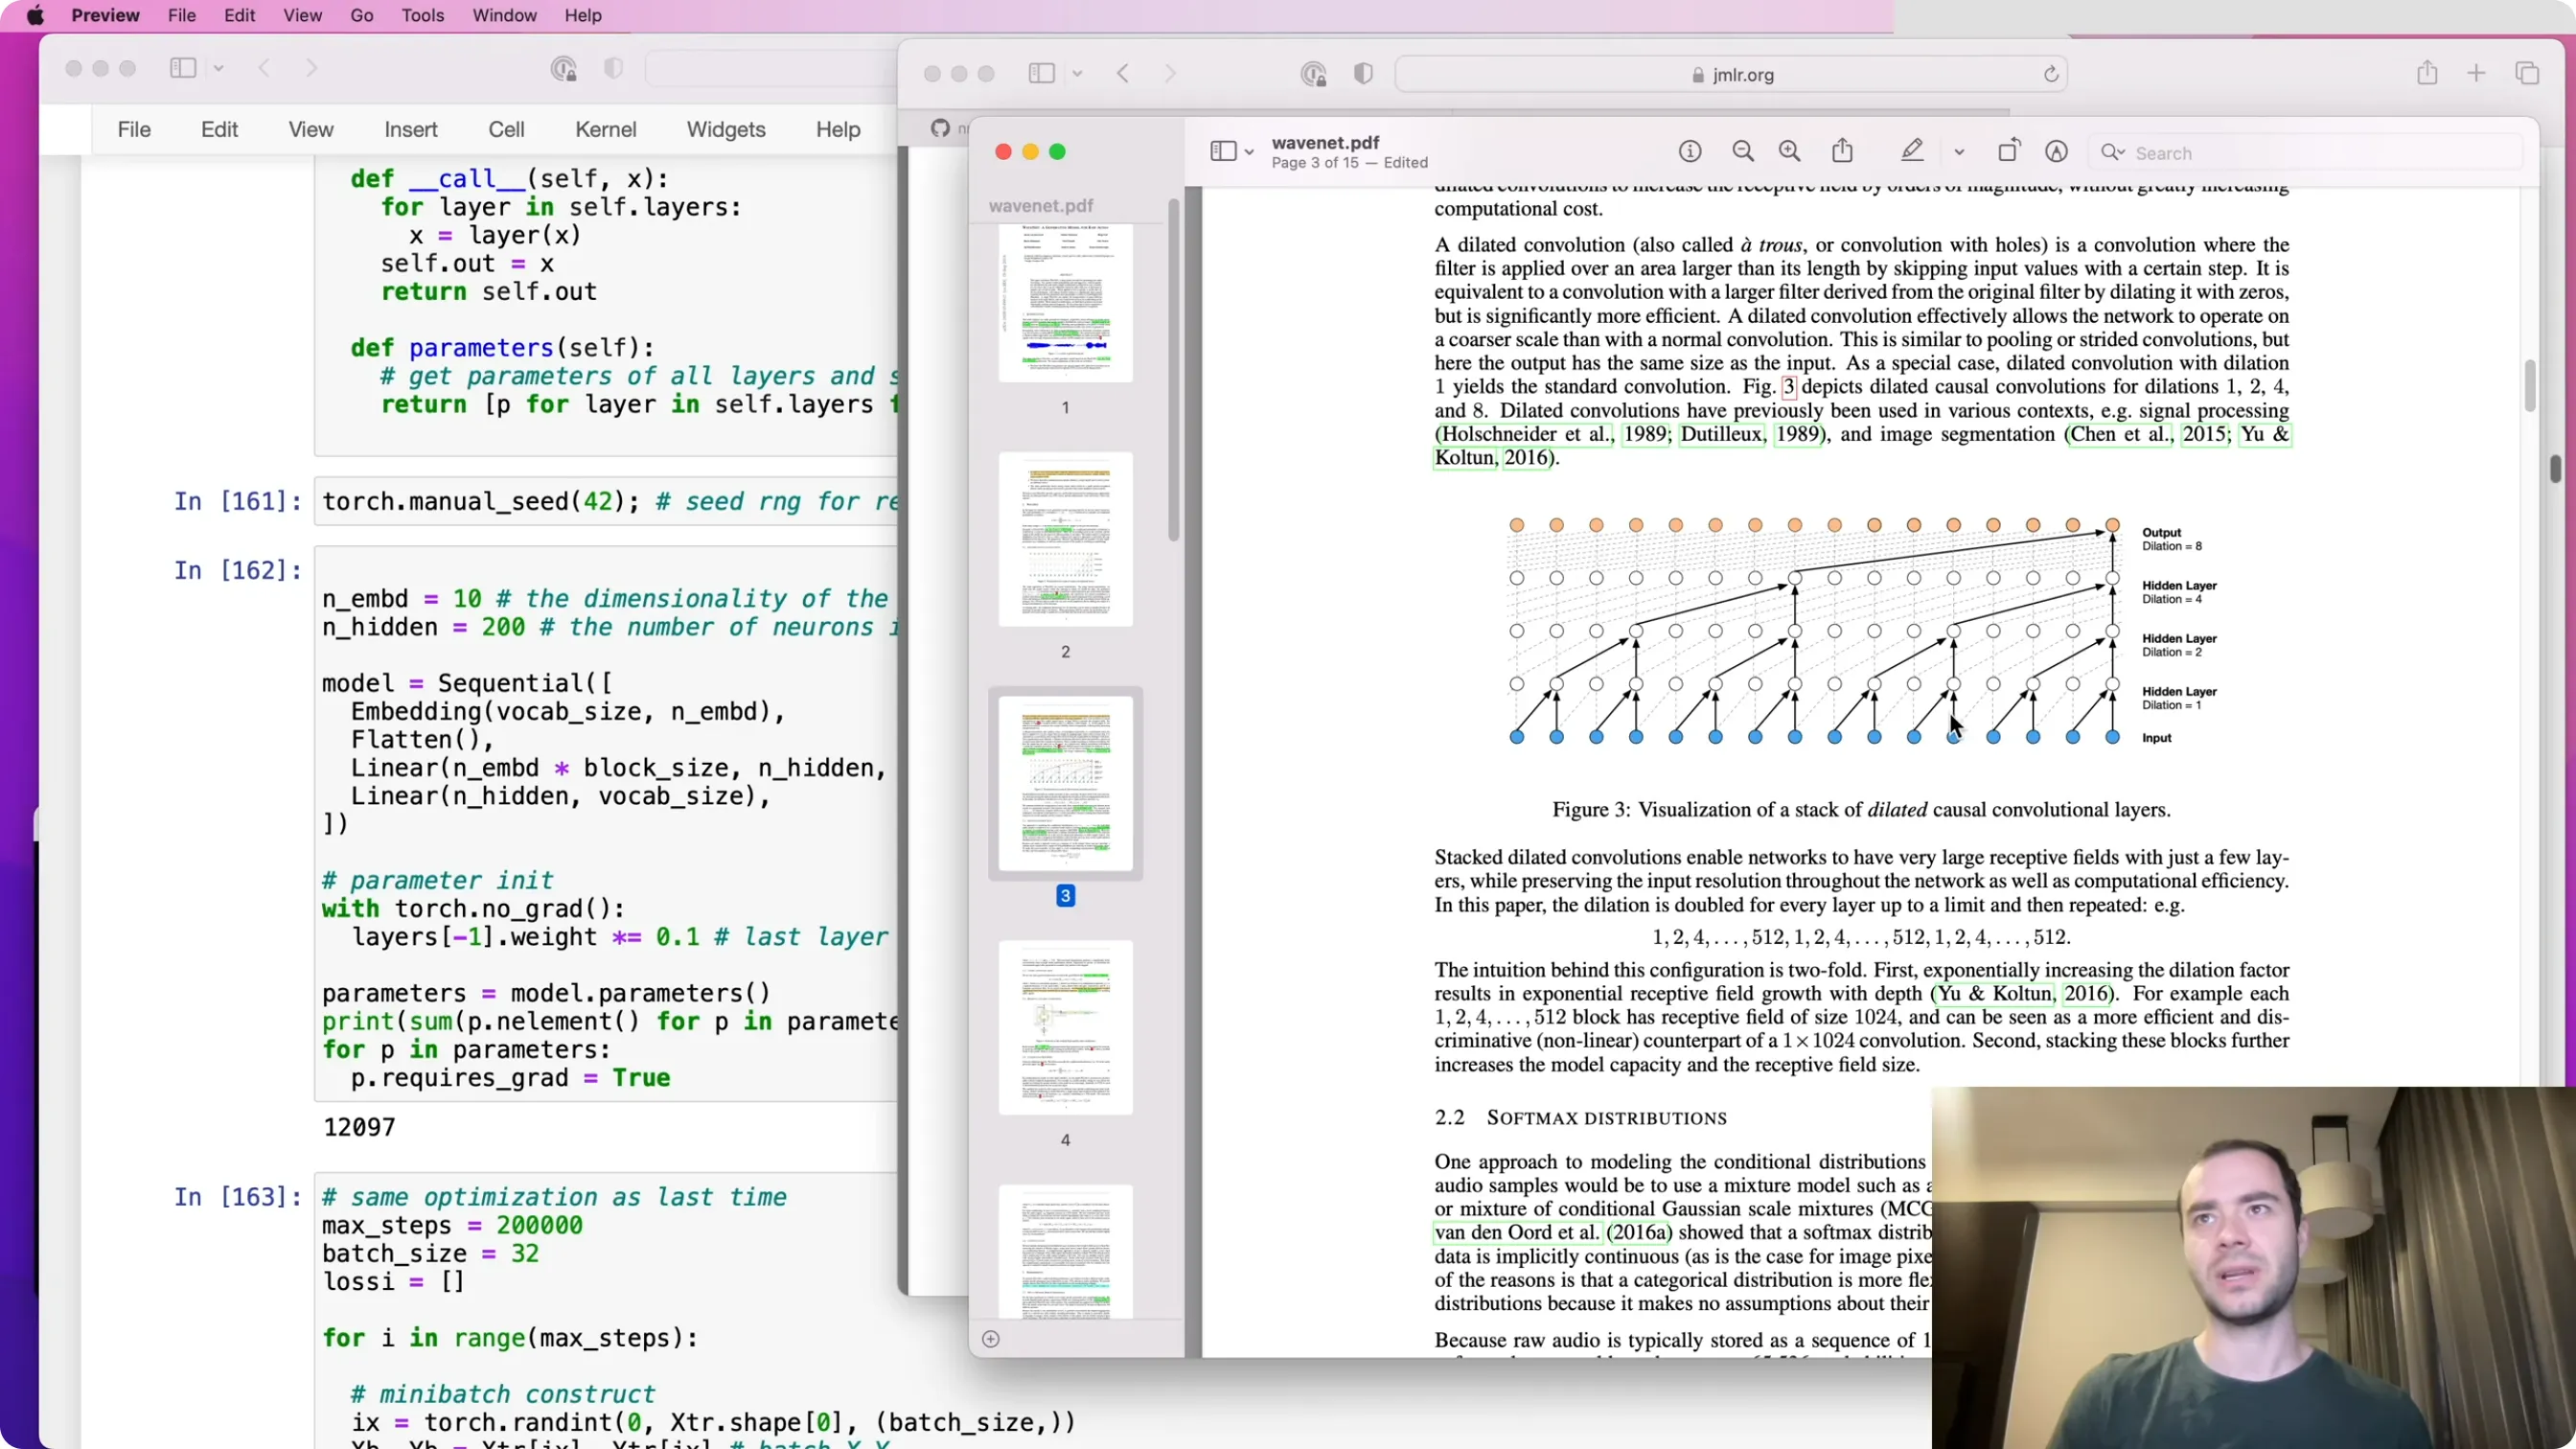
📷 WaveNet 论文 Fig.3:堆叠的膨胀因果卷积——膨胀系数逐层翻倍(1,2,4,…),感受野指数增长
回到原视频 (00:18:50)
先把 block_size 从 3 改成 8(用 8 个字符预测第 9 个)。
5.1 先量一个基线
(参考时间: 19:56 / 20:42)
Karpathy 说:「在动手重写之前,我很好奇:光是"偷懒地把上下文变长",基线能到哪?」
结果——只是把上下文从 3 拉到 8:
| 配置 | 验证损失 |
|---|---|
| 单隐层 MLP,block_size = 3 | 2.10 |
| 单隐层 MLP,block_size = 8 | 2.02 |
「相当可观的提升,采样出来的名字在质上也明显变好了。我们可以在这里花很多时间继续调大、继续 scale……但让我们把它当作一个粗略基线,先去做真正的架构。」
编者拓展|为什么会这样? 上下文从 3 变 8,输入层参数量线性增长(
n_embd × block_size从 30 变 80),模型能看到的条件信息多了。但这仍然是"一步压扁"——参数量涨了,结构没变。这也解释了 Karpathy 后面为什么要控制参数量不变来对比(22,000 参数 vs 22,000 参数)。
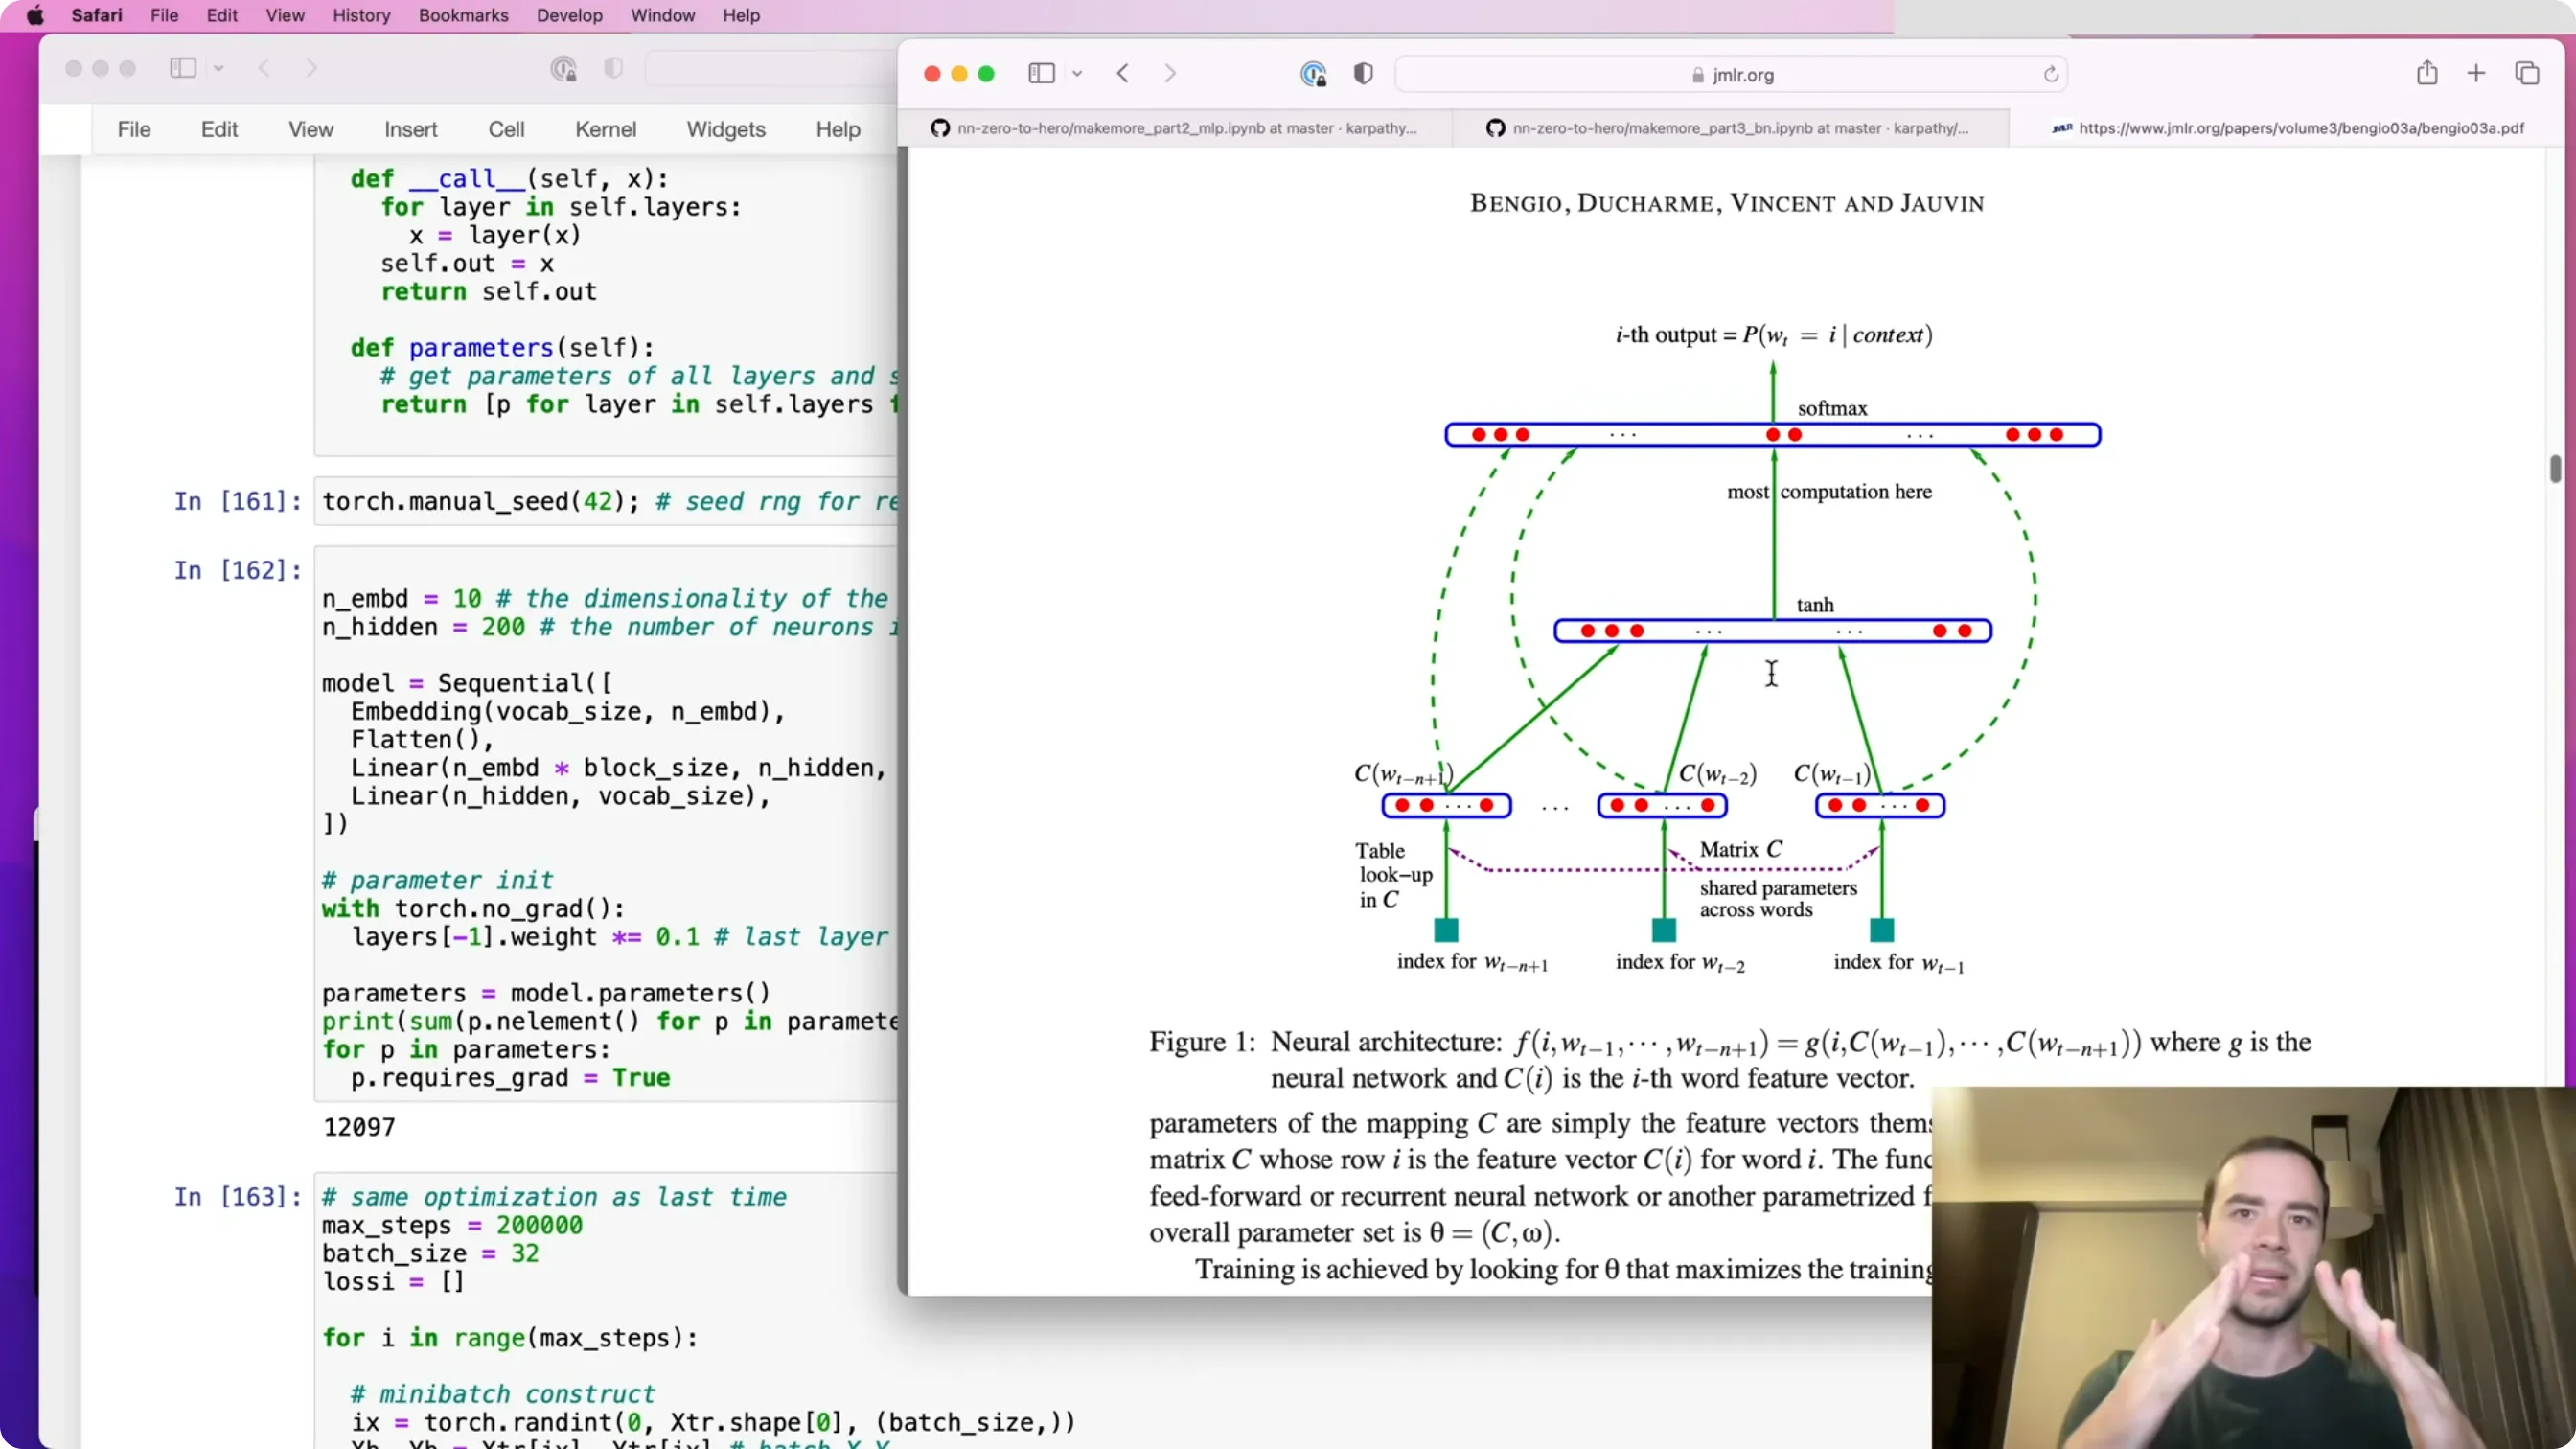
📷 Bengio 2003 的 MLP 语言模型:整段上下文一次性压进单隐层,图上即 "most computation here"
回到原视频 (00:18:00)
六、实现 WaveNet
(参考时间: 21:36)
6.1 一件"你可能没想到"的事:@ 支持额外批次维
先看形状怎么流动(用 4 个样本调试):
Xb                        (4, 8)          # 4 个样本 × 8 个字符(整数)
embedding(Xb)             (4, 8, 10)      # 每个字符 → 10 维向量
flatten                   (4, 80)         # 8×10 拼接成 80
Linear(80 → 200)          (4, 200)
然后是那个"惊喜":
「这个被乘的输入,其实不必是二维的。 PyTorch 的矩阵乘法算子很强大——你完全可以传更高维的张量,一切照常工作。 比如输入
(4, 5, 80),结果就是(4, 5, 200)。你可以在左边加任意多维度。也就是说:矩阵乘法只在最后一个维度上工作,前面的维度原封不动地保留下来——那些维度全部被当作"批次维度"。」
这正好是我们要的:不要让 80 个数一次性进线性层,而是把 8 个字符按 2 个一组分成 4 组,每组 20 个数,4 组并行处理:
(4, 80)  →  (4, 4, 20)   →  Linear(20 → 200)  →  (4, 4, 200)
              ↑                ↑
         4 个组         每个组只融合 2 个字符
6.2 FlattenConsecutive:一次只拼 n 个
改 Flatten,让它只把相邻的 n 个元素拼到最后一维:
class FlattenConsecutive:
    def __init__(self, n):
        self.n = n
    def __call__(self, x):
        B, T, C = x.shape
        x = x.view(B, T // self.n, C * self.n)
        if x.shape[1] == 1:
            x = x.squeeze(1)          # 消掉多余的长度为 1 的维度
        self.out = x
        return self.out
作者的两点坚持: 1. 不喜欢用
-1:「我喜欢尽可能显式,这样当事情不符合预期时,你能拿到报错。」所以写T // self.n而不是-1。 2. 改名:PyTorch 也有nn.Flatten,但关键字参数不同、行为也不同。为了不和它混淆,这个类改名为FlattenConsecutive——「确保我们的 API 和 PyTorch 是"对齐但不同"的。」
一个等价性的小证明(视频里现场验证):把"取偶数位字符 + 取奇数位字符 + 拼接"的显式写法与直接 view(B, T//2, C*2) 对比,逐元素全等。
说明:
view之所以能"免费"完成这个拼接,是因为内存布局本来就是连续的——(B, T, C)里相邻两个C维向量在内存里紧挨着,所以view成(B, T/2, 2C)天然就是"每两个拼起来",一步到位。连torch.cat都省了。
6.3 搭出层级网络
model = Sequential([
    Embedding(vocab_size, n_embd),
    FlattenConsecutive(2), Linear(n_embd * 2,  n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
    FlattenConsecutive(2), Linear(n_hidden*2,  n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
    FlattenConsecutive(2), Linear(n_hidden*2,  n_hidden, bias=False), BatchNorm1d(n_hidden), Tanh(),
    FlattenConsecutive(2), Linear(n_hidden*2,  vocab_size, bias=False), BatchNorm1d(vocab_size),
])
形状流水(n_hidden = 68,n_embd = 10,B = 4):
| 步骤 | 形状 |
|---|---|
Embedding |
(4, 8, 10) |
FlattenConsecutive(2) |
(4, 4, 20) |
Linear(20→68) |
(4, 4, 68) |
FlattenConsecutive(2) |
(4, 2, 136) |
Linear(136→68) |
(4, 2, 68) |
FlattenConsecutive(2) |
(4, 1, 136) |
Linear(136→68) |
(4, 1, 68) |
FlattenConsecutive(2) |
(4, 136) ← 长度为 1 的那维被 squeeze 掉了 |
Linear(136→27) |
(4, 27) ← logits |
注意 BatchNorm 那一行:「BatchNorm 居然"直接就工作"了——它接收了三维输入。但我们必须验证它做的到底对不对(下一节就是为此)。」
参数预算对齐:把 n_hidden 调成 68,参数量正好 22,000——和原来的扁平网络一模一样。这样就能公平回答一个问题:同样的参数量,层级结构是否用得更高效?
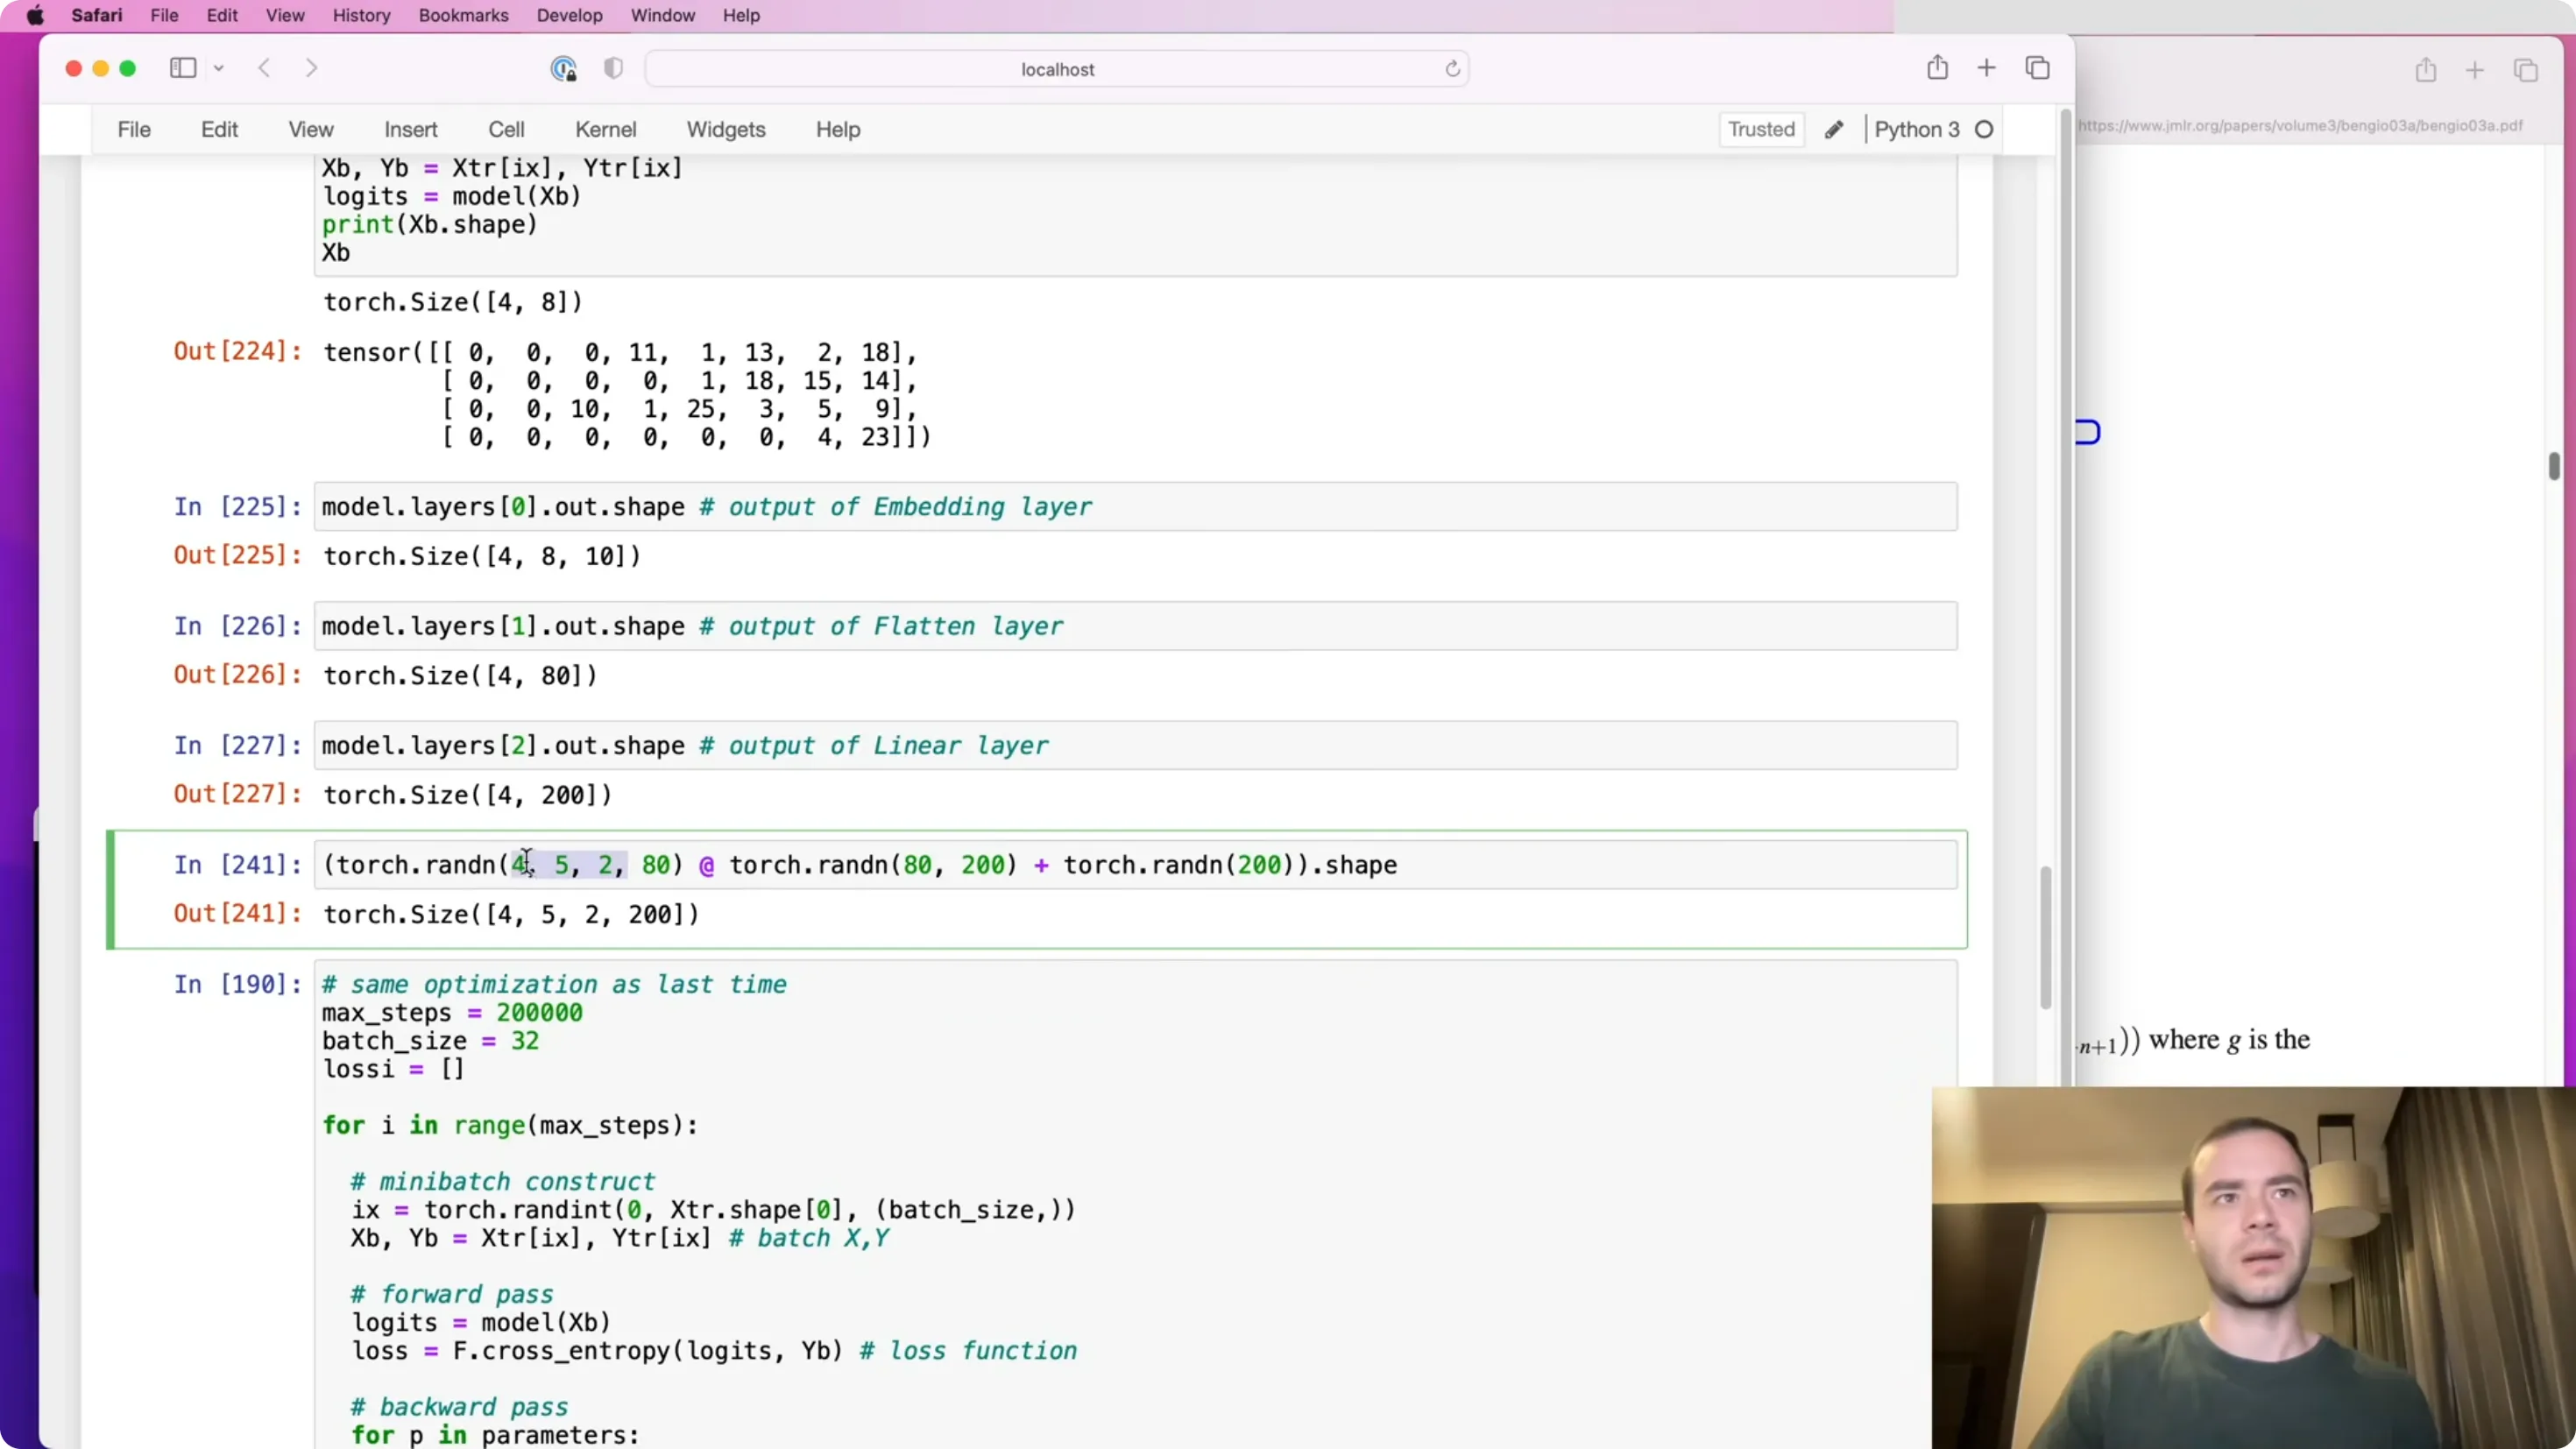
📷 矩阵乘法只作用于最后一维,前面所有维度都当作"批次维"——(4,5,80) → (4,5,200)
回到原视频 (00:25:20)
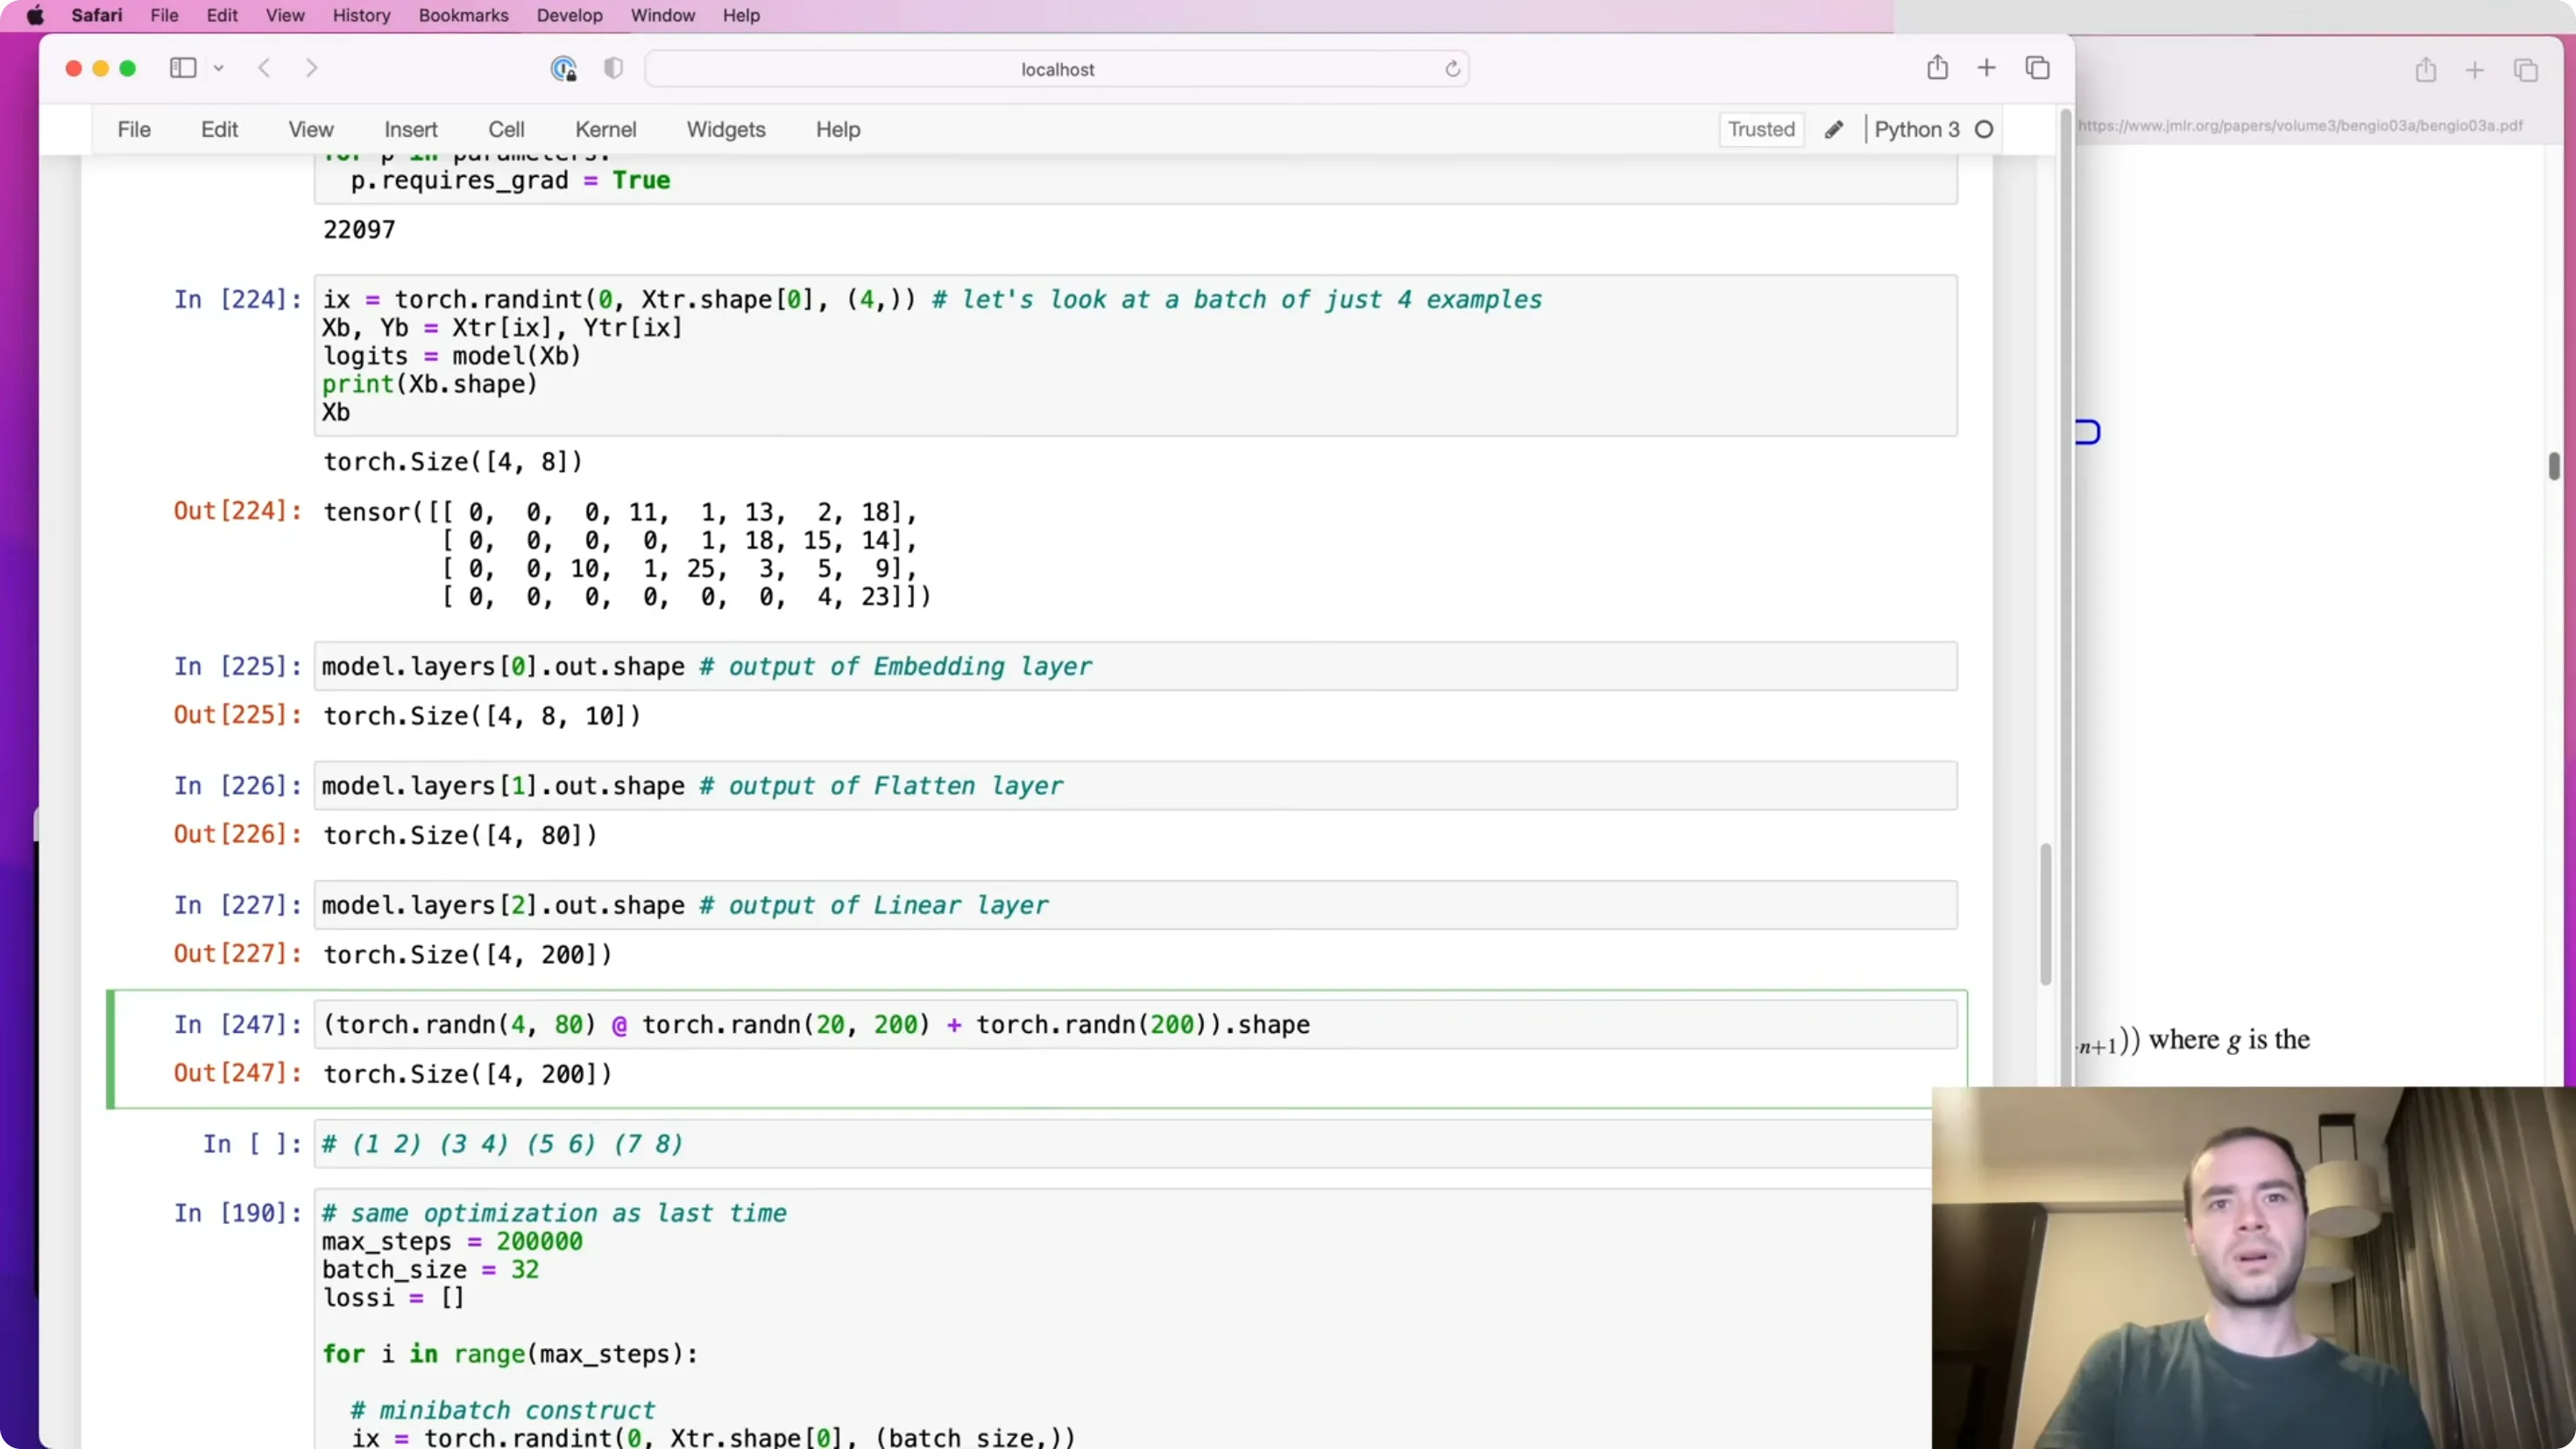
📷 把 8 个字符分成 4 组、每组 2 个:从 (4,80) 变成 (4,4,20),4 组并行融合
回到原视频 (00:27:20)
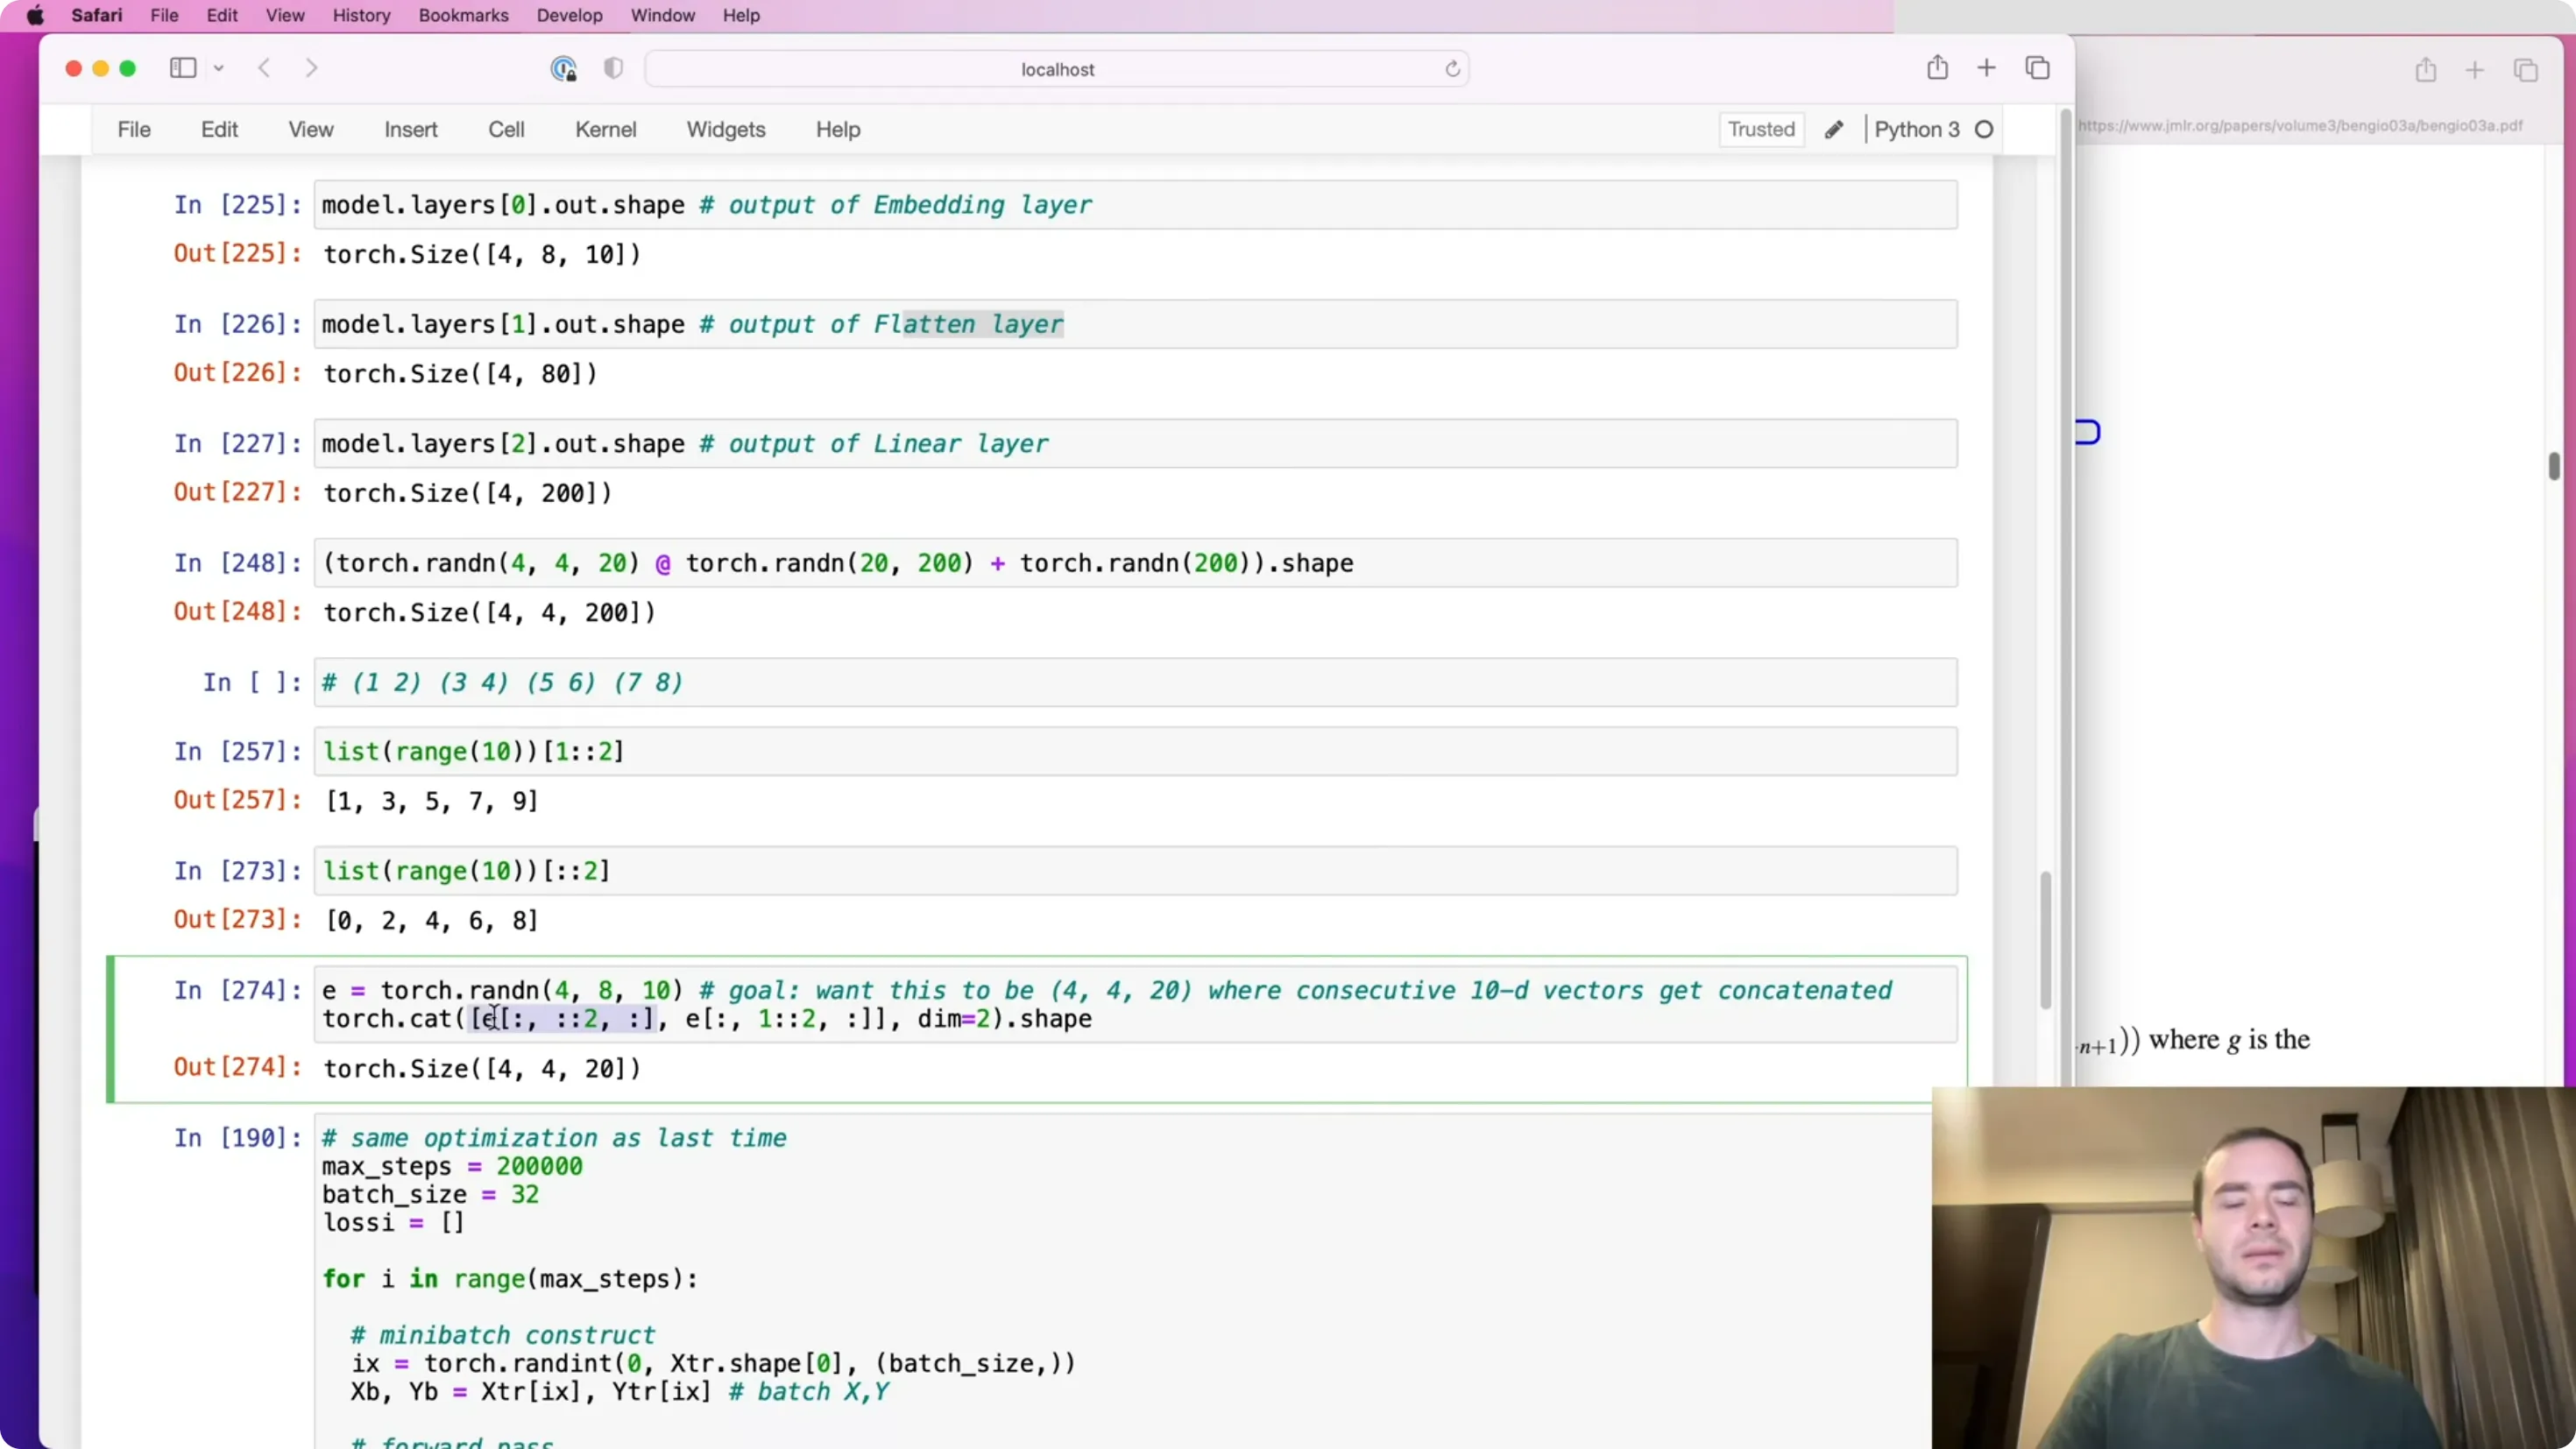
📷 形状全流程 (4,8,10)→(4,80)→(4,200);偶数位/奇数位拼接得 (4,4,20);(4,4,20)@(20,200)→(4,4,200)
回到原视频 (00:30:00)
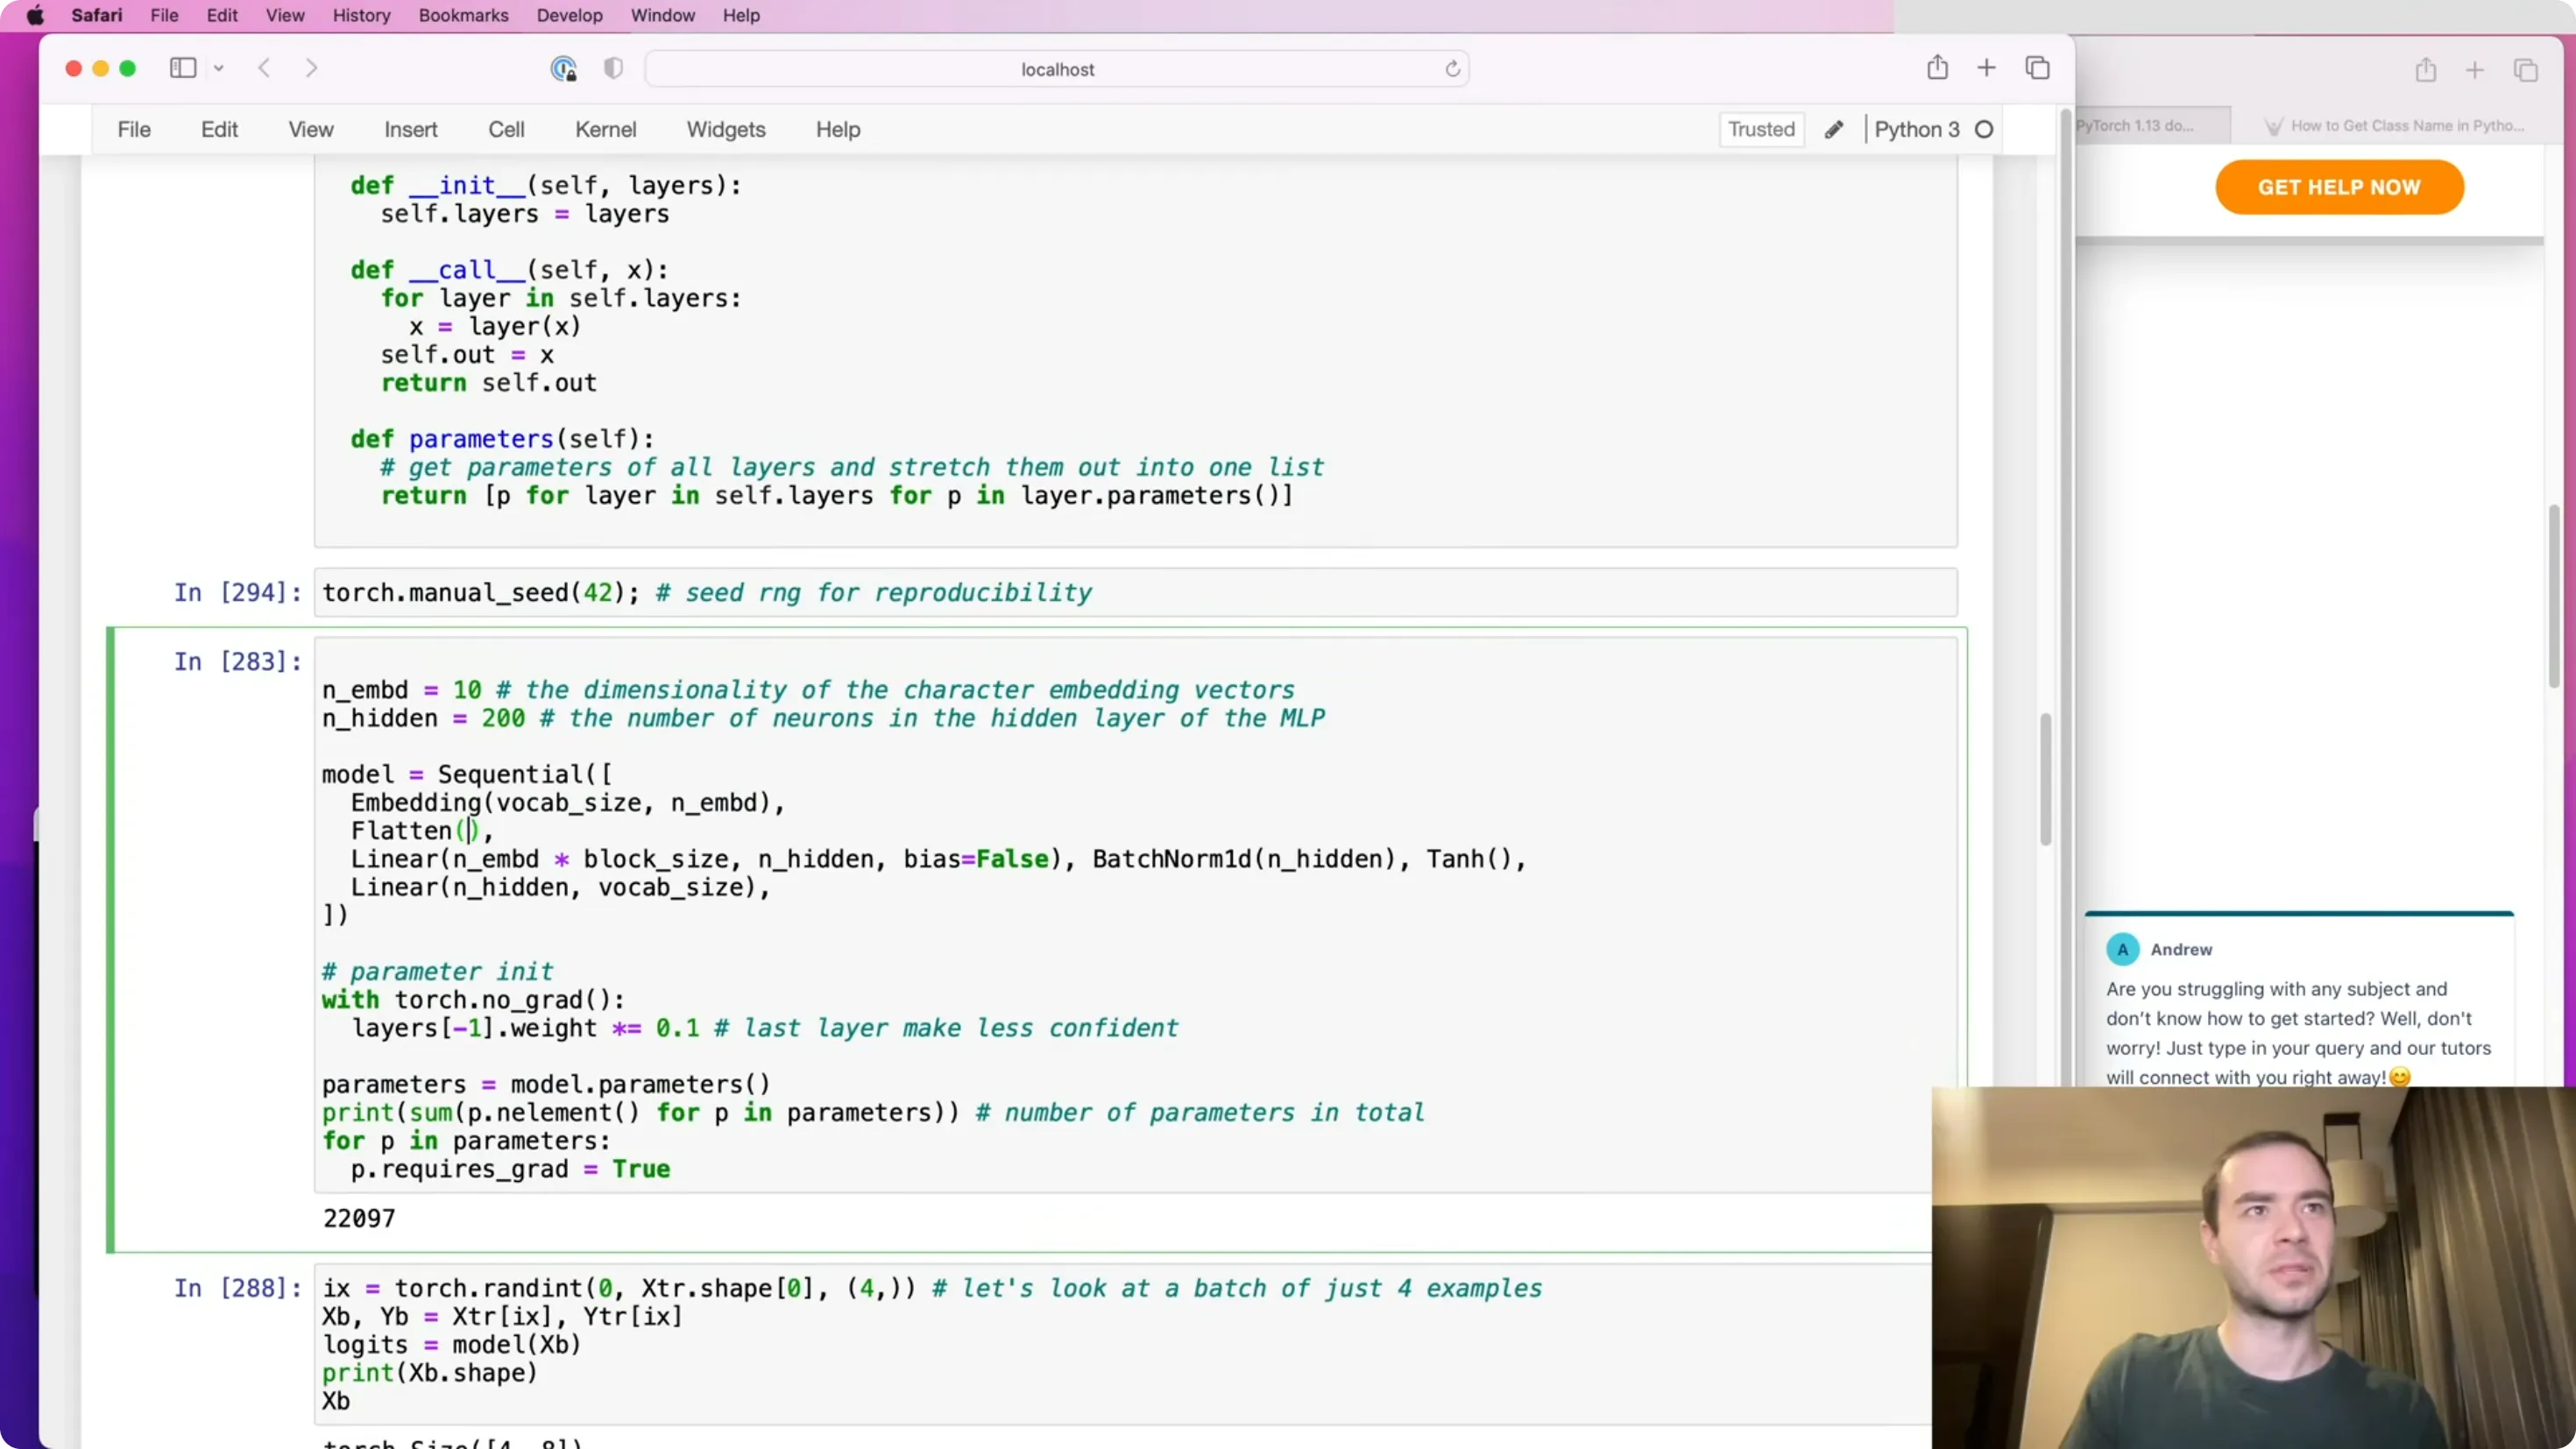
📷 FlattenConsecutive:只拼相邻 n 个,且坚持不用 -1(要能报错)
回到原视频 (00:34:40)
七、训练:第一轮(没有提升)
(参考时间: 37:41)
跑完训练:
| 配置 | 参数量 | 验证损失 |
|---|---|---|
| 扁平(block_size 8) | 22,000 | 2.027 |
| 层级(WaveNet) | 22,000 | 2.029 |
「控制参数量之后,从扁平改成层级,目前还没有带来任何好处。」
Karpathy 很坦诚地给了两个"但是":
- 我们没有真正"折磨"这个架构——这只是我的第一次猜测,通道预算怎么分配给各层,可以搜一大堆超参;
BatchNorm1d里可能还有一个 bug。「它能跑,但它做对了吗?」
八、修一个真正的 bug:BatchNorm 沿哪个维度统计?
(参考时间: 38:50)
打上"逐层形状探针"后看到:
BatchNorm 收到的输入: (32, 4, 68) # (batch, 序列位置, 通道)
而我们的 BatchNorm1d 是假定输入二维 (N, D) 写的——所以它只对第 0 维取均值和方差。
为什么它没报错? 因为广播把它掩盖了:
x.mean(0)得到(1, 4, 68)——形状对得上,广播一切正常,所以不报错;- 但
running_mean变成了(1, 4, 68)。
🔑 这说明什么? 「这个 BatchNorm 实际上是在为"4 × 68 = 272 个东西"并行地维护统计量,而不是68 个通道。 它在为每一个序列位置分别独立地维护 mean/variance——这不是我们想要的。」
我们想要的是:
「把那 4 个位置也当作批次维——不要只在 32 个数上求平均,而要在 32 × 4 个数上求平均,对每一个通道分别进行。」
修法:dim 可以是元组
(参考时间: 41:49)
翻 torch.mean 的文档会发现——dim 不只是一个 int,也可以是一个 int 的 tuple:
# 原来
x.mean(0, keepdim=True)              # 2D 输入时正确
# 修正
x.mean((0, 1), keepdim=True)         # 3D 输入时:同时对 batch 和序列位置求平均
改完之后,running_mean 的形状变成 (1, 1, 68)——只维护 68 个通道的统计量,正是我们想要的。
泛化写法:
if x.ndim == 2:
    dim = 0            # (N, C)
elif x.ndim == 3:
    dim = (0, 1)       # (N, L, C)
else:
    raise ValueError   # 其它维度直接报错——这是好事
编者说明|这里我们主动偏离了 PyTorch 的 API:
nn.BatchNorm1d接受(N, C)或(N, C, L)——通道在中间,所以它对三维输入是在 0 和 2 维上求平均。 而本讲选择的是通道在最后((N, L, C))。Karpathy 说: 「这是一个偏离。我觉得没关系,说实话我更喜欢这样。」👉 这就是后来深度学习中"channels-first(NCL/NCW)vs channels-last(NLC/NWC)"的经典分歧——channels-last 在现代 GPU 上通常更快(因为内存里相邻的就是通道),TensorFlow 默认 NLC,PyTorch 默认 NCL 但支持
memory_format=torch.channels_last。
修完再训
(参考时间: 45:21)
| 配置 | 参数量 | 验证损失 |
|---|---|---|
| 层级(BN bug 未修) | 22,000 | 2.029 |
| 层级(BN bug 已修) | 22,000 | 2.022 |
「小提升,不好说是否统计显著。但我们"预期"会有提升——因为我们不再维护那么多"只用 32 个数估出来"的 mean/variance,现在是 32 × 4 = 128 个数去估计一个统计量,估计更稳、抖动更小。」
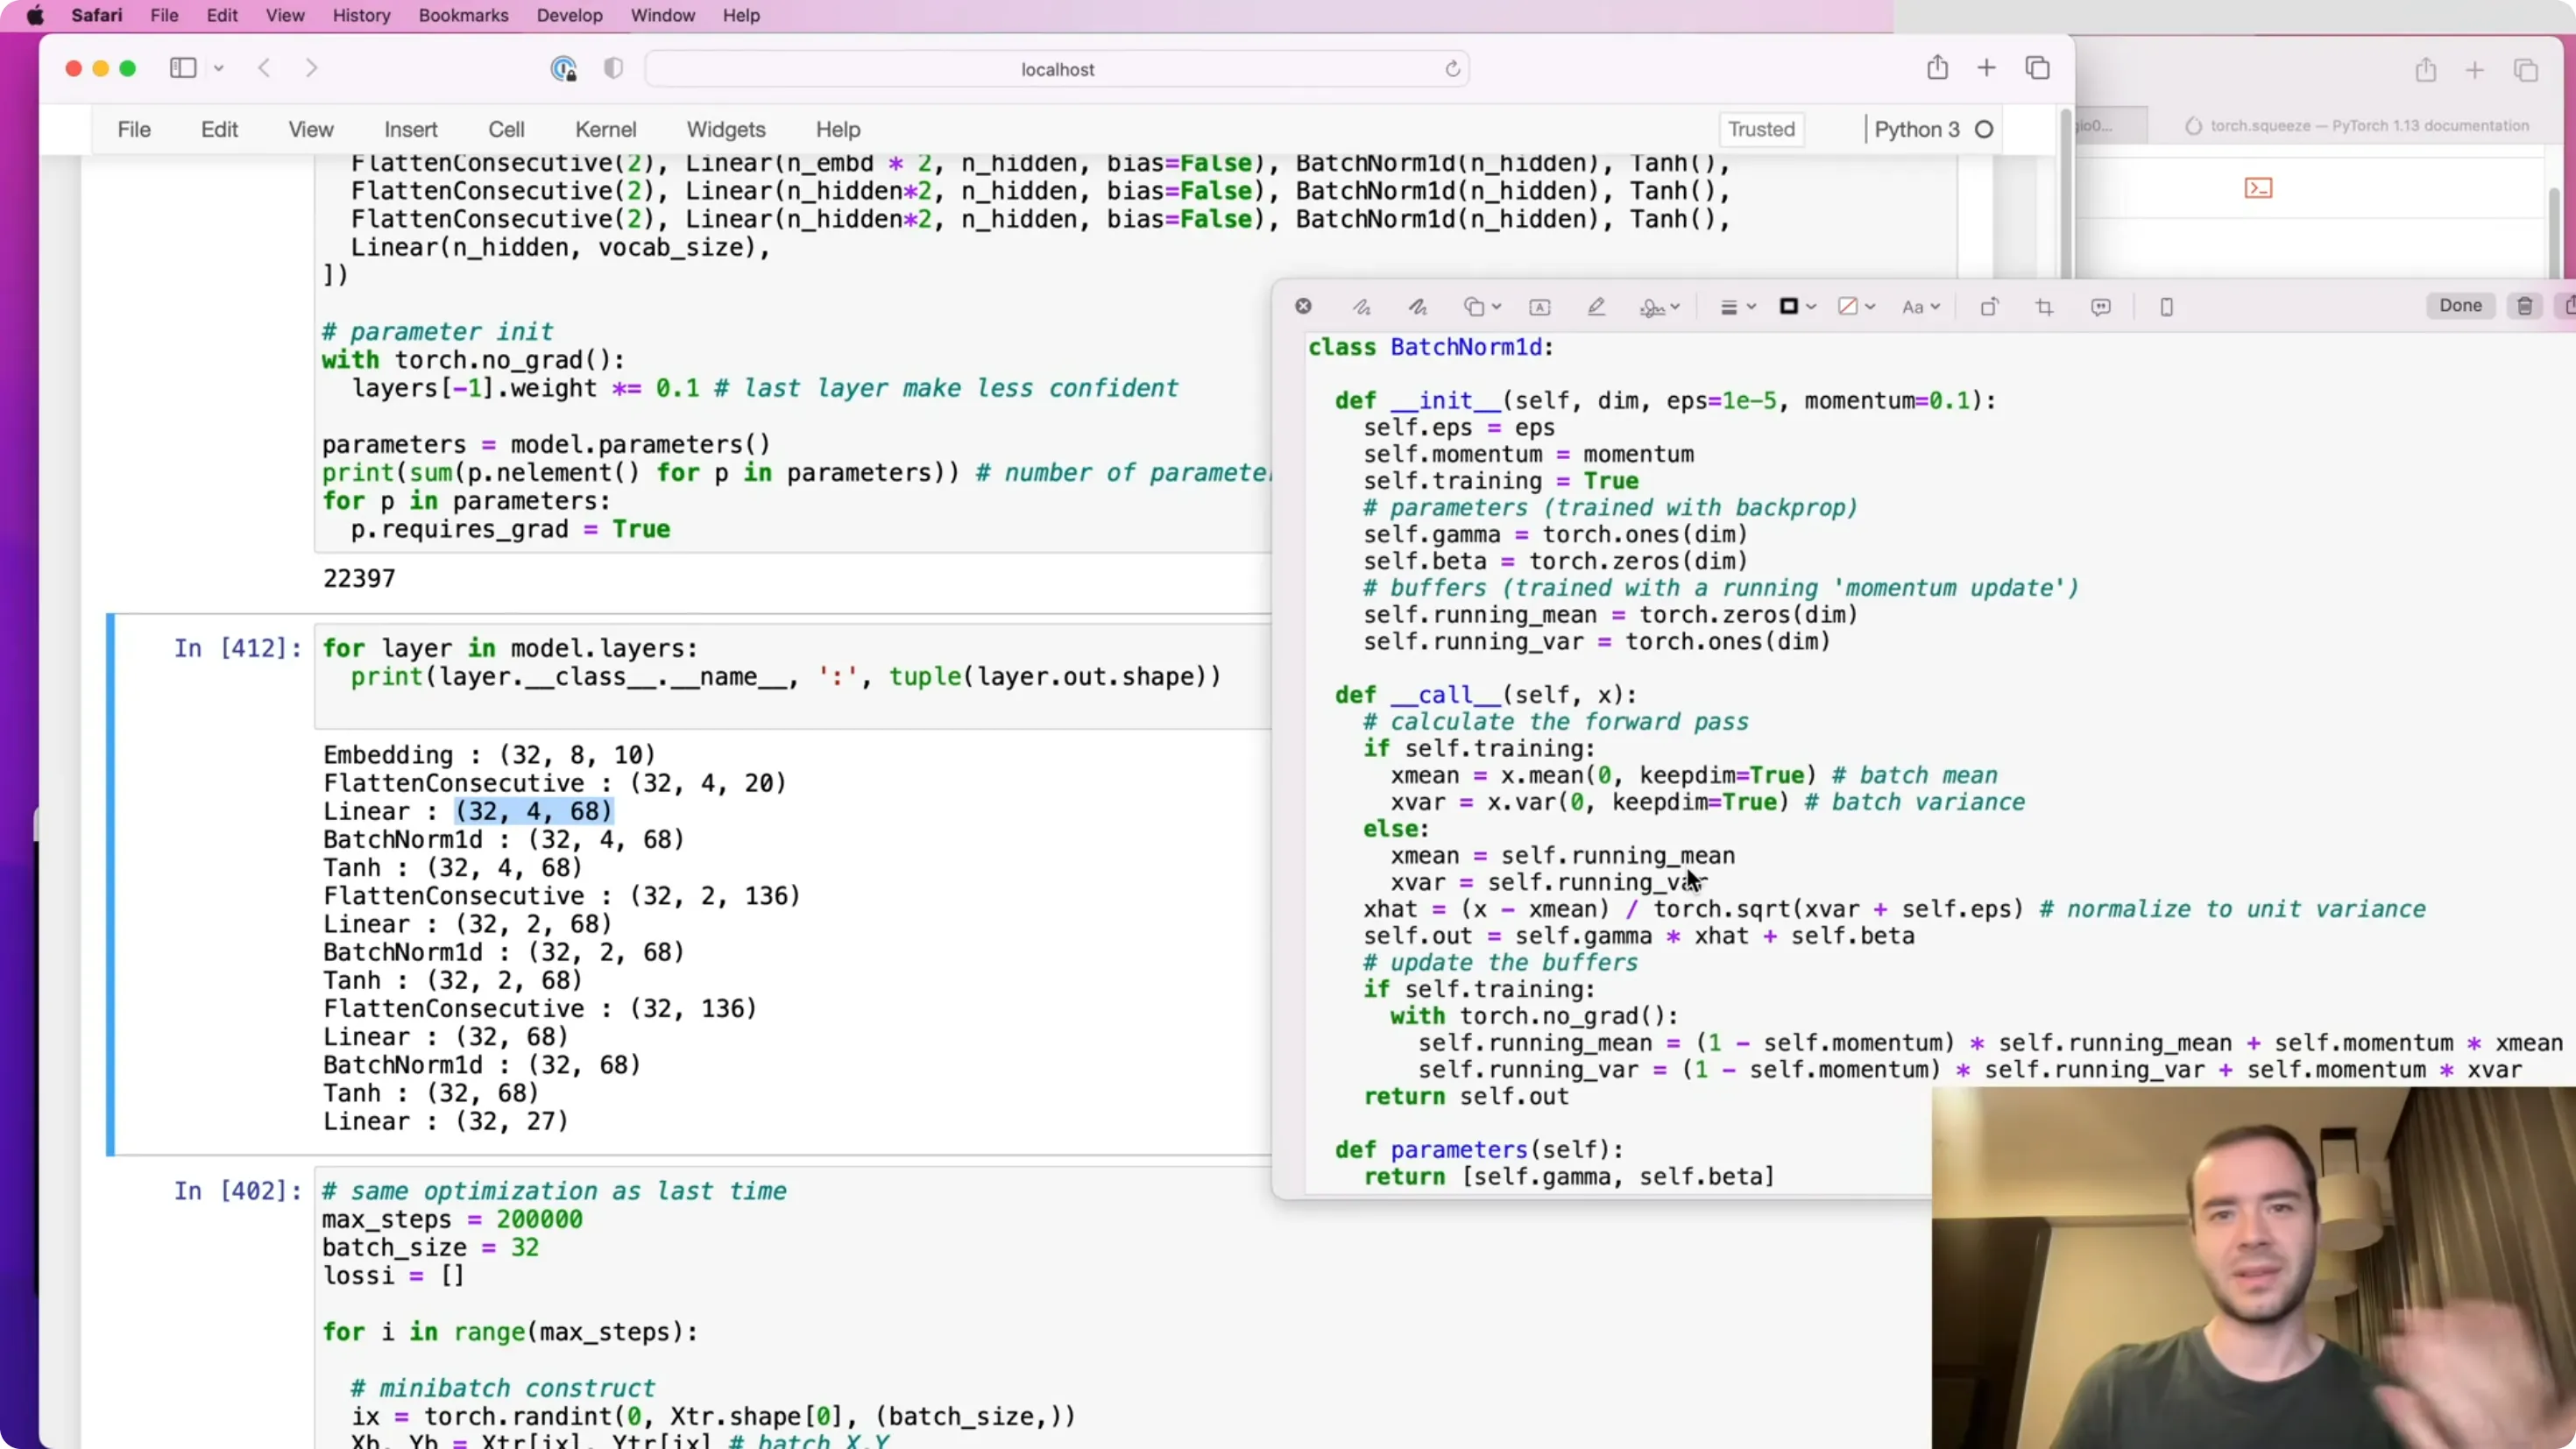
📷 BN 的 bug:输入 (32,4,68) 却只对第 0 维求平均 → running_mean 变成 (1,4,68)
回到原视频 (00:39:30)
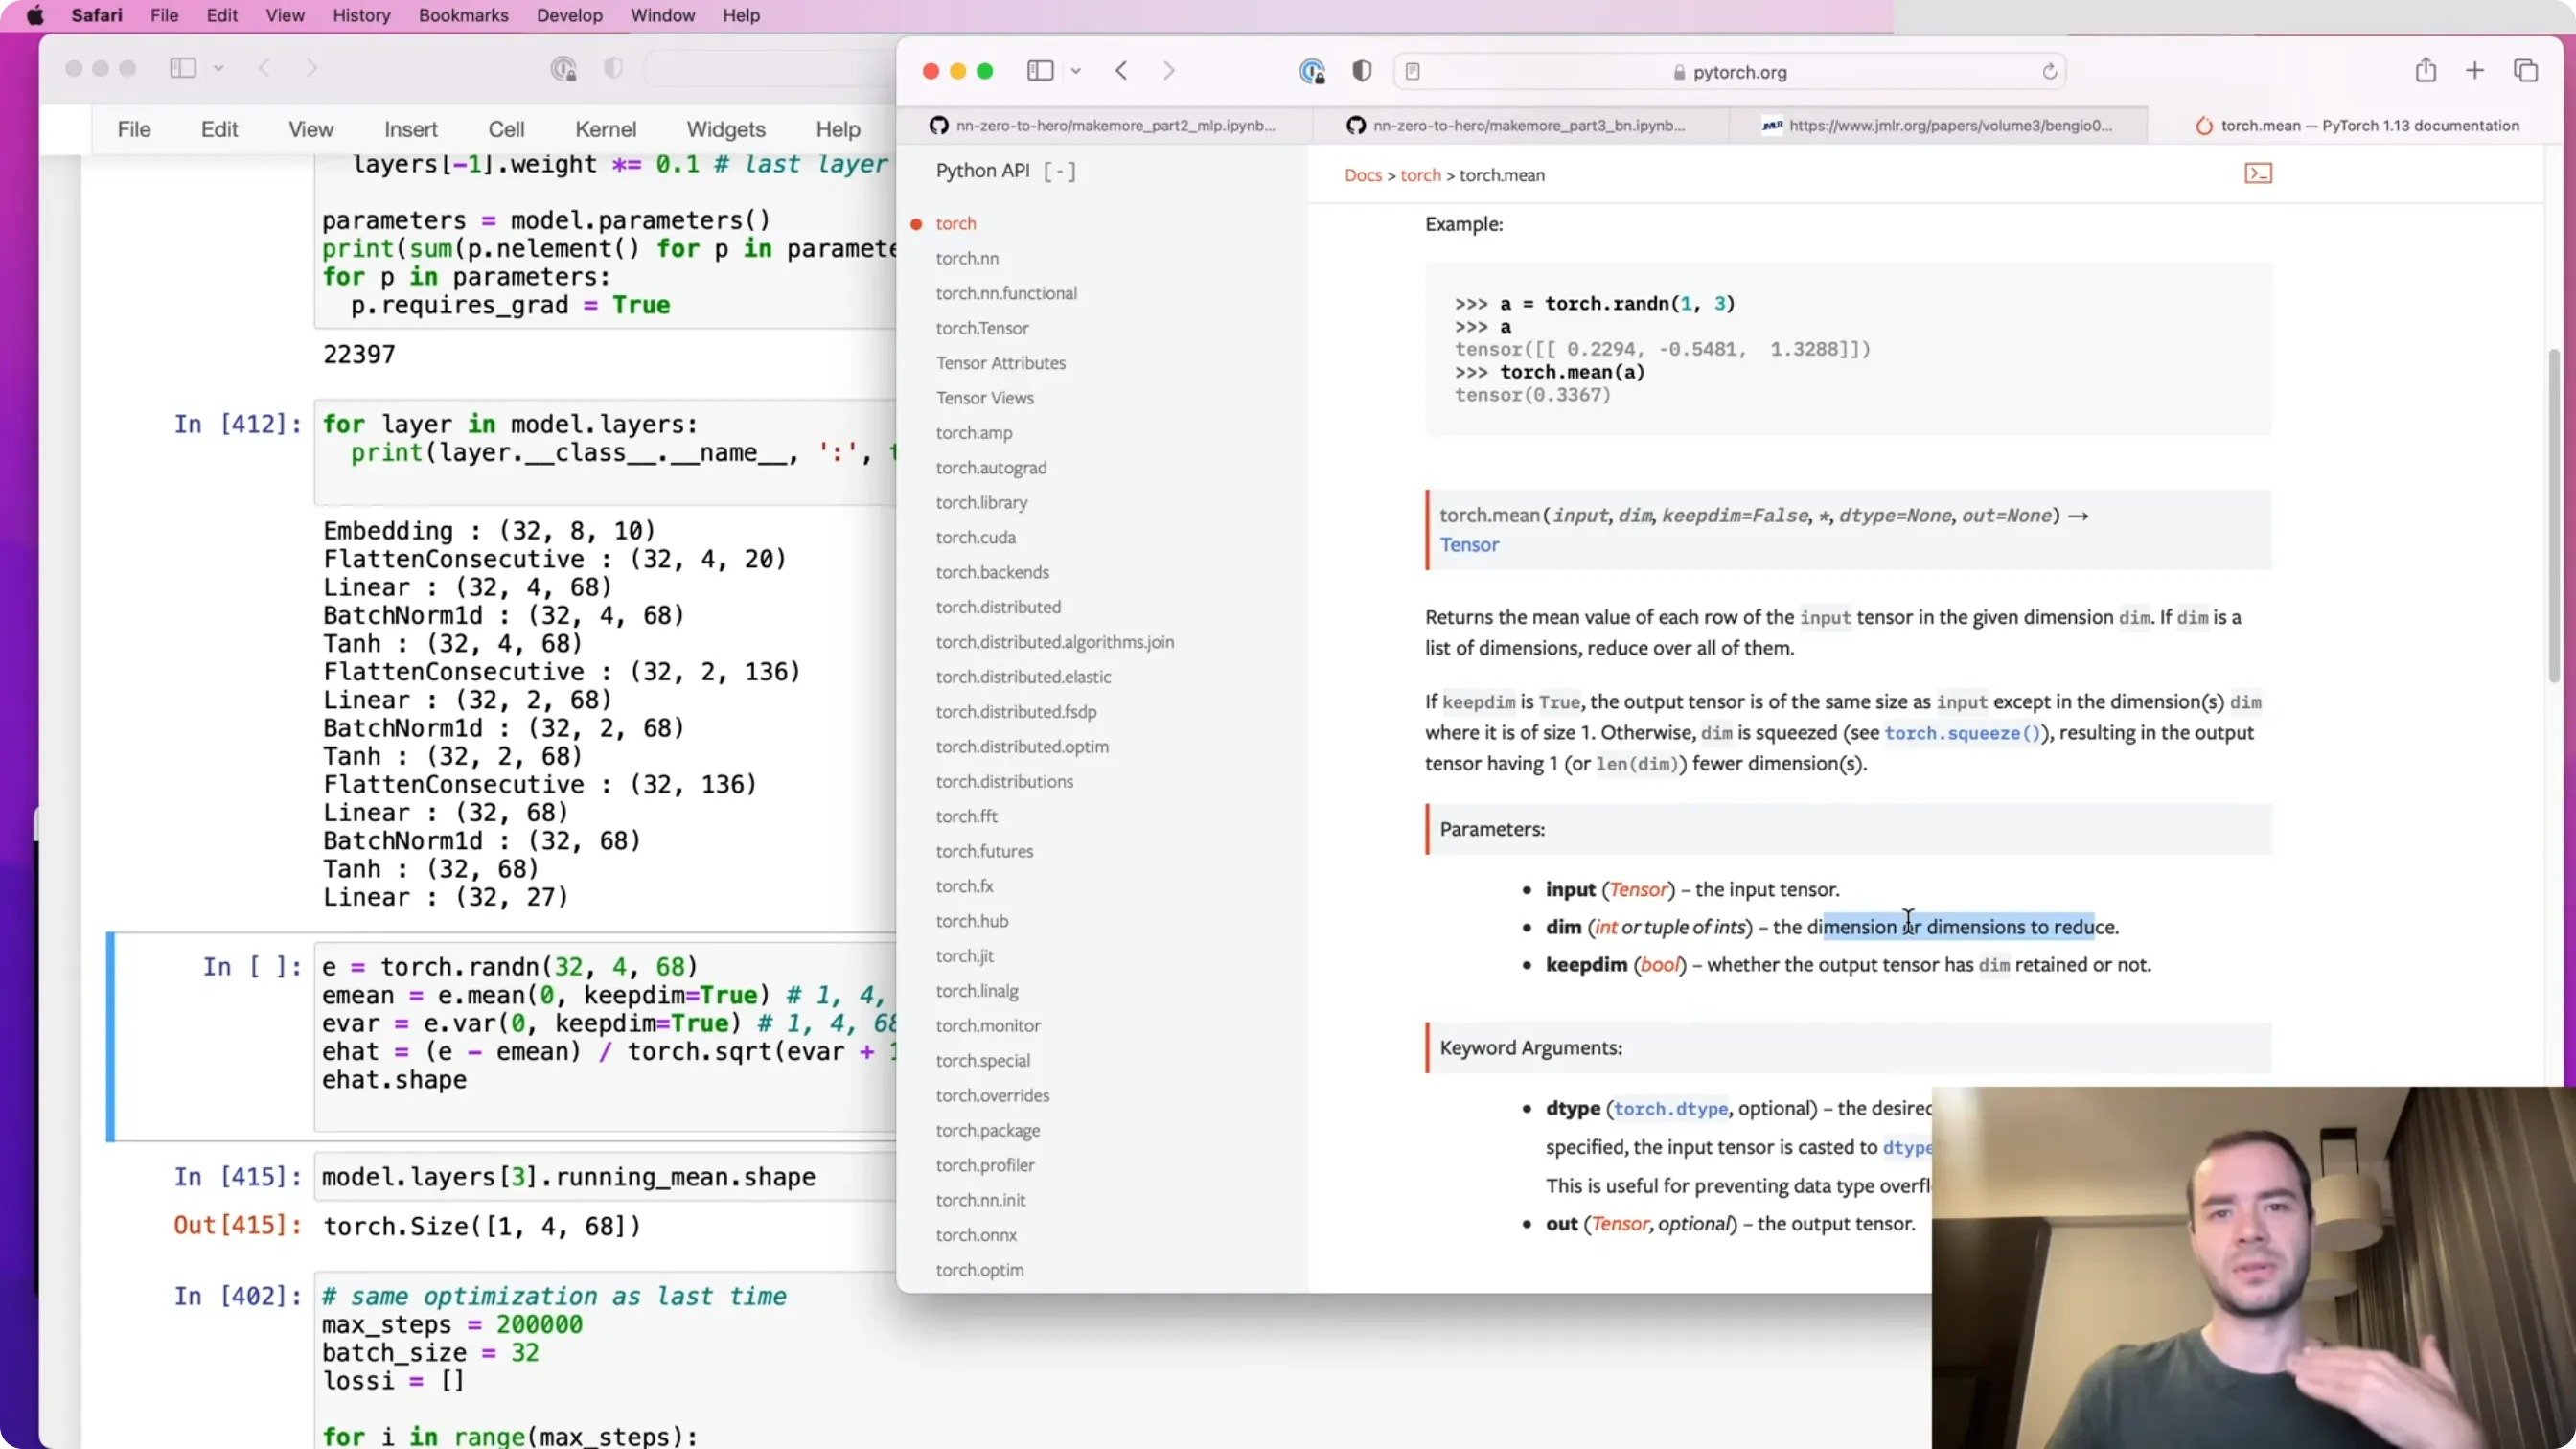
📷 修法:三维输入时 dim 传元组 (0,1)
回到原视频 (00:42:00)
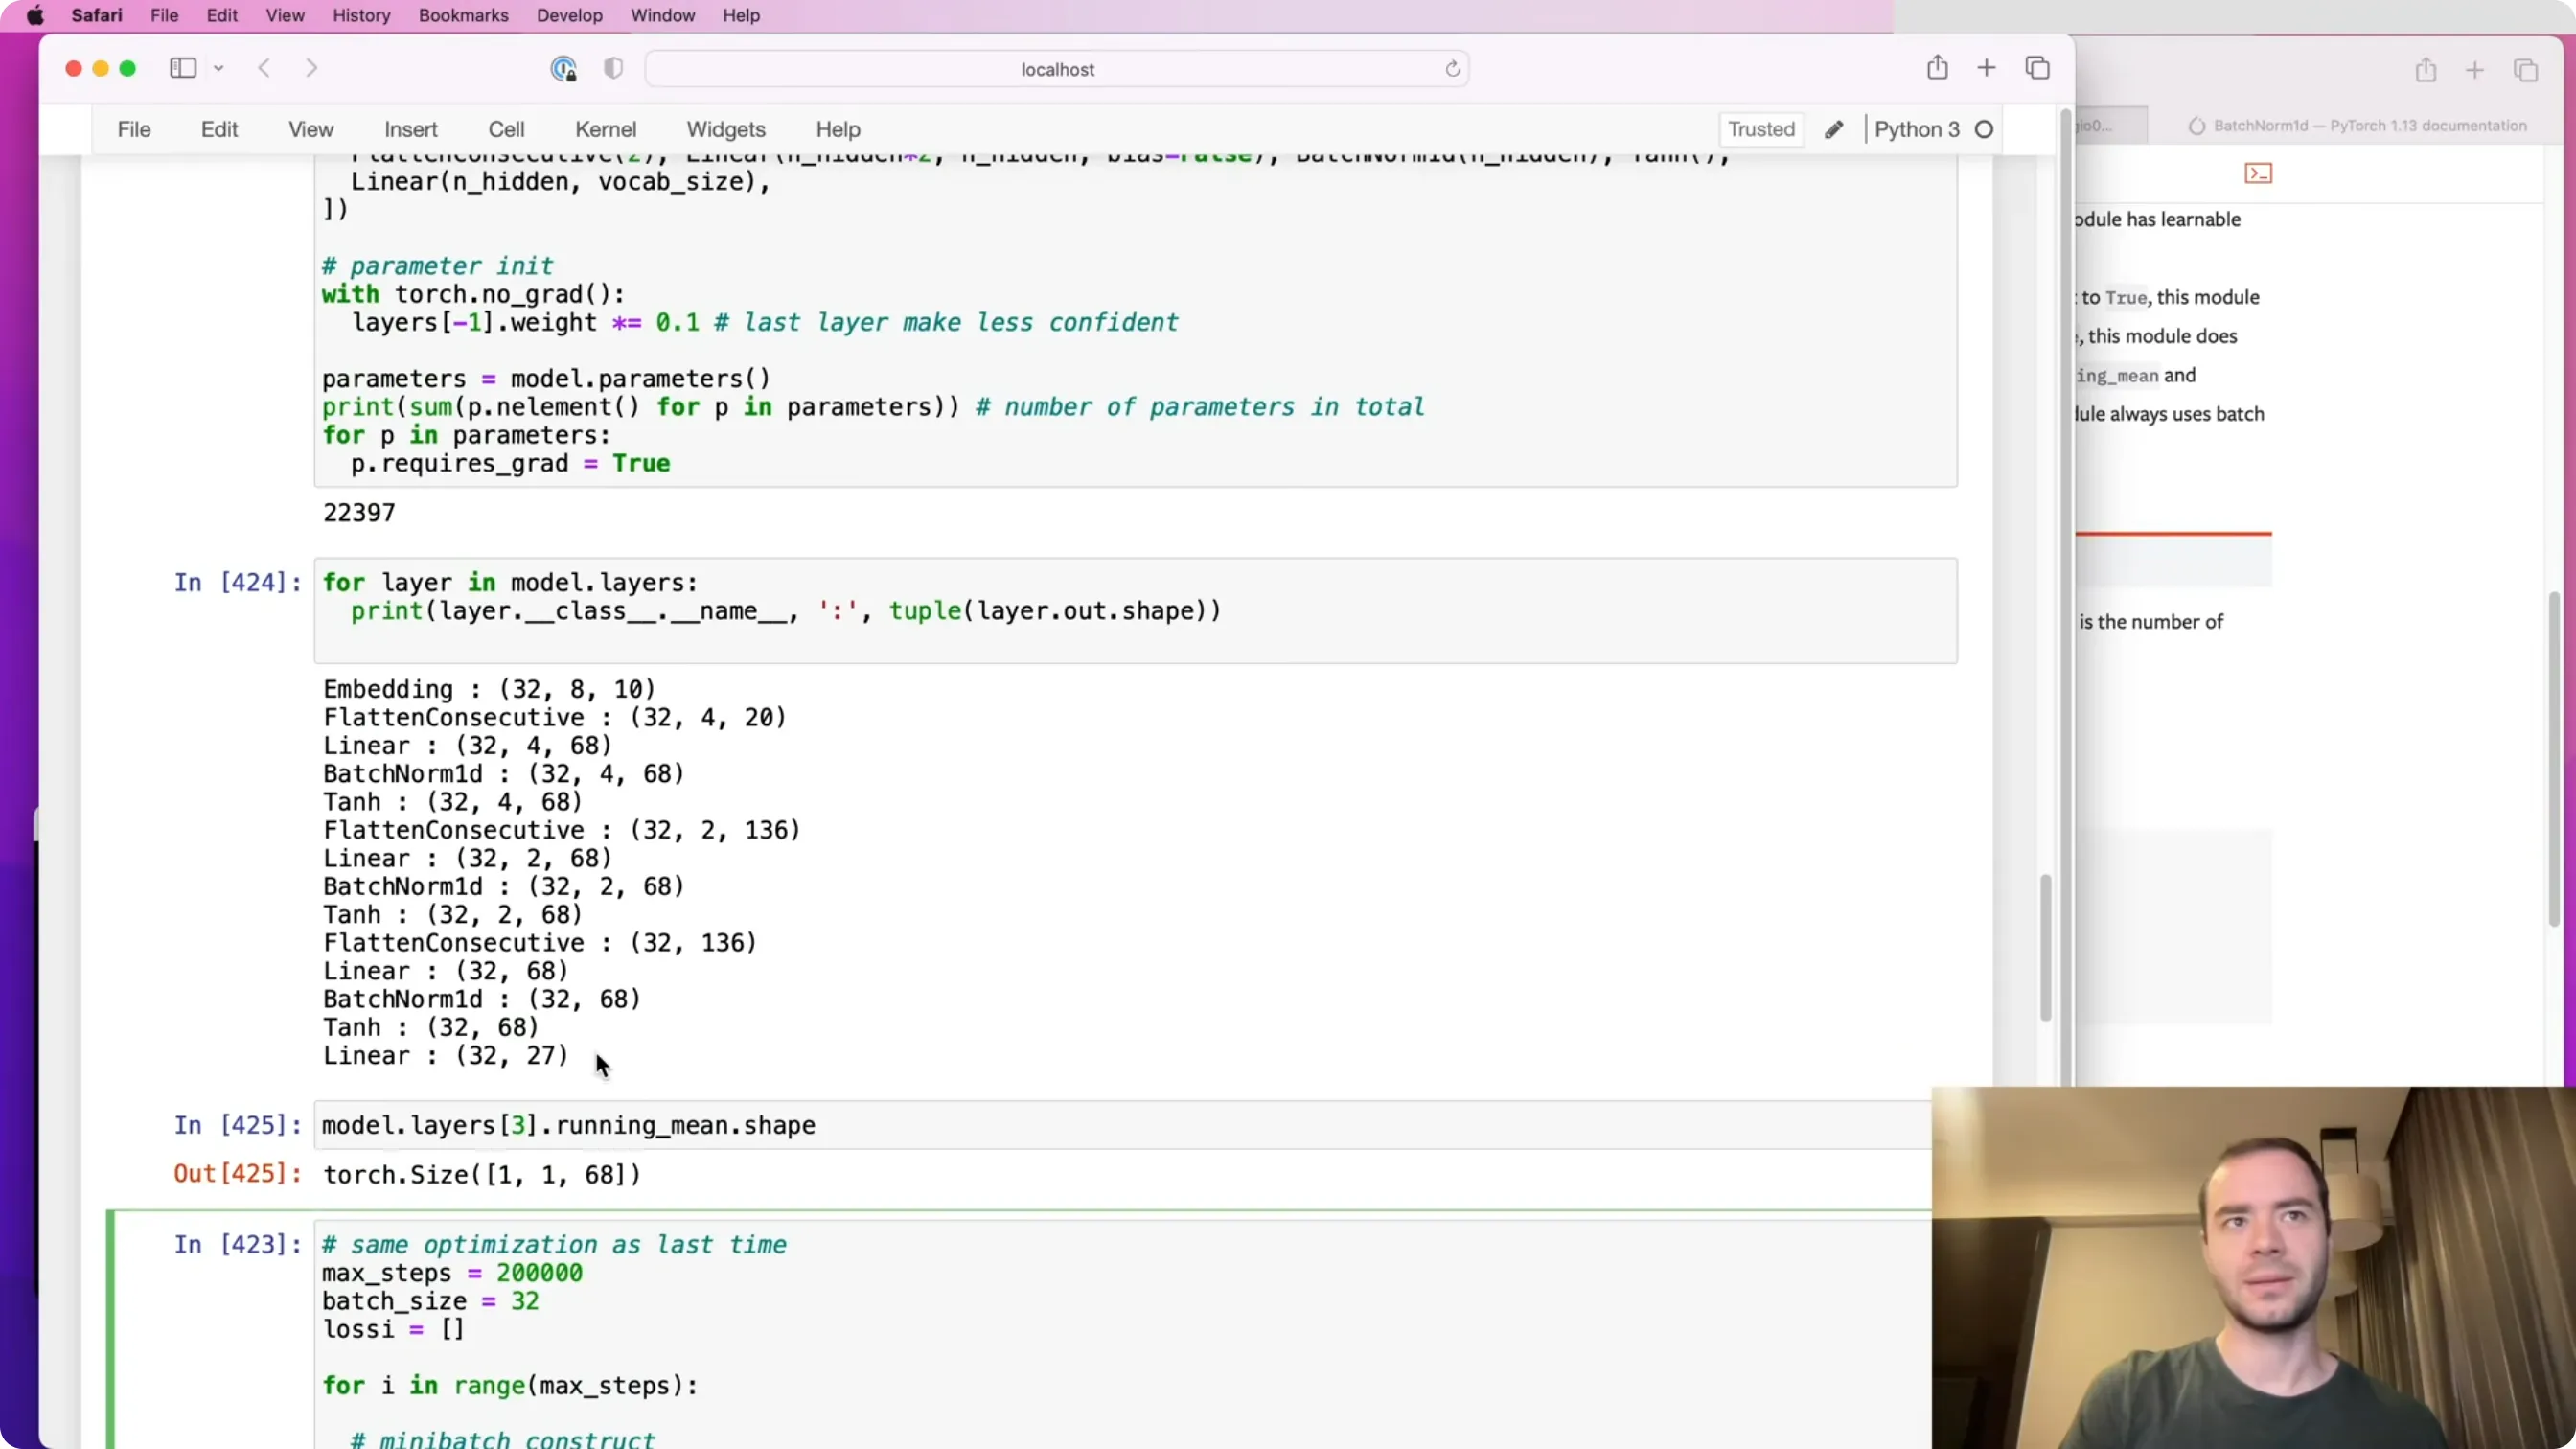
📷 修完之后 running_mean 是 (1,1,68):只为 68 个通道维护统计量
回到原视频 (00:45:00)
九、放大规模:跨过 2.0
(参考时间: 46:19)
架构更通用了,就可以往上堆规模:把 n_embd 从 10 提到 24,并增加 hidden units——
| 配置 | 参数量 | 验证损失 |
|---|---|---|
| 层级,小 | 22,000 | 2.022 |
| 层级,放大 | 76,000 | 1.993 ✅ |
「我们跨过了 2.0 这条线。」
但代价是:训练时间明显变长,而且我们对超参数(学习率等)越来越"摸黑"——因为实验变慢了,而我们从没有搭过实验框架(experimental harness)。
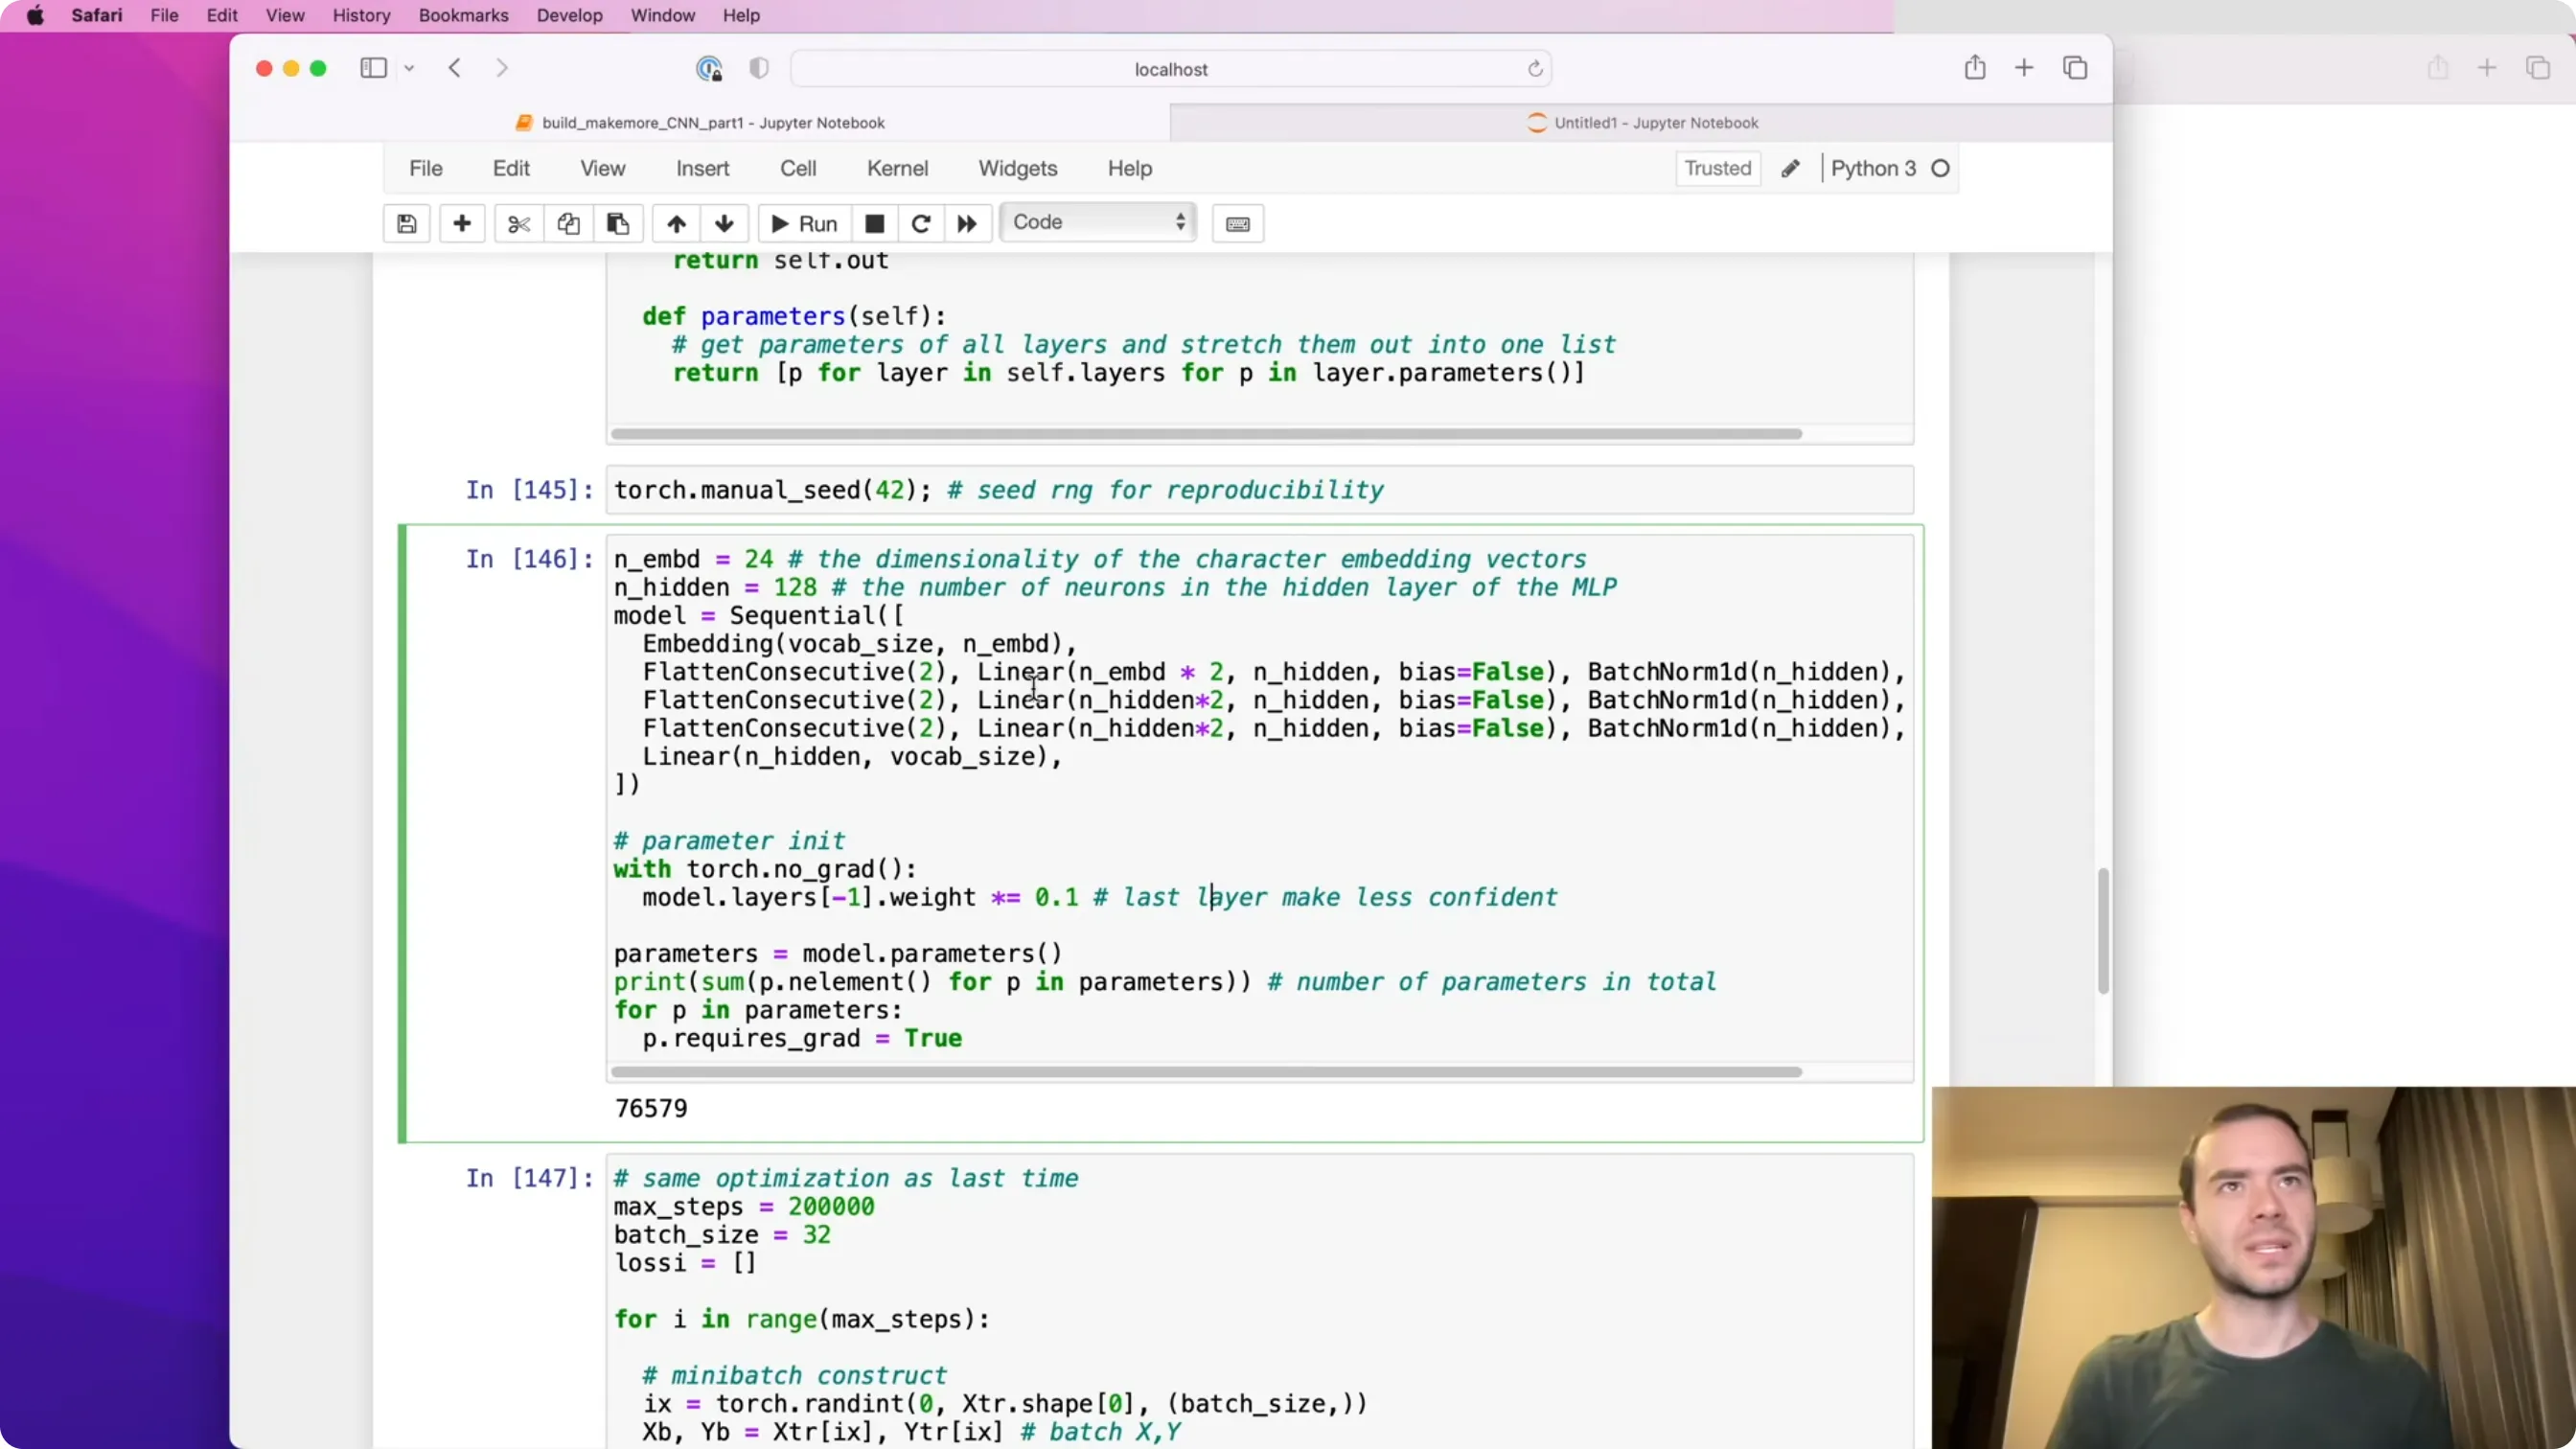
📷 放大规模后训练出的损失曲线(76,000 参数)
回到原视频 (00:46:10)
十、诚实的中场总结 + 卷积预告
(参考时间: 47:04)
「我不想让"从 2.1 降 1.9"成为本讲的重点——因为说实话,我们是在摸黑:没有实验框架,只是猜一猜、试一试,这很糟糕。 我们只看 training loss,而正常你应该同时看 training 和 validation……如果你想真正榨出数字,整个做法都不一样。」
本讲"没做到"的部分(同样重要):
「我们实现了 WaveNet 论文里的这个结构,但并没有实现它的这个具体 forward pass——那里还有更复杂的 gated linear layer、residual connections、skip connections……这些我们都没做。」
10.1 卷积:它其实只是"效率"
(参考时间: 47:52)
「用卷积纯粹是为了效率,它并不改变我们已经实现的模型。」
用训练集里的 "DeAndre" 举例(7 个字母 → 8 个独立样本):
- 我们的模型把每一行当作独立样本,可以一行一行地 forward;
- 但你往往想一次 forward 全部 8 行——最笨的办法是 Python 里跑 8 次循环。
卷积做的事:把这个循环"藏进 CUDA kernel 里"——「卷积基本上就是一个在输入序列空间上滑动小线性滤波器的 for 循环。」
卷积还有第二个好处:变量复用:
「看这个树里的这个节点——它既是上面那个节点的右孩子,又是旁边那个节点的左孩子。它的值被用了两次。 在朴素做法里,我们得把它重算一遍;而在卷积里,我们被允许复用它。」
所以:我们那些线性层就成了"滤波器",把它在这条序列上滑过去,一层、两层、三层、输出层——全都在卷积里高效完成。「这个我们会在之后的视频里讲。」
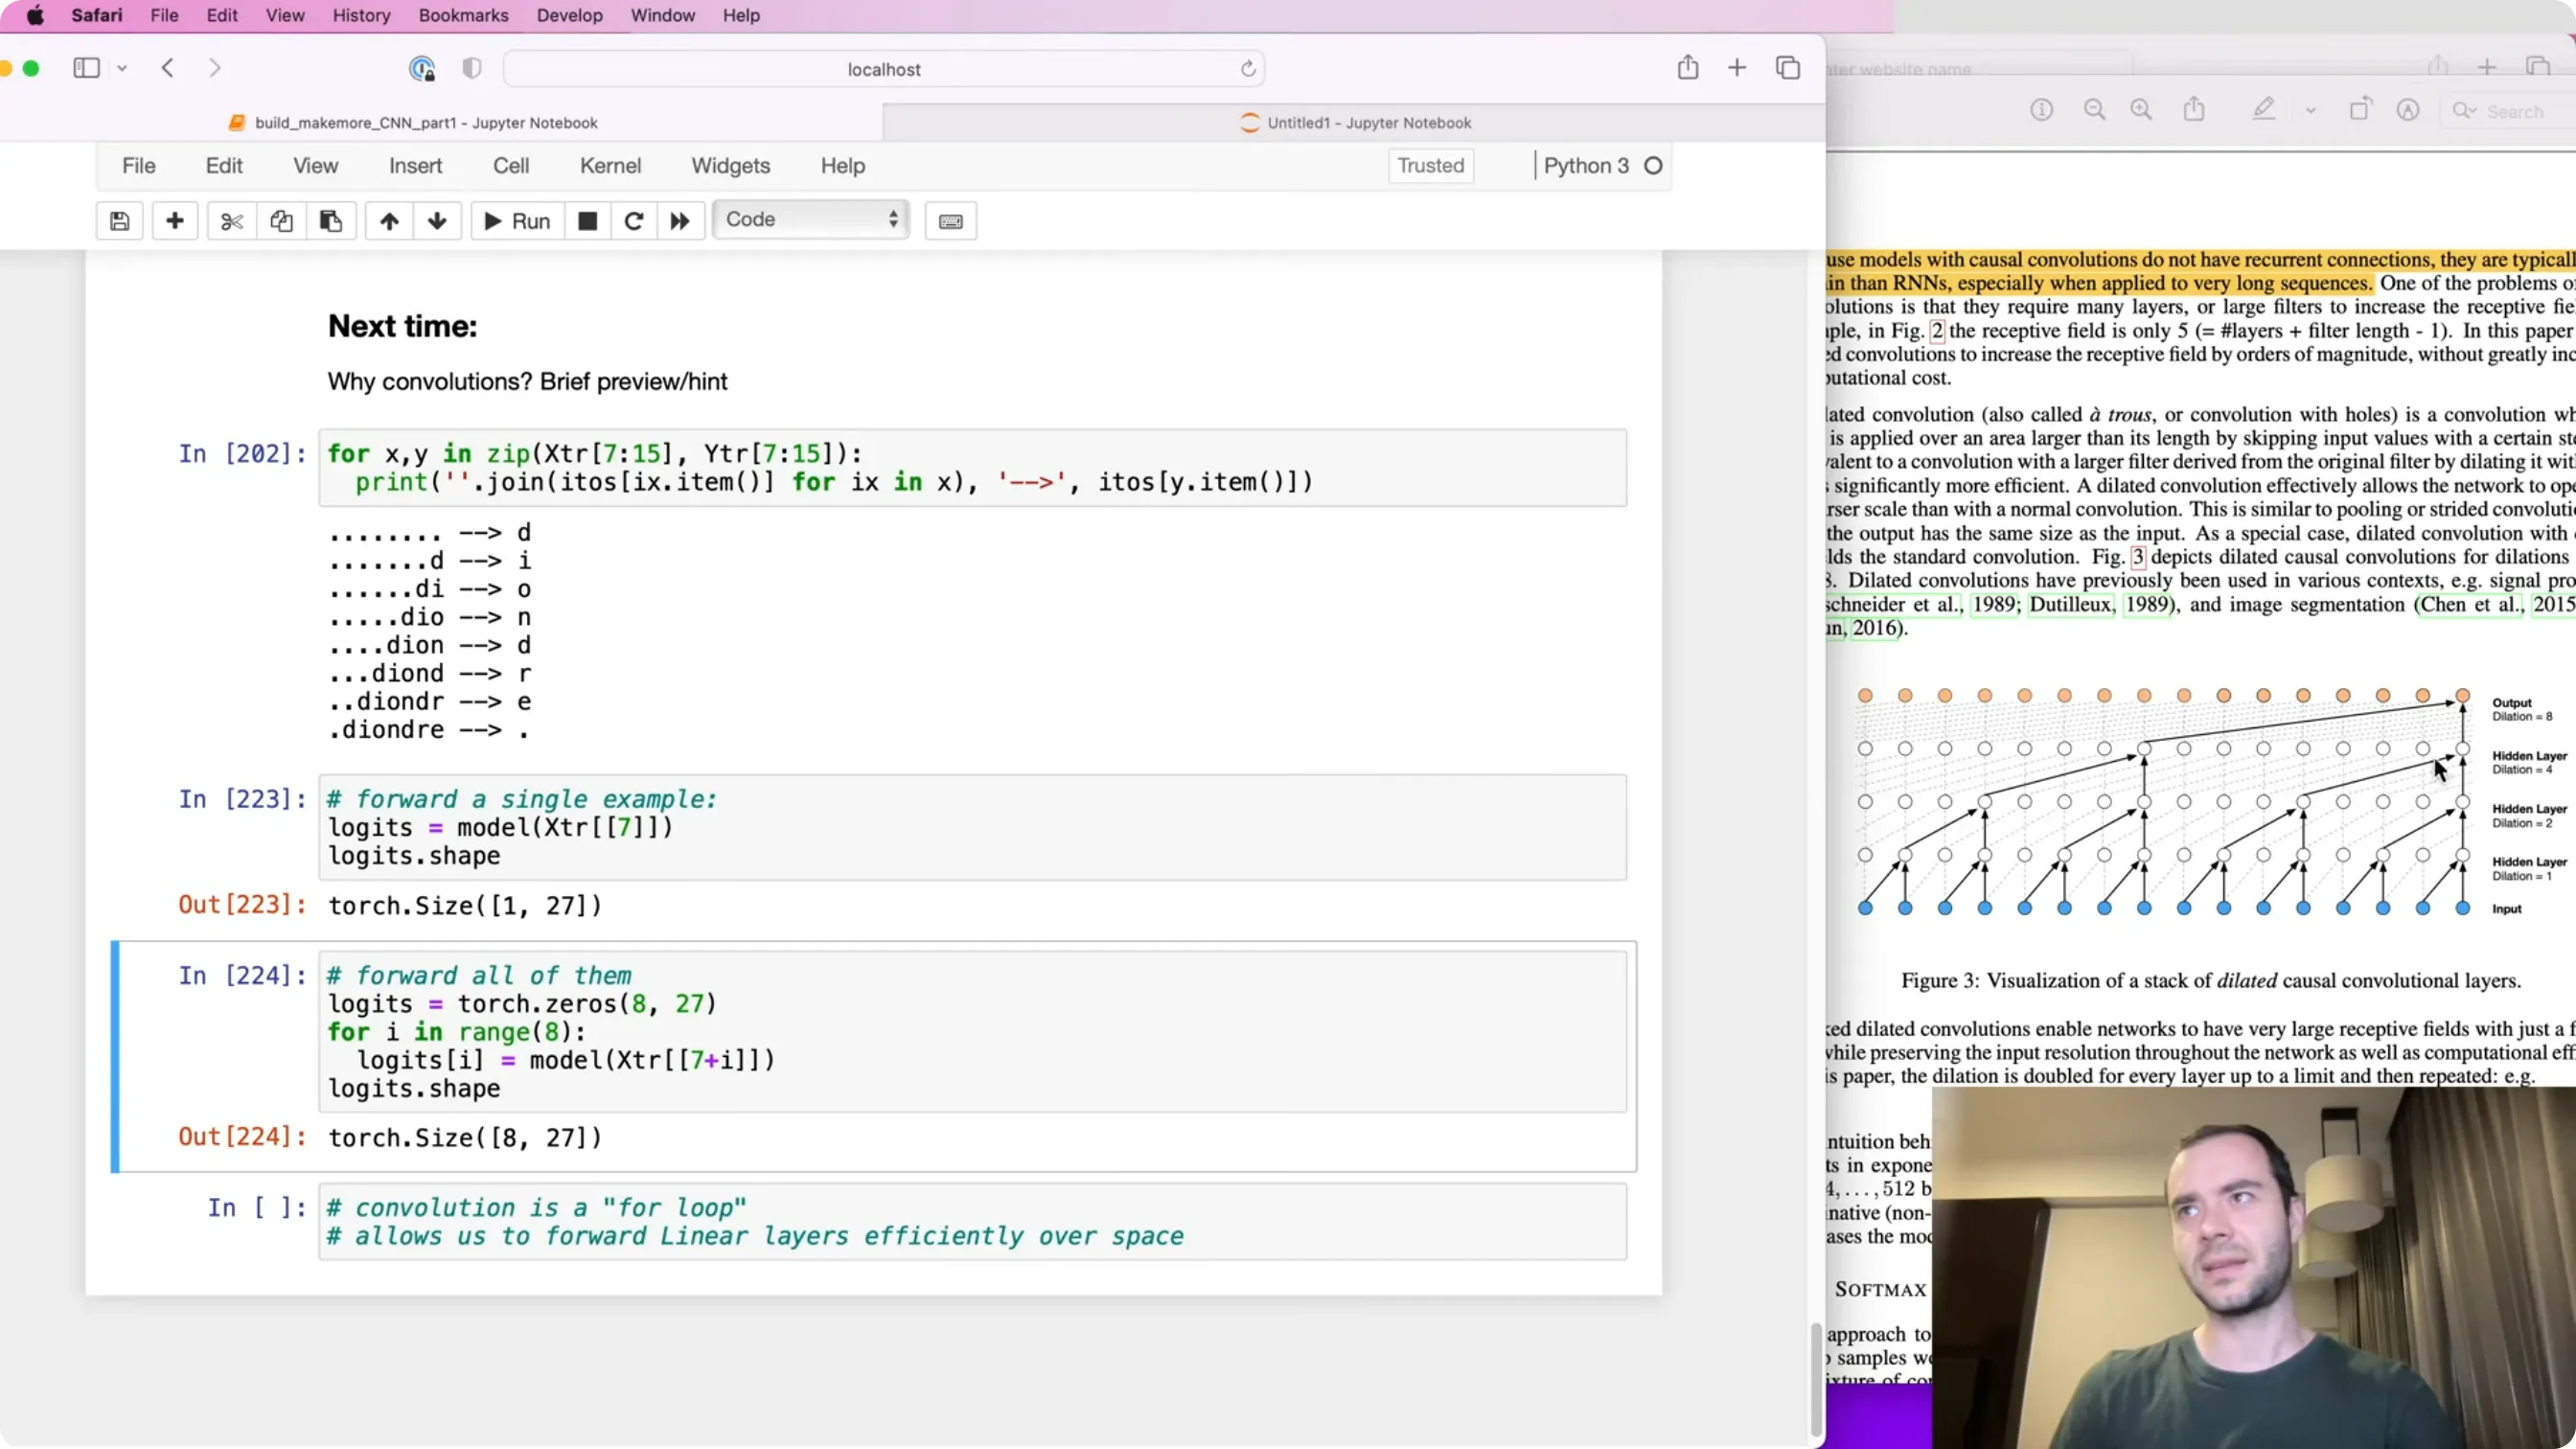
📷 卷积把"逐行 forward 的 for 循环"藏进 CUDA kernel,并复用树中被共享的中间节点
回到原视频 (00:50:20)
十一、解锁 torch.nn,以及"深度学习开发流程"长什么样
(参考时间: 51:51 / 52:39)
「我们一直在做的事,就是"在
torch.tensor之上重新实现torch.nn"。 它看起来非常像torch.nn——只不过比它更糟(毕竟我是在 Jupyter 里手搓的)。 所以往后我大概会认为:我们已经"解锁"了torch.nn——我们大致明白里面有什么、模块怎么嵌套、在torch.tensor之上做了什么。接下来我们直接用它。」
本讲顺带展示的"真实开发流程"
Karpathy 总结了三件事——这可能是本讲最有"元价值"的部分:
- 大量时间泡在 PyTorch 文档里——查每一层、看输入形状可以是什么、这一层到底干嘛。
⚠️ 「可惜我必须说,PyTorch 的文档很糟。 他们在各种分布式原语的硬核工程上花了大量时间,但据我所知没人在维护文档——它会骗你,它会错,它会不全,它会含糊。 没办法,就只能尽力而为。」
编者说明:这句话是 2022 年说的。PyTorch 文档此后有相当改善(尤其 API 示例与 shape 说明)。但"文档与实现不一致"这类问题并未绝迹——本课程 Part 3/4 遇到的
BatchNorm1d文档里关于"有偏/无偏方差"的说法,就属于同一类。 - 大量"形状体操"——「是 NCL 还是 NLC?」不断
permute/view,很容易搞乱。 - 工作流:先在 Jupyter notebook 里做原型、把形状全部验证通过(「大量时间在"照看形状"」),然后 copy-paste 到 VS Code 的正式代码仓库里,再从仓库跑实验。「所以我通常一边开着 Jupyter、一边开着 VS Code。」
十二、下一步,和那个公开挑战
(参考时间: 54:30 / 55:26)
本讲打开了后面很多内容:
- 把网络真正改成 dilated causal convolution 实现(实现那个 CNN);
- 搞清 residual connections / skip connections 是什么、为什么有用;
- 实验框架(experimental harness)——「我们现在只是猜猜试试,这不代表典型的深度学习工作流。」真正的工作流是:脚本接收一大堆命令行参数、批量启动实验、看大量 train/val 曲线、在"种群层面"工作、做超参搜索——这些我们一点都没做;
- 还有 RNN / LSTM / GRU,以及Transformer——「可去的地方太多了。」
最后,他发出了那个公开挑战:
「如果你有兴趣,我觉得试着打败这个 1.993 挺有意思的——因为我真的没有做多少实验,树上还挂着不少果子。」
- 我没试过别的通道分配方式;
- embedding 维度可能完全是错的;
- 也许把最初那个"只有一层隐层"的网络堆得足够大,就能打败我这个花哨的层级网络——「如果它做不到,那就挺尴尬的」;
- 读 WaveNet 论文,搞懂那些层,用我们已有的积木自己实现;
- 或者调初始化、调优化。
「我很好奇有没有人能想出来。」
附:官方参考与延伸阅读
- 课程主页:https://karpathy.ai/zero-to-hero.html
- 本讲 Notebook:https://github.com/karpathy/nn-zero-to-hero/blob/master/lectures/makemore/makemore_part5_cnn1.ipynb
- 🟢 本讲 Colab:https://colab.research.google.com/drive/1CXVEmCO_7r7WYZGb5qnjfyxTvQa13g5X?usp=sharing
- 📄 WaveNet(DeepMind, 2016):https://arxiv.org/abs/1609.03499
- 📄 Bengio et al. 2003:https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf
- makemore 仓库:https://github.com/karpathy/makemore
- PyTorch
nn.Conv1d:https://pytorch.org/docs/stable/generated/torch.nn.Conv1d.html - PyTorch
nn.BatchNorm1d:https://pytorch.org/docs/stable/generated/torch.nn.BatchNorm1d.html - PyTorch channels-last 内存格式:https://pytorch.org/blog/tensor-memory-format-matters/
- 讨论 Discord:https://discord.gg/3zy8kqD9Cp
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 Building makemore Part 5: Building a WaveNet 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。