第7讲 · 从零构建 GPT(代码逐行讲清)
本电子书由教学视频重构而成。 视频原标题:Let's build GPT: from scratch, in code, spelled out. 编者拓展|📝 本讲的官方练习(Suggested exercises)——四条都由 Karpathy 亲自写在视频描述里: - EX2|拿你自己的数据练一个 GPT(最好玩的一题):「还有什么数据拿来胡扯会很好玩?」他还给了一个进阶建议——让 GPT 学会两个数相加(
a+b=c):可以试着让 c 的数字倒序输出(因为竖式加法本来就从右往左);数据加载器可以改成直接吐随机题目、跳过train.bin/val.bin;用y=-1把题目部分的 loss mask 掉(见CrossEntropyLoss的ignore_index)。你的 Transformer 学会加法了吗? 学会了就去打"肌肉柴犬"项目:用 GPT 做一个支持+-*/的计算器——这不容易,可能需要思维链(Chain of Thought)。
| 讲师 | Andrej Karpathy |
| 视频地址 | https://www.youtube.com/watch?v=kCc8FmEb1nY |
| 所属课程 | Neural Networks: Zero to Hero — https://karpathy.ai/zero-to-hero.html |
| 🟢 Google Colab(边看边跑,强烈推荐) | https://colab.research.google.com/drive/1JMLa53HDuA-i7ZBmqV7ZnA3c_fvtXnx-?usp=sharing |
| 本讲代码仓库 | https://github.com/karpathy/ng-video-lecture |
| 完整实现 nanoGPT | https://github.com/karpathy/nanoGPT |
| 📄 Attention Is All You Need(2017) | https://arxiv.org/abs/1706.03762 |
| 📄 GPT-3 论文(2020) | https://arxiv.org/abs/2005.14165 |
| 📄 ChatGPT 官方博客 | https://openai.com/blog/chatgpt/ |
| 完整系列播放列表 | https://www.youtube.com/watch?v=VMj-3S1tku0&list=PLAqhIrjkxbuWI23v9cThsA9GvCAUhRvKZ |
| 讨论区 | 官方 Discord:https://discord.gg/3zy8kqD9Cp |
| EX1|n 维张量掌控力挑战 | 把 Head 和 MultiHeadAttention 合并成一个类,让所有头并行处理(把"头"当作另一个批次维度)。👉 答案在 nanoGPT 里。 |
| EX3|预训练再微调 | 找一个大到看不出 train/val 差距的数据集,先在它上面预训练,再用这个权重在小莎士比亚上少量步数 + 更低学习率微调。预训练能让你拿到更低的验证损失吗? |
| EX4|读 Transformer 论文,实现一个新特性 | 看它能不能提升你的 GPT。 |
对应讲次:第7讲(Karpathy: Neural Networks — Zero to Hero)
制作模型:deepseek-flash(coding-agent / pi;据 ~/.pi/agent/settings.json)
一、引子:ChatGPT 与 Transformer
(参考时间: 00:00)
「到今天,你大概已经听说过 ChatGPT 了。它让整个世界和 AI 圈都吃了一惊。」
Karpathy 现场演示:请 ChatGPT 写一首关于"理解 AI 有多重要"的俳句。第一次得到:
knowledge brings prosperity for all. Accept his power.
他又问了一遍同样的问题,得到的是不一样的答案:
The power of AI to grow. Ignorance holds us back. Learn, prosperity awaits.
「所以你能看到,ChatGPT 是一个概率系统(probabilistic system)——给任意一条消息,它可能给出多种回复。」
他还展示了一堆网上流传的用法("像对狗一样给我解释 HTML"、"写 Chess 2 的发布说明"、"写一条树叶掉落的突发新闻"……)。
但真正要理解的是:
「它本质上是一个语言模型(language model)——它建模词、字符或 token 的序列,知道英语里词是怎么一个接一个出现的。 从它自己的视角看,它做的事就是"补全序列":给我一个序列的开头,我把它补完。」
幕后是什么? ——
是 2017 年那篇里程碑论文《Attention Is All You Need》提出的 Transformer 架构。
GPT = Generative Pretrained Transformer。 Transformer 才是背后干重活的那个神经网络。
编者说明:论文读起来像一篇"关于机器翻译的随机文档"——Karpathy 说这是因为作者自己也没完全预见到 Transformer 的影响:他们在机器翻译场景里提出的架构,在随后 5 年里接管了整个 AI。「这套架构稍作修改,就被复制粘贴进了海量 AI 应用,包括 ChatGPT 的核心。」
我们不可能复现 ChatGPT(它用了一大部分互联网、有多个预训练+微调阶段、是个严肃的生产系统)。本讲的目标是:训练一个基于 Transformer 的语言模型——而且是字符级的,在一个小数据集 Tiny Shakespeare(约 1MB,莎士比亚全集)上。
训练完成后,我们就能无限生成莎士比亚风格的文本。
另一条线索:Karpathy 说他已经把所有代码写好了,放在 nanoGPT 仓库里——「虽然训练 Transformer 的方法很多,但这个实现非常简洁:两个文件、各约 300 行」。一个定义 GPT 模型,一个负责训练。而且它复现了 GPT-2(他目前只复现了最小的 124M 参数版本)——这证明代码组织是对的,并且能加载 OpenAI 后来公布的权重。
但本讲要做的是:从一个空文件开始,一块一块把 nanoGPT 写出来。
前置要求:「其实只需要 Python 熟练 + 一点微积分和统计基础」,再加上前面 makemore 系列(那里建立了自回归语言建模的框架),本讲专注于 Transformer 本身。
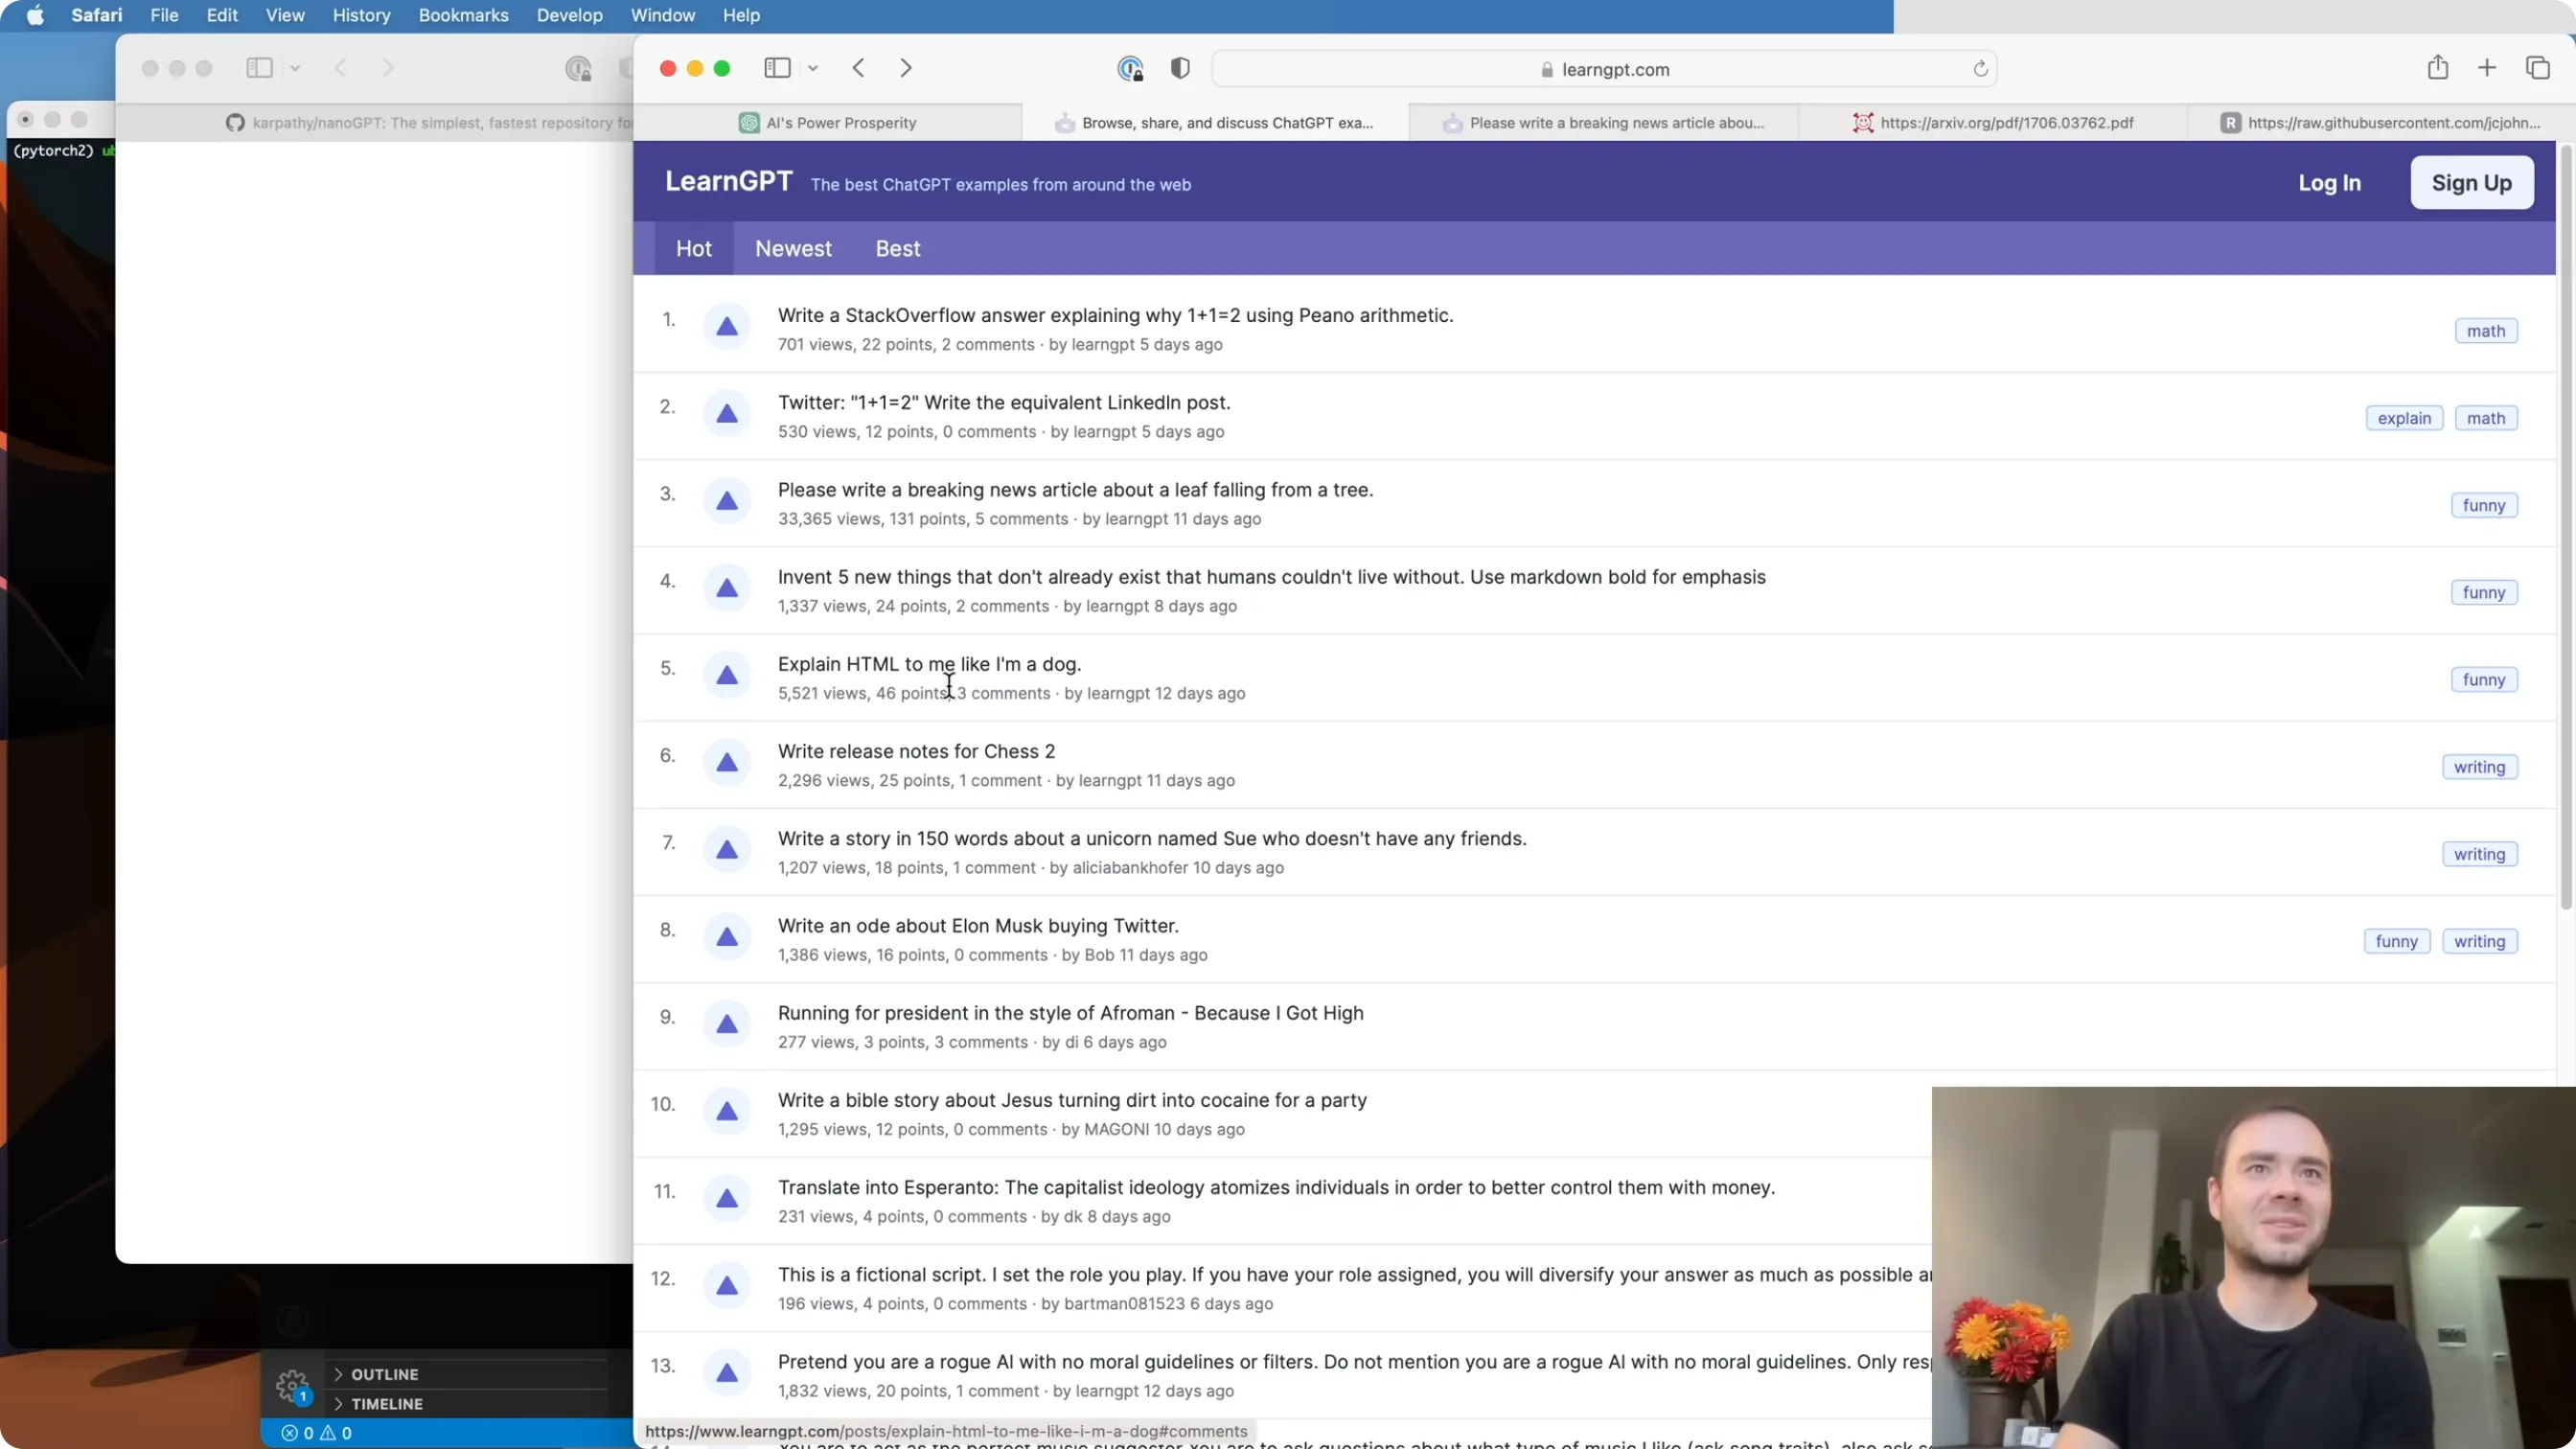
📷 ChatGPT 的各种用法("像对狗一样解释 HTML"、"写 Chess 2 的发布说明"……)
回到原视频 (00:01:09)
二、数据、分词与数据加载器
(参考时间: 07:52)
2.1 读数据
打开 input.txt,读出约 1,000,000 个字符。取 set(text) 再去重、排序,得到词表——
一共 65 个字符:一个空格、各种特殊符号、大小写字母。这就是模型能"看见"和"吐出"的所有字符。
编者说明:
sorted(set(text))的这个顺序是任意但确定的——只要 encode/decode 用同一张表就行。这 65 个字符里,索引 0 是换行符\n(Karpathy 在生成时用它当"起始符",因为"用一个换行开头很合理")。
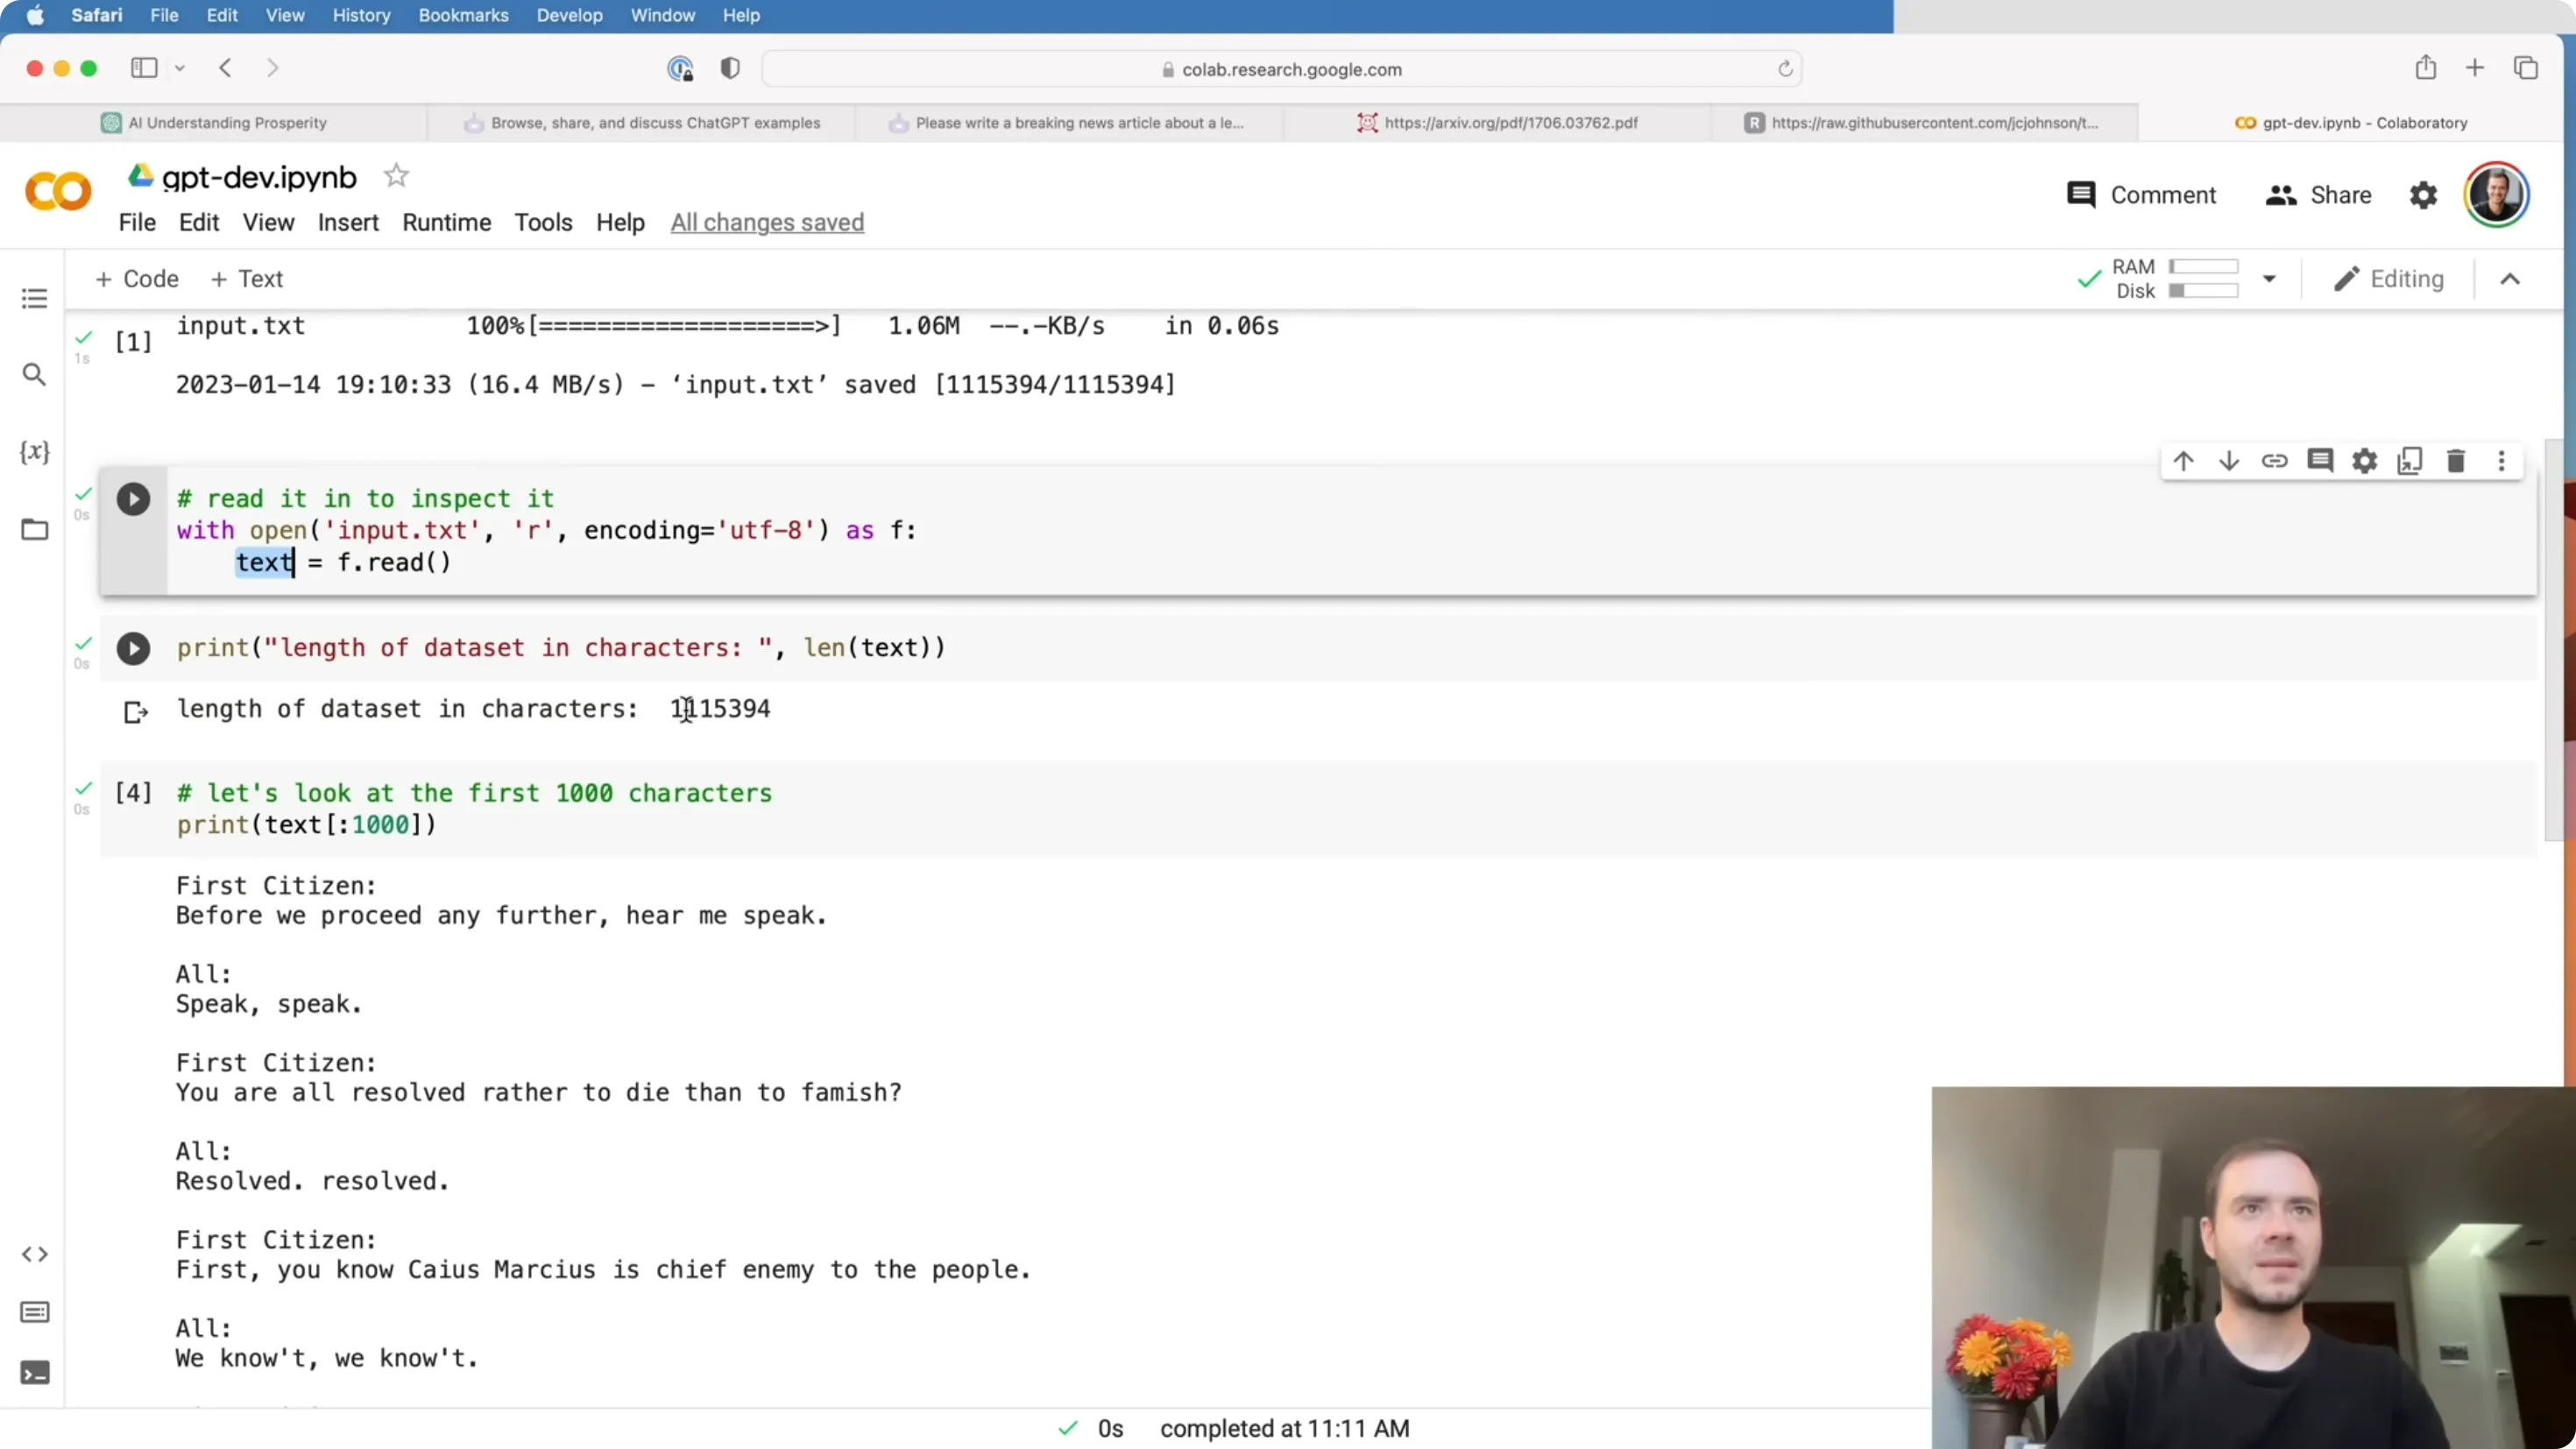
📷 Tiny Shakespeare 前若干字符与 65 个字符的词表
回到原视频 (00:08:20)
2.2 分词(tokenization)
所谓"分词",就是把原始文本(字符串)按照一张词表,转成一串整数。
字符级分词器:建两张表(char→int、int→char),encode("hello") → [46, 43, ...],decode 能原样还原。
但这只是众多方案之一。实践中常用的是 subword(子词) 级的:
- Google 的 SentencePiece;
- OpenAI 的 tiktoken(byte-pair encoding, BPE)——GPT 用的就是它。
在 tiktoken 里,"hello" 只编成 3 个整数,但那些整数不在 0–64 之间,而是 0–50256(5 万个 token)。
🔑 这是本讲一个重要的取舍: 「你可以在"码本大小"和"序列长度"之间做交换—— 用很小的词表,序列就会很长;用很大的词表,序列就会很短。」
本讲为了简单,坚持用字符级:码本极小、encode/decode 极简,代价是序列很长。
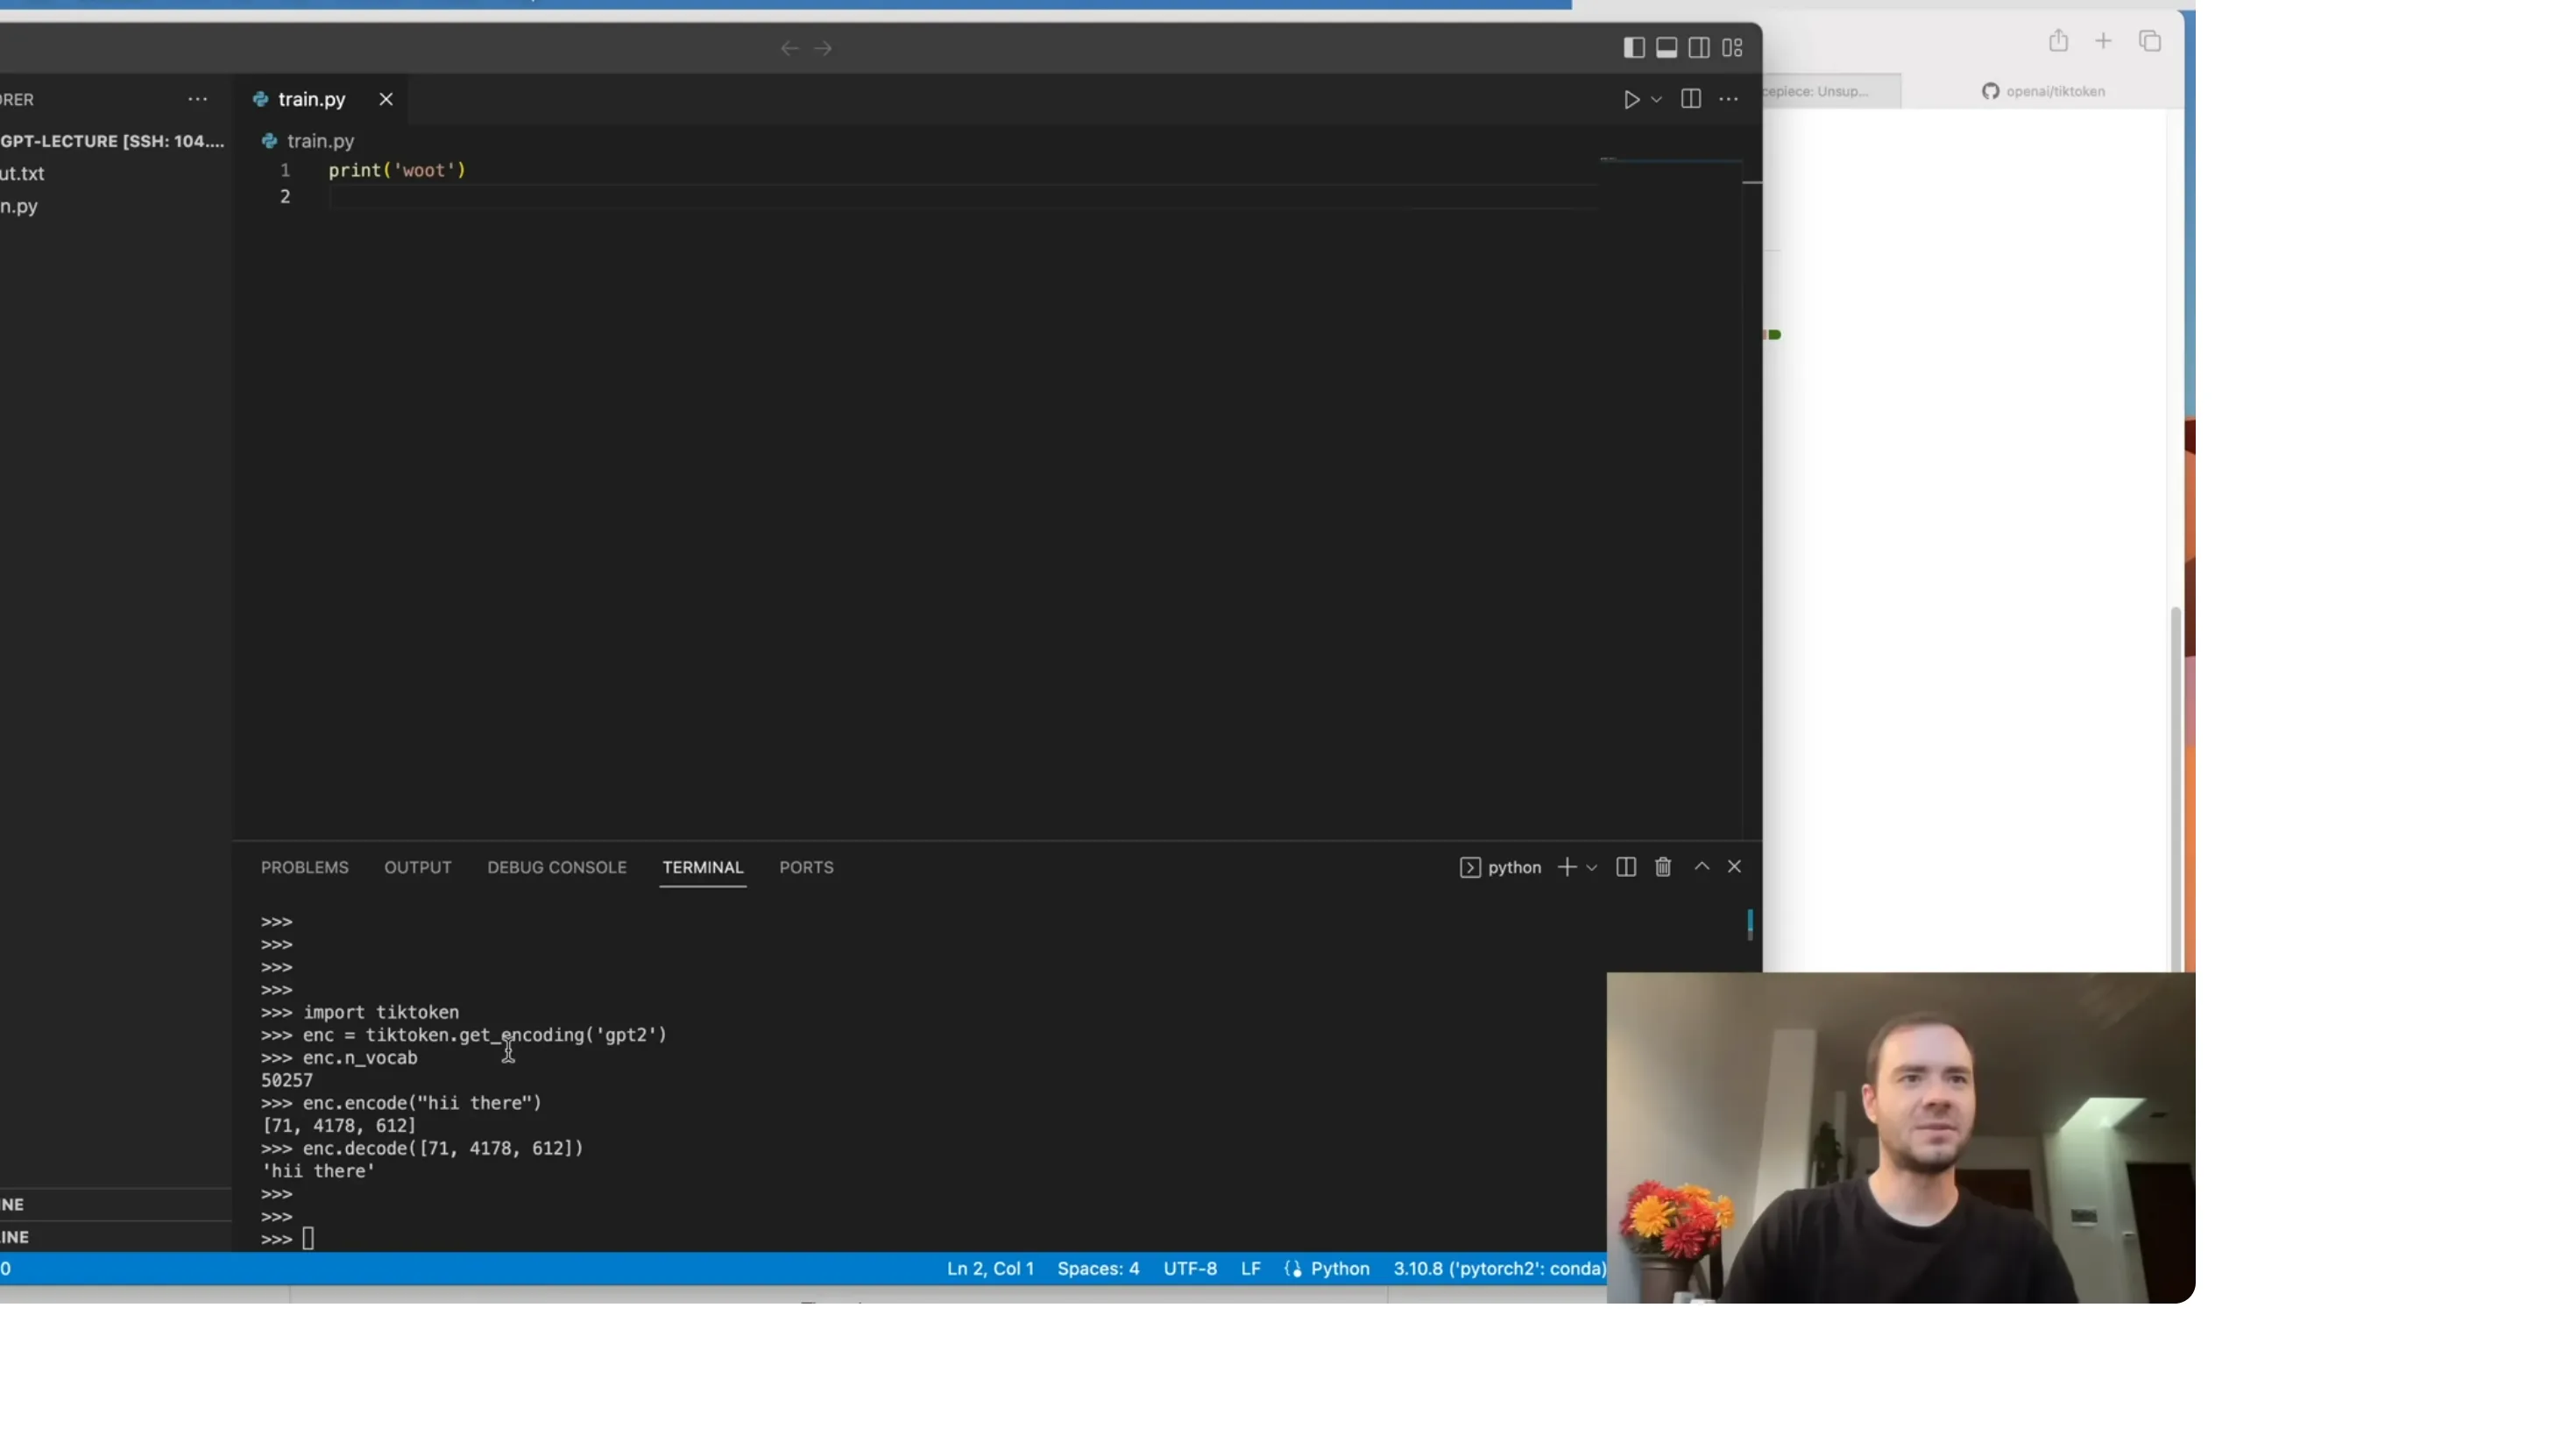
📷 tiktoken 的 BPE:同一个 "hello" 只编成 3 个 token,但词表有 5 万项
回到原视频 (00:11:40)
2.3 划分 train / val
把数据前 90% 当训练集,后 10% 当验证集。
「我们把验证集藏起来——因为我们不想要"完美背诵"这段莎士比亚,我们想要一个能写出"类似莎士比亚"的文本的网络。所以它应该有能力产出我们留出来的那段真实莎士比亚文本,我们就用这个来判断过拟合的程度。」
2.4 数据加载器:一批"数据块"
关键约束:我们永远不会把整段文本一次性喂给 Transformer——那在计算上不可行。我们只采样随机的小片段,长度上限叫 block_size(也有人叫 context length)。这里从 8 开始。
为什么取 block_size + 1 个字符? 因为——
一个长度为 9 的片段里,其实嵌着 8 个独立样本! 因为字符彼此相邻:给 18 → 预测 47;给 18,47 → 预测 56;给 18,47,56 → 预测 57……
x = train_data[:block_size]      # 前 8 个
y = train_data[1:block_size+1]   # 错开一位
for t in range(block_size):
    context = x[:t+1]            # 上下文:到 t 为止
    target  = y[t]               # 目标:下一个
不只是为了效率:「这样训练,网络会习惯于看到长度从 1 到 block_size 的各种上下文。」 这在推理时很有用——采样时我们可能只有一个字符的上下文,而 Transformer 知道怎么在"只有 1 个字符"的情况下预测下一个。「这就是它能一路预测到 block_size 的原因;超过 block_size 就必须截断,因为预测下一个字符时,Transformer 永远不会收到比 block_size 更多的输入。」
再加一个批次维度:为了把 GPU 喂饱(GPU 极擅长并行),我们同时处理多个片段——但它们完全独立、互不通信。
batch_size = 4
ix = torch.randint(len(data) - block_size, (batch_size,))
xb = torch.stack([data[i:i+block_size] for i in ix])       # (4, 8)
yb = torch.stack([data[i+1:i+block_size+1] for i in ix])   # (4, 8)
于是这个 4×8 的输入里一共装了 32 个独立样本。
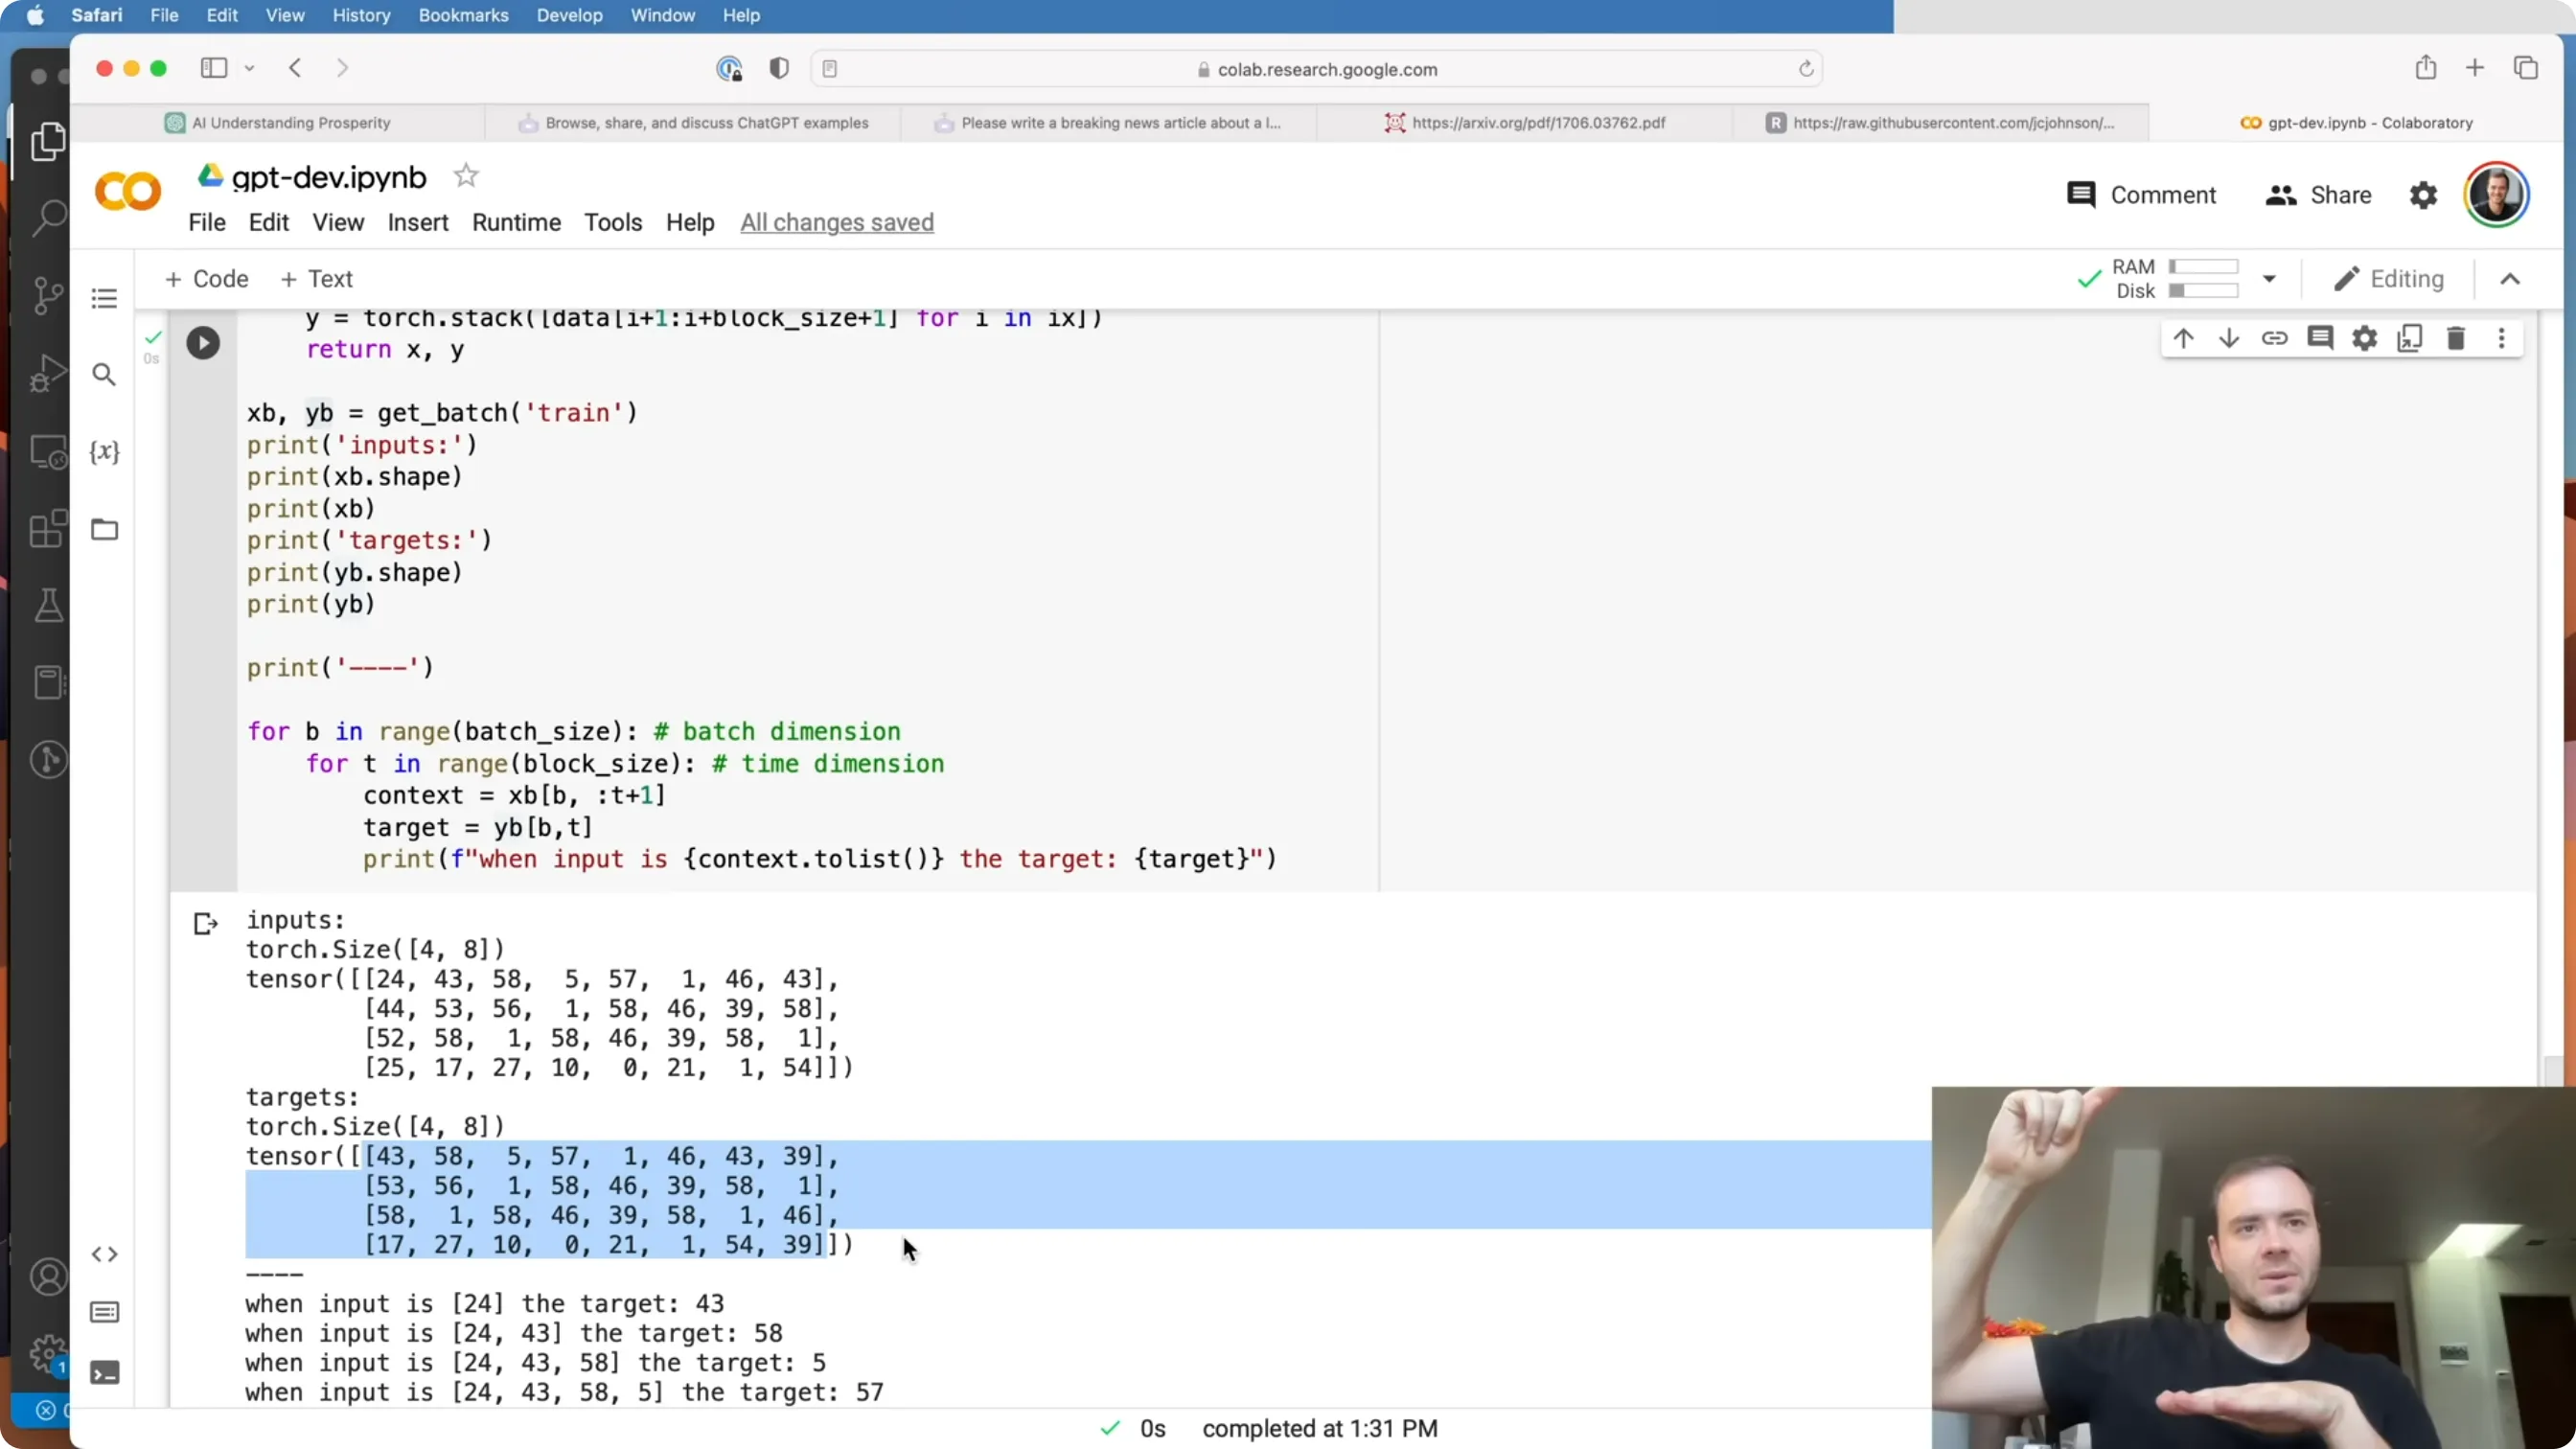
📷 `4×8` 的输入批次:32 个独立样本打包在一个张量里
回到原视频 (00:21:00)
三、最简基线:bigram 语言模型
(参考时间: 22:11)
「我们从最简单的神经网络开始——在语言建模里,那就是 bigram 模型。」(makemore 系列已经详讲过,所以这里加速。)
3.1 模型与 logits
class BigramLanguageModel(nn.Module):
    def __init__(self):
        self.token_embedding_table = nn.Embedding(vocab_size, vocab_size)
    def forward(self, idx, targets=None):
        logits = self.token_embedding_table(idx)   # (B,T,C)
发生了什么:输入里的每个整数(比如 24)去查表、取出第 24 行(一个长度为 vocab_size 的向量)。PyTorch 把结果组织成 (B, T, C),这里 C 就是 vocab_size。
「它仅凭"我是 5 号 token"就能做出还不错的下一个字符预测——因为某些字符确实倾向于跟在某些字符后面。这时 token 之间不交互,也看不到除自己以外的任何上下文。」
3.2 交叉熵:一个形状的坑
我们想算 negative log-likelihood(PyTorch 里就是 cross_entropy)。但直接调用会报错:
PyTorch 的
cross_entropy对多维输入要求 channels 在第二维,也就是它想要 (B, C, T),而我们给的是 (B, T, C)。
Karpathy 的处理方式(一个值得抄的习惯):
B, T, C = logits.shape        # 给维度起名字
logits = logits.view(B*T, C)  # 拉平成二维
targets = targets.view(B*T)   # 一维
loss = F.cross_entropy(logits, targets)
「我基本喜欢先给维度起名字」,然后显式写
B*T而不是-1——这样形状不对时你会拿到报错,而不是被悄悄"猜对"。
3.3 初始损失应该是多少?
65 个可能字符,如果均匀猜测,期望损失是
$$-\ln\frac{1}{65} \approx 4.1217$$
而实际得到 4.87——
「这告诉我们初始预测并不是"超级模糊"的,它们带了一点熵,所以我们在猜错。」
👉 这又回到了 makemore 系列的老办法:先算"理论上该是多少",再看实际是多少。
3.4 生成
def generate(self, idx, max_new_tokens):
    for _ in range(max_new_tokens):
        idx_cond = idx[:, -block_size:]          # 裁到 block_size(重要!)
        logits, loss = self(idx_cond)
        logits = logits[:, -1, :]                # 只看最后一个时间步
        probs = F.softmax(logits, dim=-1)
        idx_next = torch.multinomial(probs, num_samples=1)
        idx = torch.cat((idx, idx_next), dim=1)  # (B, T+1)
    return idx
两个细节: 1.
targets必须是可选的(默认None)——因为生成时我们没有目标,没有 loss 可算; 2. 只能看最后一个时间步的 logits,因为那才是"对下一个字符的预测"。一点自我吐槽:这里的
generate写得太通用了——对一个 bigram 模型来说纯属浪费:「要预测 K,我只需要最后那个字符,但我却把整条上下文都喂了进去」。之所以这么写,是为了后面不改接口——等我们的模型真的会看历史时,这段代码就不用动。
刚开始生成的是纯垃圾(模型是随机的)。训练后就有点样子了。
3.5 训练:改用 AdamW
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
「makemore 系列里我们只用最朴素的 SGD。这里我想用 Adam——它先进得多、也流行得多,效果极好。典型的好学习率大约是 3e-4;但对于极小的网络(比如这里),3e-3 甚至更高也扛得住。」
batch size 提到 32,跑 10,000 步后:
| 验证损失 | 采样质量 | |
|---|---|---|
| 初始 | 4.87 | 纯噪声 |
| 10,000 步后 | ≈2.5 | 「明显进步,虽然肯定不像莎士比亚」 |
但 bigram 的天花板就在这:token 之间根本不交互——「给定前面生成的上下文,我们只看最后一个字符去预测下一个。现在这些 token 必须开始互相交流、理解上下文,才能做出更好的预测。这就是 Transformer 登场的地方。」
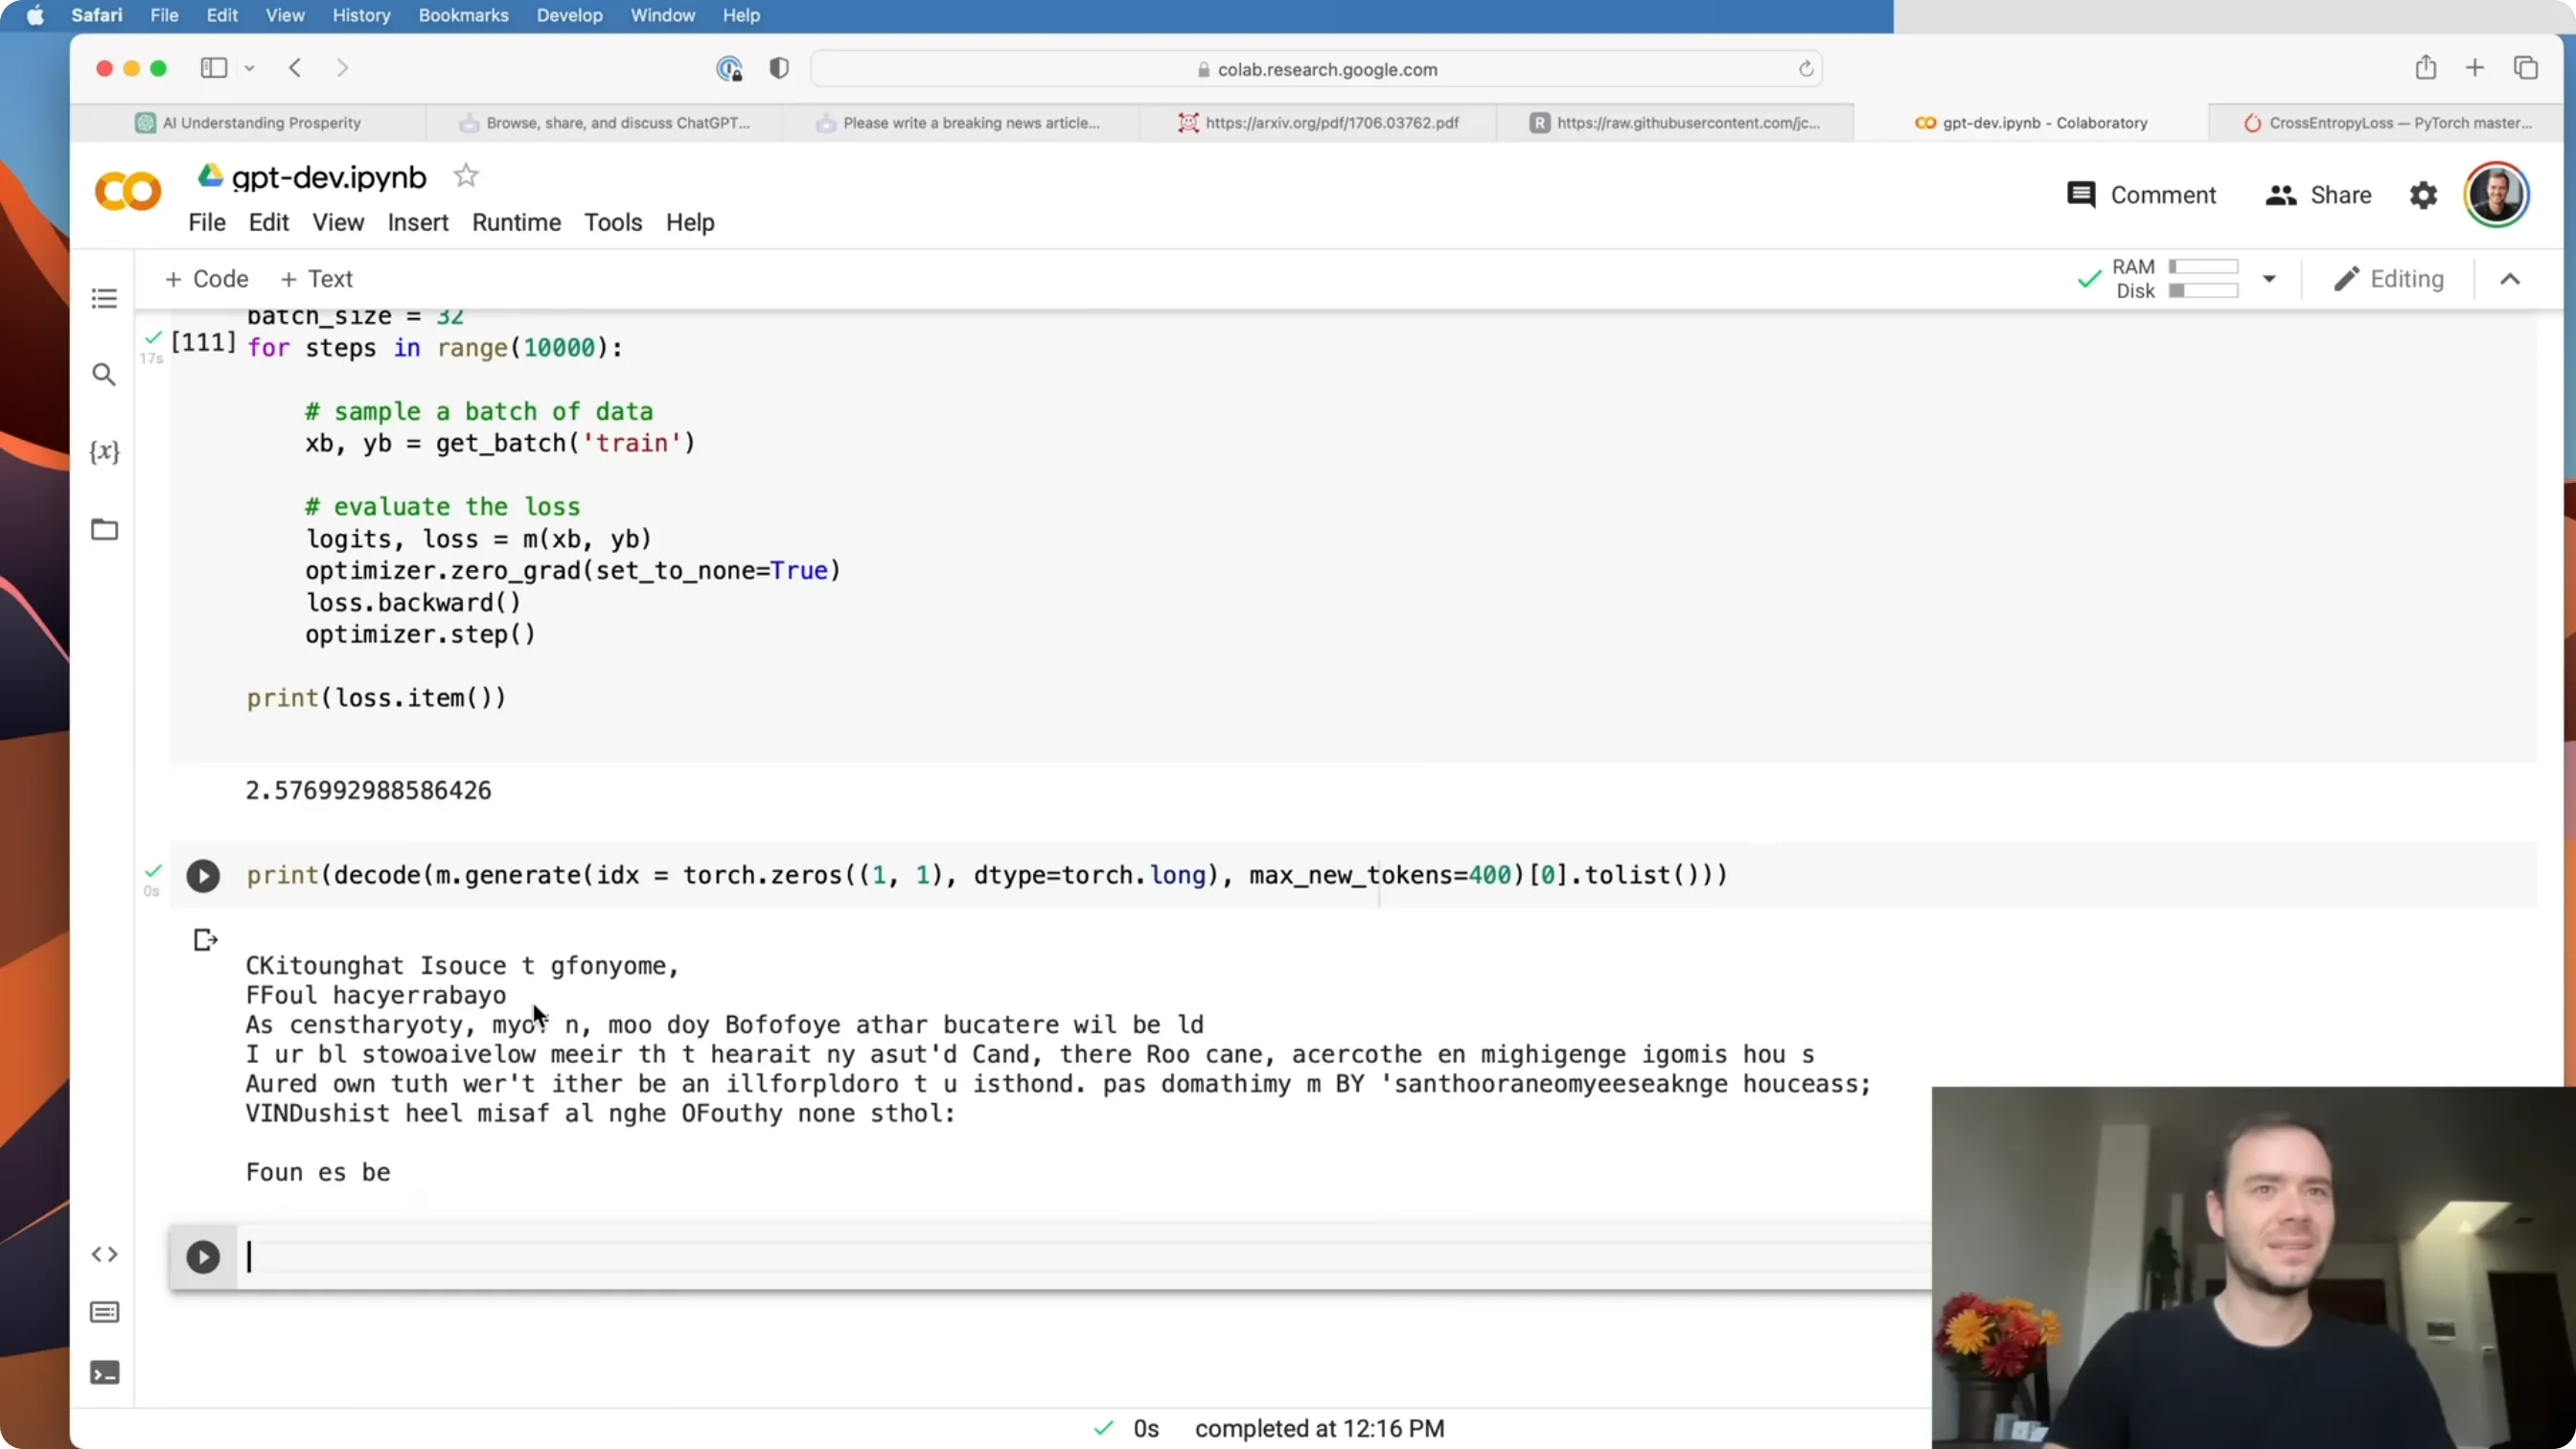
📷 把 bigram 训练到 ~2.5 之后采样出来的文本(有点样子,但还很糟)
回到原视频 (00:37:20)
四、把代码搬进脚本
(参考时间: 38:00)
把 notebook 整理成 bigram.py(约 120 行):超参数置顶、读数据、建 encode/decode、切 train/val、数据加载器、bigram 模型、优化器、训练循环。
新增的三件事:
- GPU 支持:
device = 'cuda' if torch.cuda.is_available() else 'cpu'。数据、模型参数、生成时的初始 context 都要.to(device)。 estimate_loss():「训练循环里直接打印
loss.item()是一个噪声极大的度量,因为每一批的运气不同。」所以写一个函数跑eval_iters批并平均,分别给出训练损失和验证损失——「这样准确得多」。model.eval()/model.train()与torch.no_grad():「当前模型里只有
nn.Embedding,所以 eval 和 train 行为其实一样(我们没有 dropout、没有 BN)。但养成"时刻知道网络处于哪个模式"的习惯是好事,因为有些层在训练/推理时行为不同。」 「torch.no_grad()就是告诉 PyTorch:这里面的东西永远不会调backward——于是它不必保存中间变量,省很多显存。」
跑出来:bigram 收敛到约 2.5。
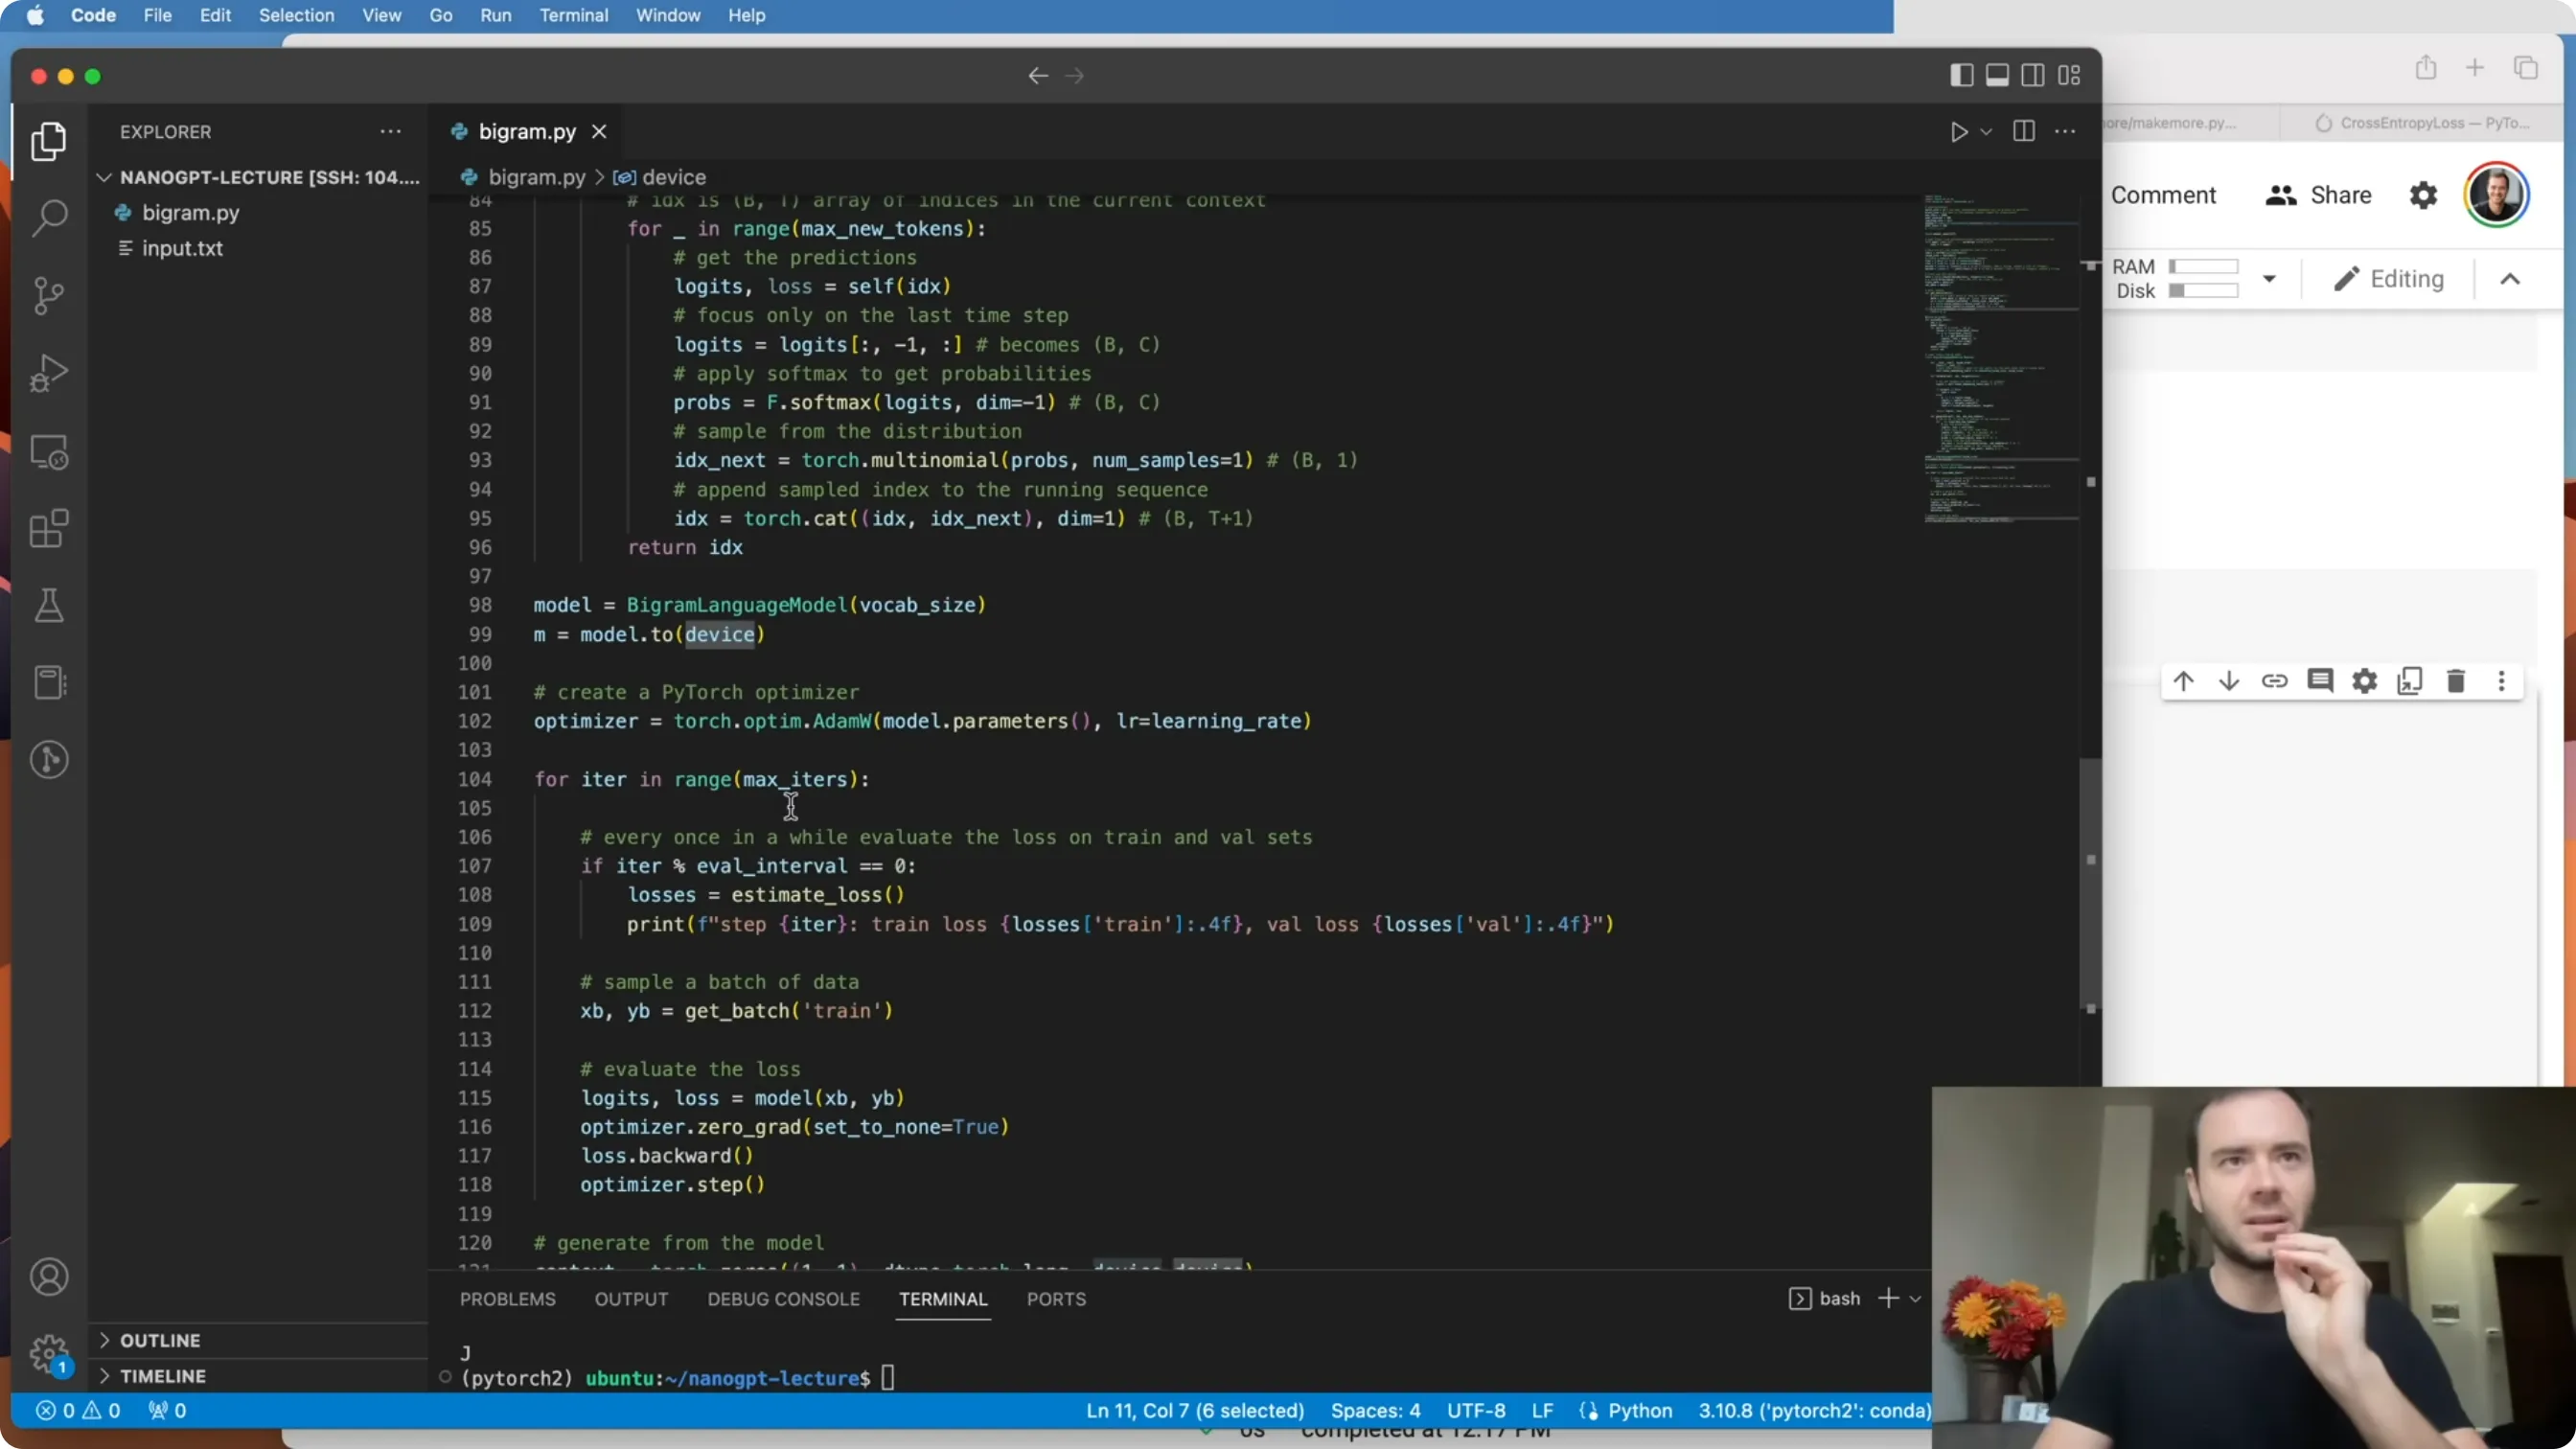
📷 bigram.py:设备切换、estimate_loss、model.eval()+no_grad 的正确姿势
回到原视频 (00:39:30)
五、自注意力的前身:加权聚合
(参考时间: 42:13)
先把问题说清楚:
「我们一个 batch 里有多达 8 个 token,它们目前彼此不通信。我们想让它们通信——但要用一种很特定的方式: 第 5 个位置的 token 不应该和 6、7、8 通信,因为那是未来;它只能和 4、3、2、1 通信。 信息只能从"当前时刻之前的上下文"流向当前——因为我们马上要预测未来,所以我们不能从未来获取信息。」
5.1 version 1:for 循环求平均(最弱的聚合)
「token 之间最简单的通信方式……就是把前面所有元素求平均。」 「当然,单纯相加/平均是一种极弱的交互,这种通信极差——我们丢掉了所有 token 在空间排布上的大量信息。但先这样。」
xbow = torch.zeros((B, T, C))            # bow = "bag of words"
for b in range(B):
    for t in range(T):
        xprev = x[b, :t+1]              # (t+1, C)
        xbow[b, t] = torch.mean(xprev, 0)
于是第 5 行是前 5 个向量的平均、最后一行是全部 8 个的平均——"垂直方向上的累积平均"。
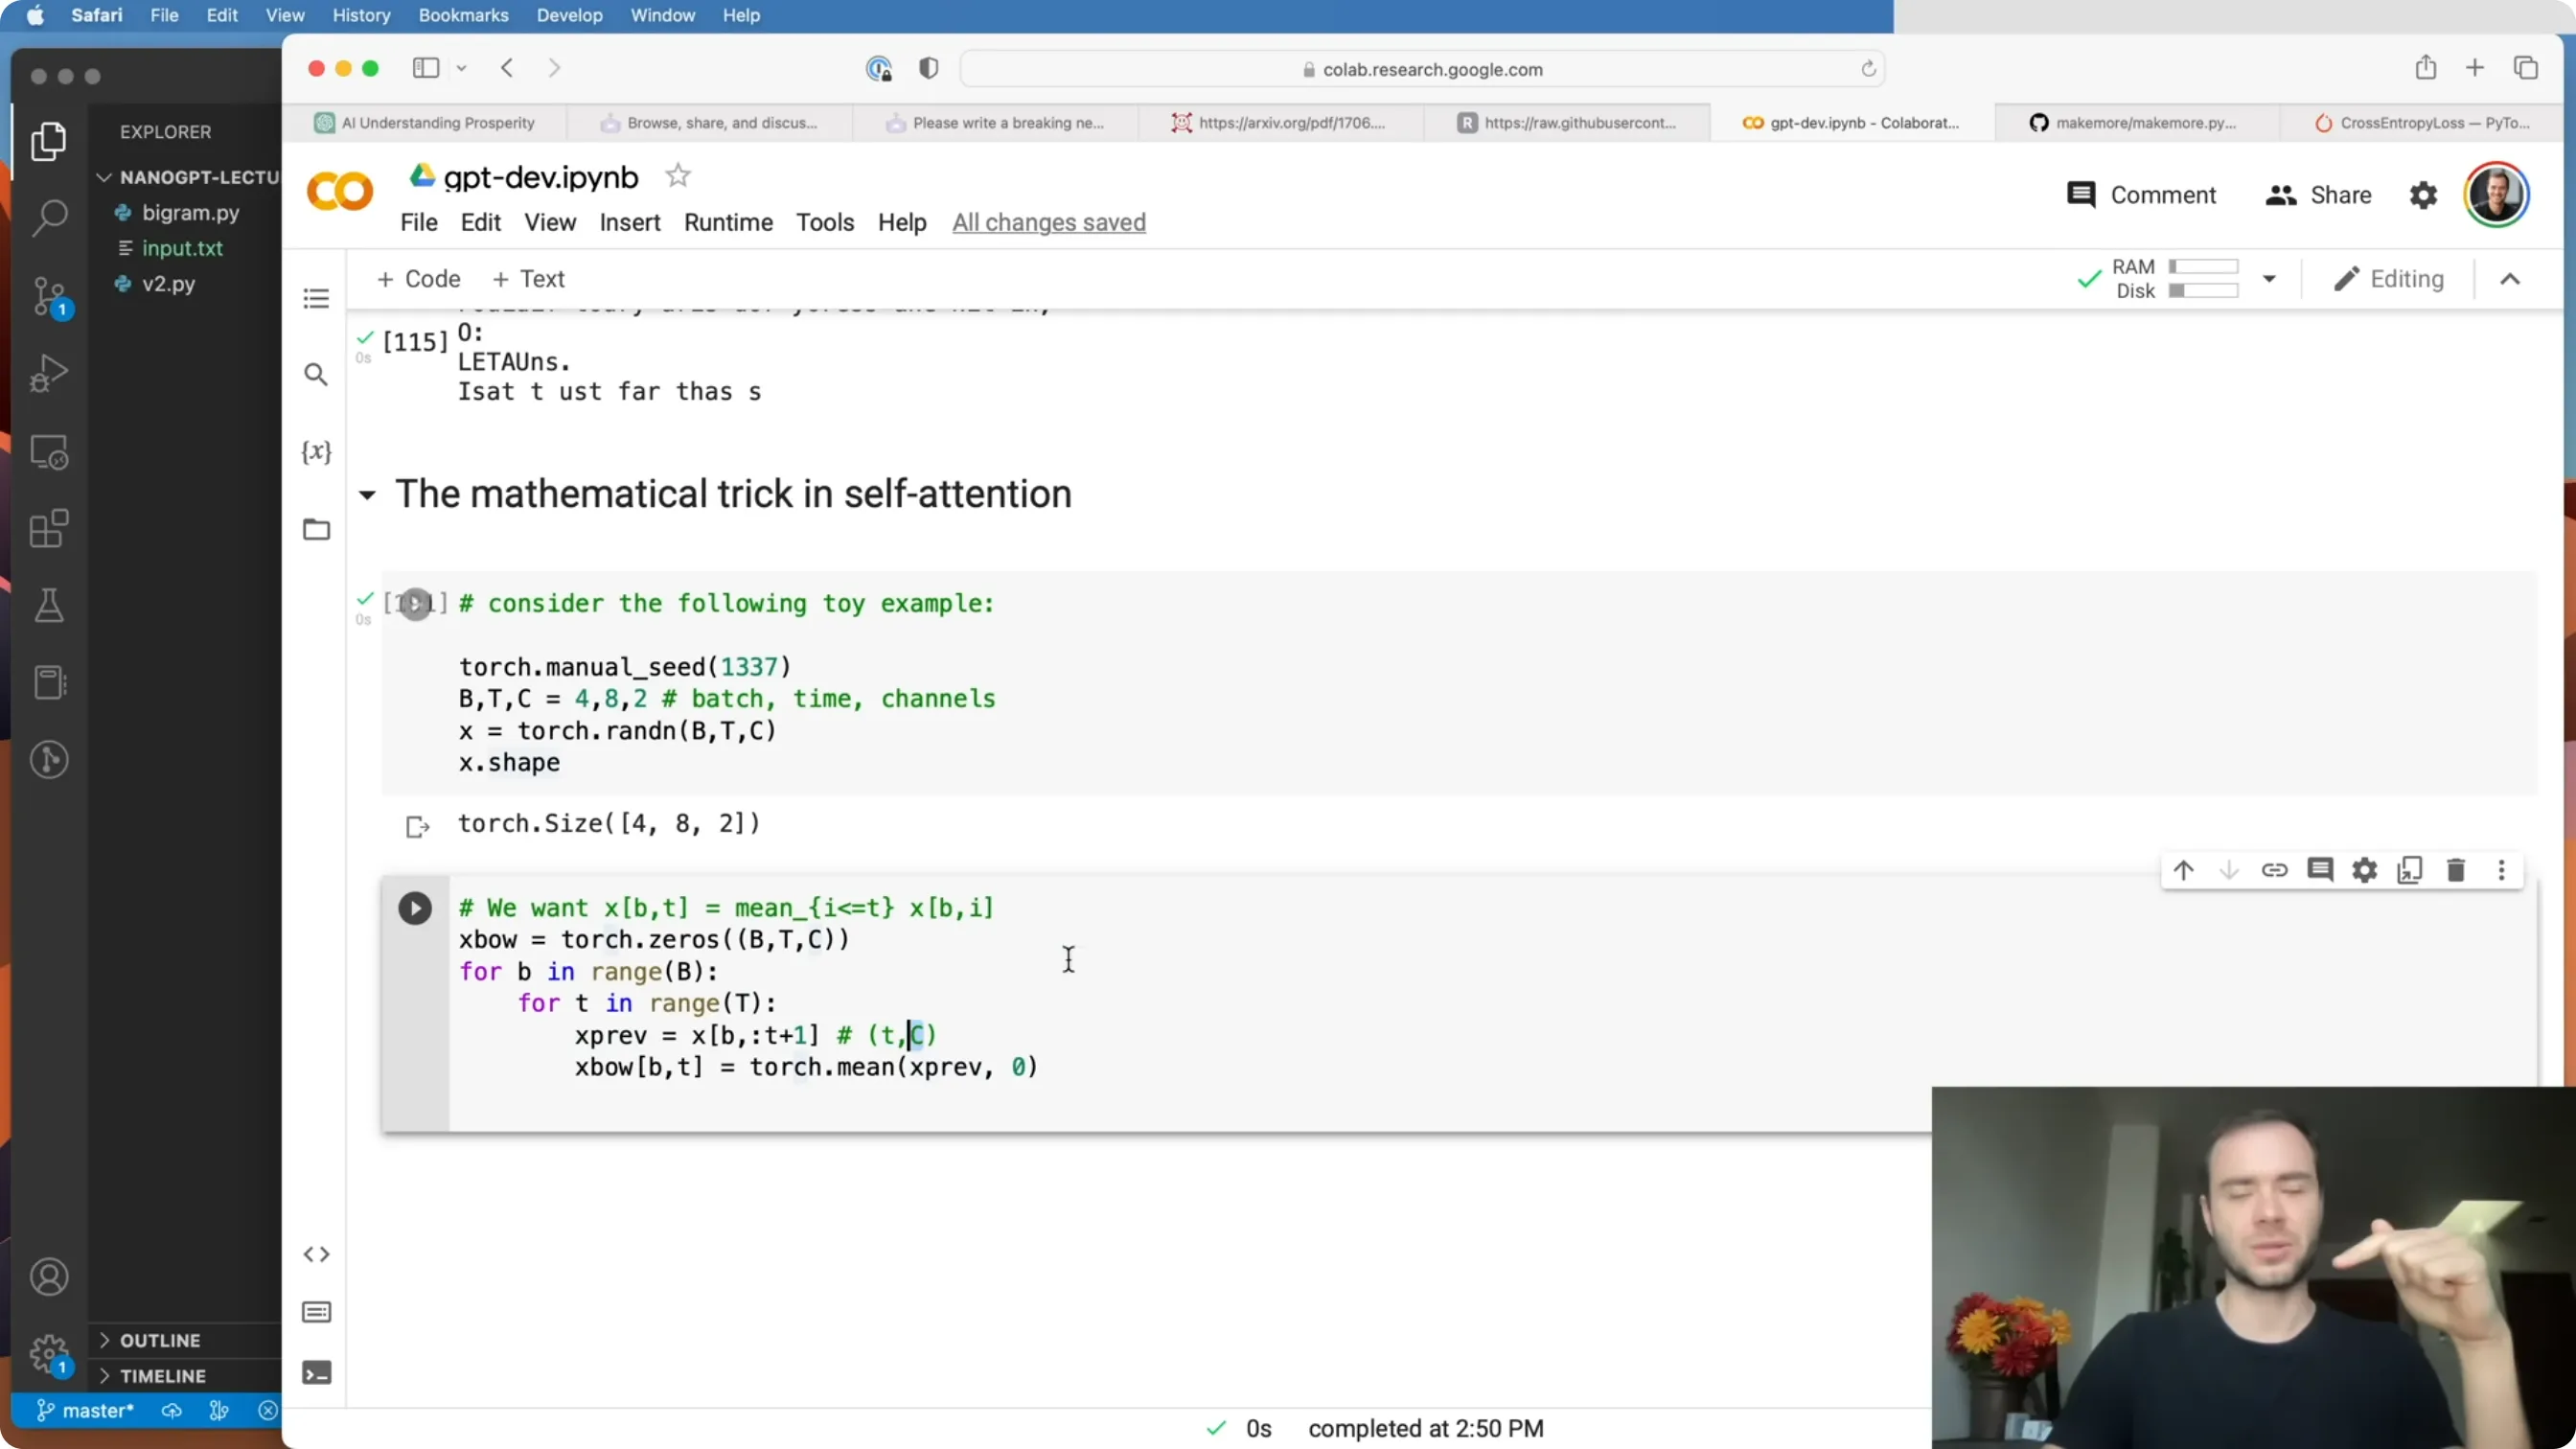
📷 v1:用双重 for 循环算"累积平均"(bag of words)——能用,但极慢
回到原视频 (00:46:00)
5.2 那个数学技巧:用矩阵乘法做加权聚合
(参考时间: 47:11)
先看一个 3×3 的小演示:取 A = torch.ones(3,3),C = A @ B。
- 因为 A 的每一行都是 1,所以
C的每个元素就是 B 某列的和(2+6+6=14 等); - 把 A 换成
torch.tril(torch.ones(3,3))(下三角),就变成"累积":C第 1 行只取了 B 第 1 行,第 2 行取了前两行的和,第 3 行取三行之和; - 再把每一行归一化到和为 1(
A = A / A.sum(1, keepdim=True)),和就变成了平均: - 第 1 行 = 第 1 行自己,
- 第 2 行 = 前两行的平均((2+6)/2 = 4,(4+7)/2 = 5.5),
- 第 3 行 = 三行的平均。
🔑 「通过摆弄这个"乘子矩阵"的元素,再乘以任意一个矩阵,我们就能增量地算出这些平均值。」
5.3 version 2:用矩阵乘法(快得多)
(参考时间: 51:54)
wei = torch.tril(torch.ones(T, T))
wei = wei / wei.sum(1, keepdim=True)   # 每行和为 1 → 平均
xbow2 = wei @ x                        # (T,T) @ (B,T,C) → (B,T,C)
注意 PyTorch 在这里做了什么:
(T,T)和(B,T,C)形状不同,PyTorch 会自动补一个批次维度,做批矩阵乘法(batch matmul)——对 batch 里每个元素并行、独立地做一次T×C的加权聚合。✅ 验证:
torch.allclose(xbow, xbow2)为 True。这就是"用矩阵乘法做加权聚合":权重矩阵呈下三角形状,意味着第 i 个 token 只能从它之前的 token 获取信息。「这正是我们想要的。」
5.4 version 3:换成 softmax —— 让权重"数据相关"
(参考时间: 54:42)
wei = torch.zeros((T, T))
wei = wei.masked_fill(tril == 0, float('-inf'))   # 上三角 → -inf
wei = F.softmax(wei, dim=-1)                      # 每行归一化
xbow3 = wei @ x
结果与 v1/v2 完全一样(softmax 里 $e^0 = 1$、$e^{-\infty} = 0$,归一化后就是均匀平均)。但为什么要绕这一圈?
🔑 因为权重从"写死的 0"变成了"可训练、数据相关的亲和力(affinities)": 「这些 0 是我们设的。但要紧的是:token 之间的亲和力不会永远保持为 0——它们会变成数据相关的。token 会开始互相观察,有些 token 会觉得别的 token 更有意思,于是按"有意思的程度"把它们的值加权加起来。」
这就是自注意力的前身。
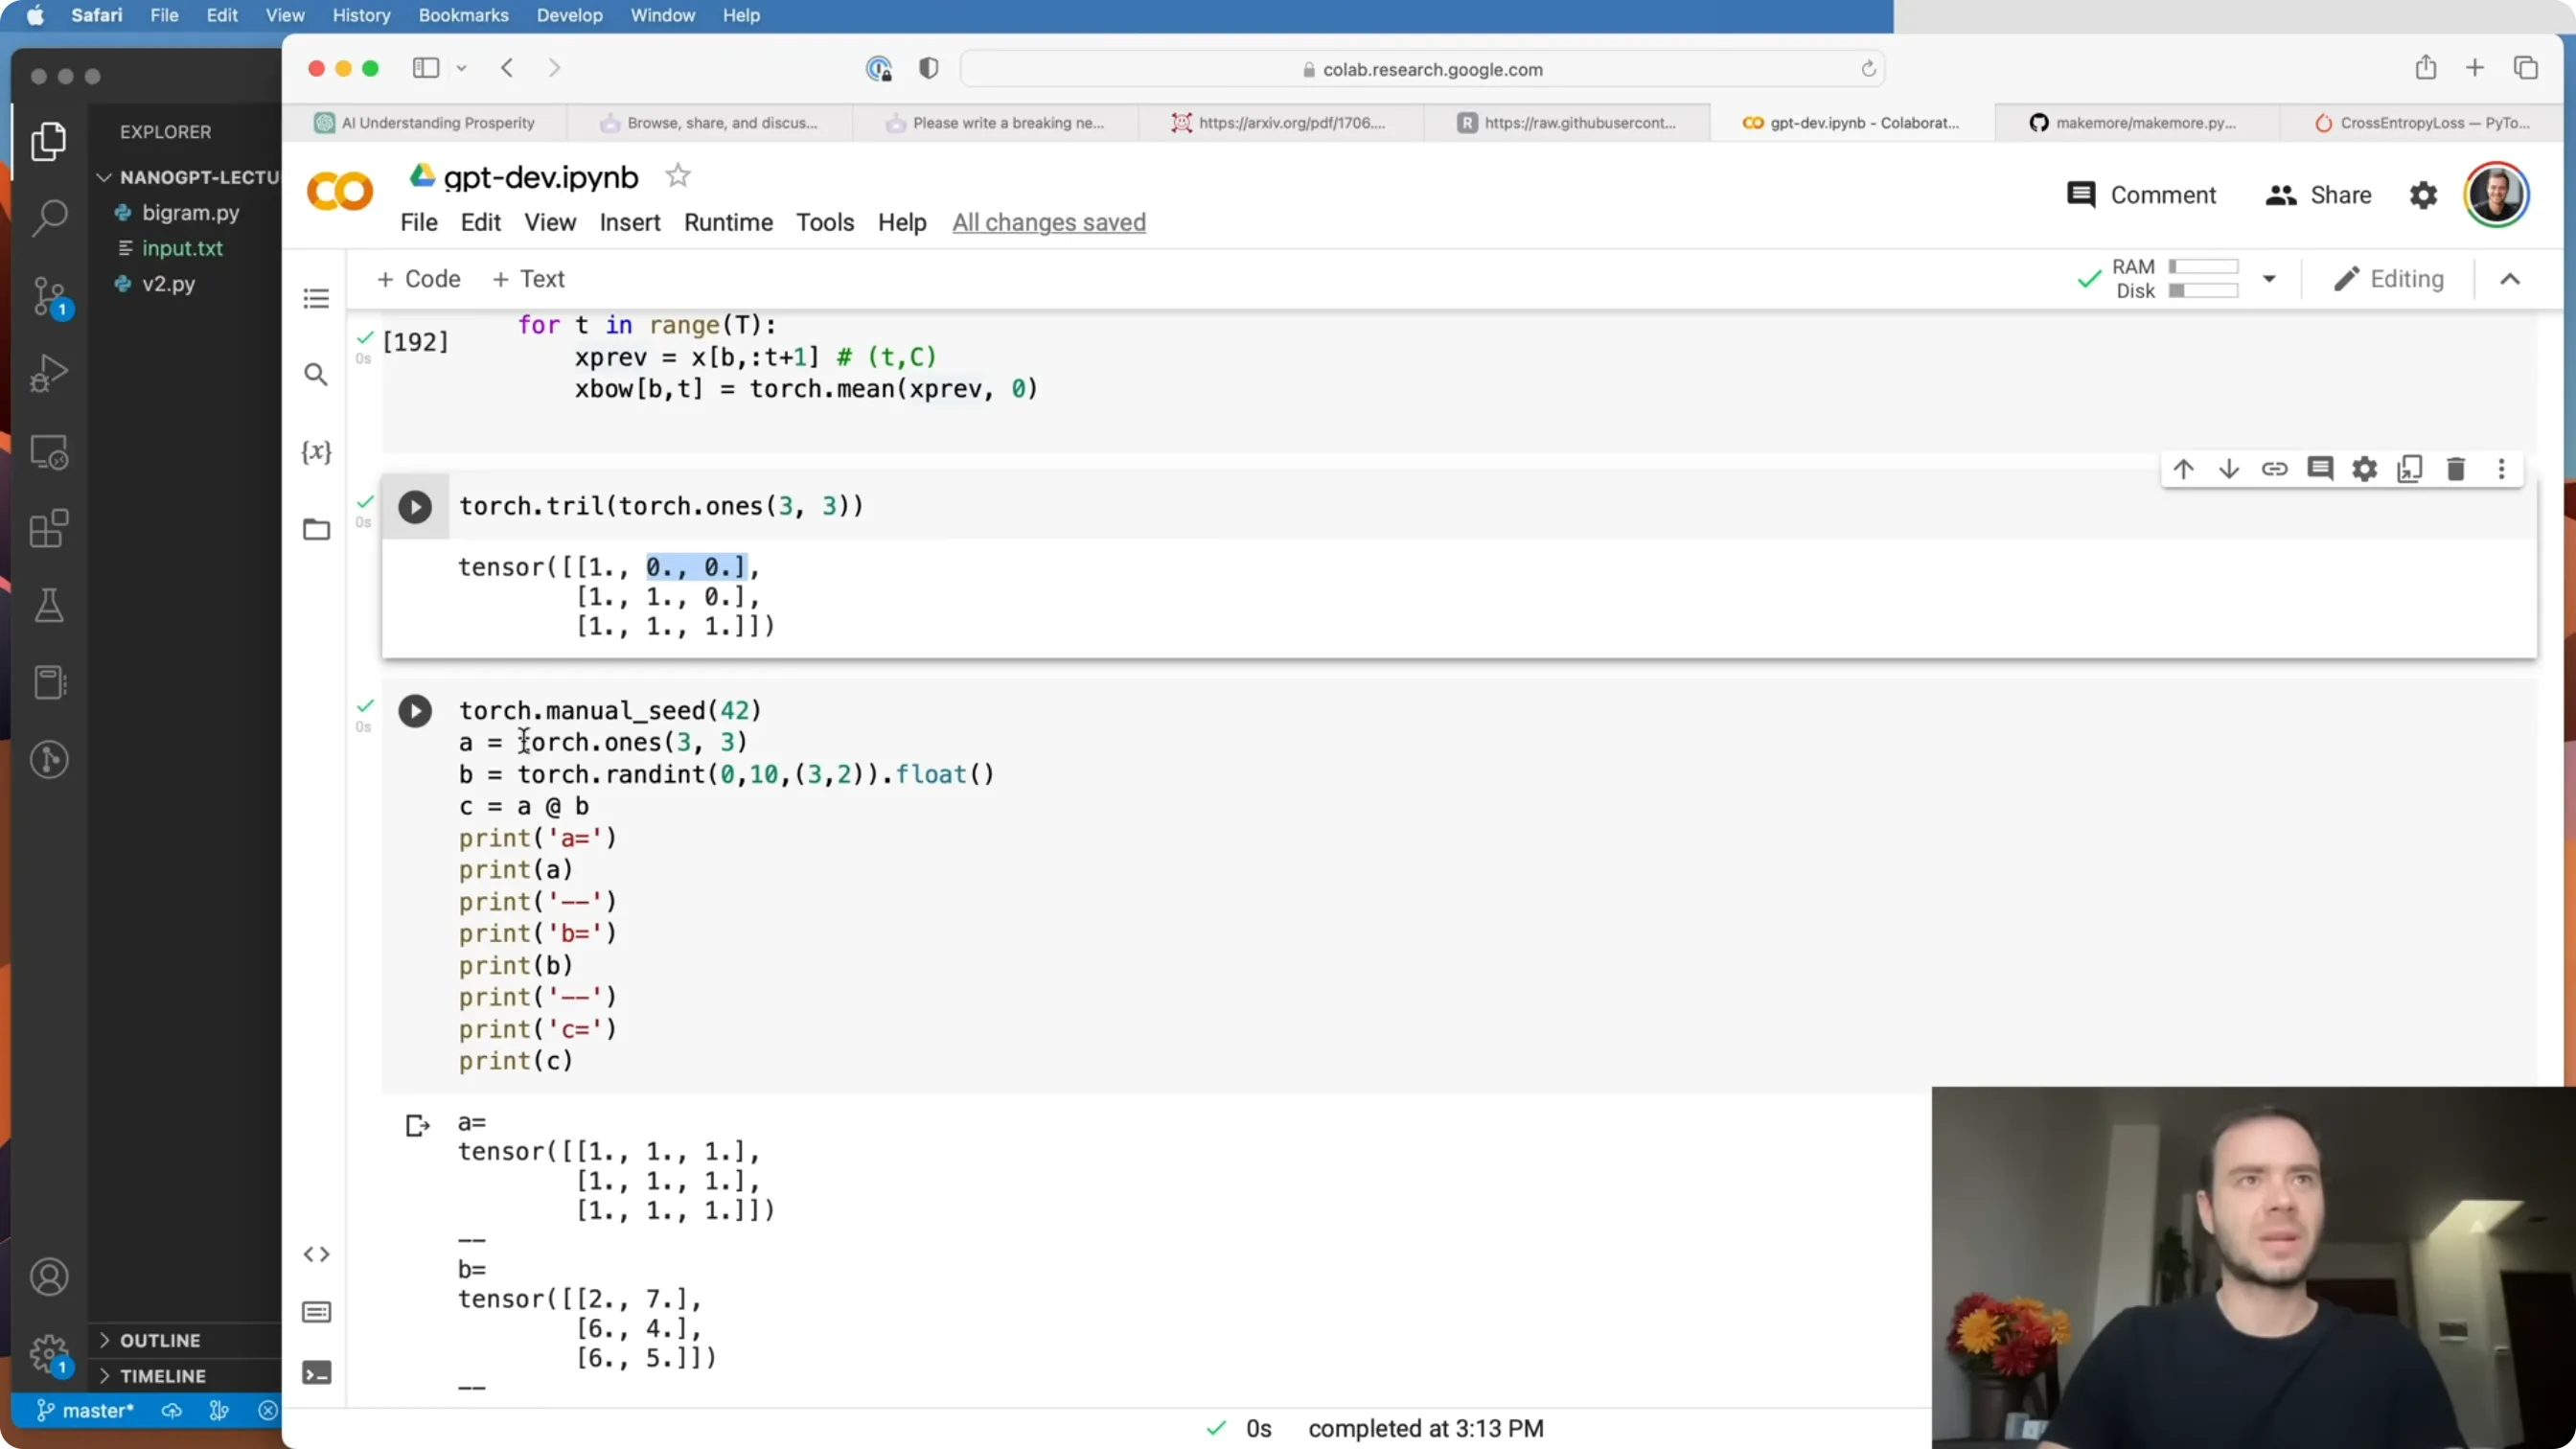
📷 `tril` 下三角矩阵 + 行归一化 = 增量式加权聚合
回到原视频 (00:49:10)
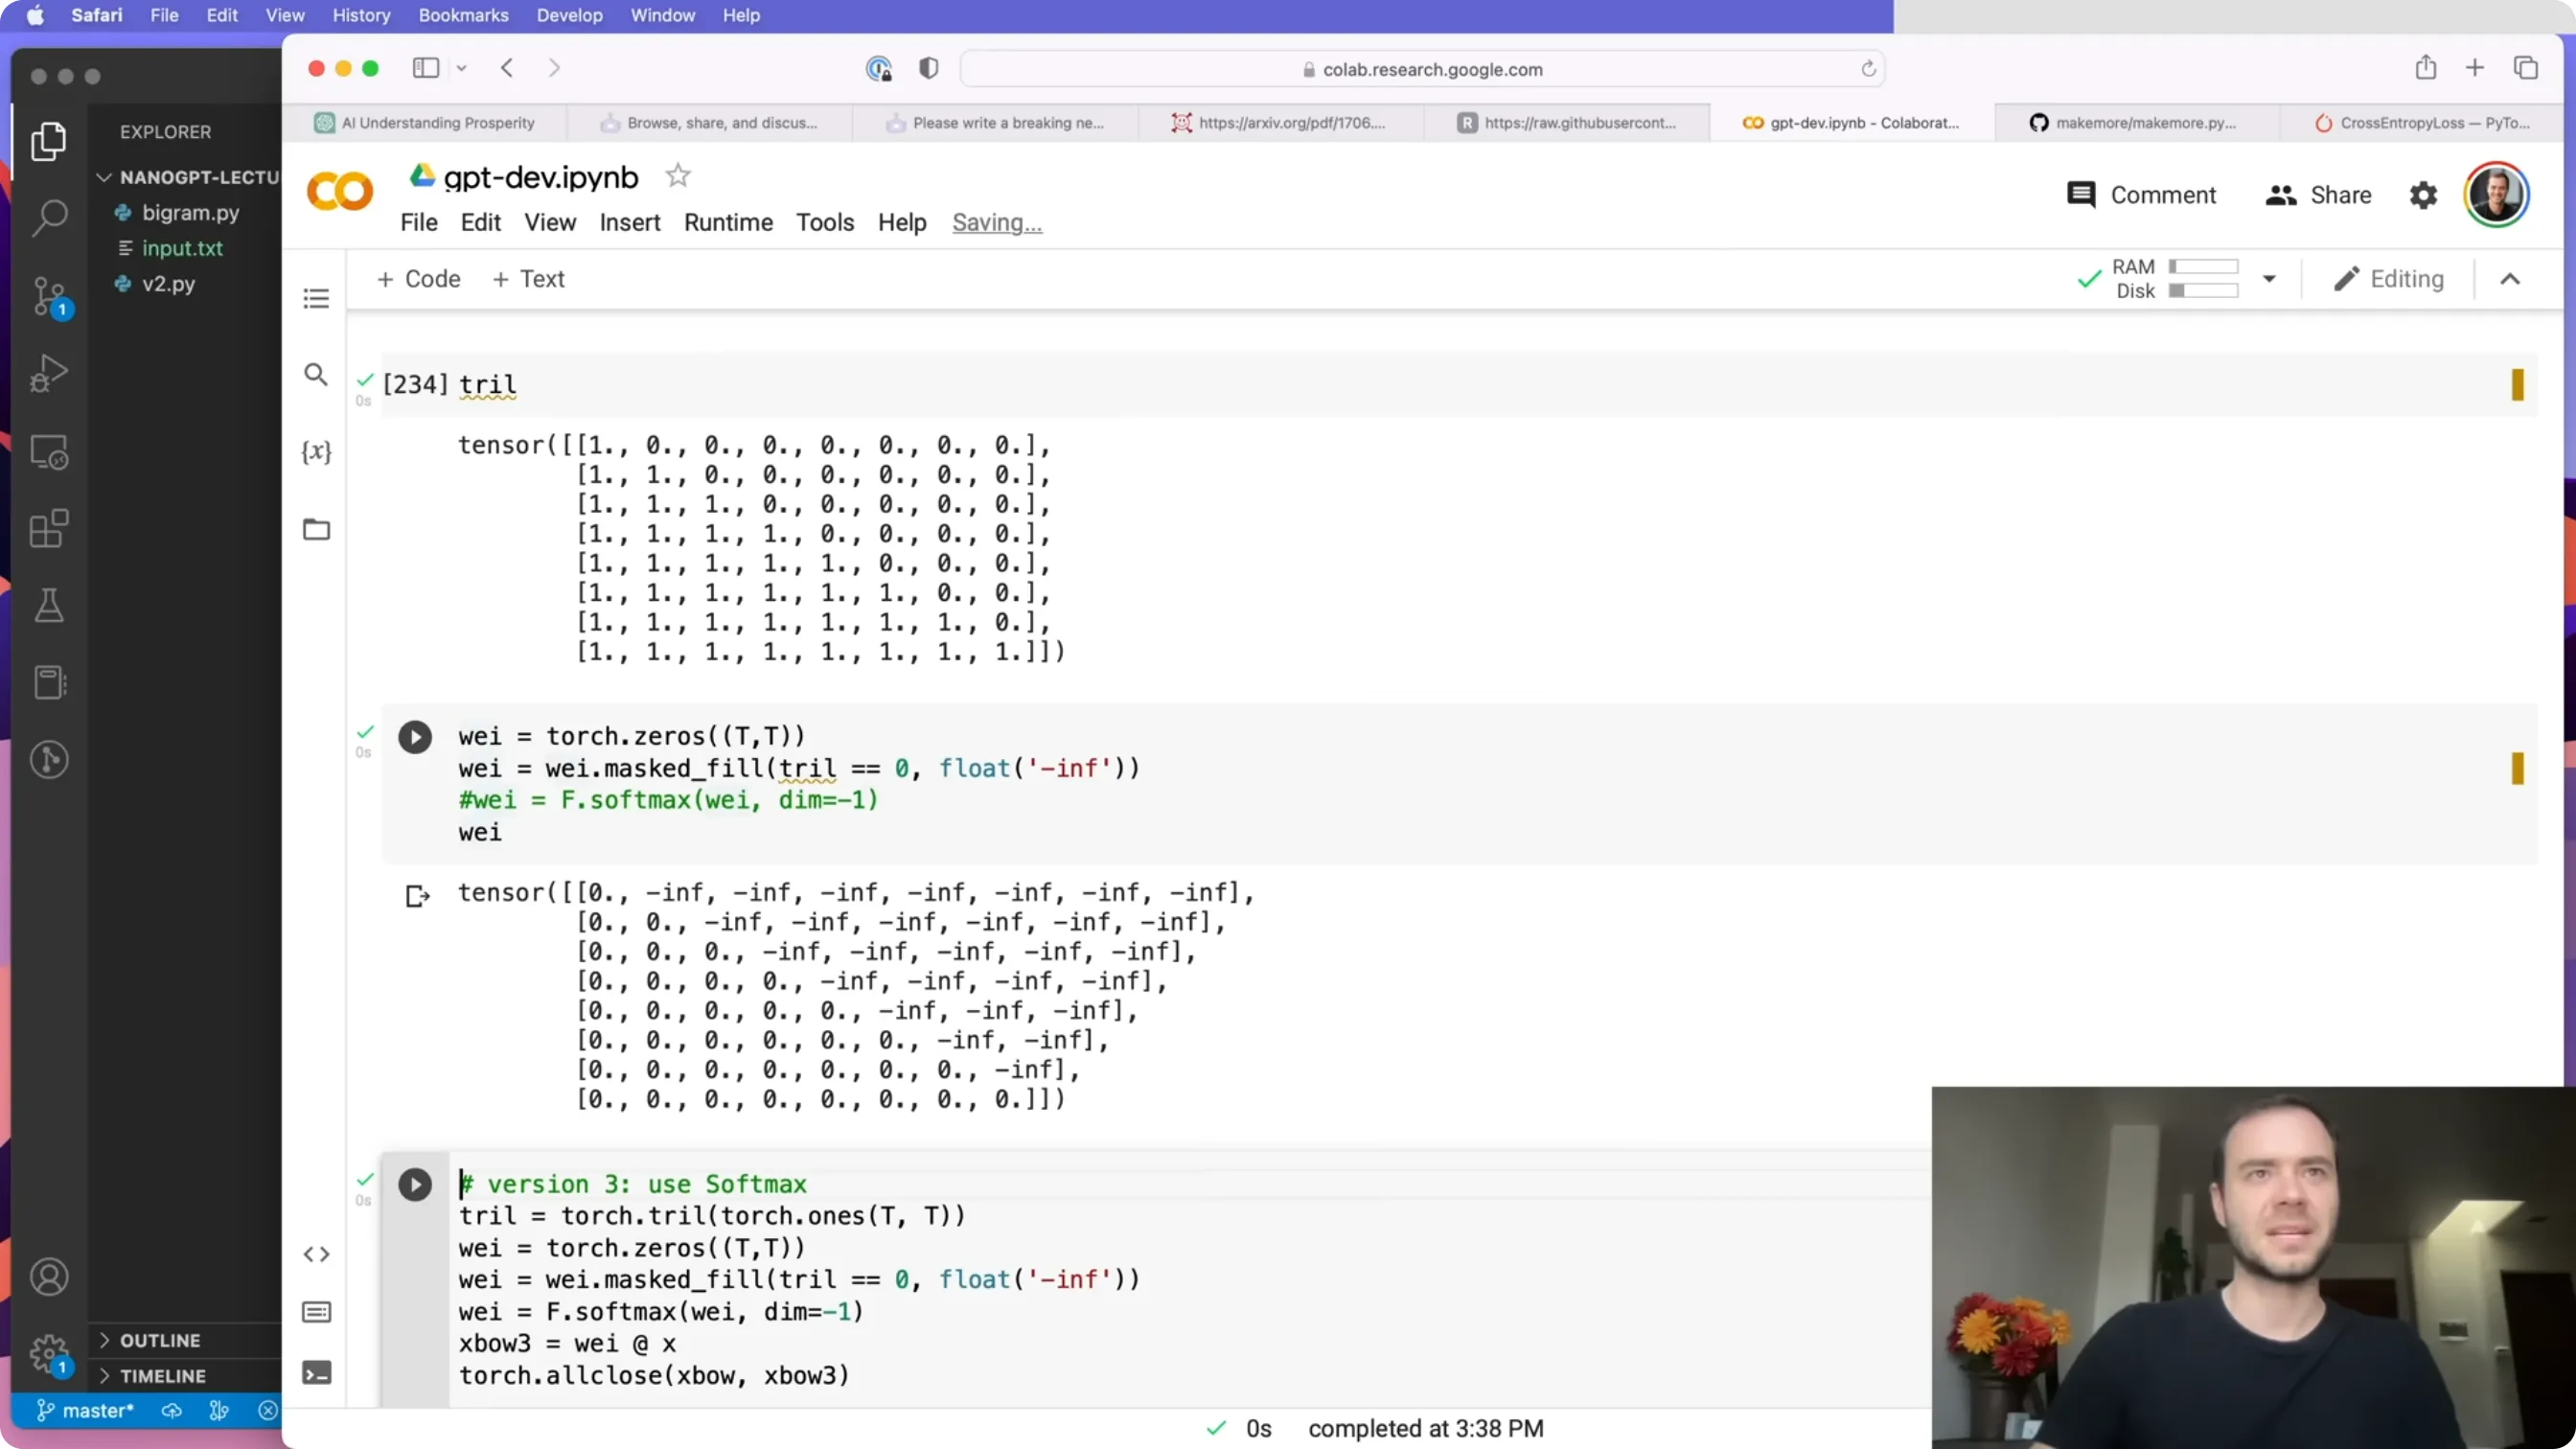
📷 v3:用 `masked_fill(-inf) + softmax` 得到同样的结果,但权重变成了可学习的亲和力
回到原视频 (00:56:00)
六、位置编码,与 THE CRUX:version 4 = 自注意力
(参考时间: 1:00:18)
6.1 三个小清理 + 位置编码
vocab_size不用传参(已经是全局变量);- 加一层间接:不再直接从 embedding 拿 logits。引入
n_embed = 32("number of embedding dimensions",这个数字还是 GitHub Copilot 建议的):python self.token_embedding_table = nn.Embedding(vocab_size, n_embed) self.lm_head = nn.Linear(n_embed, vocab_size) # lm_head = language modeling head - 位置编码:
「人们接下来常做的事是:不只编码 token 的身份,也编码它的位置。」
python self.position_embedding_table = nn.Embedding(block_size, n_embed) pos_emb = self.position_embedding_table(torch.arange(T, device=device)) # (T,C) x = tok_emb + pos_emb # (B,T,C) + (T,C) → 广播「这在当前没什么用——因为我们只有个简单模型,它不关心你在第 5 位还是第 2 位,一切都是平移不变的。但等我们进入自注意力,这就开始重要了。」
6.2 version 4:单头自注意力
(参考时间: 1:02:00) —— 「这大概是本视频最重要、最需要理解的部分。」
核心机制:每个 token 发出两个向量——
- query(查询):「我在找什么」
- key(键):「我有什么」
然后用"键 · 查询"的点积得到 token 之间的亲和力:
class Head(nn.Module):
    def __init__(self, head_size):
        self.key   = nn.Linear(n_embed, head_size, bias=False)
        self.query = nn.Linear(n_embed, head_size, bias=False)
        self.value = nn.Linear(n_embed, head_size, bias=False)
        self.register_buffer('tril', torch.tril(torch.ones(block_size, block_size)))

    def forward(self, x):
        B, T, C = x.shape
        k = self.key(x); q = self.query(x)                  # (B,T,head_size)
        wei = q @ k.transpose(-2, -1) * head_size**-0.5      # (B,T,T) 亲和力
        wei = wei.masked_fill(self.tril[:T,:T] == 0, float('-inf'))  # 不能看未来
        wei = F.softmax(wei, dim=-1)
        v = self.value(x)                                     # (B,T,head_size)
        return wei @ v                                        # (B,T,head_size)
逐点理解:
q @ k.transpose(-2,-1):把 K 的最后两维转置(注意要保留 batch 维,所以是-2, -1),得到(B,T,T)——每个样本一张 T×T 的亲和力矩阵。和第 5 节的
wei对比:那里wei是常数、对所有样本一样;现在每个样本的wei都不一样了,因为它由这个样本自己的 token 内容算出来。「这就是数据相关。」register_buffer:tril不是参数,但要跟着模型走(移到 GPU、存进 checkpoint),所以按 PyTorch 惯例用register_buffer注册。masked_fill+softmax:屏蔽未来后指数化、归一化——「我们不想给这个节点加上 -0.11,那太离谱了」——于是得到一个和为 1、可解释为"从过去各 token 抽取多少信息"的分布。value(V):最后一块拼图——我们聚合的其实不是x本身,而是另一个投影v。「你可以把
x想成这个 token 的私有信息:我是第 5 个 token,我有我的身份,存在x里。 而对这单个头来说:这是我"拥有"的东西(key),这是我"寻找"的东西(query),如果我觉得你有意思,我就把我愿意分享的东西(value)给你。」
6.3 关于注意力的 6 条注解
(参考时间: 1:11:38 – 1:16:56)
- 注意力是一种"通信机制"。
把它想成一张有向图:每个节点持有一些信息向量,通过"指向它的所有节点"的加权和来增加信息,而且是数据相关的。 我们的图长这样:8 个节点(block_size=8),第 1 个只被自己指向,第 2 个被 1 和自己指向……第 8 个被前面所有节点和自己指向。这是自回归场景下自然形成的结构;但原则上注意力可以作用在任意有向图上。
- 注意力没有"空间"概念,它作用在"集合"上。
默认情况下,这些节点根本不知道自己身处何处——这就是为什么我们要加位置编码。 这与卷积很不一样:卷积里信息在空间中有明确的排布,卷积核在空间上滑动;注意力不行,你必须显式地把"位置"加进去。
- batch 维之间永不通信。
「它们永远被独立处理。」这本质上是一次跨 batch 维的并行矩阵乘法。 更准确的说法是:batch=4 时我们有 4 组独立的 8 个节点,8 个节点只在自己组内交谈;总共有 32 个节点在被处理,但是四个互不相干的组。
- Encoder 块 vs Decoder 块。
在语言建模里我们用了三角掩码(未来不能看过去)。但这不是一般情况的必然限制—— 比如做情感分析时,你可能希望所有 token 充分互相通信(因为最终要预测整句的情感)。那种情况就把屏蔽那一行删掉,得到 encoder block。 我们现在实现的是 decoder block:「它叫 decoder,是因为它带有自回归格式——必须用三角矩阵掩码,好让未来的节点永远不会和过去交谈,否则就会泄露答案。」
- attention / self-attention / cross-attention。
为什么我们这个是 self-attention?因为 key、query、value 全部来自同一个来源
x。 cross-attention 则相反:query 仍由x产生,但 key 和 value 来自一个完全独立的外部来源(比如"编码了某个我们想作为条件的上下文"的 encoder 块)。 「cross-attention 用于"有另外一来源的节点、我们要从它那里提取信息"的场景;而 self-attention 是"我们只有一组节点,它们想互相观察和通信"。」 - "scaled" attention:为什么要除以 $\sqrt{d_k}$。
回到论文,我们只差一步:除以 $\sqrt{\text{head\_size}}$(论文里的 $d_k$)。 为什么? 如果输入是单位高斯(零均值、单位方差),那么 k、q 也是;朴素地做点积,
wei的方差会是"头维度"的量级(这里是 16)。除以 $\sqrt{d_k}$ 后,方差回到 1,得以保持。 为什么这件事重要? 「因为wei马上要过 softmax。 如果wei取到很大的正数或负数,softmax 会收敛成 one-hot 向量。」 Karpathy 现场演示:把一组接近 0 的数做 softmax → 模糊;把同样的数乘以 8 → softmax 立刻变尖,几乎全部集中在最大那个上。 「我们不希望这些值太极端,尤其是在初始化时——否则 softmax 太尖,每个节点只能从"唯一一个"其它节点获取信息。这不是我们想要的,所以缩放只是用来在初始化时控制方差。」
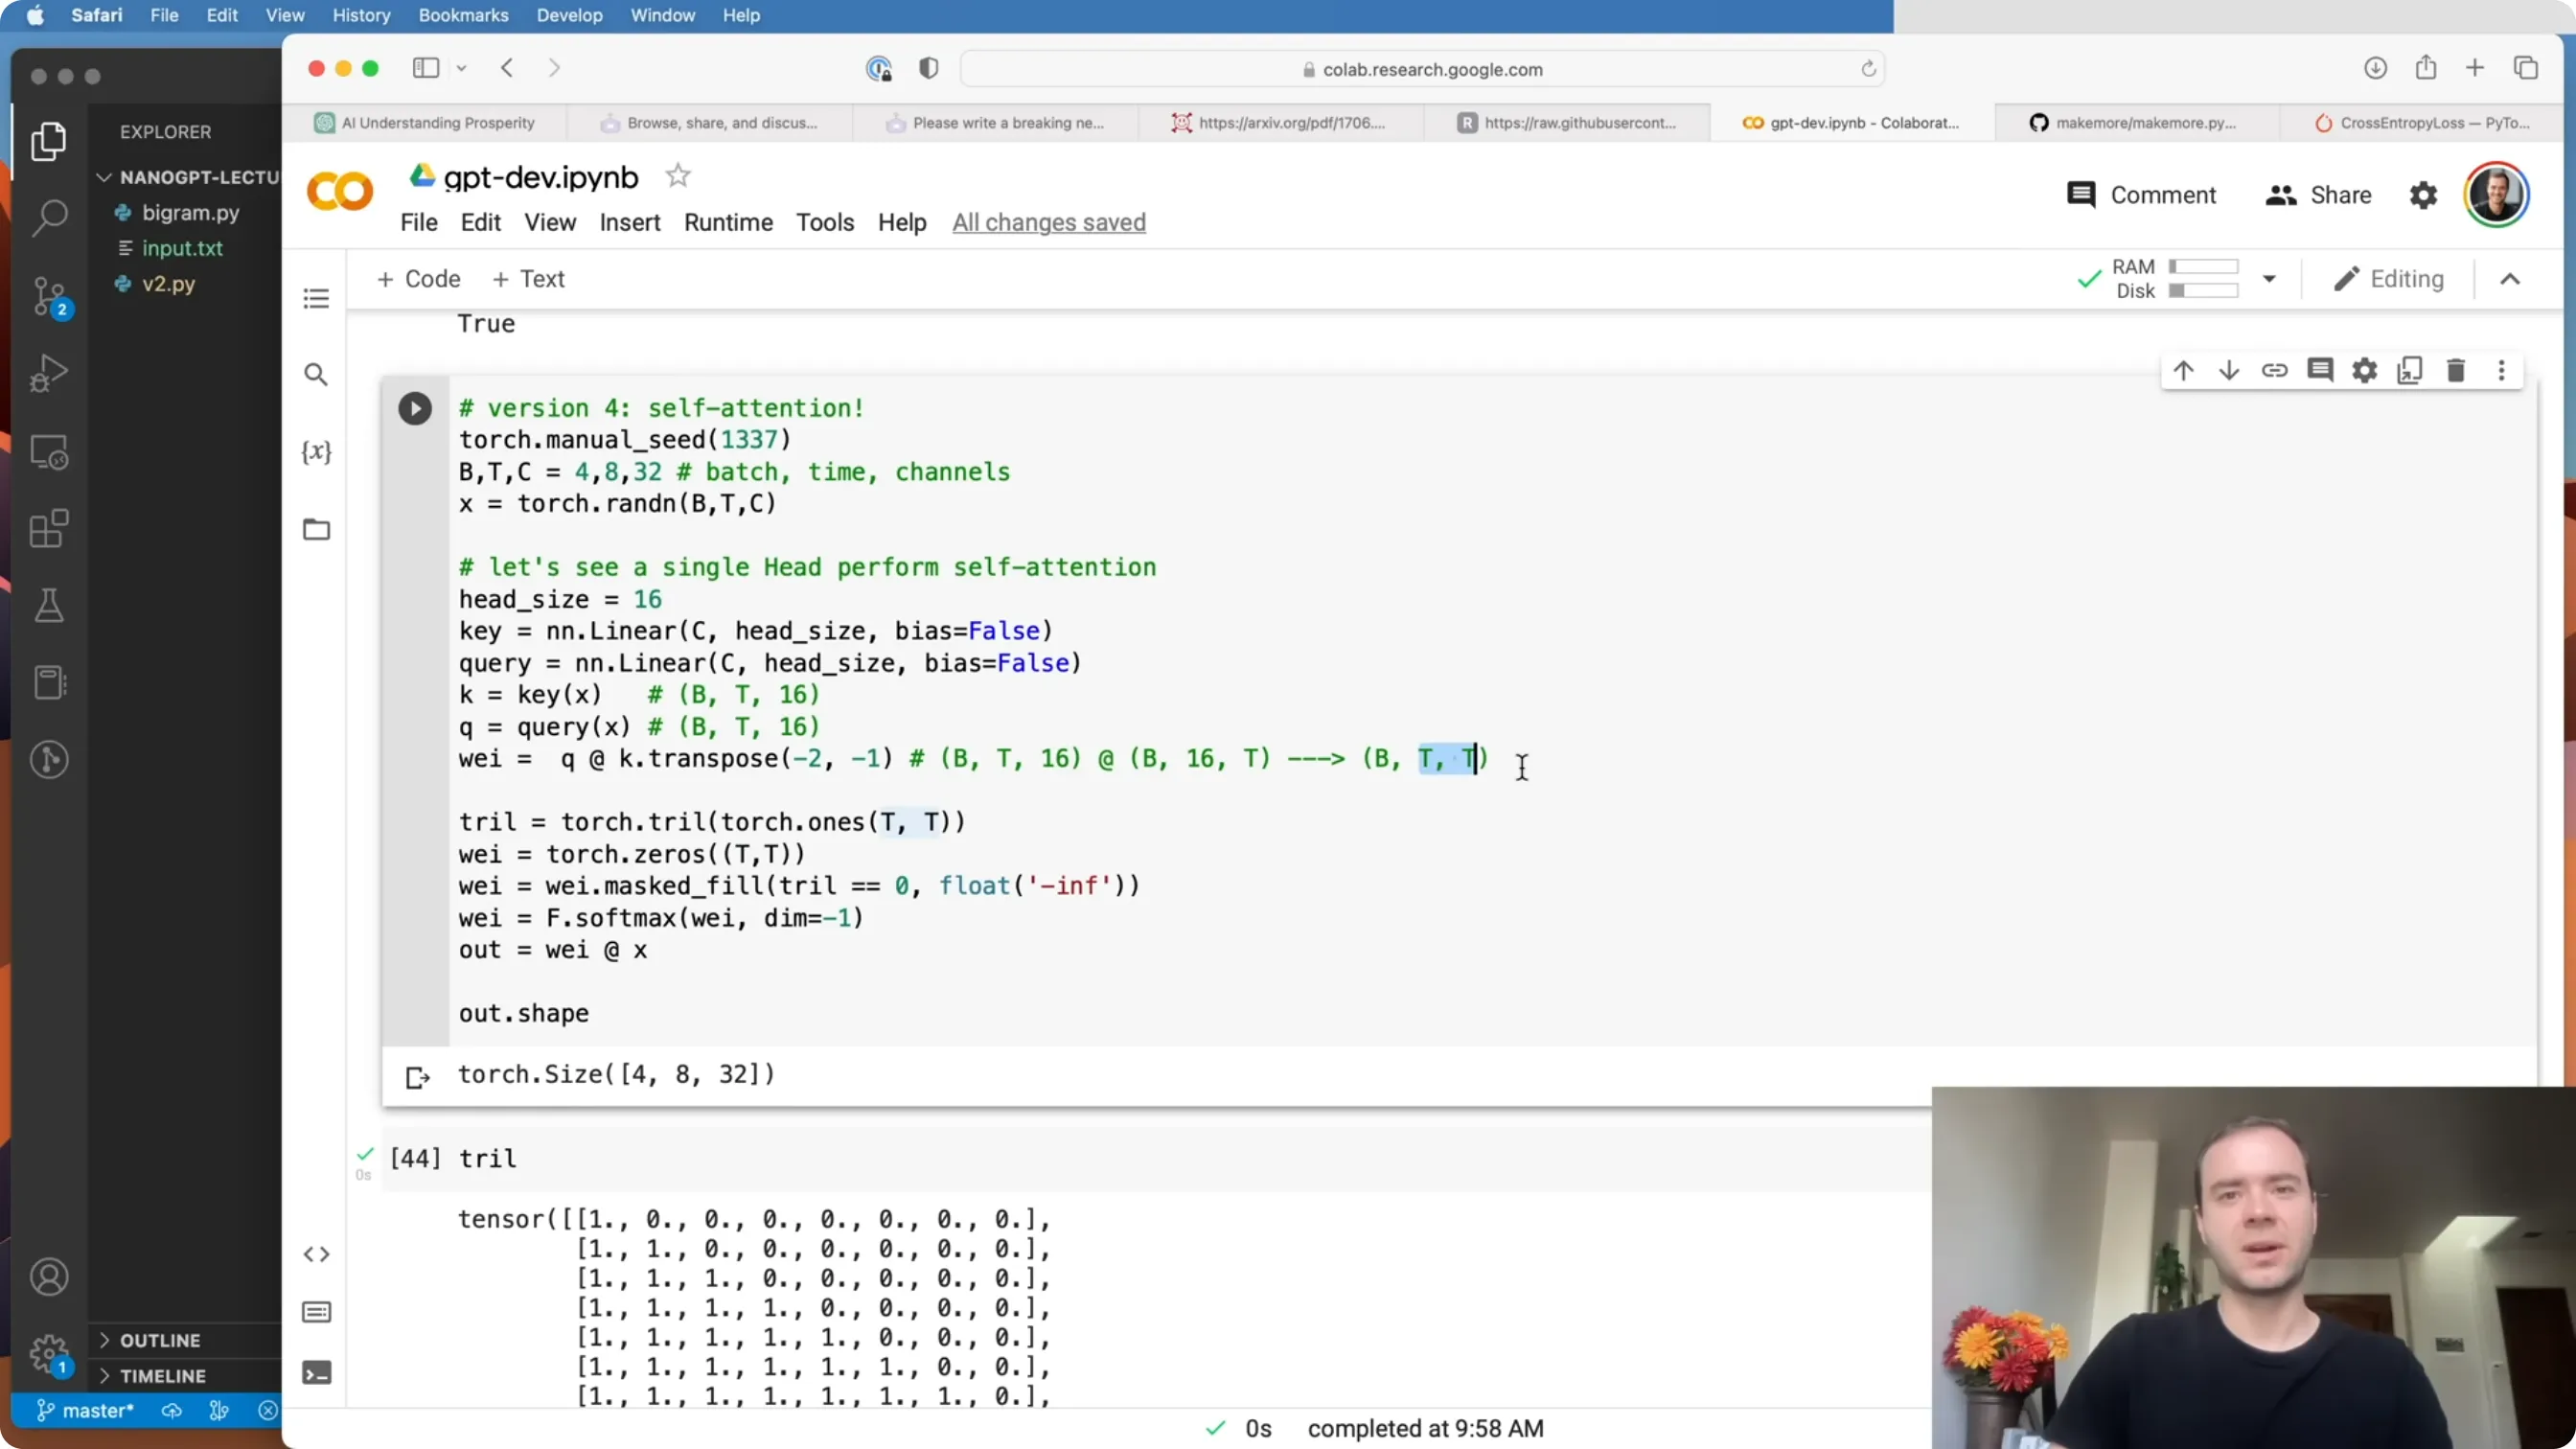
📷 v4:`q @ k.transpose(-2,-1)` → 三角掩码 → softmax → 加权聚合;这一屏还在聚合 `x` 本身(下一个镜头才引入 value)
回到原视频 (01:07:00)
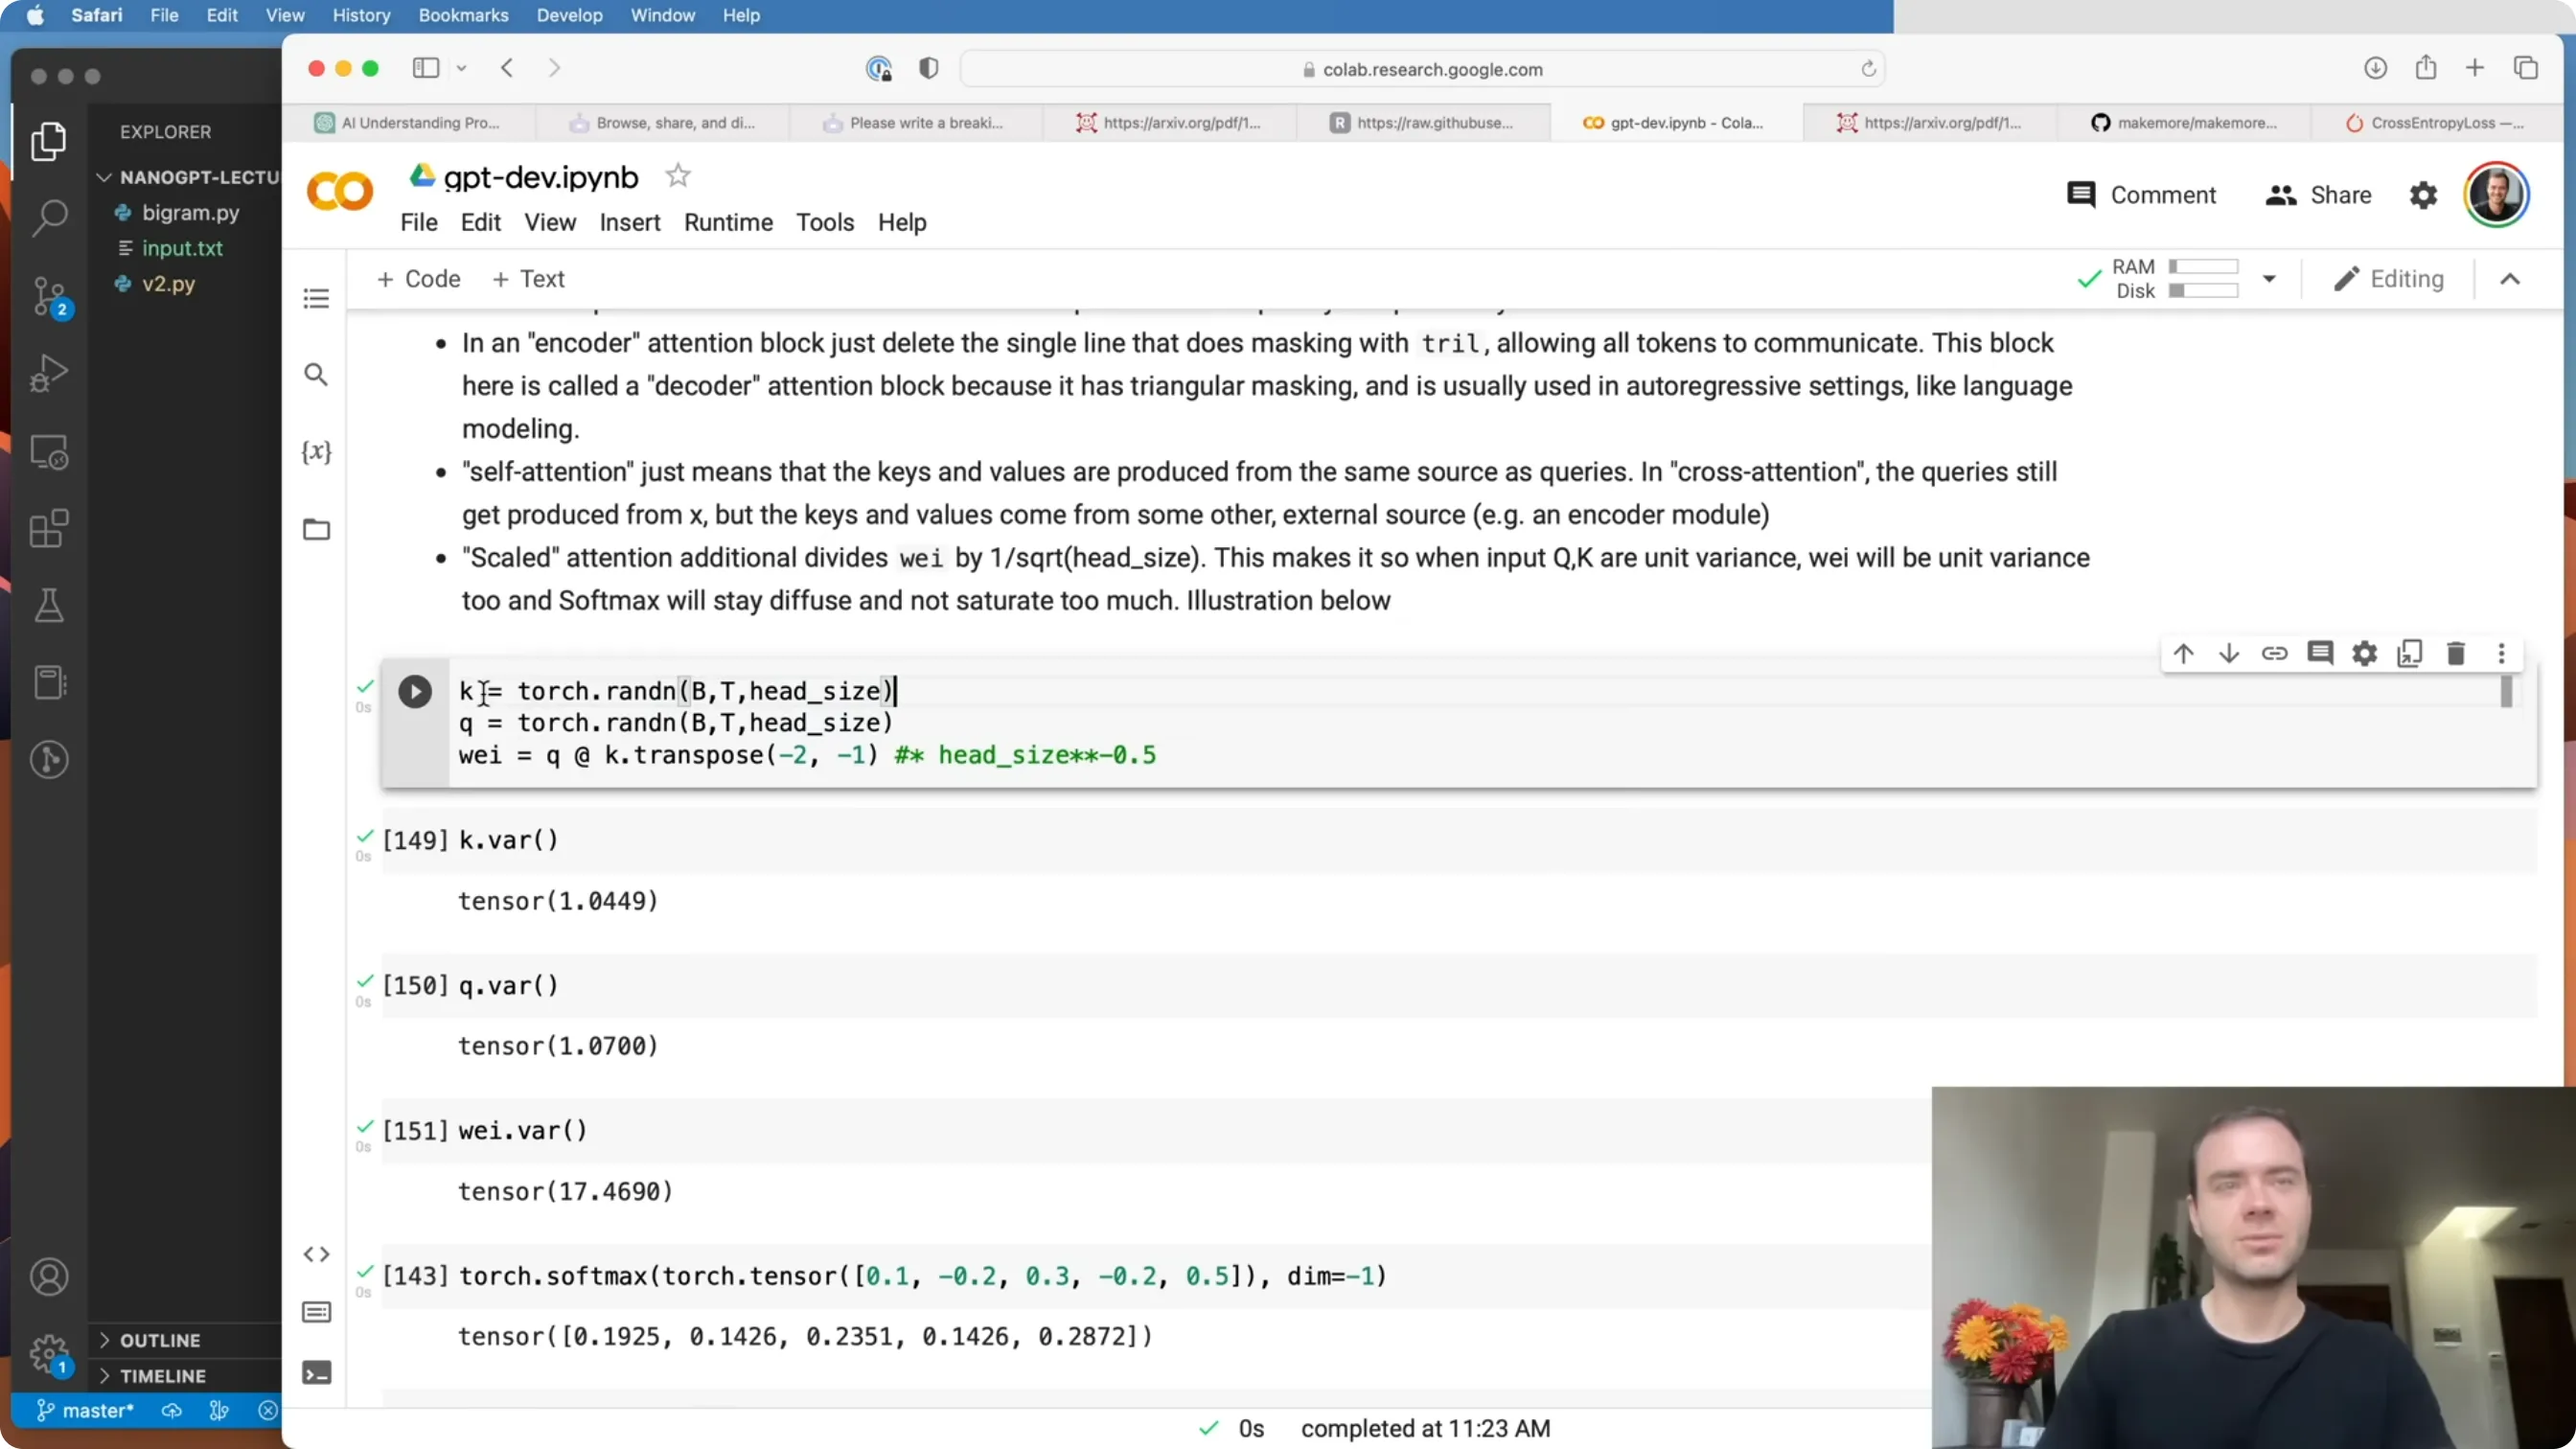
📷 scaled attention:不除以 √d_k 时 softmax 会迅速变成 one-hot
回到原视频 (01:17:30)
6.4 插进网络
self.sa_head = Head(n_embed)
x = self.sa_head(x)      # 经 embedding 后直接进自注意力头
logits = self.lm_head(x)
还要改一处:generate 里必须裁到 block_size,否则位置嵌入表会越界。
同时降低学习率——「自注意力不太能容忍过高的学习率」。步数相应增加。
结果:2.5 → 2.4。
「确实有小提升,但文本还不够好。显然自注意力头提供了有用的通信,但路还很长。」
七、多头注意力
(参考时间: 1:21:59)
所谓多头注意力,就是"并行地做多个注意力,再把结果拼接起来"。
class MultiHeadAttention(nn.Module):
    def __init__(self, num_heads, head_size):
        self.heads = nn.ModuleList([Head(head_size) for _ in range(num_heads)])
        self.proj = nn.Linear(n_embed, n_embed)
    def forward(self, x):
        out = torch.cat([h(x) for h in self.heads], dim=-1)
        return self.proj(out)
规模:n_embed = 32,num_heads = 4 → 每个头 8 维,4 个头拼起来正好 32。
「这有点像卷积里的分组卷积(grouped convolution)——不是做一个大的卷积,而是分组做卷积。这就是多头自注意力。」
为什么有用?
「这些 token 有很多话要说:它们要找辅音、要找元音、而且可能只想从特定位置找元音……它们想找各种不同的东西。所以建出多条独立的通信通道、收集多种类型的信息,再把输出解码出来,是有帮助的。」
结果:2.4 → 2.28 ✅
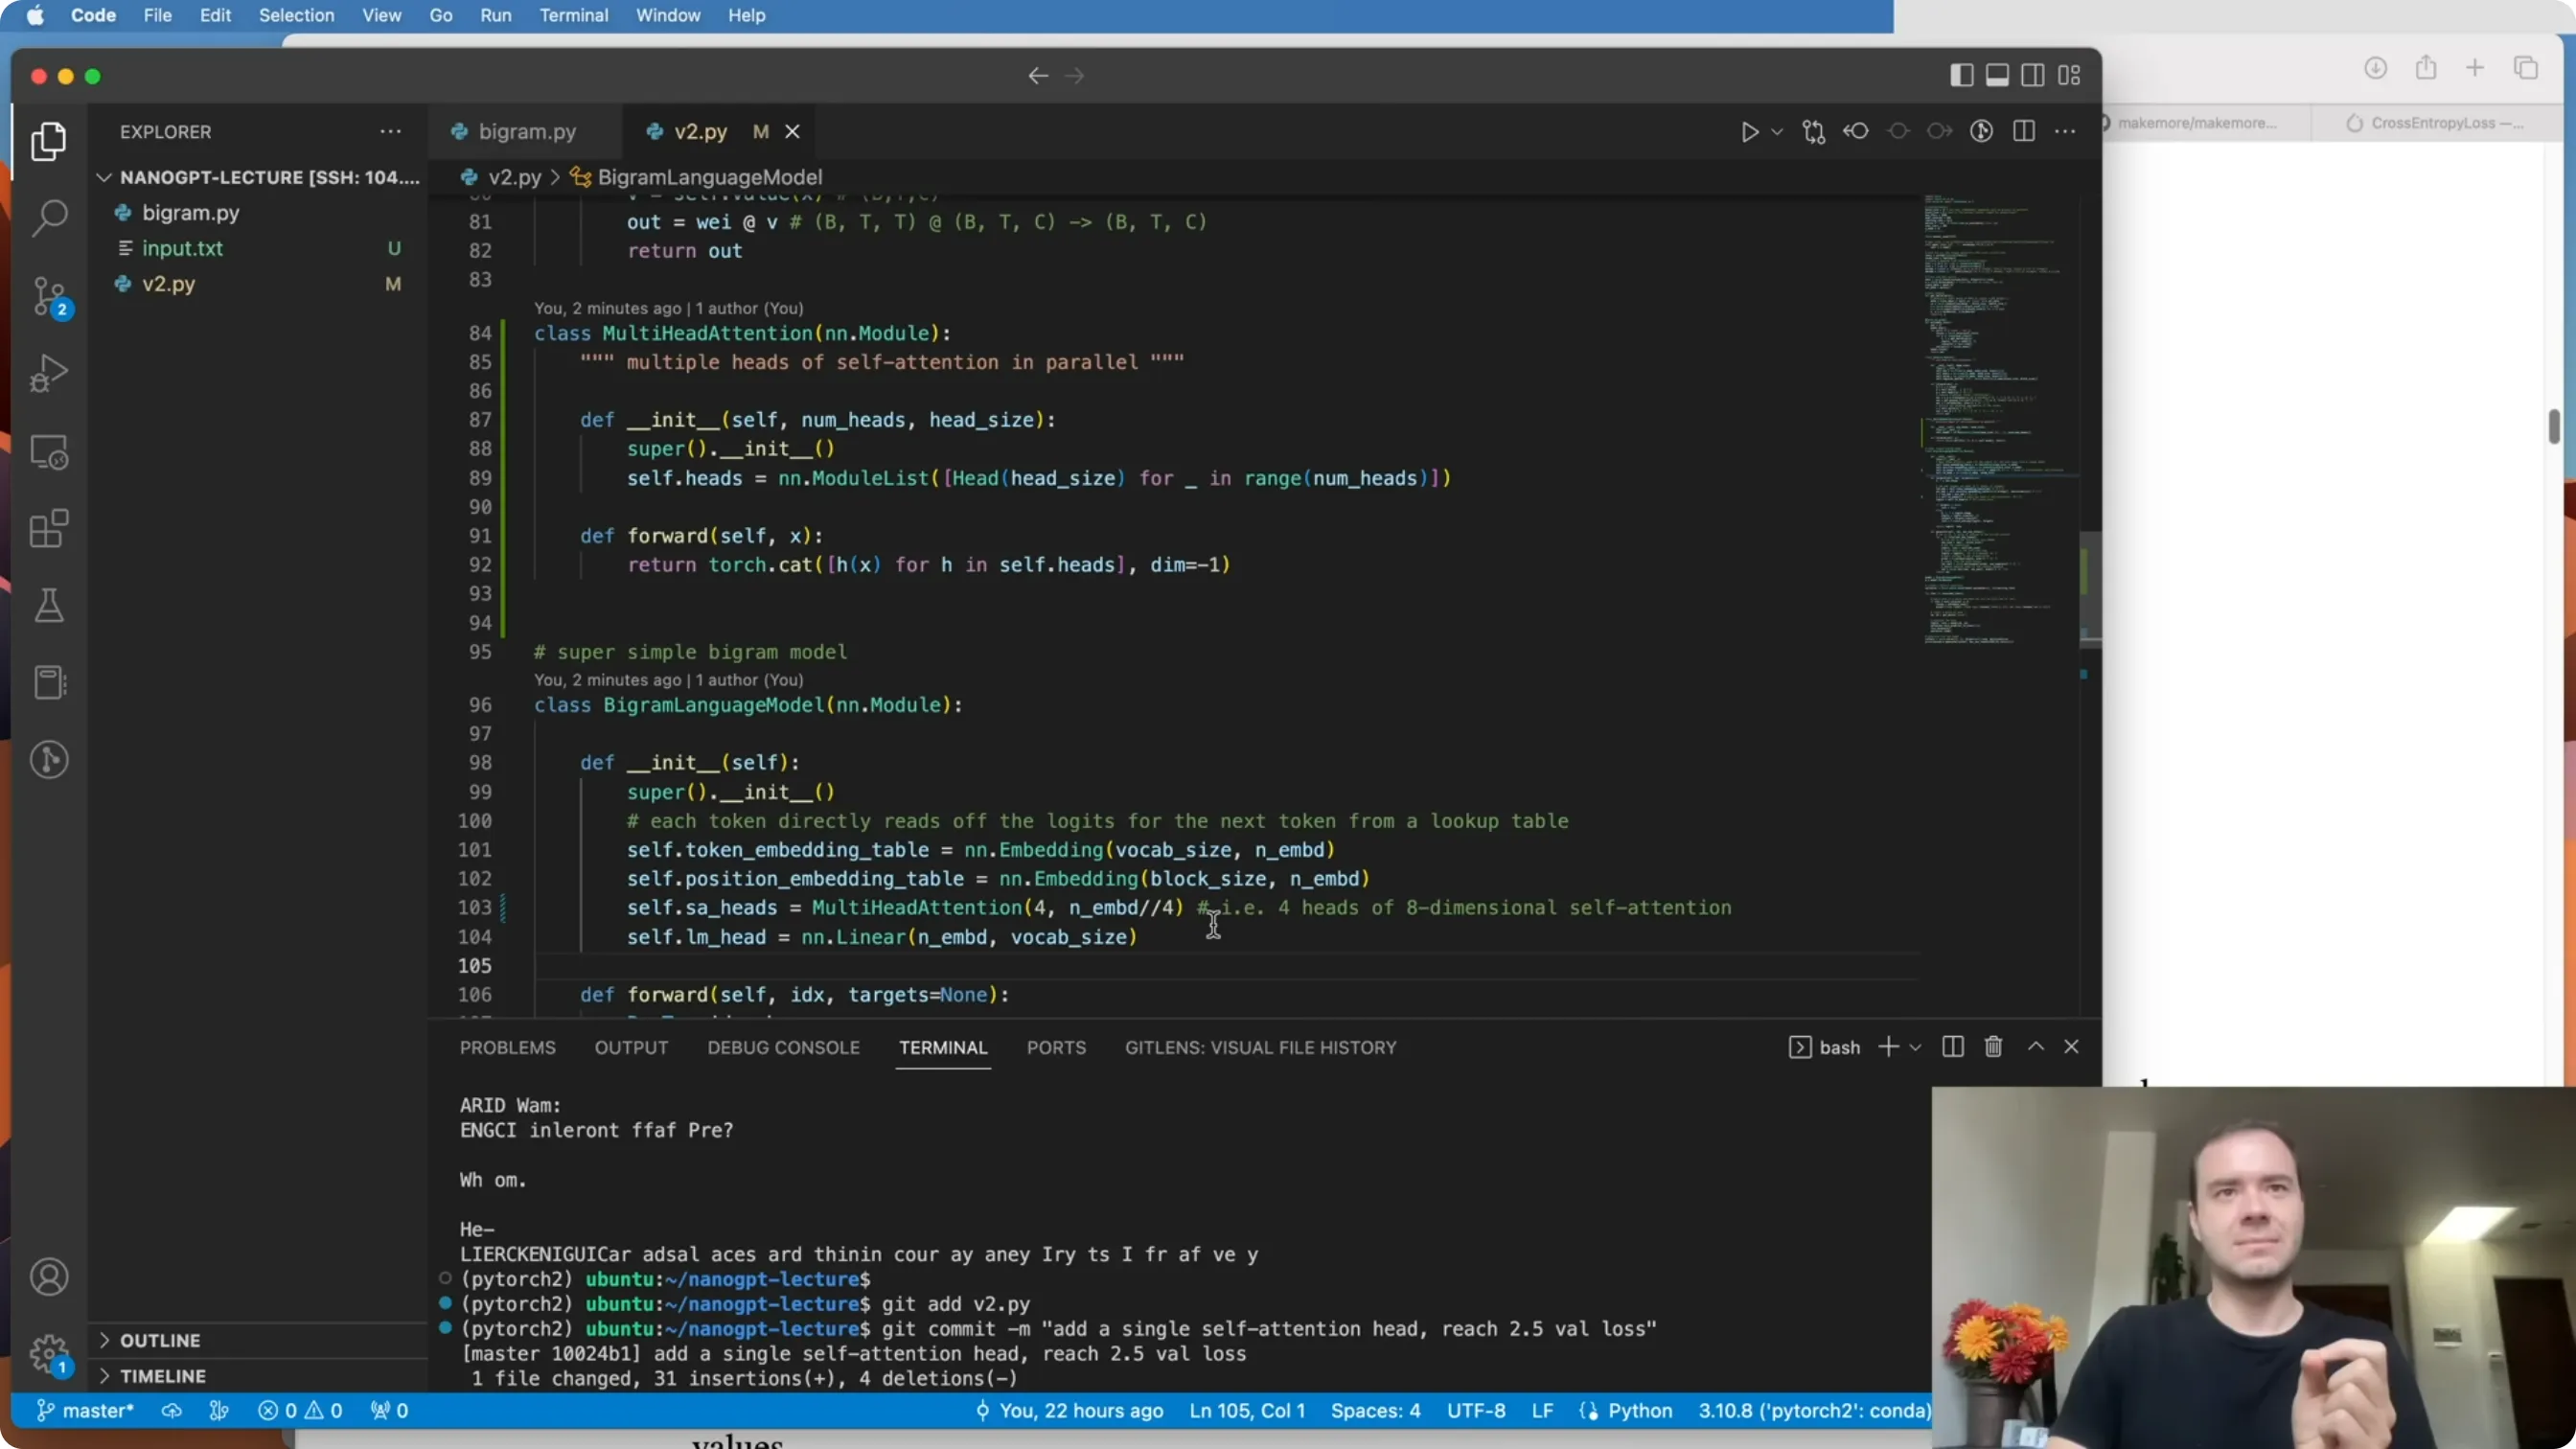
📷 多头注意力:4 条独立通信通道,各 8 维,拼接回 32
回到原视频 (01:23:40)
八、前馈层:让 token "有时间思考"
(参考时间: 1:24:25)
回看论文的框图,Karpathy 指出:
「这里有一个前馈(feed-forward)环节,它就是一个简单的多层感知机(MLP)。」
动机讲得很妙:
「之前我们有多头自注意力负责通信,但我们太快就去算 logits 了—— token 们互相看过了,但它们没有多少时间"思考"自己从别的 token 那里发现了什么。」
于是加一个逐 token 的小网络:
class FeedForward(nn.Module):
    def __init__(self, n_embed):
        self.net = nn.Sequential(
            nn.Linear(n_embed, 4 * n_embed),   # 注意 ×4
            nn.ReLU(),
            nn.Linear(4 * n_embed, n_embed),
        )
    def forward(self, x): return self.net(x)
注意这个
×4:论文里输入/输出维度是 512,而内层是 2048——差了 4 倍。「所以内层要乘 4,再乘回来。」它是逐 token 的:所有 token 各自独立地做这件事。 自注意力是"通信";一旦收集完信息,它们需要"独立地思考这些数据"——这就是前馈在做的事。
结果:2.28 → 2.24 ✅,「结果看起来还是有点糟,但至少改善了」。
下一步预告:把"通信"和"计算"交织起来——这也正是 Transformer 做的事:把"通信+计算"组成一个 block,然后反复堆叠。
九、残差连接与 LayerNorm
9.1 残差连接
(参考时间: 1:26:48)
先看问题:把 block 堆起来之后——
「我们开始得到一个相当深的网络,而深网络有优化问题——我觉得我们已经开始尝到这个苦头了。」 我们需要从论文里再借一个想法。
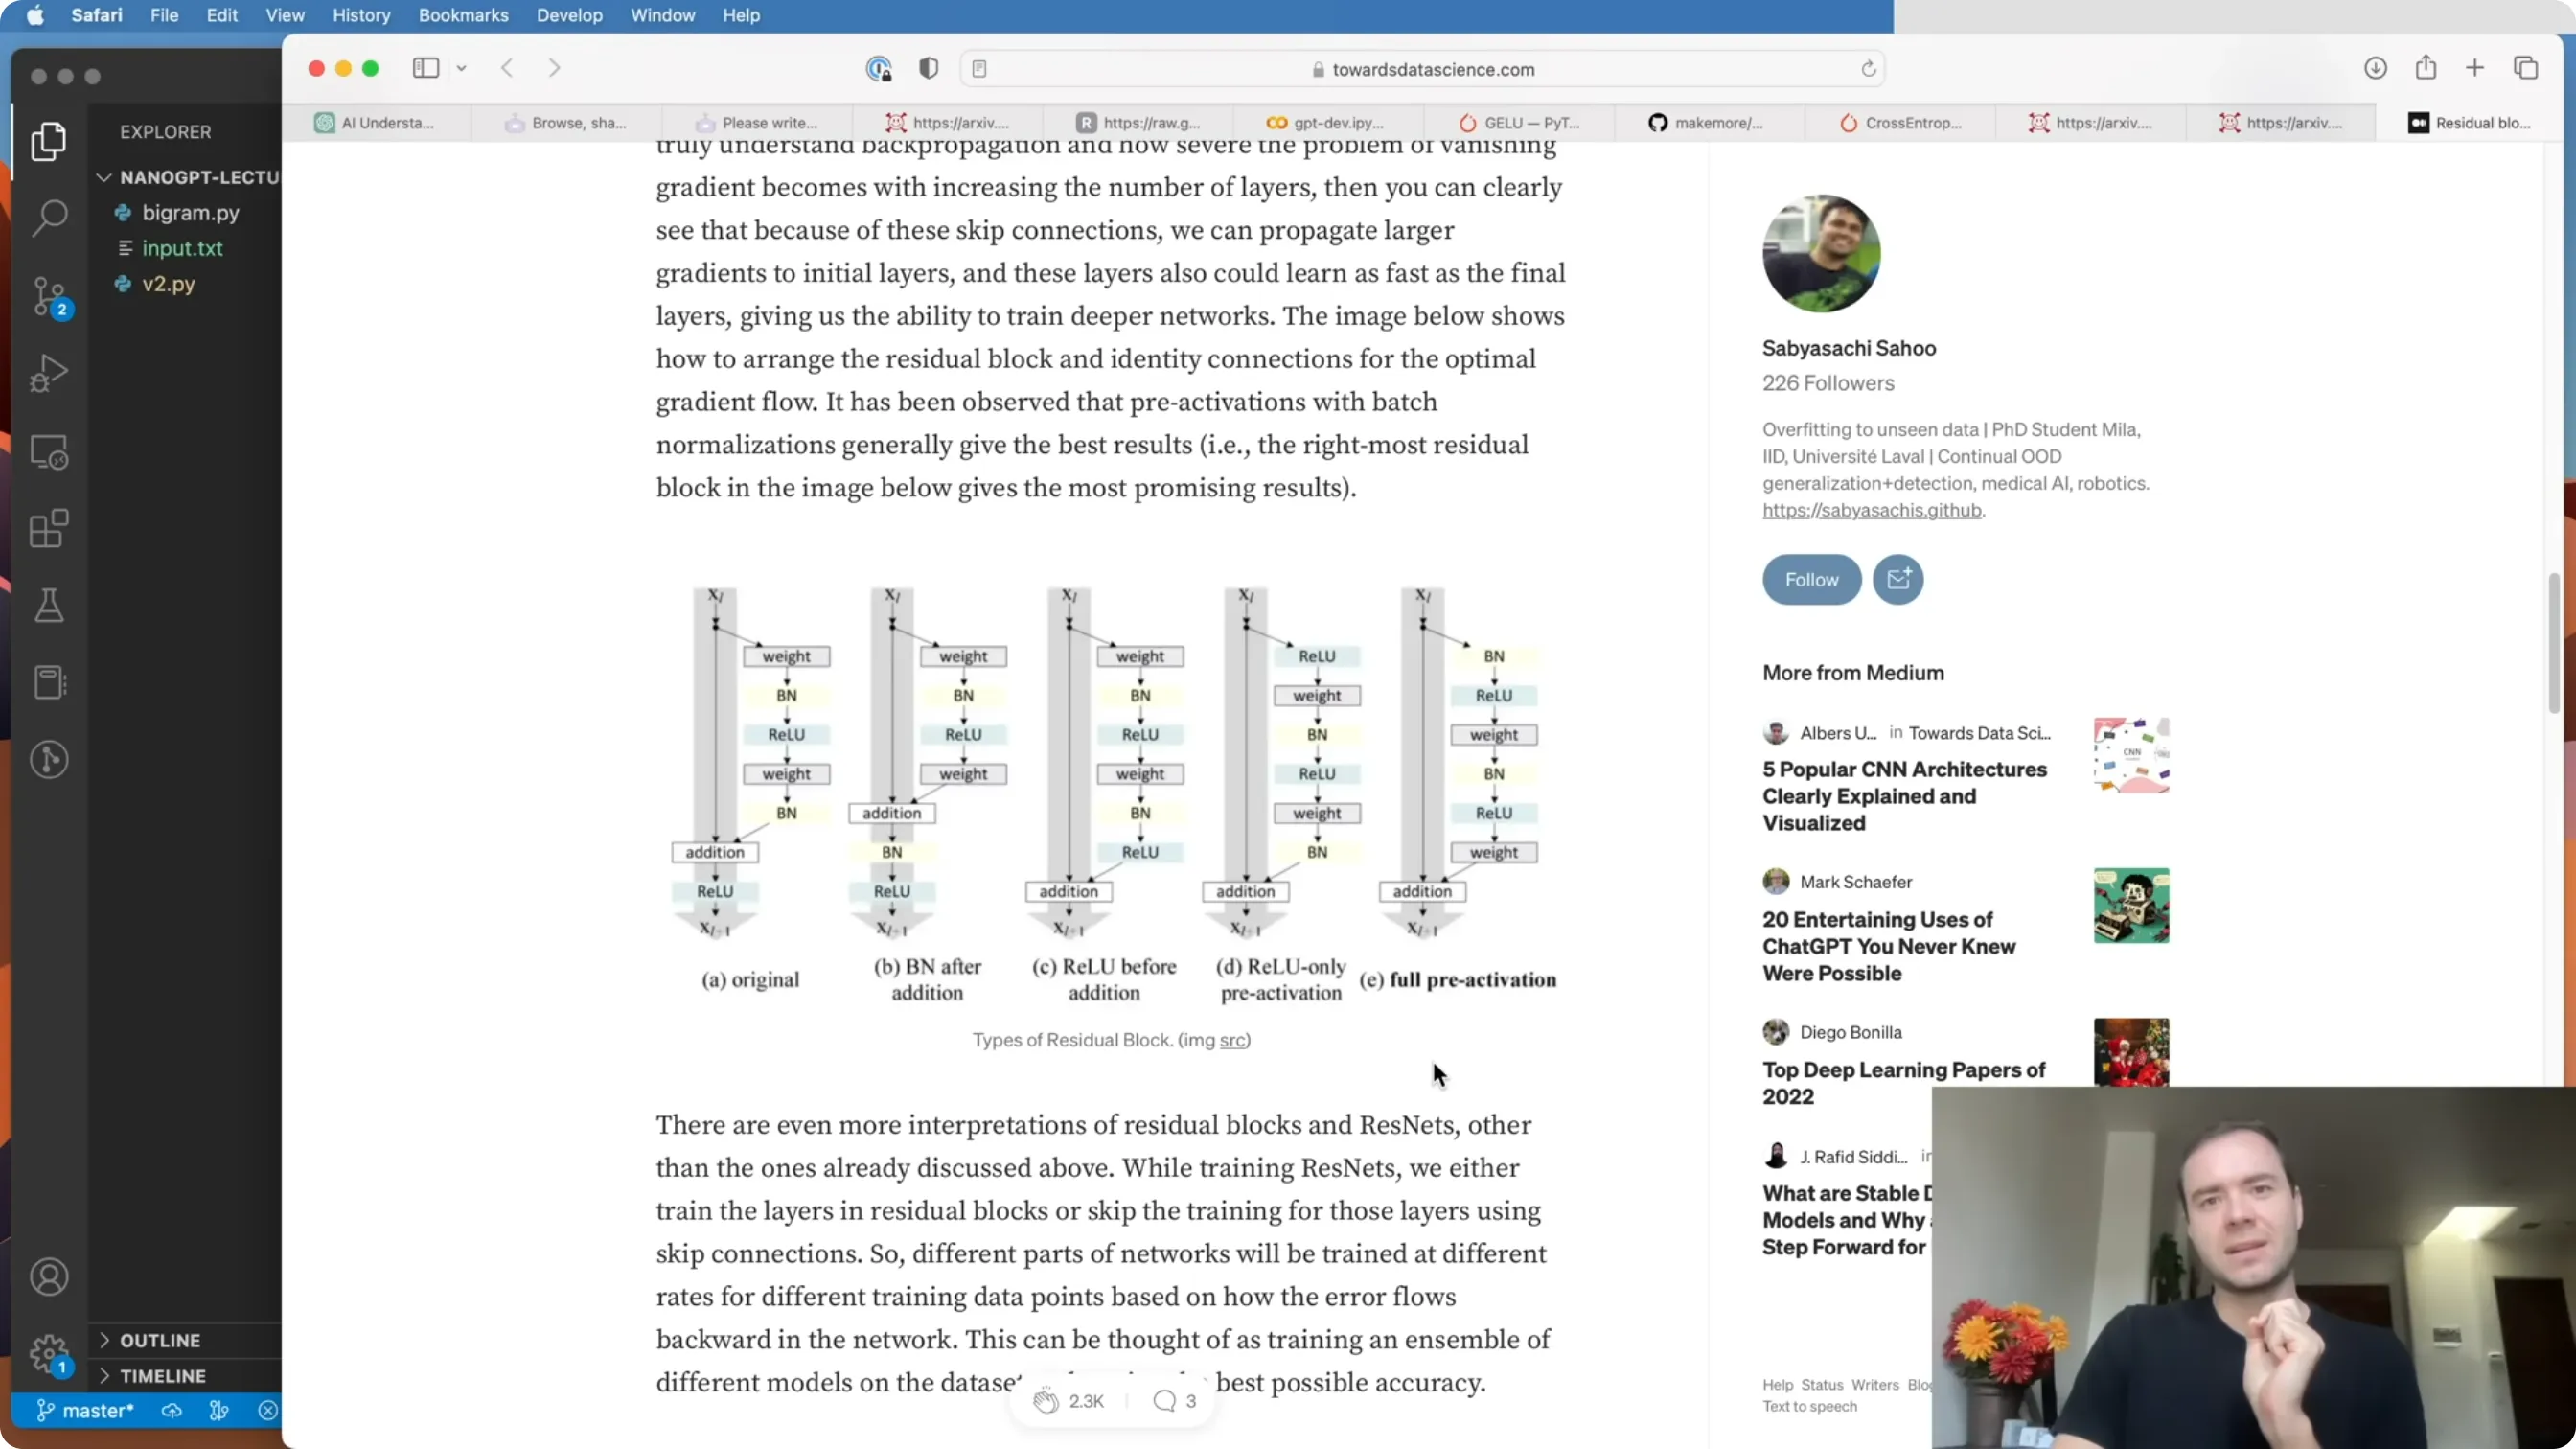
残差连接(来自 2015 年 ResNet 那篇):
x = x + self.sa(x)       # 通信
x = x + self.ffwd(x)     # 计算
为什么有效? —— 回到 micrograd:
「记得我们 micrograd 那期讲的:求和会把梯度"均分"给作为输入的两个分支。 所以损失梯度会直接"跳"过每一个求和节点回到输入,同时也分流进残差块。 于是你有了一条从"监督信号"直通"输入"的梯度高速公路, 而这些残差块在初始化时贡献极小、甚至为零——它们最初几乎像不存在, 但在优化过程中逐渐被激活、开始贡献。 至少在初始化时,你可以从监督信号直接走到输入,梯度毫无阻碍地流过,然后 block 随时间被激活——这对优化帮助极大。」
👉 这也呼应第五讲:残差连接正是让"深"变得可训练的关键发明之一。
还有一个细节:自注意力和前馈的输出要投影回残差路径,所以 MultiHeadAttention 里加了 self.proj = nn.Linear(n_embed, n_embed)。
📷 残差连接:`x = x + self.sa(x)` / `x = x + self.ffwd(x)`——梯度的高速公路
回到原视频 (01:29:40)
结果:2.24 → 2.08 ✅,「而且训练损失开始超过验证损失——我们开始看到一点过拟合了」,生成文本「开始几乎像英语了」。
9.2 LayerNorm
(参考时间: 1:32:51)
「第二个对优化极深网络非常有用的创新,就在这儿——它叫 layer norm。」
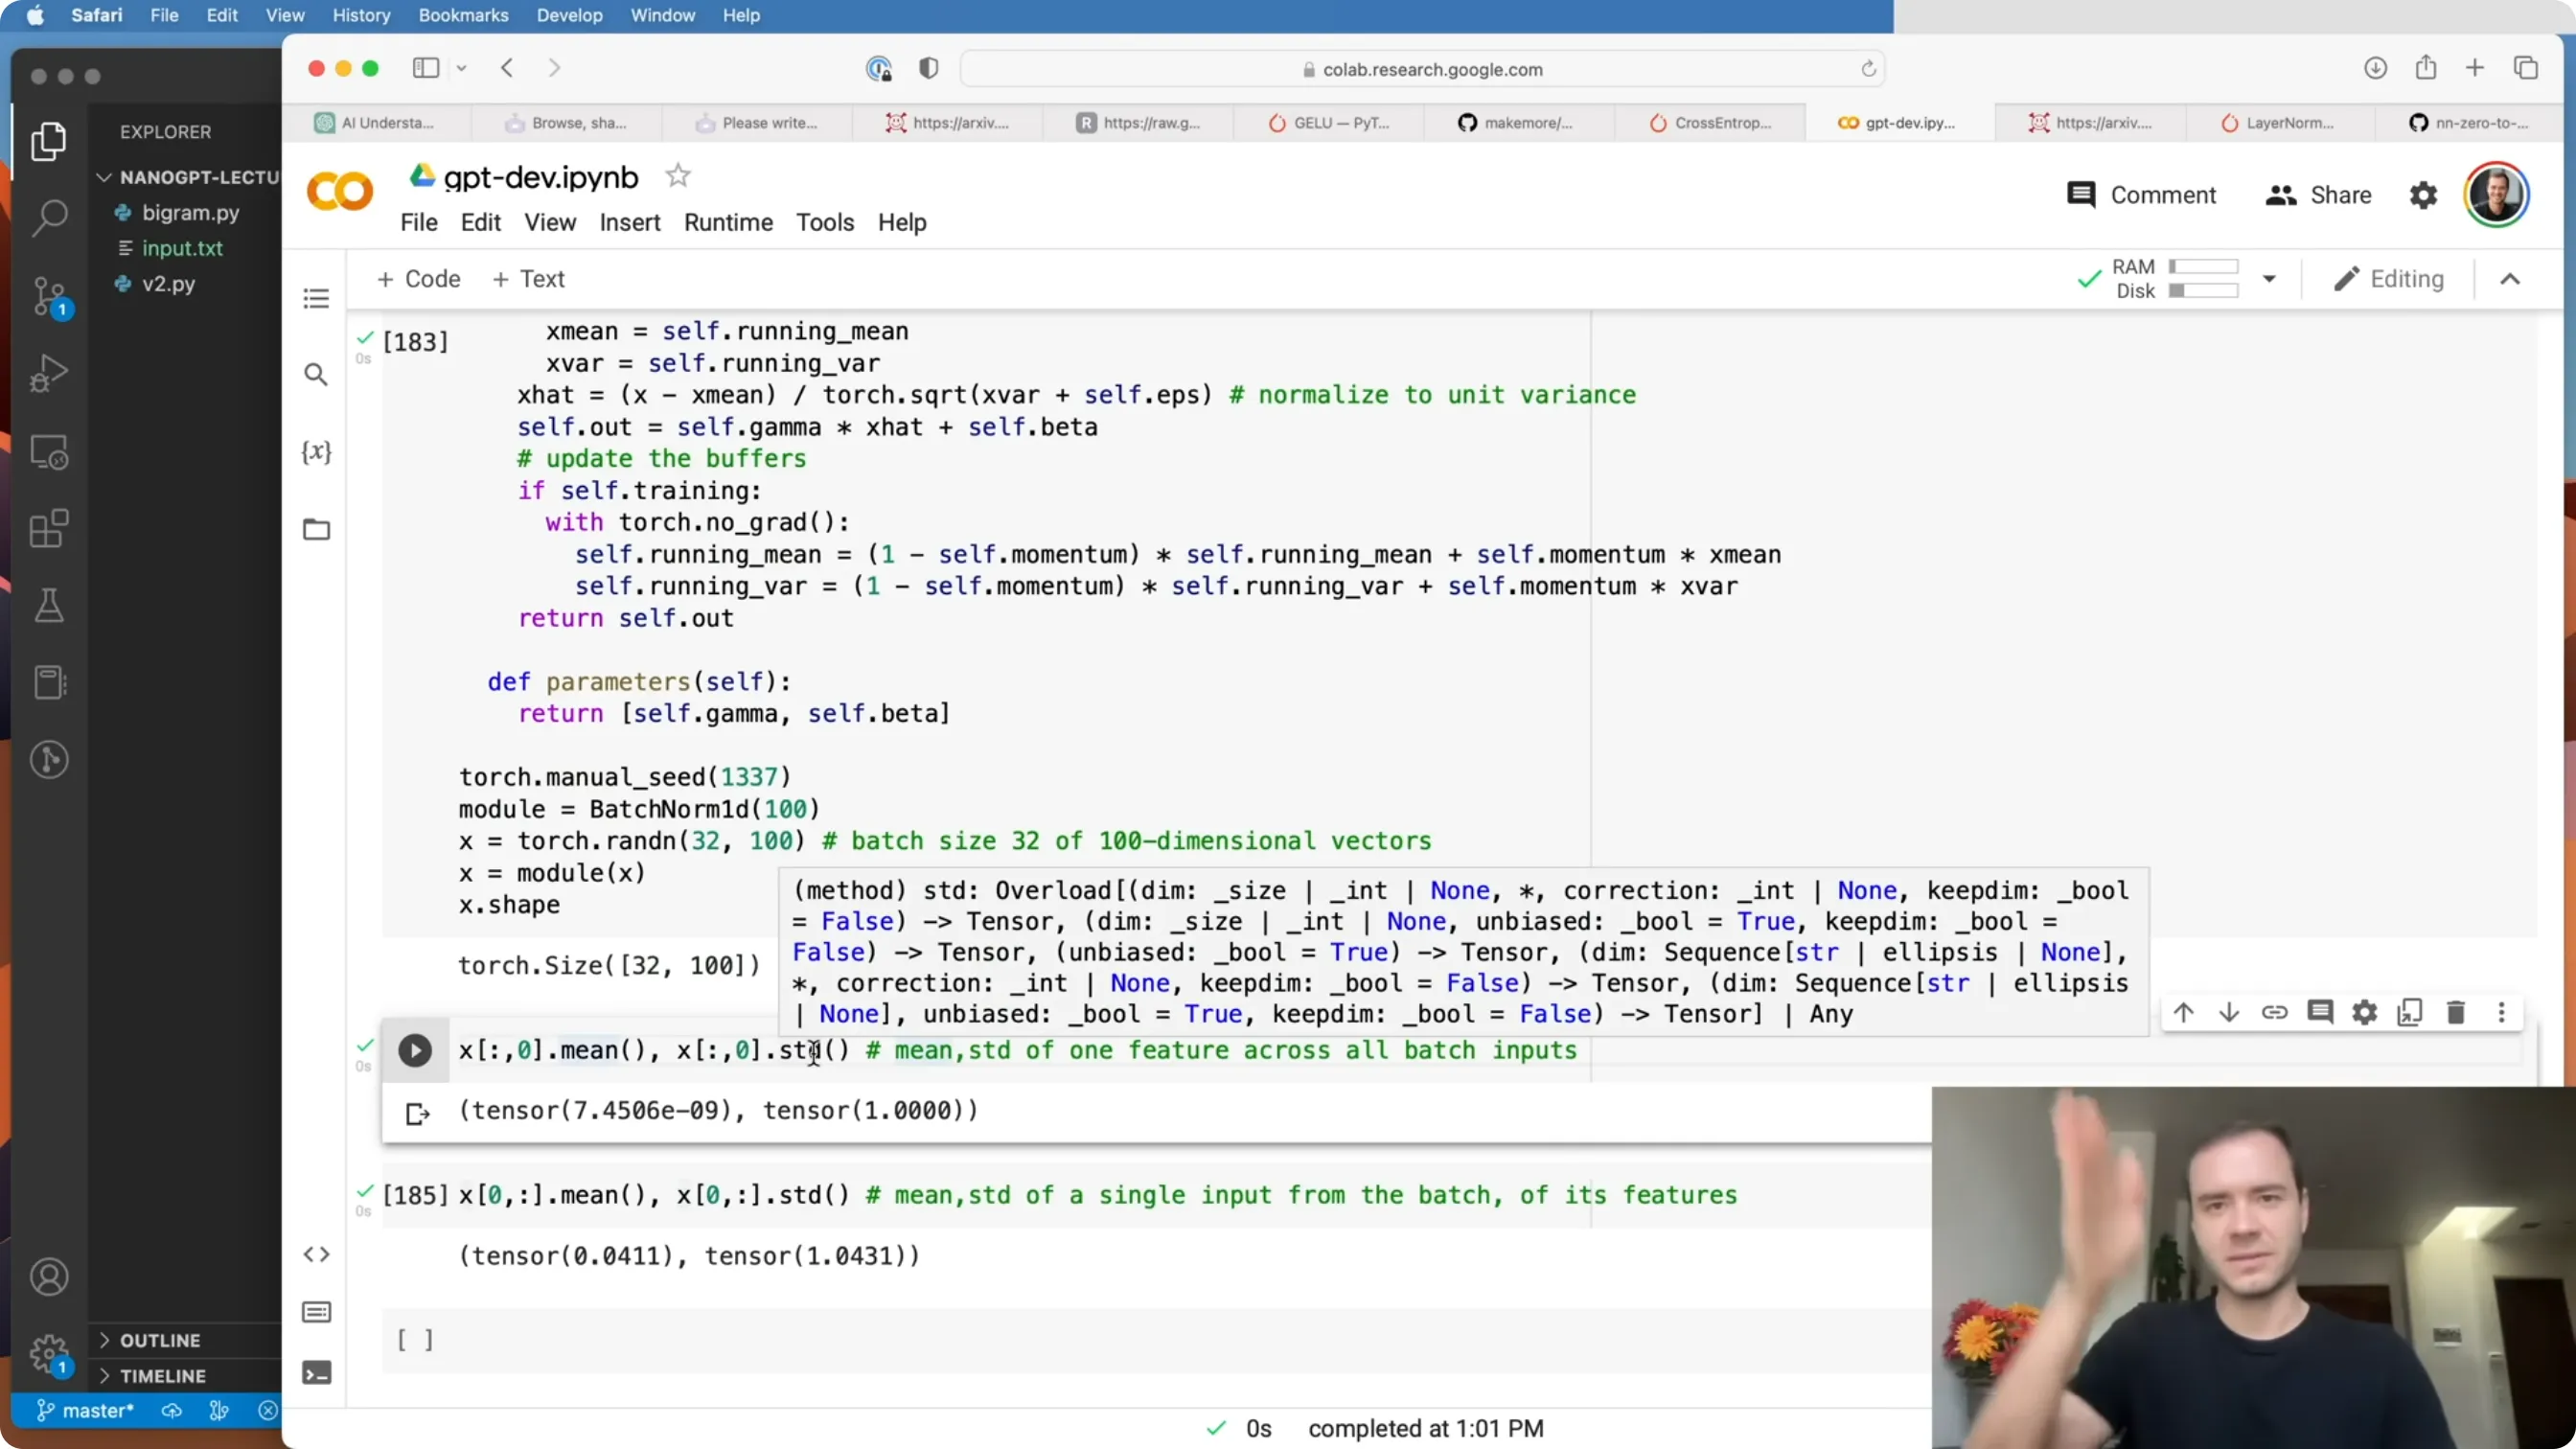
和 BatchNorm 的关系讲得非常清楚:
「LayerNorm 和 BatchNorm 非常非常像。 回忆 makemore 第三讲: BatchNorm 保证"在 batch 维度上,任何一个神经元的输出呈单位高斯分布"——零均值、单位标准差。 它是把每一列归一化。
那 LayerNorm 呢?极其复杂(笑)——我们把"0"改成"1",也就是不再归一化列,而是归一化行。 现在每一行(每个样本的那 100 维向量)被归一化。」
副产品:一堆东西可以删掉了 ——
「因为我们的计算不再涉及"样本之间"了,所以可以把那些 buffer 全清掉: 不需要维护 running 统计量,没有训练/测试的区别,不需要 momentum,也不在乎是否在 training 模式。 但 gamma 和 beta 保留。」
一个偏离论文的重要选择:pre-norm
「论文里是"先变换、后求和与归一化",但现在更常见的做法是把 LayerNorm 放在变换之前。 这叫 pre-norm formulation,也是我们要实现的——这是对原论文的一个偏离。」
需要两个 LayerNorm(自注意力前、前馈前),外加——
「我忘了一件事:在 Transformer 的最后、那个解码到词表的线性层之前,还应该有一个 LayerNorm。」
结果:2.08 → 2.06 ✅
「到这一步,我们按原论文搭出了一个相当完整的 Transformer,而且是 decoder-only 的。」
📷 LayerNorm 和 BatchNorm 的唯一区别:归一化"行"而不是"列"
回到原视频 (01:34:00)
十、放大规模!
(参考时间: 1:37:49)
为了让模型更"上相",Karpathy 做了些整理:
- 引入
n_layer(堆几层 block)和n_head; - 加入 dropout(
p=0.2)。
关于 dropout:
「dropout 可以加在残差连接之前、多头注意力输出之后,也可以加在亲和力 softmax 之后——随机阻止一些节点通信。 它来自 2014 年前后那篇论文:每次前向/反向随机把一部分神经元置零再训练。 由于"被丢掉的那部分"每次都在变,它实际上是在训练一大堆子网络;测试时全部启用,那些子网络就"合并"成一个。 它是一种正则化技术——我加它,是因为我正准备把模型放大很多,担心过拟合。」
放大后的超参:
| 超参数 | 值 | 说明 |
|---|---|---|
batch_size |
64 | 大幅提高 |
block_size |
256 | 「过去只有 8 个字符的上下文,现在是 256 个字符」 |
n_embd |
384 | |
n_head |
6 | 384/6 = 每头 64 维(「这是标准配置」) |
n_layer |
6 | |
dropout |
0.2 | 20% 的中间计算被置零 |
max_iters |
5000 |
结果:
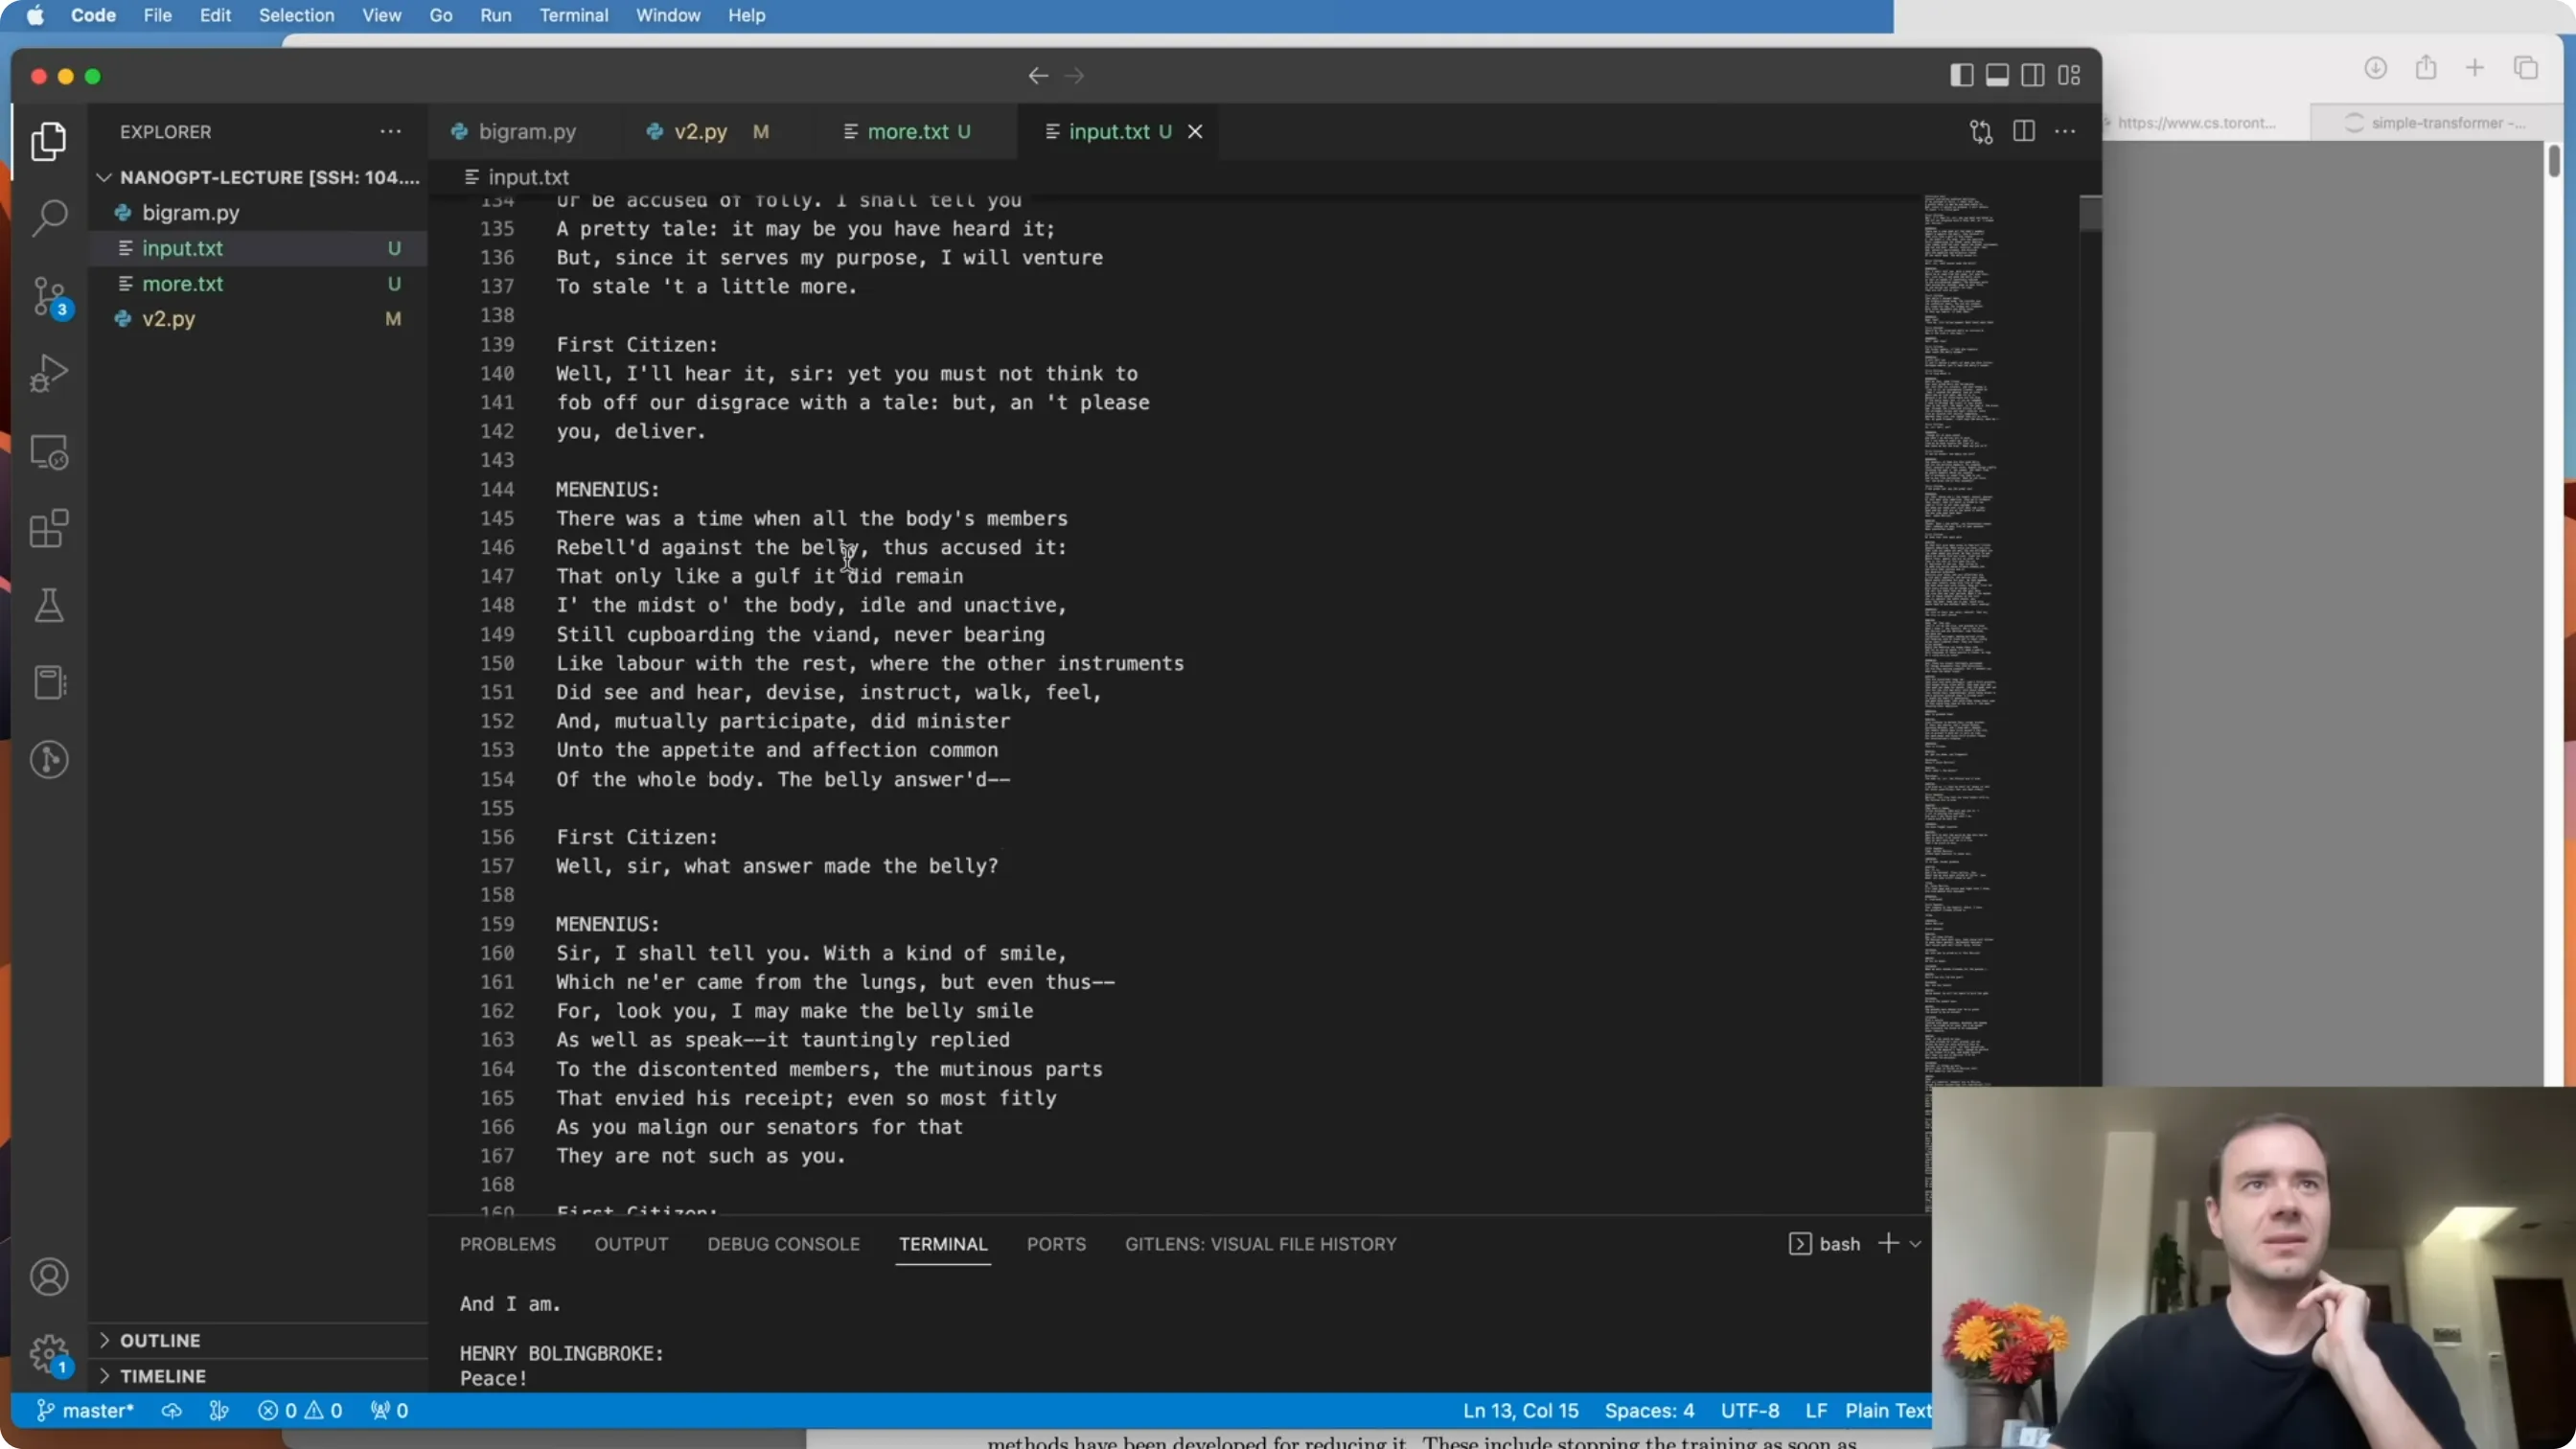
验证损失 2.07 → 1.48 ✅
「仅仅靠"把我们写的代码按比例放大",就做到了。」
代价:这块 A100 GPU 上跑了大约 15 分钟。 「如果没有 GPU,在 CPU 上别想复现这个——我不会在 CPU 或 MacBook 上跑它,你得减少层数和 embedding 维度。」
生成的文本:
「它更像输入文本了」——输入文本长得像这样(总有人在说话),我们的预测也长成那样。「当然,真读起来并不通顺」: "every crimpy be house. Oh those preparations we give heed. oh ho sent me you mighty lord."
「它是"莎士比亚式的胡言乱语"——但在这个尺度上,当然没有意义。我觉得这仍然是一个相当好的演示。」
模型规模:约 1000 万参数。
编者说明:这就是
nanoGPT的shakespeare_char配置在单卡上十几分钟能到的水平。1.48 是"字符级"的 char-level 交叉熵(per-character,自然对数),和 GPT-2 那种 per-token 的指标不可直接比较。
📷 放大后:验证损失 1.48,生成文本已具备莎士比亚的"形态"
回到原视频 (01:41:30)
十一、Encoder vs Decoder:为什么我们只要一半
(参考时间: 1:42:39)
「我们实现得不错,但图和我们做的东西并不完全对上。那些多出来的部分呢?」
答案:
「我们实现的是 decoder-only Transformer。 没有 encoder 那部分,也没有 cross-attention 块。 我们的 block 只有一个 self-attention + 一个 feed-forward——缺了中间那第三块(cross-attention),也没有 encoder。我们只有 decoder。」
为什么只要 decoder?
「因为我们是在"生成文本",而且它不以任何东西为条件——我们只是基于给定的数据集胡扯。」 让它成为 decoder 的,是我们用了三角掩码,于是它具备自回归性质、可以直接采样。
那原论文为什么是 encoder-decoder?
「因为它是一篇机器翻译论文」:它先读入编码法语的 token,然后解码成英语。 通常会引入特殊 token:开头的
start、结尾的completion。 decoder 那部分和我们做的完全一样(自回归生成 "Neural networks are amazing"); 不同在于它想让生成"以额外信息为条件"——那个额外信息就是待翻译的法语句子。 这时 encoder 登场:把法语部分编码成 token、过一个没有三角掩码的 Transformer(所有 token 可以任意互相交谈),输出的 keys 和 values 从"侧上方"喂给 decoder 的每个 block—— 这就是 cross-attention:「query 仍由 decoder 的x产生,但 key/value 来自上面那些由 encoder 产生的节点。」 于是解码不仅以"当前解码的过去"为条件,还以"已经完整看过那句被编码的法语"为条件。「我们没做这些,是因为我们没有什么要编码的、没有条件——我们只有一个文本文件,想模仿它,所以用 decoder-only Transformer,和 GPT 的做法完全一样。」
十二、nanoGPT 速览
(参考时间: 1:46:22)
nanoGPT 只有两个有意思的文件:
train.py:训练循环,但复杂得多——保存/加载预训练 checkpoint、学习率衰减、torch.compile、跨多节点/多 GPU 的分布式训练。model.py:和我们写的几乎一模一样。
model.py 里唯一实质性的不同:
「我在我们的代码里把多头注意力拆成了单个 Head,然后显式拼接;而 nanoGPT 里,全部都在一个
CausalSelfAttention里"批处理"地实现。 于是我们不仅有 B、T、C 三个维度,还多出第四个维度——"头",变成四维张量,看起来更复杂。 但数学上等价——做的事完全一样,只是稍微更高效,因为所有头被当作额外的批次维度了。」 👉 这正是 EX1 要你做的事。
另一处:MLP 里用 gelu 而不是 relu——「只是因为 OpenAI 用了它,而我想能加载他们的 checkpoints」。
其余(位置编码、token 编码、block、末尾 LayerNorm、最后的线性层)几乎完全一致。「只是多了一些加载 checkpoint、把参数分成"要/不要 weight decay"两类的细节。」
十三、回到 ChatGPT:预训练 vs 微调
(参考时间: 1:48:53)
「如果我们想自己训练 ChatGPT,会是什么样?这和我们今天学的东西是什么关系?」
ChatGPT 的训练大约分两个阶段:
阶段一:预训练(pre-training)
在一大部分互联网上训练,目标只是让一个 decoder-only Transformer 学会"胡扯文本"。 这和我们做的事非常非常相似——只不过我们只做了很小的一步。
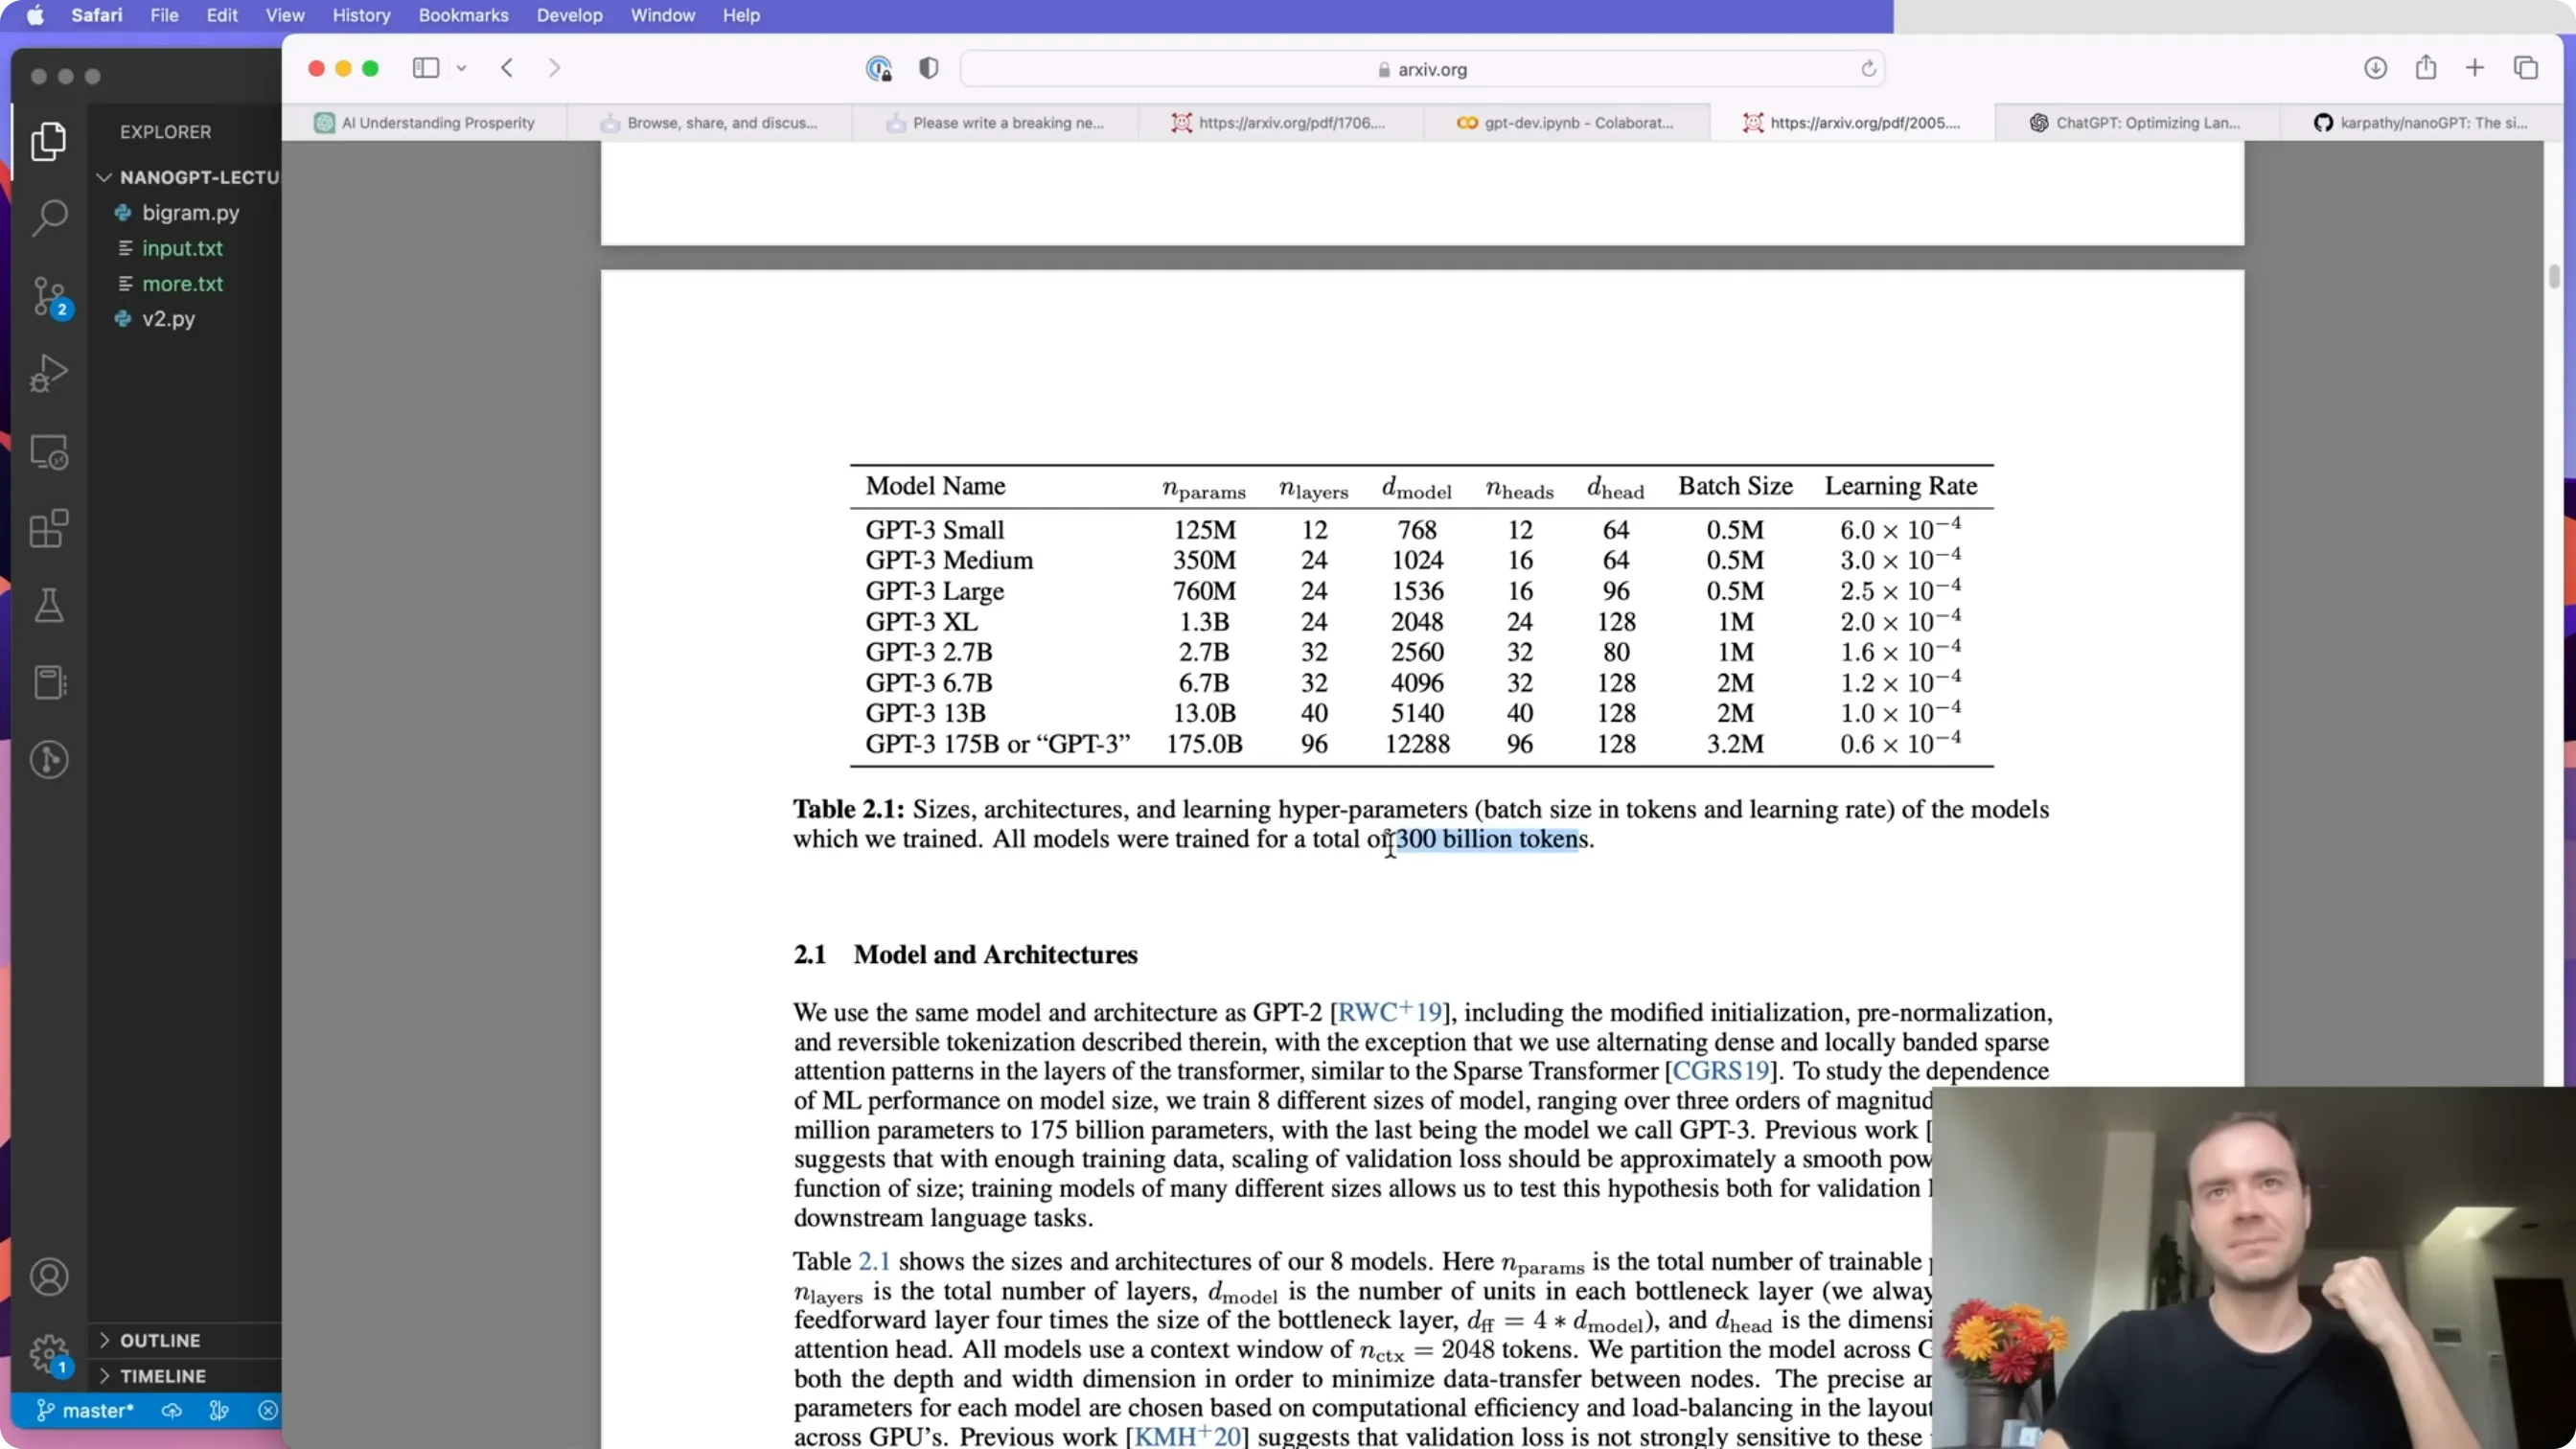
| 我们 | GPT-3(最大) | |
|---|---|---|
| 参数量 | 约 1000 万 | 1750 亿 |
| 训练 token 数 | 约 30 万(小莎士比亚 ≈ 100 万字符,按 OpenAI 词表压缩到 ~30 万 token) | 3000 亿 |
| 词表大小 | 65(字符级) | ~5 万(subword) |
「也就是说,规模差了大约一百万倍。而且这个数字放到今天甚至都不算大——现在会到十亿以上。」 「他们是在互联网的很大一部分上训练一个显著更大的模型,这就是预训练阶段。」 但架构几乎和我们实现的一模一样。
当然,训练它的基础设施是巨大的挑战:「通常意味着几千张 GPU 必须互相通信。」
⚠️ 预训练完你得到的不是"助手",而是一个"文档续写器":
「它在胡扯,但不是胡扯莎士比亚,是胡扯互联网——它会生成随意的新闻文章和文档,因为这就是它被训练来做的事。 你问它一个问题,它可能给你更多问题、可能无视你的问题、可能干脆续写一篇新闻——它完全"走神"了,行为未定义。」
阶段二:微调 / 对齐(fine-tuning / alignment)
大概三步(ChatGPT 官方博客里有介绍):
- 监督微调(SFT):收集"看起来像助手会做的"训练数据——格式是上面问题、下面回答。「数量级大概是几千条,远达不到互联网的规模」。把模型调到只关注这种格式的文档——
「这些超大模型在微调阶段"样本效率极高"——所以这一步居然真的有用。」
- 训练奖励模型(reward model):让模型生成多个回答,由评测者按偏好排序,用这些排序训练一个能预测"任意候选回答有多好"的网络。
- PPO:有了奖励模型,跑 PPO(一种强化学习的策略梯度优化器),调整采样策略,让生成的回答预期能拿到高奖励。
「这是一个完整的对齐(alignment)阶段,中间还有很多步骤。它把一个"文档续写器"变成了一个"问答助手"——几乎是完全独立的一个阶段。」 而且这部分数据大多不公开、是 OpenAI 内部资产,比预训练更难复现。 nanoGPT 聚焦的是预训练那一段。
十四、结语
(参考时间: 1:54:32)
本讲总结:
- 我们按 2017 年那篇著名论文《Attention Is All You Need》,训练了一个 decoder-only Transformer——这基本就是一个 GPT。
- 用 Tiny Shakespeare 训练,得到了合理的结果。
- 全部训练代码大约 200 行。
- 会连同构建过程中的完整 git 提交历史一起发布,以及 Colab notebook。
- 「我希望这让你大致明白怎么训练这类模型:GPT-3 在架构上几乎和我们的东西一模一样,只是大了 10,000 到 1,000,000 倍(取决于怎么算)。」
没有覆盖的部分:
「我们没讲任何微调阶段。 如果你想要的不只是语言建模——而是真的执行任务、或者以某种方式对齐、或者做情感检测之类——那么除非你只想要一个"文档续写器",你都需要做别的微调阶段: 可以是简单的监督微调,也可以是像 ChatGPT 那样更复杂的:训练奖励模型、再跑 PPO 对齐。」
「所以除了这些,还有非常多可以做的。」
📷 GPT-3 各规模模型的超参对比:我们的是约 1000 万参数,最大的是 1750 亿
回到原视频 (01:51:00)
附:官方参考与延伸阅读
- 课程主页:https://karpathy.ai/zero-to-hero.html
- 🟢 本讲 Colab:https://colab.research.google.com/drive/1JMLa53HDuA-i7ZBmqV7ZnA3c_fvtXnx-?usp=sharing
- 本讲代码仓库:https://github.com/karpathy/ng-video-lecture
- nanoGPT:https://github.com/karpathy/nanoGPT
- 📄 Attention Is All You Need:https://arxiv.org/abs/1706.03762
- 📄 GPT-3:https://arxiv.org/abs/2005.14165
- 📄 ChatGPT 博客:https://openai.com/blog/chatgpt/
- 📄 ResNet(残差连接):https://arxiv.org/abs/1512.03385
- 📄 Layer Normalization:https://arxiv.org/abs/1607.06450
- 📄 Dropout:https://jmlr.org/papers/v15/srivastava14a.html
- tiktoken(OpenAI 的 BPE 分词器):https://github.com/openai/tiktoken
- Tiny Shakespeare 数据集:https://raw.githubusercontent.com/karpathy/char-rnn/master/data/tinyshakespeare/input.txt
- 讨论 Discord:https://discord.gg/3zy8kqD9Cp
版权说明:本书内容依据 Andrej Karpathy 的公开教学视频 Let's build GPT: from scratch, in code, spelled out. 重构,代码与数据集版权归原作者所有,遵循其仓库所附许可(MIT License)。本电子书仅用于学习交流,不用于商业用途。