第1讲 · CS224N —— 导论与词向量
| 课程 | Stanford CS224N / Ling284,Natural Language Processing with Deep Learning |
| 讲座 | 第一讲 —— 导论与 NLP 的历史(客座主讲:Christopher Manning 教授,CS224N 课程的创建者) |
| 视频 | [Stanford CS224N: NLP with Deep Learning |
| 课程主页 | cs224n.stanford.edu(又名 stanford.edu/class/cs224n) |
| 本书使用的课程材料 | 随录像发布的两份讲义 PDF —— cs224n-2026-lecture01-history.pdf(历史讲义)与 cs224n-2026-lecture01-intro.pdf(课程介绍与词向量讲义)。下文引用的幻灯片标题仅作简短指代;本书未整体复制任何幻灯片。 |
对应讲次:第1讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
导览
这是对整堂讲座的 3–5 分钟地图。它说明桌面上摆着哪些问题、哪段路开始陡峭、答案以什么顺序到来。它刻意不复述答案。
-
讲师真正提出的问题,按他自己的顺序。
-
这门课是为了什么? 他用三个学习目标作答(面向 NLP 的深度学习基础、对人类的语言的全局理解、真正动手搭建系统的能力),然后在触及任何内容之前先花十分钟讲教务。
- 为什么语言恰恰是把我们与最近的亲属区分开来的那件事? 紧接着还有一个他坚持追问的问题:语言只是用于交流,还是也是思考的工具?
- 过去十年发生了什么变化? 机器翻译,然后是 GPT-2,然后是 ChatGPT/GPT-4 —— 问题在于这些系统能做什么、不能做什么,用他自己的例子来说明。
- "意义"意味着什么? 在一台计算机内部,你把一个词的意义存放在哪里?他先走了一遍词典式/指称式的答案,然后走到 WordNet,并说明为什么两者都行不通。
- 如果一个词的意义就只是它的上下文呢? 这正是整堂讲座的转折点。
- word2vec 算法到底是什么,它的目标函数是什么,训练它的梯度又该怎么算? 最后一个问题是技术核心,也正是讲座时间耗尽的地方。
2. 哪里难。 三个地方。
- 从"意义 = 符号所指代的那个东西"到"意义 = 从共现中学到的向量"这一概念切换。词典里的任何东西都无法做梯度下降;语料库里的东西却可以。
- softmax 这一步:为什么要取指数、为什么要归一化、为什么得到的量是整个词表上的概率分布,而不是两个词之间的比较。
- 推导的后半段:对数里套着一个商式,然后连锁律用了两次,再然后是一个点积的逐分量求导。Manning 自己就提醒听众:这十分钟对某些人来说是小儿科,对另一些人来说则难以穿透,而他对后一群人说,这正是他讲得慢的原因。
3. 你可能带着进来的问题。 按该有的方式分成两组。
① 讲师提出的问题,或现场学生提出的问题:
- 一个词向量该有多少维,怎么选?
- 词向量的各个分量是有界的吗?
- 空间里只有距离携带意义,还是方向也携带?
- 像 star 这样的词有好几个义项 —— 一个向量能应付吗?
- 为什么模型要给每个词配两个向量?
- (讲师自己提的)为什么我们要最小化而不是最大化?
② 编者预测你会有的问题(编者的猜测,不是讲师提的):
- "语料库(corpus)"到底是什么,为什么它的复数不是"corpys"?
- 用一句话说,独热向量和词嵌入的区别是什么?
- 这里讲的是 skip-gram 还是 CBOW?讲座从没说过,而给出的推导对应的是其中之一。
- 机器翻译图表里的 BLEU 数值是从哪里来的?
- 如果 WordNet 漏洞这么多,为什么它至今还在?
4. 路线。 课程教务(约十分钟)→ 人类的语言,以及意义是什么 → NLP 历史的形状,分四个时代 → 深度学习带来的突破,通过机器翻译、GPT-2、ChatGPT/GPT-4 和图像生成来讲述 → "意义"作为指称,以及 WordNet 的失败 → 词向量与分布语义 → word2vec、softmax 与梯度推导,而后者被下课铃截断。
1. 课程概览:CS224N 到底要教什么
(参考时间:00:00:05)
Manning 以一个关于课程本身的观察开场:这门课上上个学季刚教过,而眼下又有一大批人涌进来再上一次。他对这说明了什么的猜测,用他自己的话说,大致就是"ChatGPT"—— 一个对"为什么一门 NLP 专业课现在会爆满"的揶揄式解释。
他宣布的讲座计划是:花几分钟讲课程,花几句讲人类的语言和词义,然后进入主要技术内容 —— word2vec 算法。他形容这个算法诞生刚过十年(2013 年提出),极其成功,而且是学习词的向量表示的一种简单方法。他把它框定为刻意简单的"婴儿系统",用来引出本课程其余部分要讲的那类神经表示:它是第一个可以把目标函数、梯度和优化过程全部在课堂上手算走通的模型。
(参考时间:00:02:24 —— 课程教务)
教务方面,只简述到能解释教学理念为止:
- 讲师与课程团队:助教长当天因健康原因缺席,课程管理员在教室里,其他助教都在网站上。信息和提问的主要渠道是课程网站,它链到 Ed 作为讨论区 —— Manning 明确要求学生用 Ed,而不是给他发邮件。
- 第一次作业已经上线,下周二上课前截止:"略少于七天"。答疑时间从第二天开始;第一个周五的辅导课讲 Python 和 NumPy,之所以开这门课,正是因为课程希望没学过这些东西的人也能跟上。
- 编者说明: 上传的讲义还列出了第二个周五的 PyTorch 辅导课。整门课都建立在 Python 加 PyTorch 之上,所以对初学者来说这两次辅导不是可有可无的点缀。
1.1 三个学习目标
(参考时间:00:04:30)
Manning 列出三个目标,并说学季末的评教会问学生这门课有没有达成它们。
- 把深度学习应用到 NLP 所需的基础与当前方法。 课程是自底向上搭起来的:词向量、前馈网络、循环网络、注意力,然后是 Transformer 与编码器–解码器模型。他讲到一半时补了一句:他大概也该把大语言模型写进幻灯片,并把预训练与后训练、适配、可解释性和智能体加进 2024 年这一代的话题清单。
- 对人类的语言,以及它为什么对计算机很难,有一种感觉。 他在这里说了一句点题的话:班上只有少数学生是语言学或符号系统(Symbolic Systems)专业的 ——"为符号系统的同学欢呼"—— 而对班上其余大多数人来说,这将是他们唯一能见识语言如何运作、理解它为何困难的地方,尽管对人类而言它轻而易举。
- 搭建真实系统。 所陈述的目标是:学生离开这门课时应该想:"在我第一份工作里,无论在创业公司、大厂还是非营利组织,如果他们需要一个文本分类系统,或者需要从文档里抽取事实的信息抽取系统,我能做出来 —— 因为我上过 CS224N。"他明确表示,这门课不是纯理论课。
1.2 评分、协作与 AI 工具政策
(参考时间:00:07:05)
成绩大致在课程作业与项目之间对半分:
- 四次作业,每次大约一周半。第一次占 6%,其余三次各 14%,合计 48%。
- 期末项目(49%),要么是默认项目(带大量脚手架),要么是经课程团队批准的自选项目;1–3 人的小组可以使用任何语言和软件包。项目分为提案(8%)、里程碑(6%)、海报或网页摘要(3%)和报告(32%)。
- 参与分(3%),外加延迟政策:六天免费延迟,之后每延迟一天扣课程成绩的 1%。
有两条政策得到了实质的讨论时间:
- 协作。 学生可以和朋友们讨论,但必须自己撰写并提交作业解答,还必须记录协作情况。期末项目则预期并允许小组合作。
- AI 工具。 说法很谨慎,值得按其实质引用:"在这门课上我们热爱大语言模型,但我们不希望你靠说'嘿 ChatGPT,第三题帮我答一下'来完成作业。那不是学习的方式。"把 AI 当作编程助手没问题;把作业答案背后的推理外包出去,则是违规。
1.3 作业到底要求你做什么
(参考时间:00:08:40)
- HW1 是轻松的入门,以 Jupyter notebook 的形式下发。
- HW2 才是课程要数学、要理解神经网络如何运作的地方,也是引入 PyTorch 的地方;学生要为依存句法分析搭一个小网络。Manning 很坦率:"对一些人来说,作业二是整门课里最吓人的一次作业。"他还用一句关于机构身份的话为数学部分辩护 —— 在一所"这样一所优秀的文理兼工程院校,而非编程训练营"里,目标是深度理解,而不只是能跑的代码。
- HW3 和 HW4 转向更大的项目,在 GPU 上用 PyTorch,计算资源由 Google Cloud 提供,内容涵盖机器翻译与基于 Transformer 的信息抽取。
- 期末项目要么是默认选项(实现一个 GPT,再微调并适配到下游任务,配大量脚手架),要么是自提项目。有学生问导师如何分配;Manning 的回答是:如果学生有具体兴趣而某位老师愿意,就可以自己找导师;否则由负责期末项目的助教把学生尽可能均匀地分给课程团队。
2. 人类的语言与词义:为什么语言如此特别
(参考时间:00:11:20)
Manning 自我介绍说自己是语言学家,并给出他自称有偏见的看法。把人跟我们的近亲 —— 黑猩猩和倭黑猩猩 —— 相比,差异出人意料地小。它们会使用工具,会规划如何解决问题,而且它们的记忆不只是可比:黑猩猩的短期记忆比人类更好。在大多数维度上都很难证明存在智力差距,"除了我们拥有语言这个事实"。
接着是他赋予语言分量的那个观察:有些生物比我们更强壮、更快、更有毒,具备你能想到的各种身体优势,可到头来还是人类接管了这颗星球。靠什么?靠语言 —— 因为语言让交流成为可能,而交流让人类得以崛起。
但 Manning 主张,交流不是语言的唯一作用:
- 有些思维显然不需要语言 —— 想象一个场景、在脑子里搬动家具、感到害怕或兴奋。
- 然而大多数更高层的认知是在语言里运行的。他的例子刻意平常:你注意到朋友似乎对你昨晚说的话感到不快,于是你琢磨该怎么补救,规划要说什么,在脑子里预演这段对话。语言给了我们更细致的思考与规划的脚手架。
(参考时间:00:14:30)
论证的后半段讲文字:
- 没人确切知道人类的语言有多少年历史;多数估计是几十万年,放在演化时间尺度上并不长。
- 相比之下,文字是已知的、且近代的:大约五千年前。而文字结果成了一件极其巨大的认知工具,因为它让知识得以跨越时间与空间共享,而不只是跟站在你五十英尺内的人分享。Manning 的框法是:仅凭文字就足以把人类从青铜时代的金属加工带到我们随身携带的手机 —— 而且是在极短的时间内。"语言挺酷的。"
(参考时间:00:15:45)
接着他反对只盯着语言的知识功能。语言也是一种社会工具,一个非常灵活的系统,人们以不精确的方式、带着细腻与情感去使用它,而它仅凭给某些想法提供词语,就能开辟新的思维方式。有两点对课程其余部分很重要:
- 语言不是静态的,也不是"上帝刻在石板上递下来的"。它们由使用者建构和改变 —— 而多数创新发生在年轻人中间,从十几岁早期到二十几岁。
- 他以已退休的斯坦福心理学家 Herb Clark 的一句话作结:"常见的误解是,语言的使用主要关乎词语以及它们的意思。并非如此;它主要关乎人以及他们想表达的意思。"
编者说明: 为什么这在技术上重要,而不只是哲学上重要。Clark 的观点正是本讲后面纯词汇式、词典式语义学会失败的原因:词是人带着意图使用的工具,它们的意义随使用而变。取而代之的统计方法并没有解决这一点,但它确实把用法 —— 一个词所结交的伙伴 —— 当作原材料。
3. NLP 历史的形状:四次范式转移
(参考时间:00:17:30)
Manning 在这里只是点了点历史 ——"稍后我们会再多讲一点历史" —— 而课程的历史讲义提供了整堂讲座、乃至整门课程都围绕其组织的框架:NLP 的四个时代。
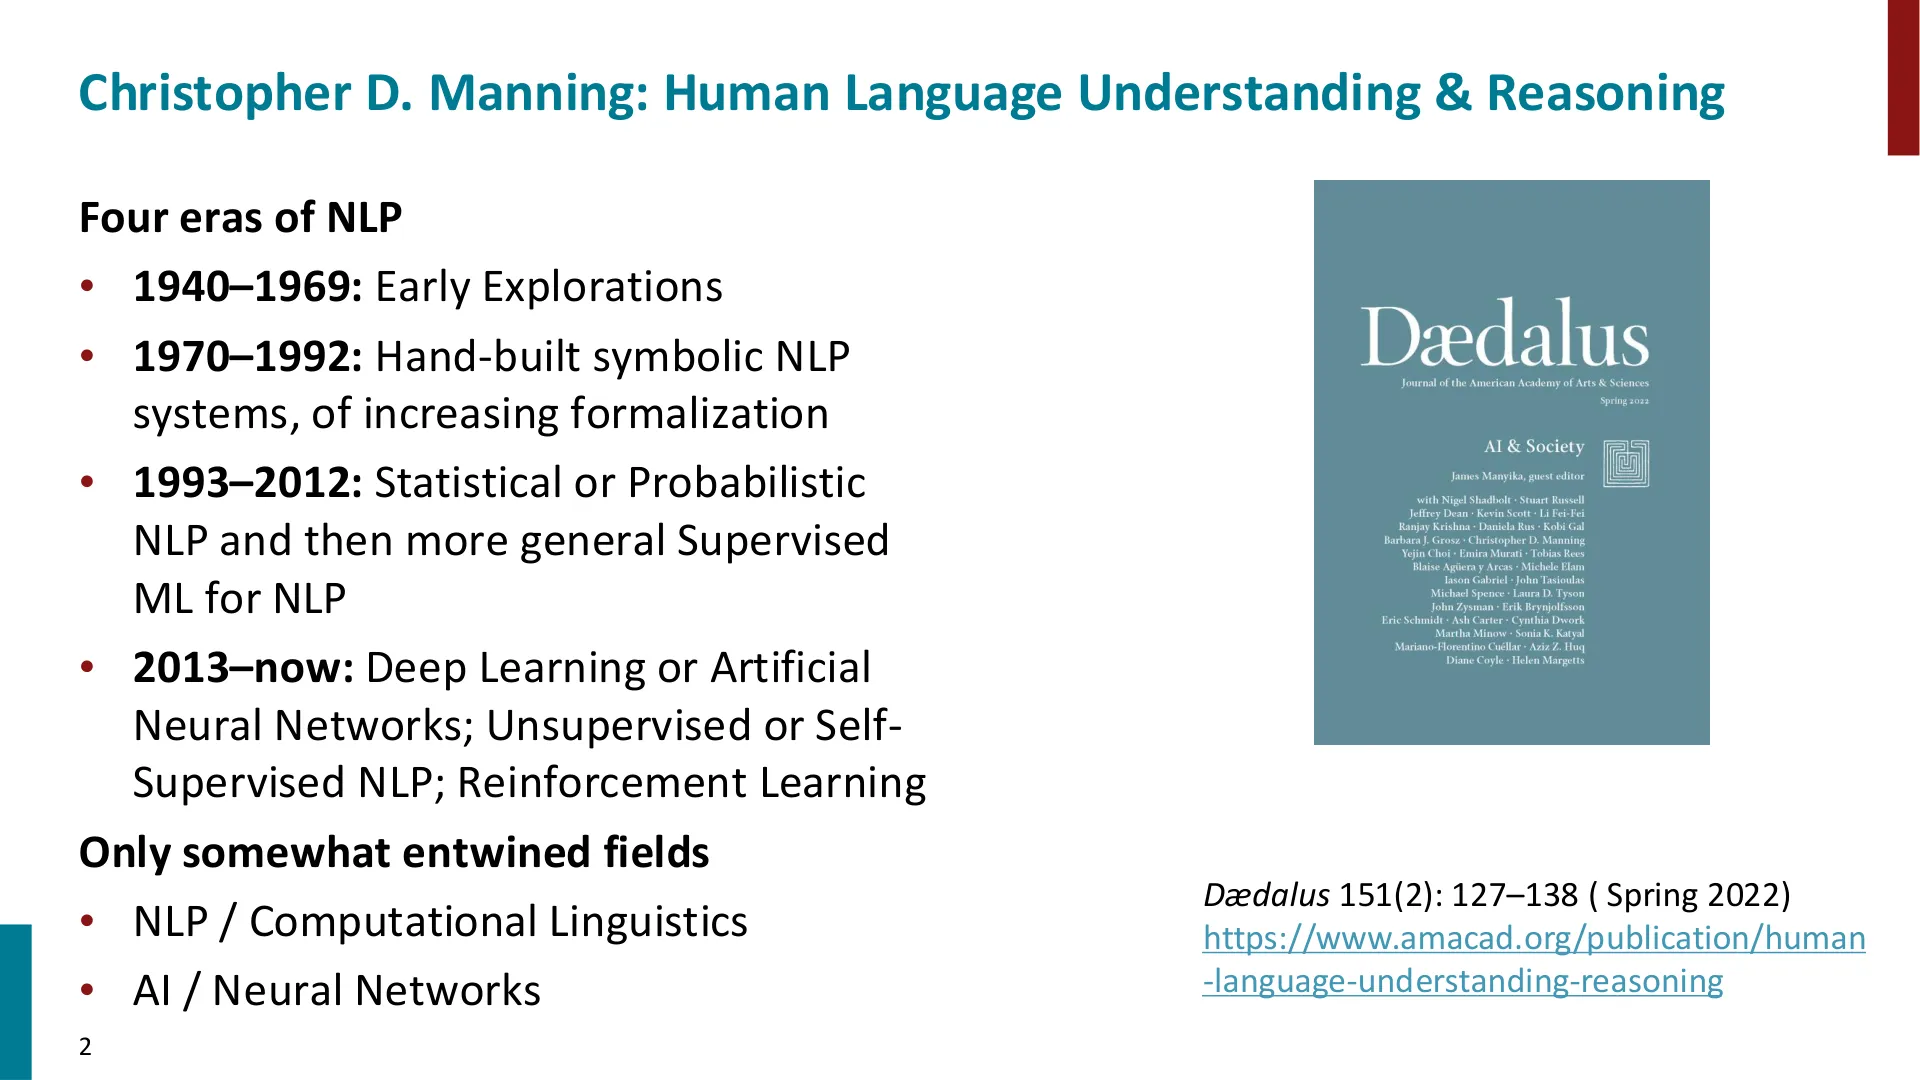
📷 Christopher Manning 绘制的 NLP 四时代地图,用来框定整堂讲座与整门课程
回到原视频 (00:17:40)
- 1940–1969 —— 早期探索。 机器翻译作为计算语言学的起源、达特茅斯会议、控制论与第一个人工数学神经元、信息检索、最早的基准测试。
- 1970–1992 —— 手工搭建的符号 NLP 系统,形式化程度不断提高。 形式语法与基于合一的语法、知识表示与推理、自然语言理解演示,然后是符号方法的墙与"AI 寒冬"。
- 1993–2012 —— 统计式或概率式 NLP,然后是更一般的面向 NLP 的监督机器学习。 来自电子工程与语音识别的想法涌入、机器可读语料库、标注训练数据、实证评估,以及刻意降低的野心。
- 2013 至今 —— 深度学习 / 人工神经网络、无监督或自监督 NLP,外加强化学习。 神经词向量、编码器–解码器序列模型、Transformer,以及大语言模型。
这个框架有两个结构性主张,讲座反复倚重:
- NLP/计算语言学与 AI/神经网络是只有部分交织的领域。把它们当作两条线而非一条来追踪,正是符号方法与统计方法轮流得势这件事得以理解的原因。
- 当天的关键学习点(如讲义所述):理解 NLP 中的范式转移,以及我们对语言的假设如何塑造了每个时代中可能做到的事。 这句话把历史部分与技术部分绑在一起:每个时代对"语言"的定义,都界定了该时代系统能力的边界。
graph LR
    A["1940–1969<br/>早期探索<br/>机器翻译、控制论、信息检索、基准测试"] --> B["1970–1992<br/>手工搭建的符号 NLP<br/>形式化程度不断提高"]
    B --> C["1993–2012<br/>统计式 / 概率式 NLP<br/>然后是监督机器学习"]
    C --> D["2013 至今<br/>深度学习、自监督<br/>+ 强化学习"]
编者拓展 —— 四时代框架从何而来。 这四个时代,以及"只有部分交织的领域"这个说法,来自 Manning 自己的文章 Human Language Understanding & Reasoning(Dædalus 151(2), 2022),它被引在幻灯片上,也是本讲对应的书面版本。口头的十分钟版本压缩掉了两个有用的细节:时代边界是模糊且相互重叠的 —— 统计革命在 1970 年代始于语音识别,比它接管 NLP 早了几十年;而第四个时代并不纯粹是关于神经网络的故事,而是关于神经网络、自监督目标,以及数量级更大的数据与算力的组合。
编者关于这次录像的说明。 在这段具体的视频里,那段很长的历史内容(按课程自己的计划约有一小时的材料)并没有完整讲出;转录稿从四时代概述直接跳到了现代深度学习成果。随录像发布的历史讲义是上文时代概述的来源。参见本书末尾的已知疑点。
4. 第一次深度学习突破:神经机器翻译
(参考时间:00:18:10)
Manning 请听众体会这个进步领域有多年轻。用人类的语言做事情的工作始于 1950 年代,到那时已经进行了约六十年,而理解和生成语言的能力"一直都颇成问题"—— 直到神经网络在大约最近十年里带来了巨大的飞跃。
第一次大突破出现在机器翻译上:
- 它大约始于 2014 年。
- 到 2016 年,它已经上线部署在 Google Translate 之类的服务里。
- 它好到商业部署极其迅速 —— Manning 的要点是:这不是一个花了十年才到达用户手里的研究奇观。
支撑那些早期系统的架构是编码器–解码器网络,讲座里的例子刻意小:读入 "I am a student",产出 "Je suis étudiant"。编码器逐词读入源句,逐步建立起其意义的表示;解码器逐词生成译文,并把上一个产出的词喂给自己。
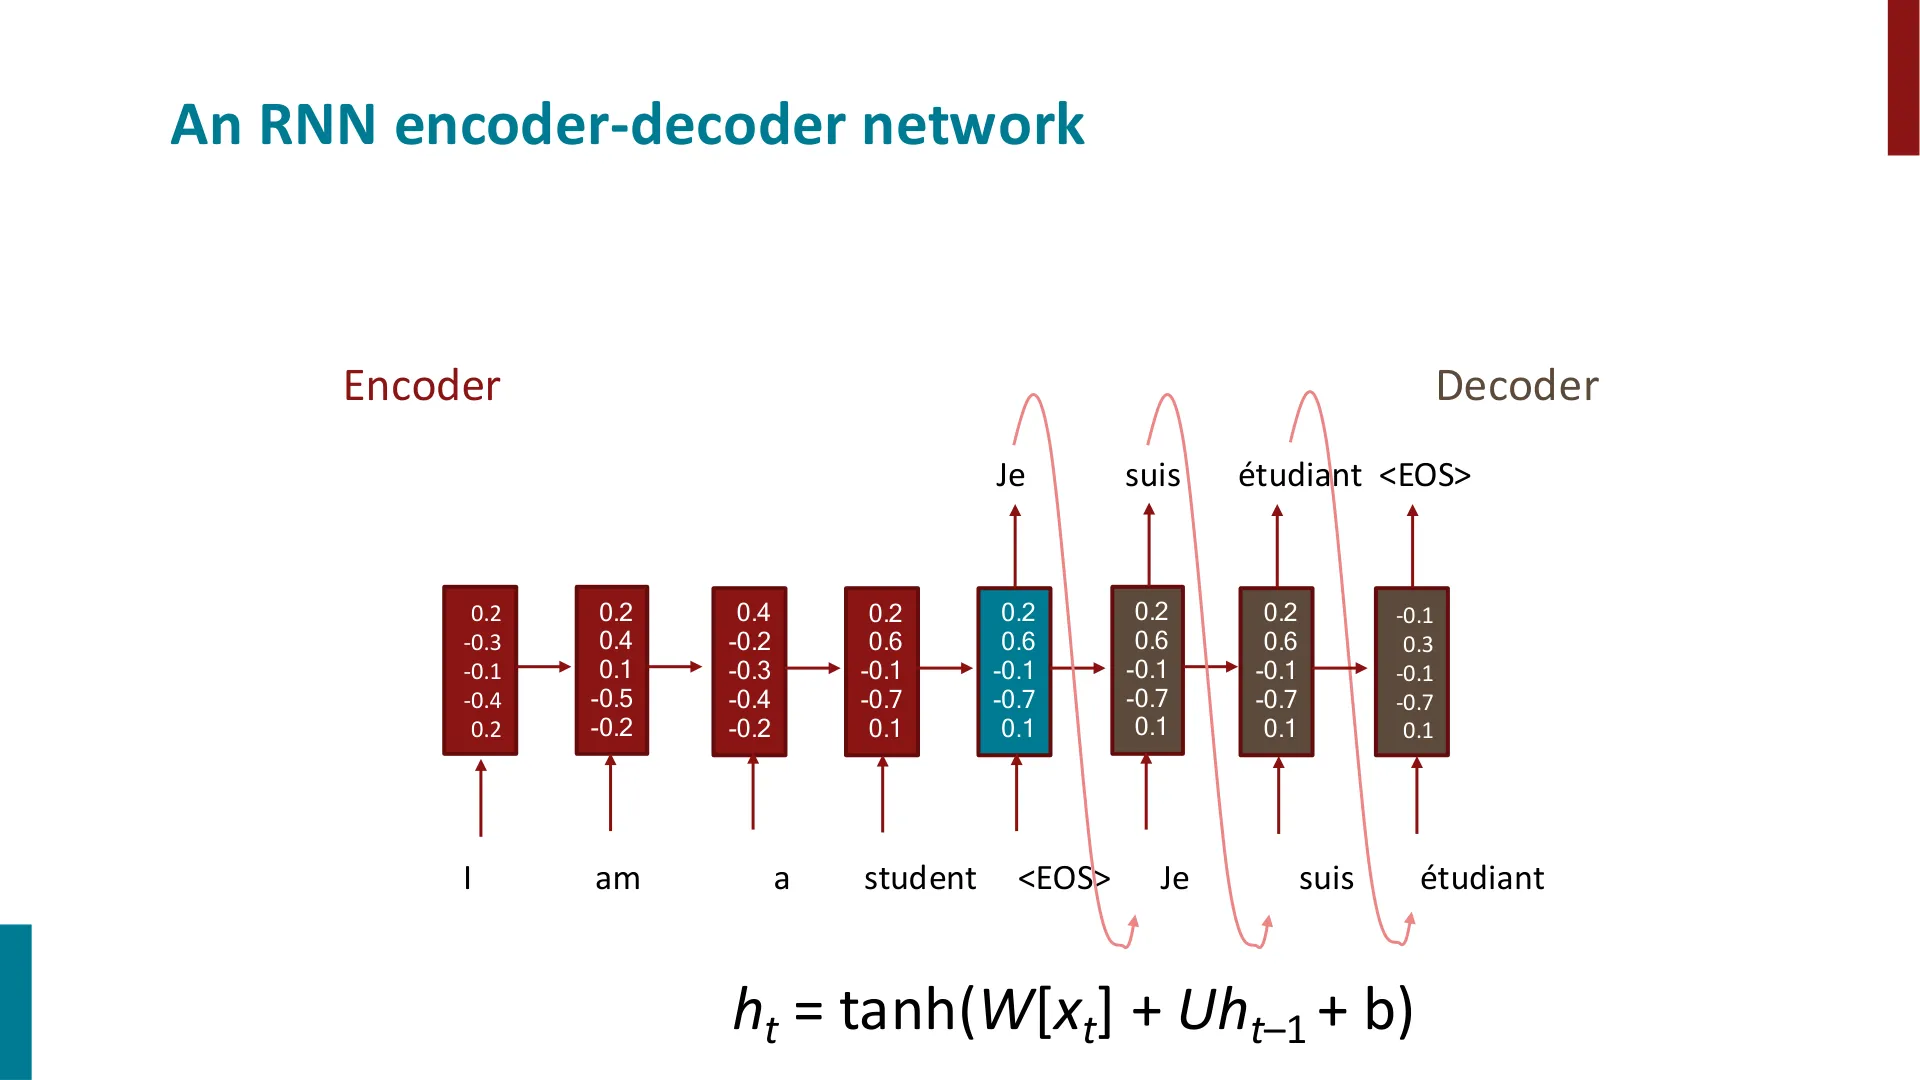
📷 用于机器翻译的 RNN 编码器–解码器架构:读入源句,把它压缩成一个向量,再生成译文
回到原视频 (00:18:25)
讲义里的循环单元是标准的那一个:
$$h_t = \tanh\!\left(W[x_t] + U h_{t-1} + b\right)$$
质量用 BLEU 衡量(一个把系统输出与参考译文作比较的分数),而数值动得很快:在英德新闻翻译上,基于短语和基于句法的统计机器翻译在短短几年内就让位于神经机器翻译,而且跳跃幅度巨大。
(参考时间:00:19:05)
在 Manning 的讲述里,这对一个学生意味着的是一个与几代人之前不同的世界。那时,除非你学会了另一门语言,否则你基本没有办法跟讲那门语言的人交流。现在我们接近于《银河系漫游指南》里的巴别鱼了 —— 只不过,正如他所说,"它不是一条巴别鱼,而是一部手机":你可以把它放在两个人中间,得到同声传译。它并不完美,研究仍在继续,但实际后果是你可以从任何地方拾取信息。他的例子是一则来自肯尼亚的斯瓦希里语新闻片段,他可以把它粘进翻译服务并从中了解到:马拉维因 COVID 感染失去了两位部长。
graph LR
    S["源句<br/>I am a student [EOS]"] --> E["编码器:逐步建立句子意义<br/>h_t = tanh(W[x_t] + U h_(t-1) + b)"]
    E --> V["瓶颈:一个向量代表整句"]
    V --> D["解码器:一次生成一个词"]
    D --> O["译文<br/>Je suis étudiant [EOS]"]
编者拓展 —— BLEU 实际上衡量什么。 BLEU 统计系统输出中有多少 n-gram 也出现在一份或多份人工参考译文里(通常到 4-gram),取其加权几何平均,再施加一个简短惩罚,使系统不能靠输出极短的文本获胜。它便宜、自动,与人类判断的相关性只是中等 —— 这正是为什么幻灯片上曲线的形状(一次迅速而巨大的改进)才是有意义的部分,而不是绝对数值。
编者拓展 —— 为什么编码器–解码器设计既是一次突破,也是一个瓶颈。 把整句源句压缩进一个固定长度的向量,正是下一讲注意力机制要移除的设计缺陷:无论源句多长多复杂,解码器都只有一个向量可供条件化。幻灯片上"瓶颈"一词指的正是这一点。
5. 大语言模型与生成式 AI 的崛起
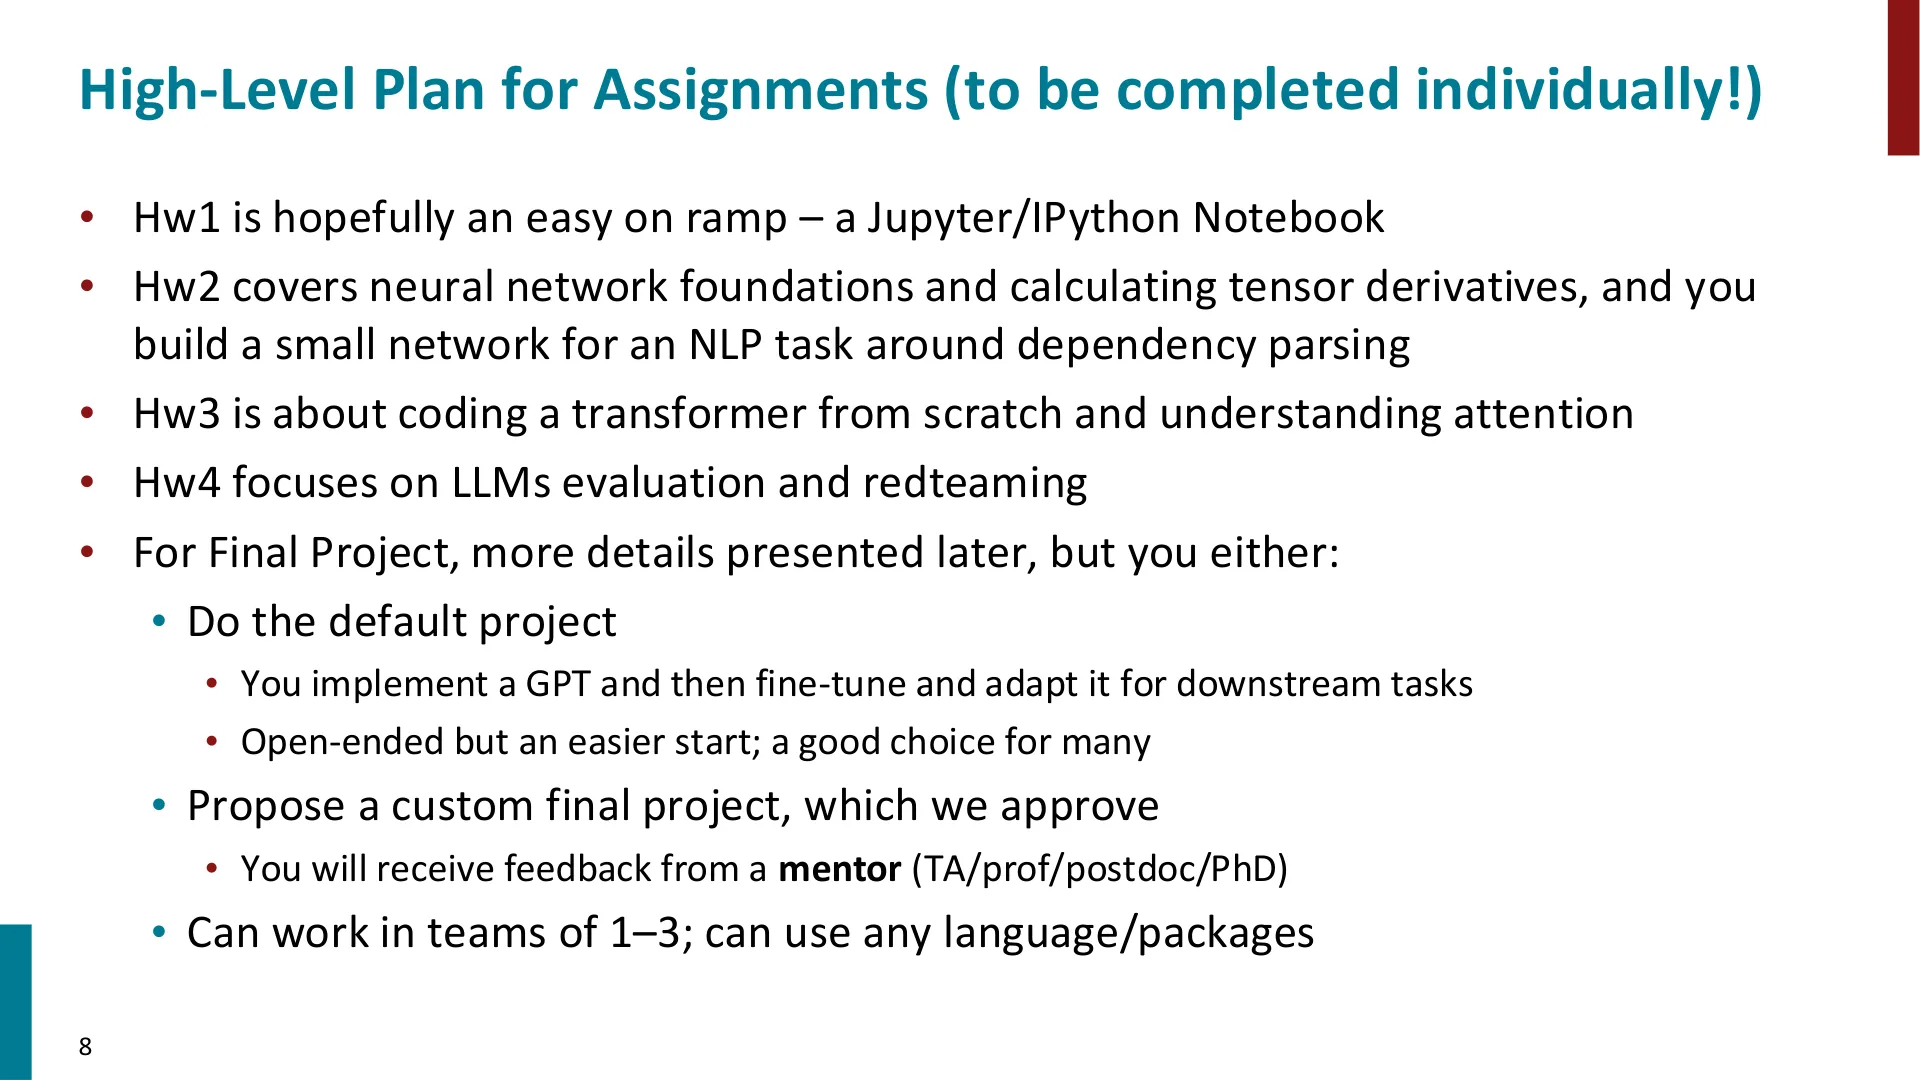
🖼️ Manning 逐一走过每次作业的内容(HW1 是 notebook,HW2 是神经网络基础与依存句法分析,HW3 是从零实现 transformer,HW4 是 LLM 评估)以及两种期末项目选项;这一页是那次讲解的清晰总结。
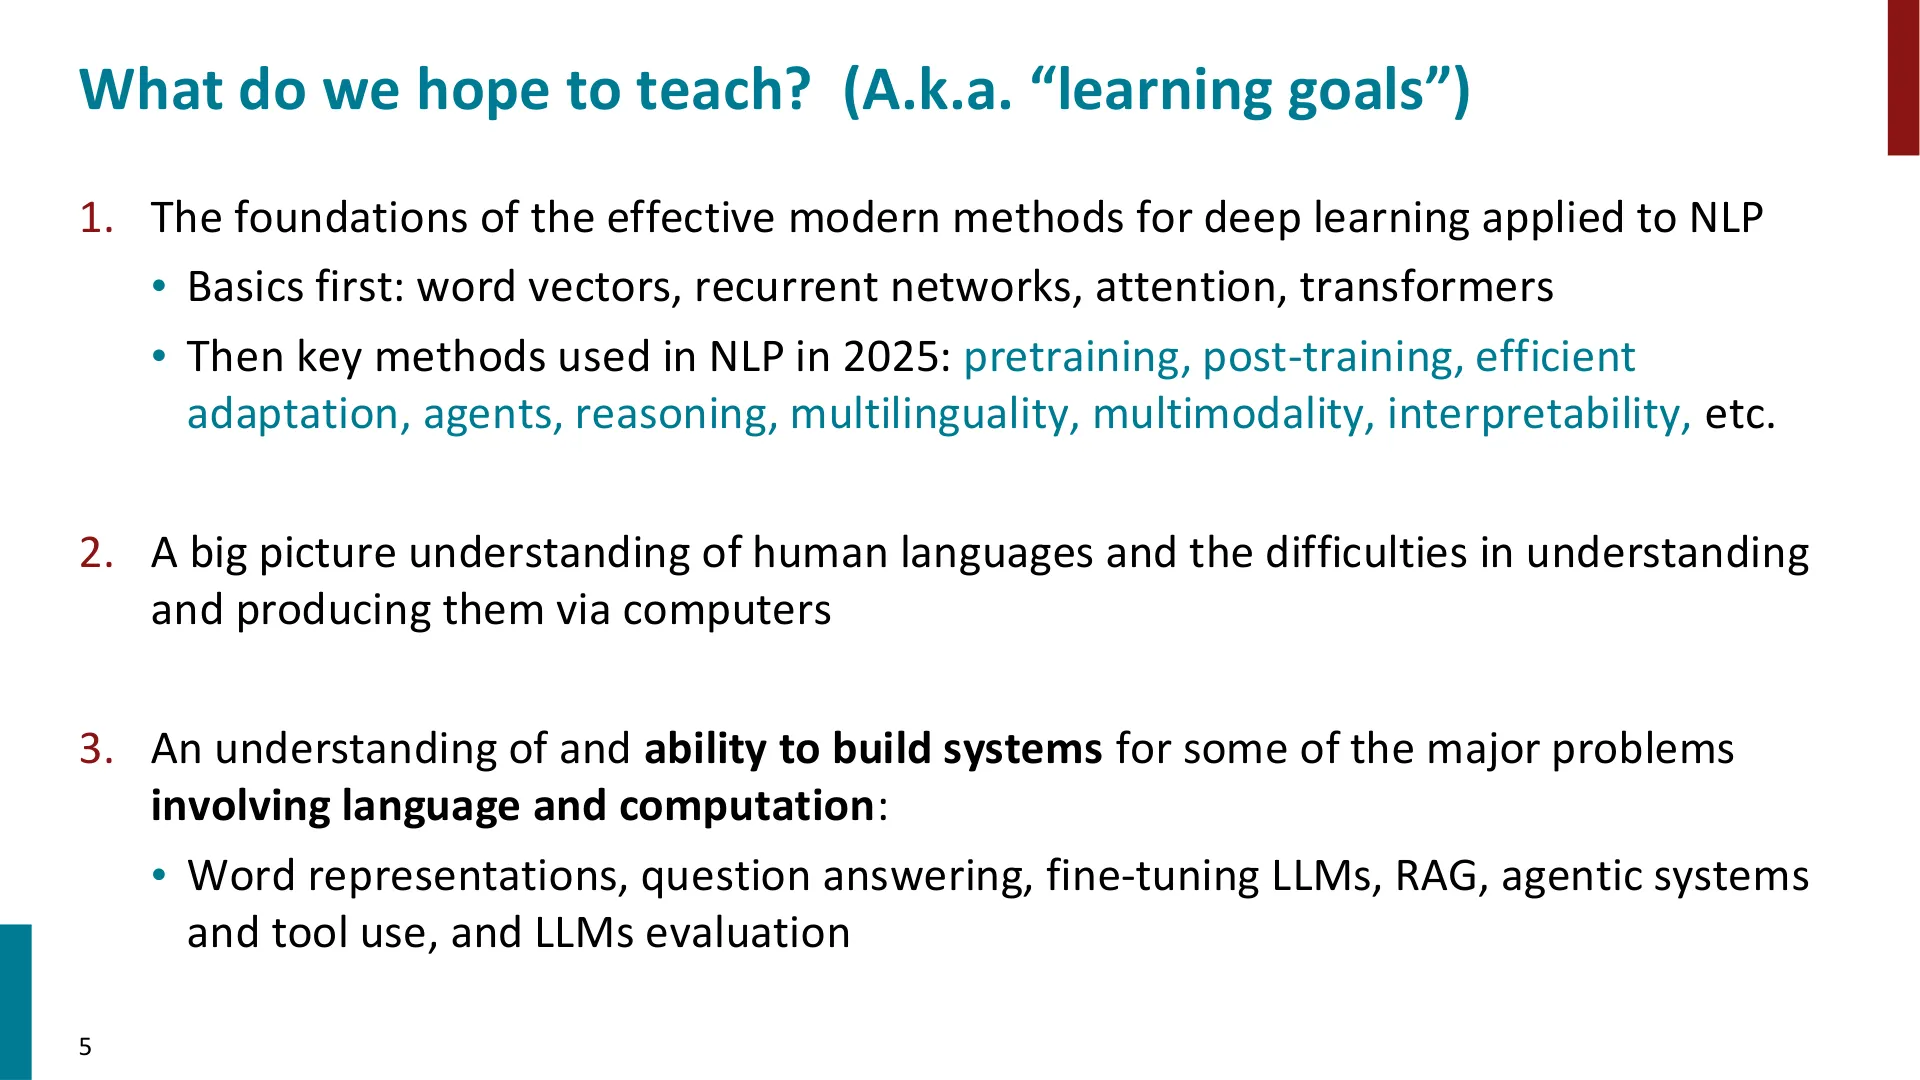
🖼️ 这一页陈述了 Manning 在讲座开头花时间解释的三个学习目标(面向 NLP 的深度学习基础、对人类语言的全局理解、以及搭建系统的能力),因此它是开篇部分的路线图。
(参考时间:00:20:10)
在转向语言模型之前,Manning 指出神经网络早已改变日常产品的第二种方式:搜索不再是关键词匹配,而变成了答案引擎。几年前,你打点什么,拿回来的是一堆可能含有答案的页面,它们是跟某个索引匹配出来的。现在你可以打一个真正的问题 —— 他的例子是 "when did Kendrick Lamar's first album come out?" —— 而系统会找到相关文档,读它们,然后返回一个答案。
从架构上看,那是一条由好几个网络串成的流水线,讲座点出了三个阶段。
graph LR
    Q["用户提问"] --> R["检索网络<br/>找出与查询相似的段落"]
    R --> K["重排序网络<br/>重新排列候选"]
    K --> RD["阅读网络<br/>从段落中综合出一个答案"]
    RD --> A["返回一个答案,而不是一串链接"]
(参考时间:00:21:35 —— GPT-2)
接着他讲到他所称的"事情又变得更先进"的那一刻。大约在 2019 年,NLP 圈子里的人开始看到大语言模型的威力,我们这些在场的人对 GPT-2 是真心兴奋的。他的保留意见既可爱又诚实:GPT-2"没怎么上晚间新闻",但在 NLP 里它很重要,因为这是第一次出现一个能够生成流畅文本的大语言模型。在那之前,NLP 系统从文本中抽取事实做得还不错,但没人能生成流畅文本。
核心机制简单得跟听起来一样:给定前面的一些文本,预测下一个词;一次一个词地生成文本。他的演示是一条编造的新闻故事。他给 GPT-2 一句开头,讲辛辛那提一辆载有受管制核材料的列车车厢被盗。GPT-2 续写出一篇像模像样的新闻报道:事件发生在市区线上,美国能源部正与联邦铁路管理局合作寻找窃贼。
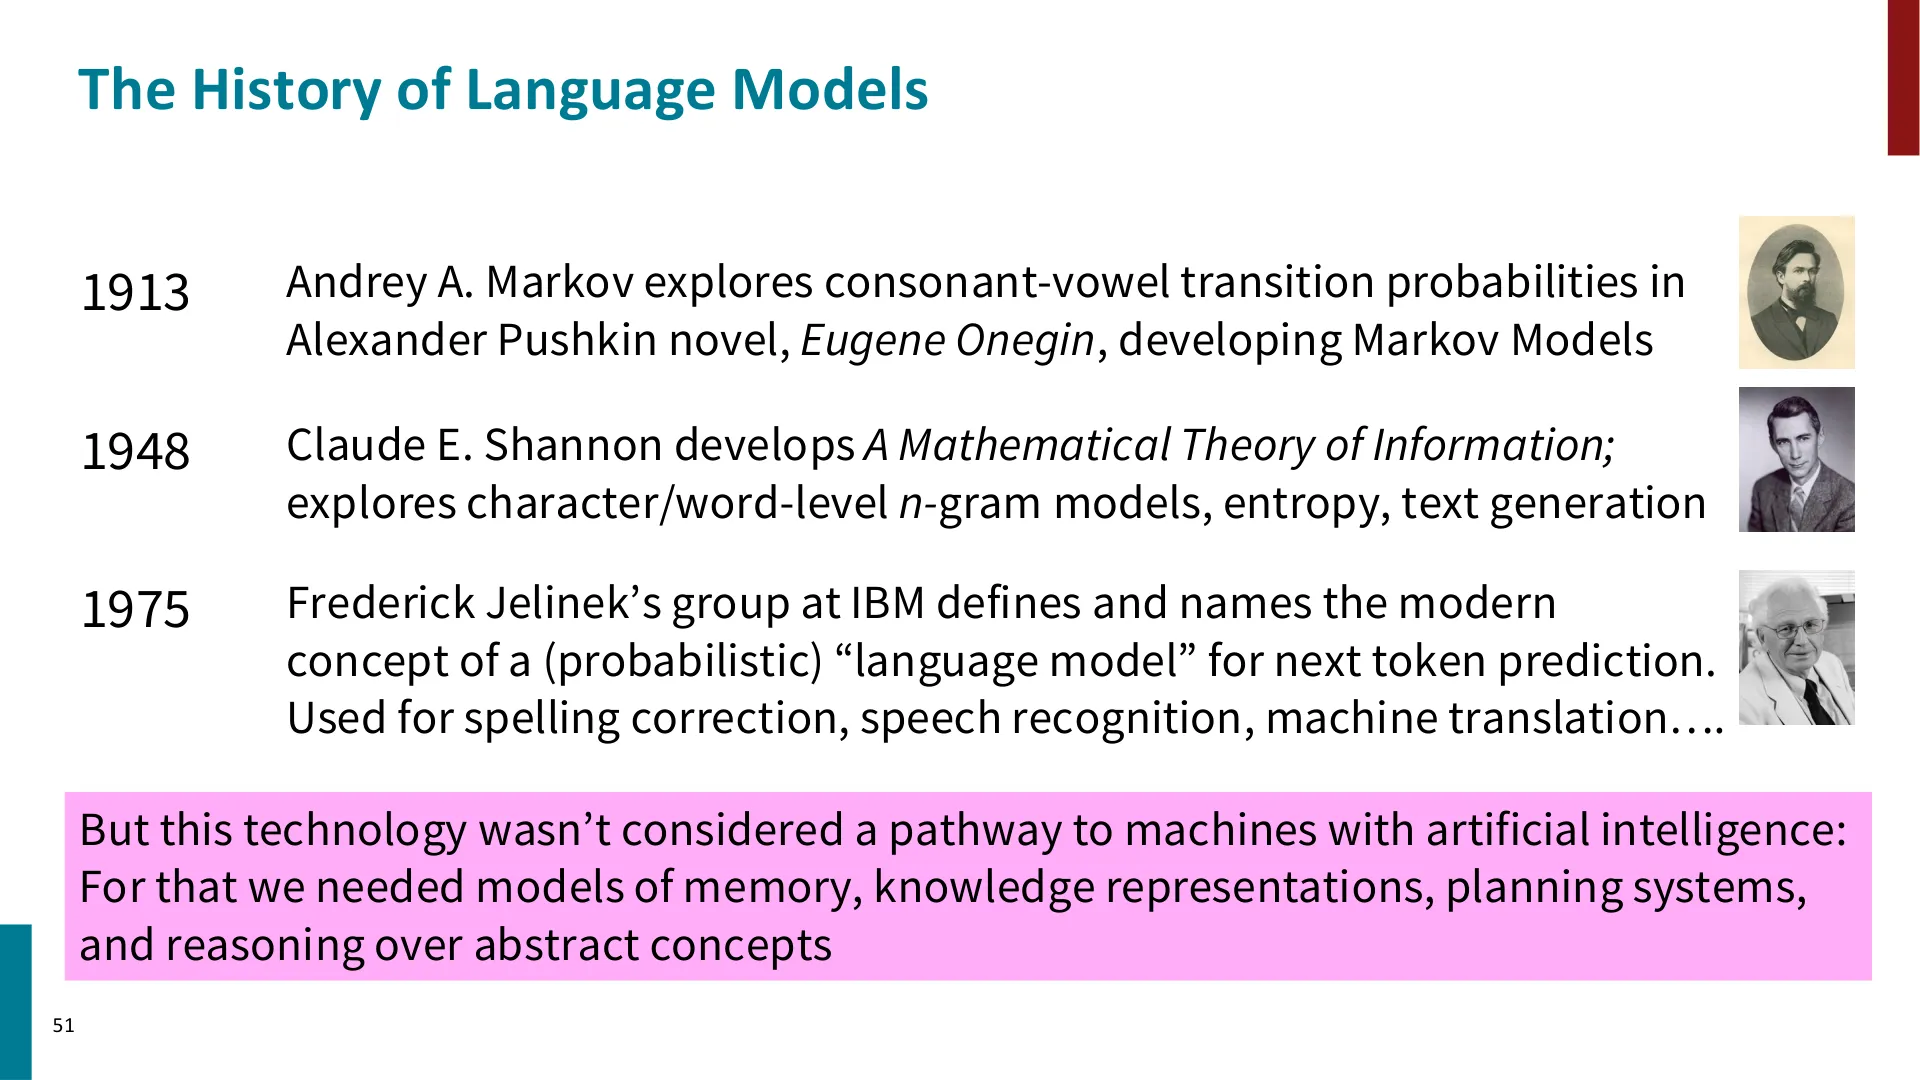
📷 语言模型的历史:马尔可夫的字模型(1913)、Shannon 的 n-gram 模型(1948)、Jelinek 的概率语言模型(1975)
回到原视频 (00:21:15)
然后 Manning 指出这为什么令人印象深刻,而他的理由是一张"语言模型必须吸收哪些知识"的清单:
- 辛辛那提在俄亥俄州。
- 在美国,能源部管制核材料。
- 有东西被盗,那就是盗窃,会有机构介入。
- 如果是列车车厢,那么是哪条铁路线、它跑在哪里,都跟此事相关。
这些没有一样写在提示里。模型自己知道。而且输出不只是局部通顺 —— 拼写是对的,句子是真句子而不是互不相干的垃圾 —— 它是连贯的话语,一个真正的故事。
编者拓展 —— 幻灯片放在语言模型背后的那段前史。 幻灯片把这个想法的年代标得比 2019 年早得多:Andrey Markov 分析普希金《叶甫盖尼·奥涅金》中的辅音–元音转换(1913);Claude Shannon 在《A Mathematical Theory of Communication》中的 n-gram 模型、熵与文本生成(1948);以及 Frederick Jelinek 在 IBM 的团队在 1975 年定义并命名了用于下一词预测的现代概率式语言模型,被用于拼写纠错、语音识别和机器翻译。幻灯片真正的点睛之笔对理解这次范式转移至关重要:几十年来这项技术并不被视为通向有智能的机器的道路 —— 人们认为,要做到那个,你需要记忆模型、知识表示、规划与抽象概念上的推理。范式转移恰恰就是这一判断的反转。
(参考时间:00:24:20 —— ChatGPT 与 GPT-4)
下一次转变是一次用户体验上的成功,Manning 强调它很重要:有了 ChatGPT 和 GPT-4,你可以提问题或下命令,系统会做你想要的事。他的例子正是让这个系统出名的那类事。他打了一段请求,要它草拟一封礼貌的邮件给他的老板 Jeremy,说他接下来两天不能来办公室,因为他 9 岁的 "song" 不舒服 —— 这是 son(儿子)的拼写错误 —— 还说 Peter 因为他没受到多少关注而生气。系统生成了一封通顺的邮件,悄悄改掉了那个拼写错误,而且完全没提歌曲的事。Manning 的评论是:尽管有错字,系统照样运行得很好,因为它知道人会拼错字。
(参考时间:00:25:15 —— 多模态与基础模型)
接着 Manning 把镜头拉宽。近来的模型是多模态的:它们跨模态运作,你可以问它们诸如"这张图有什么不寻常之处?"之类的问题。斯坦福对这次泛化的说法 —— 他注明是团队造的词 —— 是基础模型(foundation models):同一项技术被应用到图像、声音、诸如 DNA 和 RNA 这样的生物信息信号、地震波 ——"任何种类的信号"。
文生图是最清晰的演示。他要一张火车驶过金门大桥的图(并给不在湾区的 Stanford Online 听众加了一句说明:金门大桥上没有火车),然后得到了一张。接着他反复迭代,每一次迭代都很好地展示了请求如何成为模型的一部分:
- 第一张图没显出海湾,于是他要背景里有海湾 —— 得到了。
- 他想要不同的风格,于是要一张细致的铅笔画 —— 得到了。
- 只有火车过桥太不真实,于是他要火车和汽车 —— 两者都有了。
- 换一个更新的模型,他升级到完整场景:一幅图像小说风格的插画,满月之下的繁华城市街道,一位火红头发的年轻女子身披天鹅绒斗篷,正与一位脾气暴躁的老摊贩讨价还价,还有一位高挑精致、西装笔挺、胡子引人注目的男人正对着一部蒸汽朋克电话滔滔不绝地讲话。
他的玩笑 —— 说这些画是他自己画的,所以听众应该感到惊叹 —— 同时也是教学要点:模型跟随一段长而具体、可组合的描述,而输出可以辨认出是同一个想法以不同风格呈现出来的。
编者拓展 —— "基础模型"。 这个词出自斯坦福基础模型研究中心的 On the Opportunities and Risks of Foundation Models(Bommasani 等,2021)。其定义上的动作正是 Manning 的做法:一个模型,在大规模广域数据上预训练,再适配到许多下游任务和模态 —— 而不是每个任务单独定做一个模型。
编者关于规模数字的说明。 两张历史幻灯片给出的数字让"LLM 一路狂飙"的转变变得具体:1998 年在 2 亿词语料上的三元"LLM";Bengio 等人在 2000 年的第一个神经语言模型,在 32M token、31K 词表上训练;2007 年在 2 万亿 token 语料上的 n-gram 模型;2018 年的 GPT-1 和 BERT,在 33 亿 token 语料上训练;以及 2020 年之后在超过一万亿 token 上训练的千亿参数以上模型。幻灯片给早年标注的是"算力不够"、"模型灵活性不够"、"数据不够"—— 要点在于变的与其说是架构,不如说是资源。
6. 从指称语义到 WordNet:为什么词典对计算机行不通
(参考时间:00:28:20)
现在讲座转向技术核心,从"意义是什么"这个问题开始。Manning 读了一条词典定义:意义是某个词或短语所表示的观念,是一个人想通过用词来表达的观念。他说,在语言学里,思考这件事最常见的方式是把它看作能指(signifier)(一个符号、一个词)与所指(signified)(一个观念或事物)之间的配对。技术上的名字是指称语义(denotational semantics):那个观念或事物就是符号的指称(denotation)。
他指出同一个概念也被用于编程语言。while、if 和变量都是符号,它们有意义 —— 那就是它们的指称。而在自然语言里,tree 的意义大致就是你在世界各地能找到的所有树。
由此引出两件事,而 Manning 对第二件说得很明白:
- 这是一个流行、完全合理的意义概念,但它从来没有很清楚地告诉我们在计算上该拿它怎么办。
- 因此,前神经时代的各种方法退回到一个原始得多的东西上:去看词以及它们彼此之间的关系。
这一类资源的标准是 WordNet,他把它形容为一部"有点花哨的同义词典",记录词与词的关系 —— 同义关系与 is-a(上位词)关系:
- 熊猫是一种食肉动物,食肉动物是胎盘哺乳动物,胎盘哺乳动物是哺乳动物。
- Good 有多个义项:一件 trade good(贸易品),或者"善好"这个义项。
- 你可以沿这些关系的图去探索。
然后就是问题,配一个让人记得住的例子:
- 细腻之处丢失了。 WordNet 会告诉你 proficient 是 good 的同义词。但想想 "that was a good shot" 这样的句子 —— 你会说 "that was a proficient shot" 吗?在 Manning 听来,这很奇怪。词在实际使用中有色彩和细腻之处,而关系图无法表示。
- 覆盖率不完整。 任何更酷、更新、更俚俗的东西都缺失 —— 而且当年就已经缺失,不只是今天。
- 它完全是人工编的,随之而来的是昂贵、不一致与陈旧。
结论就是整堂讲座的转折点:我们能不能用另一种方式来表示意义?
编者拓展 —— WordNet 是如何组织的,以及为什么这种结构正是问题所在。 WordNet 的单位不是词,而是同义词集(synset):一组共享同一义项的近义词(于是 bank 既出现在一个金融同义词集里,也出现在一个河岸同义词集里)。同义词集之间由语义关系相连 ——
is-a的上位/下位关系、部分–整体的部分/整体关系、反义关系等等。这正是它作为词汇数据库很好、作为意义的计算模型很差的原因:它是离散的、稀疏的、扩展起来昂贵,而且它存储的是关系而不是相似程度。WordNet 里没有一个数字告诉你两个词有多相似,而那个数字恰恰是下一节要学着算出来的东西。编者拓展 —— 为什么"proficient shot"是个恰当的测试用例。 同义替换的可替换性对上下文敏感:good 和 proficient 在指称上有重叠,但在选择偏好和内涵上不同(对任务的娴熟 vs. 对象或结果的质量)。这是讲座中第一次暗示:意义必须被表示成有程度、依赖上下文的东西,而不是一个二值关系。
7. 词向量:把意义表示为数字
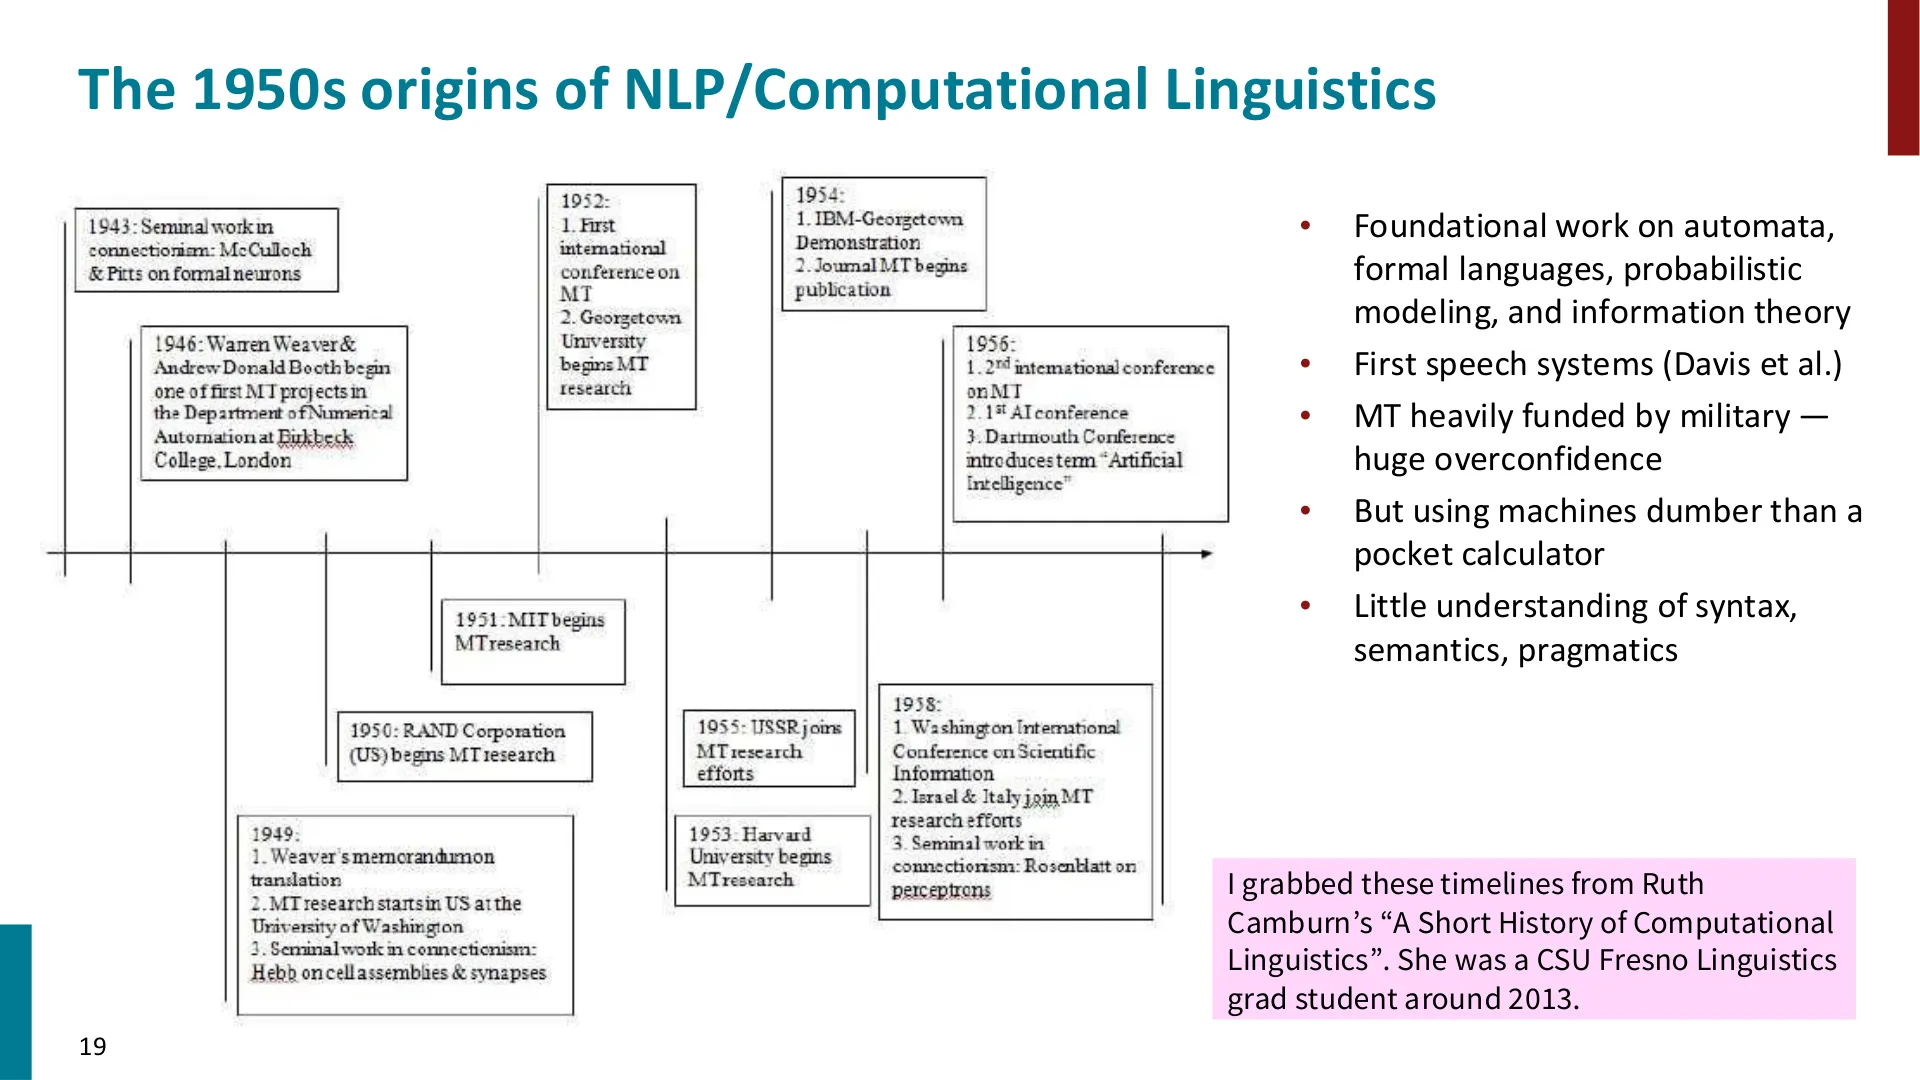
🖼️ Manning 在开启深度学习部分时说,语言工作始于 1950 年代,并挣扎了六十年;这一页正好总结了那个早期时代取得了什么、又错在哪里(过度自信的机器翻译、孱弱的硬件、对句法和语义知之甚少)。
(参考时间:00:31:20)
现在问题变得具体了:当我们有 wicked、badass、nifty、wizard 这样的词时,它们在计算机内部变成了什么?
出发点是:词是离散符号 —— 本质上是原子。把符号喂给数学系统的常规做法是给它一个词表里的索引:motel 是词表里的这一项,hotel 是那一项。计算系统把字符串索引成数字,数字又给出向量里的位置。由于词表巨大,这些向量也巨大:这就是独热向量(one-hot vector)表示,Manning 指出它被用了几十年。
接着他补进一个他刚才忘了说、要往回翻两页的术语:这些是局部表示(localist representations)——意思是词被表示在一个单独的点上。这里是 motel 的位置;那里是 hotel 的位置。
(参考时间:00:32:45)
为什么独热向量是一种糟糕的"用意义做计算"的方式:
- 所有词都一样地不相关。 从内在意义上讲,hotel 和 motel 并没有更近一说。它们就是两个不同的符号,只是 1 落在不同位置。
- 从形式上讲,它们正交,点积为零。 两个向量毫无关系。
- 人们的变通办法是另建一套词的相似度资源去查 —— 在网页搜索里这叫查询扩展(query expansion)—— 但要点依然成立:独热向量内部没有天然的相似性概念。
(参考时间:00:34:00)
接下来这个想法是:如果我们能学着把相似性装进向量本身呢?
这些就是词向量(word vectors),也叫词嵌入(embeddings)或神经词表示。Manning 陈述的性质如下:
- 它们又短又稠密 —— 是实数向量,不是跟词表一样长的向量。幻灯片展示 8 维向量纯粹是为了能塞进一页;实践中长度可能是 200 或 2,000,而词表里有五十万个词。
- 相似性是内建的,通过点积表达出来。他用 banking 和 monetary 走了一遍算术:两者在第一维都是正的,在第二维都是正的,在第三、第四维符号相反。点积把对应分量相乘再求和;当分量同号时它就变大,而当分量绝对值都大时它变得更大。所以点积大就意味着相似。
- 它们被称为嵌入,是因为我们可以把每个词想成高维空间中的一个点,而那个空间的维度就是向量的长度。
(参考时间:00:38:15 —— 关于高维直觉的提醒)
Manning 在一个初学者系统性地搞错的点上停留了一下。人类没法看一个 300 维的空间,也没法在脑子里想象里面发生什么,所以他能展示的每张图都是二维的 —— 但高维空间的行为与二维空间极其不同:
- 在二维里,你只有在 x 和 y 上都靠近时,才算离另一样东西近。
- 在高维空间里,一个点可以同时在多个不同维度上靠近各种各样的东西。
正是这个性质让单个向量能够捕捉好几种相似性、以及一个词的多个义项。
(参考时间:00:43:00 —— 学生提问)
这里有三个学生提问值得留下,因为它们正是初学者真正会问的问题。
- 维度怎么选? 靠经验或实践。大约 100 维时事情开始运作良好;很长一段时间里人们用 300,因为它看起来效果挺好;随着模型和数据集变得大得多,1,000 甚至 2,000 维越来越常见。
- 各个分量限制在 −1 到 1 之间吗? 不一定,而且就这些向量被学出来的方式而言,它们并不有界。你可以给它们加界:有时人们会做长度归一化(length-normalise),让向量长度为 1。一般而言,用正则化(regularisation)来防止系数变得巨大。
- 我们只用距离,还是也用方向? 不只是距离 —— 空间中的方向也携带语义,他承诺很快会给一个例子。
关于上下文的一个问题也在这里出现了,而 Manning 的回答界定了本讲的范畴:目前,模型对每一串字母学一个向量。所以 star 得到一个单一向量,它不会把好莱坞明星和天文恒星区分开来。它会做的是既靠近 nebula 这样的天文词,同时靠近 celebrity 这样的词。这件事的细节是本书的最后一节,而修正它的上下文表示会在课程后面出现。
编者拓展 —— 独热、局部、分布式。 Manning 画的对比就是经典的局部表示 vs. 分布式表示(localist vs. distributed)之别。局部编码把一个单元分给一个概念,所以 $n$ 个概念需要 $n$ 个单元,任意两个编码都正交:$\text{motel} \cdot \text{hotel} = 0$。分布式编码把一个概念摊到许多单元上,并在概念之间复用这些单元,所以 $n$ 个概念可以用远少于 $n$ 个单元来表示,而相似性变成一个可计算的量 —— 两个编码的点积。课程后面所有有意思的东西(权重绑定、在词表上做 softmax、句子表示之间的余弦相似度)都依赖于这次表示方式的改变。
编者拓展 —— 点积 vs. 余弦相似度。 点积既随向量的模长增长,也随它们的对齐程度增长。余弦相似度 $\cos(u,v) = \frac{u \cdot v}{\lVert u \rVert \lVert v \rVert}$ 去掉了模长,只衡量方向。这就是为什么对向量做长度归一化(上面学生的那个问题)是如此常见的操作:它把"点积大"变成"方向相同",而当你问两个词是否相似时,通常想要的正是后者。
8. 分布语义:从词所结交的伙伴中获得意义
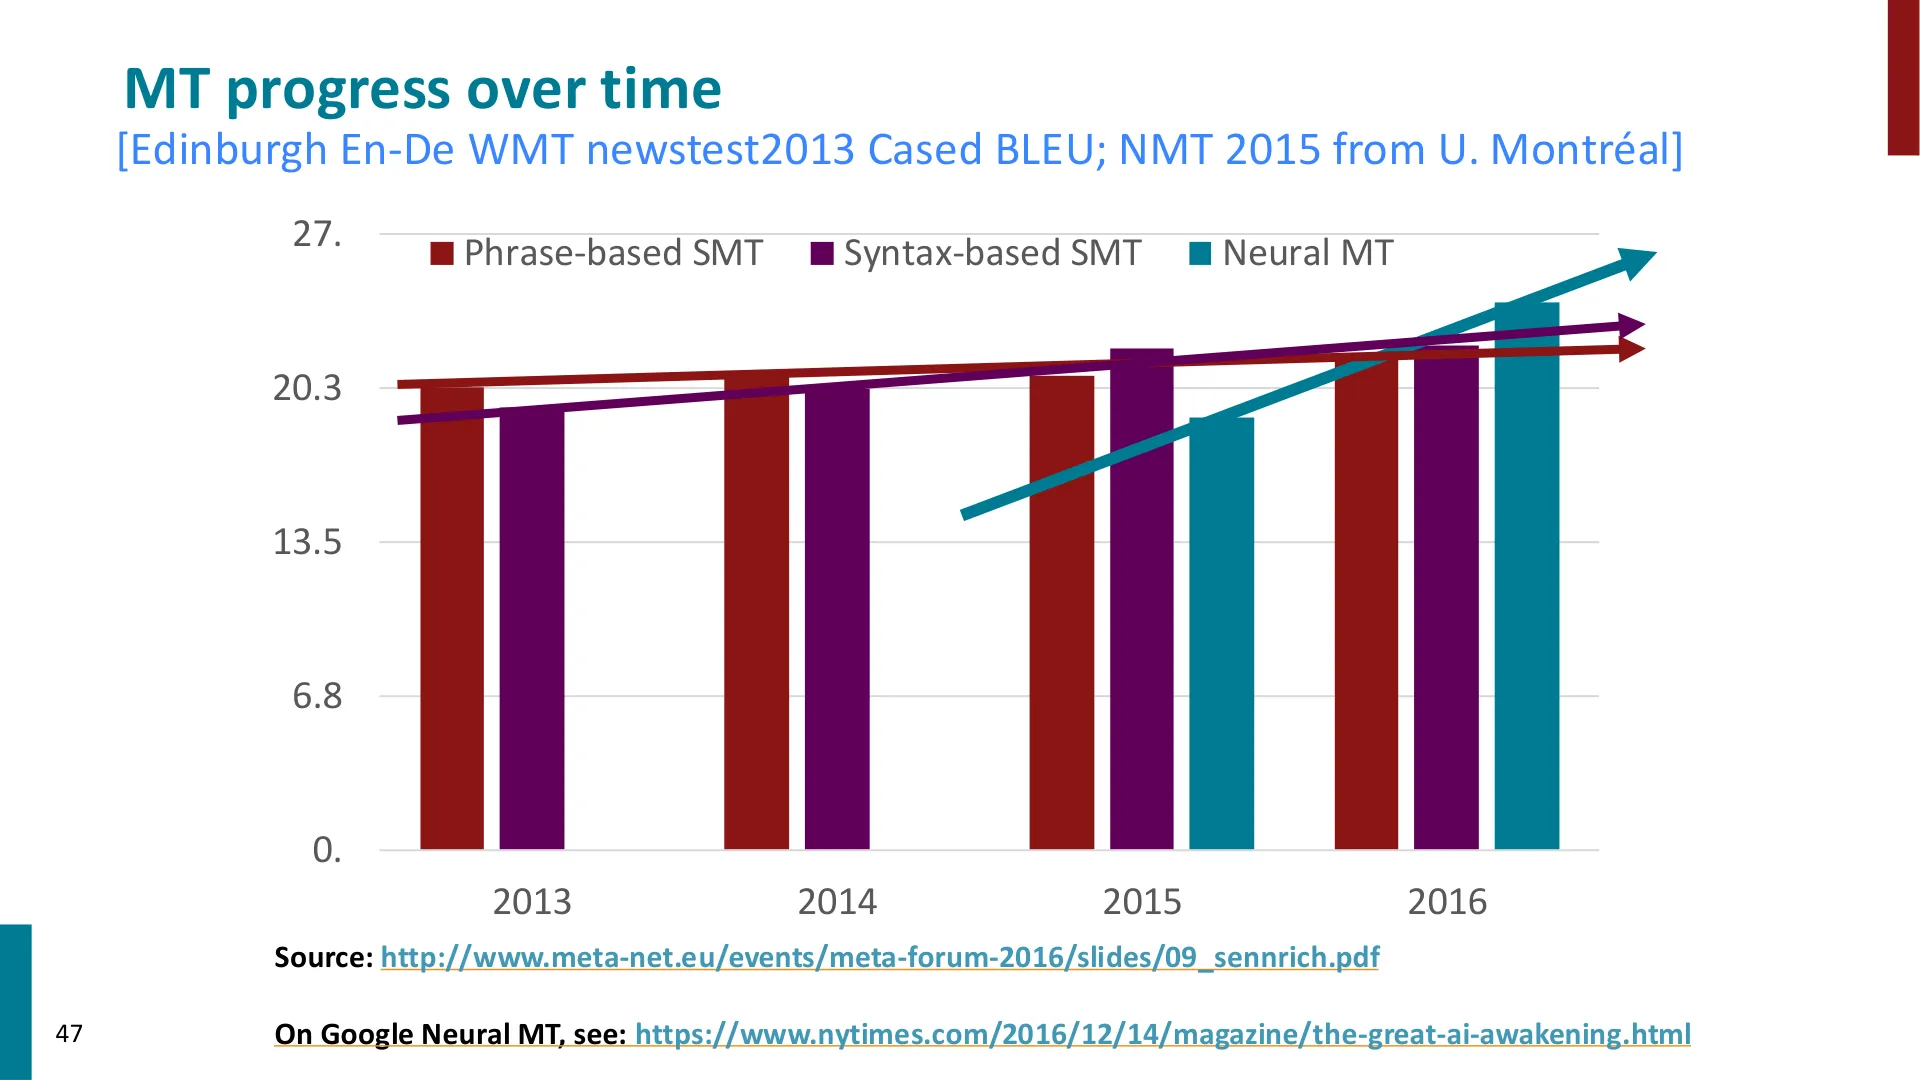
🖼️ 这张图展示了 2013 到 2016 年间从基于短语和基于句法的统计机器翻译到神经机器翻译的跃升,正是 Manning 所说的"神经机器翻译好到几乎立刻投入商业部署"这一论断背后的确切证据。
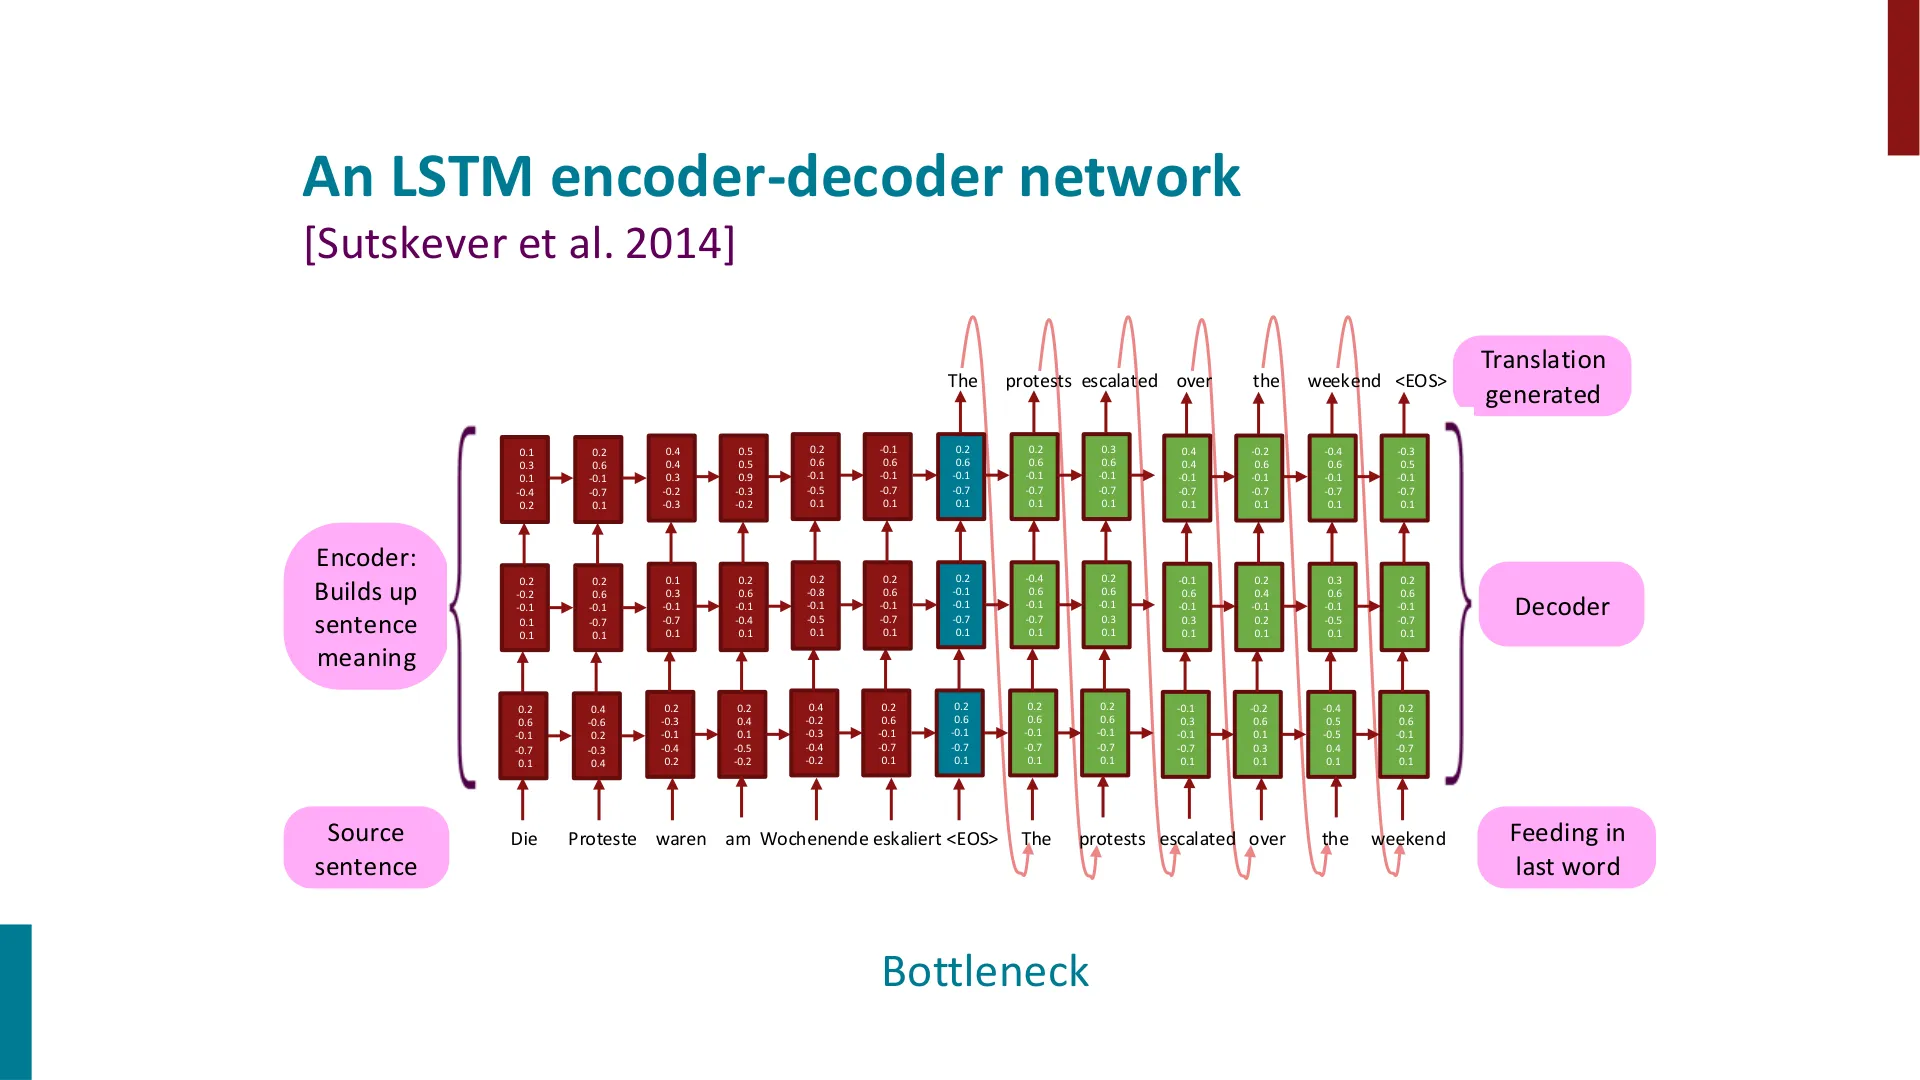
🖼️ 这是编码器-解码器图,配以 Manning 用文字给出的标签 —— 编码器建立句子意义,解码器生成译文并接收上一个词 —— 还包括一个具体的德译英例子。
(参考时间:00:34:55)
关于意义还有一个更古老的想法,词向量方法其实是在实现它。Manning 引用了人人都引的那句话,出自英国语言学家 J. R. Firth(1957):
"You shall know a word by the company it keeps."(观其伴,知其义。)
这个想法还可以再往前追,追到 Wittgenstein 等人的哲学工作:用一个词所出现的上下文来表示它的意义。一个词周围出现的词携带着关于它意义的信息。这就是分布语义(distributional semantics),与上一节的指称语义相对。
具体来说,如果我们想了解 banking 这个词,就收集用到它的句子 —— 他的例子是那种财经新闻句子,"government debt problems turned into banking crises, as happened in 2009"。在这类句子里出现在 banking 周围的词 —— debt、problems、crises、government —— 成为了 banking 的意义。
所以计划是:
- 取语料库中哪些词出现在哪些词附近的统计量。
- 用这些统计量学出一种新的表示:一个又短又稠密、捕捉该词意义的向量。
(参考时间:00:39:00 —— 学出来的空间长什么样)
预期的回报是几何上的:如果两个词彼此有关,它们最终会得到相似的向量,即大的点积。这类空间的二维投影就是 NLP 课上那些著名的图,而 Manning 放大到两个区域,说明那里的结构不只是"互不相关的词堆成的簇",而是真正可解读的:
- 一片国家与地点词的区域,附近有 British、Australian、American、European 这样的国别词。
- 一片动词的区域,且有细致的结构:
- 表示交流、陈述与思考的动词 —— saying、thinking、expecting —— 聚在一起;
- come 和 go 聚在一起;
- have 的种种形式在更下方;
- be 的种种形式在它们之上;
- 而 become 和 remain 靠近 be,因为它们接的是同一类状态补足语:正如你可以说 "I am angry",你也可以说 "he remained angry" 或 "he became angry"。
所以这个空间确实有语义结构:意义相近的东西彼此靠近,而且邻域是有信息量的。剩下的问题 —— 也是本讲的技术内容 —— 就是我们如何到达那里。
(参考时间:00:43:20 —— 关于那些图的学生提问)
有学生问,高维空间是怎样降维到低维来可视化的。这些图用的是 t-SNE,一种非线性降维方法,对高维神经表示往往比 PCA 效果更好,而 PCA 是别的课上更常见的那种。
编者拓展 —— t-SNE 做了什么,又没做什么。 t-SNE(van der Maaten & Hinton, 2008)把点摆到二维里,使得原空间的邻域结构大致保留:原本靠近的点保持靠近,原本离得很远的点被推开。看上面那些图时,有两点要注意。第一,t-SNE 图里簇与簇之间的距离没有意义 —— 只有邻域有意义。第二,这个方法本身是随机的,所以不同的运行会给同一个空间画出看起来不同的图。不要把 t-SNE 图当成一张有比例尺的地图来读。
编者拓展 —— 预测这件事的检验。 注意目标函数实际会是什么:从中心词预测上下文词,而不只是统计共现。这正是经典分布语义文献(先计数,再降维,例如用 SVD)与这里所教的神经方法(通过在一个预测任务上做梯度下降来学向量)之间的关键区别。讲座在说这些向量是预测模型的参数时,隐含地表达了同一个意思。
9. Word2vec:通过预测附近的词来学习向量
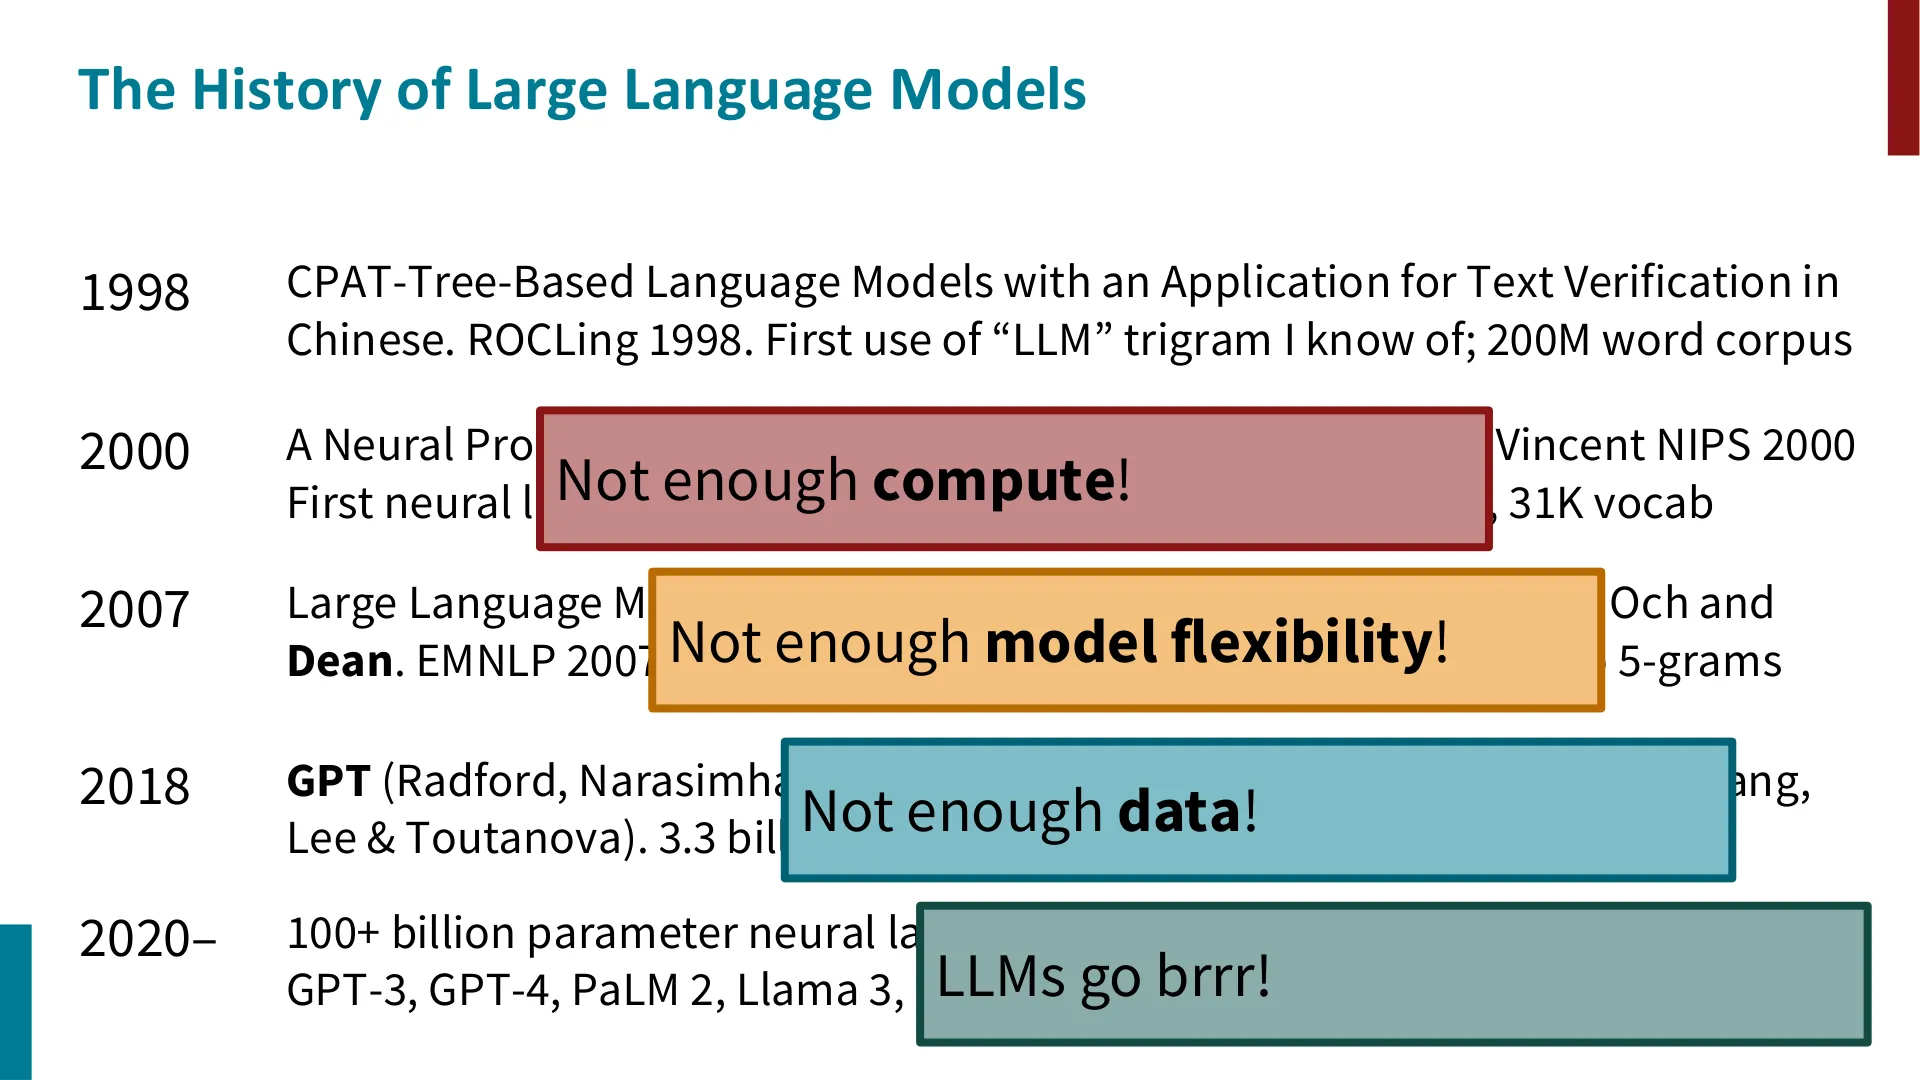
🖼️ 大语言模型的带注释时间线(1998 到 2020+)展示了 GPT-2 与 ChatGPT 讨论背后数据与模型的规模,包括在算力、模型灵活性和数据上标注的瓶颈。
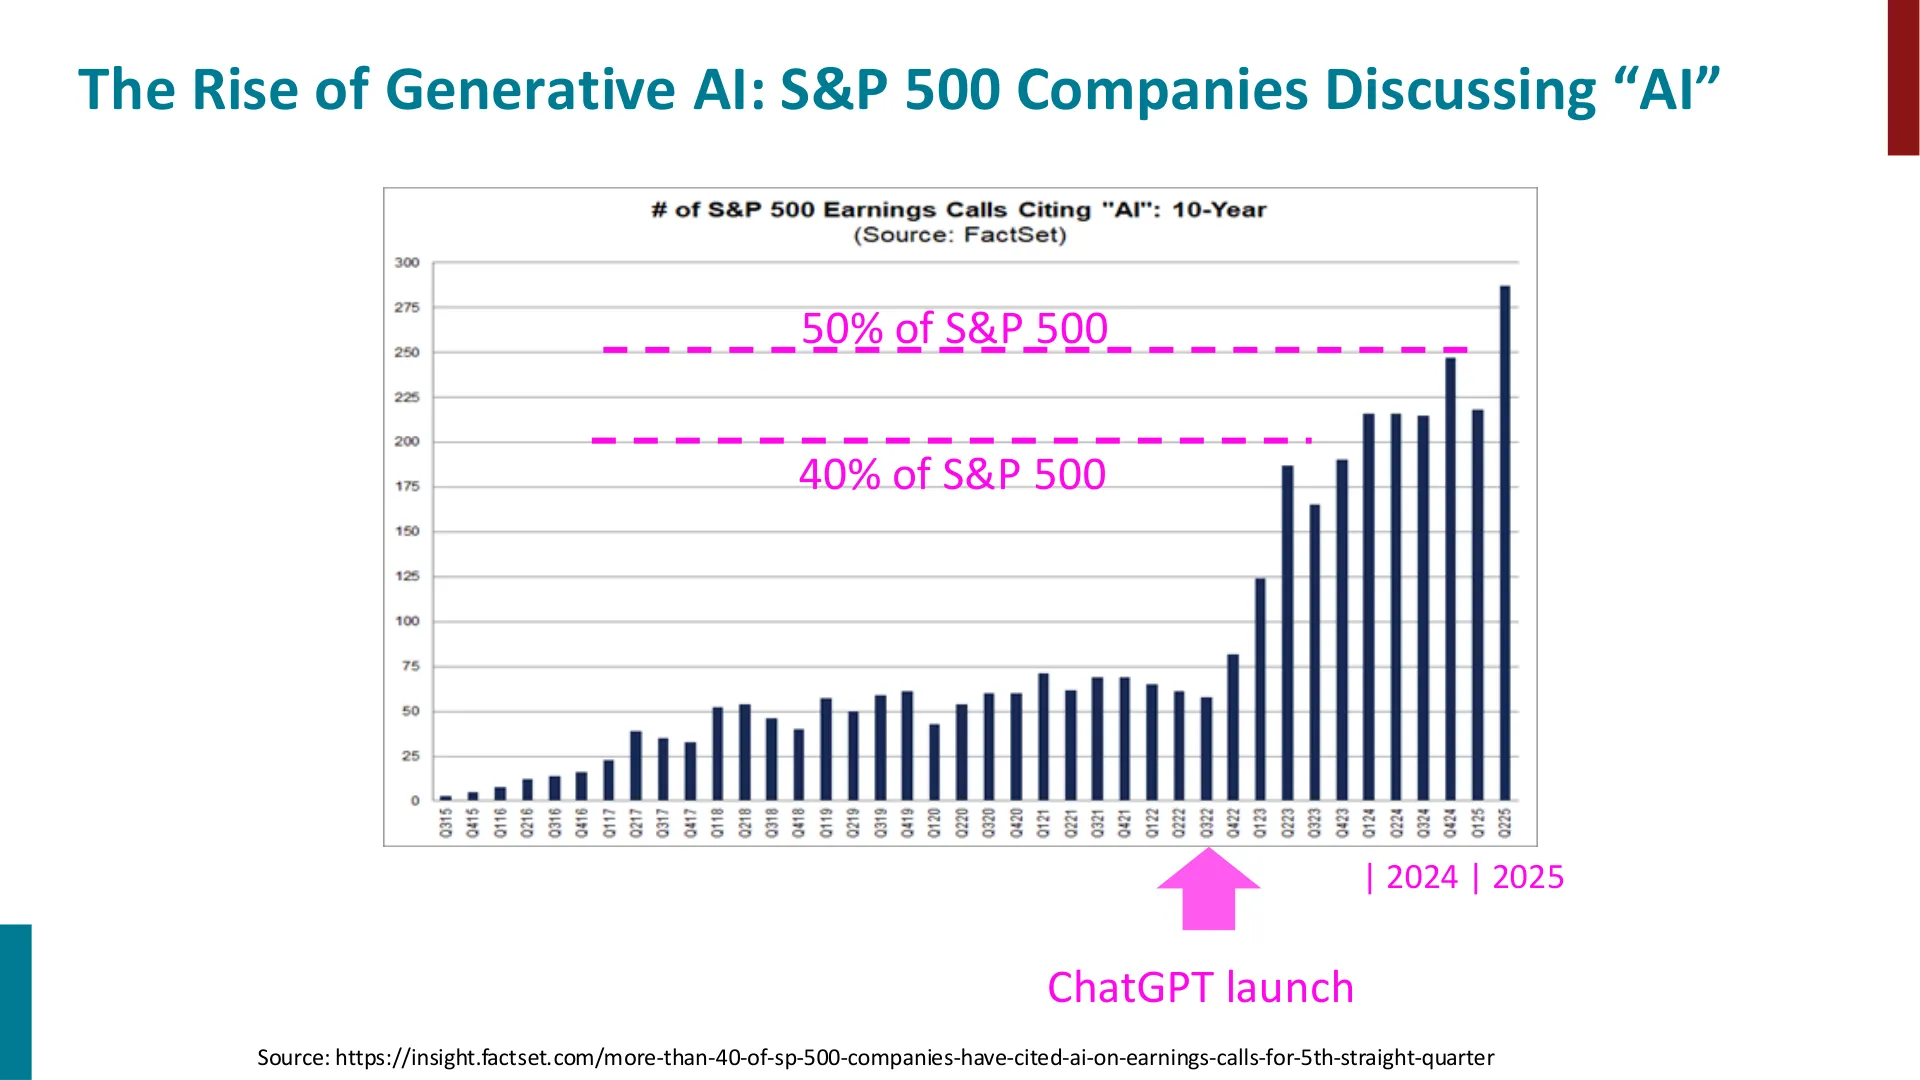
🖼️ Manning 强调 ChatGPT 是一次巨大的用户层面的成功,全世界都开始谈论 AI;这一页标出 ChatGPT 的发布,以及标普 500 公司中 AI 讨论的激增。
(参考时间:00:47:12)
现在 Manning 介绍本讲其余部分所讲的算法。word2vec 由 Tomáš Mikolov 及其在 Google 的同事于 2013 年提出。关于它的地位有三点:
- 它不是第一个学习词向量的方法 —— 别的可以追溯到世纪之交前后。
- 它也不是最后一个;在它之后还有别的方法。
- 但它特别简单、特别快,而这正是吸引人们注意的地方。
9.1 语料库、词类型与滑动窗口
(参考时间:00:47:45)
输入是大量文本:只是一长串词。在 NLP 里这叫语料库(corpus)—— 拉丁语里"身体"的意思。Manning 在这里停下来讲了一个值得保留的笑话,因为它同时让这个术语好记:没错,corpus 跟拉丁语里躺在地上的尸体是同一个词,但我们指的是文本的躯体。而且,由于古典教育已不复当年,他还补了一点词法:corpus 尽管以 -us 结尾,却是一个第四变格中性名词,所以它的复数不是 "corpys",而是 corpora。他补了一句:早晚他会读到一份项目作业里写着 "corpys",而那个人就等于证明了自己第一讲没认真听。
还有两个定义,全程都会小心使用:
- 词类型(word type)是作为词表条目的词 —— star、bank,无论它出现在哪里。
- 词例(word token)是那个词在文本中的某一个具体实例。
这个算法为每个词类型学一个向量。
机械设置:
- 走遍文本中的每一个位置。
- 每个位置都有一个中心词(center word) $c$,以及它之外、在一个固定窗口内的词,窗口大小为 $m$(例子中 $m = 2$,即左边两个词、右边两个词)。
- 用中心词与外部词的向量相似度来计算这些外部词出现在中心词附近的概率 —— 并让这个概率在观测数据上尽可能高。
他的具体例子是一个片段,其中出现 problems turning into banking crises 这些词,而模型必须回答的问题是:turning 出现在 into 之前有多可能,以及对每个位置周围的窗口里的词依次类推。模型显然不可能把这类问题答得很好 —— 看到 banking 并不能告诉你 into 会出现 —— 但 Manning 的标准谦逊而精确:在 banking 之后,crisis 应该相当可能,而 skillet 则不应该。能做到这一点就是干得不错。
9.2 从似然到目标函数
(参考时间:00:52:00)
把这个想法变成数学需要三步,每一步他都以"方便"为由给出理由:
- 最大化一个似然。 对语料里的每个位置、以及它上下文窗口里的每个词,我们希望观测到的上下文词的概率尽可能高:
$$L(\theta) = \prod_{t=1}^{T}\ \prod_{\substack{-m \le j \le m \\ j \ne 0}} P(w_{t+j} \mid w_t)$$
- 在前面加一个负号。 "出于完全随意的理由 —— 真的没什么差别 —— 大家都养成了最小化而不是最大化的习惯。"所以这些算法叫梯度下降,而我们处理的是负对数似然。
- 取对数。 处理一个巨大的乘积对数学来说更难;但乘积的对数是和。于是我们不去乘许多概率,而是把许多对数概率加起来。
最后,由于这个和否则会随语料长度增长,他除以词的个数,得到目标函数:
$$J(\theta) = -\frac{1}{T}\sum_{t=1}^{T}\sum_{\substack{-m \le j \le m \\ j \ne 0}} \log P(w_{t+j} \mid w_t)$$
这就是平均负对数似然,最小化它就等于最大化上下文词的概率。
9.3 唯一的参数就是词向量
(参考时间:00:54:50)
下一个诀窍定义了模型要最大化的那个概率。每个词类型由一个实数向量表示 —— 比方说 100 个数 —— 而这个概率只从这些向量算出来。Manning 明确说,这意味着模型的参数 $\theta$ 不外乎词表中每个词的词向量。那是很多参数,但除此之外什么都没有。
给定中心词 $c$ 时外部词 $o$ 的概率,是用两个向量的点积定义的:
$$P(o \mid c) = \frac{\exp\!\left(u_o^\top v_c\right)}{\sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right)}$$
点积高就意味着共现概率高。Manning 加了一句关于这里"相似"是什么意思的诚实提醒。是的,我们希望 hotel 和 motel 相似。但我们也希望 the 能容易地出现在 student 前面 —— 所以在这个古怪的意义上,the 也必须跟 student 相似,事实上跟几乎任何名词都相似。这暗示了这个模型有多粗糙:它是每个词一个向量,而学到的"相似性"是共现的相似性,不是词汇意义的相似性。
9.4 每个词两个向量
(参考时间:01:02:30)
还有一个设计细节,他说它让数学简单一点:每个词得到两个向量 —— 一个是词作为中心词 $v_c$ 时用的,一个是它作为外部词 $u_o$ 时用的。他承诺稍后解释好处,而好处会在推导中显现:它让梯度有一个干净的形式。
参数数量于是很容易算,而他也确实算了,因为它展示了被优化的东西有多大规模。用 100 维向量和 40 万词的词表:
$$400{,}000 \times 2 \times 100 = 80{,}000{,}000 \text{ parameters}$$
八千万个参数等着你去摆弄。"还好,我们有大型计算机。"
graph TD
    A["语料库:一长串词"] --> B["在每一个位置上滑动一个大小为 2m+1 的窗口"]
    B --> C["中心词 c,窗口 m 内的外部词 o"]
    C --> D["为每一对打分:u_o^T v_c"]
    D --> E["在整个词表上做 softmax"]
    E --> F["目标函数 J:平均负对数似然"]
    F --> G["计算 J 对 theta 中每个向量的梯度"]
    G --> H["走一步梯度下降:更新所有向量"]
    H -->|下一个位置| B
编者拓展 —— 这是哪一种 word2vec? 本讲的推导是skip-gram 变体配完整 softmax:从中心词预测上下文词,并在整个词表上归一化。原始论文同时介绍了 skip-gram 和 CBOW(从上下文预测中心词),而配套论文介绍了负采样(negative sampling),用二分类判别任务取代昂贵的归一化。讲座从未点出变体名称,但幻灯片上写下的目标 —— 对上下文词求和对数 softmax 概率 —— 就是 skip-gram。
编者拓展 —— 为什么完整 softmax 太贵,无法实用。 分母对每一个训练对都要在全部 $V$ 个词表词上求和,所以每步的代价与词表大小成正比。这正是负采样和层次 softmax 被发明出来要解决的计算问题,也是为什么本讲中概率的定义在教学上干净,却不是你会在大语料上实际运行的东西。如果你自己搭这个模型,这就是你想改的那一行。
10. Softmax:把相似度变成概率
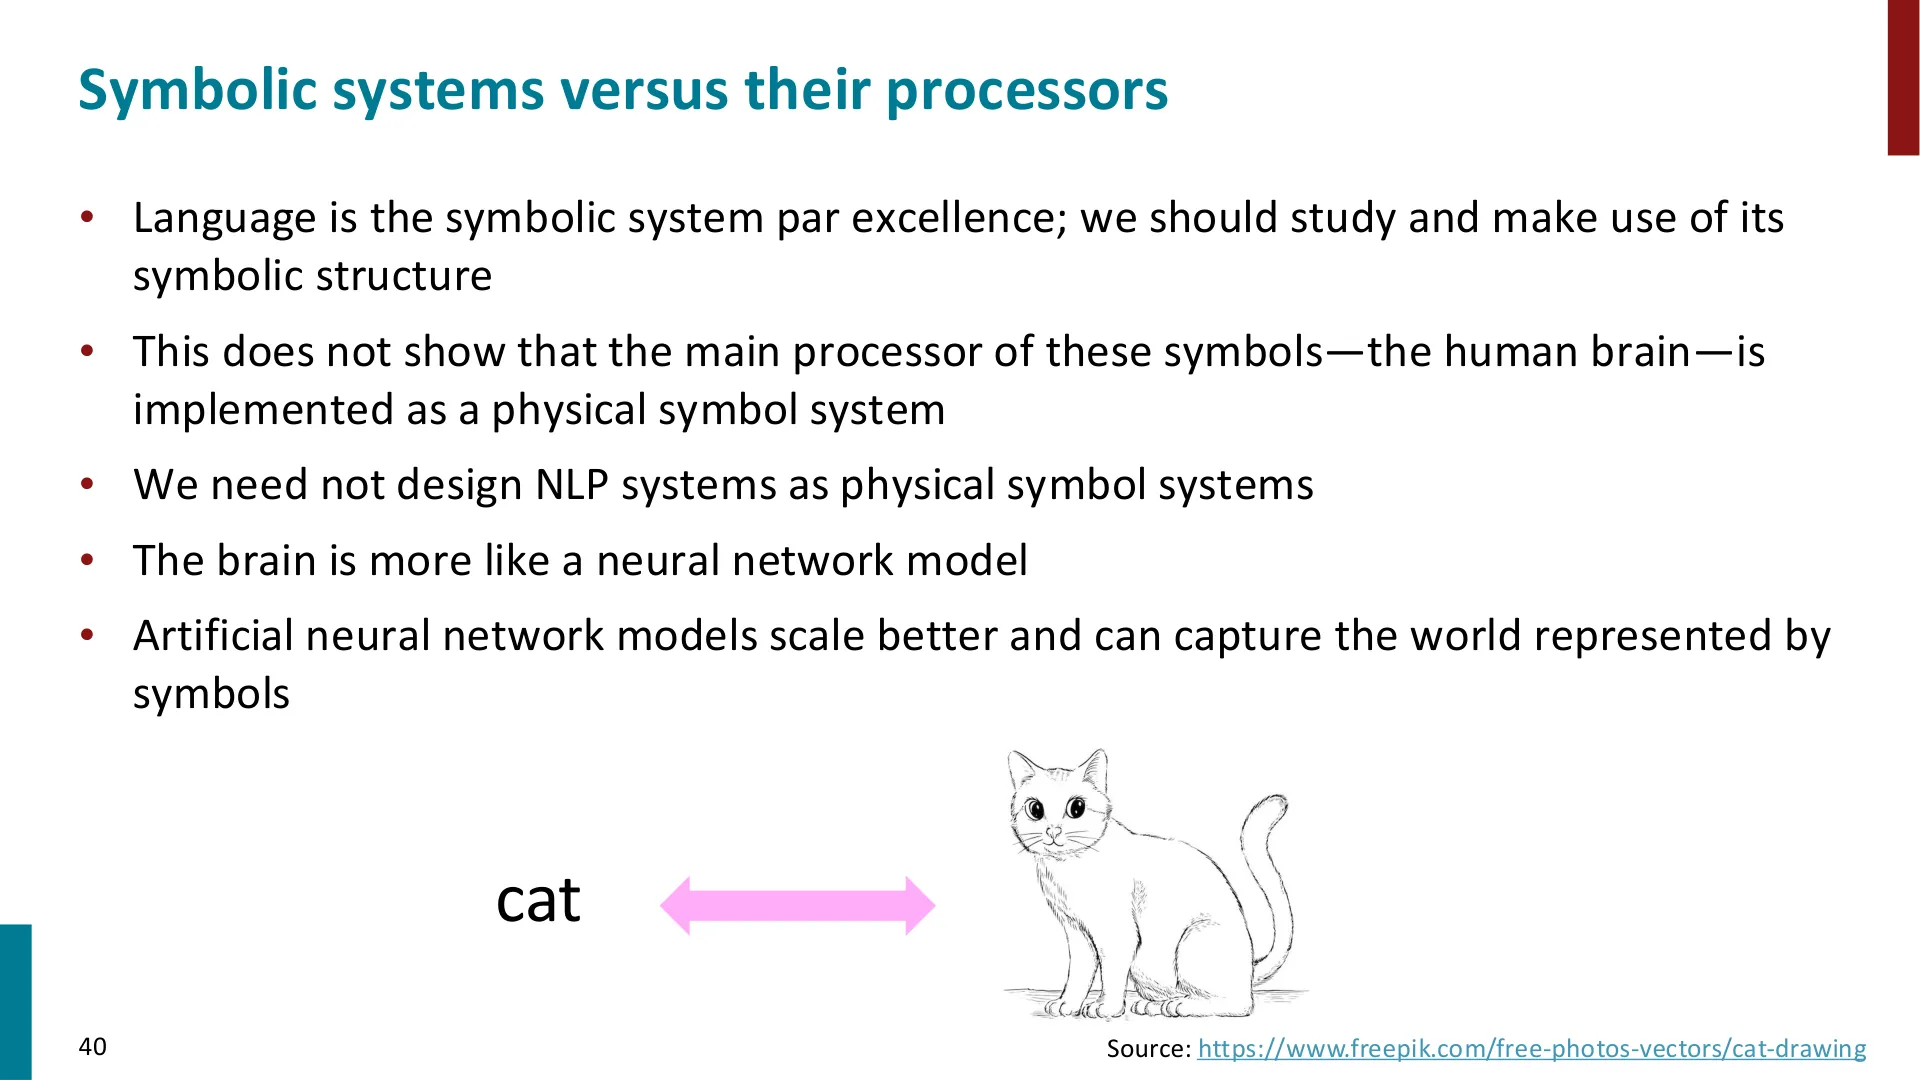
🖼️ 这一页恰好做出了 Manning 想引向的那个论断:语言是符号系统的典范,但大脑更像一个神经网络模型,而人工神经网络能更好地随规模扩展,同时捕捉符号所表示的世界 —— 从指称语义通向向量的桥梁。
(参考时间:00:56:50)
上一节的公式值得展开,因为它是整门课程会反复使用的工具。
从点积 $u_o^\top v_c$ 出发:
- 你把每对对应分量相乘再求和。
- 如果两个分量同号,就贡献正值;如果两者绝对值都大,就贡献很多。
- 所以点积是一种相似度的度量 —— 但它是一个无界的实数,可为负也可为正。
我们想从它得到一个概率。三步就能做到:
- 取指数。 $e^x$ 对任意实数 $x$ 都为正,所以指数保证非负。
- 归一化。 对每一个可能的上下文词都算出这个量,全部加起来,再除以总和 ——"用最笨的办法"把正数变成 0 到 1 之间的数。
- 读出一个分布。 结果是一个在上下文词上的概率分布,按构造就加和为 1。
$$\text{softmax}\!\left(u_o^\top v_c\right) = \frac{\exp\!\left(u_o^\top v_c\right)}{\sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right)}$$
这就是 softmax 函数。Manning 仔细解释了它的名字,因为初学者觉得它不直观:
- 它放大最大的那些值,靠的是指数 —— 这是名字里 "max" 的部分。
- 但它是软的(soft),因为较小的项仍分得一些概率,而不是被丢弃 —— 不像真正的
max,只挑出唯一一个。 - 所以这个名字"有点逗":softmax 把一堆无界实数变成一个概率分布,近似于一次最大化,但又没有真正咬定它。
结尾的话把这个工具一般化了:softmax 在深度学习中无处不在 —— 任何时候你有一堆 $\mathbb{R}^n$ 里的向量想要概率,就把它塞进 softmax。
graph LR
    A["点积 u_o^T v_c<br/>任意实数,可能为负"] --> B["取指数<br/>exp(u_o^T v_c) 恒为正"]
    B --> C["归一化<br/>除以全部 V 个词表词的求和"]
    C --> D["上下文词上的概率分布<br/>按构造加和为 1"]
编者关于数值实践的说明。 对无界分数取指数在数学上没问题,在数值上很危险:如果点积很大,
exp会溢出。真实实现会在取指数之前先减去最大分数 —— 结果仍是同一个分布,因为这个常数在分子分母里会约掉 —— 这个"平移最大值"的技巧在每一个深度学习框架里都是标配。你会在 HW2 和 HW3 里见到它。
11. 训练:目标函数、梯度与梯度下降
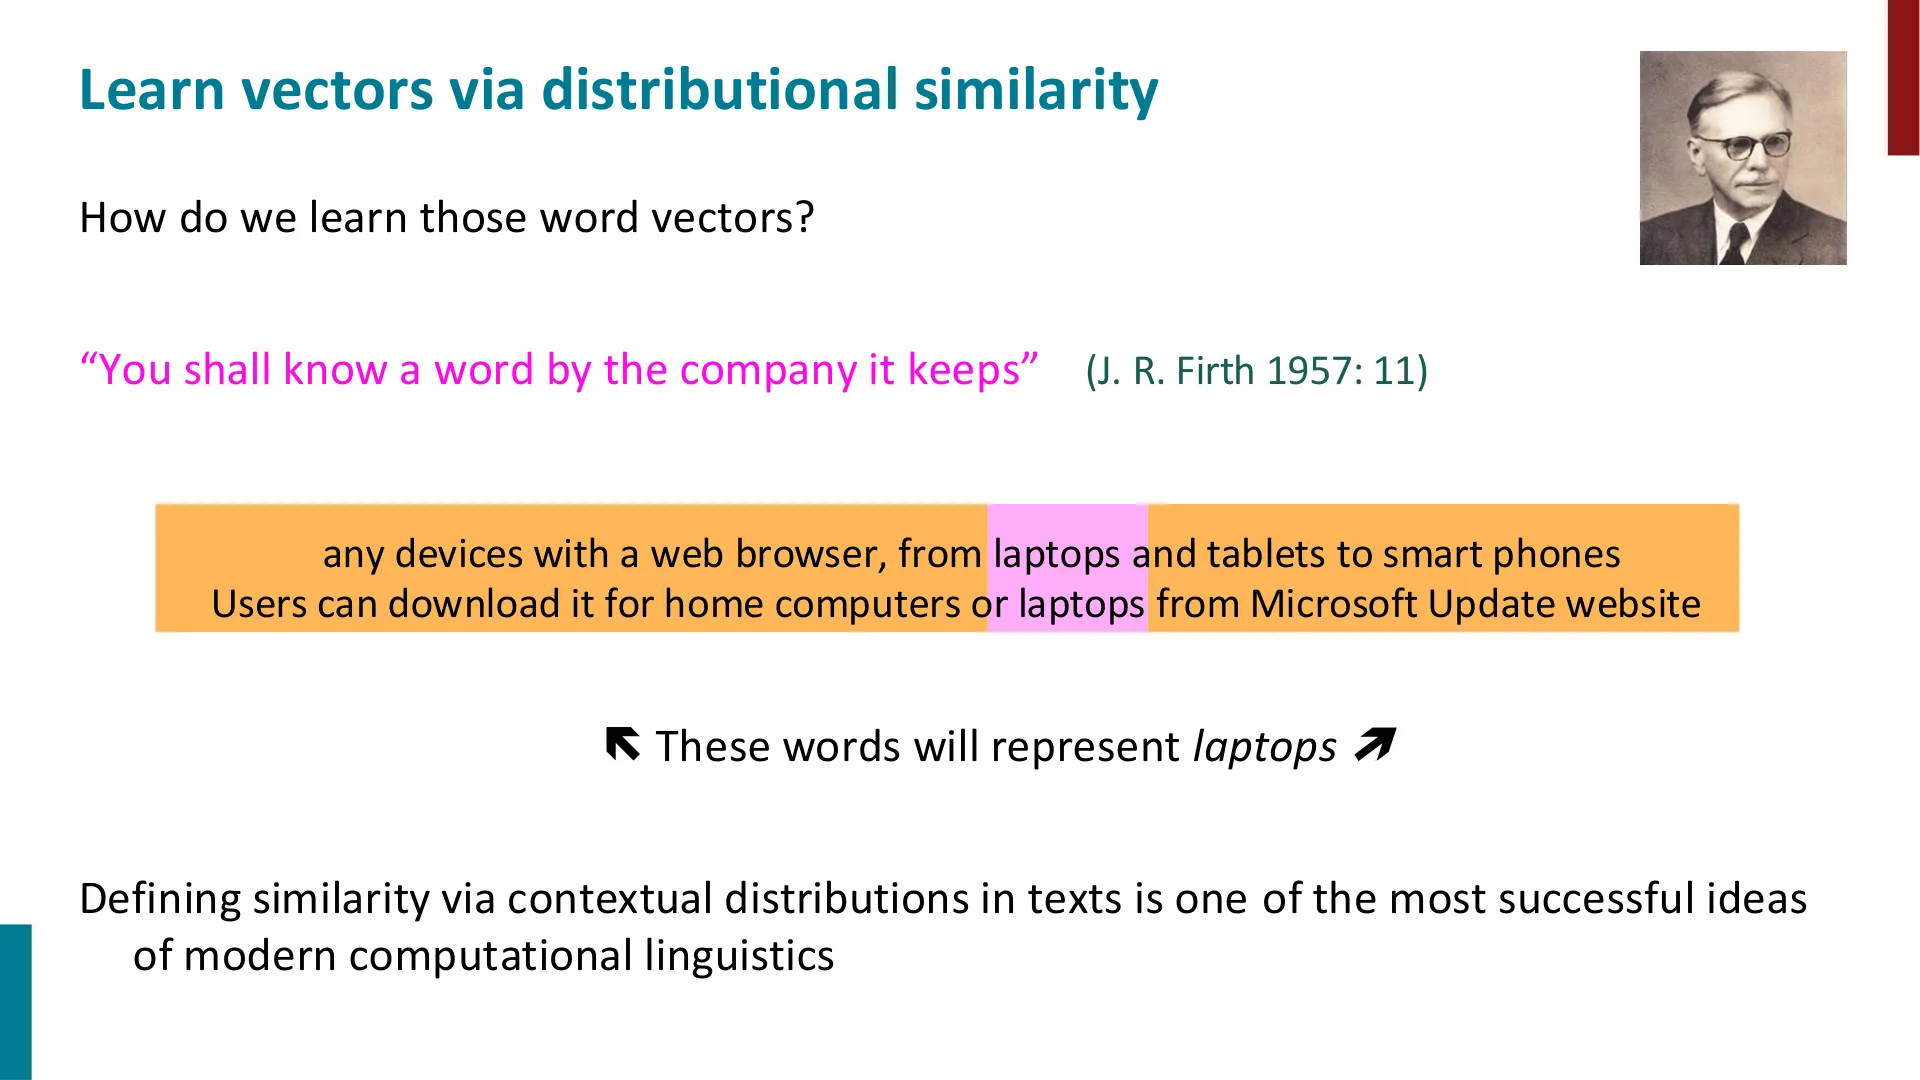
🖼️ Firth 那句"观其伴,知其义"正是 Manning 引入分布语义时所引的那句话,而这一页展示了共享的上下文词如何赋予 laptop 以意义。
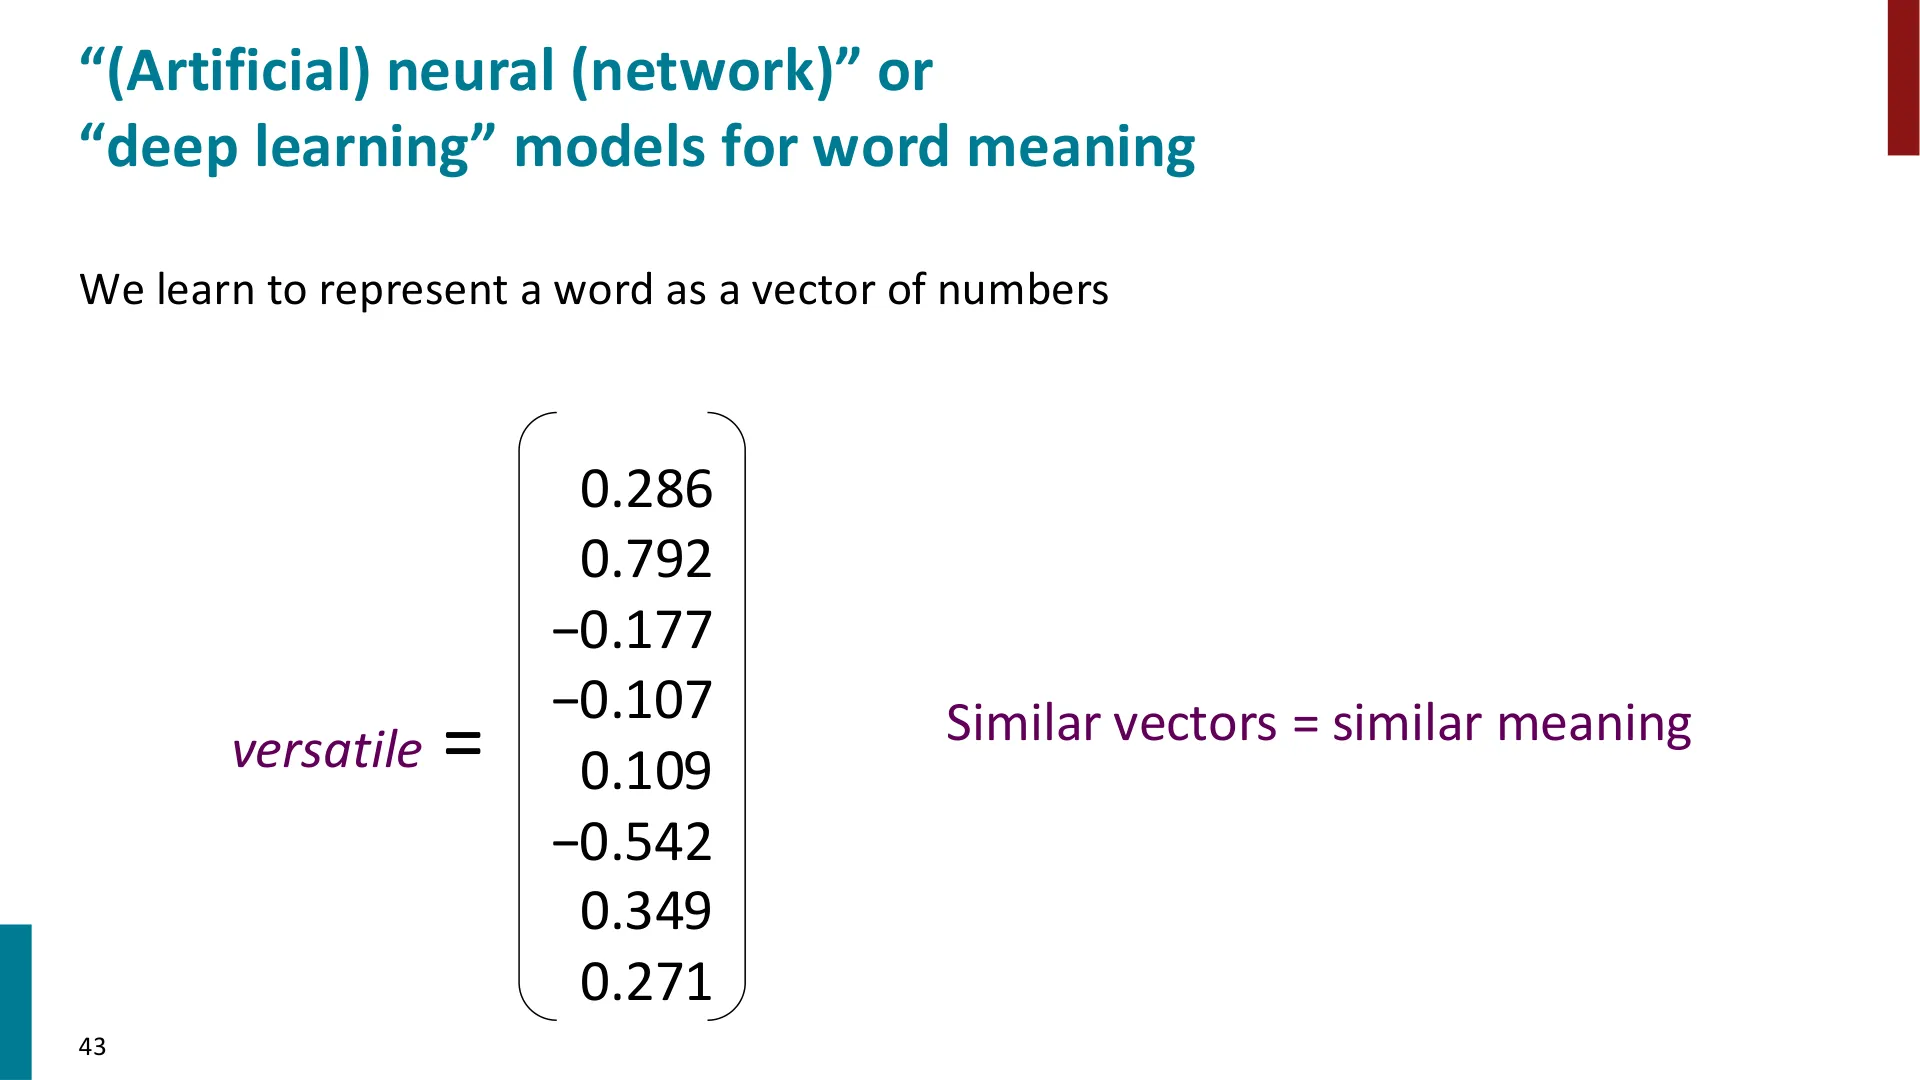
🖼️ 这是本节核心思想的一张图:像 versatile 这样的词变成一个数字向量,而相似的向量意味着相似的意义。
(参考时间:01:00:00)
现在图景完整了,只剩一个关键问题:这些向量从哪来? Manning 的回答是,我们把整件事变成一个优化问题:
- 给每个词随机初始化向量。
- 摆弄它们,让算出来的、观测到的上下文词的概率上升。
- 一直摆弄到它们不再上升 —— 也就是概率估计达到我们所能达到的最高。
- 这个"摆弄"靠微积分完成:计算目标函数对每一个参数的导数。
(参考时间:01:01:30 —— 二维直觉)
他给出那幅标准的图,值得记住,因为这是许多学生带进高维空间的唯一直觉。在二维空间里,如果你想找最小值,而从左上角出发,你在那里算导数;它们指向下方并略偏右,于是你往下并略偏右走一步。到新位置再算导数;它们仍指向下坡;再走。一直走,就到达最小值。
这个模型里远不止二维:参数是所有词向量的拼接 —— 而且如前所述,是词表的两倍,因为每个词有一个中心向量和一个外部向量。他把参数空间画成一个列表:从 aardvark 作为外部词的向量,穿过整个词表,到 zebra 作为外部词的向量,然后是后面那些中心向量:前面例子里是八千万个数。我们要为它们全部计算梯度。
接着有一句值得按其实质原样保留的话,因为这是学季剩下部分要解释的"魔法":它看起来不该能奏效。你从一无所有开始 —— 随机词向量和一堆文本 —— 做点数学,就得到了有用的东西。但这就是这些深度学习优化问题里会发生的事。
(参考时间:01:04:50 —— 推导,刻意讲慢)
在开始微积分之前,Manning 直接对听众说话,这段旁白也是教学的一部分:上 CS224N 的许多学生数学比他懂得多得多,所以接下来十分钟对他们可能极其无聊 —— 他们可以去 Discord 或 Instagram 上补进度,或者离开。但另一些上 CS224N 的学生已经不太记得上次上数学课是什么时候,他希望每个人都能学到点东西,所以头两周他会具体地走一遍。
目标函数,重述。 语料上上下文词的负平均对数似然(第 9.2 节),其中 $\theta$ 代表所有词向量。
概率,重述。 一个外部向量与一个中心向量的点积的 softmax,在词表上归一化(第 10 节)。
我们要求的导数。 目标函数对中心词向量 $v_c$ 的偏导数(外部词的参数可以另外做,而实际上没时间做了)。因为目标函数是许多项的大求和,而和的导数等于导数的和,所以我们可以一次处理一项。
第一步:拆开对数。 这一项是一个商式的对数,而商式的对数等于对数之差:
$$\frac{\partial}{\partial v_c}\log P(o\mid c) = \frac{\partial}{\partial v_c}\log \exp\!\left(u_o^\top v_c\right) - \frac{\partial}{\partial v_c}\log \sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right)$$
第二步:容易的那一半。 分子里 $\log$ 与 $\exp$ 互为反函数,于是相消,剩下 $u_o^\top v_c$。它对 $v_c$ 的导数就是 $u_o$。他不只是断言,而是按分量说明为什么:
$$u_o^\top v_c = u_1 v_1 + u_2 v_2 + u_3 v_3 + \dots$$
对 $v_1$ 求偏导会消掉除第一项之外的所有项,剩下 $u_1$;对 $v_2$ 求偏导剩下 $u_2$;依此类推。沿整个向量走一遍,答案就是向量 $u$ ——"这部分很容易。"
第三步:难的那一半,以及连锁律。 分母是函数套函数:一个关于 $v_c$ 的内层函数,他把它的输出记作 $z$,以及一个外层函数(对数)。连锁律告诉我们,取外层函数对 $z$ 的导数,乘以 $z$ 对 $v_c$ 的导数。$\log$ 的导数是 $1/x$ ——"你得记住它,或者去查,或者让 Mathematica 替你算"—— 所以:
$$\frac{\partial}{\partial v_c}\log \sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right) = \frac{1}{\sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right)} \cdot \frac{\partial}{\partial v_c}\sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right)$$
第四步:在求和内部再用一次连锁律。 求和可以移到导数外面。每一项又是函数套函数:外层是指数,内层是点积。指数的导数就是它自身,所以:
$$\sum_{w=1}^{V}\ \exp\!\left(u_w^\top v_c\right) \cdot \frac{\partial}{\partial v_c}\left(u_w^\top v_c\right) = \sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right)\cdot u_w$$
这里用了第二步中求出的点积导数。
第五步:把两半合起来。 分子的导数是 $u_o$;分母的导数是上面那个求和,除以分母。合并起来:
$$u_o - \frac{\sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right) u_w}{\sum_{w=1}^{V}\exp\!\left(u_w^\top v_c\right)} = u_o - \sum_{x=1}^{V} P(x\mid c)\,u_x$$
因为中间那个比值恰好就是第 10 节的 softmax。
(参考时间:01:18:00 —— 结果意味着什么)
Manning 停下来解读这个公式,而不只是赞美它,而这是要记住的部分:
- 梯度是观测到的向量减去所有向量的加权平均,其中权重是模型当前的 softmax 概率。
- 被减去的那个量是模型的期望:如果模型当前给某个词 $x$ 分配了高概率,那个词的外部向量在这个平均里就得到很大的权重。
- "观测 − 期望"这种形状在这类导数里反复出现。
- 你想要的是让那个加权平均 —— 即期望 —— 等于观测到的东西,因为那时导数就是零,你就到达了一个最大值。
对于完整的目标函数,你还需要对外部向量的导数,但"嘿,下课时间到了",于是他收尾:我们为每个参数把这些导数都算出来,这些导数给出一个改变数值的方向,从而让我们自动地找到好的词向量。他最后的安抚是务实的那一句:他希望学生理解这如何运作,但他们很快会发现计算机会替你完成,他们不会需要经常手算。这个周四再细讲。
(推导是讲座期间在 iPad 上手写的,Manning 讲到一半时评论说字写得不太好 —— 他在家准备好的整洁版本就在网站上的幻灯片里。本书复现的是整洁版本。)
graph TD
    A["随机初始化所有词向量"] --> B["在语料上计算 J(theta)"]
    B --> C["计算 J 对每个参数的梯度"]
    C --> D["朝下坡方向走一步"]
    D --> E{"似然还在提升吗?"}
    E -->|是| B
    E -->|否| F["停下:当前的向量就是学到的词向量"]
编者关于负号的说明。 严格地说,上面推导出的量是对数似然的导数,而它的零点是对数似然的最大值 —— 这正是 Manning 在结尾处的描述。实际被最小化的目标函数 $J$ 是负的平均对数似然,所以它的梯度是这个表达式的相反数,于是梯度下降让参数朝提高观测上下文概率的方向移动。推导本身没有任何变化;变的只是步子的符号。
编者拓展 —— 为什么"观测 − 期望"是个这么好的迹象。 这种形式是学习动力学的一个不动点:训练(对这一项而言)恰恰在模型的预测分布与数据吻合时停止。同样的代数形状也出现在逻辑回归里、出现在 EM 算法的 M 步里、出现在大得多的序列模型的梯度里。认出它一次,就等于到处都能认出它。
编者拓展 —— 为什么每个词两个向量有帮助。 有分开的 $u$(外部)和 $v$(中心)向量时,对 $v_c$ 的梯度只涉及 $u$ 向量,而对 $u_o$ 的梯度只涉及 $v$ 向量。这两组参数不会在单项的梯度里相乘出现,从而让每次更新都很简单。实践中,训练结束后这两个矩阵常被合并 —— 最常见的是相加或取平均 —— 给出每个词一个向量。
12. 小结:静态词向量成就了什么,又错过了什么
本讲最后一条技术线索是自第 7 节以来就一直可见的那个局限,Manning 把它说得直白。
一个词类型,一个向量。 目前,算法为每一串字母学一个向量,而这个向量并不捕捉词在上下文中的意义。于是:
- star 不会区分好莱坞义项和天文义项。实际发生的是它的单一向量最终既靠近 nebula 这样的天文词,同时靠近表示好莱坞明星的词。当他问现场找一个这样的词时,一名学生给出了 celebrity —— 而人类能轻松给出它,这件事本身就是要点。
- bank 也是同一个故事:金融机构还是河岸。学到的向量表现得像是在其各义项上取平均,这就是为什么它最终靠近两个义项在语义上都会唤起的那些词。
这个平均仍然有用,这正是方法奏效的原因。 在高维空间里(第 7 节),一个点可以沿不同维度靠近不同的群,所以一个单一向量可以在足够好的程度上服务好几个义项,值得拥有。多义项问题是真实存在的,但它并不使"每词一向量"变得没用。
接下来是什么,以及为什么这才是有意思的部分。 要表示上下文中的词义,你需要上下文相关的表示。那是课程其余部分的主题:循环网络、注意力、Transformer,以及预训练模型。第 7 节里那个学生的问题 ——"相似性不是取决于上下文吗?"—— 是对的,而它被刻意推迟了:"这个想法不错,你先留着,过几周再说"。
本讲的第二个收获是方法论上的,也是要带进作业里的那一个。 从随机向量和一堆文本出发,除了优化什么都不做,就产生了一个具有真实语义结构的表示 —— 国家靠近国家,思考动词靠近思考动词,become 和 remain 靠近 be。这是深度学习不断施展的"魔法"的第一个具体例子,也正是为什么课程坚持要把 word2vec 的推导讲透,而不是把它当成一个黑箱。
编者说明 —— 在这段录像里没有发生的事。 Manning 开场时说,他希望最后花几分钟玩一玩 Jupyter notebook,展示这些词向量能做什么,并在 01:04:30 承认他大概讲不完他希望讲的内容。他确实没讲完:这段视频里没有 notebook 的演示,而对外部向量的导数留到了下一讲。
附:官方参考与延伸阅读
课程材料
- 课程网站:cs224n.stanford.edu —— 教学大纲、幻灯片、作业、答疑时间、Ed 讨论区。作业通过 Canvas 经由 Gradescope 提交。
- 本讲使用的讲义 PDF:
cs224n-2026-lecture01-history.pdf(四个时代、1950–2010 年代的历史、机器翻译、语言模型的历史)与cs224n-2026-lecture01-intro.pdf(课程教务、学习目标、作业、讲座计划)。两者都随录像提供;幻灯片 PDF 在每讲之前发布在课程网站上。 - 讲义中引用的课程计划:Lecture 1 — Introduction and the History of NLP,其所述关键学习点为:"理解 NLP 中的范式转移,以及我们对语言的假设如何塑造了每个时代中可能做到的事。"
- 许可: 本录像所提供的材料未包含讲义的许可声明;这些讲义看起来是受保护的课程材料。此处引用幻灯片标题仅作为对为评论而复现的图片的简短指引。参见已知疑点。
- "一个看 NLP 历史的创意方式":斯坦福 NLP 团队在 Gates 楼 3B 房间办的实体展览(讲义上有署名)。
历史部分(第 3 章及历史幻灯片)背后的来源
- Christopher D. Manning, Human Language Understanding & Reasoning, Dædalus 151(2): 127–138, Spring 2022 — amacad.org/publication/human-language-understanding-reasoning。四时代框架的来源,也是"NLP 与 AI/神经网络是只有部分交织的领域"这一判断的来源。
- Warren Weaver(1955,引用 1947 年的一封信)论翻译即解码 —— 引自历史幻灯片。
- Norbert Wiener 1947 年的回复,怀疑准机械式翻译,因为词在各个语言中的语义边界并不相同 —— 同一批幻灯片。
- McCulloch & Pitts(1943),"A Logical Calculus of Ideas Immanent in Nervous Activity" —— 背景文章:nautil.us/the-man-who-tried-to-redeem-the-world-with-logic-235253。
- Frank Rosenblatt 与 Mark I 感知机 —— 康奈尔新闻报道。
- Vannevar Bush(1945),"As We May Think",The Atlantic — theatlantic.com/magazine/archive/1945/07/as-we-may-think/303881。"memex"与信息检索的起源。
- Claude E. Shannon(1948),A Mathematical Theory of Communication —— 背景文章:quantamagazine.org/how-claude-shannons-information-theory-invented-the-future-20201222。
- 1958 年《纽约时报》文章 "New Navy Device Learns by Doing",复现在历史幻灯片上,是早期 AI 炒作最典型的例子。
词义、词向量、word2vec
- J. R. Firth(1957),"You shall know a word by the company it keeps" —— 引自幻灯片;分布语义的源头。
- George A. Miller 等,WordNet,普林斯顿 —— 第 6 章讨论的词汇数据库。
- L. van der Maaten & G. Hinton(2008),Visualizing Data using t-SNE,JMLR 9 — jmlr.org/papers/v9/vandermaaten08a.html。
- T. Mikolov 等(2013),Efficient Estimation of Word Representations in Vector Space — arxiv.org/abs/1301.3781。提出 CBOW 与 skip-gram。
- T. Mikolov 等(2013),Distributed Representations of Words and Phrases and their Compositionality — arxiv.org/abs/1310.4546。提出负采样与下采样。
- Y. Bengio, R. Ducharme & P. Vincent(2003),A Neural Probabilistic Language Model — jmlr.org/papers/v3/bengio03a.html。第一个神经语言模型,在 LLM 历史幻灯片上被引用。
神经 NLP、LLM 与基础模型
- I. Sutskever, O. Vinyals & Q. Le(2014),Sequence to Sequence Learning with Neural Networks — arxiv.org/abs/1409.3215。机器翻译幻灯片里的 LSTM 编码器–解码器。
- A. Radford 等(2019),Language Models are Unsupervised Multitask Learners(GPT-2)— openai.com/research/language-unsupervised。
- T. Brown 等(2020),Language Models are Few-Shot Learners(GPT-3)— arxiv.org/abs/2005.14165。
- J. Devlin 等(2019),BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding — arxiv.org/abs/1810.04805。
- R. Bommasani 等(2021),On the Opportunities and Risks of Foundation Models — arxiv.org/abs/2108.07258。"基础模型"一词的来源,由斯坦福团队提出,第 5 章使用。
- 讲座中点名的系统,供参考:ChatGPT、DALL·E、Google Translate。
已知疑点
下面每一条都不确定,并标明了依据或时间点。凡本书做了判断的地方,都写明判断为何,以便你对着视频核查。
-
录像的元数据不一致。 视频标题写的是 Spring 2024,但随它提供的讲义命名为
cs224n-2026-lecture01-*.pdf,而且课程介绍讲义把 Diyi Yang 和 Yejin Choi 列为讲师,课程内容属于 2025 年前后,而录像里的讲者是 Christopher Manning(讲义上注明他是"CS224N 的创建者",以客座身份讲第一讲)。因此本书照录视频标题,把讲座归属于 Manning,并按提供原样引用讲义。这段录像实际属于哪个学季,无法从现有材料确定。 -
历史段落不在转录稿里。 课程计划承诺"the history of NLP: how we got here (65 mins)",历史讲义也随录像提供,但转录稿里只有一个指引 ——"稍后我们会再多讲一点历史"(≈00:17:45)—— 然后就转到了深度学习成果。因此第 3 章的四时代总结依据的是幻灯片和 Manning 的 Dædalus 文章,而不是这段录像里说出的话。如果历史其实是在另一场单独的课里讲的,本书对它的呈现就是不充分的;要看的是那些幻灯片。
-
靠判断修正的自动语音识别错误。 转录稿把好几个专有名词弄错了。本书悄默使用了正确形式:"binstein" → Wittgenstein;"tamas mikolov" → Tomáš Mikolov;"py talk" → PyTorch;"Jupiter notebook" → Jupyter;"DAR 2 / Dary 2 / Dary 3" → DALL·E 2 / DALL·E 3;"tne" → t-SNE;"co pandemic" → COVID 疫情;"herb Clark" → Herb Clark。每一个都是听起来相同或相近的合理错误,但全都是编者的推断,应当对照音频核实。
-
肯尼亚/斯瓦希里语新闻的例子是残缺的。 在 ≈00:20:00 处,Manning 说他看到一则来自肯尼亚的斯瓦希里语片段,并从中得知马拉维因为"co infections"失去了两位部长。本书把它写成因 COVID 感染失去了两位部长;具体措辞,以及那门语言是否真是斯瓦希里语,无法从转录稿确认。
-
"Corpus" 的词法。 Manning 顺带说 corpus 是第四变格中性名词(复数 corpora),本书照说出的内容复现。这个说法是标准的拉丁语语法;他是否还就此多说了什么,被围绕它的笑话遮住了。
-
幻灯片时间戳是近似的。 本书中的
SLIDE:n@HH:MM:SS锚点是根据对应内容被说出的位置估计的,因为转录稿没有幻灯片标记。另请注意,讲义顺序与口述顺序不同:Firth 的"company it keeps"幻灯片在 ≈00:35:05 讨论,早于 ≈00:36:25 的"versatile = [0.286, …]"向量幻灯片,而章节计划却把向量变体幻灯片放在前面。每个锚点对它自己的幻灯片而言是正确的;本书的阅读顺序是章节计划的顺序。 -
这是 skip-gram 还是 CBOW? Manning 只说了"word2vec"。所推导的目标 —— 对上下文词求和对数 softmax 概率 —— 是配完整 softmax 的 skip-gram。这是编者的判定,不是讲师的说法,而原始论文还定义了 CBOW 与负采样。
-
承诺过的类比例子从未给出。 有学生问空间中的方向是否和距离一样携带意义,Manning 回答是 ——"我们使用空间中的方向,它们有语义含义,我很快就会展示一个例子"(≈00:45:15)。录像里没有出现这样的例子;讲座时间不够了。本书记录了这个承诺,而没有自行补上那个著名的 king − man + woman 例子。
-
两个从口头话里取来的算术说法。 八千万参数(400,000 词 × 2 个向量 × 100 维)这个数字是 Manning 自己给的,与他自己陈述的假设一致;尤其是词表大小是一个示意性的数字。幻灯片上的 8 维向量也明确只是为了展示,他自己也这么说。
-
取自幻灯片而非口头文本的数字与归属。 语言模型历史的年代(马尔可夫 1913;Shannon 1948;Jelinek 1975;1998 年"首次使用 LLM"的三元模型;2000;2007;2018;2020–)以及附着其上的语料规模,来自幻灯片 51–53。1998 年 ROCLing 论文是首次使用"LLM"的说法,明确带有 Manning 自己的保留("我所知道的首次使用 'LLM' 三元"),本书照样复现。这些数字没有经过审核。
-
历史幻灯片上关于语音识别与咨询顾问生产率的数字(WER 改进;波士顿咨询集团研究中的 12.2% / 25.1% / 40%)在转录稿里没有被讨论,本书也没有使用。要依赖它们的人应当去看原始出处(Dahl 等 2012;Dell'Acqua 等 2023)。
-
课程教务因时间和开课批次而异。 截止日期("HW1 下周二上课前截止")、延迟政策、评分划分、协作与 AI 工具政策,以及作业描述,都按本讲和随附幻灯片所述记录。它们几乎肯定会因开课批次而不同,应始终对照当前的课程网站核实。
-
课堂互动中的问答是重构的。 学生提问在转录稿里只能听成碎片。本书把它们改写成完整的问题 —— 例如关于老师用 "proficient" 还是 "good" 的那个问题,关于维度、有界性、方向与 t-SNE 的那些问题,以及关于相似性是否取决于上下文的那个问题。讲师的回答忠实于转录稿;学生提问的确切措辞无法还原。
-
许可状态。 这些书的系统说明期望课程笔记带有署名作者的 CC 许可。本讲所提供的材料里没有任何许可声明,所以本书如实说明,而不是编造一个。如果 CS224N 网站声明了某个许可,那条声明应替换参考部分中的这条说明。
-
一处刻意留白的缺口。 推导停在对中心向量的梯度上;对外部向量的导数因下课而被截断,而 Manning 说会继续讲。本书如实陈述这一点,而不补上缺失的推导(那是一个标准练习,也是 HW1/HW2 存在的原因之一)。