第2讲 · Stanford CS224N:词向量(Word Vectors)
| 课程 | Stanford CS224N / Ling284《Natural Language Processing with Deep Learning》 |
| 本讲 | Lecture 2 — Word Vectors(承接第一讲) |
| 视频 | https://www.youtube.com/watch?v=nBor4jfWetQ(时长约 79 分钟) |
| 官方幻灯片 | cs224n-2026-lecture02-wordvecs.pdf |
| 课程主页 / 讲义 / 作业 | https://web.stanford.edu/class/cs224n/ |
| 助教答疑时间表 | https://web.stanford.edu/class/cs224n/office_hours.html |
| 图例 | SLIDE:n@HH:MM:SS 表示第 n 张官方幻灯片在该时刻出现在画面上;SCREENSHOT:HH:MM:SS 表示来自视频画面(演示、终端、板书等)的截图。 |
对应讲次:第2讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
版权说明:课程讲义、幻灯片及作业版权归 Stanford CS224N 课程团队所有,按其官网所列许可使用;本书是对课堂录音的书面重构,仅供学习参考,不替代官方材料。
导览
这一讲老师真正想回答的问题(按他自己提出的顺序):
- 上一讲没讲完的优化基础——有了损失函数之后,到底怎样"往山下走"?
- word2vec 究竟是如何把"谁和谁常一起出现"变成"词义"的?为什么这么简单的数学能学到语义,甚至有点"像魔法"?
- 为什么每个词要两套向量?为什么要有 Skip-gram 与 CBOW 两个变体?为什么还需要负采样?
- 既然我们要的就是"统计谁和谁常在一起",那为什么不直接数共现次数,非要用神经网络去迭代?
- 学出来的词向量到底好不好,怎么评估?
- 一个词有很多意思(bank、pike、Jaguar……),一个向量装得下吗?
- 从词向量出发,如何搭起这门课的第一个神经分类器——什么是神经网络,它和 logistic 回归差在哪?
难点在哪:
- word2vec 目标函数里的 softmax 分母要对整个词表求和,这一步的计算量是理解"为什么要负采样"的关键,也是很多同学第一次读论文时最容易卡住的地方。
- 训练时参数初始化不能全为零——全零会带来虚假的对称性,模型学不动。这是一个很容易被忽略、但写代码时会立刻踩到的坑。
- "一个词一个向量"与"一词多义"之间存在根本张力,讲义给出的是"加权平均/叠加"的近似解释。
读者可能带着的疑问(分两组,请勿混为一谈):
① 老师当场提出的问题:如何计算 $P(w_{t+j}\mid w_t)$?为什么要两套向量?为什么要负采样?3/4 次方是什么意思?为什么不直接数共现?
② 编者预判的读者疑问:king − man + woman = queen 到底为什么成立、可靠吗?SVD 与 word2vec 谁更好?两个向量最后怎么用?交叉熵损失和负对数似然是什么关系?
本讲路线:先补完优化基础(梯度下降 → 随机梯度下降)→ 回顾 word2vec 并现场演示词向量 → 讲算法细节与变体(两向量、Skip-gram/CBOW、负采样)→ 转向"直接计数"路线(共现矩阵 → SVD → COALS → GloVe)→ 讲词向量评估 → 讲一词多义 → 最后以神经分类器与神经网络收尾。
一、课程组织
(参考时间: 01:23)
📷 课程组织与答疑时间安排
回到原视频 (00:01:23)
(参考时间: 01:23) 讲师先交代了几件课程事务:
- 第一次作业已经发布,截止时间是下周二上课之前。
- Python 复习课在本周五 15:30–16:20,地点不在本教室,而在 Gates 楼地下室的 B01。
- 答疑与帮助时间(office hours / help sessions)已经开始,时间表列在课程网站上。形式是多名助教同时在教室里坐班,每场约 3 小时、周一到周六都有——到点直接去就行,不用预约。
- 在线(Stanford Online)的同学也可以通过 Zoom 参加。
- 讲师的答疑时间采用预约制,每场 15 分钟,在周一开放。讲师特别提醒了一句:不要一个人把每周的时段全占了,那样对其他人不太友好。
编者说明:本讲对应的官方幻灯片版本(2026 版)标注的讲师为 Diyi Yang。录音中讲师自我介绍的内容(GloVe 由本人与 Jeffrey Pennington 于 2014 年在 Stanford 完成)显示实际讲者应为 Chris Manning。这一版本差异请见文末「已知疑点」。本书以录音内容为准,涉及幻灯片处按官方文件编号标注。
二、优化基础:梯度下降与随机梯度下降
(参考时间: 03:03)
上一讲结尾讲师在幻灯片上现场推导 word2vec 的导数,"写得比较潦草",于是他后来在家里把推导过程重新整理好放到了课程网站上。本讲先把这条线索接上。
2.1 梯度下降的直觉
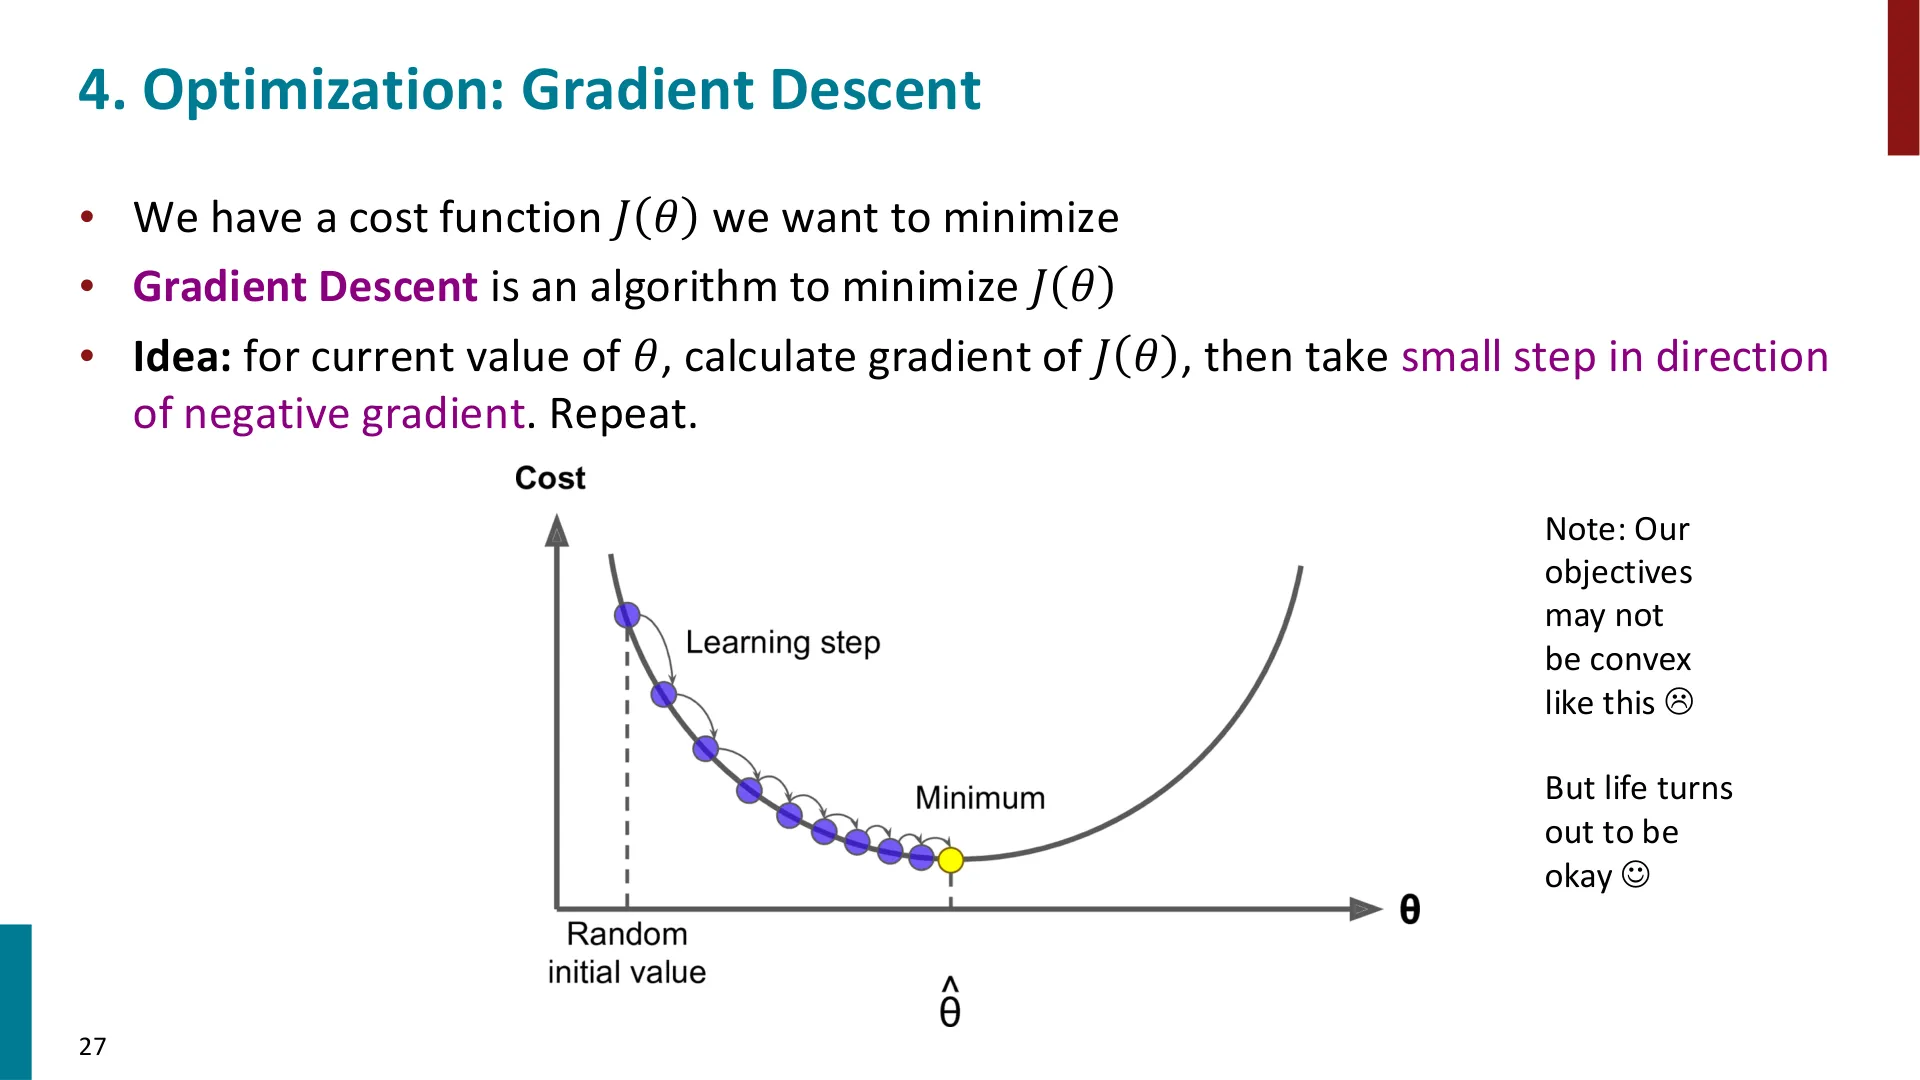
我们有一个想要最小化的代价函数 $J(\theta)$。思路非常朴素:
- 在当前参数 $\theta$ 处计算 $J(\theta)$ 的梯度;
- 朝负梯度方向走一小步;
- 重复。
在一维函数上,这就是"沿着山坡一步步往下走";而当函数有很多很多维度时,不同位置的梯度方向可能完全不同,所以我们必须借助微积分算出梯度,才知道每一步该往哪儿走。
📷 梯度下降:沿负梯度方向一步步下山
回到原视频 (00:03:03)
2.2 更新公式与学习率
(参考时间: 04:41)
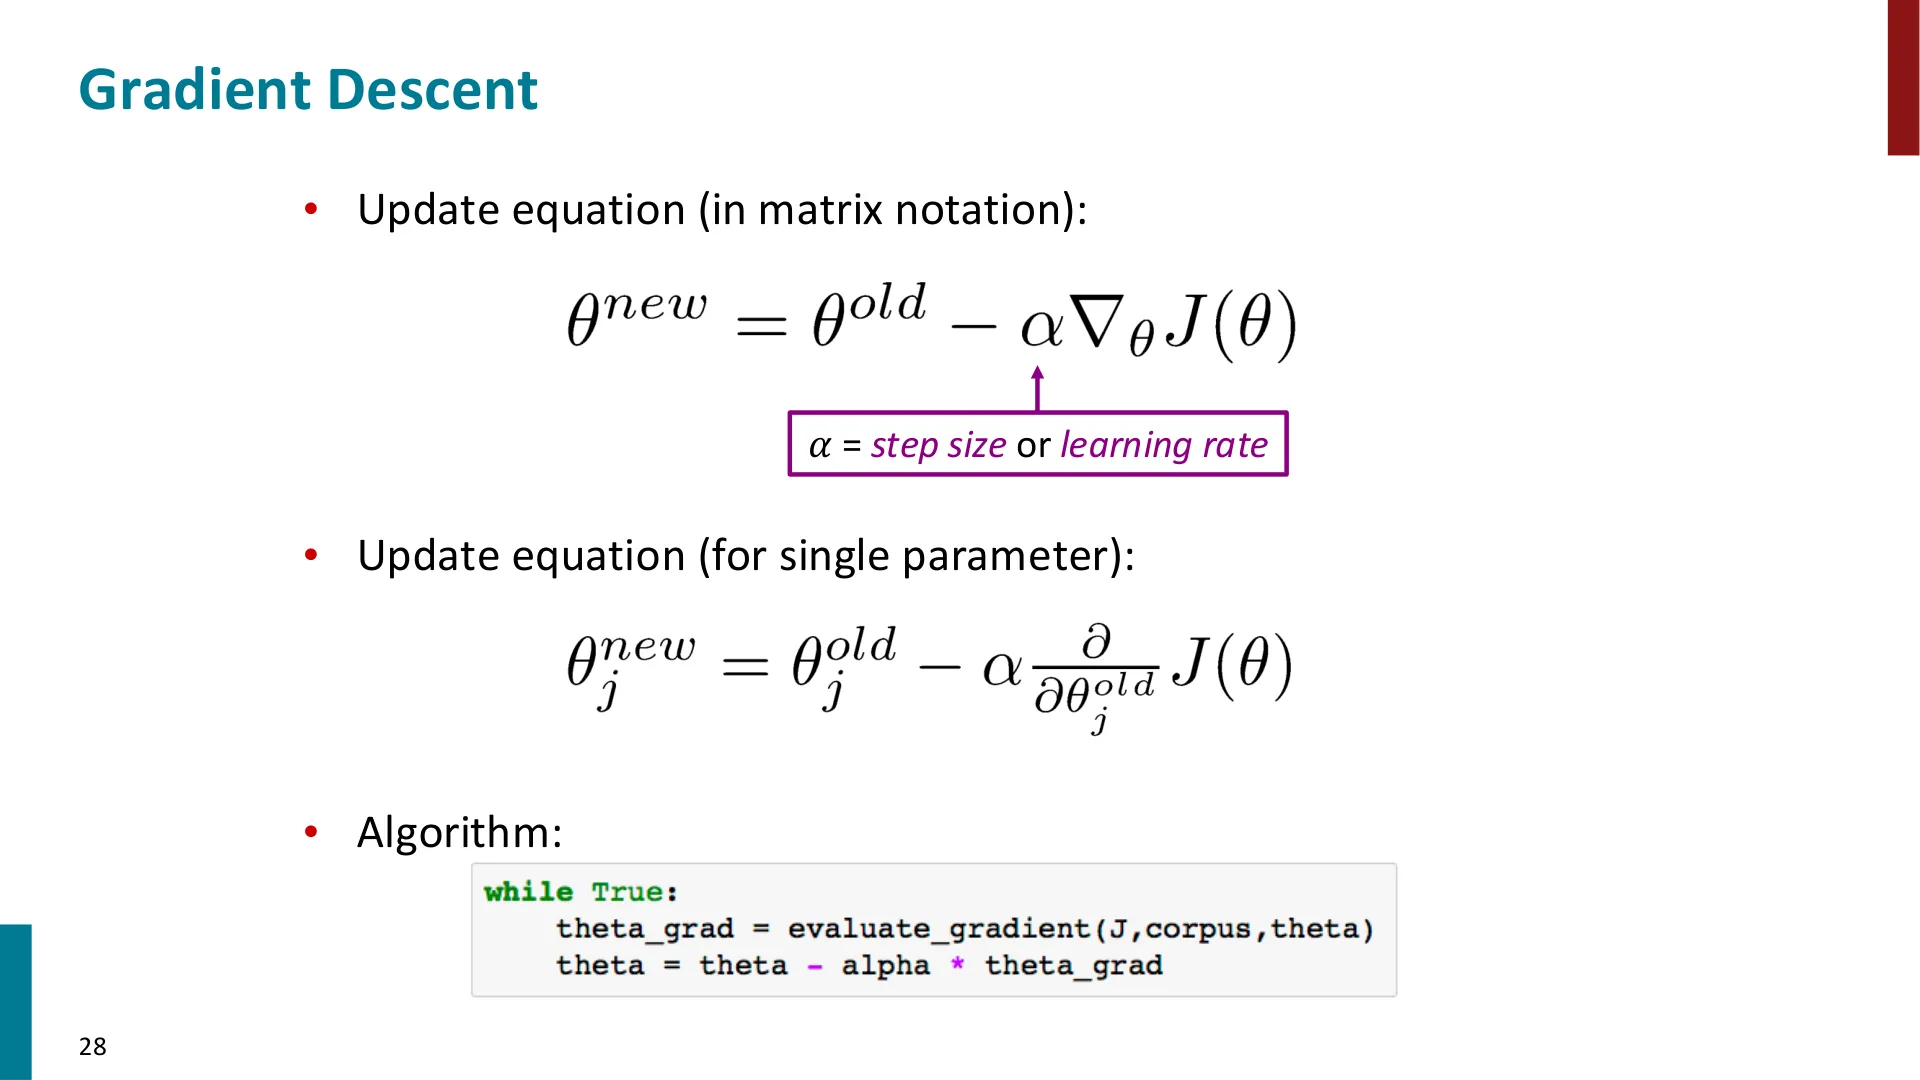
单个参数的更新式很简单:
$$ \theta \leftarrow \theta - \alpha \frac{\partial J(\theta)}{\partial \theta} $$
矩阵形式则把所有参数写成一个长向量统一更新:
$$ \theta \leftarrow \theta - \alpha \nabla_\theta J(\theta) $$
这里 $\alpha$ 是步长(step size)或学习率(learning rate)。它通常是一个很小的数,比如 $10^{-3}$、$10^{-4}$,甚至 $10^{-5}$。
为什么学习率必须小? 讲师用了一个很直观的说法:如果从某一点算出梯度、说"就朝这个方向走",然后一直走个不停,就可能冲过头,跑到很远的地方去;如果步长特别大,甚至可能走到一个比出发点还差的位置。所以我们要"一小步一小步地"往下走。
📷 梯度下降的更新算法
回到原视频 (00:04:41)
graph TD
    A["初始化参数 θ"] --> B["计算损失 J(θ)"]
    B --> C["计算梯度 ∇J(θ)"]
    C --> D["θ ← θ − α·∇J(θ)"]
    D --> E{"是否收敛?"}
    E -- "否" --> B
    E -- "是" --> F["得到训练好的参数 θ"]
编者拓展|为什么负梯度就是最速下降方向:对 $J(\theta)$ 做一阶展开,$J(\theta+\Delta)\approx J(\theta)+\nabla J(\theta)^\top \Delta$。为了让 $J$ 在单位步长下下降得最多,等价于在 $\|\Delta\|=1$ 约束下最小化 $\nabla J(\theta)^\top\Delta$,最优解正是 $\Delta \propto -\nabla J(\theta)$。因此"取梯度的反方向"不是经验选择,而是一阶近似下的严格最优方向。
2.3 随机梯度下降(SGD)
(参考时间: 05:55)
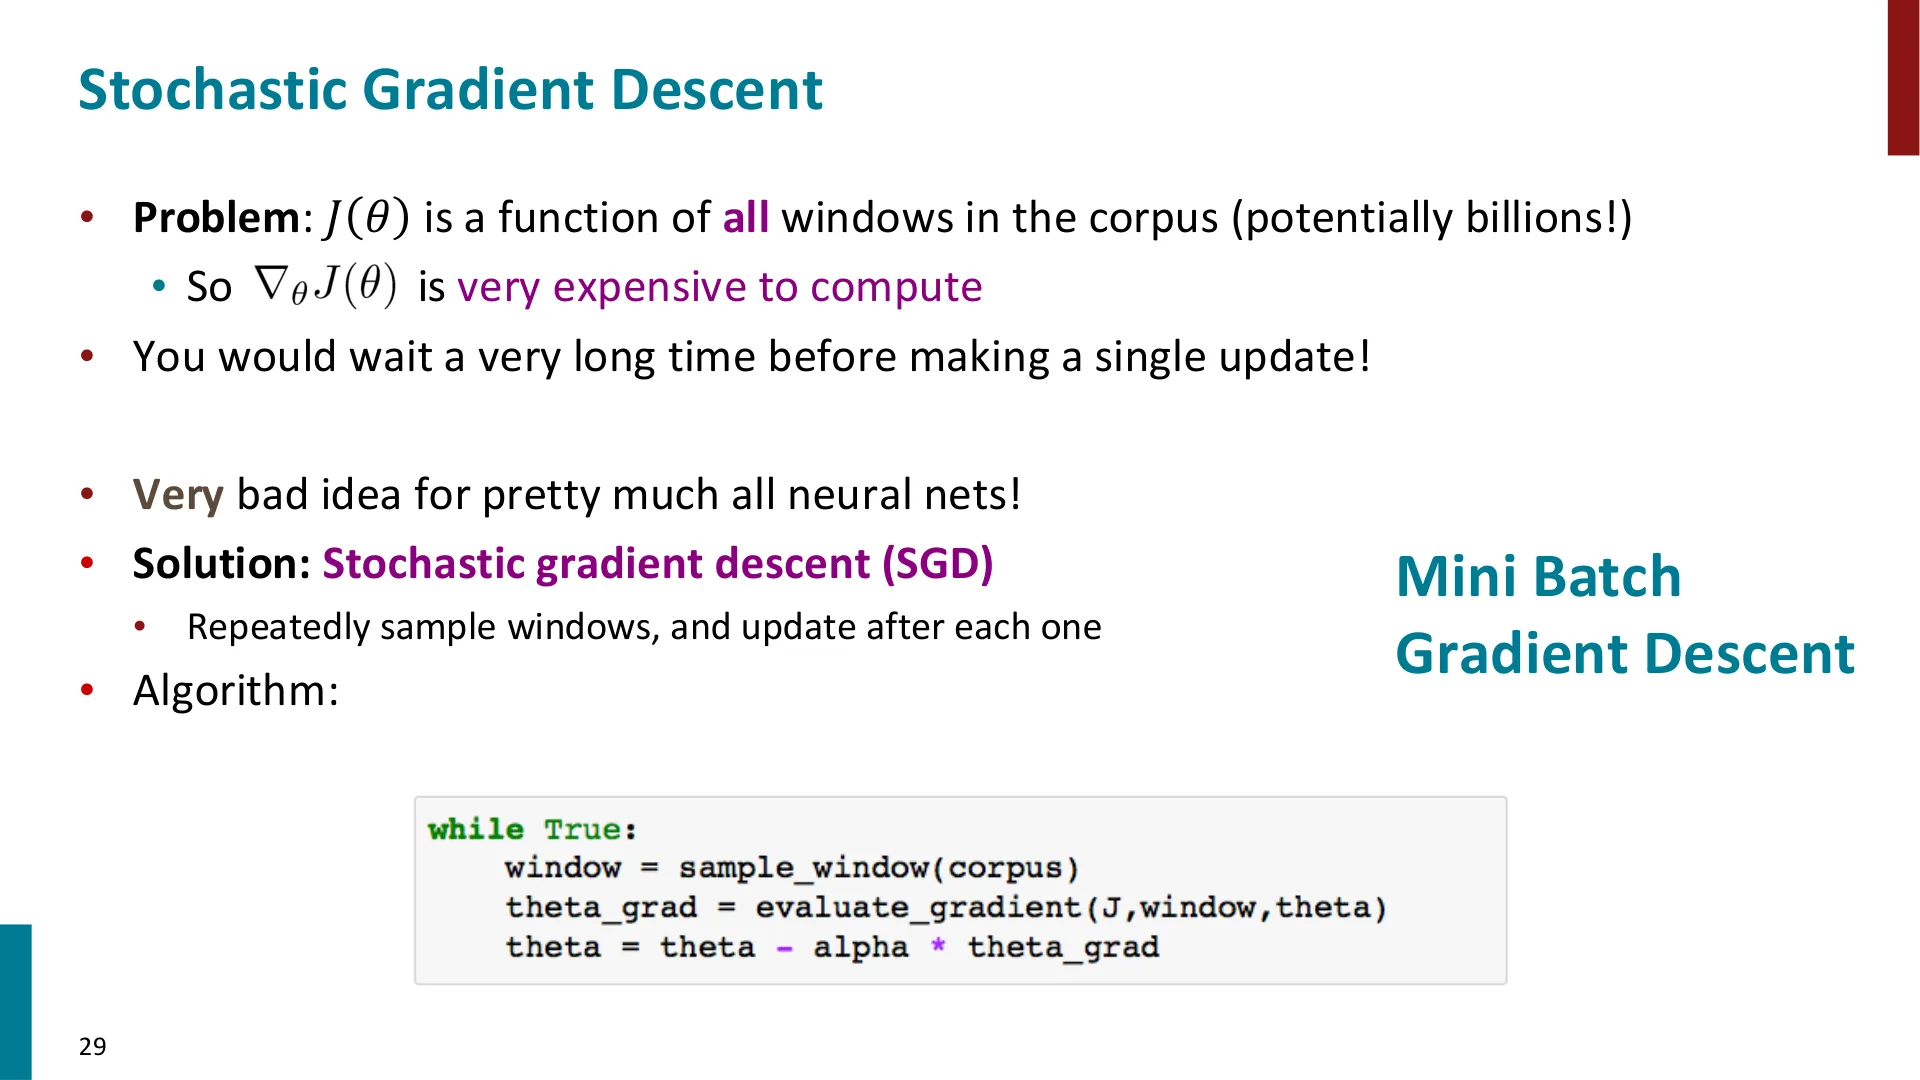
基本梯度下降在实践中几乎从不使用。 原因很直接:$J(\theta)$ 是所有窗口上的函数,而语料可能包含数十亿个窗口。如果每次更新都要遍历全部数据算一次梯度,那要等非常久才能完成哪怕一次参数更新——这对几乎所有神经网络来说都是糟糕透顶的做法。
解决办法:随机梯度下降(Stochastic Gradient Descent, SGD)。做法是:只采样一小批数据(比如 16 个、32 个数据项),假装它就是全部数据,在它上面计算 $J$ 与梯度。这个梯度是真实梯度的带噪声、不精确的估计,但我们直接拿它当作前进方向。这种做法也叫 小批量梯度下降(mini-batch gradient descent)。
📷 随机梯度下降与 mini-batch
回到原视频 (00:05:55)
graph TD
    A["整个语料的所有窗口(可能数十亿)"] --> B["全量梯度下降:每次更新要遍历全部数据"]
    B --> C["代价极高,很久才有一次更新"]
    A --> D["随机梯度下降:每次只采样一个小批量"]
    D --> E["得到带噪声的梯度估计"]
    E --> F["更新频繁,噪声本身反而有助于优化"]
有意思的是,讲师指出:神经网络往往在有噪声时反而表现得更好。这种噪声带来的"抖动"会让系统动起来,跳出一些不好的停留点。所以 SGD 不仅快得多,作为神经网络的优化方式本身往往也更有效。
编者说明:更准确地说,SGD 的噪声相当于一种隐式的正则化,它让模型不容易牢牢记住训练集的细节,从而提升泛化。这是"随机性反而有益"这一现象的常见解释之一。
三、回顾 Word2vec:从随机向量到词义
(参考时间: 08:13)
上一讲已经建立了基本图景,本讲先把它接上:
- 最初,每个词只是一个随机的小向量。这里有一个非常重要的细节:向量必须用随机的小数初始化——如果所有向量都初始化成零,什么都学不出来。因为大家起点完全一样会产生"虚假的对称性(false symmetries)",模型无法区分彼此。
- 接着遍历语料中的每一个位置,用当前估计去预测上下文里会出现哪些词;
- 这就给出了一个目标函数,我们可以据此计算误差与梯度,不断更新向量,让它们越来越擅长预测周围的词;
- 最终,向量会自动学到不少语义——词的意思、词与词之间的关系。
讲师的原话是:这感觉像魔法。2013 年这些算法刚被发现时,大家都觉得"就这么点数学、跑在一大堆文本上,居然真能学到词义",非常令人惊讶。而随着时间推移,同一套思路被推广到了各种语言行为的建模上。
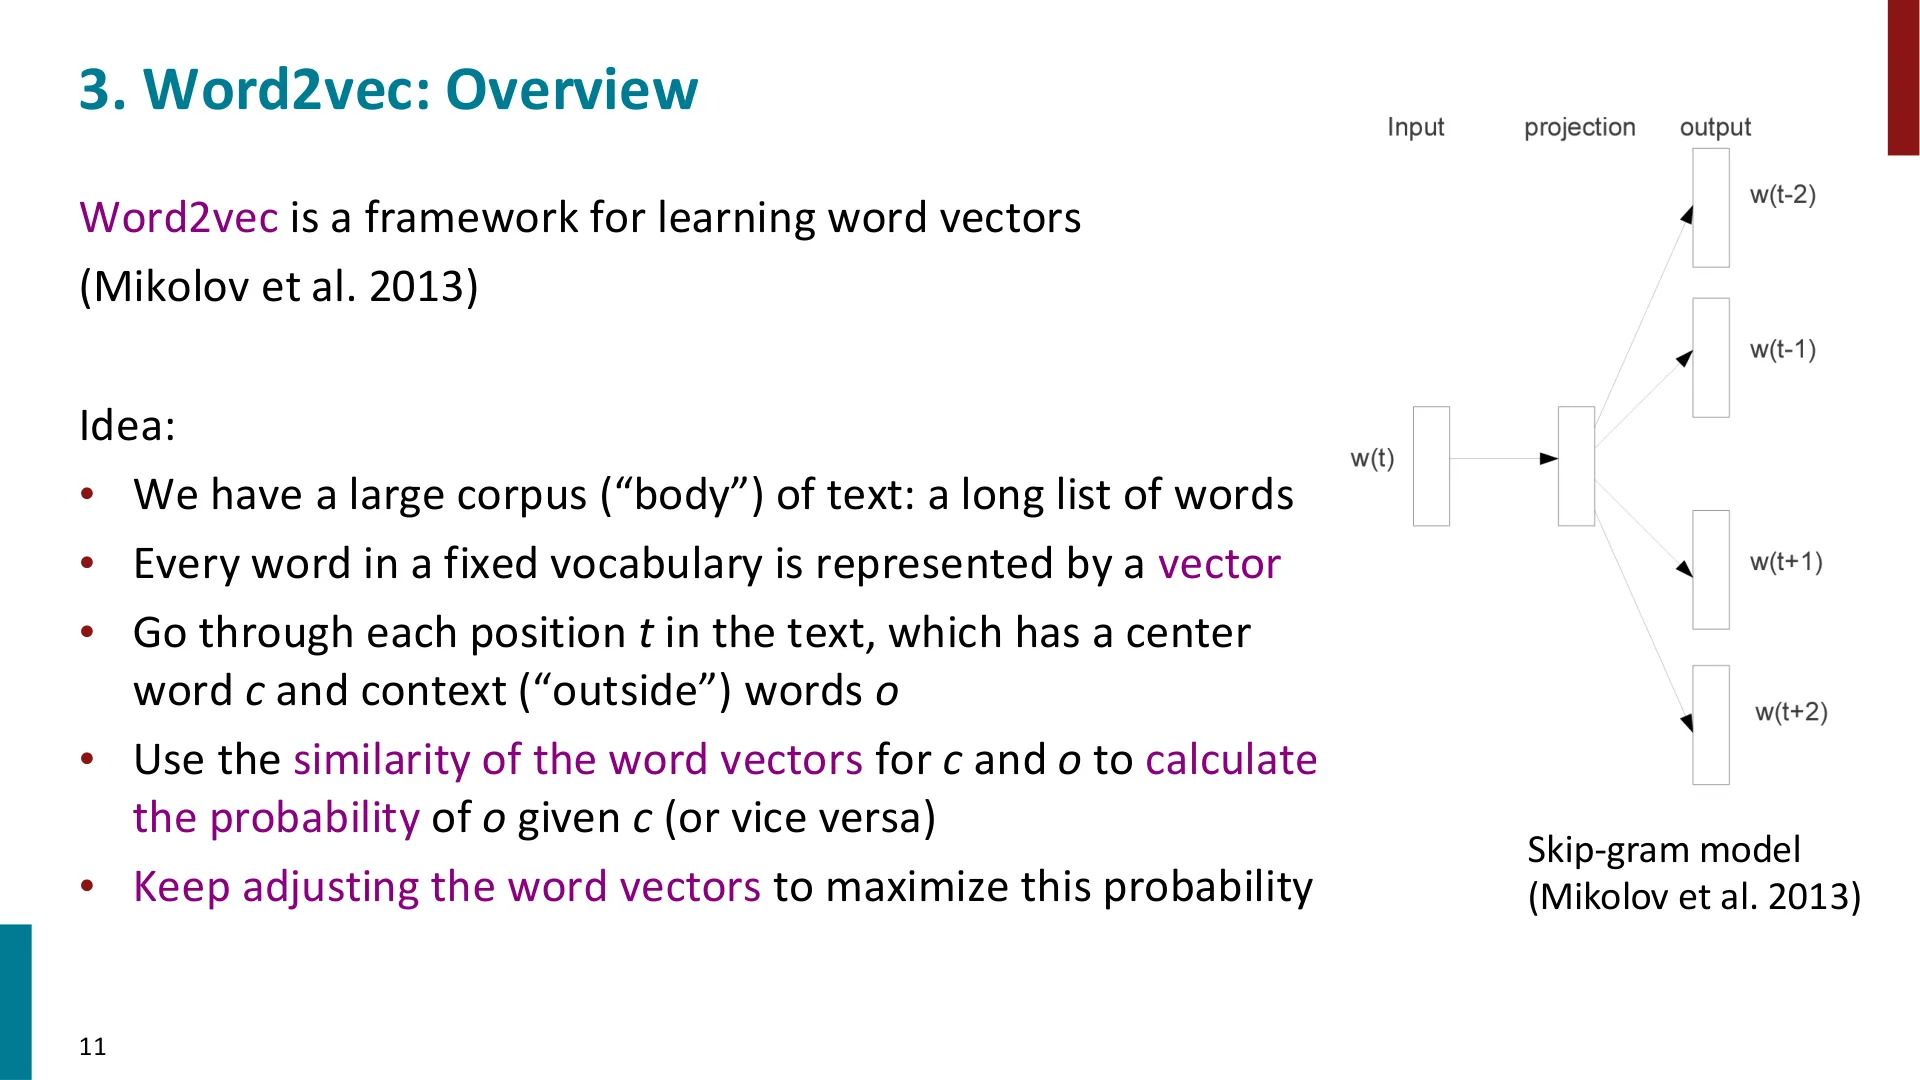
📷 Word2vec 概览:Skip-gram 模型
回到原视频 (00:08:13)
3.1 参数只有词向量,且是一个"词袋"模型
(参考时间: 09:15)
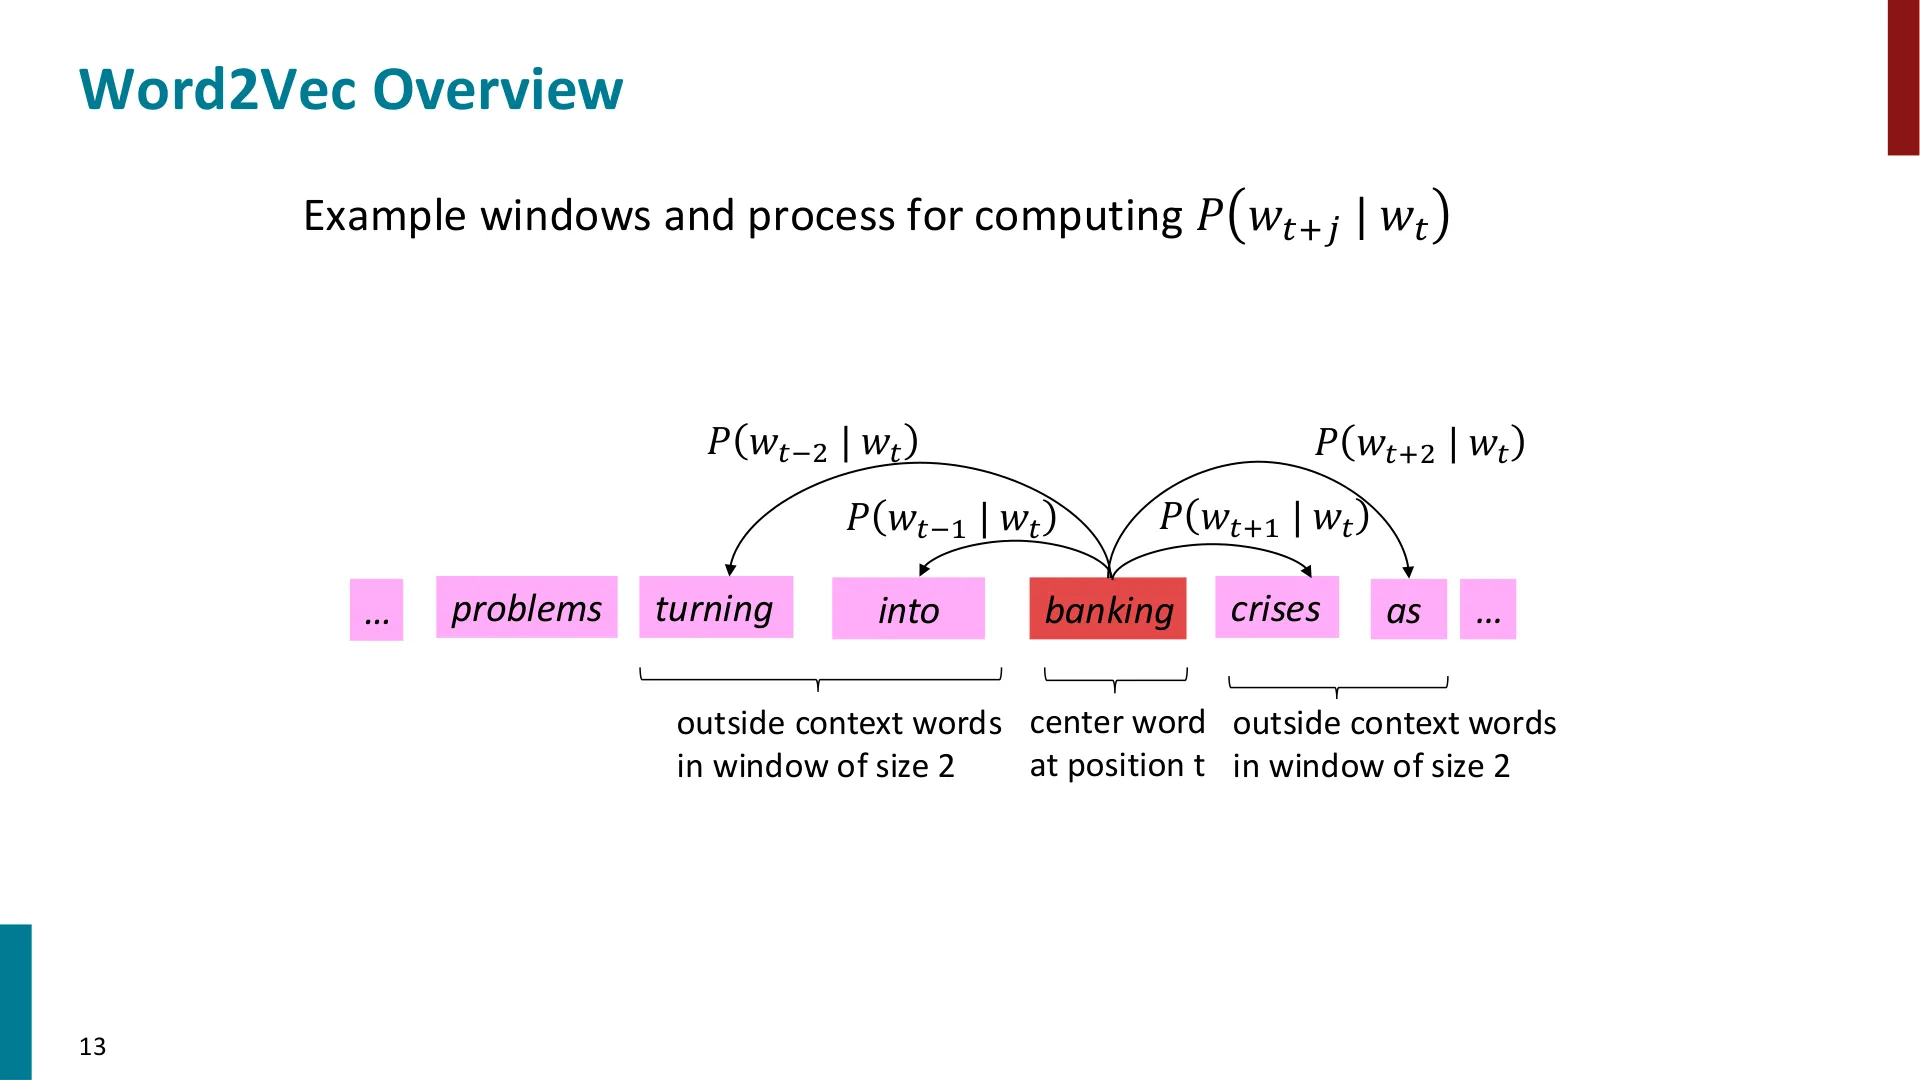
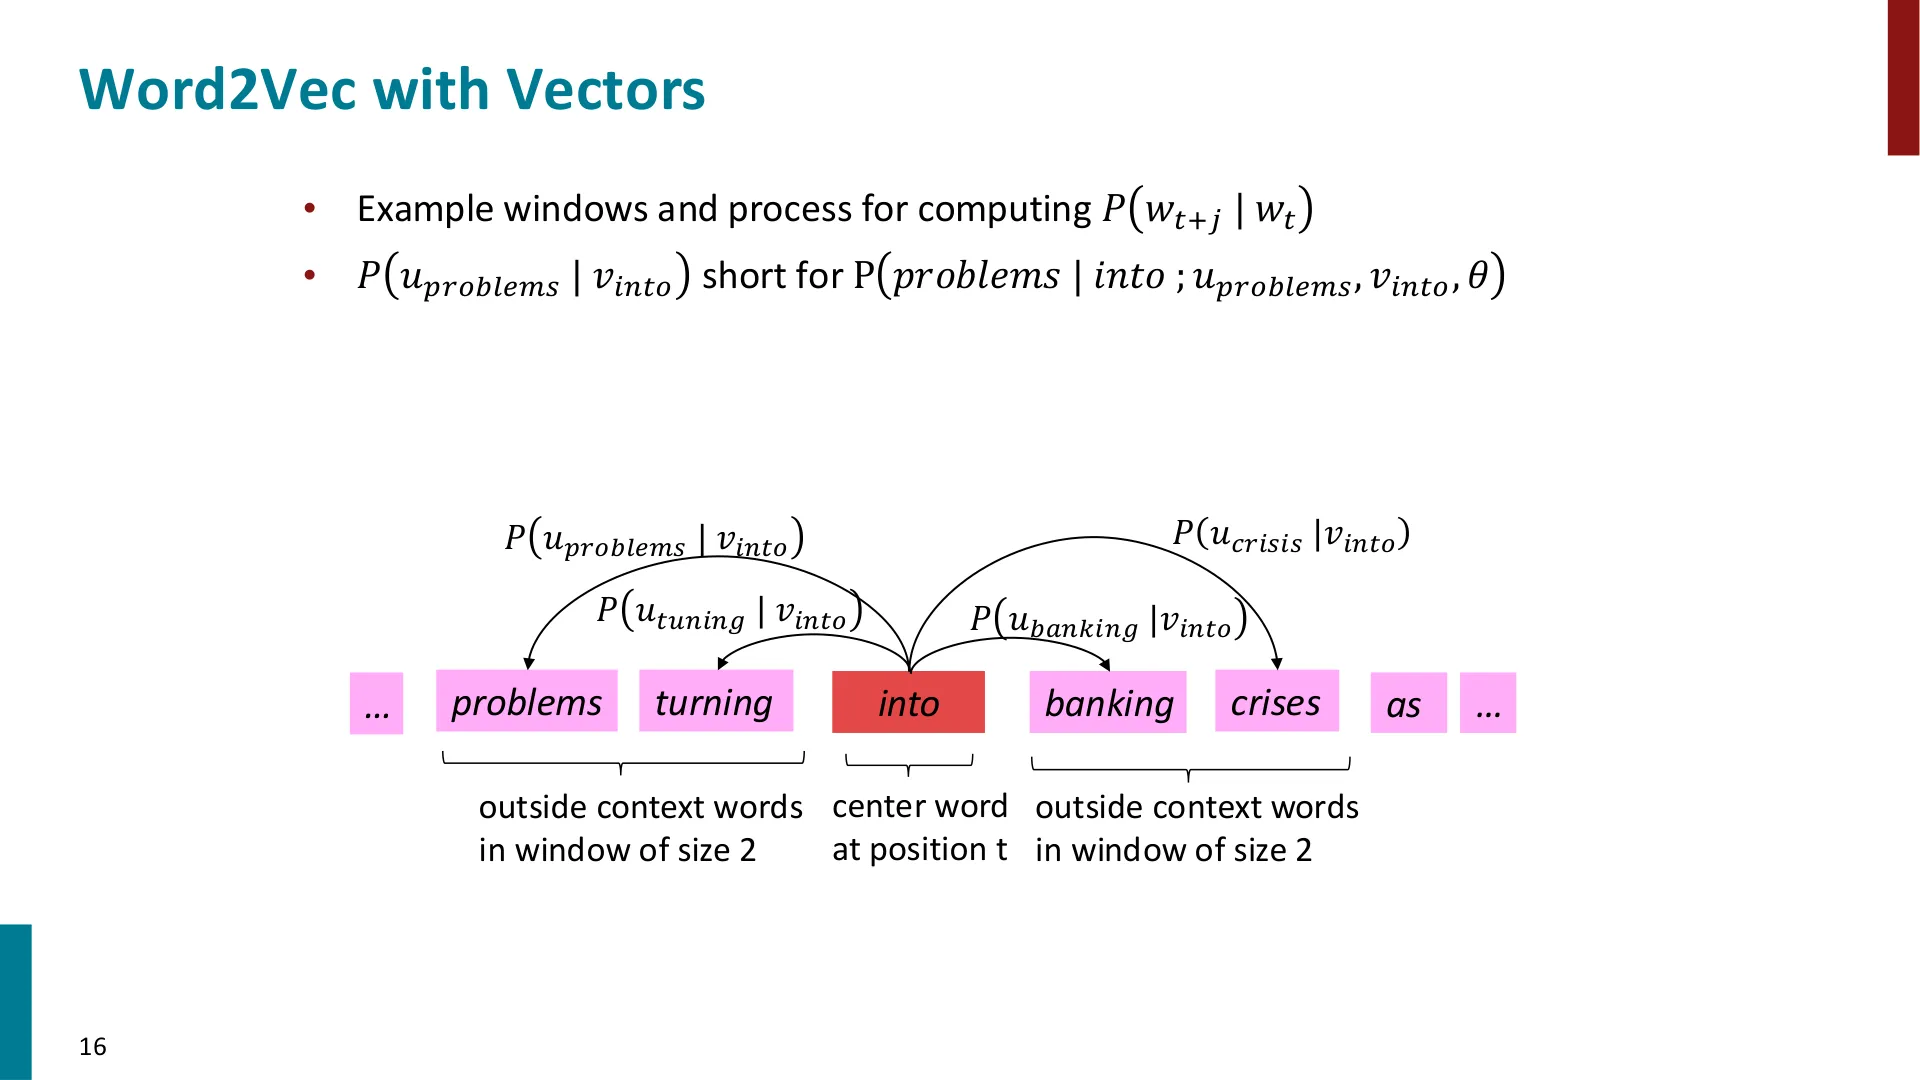
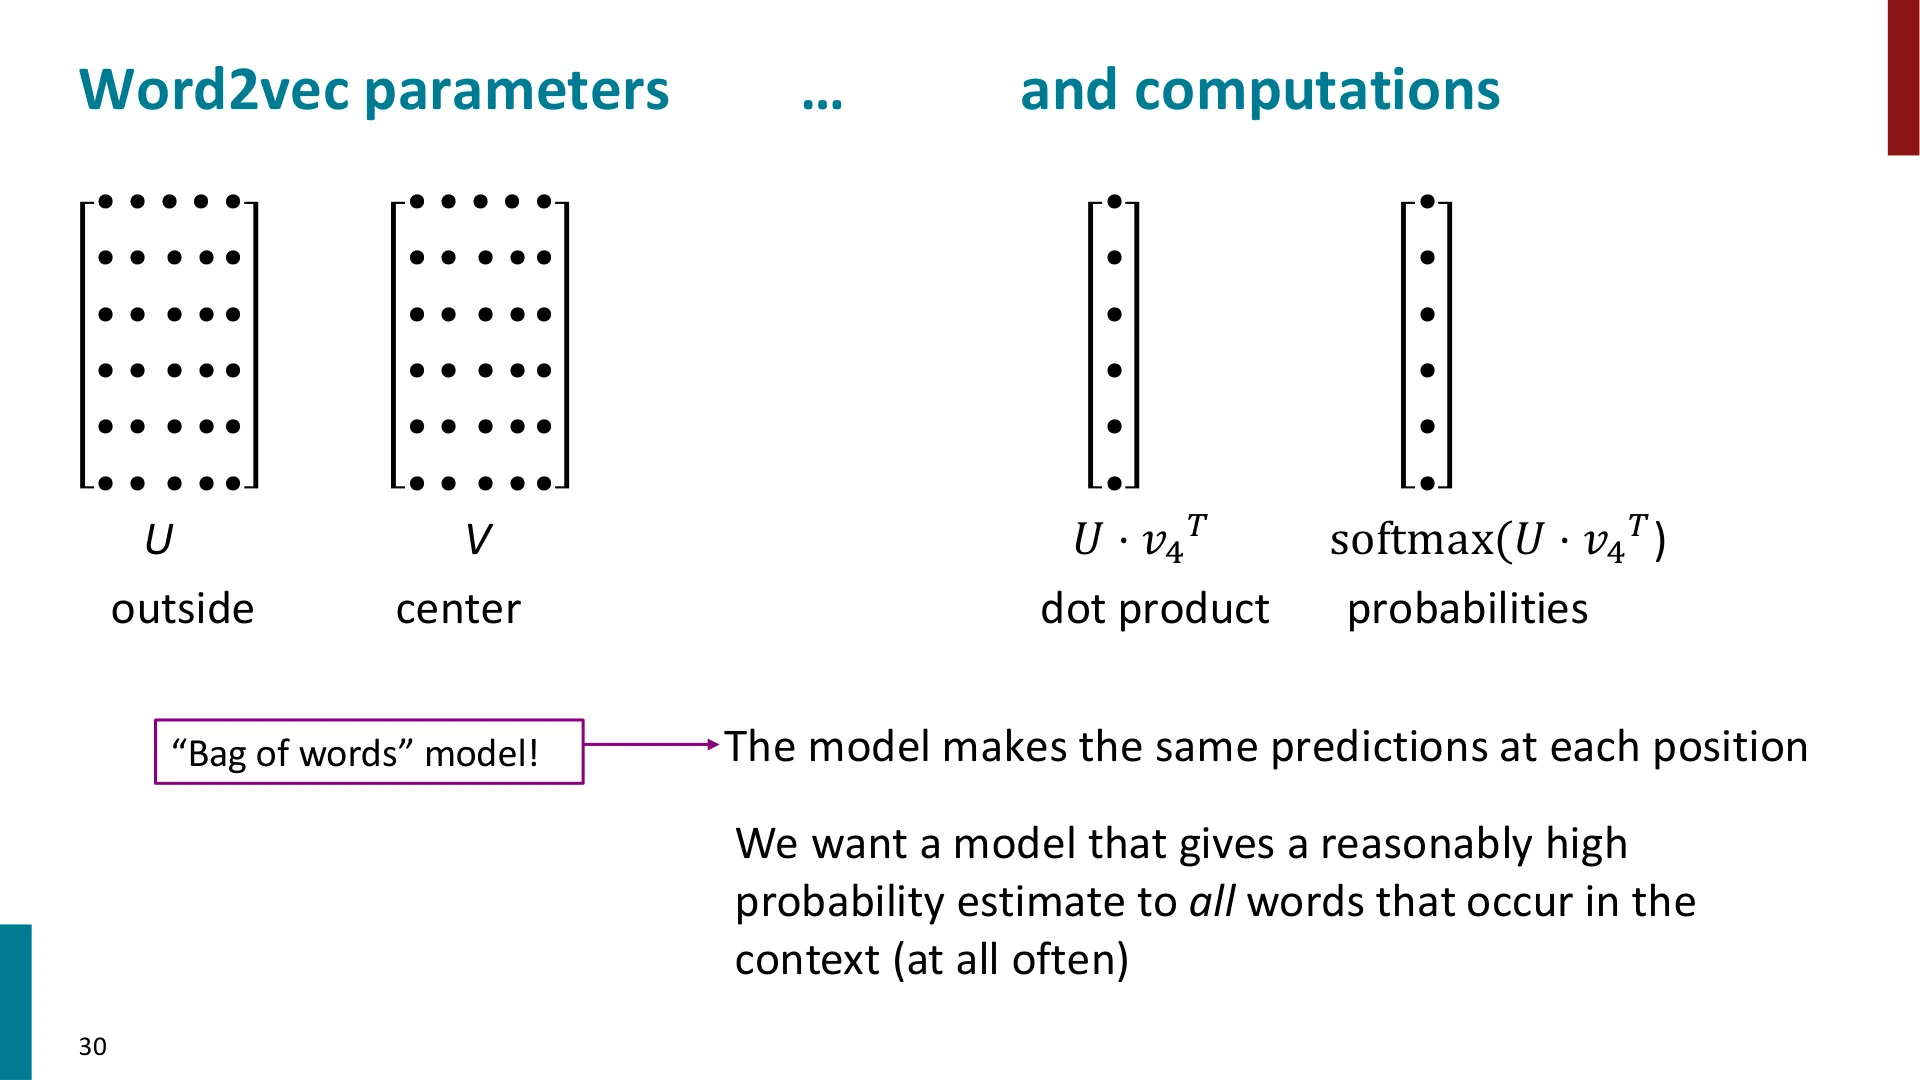
对 word2vec 来说,模型的全部参数就是这些词向量——中心词向量 $v_w$ 与外部词向量 $u_w$,且二者被当作互不相干(disjoint)的两套向量处理。
计算时,我们把各种可能的"外部词"与中心词做点积,得到词表上的一个概率分布;再把这个分布与"实际上出现在上下文中的那个词"作比较,差异就是误差来源。
因此这是 NLP 里所谓的词袋模型(bag of words):
- 它不知道句子的结构,甚至不区分左边还是右边;
- 在每个位置上,它给出完全相同的概率预测;
- 它关心的只是"中心词周围一般会出现哪类词"。
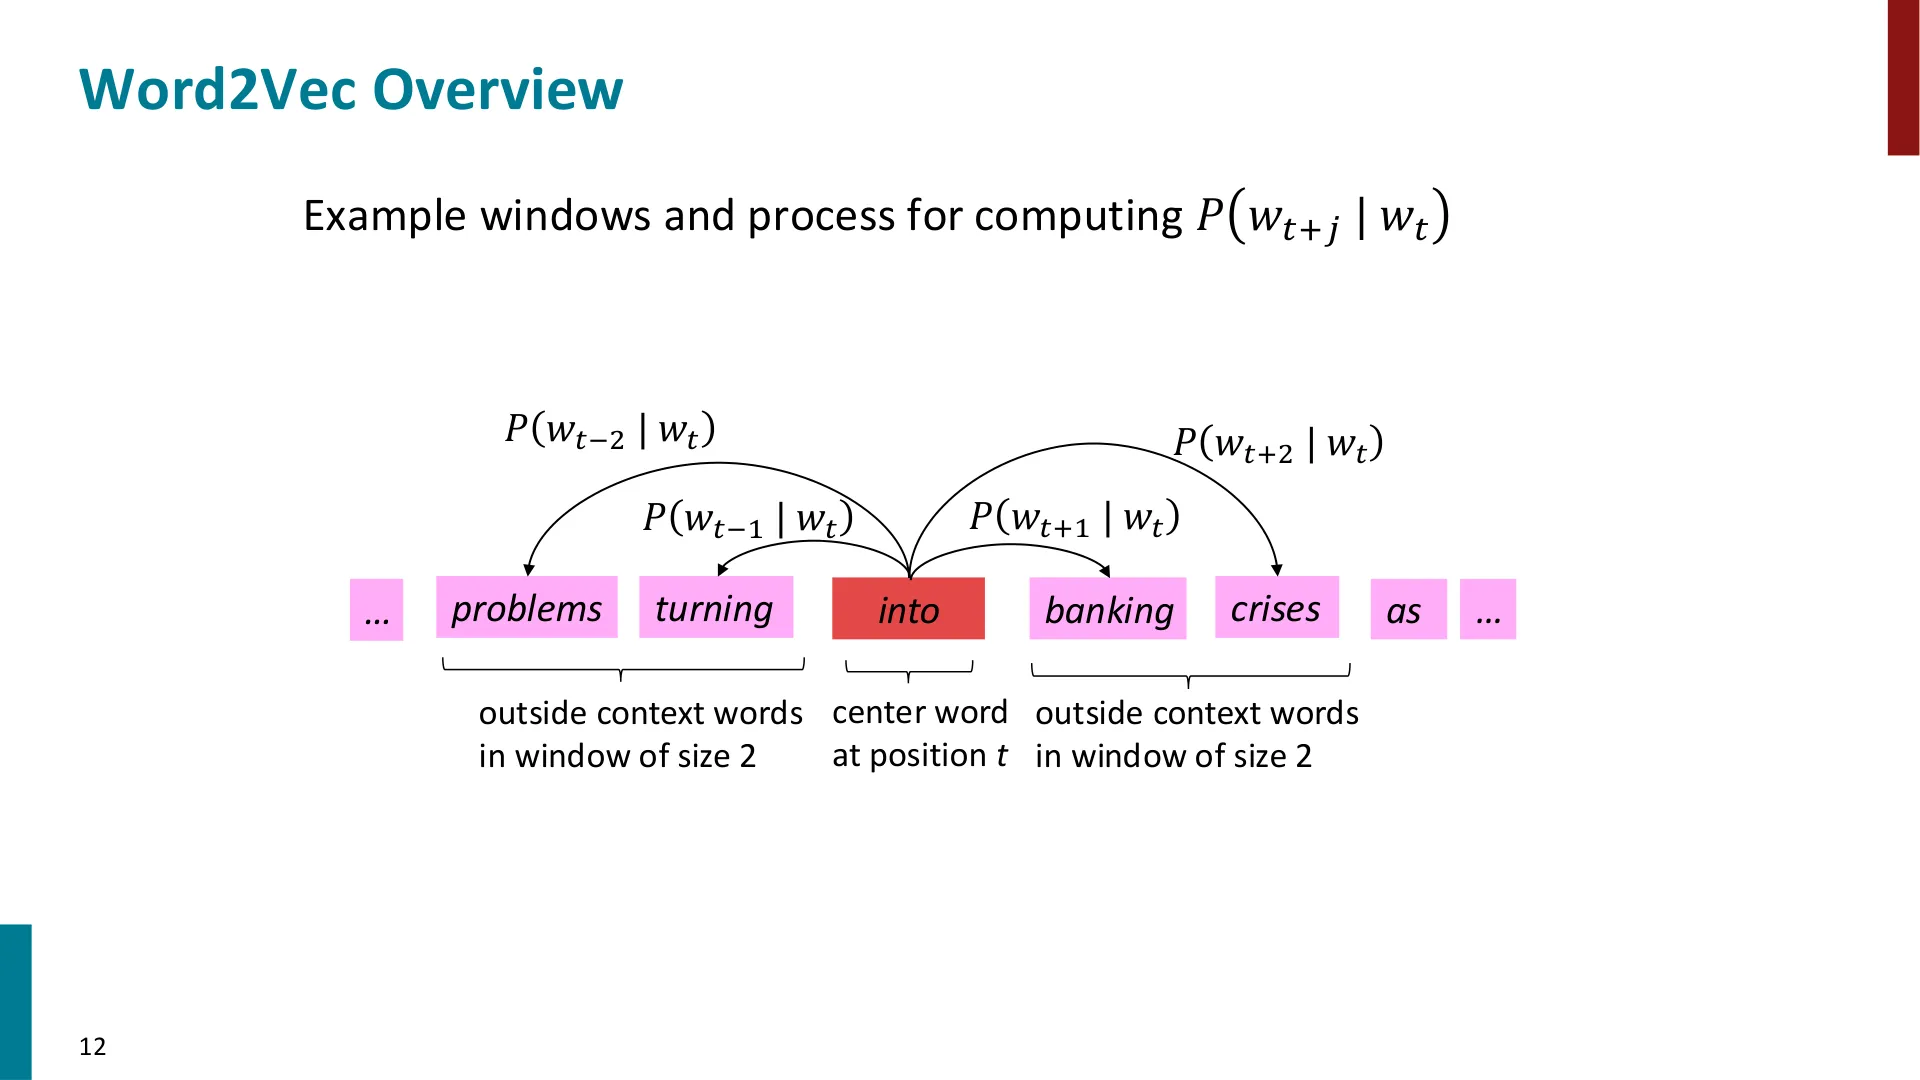
📷 Word2vec 的窗口与概率计算
回到原视频 (00:11:01)
3.2 目标函数
(参考时间: 09:15)
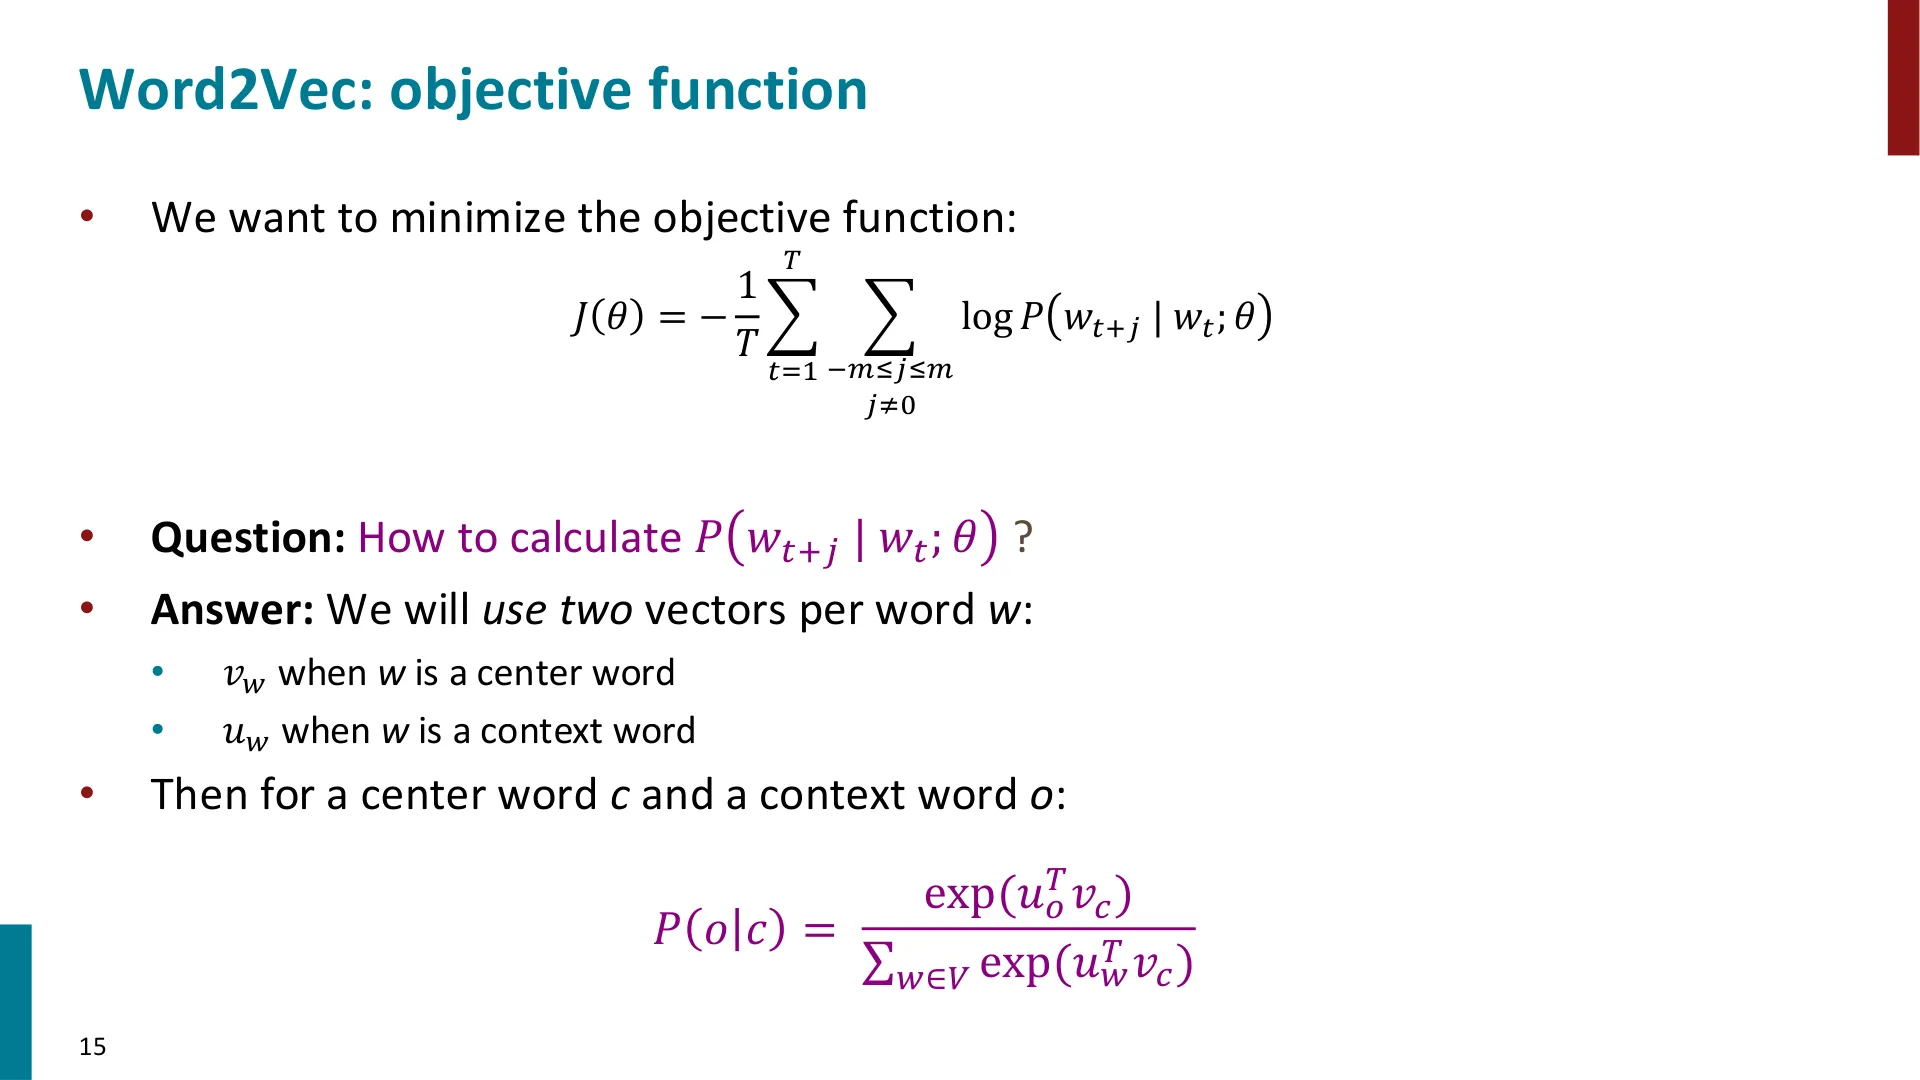
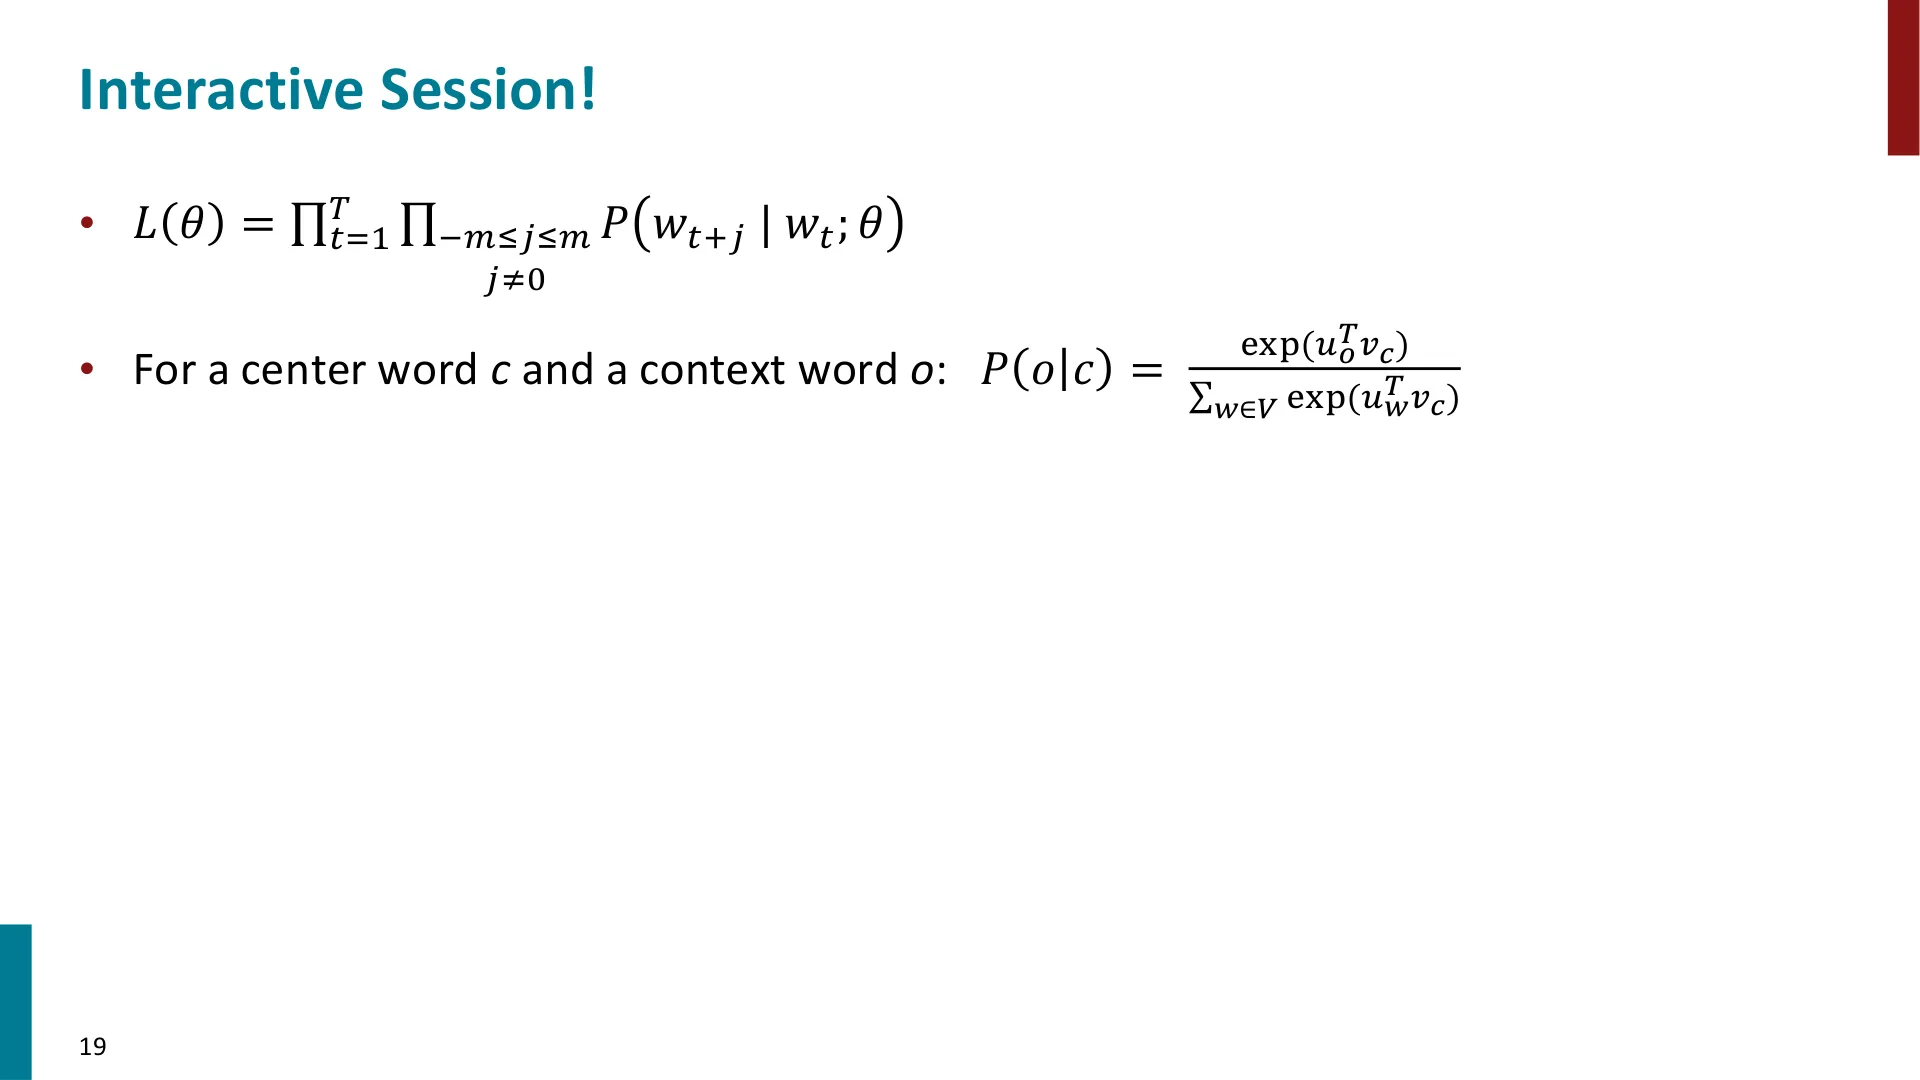
对每个位置 $t=1,\dots,T$,给定中心词 $w_t$,在固定大小为 $m$ 的窗口内预测上下文词。数据似然为:
$$ L(\theta)=\prod_{t=1}^{T}\ \prod_{\substack{-m\le j\le m\\ j\ne 0}} P(w_{t+j}\mid w_t;\theta) $$
(似然就是"在所有位置上,模型预测出真实上下文词的概率之积"。)
目标函数取(平均)负对数似然:
$$ J(\theta)=-\frac{1}{T}\log L(\theta) =-\frac{1}{T}\sum_{t=1}^{T}\ \sum_{\substack{-m\le j\le m\\ j\ne 0}} \log P(w_{t+j}\mid w_t;\theta) $$
最小化目标函数 ⟺ 最大化预测准确率。这里 $\theta$ 是所有待优化的变量;$J$ 也常被叫作代价函数或损失函数。
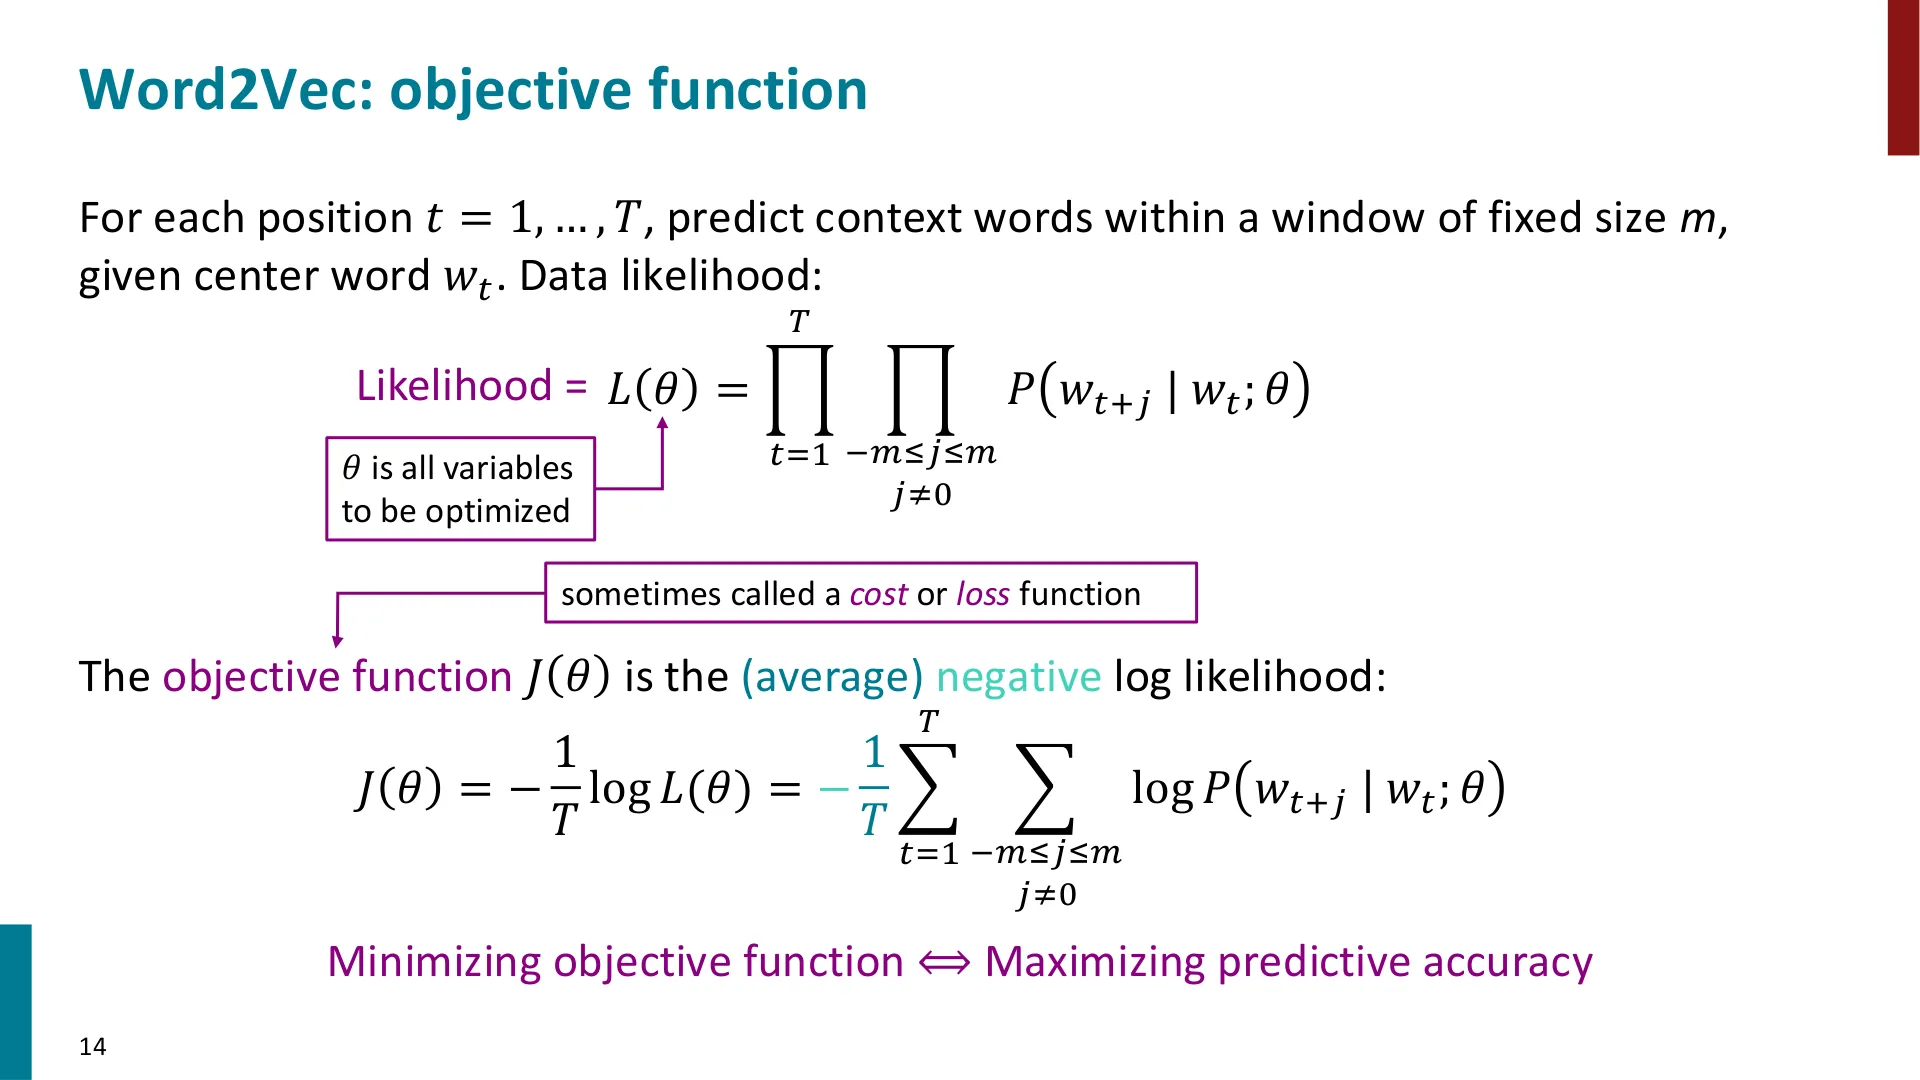
📷 Word2vec 的目标函数
回到原视频 (00:09:15)
3.3 预测函数:softmax
(参考时间: 09:30)
关键问题:$P(w_{t+j}\mid w_t;\theta)$ 怎么算?答案是每个词用两个向量:作为中心词时用 $v_w$,作为上下文词时用 $u_w$。于是对中心词 $c$ 与上下文词 $o$:
$$ P(o\mid c)=\frac{\exp(u_o^\top v_c)}{\sum_{w\in V}\exp(u_w^\top v_c)} $$
这是 softmax 函数 $\mathbb{R}^n\to(0,1)^n$ 的一个实例:
$$ \text{softmax}(x_i)=\frac{\exp(x_i)}{\sum_{j=1}^{n}\exp(x_j)}=p_i $$
它把任意实数映射成一个概率分布。名字的由来:
- "max"——它会放大最大的那个 $x_i$ 的概率;
- "soft"——但它仍会给较小的 $x_i$ 分一些概率(不像取最大那样硬)。
三个组成部分:
- 点积衡量 $o$ 与 $c$ 的相似度:$u^\top v=\sum_{i=1}^{n}u_iv_i$。点积越大,概率越大;
- 指数让任何数都变成正数(开区间 $(0,\infty)$);
- 对整个词表归一化,得到概率分布。
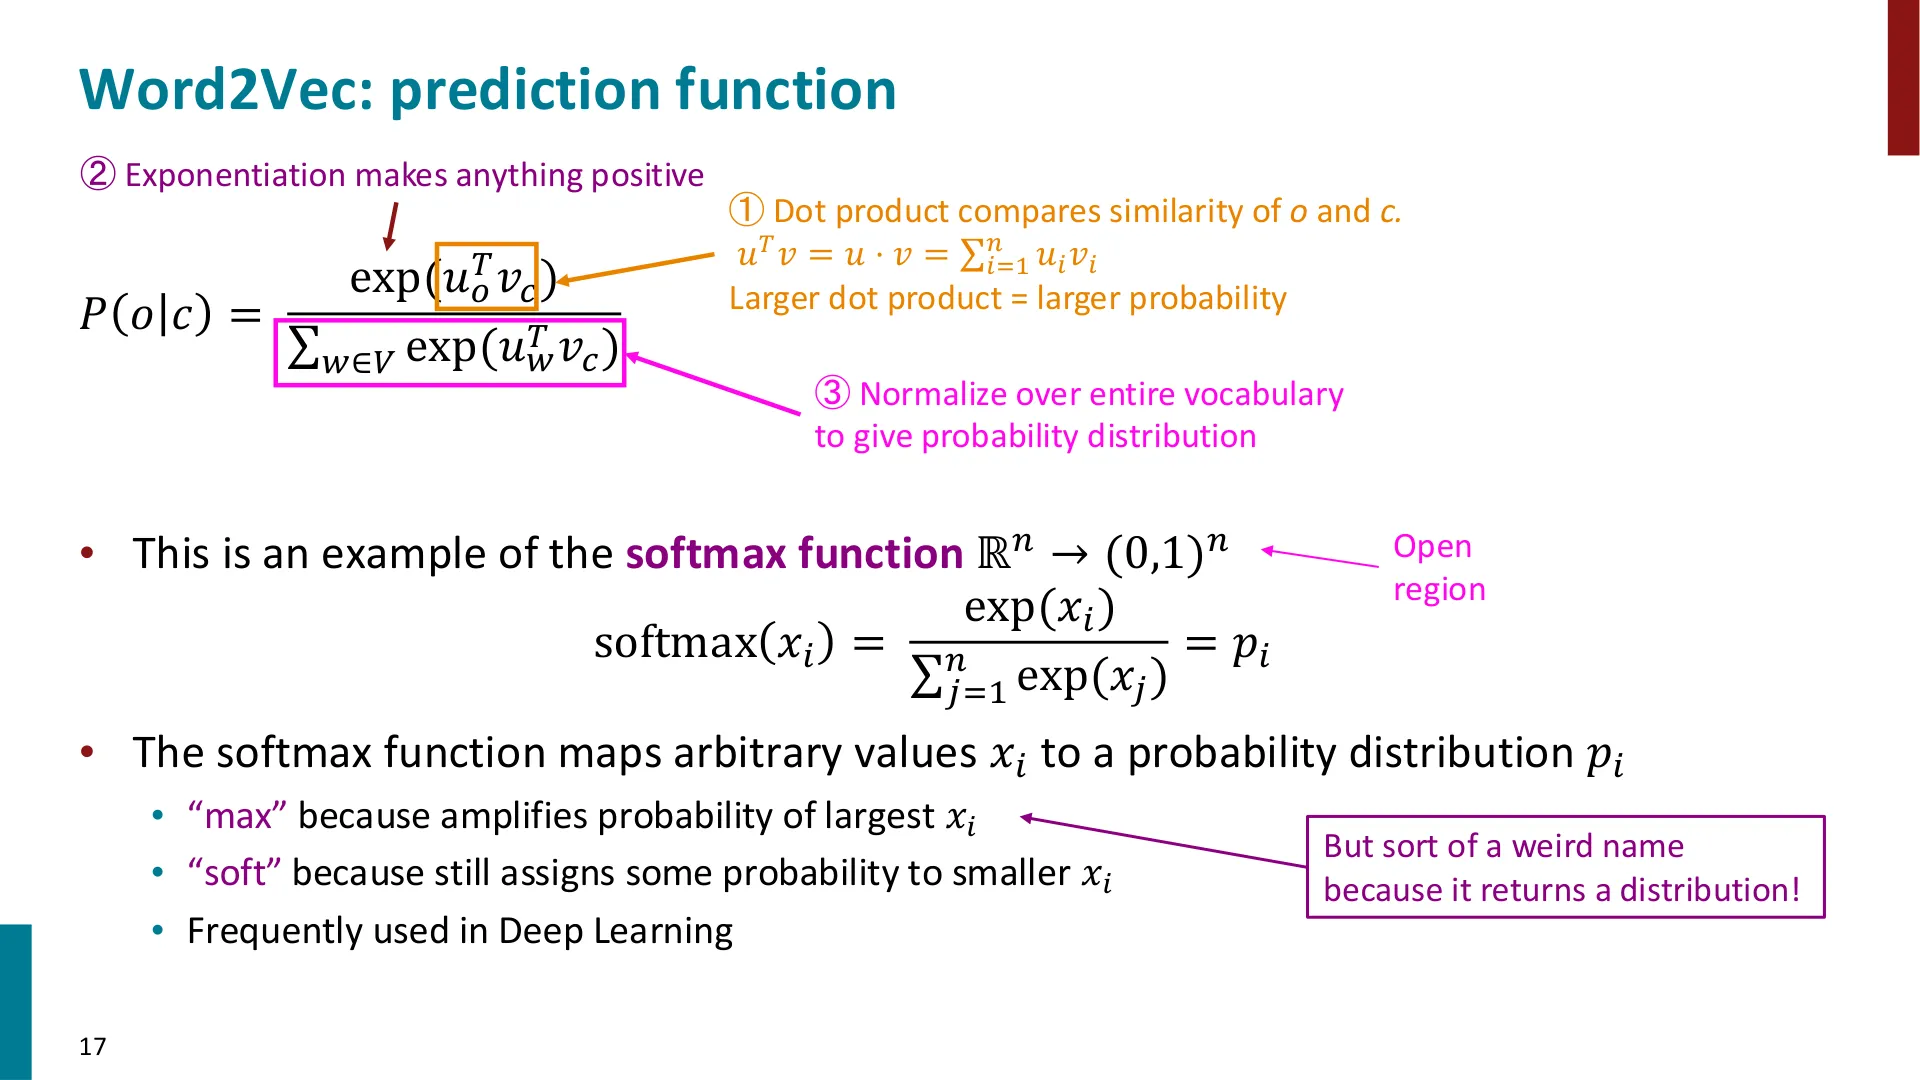
📷 Word2vec 的预测函数与 softmax 的三步
回到原视频 (00:09:50)
编者说明:讲师调侃 softmax「名字有点怪」——它返回的是一个分布,而不是一个"最大值"。名字里的 max 指"放大最大项",soft 指"不过分放大、仍保留其它项的概率"。
3.4 训练:优化参数以最小化损失
(参考时间: 10:48)
训练就是逐渐调整参数以最小化损失。把 $\theta$ 想象成一个超长向量:在 $d$ 维向量、$V$ 个词的设定下,每个词有两组向量,所以参数规模是 $2\cdot d\cdot V$。我们通过沿梯度下山来优化这些参数,并且要计算所有向量分量的梯度。
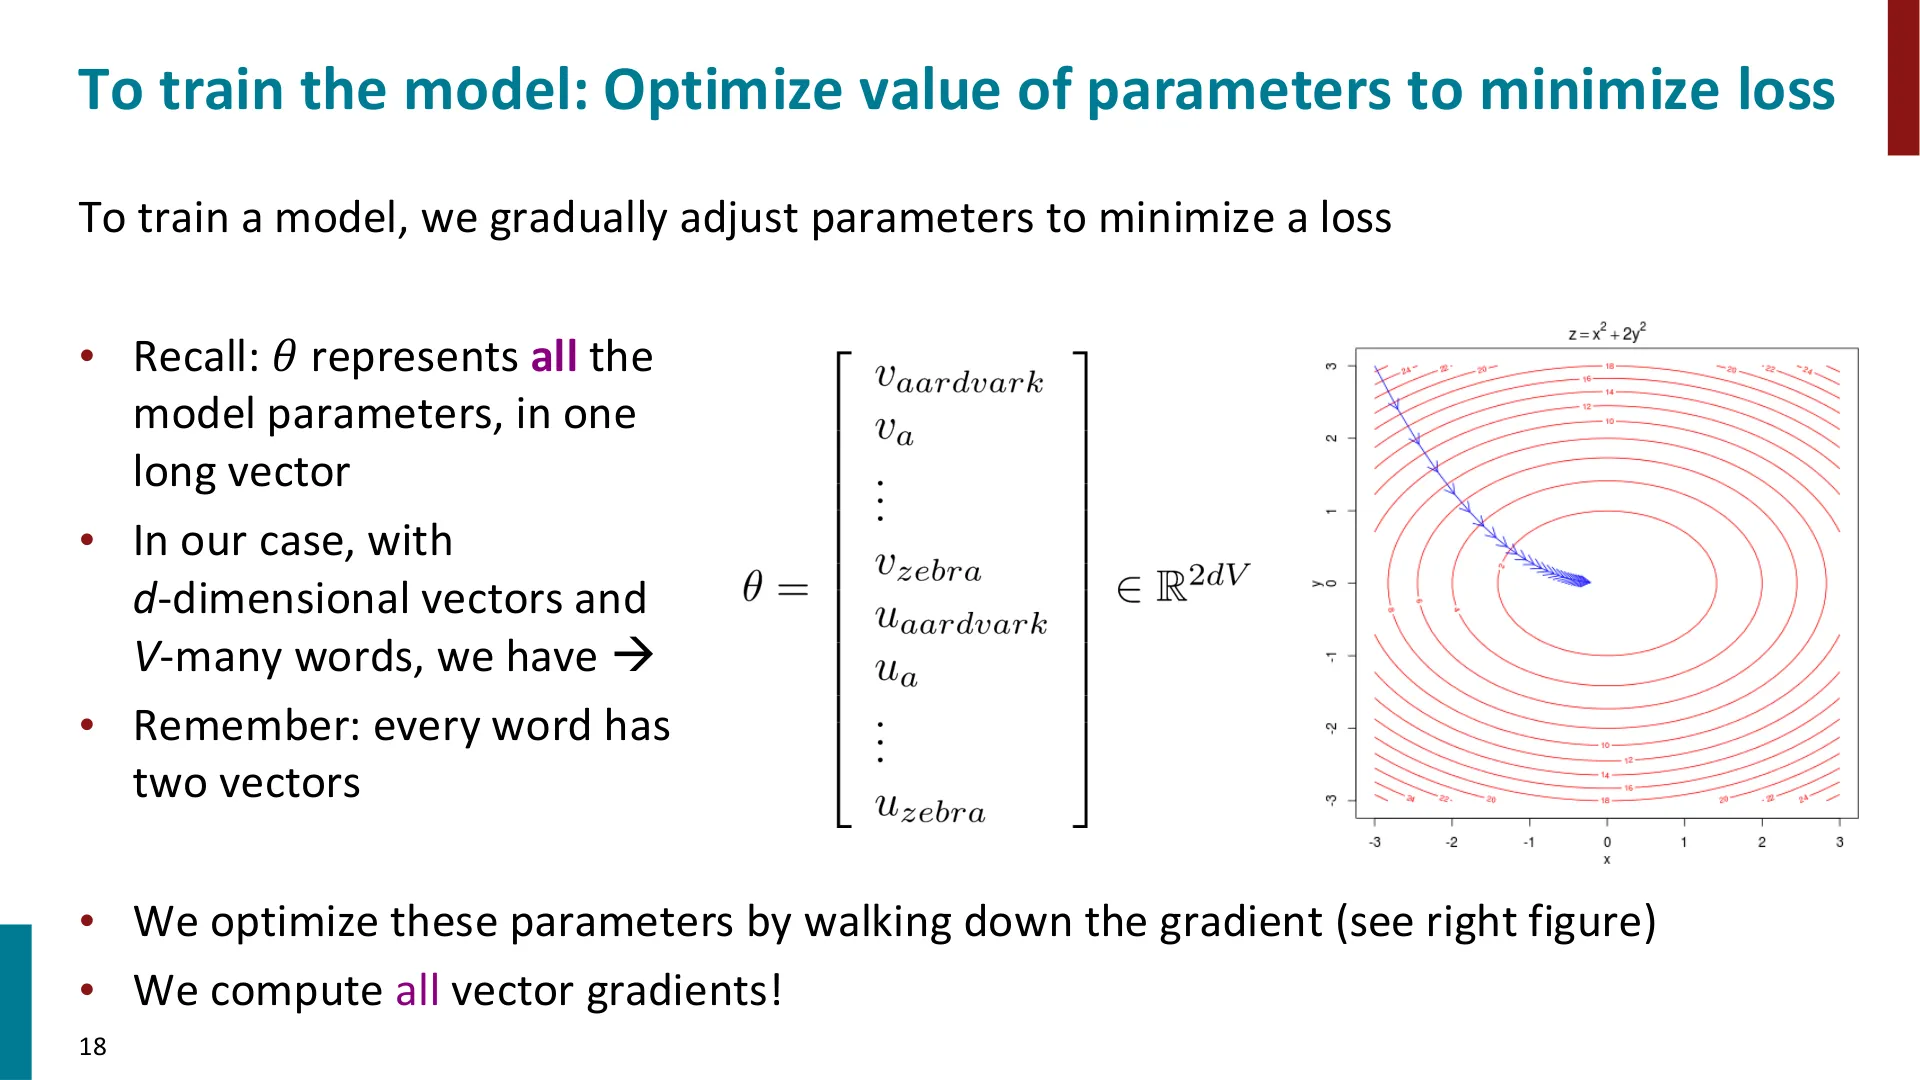
📷 训练模型:优化参数以最小化损失
回到原视频 (00:10:48)
graph LR
    A["中心词 w_t"] --> B["查表 v_c"]
    C["上下文词候选 w"] --> D["查表 u_w"]
    B --> E["点积 u_w^T v_c"]
    D --> E
    E --> F["对全部词汇做 softmax"]
    F --> G["概率分布 P(o|c)"]
    G --> H["与真实上下文词比较 → 损失"]
    H --> I["反向传播求梯度 → 更新向量"]
四、现场演示:用真实词向量玩类比
(参考时间: 11:26)
📷 讲师打开 Jupyter notebook 演示词向量
回到原视频 (00:11:40)
讲师现场打开了一个 Jupyter notebook,用 gensim 加载了一组GloVe 词向量(100 维,为了课堂演示更快)。他特别说明:GloVe 严格说不是 word2vec,但行为方式完全一样,可以放心地拿它来展示 word2vec 的性质。
第一步:看单个词长什么样。 任一个词(例如 bread)的表示就是一串实数。对比 bread 与 croissant,可以看到两者的前几个分量符号一致(都负、都正、都负、都正……),说明它们"性格相近"——模型确实知道面包和羊角面包有点像。
第二步:找最相似的词。
- 问"和
usa最像的词"→canada、america、u.s.a.、united states、australia……看起来很合理(虽然canada排第一有点意外,讲师笑说"为什么加拿大赢了带点的 USA")。 - 问"和
banana最像的词"→coconut、mango、bananas、potato、pineapple、fruit……也相当合理,只是略微偏向热带水果。 - 问"和
croissant最像的词"→ 不是bread,而是brioche、baguette、focaccia这类同级别具体食物。
第三步:取负向量。 如果问"和 banana 向量的相反数最像的词",得到的往往是一些莫名其妙的词甚至人名(比如一个日文名字),并不能当"反义词"用。取向量相反数来找反义词是行不通的。
4.1 语义类比:最有名的性质
(参考时间: 15:54)
真正令人惊叹的能力是:语义成分可以被"加加减减"地组合。经典例子:
$$ v_{\text{king}} - v_{\text{man}} + v_{\text{woman}} \approx v_{\text{queen}} $$
在向量空间里,从原点出发取 king 的正向量,减去 man,再加上 woman,然后问"离这个点最近的词是什么"——答案是 queen。
这就是后来广为人知的类比(analogy)能力,可以写成 "a 之于 b,相当于 c 之于 ?"。
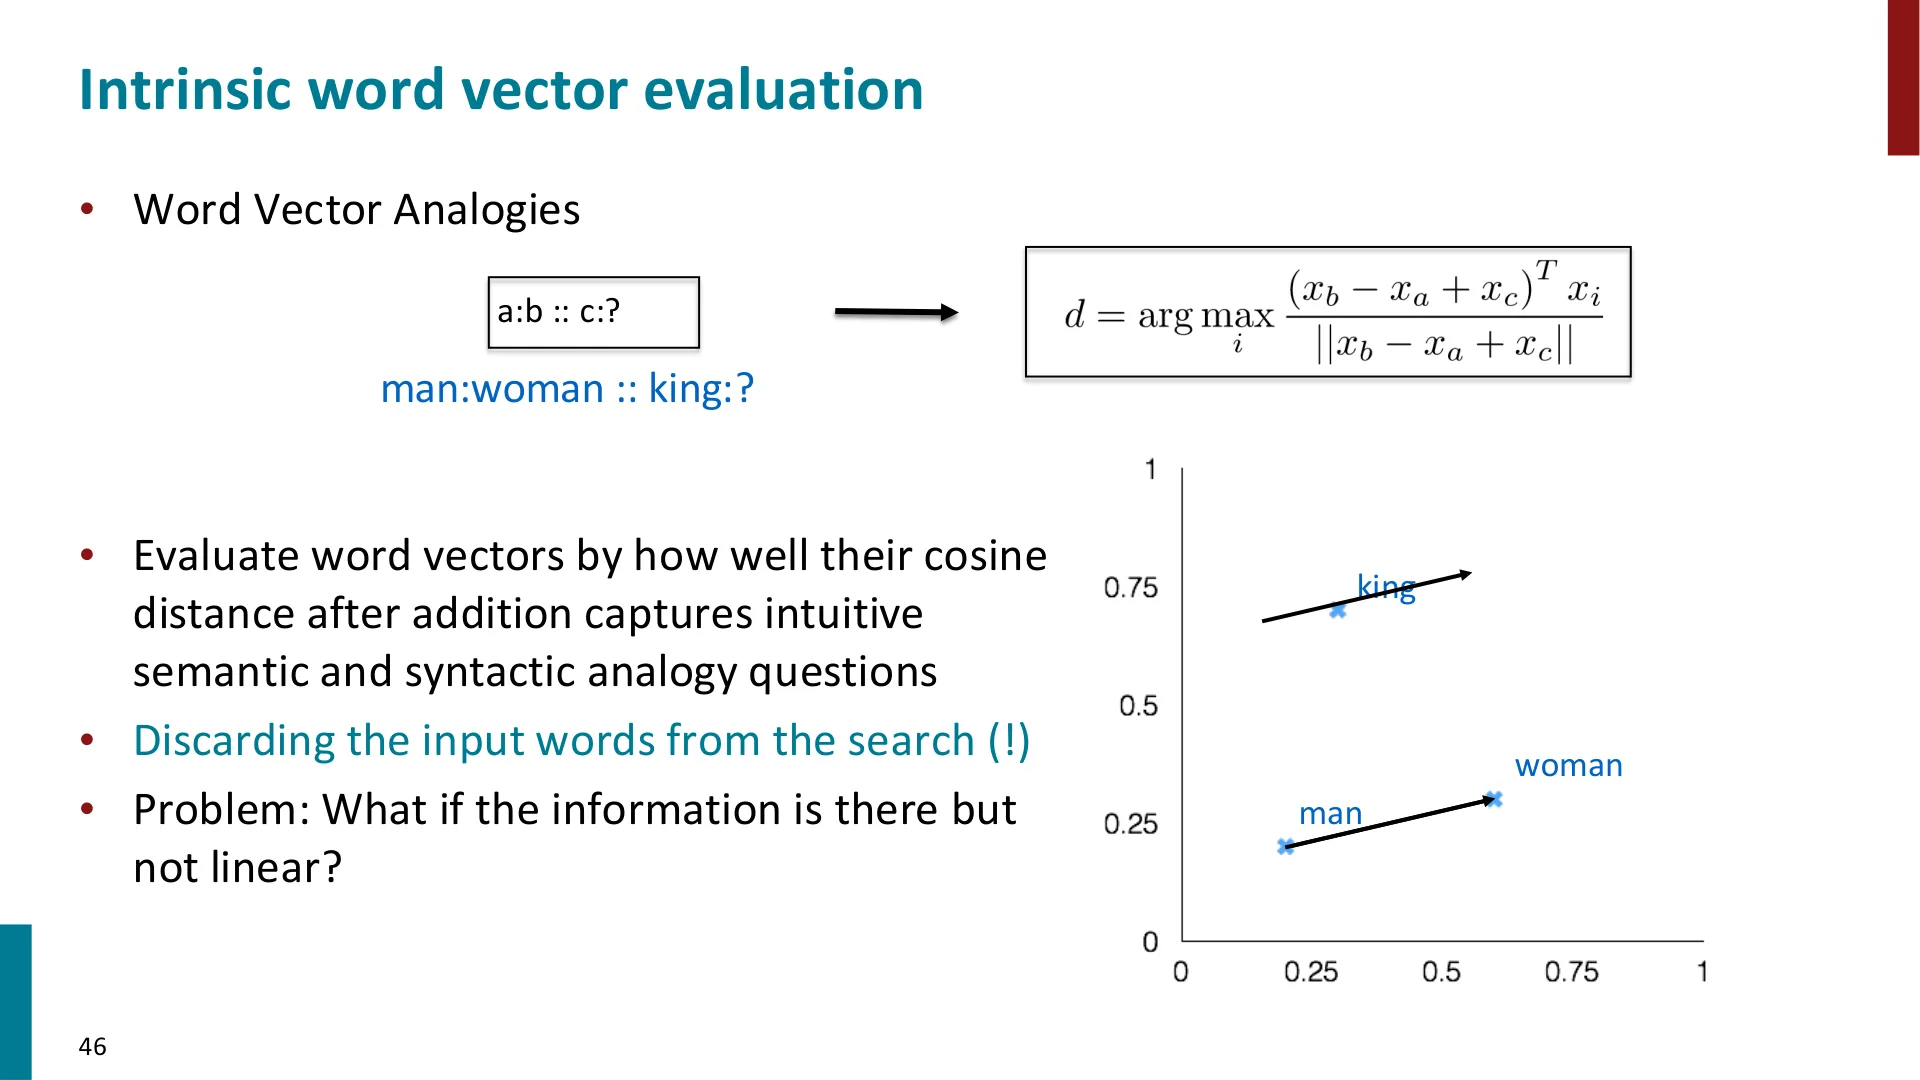
📷 词向量类比:king − man + woman = queen
回到原视频 (00:16:00)
讲师在这个老模型上玩了不少例子:
Australia之于 ?,如同France之于 ? → 得到 Champagne(香槟)。Russia之于 ? → 得到 vodka(伏特加)。pencil : sketching :: camera : ?→ 得到 photographing(拍照)。Obama : Clinton :: Reagan : ?→ 模型给出 Nixon。tall : tallest :: long : ?→ 得到 longest(纯语法上的比较级/最高级关系也学到了)。
讲师自嘲说,这些是很"老派"的东西了,现在几乎没人真用这套,因为有更强更花哨的模型如 ChatGPT;但在当年,一个用非常简单数据、非常简单模型搭出来的东西就能有相当好的语义理解、能做相当好的类比,是非常震撼的。
值得注意的是,模型学到的不只是"语言学上的词义",还包含文化世界知识——"澳大利亚之于啤酒,相当于俄罗斯之于伏特加"这种联想,超出了人们通常所说的"词义"范畴。
4.2 学生提问
(参考时间: 21:26) 学生问:减去 man 与 king 之间的差,是不是也捕捉到了"统治者(ruler)"这个概念?
讲师回答:是的。关键在于你怎么看待这个类比——"词与词之间的差值向量"既可以看成性别方向(man→king 与 woman→queen 同向),也可以看成统治者身份方向。两种解读都成立。
(参考时间: 22:32) 有学生问:word2vec 每个词有两个向量 $u$ 和 $v$,但这里每个词只有一个向量,怎么从两个变一个?
讲师回答:实践中最常见的做法就是把两个向量取平均。而且它们最终往往非常接近——因为遍历文本时,一个词既会当中心词、也会当上下文词(例如 "the octopus has legs" 里,octopus 一会儿在中心、legs 在上下文,过几步就调换过来),所以两套向量会趋于相似,人们干脆平均掉。
(参考时间: 23:40) 学生又问:能不能把上一个类比的答案再喂进下一个类比,测试能走多远?
讲师回答:可以试,但不总是成立,有很多失败例子;他当时手边没有现成的函数,建议同学们回家自己玩。
课程页面上,关于词向量的完整演示可以回顾官方幻灯片中的 GloVe 可视化:
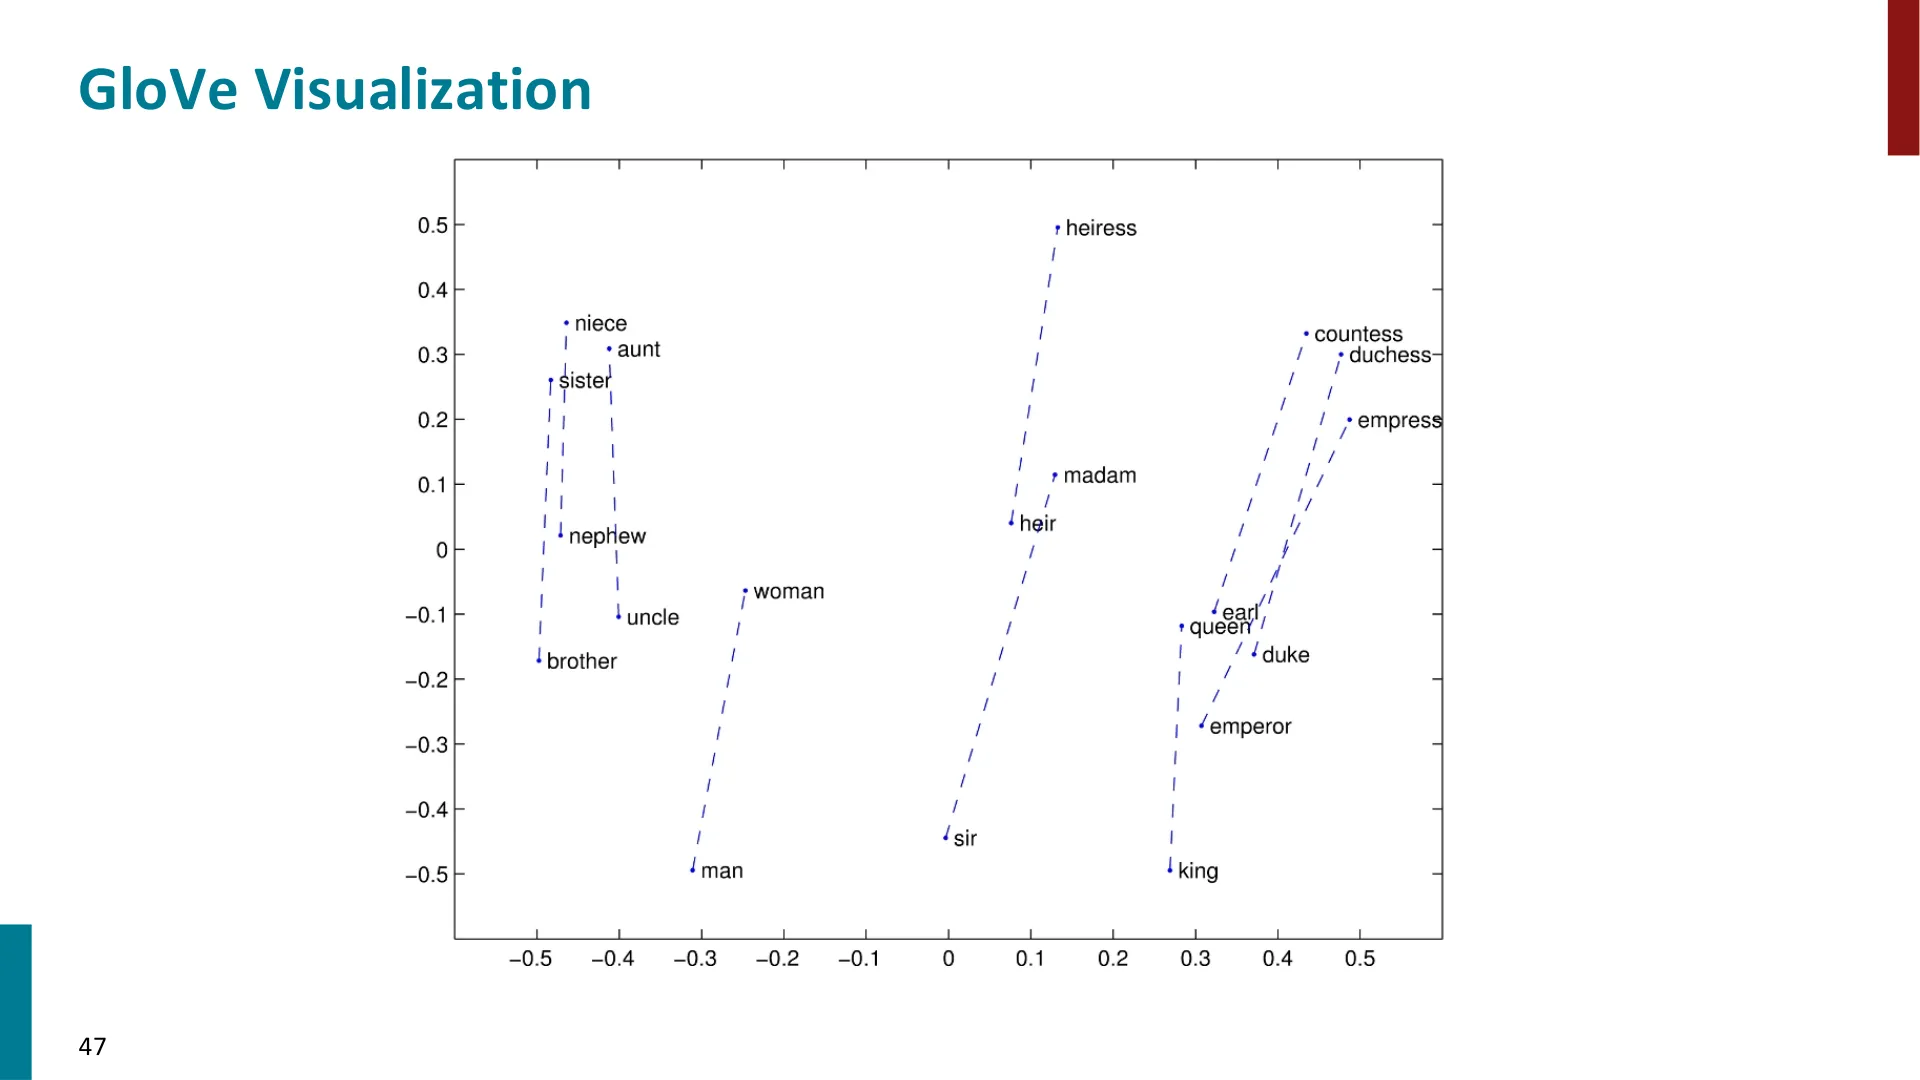
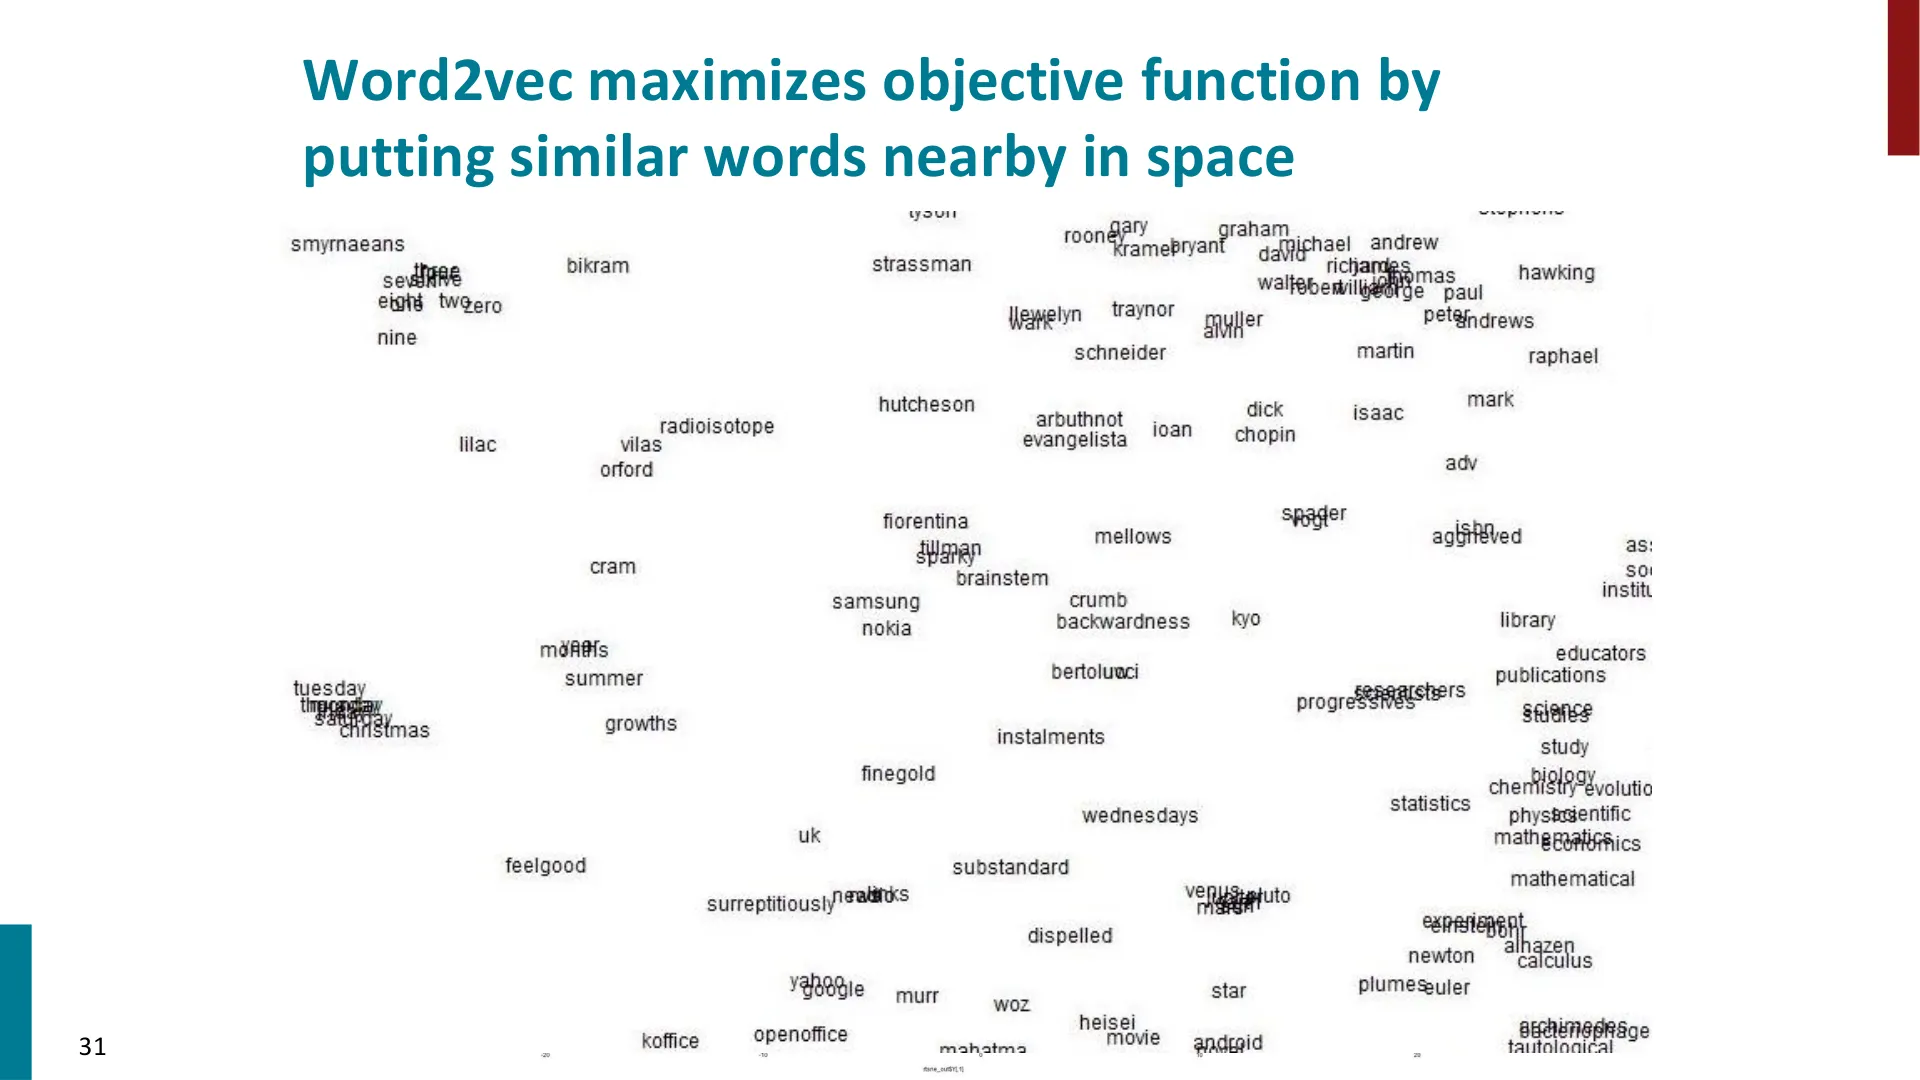
📷 GloVe 词向量的二维可视化
回到原视频 (00:48:57)
五、Word2vec 的更多细节与变体
(参考时间: 24:41)
编者说明:讲师在这里特别提醒选课的同学——不要照着旧作业去"从零实现 word2vec"。以往学期有这项作业,但本学期(春季学期较短)决定不做,请等新作业发布,以免白费时间。
5.1 为什么每个词要两套向量
(参考时间: 25:32)
回到学生刚才提的问题——为什么要用两套分开的向量? 讲师给出的是数学上的理由:
假设中心词和外部词共用同一套向量。当我们遍历"每一个可能的外部词"来做归一化时,迟早会再次碰到中心词自己。那一刻,原本形如 $x$(一次项)的每一项里会冒出一个二次项 $x^2$(即该词向量与自身的平方项)。这让整个导数推导变得更乱——别的项都是一次的,唯独这一处是二次的。
所以 word2vec 的原始做法是干脆用两套互不相干的向量,把数学保持简单。这并不是因为它"更好"——事实上一套向量的实现在数学上稍作调整后,效果反而略好一点点;但实践中人们通常还是分别估计两套向量,最后取平均。
5.2 两个模型变体和三种损失
(参考时间: 26:55)
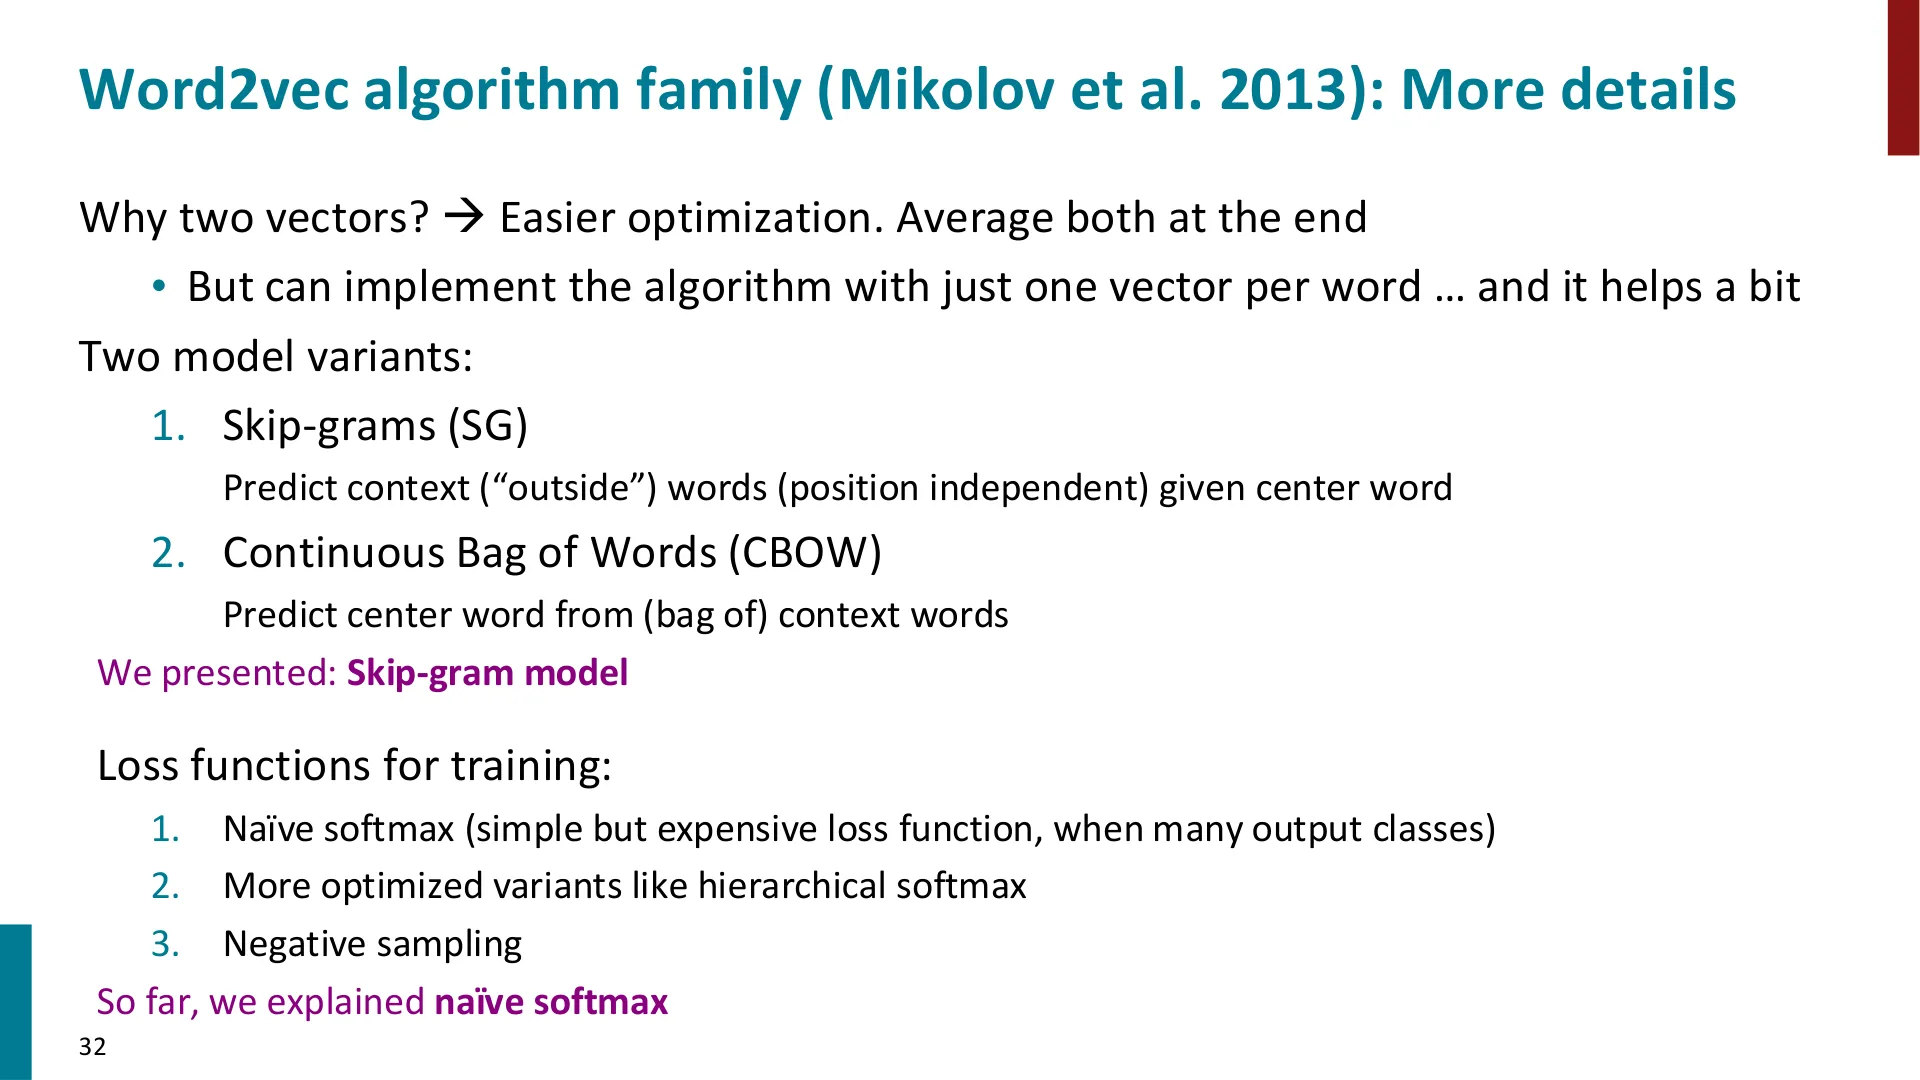
原始论文(Mikolov 等,2013)其实给出了一族方法:
两个模型变体:
- Skip-grams(SG):给定中心词,预测(与位置无关的)上下文/"外部"词。本讲讲的就是这一种,它更简单,效果也很好。
- Continuous Bag of Words(CBOW):给定上下文的"词袋",预测中心词。
三种训练损失:
- 朴素 softmax(naïve softmax):简单,但当输出类别很多时非常昂贵;
- 层次 softmax(hierarchical softmax):优化的变体;
- 负采样(negative sampling)。
📷 Word2vec 算法族:两个模型变体与三种损失
回到原视频 (00:26:55)
5.3 负采样(Negative Sampling)
(参考时间: 28:21)
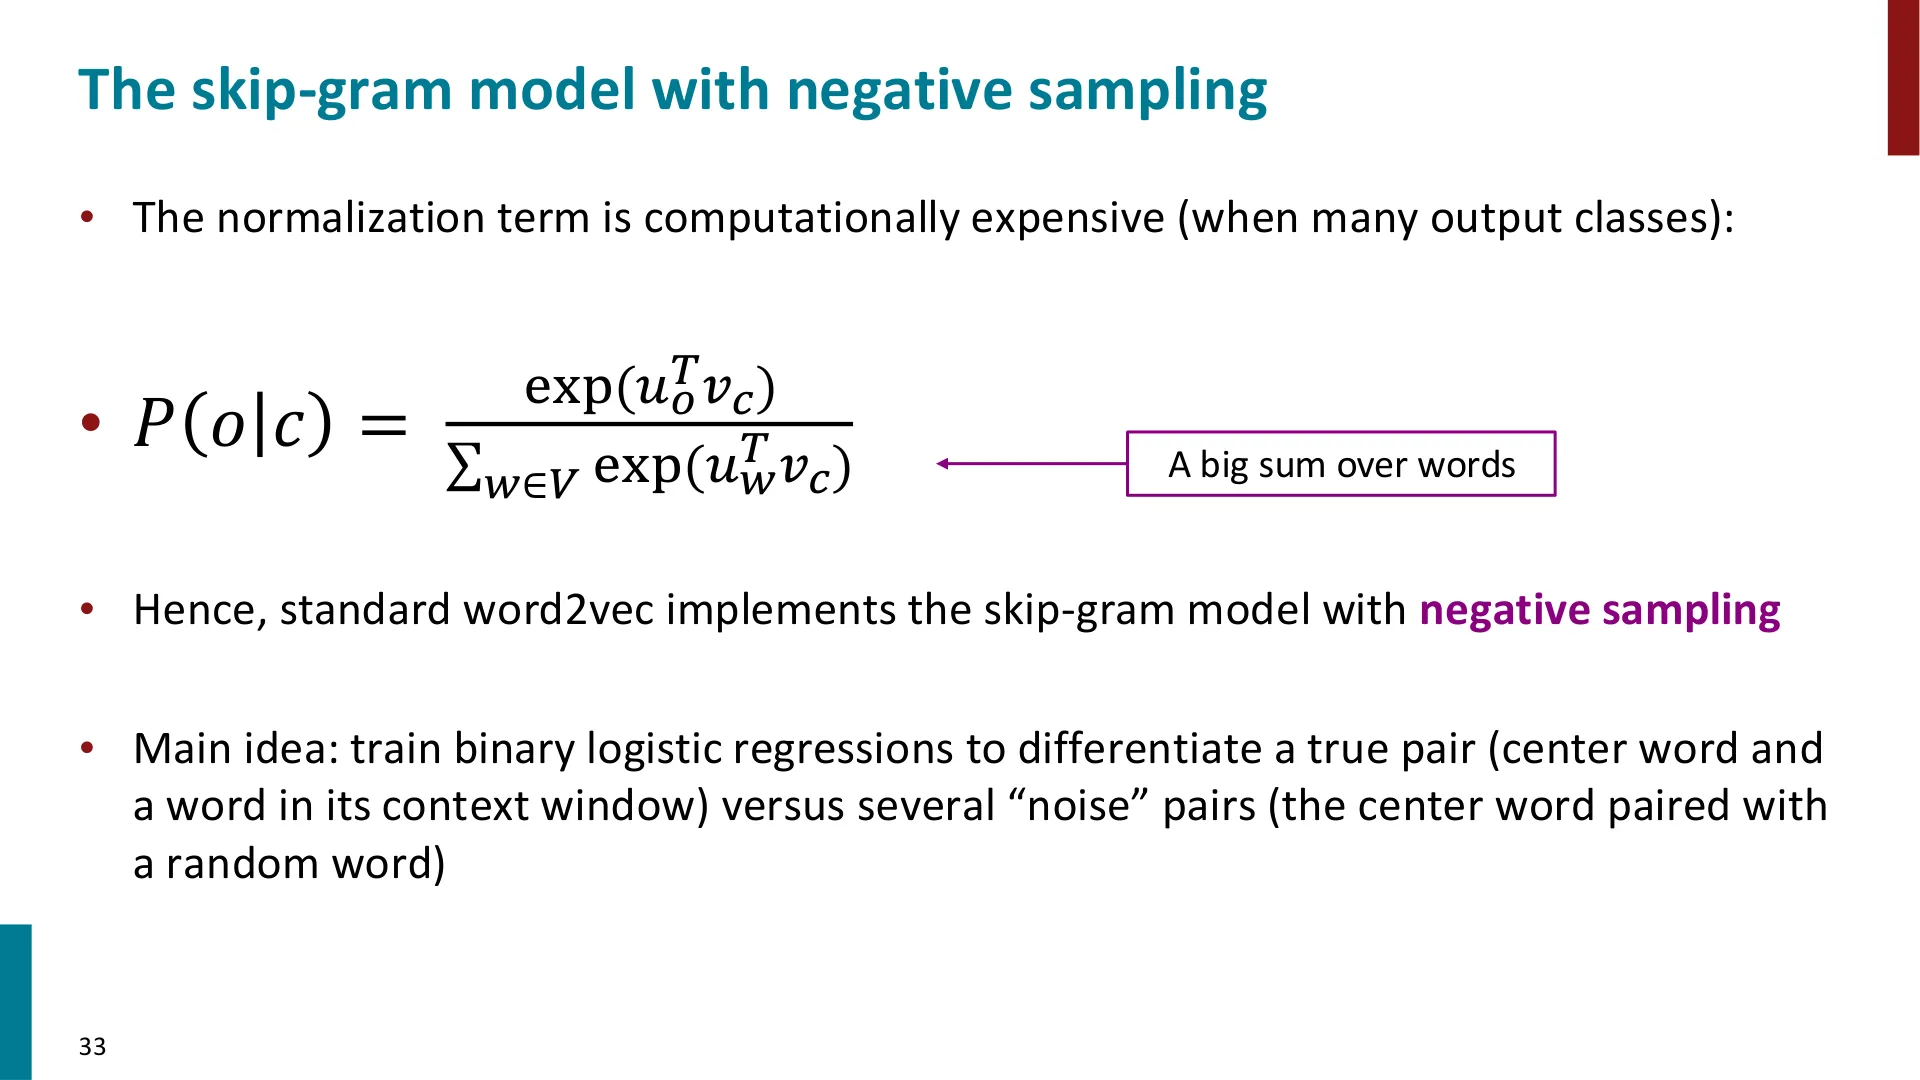
动机:朴素 softmax 的分母要遍历整个词表求和:
$$ P(o\mid c)=\frac{\exp(u_o^\top v_c)}{\sum_{w\in V}\exp(u_w^\top v_c)} $$
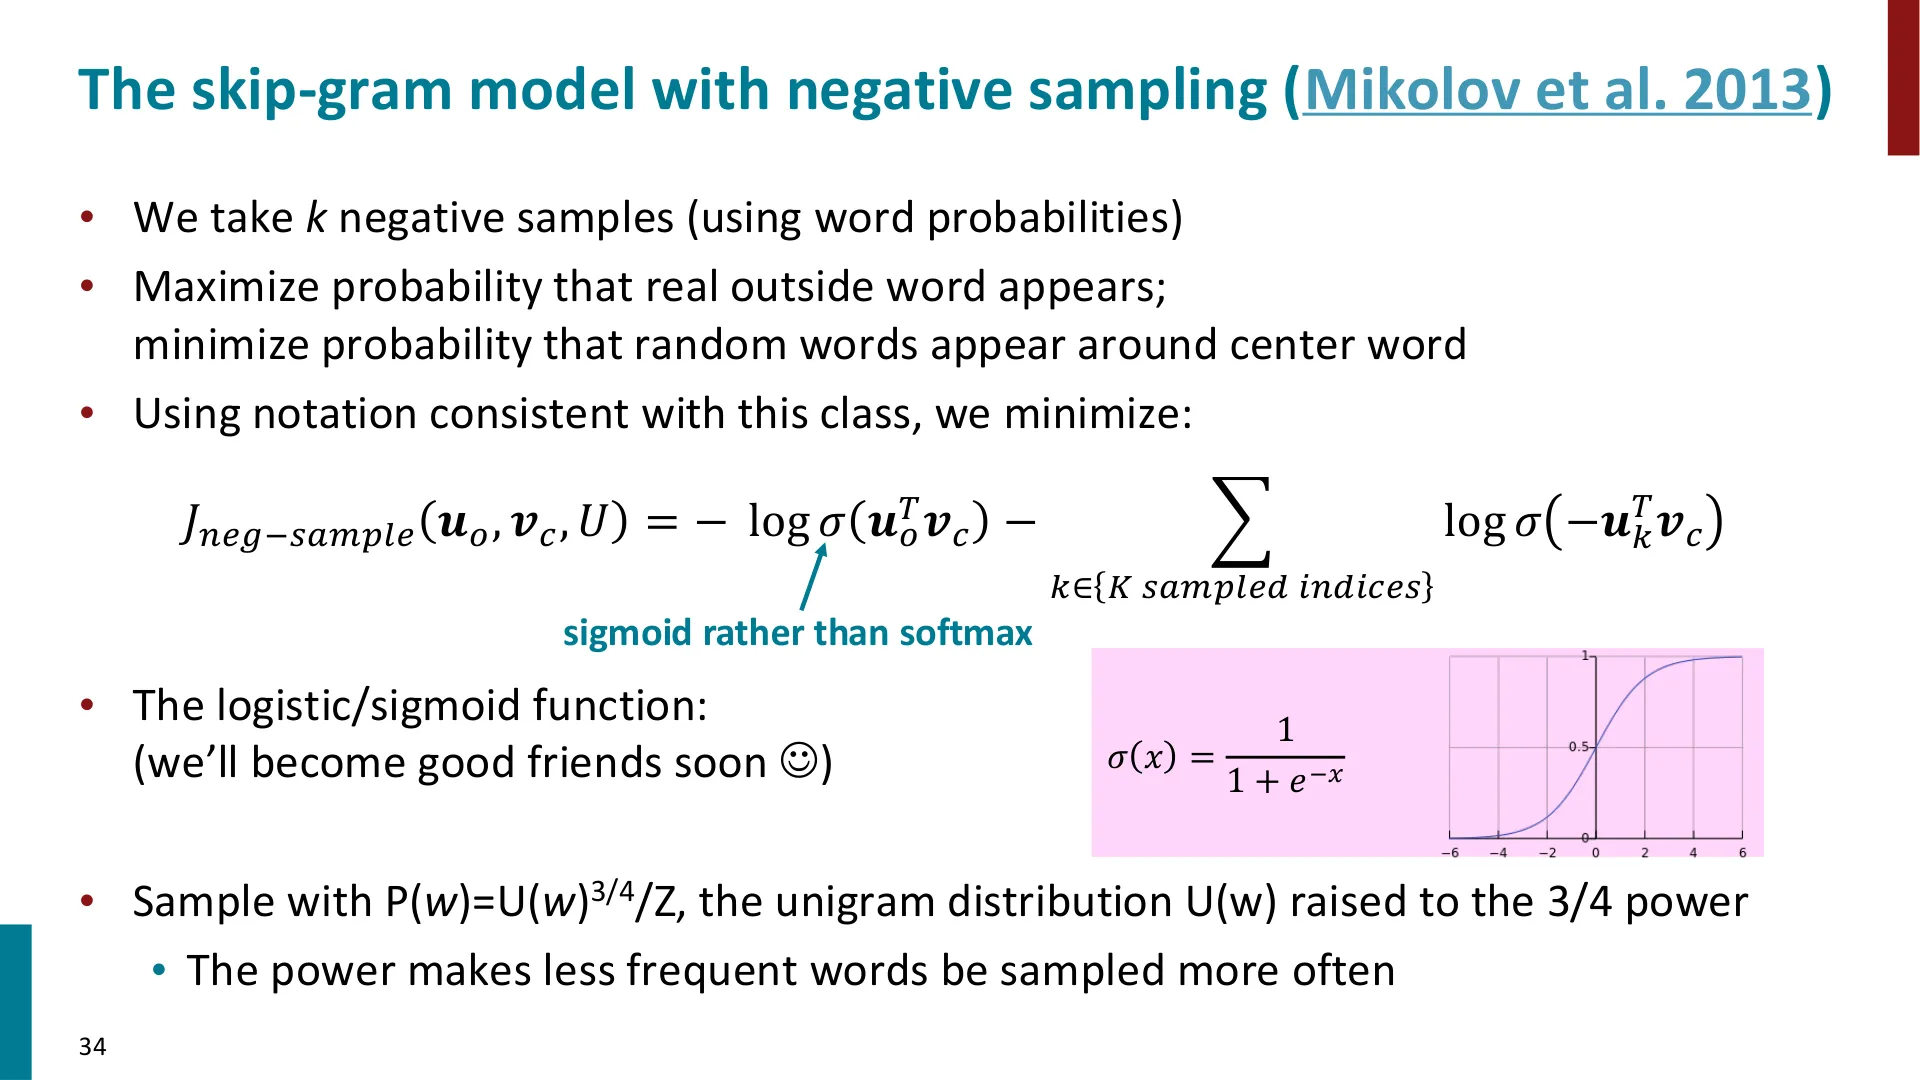
如果词表有 40 万词,那就是 40 万项求和,而每一项还要在两个 100~300 维向量之间做点积再取指数——计算量很大。于是想法是:与其对每个可能的词都算一遍,不如训练一些简单的逻辑回归,让它"喜欢"真正出现在上下文里的词、"不喜欢"随机抽出的词。这就是 Skip-gram 负采样。
损失函数(采用与本课一致的记号):
$$ J_{\text{neg-sample}}(u_o, v_c, U) = -\log \sigma(u_o^\top v_c) -\sum_{k\in K\text{ sampled indices}} \log \sigma(-u_k^\top v_c) $$
其中 logistic / sigmoid 函数为:
$$ \sigma(x)=\frac{1}{1+e^{-x}} $$
要点:
- 对真实的上下文词,我们希望 $u_o^\top v_c$ 大,从而 $\sigma(\cdot)$ 接近 1;因为是最小化,所以取负号让它下降。
- 对采样出的噪声词,我们希望概率小,于是写成 $\sigma(-u_k^\top v_c)$——这里利用 sigmoid 的对称性,把符号放到里面去,等价于让 $u_k^\top v_c$ 变小。
- 从 softmax 换成了 sigmoid。
📷 Skip-gram 负采样
回到原视频 (00:28:21)
graph TD
    A["中心词 c 与真实上下文词 o"] --> B["正样本:最大化 σ(u_o^T v_c)"]
    A --> C["按噪声分布采样 k 个负样本"]
    C --> D["负样本:最大化 σ(−u_k^T v_c)"]
    B --> E["合起来最小化 J_neg-sample"]
    D --> E
如何采样负样本? 标准做法不是在 40 万词上均匀随机抽,而是要考虑词的出现频率——也就是一元分布(unigram distribution):像 "the" 这样的词非常常见,大约有 10% 的时间会被抽到。做法是取一元概率的 3/4 次方:
$$ P(w)=\frac{U(w)^{3/4}}{Z} $$
3/4 次方起什么作用? 讲师现场提问,学生答"少见词更容易被抽到"——正确。把概率开 3/4 次(等价于降低指数),相当于把分布往"均匀"的方向推一点:既不是完全均匀,也不是严格按词频。这样做经验上效果更好。讲师补了一句:推到极致就是指数取 0,那就对应"完全均匀采样"。
编者拓展|为什么 $U(w)^{3/4}$ 会让低频词更容易被抽中:设两个词频率分别为 $p$ 和 $q$,且 $p\gg q$。原本的比值是 $p/q$,取 $\frac{3}{4}$ 次方后变成 $(p/q)^{3/4}$,由于 $p/q>1$,指数小于 1 时 $(p/q)^{3/4}
高频词相对低频词的优势被削弱,分布整体被"压平"、向均匀分布靠拢。这是 word2vec 论文里经验调出来的指数。
5.4 负采样下梯度的稀疏性(讲师跳过的旁注)
(参考时间: 33:38)
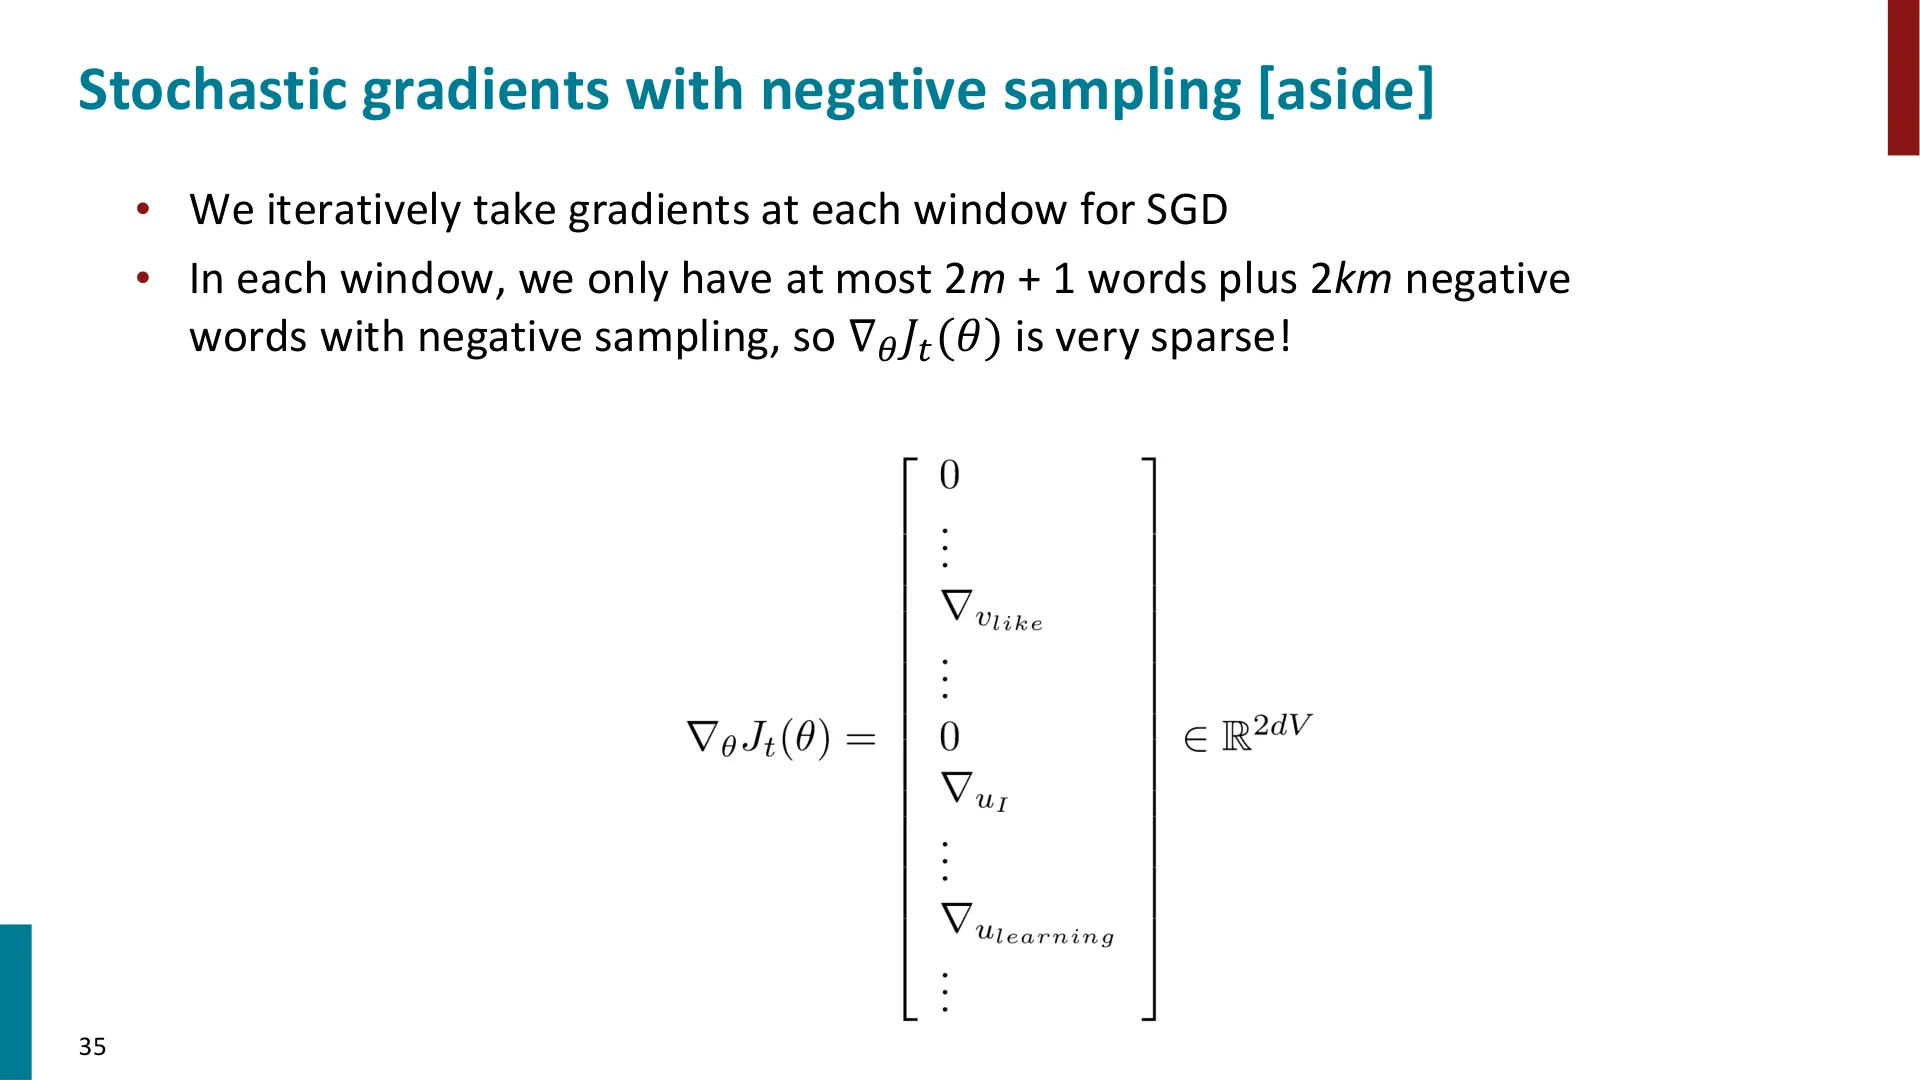
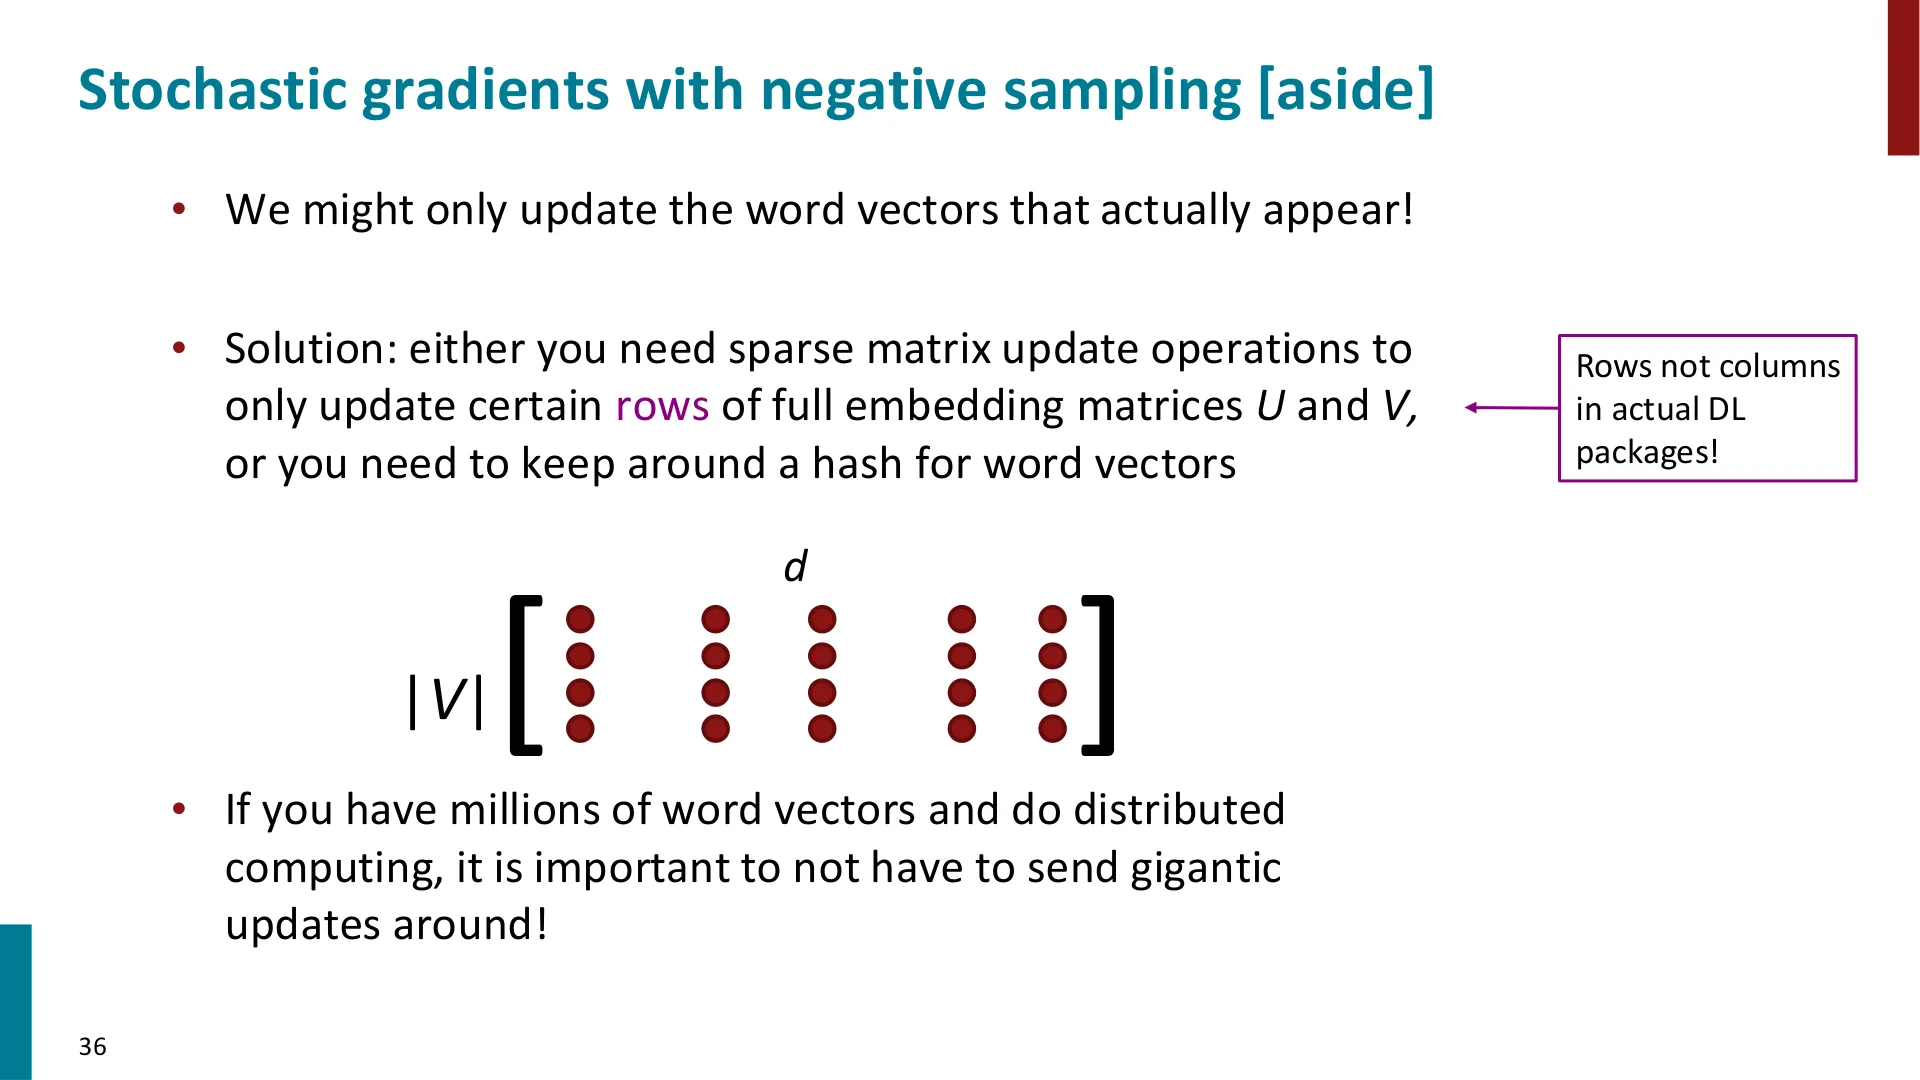
讲师此处说,原本准备了一页关于"负采样下随机梯度稀疏性"的幻灯片,但时间紧,就不讲了(该页内容仍保留在幻灯片文件中,见文末附录)。其要点是:每个窗口里最多只有 $2m+1$ 个真实词加上 $2km$ 个负样本词,因此 $\nabla_\theta J_t(\theta)$ 非常稀疏;几十万、上百万个词向量做分布式训练时,只更新真正出现过的那些行、避免传送巨大的更新,是很重要的。
六、换个思路:为什么不直接数共现次数?
(参考时间: 34:00)
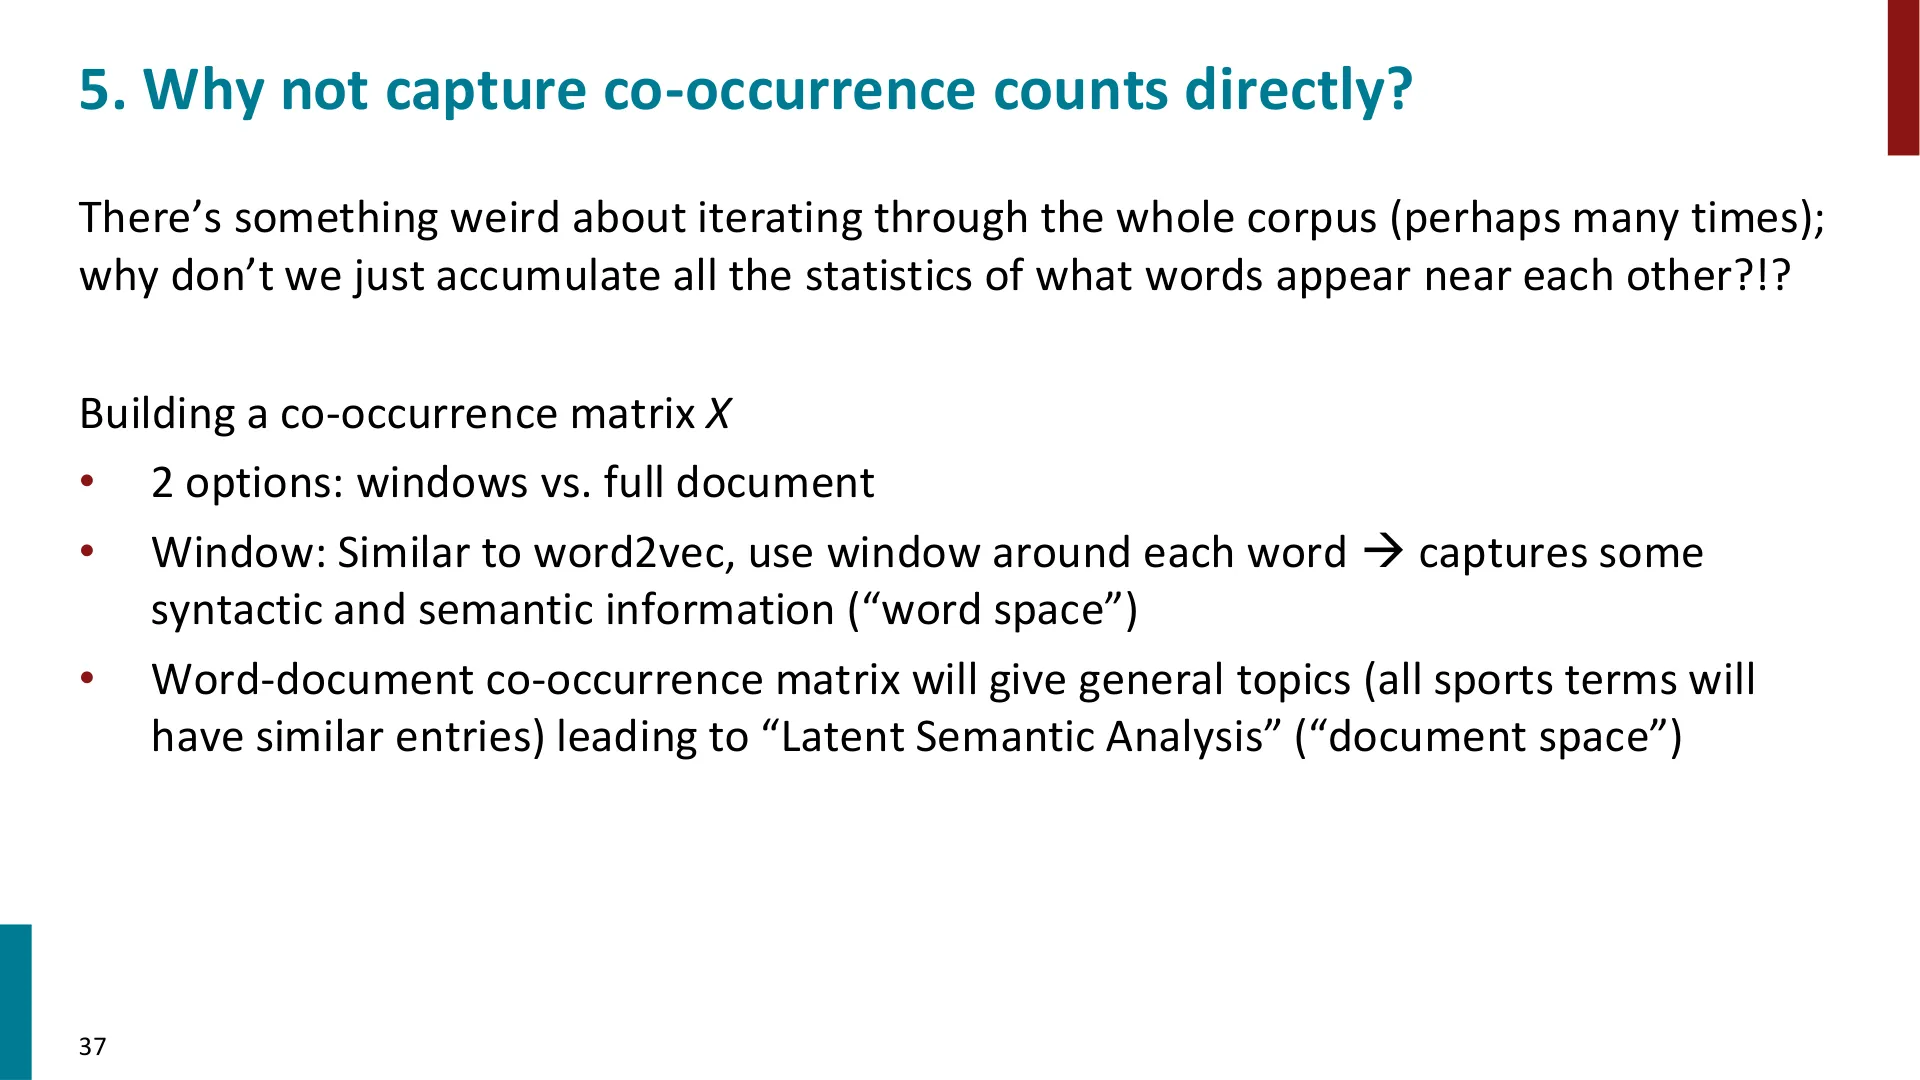
讲到这里,很自然会冒出一个疑问:既然我们就是要"知道谁和谁常一起出现",为什么不直接统计共现次数呢?我们明明有文本、有词、有词的上下文,直接数一下"swim 和 octopus 一起出现了多少次、fish 和 octopus 一起出现了多少次",然后直接拿这些计数当作词向量,不就行了吗?
这正是历史上真实走过的路。
📷 为什么不直接统计共现次数
回到原视频 (00:34:00)
6.1 共现矩阵 X
(参考时间: 35:01)
用和 word2vec 一样的"上下文窗口"概念,可以构造一个共现计数矩阵 $X$,其中 $X_{ij}$ 表示词 $i$ 出现在词 $j$ 上下文中的次数。有两种做法:
- 基于窗口:像 word2vec 一样,用每个词周围的固定窗口 → 捕捉到一些句法和语义信息("词空间");
- 基于整篇文档(词-文档共现):会给出主题层面的信息(所有体育术语会有相似的条目),这就是潜在语义分析(Latent Semantic Analysis, LSA)的路子("文档空间")。
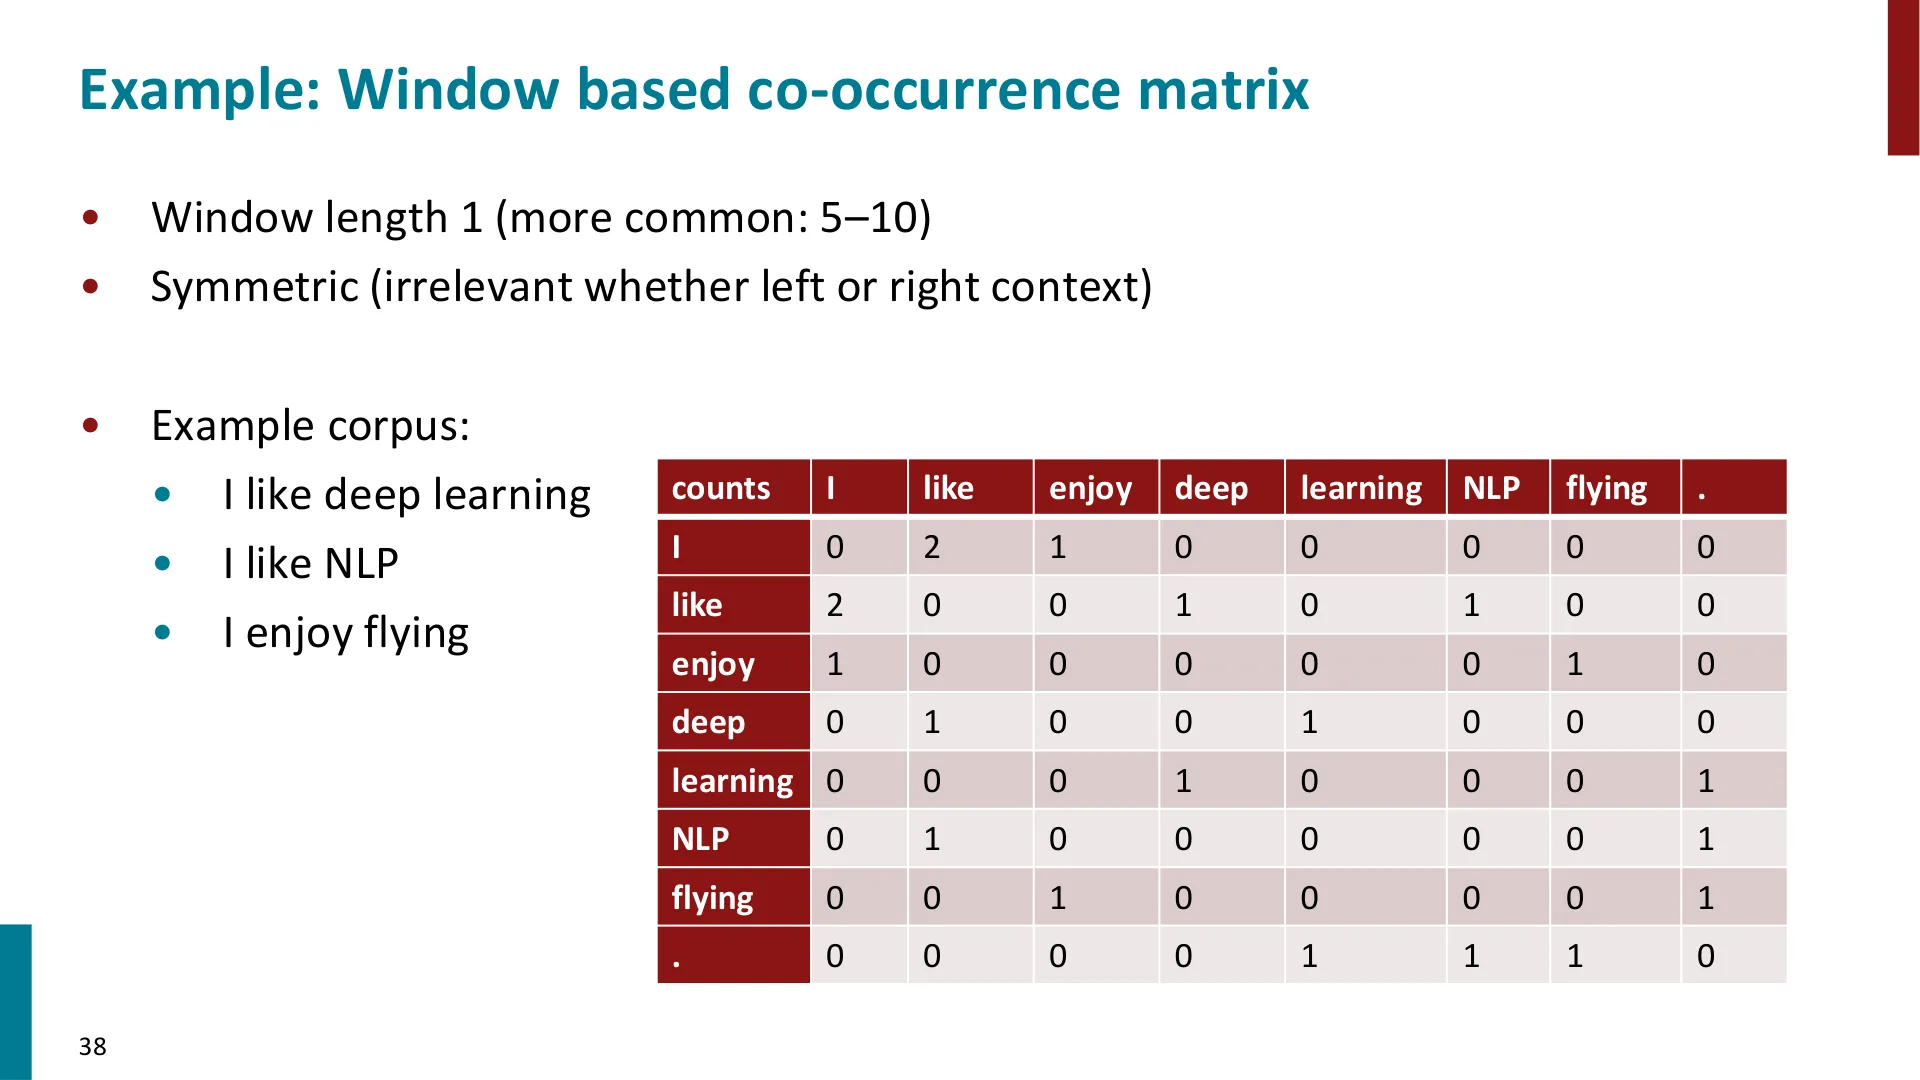
一个小例子(语料只有三句):
I like deep learning
I like NLP
I enjoy flying
窗口长度取 1(左右各一个词),得到一张对称的共现矩阵(左右上下文是否对称无所谓):
| counts | I | like | enjoy | deep | learning | NLP | flying | . |
|---|---|---|---|---|---|---|---|---|
| I | 0 | 2 | 1 | 0 | 0 | 0 | 0 | 0 |
| like | 2 | 0 | 0 | 1 | 0 | 1 | 0 | 0 |
| enjoy | 1 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| deep | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 |
| learning | 0 | 0 | 0 | 1 | 0 | 0 | 0 | 1 |
| NLP | 0 | 1 | 0 | 0 | 0 | 0 | 0 | 1 |
| flying | 0 | 0 | 1 | 0 | 0 | 0 | 0 | 1 |
| . | 0 | 0 | 0 | 0 | 1 | 1 | 1 | 0 |
因为语料很小,除 I–like 是 2 之外其余都是 0 或 1。原则上,矩阵的每一行就是一个词的向量。
📷 基于窗口的共现矩阵示例
回到原视频 (00:35:01)
6.2 直接用共现向量有什么问题
(参考时间: 35:56)
- 向量维度随词表增长:40 万词就是 40 万维,存储量惊人(尽管稀疏);
- 后续分类模型会遇到稀疏性问题,模型不稳健。
低维稠密向量的思路:把"大部分"重要信息塞进固定的小维度里(通常 25–1000 维,和 word2vec 类似)。问题就变成了:怎么降维?
📷 共现向量:稀疏高维 vs 稠密低维
回到原视频 (00:35:56)
6.3 降维:奇异值分解(SVD)
(参考时间: 36:22)
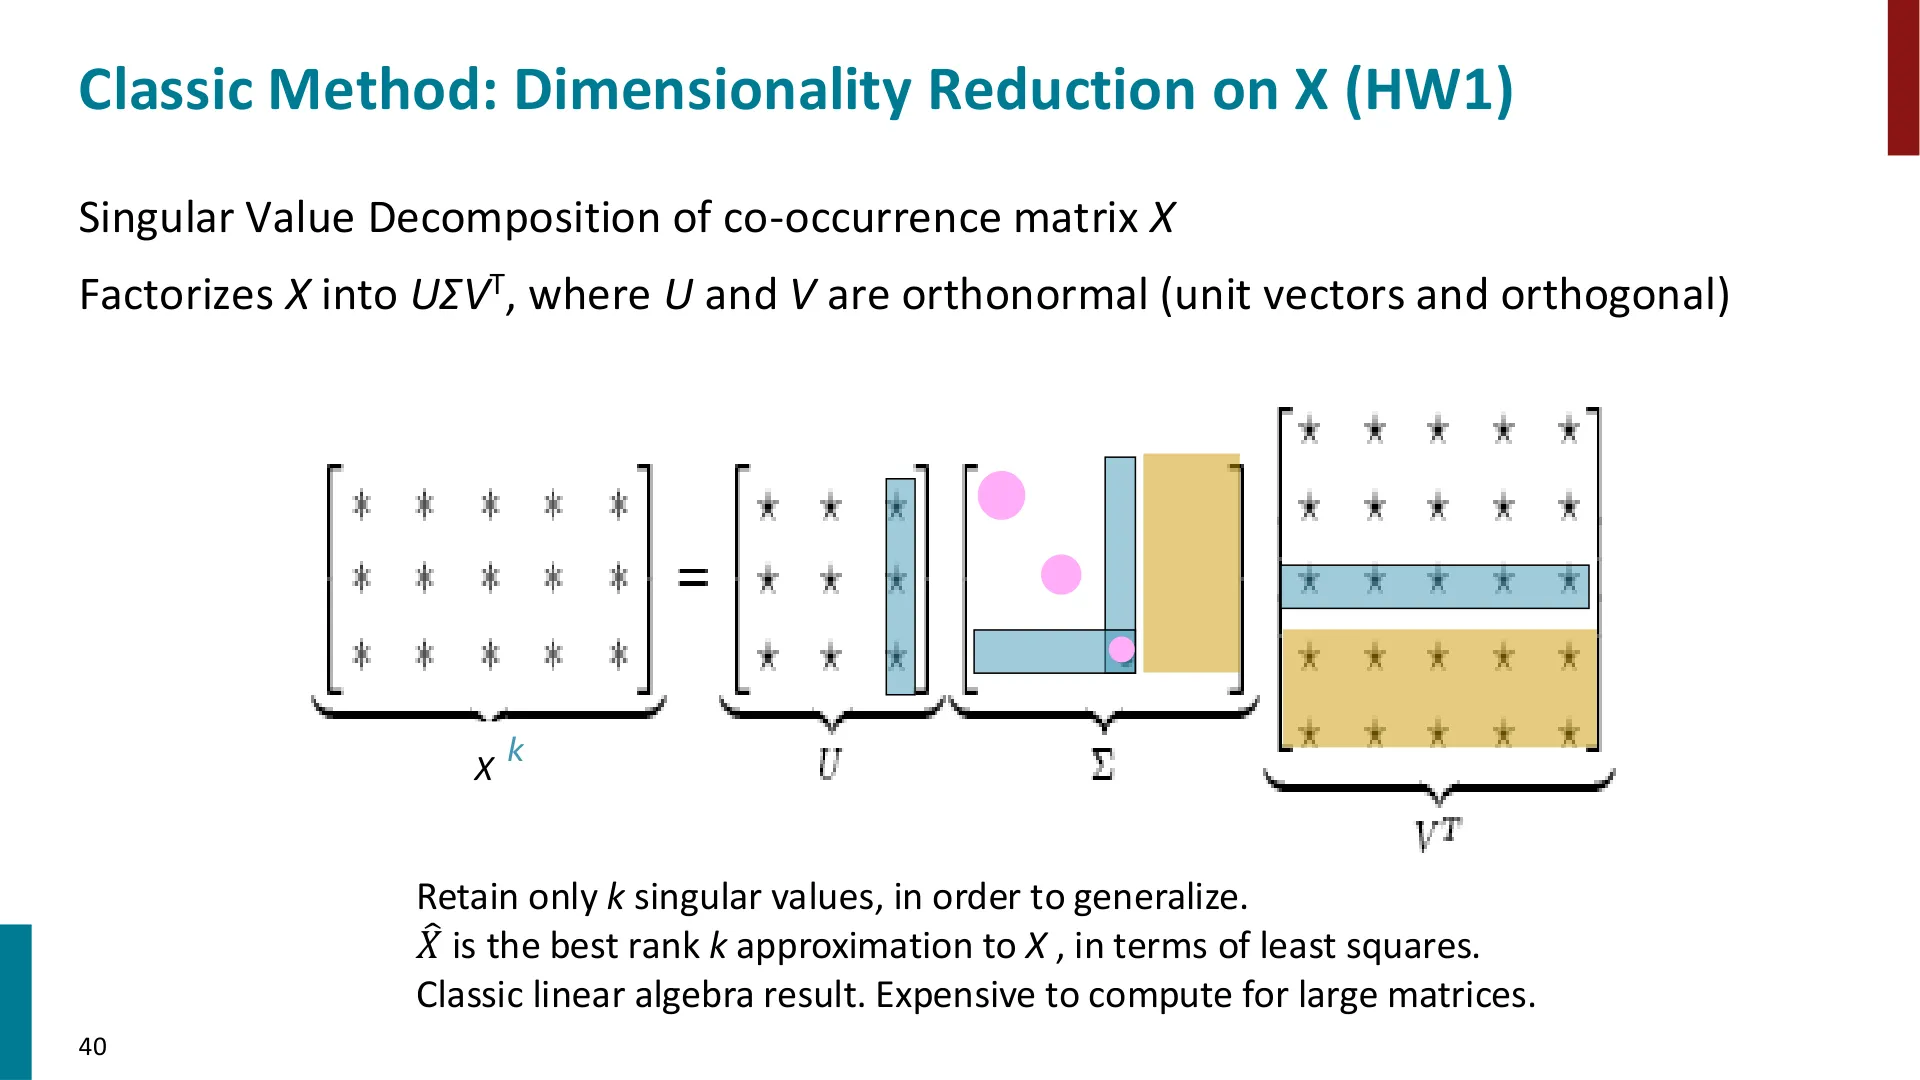
如果记得线性代数,会想到 PCA;而对任意形状的矩阵,有一个通用工具——奇异值分解(Singular Value Decomposition, SVD)。
SVD 把矩阵 $X$ 分解成:
$$ X = U\Sigma V^\top $$
其中 $U$ 和 $V$ 是正交归一的(列向量两两正交且长度为 1),中间的 $\Sigma$ 是按大小排序的奇异值——最大的那个对应最重要的成分,后面的权重越来越小。
降维的"小把戏":既然最小的那些奇异值不重要,就把它们直接置零,只保留前 $k$ 个。得到的 $\hat{X}$ 是 $X$ 在最小二乘意义下的最佳秩 $k$ 近似(这是线性代数的经典结论,但对大矩阵计算很贵)。这样就得到了低维的词表示。
📷 对共现矩阵 X 做 SVD 降维
回到原视频 (00:36:22)
graph LR
    A["语料"] --> B["统计共现 → 矩阵 X(|V|×|V|)"]
    B --> C["对 X 做修补:取 log、截断、忽略功能词、ramped window…"]
    C --> D["SVD:X = UΣV^T"]
    D --> E["只保留前 k 个奇异值"]
    E --> F["低维稠密词向量"]
(参考时间: 45:30) 学生问:幻灯片里展示的 $X$ 是 3×5 的,共现矩阵不应该是个方阵吗?
讲师答:如果做的是"词表对词表",确实应该是方阵(他承认应该直接给一个方阵的例子)。不过幻灯片里还提到过另一种做法——词对文档,那就会是非方阵。这一讲我们只考虑方阵的情形。
6.4 对矩阵 X 的"修补"(Hacks to X)
(参考时间: 39:00)
直接对原始计数做 SVD 效果很糟! 需要对单元格里的计数做一些缩放,效果会好很多。问题是功能词(the、he、has 等)出现得太频繁,导致"句法"影响过大。常见的修补手段:
- 对频率取对数;
- 截断:$\min(X, t)$,其中 $t\approx 100$;
- 忽略功能词;
- 斜坡窗口(ramped window):靠近的词计权更大,远的词计权更小;
- 用相关系数代替计数,然后把负值置 0;
- 等等。
📷 对共现矩阵 X 的常见修补
回到原视频 (00:39:00)
6.5 COALS:一个被忽视的先驱
(参考时间: 39:30)
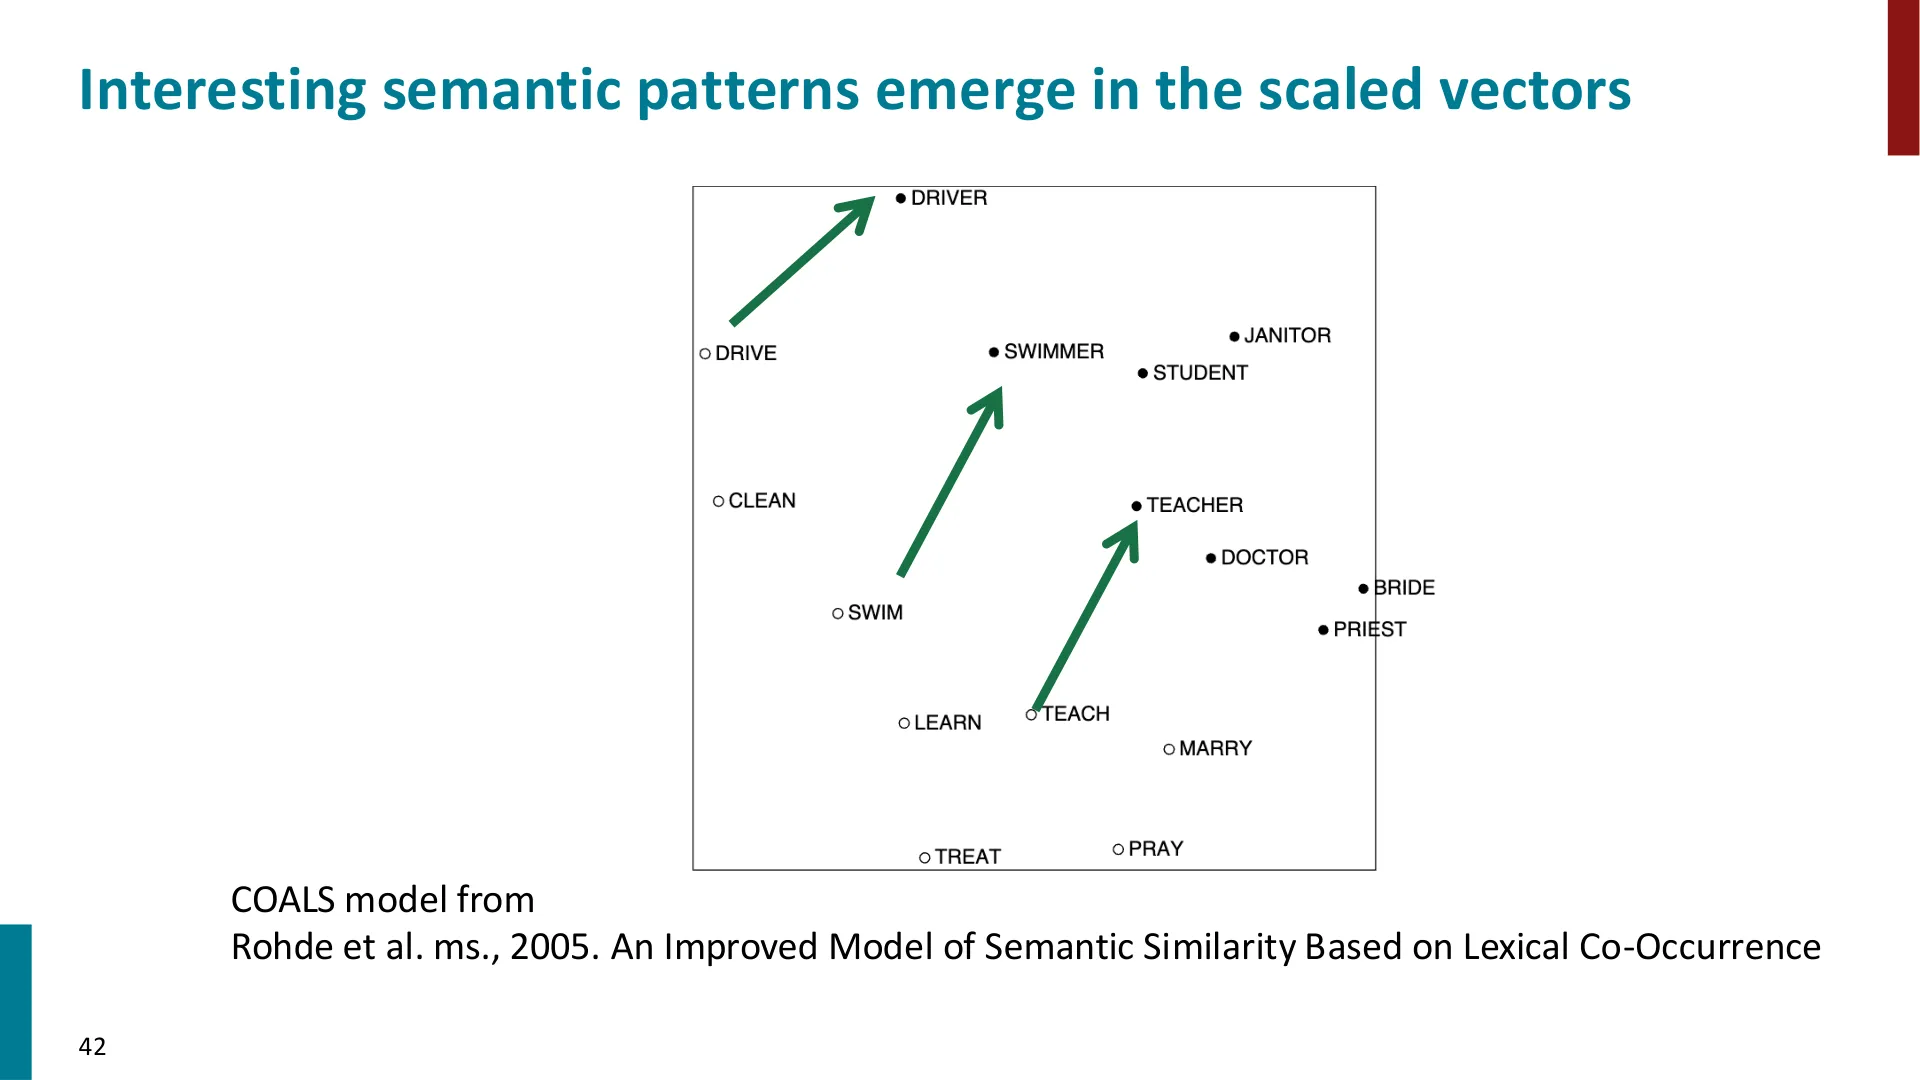
早在现代神经词向量出现之前,潜在语义分析(LSA)之类的做法就已经在探索这条路——但从没真正做得很好,只有心理学等领域的人一直在坚持。2000 年代初,一位名叫 Doug Rohde 的研究生持续在这条路上耕耘,提出了 COALS 算法。
他也知道"直接对原始计数做 SVD 效果不好",于是用了些技巧:对频率取对数、斜坡窗口(近词计权更大)、用皮尔逊相关系数代替计数等,最终得到一个仍基于 SVD 的低维词向量。
有意思的是:Doug Rohde 在他的博士论文里,实际上已经发现了"线性语义成分"这一性质——比如"动作的执行者(doer of an event)"是一个线性成分,可以用来在"动词"与"动作执行者"之间移动。这跟后来 word2vec 里"king − man + woman = queen"是同一类现象。
但当时几乎没人注意到他。 讲师说,这就是"没人关注你做了什么"的遗憾。直到 word2vec 火了之后,这类"线性成分"的能力才被广泛认识。
📷 缩放后向量中出现的语义模式(COALS)
回到原视频 (00:40:07)
6.6 GloVe:把语义成分编码进向量差
(参考时间: 41:24)
讲师当时对"共现矩阵这条路"很感兴趣,便和博后 Jeffrey Pennington 合作,想搞清楚一件事:
我们想要一个模型,使得向量空间中"相加/相减一个向量"对应"意义上的差异"——怎么才能做到这一点?
Jeffrey 想了很久,他的答案基于一个观察:
共现概率的比值(ratio of co-occurrence probabilities)可以编码语义成分。
为什么比值有用? 以 ice 和 steam 为例:
- 靠近
ice的词:solid很可能、water很可能;gas不太可能、某个随机词也不太可能; - 靠近
steam的词:gas很可能、water很可能;solid不太可能、随机词也不太可能。
如果你只看单个共现概率,很难看出"意义成分"——因为 water 对两者都高。但如果看两个概率的比值:
- 对
solid:比值大; - 对
gas:比值小; - 对
water或随机词:比值接近 1。
于是这个"比值"就给出了一种方向,恰好对应"固-液-气"这个物理维度!用真实数据统计,确实能得到这样的结果——两个方向上的比值大约相差一个数量级,而无关词的比值约为 1。
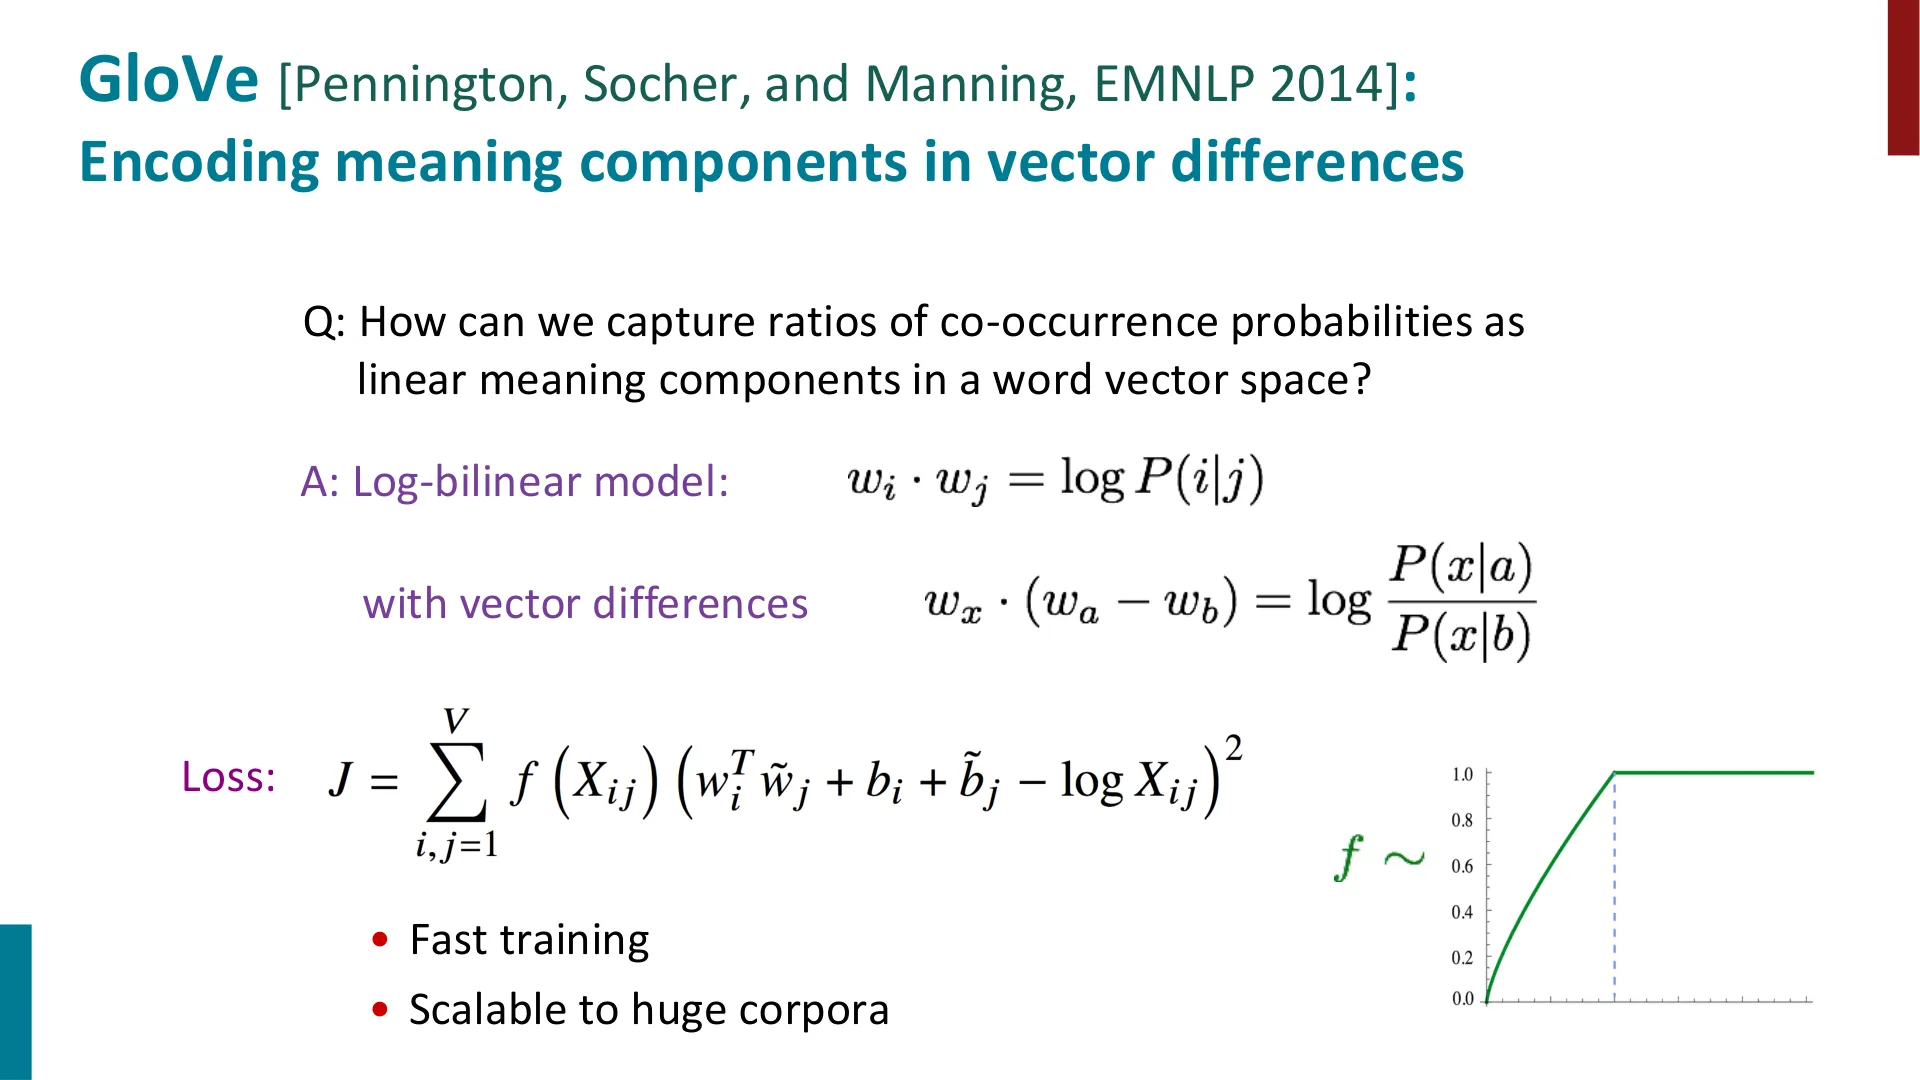
那么怎么让它变成线性成分? 关键一步是取对数:因为 $\log(a/b)=\log a - \log b$,一旦取对数,"比值"就变成了"相减"。于是只要设计一个 对数双线性(log-bilinear)模型,让两个词向量的点积去拟合这个条件概率的对数,那么"两个向量之差"就对应"共现概率比值的对数"。
这就是 GloVe 模型的直觉。实际损失函数里还加了一些偏置项和频率阈值(讲师说这些不重要,直接跳过了),但他强调:"要得到线性语义成分,核心在于取对数"这个直觉是最值得记住的。
📷 GloVe:用向量差编码语义成分
回到原视频 (00:41:24)
编者拓展|GloVe 的损失函数长什么样:设 $X_{ij}$ 是词 $j$ 出现在词 $i$ 上下文中的次数,$f(\cdot)$ 是一个加权函数(对高频词做截断、对过小计数降权),$b_i,b_j$ 是偏置。GloVe 最小化
$$\sum_{i,j=1}^{V} f(X_{ij})\big(w_i^\top \tilde w_j + b_i + \tilde b_j - \log X_{ij}\big)^2$$
可以看到它的目标就是"让点积去逼近 $\log$ 共现计数"。它的优点是训练快、可扩展到超大语料。
七、如何评估词向量?
(参考时间: 46:00)
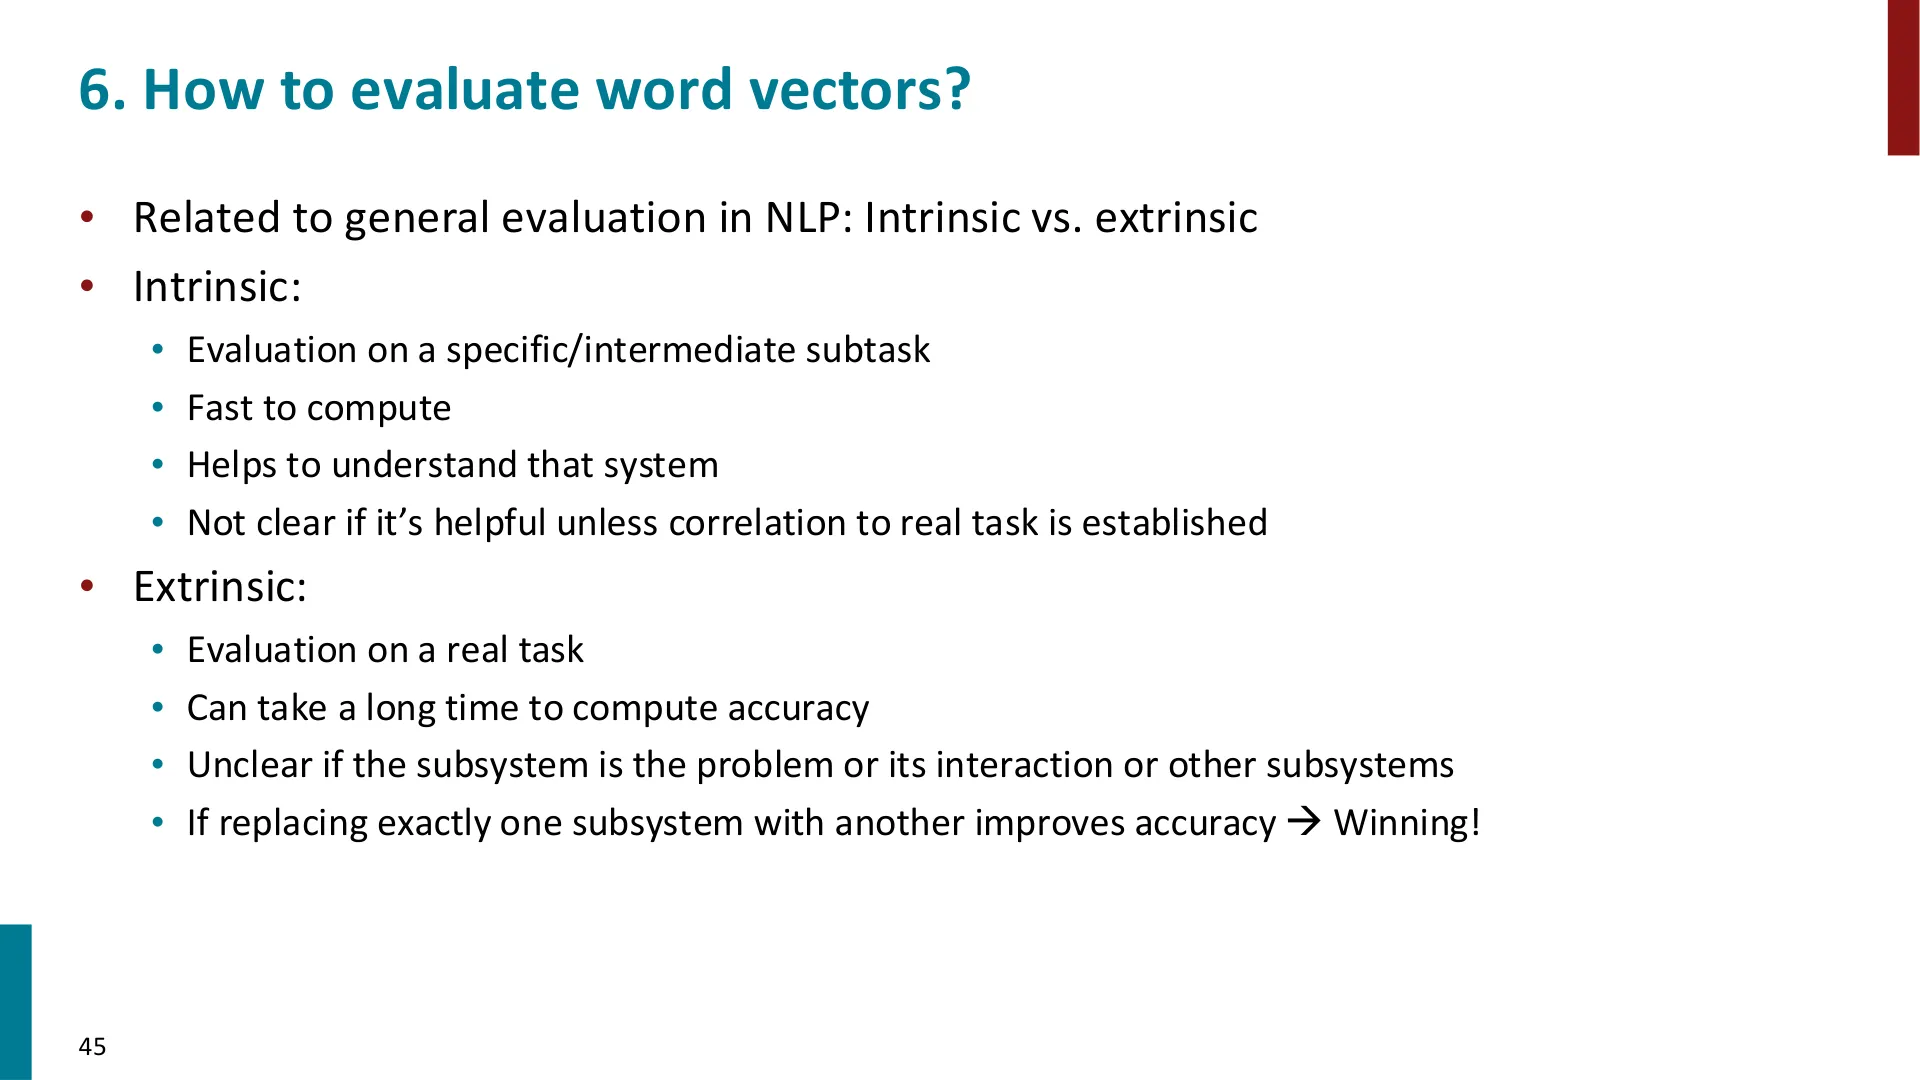
前面演示的 GloVe 向量"看起来很好",但在 NLP 里,我们需要能评估一个东西到底有多好。课程中会反复出现一个最基本的评估二分法:内在评估(intrinsic)与外在评估(extrinsic)。
内在评估:
- 在一个具体的、中间的子任务上打分;
- 计算快;
- 有助于理解你在构建的组件;
- 但除非能证明它与真实任务相关,否则你并不确定它是否真的有用。
外在评估:
- 在一个真实任务上评估;
- 算准确率可能很慢;
- 很难判断出问题的是子系统本身、还是它与其它子系统的交互;
- 但——如果把某个子系统换掉、准确率提升了,那就说明它是真的有用(Winning!)。
对词向量来说:测"它建模词相似度好不好"是内在评估;而"在网页搜索里,让 'cell phone' 和 'mobile phone' 被同等对待"就是外在评估。
📷 从零学一个真正有用的分类器
回到原视频 (00:51:00)
graph TD
    A["评估词向量"] --> B["内在评估 Intrinsic"]
    A --> C["外在评估 Extrinsic"]
    B --> B1["词向量类比"]
    B --> B2["词义相似度(与人类判断的相关性)"]
    C --> C1["命名实体识别等真实下游任务"]
7.1 内在评估一:词向量类比
(参考时间: 48:41)
用一组类比题("a 之于 b,正如 c 之于 ?")来测:先算 $b-a+c$,再找余弦距离最近的词。
- 注意:必须把输入词本身从搜索里排除掉,否则会把
a、b、c原封不动地找回来。 - 局限:如果信息其实存在,但不是线性的,这个方法就测不出来。
讲师坦诚地"自首":演示时他只挑了成功的例子。实际上有大量失败的类比题,正因为如此,才有必要统计"成功比例"来给不同词向量打分。
7.2 内在评估二:词义相似度与人类判断的相关性
(参考时间: 49:12)
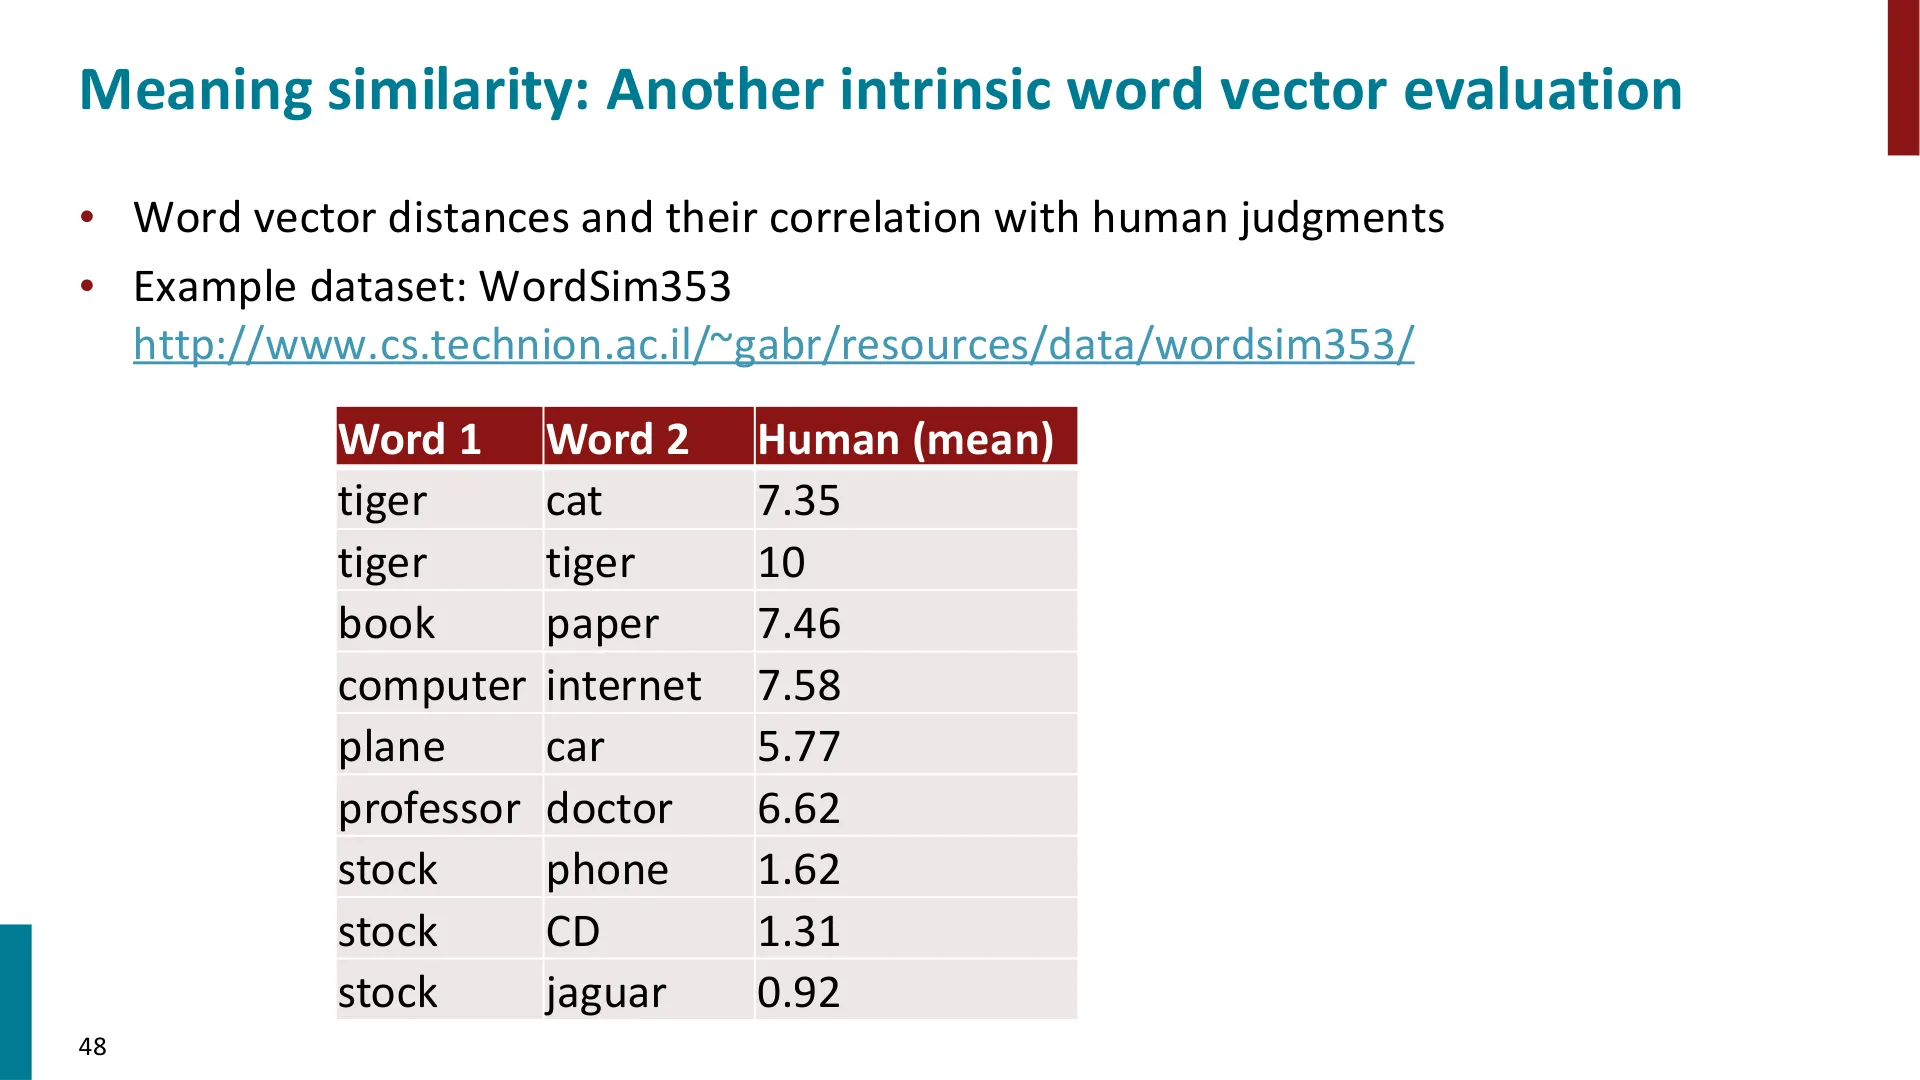
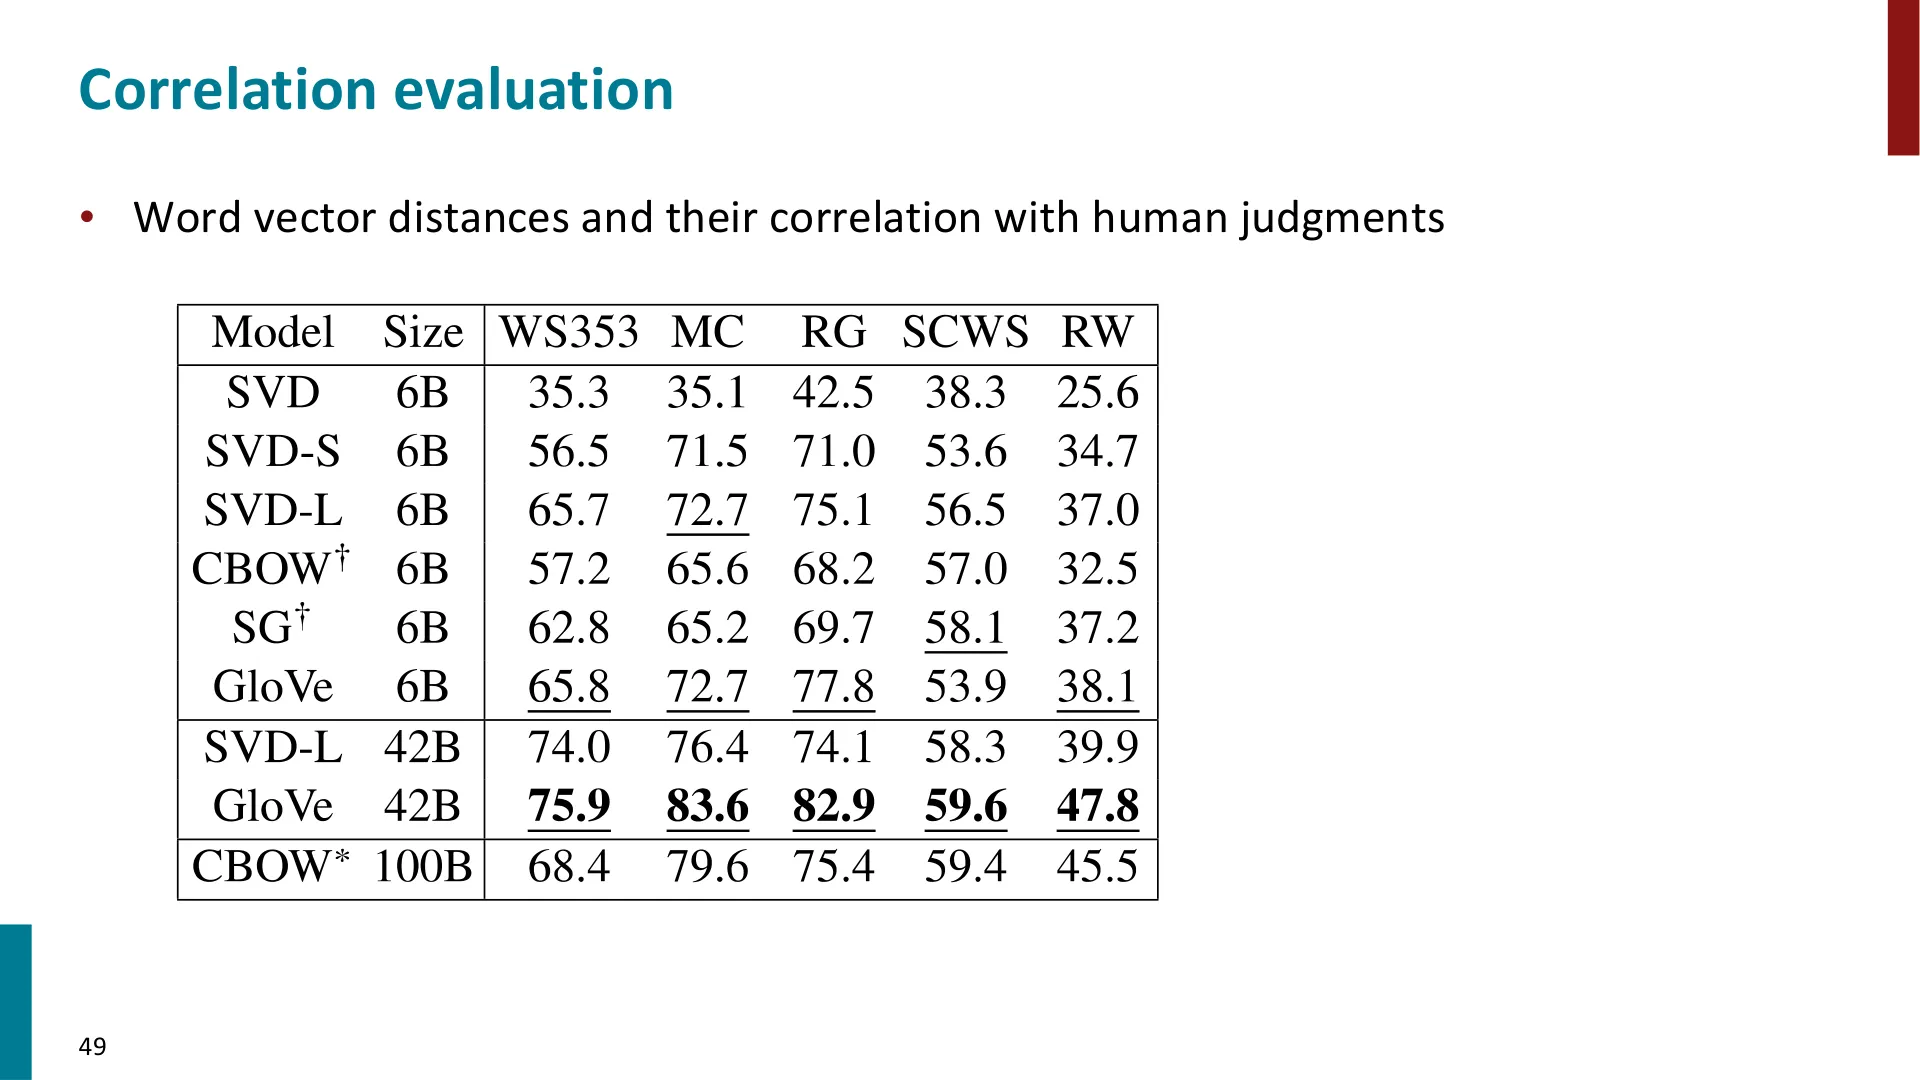
另一种内在评估是:看词向量的距离与人类判断的相关性。经典数据集是 WordSim353。
做法是:心理学家找来一群被试,问"plane 和 car 有多像,0 到 10 打分?",再平均大家的答案,得到人类评分。例如:
| Word 1 | Word 2 | 人类评分(均值) |
|---|---|---|
| tiger | cat | 7.35 |
| tiger | tiger | 10 |
| book | paper | 7.46 |
| computer | internet | 7.58 |
| plane | car | 5.77 |
| professor | doctor | 6.62 |
| stock | phone | 1.62 |
| stock | CD | 1.31 |
| stock | jaguar | 0.92 |
然后再让模型对同样的词对打分,计算模型打分与人类打分的相关性。这样就得到了一个可以横向比较不同词向量的分数表:
- 直接对原始计数做 SVD:效果极差;
- 对 log 计数做 SVD:已经有相当不错的效果;
- word2vec 的两种算法(CBOW、Skip-gram)以及 GloVe:得到各自的分数。
📷 意思相似度数据集与相关性评估
回到原视频 (00:49:12)
编者说明:
stock–jaguar得分很低,是因为 "jaguar" 既可能是动物、也可能是汽车品牌,而 "stock" 也可能指"股票"或"库存"——这正是后文"一词多义"要处理的问题。
7.3 外在评估:命名实体识别
(参考时间: 51:00)
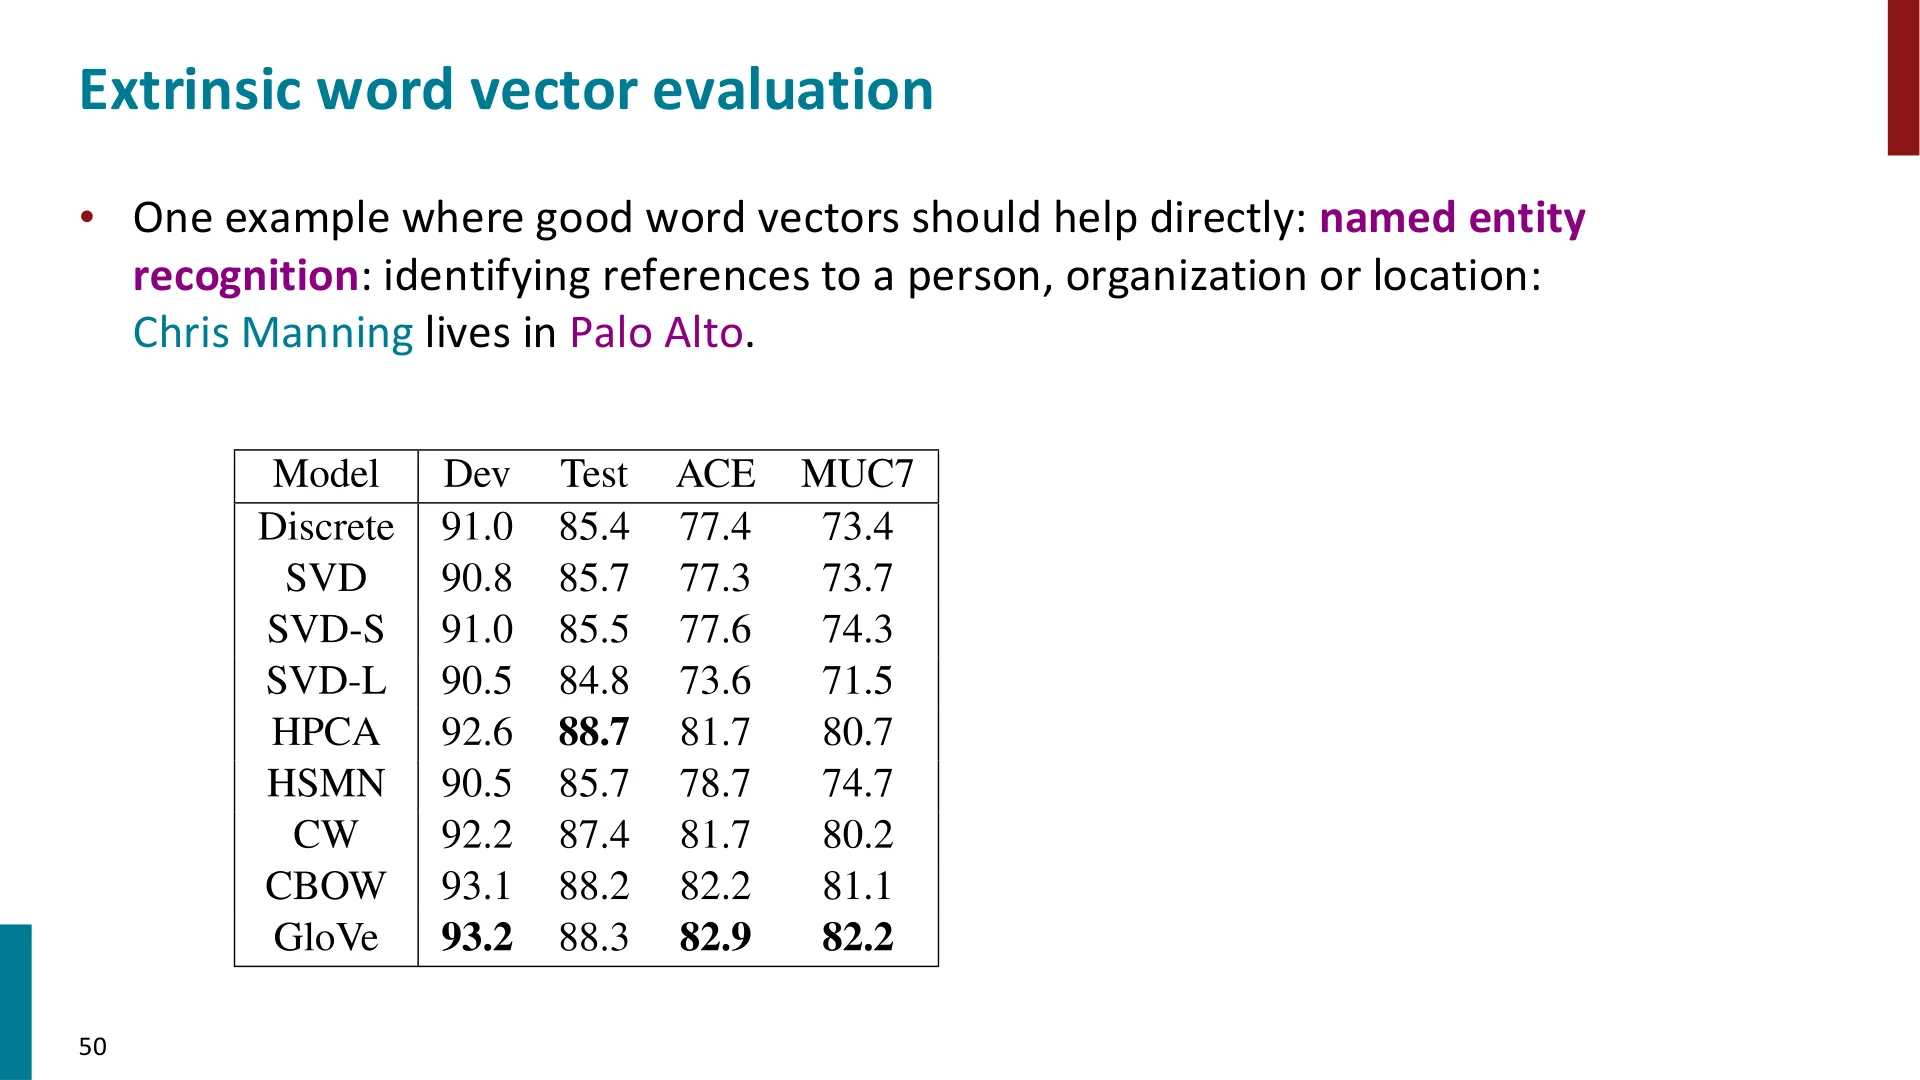
选择一个下游任务来评估。NLP 里一个常用且简单的下游任务是命名实体识别(Named Entity Recognition, NER)——识别文本里哪些词是"人、组织、地点"的名字。
例如句子 Chris Manning lives in Palo Alto:Chris、Manning 是人,Palo Alto 是地点。
一个符号化、概率式的 NER 基线加入词向量之后,指标会明显上升——这些分数比第一行要高,说明"把词向量加进系统带来了实质性的提升"。
(参考时间: 01:04:00 之后,讲师用这个任务引入了神经网络分类器,见第九节。)
八、一词多义(Word Senses)
(参考时间: 52:15)
这一节回应了上一讲学生提问里反复出现的问题。大多数词都有很多意思;只有一个意思的词往往是高度专业化的科学术语。
- 最经典的多义词是
bank(银行 / 河岸)——上一讲已经出现过; - 讲师又用了
star; - 以及一个你可能不太常用、但意思同样多的词:
pike。
pike 有哪些意思? 讲师带着大家现场数:
- 一种鱼;
- 一种长矛(长柄武器);
- 收费公路(turnpike 的简称——原来自古以来,公路起点会竖一根"矛状物"来拦车收钱);
- 一种跳水/游泳姿势(奥运跳水里的 pike);
- 也可以当动词:用矛刺某人;
- 还有更隐喻的用法("coming down the pike" 意思接近"即将到来的事物/未来");
- 在澳大利亚,
pike还有"临阵退缩"的意思(讲师说不确定美式英语里是否这么用)。
📷 一词多义:一个词向量也许是多个义项的叠加
回到原视频 (00:53:00)
8.1 做法一:为每个"义项"学一个向量
(参考时间: 55:17)
一个办法是承认词有多个意思,然后:
- 取文本中该词的每一个实例(token);
- 根据其上下文出现的相似性做聚类,判断每个 token 属于哪个义项;
- 为这些 token 簇(即"义项",sense) 学习词向量。
讲师他们在 2012 年(word2vec 之前)就这么做过。拿 Jaguar 举例,效果相当好:
Jaguar_1靠近luxury、convertible→ 汽车的意思;Jaguar_2靠近software、Microsoft→ 当年苹果用大型猫科动物给 Mac OS 版本命名(Mac OS 10.3 就叫 Jaguar),所以是软件的意思;Jaguar_3靠近string、keyboard、solo、musical、drum、bass→ 有一款叫 Jaguar 的键盘;Jaguar_4靠近hunter→ 我们通常想到的动物意思(在真实语料里其实相对少见)。
8.2 做法二:实际上大家只学一个向量
(参考时间: 57:26)
不过,如今真正普遍的做法是只学一个向量。这一个向量,实际上是各个义项向量的加权平均——权重就是各个义项出现的相对频率。
有人爱用物理学的词,把它叫作叠加(superposition)。
为什么这样做也有道理? 讲师给了一个语言学的论证:
- "词有若干义项"这个模型历史悠久,字典就是这么编的(sense 1、sense 2、sense 3……);
- 但对
bank、Jaguar这类词来说,这其实是个相当粗糙的模型:词义有大量细微差别、用在各种不同语境里; - 只有
bank(金融 / 河岸)这种极端例子,义项之间才"离得那么远";大多数词的各个意思之间并没有那么远,硬把它们切成"义项"其实非常人为; - 而且,不同字典对"一个词有几个义项"几乎从不一致;
- 以
field为例:种庄稼的地、rock field/ice field、运动场、数学上的"域"……它们多多少少都相关(都跟"平坦的空间"有关),你能说ice field和rock field是两个不同义项、还是只是修饰不同?
所以更合理的看法是:一个词的意义更像是一个概率密度分布——分布在"它可能表示的各种东西"之上。这样,用一个"所有上下文的平均向量"来表示,就说得通了。讲师预告:等讲到上下文词向量时会再回到这个话题。
8.3 意外结果:从单一向量里"恢复"义项
(参考时间: 01:00:53)
🖼️ 第 1 页幻灯片 · Natural Language Processing
既然整词向量是各义项向量的和/平均,按"标准数学"来说,你不可能从这单个向量里还原出各个义项向量。
但是,更高深的数学告诉你:这些向量空间维度极高、非常稀疏,因此可以借助稀疏编码理论(sparse coding)从整词向量中重建出义项向量。
讲师举了一篇论文的例子:作者之一(讲师提到他现在是 Stanford CS 的教职,但字幕里名字听起来像 "Tatsu",无法确认)从一个词向量出发,用稀疏编码分解出多个义项。以 tie 为例,恢复出的义项包括:
- 衣物(领带);
- 比赛中的平局;
- 绑电线的扎带;
- 音乐上的连音线(tie)。
五个里至少四个恢复得相当不错。
graph TD
    A["多义词(pike、Jaguar、tie…)"] --> B["把语料中每个 token 按上下文聚类"]
    B --> C["为每个 token 簇(义项)学一个向量"]
    C --> D["实际做法:只学一个向量"]
    D --> E["该向量 ≈ 各义项向量的加权平均(叠加 superposition)"]
    D --> F["稀疏编码可从单一向量中恢复义项向量"]
编者拓展|稀疏编码为什么能"拆开"一个向量:叠加之后的整词向量可以被看作若干稀疏"原子"(此处即义项向量)的线性组合。在维数远大于义项数、且每个义项在语料里只激活于部分上下文的稀疏假设下,可以构造带 $\ell_1$ 稀疏约束的重建问题,从观测到的整词向量反解出各个原子。这正是压缩感知 / 稀疏表示理论的核心结论,与"少数几个非零分量足以表示信号"这一直觉一致。
九、神经分类器与神经网络初探
(参考时间: 01:03:11)
最后 15 分钟,讲师开始引入神经分类器,为下一讲的神经网络做铺垫。
有意思的是,word2vec 本身就已经是一个极简单的神经分类器——它在预测"什么词可能出现在另一个词的上下文里"。但这里我们看一个更典型的分类任务。
9.1 什么是分类器
拿 NER 举例:我们要给词打上类别标签。
Paris Hilton likes to play tennis.      → Paris、Hilton 是"人"
He lives in Paris and works in Hilton.  → Paris、Hilton 是"地点"
同样两个词,在不同句子里类别完全不同——词在"是什么类"这件事上是有歧义的。第三个状态是:它根本不是命名实体。
(讲师顺带提到,这类工具用得很多,比如给公司名打股票代码、给维基百科条目做链接——后者属于"实体链接"这一第二步,本课今天不讲。)
做法:既然 Paris 有时是人名、有时是地名,我们就要看它所在的上下文。我们构建一个窗口分类器:
- 取一个目标词,左右各取几个上下文词;
- 用它们的词向量表示输入(因为我们正要展示词向量有用);
- 送入分类器。这里为了简单,只做二分类:是地点 / 不是地点。
例如窗口 ... museums in Paris are amazing ...,中心词 Paris → 标签为"是地点";而句子 I love Paris Hilton greatly 里的 Paris → 标签为"不是地点"。
9.2 监督学习与线性分类器
(参考时间: 01:06:36)
一般的分类器做的是监督学习:我们有一批带标签的训练样本——输入项 $x^{(i)}$ 和它对应的类别 $y^{(i)}$。例如:
I love Paris Hilton greatly→ 负例(不是地点)I visit Paris every spring→ 正例(是地点)
总之:输入 + 标签,标签取自一个类别集合(这里是"地点 / 非地点",也可以更丰富:地点、人名、公司名、药名……本讲为了简单只做两类)。
9.3 神经分类器比传统分类器"强"在哪
(参考时间: 01:08:06)
传统统计机器学习分类器:logistic 回归、softmax 分类器、支持向量机(SVM)、朴素贝叶斯……它们的绝大多数是线性分类器,即有一个线性决策边界。学习时,我们学的是参数 $W$,而输入是固定的——输入是由符号或数值表示的固定量。也就是说:输入固定,我们只学一组权重去乘它。
神经分类器则"更有力量":
- 我们不只是为分类器学权重 $W$,还同时为词学习分布式表示——词向量可以重新表示那些符号词,把它们在空间中挪动;
- 相对于原始空间,这让我们得到一个非线性分类器,能表达复杂得多的函数;
- 但注意:在重新表示之后的向量空间里,最后一层仍然是线性的。
用讲师的话说:在我们的深度网络末端,我们会有一个相对于"重表示后的向量"而言的线性分类器,但相对于原始空间则不是。
9.4 具体的前馈网络结构
(参考时间: 01:09:56)
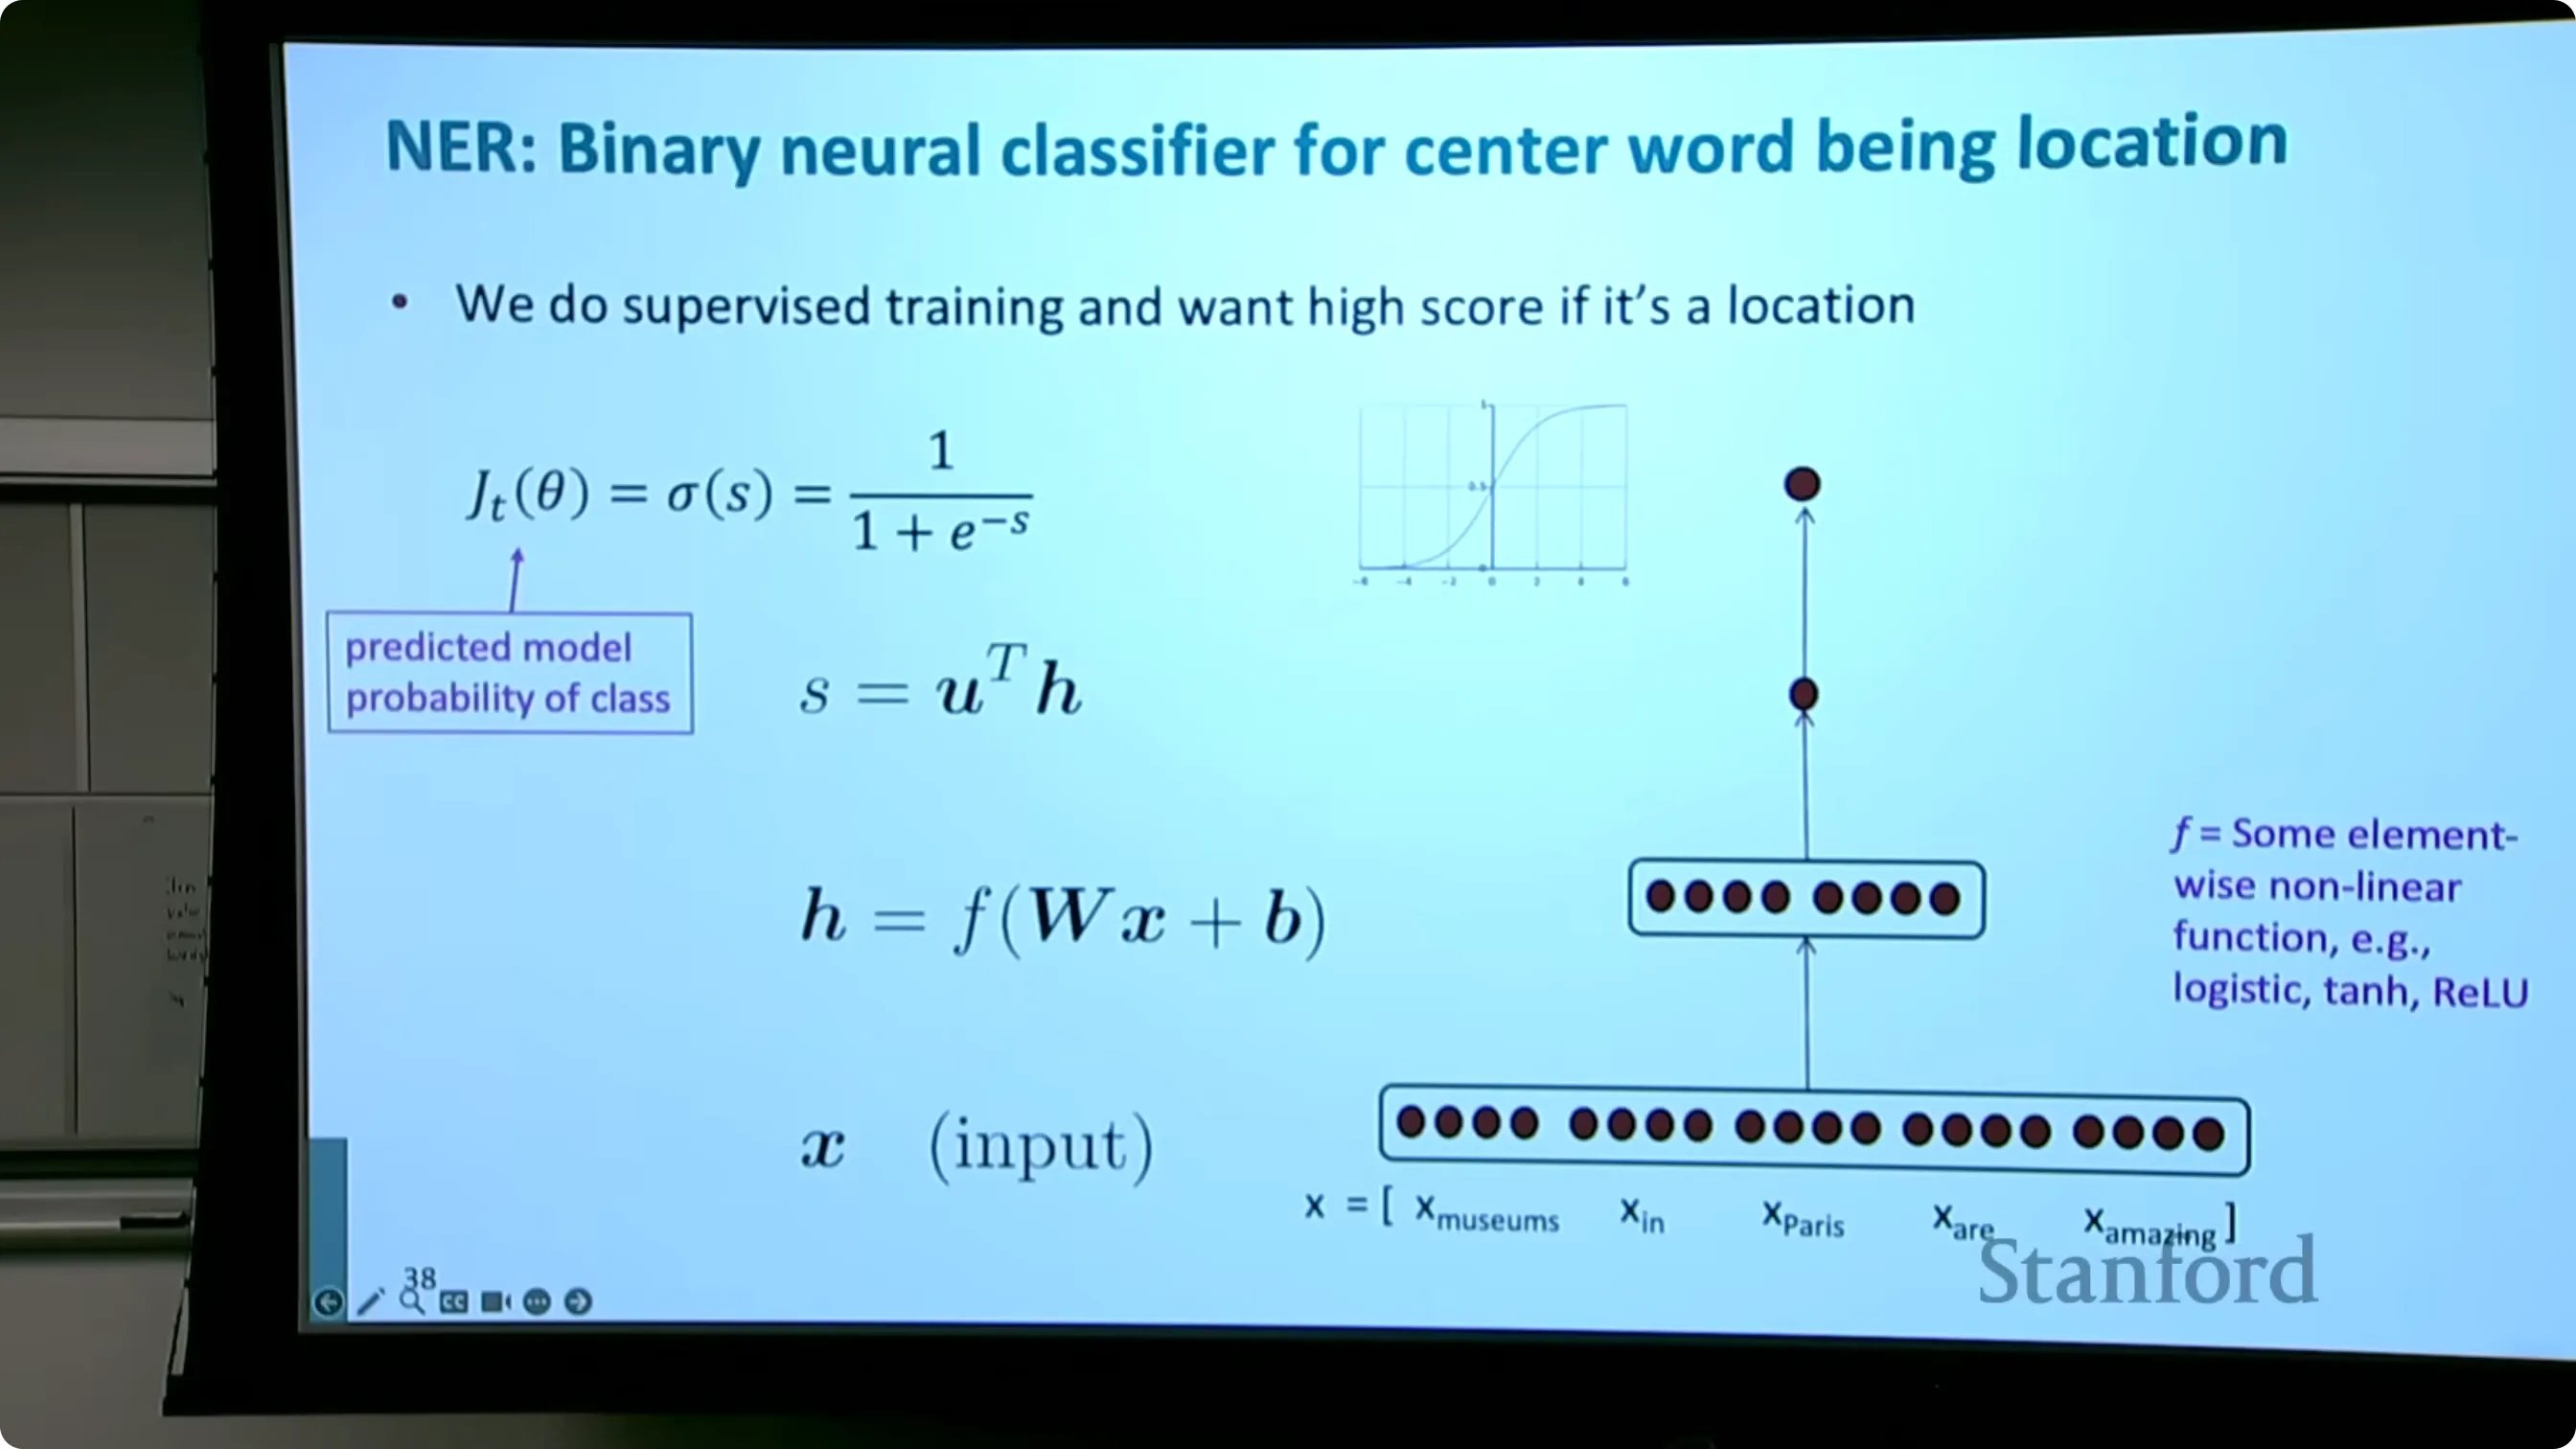
📷 用于分类的简单前馈神经网络结构
回到原视频 (01:09:56)
用一个具体例子说明:句子 museums in Paris are amazing,我们要判断 Paris 是不是地点。步骤:
- 拼接词向量:把窗口内所有词的词向量首尾相接成一个长向量。若用 100 维词向量、窗口 5 个词,那就得到 500 维的输入 $x$。
- 过一个线性层:把这个向量乘以矩阵 $W$、加上偏置 $b$。如果 $W$ 是 $8\times 500$,就把它降维到 8 维。
- 过一个非线性激活(例如我们前面见过的 logistic 函数),得到一个隐藏层表示。
- 再乘一个向量,得到一个分数。
- 把分数送进 logistic/sigmoid,得到"这是地点的概率"。
graph LR
    A["窗口内词向量拼接 x(5×100 = 500 维)"] --> B["线性层:Wx + b(8×500 → 8 维)"]
    B --> C["非线性激活(如 logistic)"]
    C --> D["隐藏层表示"]
    D --> E["再乘一个向量得到分数"]
    E --> F["logistic/sigmoid → 概率"]
9.5 神经网络的"魔力":让中间层自己学
(参考时间: 01:17:24)
前面那个结构,如果只用 logistic 函数,单神经元其实就等价于 logistic 回归(你大概在统计课里见过)。
区别在于:神经网络里不是只有一个 logistic 回归,而是一次有一大堆 logistic 回归。如果要求我们手工指定"每一个逻辑回归负责算什么",那会非常麻烦——但我们不需要。我们只把它们再喂给另一个 logistic 回归,让最终的输出去回答我们真正关心的问题("是不是地点")。
剩下的就交给机器学习:那些中间的 logistic 回归会自己找出一些有用的东西来计算——这就是"魔法"所在。模型有大量参数,内部会自己学出有用的表示。
由此可以推广:层数越多,能得到的"魔法"越多。中间层让模型能够重新表示输入数据,使数据更容易被分类、更容易被下游任务利用。
编者拓展|为什么多层非线性网络表达能力更强:一层线性变换无论怎么叠加,复合起来仍然是线性的,等价于一个单层线性模型;只有当层与层之间插入非线性激活时,网络才真正获得逼近任意复杂函数的能力(通用逼近定理)。这也是为什么"隐藏层的非线性"是神经网络区别于线性分类器的根本所在。
十、交叉熵损失
(参考时间: 01:12:00)
一个"提前打个招呼"的知识点:到目前为止,讲师都是用对数似然 / 负对数似然来构建模型的;而很快(作业二开始),当同学们用 PyTorch 写损失时,会用到的函数叫交叉熵损失(cross entropy loss)。
交叉熵来自信息论:如果你有一个真实分布 $p$ 和一个模型分布 $q$,交叉熵损失就是"在真实分布下,对模型概率的对数取期望":
$$ H(p,q) = -\sum_{i} p(i)\log q(i) $$
一个特例非常重要:当你的标注数据是"独热"(ground truth / gold / target)的——即正确类别标为 1、其余为 0——那么求和里其它所有项都变成 0,只剩下:
$$ H(p,q) = -\log q(\text{正确类别}) $$
也就是"模型给正确类别的对数概率",正是对数似然;取负号就是负对数似然。
所以一句话记住:在 PyTorch 里构建模型时,你要用交叉熵损失。
编者补充|PyTorch 里的对应写法:
torch.nn.CrossEntropyLoss内部已经包含了LogSoftmax与负对数似然(NLL),因此不要把已经过 softmax 的输出再传进去,否则会重复归一化:```python import torch import torch.nn as nn
criterion = nn.CrossEntropyLoss() # 内部含 LogSoftmax + NLLLoss logits = model(x) # 未经 softmax 的原始分数 loss = criterion(logits, target_labels) # target 是类别下标,不是 one-hot ```
关键细节:
CrossEntropyLoss默认接收的target是类别下标(如2),而不是 one-hot 向量;若要传 one-hot,需用label_smoothing等对应设置或改用其它接口。
十一、人脑神经元与人工神经元
(参考时间: 01:14:10)
最后,讲师展示了那张"每门课都要放一次"的图——人脑神经元。他说以后不会再放了。
📷 人脑神经元:人工神经网络的最初灵感来源
回到原视频 (01:14:15)
人脑神经元的工作方式:
- 有一个输出,经由轴突向下传递;
- 输出又会接入其它神经元(一个输出可以接到多个神经元),连接处就是人们常说的突触(synapse);
- 一个神经元通常有许多许多输入,从别的神经元接收信号,全部汇入细胞核;
- 细胞核把所有这些输入汇总起来:如果有足够多的正向激活,它就会沿自己的输出把信号发出去。
严格来说,神经元是以脉冲(spike)的方式发信号的,神经元的"激活水平"其实是它的发放频率;但在人工神经网络里,这一步立刻被简化成了一个实数值——即"激活水平"。
这个类比正是神经网络的灵感来源:
- 二分类 logistic 回归就有点像单个神经元:它有多个输入,你计算总的"兴奋度";其中有的输入是正的(兴奋性),有的是负的(抑制性),把它们合起来,经过某个非线性,得到一个输出(兴奋水平)。
- 这本是一个非常简化的神经元模型。人脑神经元远比这复杂,一些神经科学家认为我们应该建更接近真实神经元的模型。
- 但在当今"神经网络席卷世界"的浪潮里,大家已经把这件事忘到脑后,一直沿用这个极简模型——好处是它能非常简洁地转化为线性代数。
单个神经元若用 logistic 函数,就等同于 logistic 回归。而神经网络的区别是:同时有一大堆这样的单元,并且把它们再喂给另一个 logistic 回归;中间那些单元会自己学出有用的东西。
编者说明:讲师在此处收尾——"时间到了,我该停在这里,谢谢大家。"本讲到此结束。
附录:课堂未展示的幻灯片
以下幻灯片属于本讲官方幻灯片文件,但在本次课堂录制中未被展示:其中 Slide 4–10 的内容在第一讲已经讲过(本讲直接从"优化基础"续讲),Slide 28–29 是讲师因时间关系明确跳过的旁注页,Slide 44 是重复的讲义计划页。此处按官方幻灯片内容列出,供读者对照查阅。
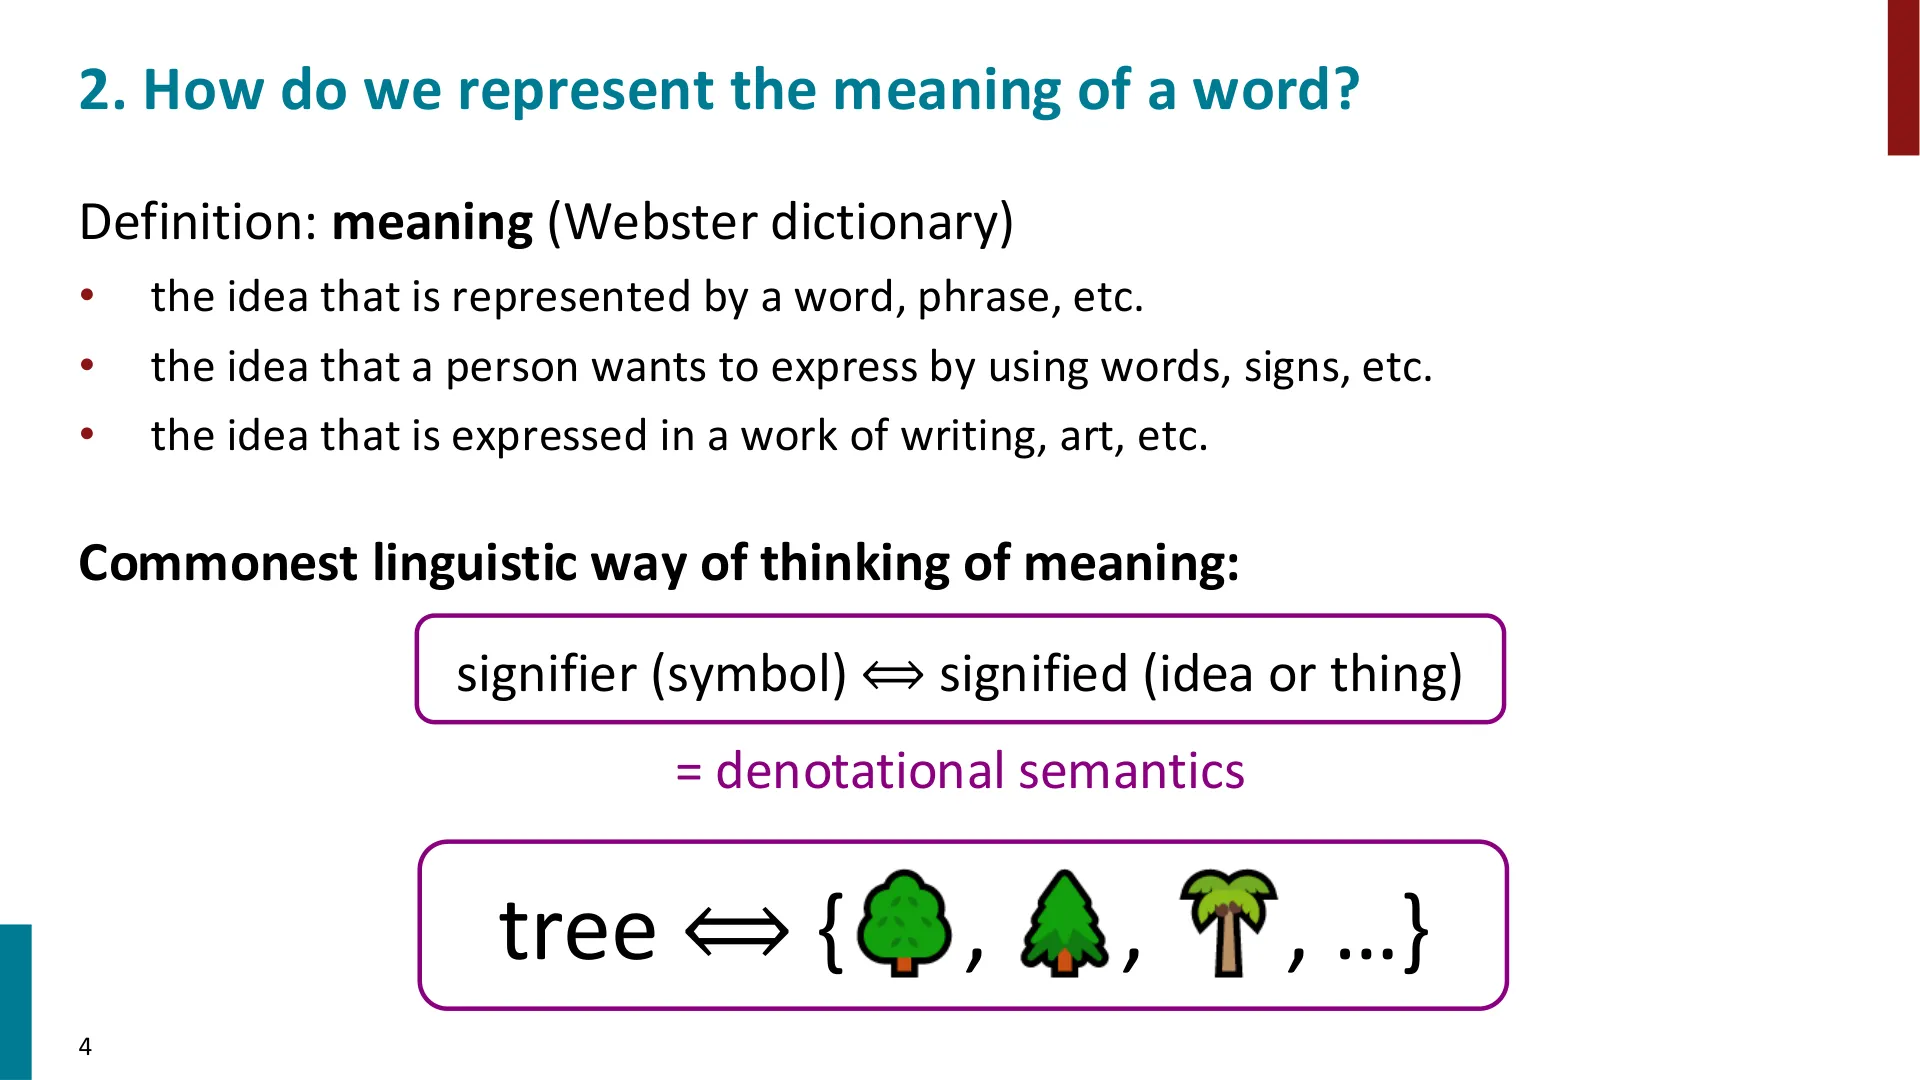
Slide 4:如何表示一个词的意义?(How do we represent the meaning of a word?)
- 词典(韦氏)对 meaning 的定义:词、短语等所代表的观念;一个人想用词语/符号表达的观念;在文字、艺术作品中表达的观念。
- 语言学中最常见的理解方式:signifier(符号)⟺ signified(观念或事物),即指称语义(denotational semantics)。例如
tree⟺ { …… 各种具体的视觉形象 …… }。
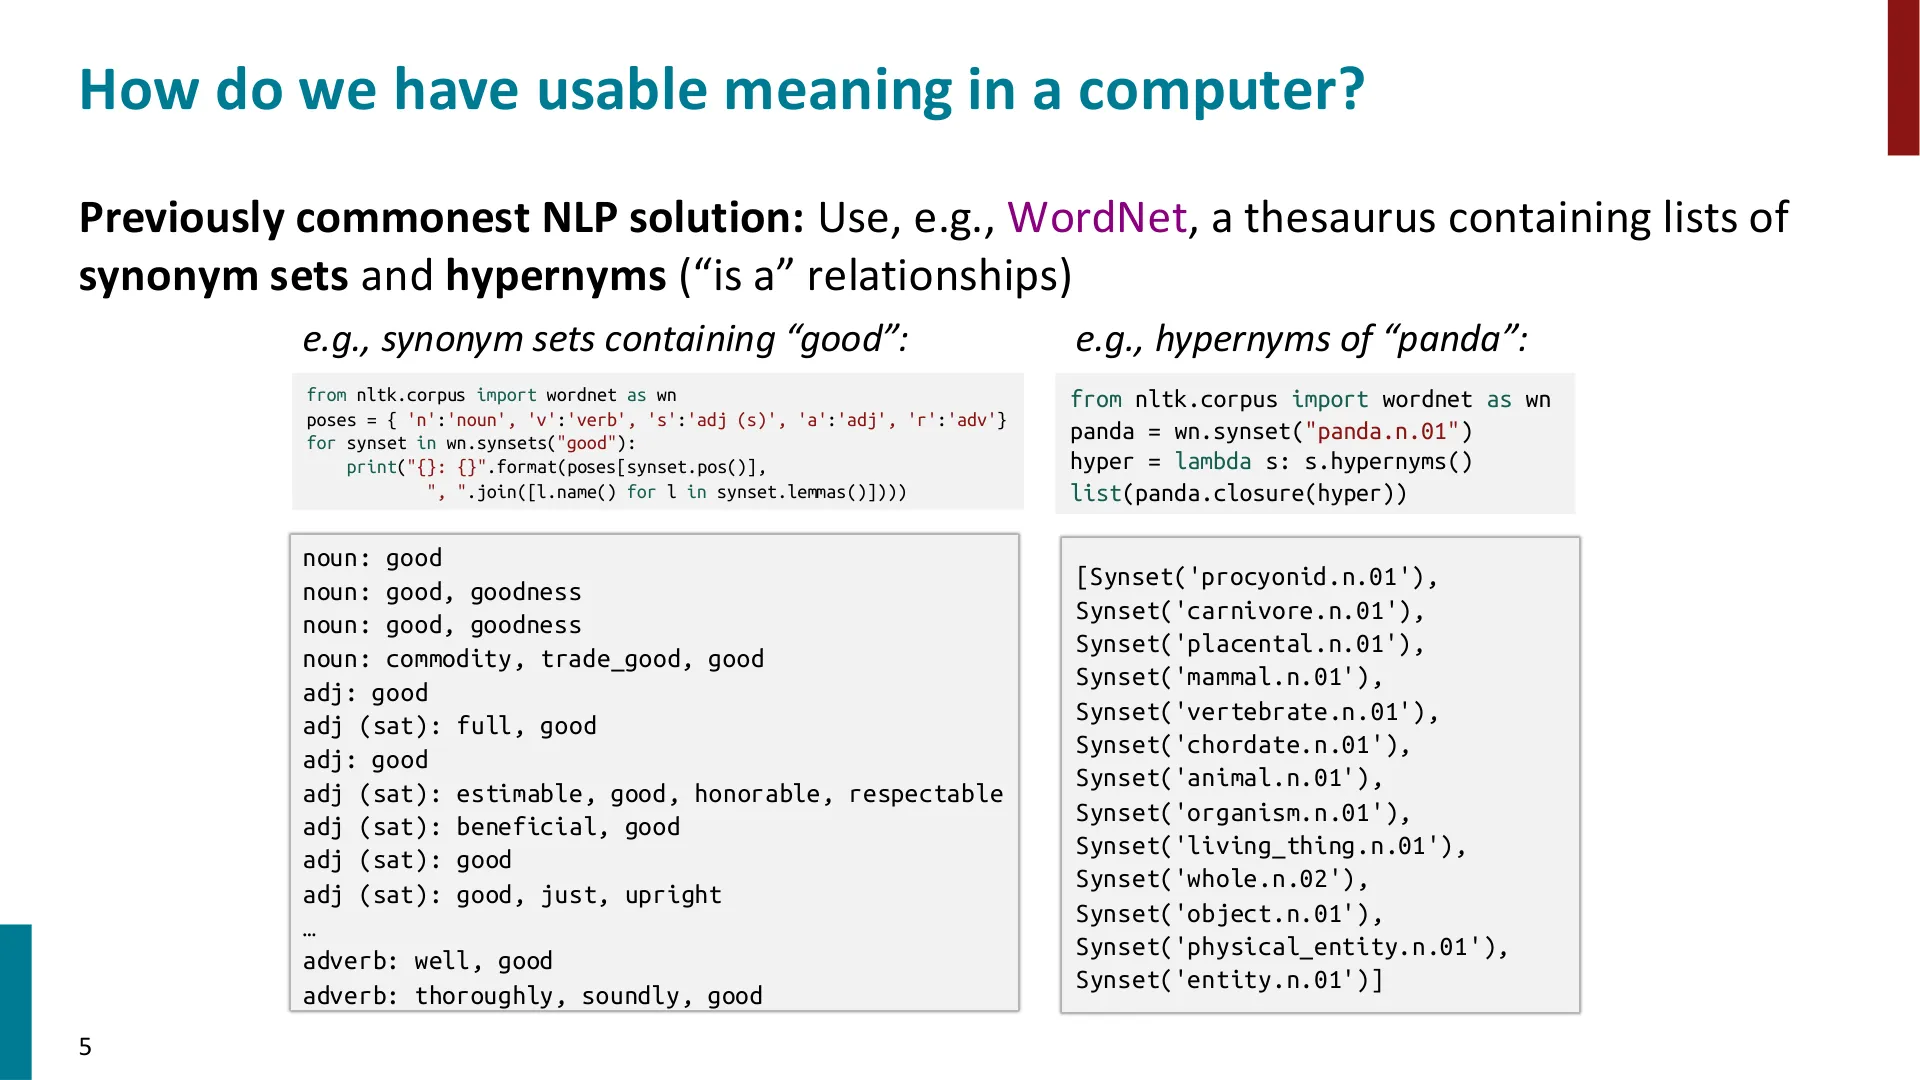
Slide 5:计算机里如何获得"可用的意义"?(How do we have usable meaning in a computer?)
- 过去最常见的 NLP 方案:使用 WordNet 这类同义词词典,它包含同义词集合(synset)与上位词(hypernym,"is a"关系)。
- 示例代码(原文):
from nltk.corpus import wordnet as wn

poses = {'n': 'noun', 'v': 'verb', 's': 'adj (s)', 'a': 'adj', 'r': 'adv'}
for synset in wn.synsets("good"):
    print("{}: {}".format(poses[synset.pos()],
                          ", ".join([l.name() for l in synset.lemmas()])))
from nltk.corpus import wordnet as wn

panda = wn.synset("panda.n.01")
hyper = lambda s: s.hypernyms()
list(panda.closure(hyper))
- 例如
good所在的同义词集合;例如panda的上位词链:procyonid → carnivore → placental → mammal → vertebrate → chordate → animal → organism → living_thing → whole → object → physical_entity → entity。
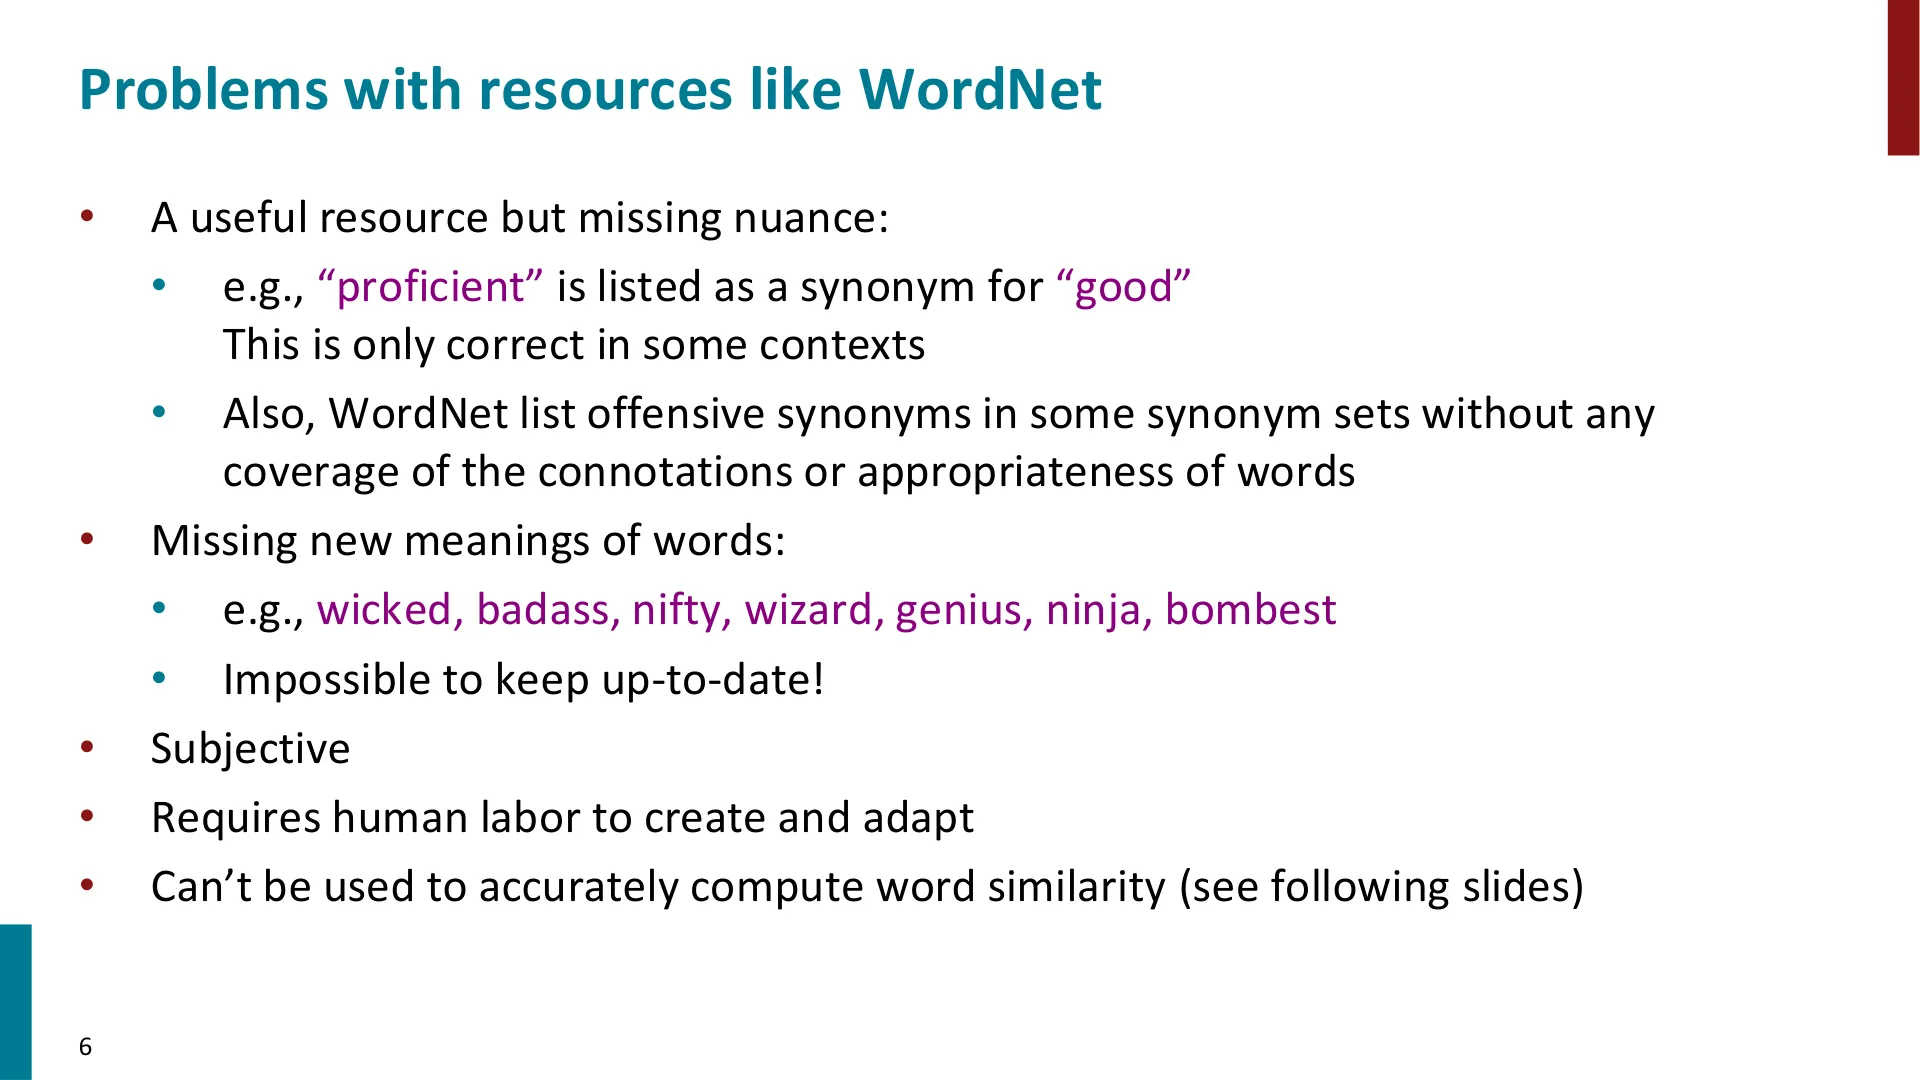
Slide 6:WordNet 这类资源的问题
- 有用,但缺少细微差别:例如把
proficient列为good的同义词,这只在某些语境下正确。 - WordNet 的某些同义词集合里含有冒犯性词汇,却完全不标注词的褒贬与得体程度。
- 跟不上新词义:例如 wicked、badass、nifty、wizard、genius、ninja、bombest 等新用法。
- 无法保持最新;主观;需要人工创建与维护;无法用来精确计算词相似度。
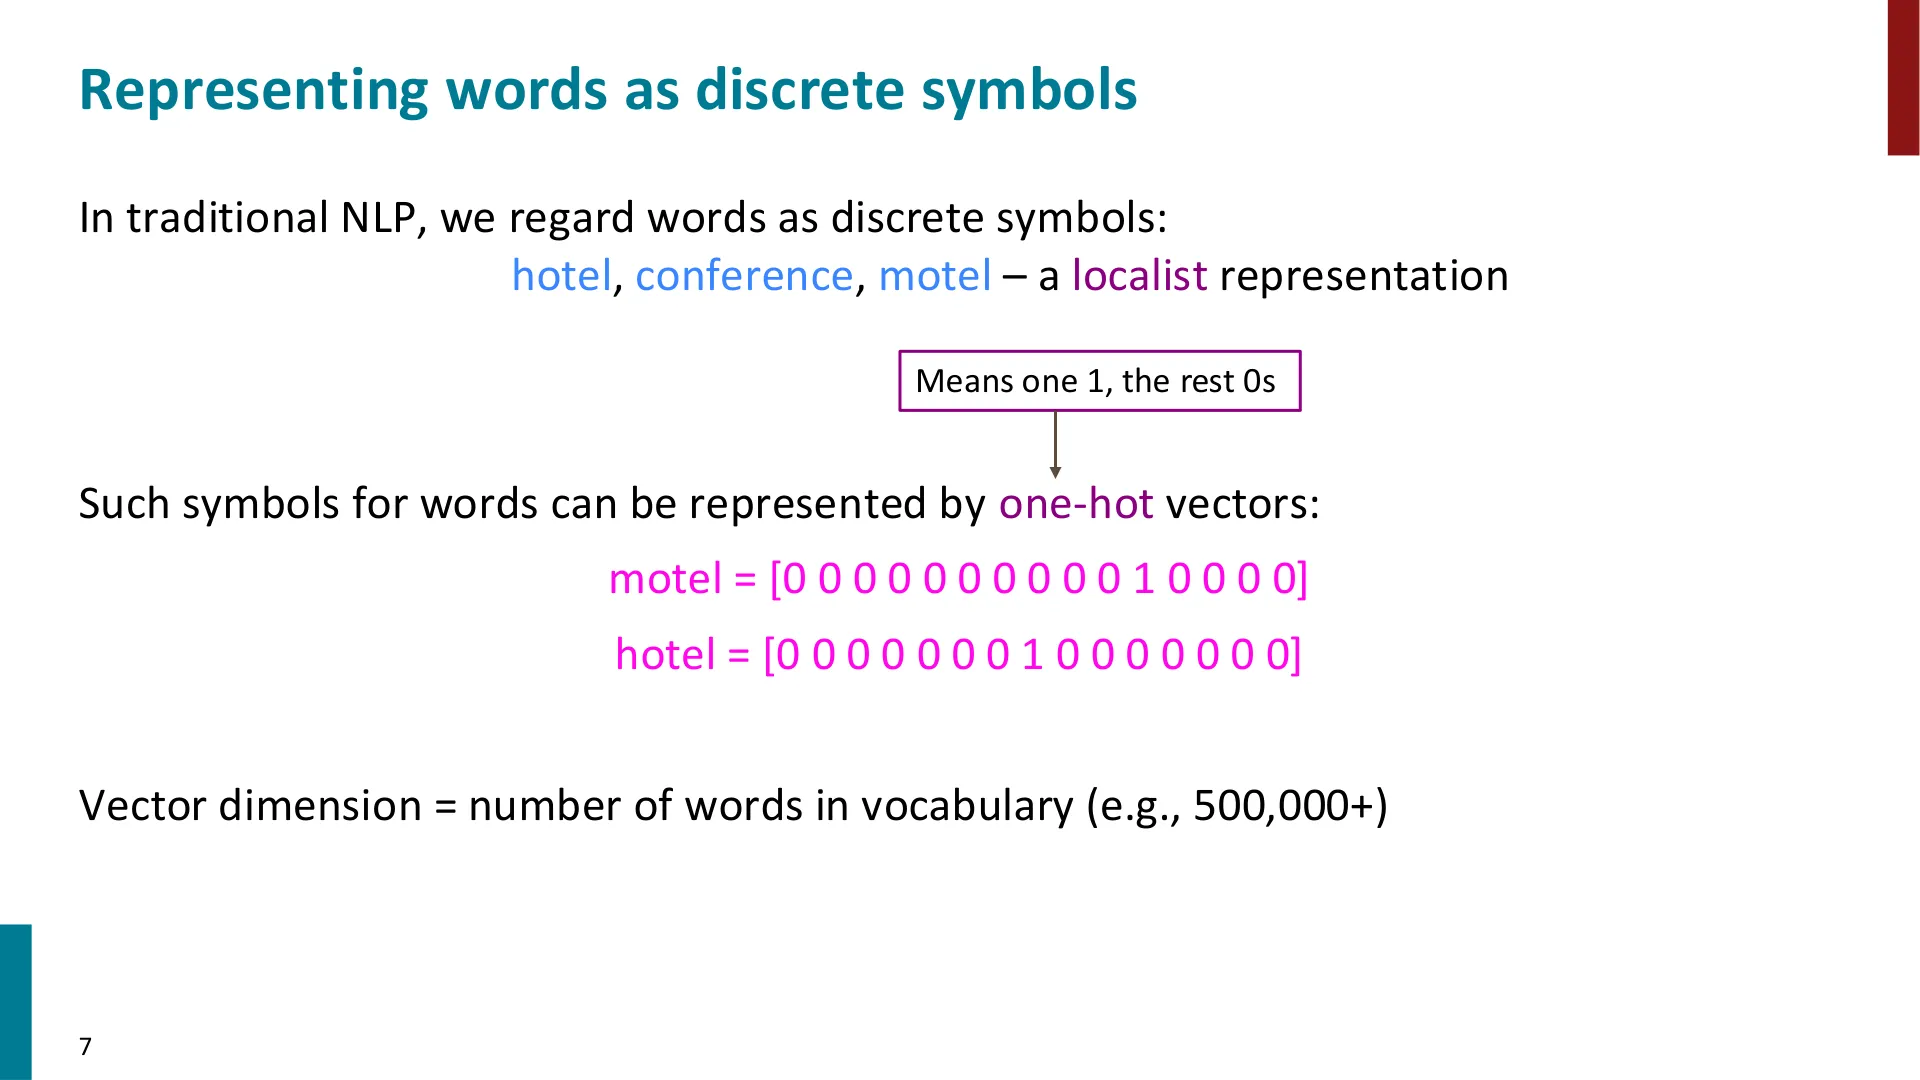
Slide 7:把词表示为离散符号
- 传统 NLP 把词视为离散符号:
hotel、conference、motel——一种局部表示(localist representation)。 - 这些符号可用独热向量(one-hot)表示:
motel = [0 0 0 0 0 0 0 0 0 0 1 0 0 0 0]
hotel = [0 0 0 0 0 0 0 1 0 0 0 0 0 0 0]
- 向量维度 = 词表大小(如 50 万+);只有一个 1,其余全为 0。
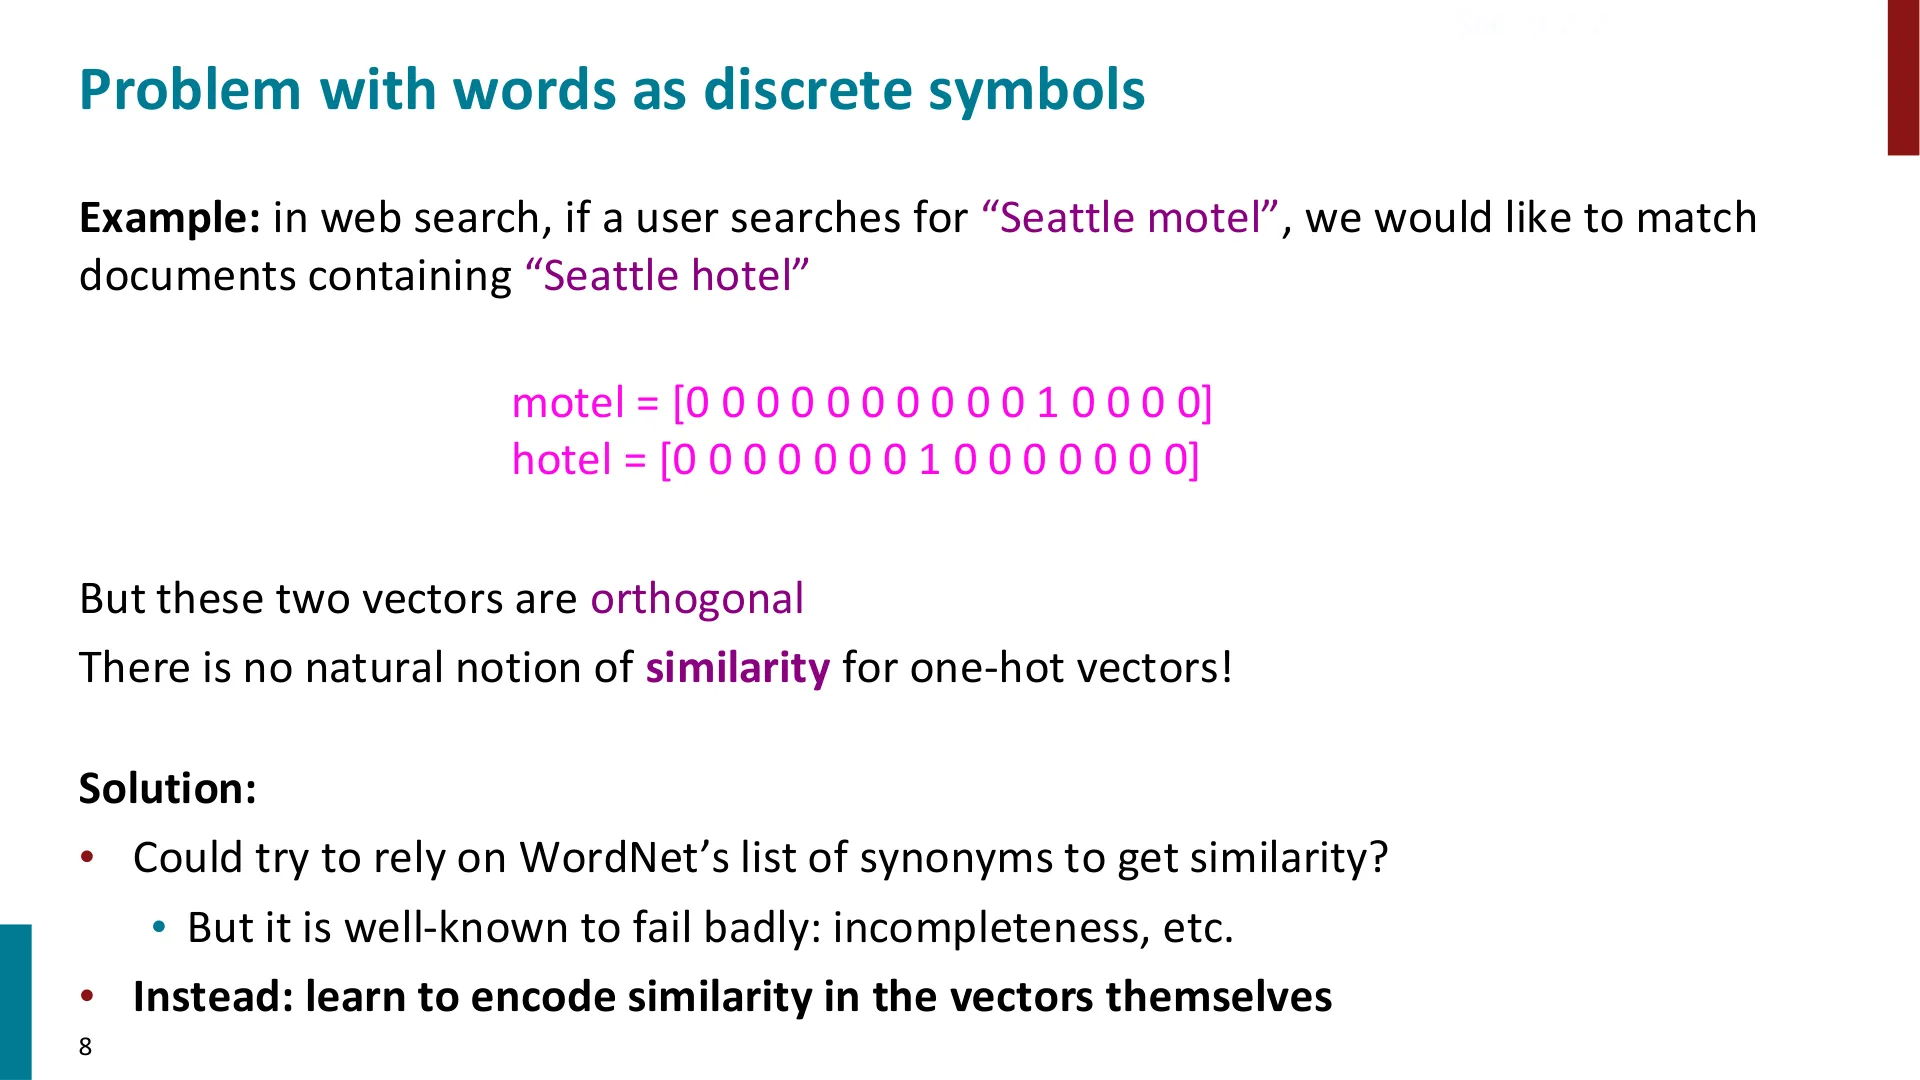
Slide 8:把词当作离散符号的问题
- 例:网页搜索里,用户搜 "Seattle motel",我们希望匹配到含 "Seattle hotel" 的文档。
- 但
motel与hotel的独热向量正交——独热向量之间没有天然的相似度概念! - 解决方案:
- 靠 WordNet 的同义词表来获得相似度?——众所周知会惨败(不完整等);
- 应当:把相似性学习进向量本身。
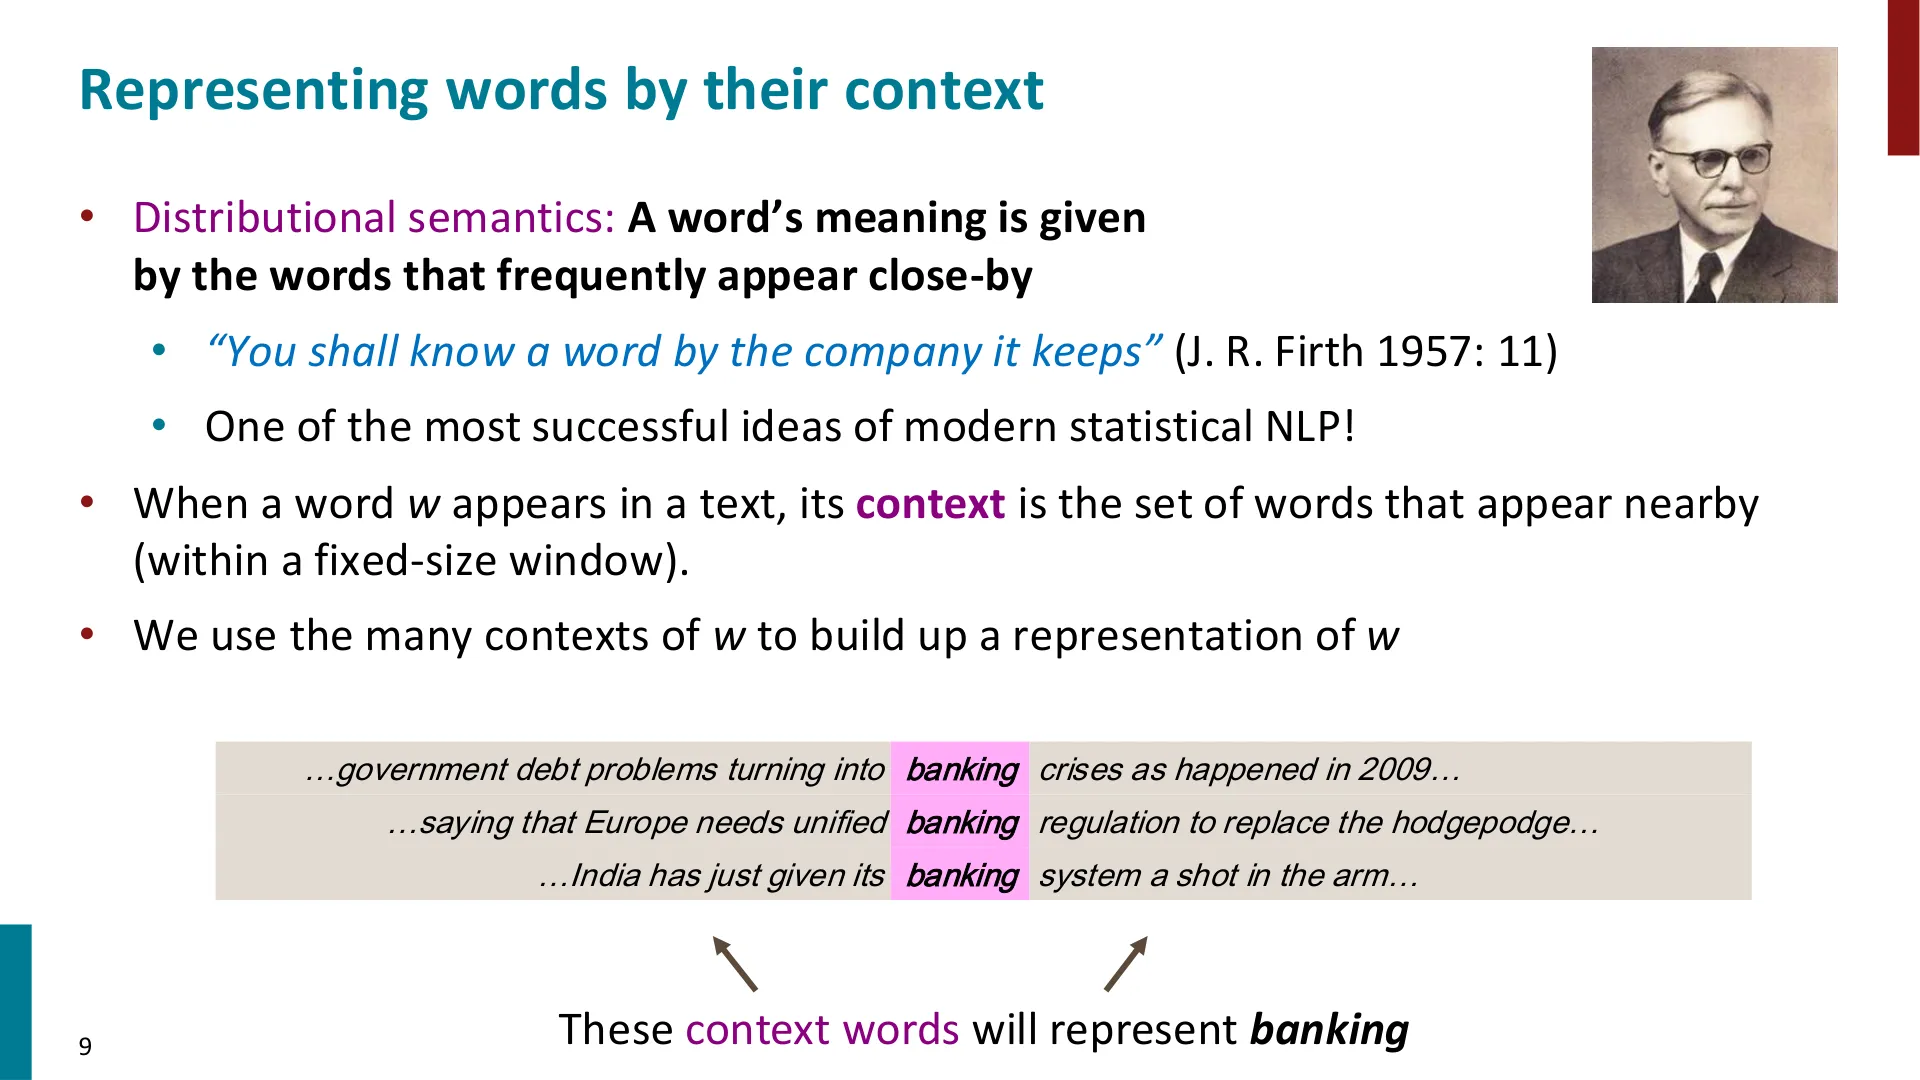
Slide 9:用上下文表示词
- 分布语义学(Distributional semantics):一个词的意义由经常出现在它附近的词给出。
- "You shall know a word by the company it keeps"(J. R. Firth, 1957: 11)——这是现代统计 NLP 最成功的思想之一。
- 当词 $w$ 出现在文本中时,它的上下文是在固定大小窗口内出现的词集合;我们用 $w$ 的众多上下文来构建 $w$ 的表示。
- 示例:
…government debt problems turning into banking crises…、…Europe needs unified banking regulation…、…India has given its banking system a shot in the arm…——这些上下文词共同表示banking。
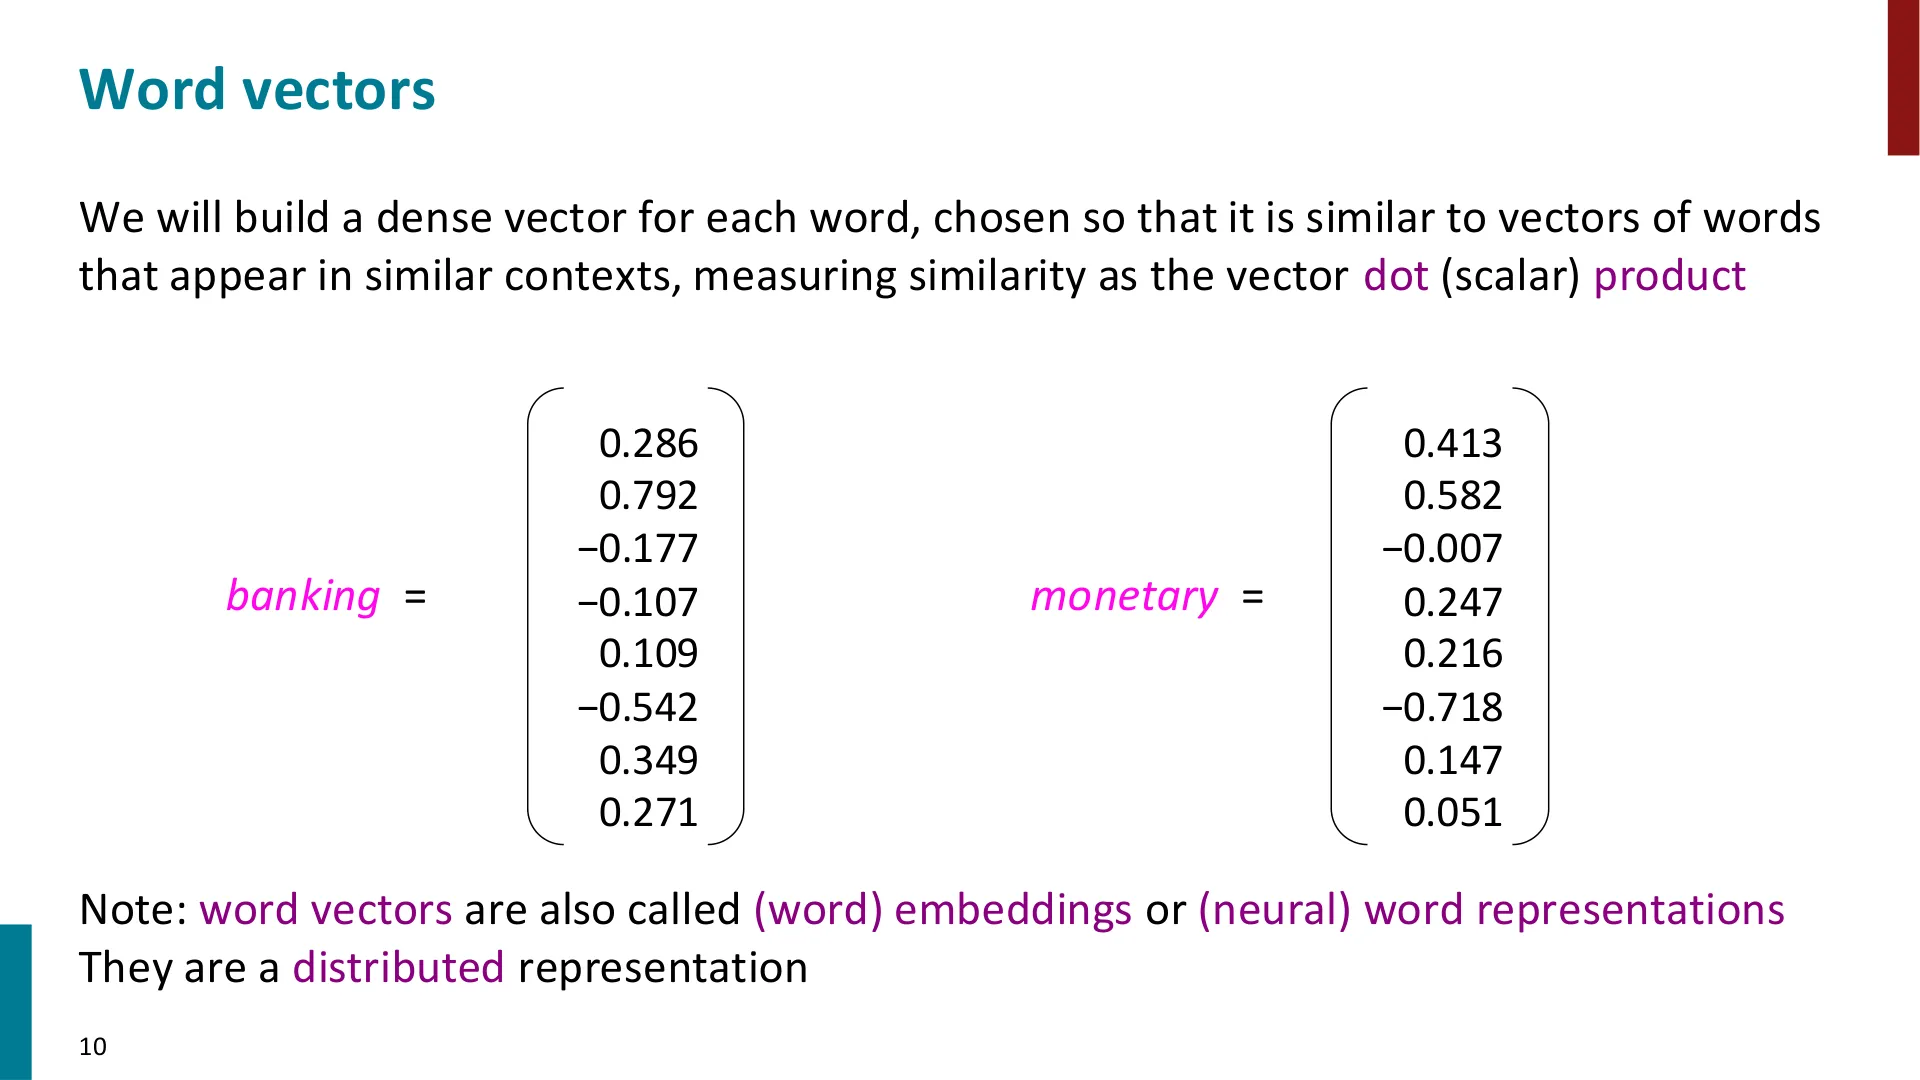
Slide 10:词向量
- 为每个词构建一个稠密向量,使得出现在相似上下文中的词,其向量(用点积衡量相似度)也相似。
- 注意:词向量也叫(词)嵌入(word embeddings)或(神经)词表示;它是一种分布式表示(distributed representation)。
- 例:
banking = [0.286, 0.792, −0.177, −0.107, 0.109, −0.542, 0.349, 0.271];monetary = [0.413, 0.582, −0.007, 0.247, 0.216, −0.718, 0.147, 0.051]。
Slide 28:负采样下的随机梯度 [旁注]
- 我们对每个窗口用 SGD 迭代地取梯度。
- 在每个窗口里,最多只有 $2m+1$ 个词,加上负采样得到的 $2km$ 个负样本,因此 $\nabla_\theta J_t(\theta)$ 非常稀疏。
Slide 29:负采样下的随机梯度 [旁注·续]
- 我们可能只需要更新真正出现过的那些词向量!
- 解决方案:要么用稀疏矩阵更新操作,只更新完整嵌入矩阵 $U$、$V$ 的某几行;要么维护一个词向量的哈希表。
- 如果有几百万个词向量、还要做分布式计算,那么"不必把巨大的更新到处传送"就很重要。
- 注:在真实的深度学习包里,是行(rows)而非列。
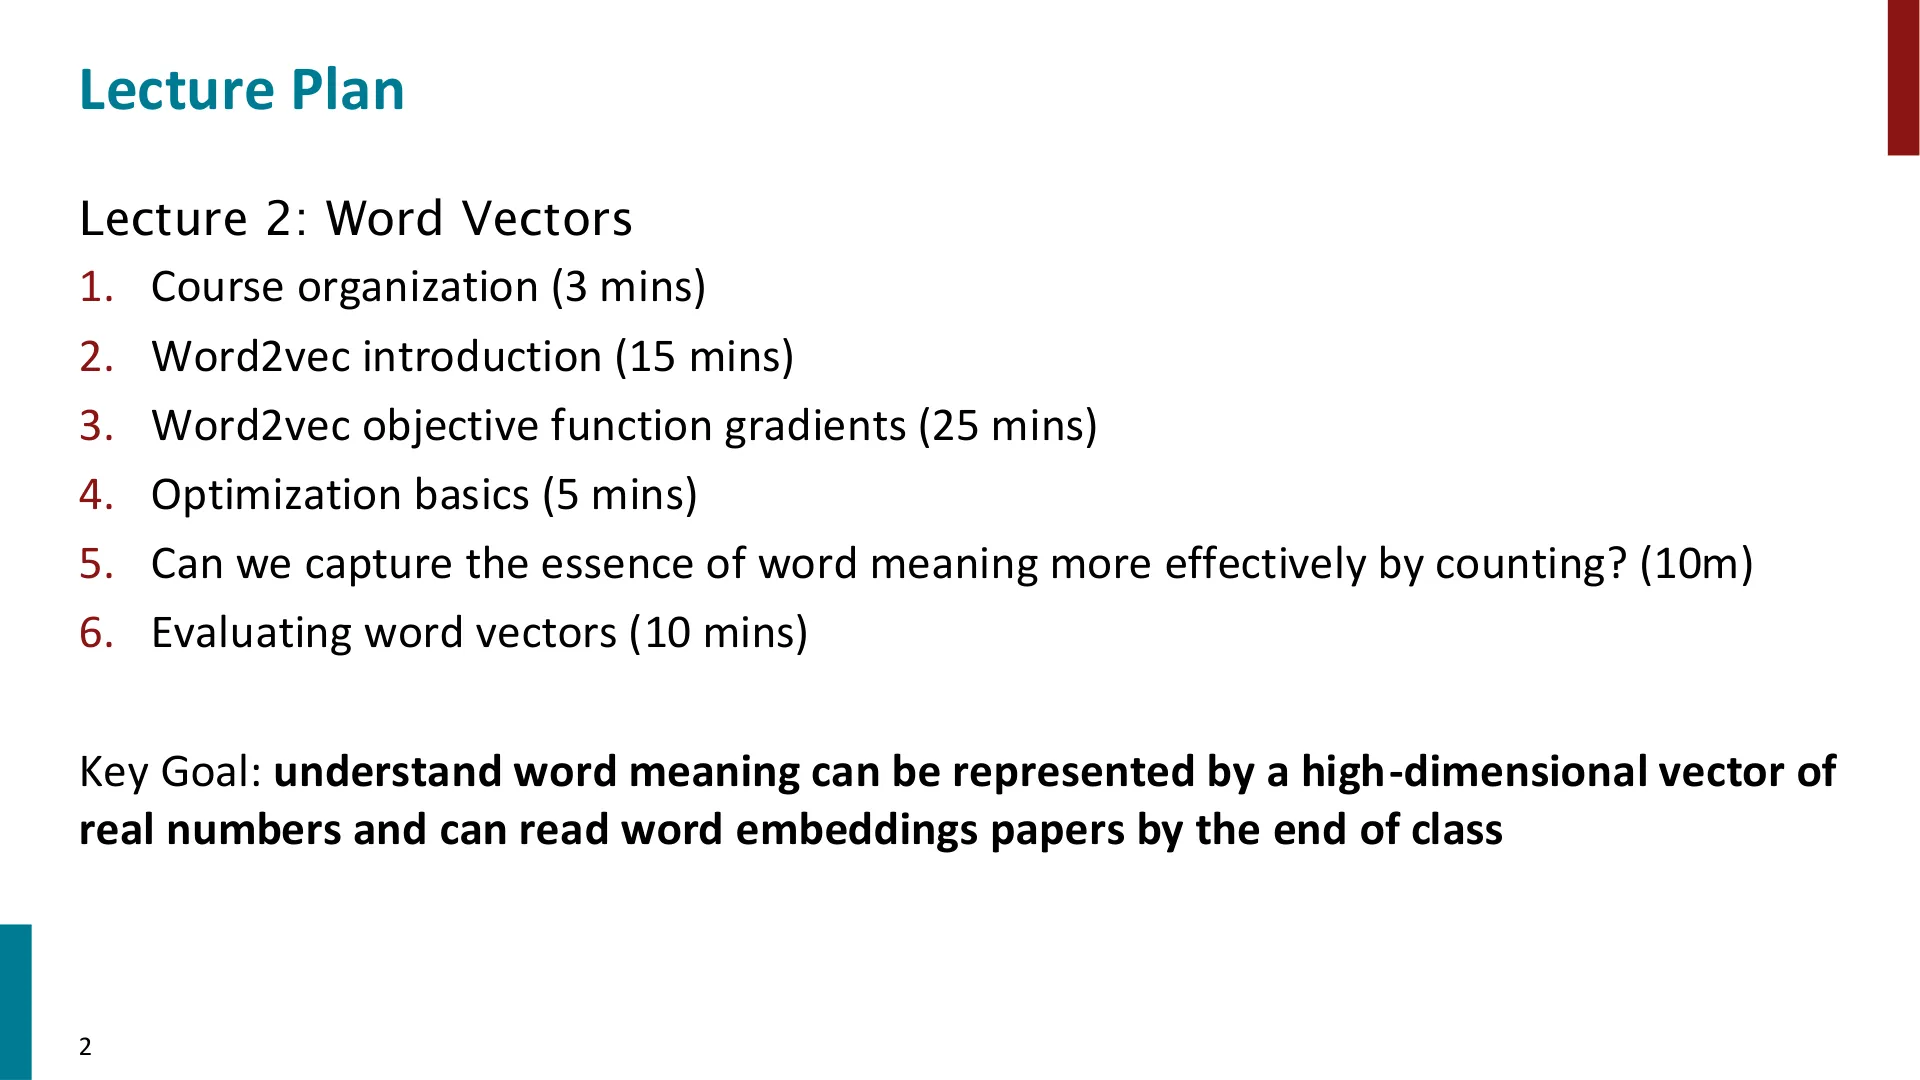
Slide 44:讲义计划(结束页)
内容与 Slide 2 相同——本讲六大板块(课程组织、Word2vec 简介、目标函数梯度、优化基础、直接计数方法、词向量评估)与"核心目标:理解词义可以用高维实数向量表示,并在课末能读懂词嵌入论文"。
附:参考与延伸阅读
编者补充
已知疑点
本讲是课堂录音的重构,以下地方存在不确定,编者按时间点与依据逐条列出,供读者自行判断:
-
讲者身份与幻灯片版本不一致:录音中讲师提到"GloVe 是 2014 年我们在 Stanford 做的""和博后 Jeffrey Pennington 合作",据此可判断讲者应为 Chris Manning;但课程资料提供的本讲幻灯片(
cs224n-2026-lecture02-wordvecs.pdf)标注讲师为 Diyi Yang。书中对讲者统一用"讲师"称呼,未强指其姓名。(依据:00:12:32–00:13:00、00:40:57–00:41:24) -
"幻灯片是否都被展示"的判断:官方幻灯片共 44 页。本讲录音从"优化基础"直接续讲,Slide 4–10(词义定义、WordNet、one-hot、分布语义学、词向量)在录音中没有对应的口头讲解,编者是依据"内容已在第一讲讲过"这一上下文推断其属于复习页,故列入附录;Slide 28–29 是讲师明确说"时间紧,不讲了"而跳过的旁注页(00:33:38);Slide 44 为重复的讲义计划页。若这些页实际曾短暂显示,请以官方录像为准。
-
幻灯片与时间的对应是近似的:本书中的
SLIDE:n@HH:MM:SS时间锚点是编者根据话题出现时刻推断的,逐页精确的对齐需要以官方录像画面为准。 -
稀疏编码论文的出处无法确认:讲师提到用稀疏编码从单一词向量中分离义项的那篇论文,"作者之一现在是 Stanford CS 的教职",字幕把该人名转写为近似 "Tatsu" 的音(01:01:56–01:02:05),且论文名被转写为类似 "San Al"。编者无法确定具体论文与人名,故正文只作概述。
-
讲师答疑预约所用的平台:字幕出现类似 "kendley" 的音(00:02:36),指代讲师办公时间 15 分钟一场的预约载体,编者无法确认是具体产品名还是转写错误,正文统一表述为"预约制"。
-
一处类比表述的自我更正:讲师在讲 "man/king ⇄ woman/queen" 时一度把关系说反,随后现场更正为"man 之于 king,正如 woman 之于 ?"(00:17:12–00:17:26)。书中已按更正后的表述处理。
-
"3/4 次方对应指数取 0" 的口误式表述:讲师在解释 3/4 次方时说"完全均匀对应把这里的指数设为 0"(00:33:20–00:33:30)。按幂律 $U(w)^\alpha$ 的惯例,$\alpha=0$ 得到均匀分布、$\alpha=1$ 得到原始一元分布,讲师此处说的应是"把指数取到 0",并非"把 3/4 改成 0"。书中已按此理解改写,特此标注。
-
一次"现场演示失败"的截断:在讲负向量取反找反义词一段(00:15:16–00:15:44),字幕出现若干零碎、不连贯的词,编者对这部分做了合并与概括,未逐字还原。
若确实没有疑点,本书也会保留本节并注明"本讲未发现明显疑点",以免读者误以为编者未做核对。本讲确有多处如上所列的不确定点,故逐条保留。
附录:课堂未展示的幻灯片
附录:课堂未展示的幻灯片
附录:课堂未展示的幻灯片
附录:官方幻灯片里课堂未展示的页
下面这些页来自官方幻灯片,但课堂录制里没有对应的展示画面。由
vb slides自动补入,供对照查阅。
附录:课堂未展示的幻灯片
附录:课堂未展示的幻灯片
🖼️ 第 2 页幻灯片 · Lecture Plan
🖼️ 第 4 页幻灯片 · 2. How do we represent the meaning of a word?
🖼️ 第 5 页幻灯片 · How do we have usable meaning in a computer?
🖼️ 第 6 页幻灯片 · Problems with resources like WordNet
🖼️ 第 7 页幻灯片 · Representing words as discrete symbols
🖼️ 第 8 页幻灯片 · Problem with words as discrete symbols
🖼️ 第 9 页幻灯片 · Representing words by their context
🖼️ 第 10 页幻灯片 · Word vectors
🖼️ 第 13 页幻灯片 · Word2Vec Overview
🖼️ 第 15 页幻灯片 · Word2Vec: objective function
🖼️ 第 16 页幻灯片 · Word2Vec with Vectors
🖼️ 第 19 页幻灯片 · Interactive Session!
🖼️ 第 23 页幻灯片 · Word2vec parameters … and computations
🖼️ 第 24 页幻灯片 · Word2vec maximizes objective function by
🖼️ 第 26 页幻灯片 · The skip-gram model with negative sampling
🖼️ 第 28 页幻灯片 · Stochastic gradients with negative sampling aside
🖼️ 第 29 页幻灯片 · Stochastic gradients with negative sampling aside
🖼️ 第 38 页幻灯片 · 6. How to evaluate word vectors?
🖼️ 第 42 页幻灯片 · Correlation evaluation
🖼️ 第 44 页幻灯片 · Lecture Plan