第3讲 · 神经网络基础:矩阵微积分、手推梯度与反向传播
| ** | |
| <img src="images/shot_00_00_00.png" alt="课程封面** | Lecture 3 Neural Network Foundations" loading="lazy"> |
📷 课程封面** | Lecture 3 Neural Network Foundations |
|
| 课程 | Stanford CS224N / Ling284 Natural Language Processing with Deep Learning(Spring 2024) |
| 主讲 | Diyi Yang |
| 本讲 | Lecture 3 — Backpropagation, Neural Network |
| 视频 | https://www.youtube.com/watch?v=HnliVHU2g9U |
| 官方幻灯片来源 | cs224n-2026-lecture03-neuralnets.pdf(CS224N 官方课程资料) |
| 课程主页 / 讲义 | https://web.stanford.edu/class/cs224n/ |
对应讲次:第3讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
编者说明:本视频录制于 2024 年春季,而随课程打包的幻灯片是一份较晚的版本(文件名标注 2026),两者在个别事务性细节(如辅导课的时间与地点)上并不一致。正文以视频录音为准,必要时用编者说明标出幻灯片的差异。幻灯片与讲义版权归 Stanford CS224N 课程组所有,按其随附的 CC 许可使用;本书为课堂口语记录的中文重构,仅供学习参考。
导览
这是读者的「3–5 分钟问题地图」,先看清今天要翻过哪几座山,再进正文。
① 老师真正提出的核心问题。 上一讲展示了「婴儿版」神经网络,并说:那些橙色的单元,每一个拆开看都像一个小小的逻辑回归。那么,这套东西究竟是怎样学出来的?老师的原话是——"我们想知道,怎么为一个任意函数计算梯度"。于是今天有两条腿:先用手推(矩阵微积分),再用算法推(反向传播)。用他自己的话概括:反向传播算法不过是两件事——用链式法则做复合函数的微积分,加上把中间结果存下来、绝不重复计算。
② 难点在哪。 最容易卡住的地方是形状(shape)。推导时用雅可比矩阵最自然,因为那样链式法则就是整齐的矩阵乘法;可真要用随机梯度下降更新参数时,又希望梯度的形状和参数一致,好直接做减法。这两套约定会打架,老师花了整整几页幻灯片解释如何取舍。第二个坎是"反向传播听起来很吓人"——其实把它拆成 +、×、max 这类基本节点的"局部梯度",就只剩一张图的正反两遍遍历。
③ 读者可能带着的疑问。
老师明确提出的问题:
- 神经网络中间层的输入特征是谁定的?
- 如果没有非线性,深网络会怎样?
- 怎么为一个任意(复杂的)函数算梯度?
编者预判读者会有的疑问:
- 反向传播为什么要做成"计算图 + 反向遍历"?不能直接对每个参数数值求导吗?
- 斯坦福数学课里的雅可比、链式法则,和这里到底是什么关系?
- 既然框架能自动算梯度,为什么还要手推、还要考试?
④ 本讲路线。 先用几分钟讲事务安排;接着从"级联的逻辑回归"讲神经网络的结构与激活函数(顺带讲清楚为什么非要非线性);然后花大约一半时间做矩阵微积分,并亲手把一个 NER 网络的梯度从头推一遍;最后用计算图和局部梯度把反向传播讲成一套可以自动化的通用算法,并收在"为什么要懂这些底细"。
一、课程事务与本周安排
(参考时间: 00:05)
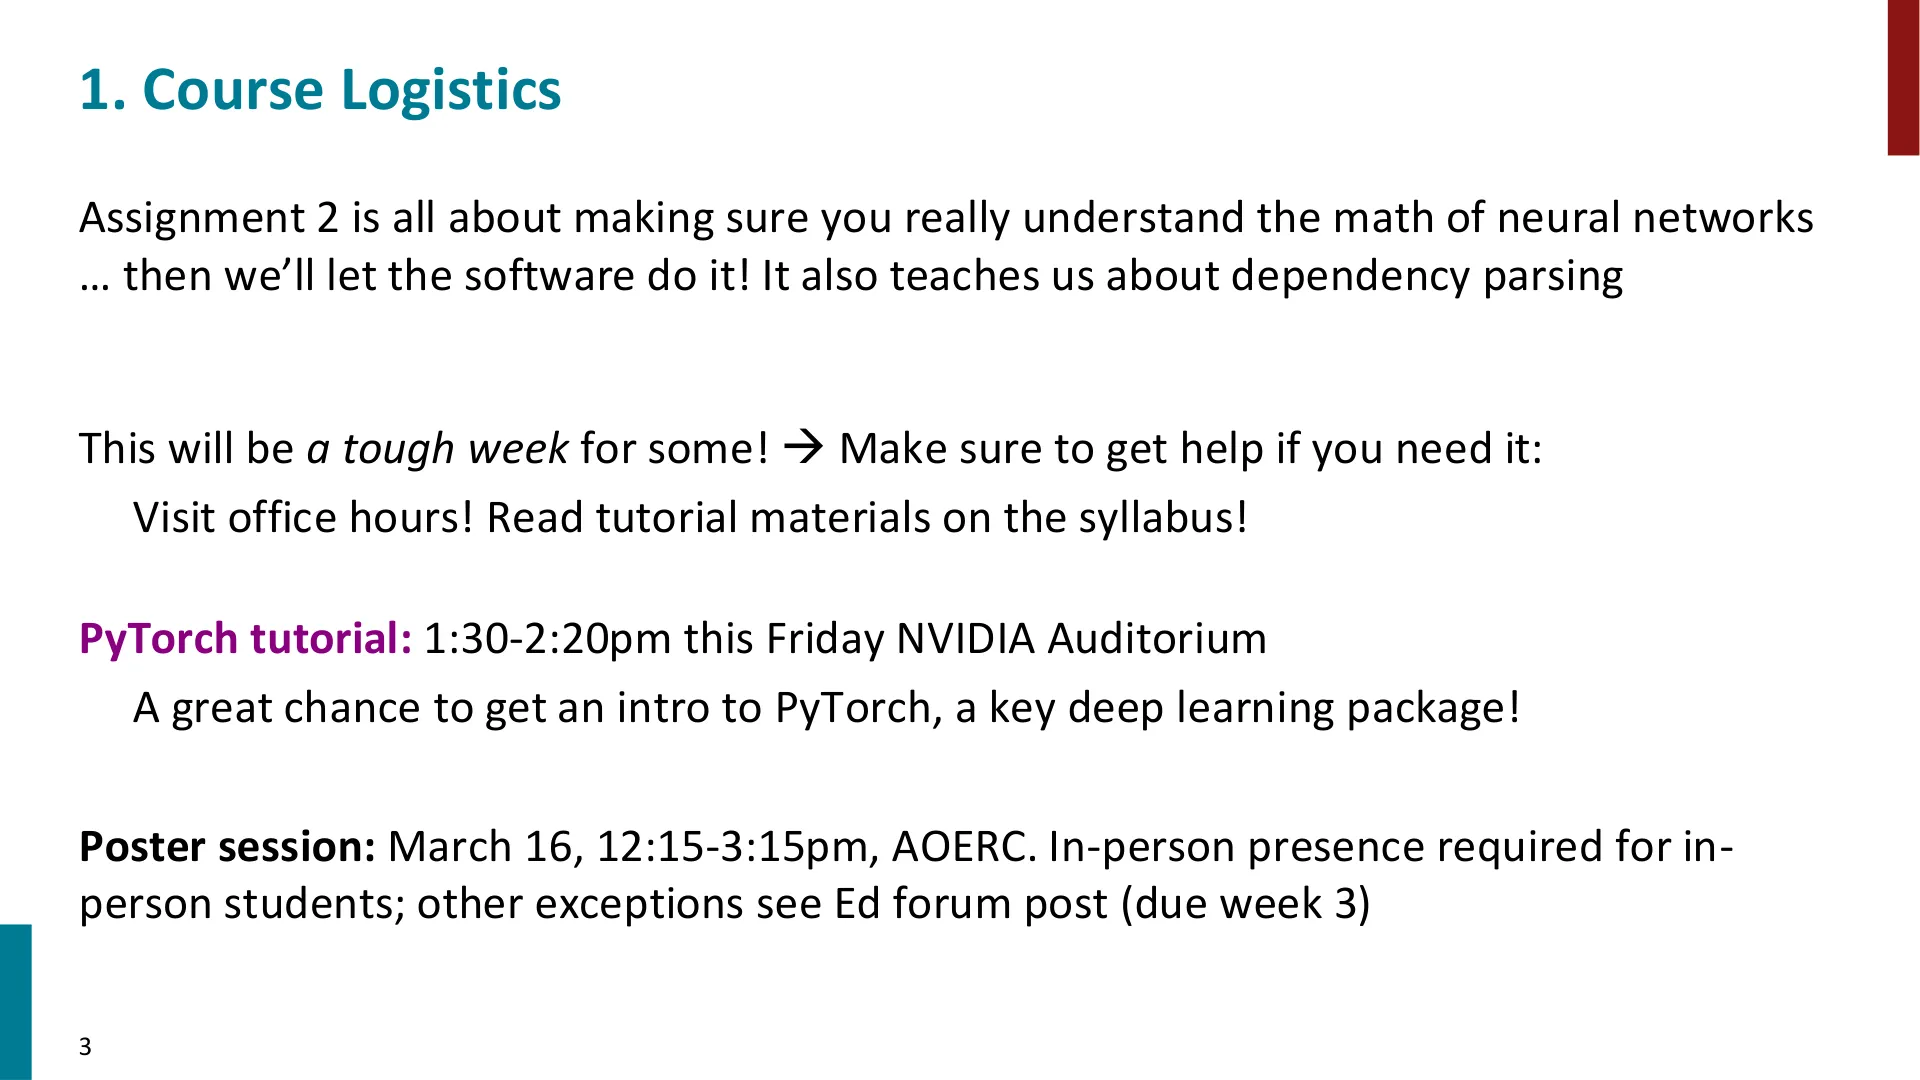
课程一开始,老师先交代本周的节奏:这是第二周的周二,按理说大家应该已经完成了作业 1。他特别提醒——作业 1 是这门课里最容易的上手台阶,不要在这里浪费迟交天数:
"每年总有一些人把迟交日用在了作业 1 上,这真的是最不该用它们的地方。"
本周下发的是作业 2,它同时承担三件事:
- 让你亲手做一遍数学,真正理解神经网络到底在算什么、又是怎么算的(这正是本讲的另一半内容);
- 顺带学习依存句法分析(dependency parsing)——这是语言结构与语言学的一部分;
- 开始使用 PyTorch——本课程将贯穿始终的主流深度学习框架。
关于 PyTorch,老师的形容很形象:作业里的脚手架给得极其充足,"这里有一段现成的代码,你只要写这两行、调用这两个函数"就行。为了帮大家上手,本周五会有一场 PyTorch 辅导课(讲师口述:周五 3:30,Gates B01,会录像)。
编者说明:随课程提供的幻灯片(较晚的版本)把这场辅导课写作"本周五 1:30–2:20,NVIDIA Auditorium"。两处时间地点不一致,以你所在学期的实际通知为准。此外,讲师在讲述中一度把"作业 2"说成了"作业 3",从上下文看应指作业 2。
他还提到海报展示环节(poster session)在 3 月 16 日 12:15–3:15,在校学生需现场出席,其他情况见 Ed 论坛说明。
最后是阅读材料:几乎每讲都配了延伸阅读,本讲的建议阅读里有好几篇是短小教程式的矩阵微积分与线性代数复习。老师说,他自己比较偏爱列表里的第一篇,但欢迎大家在 Ed 上讨论哪一篇更好。
📷 课程安排:作业 2、PyTorch 辅导与海报展示
回到原视频 (00:00:09)
编者拓展|为什么非要"手推一遍":现代框架(PyTorch、TensorFlow)都会自动求梯度,为什么还要让人手推?老师的回答在最后一张幻灯片里——反向传播并不总是开箱即用。当你遇到梯度爆炸、梯度消失、训练不收敛时,只有理解"框架底下在算什么",才能判断问题出在哪。这也呼应了 Andrej Karpathy 的那篇名文《Yes you should understand backprop》。
二、从逻辑回归到神经网络:为什么要"级联"
(参考时间: 03:25)
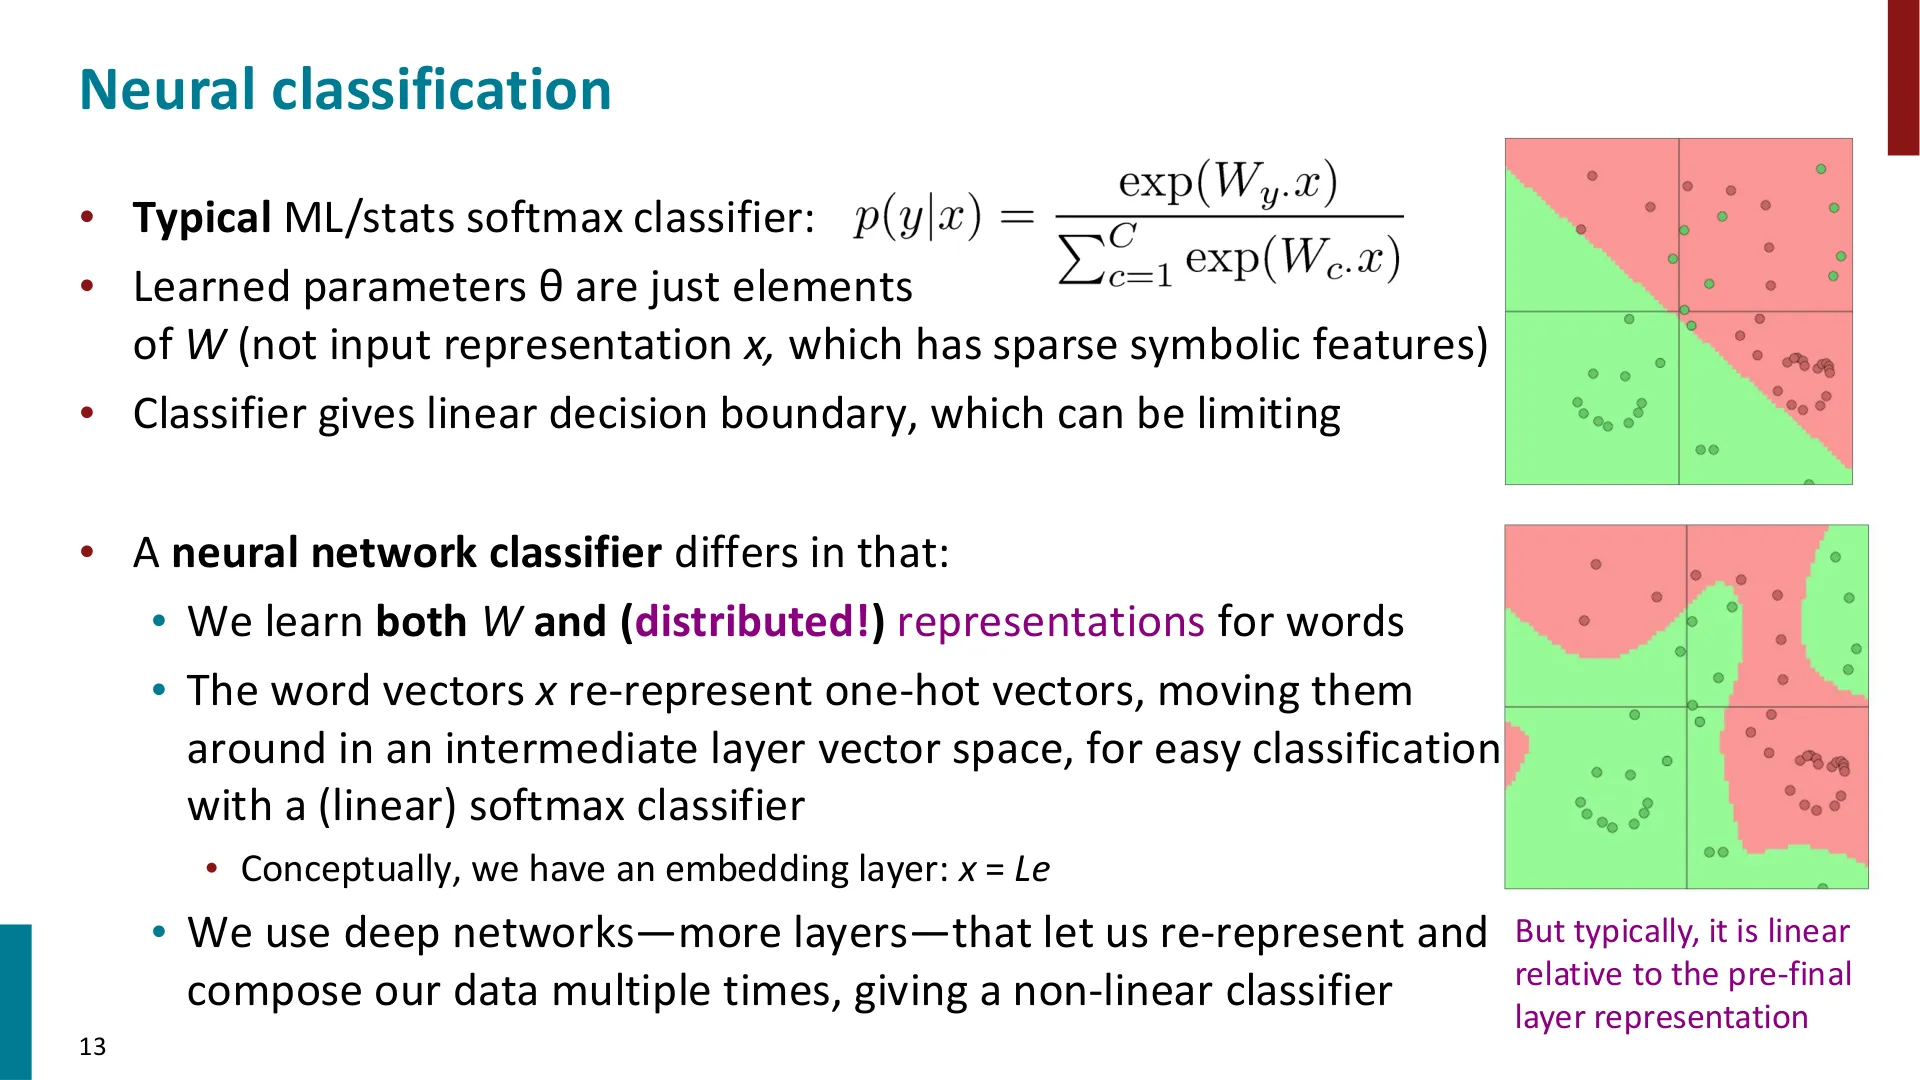
老师先回到上一讲末尾的那张"婴儿神经网络"图。图里那些橙色的单元,每一个都可以理解成一个小小的逻辑回归。它和统计课(比如 Stats 109)里见到的逻辑回归,关键差别在于:
- 在统计课里,你通常只有一个逻辑回归,输入特征由你自己定义,输出是一个决策变量;
- 在神经网络里,你是在搭一长串逻辑回归的级联。最终目标由损失函数定义,但中间那些层要用什么特征、要构造出什么函数,是交给网络自己去学的。
📷 神经网络分类器:学习 W 的同时学习词的分布式表示
回到原视频 (00:03:25)
老师特意让大家"坐下来想一想"这个想法,因为它威力极大:
"中间层表示的这种自组织(self-organization),正是神经网络在很多场景下比其他机器学习方法更强的根本原因。"
他补了一句关于"结构"的观察:人脑里的神经元更像"想怎么连就怎么连",但工程上做神经网络,几乎总是采用规整的层结构。一旦有了规整的层,从一层到下一层的计算就可以统一写成三个动作:
- 把上一层的输出向量乘以权重矩阵:$\mathbf{W}\mathbf{x}$;
- 加上偏置向量:$+\mathbf{b}$;
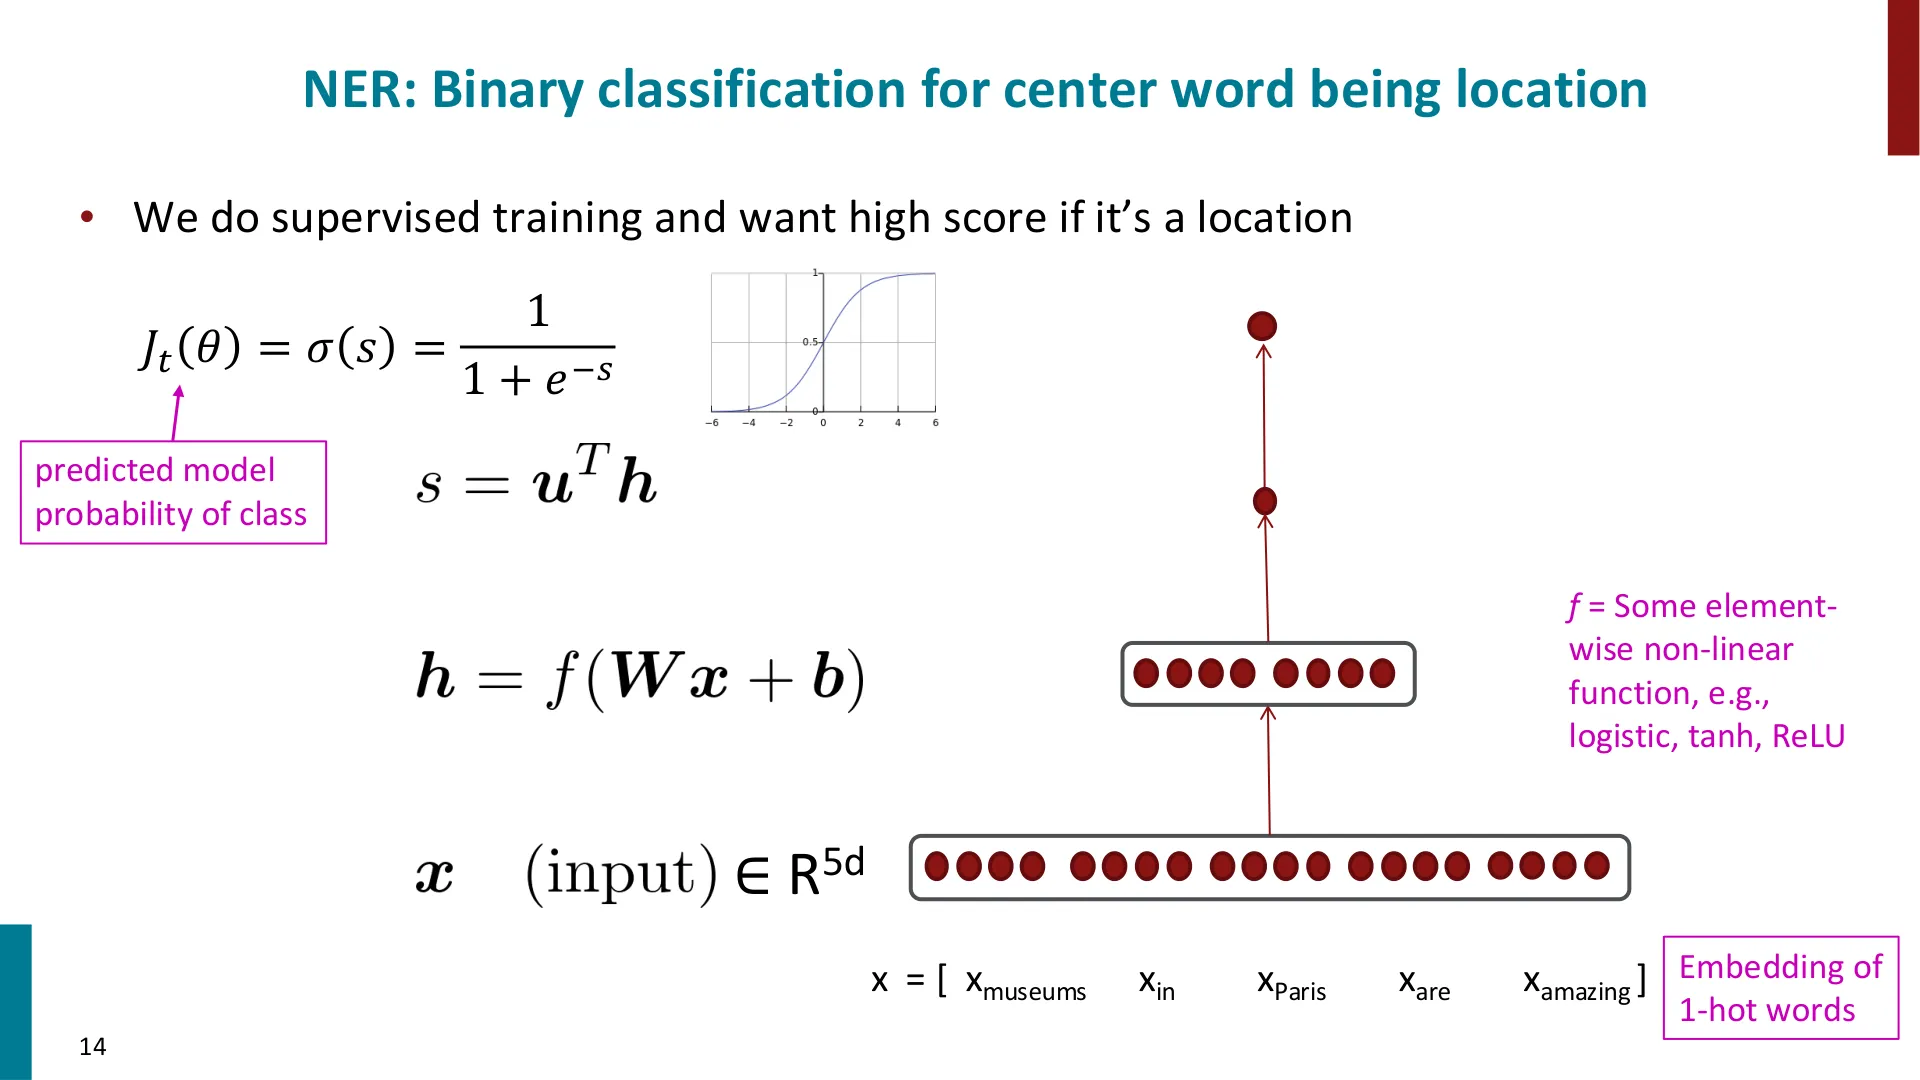
- 过一个非线性(激活)函数:$\mathbf{h} = f(\mathbf{W}\mathbf{x} + \mathbf{b})$。
这里还有一个关键细节:激活函数是逐元素作用的——它接受一个向量、产出同维度的向量,但真正的是一个标量函数,逐个作用在每个分量上。
贯穿全讲的小例子:判断中心词是不是"地点"
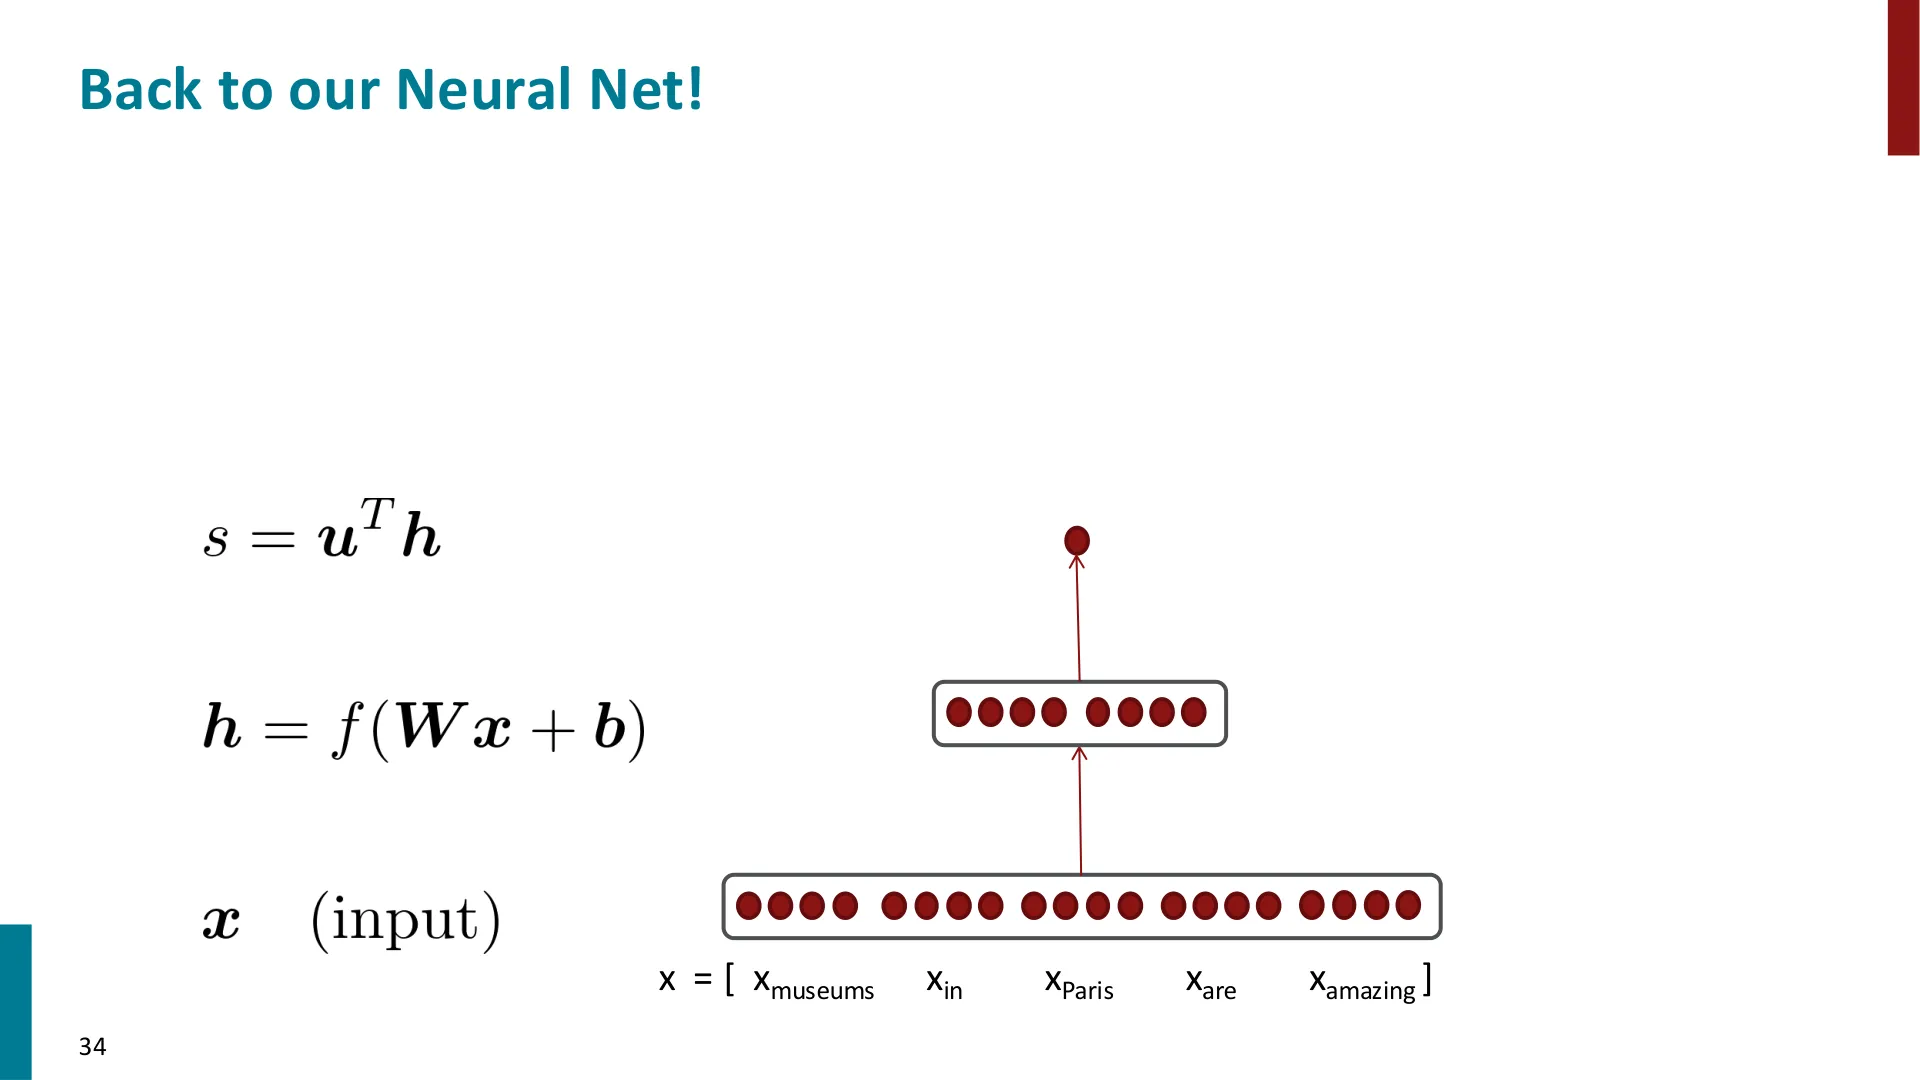
老师决定整节课都用同一个例子:给一个词窗口,判断窗口中心那个词是不是地点。做法是——把窗口里各词的向量拼接起来,做矩阵乘法、过非线性、再与向量 $\mathbf{u}$ 做点积得到一个分数 $s$,最后送进 sigmoid 预测"是 / 否"。
📷 窗口分类:用中心词周围的词向量拼接来判定它是不是地点
回到原视频 (00:07:23)
编者说明:这个"地点 / 非地点"的任务,是命名实体识别(NER)的一个简化版本。老师用二分类来降低难度——真实系统里通常用多类 softmax 一次预测所有类别。
三、激活函数:从阈值单元到 SwiGLU
(参考时间: 07:52)
这一段是老师"顺便聊聊历史"的部分,但它解释了为什么梯度式学习离不开有斜率的激活函数。
最早的神经元(可追溯到 1940 年代)用的是阈值:如果激活值大于阈值 $\theta$ 就输出 1,否则输出 0。问题在于——阈值两侧都是平的,没有斜率,也就没有梯度,这让学习变得非常困难。
于是有了"梯度式学习(gradient-based learning)"这个名字。老师打了个滑雪的比方:
"如果我们真的有斜率,那就像春假去滑雪——你能看出哪里更陡,然后就往陡的地方冲下去。这让我们能更快地优化。"
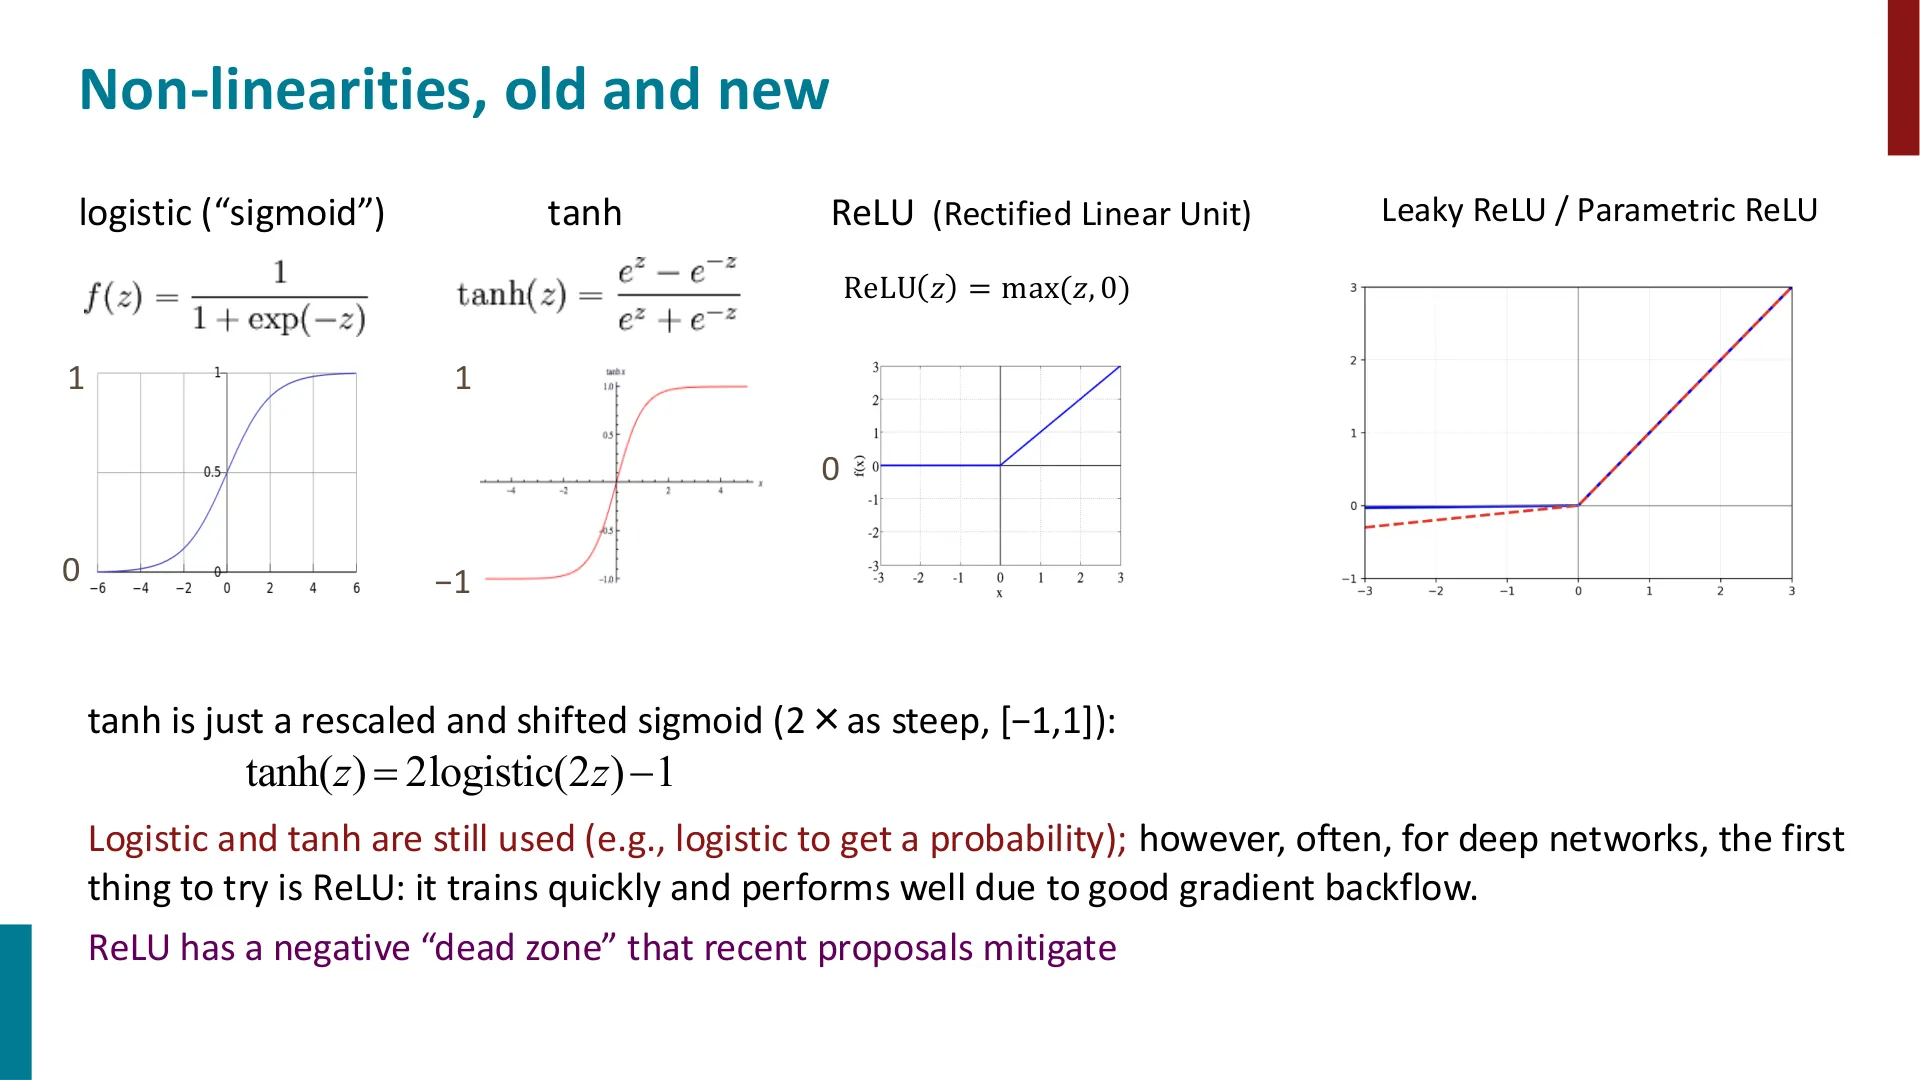
我们想要的,是有斜率、可求导的激活函数。历史上有:
- logistic(sigmoid):最早流行的一种,把值映射到概率。缺点是输出永远非负,总把数值往大的方向推。
- tanh:老师写下了它的指数公式,并提醒——如果数学生疏,可能看不出它和 logistic 的关系。其实 tanh 就是被重新缩放、平移过的 logistic:$\tanh(z) = 2\,\text{logistic}(2z) - 1$,把 logistic 拉高两倍、下移一格,就是同一个函数。作业 3 里我们会用到 tanh。
- hard tanh:因为算 tanh 要算指数、指数在计算机上很慢,人们想能不能用更便宜的东西——中间斜率为 1、两边压平。这直接引出了——
- ReLU(Rectified Linear Unit,修正线性单元):负半轴恒为 0,正半轴就是 $y = x$。
📷 激活函数的老与新:sigmoid、tanh、ReLU
回到原视频 (00:07:52)
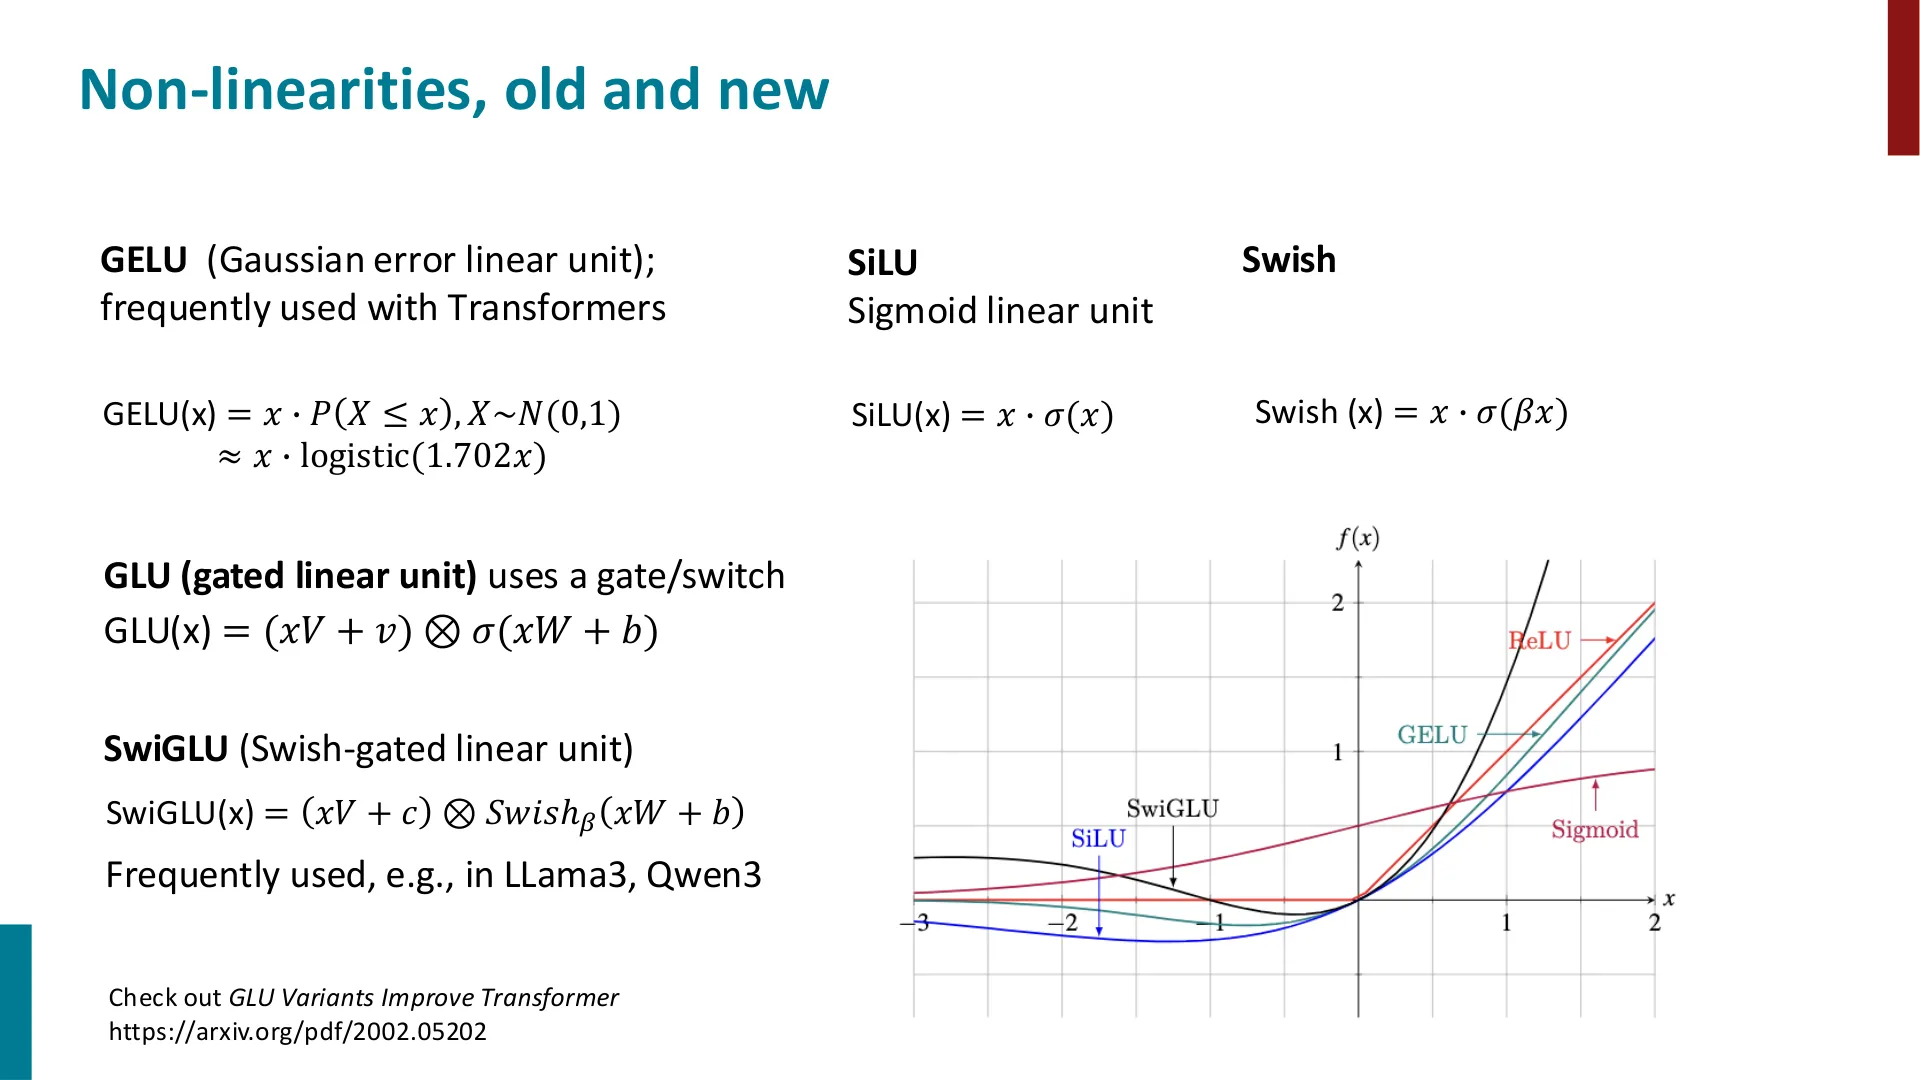
📷 更现代的激活函数:GELU、SiLU、Swish、GLU、SwiGLU
回到原视频 (00:14:03)
老师对 ReLU 有一句很有意思的吐槽:
"它看起来有点违背我刚才说的梯度式学习——一旦进入负半轴就没有梯度,那个神经元就'死'了。但正半轴有梯度,而且斜率永远是 1。这在我看来看起来还是有点别扭(perverse),但它确实成了好几年的默认选择。"
为什么"死了半边"还能用?因为整体网络里总有神经元是活的,这反而带来了一种分工(specialization);而且斜率恒为 1,让梯度反向流动时格外顺畅。不过后来人们又反悔了——"让一半范围死掉,也许并不是好主意"——于是有了:
- Leaky ReLU:负半轴改成一条很浅的直线;
- Parametric ReLU:负半轴的斜率变成一个可学习参数;
- 再后来,Transformer 时代常见的是 Swish 和 GELU——它们大体上"接近 ReLU",但在负半轴有一段"反着弯"的曲线,从而也带一点斜率;
- 还有门控类:GLU、SwiGLU(用门/开关),常用于近年的 Llama、Qwen 系模型。相关论文见《GLU Variants Improve Transformer》。
老师坦言,具体细节现在并不重要,重要的是想清楚"为什么必须要有非线性"。
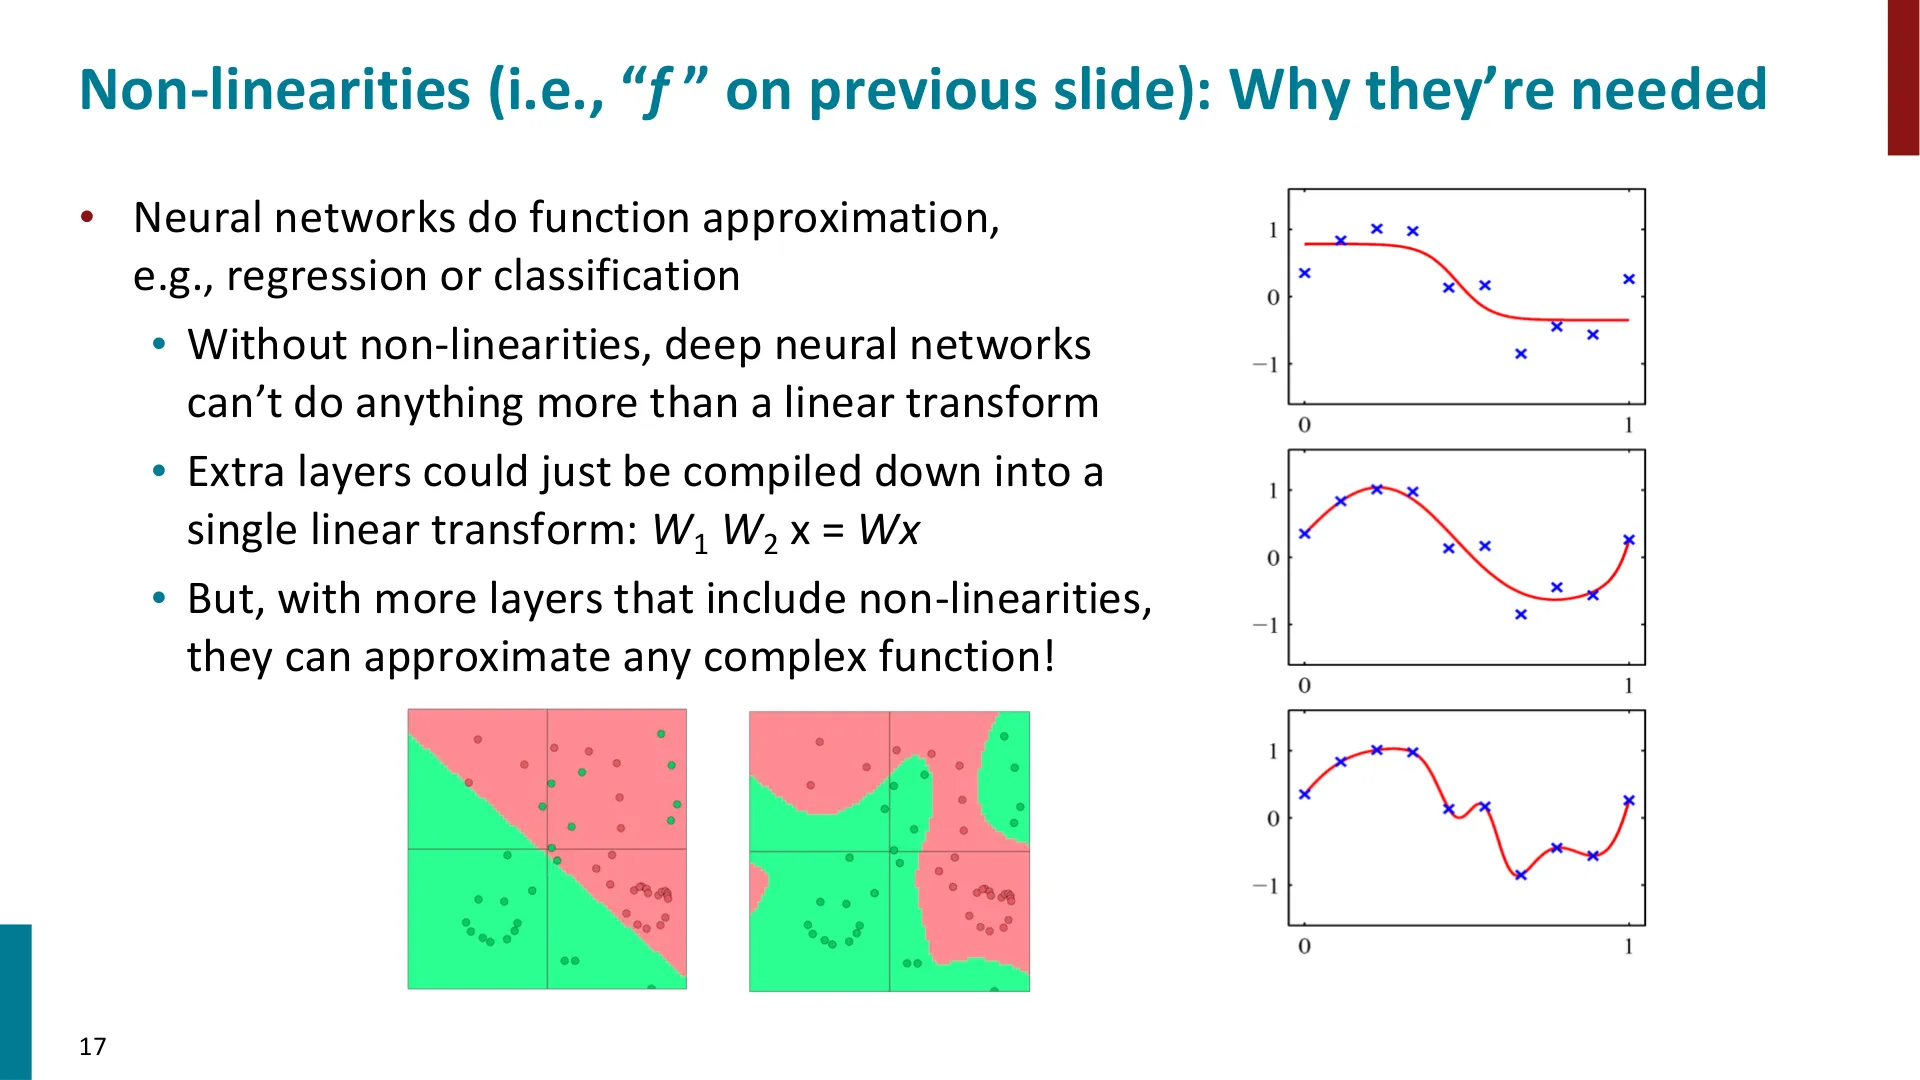
📷 为什么需要非线性:多层纯线性等价于一层
回到原视频 (00:14:45)
为什么必须要有非线性
神经网络做的是函数逼近——比如从一段文本逼近它的含义、从一幅图像逼近场景理解。而:
- 一个矩阵乘法(乘向量)就是一个线性变换;
- 如果只有多个矩阵乘法,它们会复合:$\mathbf{W}_1\mathbf{W}_2\mathbf{x} = \mathbf{W}\mathbf{x}$,最后还是一个线性变换。
所以纯线性的多层网络,在表示能力上并不比单层强。要让网络能逼近任意复杂函数,就必须加入非线性,而这正是激活函数的作用。
编者说明:老师在这里补了一个有趣的"但是"——虽然纯线性层在表示能力上没有增益,但在学习上却不乏研究价值,理论社区有不少论文专门研究"线性神经网络",因为它们有有趣的优化/学习性质。
四、梯度下降与"手算梯度"的开端
(参考时间: 16:56)
既然一切归结为梯度式学习,接下来就是今天的主线:怎么算梯度。随机梯度下降的更新式是:
$$\theta_j^{new} = \theta_j^{old} - \alpha \frac{\partial J(\theta)}{\partial \theta_j^{old}}$$
其中 $\alpha$ 是步长(学习率),$\nabla_\theta J(\theta)$ 就是要算的梯度。请注意:在深度学习中,$\theta$ 不仅包含权重,还包含数据表示本身(比如词向量)。
算梯度有两条路:1) 手工推导;2) 用算法——即反向传播。今天要把两条路都走一遍。
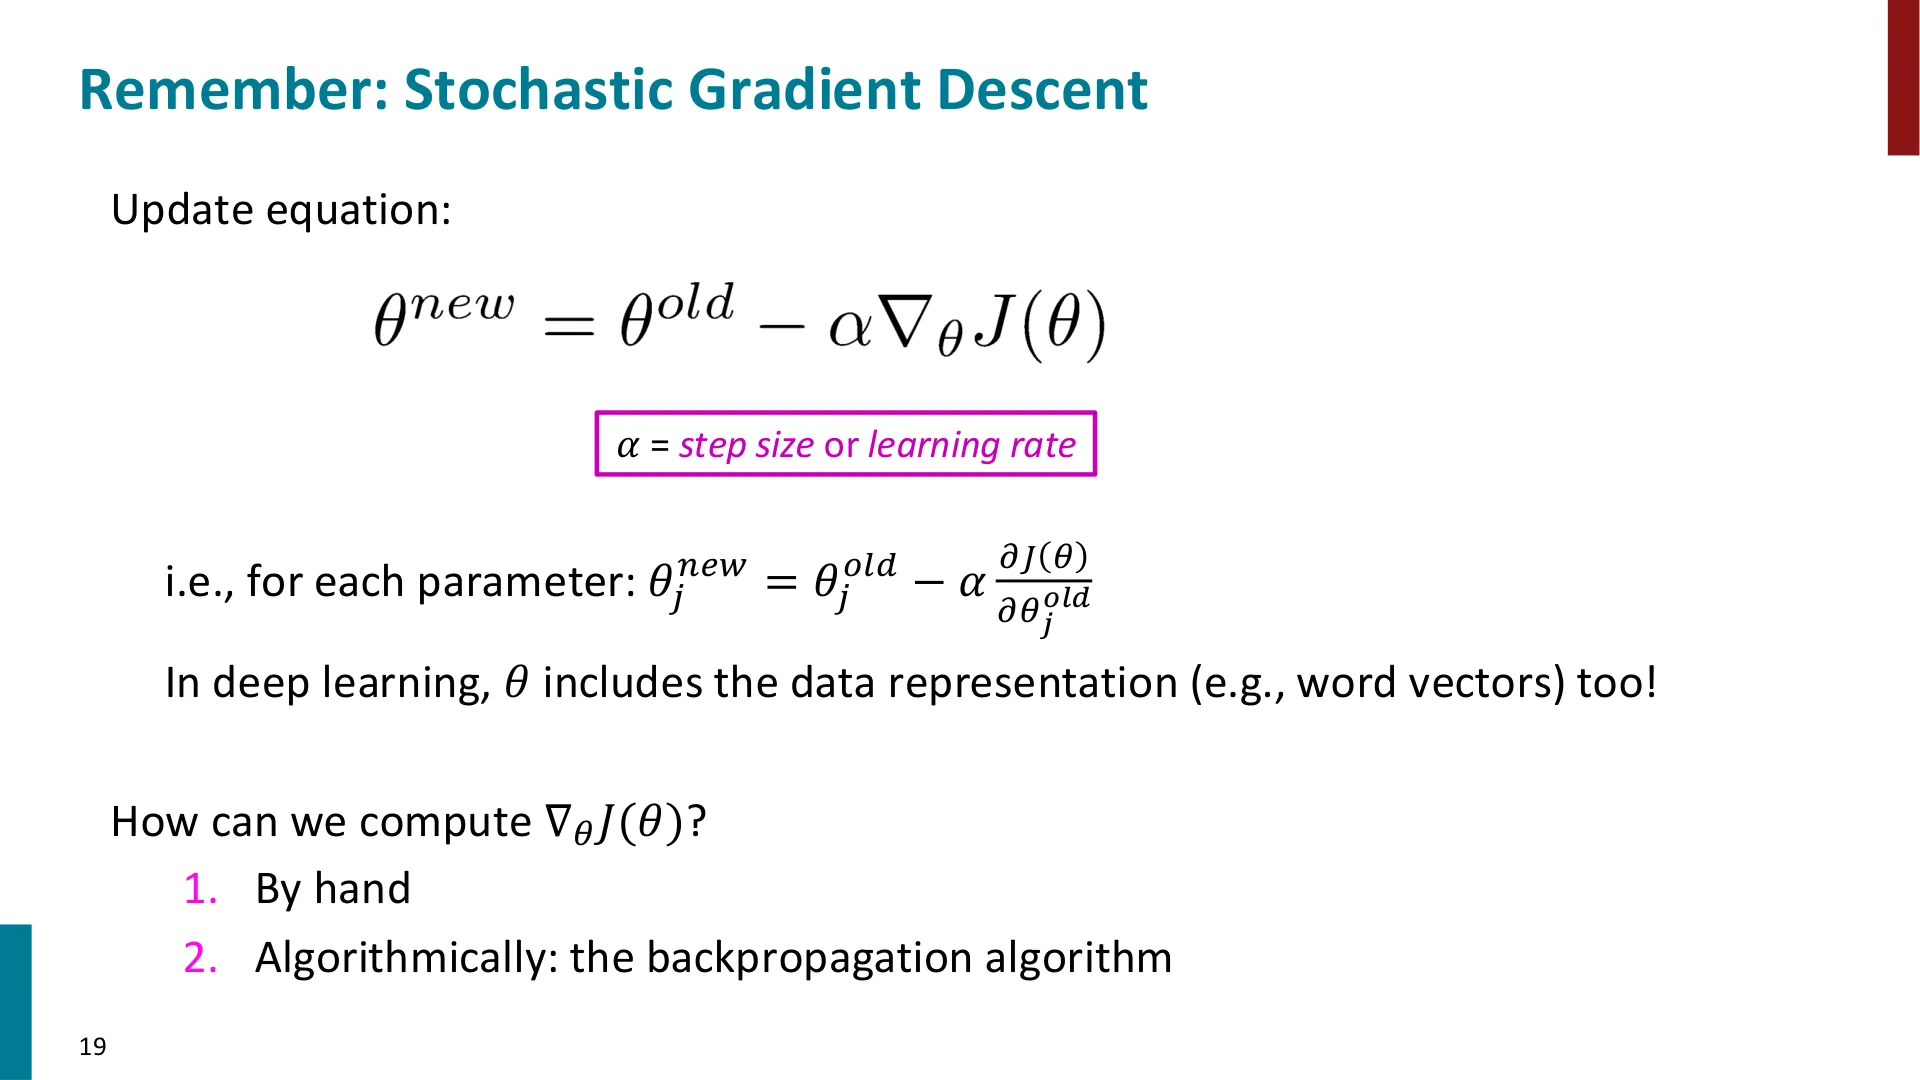
📷 随机梯度下降的更新式
回到原视频 (00:16:56)
矩阵微积分:一句"心法"
(参考时间: 17:32)
老师给出了一句贯穿全讲的"心法":
多元微积分,只要用矩阵来写,就和单变量微积分一模一样。
📷 手算梯度:完全向量化的梯度
回到原视频 (00:17:32)
为了让大家有底,他先讲了一段自己的经验。斯坦福有一门 Math 51,教线性代数、多元微积分与它们的现代应用,今天要讲的东西它都覆盖,而且更多。老师半开玩笑地说:
"如果你真的学过并且还记得 Math 51,那接下来 35 分钟你可以刷 Instagram 了。"
但现实是——不少人把它当作"凑学分"的课来修,十年课压成十周,两年后基本不会用了。他还讲了一个亲身发现:如果当年真的把那本教材从头啃到尾,会发现在书的很后面、附录 G(第 697 页),其实有一节专门讲神经网络与多元链式法则——恰恰是今天要用的东西。可惜有两个问题:一是第 697 页,他怀疑没多少人翻到过;二是就算翻到了,那几页密集的文字读起来一点都不轻松。
"这就是我今天想补上的那一块。"
编者拓展|多元链式法则的向量化:这里所谓"心法",本质是把单变量的 $\frac{dz}{dx} = \frac{dz}{dy}\frac{dy}{dx}$ 推广到向量值函数。若 $\mathbf{y} = g(\mathbf{x})$、$\mathbf{z} = f(\mathbf{y})$,则复合函数的导数不再是标量相乘,而是雅可比矩阵相乘:
$$\frac{\partial \mathbf{z}}{\partial \mathbf{x}} = \frac{\partial \mathbf{z}}{\partial \mathbf{y}} \cdot \frac{\partial \mathbf{y}}{\partial \mathbf{x}}$$
形状对得上($m\times k$ 乘 $k\times n$),链式法则就"自动成立"。这正是后面反向传播每一次"局部梯度 × 上游梯度"的形式来源。
从标量到向量再到雅可比
(参考时间: 21:23)
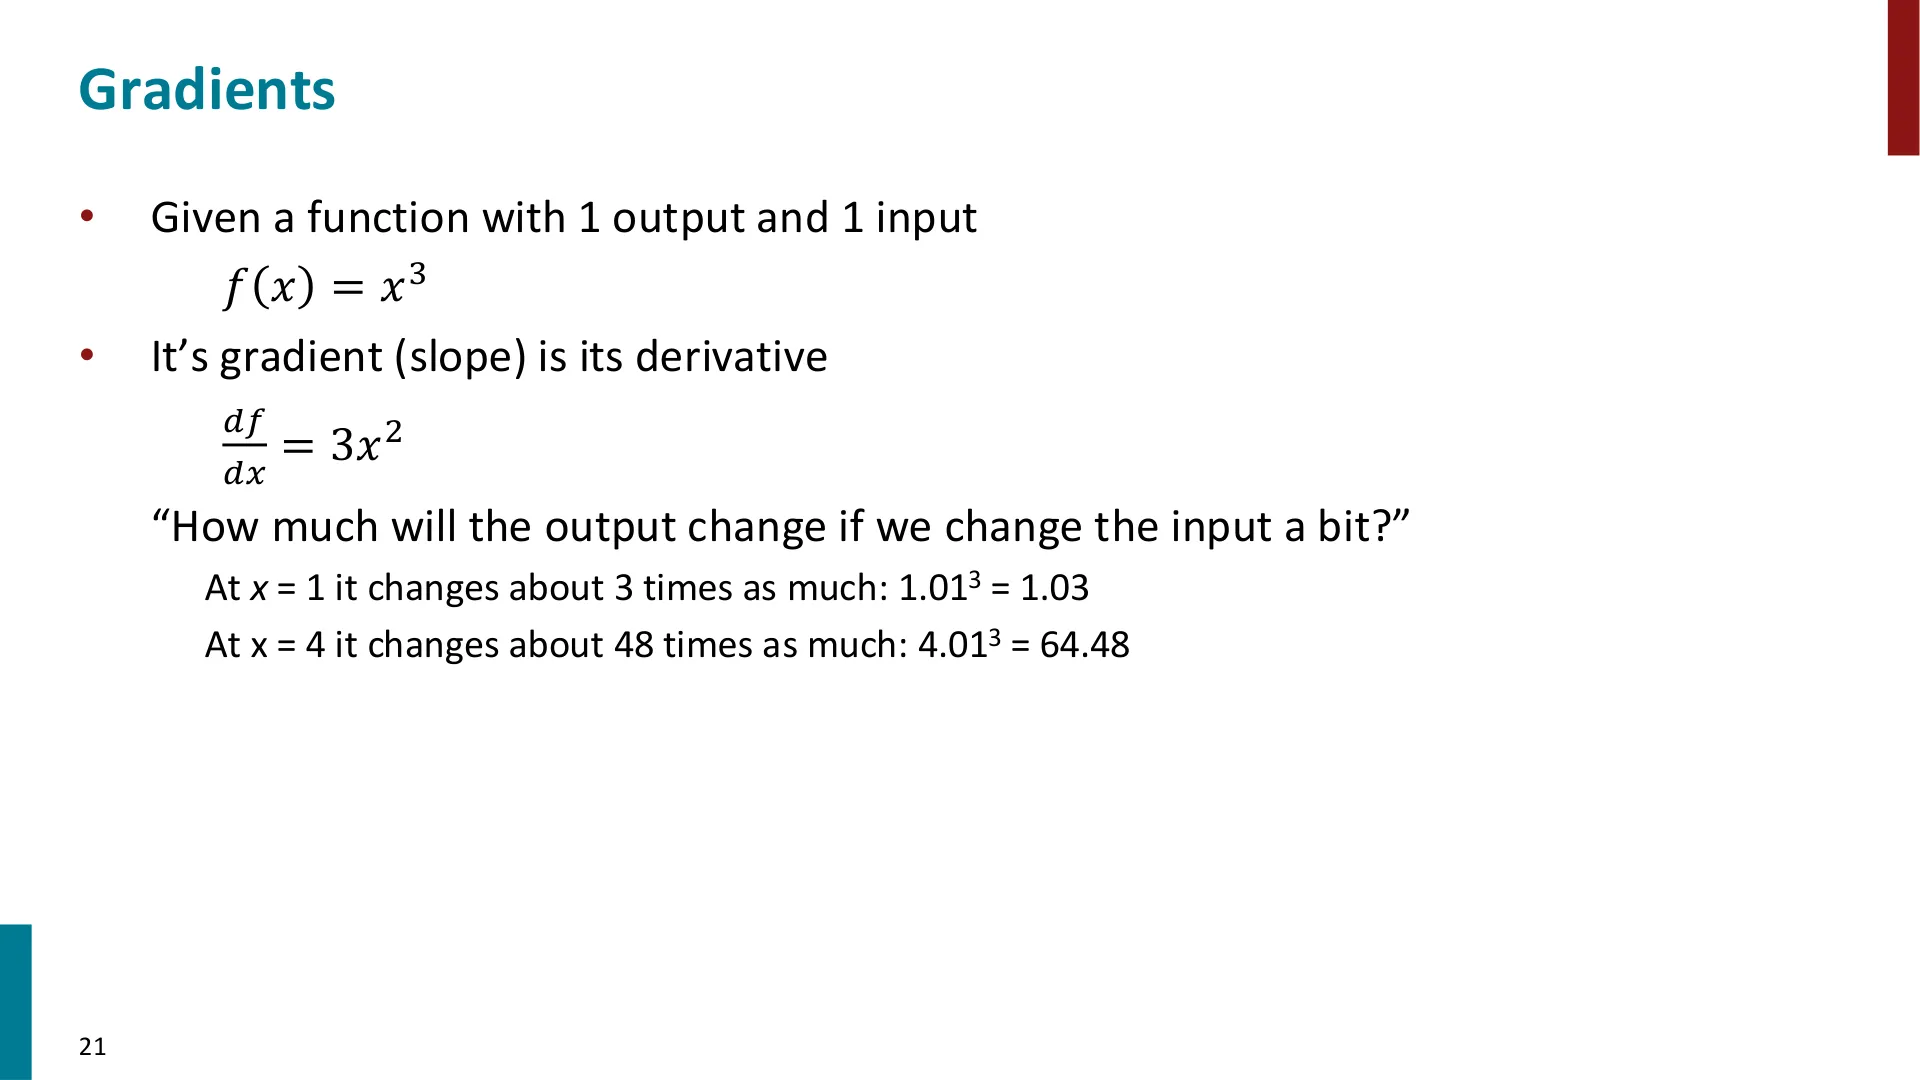
单输入单输出。以 $f(x) = x^3$ 为例,导数是 $\frac{df}{dx} = 3x^2$。导数的含义是:输入变一点,输出会变多少。
- 在 $x = 1$ 处,斜率约 3:$1.01^3 \approx 1.03$,输入动 0.01,输出动 0.03。
- 在 $x = 4$ 处,斜率 $3\times 4^2 = 48$:$4.01^3 \approx 64.48$,输入动 0.01,输出被放大了 48 倍。
📷 梯度:单输入单输出的例子
回到原视频 (00:21:23)
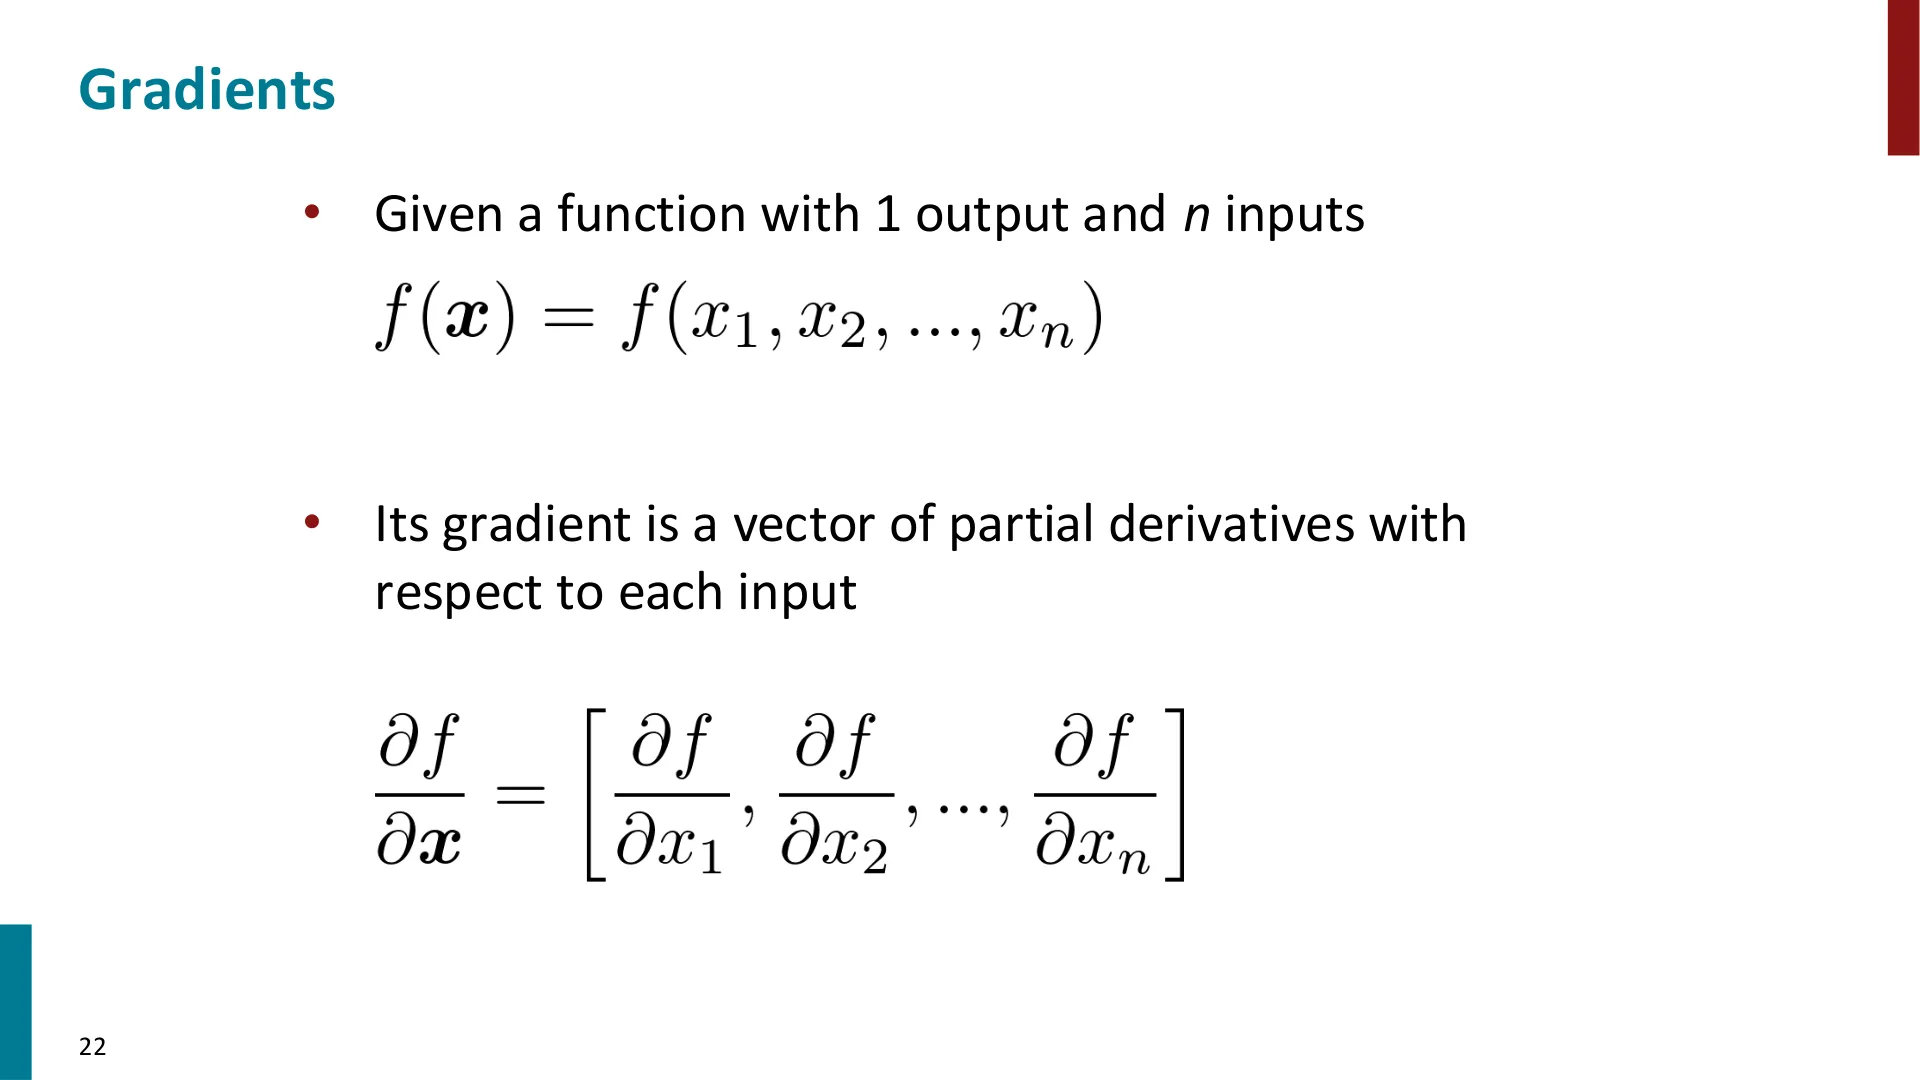
多输入单输出。若有 $n$ 个输入,梯度就是一个向量,每个分量是对某个输入的偏导:
$$\nabla_{\mathbf{x}} f = \left[\frac{\partial f}{\partial x_1}, \frac{\partial f}{\partial x_2}, \dots, \frac{\partial f}{\partial x_n}\right]$$
📷 梯度:一个输出、n 个输入
回到原视频 (00:22:58)
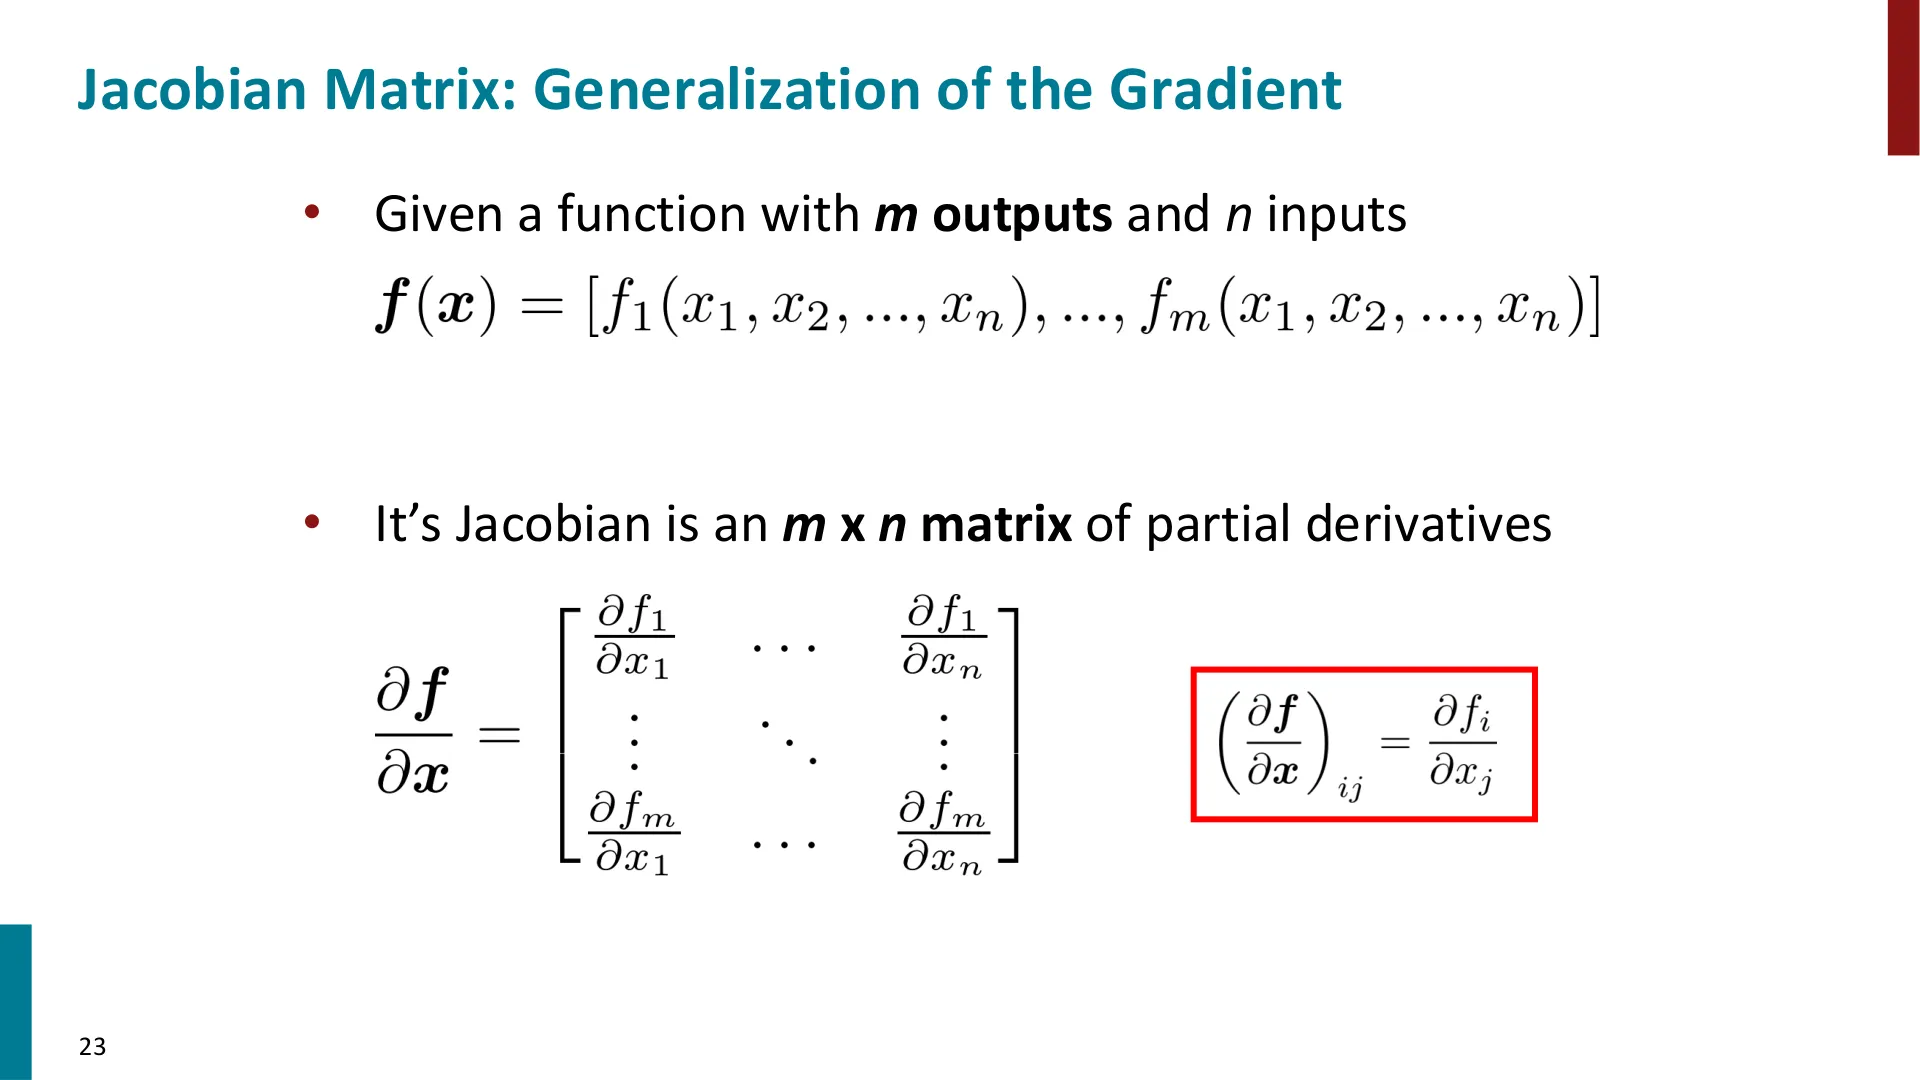
多输入多输出。若有 $n$ 个输入、$m$ 个输出,梯度就升级为雅可比矩阵——每个(输出, 输入)对一个偏导:
$$\mathbf{J} = \begin{bmatrix} \frac{\partial f_1}{\partial x_1} & \cdots & \frac{\partial f_1}{\partial x_n} \\ \vdots & \ddots & \vdots \\ \frac{\partial f_m}{\partial x_1} & \cdots & \frac{\partial f_m}{\partial x_n} \end{bmatrix}$$
老师说,这正是神经网络一层的情形:$n$ 个输入、$m$ 个输出,所以我们会(在心里)大量使用雅可比。
📷 雅可比矩阵:梯度的推广
回到原视频 (00:23:53)
(顺带一提:老师说 Jacobi 本是德国犹太姓氏,本该读作"雅可比",但在美国大家都念成"加可比"。)
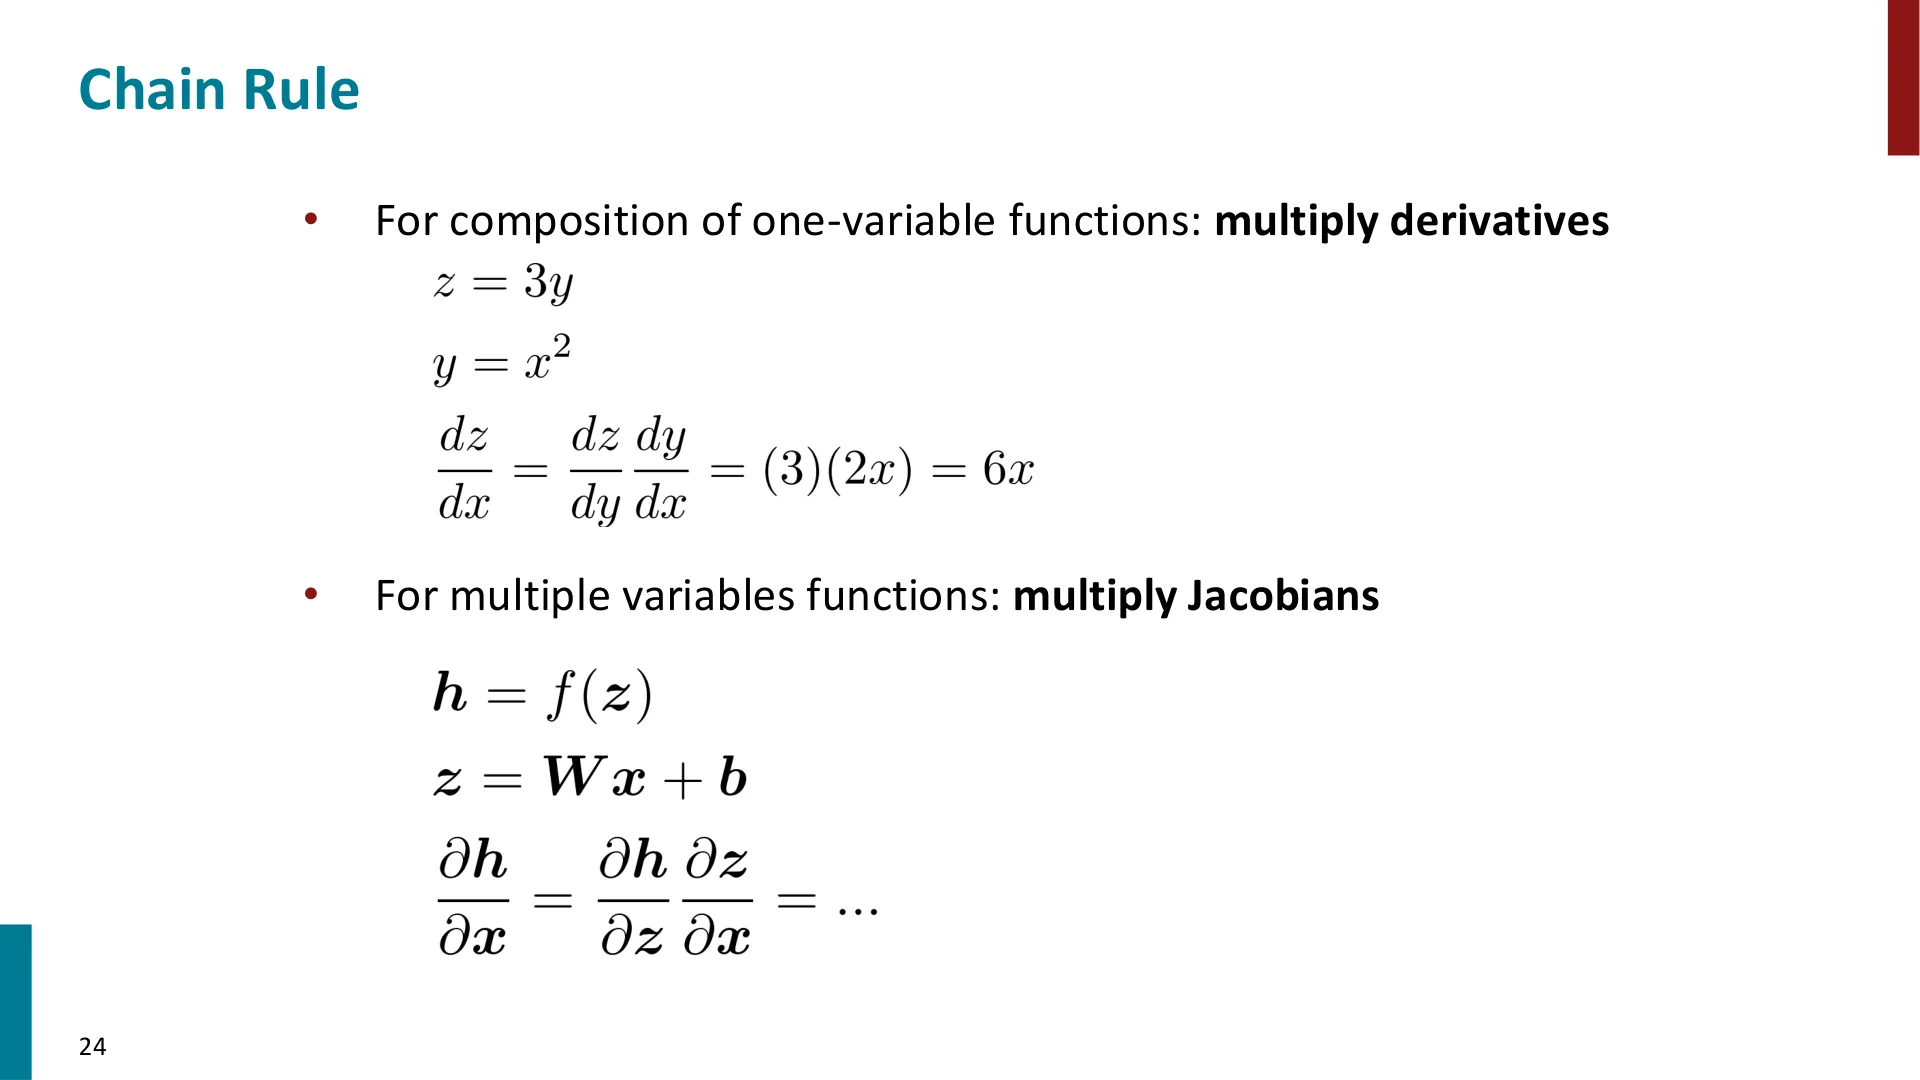
链式法则。单变量函数复合时乘导数,多变量函数复合时乘雅可比。例如 $z = 3y^2$、$y = x^2$ 复合起来是 $z = 3x^4$,导数 $12x^3$;把它拆开算 $\frac{dz}{dy} = 6y$、$\frac{dy}{dx} = 2x$,相乘得 $12xy = 12x^3$,得到同样结果。
📷 链式法则:多变量时乘雅可比
回到原视频 (00:24:56)
张量(tensor) 只是这一"维度阶梯"的统称:标量 → 向量 → 矩阵 → 更高维数组(在计算机科学里通常就叫多维数组)。
五、元件级雅可比:逐元素激活、Wx+b 与点积
(参考时间: 27:24)
要把一个网络"拆成积木"逐块求导,先得知道几种常见"积木"的雅可比长什么样。
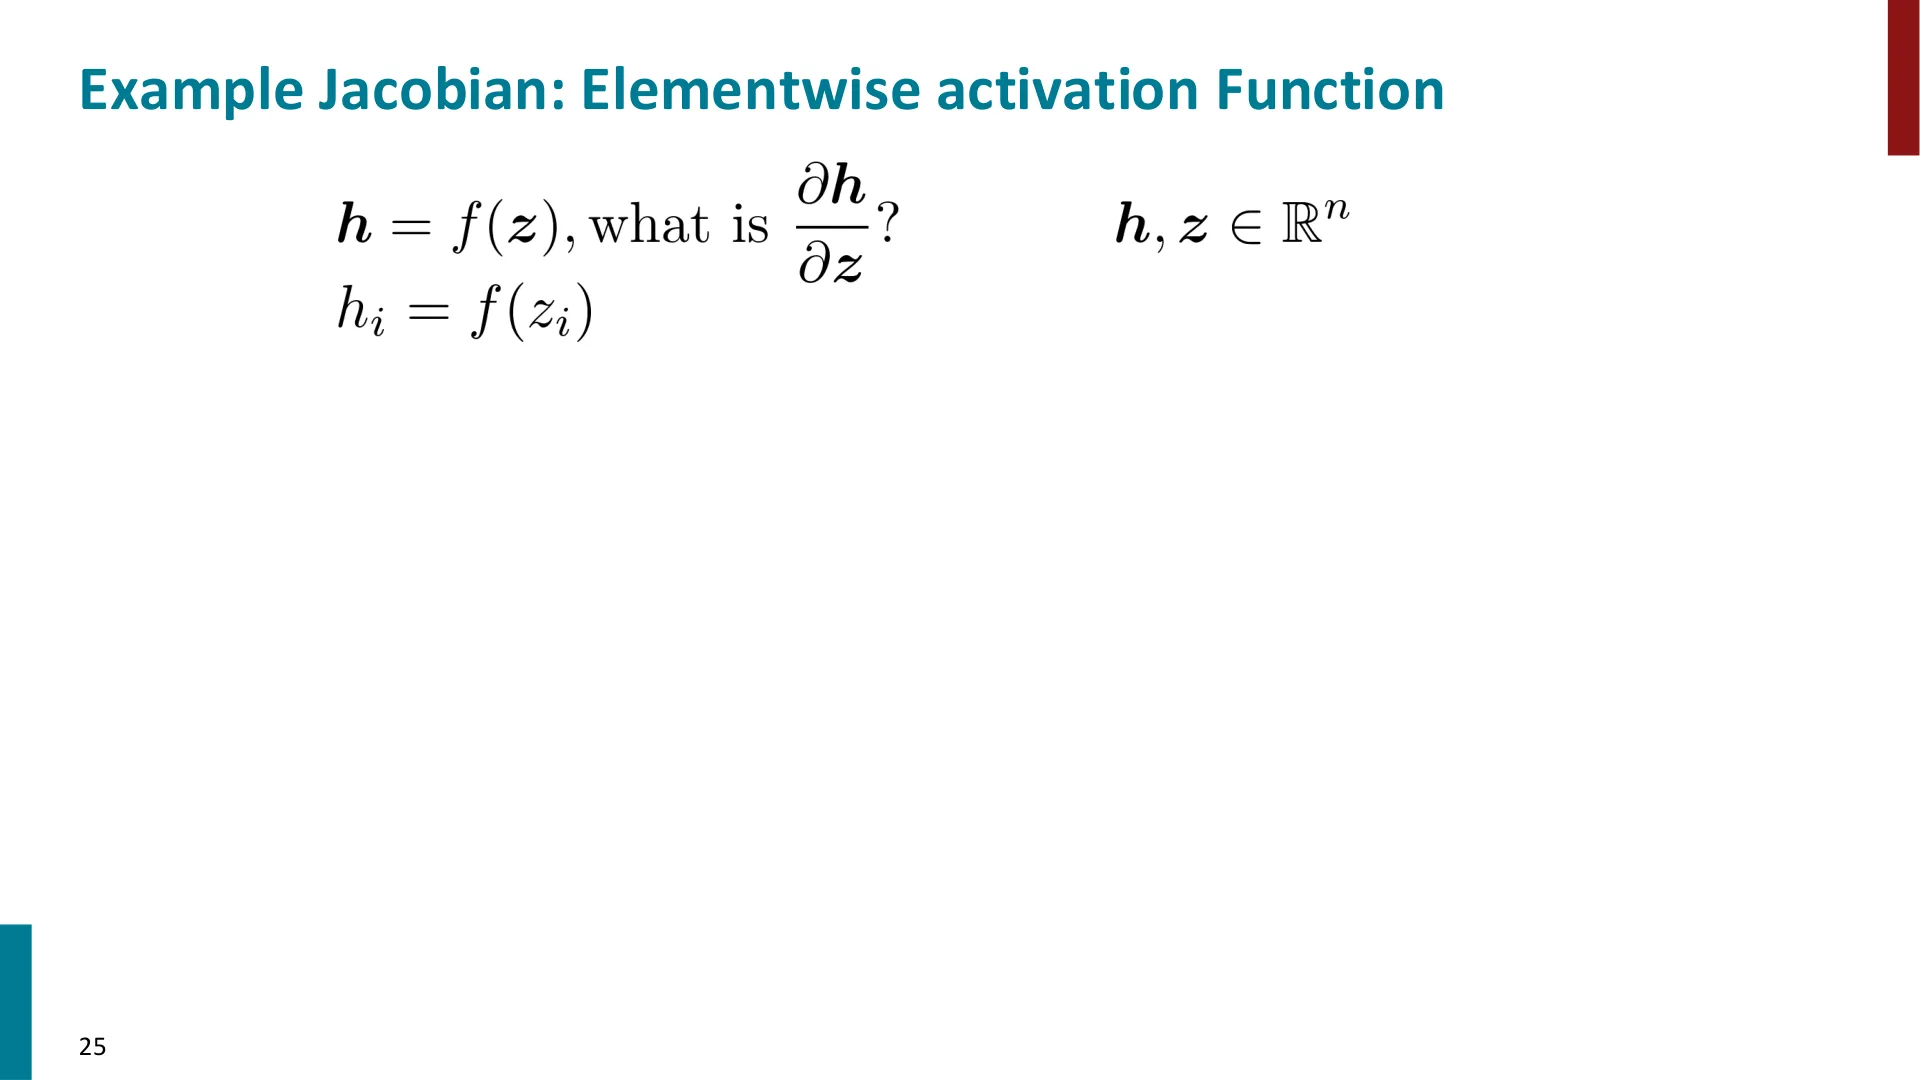
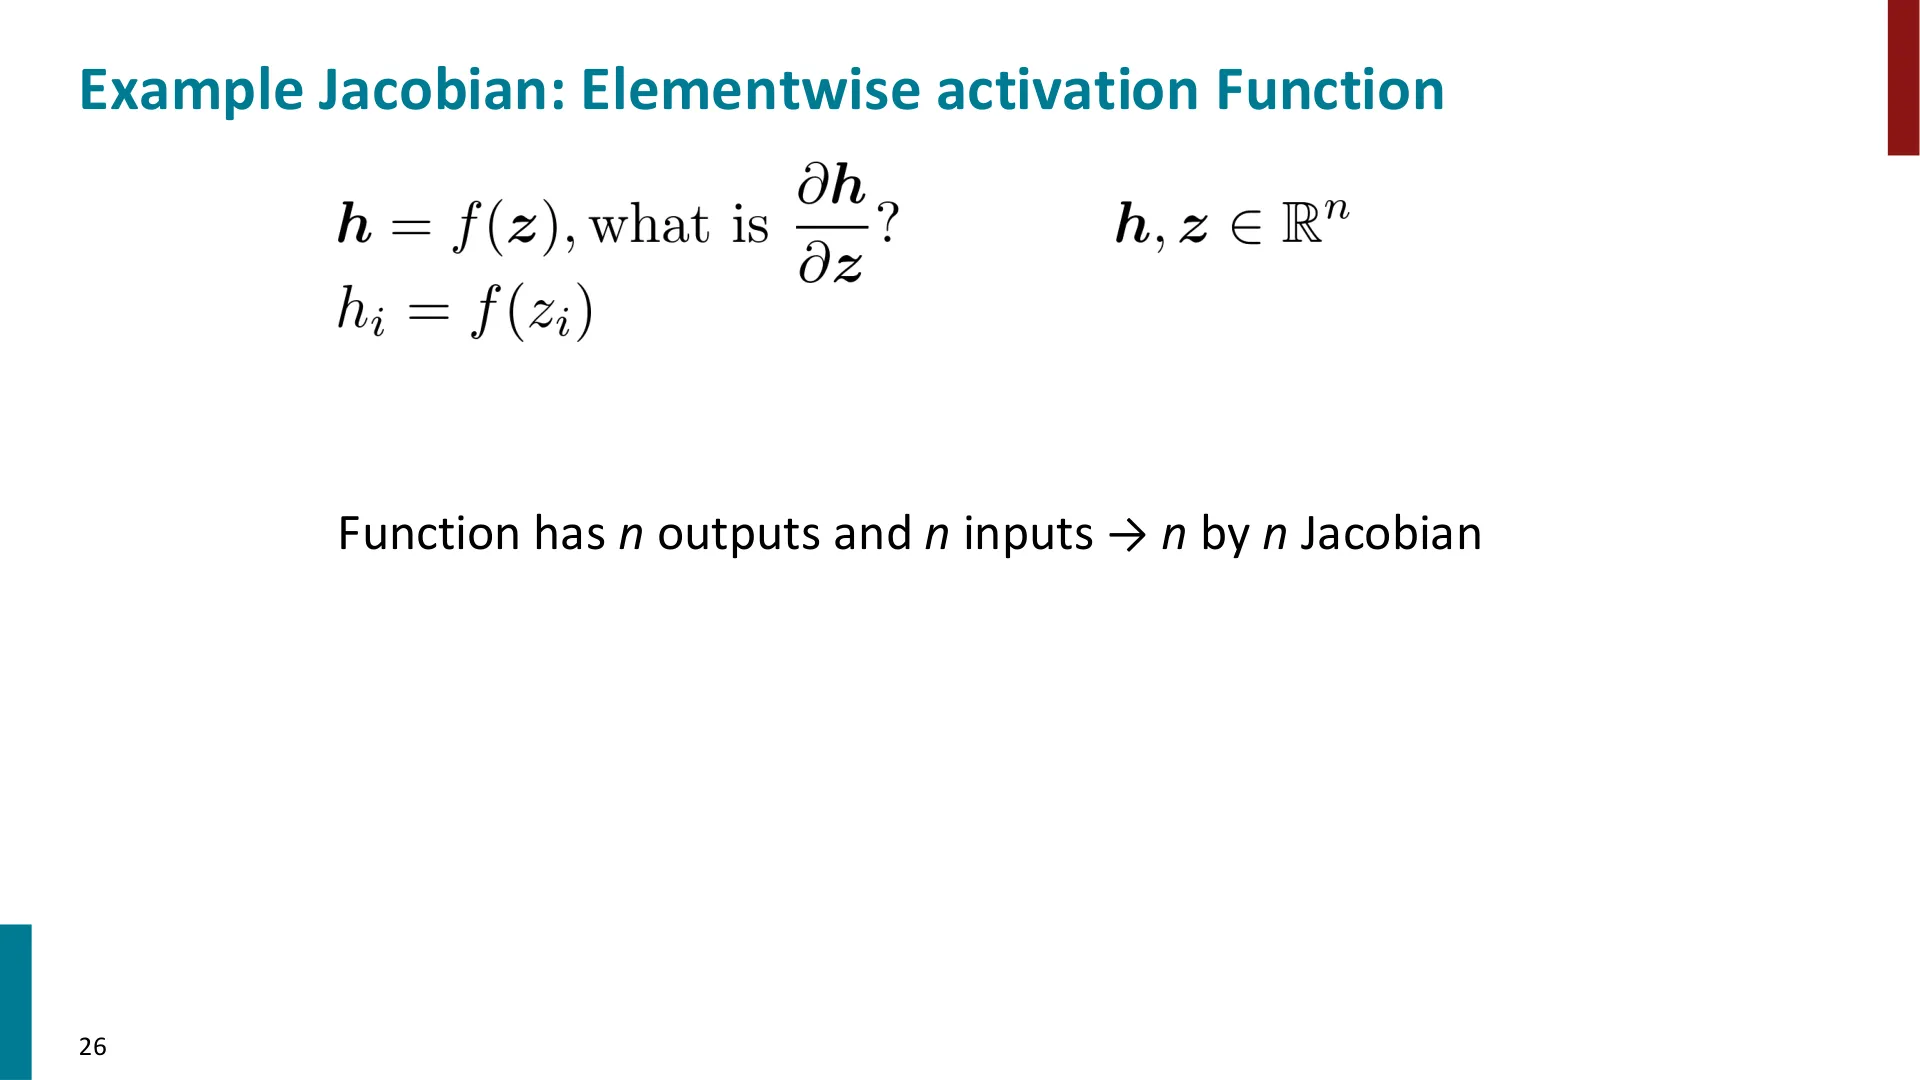
逐元素激活函数的雅可比
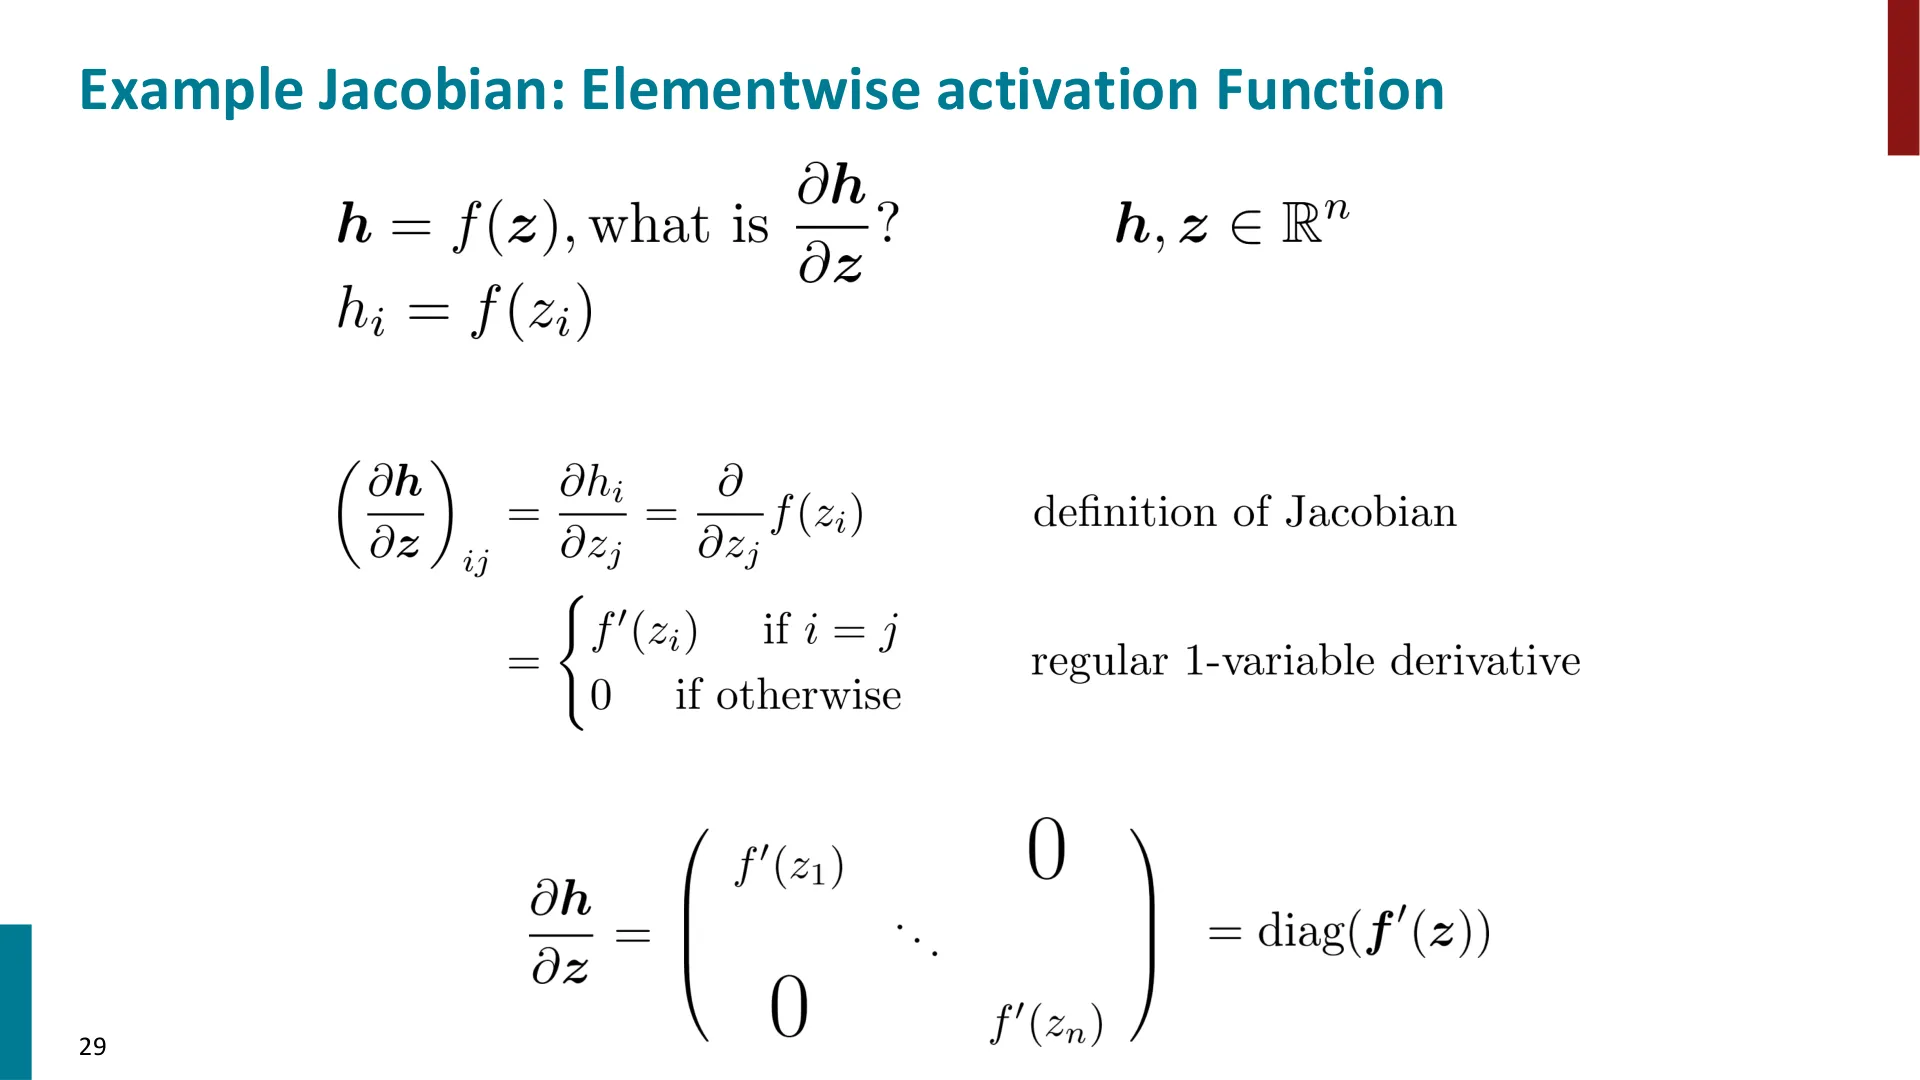
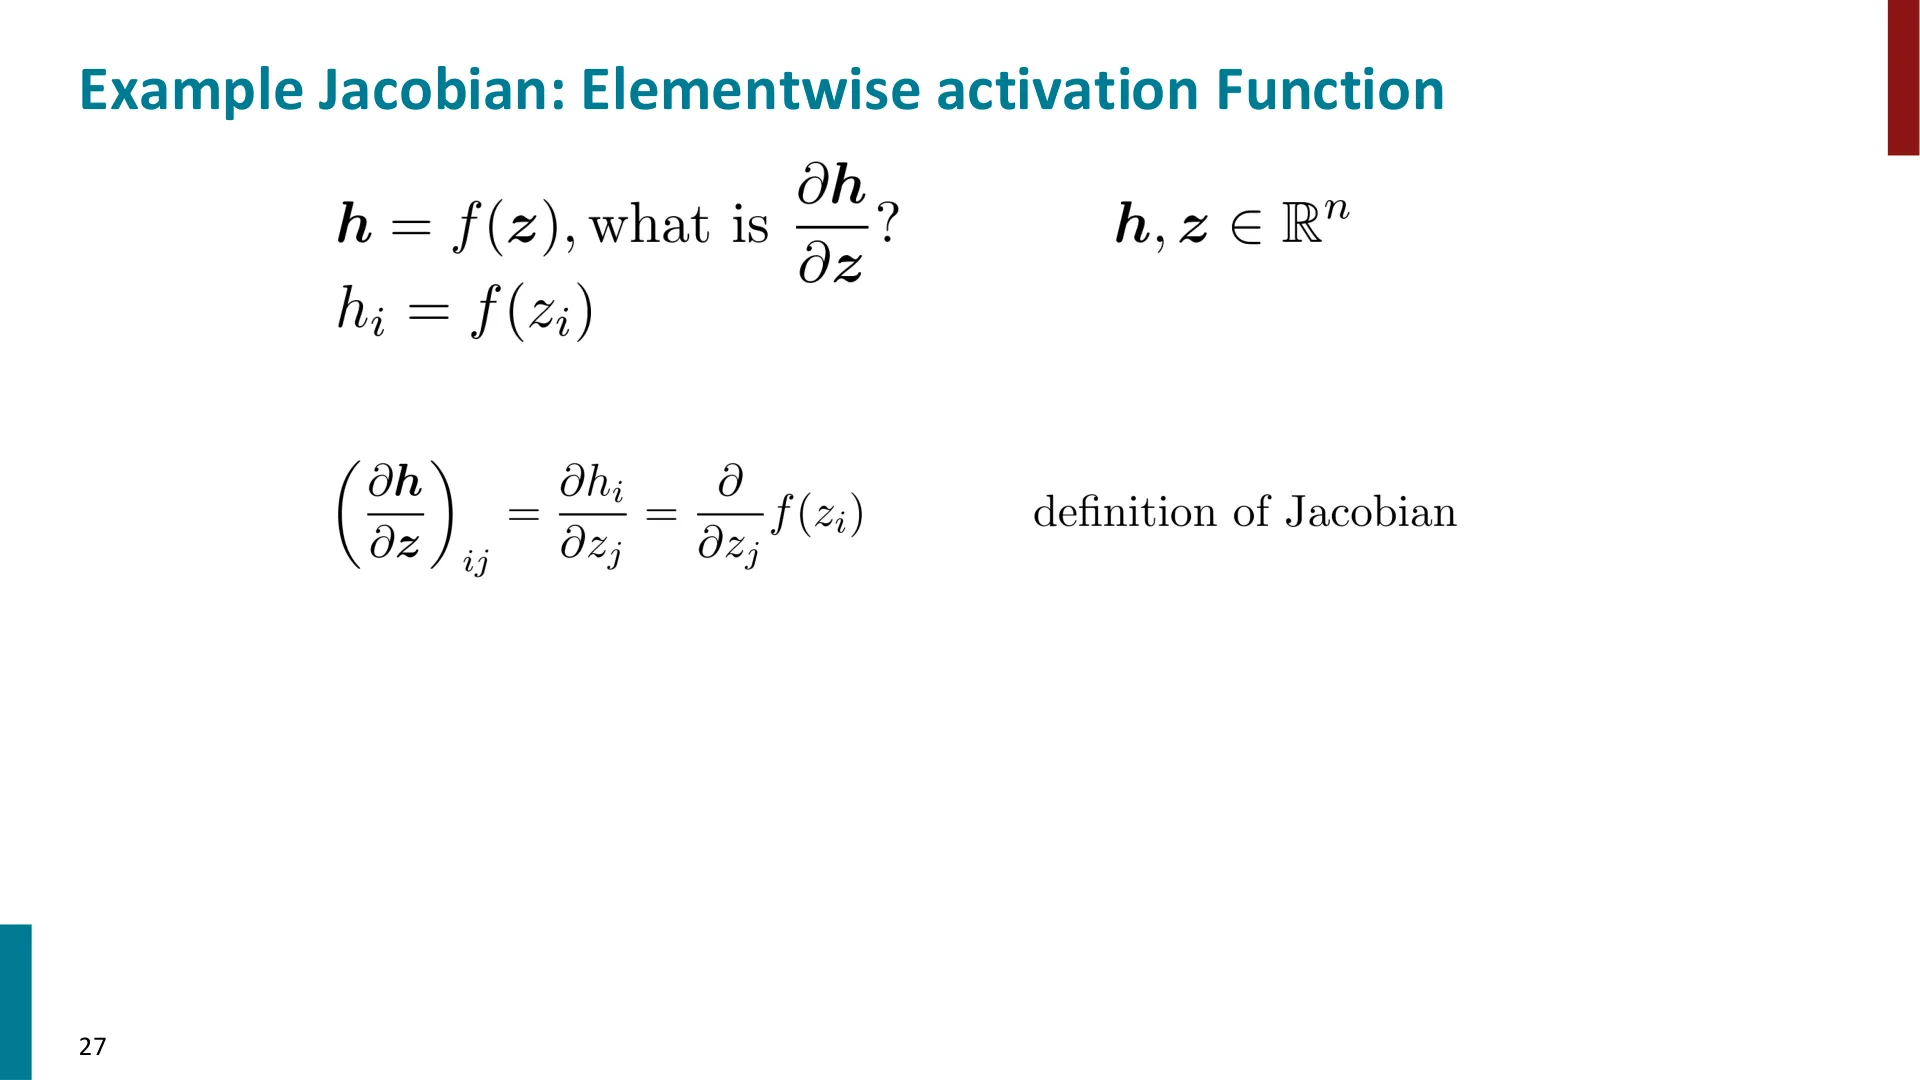
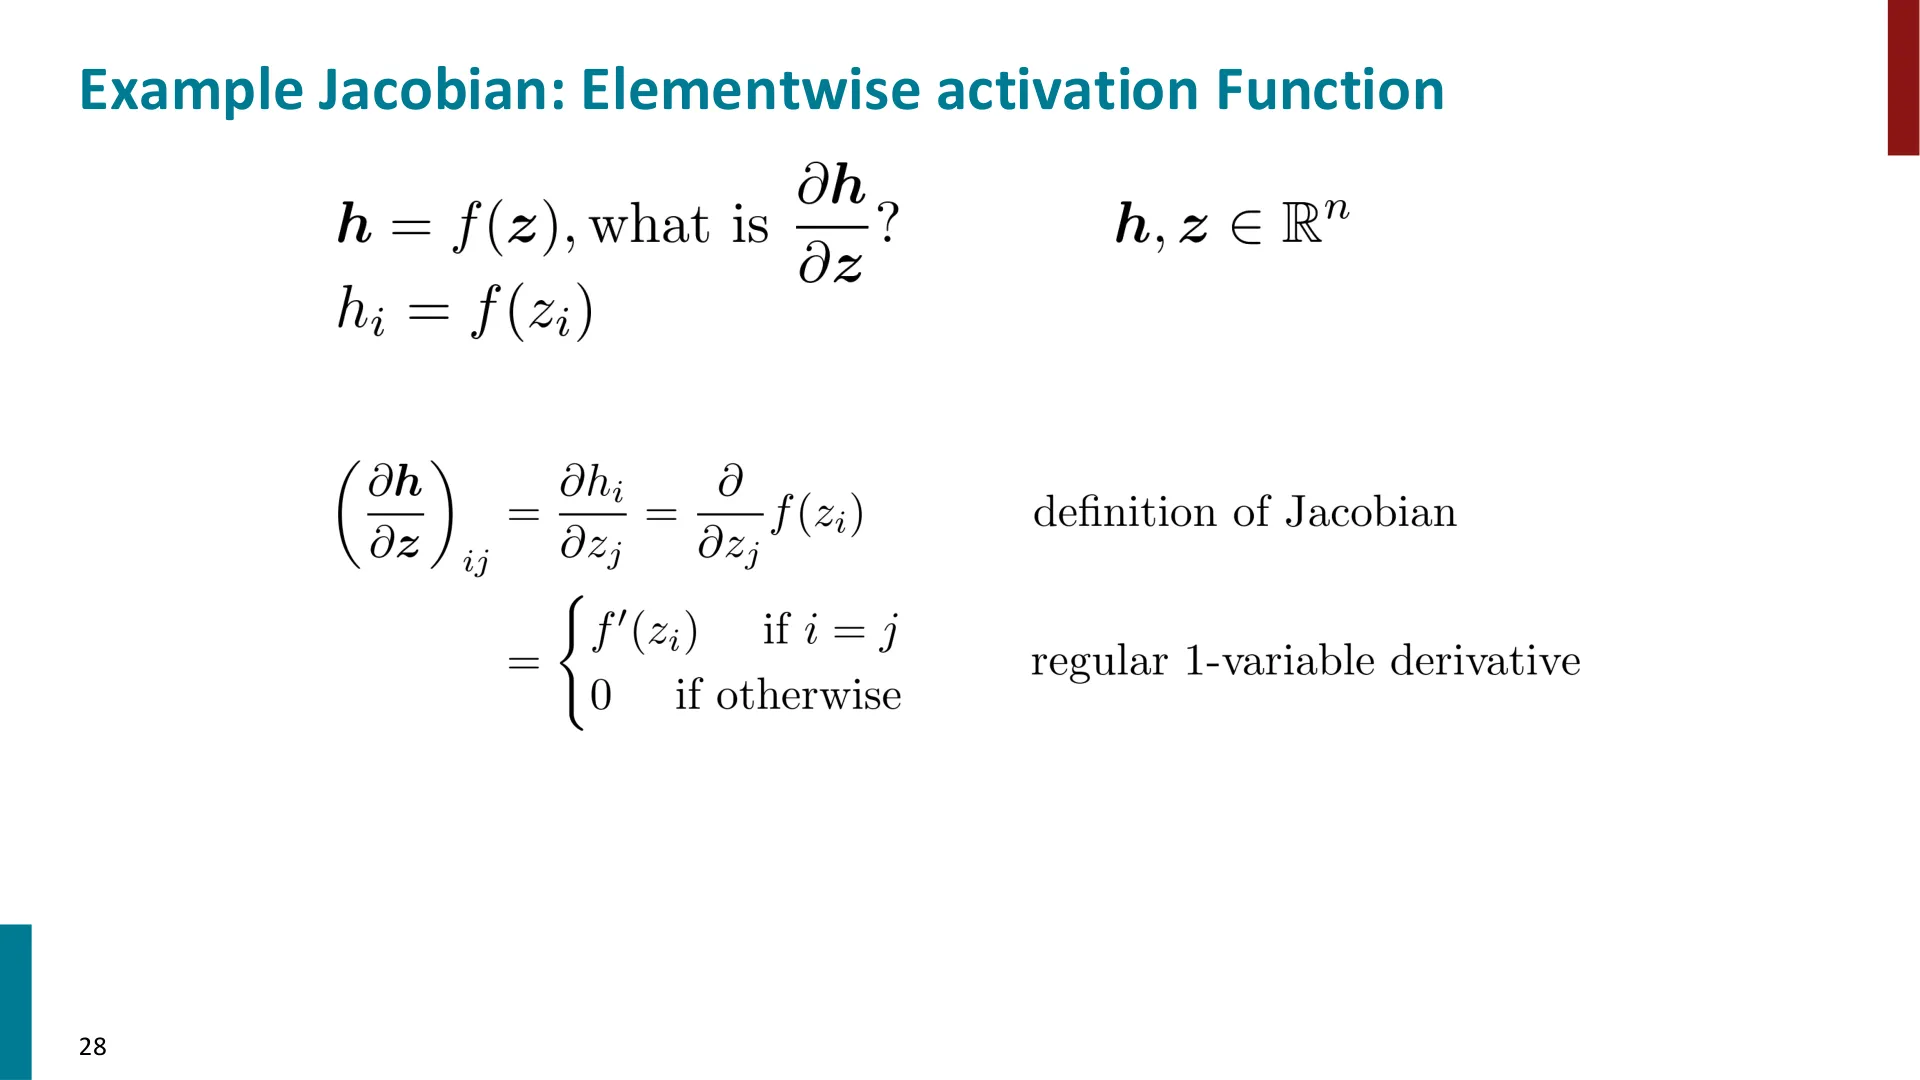
若 $\mathbf{h} = f(\mathbf{z})$ 且 $f$ 是逐元素作用的,那么它有 $n$ 个输出、$n$ 个输入,雅可比是 $n\times n$。
$$\frac{\partial h_i}{\partial z_j} = \begin{cases} f'(z_i), & i = j \\ 0, & i \neq j \end{cases}$$
因为改变 $z_j$ 只会影响 $h_j$、不会影响别的输出。结果是一个对角矩阵:$\frac{\partial \mathbf{h}}{\partial \mathbf{z}} = \operatorname{diag}(f'(\mathbf{z}))$。对角线上的值,就是激活函数的导数(作业 2 里会让你求 logistic 的导数)。
📷 逐元素激活函数的雅可比(1)
回到原视频 (00:27:24)
几块常用雅可比
(参考时间: 29:24)
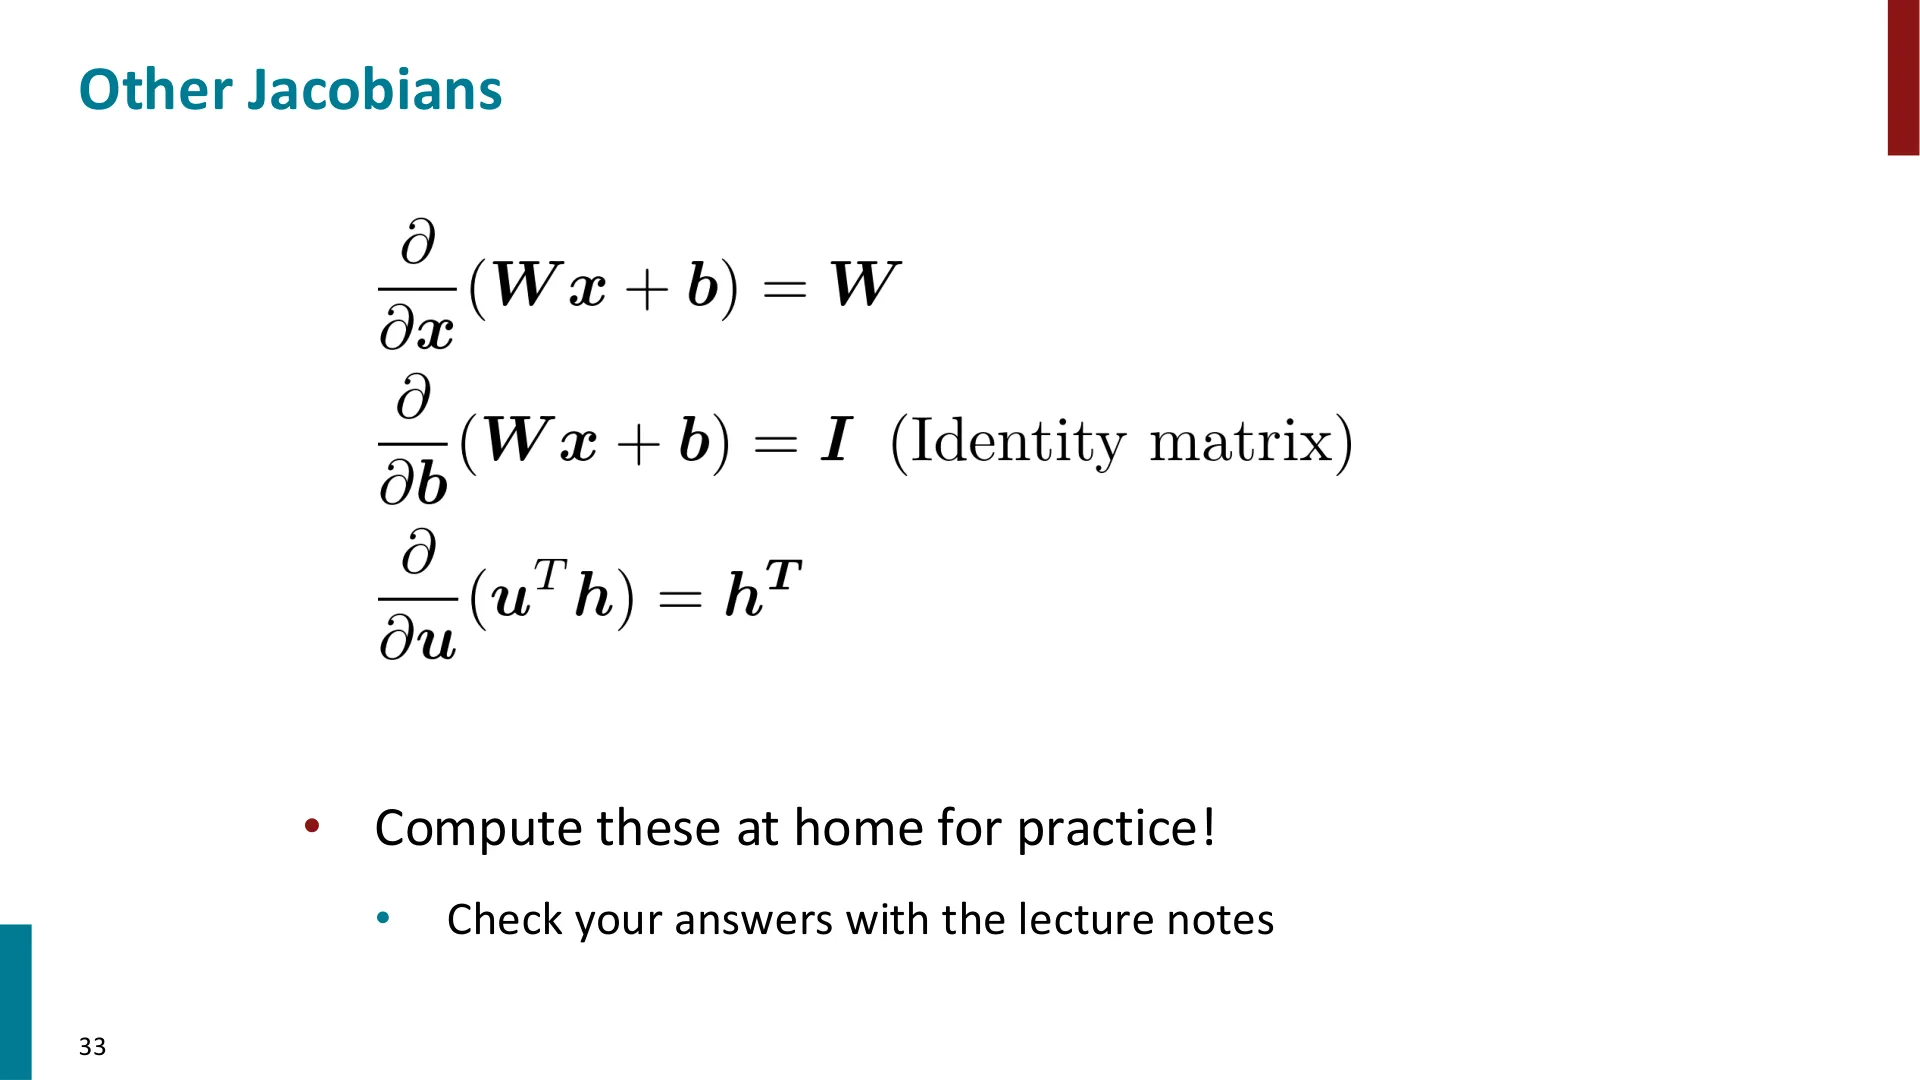
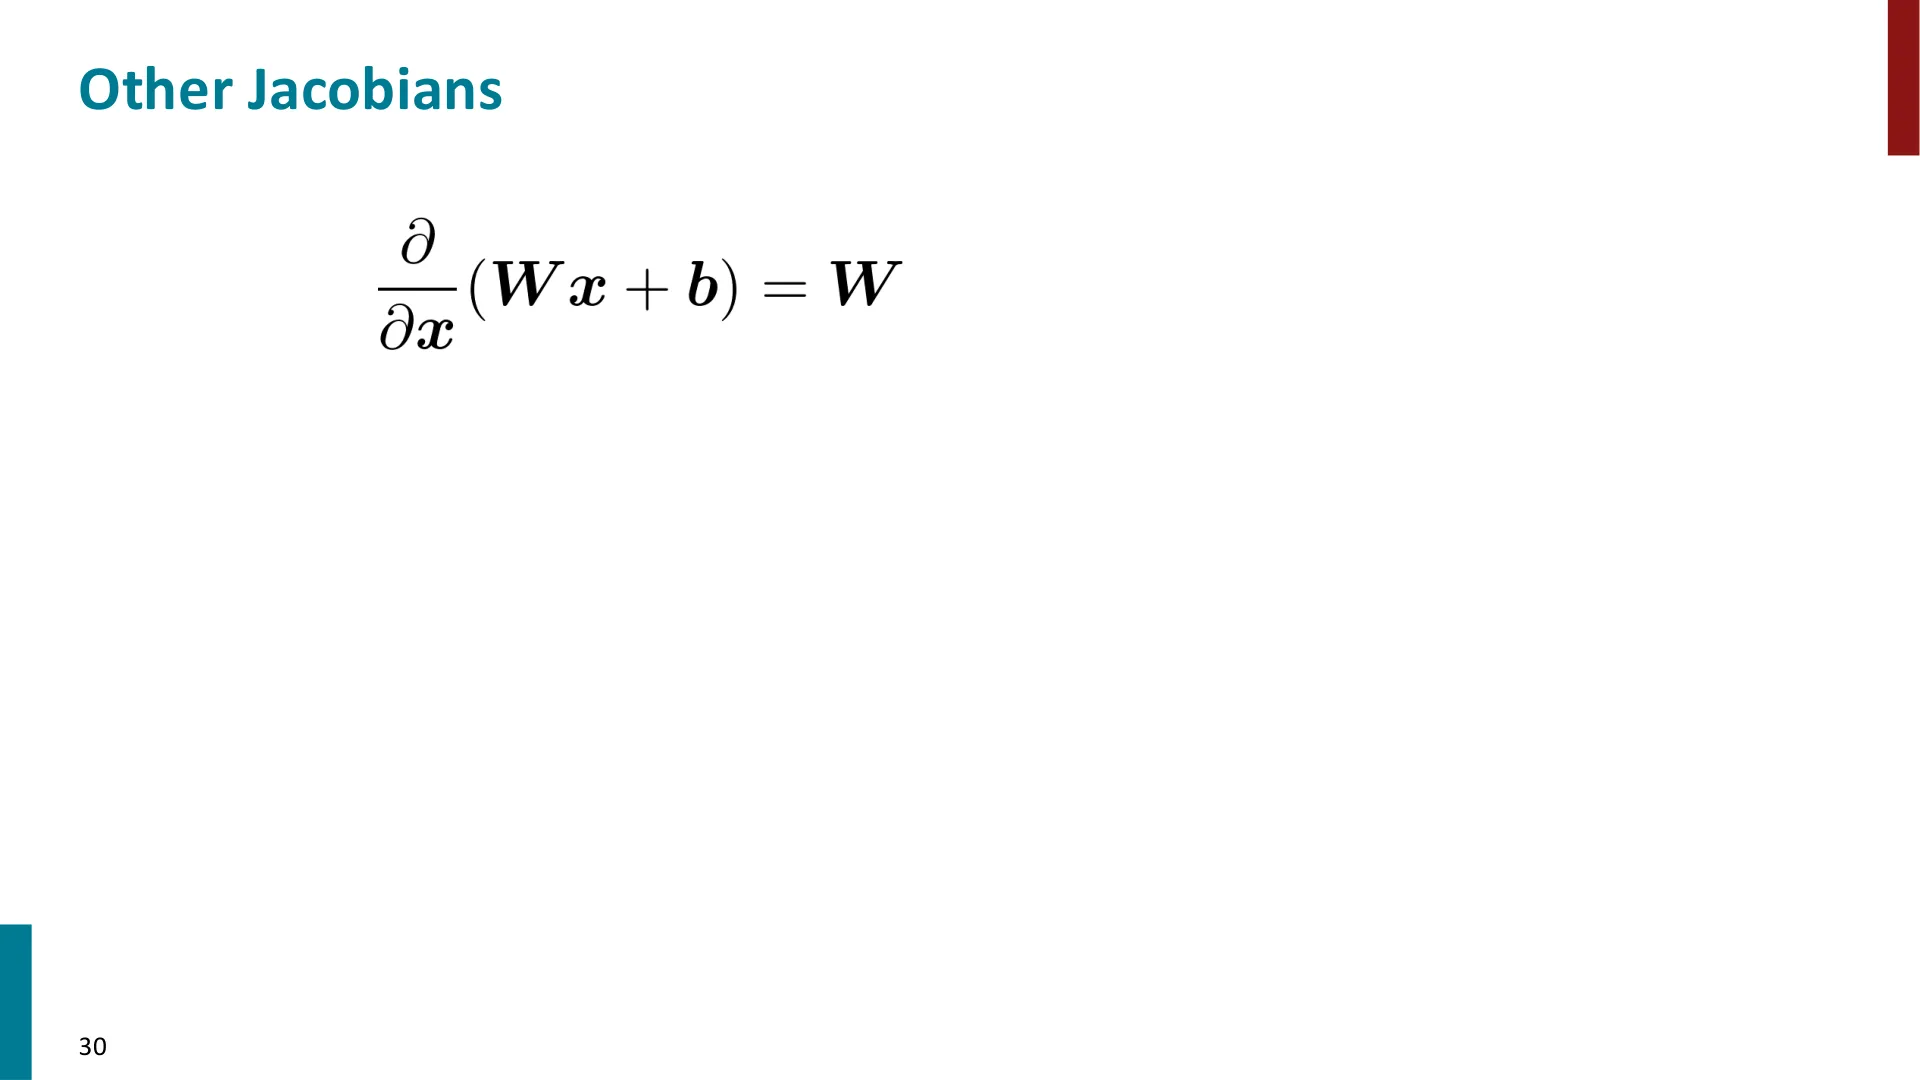
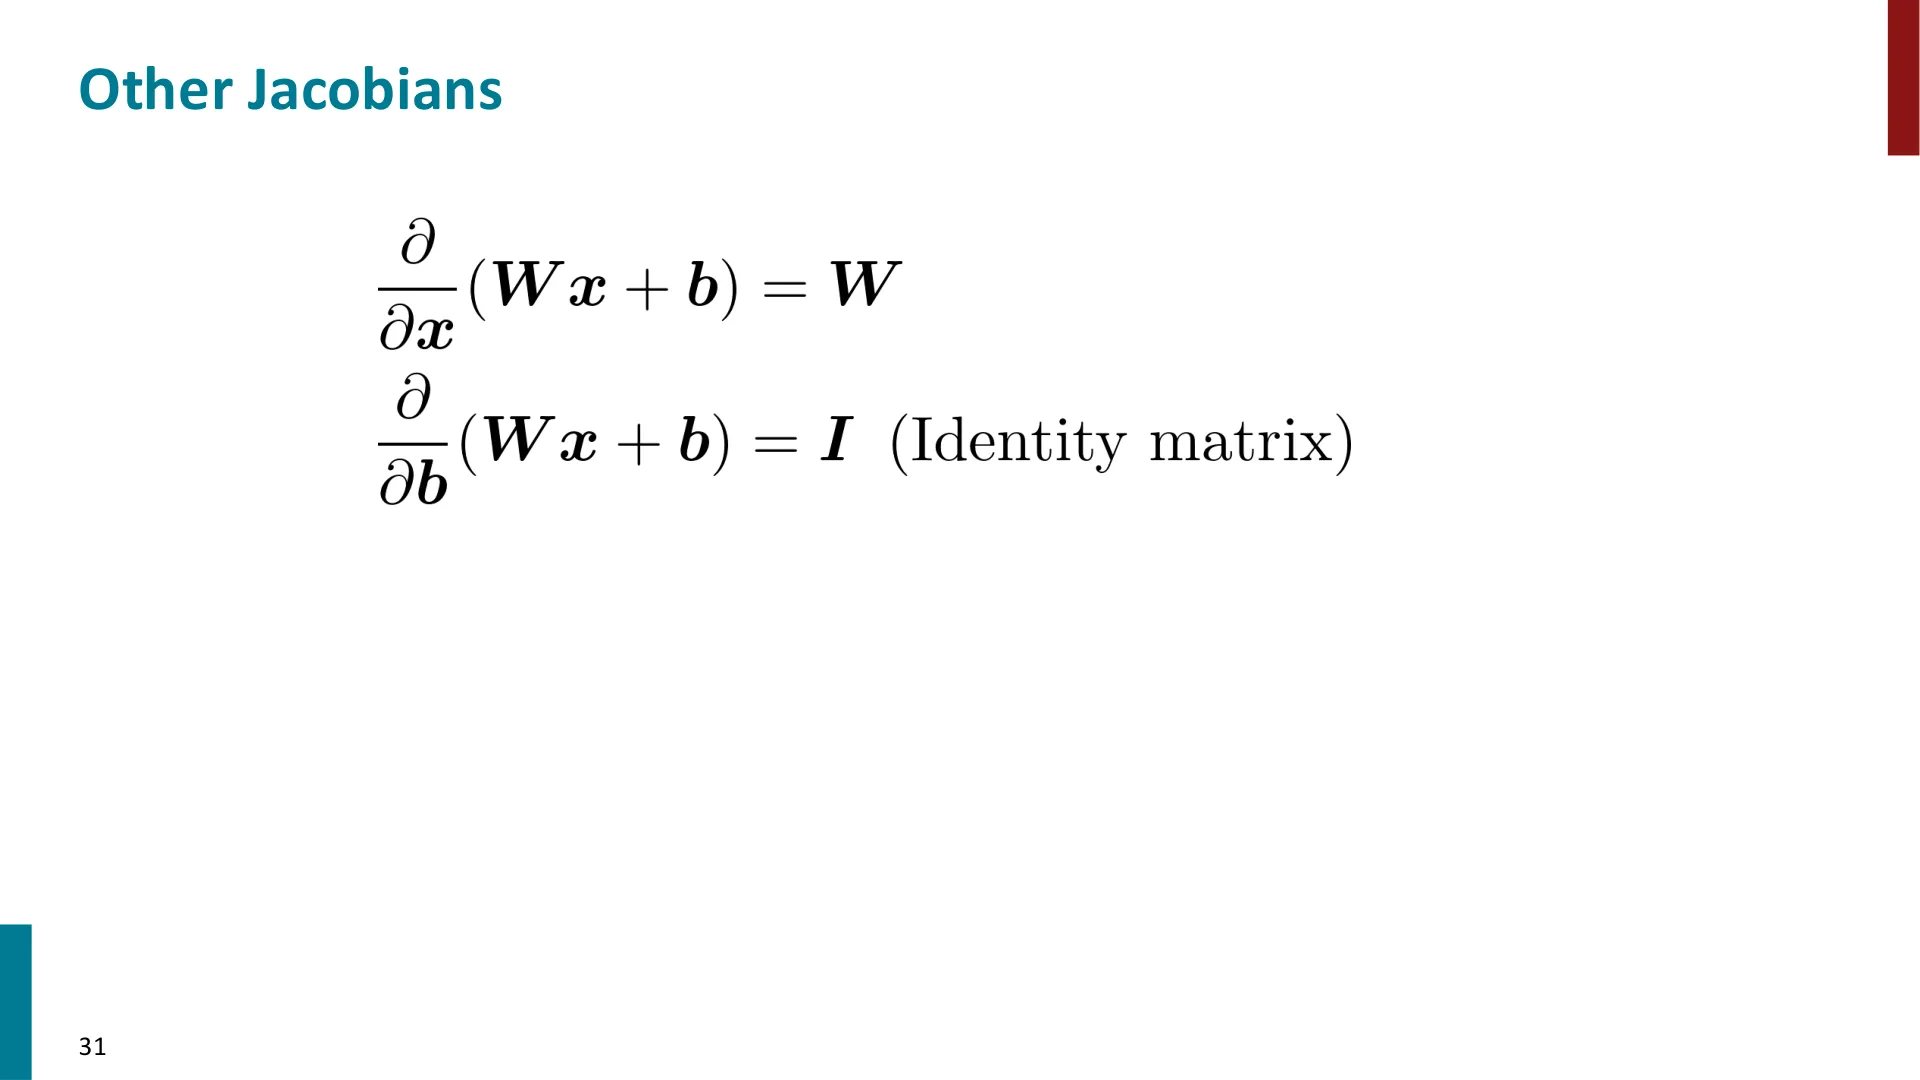
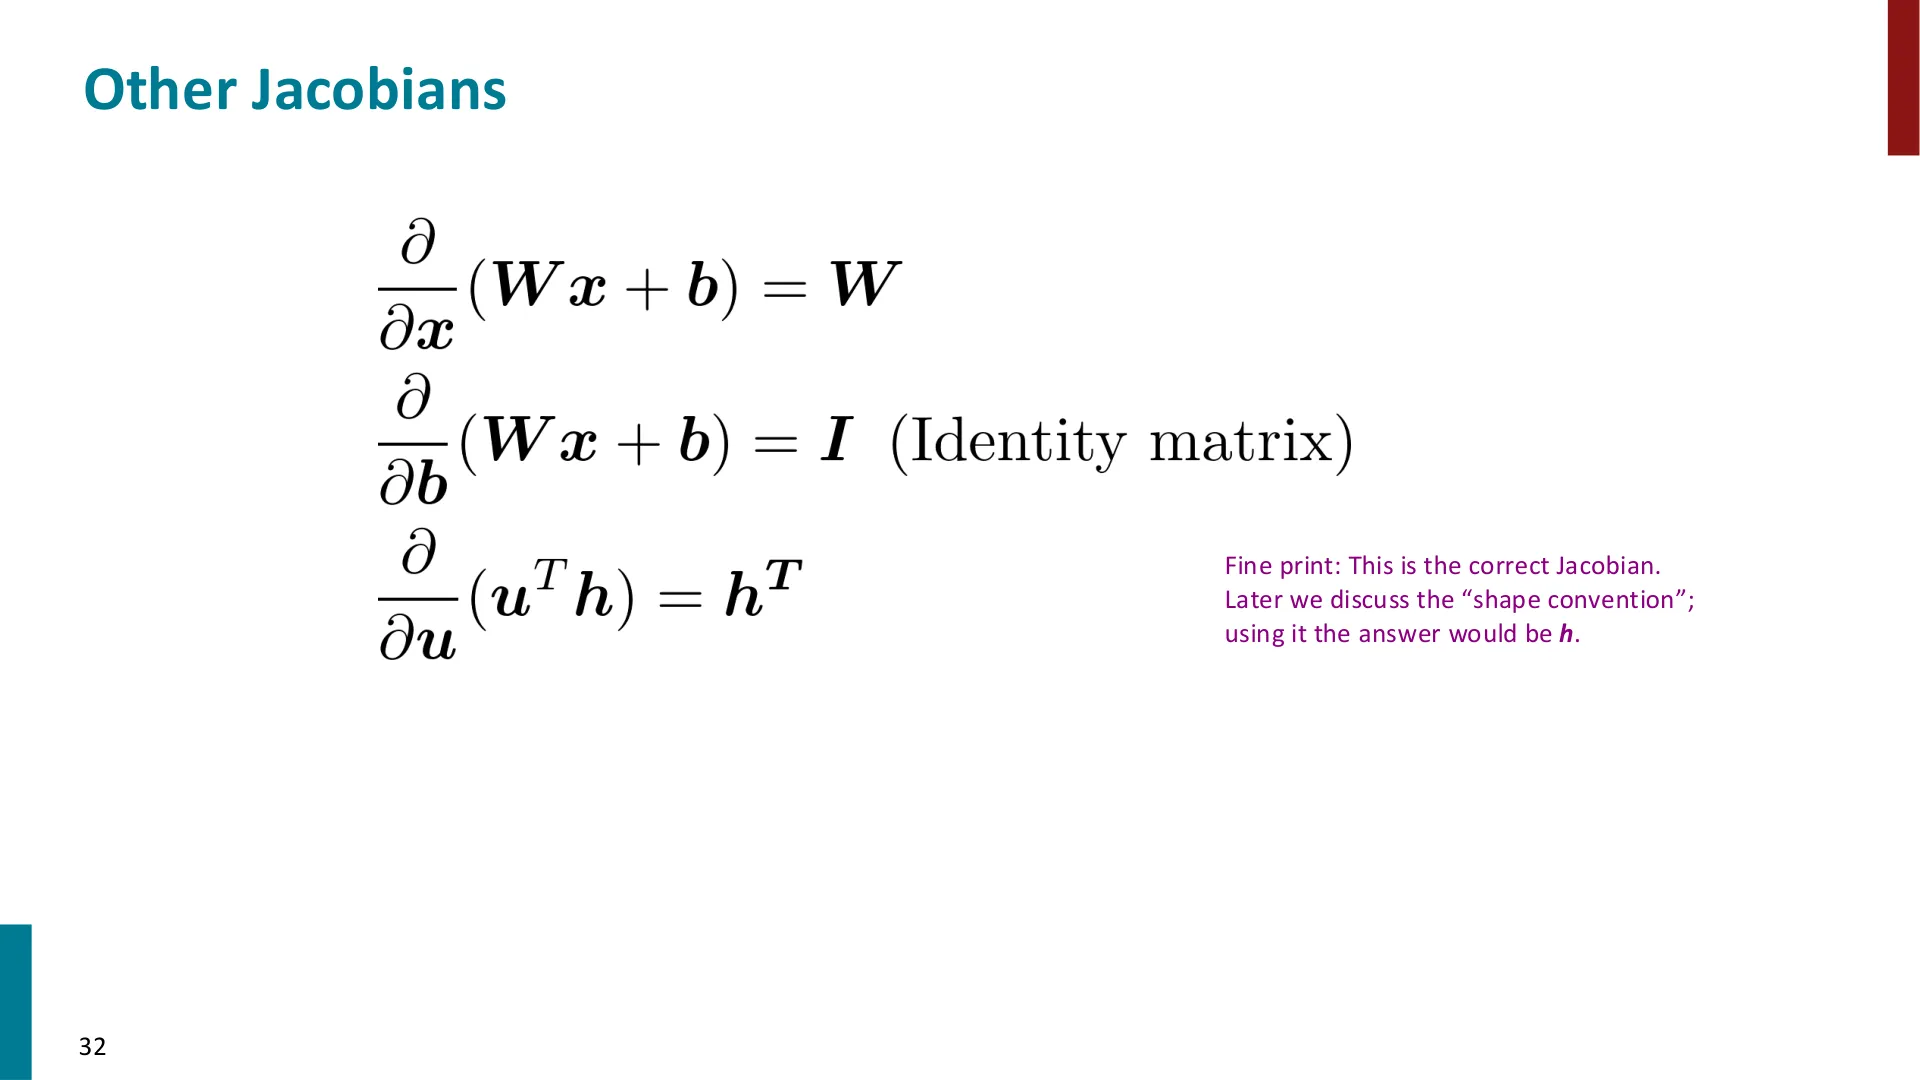
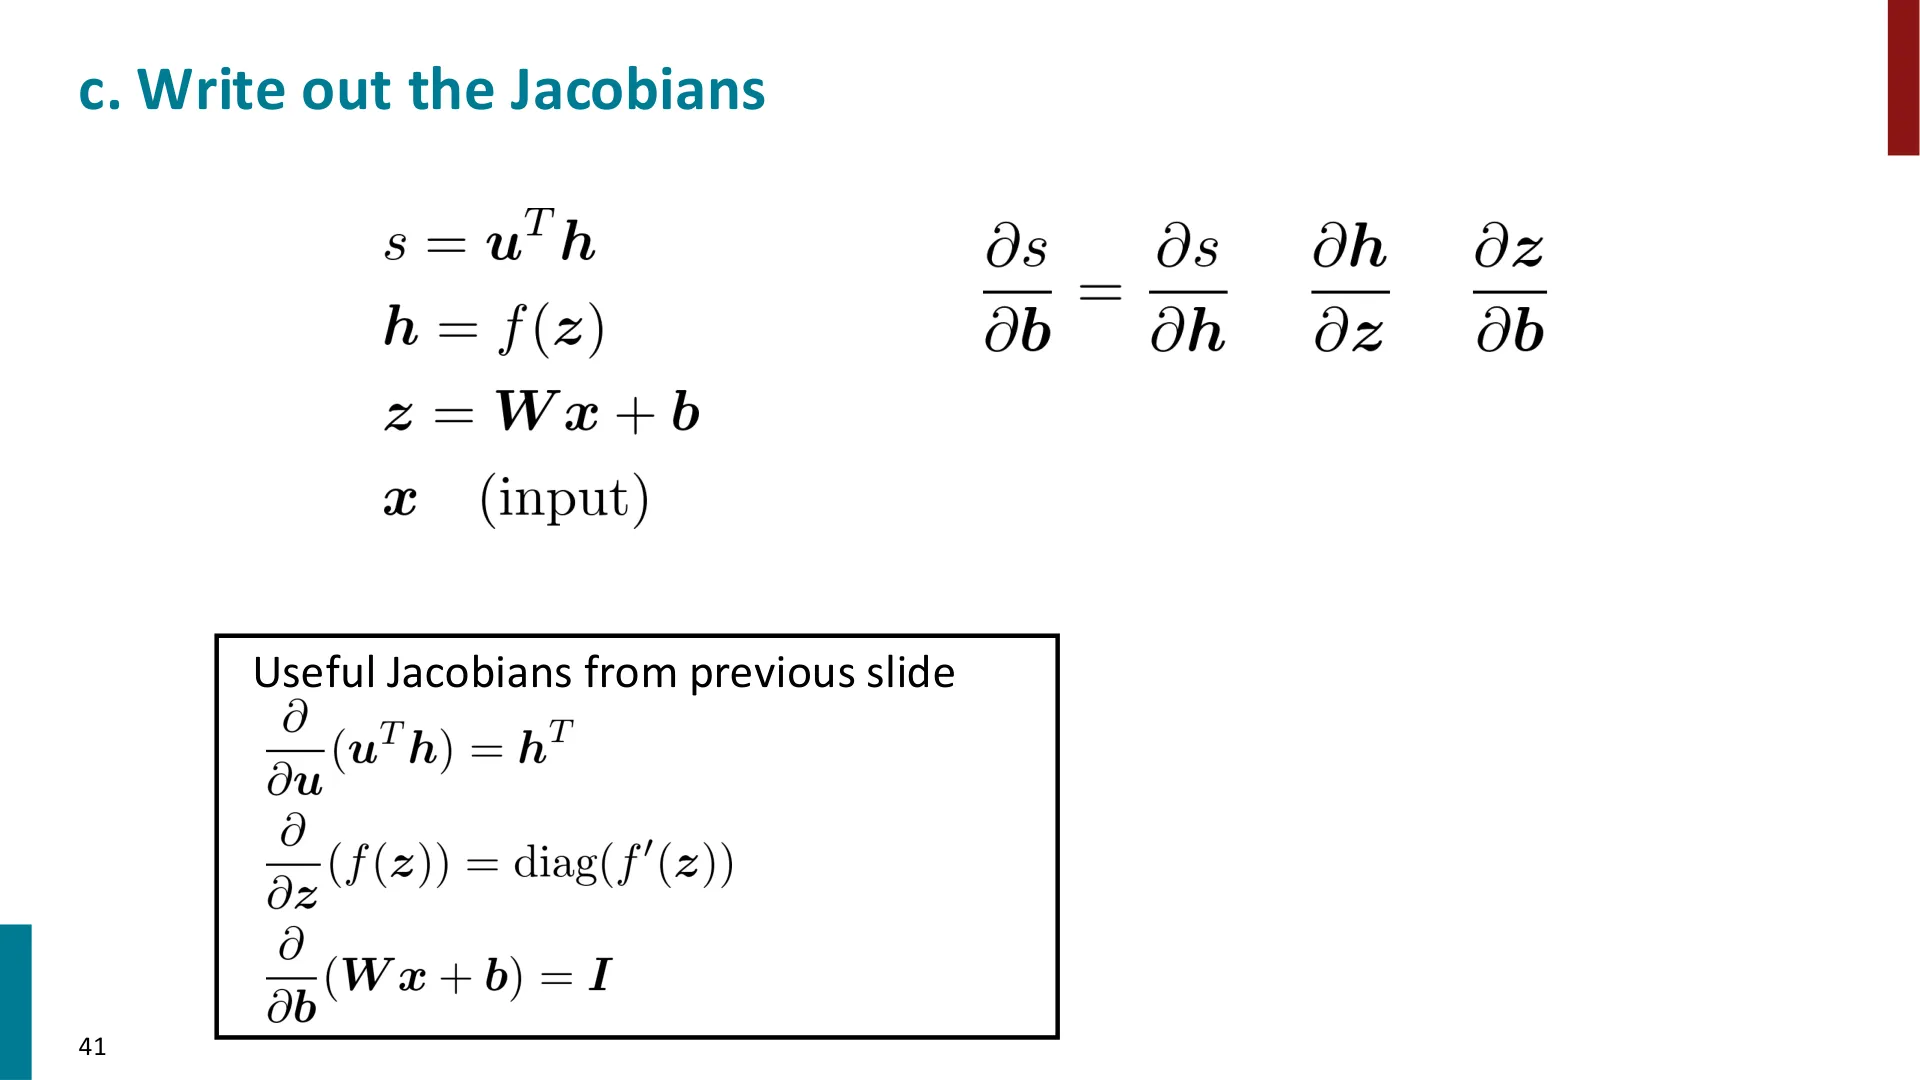
对于线性层 $\mathbf{W}\mathbf{x} + \mathbf{b}$:
- 对 $\mathbf{x}$ 求导:就是 $\mathbf{W}$("只要别想太多,按单变量微积分想:它显然就是 W");
- 对 $\mathbf{b}$ 求导:单变量里是 1,矩阵版就是单位矩阵 $\mathbf{I}$(因为 $\mathbf{b}$ 是向量,得让它以矩阵身份出现)。
对点的乘积 $\mathbf{u}^\top \mathbf{h}$,对 $\mathbf{h}$ 求导得到的是 $\mathbf{u}^\top$——每个分量取到"对面那个向量"的对应项。
📷 其他常用雅可比(1)
回到原视频 (00:29:24)
老师把这些留作"课后练习":自己动手算一遍、确认答案和为什么是这样。
六、手推一个神经网络的梯度
(参考时间: 31:34)
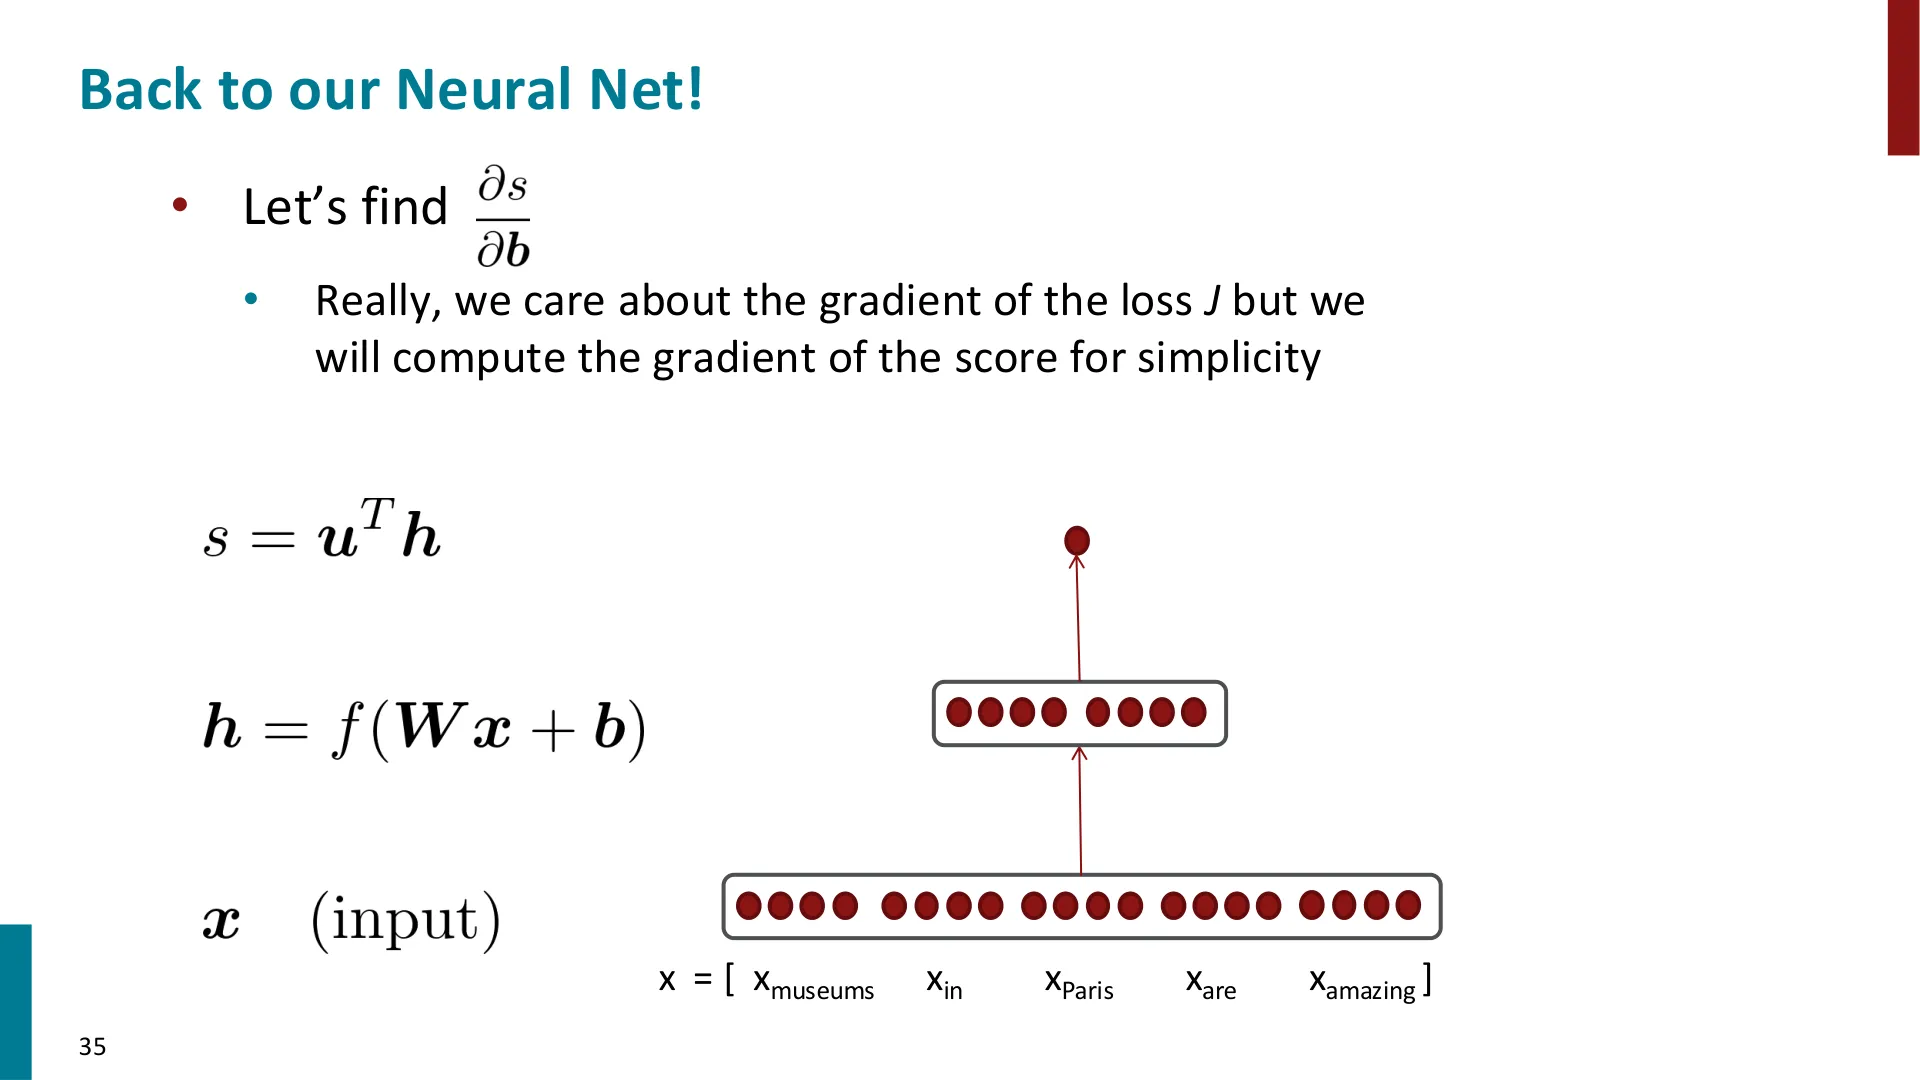
现在回到那个判断"地点"的小网络。这一节我们要手工计算它的梯度。老师说明:真正关心的是损失 $J$ 的梯度,但为了简化,今天只算分数 $s$ 的梯度($J$ 的相关推导留给作业 2)。
📷 回到我们的神经网络:输入窗口
回到原视频 (00:31:34)
📷 我们要求的是分数 s 的梯度
回到原视频 (00:32:22)
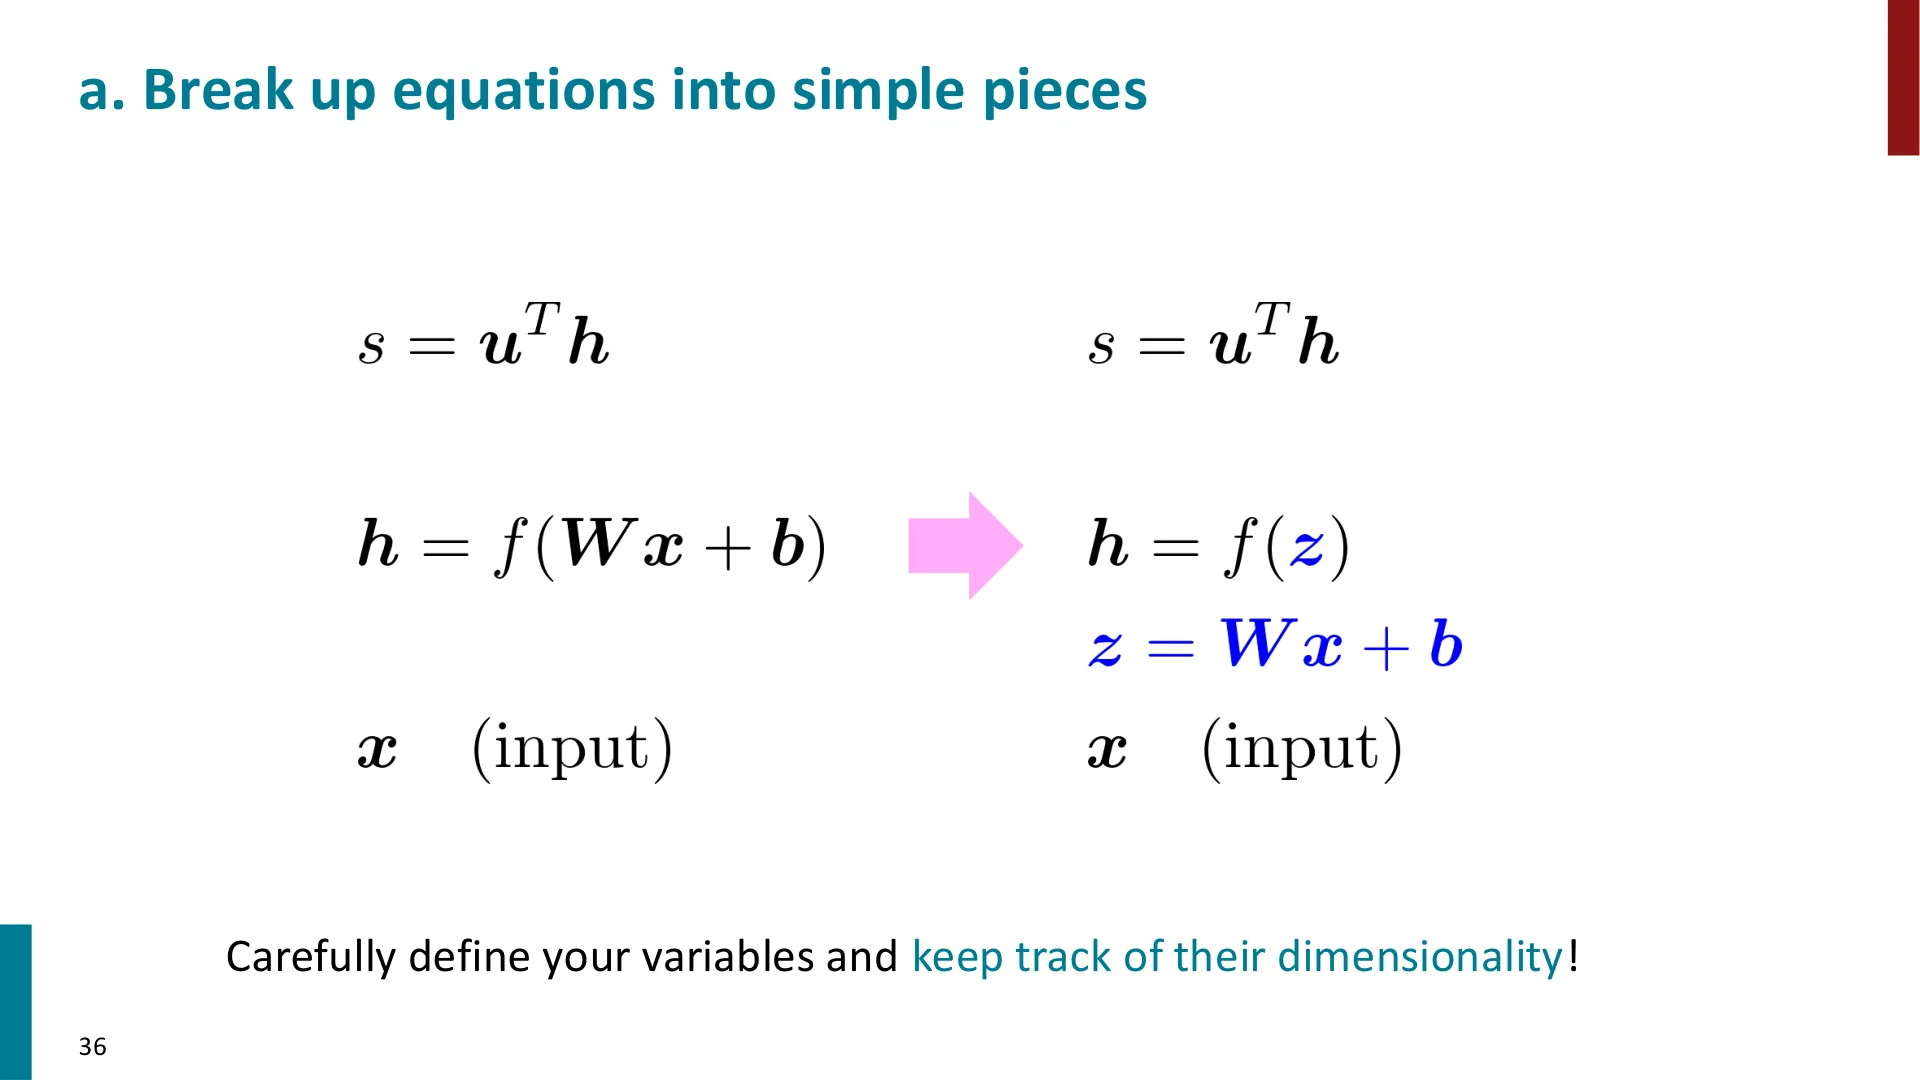
第一步:把方程拆成简单部件
(参考时间: 32:22)
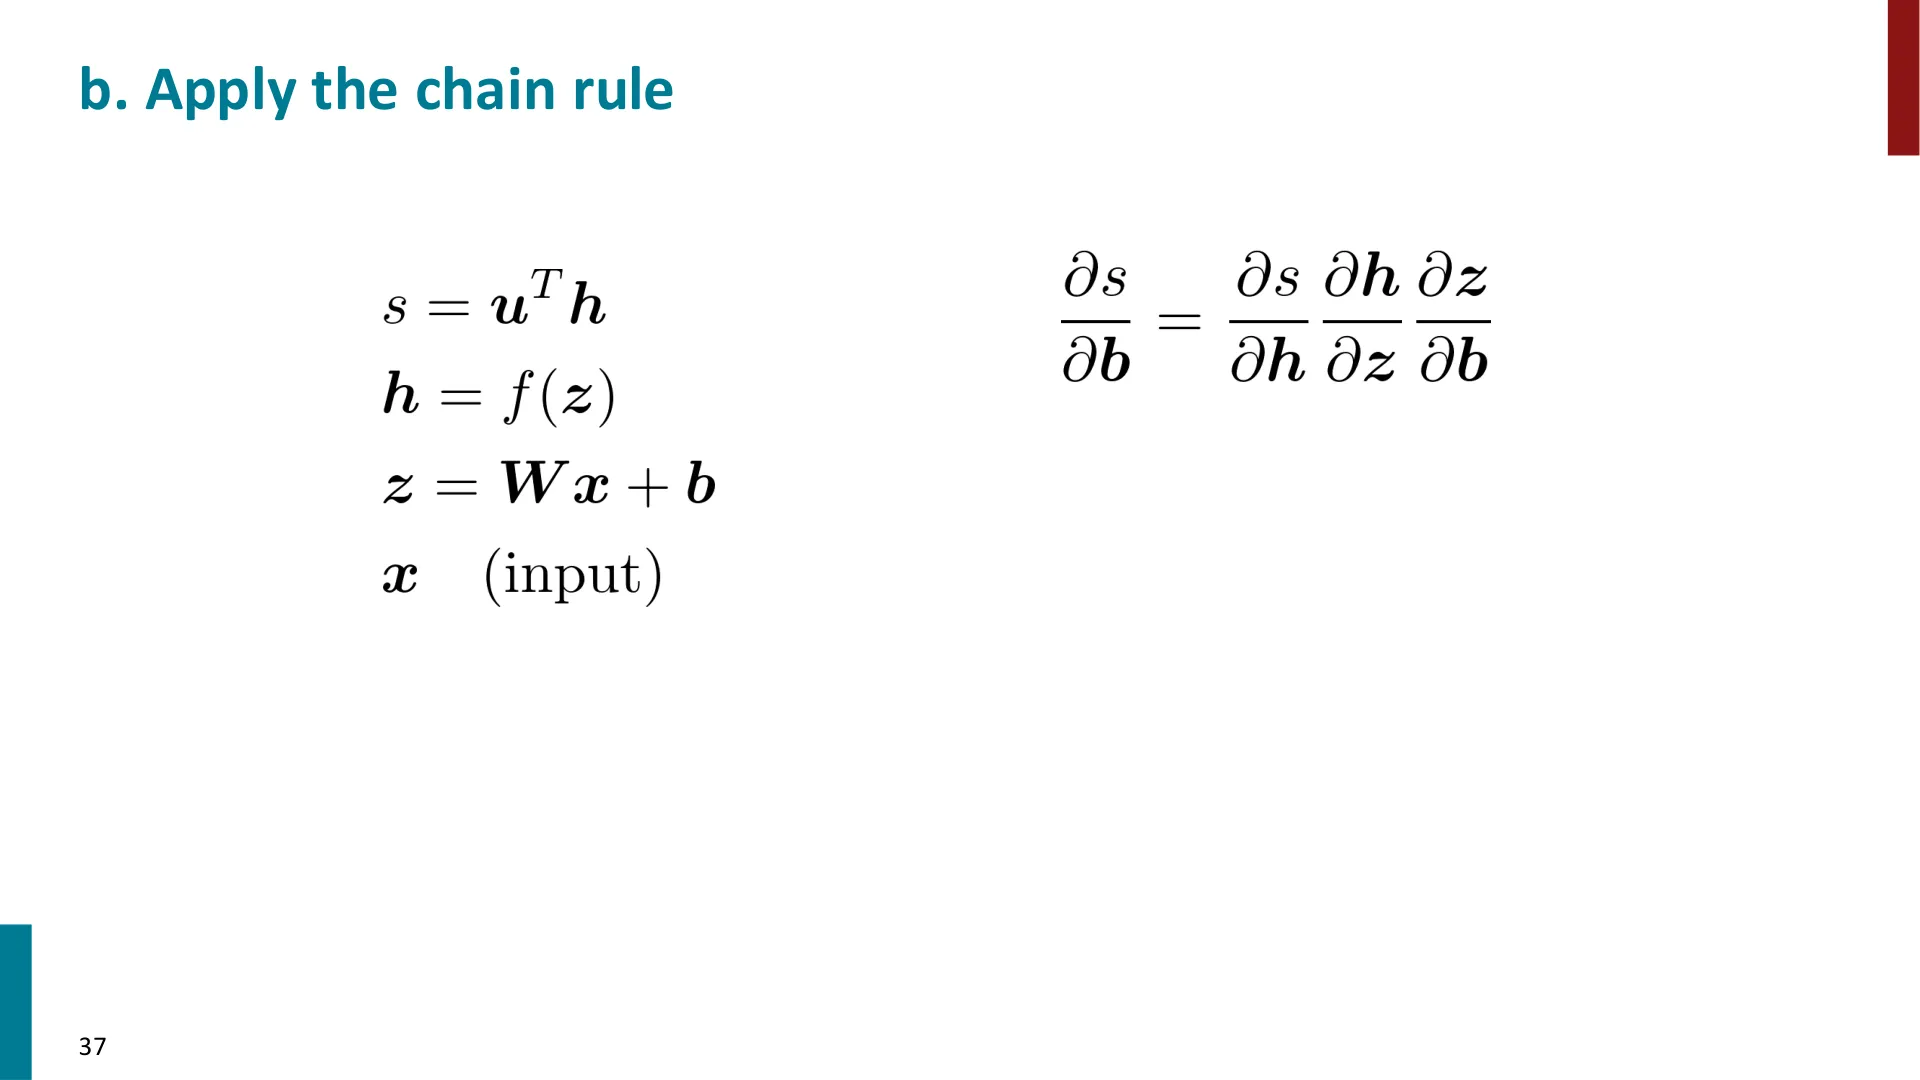
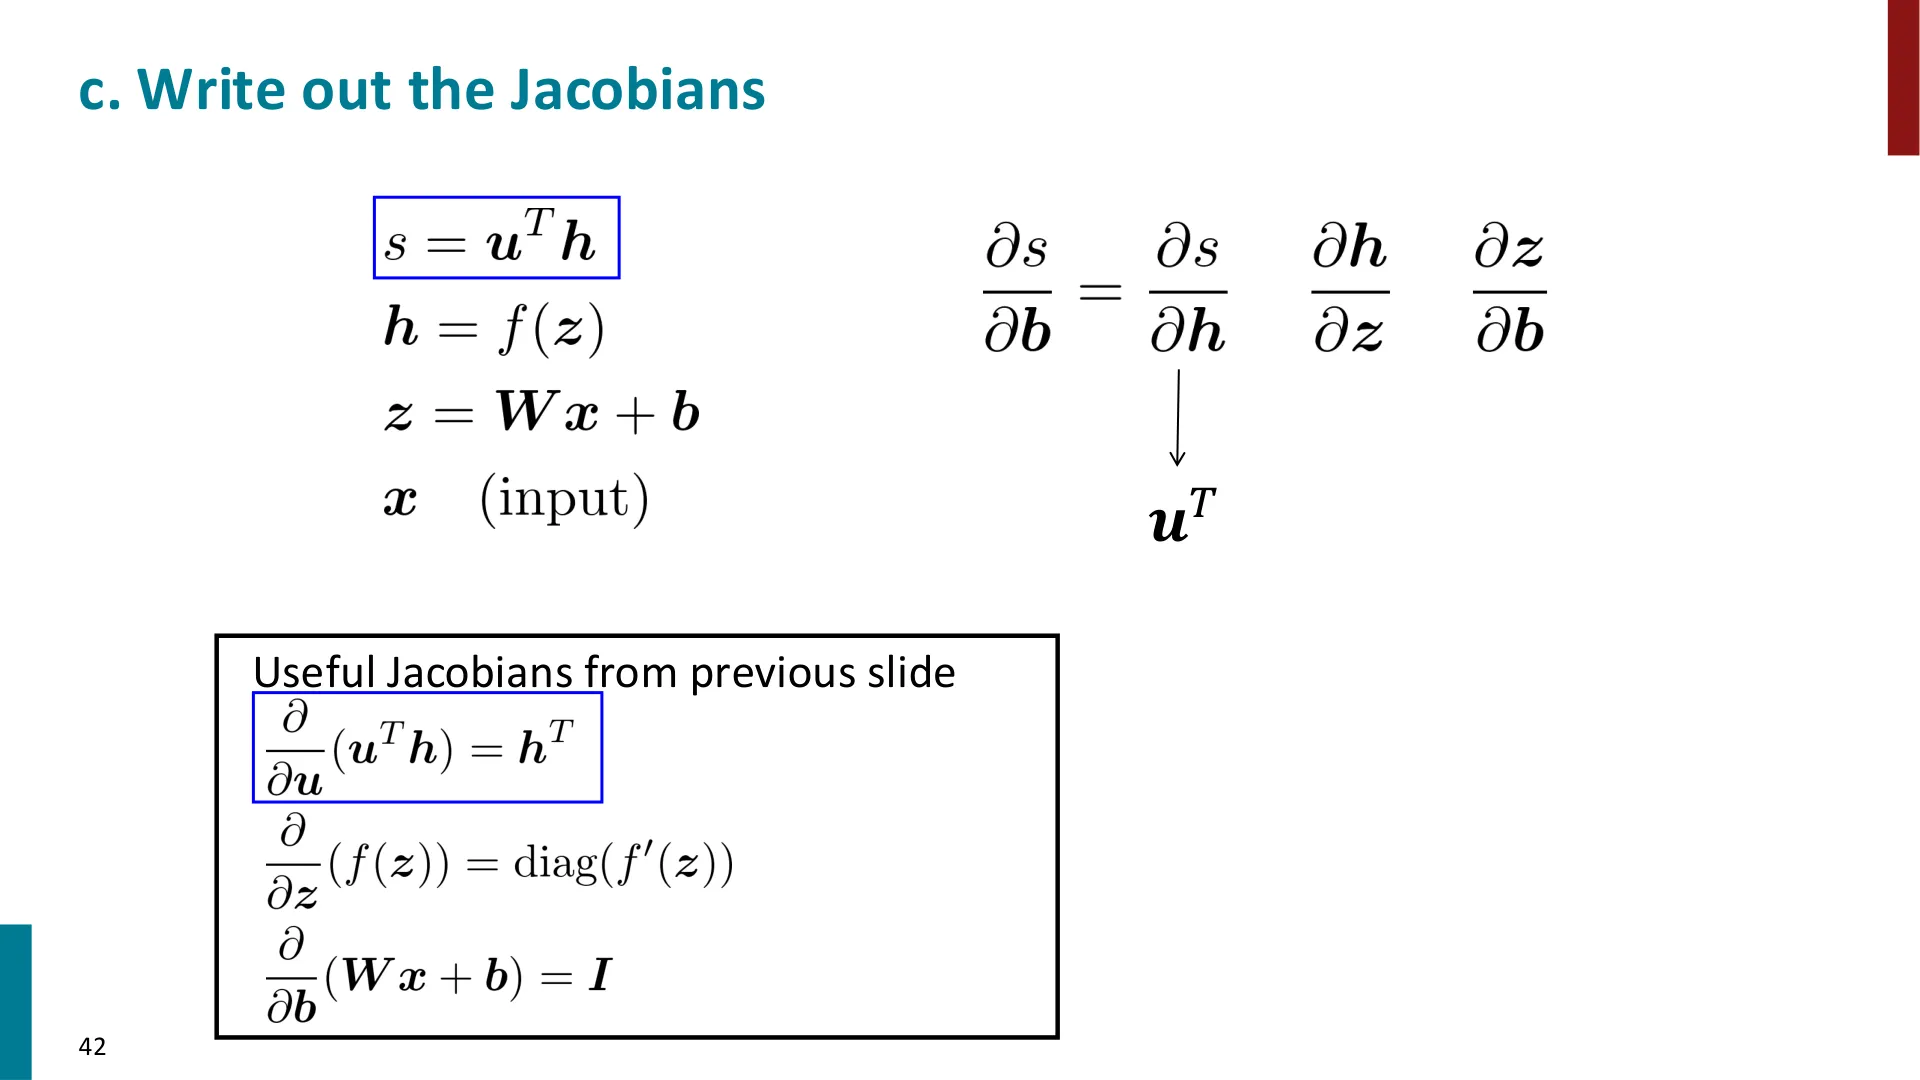
$$\mathbf{z} = \mathbf{W}\mathbf{x} + \mathbf{b}, \qquad \mathbf{h} = f(\mathbf{z}), \qquad s = \mathbf{u}^\top \mathbf{h}$$
重要提醒(老师强调):仔细定义每个变量,并盯住它们的维度。 这是作业里最常出错的地方。
第二步:用链式法则
(参考时间: 33:55)
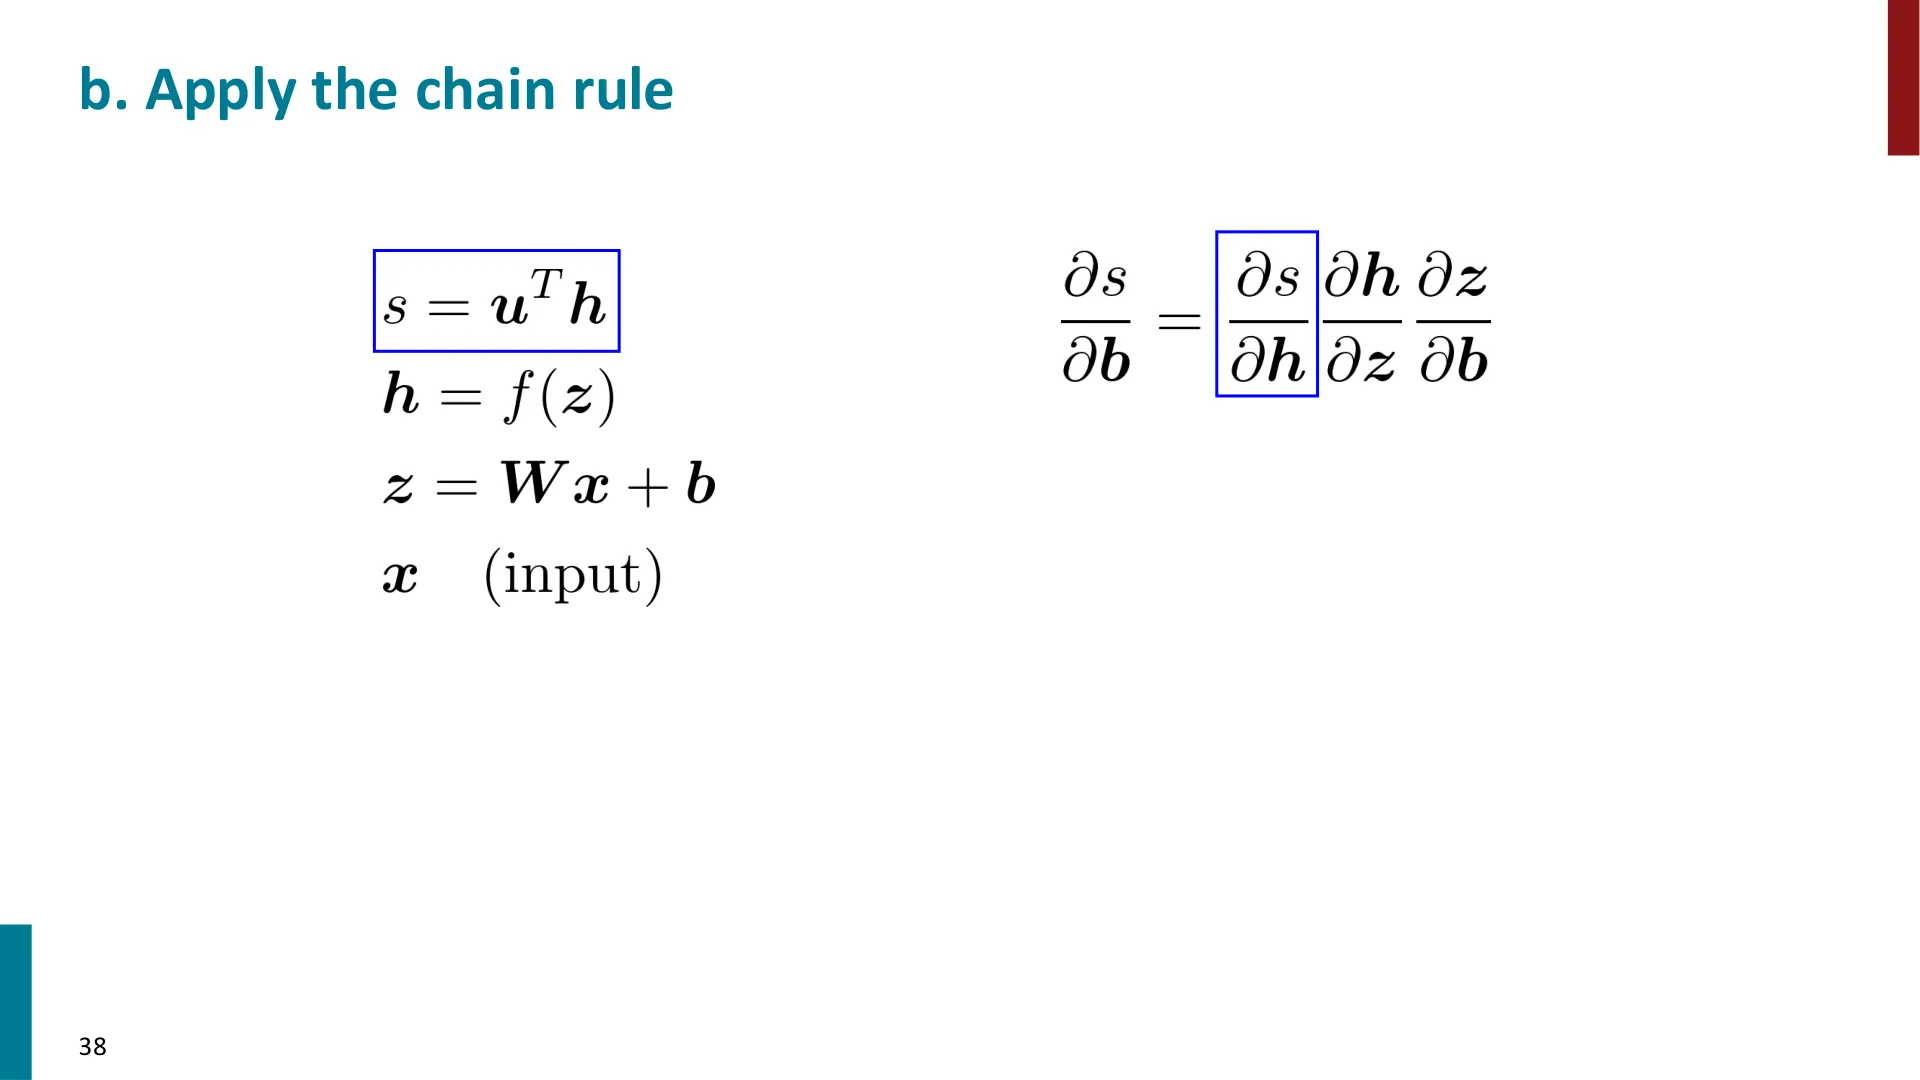
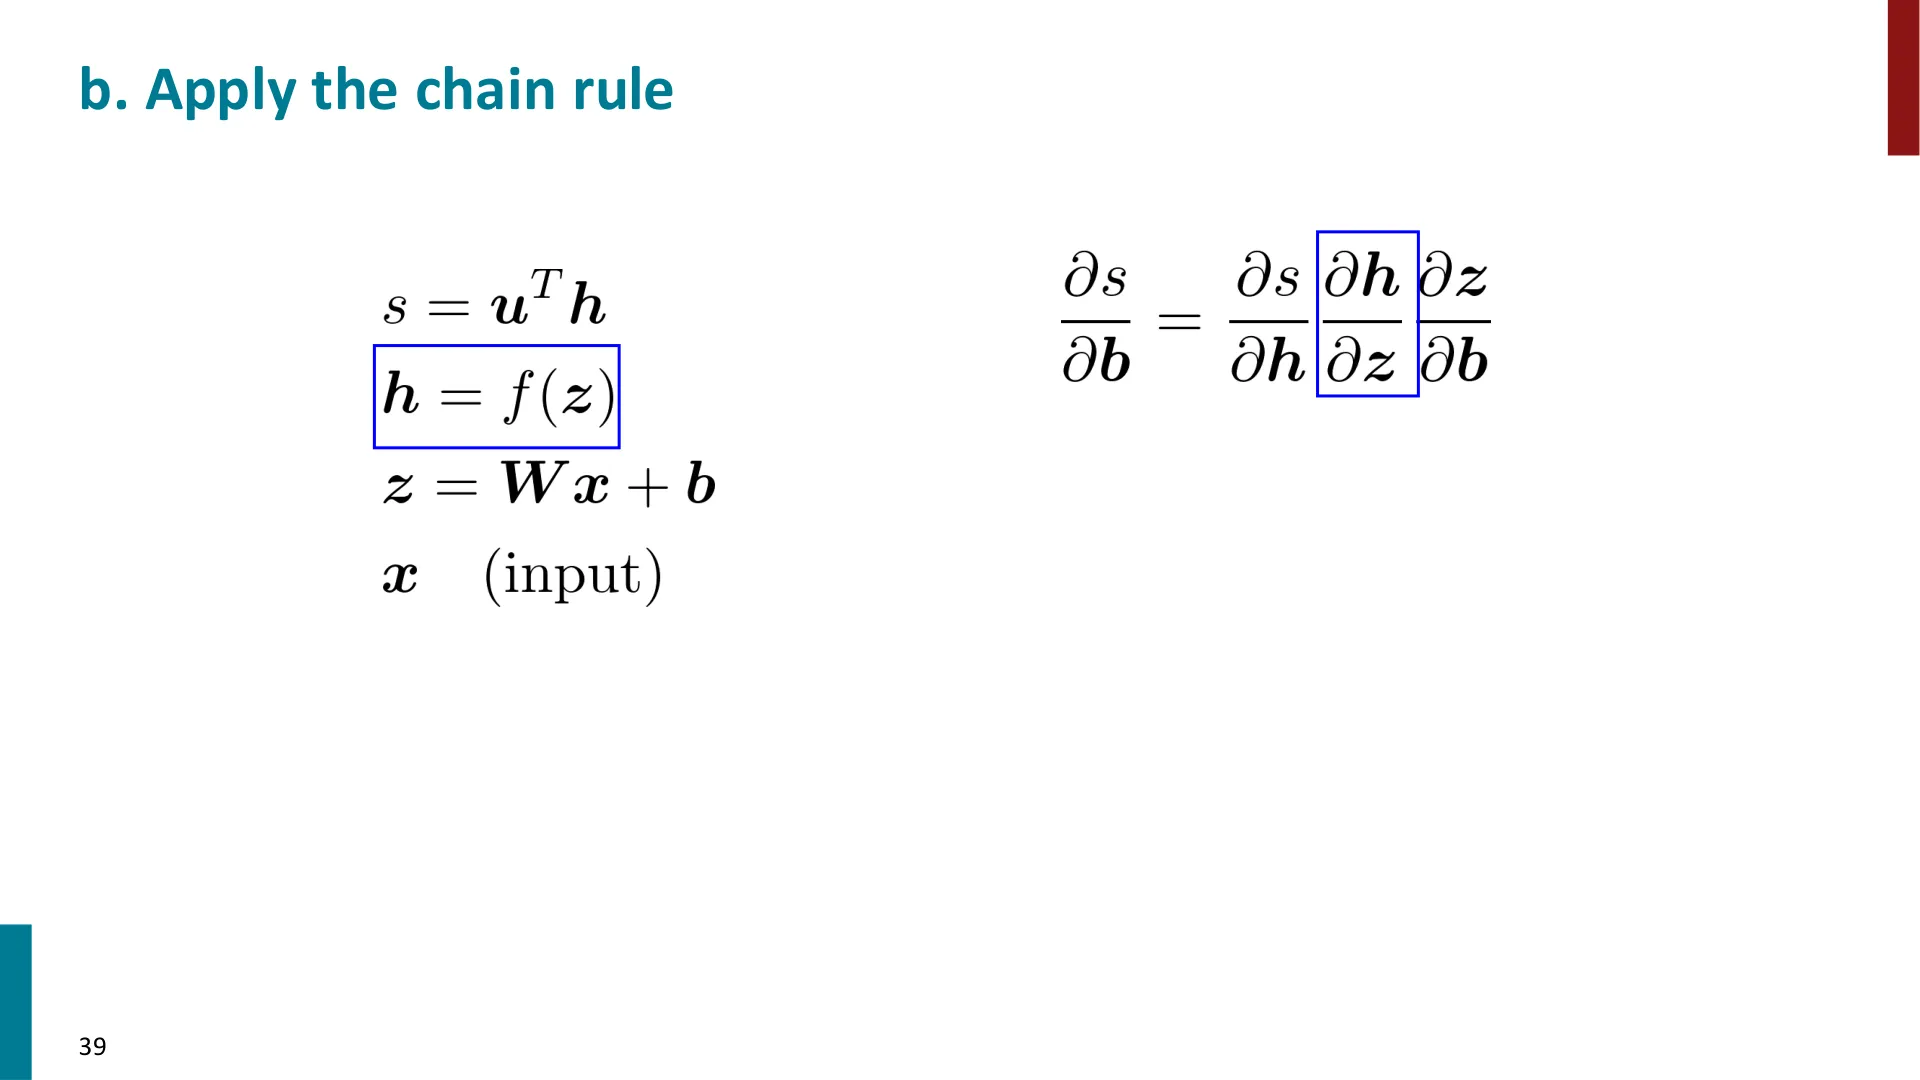
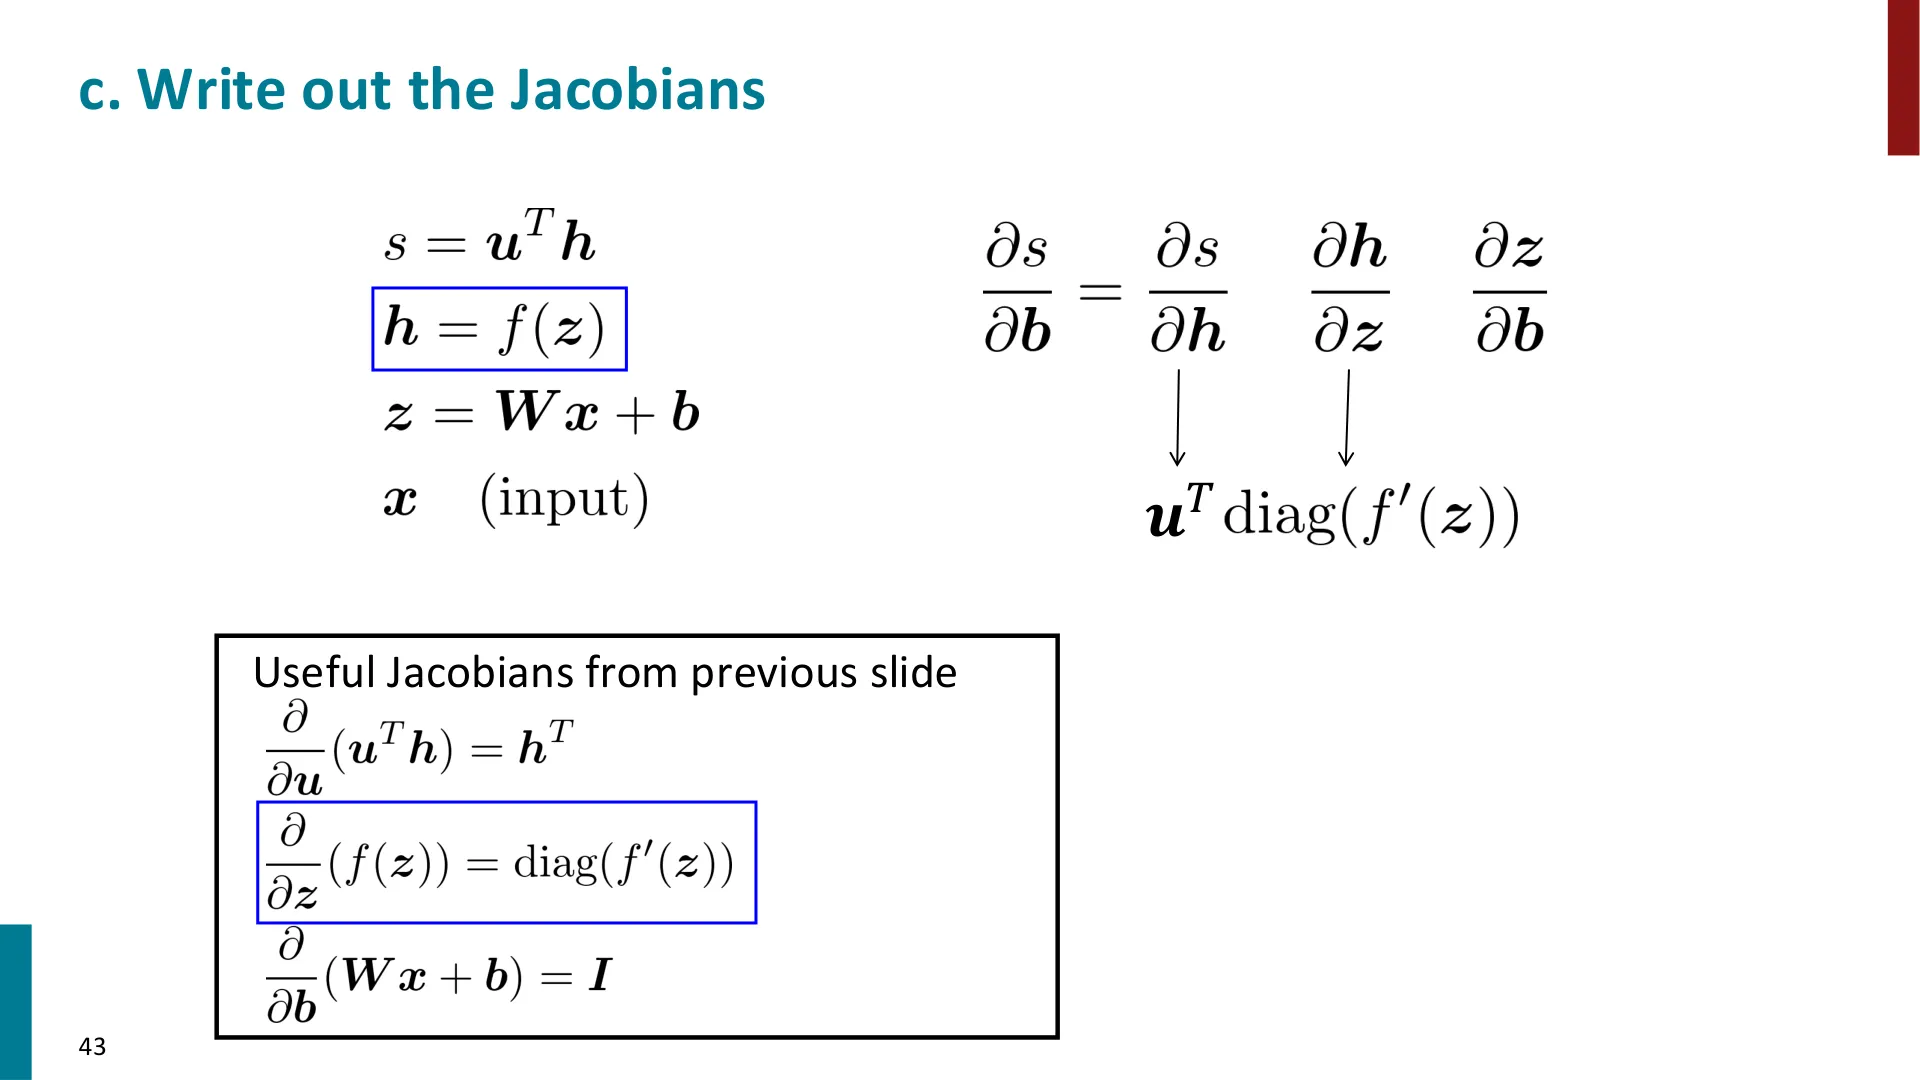
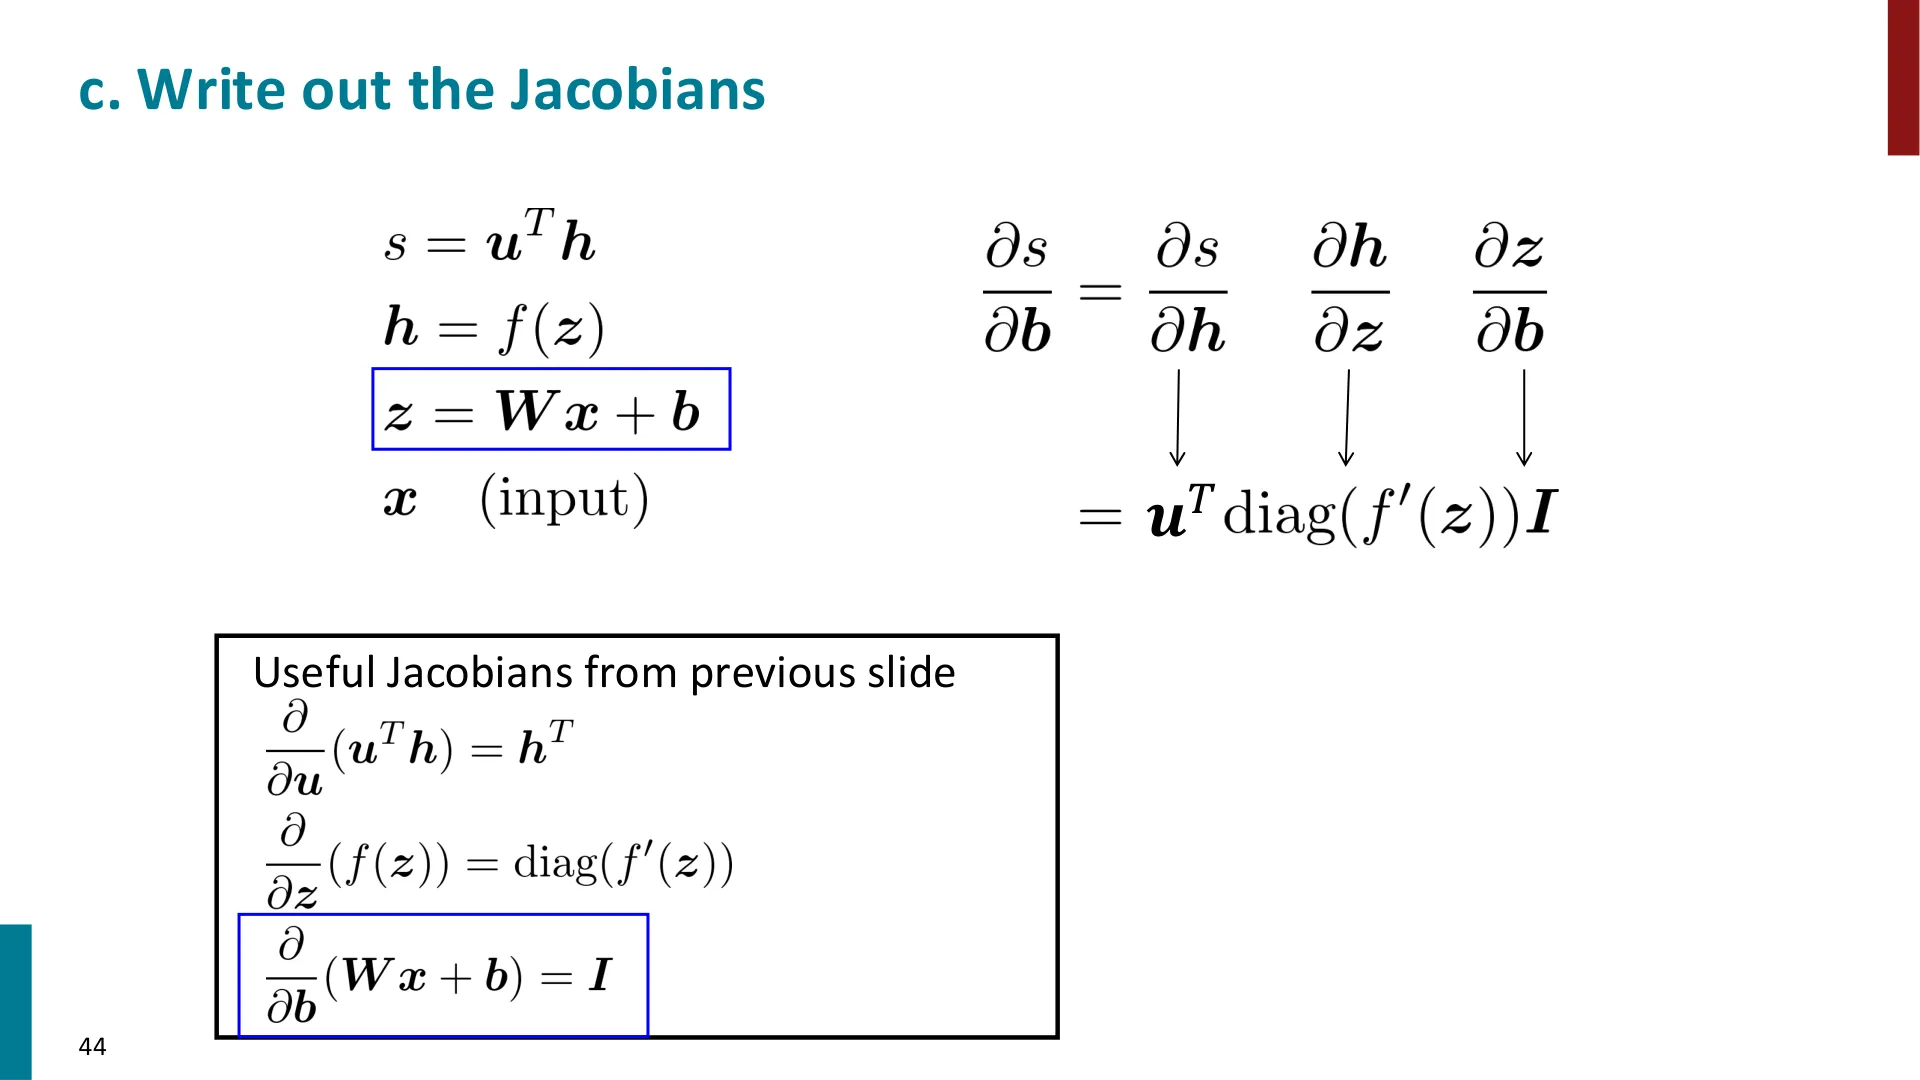
以 $\frac{\partial s}{\partial \mathbf{b}}$ 为例,按链式法则把它拆成三段相乘:
$$\frac{\partial s}{\partial \mathbf{b}} = \frac{\partial s}{\partial \mathbf{h}} \cdot \frac{\partial \mathbf{h}}{\partial \mathbf{z}} \cdot \frac{\partial \mathbf{z}}{\partial \mathbf{b}}$$
这正好对应网络里三层复合结构。
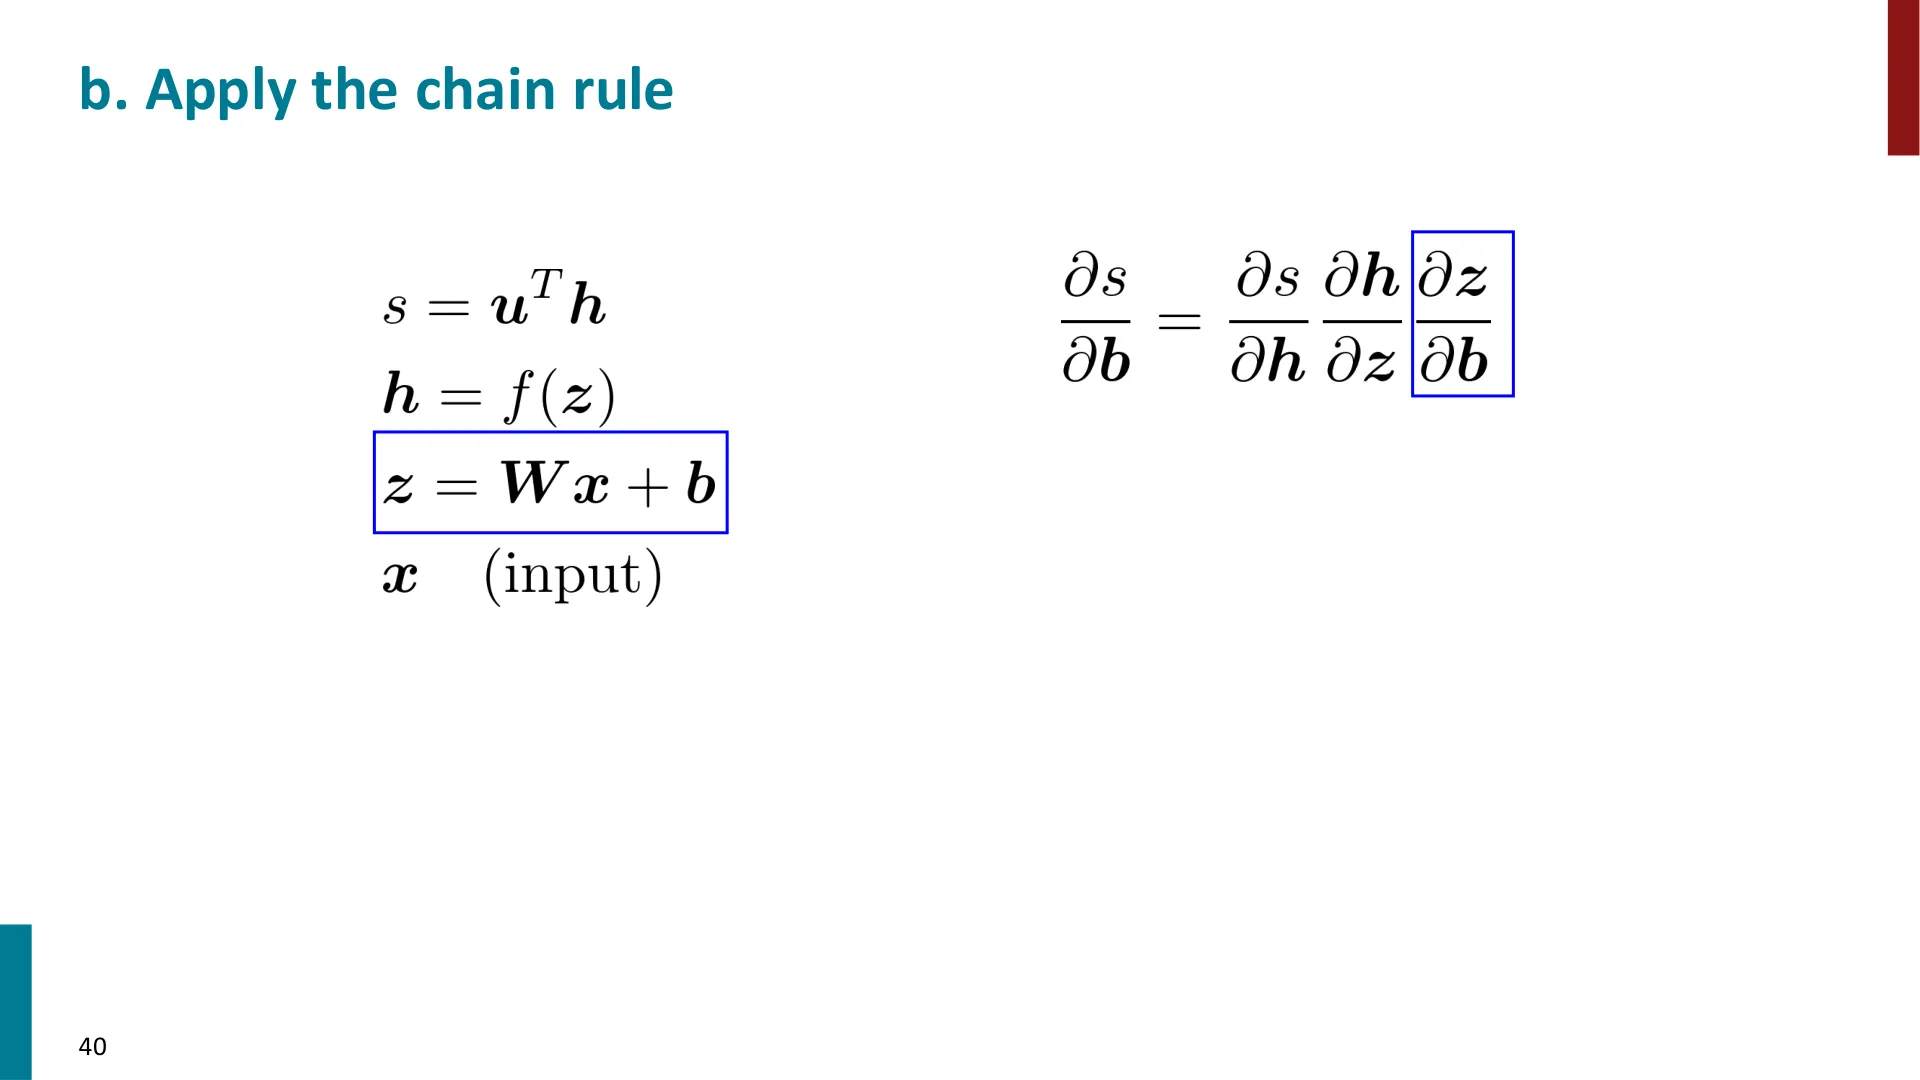
📷 应用链式法则(1)
回到原视频 (00:33:55)
第三步:代入雅可比
(参考时间: 34:30)
把第五节里那几块雅可比代进去:
- $\frac{\partial s}{\partial \mathbf{h}} = \mathbf{u}^\top$;
- $\frac{\partial \mathbf{h}}{\partial \mathbf{z}} = \operatorname{diag}(f'(\mathbf{z}))$;
- $\frac{\partial \mathbf{z}}{\partial \mathbf{b}} = \mathbf{I}$。
化简后:
$$\frac{\partial s}{\partial \mathbf{b}} = \mathbf{u}^\top \odot f'(\mathbf{z})$$
这里出现了一个新符号 $\odot$——Hadamard 积,即两个向量逐元素相乘,结果仍是一个向量(不是点积那种"合成一个标量"的运算)。
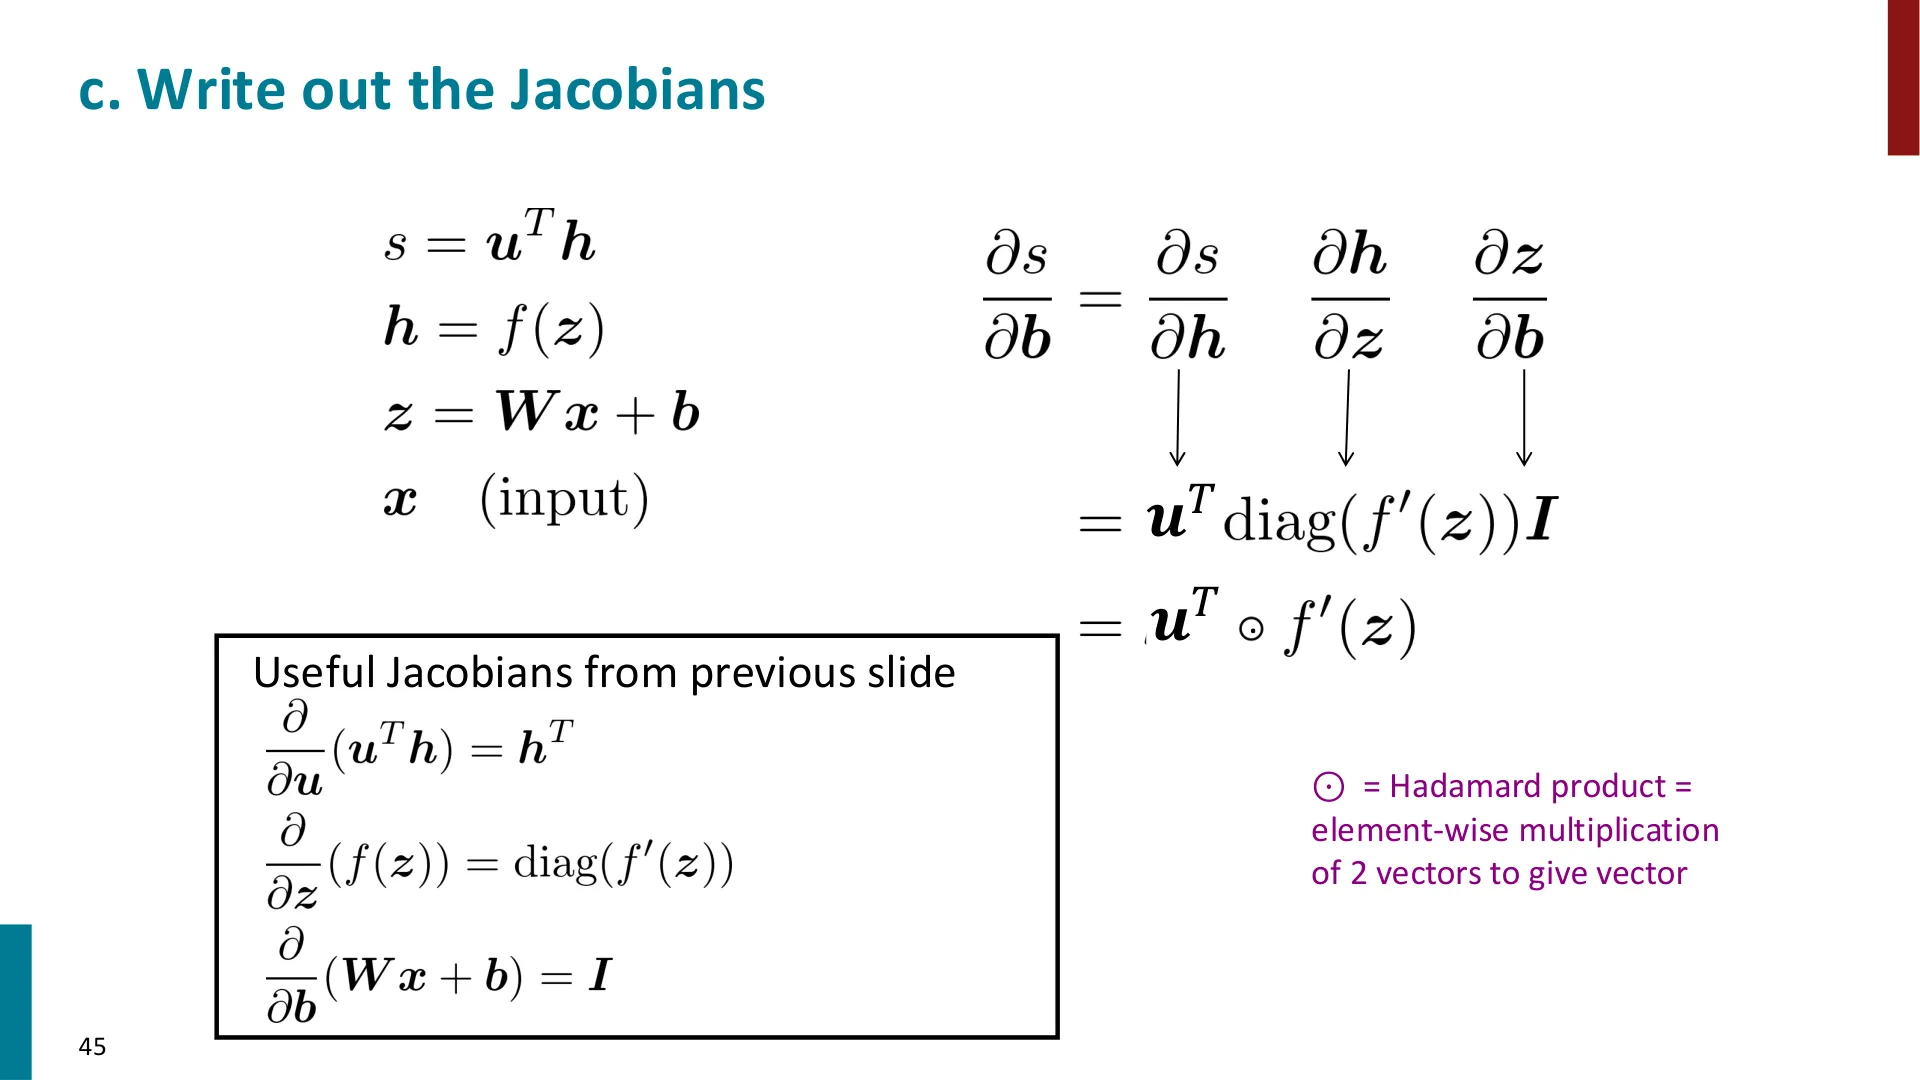
📷 代入雅可比(1)
回到原视频 (00:34:30)
复用计算:$\delta$ 的登场
(参考时间: 35:46)
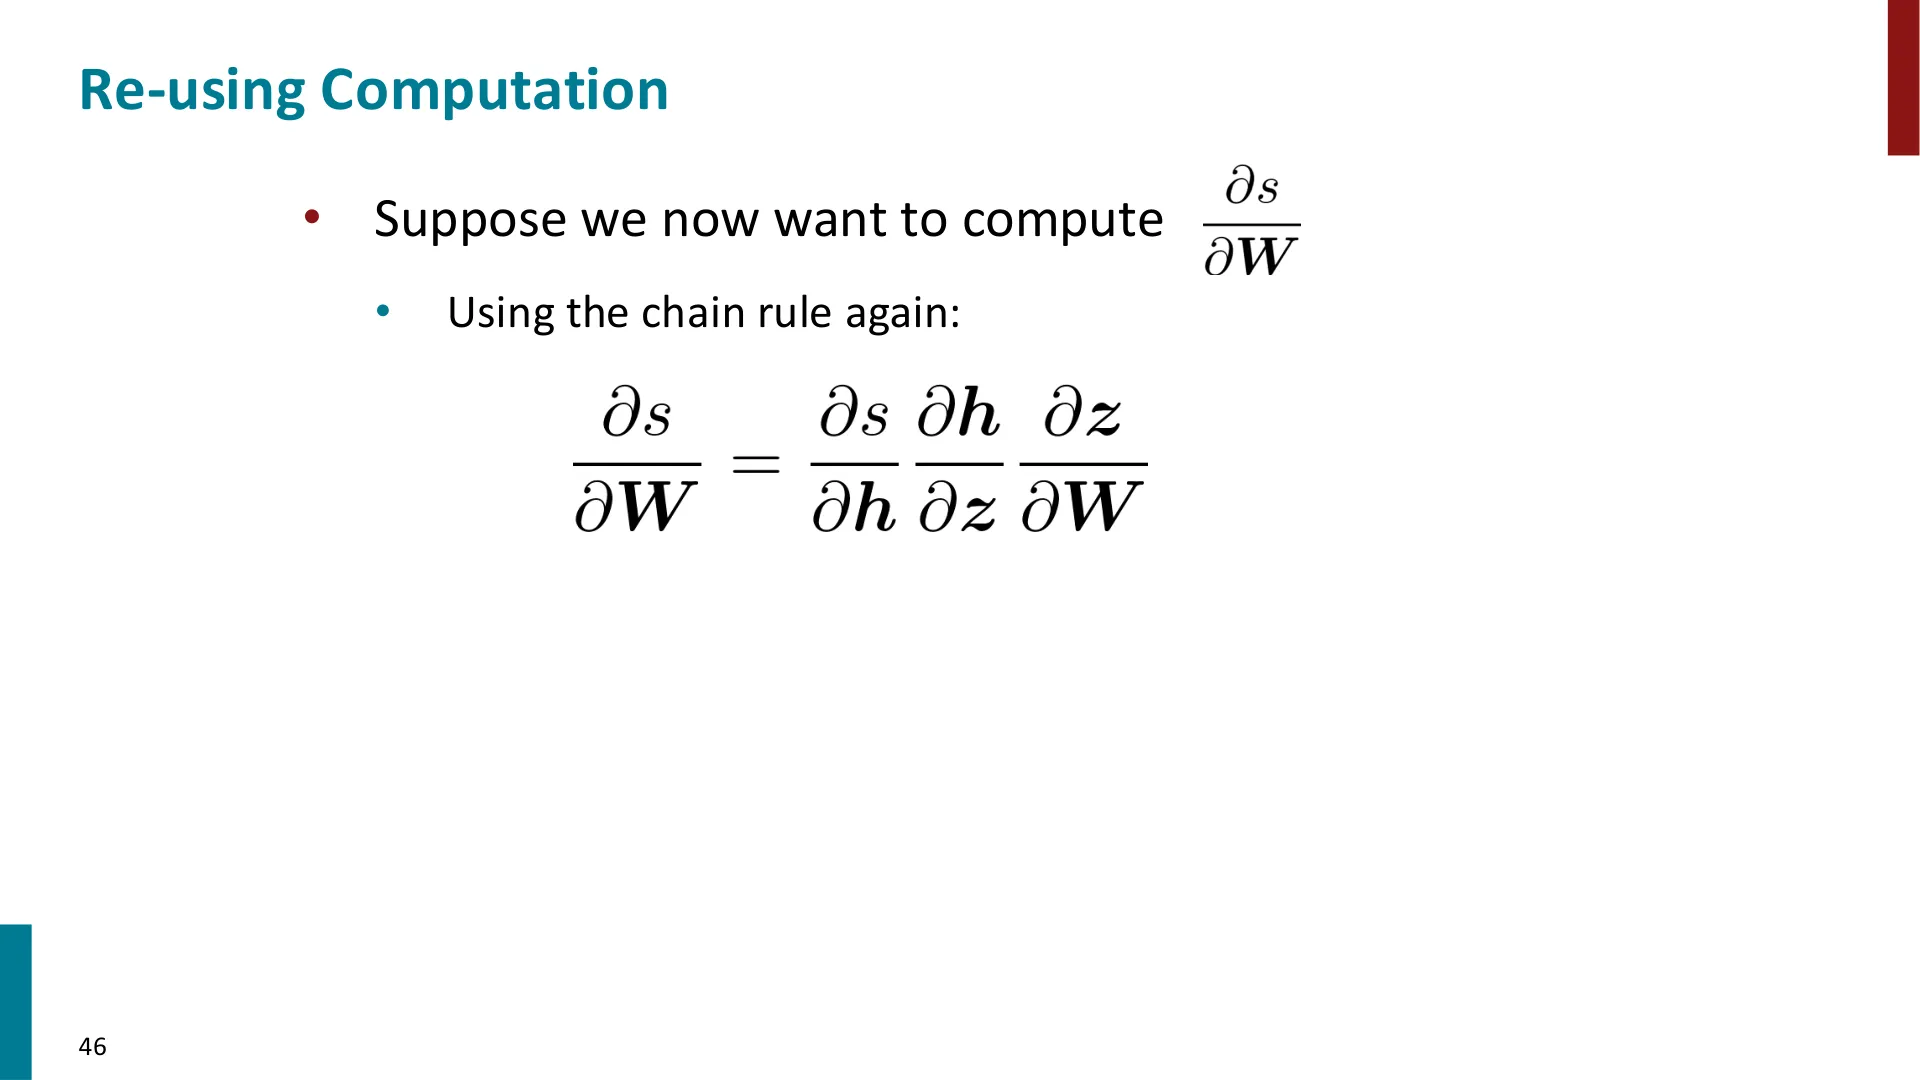
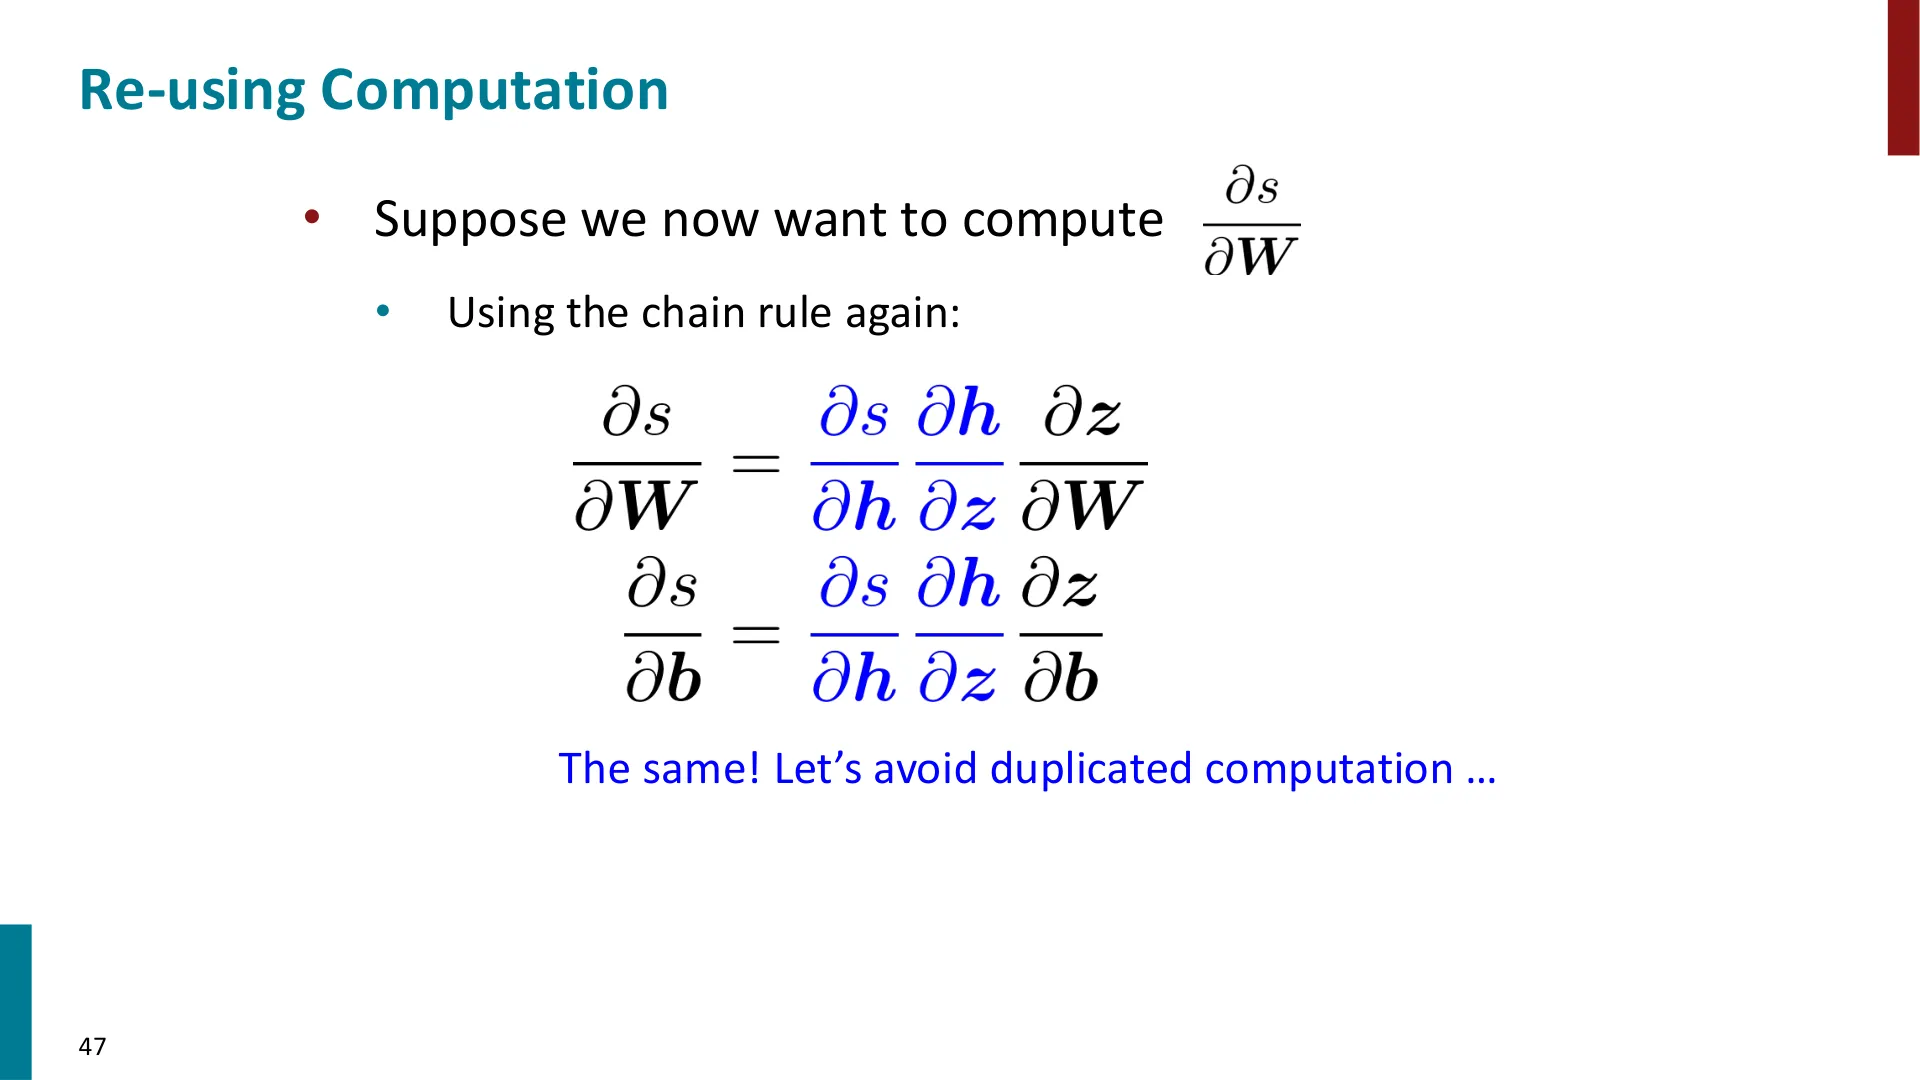
如果接着算 $\frac{\partial s}{\partial \mathbf{W}}$,链式法则会给出同样的三段结构,只是最后一段换成了 $\frac{\partial \mathbf{z}}{\partial \mathbf{W}}$。关键观察:前两段 $\frac{\partial s}{\partial \mathbf{h}} \cdot \frac{\partial \mathbf{h}}{\partial \mathbf{z}}$ 和算 $\mathbf{b}$ 时完全一样!
于是我们把它复用、命名:
$$\delta \equiv \frac{\partial s}{\partial \mathbf{h}} \cdot \frac{\partial \mathbf{h}}{\partial \mathbf{z}} = \mathbf{u}^\top \odot f'(\mathbf{z})$$
$\delta$ 就是上游梯度(upstream gradient),也叫"误差信号(error signal)"。这就是反向传播的第一条中心思想:不要重复计算。
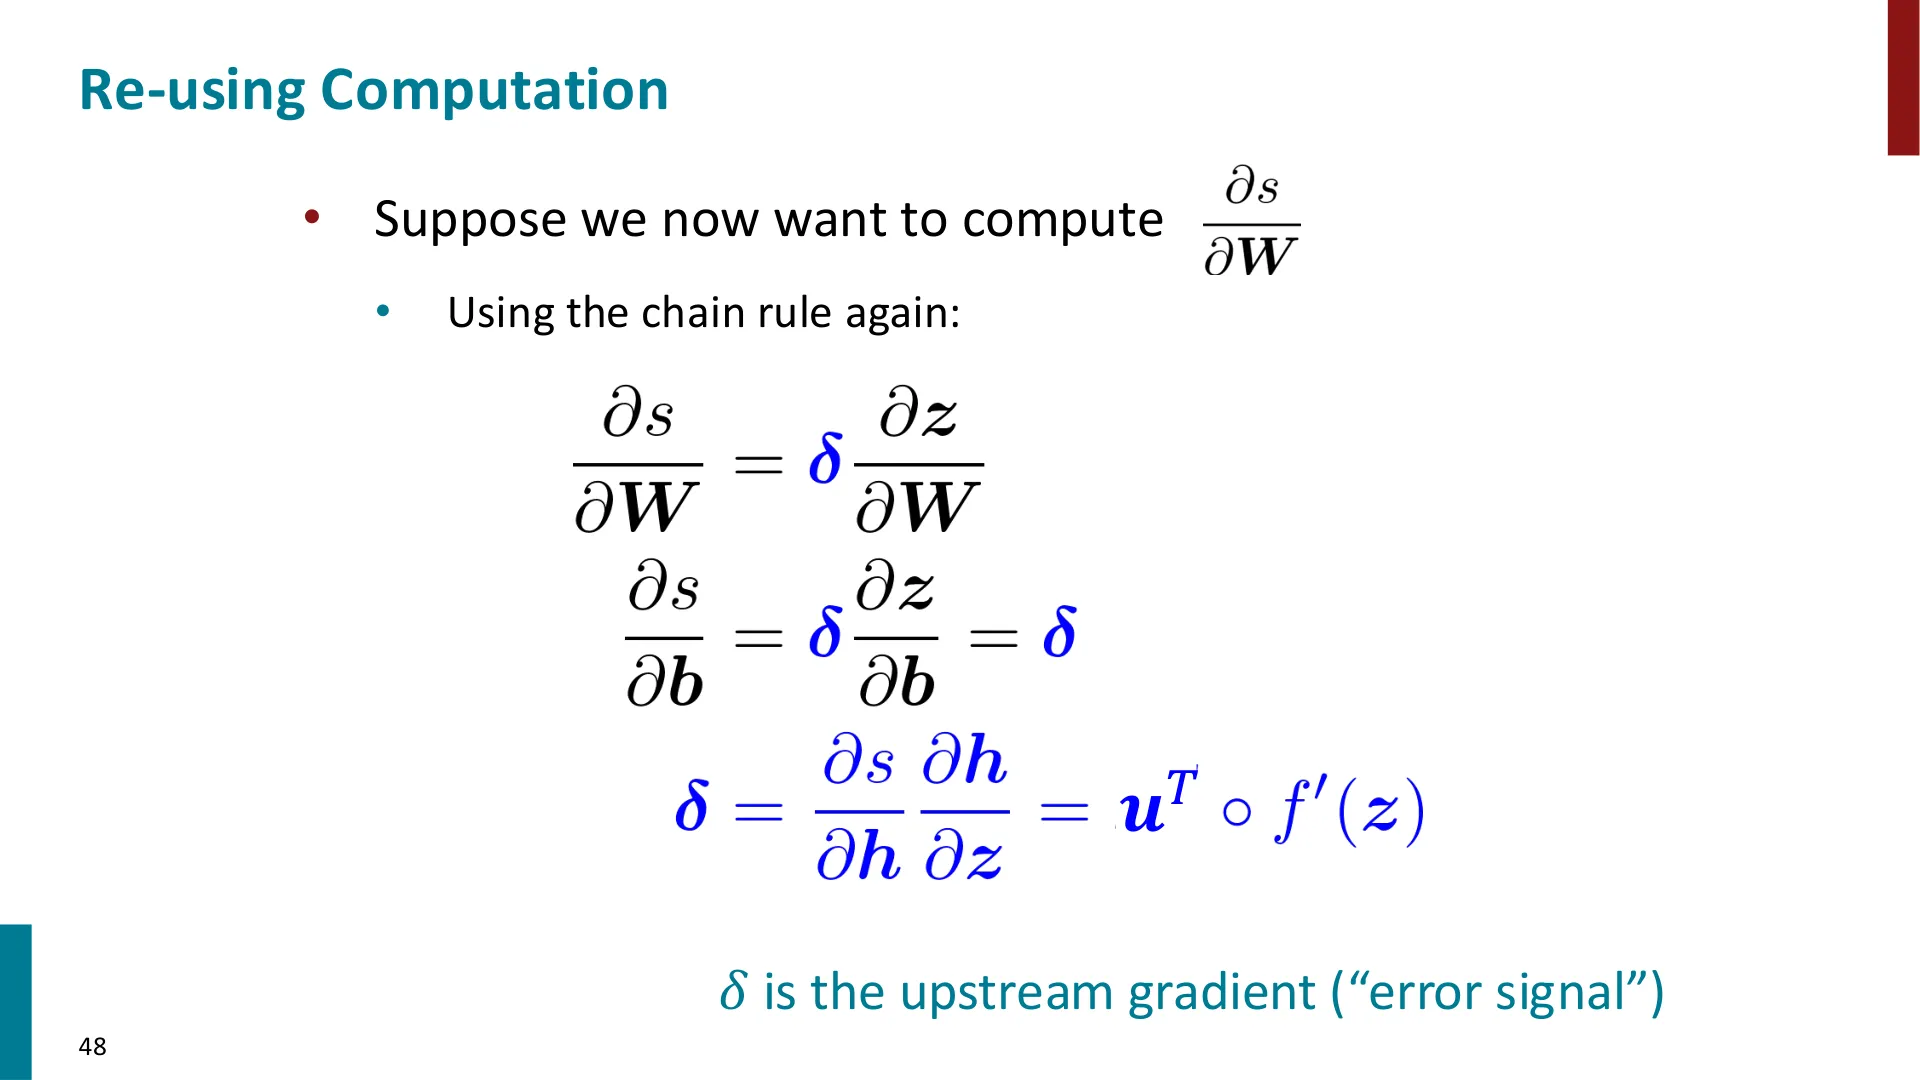
📷 复用计算(1)
回到原视频 (00:35:46)
形状之争:雅可比还是"形状约定"?
(参考时间: 37:24)
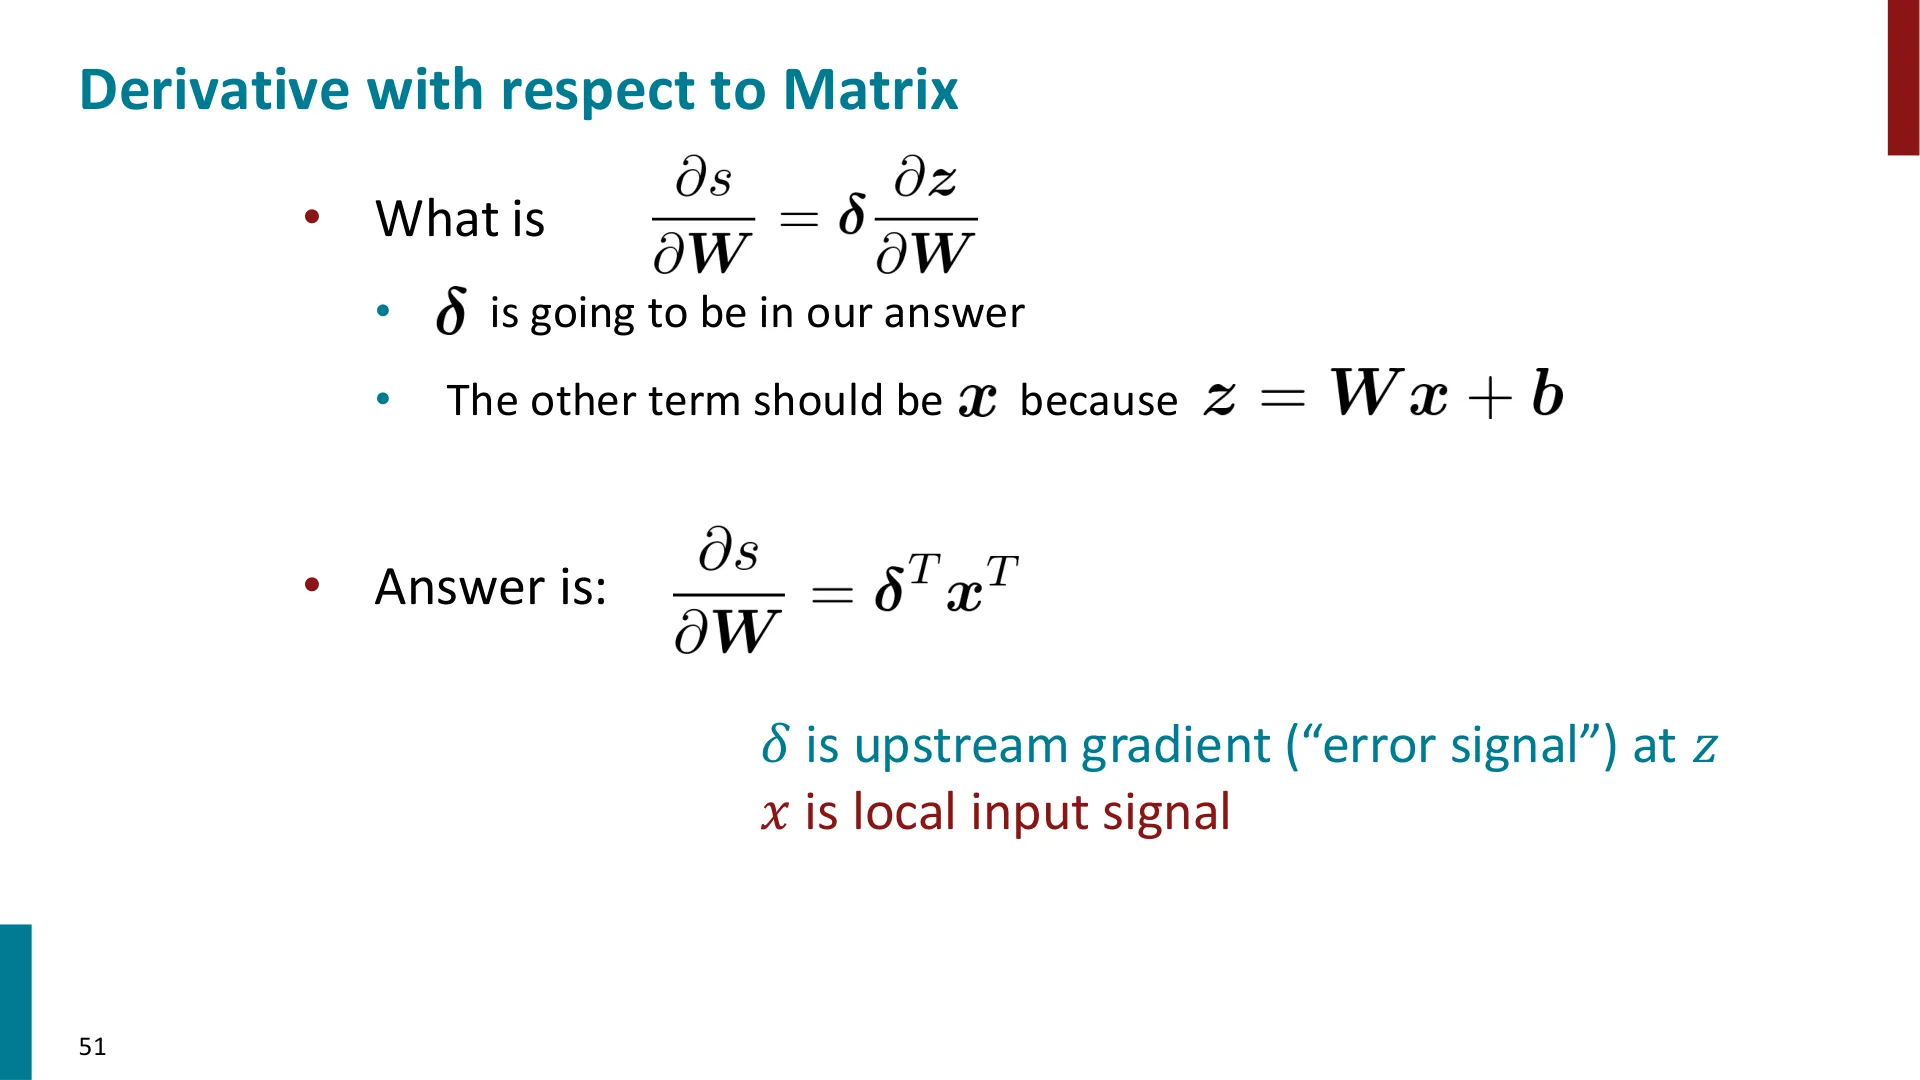
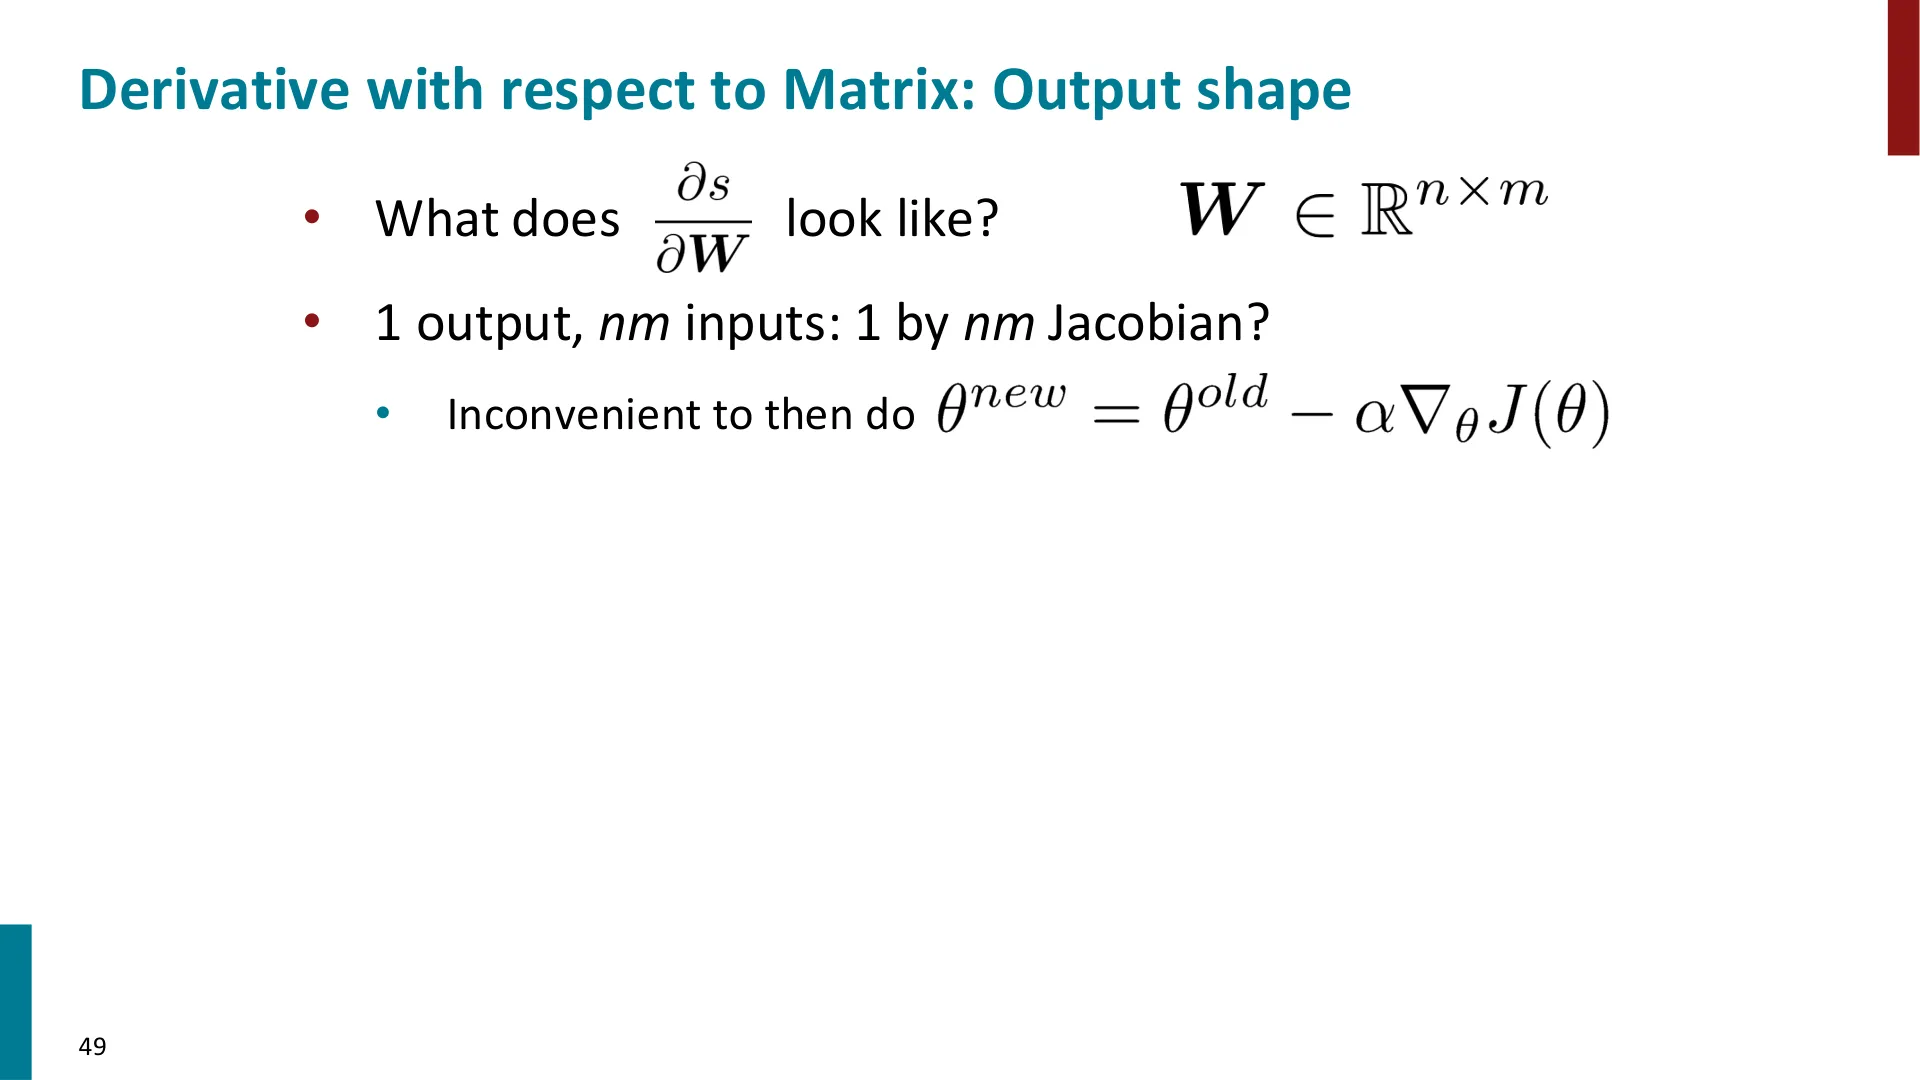
接着算 $\frac{\partial s}{\partial \mathbf{W}}$。因为 $s$ 是标量、$\mathbf{W}$ 有 $n\times m$ 个元素,按纯数学,答案该是一个 $1\times nm$ 的大长行向量。但这就麻烦了——我们想用梯度去更新参数,希望梯度的形状和参数一致,才能直接做减法。
于是引入"形状约定(shape convention)":梯度的形状,就是参数的形状。所以 $\frac{\partial s}{\partial \mathbf{W}}$ 应该是 $n \times m$。
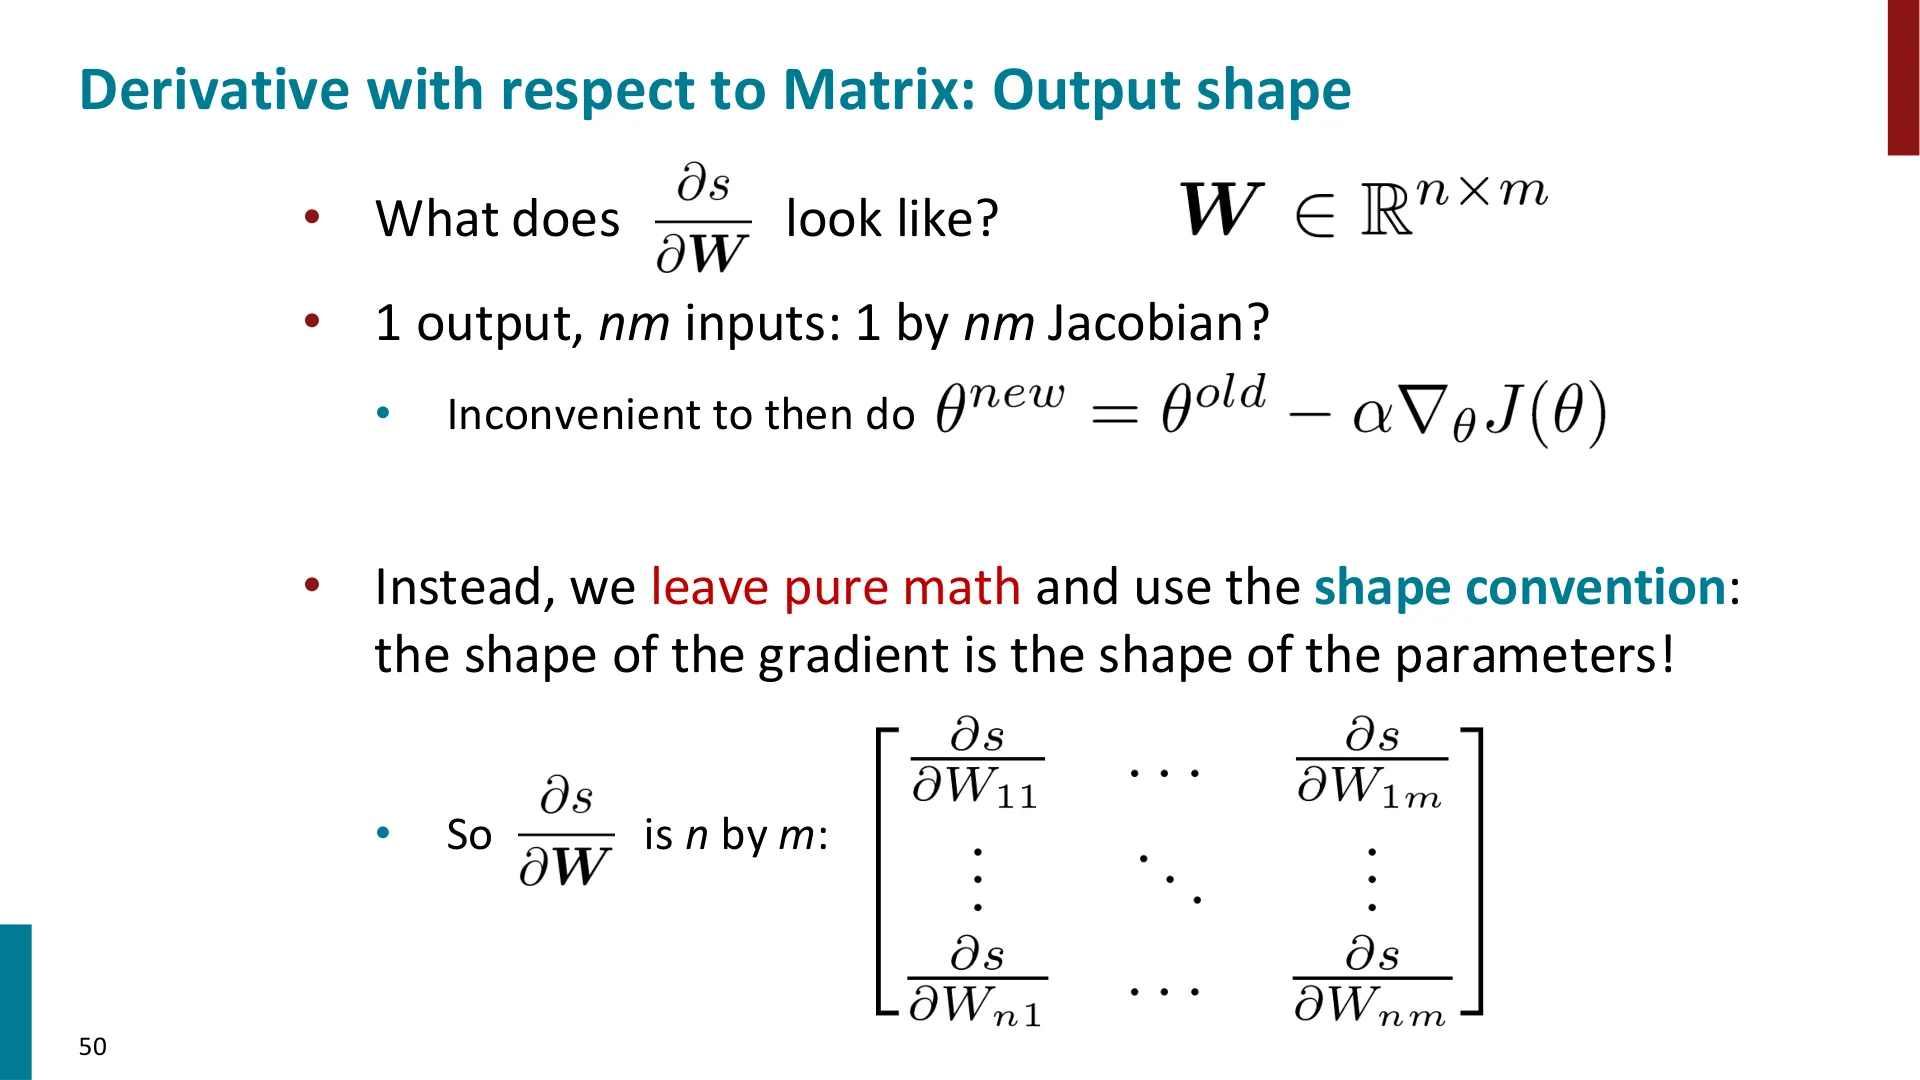
📷 对矩阵求导:输出形状(1)
回到原视频 (00:37:24)
最终答案写成外积:
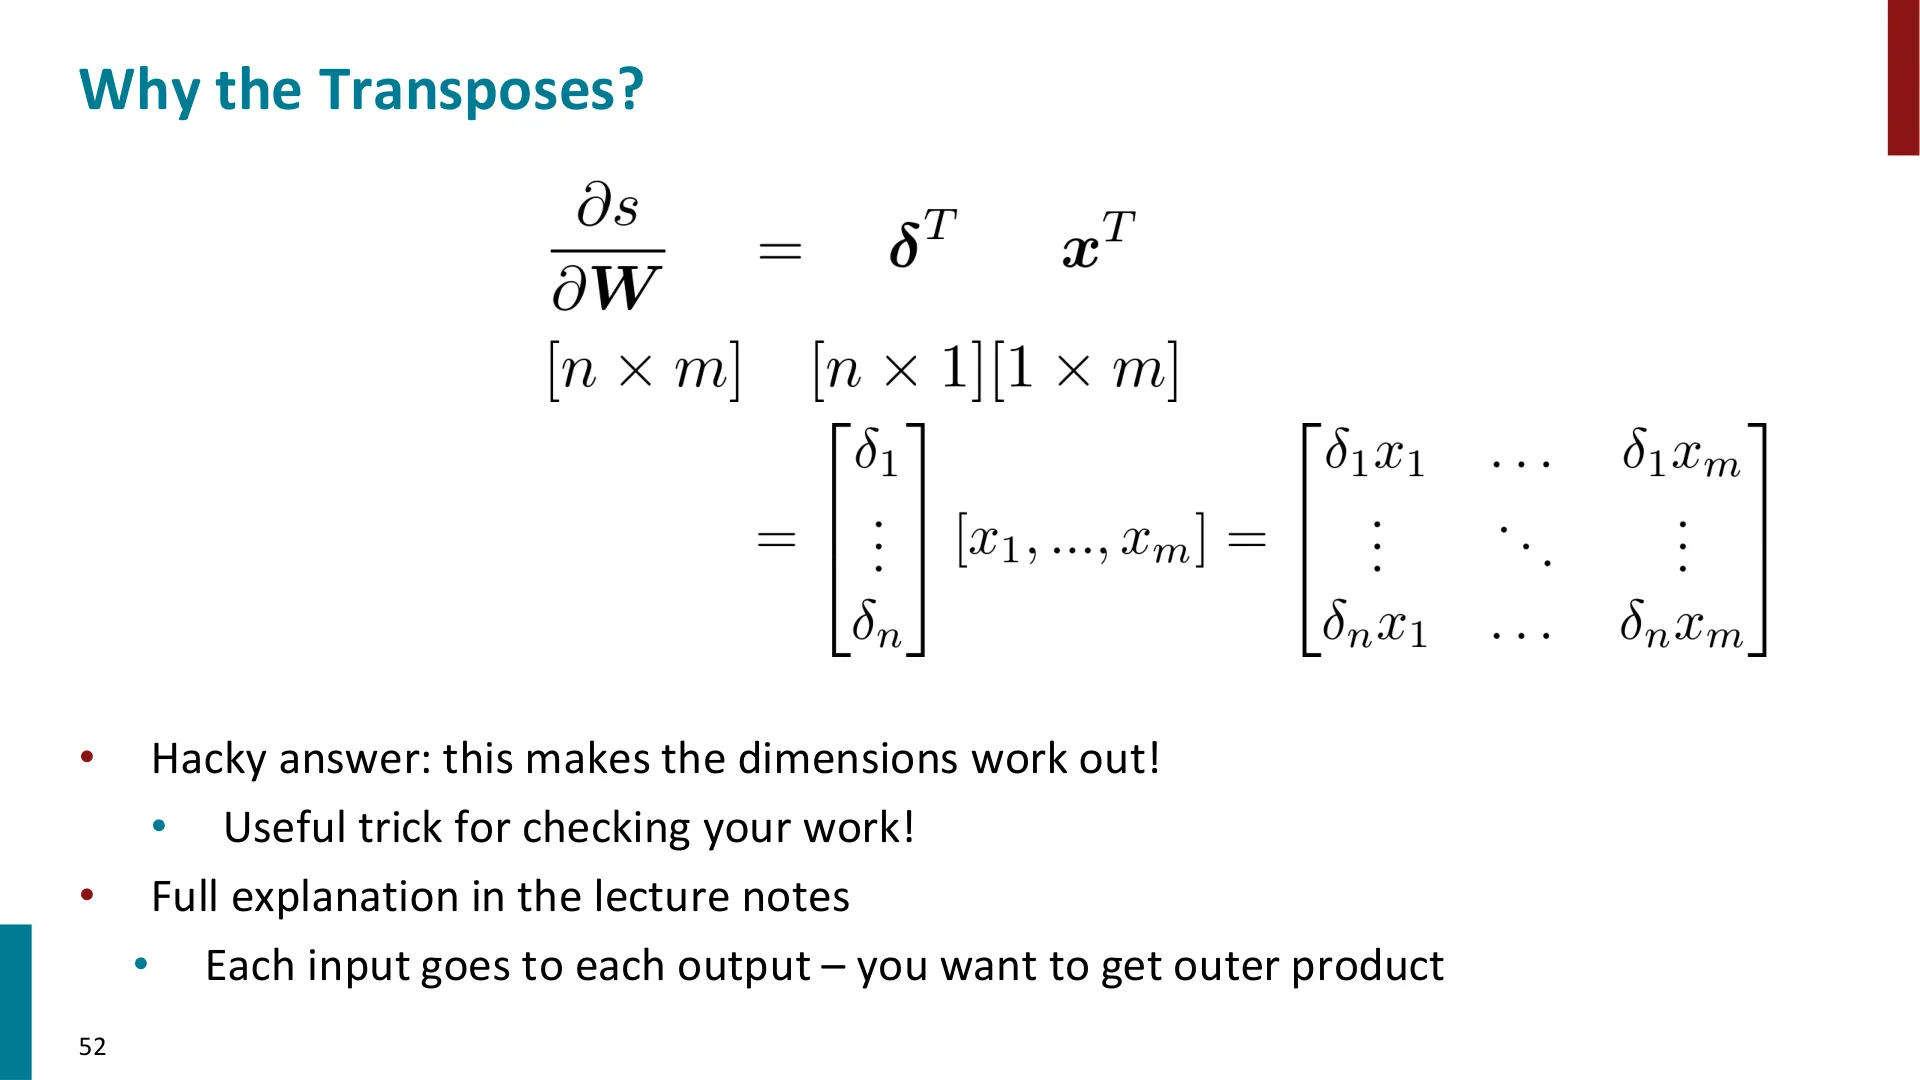
$$\frac{\partial s}{\partial \mathbf{W}} = \delta\,\mathbf{x}^\top$$
其中 $\delta$ 是 $z$ 处的上游梯度,$\mathbf{x}$ 是局部的输入信号。
📷 对矩阵求导:答案
回到原视频 (00:40:10)
为什么会有转置?
(参考时间: 41:15)
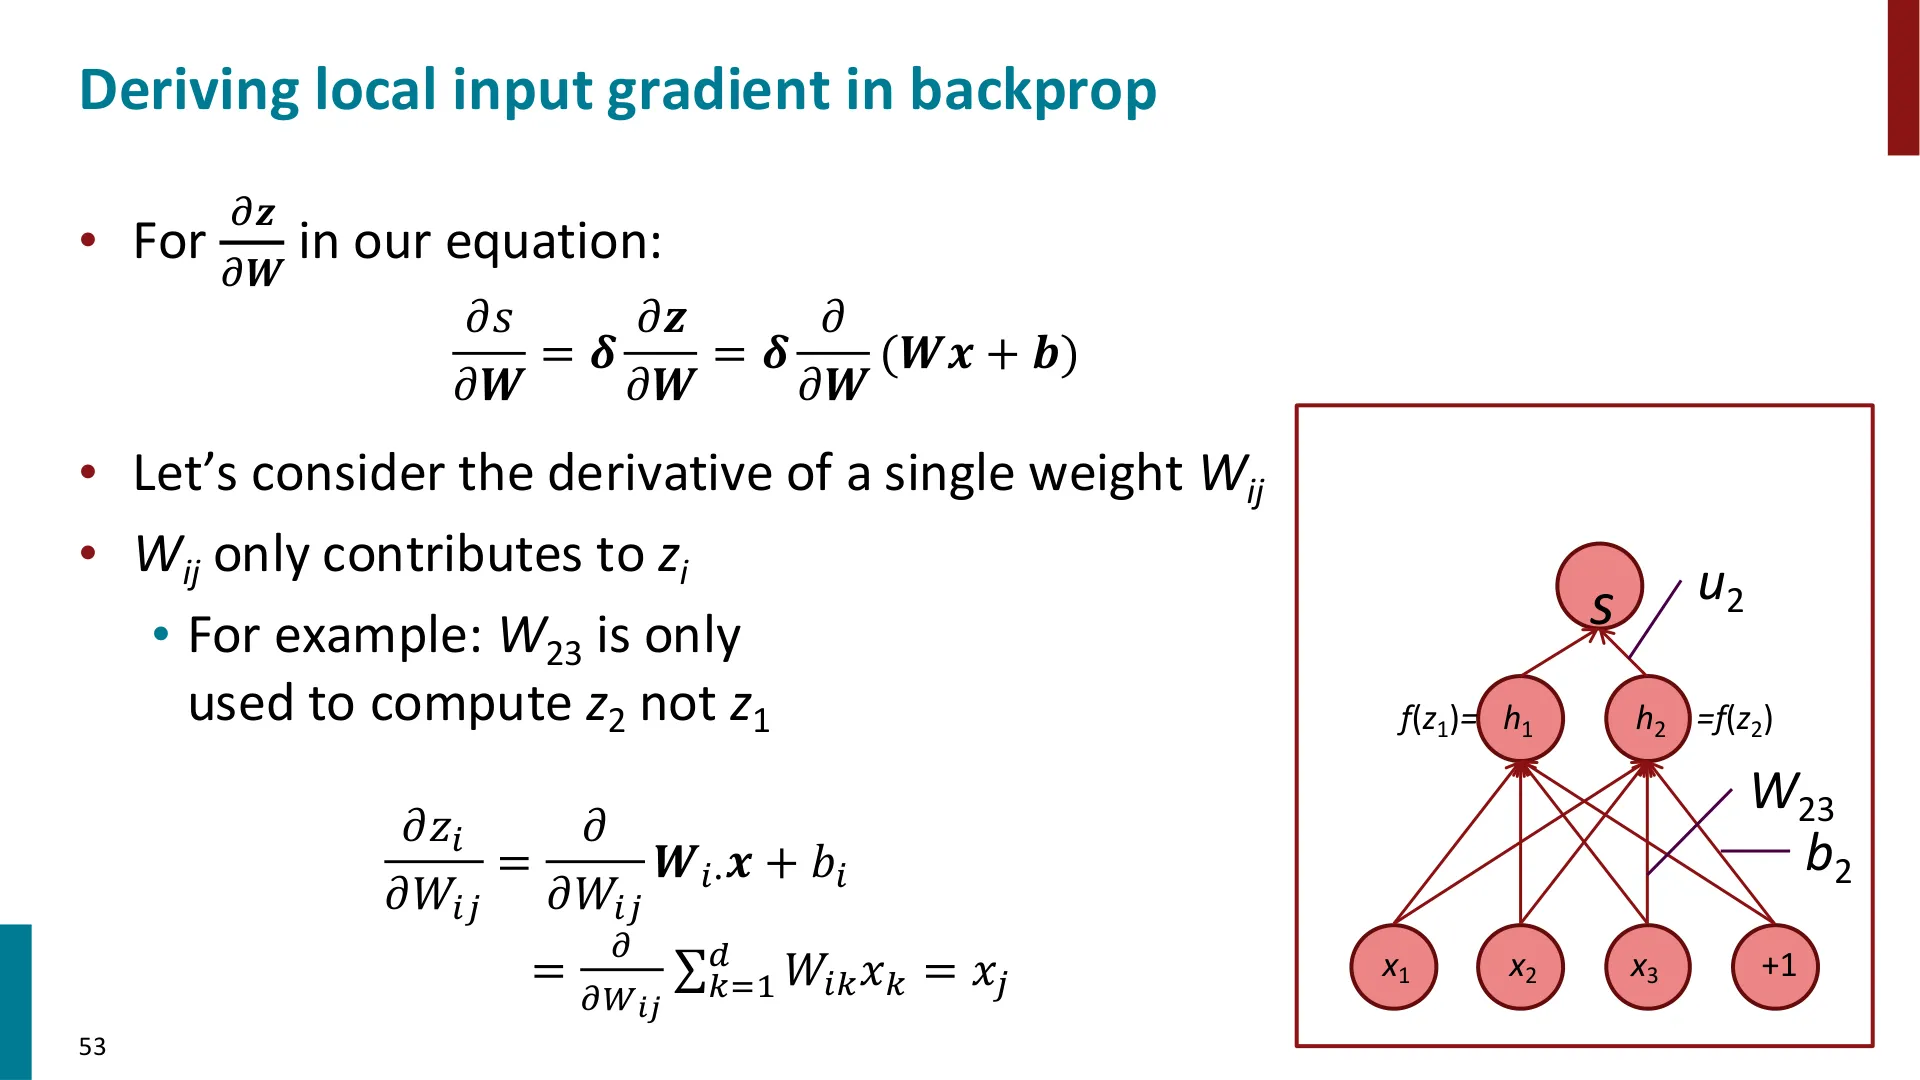
老师的"偷懒版"回答是:这样维度就对得上了,而且这是个检查作业的好技巧。完整解释在讲义里。直观上:每个输入都连到每个输出,所以想要的是外积。
他画了一个具体例子来验证:权重 $W_{23}$ 这条线,把输入 3 连到 $z_2$。它只参与 $z_2$ 的计算,且只依赖 $x_3$。所以:
$$\frac{\partial z_i}{\partial W_{ij}} = \frac{\partial}{\partial W_{ij}}\left(\sum_k W_{ik}x_k\right) = x_j$$
——也就是"某个权重只影响它对应的那个输出、只依赖它对应的那个输入",这正是外积的结构。
📷 为什么需要转置:W23 只影响 z2
回到原视频 (00:41:15)
两种做题方式
(参考时间: 42:35)
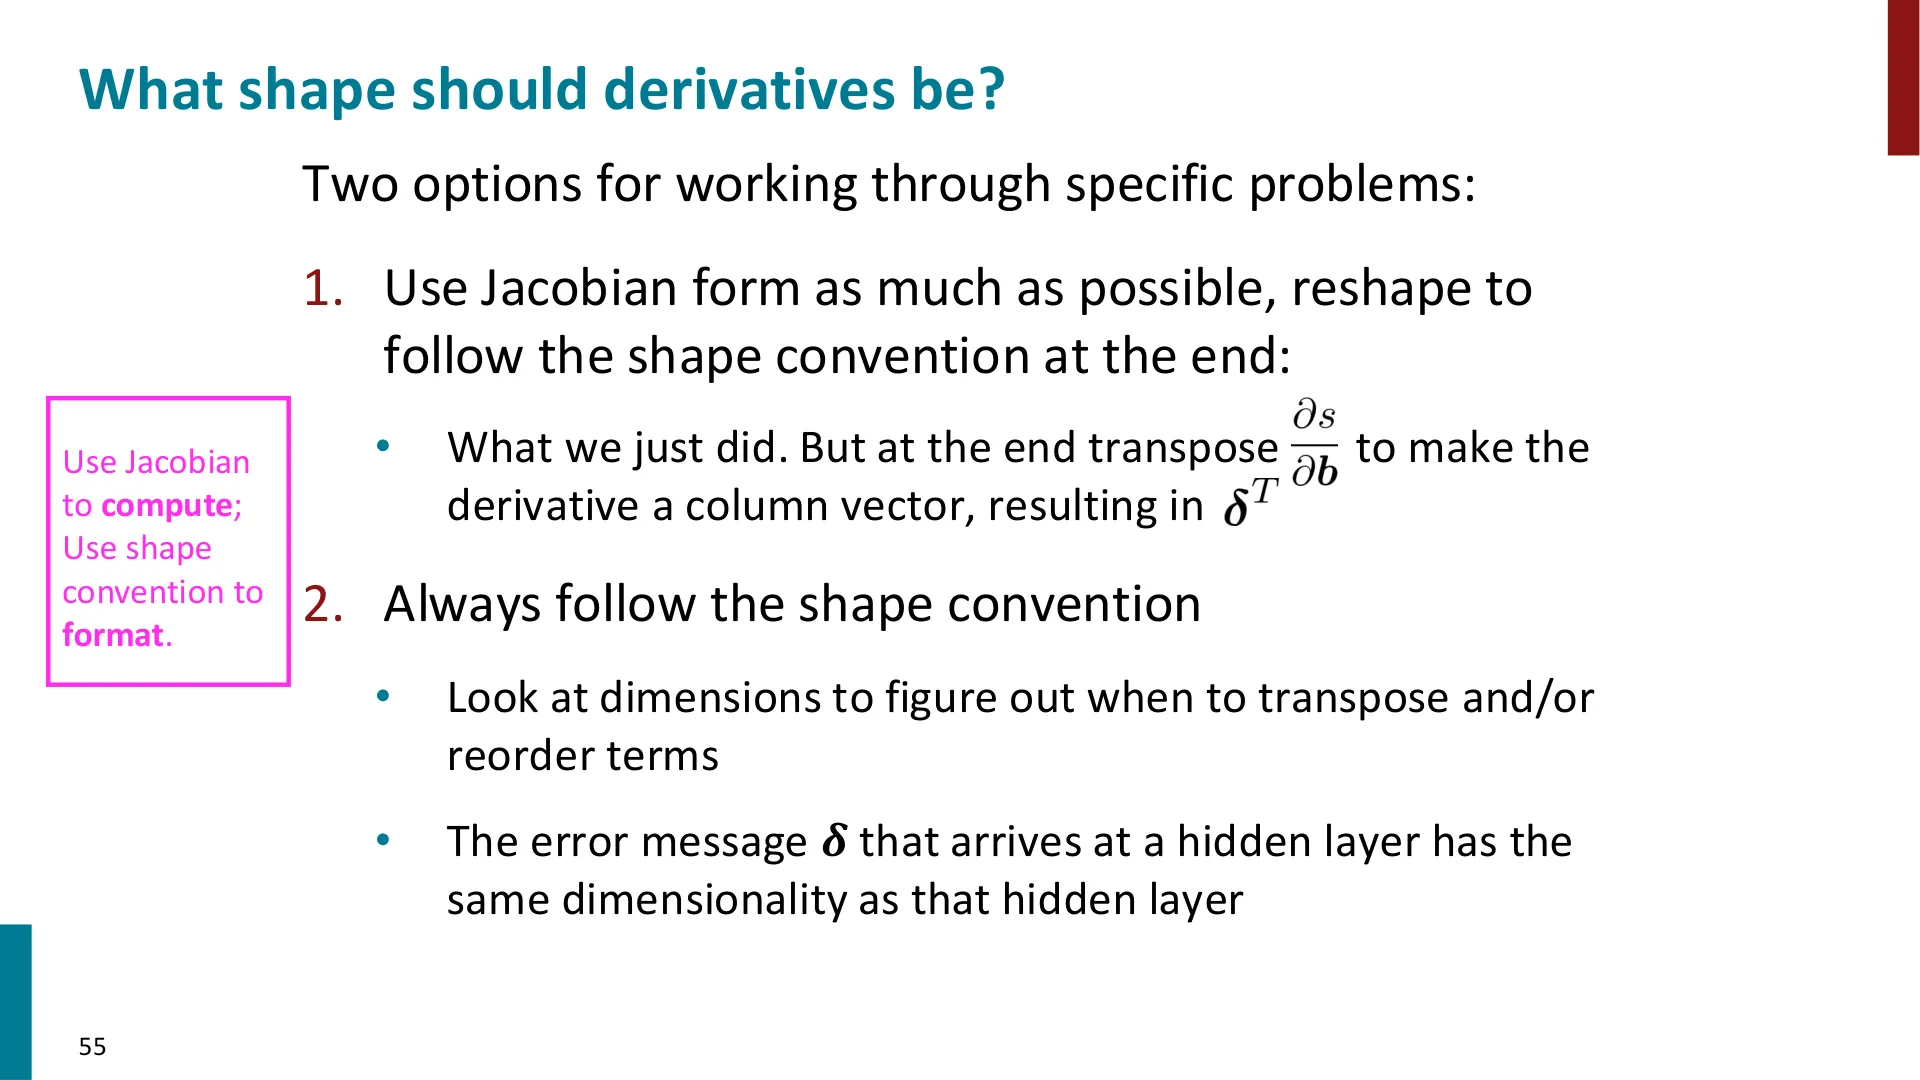
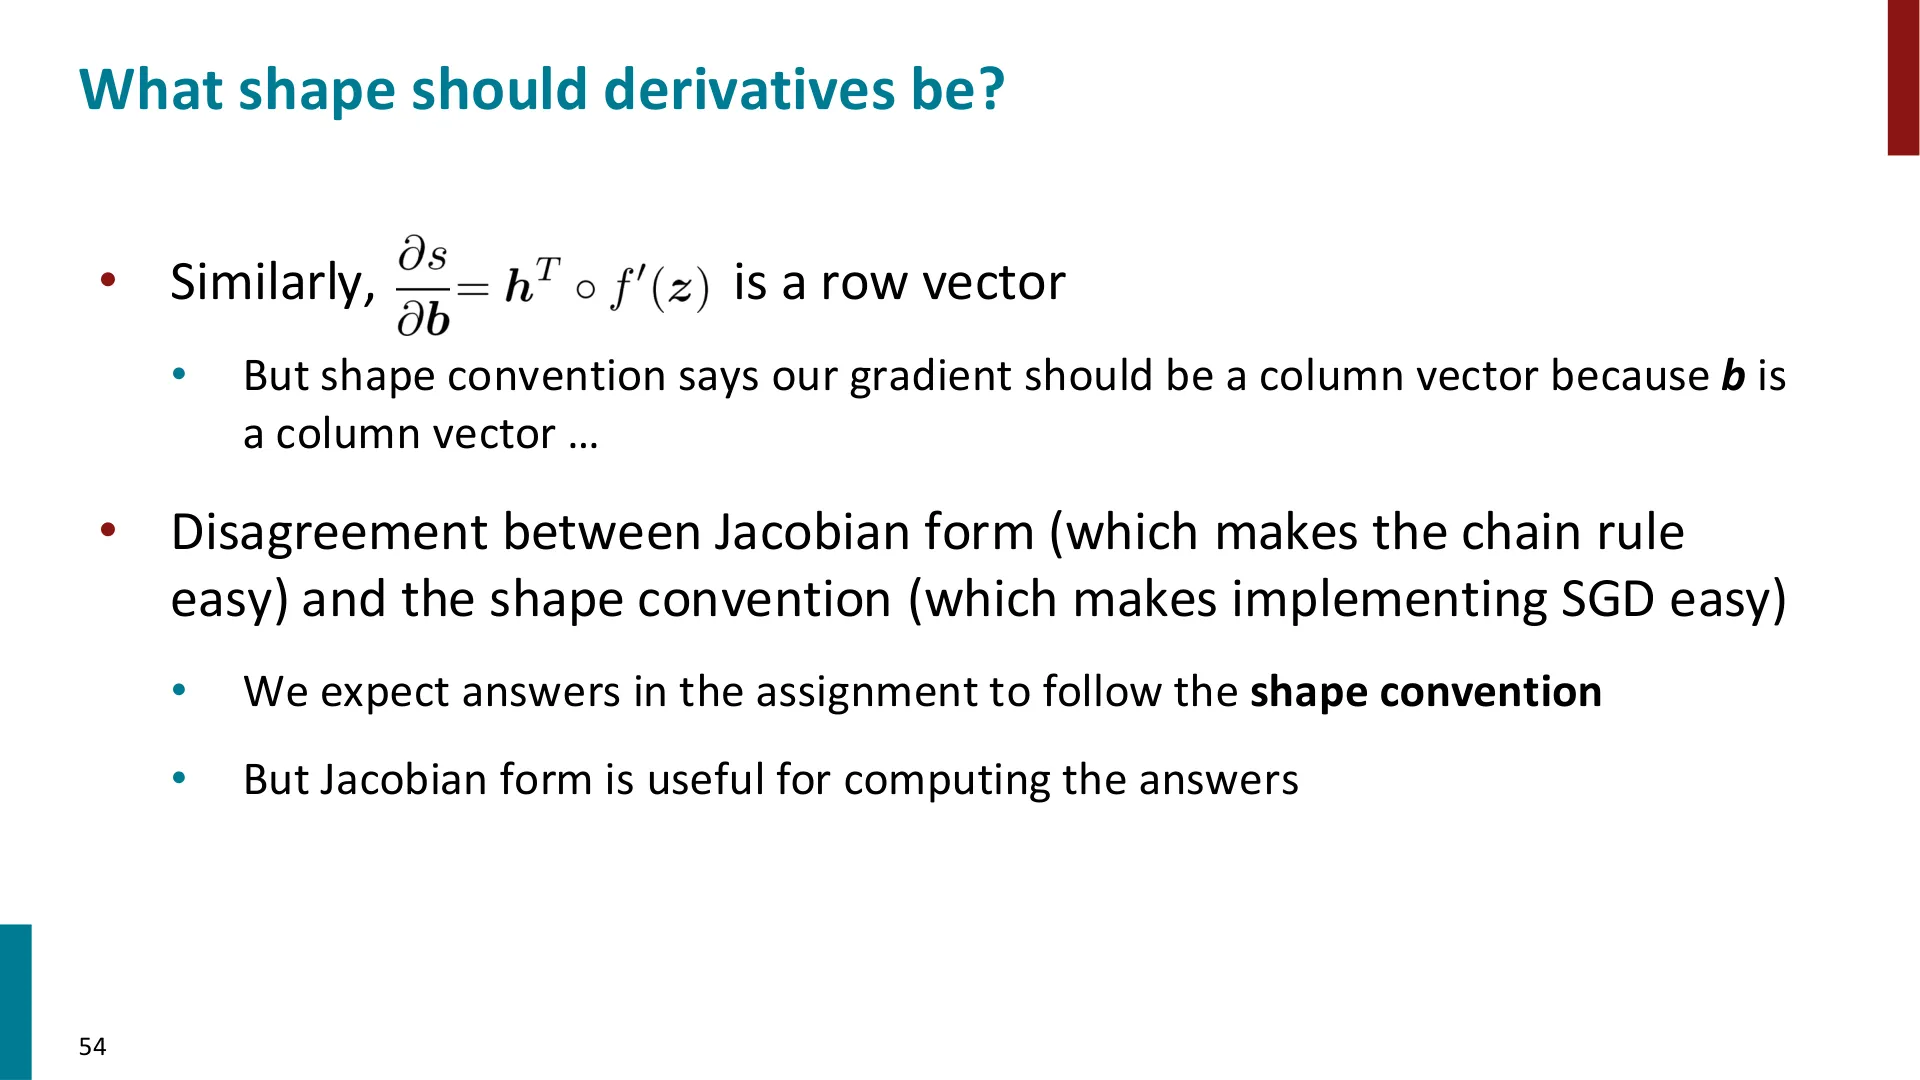
老师总结了处理"形状问题"的两条路线:
- 尽量用雅可比形式算,最后再改形,让它符合形状约定;
- 全程遵守形状约定,靠看维度决定何时转置、如何重排。
他给了一个非常有用的直觉:到达某个隐藏层的误差信号 $\delta$,其维度应该和该隐藏层本身相同。
在作业里,我们期望你按形状约定给出答案;但用雅可比形式来"算"往往更方便。
📷 导数应该是什么形状(1)
回到原视频 (00:42:35)
七、反向传播:计算图与局部梯度
(参考时间: 44:50)
到这里,其实已经"几乎把反向传播展示完了"。老师把它精炼成两句话:
反向传播 = 求导并用(广义 / 多元 / 矩阵)链式法则 + 复用高阶层已算出的导数,来算低阶层的导数,从而把重复计算降到最低。
📷 反向传播:链式法则 + 复用计算
回到原视频 (00:44:50)
计算图
(参考时间: 45:42)
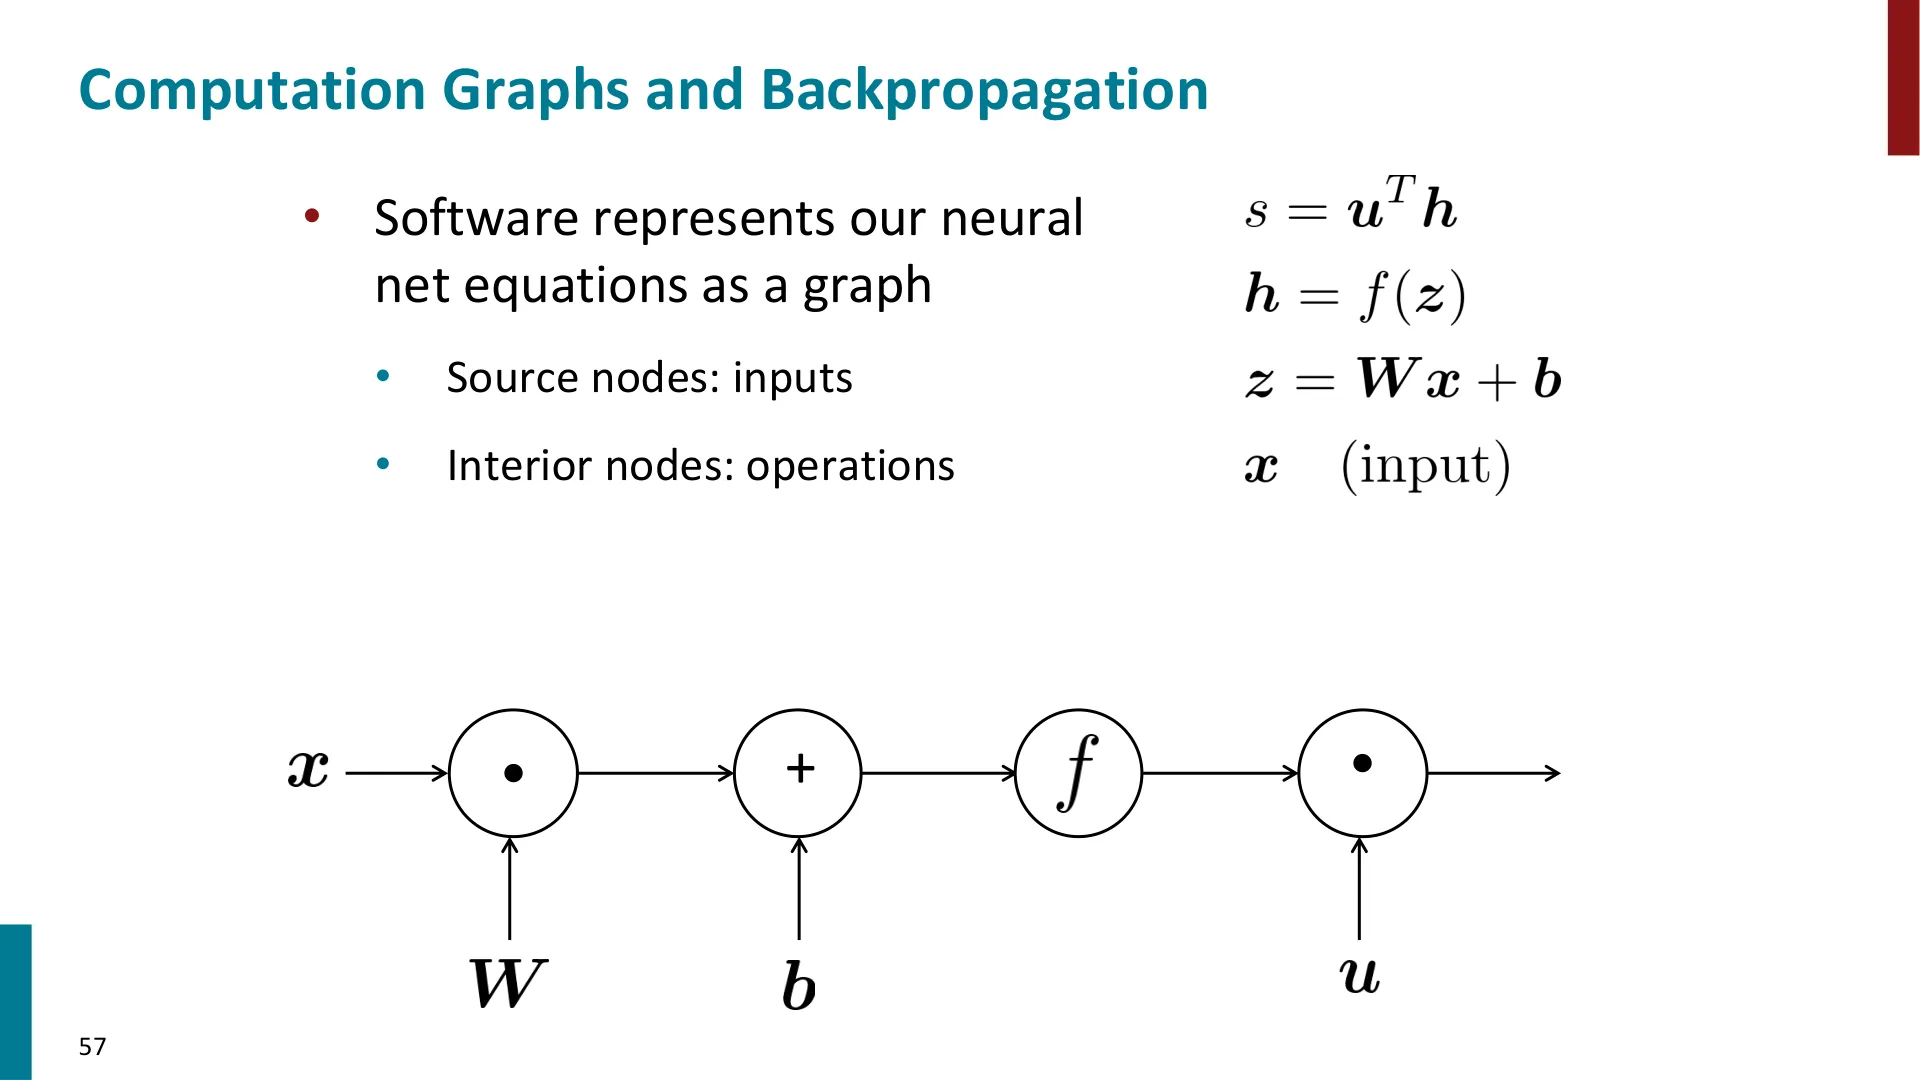
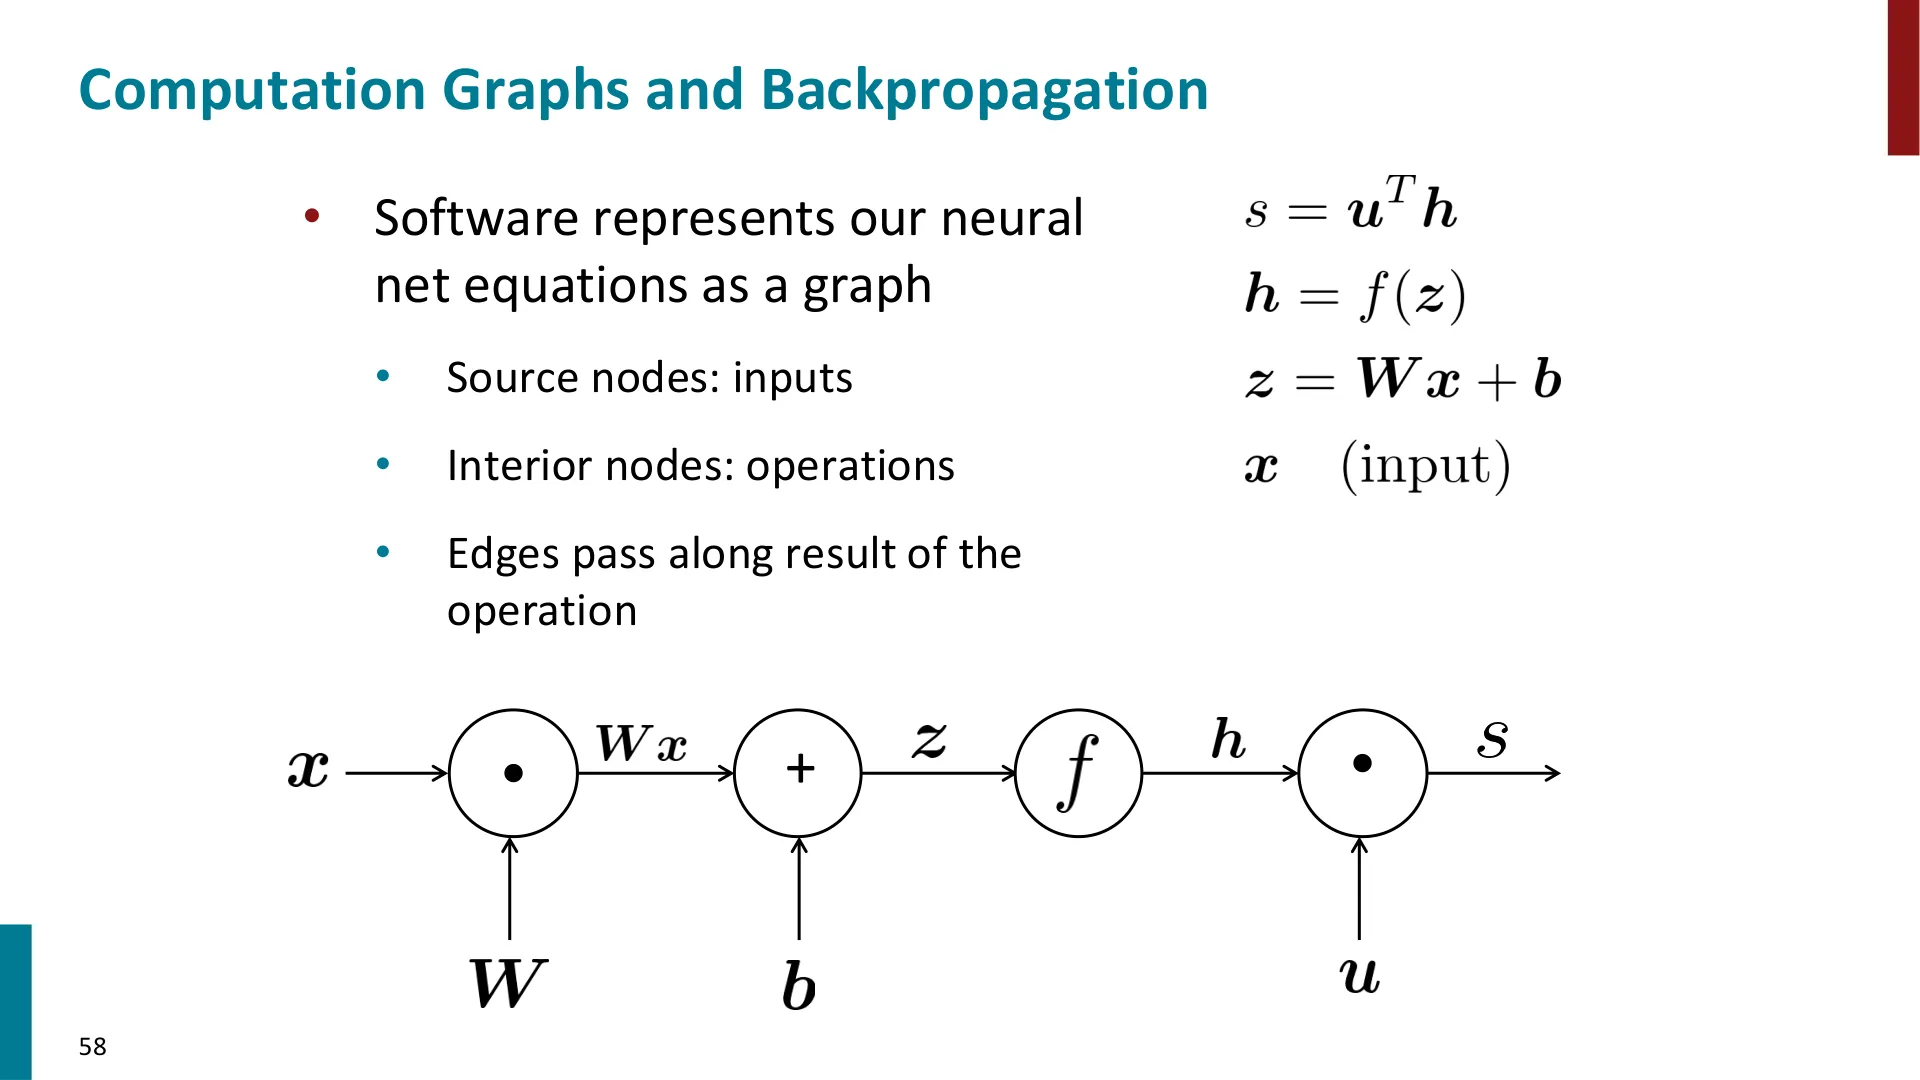
软件把神经网络的方程表示成一张图:
- 源节点:输入;
- 内部节点:运算;
- 边:把运算结果往下传。
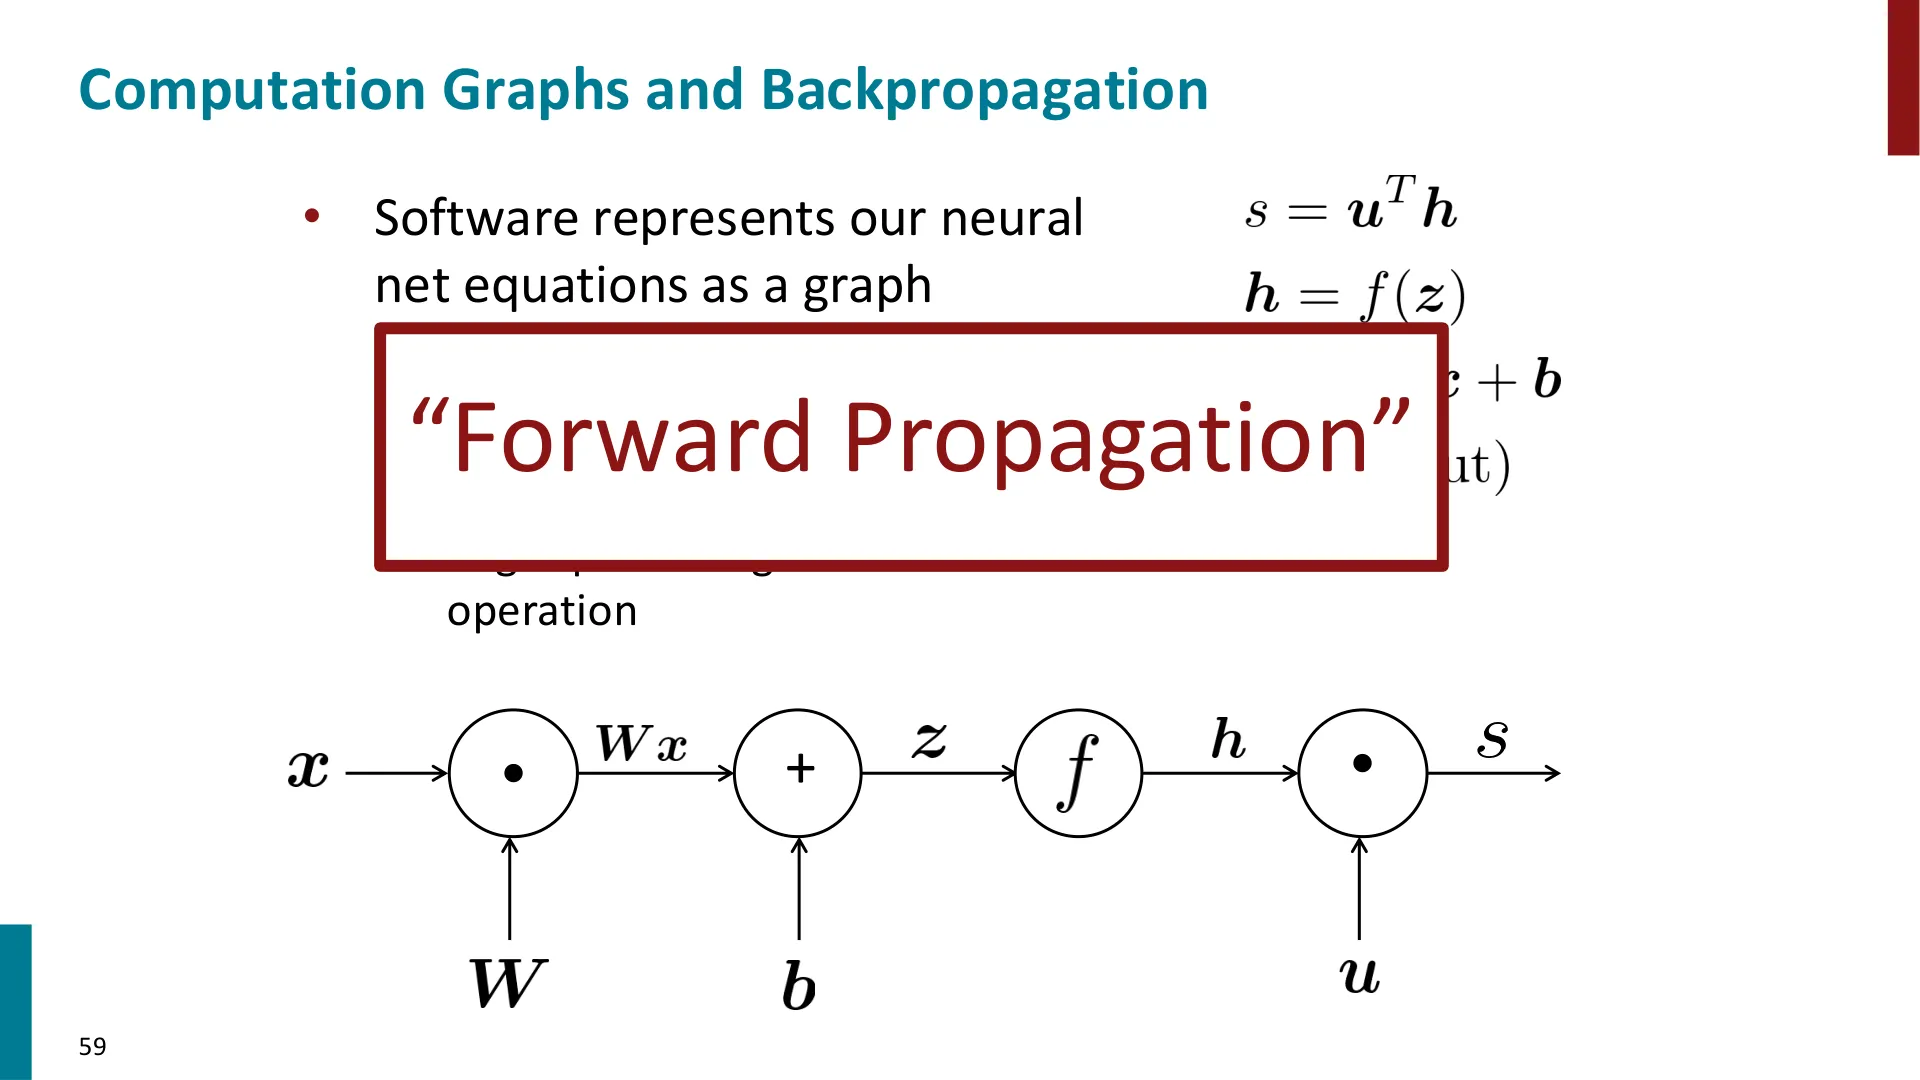
📷 计算图:源节点、内部节点与边
回到原视频 (00:45:42)
把我们的小网络画成图,就是"从 $\mathbf{x}$ 出发 → $\times \mathbf{W}$ → $+\mathbf{b}$ → 过非线性 → 与 $\mathbf{u}$ 点积 → 得到 $s$":
graph LR
    X["x(词向量拼接)"] --> MUL["× W"]
    W["W"] --> MUL
    MUL --> ADD["+ b"]
    B["b"] --> ADD
    ADD --> Z["z"]
    Z --> NL["f(·) 非线性"]
    NL --> H["h"]
    H --> DOT["点积 uᵀh"]
    U["u"] --> DOT
    DOT --> S["s"]
前向传播(forward propagation)就是顺着这张图算函数值。
反向传播:单个节点
(参考时间: 47:32)
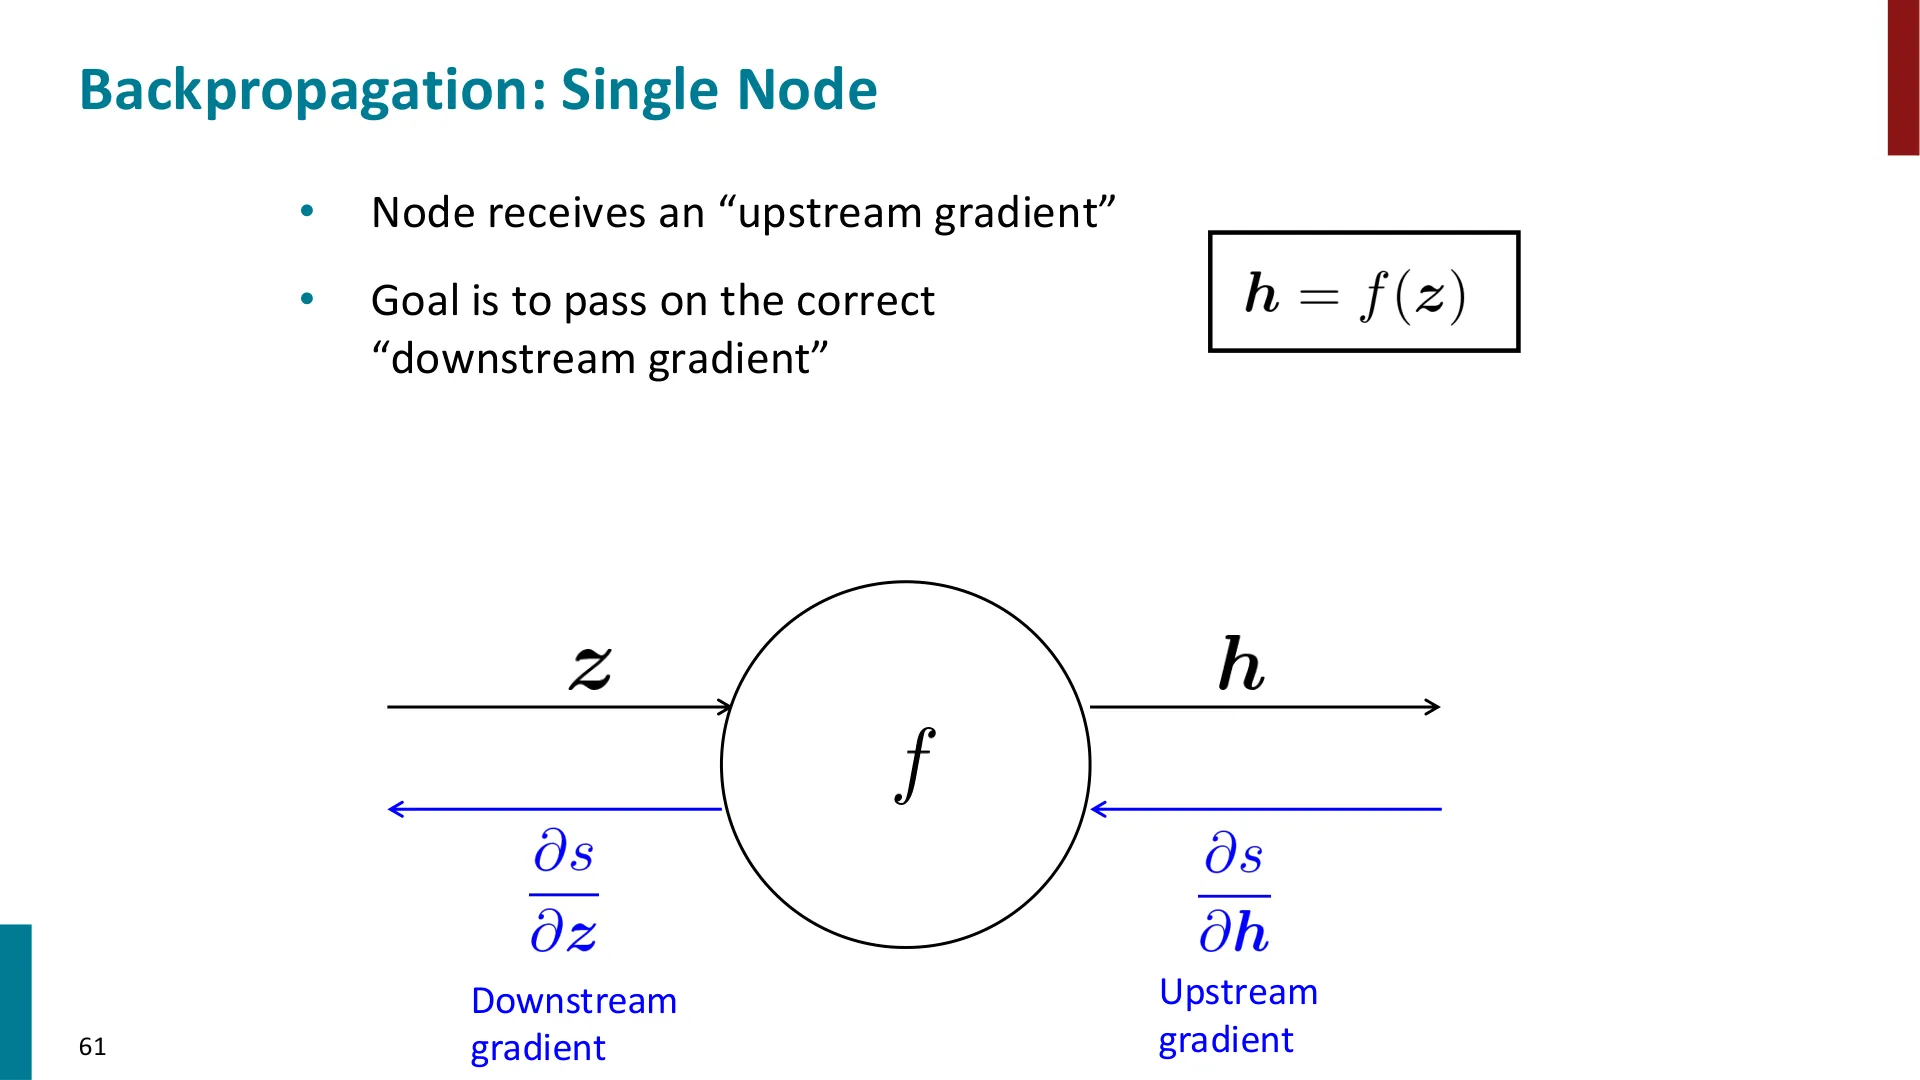
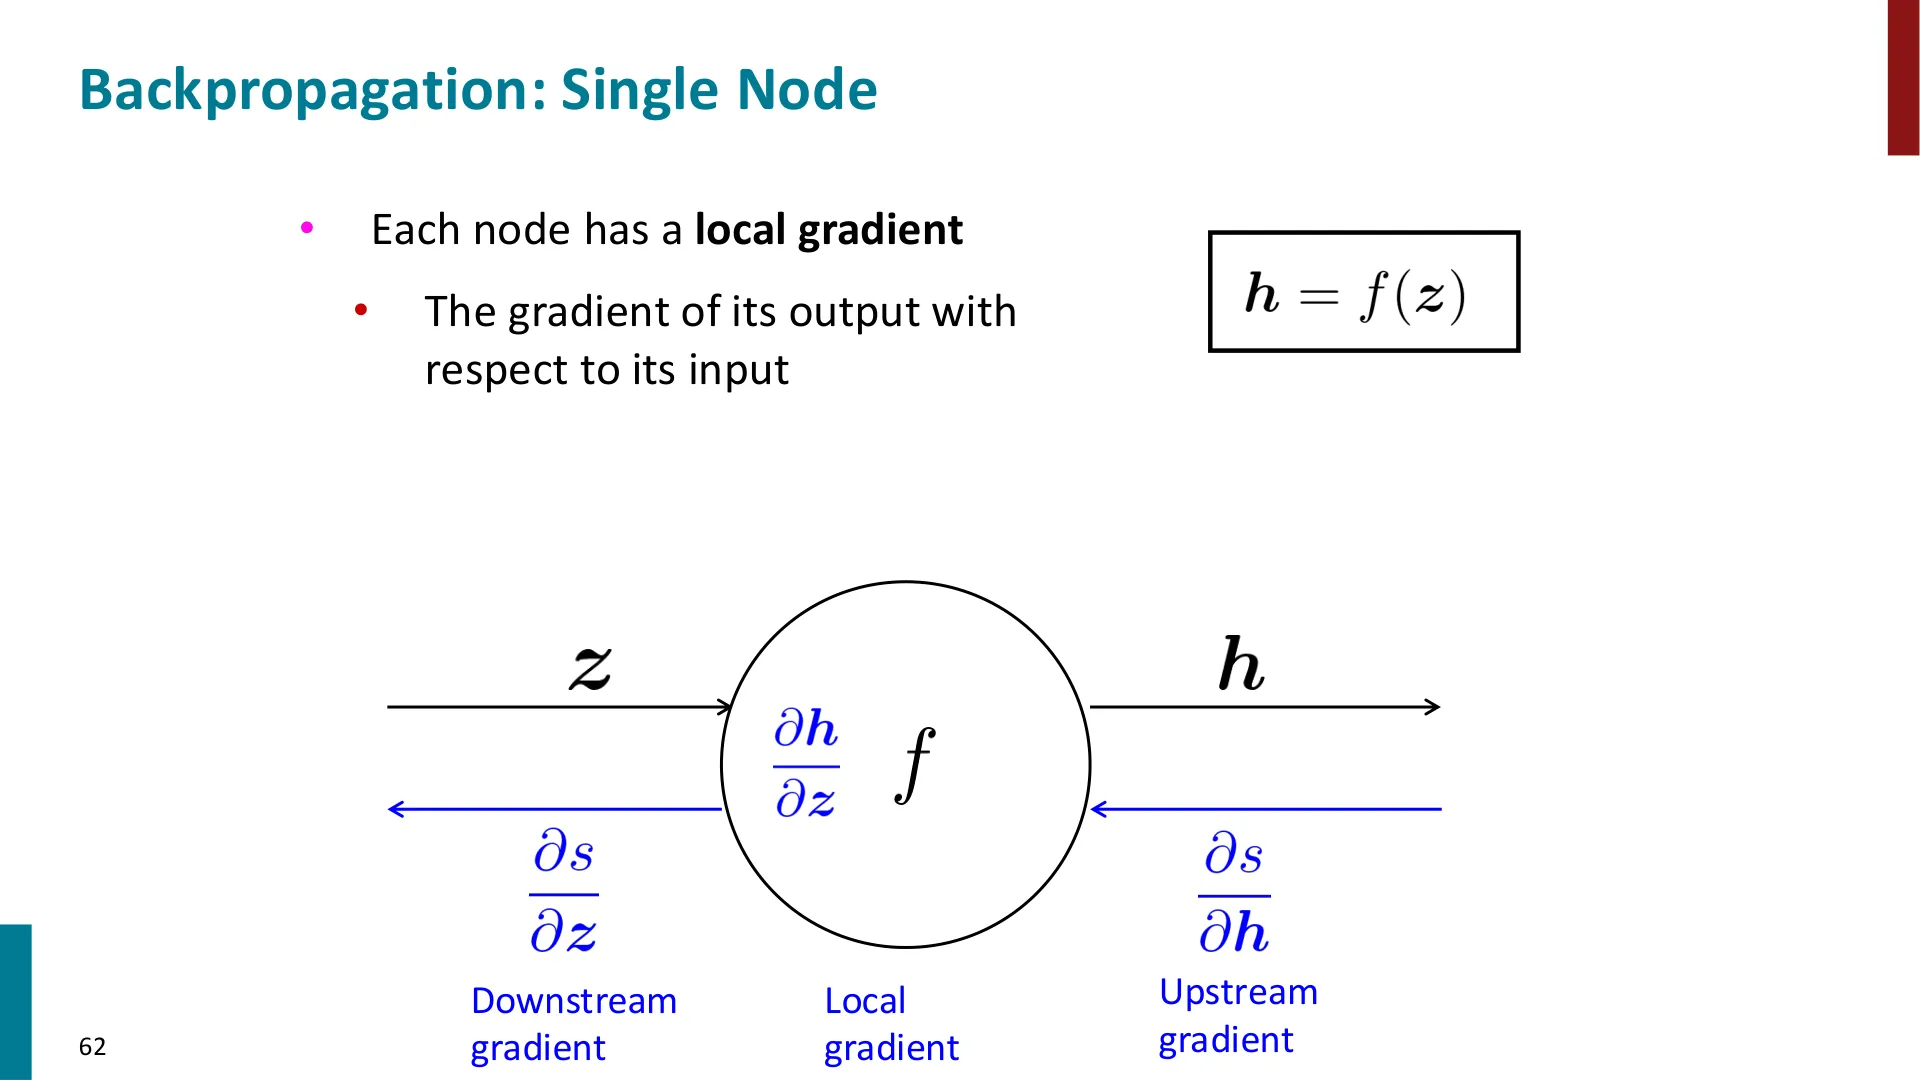
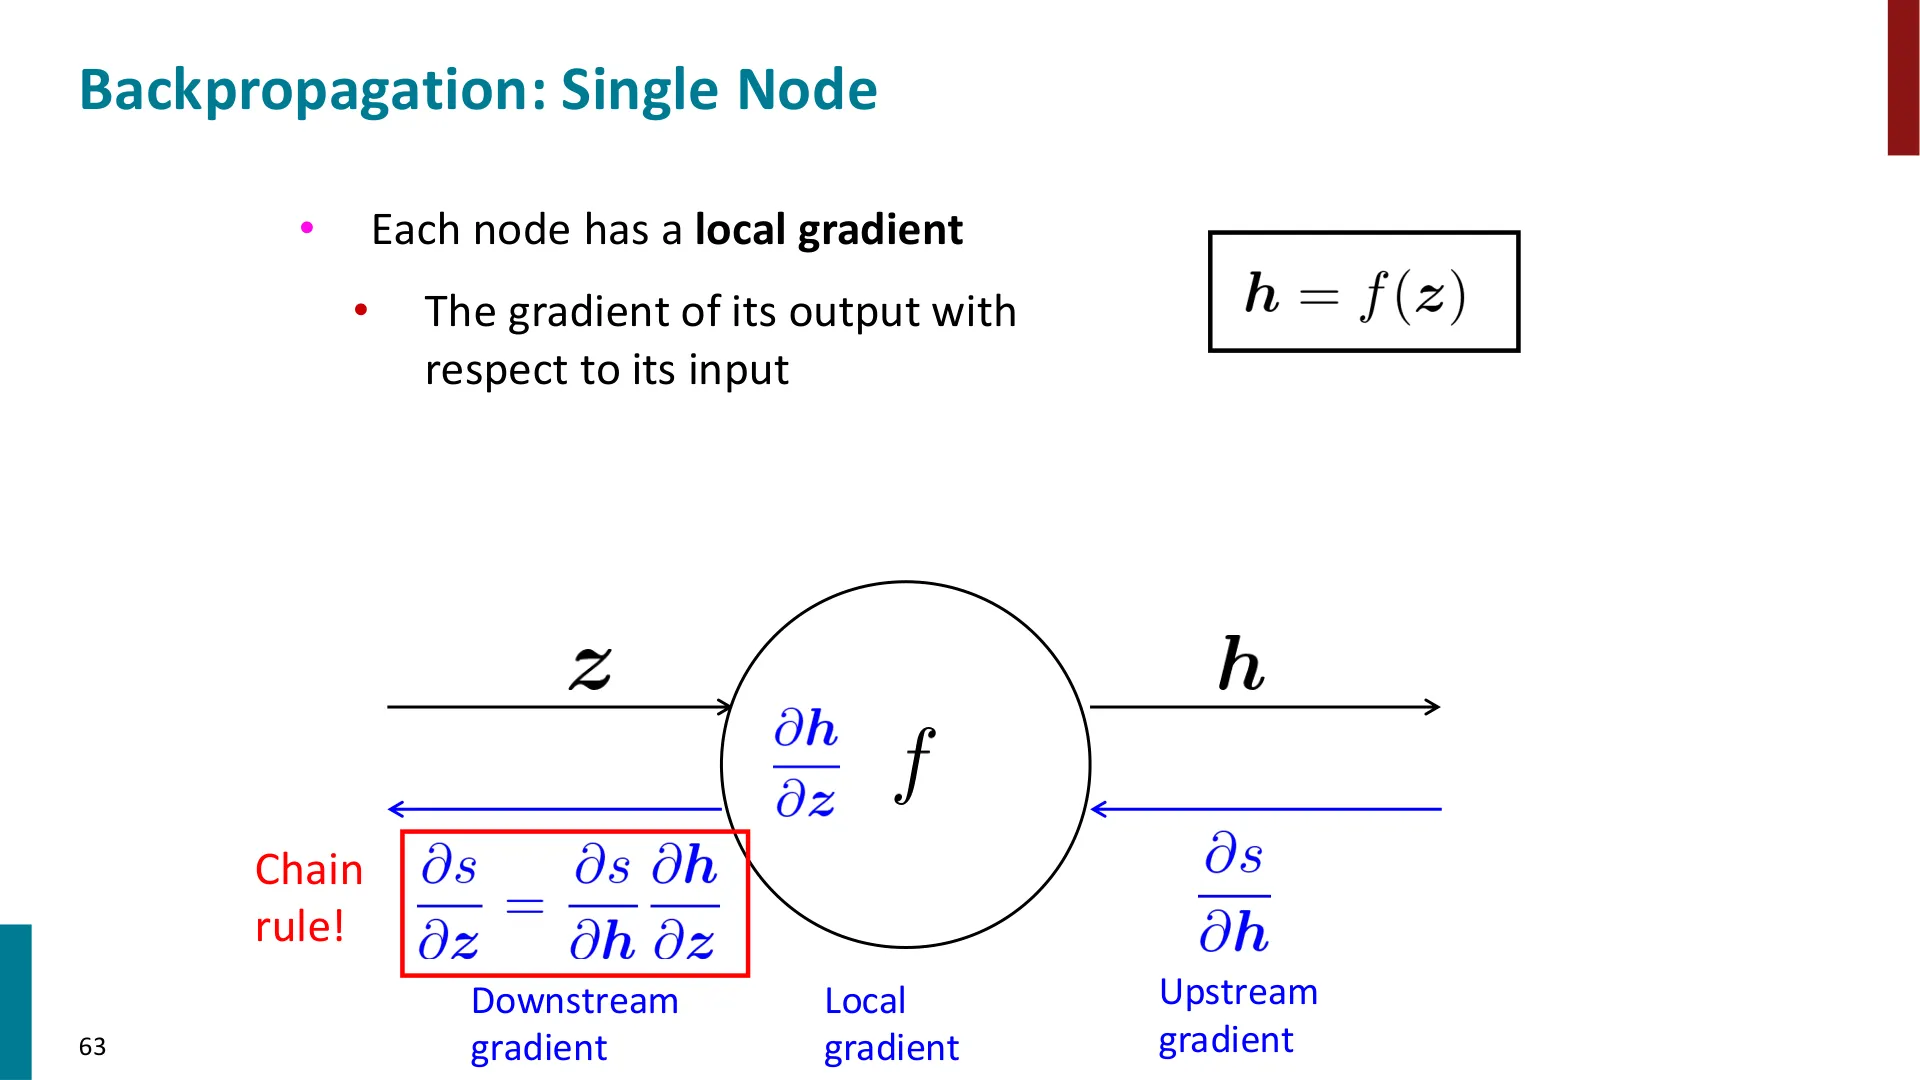
然后沿边反向走,传递梯度。每个节点:
- 收到一个上游梯度;
- 目标是传出正确的下游梯度;
- 每个节点有一个局部梯度(它"输出对输入"的导数)。
于是链式法则给出:
$$\text{[下游梯度]} = \text{[上游梯度]} \times \text{[局部梯度]}$$
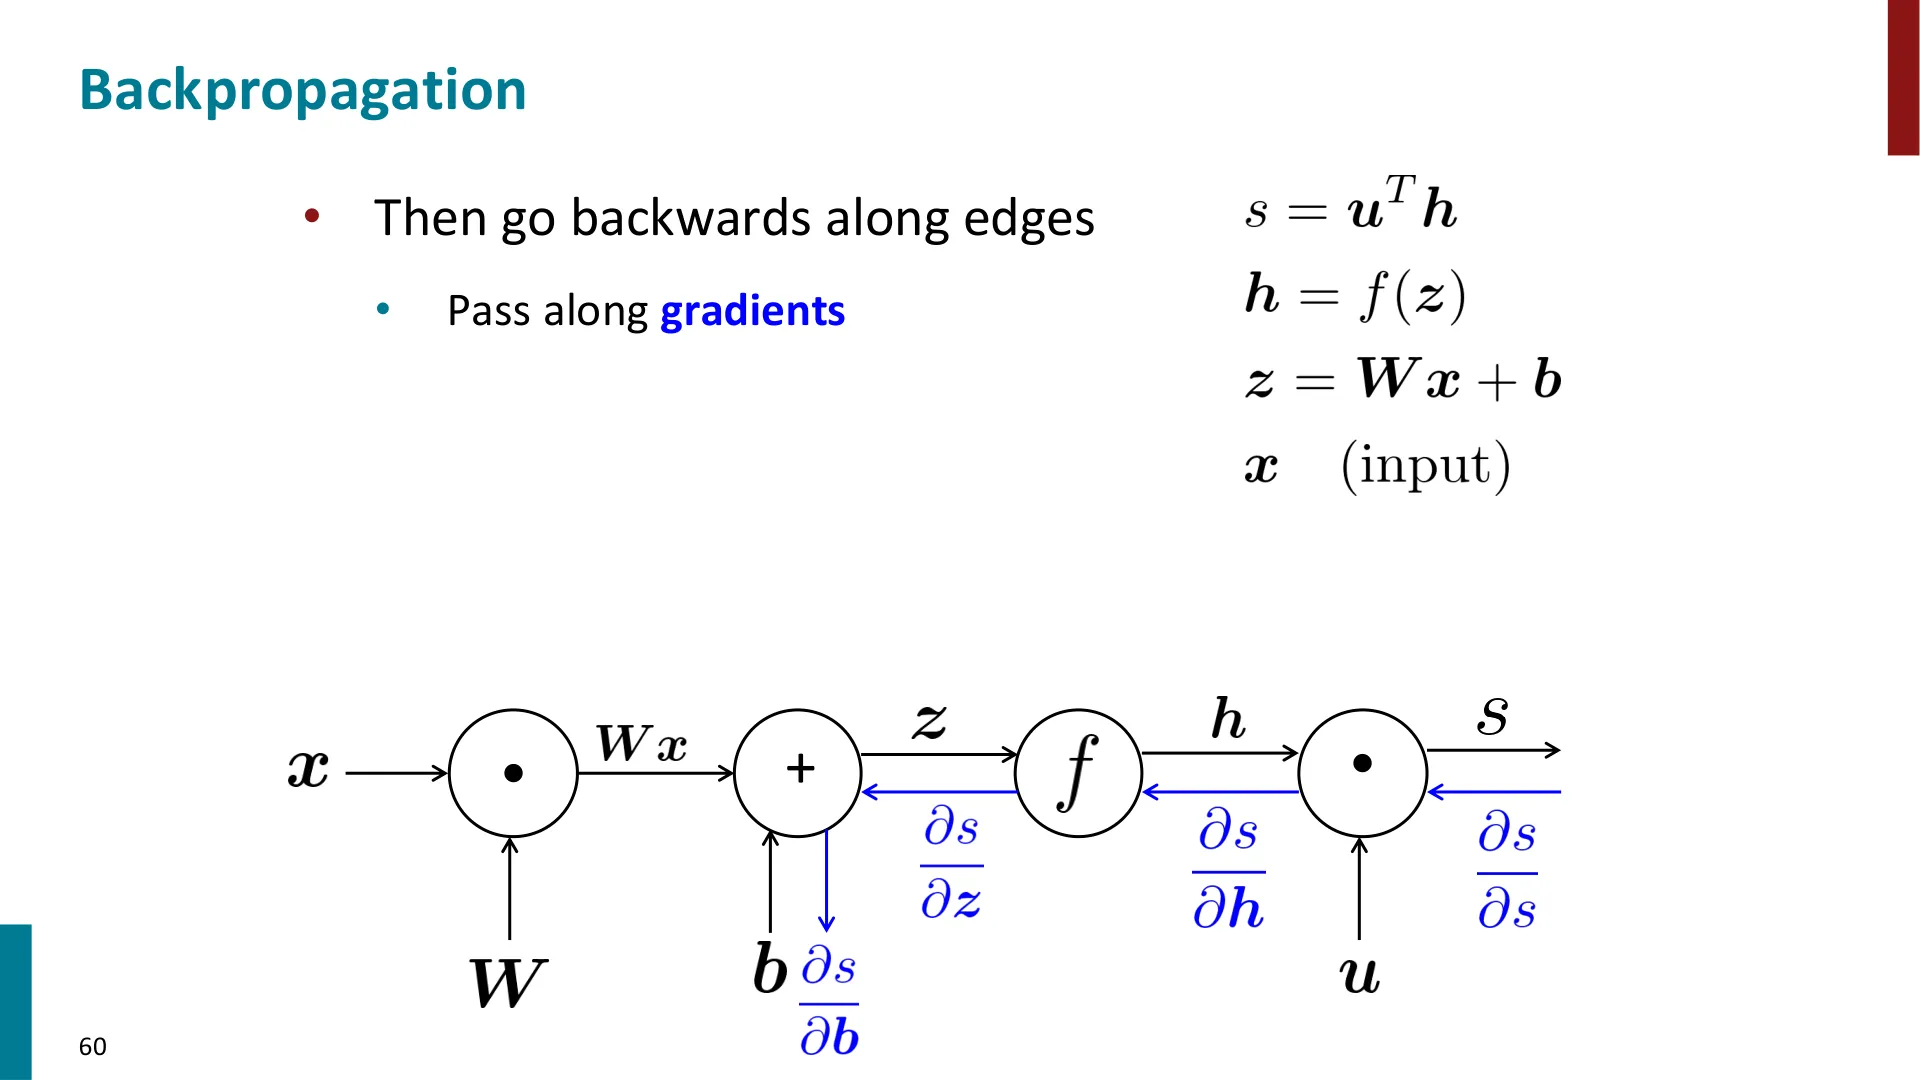
📷 反向传播:沿边反向传递梯度
回到原视频 (00:47:32)
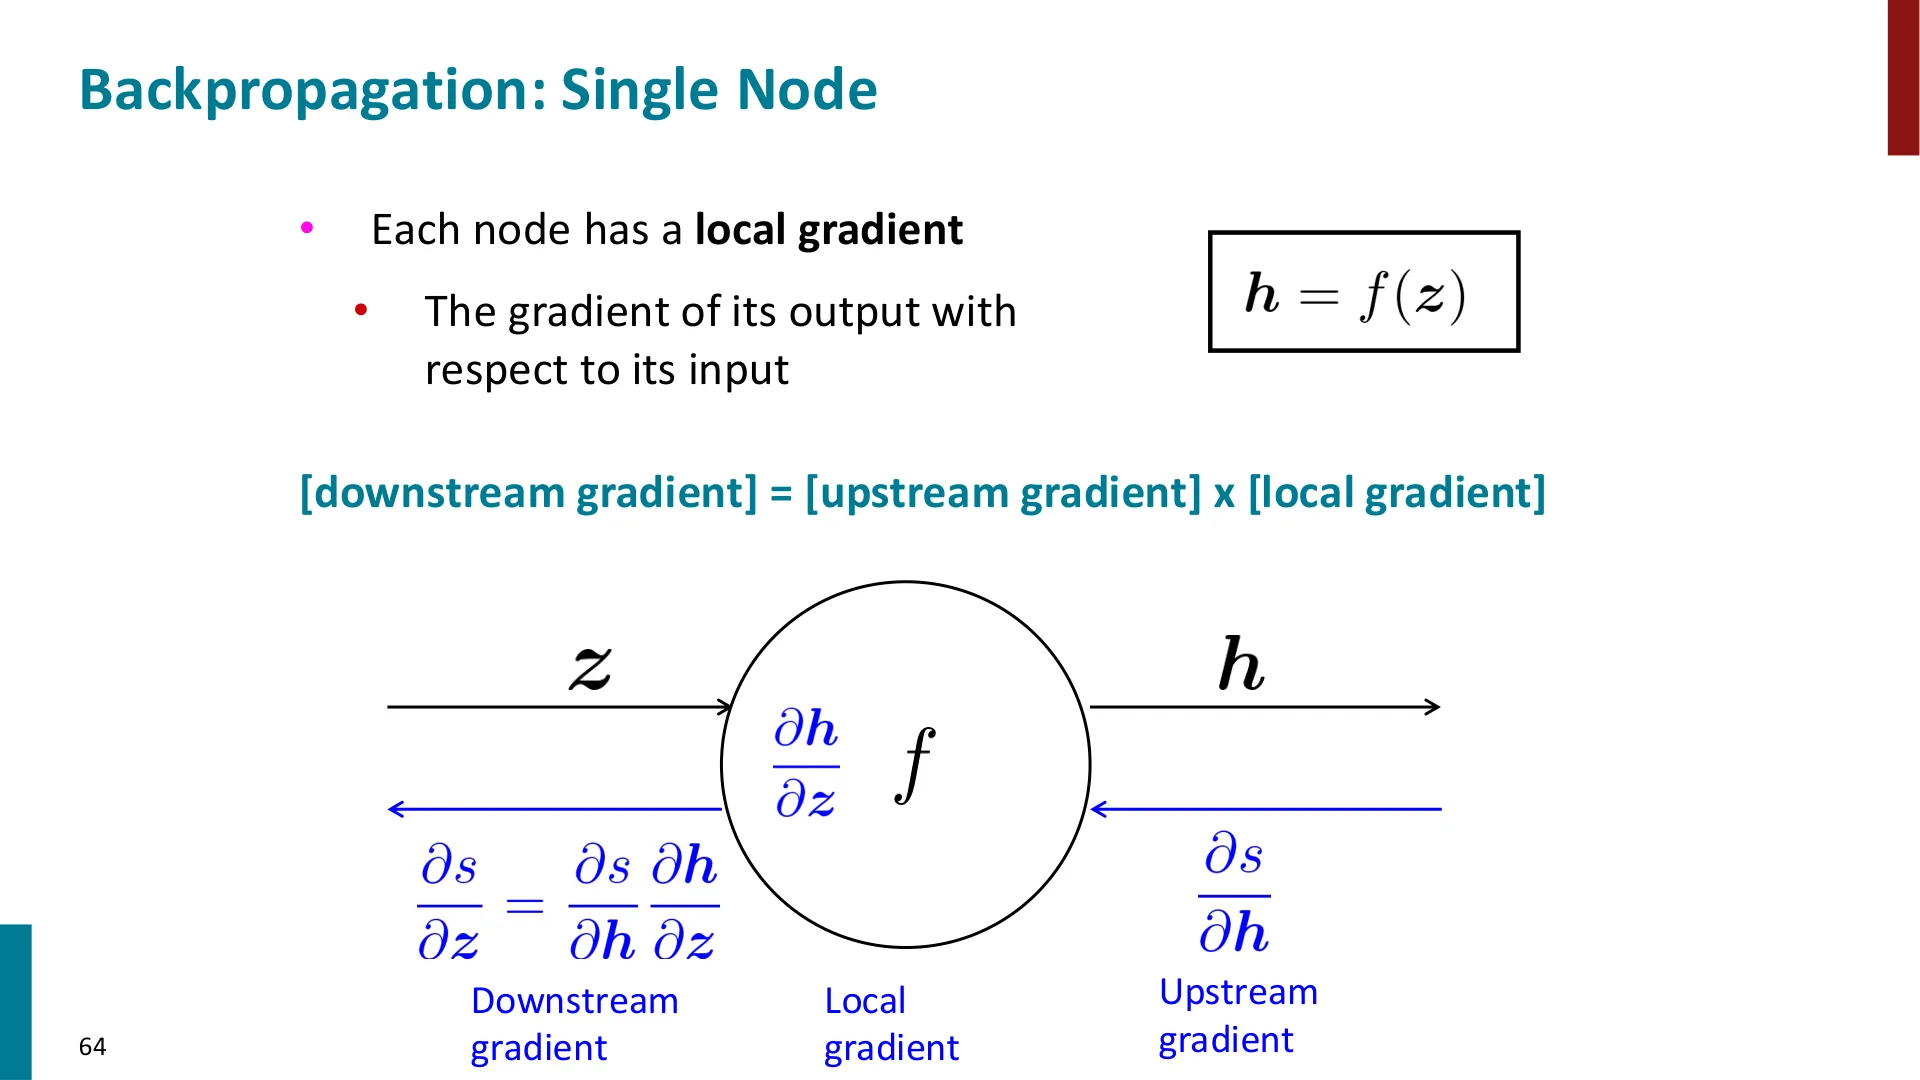
📷 单节点反向传播(1)
回到原视频 (00:48:11)
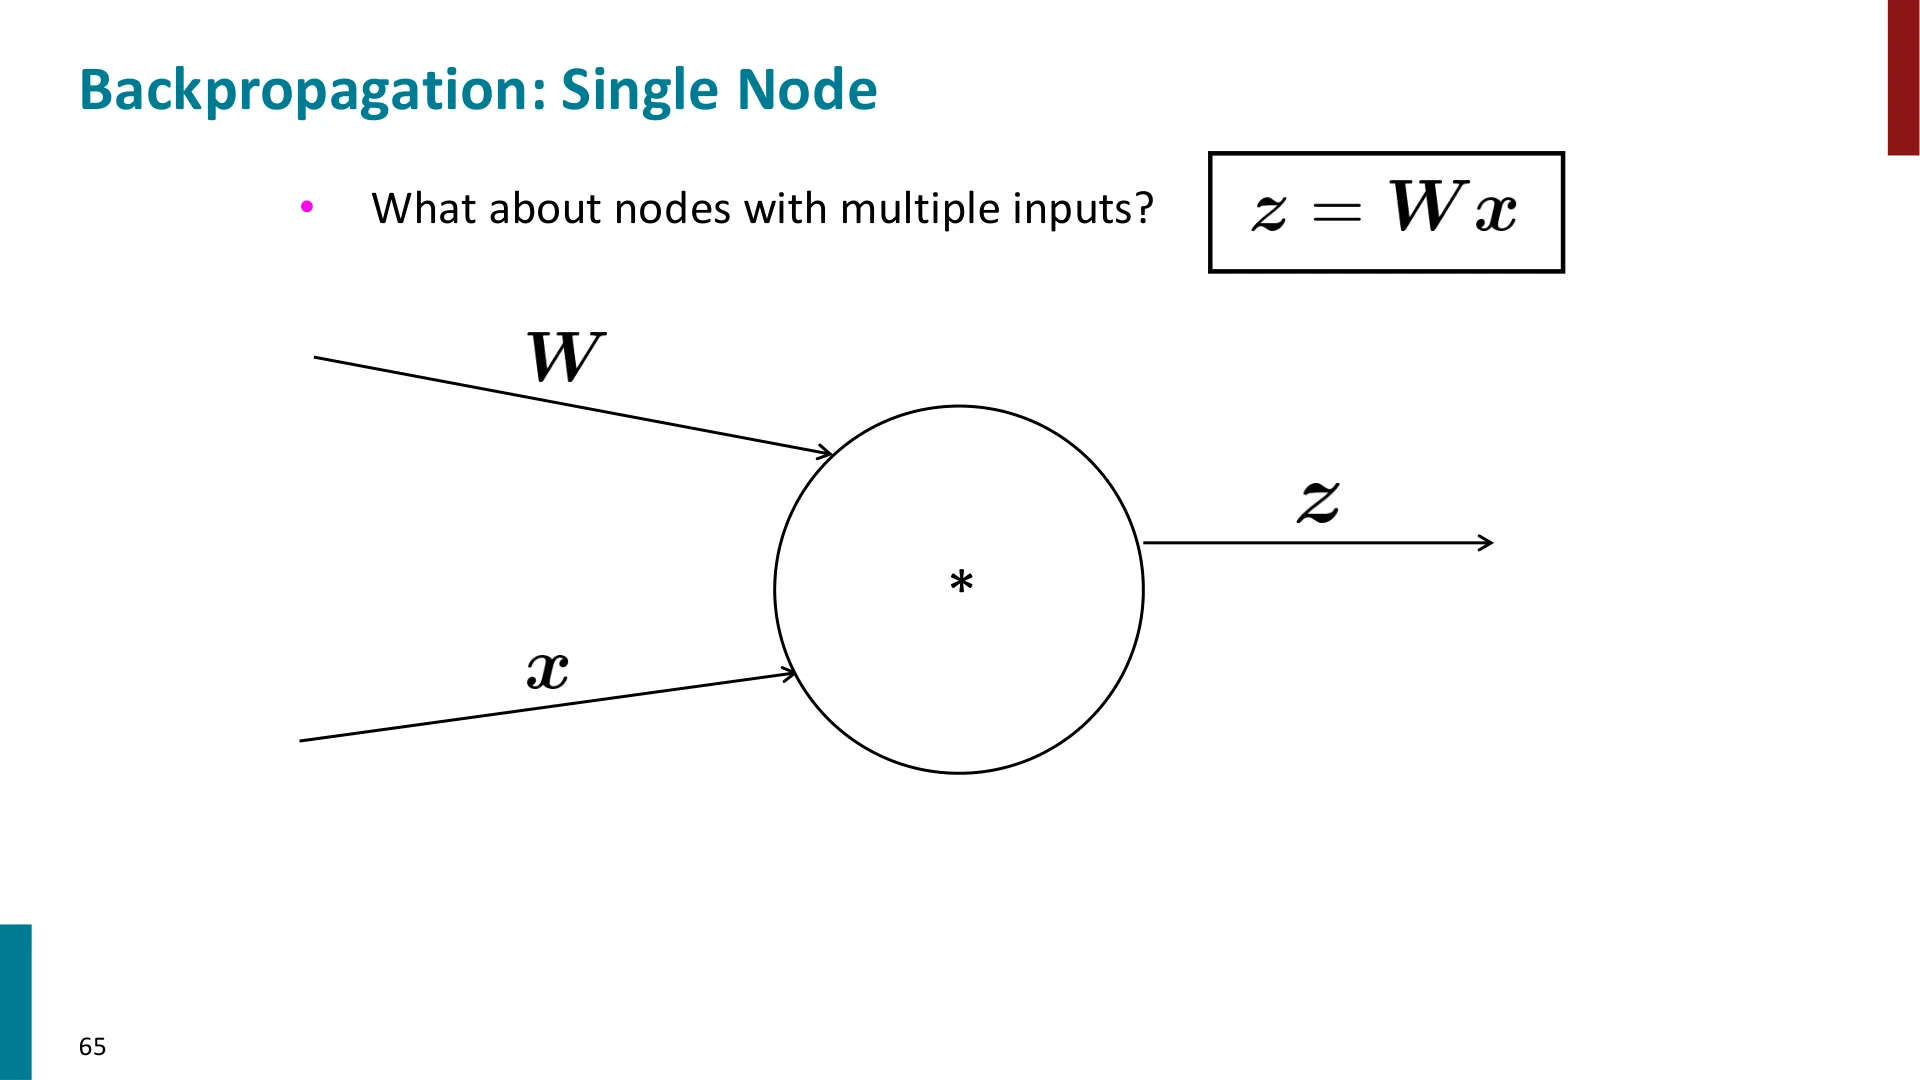
多输入的节点
(参考时间: 49:34)
如果一个节点有多个输入(比如 $\mathbf{W}\mathbf{x}$),那么是一个上游梯度、多个局部梯度,对每个输入分别做"上游 × 对应局部梯度"。
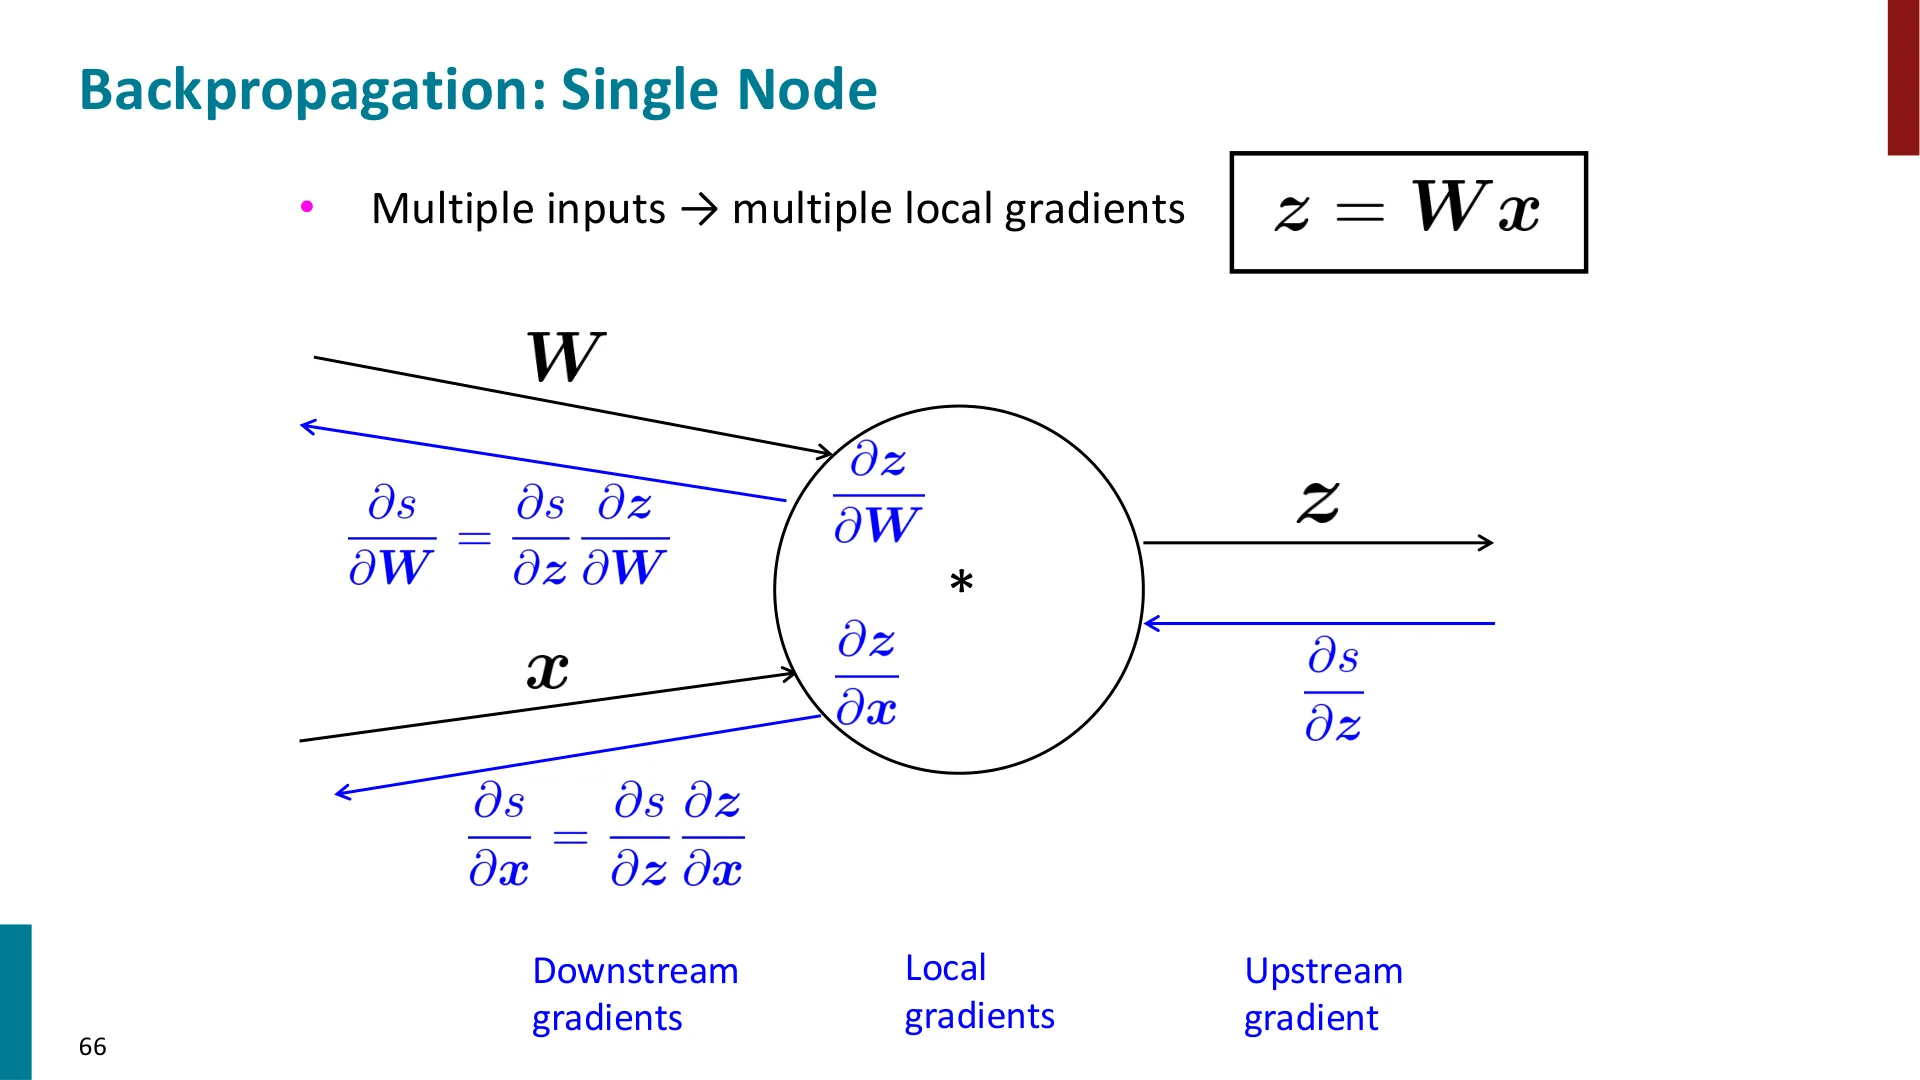
📷 多输入节点:多个局部梯度
回到原视频 (00:49:34)
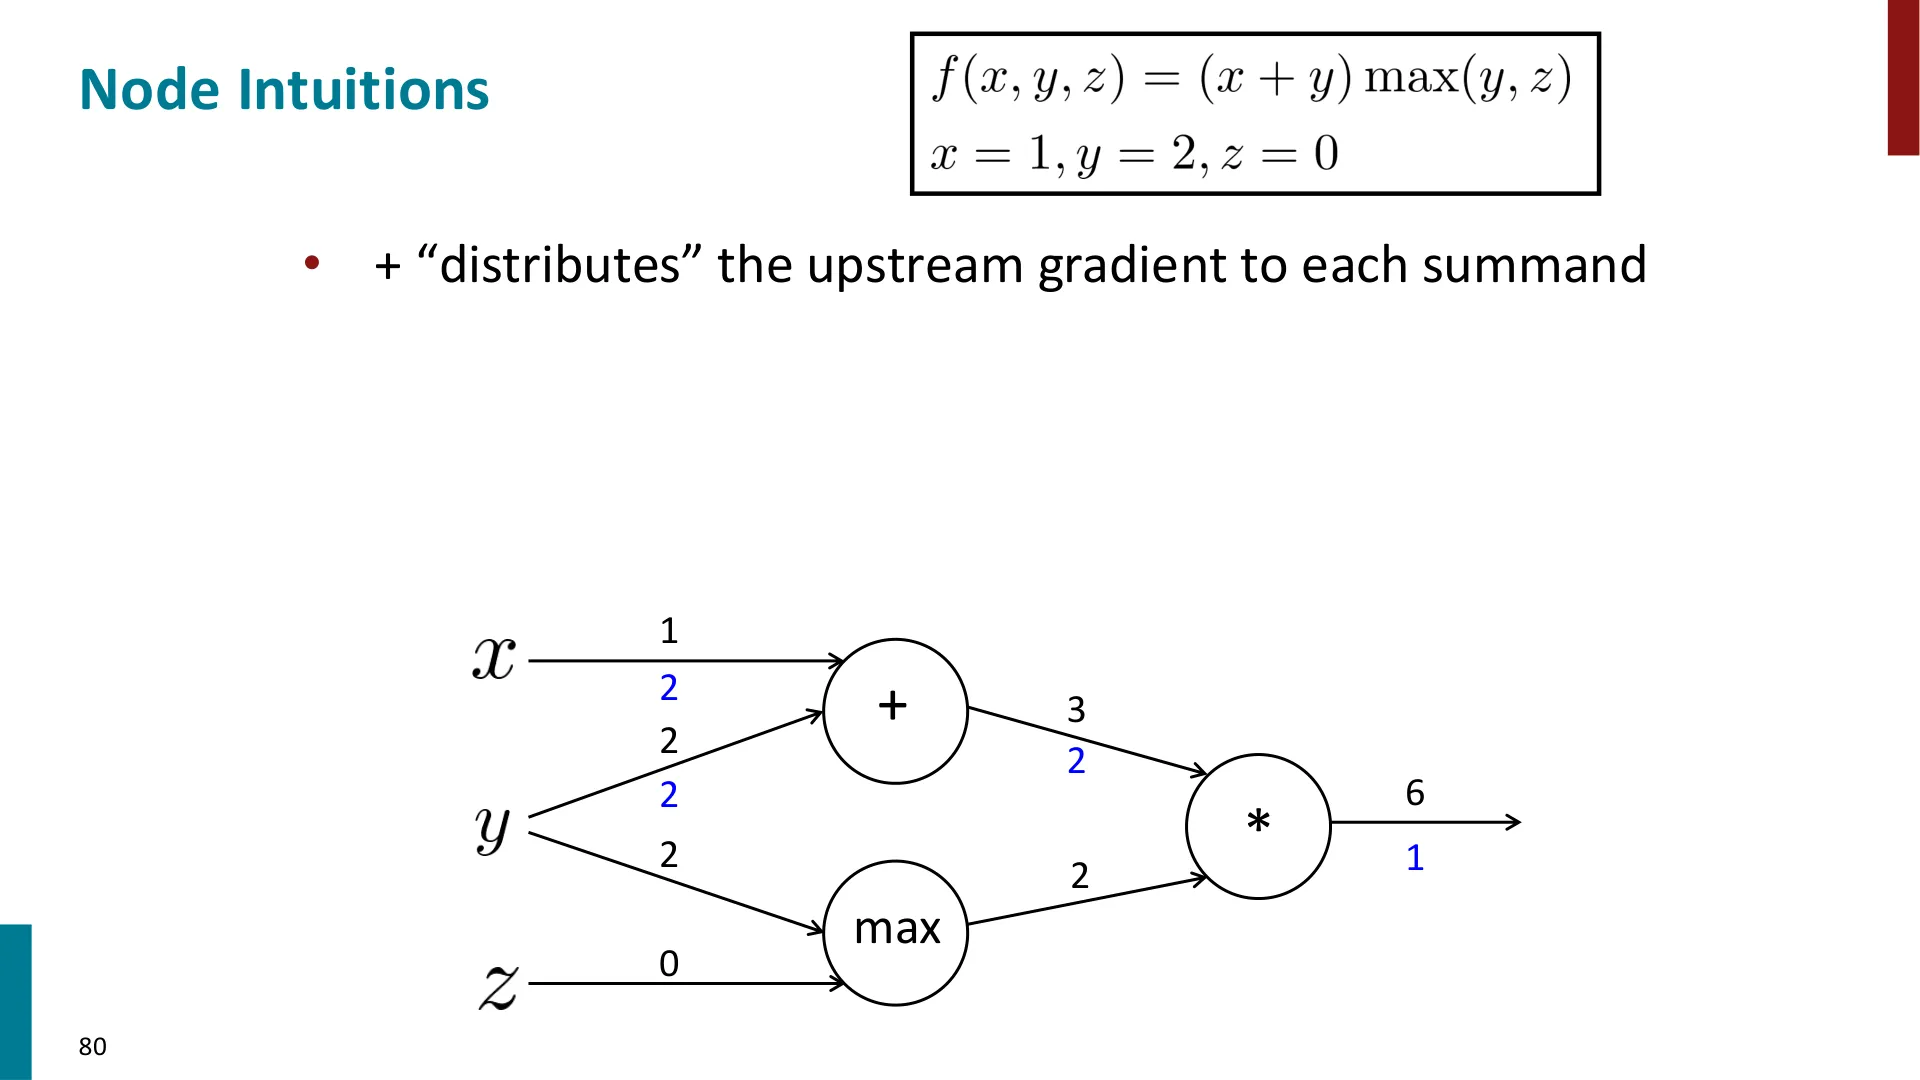
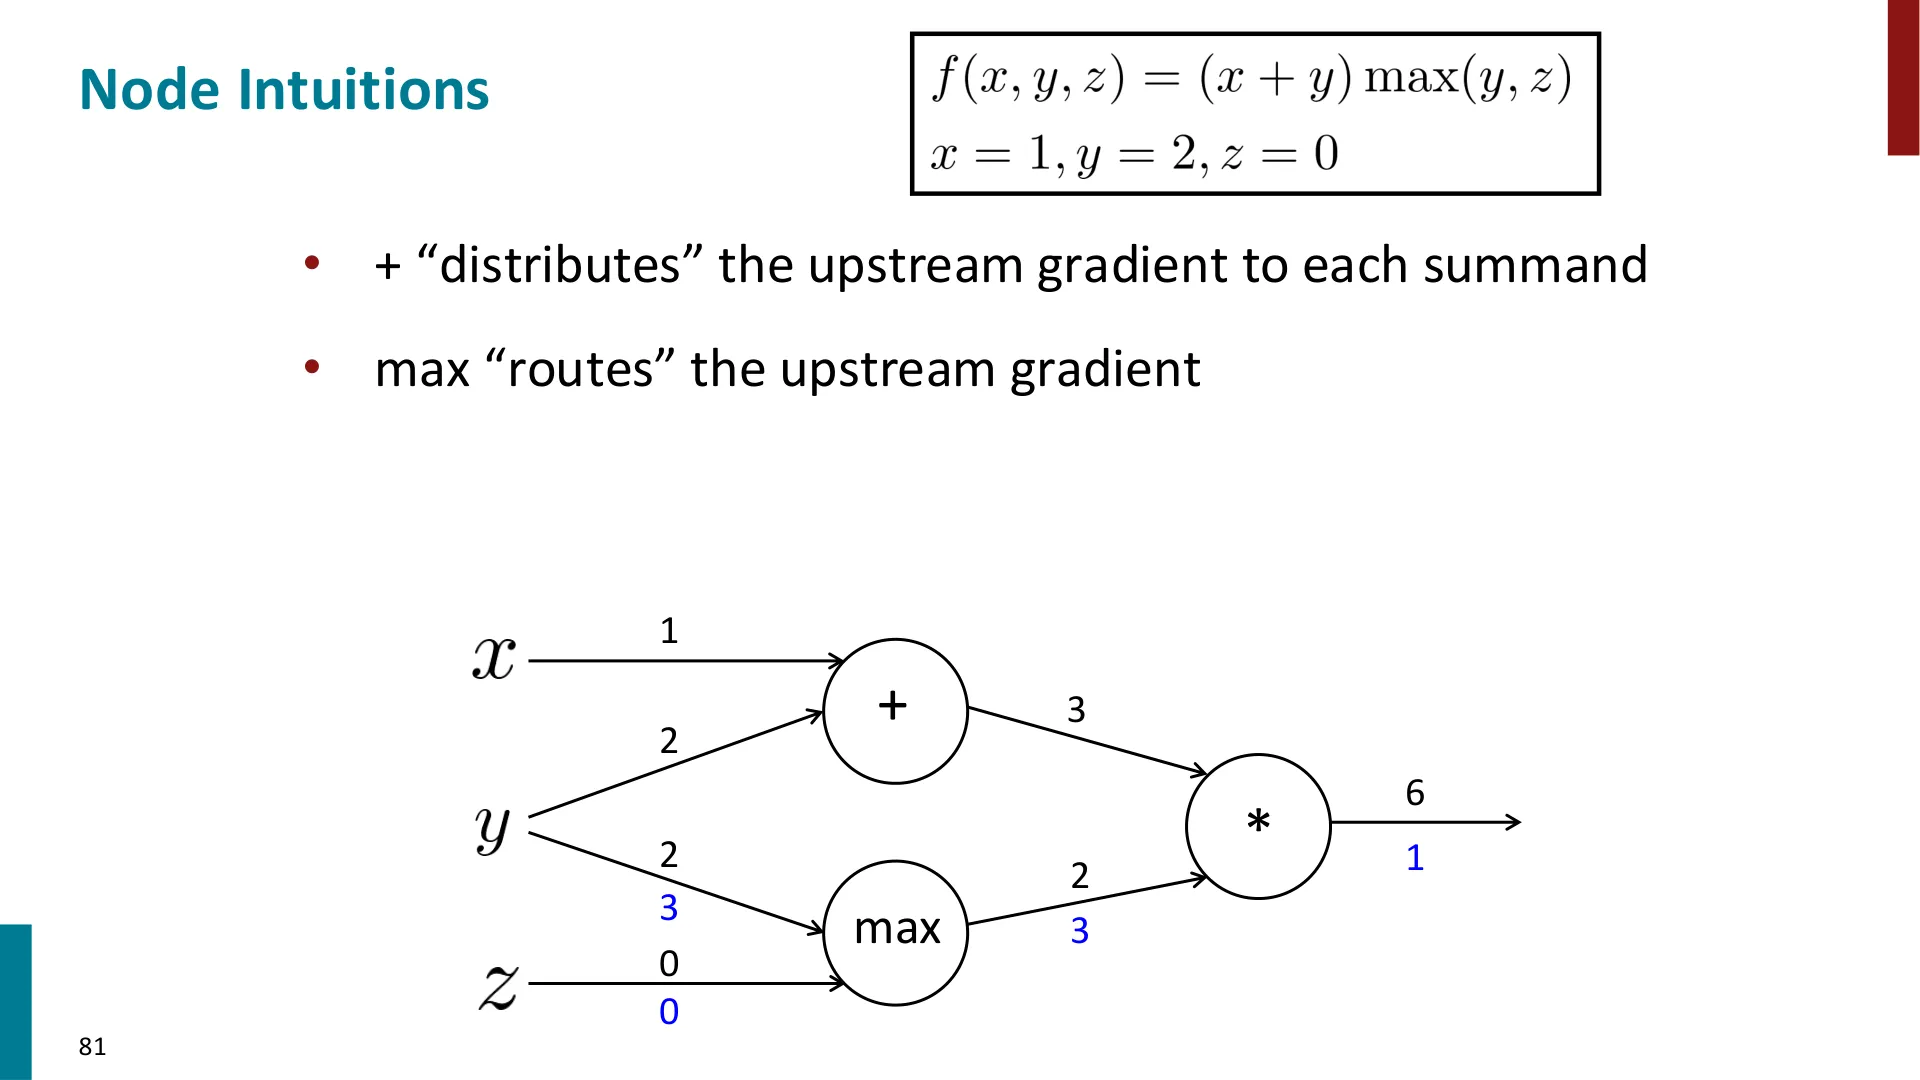
一个完整的例子:$f = (x+y)\max(y,z)$
(参考时间: 50:36)
老师用一个并非神经网络、但简单直观的例子演示整条流程。取 $x=1, y=2, z=0$:
$$f = (x+y)\cdot \max(y,z) = 3 \times 2 = 6$$
先把图搭好:
graph LR
    X["x = 1"] --> PLUS["+"]
    Y1["y = 2"] --> PLUS
    PLUS --> Q["q = 3"]
    Y2["y = 2"] --> MAX["max"]
    Z1["z = 0"] --> MAX
    MAX --> M["m = 2"]
    Q --> MUL["×"]
    M --> MUL
    MUL --> F["f = 6"]
前向:$q = 3$,$m = 2$,$f = 6$。
反向:先写出各节点的局部梯度:
- $q = x + y$:$\frac{\partial q}{\partial x} = 1$,$\frac{\partial q}{\partial y} = 1$;
- $m = \max(y,z)$:较大的那个斜率为 1、较小的为 0,即 $\frac{\partial m}{\partial y} = 1$,$\frac{\partial m}{\partial z} = 0$;
- $f = q\cdot m$:$\frac{\partial f}{\partial q} = m = 2$,$\frac{\partial f}{\partial m} = q = 3$。
再逐节点回传:$\frac{\partial f}{\partial q} = 2$,$\frac{\partial f}{\partial m} = 3$;$\frac{\partial f}{\partial z} = 3\times 0 = 0$;而 $y$ 走两条分支,两条路径的梯度要相加:
$$\frac{\partial f}{\partial x} = 2\times 1 = 2,\qquad \frac{\partial f}{\partial y} = \underbrace{2\times 1}_{经\ q} + \underbrace{3\times 1}_{经\ m} = 5,\qquad \frac{\partial f}{\partial z} = 0$$
老师现场用数值扰动来验证:
- $x$ 从 1 变到 1.1:$f$ 从 6 变到 $3.1\times 2 = 6.2$,变化约 0.2,对应梯度 2 ✓;
- $z$ 微动:$f$ 完全不变,梯度 0 ✓;
- $y$ 从 2 变到 2.1:$q = 3.1$、$m = 2.1$,$f = 6.51$,变化约 0.5,对应梯度 5 ✓。
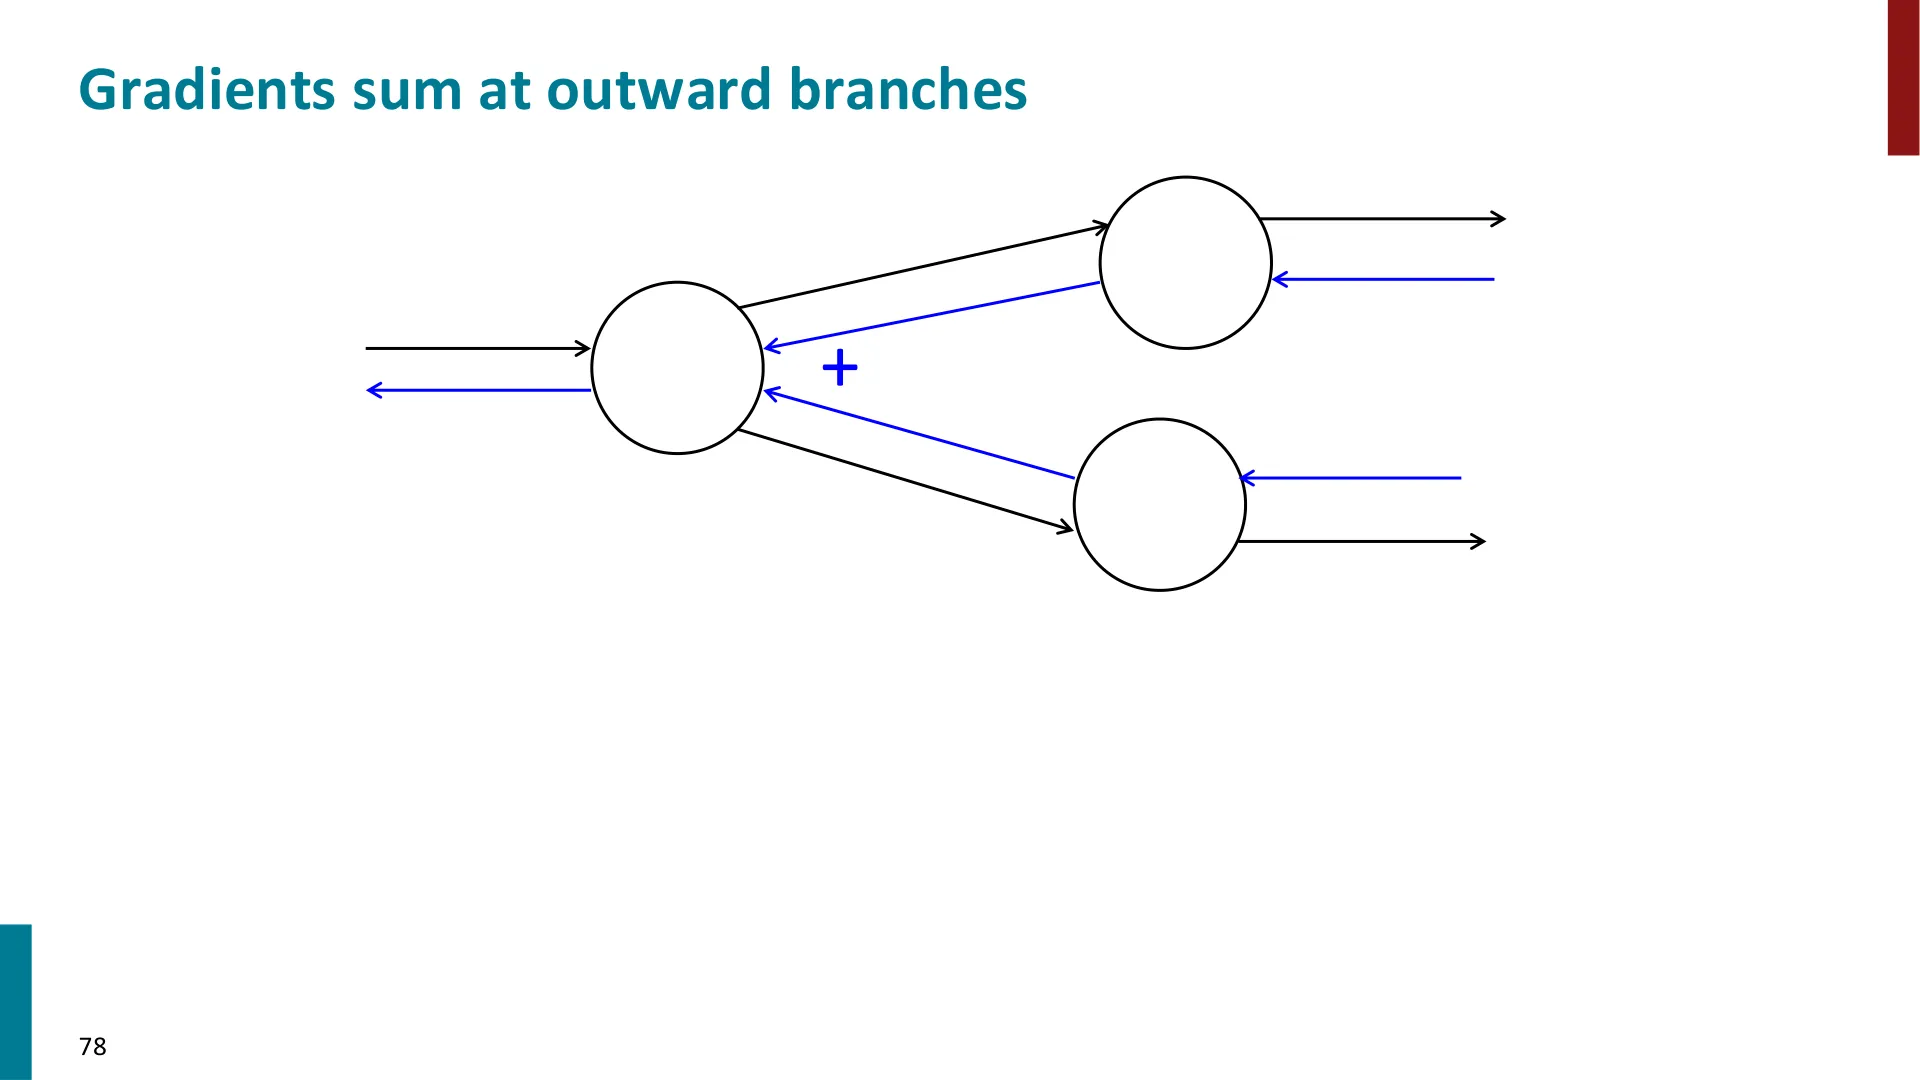
梯度在分支处相加
(参考时间: 56:02)
这个例子最重要的结论:当计算图出现向外分支时,反向传播要把各路梯度求和。(在本例里,$y$ 同时流向了"加法"和"max"两条路,于是把两条上游梯度 2 和 3 相加得 5。)
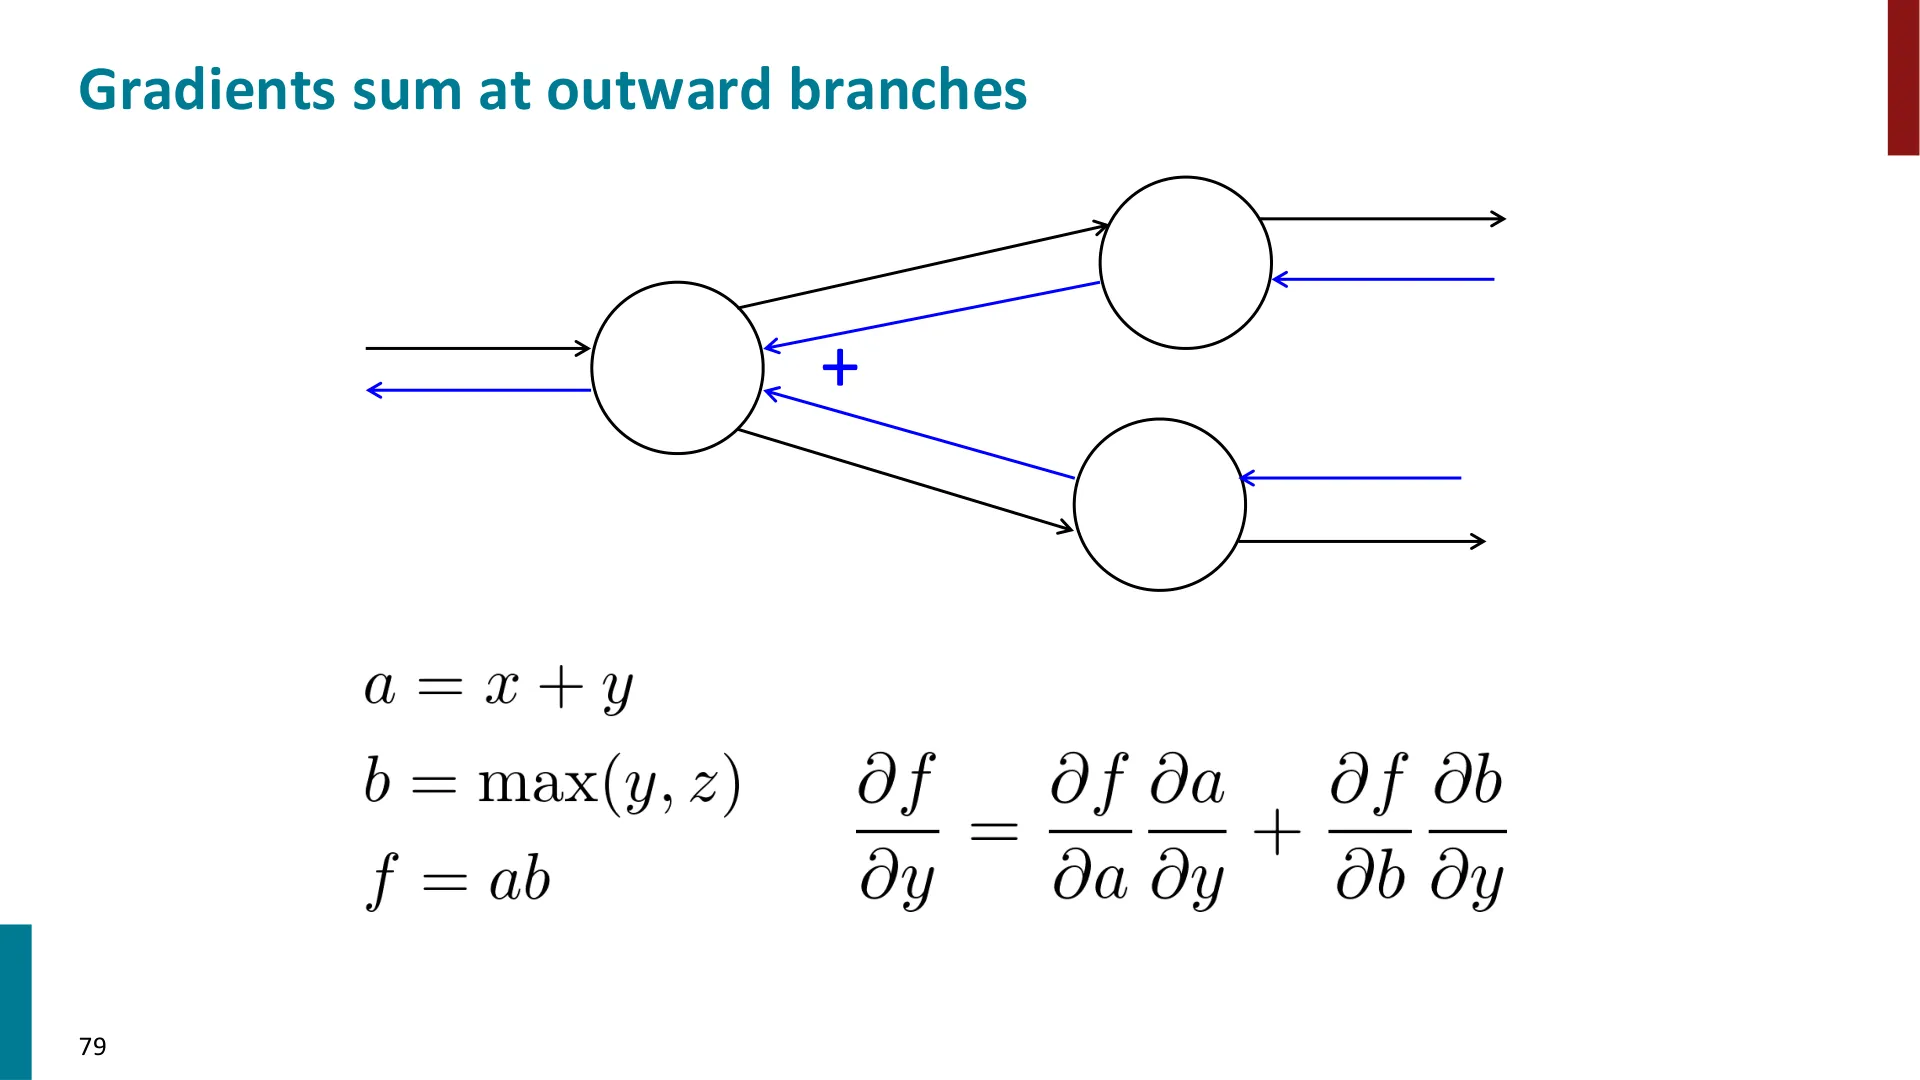
📷 分支处梯度相加(1)
回到原视频 (00:56:02)
三种节点的直觉
(参考时间: 57:07)
老师给了三个非常形象的比喻:
+:分发(distributes) 上游梯度——每个加数都收到同样的一份;max:路由(routes) 上游梯度——只把它送给最大的那个输入,其余给 0;*:切换(switches) 上游梯度——把上游梯度乘上"对面的那个输入"再送下去。
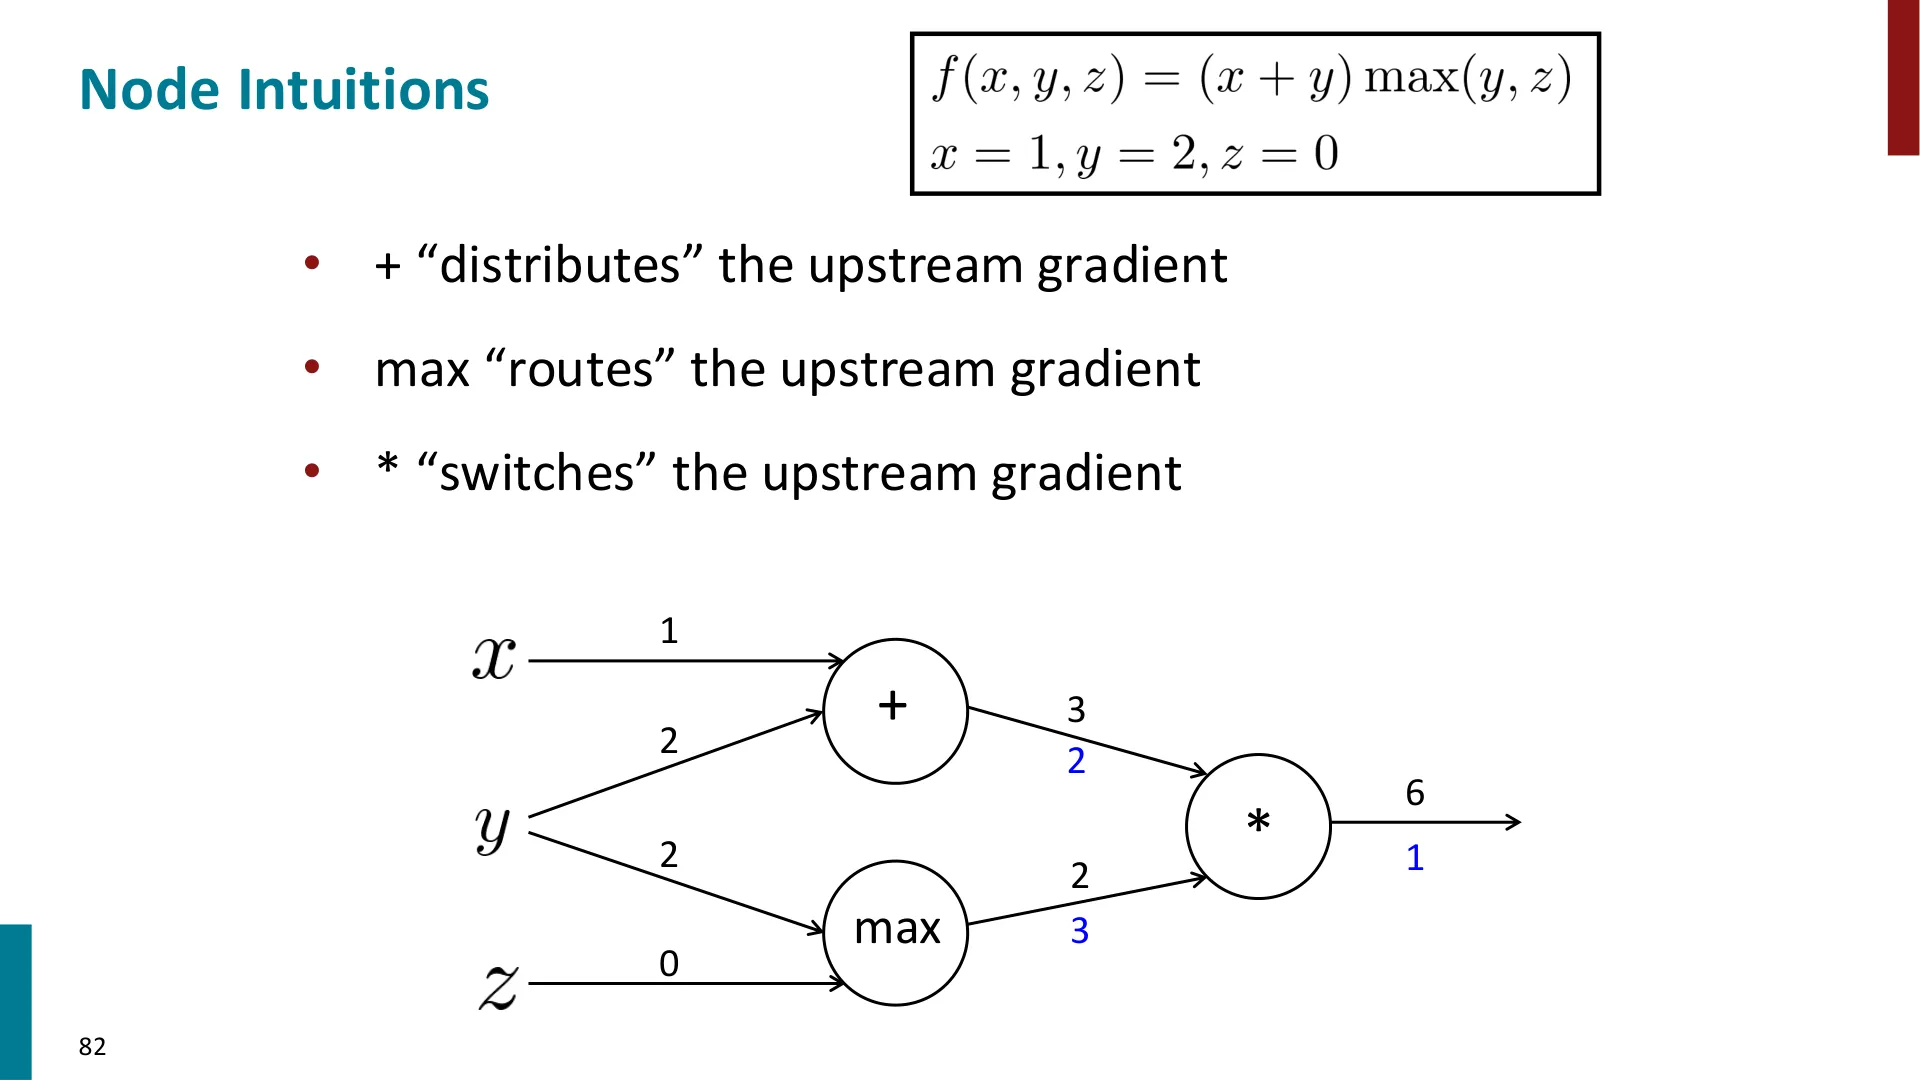
📷 节点直觉:+ 分发
回到原视频 (00:57:07)
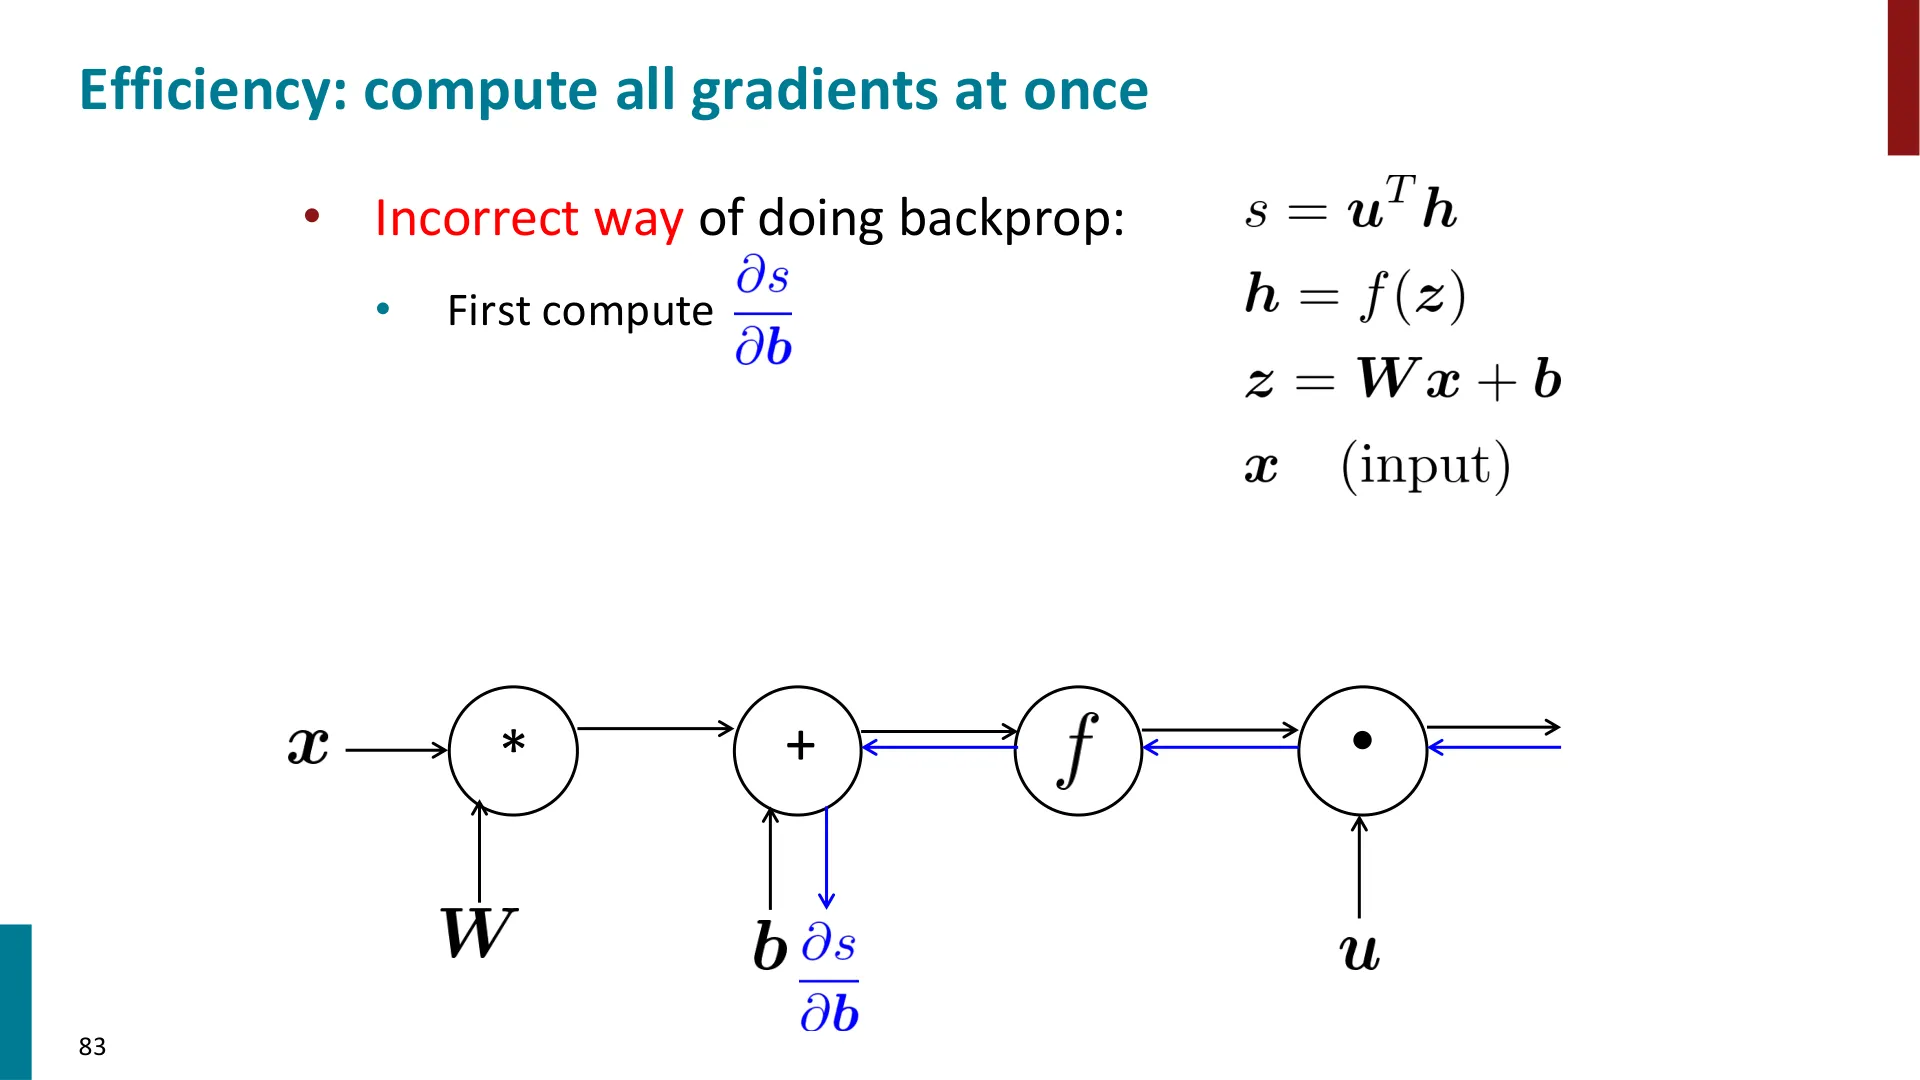
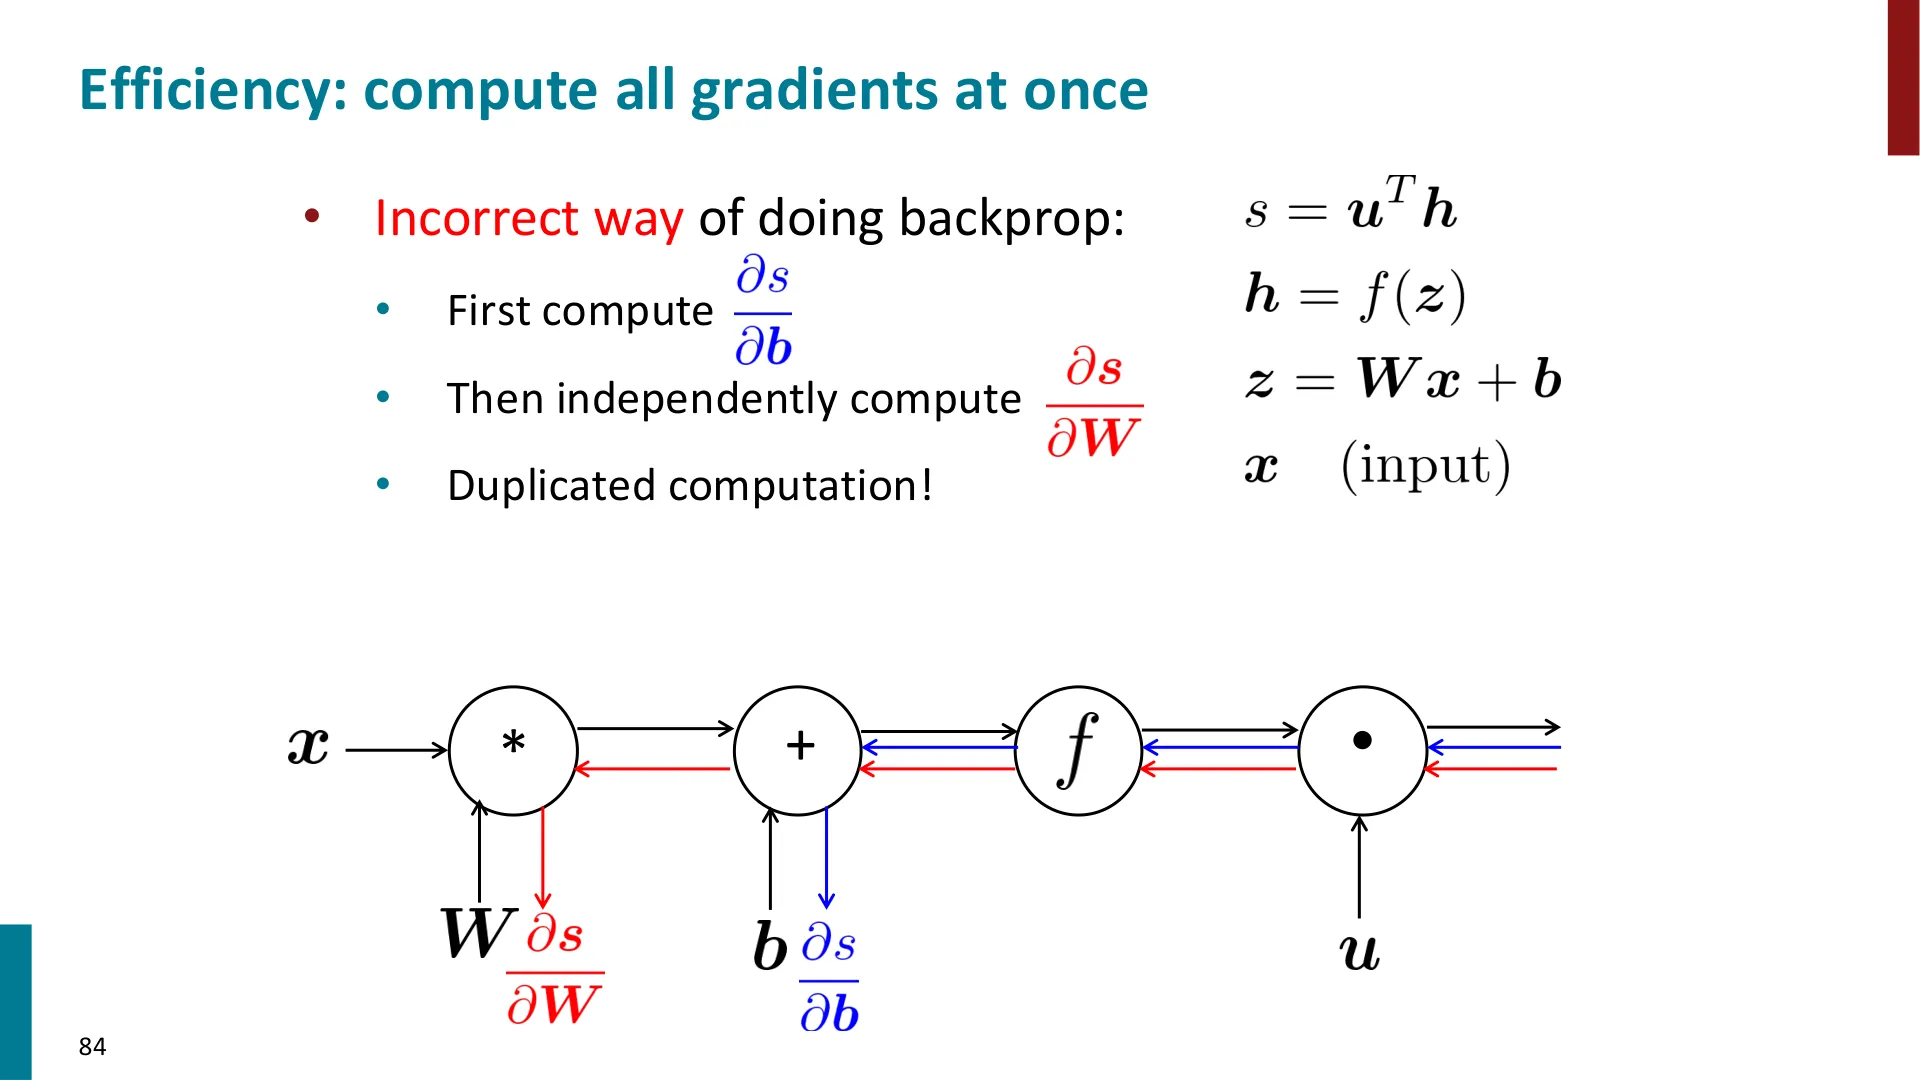
效率:一次算完所有梯度
(参考时间: 58:13)
错误做法:先单独算 $\frac{\partial s}{\partial \mathbf{b}}$,再单独算 $\frac{\partial s}{\partial \mathbf{W}}$……这会把共享的部分重复计算。
正确做法:把共享的那部分(就是 $\delta$)只算一次,然后像我们手推时那样复用它——这与前面用 $\delta$ 的做法完全一致。
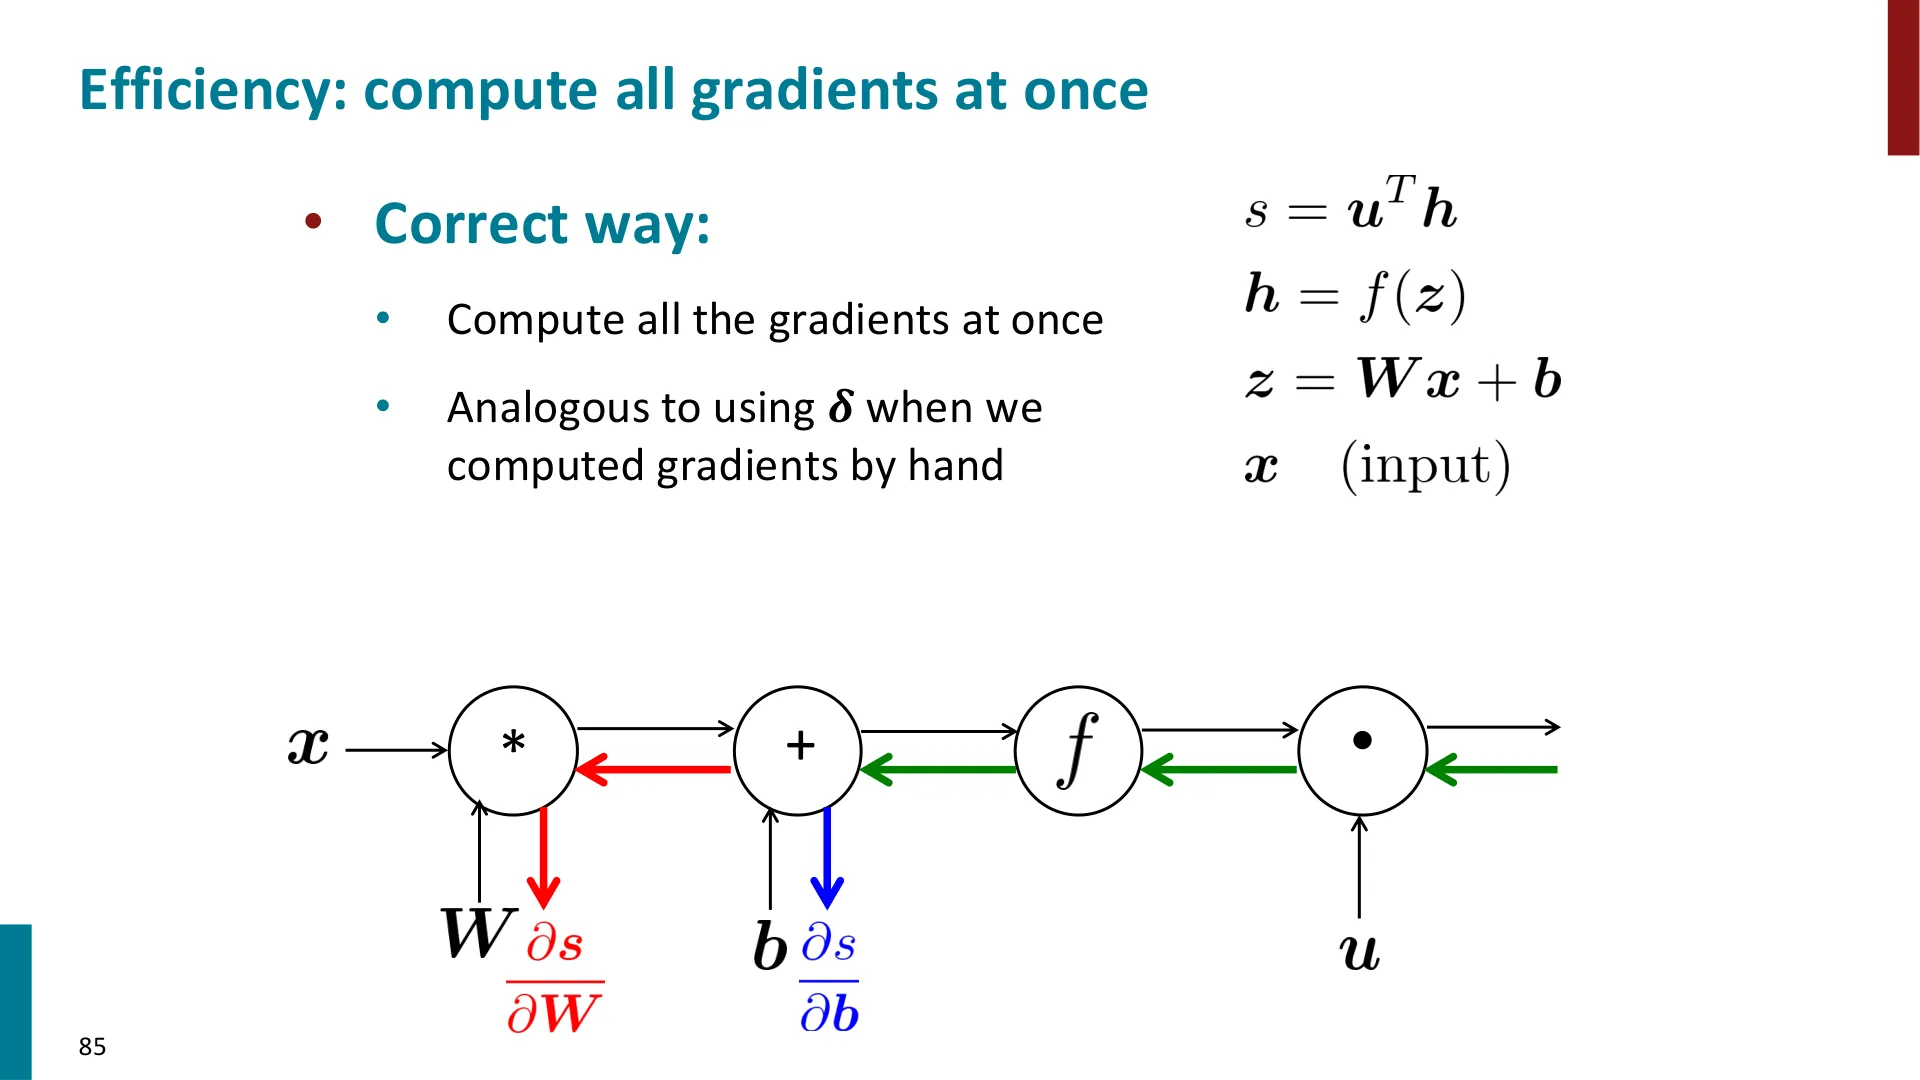
📷 效率:一次性算完所有梯度(1)
回到原视频 (00:58:13)
通用计算图上的反向传播
(参考时间: 59:46)
老师强调:这套算法不限于规整的层结构。只要计算图是一个有向无环图(DAG,没有环),就可以跑。图里可以有古怪的运算、可以不是全连接——都行。
前向传播:
- 对节点做拓扑排序;
- 按顺序访问每个节点,用已经算好的前驱求这个节点的值。
反向传播:
- 把输出梯度初始化为 1;
- 按拓扑排序的逆序访问节点;
- 用后继节点的梯度求每个节点的梯度。
关键结论:如果做对了,前向和反向的大 O 复杂度是相同的。如果你发现反向比前向贵得多,那说明你漏掉了复用、在重复计算。
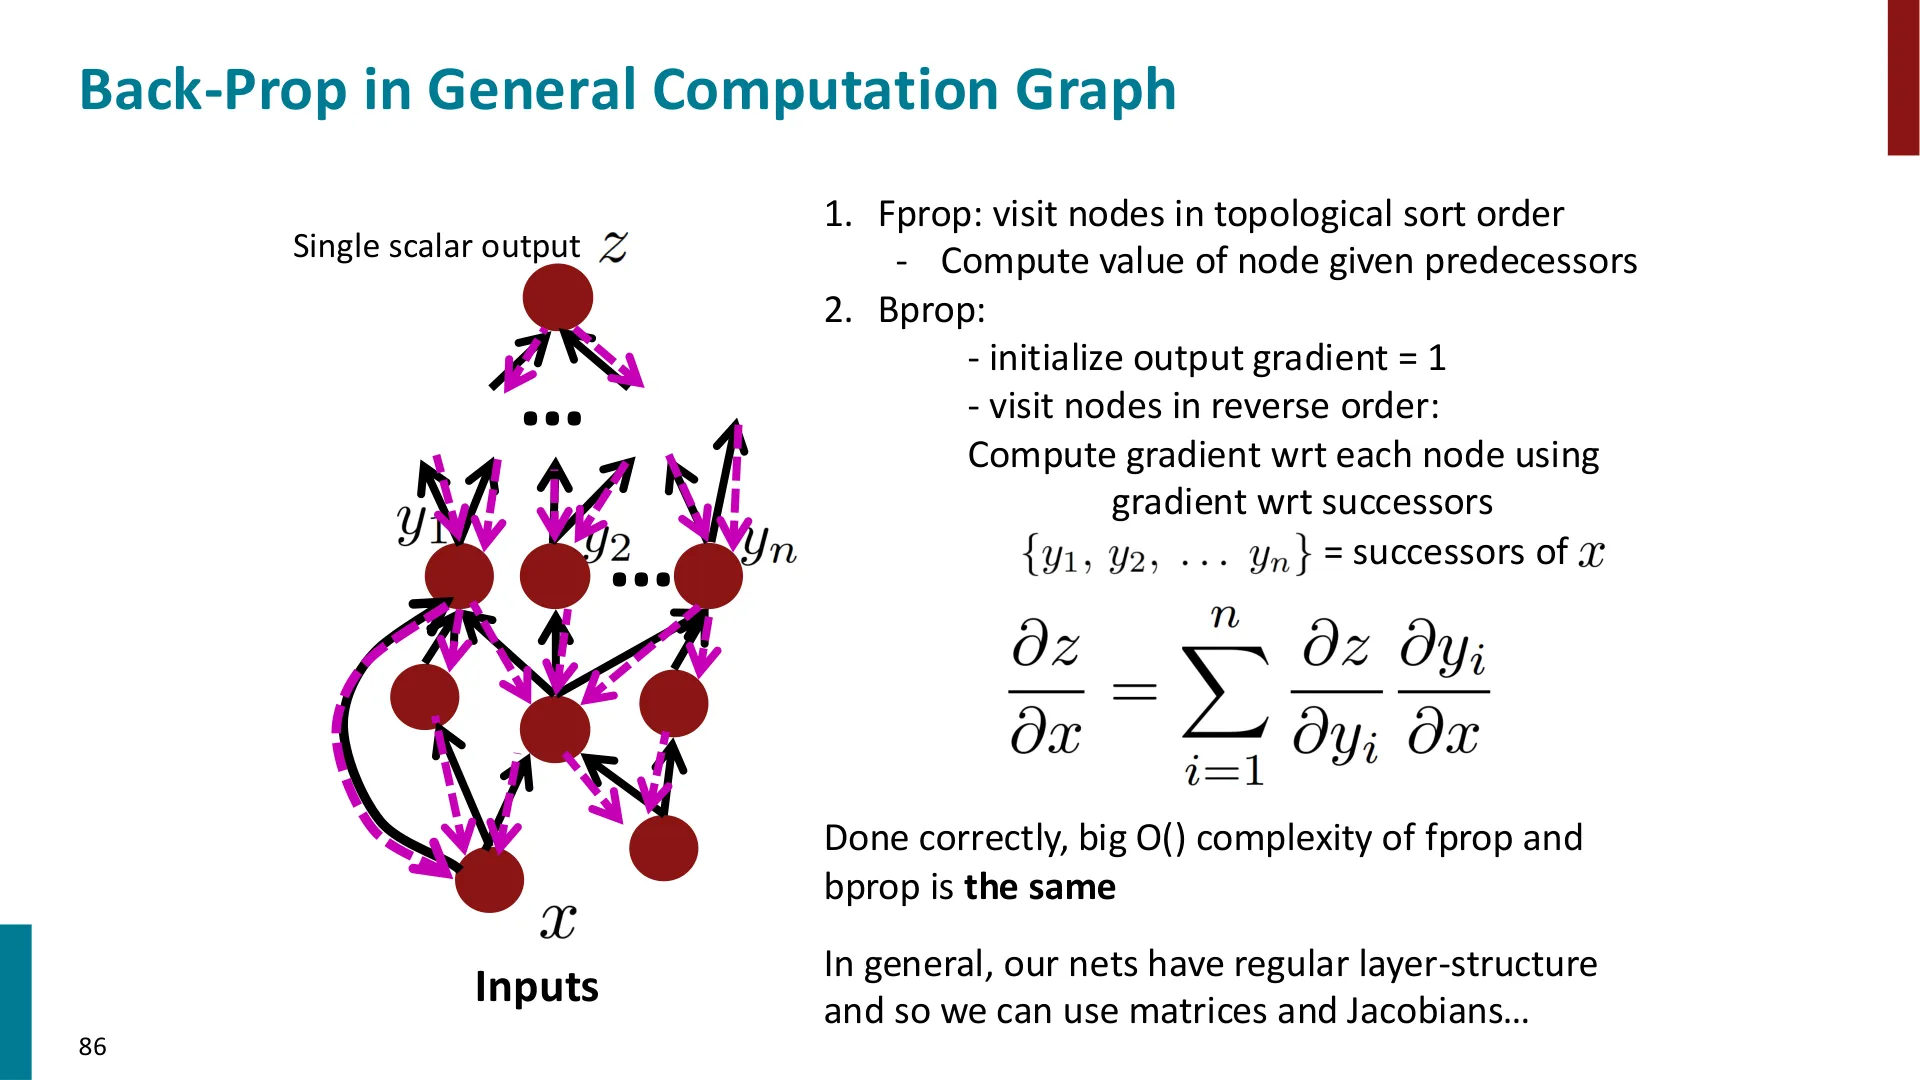
📷 通用计算图上的反向传播:前向与反向
回到原视频 (00:59:46)
自动微分
(参考时间: 62:41)
既然算法这么好用,就干脆让它自动。这就是自动微分(automatic differentiation):从前向的符号表达式自动推出反向。
老师讲了一段技术史:早期有一个开创性的框架叫 Theano(主要由蒙特利尔大学提出),它试图把整个前向计算写成符号形式,然后全自动地求出反向。但这条路"太重、不好处理各种情况,或者大家就是喜欢自己写 Python",所以没有完全成功。于是今天的主流框架退回到一种更"手动"的方案——虽然听上去像倒退,但软件稳定、快速得多:
框架负责:维护计算图、跑前向、跑反向;
你负责:为你的层 / 节点手工写出局部梯度。
也就是说,你写一个表示某层的 Python 类时,必须告诉框架:前向怎么算、局部梯度怎么算。框架"相信"你的局部梯度是对的。
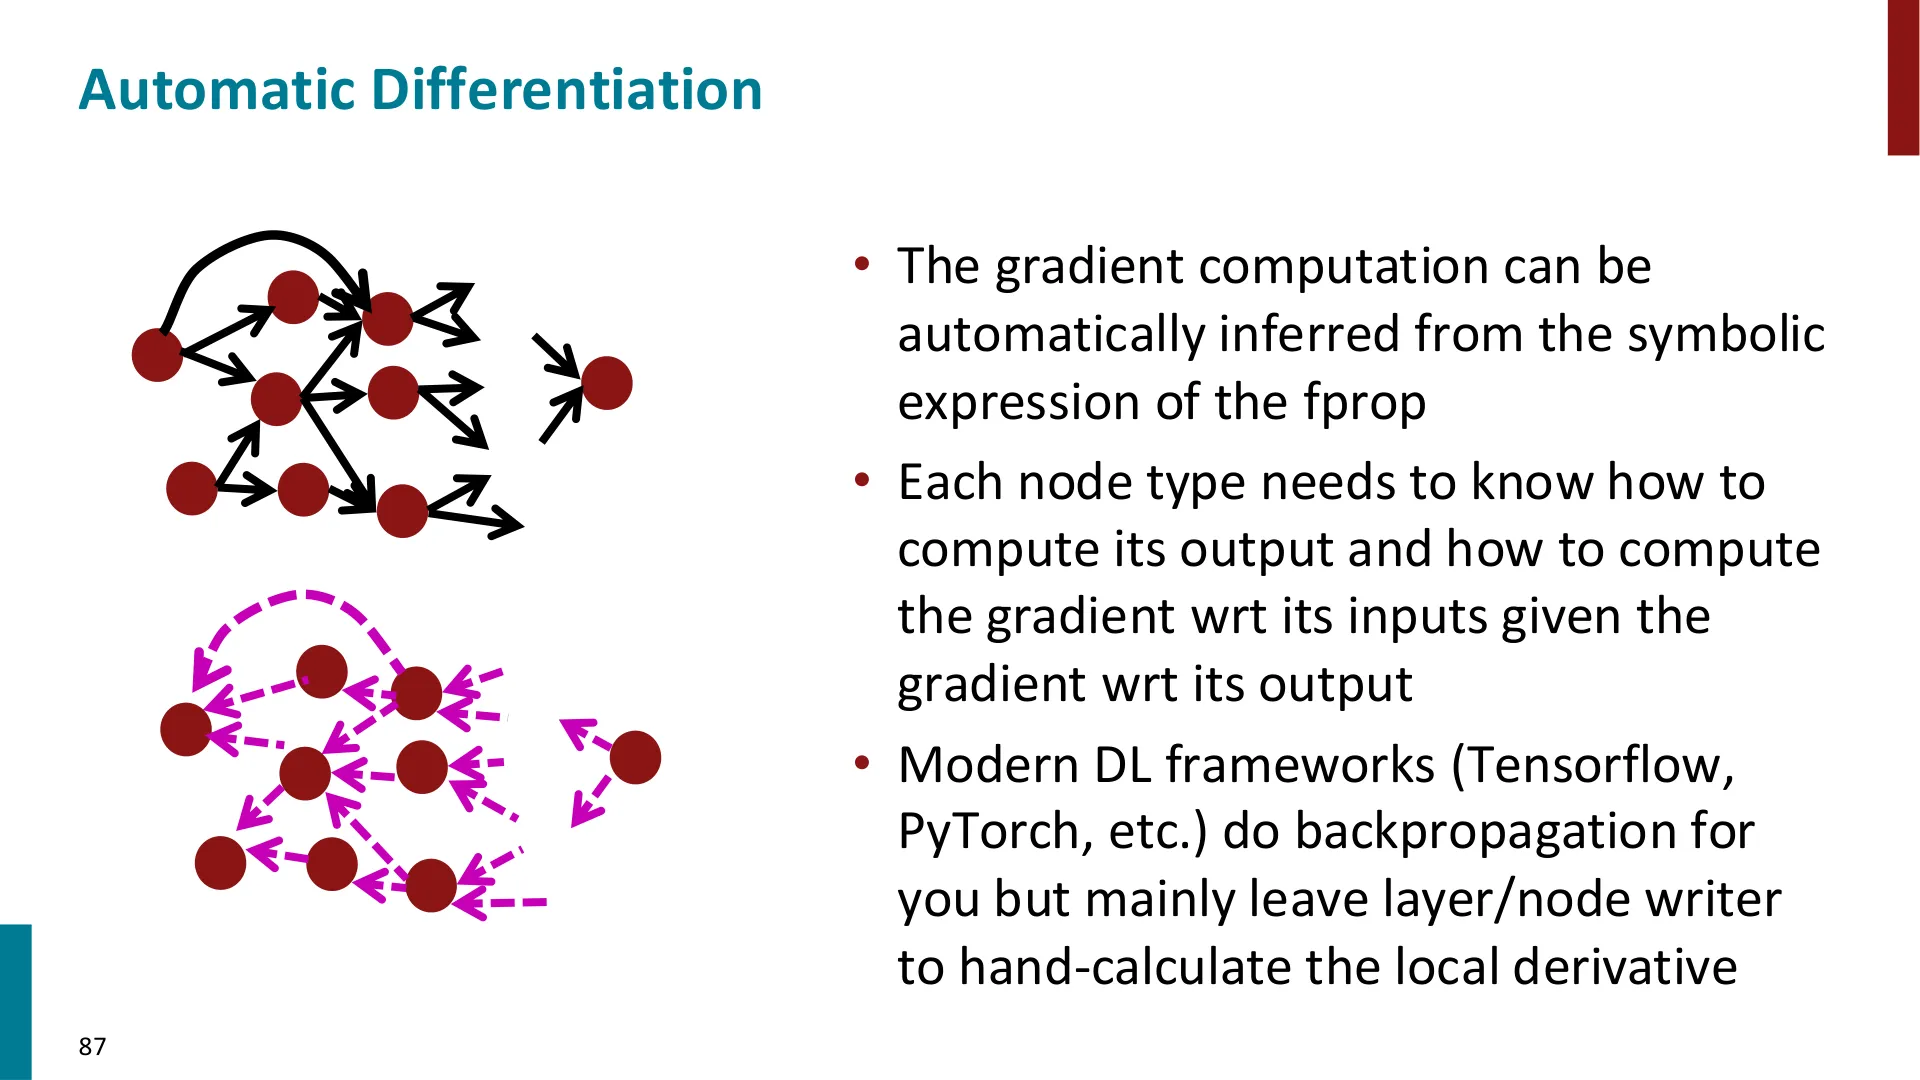
📷 自动微分:框架管图,人管局部梯度
回到原视频 (01:02:41)
反向传播在代码里的样子
(参考时间: 64:14)
在框架内部,前向遍历时调用每个节点的前向函数,算出它的值;反向遍历时,计算"上游误差信号 × 局部梯度"。以一个乘法门为例:前向就是"把两个数相乘并返回";反向则需要 $\frac{\partial}{\partial x}$ 和 $\frac{\partial}{\partial y}$。这里有个标准技巧:
反向拿到的输入是上游梯度,但要算出下游梯度,你必须知道前向时的函数值。所有框架的做法是——前向先把输入值存进类的局部变量,等反向时再取用。因为前向一定先于反向发生,所以这些值是现成的。
# 乘法门的示意(伪代码)
class Multiply:
    def forward(self, x, y):
        self.x = x          # 存下来,供反向使用
        self.y = y
        return x * y

    def backward(self, dout):
        # dout 是上游梯度(∂s/∂(x*y))
        dx = dout * self.y  # 切换:乘对面那个输入
        dy = dout * self.x
        return dx, dy
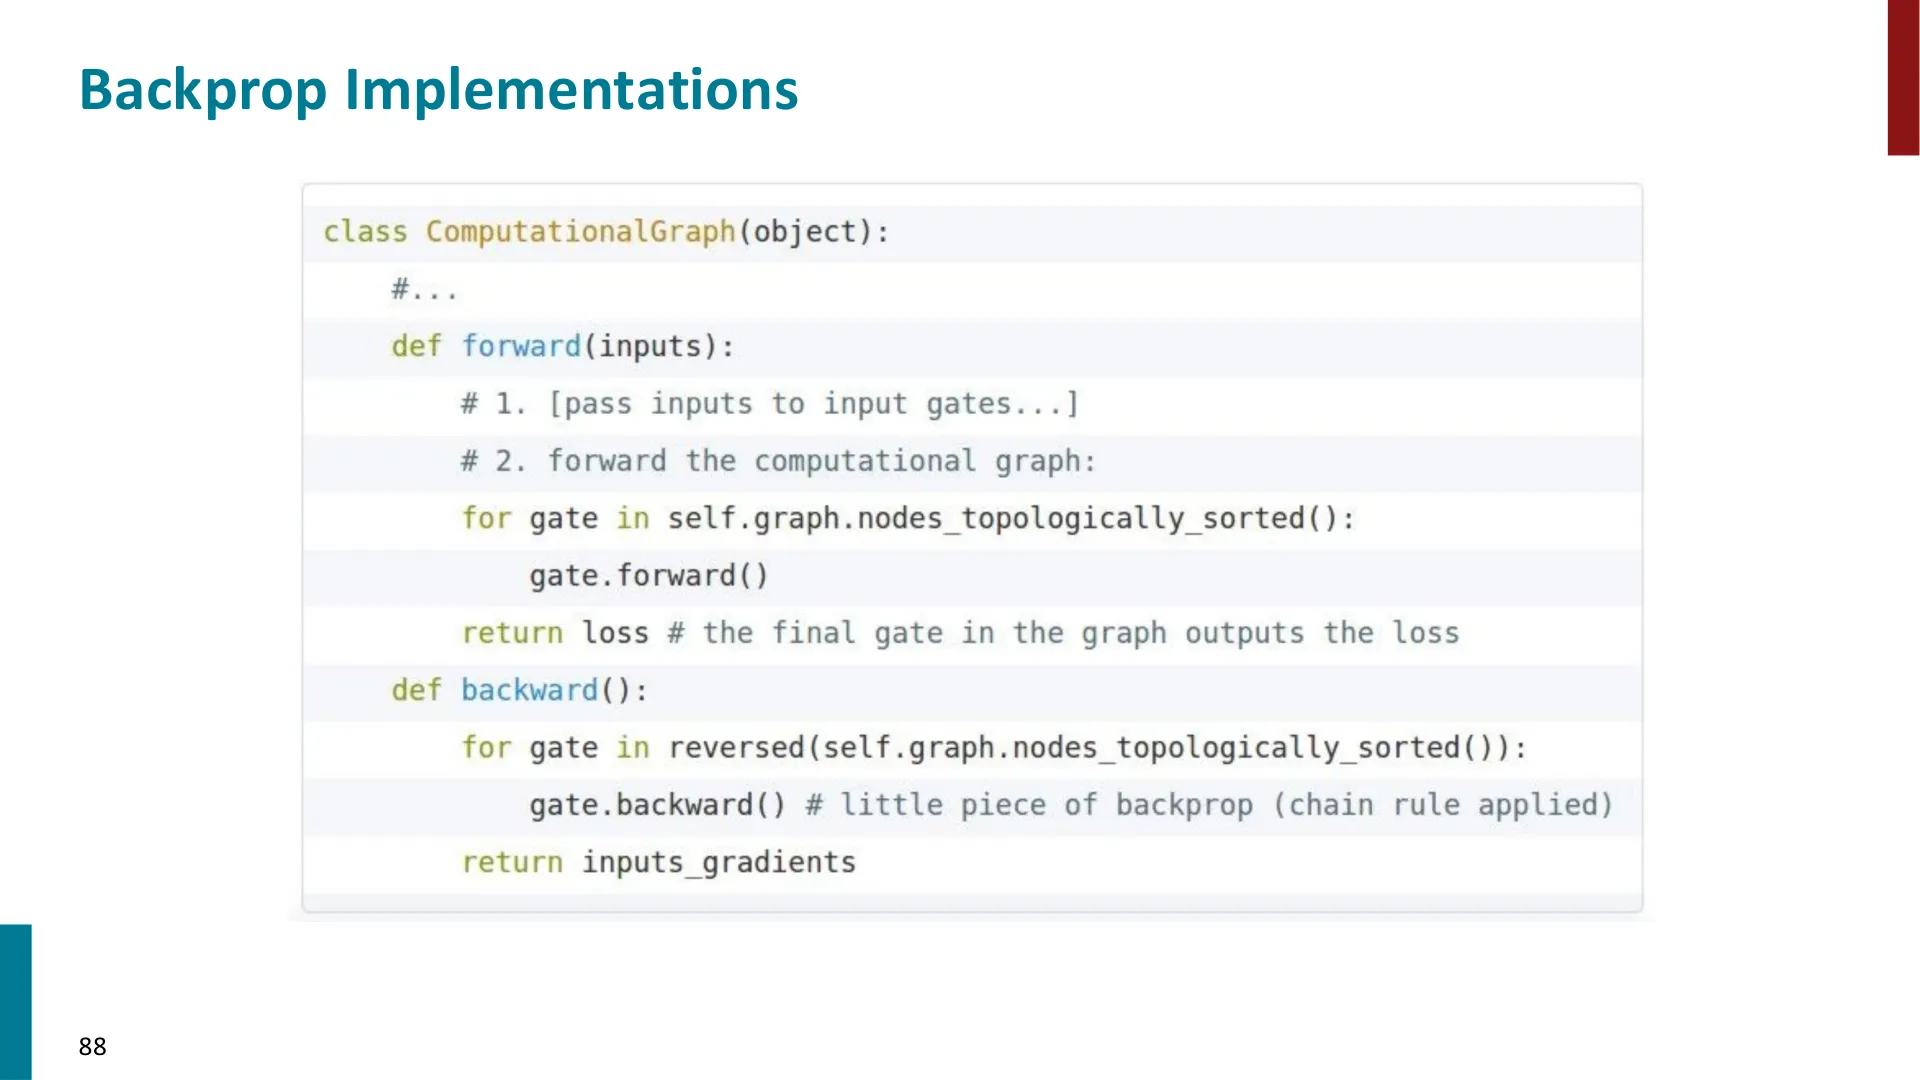
📷 反向传播的实现:前向存值,反向取用
回到原视频 (01:04:14)
八、梯度检查,以及"为什么还要学这些"
(参考时间: 68:17)
写了反向代码,怎么确认它是对的?答案是数值梯度检查(numeric gradient checking)。
用中心差分来估计斜率:
$$\frac{\partial f}{\partial x} \approx \frac{f(x+h) - f(x-h)}{2h}, \qquad h \approx 10^{-4}$$
把数值估计与反向传播算出的梯度对比,如果两者的差在 $10^{-2}$ 之类的量级内,基本就说明实现正确了。
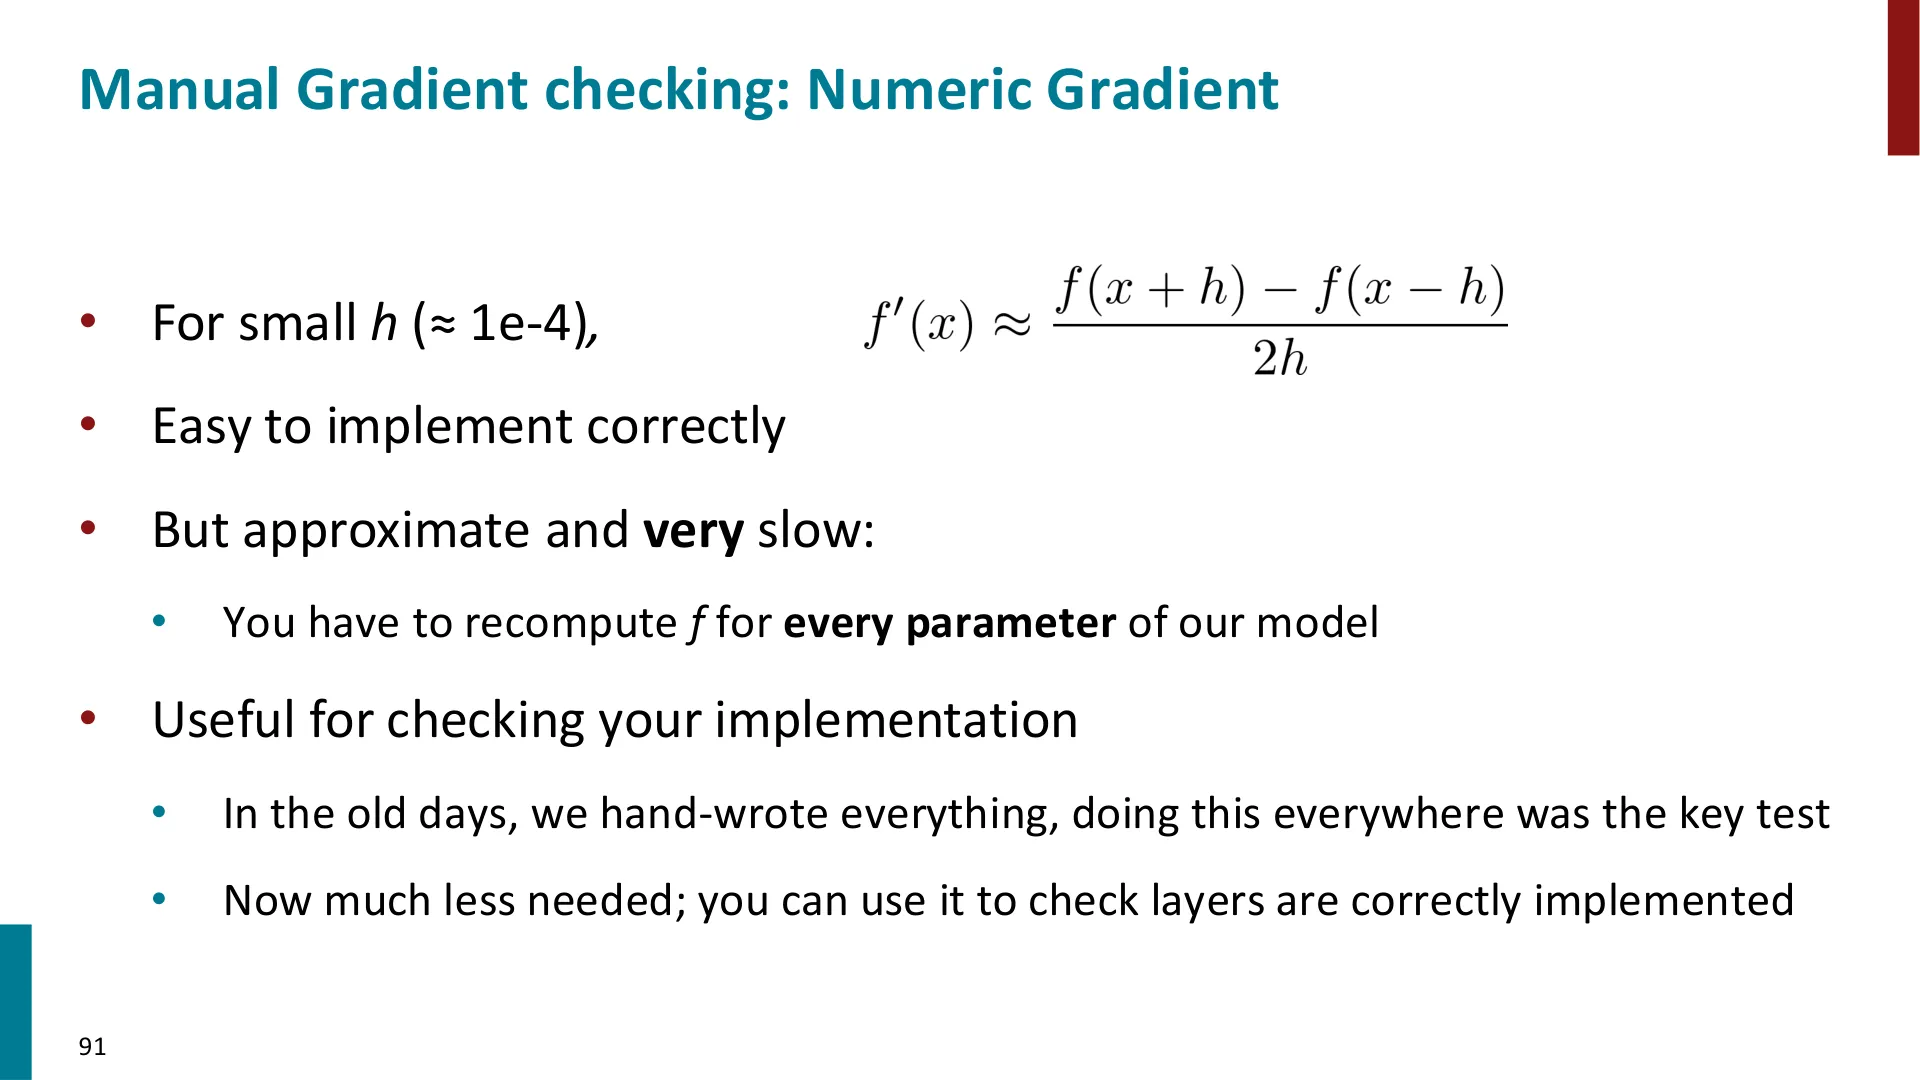
📷 数学梯度检查:数值梯度
回到原视频 (01:08:17)
老师特别提醒——这跟"数学课上教的一侧估计"不一样:
我前面举例时只比较了 $x$ 和 $x+h$(单侧估计)。但做梯度检查时,用双侧估计(对称地取 $x\pm h$)要好得多,因为它更准确、更稳定。
那为什么不干脆全都用数值梯度、彻底忘掉微积分?因为——太慢了。数值梯度要为模型的每一个参数重新计算一次 $f$,完全拿不到反向传播带来的加速。所以它只用来校对你自己的实现(尤其是你自己写的层)。
老师说,在 PyTorch 这类框架出现之前,大家什么都手写、经常出错,所以"到处做数值梯度检查"是当时的关键测试手段;今天用它的人少了,但检查自定义层是否正确时仍然非常有用。
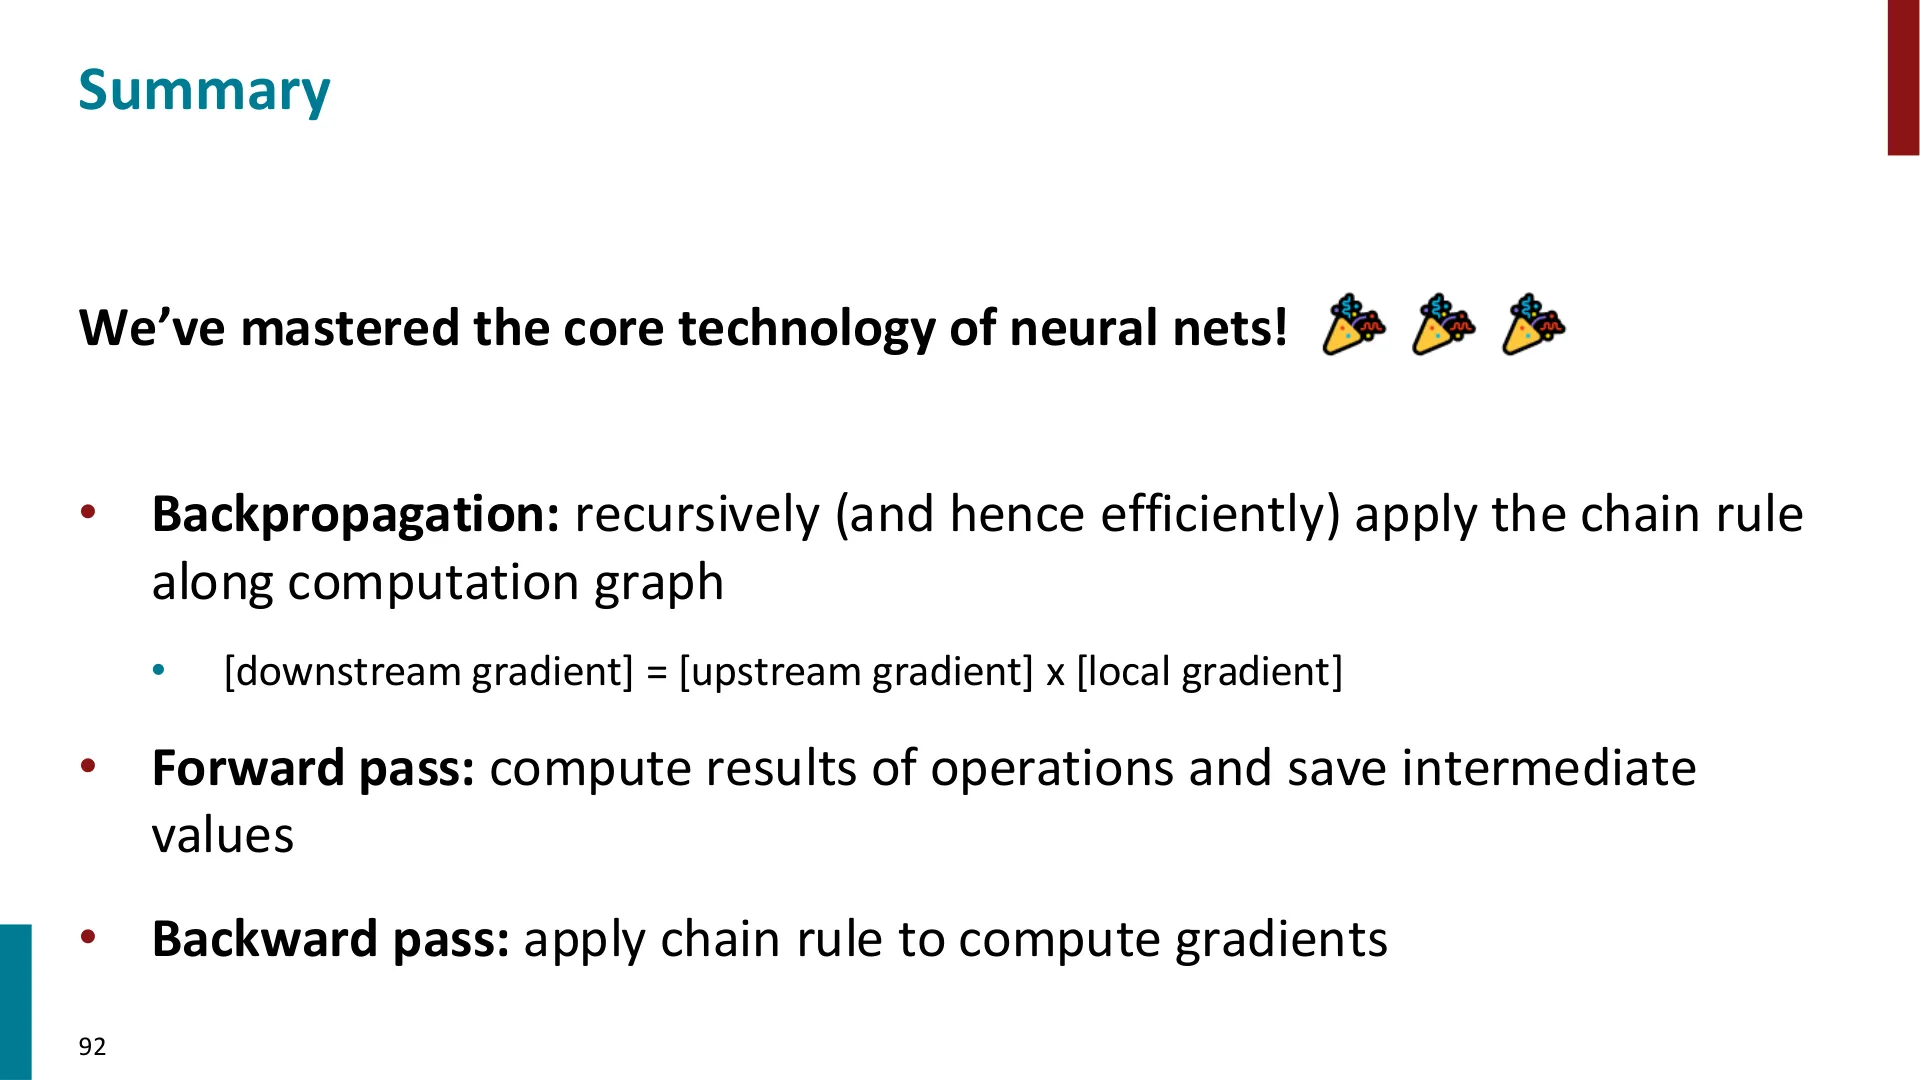
📷 总结:我们已经掌握了神经网络的核心技术
回到原视频 (01:11:23)
本讲总结(概括老师的收官)。
反向传播 = 沿计算图递归、因此高效地应用链式法则。 - [下游梯度] = [上游梯度] × [局部梯度] - 前向:算出各运算的结果,保存中间值。 - 反向:应用链式法则计算梯度。
为什么要懂这些底细
(参考时间: 71:38)
🖼️ 第 2 页幻灯片 · Lecture Plan
老师承认一个事实:现代框架会替你算梯度,"你可以像拼乐高一样把预定义的层拼起来,它们会自动被算对"。这也是为什么今天全世界的高中生都能在科学展上做深度学习项目——他们不需要懂这些数学。
但他接着反问:既然编译器、操作系统也都帮你实现好了,为什么还要上编译原理、系统课? 因为:
- 理解底层什么时候有用——反向传播并不总是开箱即用;
- 当模型出问题时,理解原因是调试和改进的关键;
- 后续讲到 梯度爆炸与梯度消失时,你会需要知道"它实际在算什么",而不是把它当成黑箱魔法。
最后他叮嘱:作业确实会让一些同学"受苦",但"我们希望你真的理解网络在底层发生了什么",所以"只得让你们稍微吃点苦头"。
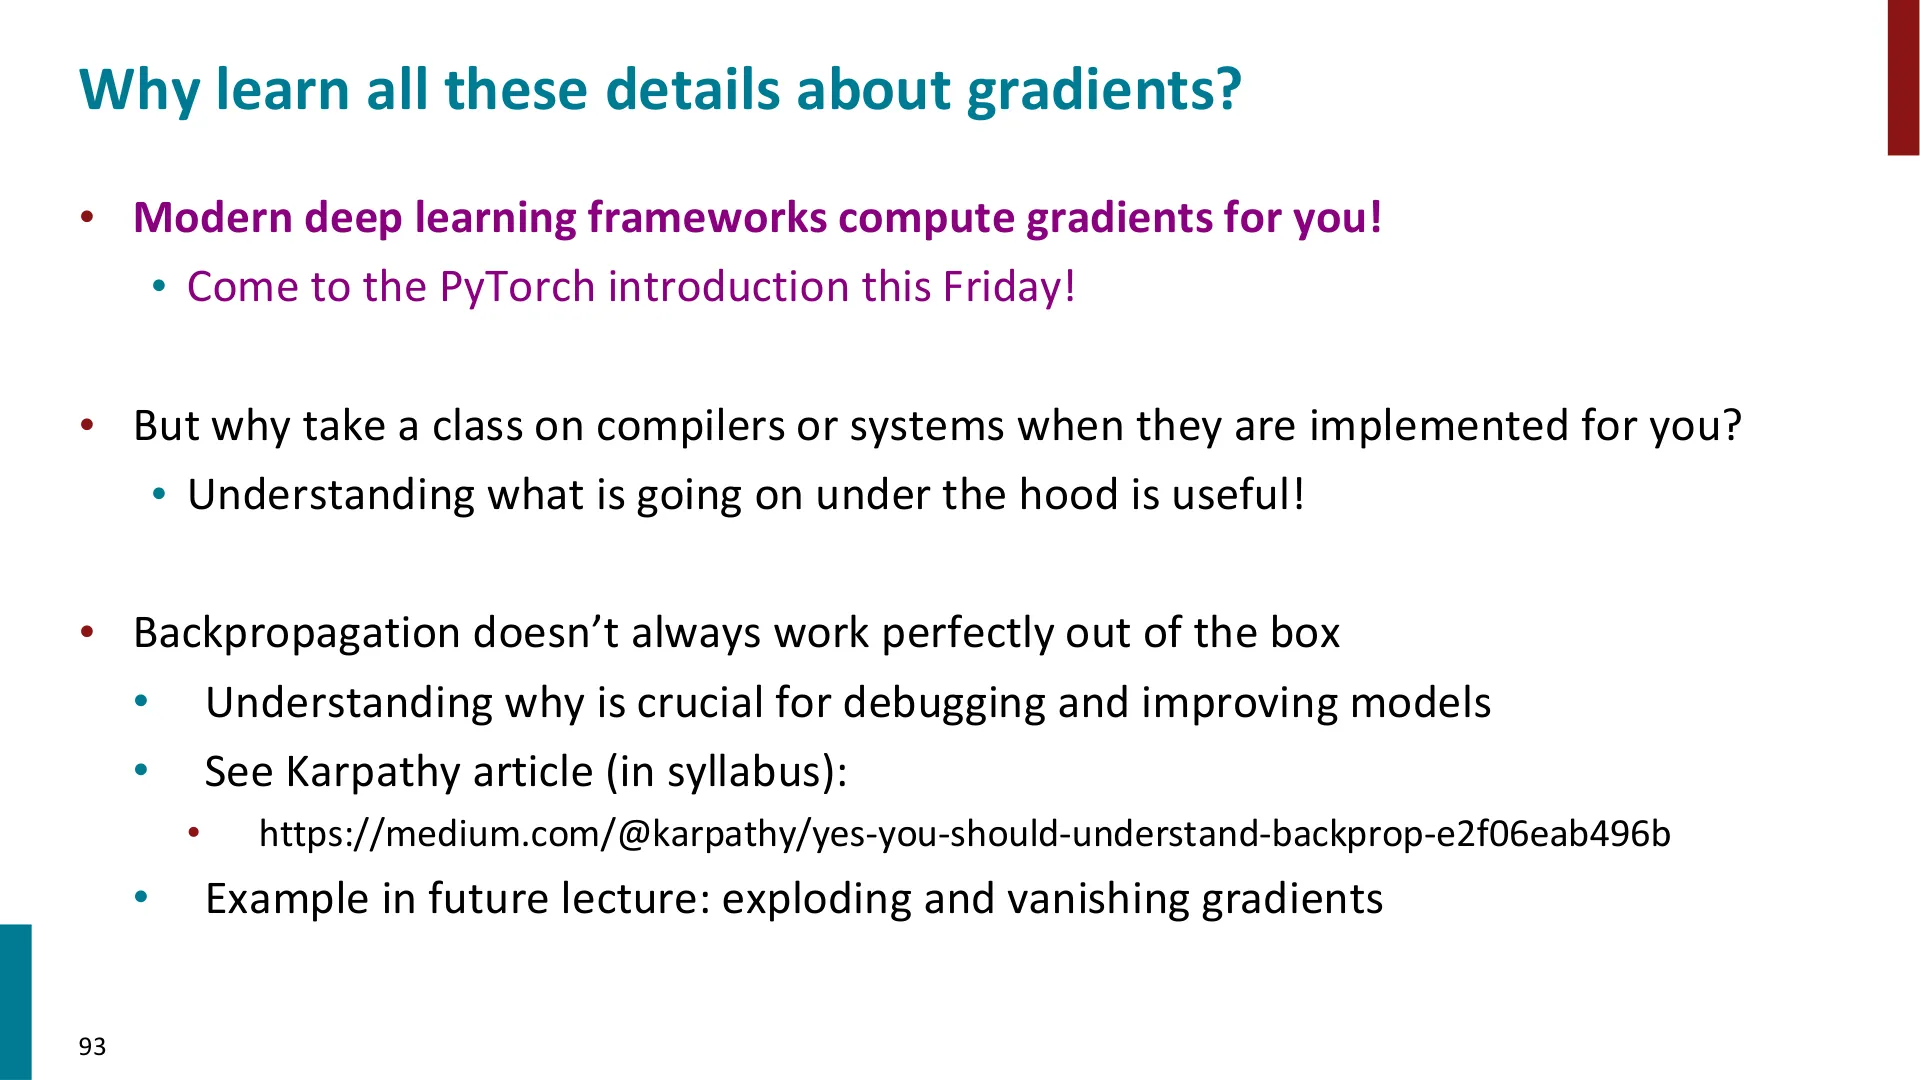
📷 为什么还要学梯度的细节
回到原视频 (01:11:38)
附录:课堂未展示的幻灯片
以下幻灯片随讲义提供,但在本次录像中未出现或未展开(多为承接上一讲的内容与备用页)。为完整起见在此列出:
- Slide 4 — 回顾第 2 讲:如何评价词向量? 内蕴(intrinsic)评价 vs. 外蕴(extrinsic)评价:内蕴评价针对特定子任务、快、有助于理解系统,但除非能证明与真实任务相关,否则意义不明;外蕴评价针对真实任务,计算慢,且难以判断是子系统本身还是子系统交互出了问题——但"若能靠替换恰好一个子系统提升精度,那就是胜利"。
- Slide 5 — 内蕴评价 I:词向量类比。用"相加后余弦距离"判断词向量能否捕捉语义/句法类比(如
man:woman :: king:?),搜索时要丢弃输入的词本身。其局限是:如果信息存在但不是线性的怎么办? - Slide 6 — GloVe 可视化。
- Slide 7 — 内蕴评价 II:语义相似度。以 WordSim353 数据集为例,比较词向量距离与人判断的相关性(如 tiger–cat 7.35、tiger–tiger 10、stock–jaguar 0.92 等)。
- Slide 8 — 相关性评价:词向量距离与人类判断的相关性。
- Slide 9 — 外蕴词向量评价:以命名实体识别为例——好的词向量应直接帮助识别"人名 / 机构 / 地点"(如 Chris Manning lives in Palo Alto)。
- Slide 10 — 深度学习分类任务:命名实体识别(NER)。任务是为每个词打标签(如
Paris Hilton标为 PER、Hilton Hotel的 Hotel 标为 LOC 等);常见用途包括追踪文档中的实体、问答(答案通常是实体)、把情感分析关联到所讨论的实体,以及后续接入知识库(如 Wikidata)做实体链接。 - Slide 12 — 分类复习与记号。监督学习的数据集为 $\{x_i, y_i\}_{i=1}^N$,$x_i$ 是输入(词、句子、文档……),$y_i$ 是 $C$ 类标签之一(情感 +/–、命名实体、买卖决策……)。
- Slide 18 — 交叉熵损失。把我们一直说的"最大化正确类别的概率(等价于最小化其负对数概率)",重述为信息论中的交叉熵:设真实分布为 $p$、模型分布为 $q$,则交叉熵为 $H(p,q) = -\sum_c p(c)\,q(c)$;当 $p$ 是 one-hot 时,只剩一项 $-\log p(y_i \mid x_i)$。PyTorch 里用的就是它。
附:参考与延伸阅读
编者补充
- GLU Variants Improve Transformer
- Llama
- PyTorch
- TensorFlow
- Theano
- WordSim353
- Yes you should understand backprop
已知疑点
以下为本讲在重构过程中发现的、无法当场判定的不确定之处,逐条列明依据或时间点:
- 幻灯片版本与视频年份不一致。随课程提供的幻灯片文件名标注为
cs224n-2026-lecture03-neuralnets.pdf,而视频录制于 2024 年春季。两者在事务性细节上确有出入(见下条)。因此凡是"以幻灯片为准"的表述,可能与当年视频中的实际内容有差异。 - PyTorch 辅导课的时间与地点冲突。视频录音(约 00:01:59)说的是"周五 3:30,Gates B01";而幻灯片第 3 页写的是"本周五 1:30–2:20,NVIDIA Auditorium"。两处无法调和,正文以录音为准并已加编者说明。
- "作业 2"还是"作业 3"。讲师在 约 00:01:40 附近提到 PyTorch 脚手架时口述为"assignment 3",但从上下文(本周下发的是作业 2、且作业 2 引入 PyTorch)判断应为作业 2。已按作业 2 处理。
∂s/∂W的最终表达式。录音(约 00:40:10)听上去是"delta 的转置乘 x 的转置"。按形状约定与数学推导,正确的应是外积 $\delta\,\mathbf{x}^\top$($\delta$ 为 $z$ 处上游梯度、$\mathbf{x}$ 为输入)。正文采用了后者,但无法排除讲师板书采用了某种等价书写约定。- 激活函数命名。录音中"Swish""GELU"的发音("swis""jello")经核对应为 Swish 与 GELU;正文按幻灯片更正。
- 人名与专有名词的听写。"Jacobi(雅可比)"的德语读音、以及讲师提到的若干人名,字幕存在噪声,正文依据幻灯片与通行写法定夺。
codeix/ 框架代码片段。讲课时在幻灯片上展示了 PyTorch 反向传播的实现示意;由于无法看到画面,正文中的Multiply伪代码为编者按讲师口述逻辑补写的示意,非幻灯片原图逐字转录,请以官方讲义为准。- 本讲"回忆上一讲"部分涉及的字向量评价内容(内蕴 / 外蕴评价、类比任务、WordSim353 等)在录音中几乎未展开——讲师从课程事务直接跳到了神经网络部分。相关幻灯片被一并收入文末附录,读者若需完整背景,请参阅上一讲。
附录:课堂未展示的幻灯片
附录:官方幻灯片里课堂未展示的页
下面这些页来自官方幻灯片,但课堂录制里没有对应的展示画面。由
vb slides自动补入,供对照查阅。
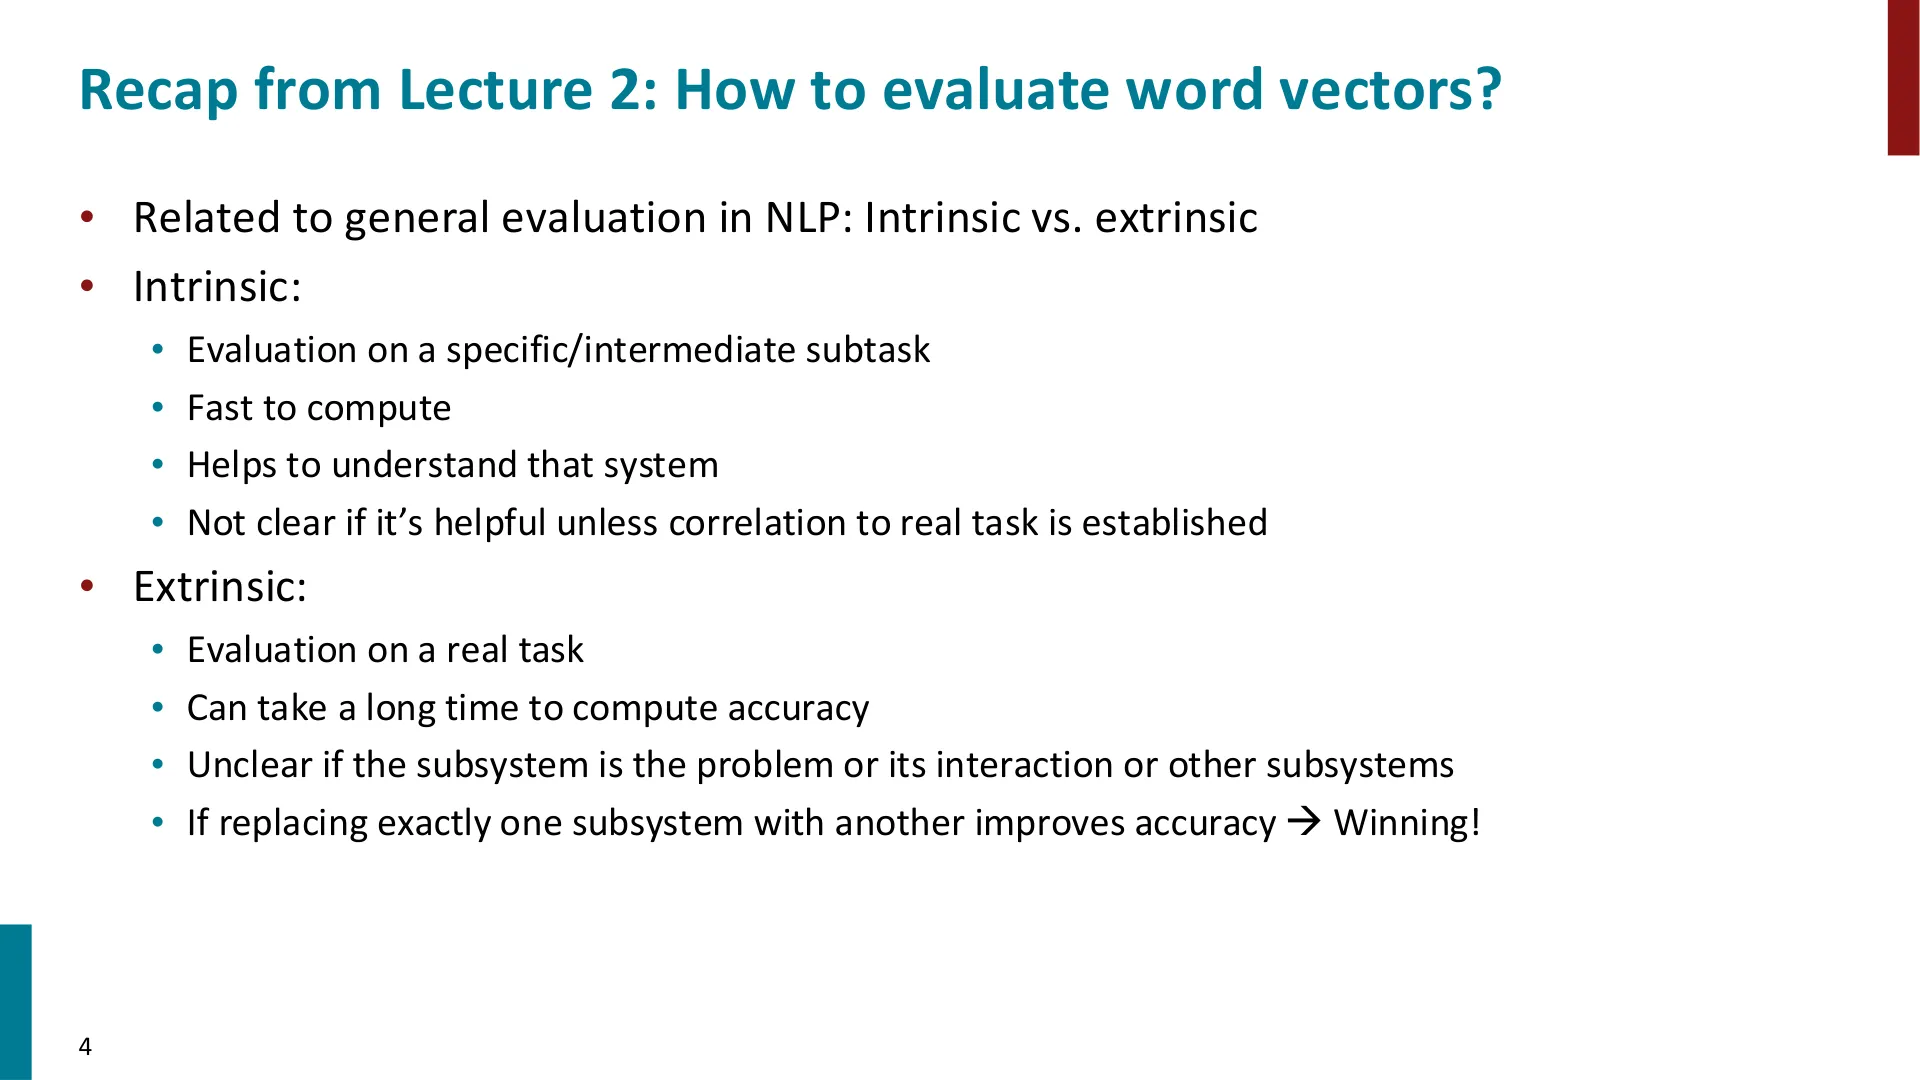
🖼️ 第 4 页幻灯片 · Recap from Lecture 2: How to evaluate word vectors?
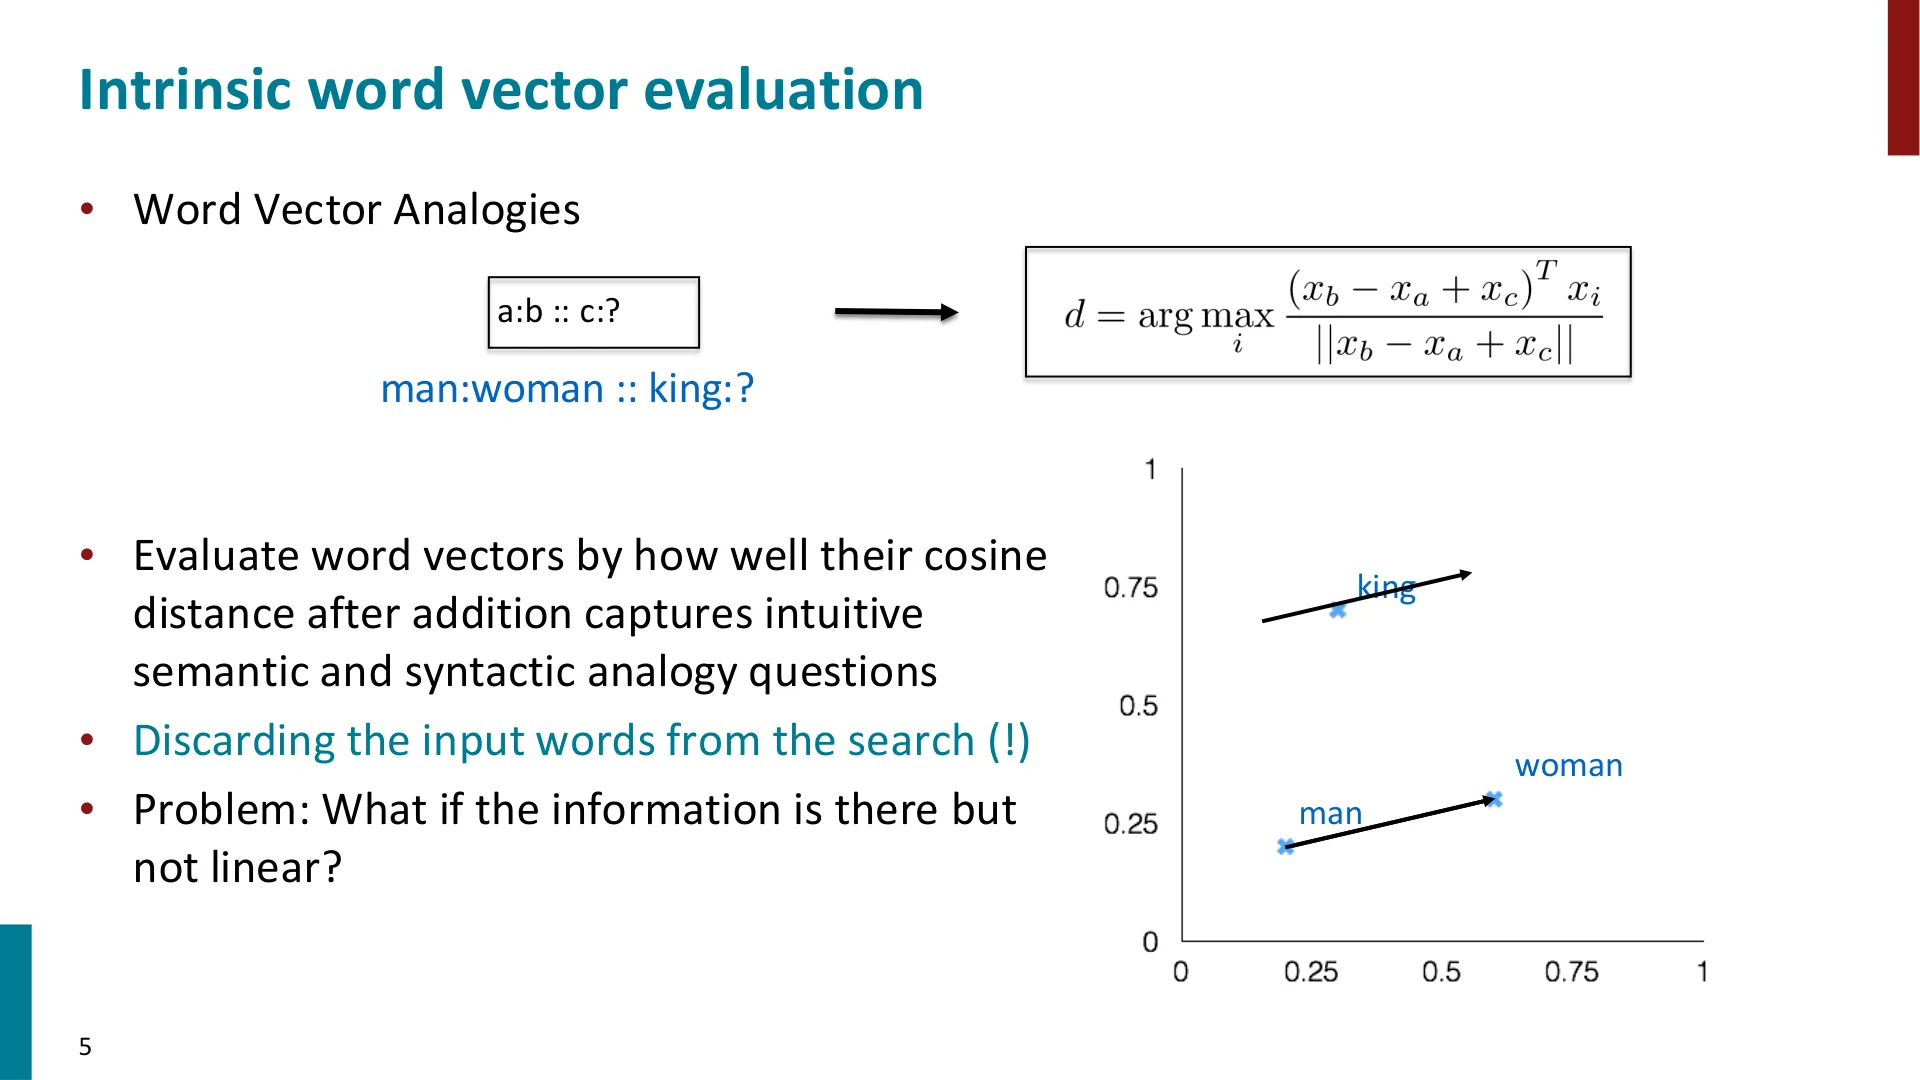
🖼️ 第 5 页幻灯片 · Intrinsic word vector evaluation
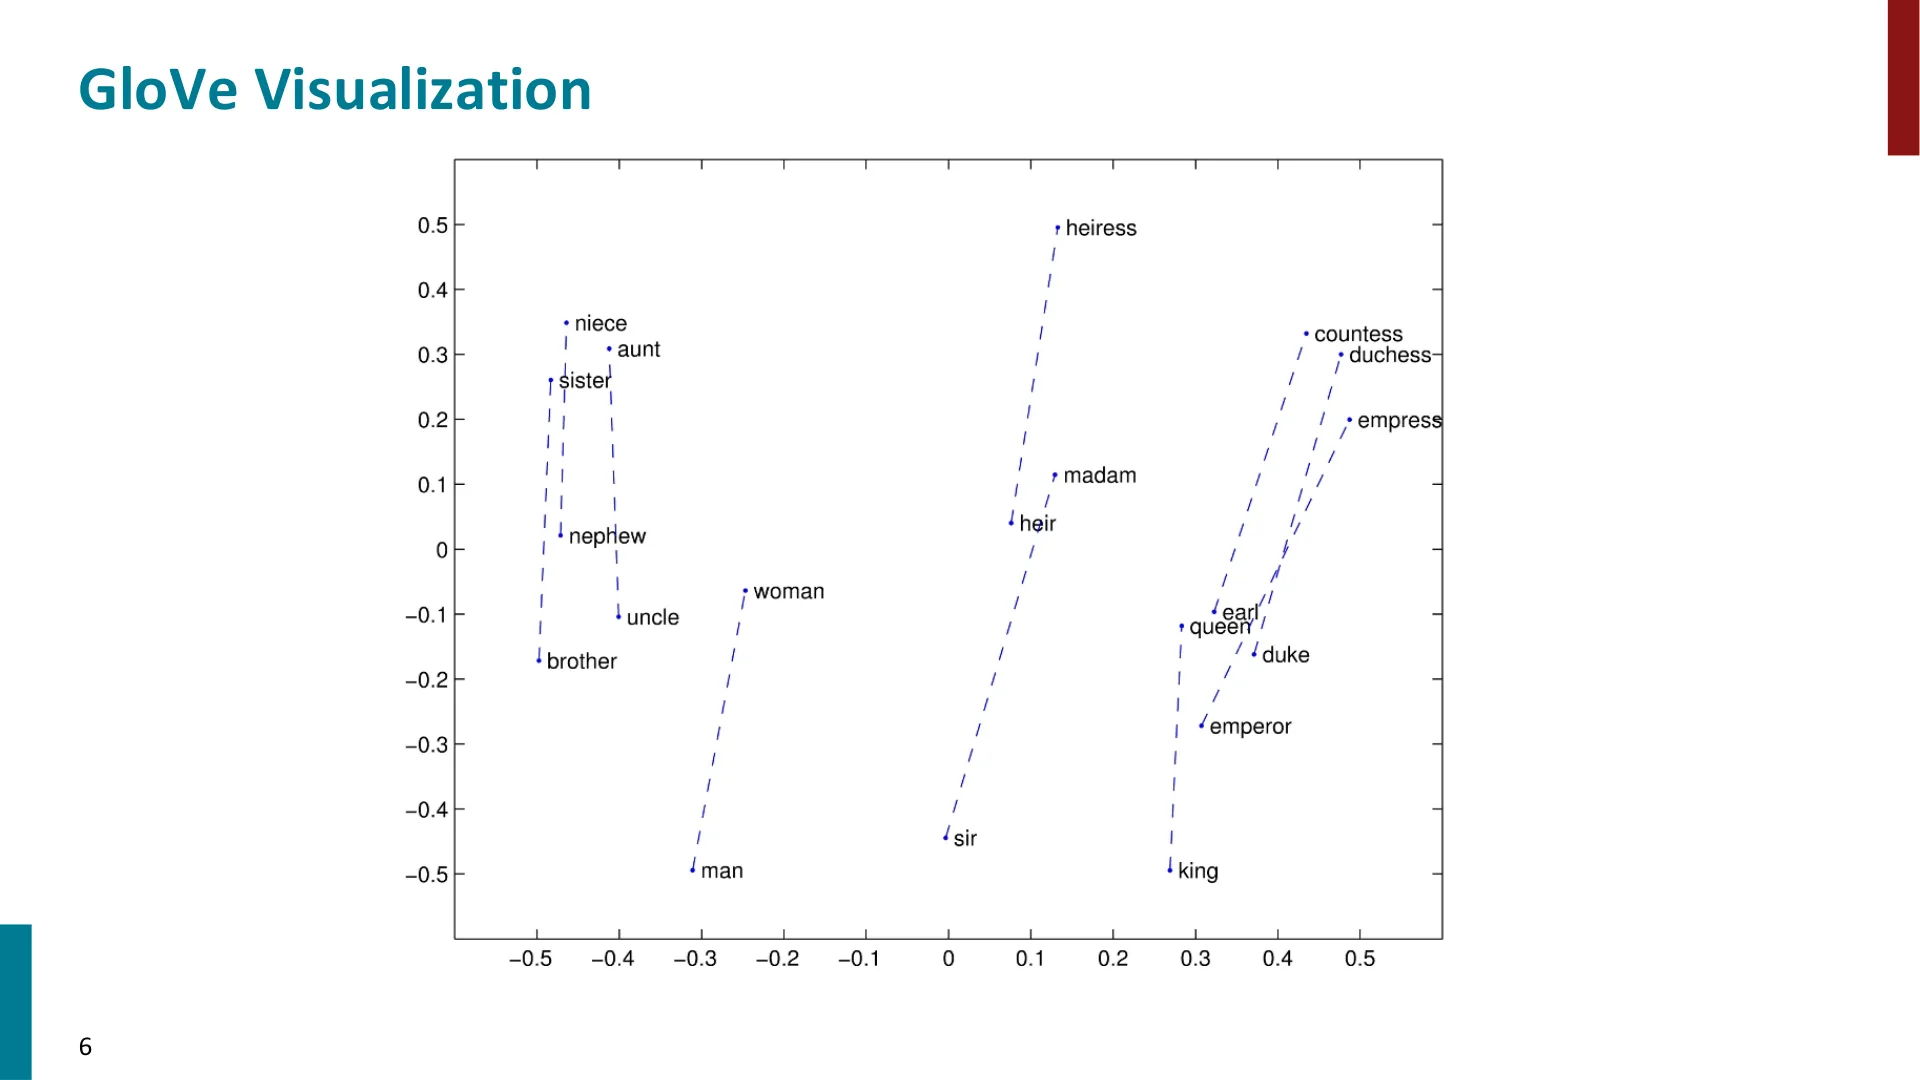
🖼️ 第 6 页幻灯片 · GloVe Visualization
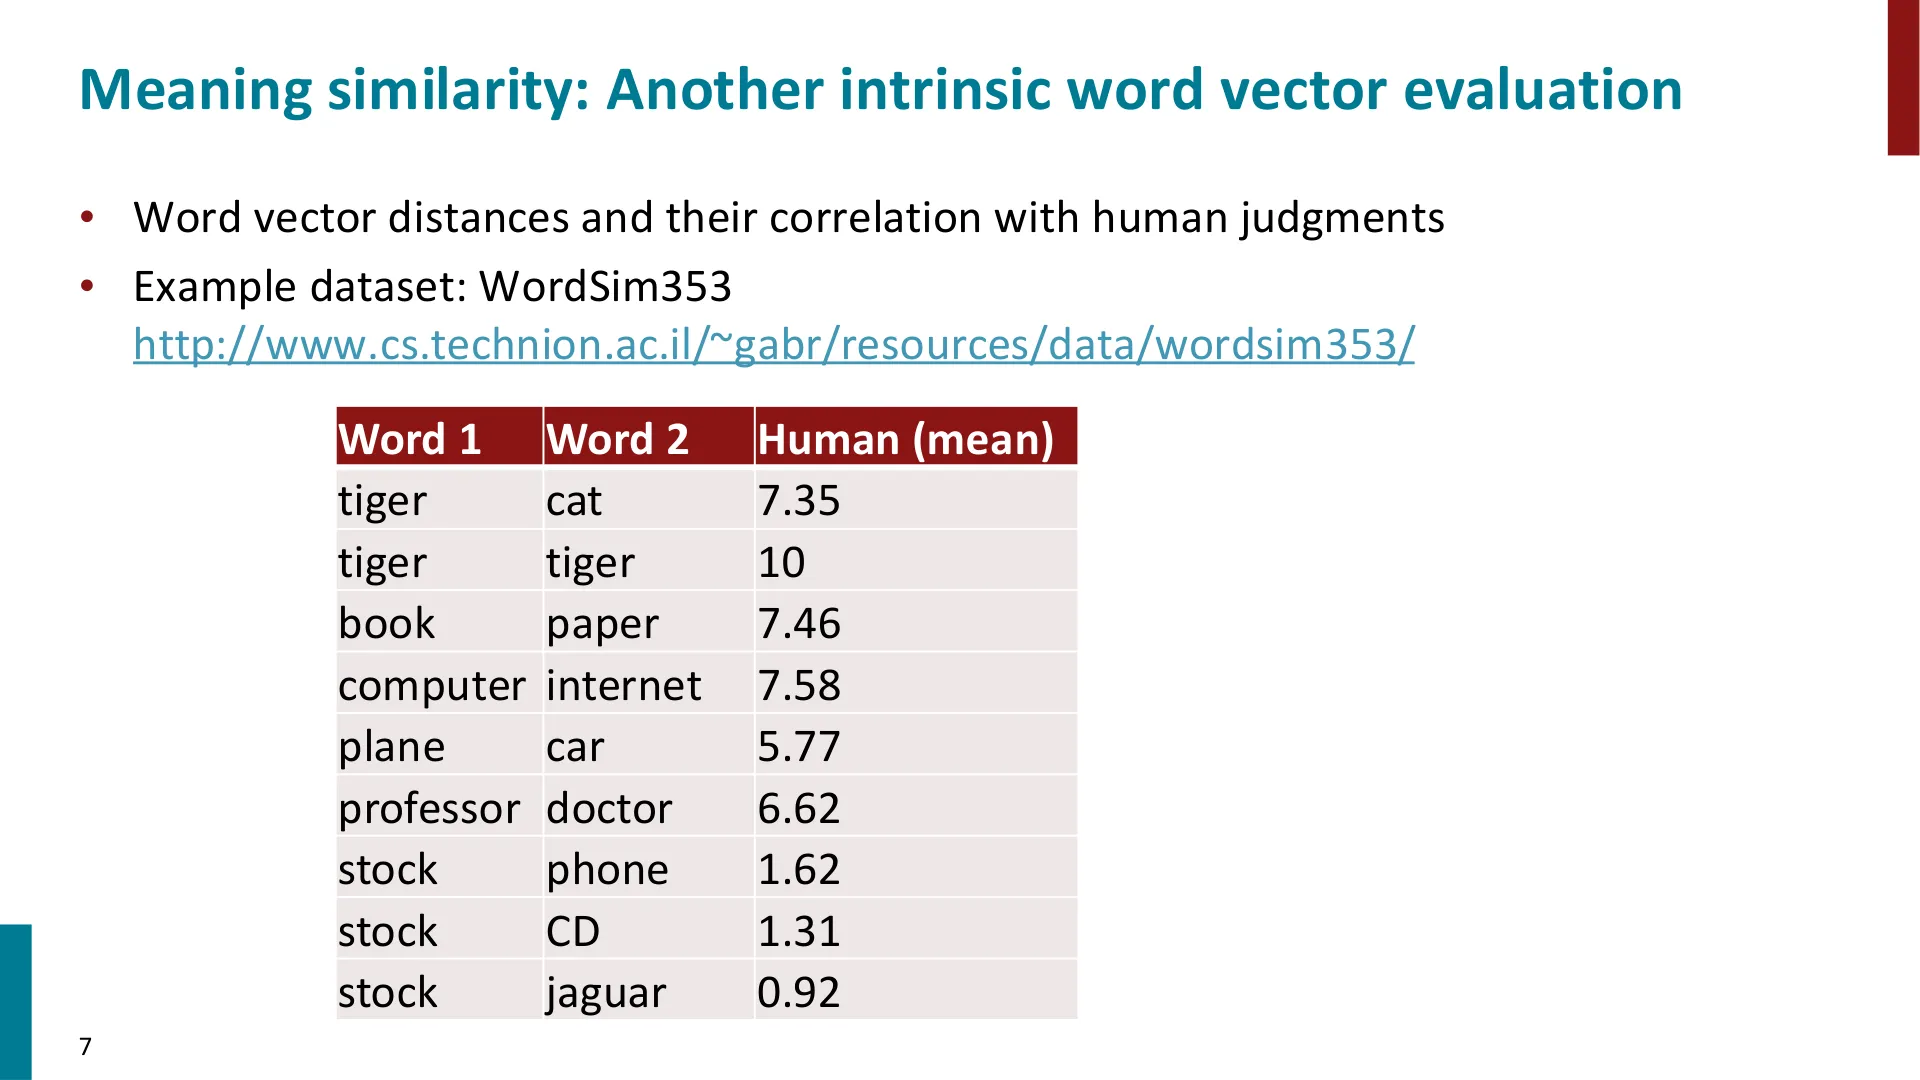
🖼️ 第 7 页幻灯片 · Meaning similarity: Another intrinsic word vector evaluation
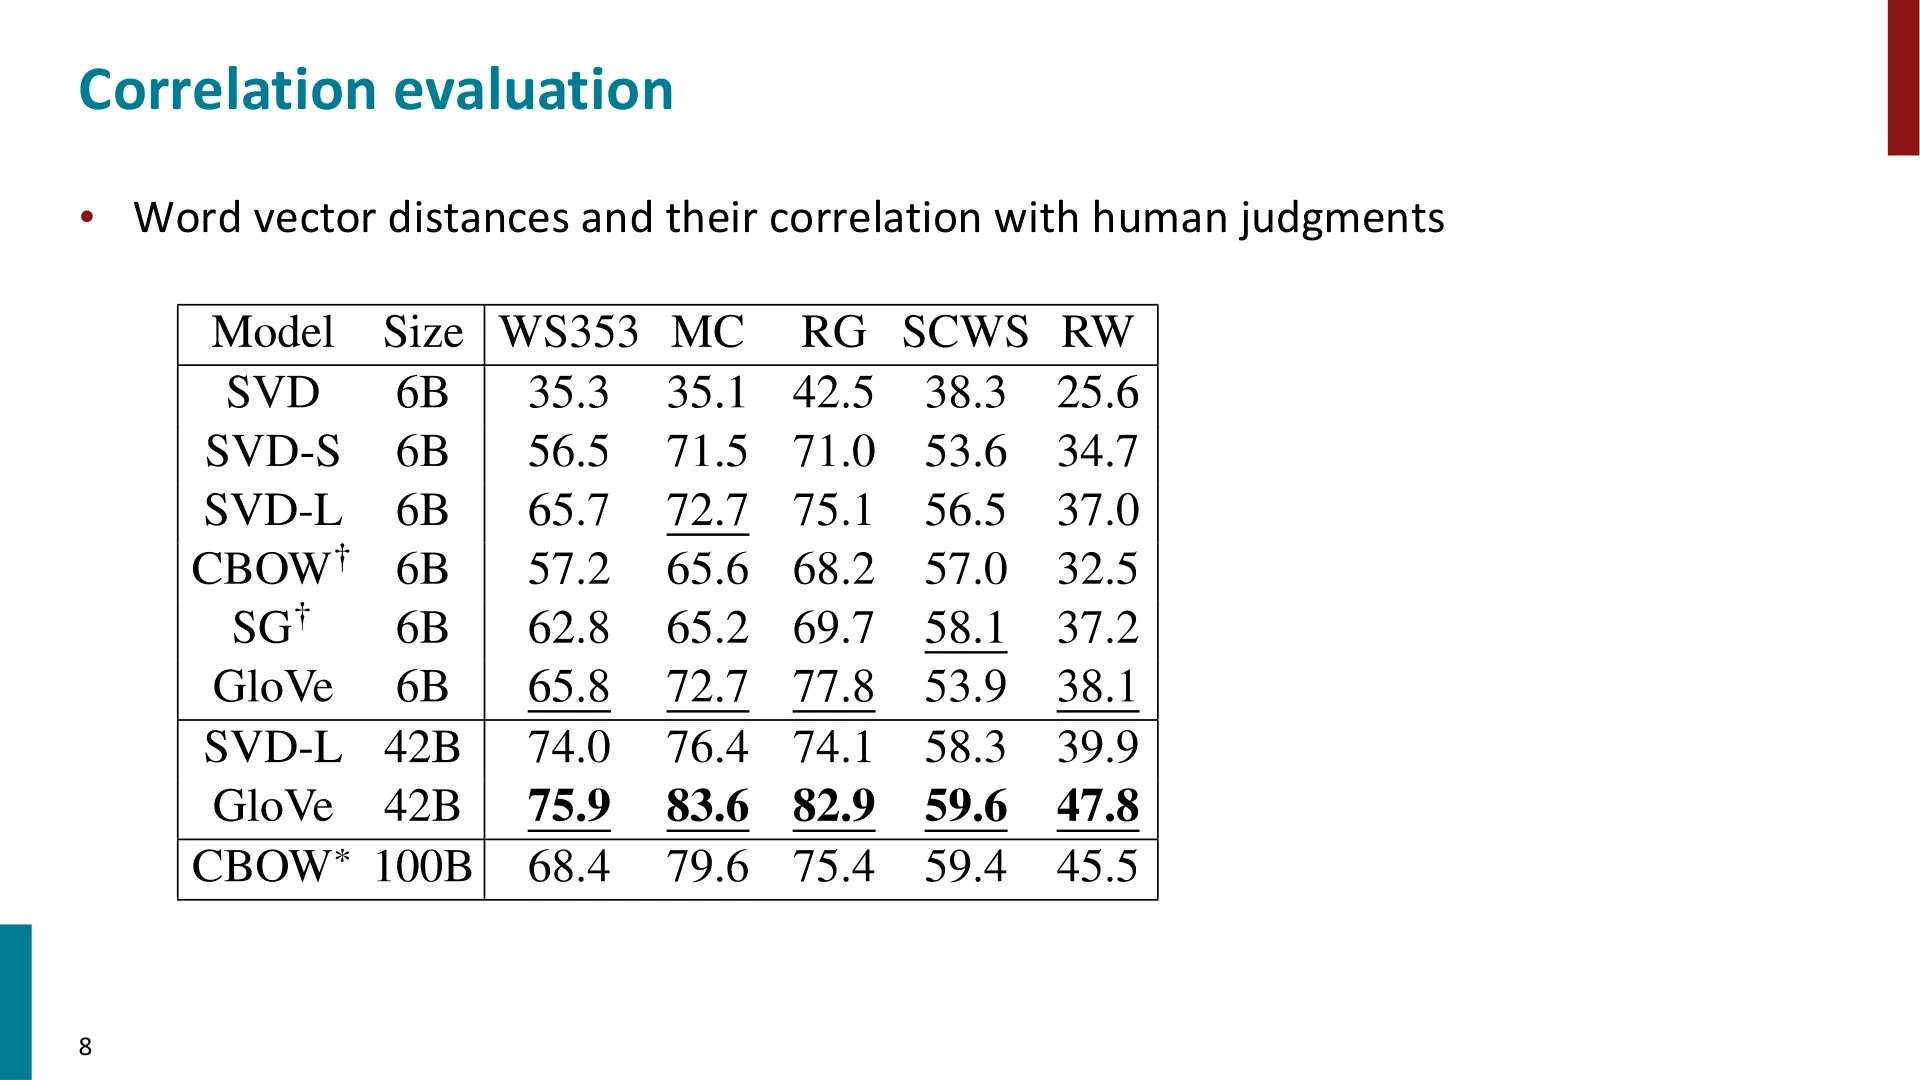
🖼️ 第 8 页幻灯片 · Correlation evaluation
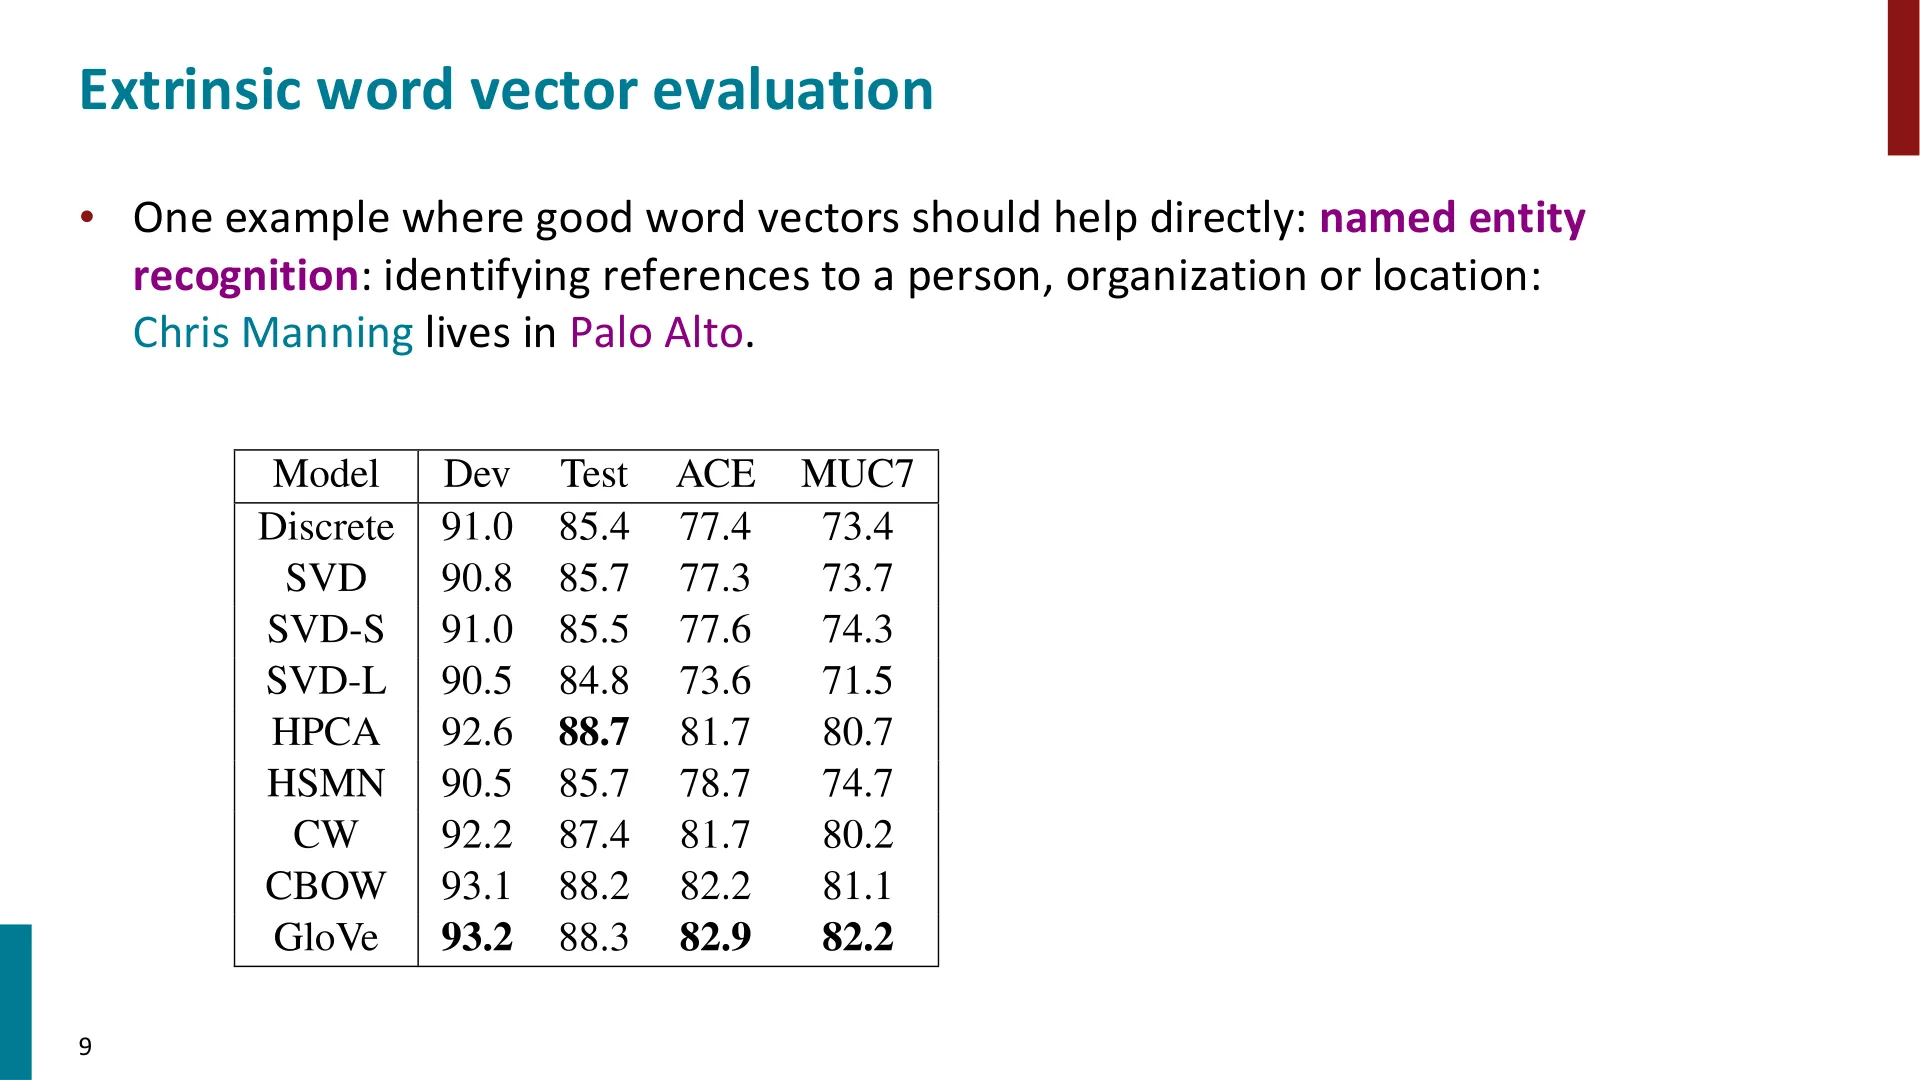
🖼️ 第 9 页幻灯片 · Extrinsic word vector evaluation
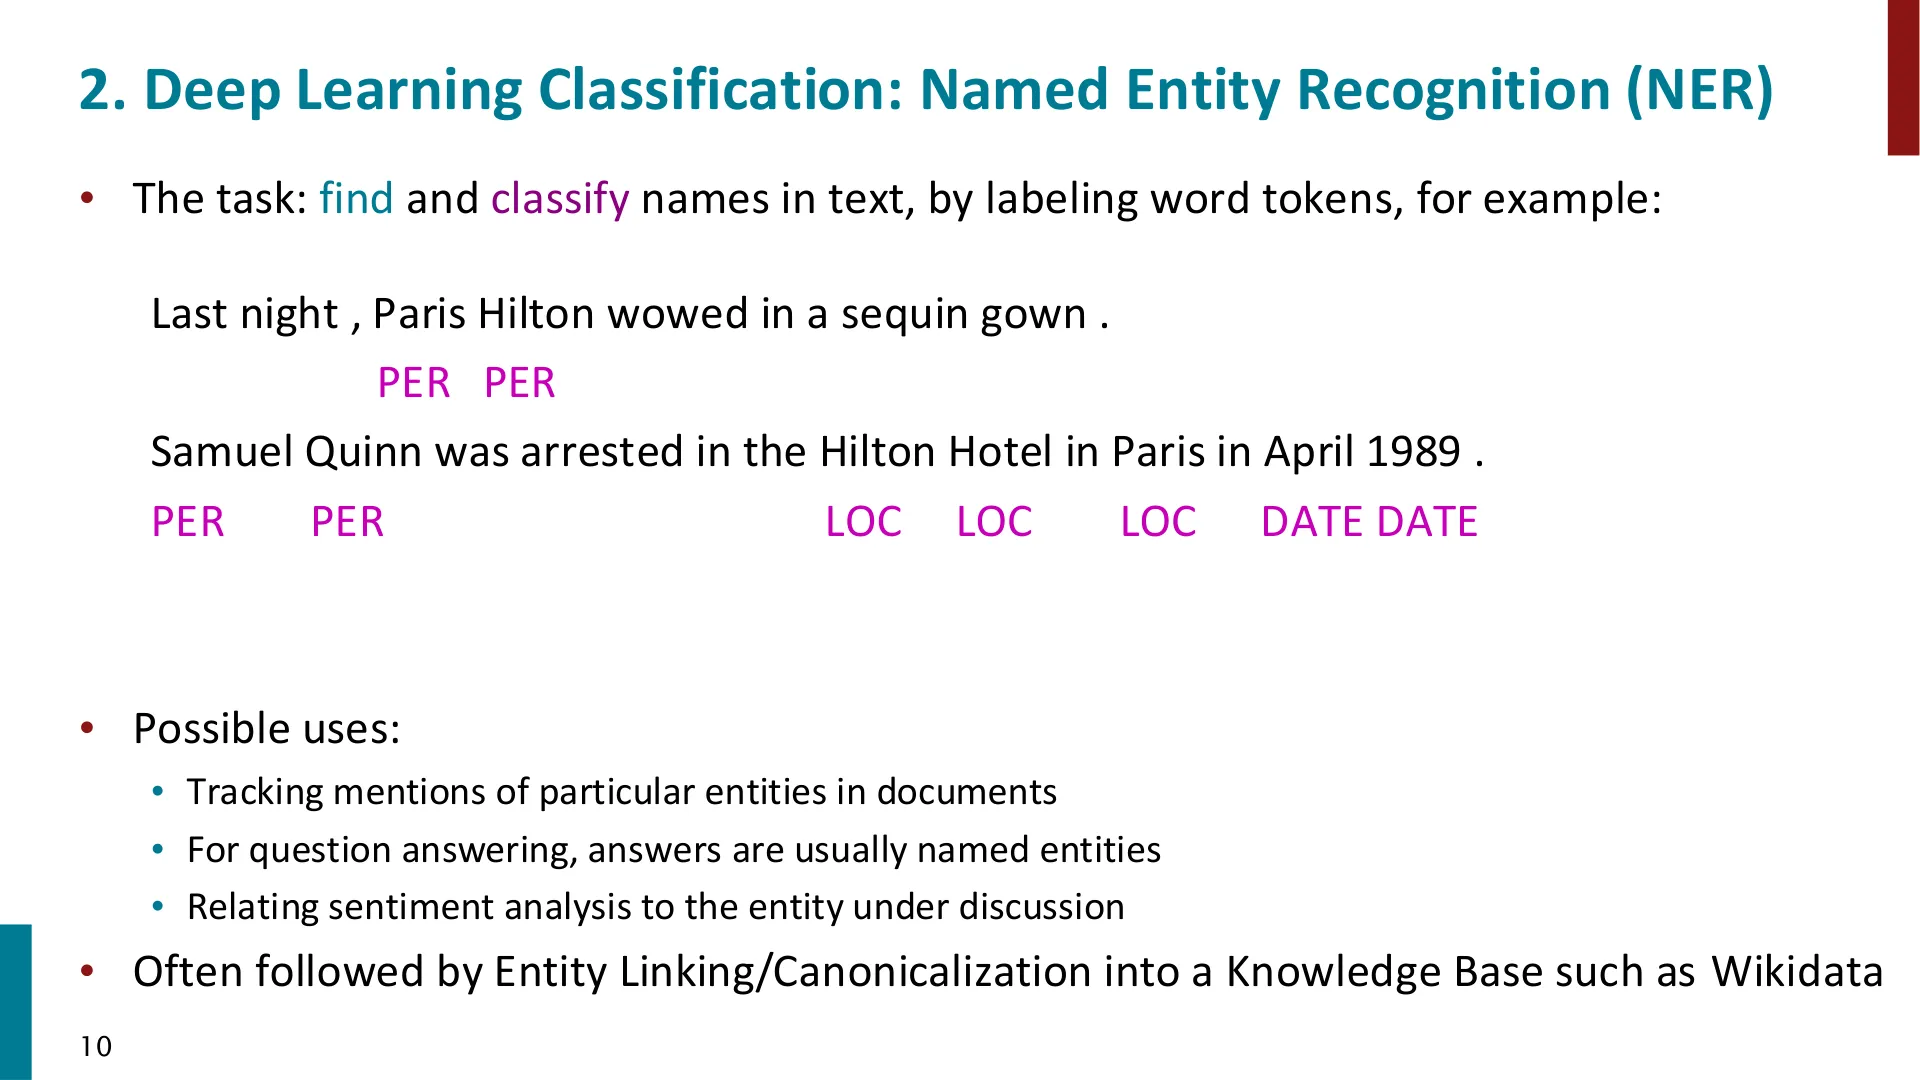
🖼️ 第 10 页幻灯片 · 2. Deep Learning Classification: Named Entity Recognition (NER)
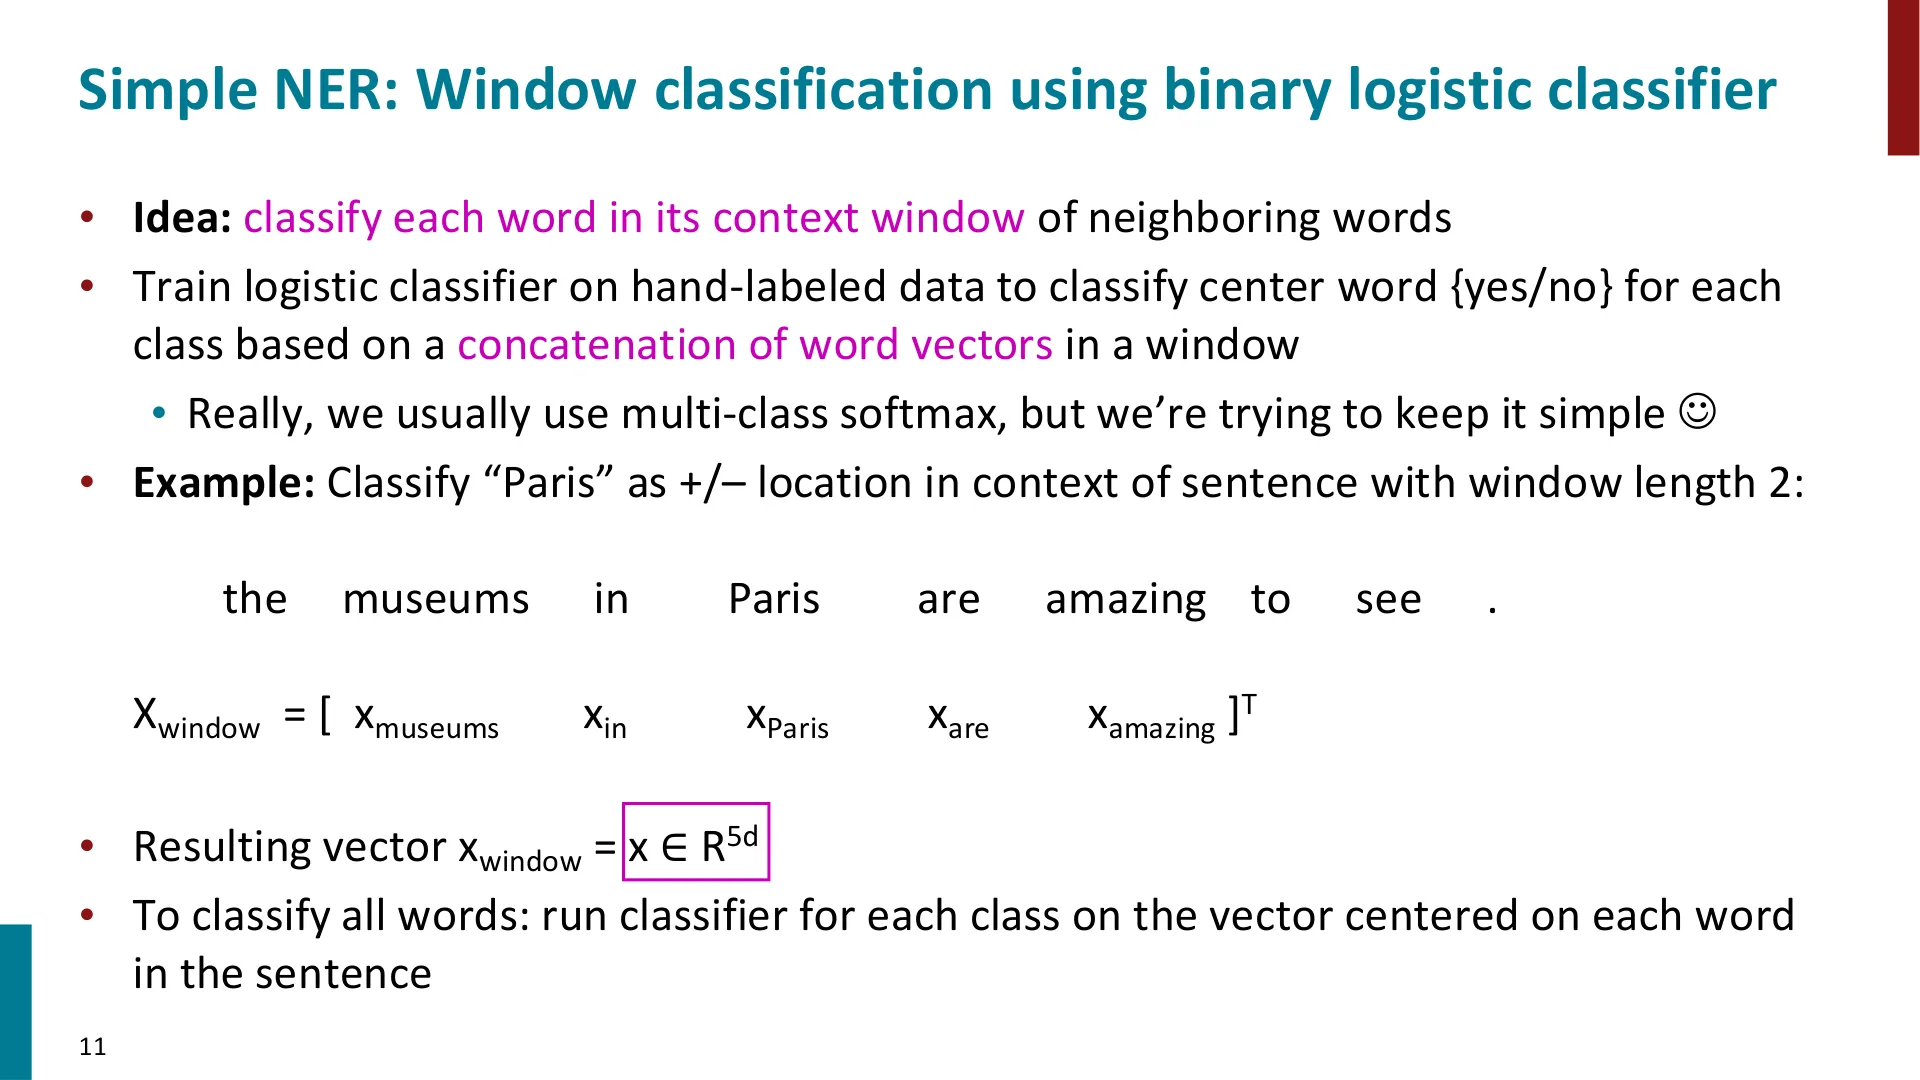
🖼️ Slide 11
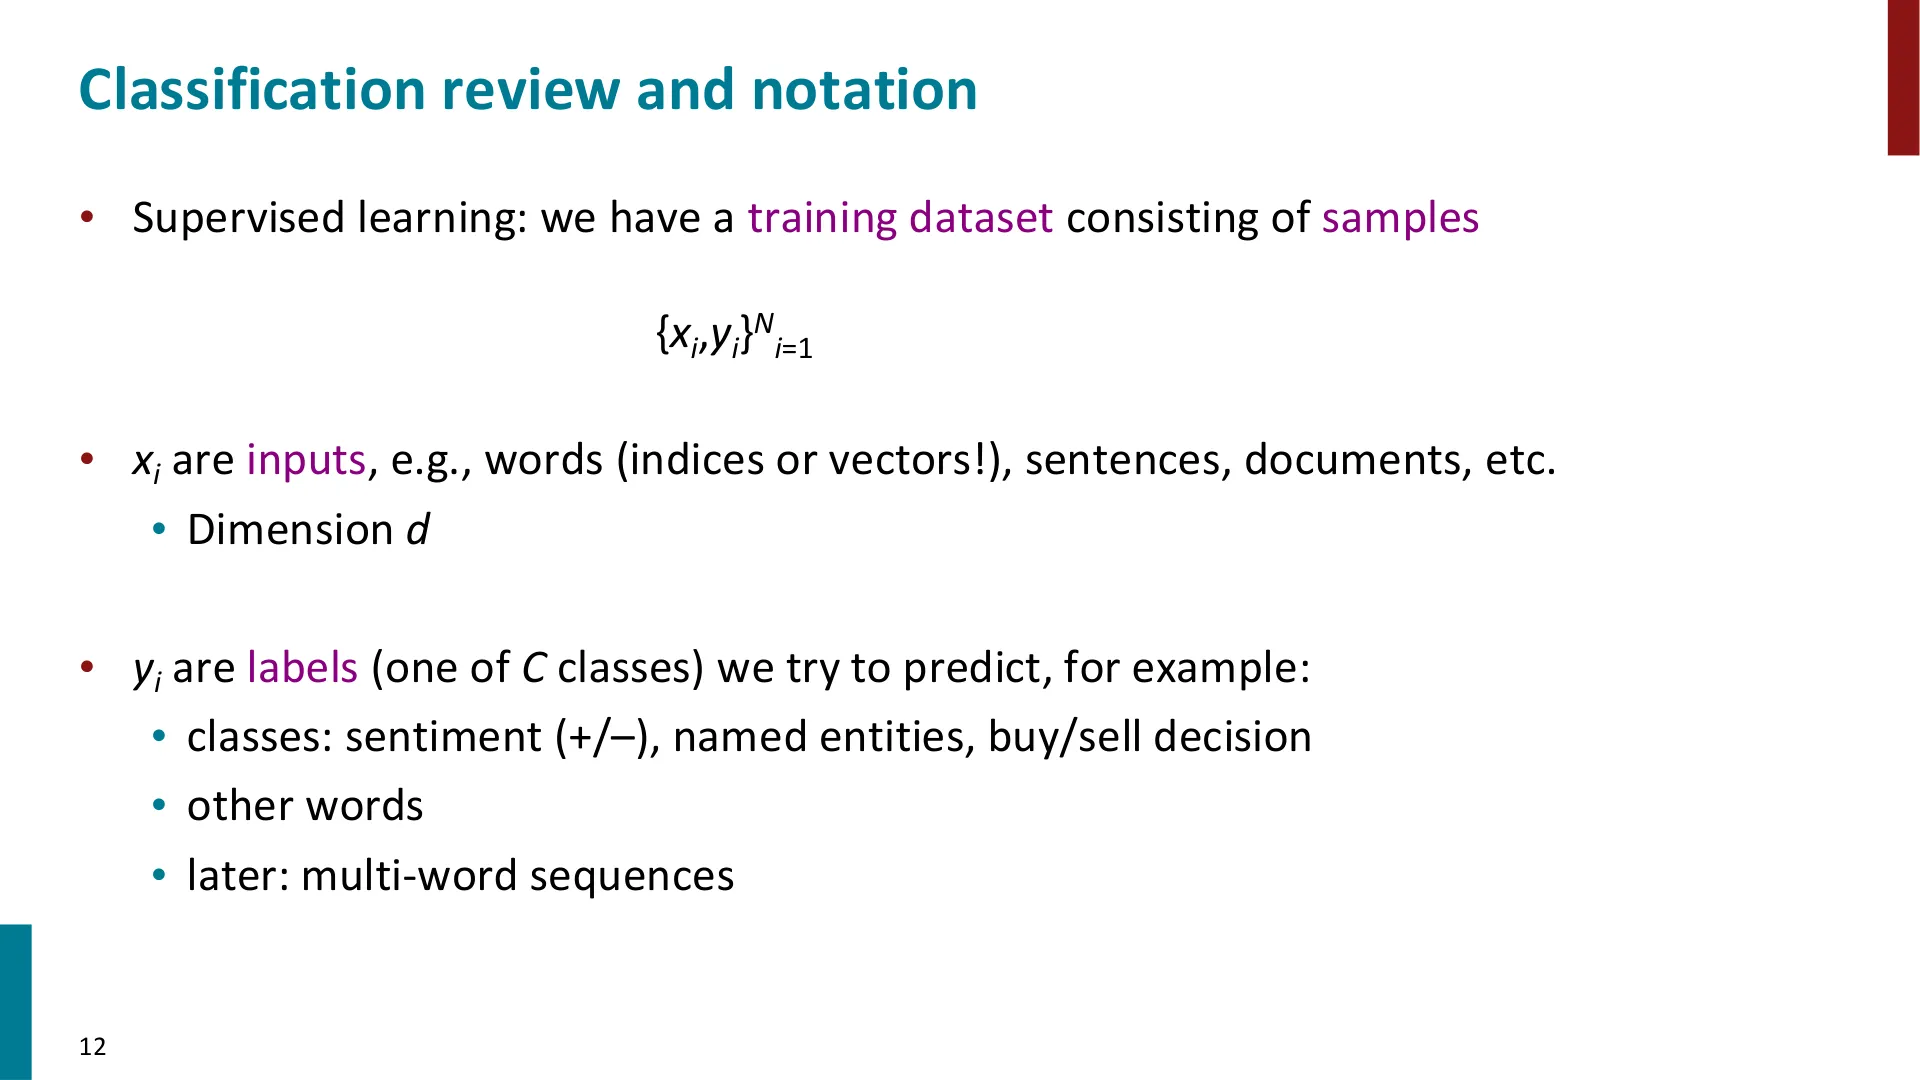
🖼️ 第 12 页幻灯片 · Classification review and notation
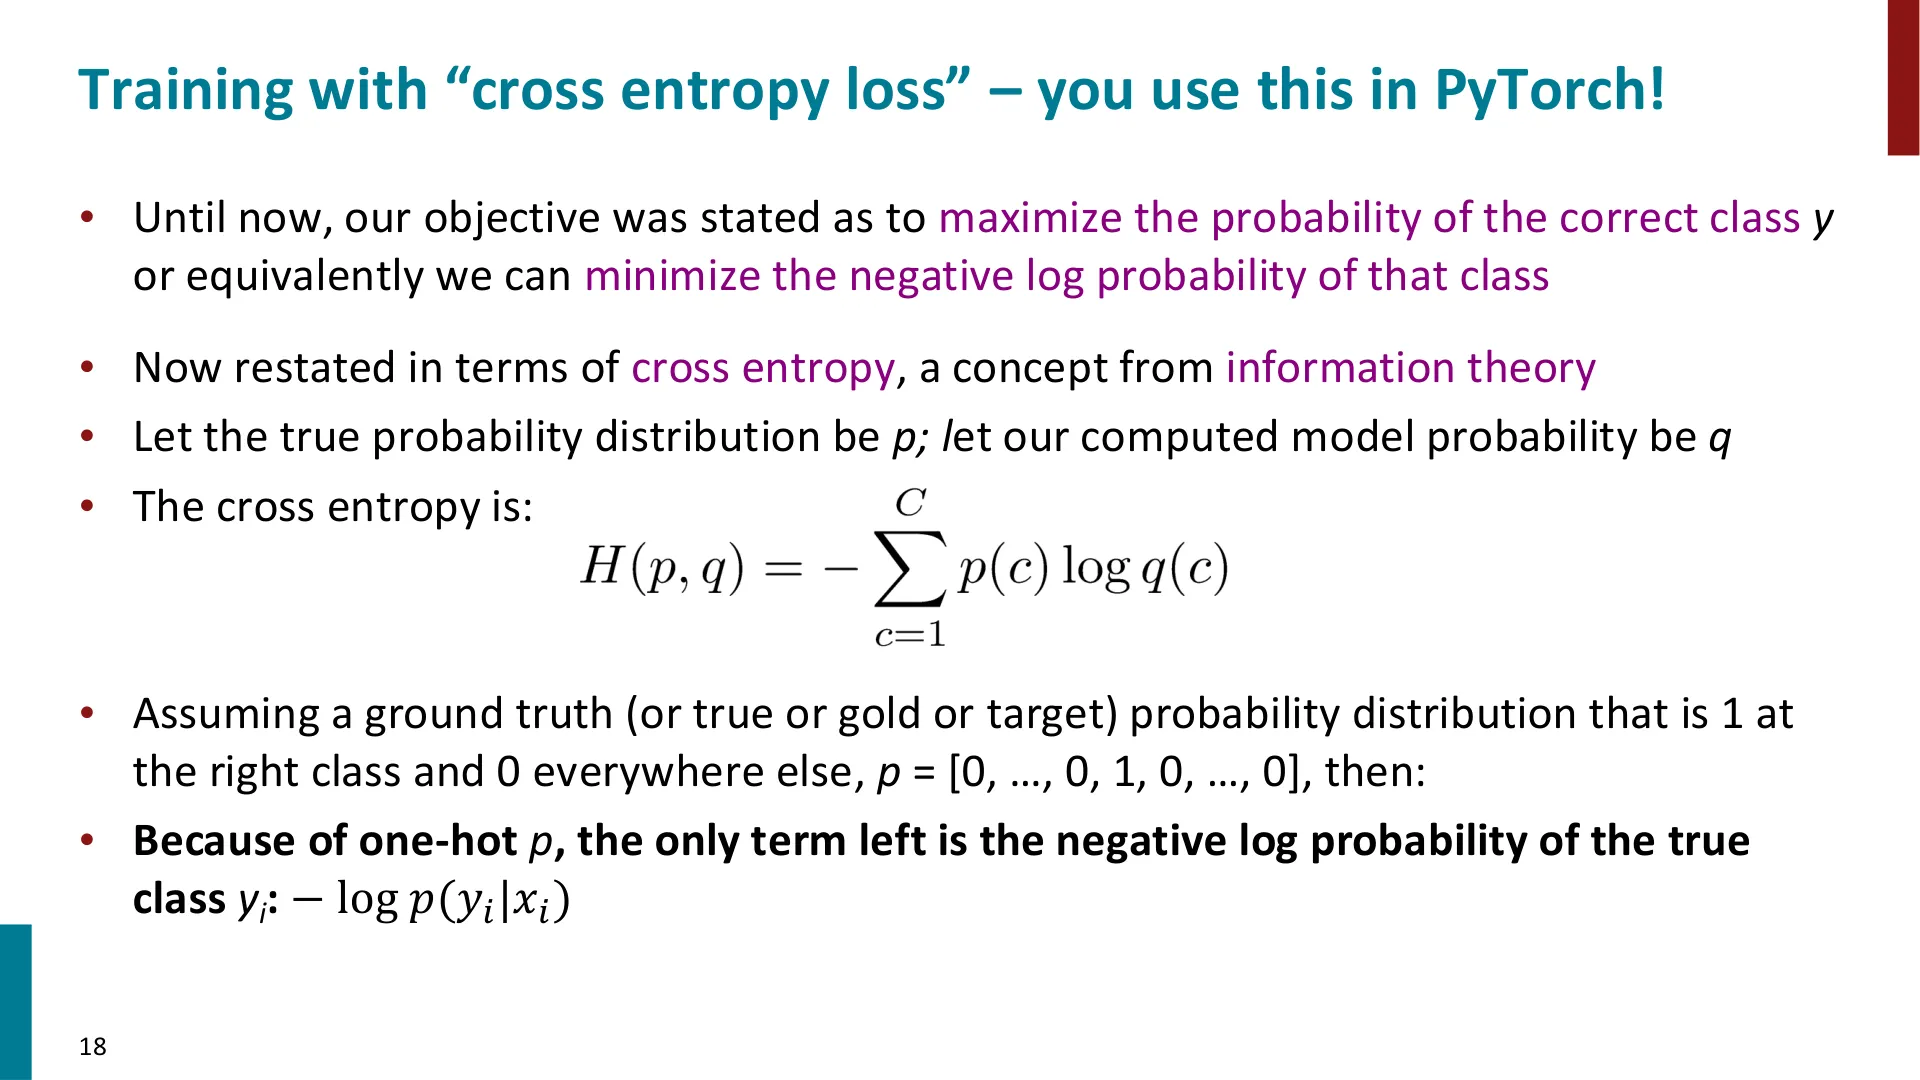
🖼️ 第 18 页幻灯片 · Training with “cross entropy loss” – you use this in PyTorch!
🖼️ Slide 25
🖼️ Slide 26
🖼️ Slide 27
🖼️ Slide 28
🖼️ Slide 30
🖼️ Slide 31
🖼️ Slide 32
🖼️ Slide 35
🖼️ Slide 37
🖼️ Slide 38
🖼️ Slide 39
🖼️ Slide 41
🖼️ Slide 42
🖼️ Slide 43
🖼️ Slide 44
🖼️ Slide 46
🖼️ Slide 47
🖼️ Slide 49
🖼️ Slide 52
🖼️ Slide 54
🖼️ Slide 57
🖼️ Slide 58
🖼️ Slide 61
🖼️ Slide 62
🖼️ Slide 63
🖼️ Slide 65
🖼️ Slide 67
🖼️ Slide 69
🖼️ Slide 70
🖼️ Slide 72
🖼️ Slide 73