第4讲 · 语言模型与循环神经网络:CS224N 重构
| 课程 | Stanford CS224N / Ling284《Natural Language Processing with Deep Learning》 |
| 视频 | Lecture 5 - Recurrent Neural Networks(Spring 2024) |
| 课程主页 | https://web.stanford.edu/class/cs224n/ |
| 本讲配套讲义 / 幻灯片 | cs224n-2026-lecture04-rnnlm.pdf(标题:Language Models and Recurrent Neural Networks) |
| 视频 ID | fyc0Jzr74y4 原始时长:约 78 分 52 秒 |
| 本书性质 | 由课堂口语记录重构而成的中文技术读物,非官方讲义翻译。 |
对应讲次:第4讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
版权说明:CS224N 的课程讲义、幻灯片与作业版权归 Stanford 大学及课程作者所有(材料的公开授权方式以课程主页与讲义页脚的声明为准)。本书是对课堂讲授的中文重构,引用讲义内容仅用于教学与学习目的。
导览
这是一张帮你 3–5 分钟读完的"问题地图",只告诉你这一讲要回答什么、难点在哪、老师打算怎么走,不替你推导、不替你下结论。
① 老师真正提出的核心问题(按他自己的顺序)
- 我们怎样让一个系统"预测下一个词是什么"?这个任务是干什么用的,为什么它是 NLP 的枢纽?
- 在没有深度学习的年代,人们怎么建这种系统?——n-gram 语言模型。它为什么会"卡住"?
- 用神经网络来建语言模型行不行?先从最简单的"固定窗口"神经语言模型开始,它的天花板在哪里?
- 需要一个能处理任意长度输入、且对每个位置用同一套参数的架构——这就是循环神经网络(RNN)。它长什么样、有什么优缺点?
- RNN 语言模型怎么训练、怎么生成文本?反向传播到一个"被反复使用的权重矩阵"上要怎么求导?
② 难点在哪
- n-gram 的两堵墙:语料里没出现过的 n-gram 会导致概率为 0(稀疏性);上下文一长,要存的 n-gram 数量指数级膨胀(存储)。这两个问题互相纠缠,把 n 死死压在 5 左右。
- 固定窗口的伪解决方案:把窗口开大一点?窗口越大,矩阵 $W$ 越大,而且永远不够大;更隐蔽的问题是"同一个词出现在不同位置会被当成完全不同的东西"。
- 对"重复权重"求导:$W_h$ 在每个时间步都用到,$\frac{\partial J}{\partial W_h}$ 不是一个简单的局部导数——这是本讲符号上最绕的一步。
③ 读者可能带着的疑问
(以下为编者预判,不是老师提出来的)
- 都已经有 Transformer 了,为什么还要学 RNN?
- "teacher forcing"到底是什么?为什么训练时不能让它自由生成?
- 为什么梯度对重复权重要"在每个位置分别求、再求和"?
④ 本讲路线
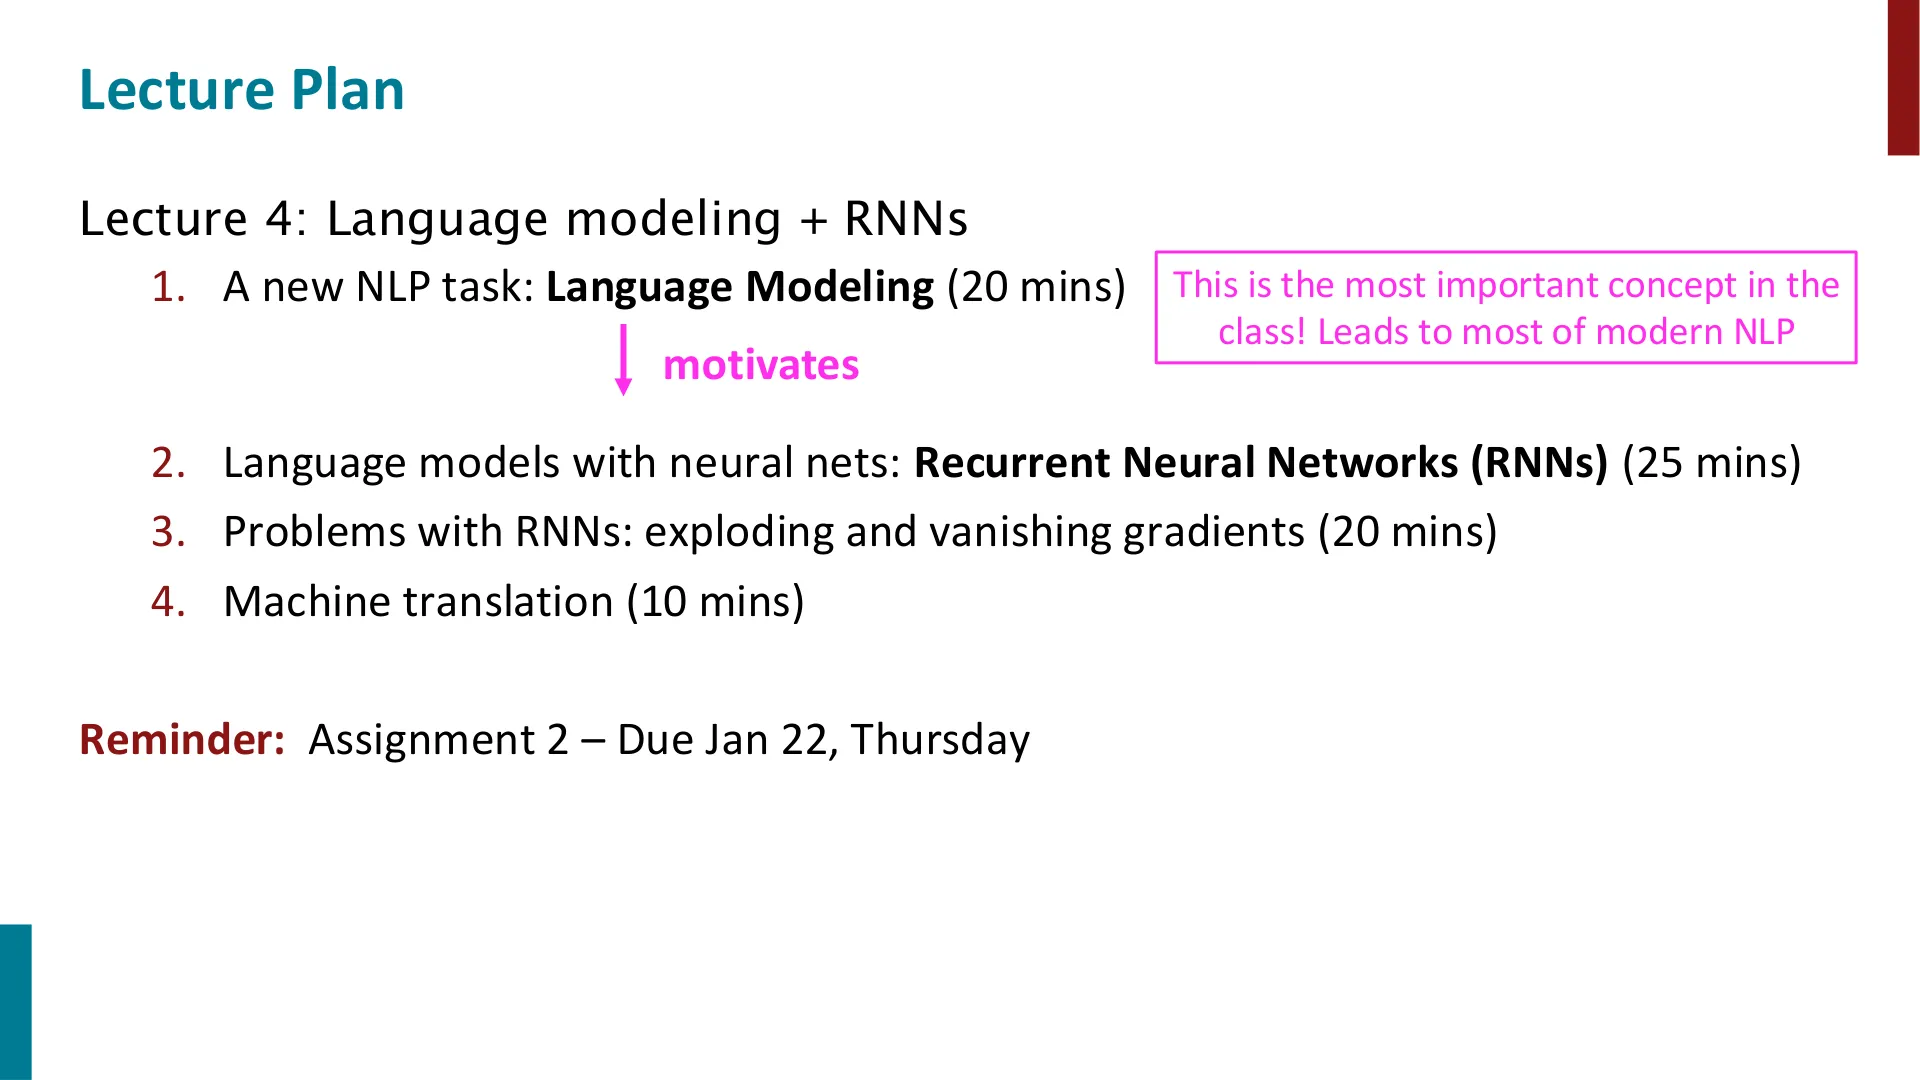
老师先花几十分钟热了一下身,把"让深度网络真正能训练起来"的几个工程要点(正则化、Dropout、向量化、初始化、优化器)过一遍——这些正好是作业二里会用到的。然后正式进入语言模型:从 n-gram 讲到固定窗口神经模型,再引出 RNN,讲它的训练、反向传播(BPTT)与文本生成。本讲最后停在"用 RNN 生成文本"的趣味演示上,梯度消失/爆炸与机器翻译被明确留到下一次课。
一、课前热身:让神经网络真正能训练起来的几个要点
(参考时间: 00:00:06)
在进入正题之前,老师用几分钟回顾了几个"新网络"概念,其中好几个会直接出现在作业二里。
从"浅"到"深":一段卡了 15 年的历史
(参考时间: 00:03:05)
先说个背景。现代神经网络、尤其是语言模型,规模极其庞大。老师展示了一张"模型规模增长"的图。
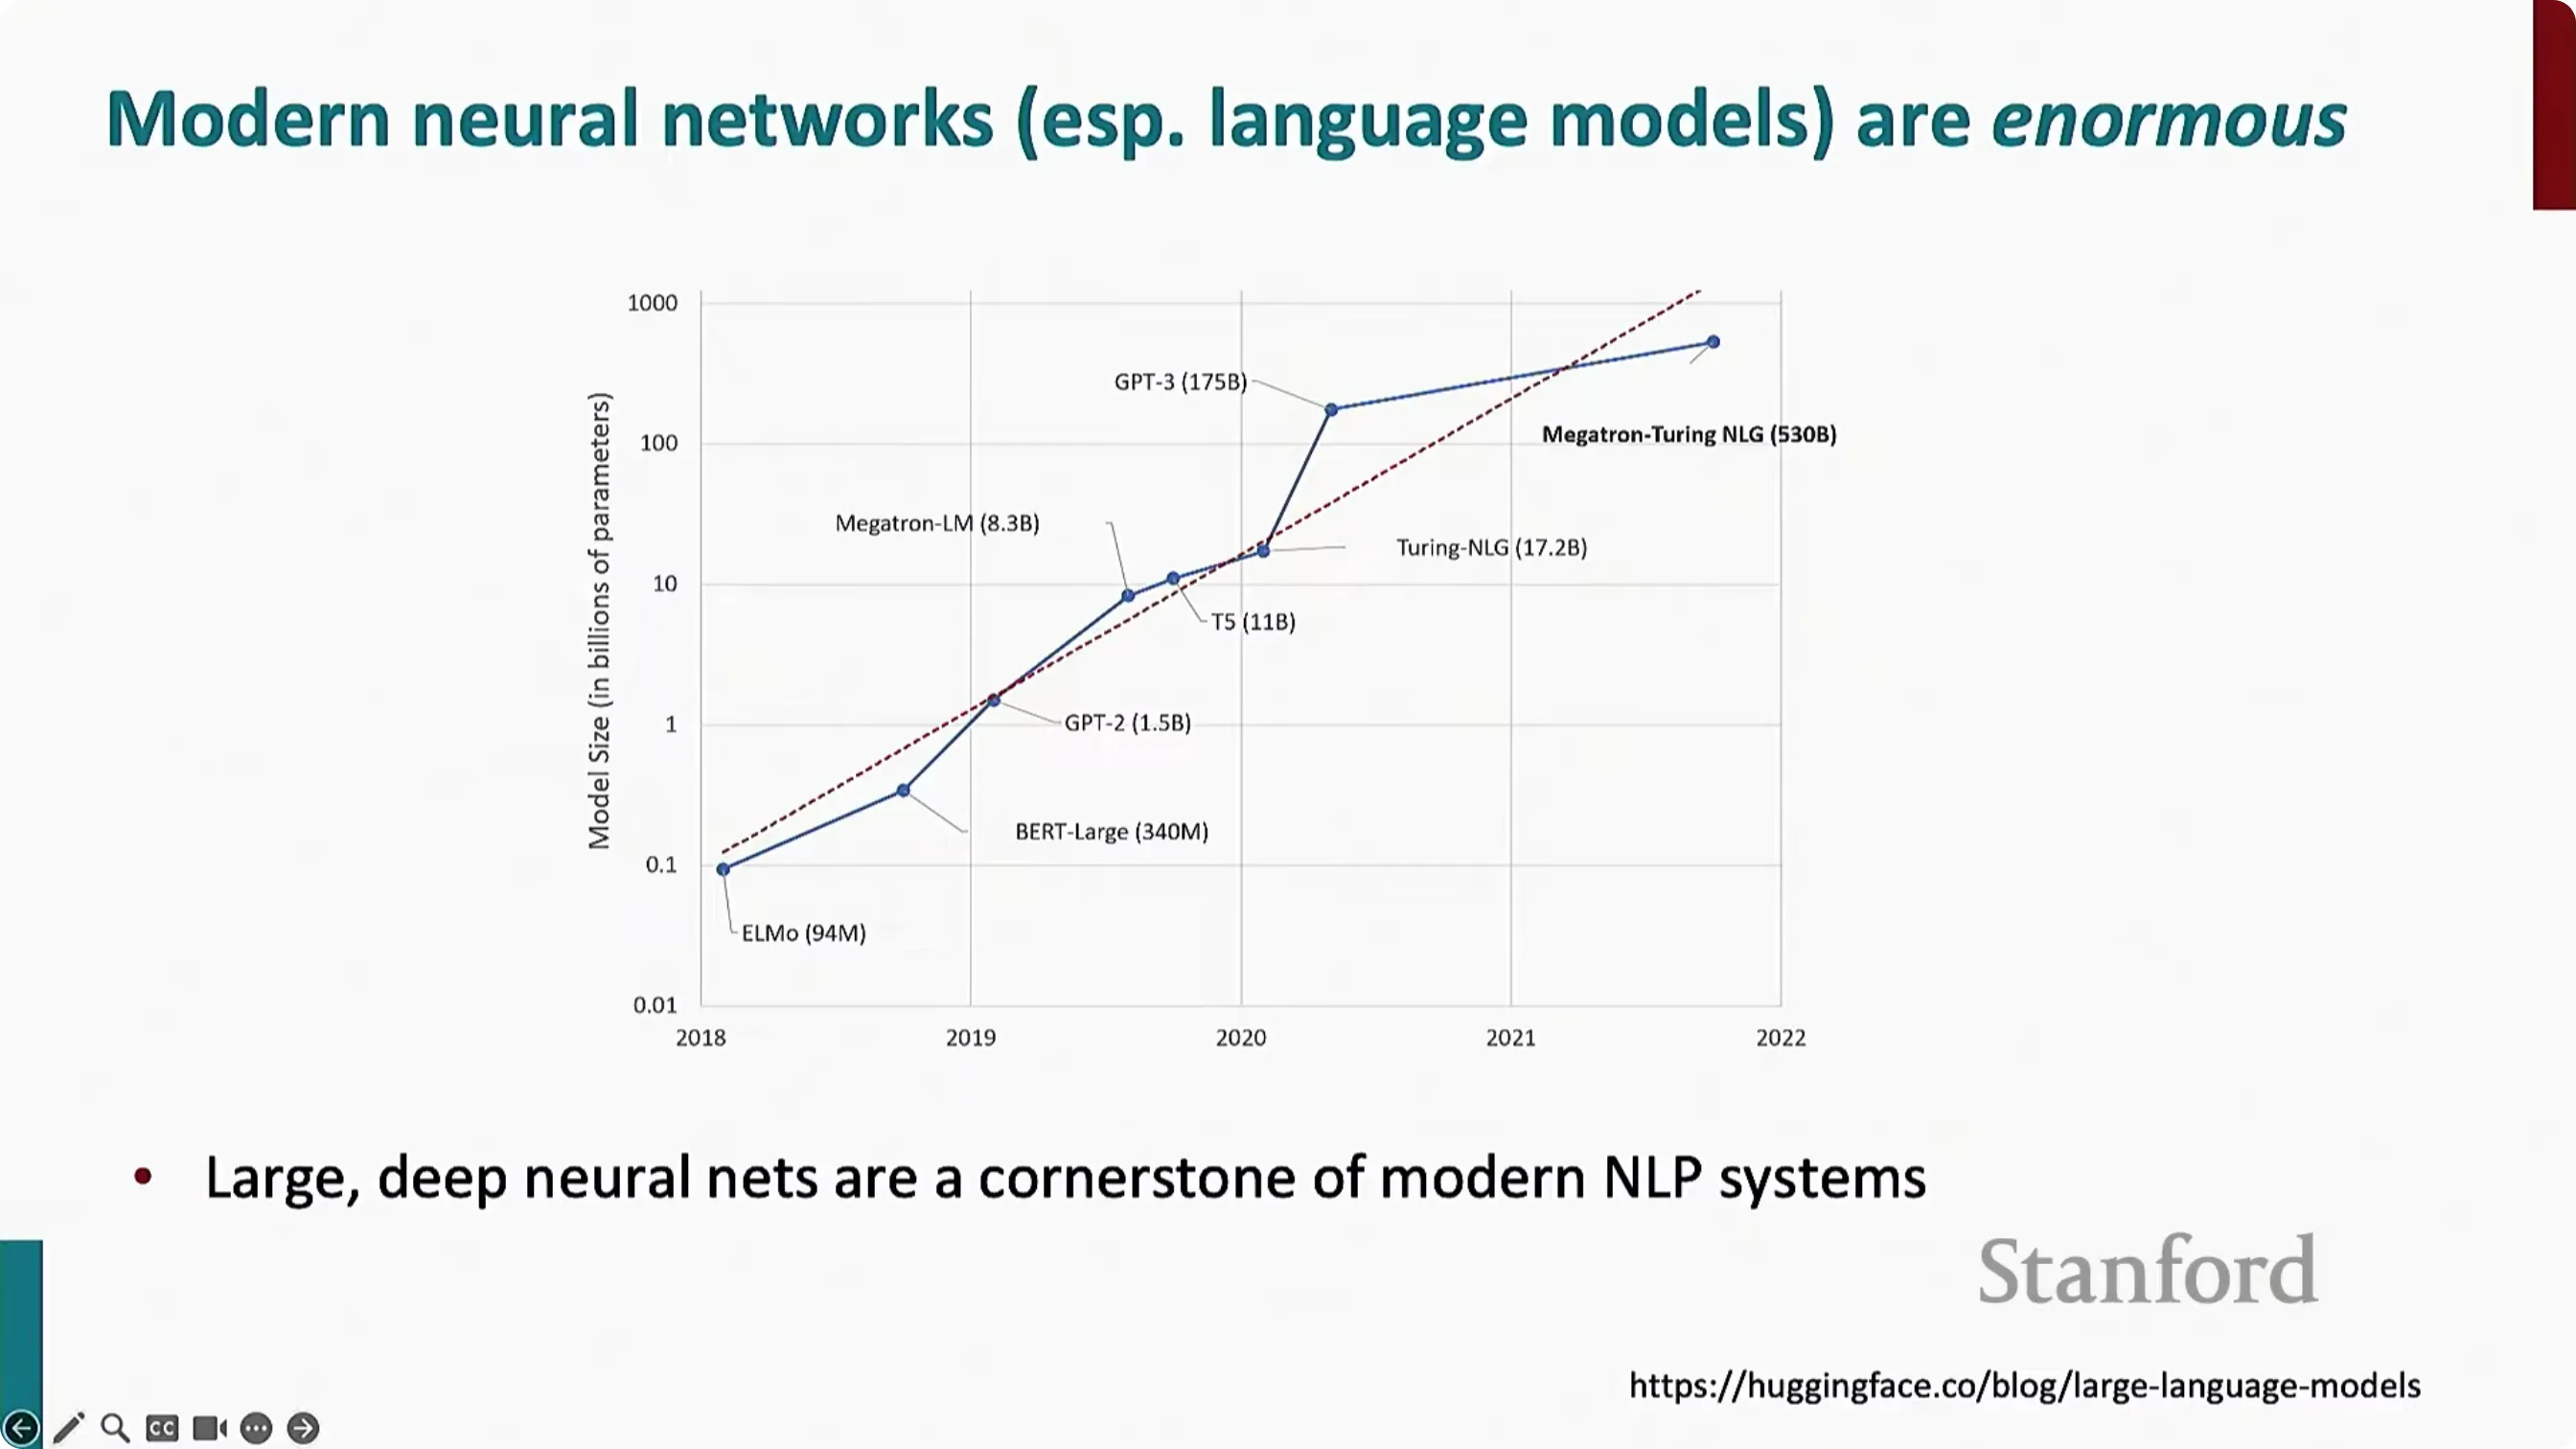
📷 课程开场展示的模型规模增长曲线(讲师提醒该图只更新到 2022 年)
回到原视频 (00:03:08)
这张图有点过时,只画到 2022 年。其实 2024 年已经很难画准了——最近两三年,最大的几个语言模型团队基本不再公开自己模型有多少参数了。但无论如何,这些模型显然是庞然大物,参数量超过一千亿,而且层数极深。神经网络是现代 NLP 系统的基石。
接着老师讲了一段很值得留意的历史:
神经网络上一次流行是在 80、90 年代。那个年代人们发明了反向传播算法——Geoffrey Hinton 和同事把它变得广为人知,它让"带隐藏层的神经网络"第一次可以被训练。但那个年代,几乎所有被训练出来的带隐藏层的网络,都只有一个隐藏层:输入 → 隐藏层 → 输出,就这么多。原因是:在很长一段时间里,人们根本没办法让"更多隐藏层"工作起来。
(参考时间: 00:05:37)
直到 2006 年前后,"深度学习"的复兴才开始,标志之一是 Bengio 等人 Greedy Layer-Wise Training of Deep Networks 那篇论文。论文开头就点出了当时的困境:
在很长一段时间里,人们认为深度多层神经网络在经验上太难训练;实践中,深层网络通常不比只有一两个隐藏层的网络好,甚至更差。
编者说明:老师提到这篇论文是"Yoshua Bengio 和同事",并把它当作"深度网络之难"的典型出处。Bengio 等人确实在 2007 年发表了 Greedy Layer-Wise Training of Deep Networks;而 2006 年前后与之呼应的还有 Hinton 等人的工作。两篇常被并提,这里以讲义/字幕提到的 Bengio 版本为准。
老师还提到一位早期用神经网络做自动驾驶的老师(字幕音译为"Jerry Torro",具体所指见文末疑点),并强调那是一个负面结果,机器学习文献里不大报道这种结果。于是:
尽管人们手里早就有神经网络、有反向传播、也有今天要讲的循环神经网络,但在大约 15 年里,整个领域像是卡死了——理论上看起来很有前途,实践上就是不行。真正让情况扭转的,是 2000 年代后期的一些进展,以及 2010 年代更深刻的变化。
老师提醒了一句"心态问题":
当你看到那些"让神经网络突然变得好用"的东西时,本能反应往往是耸耸肩:就这?这看起来也不像什么硬核科学啊。某种意义上你说得对——它们很多只是很小的新想法、小修小补。但就是这一小撮小想法、小修补,把一个卡了 15 年、几乎被所有人放弃的领域,翻了过来。
这些"小想法"包括:更好的正则化、向量化、参数初始化、优化的优化器。下面逐个过。
要点一:更好的正则化——以 Dropout 为例
(参考时间: 00:08:00)
正则化的想法是:除了"最小化描述数据的损失"之外,我们还想以别的方式约束学到的参数,让模型工作得更好。最常见的是 L2 正则化——在损失后面加一项参数平方和,它的意思大致是"你最好找到一个参数权重较小的模型,用尽可能小的权重把数据解释好"。
老师特别强调观念上的一次翻转:
经典教科书里的图是这样的:训练误差随训练下降,但到某一点之后,验证误差会掉头向上——你过拟合了训练数据,学到了只在训练样本上成立的东西,于是泛化变差。现代神经网络的人根本不信这张图。 图变成了另一个样子:我们照样把训练集几乎完全过拟合(大模型甚至能把训练损失压到接近 0),但只要正则化做得好,验证损失也会一路降下去。换句话说,我们就是要让它在训练集上过拟合,因为只要泛化也好,这就不是灾难。
问题是:L2(或 L1)这种经典正则化往往不够强,达不到那个效果。于是大家转向别的方法,最受欢迎的就是 Dropout。
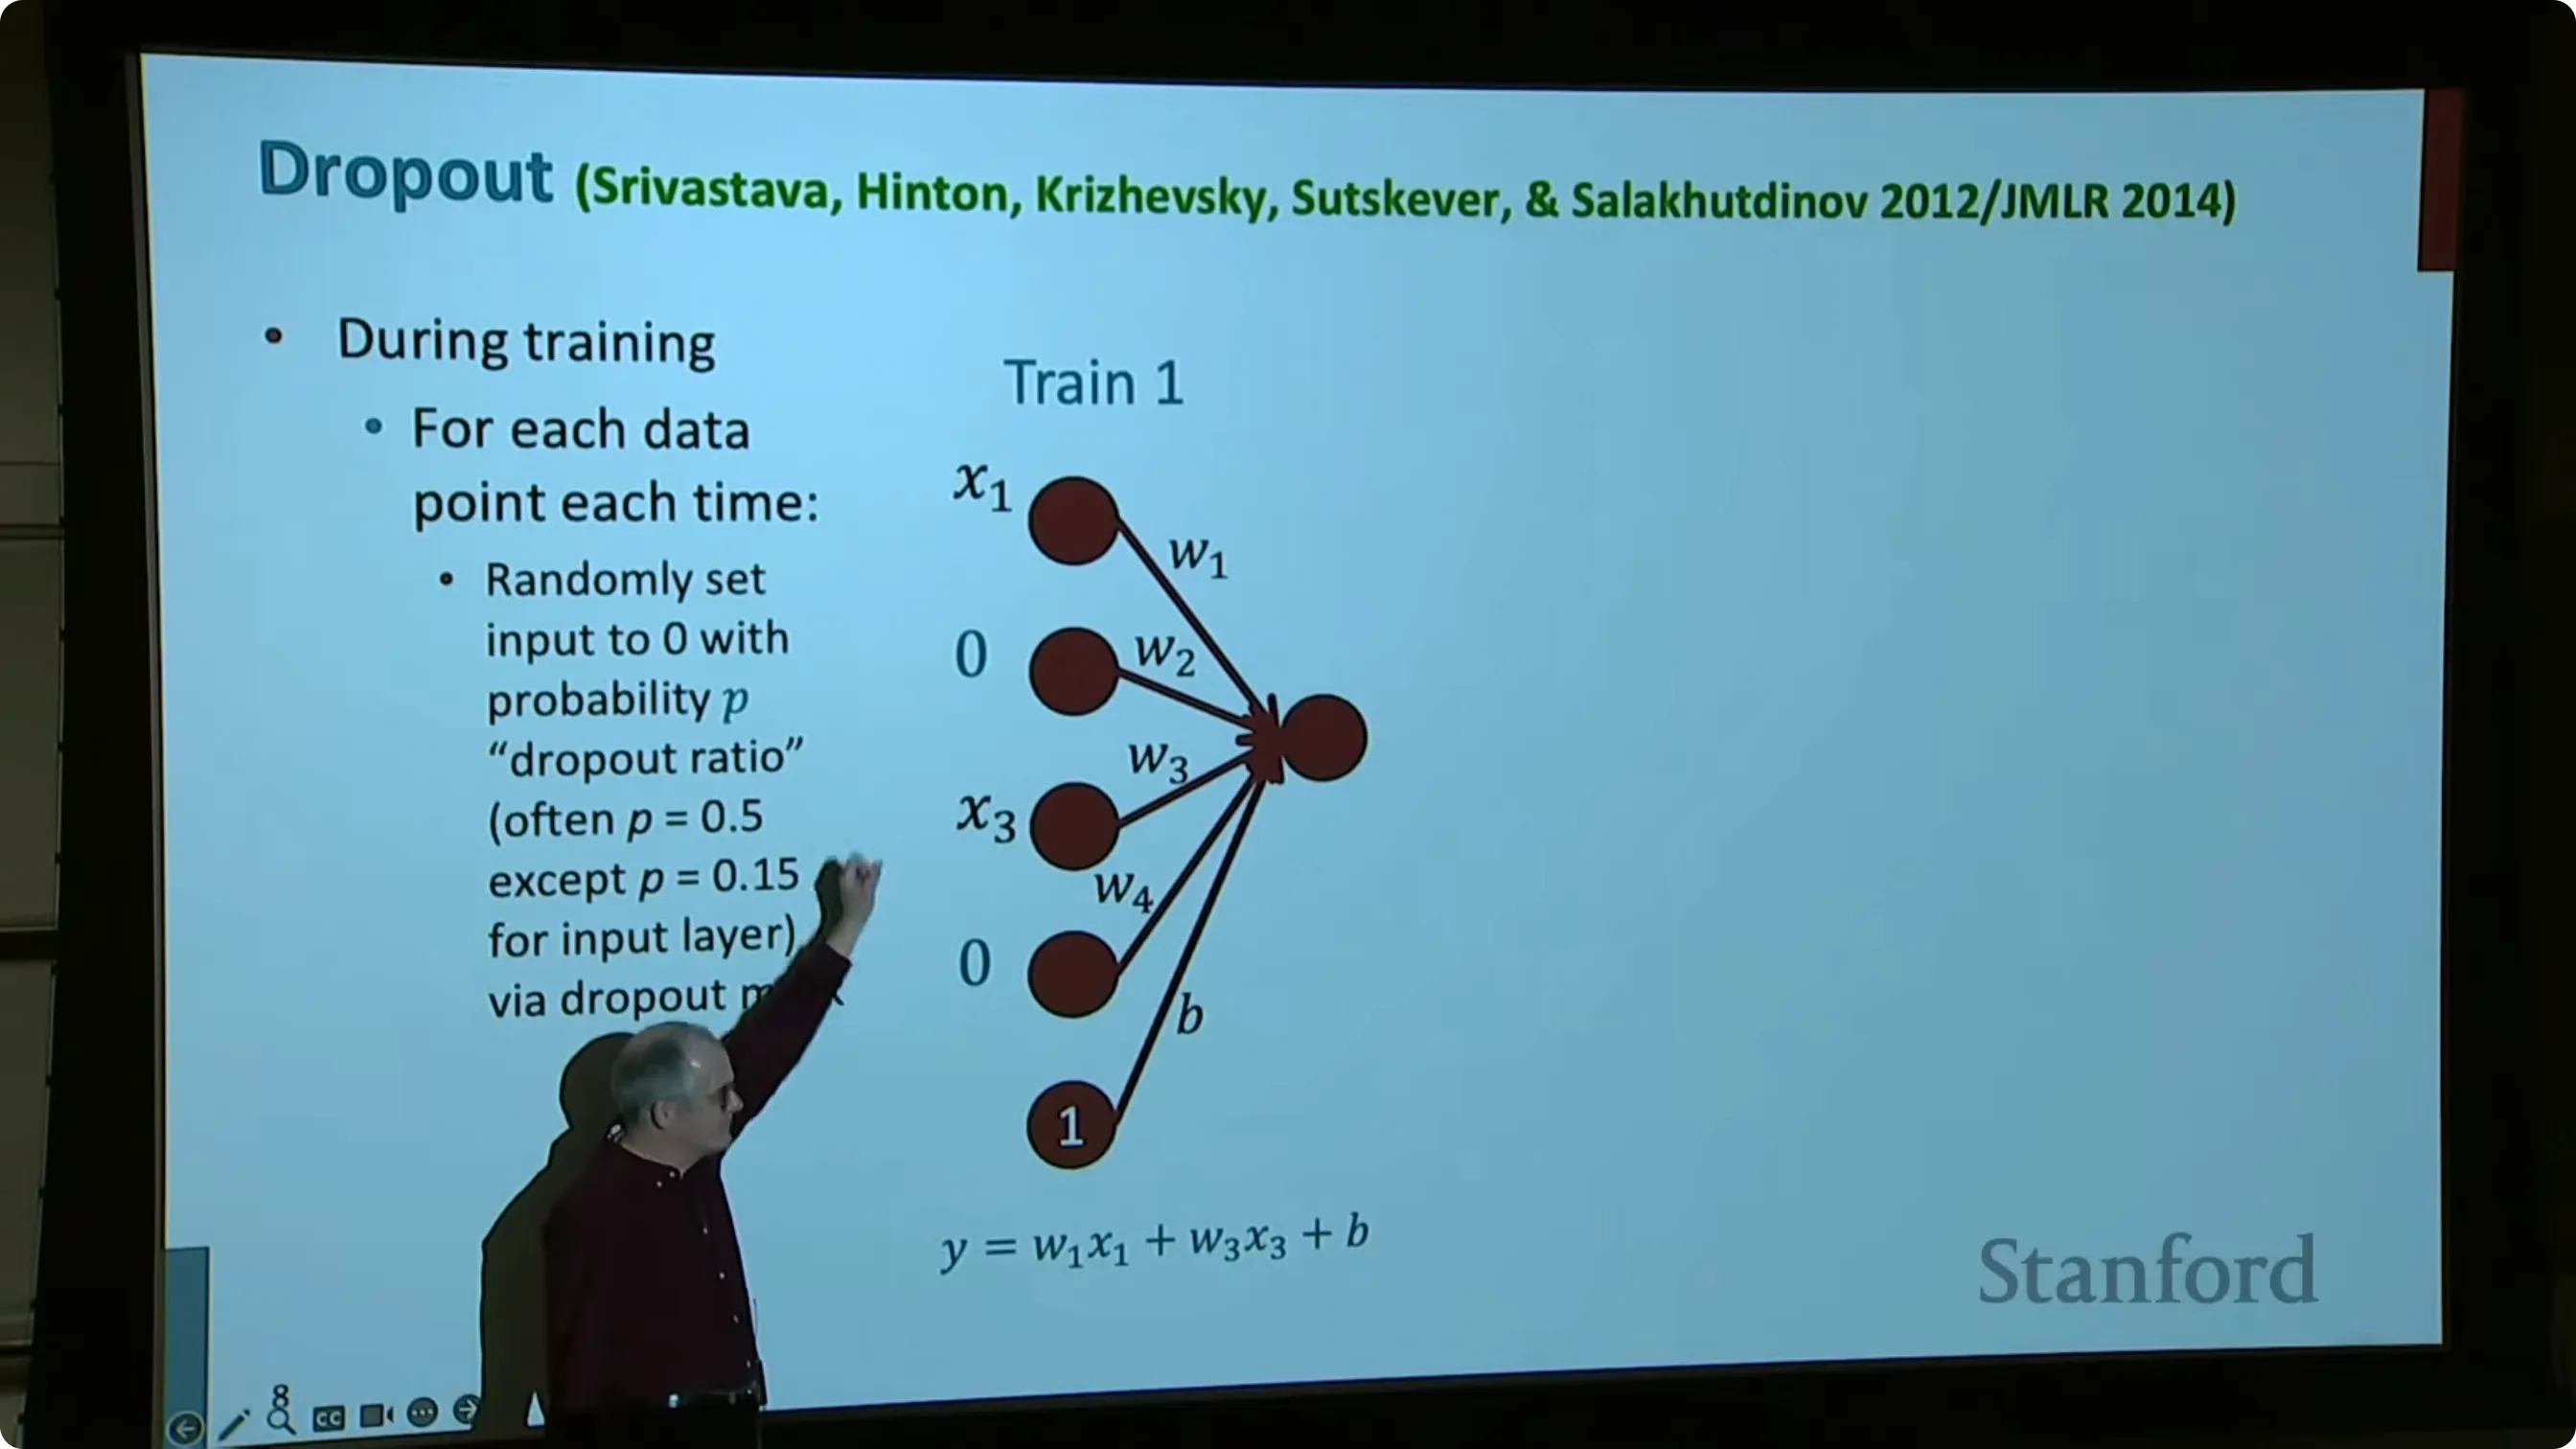
📷 Dropout:训练时随机"丢弃"一部分中间层输入
回到原视频 (00:14:20)
Dropout 的想法是:
- 训练时,每做一次前向计算,就在中间层里随机丢掉一些输入。技术上就是采样一个由 0 和 1 组成的随机掩码,与数据做逐元素相乘,让一部分数据变成 0;每换一个样本,掩码都重新采样。还可以用逐元素乘积写成:
$$y = m \odot x,\qquad m_i \sim \text{Bernoulli}(p)$$
其中 $\odot$ 是逐元素乘(Hadamard 积)。 - 测试时,不丢任何东西,保留所有权重,但要做缩放,来补偿训练时"曾经丢掉过"这件事。
为什么有效?老师给了几种理解:
- 防止特征共适应(co-adaptation):模型不能指望"第 7、8、11 号特征一起出现"来帮助预测,因为它知道有些特征随时会消失,所以必须以更灵活的方式利用特征。
- 模型集成(ensemble):Dropout 相当于同时训练了"所有可能的丢弃子集"构成的巨大模型集成——是对特征幂集(指数多个子模型)的一次性训练。
- 一个很好的直觉:朴素贝叶斯让每个特征独立地看数据;逻辑回归让权重在所有其他特征的语境里设定;而 Dropout 落在两者之间——权重是在一部分其他特征的语境里学到的,而且每次消失的是不同的那部分。
老师提到,斯坦福的 Stefan Wager 等人的后续工作,倾向于把 Dropout 看作是一种与特征相关的正则化。
编者说明:这里用的是 Dropout 的"原始表述"。在今天的深度学习框架(如 PyTorch)里,实现细节(缩放放在训练还是推理、是否原地操作等)略有不同,以作业和框架文档为准。经典参考文献见文末。
要点二:向量化
(参考时间: 00:17:44)
千万不要写 for 循环,尽量用向量、矩阵和张量。
整个深度学习的成功和速度,都来自"能用向量、矩阵、张量做运算"这件事。在任何语言里写 for 循环——尤其在 Python 里——都跑得很慢;换成向量/矩阵运算,即便在 CPU 上也至少快一个数量级;如果搬上 GPU(现在甚至还有神经网络专用处理器),就能再快两三个数量级。
所以老师的建议很直接:如果你为了某个不是特别浅的输入处理写了 for 循环,你几乎肯定犯了错,应该想办法用矩阵去表达。哪怕是 Dropout,也别写个循环挨个把位置置零,而应该用掩码做一次向量运算。
要点三:参数初始化
(参考时间: 00:19:16)
几乎在所有情况下,把参数矩阵初始化成随机的、很小的数都至关重要。原因是:
如果一开始把矩阵全设成 0(或某个常数),通常会陷入对称性——用老师的话说,就像站在一个鞍点上,左右对称、前后对称,你不知道该往哪儿走,可能就卡在原地不动。更实际一点的看法是:你对矩阵里每个元素做的操作是一样的,所以如果一开始所有元素都相同,那就相当于"你其实只有一个特征,只不过复制了很多份"。
所以我们要把权重设成很小但非零的随机数,并且让它们落在合适的范围:既不能在连乘时衰减到 0,也不能一开始就爆炸成大数。"初始化到正确尺度"曾经被认为相当重要,有一批基于"矩阵连乘会发生什么"分析出来的方法。
编者说明:老师提到的那个初始化方法,字幕音译为"harier"。按其描述("依据一层的输入、输出数量来决定所用分布的方差"),它对应的应是由输入/输出单元数决定方差的 Xavier / Glorot 初始化(见文末参考文献)。老师补充说,后来大家发明了更聪明的方法,特别是层归一化(Layer Normalization),使得初始化不必那么小心翼翼——但"初始化成某个东西(哪怕是随机的)"仍然必要。
要点四:更聪明的优化器(Adam 等)
(参考时间: 00:22:05)
我们之前讲过随机梯度下降(SGD)及其基本公式。SGD 其实没大毛病——只要调得够多,几乎任何问题它都能凑合work。但麻烦在于,它高度依赖"尺度调对":步长要合适,往往还得配一个学习率衰减(learning rate schedule),外加各种小细节。
于是人们发明了更复杂的优化器。这类方法的共同思想是:
对每个参数,累积一个"它过去的梯度大概是多少"的度量——也就是对某个参数而言,梯度(斜率)的尺度大概多大——然后用它来决定每一步移动多少(等效于动态调整该参数的学习率)。
几个关键名字:
- Adagrad(John Duchi 等):最简单,但容易很早"停滞"。
- Adam(作业二里用的就是它):非常好、非常安全的起点。
老师还特别提到:词向量有它的特殊性——因为稀疏性,你更新得很稀疏(某个词只是偶尔出现),所以有一些专门针对这类情形的优化器变体(名字常以 w 结尾),值得一试。更进一步的还有动量(momentum)、Nesterov 加速等,想深入可以去学专门的优化课。
编者说明:Adam、Adagrad、Dropout、Xavier 初始化、层归一化的原始论文都列在文末。Adam 的论文里给出的动机正是"为每个参数维护梯度的一阶/二阶矩估计"。
二、语言模型(Language Modeling)
什么是语言模型
(参考时间: 00:24:59)
🖼️ 第 1 页幻灯片 · Natural Language Processing
在 NLP 里,"language model"(语言模型)是一个术语,有确定含义:
语言模型就是能预测"下一个词是什么"的系统——更精确地说,它对下一个词给出一个概率分布。
例子:the students opened their ______。可能的词有 exams、minds、laptops、books……如果我们在这些词上放一个概率分布,就得到了一个语言模型。
形式上:给定一个词序列 $x^{(1)}, \dots, x^{(t)}$,计算下一个词 $x^{(t+1)}$ 的概率分布,其中 $x^{(t+1)}$ 可以是词表里的任意词。既然是一个分布,它对词表里所有词的估计之和就为 1。
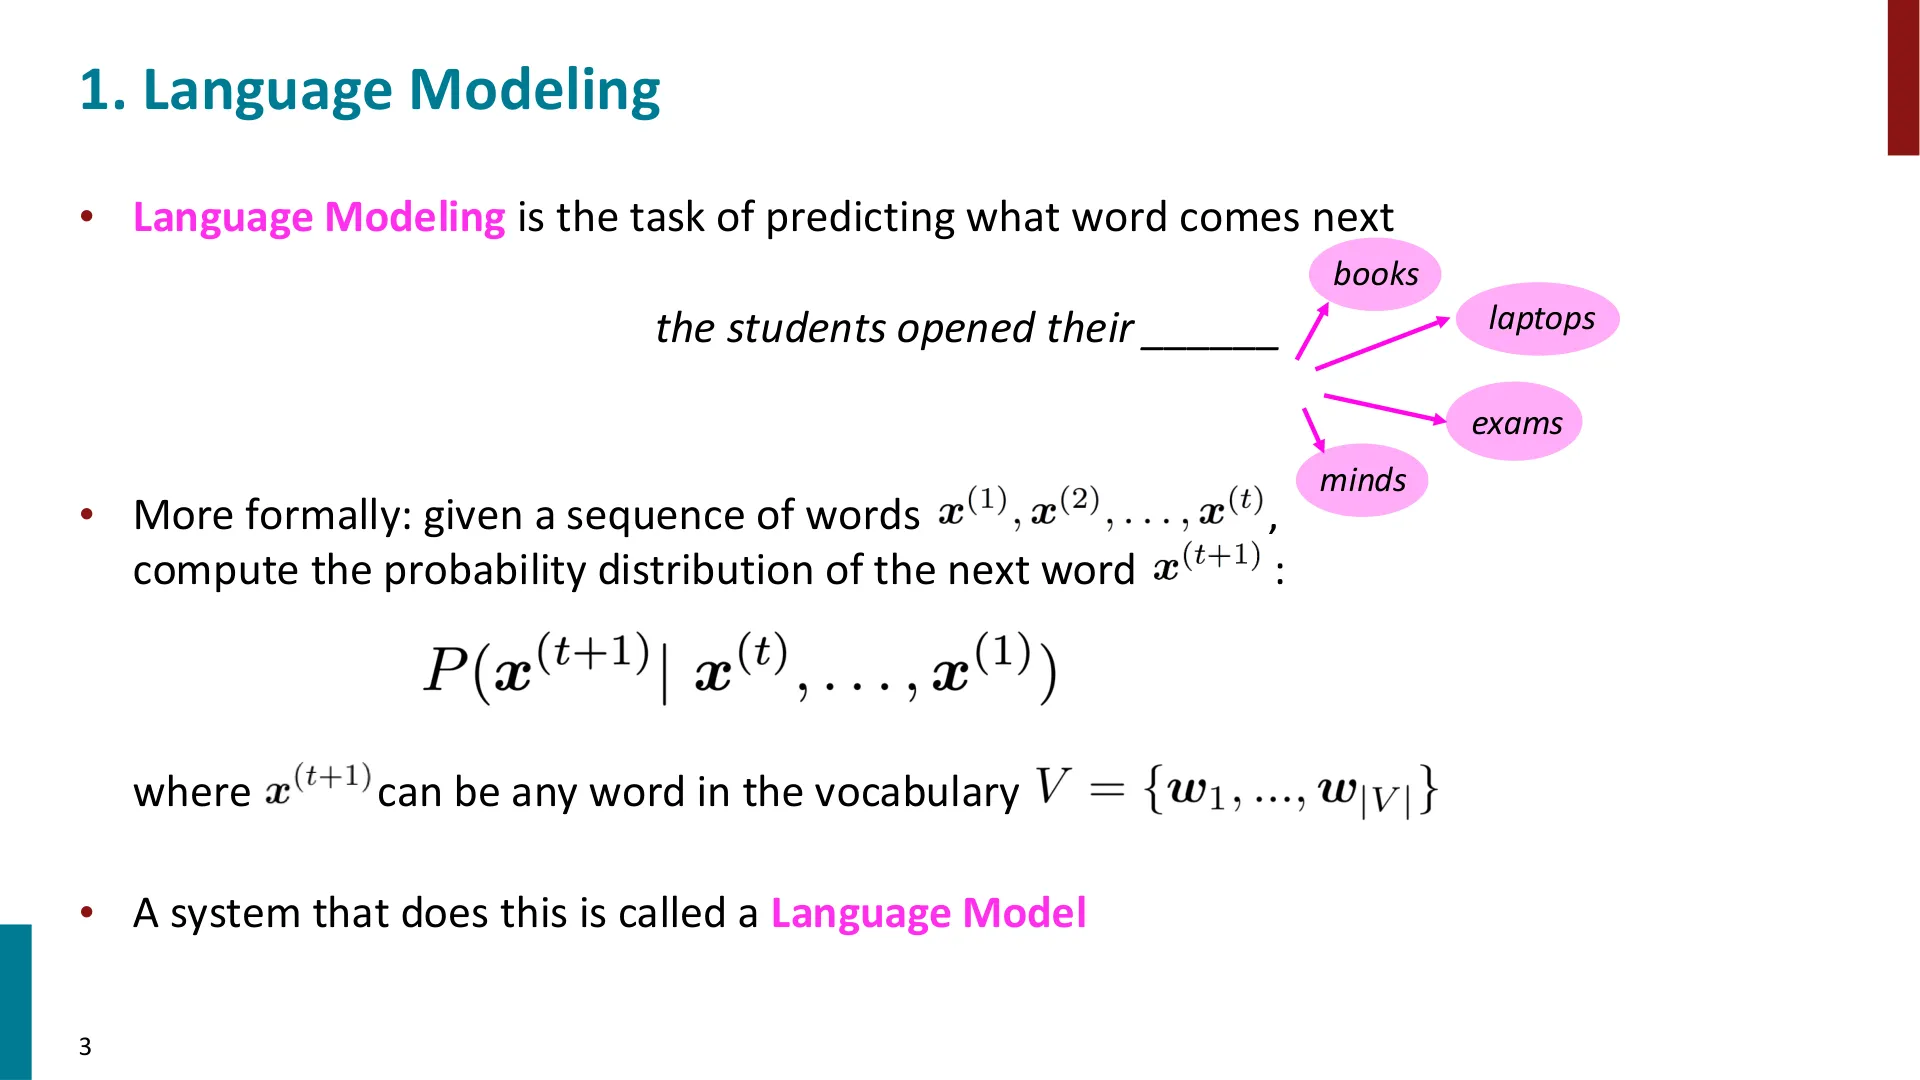
📷 语言建模:给定上文,输出下一个词的概率分布
回到原视频 (00:24:59)
语言模型还有另一种等价视角:它是一个"给一段文本赋予概率"的系统。
(参考时间: 00:26:32)
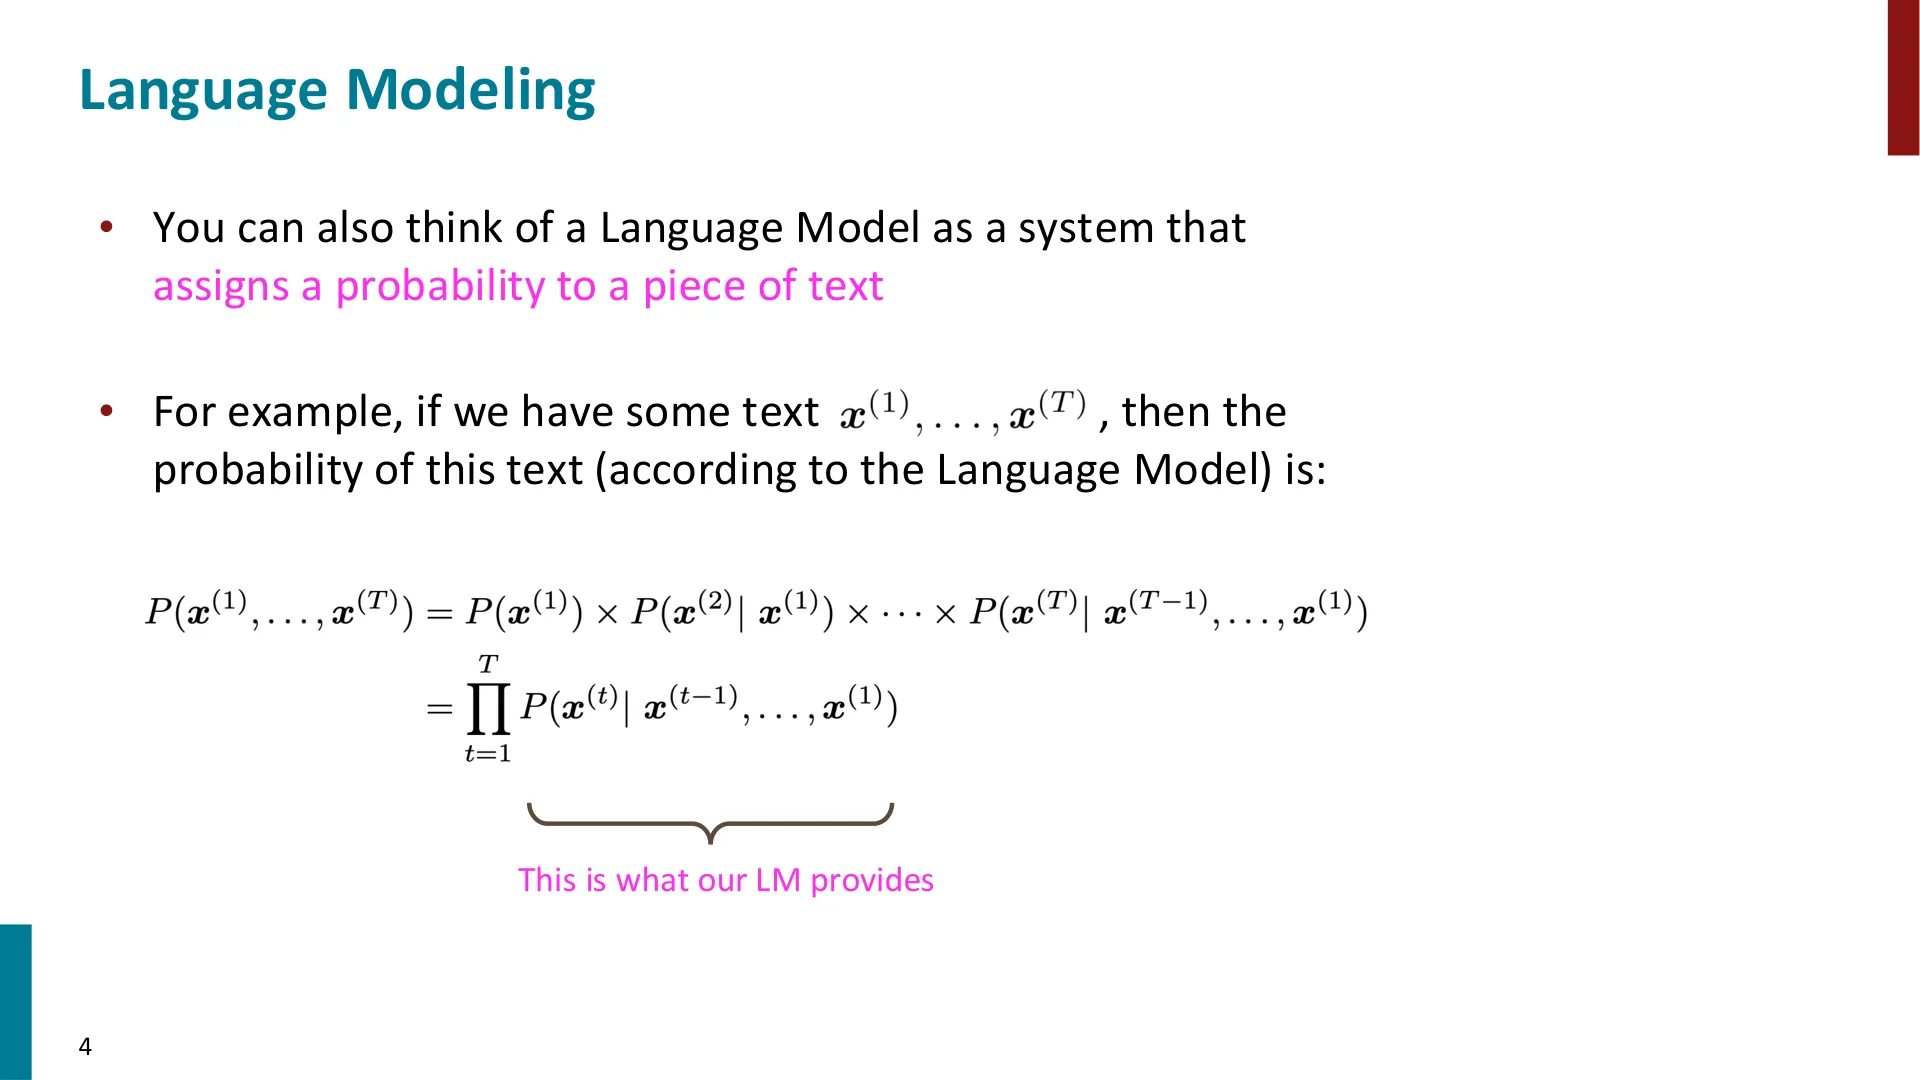
📷 语言模型也可以理解为"给一段文本打分"
回到原视频 (00:26:32)
如果已知 $P(x^{(t+1)} \mid x^{(1)}, \dots, x^{(t)})$,那么用链式法则就能给任意一段文本打分:
$$P(x^{(1)}, x^{(2)}, \dots, x^{(T)}) = \prod_{t=1}^{T} P(x^{(t)} \mid x^{(1)}, \dots, x^{(t-1)})$$
其中每一项正是"按前面定义的语言模型"所提供的。也就是说:会预测下一个词,就等于会为整段文本打分。
编者说明:链式法则这一步是本讲后面一切的基础。它把"局部地预测下一个词"和"整体地评估一段文本"接了起来。
语言模型无处不在
(参考时间: 00:27:22)
语言模型是 NLP 的基础技术,几乎从最底层的地方开始,只要人用计算机处理语言,就会用到它。而且它不是 2022 年 ChatGPT 才发明的东西——语言模型作为 NLP 的核心,至少从 80 年代就开始了,其想法更可上溯到 50 年代。
- 你在手机上打字时,键盘弹出的"下一个词"候选,是语言模型生成的(传统上是一个很小、不太强的模型,好塞进键盘应用里、跑得快)。
- 你在 Google 搜索框里打字、它给你补全查询,背后也是语言模型。
讲义的这一页用"你每天都在用语言模型"来强调这件事:
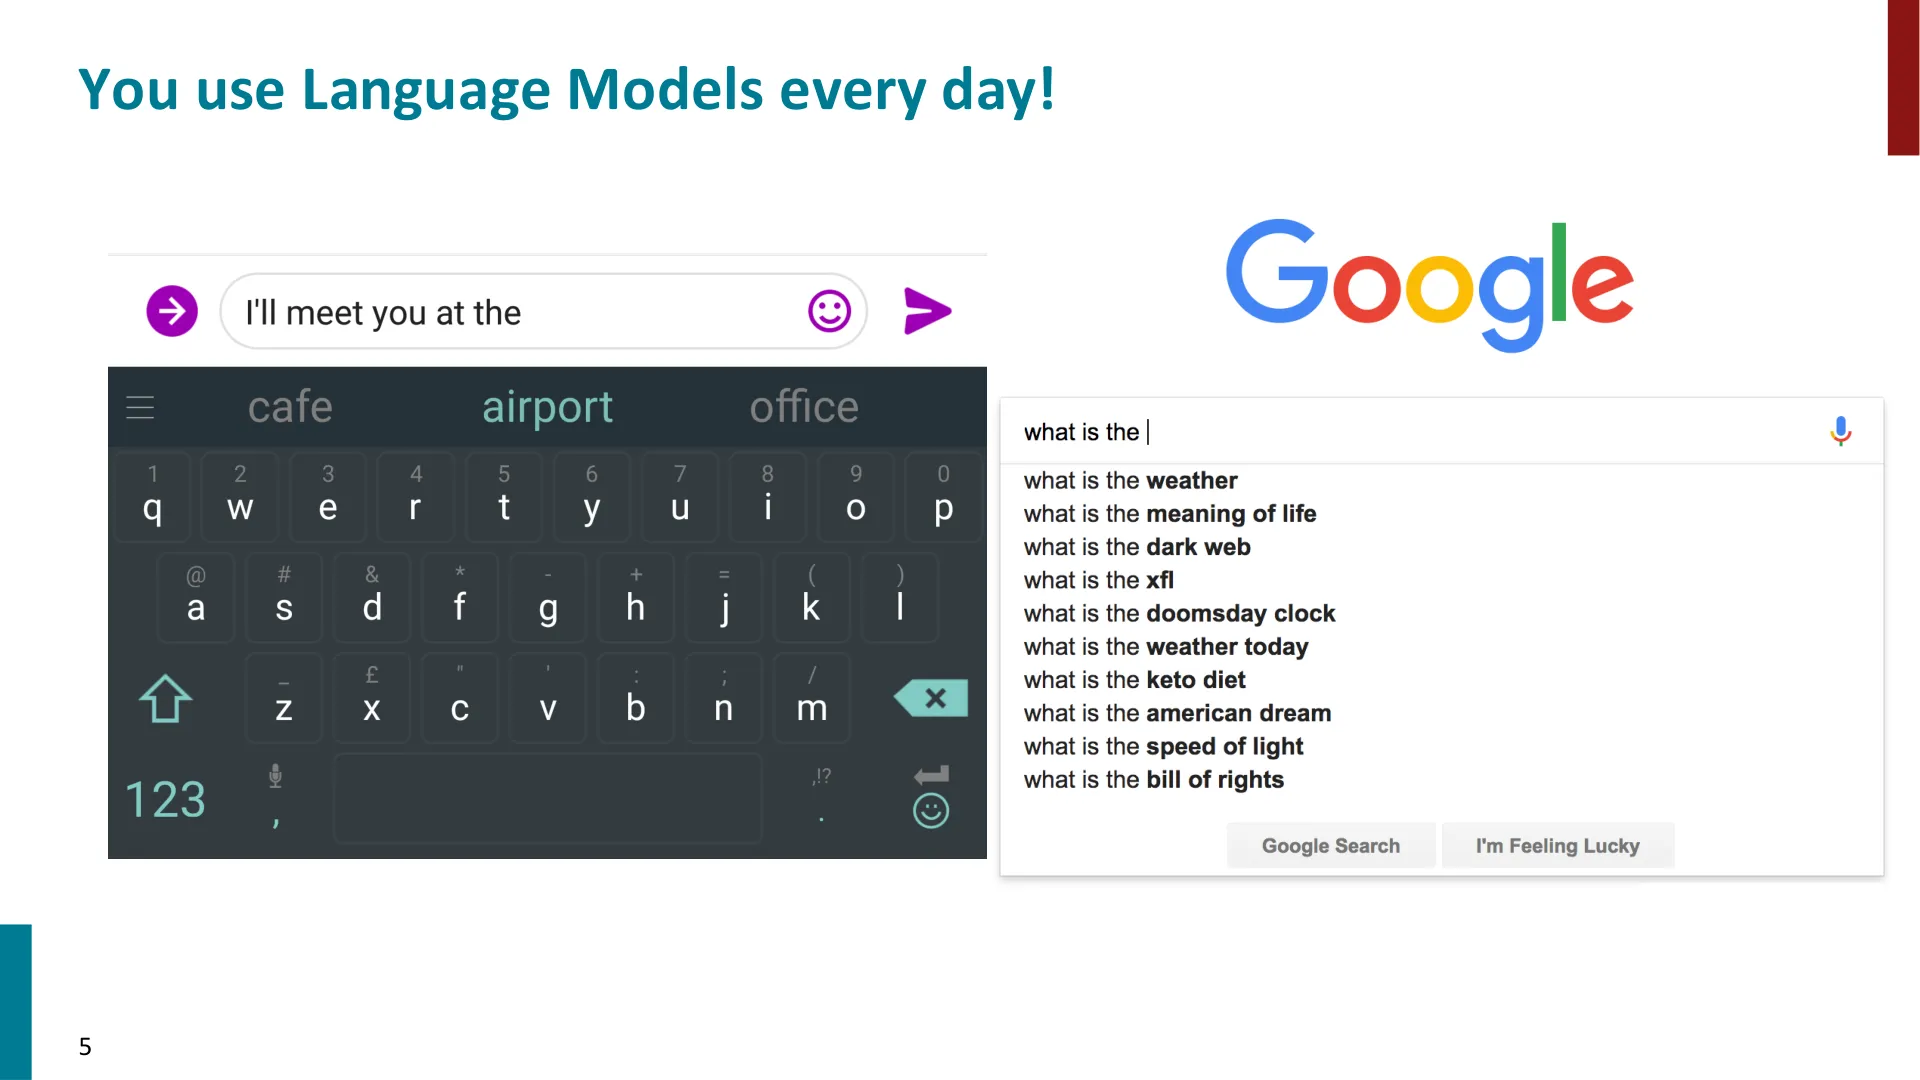
📷 你每天都在使用语言模型(输入法联想)
回到原视频 (00:27:22)
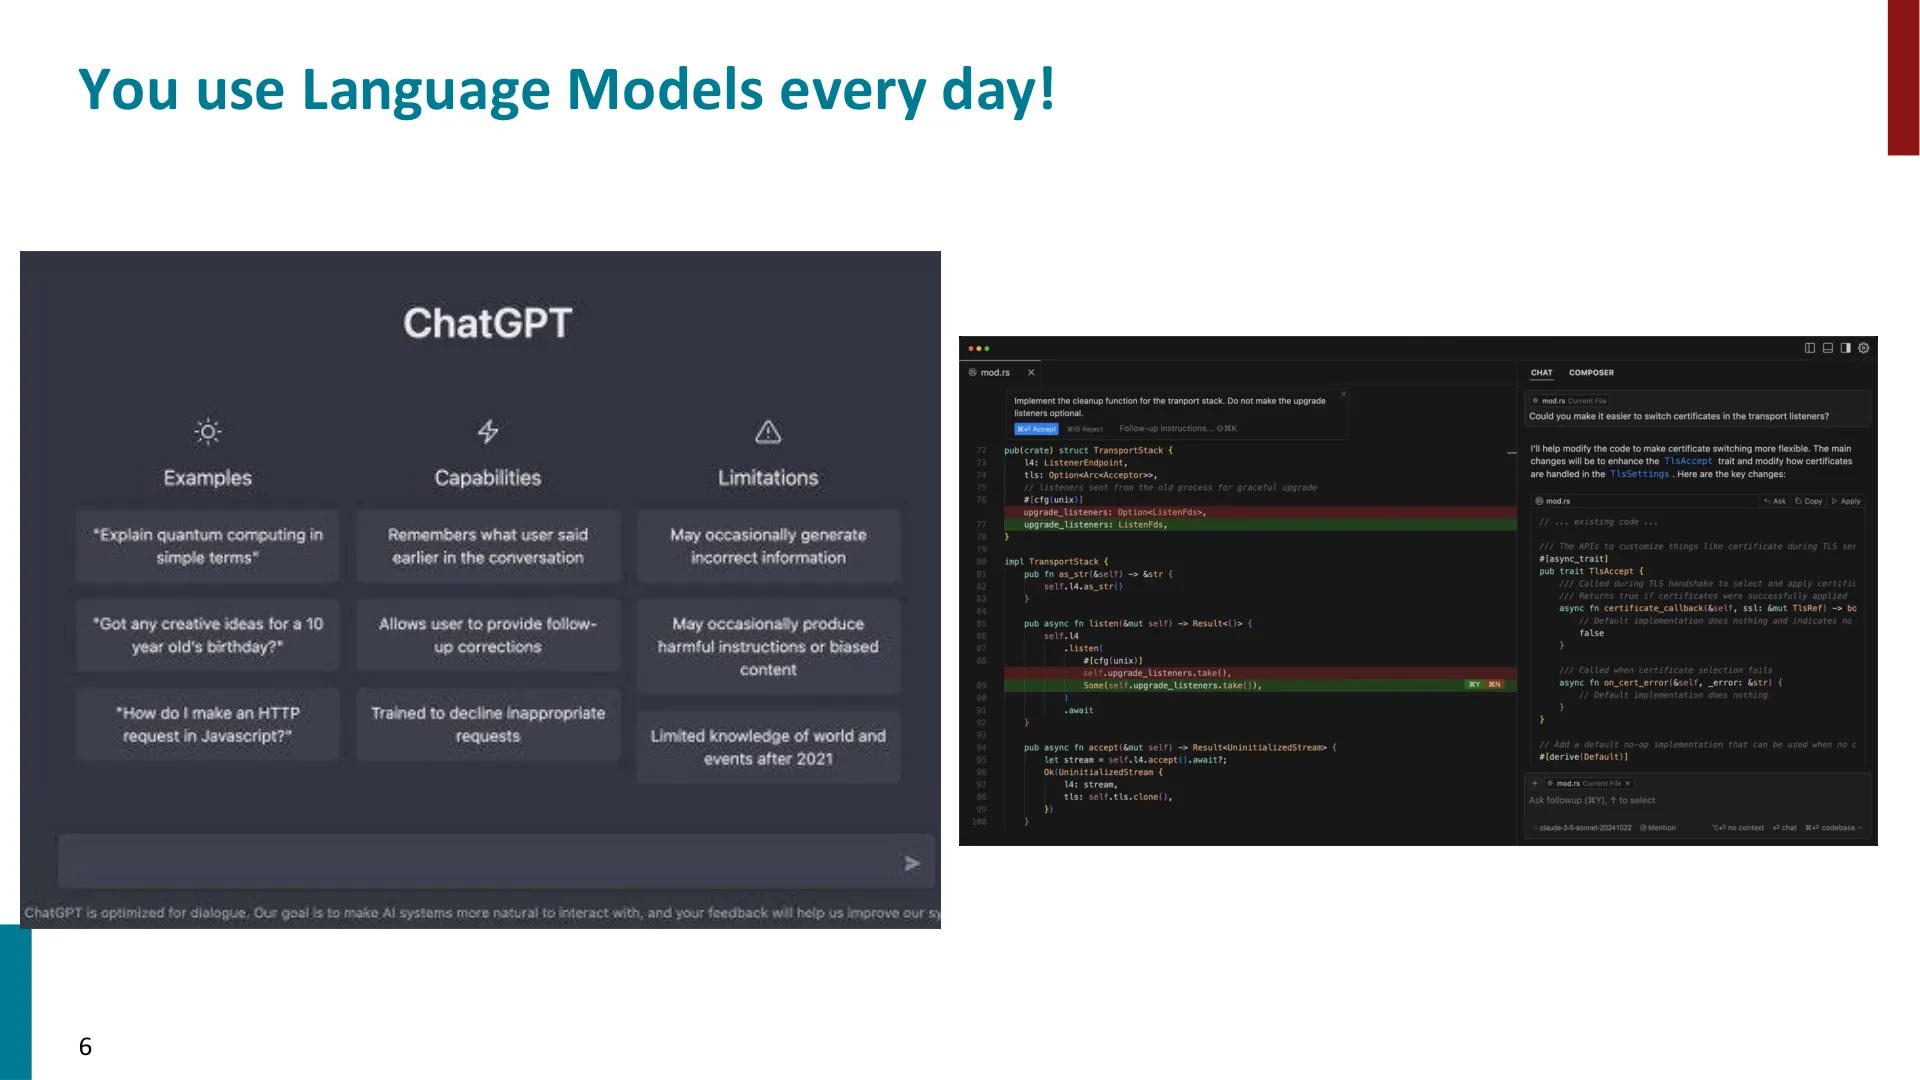
📷 你每天都在使用语言模型(搜索框自动补全)
回到原视频 (00:27:40)
讲义紧接着用一页说明"为什么值得关心语言模型",并给出几组填空题,展示一个足够强的语言模型能做什么:
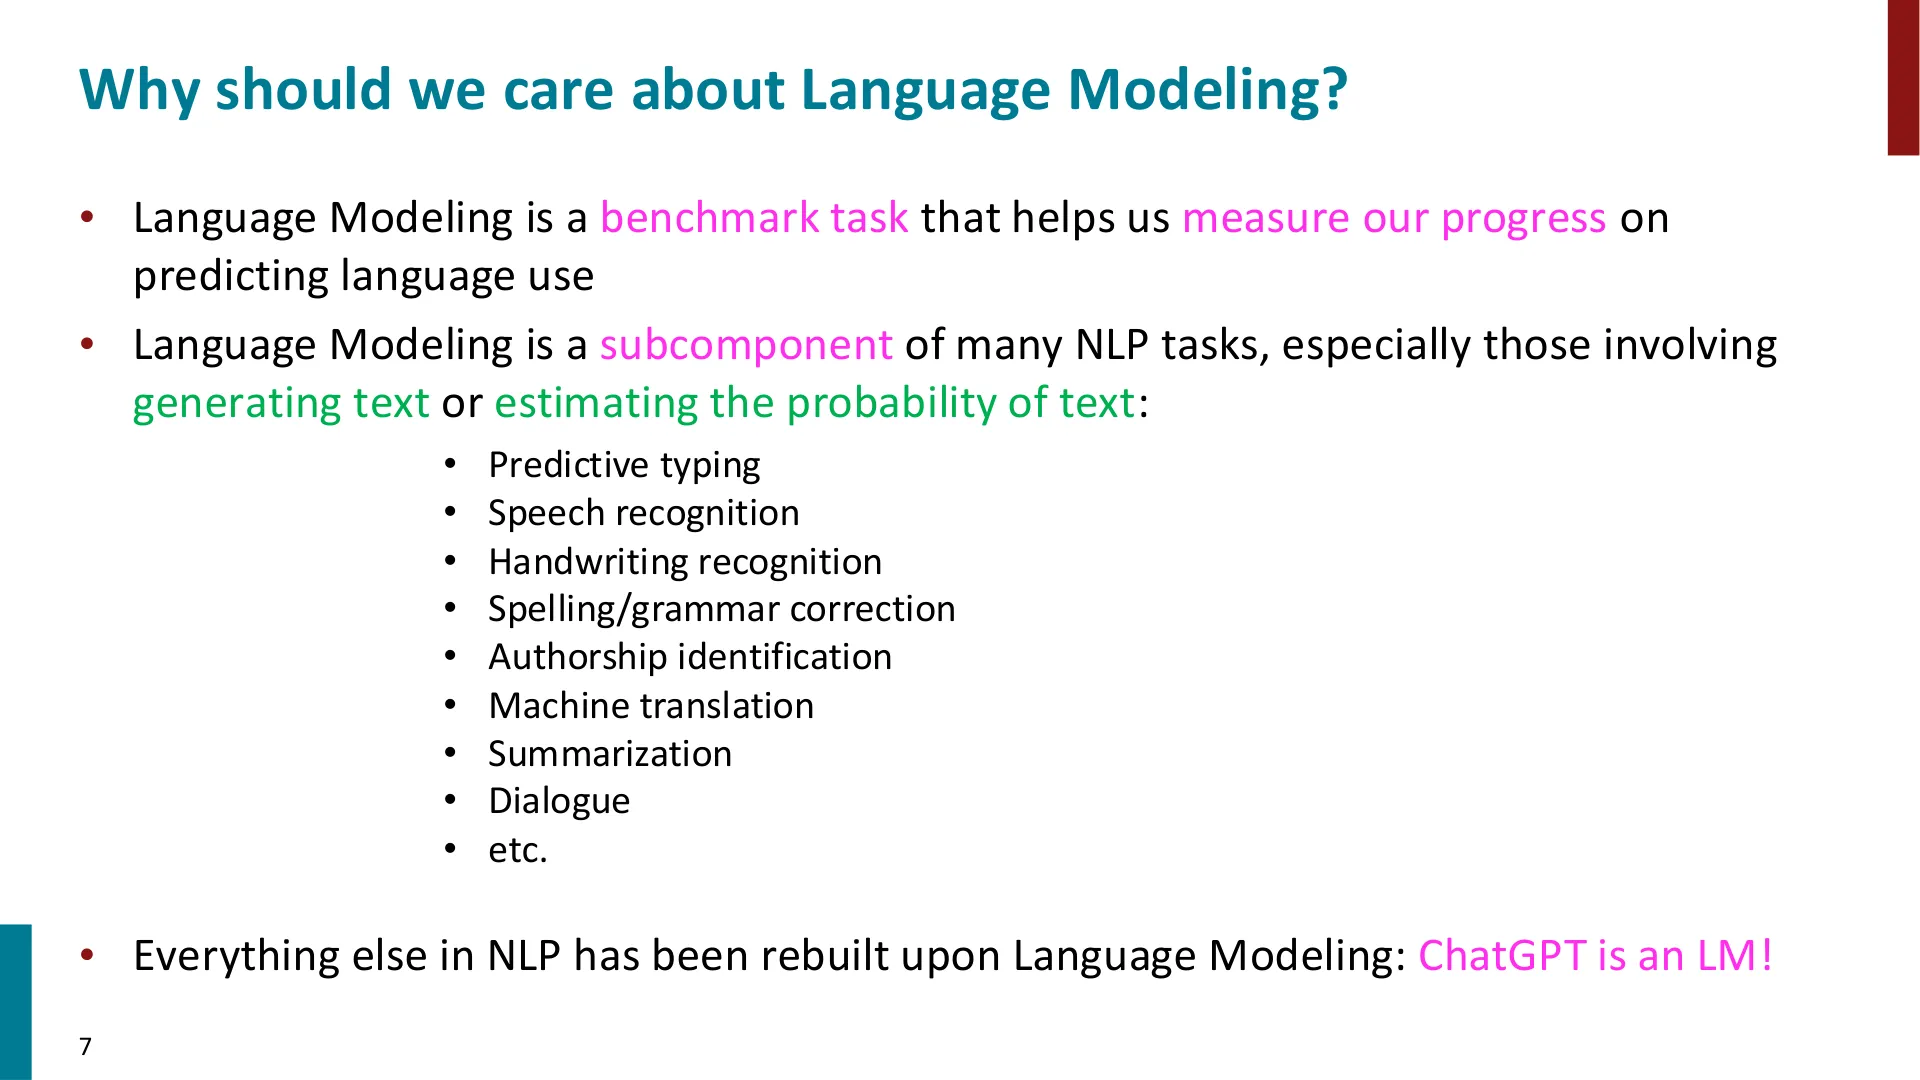
📷 为什么语言模型重要,以及强语言模型能做的填空
回到原视频 (00:27:56)
编者补充:讲义这一页列举的能力,从简单到困难依次是——纯事实(Stanford University is located in ___ , California)、句法(I put ___ fork down on the table,答案 a/the)、指代(… checking for traffic over ___ shoulder,答案 her)、词义/主题(fish, turtles, seals, and ___)、情感(评价一部电影)、以及需要推理的(Zuko left the ___)和最简单的算术(斐波那契数列 1,1,2,3,5,8,13,21,___)。越往后,越考验模型是否"真的懂了"。
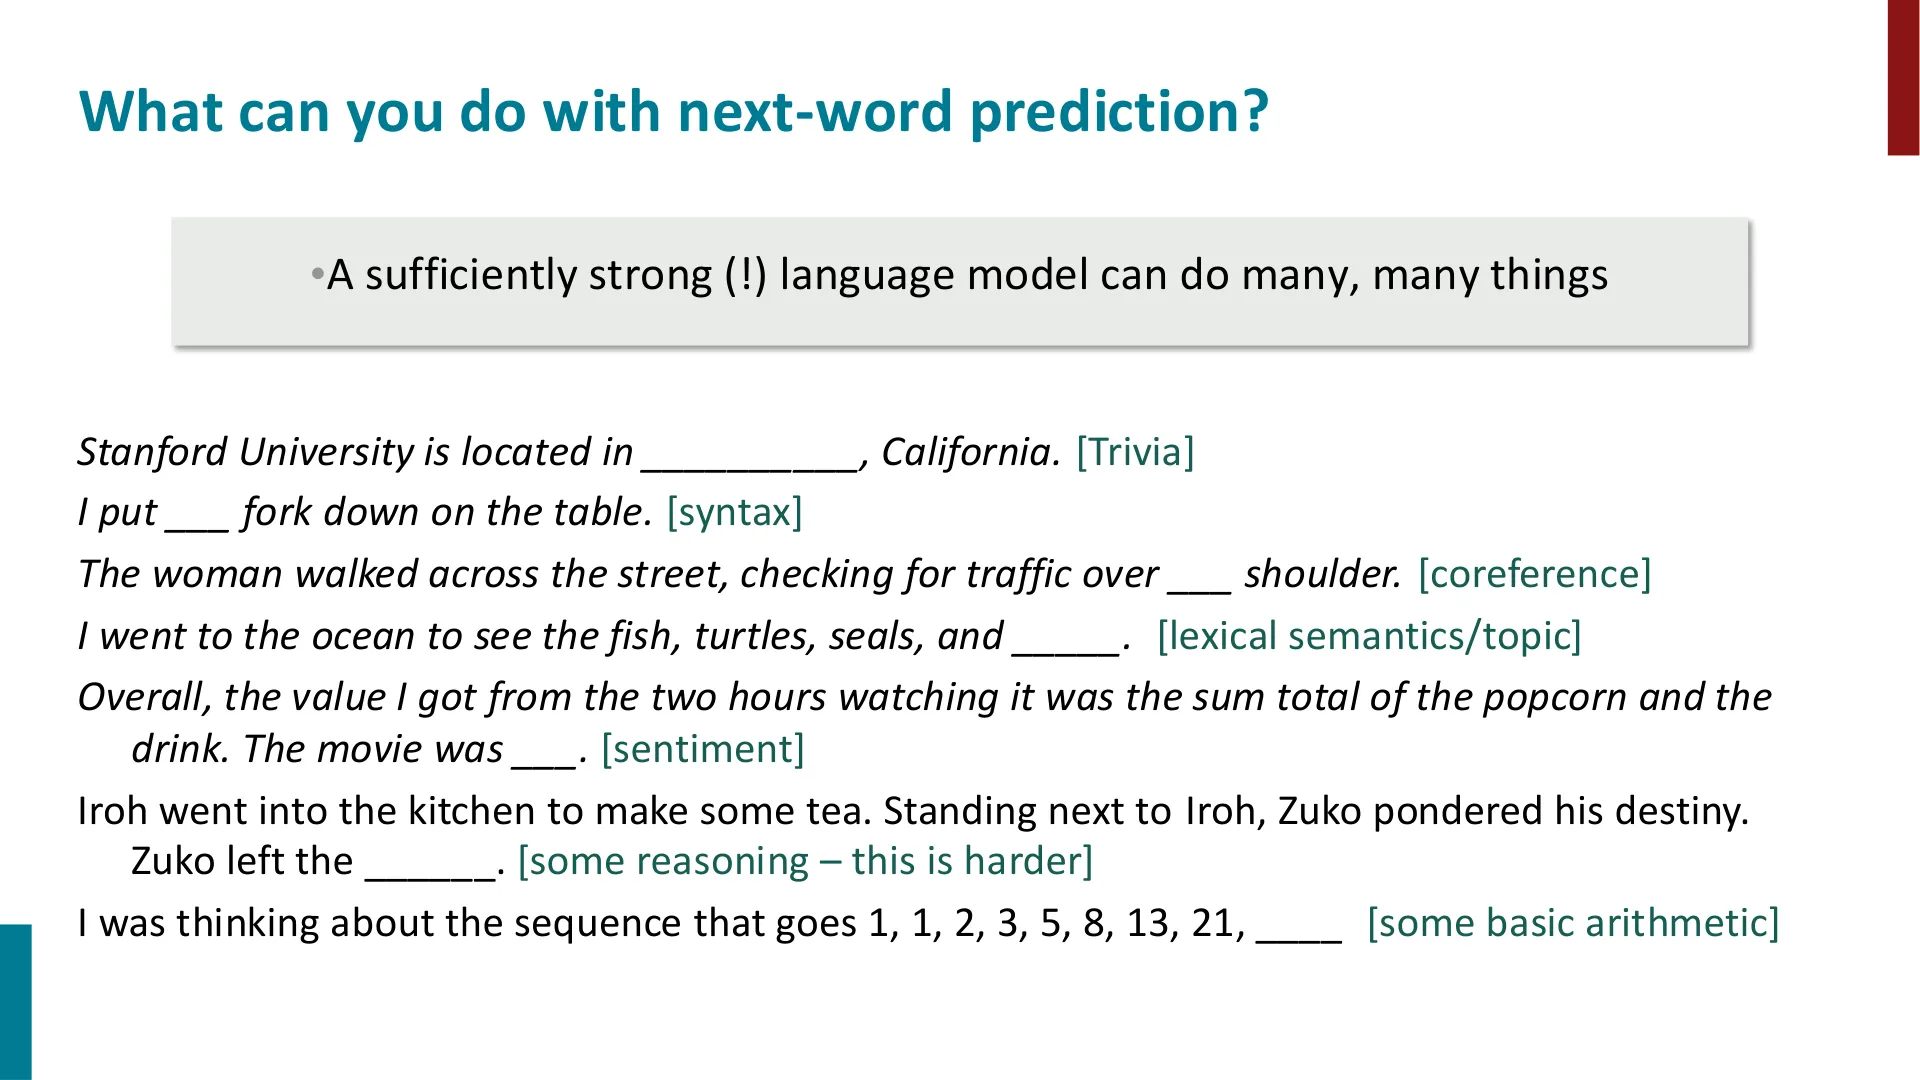
📷 一个足够强的语言模型能完成的任务谱系
回到原视频 (00:28:16)
从 n-gram 开始
(参考时间: 00:28:56)
问题:怎么学一个语言模型?
在深度学习之前的年代,答案是:学一个 n-gram 语言模型。
- 定义:一个 n-gram 就是 n 个连续词构成的块。以
the students opened their为例: - unigram(一元):
the、students、opened、their - bigram(二元):
the students、students opened、opened their - trigram(三元):
the students opened、students opened their -
four-gram(四元):
the students opened their -
思路:统计不同 n-gram 出现的频率,用它们来预测下一个词。
编者说明:老师顺带吐了个槽:对受过古典教育的人来说,这套命名挺"可怕"的——
-gram是希腊词根,前面却配了拉丁数字前缀。严格说应该叫 monogram、digram……但这个约定俗成的叫法一直沿用下来。顺带一提,最早提出 n-gram 想法的是 Claude Shannon,就是搞出交叉熵的那位,他在 1951 年的论文里用的是"diagram"。
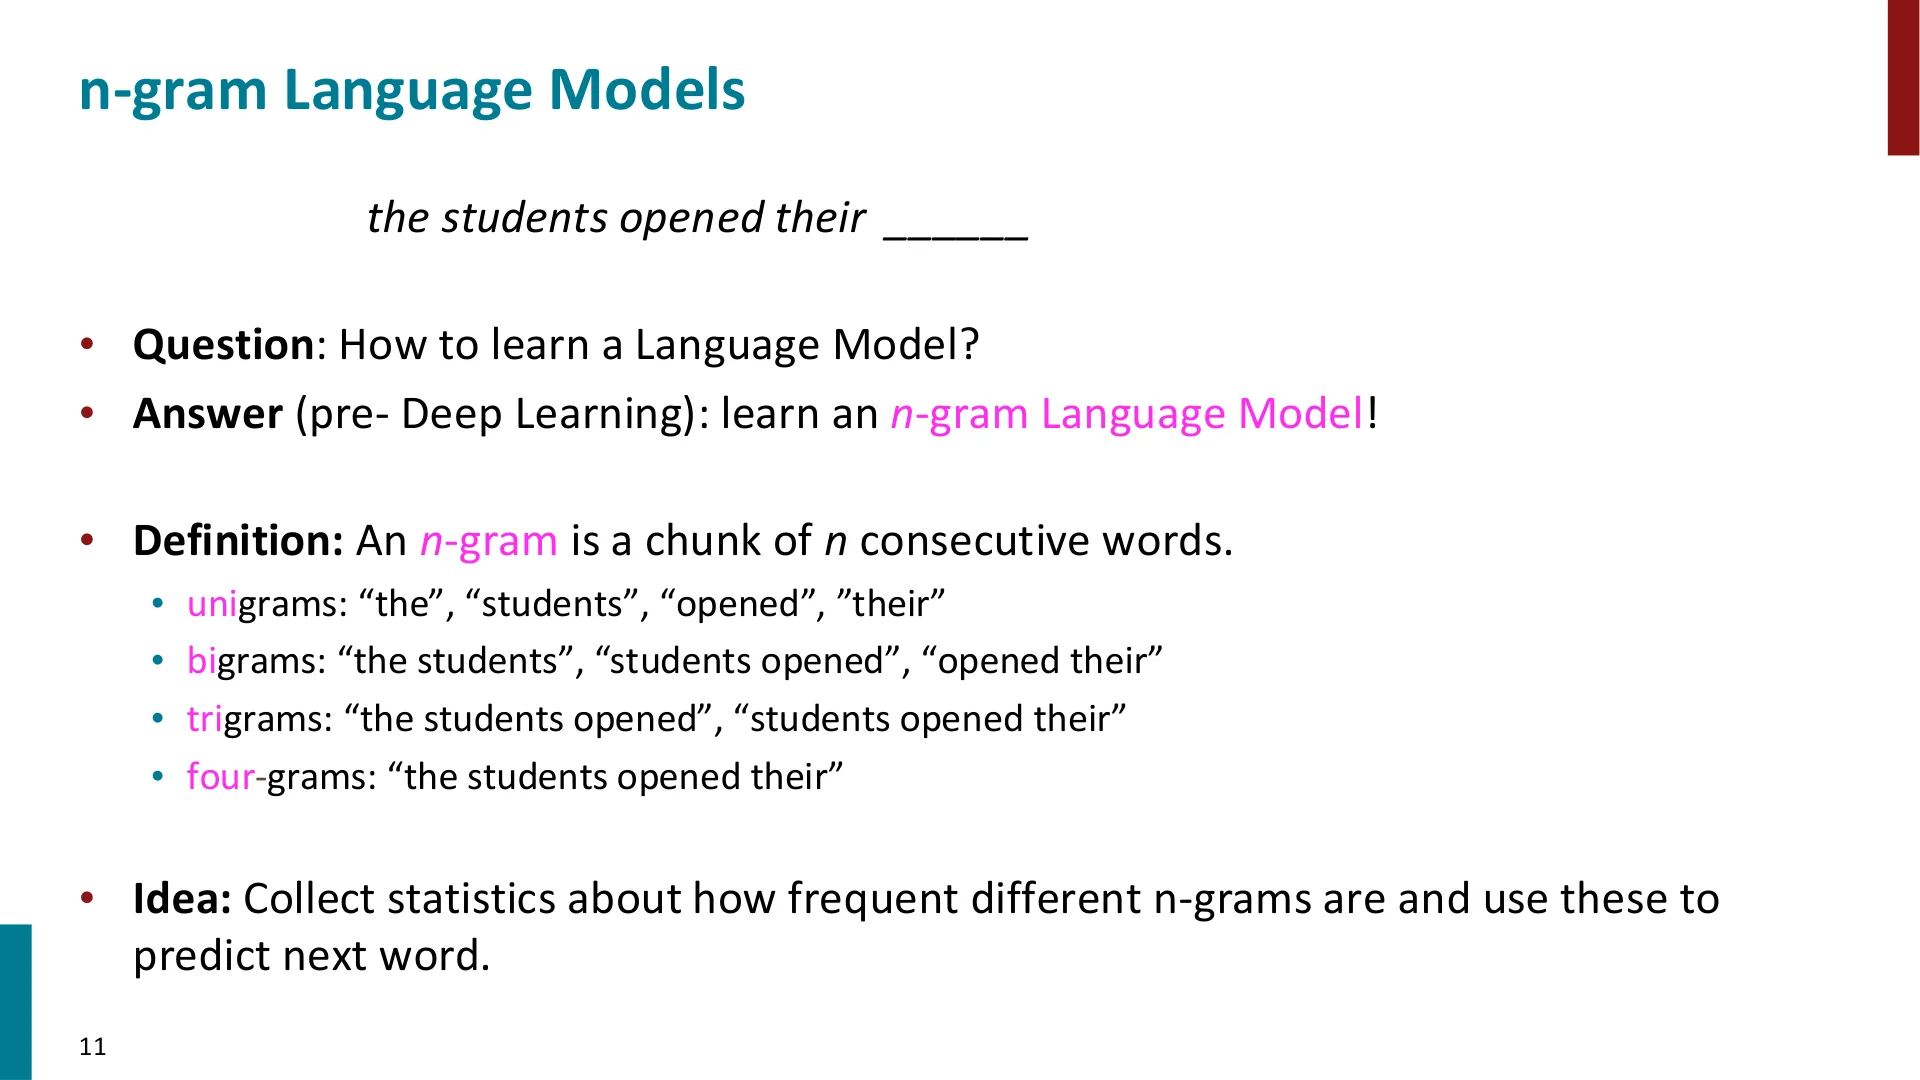
📷 n-gram 语言模型:用 n 个连续词构成的块来预测
回到原视频 (00:28:56)
核心技巧是马尔可夫(Markov)假设:
(参考时间: 00:30:56)
预测下一个词时,我们不使用全部上下文——只用最近的 $n-1$ 个词,把更早的都扔掉。
于是:
$$P\!\left(x^{(t+1)} \mid x^{(t)}, \dots, x^{(1)}\right) \approx P\!\left(x^{(t+1)} \mid x^{(t)}, \dots, x^{(t-n+2)}\right) = \frac{P\!\left(x^{(t+1)}, x^{(t)}, \dots, x^{(t-n+2)}\right)}{P\!\left(x^{(t)}, \dots, x^{(t-n+2)}\right)}$$
分子是一个 n-gram 的概率,分母是一个 $(n-1)$-gram 的概率。而这些概率怎么得到?数出来——在一个大语料里数这些 n-gram 出现的次数,做相对频率估计。
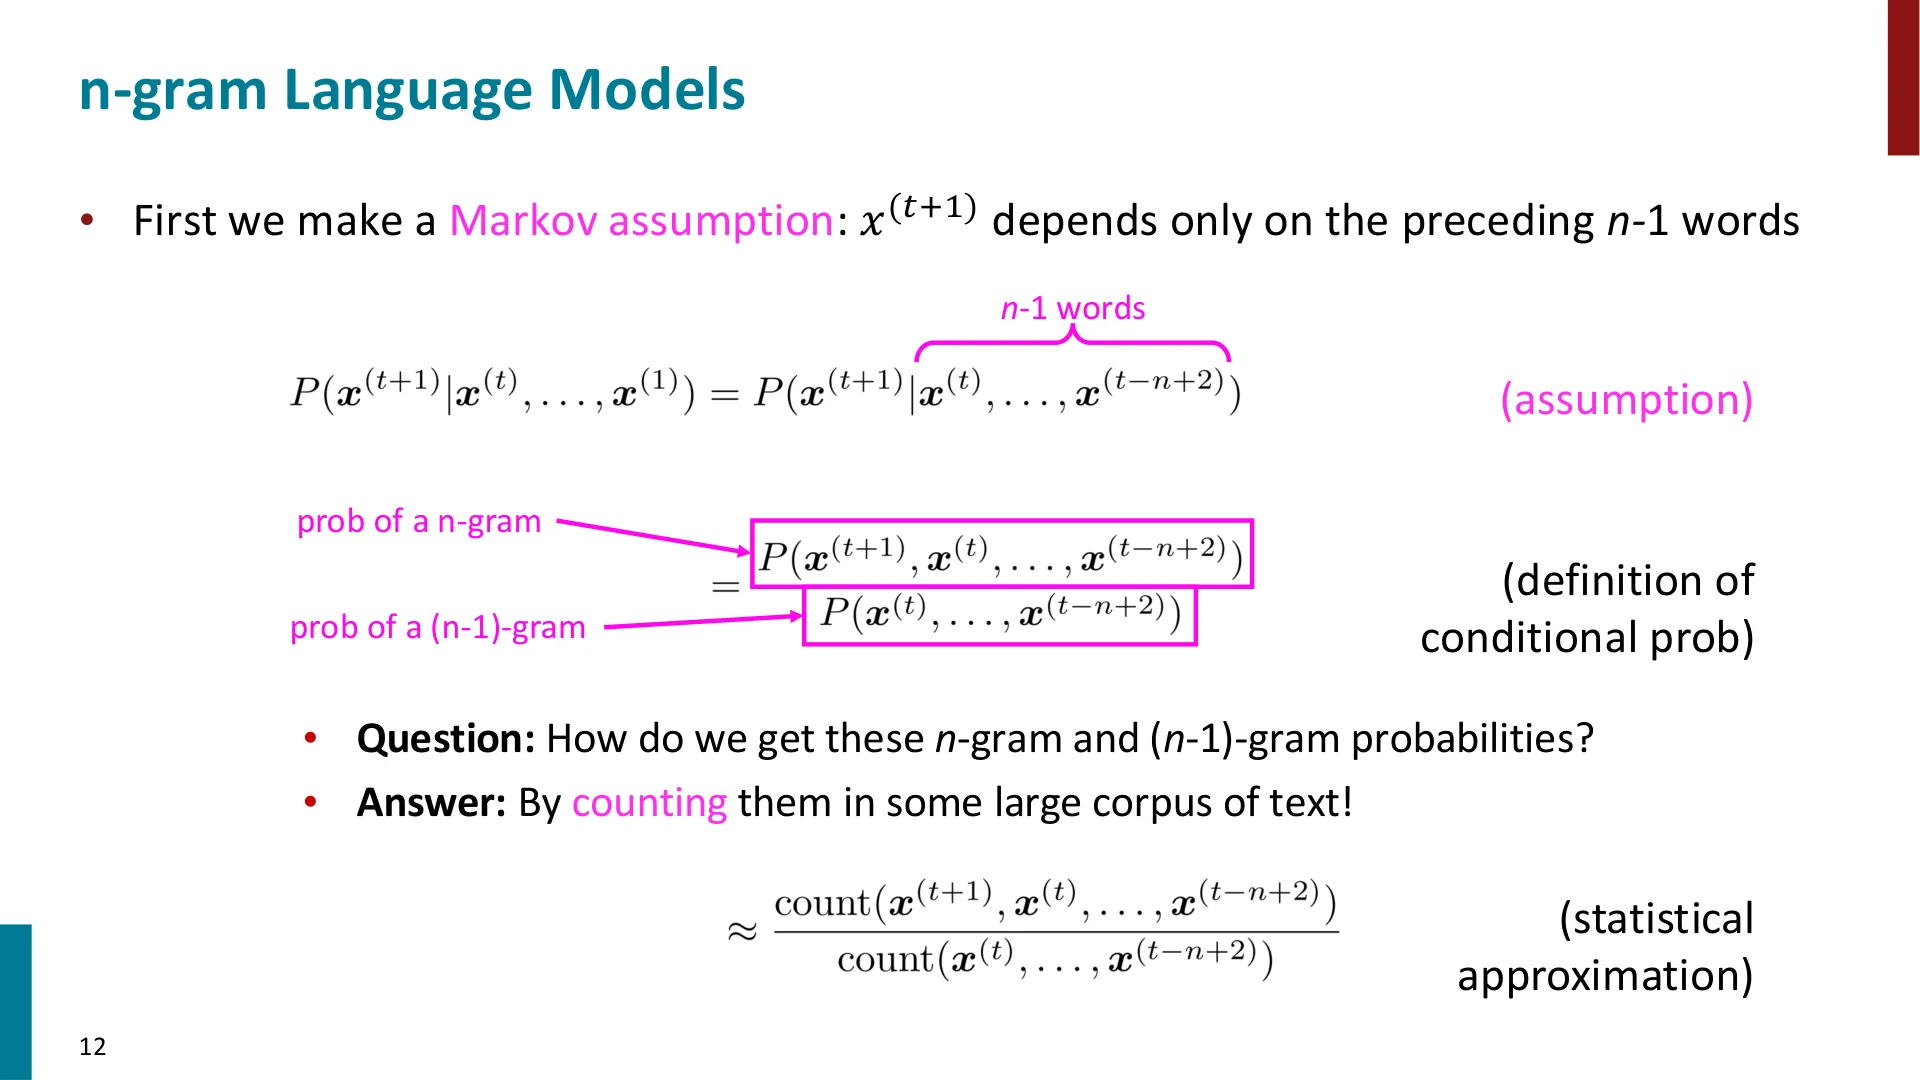
📷 n-gram 的马尔可夫假设:只依赖前 n−1 个词
回到原视频 (00:30:56)
举例(四元模型):
(参考时间: 00:32:15)
句子:as the proctor started the clock, the students opened their _____
用四元模型,就丢掉更早的内容,只看 students opened their。若语料里:
students opened their出现 1000 次;students opened their books出现 400 次 → $P(\text{books} \mid \text{students opened their}) = 0.4$students opened their exams出现 100 次 → $P(\text{exams} \mid \text{students opened their}) = 0.1$
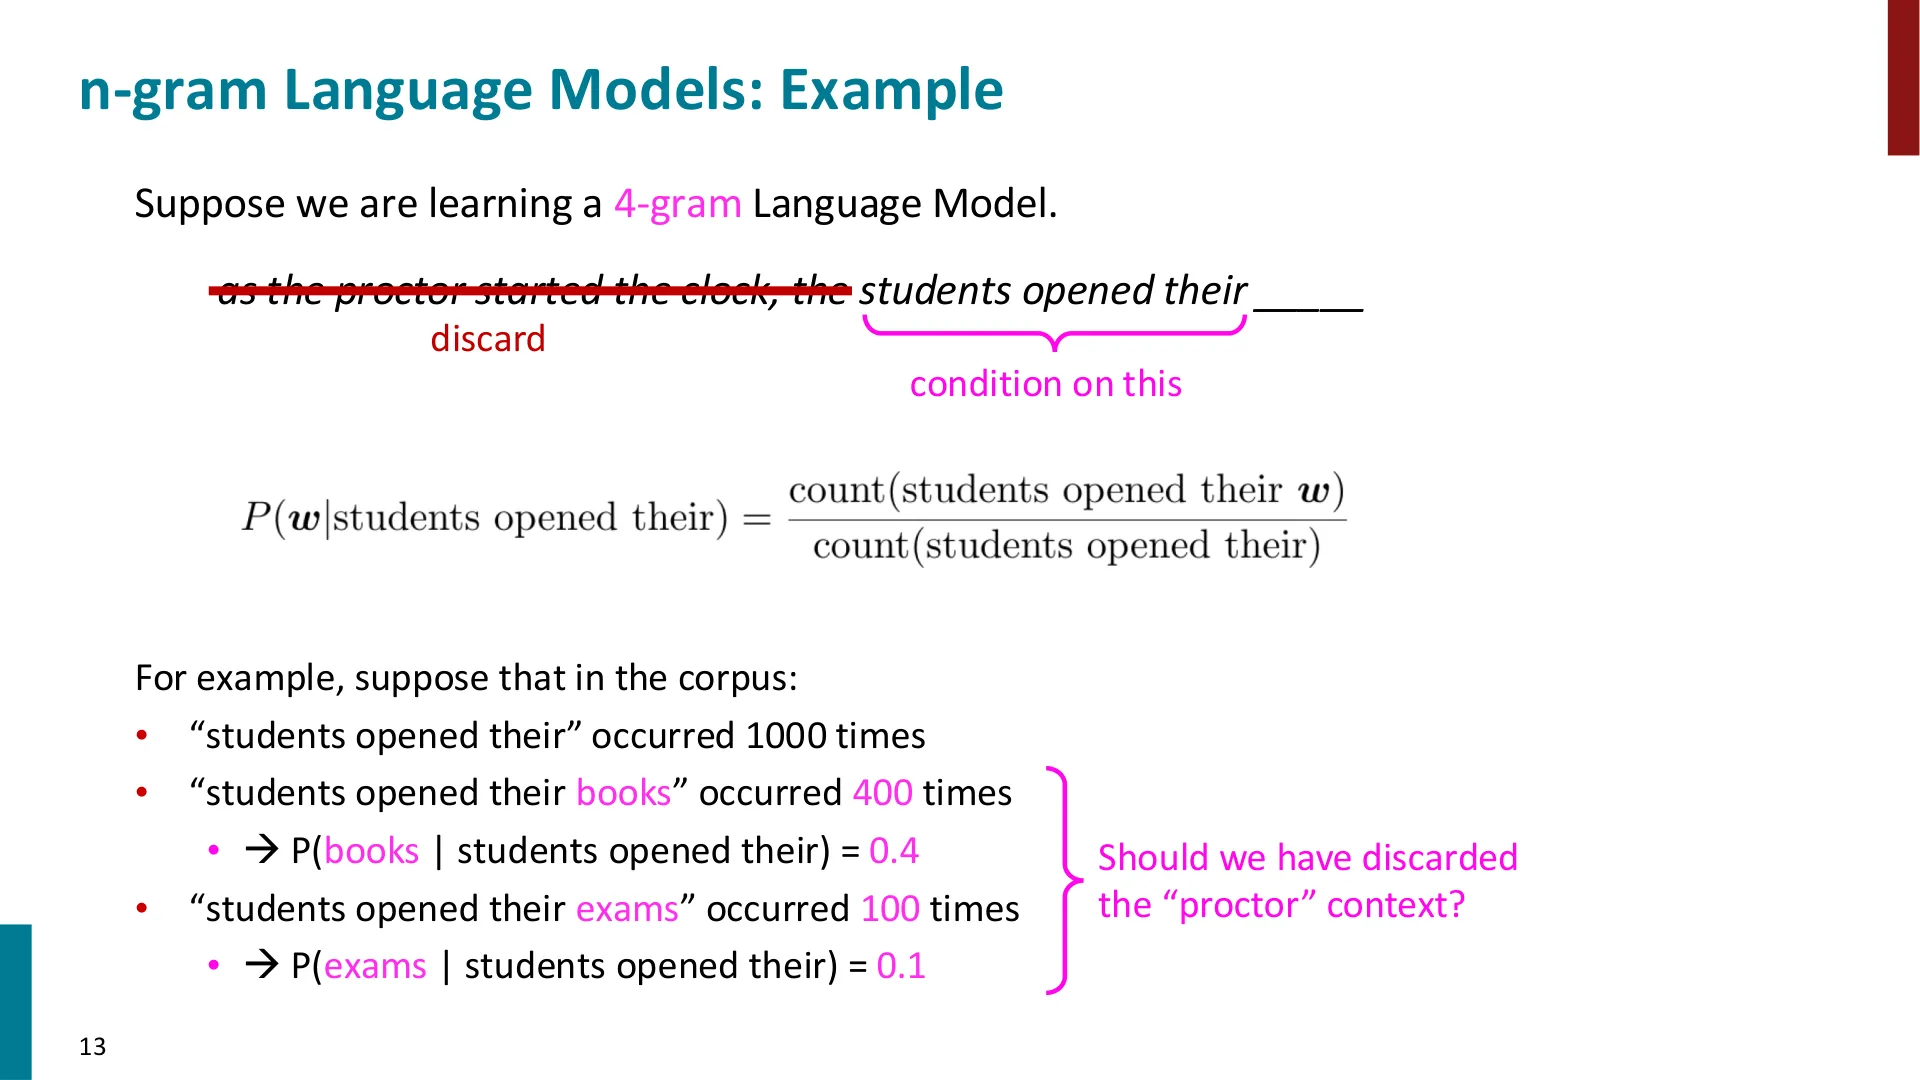
📷 四元语言模型的计数示例
回到原视频 (00:32:15)
老师提醒大家注意这个估计的"粗糙":
这不算太糟,因为紧接着的前几个词确实往往是最有用的。但它明显很原始——如果你知道前文是
the proctor started the clock,那exams其实更合理;可你只依据students opened their来估计,就更容易选books,因为它更常见。要不要丢掉 "proctor" 那段上下文? 这正是马尔可夫假设的代价。
n-gram 的两堵墙:稀疏与存储
稀疏问题(sparsity)
(参考时间: 00:34:08)
老师先问:这样用计数来估计,会出什么问题?台下的回答点出了要害——词太多、n-gram 太多,而且有些词可能压根没在训练数据里出现过,于是计数为 0。
这就是两个稀疏问题:
- 稀疏问题 1:如果"
students opened their w"从没出现过,那 $w$ 的概率就是 0。 - 稀疏问题 2:如果"
students opened their"本身都没出现过,那我们连分母都没有,无法计算任何 $w$ 的概率。
老师强调,给某个词赋概率 0 尤其糟糕:因为一旦某个概率是 0,任何包含它的计算都会"立刻塌成 0"。
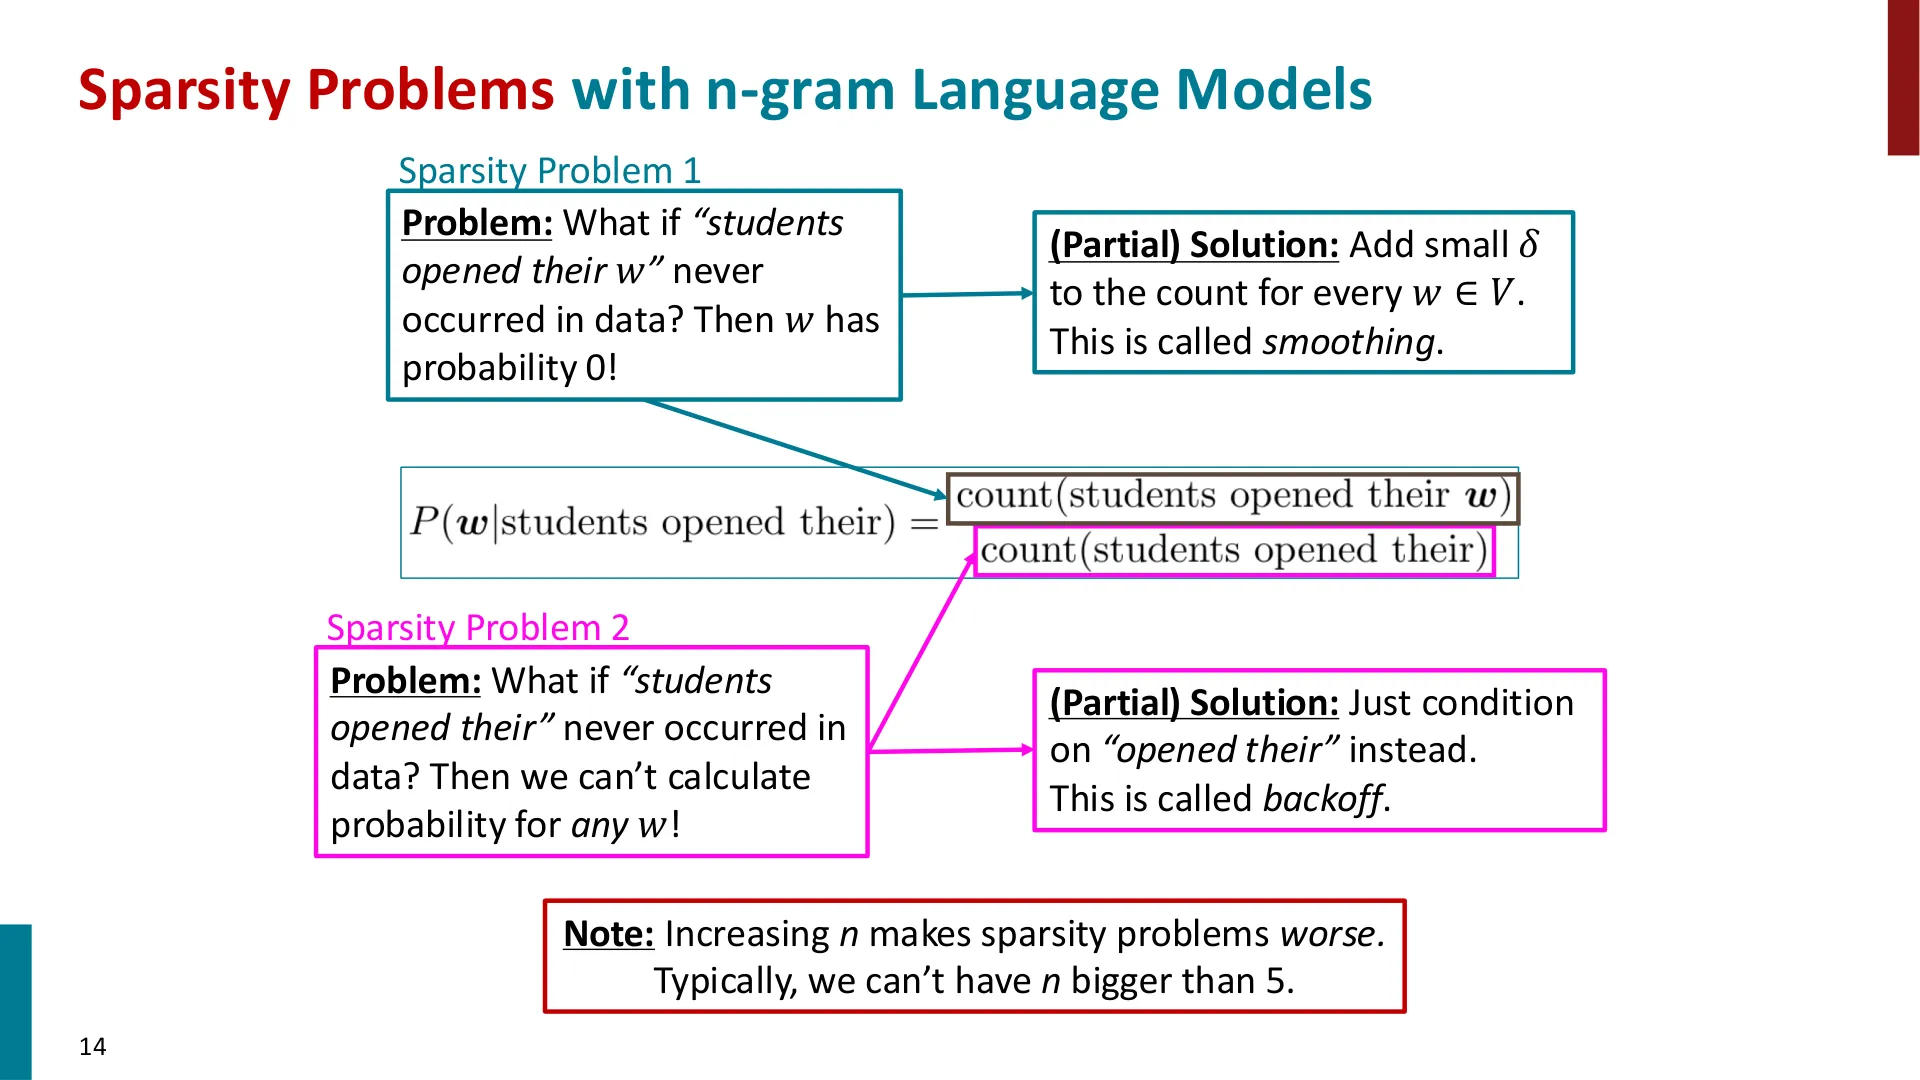
📷 n-gram 的两个稀疏问题及部分对策
回到原视频 (00:34:08)
(部分)对策:
- 对稀疏问题 1 → 平滑(smoothing):给词表里每个词 $\in V$ 的计数都加上一个很小的 $\delta$,这样就没人是 0 了。老师形象地说:"没见过的词得到 0.25 次,只见过一次的词得到 1.25 次——于是没有零,一切皆有可能。"
- 对稀疏问题 2 → 回退(backoff):如果估不了"
students opened their之后",就退一步用"opened their之后"来估;还不行,就再退到"their之后"。用越来越短的上下文,直到能估为止。
下面这张图把 n-gram 的应对逻辑画清楚:
graph TD
  P["估计 P(w | 前 n−1 个词)"] --> Q1{"n-gram『前 n−1 个词 + w』是否在语料中出现?"}
  Q1 -->|否| S1["平滑 smoothing: 给词表每个词 +δ, 消灭零概率"]
  Q1 -->|是| R1["用相对频次直接估计"]
  P --> Q2{"『前 n−1 个词』本身是否出现?"}
  Q2 -->|否| S2["回退 backoff: 改用更短的上下文估计"]
  Q2 -->|是| R2["正常按下式计算"]
存储问题
(参考时间: 00:37:26)
另一个问题来自存储:你必须把语料里见过的所有 n-gram 的计数存下来。n 越大、语料越大,模型就越大。
而且,这两个问题方向相反、彼此拉扯:
- 想估得更准 → 想用更多上下文 → 想把 n 调大;
- 但 n 一大,要存的 n-gram 数量指数级增长(存储问题恶化),而且几乎必然遇到稀疏问题(稀疏问题恶化)。
结果就是:实践中 n 一般顶多到 5,偶尔有人用 6-gram、7-gram。老师举了个著名例子:2000 年代 Google 发布的 Google n-grams,基于一个万亿词的网页语料,给出了 n 到 5 的计数——到 5 就停了。
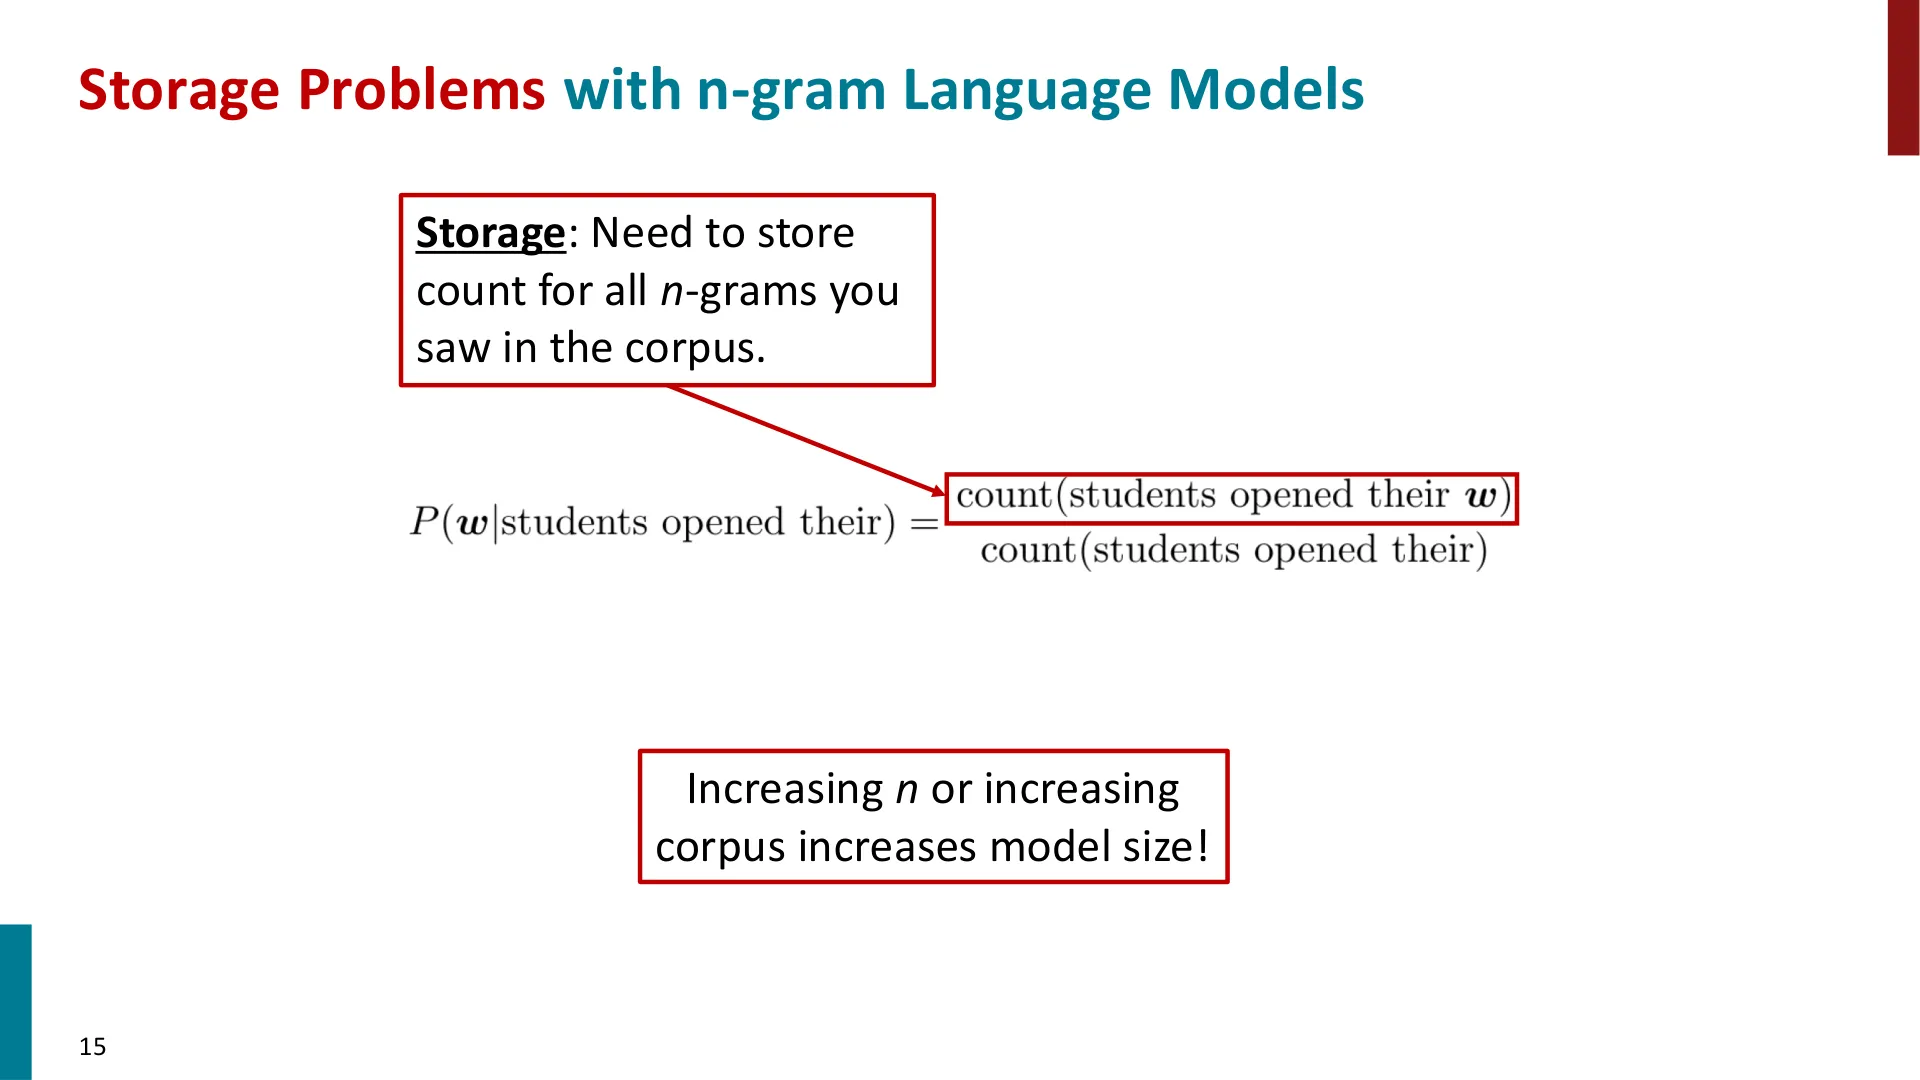
📷 n-gram 的存储问题
回到原视频 (00:37:26)
编者说明:Google 的 n-gram 数据集见 Google Books Ngram Viewer。它是"规模换质量"路线的历史见证。
用 n-gram 生成文本
(参考时间: 00:38:40)
n-gram 语言模型的好处是极易搭建:不用训练神经网络,只要数数。在几百万词的语料上,一个 trigram 模型写代码几分钟、建模几秒钟。
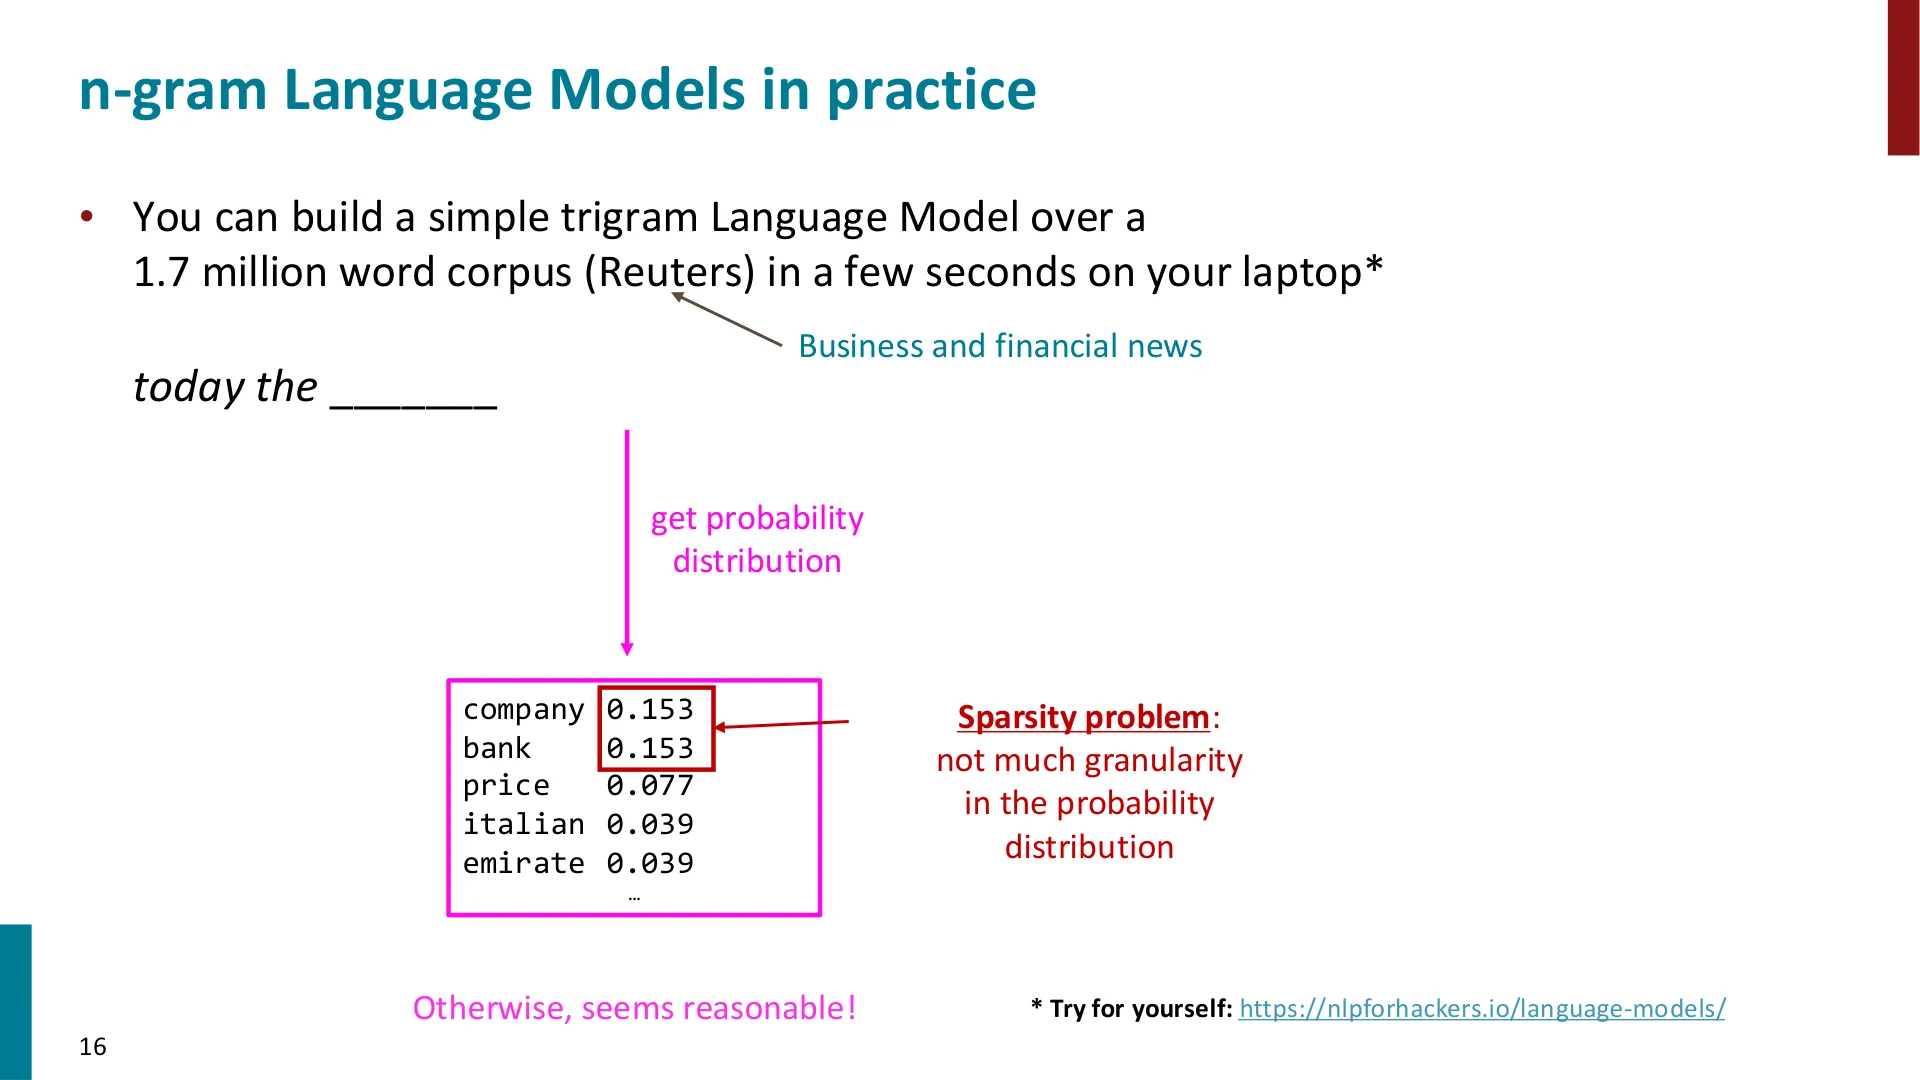
📷 n-gram 语言模型的实践:几秒钟建好一个 trigram 模型
回到原视频 (00:38:40)
文本生成的思路和前面一样,只是多了一步采样:
- 给一个开头,例如
today the; - 查存储的 n-gram,得到下一个词的概率分布;
- 掷骰子(从 [0,1] 取一个随机数),从分布里采样出一个词,例如
price; - 把
price接到开头后面,重复。
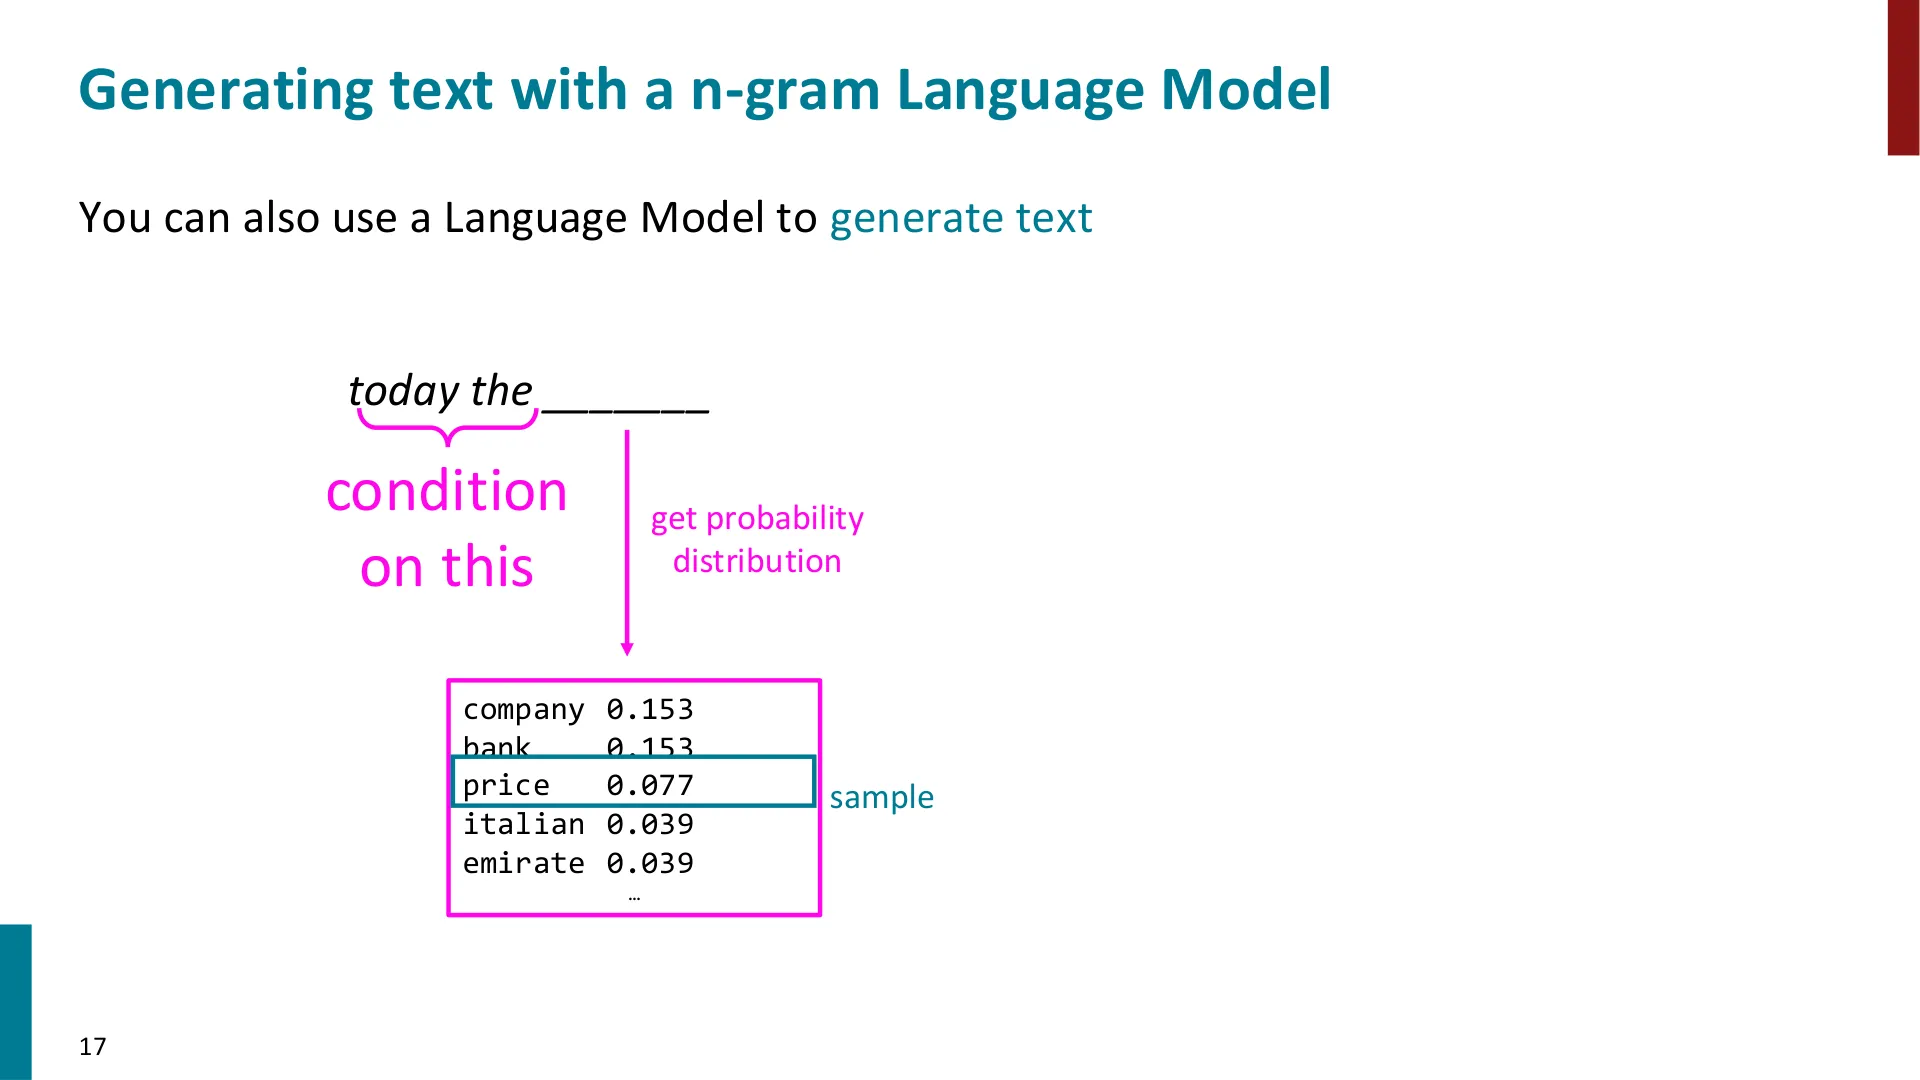
📷 从分布中采样,生成下一个词(today the → price)
回到原视频 (00:39:33)
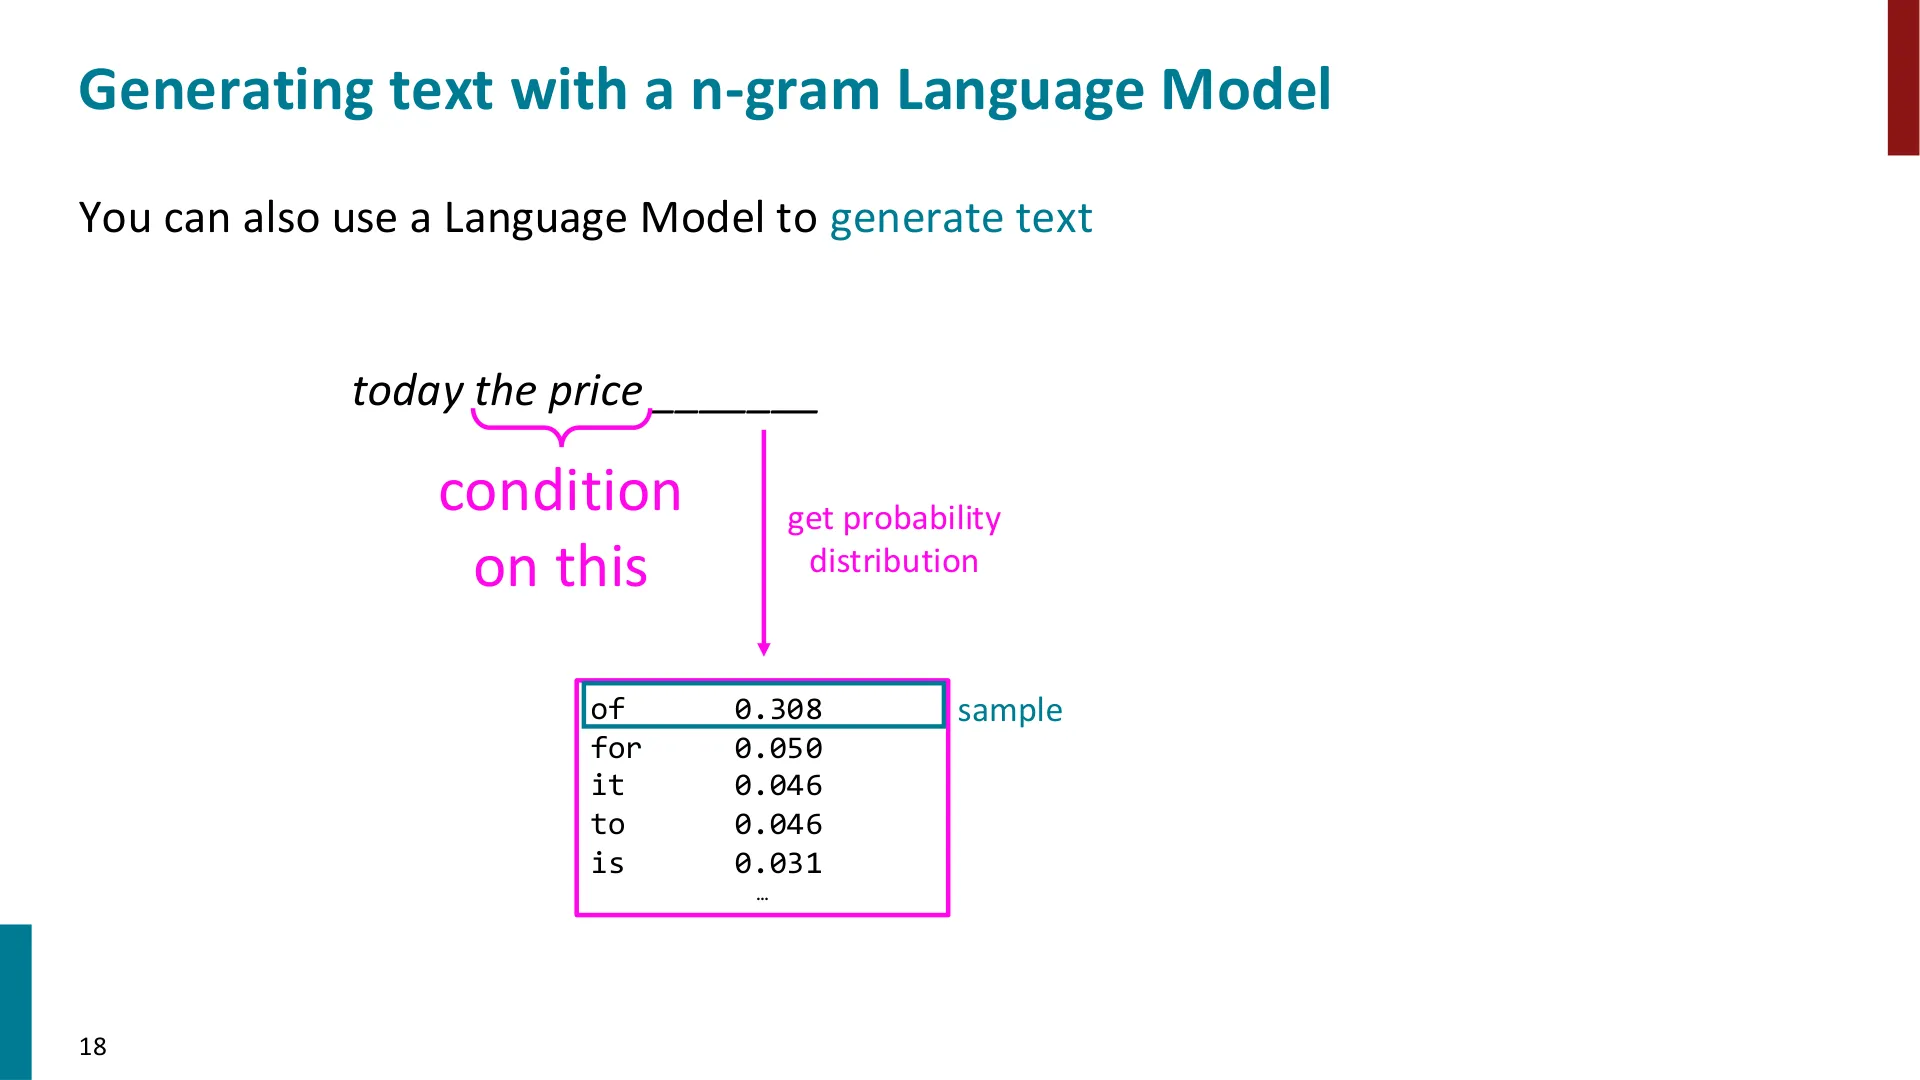
📷 继续:today the price → of
回到原视频 (00:40:48)
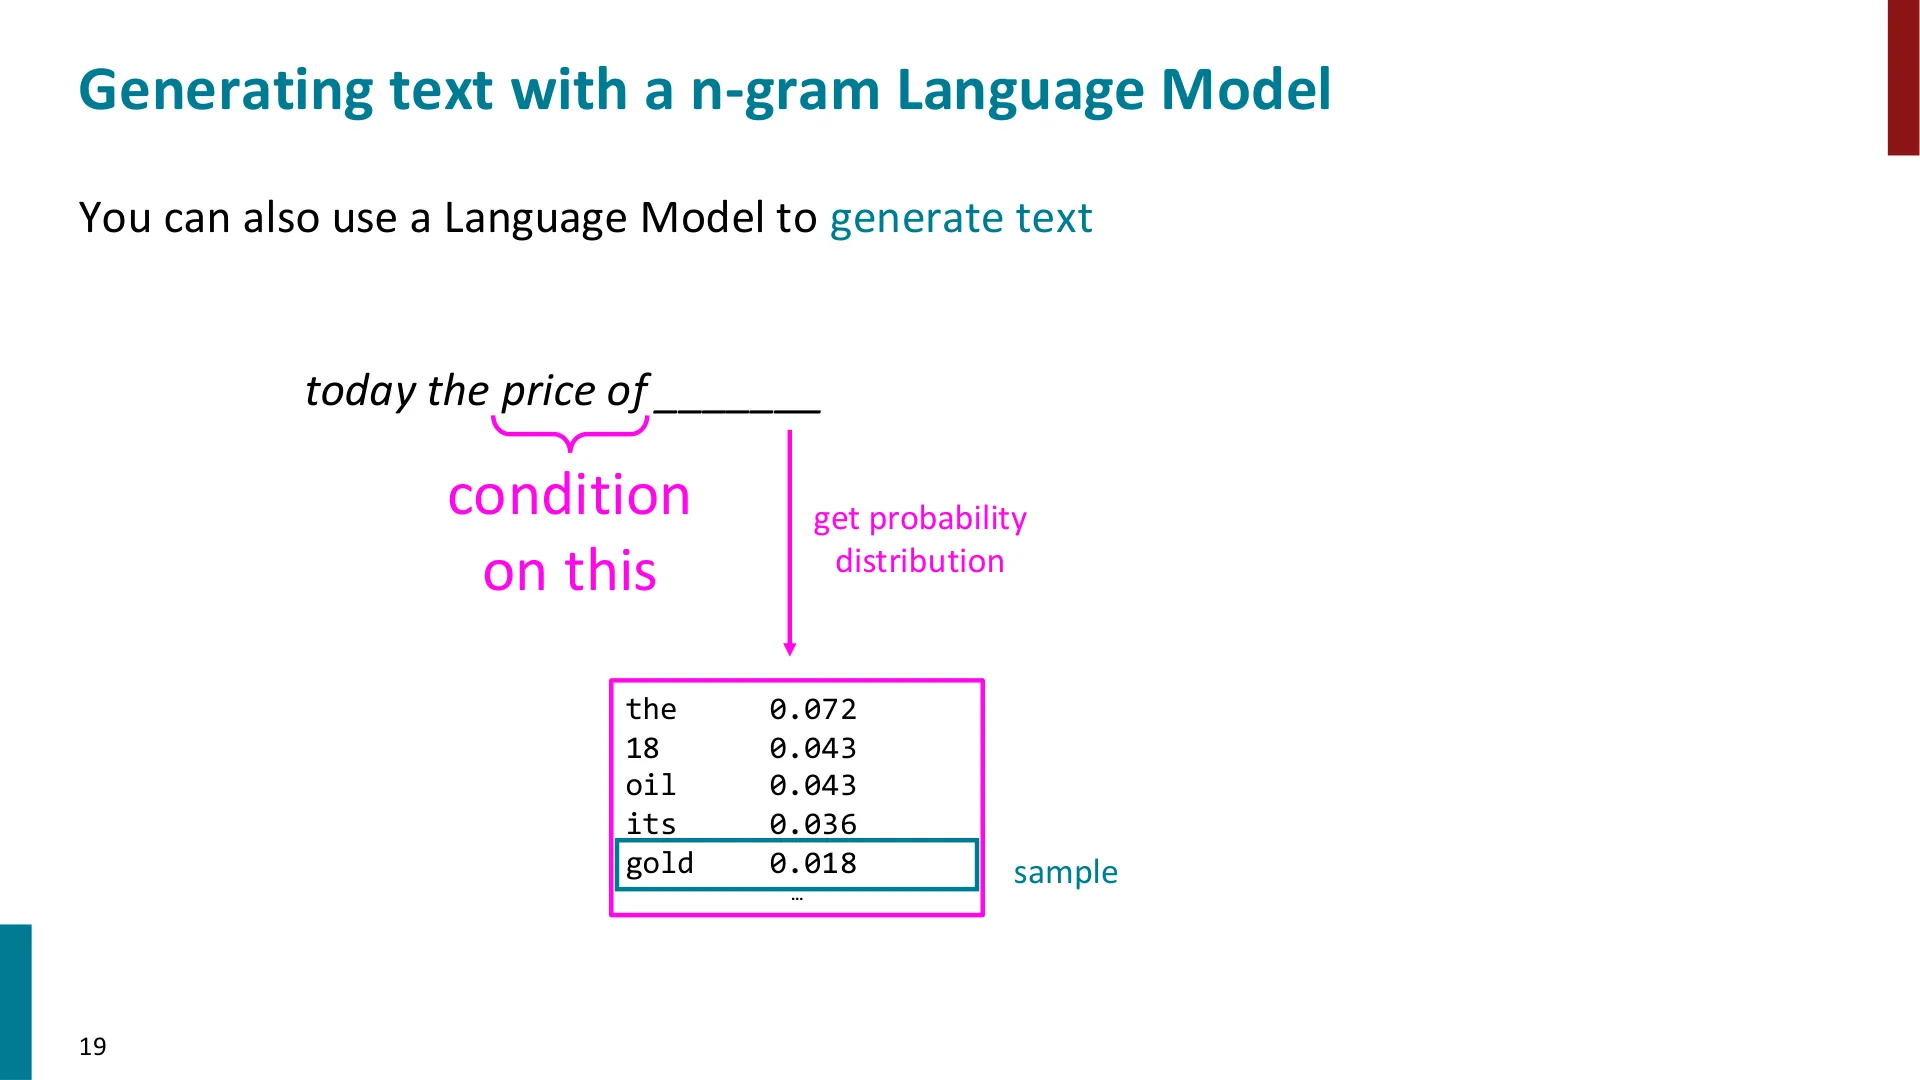
📷 继续:today the price of → the/18/oil…
回到原视频 (00:41:10)
老师提醒注意这些概率的"强规律性":因为都来自计数归一化,"出现一次的词""出现两次的词""出现四次的词"会呈现明显的阶梯。
演示用的语料是 200 万词的路透社新闻(商业/金融),生成的文本是:
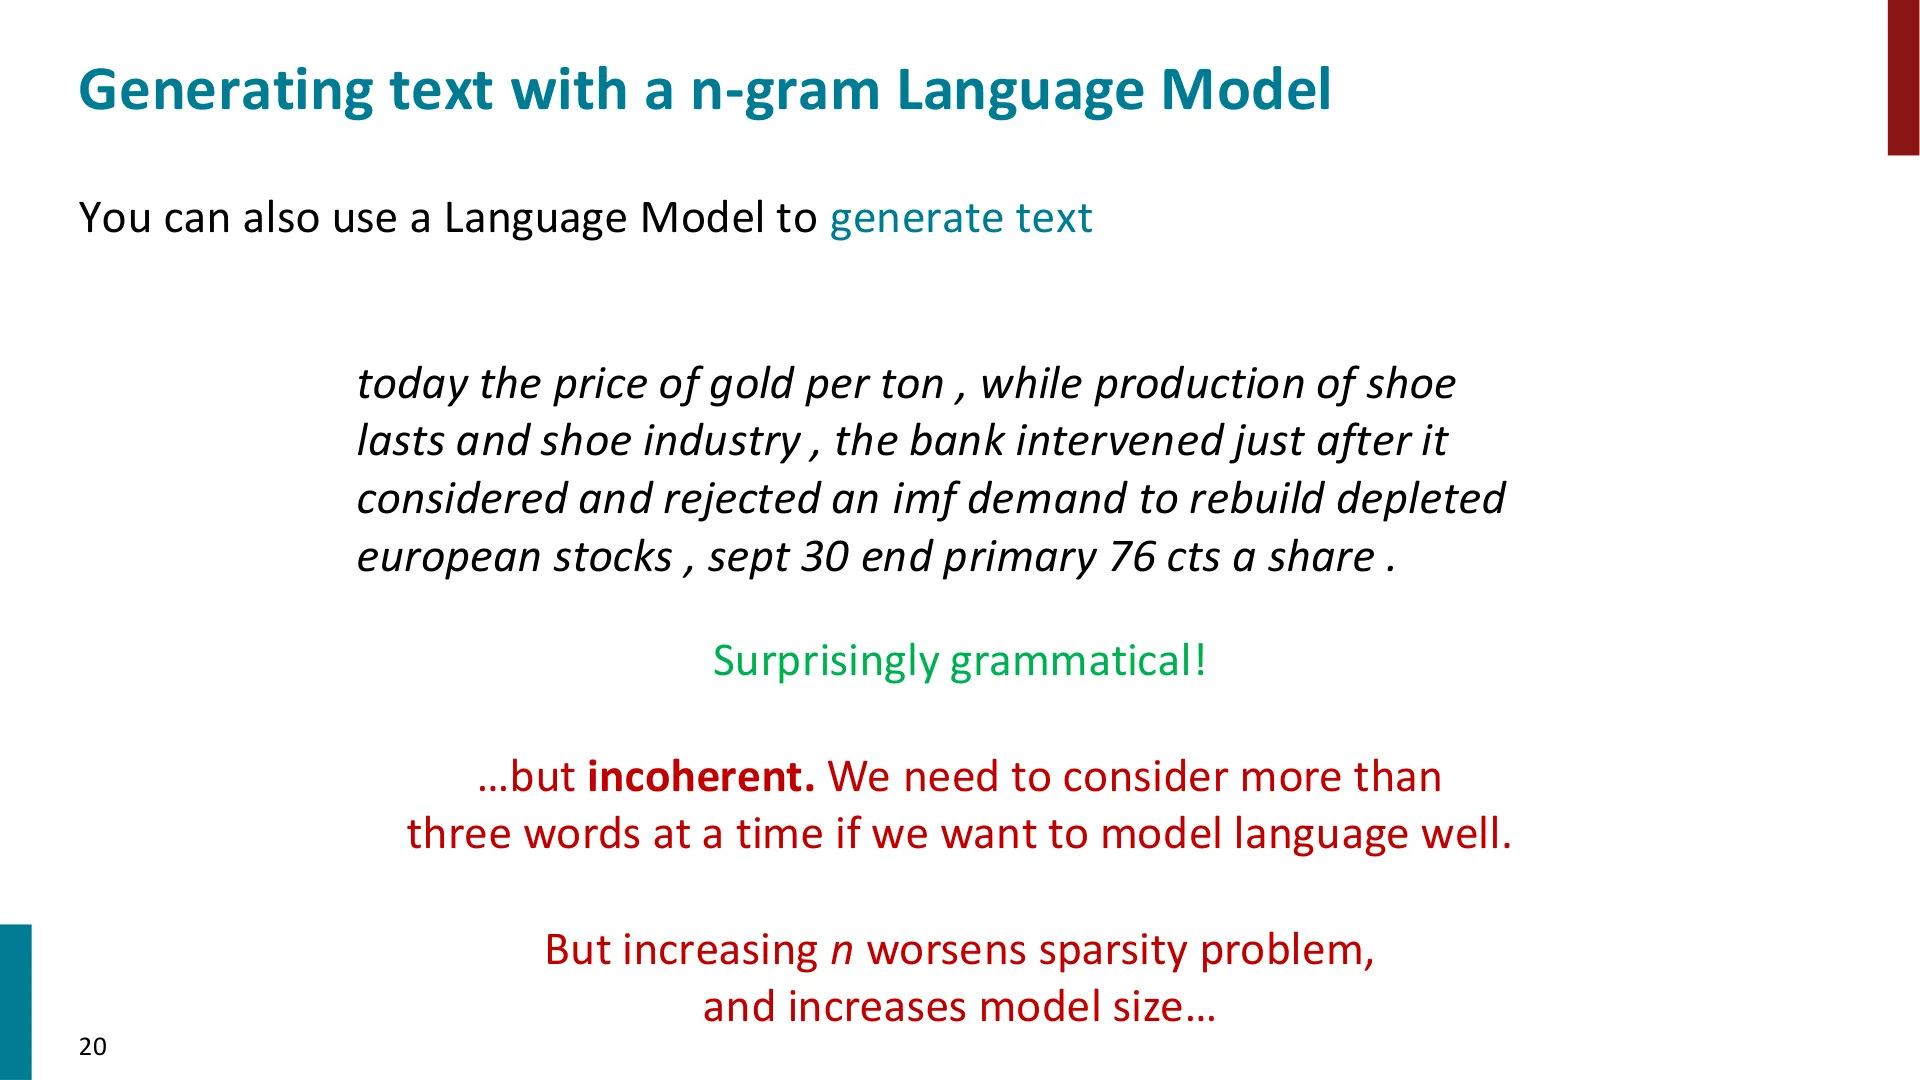
📷 用 trigram 语言模型生成的文本:语法像样,但内容不连贯
回到原视频 (00:41:35)
today the price of gold per ton , while production of shoe lasts
and shoe industry , the bank intervened just after it considered
and rejected an imf demand to rebuild depleted european stocks ,
sept 30 end primary 76 cts a share .
老师的点评(这里有一个很值得学习的判断力):
这段文本不怎么样,但我想让大家今天心情好一点——它其实没有那么糟。它出人意料地合语法。比如
the bank intervened just after it considered and rejected an imf demand,这半句几乎像是真的。它只是完全不连贯(incoherent)。所以还有工作要做,但你已经能看到:即便是这么简单的 n-gram 模型,也能从很低的层次"逼近"人类语言的样子。
而且这个结果很容易改进:2 百万词换成 1 千万词会更好,trigram 换成 four-gram 会更好。这正是人们到 2012 年为止一直在做的事。
编者说明:老师特别点出一个观念上的相似性——今天大家说"规模解决一切",和 2010 年代初 n-gram 时代说的是同一个故事:10 万词不够?那就 1 亿词 + four-gram;1 万亿词 + five-gram 更好;那要是能集到 10 万亿词……但事实证明,有时候"更好的模型"和"规模"一样重要。于是语言模型这件事被重新发明,从神经网络开始。
三、神经语言模型:从固定窗口到 RNN
固定窗口神经语言模型
(参考时间: 00:44:18)
任务不变:输入一个词序列,输出下一个词的概率分布。最简单的一个想法,来自前面几讲已经见过的命名实体识别那套架构——把上下文表示成若干词向量的拼接,送进神经网络。
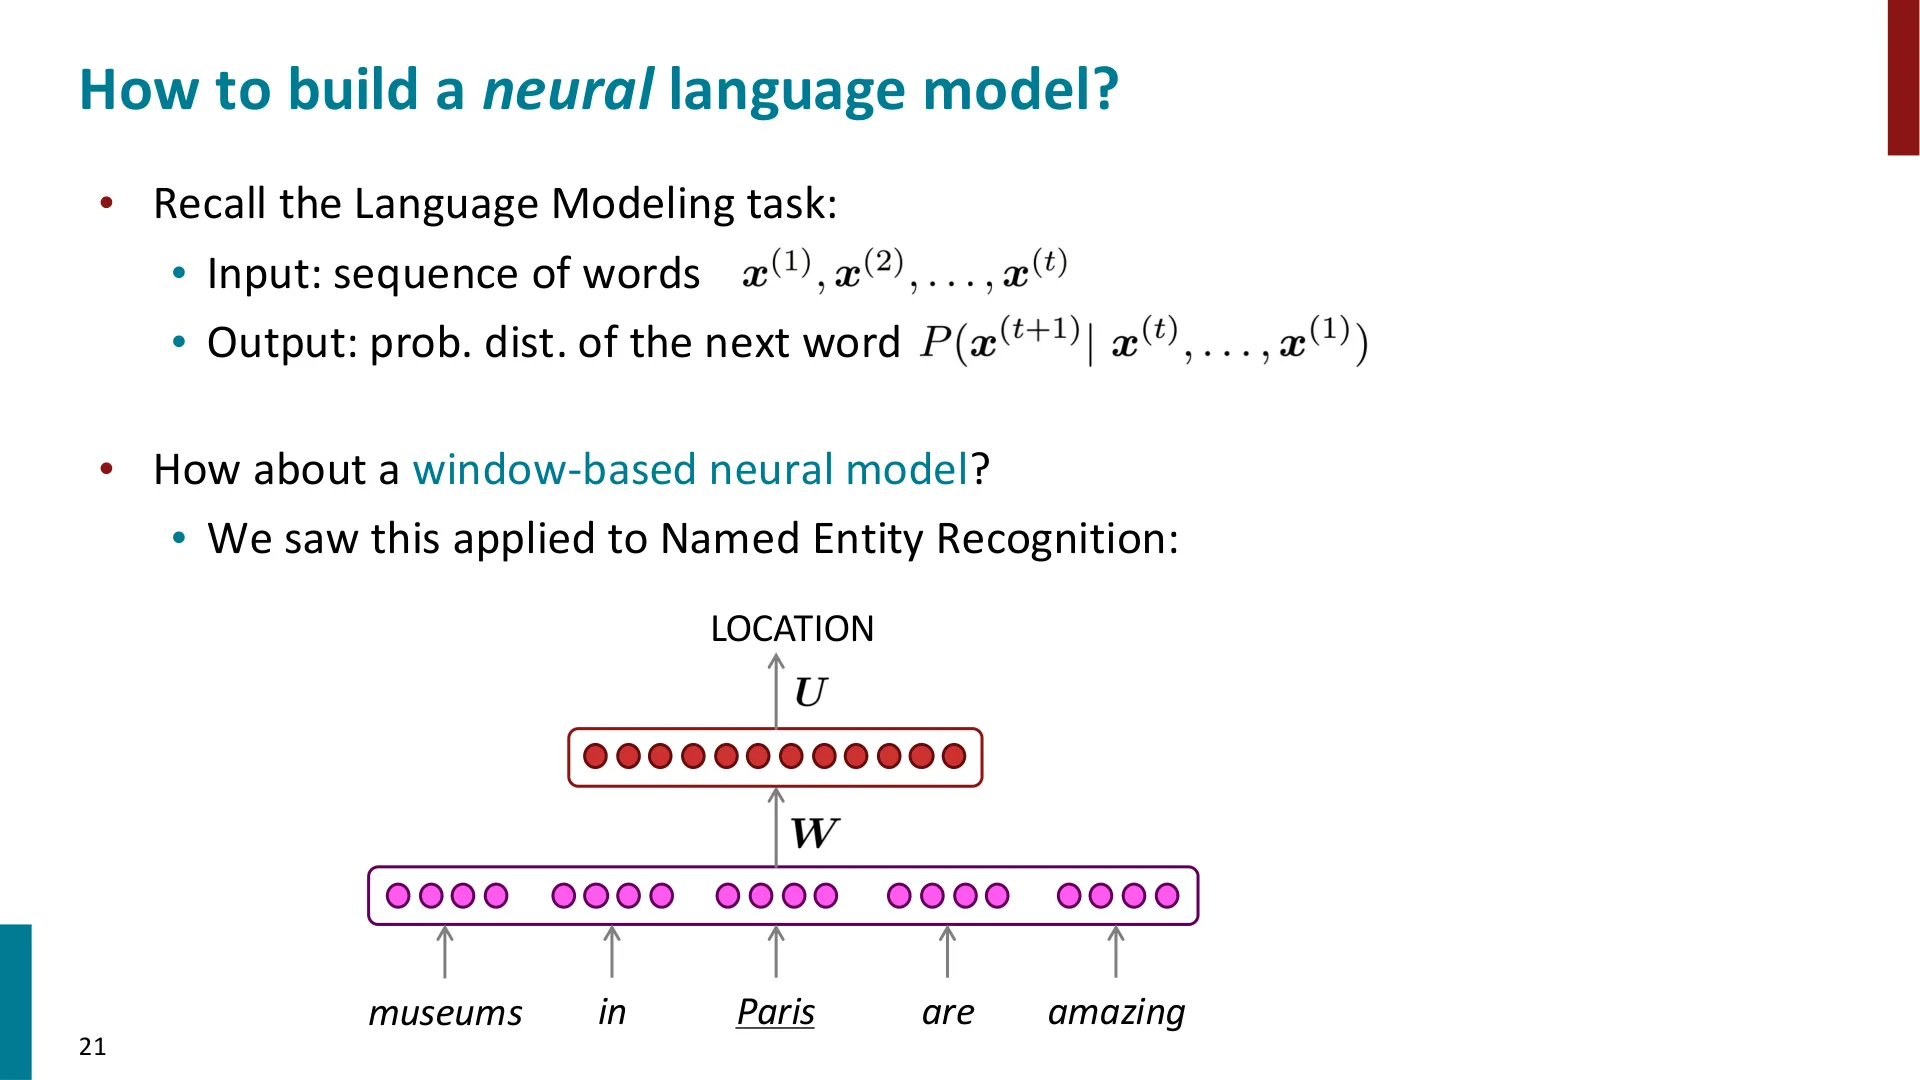
📷 用窗口式神经网络来建模语言
回到原视频 (00:44:18)
于是就有了固定窗口神经语言模型:先做一个马尔可夫式的"丢弃",把更早的上下文扔掉,只保留一个固定大小的窗口。
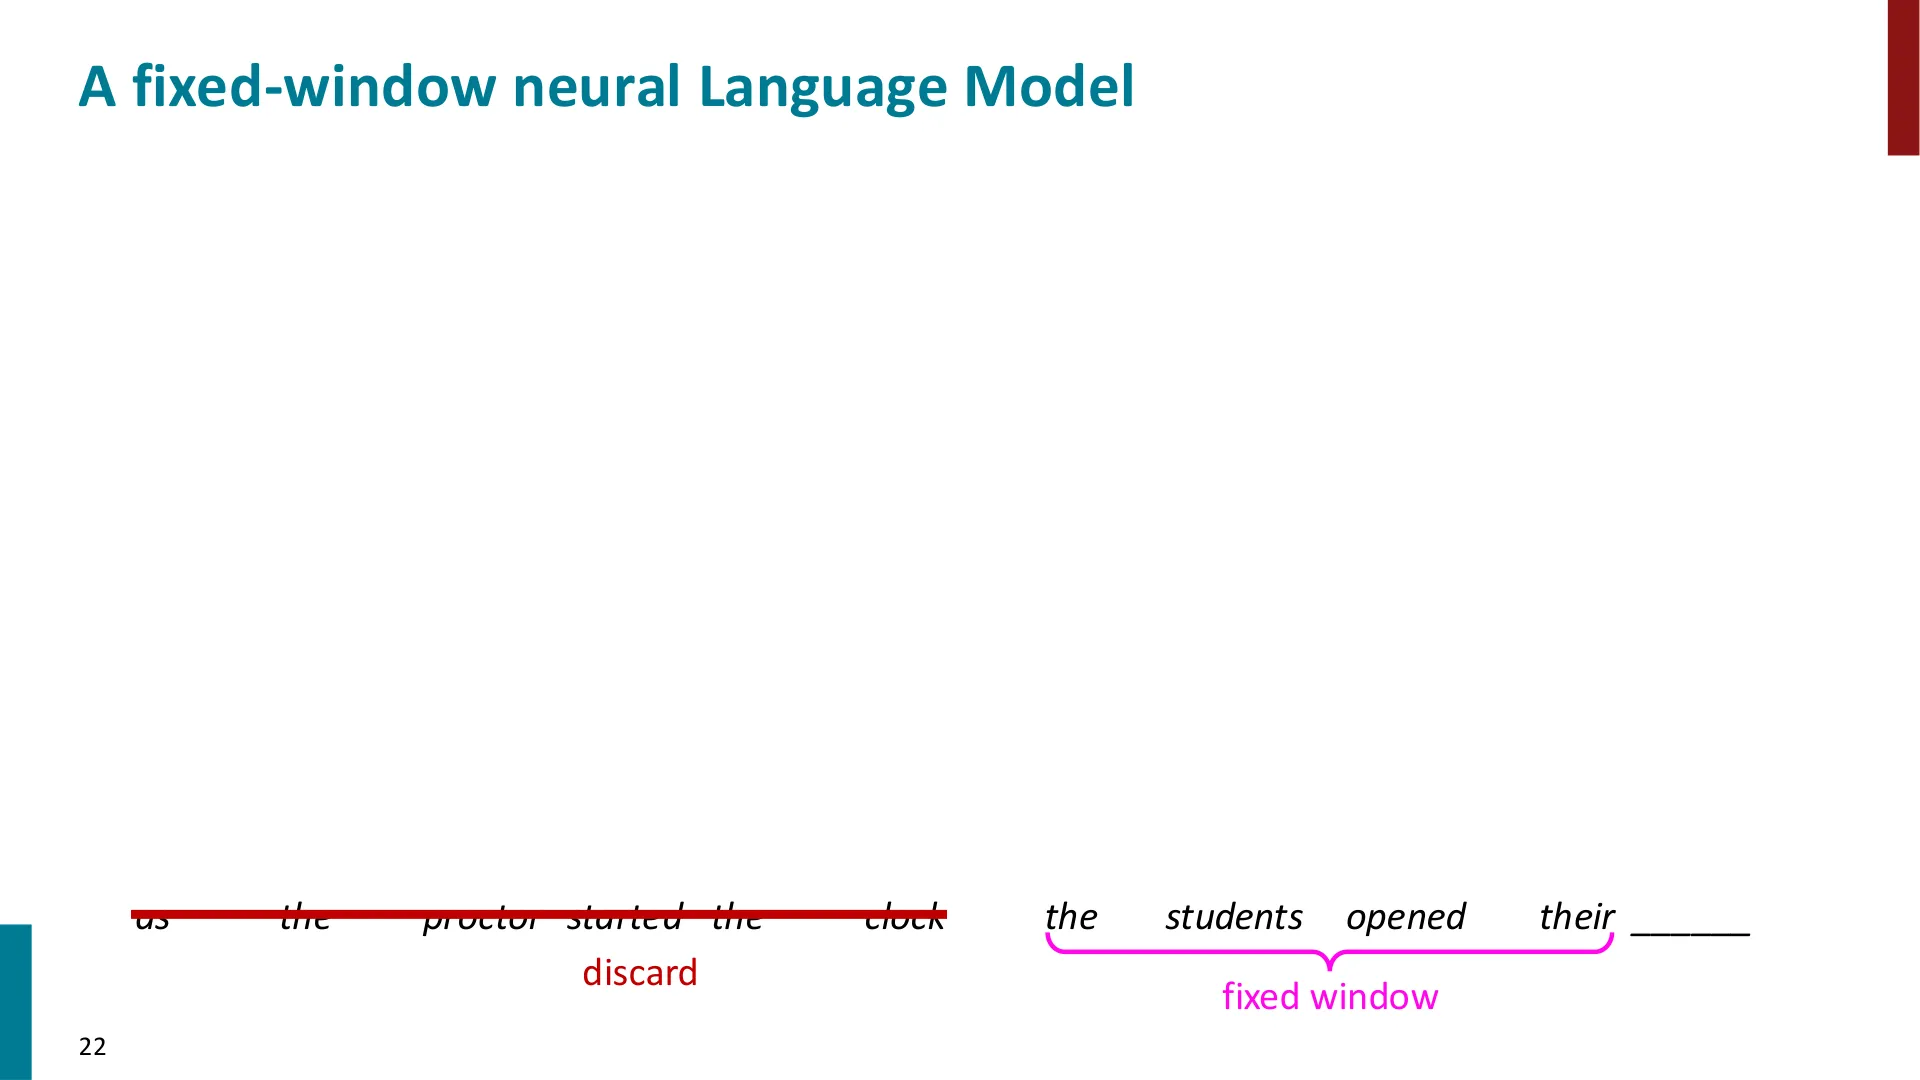
📷 固定窗口:丢弃窗口之外的内容
回到原视频 (00:46:07)
它的前向过程是:
- 窗口内的词先变成 one-hot 向量;
- 查表得到词嵌入,拼接起来;
- 送进隐藏层;
- 隐藏层输出再乘一个矩阵、加偏置,送进 softmax,得到词表上的输出分布。
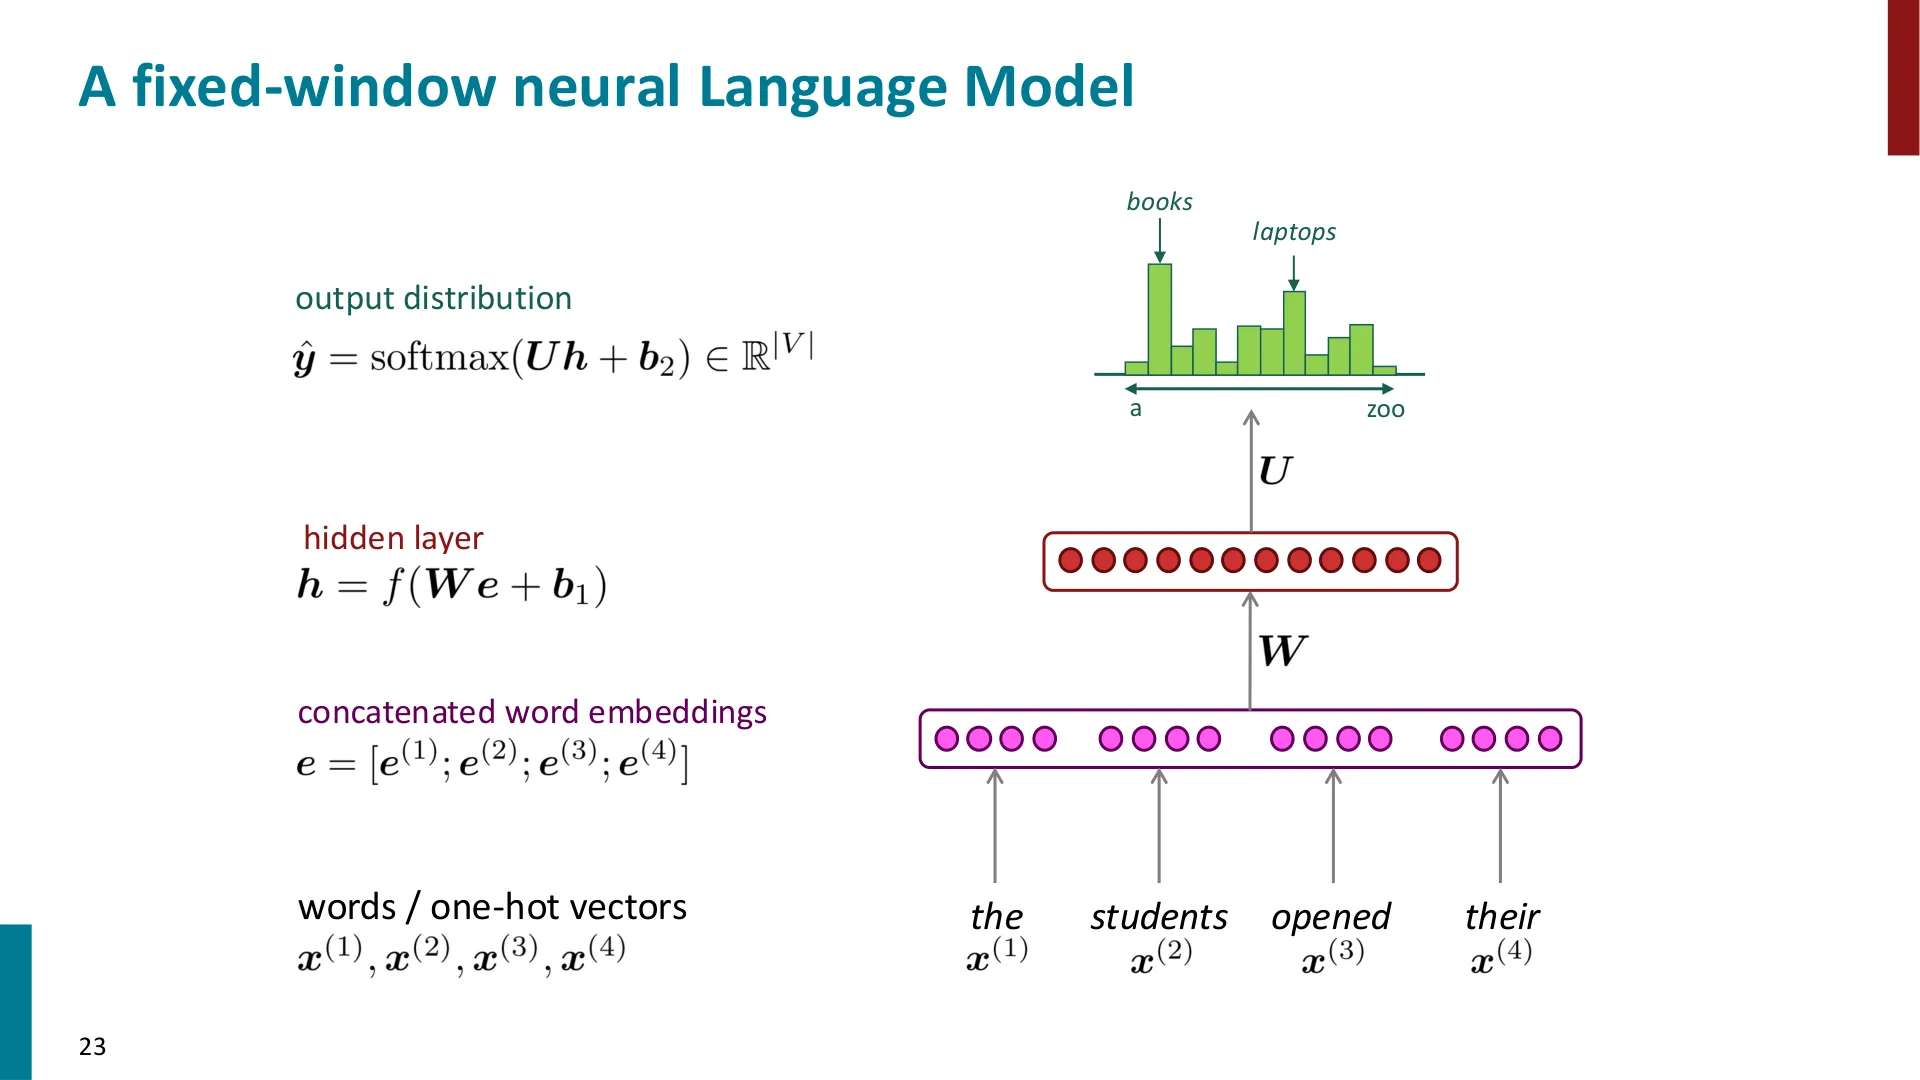
📷 固定窗口神经语言模型的前向结构
回到原视频 (00:46:24)
老师说,这和上周做的(例如判断中心词是不是地名)几乎一样,唯一区别是从二分类变成了"很多很多类"的分类——目标是"下一个词是哪一个"。这大致就是第一个被提出的神经语言模型:21 世纪初,Yoshua Bengio 等人就提出可以用固定窗口神经语言模型取代 n-gram 模型。
编者说明:Bengio 等人在 2000/2003 年的 A Neural Probabilistic Language Model 中提出了这个架构。当时他们确实拿到了一些正面结果,但没有引起广泛关注、没有真正流行起来。原因有几层:固定窗口本身和 n-gram 差别不算大;神经网络当时在没 GPU 的情况下很难跑;而且大家觉得"收集几百亿词的 n-gram 计数"能榨出的收益,可能比"折腾神经网络"更多。
固定窗口的局限
(参考时间: 00:48:42)
它确实解决了 n-gram 的两个老问题:
- 没有稀疏问题(不再依赖"某个 n-gram 出现过没有");
- 不需要存储所有见过的 n-gram(只存网络参数)。
但它没有解决所有问题:
- 仍然带着马尔可夫假设——只用一小段固定上下文;
- 窗口永远不够大:窗口一大,权重矩阵 $W$ 就变大;
- 还有个更微妙、也更"可疑"的问题:同一个词出现在不同位置,会被 $W$ 里完全不同的部分处理。也就是说,输入的处理方式没有对称性。
老师举例说明最后这一点:
预测
books会不会出现时,"出现的是 students"这件事很重要,但 students 具体落在哪个位置其实没那么重要。the students slowly opened their和the students opened their里的 students 是同一个词——可在固定窗口模型里,它处在不同位置,就会用到 $W$ 里完全不同的参数去学同一件事。这显然低效,而且不对。由此我们需要的,是一个能处理任意长度输入、并且对每个位置用同一套参数的架构。这就是循环神经网络。
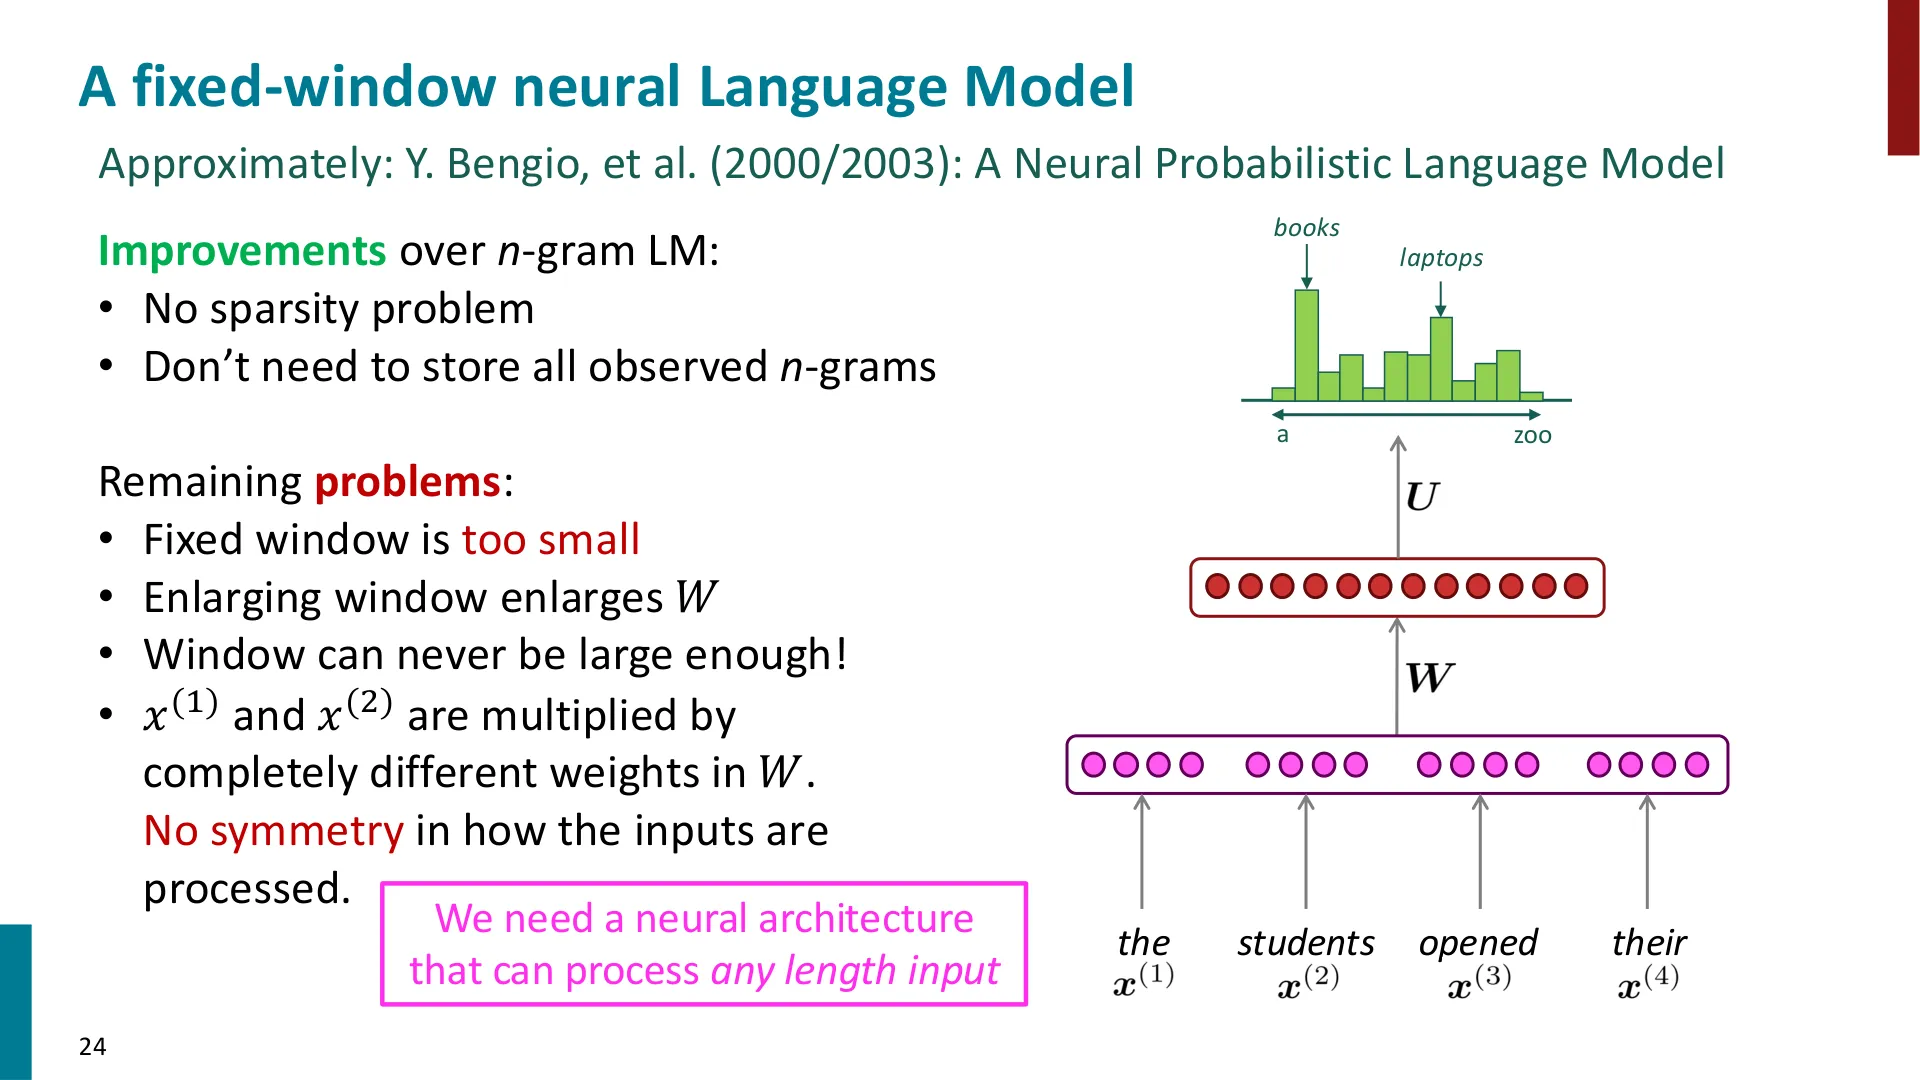
📷 固定窗口的改进与遗留问题:我们需要能处理任意长度输入的架构
回到原视频 (00:48:42)
循环神经网络(RNN)
(参考时间: 00:50:56)
回到"这一门课要见的几种神经网络架构"这个脉络:
- 第一个是 word2vec——一种很简单的编码器-解码器式结构;
- 第二个是前馈网络(全连接层,经典神经网络);
- 第三个就是循环神经网络(RNN),它还有不同变体;
- 之后我们还会走到 Transformer。
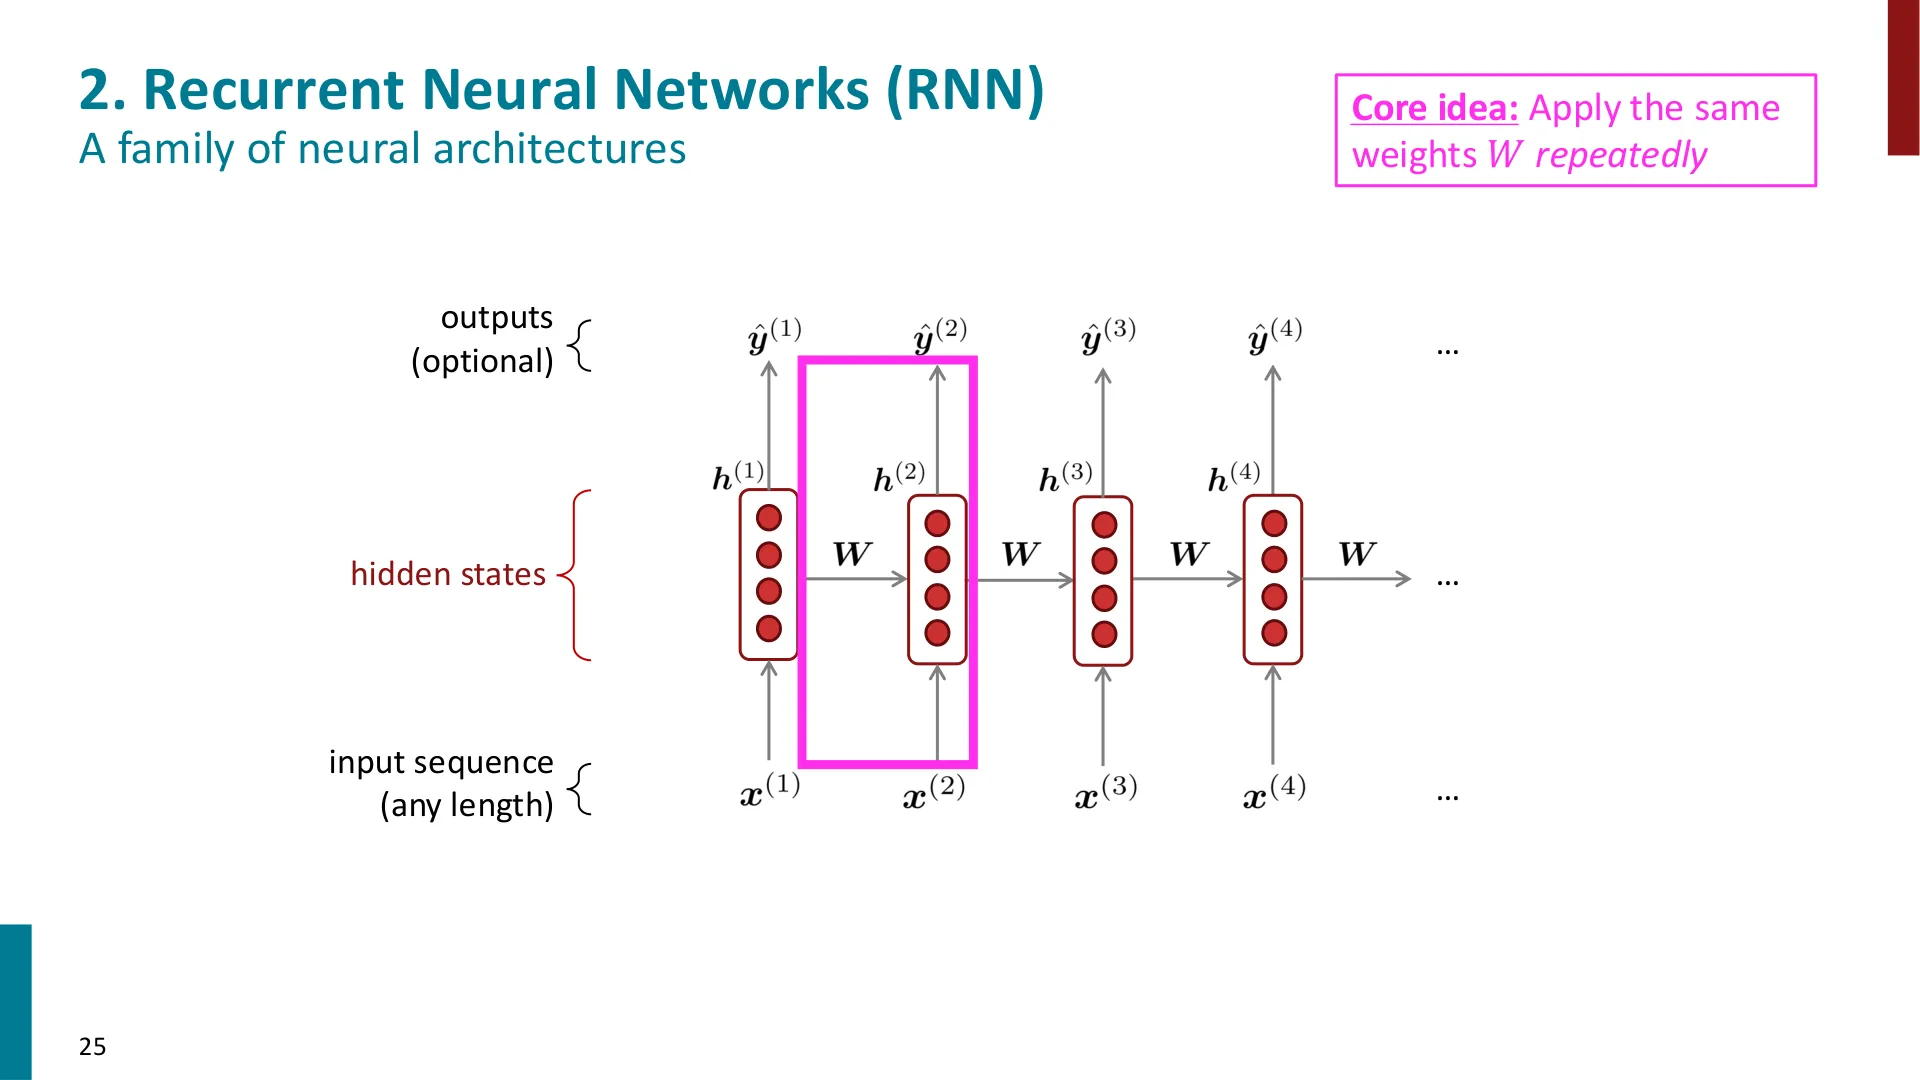
📷 循环神经网络:对每个时间步重复使用同一套权重
回到原视频 (00:50:56)
RNN 的核心想法:
有一套权重,在时间上、也就是文本的接连位置上,被反复使用。
它的前向过程如下(以 the students opened their 为例):
- 词先变成 one-hot 向量,再查表得到词嵌入;
- 但计算下一个词的概率时,做法变了:隐藏层是"循环"的——我们会随着文本从左到右推进,逐步更新一个隐藏状态 $h$;
- 从一个初始隐藏状态 $h^{(0)}$ 出发(可以就设成全 0);
- 每一步:把上一个隐藏状态乘一个权重矩阵 $W_h$,把当前词的嵌入乘另一个权重矩阵 $W_e$,两者相加,再加偏置、过非线性——常用的非线性是 $\tanh$:
$$h^{(t)} = \tanh\!\left(W_h\,h^{(t-1)} + W_e\,e^{(t)} + b_1\right)$$
- 连续做下去。走到第 4 步时,$h^{(4)}$ 就在某种意义上"读过了"到此刻为止的全部文本
the students opened their。如果students出现在其中任何位置,它都会被同样的 $W_e$ 乘一遍、加进隐藏状态——这就是"不管位置在哪,同一套参数处理"的意思。 - 最后,用最终隐藏状态去预测下一个词:
$$\hat{y}^{(t)} = \text{softmax}\!\left(W_o\,h^{(t)} + b_2\right)$$
一个 softmax 就给出"词表上所有下一个词的概率分布",从中采样即可生成下一个词。
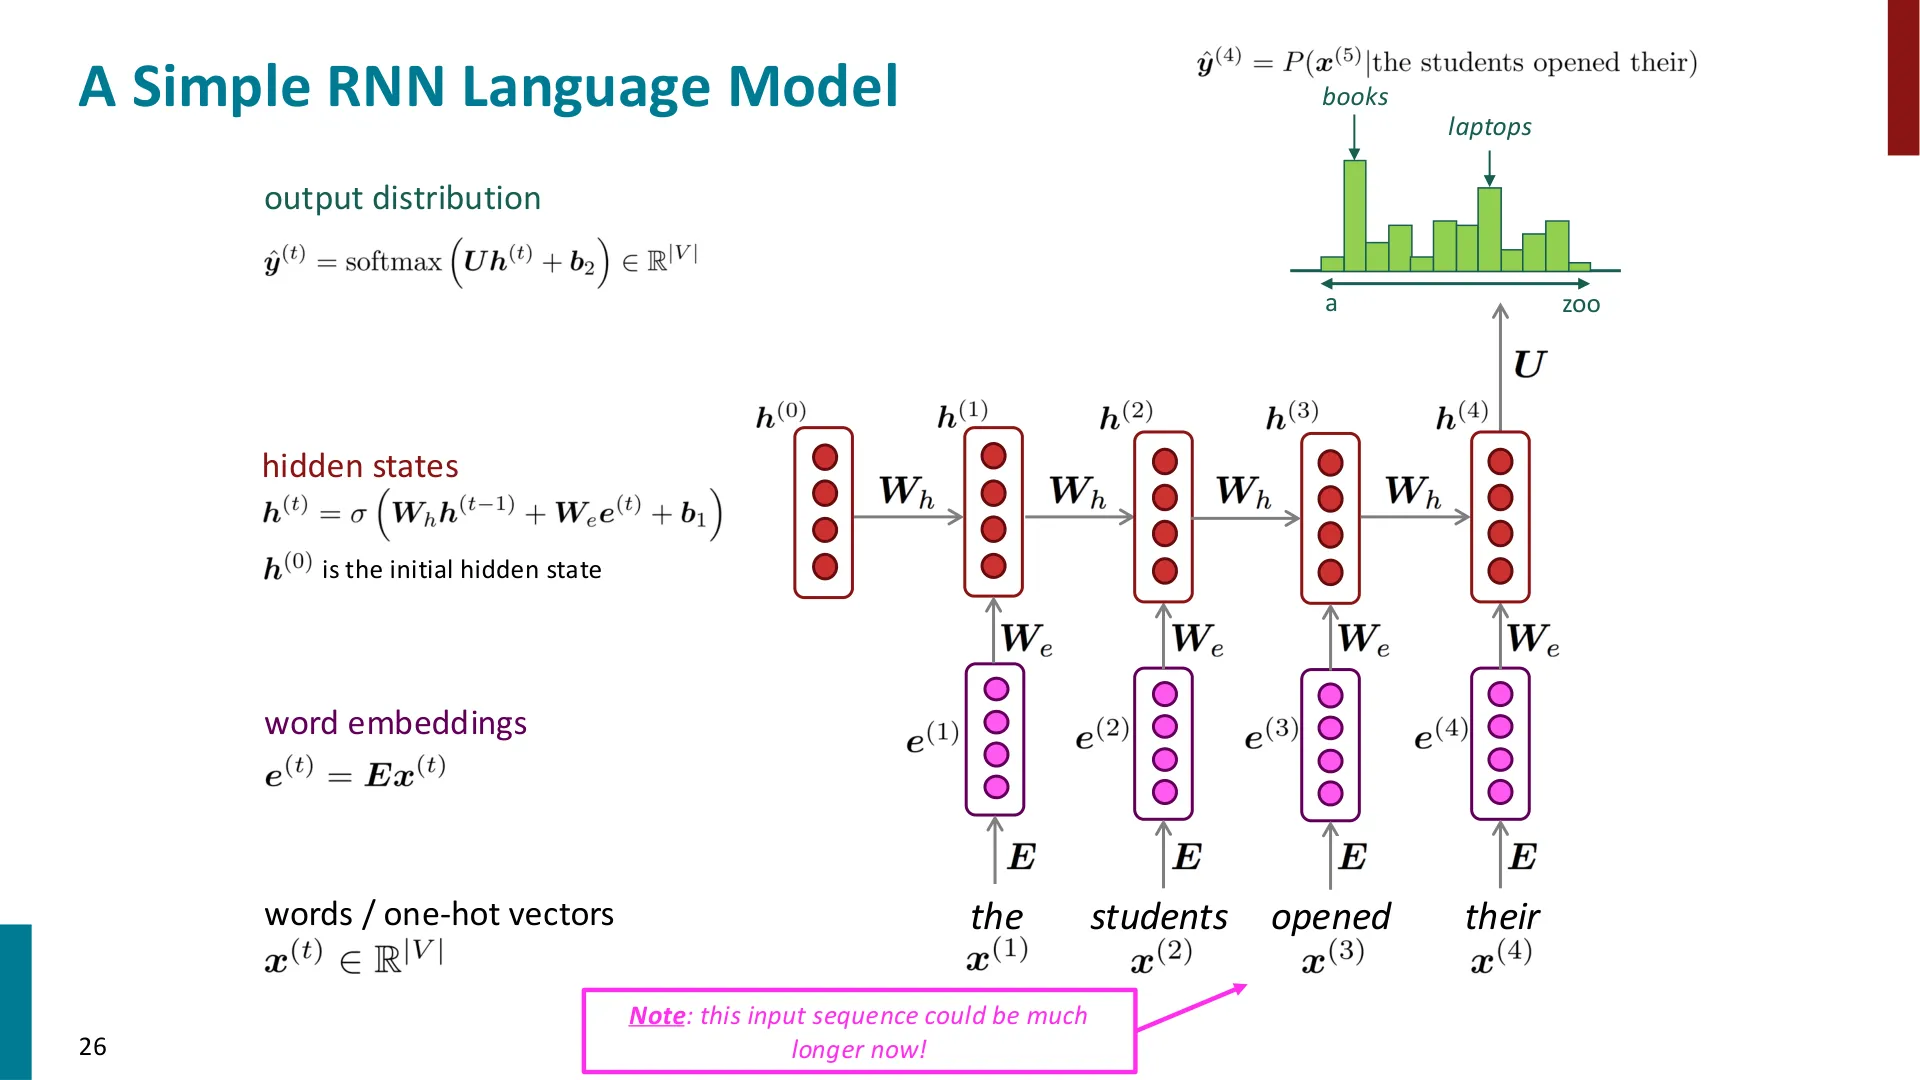
📷 简单 RNN 语言模型的前向结构
回到原视频 (00:52:32)
把时间展开看,它就是一个"链":
graph LR
  h0["h⁽⁰⁾ = 0"] --> h1["h⁽¹⁾"]
  h1 --> h2["h⁽²⁾"]
  h2 --> h3["h⁽³⁾"]
  h3 --> h4["h⁽⁴⁾"]
  e1["e⁽¹⁾ the"] --> h1
  e2["e⁽²⁾ students"] --> h2
  e3["e⁽³⁾ opened"] --> h3
  e4["e⁽⁴⁾ their"] --> h4
  h4 --> y["ŷ⁽⁴⁾ = softmax(Wₒh⁽⁴⁾+b₂)"]
编者说明:讲义里用的符号是 $W_h$(隐藏到隐藏)与 $W_e$(词嵌入到隐藏),以及输出层的 $W_o$。不同教材的记法可能不同,但含义一致。
RNN 的优缺点
(参考时间: 00:55:50)
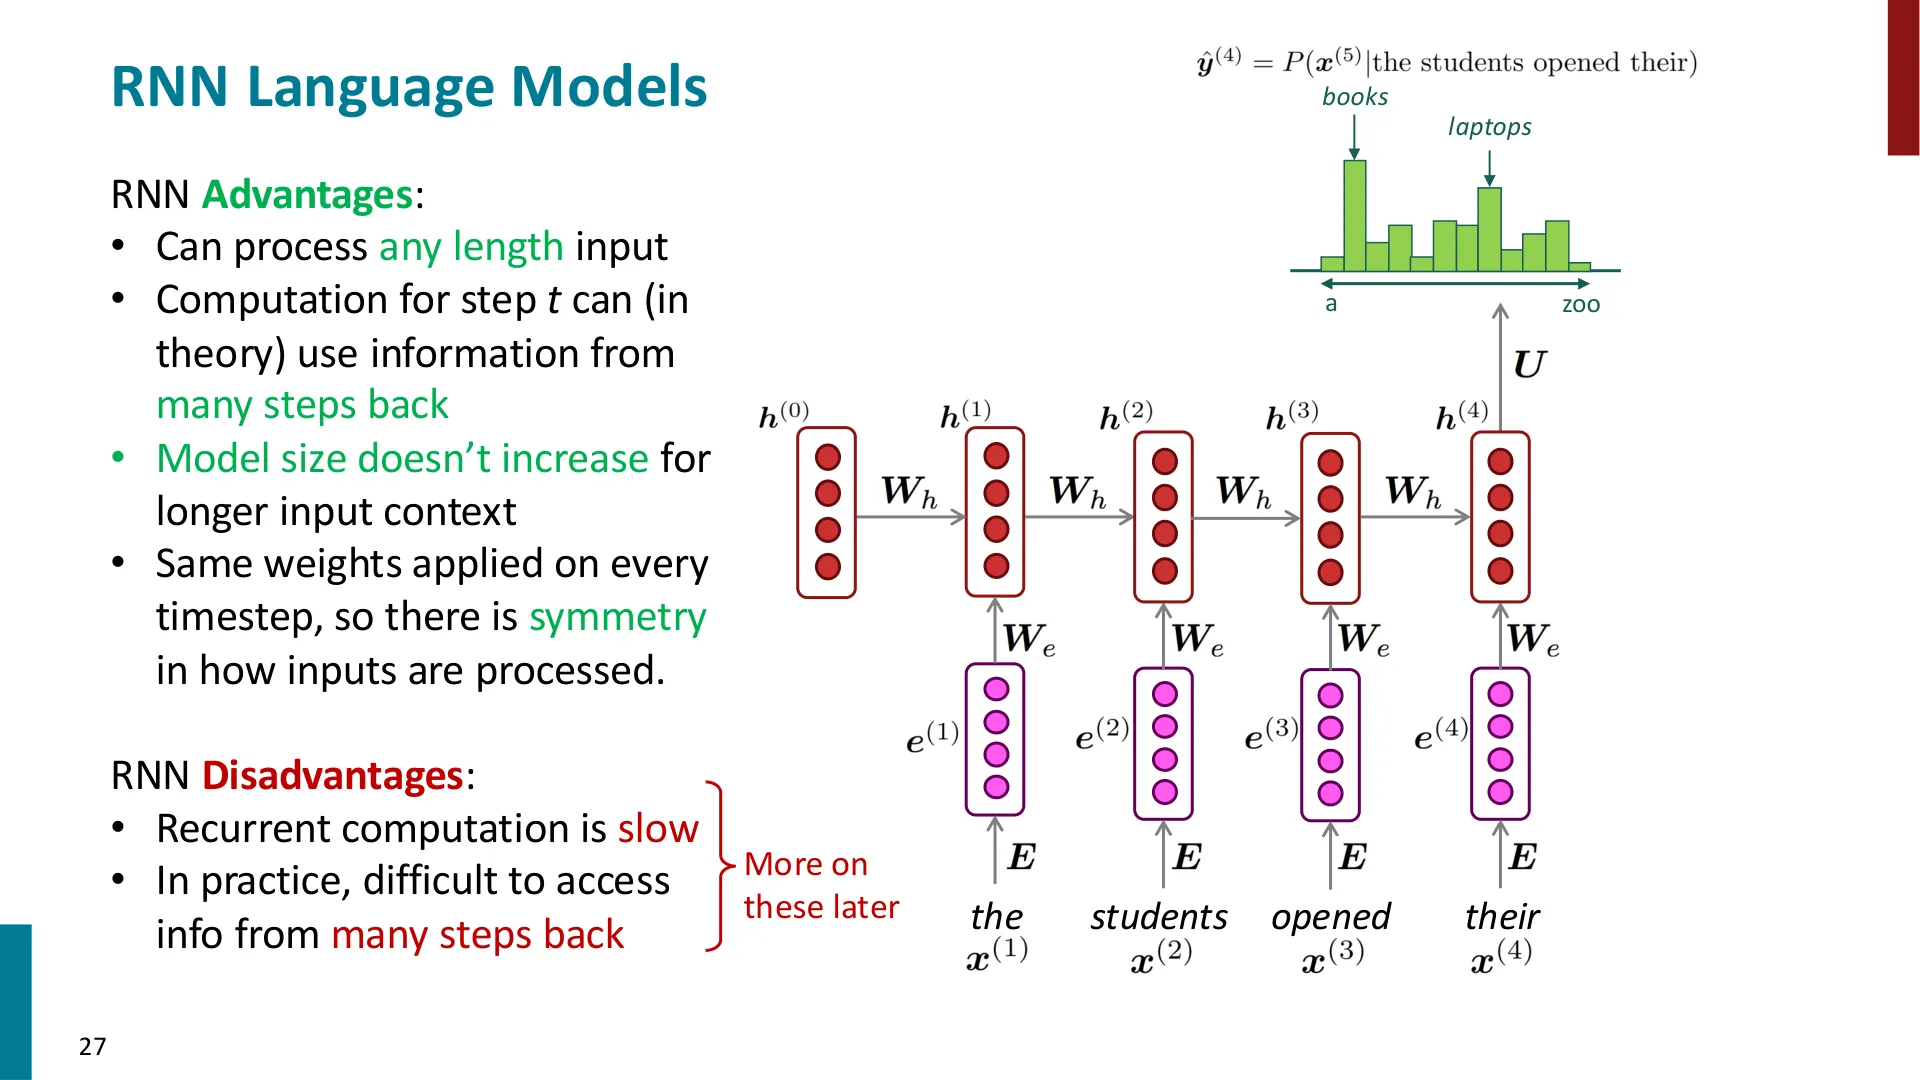
📷 RNN 的优势与劣势
回到原视频 (00:55:50)
优点:
- 能处理任意长度的输入;
- 第 $t$ 步的计算在理论上可以利用很多步之前的信息;
- 模型规模不随上下文变长而增大——上下文再长,也只是把那"固定维度的隐藏向量 $h$"继续更新,不会指数爆炸;
- 每个时间步用同一套权重,输入的处理方式是对称的。
缺点(老师特意加重):
- 循环计算很慢。前馈网络是"输入乘矩阵、再乘矩阵……一次做完";而 RNN 本质上是个沿着时间走的 for 循环(for t = 1 to T),必须一个隐藏向量接一个隐藏向量地算——这恰恰违背了本讲开头"千万别写 for 循环"的告诫,也正是 RNN 后来失宠的重要原因之一。
- 实践中很难真正访问到很多步之前的信息。理论上它应该完美地把所有历史都压进隐藏向量;但越早看到的东西,在隐藏状态里就"越淡",近期词会主导隐藏状态。老师打了个很生动的比方:
这有点像人——人也是越近的事记得越清楚,越远的事越容易忘,而这本身是合理的,因为最近的事确实最重要。但 RNN 尤其是我刚讲的这种最简单形式,忘得太快了。这一点我们下次课(周四)再展开。
四、训练 RNN 语言模型
损失函数
(参考时间: 00:58:35)
训练流程:
- 取一个大语料(一个词的序列);
- 把它喂进 RNN-LM,对每个时间步 $t$ 计算输出分布——也就是"在已知目前为止所有词的前提下,每个词的概率";
- 第 $t$ 步的损失,是"预测分布"与"真实下一个词"之间的交叉熵。真实下一个词是一个 one-hot 向量,所以交叉熵就等于真实词负对数似然:
$$J^{(t)} = -\log \hat{y}^{(t)}_{x^{(t+1)}}$$
- 对整个训练集取平均,得到总体损失:
$$J = \frac{1}{T}\sum_{t=1}^{T} J^{(t)}$$
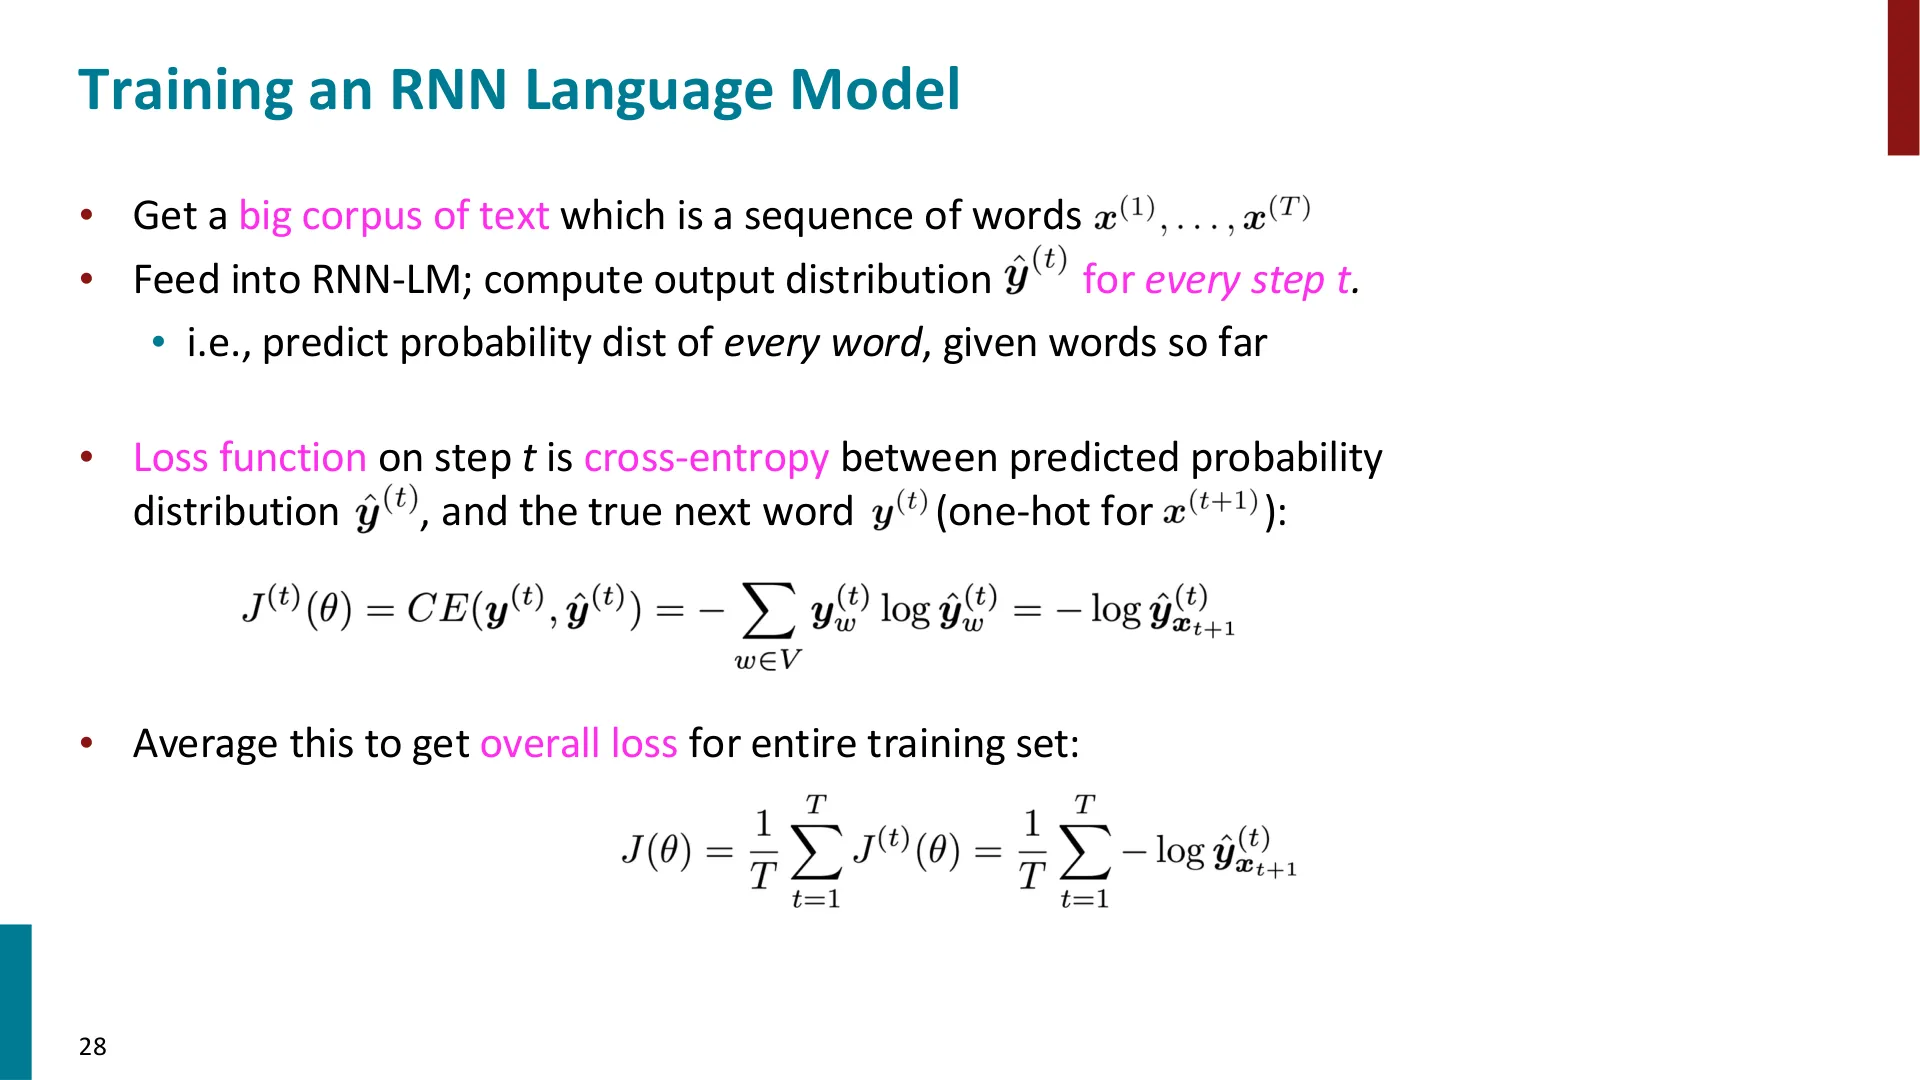
📷 训练 RNN 语言模型的损失定义
回到原视频 (00:58:35)
一个具体例子:假设语料是 the students opened their exams。
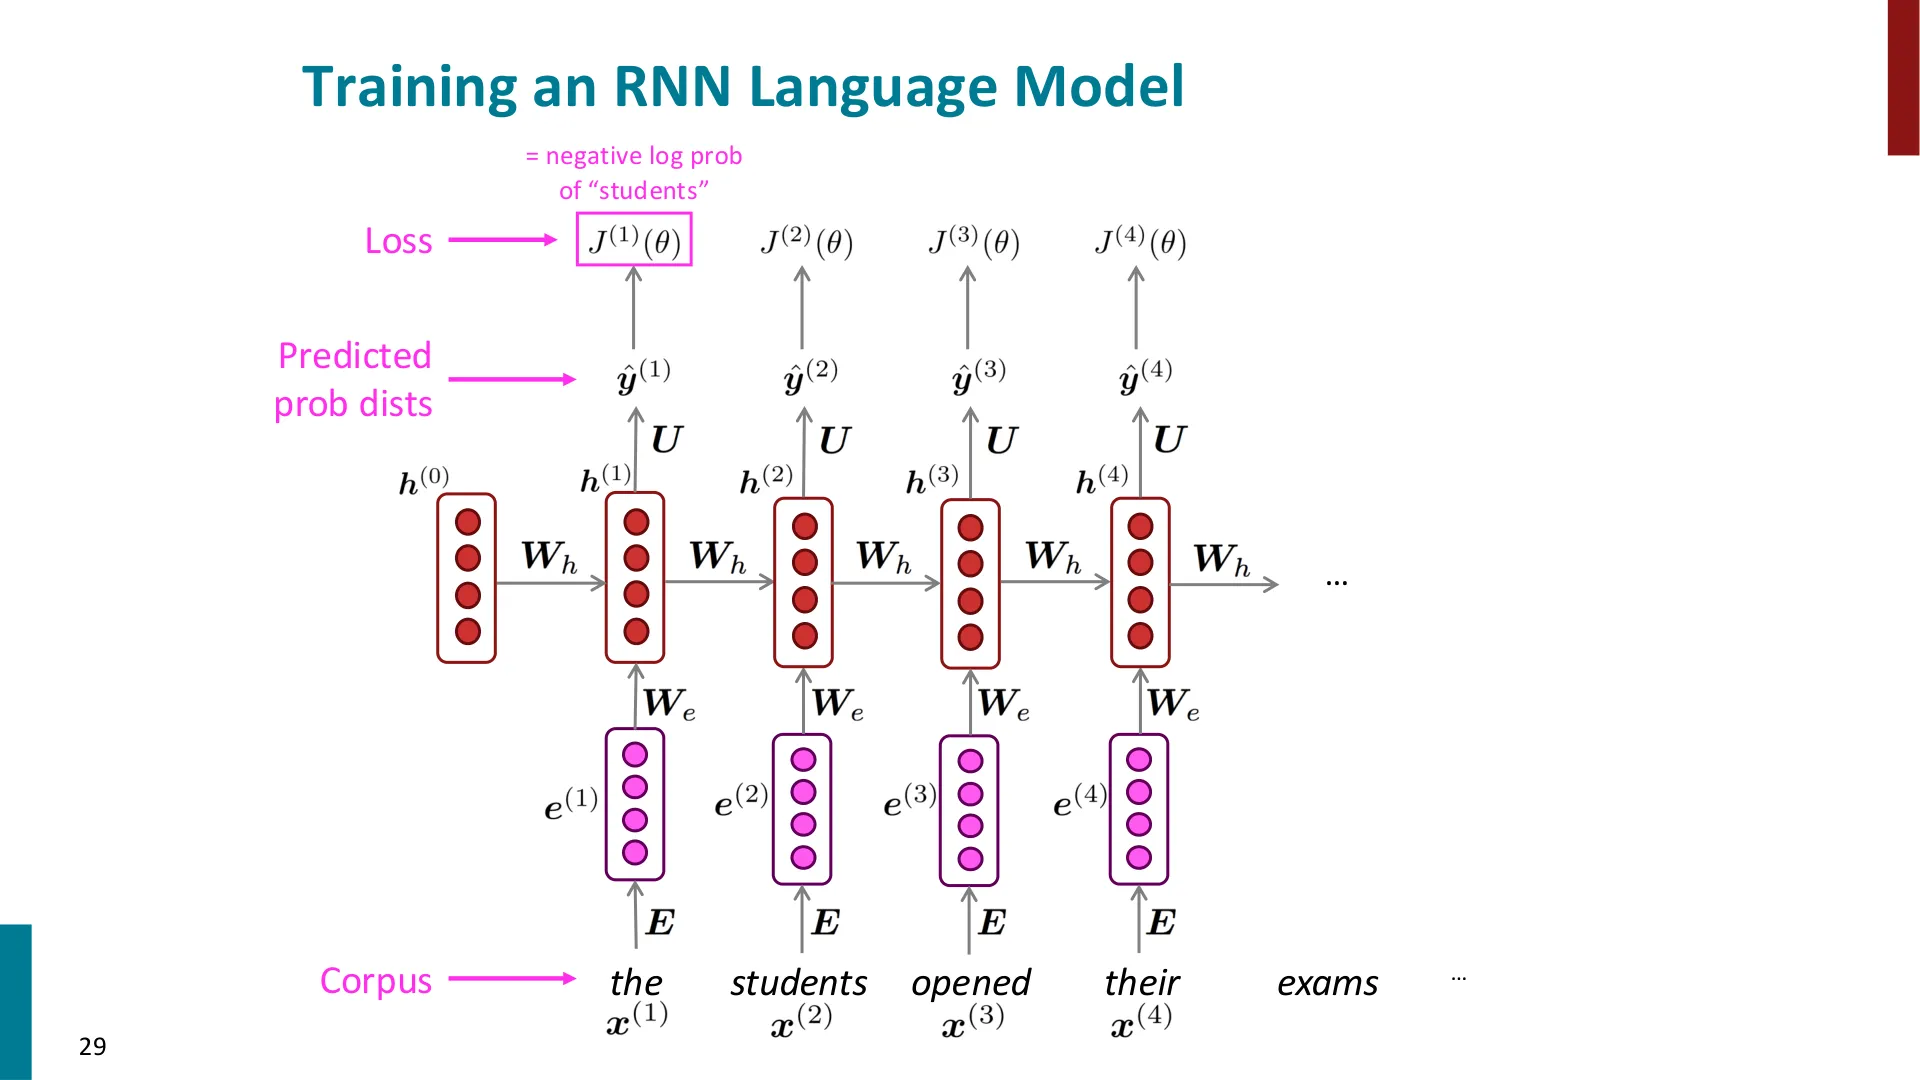
📷 对 "the" 之后预测 "students" 的损失
回到原视频 (00:59:55)
- 第一步,在只知道第一个词是
the的情况下,模型给出下一个词的概率分布;真实下一个词是students,假模型给了它 0.05 的概率 → 于是有一个损失 $=$ "给 students 的负对数概率"。 - 继续:生成下一个词的概率分布,真实词是
opened,看模型给了它多少概率 → 又一项损失。
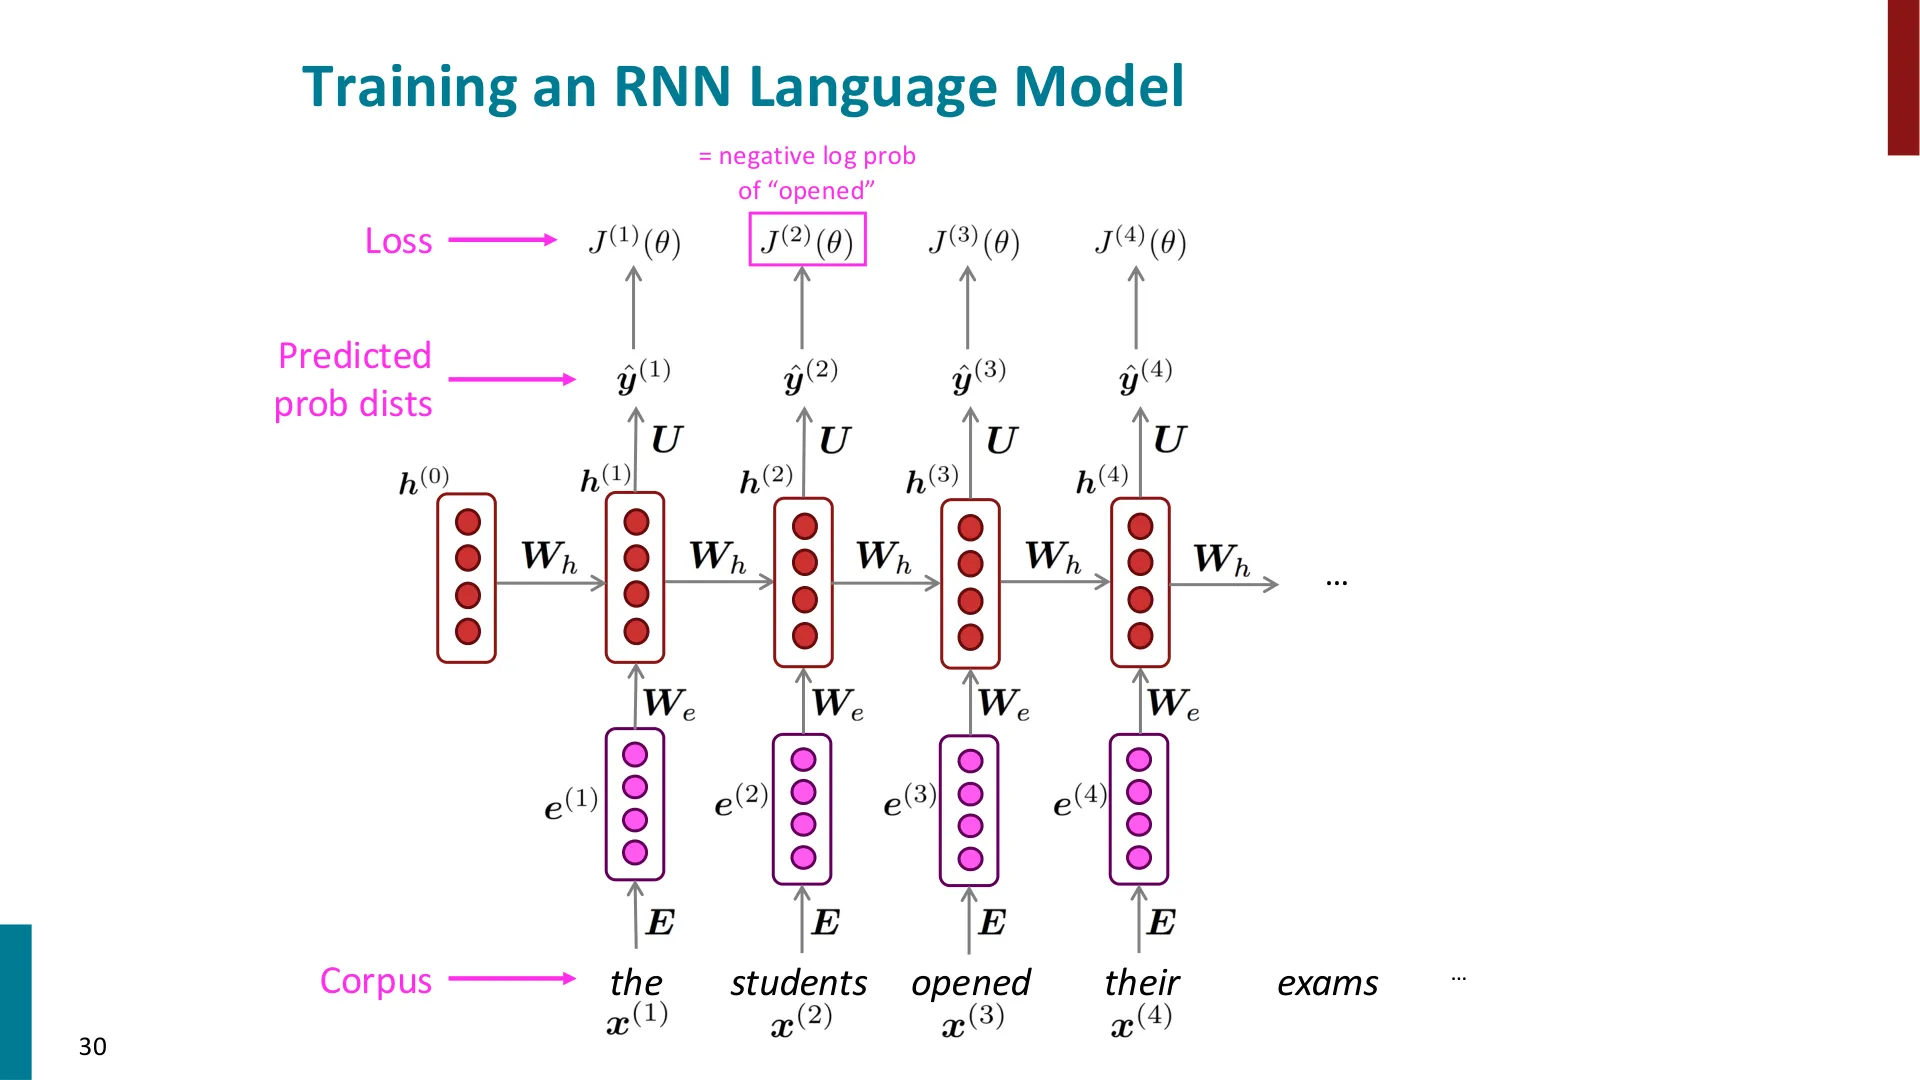
📷 继续对 "opened" 计算损失
回到原视频 (01:00:28)
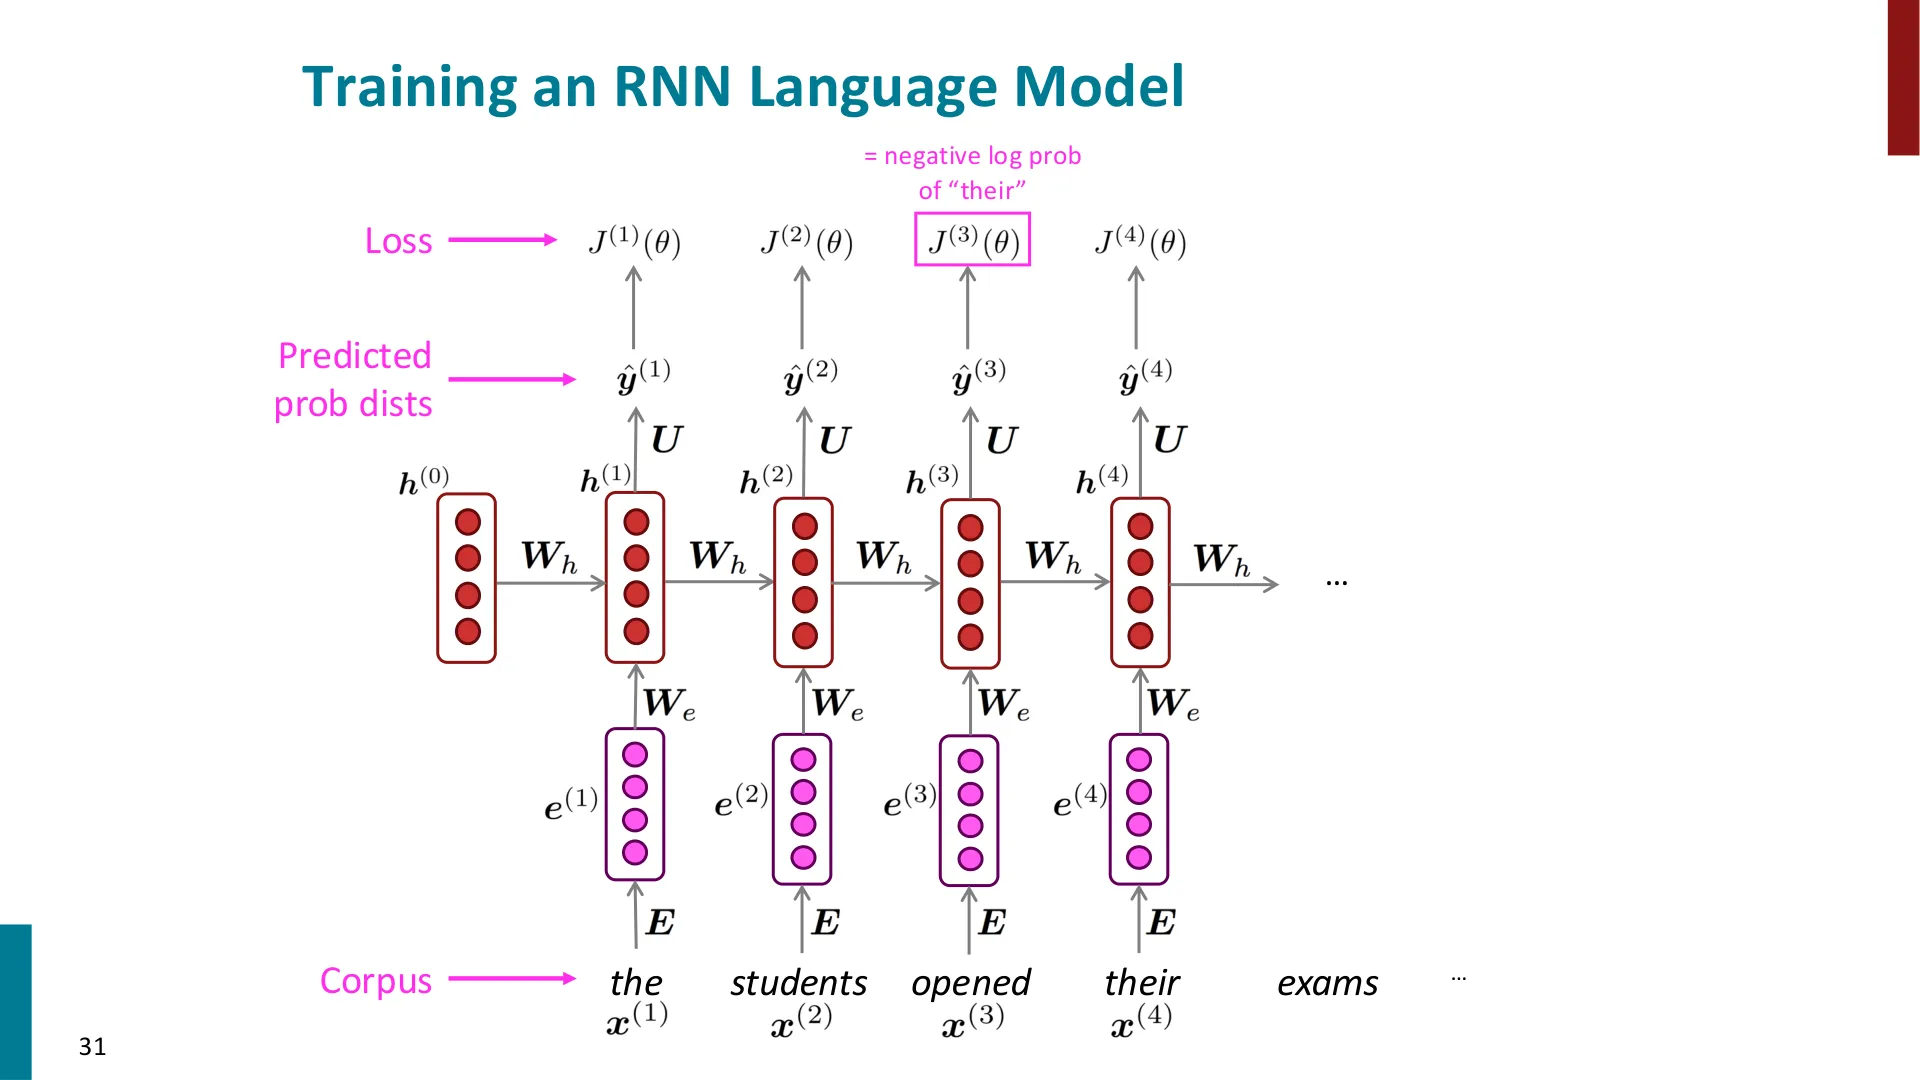
📷 继续对 "their" 计算损失
回到原视频 (01:00:40)
- 再一步步走完,最后对真实词
exams计算损失。
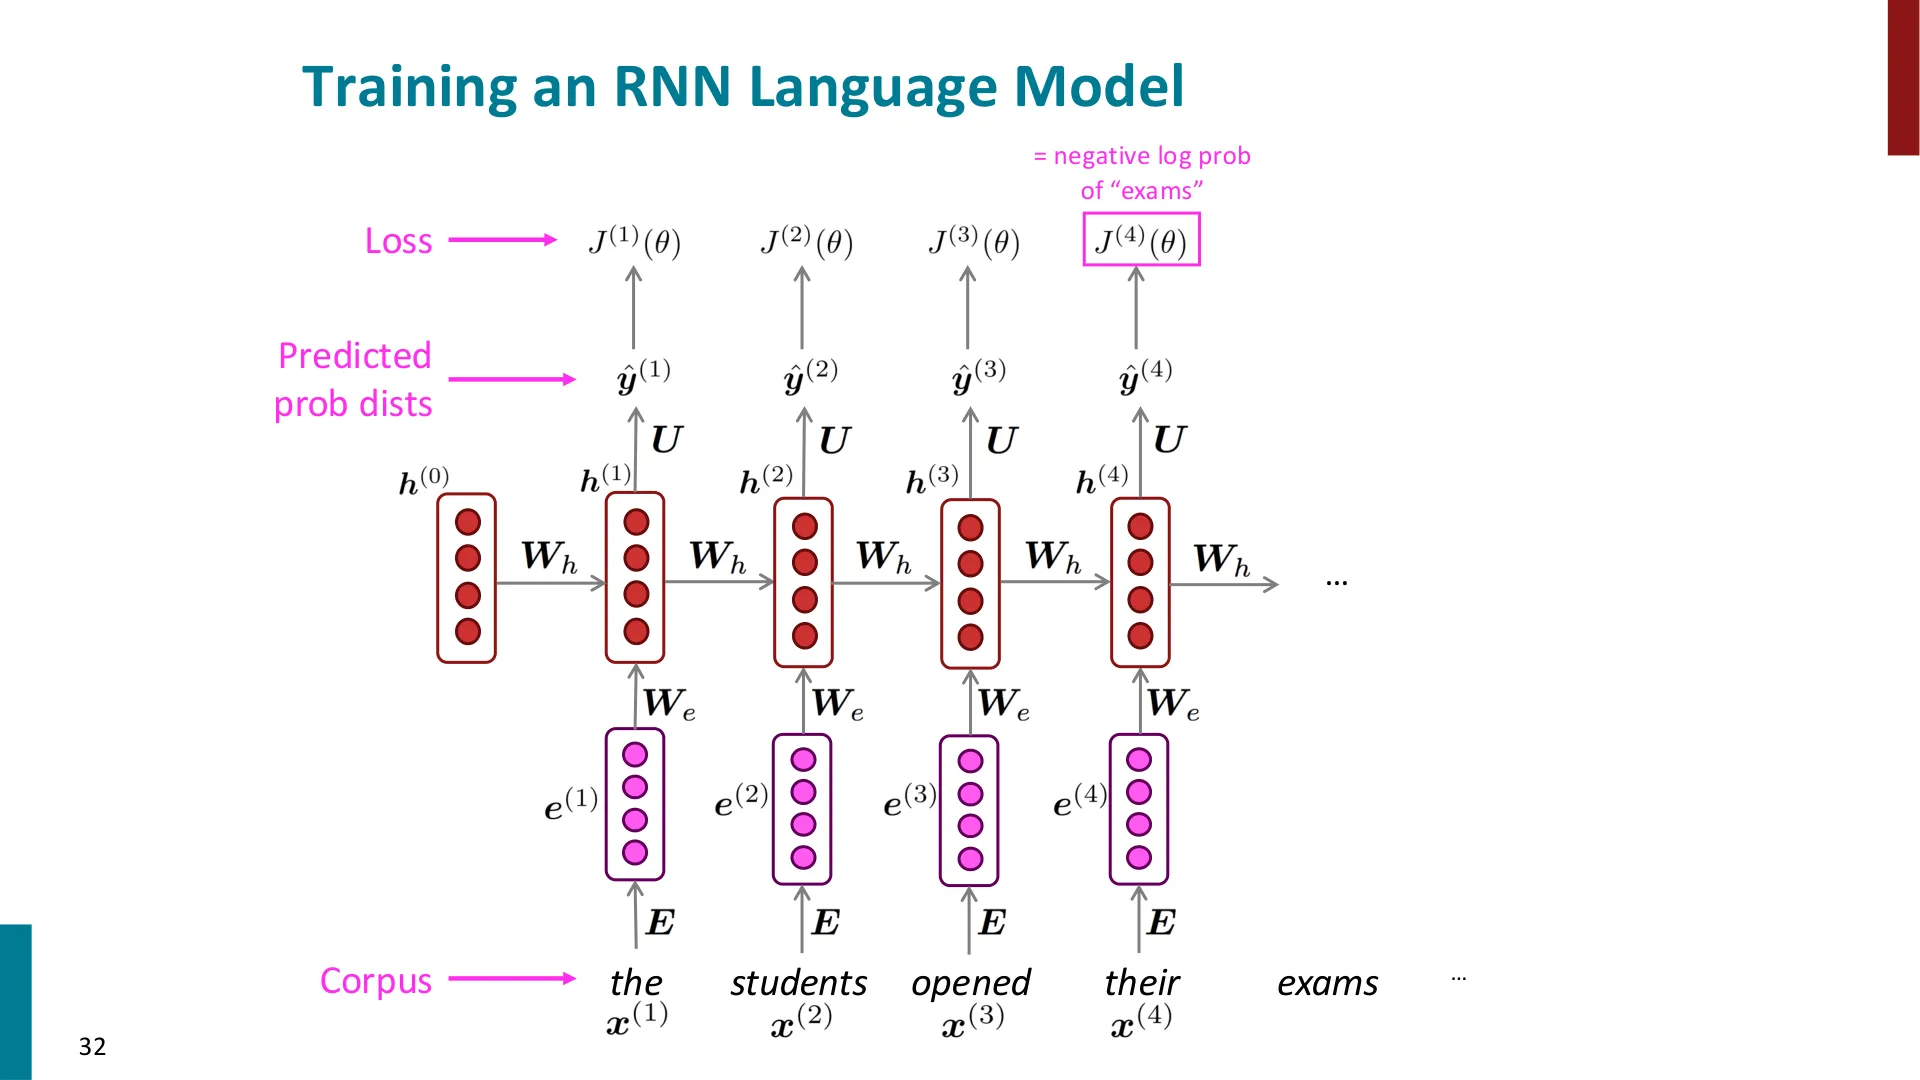
📷 对 "exams" 计算损失
回到原视频 (01:01:47)
- 把所有损失加起来、按词平均,就是"平均每词损失"。我们希望它尽可能小。
理想情况:模型给真实下一个词的概率是 1,那么 $-\log 1 = 0$,没有损失。实践中给 0.5 就只有一点损失,给更小就有更大损失。
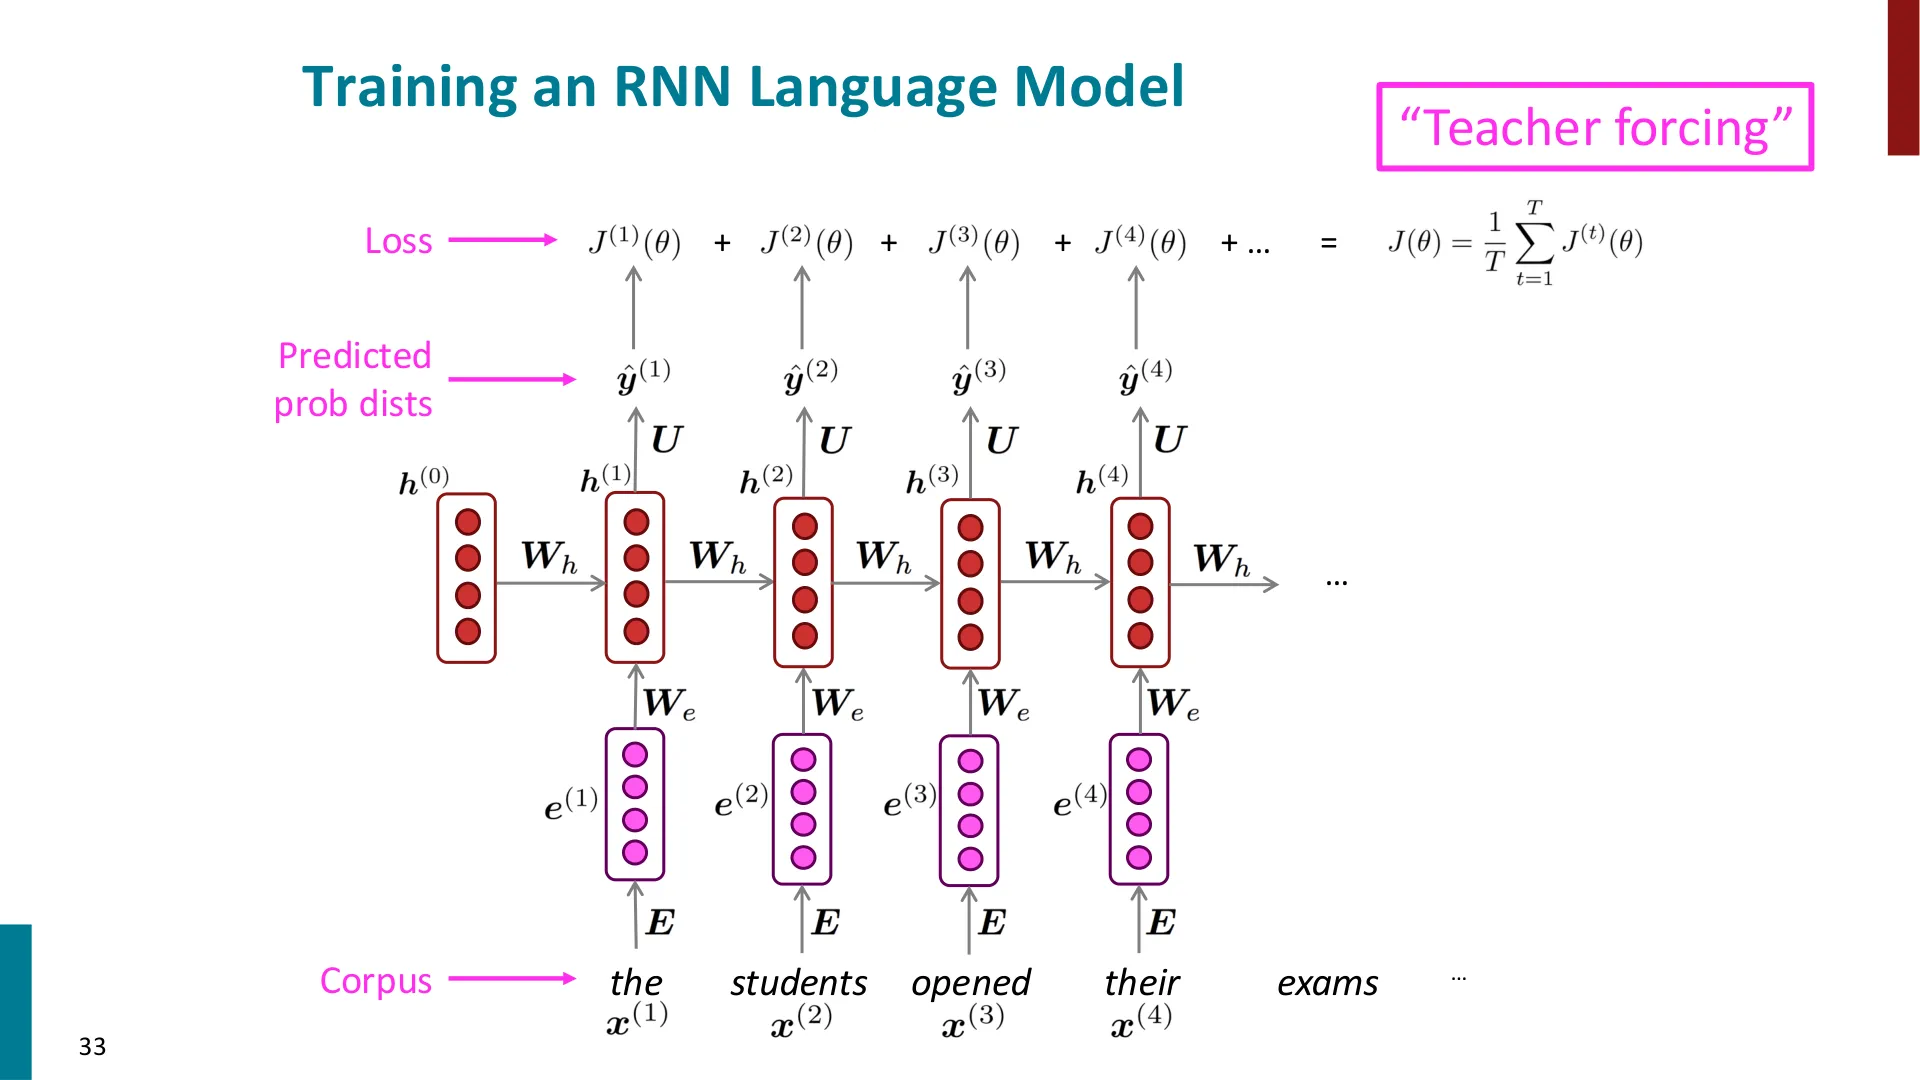
📷 把各步损失相加,得到总损失
回到原视频 (01:02:32)
Teacher Forcing
(参考时间: 01:00:57)
这里有个非常关键、也容易第一次学漏的细节:
生成这些损失时,我们不是让模型自由生成(free generation)。我们不是在说"你现在去生成一句话吧"。而是:每一步都喂给它真实的前缀。
具体地说,每走一步:
- 用当前网络、以真实前缀(如
the students opened)为条件,生成"下一个词"的概率分布; - 问它:"对于真实的下一个词(如
their),你给了多少概率?"——这就是那一步的损失; - 下一步,把语料里的真实词(而不是模型自己猜的词)喂回去,再生成、再算损失。
也就是说:走一步生成,然后立刻"掰回"真实文本,再问下一步,如此循环。
因为每一步都"掰回"到真实文本,我们就总是知道作者实际用的下一个词是什么——这让训练变得简单。这个过程叫做 teacher forcing(教师强制)。
老师也点出了它的不完美之处:
我们其实没有去探索"模型自己想生成什么、生成之后又会接什么",我们只是在不断问它:"对某段人类写好的文本,你的下一个词预测是什么样的?"
编者说明:teacher forcing 是序列生成任务里最常见的训练方式,但它在"训练"和"推理"之间引入了不一致——训练时喂真实前缀,推理时只能喂模型自己生成的词。这种不一致通常被称为 exposure bias,后来的"计划采样(scheduled sampling)"等工作正是针对它。本讲未展开,此处仅作提示。
切分语料与随机梯度下降
(参考时间: 01:03:14)
知道了怎么算损失,下一步是用它更新参数。原则上,你可以把所有文本看成一个"10 亿词的长序列",直接让 RNN 从头跑到尾——但那行不通:你要为 10 亿步累积损失、还要存下隐藏状态以便反向传播,内存吃不消。
所以实际做法是把训练数据切成合理长度的片段,在每个片段上跑 RNN、算损失、更新参数。
讲义把片段描述为"句子或文档"——这在语言学上很好听。但老师透露了一个很实际的工程事实:
最近实践中,为了在 GPU 上最有效率地扩展,人们已经不在乎这种语言学上的讲究了:直接规定"一个片段 = 100 个词",每 100 词切一刀。这样做特别方便——你可以把一批长度都是 100 的片段放进一个矩阵里,做向量化训练。于是事情就顺利了。
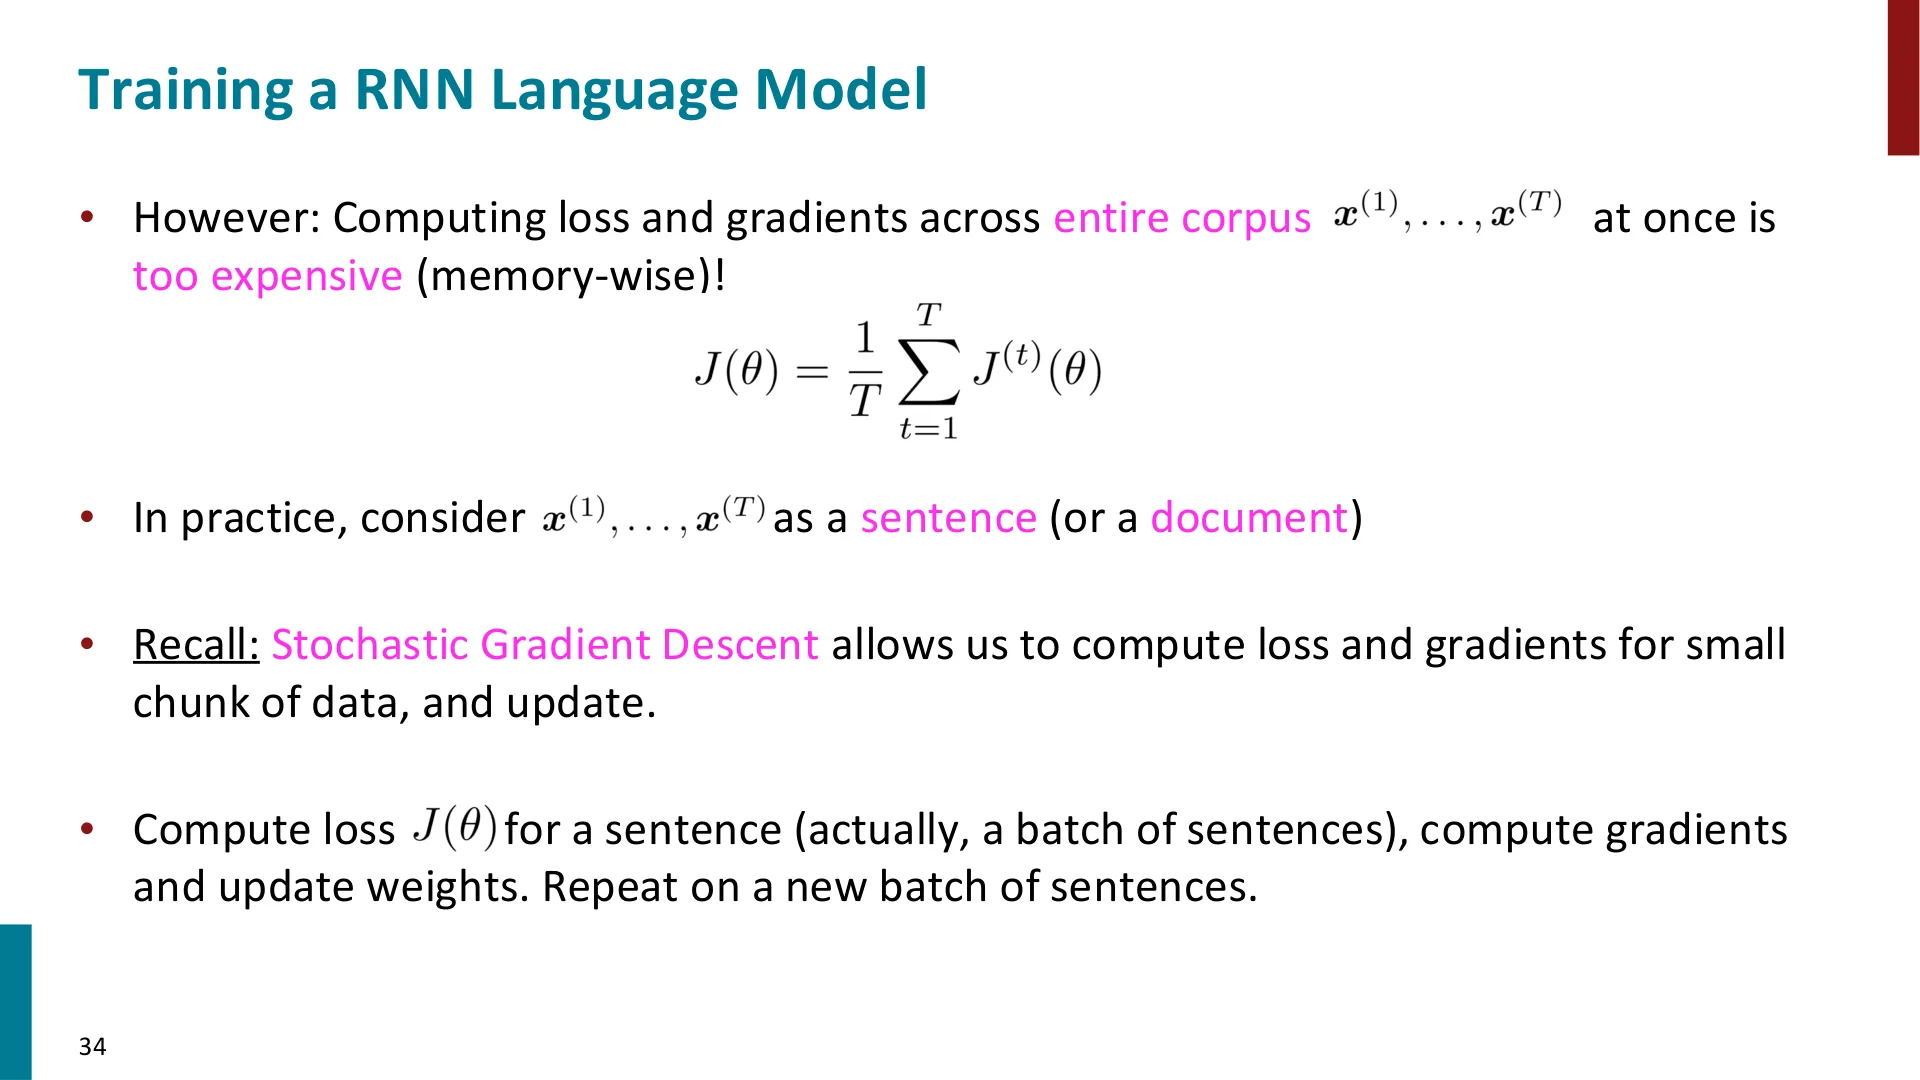
📷 用 SGD 在句子/片段上计算损失并更新参数
回到原视频 (01:03:14)
五、RNN 的反向传播
对"重复权重"求导
(参考时间: 01:05:35)
接下来要算损失对 RNN 参数的导数。有意思的是——$W_h$(以及 $W_e$)在网络的每个阶段都被用到,它们出现在很多地方。那么,怎么求损失对"重复出现的权重矩阵"的偏导?
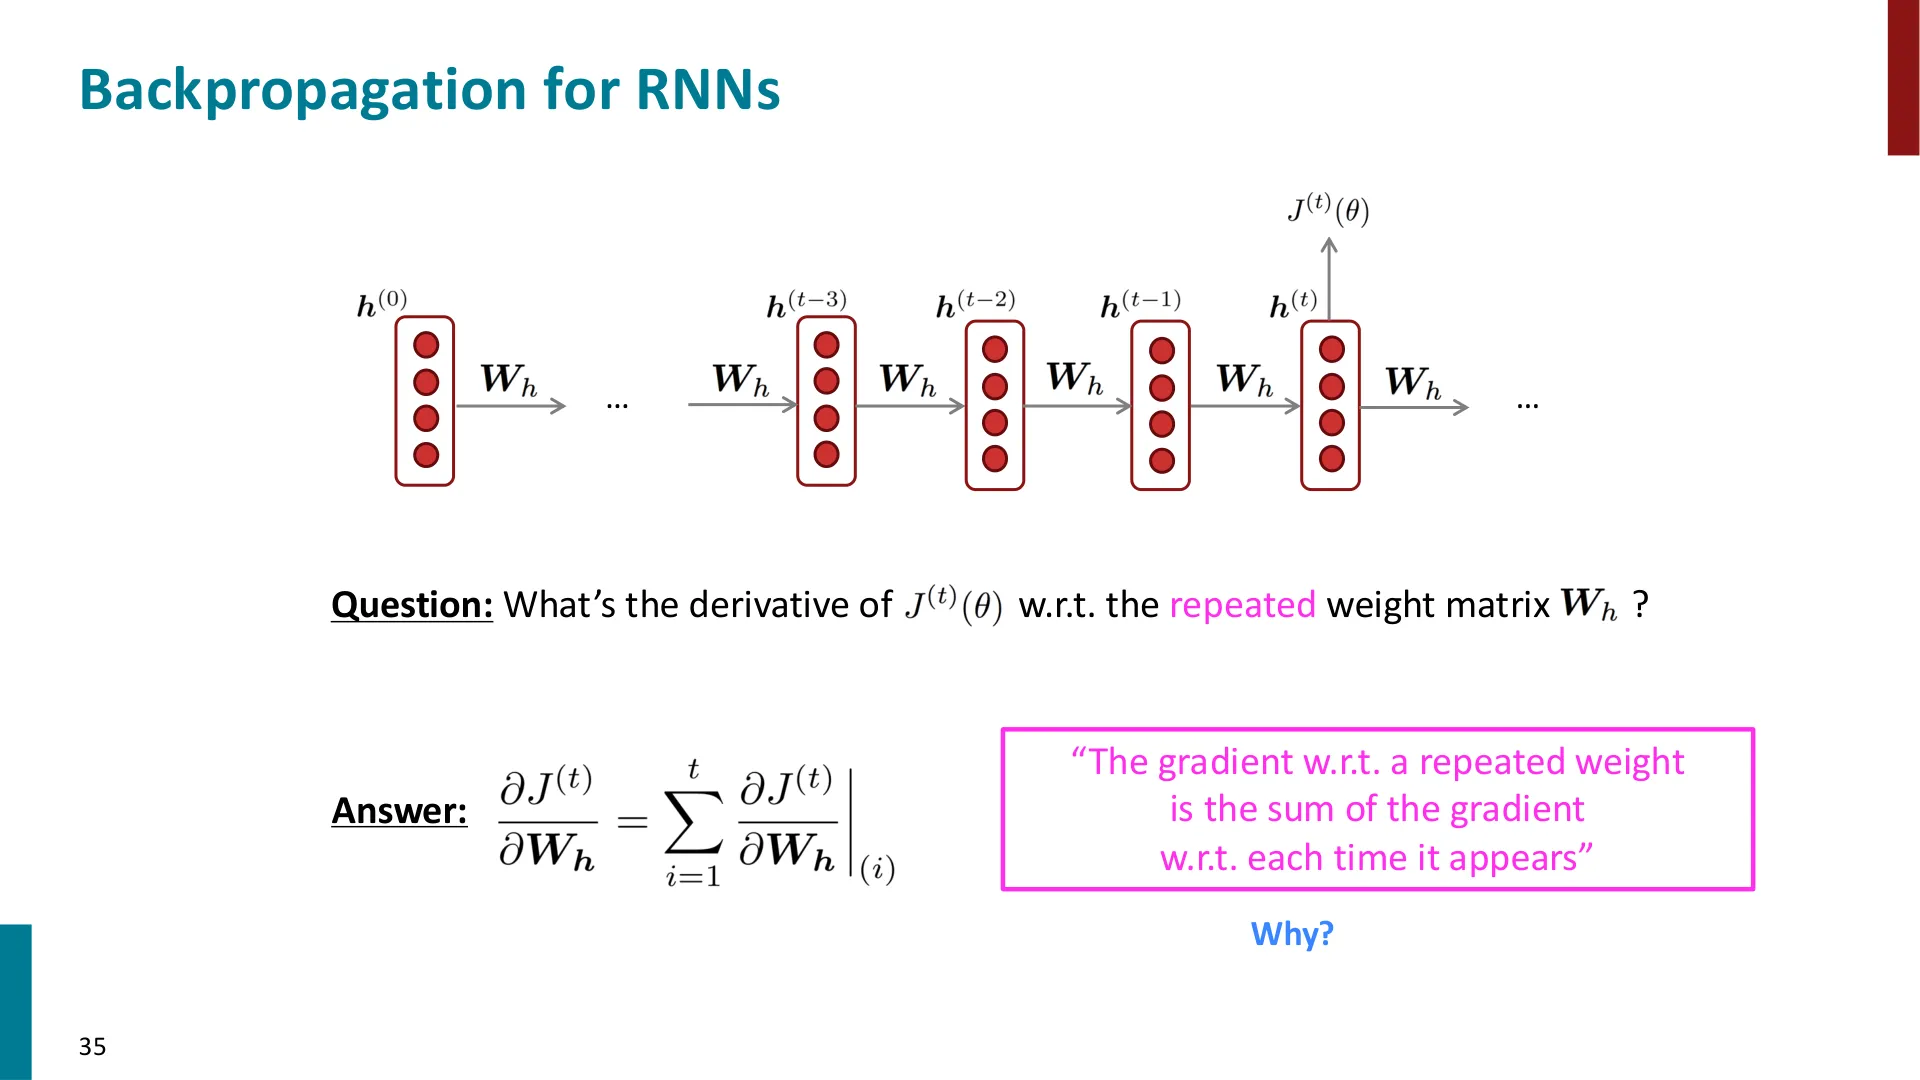
📷 对重复权重求导:梯度对重复权重的导数 = 各处梯度之和
回到原视频 (01:05:35)
老师的答案简单得有点出乎意料:
你可以假装每个位置的 $W_h$ 是不同的(记作 $W_h^{(1)}, W_h^{(2)}, \dots$),先在某一个位置求出对它的偏导;要得到对真正的 $W_h$ 的偏导,就把各个位置求出的结果加起来。
也就是那句关键结论:
对一个"重复出现"的权重的梯度,等于它在每次出现处的梯度之和。
为什么?可以借用第三讲讲过的"梯度在向外分支处相加"的图景来理解:
(参考时间: 01:07:16)
想象有一个 $W_h$,它通过"恒等复制"分给了 $W_h^{(1)}, W_h^{(2)}, W_h^{(3)}, W_h^{(4)}, \dots$,每个时间步一份。因为这些是恒等复制,它们彼此之间的偏导就是 1。于是这里形成了一个向外分支的节点,按照多元链式法则,把各分支的梯度相加,就得到对 $W_h$ 的总梯度。
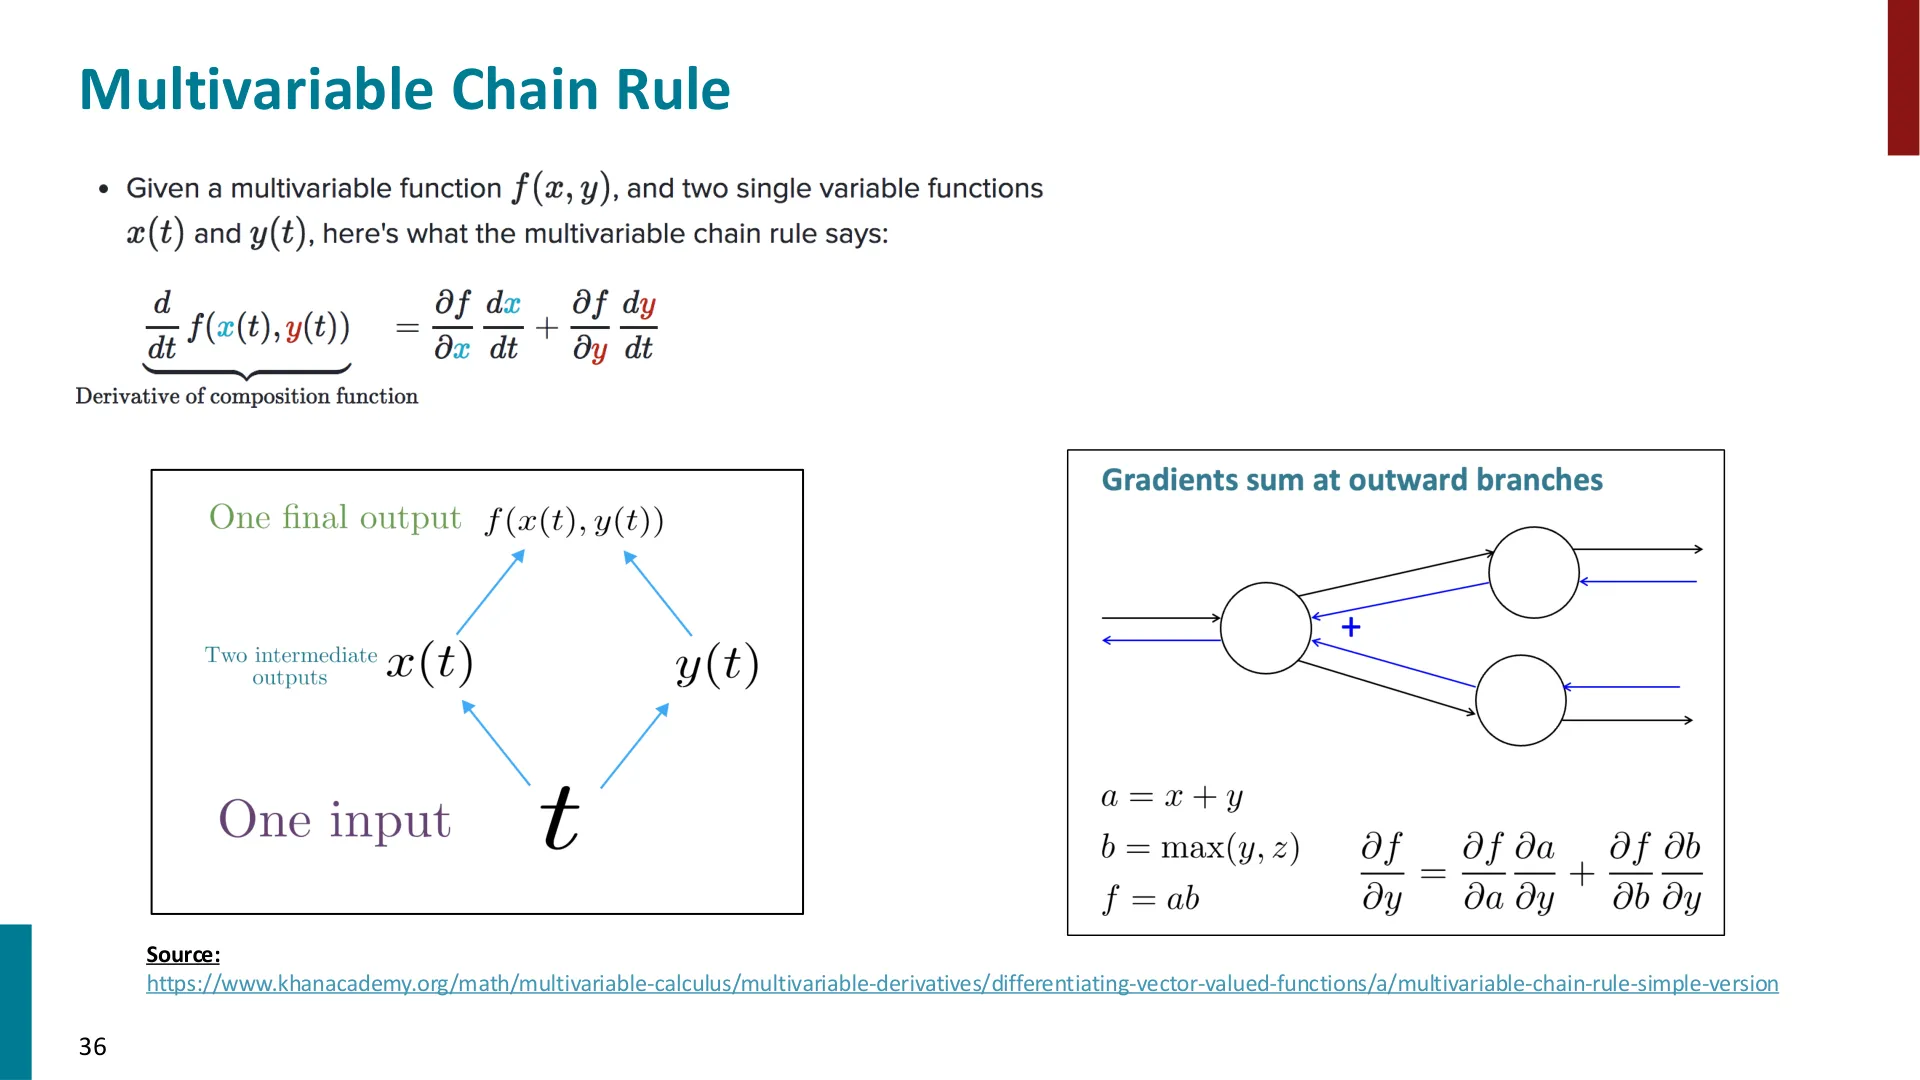
📷 多元链式法则(讲义引用了 Khan Academy 的图示)
回到原视频 (01:06:46)
编者拓展|为什么是"求和"而不是"求积"
这常让人困惑:链式法则不是"相乘"吗?要分清两件事。
- 沿一条路径把梯度传回去,是相乘(连乘会产生梯度消失/爆炸——这正是下次课的主题)。
- 而同一个 $W_h$ 在不同时间步用到,是多条并列路径共享同一个变量。对"共享变量"的上游有多个出口时,按多元链式法则,各出口的贡献相加:
$$\frac{\partial J}{\partial W_h} = \sum_{t=1}^{T} \frac{\partial J}{\partial W_h}\bigg|_{\text{第 } t \text{ 次出现}}$$
这就是"对重复权重的梯度 = 各处梯度之和"。
时间反向传播(BPTT)与截断
(参考时间: 01:07:16)
那具体怎么把这些梯度算出来?答案是:沿着时间步反向传播,从 $i = t$ 一路回到 $0$,边走边把梯度累加。这个算法叫时间反向传播(Backpropagation Through Time, BPTT)(Werbos, 1988)。
graph RL
  L["总损失 J"] --> g4["∂·/∂h⁽⁴⁾"]
  g4 --> g3["∂·/∂h⁽³⁾"]
  g3 --> g2["∂·/∂h⁽²⁾"]
  g2 --> g1["∂·/∂h⁽¹⁾"]
  g1 --> g0["∂·/∂h⁽⁰⁾"]
实践中还有一个加速技巧:
如果片段长 100,我们未必真要反向传播 100 步——可以只传播大约 20 步就停下。这叫截断的时间反向传播(truncated BPTT)。
老师强调了一个容易被误解的细节:
注意:前向传播仍然使用完整的上下文(隐藏状态还是照常一路更新);只是在反向时把它截短,以加快训练。
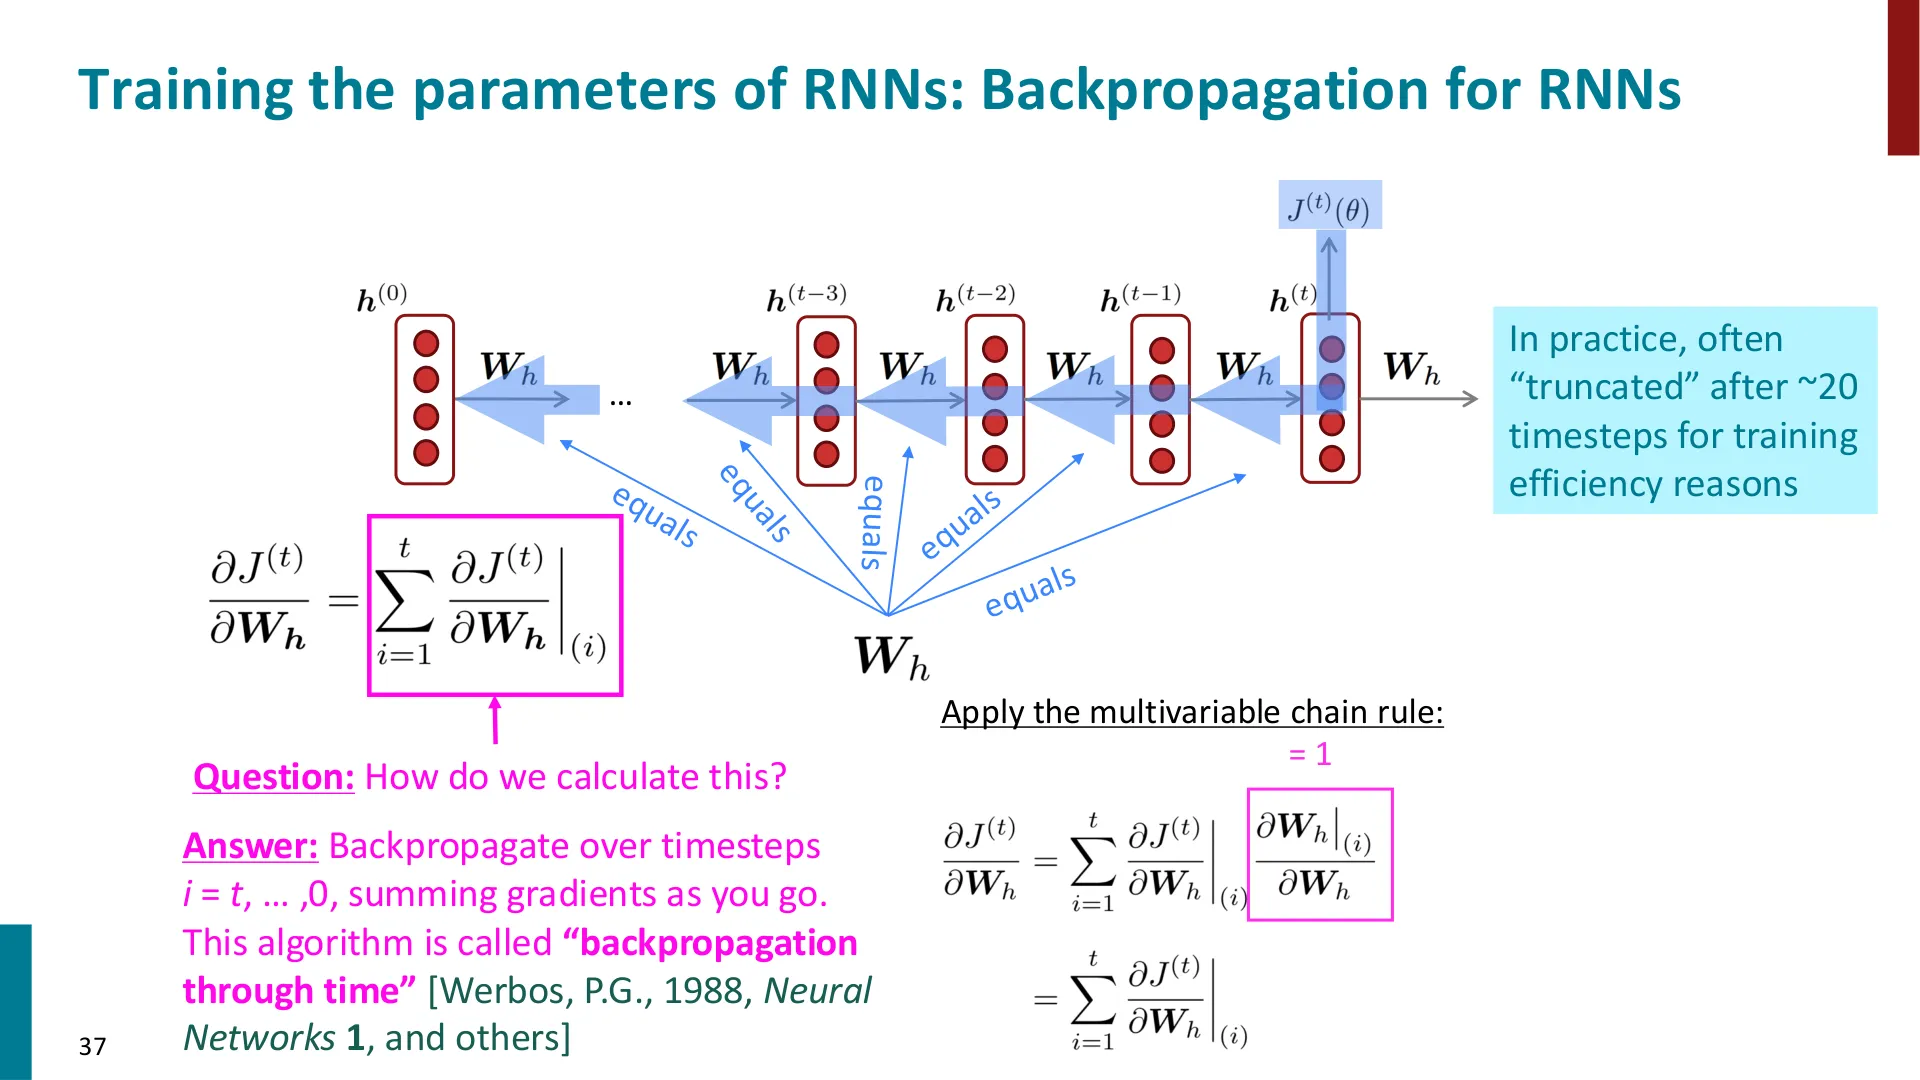
📷 时间反向传播与截断(讲义注明实践中常在约 20 步处截断)
回到原视频 (01:07:16)
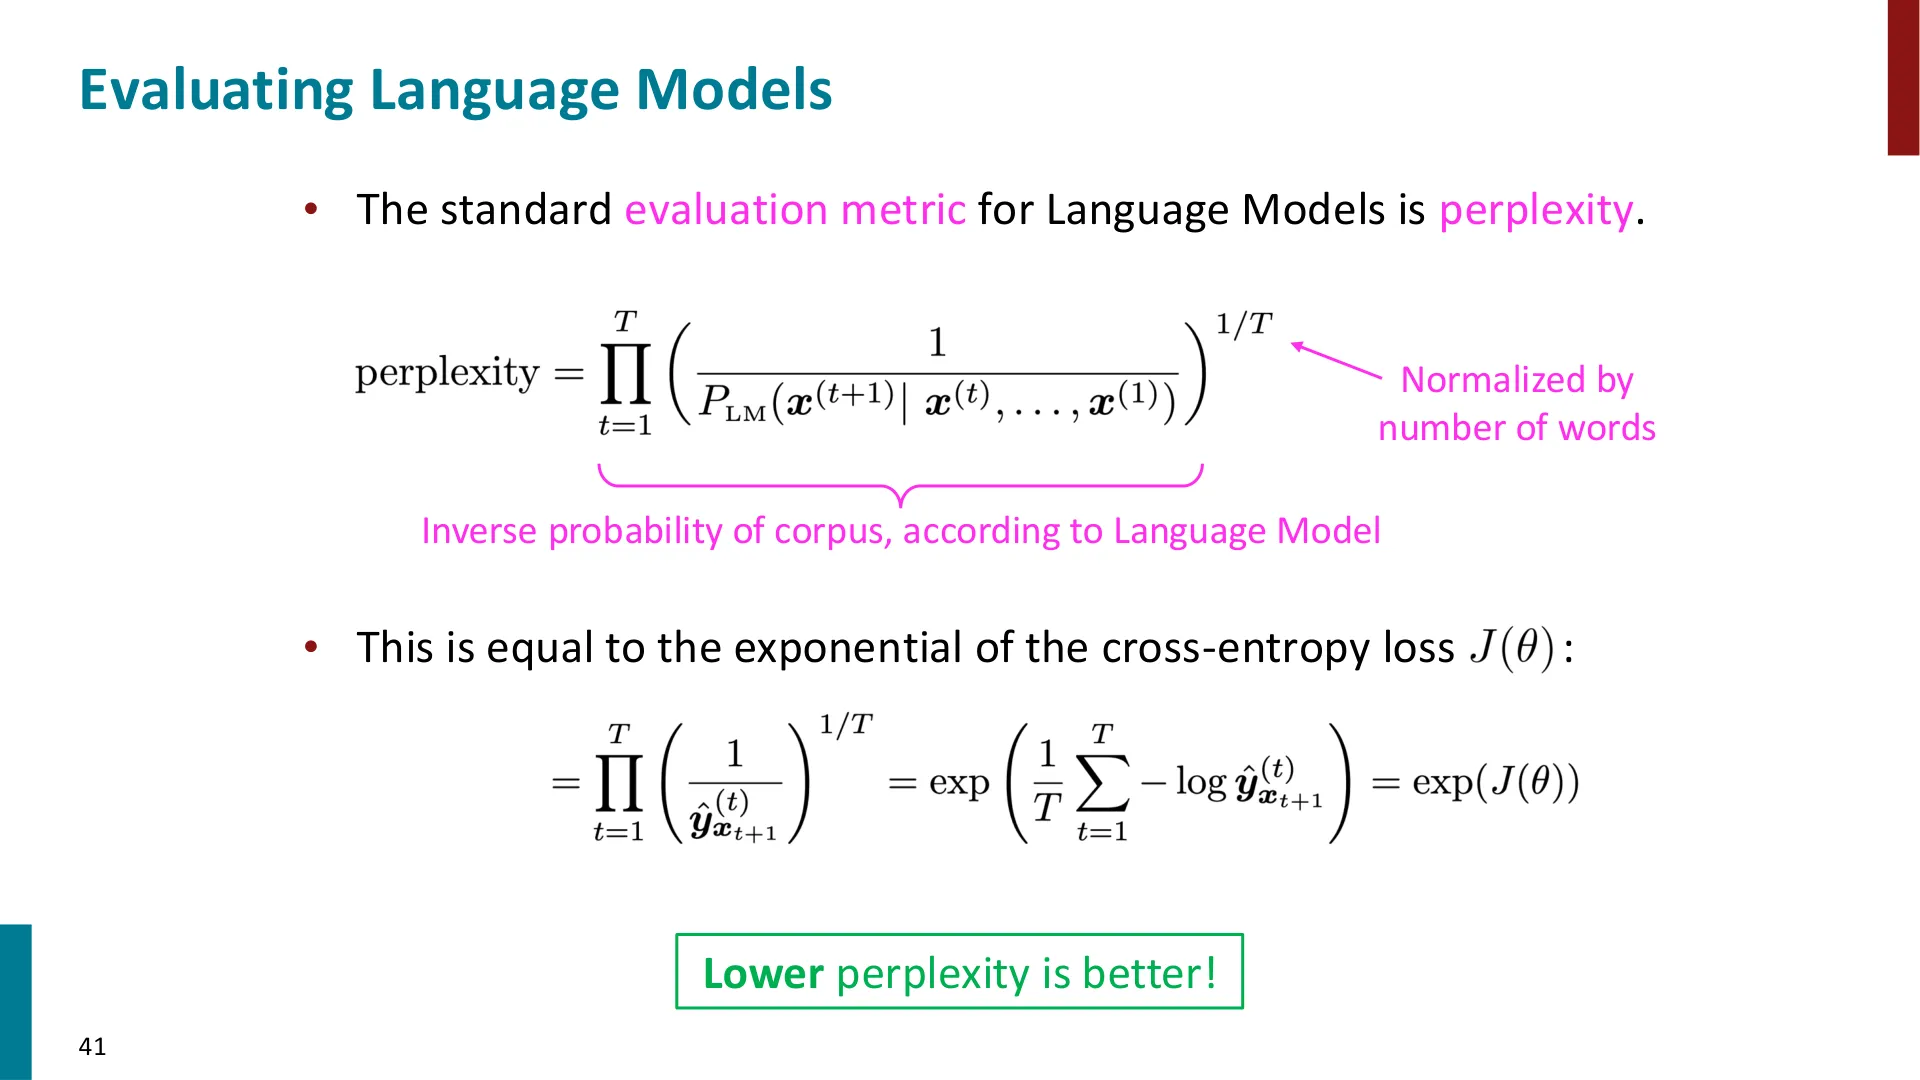
(附录中另有)评估语言模型:困惑度
讲义里"如何评估语言模型"那一页用的是困惑度(perplexity)。本讲因时间关系没有展开(该页已列入文末附录)。这里用编者拓展补上,方便你自学时对上号。
编者拓展|困惑度(Perplexity)
语言模型的标准评估指标是困惑度,它等于交叉熵损失的指数:
$$\text{perplexity} = \exp(J) = \exp\!\left(-\frac{1}{T}\sum_{t=1}^{T}\log \hat{y}^{(t)}_{x^{(t+1)}}\right)$$
直观上,它是"语言模型对这段语料的逆概率,再按词数归一化"——可以粗理解为"模型在每一步平均在多少个词之间犹豫"。困惑度越低越好。 如果模型每一步都完全确定地给出正确答案,困惑度就是 1。
六、用 RNN 语言模型生成文本
生成 rollout
(参考时间: 01:08:50)
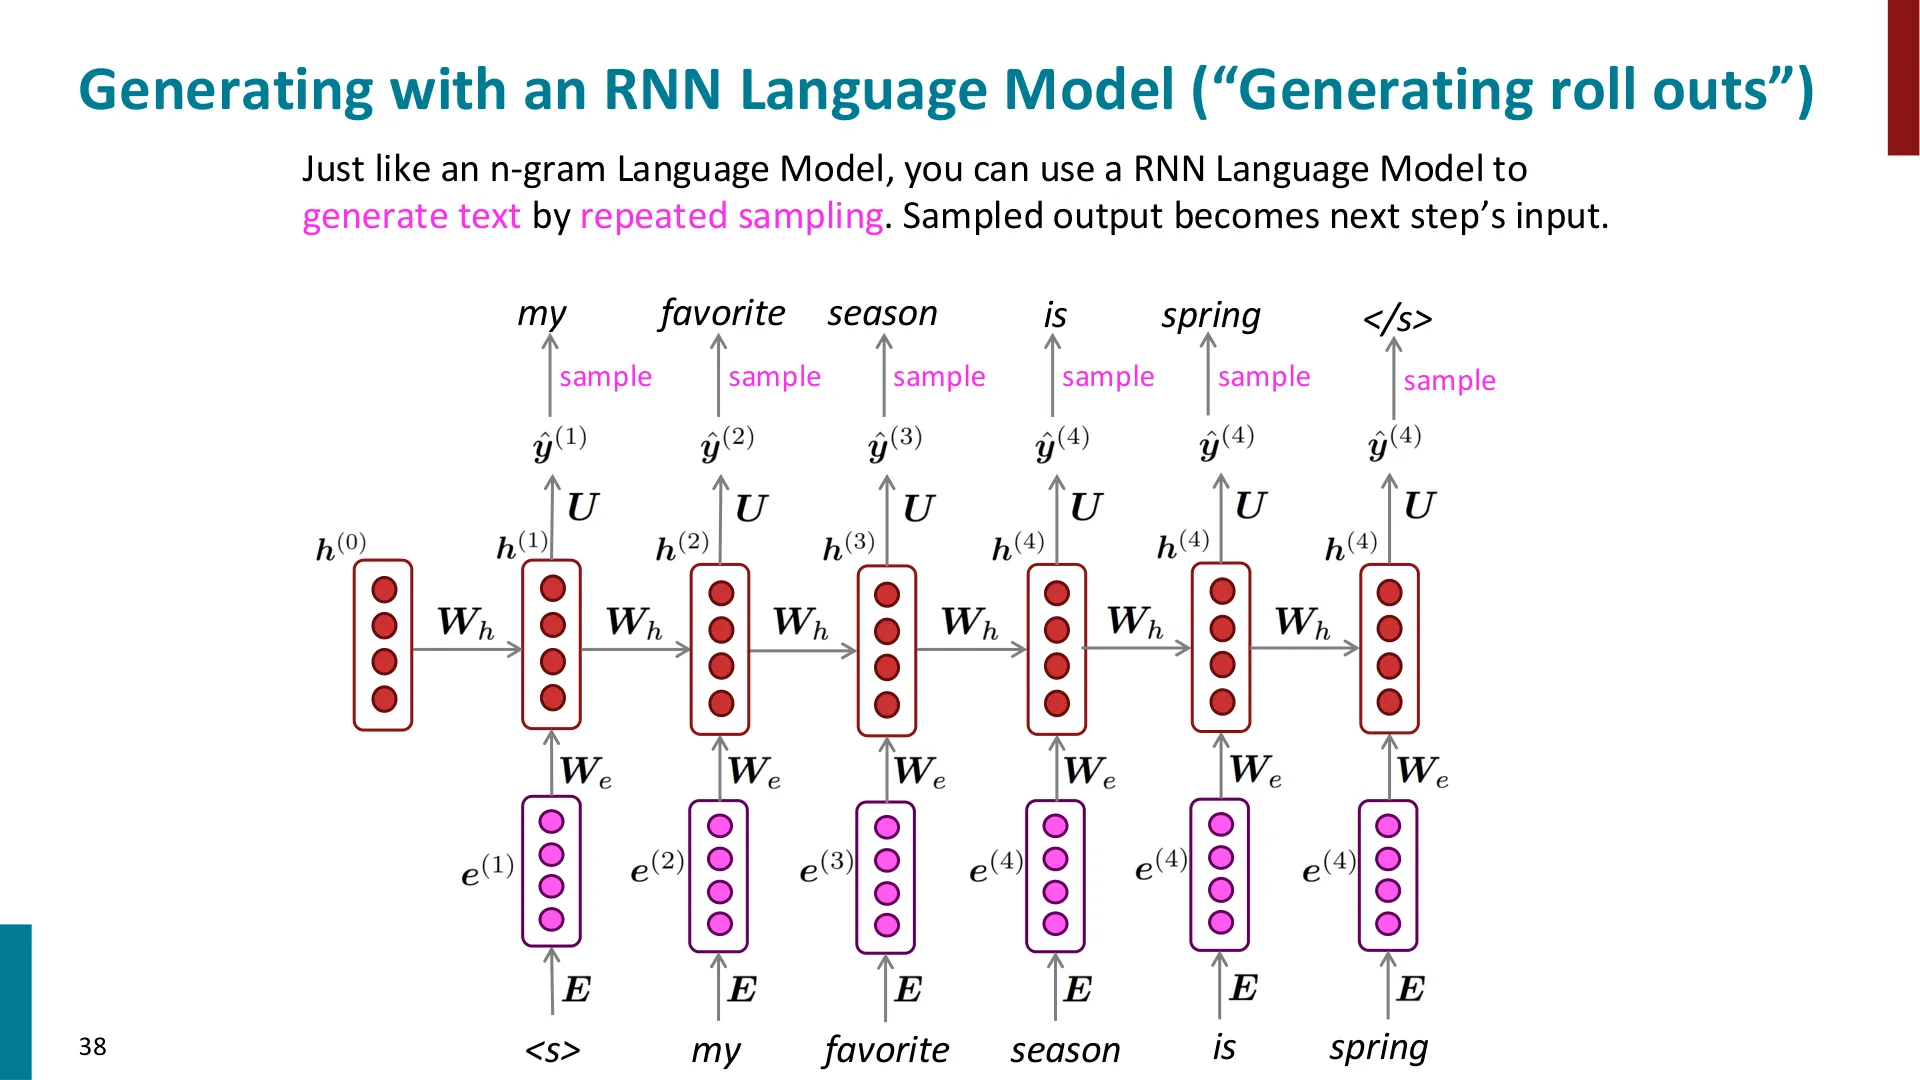
和 n-gram 语言模型一样,RNN 语言模型也能通过反复采样来生成文本——只不过现在我们用神经网络的隐藏状态去产生一个可采样的概率分布,而不是用 n-gram 的计数。
📷 用 RNN 语言模型生成:采样出的词成为下一步的输入
回到原视频 (01:08:50)
流程("生成 rollout"):
- 从初始隐藏状态出发;
- 用句首符号
<s>(start of sequence)当作一个"伪词"喂进去——它也有词嵌入。你会先得到第一词的概率分布,采样得到第一个词; - 因为此时没有任何真实文本,我们把刚生成的词复制回来作为下一步的输入;
- 再跑一步、再采样、再把结果接上……如此一路"掷骰子"往前滚;
- 为了能停下来,还设一个句尾符号
</s>(end of sequence),一旦采样到它就结束。
老师借这一点点破了 ChatGPT 的本质(虽然还没讲到那个模型):这正是 ChatGPT 之类系统在生成回答时做的事——一次生成一个词、把它当作下一步的输入、不断 rollout。而且因为是概率性地生成,你多跑几次会得到不同的答案。
编者说明:这段"逐词采样、把输出当输入"的描述,就是今天所有自回归语言模型的生成范式。RNN 与 Transformer 在这里的区别只在"用什么网络维护状态",生成流程本身完全一致。
玩一玩:奥巴马演讲、哈利波特、食谱
(参考时间: 01:11:41)
你可以拿这个简单的 RNN 去训练任何文本,然后生成那种风格的文字。
奥巴马演讲(语料只有几十万词,很小):
📷 在奥巴马演讲语料上训练的 RNN 生成的文本
回到原视频 (01:11:50)
the United States will step up to the cost of a new challenges of
the American people that will share the fact that we created the
problem they were attacked and so that they have to say that all
the task of the final days of war that I will not be able to get
this done
老师的评语很坦率:"也许比我刚才的 n-gram 语言模型好一点点,但还是不完美。"
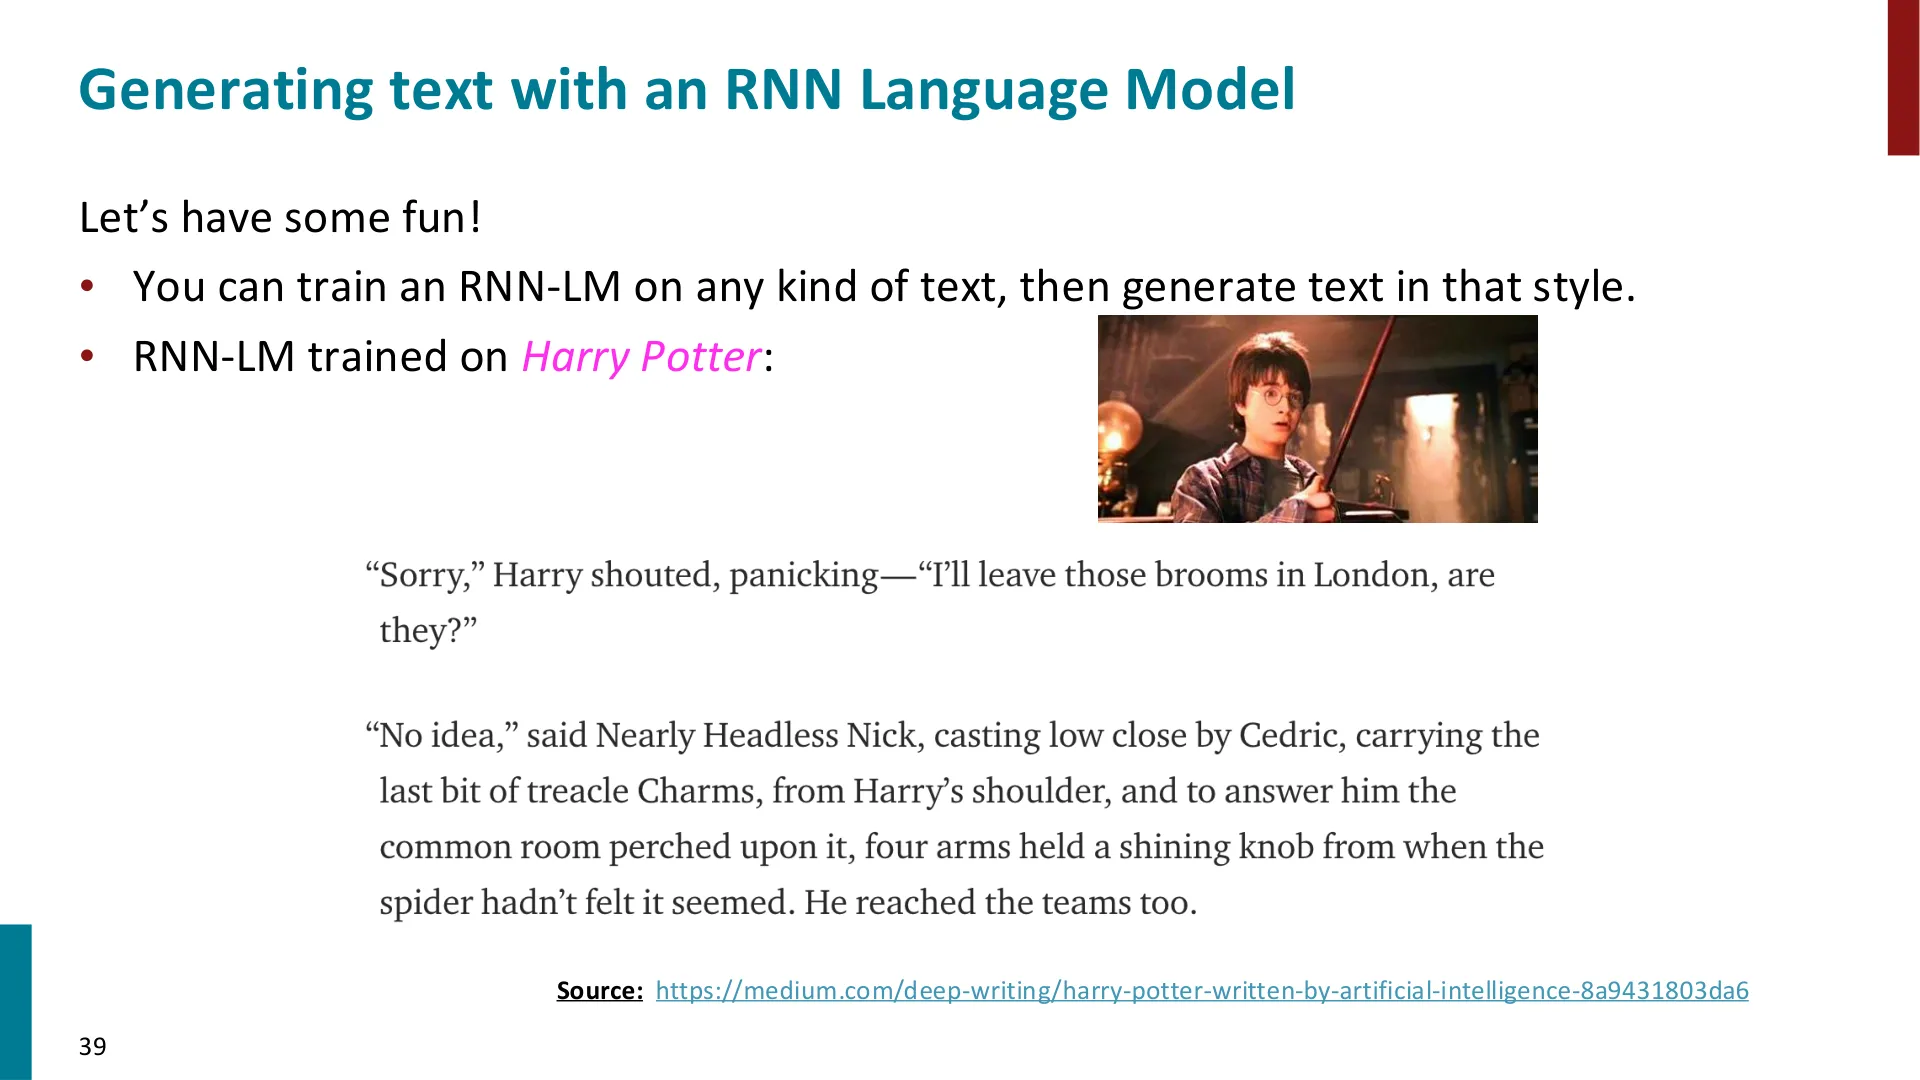
哈利波特(语料稍大):
📷 在哈利波特语料上训练的 RNN 生成的文本
回到原视频 (01:13:52)
Harry shouted panicking I'll leave those brooms in London are they
no idea said nearly headless Nick casting low close by Cedric
carrying the last bit of trial charms from Harry's shoulder and to
answer him the common room perched upon it forearms held a shining
knob from when the spider hadn't felt it seamed he reached the
teams too well there you are
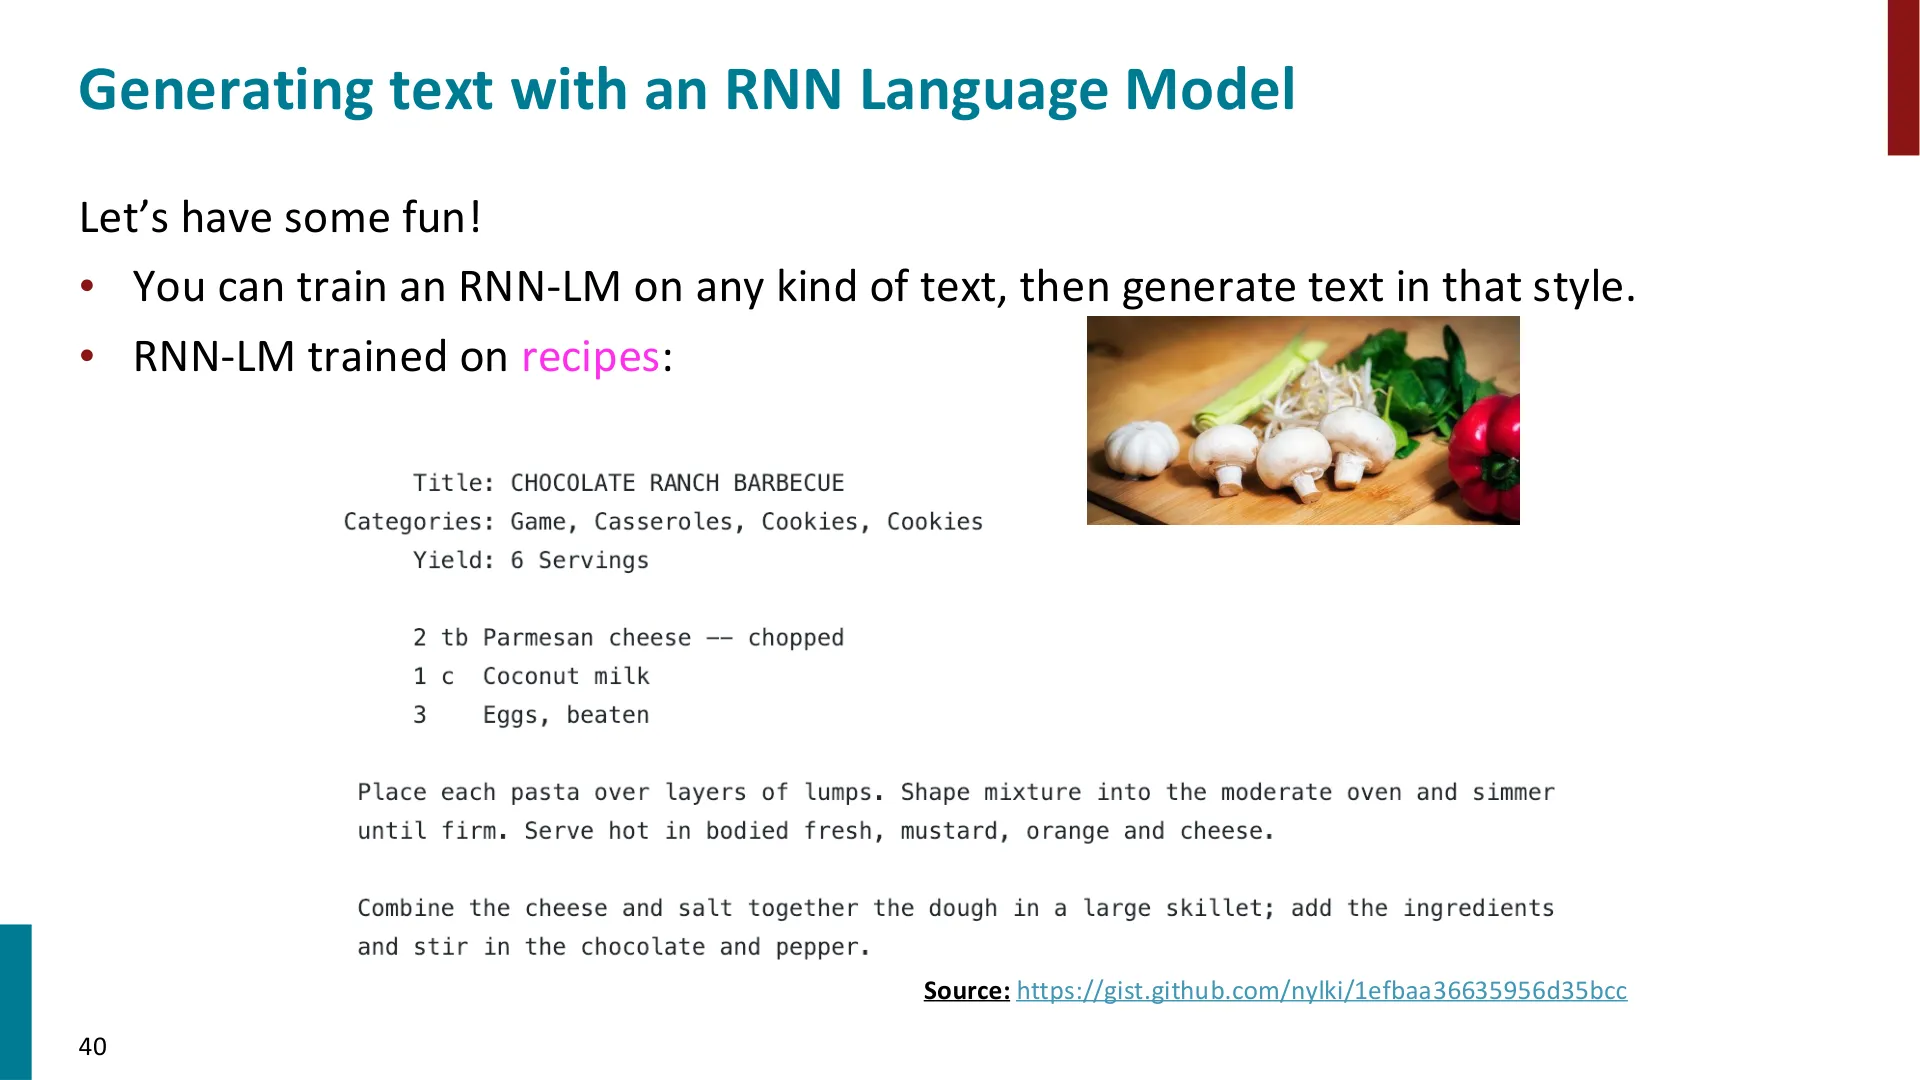
食谱(老师特意声明:别照着做):
📷 在食谱语料上训练的 RNN 生成的"食谱"
回到原视频 (01:14:28)
chocolate Ranch Barbecue categories game casseroles cookies
cookies yield six servings two P two tablespoons of Parmesan
cheese chopped one cup of Co coconut milk and three eggs beaten
Place each pasture over layers of lumps shape mixture into the
moderate oven and simmer until firm serve hot and bodied fresh
mustard orange and cheese combine the cheese and salt together
the dough in a large Skillet and the ingredients and stir in the
chocolate and pepper
老师点评:
它看起来像一份食谱——如果你不仔细看的话。它有食谱的"语言",但讲到具体配料时完全不连贯。也许如果我把语料扩大、多训一训,会好一些。但它显然没有在用那些配料。
更小的单位:字符级 RNN 与"给颜色起名"
(参考时间: 01:15:20)
到目前为止,我们都是以词为时间步建的 RNN。但 RNN 的想法可以用在任何单位上:
🖼️ 第 39 页幻灯片 · Evaluating Language Models
- 生物信息学里,可以用它做 DNA 序列、基因测序、蛋白质测序;
- 即使只谈语言,也可以以字符为单位——一次生成一个字母而不是一个词。这样有时很有用,因为它能生成"看起来像词、并且带有英语词结构"的东西。
还有一个更有意思的变体:上下文 RNN(contextual RNN)。前面说初始隐藏状态可以设成全 0,但其实可以用别的东西来初始化隐藏状态。老师举了一个特别妙的例子:
(参考时间: 01:17:04)
我可以用一个颜色的 RGB 值来初始化隐藏状态,然后逐字符生成这个颜色的名字。训练数据来自某涂料公司"颜色名 ↔ RGB"的目录。然后我给它不同的颜色,它就会为这些颜色取名字。
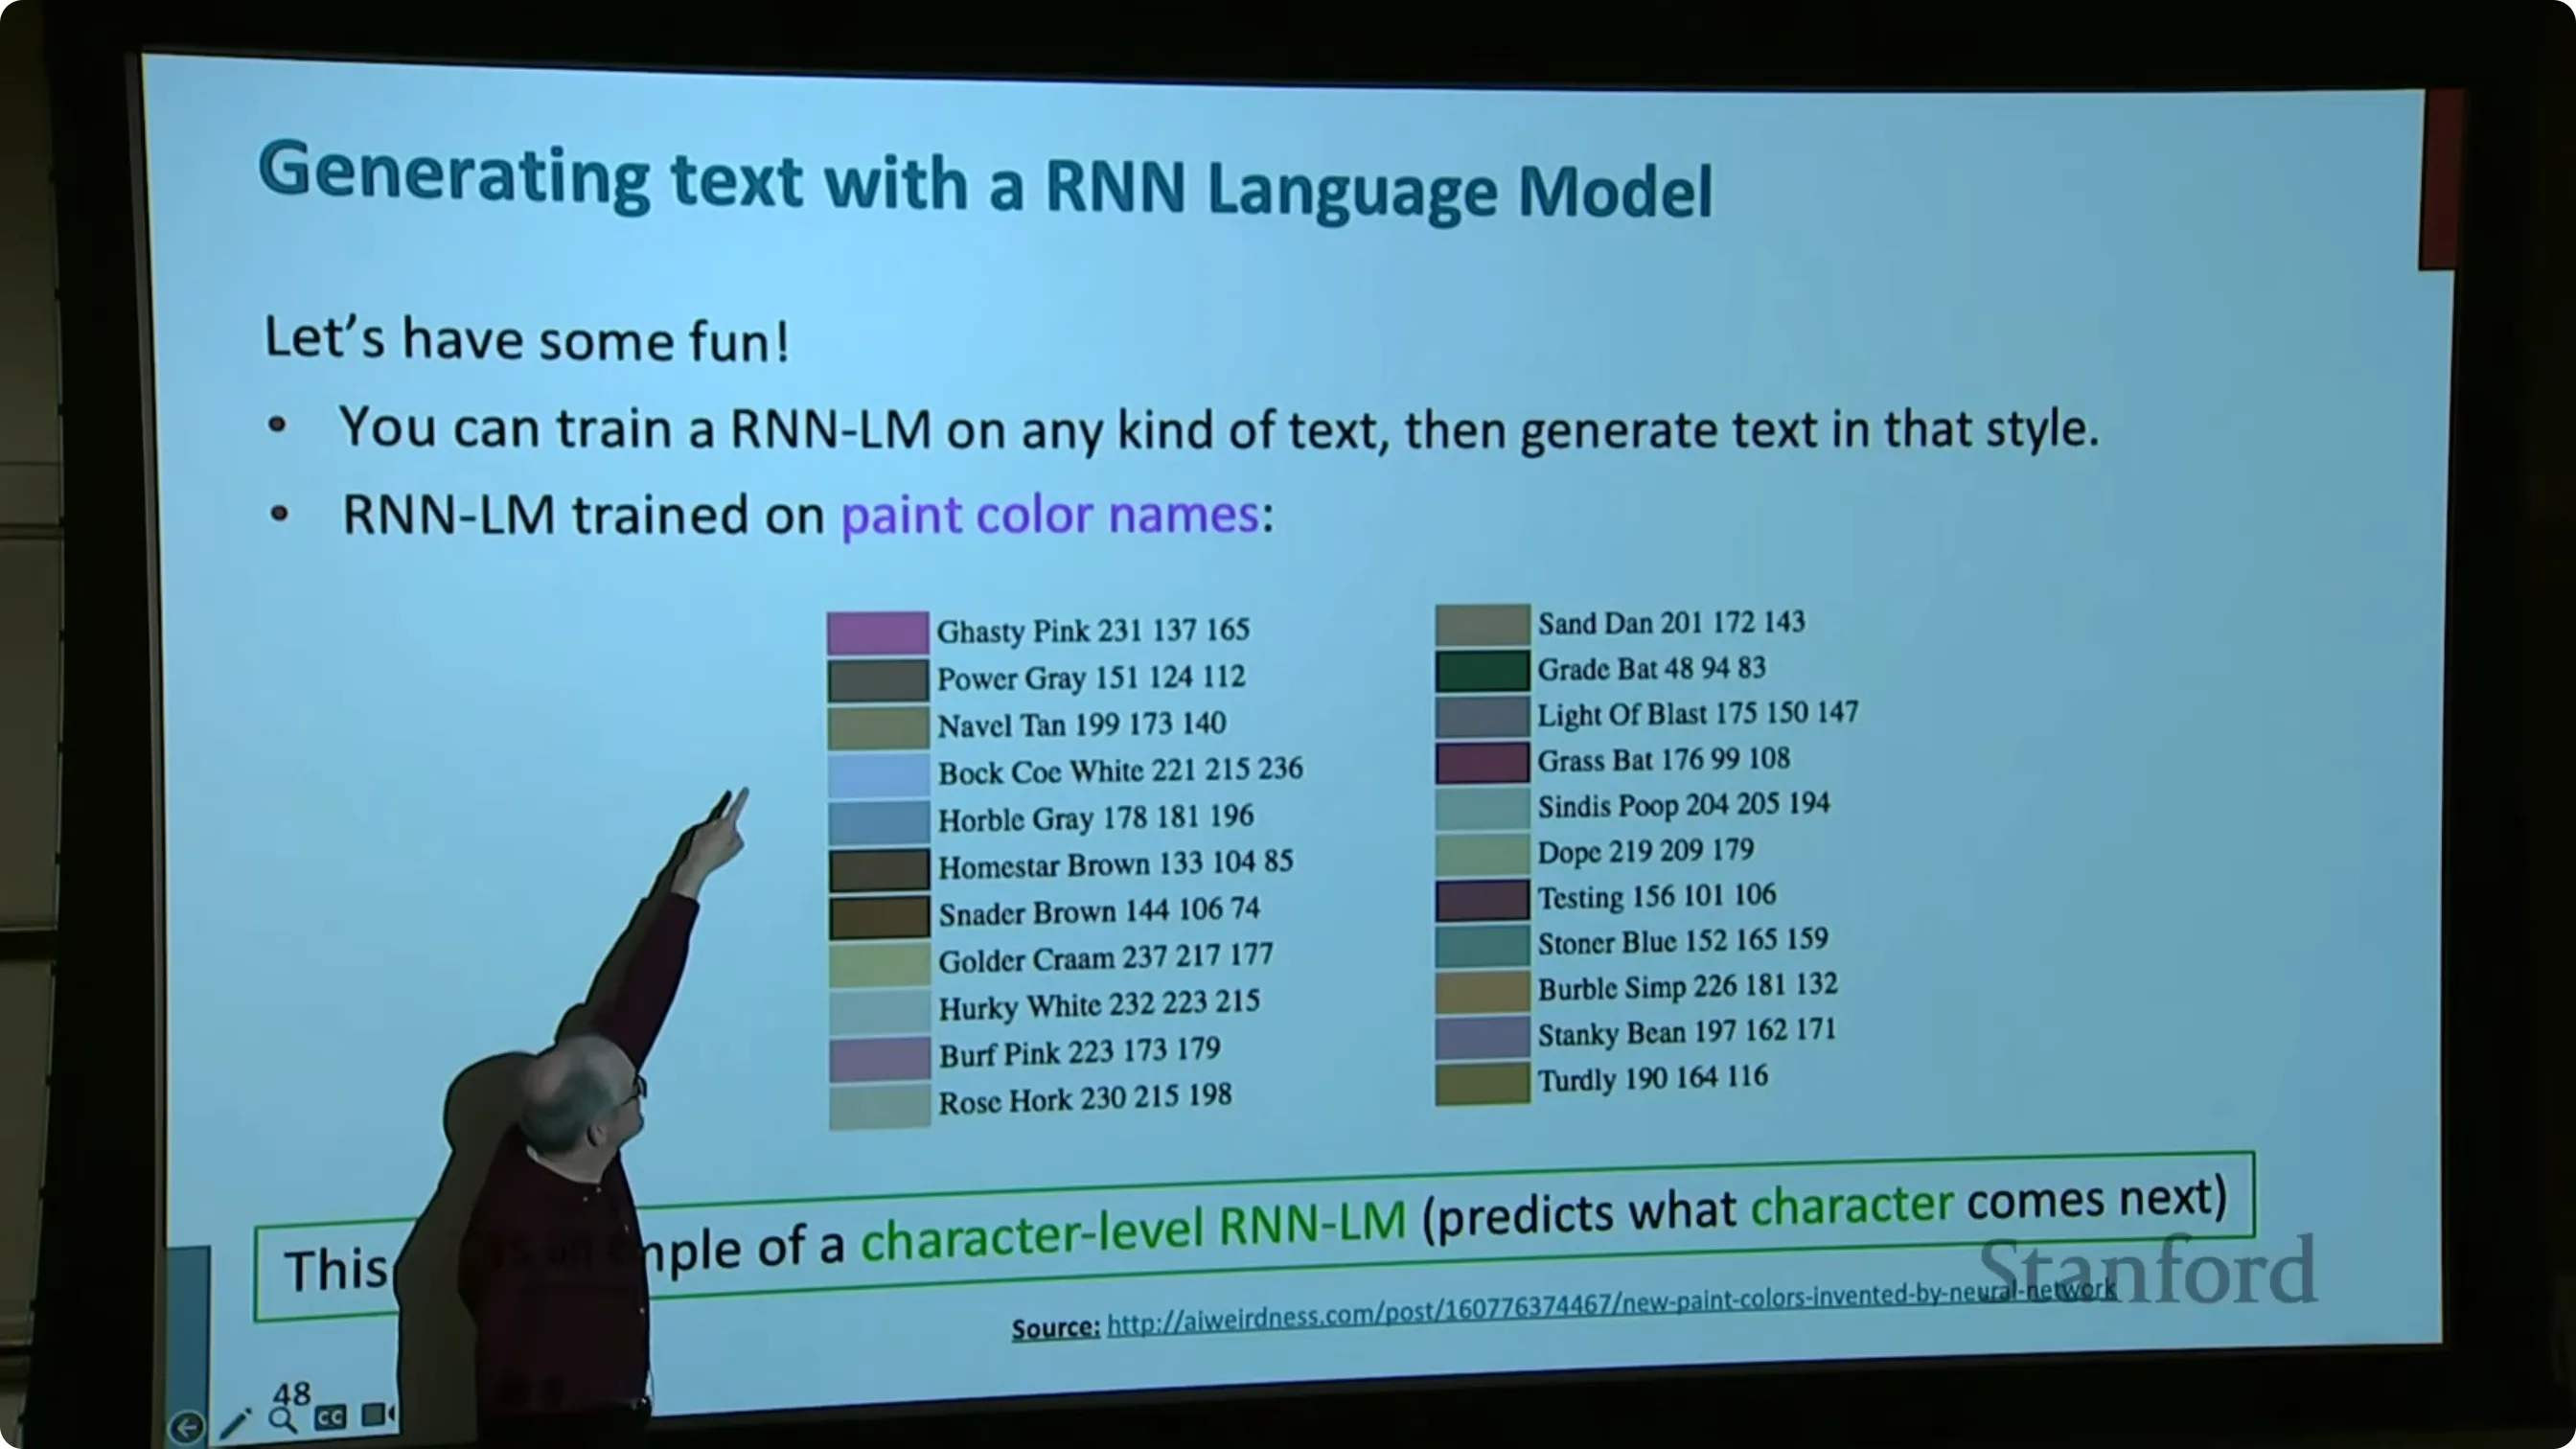
📷 用 RGB 初始化隐藏状态、逐字符生成颜色名字:模型给不同颜色起了名字
回到原视频 (01:18:00)
老师对这个演示非常满意:
这个做得非常好!你看——
gasty pink、Power gray、Naval、tan、bco white、hble gray、Home Star Brown……你完全能想象它们出现在一份涂料目录里。右下角这个颜色叫dope;再看这个Stoner blue、purple stinky bean、Turley……我觉得我在这里发现了一个真正的商业机会,就在涂料公司市场里,为我的循环神经网络!编者说明:这个"RGB → 颜色名"的演示属于条件生成——用外部信息(颜色)而非文本前缀来初始化隐藏状态,从而控制生成内容。它是"用一个向量控制 RNN 输出"的早期直观示例,也预示了后来"用编码器输出初始化解码器"的做法(下次课要讲的机器翻译正是如此)。
附录:课堂未展示的幻灯片
官方讲义里还有一些页,因为本讲时间不足没有在课堂上讲(讲师原话:"I'll stop there for today and do more of the science of neural networks next time.")。为完整覆盖讲义,把它们列在这里,供你自学时对照。
-
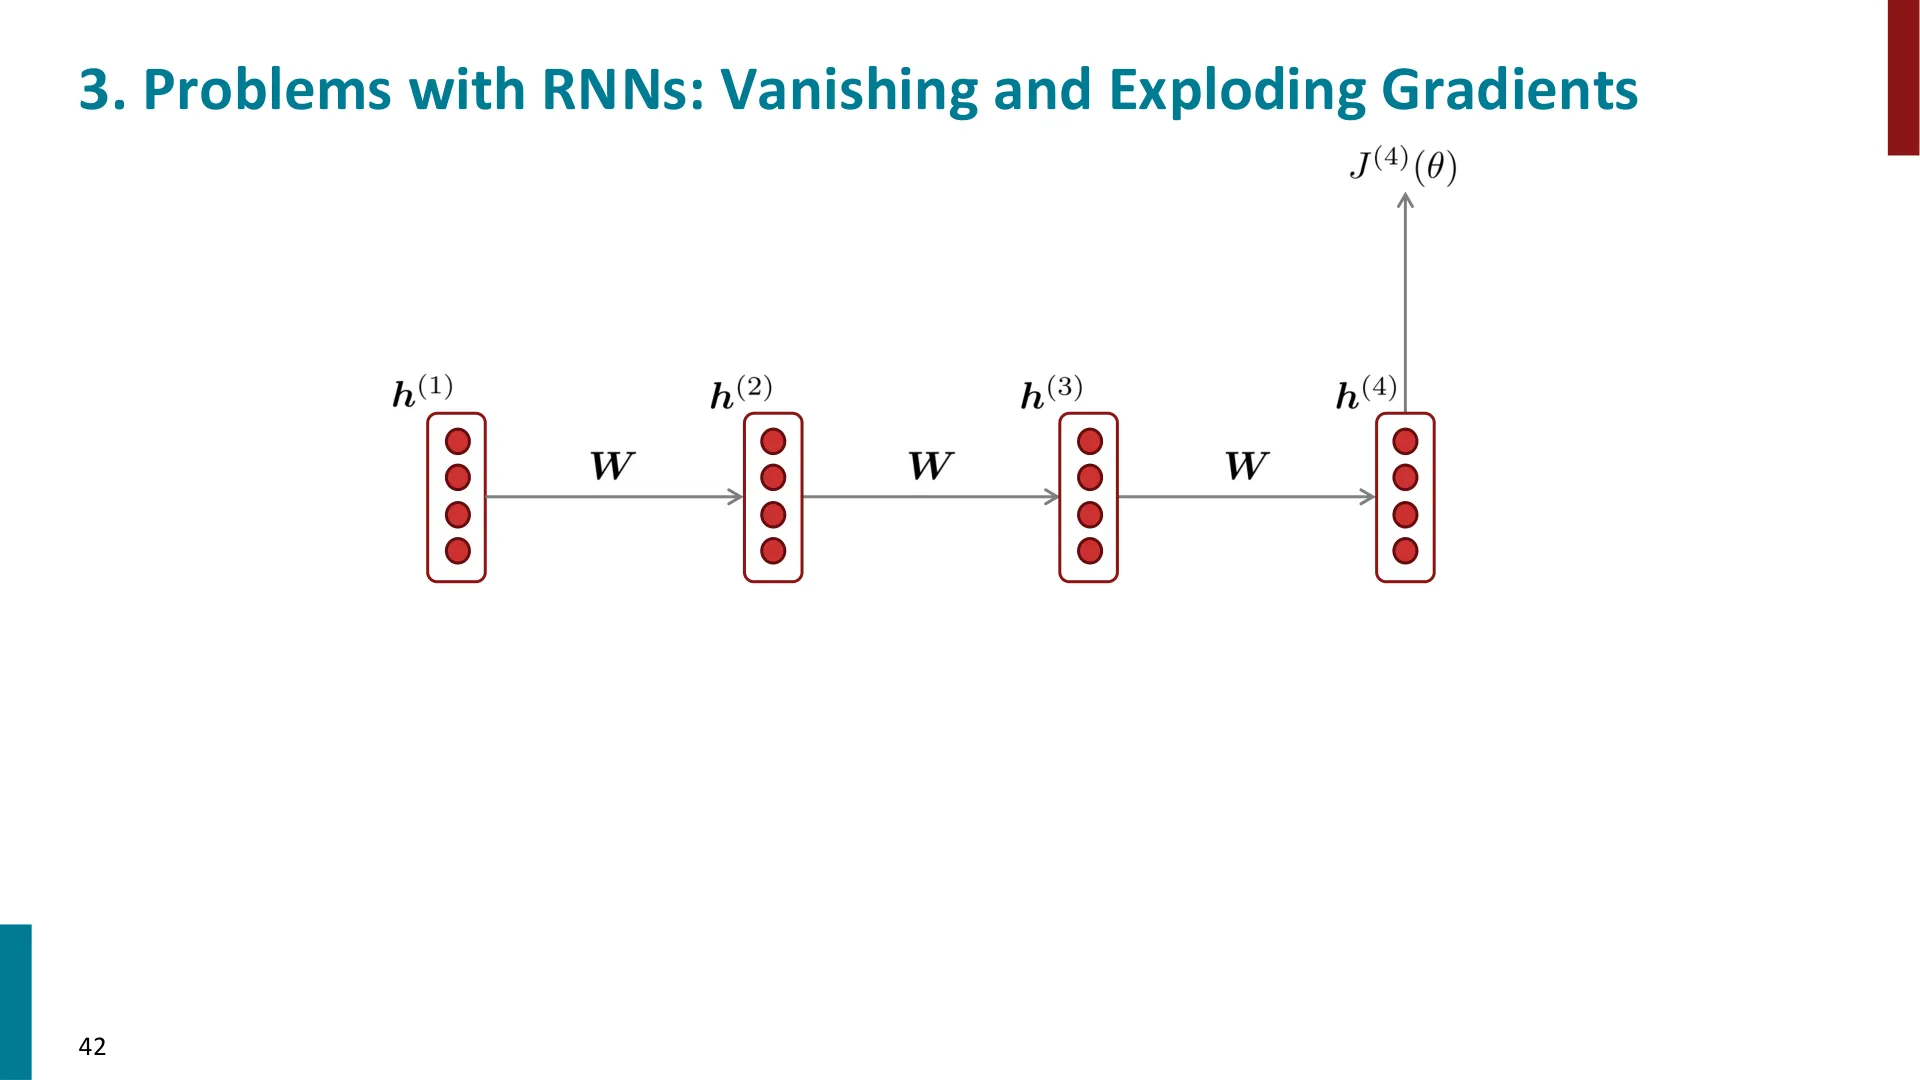
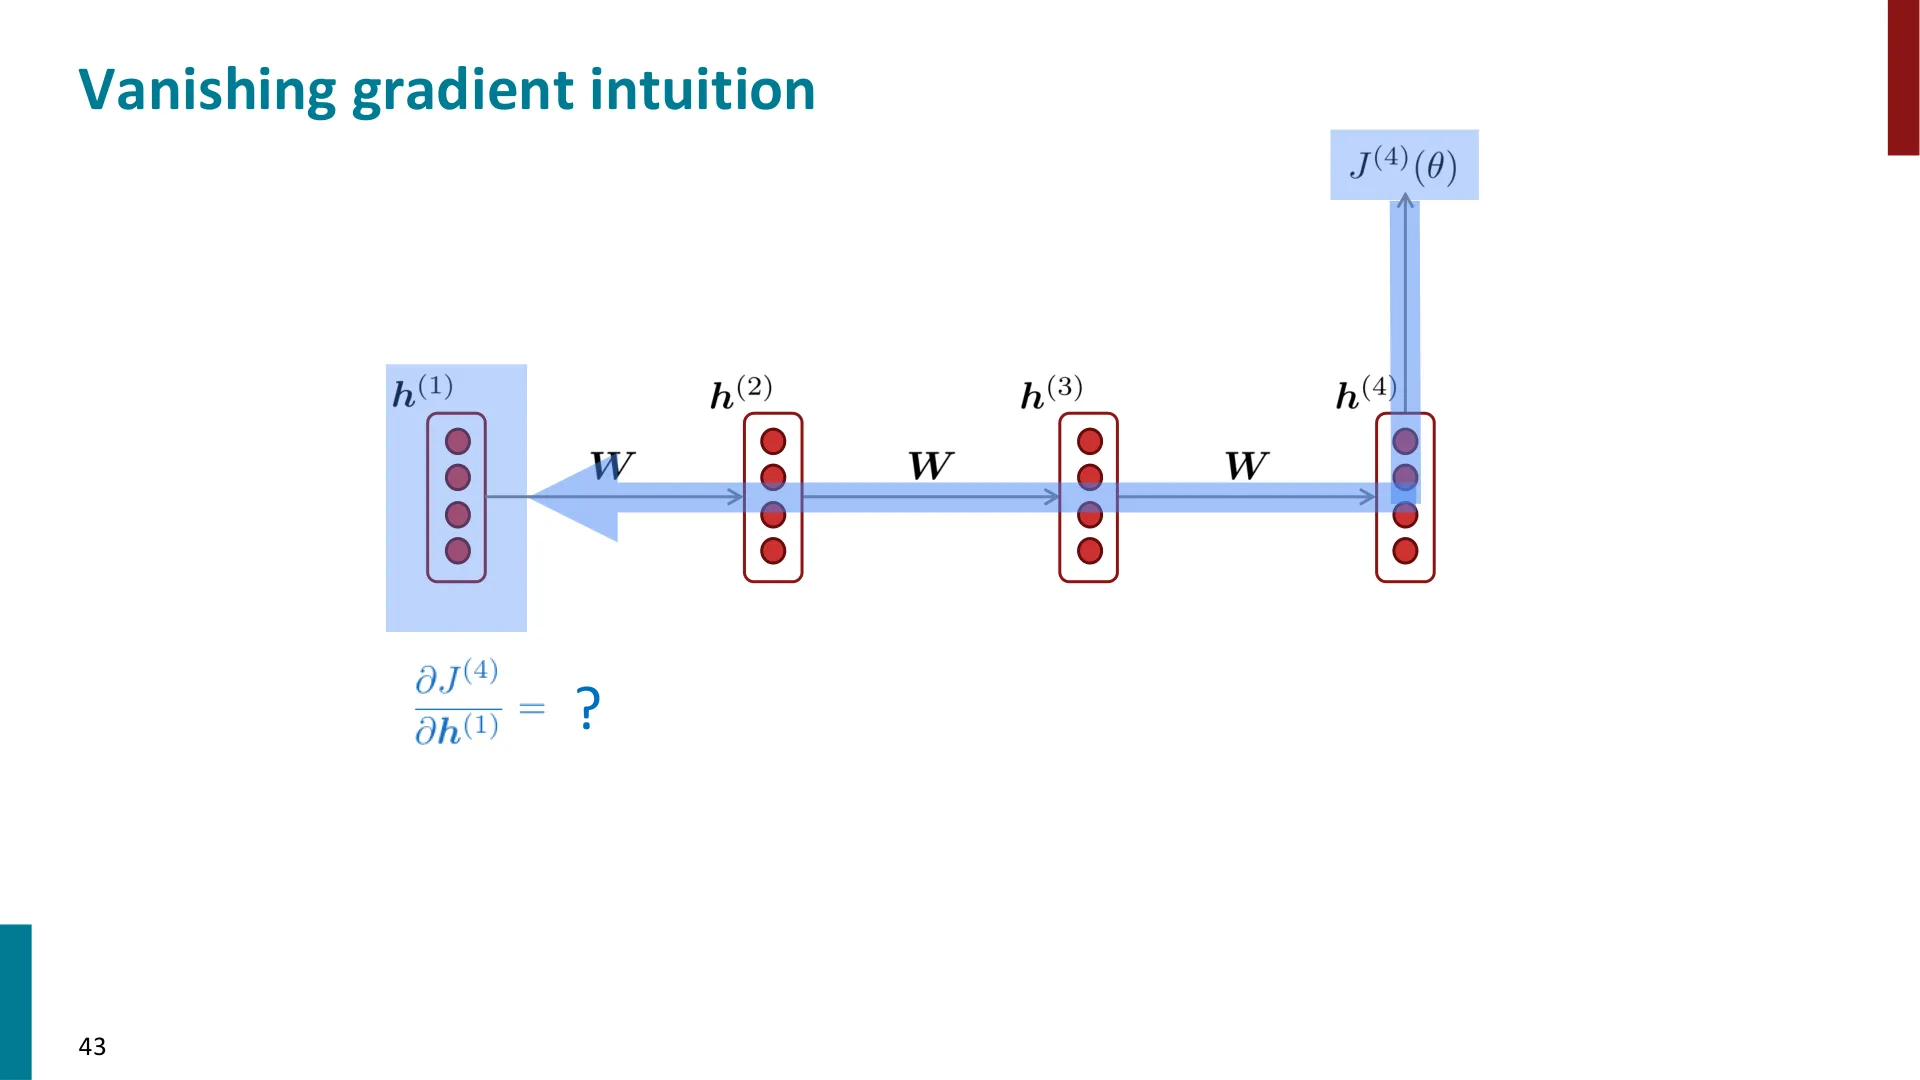
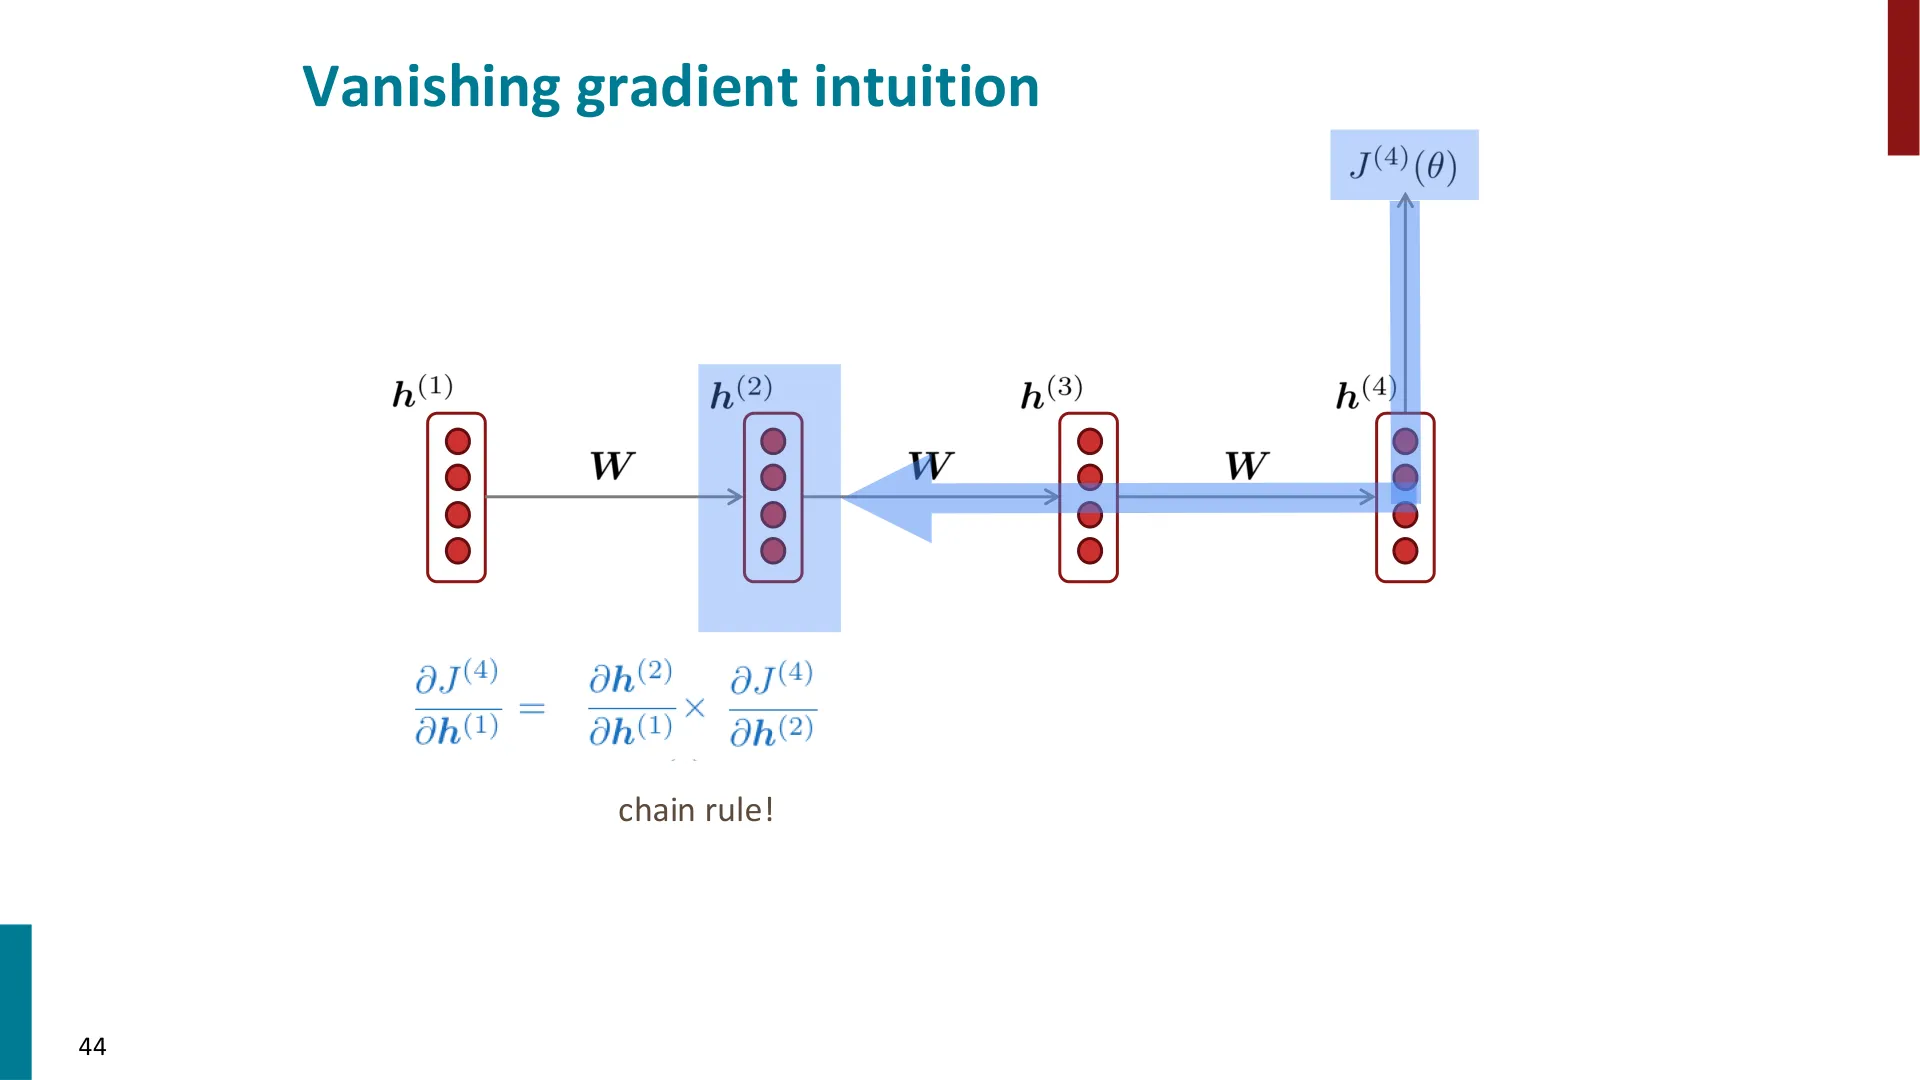
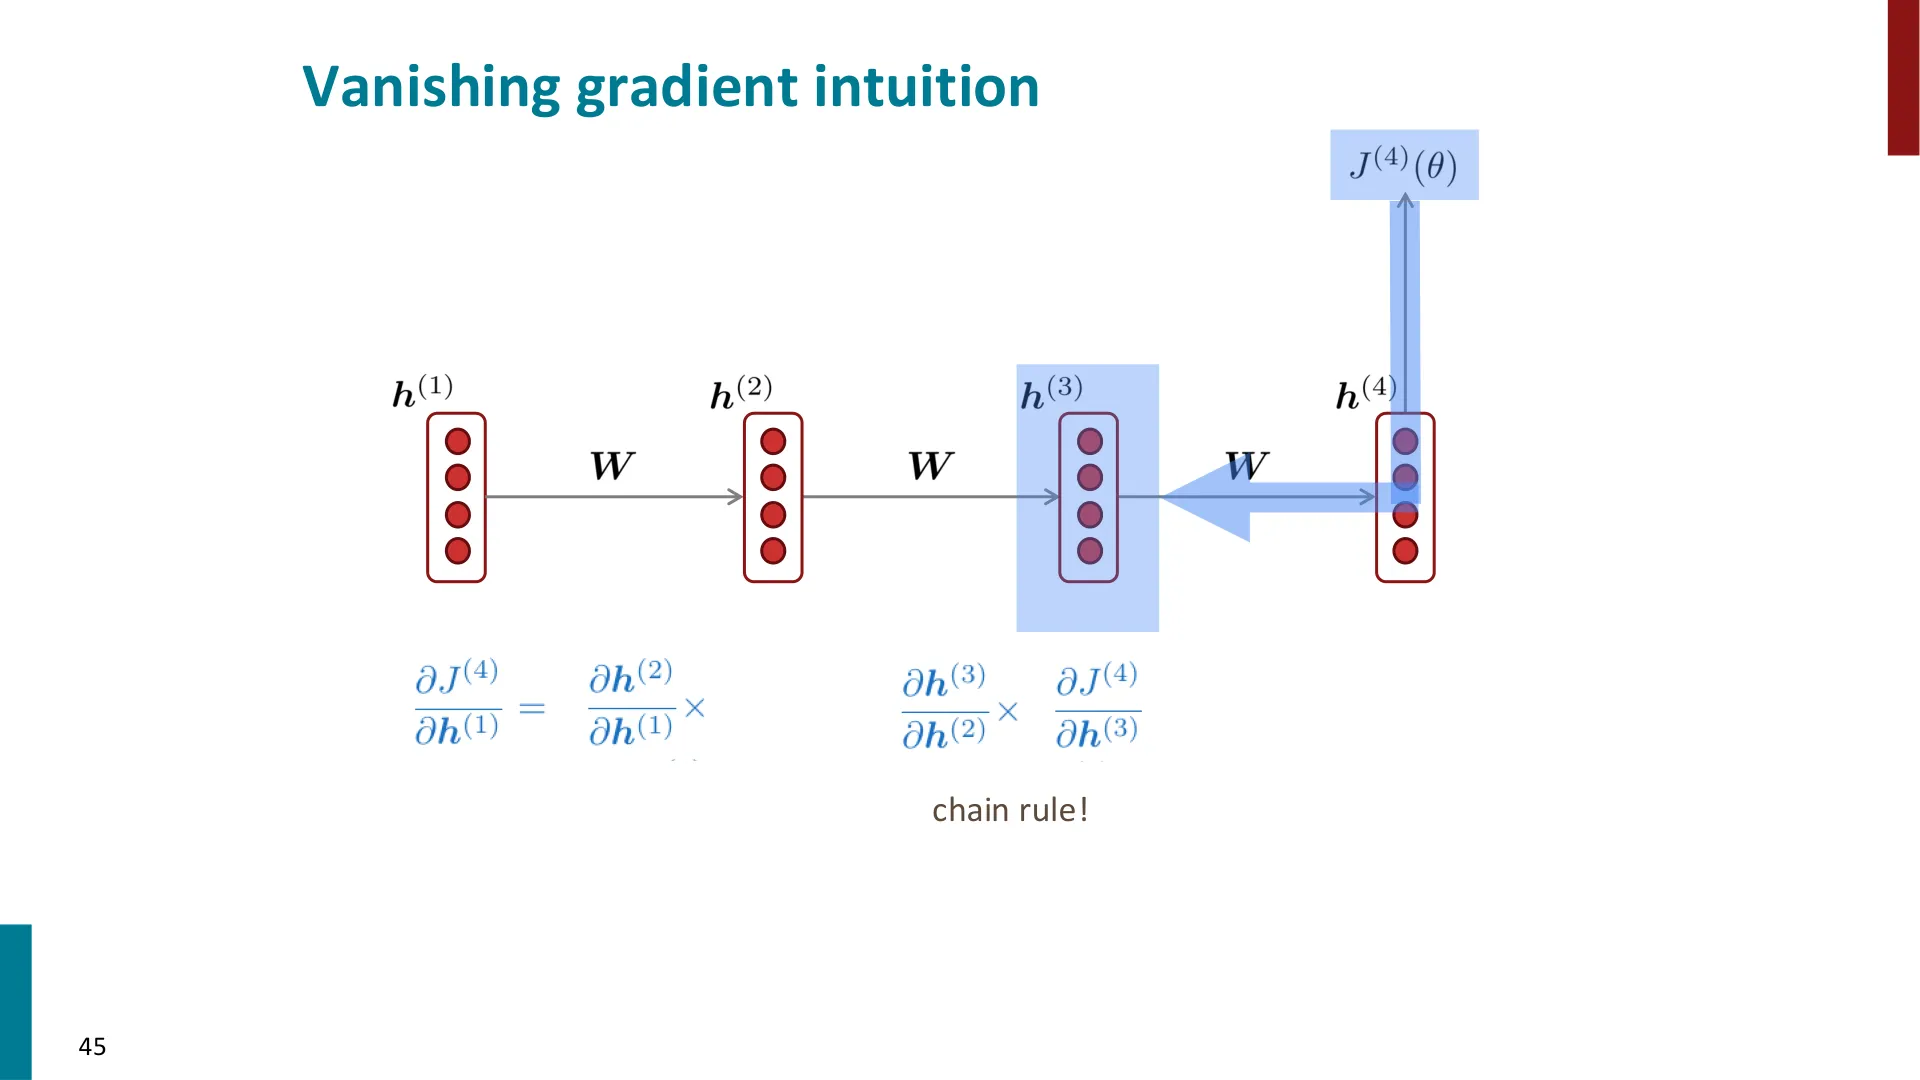
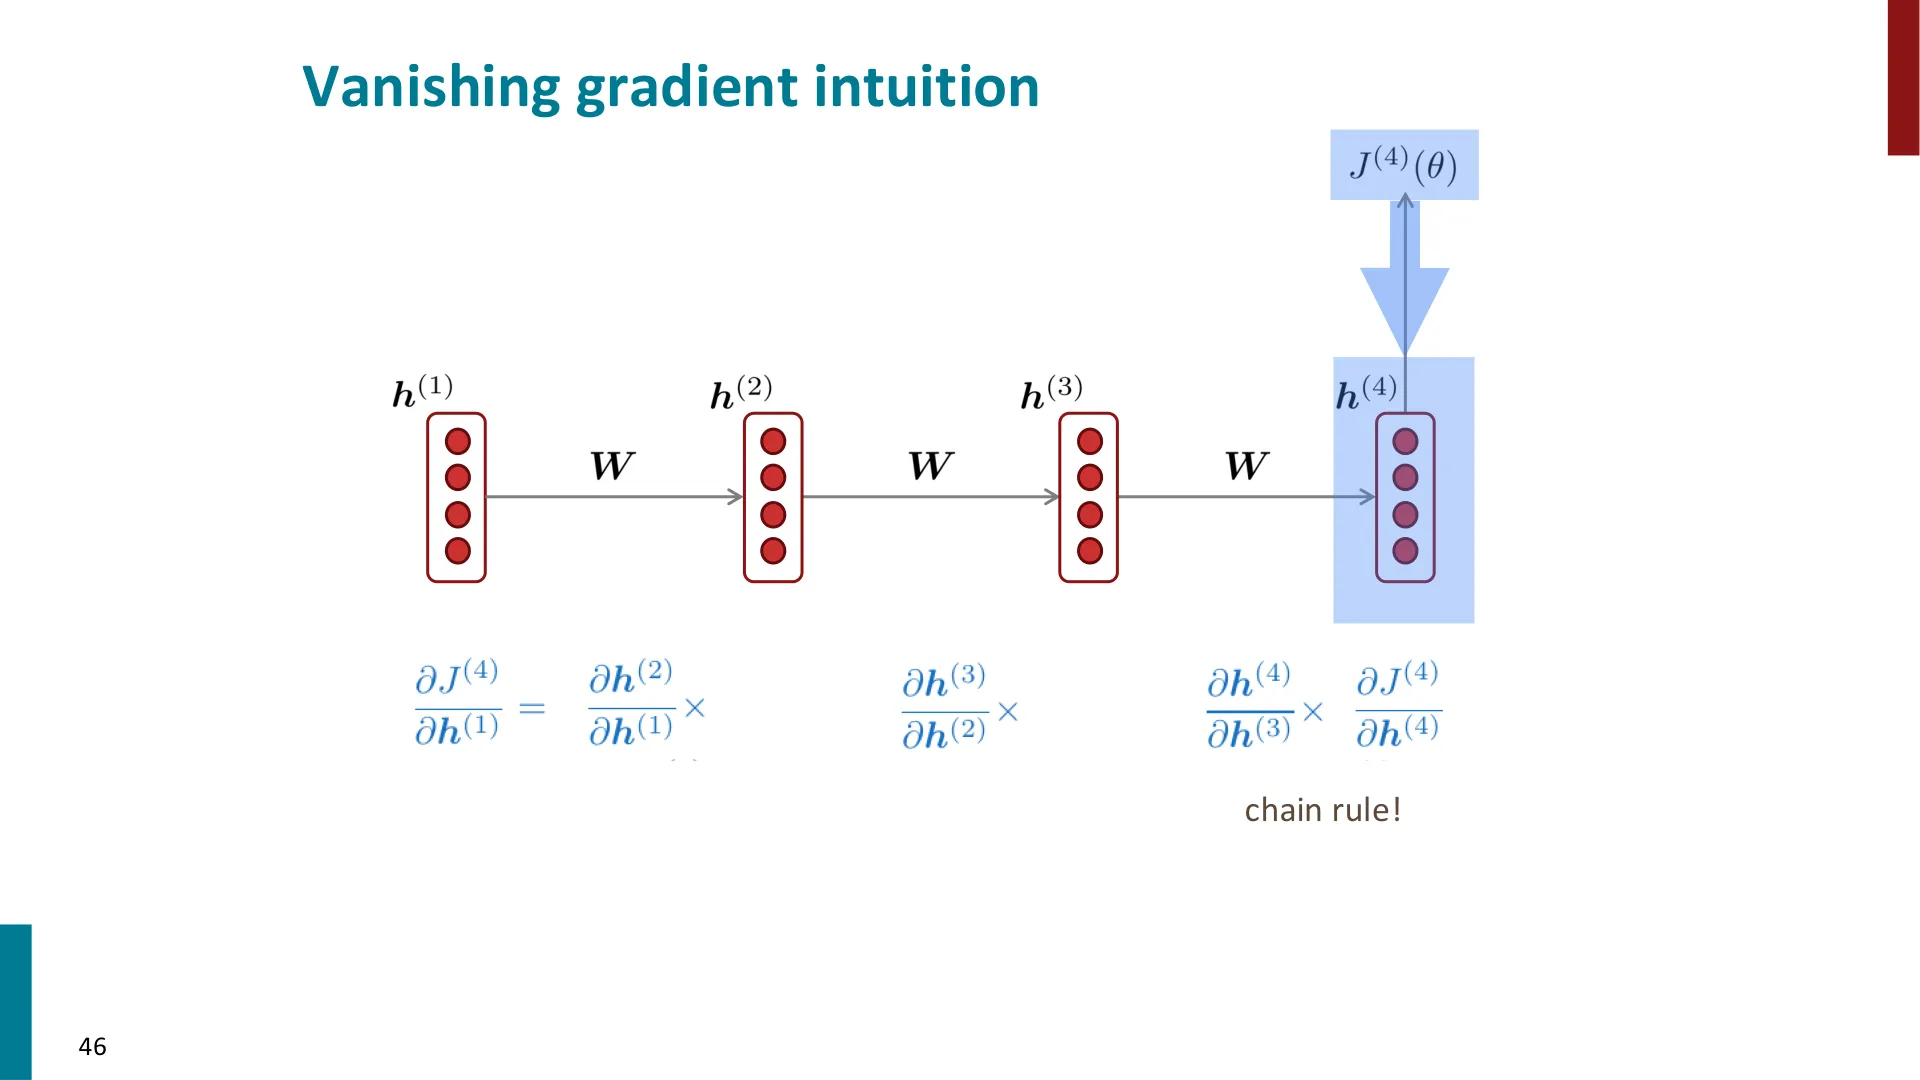
Problems with RNNs: Vanishing and Exploding Gradients(第 40–50 页)
-
SLIDE:40 — 章节标题页:RNN 的梯度消失与梯度爆炸
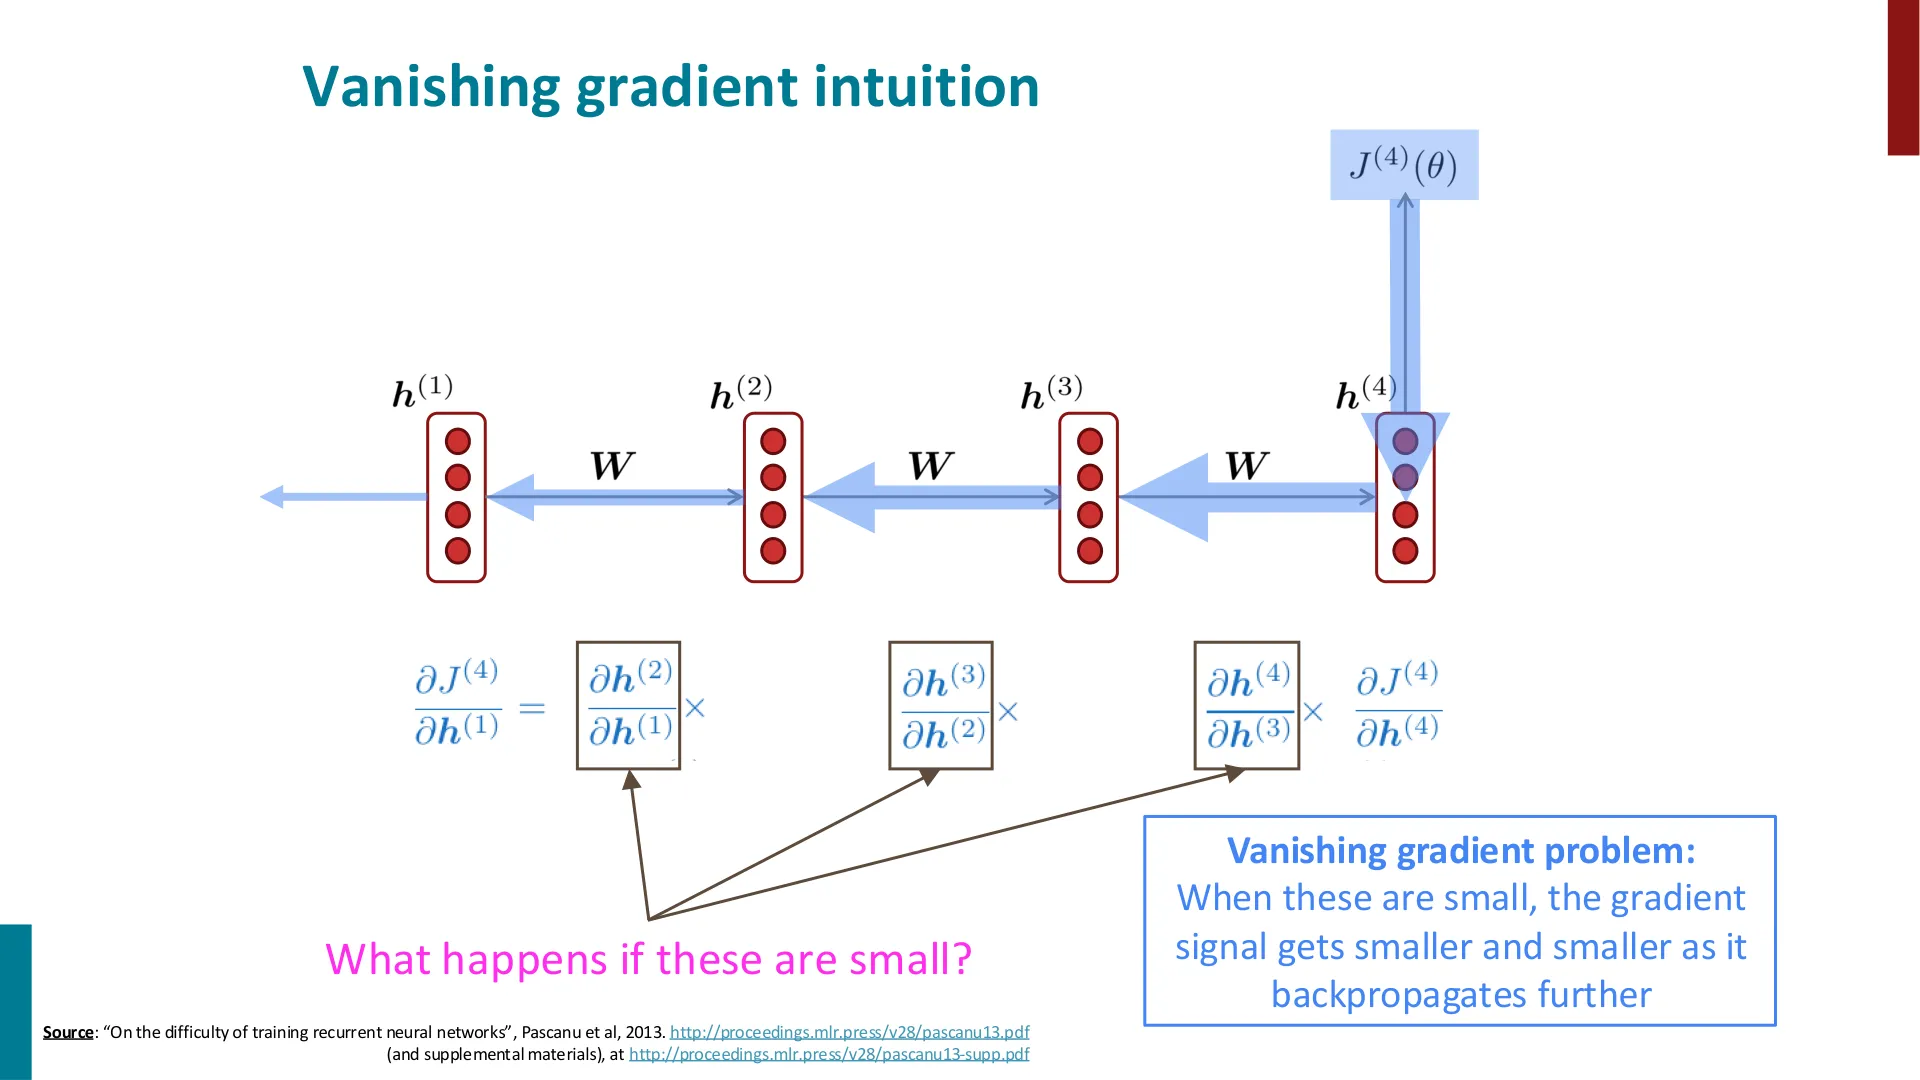
- SLIDE:41 — Vanishing gradient 直觉(引入)
- SLIDE:42 — Vanishing gradient 直觉(链式法则)
- SLIDE:43 — Vanishing gradient 直觉(链式法则)
- SLIDE:44 — Vanishing gradient 直觉(链式法则)
- SLIDE:45 — 梯度消失问题:这些项很小时,梯度信号越往回收缩越小
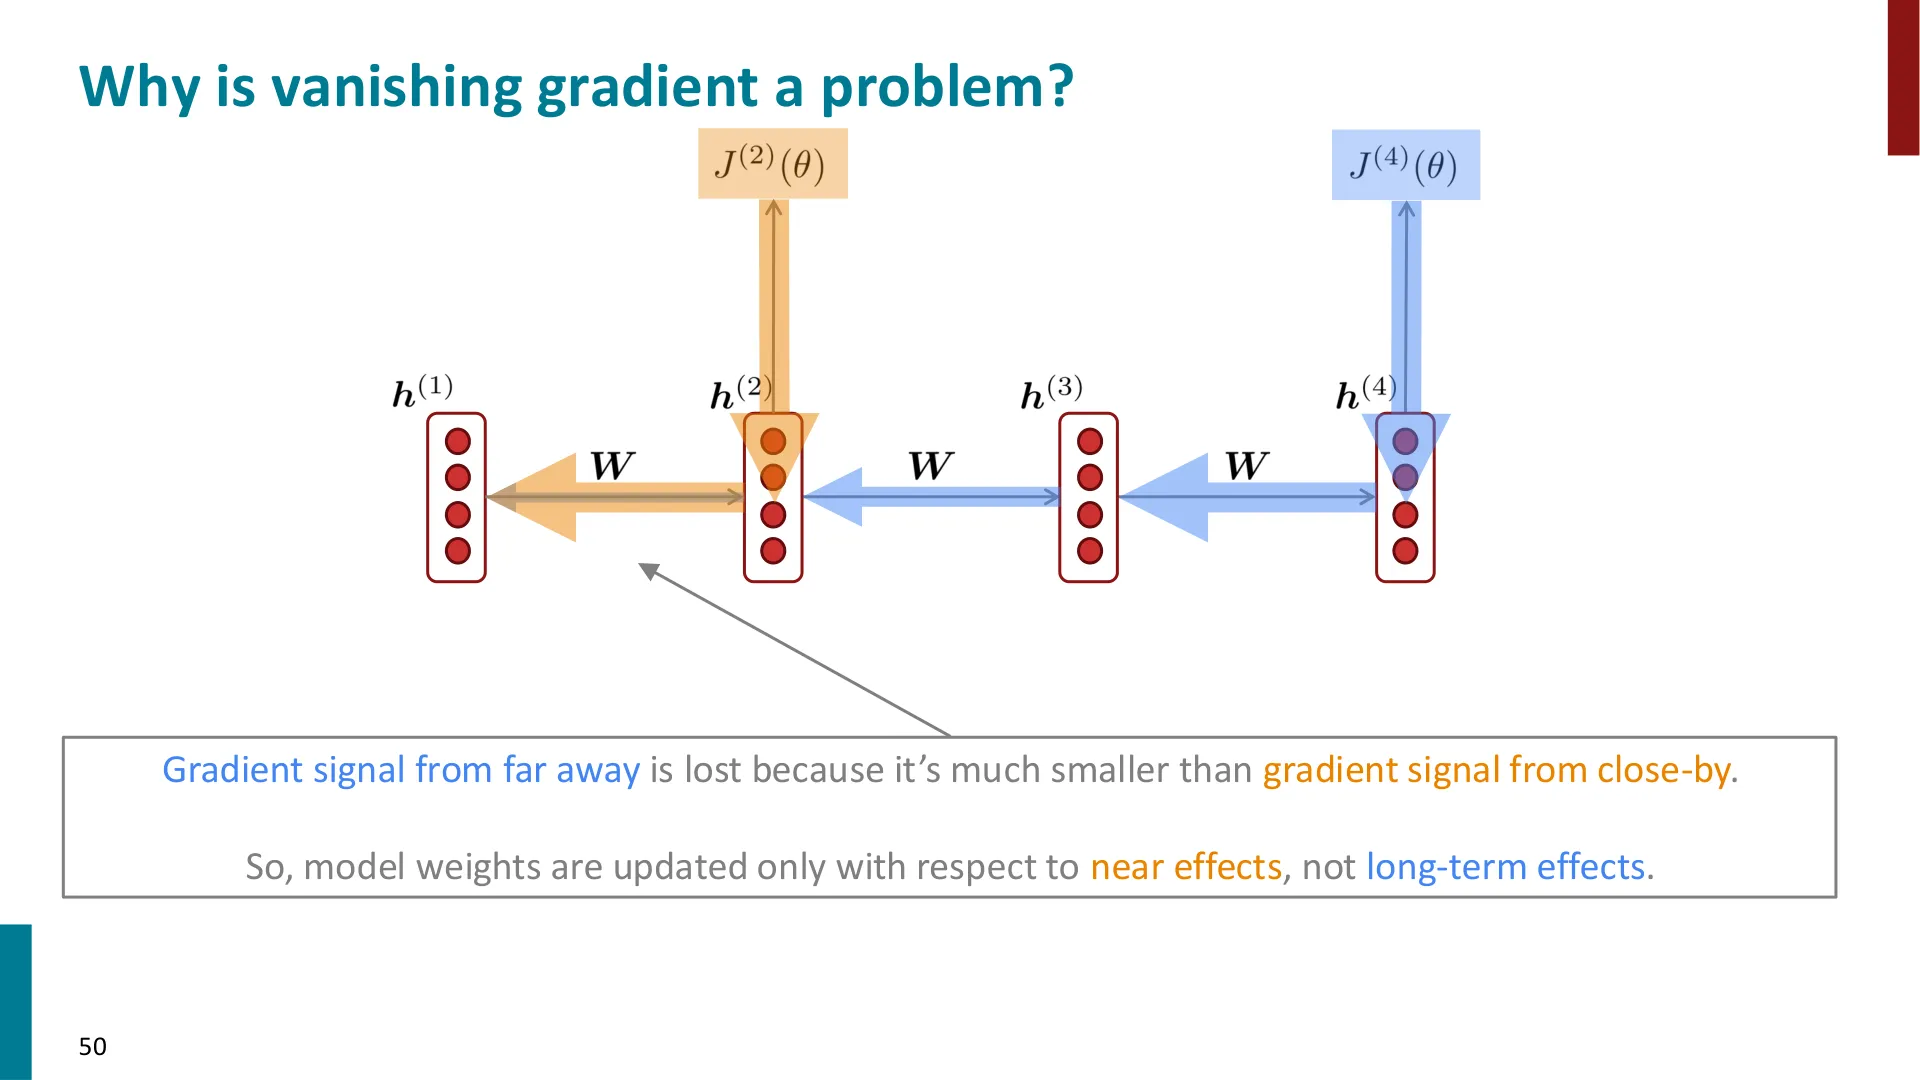
- SLIDE:46 — 为什么梯度消失是问题:远处的梯度信号被"淹没",权重只按近期效应更新
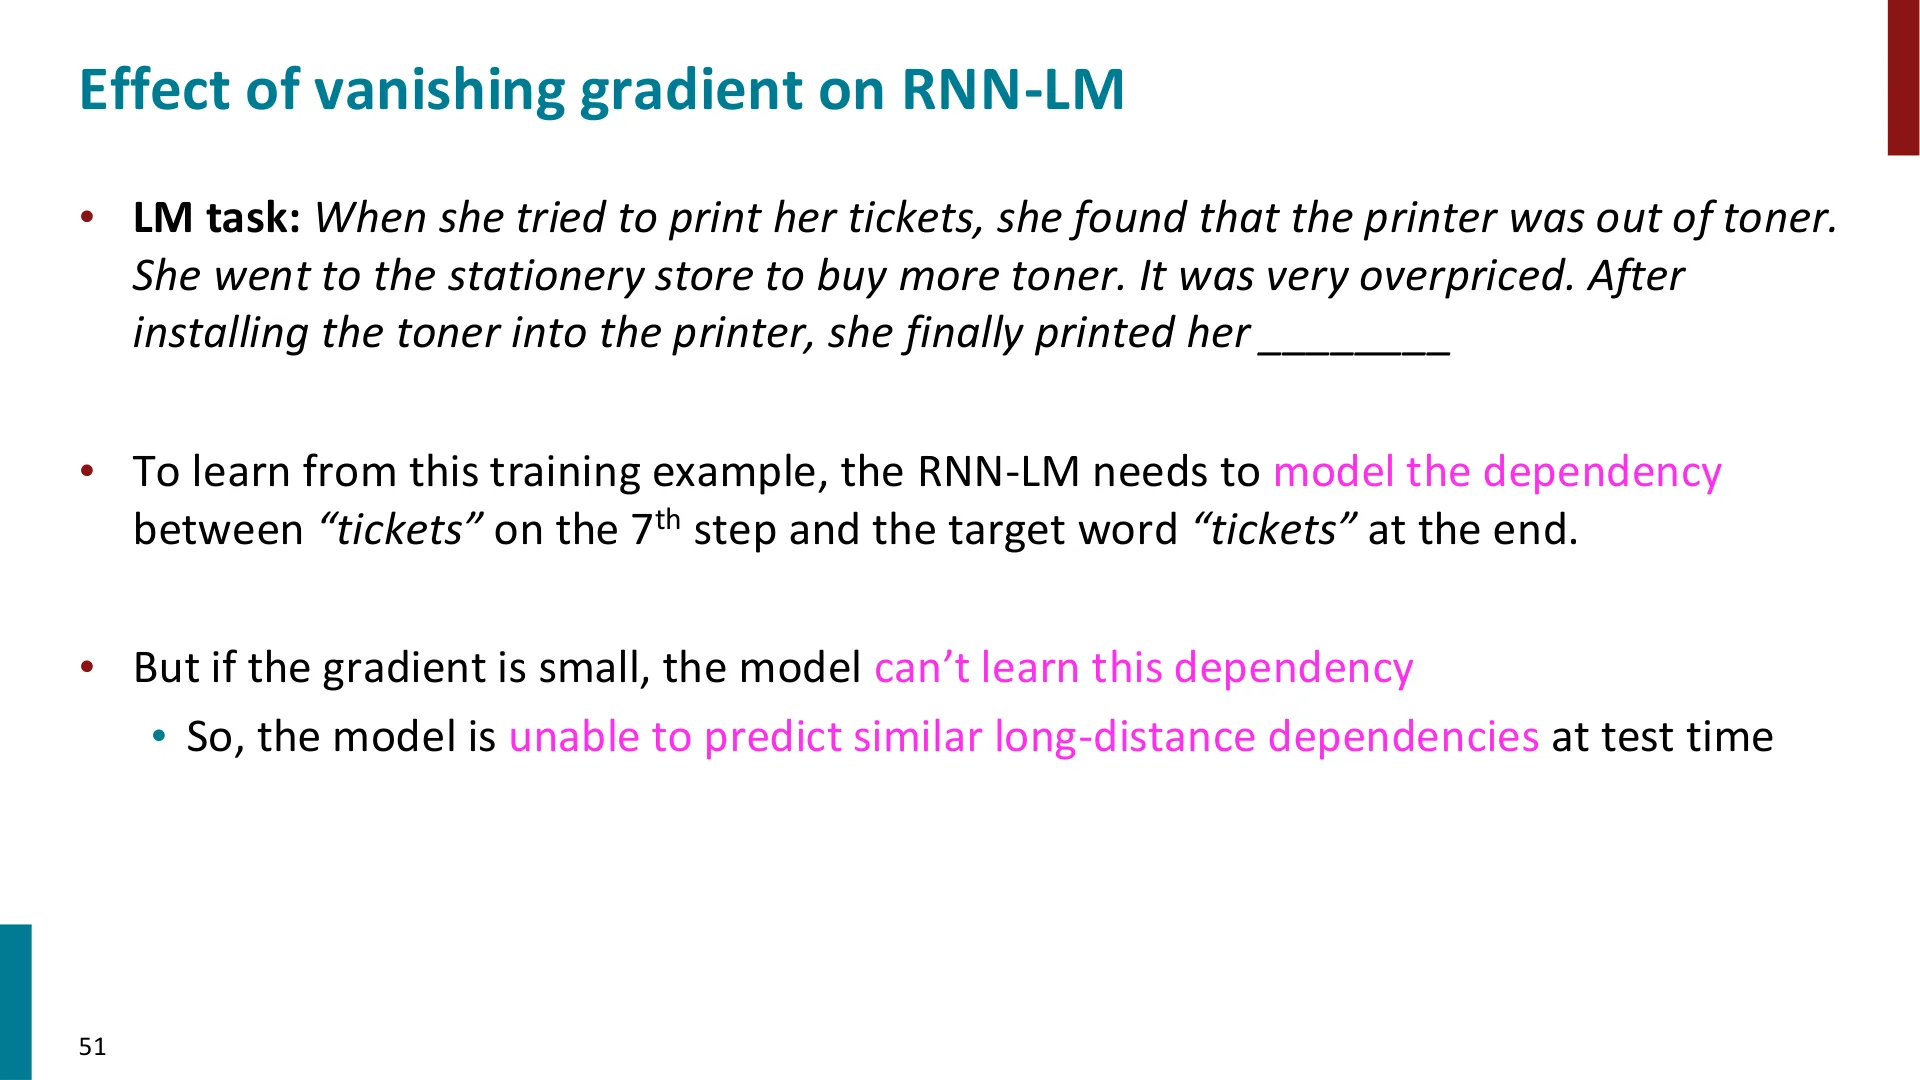
- SLIDE:47 — 梯度消失对 RNN-LM 的影响(tickets/toner 长距离依赖的例子)
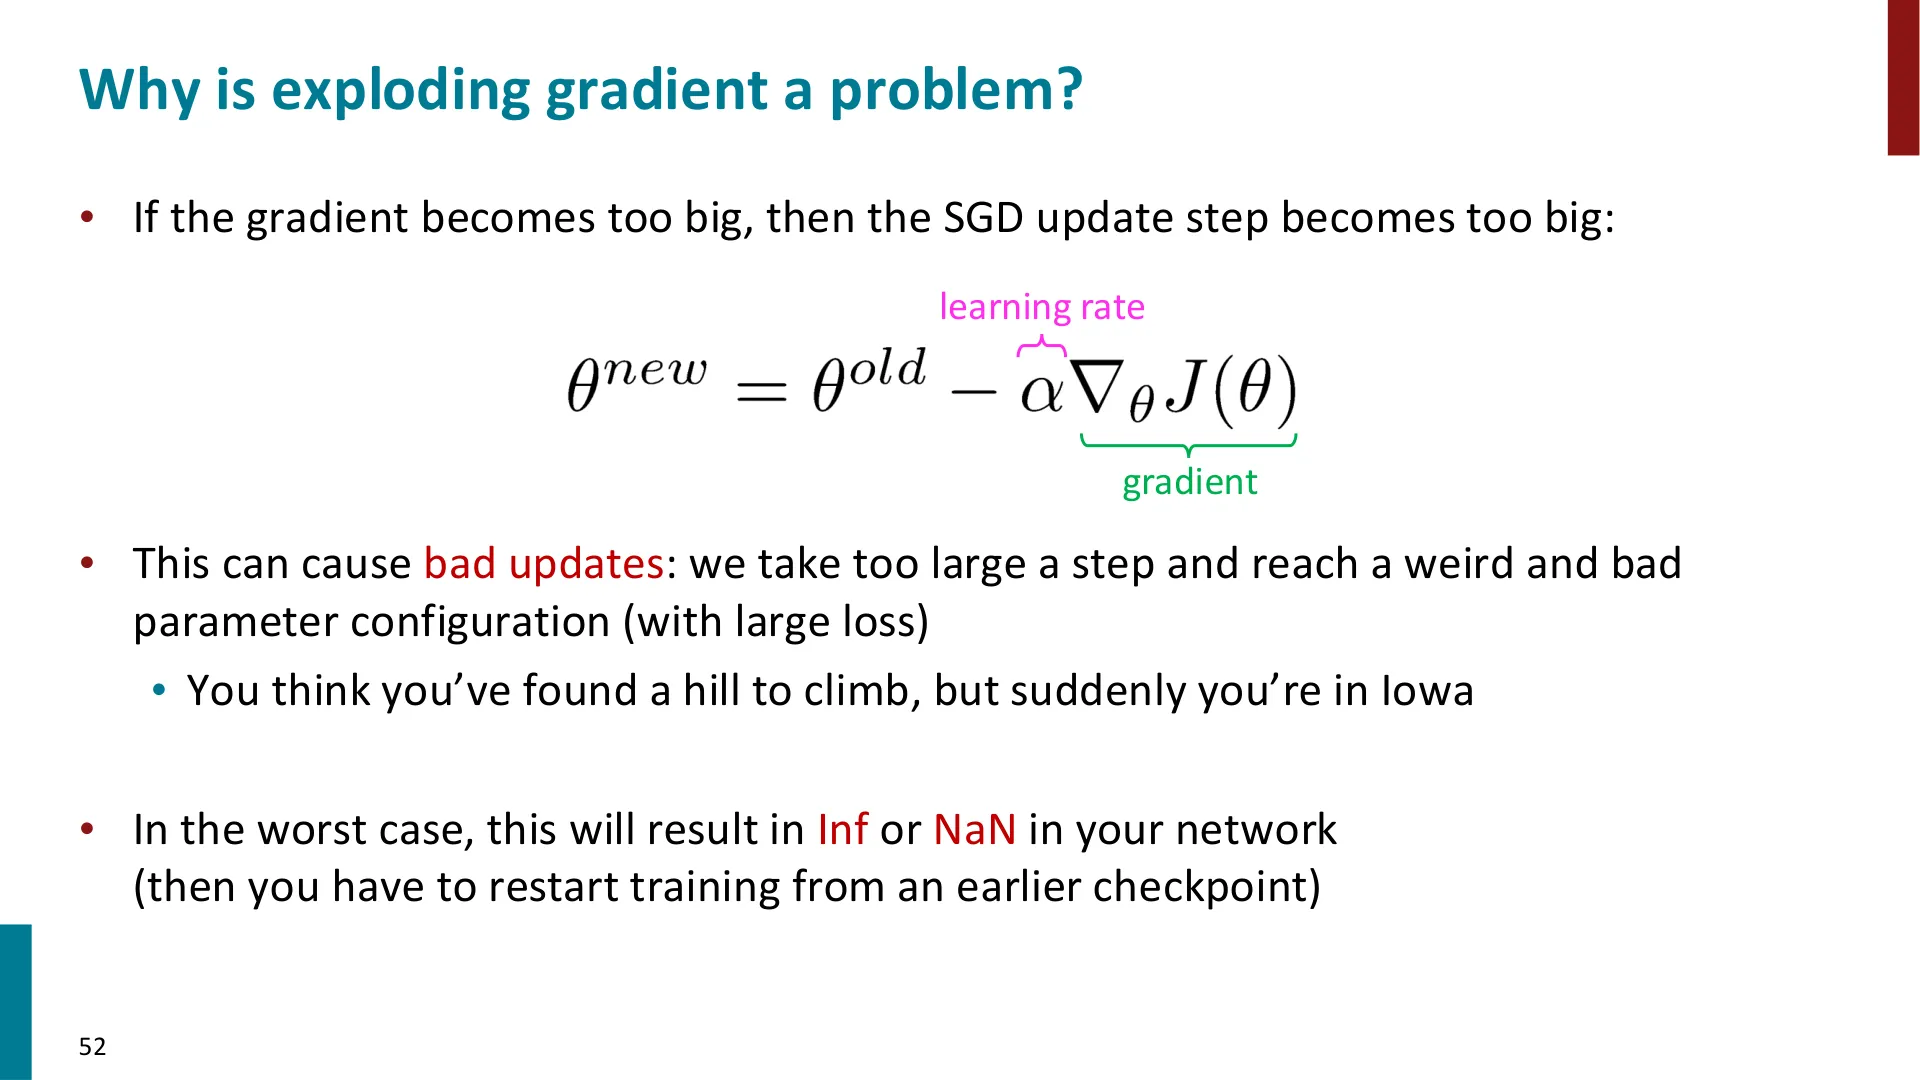
- SLIDE:48 — 为什么梯度爆炸是问题:SGD 步子过大 → 坏更新 → Inf/NaN
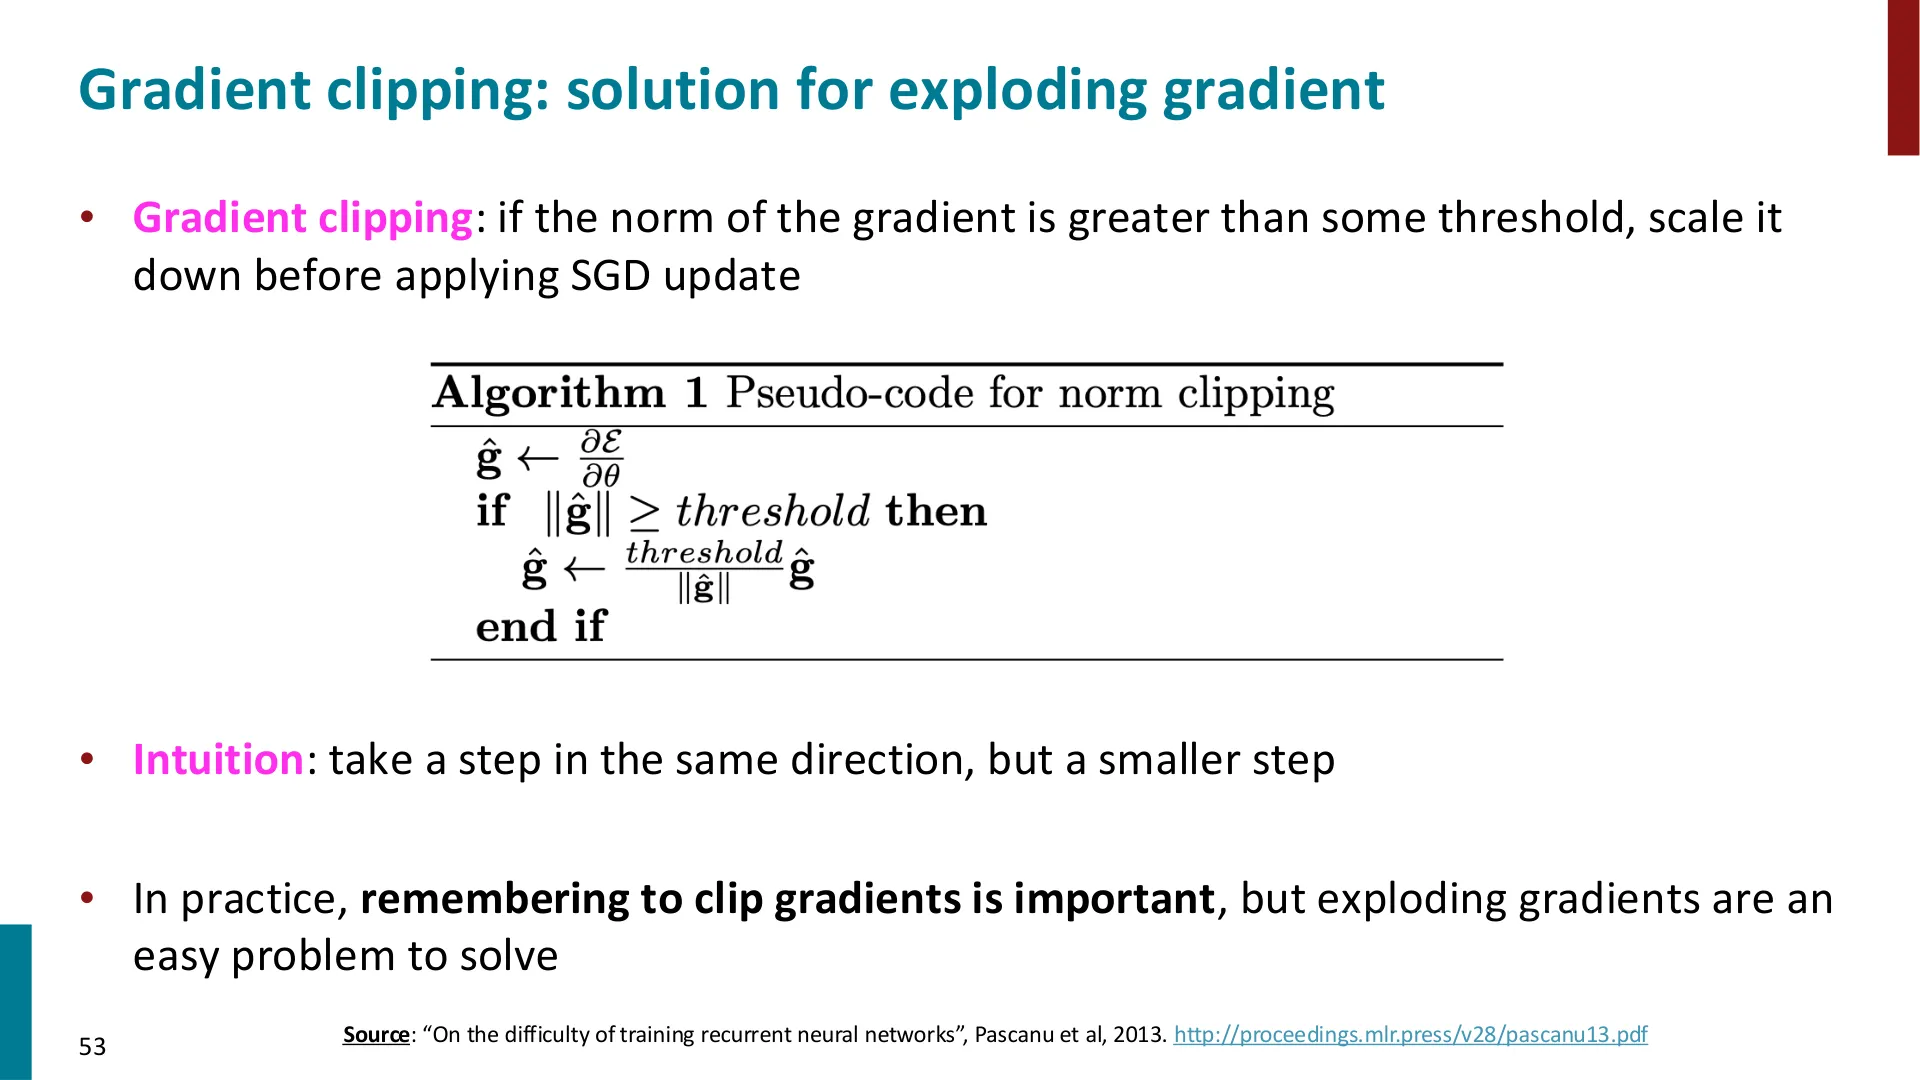
- SLIDE:49 — 梯度裁剪(gradient clipping):梯度范数超过阈值就按比例缩小
-
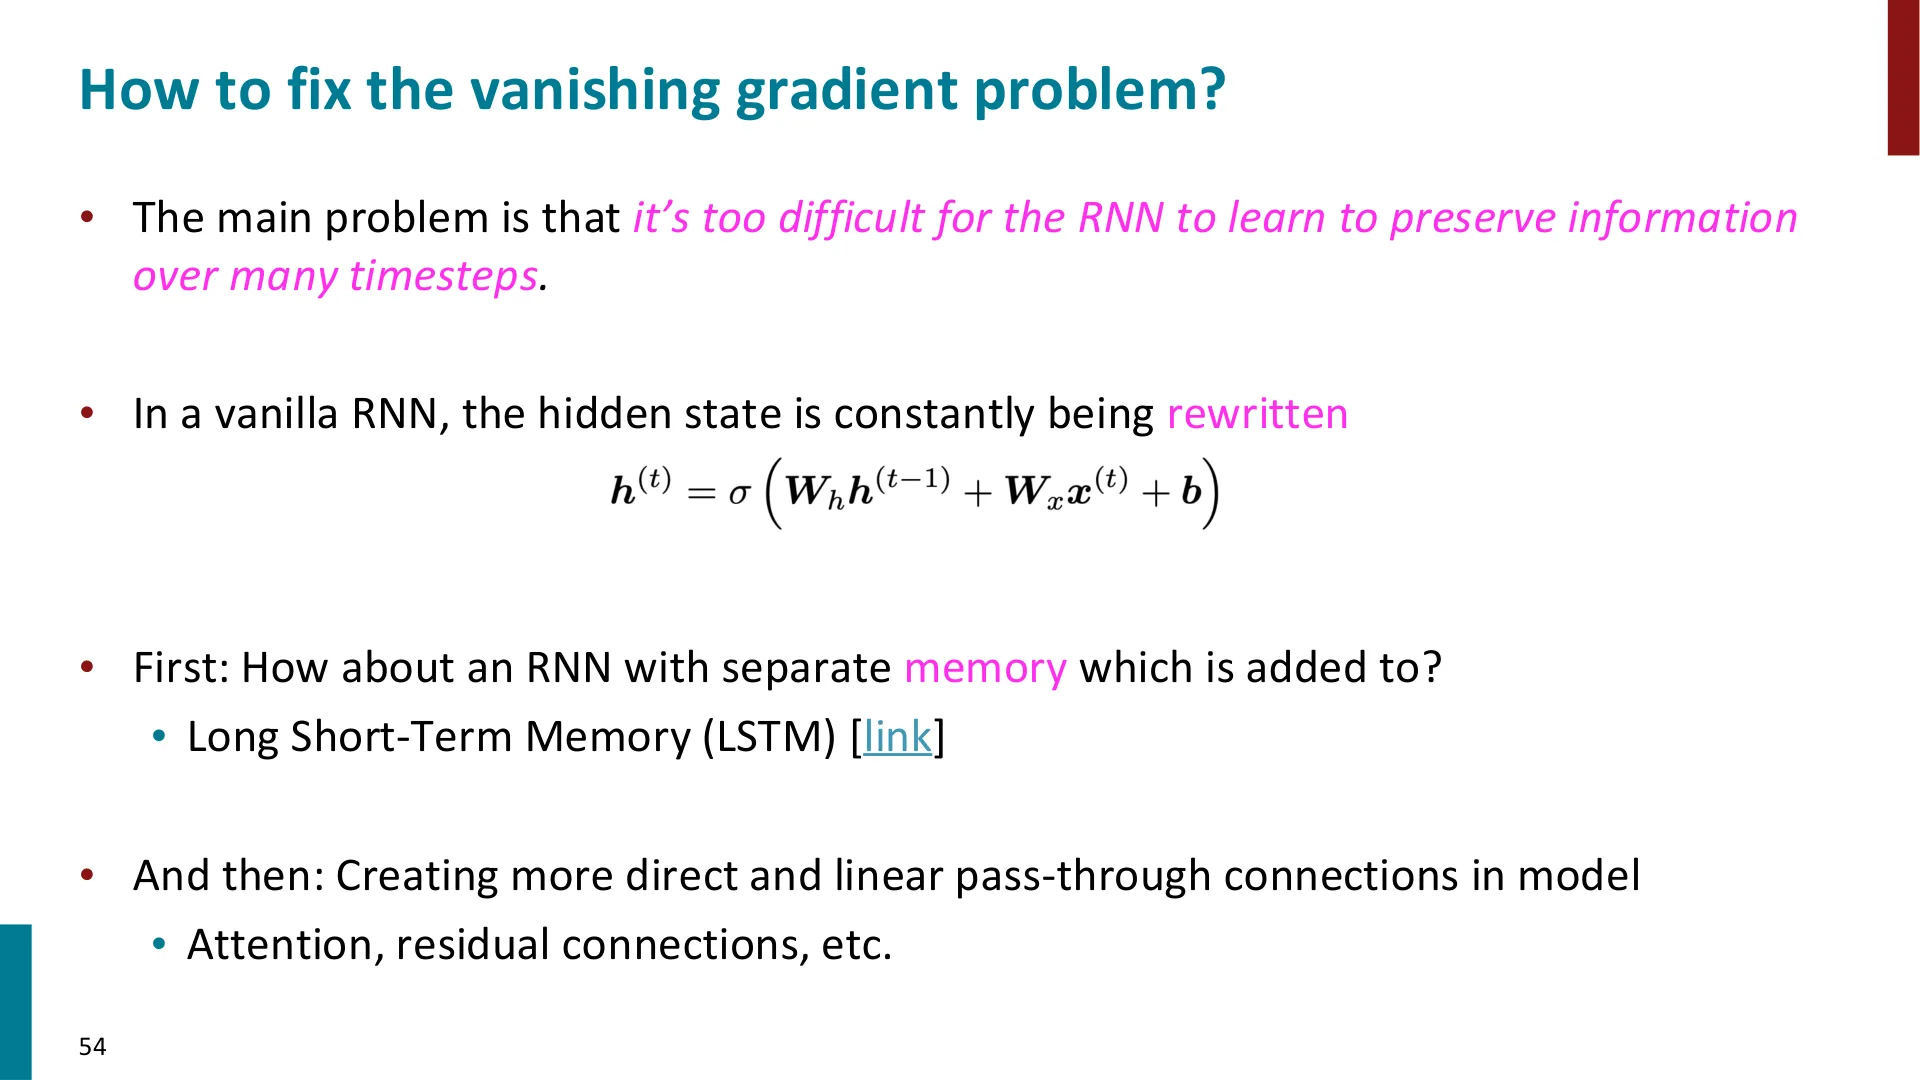
SLIDE:50 — 如何缓解梯度消失:独立记忆(LSTM)、更直接的直连通道(Attention、残差连接)
-
Machine Translation(第 51–58 页)
-
SLIDE:51 — 机���翻译任务定义(把源语言句子 $x$ 译成目标语言句子 $y$)
- SLIDE:52 — NMT:NLP 深度学习的第一个大成功故事(2014 首篇 seq2seq,2016 Google Translate 转向 NMT)
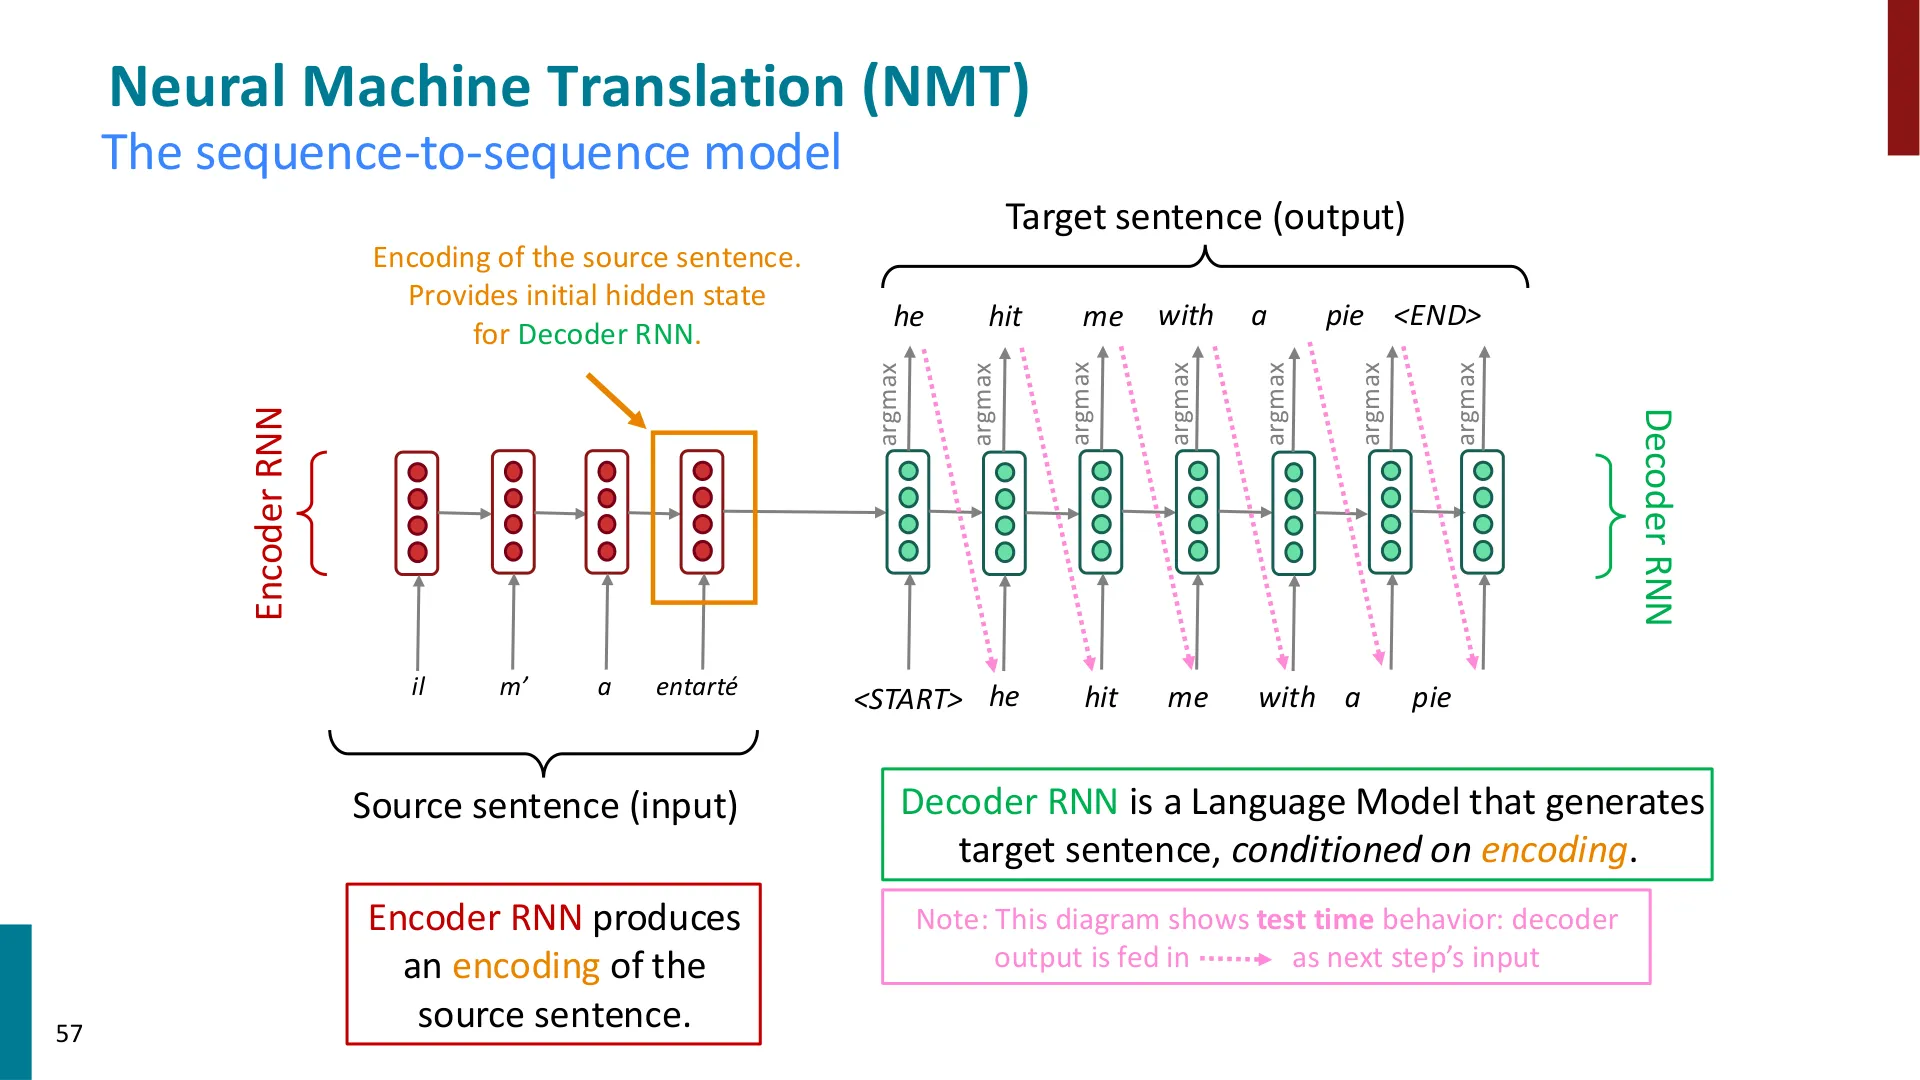
- SLIDE:53 — 序列到序列模型(编码器 RNN + 解码器 RNN)
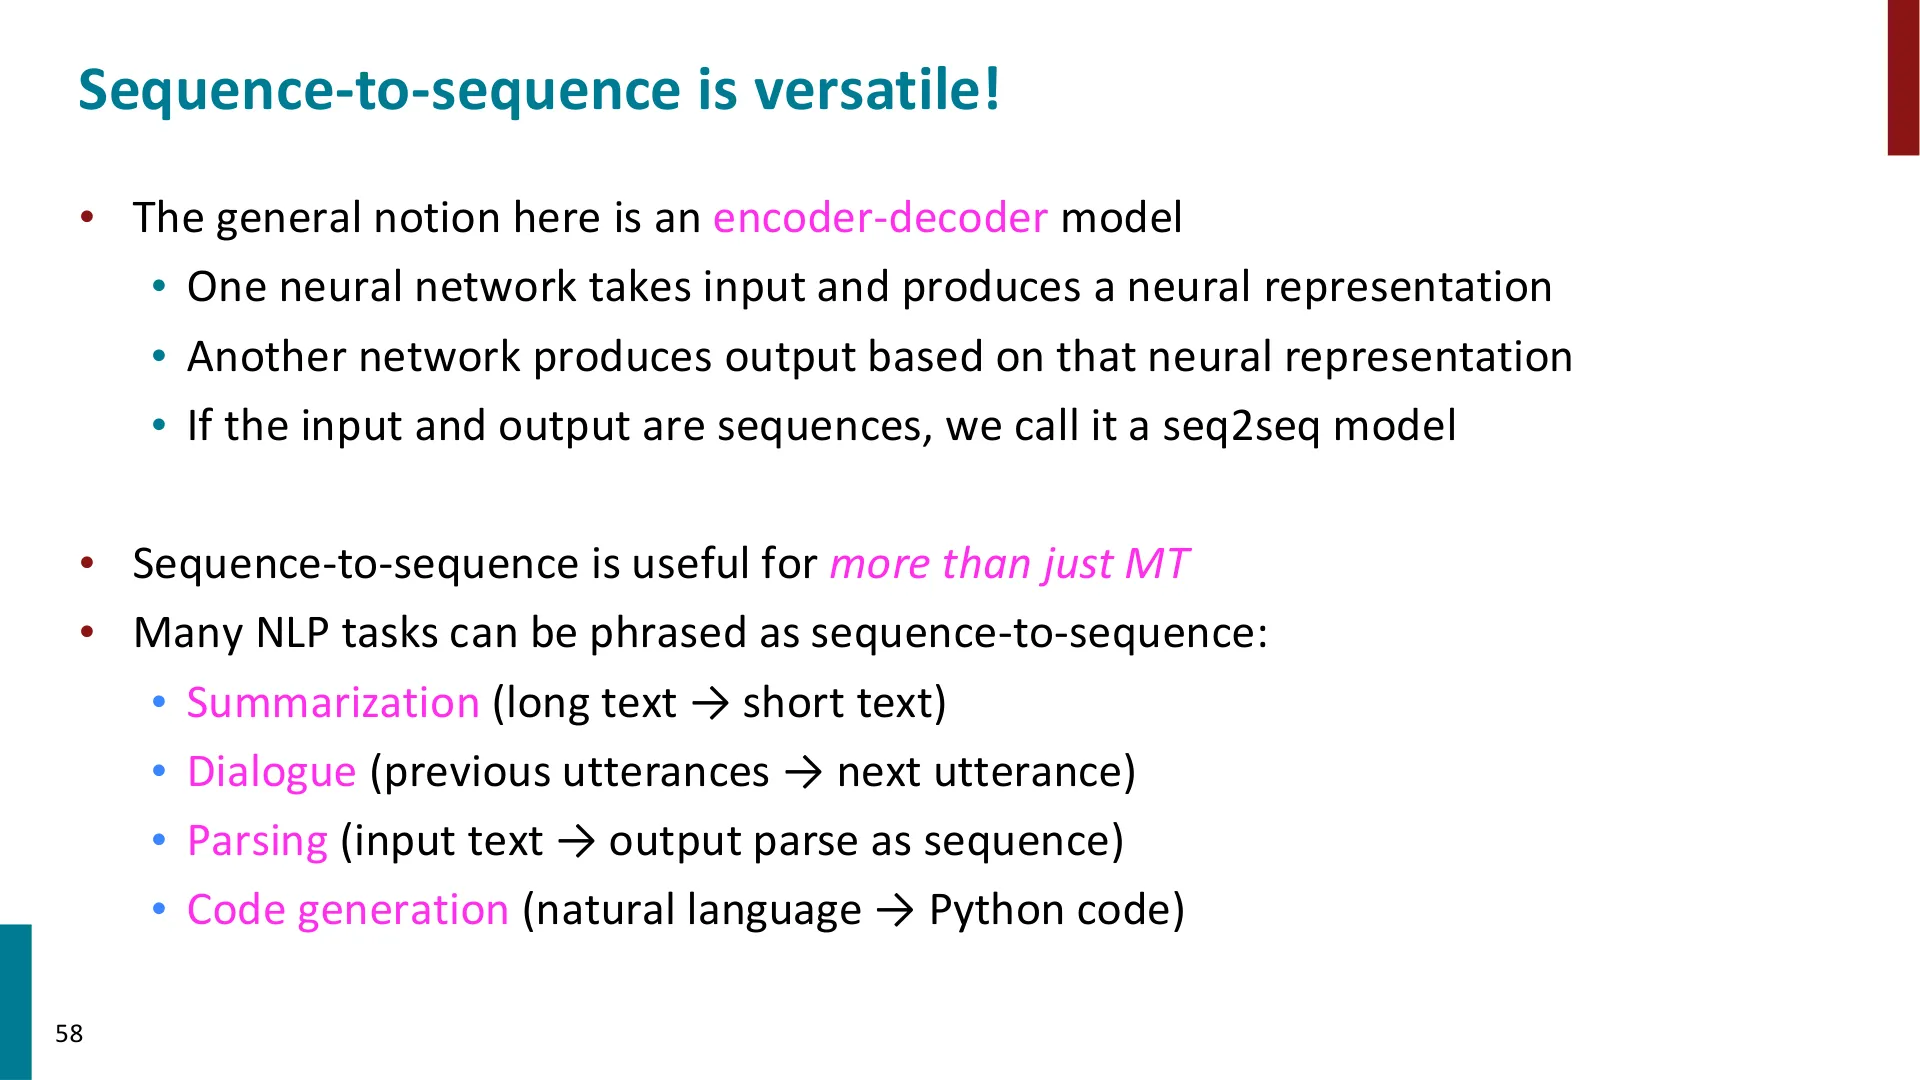
- SLIDE:54 — seq2seq 的通用性:摘要、对话、句法分析、代码生成
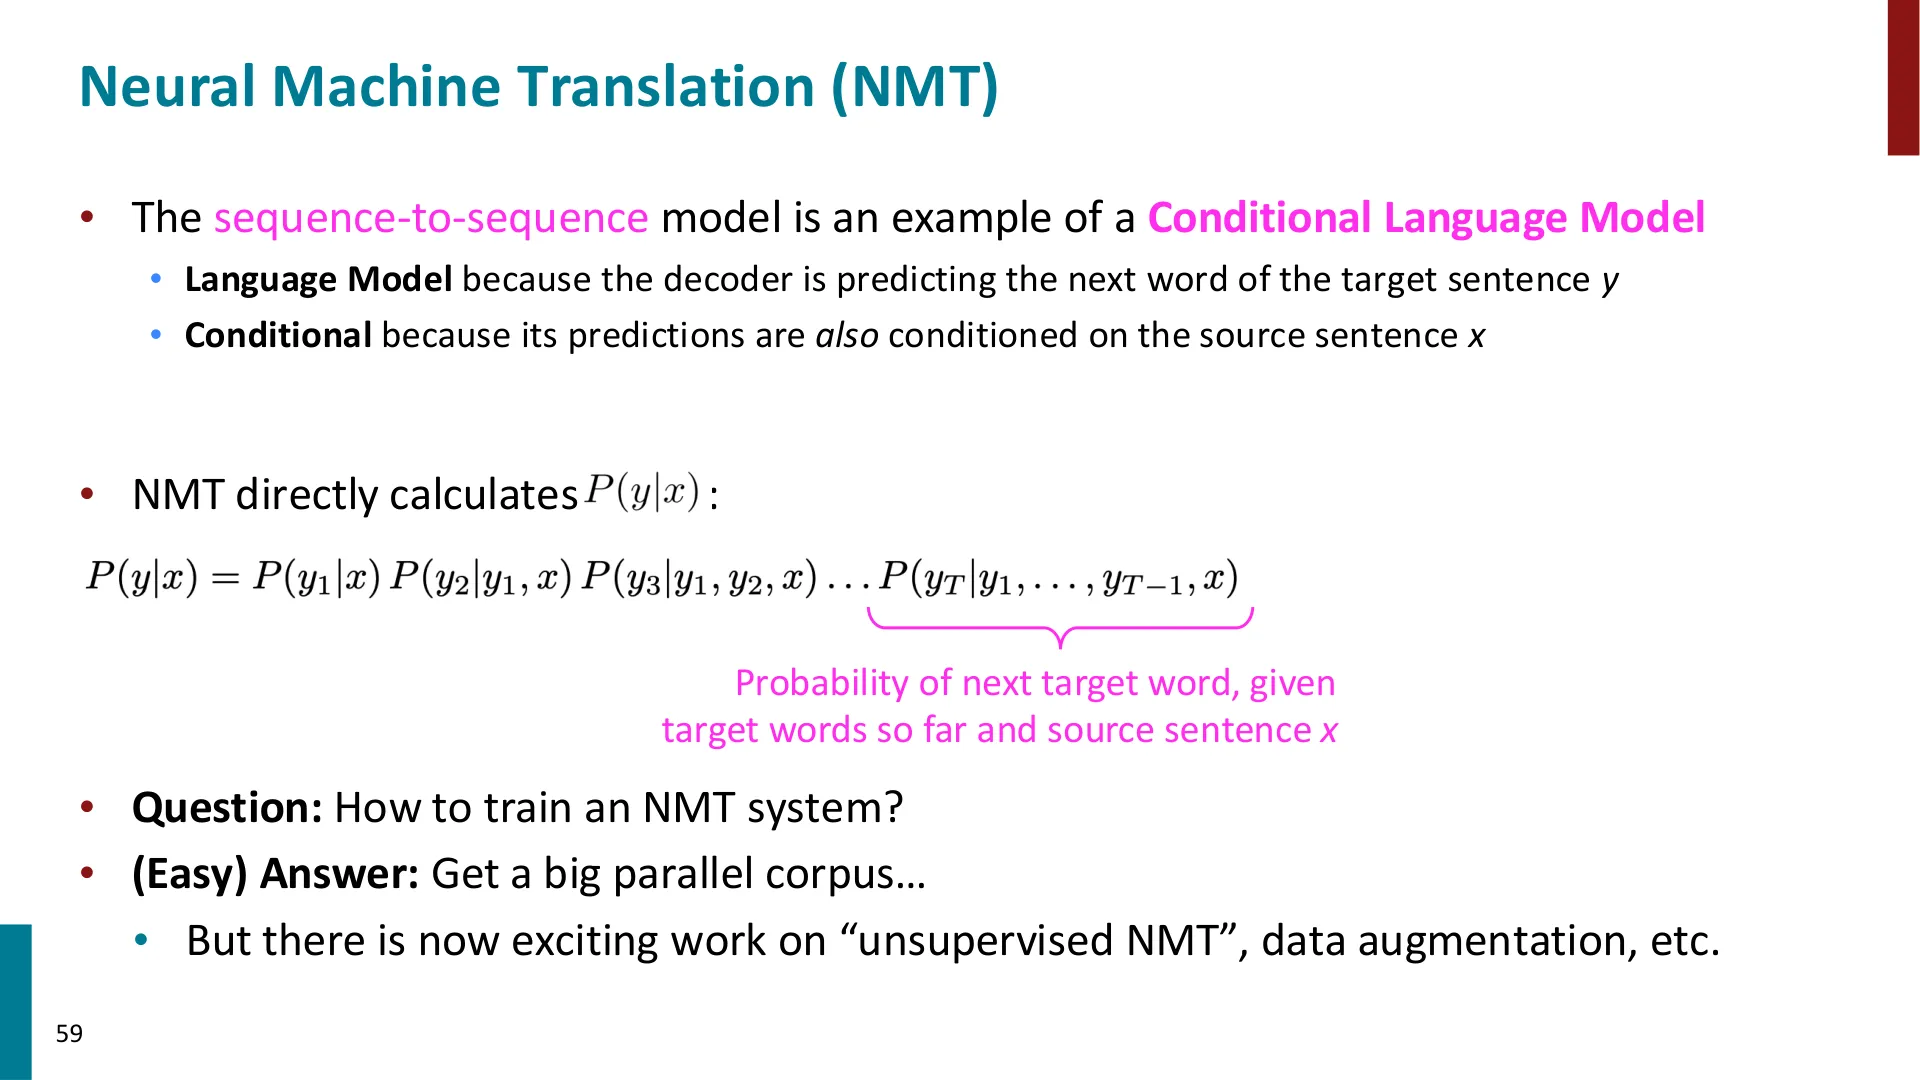
- SLIDE:55 — NMT 是一种条件语言模型:计算 $P(y \mid x)$
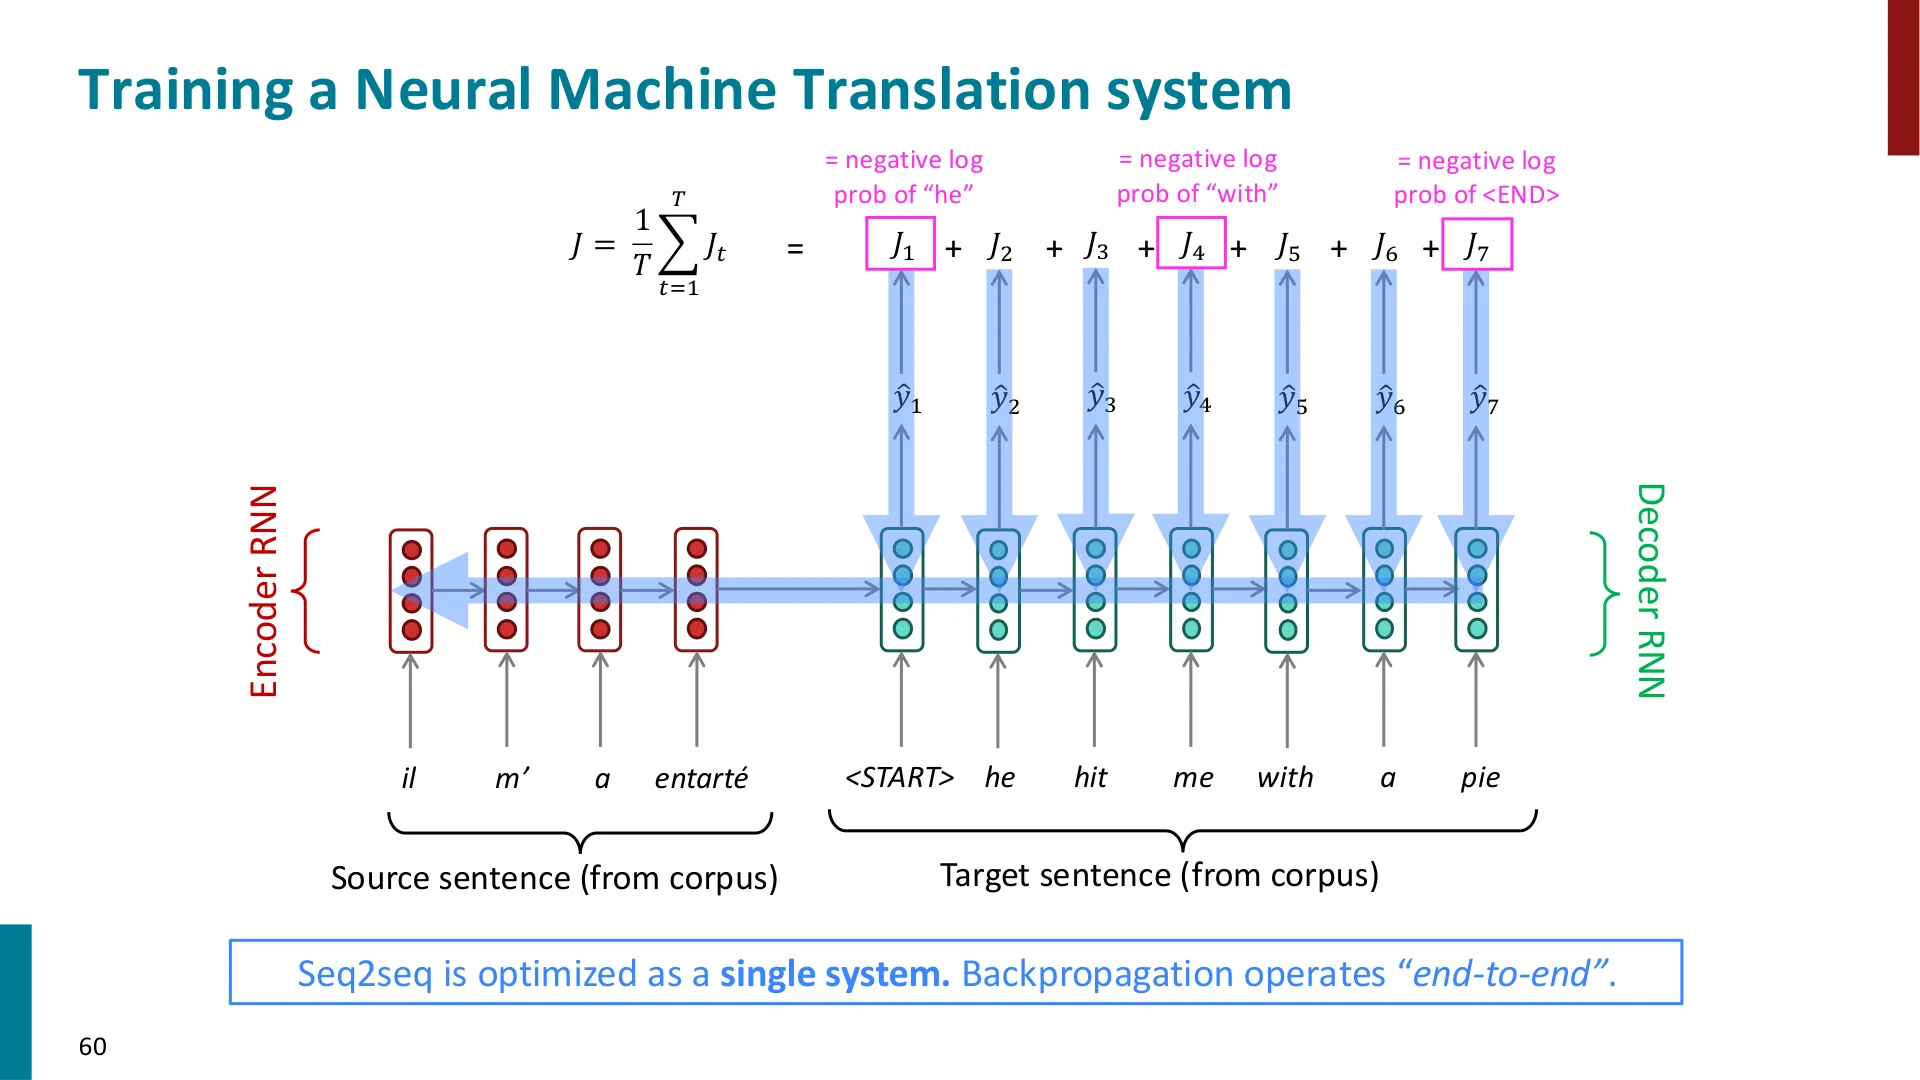
- SLIDE:56 — 训练 NMT 系统:端到端、以 $\frac{1}{T}\sum_t J_t$ 为目标的负对数似然
- SLIDE:57 — 多层深度的编码器-解码器翻译网络
- SLIDE:58 — 最后一块拼图:RNN 中的瓶颈(bottleneck)问题
其它
- SLIDE:59 — Lecture Plan(与第 2 页相同的课程计划页;课堂开头已展示,此处为讲义末尾的重复页)
附:参考与延伸阅读
编者补充
- Google Books Ngram Viewer
- https://web.stanford.edu/class/cs224n/
- Lecture 5 - Recurrent Neural Networks(Spring 2024)
- Python
- PyTorch
- RNN
- Transformer
已知疑点
以下是编者在重构过程中无法完全确定的地方,逐条列出,并给出依据或时间点。若某处确实没有疑点,本节也会保留——因为省略会让读者分不清"没有"和"没查"。
-
课程资料与视频版本不一致。 视频标题是 "Spring 2024 | Lecture 5",但提供的讲义文件名是
cs224n-2026-lecture04-rnnlm.pdf、标题也写作 "Lecture 4: Language Models and Recurrent Neural Networks",作者署名为 Diyi Yang。讲义与视频很可能来自不同年份的课程开设。据此,正文中的讲义页号、章节编号可能与视频当时的幻灯片略有出入;本书对涉及的页号以提供的slides_text.md为准。 -
讲师身份未在字幕中出现。 视频标题与字幕都没有点出本讲授课人是谁。讲义署名是 Diyi Yang,但 2024 年该讲是否由其讲授无法从材料确认。本书信息块因此未强行署名。
-
部分幻灯片"是否展示过"无法从字幕判定。 第 8 页(What can you do with next-word prediction?)、第 39 页(Evaluating Language Models / 困惑度)在字幕里找不到对应话语。编者把第 39 页与梯度、机器翻译等页一并放入附录;把第 8 页保留在正文语言模型一节(因其处在字幕明确对应的第 5–7 页之后)。这一取舍有不确定性。
-
本讲确实没有讲到梯度消失/爆炸与机器翻译。 字幕在 01:18:44 明确收尾:"I'll stop there for today and do more of the science of neural networks next time.";且 00:57:26 处讲师说梯度相关问题"下次课(周四)再讲"。故第 40–58 页归入附录。
-
若干专有名词疑似 ASR 音误,编者已据上下文猜测,但不敢断言:
- "Jerry Torro"(早期用神经网络做自动驾驶的老师)——无法确定对应哪一位,可能与某位研究者的名字音近。未在正文中给定具体人名。
- "harier initialization"——据"按层的输入/输出数量决定方差"这一描述,应为 Xavier/Glorot 初始化(或 He 初始化)。正文以此为准并标注。
- "adrad"——应为 Adagrad;"John duci" 即 John Duchi。
-
"Stefan varer"——应为斯坦福的 Stefan Wager(Dropout 作为"特征相关正则化"的工作)。
-
数字与细节: n-gram 演示语料的规模("200 万词""1.7 百万词路透社语料")在两处幻灯片里略有差异,正文以讲师口述的"200 万词训练数据"和讲义标注为准;Google n-grams 的"万亿词"规模取自字幕与讲义。
-
时间锚点已取整到秒。 字幕时间戳偶有跳变(如
01:02:46之后出现00:02:51),本书统一按语义就近取整,可能与原始画面存在几秒误差。 -
颜色名称示例(
gasty pink、bco white、hble gray、Home Star Brown等)本身是模型生成的、且经字幕转录,拼写未必与模型实际输出完全一致,仅为示意。
附录:课堂未展示的幻灯片
🖼️ 第 2 页幻灯片 · Lecture Plan
🖼️ 第 40 页幻灯片 · 3. Problems with RNNs: Vanishing and Exploding Gradients
🖼️ 第 41 页幻灯片 · Vanishing gradient intuition
🖼️ 第 42 页幻灯片 · Vanishing gradient intuition
🖼️ 第 43 页幻灯片 · Vanishing gradient intuition
🖼️ 第 44 页幻灯片 · Vanishing gradient intuition
🖼️ 第 45 页幻灯片 · Vanishing gradient intuition
🖼️ 第 46 页幻灯片 · Why is vanishing gradient a problem?
🖼️ 第 47 页幻灯片 · Effect of vanishing gradient on RNN-LM
🖼️ 第 48 页幻灯片 · Why is exploding gradient a problem?
🖼️ 第 49 页幻灯片 · Gradient clipping: solution for exploding gradient
🖼️ 第 50 页幻灯片 · How to fix the vanishing gradient problem?
🖼️ 第 51 页幻灯片 · 5. Machine Translation
🖼️ 第 52 页幻灯片 · NMT: the first big success story of NLP Deep Learning
🖼️ 第 53 页幻灯片 · Encoder RNN
🖼️ 第 54 页幻灯片 · Sequence-to-sequence is versatile!
🖼️ 第 55 页幻灯片 · Neural Machine Translation (NMT)
🖼️ 第 56 页幻灯片 · Training a Neural Machine Translation system
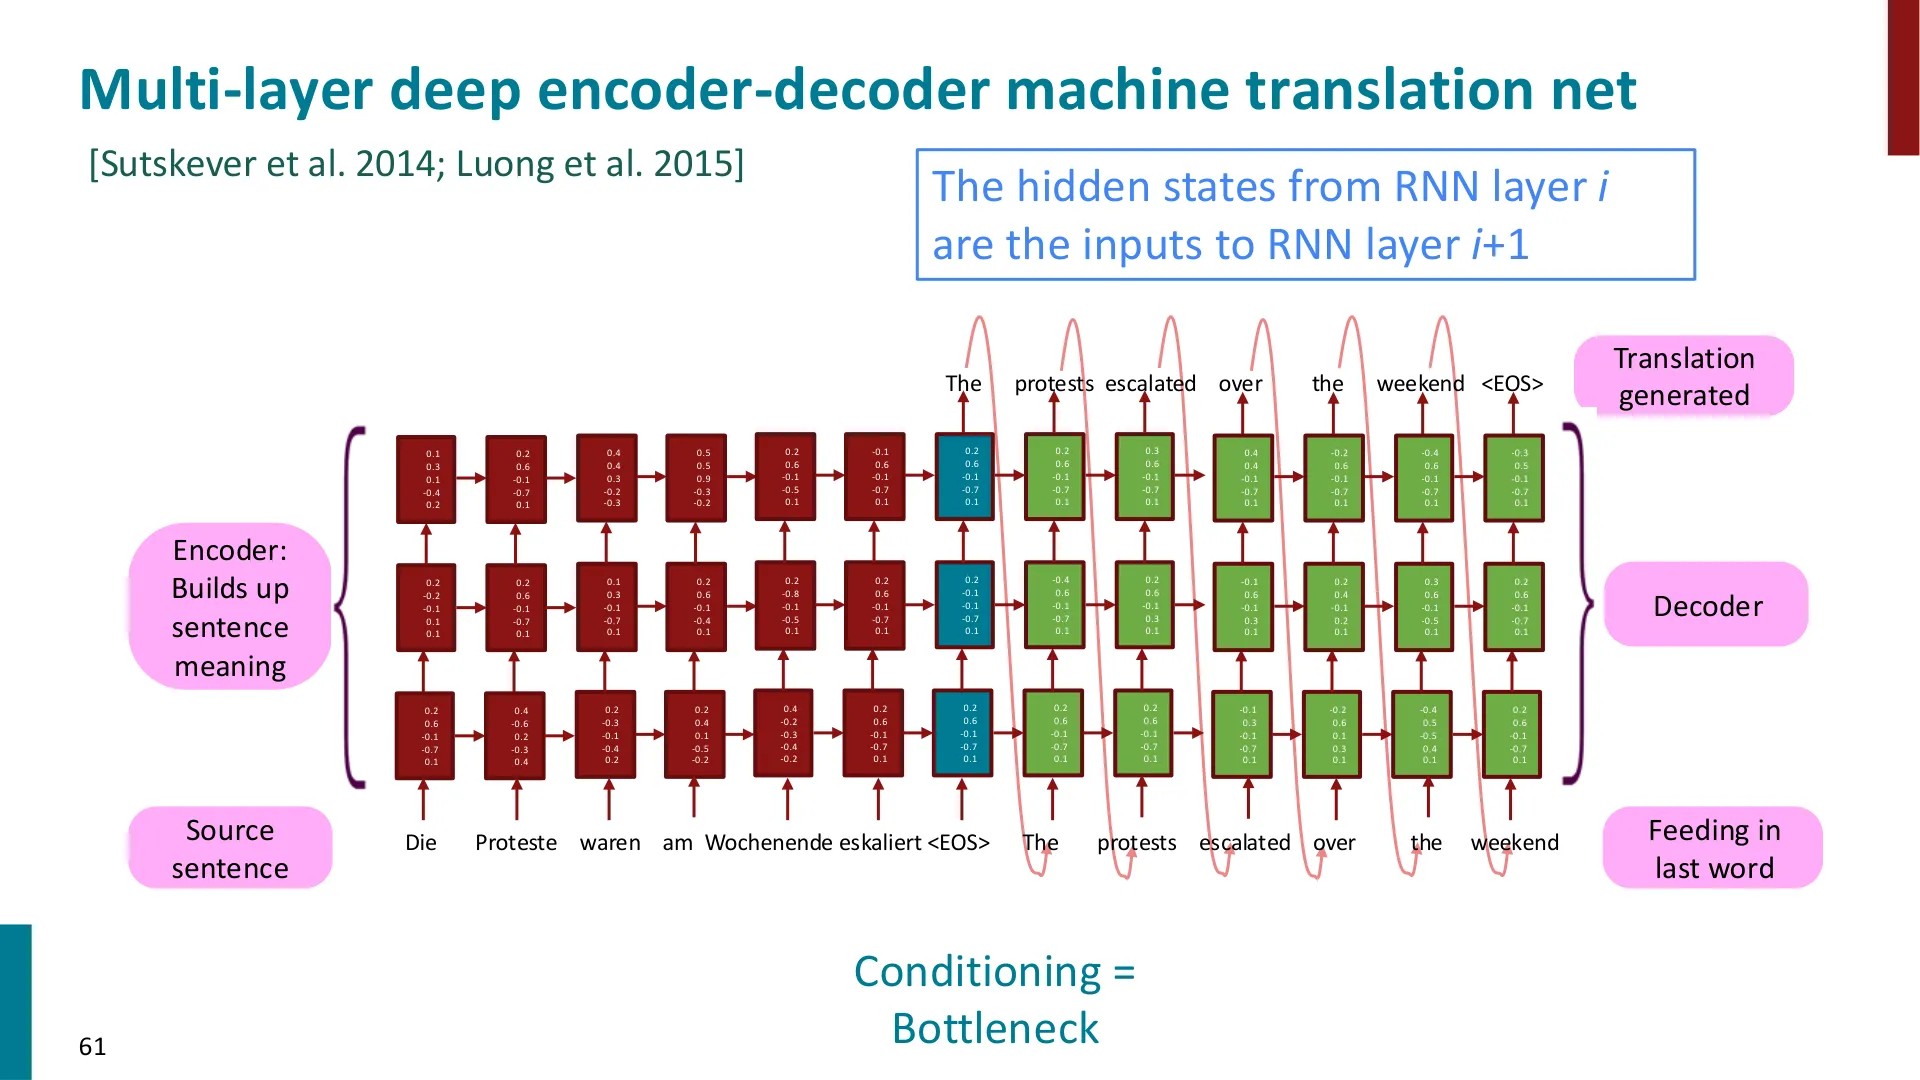
🖼️ 第 57 页幻灯片 · Multi-layer deep encoder-decoder machine translation net
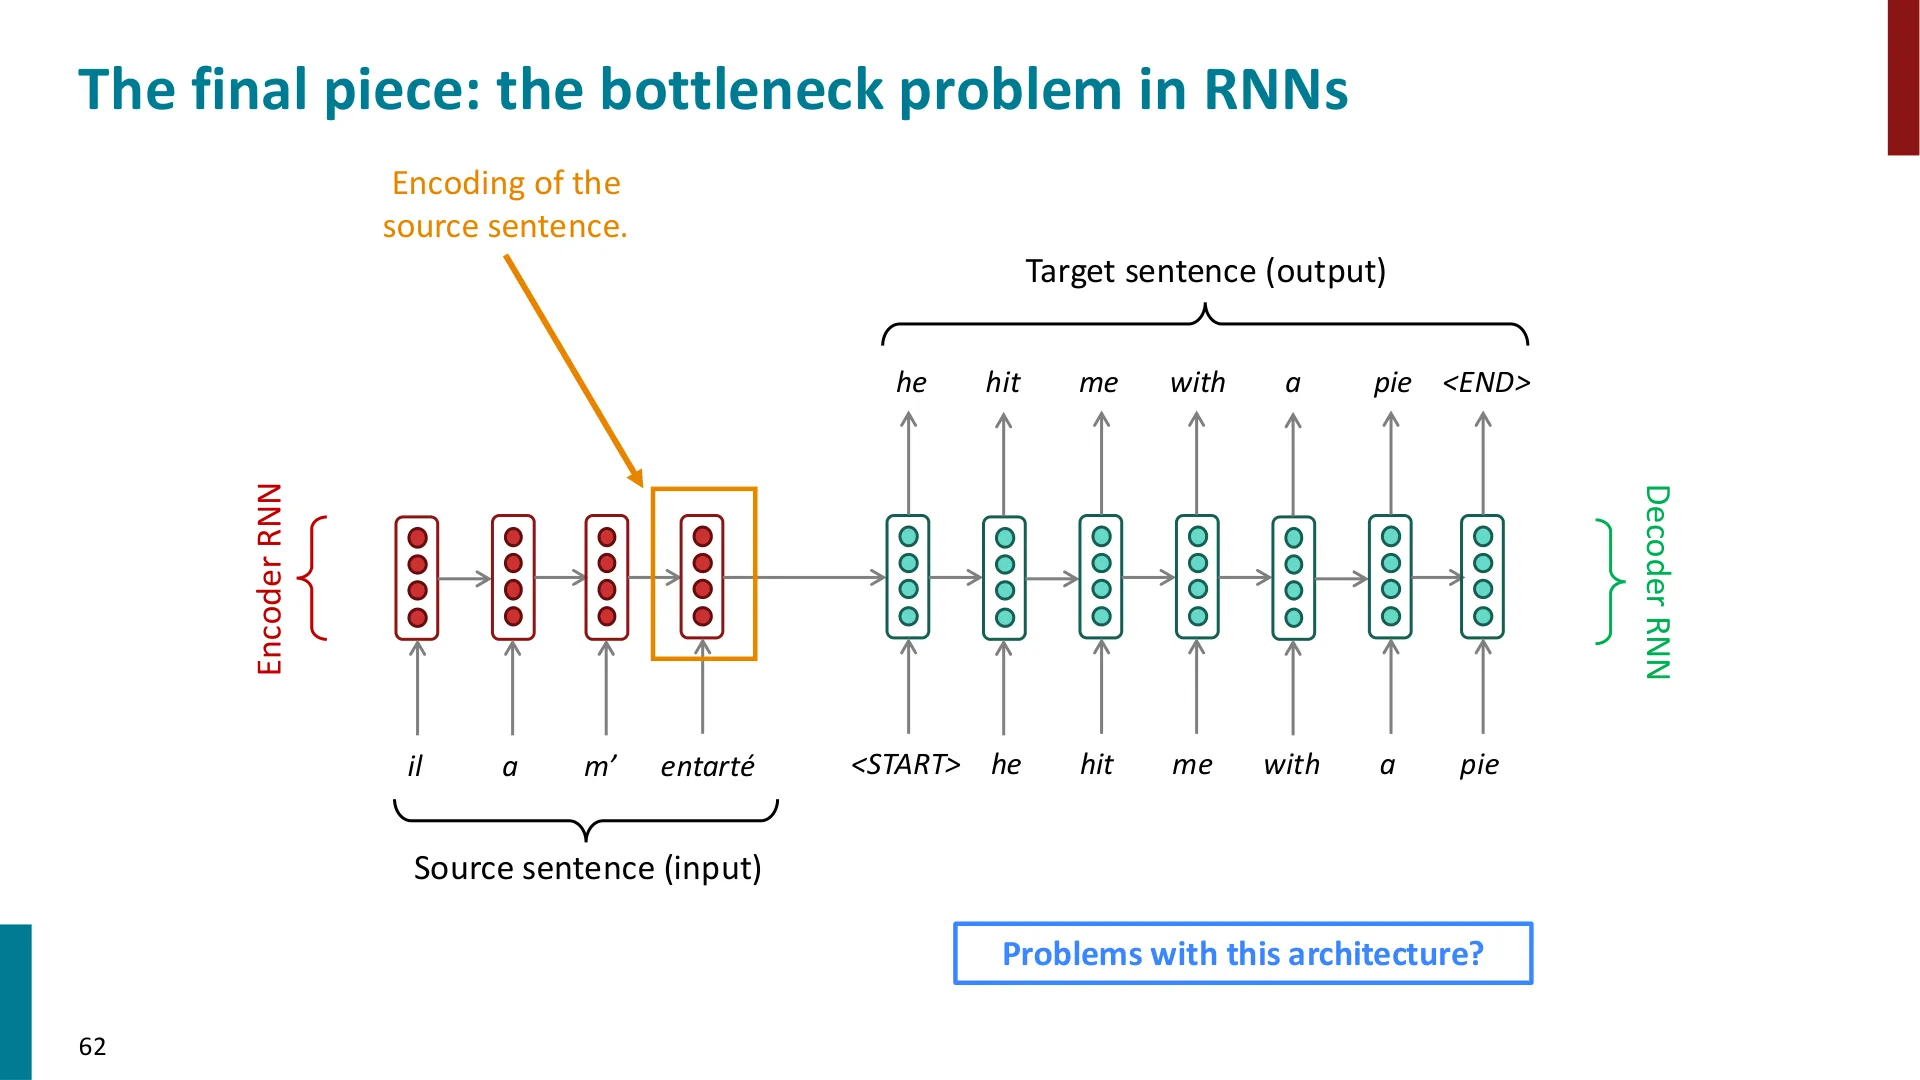
🖼️ 第 58 页幻灯片 · The final piece: the bottleneck problem in RNNs
🖼️ 第 59 页幻灯片 · Lecture Plan