第5讲 · CS224N 深度学习自然语言处理:自注意力与 Transformer
| 课程 | Stanford CS224N / Ling284 · Natural Language Processing with Deep Learning |
| 本讲 | Self-Attention and Transformers(本视频为 2023 年录制版,对应课程第 8 讲) |
| 视频地址 | https://www.youtube.com/watch?v=LWMzyfvuehA |
| 官方幻灯片 | cs224n-2026-lecture05-transformers.pdf(Lecture 5: Attention and Transformers,作者 Diyi Yang) |
| 课程主页 | https://web.stanford.edu/class/cs224n/ |
| 版本提示 | 本视频录制于 2023 年,而随书附带的幻灯片是 2026 年版(视频为第 8 讲、幻灯片为第 5 讲)。两者的编号与内容并不完全对应,书中凡是「课堂未展示的幻灯片」都集中收在文末附录里,具体差异见「已知疑点」。 |
| 版权与署名 | 课程讲义与幻灯片版权归 Stanford University 及其作者所有,通常以 Creative Commons 系列许可(如 CC BY-NC-SA)发布。引用、转载请以课程主页标注的许可名与署名为准。 |
对应讲次:第5讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
导览
这是一张「问题地图」,帮助你在 3–5 分钟内知道这一讲要解决什么、卡在哪里,以及大致路线。
① 老师这一讲真正想回答的问题(按他本人的提问与顺序)
- 我们过去处理 NLP 问题的「标准打法」是:用双向 LSTM 编码源句、用单向 LSTM 逐步解码,再配上注意力去灵活访问记忆。这套东西工作得很好。那么——循环网络到底有什么毛病?
- 具体有两个毛病:一个是 线性交互距离(相隔很远的词,要在网络里走很多步才能「相遇」),另一个是依赖序列索引(前向/反向传播有 O(序列长度) 个没法并行的操作)。那么——能不能干脆不要循环,只留下注意力?
- 如果只用注意力,会缺什么?需要补上哪些「最小零件」,它才能当作 LSTM 的直接替代品?
- 补全之后就是 Transformer。它长什么样?为什么好用?还有什么没解决的问题?
② 难点在哪
- 自注意力本质上是「在集合上做的一次无序加权平均」:它不懂顺序、里面没有非线性、还会偷看未来。理解「为什么必须补上位置编码 / 前馈网络 / 掩码」这条推理链,是本节最容易卡住、也最值钱的地方。
- 多头注意力在矩阵层面怎么高效实现(reshape 成
n×h×(d/h)、把「头」轴当成 batch 轴)——初学者容易在这里失去画面感。 - 层归一化的统计量到底在哪个维度上算(答案会让你意外:既不是跨词、也不是跨 batch)。
③ 读者可能带着什么疑问进来
(下面 ① 是老师课上真正被问到的问题;② 是「编者预判」的读者疑问,两者分开列出。)
- ① 老师课上亲口被问到的:为什么我们要学两套矩阵 Q 和 K,而不是只学一套?
e_ii(词看自己)会不会长得像「恒等」?既然担心长序列,为什么不把最大长度 n 设大一点就好?我怎么知道学出来的那个 P 矩阵真的在表示「位置」?掩码到底该给解码器用还是编码器也用?掩码跟机器翻译有什么关系? - ② 编者预判的读者疑问:既然有注意力了,为什么还要 Q、K、V 三套东西,不能像查字典一样直接匹配吗?位置编码为什么要用 sin/cos,学一个矩阵不行吗?掩码为什么用 −∞ 而不是直接把未来的词删掉?多头注意力会不会比单头更贵?层归一化和批归一化差在哪?Transformer 已经封神了吗?
④ 本讲路线(老师打算怎么走)
先回顾循环网络的毛病 → 讲清「注意力其实就是一种软查找」→ 给出自注意力的数学定义 → 逐个修补它的三个缺陷(顺序、非线性、掩码)→ 得到一个「最小自注意力模块」→ 升级为多头注意力 → 加上残差连接与层归一化 → 组装出 Transformer 解码器 / 编码器 / 编码器-解码器 → 最后看它带来的成果、局限与变体。
导览到此为止,下面进入正文。
一、回顾与动机:循环网络究竟卡在哪
(参考时间: 00:00:04)
整堂课的开场,老师先点题:这节课要讲的是自注意力与 Transformer——「这些想法几乎构成了现代自然语言处理、乃至广义上很多 AI 系统最前沿进展的基础」。
📷 本讲标题页
回到原视频 (00:00:04)
老师接着给出本讲的路线图,并顺带交代了几件事务性通知:新的讲义已经上线;作业四一周后截止;由于 Azure 环境不稳定,TA 已验证可以在 Colab 上跑通,训练量一台 Colab 就能完成,没有 GPU 的同学请用 Colab;期末项目提案今晚发布。
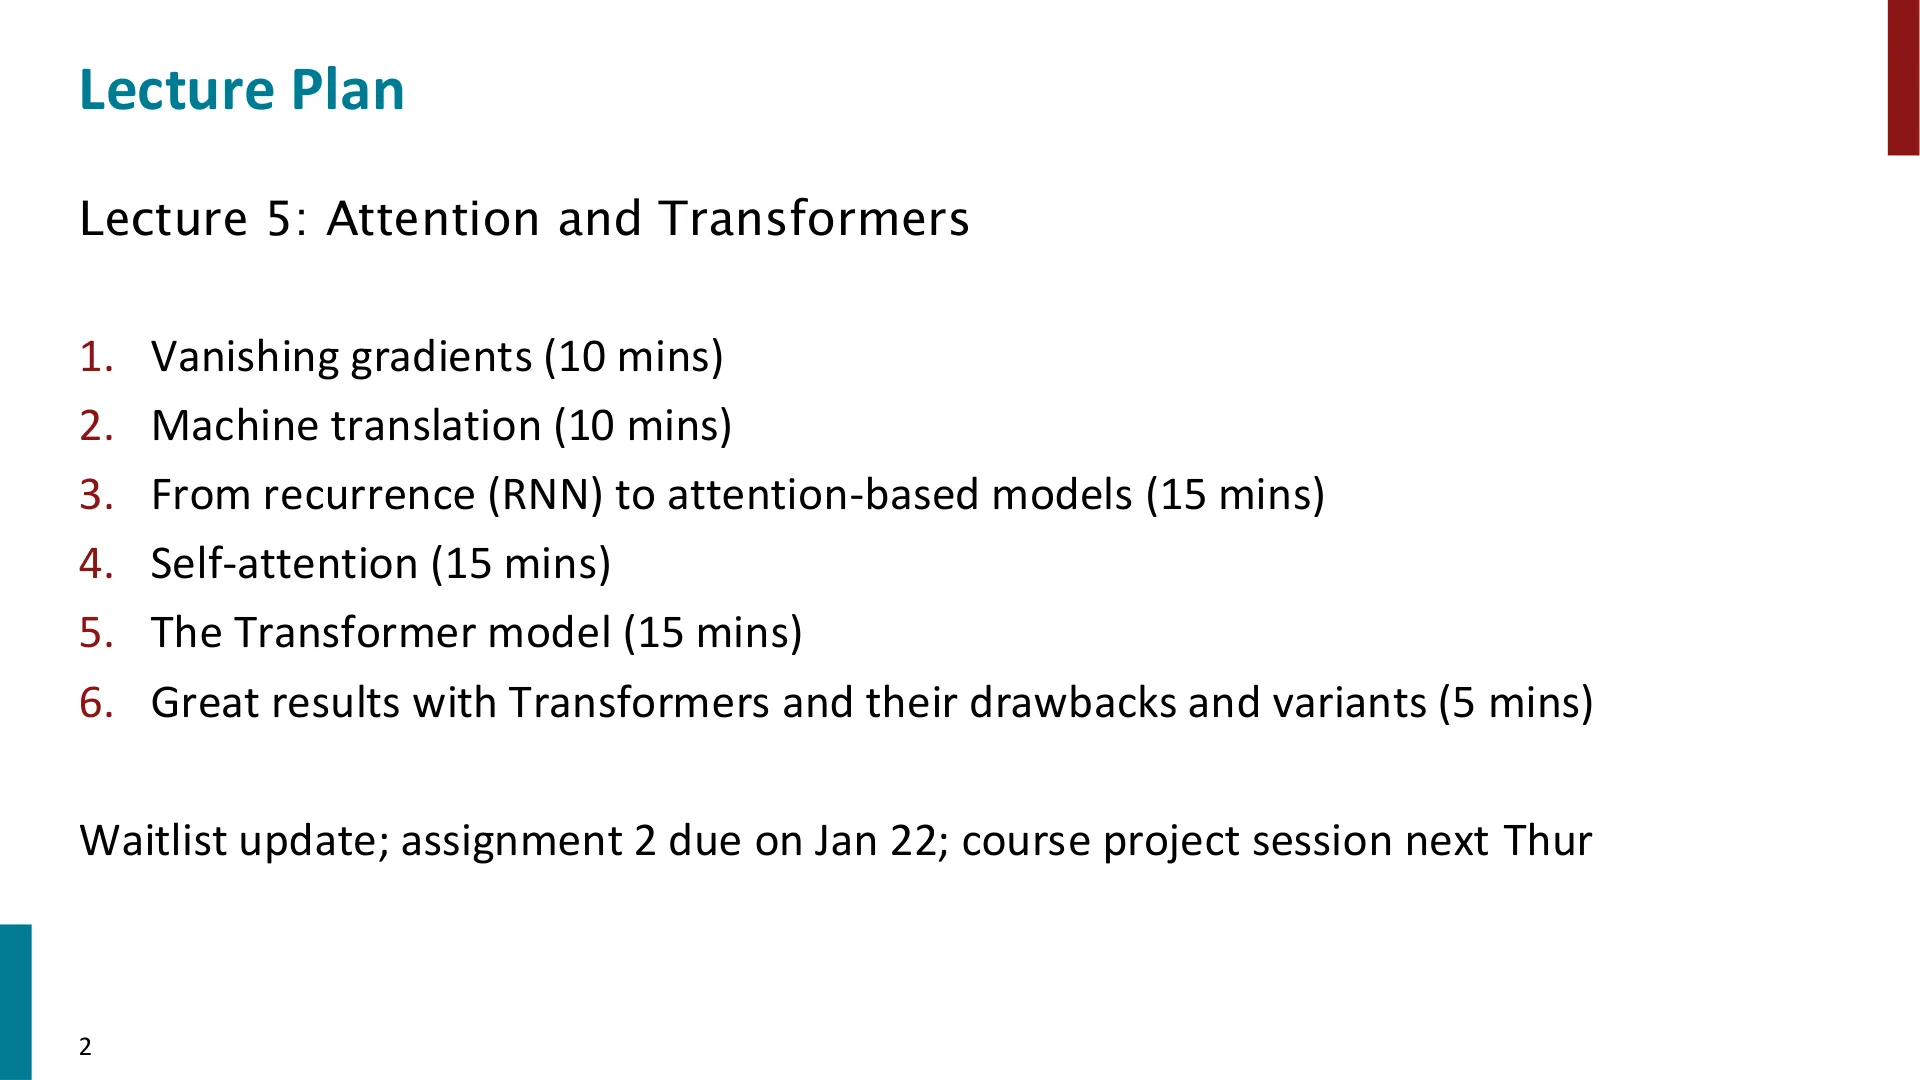
📷 本讲教学计划
回到原视频 (00:00:11)
编者说明:本视频是 2023 年录制版,事务性通知(作业、GPU 资源、期末项目)每年会变,这里只作背景保留。视频里提到的「作业四」是机器翻译相关的作业,「作业五」是自注意力相关的作业,与本节课的技术主题直接呼应。
1.1 过去的标准打法
(参考时间: 00:02:32)
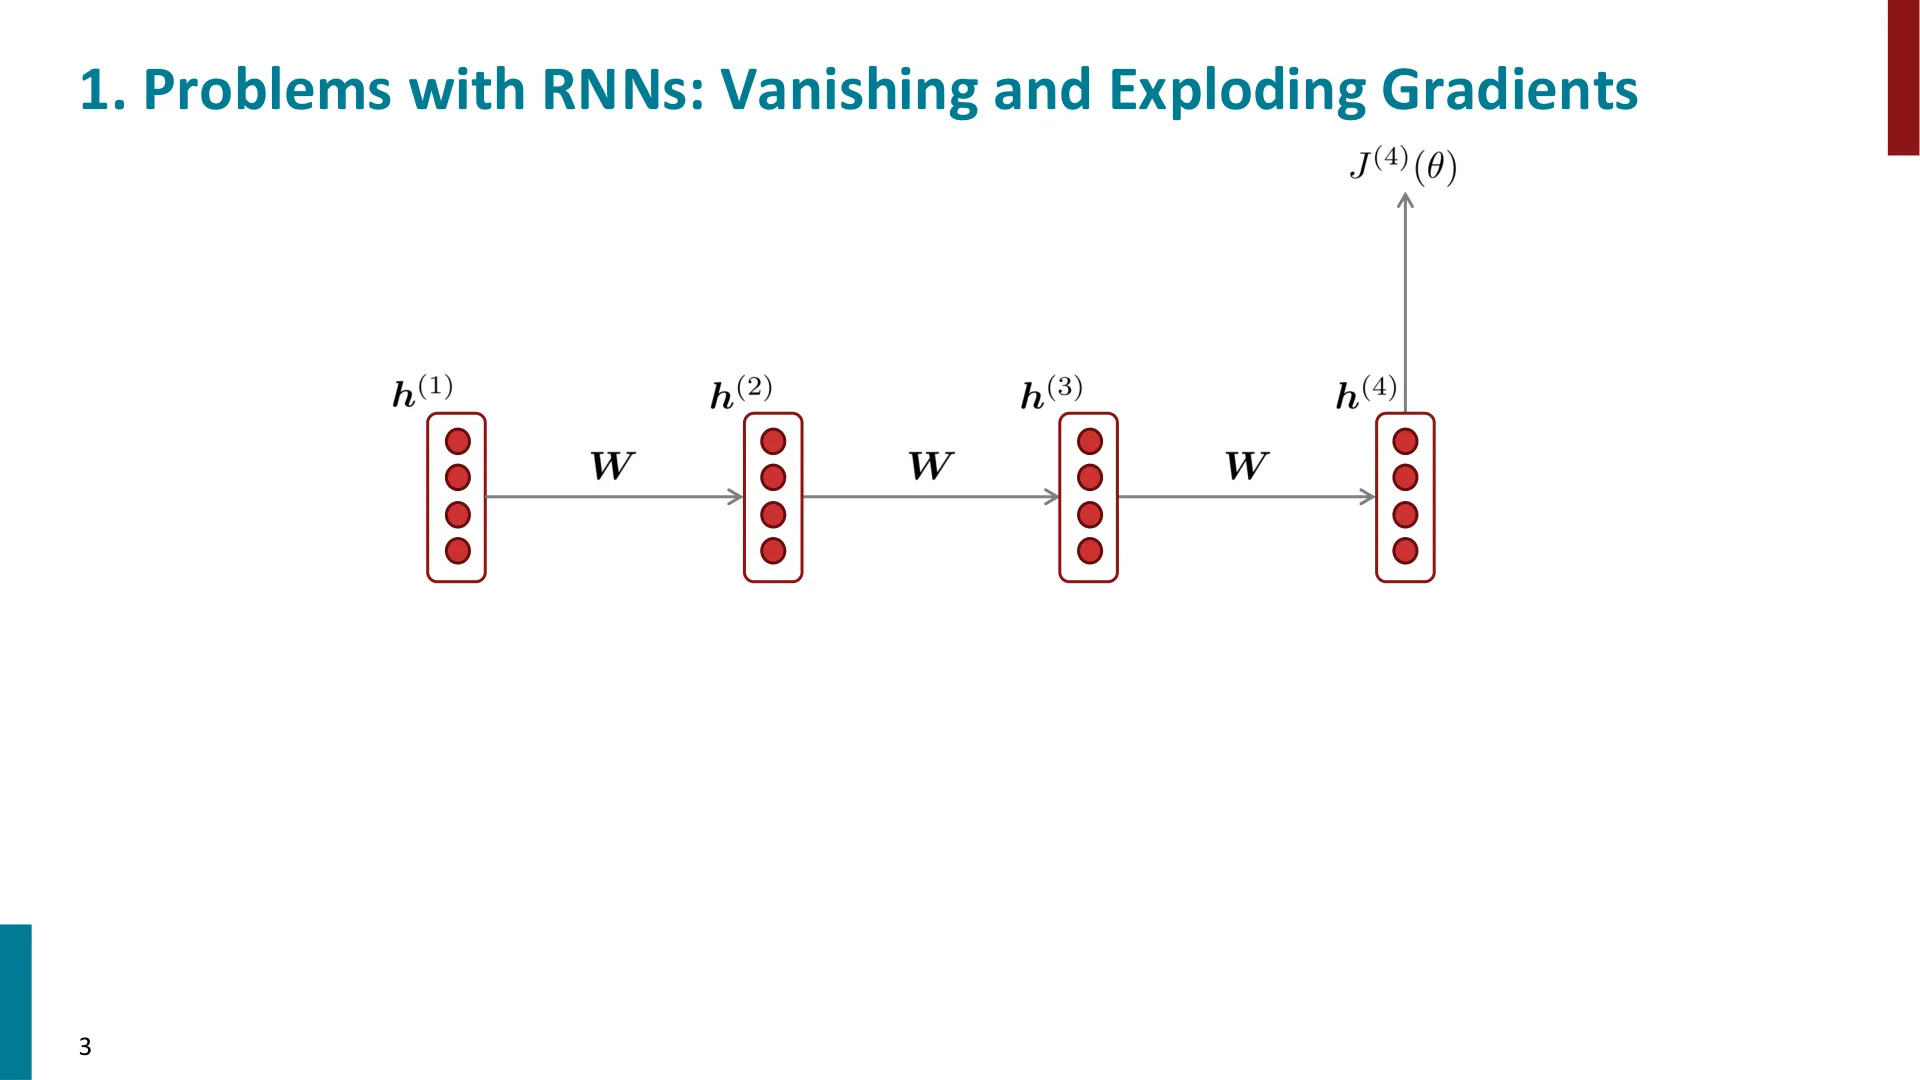
🖼️ 第 3 页幻灯片 · 1. Problems with RNNs: Vanishing and Exploding Gradients
老师先带大家「回头看」:以往遇到一个 NLP 问题,最朴素但很有效的做法是——
-
用双向 LSTM 编码源句,拿到双向上下文;
-
如果还要生成输出,就用一个单向 LSTM 逐词解码(翻译、句法分析等);
-
再配上注意力,让解码时可以「回头看」源句的相关位置,而不用把整句压进一个向量。
他特意强调这条动机链:当年就是为了做机器翻译,才引出注意力——因为「瓶颈」问题:你不想把整个源句都编码进单一向量。 而今天这节课目标相同、问题相同,只是换一套积木。
编者拓展|什么是「线性交互距离」 在循环网络里,两个词之间的信息要「流动」一次,就必须沿序列走一步。若两个词相隔 $k$ 个位置,反向传播就要穿过 $k$ 个循环权重矩阵的连乘。链条越长,梯度越容易消失或爆炸(这是循环网络的老毛病)。 这就是所谓的 线性交互距离:词与词之间「在计算图上的距离」与它们在句子里相隔的位置数成正比。理想情况下,我们更希望语义相关的词能「就近」互相影响,而不是被线性距离绑住。
1.2 两个根本问题
(参考时间: 00:04:34)
问题一:线性交互距离会导致长距离依赖难学。
老师用两个例子铺开。先是近距离的词——「tasty pizza」:在 RNN 里你编码 tasty,走一步,再编码 pizza,相邻的词天然容易互相影响,这没问题(这正是「线性局部性」有用的一面)。
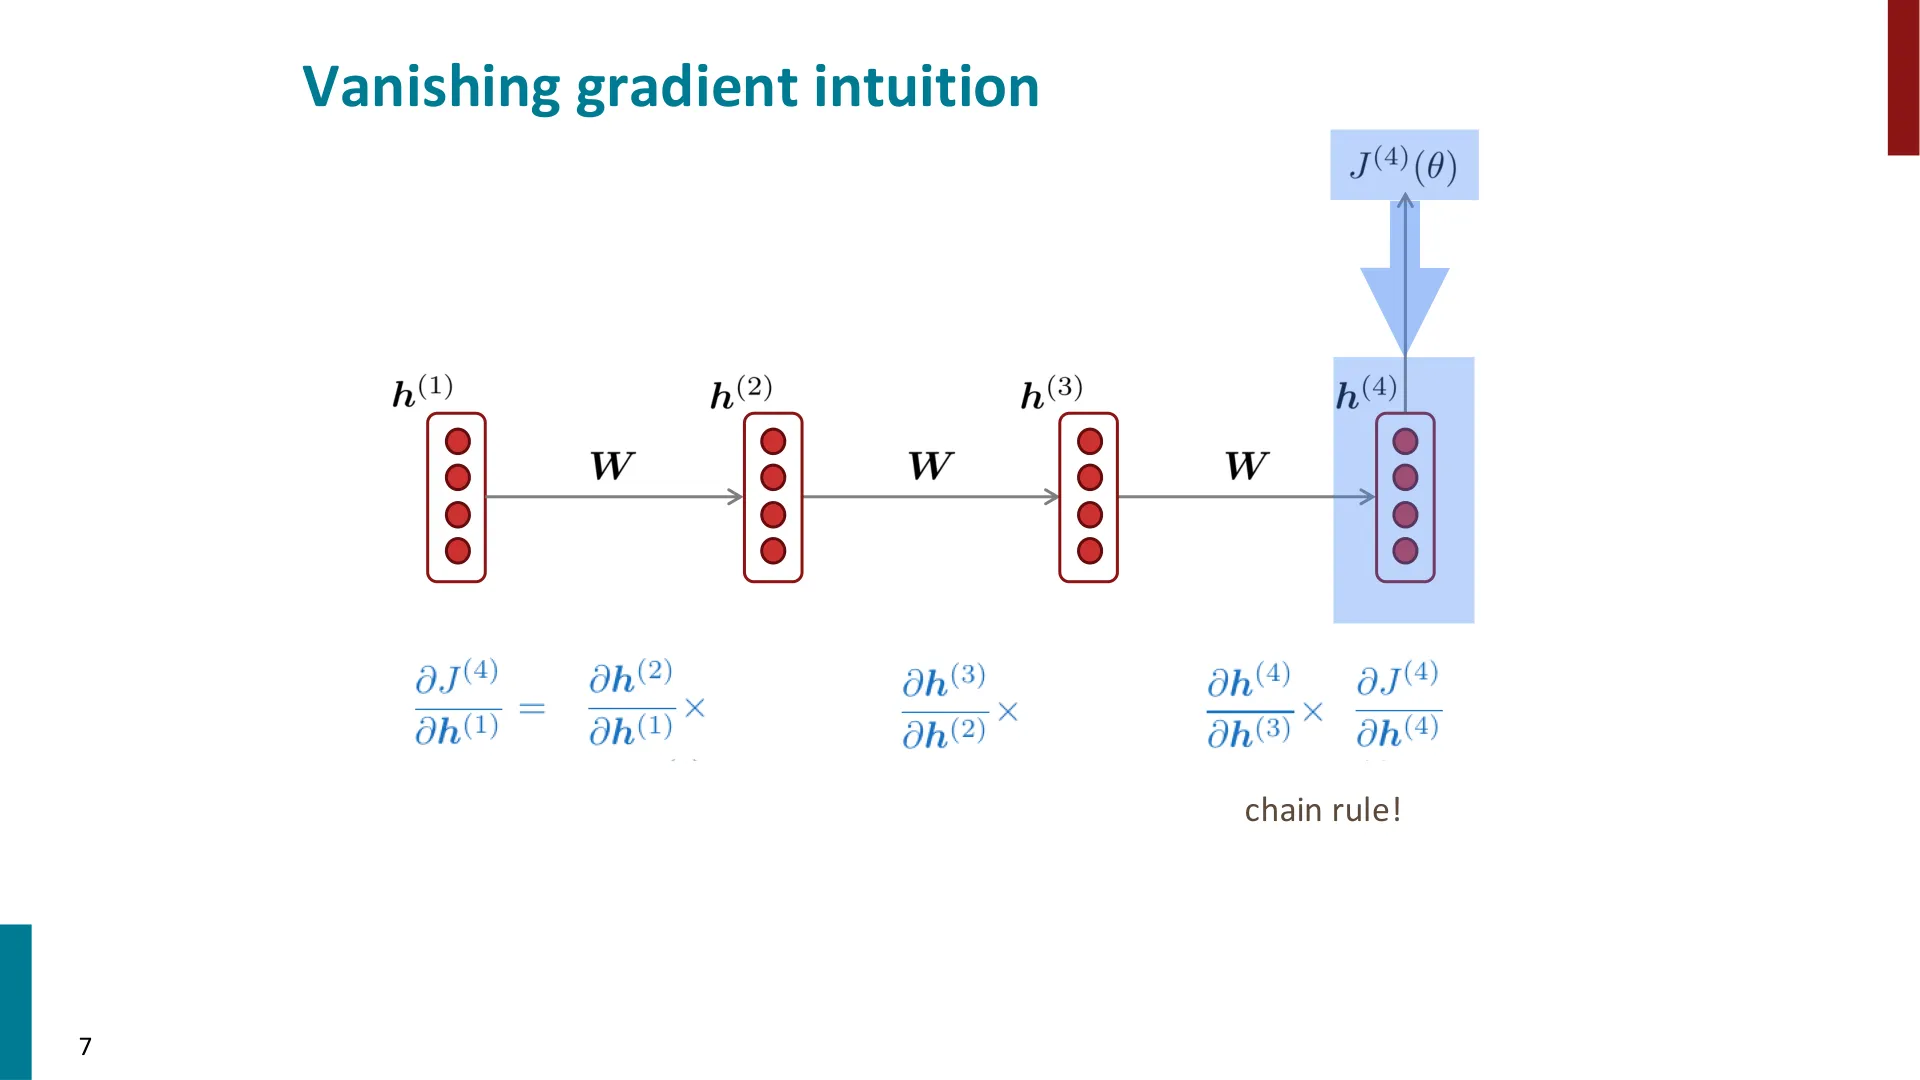
🖼️ 第 7 页幻灯片 · Vanishing gradient intuition
但到了长距离依赖就出问题了:设想句子
the chef who went to the stores and picked up the ingredients and … loves garlic … was …
其中 the chef 与结尾的 was 之间存在一个主谓依赖。老师强调:从 was 到 chef 的梯度要穿过多少个循环权重矩阵和逐元素非线性,取决于这两点之间的序列长度——「走一遍、两遍、三遍……就像 chef 和 was 之间那么多次」。距离一远,这些词就很难学到它们应该相关。虽然 LSTM 在长距离梯度上比简单 RNN 好很多,但并不完美。老师的判断是:「线性顺序其实并不是理解句子的正确方式」——我们希望相关的词在网络计算图里能更直接地相连。
graph LR
  X1["x1: the"] --> H1["h1"]
  H1 --> H2["h2: chef"]
  X2["x2: chef"] --> H2
  H2 --> H3["h3"]
  H3 --> H4["..."]
  H4 --> H5["hn: was"]
  X5["x5: was"] --> H5
  H1 -. "梯度要穿过 k 个循环步骤" .-> H5
编者拓展|对应到依赖句法 老师在课上把这件事和之前的依存句法联系起来:「should feel kind of related to the stuff that we did in dependency syntax」。在依存句法里,词与词是由句法关系直接连边的,
chef → was是一条短边;但循环网络把它拉成了一条很长的路径。这正是「线性顺序 ≠ 正确结构」的直观依据。
问题二:依赖序列索引,无法并行。
老师指出第二个相关问题:循环网络依赖序列索引(常被称作「依赖时间」)。前向和反向传播都有 O(序列长度) 个无法并行的操作。他在白板/幻灯片上画了一串「盒子里的整数」来表示「要算这一步之前,必须先做几步操作」:第一个位置 0 步,第二个位置 1 步,第三个位置 3 步……序列越长,这个链越深。
原因很直白:GPU 擅长一次性做很多互不依赖的运算,但你无法在算完第 5 个时间步的隐状态之前去算第 4、第 3 步——「这里有个严格的时间依赖」。于是老师说:「你没法拿一块大 GPU,用一次矩阵乘法就把这个状态算出来,因为你得先把之前所有状态都算出来。」
编者说明(学生问答):有同学问——线性交互距离这件事,不正是注意力想解决的吗?那用它不就好了?老师回答:是的,注意力正是要解决它,但它解决不了并行性。 接着说出一条贯穿全讲的主线:「这一讲接下来做的所有事都是基于注意力的——我们会把循环整个拿掉,基本只做注意力。」 所以注意力不是「补丁」,而是「替代品」的原料。
1.3 那么,还需要循环吗?
(参考时间: 00:09:48)
顺着上面的逻辑,老师抛出关键提问:抽象地看,注意力是把一个序列($x$)的信息传给神经网络输入($h_t$)的一种方式——而这恰恰也是 RNN 在做的事(传递信息)。那么——
能不能干脆不要 RNN?说不定注意力本身就是一种更好的信息传递方式!
这段「2014–2017 靠循环、大量试错 → 后来出现全新积木」的历史转折,是理解 Transformer 为什么诞生的关键。
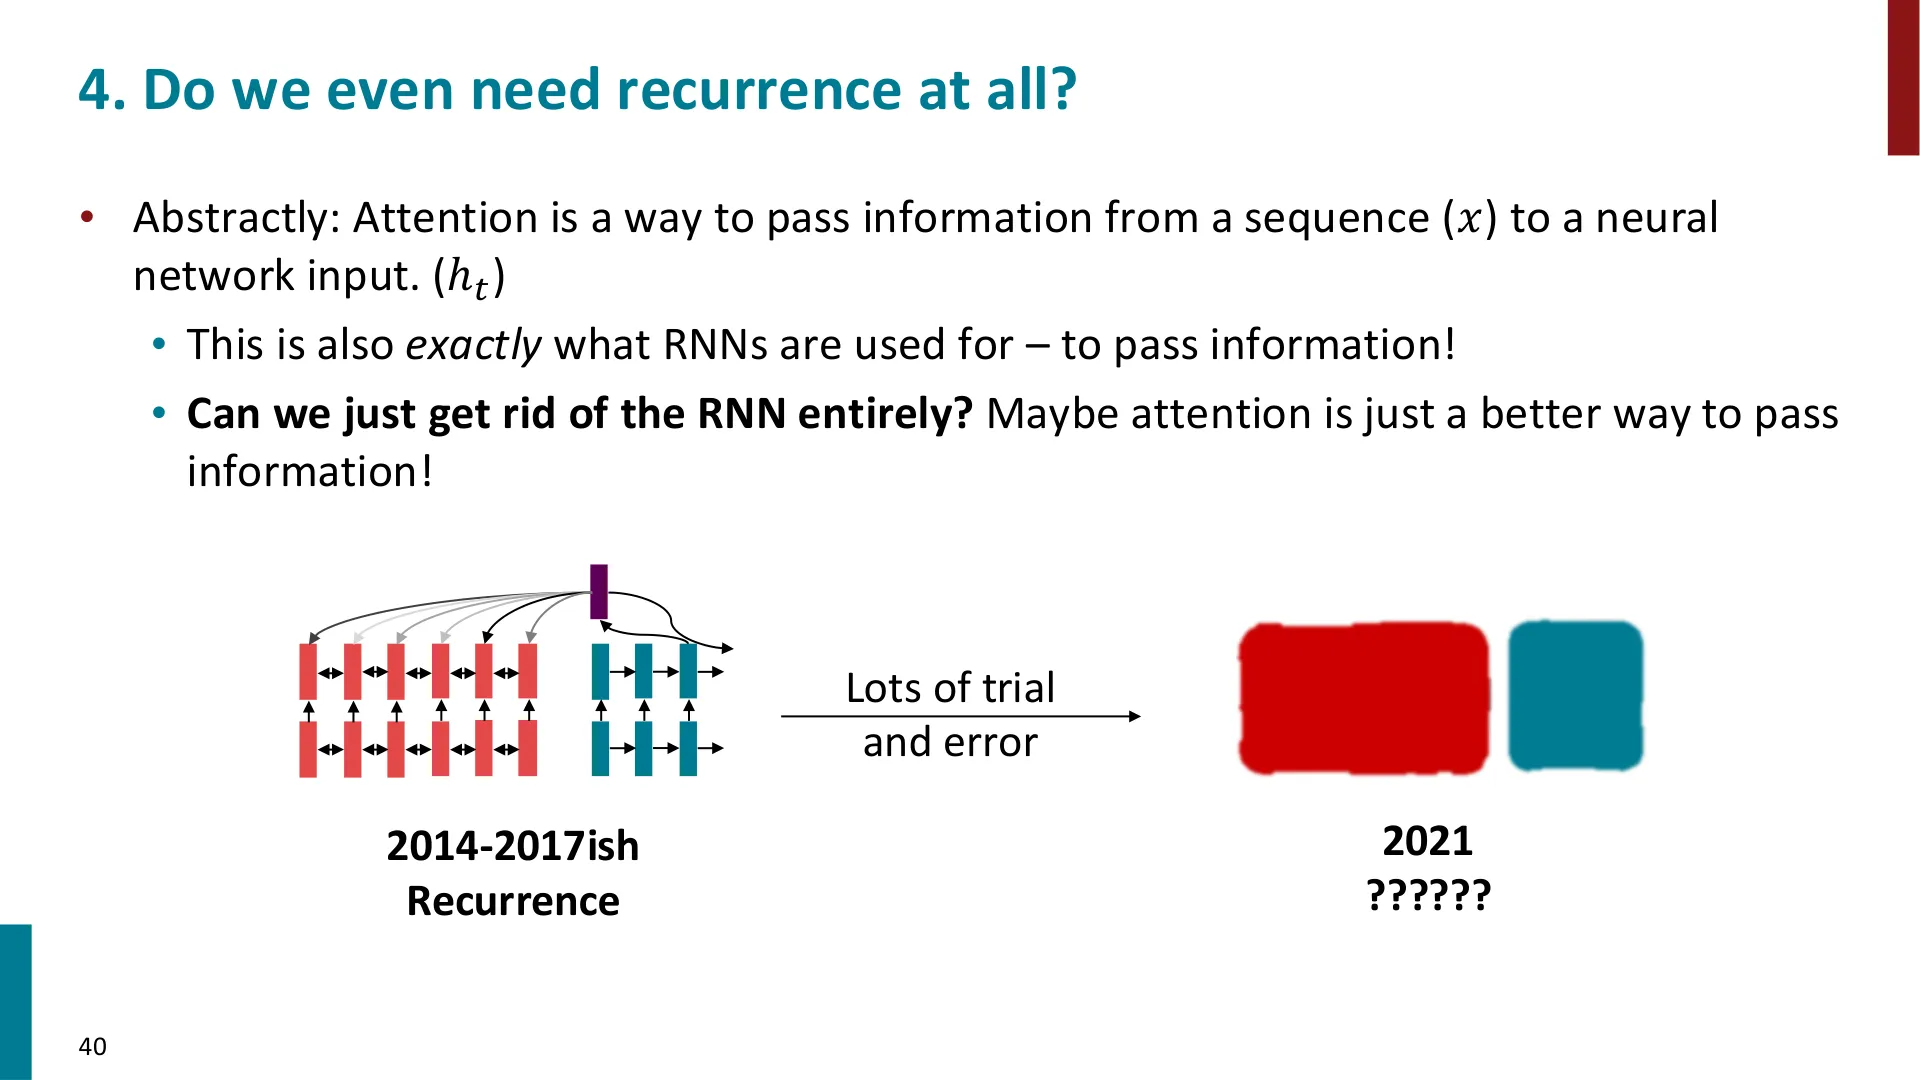
📷 我们还需要循环吗?
回到原视频 (00:09:48)
🖼️ 第 11 页幻灯片 · Why is exploding gradient a problem?
老师随即给出直觉:注意力把每个词的表示当作一个 query,去访问并融合一组 value。以前我们是在解码器里,用它去访问编码器,避免把源句压进单向量;今天我们要把注意力用在同一个句子内部。幻灯片上再次出现那串「盒子里的整数」,但这次每个词的嵌入可以独立并行地算出来(只依赖词本身),而「对某个词做注意力、看整句其余词」也只需一次大运算、所有词可并行。于是——线性交互距离问题、无法并行问题,一并被化解:无论两词相隔多远,都可能直接互相访问,且不必沿序列线性地走。
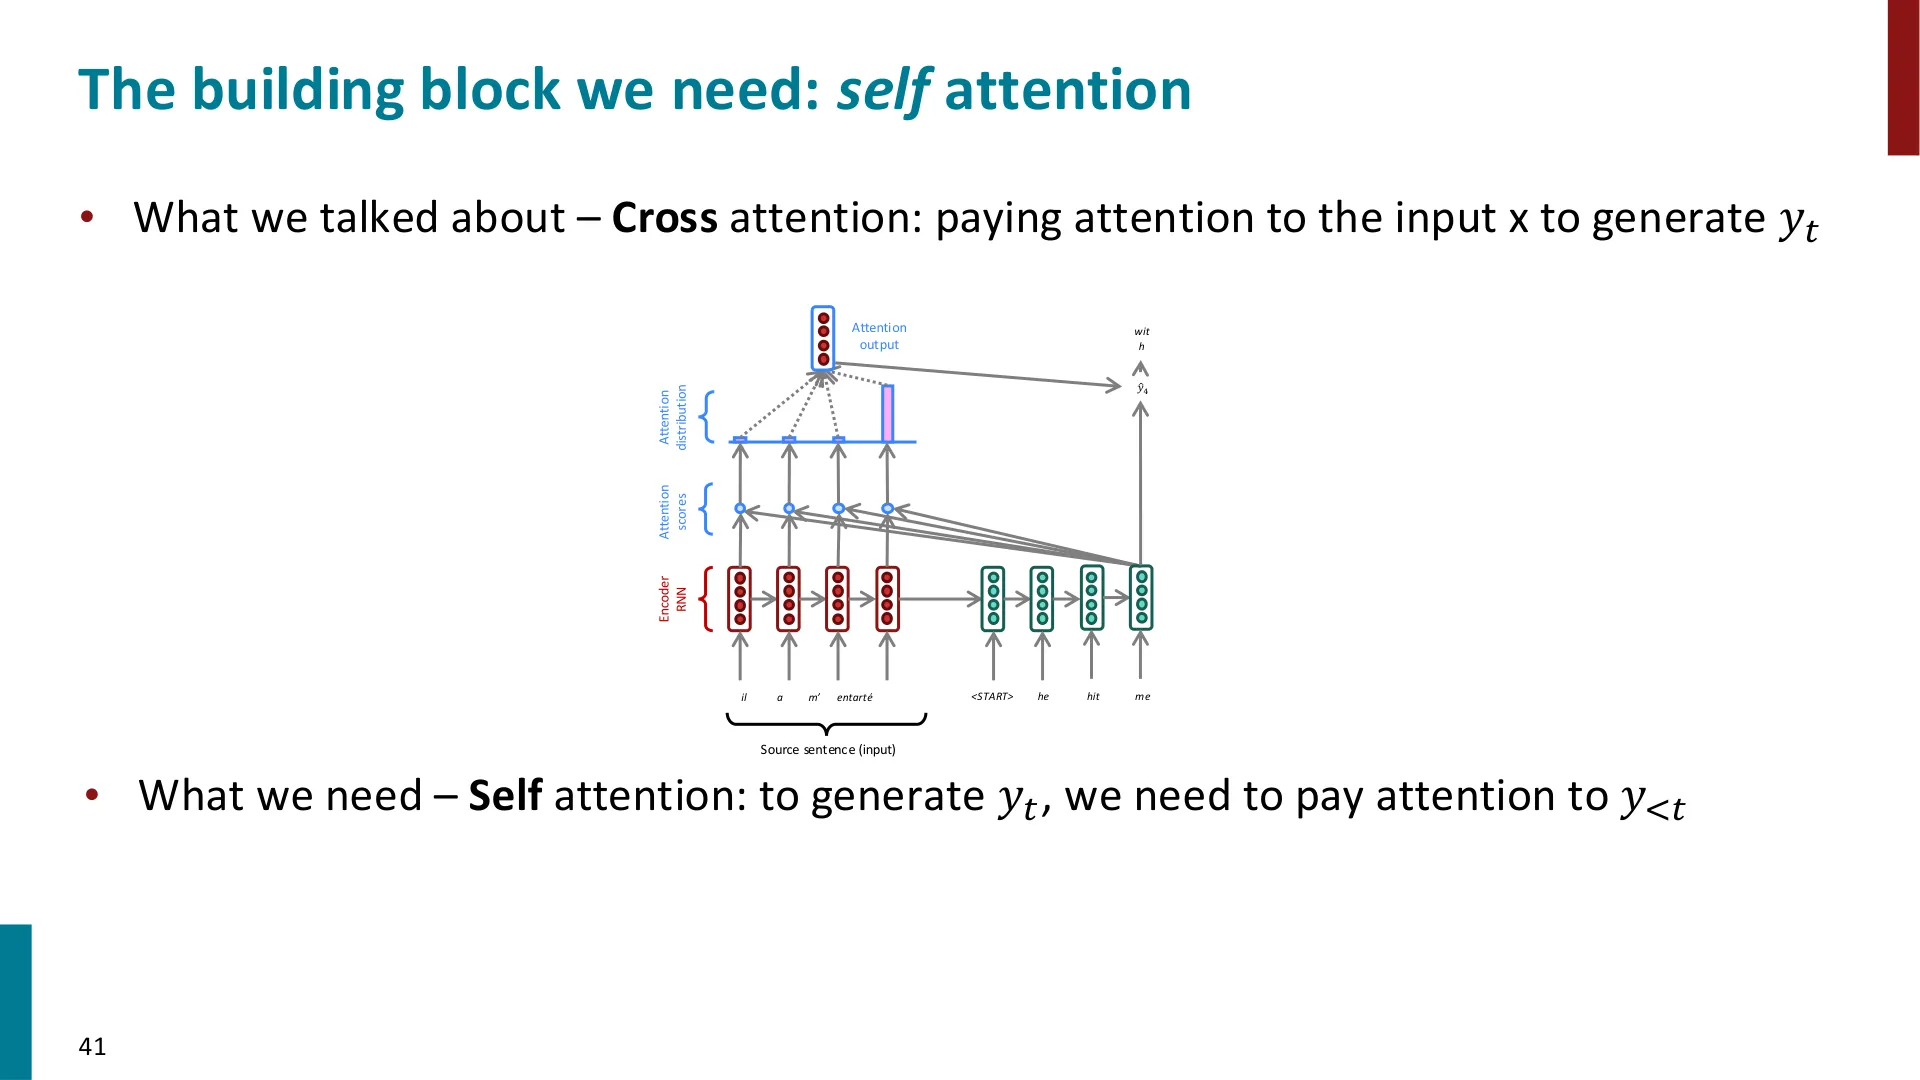
📷 我们需要的新积木:自注意力
回到原视频 (00:10:00)
编者拓展|为什么自注意力天然并行,而 RNN 不能 关键在于计算图有没有「时间依赖」。RNN 的 $h_t$ 依赖 $h_{t-1}$,是一条串行链,深度为 $n$;自注意力里,每个词的输出只依赖输入矩阵 $X$,而 $X$ 的每一行可以同时算,$XQ$、$XK^\top X^\top$ 等全是矩阵乘法,没有第 $i$ 步依赖第 $i-1$ 步,深度为 $O(1)$。这就是它「吃了并行红利」的根源。
二、注意力:一种「软」的键值查找
(参考时间: 00:11:55)
老师给了一个非常关键的心智模型:注意力就是在做一次「模糊的键值查找(fuzzy lookup in a key–value store)」。
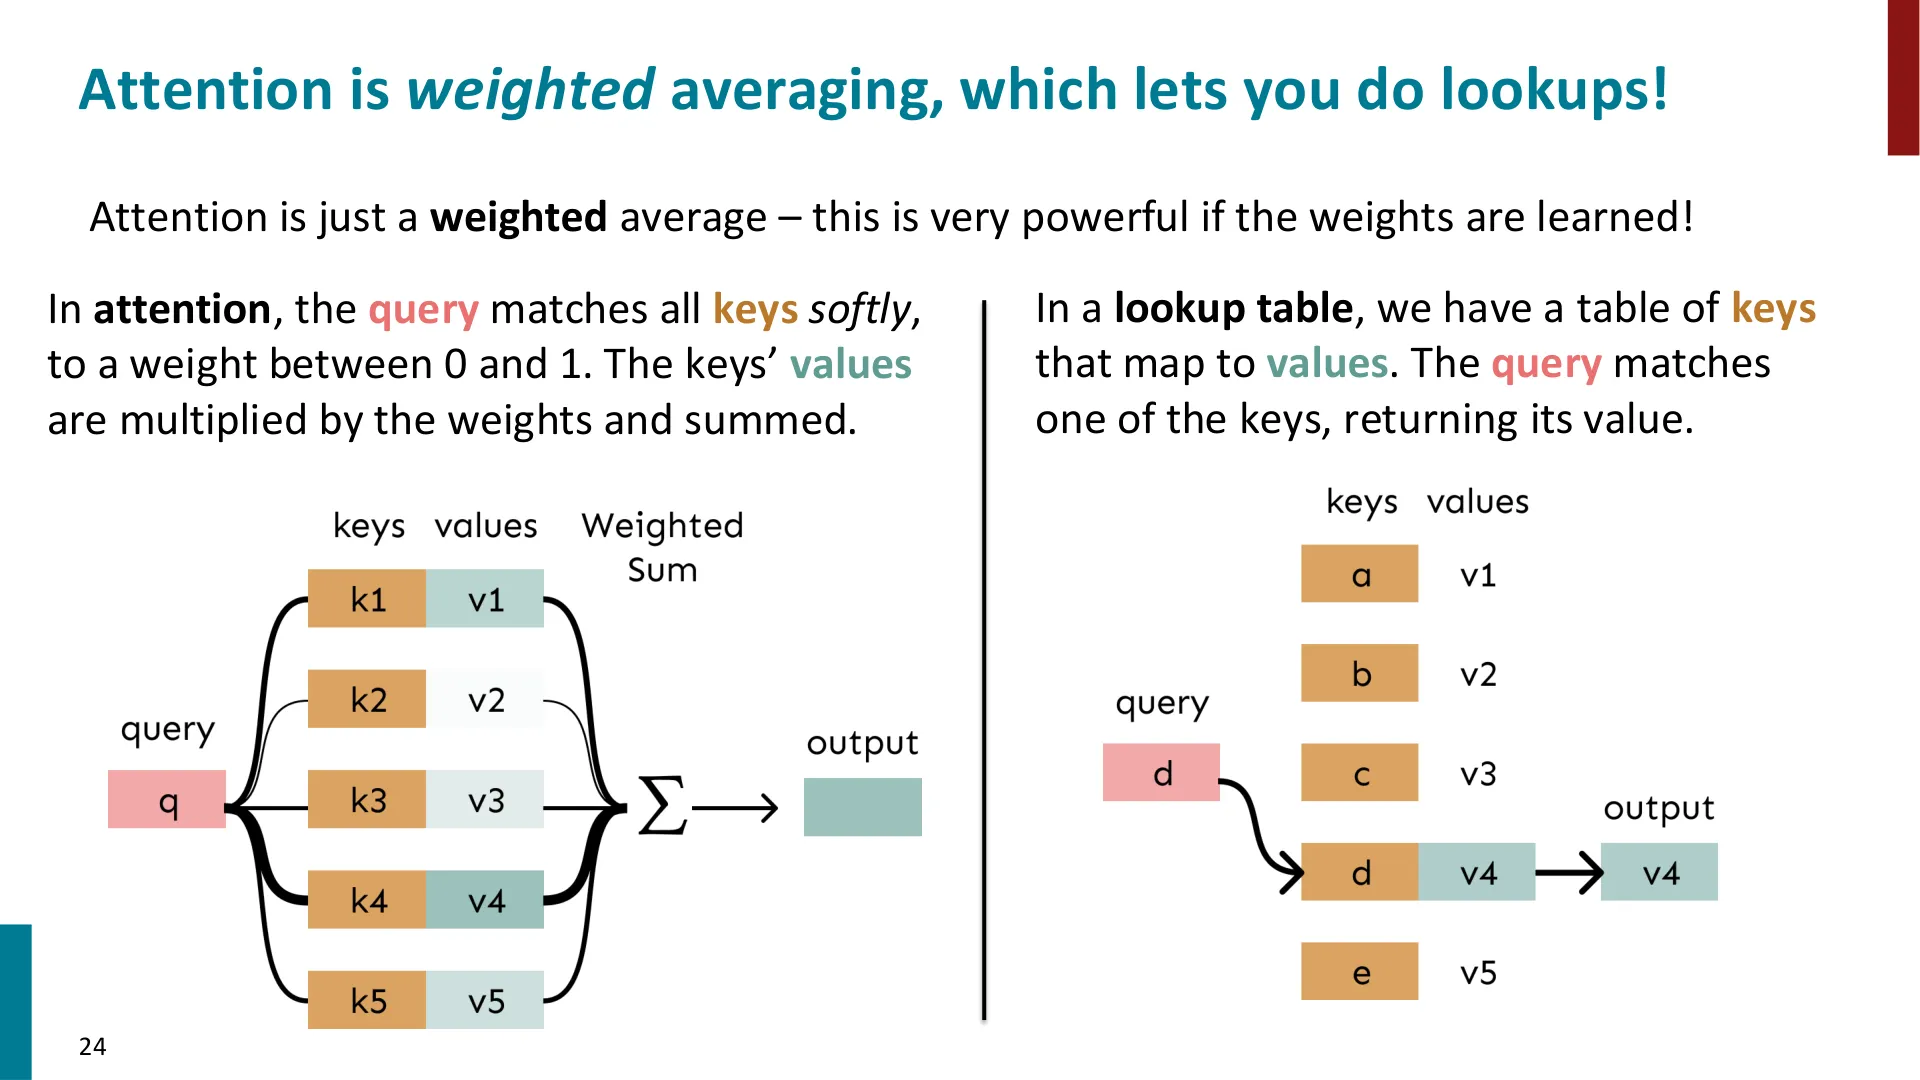
📷 注意力是加权平均,因此可以做查找
回到原视频 (00:11:55)
先看普通的查表:就像 Python 里的字典——一堆 键(key) 各自映射到一个值(value);你给一个查询(query),它精确地匹配到某个键,返回对应的值。
注意力的区别在于:查询会「软性地」匹配所有键,而不是精确命中一个。它对每个键算一个相似度(介于 0 和 1 之间的权重,经 softmax 归一化),然后用这些权重对值做加权求和,得到输出。老师说:「它真的很像一张查找表,只不过是在一个软的、向量的、糊糊的(mushy) 空间里做访问。」
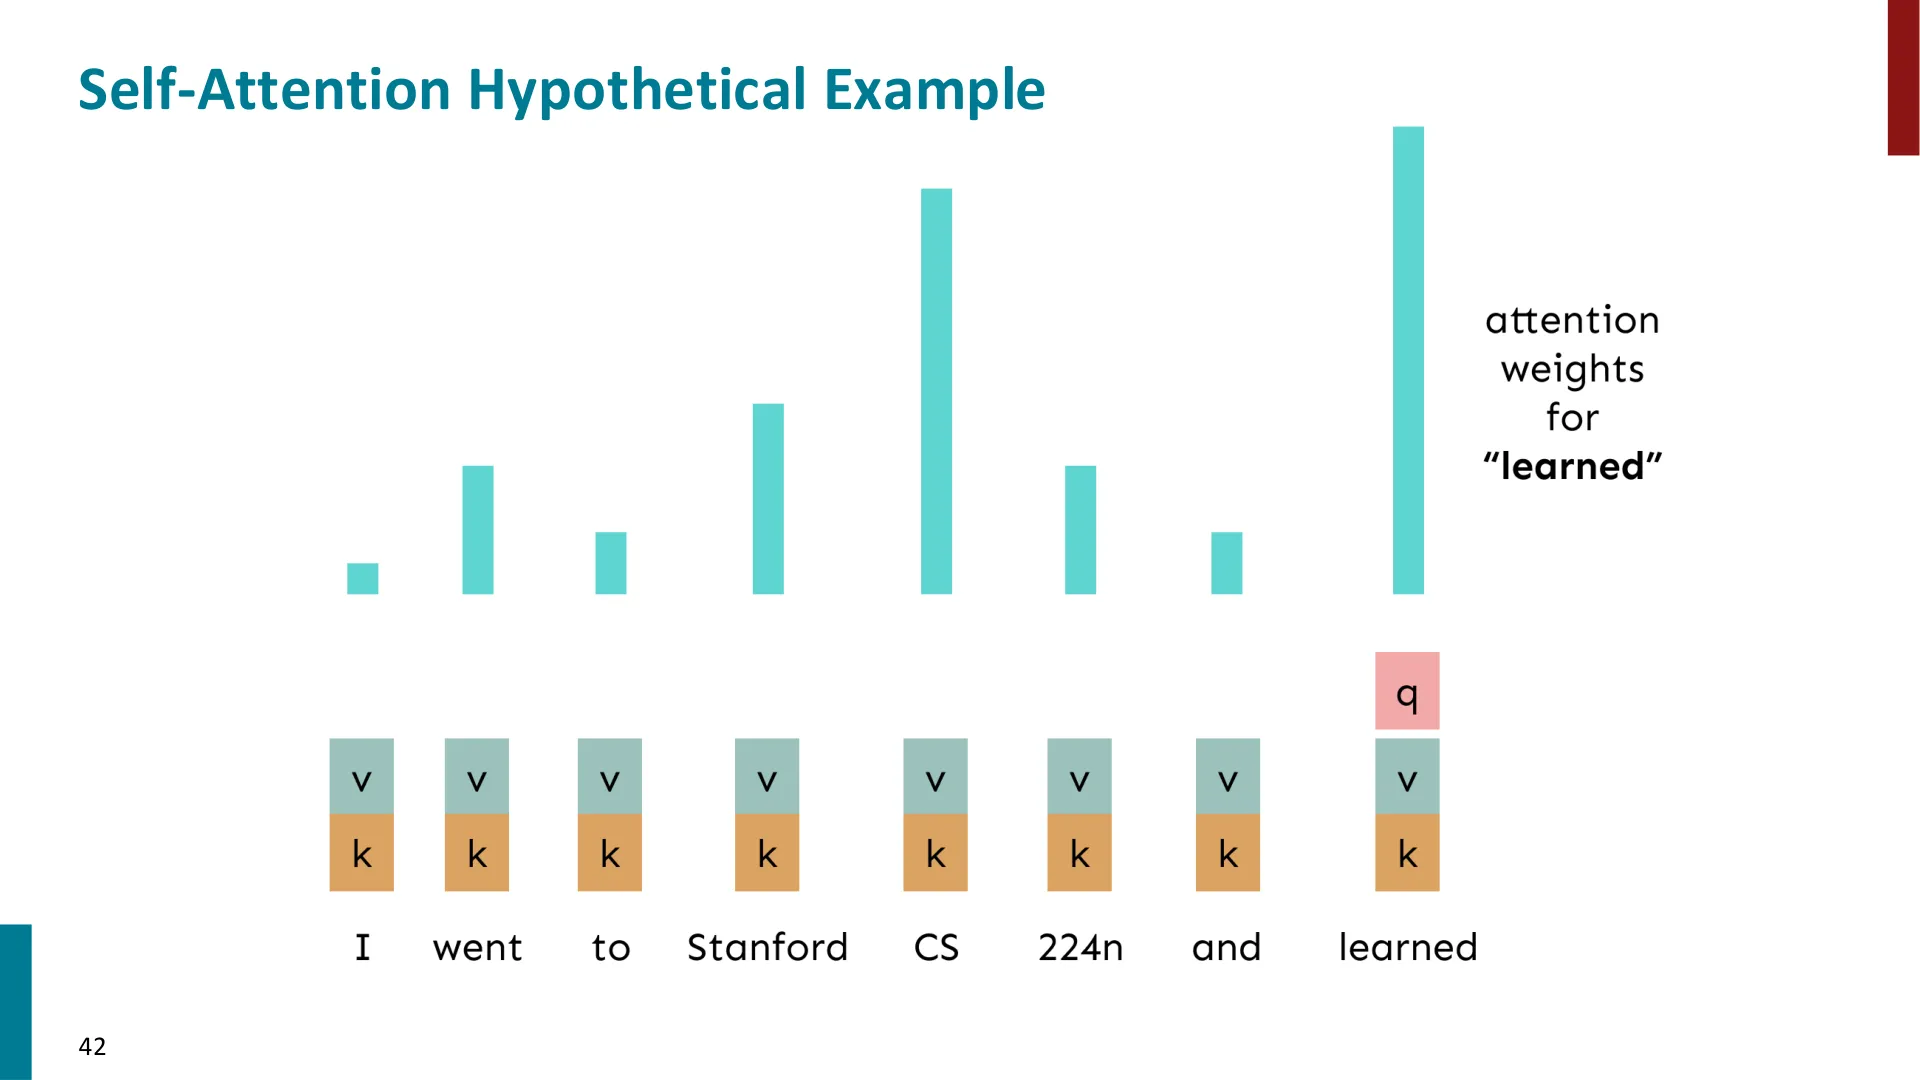
2.1 一个玩具例子:「I went to Stanford's cs224n and learned」
(参考时间: 00:13:40)
假设我们要为句子里的 learned 这个词建立表示。老师画了一张示意图:每个词有一个 key、一个 value,而 learned 有一个 query;顶部那些「青绿色的小条」表示每个词被访问的多少。直觉上:
cs224n也许不太重要,Stanford可能才决定「你学到了什么」——所以 Stanford 权重高;- 也可能
learned要重点看它自己。
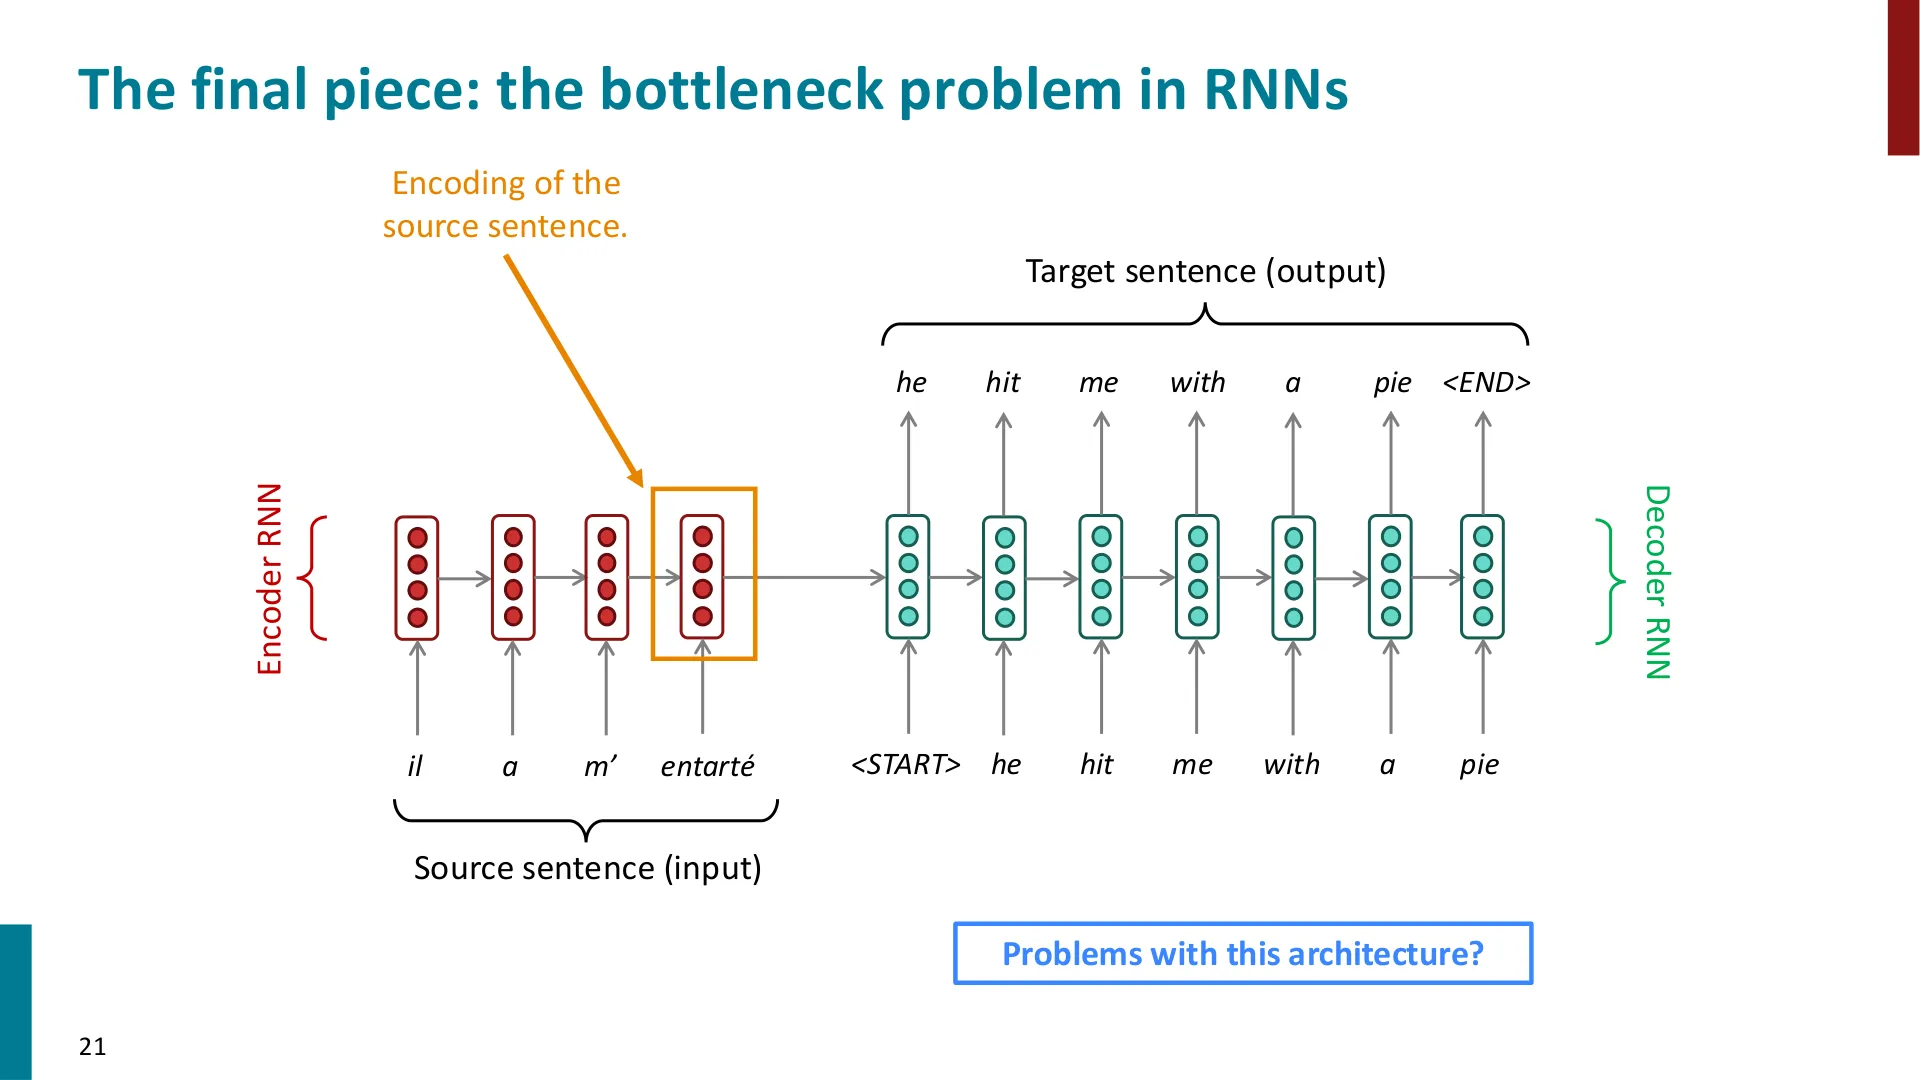
🖼️ 第 21 页幻灯片 · The final piece: the bottleneck problem in RNNs
也就是说,你横扫整句,软性地取用各处信息,来把「learned」放到语境里表示出来。这就是自注意力的雏形。
编者说明:这张玩具图出现在幻灯片的「Self-Attention Hypothetical Example」页,但老师在此时先用它讲「注意力的直觉」。注意它是句内的注意力(query/key/value 都来自同一句),这正是自注意力(self-attention)与之前的交叉注意力(cross-attention,query 来自解码器、key/value 来自编码器)的区别——这个区别老师稍后会再点明。
三、自注意力:查询、键、值
(参考时间: 00:14:41)
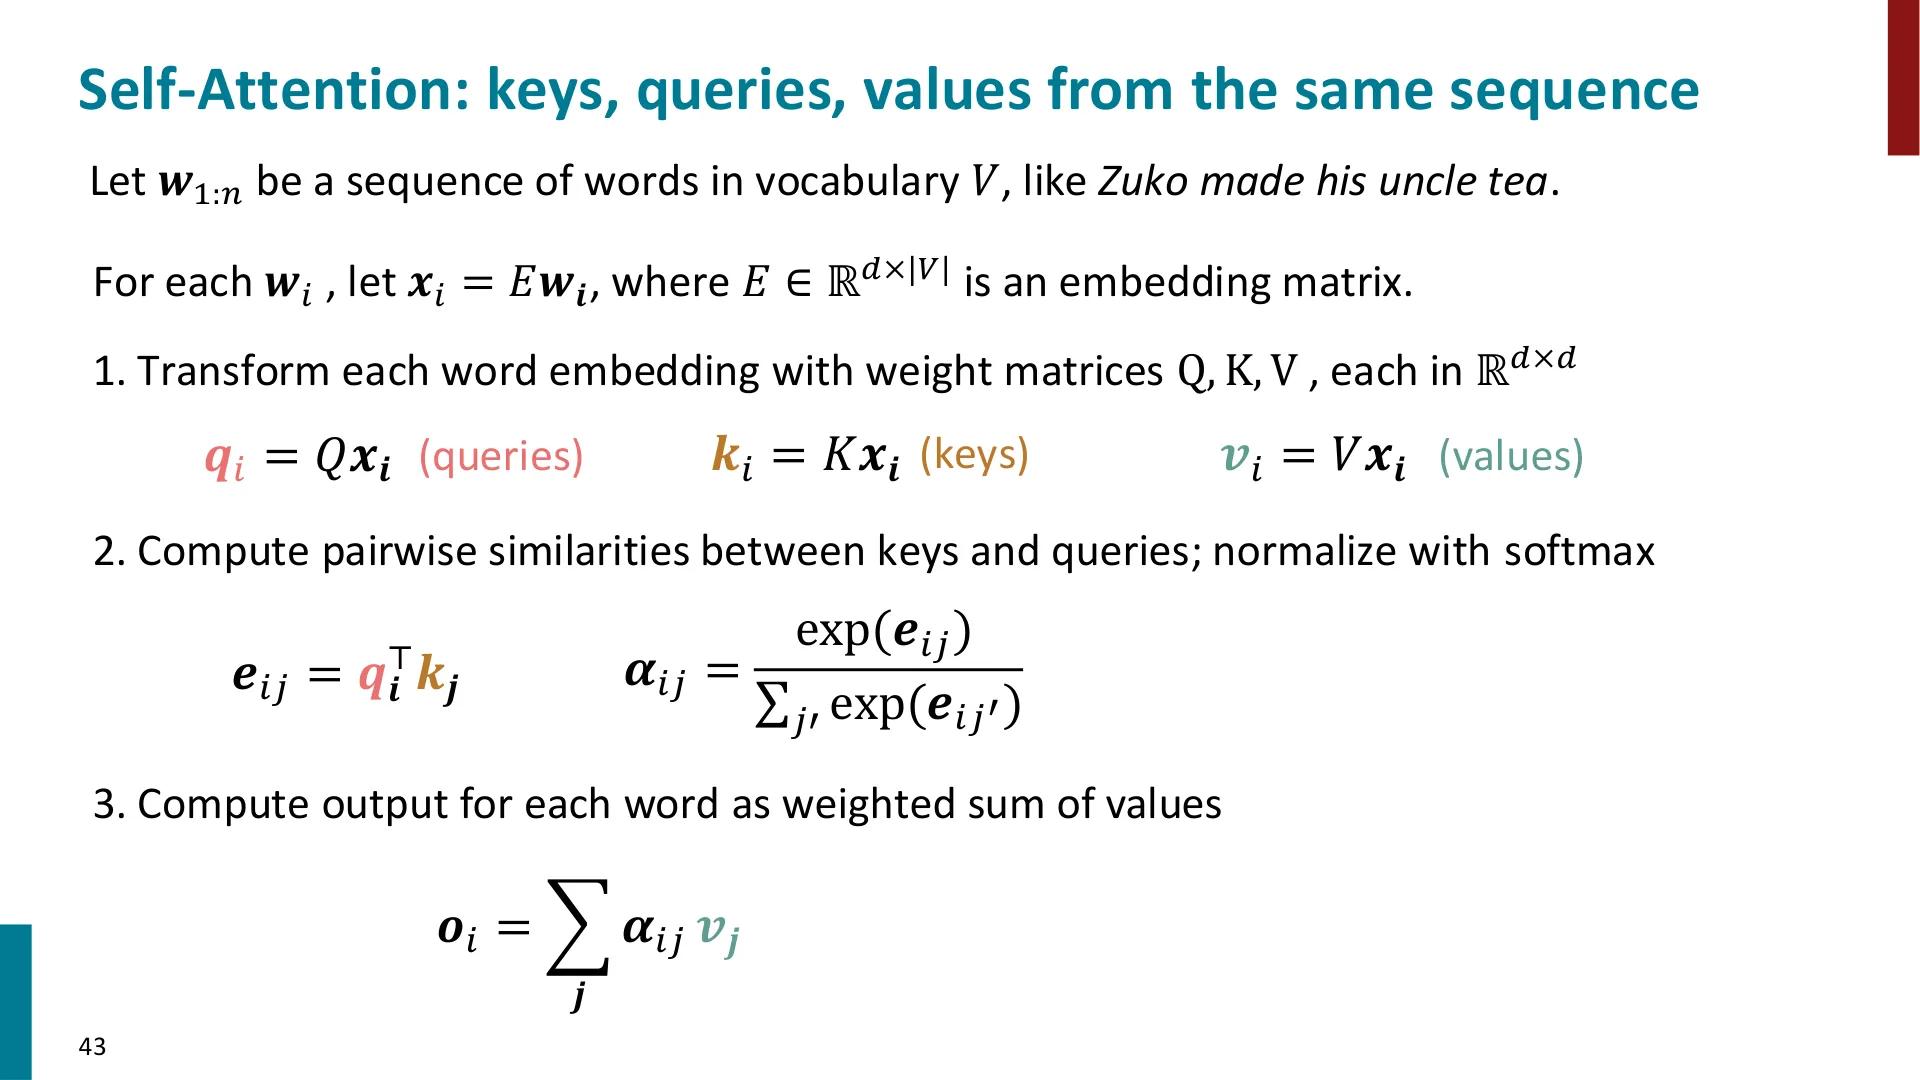
现在进入数学。设一个由词组成的序列 $w_{1:n}$(例如 Zuko made his uncle tea)。对每个词 $w_i$,先用词嵌入矩阵得到
$$x_i = E w_i,\qquad E \in \mathbb{R}^{d \times |V|}$$
其中 $|V|$ 是词表大小,$d$ 是词向量维度。$x_i$ 只依赖词本身,是非上下文的。
接着,用三个不同的可学习权重矩阵 $Q, K, V$(每个都是 $\mathbb{R}^{d \times d}$)把同一个 $x_i$ 变换出三样东西:
$$q_i = Q x_i \quad(\text{查询}),\qquad k_i = K x_i \quad(\text{键}),\qquad v_i = V x_i \quad(\text{值})$$
老师形容这些矩阵的作用:「把 $x_i$ 旋转一下、搅一搅、拉伸一点、压扁一点,让它变得不一样」。于是每个词都同时扮演 query、key、value 三种角色。
📷 自注意力:键、查询、值来自同一序列
回到原视频 (00:14:41)
第二步,计算所有 query 与所有 key 两两之间的相似度(点积),得到一个分数:
$$e_{ij} = q_i^\top k_j$$
这个分数是实数,可能很大、可能为零、也可能很负——它表示「词 $i$ 应该看词 $j$ 多少」。再用 softmax 在 $j'$ 上归一化,得到权重:
$$\alpha_{ij} = \frac{\exp(e_{ij})}{\sum_{j'} \exp(e_{ij'})}$$
第三步,对 value 做加权求和,得到每个词的输出:
$$o_i = \sum_j \alpha_{ij} v_j$$
老师用 Zuko 举例:Zuko 的输出,就是它「按 $\alpha_{ij}$ 的权重」去融合 Zuko、made、his、uncle、tea 各自 value 的结果。
编者说明(学生问答一:为什么 Q 和 K 要分成两套矩阵?) 有同学问,$q_i^\top k_j$ 本质上就是 $x_i^\top (Q^\top K) x_j$,中间的 $Q^\top K$ 是一个矩阵,为什么不直接学一个矩阵就好? 老师的回答很关键:这其实是在学一个「低秩近似」。$Q^\top K$($d\times d$)由两个 $d\times d$ 矩阵相乘得到,天然被压低了秩,这是出于计算效率的考虑,同时也让表示更「好看」。事实上大家就是这么做的。
编者说明(学生问答二:词看自己
e_ii会不会像恒等?) 同学问,$j=i$(词看自己)时会不会长得像恒等映射?老师说:不一定,而且这件事是学出来的。如果 $Q$ 和 $K$ 都是恒等、$q_i=k_i$,那「自己点自己」$\|x_i\|^2$ 平均会比较大;但训练完全可以让 $Q$ 是恒等、$K$ 把向量映成自己的相反数,从而故意不去看自己。这种「要不要看自己」的灵活性,正是用两套矩阵而不是直接用 $x_i$ 才能提供的。
四、把自注意力打造成可用的「基本模块」
(参考时间: 00:21:01)
老师明确说:上面这套原始的自注意力,还不能直接拿来替代 LSTM。它有三个「障碍(barriers)」,要逐一修补。这一节就是「最小自注意力积木」的搭建过程,也是本讲推理链最密的部分。
📷 自注意力作为基本模块的三个障碍
回到原视频 (00:21:29)
4.1 障碍一:没有顺序概念 → 位置表示
(参考时间: 00:21:36)
📷 顺序问题的白板例子
回到原视频 (00:21:38)
老师走到白板前写下两句:
Zuko made his uncle his uncle made Zuko
这两句意思完全不同。但在自注意力里,词嵌入不依赖词的位置索引:第 1、2、3、4 个位置分别是 Zuko, made, his, uncle,而第二句里 his 到了别的位置。关键问题是:计算出的自注意力表示,对这两个序列会完全相同——因为自注意力本质上是作用在「集合」上的运算,词的具体位置根本没有直接进入计算。这显然不行。
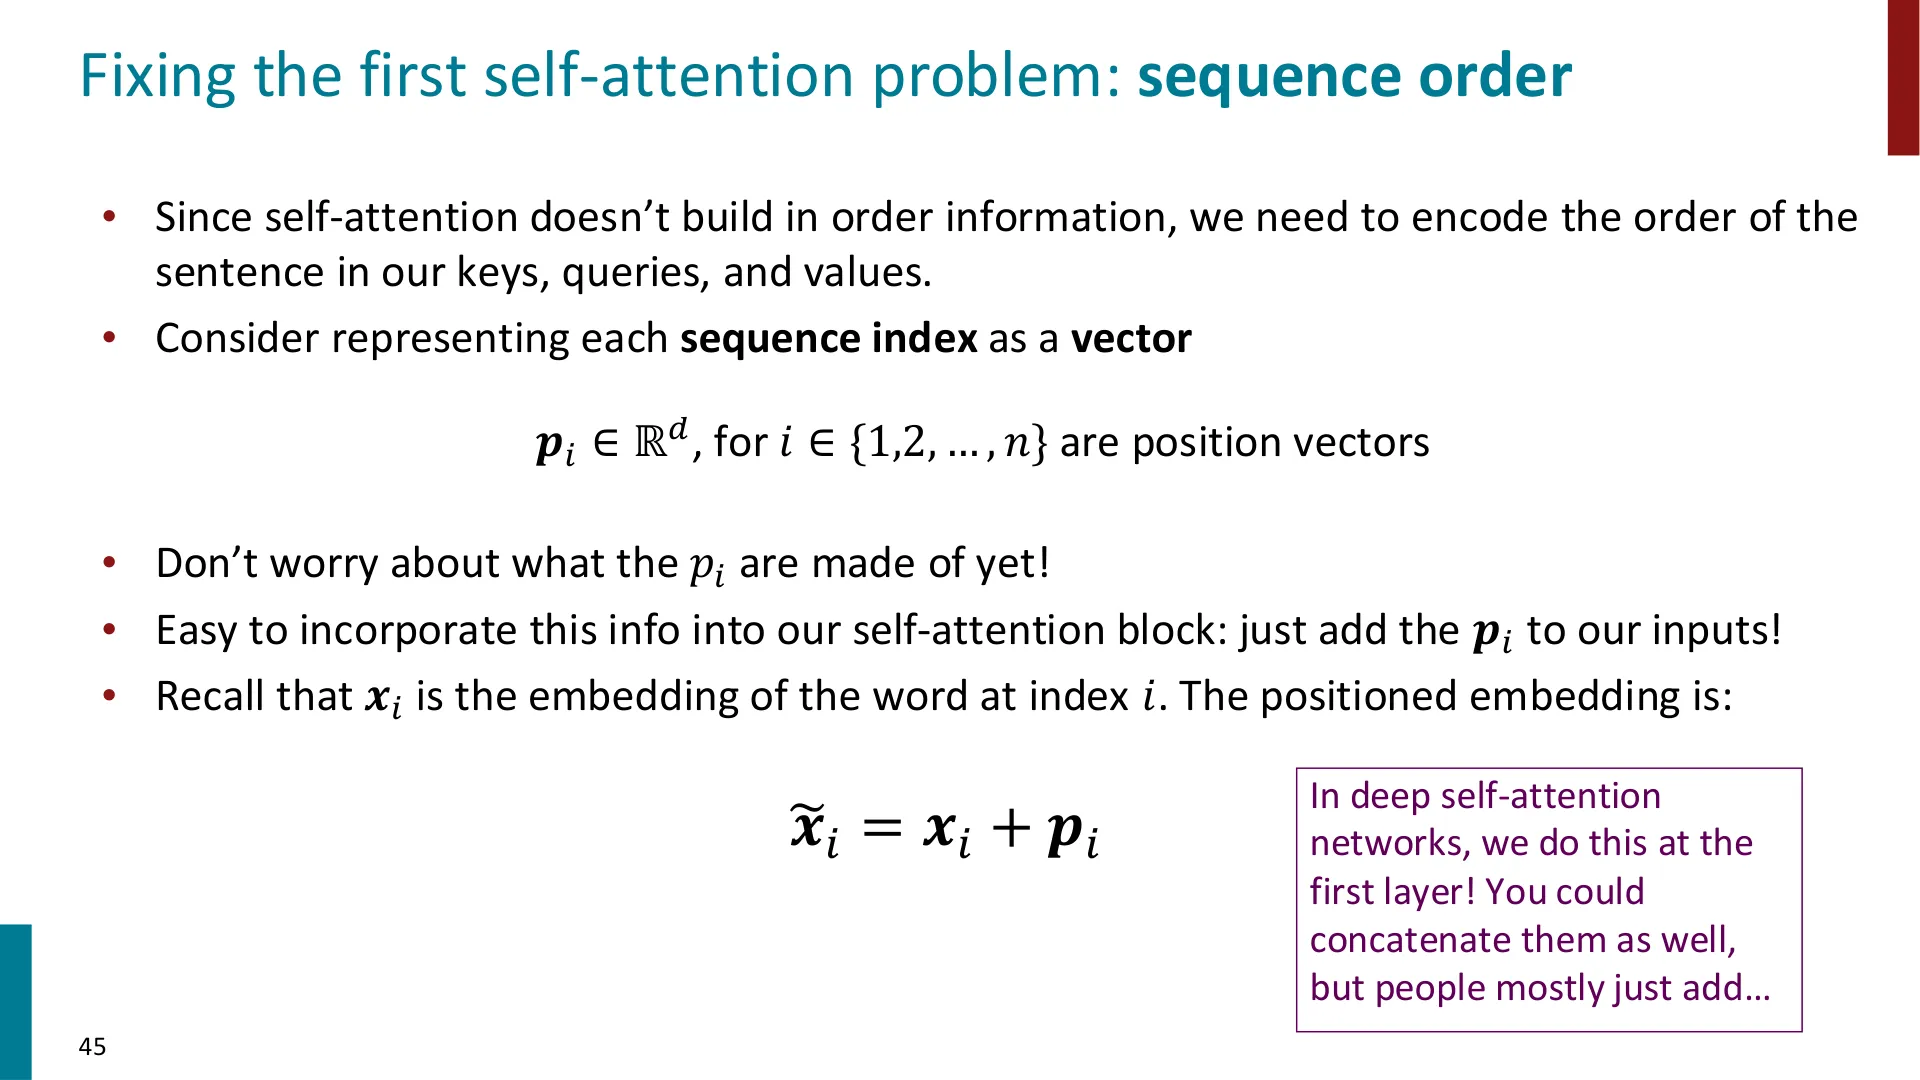
修法是:给每个位置准备一个向量并把位置信息编码进 key/query/value。为每个序列索引 $i \in \{1, 2, \dots, n\}$ 定义位置向量 $p_i \in \mathbb{R}^d$,然后直接加到输入上:
$$\tilde{x}_i = x_i + p_i$$
📷 修正顺序问题
回到原视频 (00:22:59)
老师强调两点:这种加法通常只在网络最底层做一次就够了(上层已经从输入里「知道」了位置);当然也可以拼接,但大多数做法是相加。
具体怎么造 $p_i$? 有两种主流方案:
(a) 正弦位置表示(sinusoidal) (参考时间: 00:24:23)
📷 正弦位置表示
回到原视频 (00:24:23)
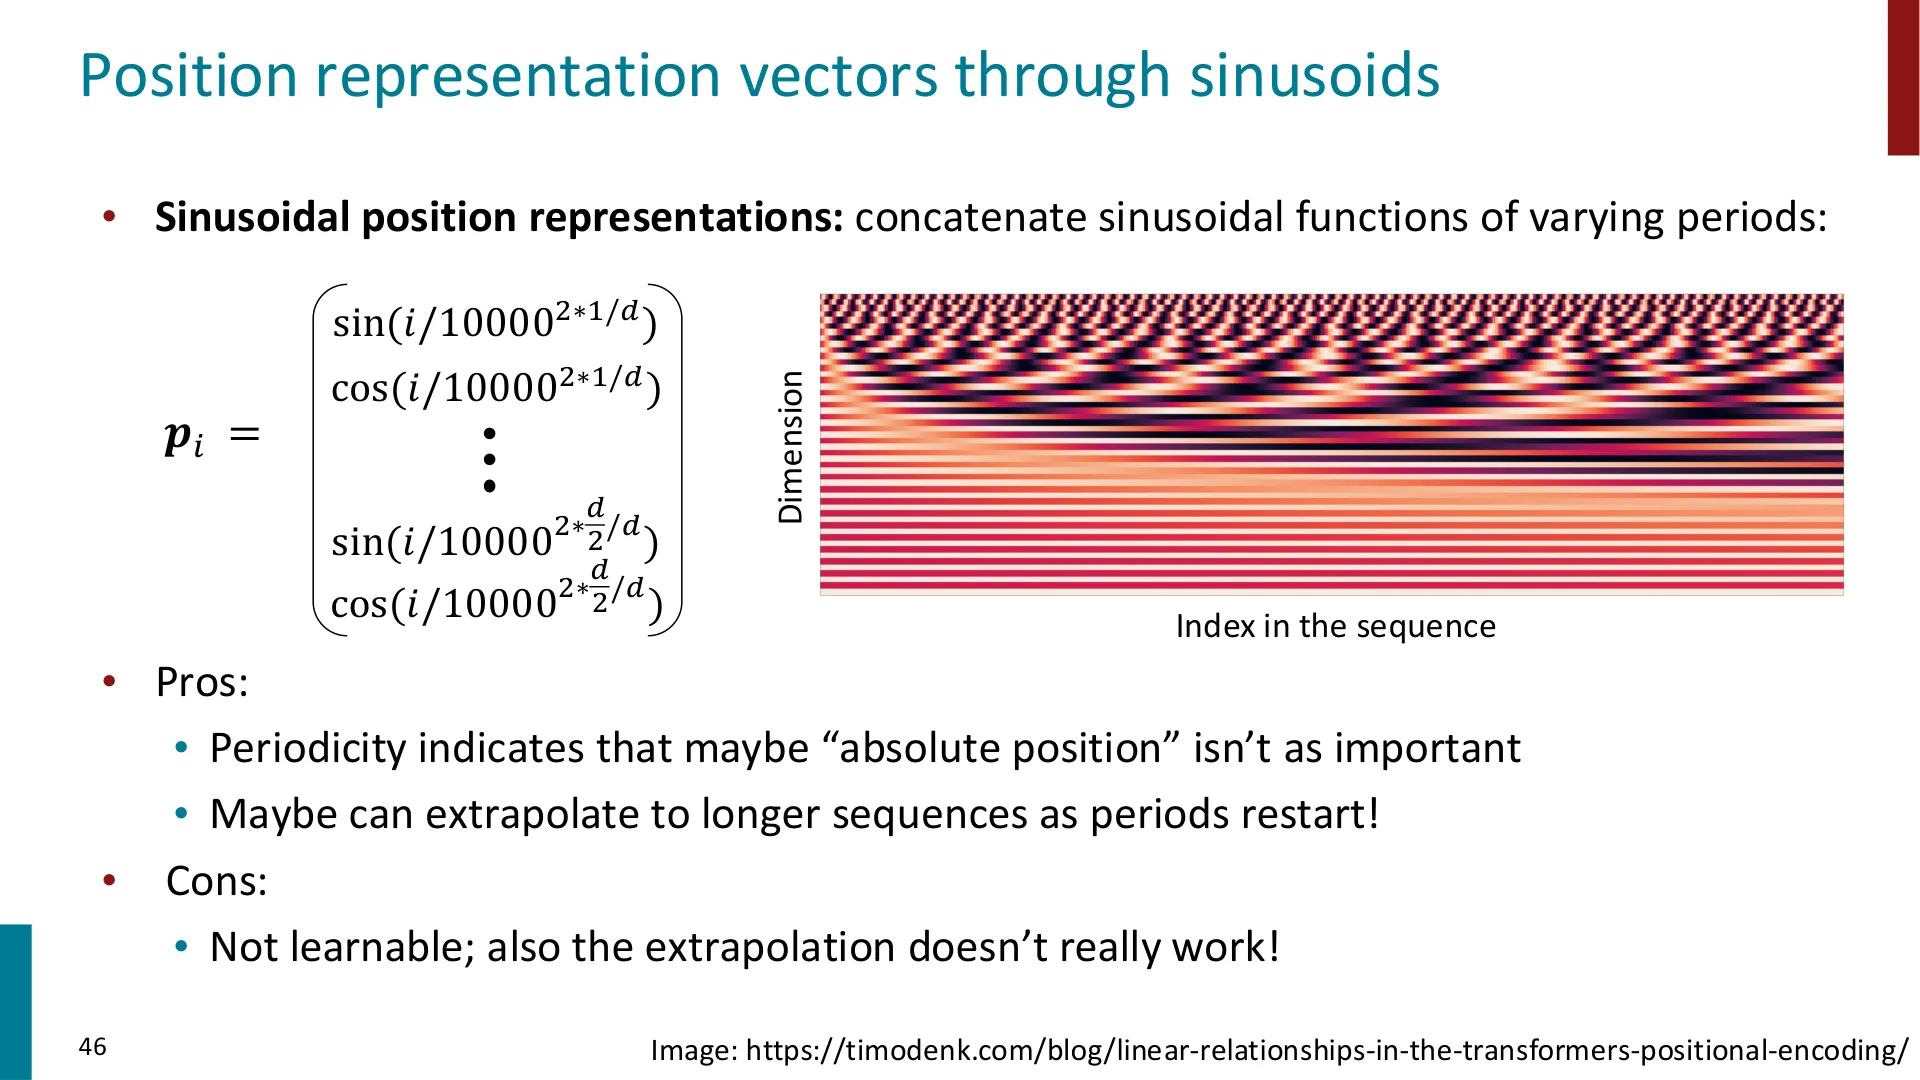
用不同周期的正弦/余弦函数拼出位置向量。第 $i$ 个位置、第若干维度的取值形如:
$$ p_i = \begin{bmatrix} \cos(i / 10000^{2\cdot 1 / d}) \\ \sin(i / 10000^{2\cdot 1 / d}) \\ \vdots \\ \sin(i / 10000^{2\cdot \frac{d}{2} / d}) \\ \cos(i / 10000^{2\cdot \frac{d}{2} / d}) \end{bmatrix} $$
可视化出来是一个「$d$ 为纵轴、$n$ 为横轴」的矩阵,每一维有不同的周期,合起来就能唯一地表示不同位置。它的好处是:周期性能体现「也许绝对位置没那么重要」;听起来也能外推到更长的序列(周期会重复)。但老师诚实地说:「实际外推基本不工作」,而且这些是不可学习的。所以它是一种「早期思路,今天仍偶尔使用」。
(b) 学习出来的绝对位置表示(learned absolute position) (参考时间: 00:25:42)
📷 从零学习的位置表示
回到原视频 (00:25:42)
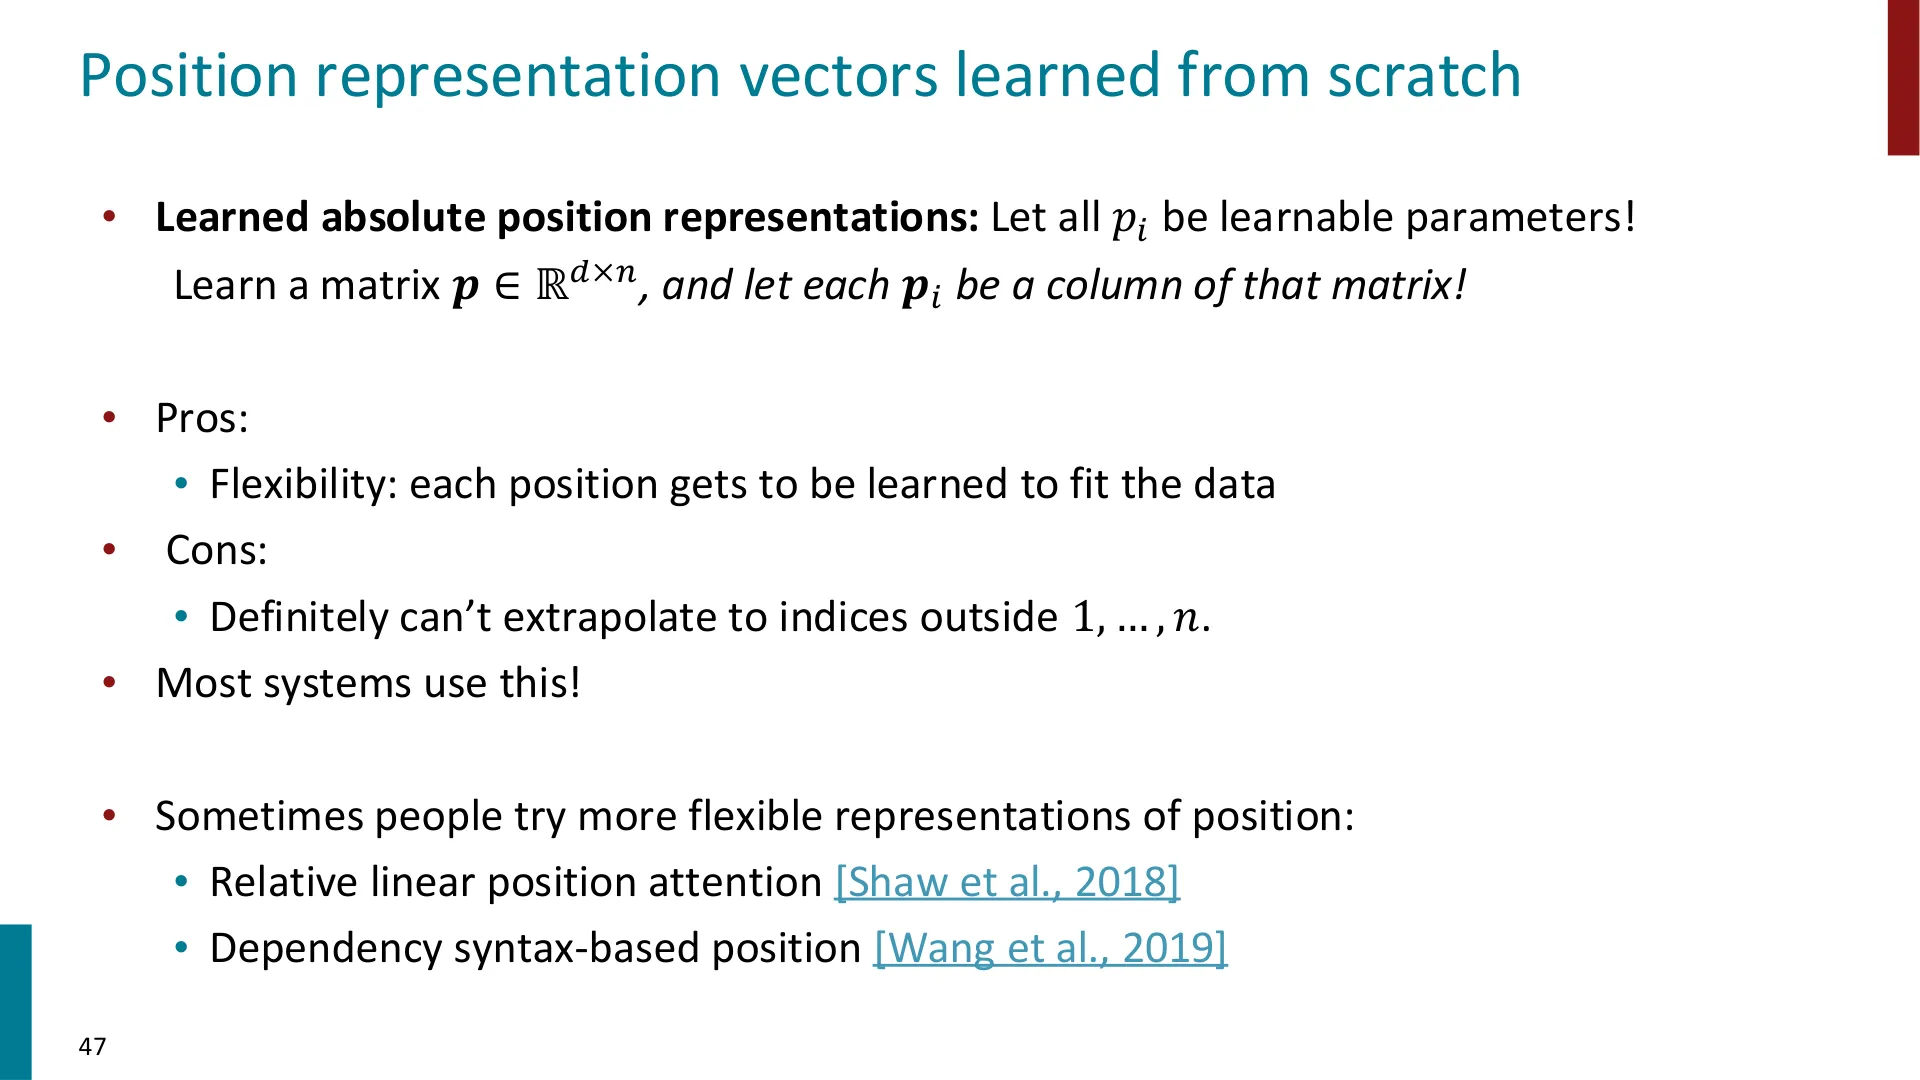
更「深度学习」的做法:直接学一个矩阵 $P \in \mathbb{R}^{d \times n}$,让每个位置的向量成为其中一列,像其它参数一样训练。
- 好处:灵活,每个位置都能拟合数据。
- 代价:完全无法外推到超过 $n$ 的索引——超过就会直接报错「我处理不了」。
- 老师指出:如今大多数系统用的是这种。
编者说明(学生问答:我怎么知道学出来的 P 真在表示位置?) 同学问:你凭什么说这个学出来的矩阵在表示位置?老师答得很干脆:因为它是数据里唯一和「索引」相关的东西。 词嵌入会随每个位置出现什么词而变,但 $P$ 矩阵在每个样本、每次梯度更新里都严格固定在第几个索引上——「没有任何别的东西像这样共现」。所以模型隐式地把「位置」学到了这个向量里。至于它具体学到了什么,老师承认:「我不知道。」
除上述两种,课堂上还提到一些更灵活的位置表示:相对线性位置注意力([Shaw et al., 2018],用「前后几个词」而不是绝对位置)和基于依存句法的位置([Wang et al., 2019])——后者是「句法树上近的词,在自注意力里也应该近」。
编者说明(学生问答:为什么不干脆把 n 设大一点?) 同学问,实践中是不是把最大长度 $n$ 调大就绕过了限制?老师明确否认:这是至今都没解决的真问题。原因在自注意力是序列长度的二次复杂度——要花 $O(n^2)$ 的内存。所以他打趣地说,最大模型可能也就 $n \approx 4000$,「能装 4000 个词,感觉不少,但装不下一篇维基百科页面,更别说一本小说」。而且——「我这条 prompt 塞不塞得进 ChatGPT」这类问题,正是它造成的。
编者拓展|为什么 sin/cos 能编码位置 正弦编码的巧妙之处在于:不同维度有从高到低的一系列频率,相当于用「多把不同刻度的尺子」同时测量位置,从而让每个位置拥有一个独特的、平滑变化的指纹——相邻位置编码相近。用三角恒等式还可以证明:固定偏移量 $\Delta$ 的相对位置,可以表示为位置编码上的一个线性变换,这正是「相对位置」直觉的来源。但如老师所说,它在超出训练长度时的外推并不可靠。
4.2 障碍二:没有非线性 → 前馈网络
(参考时间: 00:30:28)
📷 障碍:没有非线性
回到原视频 (00:30:28)
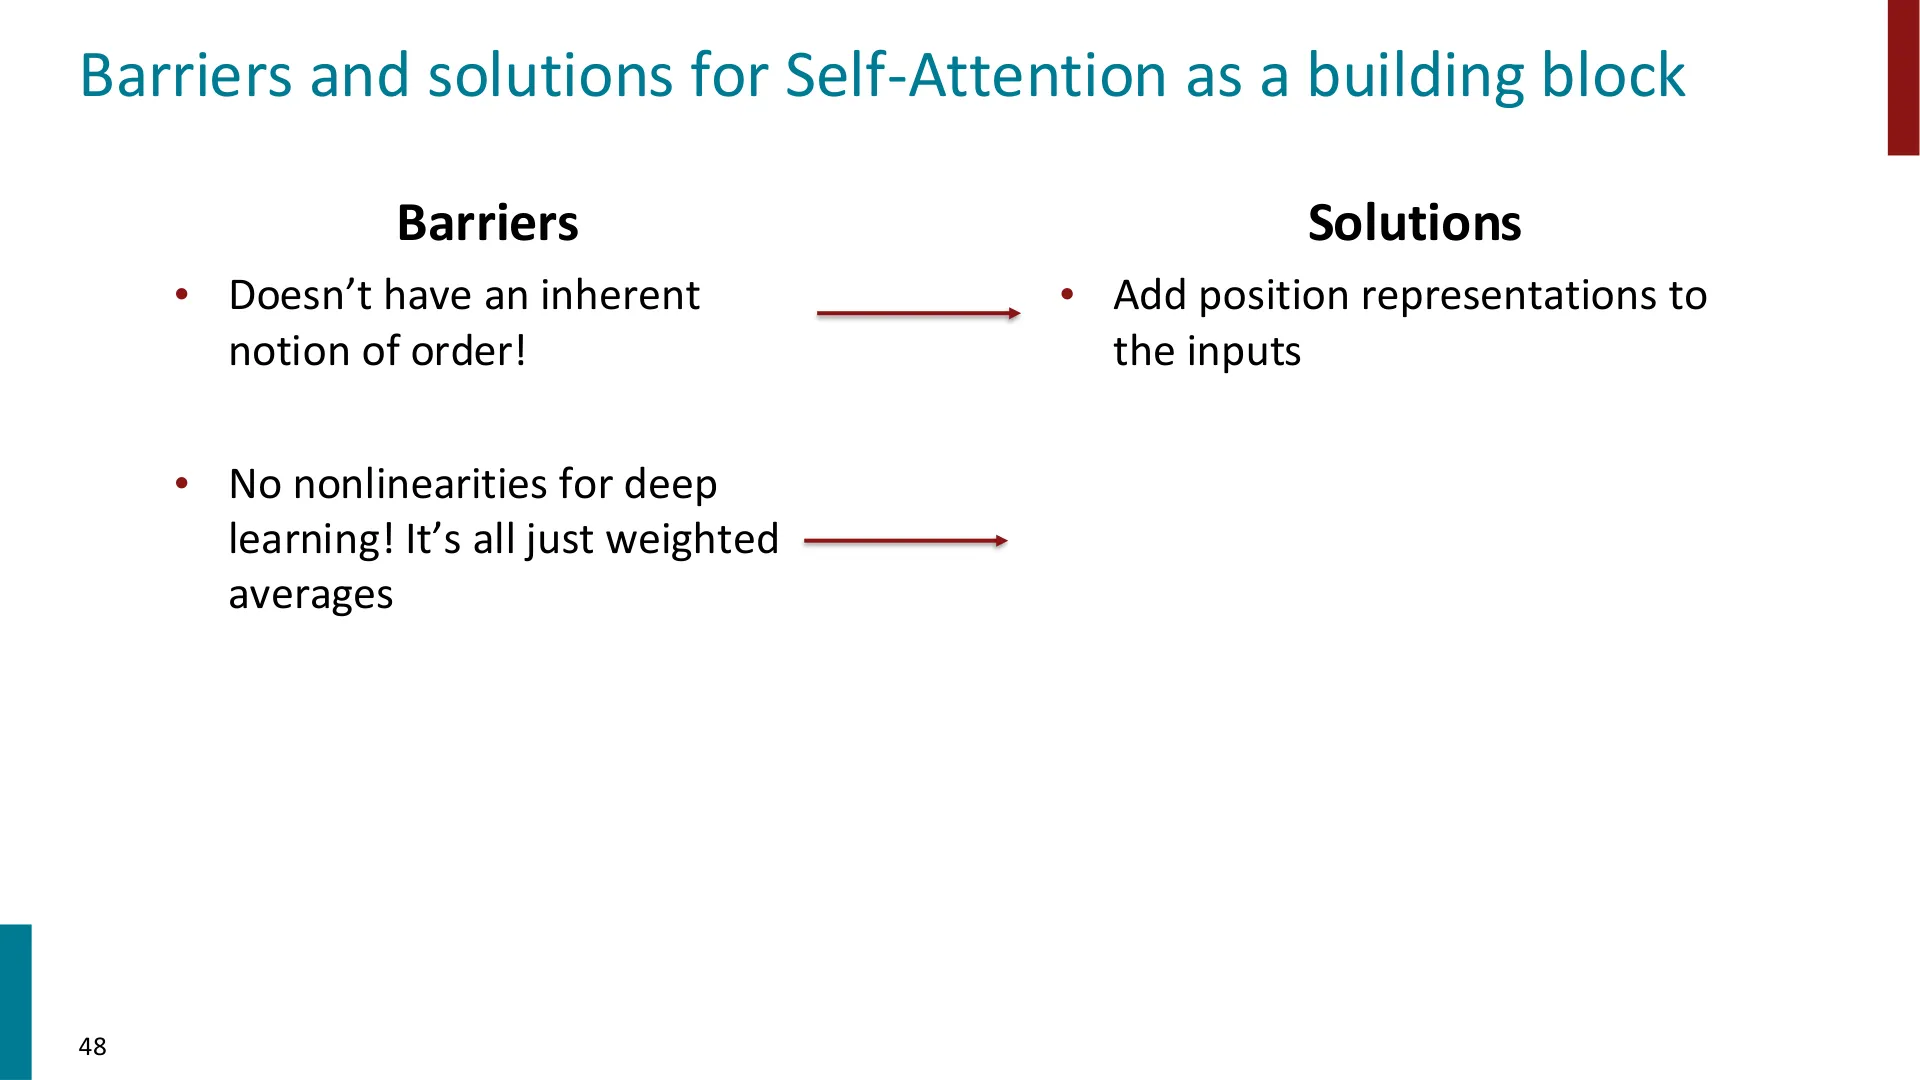
第二个障碍:自注意力里没有逐元素的非线性,全是加权平均。老师指出一个有趣(且值得读讲义)的事实:你把自注意力一层层叠下去,其实只是在反复对 value 向量求平均——到最后「看起来就像一次大的自注意力」。这显然浪费了「深度」的价值。
修法很直接:在每个位置的自注意力输出后面,接一个前馈网络(FFN / MLP)来后处理。
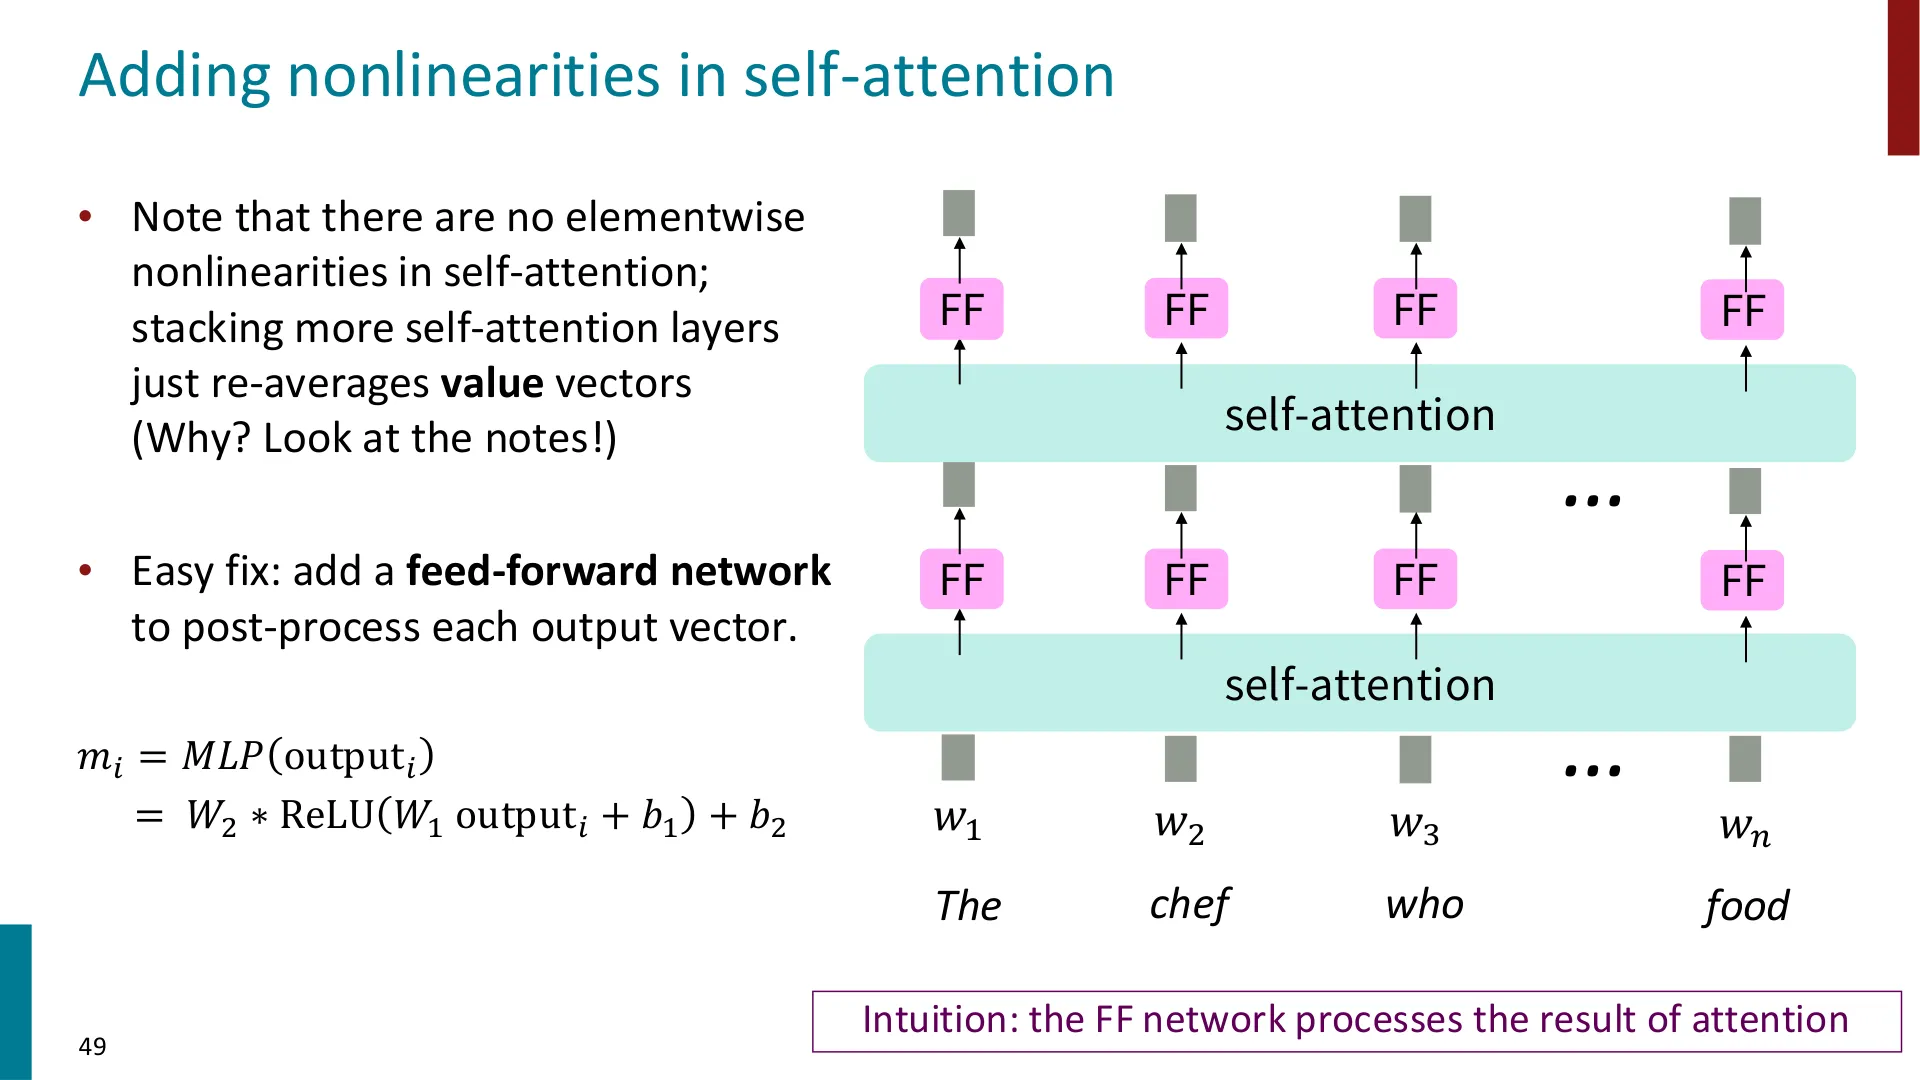
📷 为自注意力加入非线性
回到原视频 (00:31:04)
$$m_i = \mathrm{MLP}(\text{output}_i) = W_2 \cdot \mathrm{ReLU}(W_1\,\text{output}_i + b_1) + b_2$$
直觉是把每个词的自注意力结果独立地过一遍 MLP,相当于「对注意力结果做加工」。老师还补充了一个工程动机:FFN 里可以塞进大量计算,而且非常可并行、对 GPU 友好。
编者说明:老师举的例子是句子 the chef who [the] food——把每个词(如
the)的自注意力输出各自独立送进同一个前馈网络处理。注意关键词是「position-wise(逐位置)」:不同词共享同一套 FFN 参数,但各算各的。
4.3 障碍三:会偷看未来 → 掩码
(参考时间: 00:32:51)
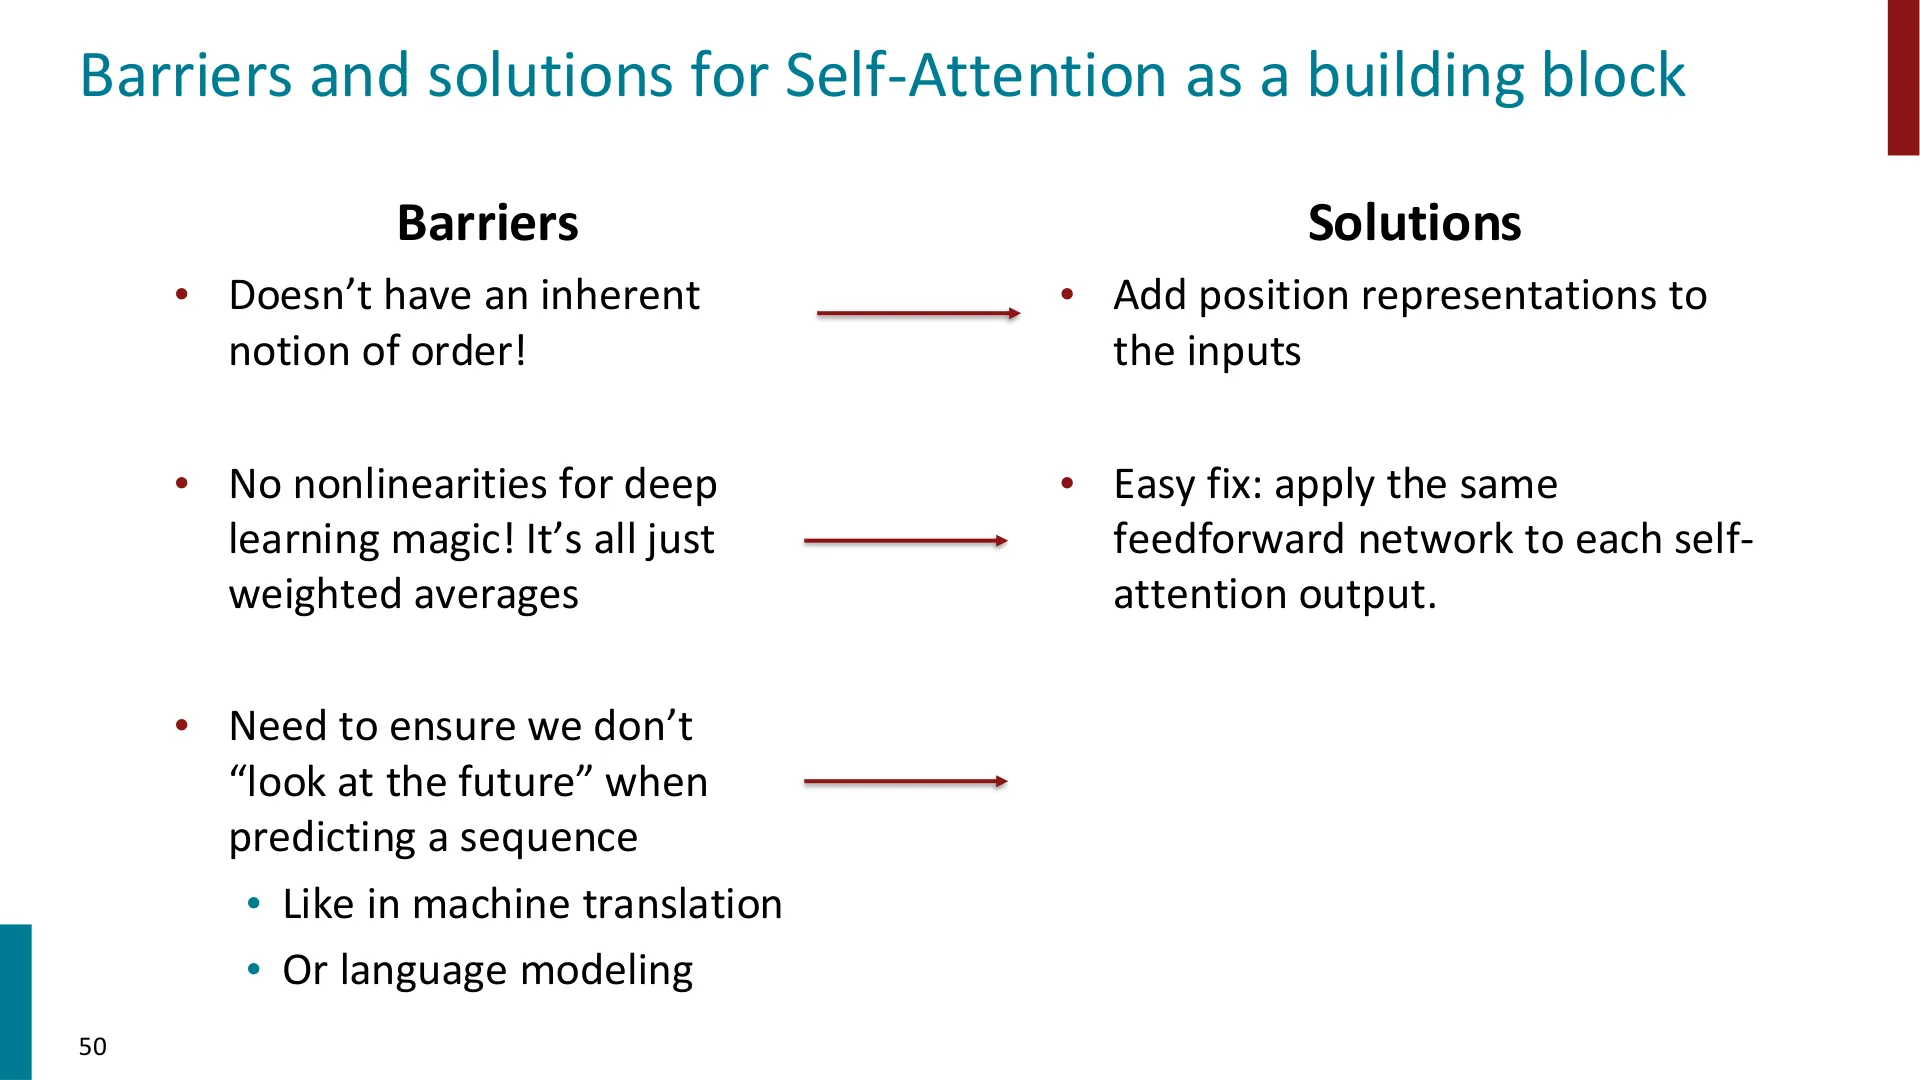
📷 障碍:不能偷看未来
回到原视频 (00:32:51)
第三个障碍:我们前面的例子能看整句。但对于机器翻译、语言模型这类要在一个序列上定义概率分布的任务,你不能作弊去看未来。
一种朴素做法是:在每一步只把「过去」的词放进 key/query 集合。但老师指出这样无法并行。于是改用「先全算、再遮住」的办法:照常算出整个 $n \times n$ 的分数矩阵,然后把「未来」位置的分数设为 $-\infty$:
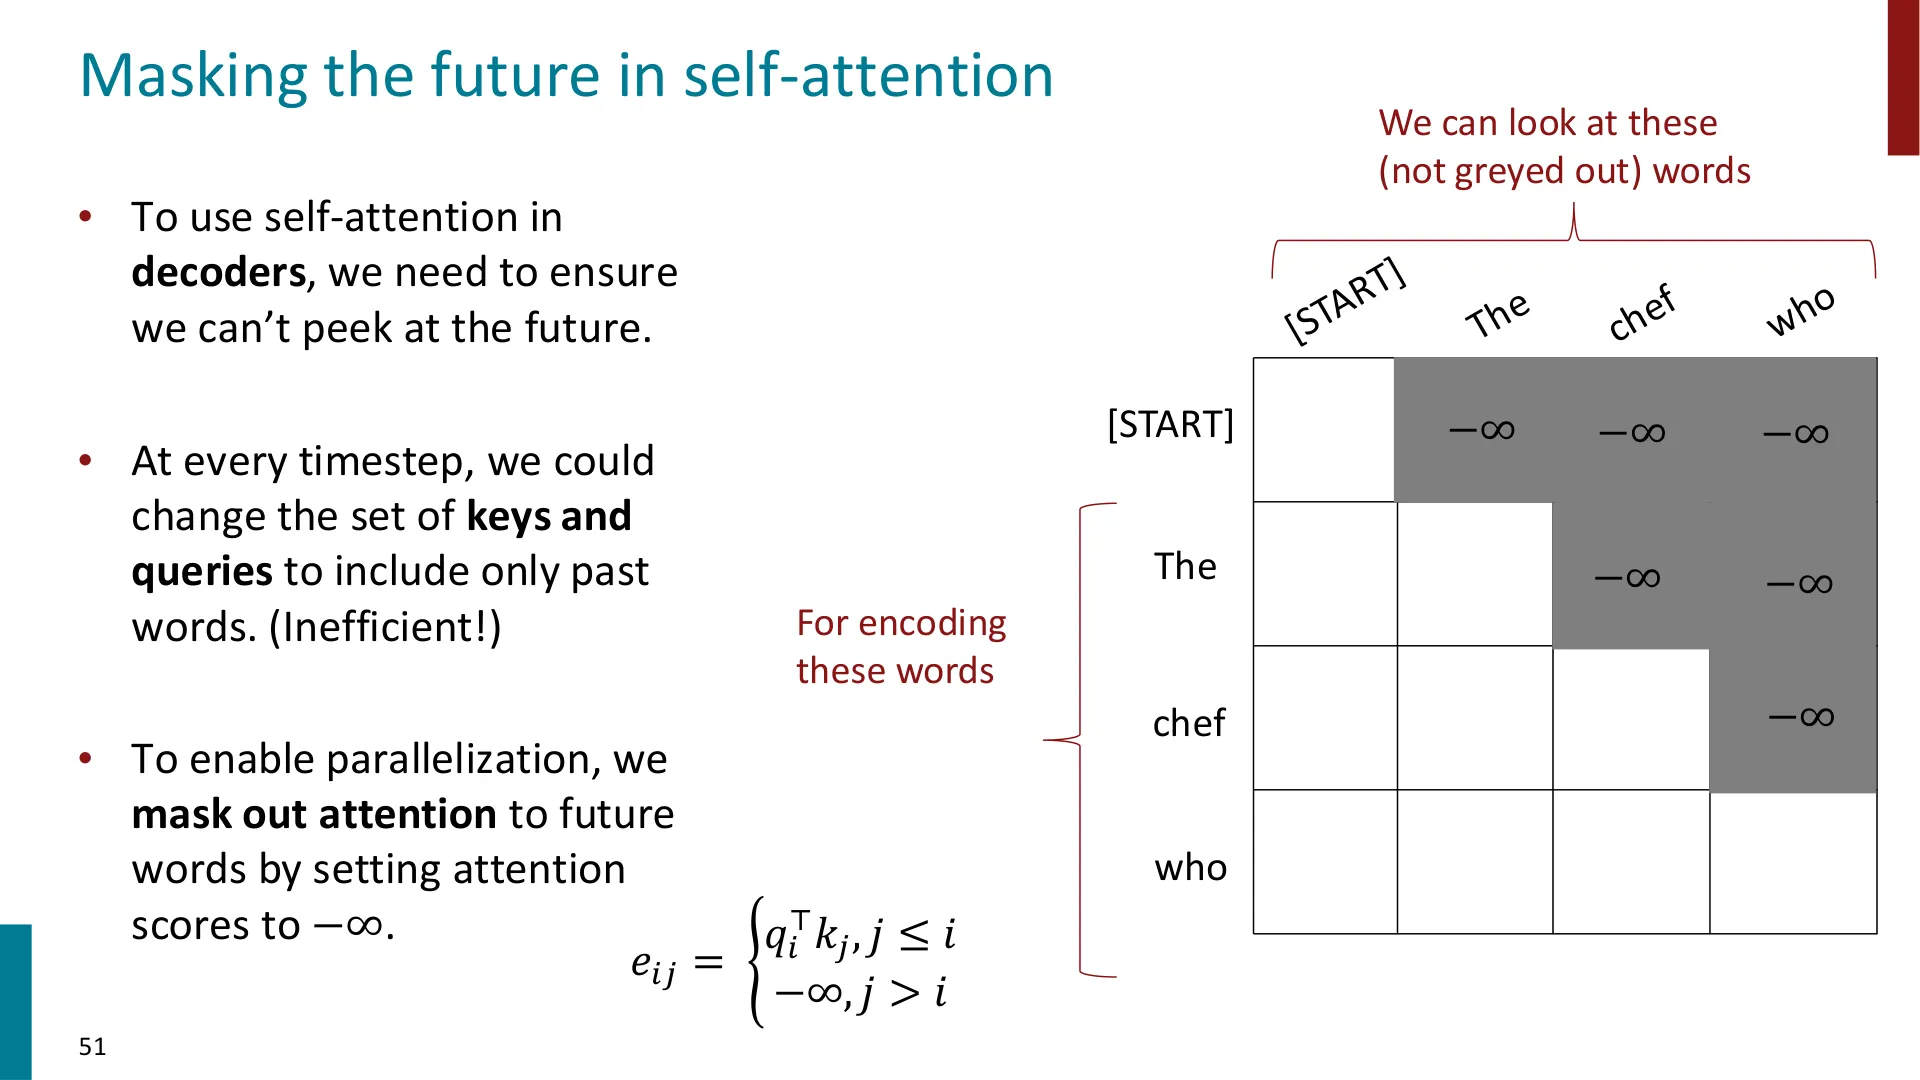
📷 在自注意力里掩码未来
回到原视频 (00:33:35)
$$ e_{ij} = \begin{cases} q_i^\top k_j, & j \le i \\ -\infty, & j > i \end{cases} $$
因为 softmax 会把 $-\infty$ 映射为 0,所以未来词的注意力权重就变成 0,等于「看不见」。
老师用 the chef who 举例(含一个起始符号 [START]):
- 编码
[START]时,只能看[START]; - 编码
the时,能看[START]和the; - 编码
chef时,能看[START]、the、chef,但不能看who。
这样,用 chef 的表示就能定义一个概率分布去预测下一个词 who,而不会「先偷看答案」。
编者说明(学生问答:编码器要不要掩码?) 同学问:掩码是给解码器用的,那编码器也用吗?老师区分得很清楚:这就像双向 LSTM vs 单向 LSTM——凡是需要「自回归」约束($p(w_1)p(w_2\mid w_1)p(w_3\mid w_1,w_2)\dots$)的地方就用掩码(解码器);不需要约束的地方(如翻译的源句编码器)就不用,「让大家互相看通常更好」。所以传统上:解码器掩、编码器不掩。
编者说明(学生问答:人类不也会「预判」未来吗?) 有同学抛出一个颇哲学的问题——人类说话/写作前,脑子里也有对后文的预判,为什么模型不能也「往前想一想」?老师区分了两件事:在推理/生成时,做一个高层计划、预判很远的词当然可能有用;但在训练时,如果你把未来的答案直接喂给网络去预测下一个词,「它就太容易了、没东西可学」。他补充说,「给网络一点关于『接下来大概是什么类型』的提示」之类方向很有意思,但超出本节范围。
编者说明(学生问答:机器翻译为什么也要掩码?) 老师走到白板,画出翻译例子:
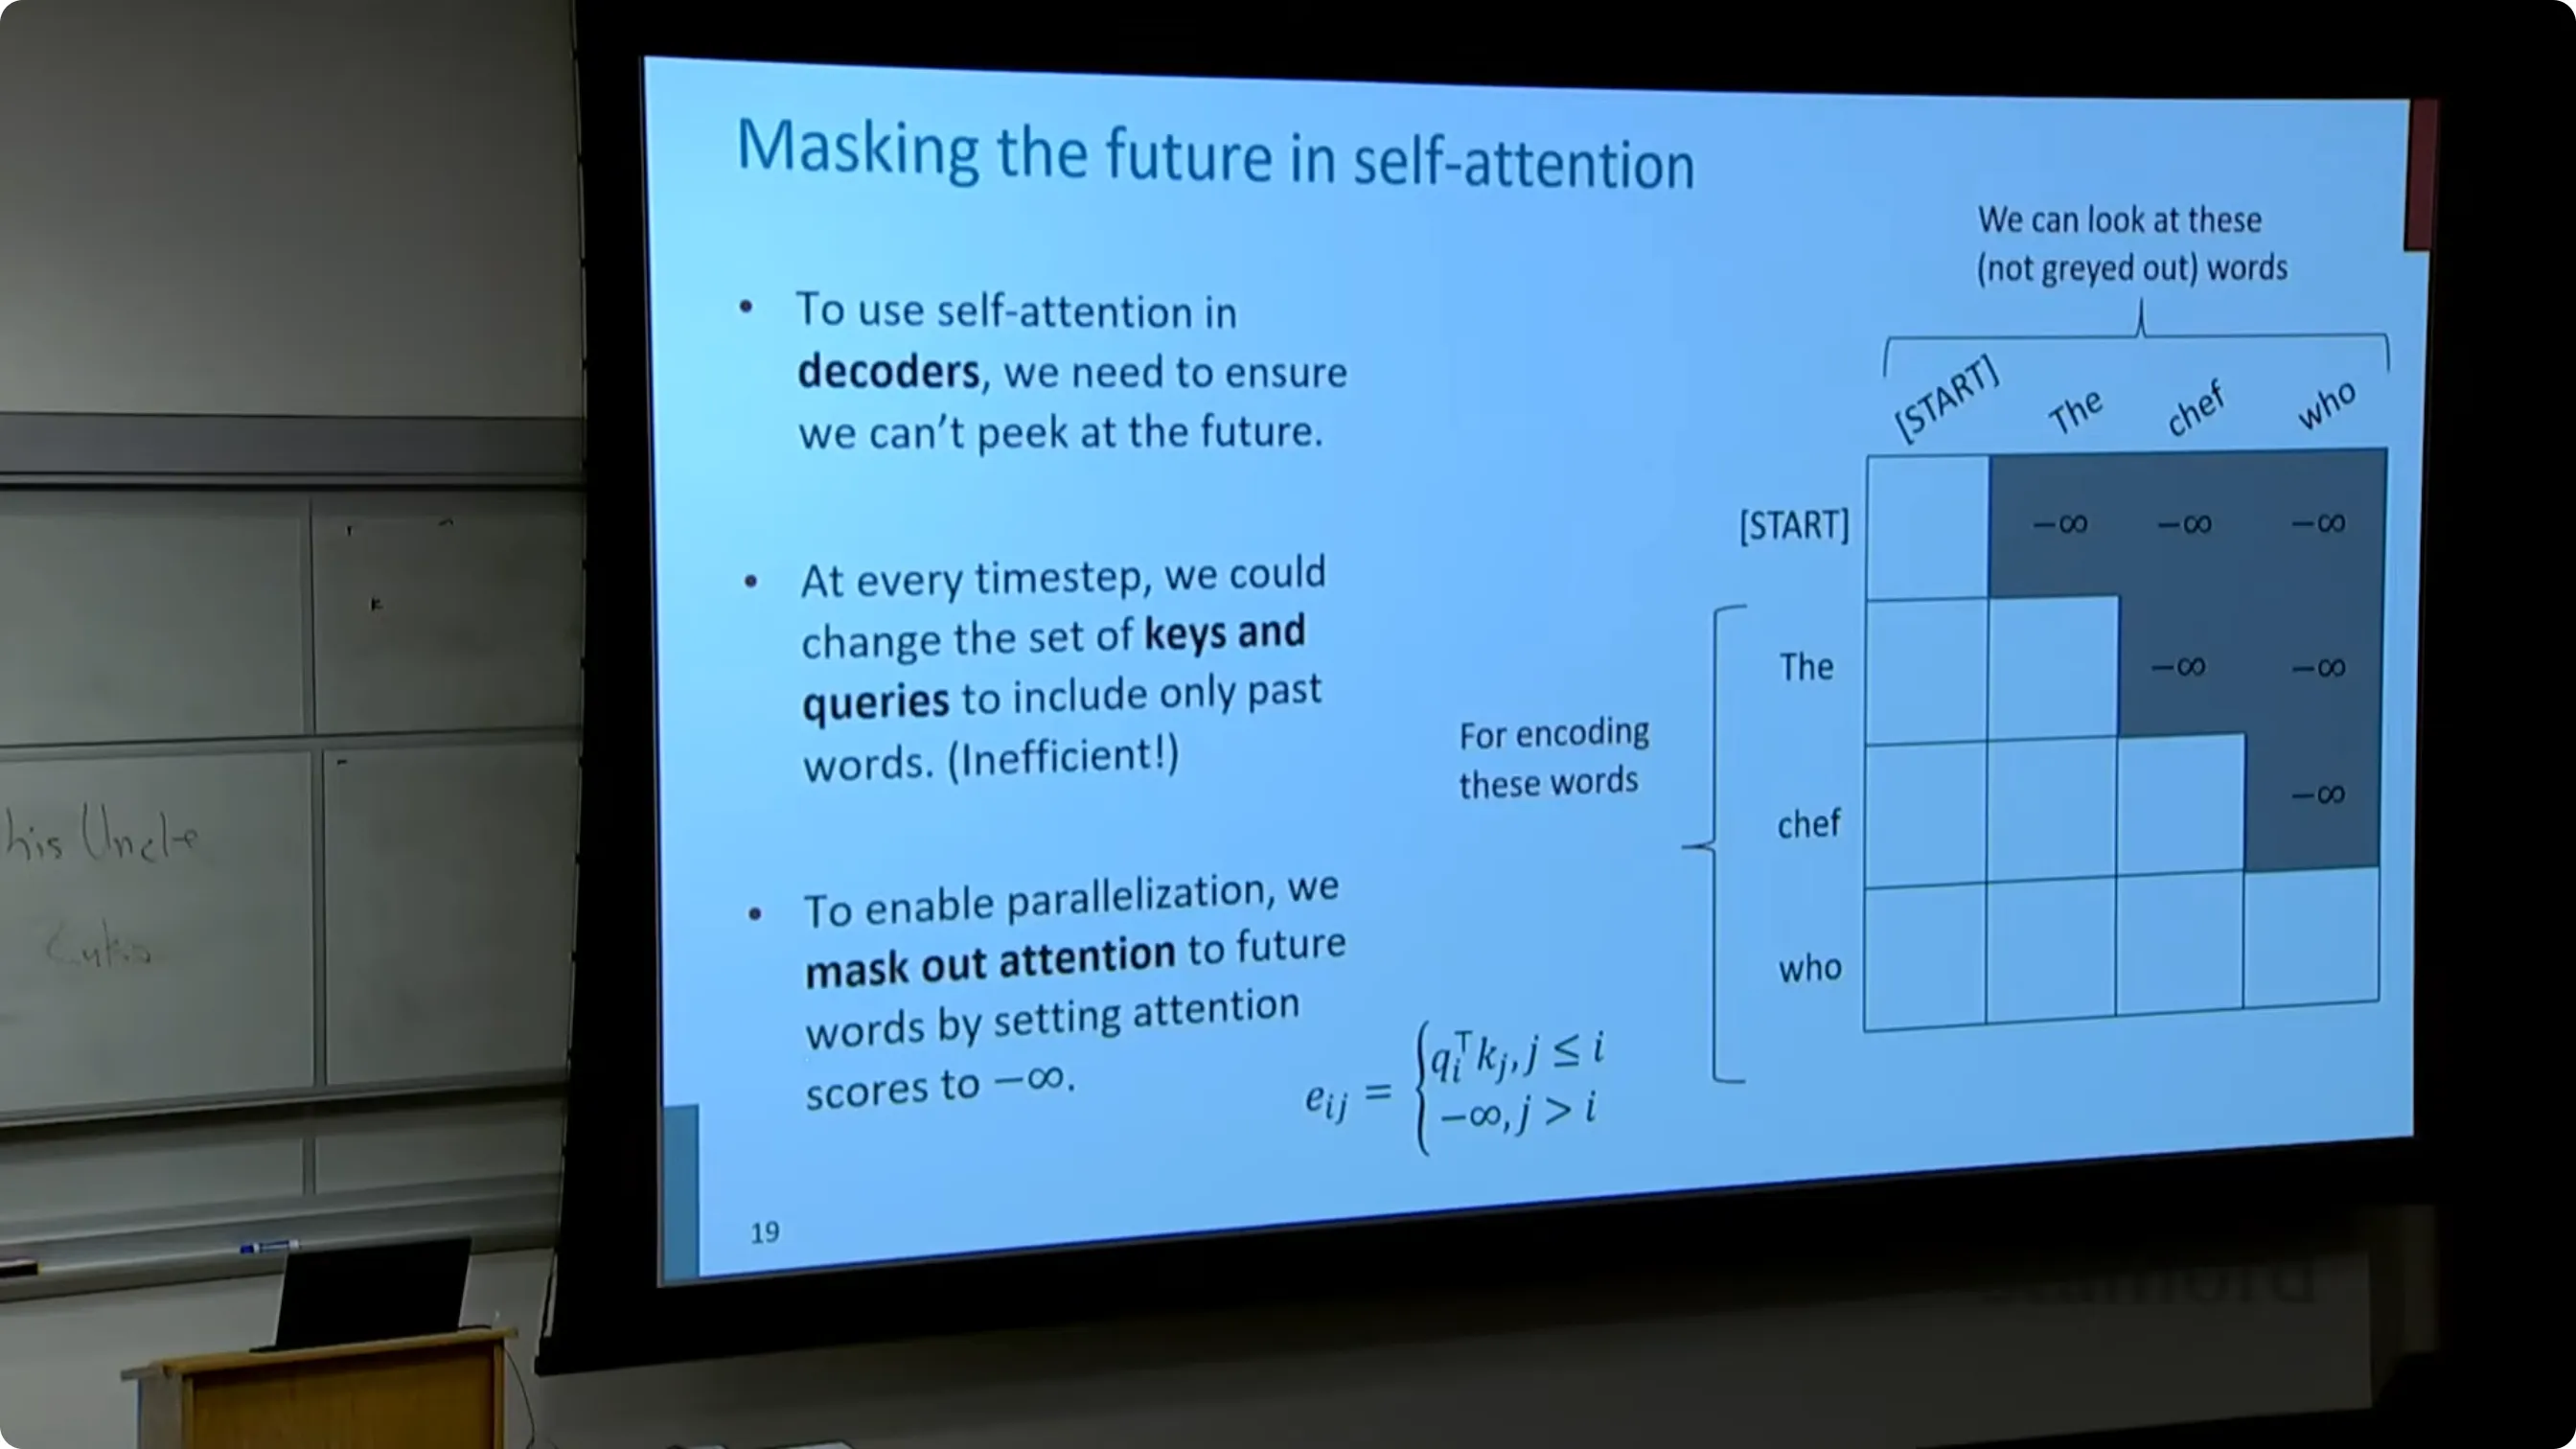
📷 机器翻译掩码示例的白板
回到原视频 (00:37:45)
源句 I like pizza → 目标 J'aime la pizza。编码源句时不做掩码(要让 I 看 like、I 看 pizza、like 看 pizza,全都互相看);生成目标句时做掩码——编到某个目标词时,只能看自己和之前,不能看后面的词。老师的原话:为了「正确地表示这个词,我就不能拥有未来的信息」。
4.4 最小自注意力模块的「四件套」
(参考时间: 00:39:12)
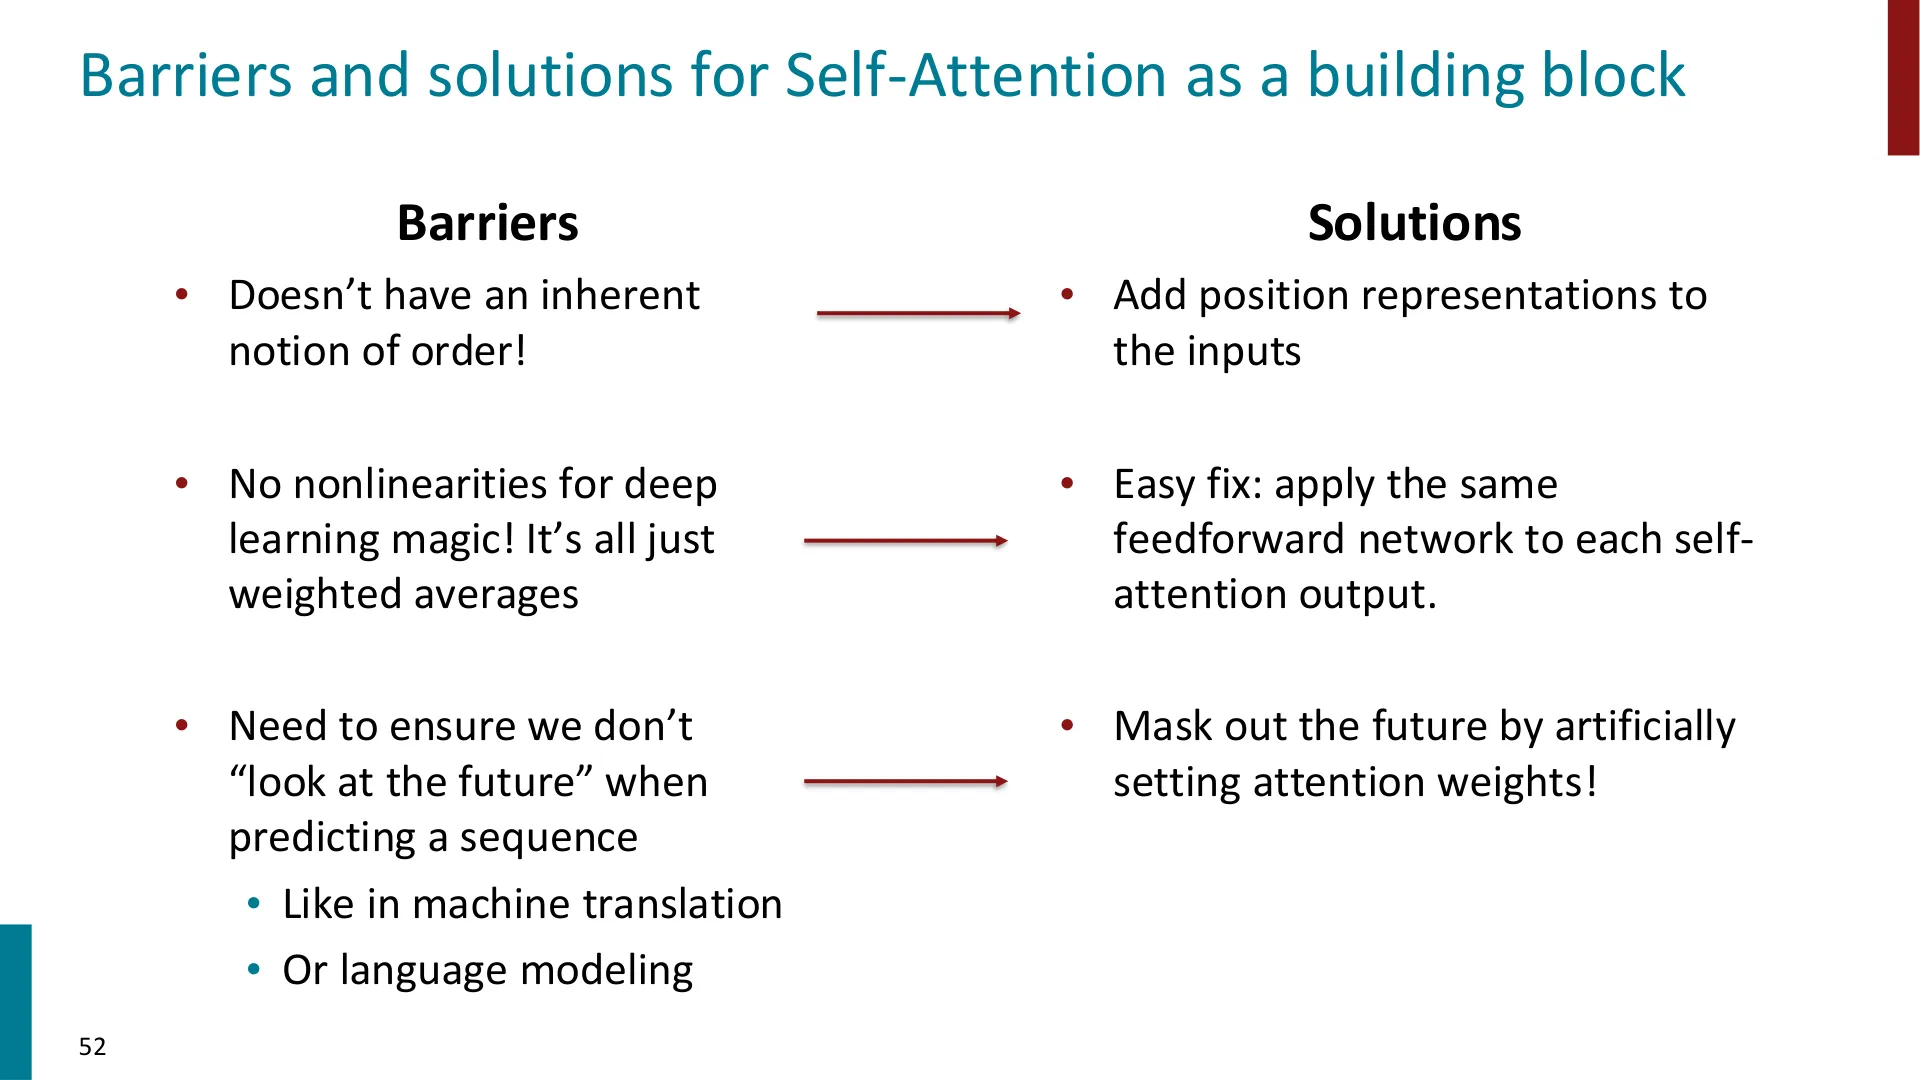
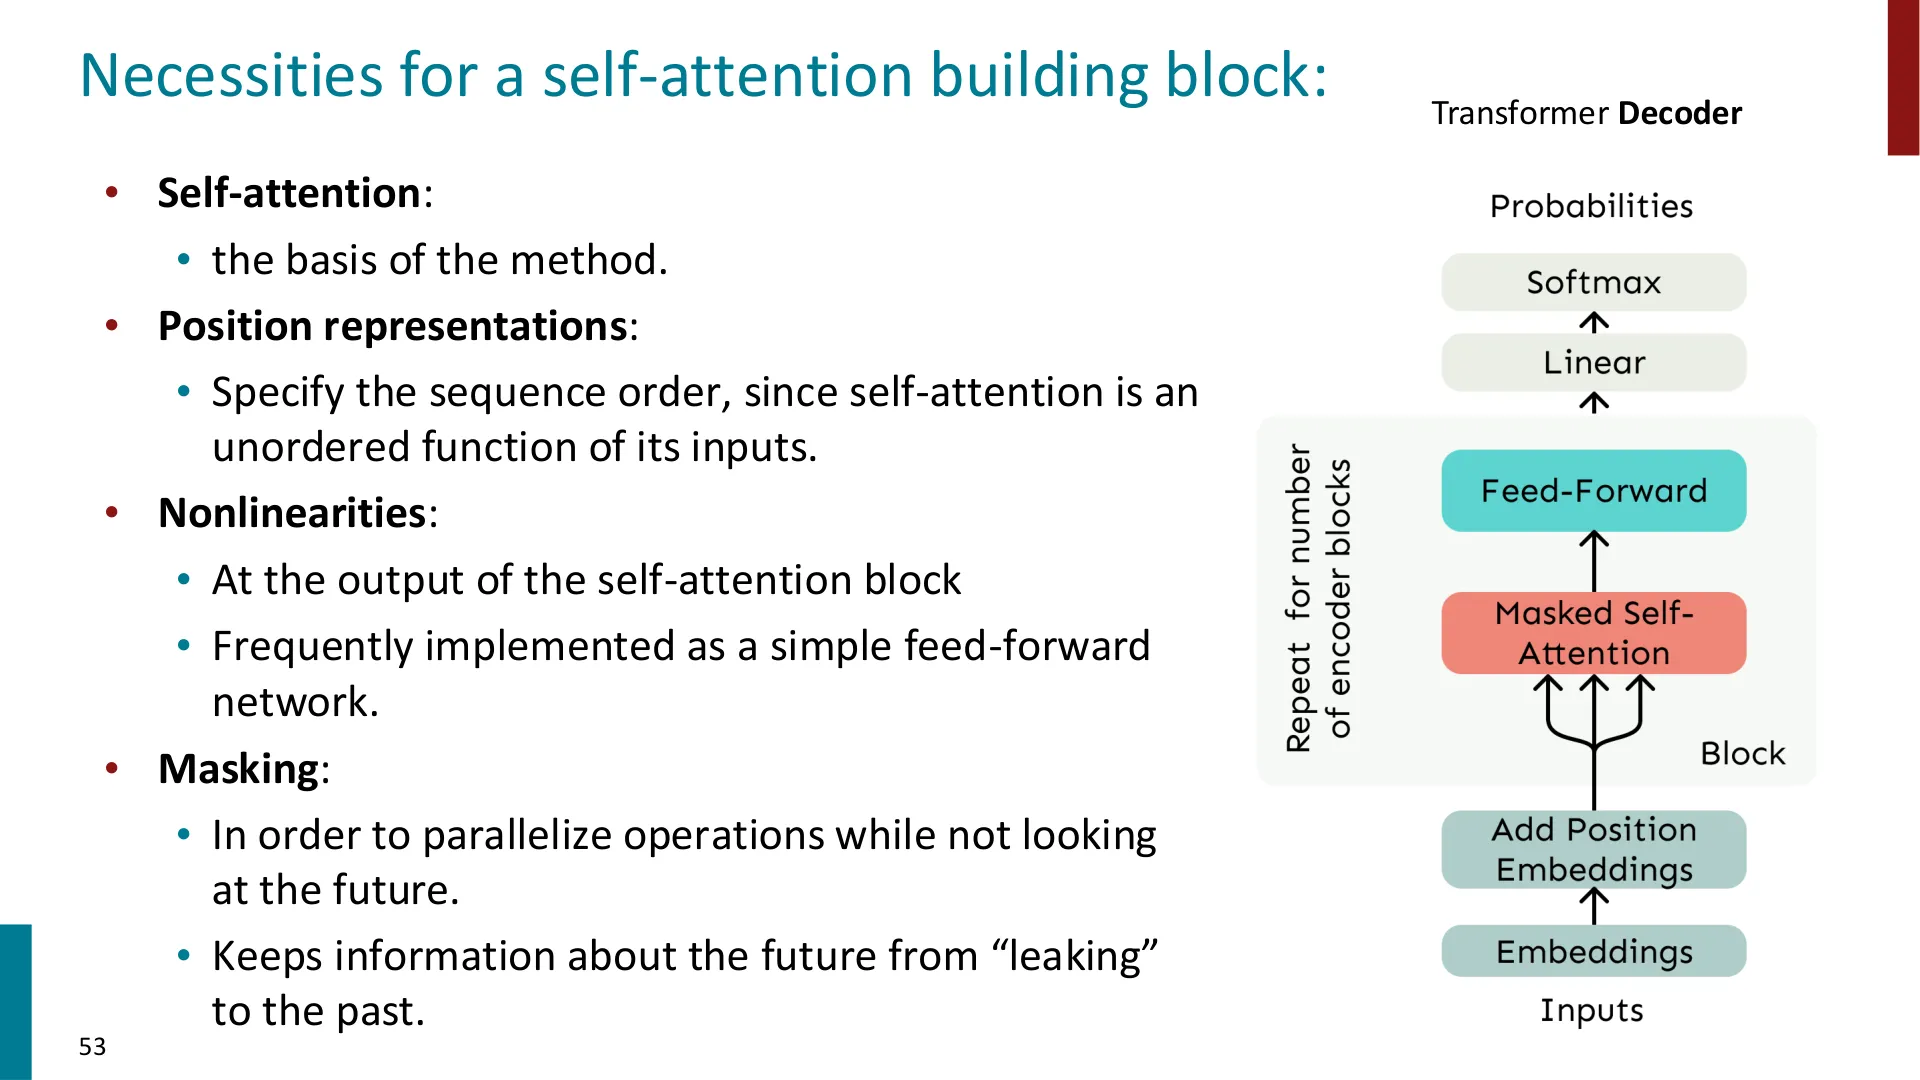
把上面的修补汇总起来,就是老师所说的「最小自注意力模块」:
📷 自注意力基本模块的必要组件
回到原视频 (00:39:09)
- 自注意力——方法的基础;
- 位置表示——因为自注意力是无序函数,所以必须显式指定顺序;
- 非线性——接在自注意力块的输出后,通常实现为一个简单的前馈网络;
- 掩码——既为了并行、又为了不偷看未来,防止未来信息「泄漏」到过去。
📷 自注意力基本模块的组件清单
回到原视频 (00:39:17)
在架构图上,可以这样理解:输入 → 词嵌入 $E$ + 位置嵌入 → 三个箭头分别变成 query/key/value → 自注意力 → 逐位置前馈网络 → 掩码。这个子结构可以重复多次(自注意力 → 前馈 → 自注意力 → 前馈……),最后再接一个「预测头」去预测下一个词、情感、或其它东西。
编者说明:老师特别说,这是他个人偏爱的一种「教学式」讲法——先拼出一个最小积木,再往上叠 Transformer。他同时提醒:真实系统并不直接使用这个最小积木,因为「它没有它本该有的那么好用」,还需要后面那些关键细节。
五、Transformer 解码器:多头注意力与训练技巧
(参考时间: 00:41:15)
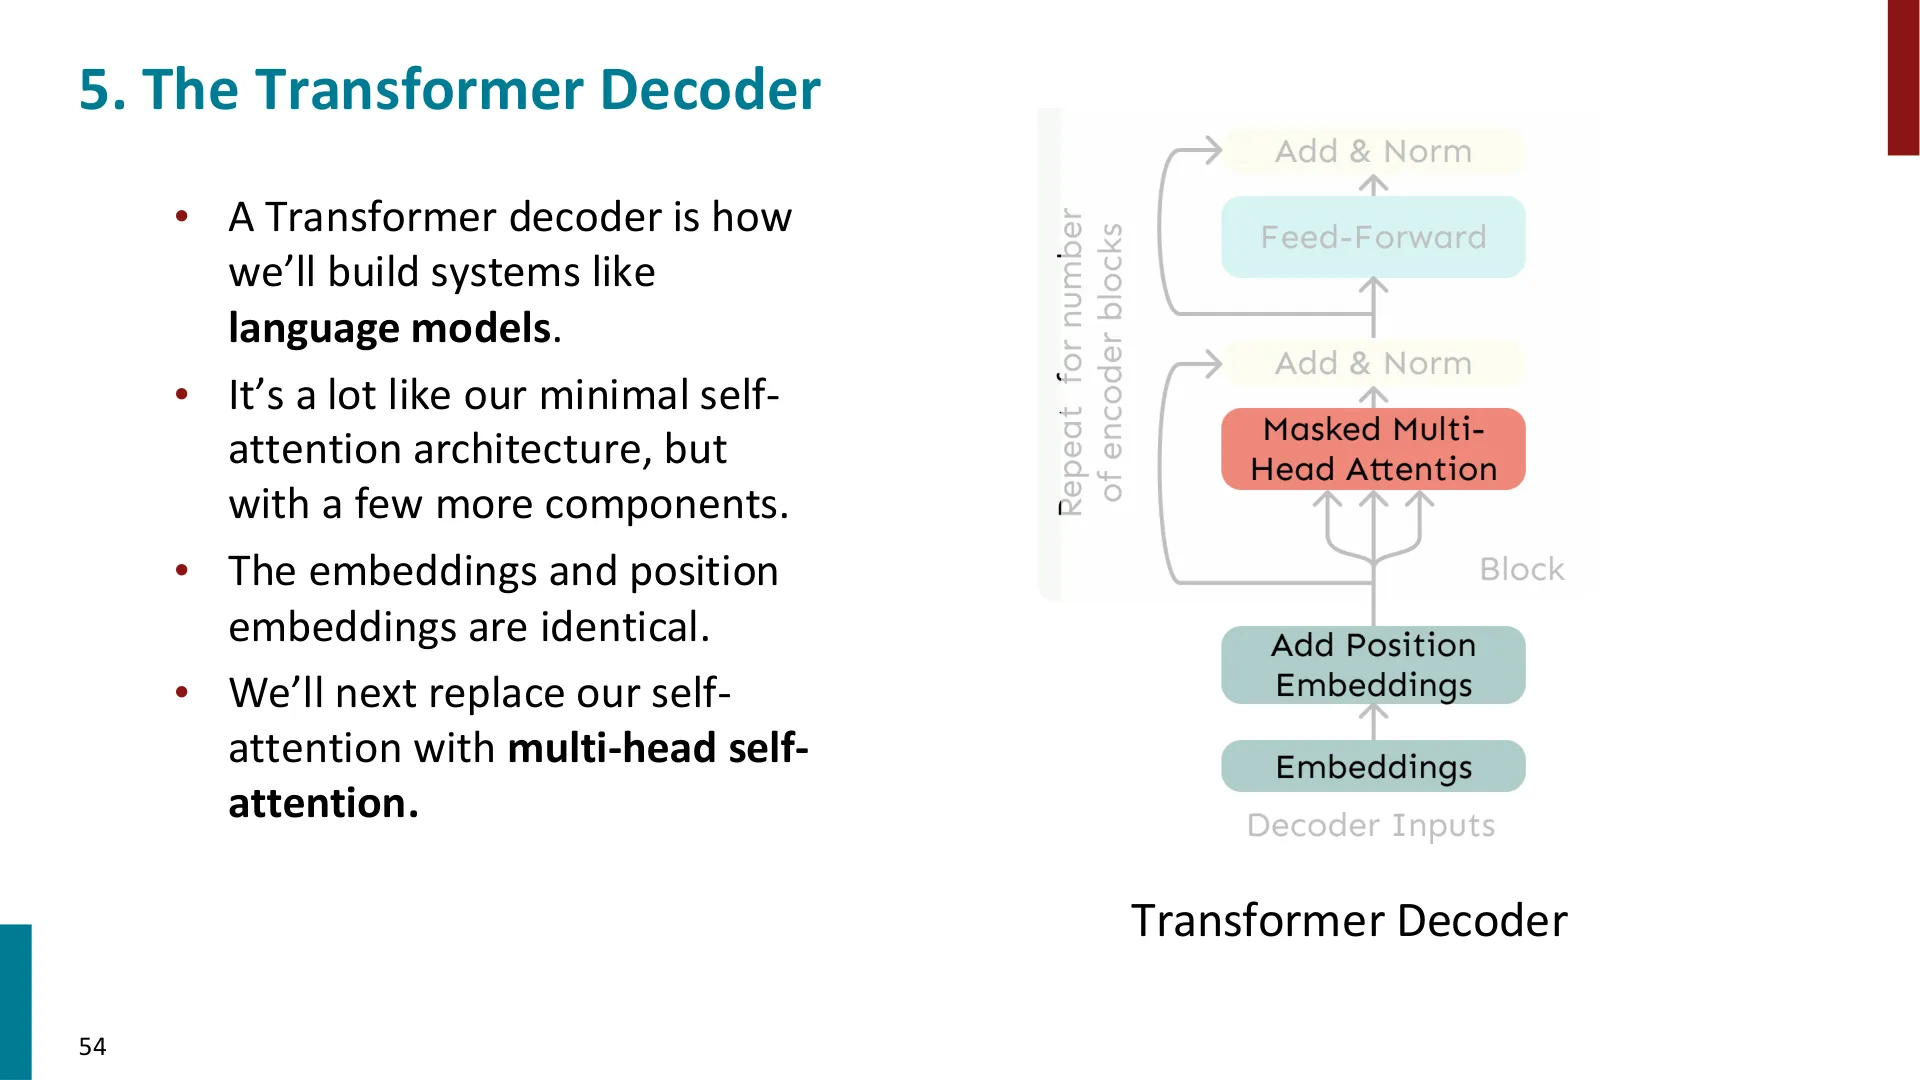
老师把话题推进到正式的 Transformer。他强调一个心态:Transformer 并不是「寻找更好语言表示」的终点,尽管它已无处不在、流行了好几年;要始终带着「它有哪些问题、怎么改进」的眼光去看它。
编者说明:把「最小积木」升级成 Transformer 解码器,主要在一处替换(自注意力 → 掩码多头自注意力)加两处训练技巧(残差连接 + 层归一化)。老师称「掩码多头自注意力」是 Transformer 与最小积木之间最重要的差别。
📷 Transformer 解码器
回到原视频 (00:42:08)
5.1 为什么需要多头注意力
(参考时间: 00:42:43)
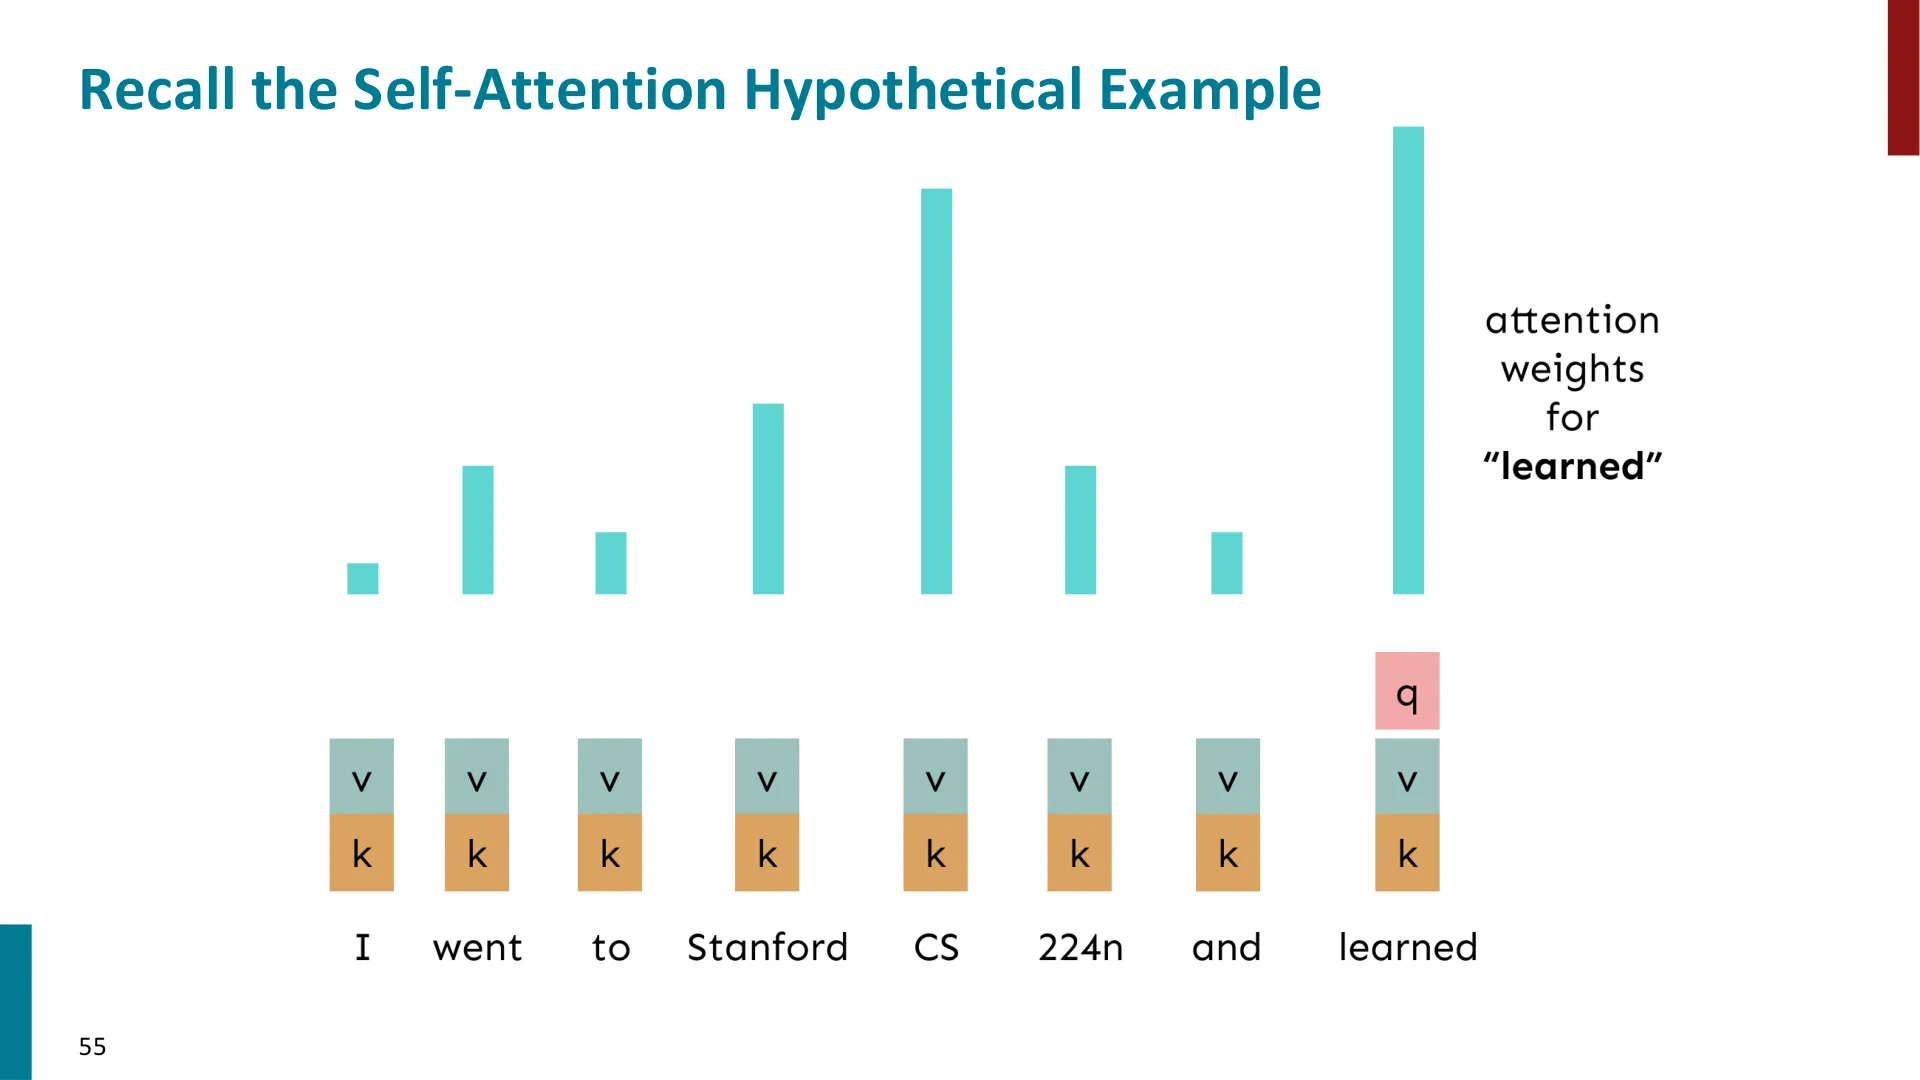
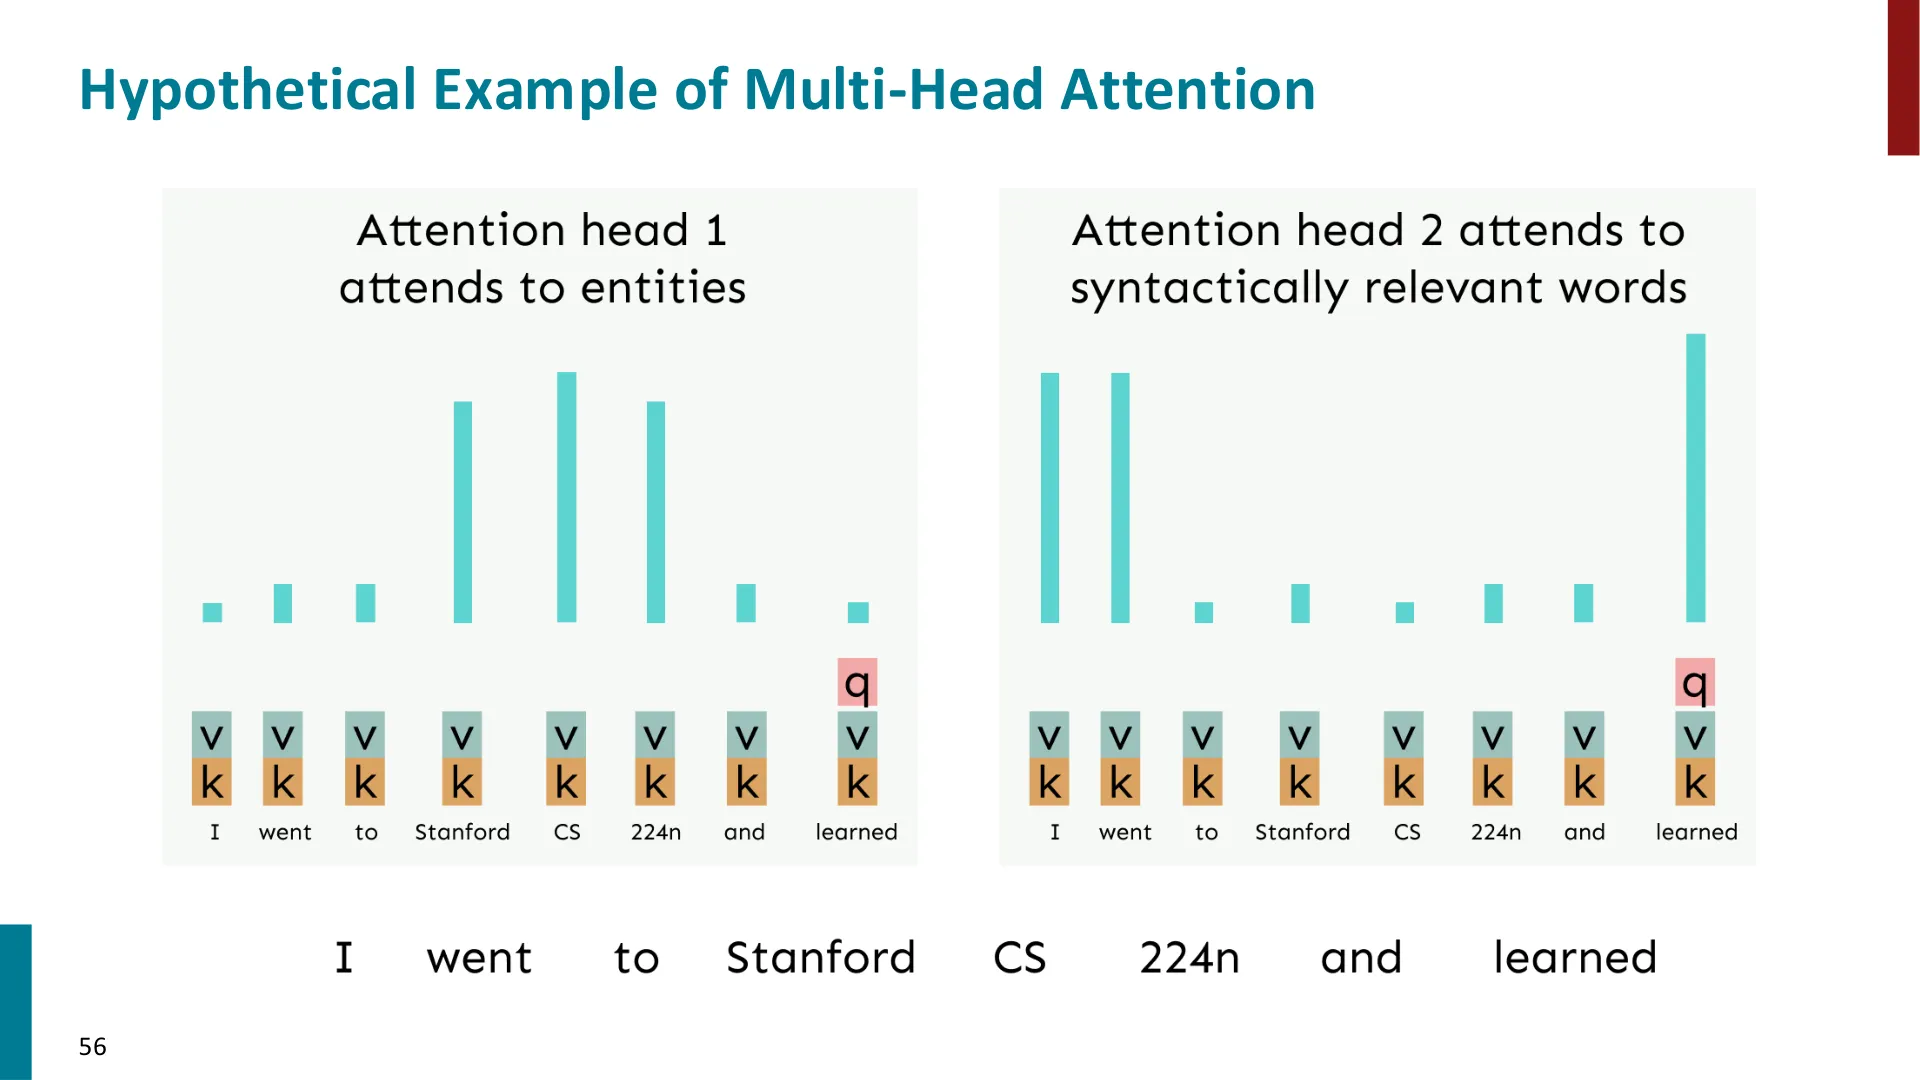
回到那个玩具例子 I went to Stanford's cs224n and learned。老师指出,为一个词建立表示时,你其实想从不同角度、为了不同原因去看不同的地方:
📷 多头的直觉:从多处、为不同原因去看
回到原视频 (00:42:43)
- 一方面,也许想重点看 Stanford cs224n——因为「你在 Stanford cs224n 学到的东西,和在别处学到的不同」(实体类的信息);
- 另一方面,也许想重点看 I went … learned 这些和
learned句法上相关的词。
「为了这么不同的原因去看不同的东西,如果只用一次自注意力把这些平均掉,可能就太难了」——这正是需要多头的直觉。
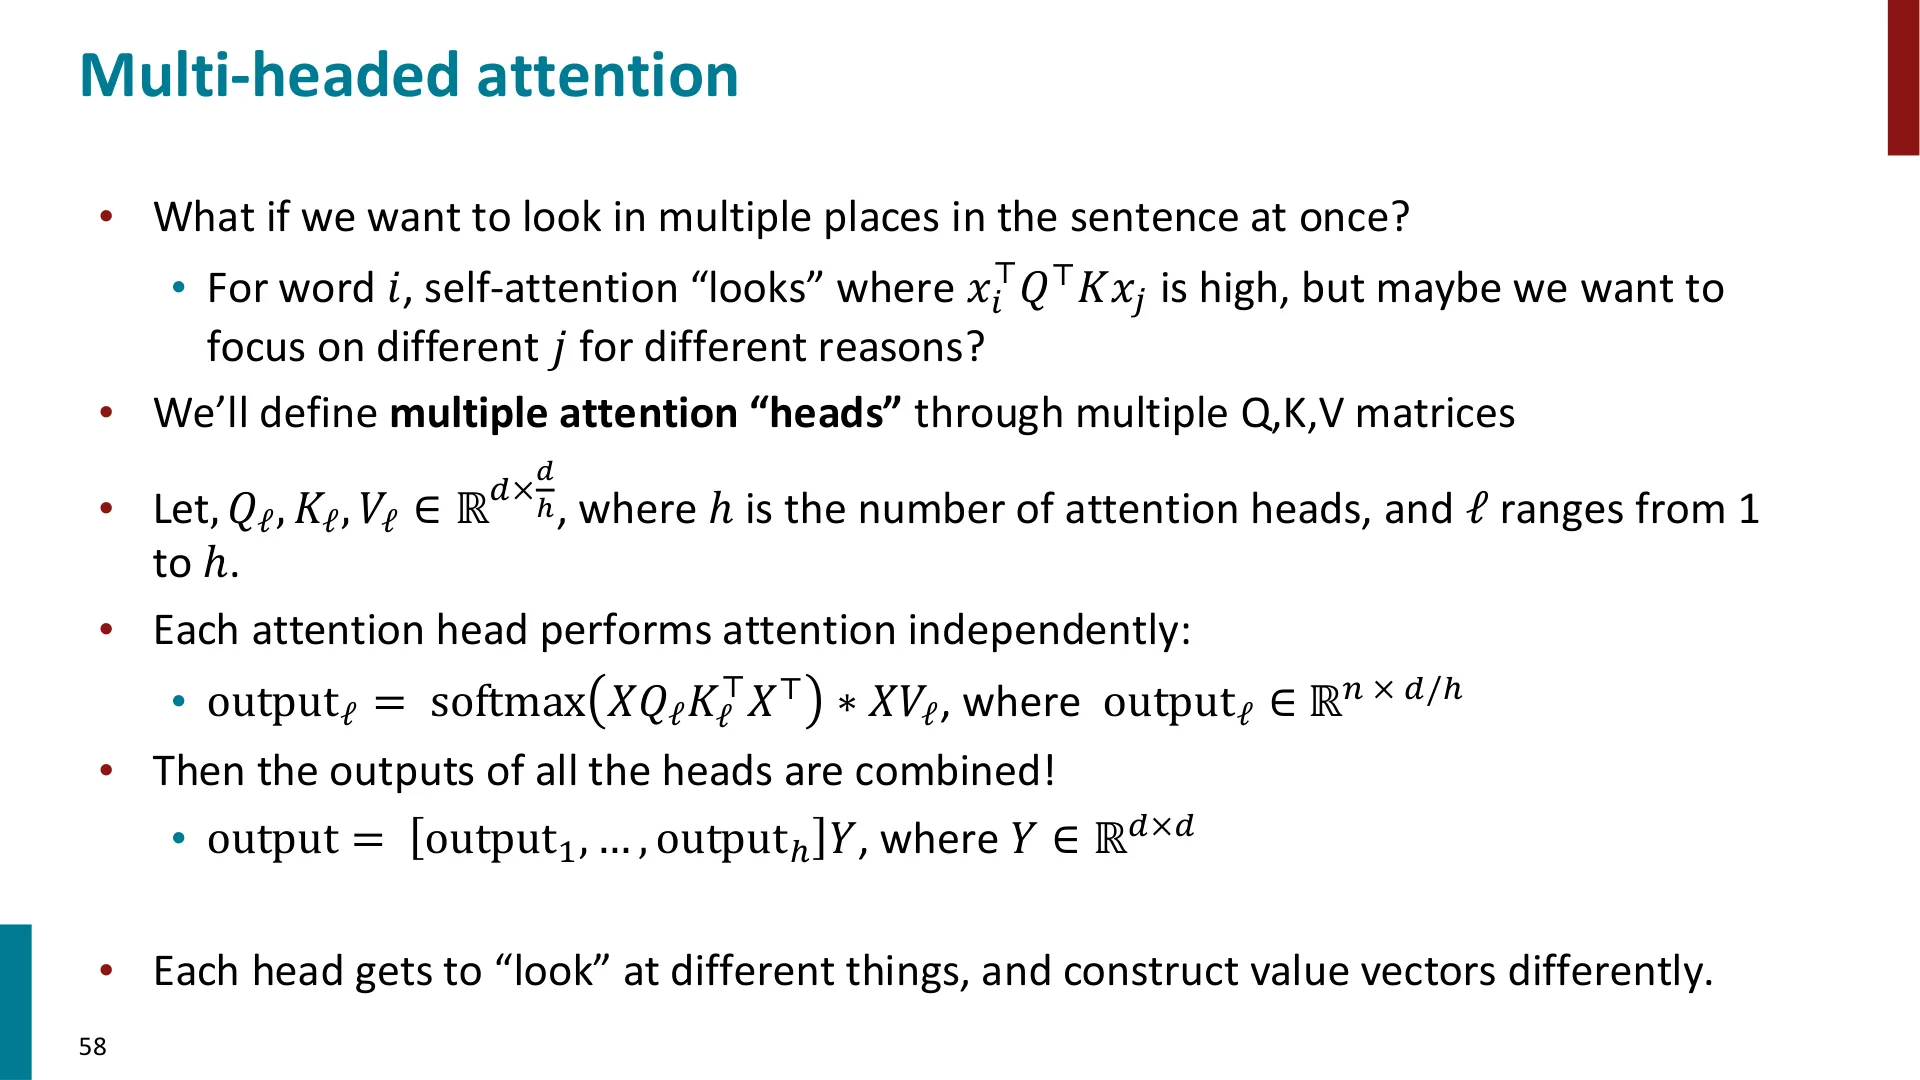
定义多头 (参考时间: 00:47:50):用多组 $Q, K, V$ 矩阵。设 $Q_\ell, K_\ell, V_\ell \in \mathbb{R}^{d \times d/h}$,其中 $h$ 是头数,$\ell$ 取 $1 \dots h$。每个头独立地做注意力:
$$\text{output}_\ell = \mathrm{softmax}\!\left(X Q_\ell K_\ell^\top X^\top\right) X V_\ell,\qquad \text{output}_\ell \in \mathbb{R}^{n \times d/h}$$
📷 多头注意力
回到原视频 (00:43:31)
然后把所有头的输出拼接起来再混合:
$$\text{output} = [\text{output}_1, \dots, \text{output}_h]\, Y,\qquad Y \in \mathbb{R}^{d \times d}$$
老师总结:每个头可以看不同的东西、以不同方式构造 value 向量,最后再统一混合。
编者说明(学生问答:不同块之间共享参数吗?) 老师定义「一个 block = 一次自注意力 + 一次前馈」;「多层」就是把 block 叠起来。不同 block 之间一般不共享参数,每个 block 有自己独立的参数(有少数例外)。
编者说明(学生问答:每个 block 的头数一样吗?) 大体上都一样,人们没找到非要变化的理由。老师补充:训练完后其实可以把一些注意力头整个置零删掉,他很想知道不同层能不能删不同数量——那样也许说明该层该少给点头。但由于「多给头并不更贵」,实践中大家更倾向于按模型维度 $d$ 来定头数:比如希望每个头至少保留 64 维($d=128$ 就大致定出 $h$)。总之——头数随模型维度一起放大。
5.2 用矩阵高效实现:序列堆叠形式
(参考时间: 00:45:29)
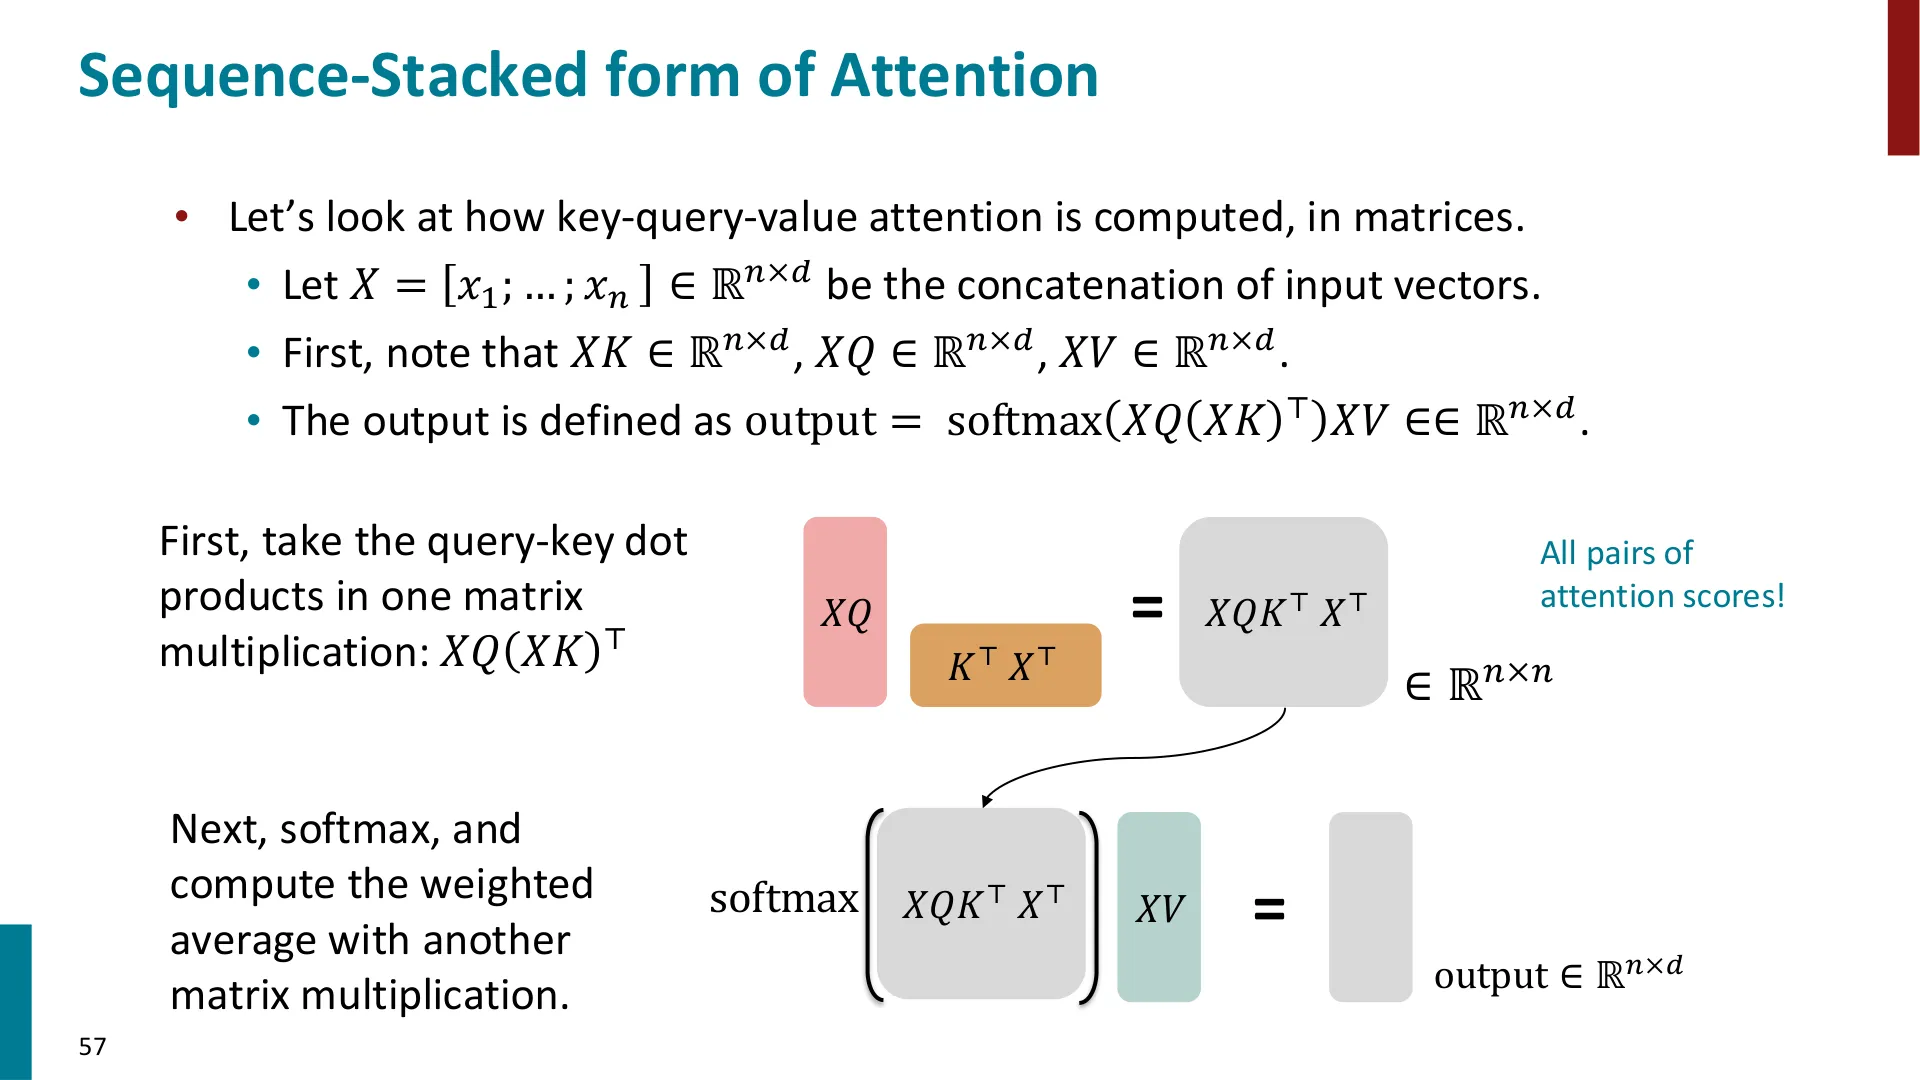
前面都是「一个词一个向量」地讲,但真正实现要把词堆成大矩阵。设
$$X = [x_1; \dots; x_n] \in \mathbb{R}^{n \times d}$$
于是 $XK, XQ, XV \in \mathbb{R}^{n \times d}$,一次矩阵乘法就能把整句每个词都变换出来(不要 for 循环遍历序列)。整个自注意力的输出可写成:
📷 注意力的序列堆叠形式
回到原视频 (00:45:29)
$$\text{output} = \mathrm{softmax}\!\left(X Q K^\top X^\top\right) X V \in \mathbb{R}^{n \times d}$$
老师逐步拆解:
- 先算 所有 query–key 点积:$(XQ)(XK^\top X^\top)$ 这一步得到 $n \times n$ 的矩阵,装的就是所有 $e_{ij}$;
- 对这一 $n \times n$ 矩阵的第二个维度做 softmax,得到归一化权重;
- 再乘 $XV$($n\times n$ 乘 $n\times d$),就是一次大的加权平均,得到 $n \times d$ 的输出。
「我只是把自注意力运算用矩阵重述了一遍,这样就能在 GPU 上高效地跑。」
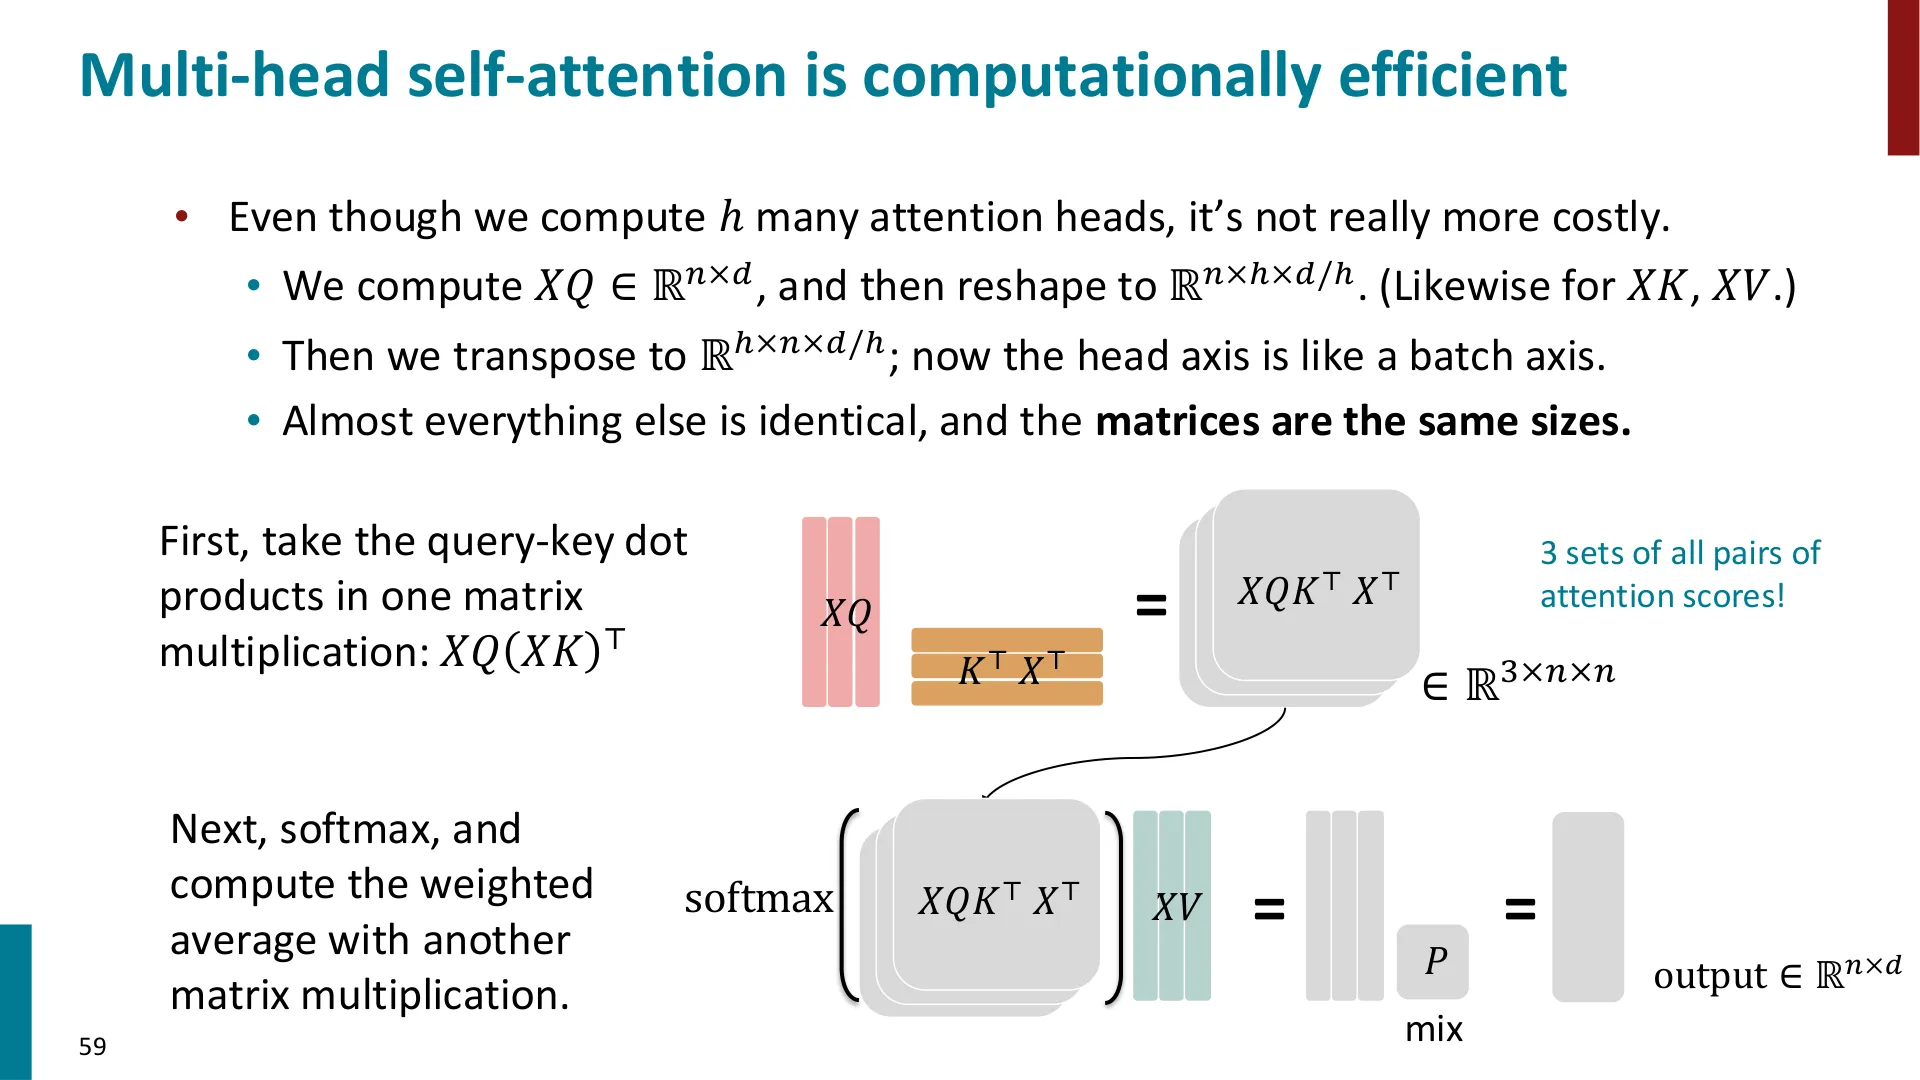
5.3 多头在矩阵层面为什么不更贵
(参考时间: 00:49:49)
老师强调:做多头,其实和做单头一样便宜。看张量整形就明白了:
- 先算 $XQ \in \mathbb{R}^{n \times d}$,然后 reshape 成 $\mathbb{R}^{n \times h \times d/h}$($XK$、$XV$ 同理);
- 再 transpose 成 $\mathbb{R}^{h \times n \times d/h}$——此时「头」这一维就像 batch 维一样;
- 之后几乎所有操作都不变,矩阵大小也不变,只是多出 3 套「分组」的 $XQ$ 矩阵。
graph TD
  X["X (n×d)"] --> Q["XQ (n×d)"]
  X --> K["XK (n×d)"]
  X --> V["XV (n×d)"]
  Q --> RQ["reshape → (n×h×(d/h)),head 轴当 batch"]
  RQ --> H1["head 1: softmax(XQ₁K₁ᵀXᵀ)XV₁"]
  RQ --> H2["head 2: …"]
  RQ --> H3["head h: …"]
  H1 --> C["拼接 + 线性变换 Y"]
  H2 --> C
  H3 --> C
输出阶段每个头只有 $d/h$ 维,最后用一个线性变换 $Y$ 把它们「揉」回 $d$ 维。
编者说明(学生问答:这不会把最终矩阵的秩压得很低吗?) 同学担心:这么多小切片的低秩近似,会不会有损失?老师说:实践中没问题。这正是「按模型维度限制头数」的原因——不希望每个头分到的维度太少(64 或 128 是常见选择)。而且「我们唯一的确定性结论是:经验上多头远好过单头」。
编者说明(学生问答:不同头学到的东西有规律吗?) 有同学问,是否研究过各注意力头是否编码一致/有规律的信息?老师说有,可解释性研究发现了不少有趣角色——有的头专门抓句法依赖,有的头做全局上下文平均。但他提醒这是一个微妙且活跃的方向:在很深的网络里,「看第 10 层的某个词」时,它早已融合了别处的上下文,你未必能说清「你到底在看什么」。老师表示愿意课后继续聊。
5.4 缩放点积注意力
(参考时间: 00:56:25)
📷 缩放点积注意力
回到原视频 (00:56:25)
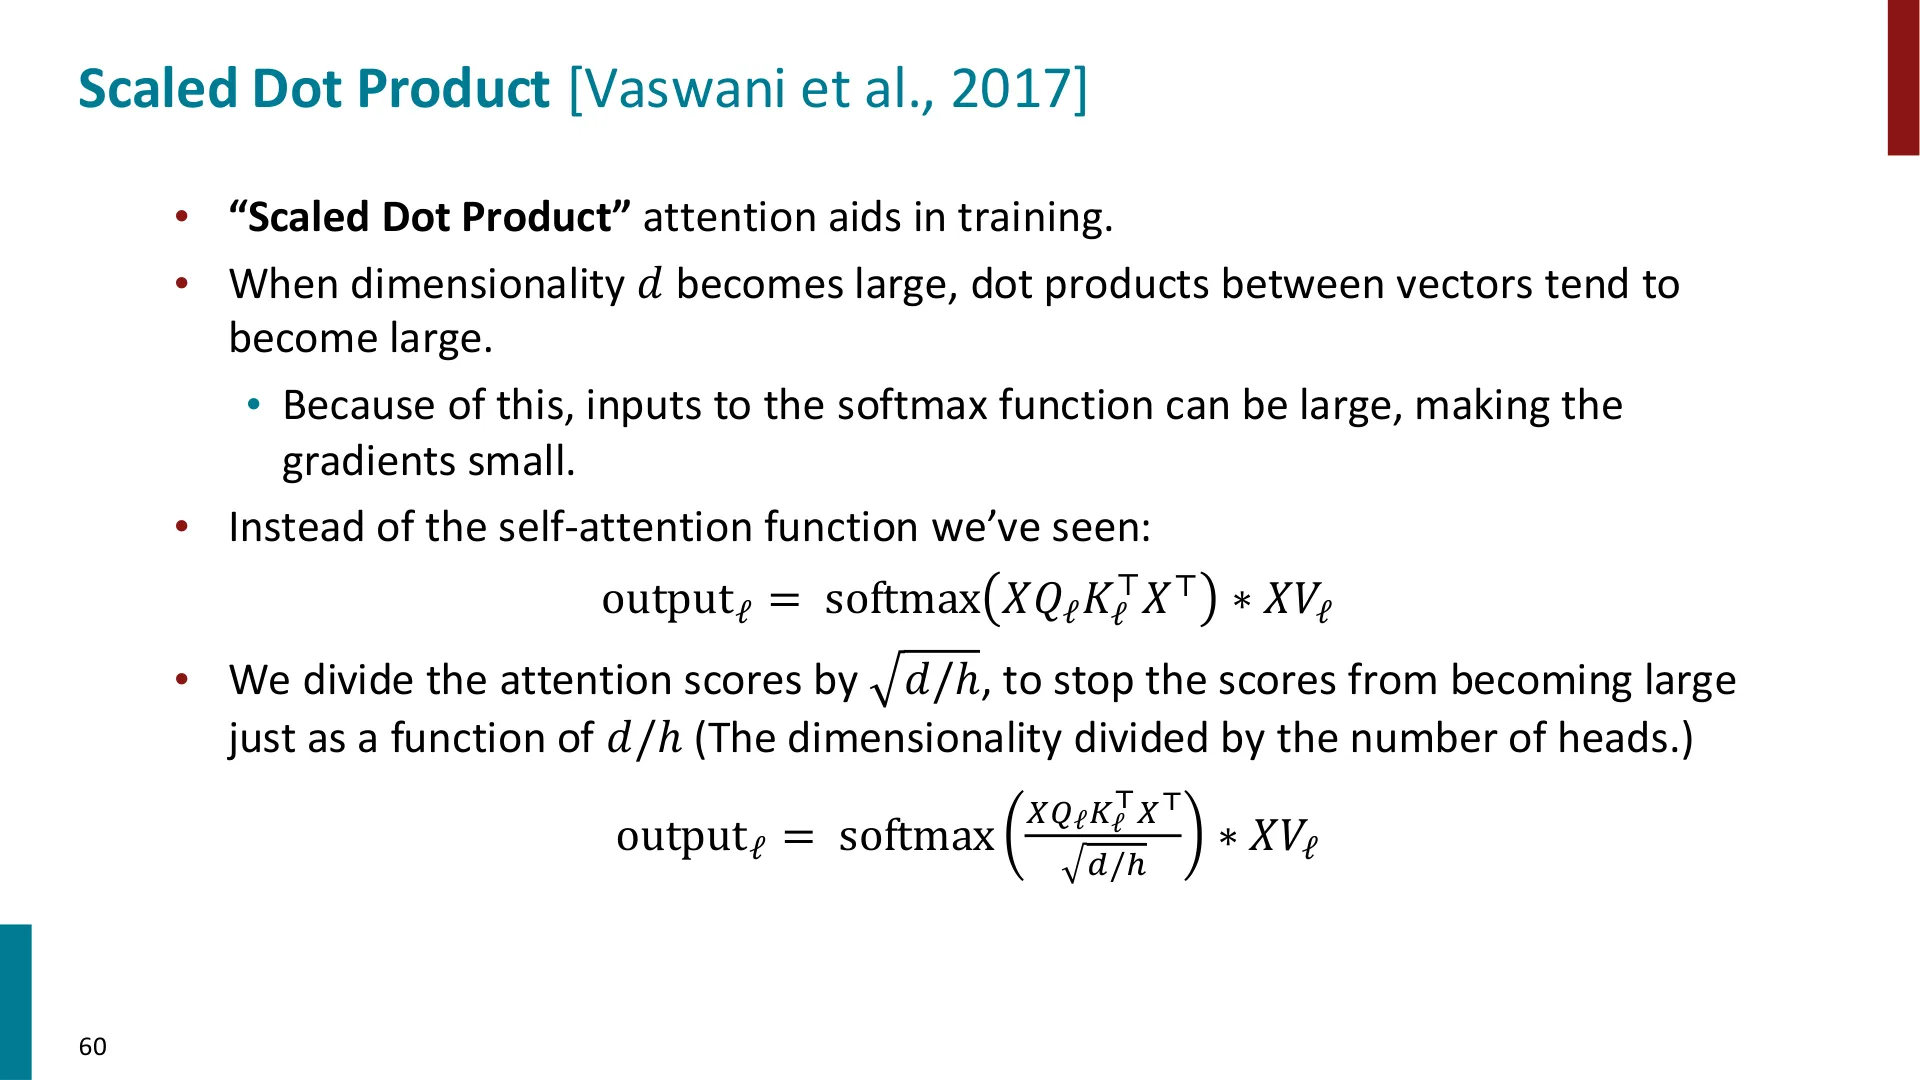
老师说这是个「小技巧」,但值得知道。问题在于:当模型维度 $d$ 变大时,即使是随机向量,点积也倾向于变大。分数一大,送进 softmax 的输入就很大,导致梯度变小。理想情况是训练初期注意力「又均匀又平」(哪里都大致看看),但如果个别点积特别大,学习就会被拖住。
修法:把每个头的分数除以 $\sqrt{d/h}$(维度除以头数):
🖼️ 第 57 页幻灯片 · Multi-headed attention
$$\text{output}_\ell = \mathrm{softmax}\!\left(\frac{X Q_\ell K_\ell^\top X^\top}{\sqrt{d/h}}\right) X V_\ell$$
这就是 Scaled Dot Product(缩放点积)注意力([Vaswani et al., 2017])。之后默认都这么做,「实现起来就是除以一个常数」。
编者拓展|为什么要除以 $\sqrt{d/h}$ 设 query、key 的每一维近似独立、均值 0、方差 1,则它们点积的方差约为维度 $d_k$,标准差约为 $\sqrt{d_k}$。若不做缩放,维度越大,点积的绝对值越容易偏大,softmax 就越容易「饱和」到接近 one-hot,从而让梯度消失。除以 $\sqrt{d/h}=\sqrt{d_k}$ 正是把点积重新标准化到单位方差,使 softmax 在初始化时保持平滑。
5.5 两个训练技巧:残差连接与层归一化
(参考时间: 00:58:04)
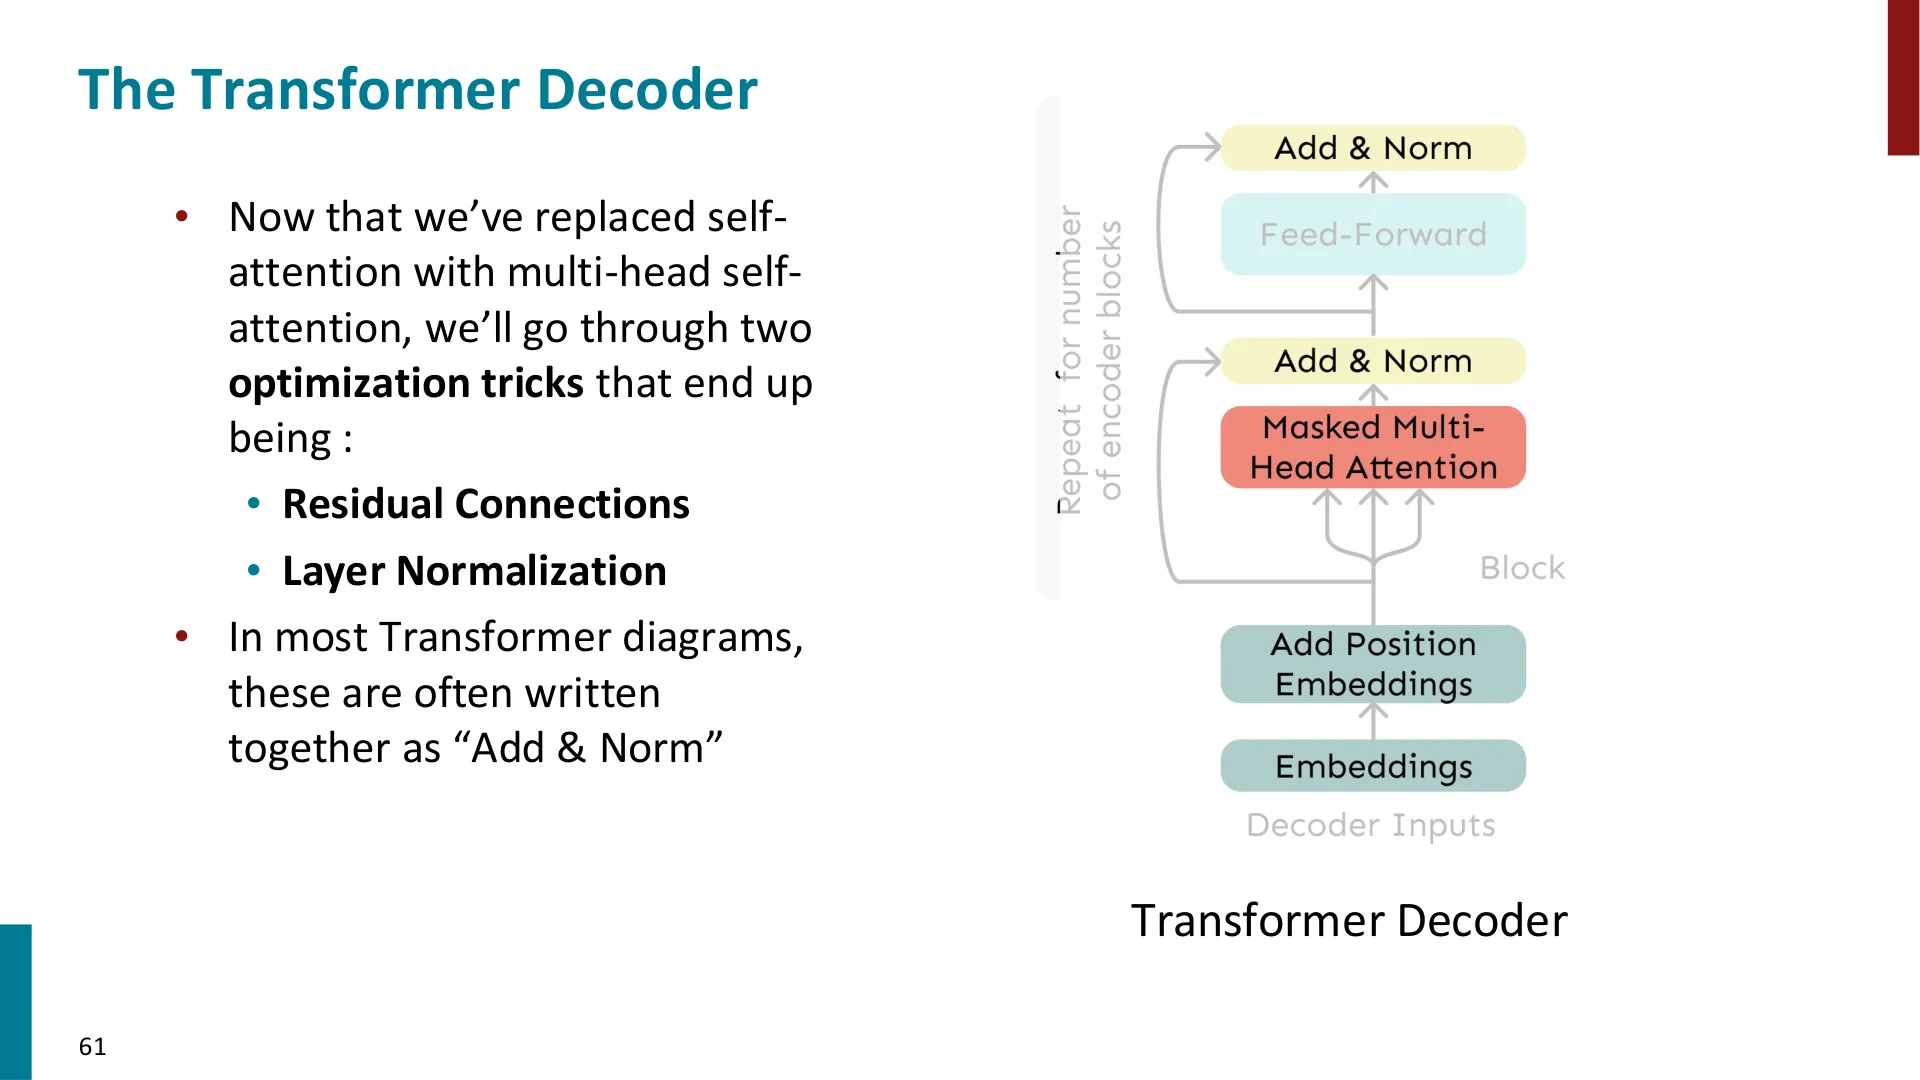
📷 Transformer 解码器中的 Add & Norm
回到原视频 (00:58:04)
老师指出,Transformer 解码器里,在「掩码多头注意力」和「前馈网络」之后各接一个 Add & Norm 盒子。它在很多 Transformer 示意图里被画成同一个模块,但实际上是两件事:残差连接和层归一化。
(a) 残差连接 (参考时间: 00:58:51)
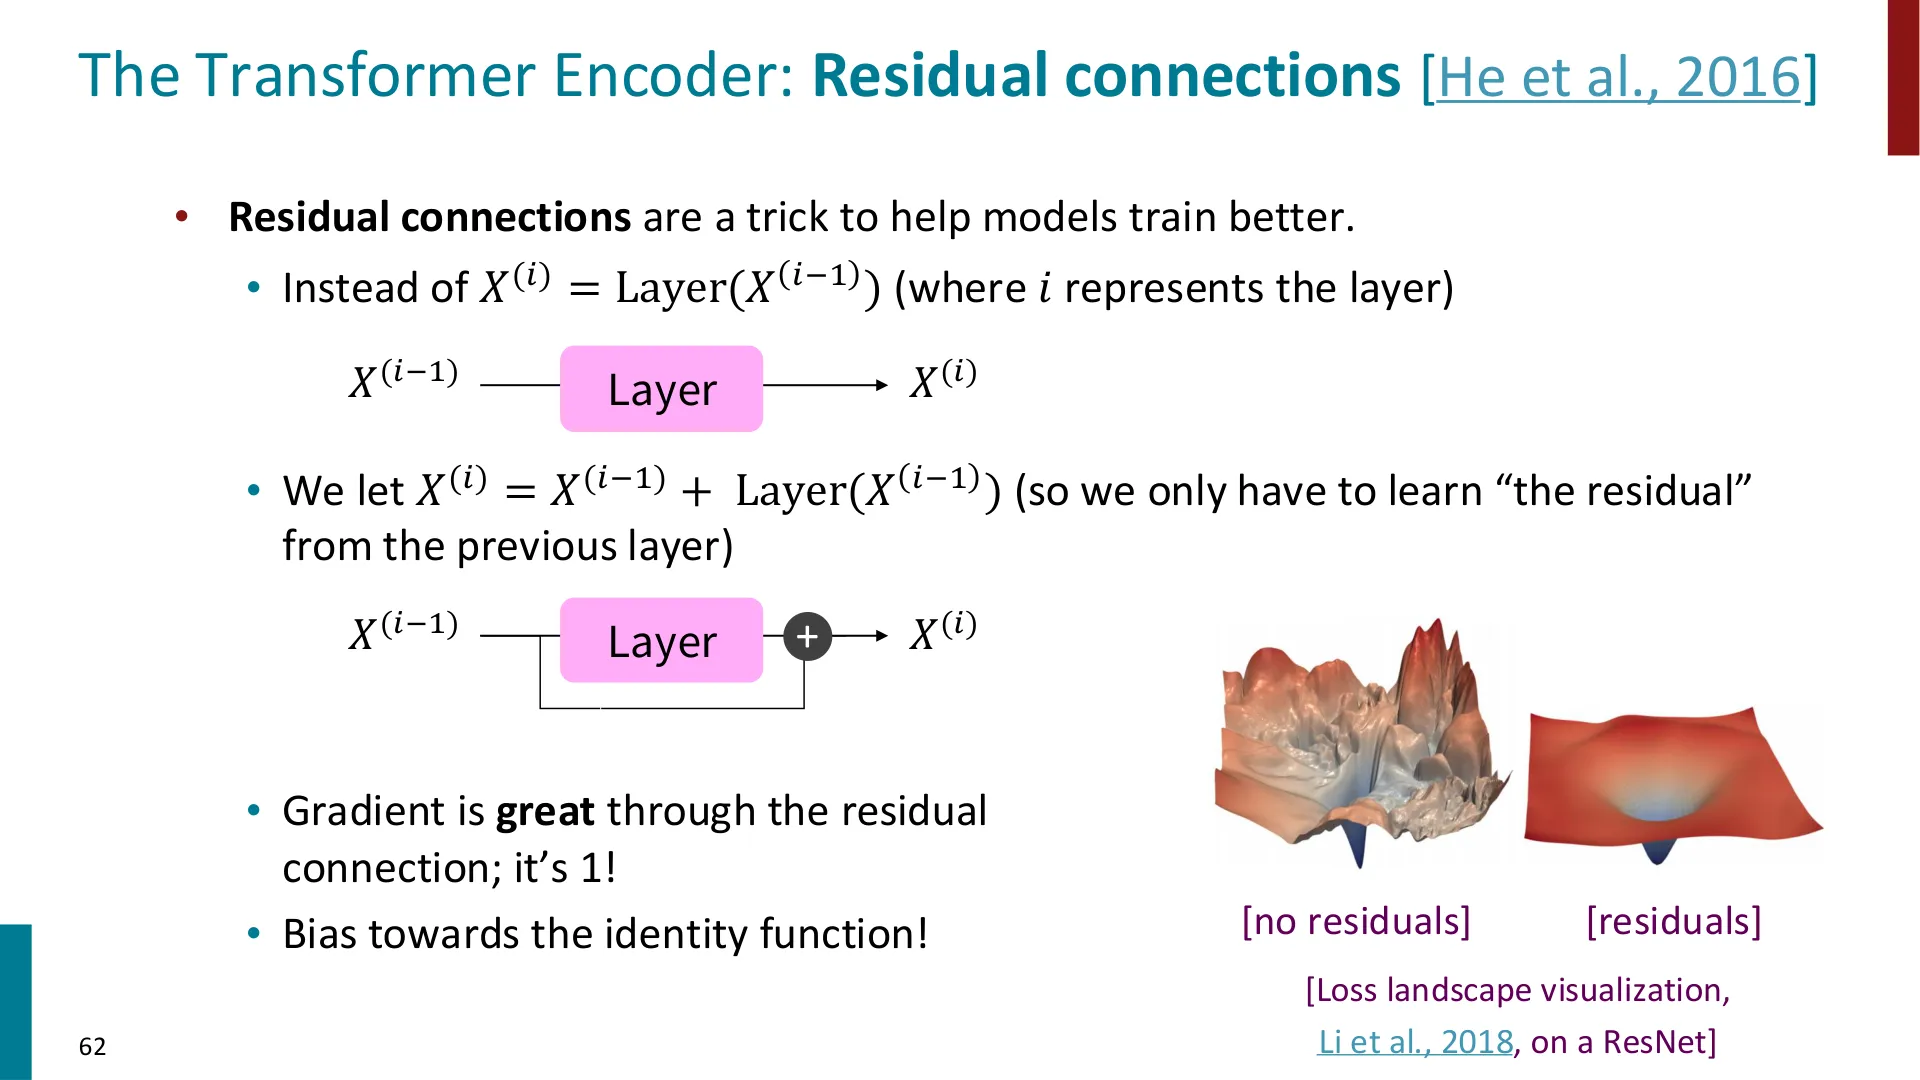
📷 残差连接
回到原视频 (00:58:51)
普通做法是 $X^{(i)} = \mathrm{Layer}(X^{(i-1)})$;残差做法改成
$$X^{(i)} = X^{(i-1)} + \mathrm{Layer}(X^{(i-1)})$$
也就是只让这一层学「残差」。老师强调它的好处:梯度穿过残差连接是 1! ——即使这一层有梯度消失/爆炸,我至少还能通过这条「高速公路」学到它背后的东西;同时它偏向恒等函数(初始化时权重小,整体像恒等),是个不错的起点。
他忍不住展示了一张他非常喜欢的图([Li et al., 2018],在 ResNet 上做的损失地形可视化):
「你看,有残差连接后,你就顺着走下去了……我不敢说它总是这样,但我真的很喜欢这张图。」
🖼️ 第 58 页幻灯片 · Multi-head self-attention is computationally efficient
(b) 层归一化 (参考时间: 01:00:51)
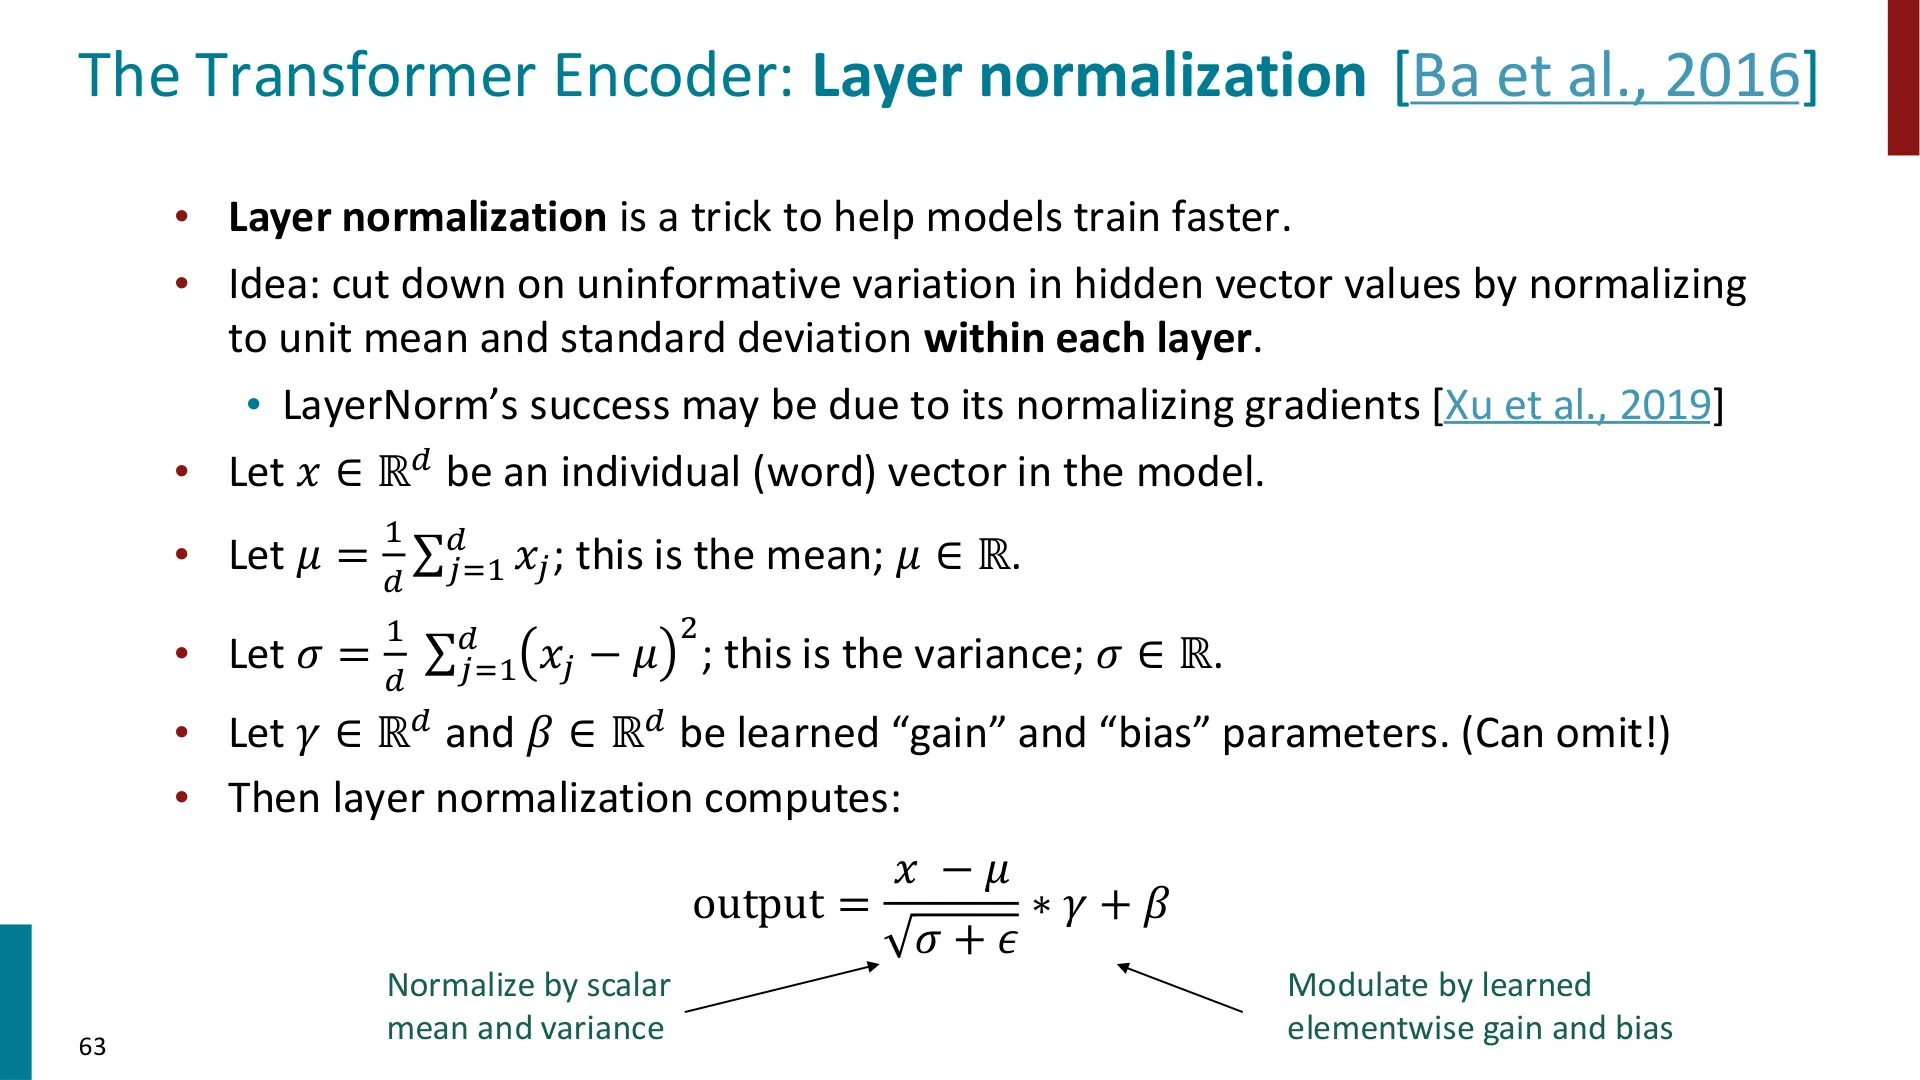
📷 层归一化
回到原视频 (01:00:51)
第二件是层归一化(LayerNorm,[Ba et al., 2016]),目的是让模型训练更快。动机是「削减各层之间无信息量的波动」——层里的数值可能变得很大、也可能变得很小,这些变化未必有信息量,归一化到单位均值和单位标准差后,能让下一层更容易学。
设 $x \in \mathbb{R}^d$ 是模型里的单个(词)向量:
$$\mu = \frac{1}{d}\sum_{j=1}^d x_j,\qquad
\sigma = \sqrt{\frac{1}{d}\sum_{j=1}^d (x_j - \mu)^2}$$
然后
$$\text{output} = \frac{x - \mu}{\sigma + \epsilon} \ast \gamma + \beta$$
其中 $\gamma \in \mathbb{R}^d$、$\beta \in \mathbb{R}^d$ 是可学习的「缩放(gain)」与「偏移(bias)」参数(可以省略)。老师说,实践中后半段的调制「可能没那么重要」,关键是那步标准化让输出「又整齐、又相似」,对下一层更友好。
编者说明(记号澄清):幻灯片把 $\sigma$ 直接写作方差 $\frac{1}{d}\sum(x_j-\mu)^2$,但在计算时是按标准差去做的;本书记为 $\sigma$(标准差)更严谨。另外,老师口头指出幻灯片第 4 点里「减去的 $\mu$」是一个标量,要广播到 $d$ 维后从 $x$ 的每一维里减掉。
编者说明(学生问答一:均值是不是除以 d?) 是的,除以 $d$,即「所有维度相对均值的平均偏离」。
编者说明(学生问答二:统计量跨词共享吗?) 这是个好问题,老师坦言论文里其实没写清楚,但答案是——不跨词共享:句子里 5 个词,每个词各自独立地算自己的均值和方差。他承认「这点我也有点困惑」。
编者说明(学生问答三:跨 batch 共享吗?) 也不跨 batch。 老师解释:层归一化正是为了取代批归一化(BatchNorm)而发明的。BatchNorm 的统计量依赖同 batch 里本不相关的样本,会让前向计算「被别人牵着走」,这不是你想要的。所以层归一化只在一个词向量内部、沿特征维做统计。
编者拓展|层归一化 vs 批归一化 - 批归一化:对每个特征维,在一个 mini-batch 的样本上统计均值/方差。它依赖 batch 组成,序列长度可变、batch 很小时很不稳定。 - 层归一化:对每个样本(这里是一个词向量),在它的全部特征维上统计均值/方差。它不依赖 batch,天然适合变长序列和 Transformer。 - 这也解释了老师给出的那条「不跨词、不跨 batch」的判断。
5.6 组装出完整的 Transformer 解码器
(参考时间: 01:06:40)
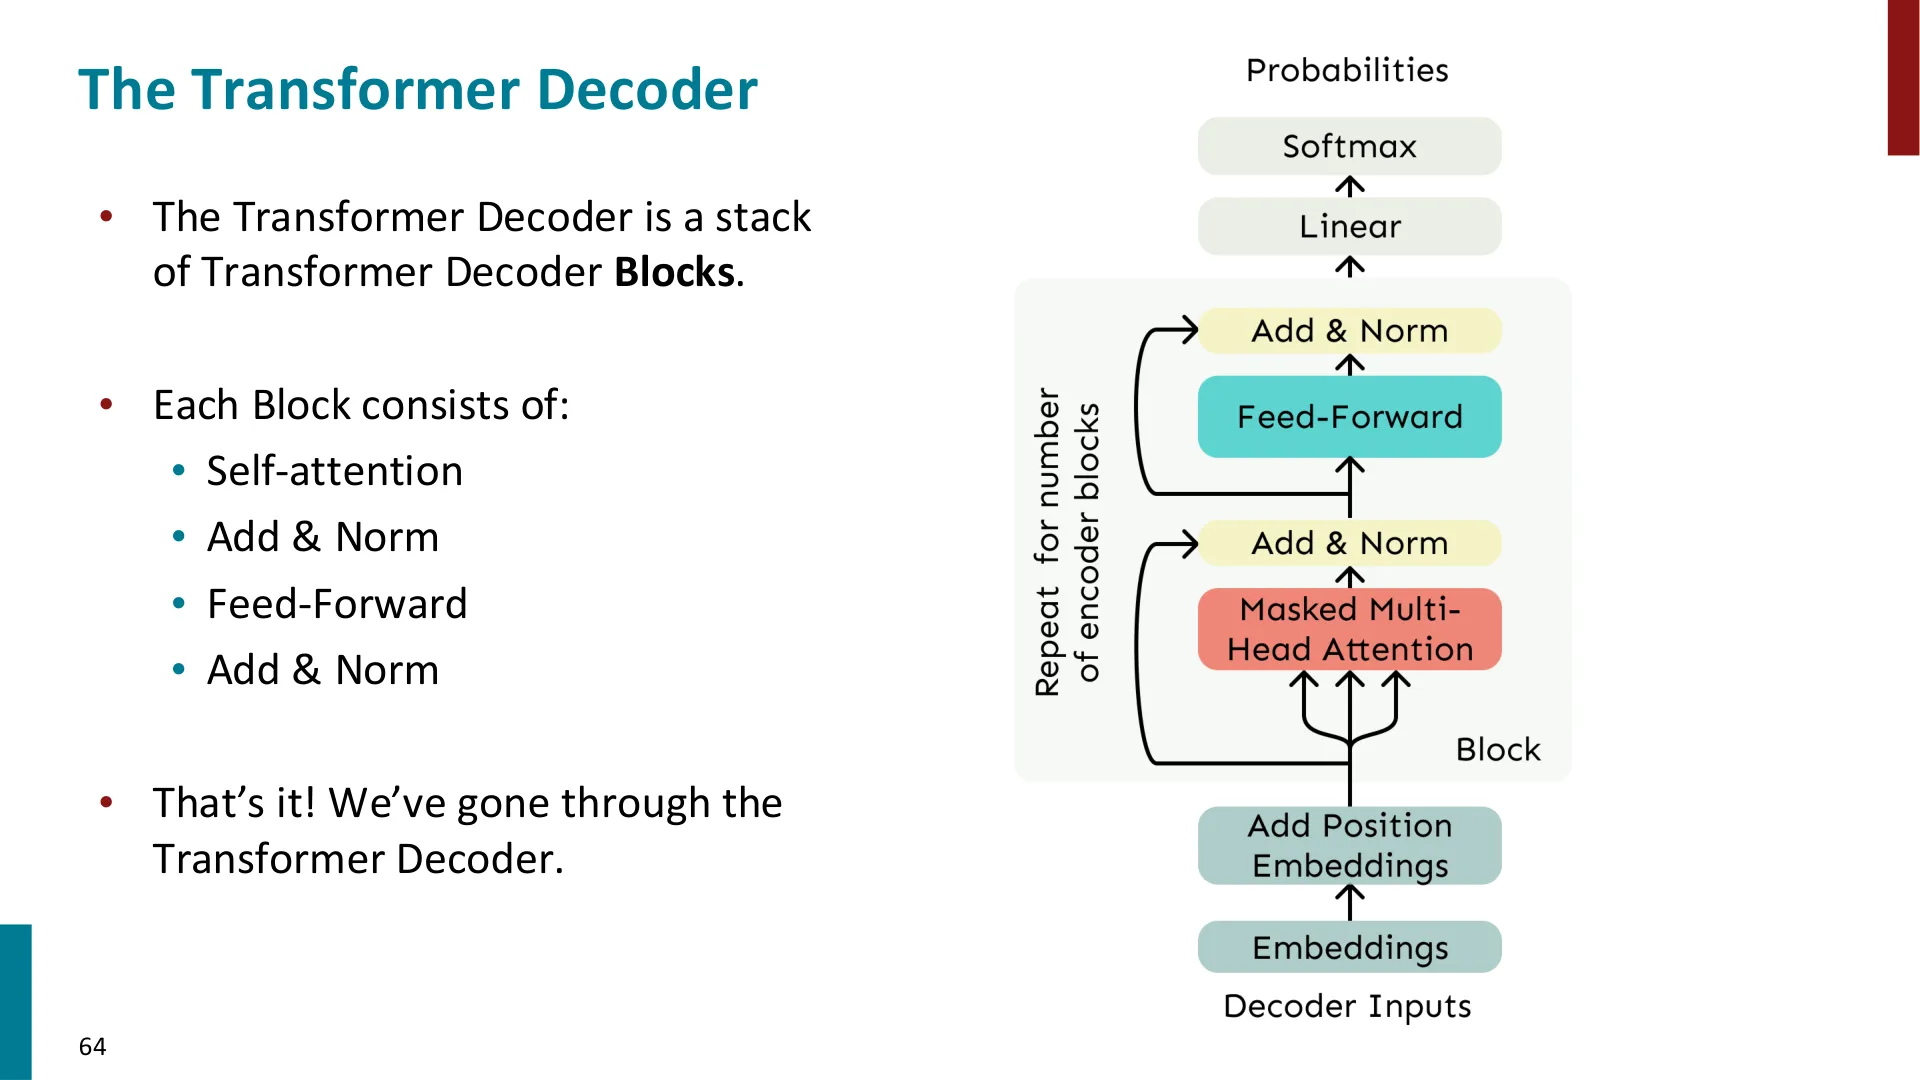
📷 完整的 Transformer 解码器
回到原视频 (01:06:40)
现在把所有部件拼起来。每个 Transformer 解码器块由四步组成:
graph TD
  IN["输入:词嵌入 + 位置嵌入"] --> MHA["掩码多头自注意力"]
  MHA --> AN1["Add & Norm(残差 + 层归一化)"]
  AN1 --> FF["前馈网络(逐位置 MLP)"]
  FF --> AN2["Add & Norm(残差 + 层归一化)"]
  AN2 --> OUT["输出表示 → 预测头"]
这个块重复若干次。老师总结:「这就是完整的 Transformer 解码器」。
编者说明(学生问答:掩码多头注意力里,缩放也带着 $\sqrt{d/h}$ 吗?) 同学追问,老师确认:是的,和第 5.4 节讲的一致,缩放项是 $\sqrt{d/h}$。
编者说明(学生问答:变长输入怎么处理?) 同学问这些模型怎么处理长度可变的输入。老师说:前向传播的输入长度是常数,所以通常先 padding 到固定长度;而为了「不偷看未来」,可以把 padding 出来的 token 也掩码掉——把它们的注意力分数设成 $-\infty$,和「掩码未来」是同一套机制。他还补充:其实不必总按最大长度算,如果一批输入都短于 5,就把长度设成 5,能省大量计算,所有自注意力运算照样成立。
编者说明(学生问答:前馈网络有几层?) 老师确认:前馈网络里有一个隐藏层(即两层线性 + 一个非线性)。
六、编码器、编码器-解码器与交叉注意力
6.1 Transformer 编码器
(参考时间: 01:09:28)
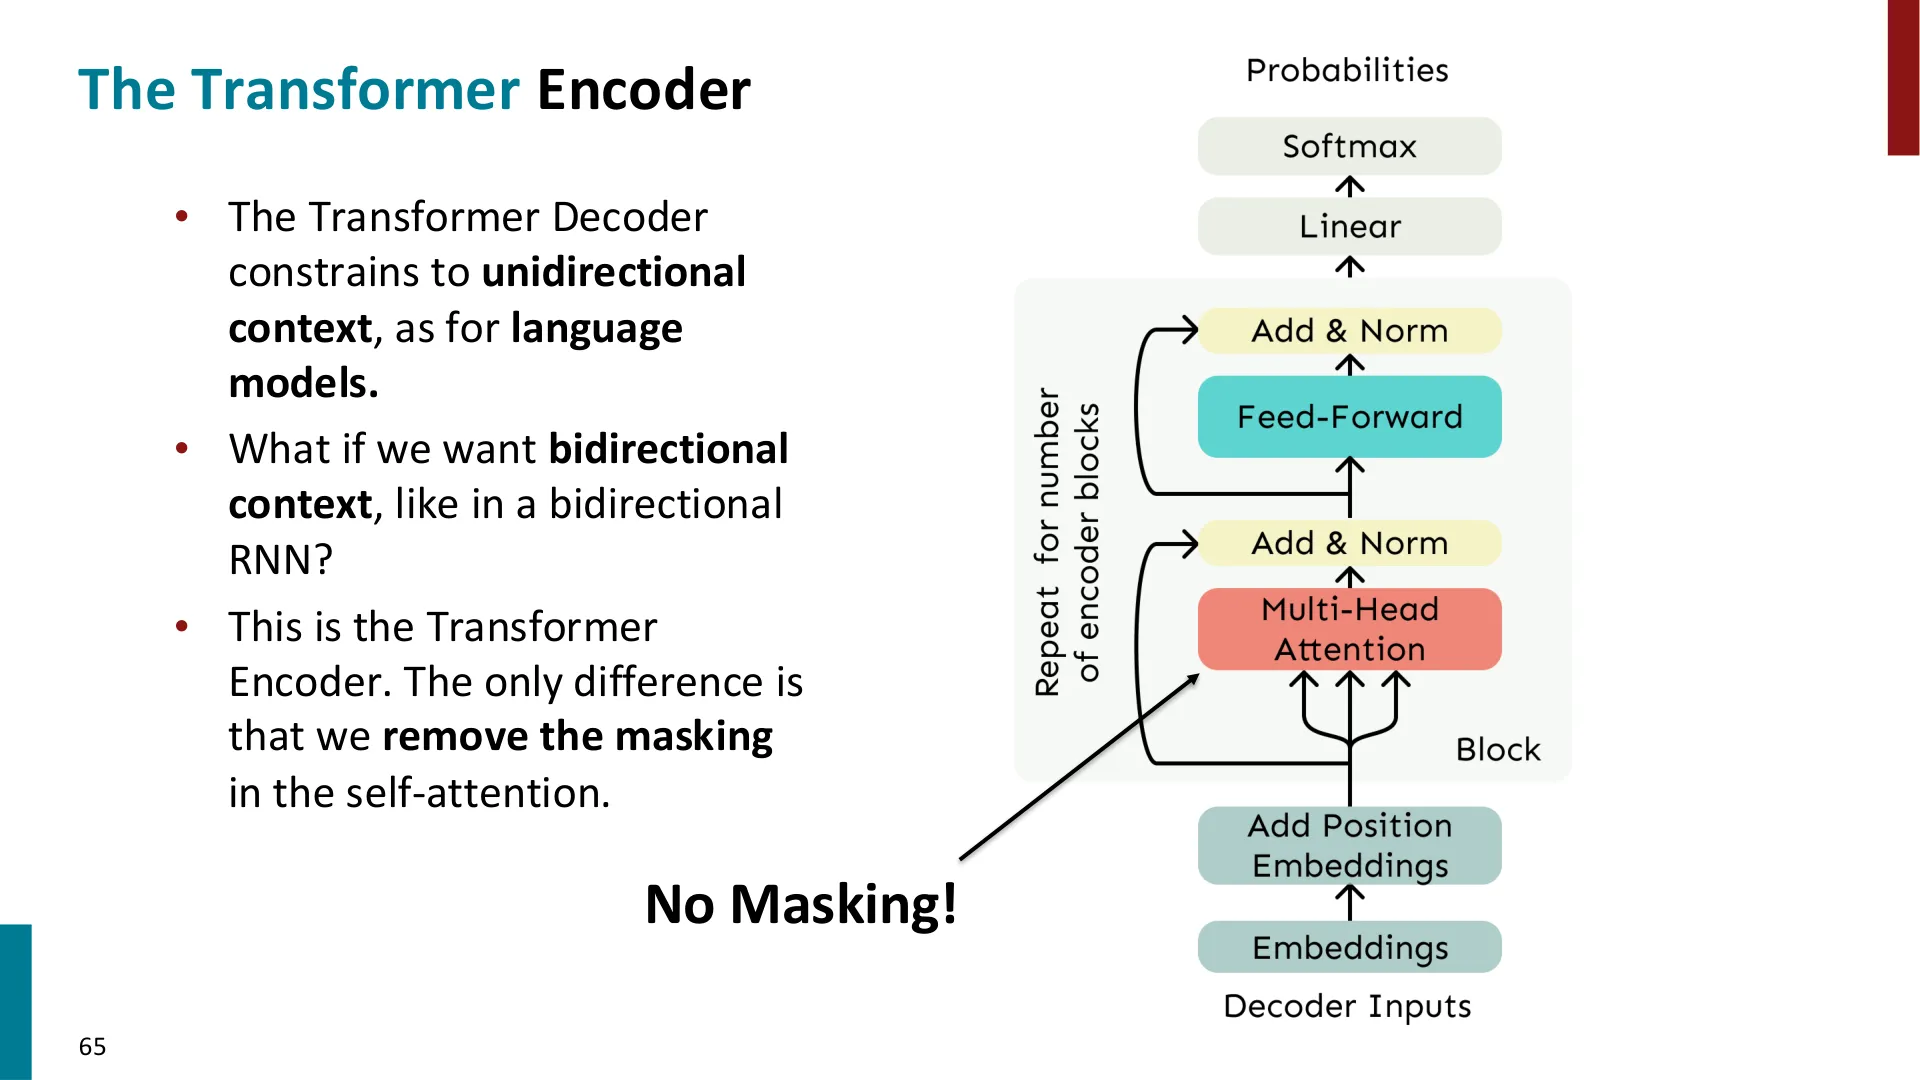
📷 Transformer 编码器(去掉掩码)
回到原视频 (01:09:28)
Transformer 解码器约束的是单向上下文(因为要做语言模型)。如果我们想要双向上下文(像双向 RNN 那样)呢?答案简单得惊人:这就是 Transformer 编码器——唯一的区别就是把自注意力里的掩码去掉。「就这么简单,模型就变成双向的了。」
6.2 编码器-解码器与交叉注意力
(参考时间: 01:09:58)
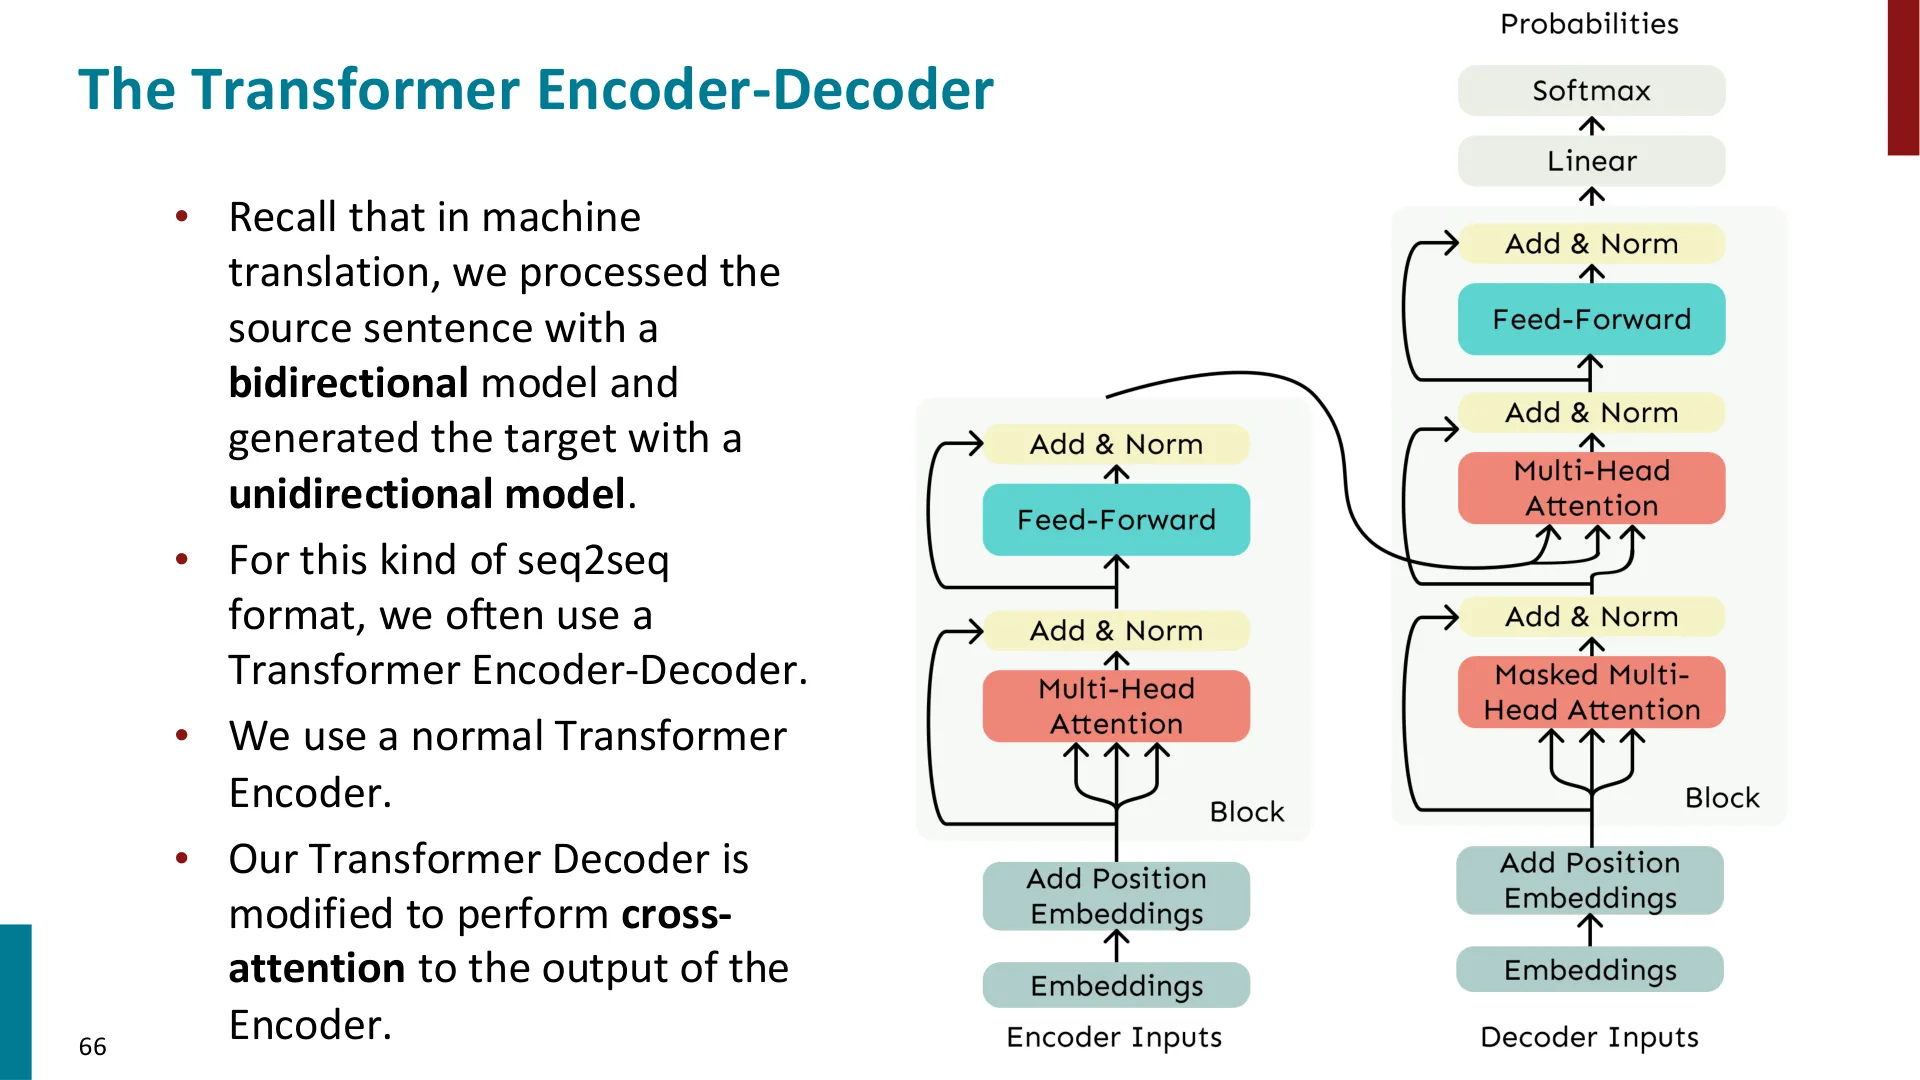
📷 Transformer 编码器-解码器
回到原视频 (01:09:58)
这正是原版 Transformer 论文《Attention Is All You Need》里的结构([Vaswani et al., 2017])。当你要「双向编码一端、单向生成另一端」(比如机器翻译:编码源句、生成目标句)时,就用编码器-解码器:
- 用一个标准的 Transformer 编码器处理源句(多头注意力、不掩码);
- 解码器则在自注意力之上再多一步,叫做交叉注意力(cross-attention)。
交叉注意力的细节 (参考时间: 01:10:54):
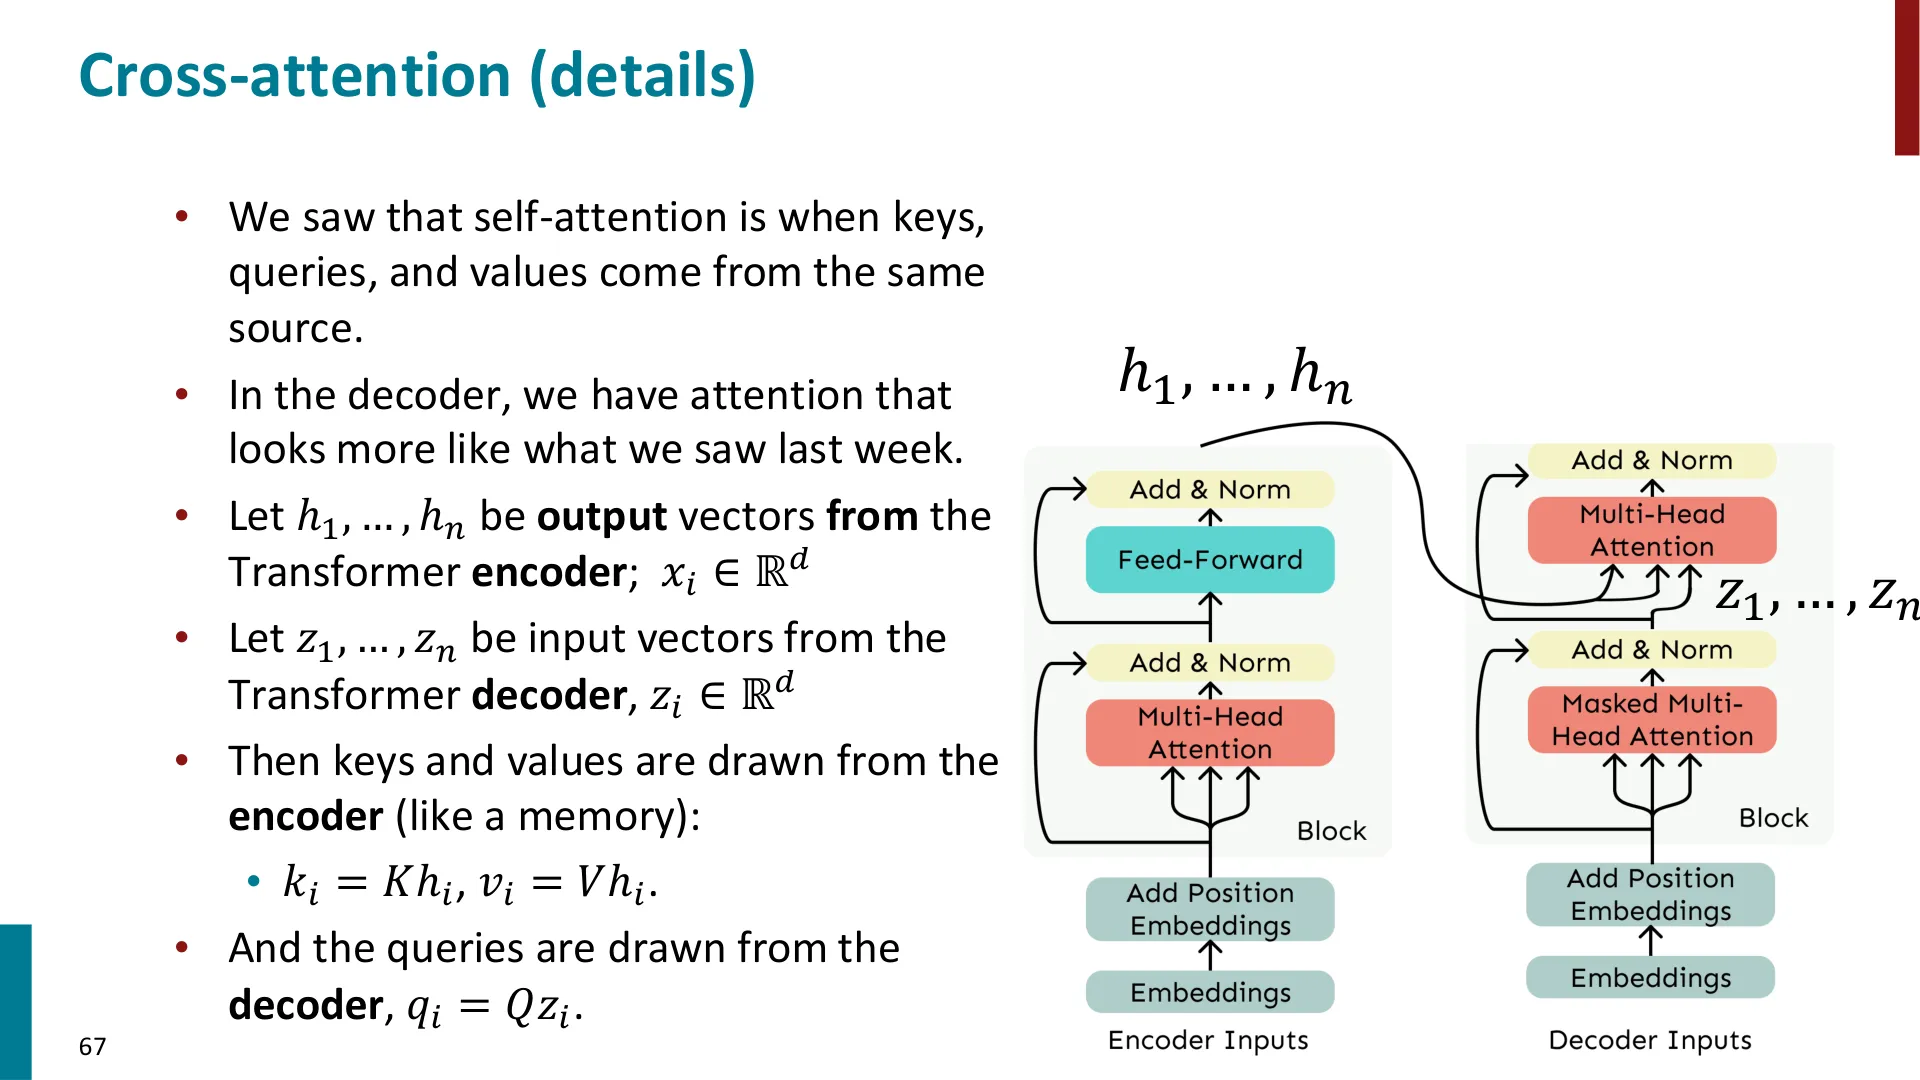
📷 交叉注意力细节
回到原视频 (01:10:54)
- 设编码器输出为 $h_1, \dots, h_n$($h_i \in \mathbb{R}^d$),解码器输入为 $z_1, \dots, z_n$($z_i \in \mathbb{R}^d$);
- 键和值从编码器取(像一份记忆):$k_i = K h_i,\; v_i = V h_i$;
- 查询从解码器取:$q_i = Q z_i$。
所以交叉注意力里,「两个箭头来自编码器、一个箭头来自解码器」。老师强调:对解码器的每个词,它都在看编码器所有块的输出中的所有可能词——这其实就是前一讲里 seq2seq 注意力的 Transformer 版。
graph TD
  SRC["源句"] --> ENC["Transformer 编码器(无掩码)"]
  ENC --> H["编码器输出 h₁…hₙ"]
  TGT["目标端(已生成前缀)"] --> MSelf["掩码多头自注意力"]
  MSelf --> Z["解码器向量 z₁…zₙ"]
  Z --> Q["查询 q = Qz"]
  H --> K["键 k = Kh"]
  H --> V["值 v = Vh"]
  Q --> CA["交叉注意力"]
  K --> CA
  V --> CA
  CA --> OUT["解码器输出 → 预测下一个词"]
编者说明(学生问答:key/value 是从哪里「取出来」的?) 有同学困惑:前面把 key/value 都「塌缩」成一个输出了,那交叉注意力怎么还能拿到独立的 key 和 value?老师澄清:每个词的输出只是「它在前一层被加权平均后的结果」;到了下一层,我们会重新应用一套新的 key/query/value 变换,从这个输出里再造出新的 key/query/value。也就是说,key 和 value 并不是「一次性存起来」的,而是每层都对上一层的输出重新投影得到的。你只要把 query 矩阵、key 矩阵作用在「上一层传下来的东西」上就行。
编者拓展|自注意力、交叉注意力、掩码注意力一览
类型 Query 来源 Key / Value 来源 是否掩码 编码器自注意力 同一句 同一句 否(双向) 解码器自注意力 目标前缀 目标前缀 是(单向) 交叉注意力 解码器 编码器 否 这三者构成了 Transformer 编码器-解码器的全部注意力「接线方式」。
七、成果、局限与变体
(参考时间: 01:12:39)
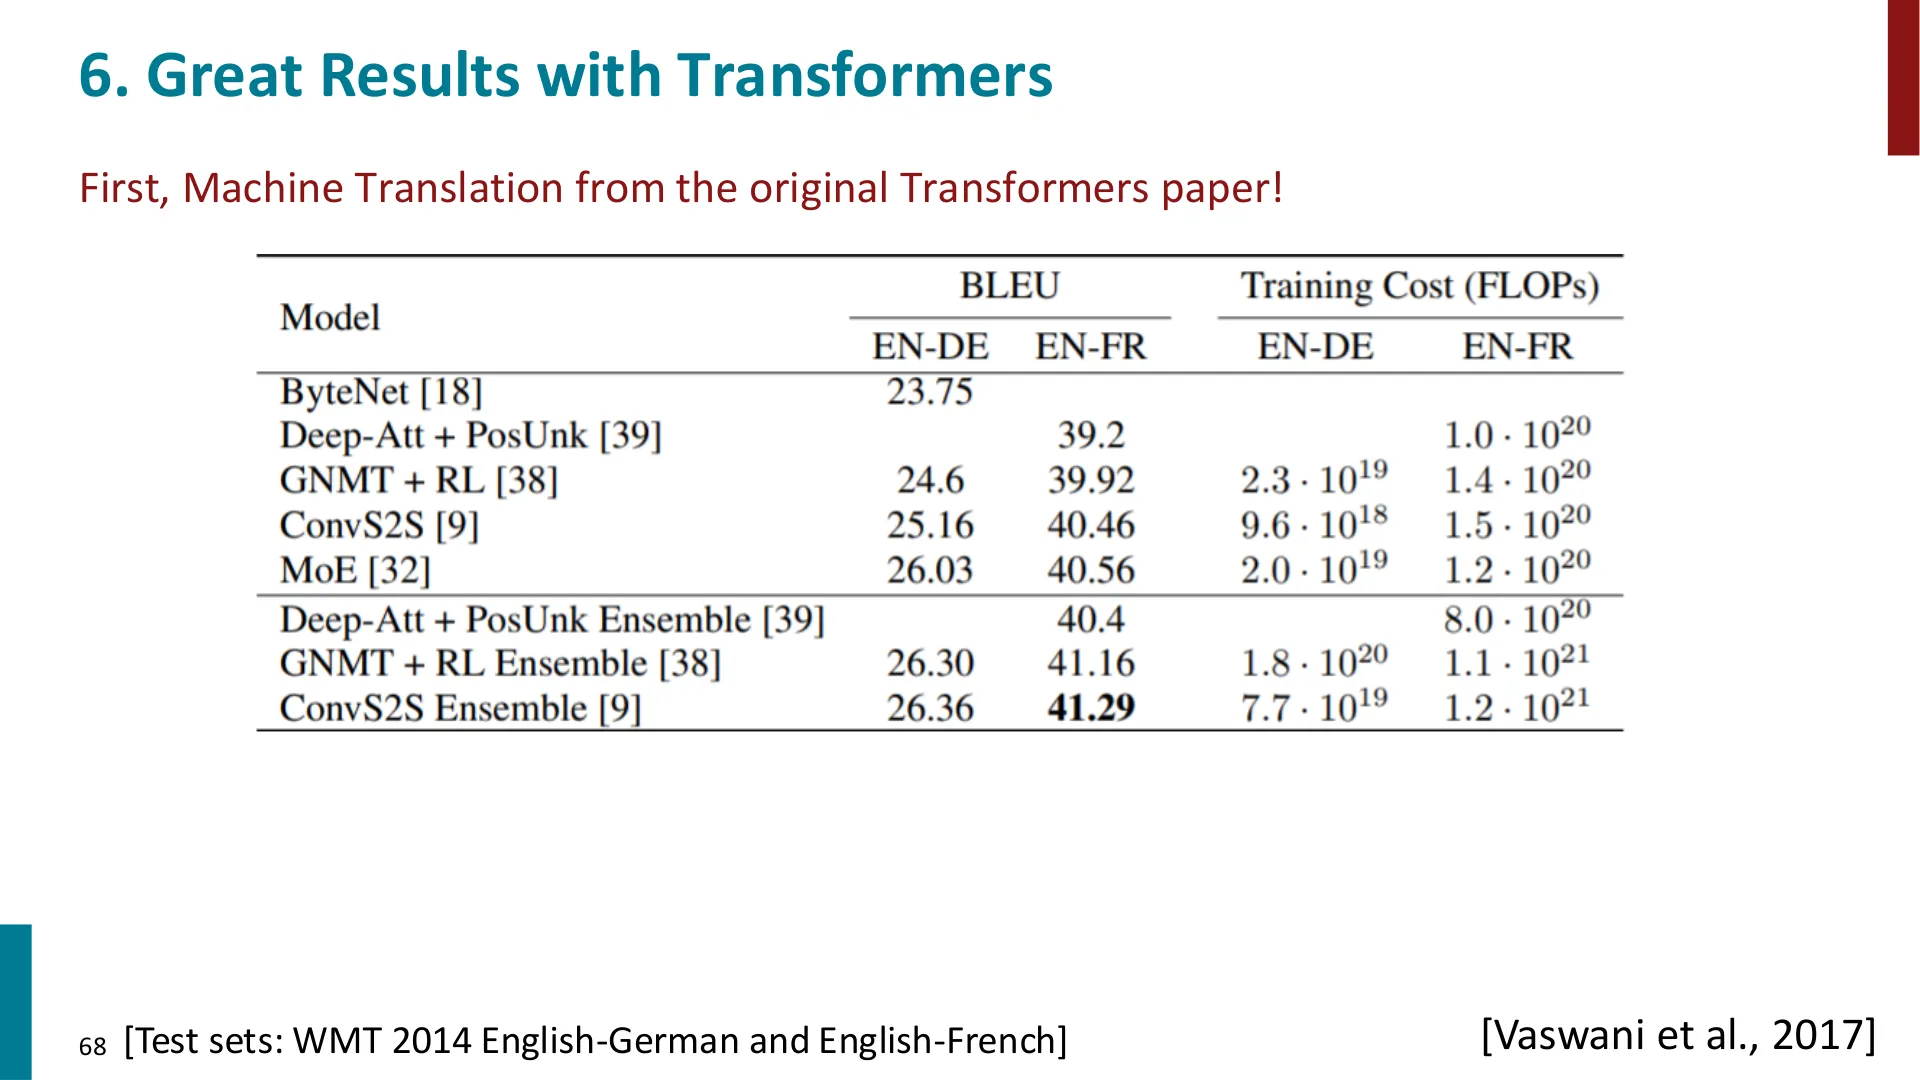
📷 Transformer 的成果
回到原视频 (01:12:39)
老师收束到结果层面。原版 Transformer 的「卖点」有两层:
- 翻译质量好——在 WMT 2014 英德、英法测试集上拿到不错的 BLEU(就质量而言,并非「惊世骇俗地」超过既有系统);
- 训练效率高——因为消除了并行化瓶颈,同样时间内能算更多数据、更快地利用更强的 GPU。这一点是关键:它让「用海量数据 + 海量算力」变得可行。
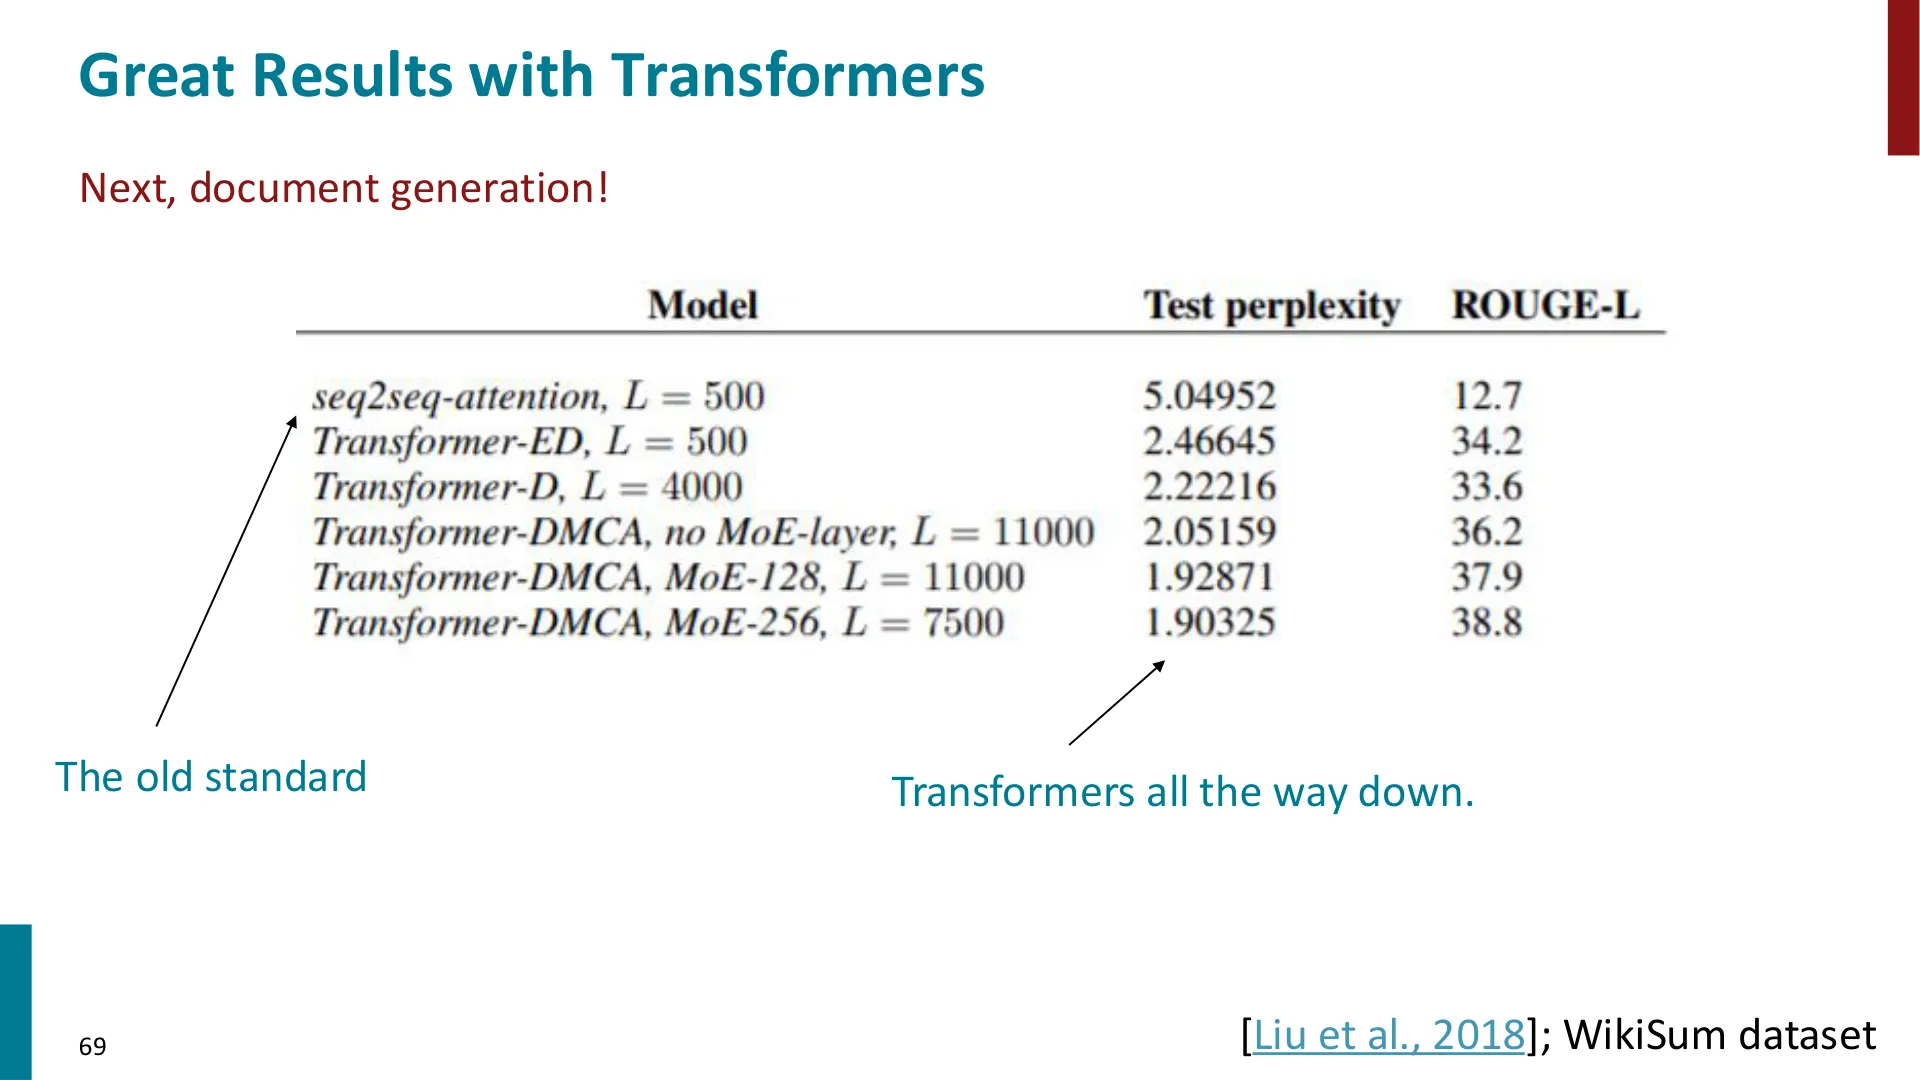
📷 文档生成也全面 Transformer 化
回到原视频 (01:13:31)
随后,从文档生成([Liu et al., 2018] 的 WikiSum)开始,「Transformers all the way down」——几乎所有标准大型基准都被 Transformer 系方法占据。老师还点出:Transformer 直接催生了「预训练」革命(留到下一讲)。
编者说明:把「翻译质量提升」和「可并行、可规模化的训练」分开看很重要。老师的判断是:让 Transformer 真正「高人一头」的,是后者——它让你能把数据和算力「堆上去」,而 LSTM 做不到这一点。
7.1 想改进什么?当前的分歧
(参考时间: 01:14:19)
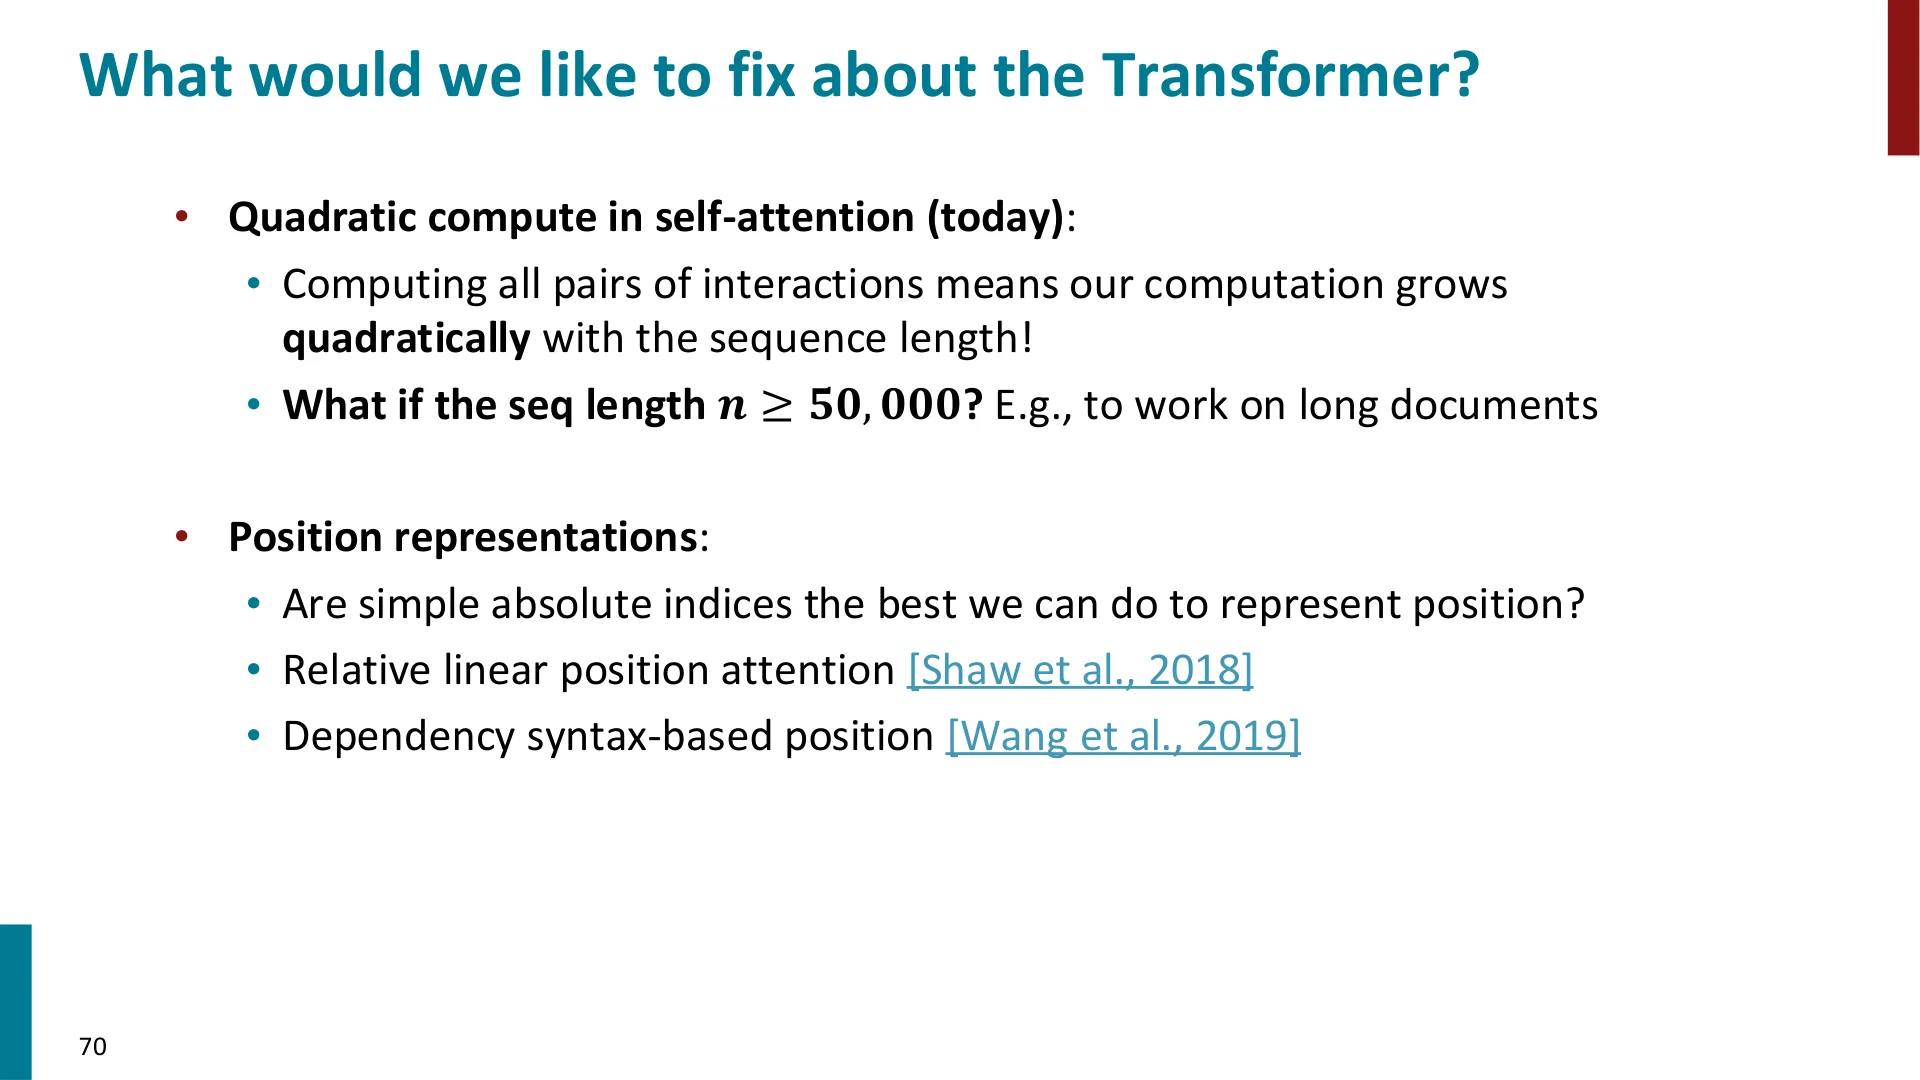
📷 Transformer 还该修什么
回到原视频 (01:14:19)
老师列出两个主要想改进的方向:
- 自注意力的二次计算:计算「所有对」的交互,使得计算量随序列长度平方增长。你想处理一整篇维基百科、一整本小说就很吃力——而且某种意义上是退步:循环网络只随序列长度线性增长。
- 位置表示:简单的绝对索引一定是最好的吗?(可考虑相对位置注意力 [Shaw et al., 2018]、基于依存句法的位置 [Wang et al., 2019]。)
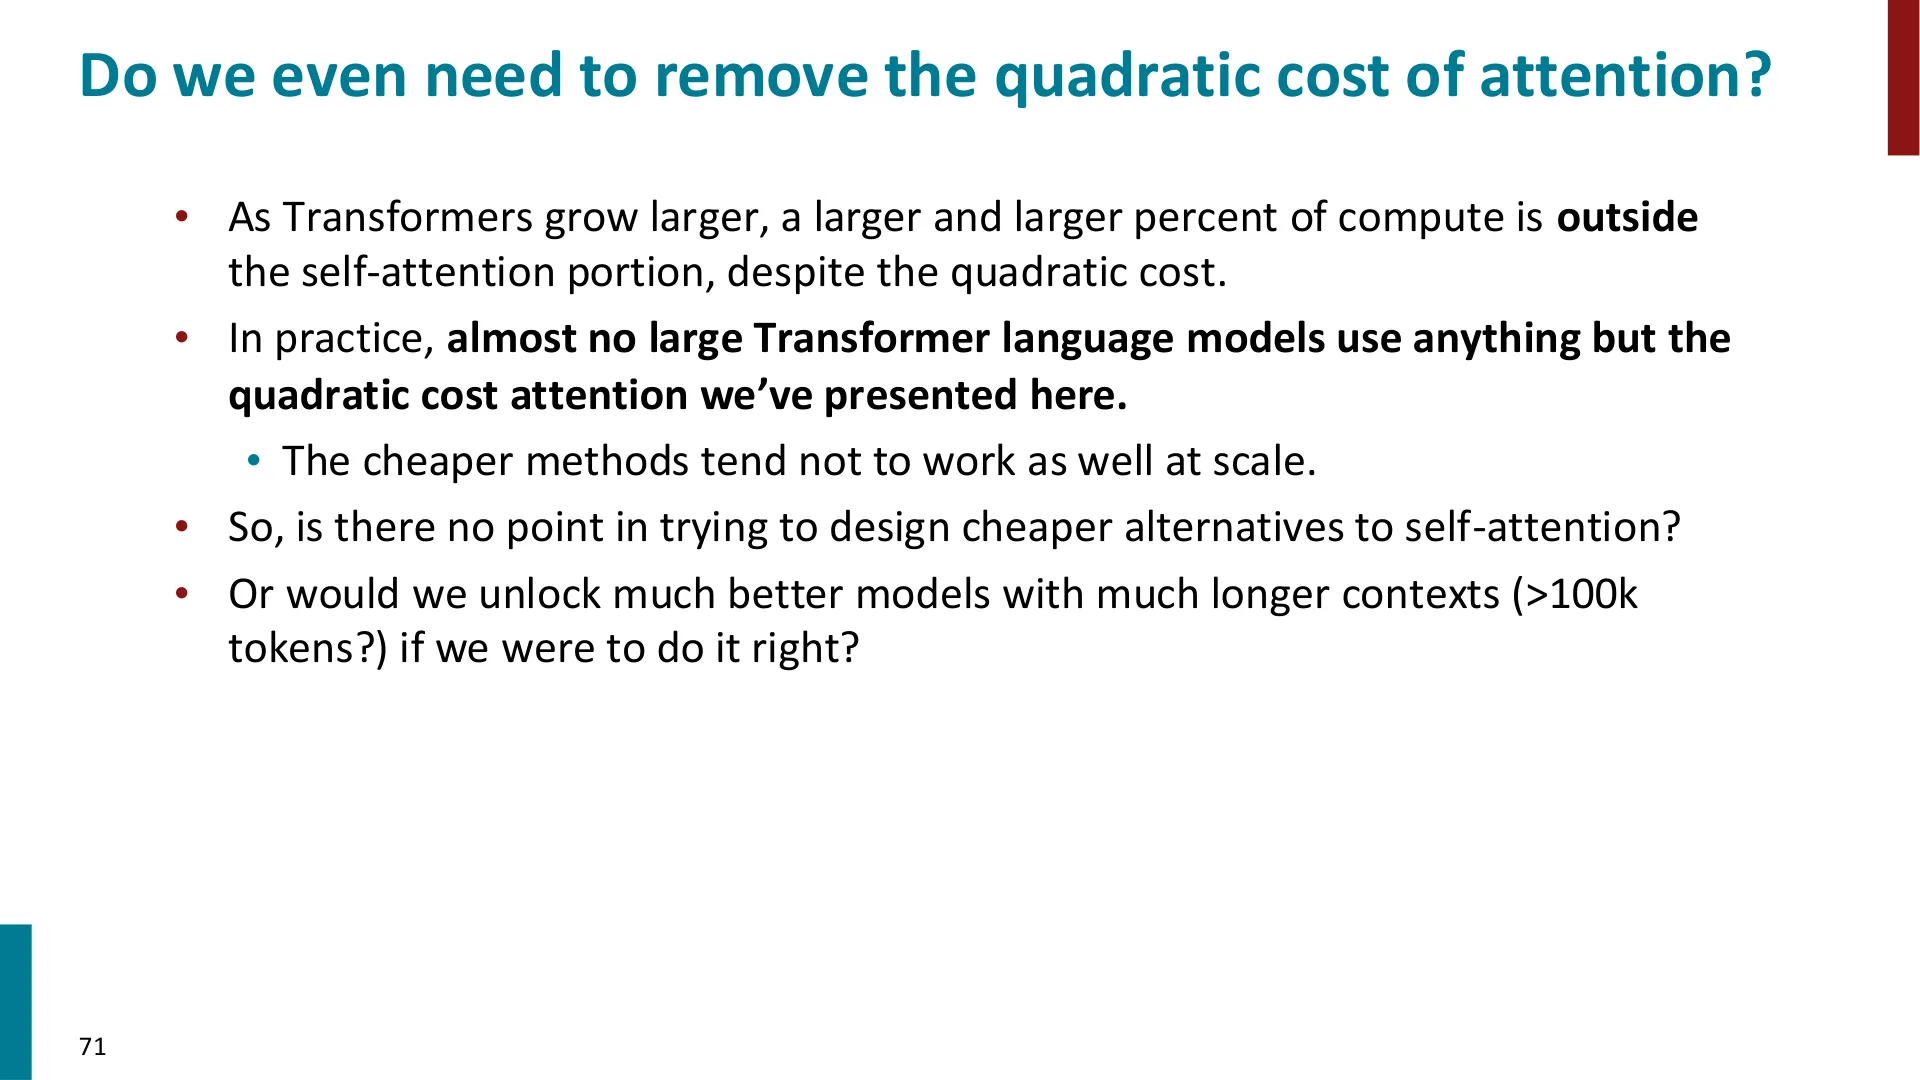
📷 我们真的要去掉二次代价吗
回到原视频 (01:16:00)
但老师给了一个反直觉的补充:随着 Transformer 变大,「自注意力之外」的计算占比越来越高——尽管自注意力本身是二次的。实践中,几乎所有大型 Transformer 语言模型用的都是这里的二次注意力,而「更便宜的近似方法在大规模上往往效果更差」。于是他抛出两个开放问题:
- 到底有没有必要去掉自注意力的二次代价?
- 如果做对了,我们能否解锁超长上下文(>100k token)、进而得到更好的模型?
编者说明(学生问答背景):前面有同学问过「把 n 设大不就行了吗」,老师借此再次强调 $O(n^2)$ 代价:维数 $d$ 取到 1000 时,短序列 $n\approx30$ 还好;但 $n=50000$,$n^2\times d$ 就完全不可行。这也是「长上下文」至今仍是研究热点的原因。
7.2 结课展望
(参考时间: 01:16:20)
老师最后的判断:过去四五年出现了大量对 Transformer 的修改,但「原版 Transformer + 少数几处修改」至今仍是最好的东西。其中一处重要修改是替换前馈网络里的非线性。「它有持久力。但我认为人们应该继续进来想怎么改进它。」——下节课讲预训练,祝作业四顺利。
附录:课堂未展示的幻灯片
本次视频录制于 2023 年,随书附带的官方幻灯片是 2026 年版,两者版本与编号不同。以下幻灯片属于循环网络的梯度问题、机器翻译与序列到序列、面向序列到序列的注意力等主题——它们(在本次录像中)没有被讲授(多半在其它讲次里讲),故按「幻灯片覆盖完整」的要求集中列于此,供你需要时对照。
一、循环网络的梯度问题(Slide 3–13)
- Slide 3:1. Problems with RNNs: Vanishing and Exploding Gradients
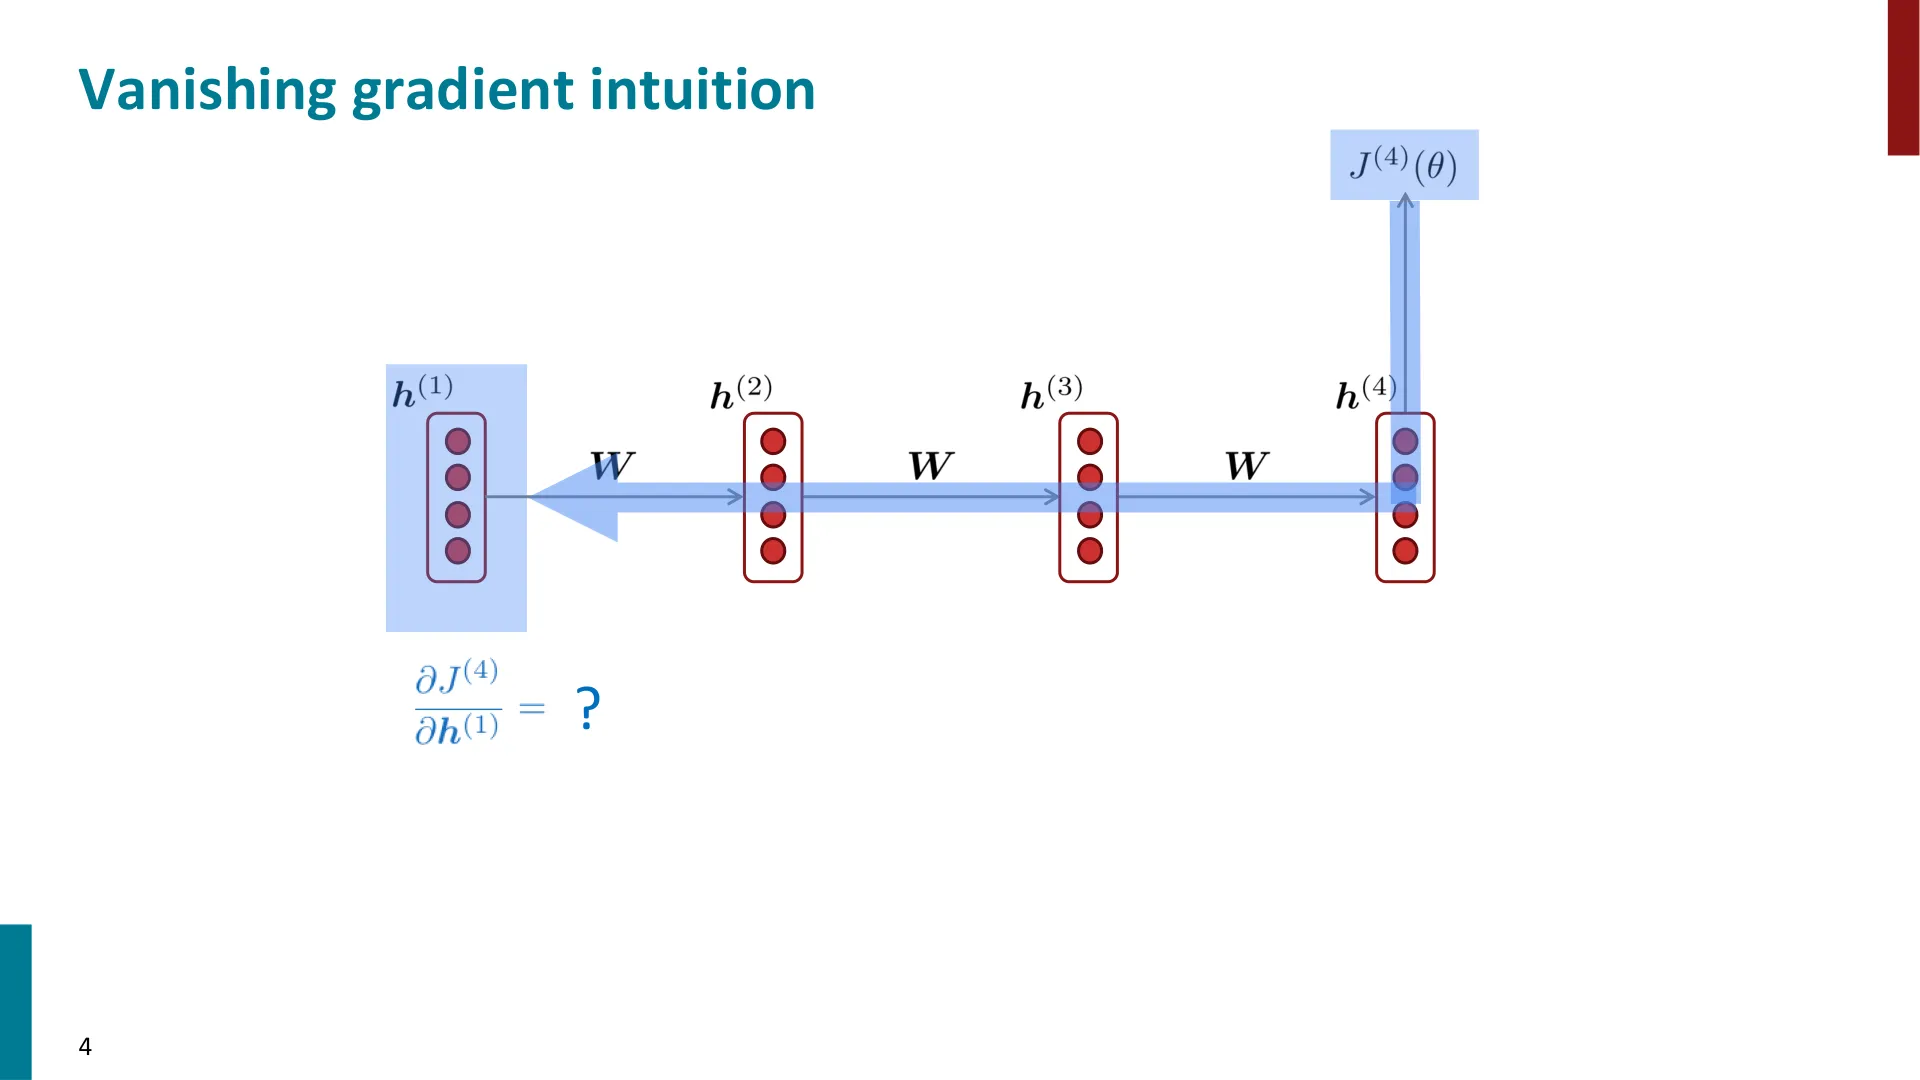
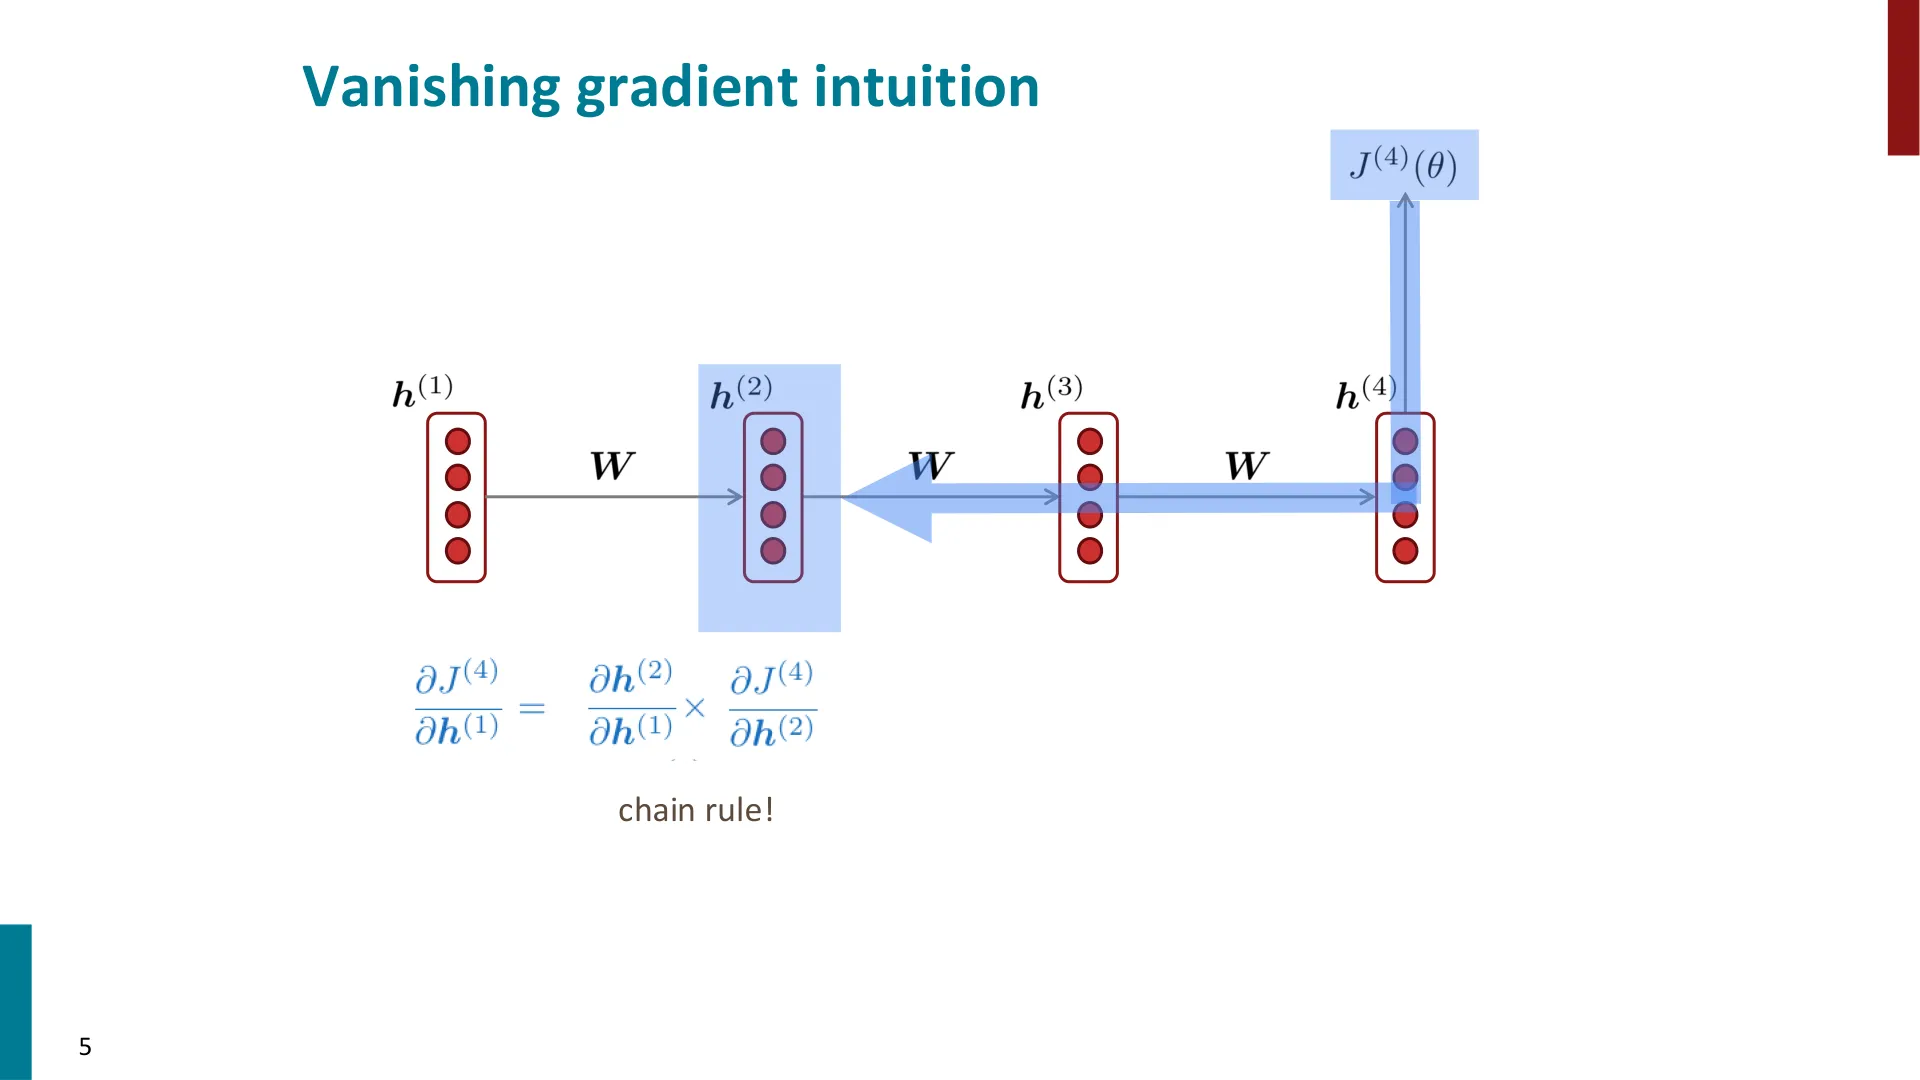
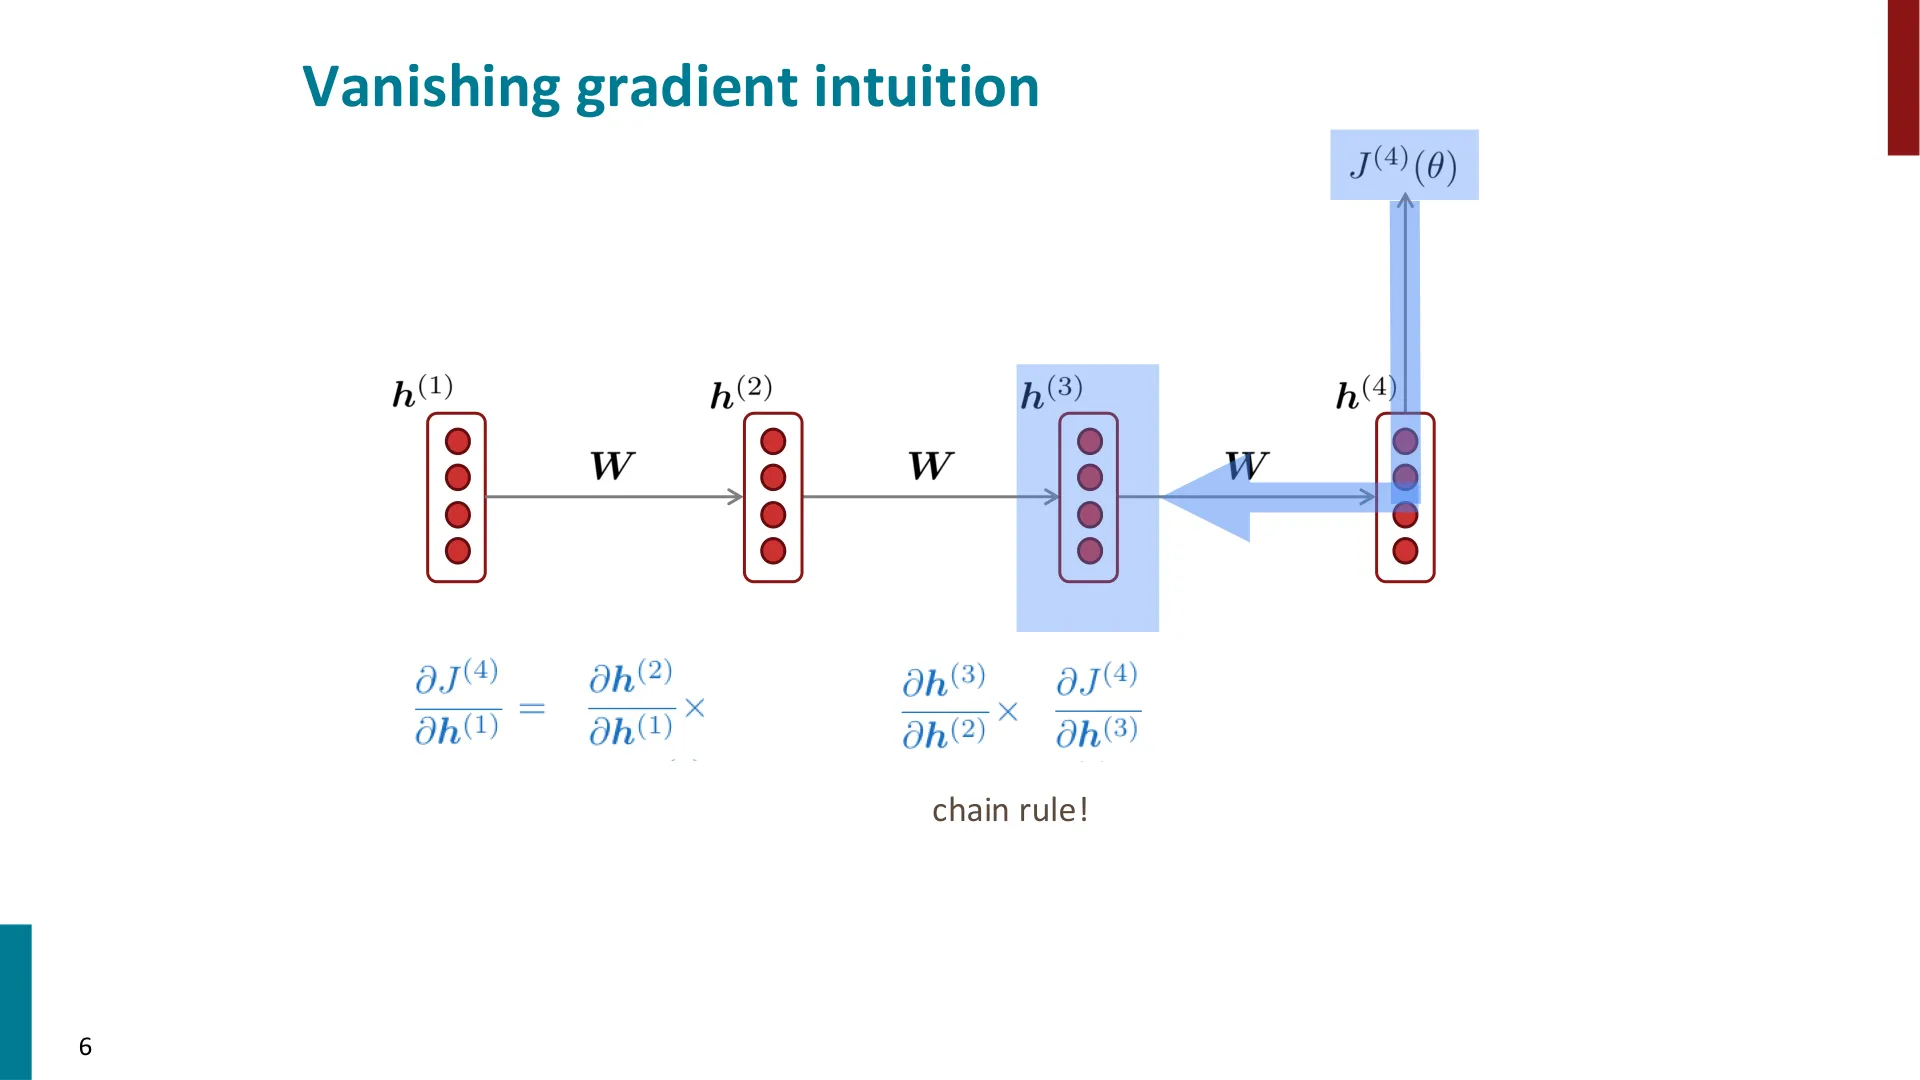
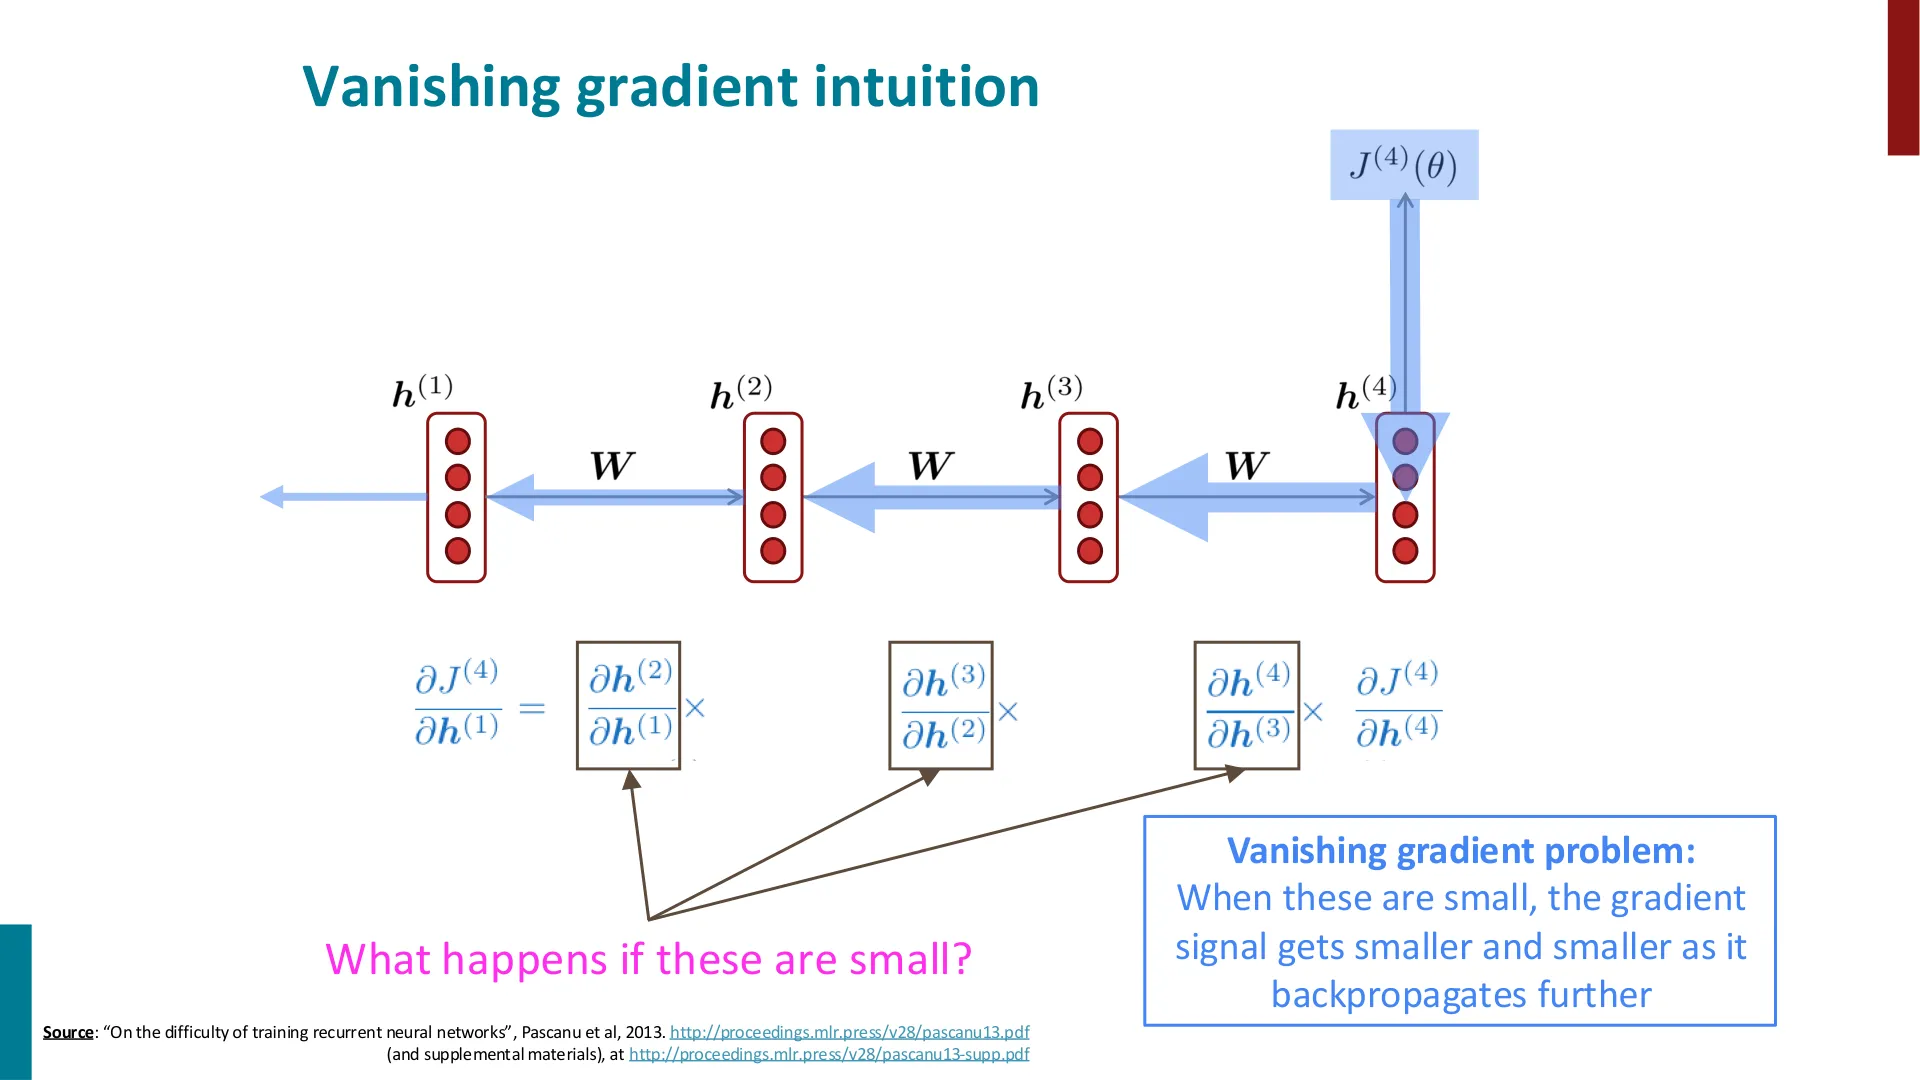
- Slide 4:Vanishing gradient intuition(链式法则)
- Slide 5:Vanishing gradient intuition(chain rule)
- Slide 6:Vanishing gradient intuition(chain rule)
- Slide 7:Vanishing gradient intuition(chain rule)
- Slide 8:Vanishing gradient intuition——若这些因子很小,梯度信号随反向传播越走越小(Pascanu et al., 2013)
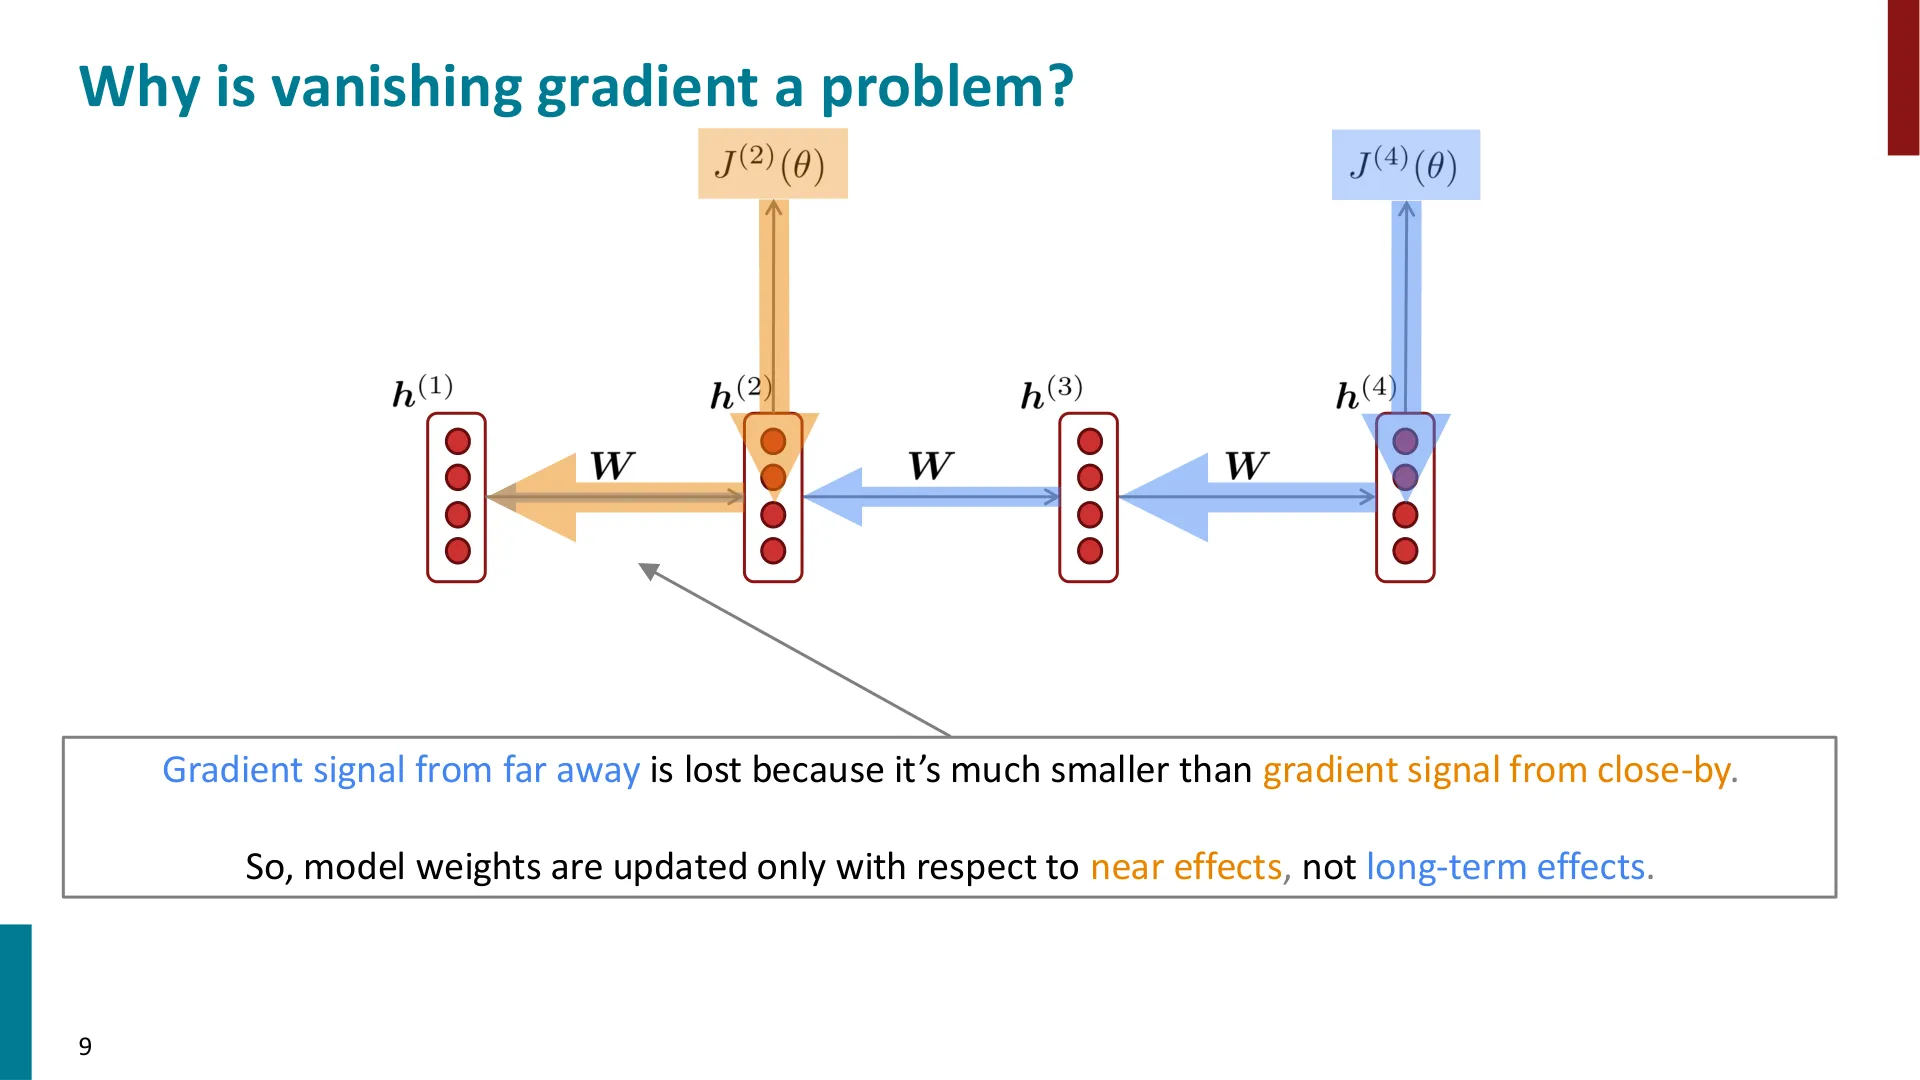
- Slide 9:Why is vanishing gradient a problem?——远处梯度信号远小于近处,权重只按近处效应更新
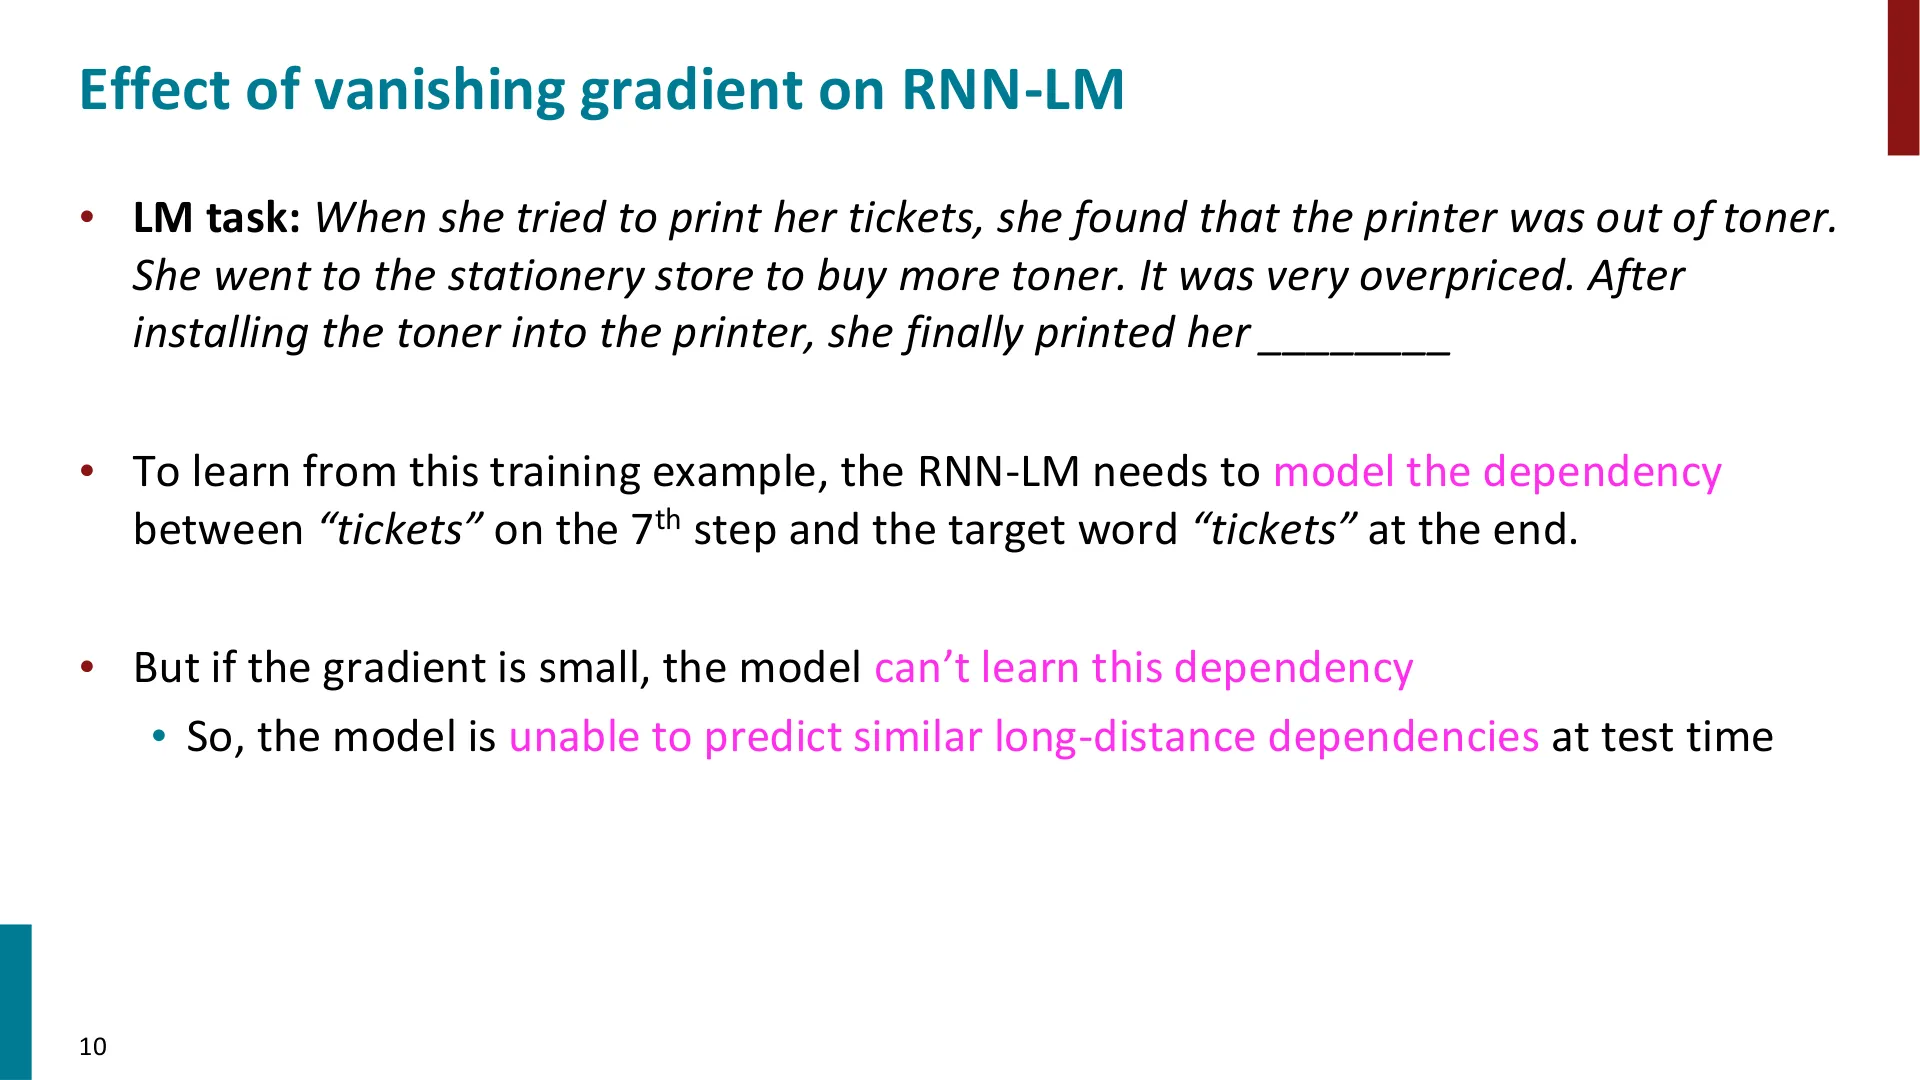
- Slide 10:Effect of vanishing gradient on RNN-LM——长距离依赖(如第 7 步的 "tickets" 与结尾)学不到
- Slide 11:Why is exploding gradient a problem?——梯度过大导致更新步过大("你以为找到了一座山,结果突然身处艾奥瓦")
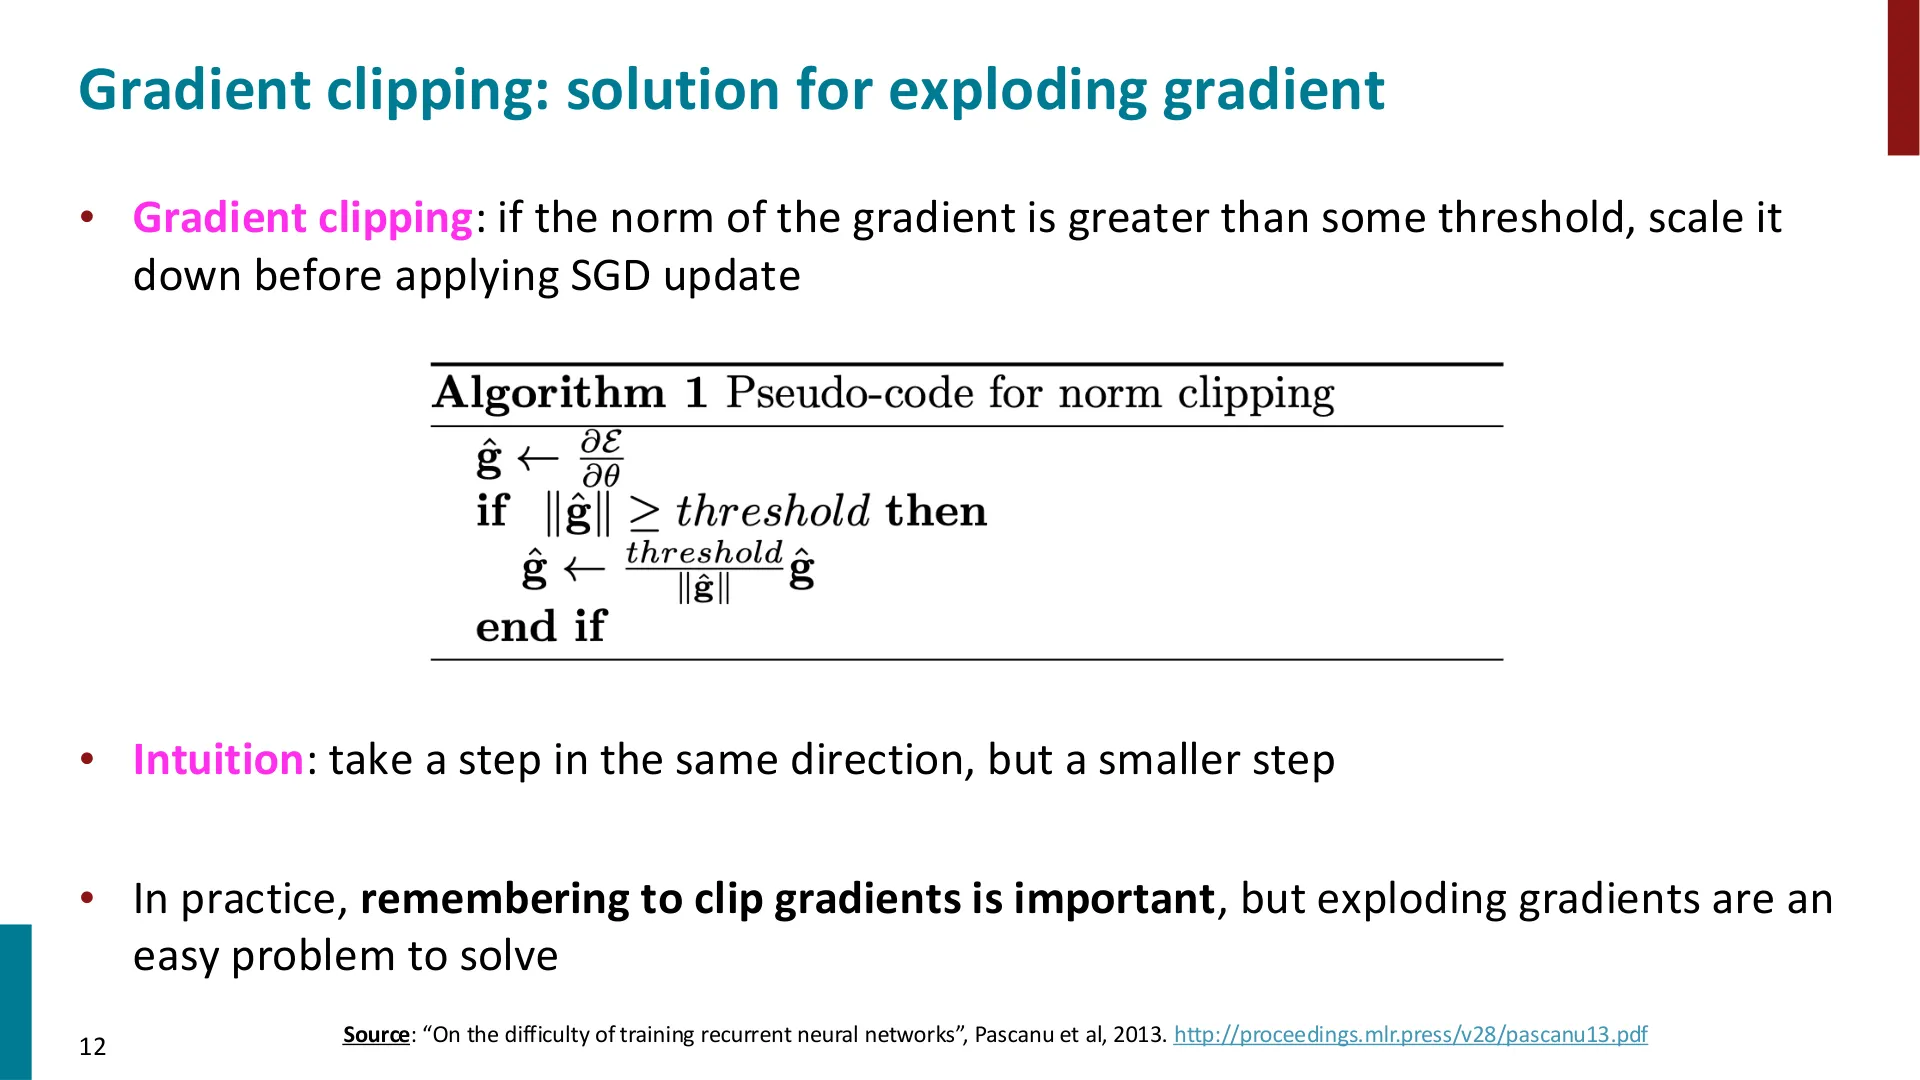
- Slide 12:Gradient clipping——梯度裁剪,按范数缩回去(Pascanu et al., 2013)
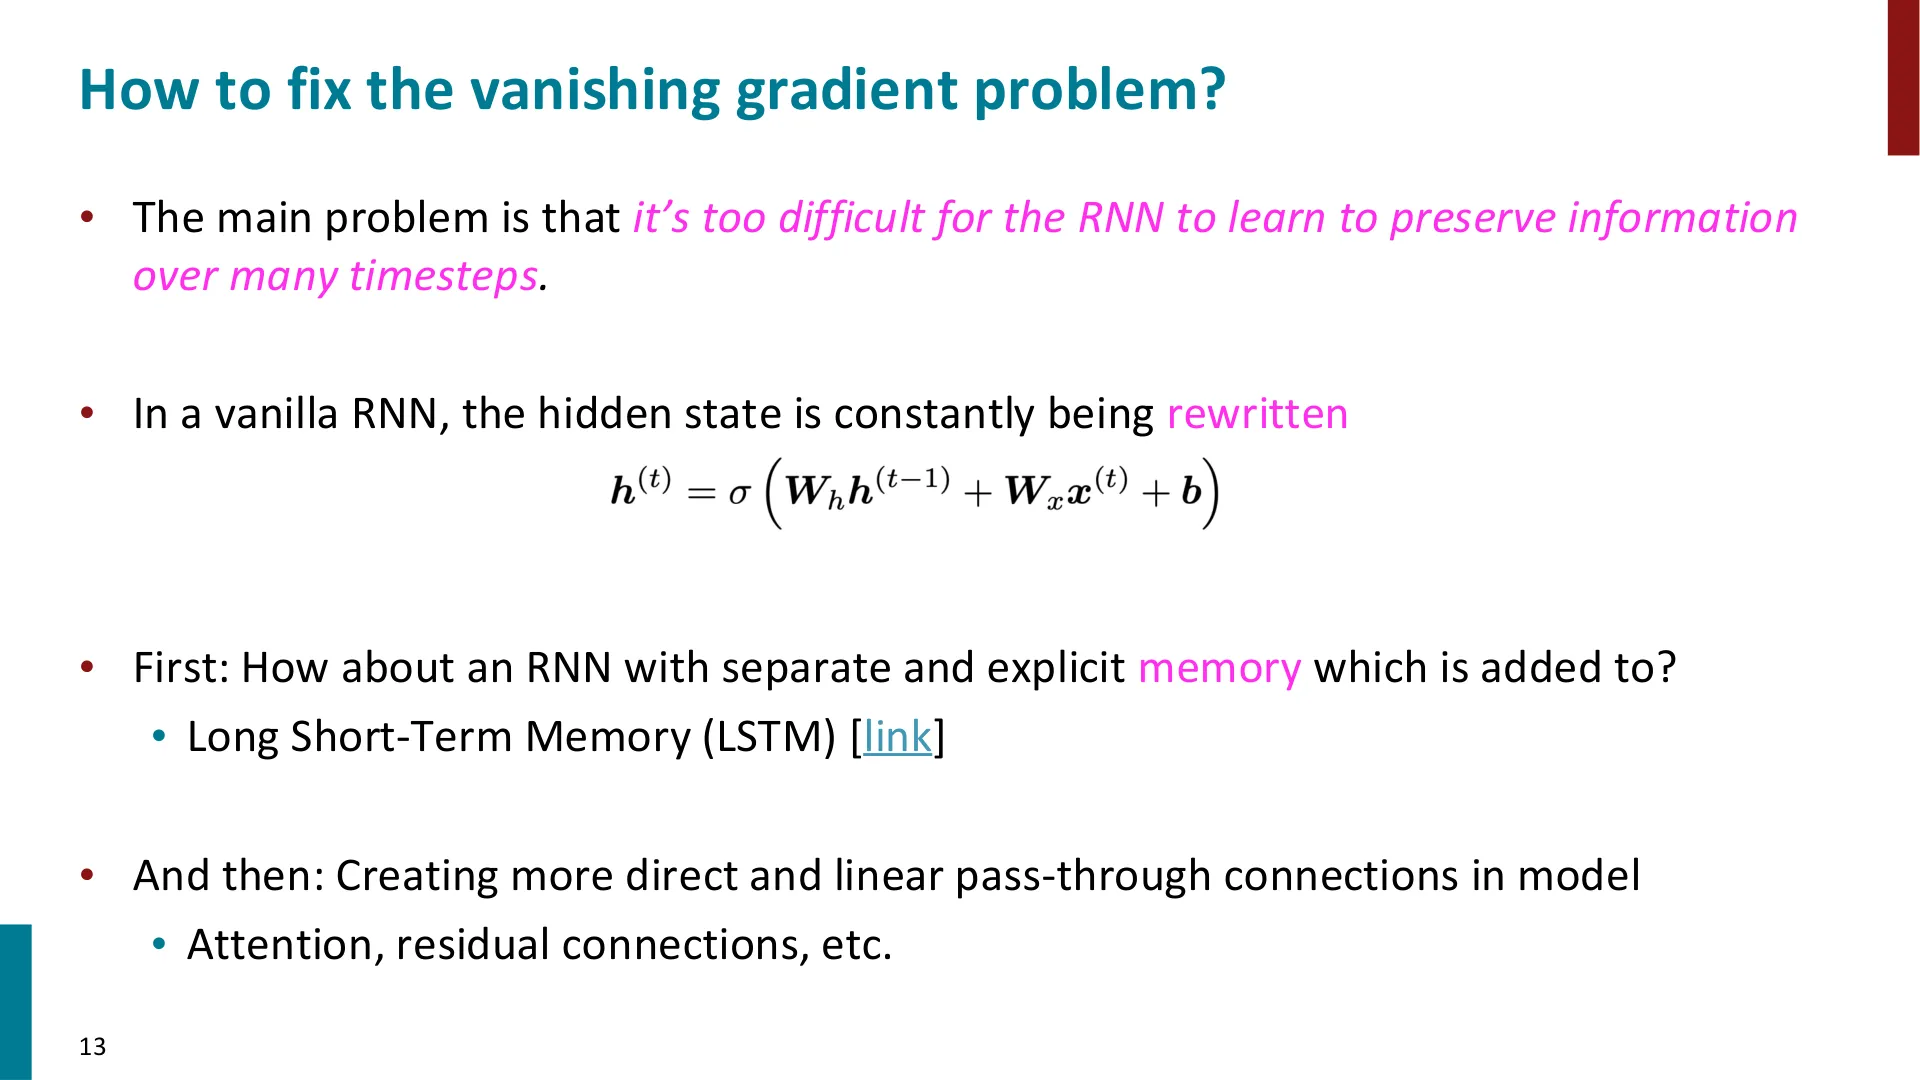
- Slide 13:How to fix the vanishing gradient problem?——LSTM 的显式记忆、以及注意力/残差等直连通路
二、机器翻译与序列到序列(Slide 14–21)
- Slide 14:2. Machine Translation——MT 的定义(源语言 $x$ → 目标语言 $y$)
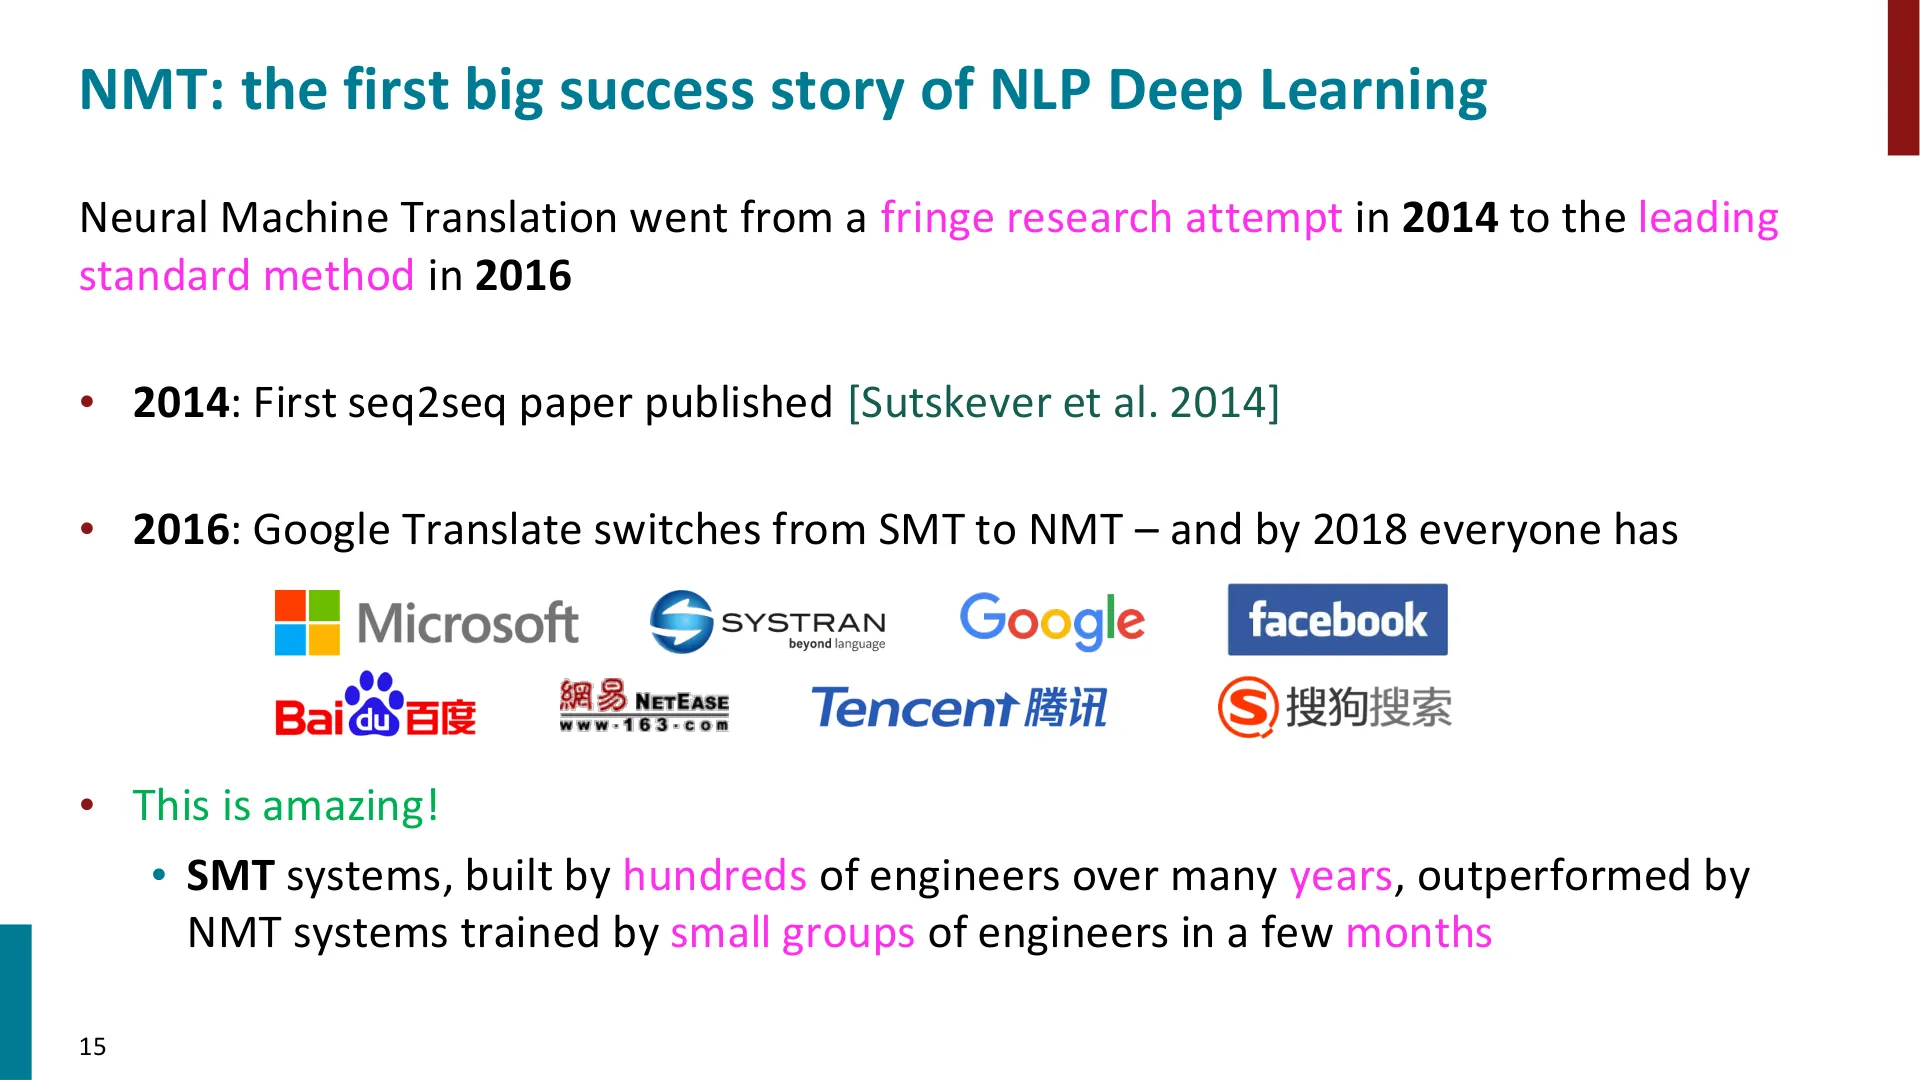
- Slide 15:NMT:NLP 深度学习的第一个大成功(2014 首篇 seq2seq 论文;2016 Google 翻译切换;Sutskever et al. 2014)
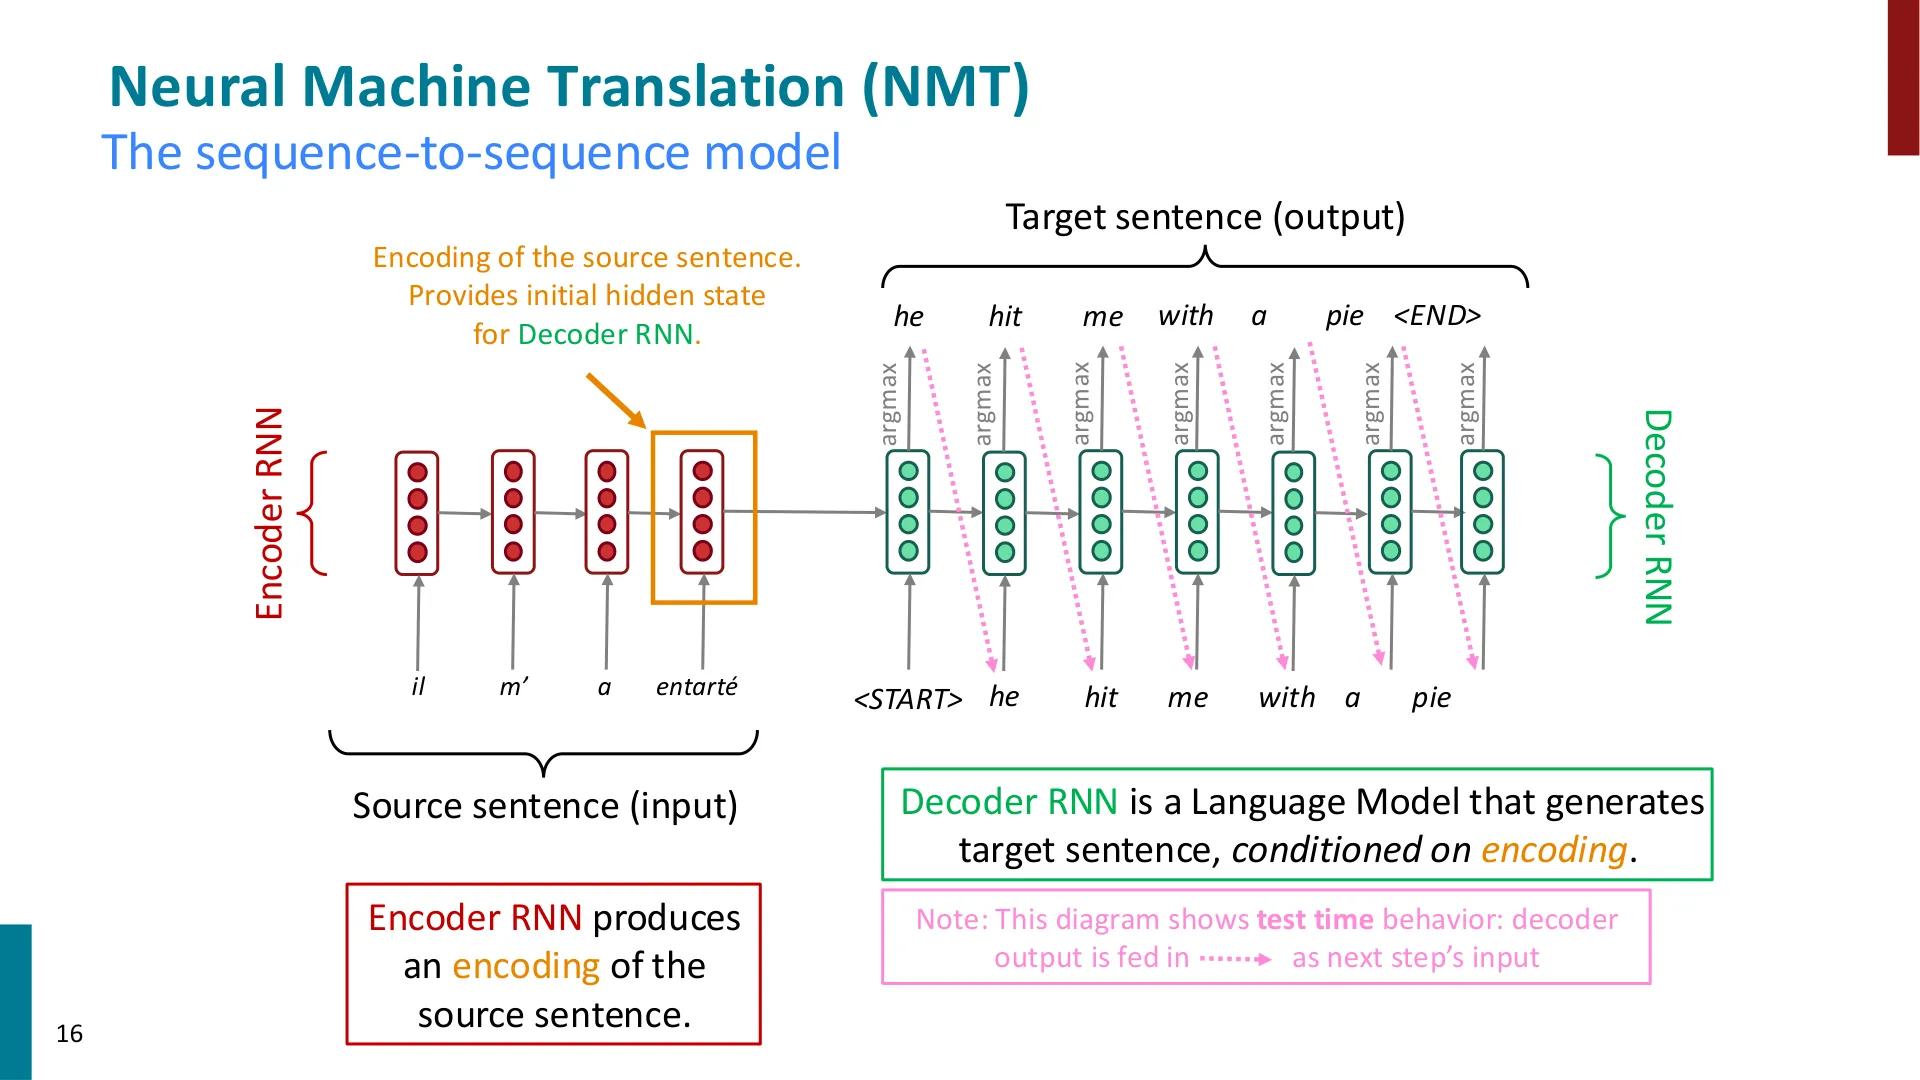
- Slide 16:Neural Machine Translation(NMT)——编码器 RNN / 解码器 RNN 的 seq2seq 模型
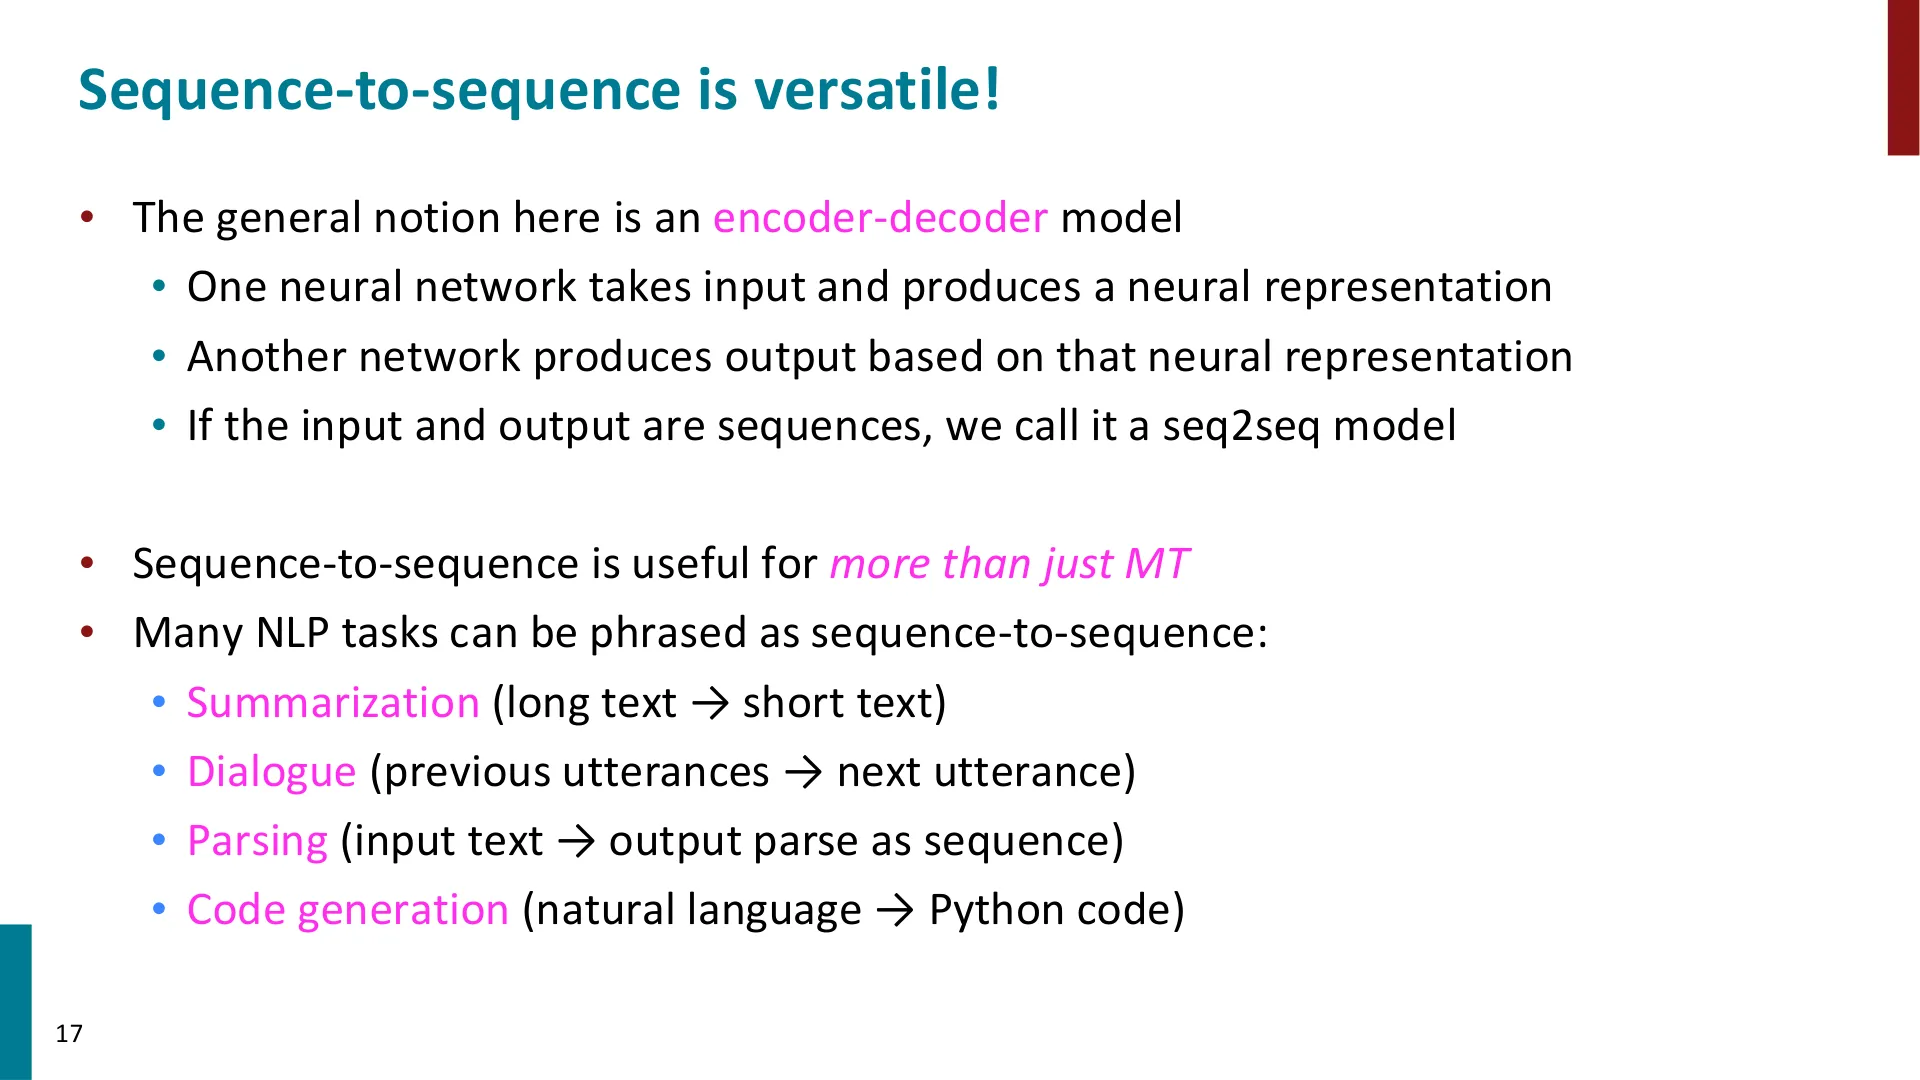
- Slide 17:Sequence-to-sequence is versatile!——摘要、对话、句法分析、代码生成
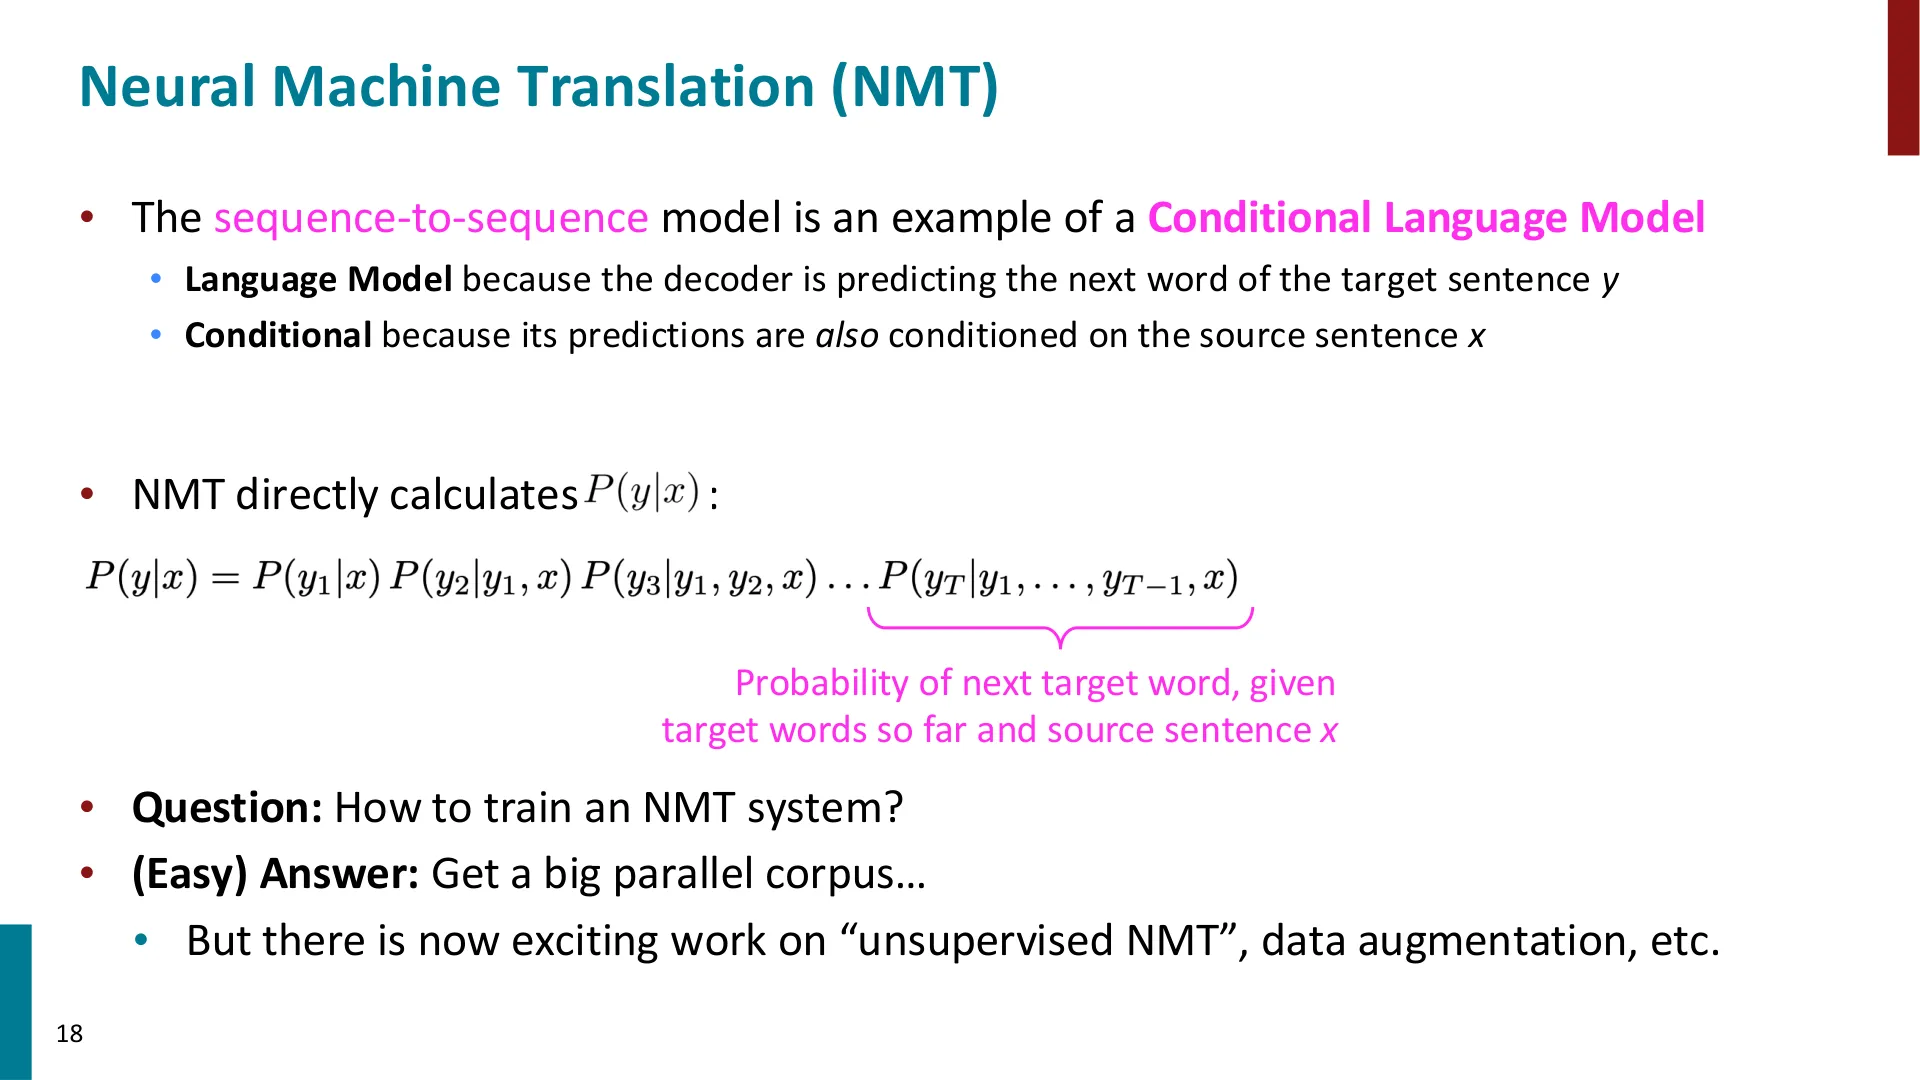
- Slide 18:NMT 是一种条件语言模型(Conditional Language Model)
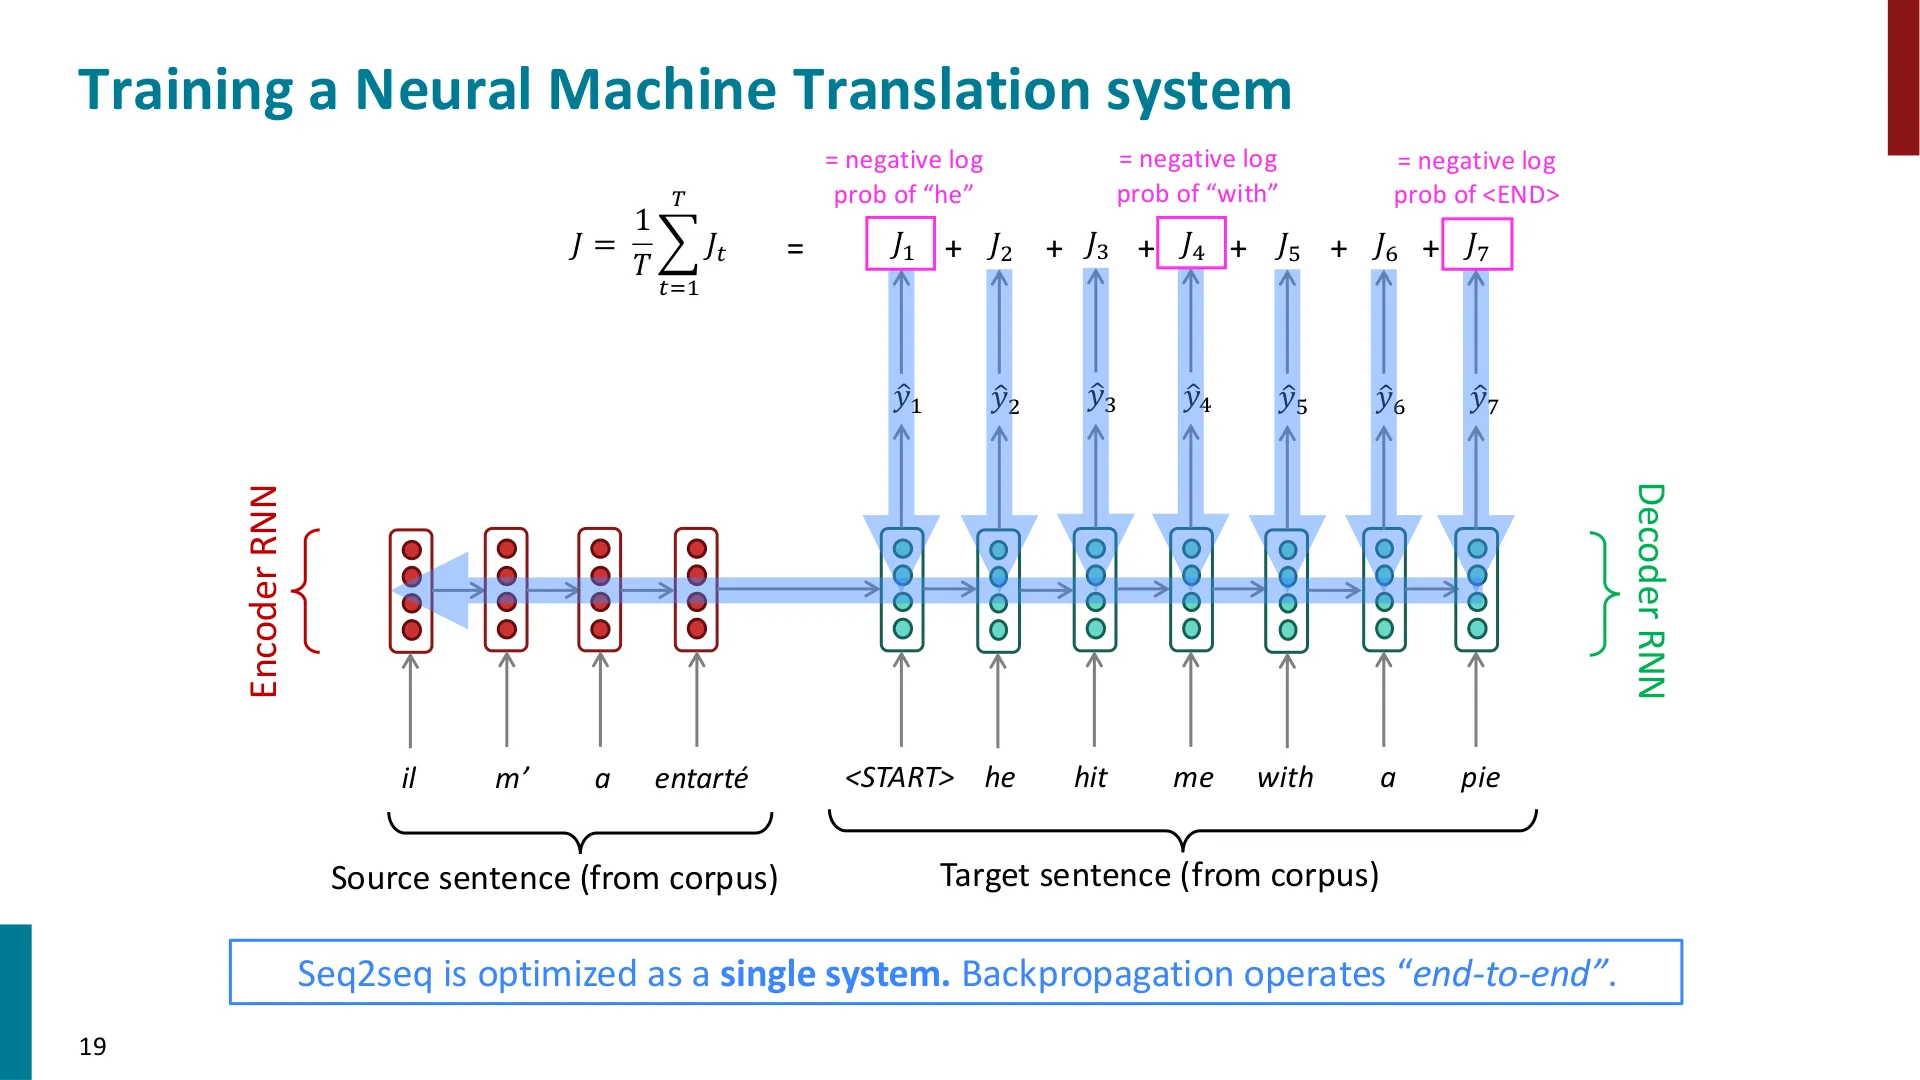
- Slide 19:Training a Neural Machine Translation system——端到端反向传播、逐词负对数概率求和 $J=\frac{1}{T}\sum_{t=1}^T J_t$
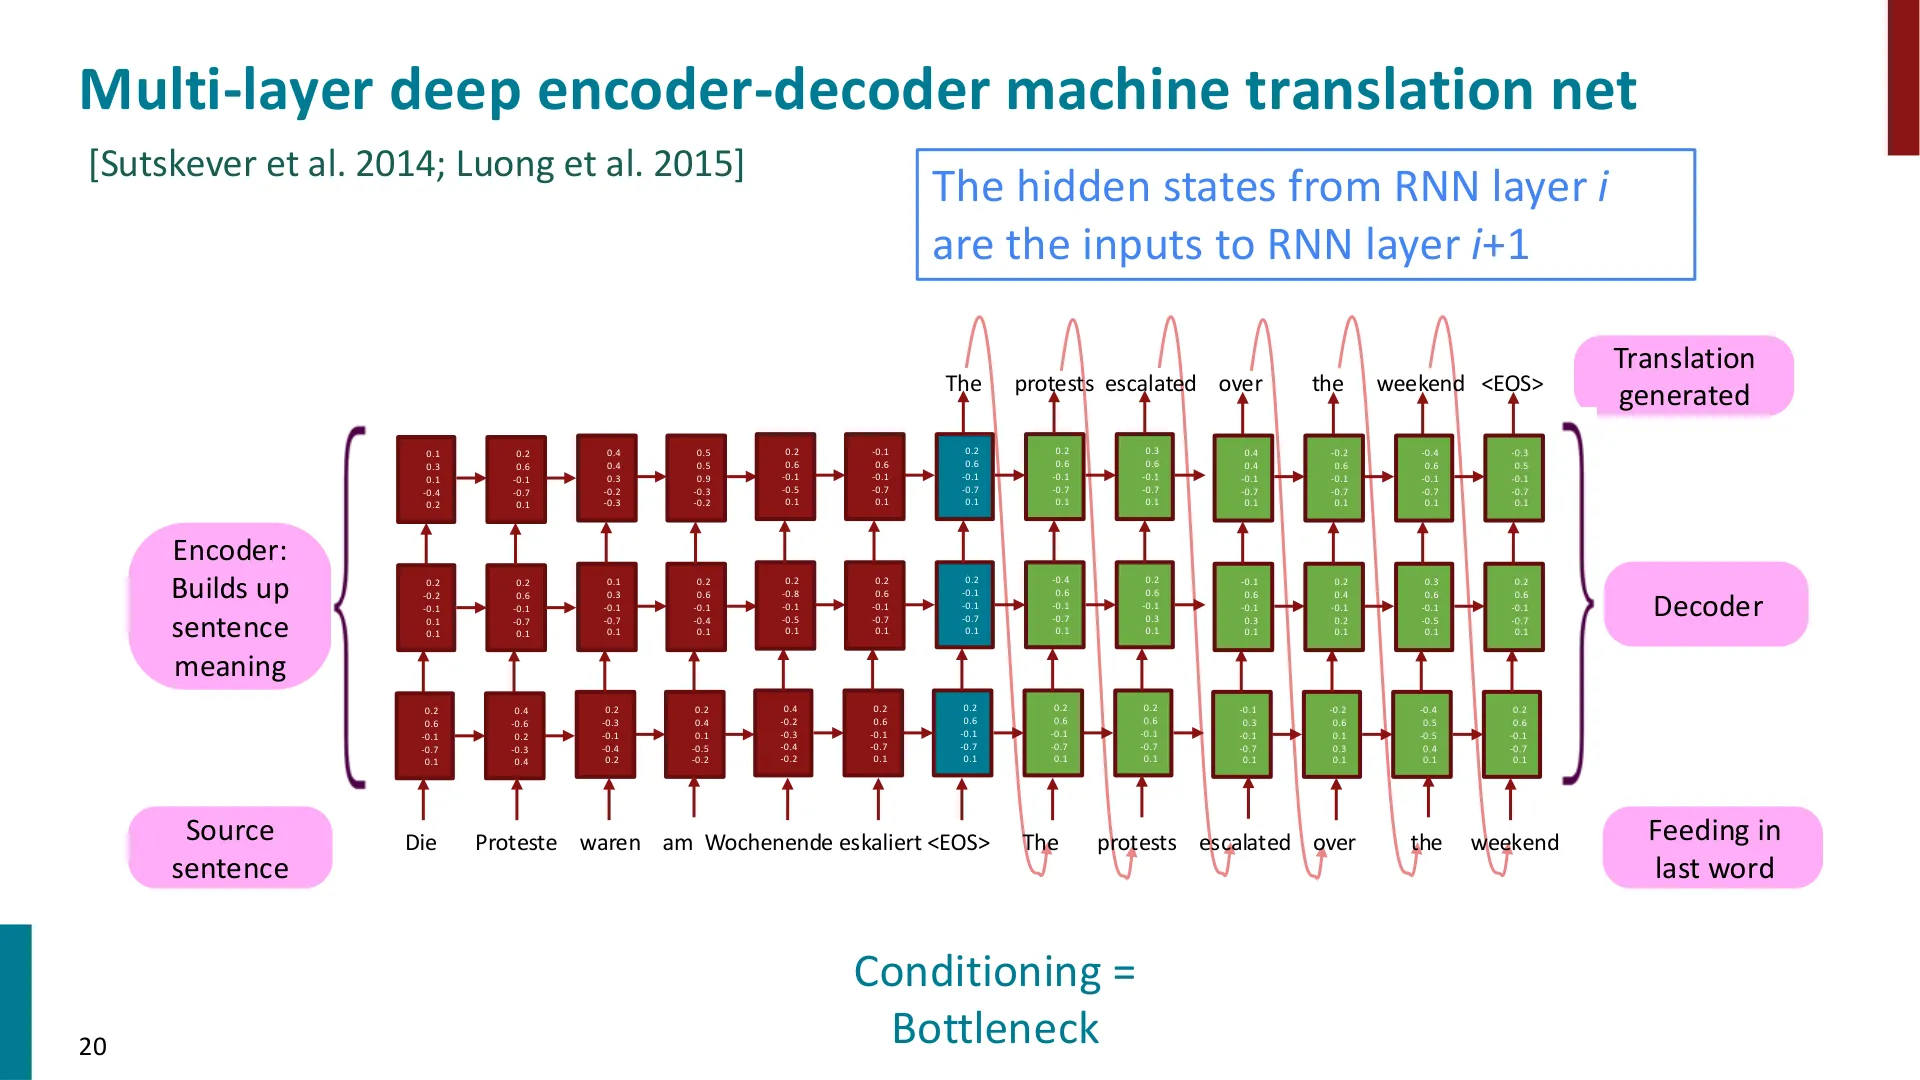
- Slide 20:Multi-layer deep encoder-decoder machine translation net——多层 RNN、条件信息作为「瓶颈」
- Slide 21:The final piece: the bottleneck problem in RNNs——条件信息瓶颈
三、面向序列到序列的注意力(Slide 22–23、Slide 25–38)
- Slide 22:3. Attention——注意力解决瓶颈问题
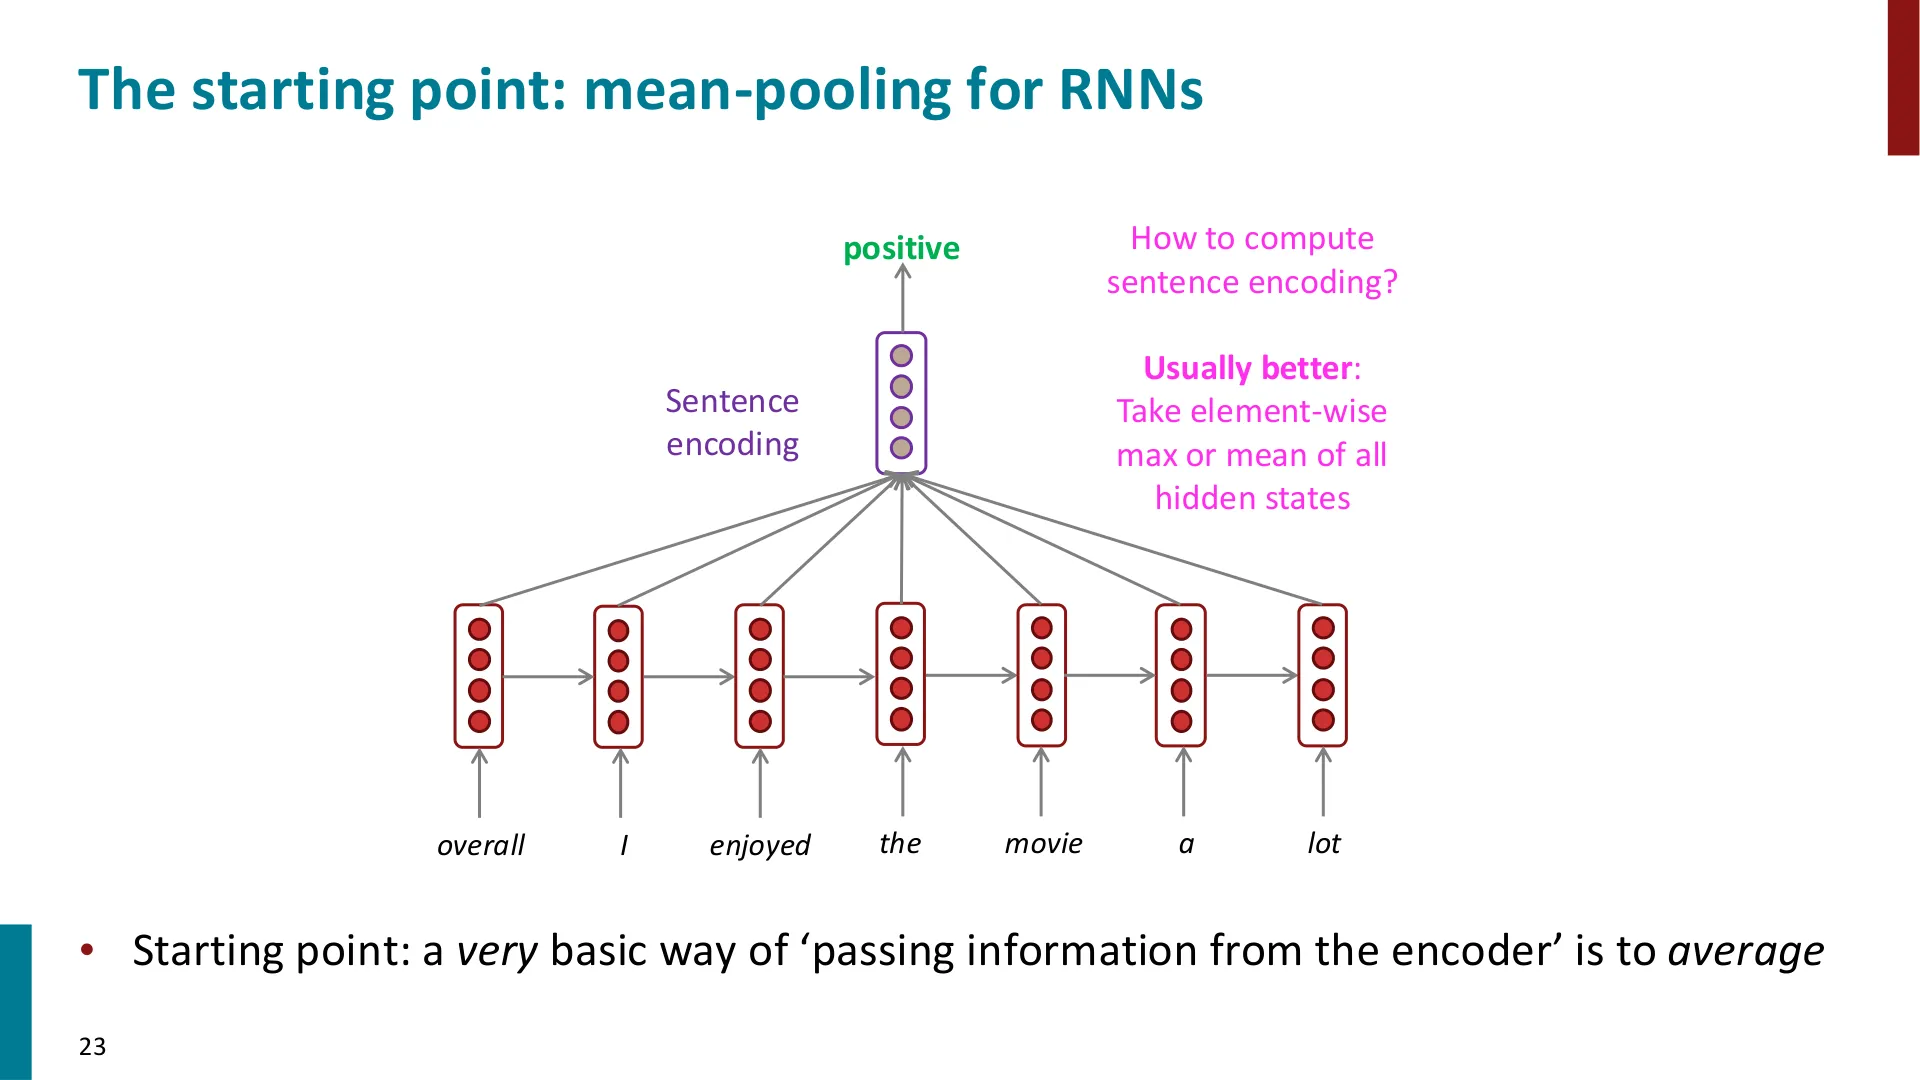
- Slide 23:The starting point: mean-pooling for RNNs——把隐状态做逐元素 max/mean
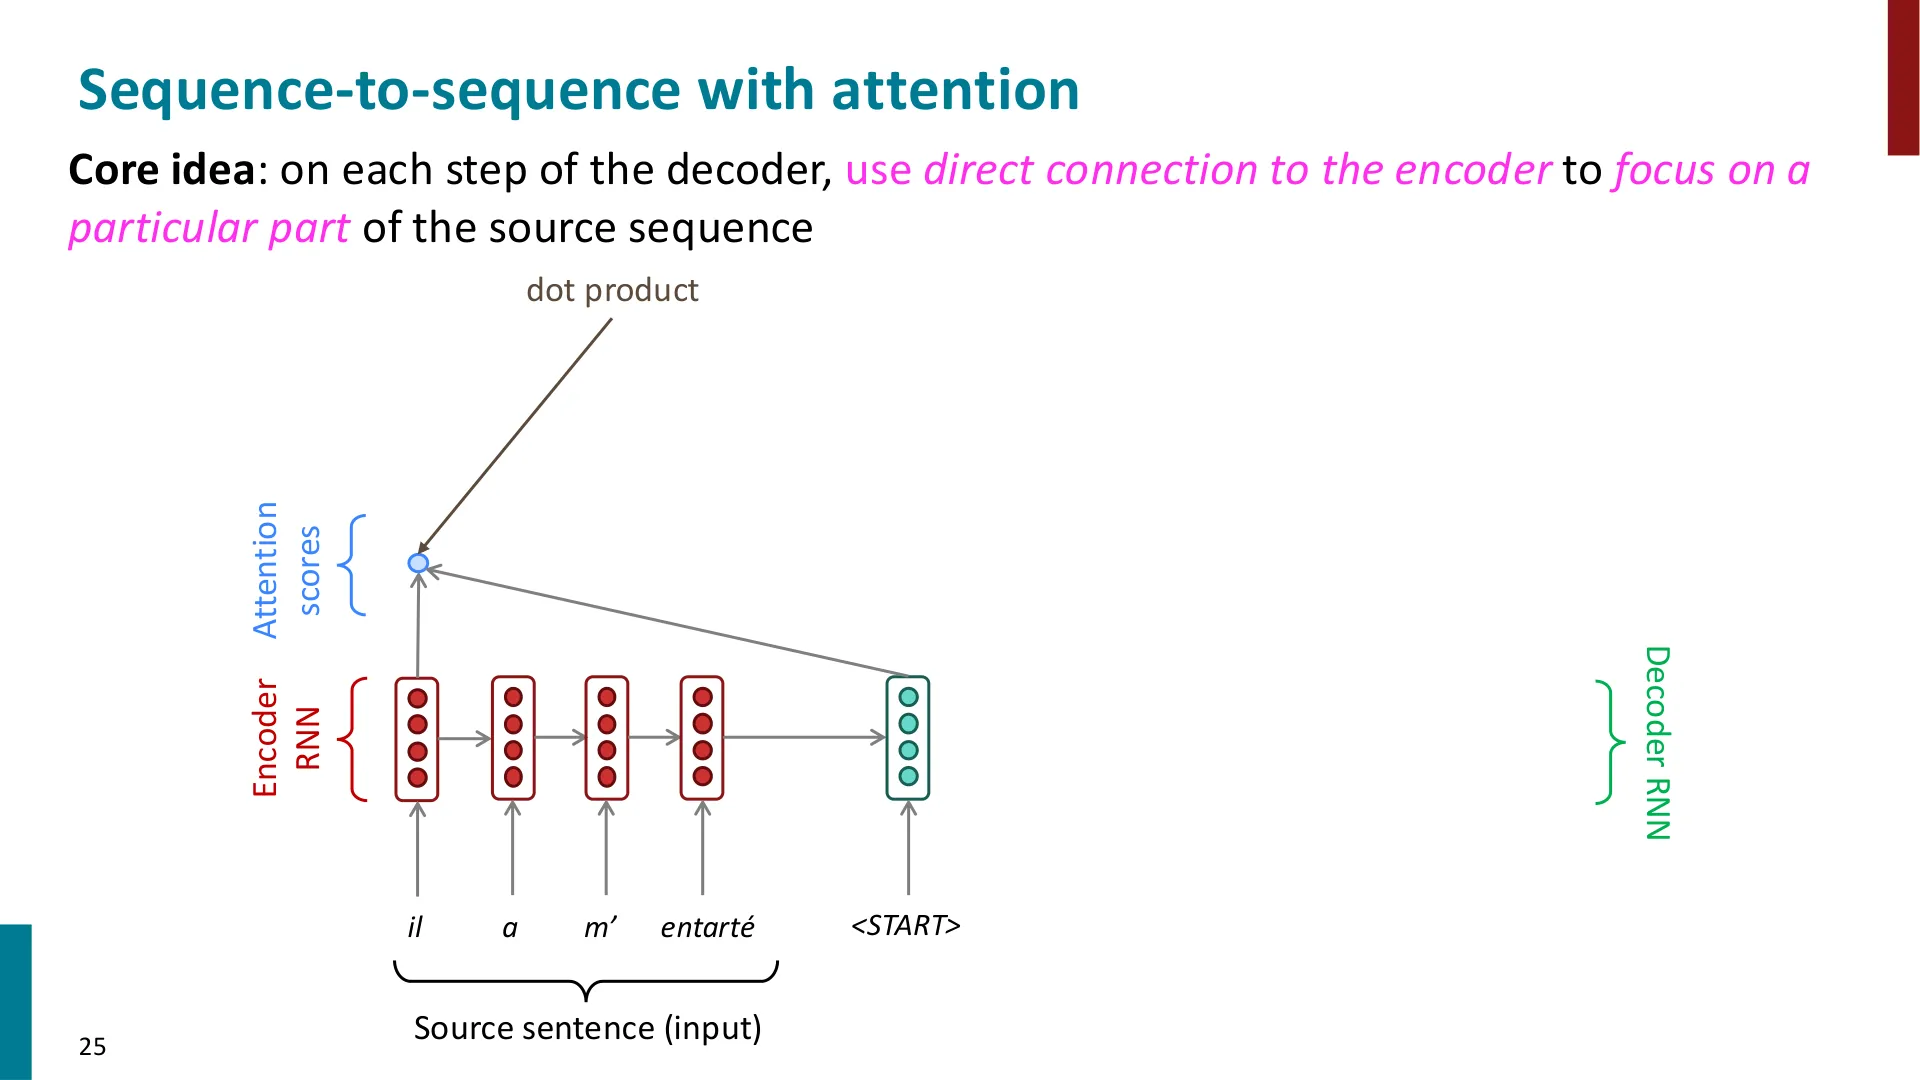
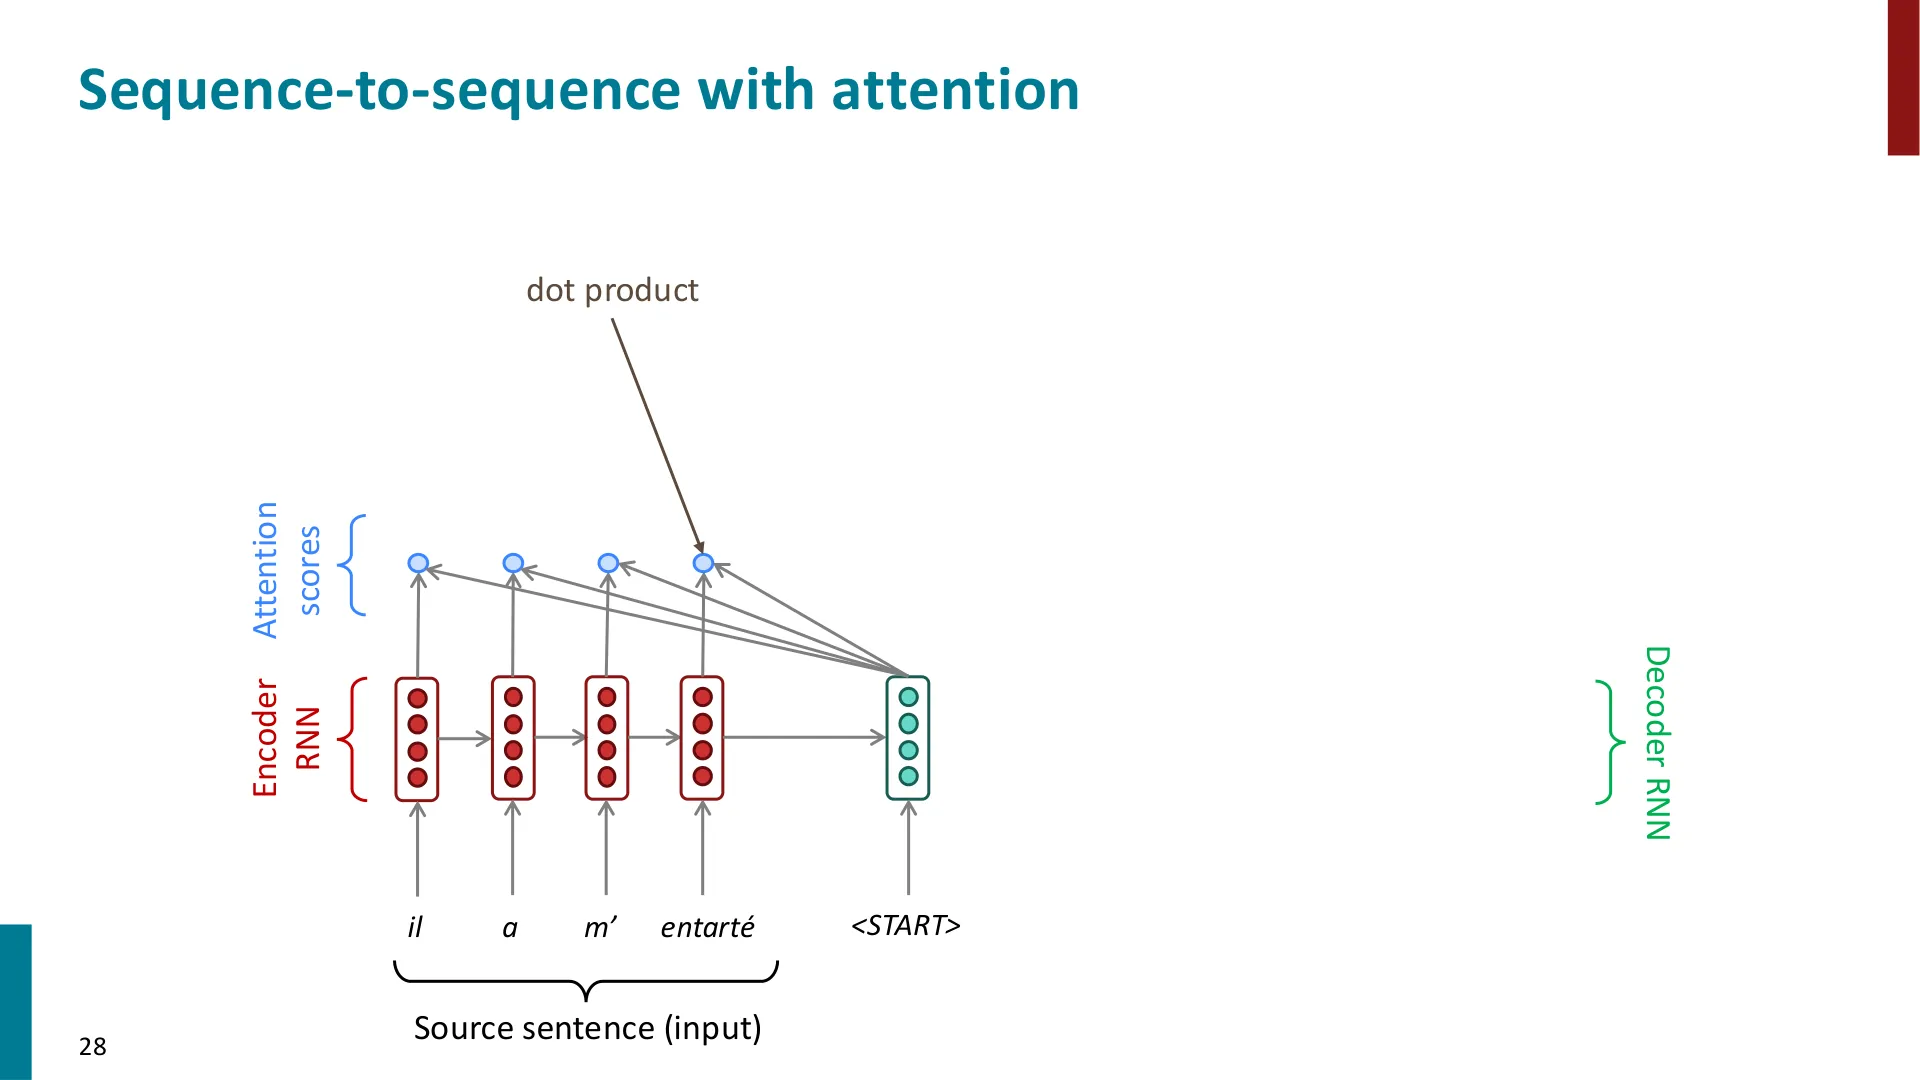
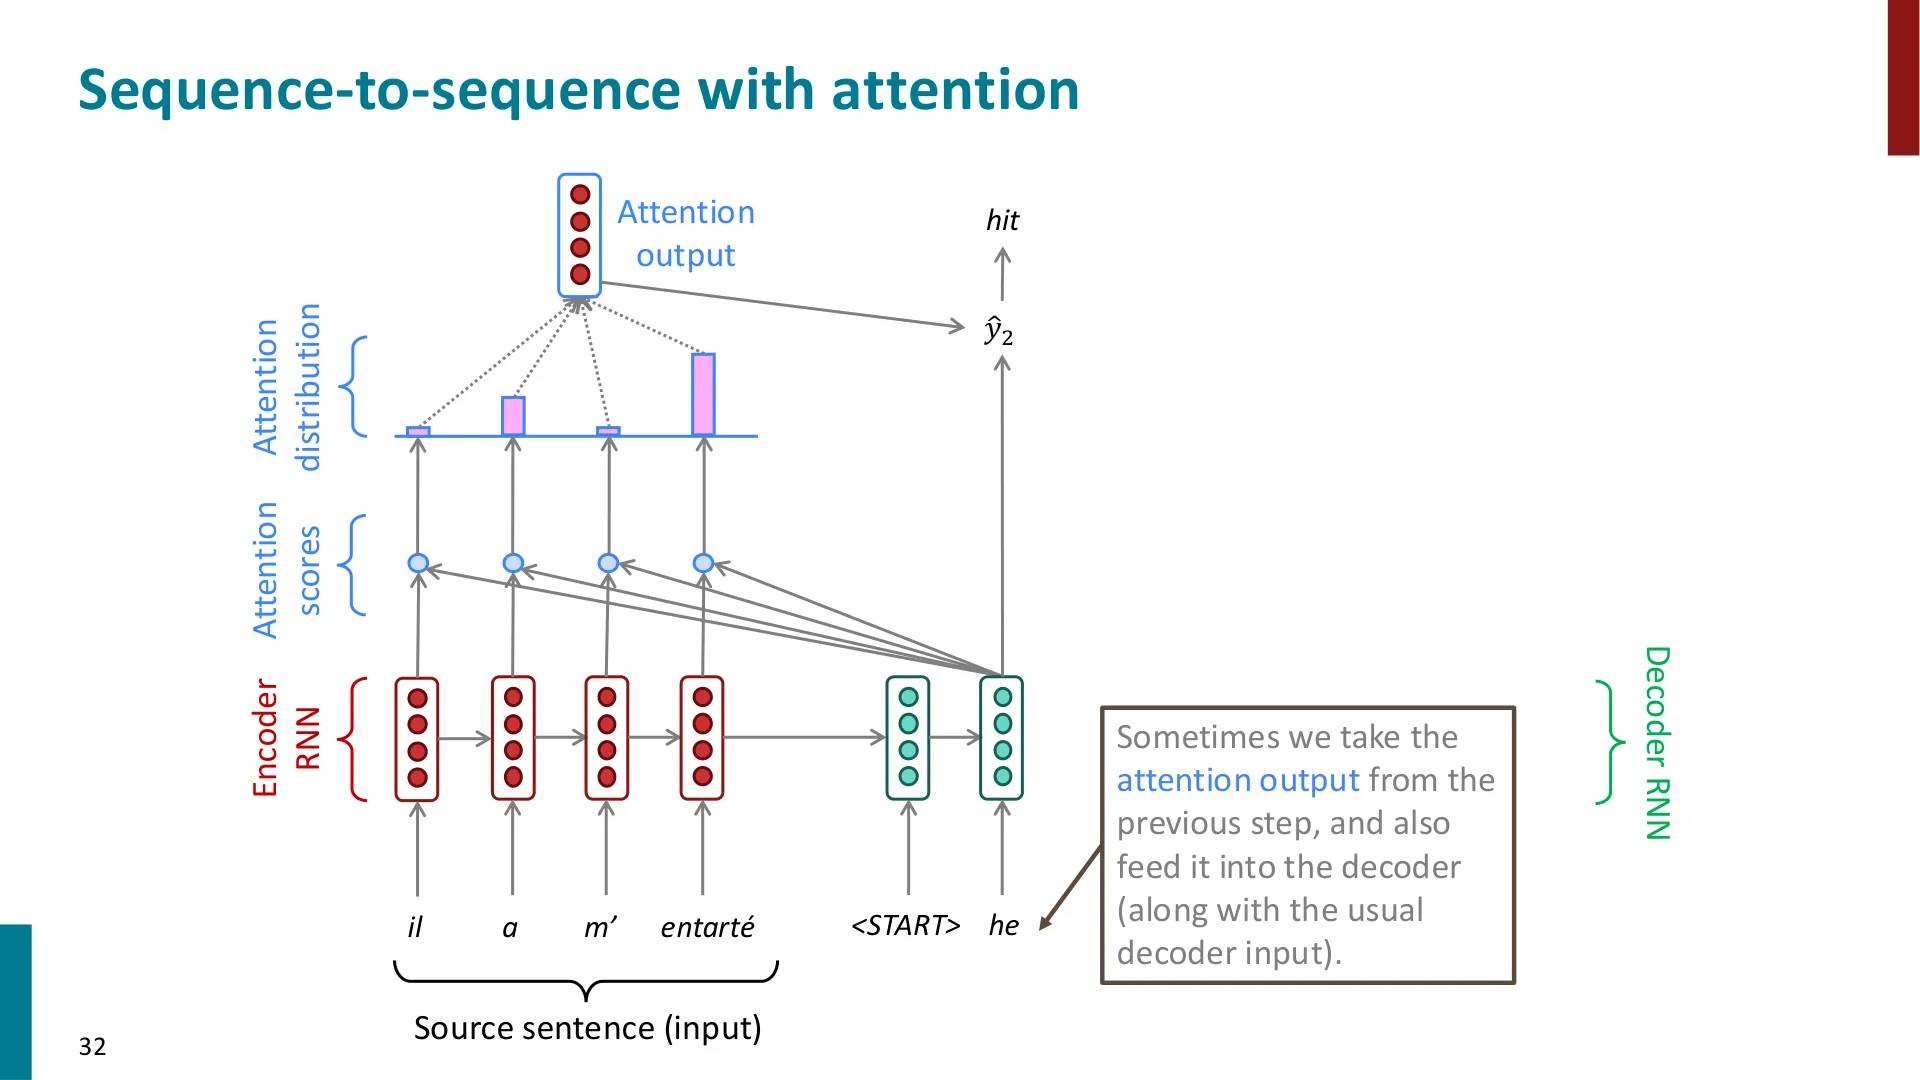
- Slide 25:Sequence-to-sequence with attention(注意力分数 = 点积)
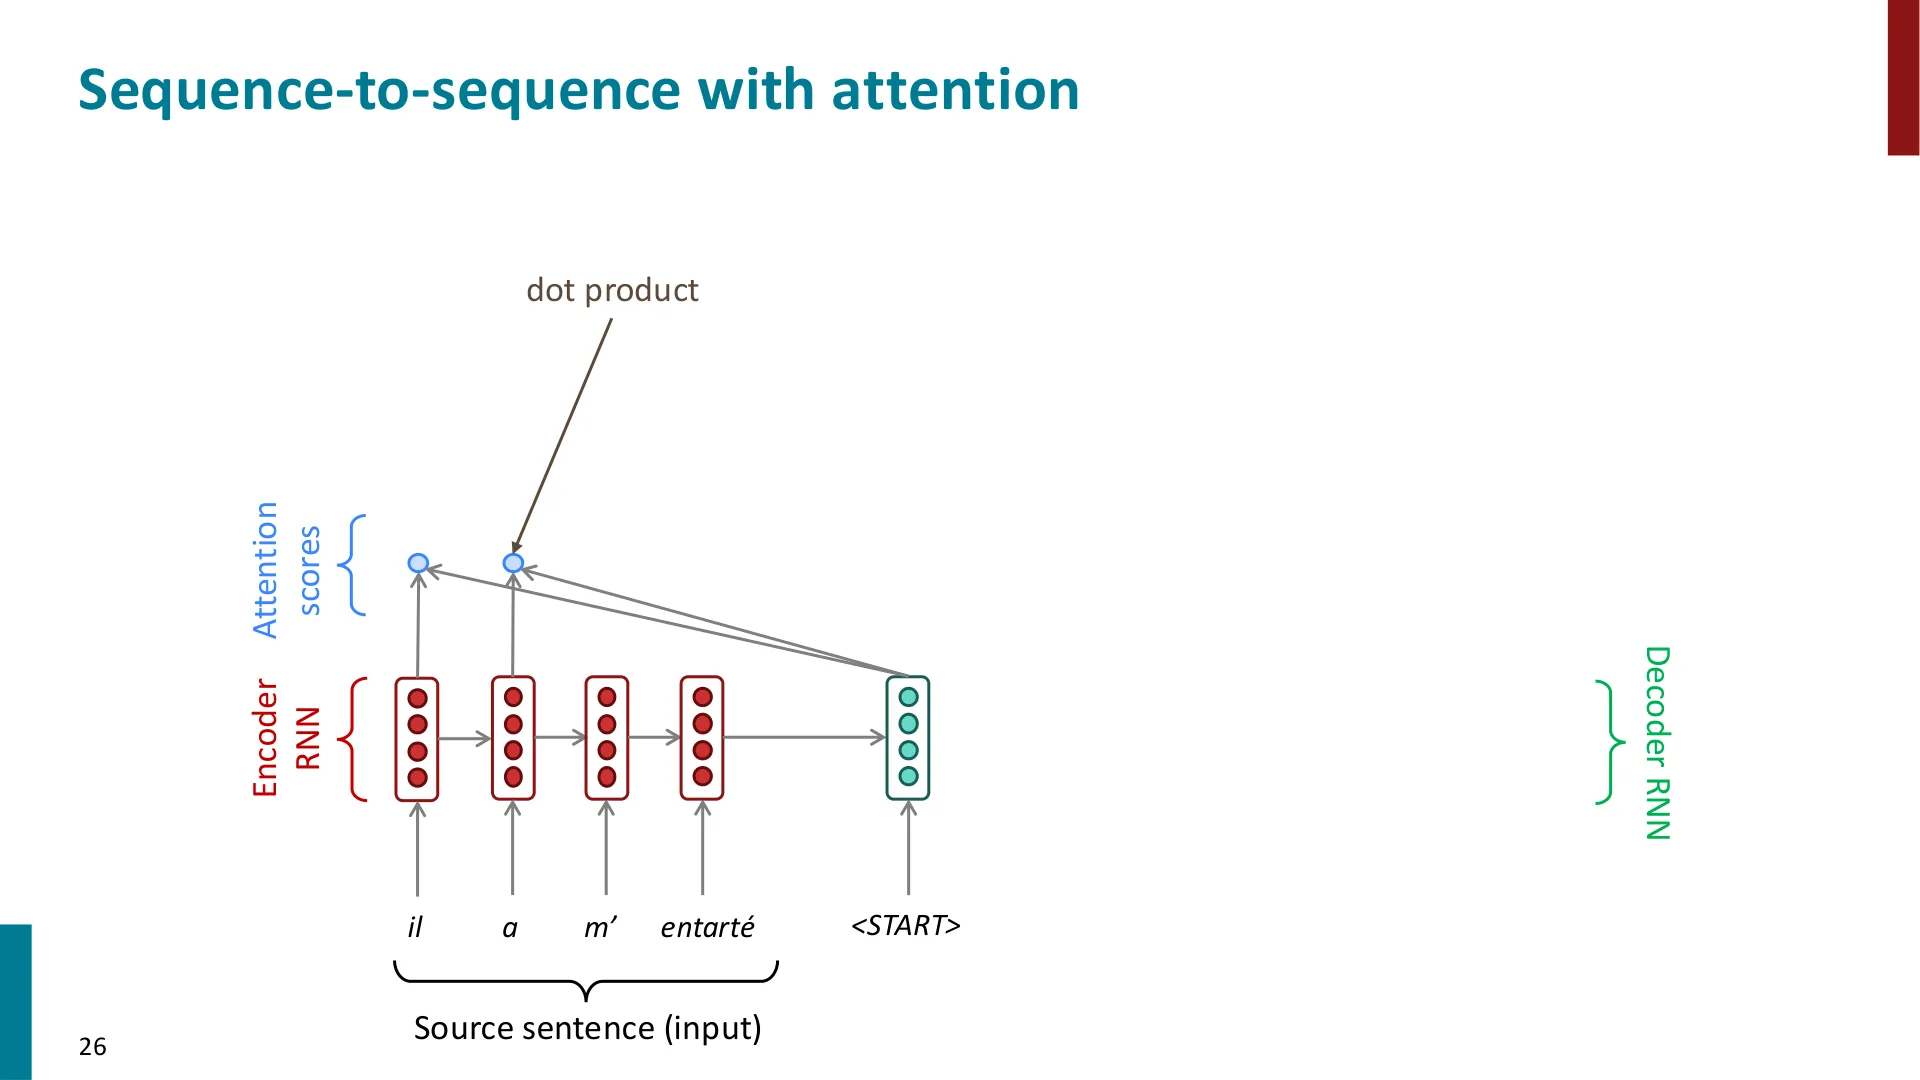
- Slide 26:Sequence-to-sequence with attention
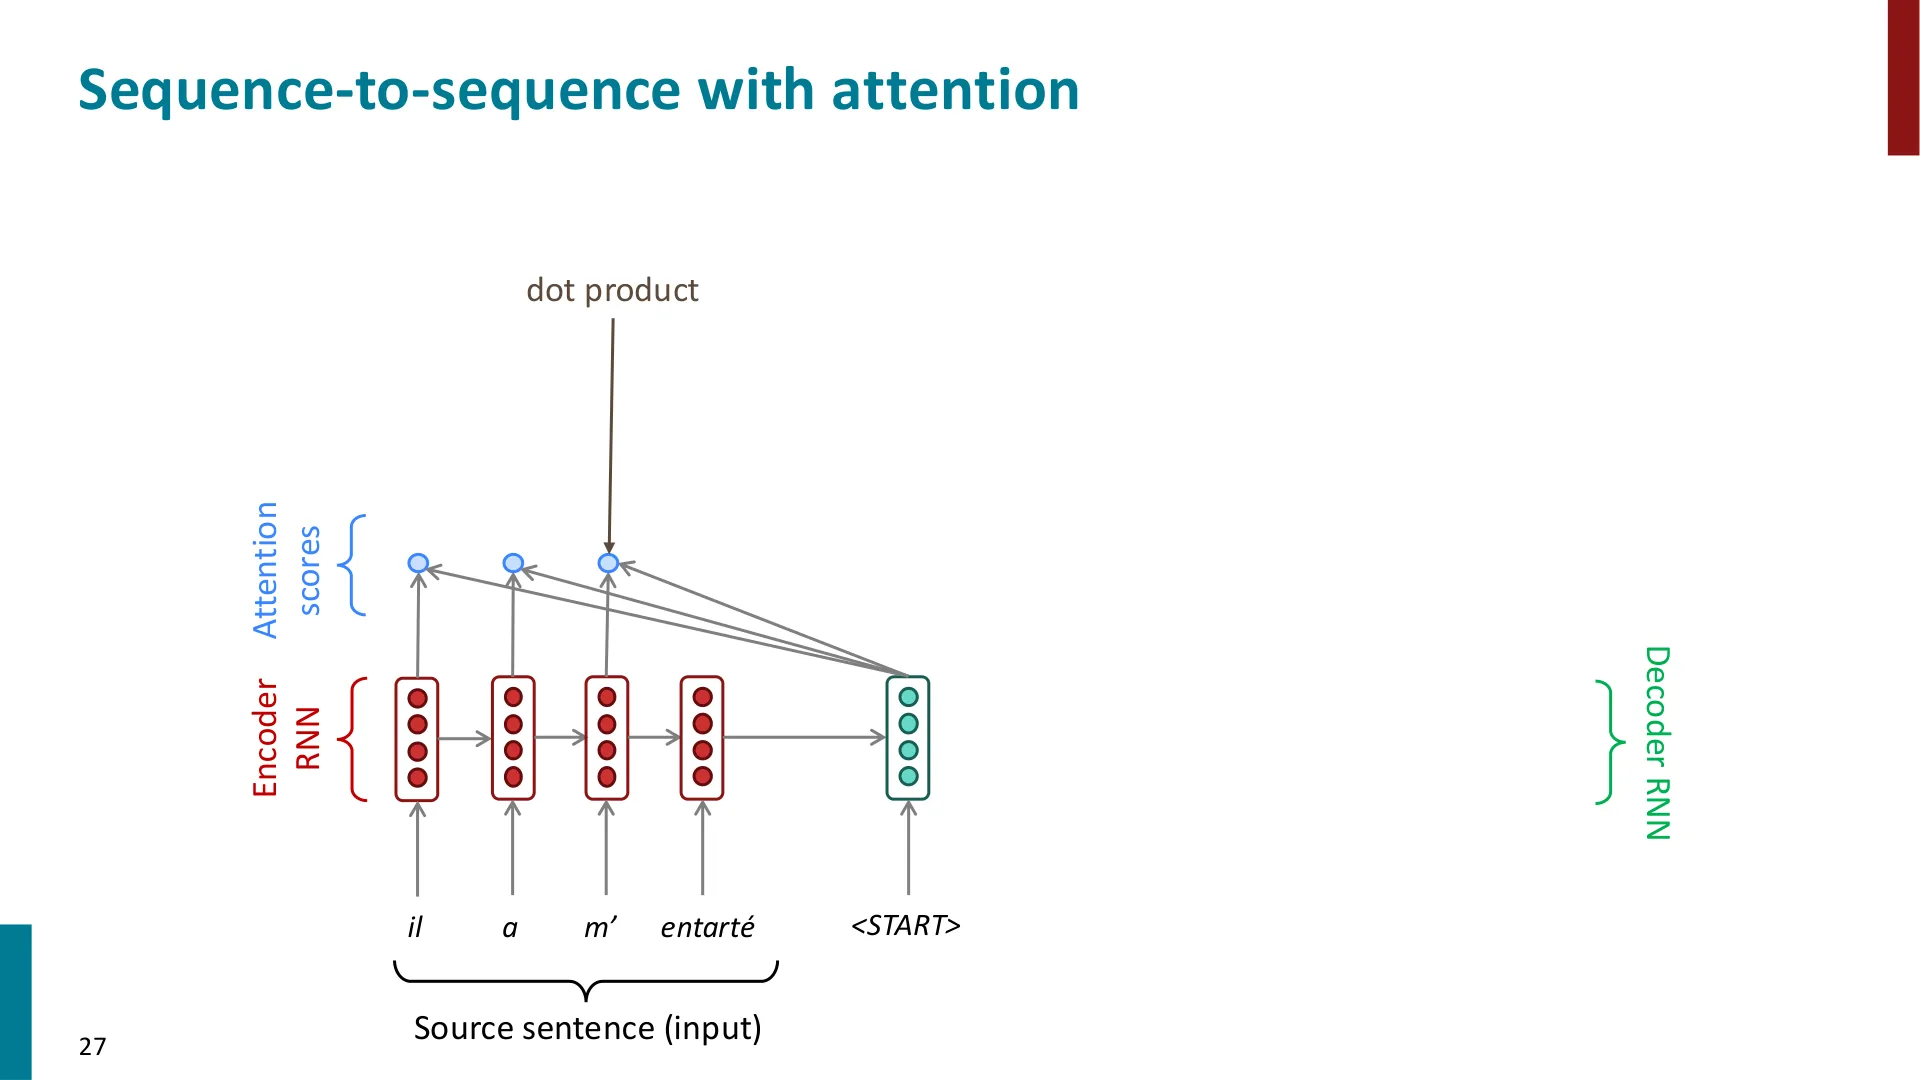
- Slide 27:Sequence-to-sequence with attention
- Slide 28:Sequence-to-sequence with attention
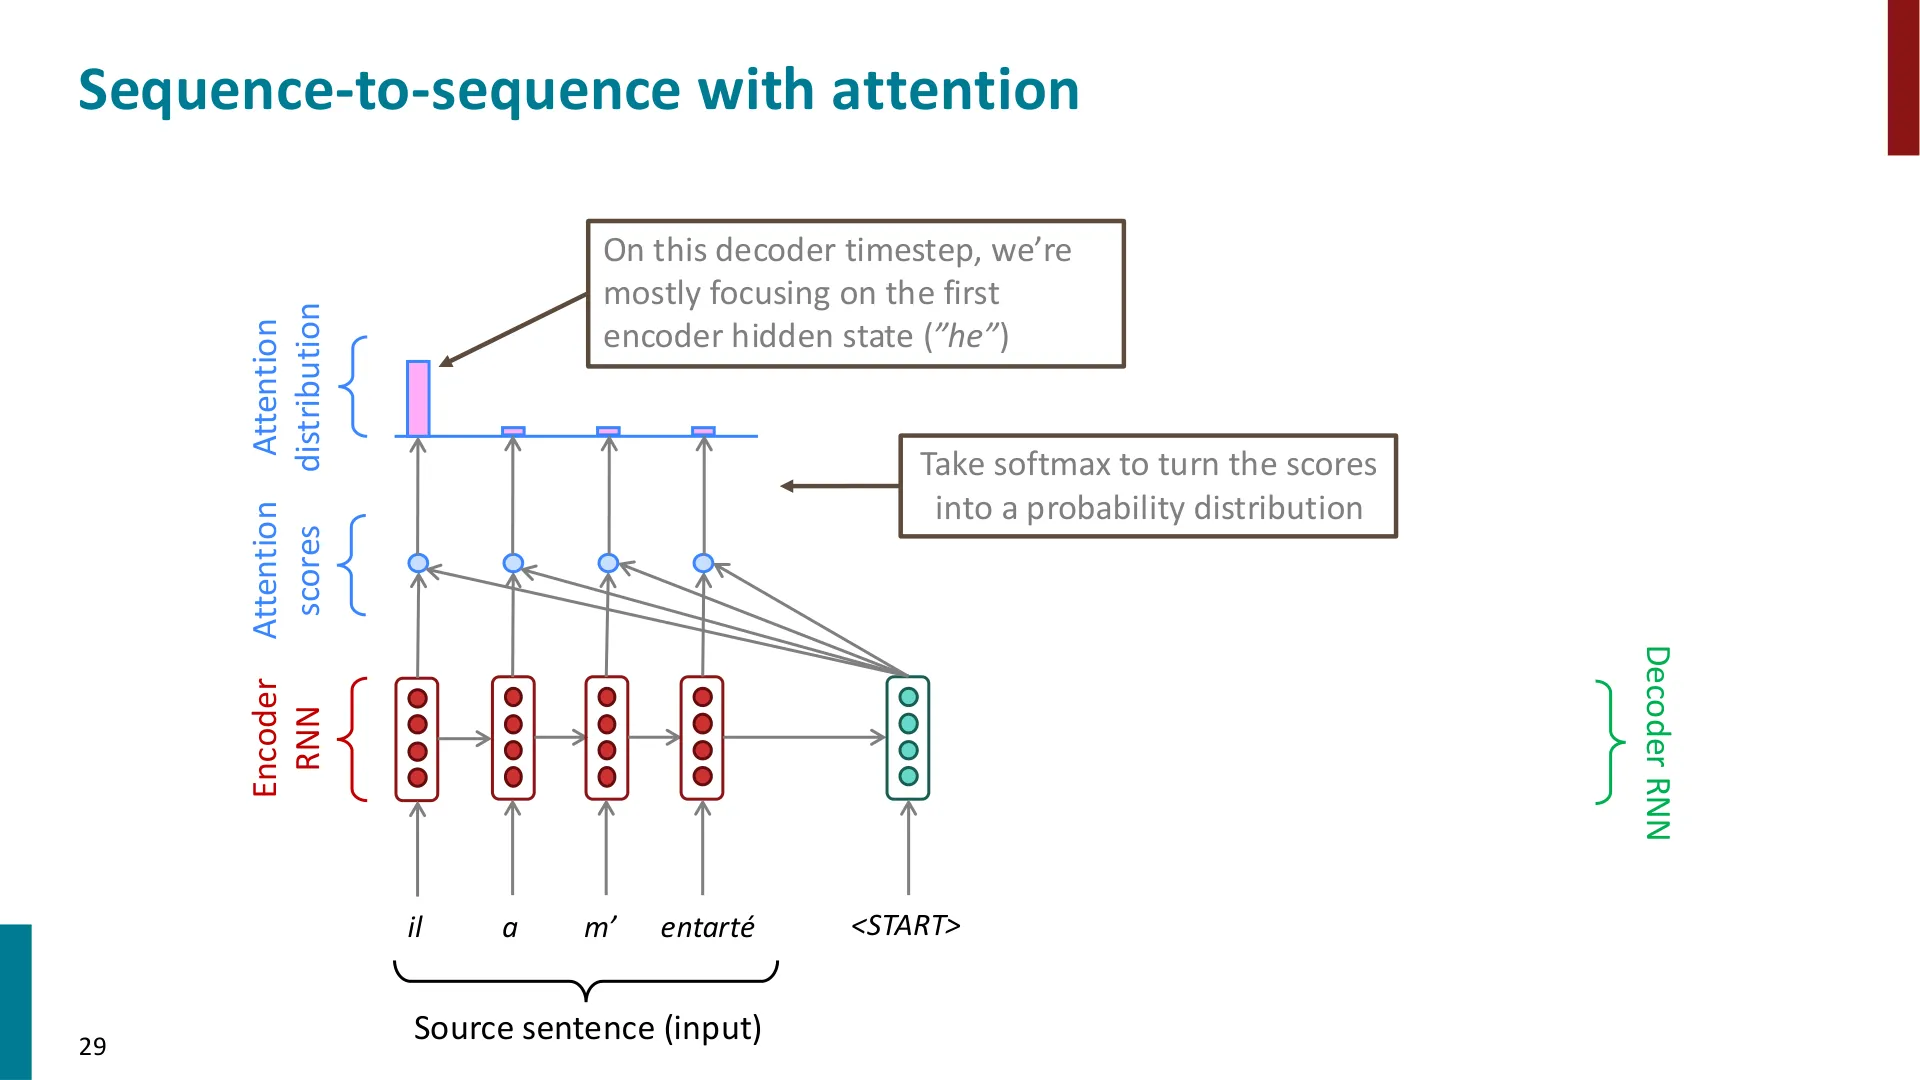
- Slide 29:加入 softmax 得到注意力分布(此步主要聚焦第一个编码器隐状态 "he")
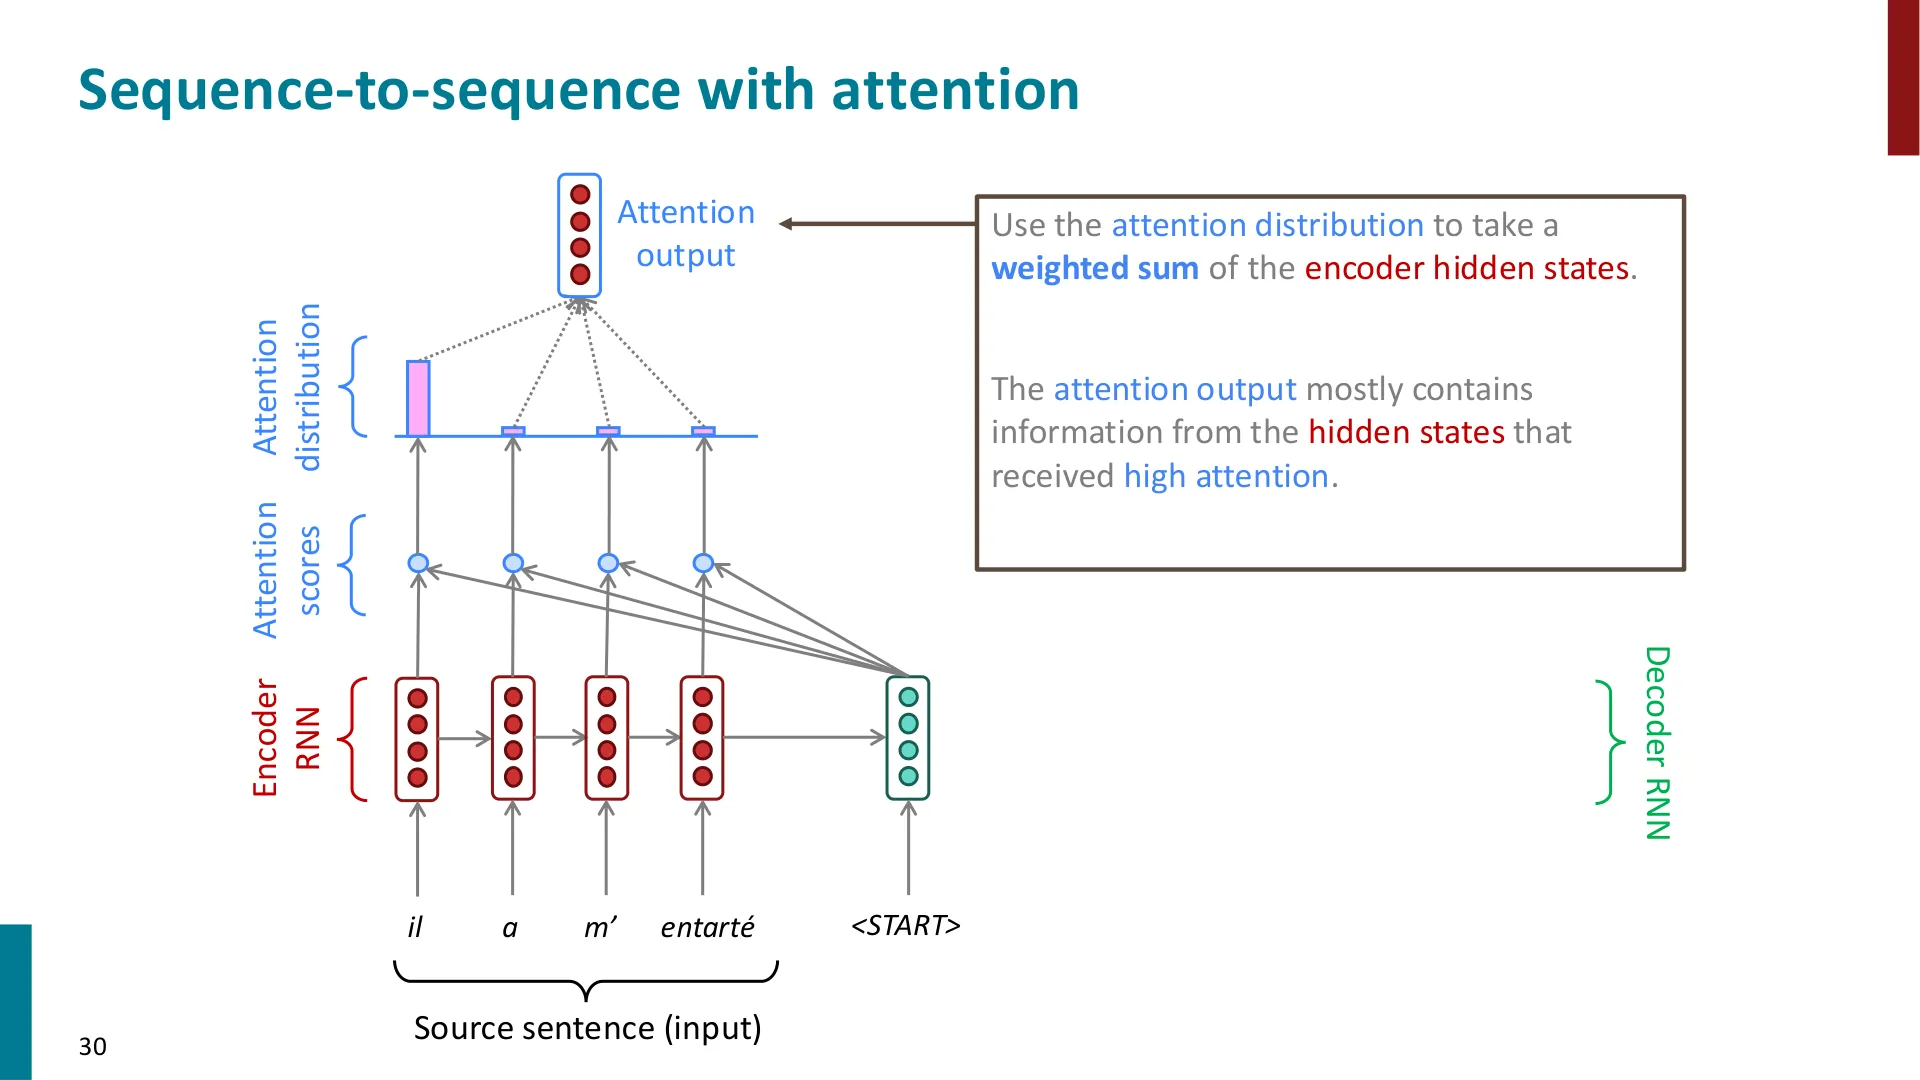
- Slide 30:用注意力分布对编码器隐状态加权求和,得到注意力输出
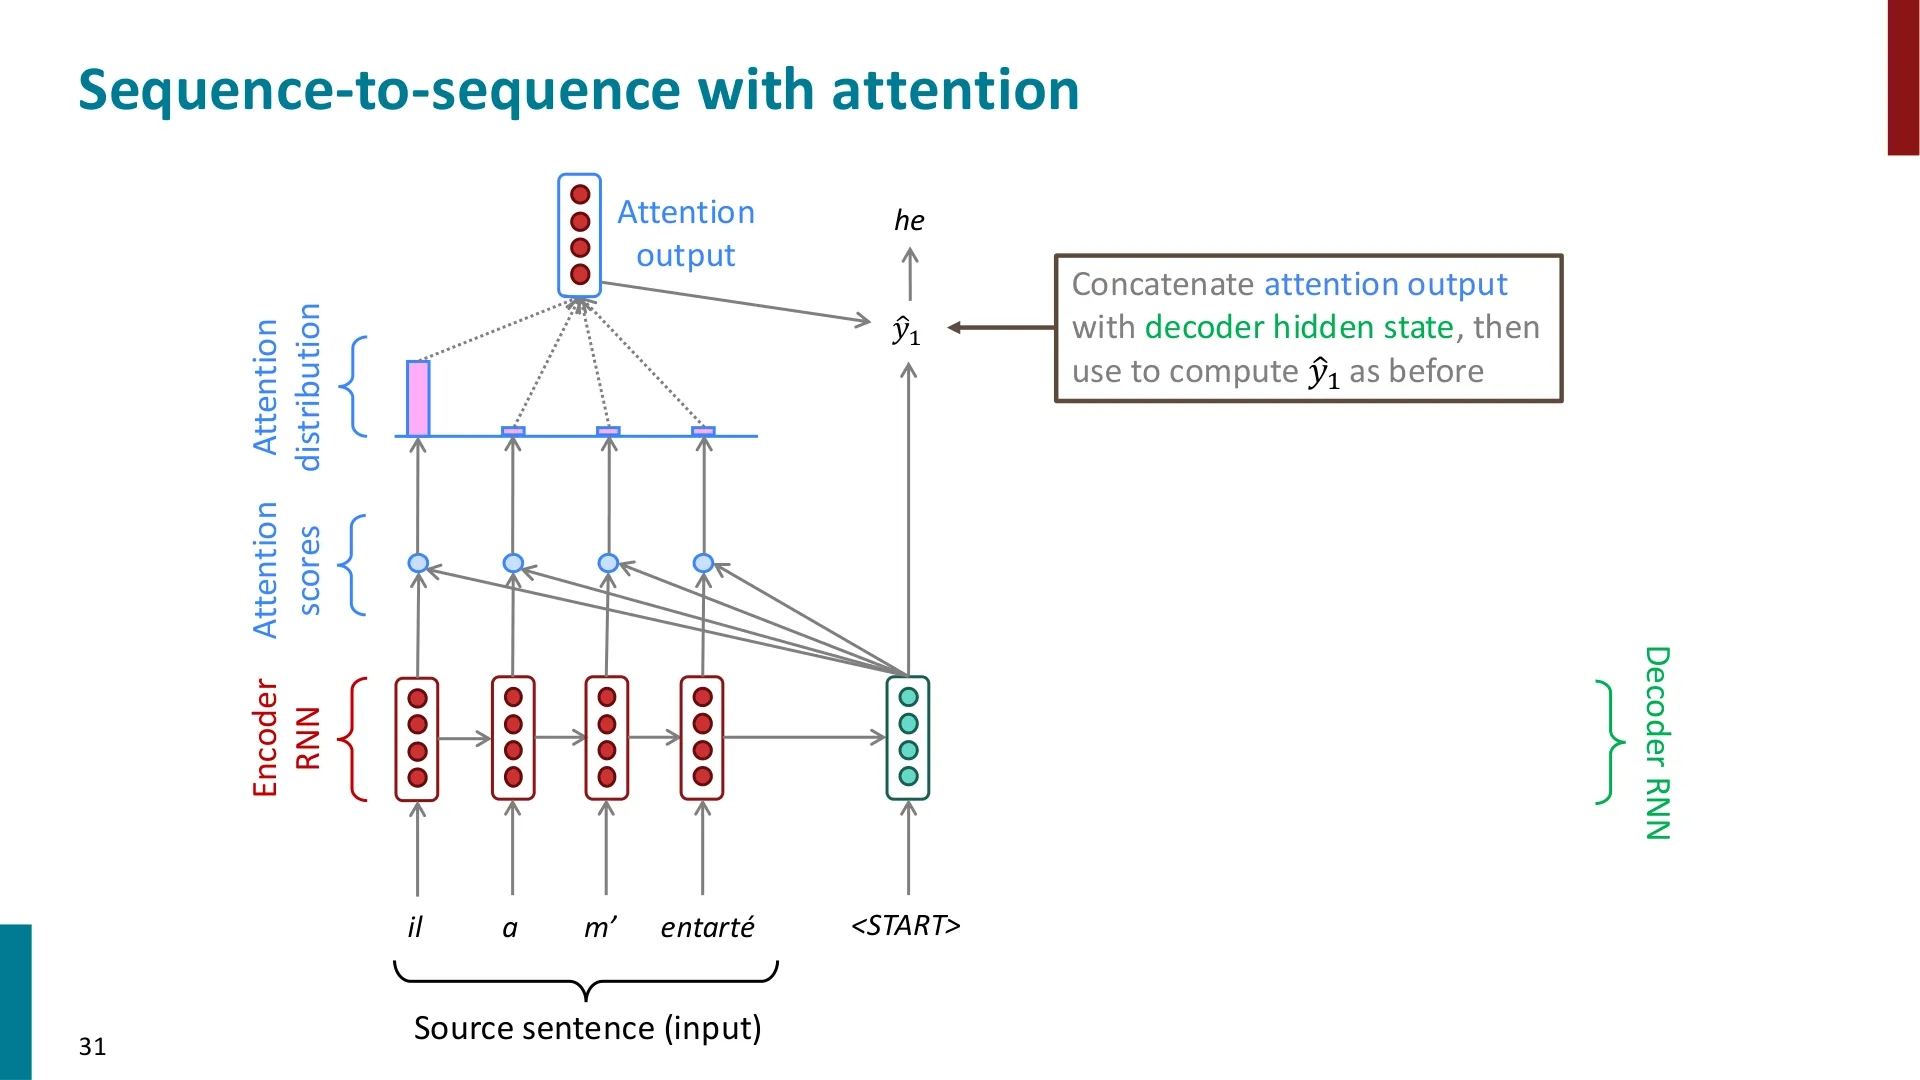
- Slide 31:把注意力输出与解码器隐状态拼接,计算 $\hat{y}_1$(he)
- Slide 32:$\hat{y}_2$(hit);有时把上一步注意力输出也喂给解码器
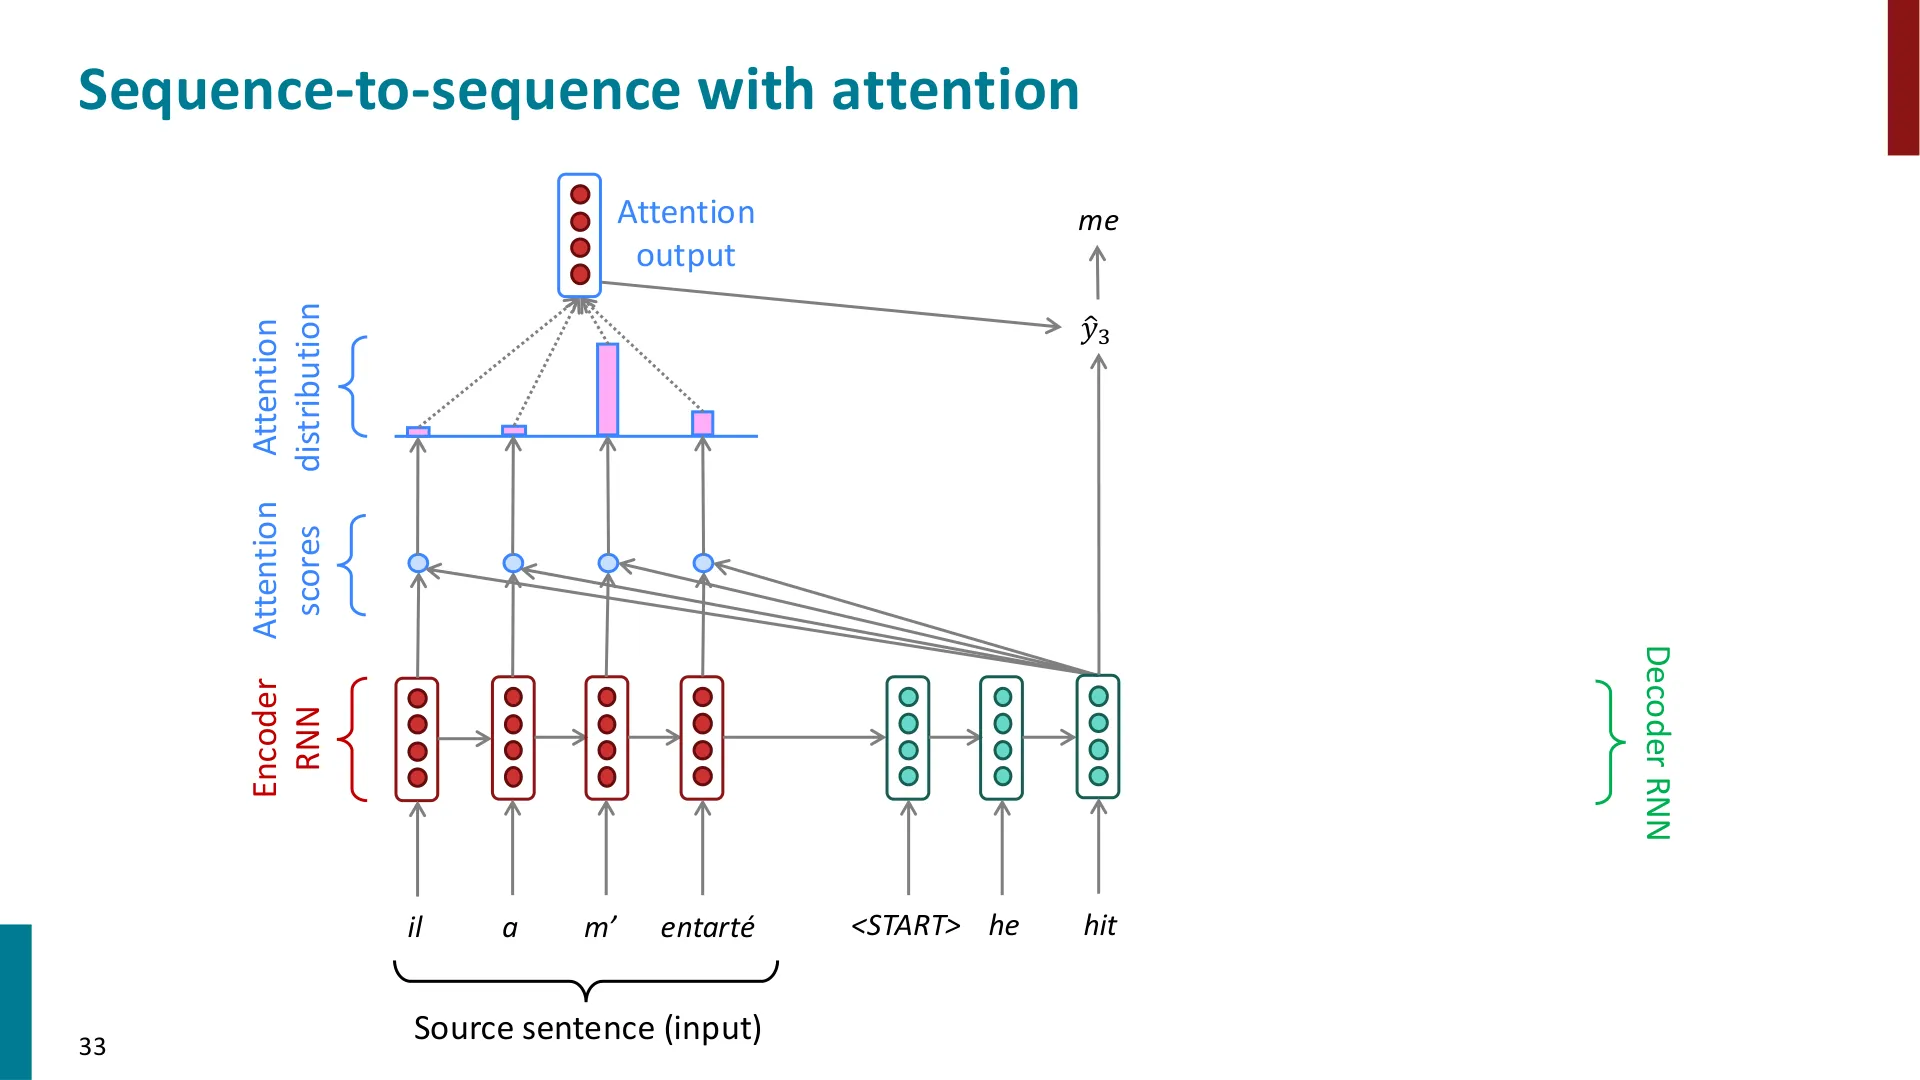
- Slide 33:$\hat{y}_3$(me)
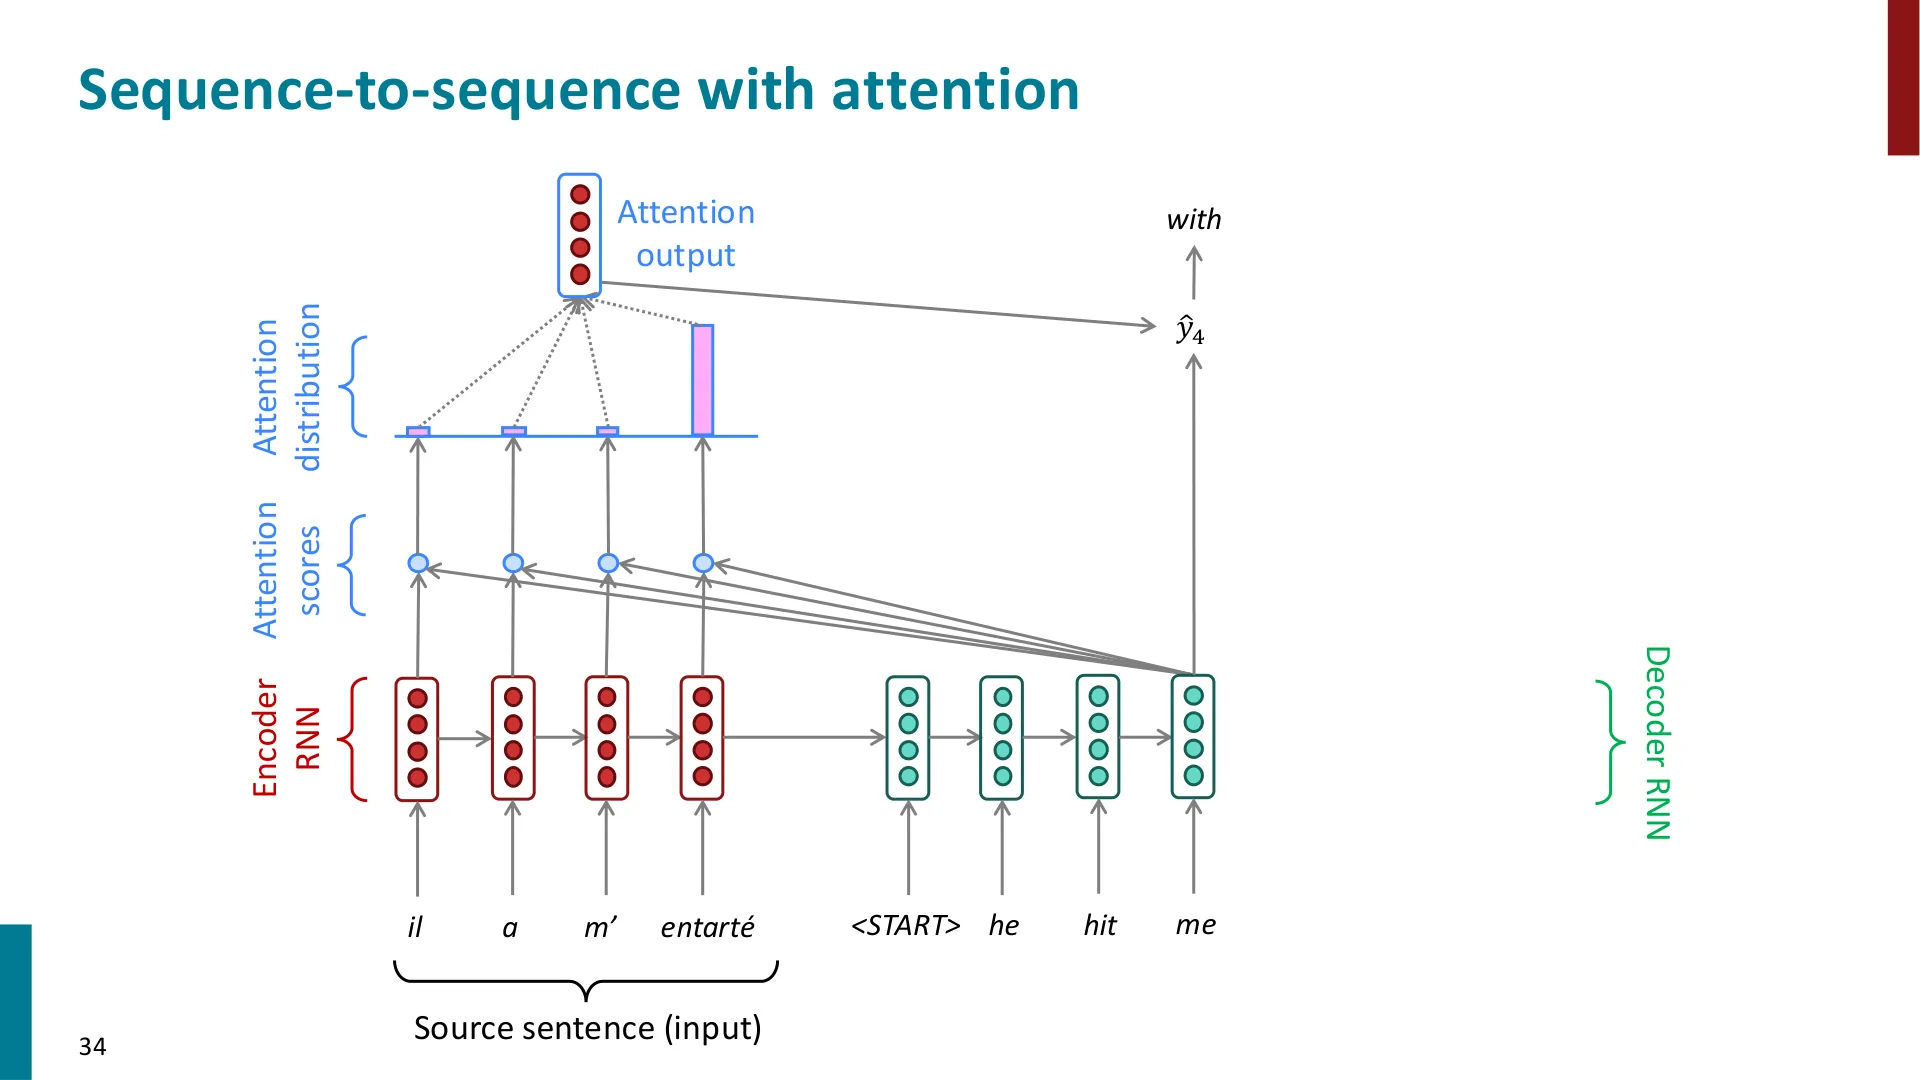
- Slide 34:$\hat{y}_4$(with)
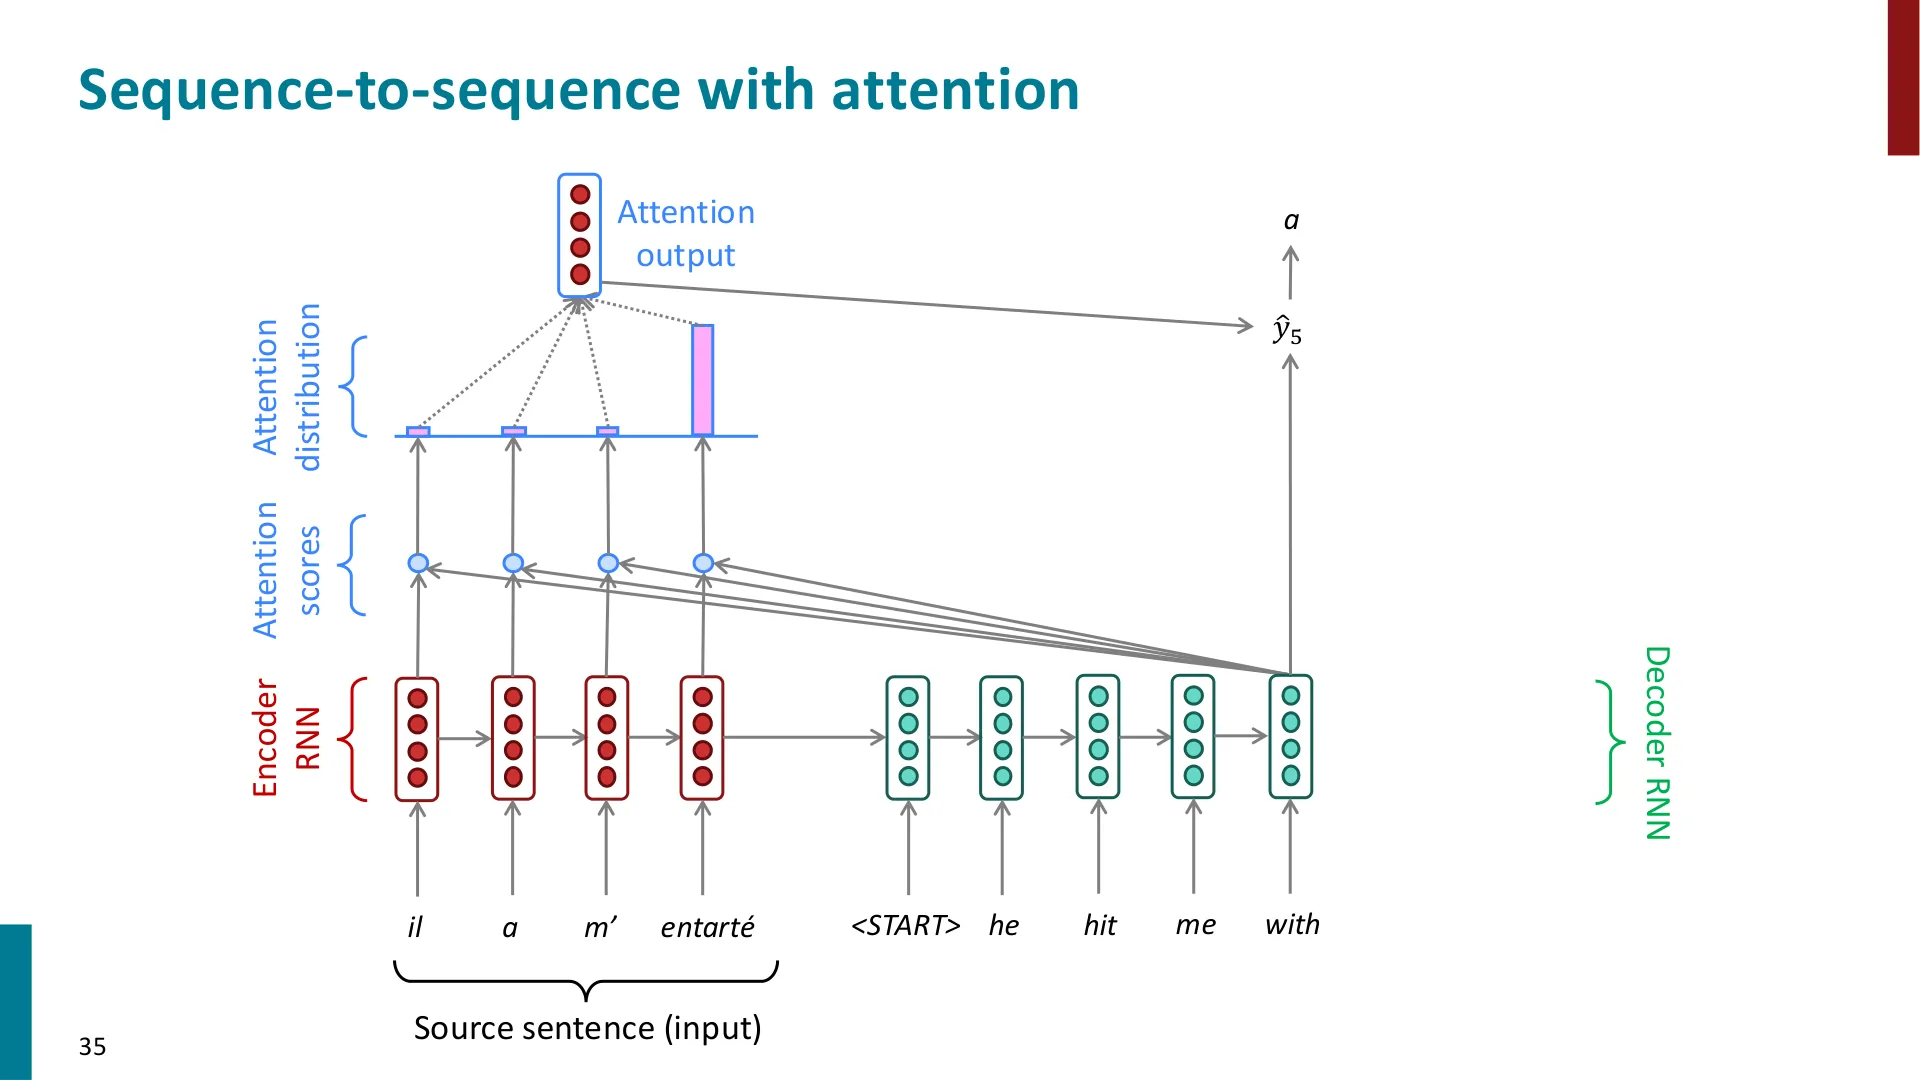
- Slide 35:$\hat{y}_5$(a)
- Slide 36:$\hat{y}_6$(pie)
- Slide 37:Attention is great!——显著提升 NMT;更「像人」;解决瓶颈;缓解梯度消失;提供可解释性(得到软对齐);但对序列长度是二次代价
- Slide 38:Attention is a general Deep Learning technique——查询对一组值做加权和
编者说明(关于本附录的划分):本讲正文中实际用到的幻灯片也只有一张属于上面的「注意力」主题,即 Slide 24(Attention is weighted averaging, which lets you do lookups!),它已按视频讲述顺序插入正文第二节。其余未展示页按主题归类列于此。若你对照讲义发现某页其实在别的讲次讲过,请以讲义为准。
附:参考与延伸阅读
编者补充
已知疑点
本节把本讲重构过程中不确定的地方集中列出,遇到疑问处请回溯对应时间点或核对官方讲义。
-
视频与幻灯片版本不一致。视频标题是本课程 2023 年第 8 讲,而随书附带的幻灯片文件是
cs224n-2026-lecture05-transformers.pdf(2026 年第 5 讲)。因此:编号不对应(正文用 2023 视频内容,附录幻灯片用 2026 编号);部分幻灯片主题(如「循环网络的梯度问题」「机器翻译与序列到序列」)在本录像中未被讲授。本书据此把未展示页放进附录,判断依据是「录像中是否有对应讲述」。 -
讲师姓名未在视频中出现。字幕全程没有出现讲师自我介绍,书中统一称「老师」。附带幻灯片的作者署名为 Diyi Yang(2026 版),但视频录制于 2023 年,讲述者是否与之相同无法从字幕确认,故未署名到正文。
-
课程许可名未能逐字照抄。CS224N 讲义/幻灯片通常以 Creative Commons 许可发布,但本书所据材料只给到文件名,没有给出确切许可字符串,故书首只作概括性说明并指向课程主页。若需正式引用,请以 https://web.stanford.edu/class/cs224n/ 标注的许可与署名为准。
-
专有名词/数字的听写风险。以下项的英文拼写或数值可能受语音识别影响,仅供参考:
- 作业编号(字幕中「assignment four」「assignment five」);
- 句子示例(Zuko made his uncle tea、the chef who ... was、I went to Stanford's cs224n and learned、I like pizza → J'aime la pizza)中的中文/法文拼写;
-
位置编码里的常数与维度(字幕对应幻灯片 Slide 45,具体到 $10000^{2i/d}$ 这一形式见幻灯片)。
-
幻灯片 Slide 62 的层归一化公式记号不一。幻灯片把 $\sigma$ 写作方差 $\frac{1}{d}\sum(x_j-\mu)^2$,而计算时按标准差对待。本书采用「$\sigma$ = 标准差」这一更严谨的写法,并以「编者说明」注明差异;若以讲义为准,请回看原页。
-
引用文献的年份/作者存在不确定项。幻灯片沿用了若干缩写引用,其中 [Wang et al., 2019](依存句法位置) 与 [Liu et al., 2018](WikiSum 文档生成)、[Xu et al., 2019](LayerNorm 归一化梯度) 的确切论文出处本书未能逐一核对到唯一链接,引用时请以讲义参考文献为准。下面「延伸阅读」中标 ★ 的条目属此类。
-
老师表述含糊、当场未定的地方:
- 位置编码「外推到更长序列」是否真的可行——老师一方面列其为好处,另一方面又说「实际不工作」,本书按他的原话保留这一矛盾;
- 层归一化「统计量为什么不跨词共享」——老师坦言「我也有点困惑、论文没写清」,本书照实保留;
-
多头注意力是否应随层数变化——老师表示「很想试,但没找到理由」,属开放问题。
-
编辑改写中的判断。为可读性,编者把零散的口语问答重组为「编者说明」,并把重复的幻灯片图示合并叙述;但讲师的类比、例子与推理链(如 linear interaction distance、lookup、损失地形图)均按原样保留。若发现某处概括过头,欢迎对照时间点回听。
附录:课堂未展示的幻灯片
🖼️ 第 4 页幻灯片 · Vanishing gradient intuition
🖼️ 第 5 页幻灯片 · Vanishing gradient intuition
🖼️ 第 6 页幻灯片 · Vanishing gradient intuition
🖼️ 第 8 页幻灯片 · Vanishing gradient intuition
🖼️ 第 9 页幻灯片 · Why is vanishing gradient a problem?
🖼️ 第 10 页幻灯片 · Effect of vanishing gradient on RNN-LM
🖼️ 第 12 页幻灯片 · Gradient clipping: solution for exploding gradient
🖼️ 第 13 页幻灯片 · How to fix the vanishing gradient problem?
🖼️ 第 14 页幻灯片 · 2. Machine Translation
🖼️ 第 15 页幻灯片 · NMT: the first big success story of NLP Deep Learning
🖼️ 第 16 页幻灯片 · Encoder RNN
🖼️ 第 17 页幻灯片 · Sequence-to-sequence is versatile!
🖼️ 第 18 页幻灯片 · Neural Machine Translation (NMT)
🖼️ 第 19 页幻灯片 · Training a Neural Machine Translation system
🖼️ 第 20 页幻灯片 · Multi-layer deep encoder-decoder machine translation net
🖼️ 第 22 页幻灯片 · 3. Attention
🖼️ 第 23 页幻灯片 · The starting point: mean-pooling for RNNs
🖼️ 第 25 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 26 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 27 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 28 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 29 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 30 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 31 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 32 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 33 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 34 页幻灯片 · Sequence-to-sequence with attention
🖼️ 第 35 页幻灯片 · Sequence-to-sequence with attention
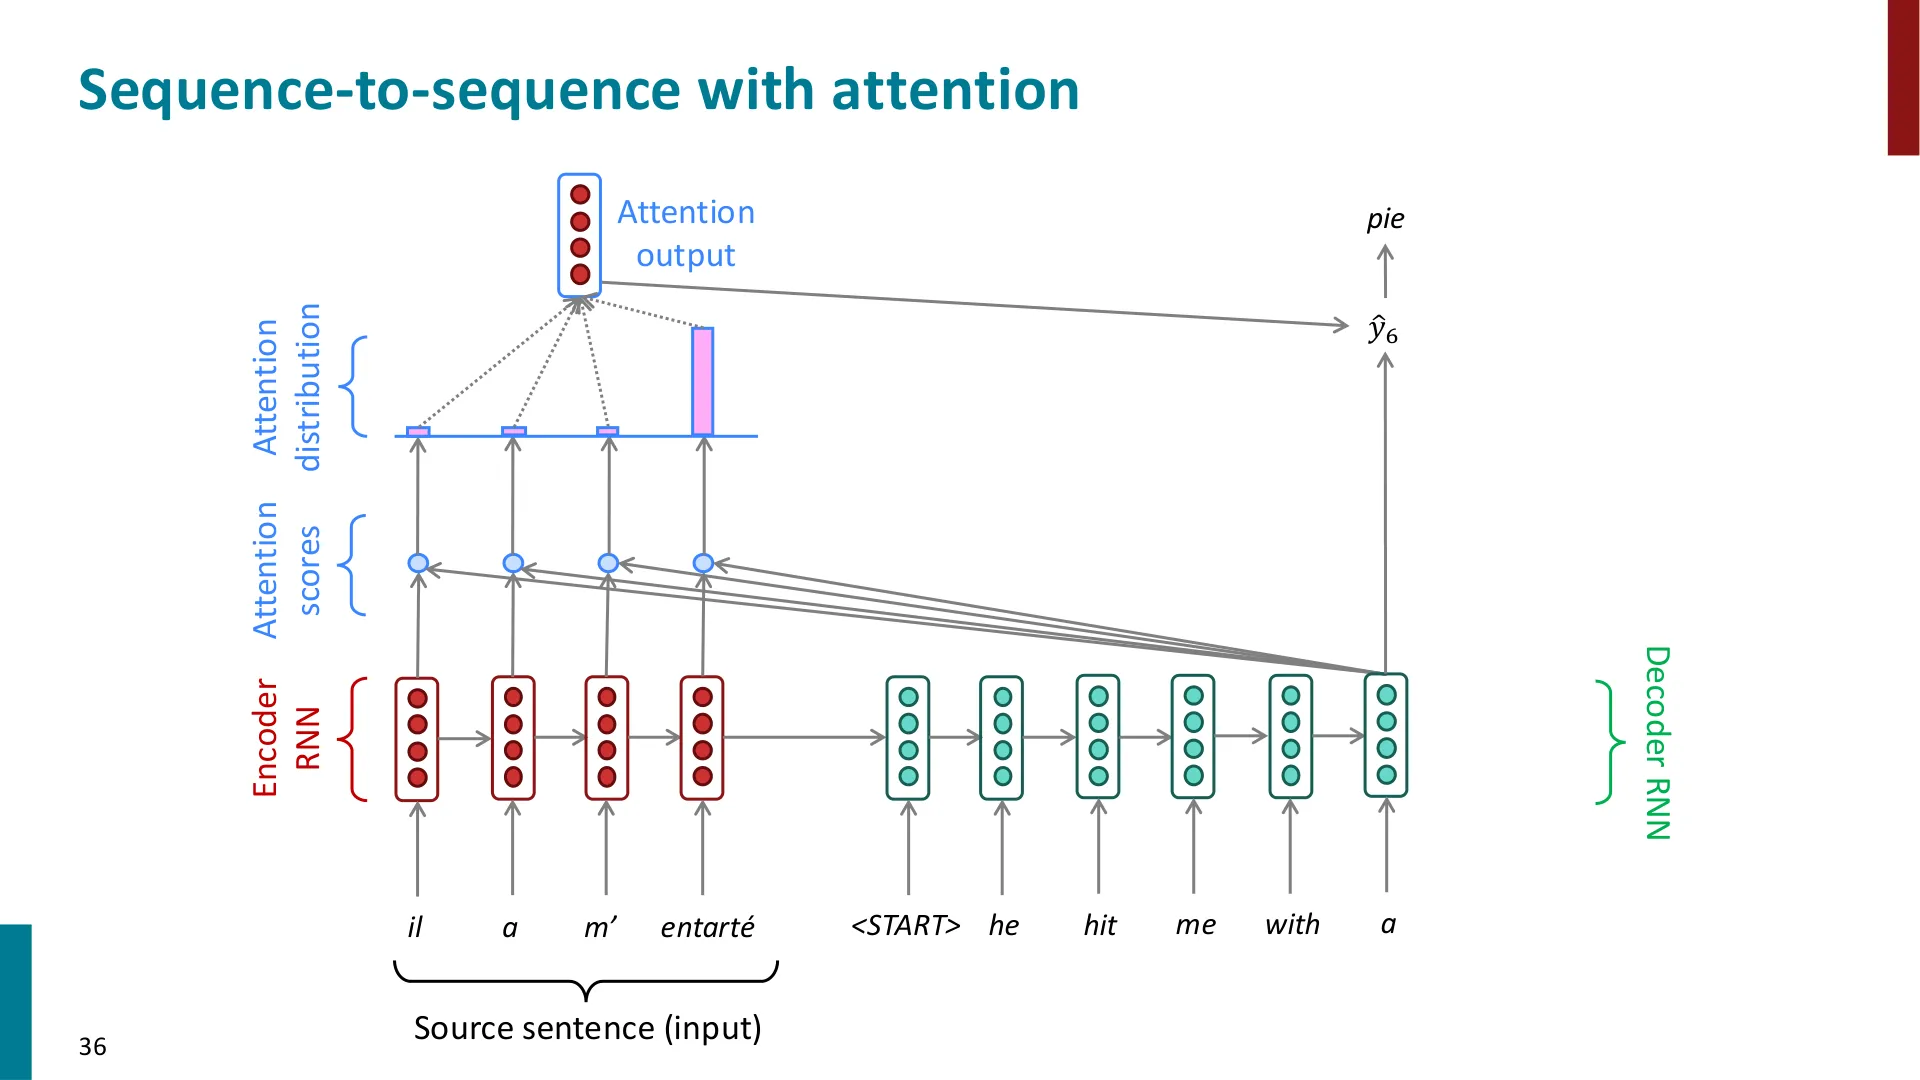
🖼️ 第 36 页幻灯片 · Sequence-to-sequence with attention
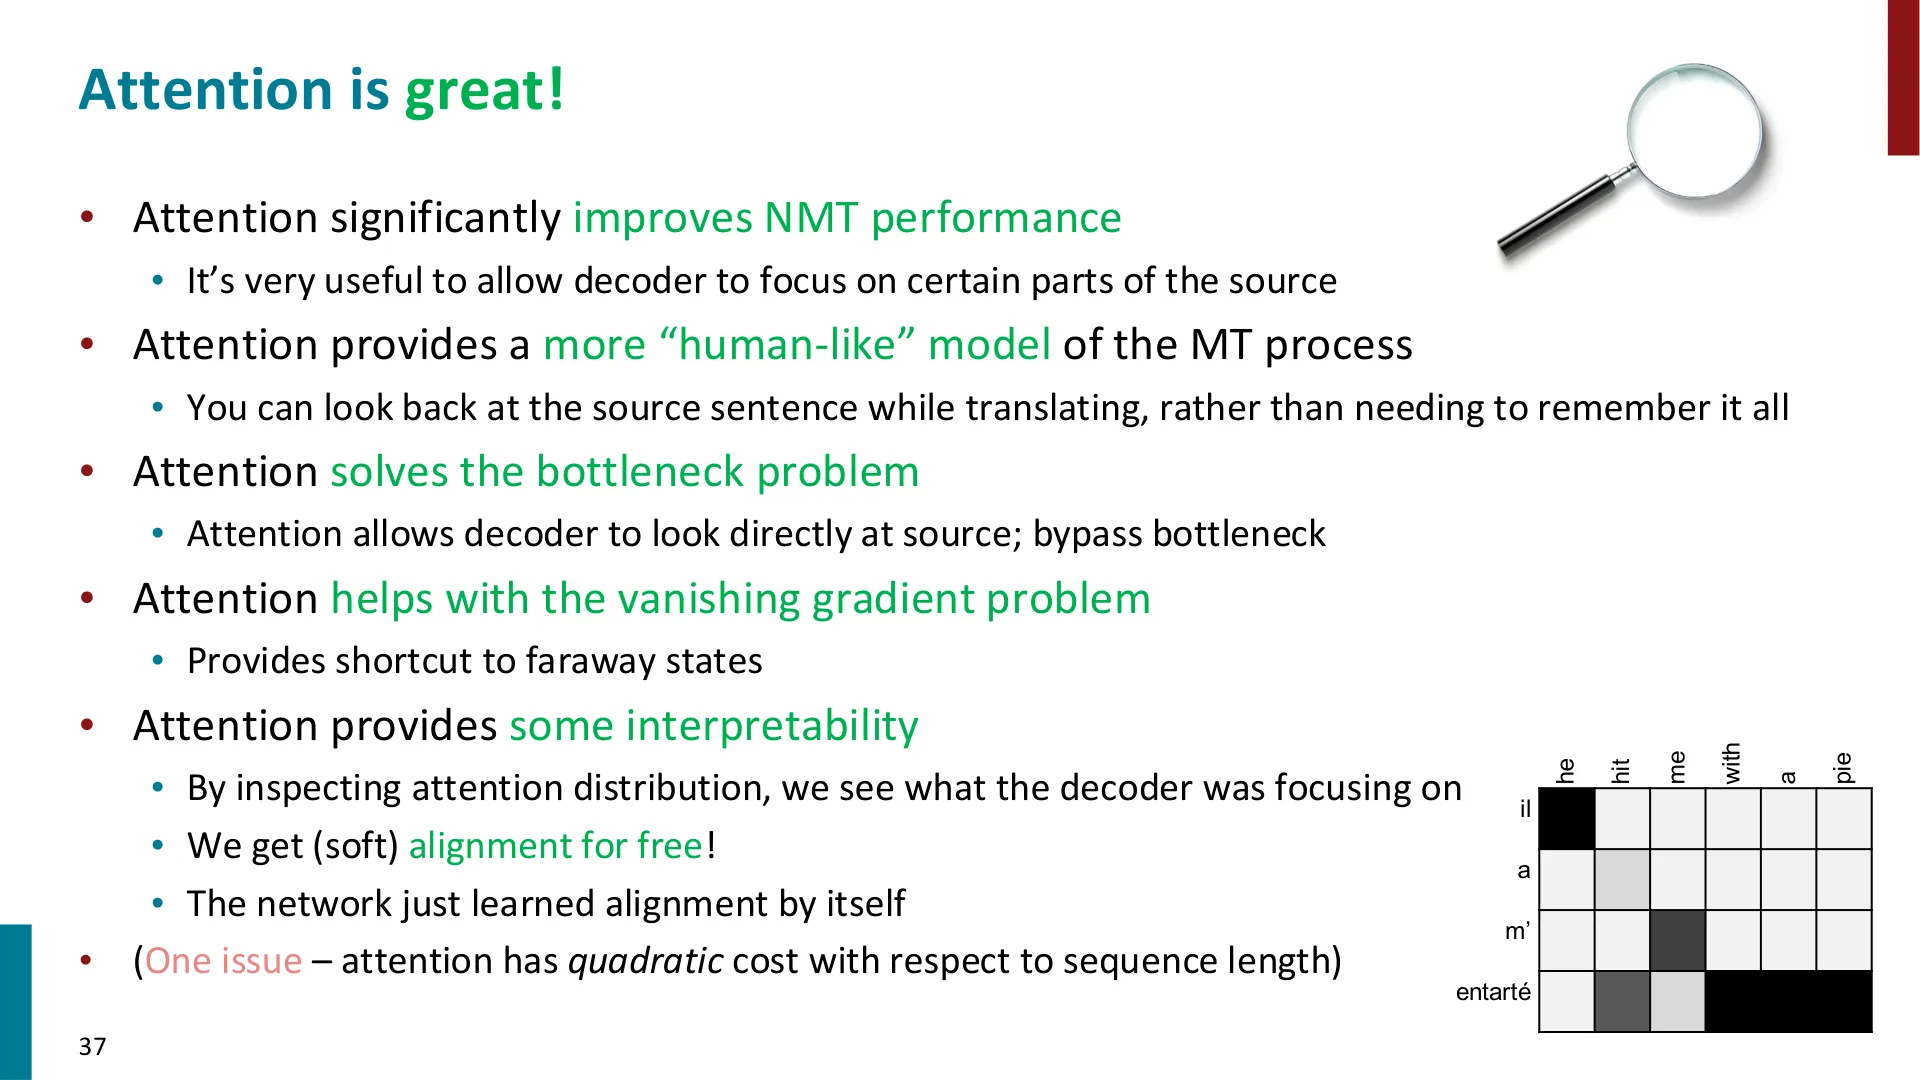
🖼️ 第 37 页幻灯片 · Attention is great!
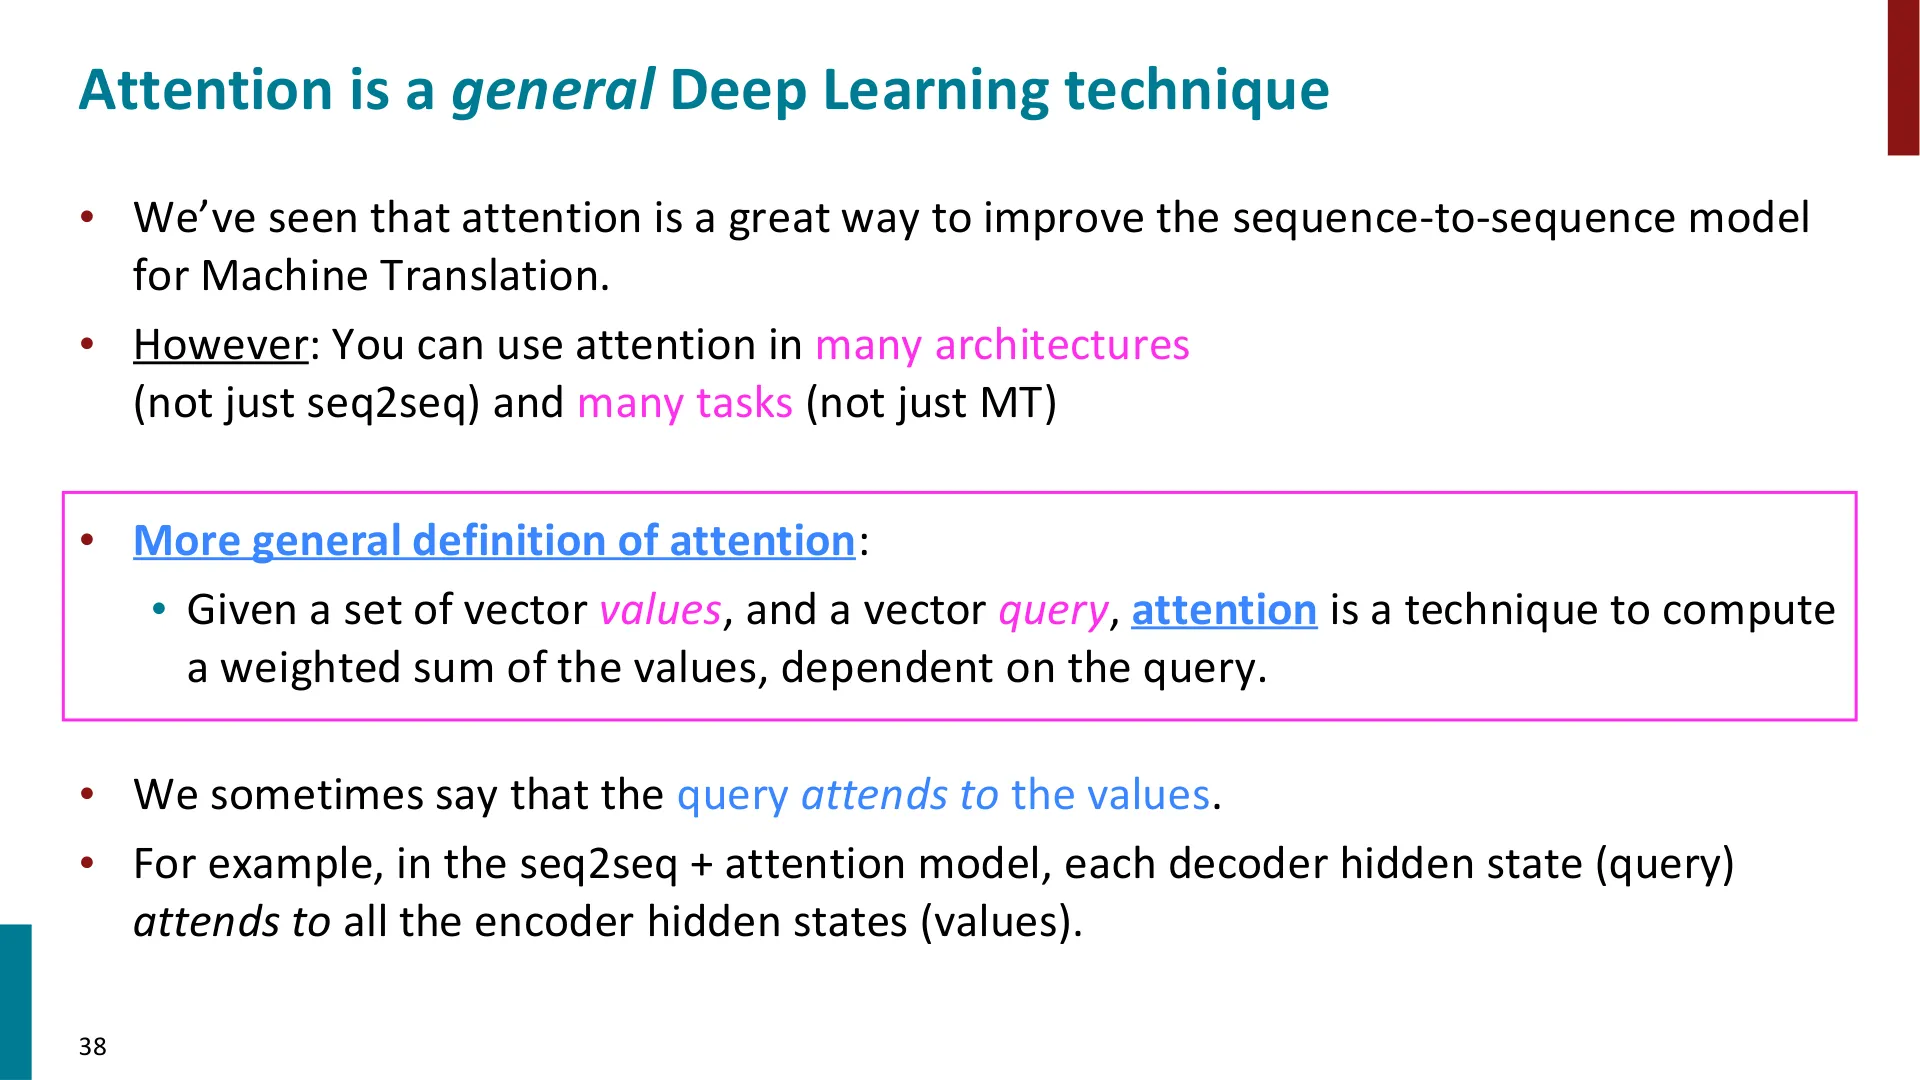
🖼️ 第 38 页幻灯片 · Attention is a general Deep Learning technique
🖼️ 第 41 页幻灯片 · Self-Attention Hypothetical Example