第7讲 · Stanford CS224N 深度学习自然语言处理:预训练(Pretraining)
| 课程 | Stanford CS224N / Ling284 — Natural Language Processing with Deep Learning |
| 讲次 | Lecture 9 — Pretraining(幻灯片内部标题写作 “Lecture 6: Pretraining”) |
| 视频 | https://www.youtube.com/watch?v=DGfCRXuNA2w 时长 1:18:46 |
| 视频 ID | DGfCRXuNA2w |
| 讲者 | Diyi Yang(本讲由其主讲) |
| 课程主页 | Stanford CS224N |
| 官方幻灯片 | cs224n-2026-lecture07-pretraining.pdf(本讲未提供独立的 .notes.md 书面讲义,术语以幻灯片为准) |
| 本书体裁 | 由课堂字幕重构的中文技术读物,非逐字翻译;口语、口癖与重复已做书面化处理,讲者的类比、案例、提问与推理链予以保留。 |
对应讲次:第7讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
版权说明:幻灯片与讲义版权归 Stanford CS224N 课程组与讲者所有,此处仅作学习用途整理;具体许可条款(如 CC 协议版本)编者未能核对,详见文末「已知疑点」。
导览
① 这一讲老师想回答的核心问题(按他本人提出的顺序)
- 我们之前一直默认存在一张有限词表,测试时没见过的词统统塞进
UNK。这个假设站得住吗?站不住的话怎么办?(→ 子词建模) - 如果“一个词的意义由上下文决定”,那为什么还要给
record只学一个向量?我们能不能干脆把整个网络都预训练? - 预训练到底怎么落到具体的三种架构上——编码器、编码器-解码器、解码器各自该用什么目标函数?
- 预训练究竟在教模型什么?它学到的能力边界在哪?会带来什么我们不想要的东西?
- 模型越来越大以后,出现了一种谁也没教过的能力(上下文学习);为什么会这样?这和扩展定律(scaling laws)有什么关系?
② 读者可能带着的疑问(编者预判)
- BPE 到底是怎么“切词”的?我作为一个初学者,能不能手算一遍?
- 掩码语言建模听起来简单,可
[MASK]这个符号在真实文本里根本不会出现,为什么训练出来的模型还能用? - BERT、T5、GPT 名字天天听,它们在架构和预训练目标上到底差在哪?
- 所谓“预训练—微调”范式,凭什么比“直接堆更多层、更多数据”更好?
- “上下文学习”“思维链”是不是被夸大了?训练目标里并没有这些东西,它们是从哪冒出来的?
③ 本讲路线
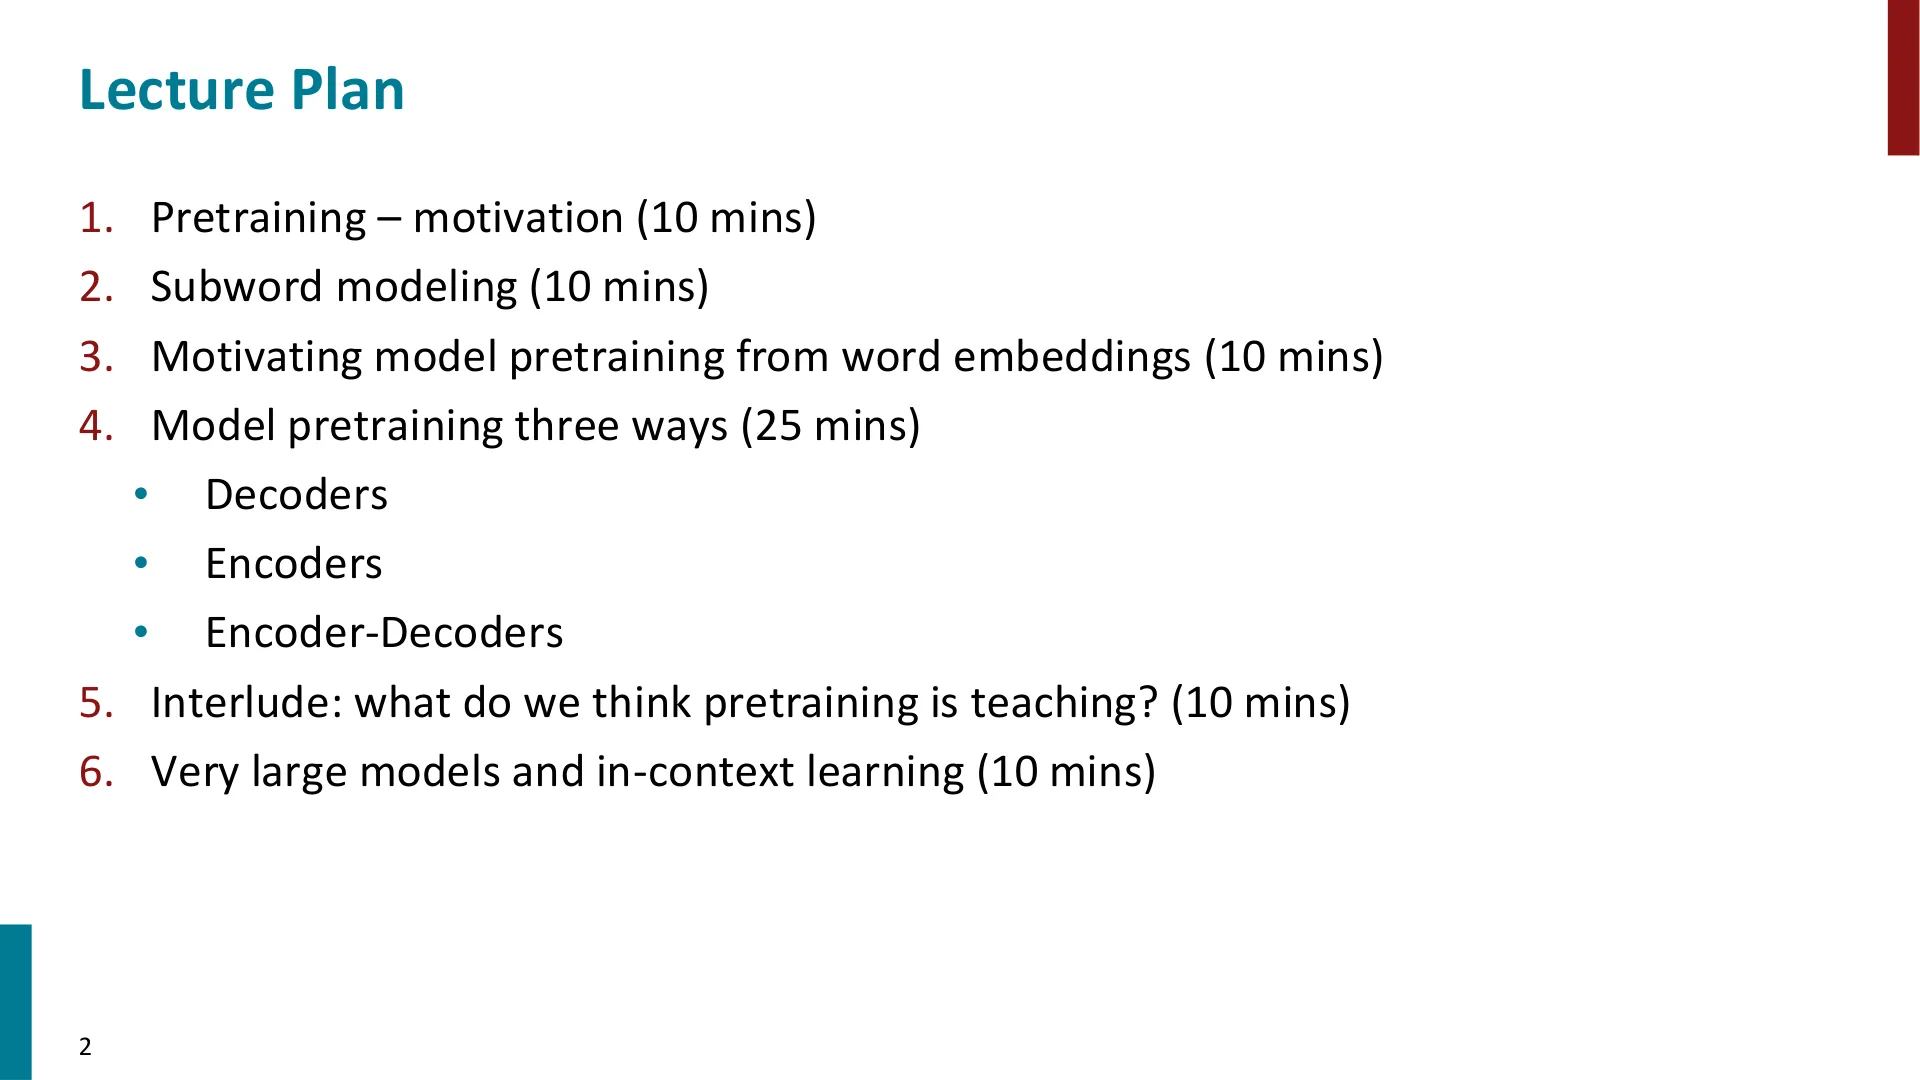
老师先花约十分钟补上一个此前一直回避的技术细节——子词建模(Byte-Pair Encoding);接着从“词义与上下文”的老问题出发,说明为什么要从“只预训练词向量”走向“预训练整个模型”;然后用大半节课逐一讲解编码器 / 编码器-解码器 / 解码器三种架构的预训练目标(BERT → T5 → GPT 系列);最后收拢到两个更大的话题——预训练究竟教会了什么,以及模型变大之后出现的上下文学习与扩展定律。全程穿插大量学生提问,这些问答是理解“为什么这么设计”的关键。
编者说明:本讲的信息密度低于上一讲自注意力/Transformer,讲者本人也说明本讲“技术细节上明显更少”,更偏“图景与直觉”。因此本书会在讲者点到而未展开的概念(如 WordPiece、TPU、GLUE、Chinchilla)处补充编者拓展。
一、子词建模:先把“词”这件事解决掉
(参考时间: 00:02:00)
在讲预训练之前,老师先回过头来处理一个“我们一直在偷偷假设、却从没认真审视”的问题:词表。
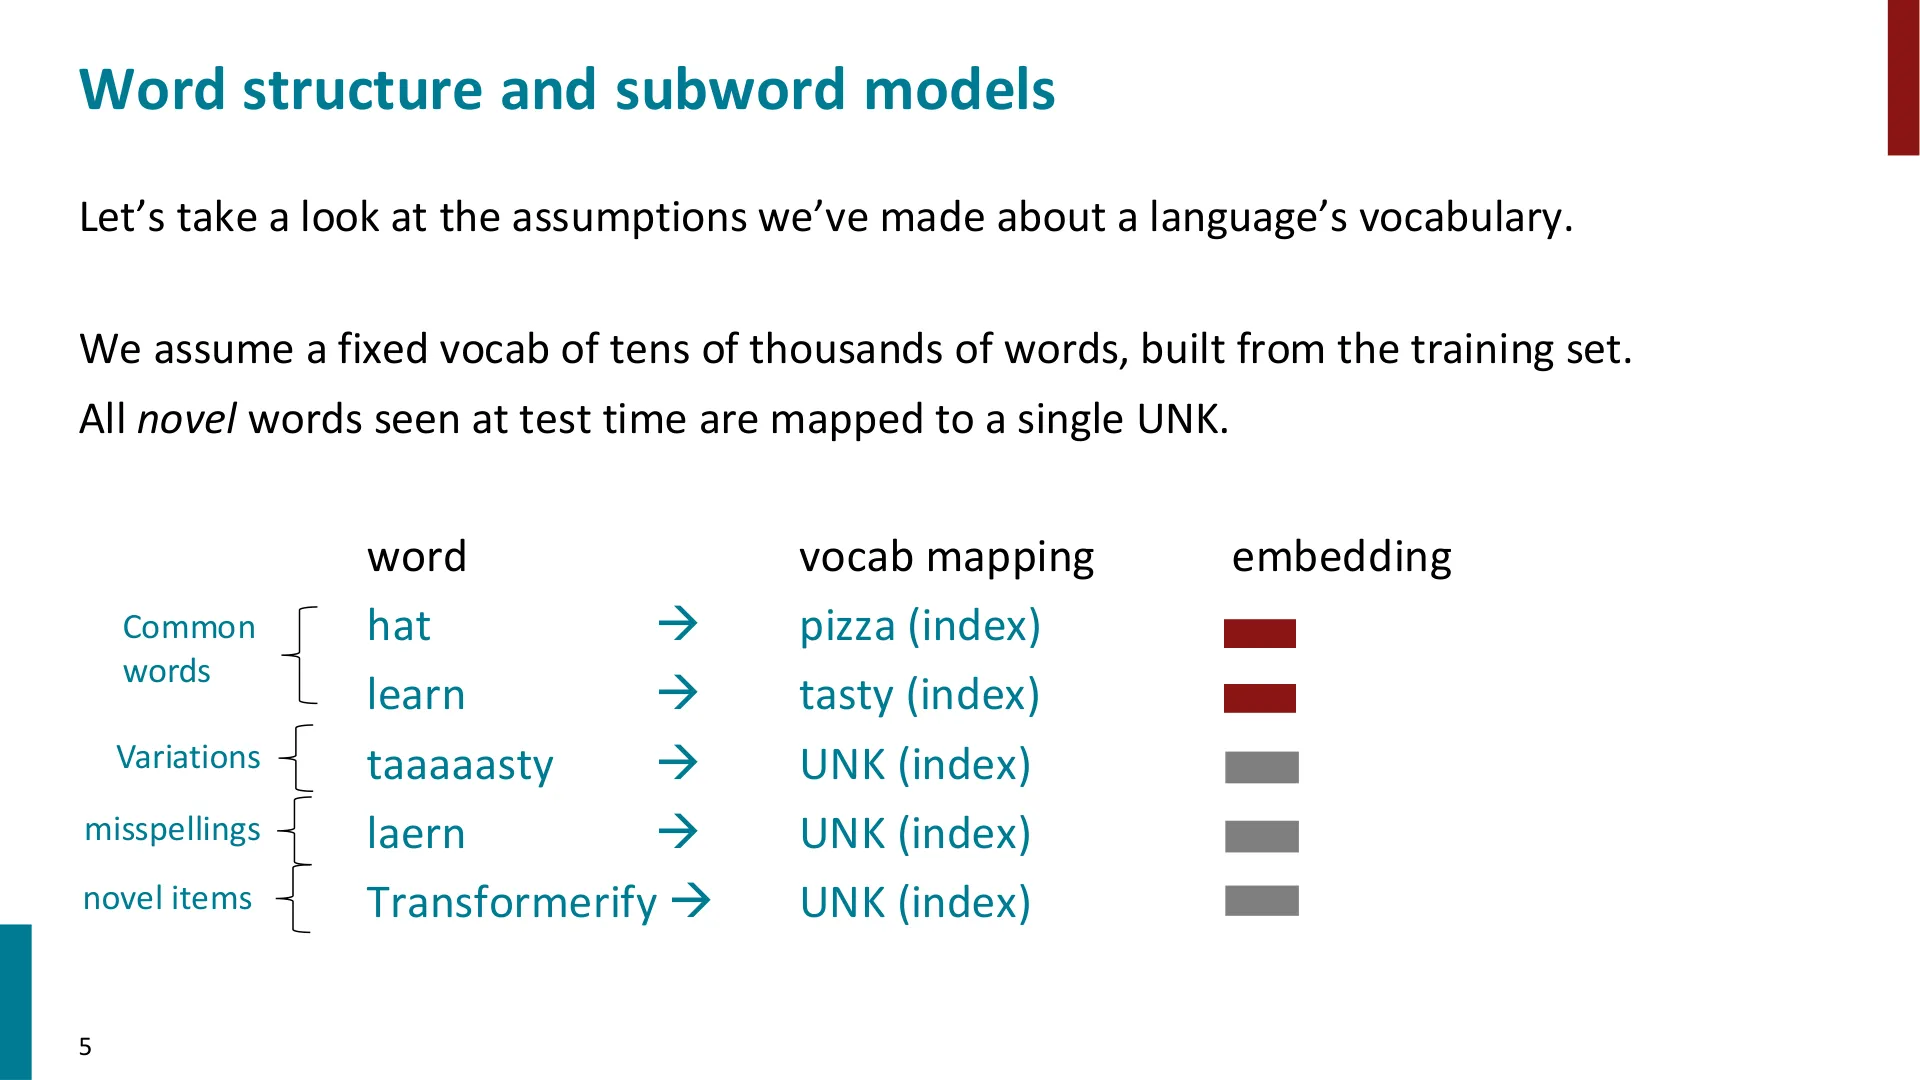
📷 词结构与固定词表假设:词 → 词表映射 → 嵌入
回到原视频 (00:02:15)
(参考时间: 00:02:00)
1.1 固定词表的裂缝
在讲 word2vec 以及此前所有方法时,我们都假设:存在一张有限词表 $V$,你看了些数据,确定了哪些是“词”,然后给每个词一个嵌入。于是:
- 常见词(
hat、learn)→ 有自己训练好的嵌入向量; - 变体(
taaaaasty)→ 没在训练语料里出现过 →UNK; - 拼写错误(
laern)→UNK; - 新造词(
Transformerify)→UNK。
问题在于,语言无时无刻不在造新词:有新领域、有年轻人的黑话、有派生构词(derivational morphology)。Transformerify 这种词,人类一眼就懂——把名词变成动词,意思是“变得更像那个名词”。可模型只看到一串它没见过的字符,就只能全部映射到一个统一的 UNK。
老师原话的意思是:把不同的词全映射到同一个
UNK,“完全是在丢失大量信息”。
英文的构词相对简单(eat / eats / eaten / ate 就几个屈折形式),但在形态丰富的语言里这个问题严重得多。老师举了一个具体到有点夸张的例子:斯瓦希里语(Swahili)的一个动词有超过 300 种变位。
编者拓展|为什么‘每一种变位一个向量’是错的 假设我们把每种字符组合都当作一个独立词:斯瓦希里的 300 种变位就会各拿一个互不相干的向量。可这 300 种形式显然共享大量结构——它们有共同的词根、共享时态/人称/宾语标记,只在少数有意义的位置上变化。把它们当成互不相关的词,既让词表爆炸(效率问题),又让模型无法把“词根的意义”迁移到没见过的变位上(学习问题)。设词表大小为 $|V|$、词向量维度为 $d$,嵌入矩阵是 $|V| \times d$:词表越大,参数与内存越大,而每个词能分到的训练样本越稀疏。
1.2 字节对编码(BPE)
(参考时间: 00:05:55)
解决方案是子词建模(subword modeling):不再试图定义“所有的词”,而是让词表包含词的部件,再把每个词拆成一串已知的子词。
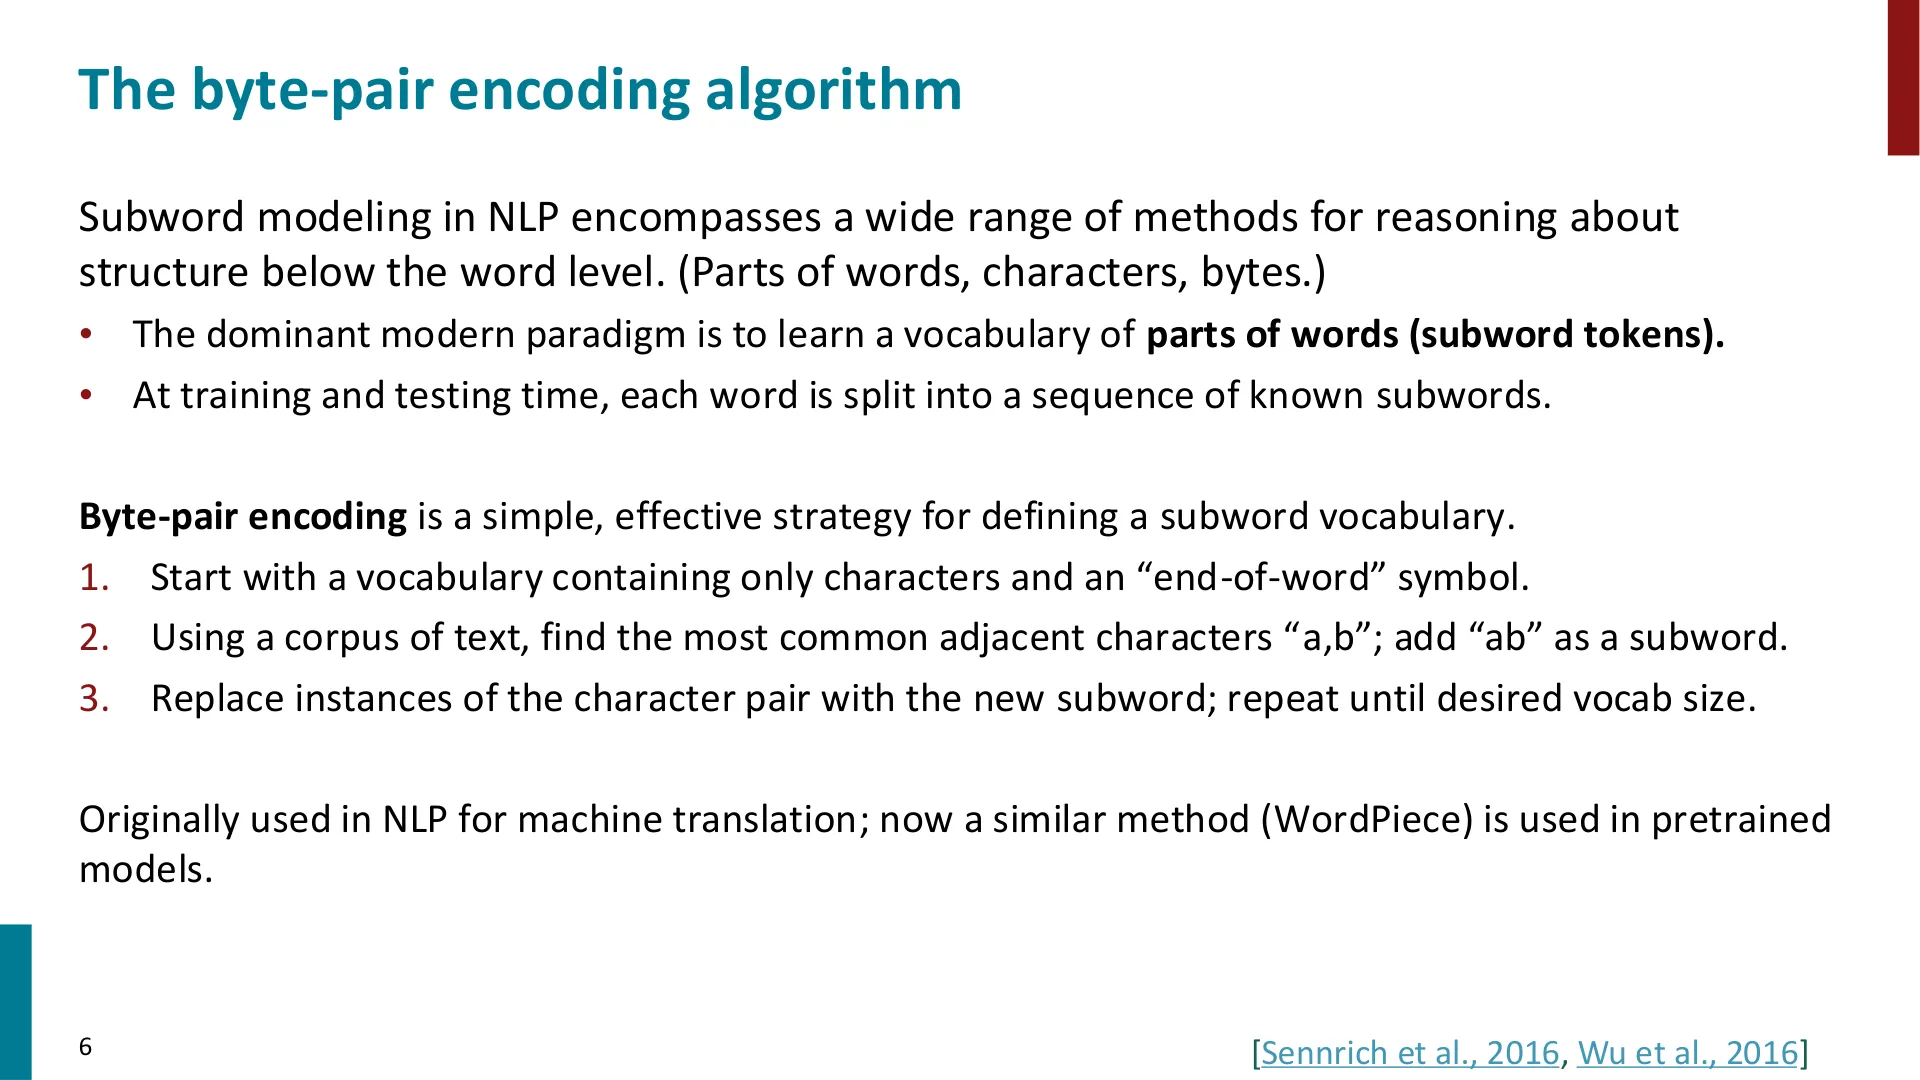
📷 字节对编码算法:从字符出发,合并共现最多的相邻字符对
回到原视频 (00:06:20)
(参考时间: 00:06:20)
讲者介绍的算法是 字节对编码(Byte-Pair Encoding, BPE),步骤非常朴素:
graph TD
    A["初始化词表:所有单个字符 + 词尾符号 (</w>)"] --> B["统计语料中相邻字符对 (a, b) 的共现频次"]
    B --> C["挑出出现最频繁的字符对 (a, b)"]
    C --> D["把 'ab' 作为一个新的子词加入词表"]
    D --> E["在语料中把所有 'a b' 的相邻出现替换成 'ab'"]
    E --> F{"词表大小达标?"}
    F -- 否 --> B
    F -- 是 --> G["得到由高频共现子串组成的子词词表"]
(参考时间: 00:06:20)
只要词表里有全部字符,理论上任何词都能表示出来(最坏情况就是拆成一个个字符),彻底绕开了 UNK 问题。BPE 最初是为机器翻译开发的(Sennrich et al., 2016;Wu et al., 2016),后来几乎所有现代语言模型都在用它的各种变体。
拆分之后,效果大致是这样:
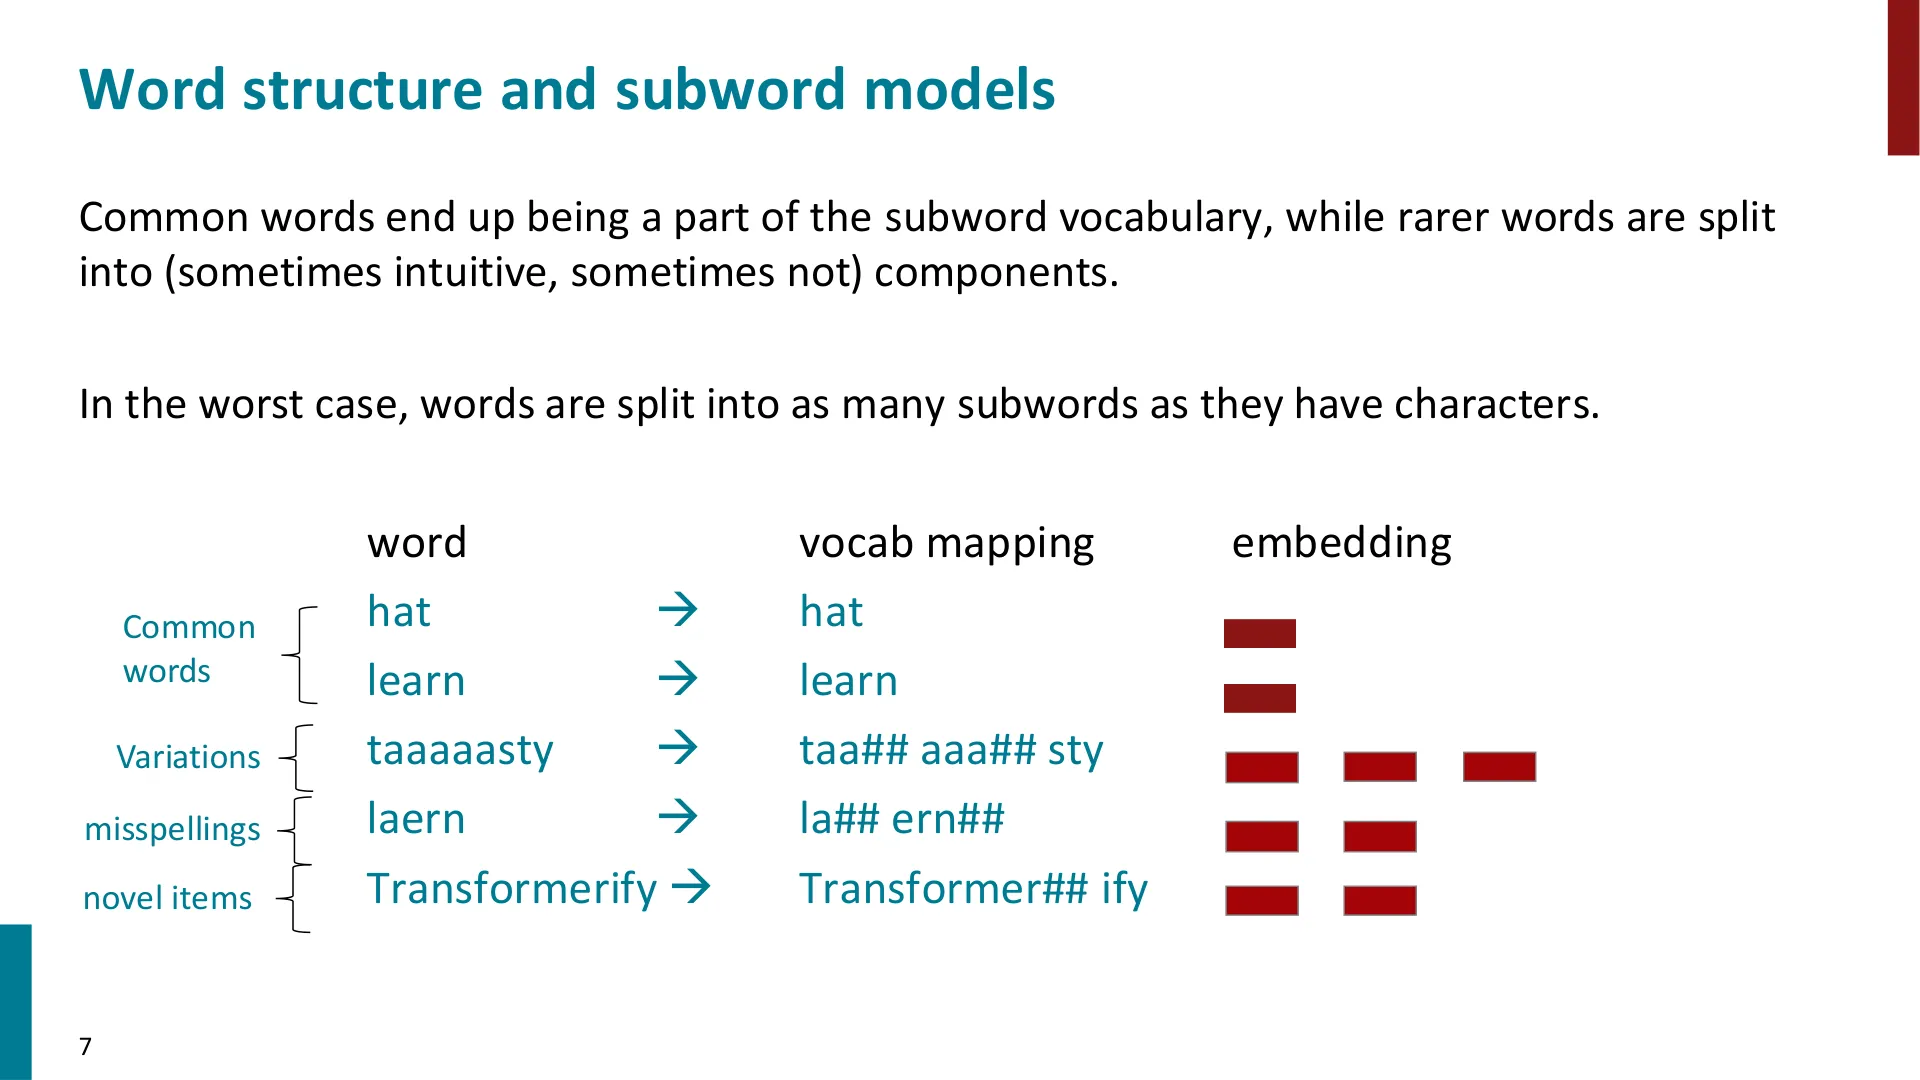
📷 子词建模后的词表映射:常见词保持整词,罕见词/错拼/新词被拆成子词
回到原视频 (00:07:50)
(参考时间: 00:07:50)
hat→hat(足够常见,独占一个词条)learn→learntaaaaasty→taa## aaa## stylaern→la## ern##Transformerify→Transformer## ify
其中 ## 是个约定记号,表示“这里不要加空格,它是上一个子词的延续”。
编者拓展|BPE 之后还有 WordPiece 与 Unigram BPE 的核心是“自底向上合并最频繁的相邻对”。BERT 使用的是它的近亲 WordPiece:同样是自底向上,但挑选合并对时按“合并后似然增益最大”而非单纯频次。T5 与后续的部分模型则偏向 Unigram LM(自顶向下,从大词表出发不断删减),它在数学上是一个概率模型,天然支持“一段文本有多种切分方式、按概率加权”。三者的动机相同:用有限的词表覆盖无限的语言。
1.3 学生提问:关于子词的几个常见疑问
(参考时间: 00:09:25)
课堂上有几位同学问得很具体,这些问答本身就是很好的脚注:
-
“
tasty拆成三个子词,我们是不是要把三个嵌入加起来?” 讲者回答:不一定。处理序列时,I learned about the taa aaa sty就是三个独立 token,模型会把它们当独立输入送进 RNN/Transformer;只有当你需要“这个词整体是什么表示”时,才会考虑(比如)对三个上下文表示的平均,或取最后一个。到那个阶段“其实不太确定该怎么做,但各种做法都还工作得不错”。 -
“怎么知道该在哪里切?” 切分依据就是一开始学出来的词表:合并最频繁的相邻字符串得到新的子词。实际编码时,尽量少切——用能覆盖最多字符的那个子词去匹配,找“用最少数量子词覆盖整串”的近似最优解。
-
“标点符号进字符集吗?” 会。老师借这个问题讲了一条更重要的原则:文本预处理越少越好。除了去掉 HTML 标签这类“清理噪声”,不要做过多加工,让输入尽量接近用户真实会输入的东西。
...(省略号)、一串连字符都可能成为独立词条。这和早期做 word2vec 时“可能不想给标点学向量”的做法已经完全不同。 -
“整词和子词,系统会区别对待吗?” 不会。 系统根本不知道某个 token 是“完整的词”还是“词的一部分”——它们都只是嵌入矩阵里的一个下标,一视同仁。
-
“很长的常见词怎么办?” 统计说了算:频次高就进词表,频次低就拆开。训练出的词表里确实能看到一些很长的词——因为它们出现得足够多。
-
“如果
ify很常见、Trans又和former常共现,是拆成两个还是三个?” 这是个取舍:通常选择更少、更大的子词,因为序列长度才是 Transformer 的瓶颈。也有人试过“同时跑多种切分,看哪种更好”,但“少而大的子词”总体是最佳思路。
编者说明:这段问答里藏着一个容易被忽略的工程事实——子词切分直接决定序列长度,而序列长度决定了注意力的计算量。复杂度对序列长度是平方级的(自注意力为 $O(n^2 d)$),所以“用更少的子词表示同样的文本”是有实际收益的优化目标。
二、为什么要把整个模型都预训练
(参考时间: 00:15:00)
📷 课程大纲:子词 → 预训练动机 → 三种架构的预训练 → 预训练在教什么
回到原视频 (00:15:00)
(参考时间: 00:15:00)
2.1 两段 Firth 的引文
📷 词义与上下文:Firth 的两句名言
回到原视频 (00:15:20)
(参考时间: 00:15:20)
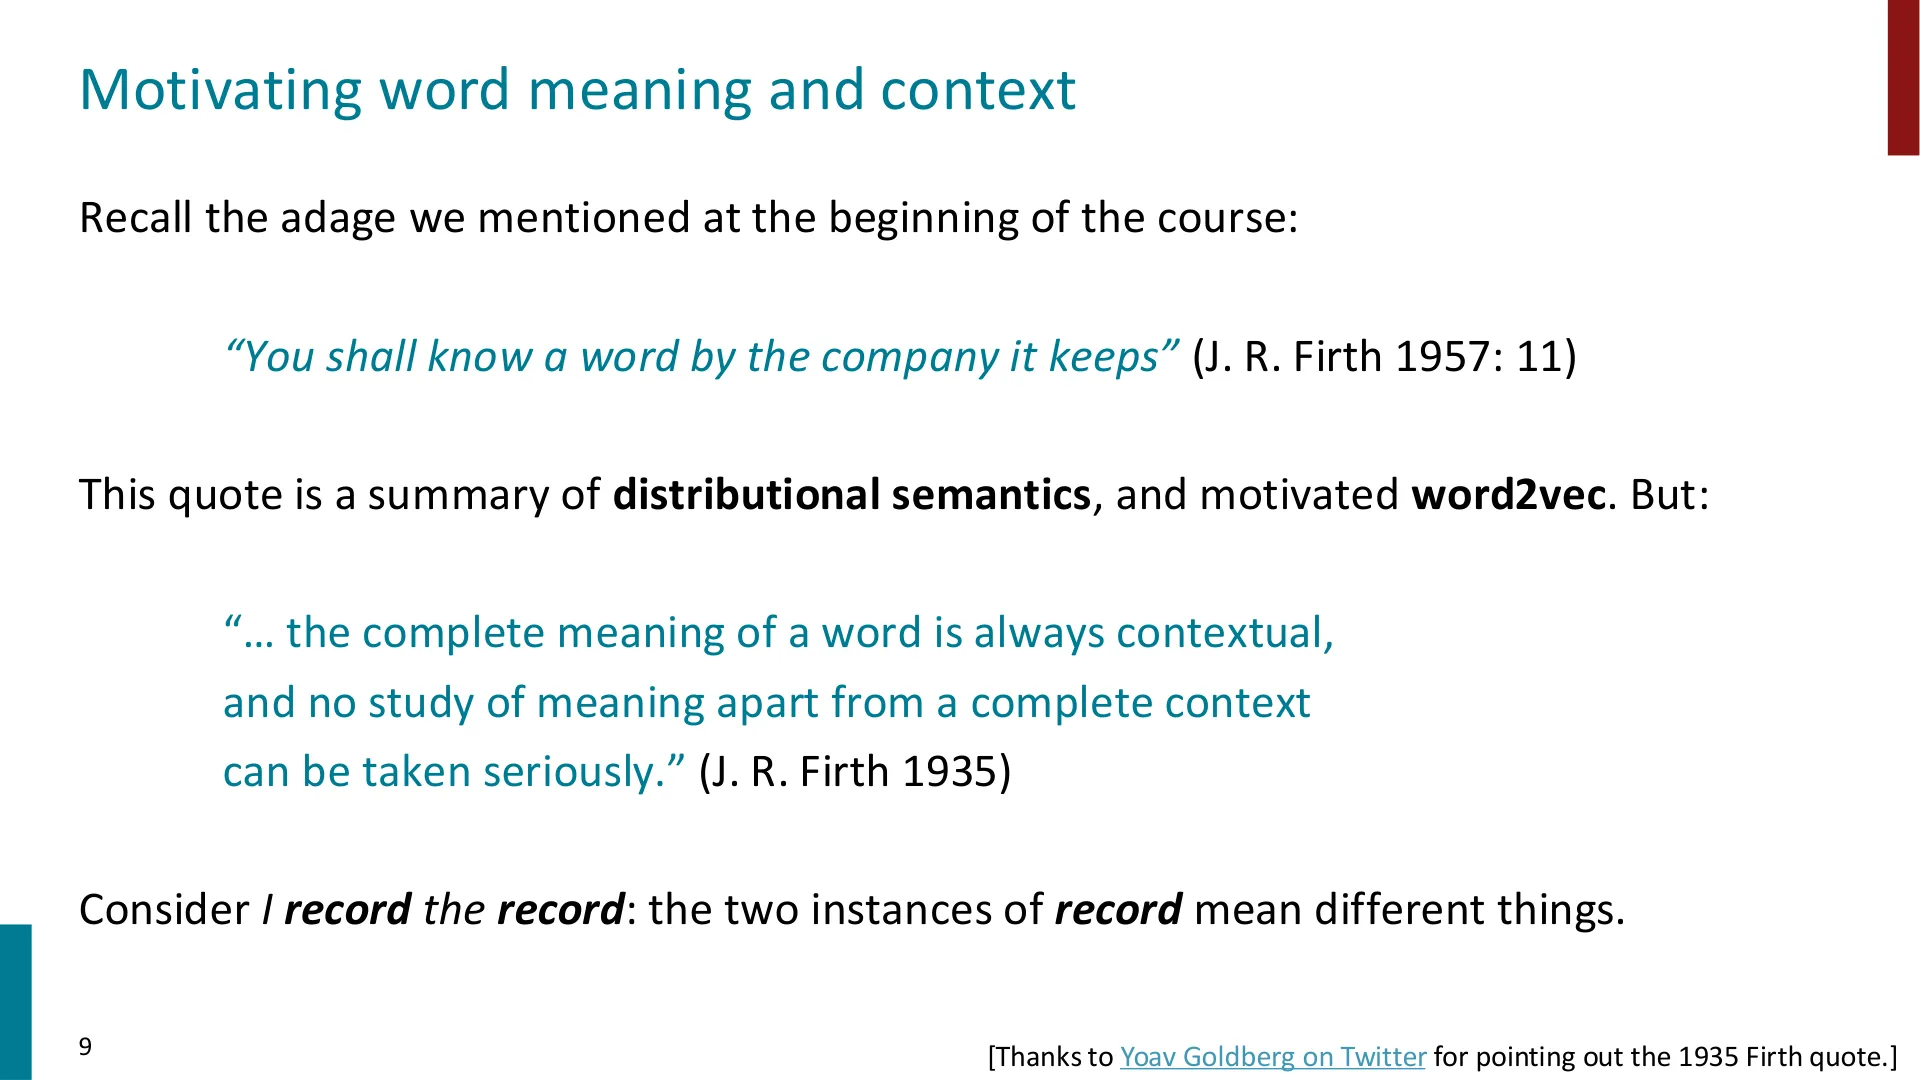
课程一开始引用过 J. R. Firth 的那句老话:
“You shall know a word by the company it keeps.”(1957: 11)
这是分布式语义(distributional semantics)的纲领,也是 word2vec 的思想源头。但老师提醒我们注意 Firth 更早(1935)说过的一段话:
“… the complete meaning of a word is always contextual, and no study of meaning apart from a complete context can be taken seriously.”
翻译过来:一个词的完整意义总是依赖上下文;脱离完整上下文去研究词义,是不可信的。
编者拓展|为什么这两句话听起来矛盾 1957 那句讲的是“词的意义可以从它的邻居统计出来”——这导向“一个词一个向量”。1935 那句讲的是“意义是上下文相关的”——这导向“同一个词在不同句子里应当有不同表示”。前者的成果是 word2vec 这类静态词向量;后者才是预训练整模型的理由。老师点出这一点,正是为了给本讲后面的内容立论。
一个最小的反例就是 record:
- “I record the record.” —— 同一个字符串出现了两次,一次是动词(录制),一次是名词(唱片、记录),意思不同。
2.2 2017 年的图景:只预训练词向量
📷 2017 年的做法:预训练词向量 + 随机初始化的 LSTM/Transformer
回到原视频 (00:17:05)
(参考时间: 00:17:05)
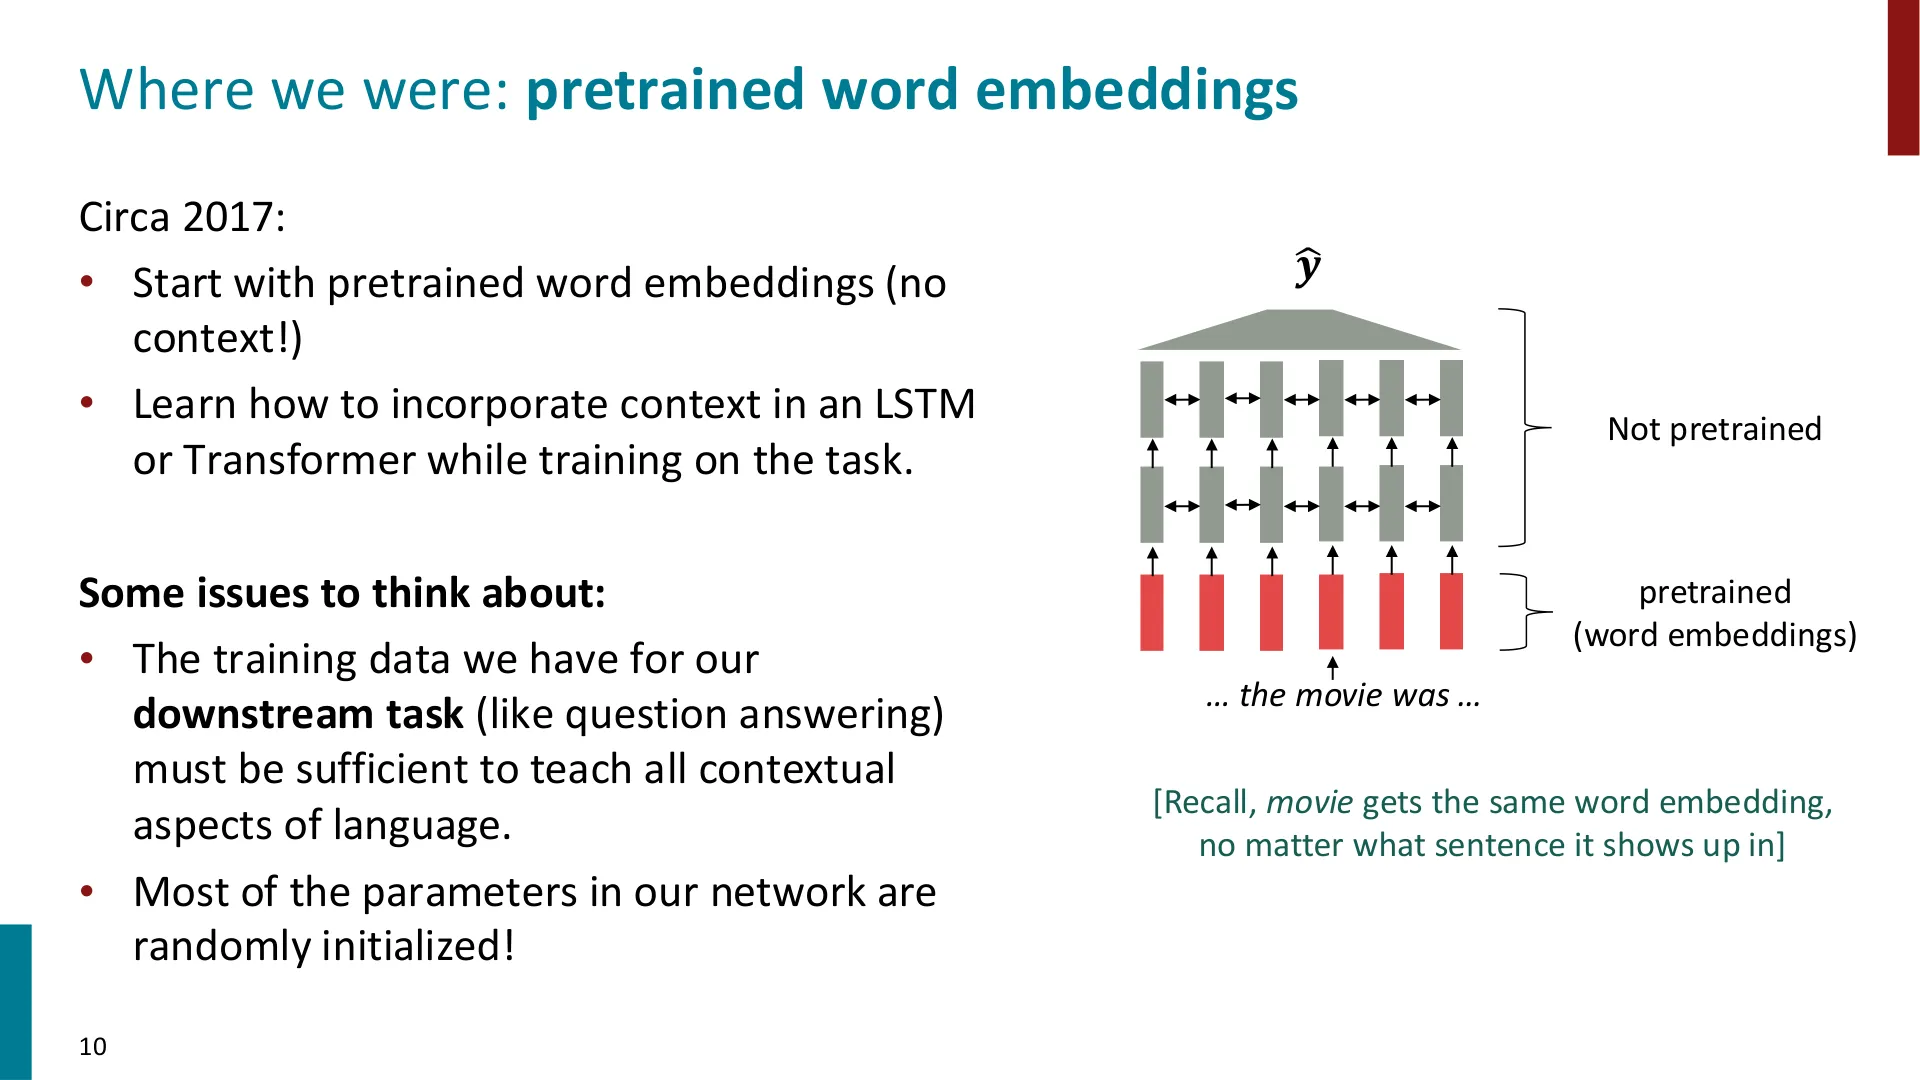
大约 2017 年的标准做法是:
- 先拿到预训练词向量(没有上下文);
- 在你的下游任务上,学习怎么把上下文塞进 LSTM / Transformer;
- 网络里绝大多数参数是随机初始化的。
老师指出这里有两个隐患:
- 你下游任务(比如问答)的训练数据,必须足够多,才能教会模型“语言中所有跟上下文有关的方面”;
- 大部分参数是随机初始化的。
而 word2vec 的问题是:record 无论出现在哪句句子里,拿到的都是同一个向量。这个向量只能是两种意思的混合体,无法“专业化”地分别表示动词义和名词义。
编者说明:当年的论文里常画一张图,横轴是训练步数,纵轴是指标——只预训练词向量的模型往往收敛得更快但天花板更低;把整个模型预训练后微调,起点就已经很高。
2.3 现代图景:预训练整个模型
📷 现代做法:整个网络一起预训练,学习整句表示
回到原视频 (00:17:40)
(参考时间: 00:17:40)
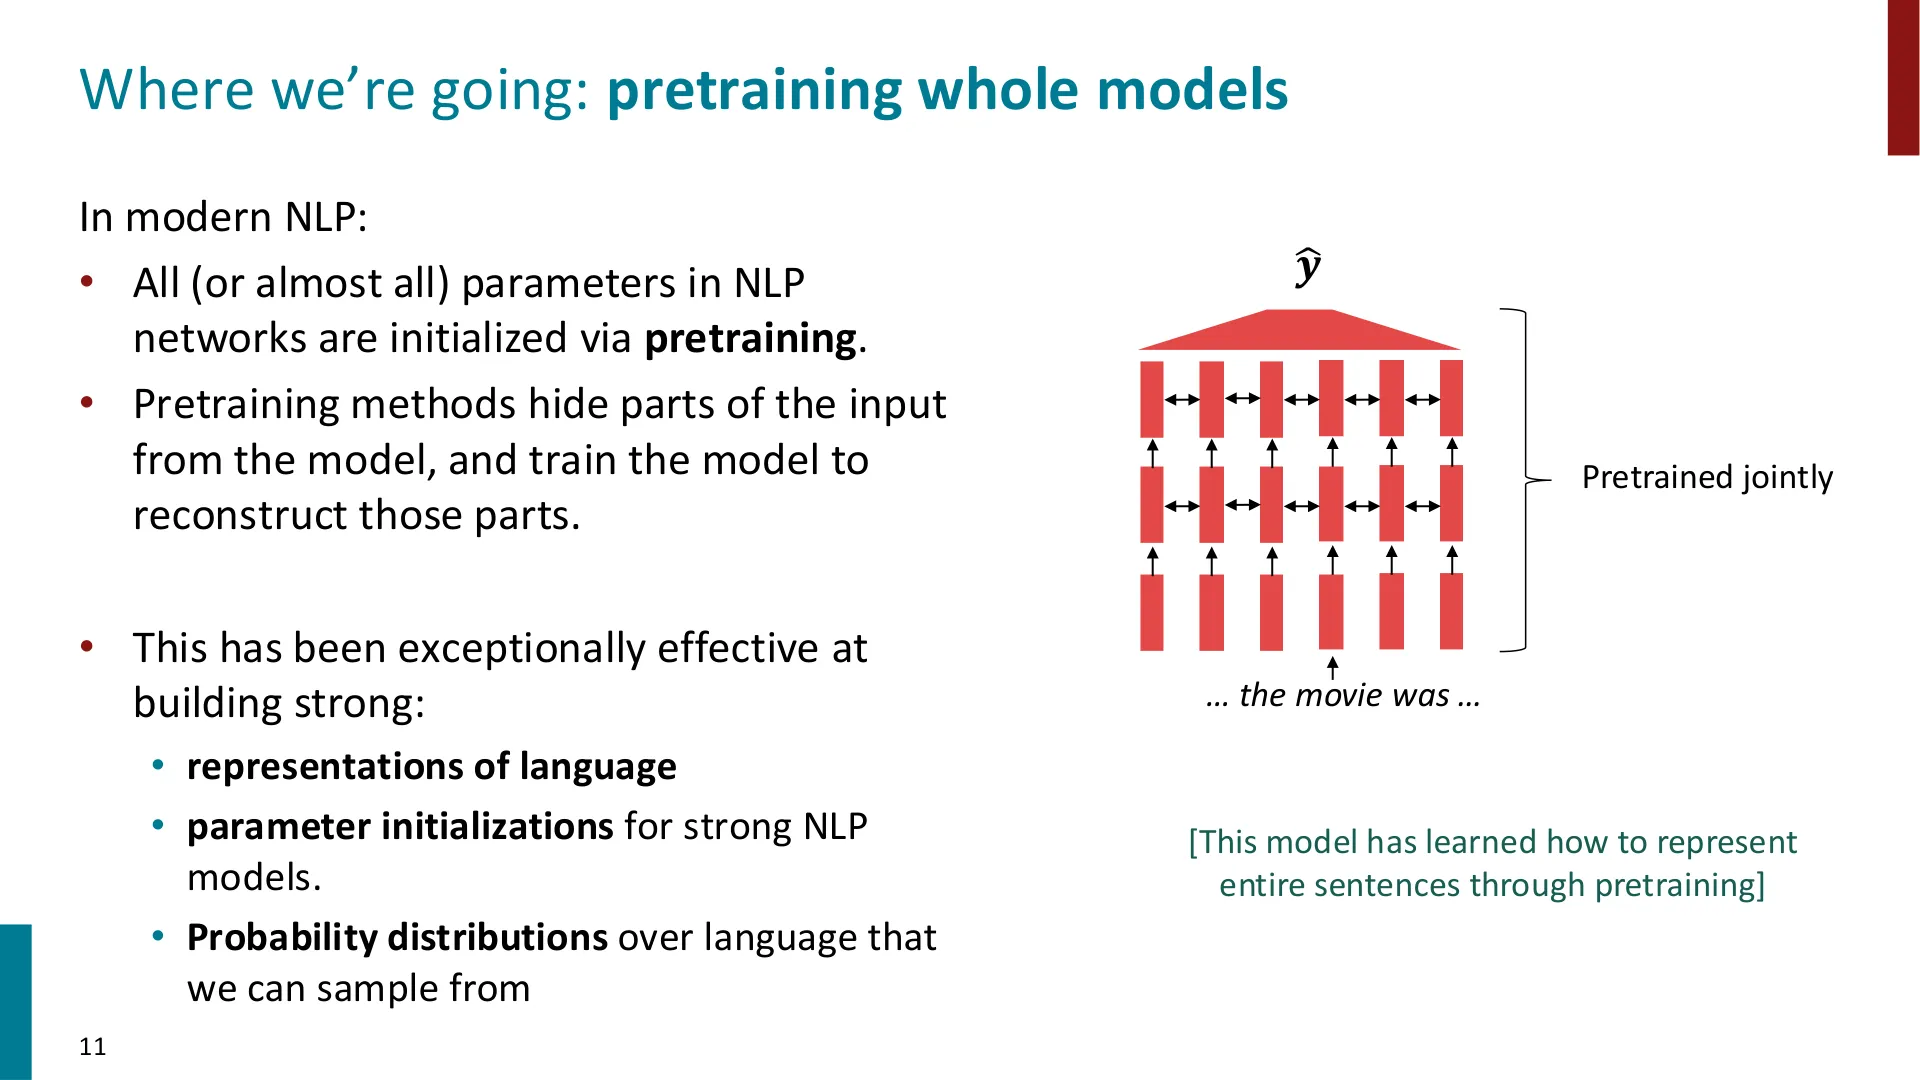
现代 NLP 的做法完全不同:
- 几乎所有参数都由预训练初始化(而不是随机);
- 预训练方法的核心套路是:把输入的一部分藏起来,让模型去重建它;
- 这在三件事上极其有效:
- 学到强语言表示(
record与record在上下文中得到不同表示); - 为下游模型提供强参数初始化;
- 得到可以从中采样的语言概率分布。
一句话:以前是“预训练词向量 + 随机初始化的上层”,现在是“整网联合预训练”。
2.4 从“补全输入”中能学到什么
(参考时间: 00:20:10)
讲者用一串“填空”例子,让听众自己体会预训练到底逼着模型学到了什么。
例子一:事实知识(trivia)
📷 Stanford University is located in ____, California.
回到原视频 (00:20:15)
Stanford University is located in ______, California.
要给对空格,模型必须编码“Stanford 在加州(帕洛阿尔托)”这个事实性共现。
例子二:句法(syntax)
📷 I put ___ fork down on the table.
回到原视频 (00:21:00)
I put ___ fork down on the table.
能填的只有 the、a 之类——这是句法约束:什么词能出现在什么位置。
例子三:指代(coreference)
📷 The woman walked across the street, checking for traffic over ___ shoulder.
回到原视频 (00:21:25)
The woman walked across the street, checking for traffic over ___ shoulder.
空格处只能是 her。这里 her 是回指 the woman——同一个话语实体的共指关系。模型要学到“谁在做什么、在哪里”。
例子四:词汇语义 / 话题(lexical semantics / topic)
📷 I went to the ocean to see the fish, turtles, seals, and _____.
回到原视频 (00:22:00)
I went to the ocean to see the fish, turtles, seals, and _____.
空格处要属于“海洋生物”这个类别——模型学到的是语义类别。
例子五:情感(sentiment)
📷 Overall, the value I got from the two hours... The movie was ___.
回到原视频 (00:22:30)
Overall, the value I got from the two hours watching it was the sum total of the popcorn and the drink. The movie was ___.
这里其实是在学作者潜在的(latent)情绪态度。老师顺带点出一个实用推论:如果以后看到一条新影评,把它变成 The movie was ___,让模型生成 bad 还是 good,其实就隐式地完成了情感分析。
例子六:一点推理(reasoning,更难)
(参考时间: 00:23:13)
Iroh went into the kitchen to make some tea. Standing next to Iroh, Zuko pondered his destiny. Zuko left the ______.
这里需要一个被文字隐含勾勒出的“世界”:Iroh 在厨房,Zuko 站在 Iroh 旁边,所以 Zuko 也在厨房——那么 Zuko 离开的只能(大概率)是 kitchen。模型要学一点关于物理位置、人的具身性(embodiment)的常识。
例子七:基本算术(Fibonacci)
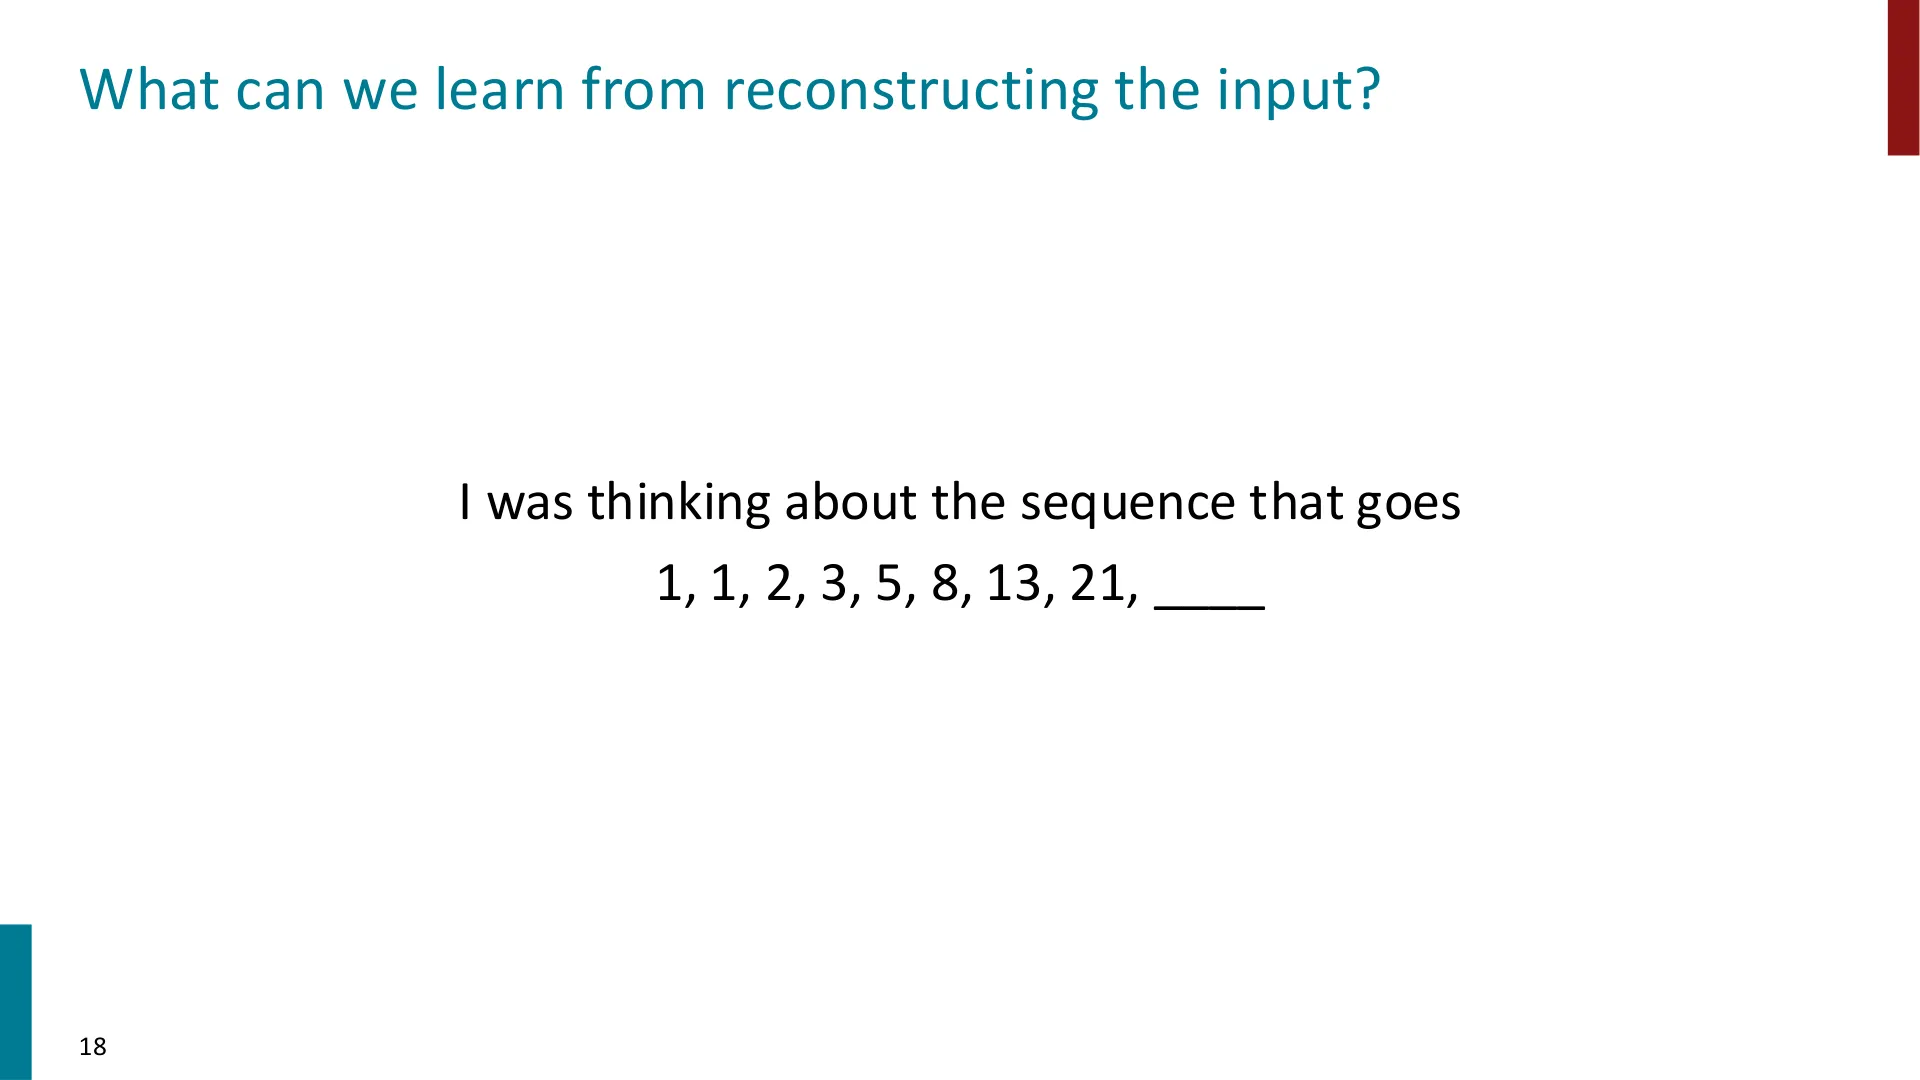
📷 I was thinking about the sequence that goes 1, 1, 2, 3, 5, 8, 13, 21, ____
回到原视频 (00:24:05)
I was thinking about the sequence that goes 1, 1, 2, 3, 5, 8, 13, 21, ____
这是斐波那契数列,下一个是 34。讲者说这一条“挺难”。他随后提醒全班:“预训练到底在教什么”是你整节课都该带着想的问题。
编者说明:这些例子并非随口举的,它们对应了后面「预训练在教什么」一节的分类清单(trivia / syntax / coreference / lexical semantics / sentiment / reasoning / arithmetic)。讲者是在用同一批例子,先建立直觉,最后再回收。
2.5 语言建模式预训练与“预训练 / 微调”范式
(参考时间: 00:24:45)
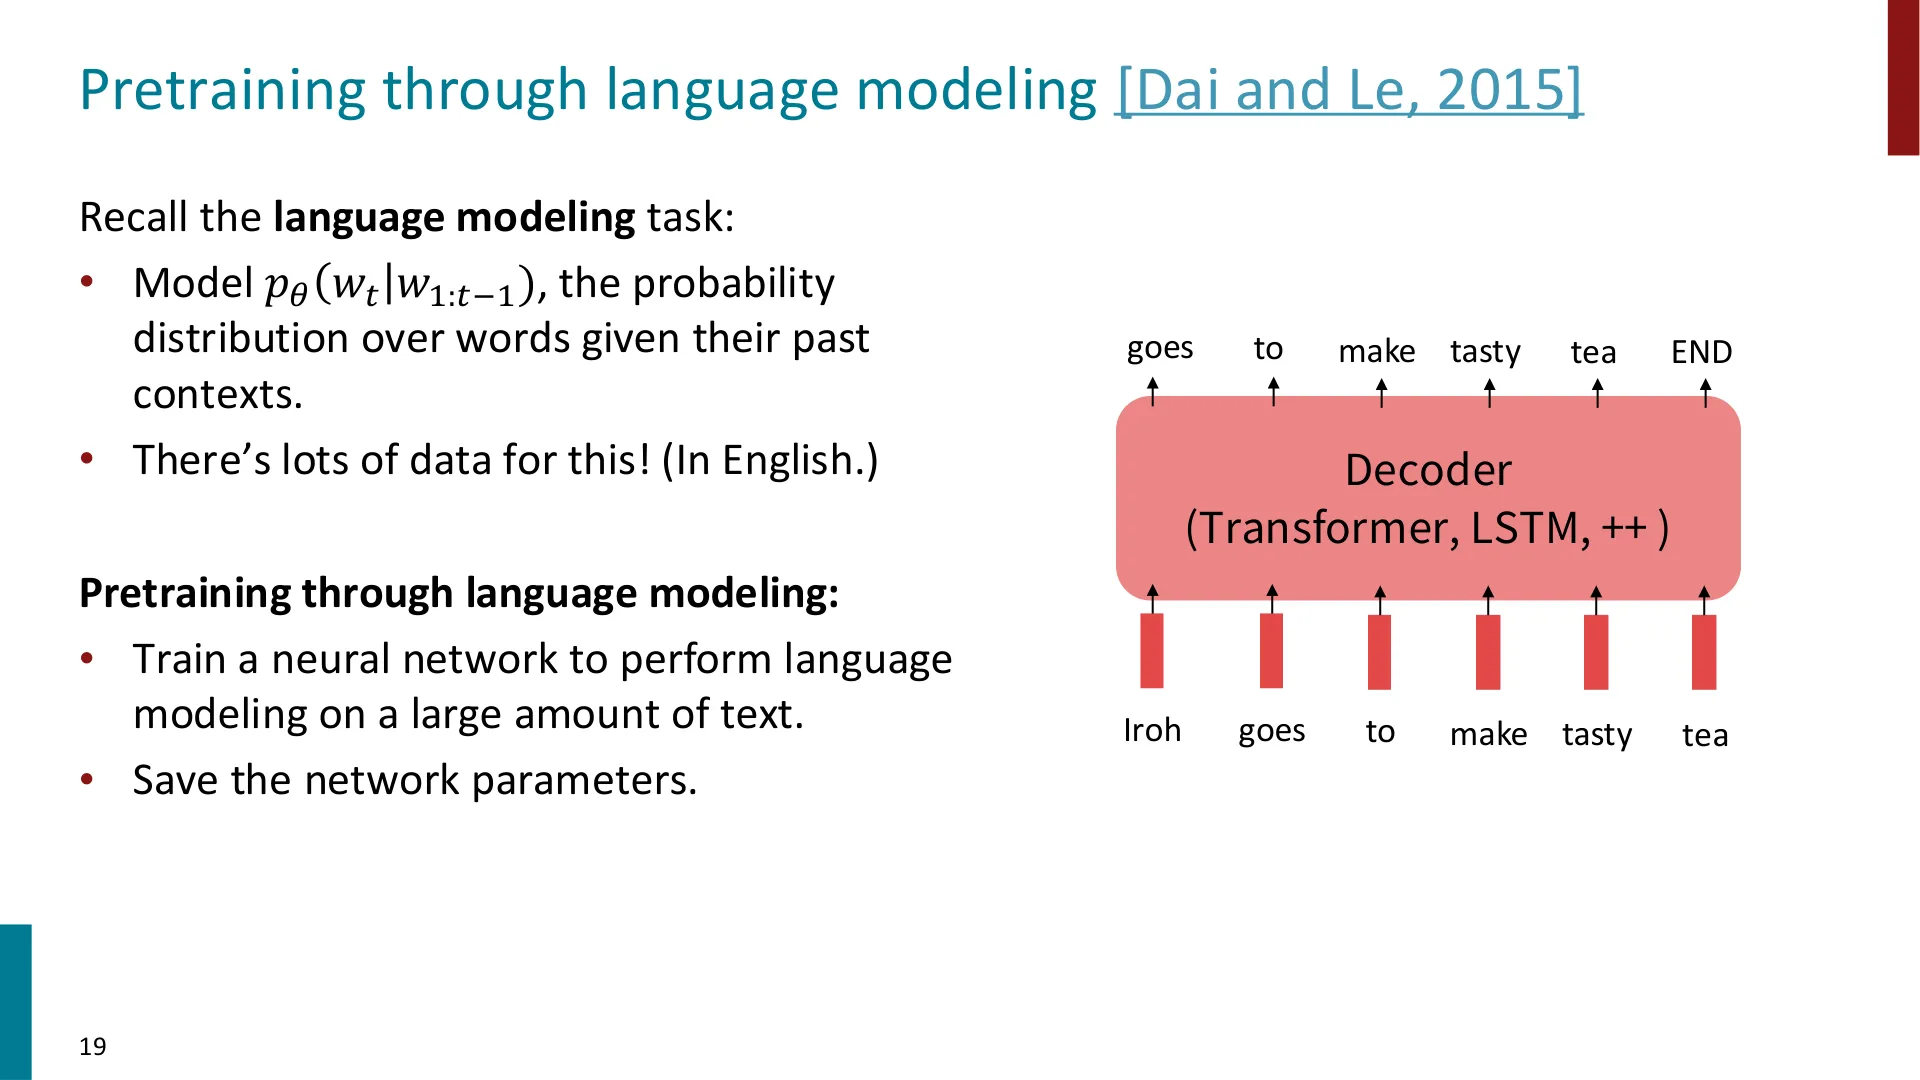
📷 语言建模预训练:训练网络做 $p_θ(w_t | w_{1:t-1})$,然后保存参数
回到原视频 (00:24:50)
最直白的预训练方式就是语言建模:训练一个网络去建模
$$ p_\theta(w_t \mid w_{1:t-1}) $$
即“在给定前文的情况下,下一个词的分布”。用的是教师强制(teacher forcing)——先给 Iroh 预测 goes,再给 Iroh goes 预测 to……训练完之后把所有权重保存下来。
好处是这类数据极多(尤其在英文里)。老师特别强调:几乎世界上所有其他语言都缺这类数据,这是另一个独立的大问题。
编者说明:这里有一个关键点——语言建模不需要人工标注。一段人类写的文本本身,就自带“输入→输出”的训练对(
Iroh→goes,Iroh goes→to……)。这正是它能无限扩张的原因。
于是就有了贯穿现代 NLP 的两阶段范式:
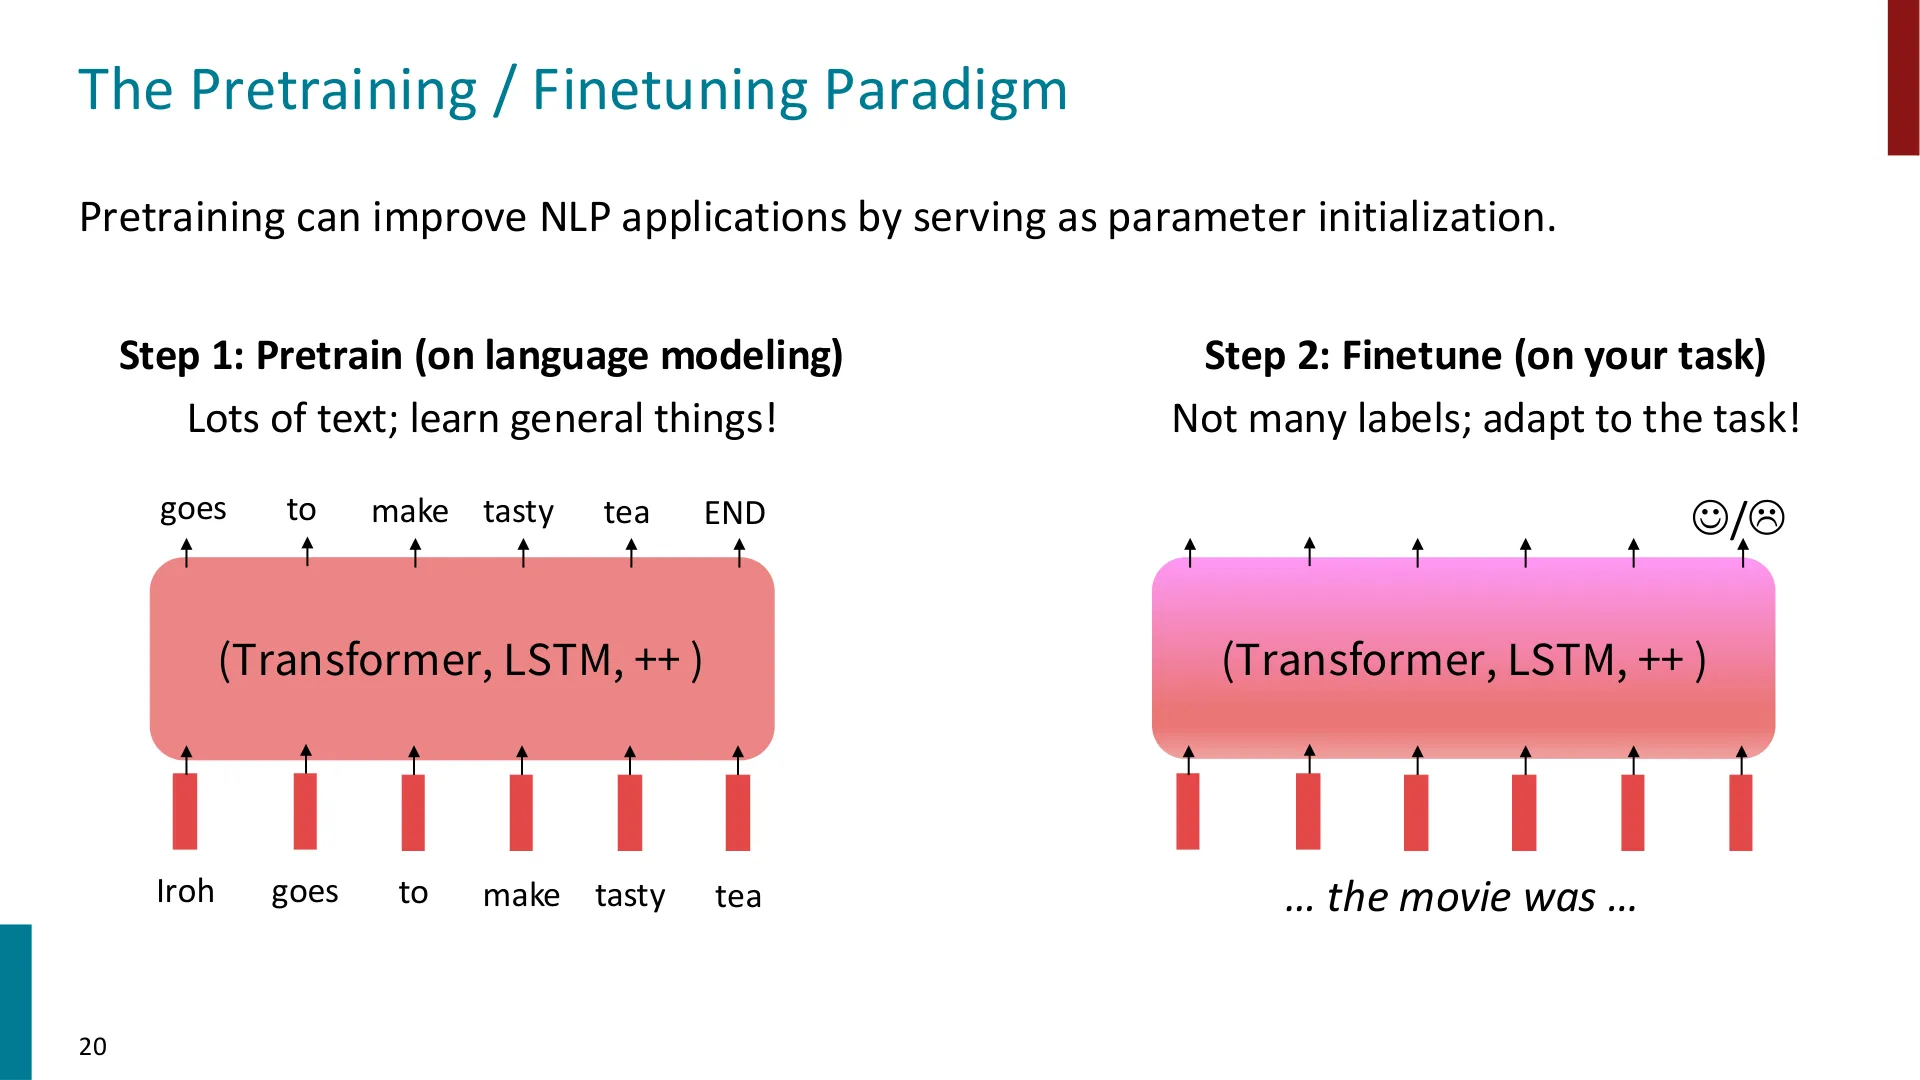
📷 预训练 / 微调两阶段范式:先用大量文本预训练,再用少量标注数据微调
回到原视频 (00:26:00)
graph LR
    A["Step 1 预训练<br/>海量文本 · 无标注<br/>学通用规律"] --> B["得到参数 θ̂"]
    B --> C["Step 2 微调<br/>少量标注数据<br/>适配具体任务"]
    C --> D["任务模型<br/>(情感分析/翻译/…)"]
- Step 1 预训练:大量文本,“学通用规律”;得到参数初始化 $\hat{\theta}$。
- Step 2 微调:标注不多,“适配任务”;在 $\hat{\theta}$ 的基础上继续做梯度下降。
老师提到:你们很多人的期末项目其实都会落在“别人替你预训练好了,你来做微调”这个格局里。
2.6 为什么这套范式有效:优化视角
(参考时间: 00:30:00)
🖼️ 第 20 页幻灯片 · Where does this data come from?
老师给出一个形式化的说法。预训练解的是
$$ \hat{\theta} \;=\; \arg\min_{\theta}\; \mathcal{L}_{\text{pre}}(\theta) $$
给出一个起点 $\hat{\theta}$;微调则在这个起点上、用微调损失继续做梯度下降,去逼近
$$ \arg\min_{\theta}\; \mathcal{L}_{\text{finetune}}(\theta) $$
关键在于:
如果理论上真能解这个最小值,起点似乎不该有影响;但它“真的、真的、真的”有影响。
用几何直觉说:梯度下降从 $\hat{\theta}$ 出发,“沿山坡往下走”直到落进某个山谷,而这个山谷之所以好,是因为它离预训练参数 $\hat\theta$ 很近——而 $\hat\theta$ 本身对很多事情都很好。老师说这是个“实践与理论相遇”的地方:搞优化的人想知道“为什么有用”,搞 NLP 的人只想把系统做得更好。
学生问:如果换个优化器,结论会变吗? 答:只要是一阶方法(比如课里用的 Adam、AdaGrad 之类),性质都非常相似;其他类型的优化我们在 NLP 里一般不使用,“谁知道呢”。
学生问:为什么不让模型更大、层更多、微调数据更多,直接硬堆? 答:最直接的回答是——无标注数据的量级大出好几个数量级。粗略地讲,互联网上有至少 5 万亿、可能 10 万亿词的纯文本,而你精心标注的数据可能只有一百来万词。差距太大了。 此外还有一个直觉:只学“情感分析”这么一件简单的事,很难得到一个在广泛场景下都通用的能力。哪怕你有大量今天的影评,明天人们换一种写法,系统可能就不行了;而在来源广泛、内容多样的文本上预训练过的模型,更可能迁移到不那么像训练数据的输入。老师也提醒:互联网上文本良莠不齐,必须谨慎挑选喂给模型什么、以及不喂什么。
学生问:预训练数据远多于微调数据,怎么让模型“更重视”微调任务? 答:靠顺序。先预训练得到初始化,再在微调任务上移动参数——代价是它可能会“忘掉”不少之前学到的东西。
编者拓展|围绕 $\hat\theta$ 的“平坦解”假说 一个常被引用的解释是:预训练把参数带到损失曲面上一个又宽又平的区域。平坦极小值对参数扰动不敏感,因而泛化更好;微调只在这个区域附近做小幅移动,就更容易落到“对下游任务也友好”的解上。相关实证与讨论可参考关于微调鲁棒性、损失曲面几何的文献。这仍是开放话题,老师也明说这是“开放的研究领域”。
2.7 预训练数据从哪来
(参考时间: 00:33:00)
🖼️ 第 1 页幻灯片 · Natural Language Processing
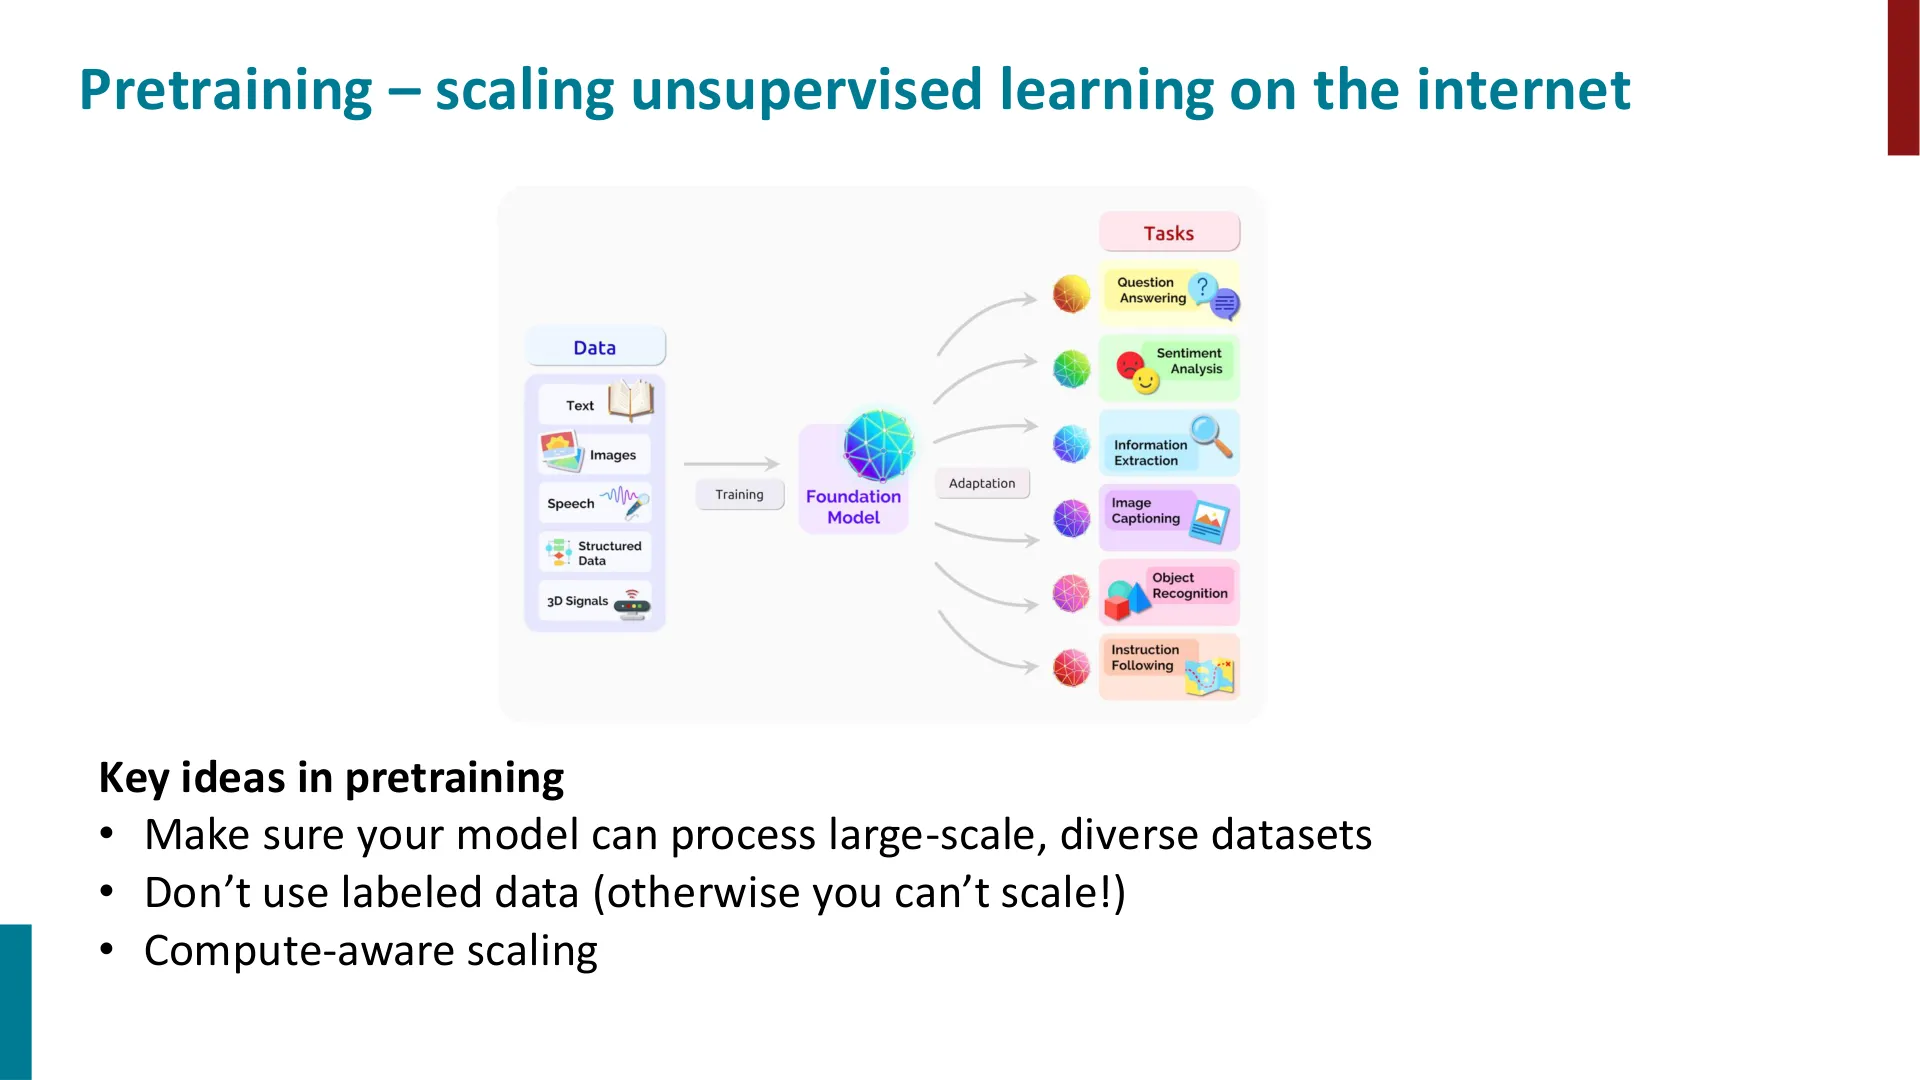
📷 预训练要点:能处理大规模多样数据;不使用标注数据;算力感知的扩展
回到原视频 (00:32:45)
讲者把预训练的三条“关键要点”收拢为:让模型能处理大规模、多样化的数据;不要用标注数据(否则无法扩展);算力感知的扩展(compute-aware scaling)。
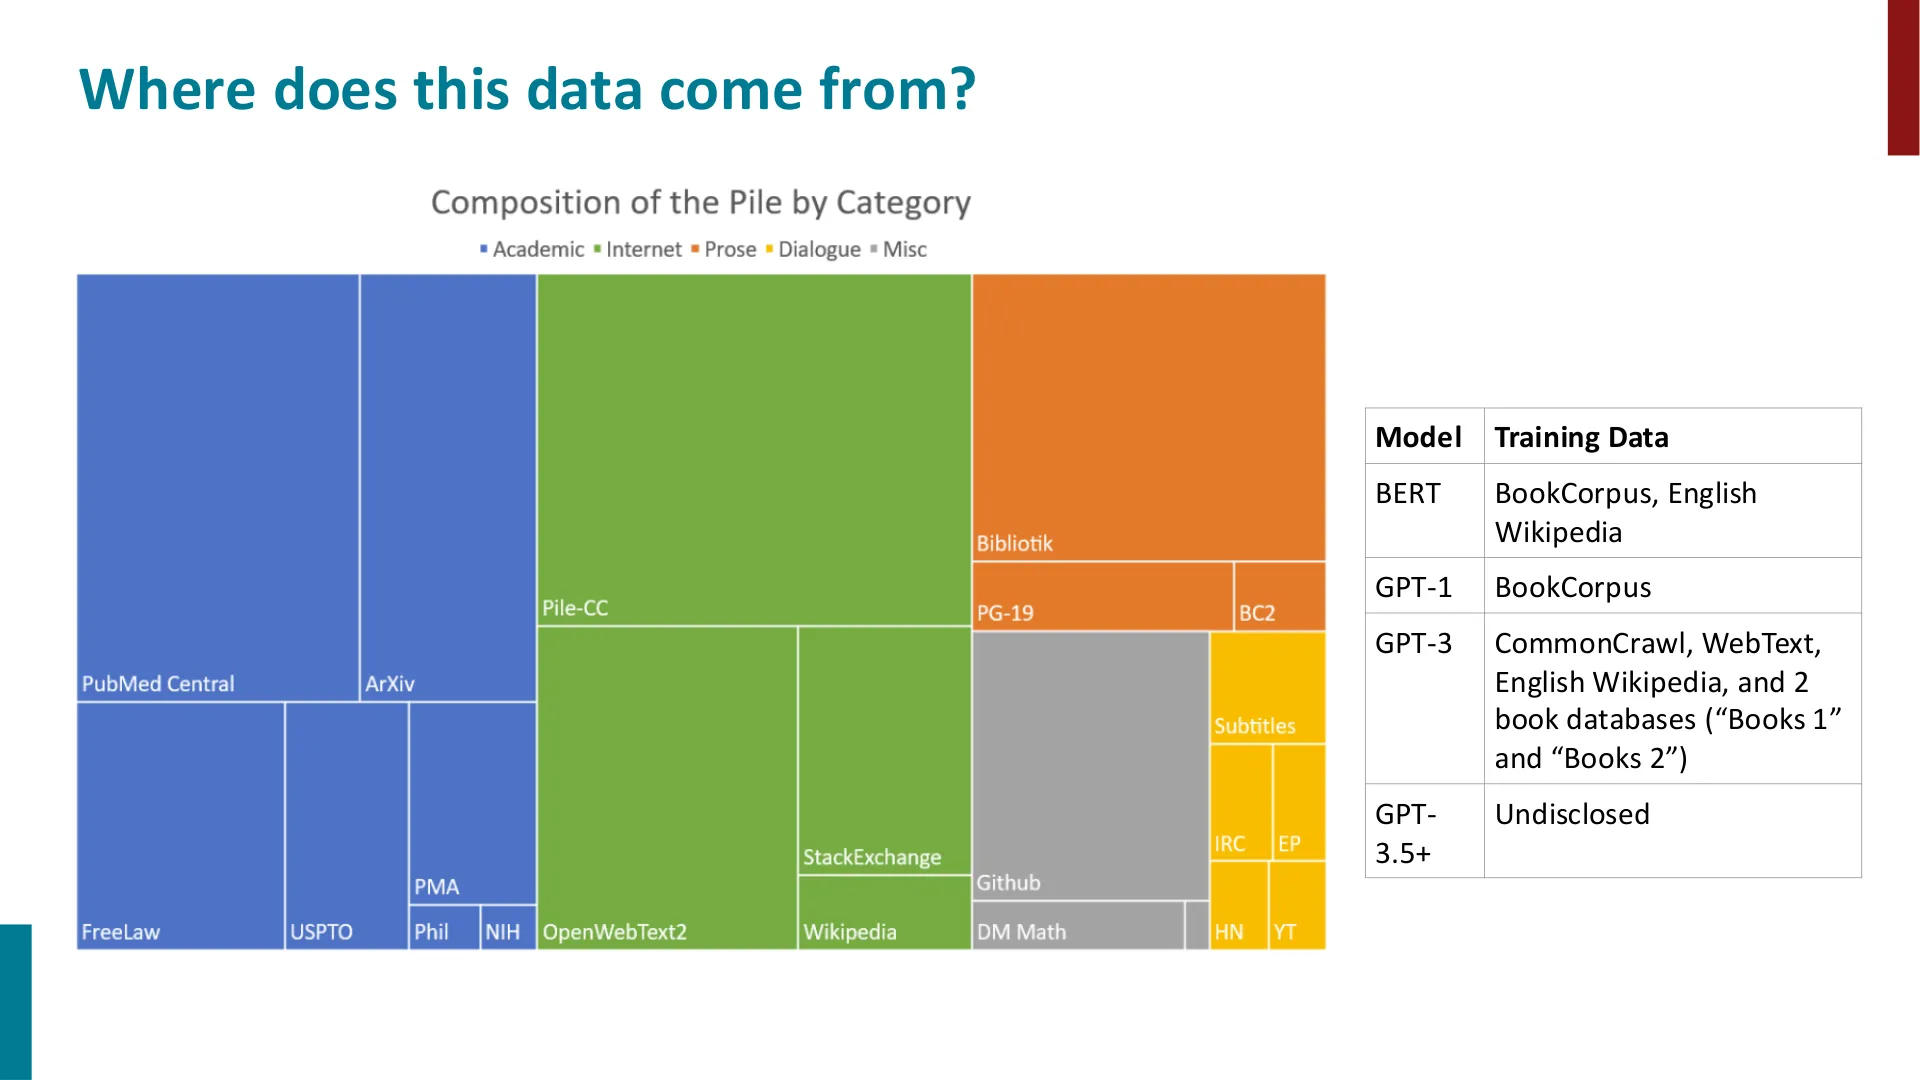
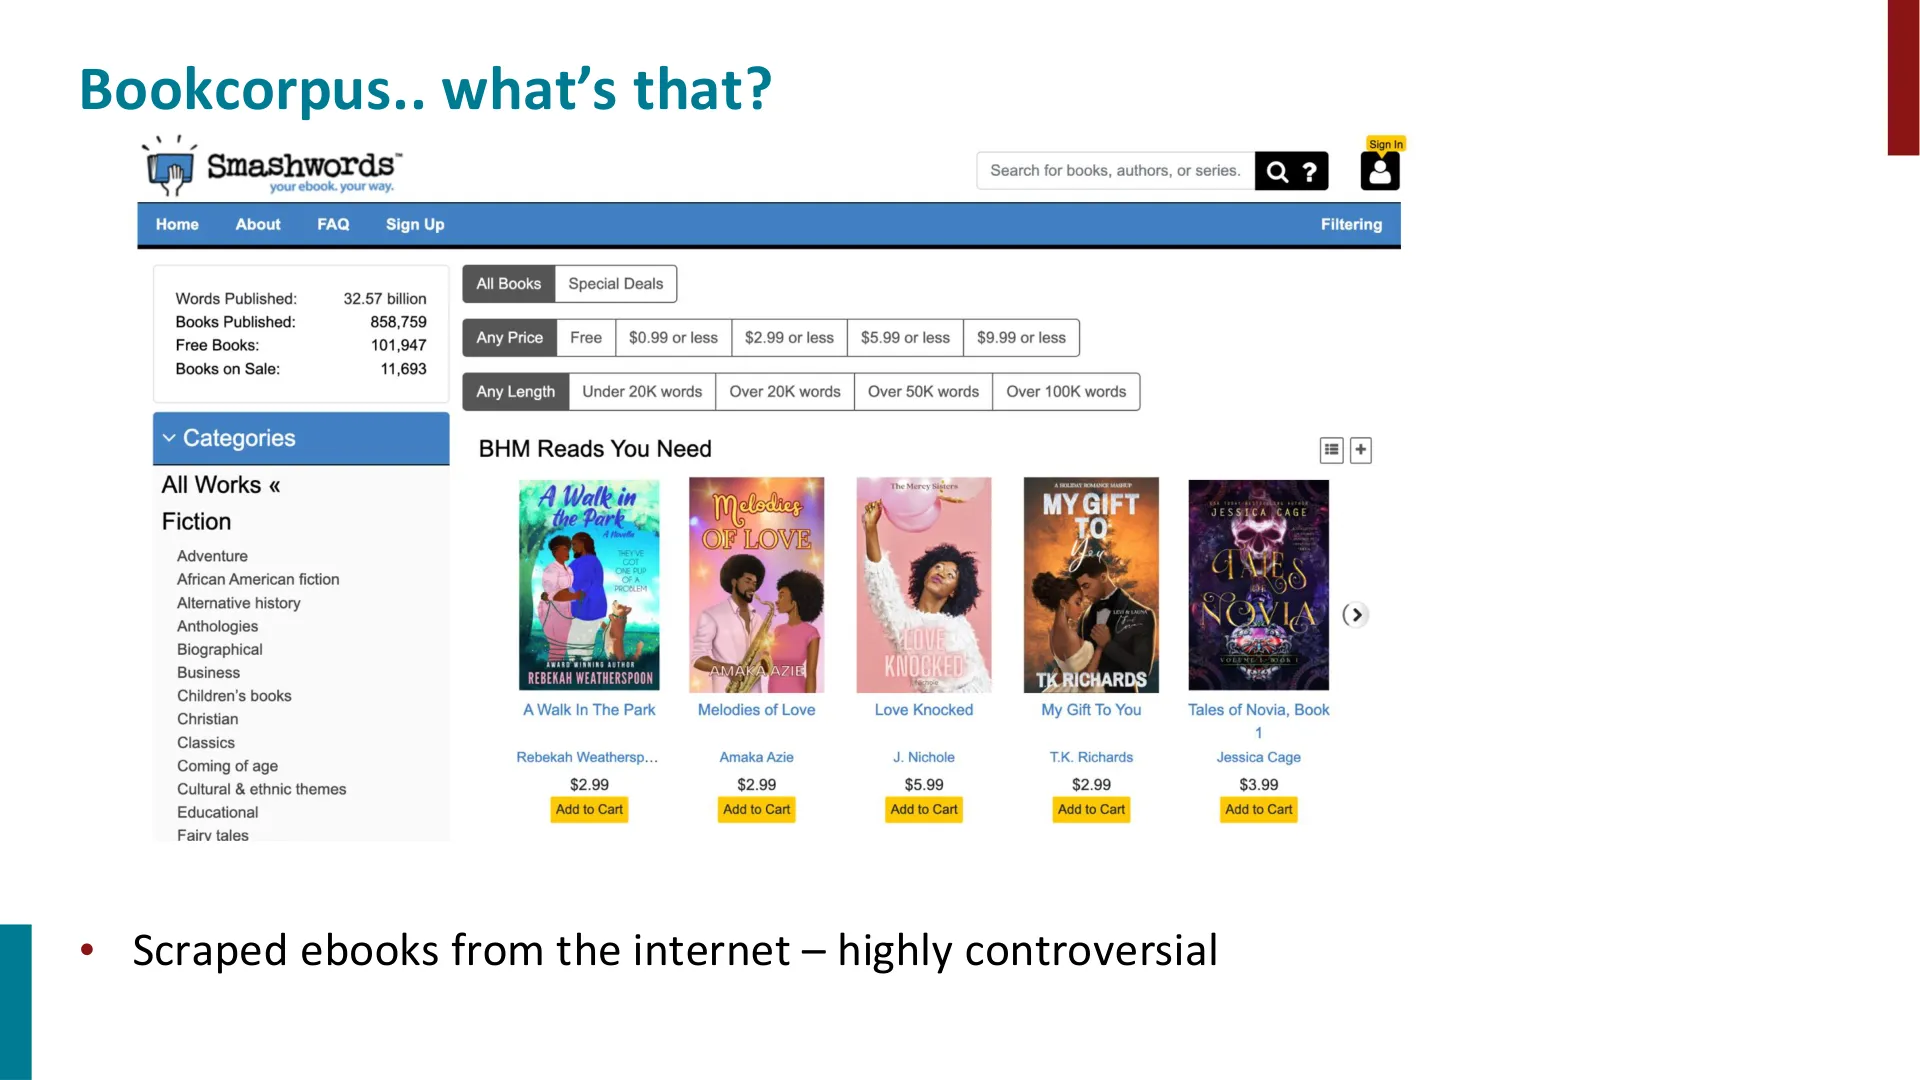
常用语料包括 BookCorpus、英文 Wikipedia、Common Crawl、WebText 等(详见文末附录中的对照表)。关于 BookCorpus 的来源、以及“从互联网抓电子书”的争议与合理使用(fair use)问题,见文末「附录:课堂未展示的幻灯片」。
三、三种架构的预训练
(参考时间: 00:35:55)
📷 课程大纲:三种架构(编码器 / 编码器-解码器 / 解码器)的预训练
回到原视频 (00:35:55)
3.1 三种架构回顾
🖼️ 第 22 页幻灯片 · Fair use and other concerns
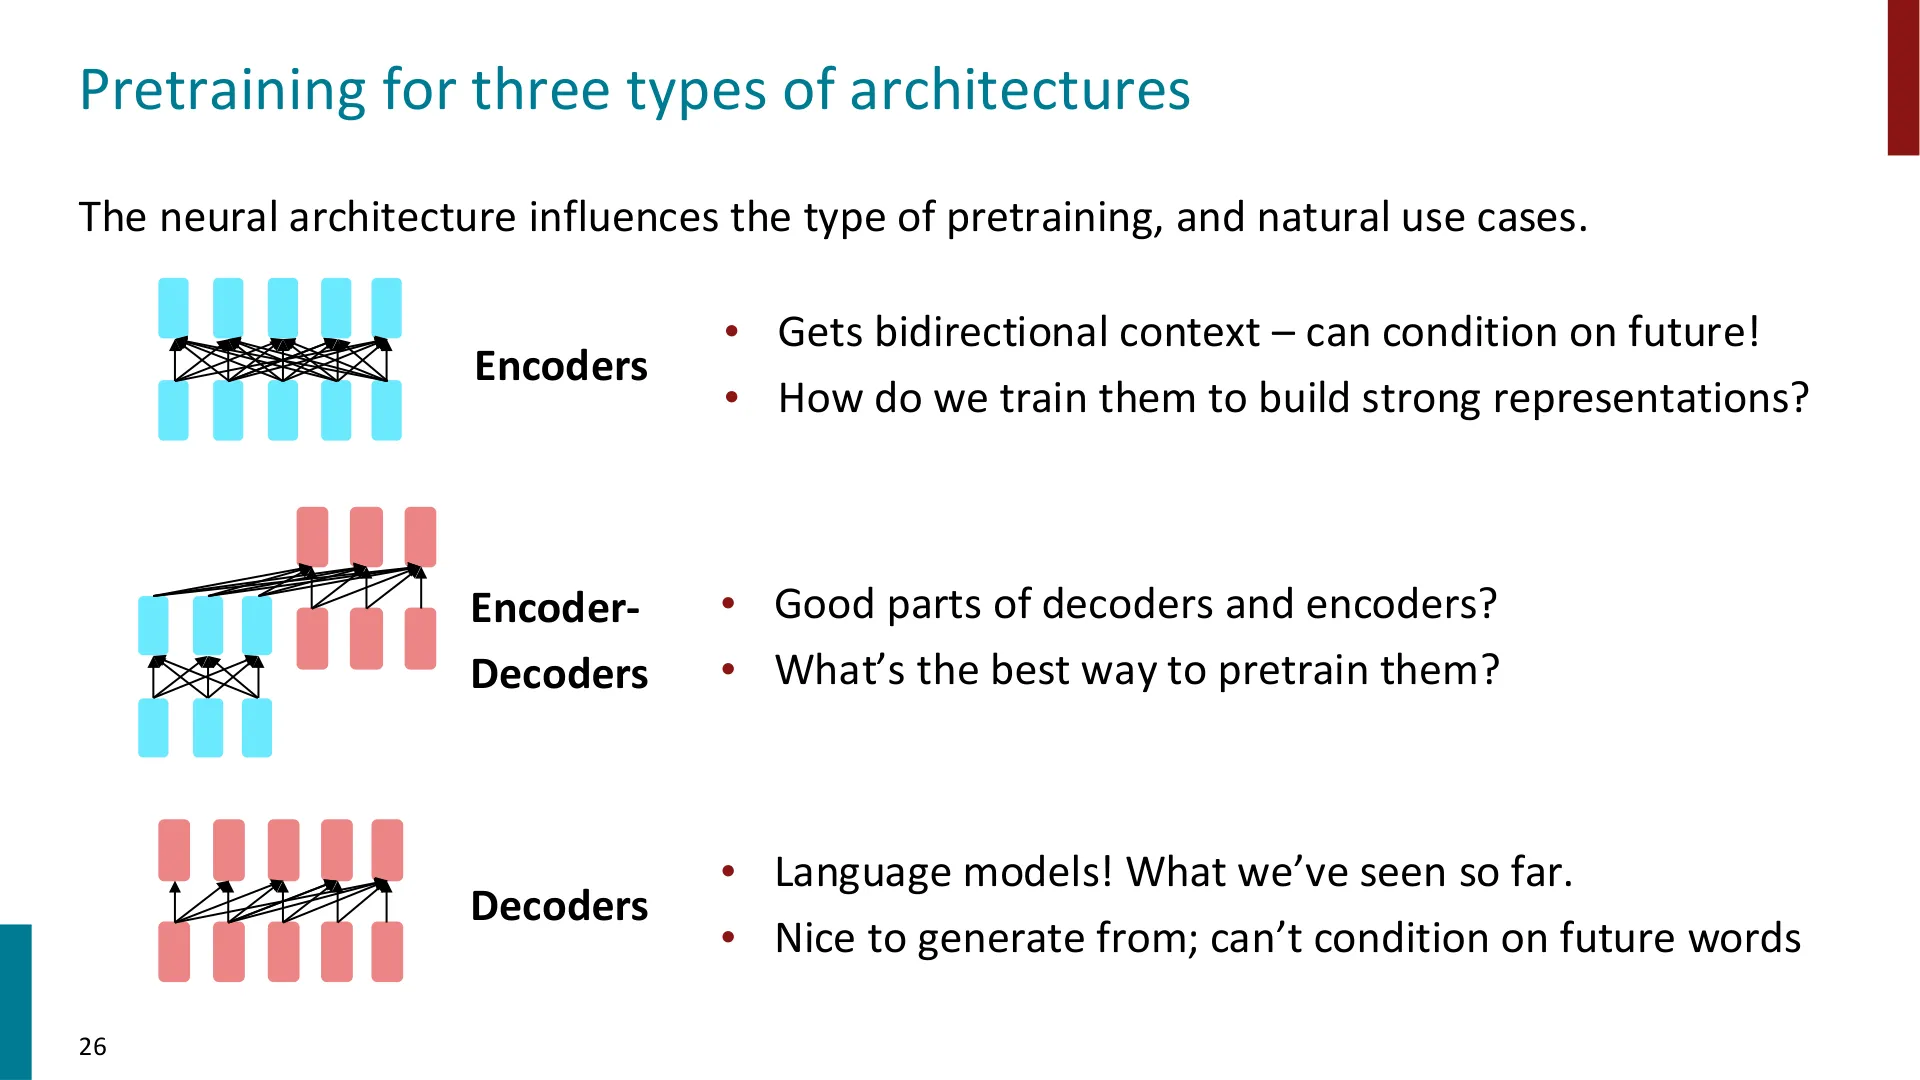
📷 三种架构:解码器、编码器、编码器-解码器
回到原视频 (00:36:15)
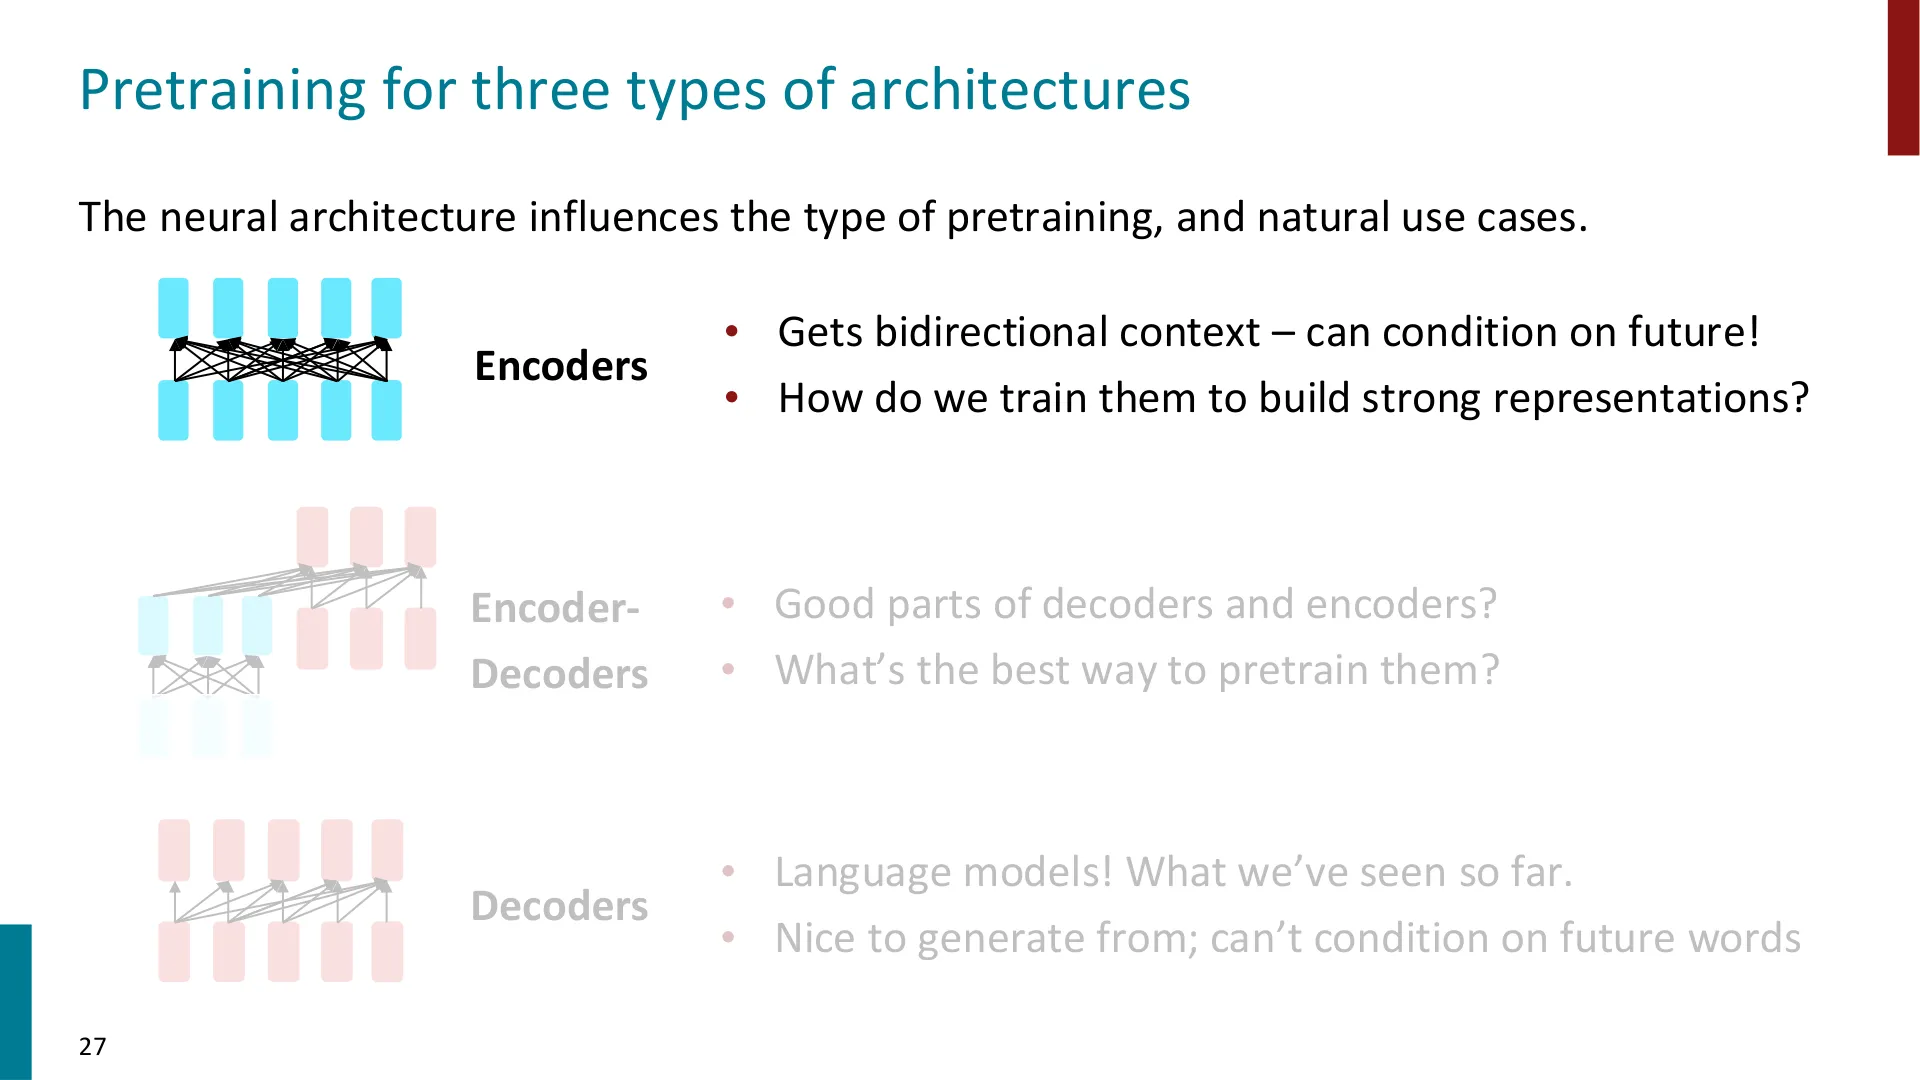
在上一讲的 Transformer 里我们见过三类架构,它们的上下文可见性和自然用途不同:
| 架构 | 上下文 | 天然用途 | 预训练要回答的问题 |
|---|---|---|---|
| 编码器 Encoder | 双向(能看未来) | 理解、表示 | 不能做语言建模,那该怎么训? |
| 编码器-解码器 | 编码器双向 + 解码器单向 | 序列到序列(翻译等) | 什么目标最好? |
| 解码器 Decoder | 单向(不能看未来) | 生成、语言模型 | 语言建模即可 |
- 编码器:拿到一整条序列,能同时看到左右两边,就像机器翻译里的源句编码器。
- 编码器-解码器:前半部分双向(源句),后半部分单向(在信息掩码下逐词生成译文)。
- 解码器:就是语言模型,只能看历史,不能看未来。
讲者说,接下来会先讲编码器,再讲编码器-解码器,最后讲解码器——因为当今最大的模型几乎都是解码器,值得多花时间。
3.2 编码器如何预训练:掩码语言建模
(参考时间: 00:37:30)
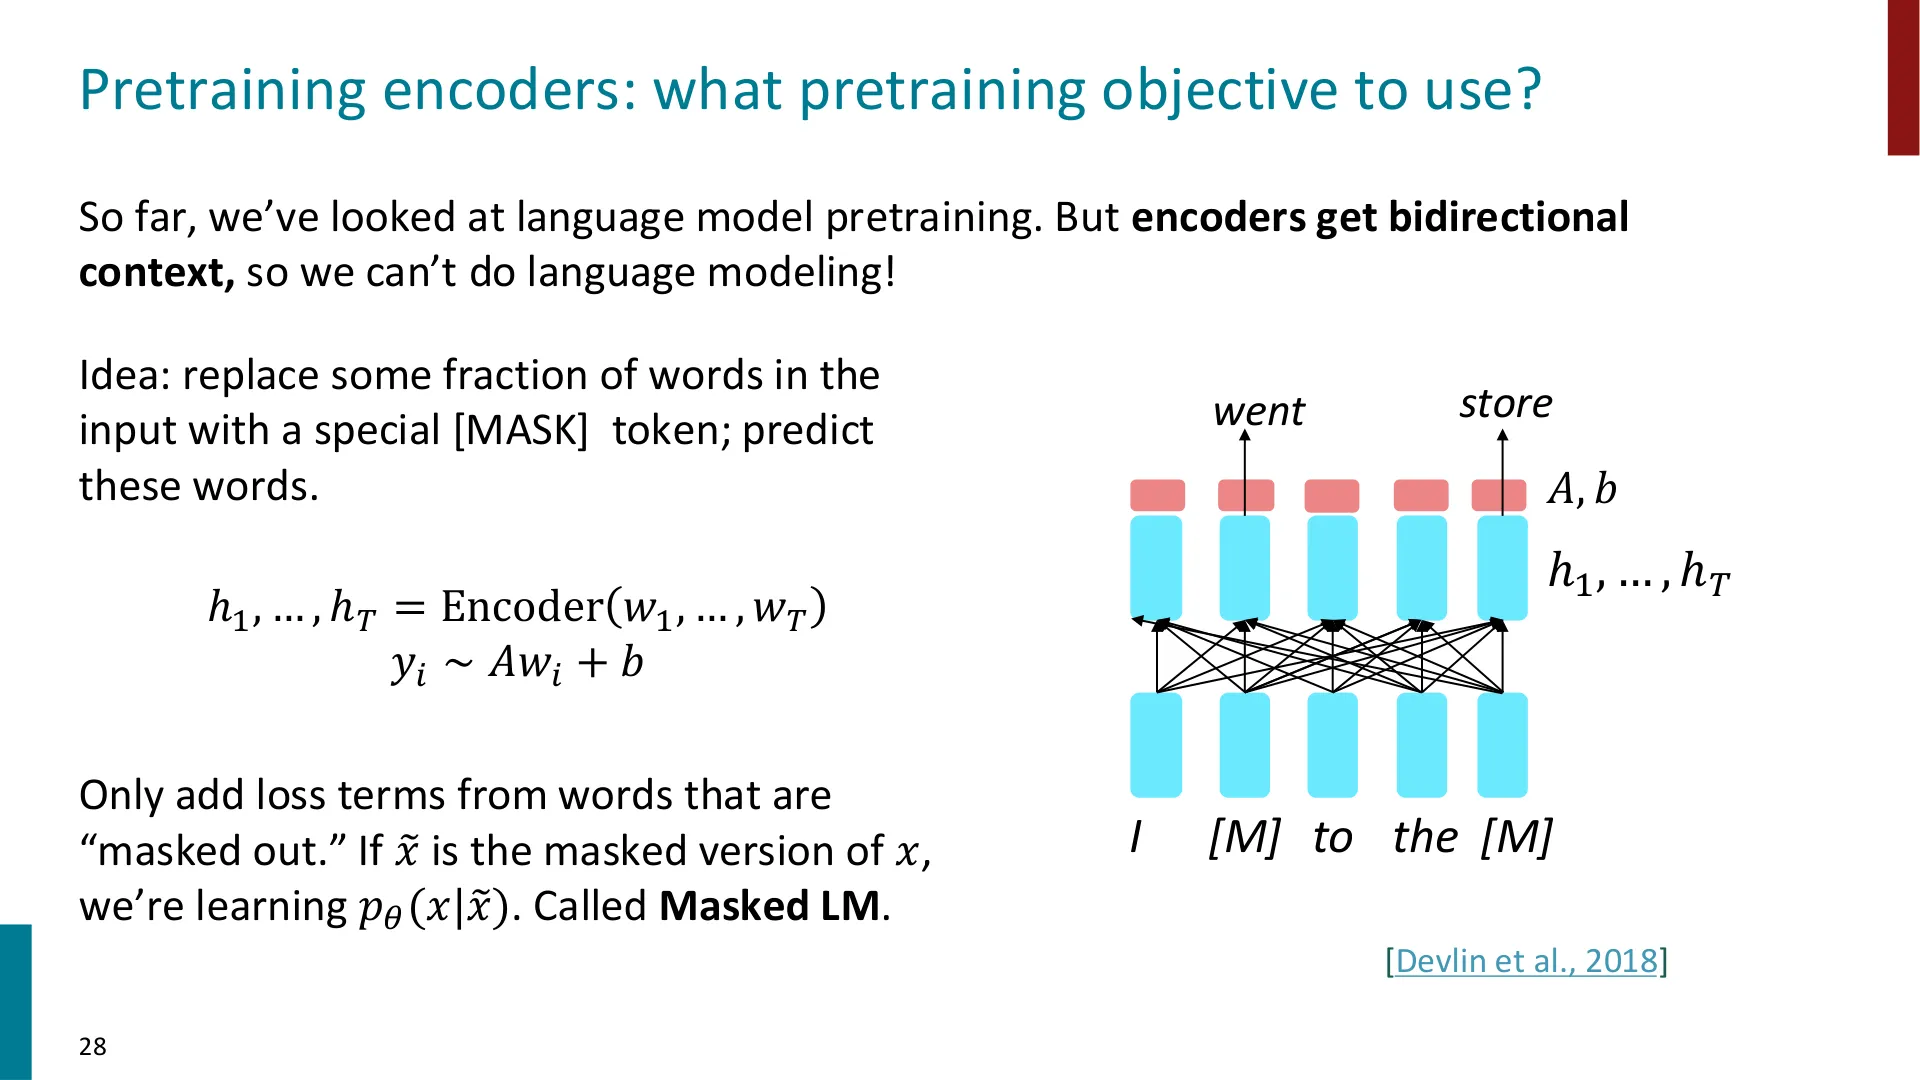
📷 编码器预训练:把部分词替换成 MASK,只对 mask 位置计算损失
回到原视频 (00:38:00)
困难在于:编码器能看双向上下文,所以不能做语言建模。为什么?如果我在位置 $i$ 要预测“下一个词”,而模型在中间某层已经能看到 $i+1$ 的词,那直接从上面“抄下来”就行了——这个任务变得毫无难度,学不到任何东西。
于是要“更聪明一点”。做法是:
🖼️ 第 25 页幻灯片 · Pretraining for three types of architectures
- 把输入里的一部分词替换成特殊的
[MASK]; - 让网络的编码器输出每个位置的向量
$$ h_1, \dots, h_T = \text{Encoder}(w_1, \dots, w_T) $$
- 只对被 mask 掉的位置计算损失:
$$ y_i \sim A\,h_i + b $$
其中 $A, b$ 是一个线性层(把隐藏状态映射到词表大小),只对“被遮住”的词加损失项。
如果记 $x$ 为原始文本、$\tilde{x}$ 为掩码后的版本,那我们学的其实是
$$ p_\theta(x \mid \tilde{x}) $$
——给定被破坏的文档,还原真实的文档。这就是掩码语言建模(Masked LM)。
编者说明:
[MASK]只是一个占位符。它把“这里有个洞”这件事显式地喂给网络,网络则利用洞两侧的全部上下文去推断洞里原本是什么。这就是为什么它天然适配双向编码器——被遮住的位置看不见自己,但看得见左右所有邻居。
3.3 BERT:掩码语言建模的第一次大规模落地
(参考时间: 00:40:47)
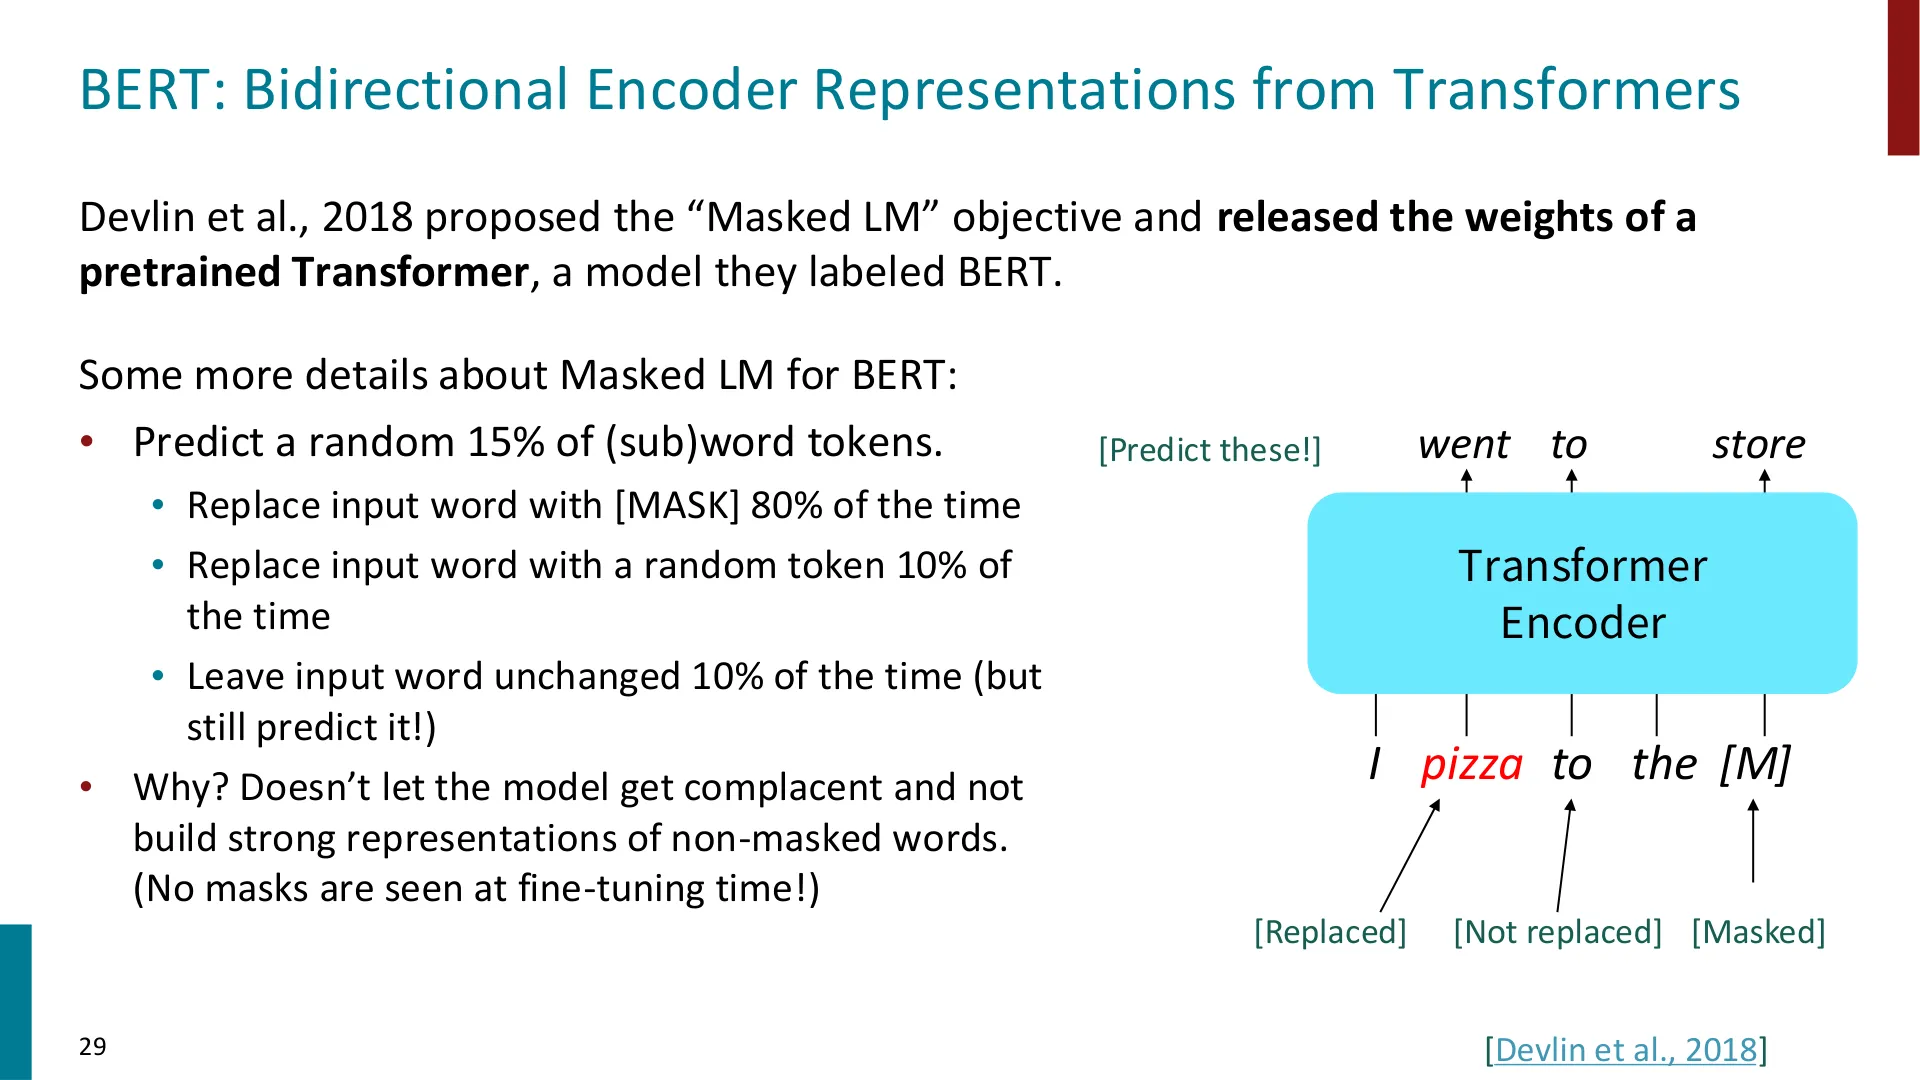
📷 BERT 的掩码策略:15% 子词被选中,其中 80% 换成 MASK、10% 换成随机词、10% 保持不变
回到原视频 (00:41:25)
BERT(Bidirectional Encoder Representations from Transformers,Devlin et al., 2018) 是第一个把这个目标大规模做出来、并把权重开源出来的模型,因此你“必须知道它”。你可以通过 Hugging Face 发布的代码下载、直接使用;很多同学的期末项目都会用到它,因为它是“语言与上下文表示的极其有用的构造器”。
BERT 的掩码细节很讲究:
- 随机挑选 15% 的(子)词 token;
- 对这 15%,再做三档处理:
- 80% 换成
[MASK]; - 10% 换成一个从词表随机采样的其他词;
- 10% 保持不变(但仍然要预测它原本是什么)。
为什么这么绕?老师的解释是:如果模型只会为带 [MASK] 的位置构造“好表示”,那么真实使用时(文本里一个 [MASK] 也没有)它会“懒得干活”——“哦,这里没我什么事”。通过让它有时要预测被换掉的词、有时要预测原封不动的词,就强迫它对每一个词都构建强表示,因为它随时可能被要求预测任何位置。
编者说明(“微调时没有 mask”这一句怎么理解): 预训练时看的文本里到处是
[MASK];而微调/推理时看到的都是正常文本。两者输入分布不一致是这个目标的设计缺陷。80/10/10 这套比例的动机,正是缩小预训练与微调之间的这种不匹配——因为只有 80% 的受损位置真的用了[MASK],剩下 20% 的位置看起来多少还像正常文本。
3.4 BERT 的规模与成本
(参考时间: 00:52:20)
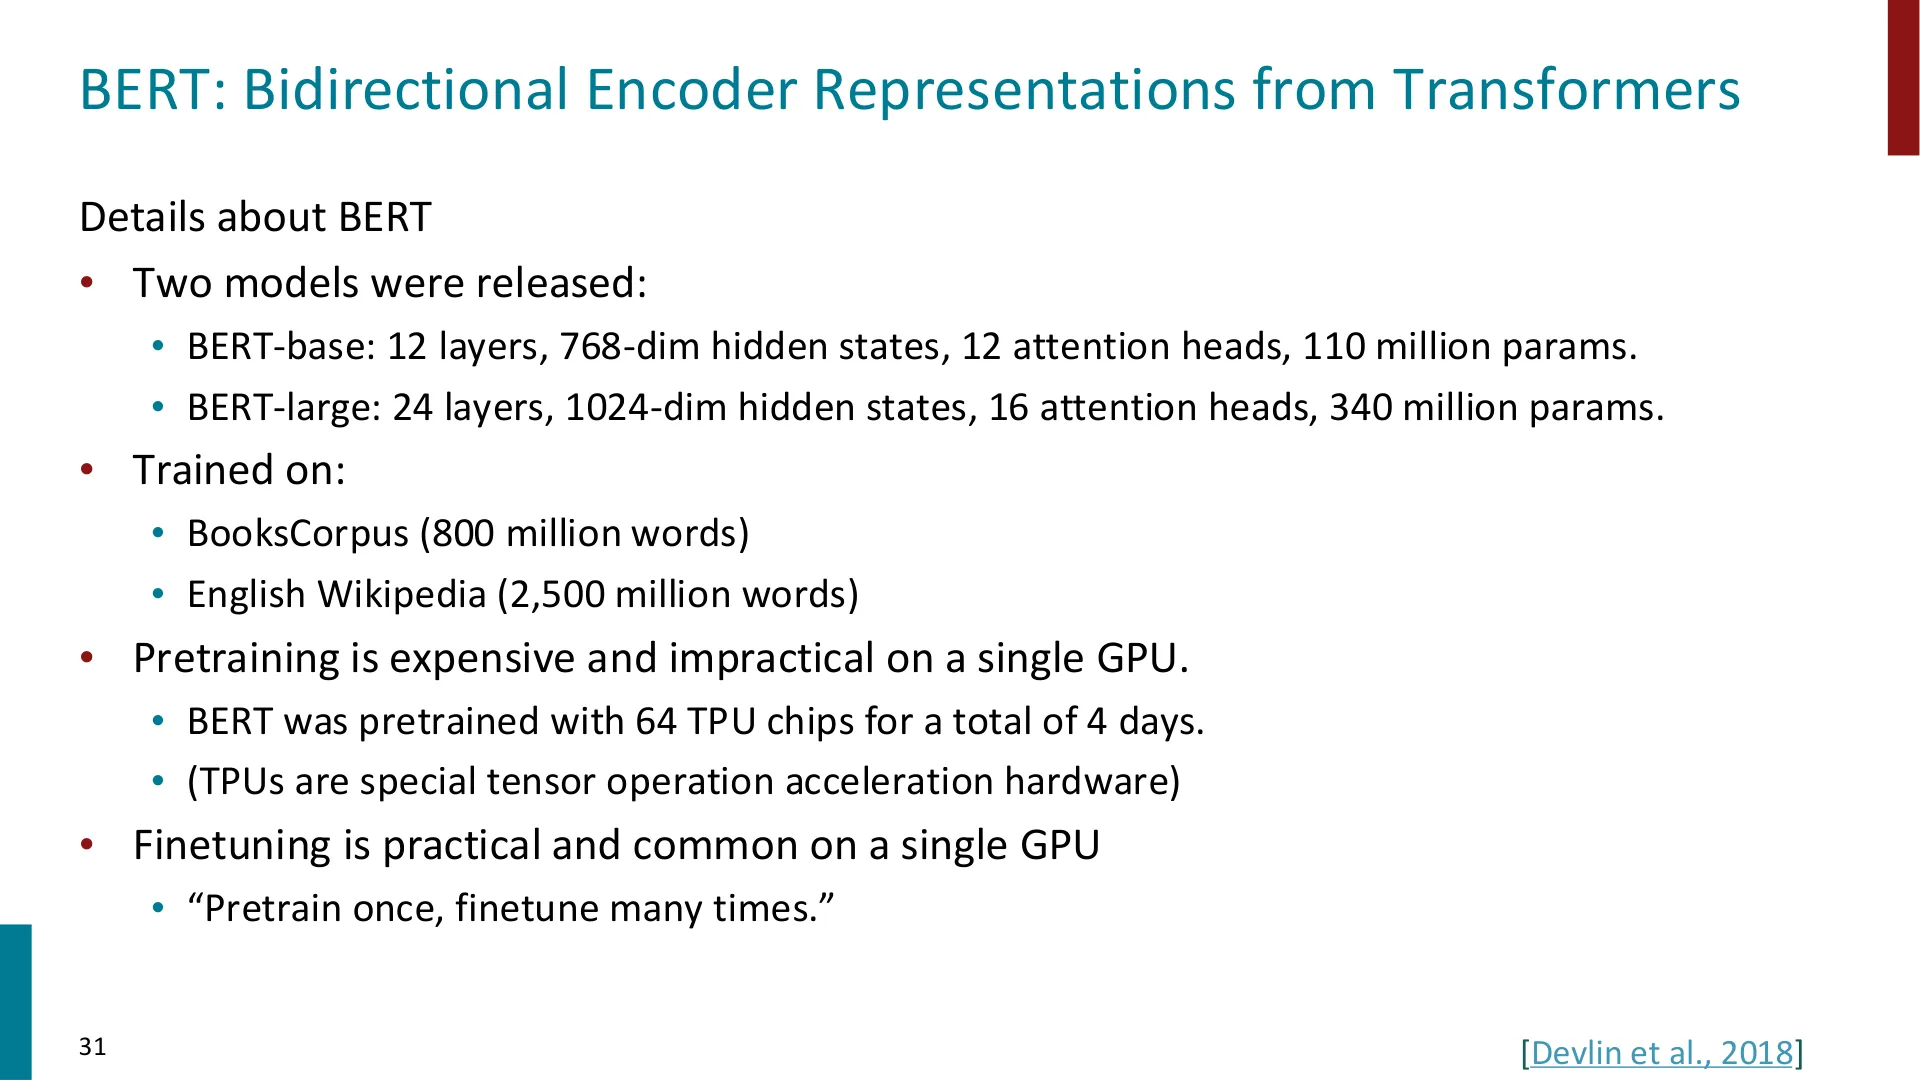
📷 BERT 的细节:两个规模、训练语料、预训练成本
回到原视频 (00:52:20)
BERT 的两个版本:
| 版本 | 层数 | 隐藏状态维度 | 注意力头数 | 参数量 |
|---|---|---|---|---|
| BERT-base | 12 | 768 | 12 | 1.1 亿 |
| BERT-large | 24 | 1024 | 16 | 3.4 亿 |
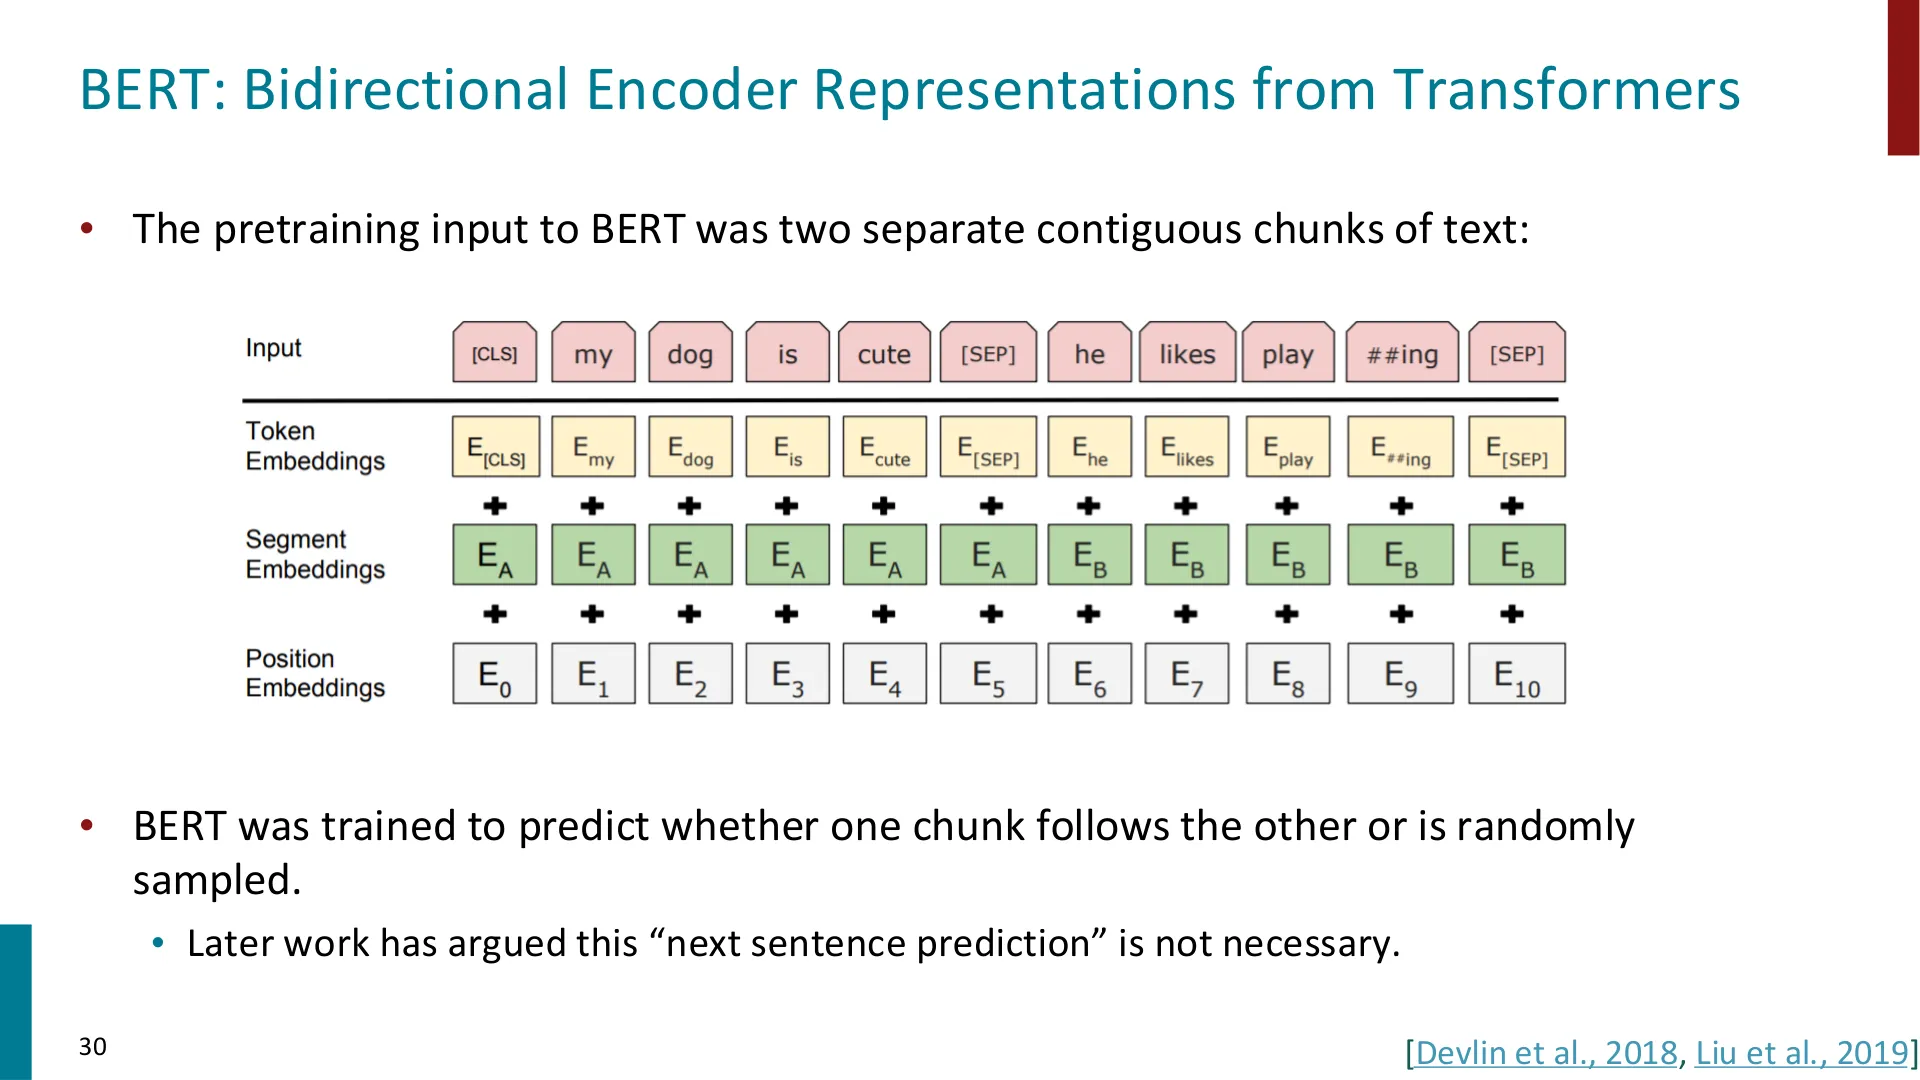
🖼️ 第 28 页幻灯片 · BERT: Bidirectional Encoder Representations from Transformers
训练语料: BookCorpus(约 8 亿词)+ 英文 Wikipedia(约 25 亿词)。“不到十亿词级别”——在当时仍然是相当大的量。
预训练成本: 用 64 块 TPU 芯片训练了 4 天。老师提醒大家记住这个量级(base 1.1 亿、large 3.4 亿参数),因为后面会讲到参数量大得多的模型。
编者拓展|TPU 是什么 TPU(Tensor Processing Unit)是 Google 为张量运算专门设计的加速芯片,它的矩阵乘/卷积吞吐与访存结构与 CPU/GPU 不同,在大规模训练上更省时省电。硬件细节对理解本讲不是必需的,记住“预训练单卡 GPU 不现实,微调单卡可行”这个结论即可。
由此得到一句要背下来的口号:
“Pretrain once, finetune many times.”(预训练一次,微调多次。)
预训练又贵又不适合单卡;但微调便宜、常见,一块小小的 GPU 就能跑。
3.5 BERT 带来的冲击
(参考时间: 00:48:30)
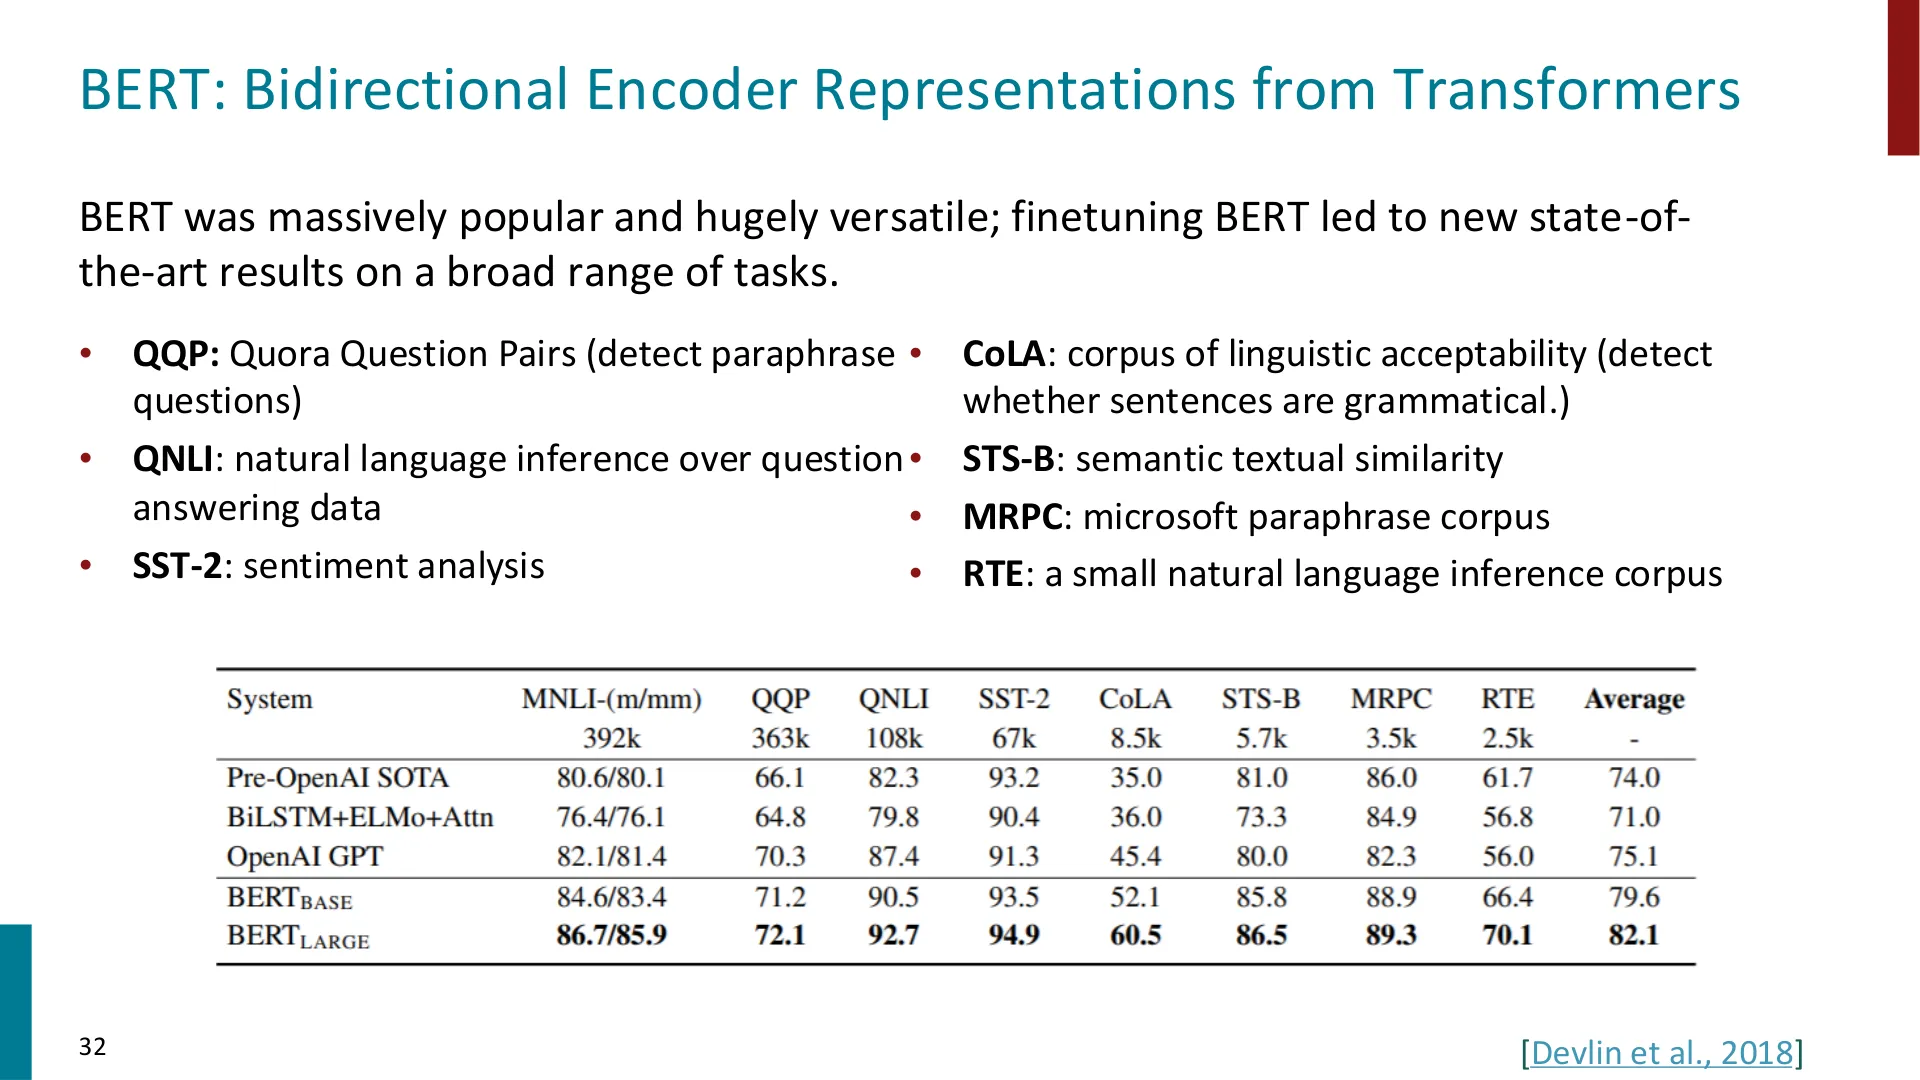
📷 BERT 在多个基准任务上刷新了当时的最佳结果
回到原视频 (00:48:30)
微调 BERT 在一大堆任务上刷新了当时的最佳结果,包括:
- QQP:Quora Question Pairs(判断两个 Quora 问题是否只是换了个说法)
- QNLI:基于问答数据的自然语言推理
- SST-2:情感分析
- CoLA:语言学可接受性语料库(判断句子是否符合语法)
- STS-B:语义文本相似度(两句意思是否接近)
- MRPC:Microsoft 转述语料库
- RTE:一个小型自然语言推理语料库
编者拓展|这些任务就是 GLUE 上面这组任务合起来就是 GLUE(General Language Understanding Evaluation)基准。它的设计意图是:用一组风格各异、且各自都让当时的系统很头疼的任务,来近似衡量“语言理解的通用程度”。这恰好回应了课堂上“该怎么评价一个如此通用的预训练模型”这个问题——没有单一指标,只能用一整套基准来论证。
老师说,这件事对领域的冲击“难以用语言形容”:
过去,每个任务都要精心设计专属架构,每个人都自己设计网络、琢磨怎么连、怎么定权重,各干各的。而这一切,被“搭一个大 Transformer、教它预测缺失的词、再在各项任务上微调”彻底冲垮了。
他补了一句很诚实的话:
“这没有 ChatGPT 那么炫,我得承认,但它确实是通往 ChatGPT 那个故事的一部分。”
3.6 编码器的局限:不能自然生成
(参考时间: 00:53:20)
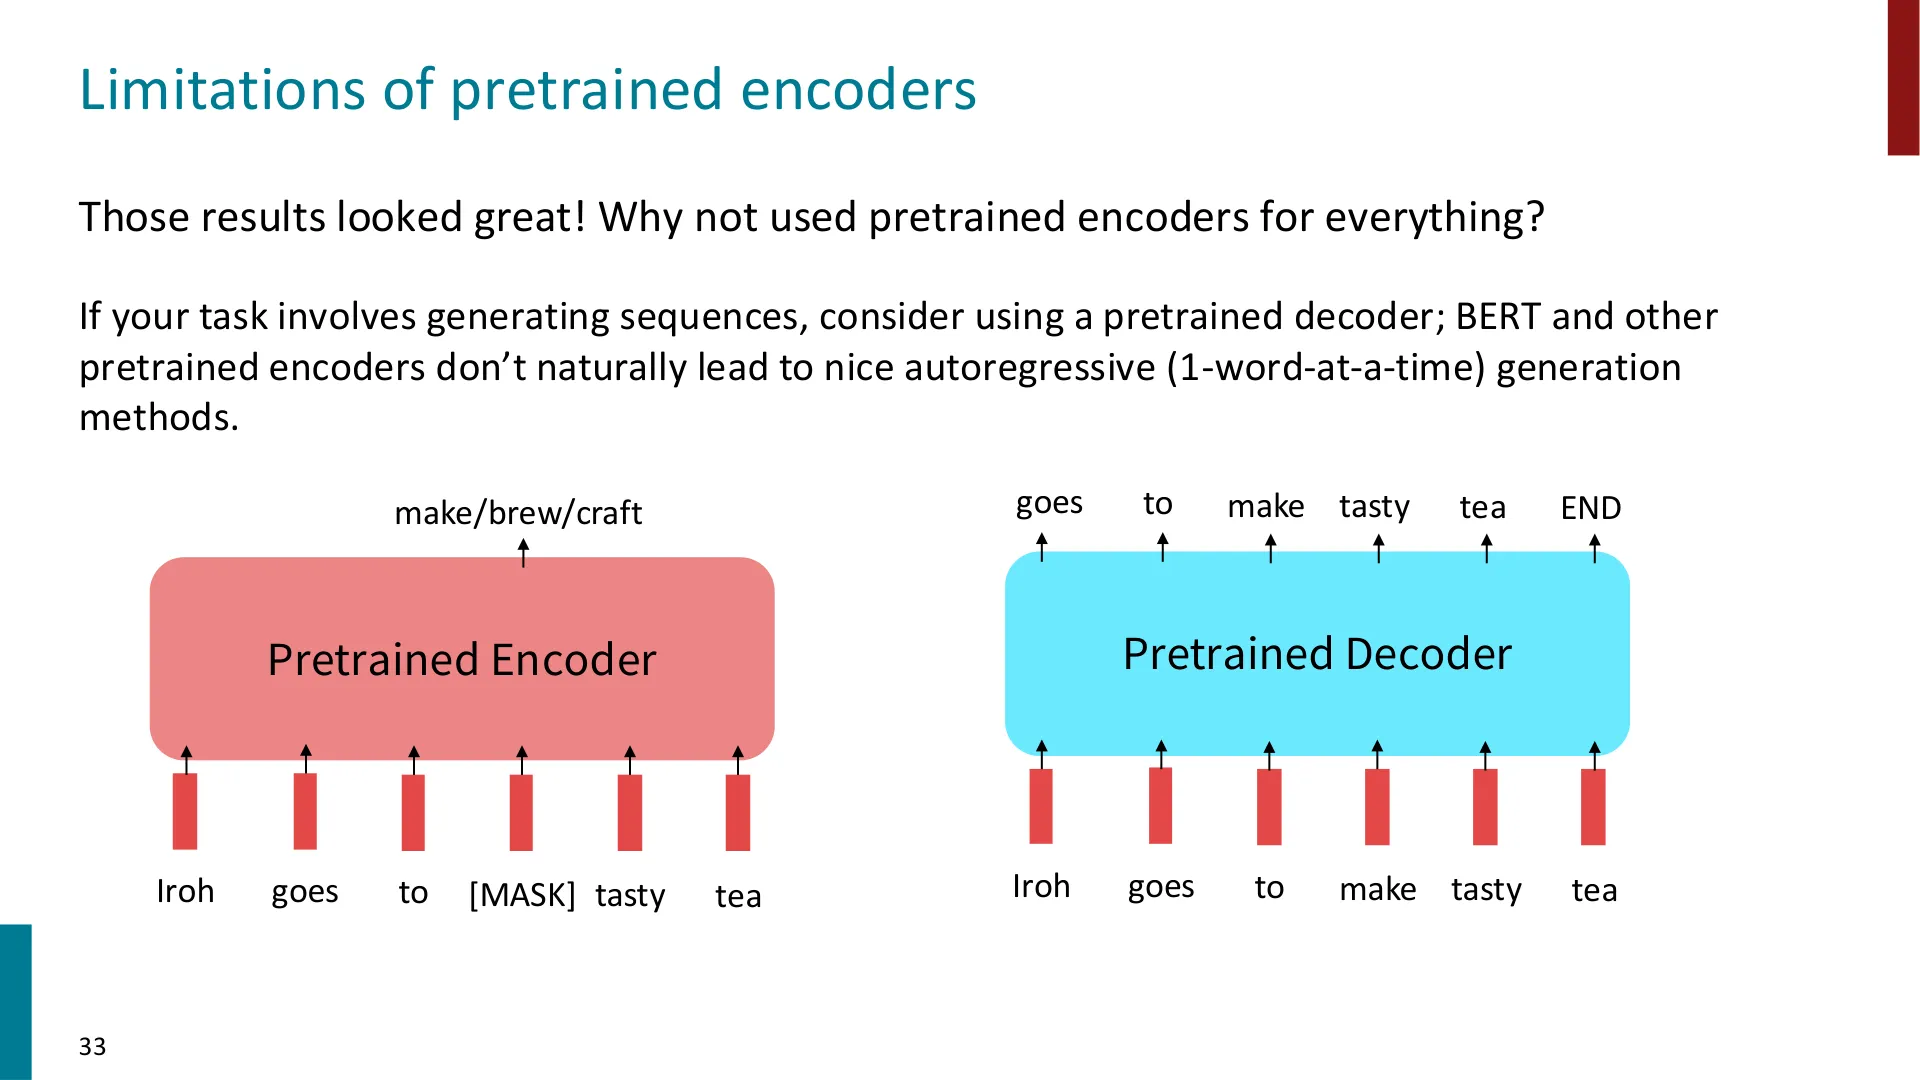
📷 预训练编码器不适合自回归生成
回到原视频 (00:53:20)
那为什么不干脆哪里都用 BERT?因为要看预训练目标和模型结构是不是匹配任务。
BERT 擅长填空,但不适合生成文本。它既不天然地定义“给定全部历史预测下一个词”,也就没有自回归(一次一个词)的生成机制。
graph TD
    A{"你的任务是什么?"} -->|"需要理解/表示整段文本<br/>分类、判断、抽取"| B["用预训练编码器<br/>例如 BERT / RoBERTa"]
    A -->|"需要逐词生成序列<br/>摘要、对话、翻译"| C["用预训练解码器<br/>例如 GPT 系列"]
具体来说:想要一篇文章的好表示,比如给文档打主题标签、判断是否有毒——用 BERT 很合适;想要生成一整段序列,比如写摘要——就不该用 BERT。
3.7 BERT 的扩展:RoBERTa 与 SpanBERT
(参考时间: 00:54:10)
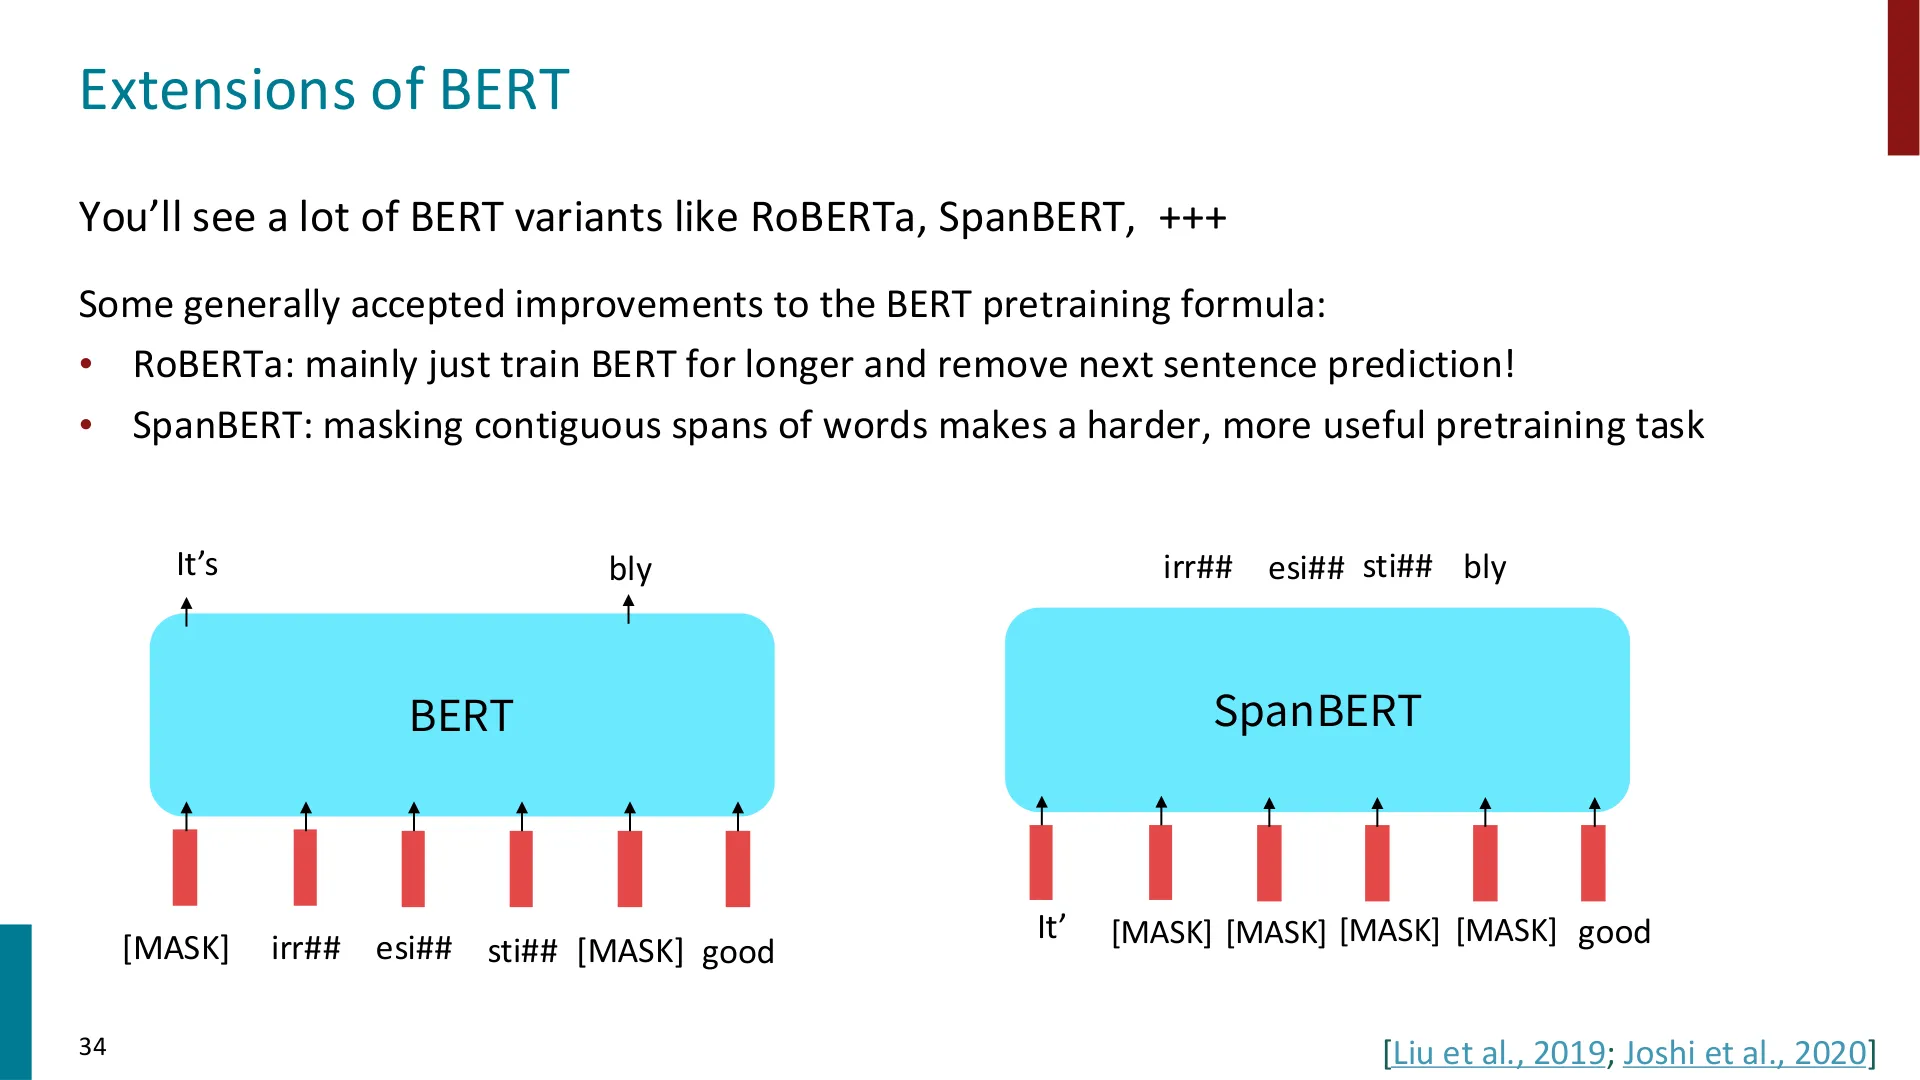
📷 SpanBERT:把连续的整段子词一起遮住,任务更难也更有用
回到原视频 (00:54:15)
SpanBERT(Joshi et al., 2020):既然单个子词的预测太容易,那就一次遮住一整段连续的词。例如:
- BERT:
It's irr## esi## sti## [MASK] good(只遮一个子词,靠左边的irr##esi##sti##基本就能猜出bly) - SpanBERT:
It' [MASK][MASK][MASK][MASK] good(整段一起遮,更难,也更有用)
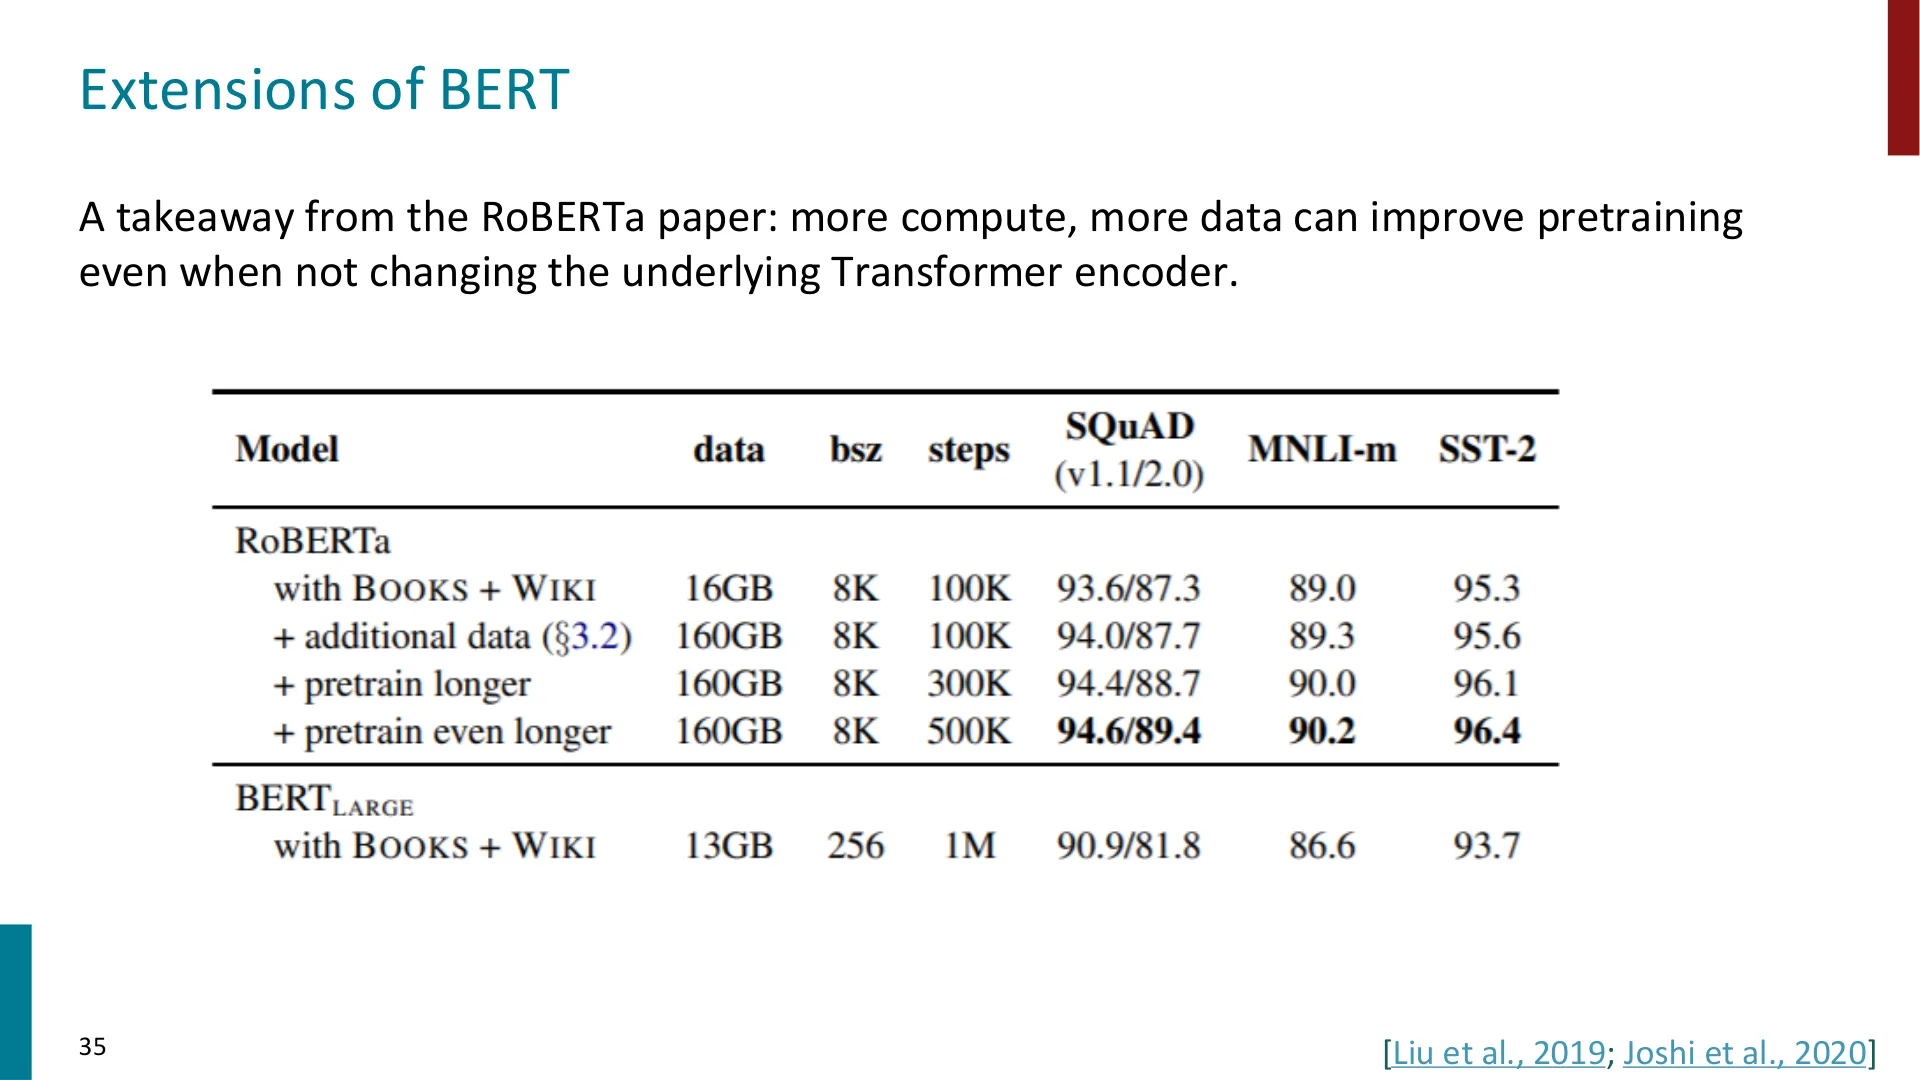
RoBERTa(Liu et al., 2019):本质上是把 BERT 训得更久,并去掉下一句预测。它是即插即用的替代品——如果你想用 BERT,直接用 RoBERTa 就好,它更好。
由此得到一条更普适的经验:
更多的算力、更多的数据,即使不改动底层 Transformer 编码器,也能改善预训练。
老师也指出这里的研究困境:这些模型又大又贵,很难做迭代实验,“你只能豁出去多久就训多久,然后看效果”。
3.8 参数高效微调:只动一小部分参数
(参考时间: 00:55:45)
前面讲的都是“预训练全部参数,微调也全部参数”。另一种思路是参数高效 / 轻量微调(parameter-efficient / lightweight finetuning):冻结大部分预训练参数,只训练很少量的新参数。动机是——预训练参数本来就很好,我们希望从预训练模型到目标任务模型,只做最小的改动,从而保留预训练带来的通用性。
graph TD
    A["参数高效微调"] --> B["Prompt / Prefix Tuning<br/>冻结全部参数,只学一小段<br/>可训练的伪词向量"]
    A --> C["添加少量新层<br/>只训练新加的部分"]
    A --> D["LoRA<br/>冻结原权重矩阵,只学一个<br/>低秩增量 ΔW"]
Prefix Tuning / Prompt Tuning:把网络参数全部冻结,而在序列最前面加上一串“伪词向量(pseudo word vectors)”——它们本来是输入的位置,现在我们把它当作参数来训练。结果是:只改变这几个“假词”的取值,就能把整个网络导向做情感分析。好处是:保留全部好的预训练参数,把“差异”压缩到极小的可训练量里;而且更便宜——不必为所有参数计算、存储梯度与优化器状态。老师提醒:这些“假词”必须放在开头,因为解码器是单向的,放后面就看不到了。
添加新层:在预训练网络的顶部加几层,只训练这几层。老师确认“绝对可行,而且效果略好一些”。
LoRA(Hu et al., 2021):对每一个权重矩阵 $W$,冻结 $W$,只学一个低秩的增量 $\Delta W$,把实际权重设成
$$ W_{\text{new}} = W + \Delta W, \qquad \Delta W = B A,\quad \text{rank}(BA) \ll \min(m,n) $$
总体思想都一样:训练的参数远少于预训练,把大部分预训练参数冻结住。
编者拓展|为什么低秩增量够用 微调的实质往往是把预训练模型的表示在一个比较低维的子空间里做小旋转。因此 $W$ 的改动 $\Delta W$ 常常近似低秩。若 $W$ 是 $m\times n$,把一个满秩的 $m\times n$ 增量换成 $m\times r$ 与 $r\times n$ 的乘积($r$ 很小),可训练参数就从 $mn$ 降到 $r(m+n)$。这也是 LoRA 在显存和存储上都很划算的原因。
3.9 编码器-解码器:T5 与 span corruption
(参考时间: 00:58:40)
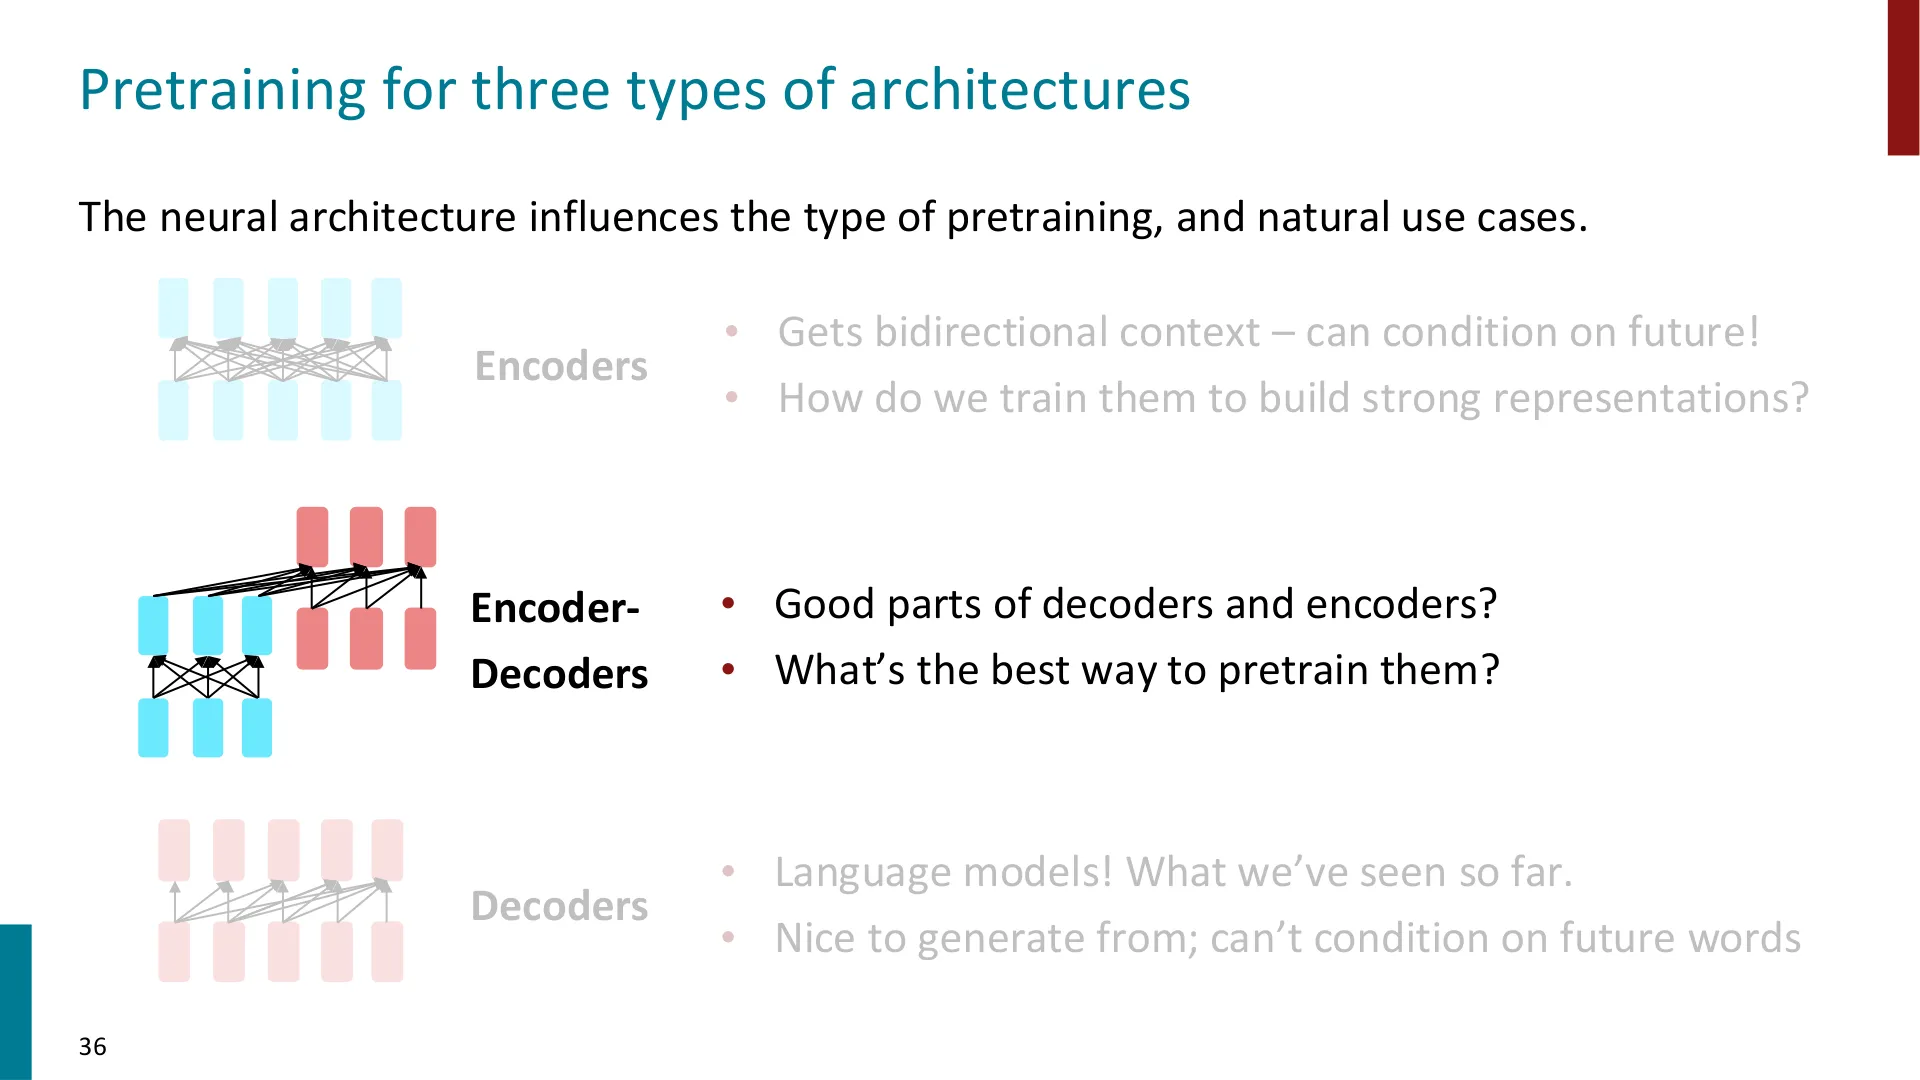
📷 三种架构再次出现,导入编码器-解码器部分
回到原视频 (00:58:40)
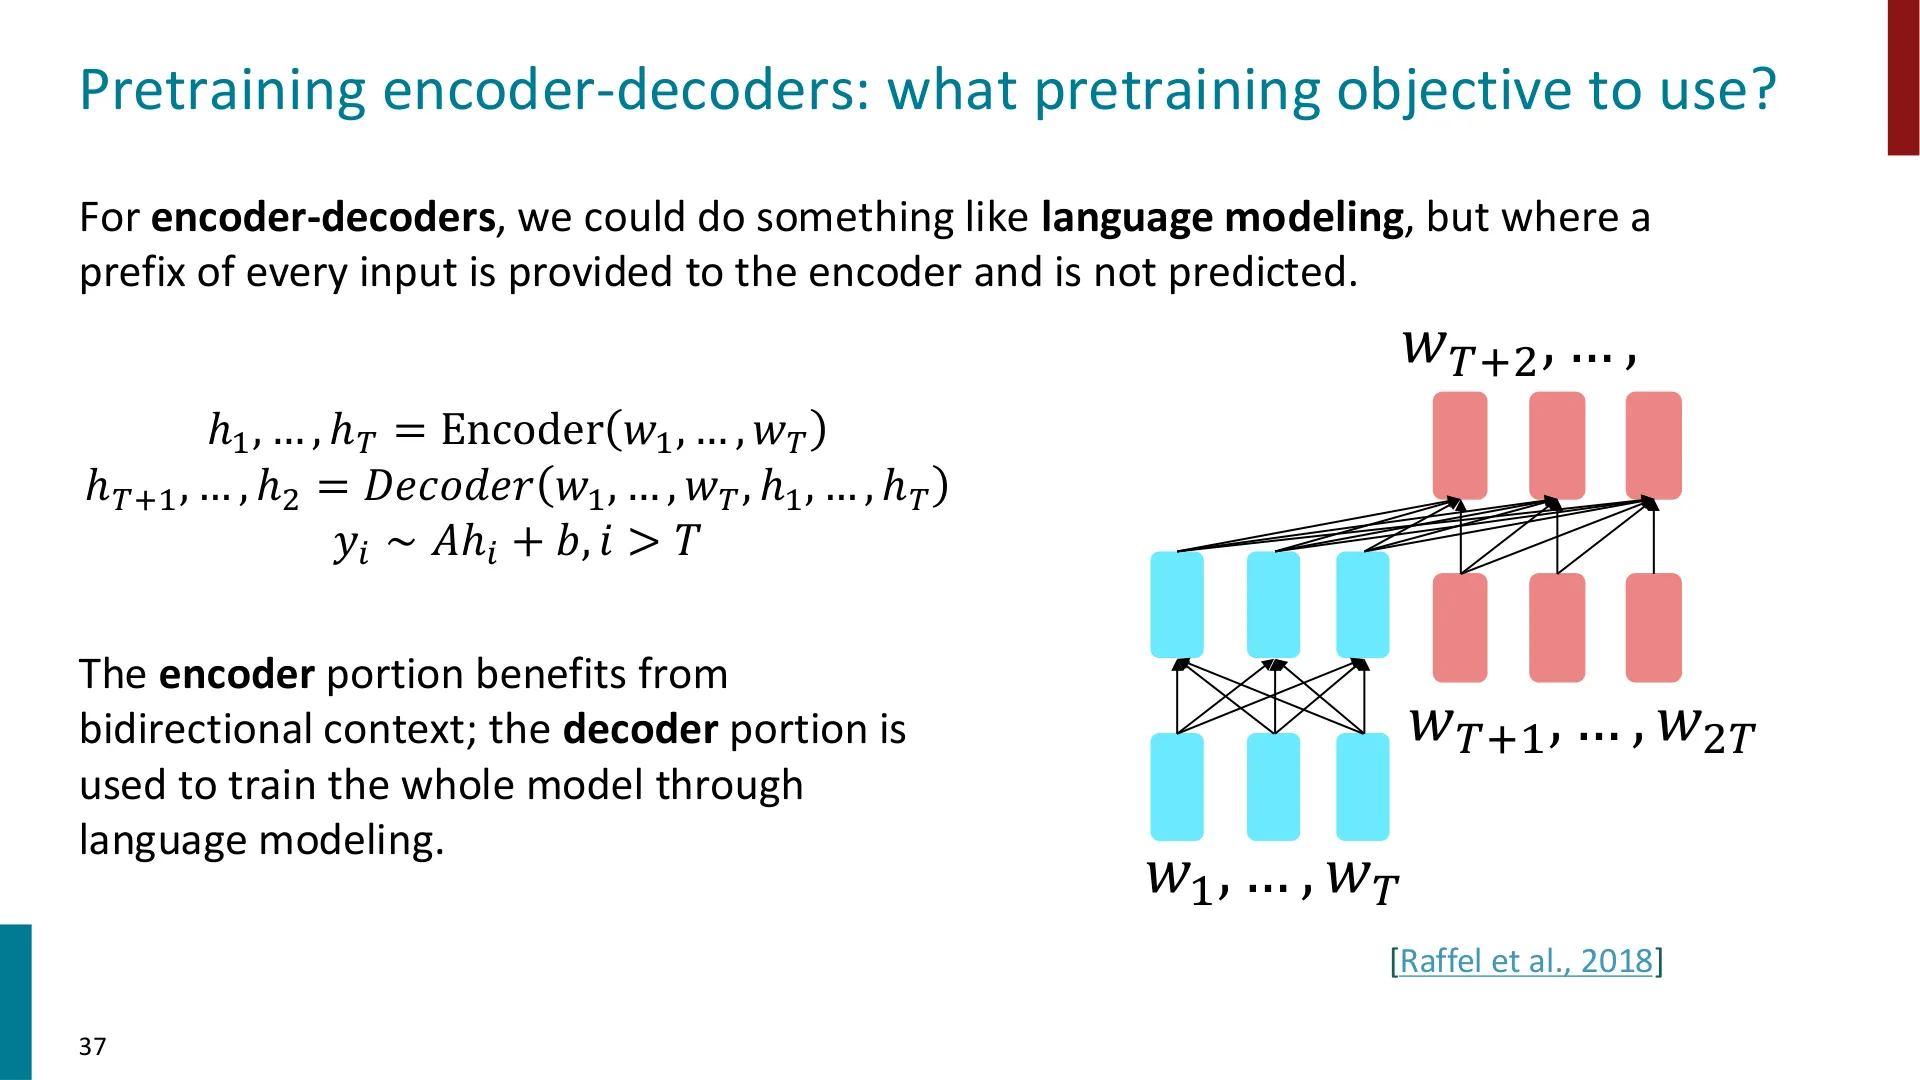
📷 编码器-解码器的朴素做法:把前缀给编码器,用解码器预测后半段
回到原视频 (00:59:05)
对编码器-解码器,一个朴素的做法是:把输入序列的前缀($w_1,\dots,w_T$)交给编码器(享受双向上下文),再让解码器去预测后半段($w_{T+1},\dots,w_{2T}$),就像语言模型那样:
$$
🖼️ 第 33 页幻灯片 · Extensions of BERT
$$ h_{T+1},\dots,h_{2T} = \text{Decoder}(w_1,\dots,w_T,\; h_1,\dots,h_T) $$
$$ y_i \sim A h_i + b,\qquad i > T $$
这确实能用:把一段文本劈成两半,前半给编码器,后半用解码器生成。
但实践中效果更好的,是 span corruption(片段腐蚀)。
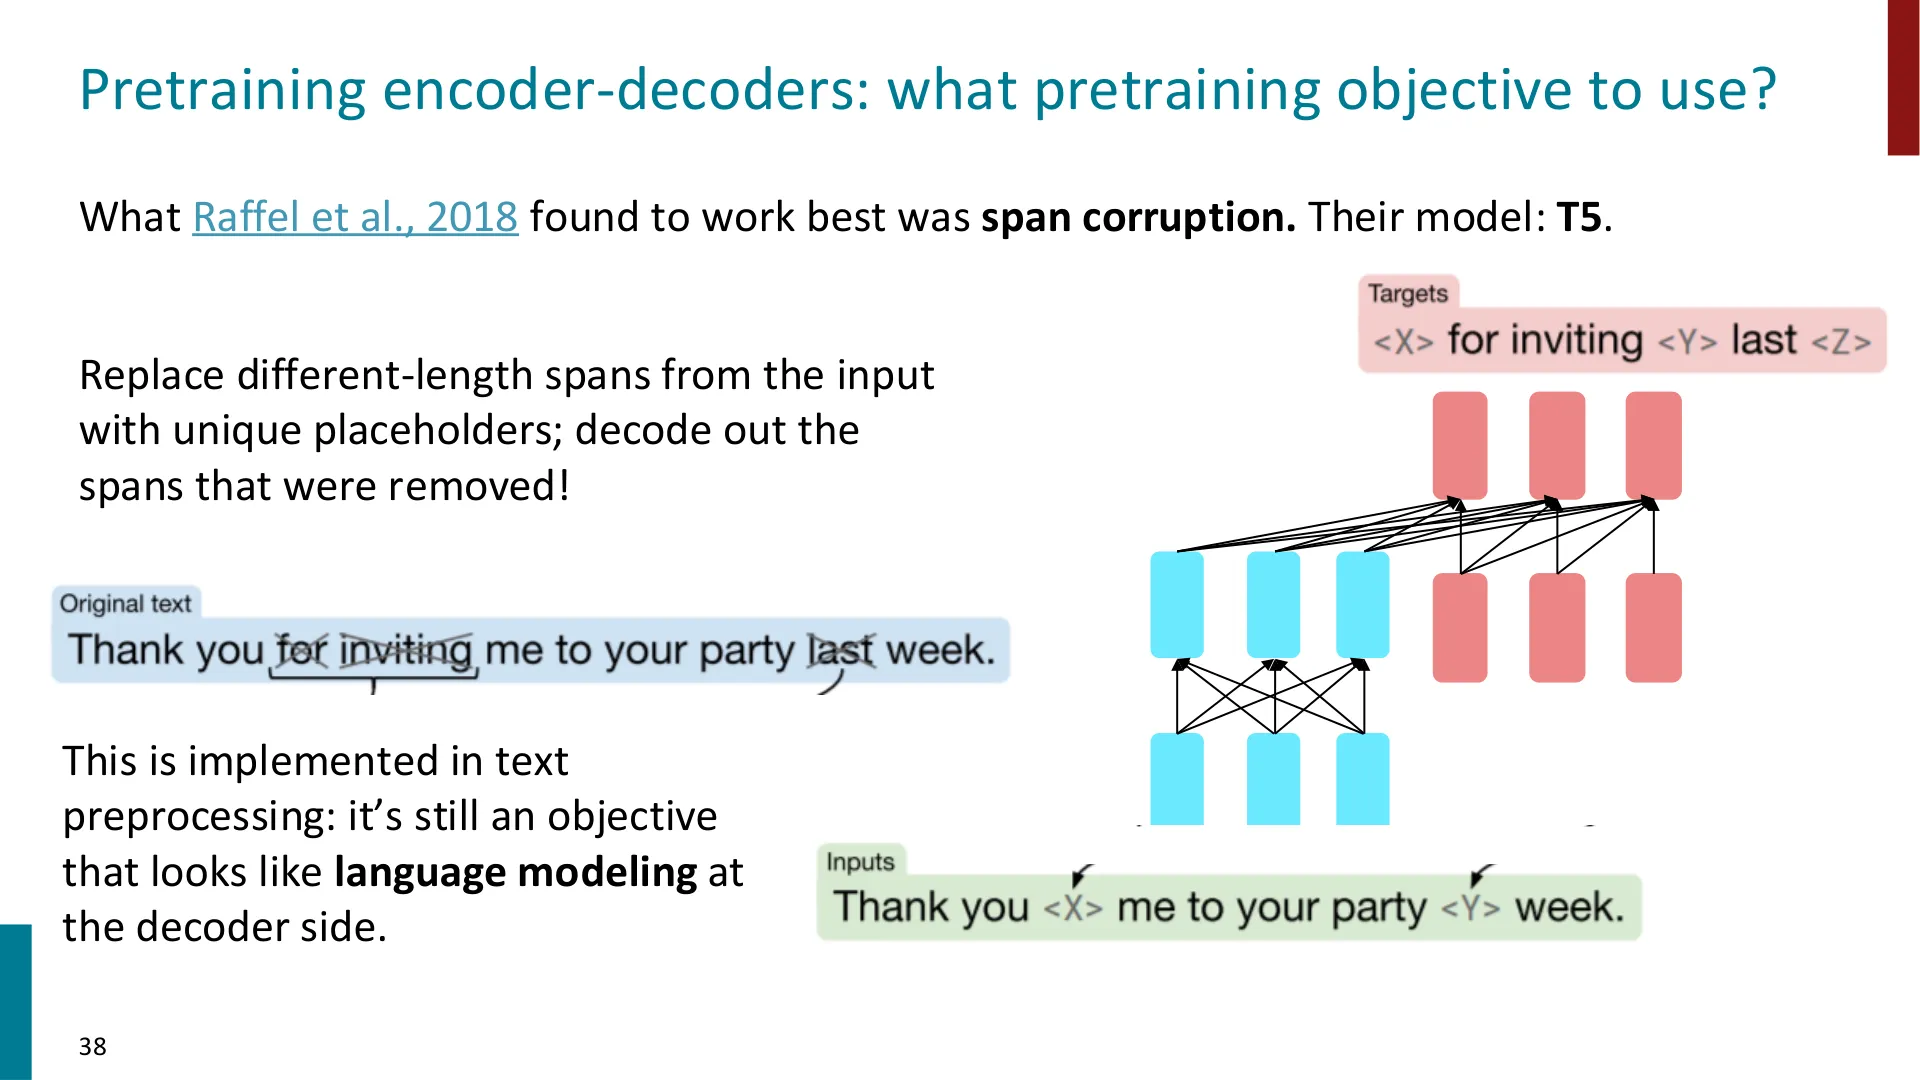
📷 T5 的 span corruption:把不同长度的连续片段替换成唯一占位符,再在解码器端把它们“解码回来”
回到原视频 (00:59:20)
它的思路很像 BERT,但是生成式的:把输入里的若干段词替换成特殊占位符,然后让解码器把这些被拿掉的片段生成出来。
输入:Thank you [X] me to your party [Y] week
输出:[X] for inviting [Y] last
也就是说:
- 编码器看到的是被挖掉了若干片段的、带双向上下文的完整序列;
- 解码器要依次生成被移除的那些片段。
这看起来像“遮住一部分输入”,但输出端像语言建模一样逐词生成——因此特别适合“输入需要双向上下文、输出需要生成”的任务,比如机器翻译。
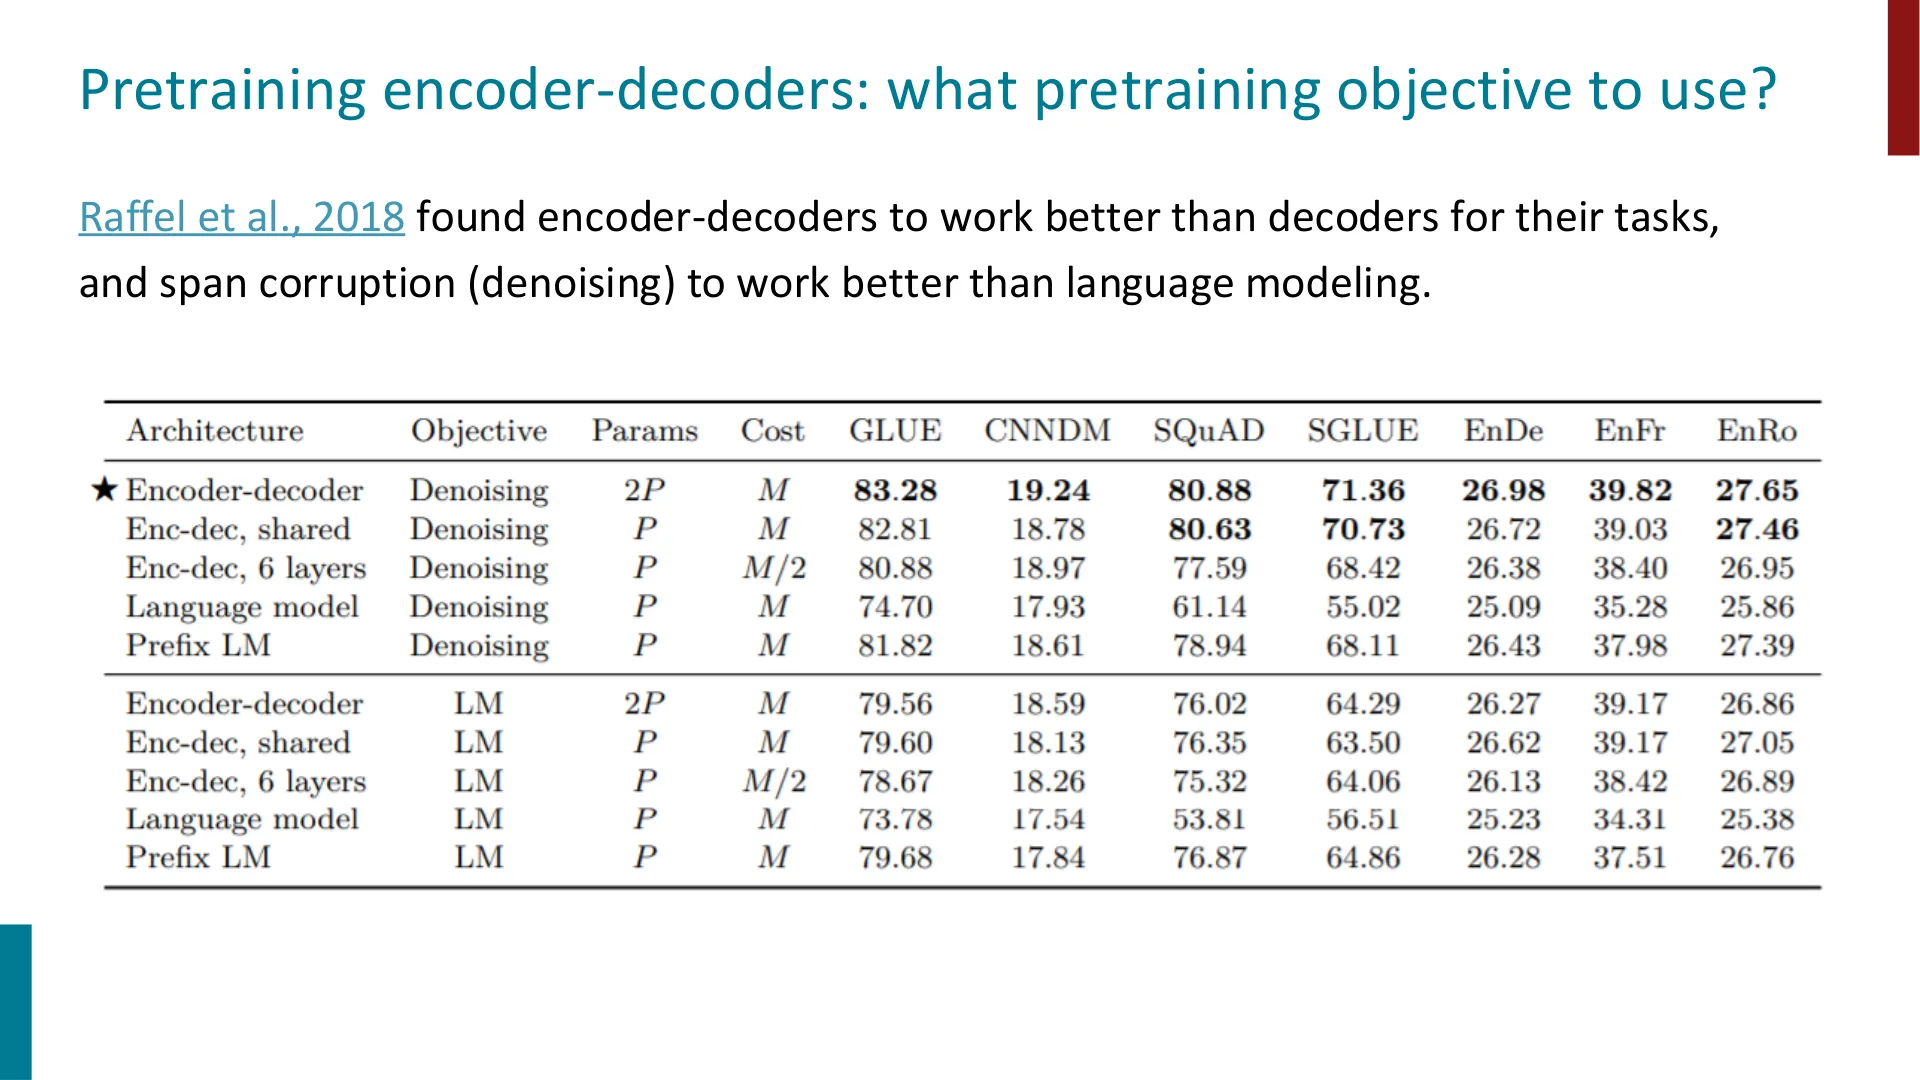
📷 实验结论:编码器-解码器在其任务上优于解码器,span corruption(去噪)优于语言建模
回到原视频 (01:00:34)
Raffel et al., 2018 发现:在他们的任务上,编码器-解码器优于解码器,span corruption(去噪)优于语言建模。这个模型就是 T5。
编者说明:注意一个细节——span corruption 其实是在文本预处理阶段实现的(先把片段替换成占位符),所以“对模型而言”,解码器端看到的目标仍然长得像语言建模。这说明:目标函数的灵活性可以放在数据构造那一侧。
T5 的一个迷人性质:隐式检索
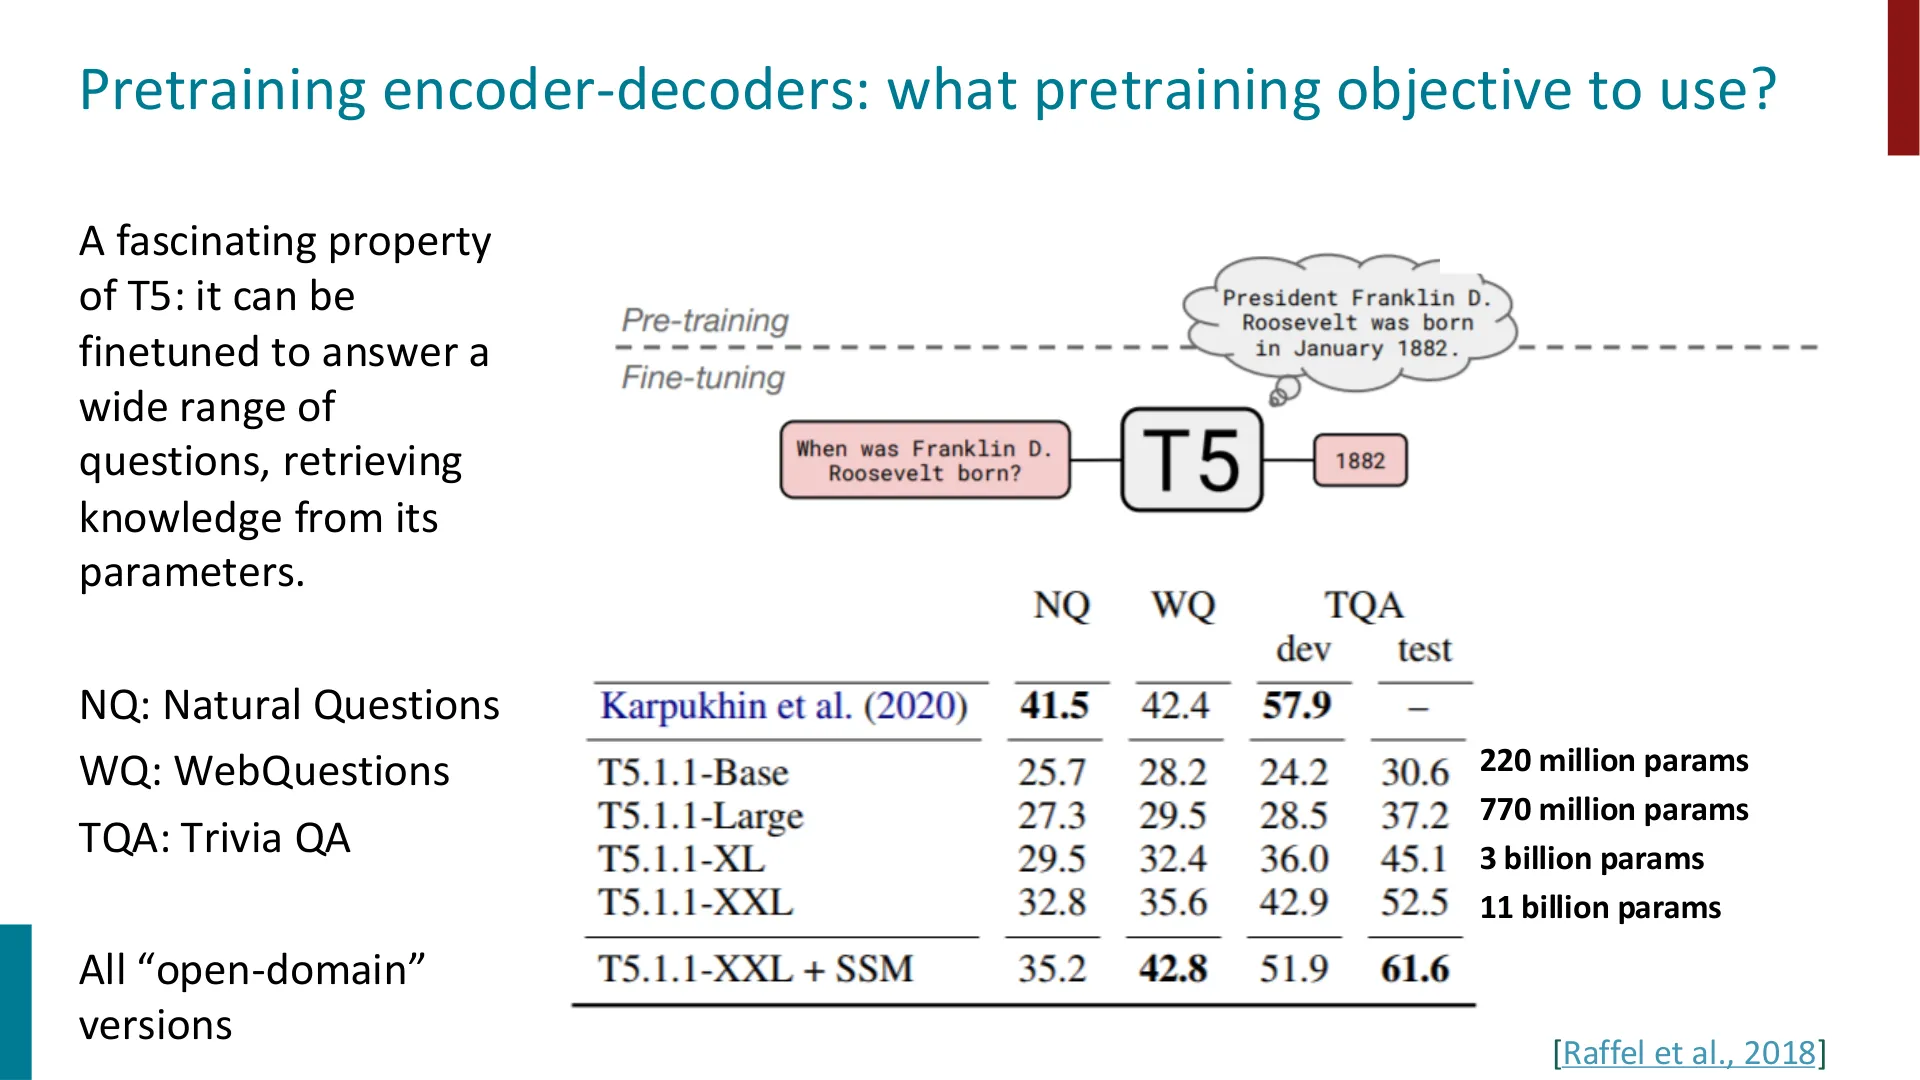
📷 T5 在不同规模与开放域问答数据集上的表现
回到原视频 (01:00:44)
预训练时它见过大量“Franklin D. Roosevelt 出生于 ____”之类的文本;然后有一个任务叫开放域问答(open-domain QA):给你一堆冷知识问题(如“罗斯福哪年出生”),要求直接从参数里生成答案字符串。
T5 的做法是:先用一些问答样本做微调,然后在从未见过的新问题上作答时,模型似乎能“隐式地”从预训练数据里把答案取出来——虽然它在微调时从没显式见过那个答案。
相关数据集包括 NQ(Natural Questions)、WQ(WebQuestions)、TQA(TriviaQA),都用“开放域”版本。
编者拓展|“隐式检索”为什么令人惊讶 传统的开放域问答要外挂一个检索器(先搜文档,再读文作答)。T5 表明:参数本身可以充当一个压缩的“知识库”。这被称为参数化知识(parametric knowledge)与检索式知识(retrieval-based knowledge)的对比。它的意义在于——模型不只是学会了语言形式,还在权重里存下了事实。但代价也很明显,见下文“常有答案很流畅却错误”。
老师强调两点:
- 这些答案总是很流畅、看上去很合理,但经常是错的——这个现象至今仍适用于 ChatGPT 一类系统;
- 这背后是隐式检索这一“迷人”的性质。
3.10 解码器:GPT 系列
(参考时间: 01:02:20)
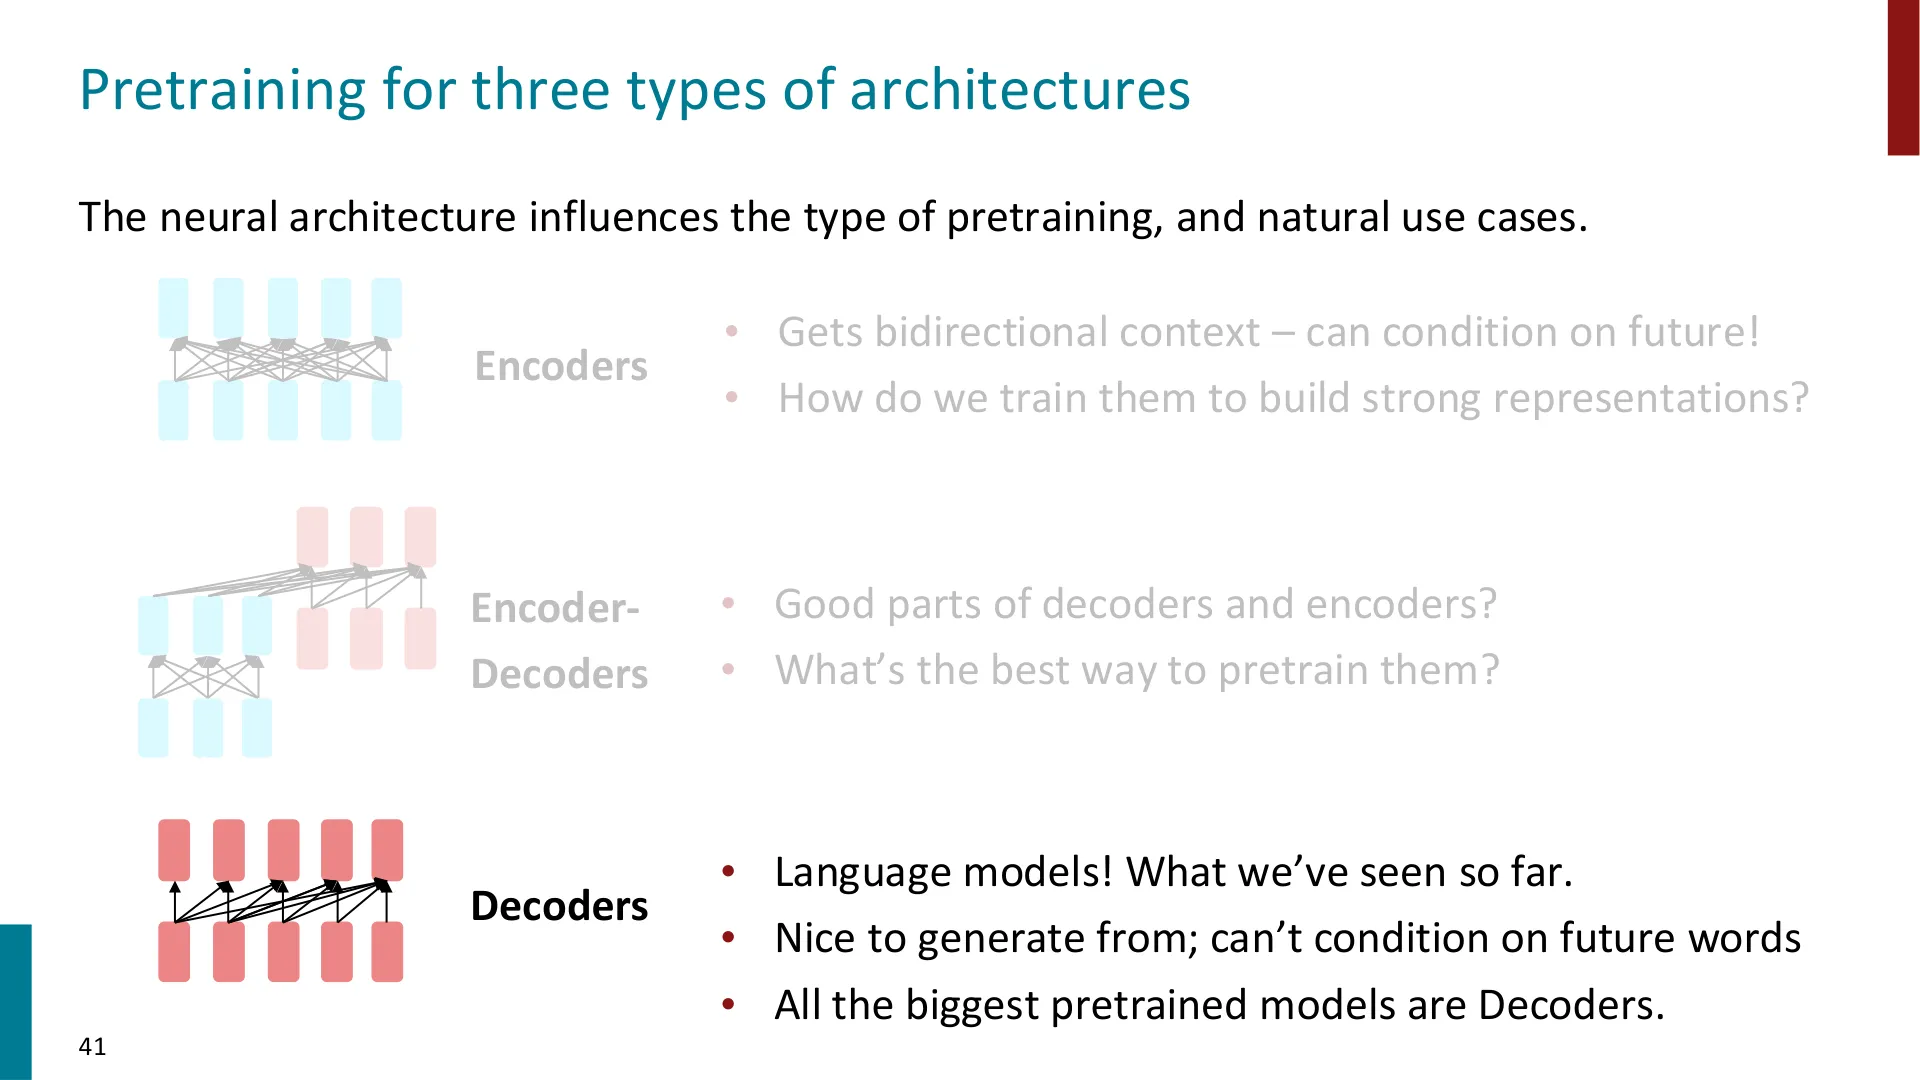
📷 三种架构再回顾:今天的最大预训练模型都是解码器
回到原视频 (01:02:30)
为什么最大的模型都是解码器? 老师给的猜测是:
- 解码器更简单;
- 全部参数共享在同一个大网络里,而编码器-解码器必须把参数拆成两部分(一部分给编码器、一部分给解码器)。
因此“大大小小的网络,只要够大,往往都是解码器”。
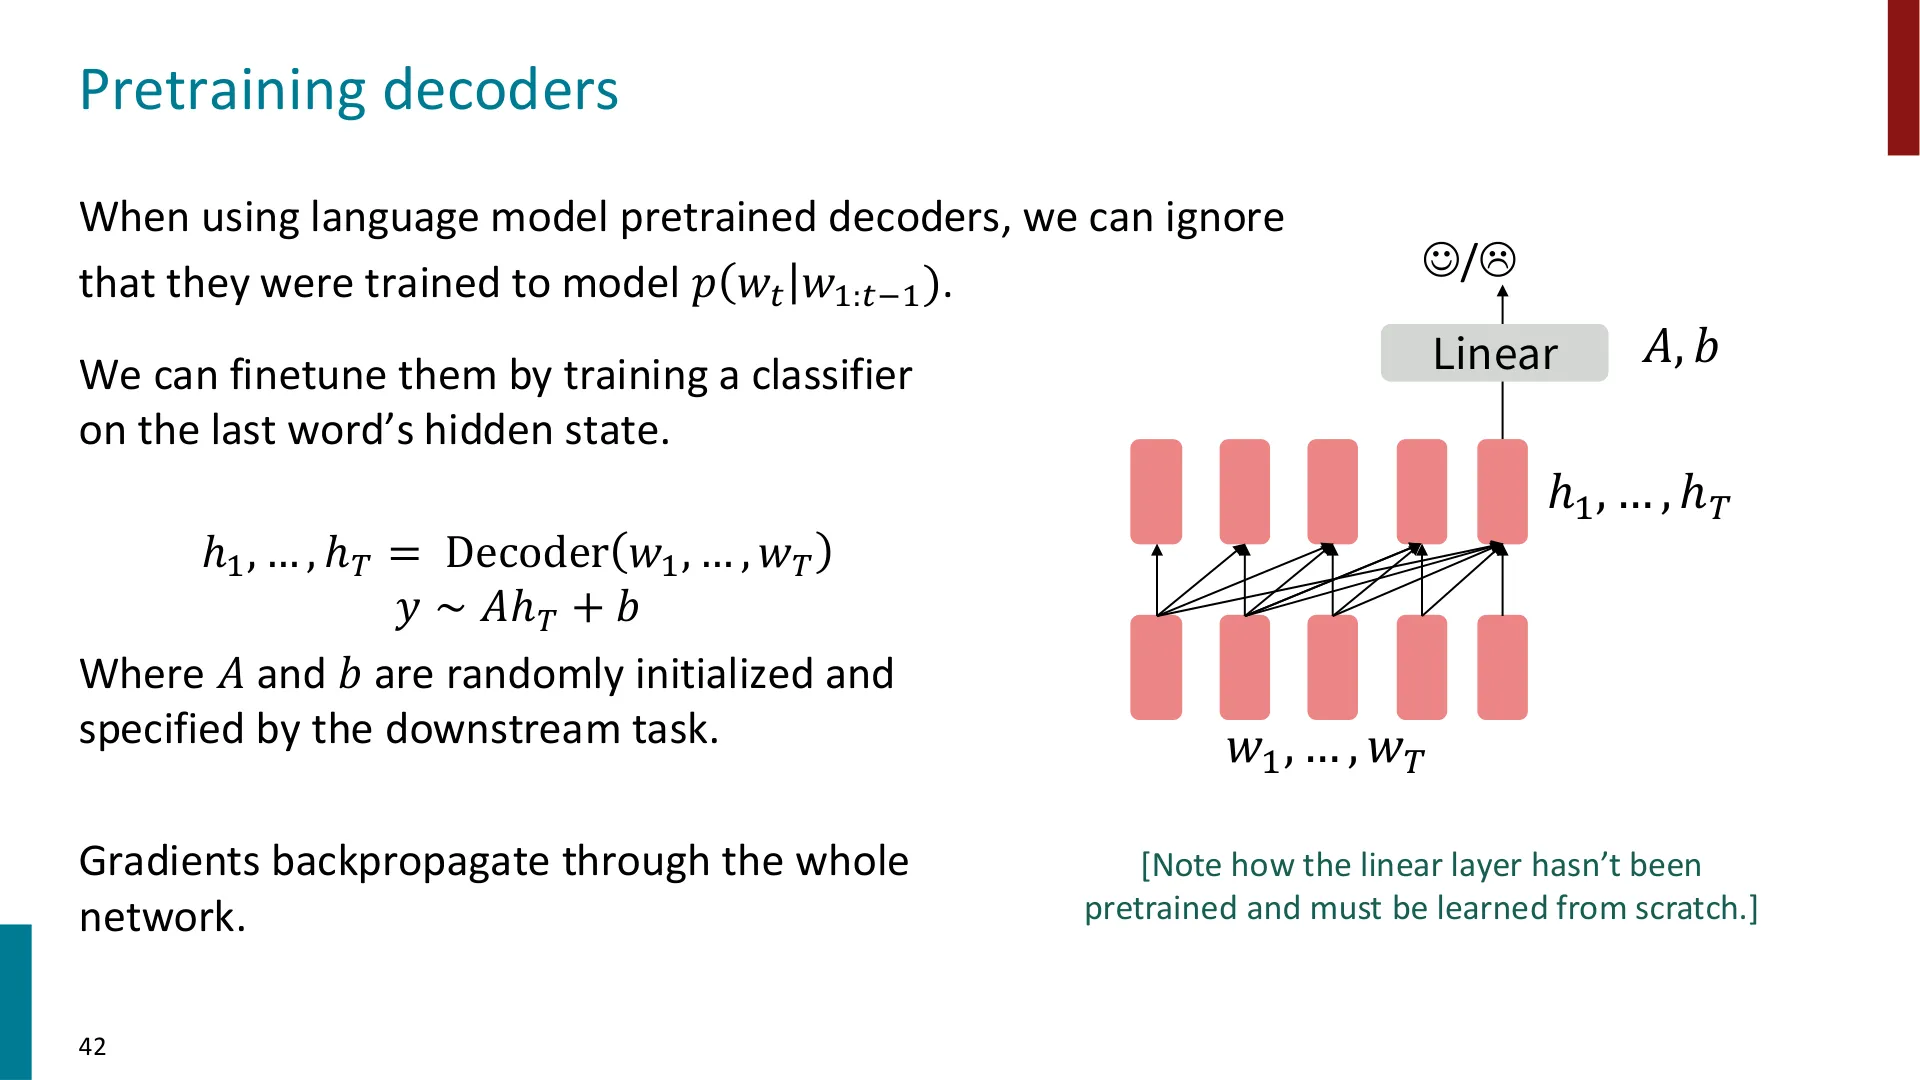
📷 预训练解码器用于分类:取最后一个词的隐状态,接一个线性分类器
回到原视频 (01:02:50)
用法一:当分类器。 忘掉它是语言模型这件事:取最后一个词的隐状态 $h_T$,接一个线性层
$$ y \sim A h_T + b $$
其中 $A,b$ 随机初始化、由下游任务决定,反向传播穿过整个网络。(注意:这个线性层没有经过预训练,必须从头学。)
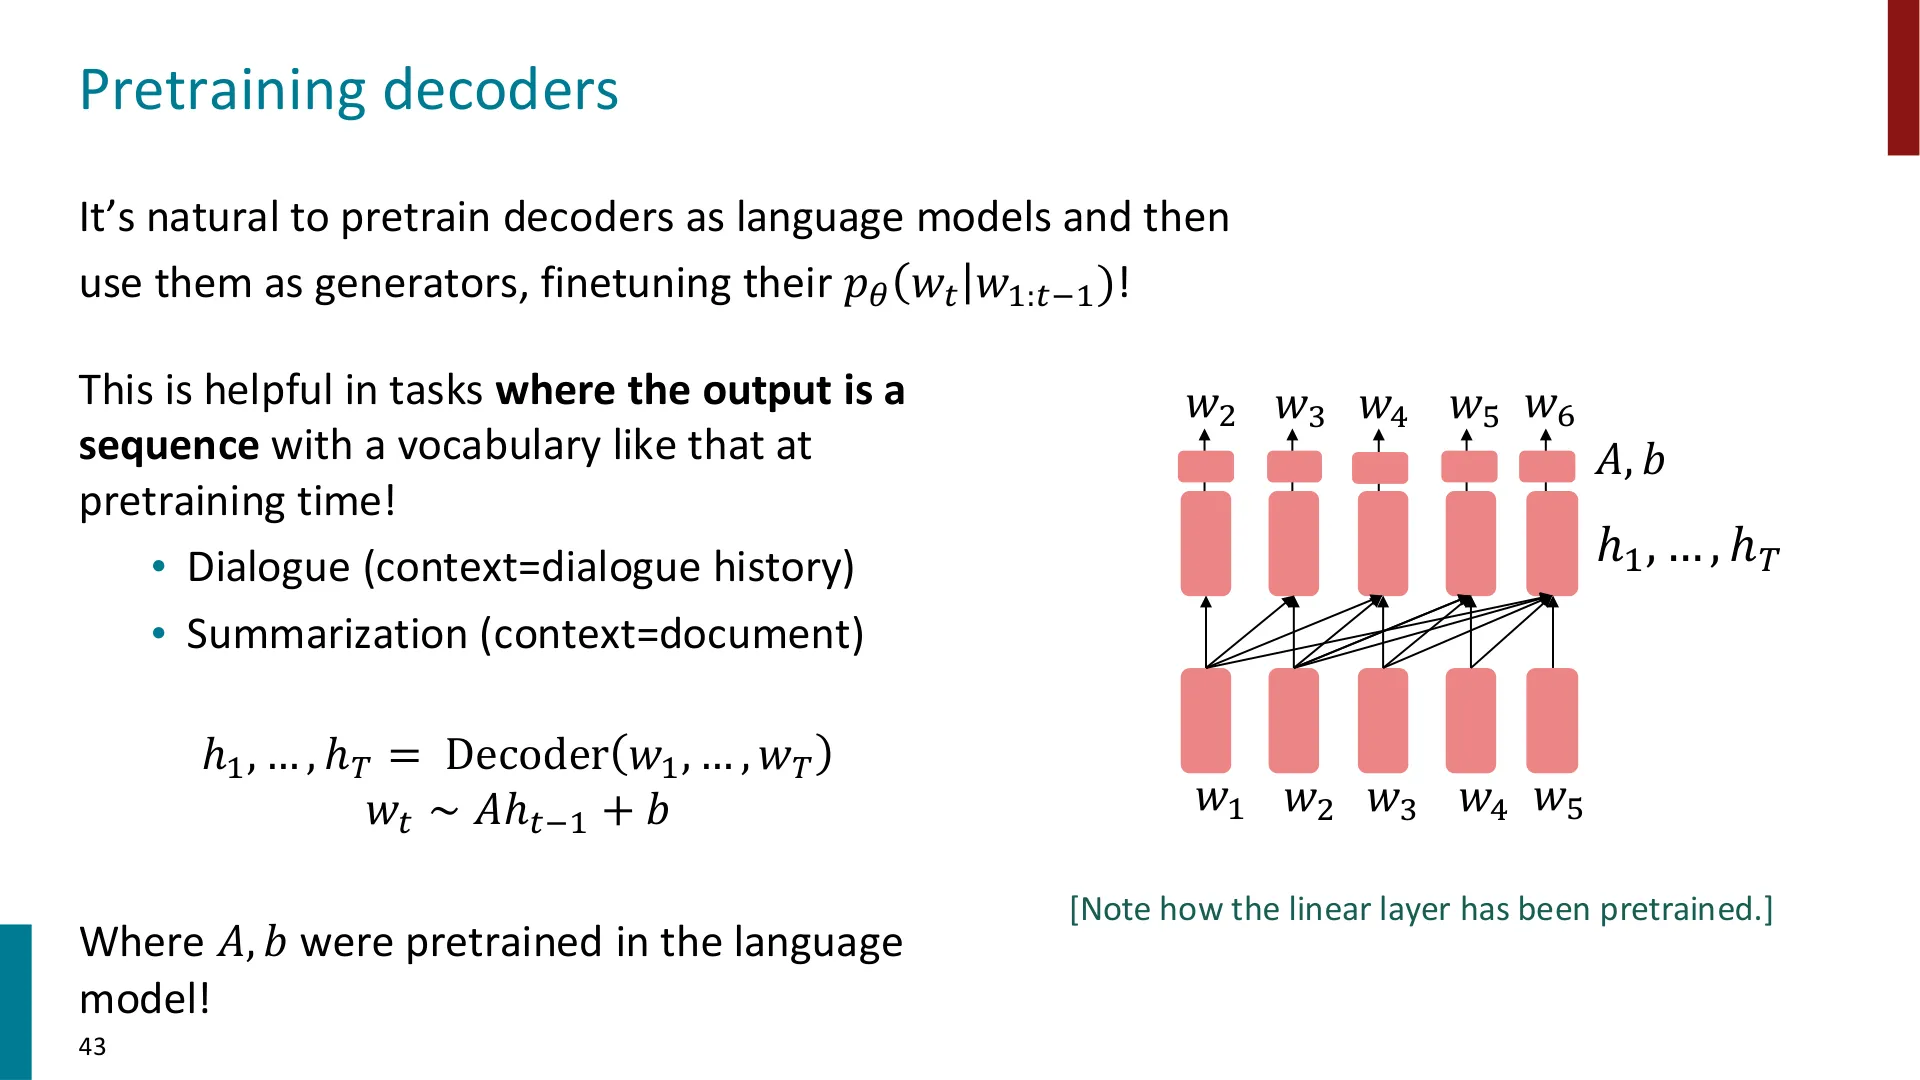
📷 预训练解码器用于生成:$A,b$ 也在预训练中已经学过
回到原视频 (01:03:10)
用法二:当生成器。 把解码器当语言模型预训练,再当成生成器微调它的 $p_\theta(w_t \mid w_{1:t-1})$。此时
$$ w_t \sim A h_{t-1} + b $$
这里的 $A,b$ 是语言模型预训练时就已经学好的。这适用于“输出是一段序列、且词表与预训练相近”的任务,比如对话(上下文=对话历史)、摘要(上下文=文档)。
GPT-1(Radford et al., 2018)
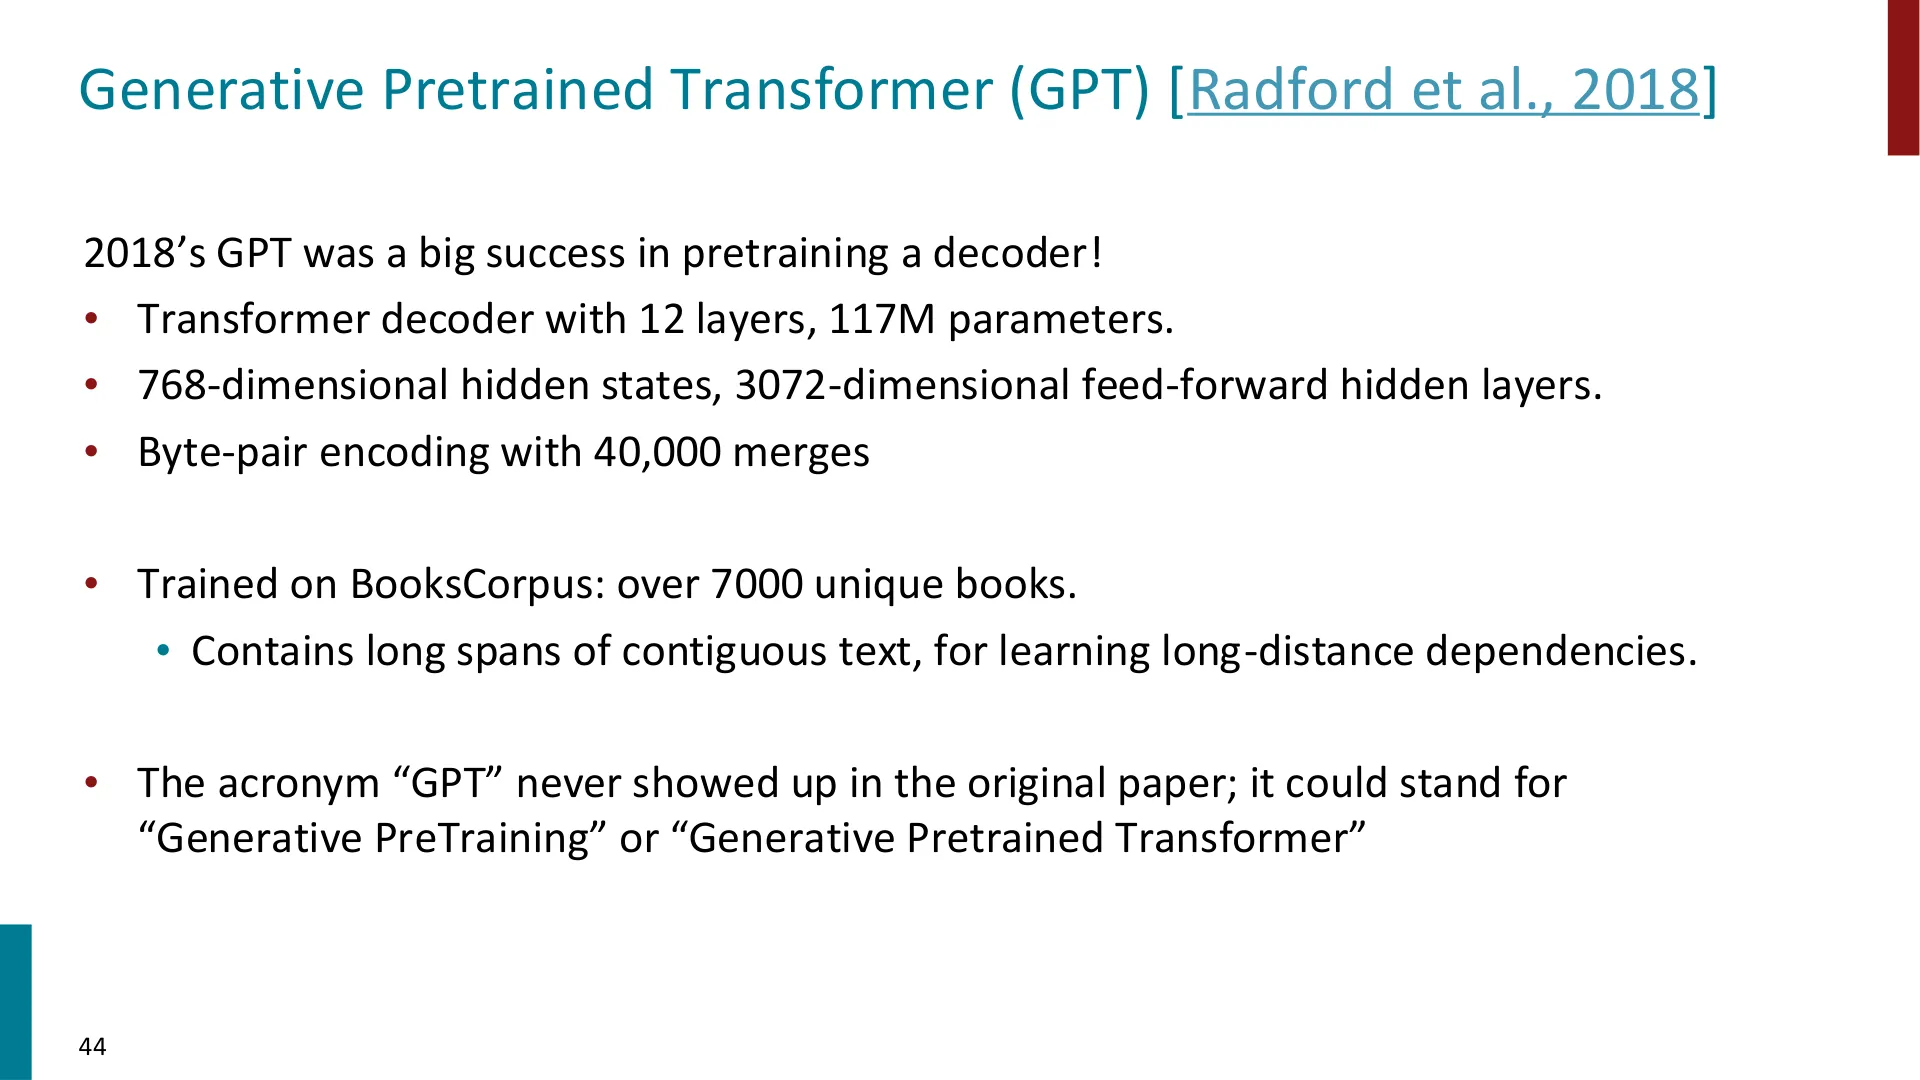
📷 GPT-1:首个成功预训练的解码器
回到原视频 (01:04:05)
- 12 层 Transformer 解码器,1.17 亿参数;
- 隐藏状态 768 维,前馈隐藏层 3072 维;
- 用 BPE,40,000 次合并;
- 训练语料 BookCorpus,7000 多本去重书籍——里面有很长的连续文本,适合学长距离依赖;
- 一个有趣的冷知识:“GPT”这个缩写从未在原论文里出现过,它大概代表 “Generative PreTraining” 或 “Generative Pretrained Transformer”。
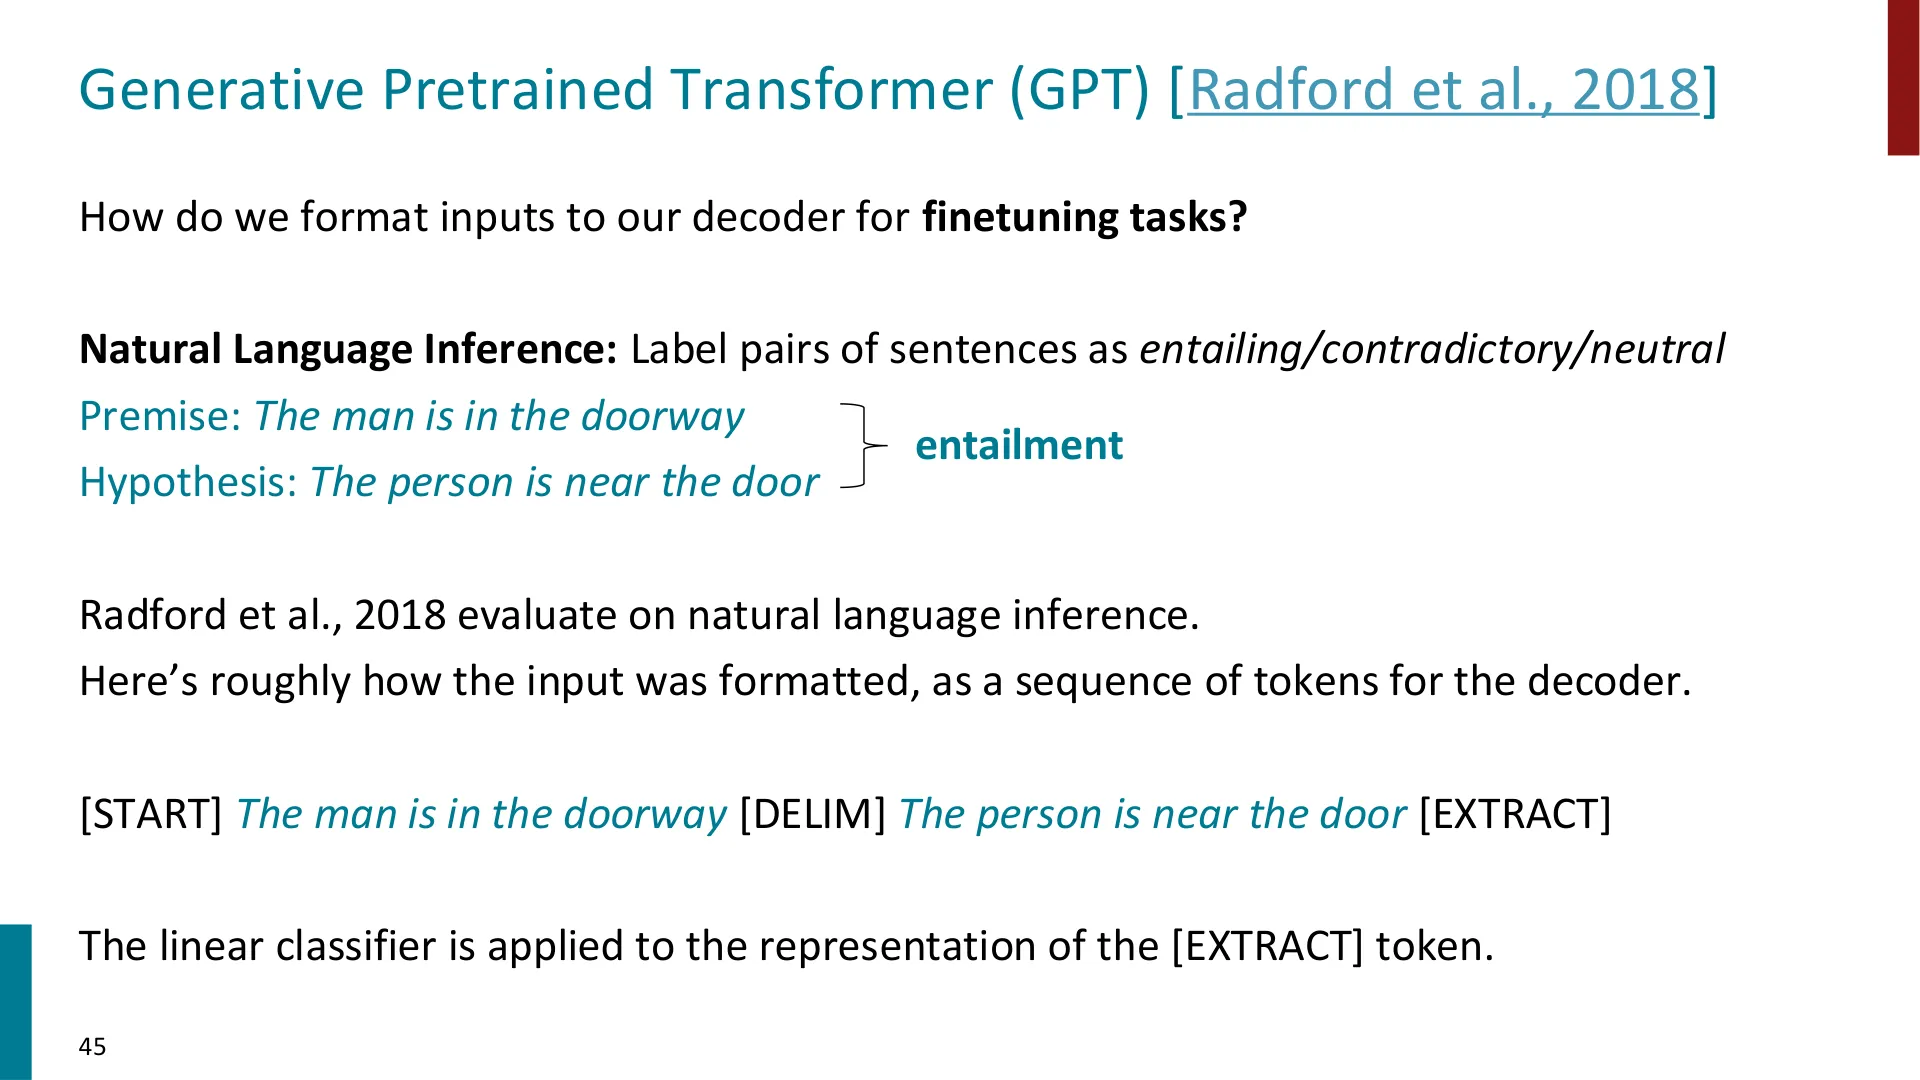
怎么把下游任务塞进解码器? 讲者用自然语言推理(NLI)举例。给定
- 前提(premise):
The man is in the doorway - 假设(hypothesis):
The person is near the door
要把这一对句子标为 entailment / contradiction / neutral。做法是把两句话拼起来,用特殊符号分隔:
[START] The man is in the doorway [DELIM] The person is near the door [EXTRACT]
然后在 [EXTRACT] 这个位置的表示上接线性分类器。
编者说明:这套“加特殊 token 把输入拼成一条序列”的做法,正是后来所有序列标注/分类任务在预训练模型上微调的通用套路(BERT 里叫
[CLS]/[SEP],GPT 里就叫[START]/[DELIM]/[EXTRACT])。它的本质是:把各式各样的任务统一成“文本进、文本出”。
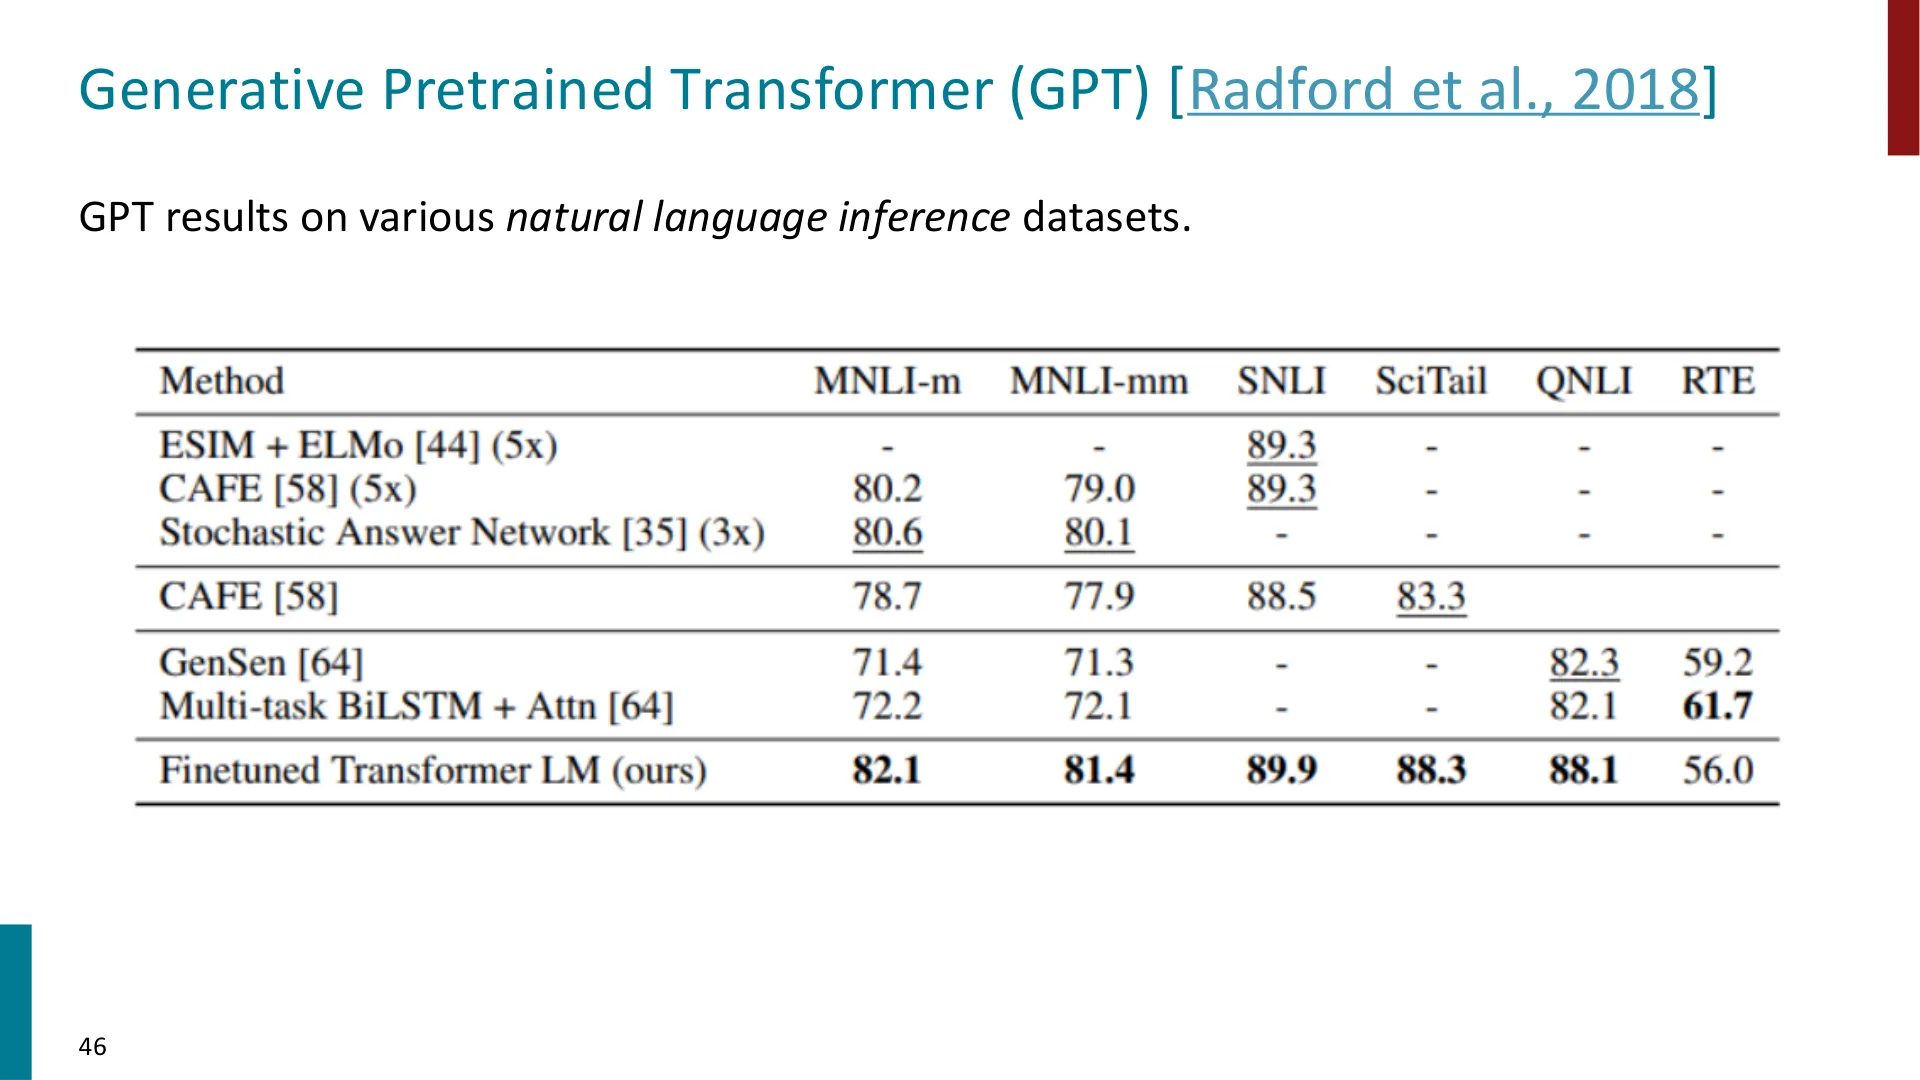
📷 GPT 在各自然语言推理数据集上的结果
回到原视频 (01:05:33)
老师说:在 NLI 上用 GPT 微调效果很好;接着 BERT 出来了,因为双向上下文而做得更好一点。但 GPT 已经做得非常出色。
GPT-2(Radford et al., 2019)
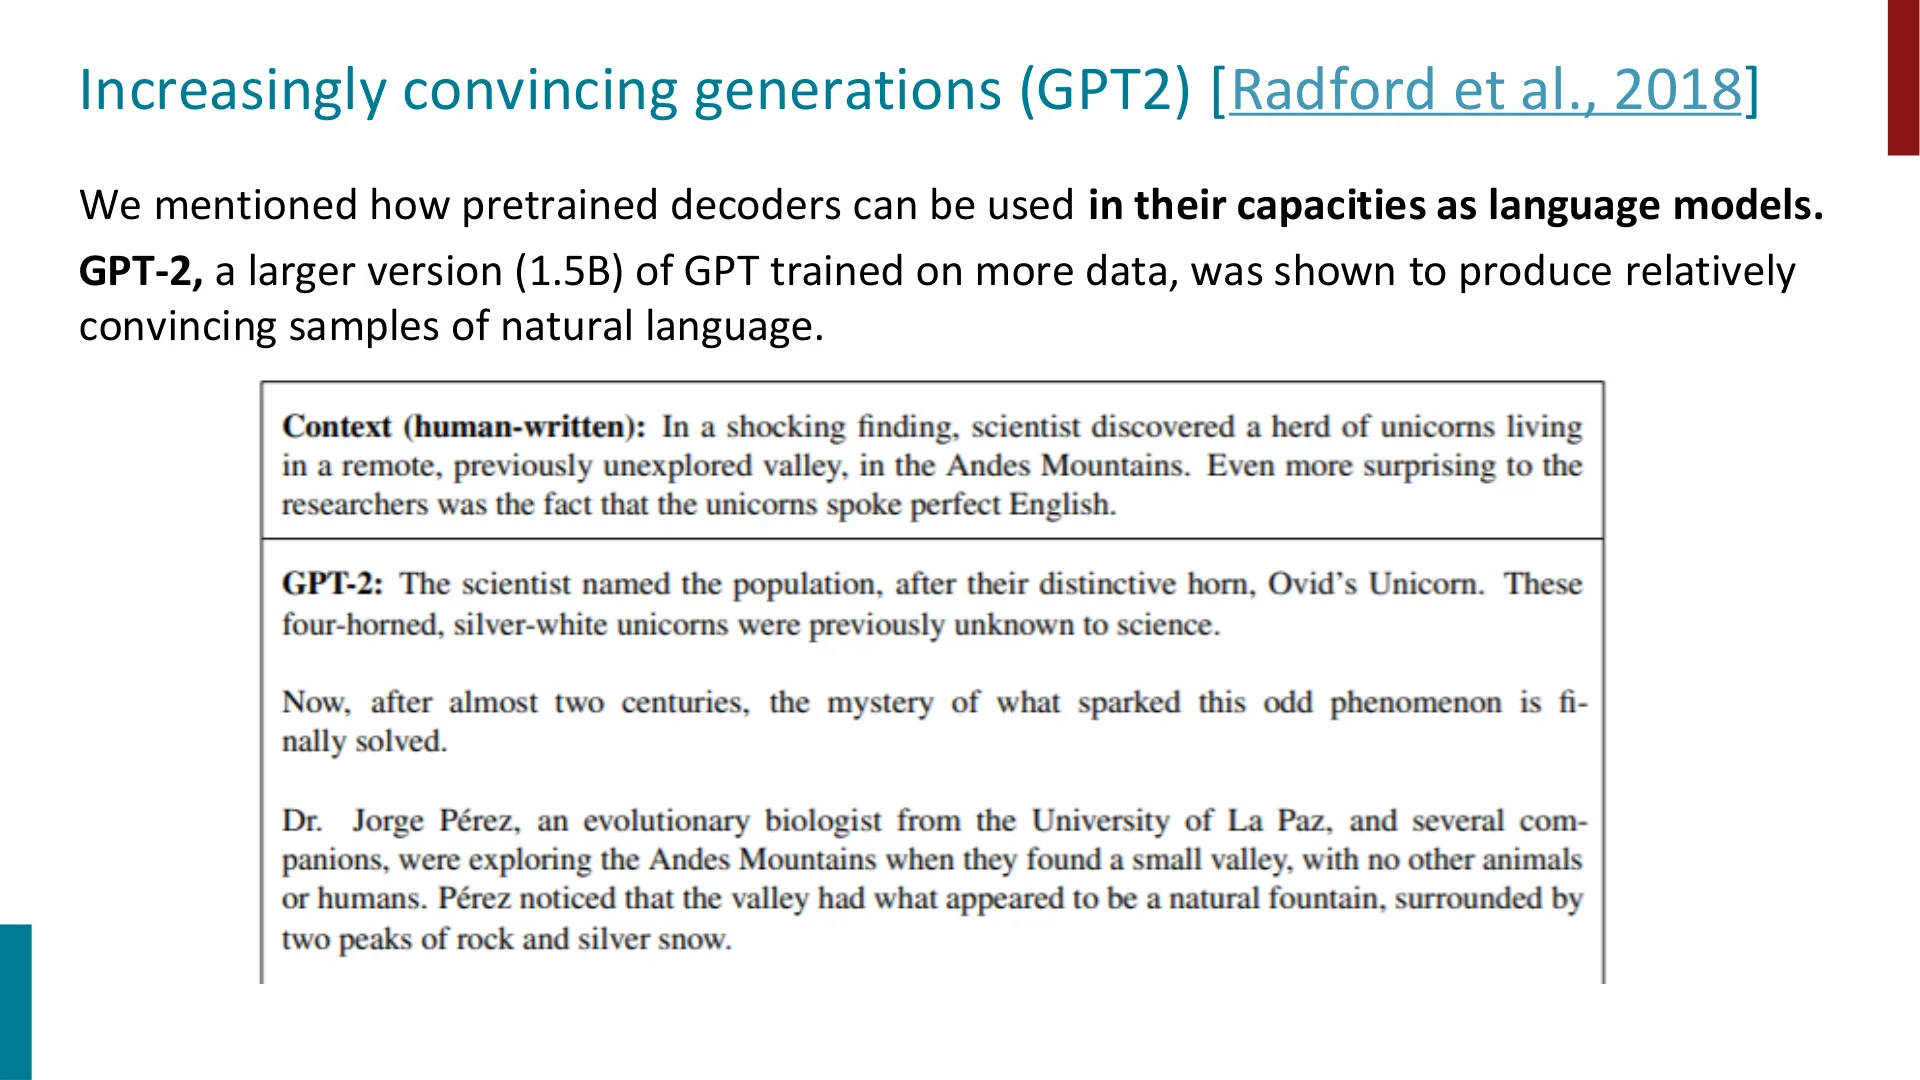
📷 GPT-2:1.5B 参数,能生成愈发连贯的长文本
回到原视频 (01:05:45)
- 从 1.17 亿参数跳到 15 亿参数;
- 训练数据更多(约 90 亿词);
- 给定一个提示(prompt),它能生成在当时看来相当连贯的续写。老师放了一段关于“科学家和独角兽”的故事生成作为例子;
- 这个规模仍小到可以塞进一块小 GPU 上微调。
GPT-3(Brown et al., 2020)
📷 GPT-3:175B 参数,上下文学习
回到原视频 (01:06:39)
到这里,我们与预训练模型的交互方式出现了第三种。此前有两种:
- 从它定义的分布里采样(或许给一个提示);
- 在关心的任务上微调它,取它的预测。
而 GPT-3 非常大:T5 最大 110 亿参数,GPT-3 有 1750 亿参数,在 3000 亿词上训练。它表现出一种新能力:
非常大的语言模型,似乎能仅凭你在上下文里给的例子,就在不做任何梯度步的情况下“学习”某种东西。
3.11 上下文学习与思维链
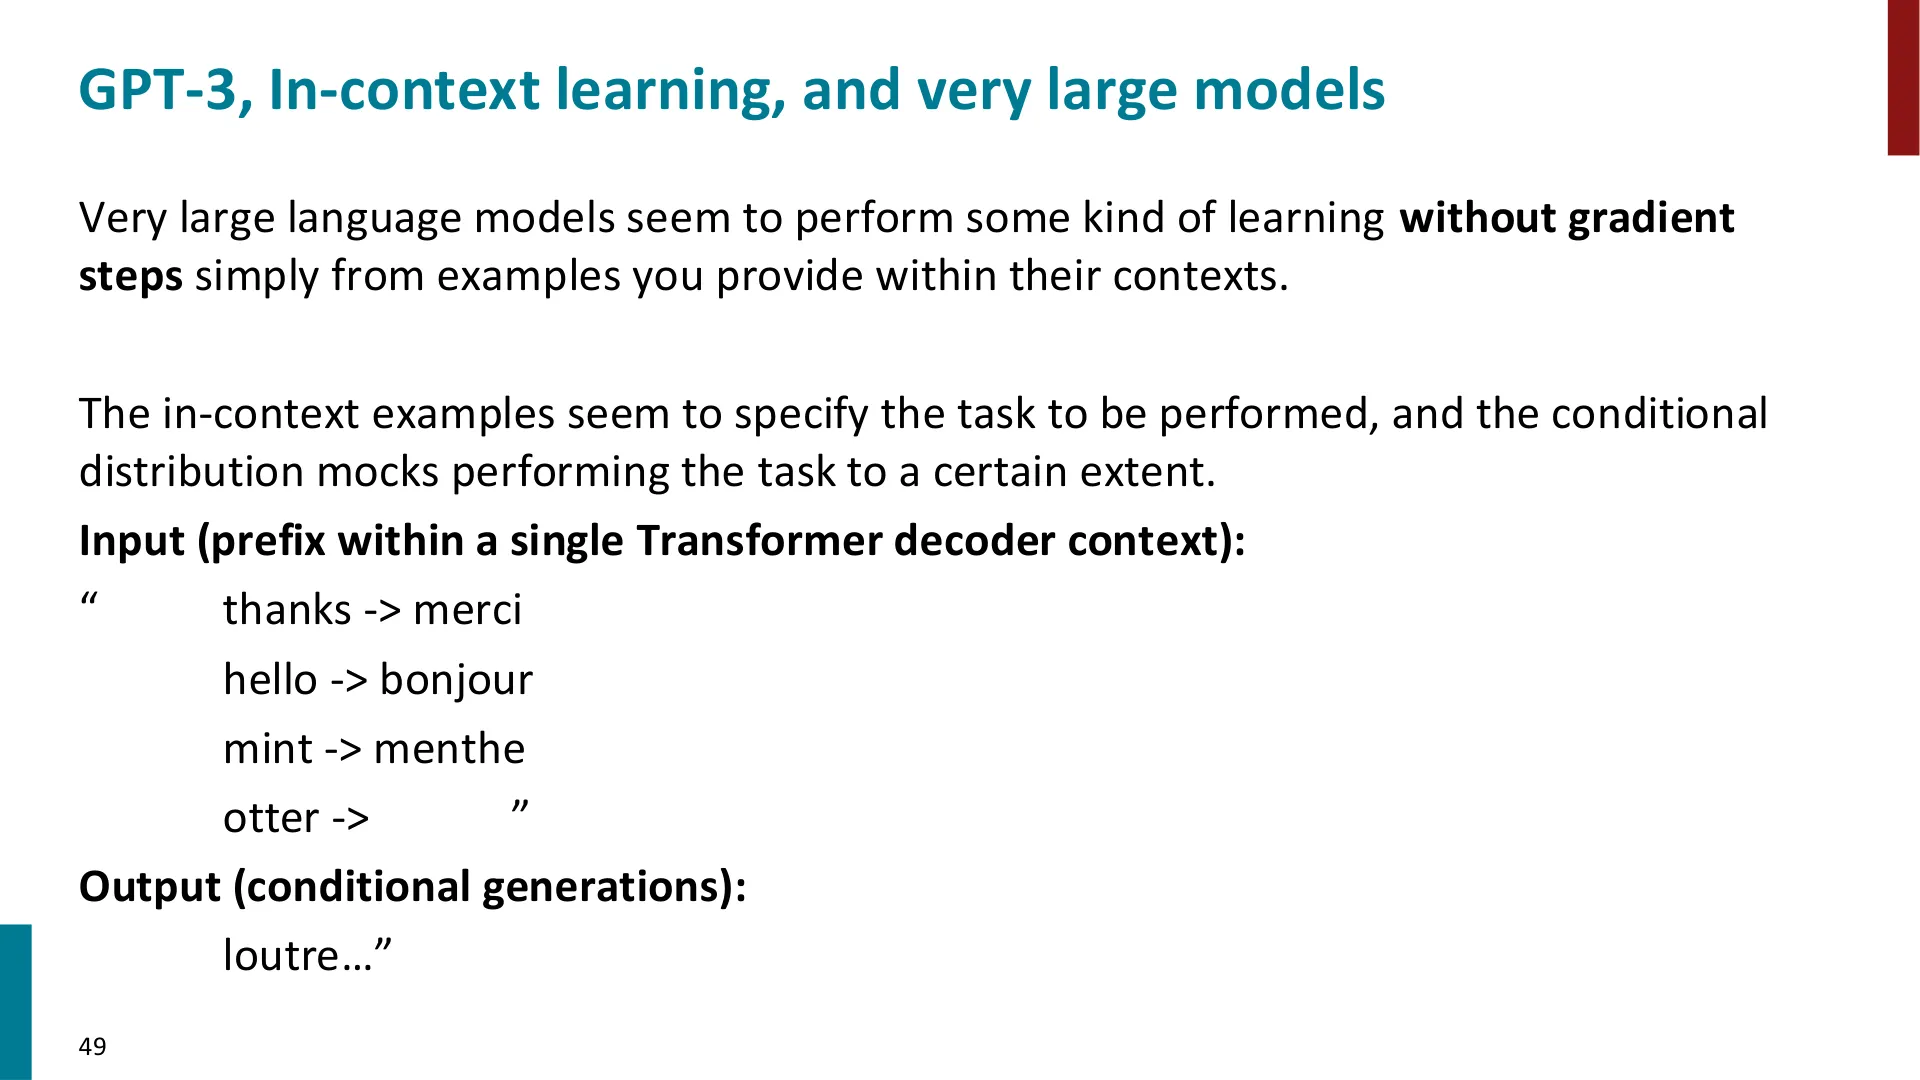
📷 上下文学习示例:给“thanks→merci, hello→bonjour, mint→menthe”,模型补出“otter→loutre”
回到原视频 (01:07:42)
上下文学习(in-context learning)的经典例子是翻译。你给模型一段单个 Transformer 解码器上下文里的前缀:
" thanks -> merci
hello -> bonjour
mint -> menthe
otter -> "
模型条件生成:
loutre"
注意:你没有说“请翻译”,也没有在翻译任务上微调——你只是把例子塞进输入,模型就把这个模式续写了下去。
📷 更多上下文学习示例:加法、拼写纠错等
回到原视频 (01:08:25)
其他例子还有:给几个加法例子,它接着做简单加法;给几个把错别字改对的例子,它学会改写错别字。
老师说这“相当令人意外”:
前面我们讲的是“好的表示”“上下文表示”“词在语境中的意义”——这些都还算有据可循。但现在我们看到的是一种非常高级的模式匹配:从当前这一条输入里找出模式,然后按模式续写。这在语言建模的信号里并不显然。你只是让它在 3000 亿词上“预测下一个词”,它却因此学会了在上下文中执行相当复杂的任务。
那它到底是在“真正学习任务”,还是只是“背了训练数据里的模式”?
老师的回答很谨慎、也很诚实:
- 有可能:它在训练数据里见过大量双语词典、词对,所以学会了这种“词对”格式;
- 也有可能:它在做某种更一般的、真正在上下文中学会任务的事;
- 学界并不完全确定。 看起来真相在两者之间:它一定以某些我们尚不理解的机制和训练数据绑得很紧,但也表现出非平凡的能力,能从上下文里学到“至少是一类新模式”。这是个很有意思的方向。
扩展定律(Scaling Laws)
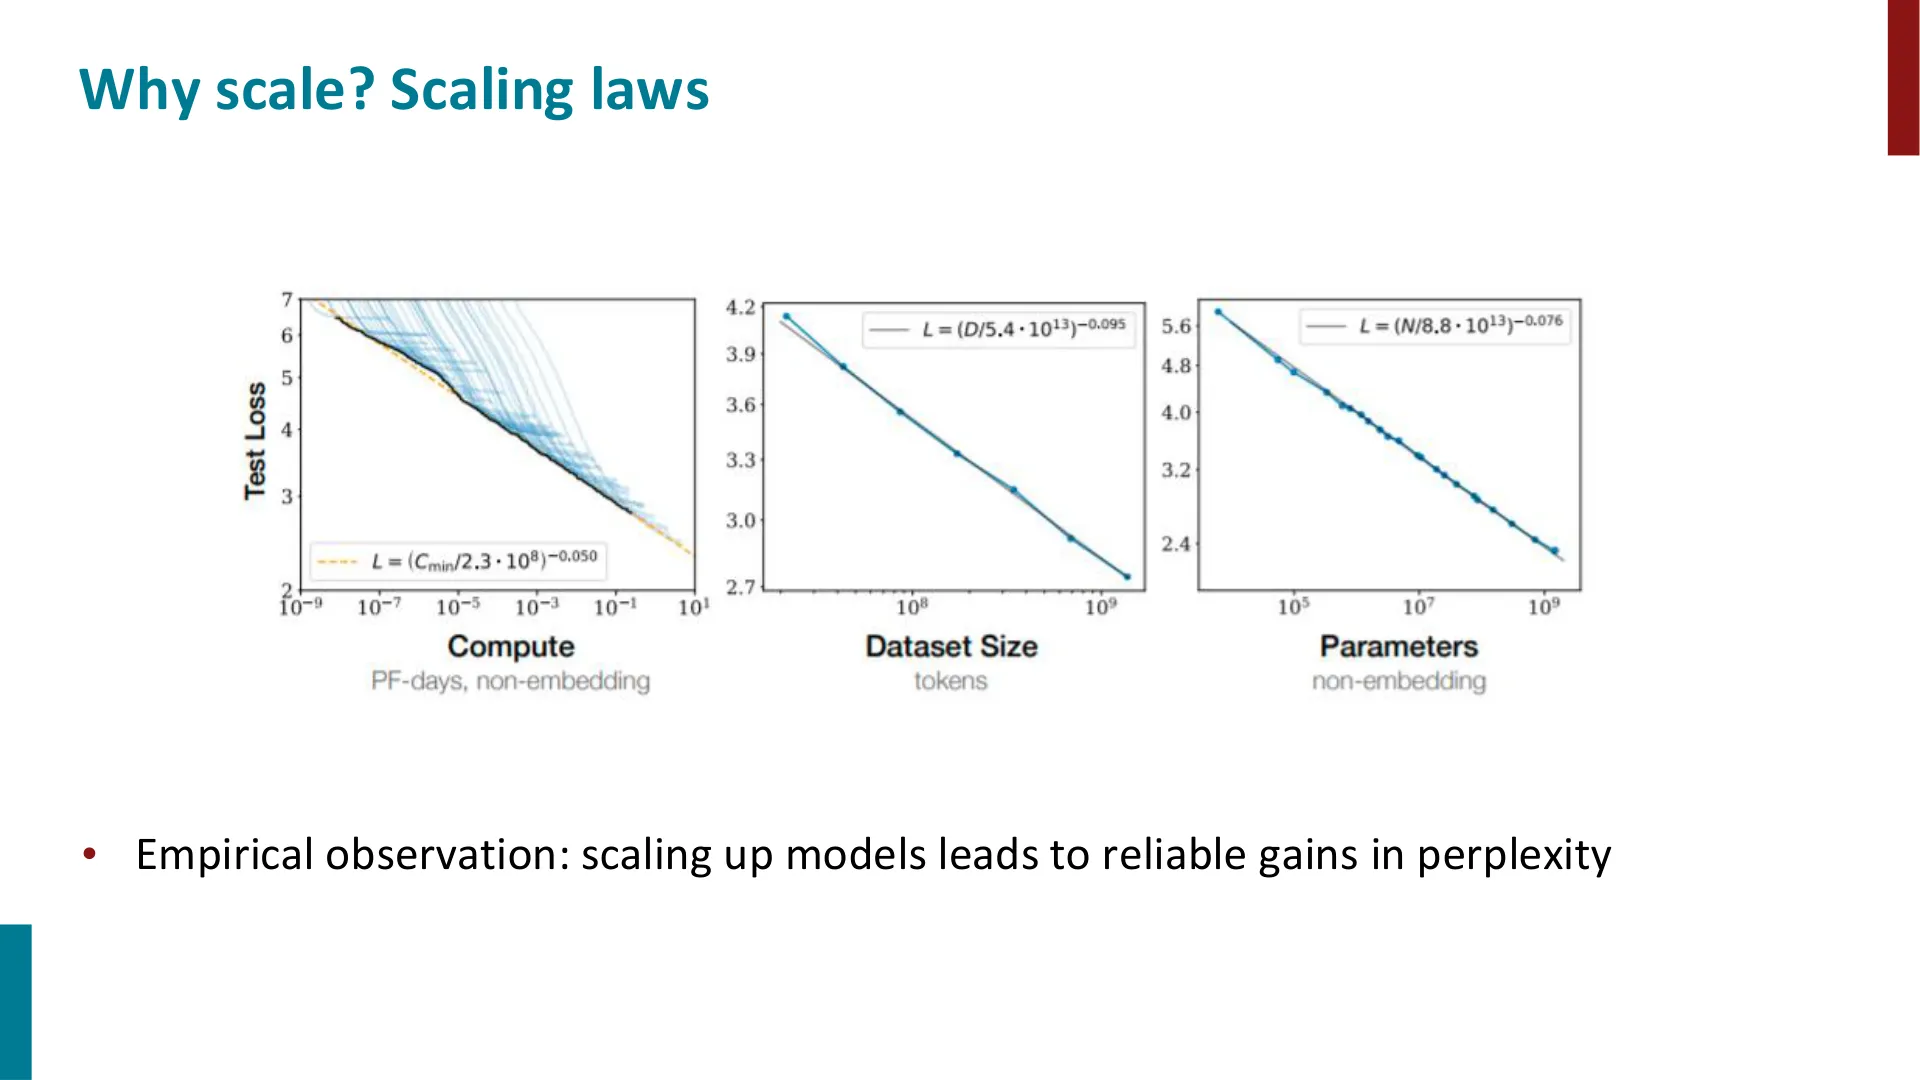
📷 扩展定律:模型变大,困惑度可靠地下降
回到原视频 (01:10:35)
经验观察:把模型做大,困惑度(perplexity)会可靠地下降。
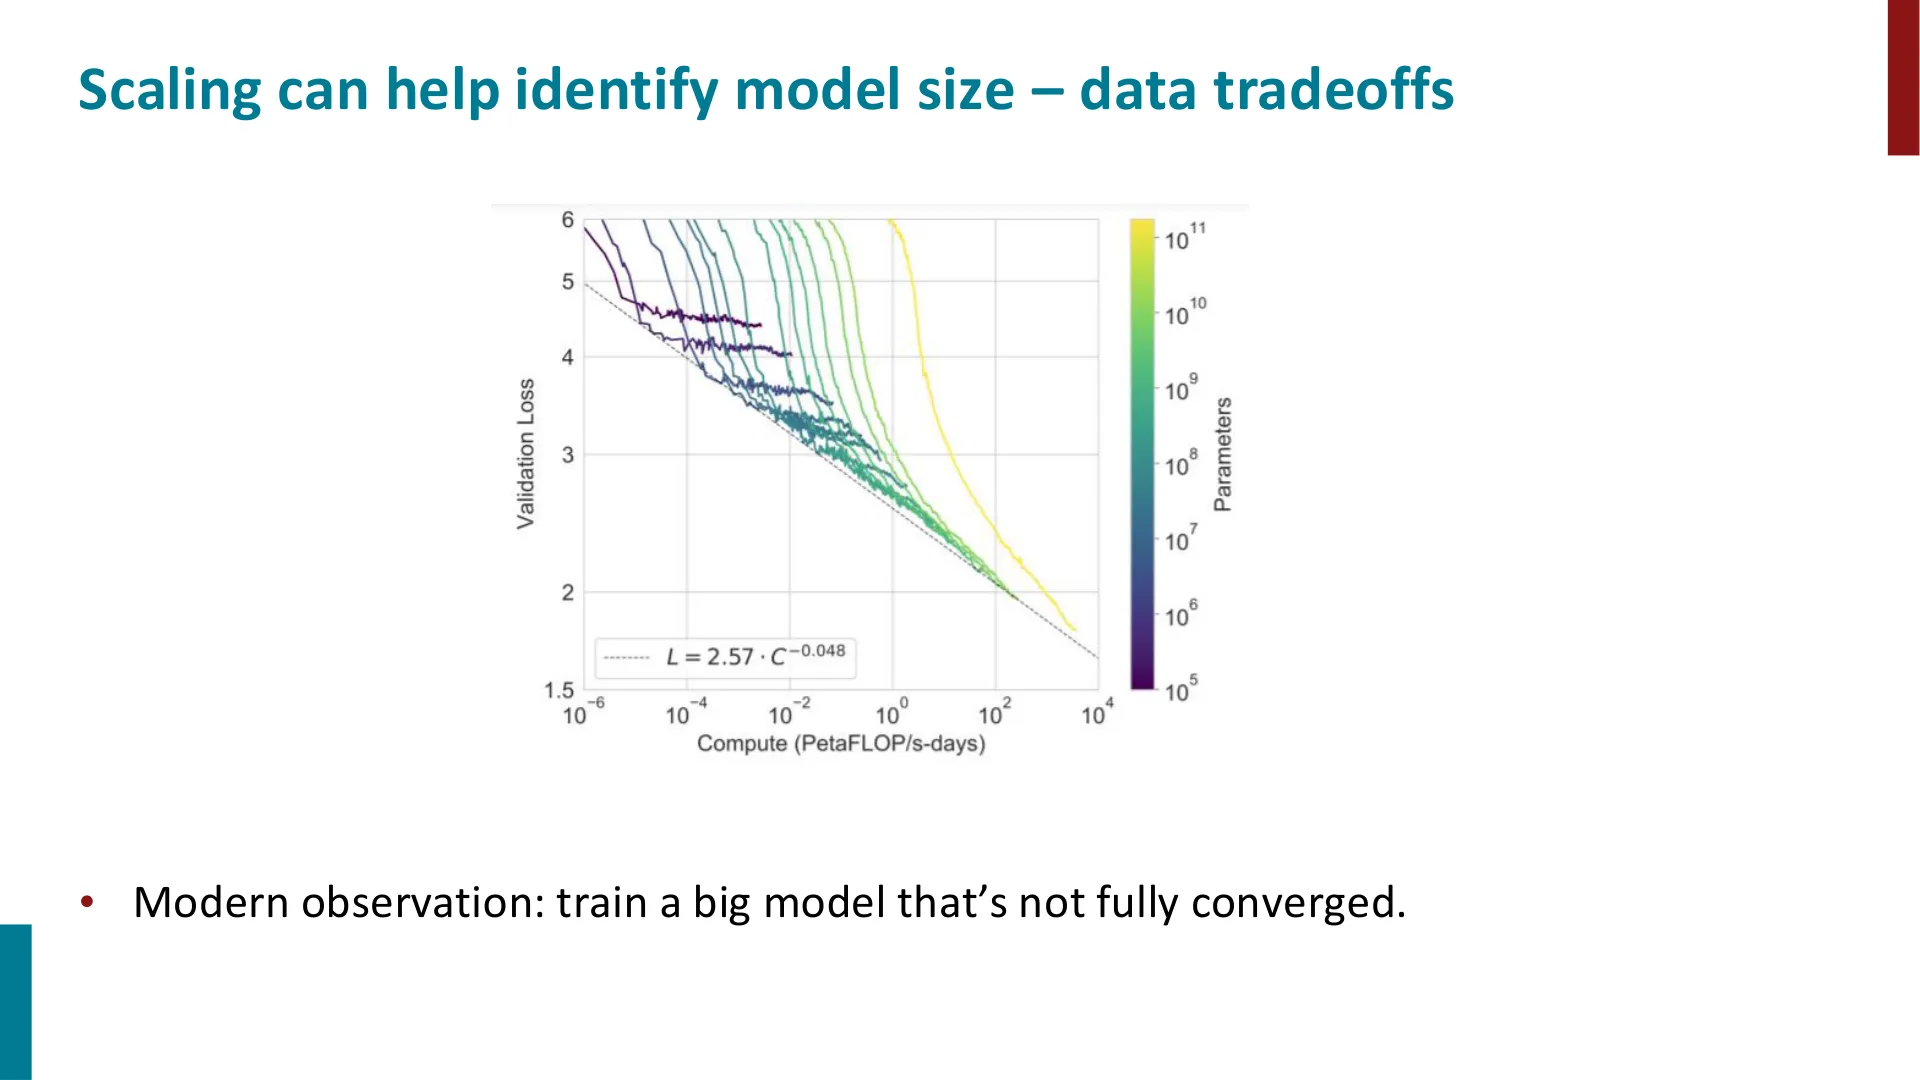
📷 用“不完全收敛的大模型”来估计模型规模与数据量的取舍
回到原视频 (01:11:00)
现代做法:先训练一个“没有完全收敛的大模型”,用它来预测“规模—数据量”之间的取舍。
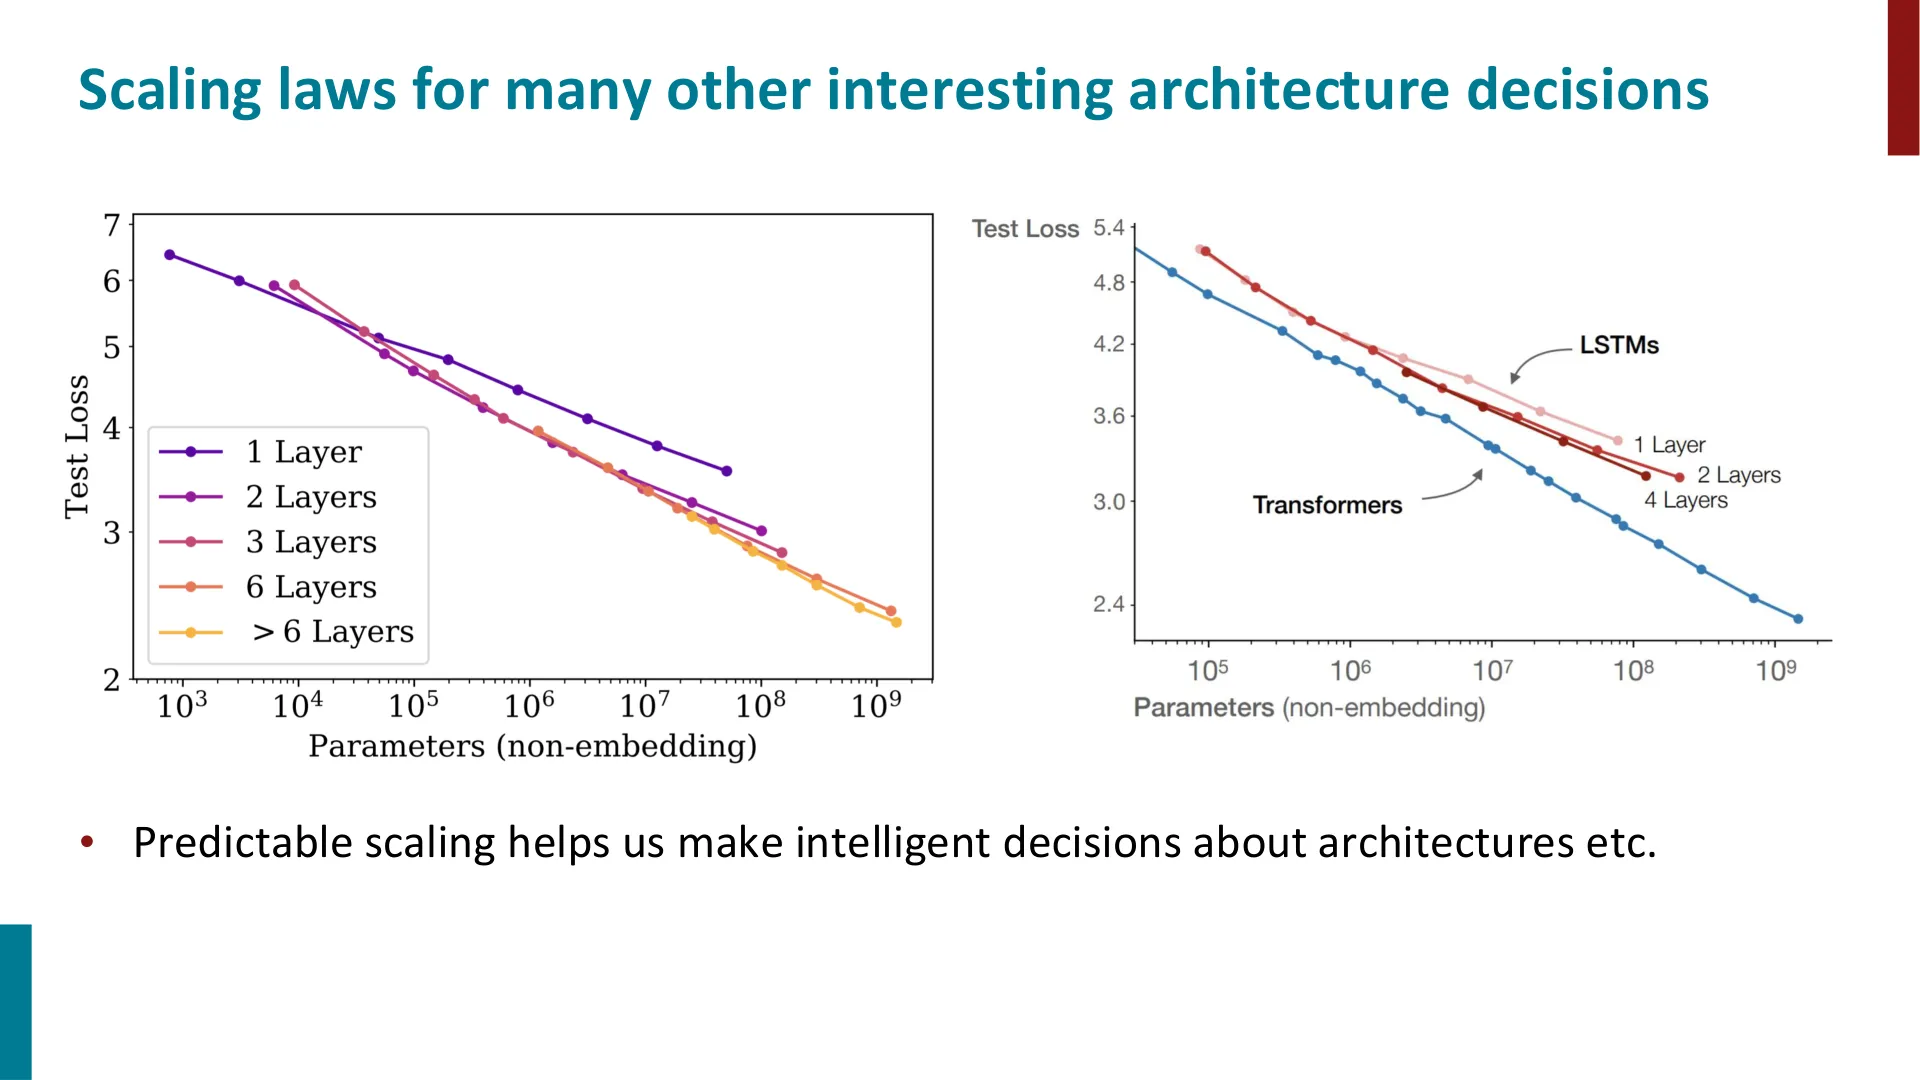
📷 扩展定律也适用于许多其他架构决策
回到原视频 (01:11:15)
可预测的扩展,让我们对架构等决策也能做出更明智的选择。
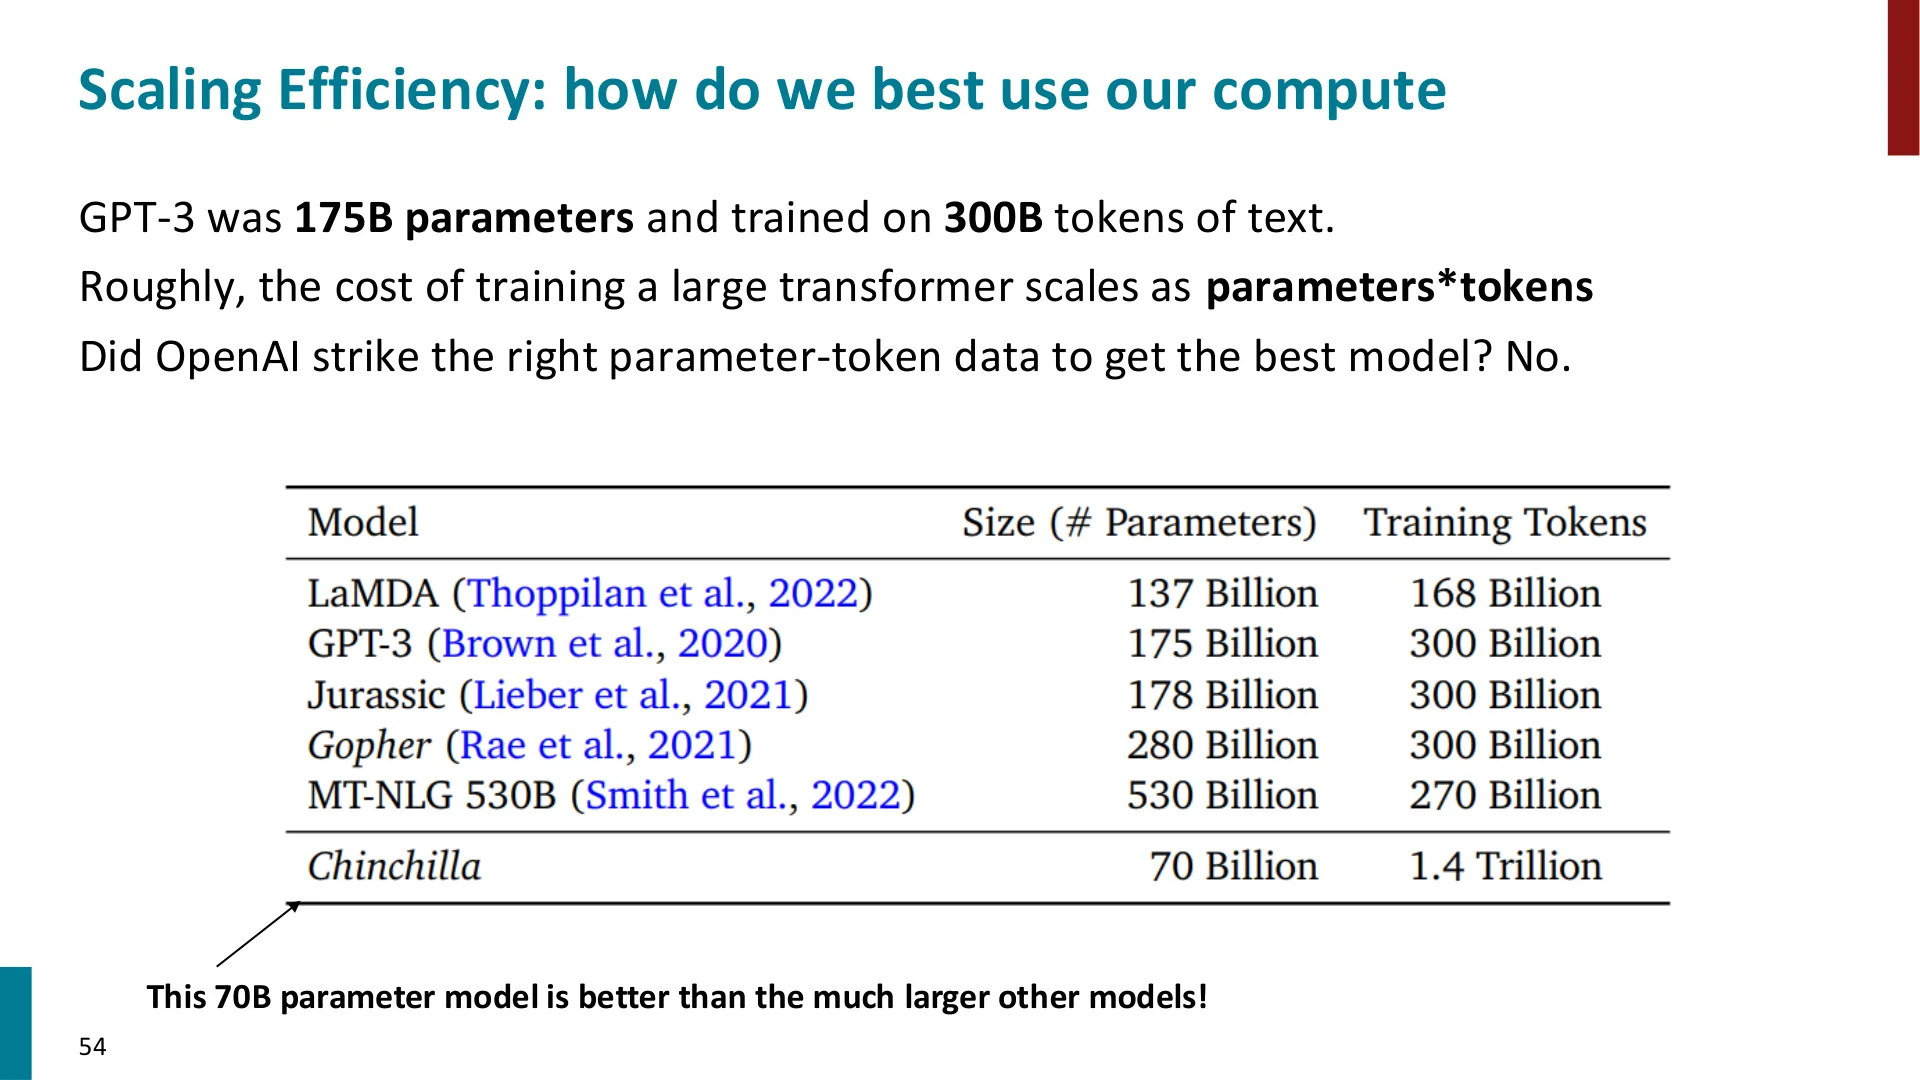
📷 算力效率:GPT-3 是 175B 参数、300B token;但参数×token 的花费结构并不最优
回到原视频 (01:11:20)
一个粗略事实:训练一个大 Transformer 的成本大致正比于“参数量 × token 数”:
$$ \text{Cost} \;\propto\; N_{\text{params}} \times N_{\text{tokens}} $$
编者拓展|Chinchilla 的结论 Hoffmann et al., 2022(Chinchilla) 指出:在给定算力预算下,参数量与训练 token 数应当大致按比例一起增长,而不是一味堆参数。GPT-3 属于“参数量过大、训练 token 相对不足”。他们的 Chinchilla 模型不到 GPT-3 一半大小,却因为用远更多的数据训练而表现更好。老师用“comically oversized(大得离谱)”来形容 GPT-3——这也是对“参数×token 该怎样配比”这个问题的最好注脚。
思维链(Chain of Thought)
(参考时间: 01:11:52)
标准提示里,前缀是“问题 + 答案”的示例;给一个新问题,模型直接生成答案——往往答错。
思维链提示换了个做法:在示例里把推理步骤写出来(人类手工标注的分解过程),再给新问题。模型就会先把中间推理步骤一步步写出来,最后再说“答案是……”。
结果很反直觉:
模型往往能生成“看上去合理”的推理步骤,并且在写出这些步骤之后,答对率显著高于直接作答。
🖼️ Slide 43
怎么理解?可以把它看作:
- 一块草稿纸(scratch pad);
- 给问题投入了更多计算——每生成一个词,都能条件于此前所有已生成的词;
- 把问题分解成更小、更简单的子问题,逐个解决。
老师坦承:为什么它有效,目前也没人能确切说清。对于这么大的网络,它们的涌现性质既非常强大、又极难理解,也因此很难被信任——我们并不清楚它们的能力边界、会在哪里失败。
四、预训练究竟教会了什么
(参考时间: 01:14:09)
📷 课程大纲收束到“预训练在教什么”
回到原视频 (01:14:09)
4.1 能力清单
📷 预训练教会了什么:事实、句法、指代、语义、情感、推理……以及偏见
回到原视频 (01:14:15)
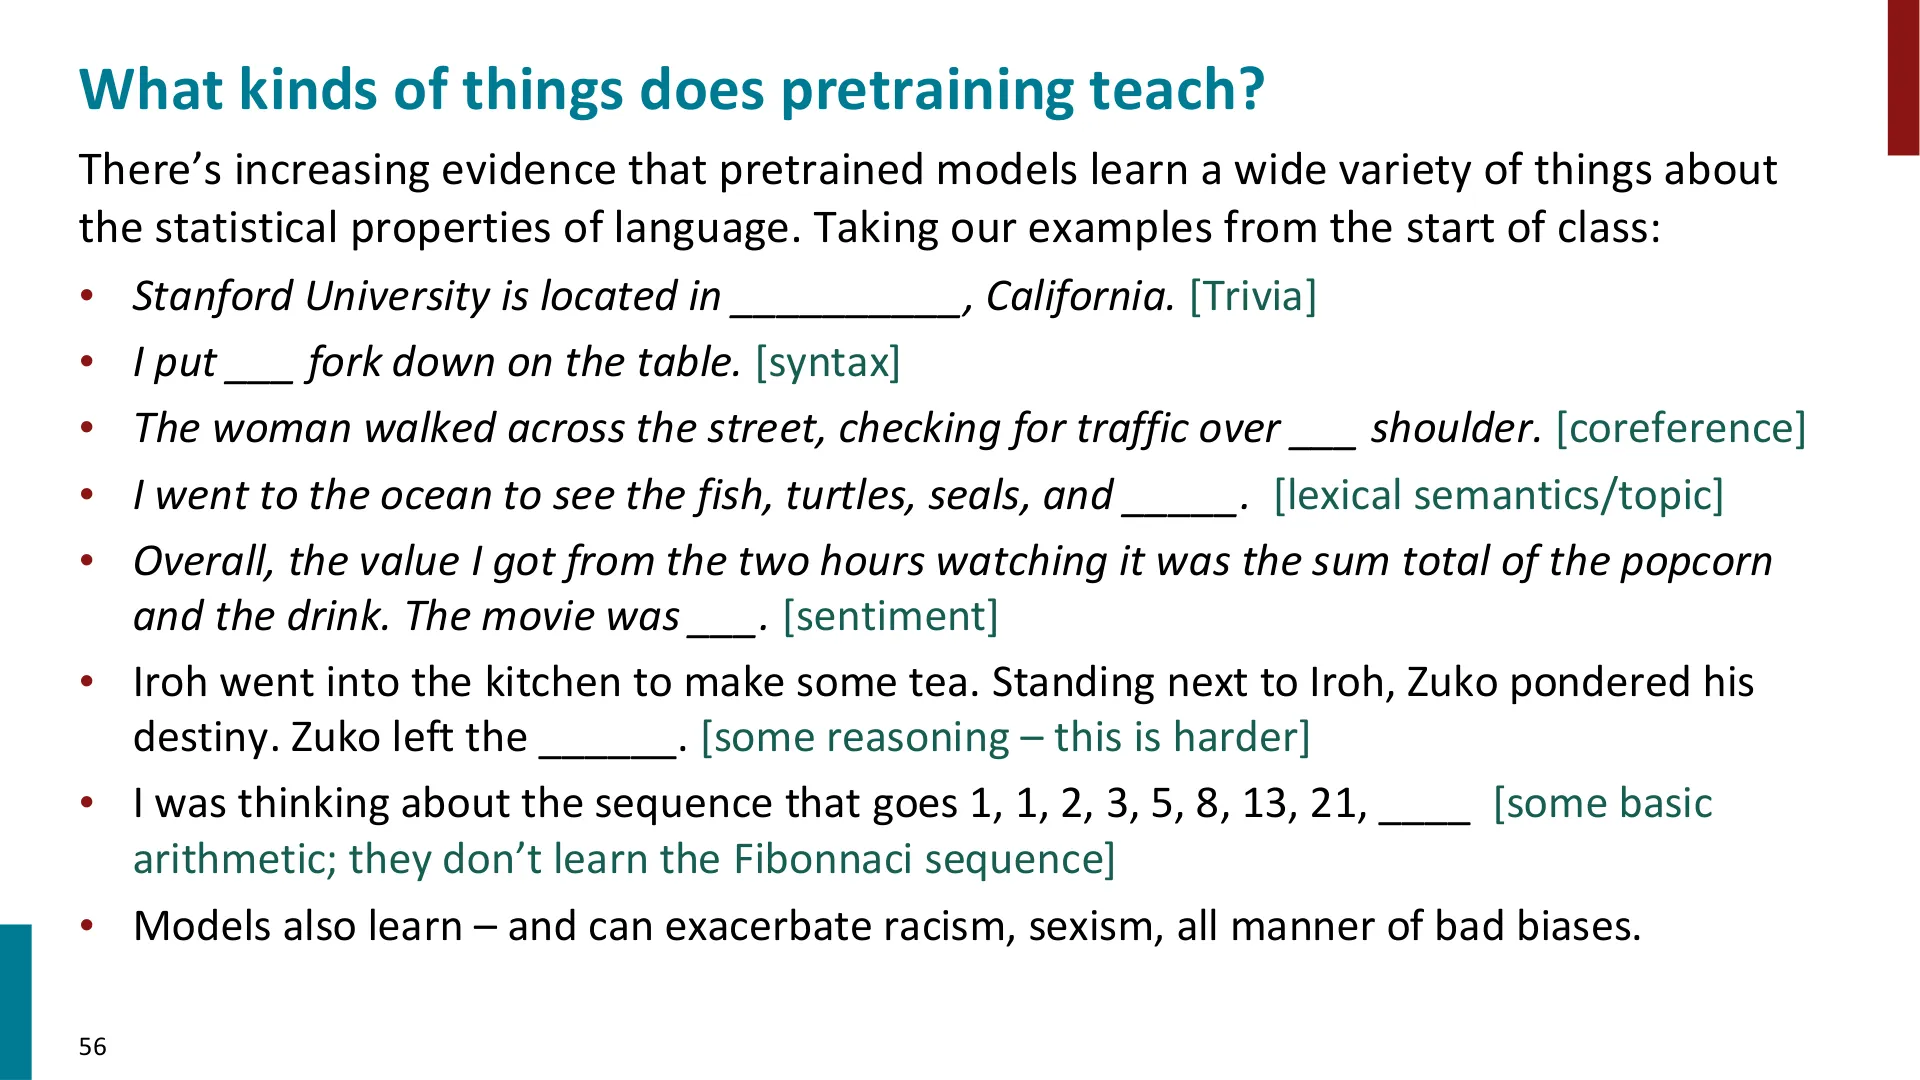
越来越多的证据表明:预训练模型学到了关于语言统计性质的广泛知识。回收开头那批例子:
Stanford University is located in ____, California.→ 事实知识(trivia)I put ___ fork down on the table.→ 句法(syntax)The woman walked across the street, checking for traffic over ___ shoulder.→ 指代(coreference)I went to the ocean to see the fish, turtles, seals, and _____.→ 词汇语义 / 话题... The movie was ___.→ 情感(sentiment)Iroh went into the kitchen... Zuko left the _____.→ 一点推理(更难)1, 1, 2, 3, 5, 8, 13, 21, ____→ 一点基本算术(但模型并没有真正“学会”斐波那契数列)
并且讲者强调:这几年它展现出的“推理”能力,远超过三年前我们的预期。
但同时:
模型也会学到——甚至放大——种族主义、性别歧视以及各种各样的偏见。
老师还提到:“这张幻灯片我主要是两年前写的,但实际情况远超这里所列。”以及一个更宏观的观察:这些模型逐渐不只是被拿来用,也被当作研究对象,用来理解它们为什么会工作、会在哪里失败。
4.2 偏见、记忆与隐私
详见文末「附录:课堂未展示的幻灯片」中关于版权材料记忆与成员推断(membership inference)的两页。
4.3 课堂问答精粹
(参考时间: 01:15:05)
“有人拿 GPT 做过编程任务的基准测试吗?” 有,而且不少。现代竞技编程成绩最好的系统,都建立在语言建模的思路之上,而且本身也是预训练语言模型。如果把所有这些想法应用到 GitHub 的代码上,会出现一些关于代码的、很有意思的涌现行为。此外,GitHub Copilot 的基础也正是这套东西(虽然具体细节我们并不完全清楚,但“就是这些想法”)。
“如果预训练数据很多、微调数据也很多,是不是干脆用微调数据单独训一个新模型更好?” 几乎从不这样。 常见的做法是三段式训练: 1. 在大规模、宽泛的语料上预训练; 2. 用你手上带标签数据的“无标签版本”(把标签剥掉、只当文本)继续做语言建模,让参数再“适配”一点; 3. 最后用带标签的数据做正式微调。
这有一个很形象的名字——“Don’t Stop Pretraining”。效果更好。
🖼️ 第 55 页幻灯片 · Sometimes it also memorizes copyrighted material
“预训练模型真的能做它没见过、也没微调过的任务吗?” 关键在“没见过”怎么定义。尤其是 GPT-3 这类超大模型:预训练时它是否见过一模一样的算术题?其实说不清。它明显能把预训练中隐式见过的零件重新组合。语言的续写有时很像冷知识问答——比如读一段维基百科开头,本身就像在回答一串“某人生于何地、何时”的问题。但它显然也见过一些不完全像这类的内容,而它仍能完成不少看起来不该在预训练数据里直接出现的任务。“这个能力到底有多大”仍是一个开放的研究问题。
附录:课堂未展示的幻灯片
以下幻灯片属于官方讲义,但在本讲字幕中未见对应讲解(可能为备份页、时间紧张跳过、或录音缺失)。按惯例集中列出,供读者参考。
幻灯片 20|Where does this data come from?(常用预训练语料对照)
| 模型 | 训练数据 |
|---|---|
| BERT | BookCorpus、英文 Wikipedia |
| GPT-1 | BookCorpus |
| GPT-3 | Common Crawl、WebText、英文 Wikipedia,以及两个书籍库(“Books 1” 与 “Books 2”) |
| GPT-3.5+ | 未公开 |
幻灯片 21|BookCorpus… 那是什么?
- 从互联网上抓取的电子书——极具争议。
幻灯片 22|合理使用(fair use)及其他担忧
- (幻灯片仅给出标题,未列出具体条目。)
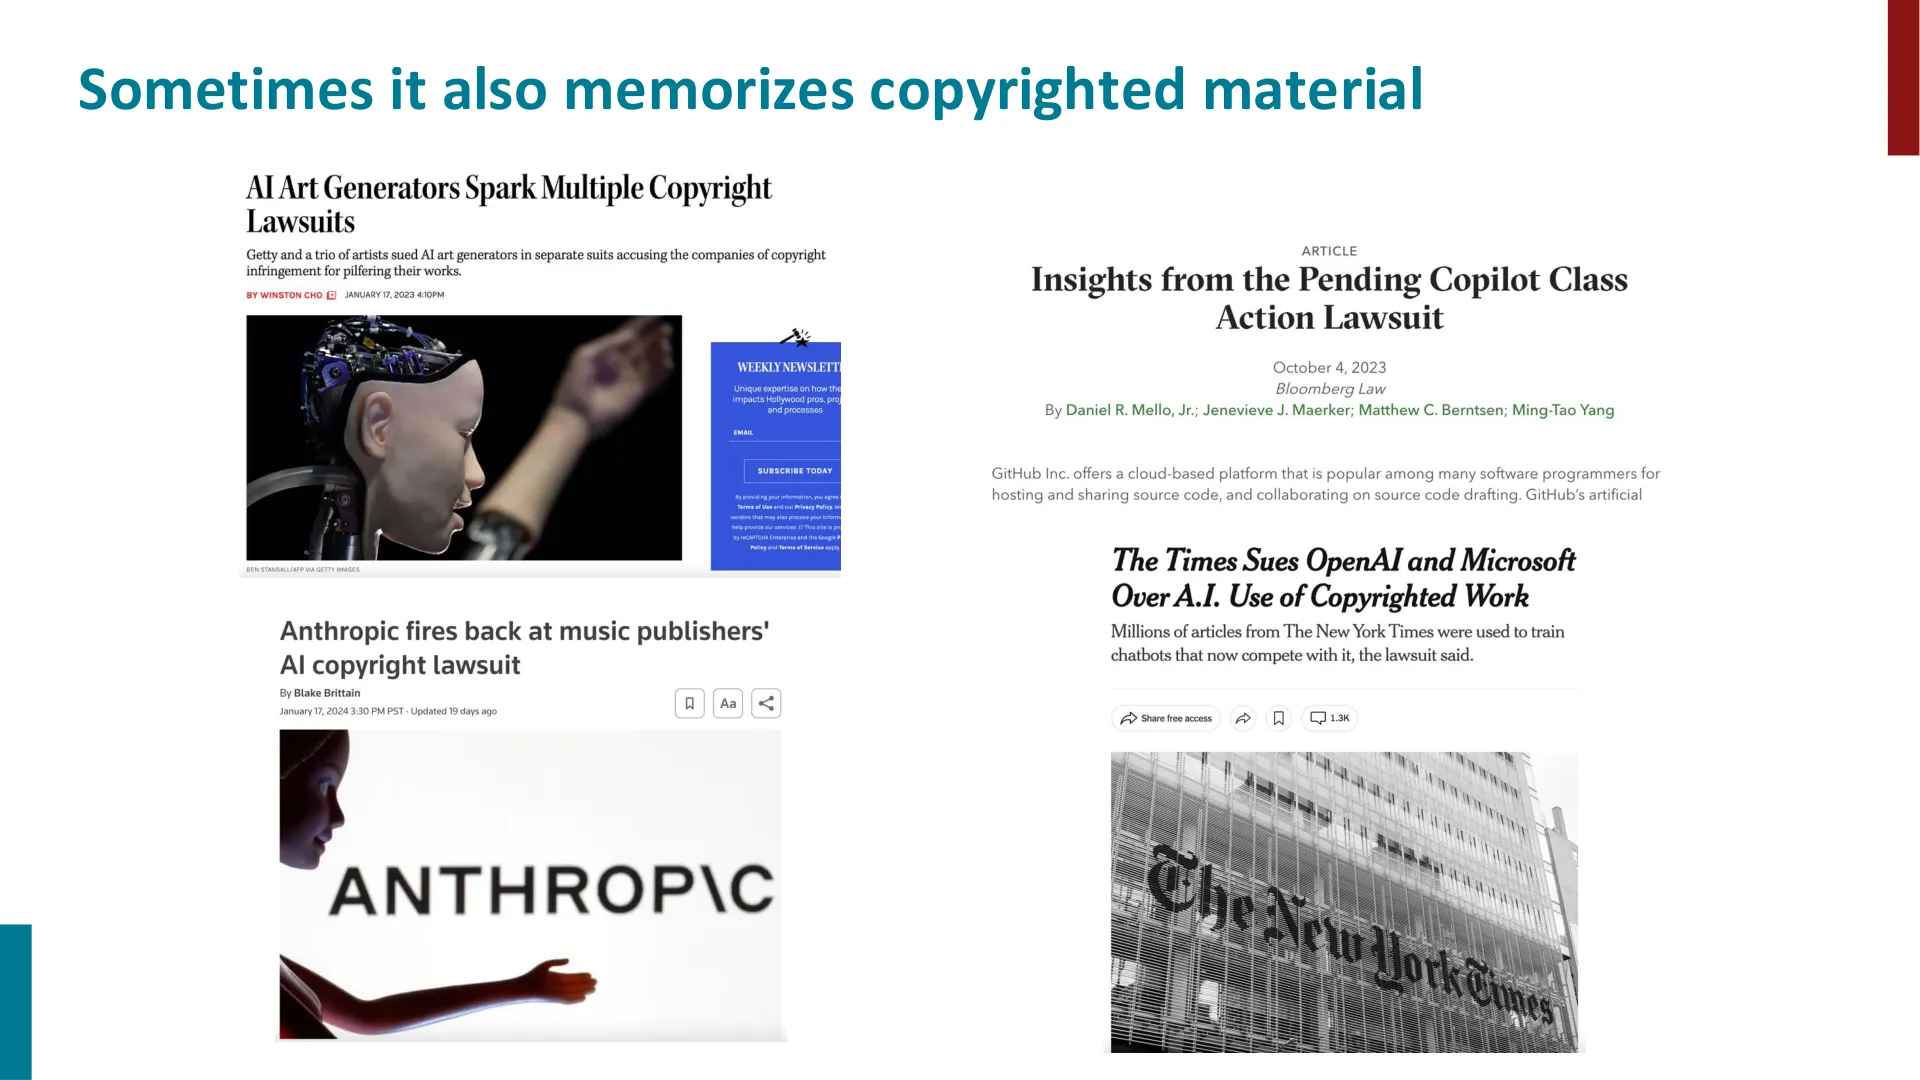
幻灯片 55|有时它还会记住受版权保护的材料
- (幻灯片仅给出标题。)
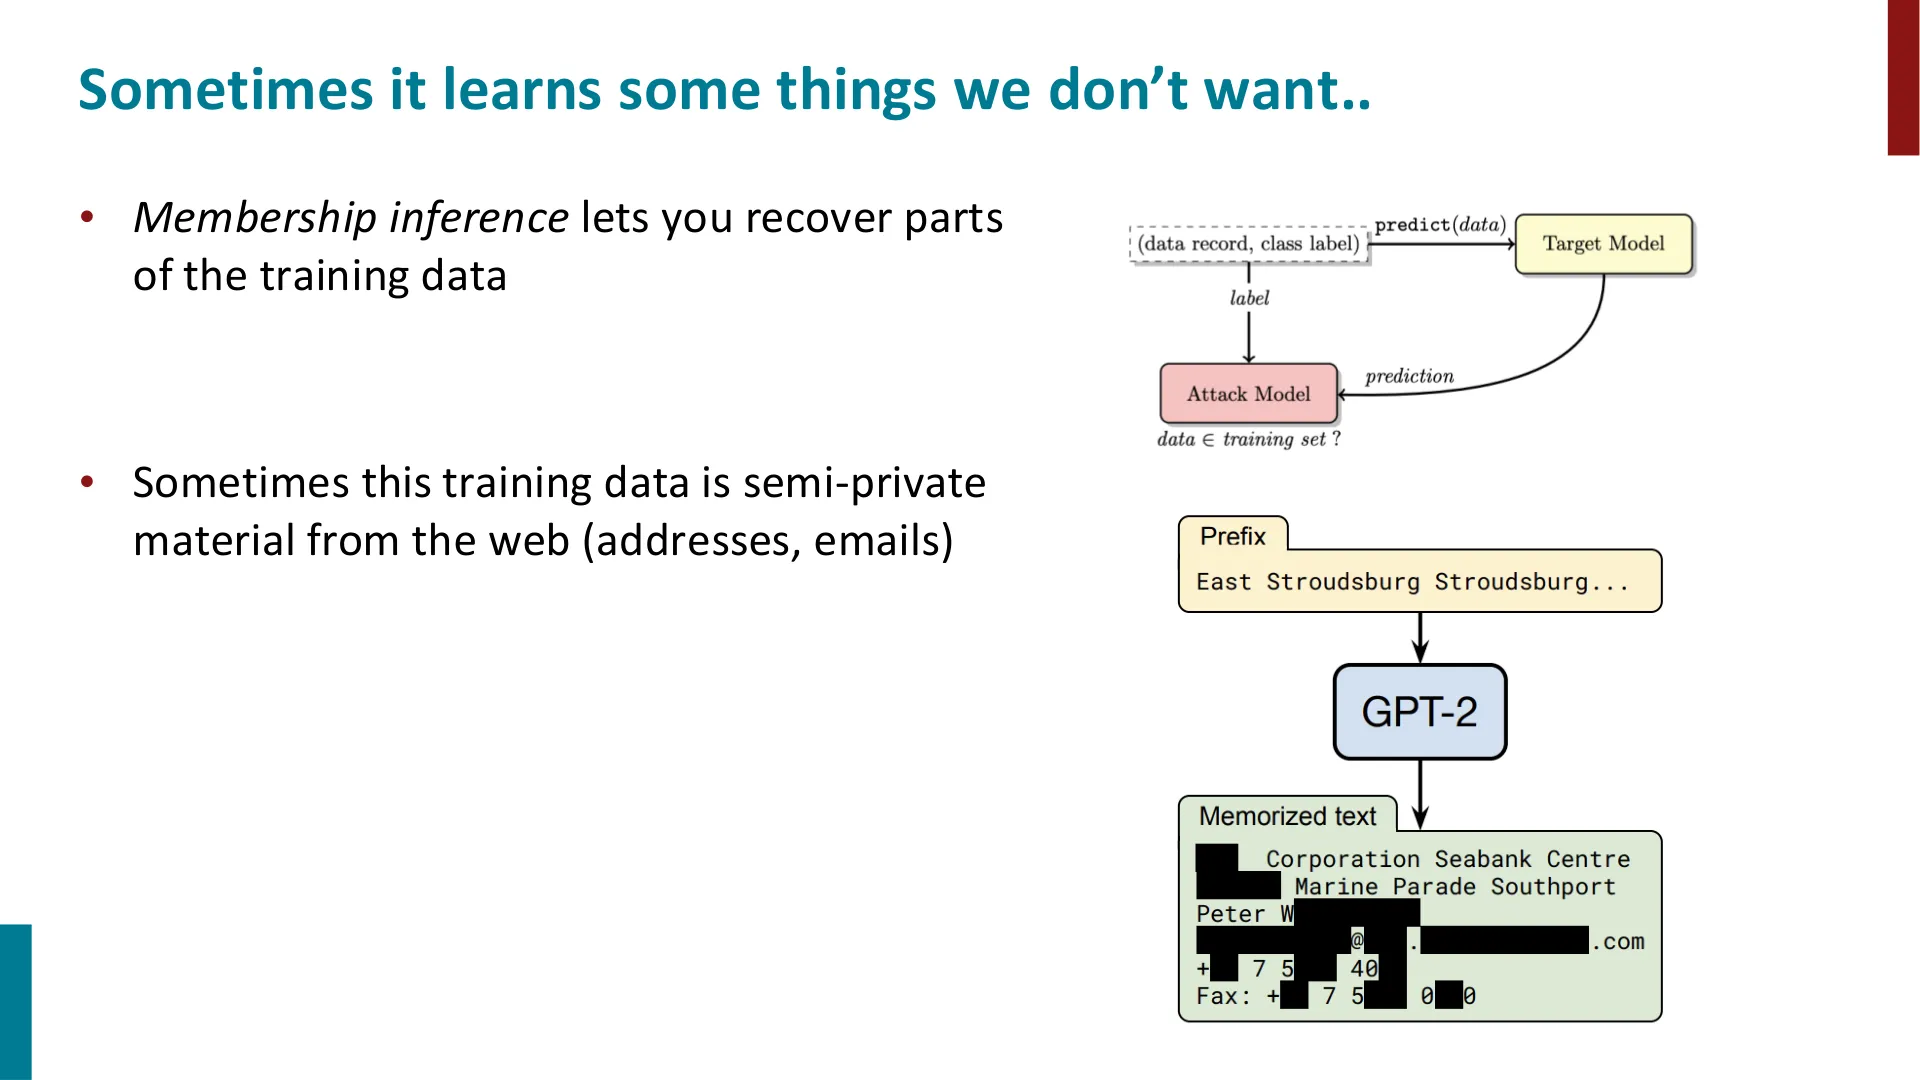
幻灯片 56|有时它会学到一些我们不想要的东西
- 成员推断(membership inference)可以让你还原出部分训练数据;
- 这些训练数据有时是网络上半私密的材料(地址、邮箱等)。
编者拓展|什么是成员推断 成员推断攻击(membership inference attack)试图回答:“这条具体样本,是否在模型的训练集里?” 语言模型对训练见过的文本往往给出异常高的似然,攻击者据此可以判断某条记录(某人地址、某封邮件)是否被“喂过”。它把“模型记住了训练数据”这一现象,从有趣的观察变成了可被利用的隐私风险。这也与幻灯片 55 的“记住受版权保护材料”同源:记忆(memorization)既是能力的来源,也是风险的来源。
附:参考与延伸阅读
编者补充
- BERT
- BookCorpus
- Brown et al., 2020
- Common Crawl
- Devlin et al., 2018
- GitHub
- GitHub Copilot
- GLUE
- Hoffmann et al., 2022(Chinchilla)
- https://www.youtube.com/watch?v=DGfCRXuNA2w
- Hu et al., 2021
- Hugging Face
- Joshi et al., 2020
- Liu et al., 2019
- Quora
- Radford et al., 2018
- Radford et al., 2019
- Raffel et al., 2018
- Sennrich et al., 2016
- Stanford CS224N
- T5
- Wikipedia
- word2vec
- Wu et al., 2016
- “Don’t Stop Pretraining”
已知疑点
本节把本次重构中所有不确定、拿不准、或与常识/讲义可能冲突的地方集中列出,供读者自行判断。
- 讲次编号不一致:视频标题是 “Lecture 9”,而官方幻灯片内页与文件名分别写作 “Lecture 6: Pretraining” 与
cs224n-2026-lecture07-pretraining.pdf。三个编号互不相同,疑为不同学期/不同授课版本混用,编者无法判定哪一个是当年实际的讲次号。本书沿用幻灯片标题中的 “Pretraining”。 - 讲者署名:幻灯片封面署名 “Diyi Yang”,但课堂口吻(“上一讲是周四的自注意力/Transformer”“我两年前写的这张幻灯片”)无法从字幕确认讲课人身份是否即 Diyi Yang 本人。编者按幻灯片署名处理。
- BPE 的论文出处:幻灯片标注为
[Sennrich et al., 2016, Wu et al., 2016]。其中 Sennrich et al. 是 BPE 用于 NMT 的经典工作,Wu et al. 2016 一般指 Google NMT 系统(使用 WordPiece)。幻灯片把两者并列标注,但字幕未展开说明二者的分工,本书在正文中按“BPE 原用于机器翻译、WordPiece 用于预训练模型”转述,如与原意有出入以此处为据。 - BERT 训练语料数字:幻灯片写 “BooksCorpus (800 million words) / English Wikipedia (2,500 million words)”;而字幕中讲者口述过一次“800 million words plus… 那肯定不对,也许 2.5 billion”。口述数字与幻灯片有出入,本书以幻灯片为准。
- BookCorpus 的“争议”与“fair use”两页:幻灯片 21、22 主题分别为 “BookCorpus…what‘s that?” 与 “Fair use and other concerns”,但字幕中并无对应讨论。本书将这两页(及数据来源对照表,幻灯片 20)放入附录,若课堂其实讲过但录音未收录,附录放置位置可能与该段讲述的时间不符。
- 幻灯片 55、56(版权材料记忆 / 成员推断):同理,字幕未出现对应讨论。这两页被放入附录。编者无法确认课堂上是否展示过。
- 若干幻灯片时间锚点为估算:由于字幕中并未逐页点名,
SLIDE:n@HH:MM:SS的时间锚点由内容对应关系推断,尤其是开场(幻灯片 2–4)、以及 BERT/T5/GPT 之间若干过渡页,可能存在±1 分钟左右的偏差。 - 重复出现的“三种架构”幻灯片(幻灯片 24、25、34、39):四页内容高度相同(39 多一条 “All the biggest pretrained models are Decoders.”),应为渐显式重复页。本书在每次架构切换处各引用一次,不保证与课堂实际翻页次序完全一致。
- 讲者“我忘了这条引用”处:在讲 Chinchilla 时,讲者说 “some folks at DeepMind… I forgot the citation on this”。字幕未给出论文名,本书据公开信息补注为 Hoffmann et al., 2022(Chinchilla),属于编者补充,非讲者原话。
- “数据量 5 万亿~10 万亿词”:讲者口中的这个数量级为口头估计,不同口径(是否去重、是否含代码、是否按 token 计)差别很大,不宜当作精确数字引用。
- “Don’t Stop Pretraining”与“三段式训练”:讲者在问答环节提到该论文名,但未给出作者与年份;本书据公开信息链接到
arXiv:2004.10964,属编者补全。 - 课程许可与版权:书首信息块中注明“具体许可条款(如 CC 协议版本)编者未能核对”。本讲提供的素材中未见讲义/幻灯片的许可声明,如需正式引用请以课程主页为准。
附录:课堂未展示的幻灯片
附录:官方幻灯片里课堂未展示的页
下面这些页来自官方幻灯片,但课堂录制里没有对应的展示画面。由
vb slides自动补入,供对照查阅。
🖼️ 第 2 页幻灯片 · Lecture Plan
🖼️ 第 3 页幻灯片 · The pretraining revolution
🖼️ 第 21 页幻灯片 · Bookcorpus.. what’s that?
🖼️ 第 56 页幻灯片 · Sometimes it learns some things we don’t want..