第10讲 · Stanford CS224N:推理与智能体(Reasoning and Agents)
| 课程 | Stanford CS224N / Ling284 — Natural Language Processing with Deep Learning |
| 讲次 | Lecture 14 — Reasoning and Agents |
| 讲者 | Shikhar Murty |
| 视频 | https://www.youtube.com/watch?v=I0tj4Y7xaOQ(时长约 63 分钟) |
| 课程主页 | https://web.stanford.edu/class/cs224n/ |
| 版权 | 课程与幻灯片版权归 Stanford University 及讲者所有,此处仅供学习与个人阅读使用。 |
对应讲次:第10讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
整理说明:本文依据课堂口语字幕重构为中文书面语。讲师的类比、案例、推理链与"思想的起源"(他为什么这么想、当时踩过什么坑)均予保留;只删去无意义口癖、卡顿与纯重复。凡编者补充处,一律以「编者说明」或「编者拓展|…」显式标注,不与讲师原话混淆。
导览
一张 3–5 分钟的问题地图。只给路线,不剧透推导与结论。
一、这一讲老师想回答的核心问题
Shikhar Murty 把这一讲切成两半,各自带一个他自己提出的核心问题:
- 前半场(约 00:47–30:08):语言模型到底会不会推理? 他会先停下来问"什么叫推理"(还专门分了类),再依次追问三件事:提示能不能把推理逼出来?这种能力能不能搬到小模型、或者让模型自己教自己?最后落在最关键的一问上——我们看到的那些"推理",到底是推理,还是记忆?
- 后半场(约 30:08–结束):语言模型怎么在一个有反馈的环境里采取行动? 也就是所谓"语言智能体(language agent)":给定一句自然语言指令,模型要在一个环境里发出一连串动作。
他说得很清楚:今天讲的内容大多是最近三四年的研究,"很多问题没有答案",所以他更希望这是一场讨论,而不是一份定论。
二、难点在哪
- 概念的坑:演绎 / 归纳 / 溯因三种推理,加上"形式 / 非形式"两个维度,一共四五个名词,很容易当场糊成一团,后面 CoT、自洽性、最少到最多就全部失焦。
- 方法的坑:CoT、自洽性、最少到最多看起来都是"让模型多想一步",但机制完全不同——一个是改提示、一个是改解码与聚合、一个是改问题结构。把它们混为一谈,就学不到东西。
- 评估的坑:这是全讲最容易被低估的一步。模型答对了,可能是推理,也可能是训练数据里见过。要区分二者,必须主动构造反事实(counterfactual)任务、做忠实性实验、做提前退出 / 破坏推理链的对照。讲师花了整段讲这些"看起来不像主菜"的实验,恰恰是因为没有它们,前面所有结论都不成立。
- 智能体部分的坑:把"决策"重新表述成"自回归生成",这个因式分解第一次看会有点抽象;而"没有监督信号时怎么造训练数据",是这一段最反直觉的地方。
三、读者可能带着什么疑问进来
① 老师真正提出的问题(他的原话顺序)
- 推理有哪几类?形式推理和非形式推理的区别是什么?
- 语言模型擅长产生"看起来像人话的续写",那它会不会推理?
- 用提示(CoT、自洽性、最少到最多)能让它推理吗?能推广到多步吗?
- 能不能把大模型的推理能力蒸馏进小模型?能不能让模型在自己生成的推理上微调并反复迭代?
- 那些"推理链"是忠实的吗?换个域外设定,模型还做得到吗?
- 语言模型之前,人们怎么做"指令 → 动作"?现在(2024)怎么做?
- 智能体在什么环境里评测?怎么训练?看文字还是看像素?差在哪?
② 编者预判的读者疑问(编者预判)
- "自洽性是不是就是集成(ensembling)?" —— 讲师当场就想过这个问题,并且在课上回答了,请留意他对这个疑问的处理。
- "把大模型的解释拿来蒸馏小模型,跟直接把大模型在自己输出上微调,有什么区别?" —— 这正是他讲到 Orca 之后马上抛出的问题。
- "反事实评估里为什么用 9 进制而不是别的?" —— 课上有同学当场问了,讲师也回答了,这一段对话值得完整保留。
- "智能体评测的分数能信吗?" —— 他给出的答案会让人有点意外:很多错误相当"低级"。
四、本讲路线
- 第一部分:推理。先讲分类 → 再讲三类提示方法 → 再讲两条"训练"路线(蒸馏 / 自训练)→ 最后用一整段做"打假":忠实性、反事实、类比推理。
- 第二部分:智能体。先给术语与设定 → 回顾语言模型之前的三条老路线 → 把决策改写成生成问题 → 用语言模型当策略 → 介绍评测环境 → 讲"合成演示 + 迭代重标注"这条训练路线 → 最后从文本走到像素(多模态智能体),并点出那道很宽的"提示鸿沟(prompting gap)"。
第一部分 语言模型会推理吗?
(本部分参考时间:00:47 – 30:08)
1.1 先把"推理"这个词说清楚
编者说明:这一节的内容,讲师是口头展开的,用来给整场讲座打地基。他特别强调:如果连"推理"是什么都不统一,后面讨论"模型会不会推理"就没有意义。
高层面讲,推理就是使用事实与逻辑去得到一个答案。但更具体地说,可以分成三类:
演绎推理(deductive)
从逻辑规则 + 一个前提出发,推出一个确定的结论。
讲师的例子:
所有哺乳动物都有肾。 所有鲸都是哺乳动物。 ⟹ 所有鲸都有肾。
而且可以多步叠加——这就是最常见的"代数式推理"形态。
归纳推理(inductive)
从观察出发,推出一个(不一定确定的)结论。
讲师的例子:
经验:每次看到有翅膀的生物,它通常是一只鸟。 观察:这只生物有翅膀。 ⟹ 它大概率是鸟。
溯因推理(abductive)
给定一个观察,然后去构造可能的解释。
讲师的例子:
一辆车打不着火,引擎下方有一滩液体。 ⟹ 可能的水箱漏水。
graph LR
  A["演绎 deductive"] --> A1["规则 + 前提 → 必然结论<br/>哺乳动物有肾 / 鲸是哺乳动物 → 鲸有肾"]
  B["归纳 inductive"] --> B1["观察 → 可能结论<br/>带翅膀的多是鸟 → 这只大概是鸟"]
  C["溯因 abductive"] --> C1["观察 → 最佳解释<br/>车打不着火 + 车下有水渍 → 可能水箱漏水"]
形式推理 vs 非形式推理
除了上面这套分类,还可以按另一个维度切:
- 形式推理(formal):用公理与形式逻辑规则去推导真值条件。
- 非形式推理(informal):你和我在日常生活中每天在做的——围绕日常情境,用常识得出结论。
讲师原话式的界定:在本讲剩下的时间里,"推理"一词默认指非形式的演绎推理,而且通常涉及多个步骤。
编者拓展|为什么要把三种推理分清楚 这三类的"出错方式"完全不同,这决定了后面评估手段的选择: - 演绎是保真的:只要前提和规则对,结论必然对。所以它可以用"格式化的正确性"来检验(比如布尔表达式求值、定理证明)。 - 归纳只给出概率性结论,所以评估它要关心"分布内 / 分布外"——这也是后面反事实评估的逻辑起点。 - 溯因关注"哪个解释最好",天然带主观性,评估最难,在今天的语言模型评测里反而是最少被认真对待的一类。 在逻辑学与认知科学里,这套三分法通常可追溯到 C. S. Peirce;而"形式 / 非形式"这一对区分,则更多是论证理论(argumentation theory)里的用法。讲师把它们并置,是为了给今天所有实验一个共同的坐标系。
1.2 思维链提示:让模型"先想再答"
(参考时间:04:04)
回到语言模型。前面几讲(第 9、10、11 讲)已经确立了一件事:大语言模型非常擅长生成"看起来合理、符合人类偏好与约束"的文本续写。
于是今天的问题就是:它们能不能推理?
最基础的试探方法是提示(prompting)。
- 思维链提示(Chain-of-Thought, CoT):让模型在给出答案之前先产生一步推理。做法是给若干带显式推理步骤的上下文示例(in-context examples),模型在测试时就会模仿这套格式。
- 一个有点意外的事实:有时候连示例都不需要,直接说一句 "Let's think step by step"(让我们一步步想),模型就会先产生推理,再给答案。
编者拓展|两个出处 CoT 提示出自 Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models(NeurIPS 2022)。而"只加一句 Let's think step by step 就能生效"来自 Kojima et al., Large Language Models are Zero-Shot Reasoners(NeurIPS 2022),后者被称为 Zero-shot CoT。两者一个依赖示例、一个不依赖示例,这是它们的核心差别。
graph LR
  Q["问题"] --> P["提示:<br/>CoT 示例 或 'Let's think step by step'"]
  P --> R["推理步骤(rationale)"]
  R --> A["最终答案"]
1.3 自洽性:多采样 + 多数投票
(参考时间:05:01)
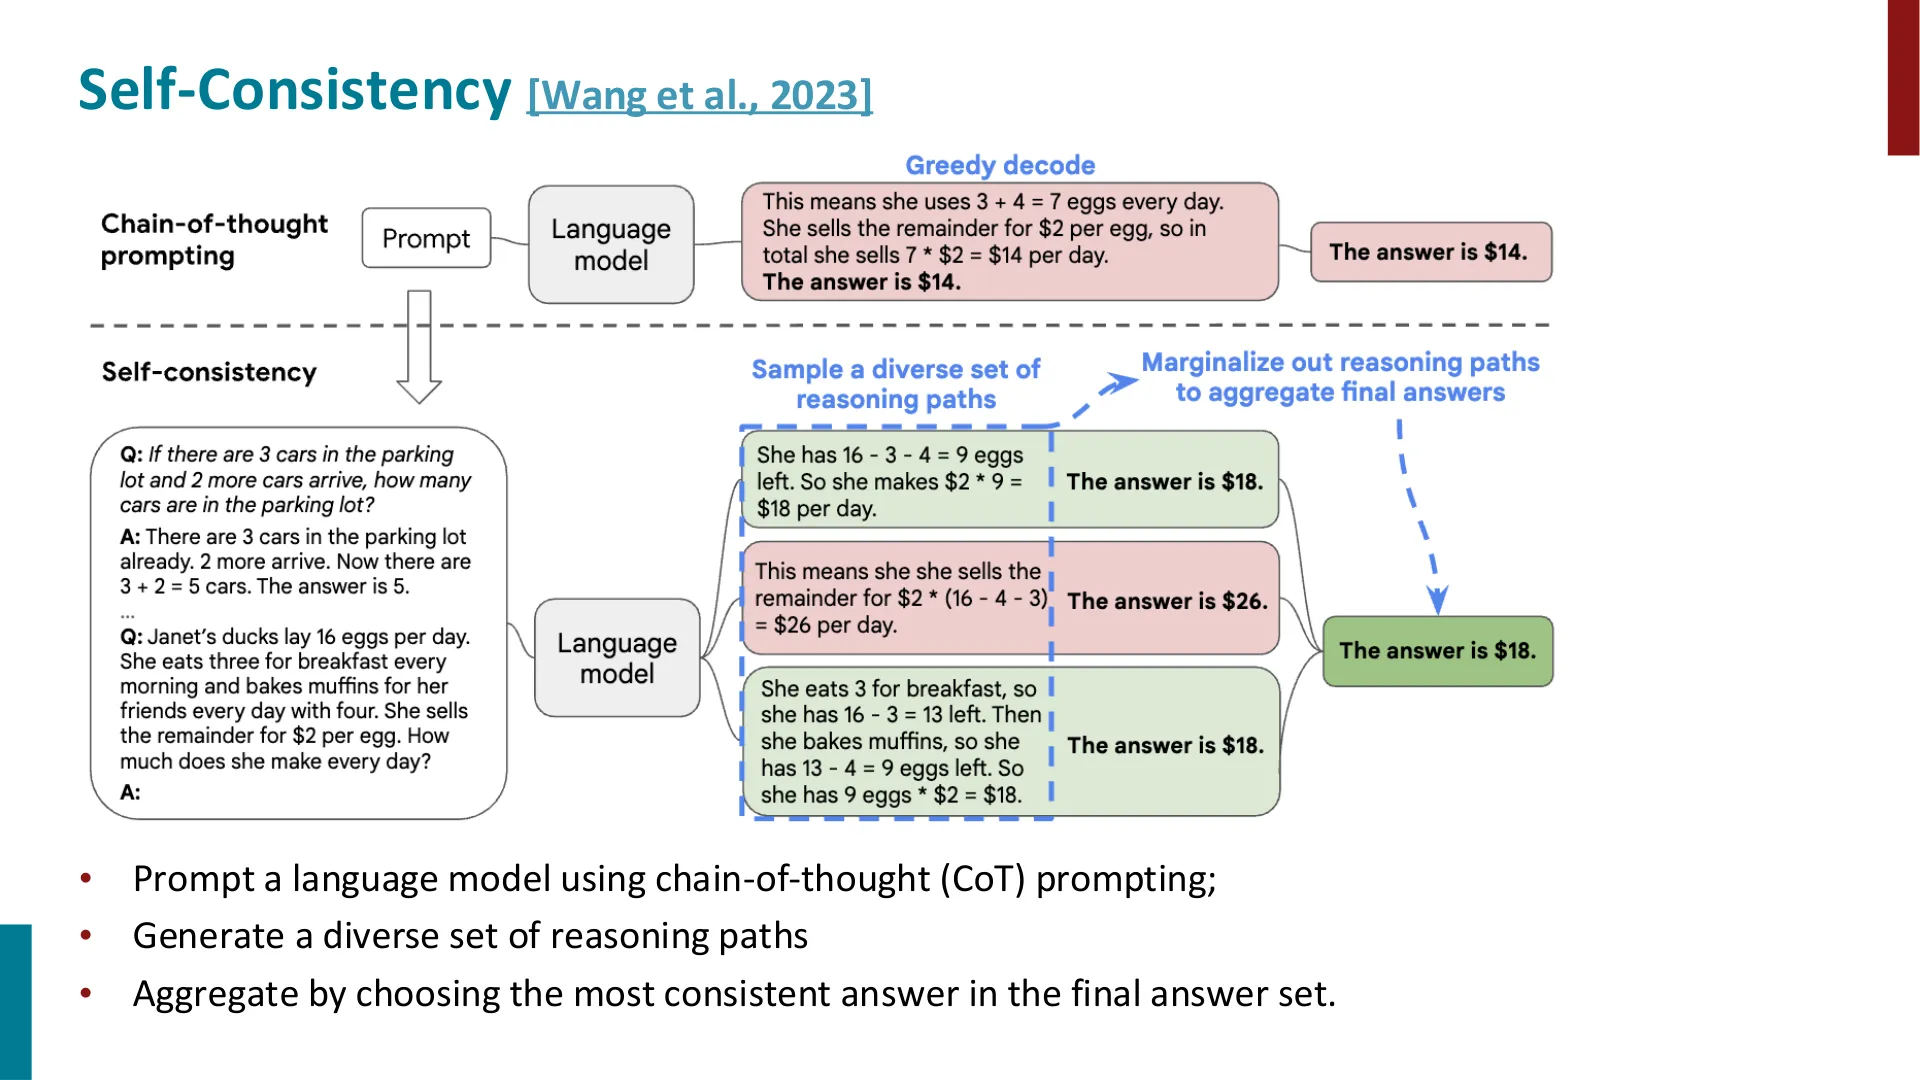
第二种提示方式是自洽性(Self-Consistency)。
做法与 CoT 的差别在于"采样方式":
- 标准 CoT:贪心解码一条推理链,然后基于这条链生成答案。
- 自洽性:采样多条推理链,每条链对应一个答案;最后选出现次数最多的那个答案(多数投票)。
背后的假设很朴素:如果多个不同的推理链都指向同一个答案,那这个答案更可能是对的。
作者发现在一批数学推理任务上,这个简单的改动相比标准 CoT 有相当显著的提升。
讲师的一段"思想起源":我第一眼以为这就是集成
讲师原话大意:我第一次看到这个结果的时候想,这不就是集成(ensembling)吗——我在 CS229 学过:训练 10 个不同随机种子的分类器,做多数投票,性能就上去了。 但事实证明,它可能比简单的集成多做了一点东西。作者也做了对照实验:用同一个语言模型 + 多个不同的提示做多数投票(这就是标准的集成做法),结果自洽性仍然更好。
这段"我以为是 A,结果是 B"的对照,是本讲的核心方法论之一:当你看到一个提升,先问它是不是某个更平凡的机制在起作用,然后去设计能区分二者的对照实验。
graph TD
  Q["问题 Q"] --> S["多次采样(非贪心解码)"]
  S --> R1["推理链 r₁ → 答案 a"]
  S --> R2["推理链 r₂ → 答案 b"]
  S --> R3["推理链 r₃ → 答案 a"]
  S --> R4["推理链 r₄ → 答案 a"]
  R1 --> V["多数投票"]
  R2 --> V
  R3 --> V
  R4 --> V
  V --> A["最终答案 a"]
编者拓展|自洽性为什么可能强于普通集成 普通集成的不同"成员"来自不同的随机种子或不同的提示,它们共享同一份权重的隐表示;而自洽性的多样性来自解码过程中的随机性(温度采样)。差异在于: - 集成是在输出空间做投票; - 自洽性是在推理路径空间做投票,然后由路径收敛到答案。 换句话说,它额外利用了一个先验:"同一道题的正确推理路径之间,比错误路径之间更容易彼此接近。"这也是它偶尔能强于普通集成的原因,但也意味着——它并不能保证那些路径本身是忠实的(这正是 1.7 节要打的问题)。
1.4 最少到最多提示:把大问题拆成小问题
(参考时间:07:00)
到目前讲的方法都还停留在"单次推理"。而多步推理的核心特征是:把一个大问题拆成若干子问题,分别作答,再合并成解。
把这种分解策略整合进提示,就是最少到最多提示(Least-to-Most Prompting):
- 给定问题,先让模型把它分解成若干子问题;
- 让模型逐个回答子问题;
- 再以这些子答案作为条件,生成最终答案。
对比一下两种提示下的输出形态:
- 标准 CoT:
问题 → 一条推理链 → 答案 - 最少到最多:
问题 → 子问题 1 / 子问题 2 → 子答案 1 / 子答案 2 → 最终答案
graph TD
  Q["原始问题"] --> D["分解:产生子问题"]
  D --> Q1["子问题 1"]
  D --> Q2["子问题 2"]
  Q1 --> A1["子答案 1"]
  Q2 --> A2["子答案 2"]
  A1 --> F["最终答案"]
  A2 --> F
一个有意思的实验:从 2 步推广到 5 步以上
最少到最多提示里有一个特别值得注意的结果:用少量推理步(比如只有 2 步)的示例做上下文学习,模型却能推广到需要 5 步以上推理的题目上,而且比标准 CoT 好得多。
但讲师随即泼了一盆冷水:这不一定说明这种结构本身是根本性的。作者自己报告的另一个结果是——只要提示工程做得足够充分,最好的标准 CoT 也能追平最少到最多。
他的评价是:拆解问题、逐个击破、再自底向上组装,这个思路本身很有意思,但它是不是"推理能力的本质",还不好说。
1.5 把推理能力蒸馏进小模型:Orca
(参考时间:09:53)
前面全是提示工程。接下来换一个方向:与其让巨大的模型去推理,能不能让一个更小的模型也具备这种推理行为?
一条常见的路线是蒸馏(distillation):微调一个小一点的 Llama,让它去模仿一个大 Llama 的输出。
具体案例是 Orca:用一个13B 的 Llama,去学 GPT-4 产生的解释(explanations)。数据构造分三步:
- 取一批多样化的指令:来源是 FLAN v2 集合。它把多个数据集汇聚在一起,由
指令 + 问题 + 答案组成。 - 提示 GPT-4 / ChatGPT:把指令连同一条系统消息(system message)一起送进去,系统消息的作用是要求模型给出信息量充足的解释,并一步步作答。
- 在解释上微调小模型:用这些含详细解释的输出去微调 13B 的 Llama。
讲师举了一个具体的例子:给出一道计算中位数的简单数据处理题,系统指令是"请论证你的每一步,一步一步回答",于是模型输出了一段相当详细的推理过程——而 Orca 要做的,正是用这段解释去训练一个小得多的模型。
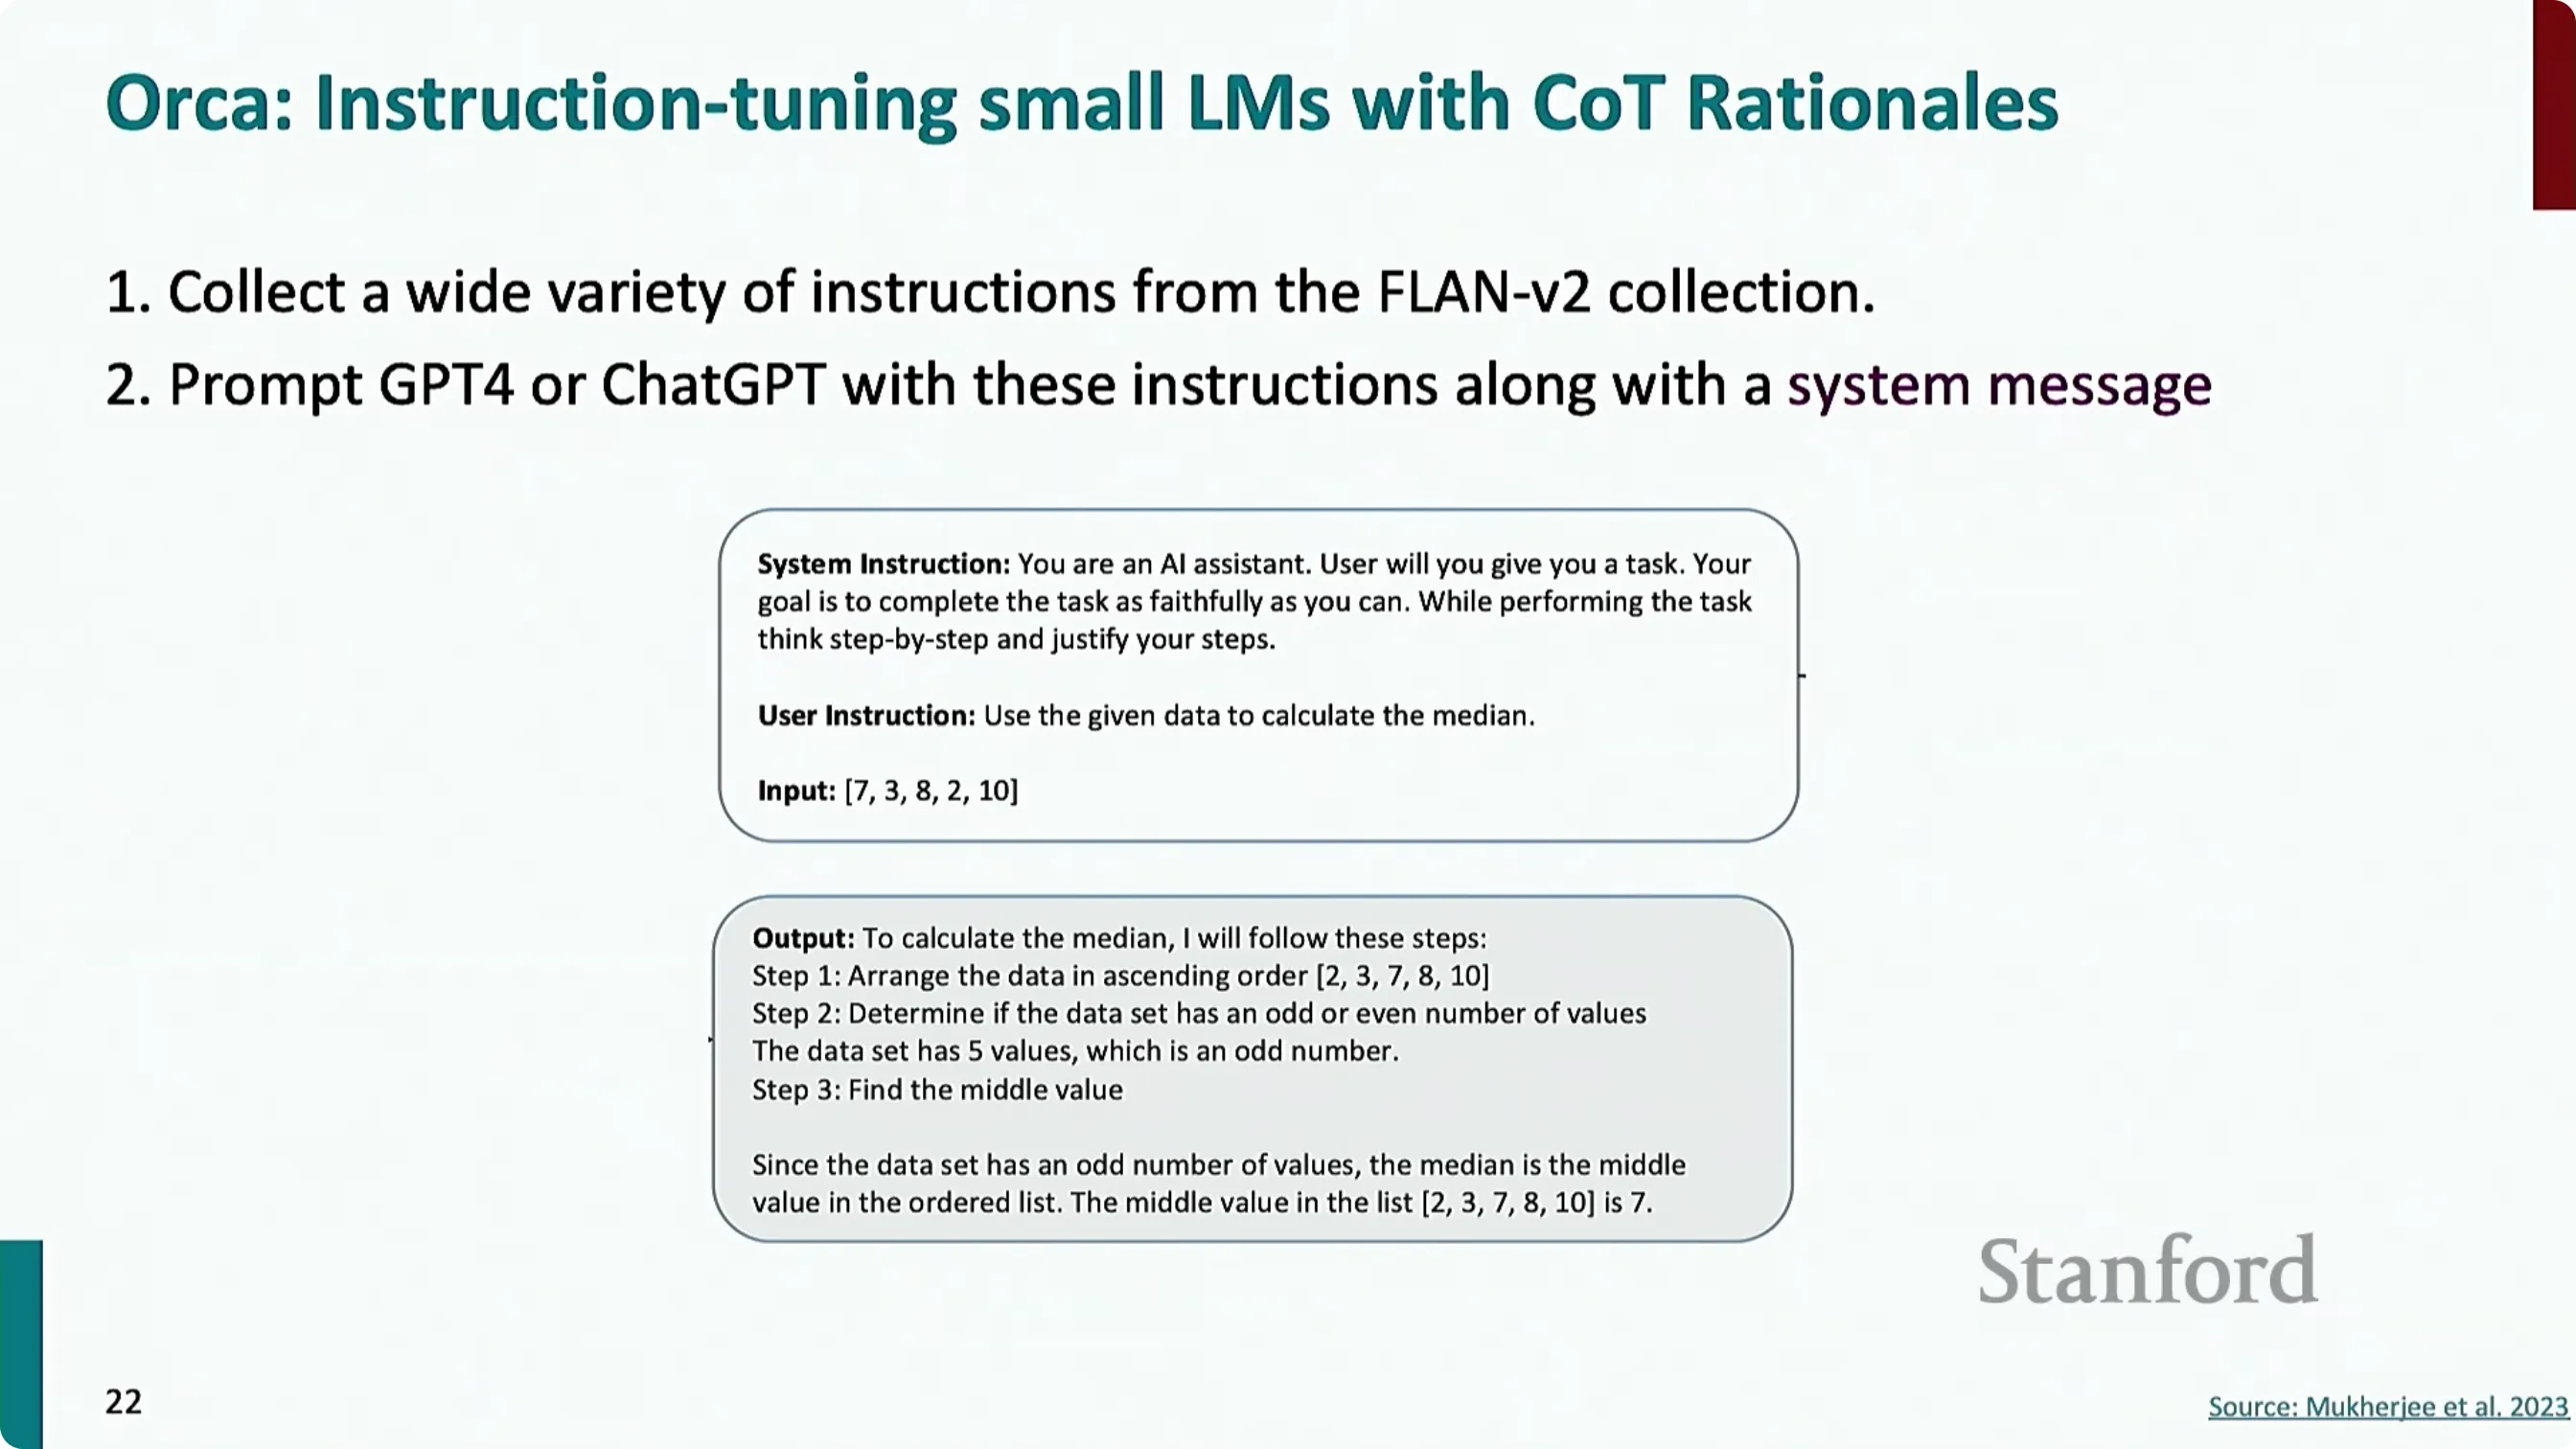
📷 Orca 数据构造中的中位数计算示例
回到原视频 (00:11:45)
换一个基准:BIG-bench Hard
(参考时间:12:24)
为了不只盯着数学题,讲师把视角转到 BIG-bench Hard(BBH)——一个用于多步推理的数据集,一共 23 个子任务。他展示了几个:
- 布尔表达式求值:题目形如
True and False and not True and True。用 CoT,模型可以逐个求值子表达式再给出最终答案。 - 日期理解:题目形如"明天是某个给定日期,那么一年前的今天是几号?请按给定格式回答",并附带若干选项;模型同样可以一步步推出答案。
- 几何形状:直接给你一段 SVG 的 path 元素,问"由它渲染出来的是什么形状?"——讲师很坦率地说:"我自己都看不出来这段 SVG 会渲染成什么",但模型被
let's think step by step一提示,就会给出一个答案(对不对另说)。
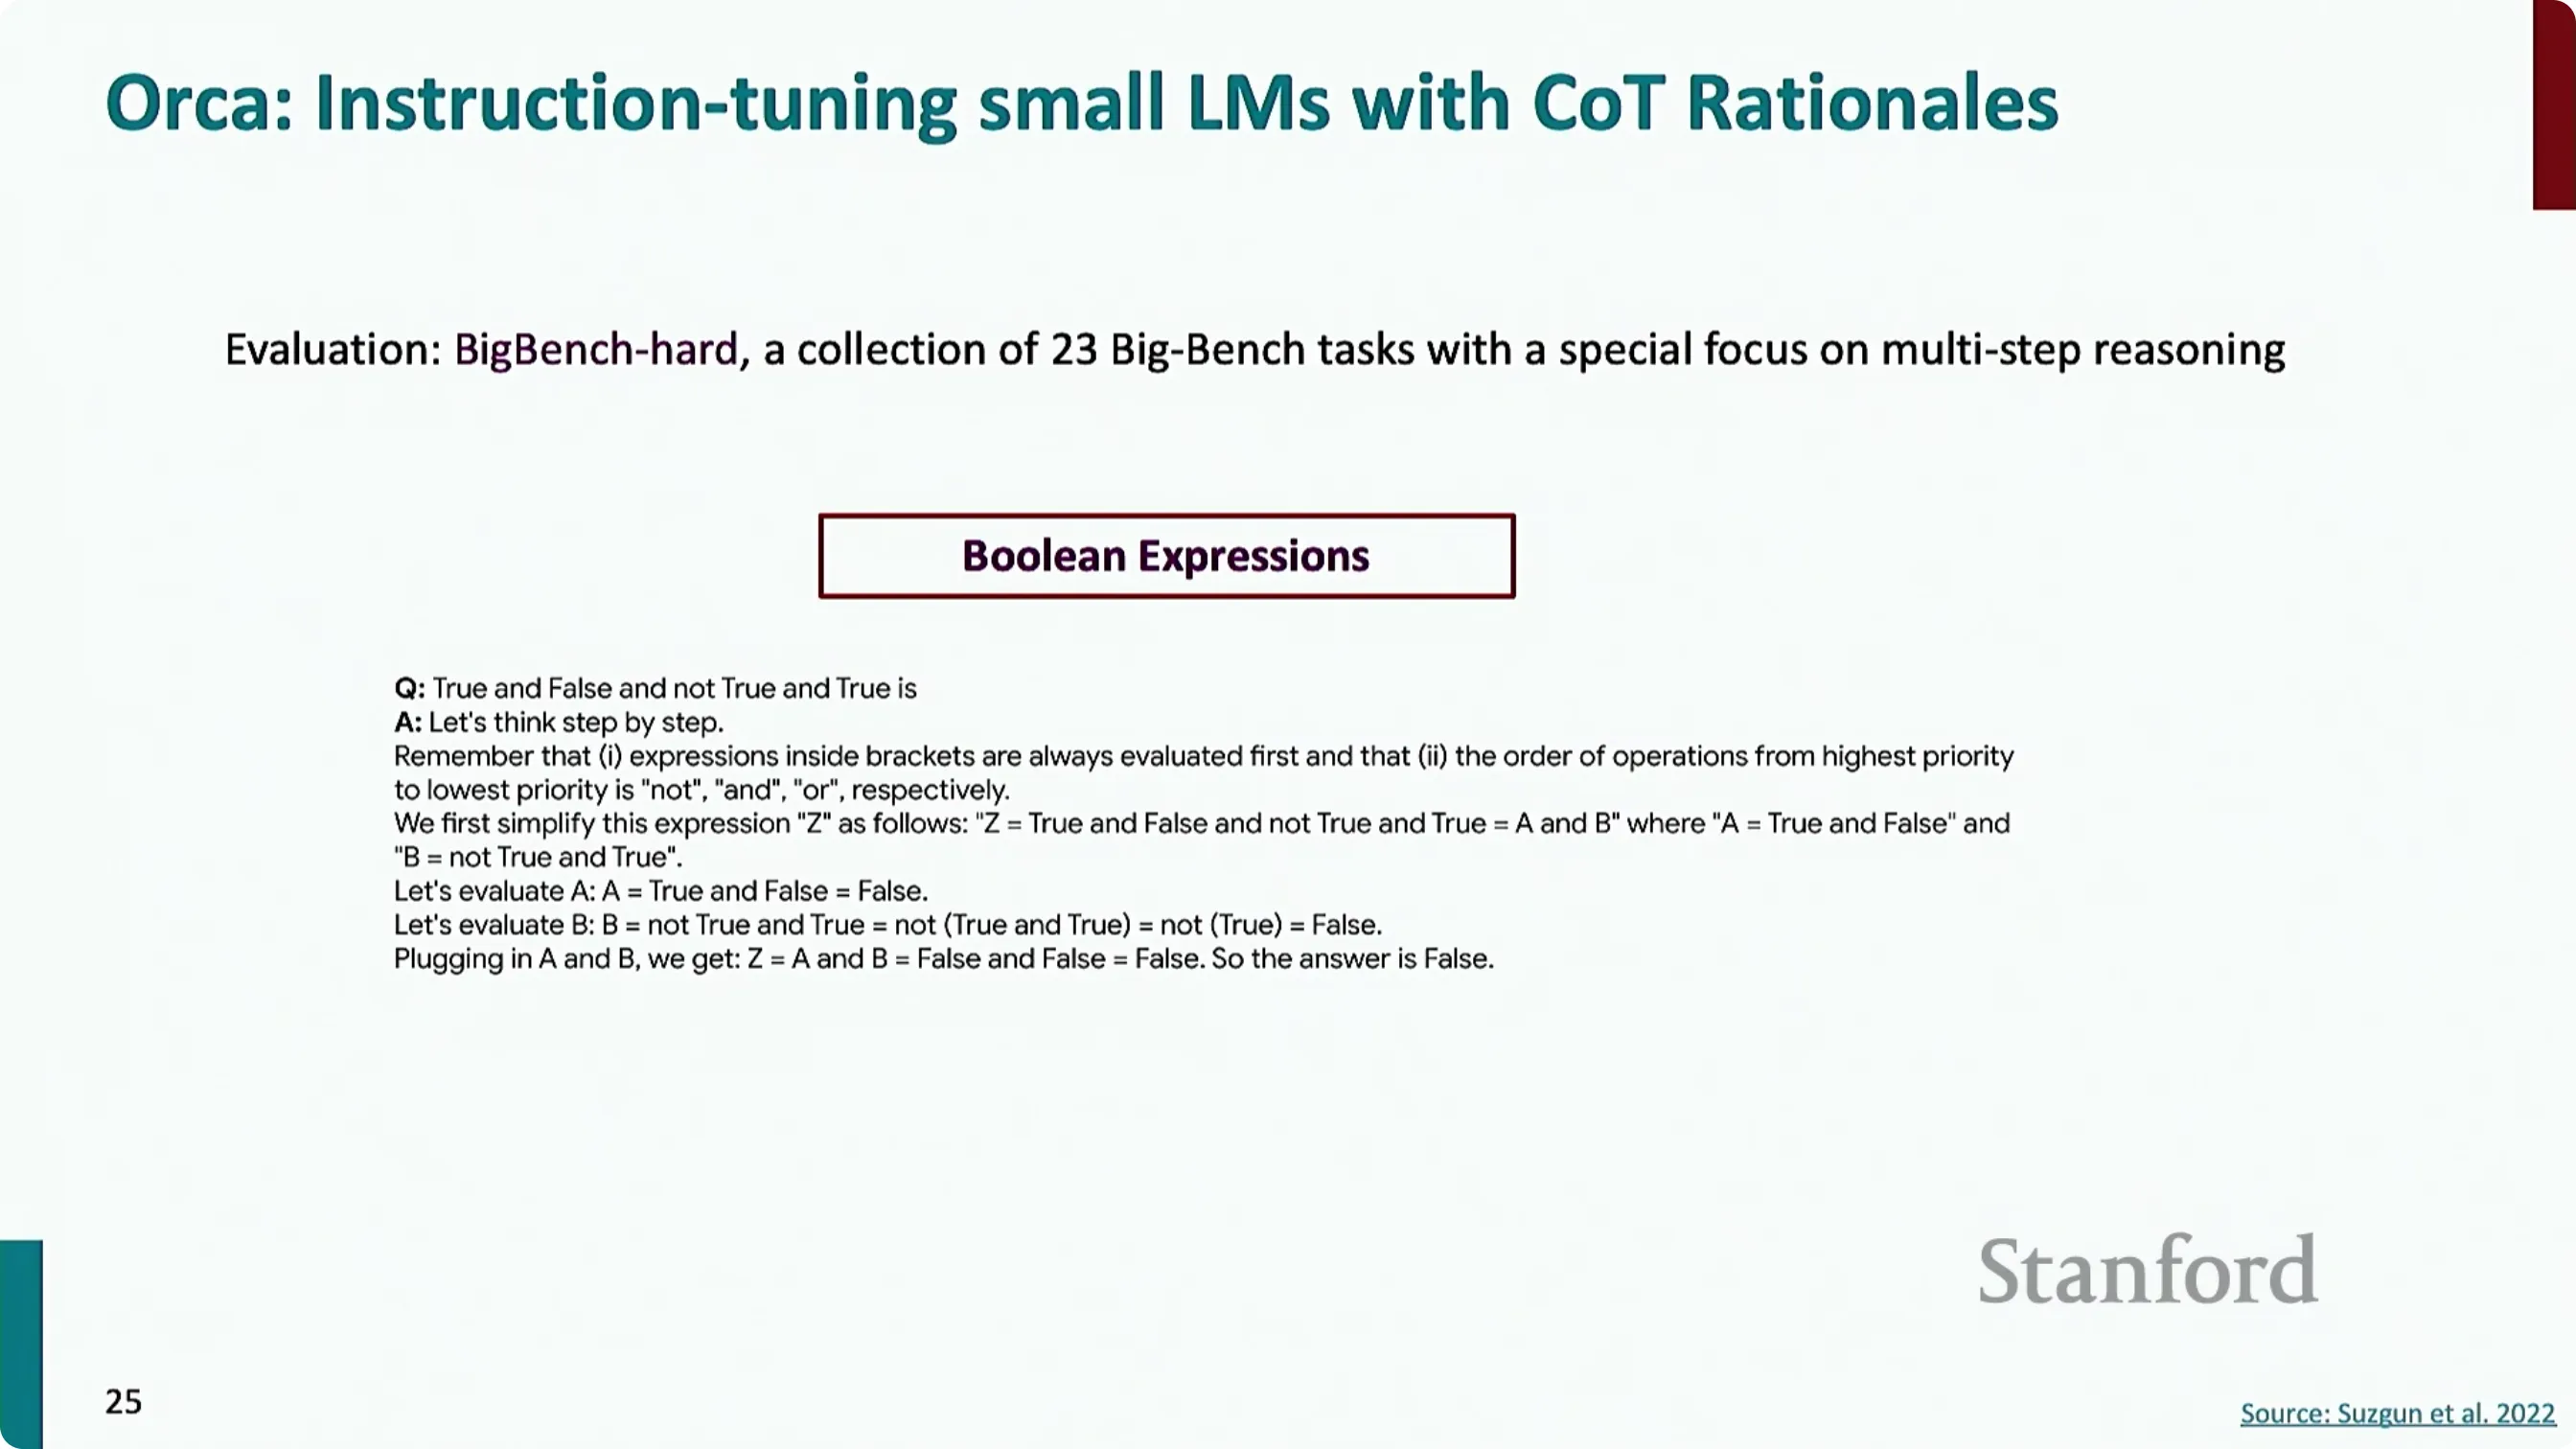
📷 BIG-bench Hard 中的布尔表达式与日期理解任务
回到原视频 (00:13:05)
这些任务大多带有选项(多选),所以比较容易得到一个准确率数字。结果:
- GPT-4 那一列存在数据污染的嫌疑,讲师建议先忽略;
- Vicuna:几个月前的 SOTA,是一个指令微调过的 13B Llama;
- Orca:同样是 13B 的 Llama,但专门在这批"解释数据"上微调过。
结论是:Orca 总体上超过了 ChatGPT(可能因为它专精于这类推理题),也超过了 Vicuna(Vicuna 没有在这类详尽的解释上训练过)。
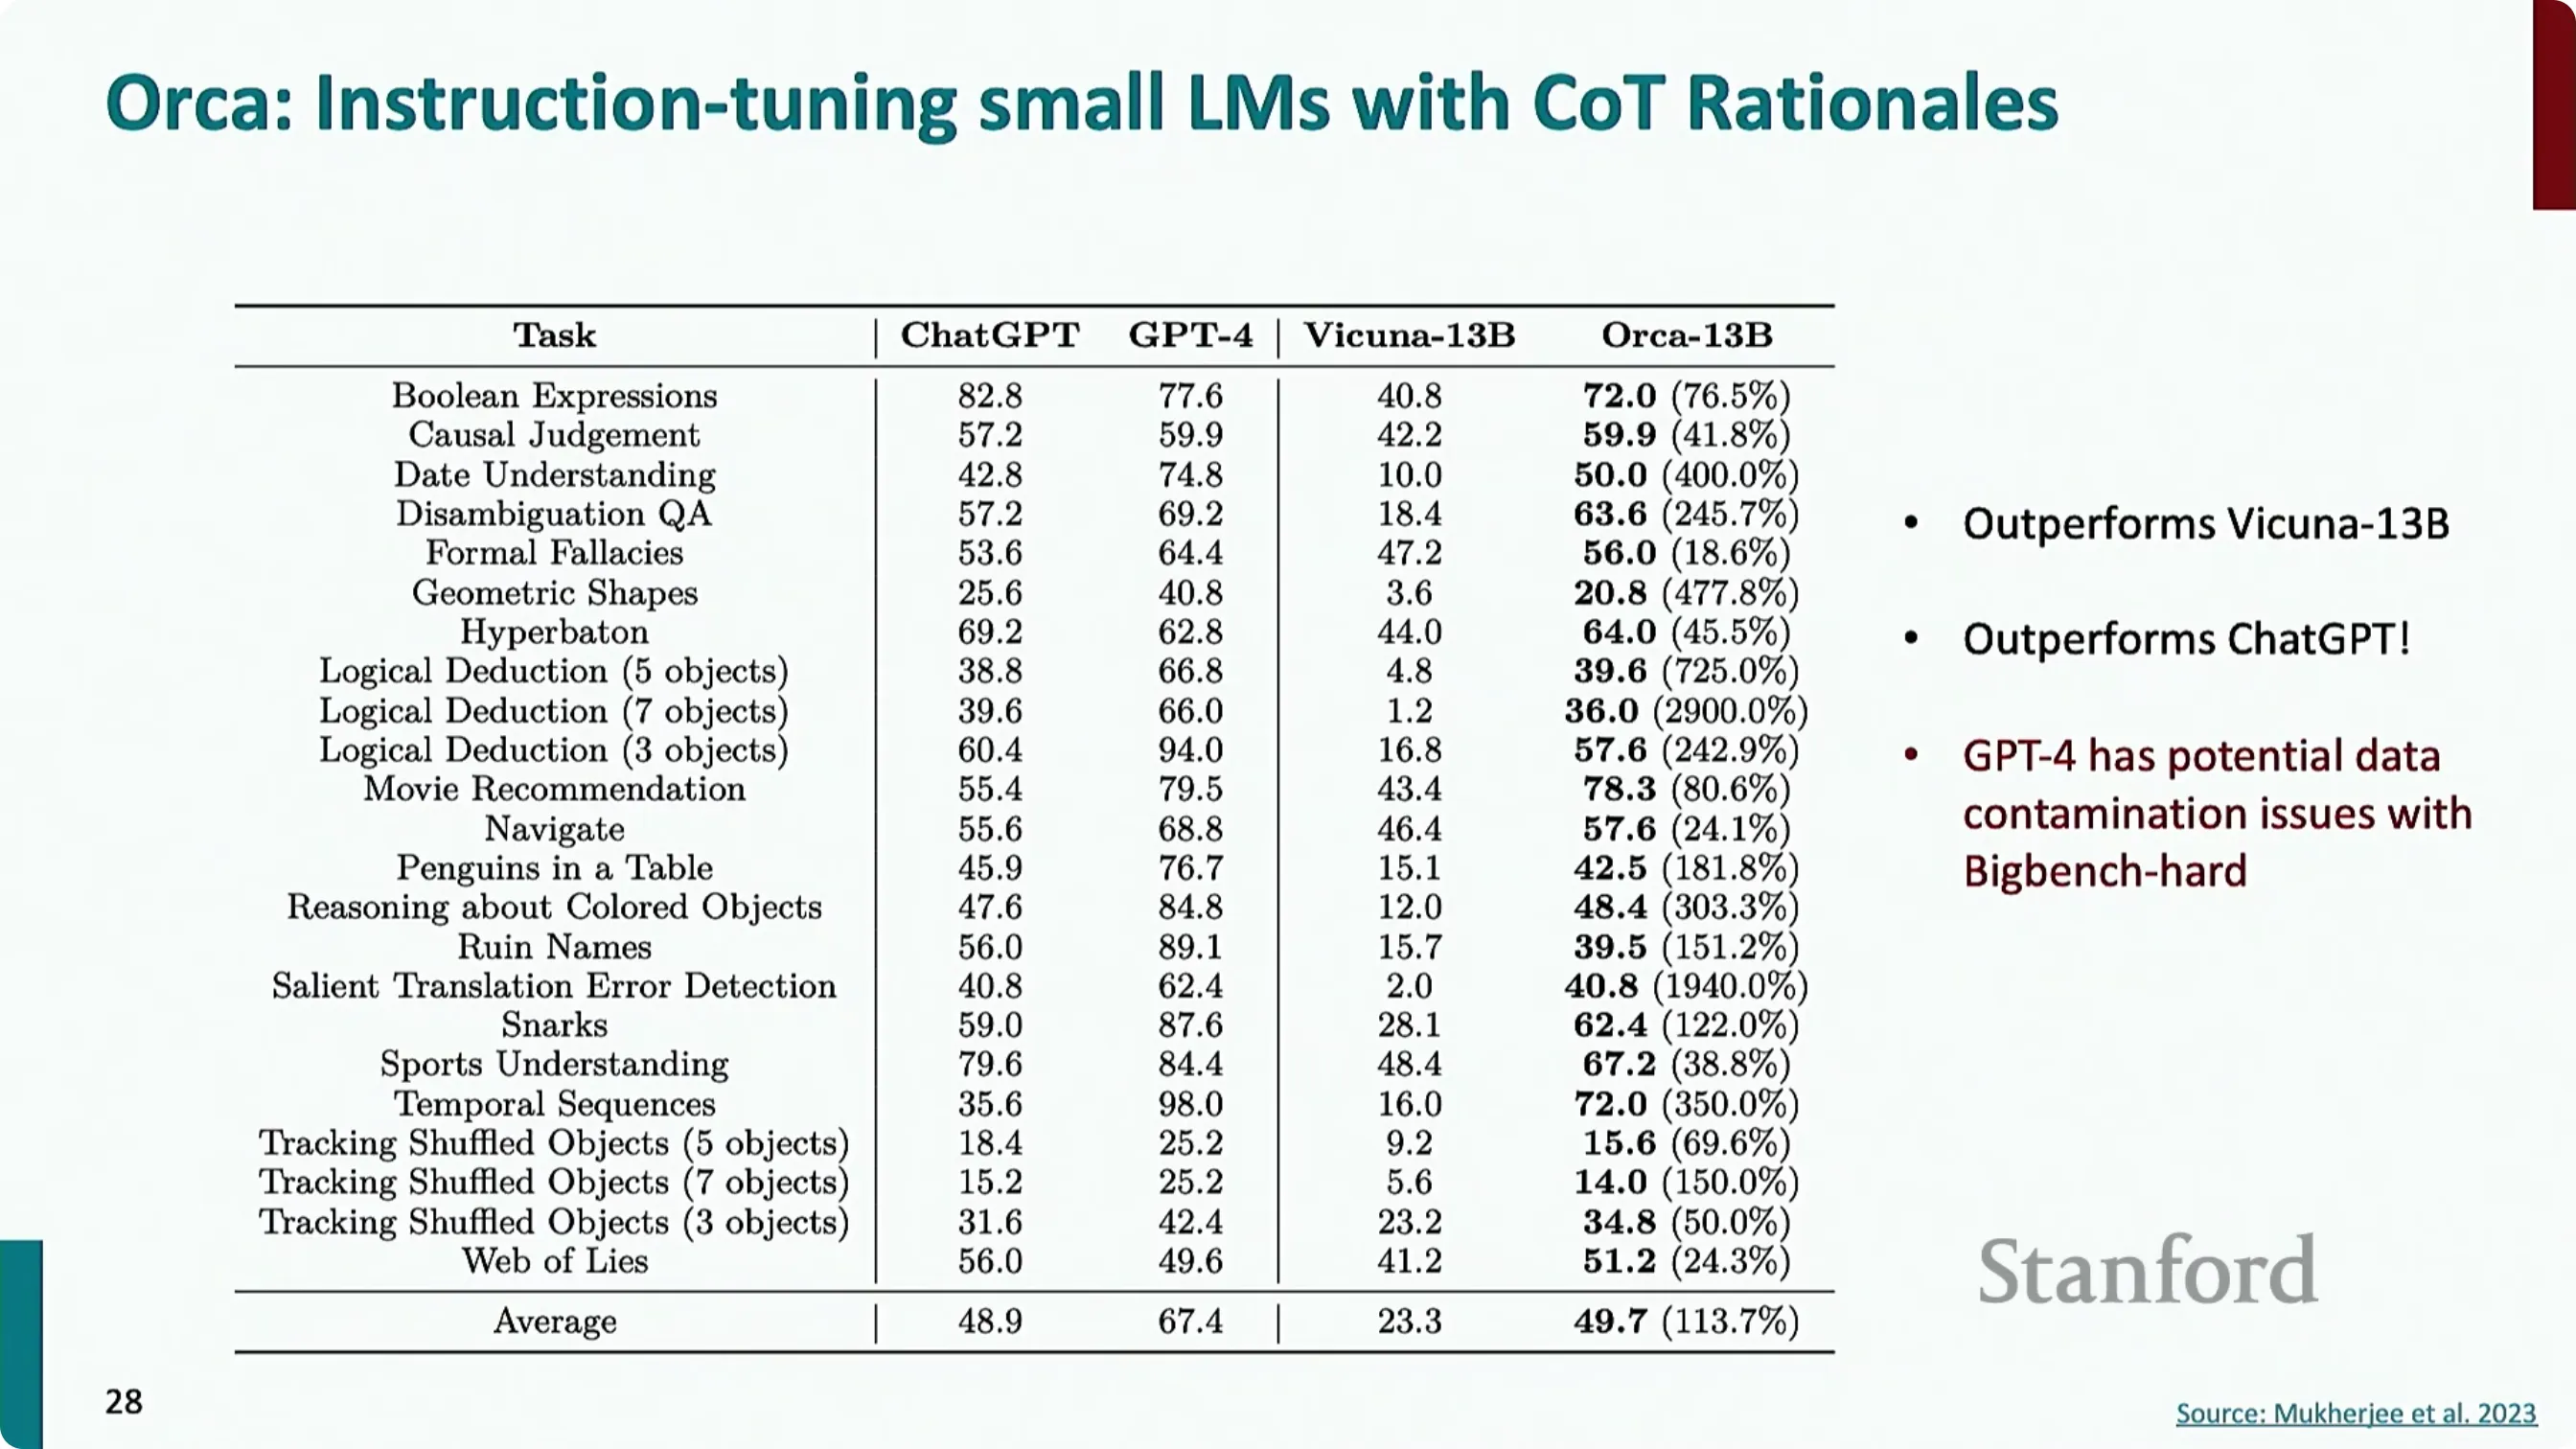
📷 不同模型在 BIG-bench Hard 上的对比
回到原视频 (00:15:10)
1.6 强化自训练:让大模型教自己
(参考时间:16:20)
讲完 Orca,讲师马上抛出一个反问——这正是很多同学心里的疑问:
"那为什么不干脆让大模型在自己的推理链上微调呢?"
这条路也被探索过,其中一个代表方法是强化自训练(Reinforced Self-Training,简称 ReST)。它交替执行两个阶段:
- 阶段一 · 生成并筛选:给定一道推理题(可能带上
let's think step by step),让语言模型生成多条推理链,然后按最终答案是否正确来过滤。 - 讲师的例子:三个人有 3 个苹果,另一个人有 4 个苹果。模型生成一条推理链,答案是 7 → 保留;另一条答案算成 12 → 丢掉。
- 阶段二 · 更新:在阶段一筛选出来的推理链上微调模型。
然后反复迭代:现在有了更新后的模型 → 期望它产生更好的推理链 → 再用更好的数据更新模型 → 不断循环。
graph LR
  M["语言模型 M_t"] --> G["生成多条推理链"]
  G --> F["按最终答案正确性过滤"]
  F --> T["在保留的推理链上微调"]
  T --> M2["语言模型 M_(t+1)"]
  M2 --> G
结果:既能涨、也会崩
- 在 GSM8K(小学数学应用题数据集)上:随着自训练迭代次数增加,性能先有小幅提升,随后开始下降。
- 在 MATH(覆盖更广泛数学问题的多步推理数据集)上:迭代越多,准确率持续提升。
在 MATH 的那张图里,橙色是更大的 PaLM 模型,蓝色是较小的模型,虚线代表"在人类写的推理链上做监督微调"能得到的结果。
一个相当鼓舞人的结论是:在自身推理链上做多轮训练,可以超过人类写的推理链。
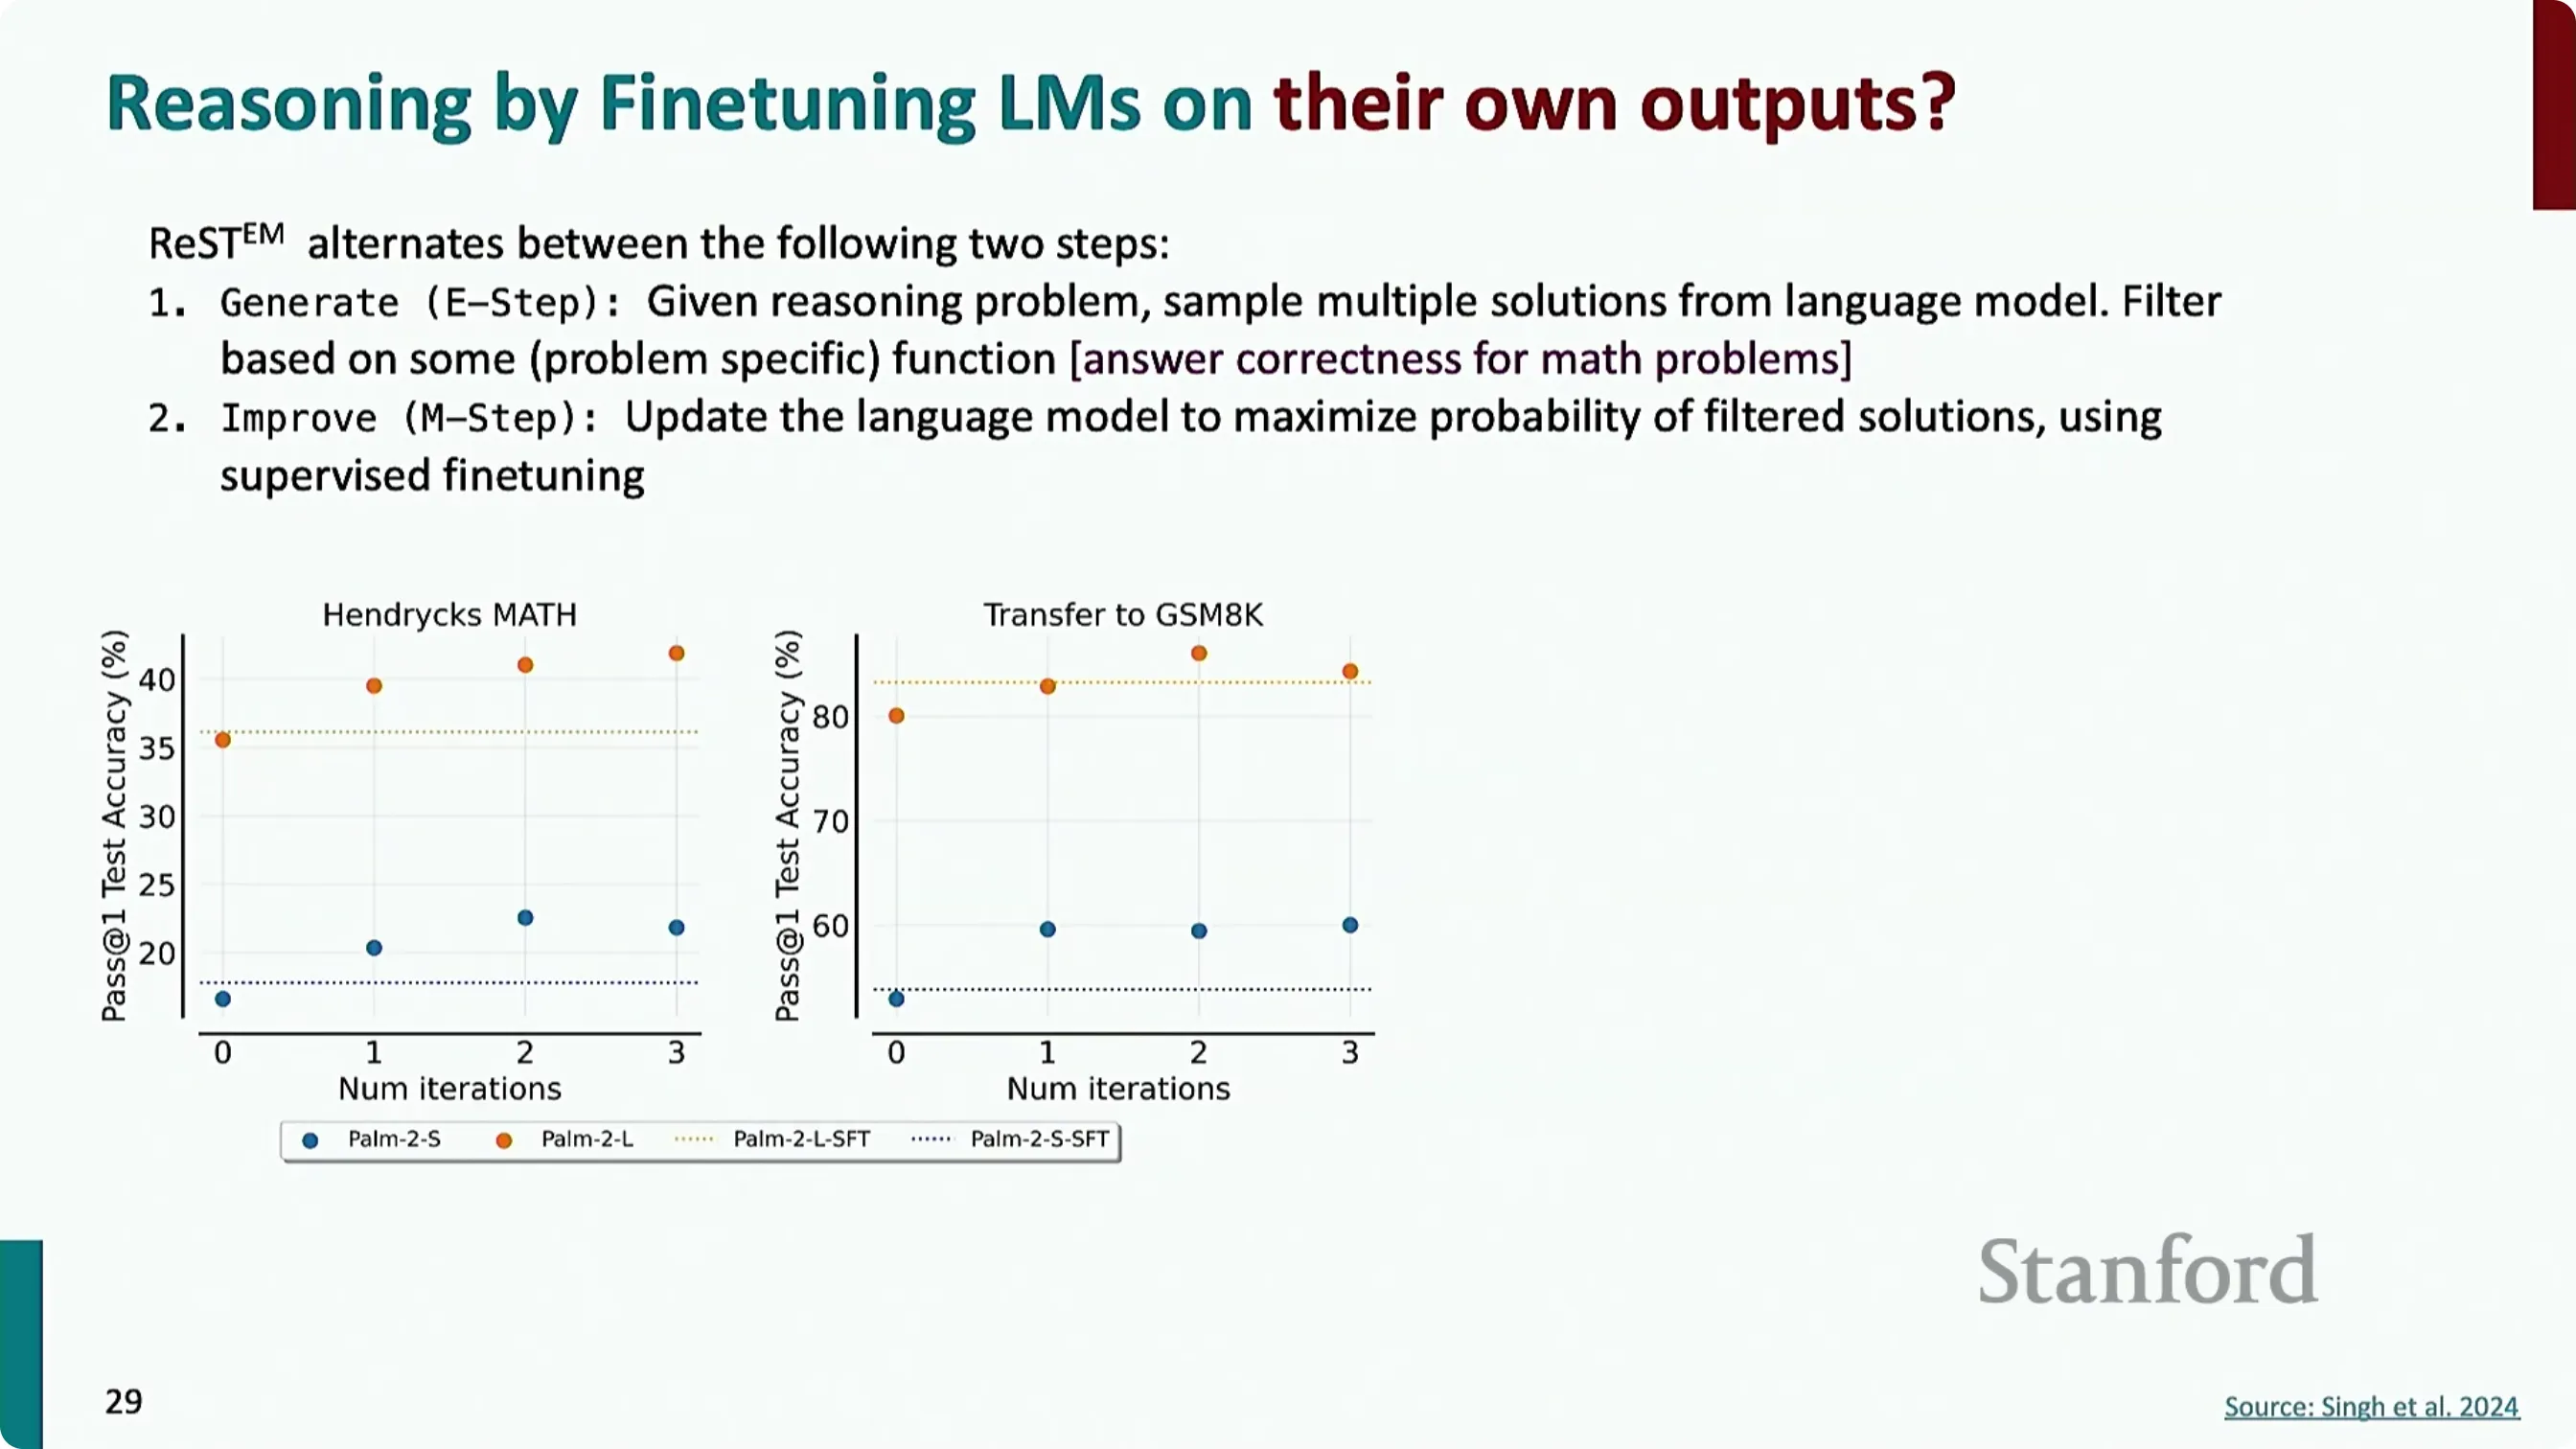
📷 强化自训练在 GSM8K / MATH 上的迭代曲线
回到原视频 (00:17:55)
一张关键的对照柱状图
讲师随后给出一张更严格的对照图,用来"控制变量":
- 蓝色柱:用 PaLM 在人类提供的推理链上做监督微调;
- 橙色柱:用 一道人类写的推理链每道题做微调;
- 绿色柱:用模型为每道题随机挑一条自己生成的推理链做微调(这样就和橙色在数量上对齐了);
- 最后是完整的多轮迭代流程。
结果:绿色超过蓝色——即"模型自己生成、数量受控的推理链"比"人类写的推理链"更有效;再叠上完整的多步迭代,性能又往上抬了一截。
编者拓展|这条结论为什么重要,又为什么危险 它重要,是因为它第一次在受控条件下说明:模型自产的中间过程,可能比人工标注的中间过程更"适配"模型自身的分布。它危险,是因为这套流程没有"真实性"约束——模型完全可以一边编出漂亮的推理链、一边靠某个捷径答案蒙对,而这些"蒙对"的样本会被过滤器当作正样本喂回去。这就直接引出了下一节的问题。
1.7 这些"推理"是真的吗?
(参考时间:20:13)
讲师把话头收回到最开始的问题:我们看到的推理,究竟是真的推理,还是记忆?
他说:看排行榜是一种回答方式,但更系统的回答方式是——构造反事实任务,并且对可能的数据污染保持极度谨慎。
7.1 推理链是"忠实"的吗?
第一个要问的是:模型产生的推理链,是不是"忠实的(faithful)"?
所谓不忠实,是指:模型先产出一条推理链,再产出一个答案,但这个答案根本不依赖那条推理链。讲师给的例子非常直白:
问题:Tom 有 3 个苹果,Jerry 有 4 个苹果。 推理链:Tom 有 3 个,Jerry 有 4 个,3 + 4 = 7。 答案:25。
这种情况就叫不忠实——答案是凭空来的,跟推理链没关系。
实验设计一:强制提前退出。
- 每道题模型先产出一条推理链(多条句子构成)。
- 然后强制模型从推理过程中提前退出:只让它写完第 1 条句子就给答案;再试只写前 2 条给答案……以此类推。
- 横轴是"允许的推理样本数",纵轴是"提前退出后的准确率"。
- 判据:如果"只看第一条就答"和"看完整四条再答"给出同样的答案,那就说明推理链对答案没有影响——推理不是忠实的。极端情况下,完全不给推理链也能答对。
结果总体喜忧参半,但有足够多的数据集呈现出"看不看完整推理链都一个样"的现象——这暗示这些推理链可能是模型答案的事后解释(post-hoc explanation)。
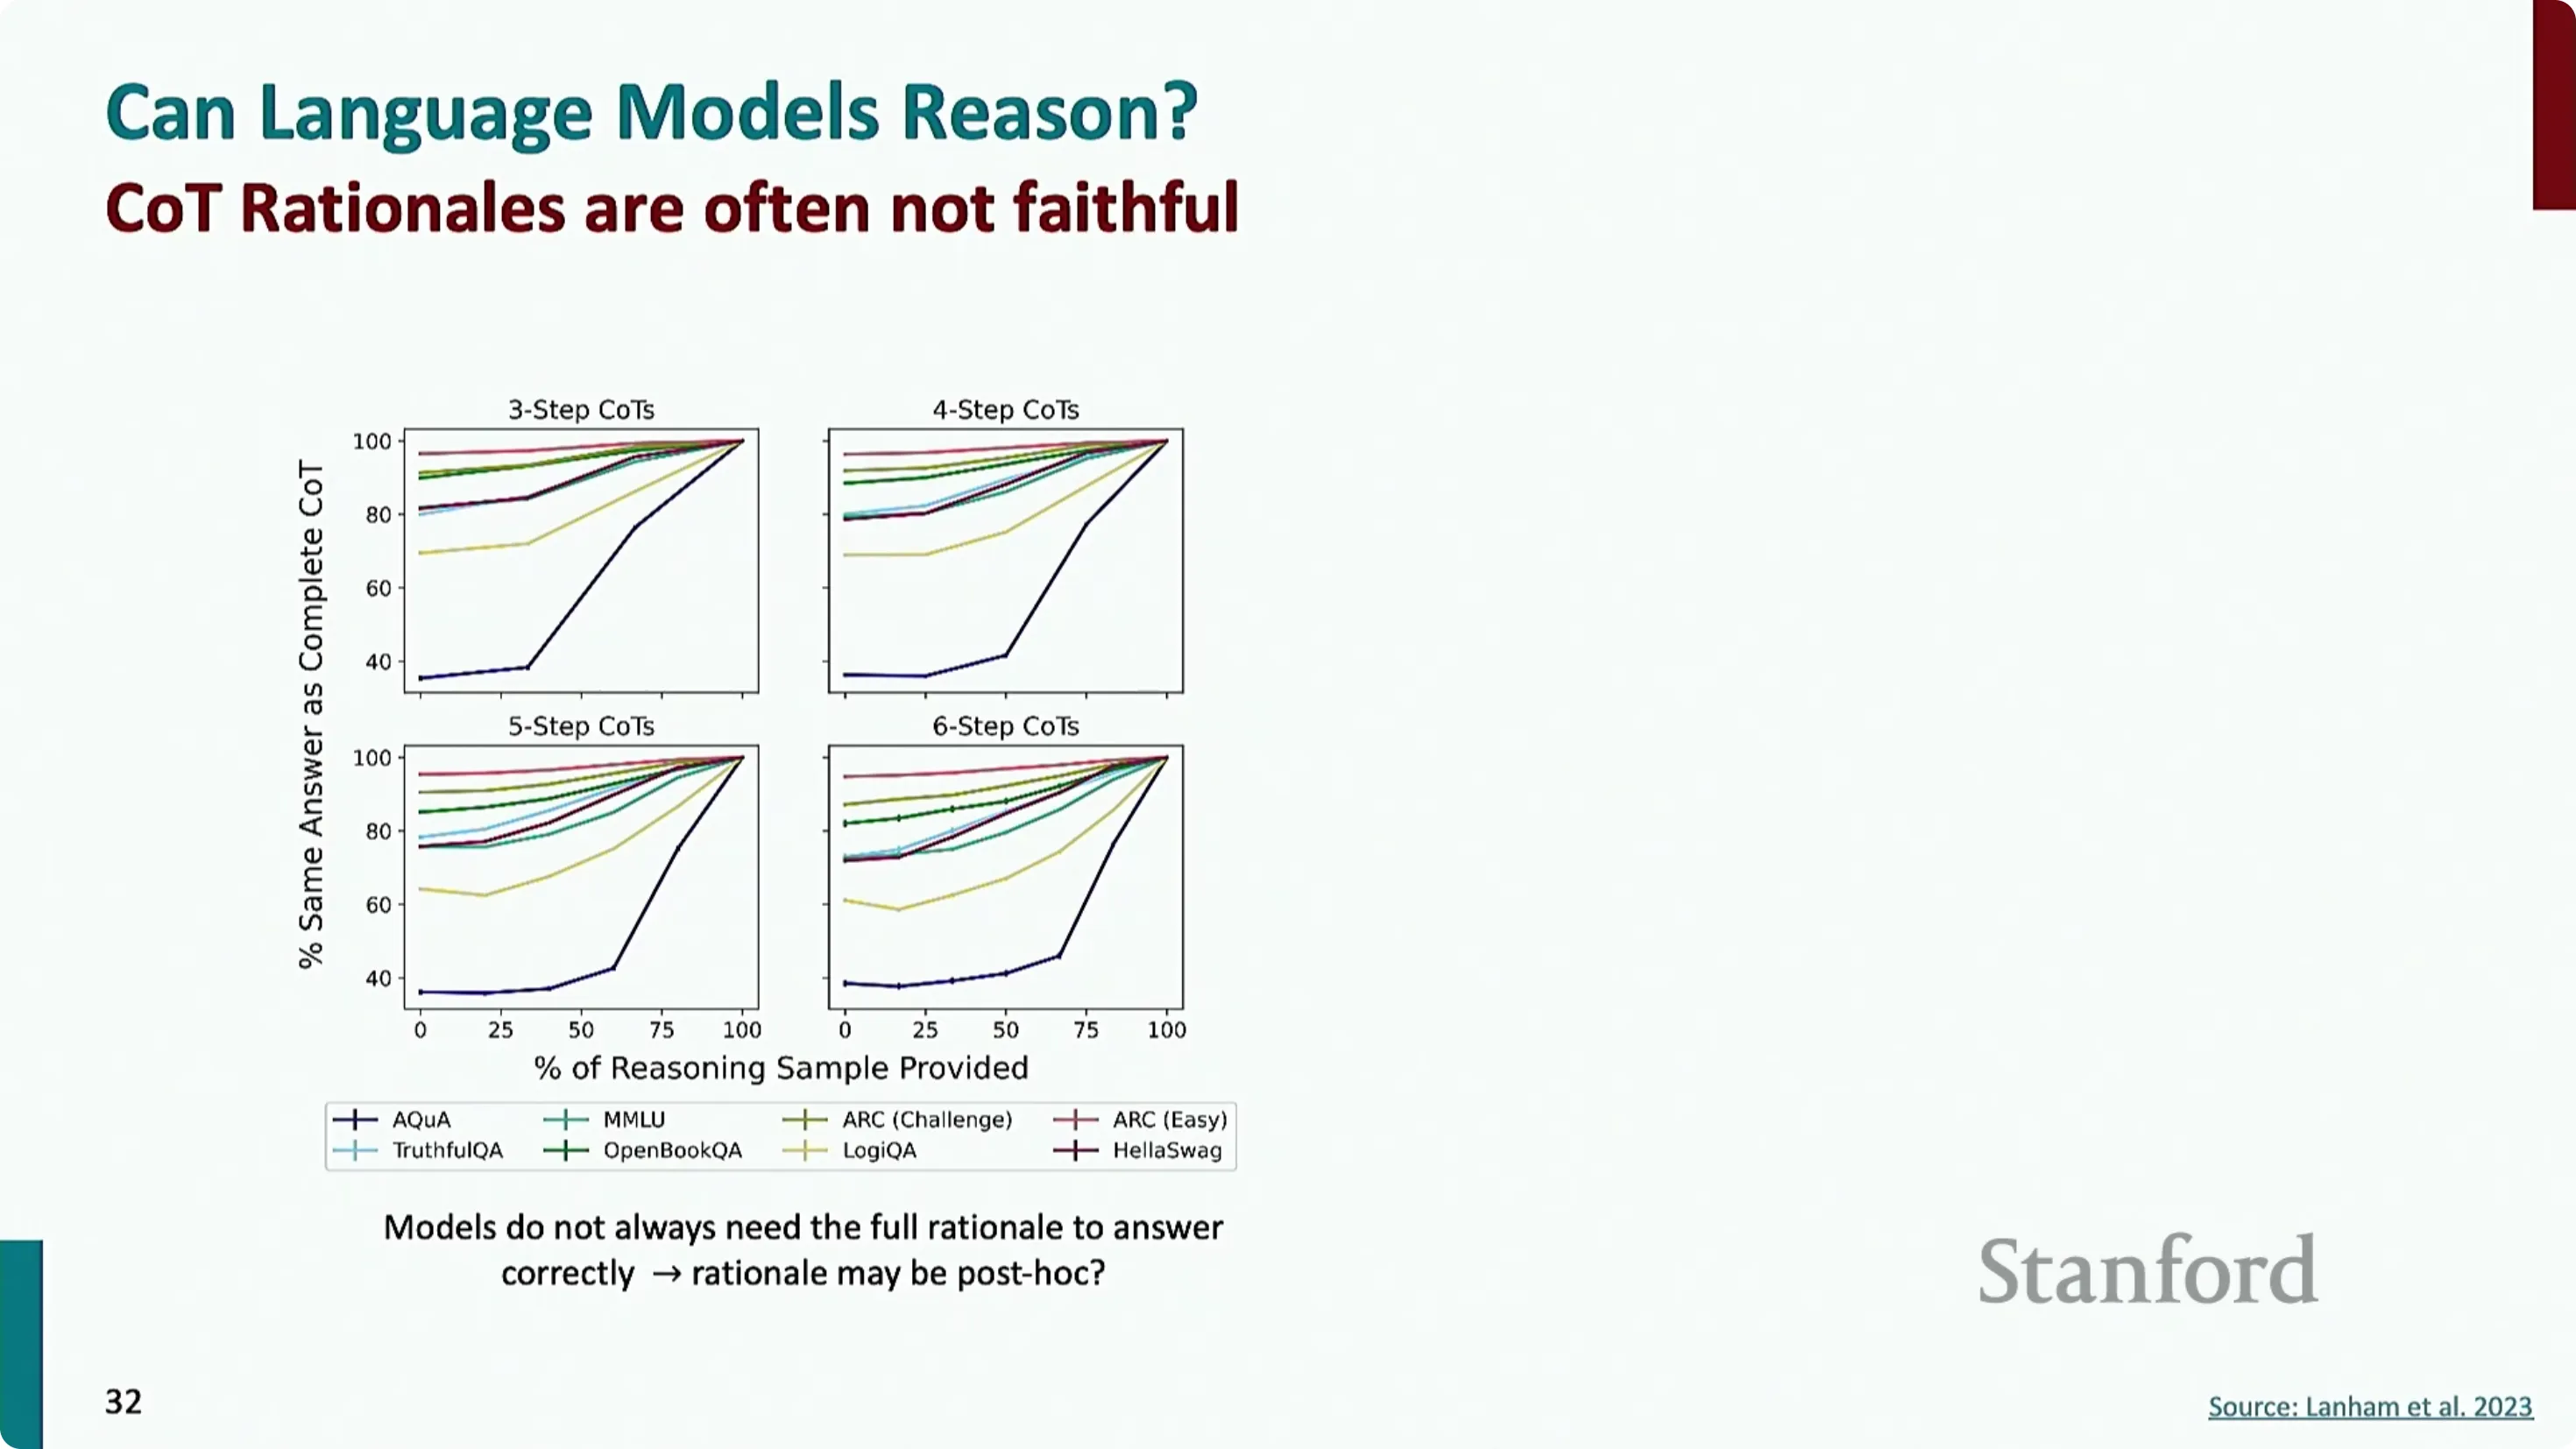
📷 忠实性实验:提前退出推理链后的准确率曲线
回到原视频 (00:21:38)
实验设计二:破坏推理链。
- 先正常生成第 1、第 2 步,然后把第 3 步人为弄错,再生成第 4 步,最后问答案。
- 横轴是"在加入错误之前已完成多少比例的正确推理步"。
- 预期的趋势:错误加得越早,答案变化应该越大(一条严格单调上升的曲线)。
- 实际结果:某些数据集上,即使第一句就被污染,答案也几乎不变。这是"推理链是事后解释"的又一个信号。
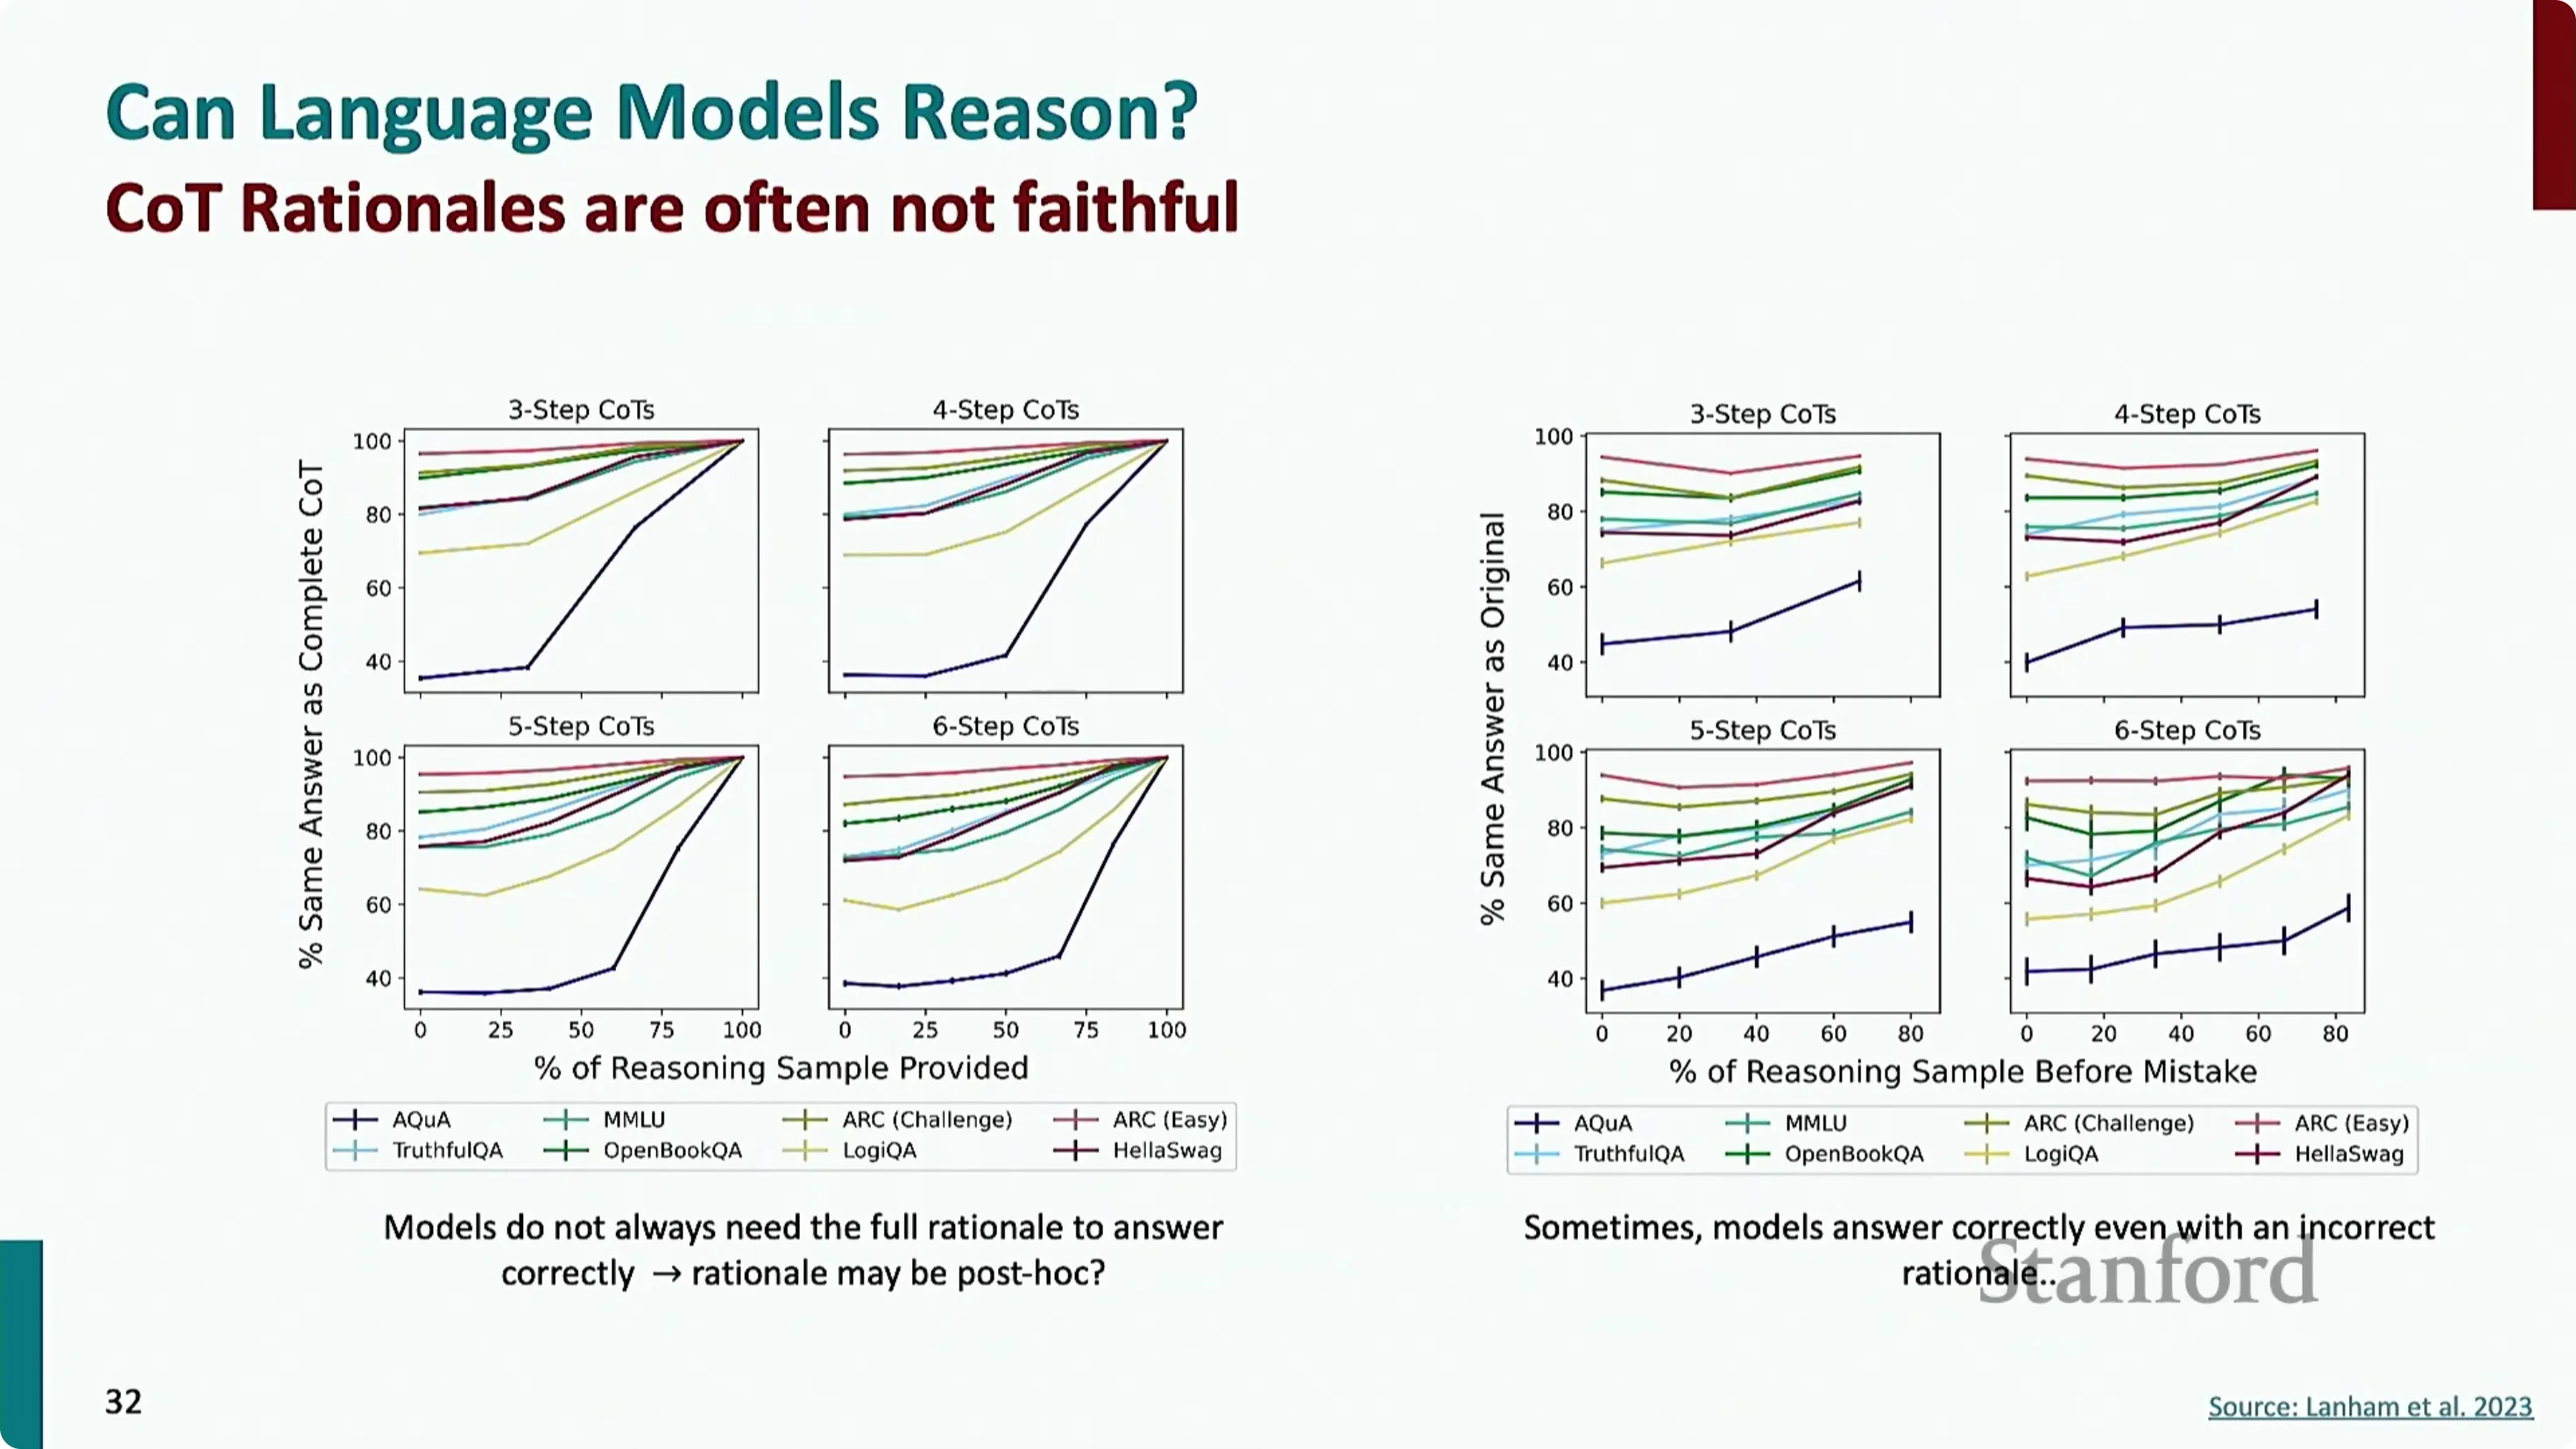
📷 破坏推理链实验:错误注入位置与答案变化的关系
回到原视频 (00:23:55)
编者拓展|"忠实性"这条研究线的标准做法 上面两类实验(提前退出 / 中途注入错误)来自 Lanham et al., Measuring Faithfulness in Chain-of-Thought Reasoning(2023)。它的核心思想是干预—观察:不去问"推理链看起来对不对",而是直接改动推理链,看答案是否随之改变。如果答案不随推理链变化,那么这条推理链在因果上就是装饰性的。 与之互补的是反事实评估(下一小节):不改推理链,改题目的设定,看模型是否还能做对——用来区分"真会"与"见过"。
7.2 反事实评估:换一个设定,它还做得到吗?
(参考时间:25:01)
第二个问题更根本:如果我把设定稍微改一改,模型还能做对吗?
- 假设模型会做 10 进制加法(比如
12 + 14),那说明它会做加法,还是说明这道题恰好出现在训练数据里? - 检验方式:构造反事实(counterfactual)——用9 进制做加法。如果模型在 9 进制上的准确率一样高,那才可以推断它真的掌握了加法。
- 逻辑任务同理:模型解逻辑题很厉害,可能只是因为见过类似表述。那就构造一个不常见的世界,比如"柯基是爬行动物",看它还解不解得出来。
课上的现场问答:为什么 9 进制算反事实?
有同学当场提问:"为什么 9 进制是反事实,而 10 进制不是?"
讲师回答的要点:
- 10 进制加法在训练数据里被频繁观察到,而几乎没有人做 9 进制加法,所以训练数据里这类例子少得多;
- 更准确地说,这是一种分布外(out-of-distribution)的设定——作者在论文里也正是这么表述的;
- 当然,你也可以直接叫它"分布外",两者说的是同一件事。
结果:从常规设定切到反事实设定时,性能会出现——有时相当显著——的下滑;而且即便是不涉及多步推理的简单逻辑题也有明显下降。
讲师的判断:这或许说明,其中推理的成分没有那么多,记忆的成分更多。
7.3 类比推理:字符串变换任务
(参考时间:27:29)
沿着同一条思路——把问题改到更像分布外——还可以用类比推理(analogical reasoning)来测。
设定:给若干字符串变换的例子,让模型泛化到新例子。
- 正常任务:"扩展序列"。输入
ABCD,输出ABCDE;那么给定IJKL,模型应输出IJKLM。 - 反事实一(换规则):不再输出下一个字符,而是跳一个——
ABCD应输出ABCDF。 - 反事实二(换字母表):不再从标准字母表出发,而是从
XY开始,重排整个字母表。
graph LR
  T["任务:扩展序列 ABCD → ABCDE"] --> N["常规:IJKL → IJKLM"]
  T --> C1["反事实 1:跳一个 ABCD → ABCDF"]
  T --> C2["反事实 2:换字母表 从 XY 开始"]
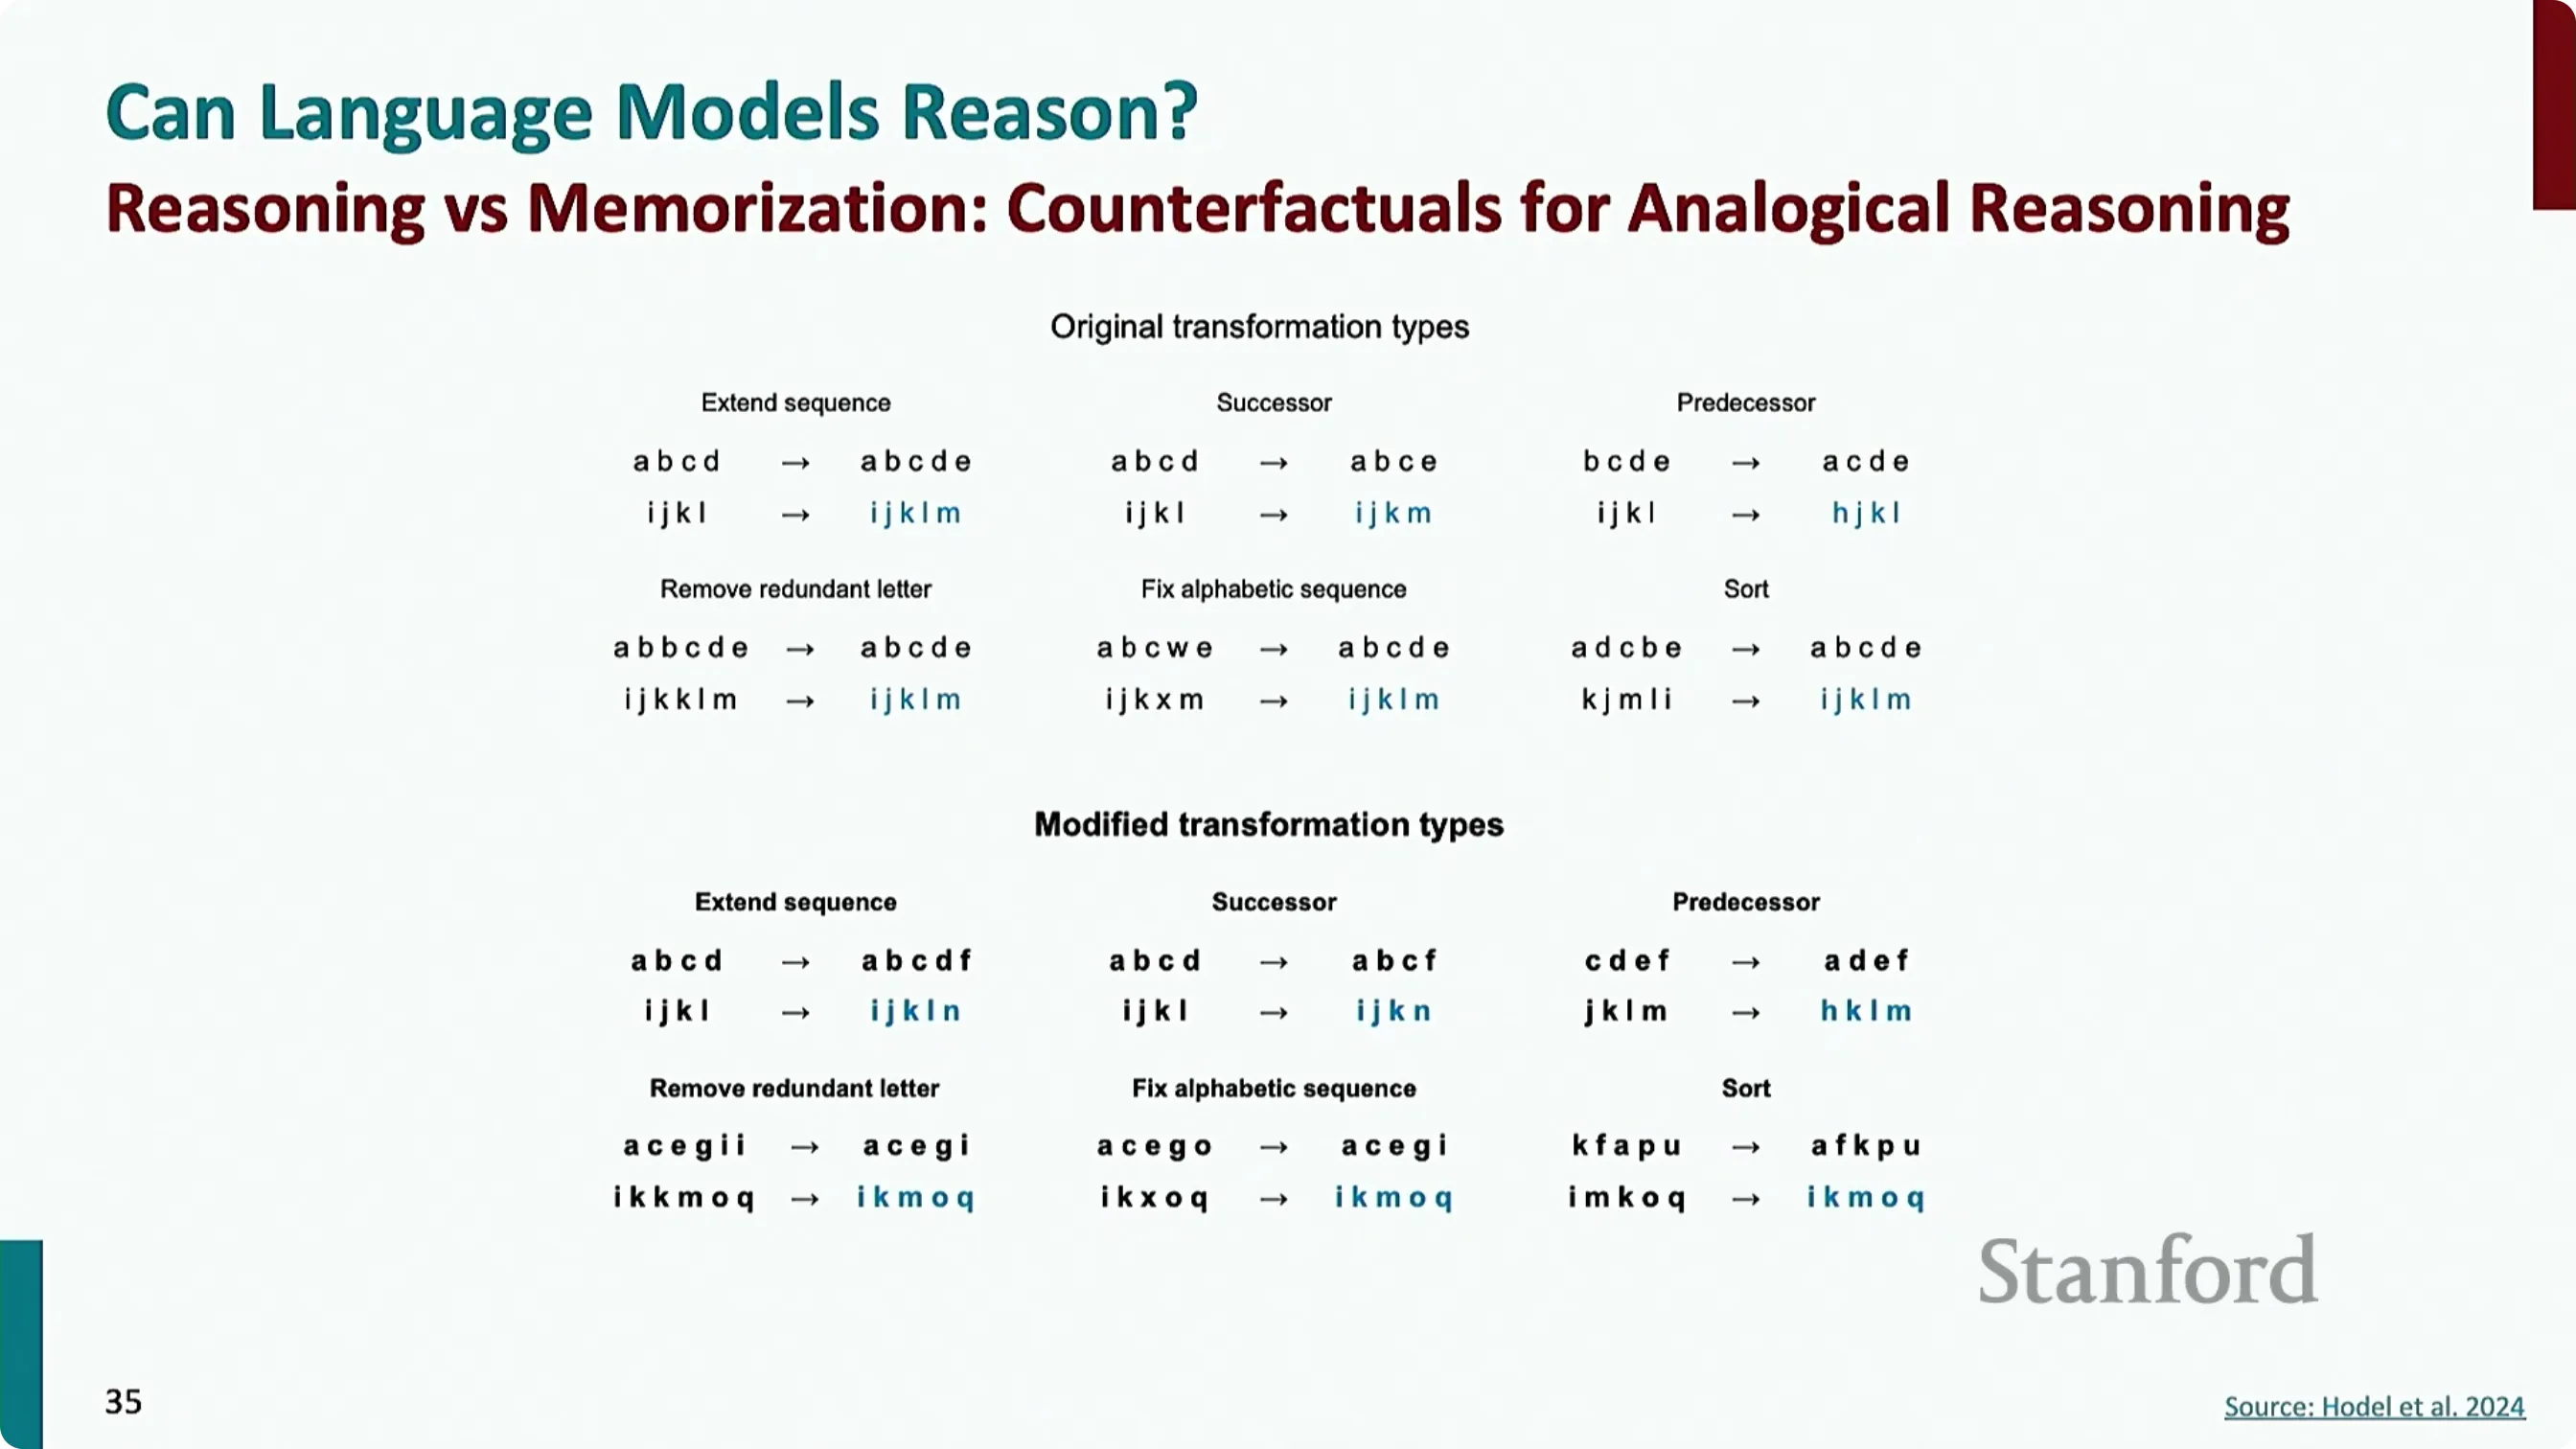
📷 类比推理的字符串变换任务与反事实变体
回到原视频 (00:27:51)
两个发现:
- 从标准问题切到反事实变体时,性能显著下降;
- 作者在人类被试身上做了完全相同的实验,人类的性能几乎没有下降。
7.4 本部分的小结(讲师的措辞)
"总体上,这个结果说明:可能有一些推理,可能有一些记忆,但没有什么系统性的东西。" "这些都还在涌现之中……也许以后有人会发现在某种提示下模型真的能做推理——但这就是当前这块领域的地貌。"
编者拓展|三篇"打假"论文的坐标 - 反事实评估:Wu et al., Reasoning or Reciting? Exploring the Capabilities and Limitations of Language Models Through Counterfactual Tasks(2023)——9 进制加法、反事实逻辑世界正是出自这里。 - 类比推理:Webb, Holyoak & Lu, Emergent analogical reasoning in large language models(Nature Human Behaviour, 2023)——字符串变换 + 人类被试对照。 - 忠实性:Lanham et al., Measuring Faithfulness in Chain-of-Thought Reasoning(2023)——提前退出与错误注入。 三篇合起来构成了一个方法论三角:改题目(反事实)× 改推理链(忠实性)× 与人类对照(类比)。掌握这三招,就能自己判断任何一个"模型会推理"的宣称有多少含金量。
第二部分 从词到动作:语言智能体
(本部分参考时间:30:08 – 结束)
2.1 智能体与环境:先把术语钉死
(参考时间:30:47)
讲师先说明智能体和推理的关系:推理是"给定一些事实,推出全新的结论";而智能体则是"给定一个高层目标,模型要能就后置条件(postconditions)、物体可供性(affordances)、以及世界中的不确定性进行推理,然后执行一串动作"。
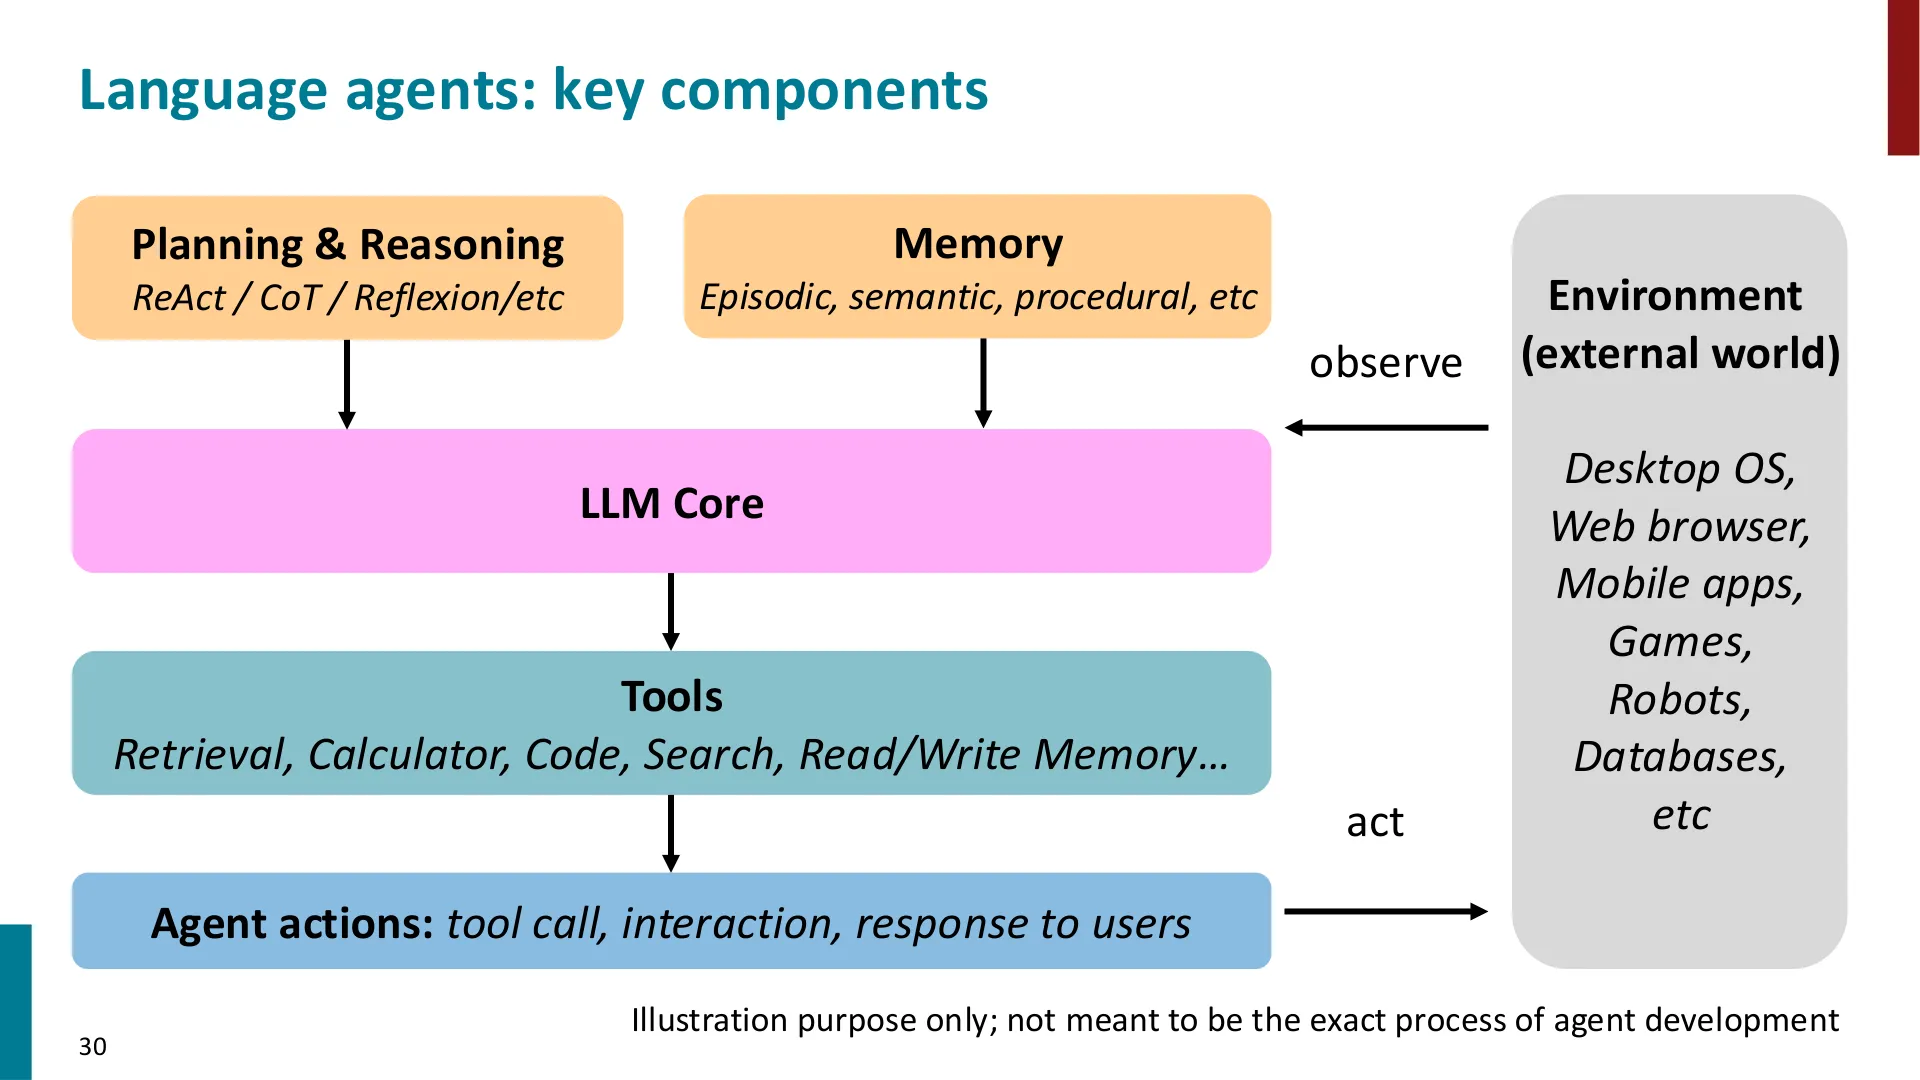
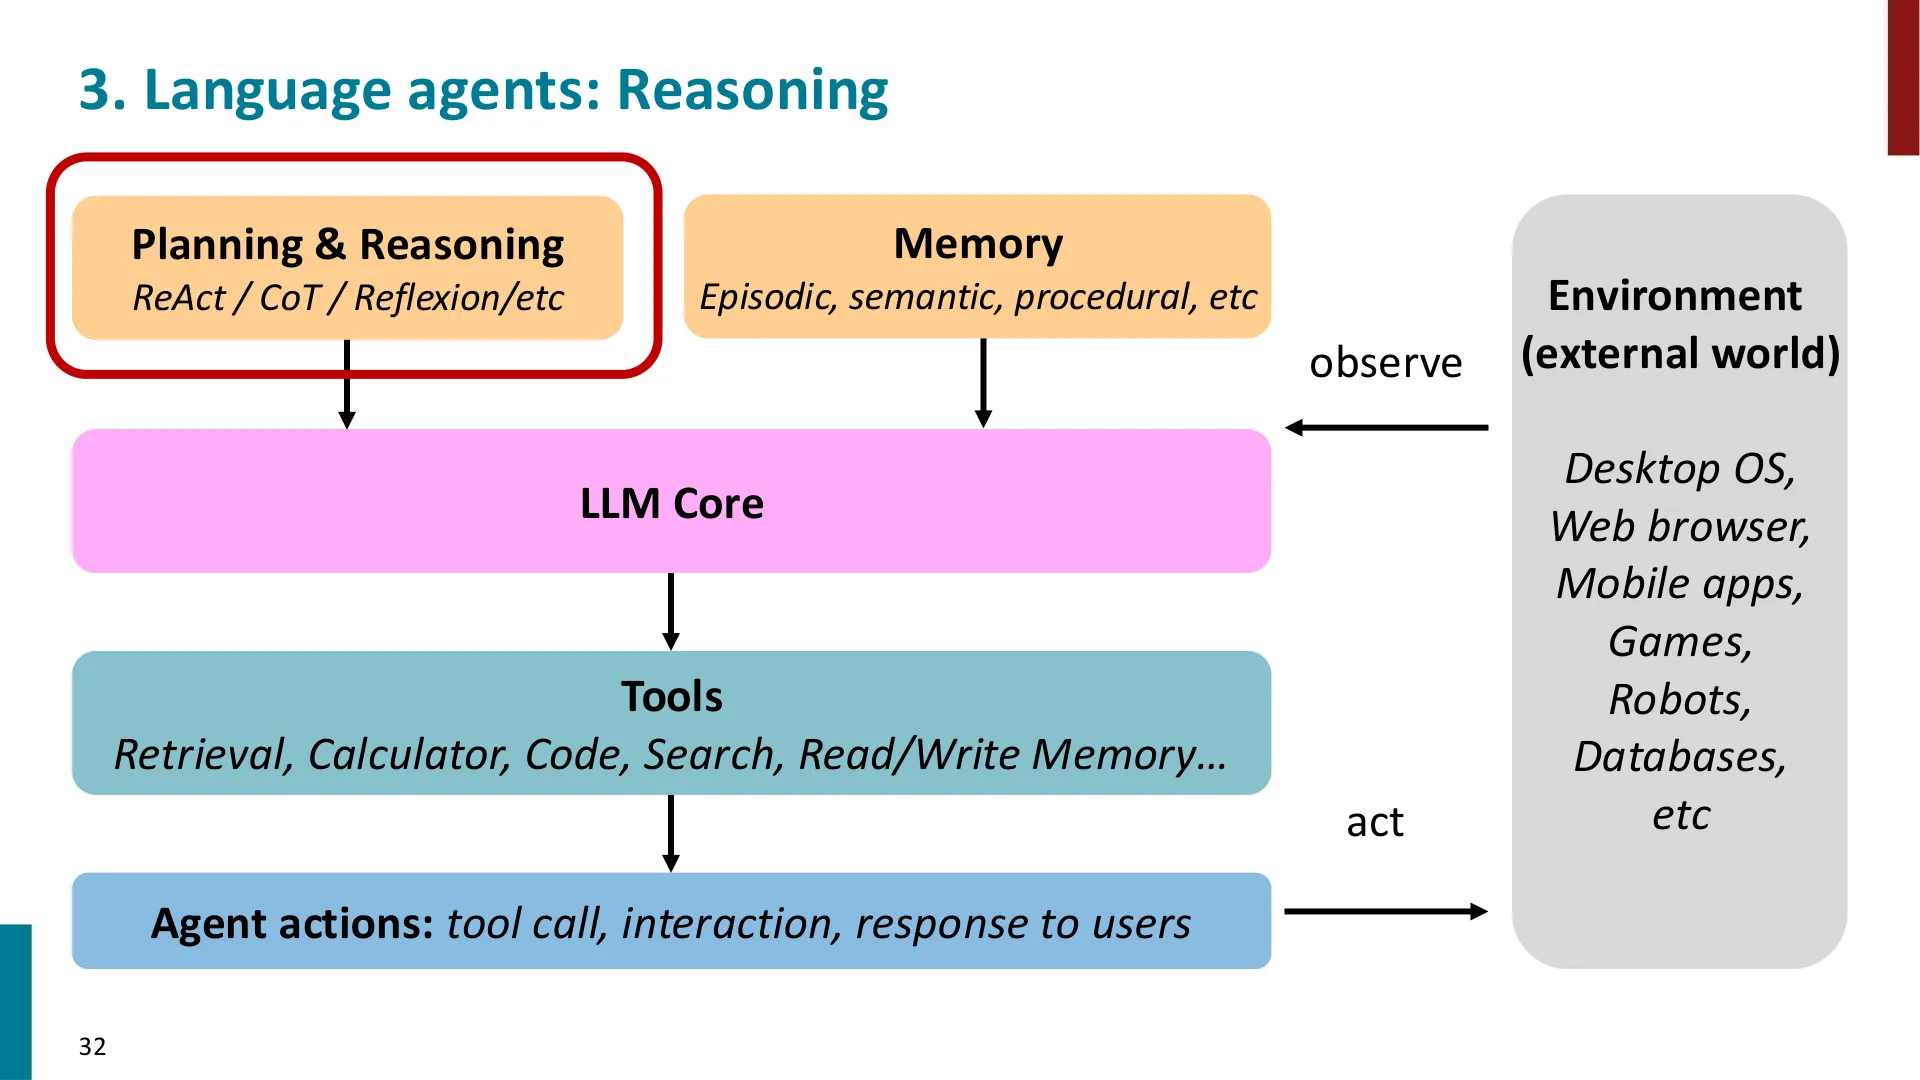
📷 语言智能体的关键组件:LLM 核心、规划、记忆、工具、环境
回到原视频 (00:30:47)
基本术语
- 智能体(agent):在图上位于右侧,本质是某个神经网络。
- 环境(environment):智能体所作用的外部世界。
- 智能体从环境接收观察(observation),据此发出动作(action)。
- 此外它还接收一个变量 G,代表语言指令(language instruction)。
graph LR
  A["智能体(策略)"] -- "动作 a_t" --> E["环境"]
  E -- "观察 o_(t+1)" --> A
  G["语言指令 g"] --> A
这套设定有很多名字:数字智能体(digital agent)、语言条件策略(language-conditioned policy)、指令跟随智能体(instruction-following agent)——说的是同一件事。
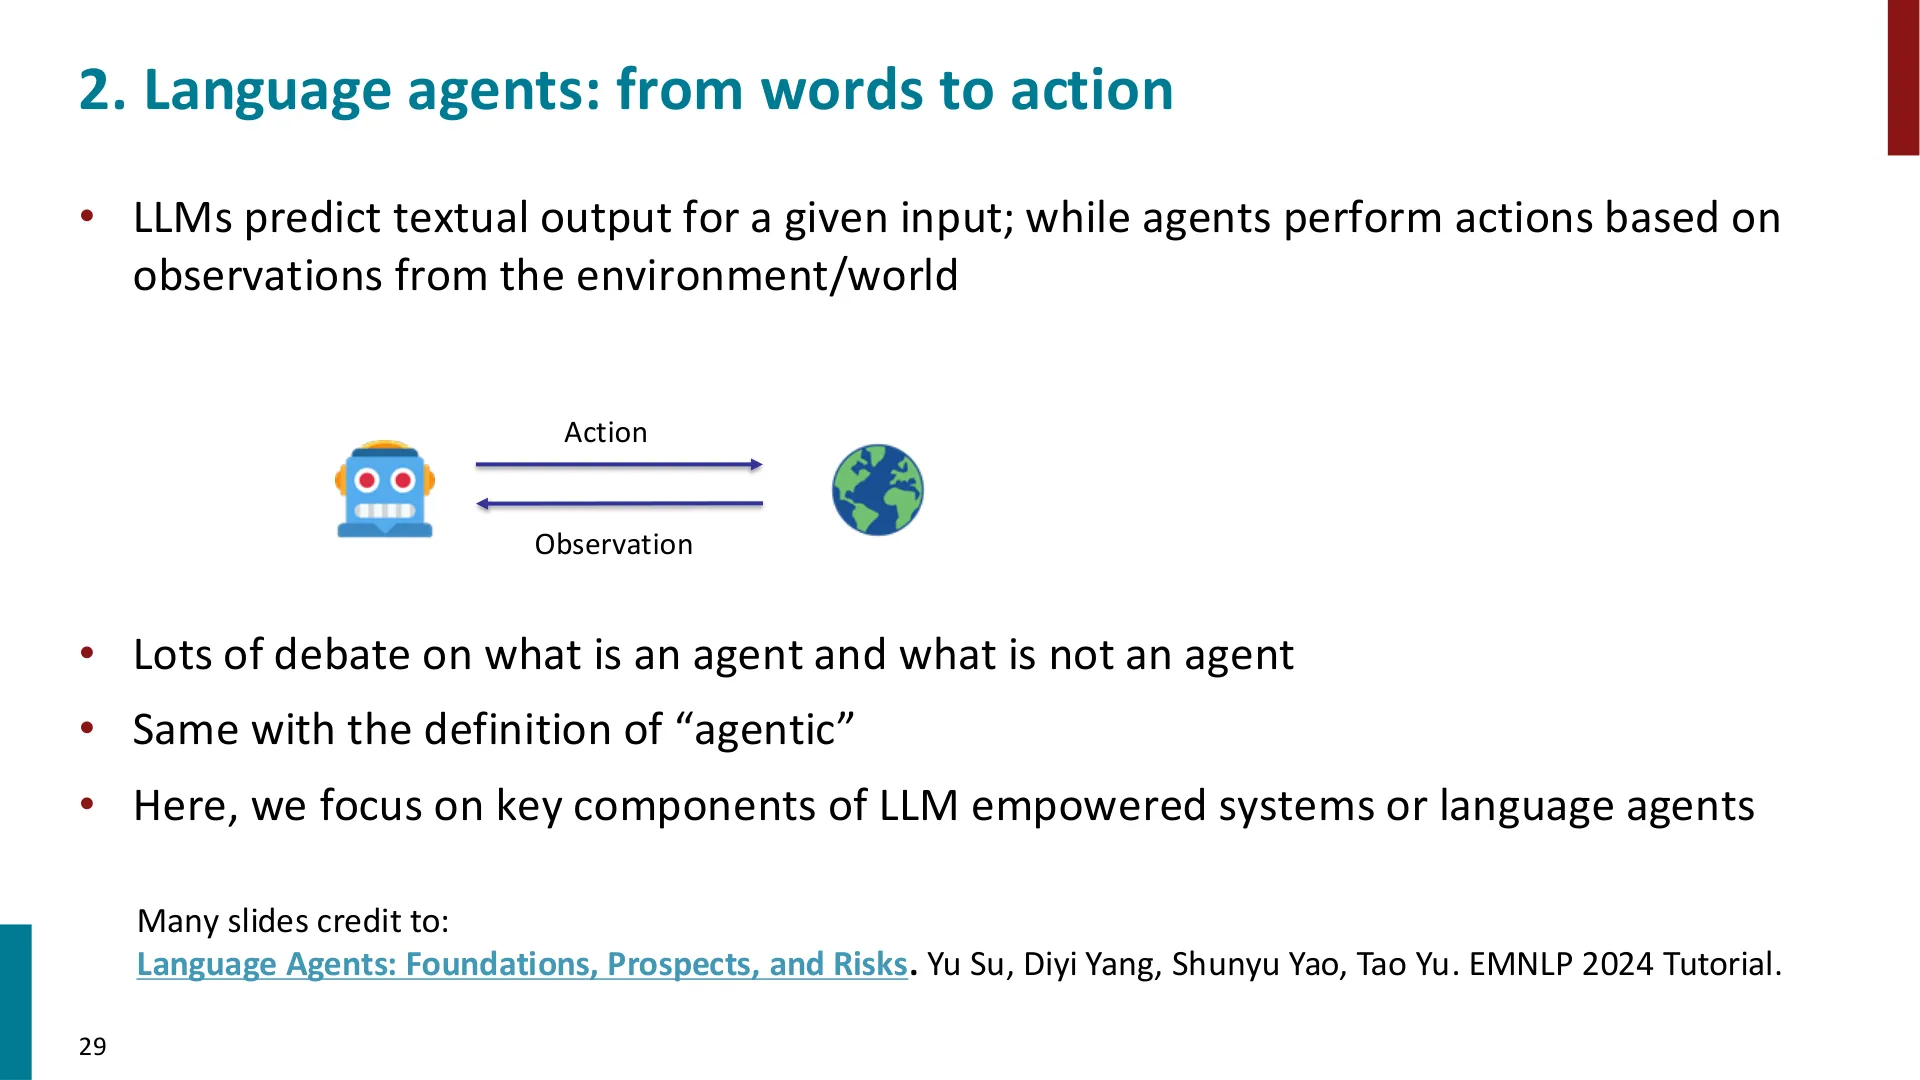
📷 语言智能体:从词到动作
回到原视频 (00:30:10)
一个具体的环境
想象一个网页浏览器环境:目标是"订一张从旧金山到纽约的机票"。
- 观察可以是模型看到的原始像素,也可以是 HTML 的 DOM 表示;
- 动作空间可以是:在某个网页元素上输入文字、点击网页元素、移动鼠标到某个元素上进行交互,等等。
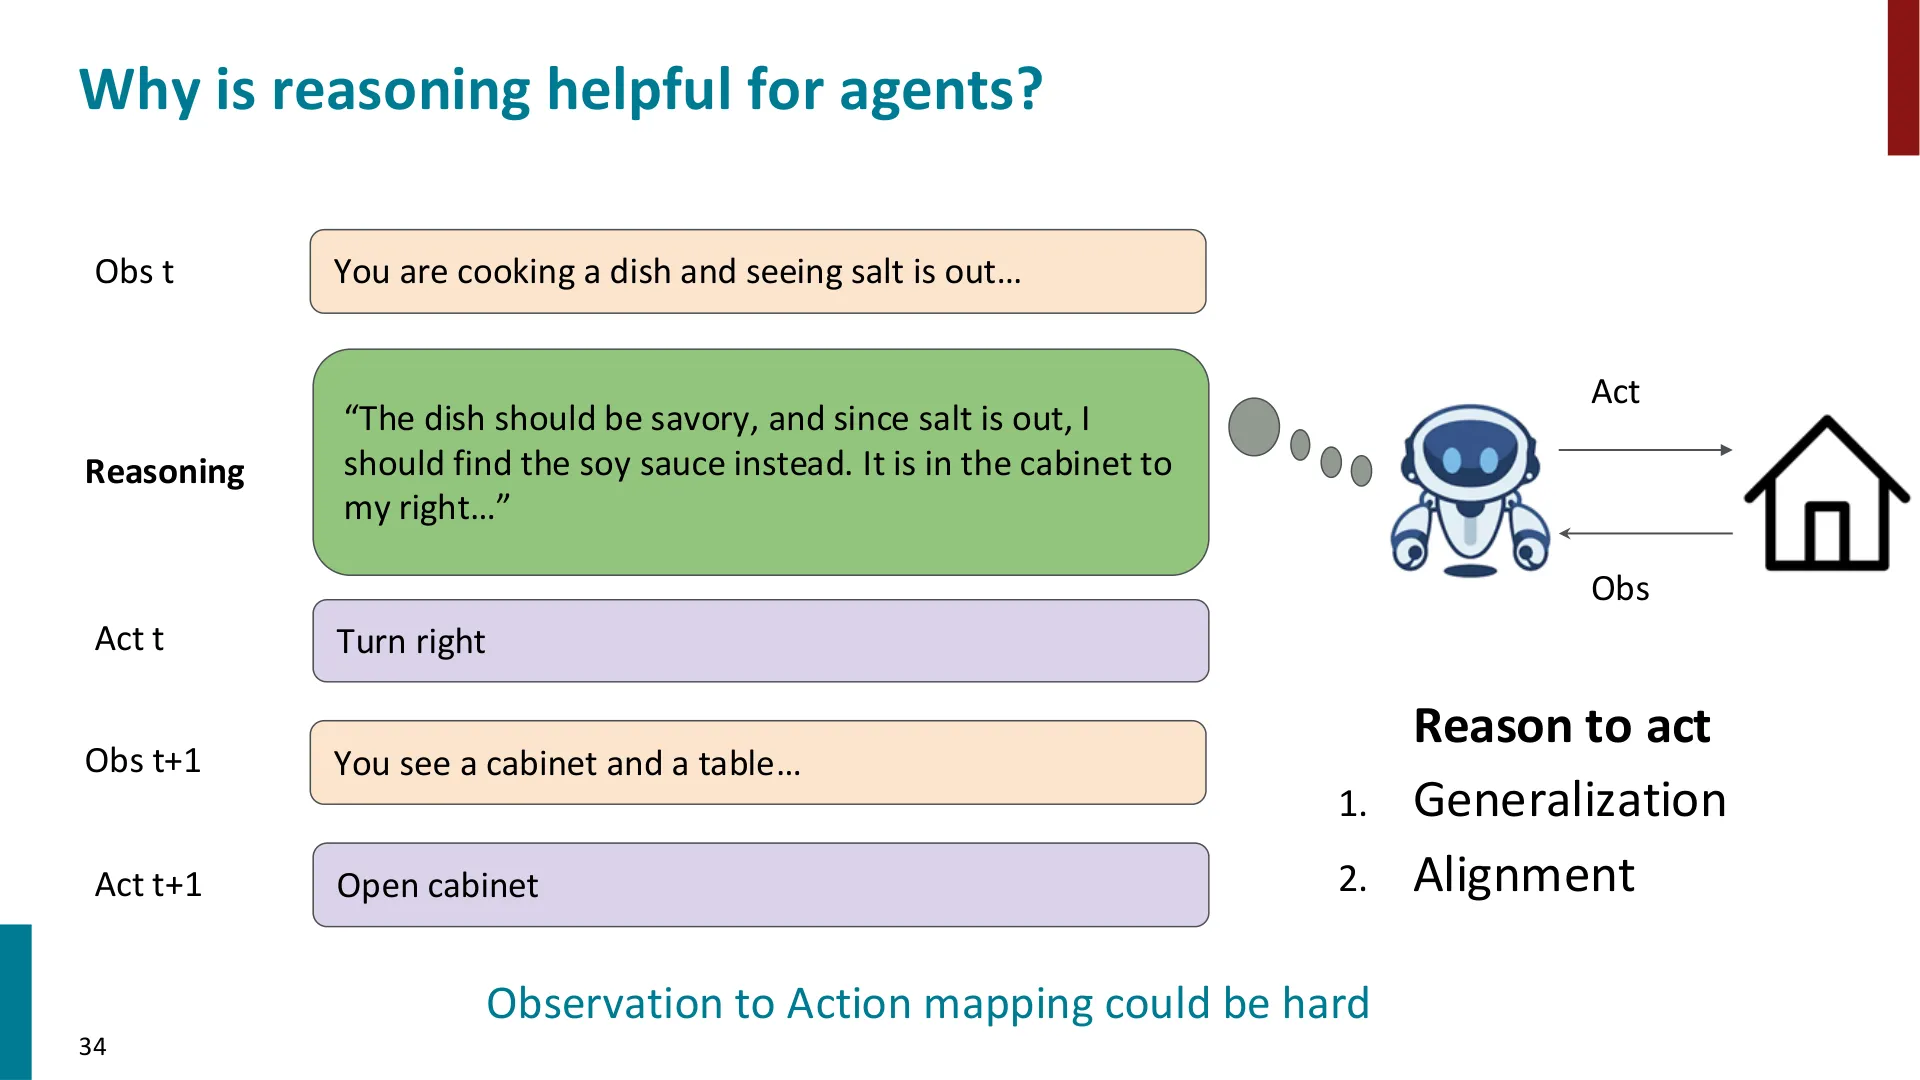
📷 为什么推理对智能体有帮助:从观察到动作的映射可能很难
回到原视频 (00:30:25)
都有哪些应用
讲师说他不可能覆盖全部应用,但列举了几类:
- 数字助理:给自然语言命令,设定闹钟、设提醒等。(他打趣说不敢念出具体名字,因为听众的手机可能会突然弹出来。)
- 自然语言编程:给定自然语言描述,让模型写 Python 代码。
- UI 自动化:比如对 UI 元素做自动化测试,由模型代替人工去执行动作、验证元素是否正常。
- 面向用户的任务:比如在一个复杂环境(他举了 Spotify)里,让智能体播放某些歌曲。
- 给语言模型挂工具 / 插件:让模型能去控制各种不同的应用。
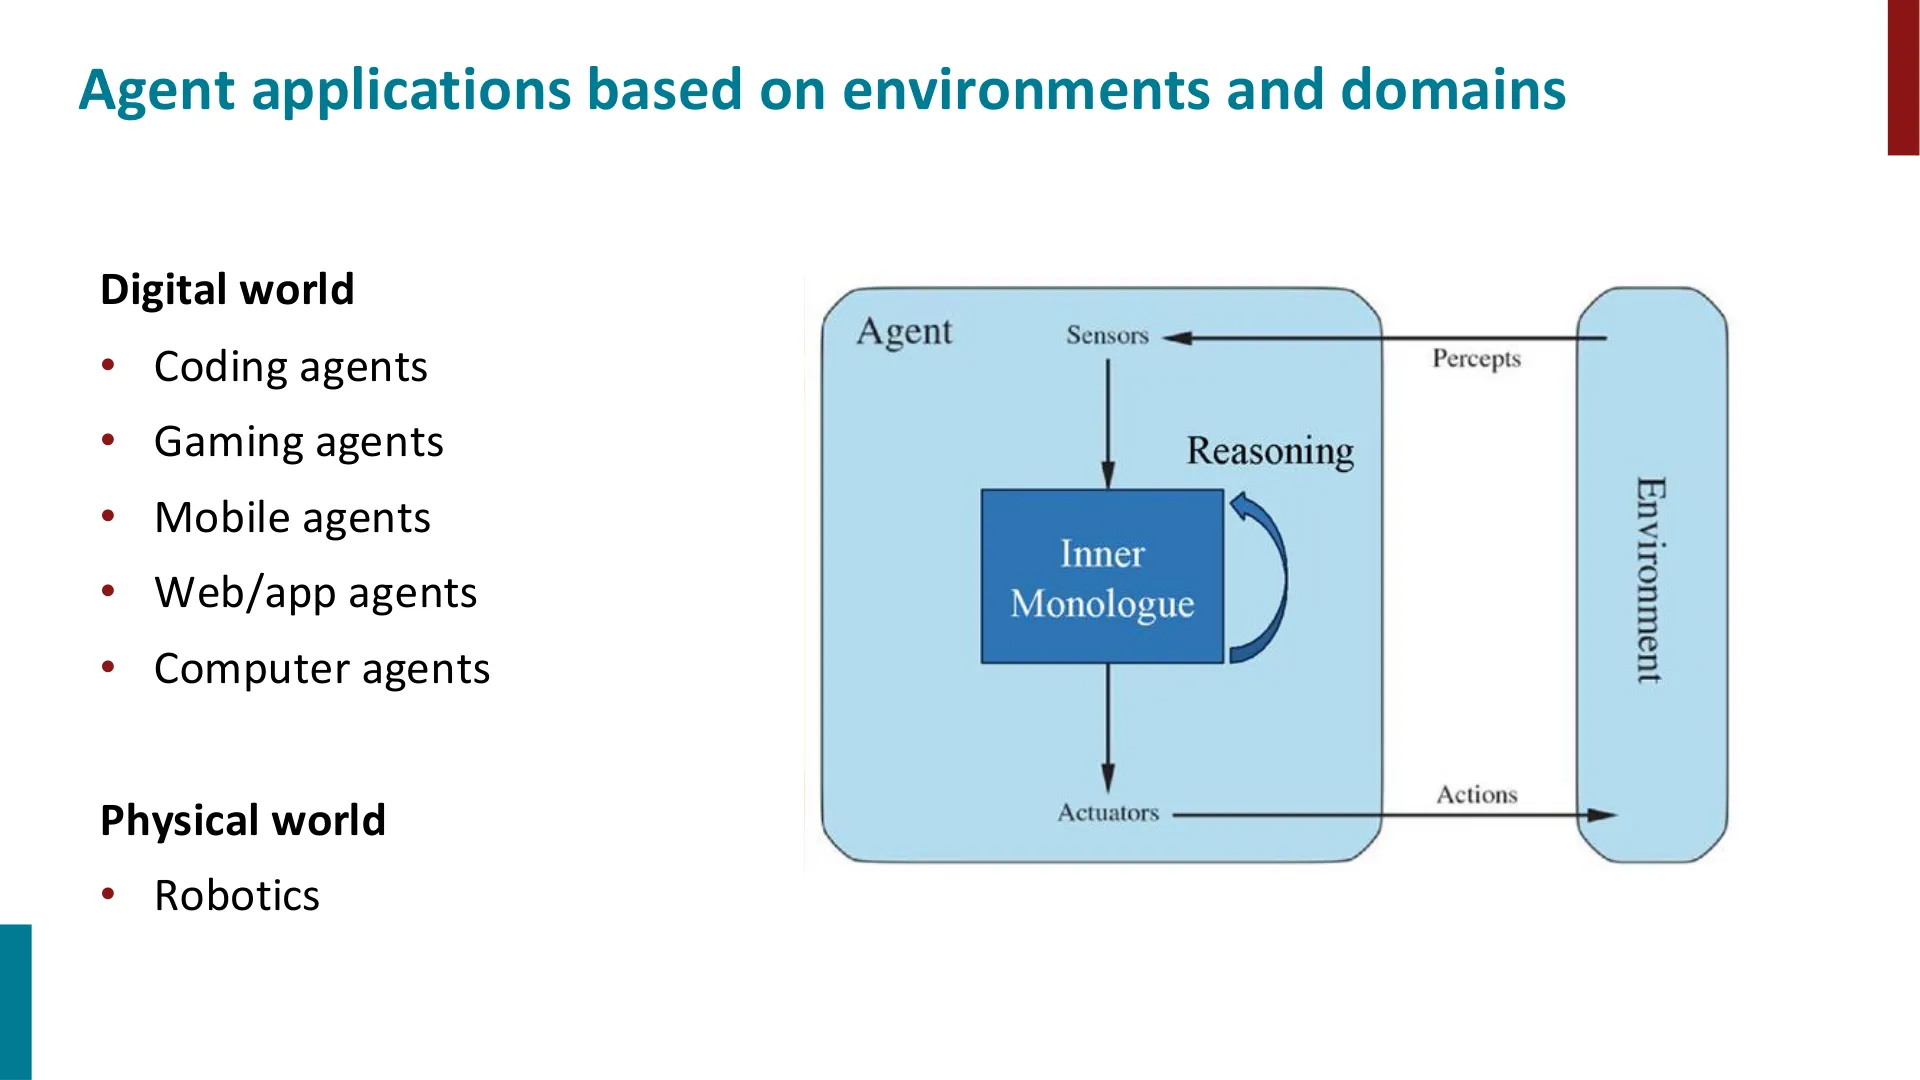
📷 按环境与领域划分的智能体应用:数字世界与物理世界
回到原视频 (00:32:25)
2.2 语言模型之前,人们怎么做"指令 → 动作"
(参考时间:33:52)
讲师说,理解今天的做法之前,先看"以前怎么做"会非常有帮助。在语言模型出现之前,大体上有三条主要思路。
思路一:训练语义解析器(semantic parser),把指令当"翻译"
第一种做法是收集"话语 ↔ 逻辑形式(logical form)"配对数据。
- 逻辑形式是一种可执行的表示,可以拿去对知识图谱或数据库执行,从而得到答案。
- 例子:查询"哪些州与得克萨斯州接壤?",对应有一段程序描述,对知识图谱执行后得到州名列表。
然后把它当作机器翻译来做:
- 源语言 = 英文命令;
- 目标语言 = 意义表示 / 逻辑形式;
- 于是可以直接套用作业 3 里的那套机器翻译机器,去直接最大化"给定目标(goal),动作序列的概率"。
思路二:先推断可执行计划(plan),再用执行模型执行
第二种更复杂一些:
- 手上是
指令 ↔ 动作配对数据; - 但不直接把指令映射成动作,而是先从中推断出一个可执行的计划;
- 训练一个模型:
指令 → 计划; - 再定义一个很丰富的执行模型(execution model)去执行这些计划。
这样做的优势:计划里可以编码一些更高层的决策,而这些决策如果直接让模型端到端产生动作轨迹,是很难表达出来的。
讲师给的例子是一个 2011 年的系统:一个能在具身(grounded)环境中导航的智能体。
- 先拿到一条指令,得到一个计划;
- 训练一个语义解析器(本质上就是前面说的那套机器翻译系统),把命令转换成这个计划;
- 训练完成后,在测试时给一条全新的指令:跑语义解析器 → 得到计划 → 交给执行模型执行。
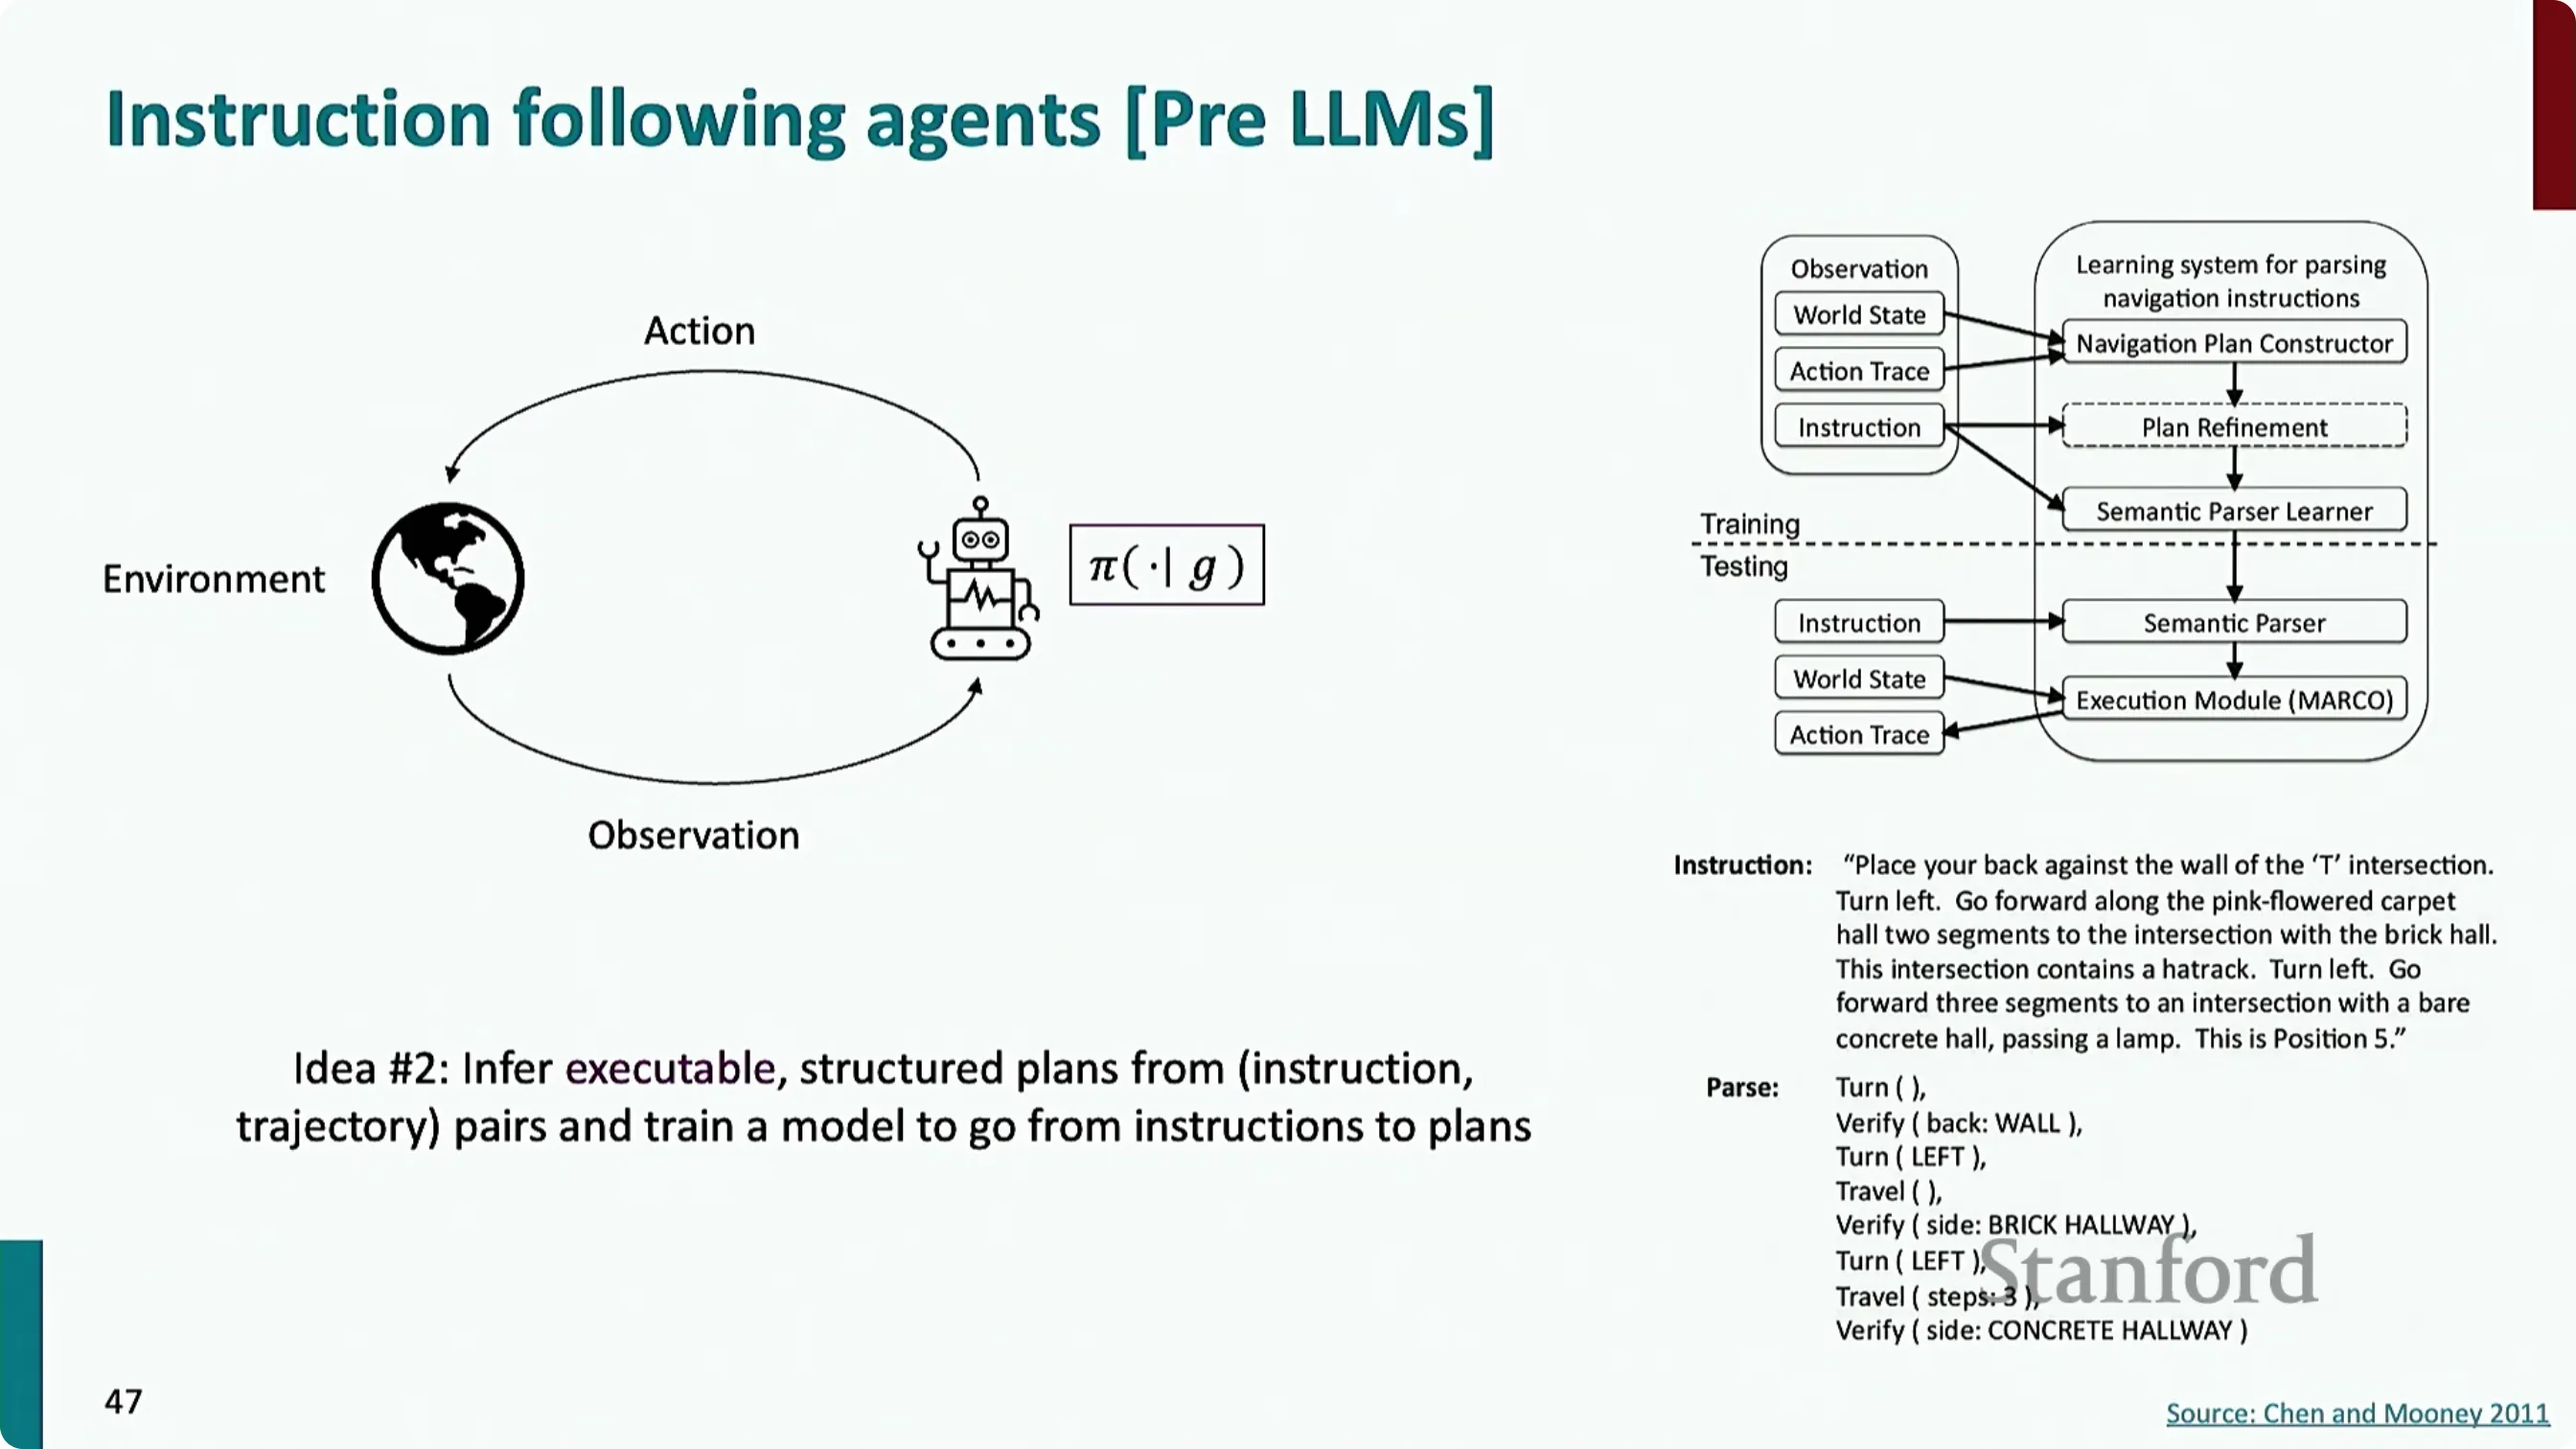
📷 2011 年导航系统:指令与对应计划示例
回到原视频 (00:37:05)
思路三:用强化学习直接学策略
第三条路是直接用强化学习(RL):
- 学一个策略(policy),输出动作,最大化某个奖励;
- 策略以自然语言指令 + 观察为条件;
- 奖励可以是:
- 稀疏奖励:只有整件事做完,环境才告诉你成功没有;
- 每步奖励:每执行一个动作,环境告诉你完成了任务的百分之多少。
讲师举的例子上是一个 2009 年的系统,用于自动化的 Windows 调试:给一段自然语言指令去点击某些 UI 元素,指令被映射成一串 API 命令,模型逐个执行。
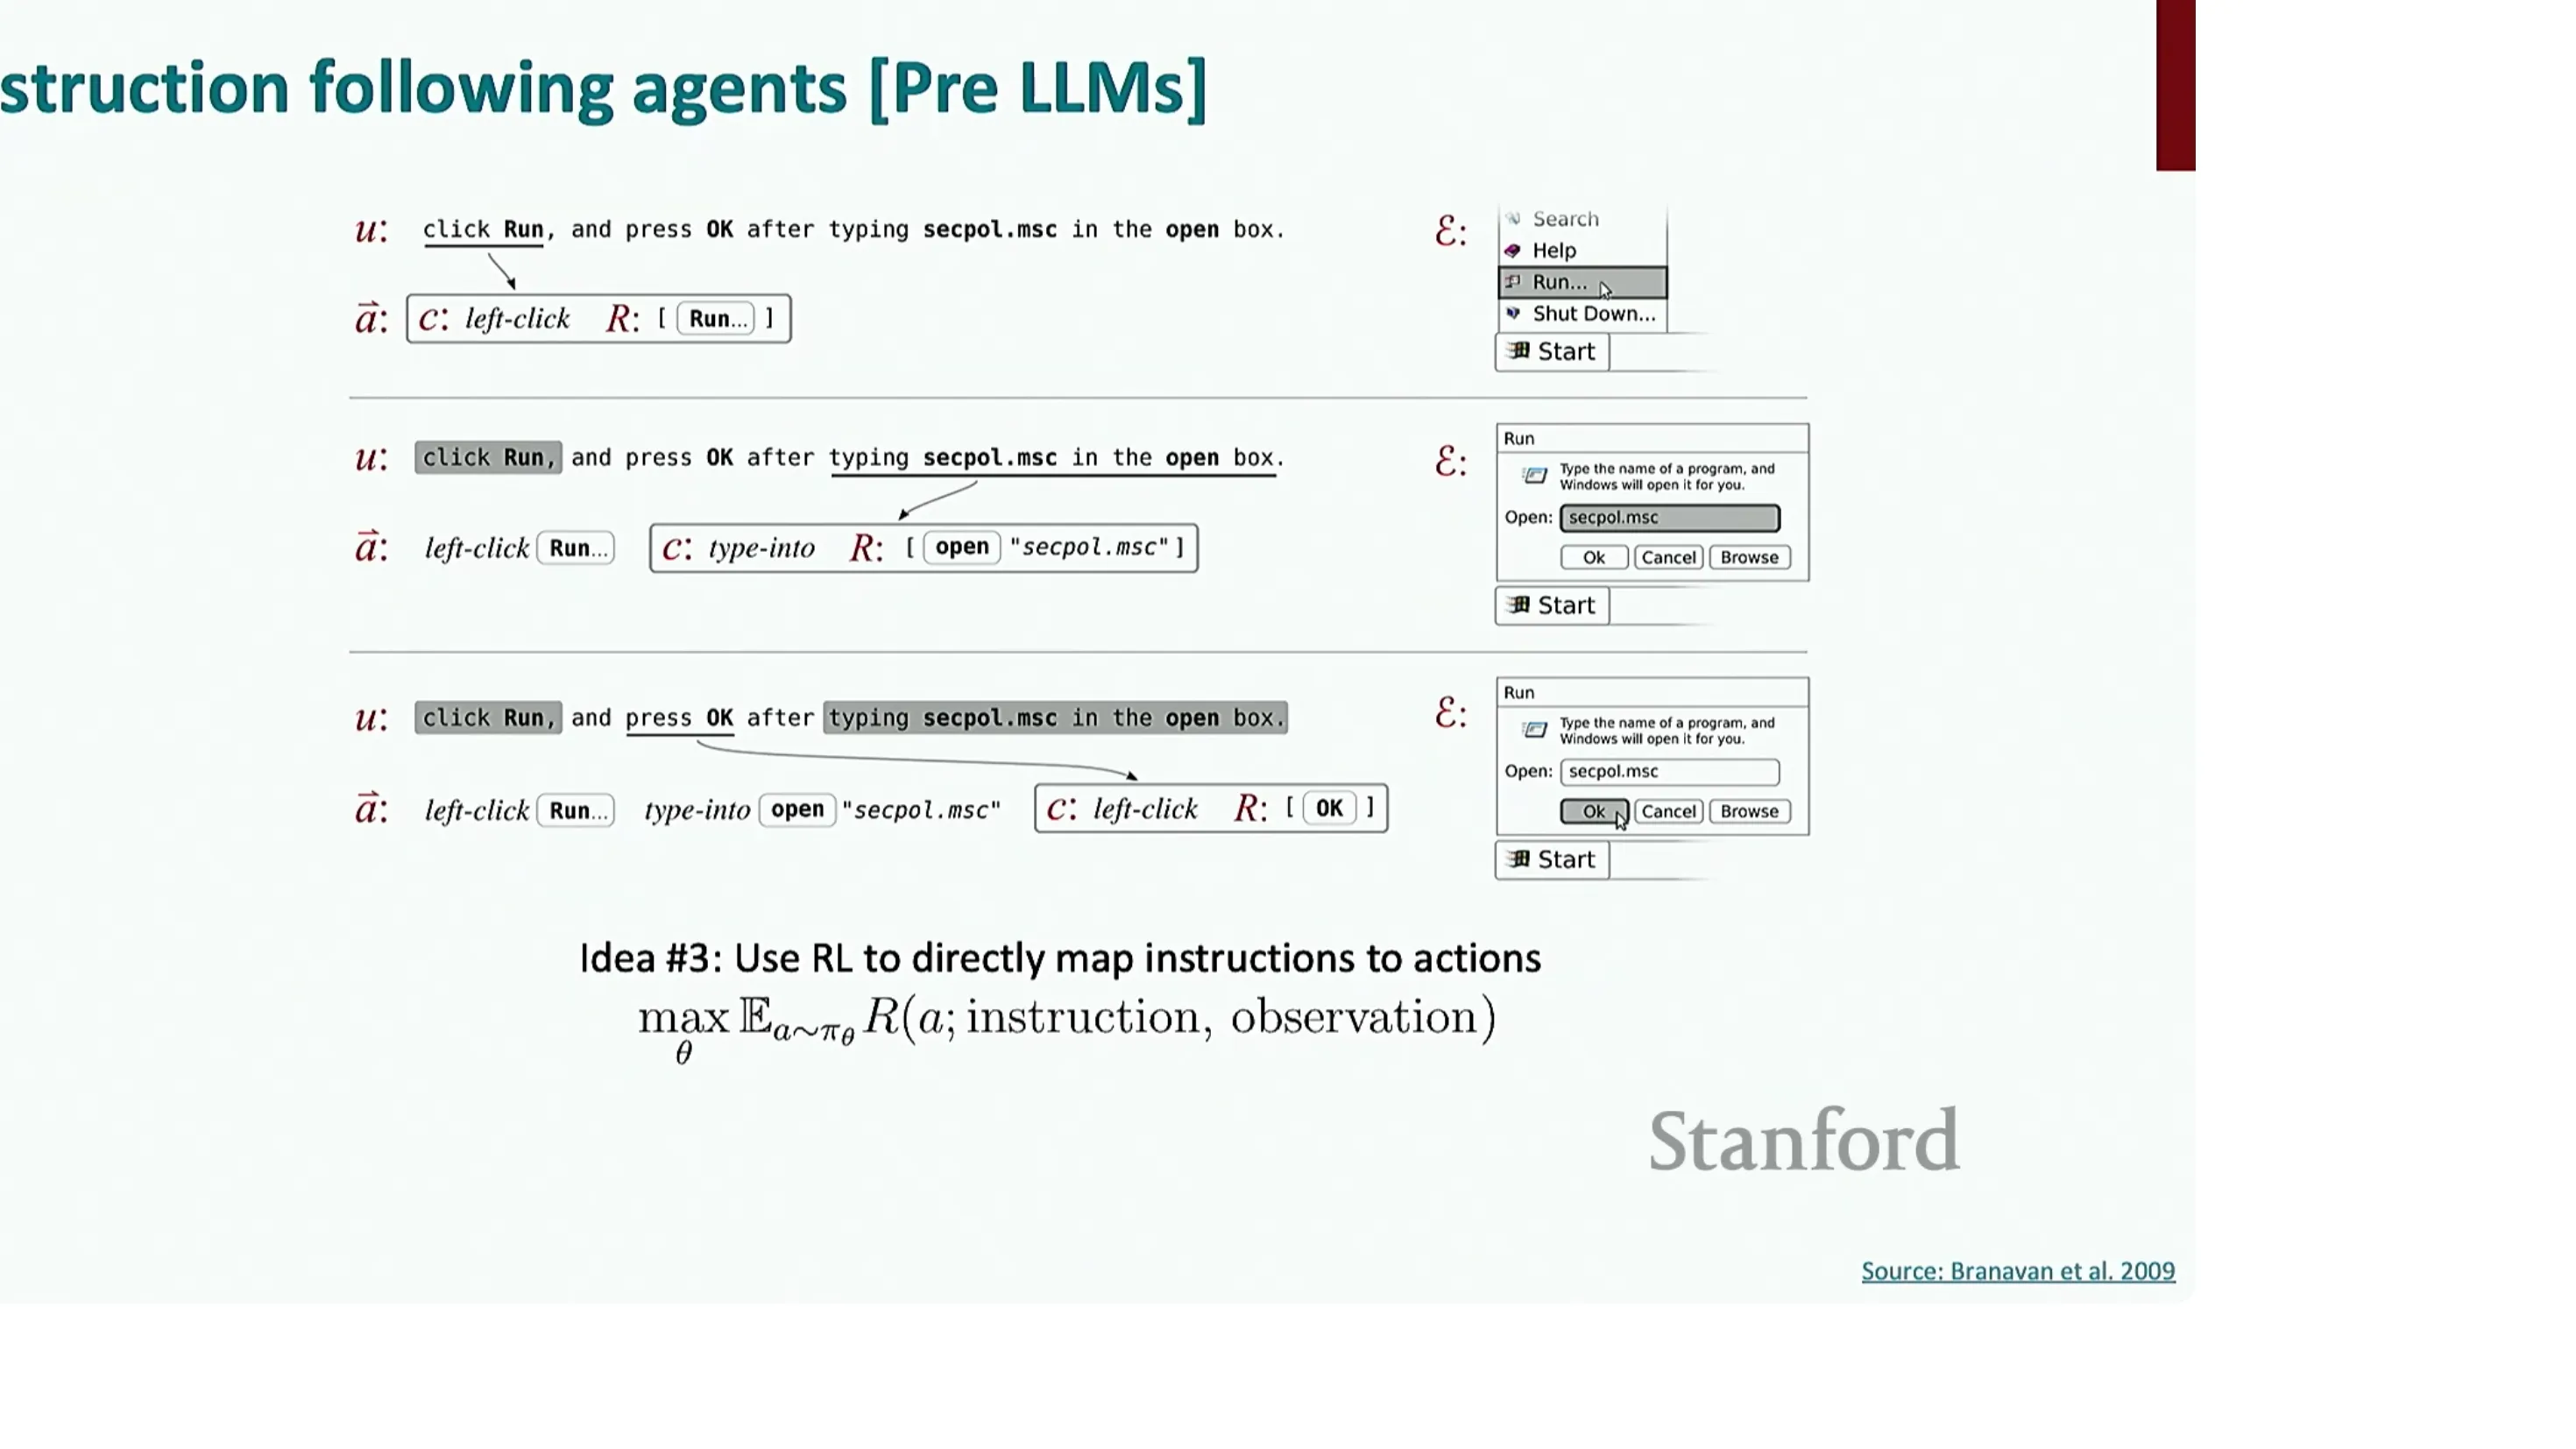
📷 2009 年自动化 Windows 调试系统
回到原视频 (00:38:05)
三条老路线的总结:训练语义解析器;或从指令—轨迹对中推断计划、直接对计划建模、再配一个执行模型;或者在有奖励信号时用强化学习。
graph TD
  I["自然语言指令"] --> P1["路线一:语义解析器<br/>指令 → 逻辑形式 → 对 KG/DB 执行"]
  I --> P2["路线二:计划推断<br/>指令 → 计划 → 执行模型"]
  I --> P3["路线三:强化学习<br/>策略直接输出动作,最大化奖励"]
编者说明:讲师在这里提到的"作业 3"指的是 CS224N 课程中关于神经机器翻译的那次编程作业,其核心组件(编码器—解码器 + 注意力)正好可以用来做"英语 → 逻辑形式"的翻译。他说这句话,是为了让听众把新问题接到已有的知识上,而不是当成全新魔法。
2.3 把决策重新表述成生成问题
(参考时间:38:52)
那么 2024 年怎么做?
讲师说,最有益的思路是回到"我们到底想做成什么":我们要对轨迹(trajectory)建模,即在给定某个目标(goal)的条件下,产生一串动作。
例如:我想让模型"订一张旧金山到纽约的机票",就希望它产出一串输入与点击动作。
把它写成概率并做因式分解:轨迹在给定目标下的概率,可以分解成"状态—动作—下一状态"的链式乘积,而每一项又可以拆成两个因子的乘积:
$$
P(\tau \mid g) \;=\; \prod_{t=0}^{T-1} \underbrace{P(s_{t+1} \mid s_t,\, a_t)}_{\text{环境转移动力学}} \;\cdot\; \underbrace{P(a_t \mid g,\, s_{\le t},\, a_{ 关键在于:第二项就是一个条件语言模型要学的东西。于是人们很快意识到,可以把决策问题当成一个生成式轨迹建模问题。 讲师给出的示意(右上角那张图)是:一个 Transformer,输入是已经执行过的动作历史、当前状态,以及某种任务指示(图里用的是基于奖励的表示,但也可以是一段自然语言字符串),被训练去预测下一个动作。 课上问答
学生问:图中为什么只预测一个动作?
讲师答:是先预测一个动作 → 执行它 → 把它追加到轨迹后面 → 再预测下一个动作,如此循环。
学生追问:所以我们把三个输入 token 归约成一个输出 token?
讲师:对,可以这么理解。 📷 把决策建模为轨迹生成:根据历史动作、当前状态与任务指示预测下一个动作 这个做法在离线强化学习(offline RL) 的设定下效果相当好。于是相比于以前去学隐式计划、训语义解析器、做强化学习,人们开始把语言模型直接当作策略。 编者拓展|"把 RL 当序列建模"这条线的两位主角
- Trajectory Transformer(Janner et al., 2021):把轨迹(状态、动作、奖励)离散化成一长串 token,用 Transformer 建模,然后用 beam search 做规划。
- Decision Transformer(Chen et al., 2021):把强化学习重写成"给定回报(return-to-go),用自回归模型预测动作",是"把 RL 变成条件生成"最著名的一篇。
讲师图里那个"输入历史动作 + 当前状态 + 任务/回报指示,输出下一个动作"的结构,正是这两篇的形态。理解了这一点,就能理解为什么后面"用语言模型当策略"是顺理成章而不是突然冒出来的。 (参考时间:41:25) 最简单的方式就是在一个循环里提示语言模型。把三样东西塞进上下文: 然后让模型预测下一个动作。 讲师的自我评价很直白: "这里没有什么深刻的东西——这就是在循环里的思维链提示。"
"但我希望的是——因为我们把决策问题归约成了自回归建模,所以它可能真的能工作。" 而且他补充:稍微复杂一点的版本,在某些环境里确实能工作。 (参考时间:42:58) 讲师说,接下来给一个环境风味(flavor)的概览,从最简单的开始。 📷 MiniWoB 中的基础浏览器交互任务 📷 WebArena:接近真实网站的沙盒环境,支持多标签页浏览 编者说明:讲师在此处特别强调了"环境(environment)"与"数据集(dataset)"的区别——前者可以被智能体反复交互、产生新数据,后者只能用来评估。这个区分在选择实验方法时非常关键。 (参考时间:46:29) 那么这些模型怎么训?既然我们已把决策当成因果语言建模,就不必动用前面(预训练阶段)那些复杂手段。 标准做法是上下文学习(in-context learning)加少量示例(few-shot): 讲师直接点出问题:这不具备可扩展性。环境有成千上万,每个环境里可交互的组合又非常多。 于是要找一个比"给每个新用例都找人标注演示"更好的办法。 在推理部分,我们让模型生成推理链,再在推理链上微调。这里没有推理链,但有动作轨迹——那就生成动作轨迹,把轨迹当作监督信号。 假设我们以"订一张旧金山到纽约的机票"为条件重新跑了一遍,模型产出的第二条轨迹显然没有成功订到票。怎么办? 📷 随机探索 → 生成描述 → 重新标注 → 迭代生成轨迹 整体方法:让一个无条件语言模型随机探索环境产生轨迹 → 迭代地把轨迹转成自然语言描述、再把描述转成更好的轨迹 → 得到一批合成训练数据。 有了这批数据,有两条路: 结果:在 MiniWoB 上取得约 13 个百分点的提升;在一个多步工具使用环境上也有改进。讲师再次强调:即便 MiniWoB 那么简单,最好的语言模型的零样本表现依然远非完美。 (参考时间:53:34) 到这里我们看的都是文本。但讲师指出,对真实应用来说,为每个环境拿到 HTML 再塞进上下文,可能是行不通的: 也许最好的方式是直接给模型看像素。 思路和推理部分的 Orca 很像: 📷 LLaVA:用 GPT-4 生成图文指令数据,联合微调 CLIP 与 Vicuna 第二种做图像—语言联合模型、后来被迁移到智能体上的工作,是 Pix2Struct。它的结构仍然是图像编码器 + 文本解码器: 它引入的新东西是一个新的预训练任务。 讲师的对比很清楚: Pix2Struct 的做法是:拿网站的截图,遮掉(mask)其中一部分,然后让 Transformer 解码器输出被遮掉的那部分对应的 HTML。 一个具体的数据点长这样:页面上有一个列表,其中某一项(比如 "Python")有对应的 HTML;把这一项的图像 patch 遮掉,让模型只根据周围上下文,生成这段被遮掉的 HTML。 讲师评价:这看起来是一个更自然的预训练目标,也许能让图像与文本之间有更好的交互;后来它也被迁移到构建多模态智能体上。 📷 Pix2Struct:遮住截图中的某个元素,让解码器生成对应的 HTML (参考时间:57:41) 讲师在这里停下来,做了一段总结性的判断——他把这称为 "提示鸿沟(prompting gap)": 讲师举了两个让他印象深刻的例子: 这里有大量改进空间,同时也有大量的工作要做。 (参考时间:00:59:40 – 01:03:30) 讲师把两半内容各自收拢了一遍。 推理部分 智能体部分 讲师最后一句是:"也许你们中的一些人正在你们的项目里做这件事。" 编者说明:本讲配套提供的官方幻灯片来自同一课程的 Lecture 10: RAG and Language Agents(讲者 Diyi Yang)。它与本视频(Lecture 14: Reasoning and Agents)主题相邻但不重合:幻灯片中相当多的篇幅(如 PEFT / Adapter、检索增强生成 RAG、记忆、工具使用、智能体数据与评测、从零构建编程智能体)并未在本段课堂口语中出现,反之本讲口语中的推理分类、反事实评估、类比推理等主题也不在幻灯片中。
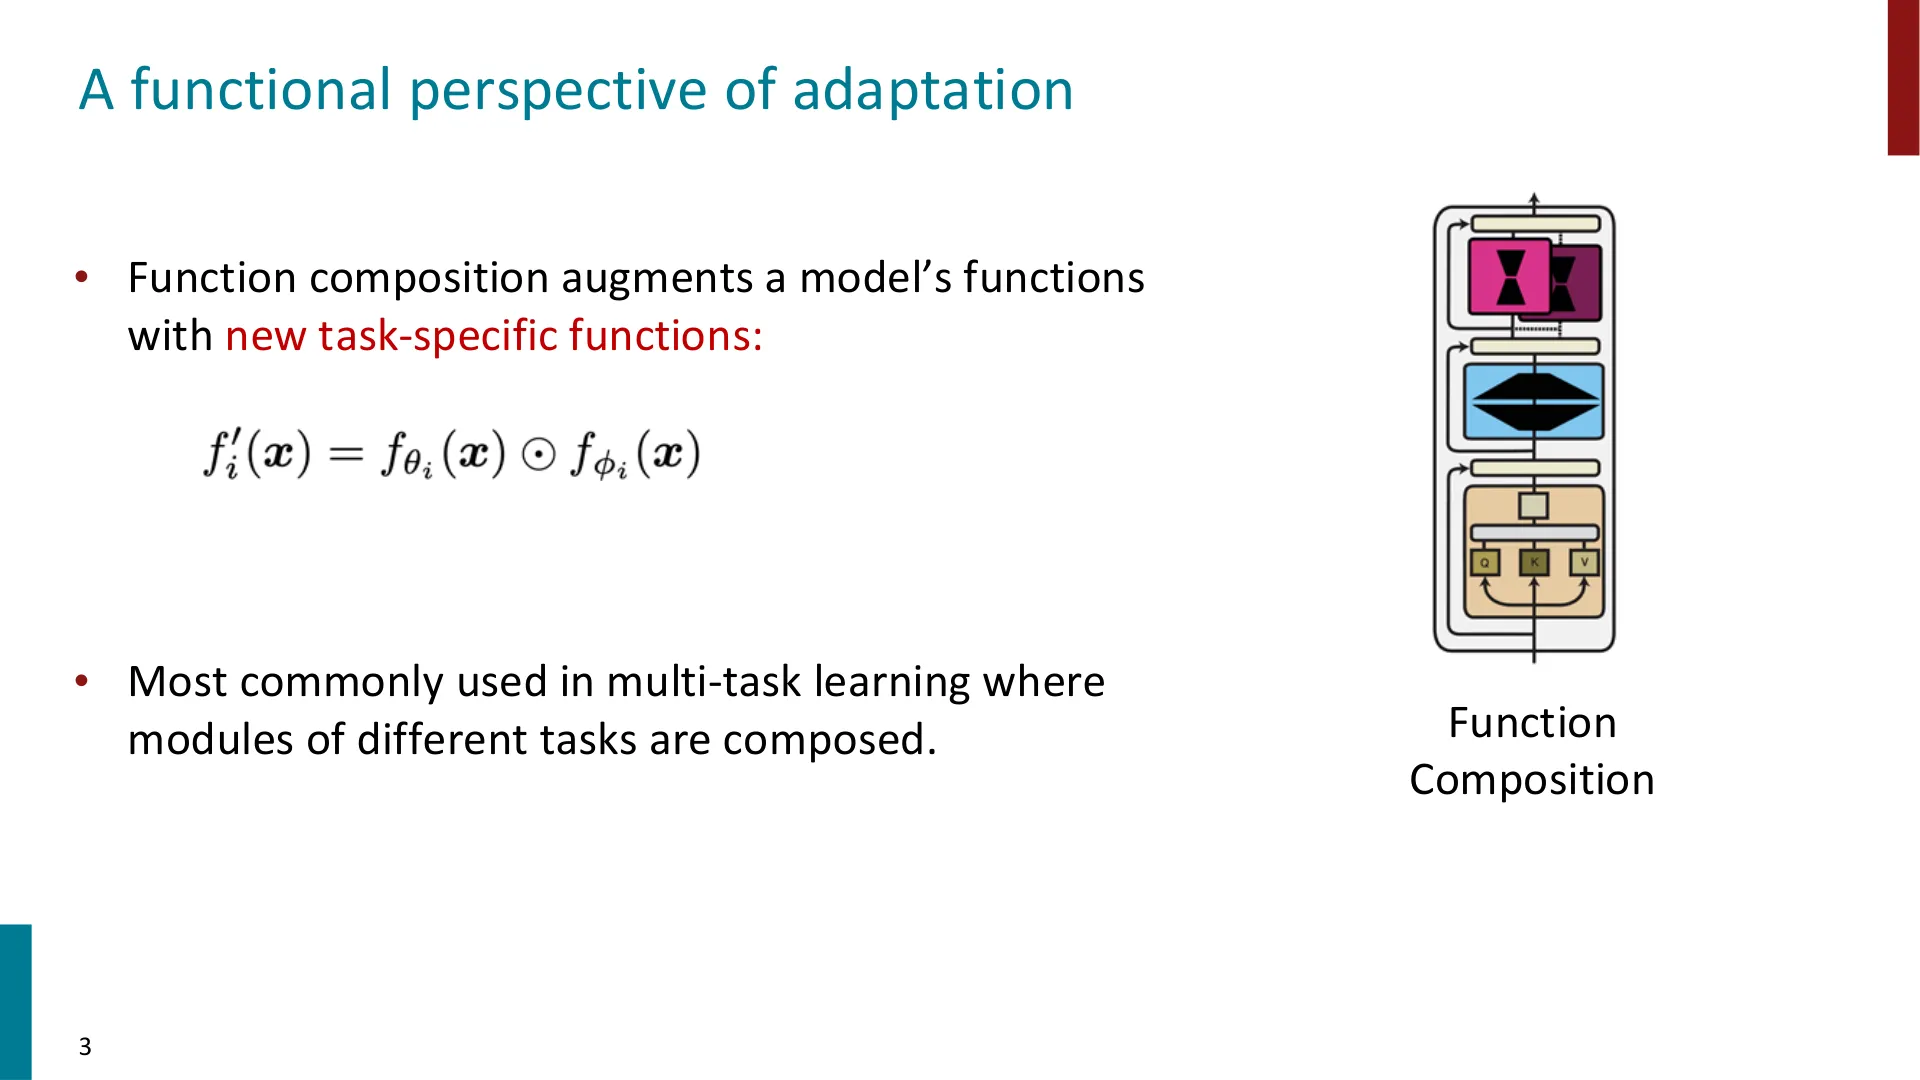
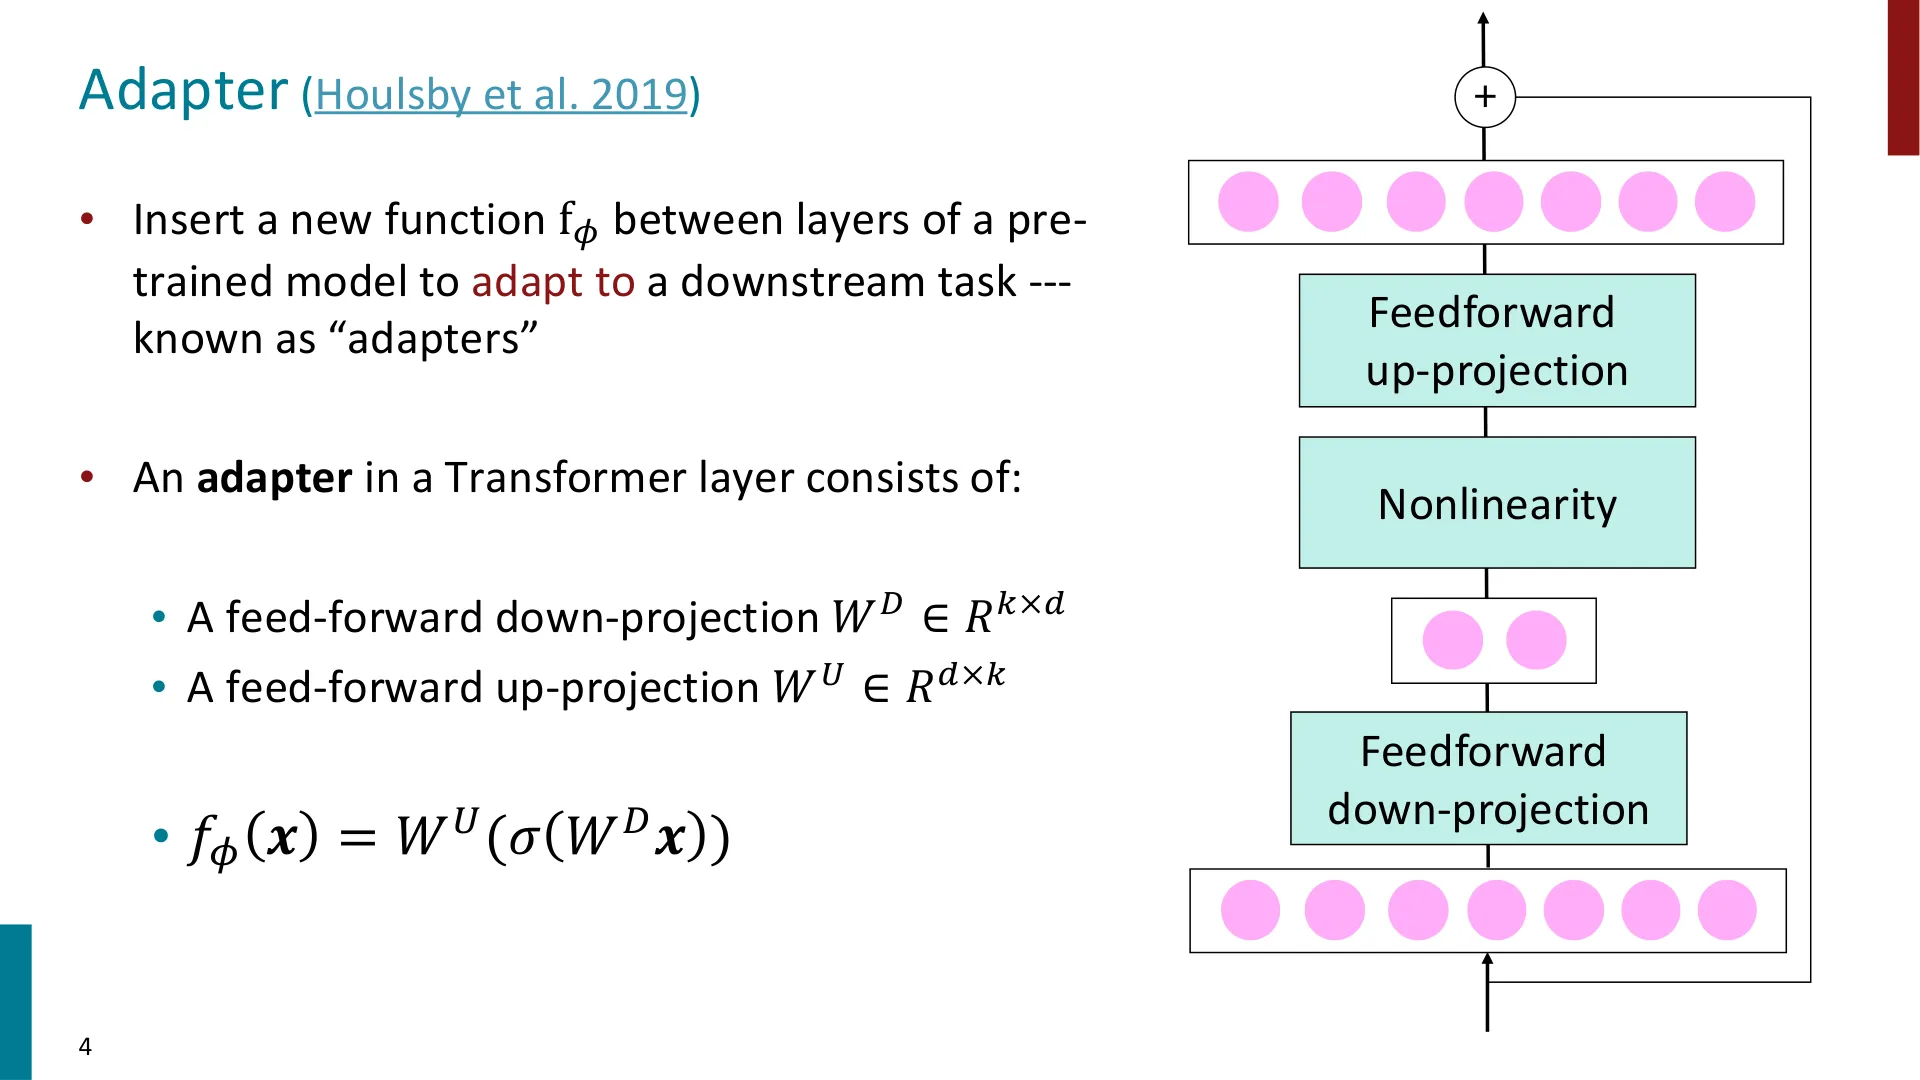
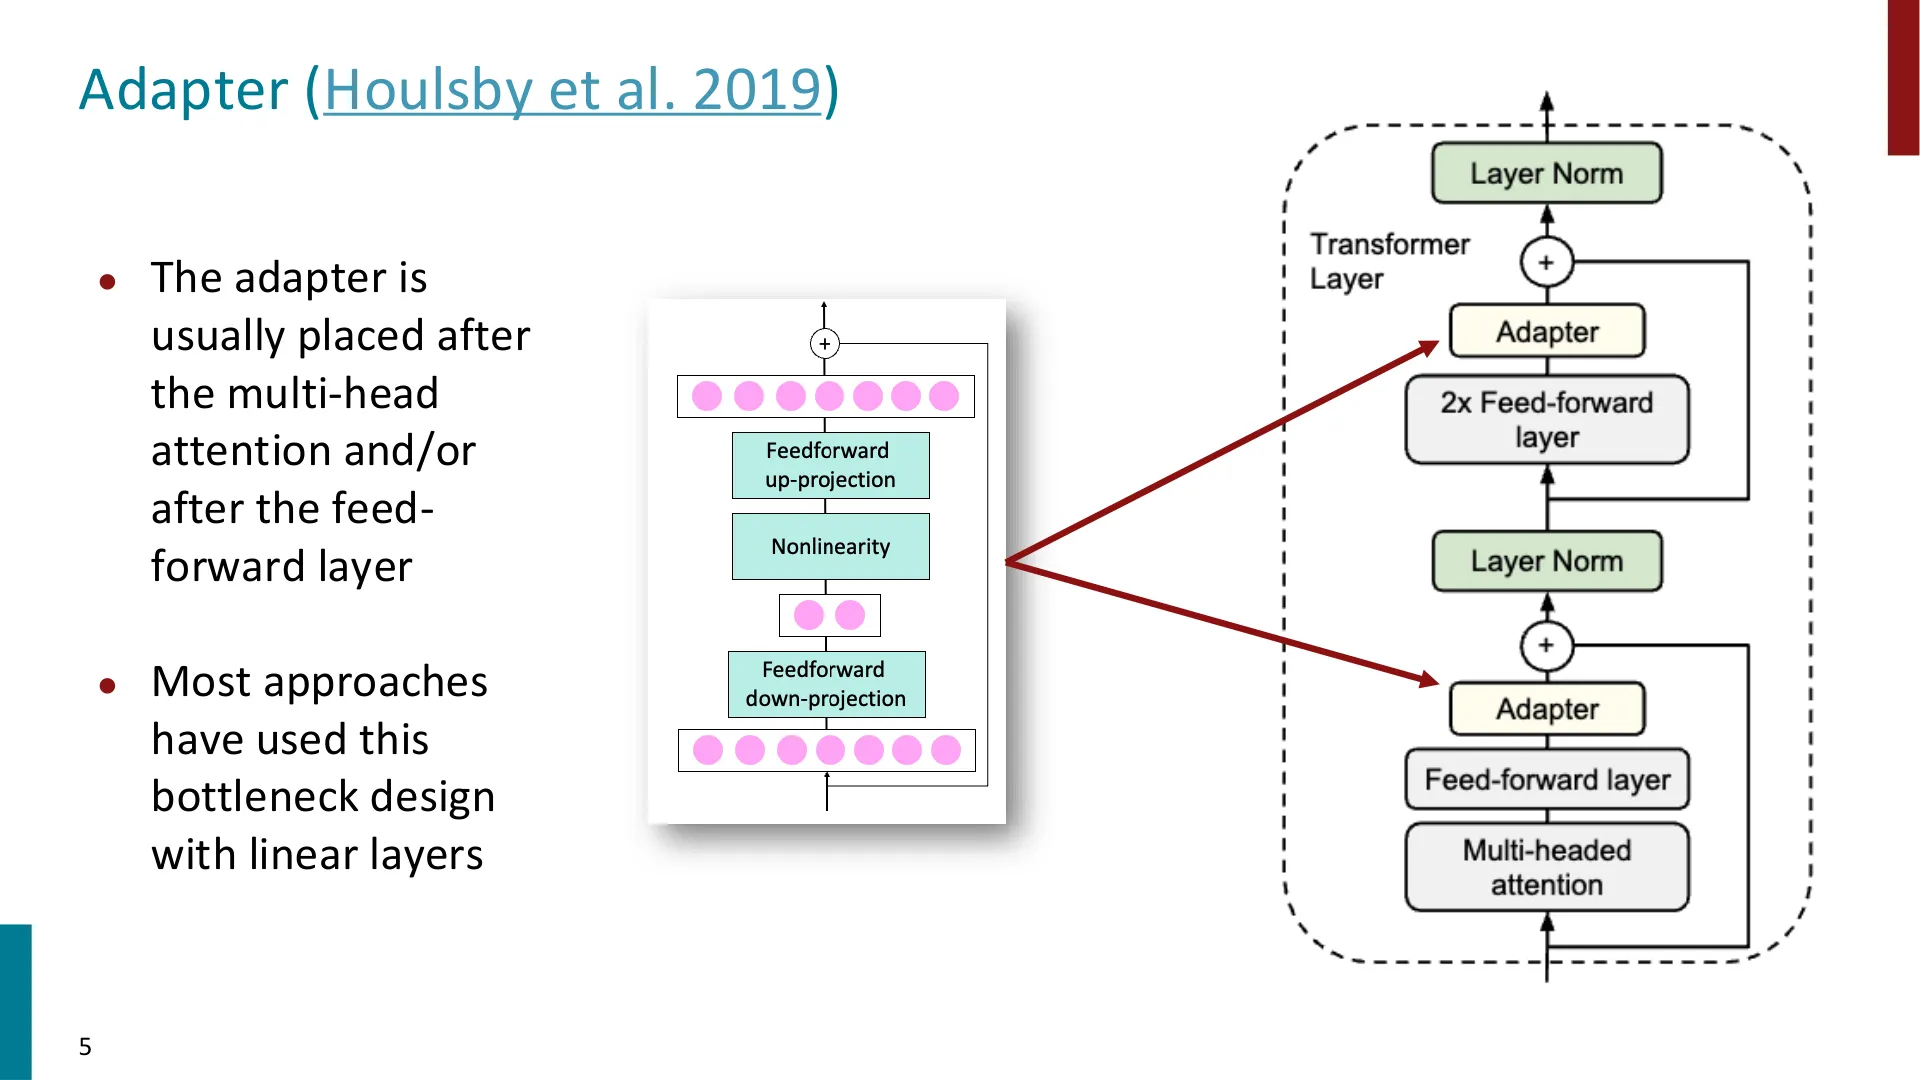
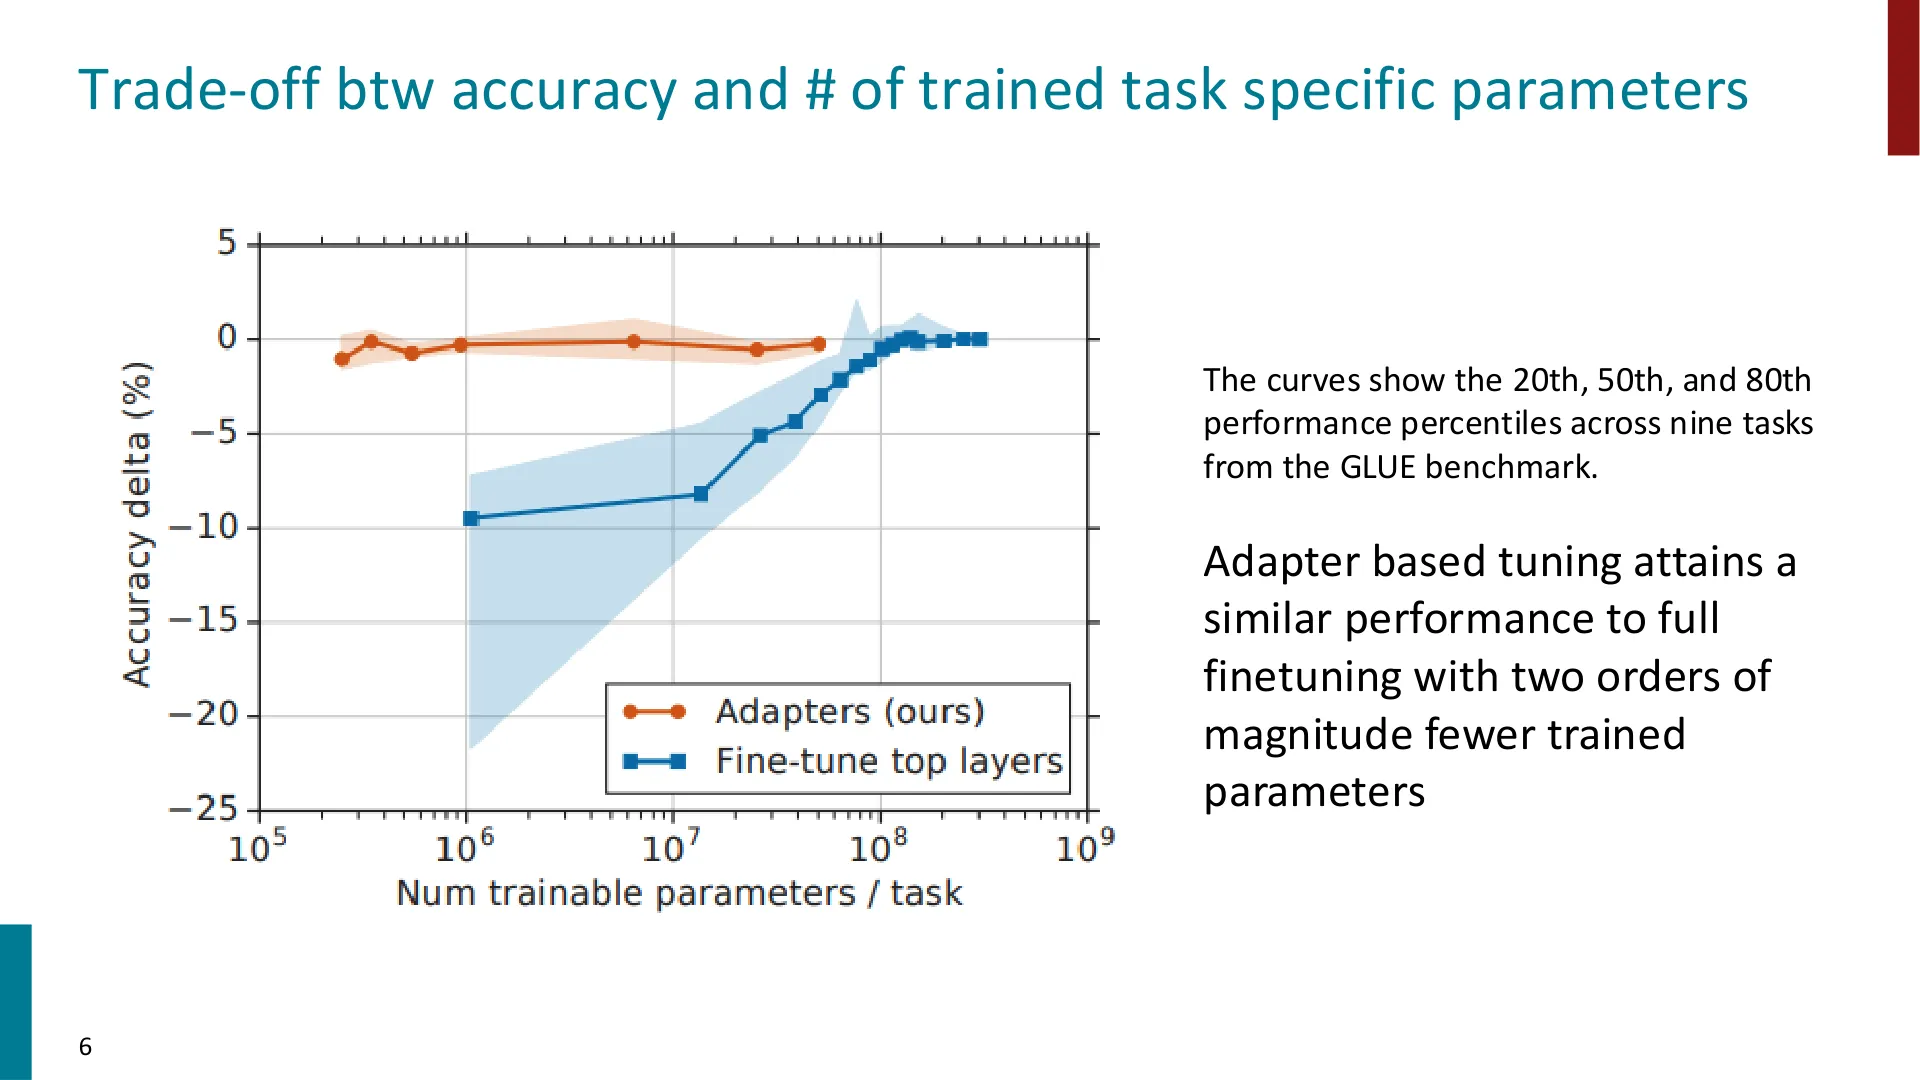
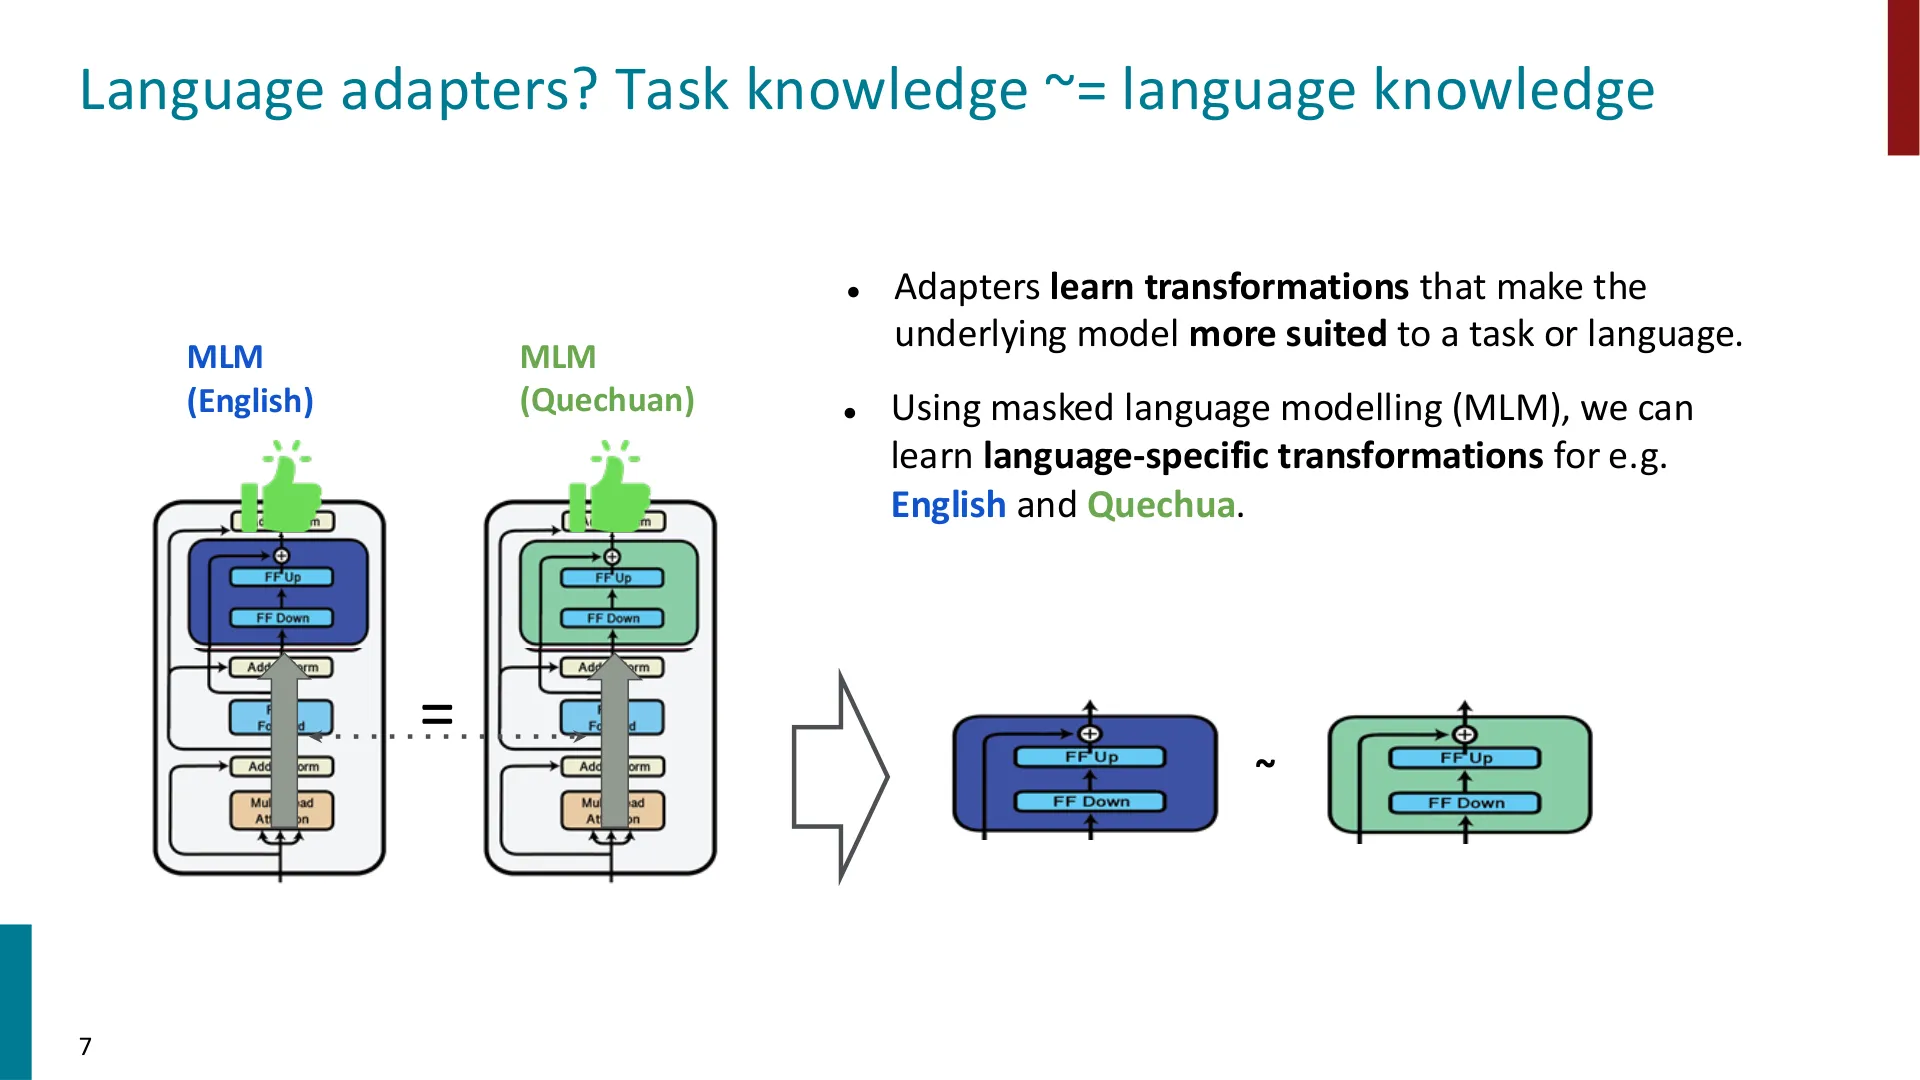
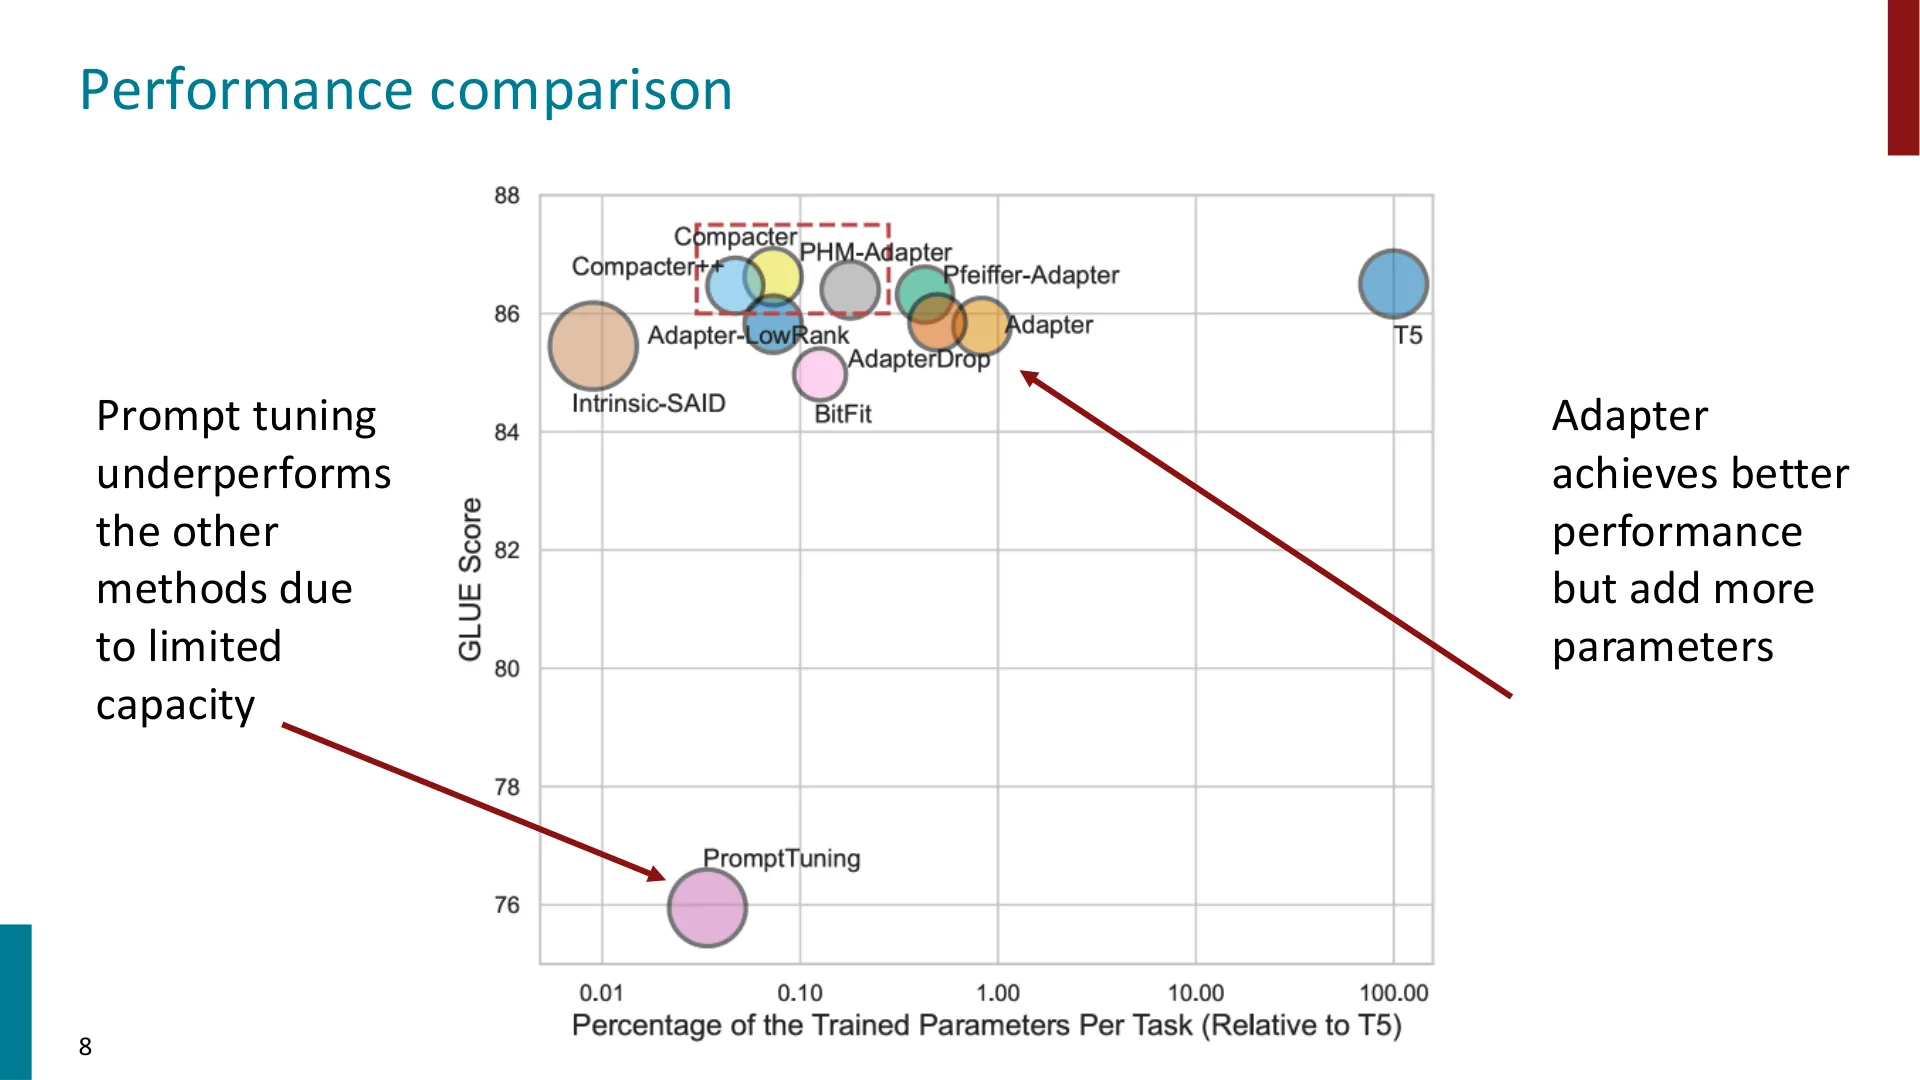
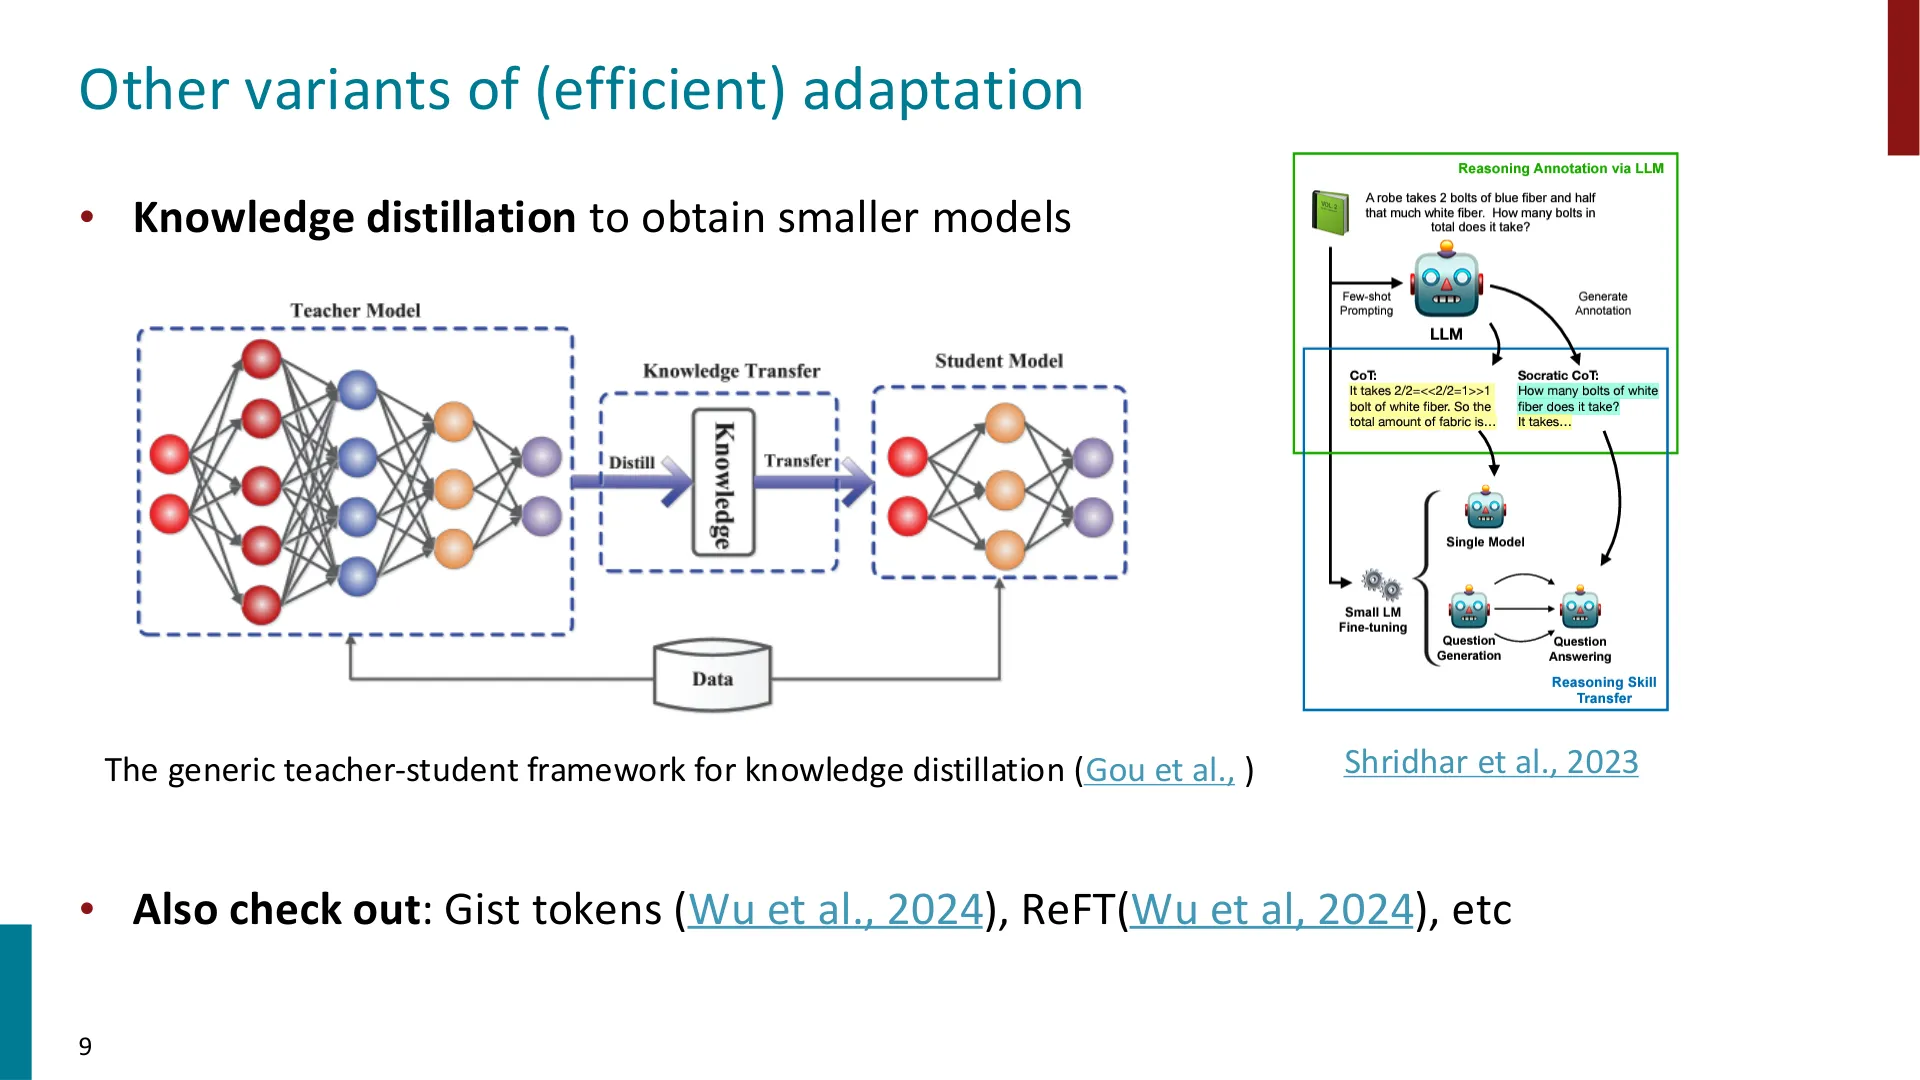
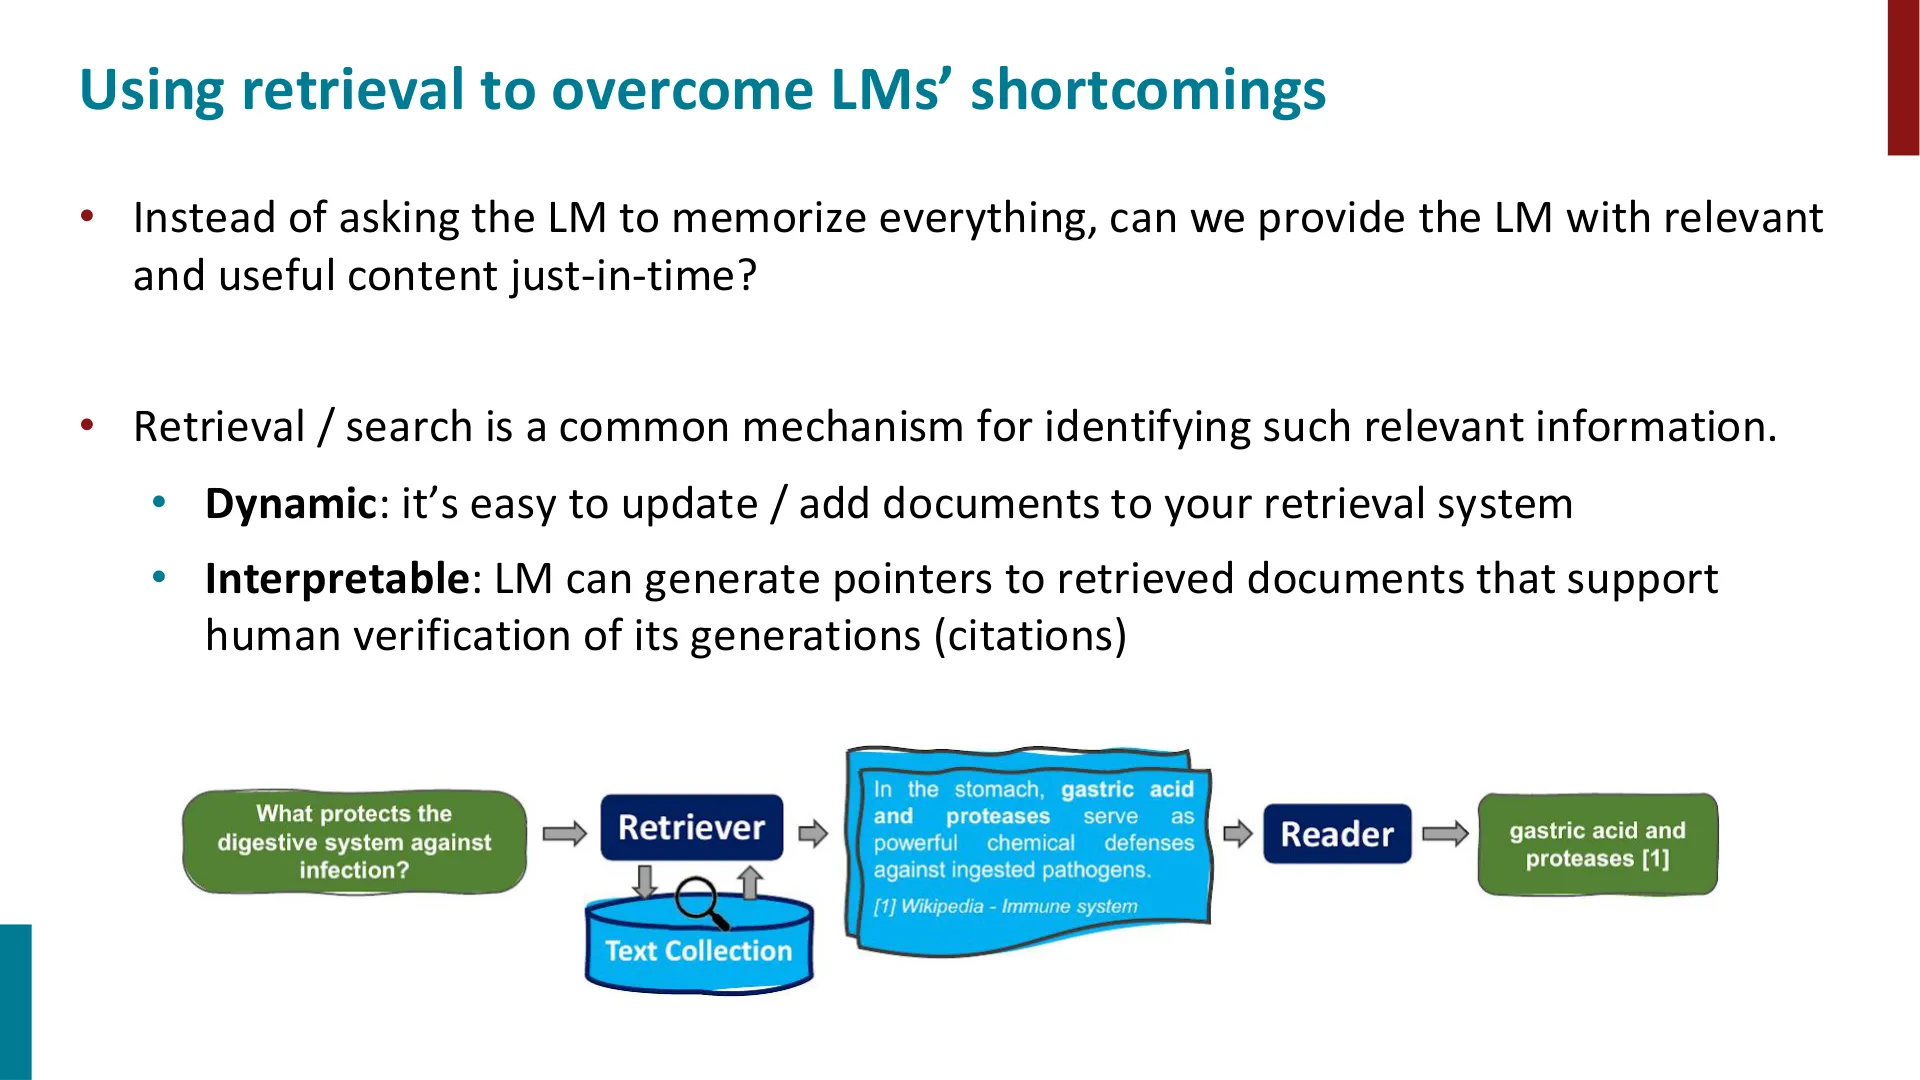
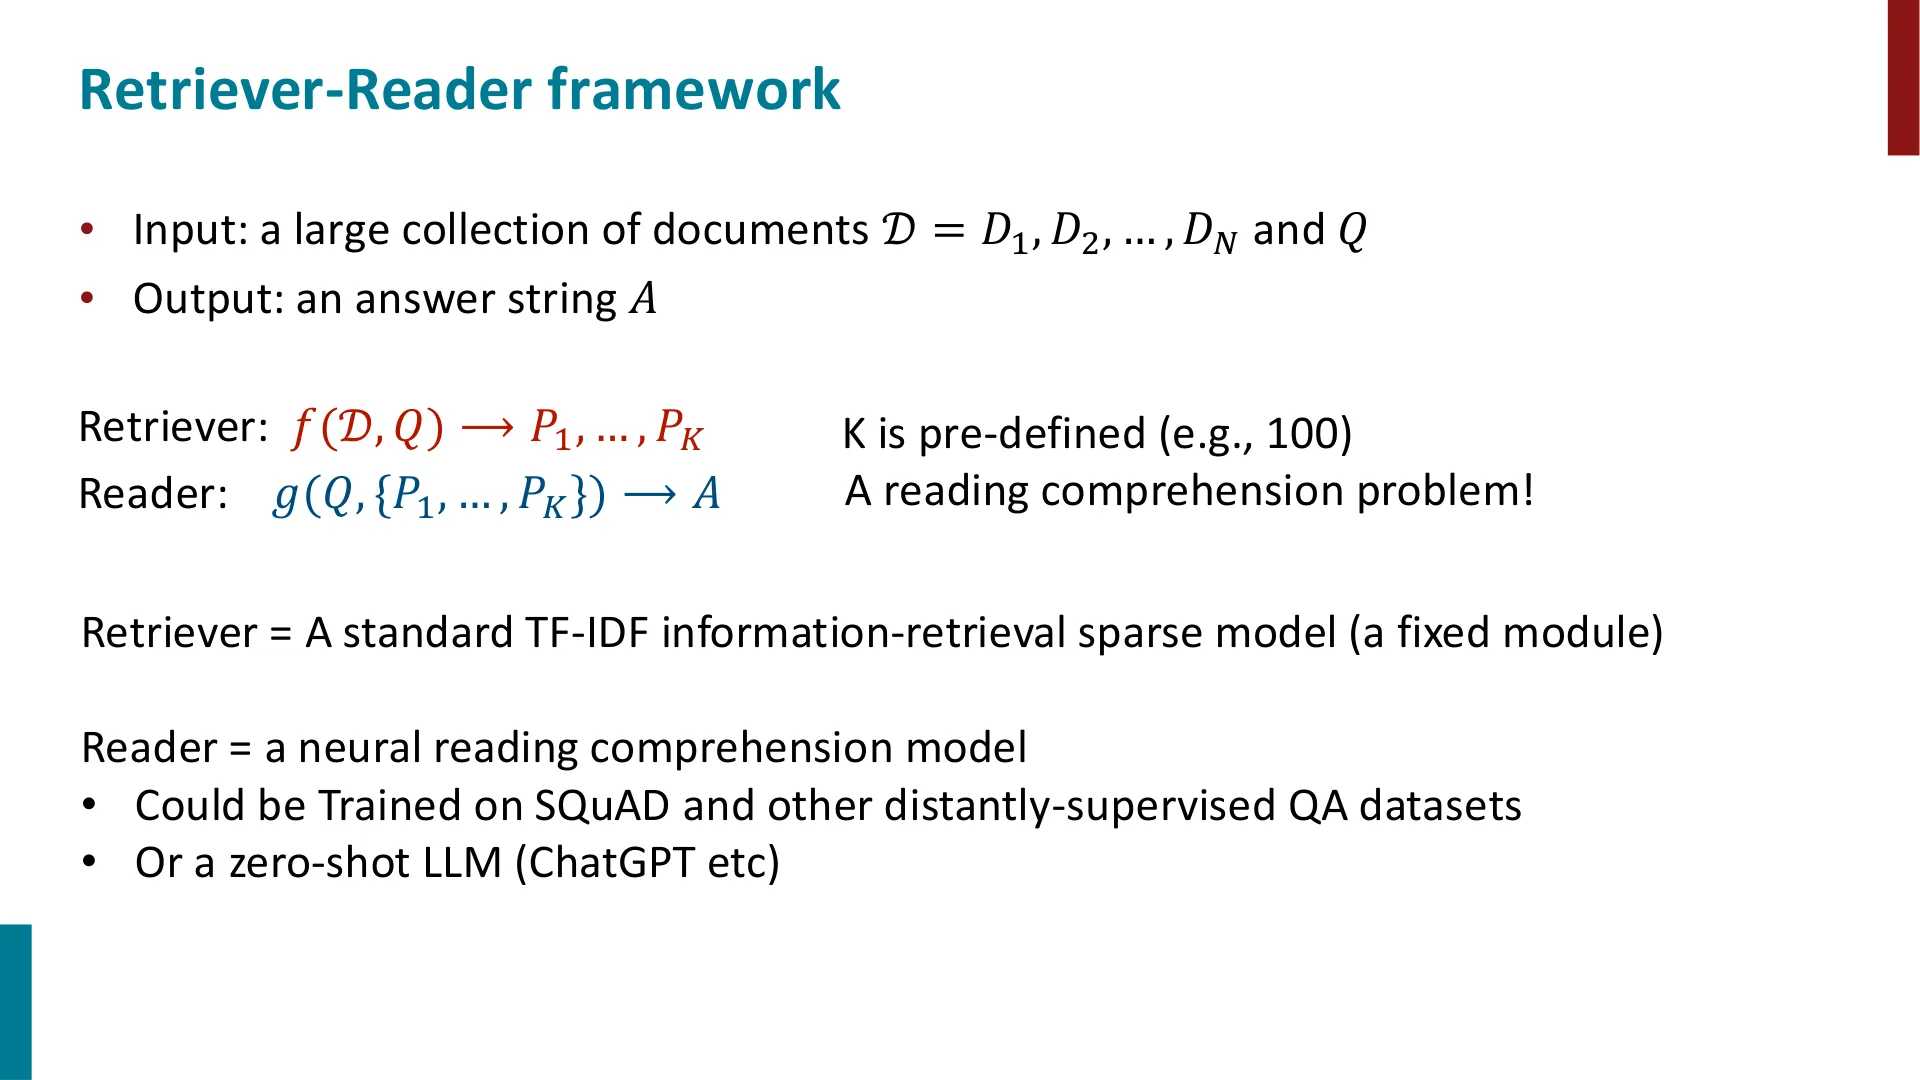
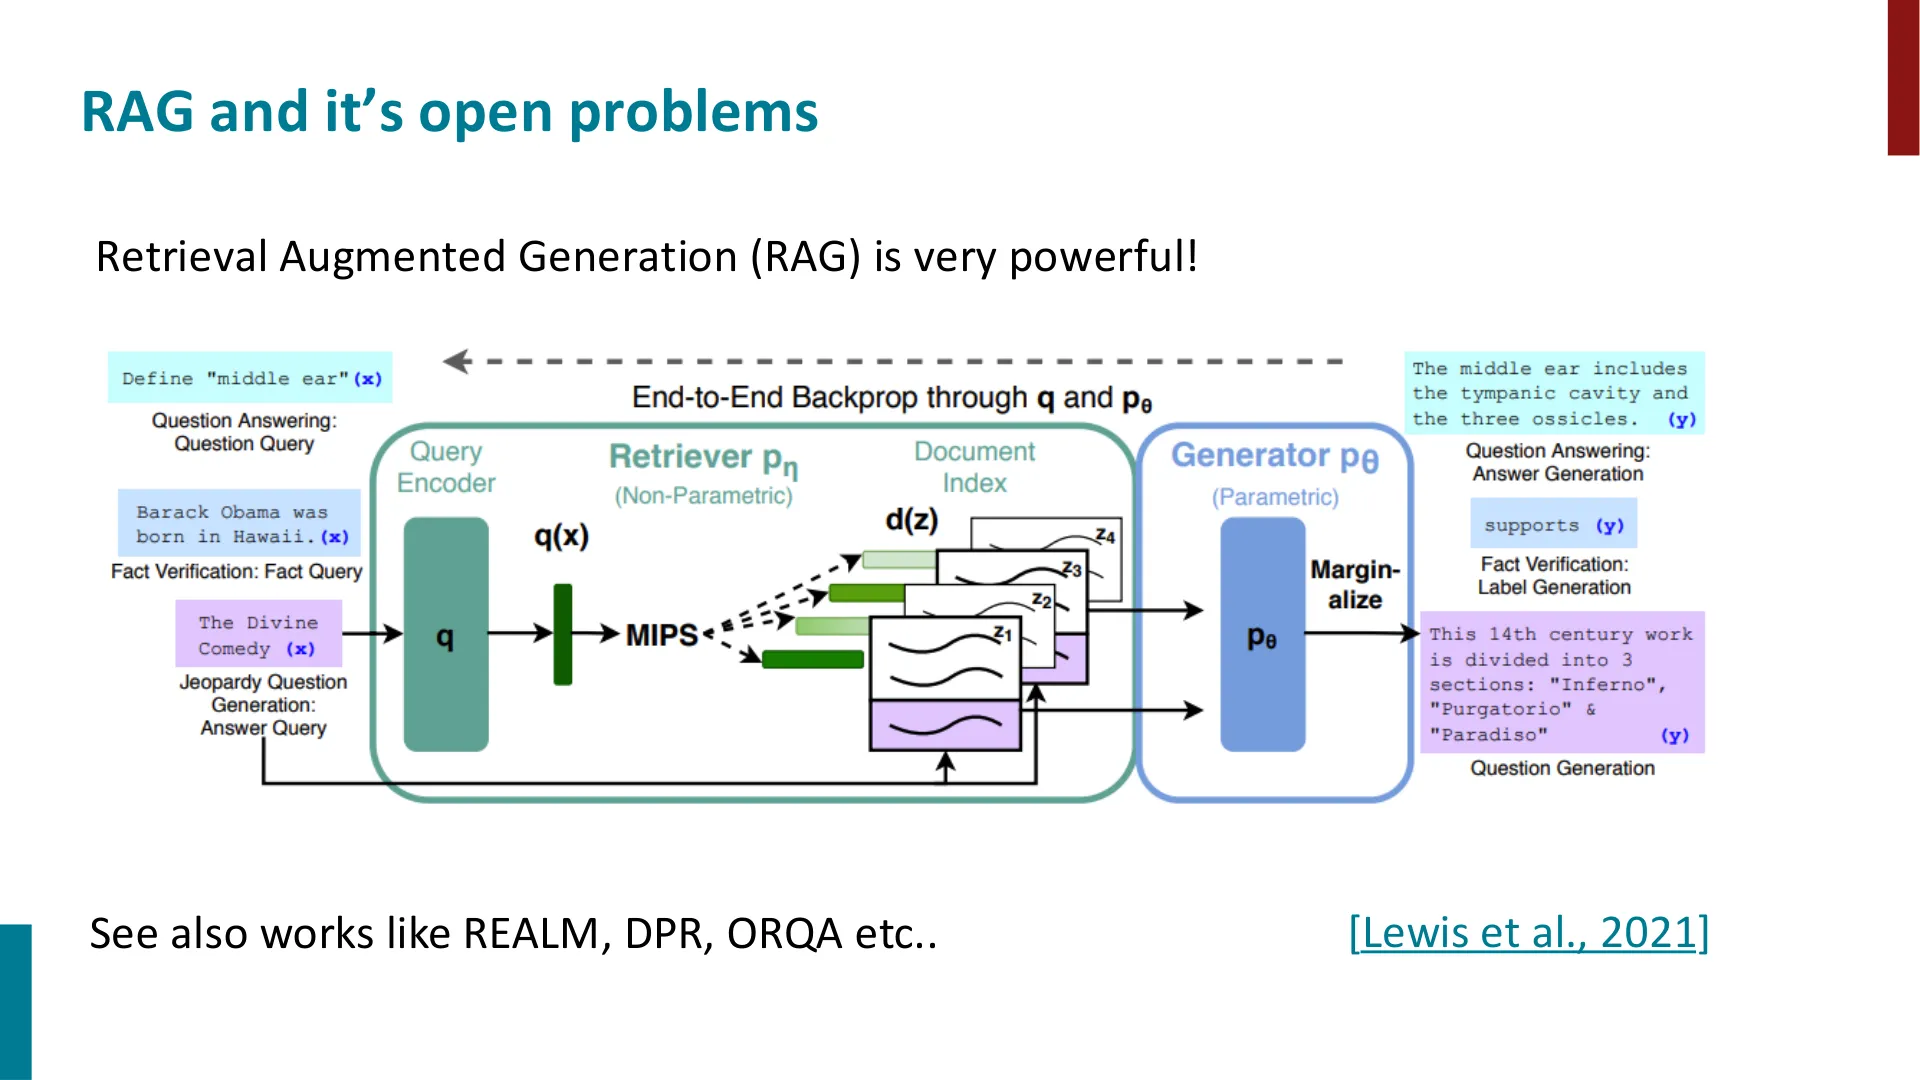
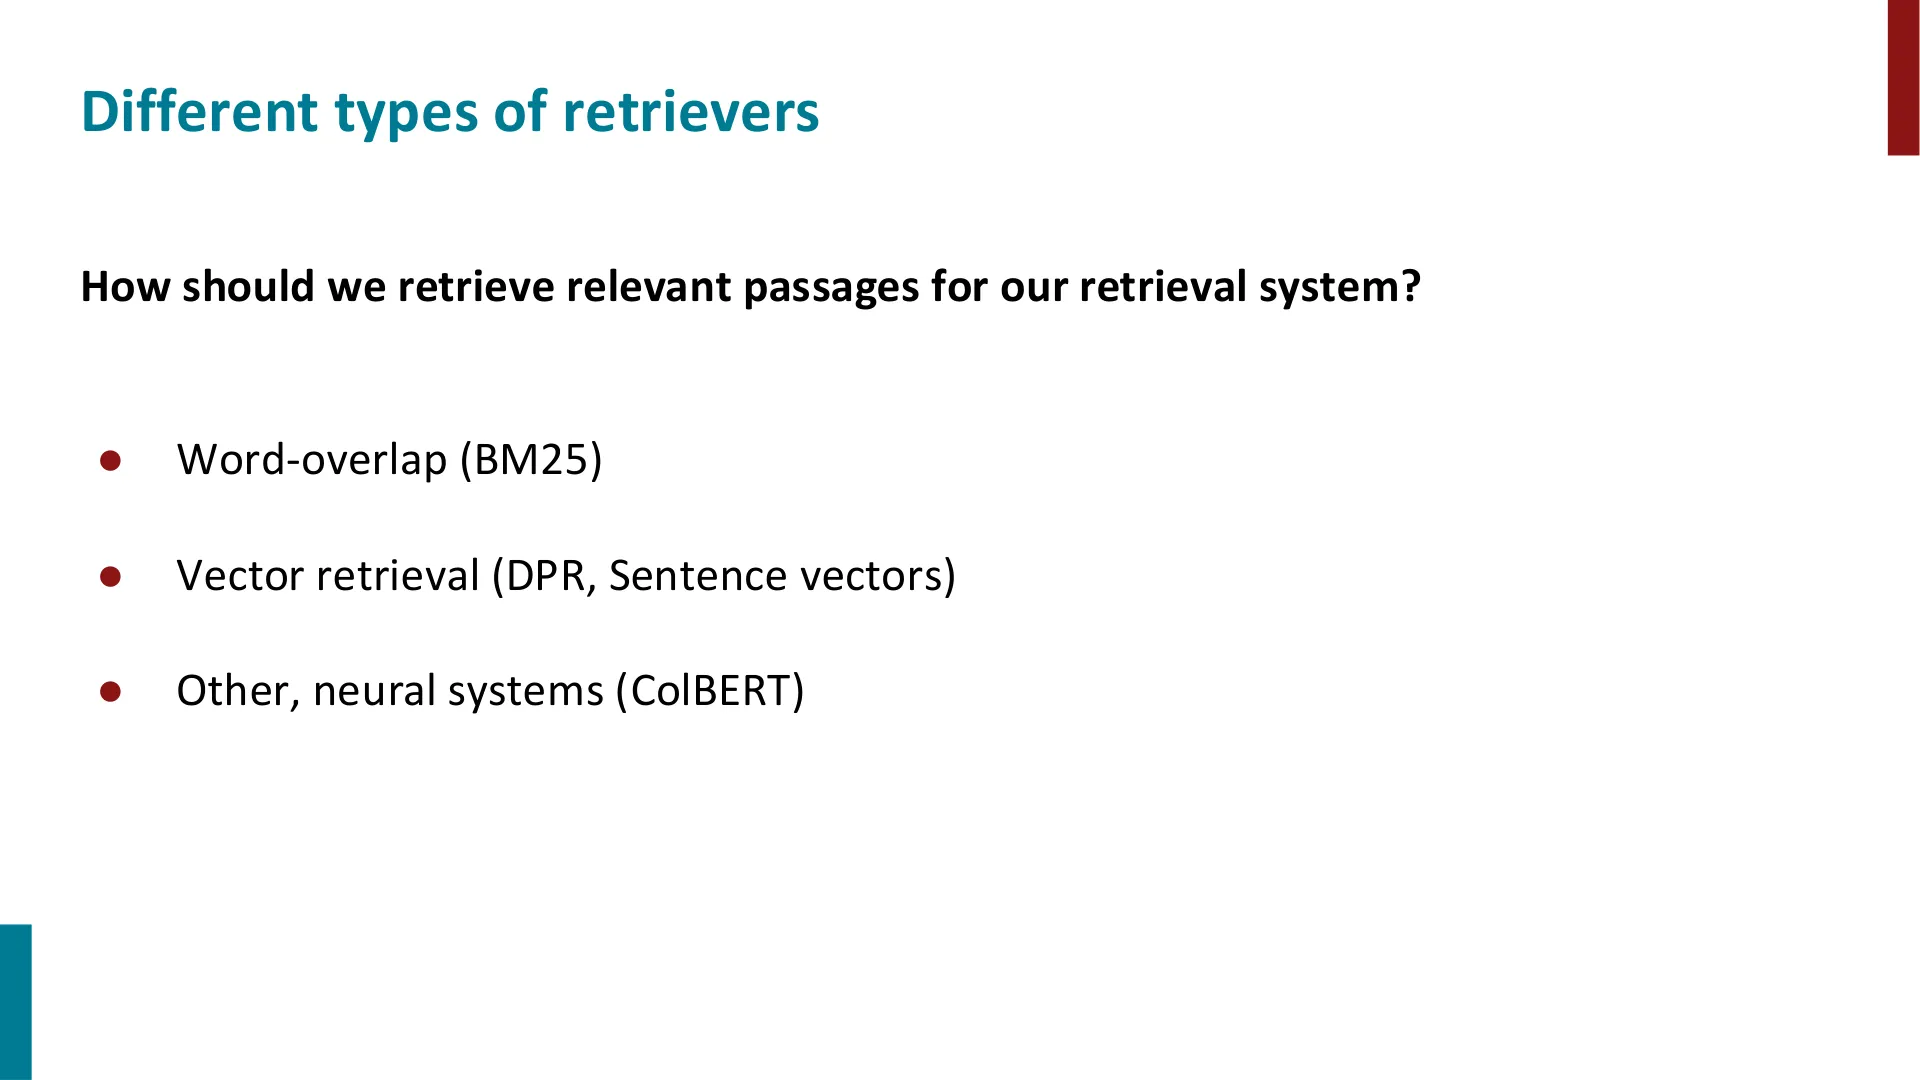
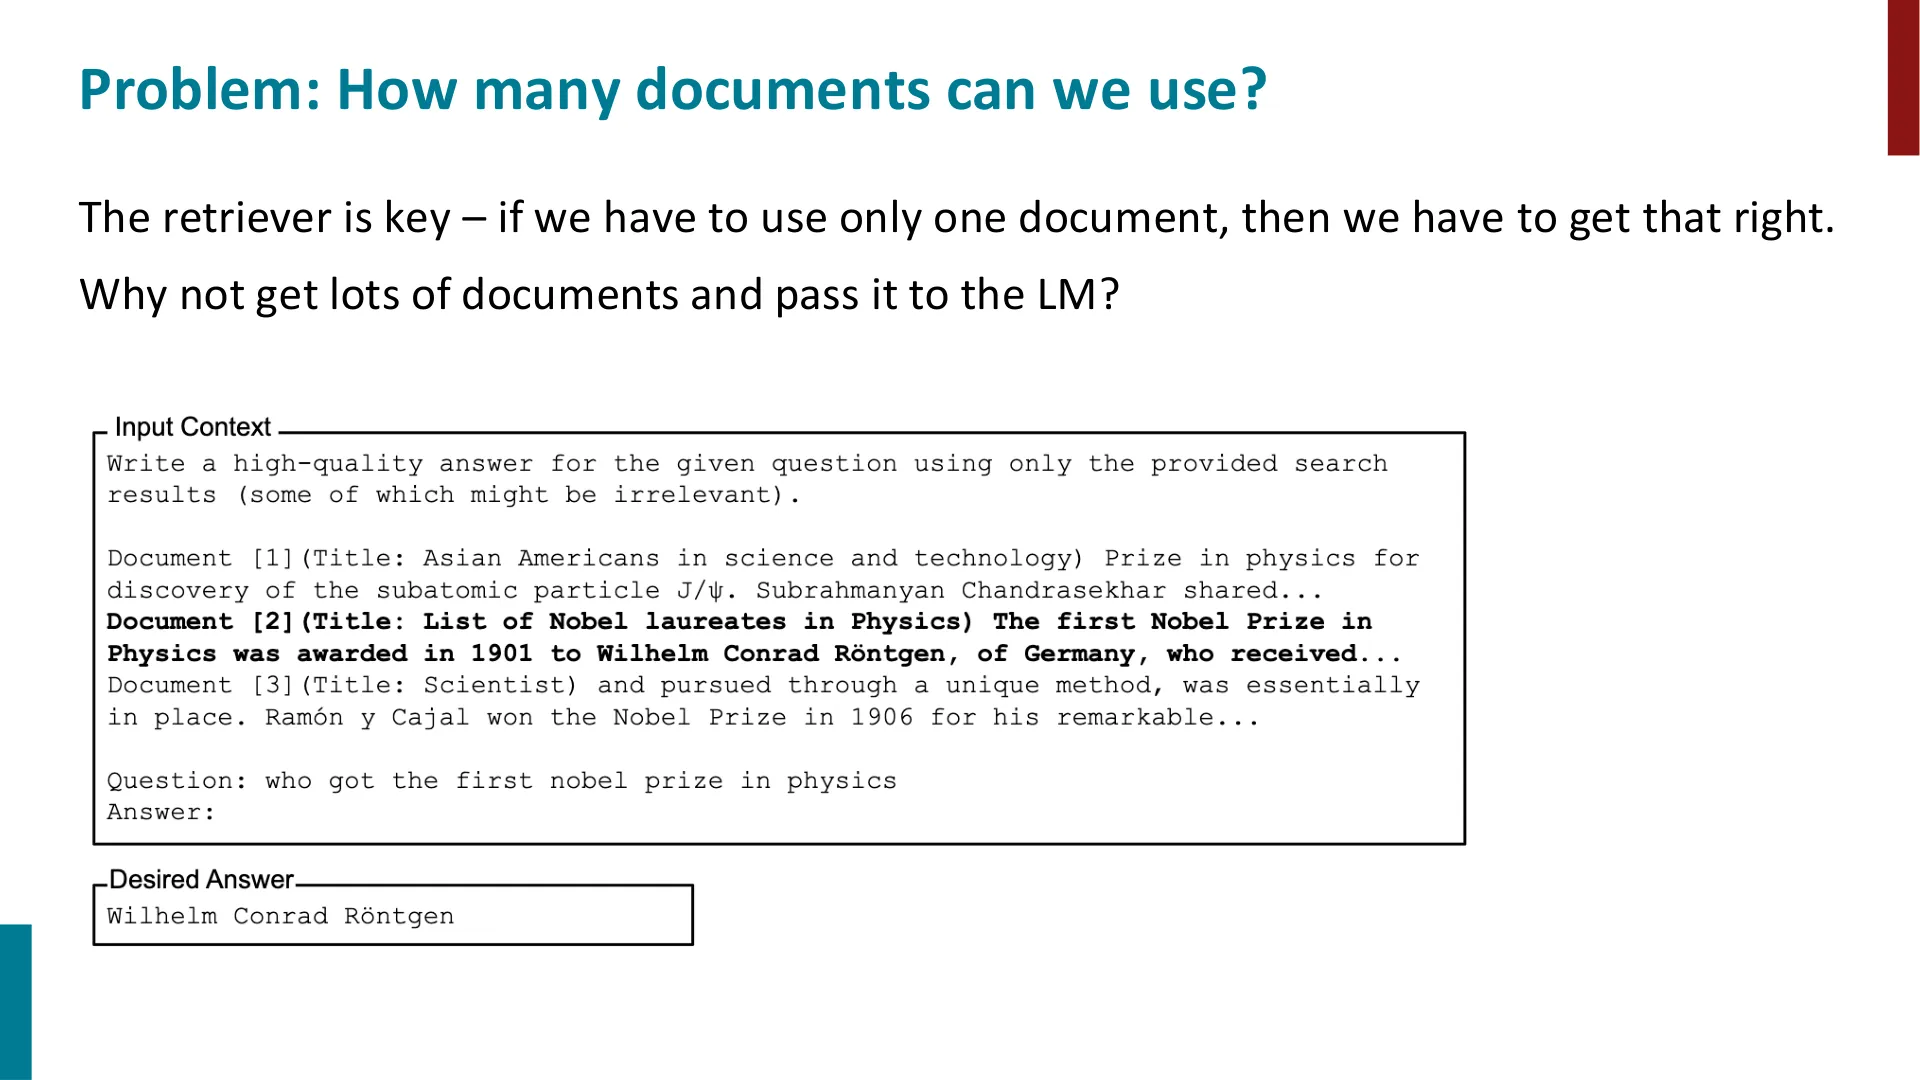
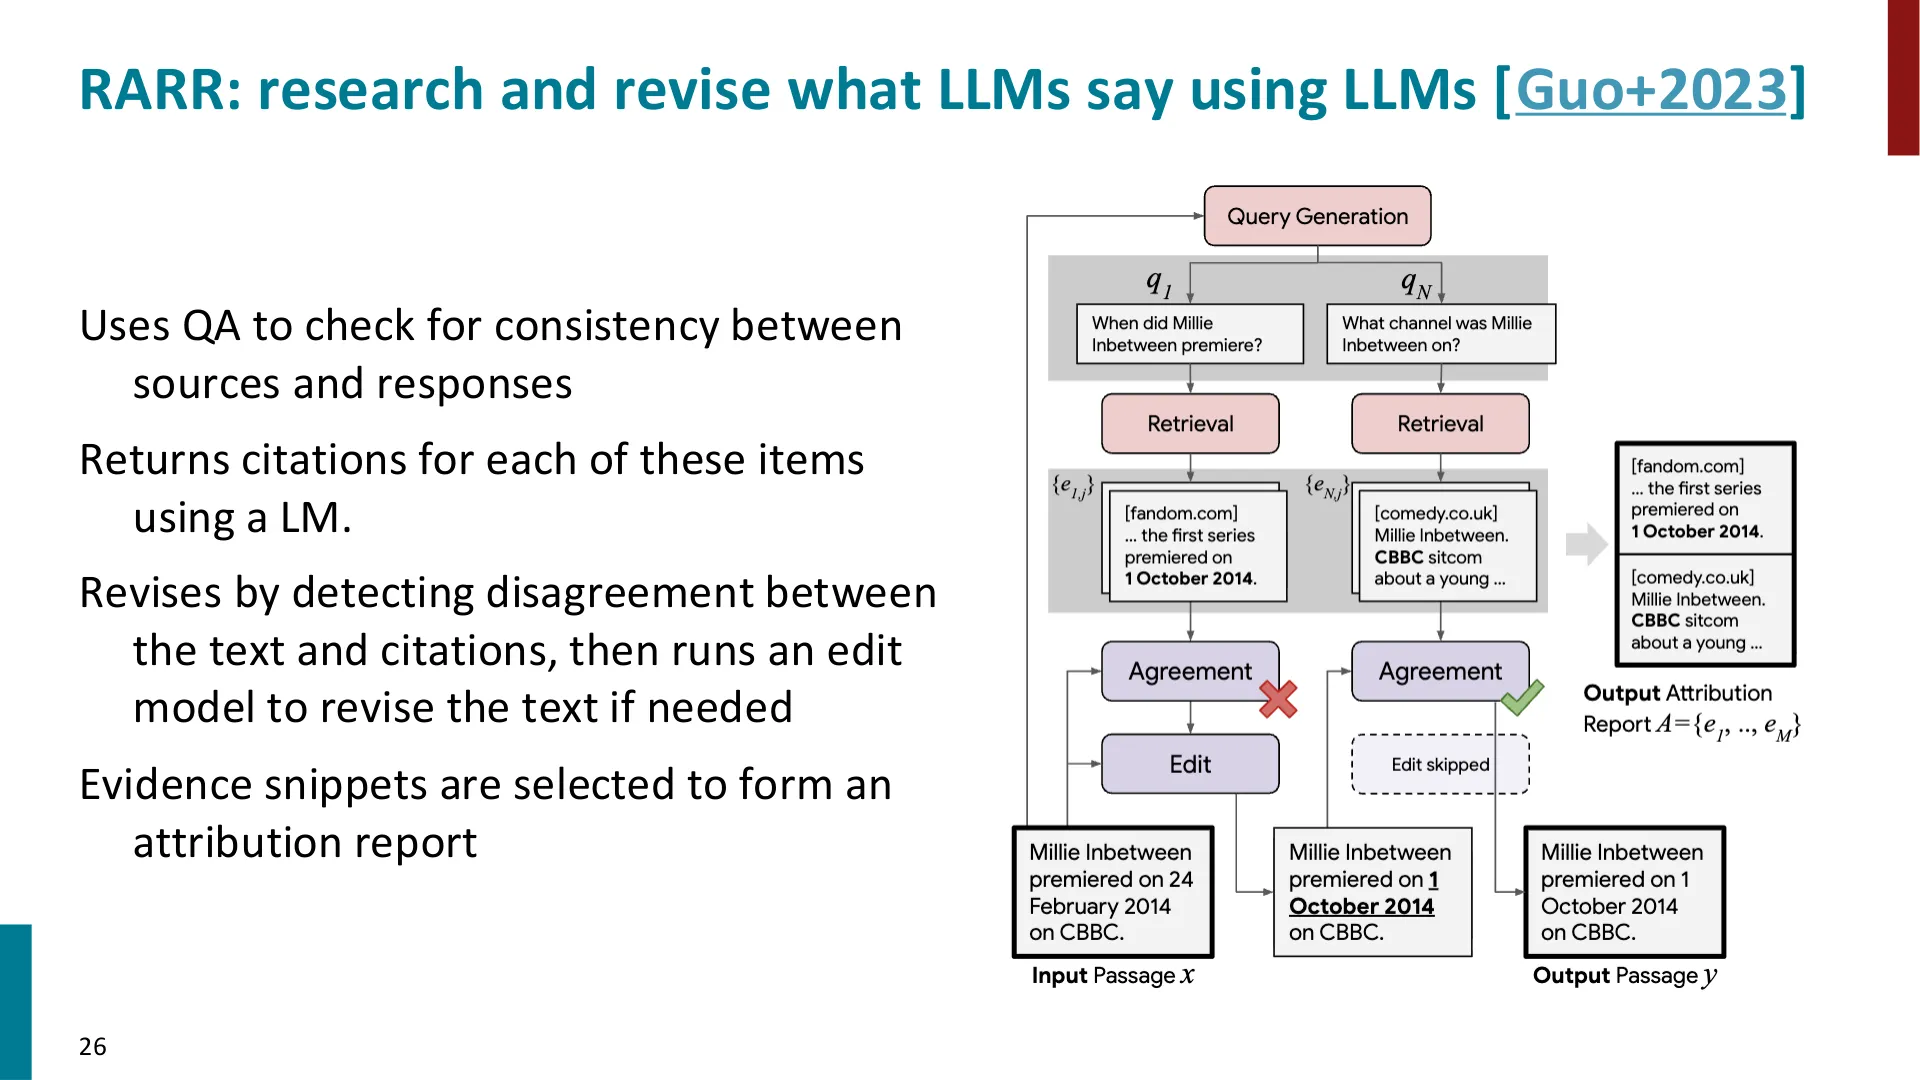
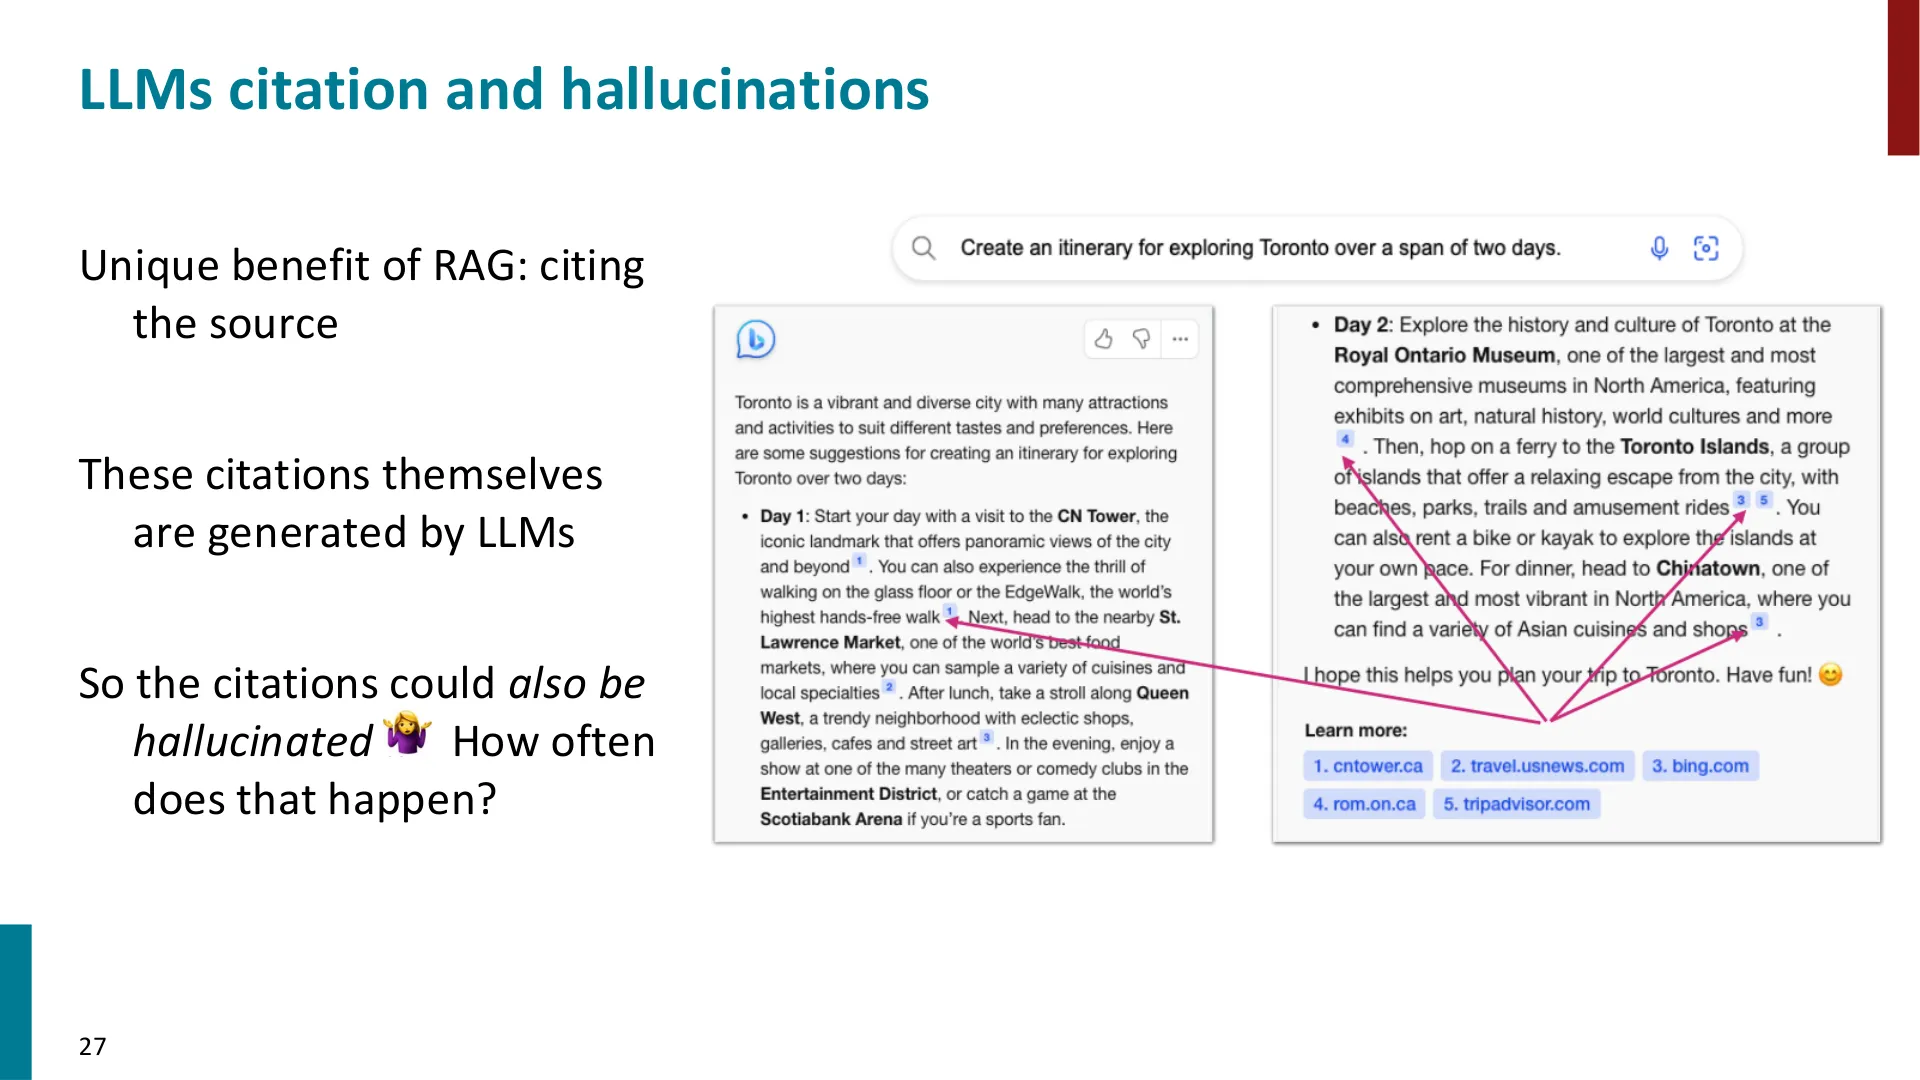
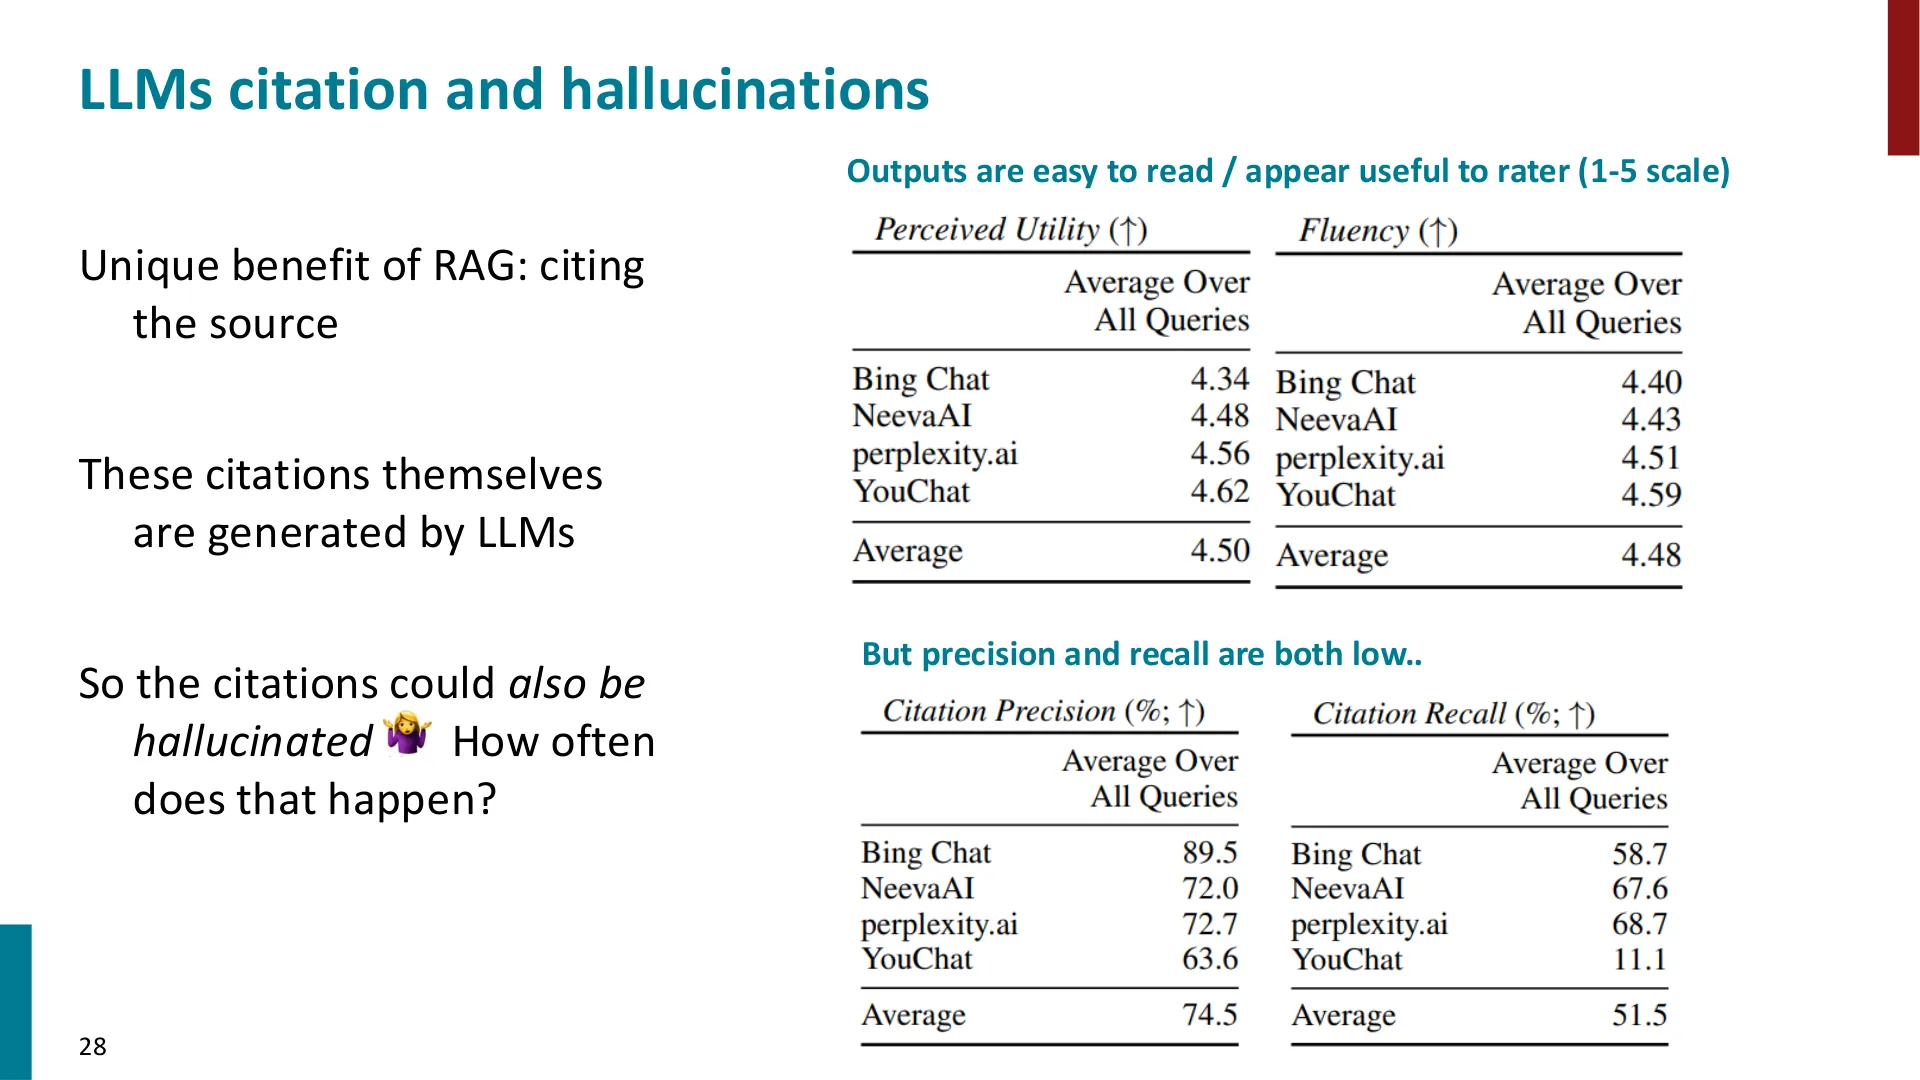
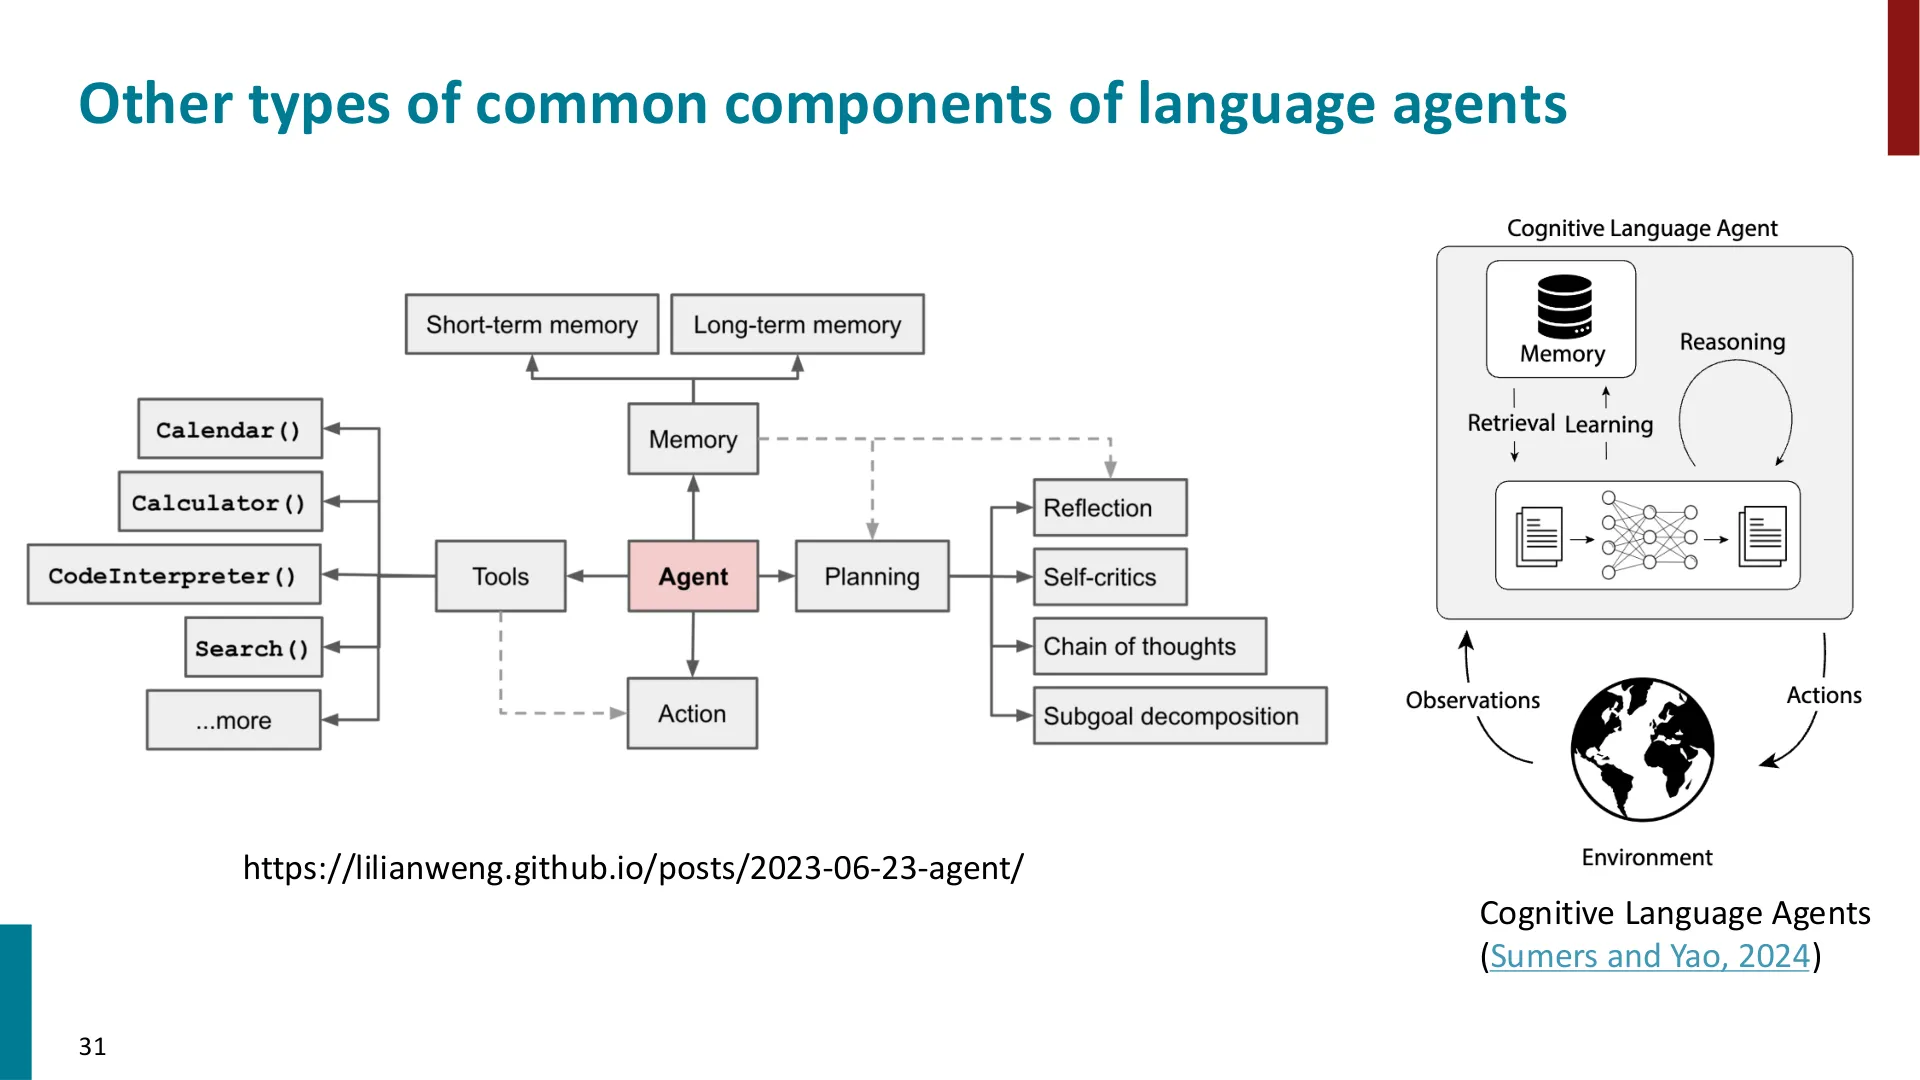
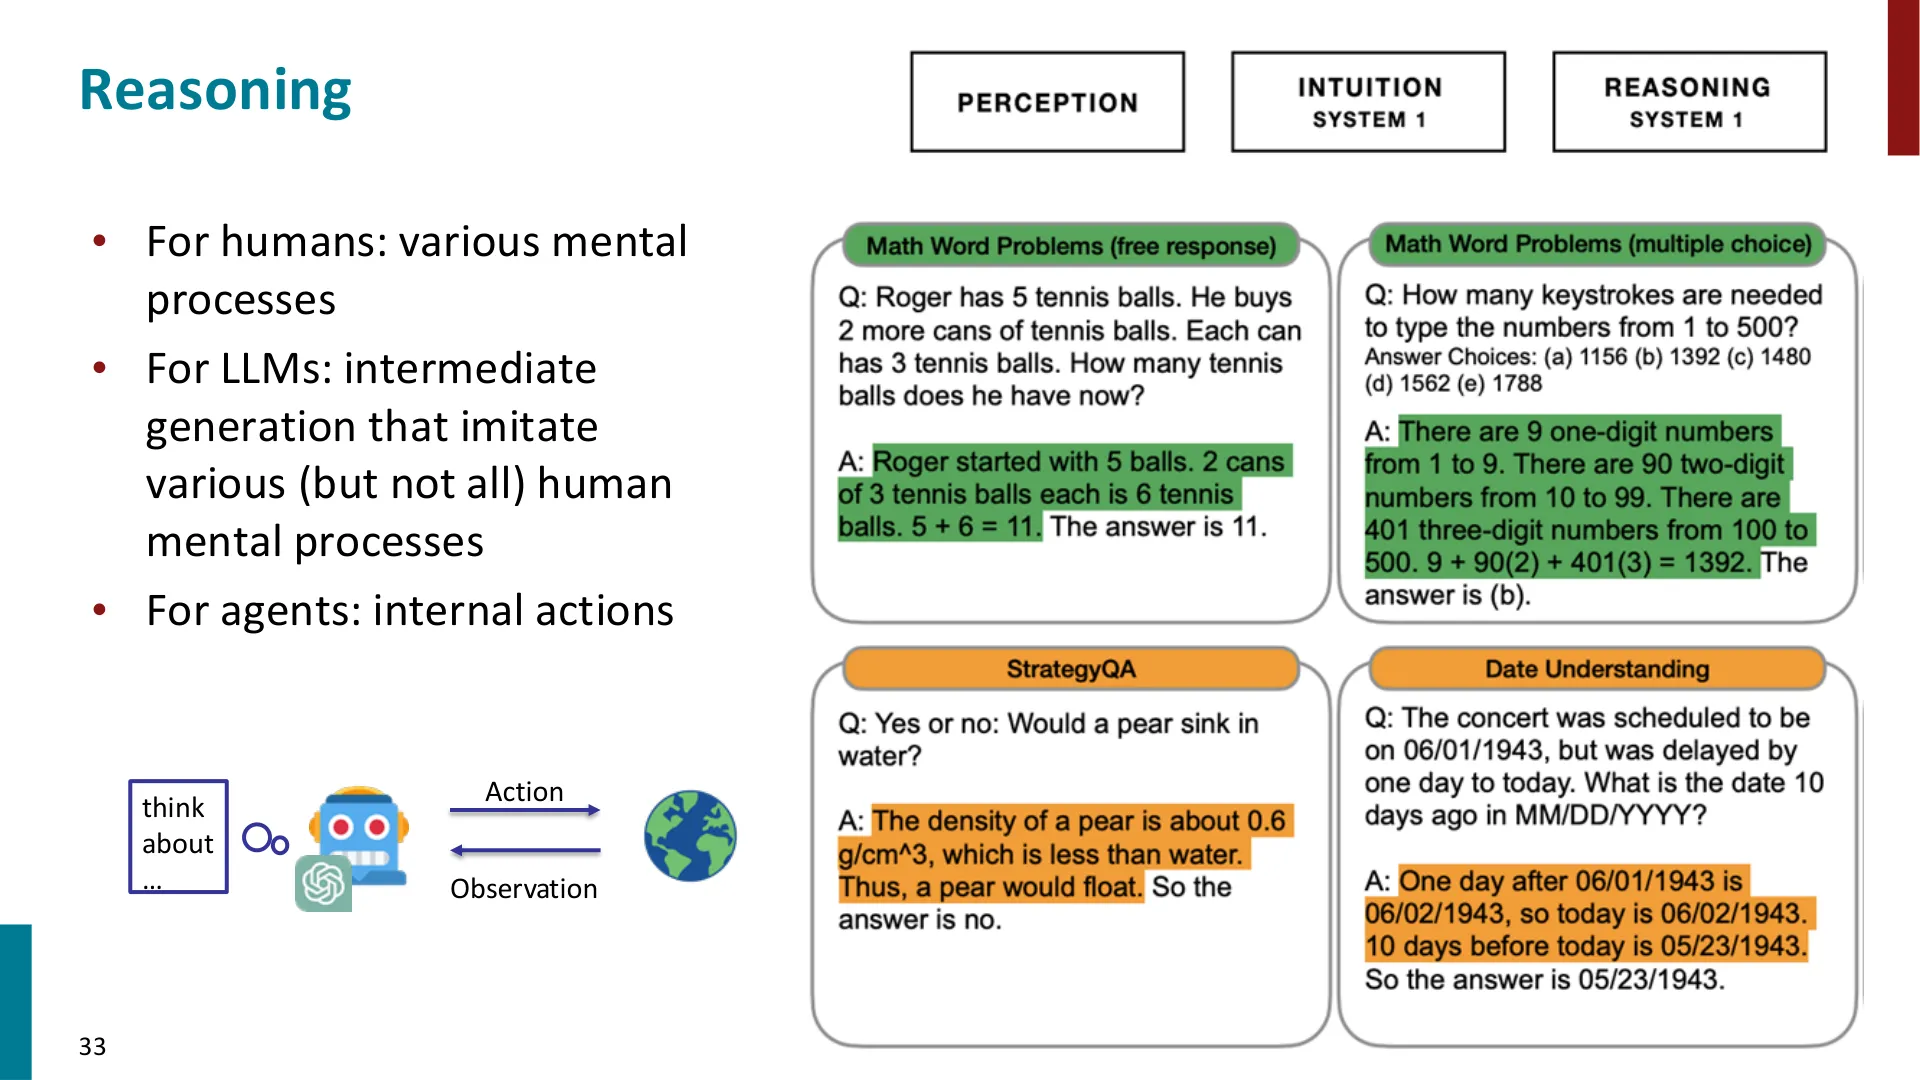
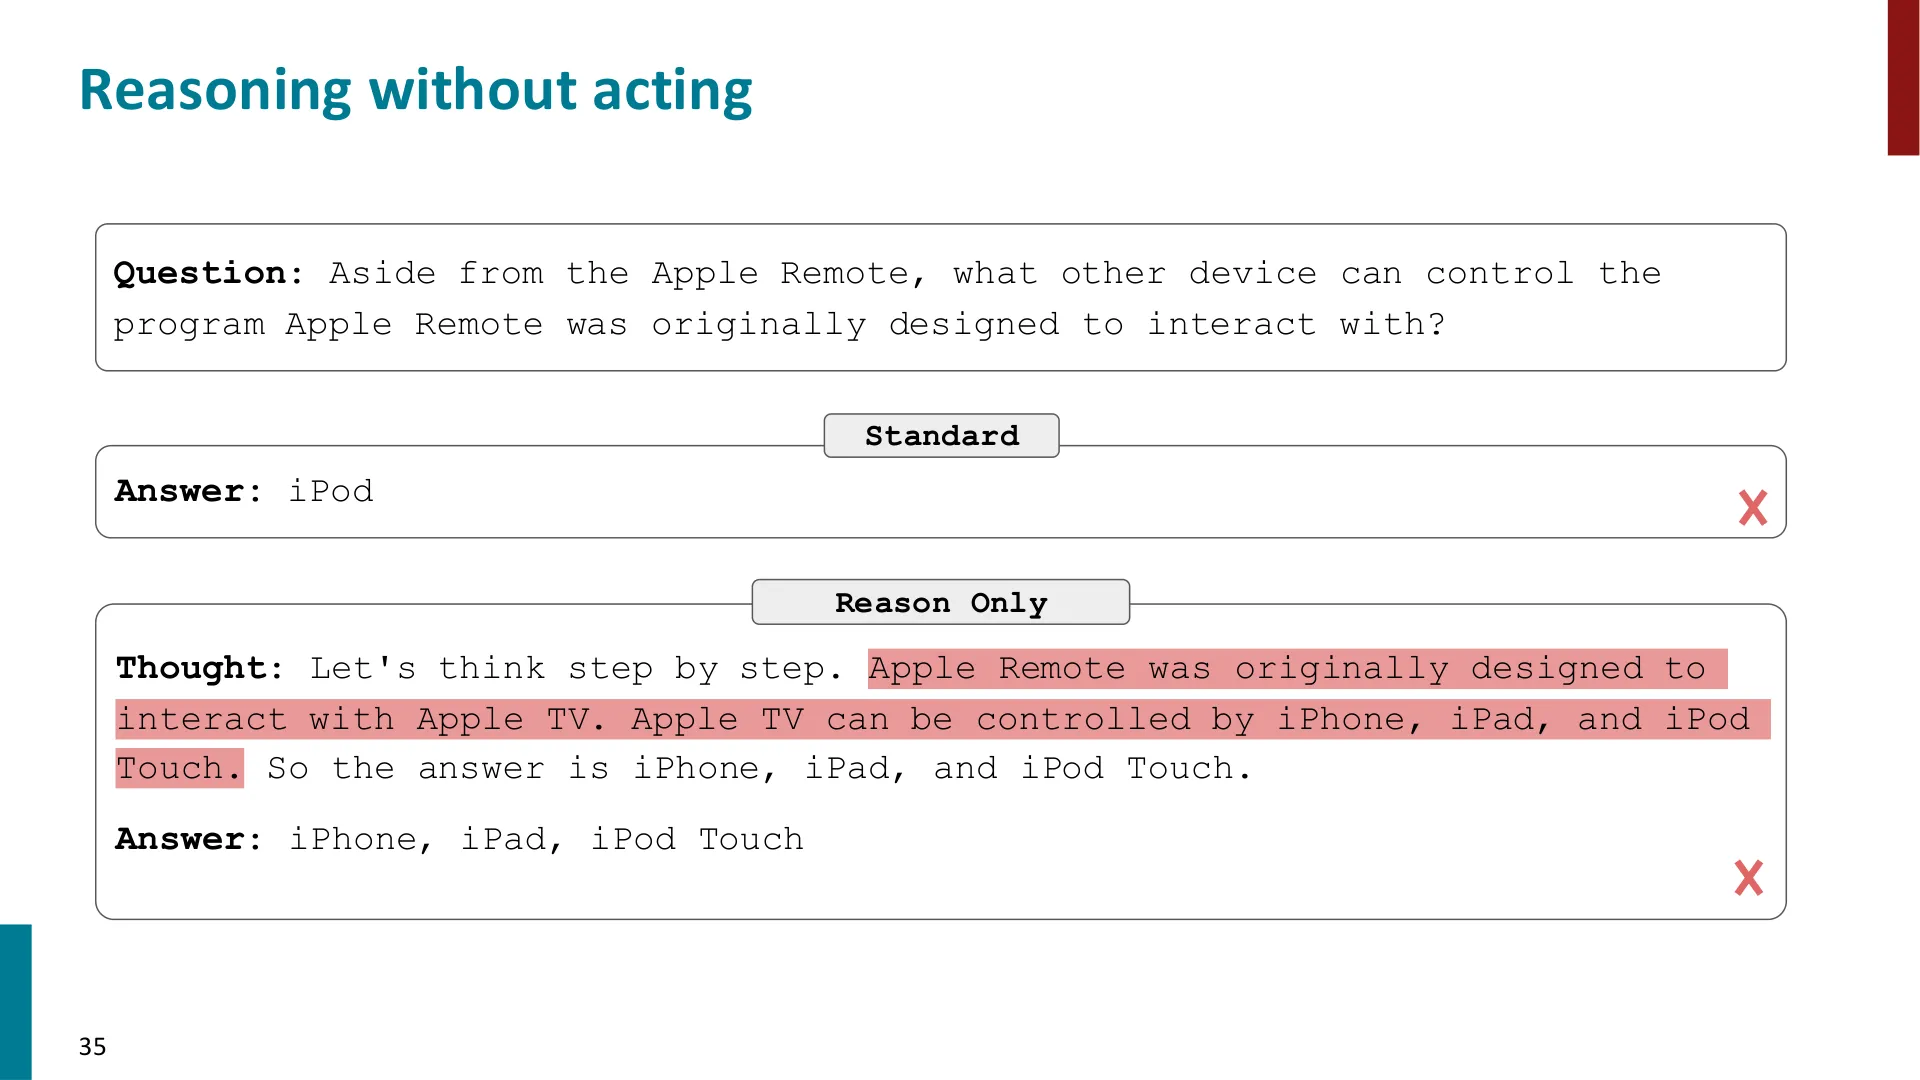
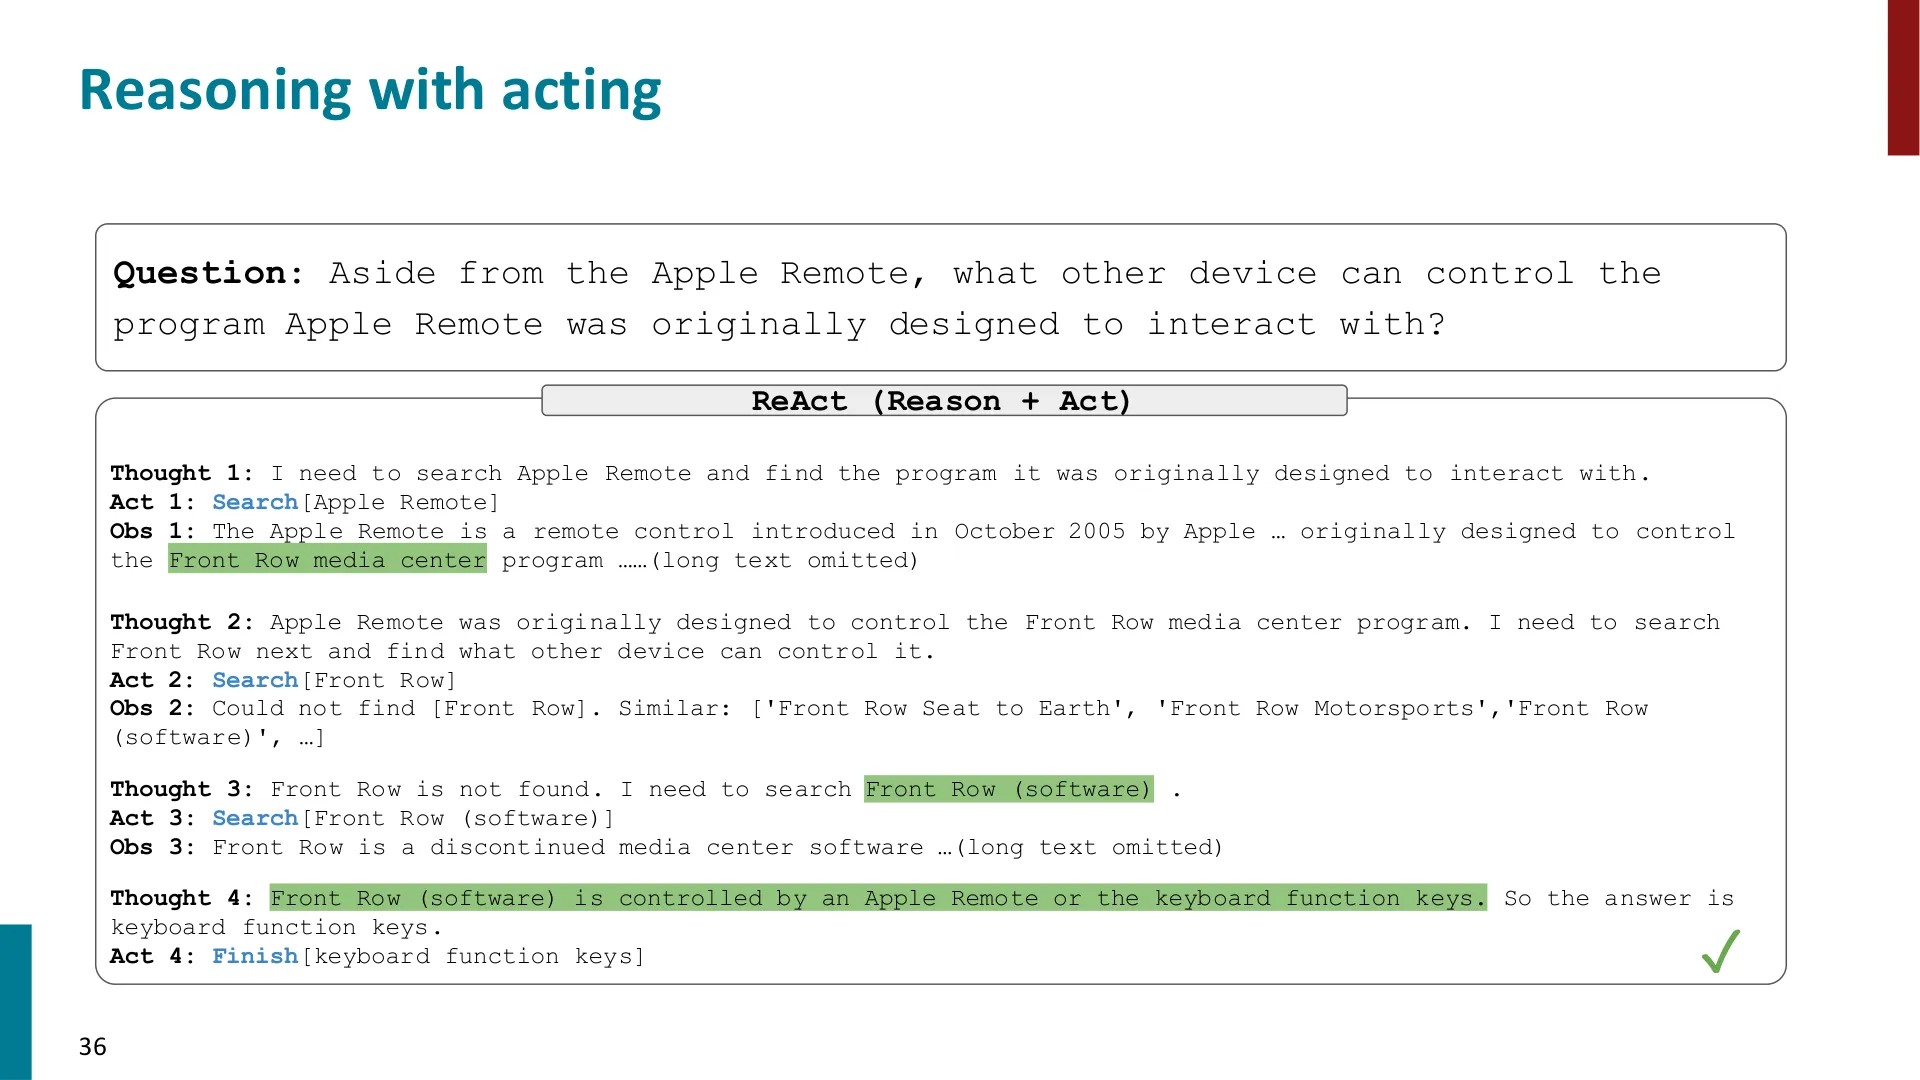
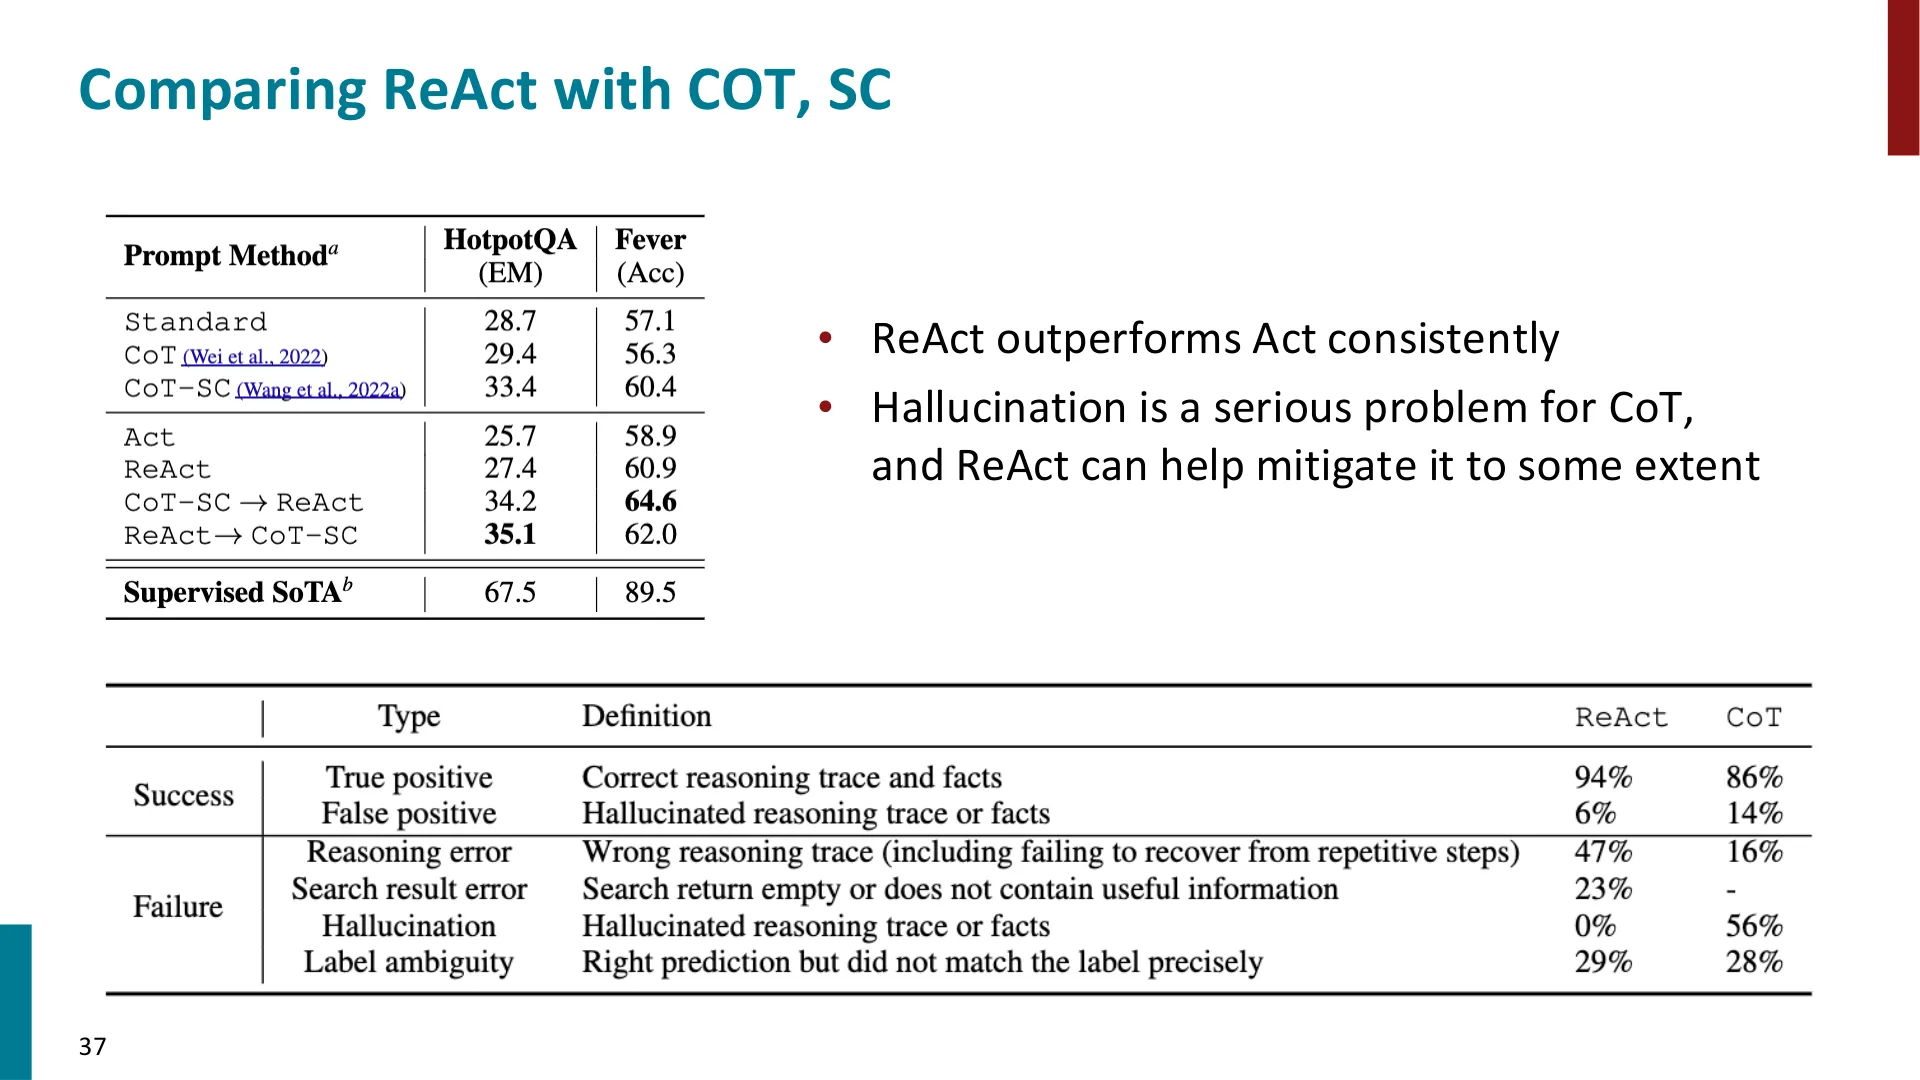
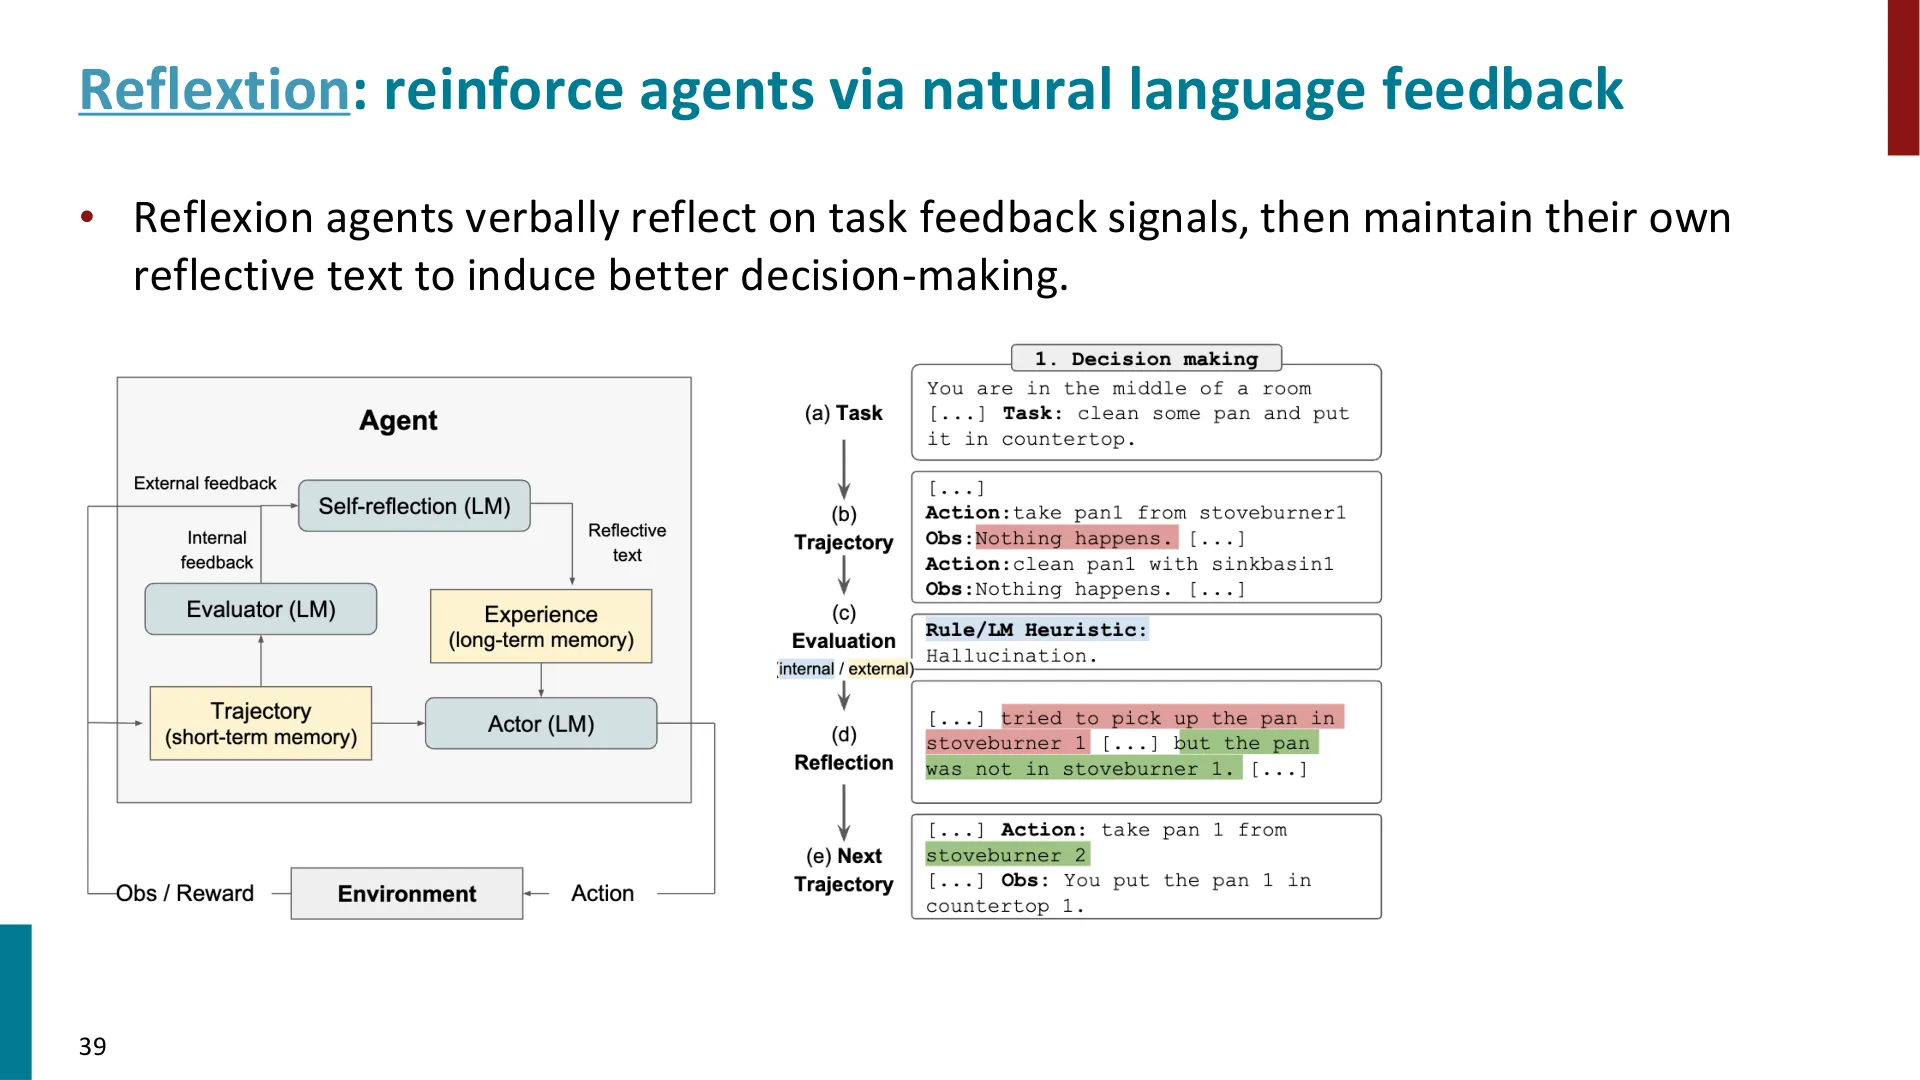
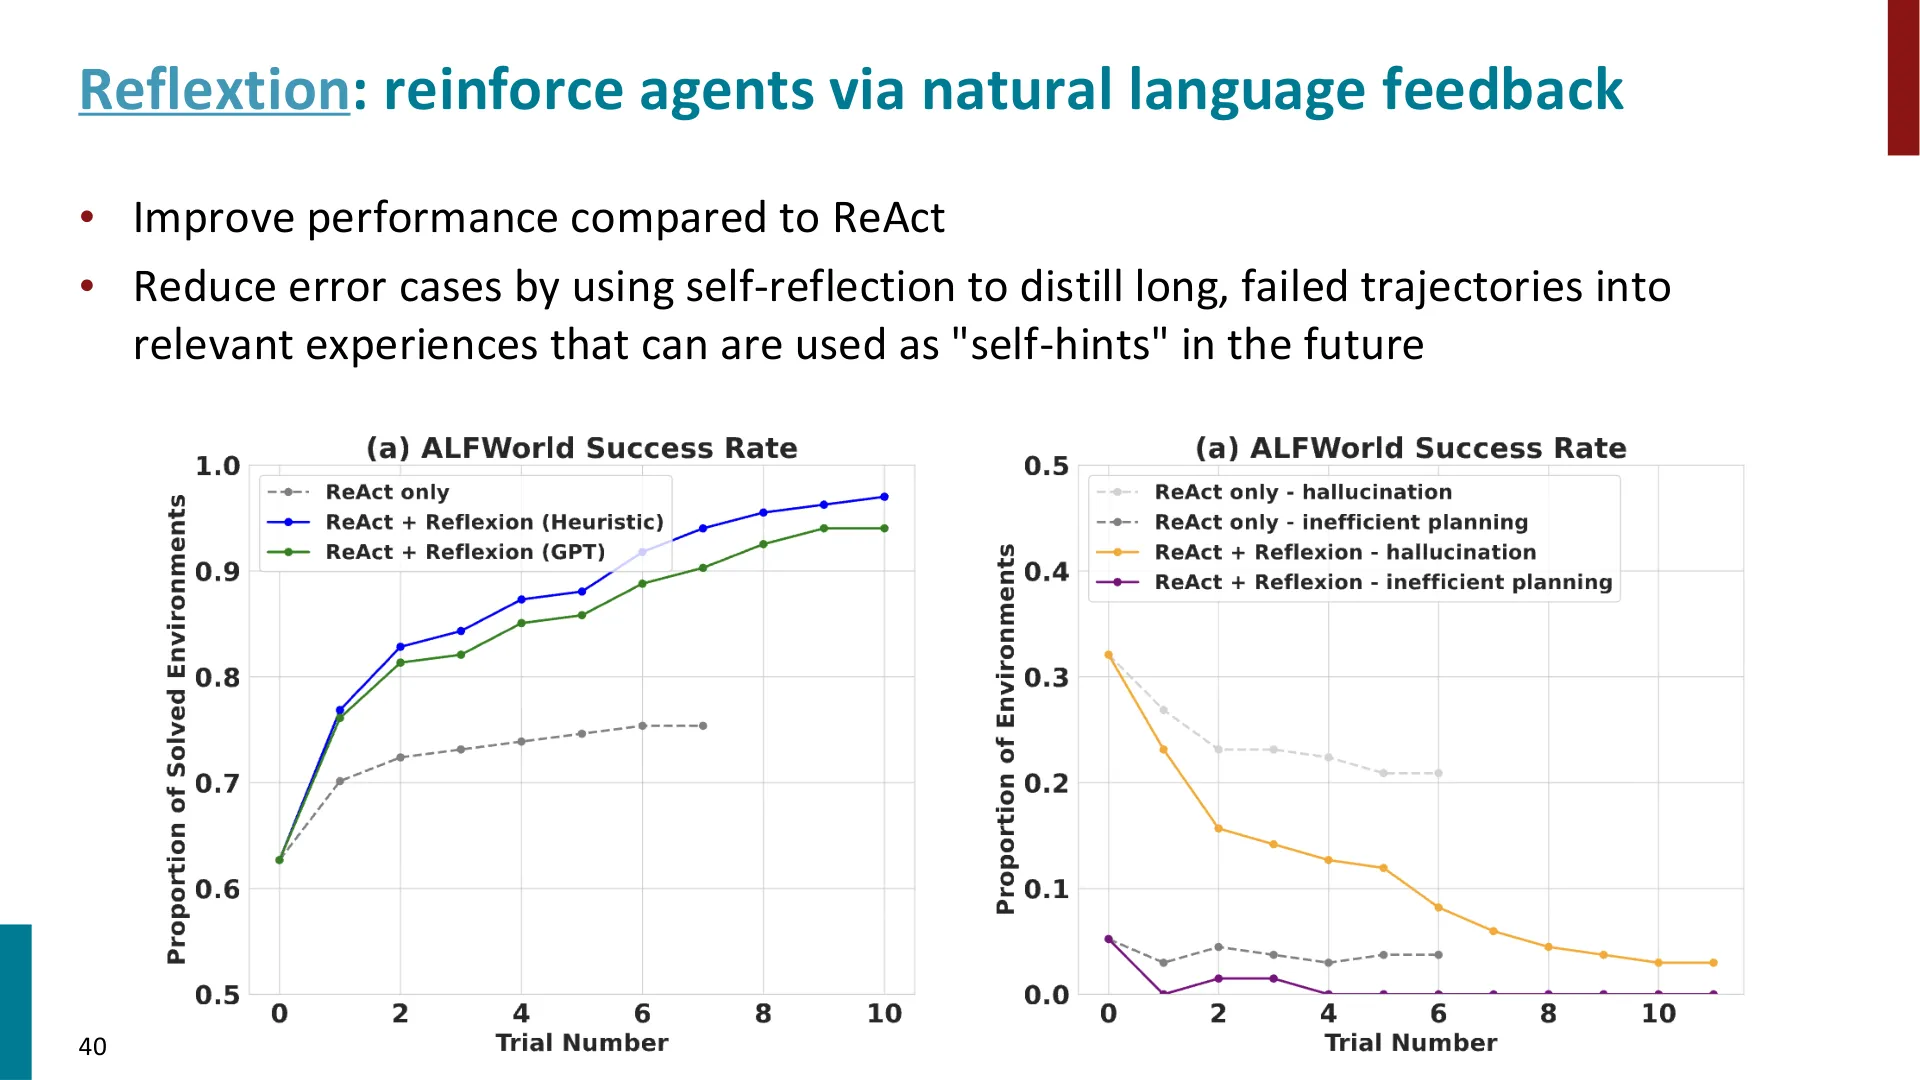
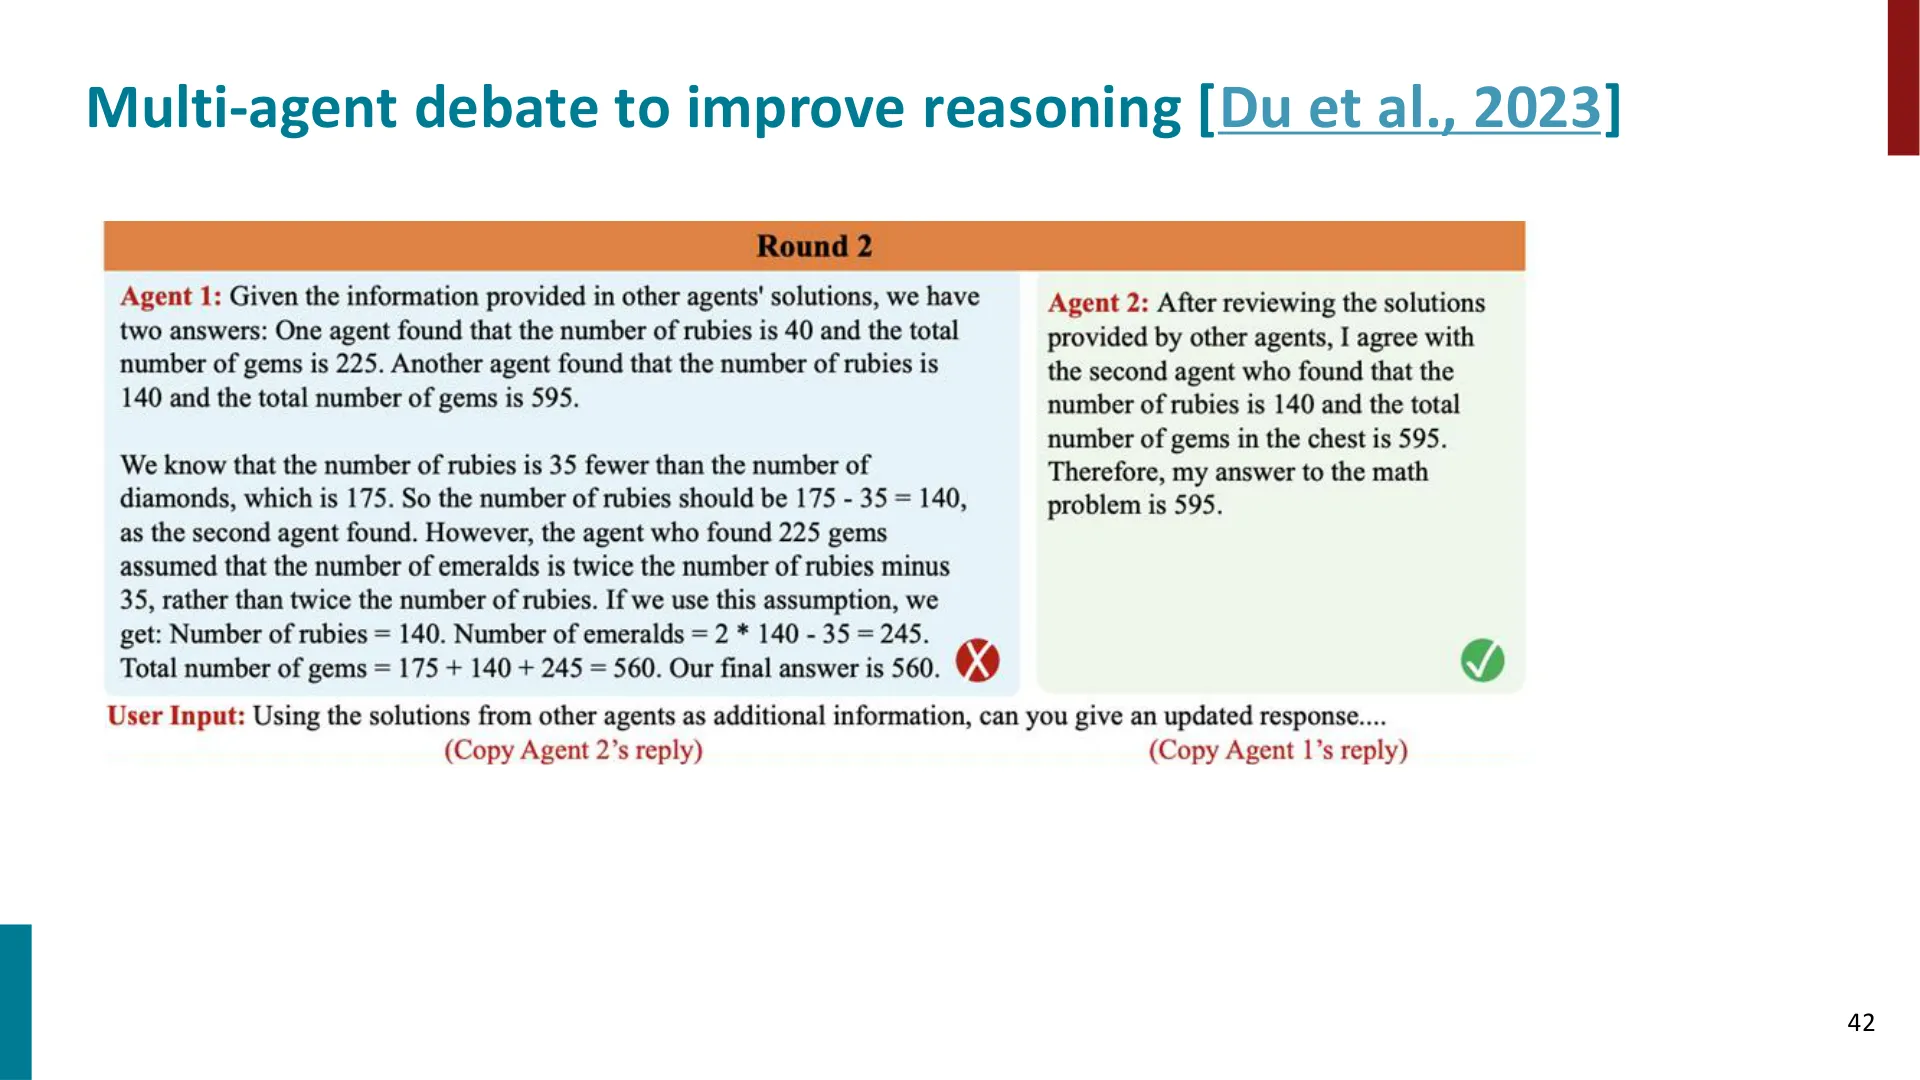
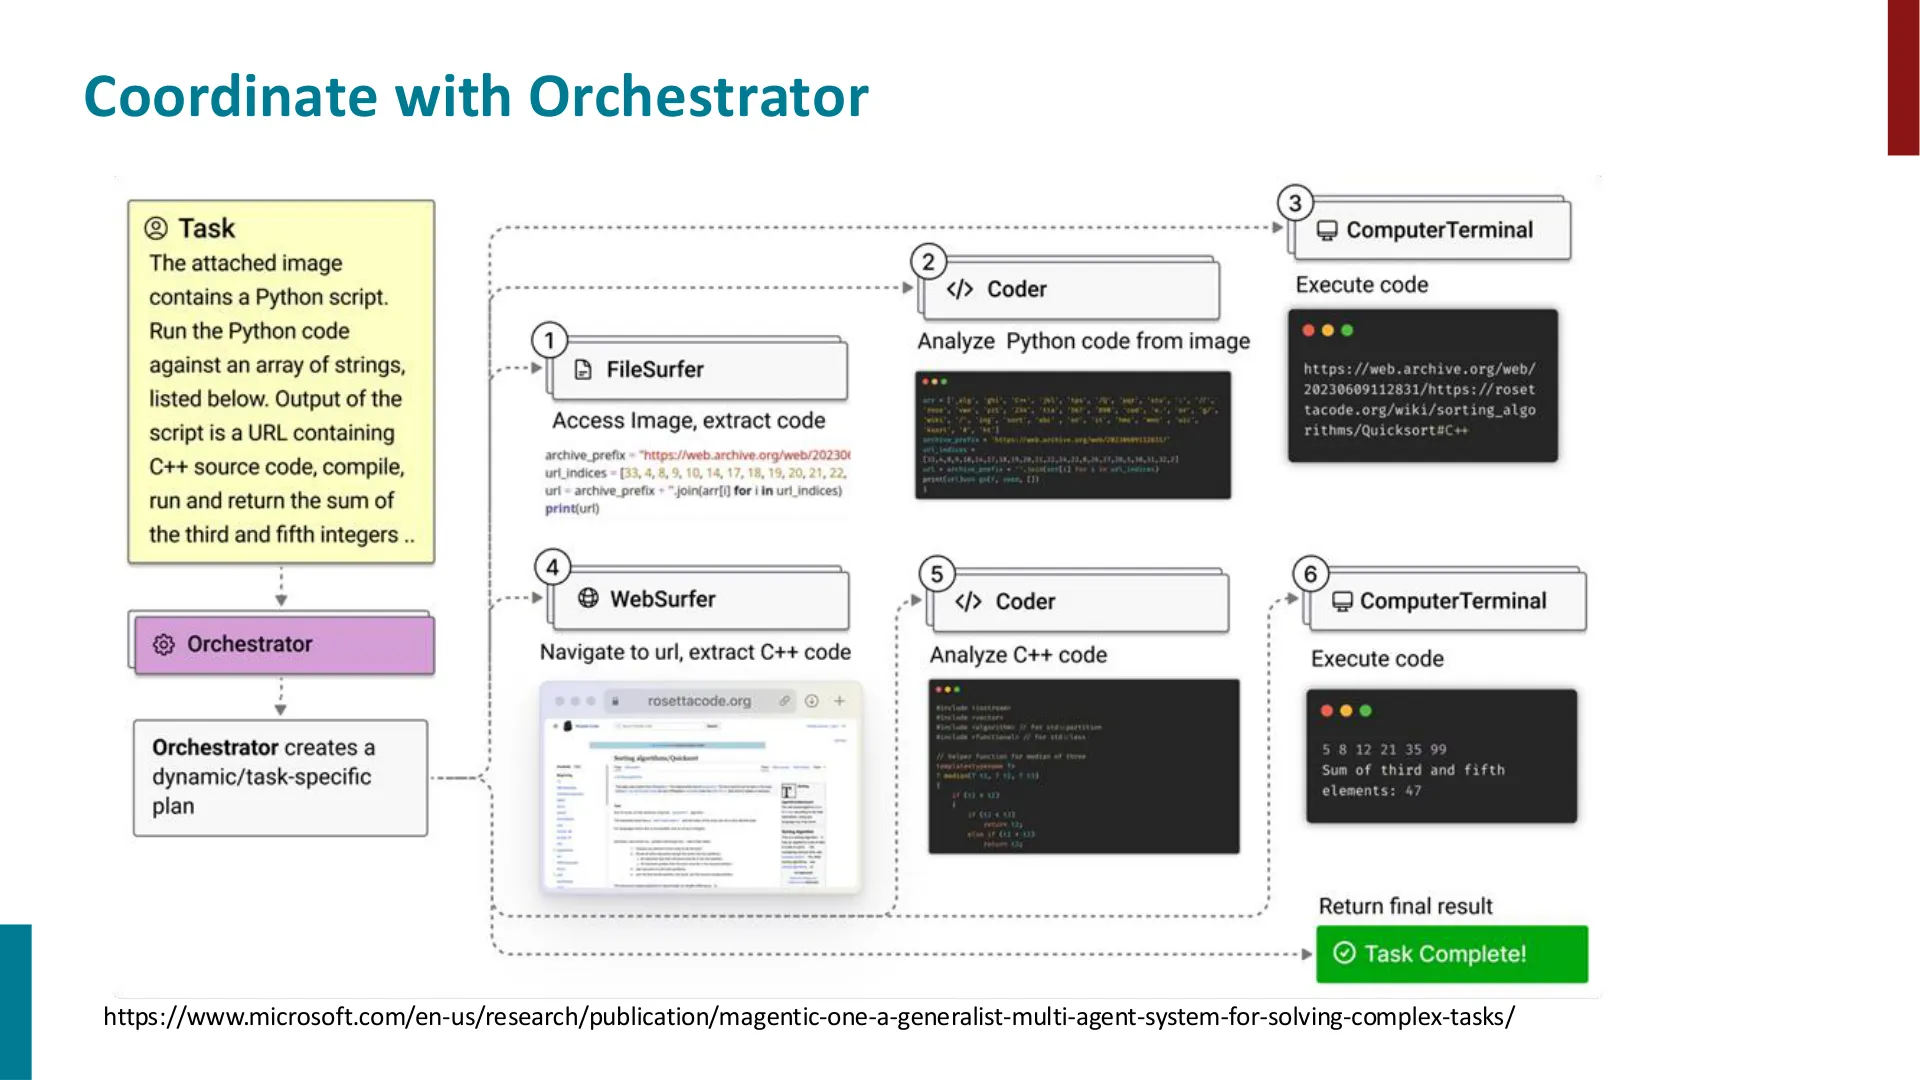
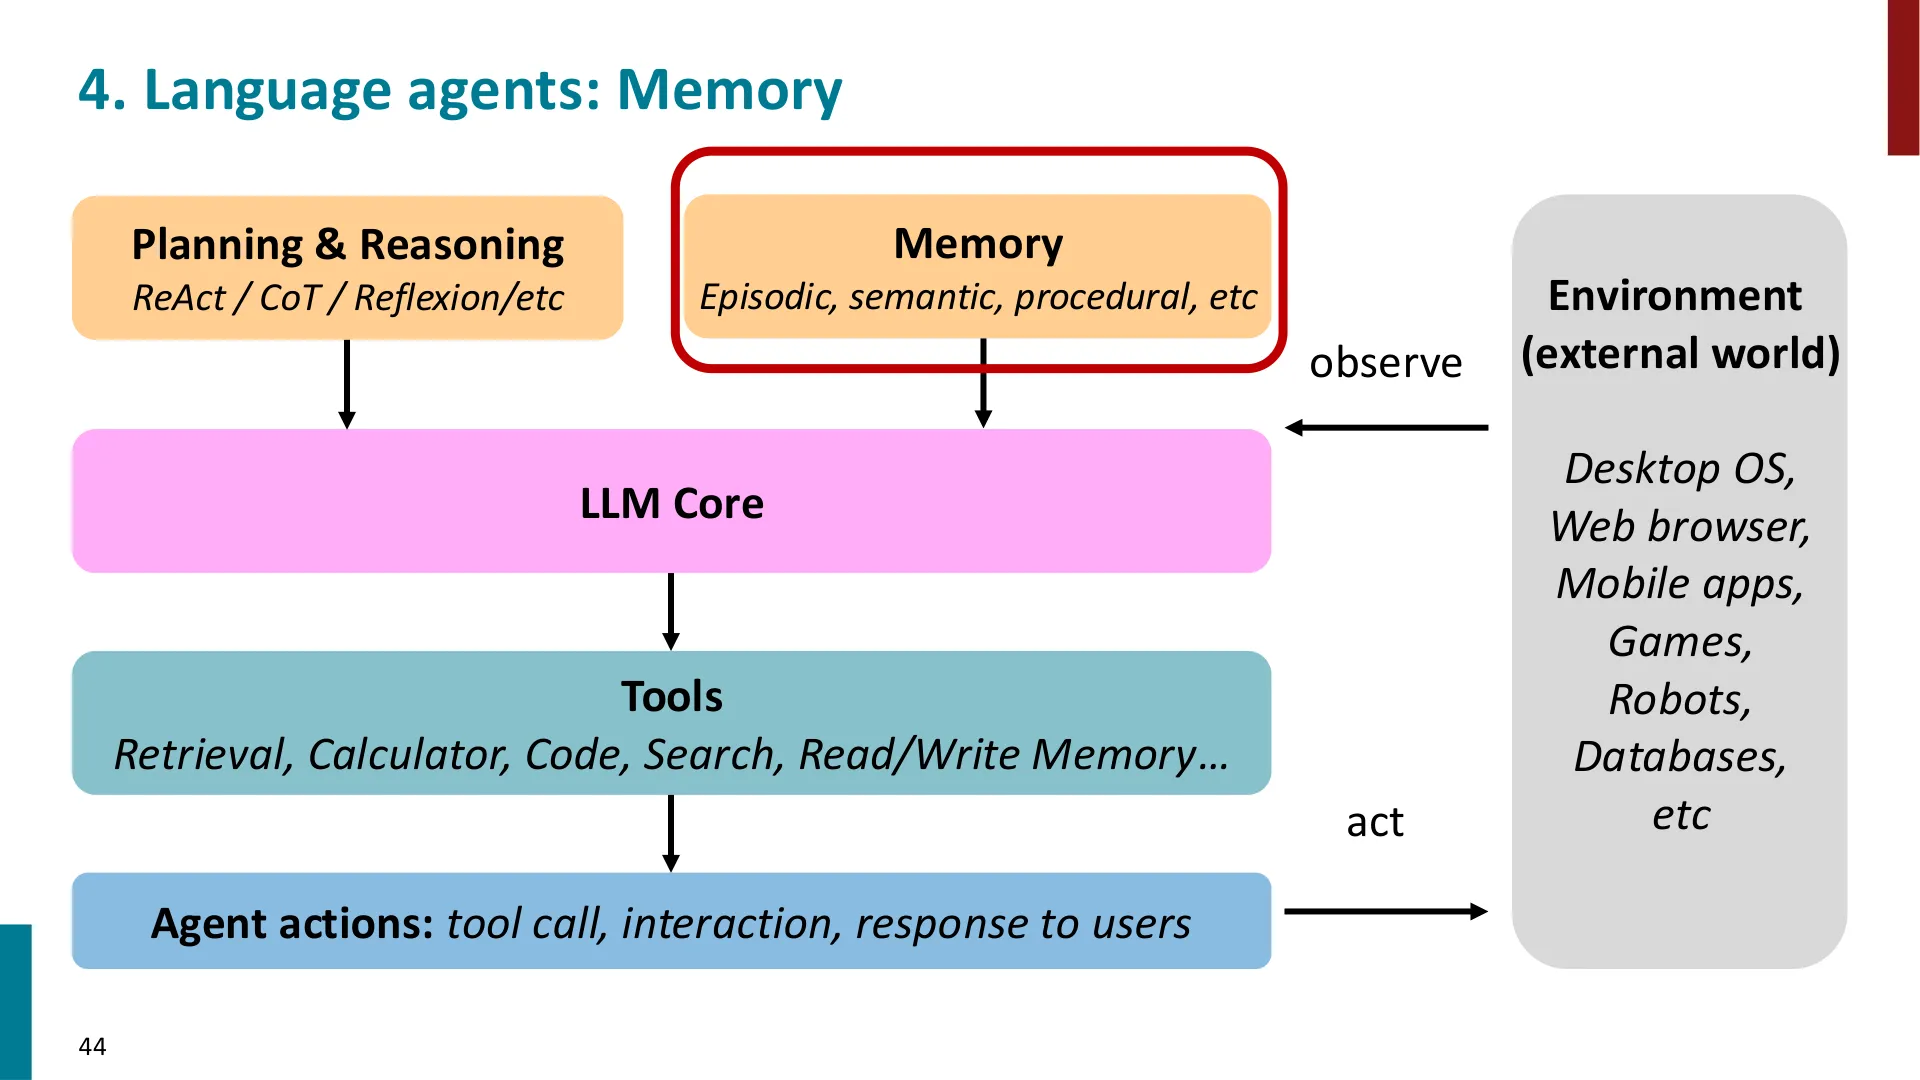
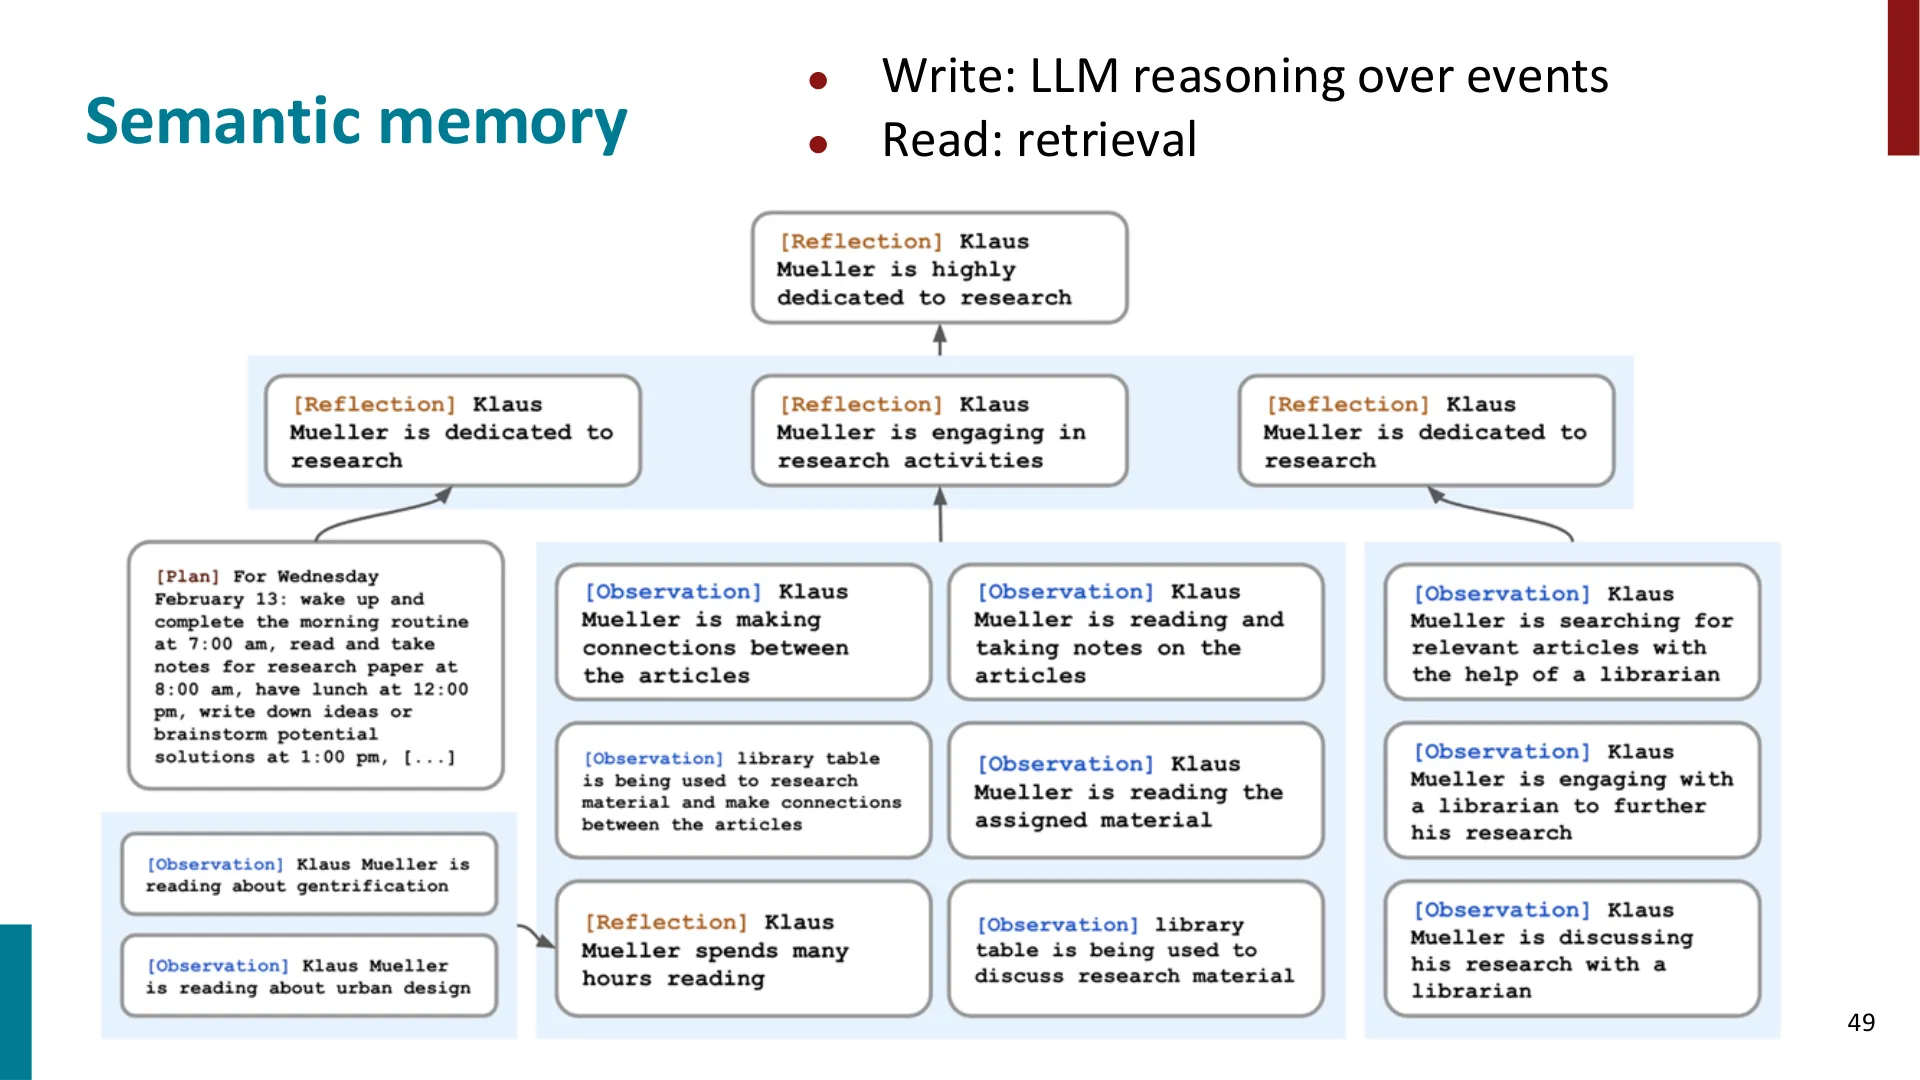
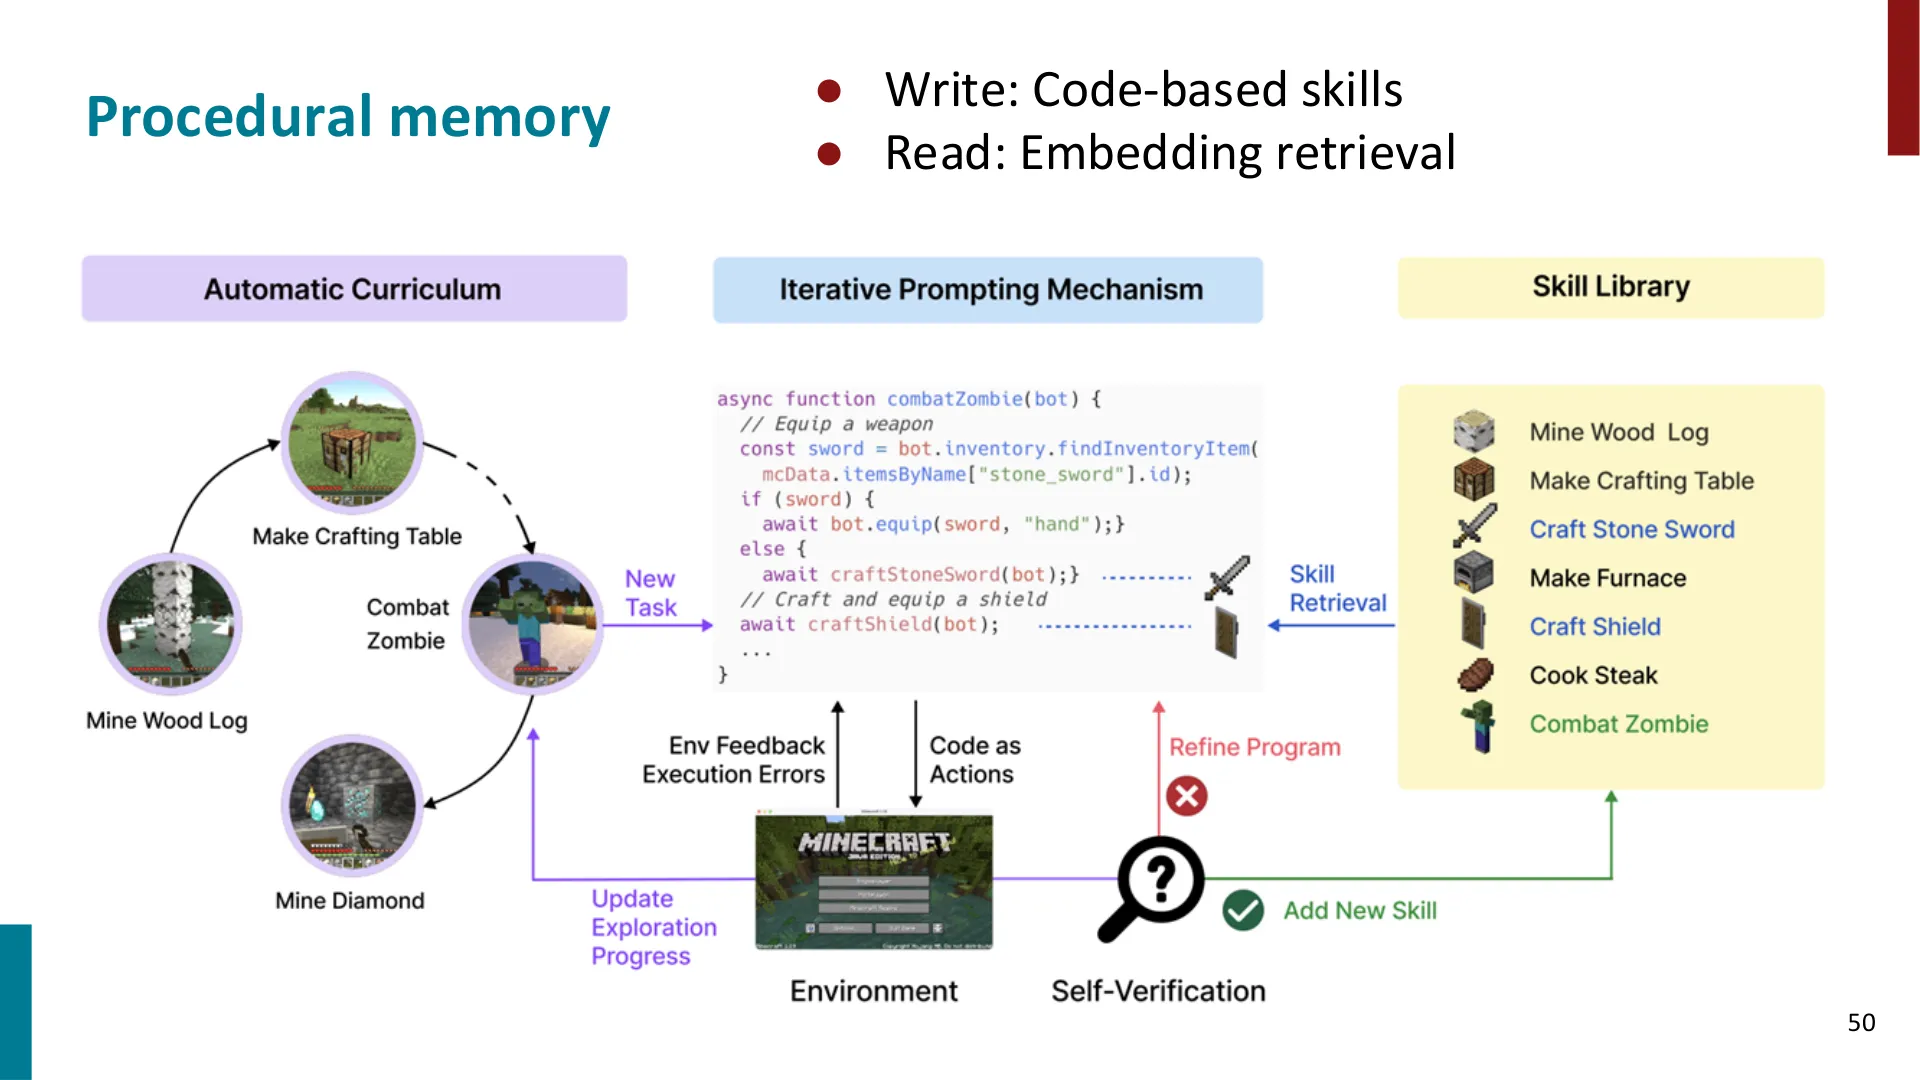
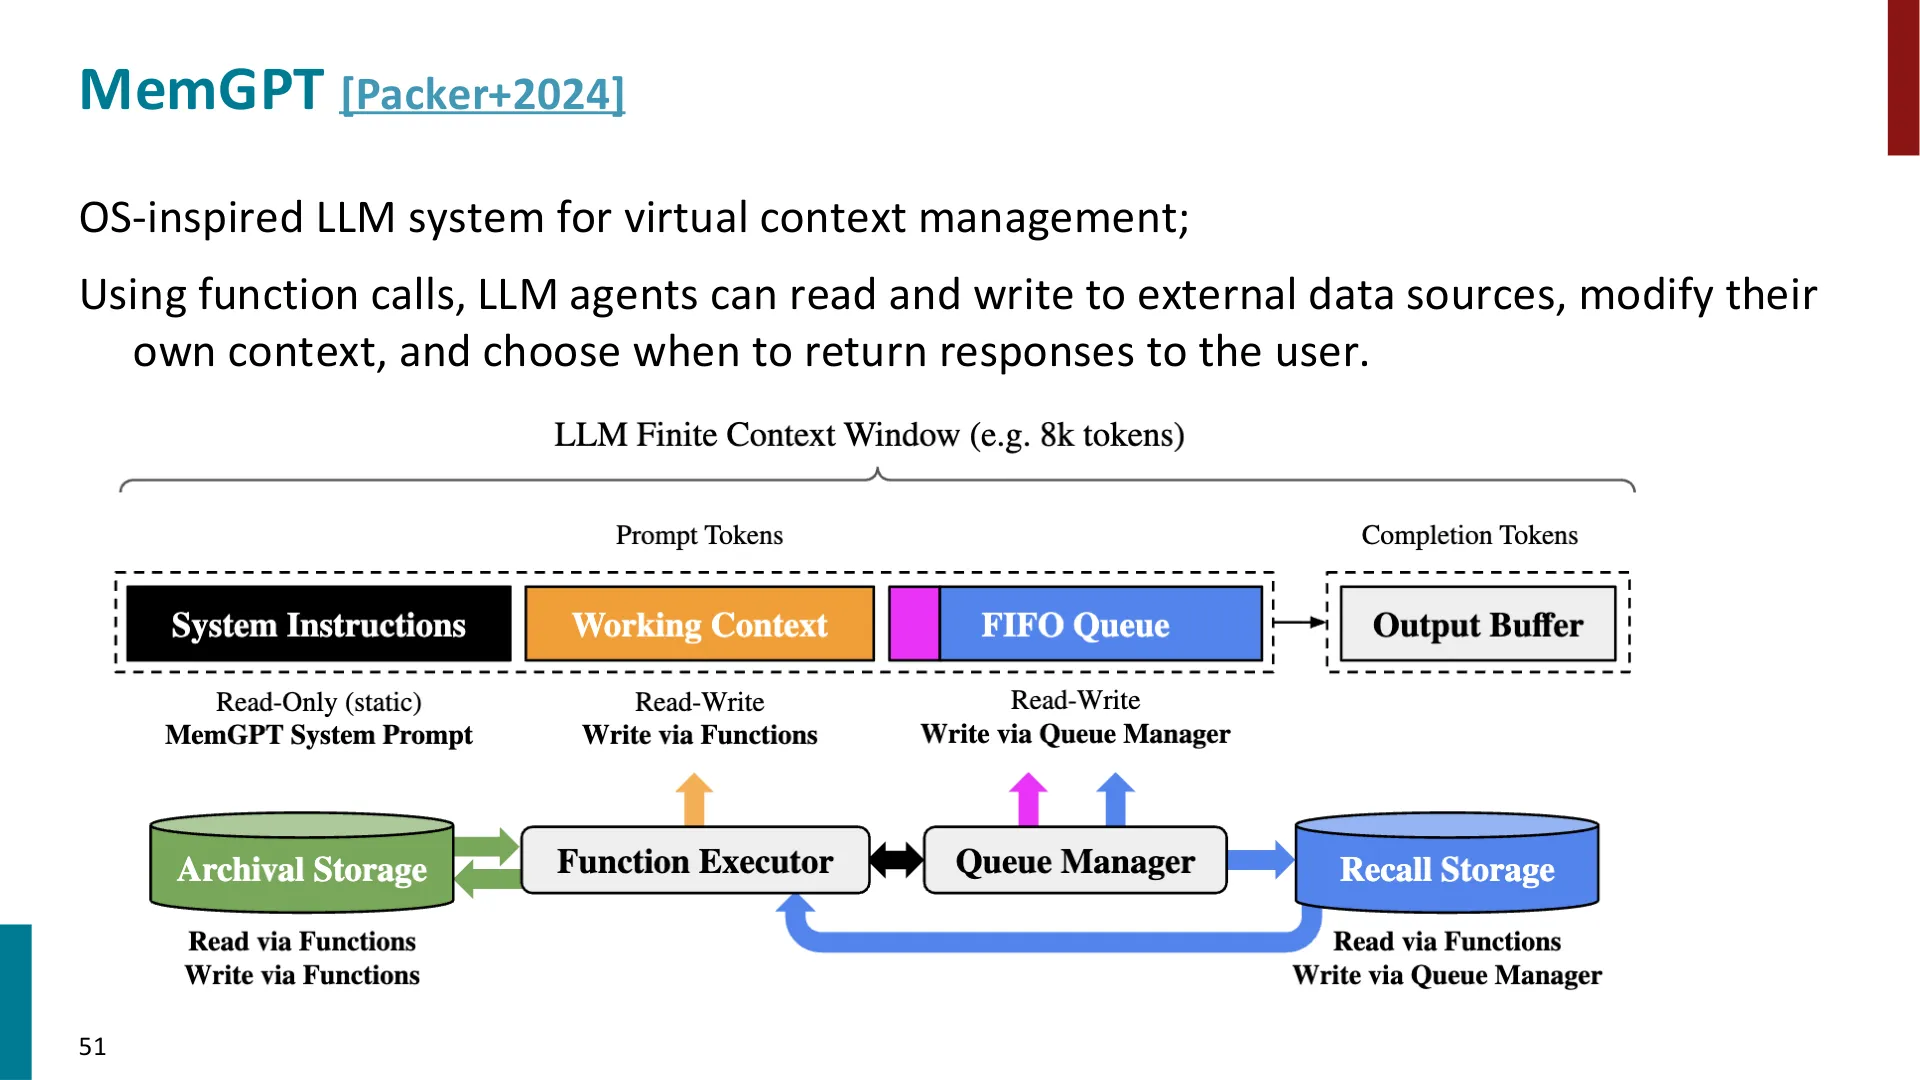
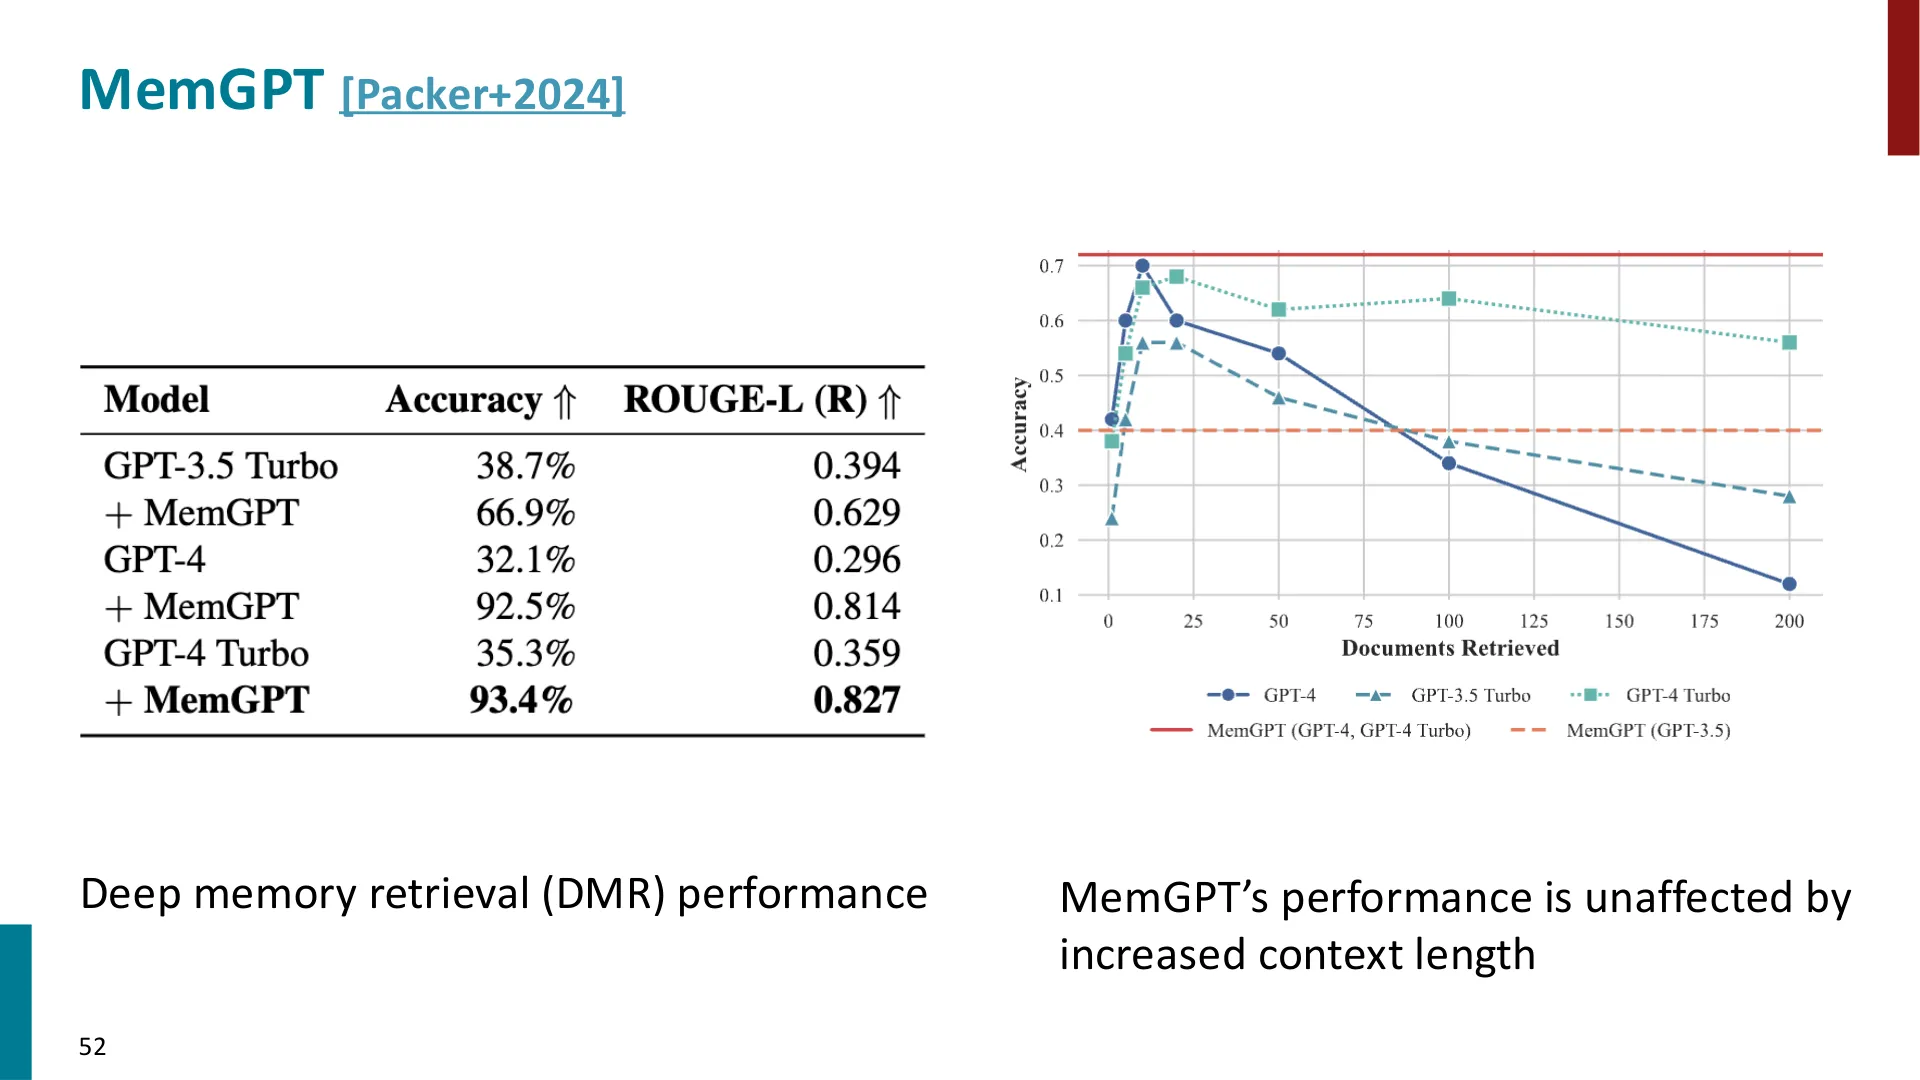
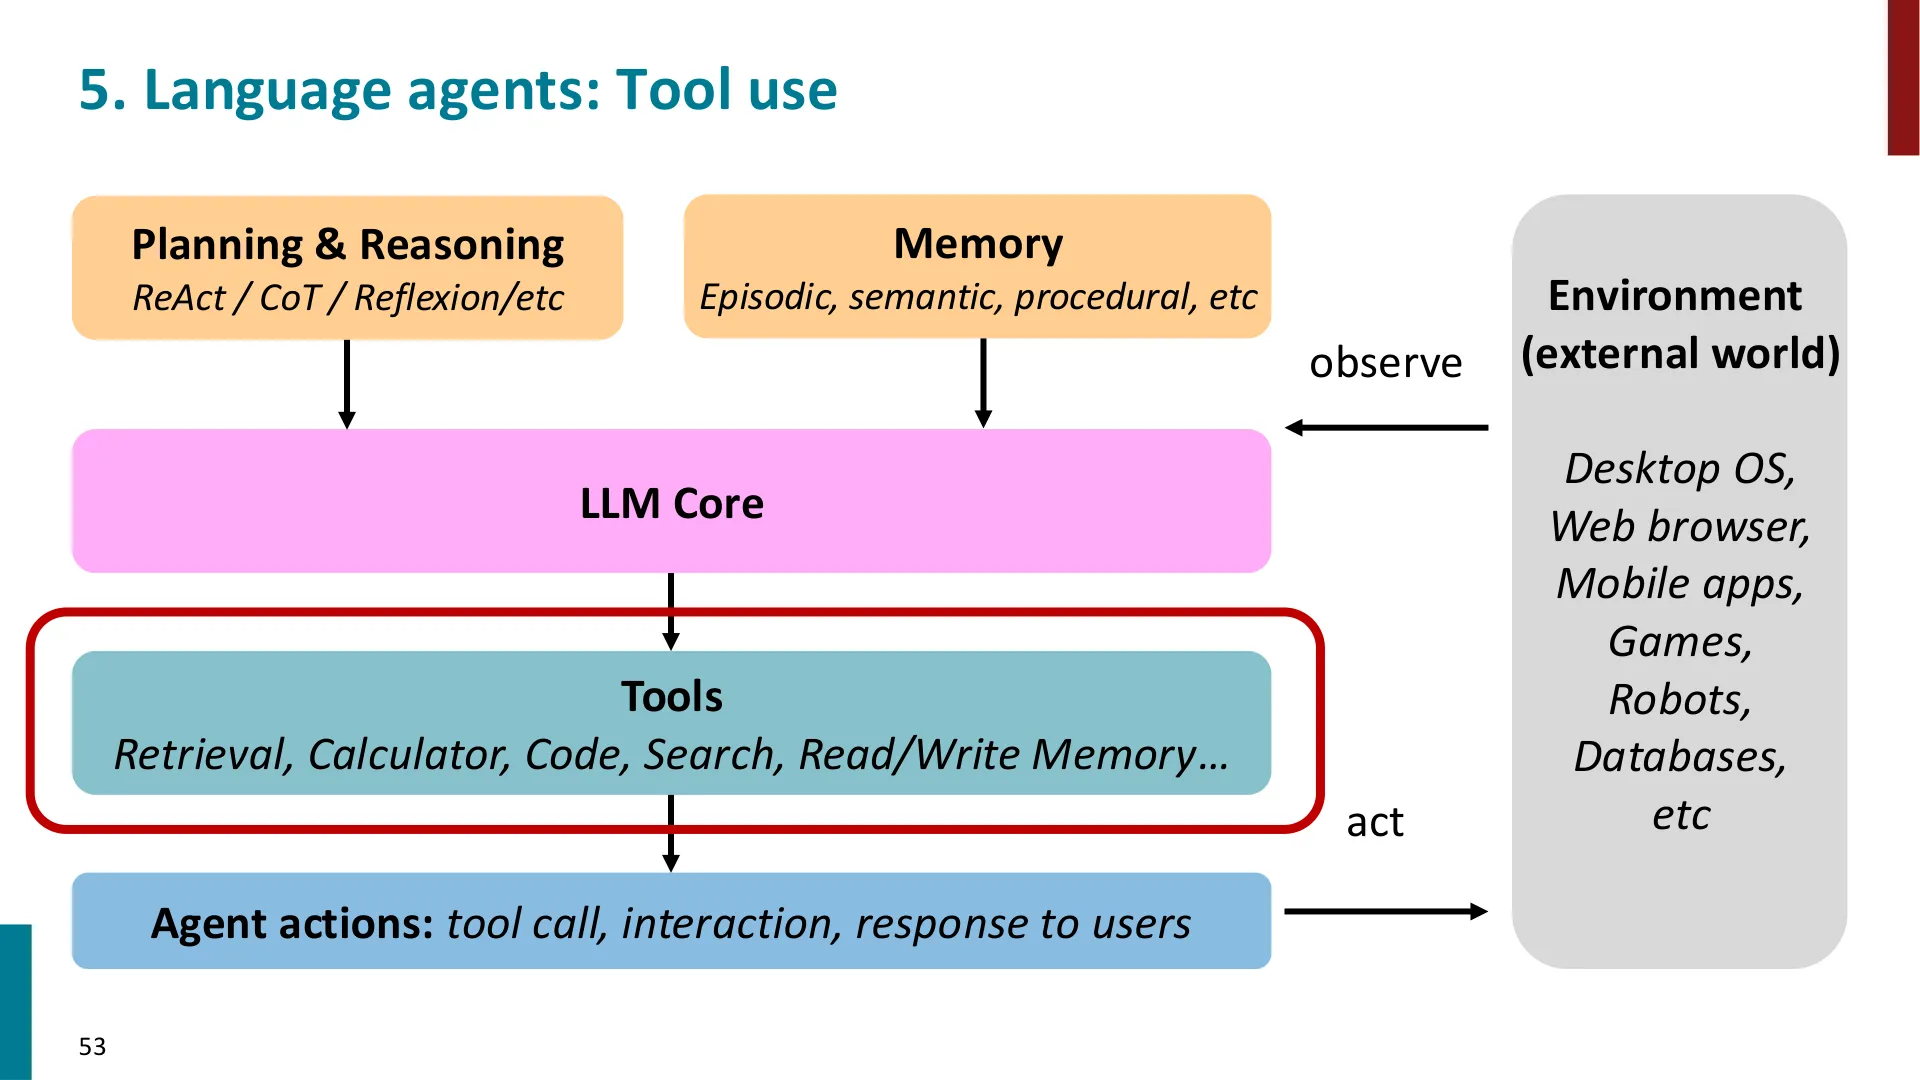
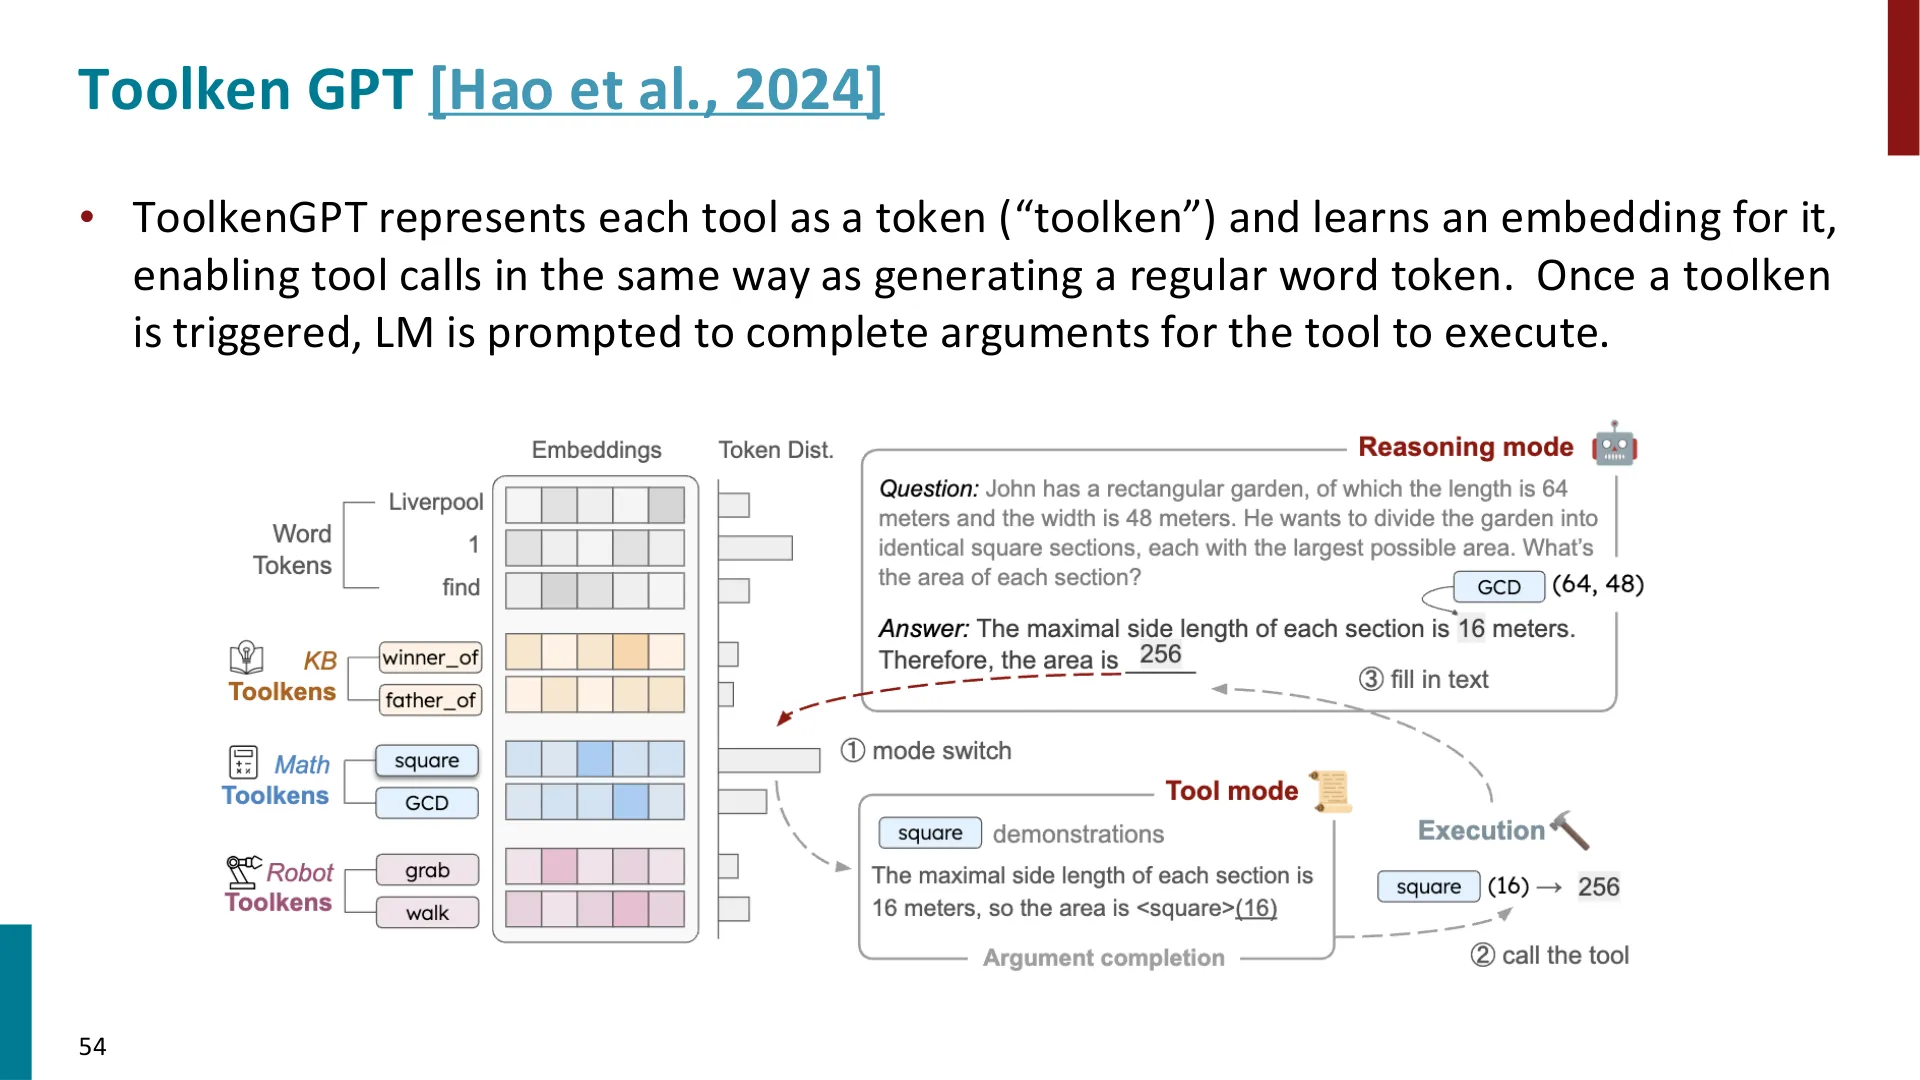
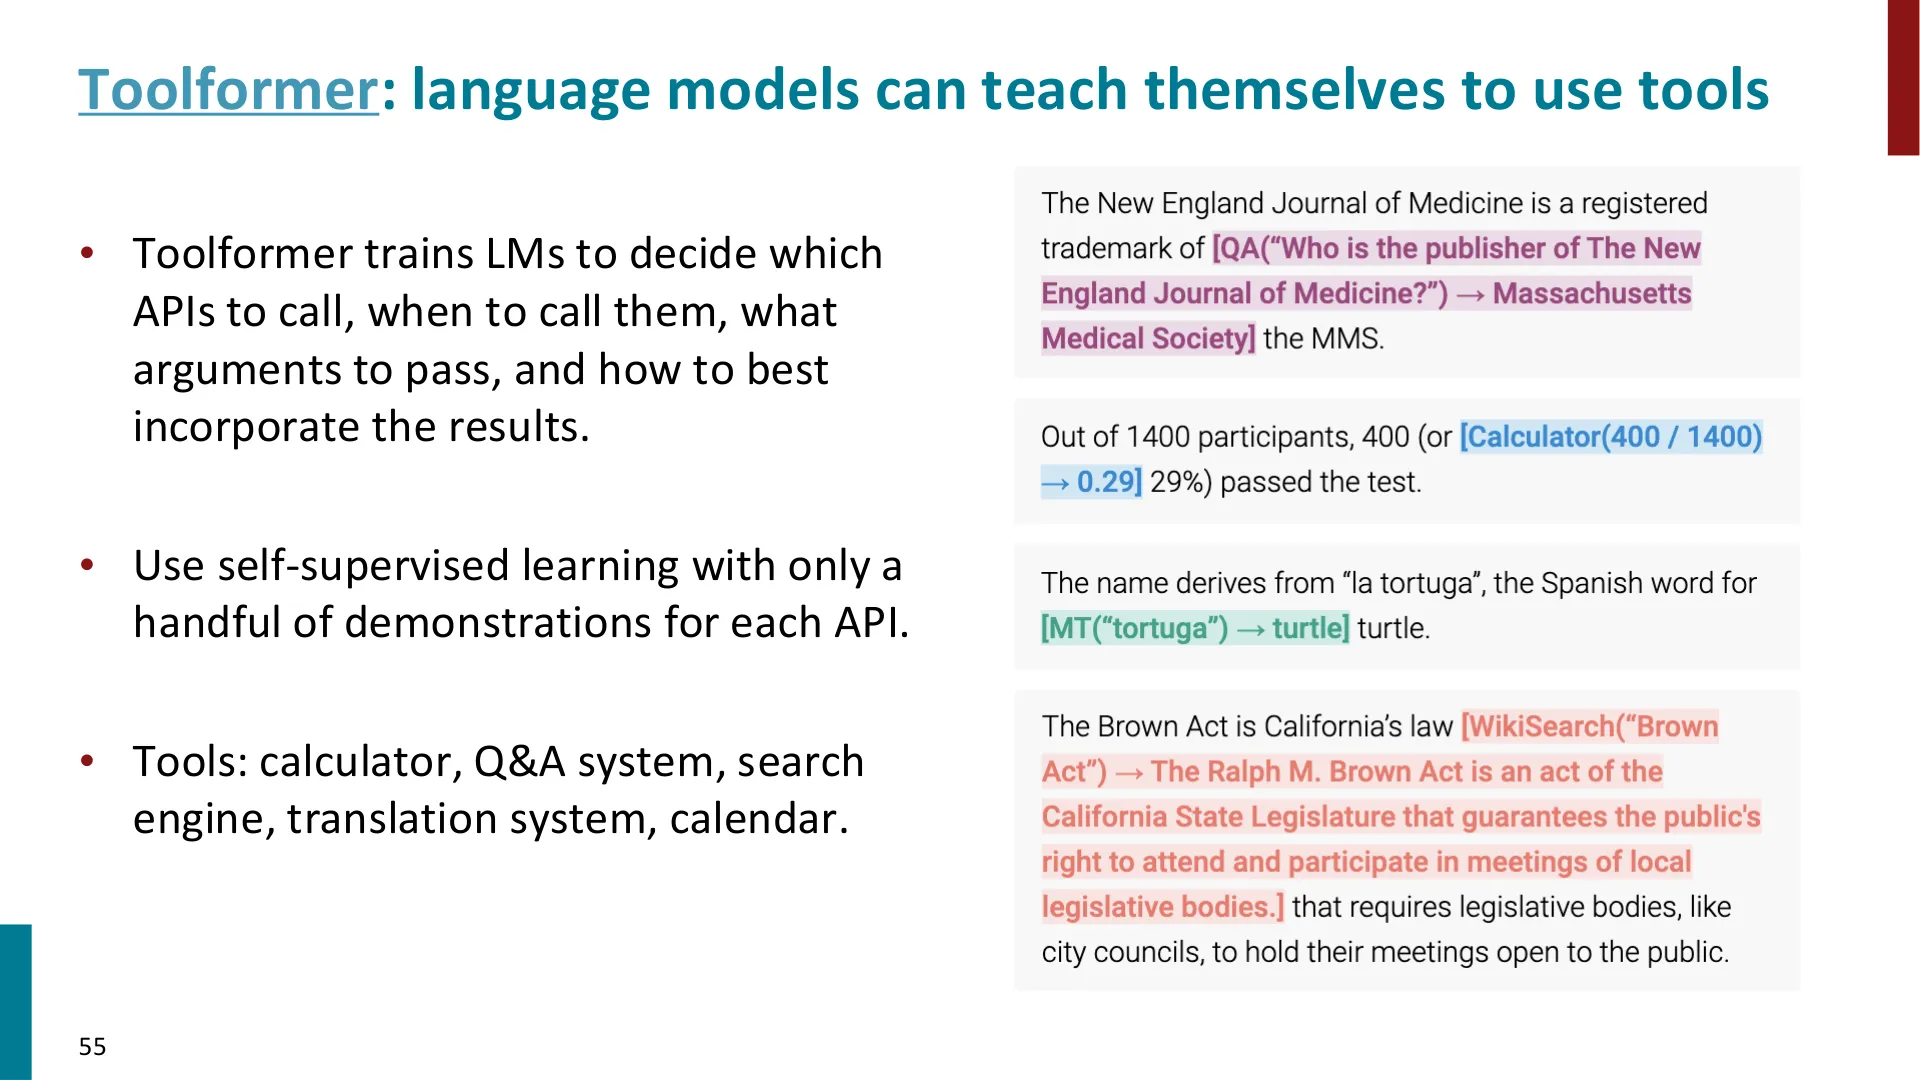
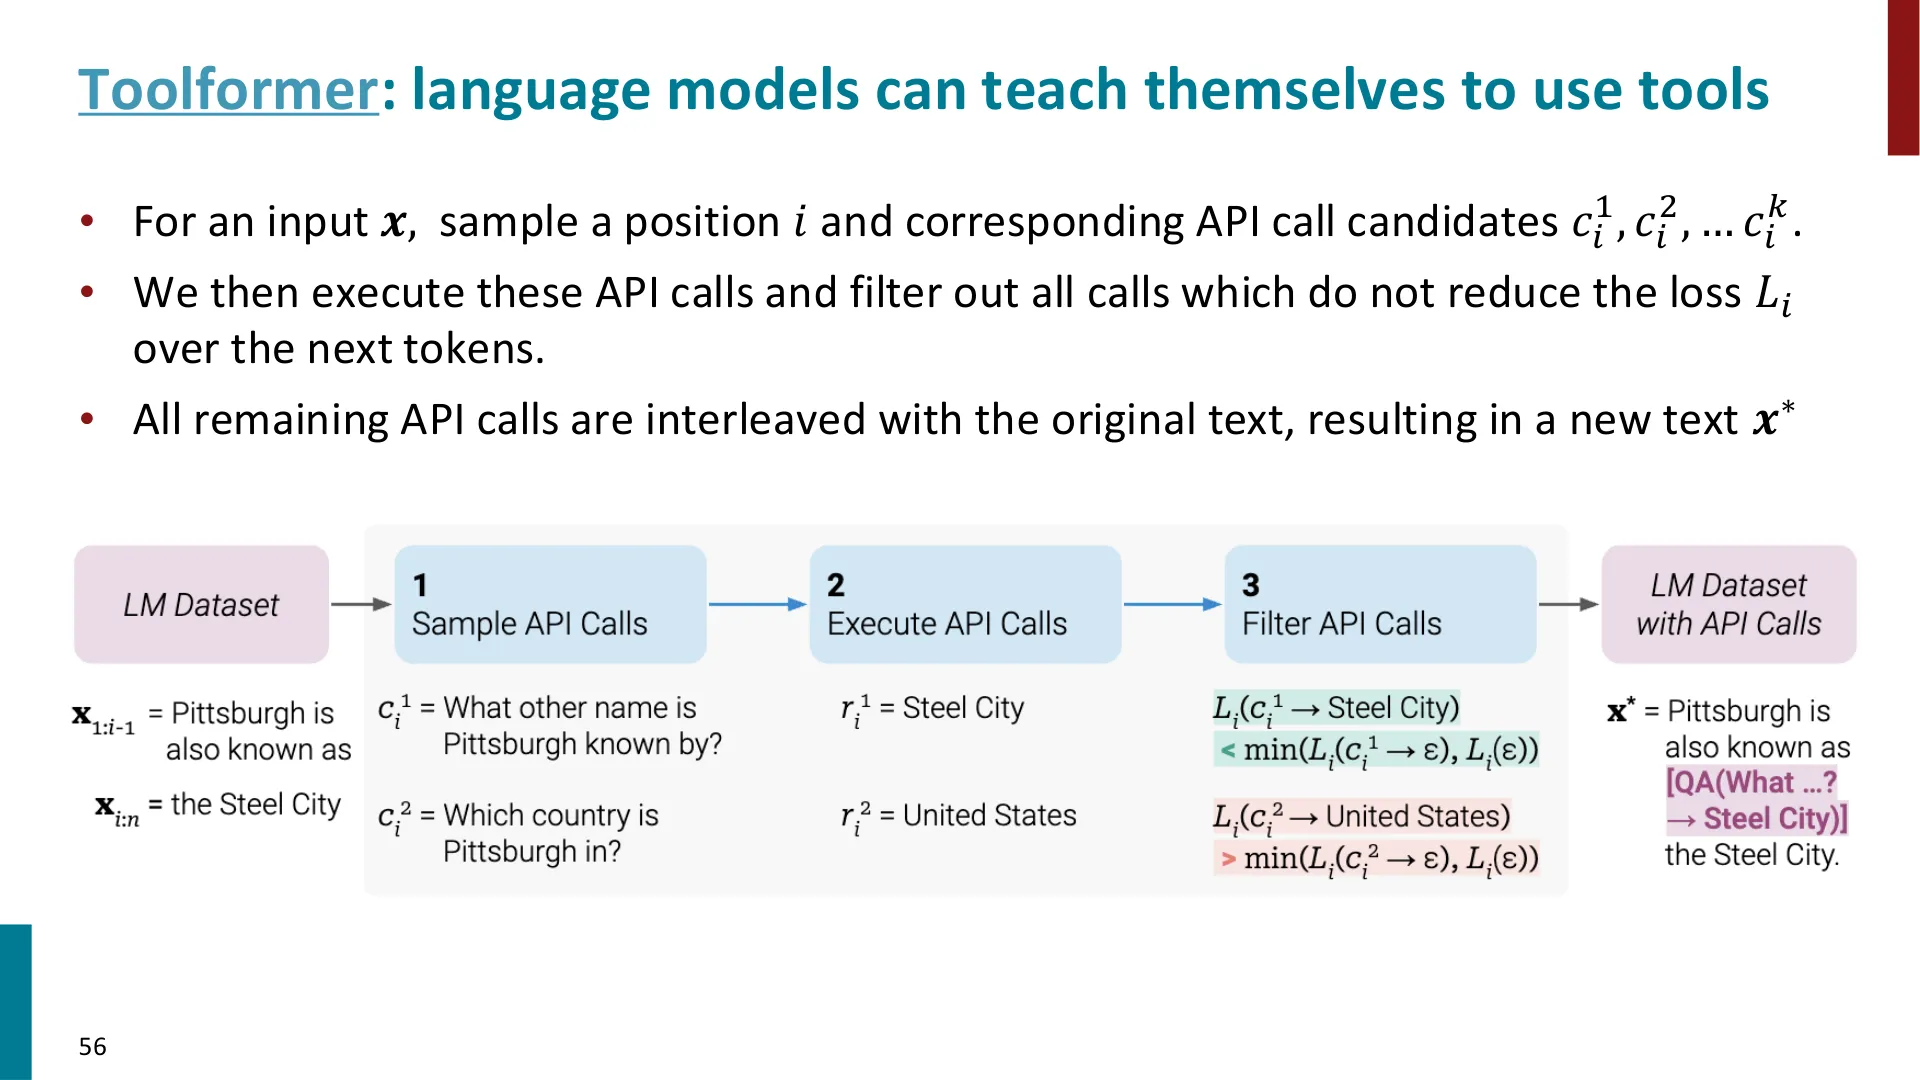
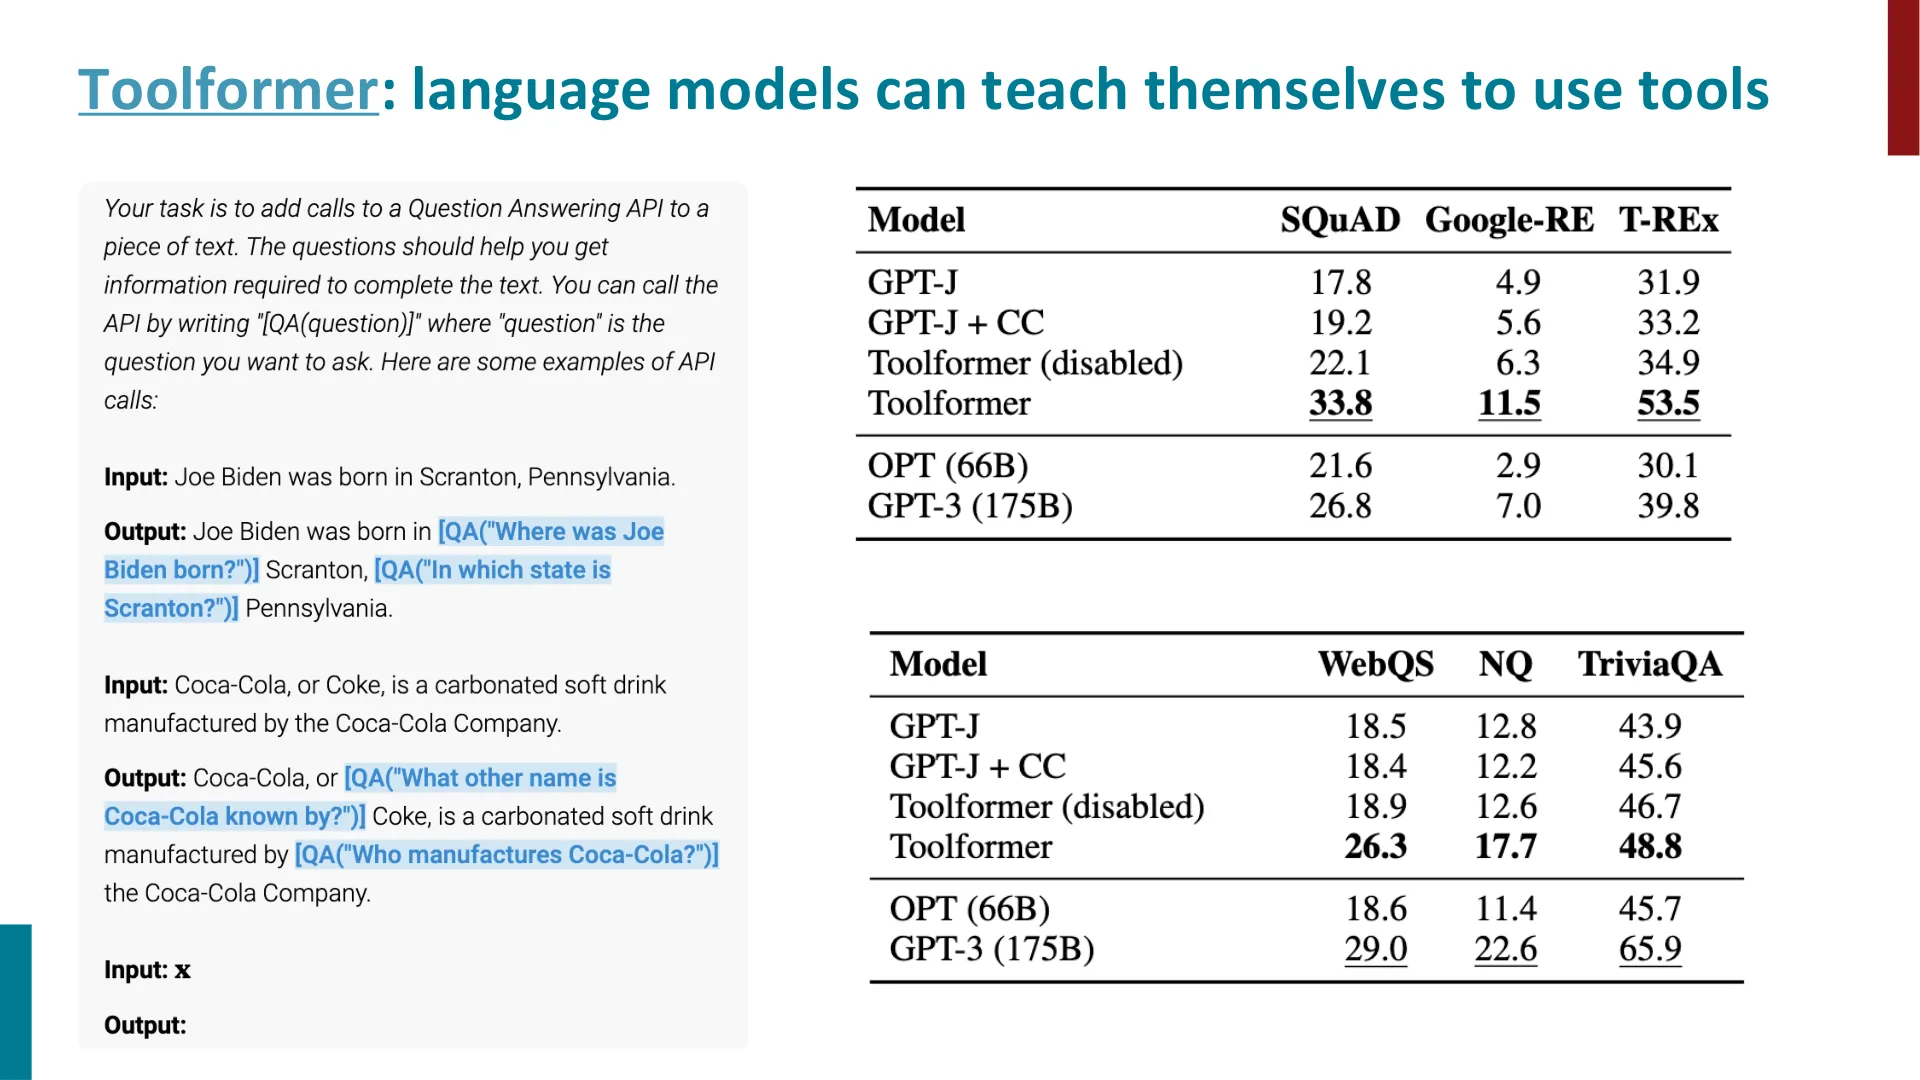
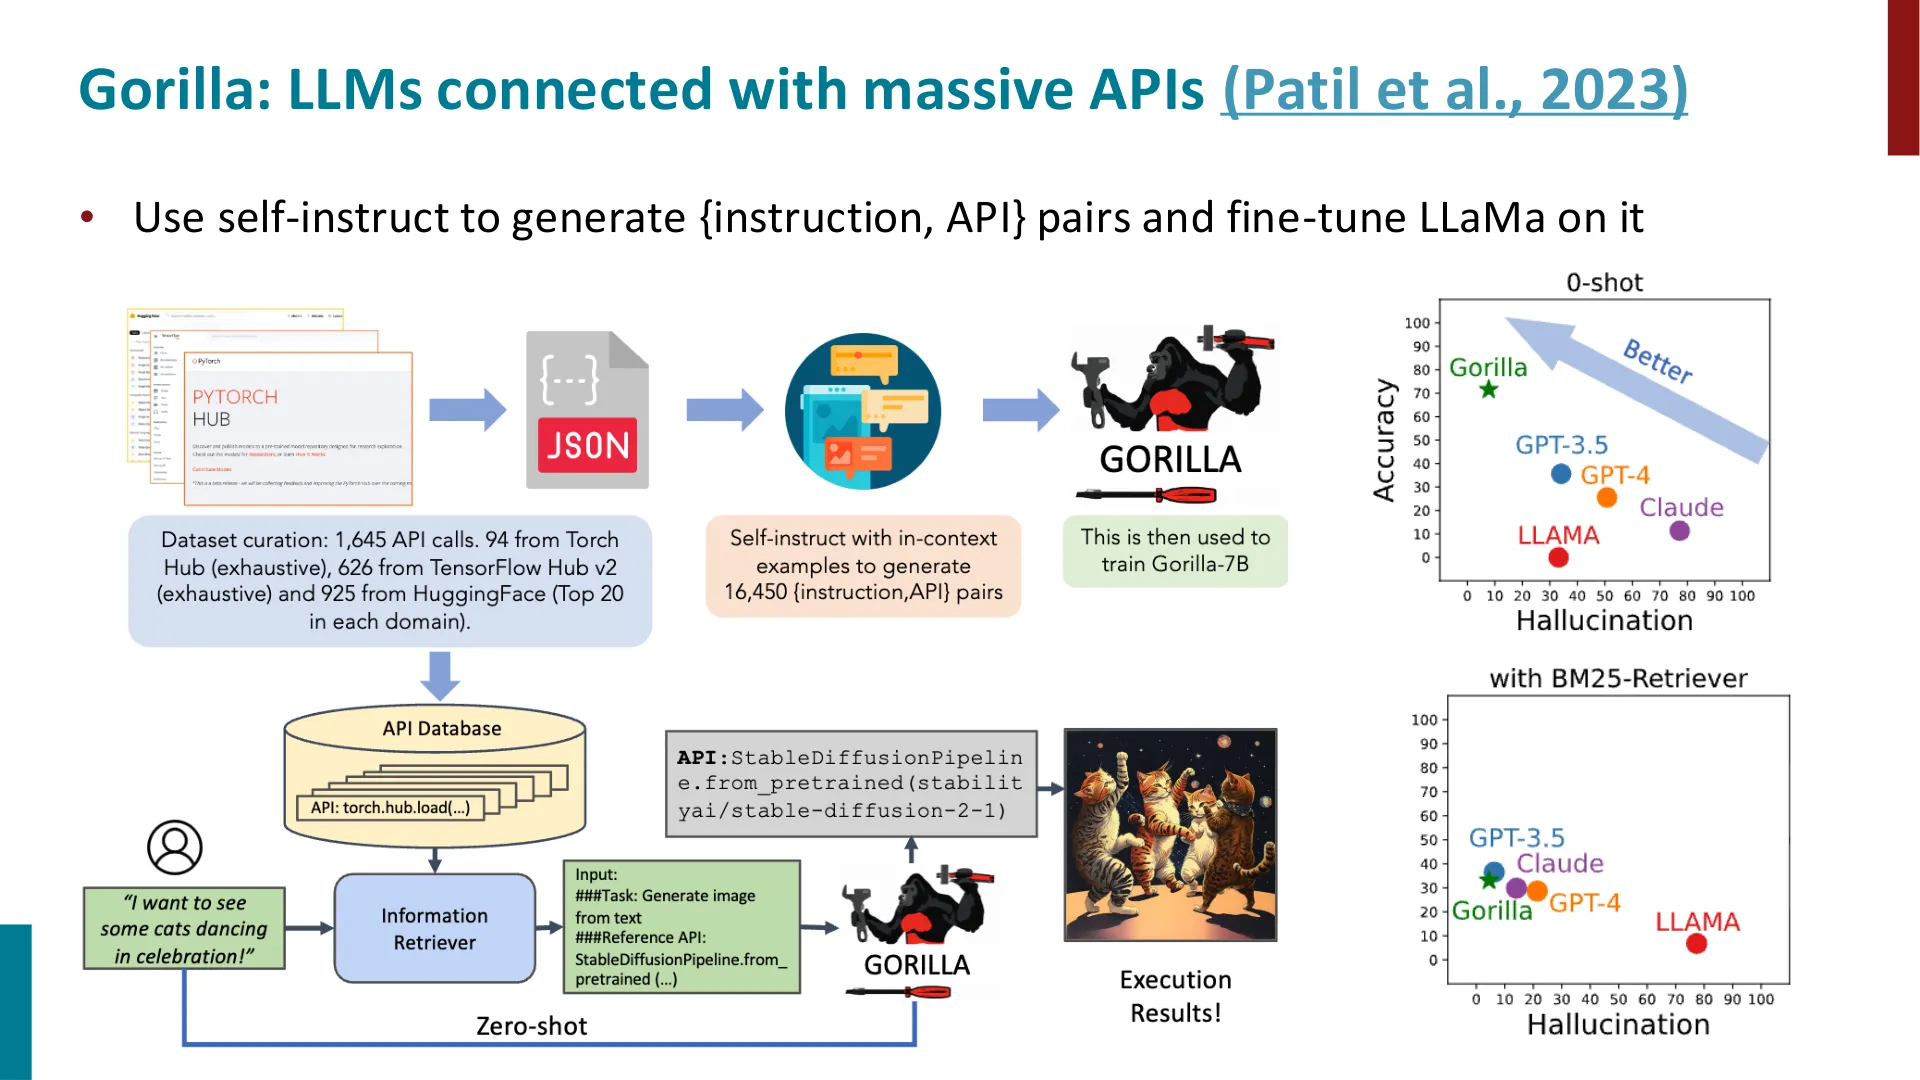
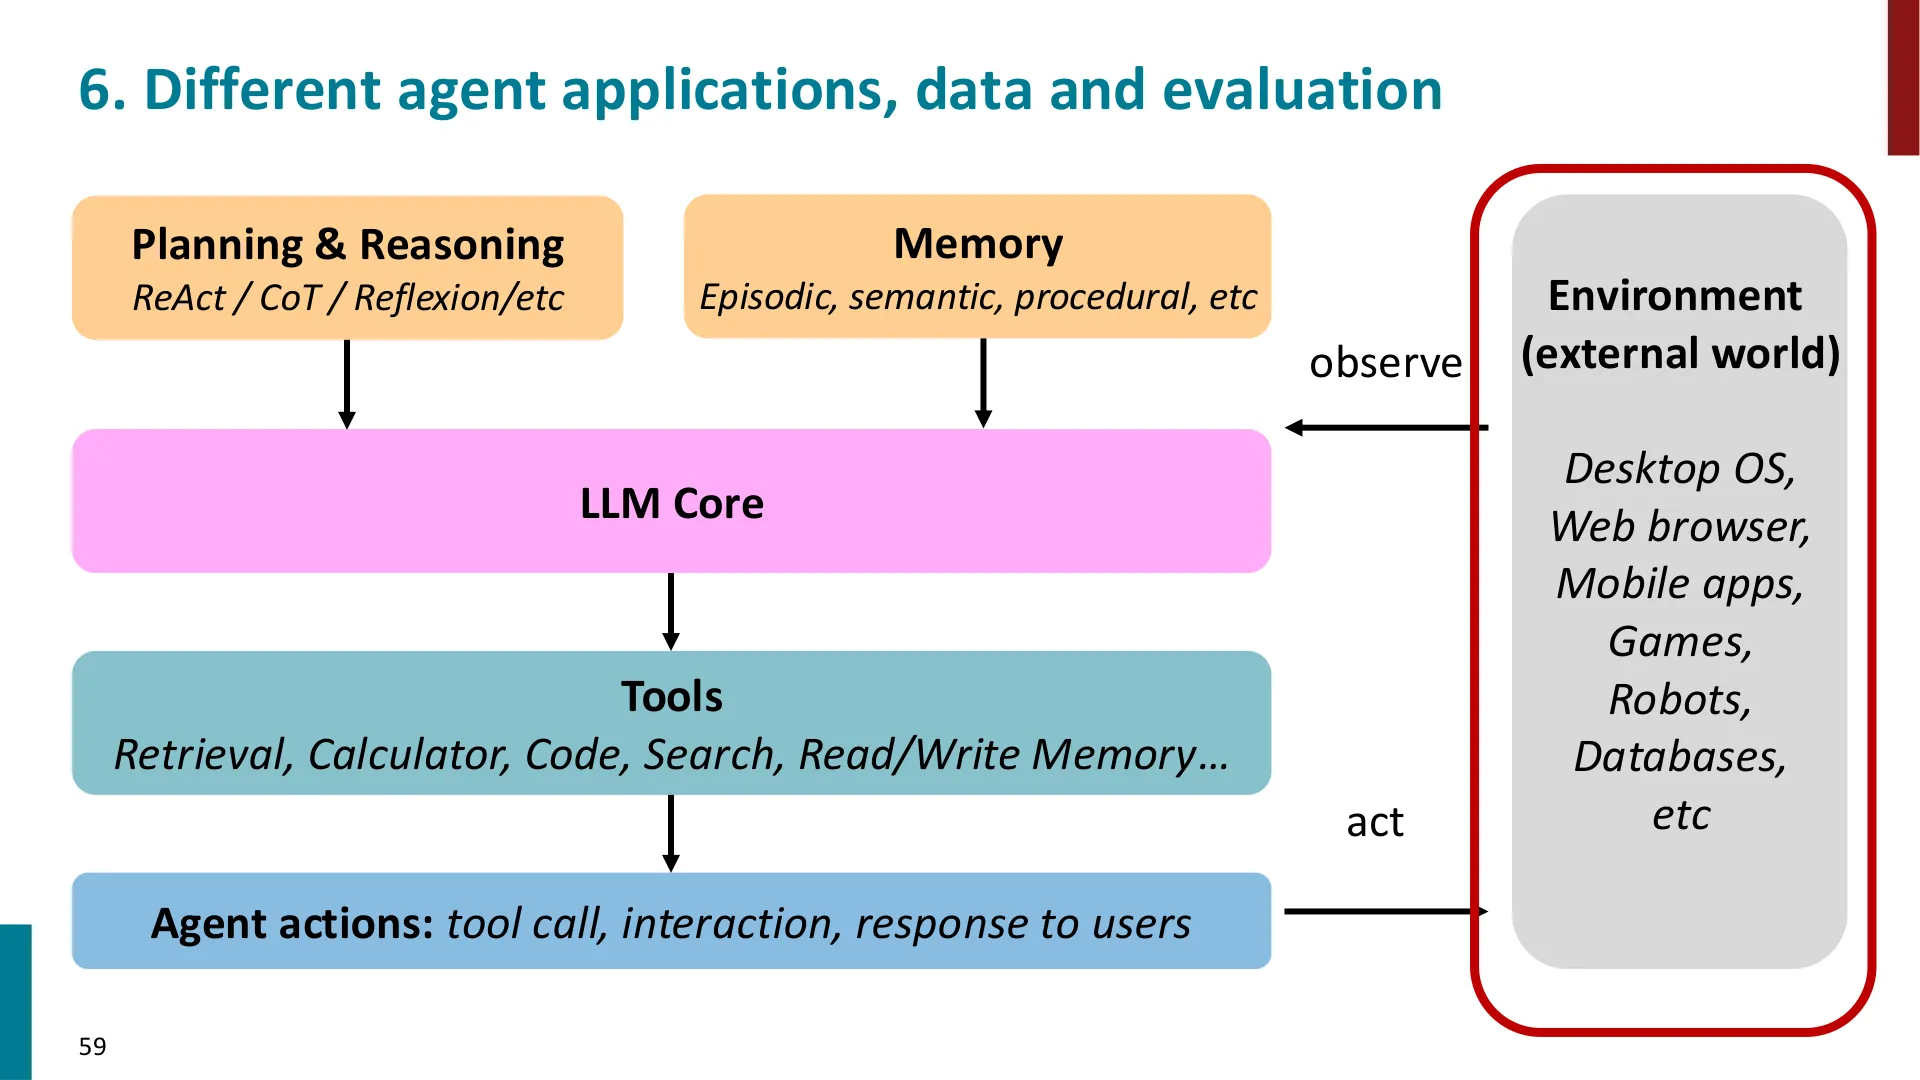
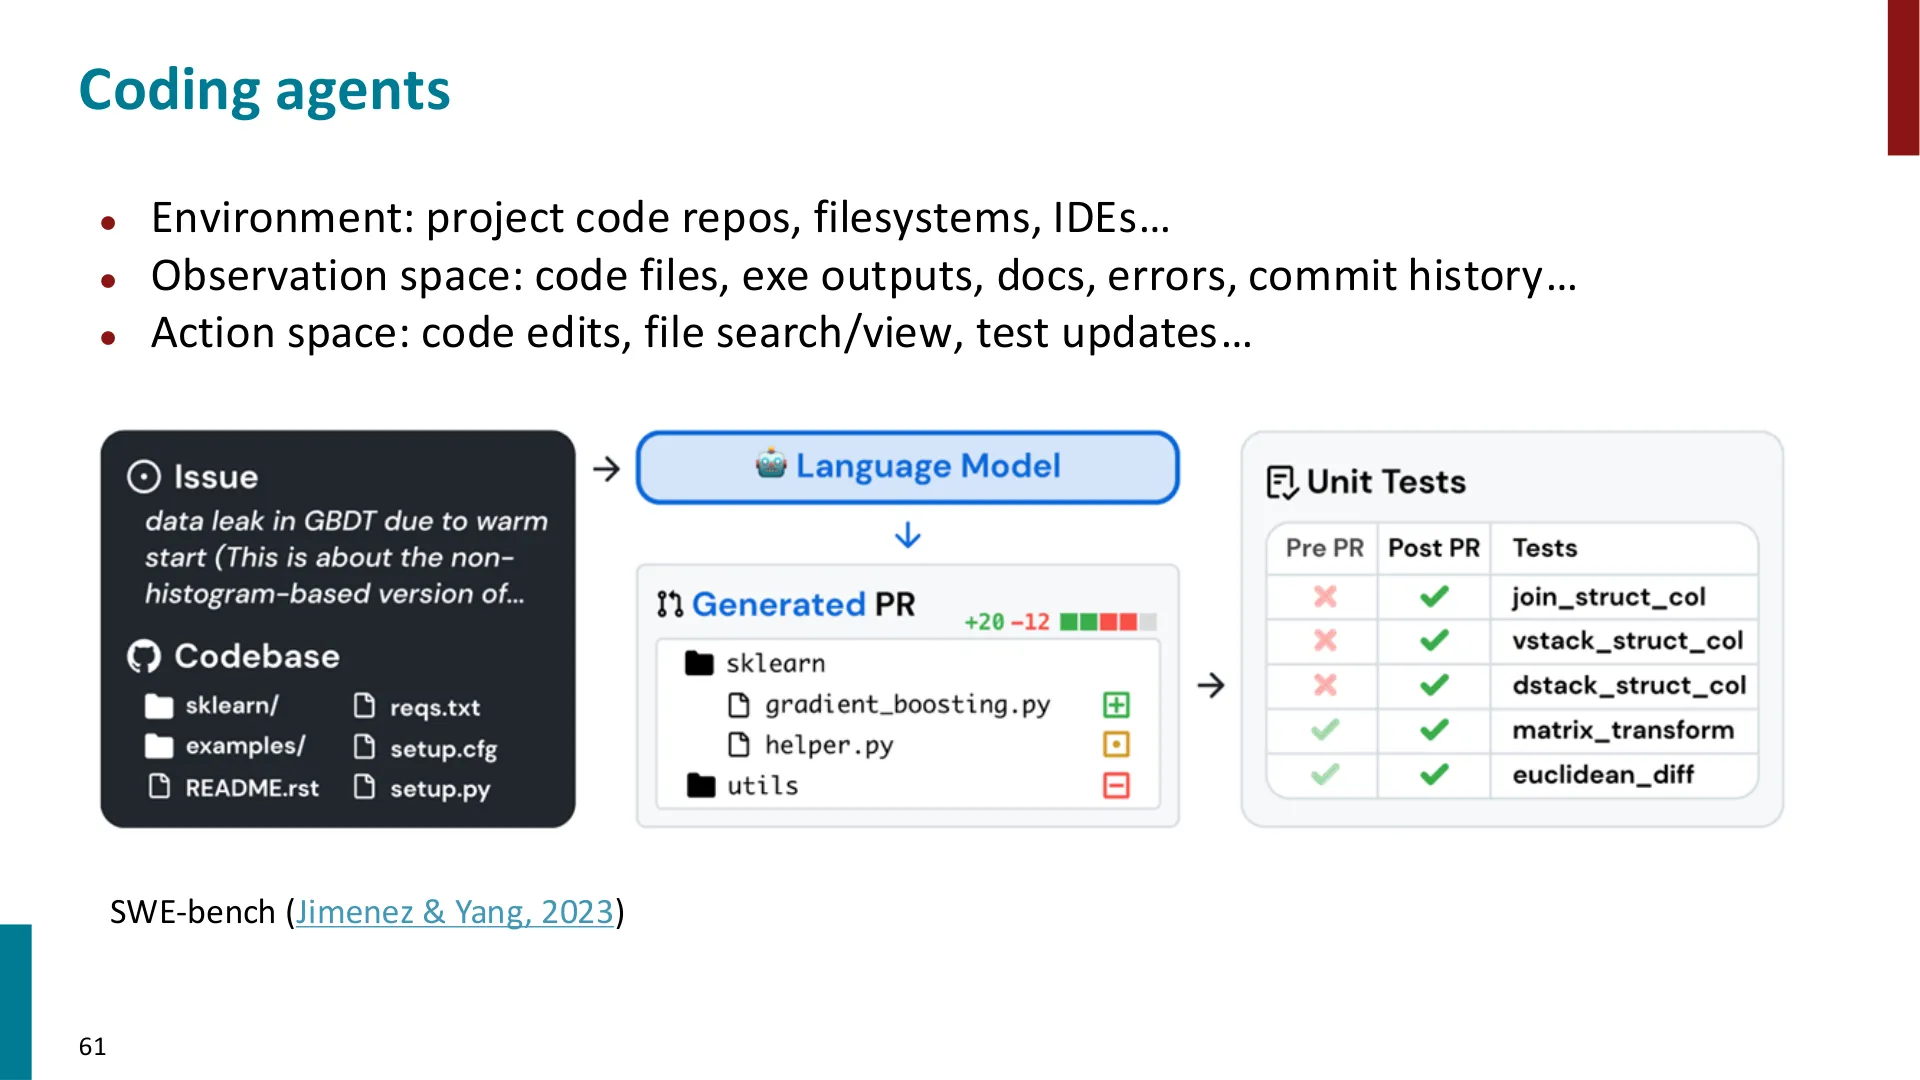
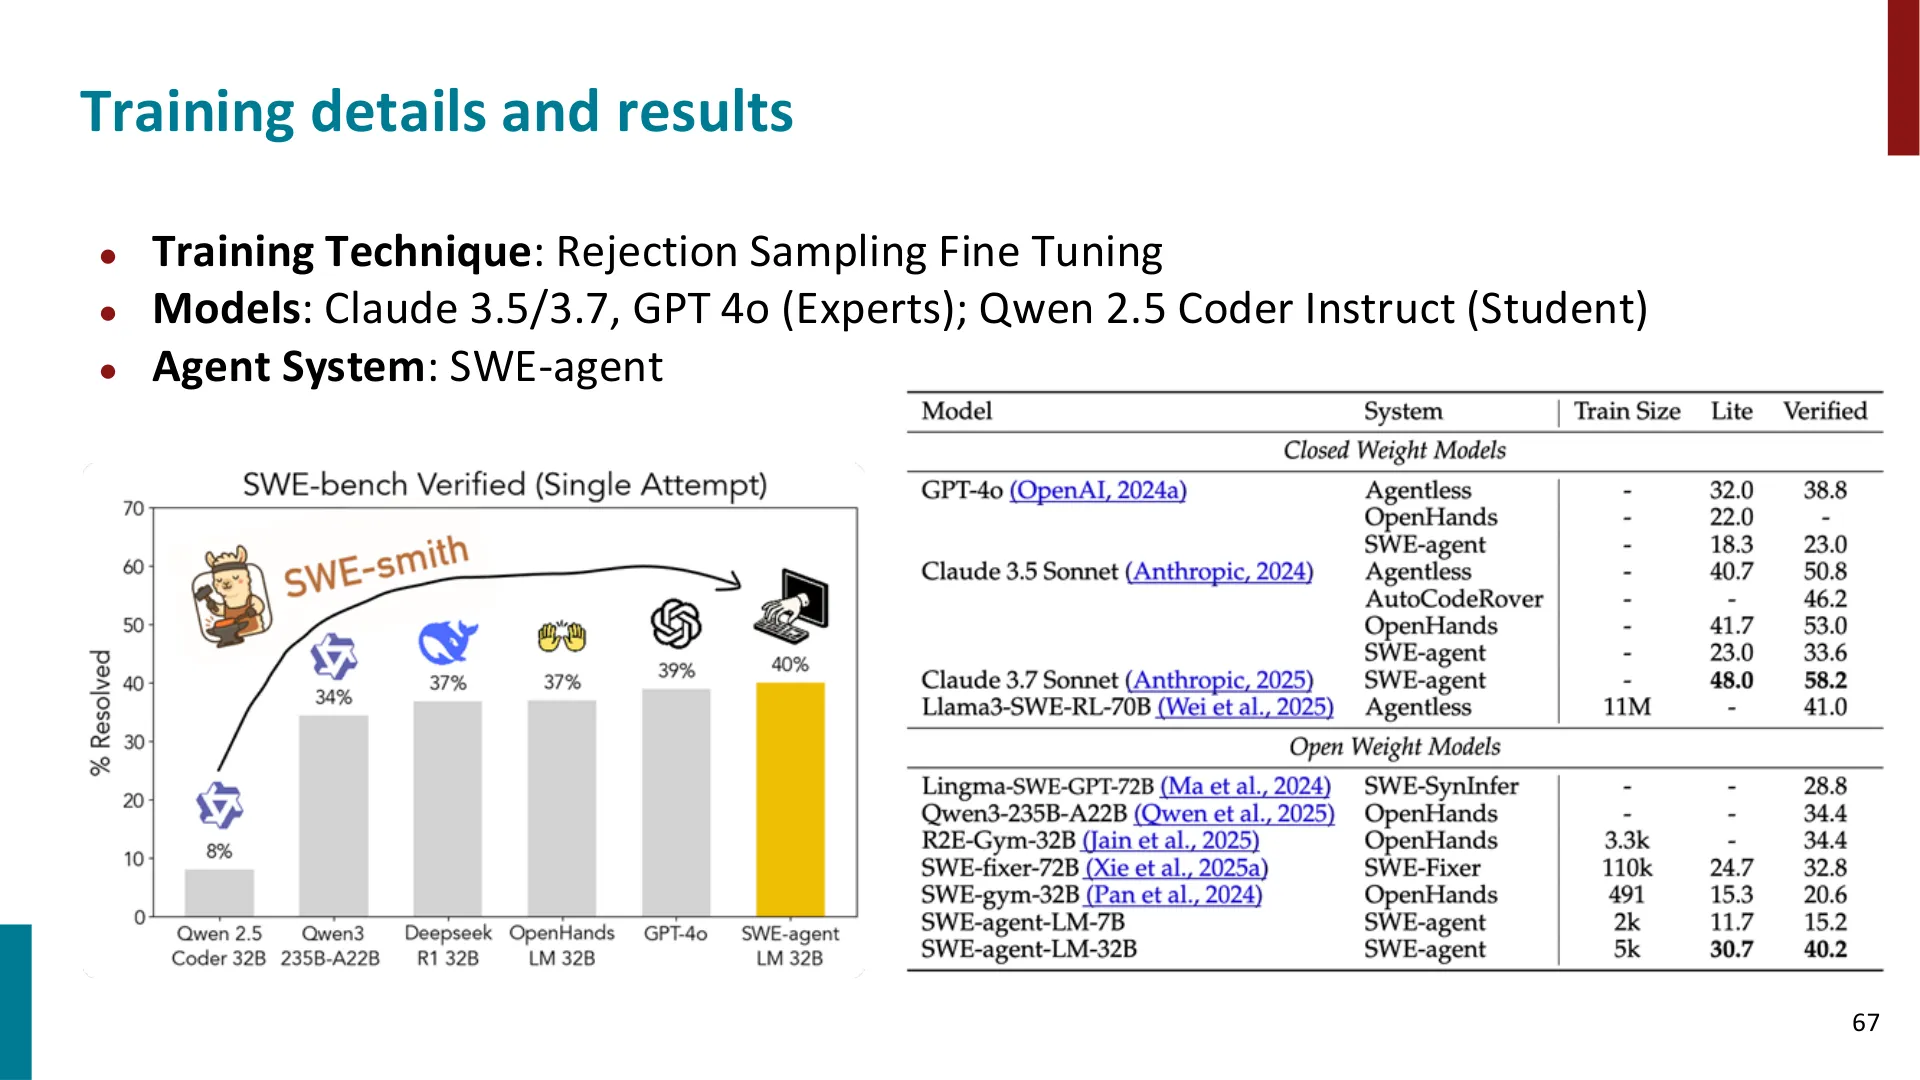
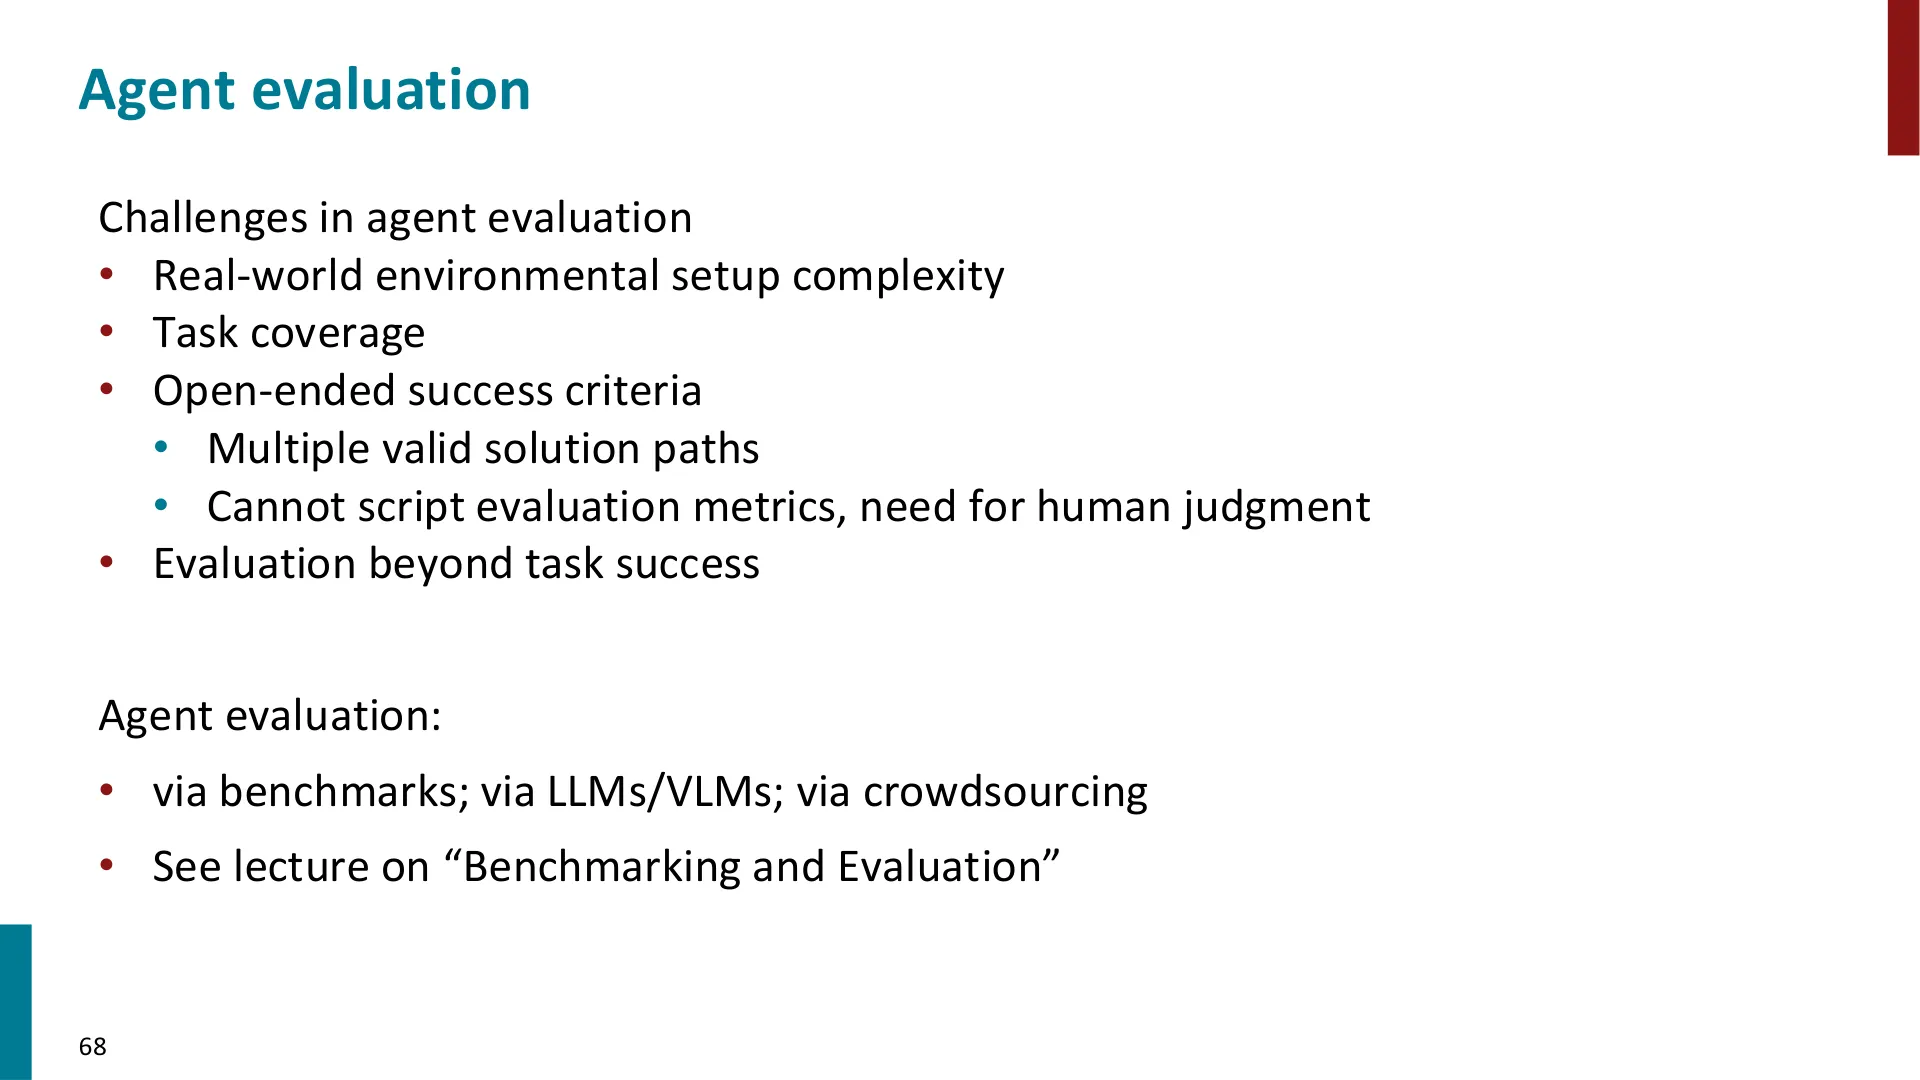
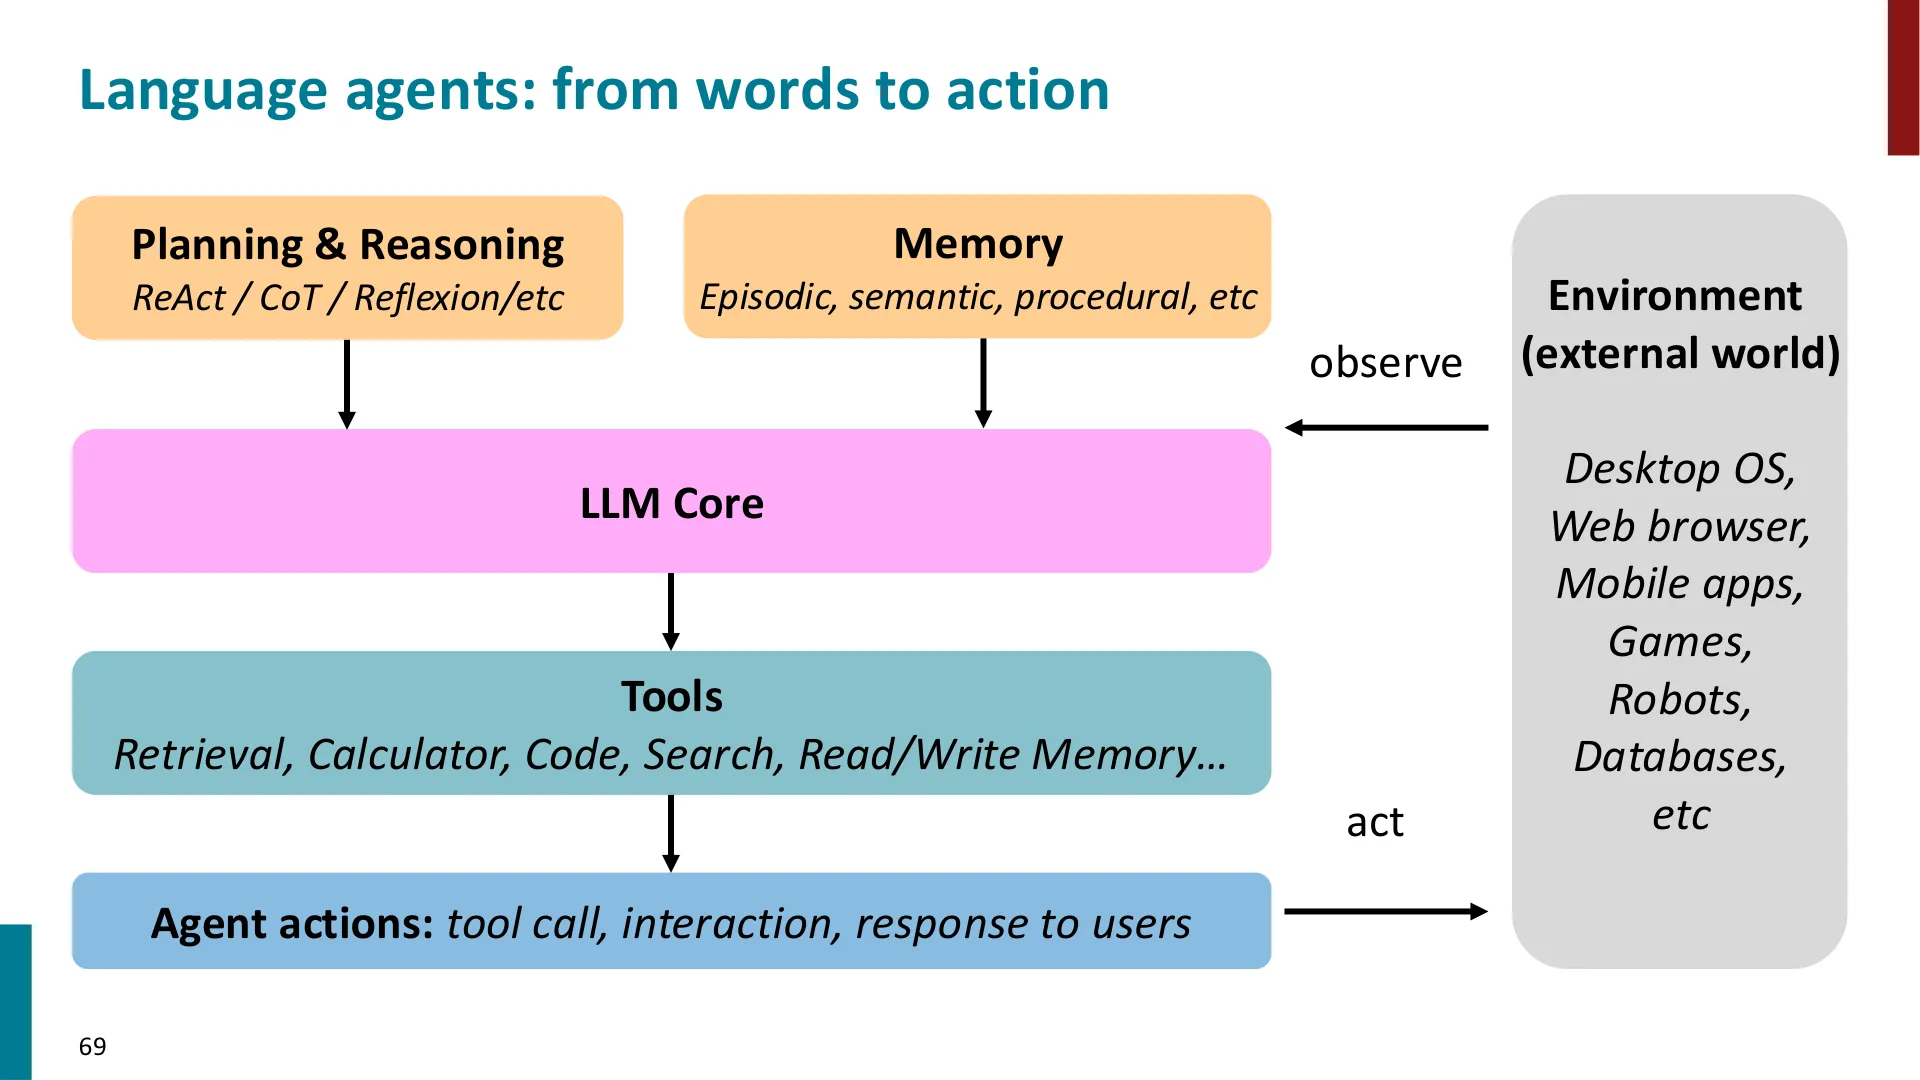
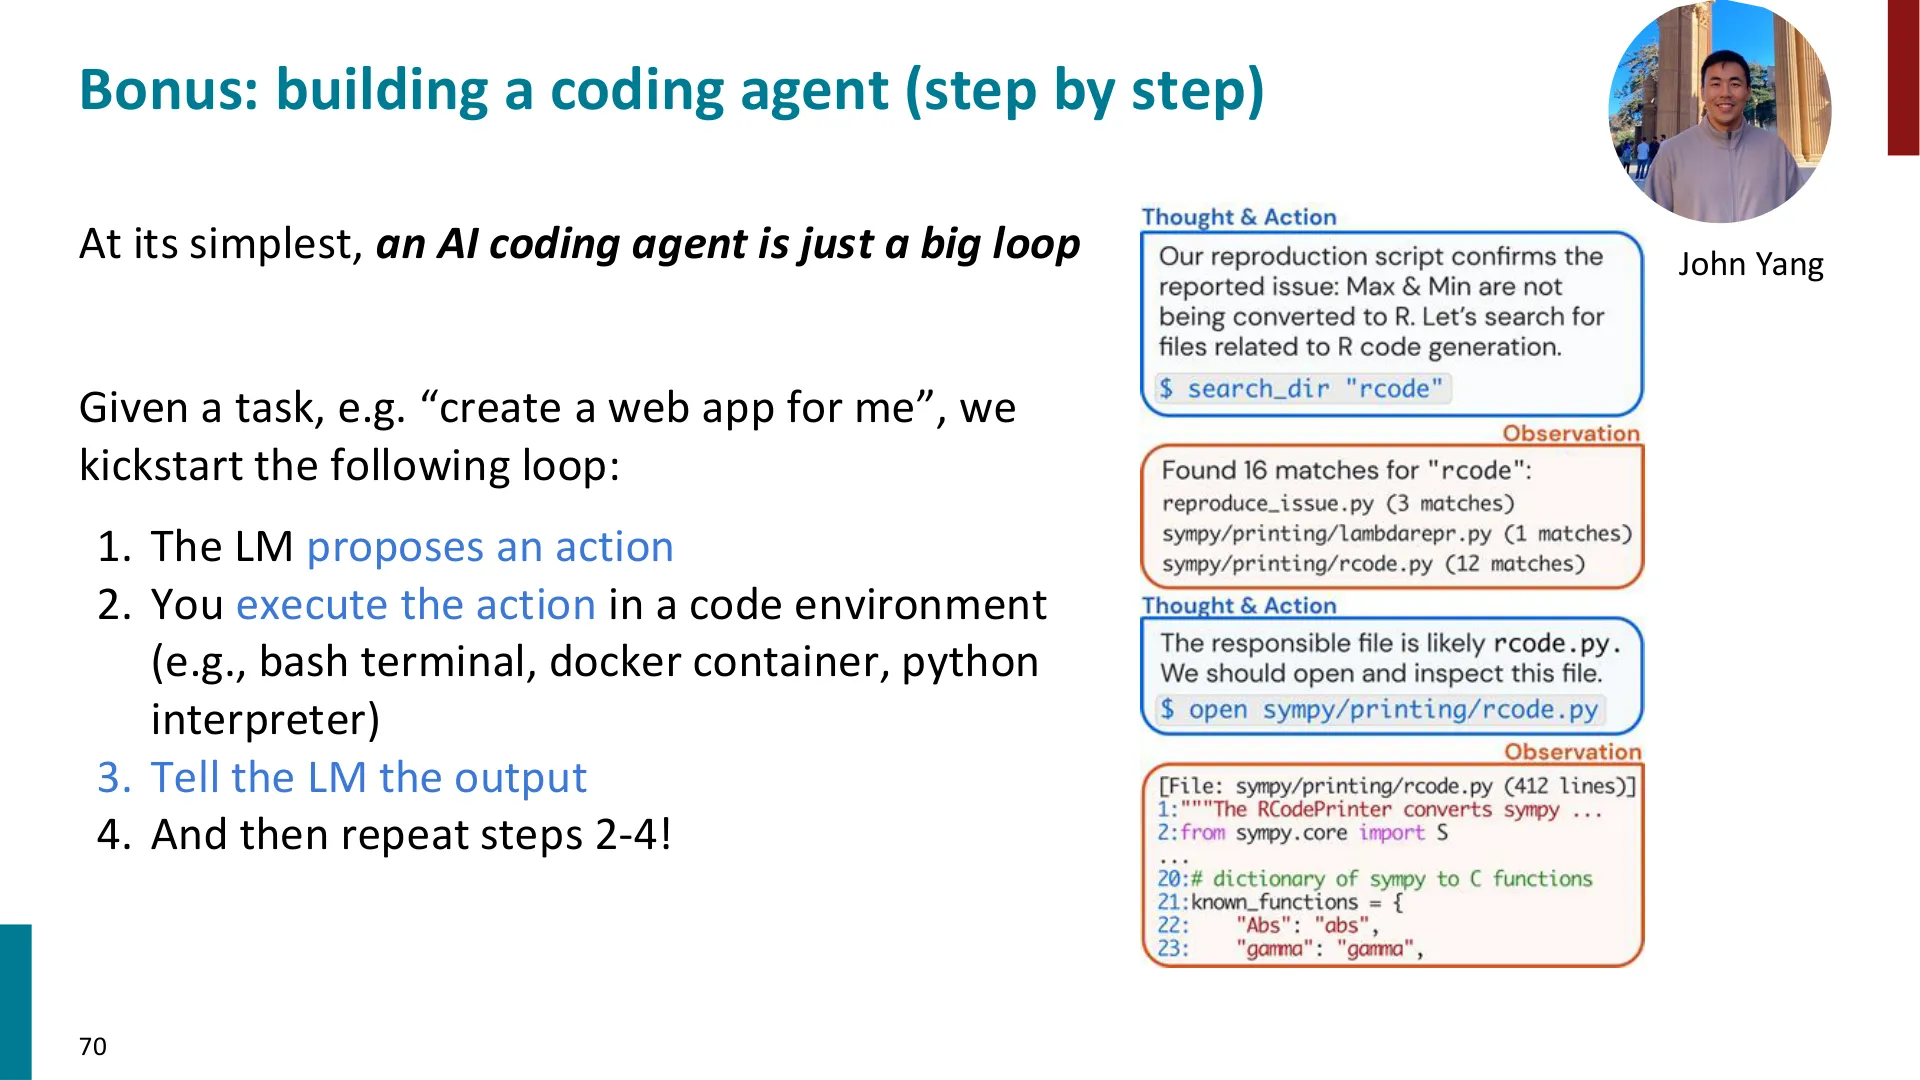
按规范,课堂上未展示的幻灯片统一收录于此,供读者延伸阅读,不计入正文叙事。每页仅列出一次。 一、PEFT 与 Adapter(幻灯片 1–9) 二、问答与检索增强生成(幻灯片 10–28) 三、推理与规划(幻灯片 31–43,课堂未展开的部分) 四、记忆(幻灯片 44–52) 五、工具使用(幻灯片 53–58) 六、智能体应用、数据与评测(幻灯片 59、64–69) 七、附赠:从零构建一个编程智能体(幻灯片 70–72) 按规范,课程主页、讲义与幻灯片链接集中列于此处,并注明对应章节。 检索增强生成与开放域问答的经典工作:Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks(RAG), 2020;Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering(DPR), 2020;Izacard & Grave, Leveraging Passage Retrieval with Generative Models for Open Domain Question Answering(Fusion-in-Decoder), 2020;Gao et al., RARR: Researching and Revising What Language Models Say, Using Language Models, 2023。 以下列出在把本讲从口语转成书面语的过程中,编者无法完全确定的地方。凡有依据或时间点可考的,均已标注。 幻灯片与视频并非同一讲。本讲视频是 Lecture 14 — Reasoning and Agents(Shikhar Murty,Spring 2024),而提供的官方幻灯片文件是 Lecture 10: RAG and Language Agents(Diyi Yang)。两者主题相邻、部分重叠(语言智能体),但不是同一套课件。因此本讲正文章节以视频口语的讲述顺序为准;官方幻灯片中未被讲述的页面统一收入附录,正文里少量 讲师引用的若干文献未在口语中报出题目。他多次提到"作者发现……""这篇论文……"而未念出论文标题(如自洽性、最少到最多、Orca、ReST、忠实性、反事实、类比推理)。正文中给出的论文标题与年份是编者依据内容特征匹配的结果(见"附:官方参考与延伸阅读"),其中: 类比推理的人类实验:讲师说"作者在人类被试上做了同样的实验,性能几乎没有下降",编者对应到 Webb, Holyoak & Lu (2023) 的 Nature Human Behaviour 论文,但具体降幅数字未在课上给出。 专有名词的听写风险。以下几处属 ASR 易错项,编者做了统一,但不排除听错: Meta / Magentic-One、MIND2WEB、OSWorld 等只出现在附录幻灯片中,非课堂口语,未做听写判定。 两处课程内部指代。讲师说"作业 3(assignment 3)",编者按 CS224N 课程设置判定为神经机器翻译那次作业,并在正文以编者说明标注;若该学期作业编号有调整,此处可能有误。他又说讲座 9、10、11 讲过"大模型擅长生成合理续写",具体是哪几讲、覆盖到哪一步,编者未逐讲核对。 讲师的判断 vs 客观事实。以下几处是讲师本人的观点或现场措辞,编者照实保留、未做外部纠正: "提示鸿沟"这个说法,讲师说"是我喜欢这么叫的",属于他本人的命名,非领域标准术语,读者不宜当作出处引用。 被略去但可能重要的现场细节。讲座中约在 24:42–25:04 处有一段回答学生提问的环节,字幕在此处几乎空白(只有"okay so let's keep moving"之类过渡语),提问内容与回答均缺失。同类的短问答还有若干(如 26:30 前后"为什么 9 进制算反事实"那段,字幕断续)。凡未能还原的,本讲一律未凭猜测补写。 数字的取整。讲师提到的"约 13 个百分点提升"(MiniWoB)与"GPT-3.5-Turbo 闭卷约 56% / Oracle 约 88.5%"来自口语与附录幻灯片,编者未做二次核算;若与原论文有出入,以原论文为准。 🖼️ 第 1 页幻灯片 · Natural Language Processing 🖼️ 第 2 页幻灯片 · Overview 🖼️ 第 3 页幻灯片 · A functional perspective of adaptation 🖼️ 第 4 页幻灯片 · Adapter (Houlsby et al. 2019) 🖼️ 第 5 页幻灯片 · 5 🖼️ 第 6 页幻灯片 · Trade-off btw accuracy and # of trained task specific parameters 🖼️ 第 7 页幻灯片 · Language adapters? Task knowledge ~= language knowledge 🖼️ 第 8 页幻灯片 · Performance comparison 🖼️ 第 9 页幻灯片 · Other variants of (efficient) adaptation 🖼️ 第 10 页幻灯片 · (Rajpurkar et al, 2016): SQuAD: 100,000+ Questions for Machine Comprehension of Text 🖼️ 第 11 页幻灯片 · Conventional methods for reading comprehension 🖼️ 第 12 页幻灯片 · Open-domain question answering 🖼️ 第 13 页幻灯片 · Retrieval augmentation 🖼️ 第 14 页幻灯片 · Using retrieval to overcome LMs’ shortcomings 🖼️ 第 15 页幻灯片 · Retriever-Reader framework 🖼️ 第 16 页幻灯片 · RAG and it’s open problems 🖼️ 第 17 页幻灯片 · Different types of retrievers 🖼️ 第 18 页幻灯片 · Fast vs slow retrievers 🖼️ 第 19 页幻灯片 · We can train the retriever! Joint training of reader and retriever 🖼️ 第 20 页幻灯片 · We can train the retriever! 🖼️ 第 21 页幻灯片 · Deep retrieval + generative models 🖼️ 第 22 页幻灯片 · Problem: How many documents can we use? 🖼️ 第 23 页幻灯片 · LM’s can’t pay attention to the entire context 🖼️ 第 24 页幻灯片 · In practice: LMs cant use many documents 🖼️ 第 25 页幻灯片 · LLMs with web search (systems that search and cite the web) 🖼️ 第 26 页幻灯片 · RARR: research and revise what LLMs say using LLMs Guo+2023 🖼️ 第 27 页幻灯片 · LLMs citation and hallucinations 🖼️ 第 28 页幻灯片 · LLMs citation and hallucinations 🖼️ 第 31 页幻灯片 · Other types of common components of language agents 🖼️ 第 32 页幻灯片 · 3. Language agents: Reasoning 🖼️ 第 33 页幻灯片 · Reasoning 🖼️ 第 35 页幻灯片 · Reasoning without acting 🖼️ 第 36 页幻灯片 · Reasoning with acting 🖼️ 第 37 页幻灯片 · Comparing ReAct with COT, SC 🖼️ 第 38 页幻灯片 · Self-Consistency Wang et al., 2023 🖼️ 第 39 页幻灯片 · Reflextion: reinforce agents via natural language feedback 🖼️ 第 40 页幻灯片 · Reflextion: reinforce agents via natural language feedback 🖼️ 第 41 页幻灯片 · Multi-agent debate to improve reasoning Du et al., 2023 🖼️ 第 42 页幻灯片 · 42 🖼️ 第 43 页幻灯片 · Coordinate with Orchestrator 🖼️ 第 44 页幻灯片 · 4. Language agents: Memory 🖼️ 第 45 页幻灯片 · Different types of memory for language agents 🖼️ 第 46 页幻灯片 · Generative agents 🖼️ 第 47 页幻灯片 · Generative agents: the need for memory 🖼️ 第 48 页幻灯片 · Episodic memory 🖼️ 第 49 页幻灯片 · Semantic memory 🖼️ 第 50 页幻灯片 · Procedural memory 🖼️ 第 51 页幻灯片 · MemGPT Packer+2024 🖼️ 第 52 页幻灯片 · MemGPT Packer+2024 🖼️ 第 53 页幻灯片 · 5. Language agents: Tool use 🖼️ 第 54 页幻灯片 · Toolken GPT Hao et al., 2024 🖼️ 第 55 页幻灯片 · Toolformer: language models can teach themselves to use tools 🖼️ 第 56 页幻灯片 · Toolformer: language models can teach themselves to use tools 🖼️ 第 57 页幻灯片 · Toolformer: language models can teach themselves to use tools 🖼️ 第 58 页幻灯片 · Gorilla: LLMs connected with massive APIs (Patil et al., 2023) 🖼️ 第 59 页幻灯片 · 6. Different agent applications, data and evaluation 🖼️ 第 61 页幻灯片 · Coding agents 🖼️ 第 63 页幻灯片 · Computer use agents 🖼️ 第 64 页幻灯片 · Agent data --- scaling agent data 🖼️ 第 65 页幻灯片 · Agent data --- scaling agent data 🖼️ 第 66 页幻灯片 · Case study of SWE-smith: scaling data for coding agents 🖼️ 第 67 页幻灯片 · Training details and results 🖼️ 第 68 页幻灯片 · Agent evaluation 🖼️ 第 69 页幻灯片 · Language agents: from words to action 🖼️ 第 70 页幻灯片 · Bonus: building a coding agent (step by step) 🖼️ 第 71 页幻灯片 · Bonus: building a coding agent (step by step) 🖼️ 第 72 页幻灯片 · Bonus: building a coding agent (step by step) 下面这些页来自官方幻灯片,但课堂录制里没有对应的展示画面。由
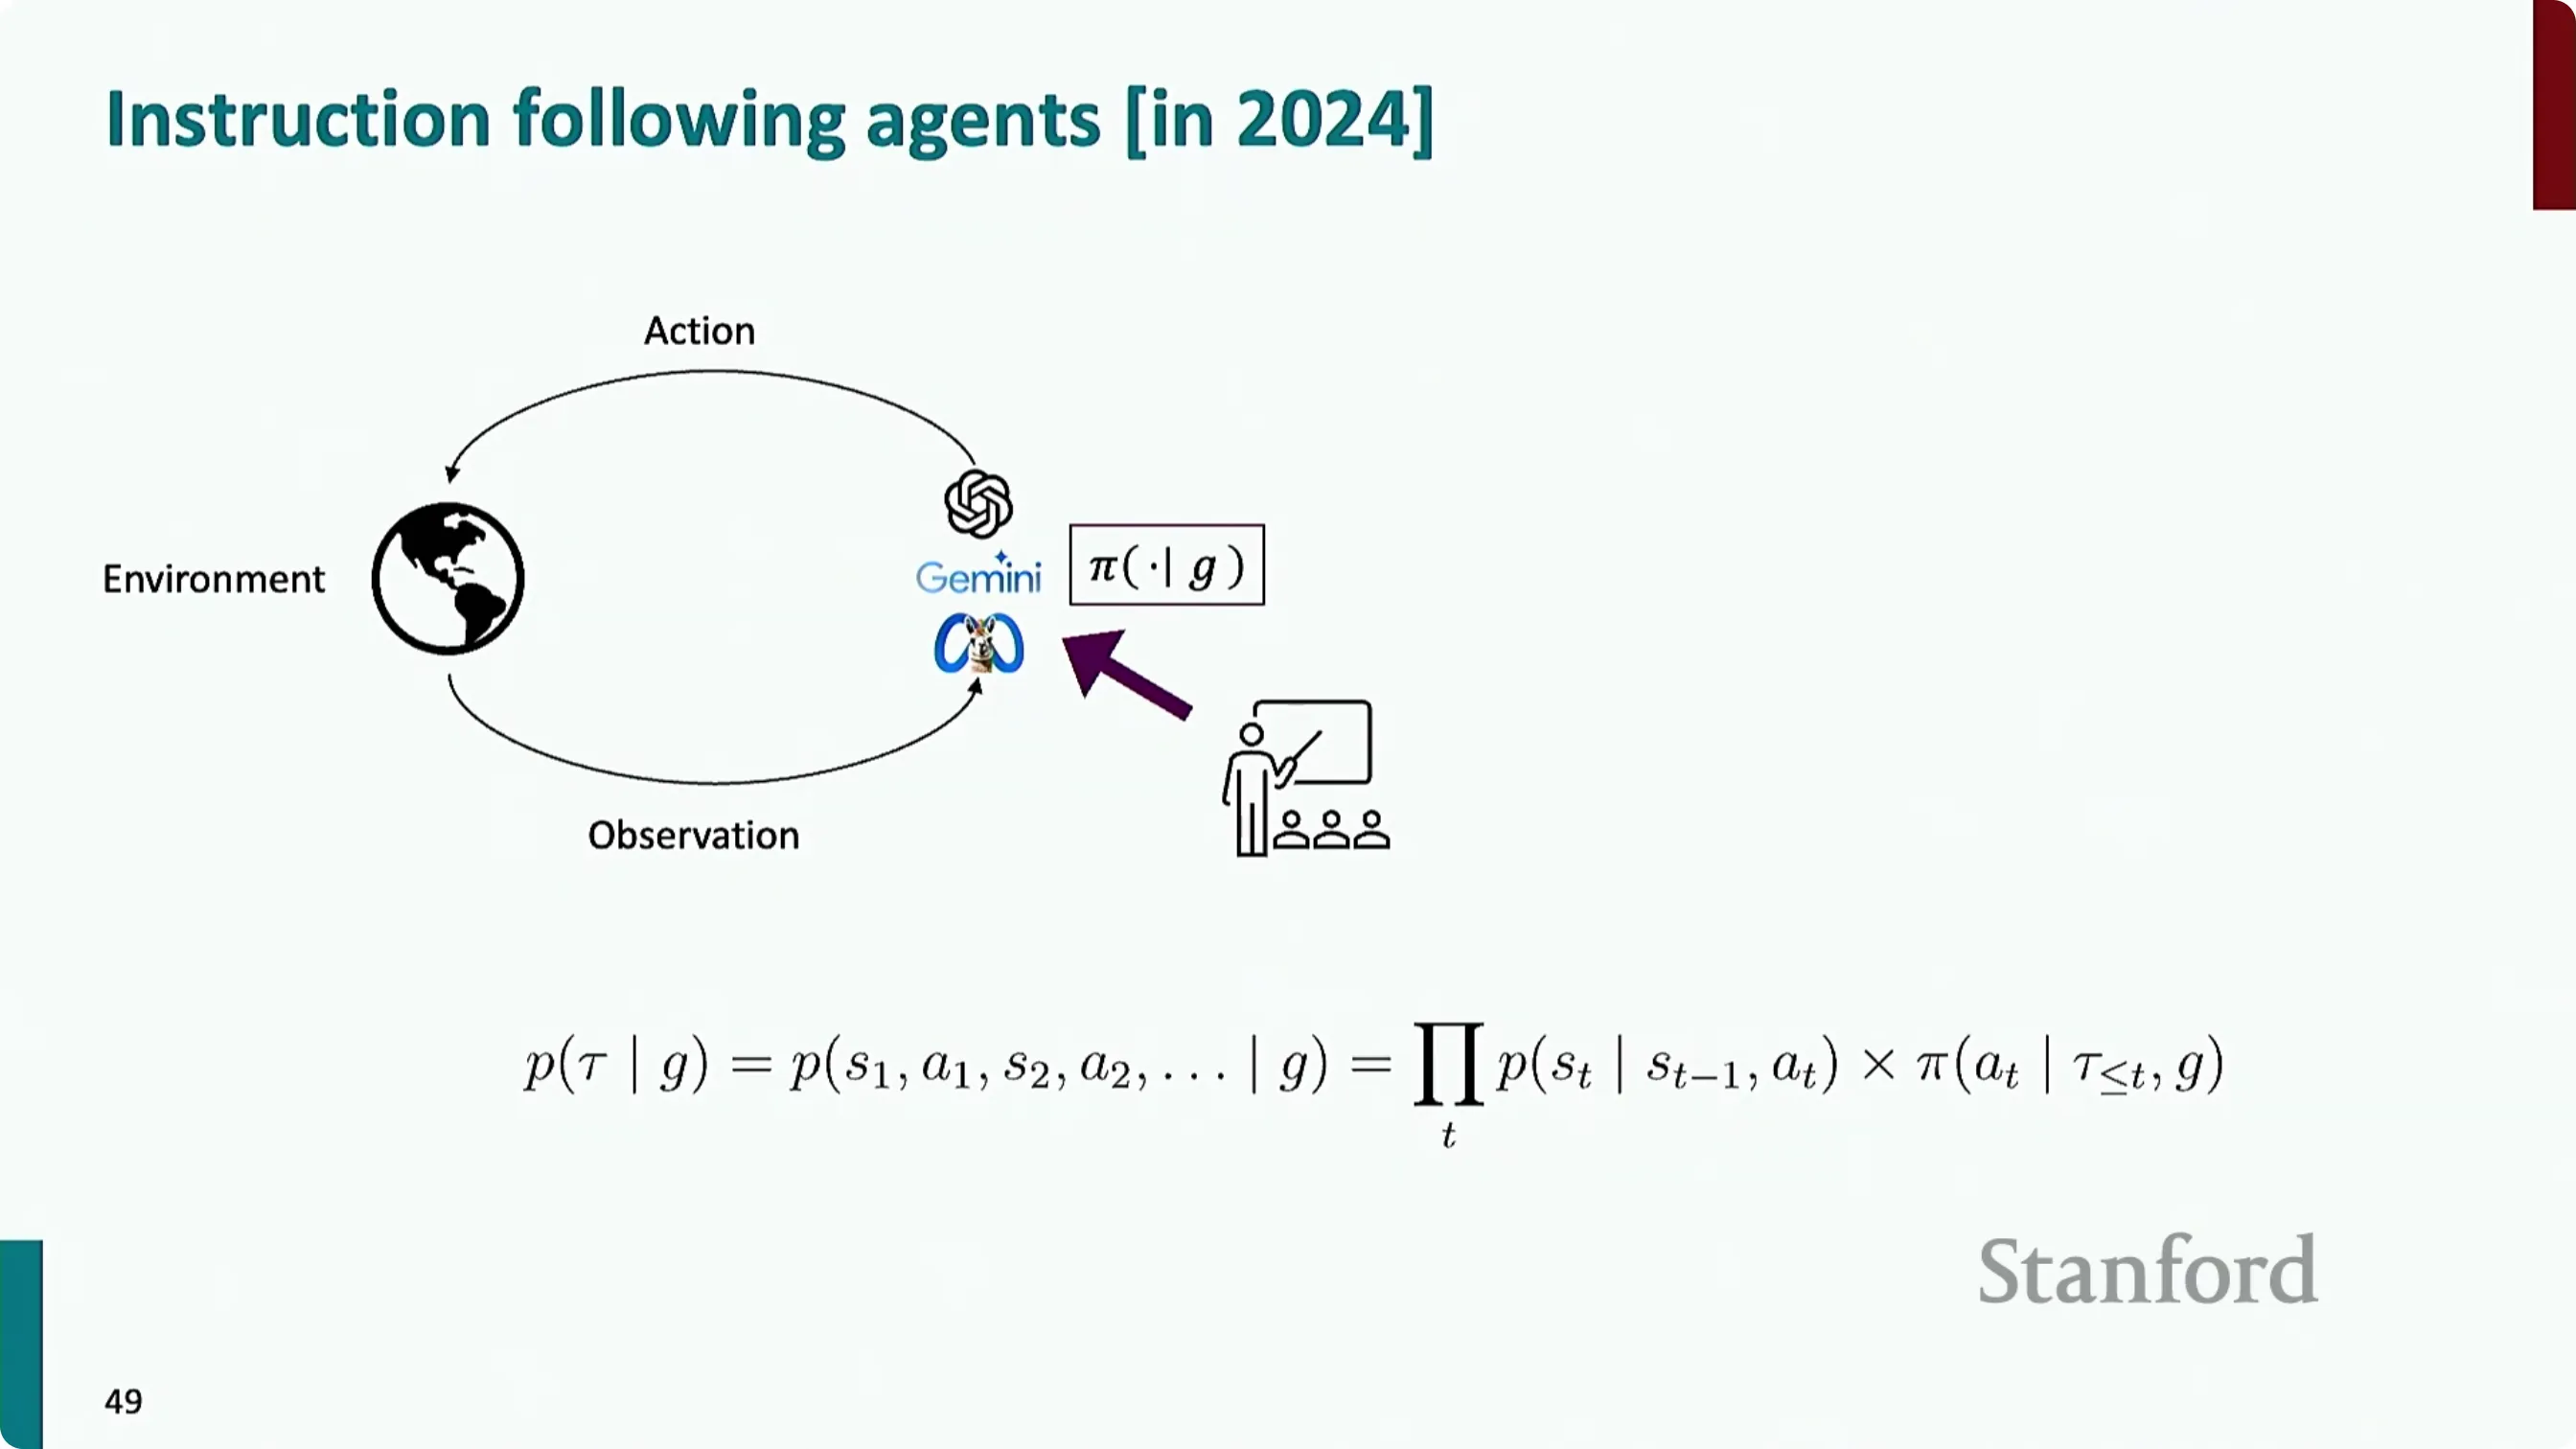
回到原视频 (00:39:15)
2.4 用语言模型当策略:在循环中提示
graph TD
  S["动作空间(文本描述)"] --> C["上下文"]
  I["指令 g"] --> C
  H["动作/观察历史"] --> C
  C --> M["语言模型"]
  M --> A["预测下一个动作 a_t"]
  A --> X["在环境中执行"]
  X --> O["得到新的观察"]
  O --> H
2.5 用来评测智能体的环境
MiniWoB:最简单的沙盒
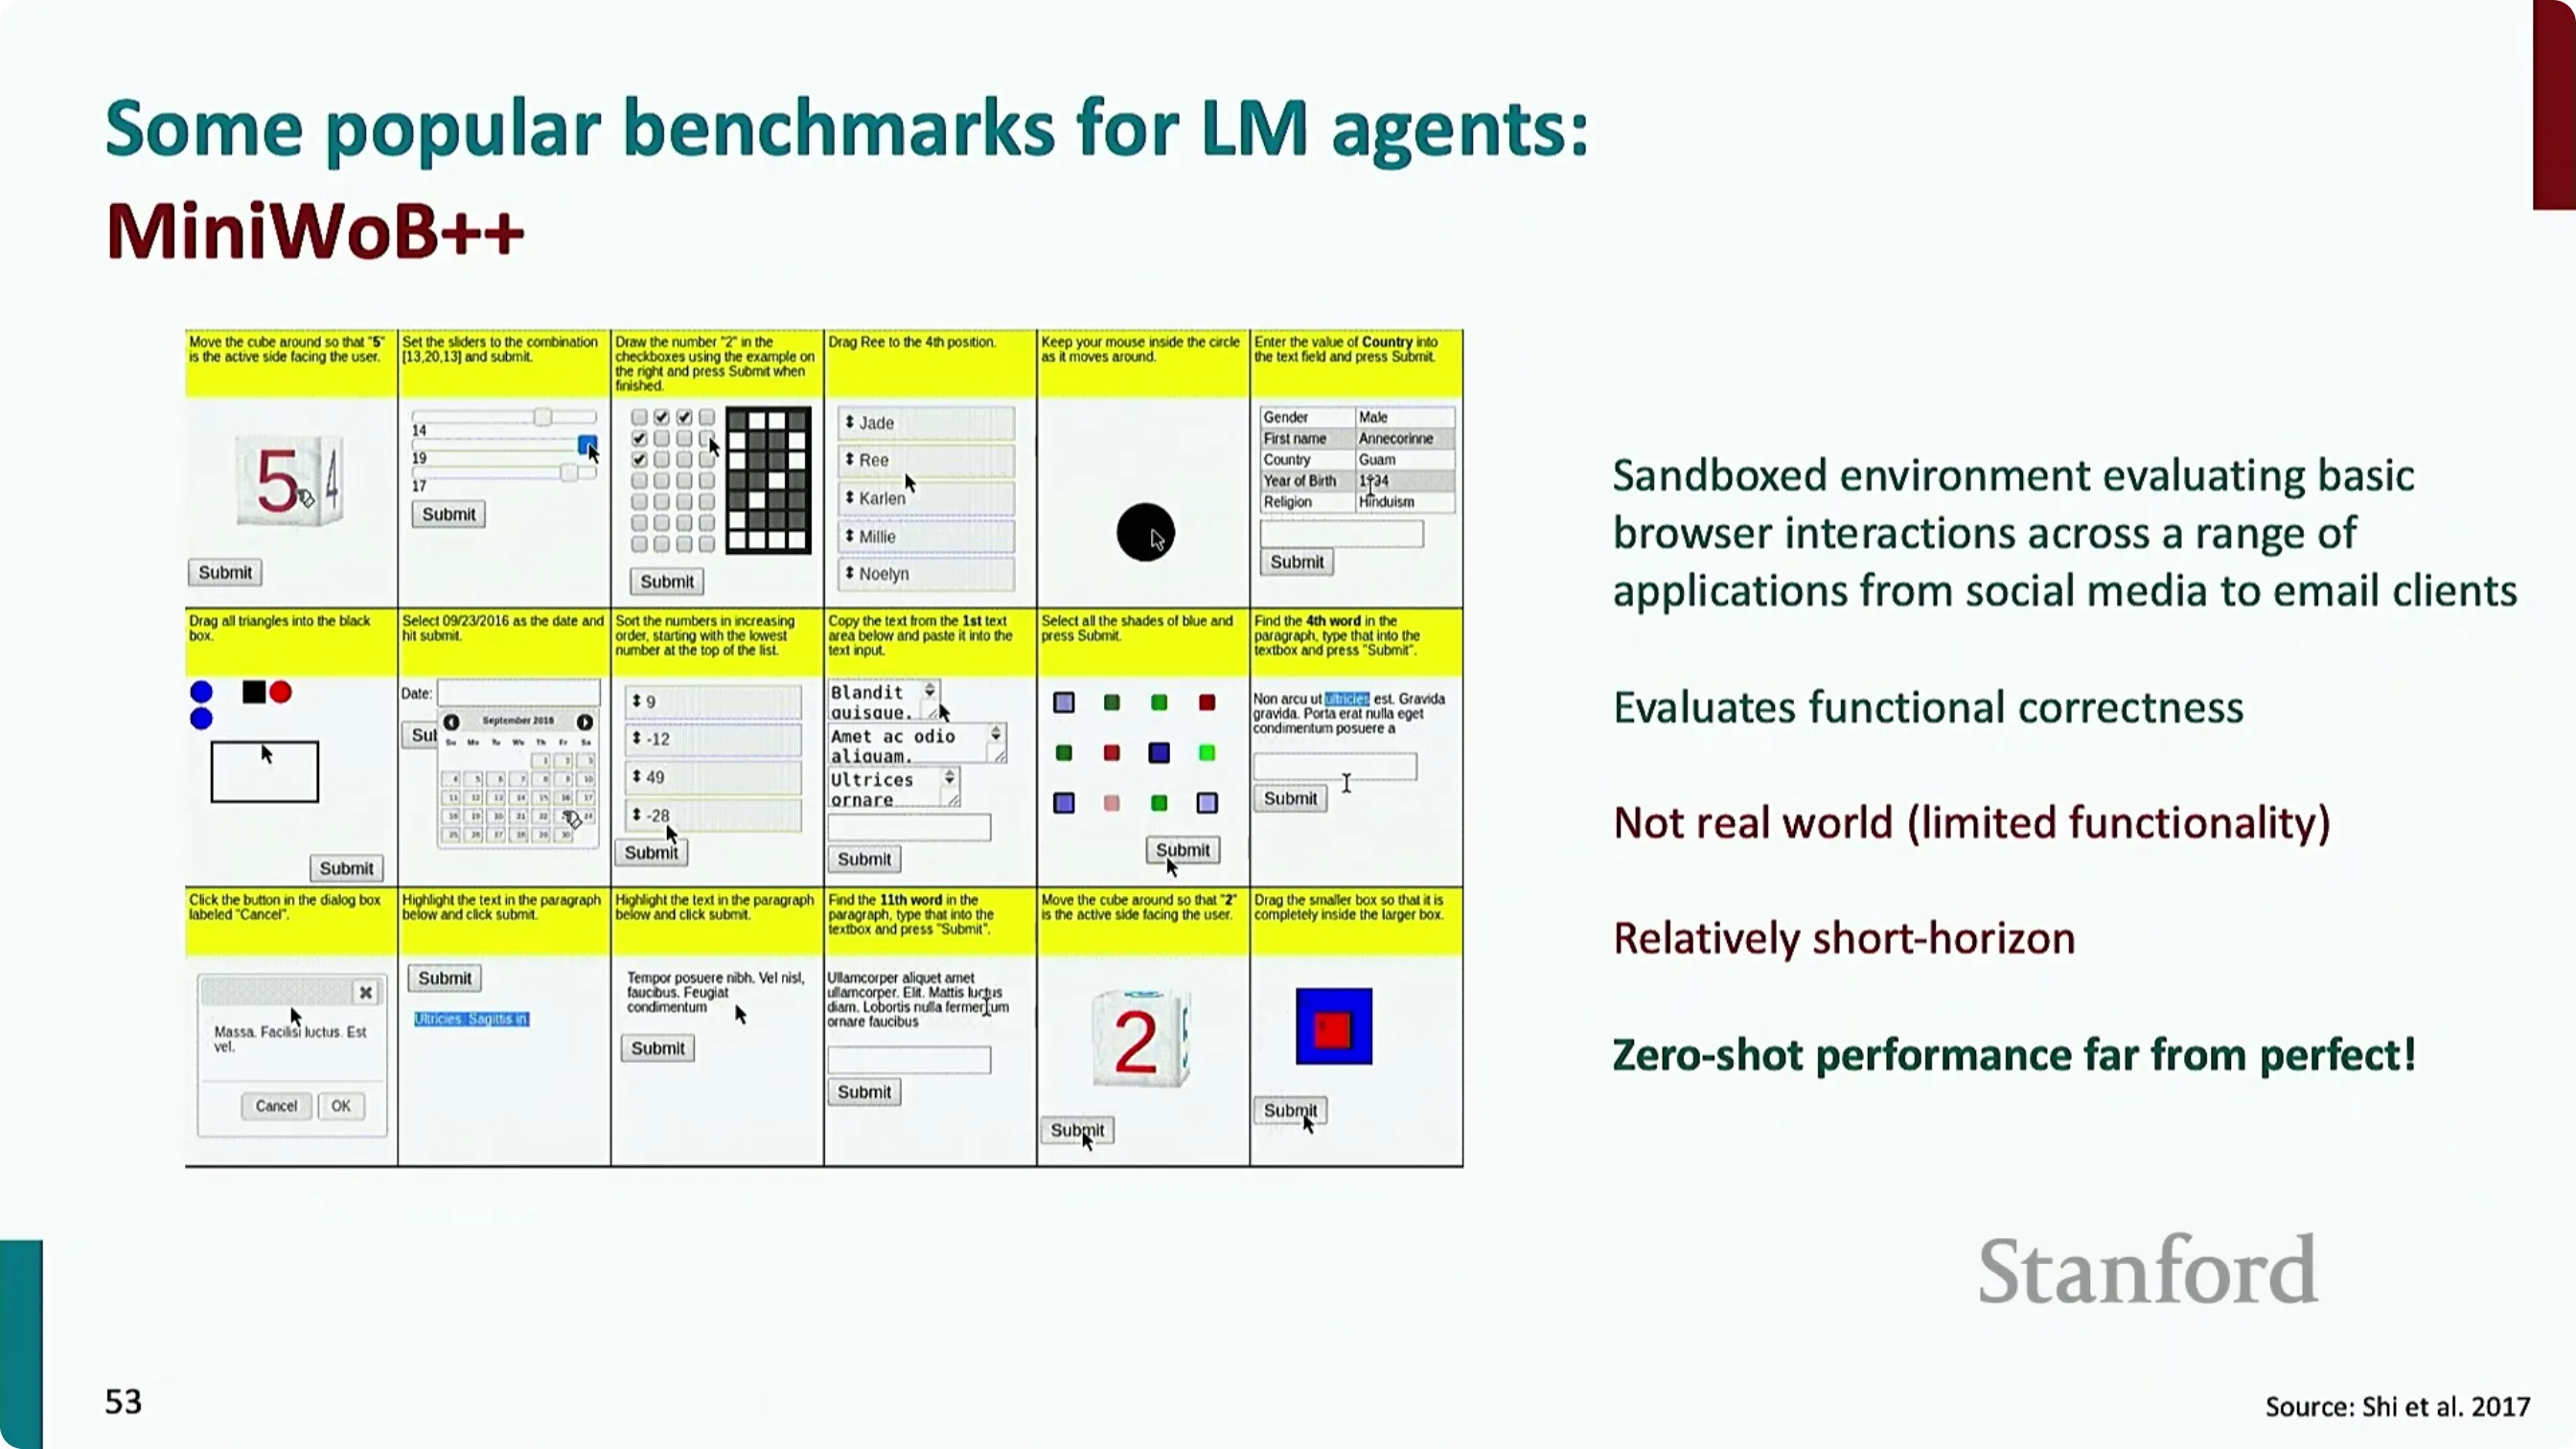
回到原视频 (00:43:15)WebArena:接近真实网站的沙盒
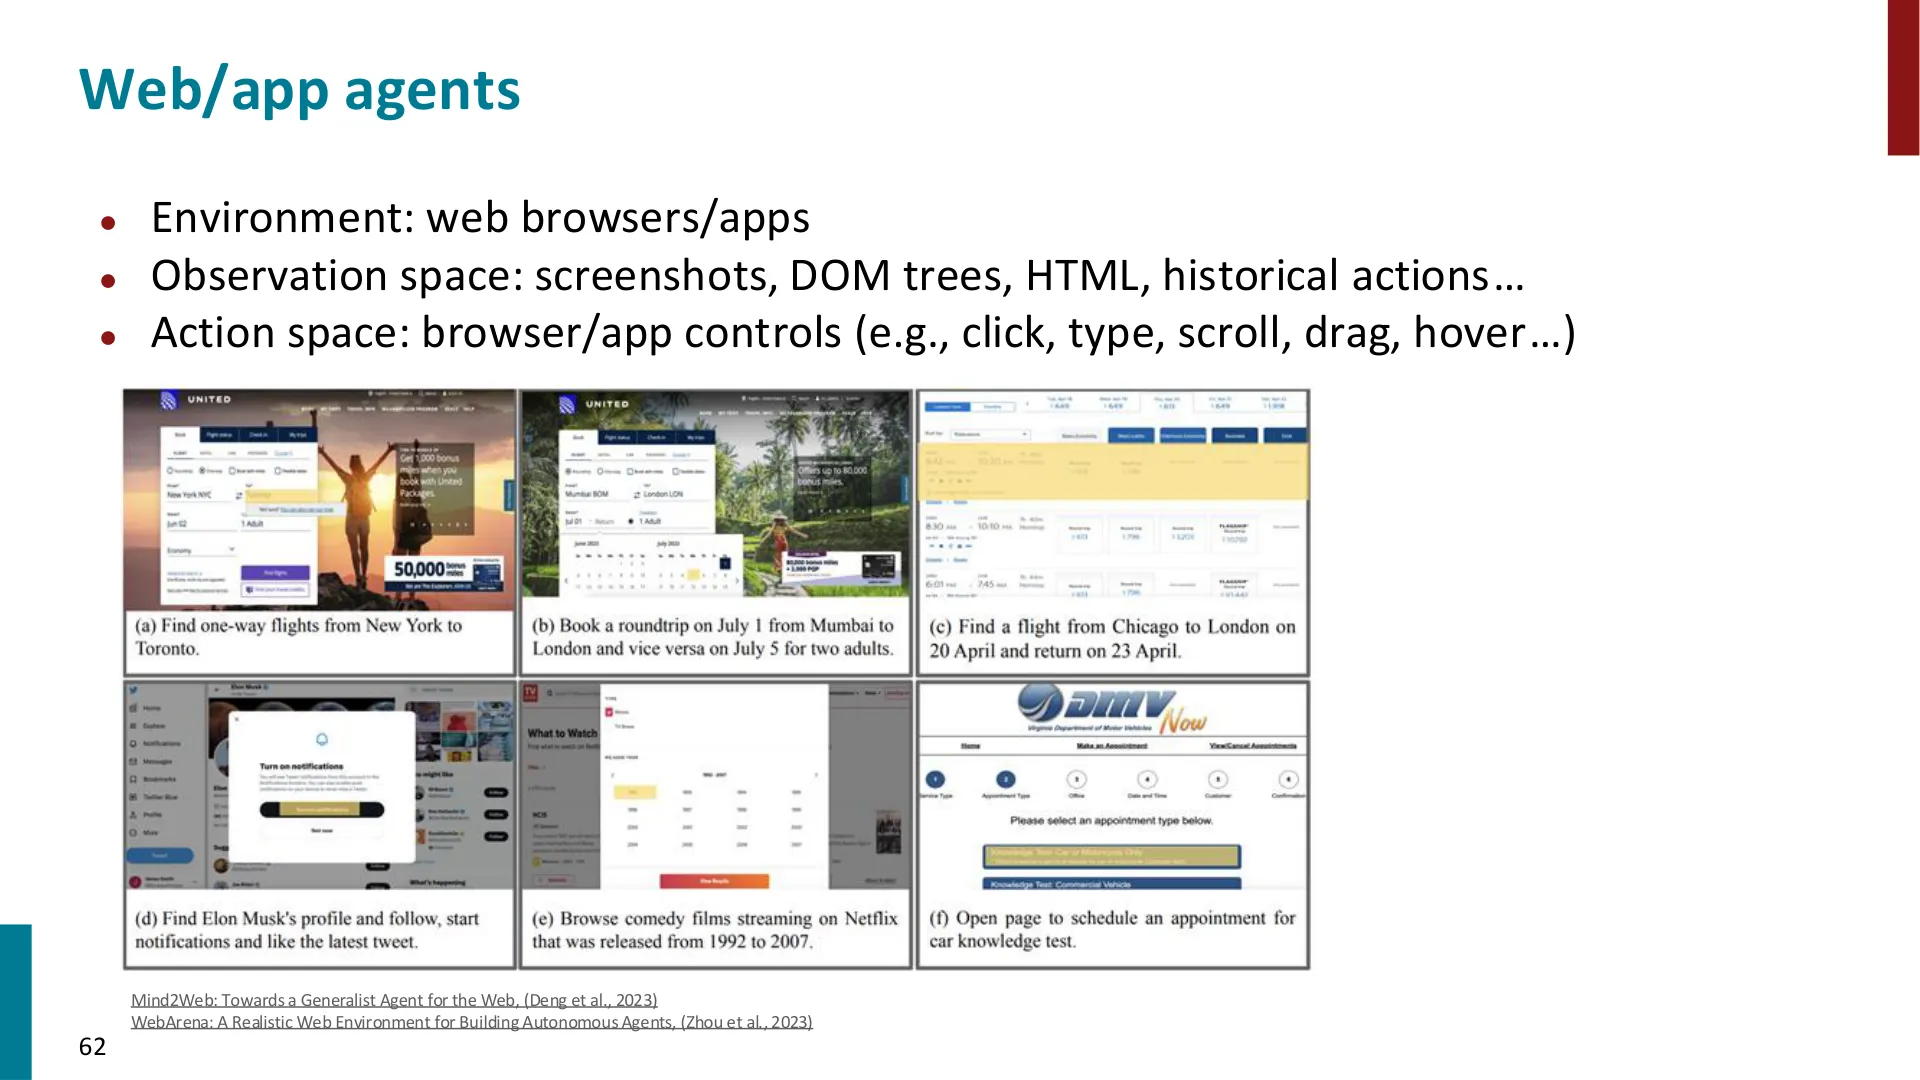
回到原视频 (00:44:10)WebLINX:真实网站上的交互记录
2.6 用合成演示训练智能体
回到第一部分的思想:让模型生成中间产物,然后在上面微调
具体流程
关键的一步:失败的轨迹不要扔,重新贴标签
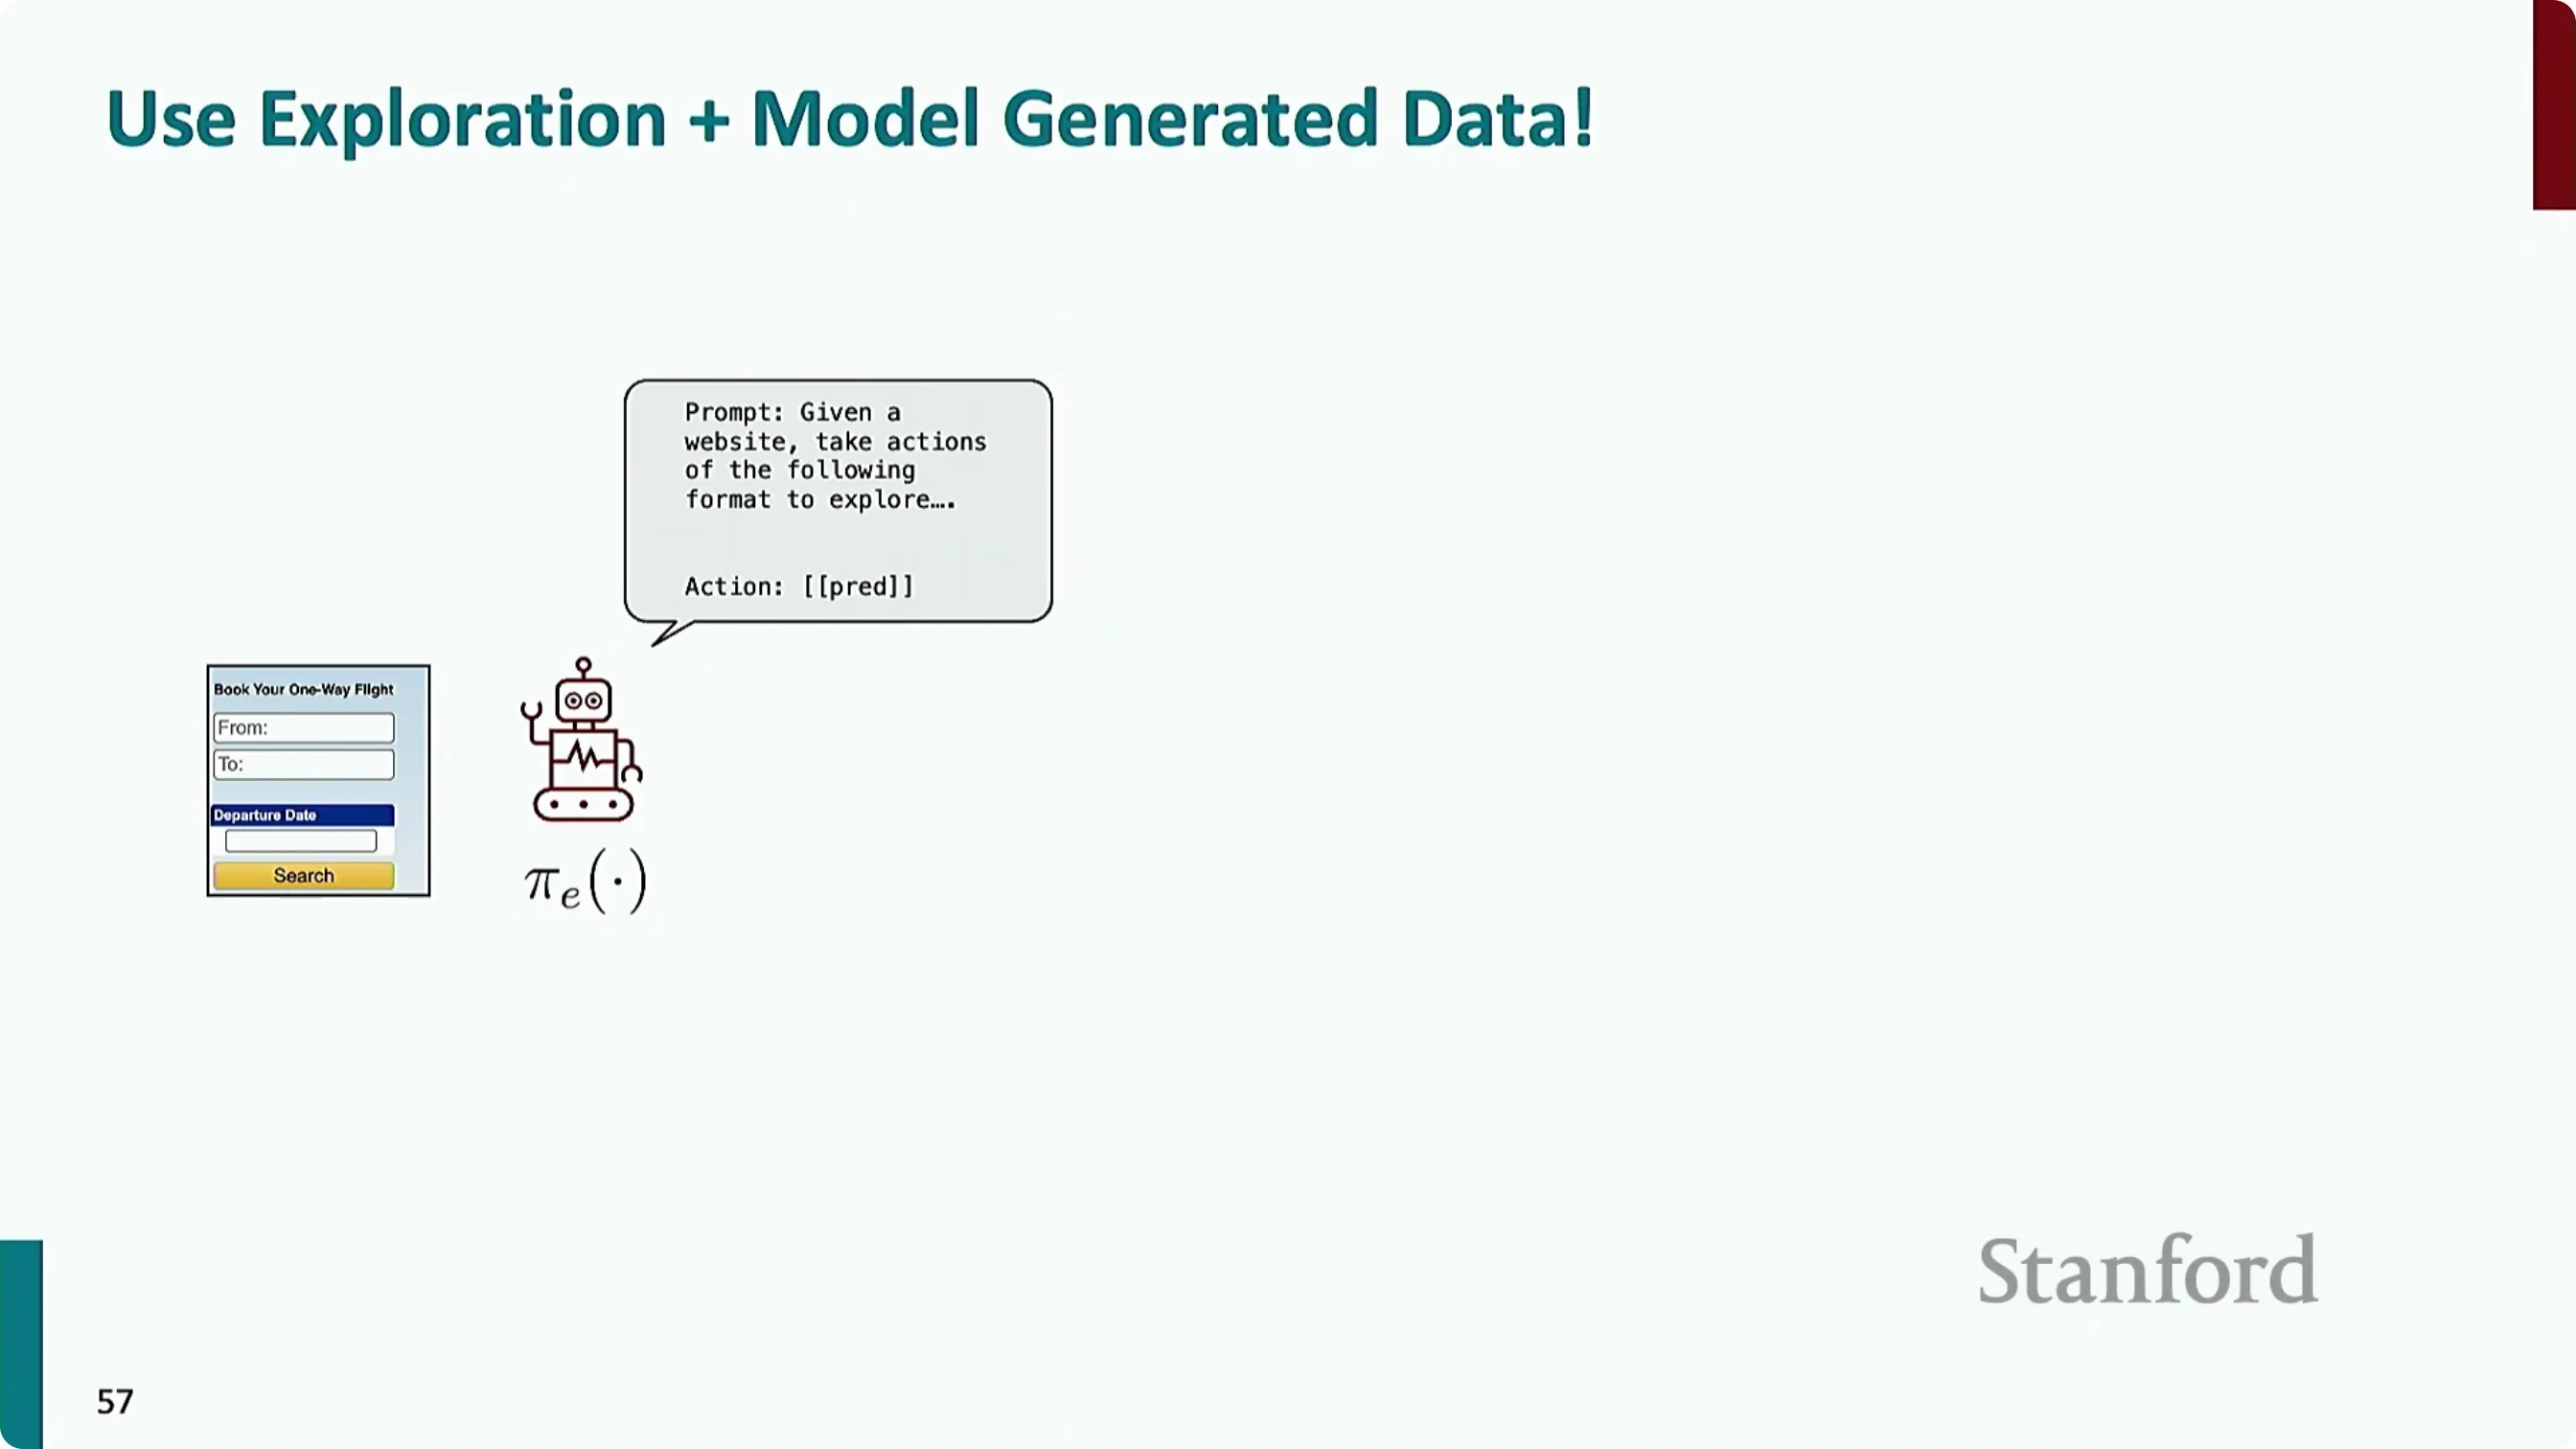
回到原视频 (00:48:20)graph TD
E["环境"] --> X["无条件语言模型:随机探索"]
X --> T["轨迹 τ"]
T --> L["第二个语言模型:为轨迹生成自然语言描述(当作标签)"]
L --> F{"粗过滤器:指令与轨迹、状态是否对应良好?"}
F -- "是" --> D["加入合成演示数据集"]
F -- "否" --> R["重标注:为这条轨迹指派最接近的指令"]
R --> P["以新指令为条件,重新生成轨迹"]
P --> F
整体方法与结果
2.7 从像素出发:多模态智能体
LLaVA:用 GPT-4 生成图文数据,联合微调
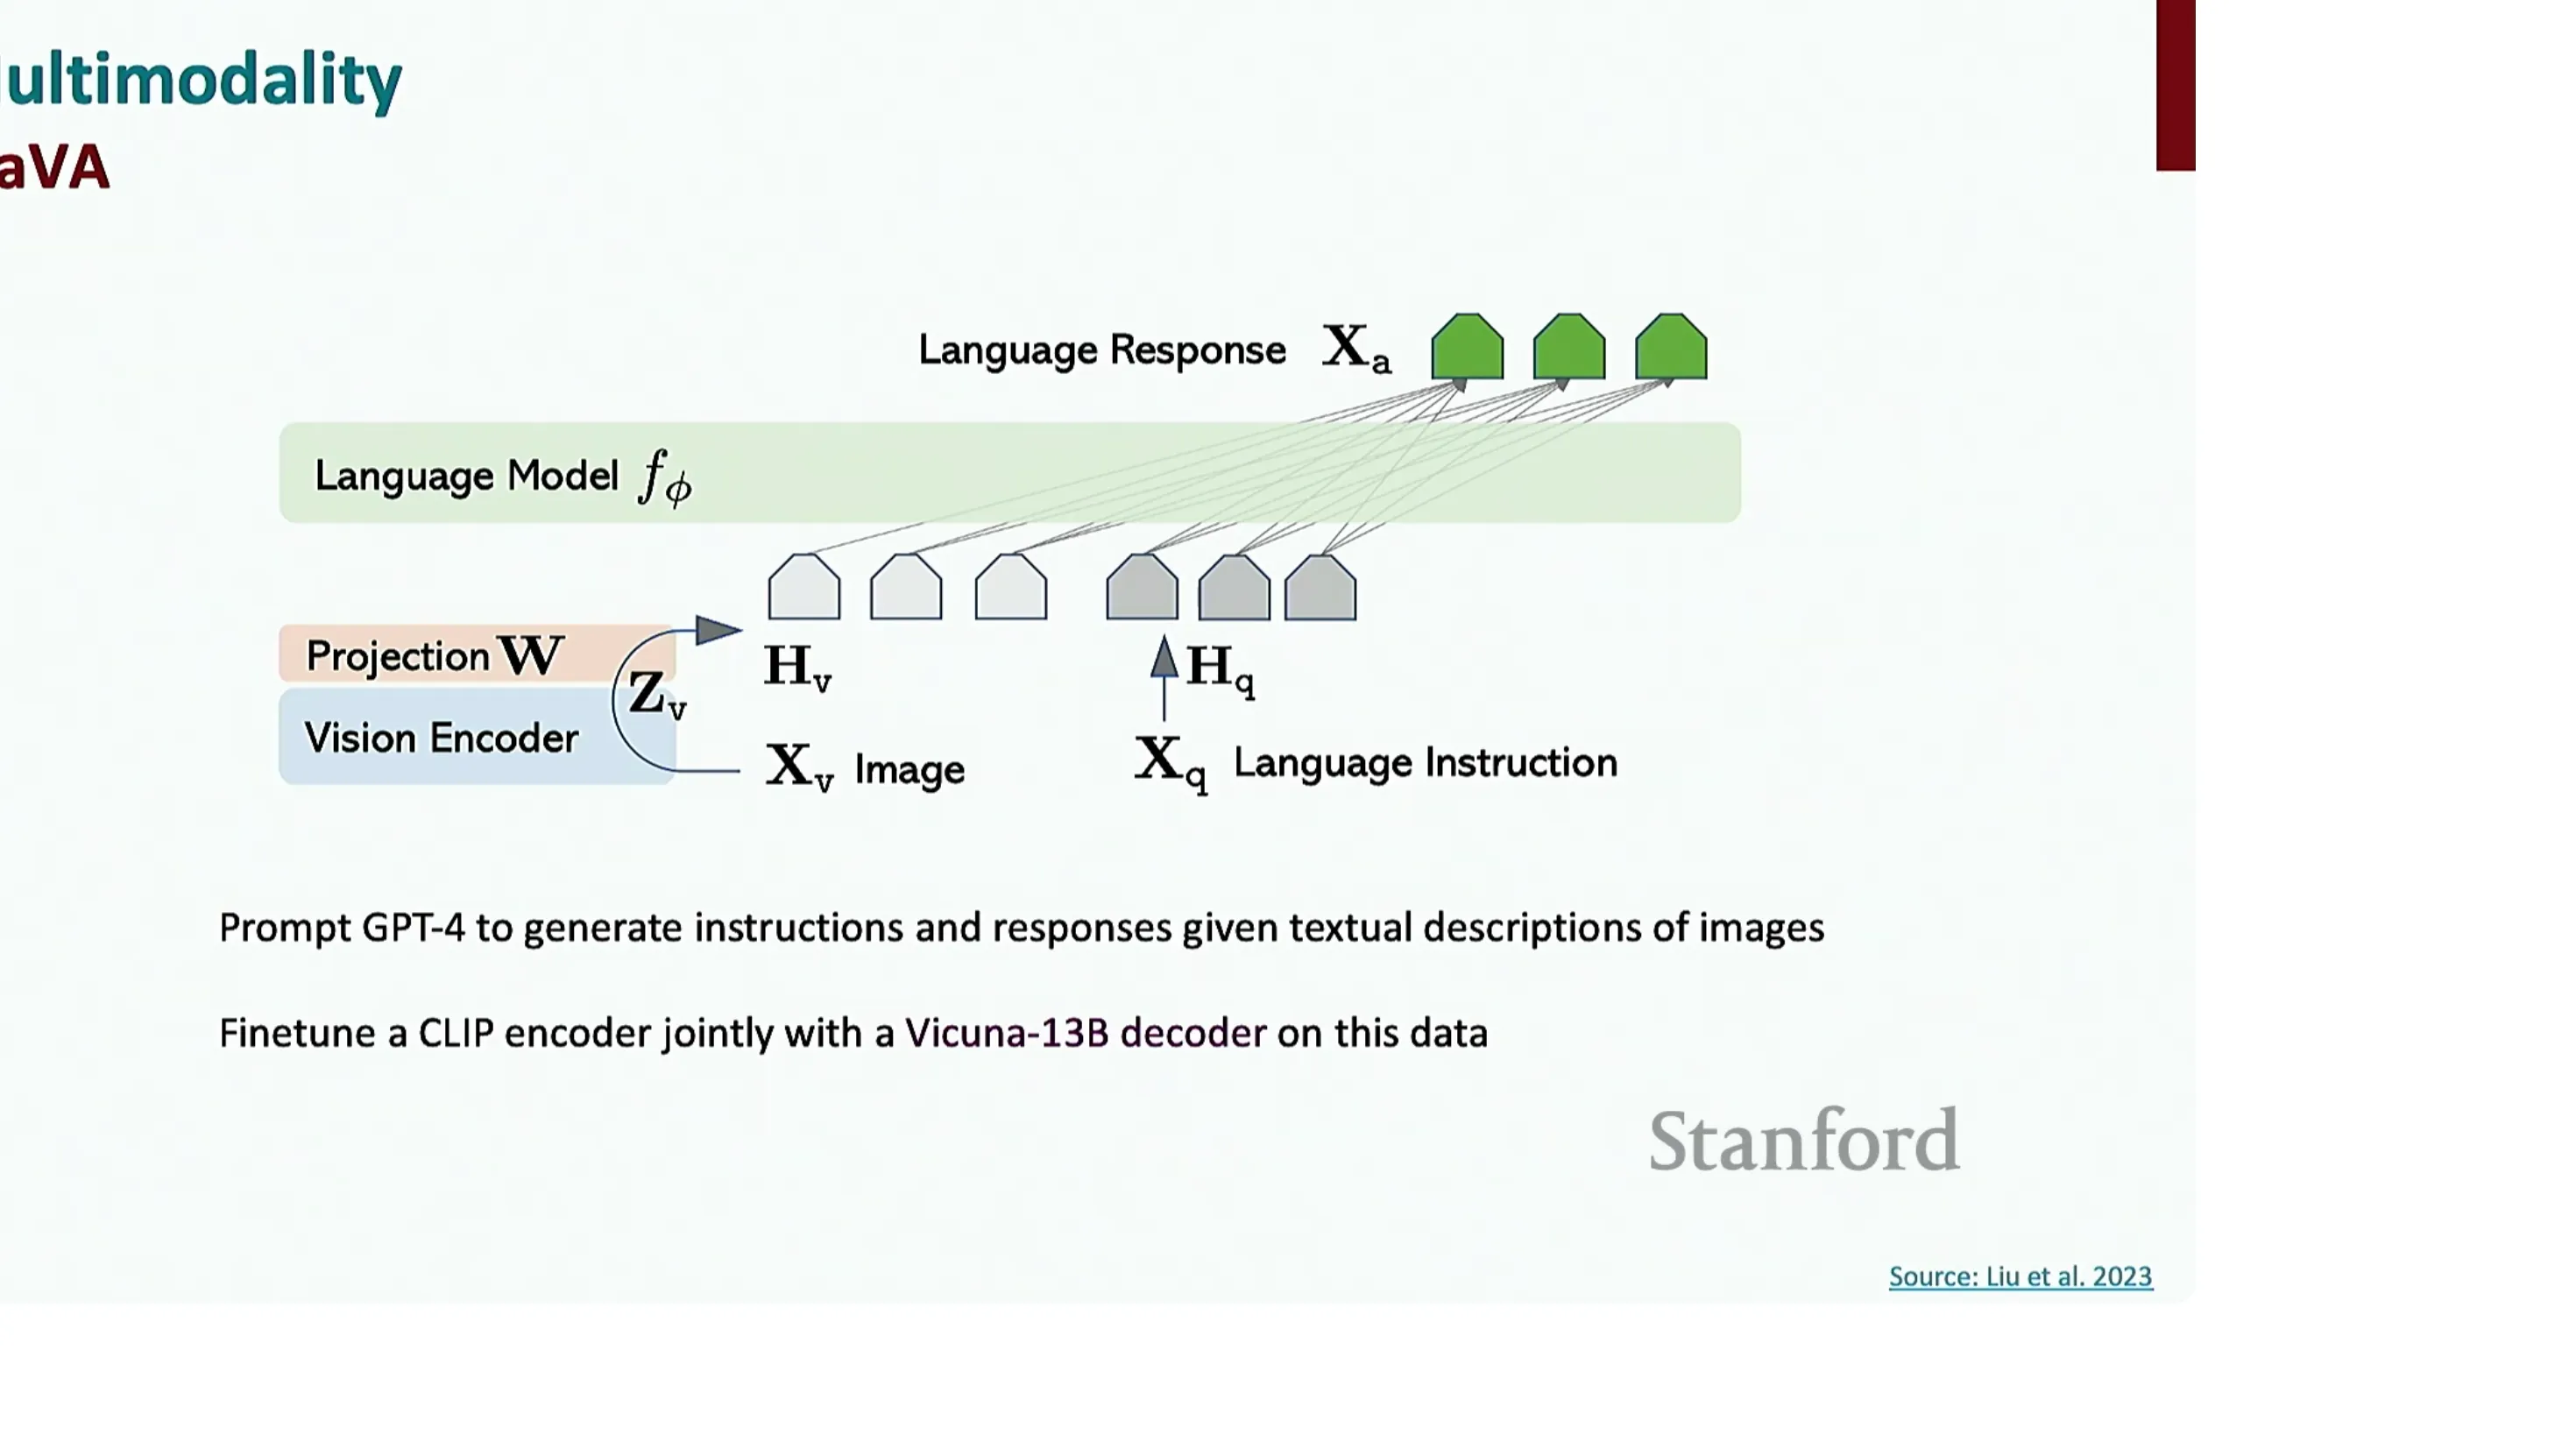
回到原视频 (00:54:55)Pix2Struct:新的预训练任务——看图补 HTML
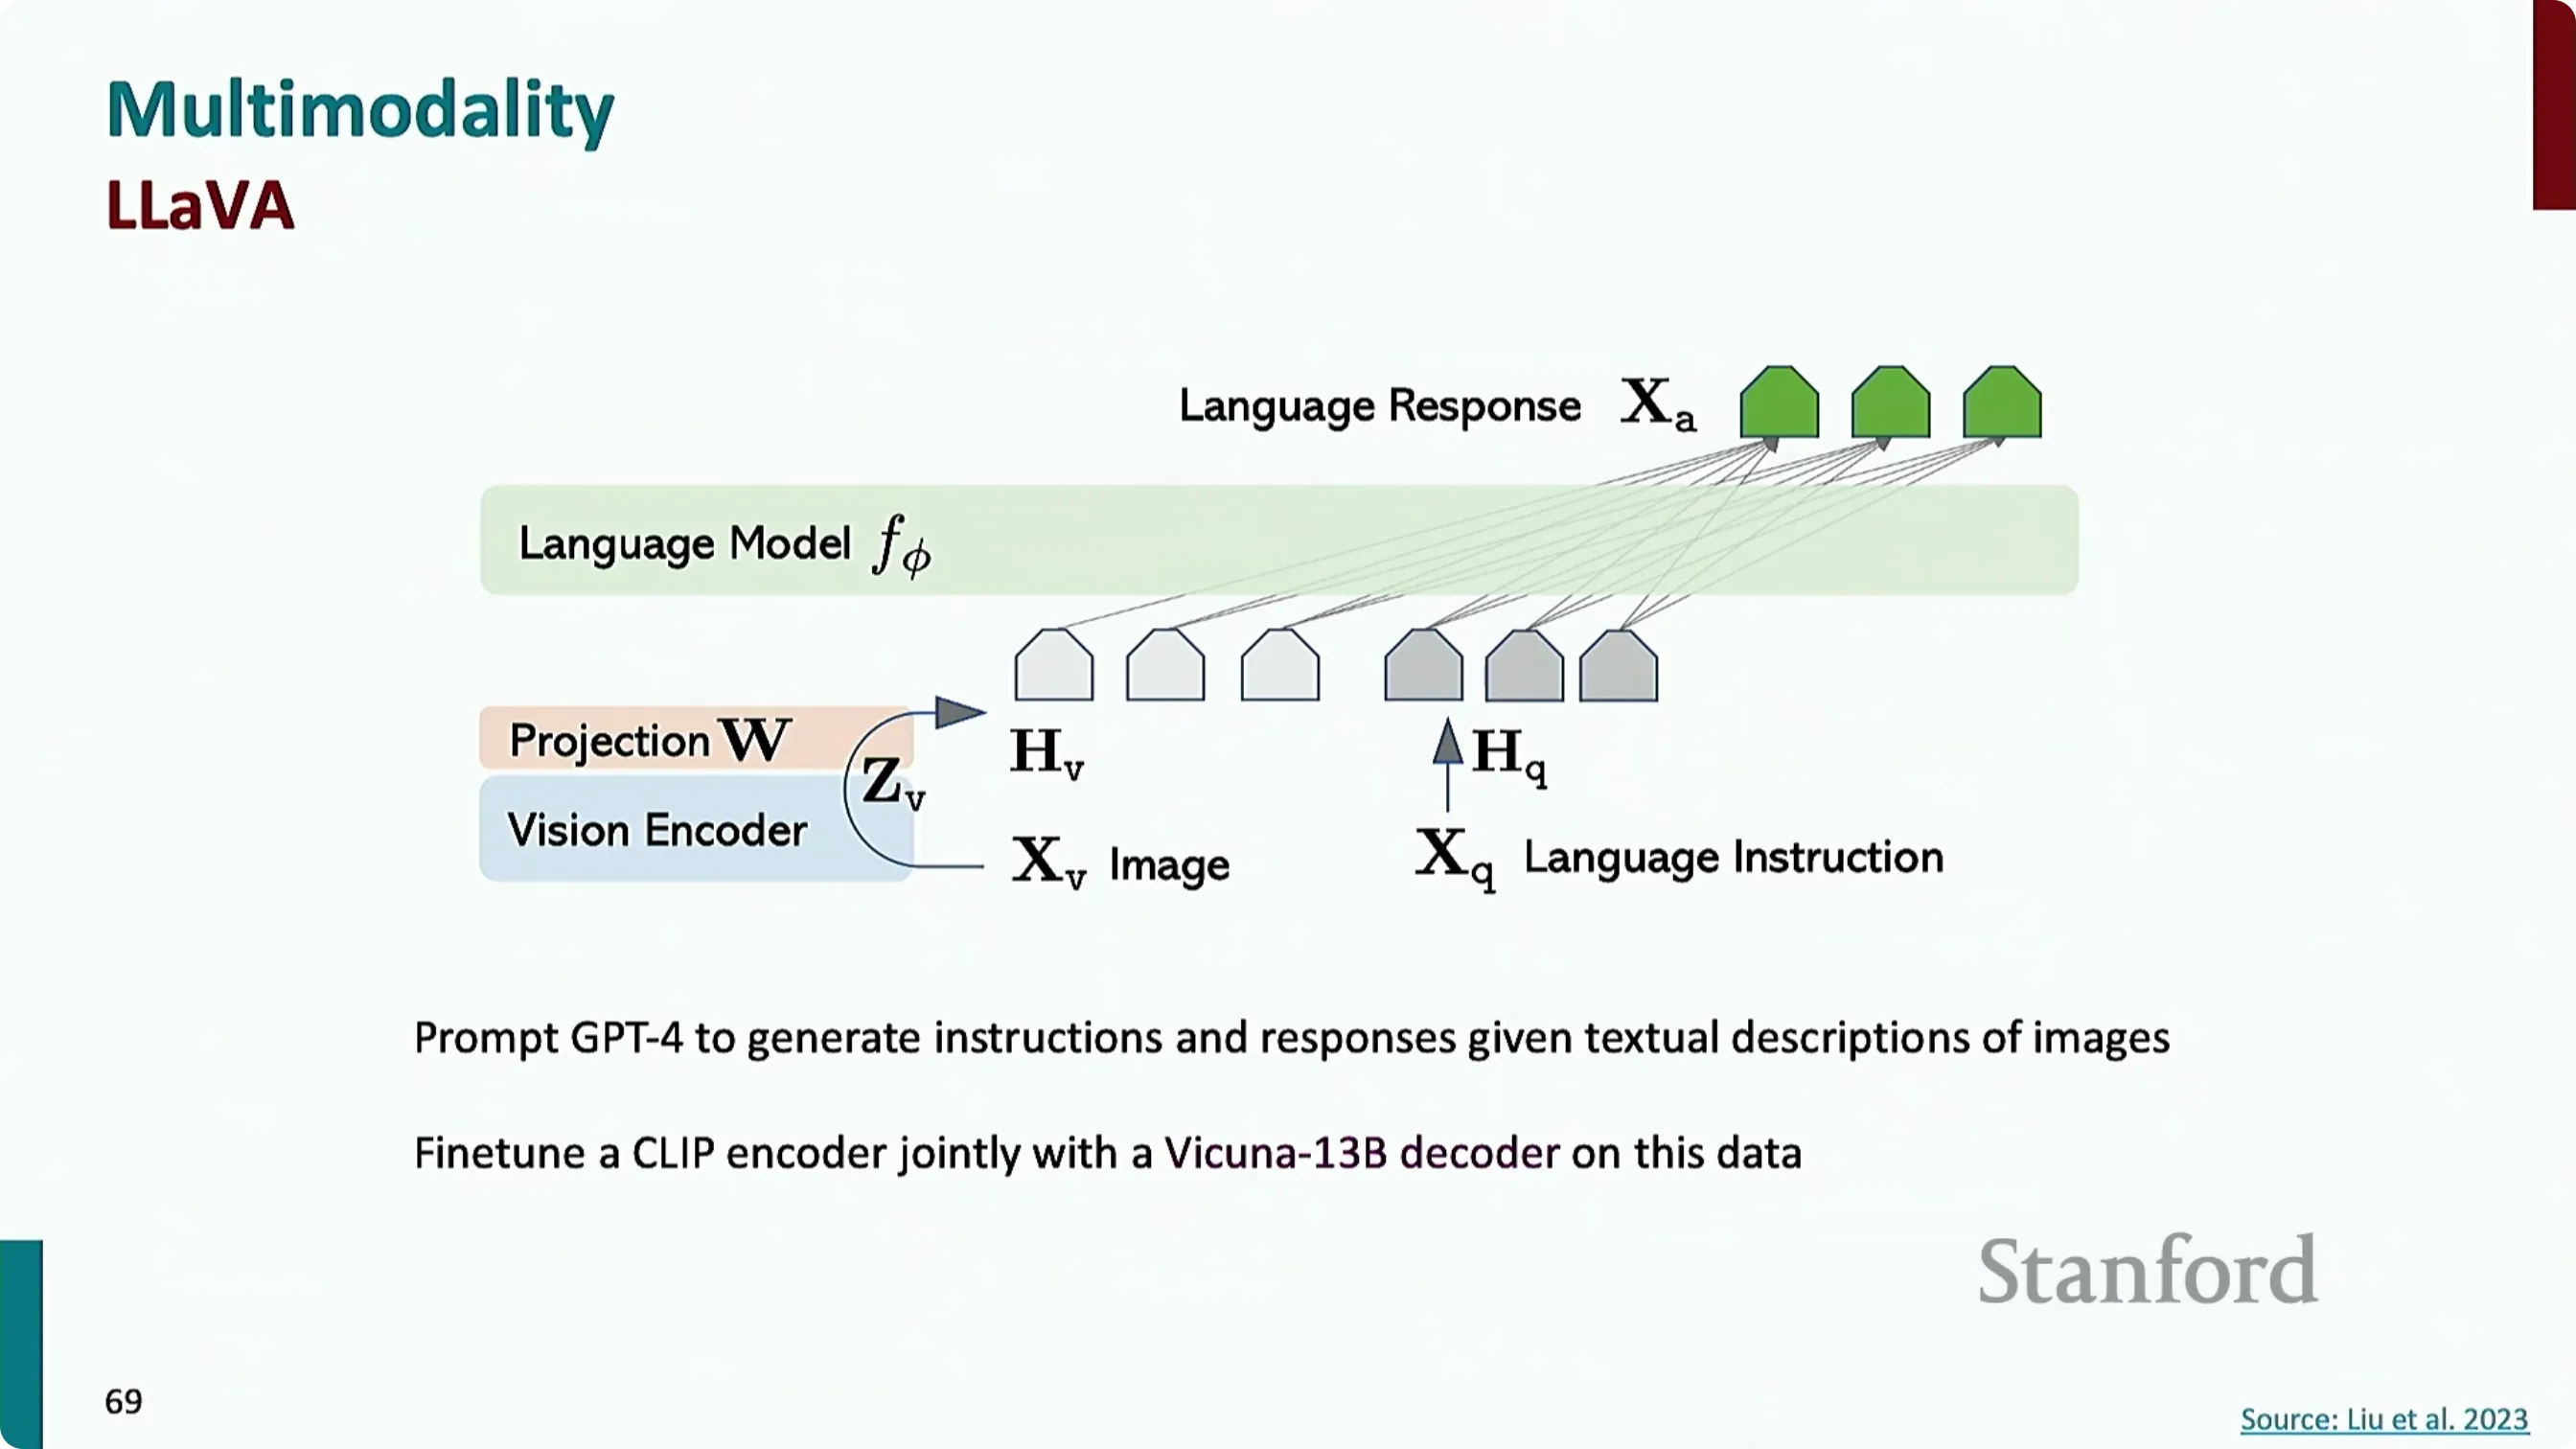
回到原视频 (00:56:30)2.8 那道很宽的"提示鸿沟"
模型犯的错,还相当"低级"
他的结论
结语:本讲回顾
graph TD
  R["推理 Reasoning"] --> R1["提示:CoT / 自洽性 / 最少到最多"]
  R --> R2["训练:Orca 蒸馏 / 强化自训练"]
  R --> R3["打假:忠实性 / 反事实 / 类比推理"]
  A["智能体 Agents"] --> A1["术语与设定:观察—动作—指令"]
  A --> A2["历史:语义解析 / 计划 / 强化学习"]
  A --> A3["新范式:决策 = 自回归生成"]
  A --> A4["评测:MiniWoB / WebArena / WebLINX"]
  A --> A5["训练:随机探索 + 迭代重标注"]
  A --> A6["多模态:LLaVA / Pix2Struct"]
附录:课堂未展示的幻灯片
Search[Apple Remote] → Obs₁ → Thought₂ → Search[Front Row] → Obs₂(未找到,给出相似项)→ Thought₃ → Search[Front Row (software)] → Obs₃ → Thought₄ → Finish[keyboard function keys]。
{instruction, API} 配对,并在 LLaMA 上微调。
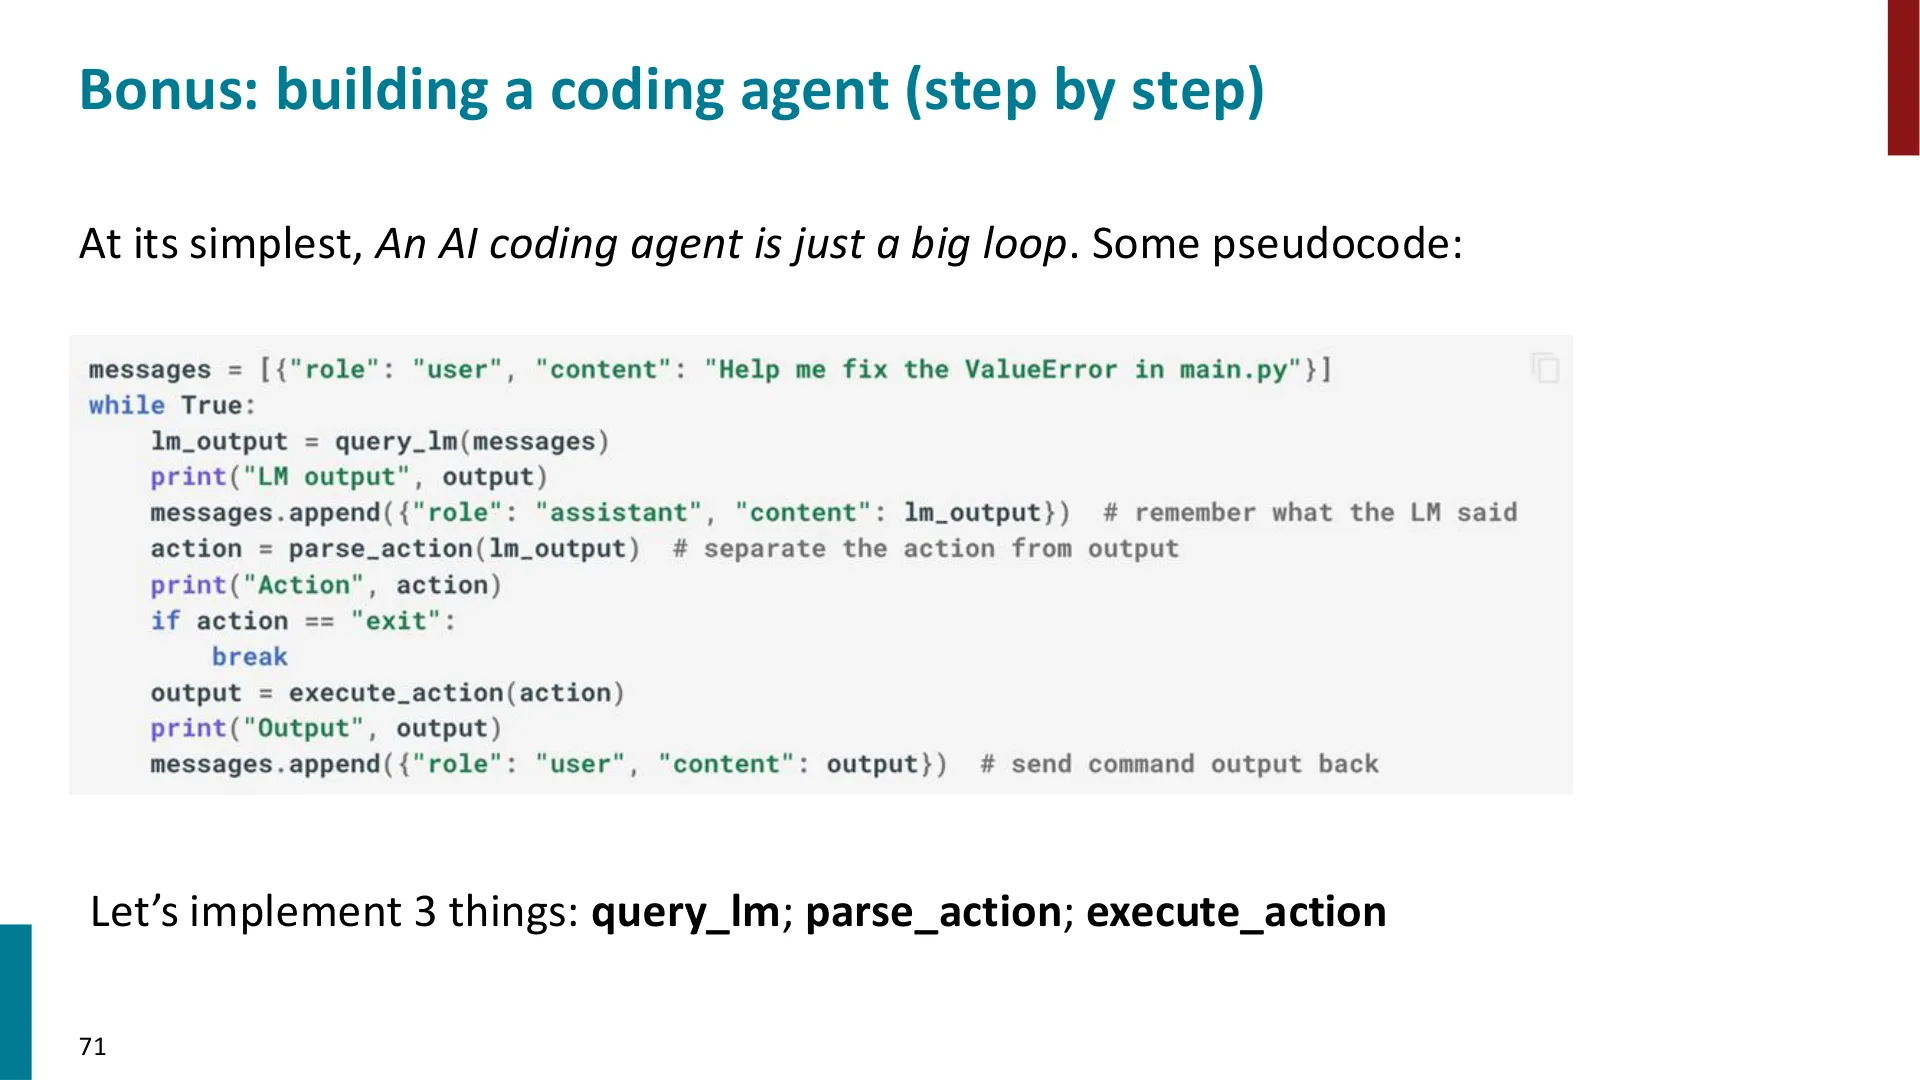
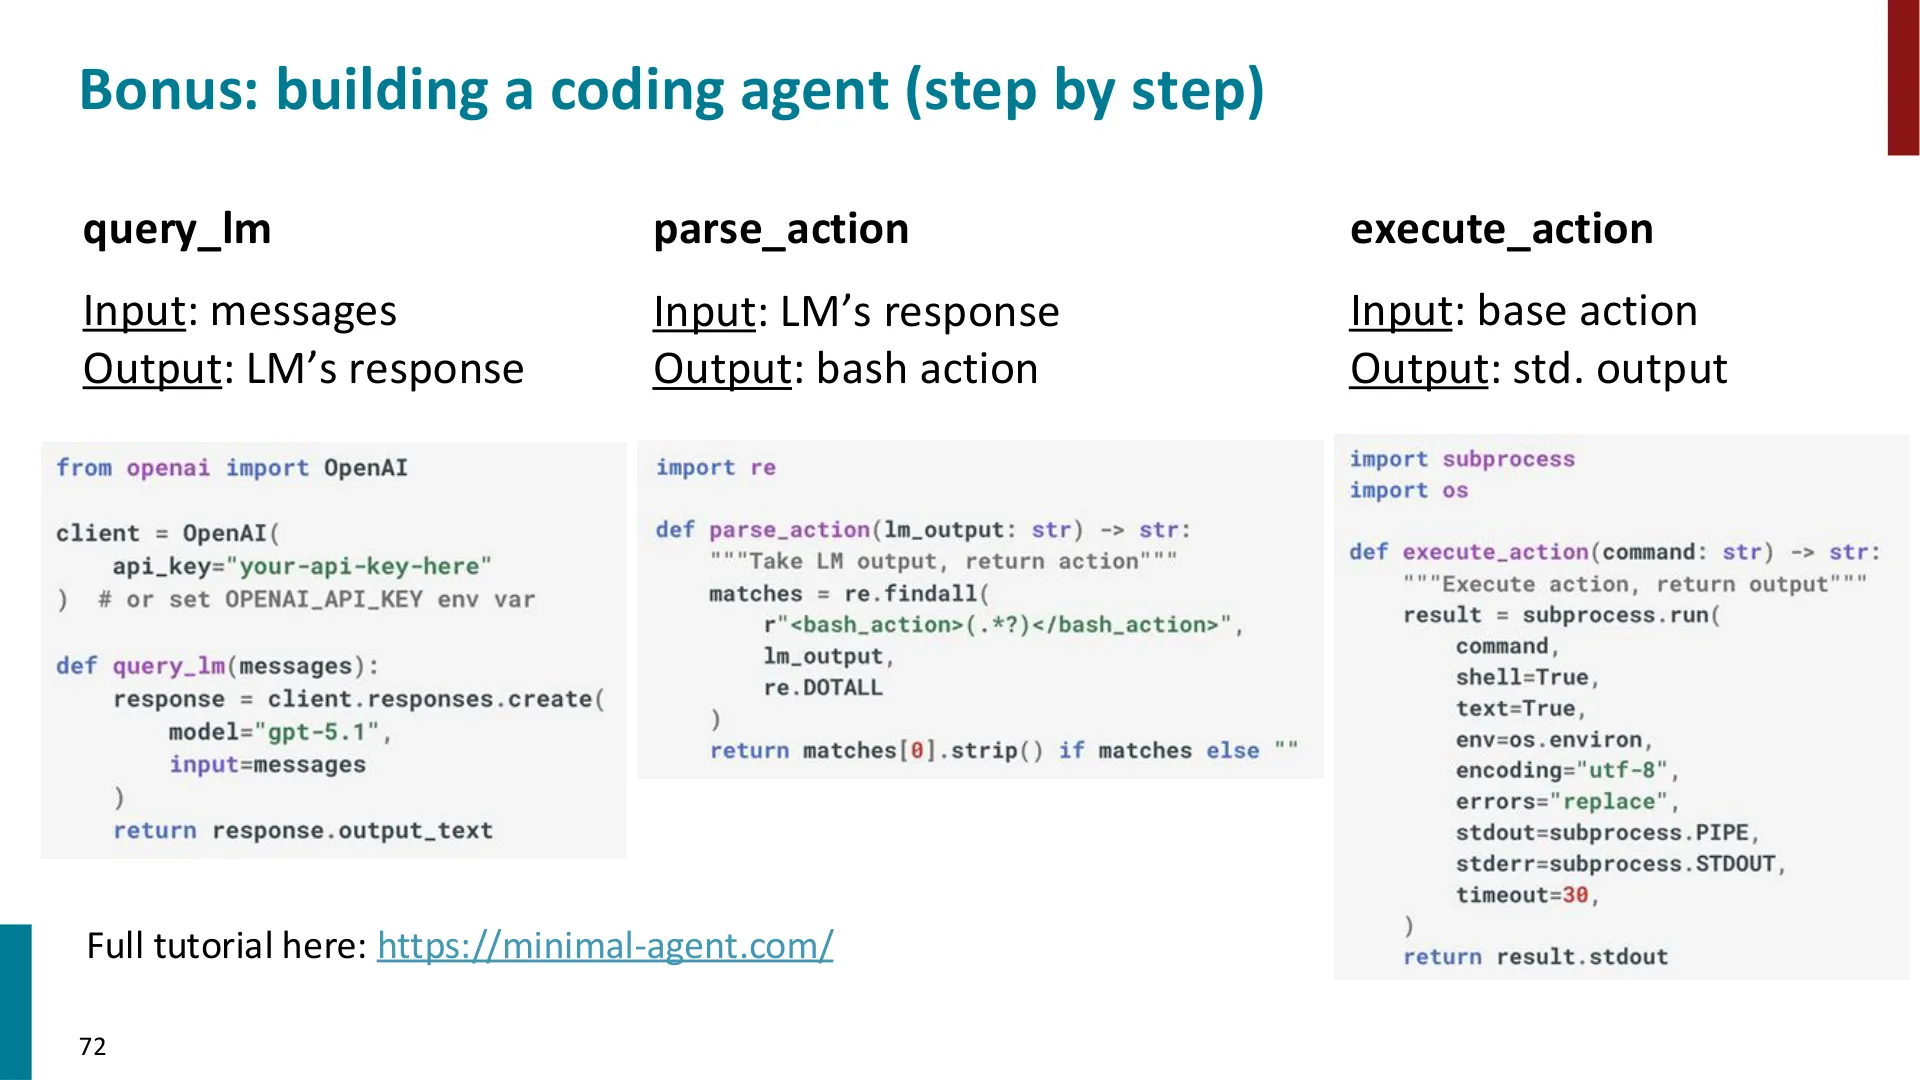
query_lm、parse_action、execute_action。query_lm(输入 messages,输出 LM 的响应)、parse_action(输入 LM 的响应,输出 bash 动作)、execute_action(输入基础动作,输出标准输出)。完整教程见 https://minimal-agent.com/。
附:官方参考与延伸阅读
课程与课件
cs224n-2026-lecture10-rag-agents.pdf(本讲附录收录了课堂未展示的各页)第一部分 · 推理
主题
文献
思维链提示
Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, NeurIPS 2022
零样本"一步步想"
Kojima et al., Large Language Models are Zero-Shot Reasoners, NeurIPS 2022
自洽性
Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023
最少到最多
Zhou et al., Least-to-Most Prompting Enables Complex Reasoning in Large Language Models, ICLR 2023
指令数据
Longpre et al., The Flan Collection;Wei et al., Finetuned Language Models Are Zero-Shot Learners(FLAN)
蒸馏 / 解释式训练
Mukherjee et al., Orca: Progressive Learning from Complex Explanation Traces of GPT-4, 2023
强化自训练
Gulcehre et al., Reinforced Self-Training (ReST) for Language Modeling, 2023
小学数学基准
Cobbe et al., Training Verifiers to Solve Math Word Problems(GSM8K), 2021
数学基准
Hendrycks et al., Measuring Mathematical Problem Solving With the MATH Dataset, 2021
多步推理基准
Suzgun et al., Challenging BIG-Bench Tasks and Whether Chain-of-Thought Can Solve Them(BIG-bench Hard), 2022
推理链忠实性
Lanham et al., Measuring Faithfulness in Chain-of-Thought Reasoning, 2023
反事实评估
Wu et al., Reasoning or Reciting? Exploring the Capabilities and Limitations of Language Models Through Counterfactual Tasks, 2023
类比推理
Webb, Holyoak & Lu, Emergent analogical reasoning in large language models, Nature Human Behaviour, 2023
第二部分 · 智能体
主题
文献 / 链接
把 RL 当序列建模
Janner et al., Reinforcement Learning as One Big Sequence Modeling Problem(Trajectory Transformer), 2021;Chen et al., Decision Transformer, 2021
极简浏览器沙盒
MiniWoB(Shi et al., World of Bits, 2017)
接近真实网站的沙盒
Zhou et al., WebArena: A Realistic Web Environment for Building Autonomous Agents, 2023 · https://webarena.dev/
真实网站交互集合
Lù et al., WebLINX, 2024 · https://mcgill-nlp.github.io/weblinx/
通用网页智能体
Deng et al., Mind2Web: Towards a Generalist Agent for the Web, 2023
多模态模型
Liu et al., Visual Instruction Tuning(LLaVA), 2023 · https://llava-vl.github.io/;Radford et al., CLIP, 2021
图文预训练
Lee et al., Pix2Struct: Screenshot Parsing as Pretraining for Visual Language Understanding, 2023
推理 + 行动
Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, 2023
言语反思
Shinn et al., Reflexion: Language Agents with Verbal Reinforcement Learning, 2023
虚构小镇智能体
Park et al., Generative Agents: Interactive Simulacra of Human Behavior, 2023
虚拟上下文管理
Packer et al., MemGPT: Towards LLMs as Operating Systems, 2023
终身学习智能体
Wang et al., Voyager: An Open-Ended Embodied Agent with Large Language Models, 2023
工具调用(自学习)
Schick et al., Toolformer: Language Models Can Teach Themselves to Use Tools, 2023
工具调用(词元化)
Hao et al., ToolkenGPT, 2024
海量 API
Patil et al., Gorilla: Large Language Model Connected with Massive APIs, 2023
多智能体辩论
Du et al., Improving Factuality and Reasoning in Language Models through Multiagent Debate, 2023
多智能体编排
Microsoft, Magentic-One: A Generalist Multi-Agent System for Solving Complex Tasks
编程智能体基准
Jimenez & Yang, SWE-bench, 2023 · https://www.swebench.com/
计算机使用基准
Xie et al., OSWorld, 2024
从零构建编程智能体
https://minimal-agent.com/
第一部分之外的相邻主题(来自附录幻灯片)
已知疑点
SLIDE: 引用(第 29、30、34、38、60、61、62、63 页)是编者依据话题对应做出的判断,不保证讲师当时屏幕上显示的就是这一页。若读者以课件为准,请直接查阅原 PDF。附:参考与延伸阅读
编者补充
附录:课堂未展示的幻灯片
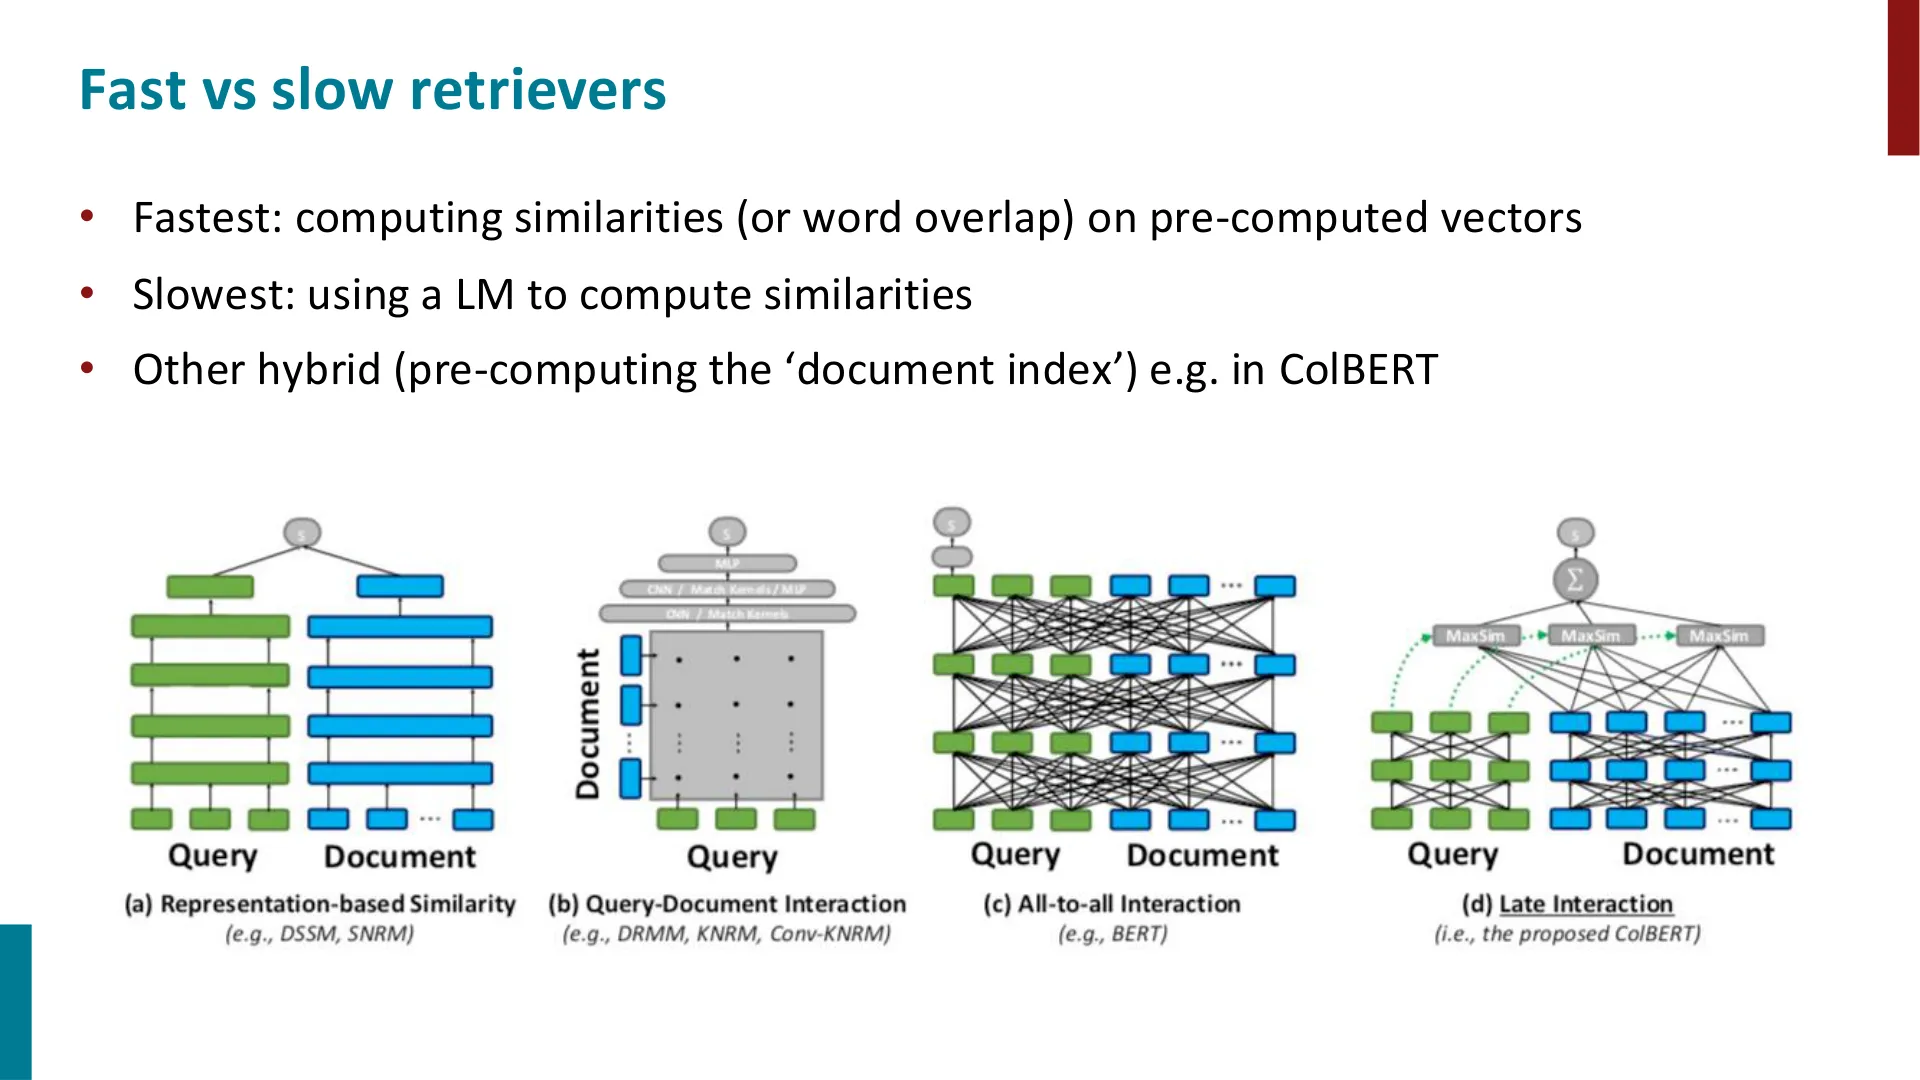
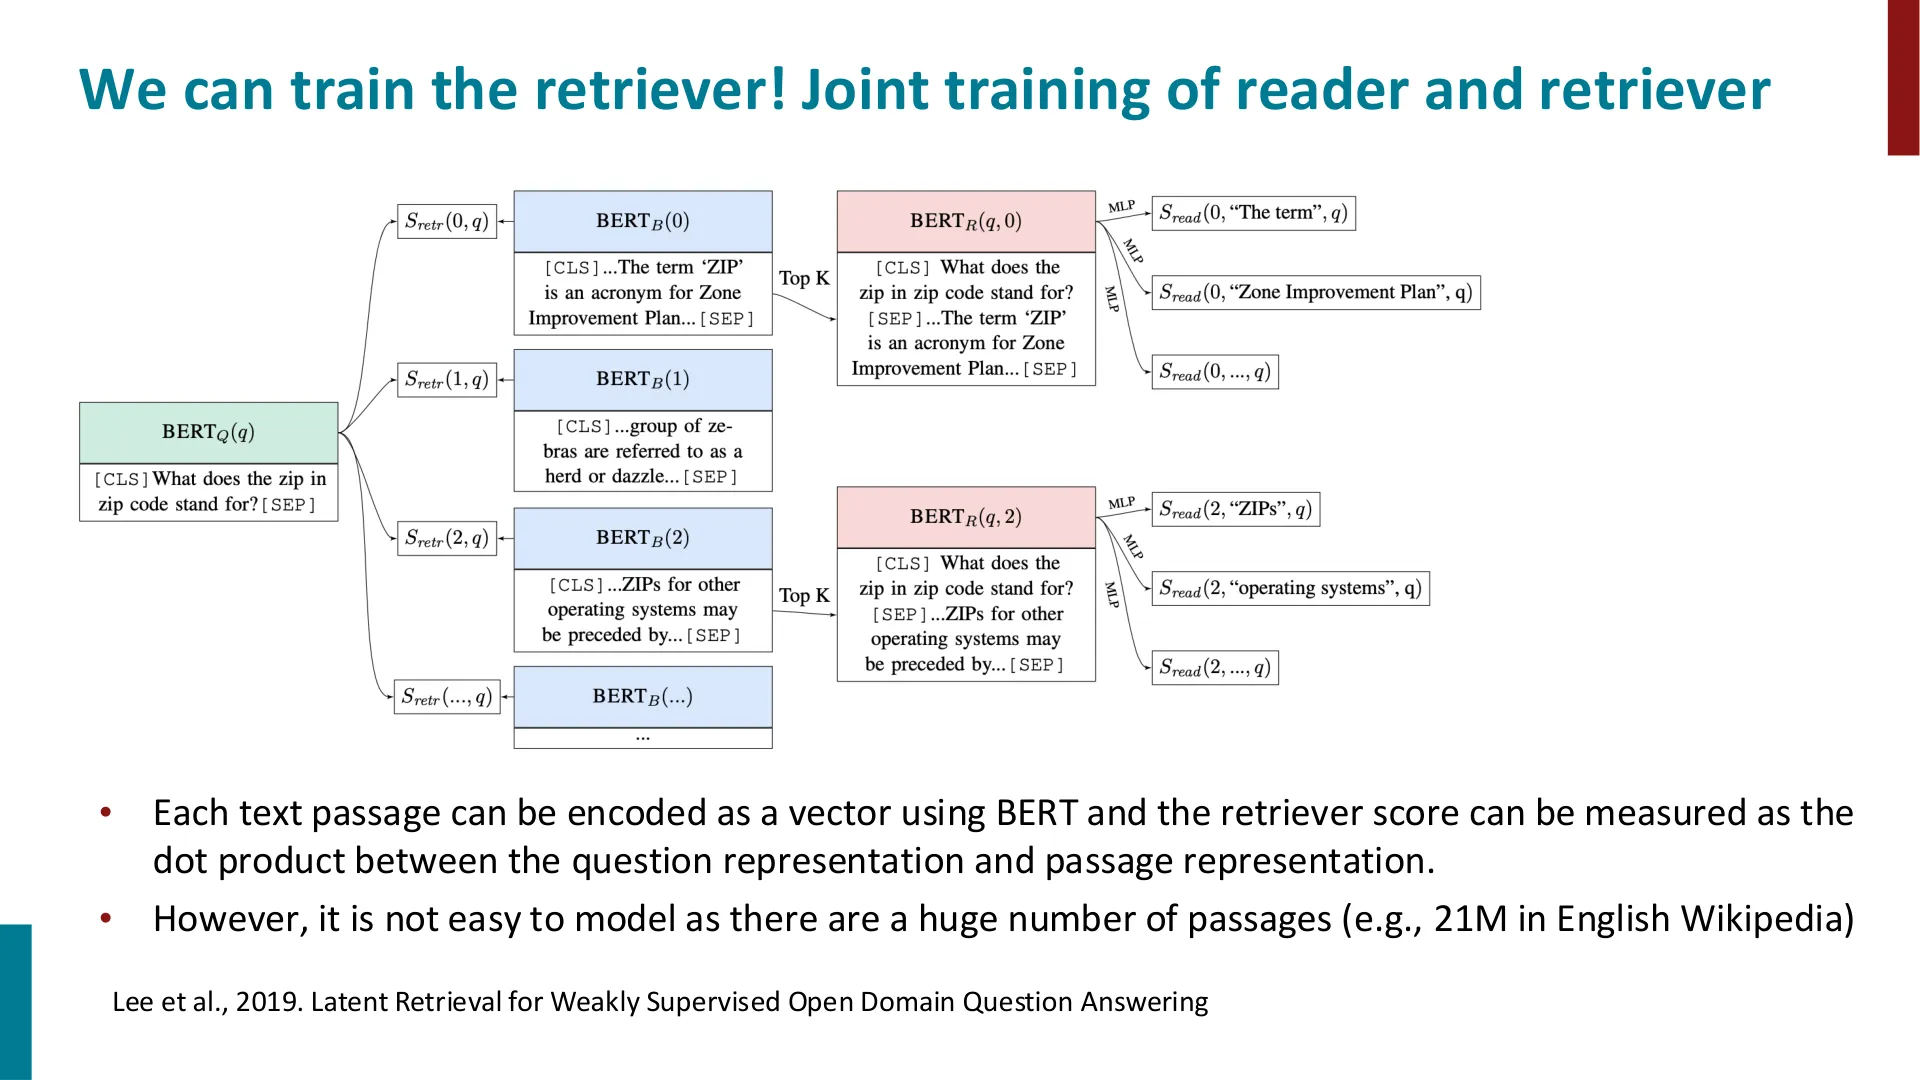
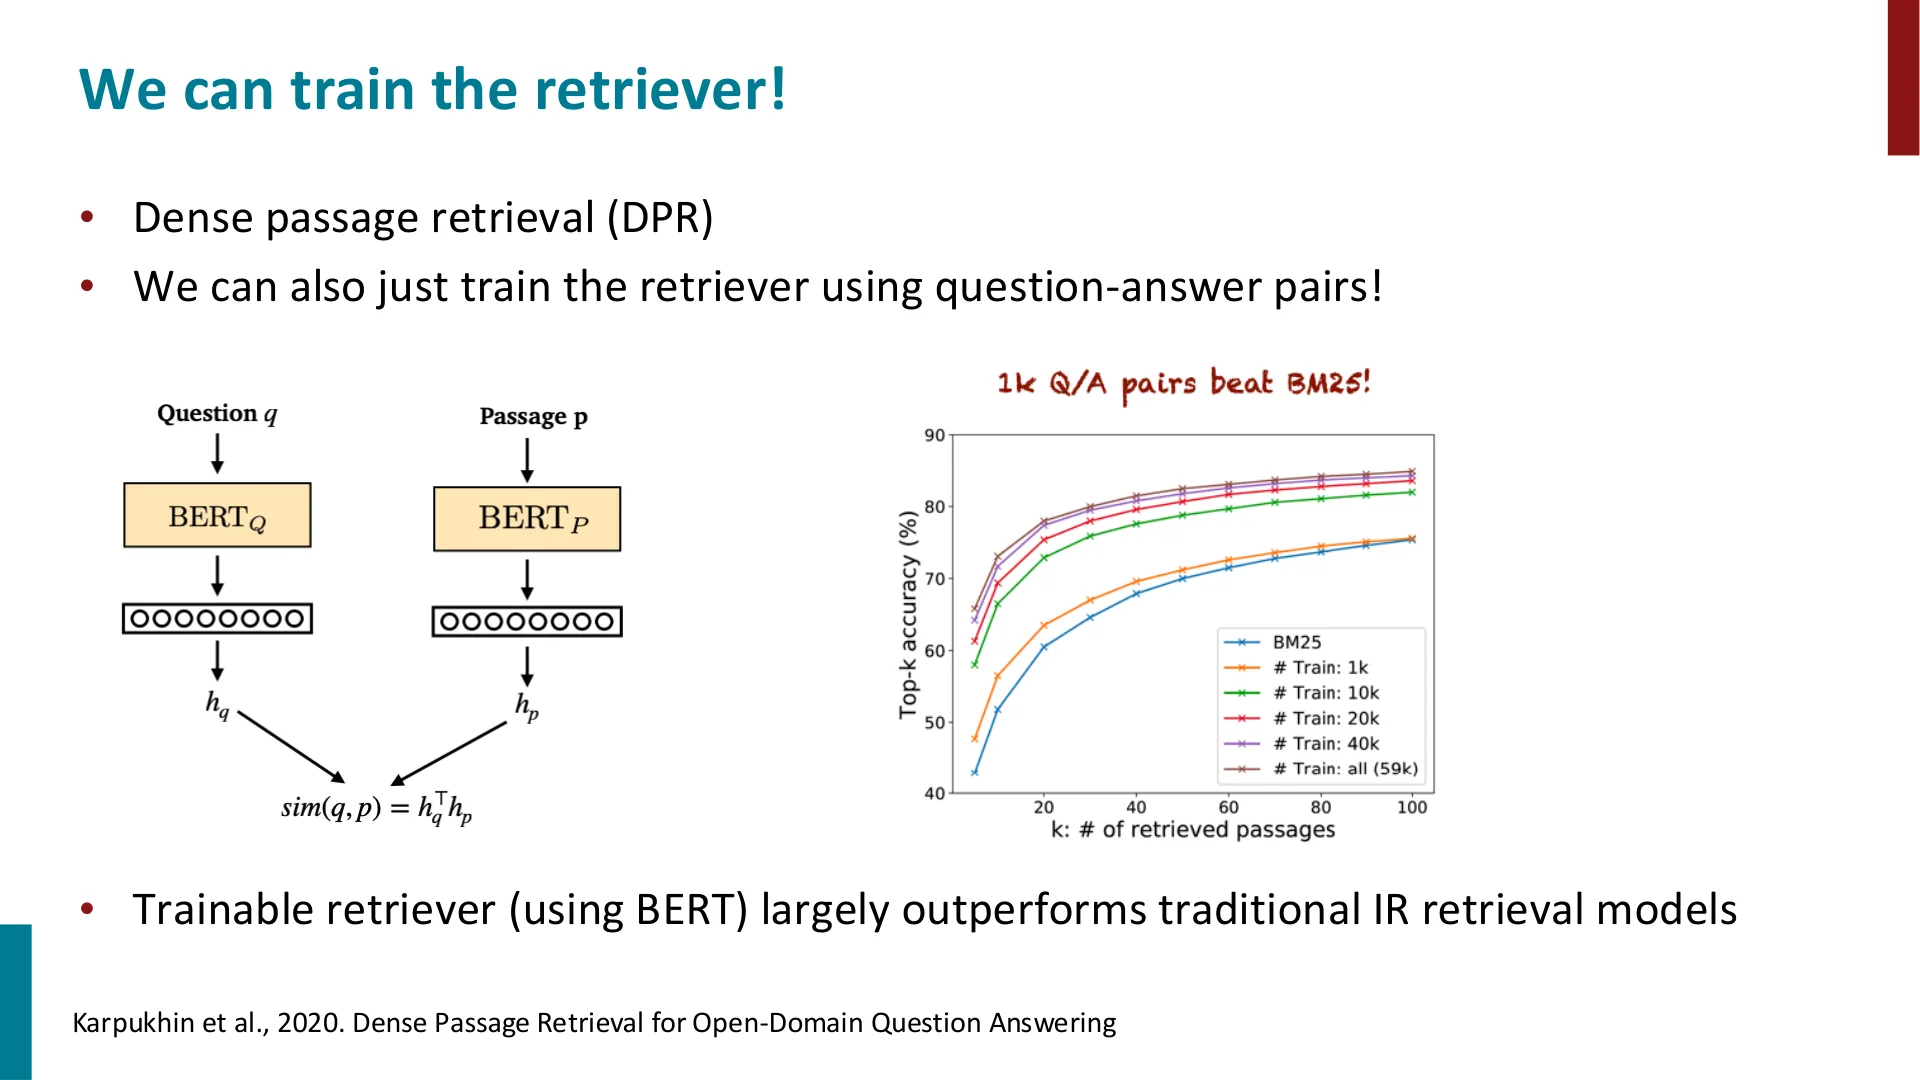
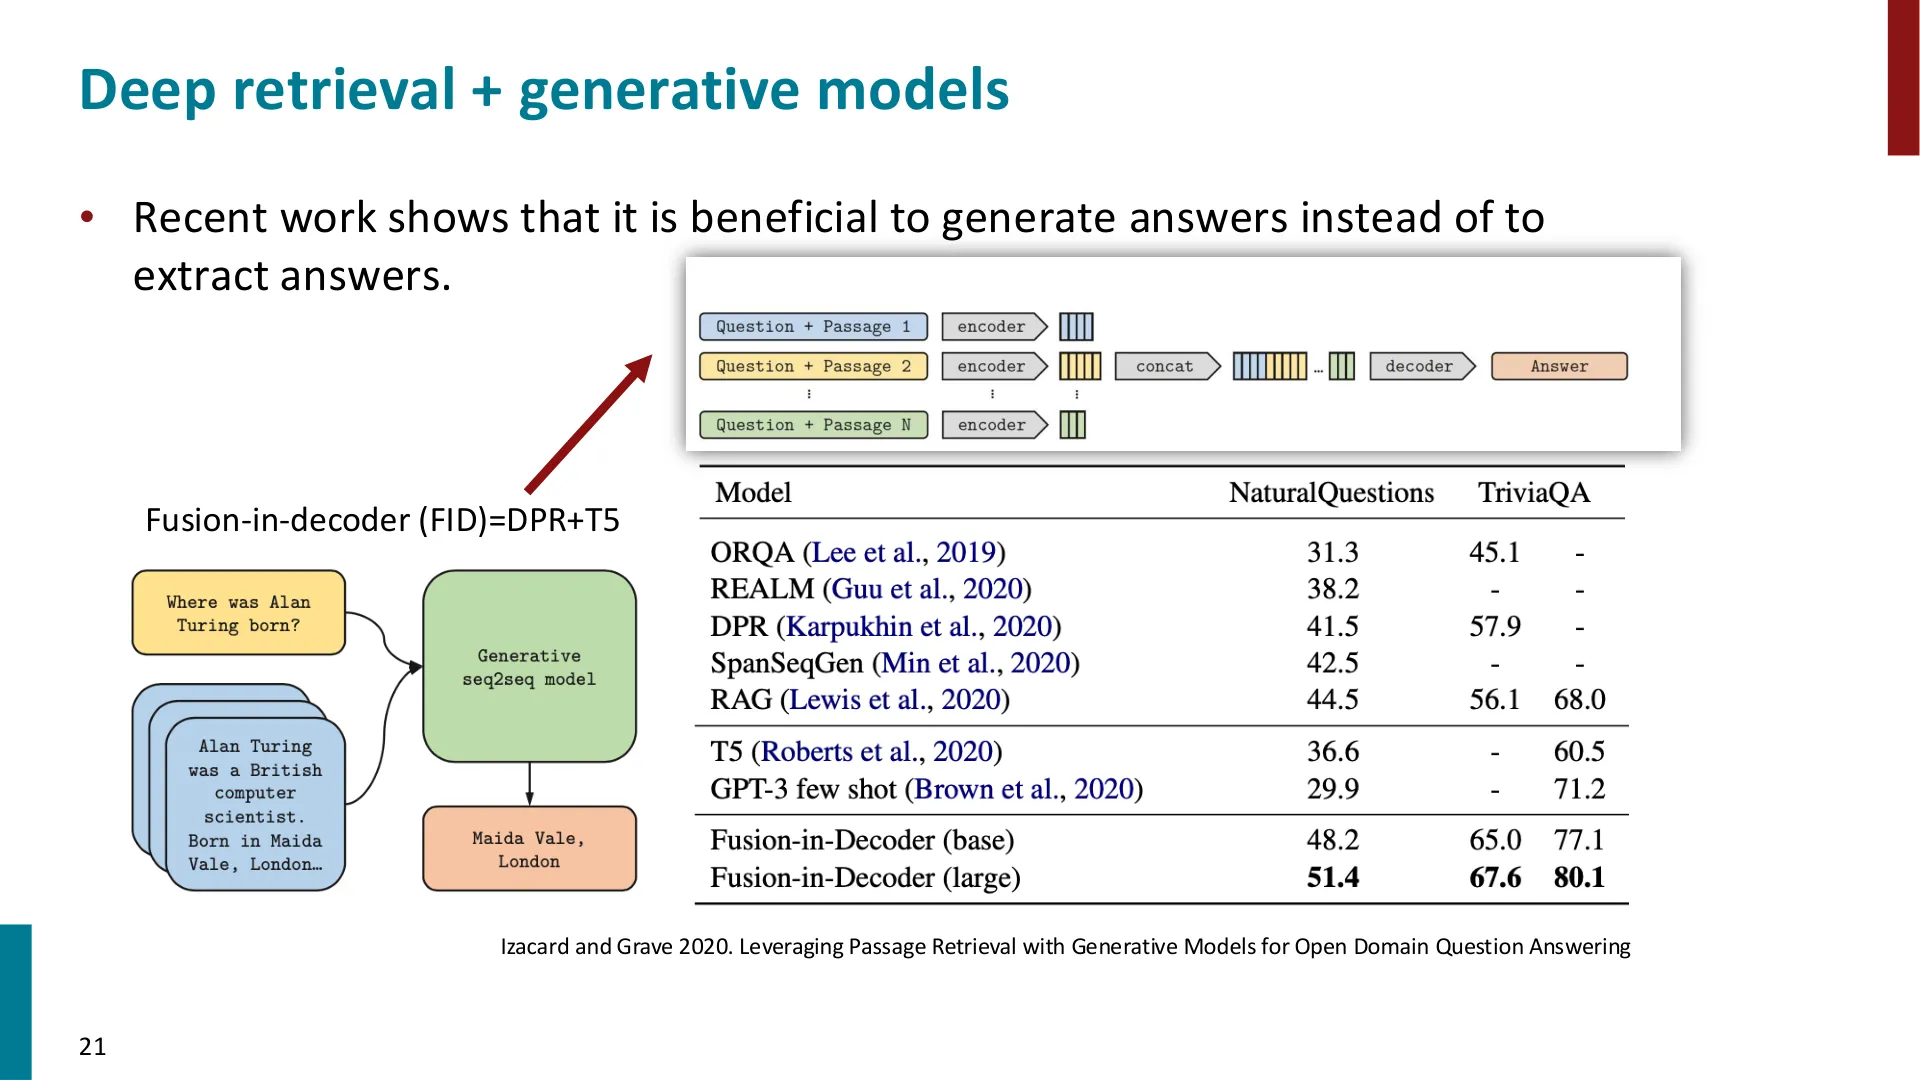
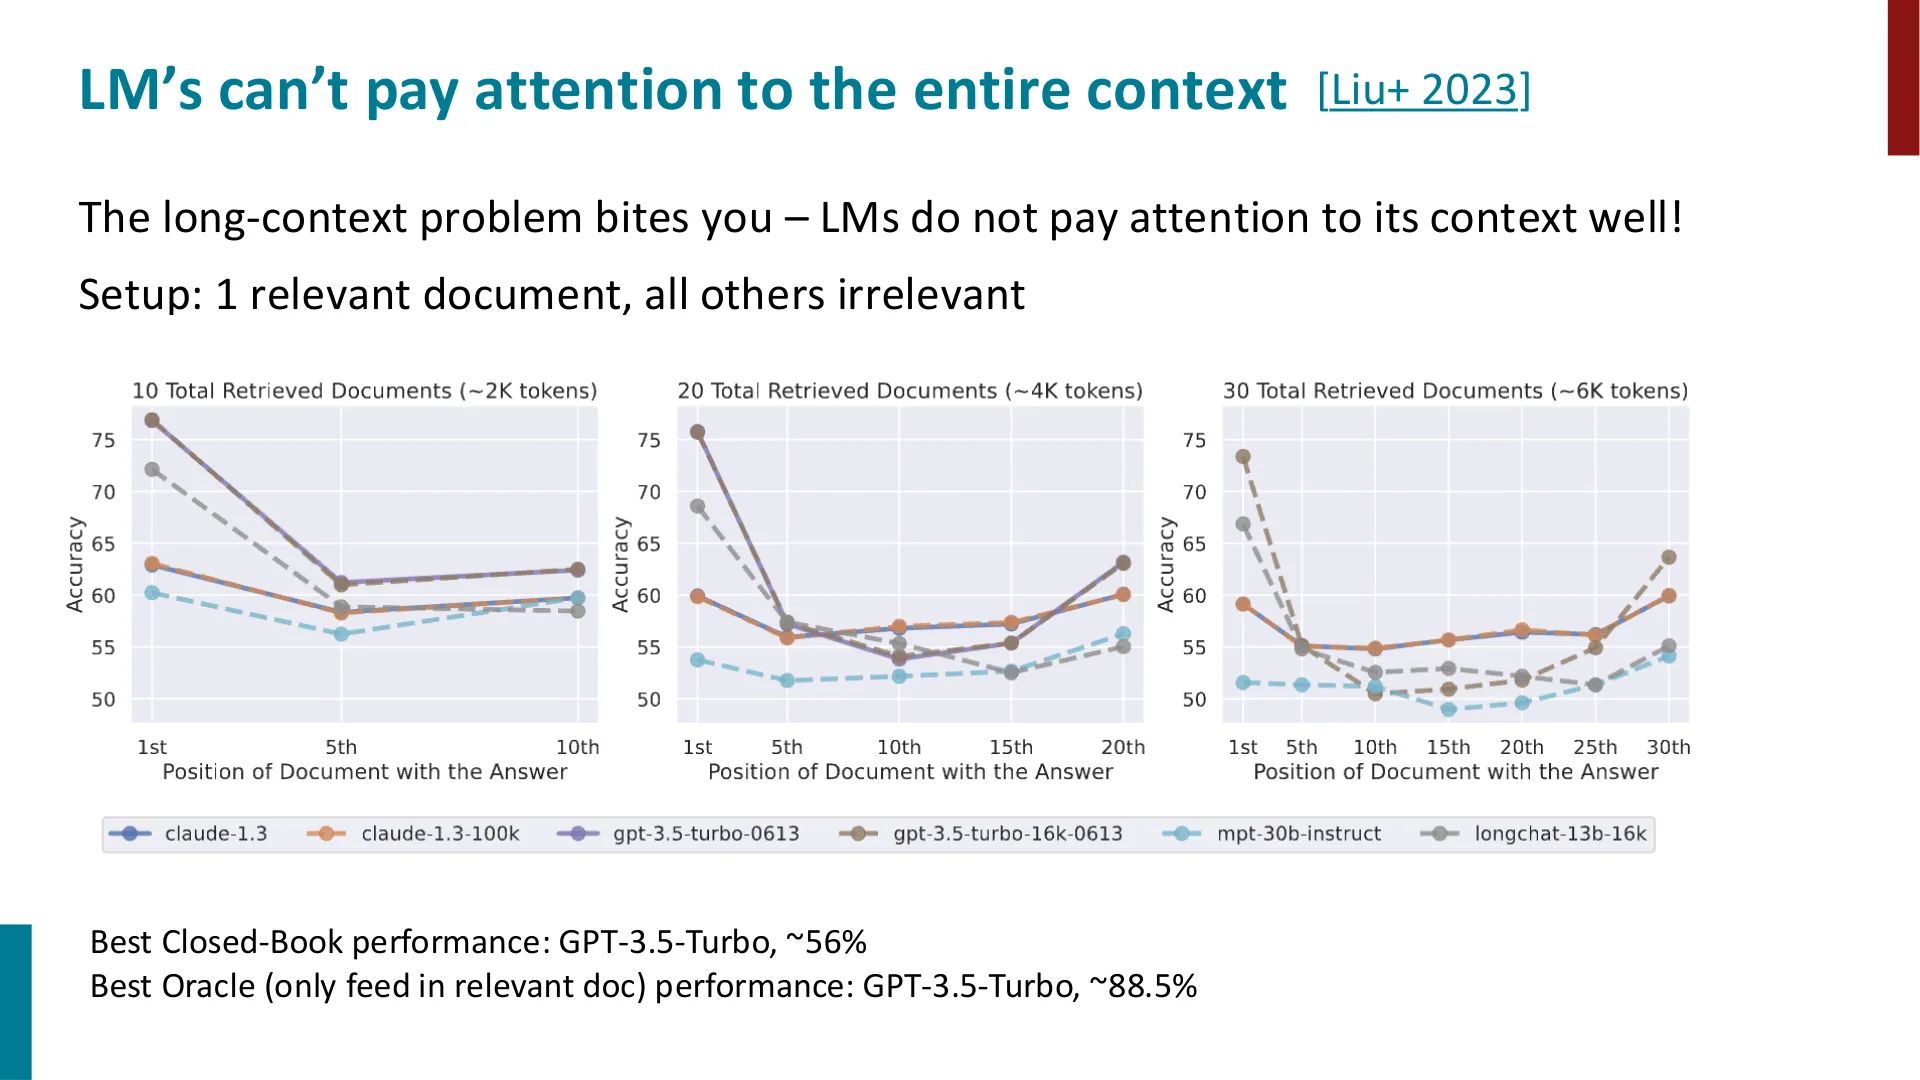
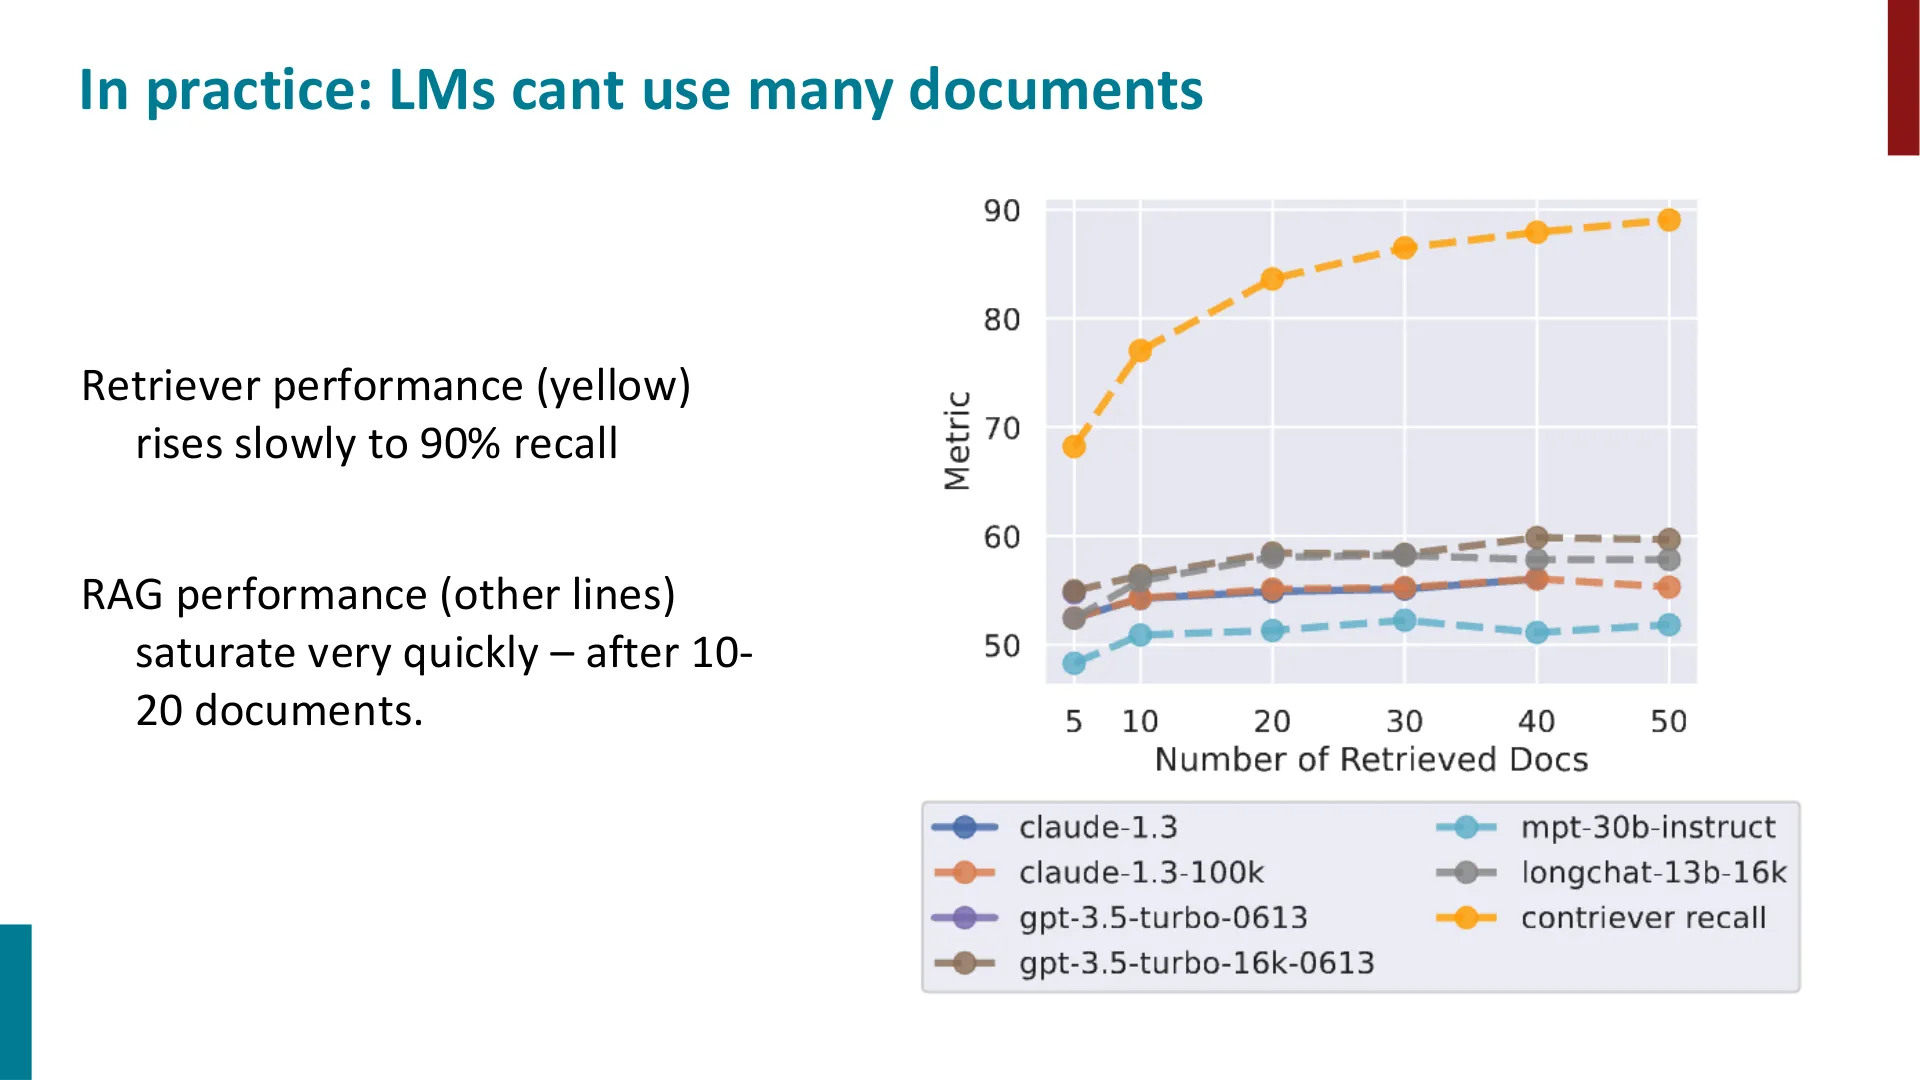
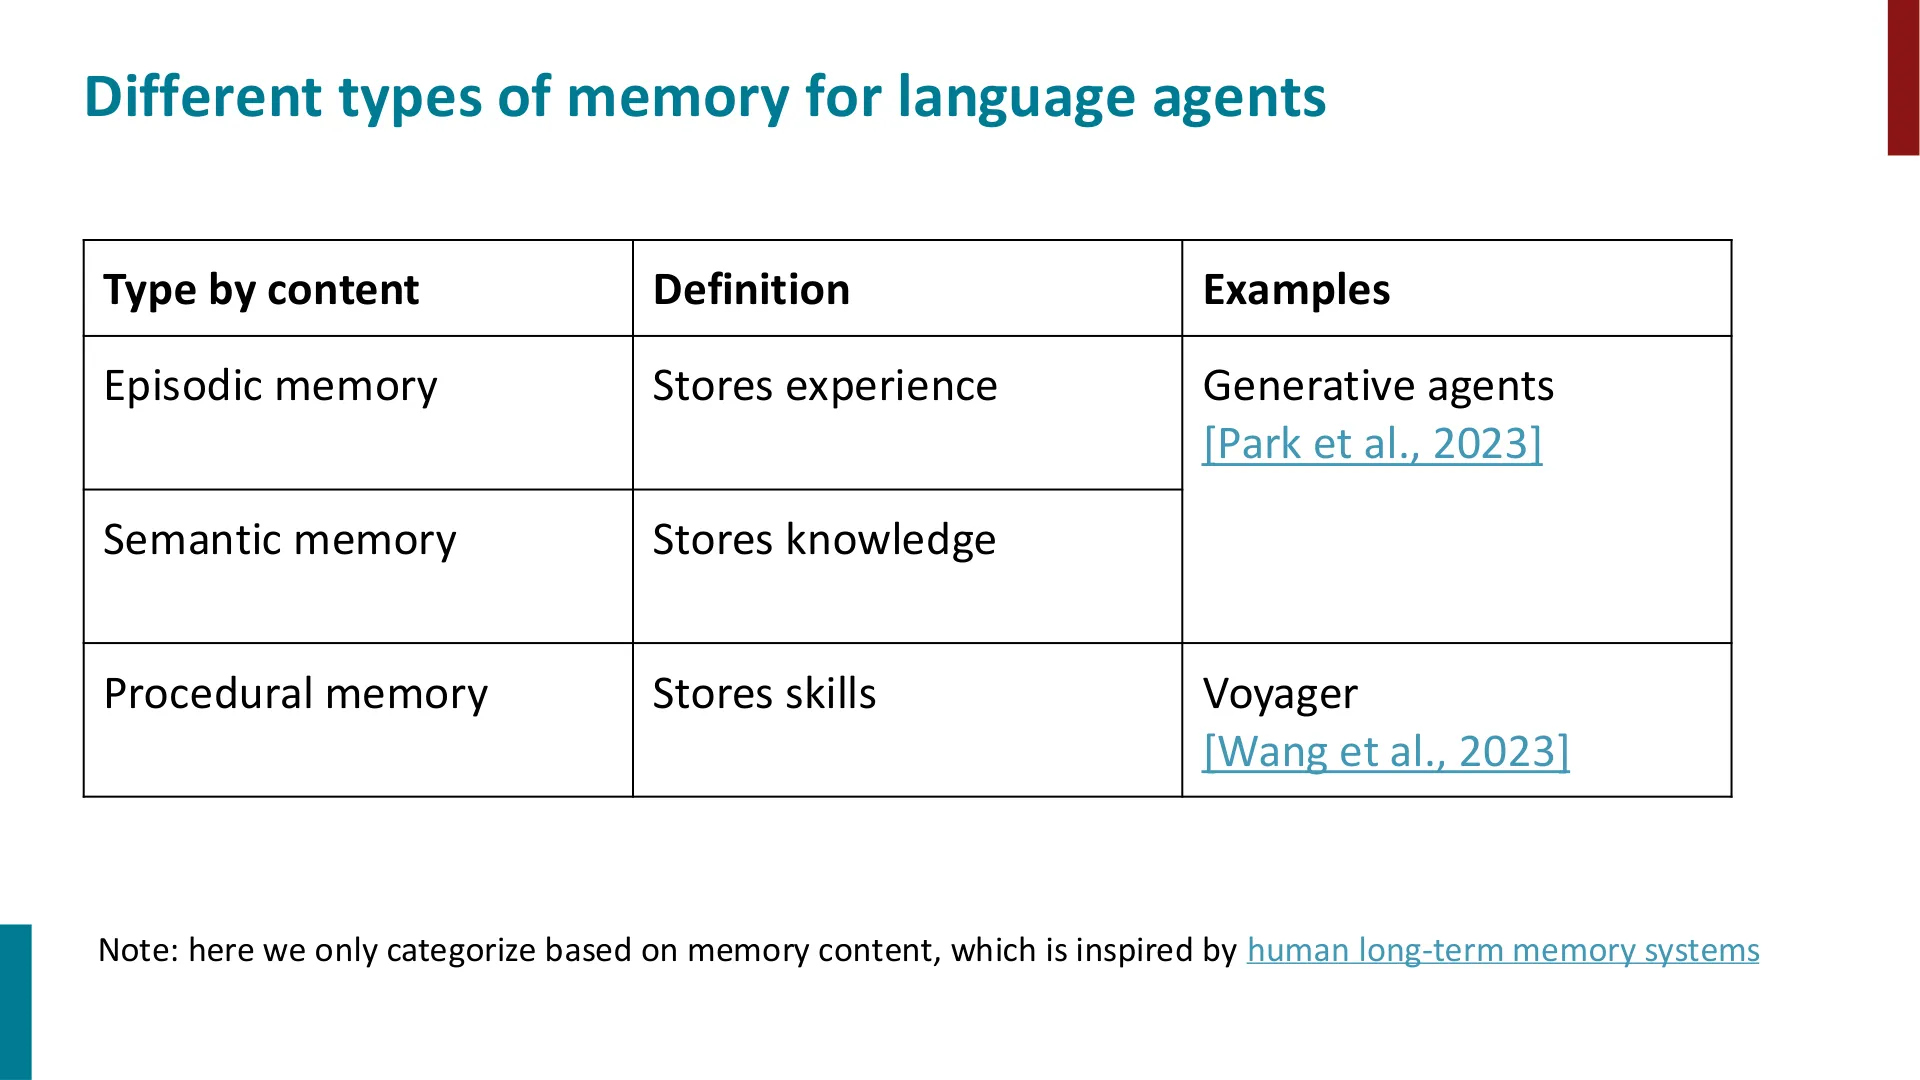
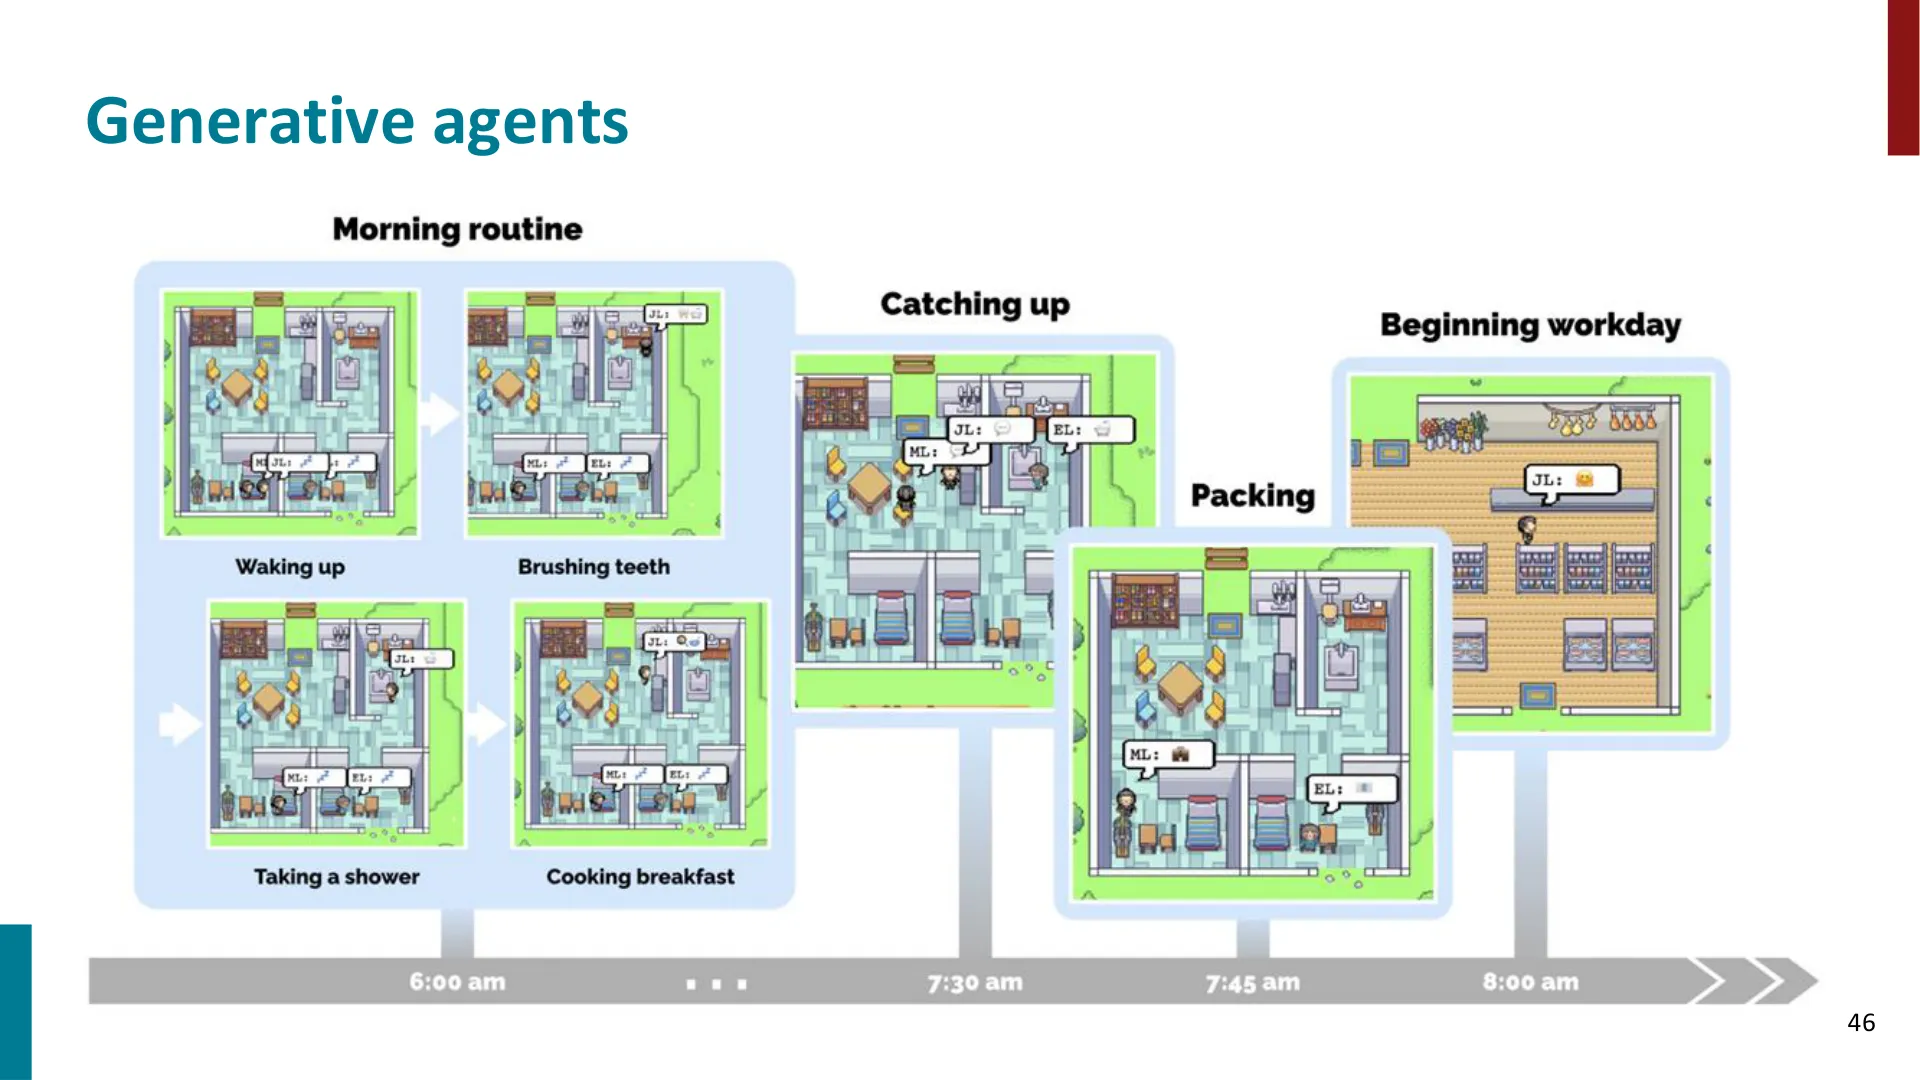
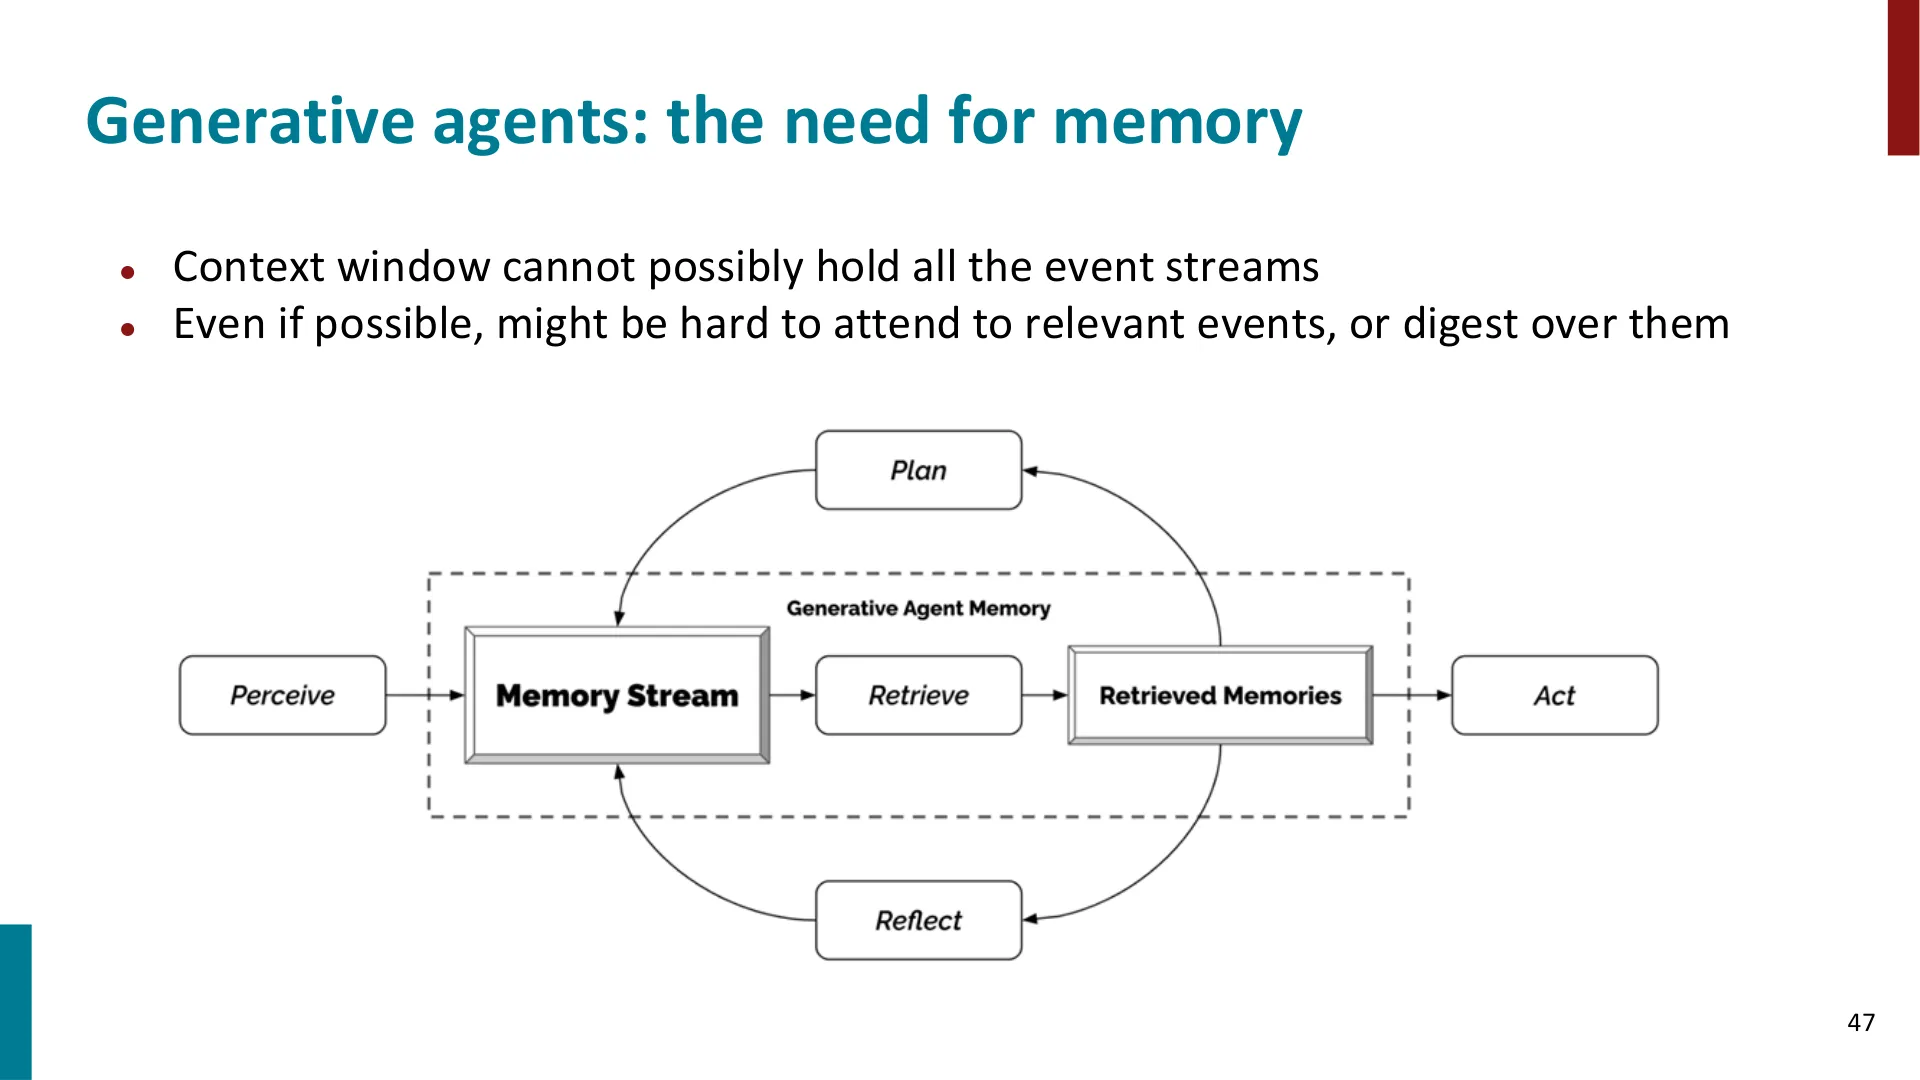
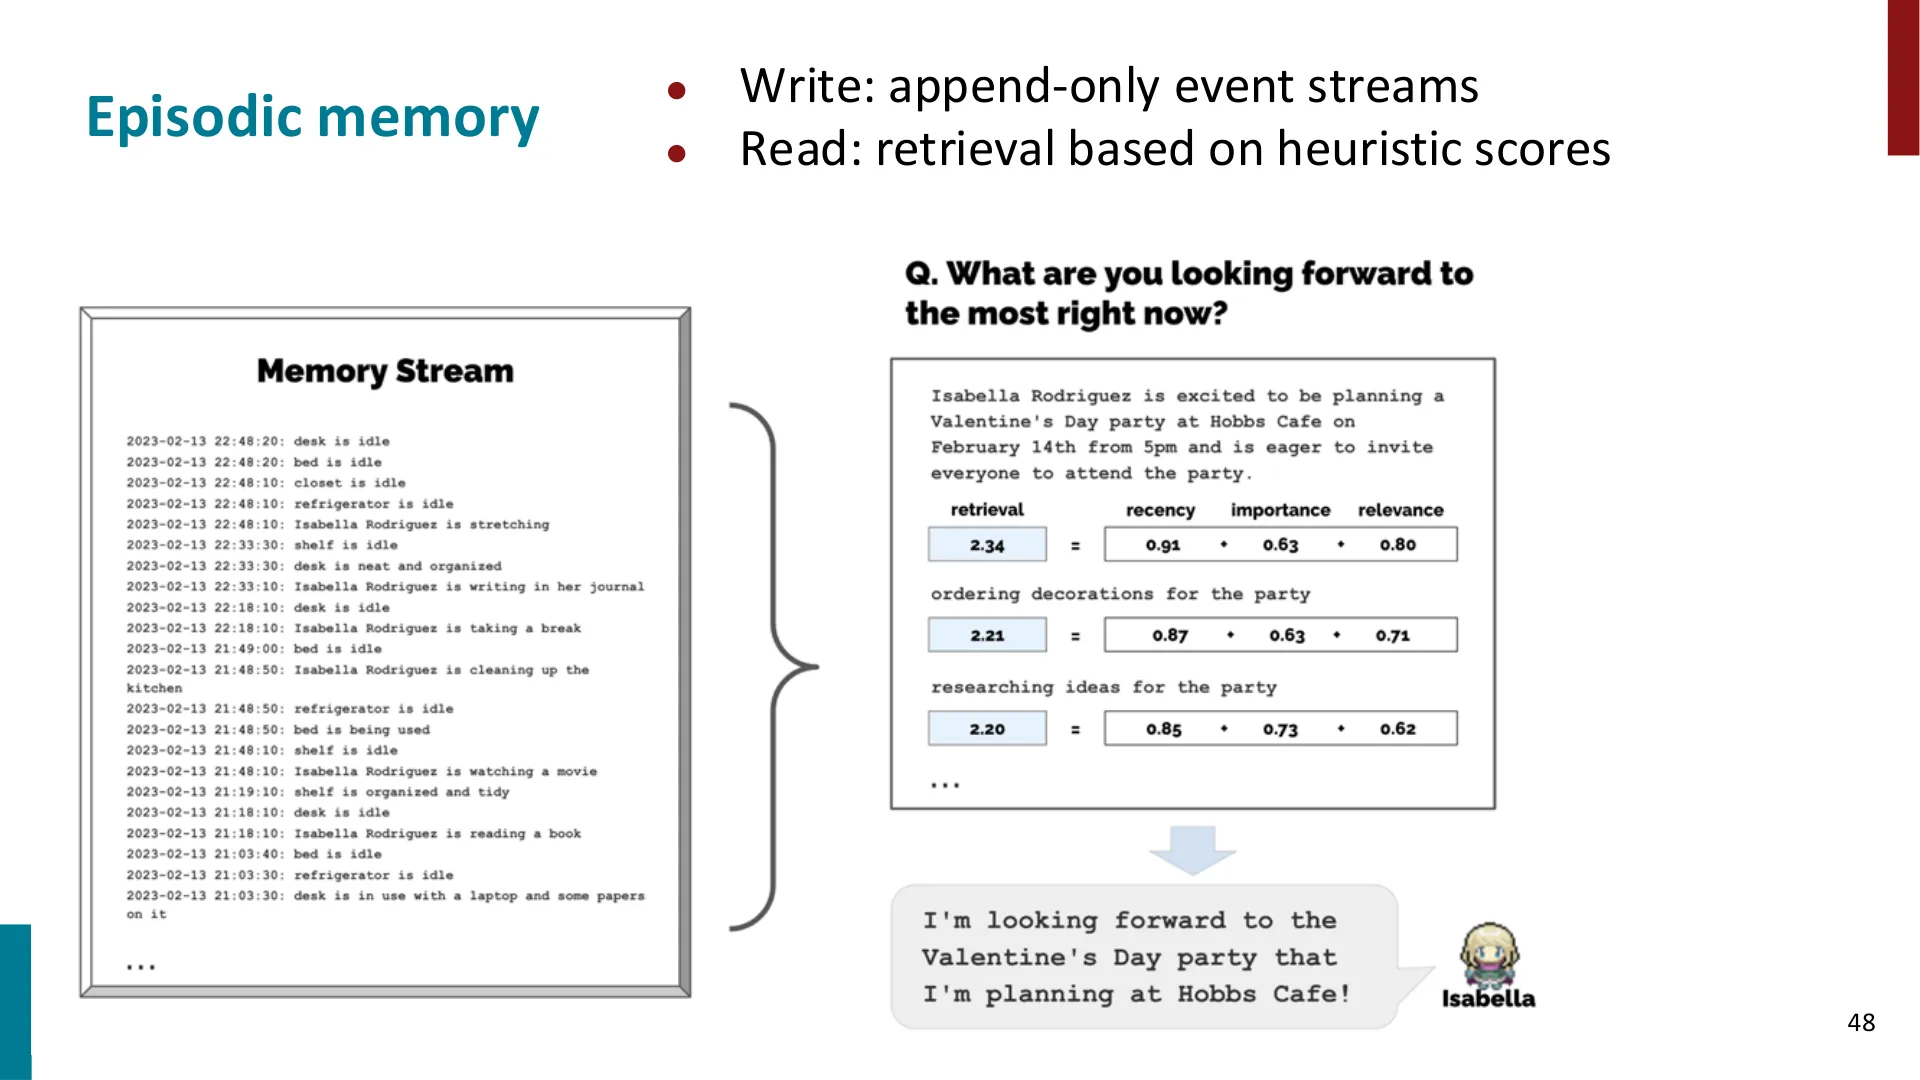
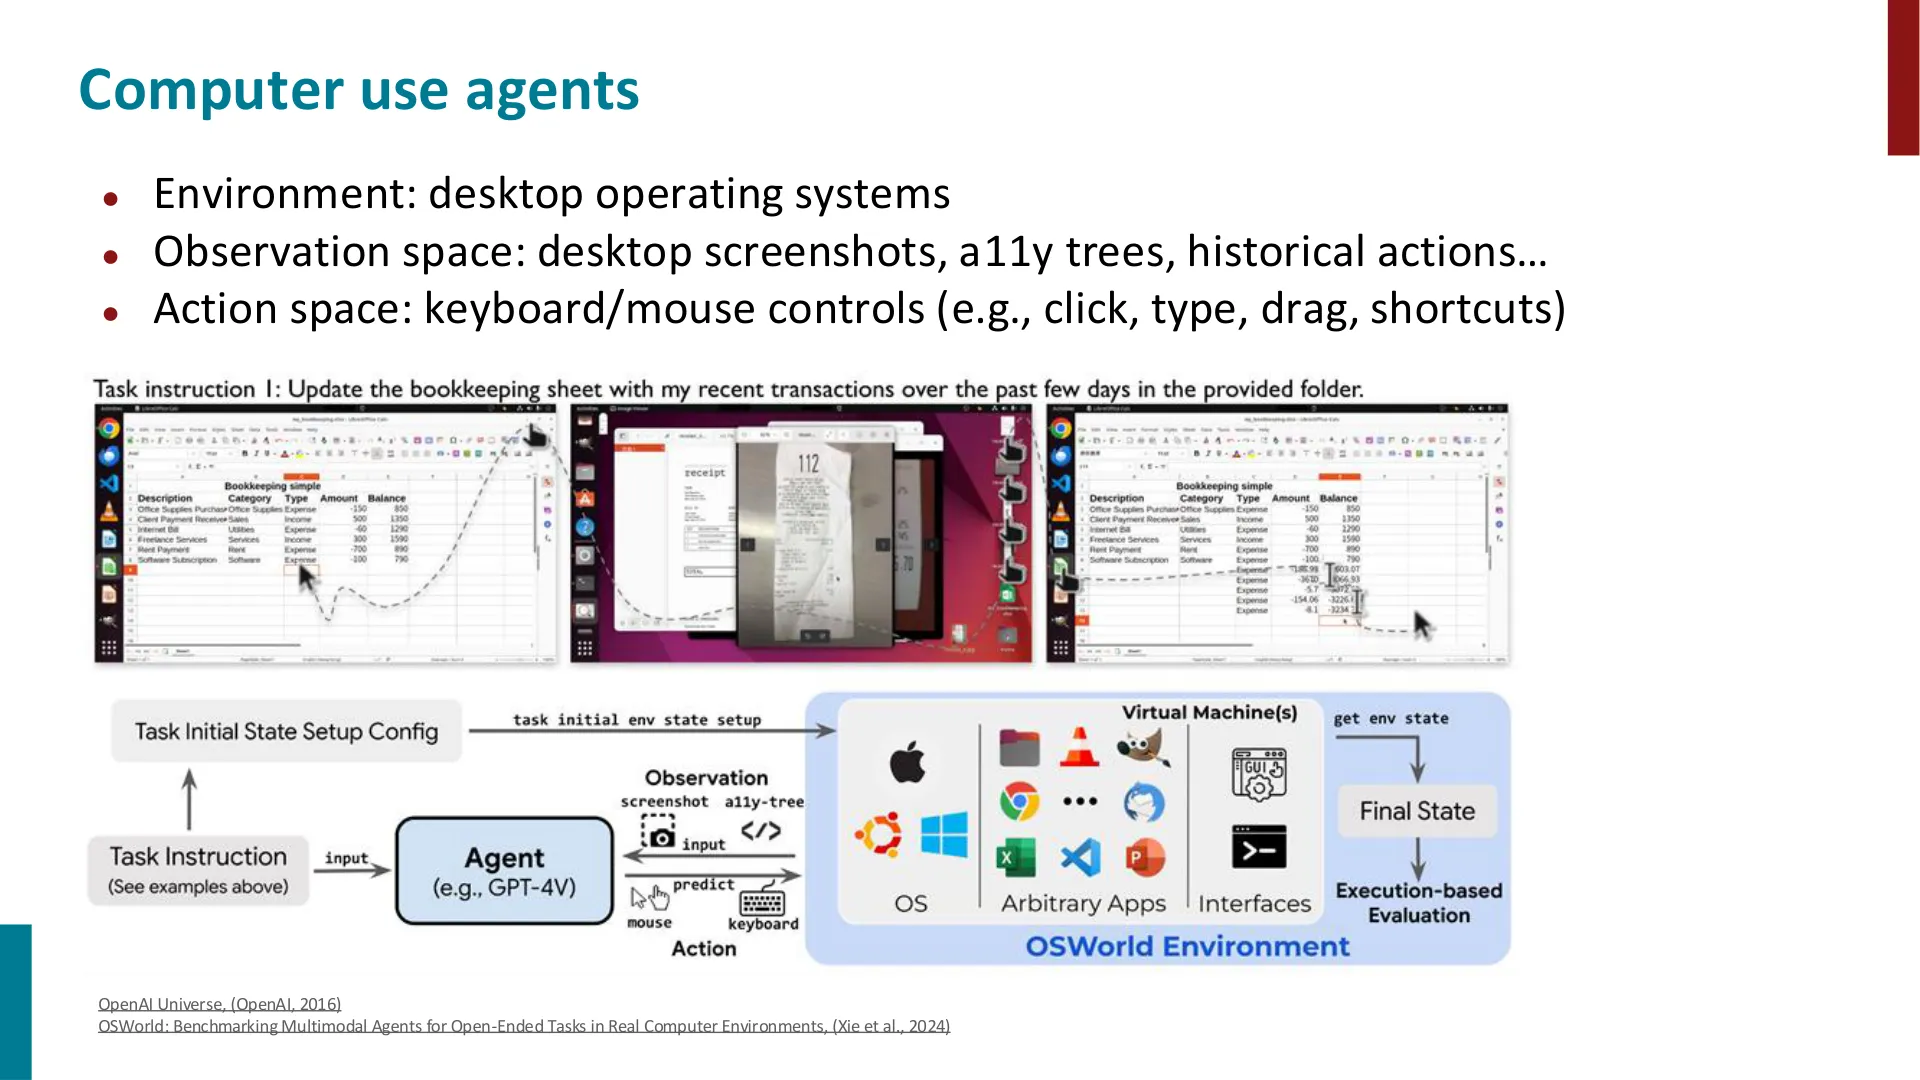
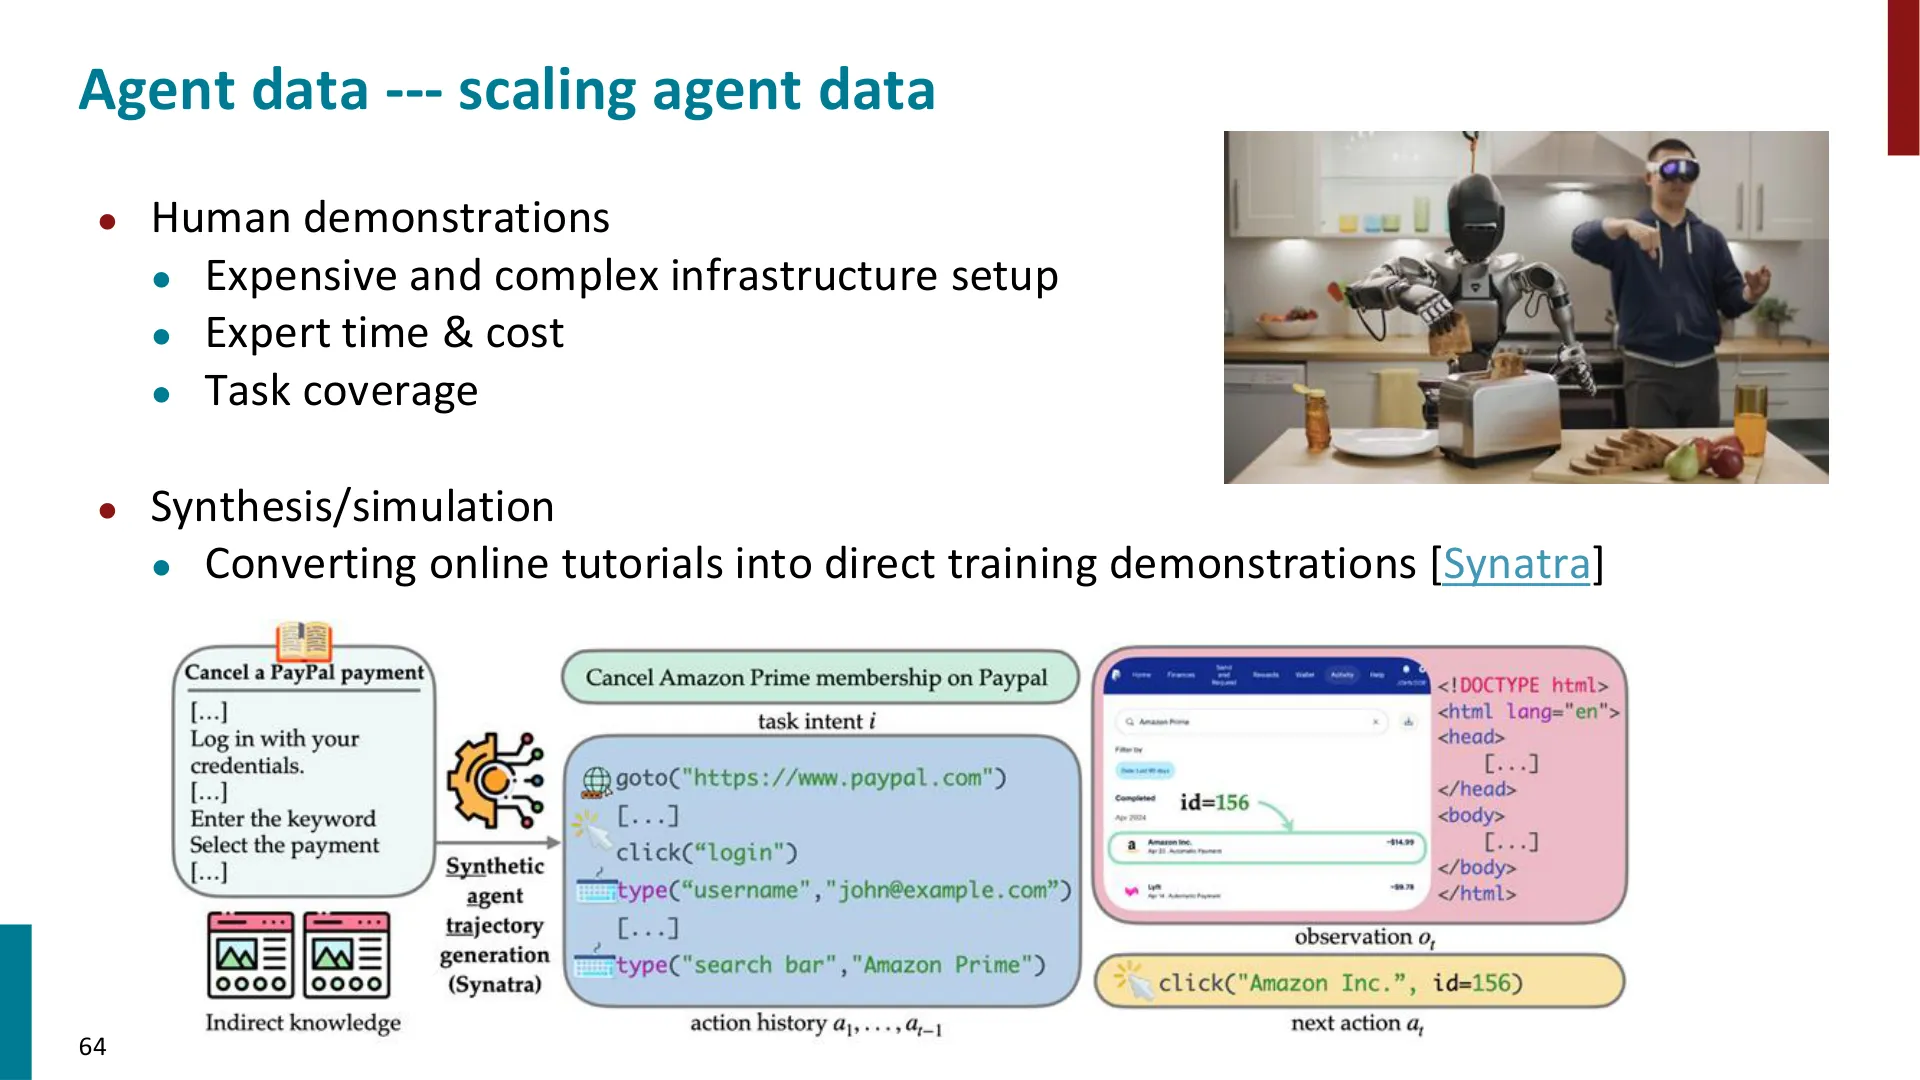
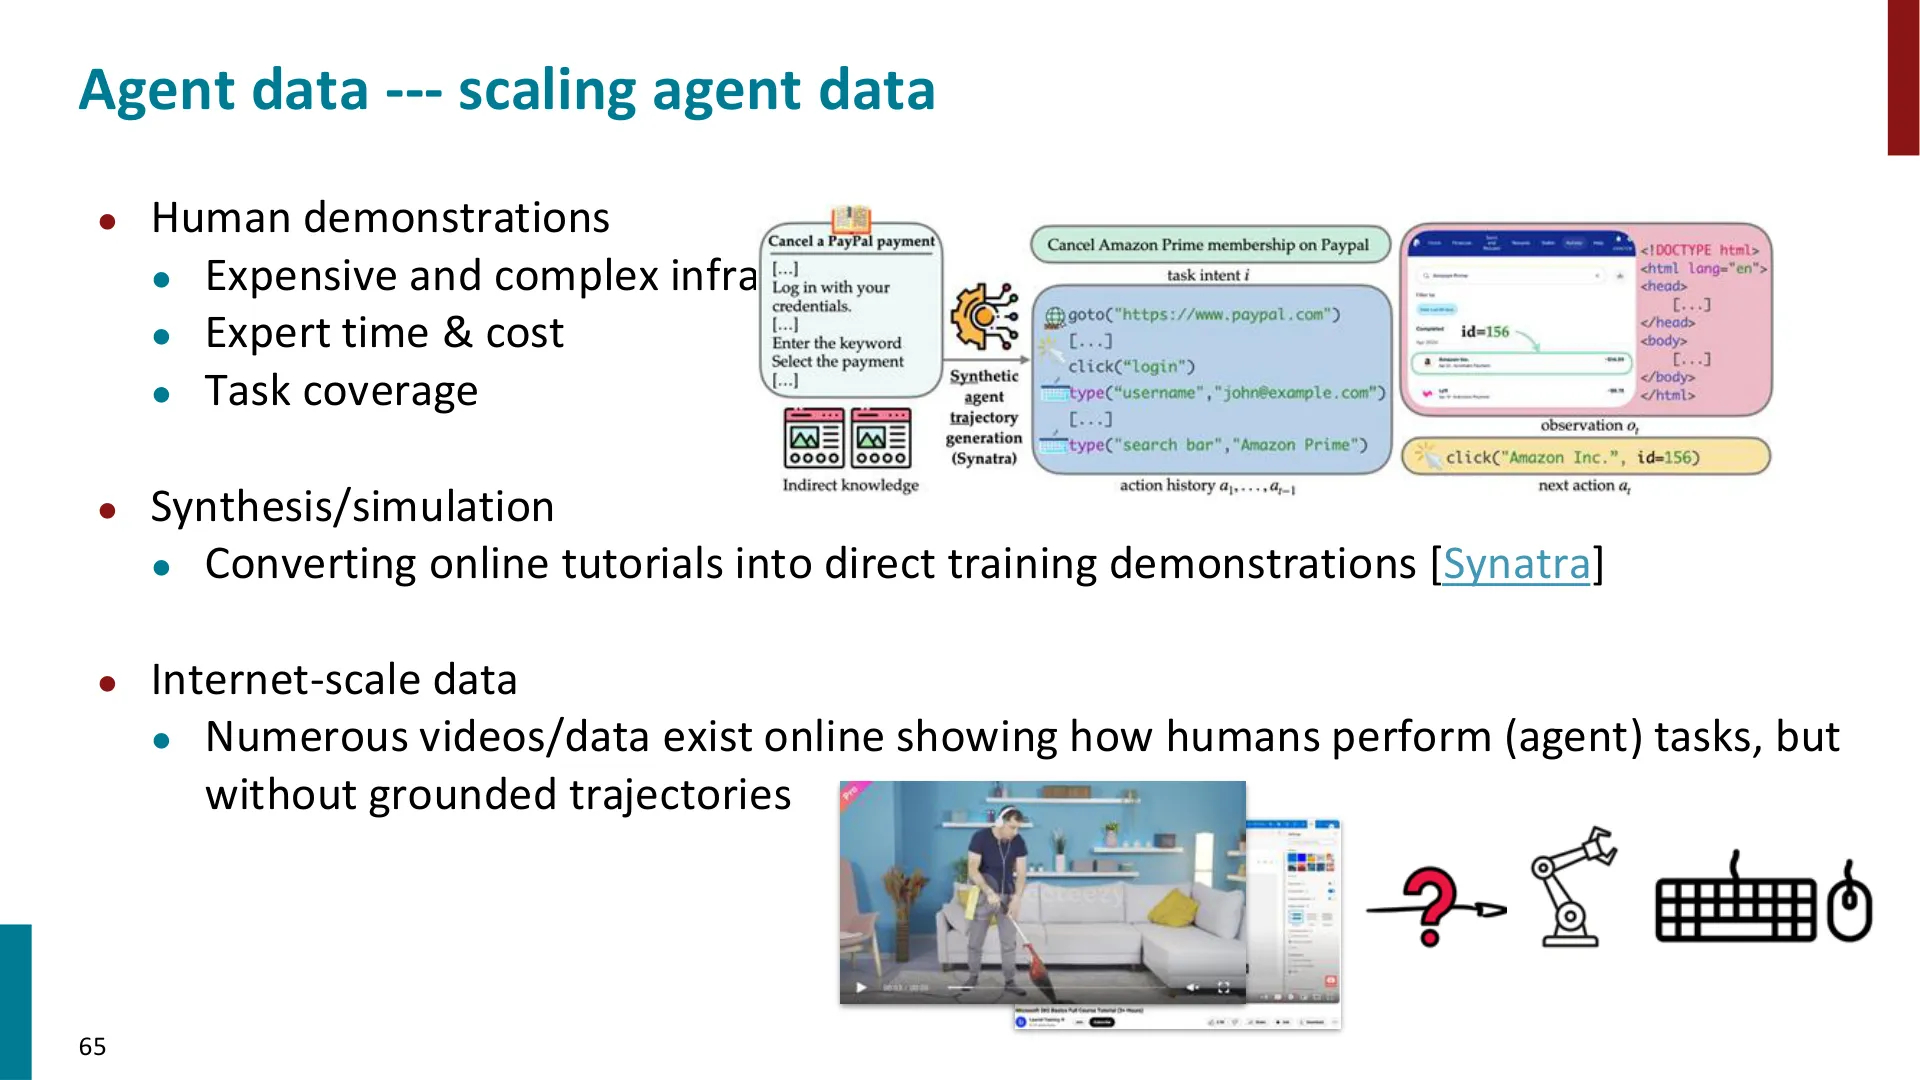
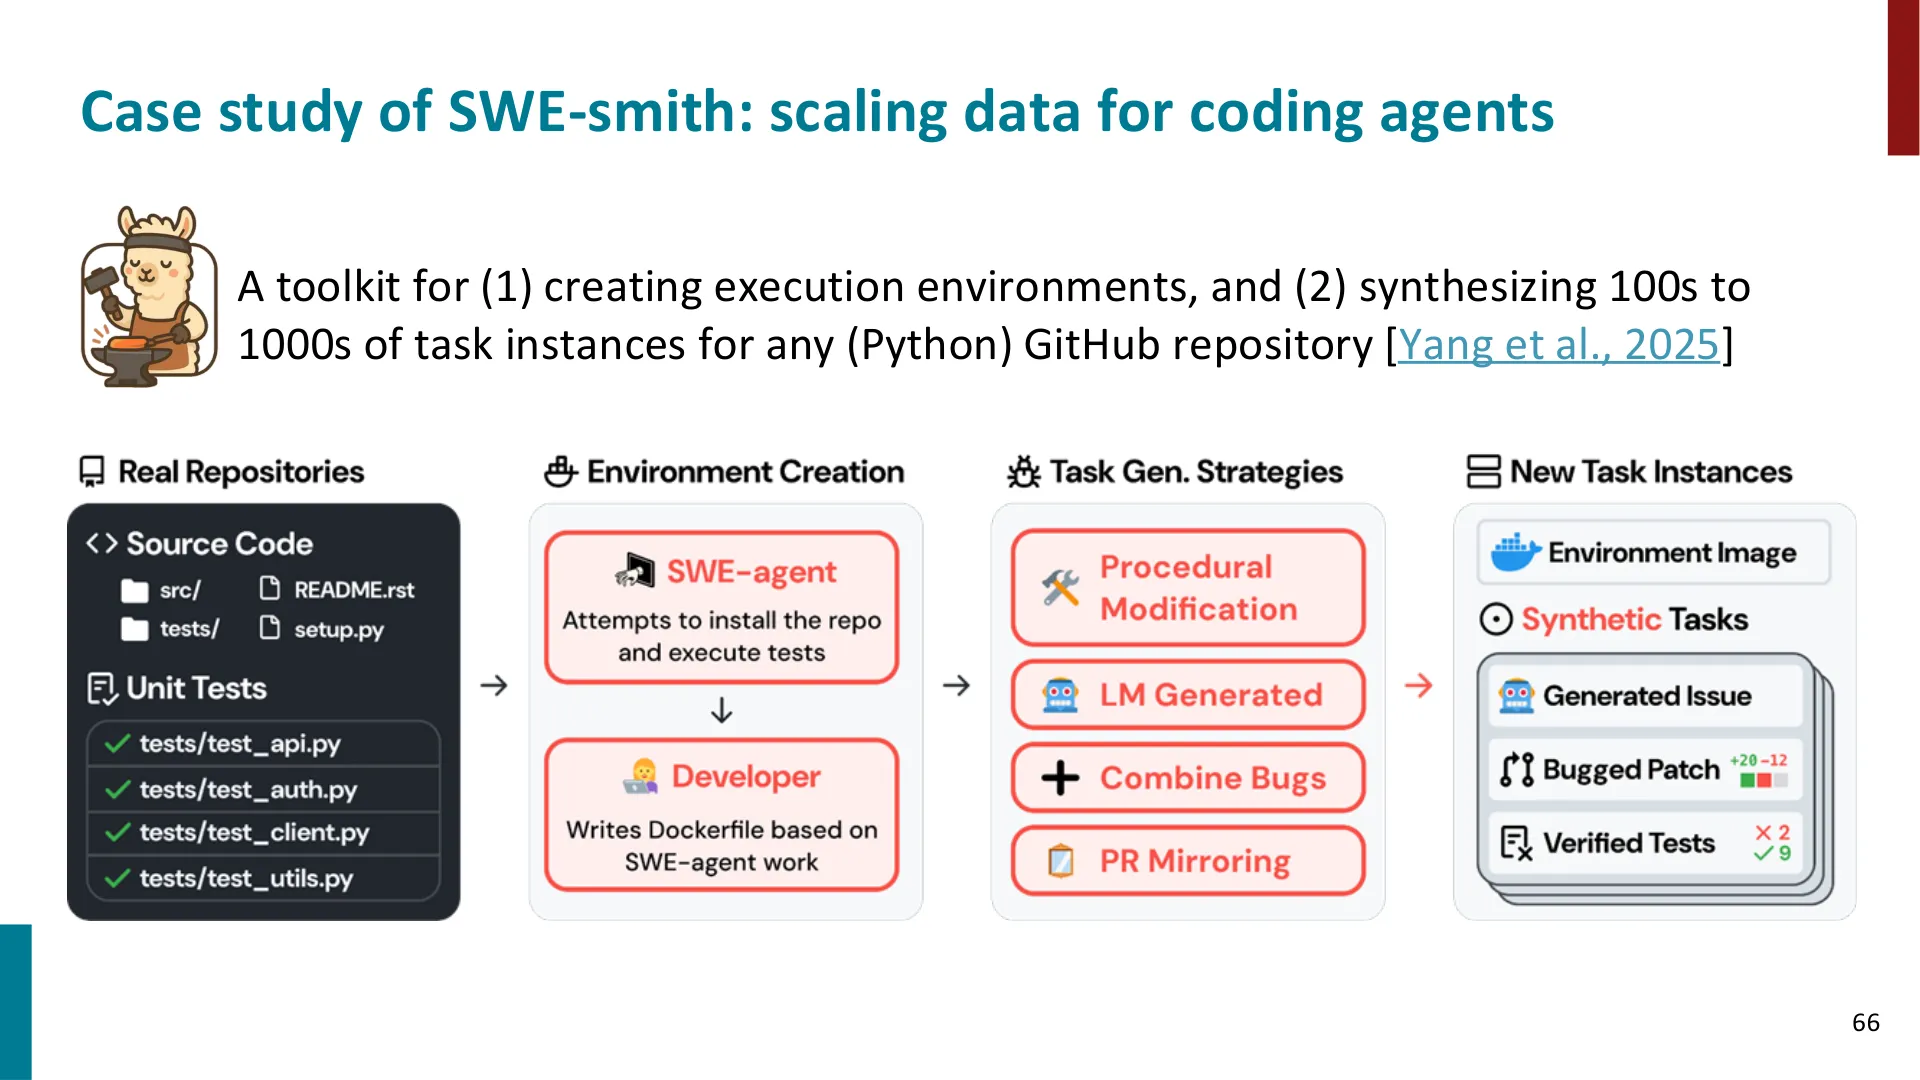
附录:官方幻灯片里课堂未展示的页
vb slides 自动补入,供对照查阅。