第14讲 · 分词与多语言性:语言模型眼中的「文本原子」
CS224N/Ling284《使用深度学习的自然语言处理》2026 冬季 官方讲义 · 中文重构 本书是一次补充讲次:既有课堂实录版电子书按主线讲次整理,本讲为客座讲座, 内容依据官方讲义幻灯片补全——分词的三种方案、BPE 训练算法的完整手工推演、 分词失效的两个案例研究,以及多语言场景下的公平性问题。
| 原始标题 | Lecture 14: Tokenization and Multilinguality(客座讲座,讲者:Julie Kallini) |
| 讲义来源 | cs224n-2026-lecture14-guest-julie-tokenization-multilinguality.pdf(课程讲义幻灯片) |
| 课程主页 | https://web.stanford.edu/class/cs224n/ |
| 材料版权 | 课程材料版权归 Stanford University 及授课教师、讲者所有,本书仅供学习 |
对应讲次:第14讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
回顾:两个悬而未决的问题
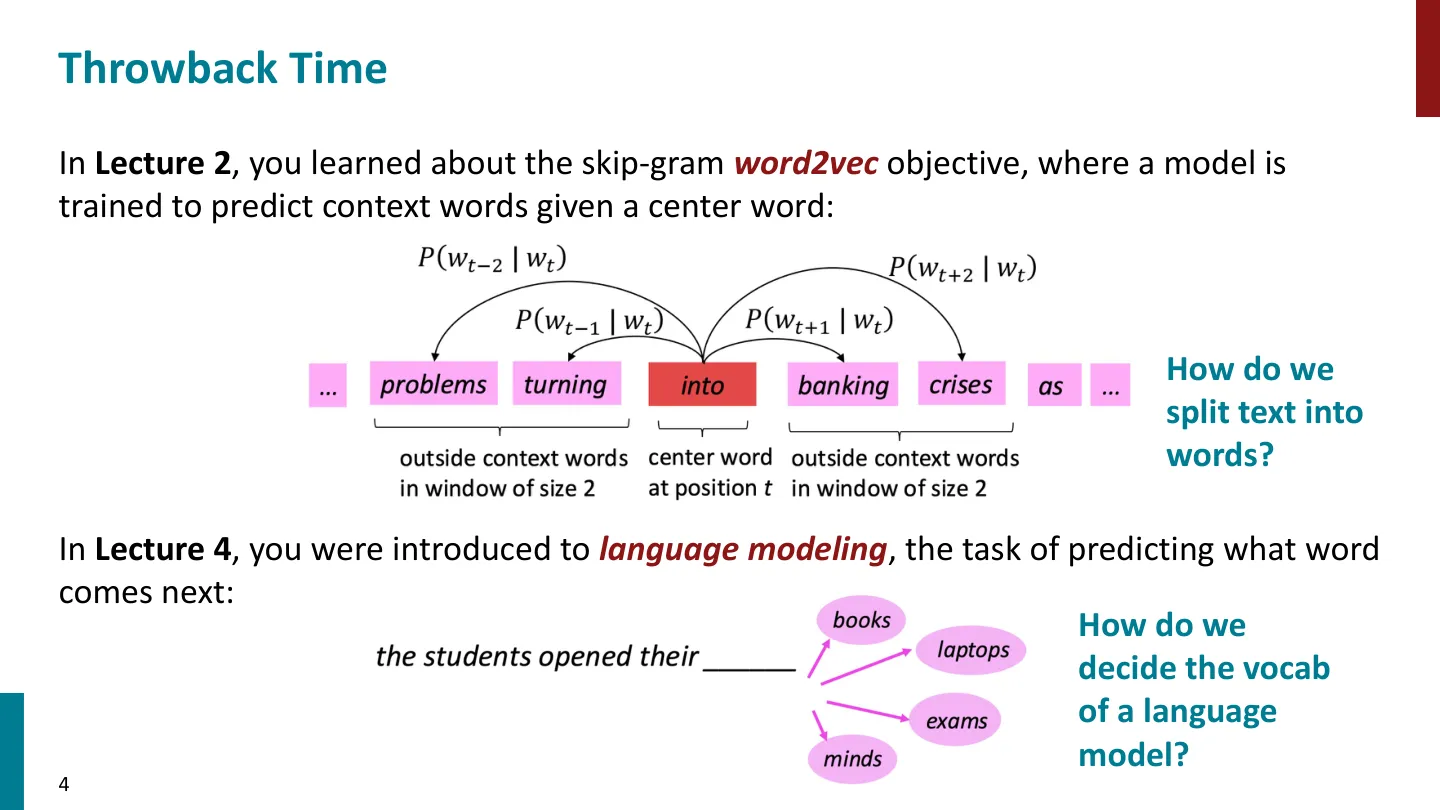
在 Lecture 2 里,大家学过 skip-gram 版的 word2vec 目标函数——给定中心词预测上下文词:
🖼️ 第 1 页幻灯片 · Natural Language Processing
$$ \max \sum_{w \in \text{corpus}} \sum_{c \in \text{context}(w)} \log P(c \mid w)
🖼️ 第 4 页幻灯片 · Throwback Time
在 Lecture 4 里,大家接触到语言建模(language modeling),也就是「预测下一个词」这个任务。
编者说明:这两部分内容在本套电子书的《词向量》与《语言模型》讲次中已有完整推导,这里只做定位用,不再展开。本讲真正要回答的是它们背后被跳过的一步。
这两个任务都默默假设了一件事:文本已经被切成了「词」,词表也已经定好了。于是有两个问题一直没有正面回答:
- 我们怎么把文本切分成词?
- 我们怎么决定一个语言模型的词表?
这两个问题就是本讲的主题。
「词」到底是什么?
先看一个具体句子:
🖼️ 第 5 页幻灯片 · What is a word?
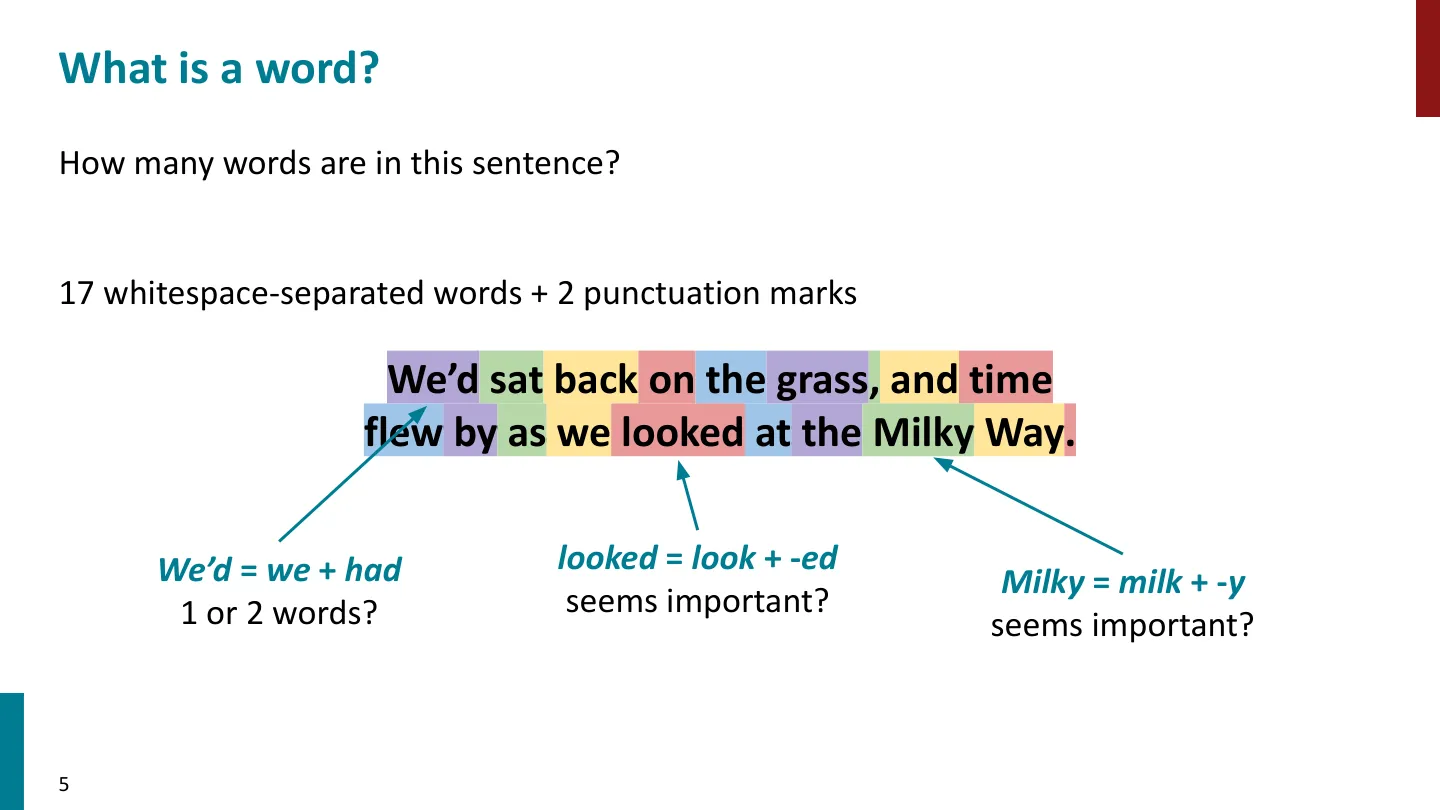
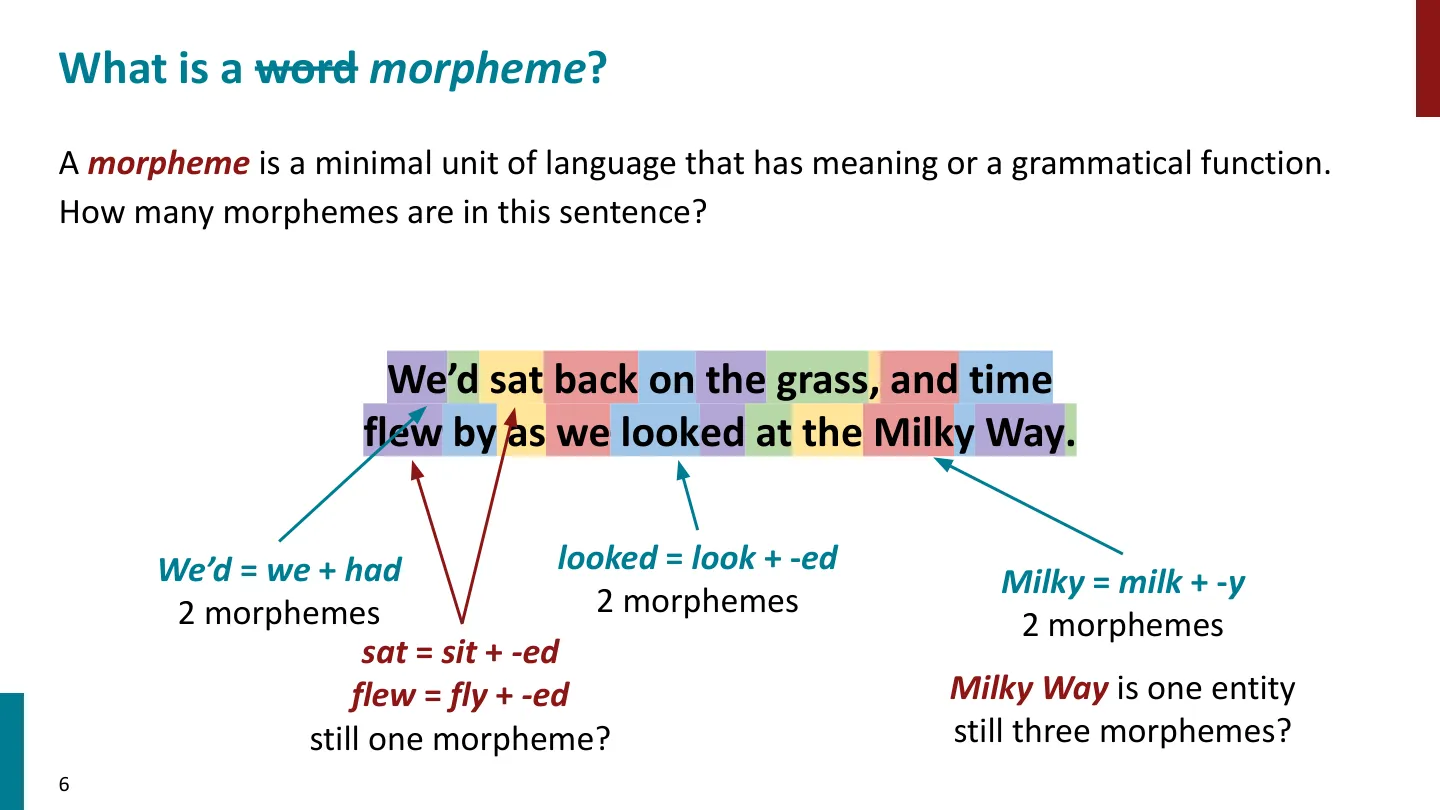
We'd sat back on the grass, and time flew by as we looked at the Milky Way.
它有多少个词?
- 按空白切分:17 个以空白分隔的词 + 2 个标点符号。
- 但
We'd是we+had,这算 1 个词还是 2 个词?
🖼️ 第 8 页幻灯片 · How do language models see text?
looked=look+-ed,这个切分看起来很重要?Milky=milk+-y,这个切分看起来也很重要?
语素(morpheme) 的定义是:语言中最小的、有意义的、或具备语法功能的单位。那么上面这个句子里有多少个语素?
We'd=we+had→ 2 个语素looked=look+-ed→ 2 个语素Milky=milk+-y→ 2 个语素sat=sit+-ed→ 还算 1 个语素吗?flew=fly+-ed→ 还是 1 个语素?Milky Way在语义上是一个整体(银河),那它还是 3 个语素吗?
这些例子的意义不在于「找到正确答案」,而在于说明:「词」这个概念在语言学上本身就是模糊的,任何硬性的切分规则都会在某个边界上失效。
超越词与语素:可选的切分粒度
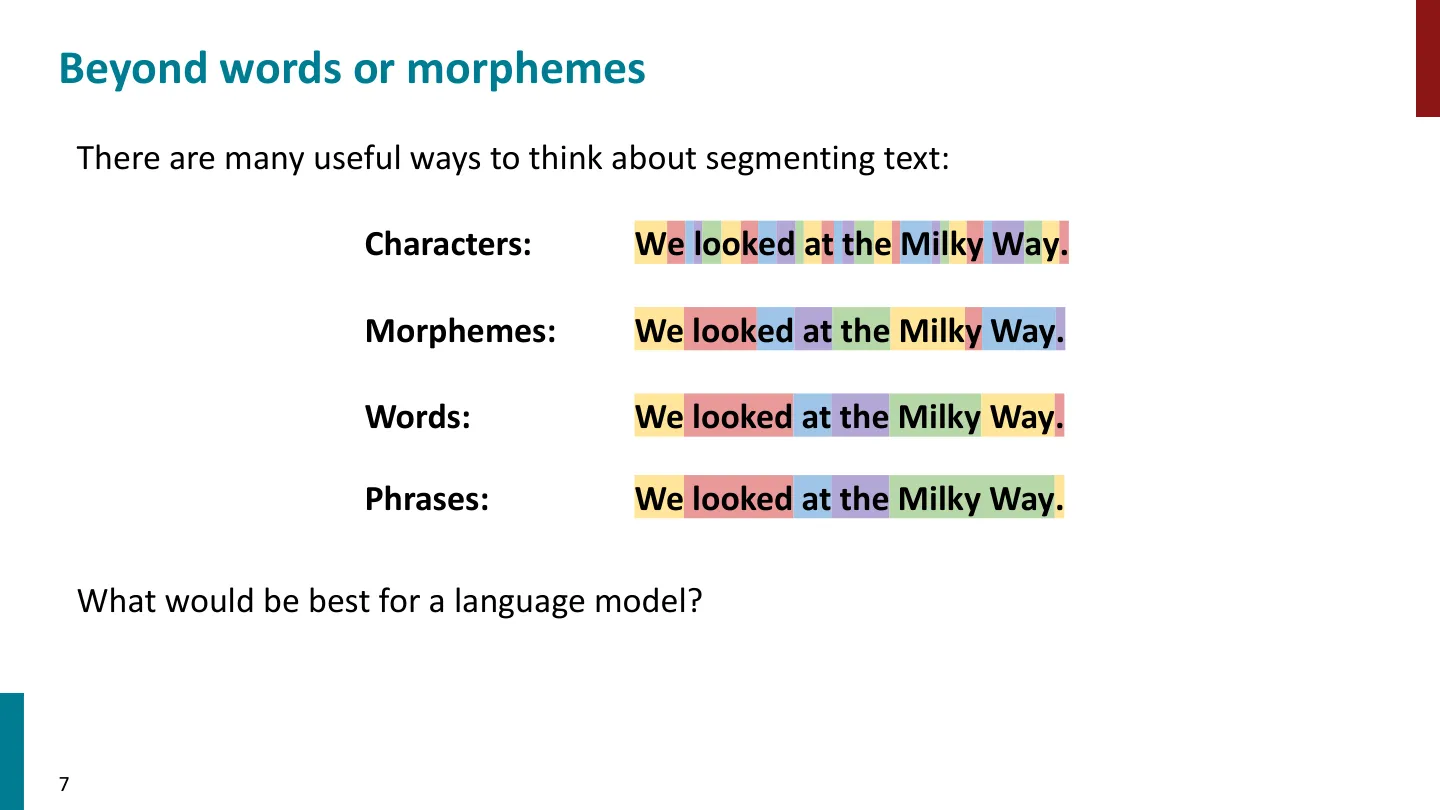
文本切分有很多种有用的思考方式(讲义 cell 22):
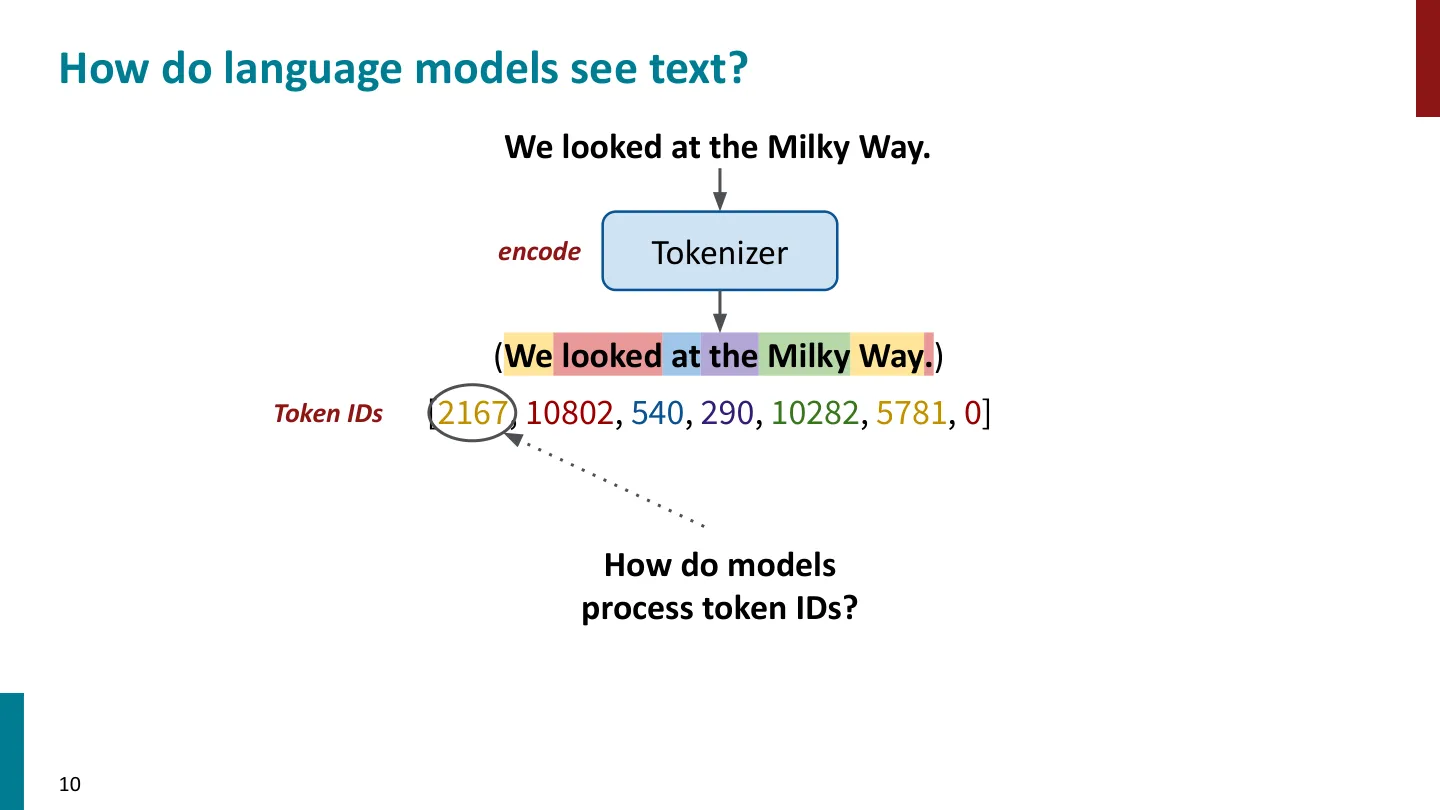
🖼️ 第 10 页幻灯片 · How do language models see text?
| 粒度 | 切分结果 |
|---|---|
| 字符(Characters) | W e l o o k e d a t t h e M i l k y W a y . |
🖼️ 第 12 页幻灯片 · How do language models see text?
| 语素(Morphemes) | We look -ed at the Milk -y Way . |
| 词(Words) | We looked at the Milky Way . |
| 短语(Phrases) | We looked at the Milky Way .(整段作为一个单位) |
问题:对语言模型来说,哪一种最好?
语言模型是怎么「看」文本的
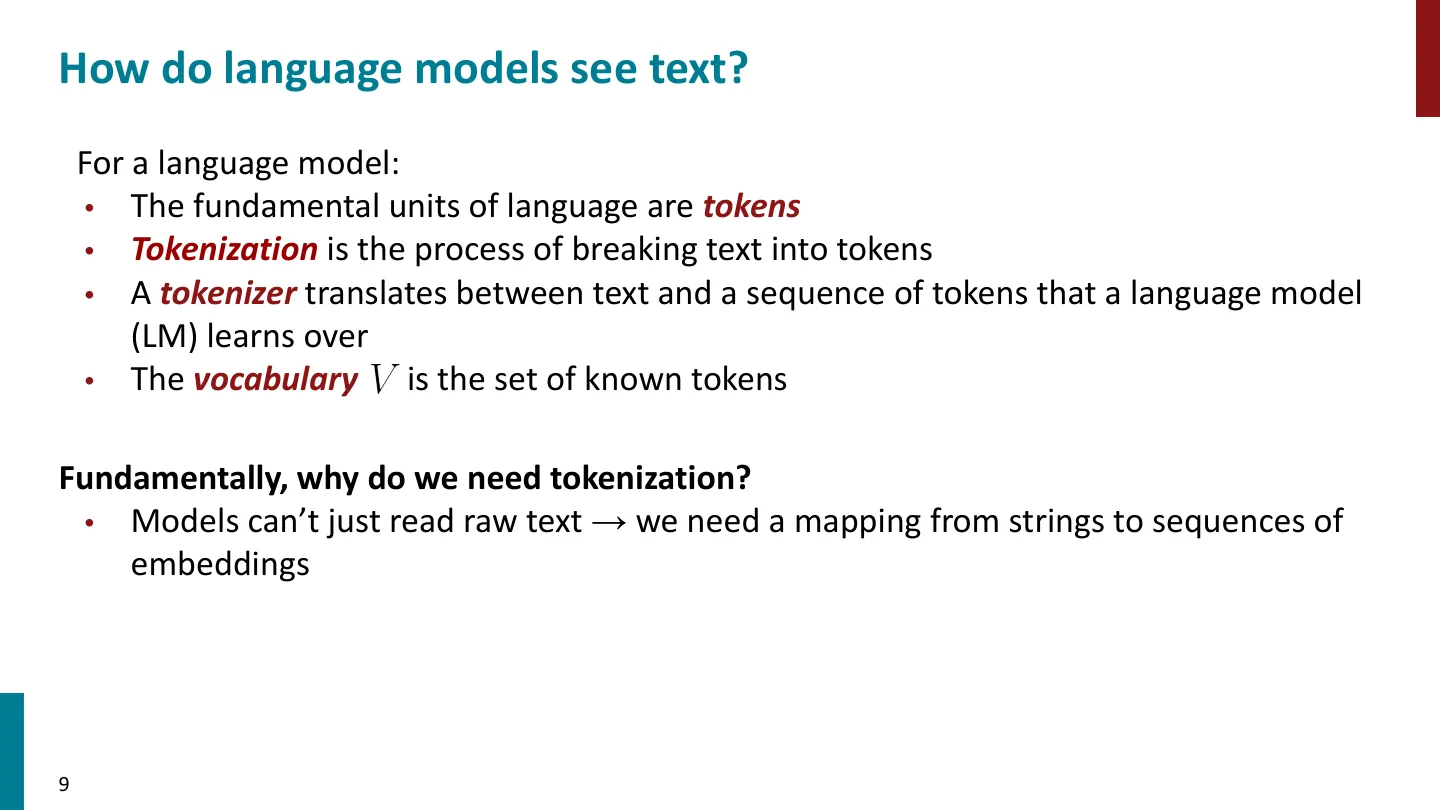
对一个语言模型而言(讲义 cell 25):
🖼️ 第 13 页幻灯片 · How do language models see text?
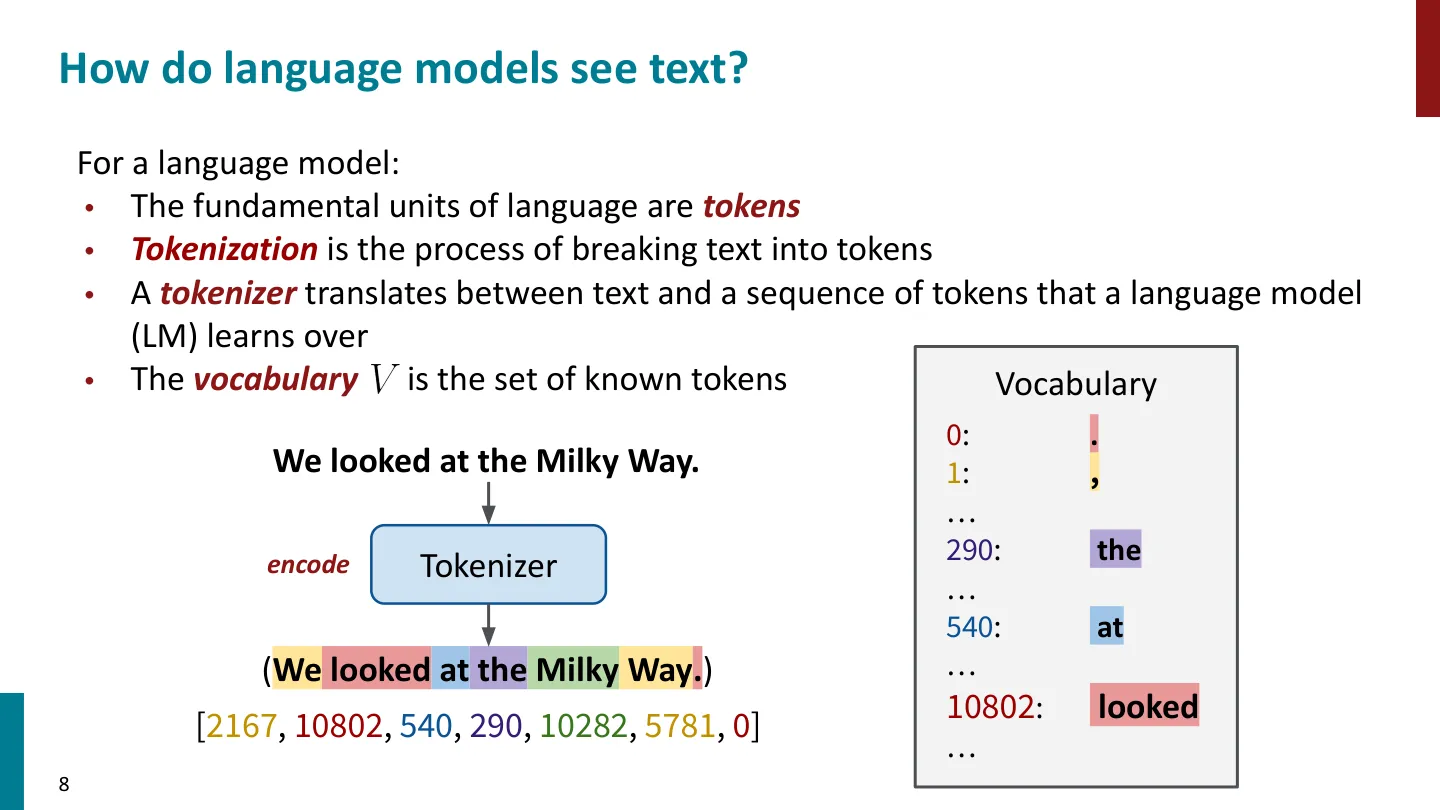
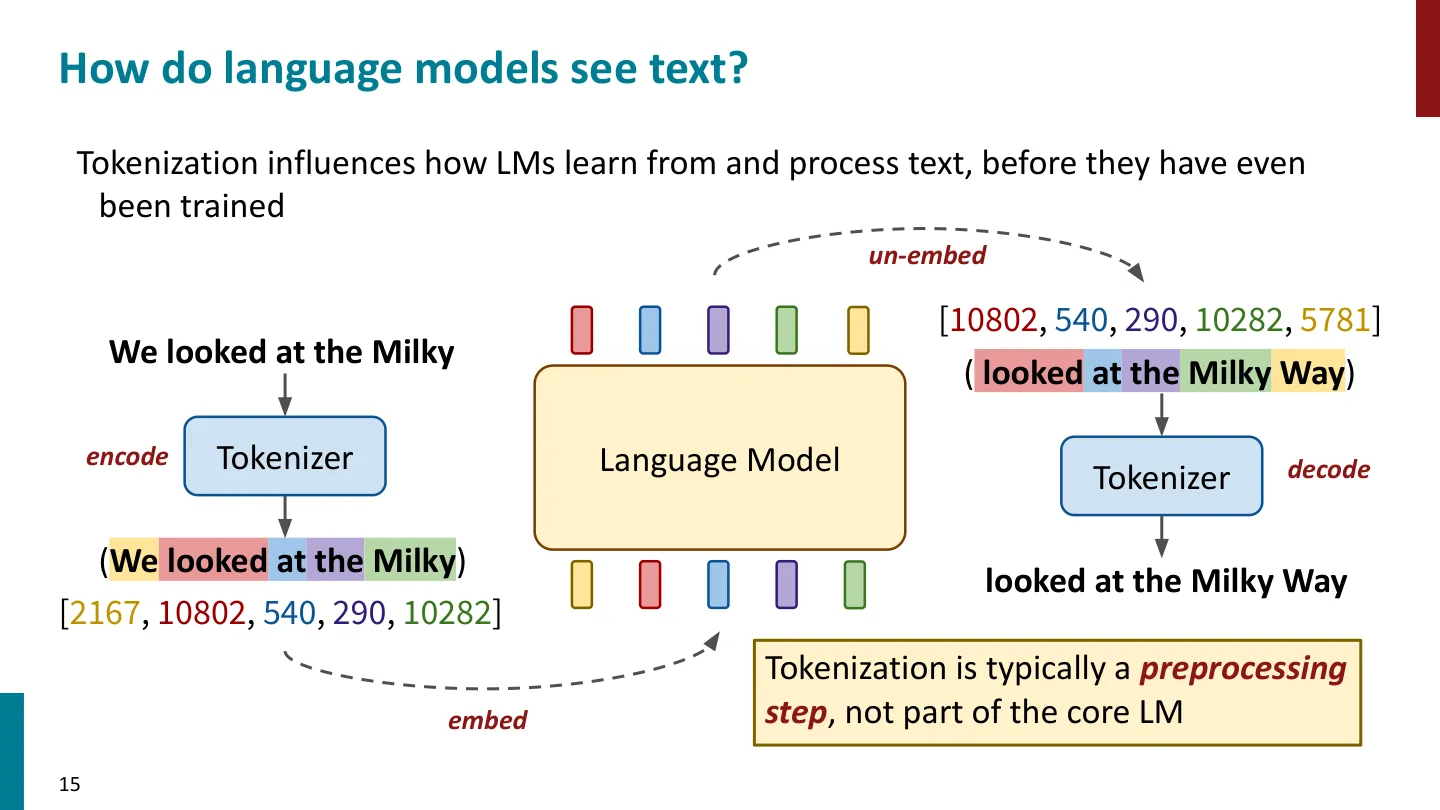
- 语言的基本单位是 token;
- 分词(tokenization) 就是把文本切成 token 的过程;
- 分词器(tokenizer) 负责在「文本」与「token 序列」之间来回翻译;
- 词表(vocabulary) 是所有已知 token 的集合。
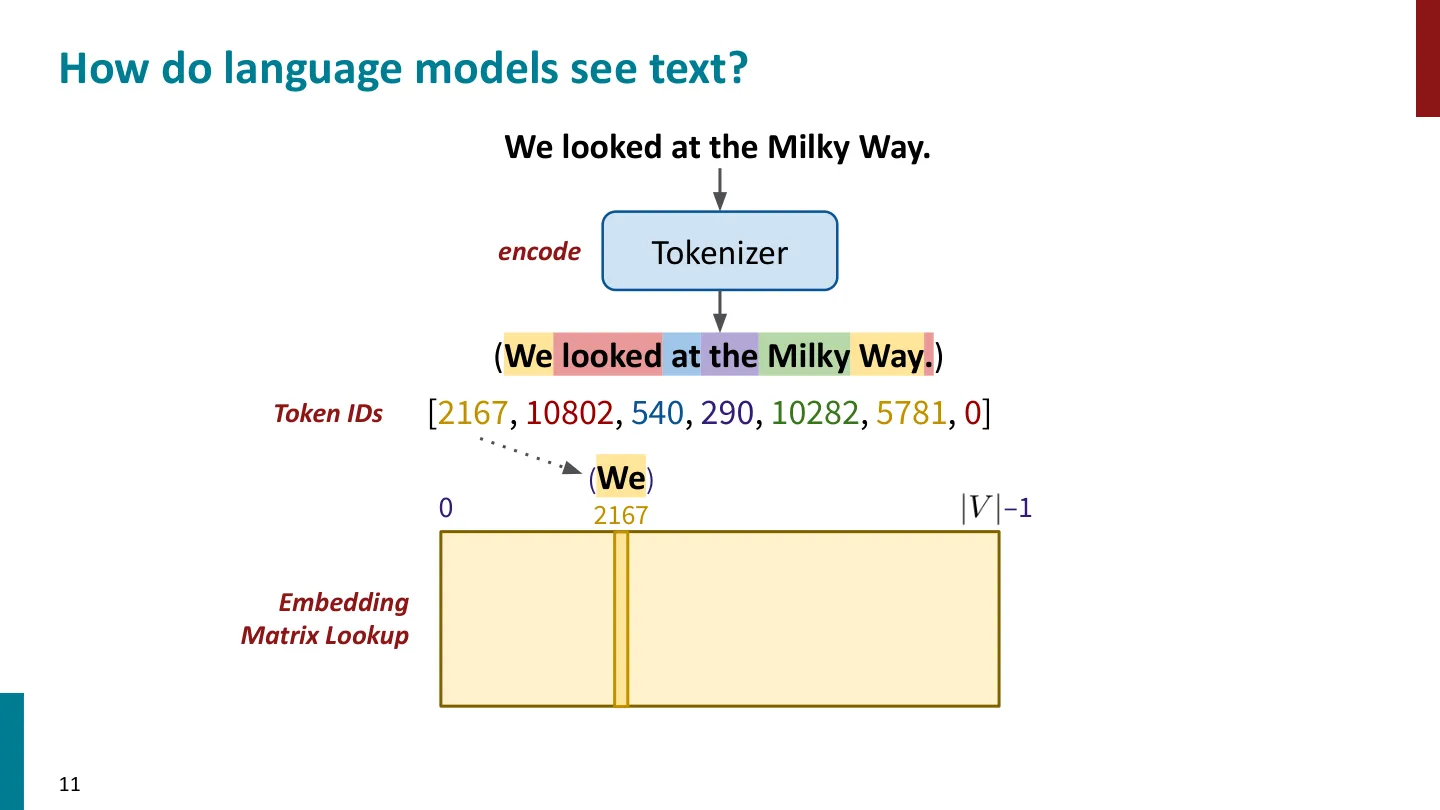
以句子 We looked at the Milky Way. 为例:
$$ \text{We looked at the Milky Way.} \xrightarrow{\text{tokenizer.encode}} [2167,\ 10802,\ 540,\ 290,\ 10282,\ 5781,\ 0]
🖼️ 第 14 页幻灯片 · How do language models see text?
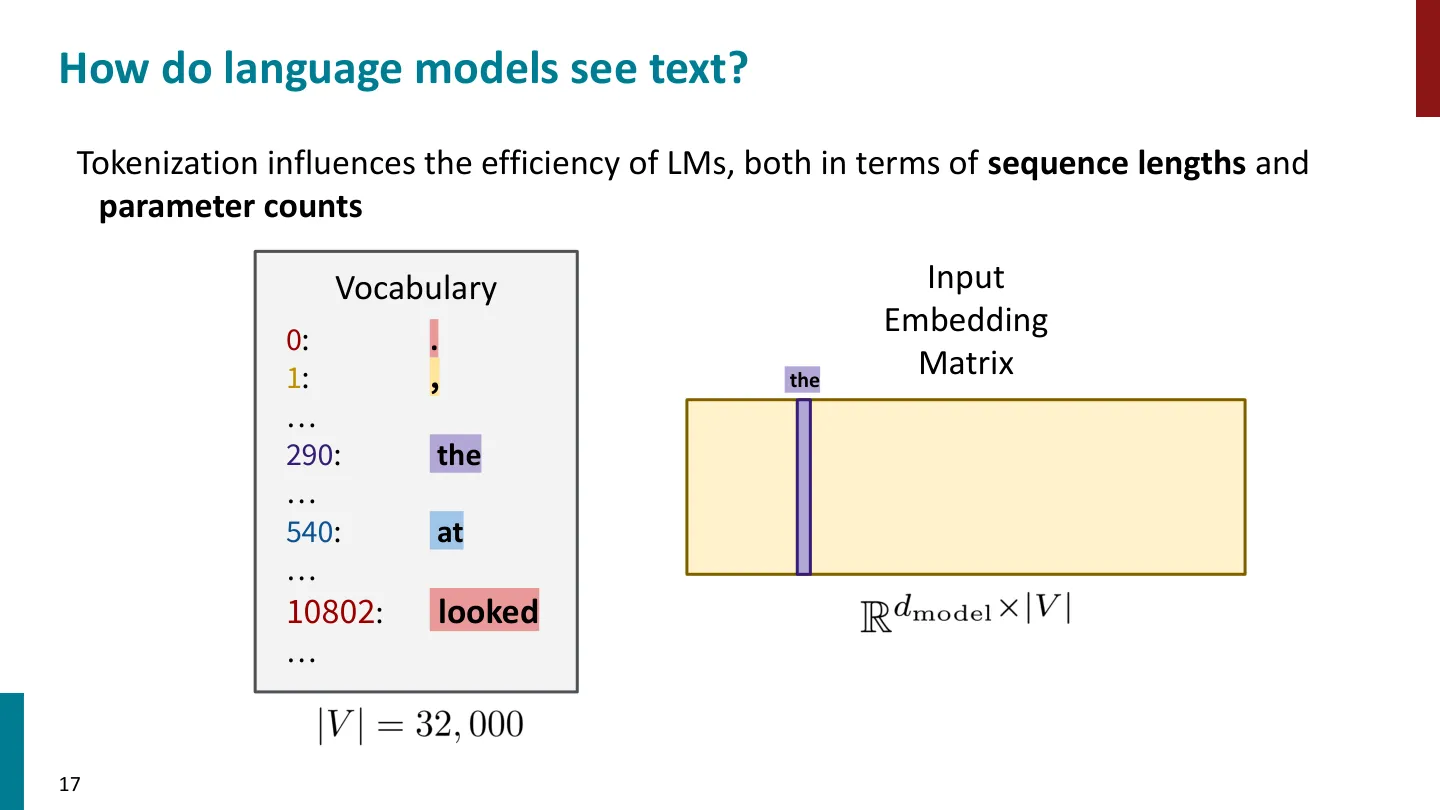
其中词表的片段长得像:
| ID | token |
|---|---|
| 0 | . |
| 1 | , |
| … | … |
| 290 | the |
| … | … |
🖼️ 第 15 页幻灯片 · How do language models see text?
| 540 | at |
| … | … |
| 10802 | looked |
| … | … |
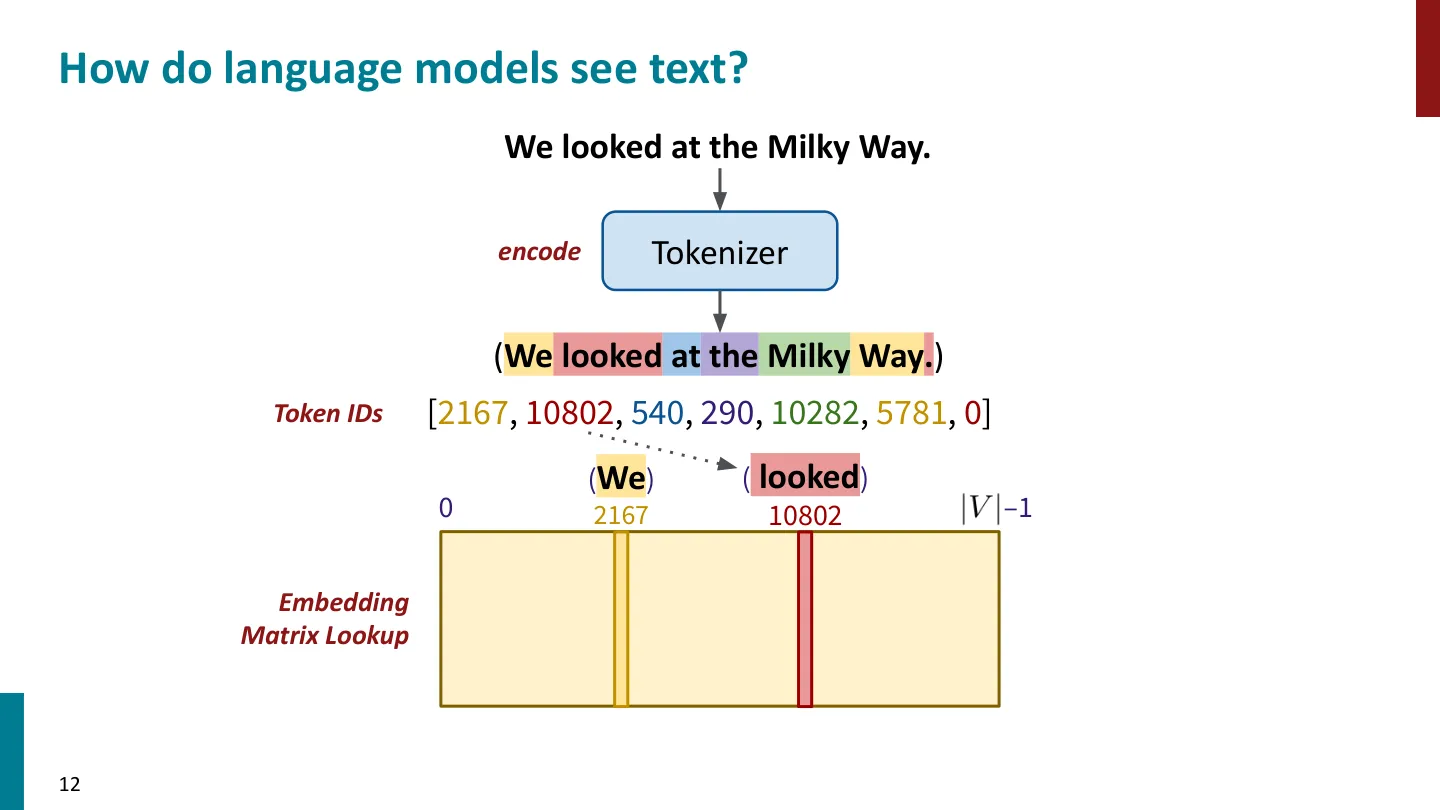
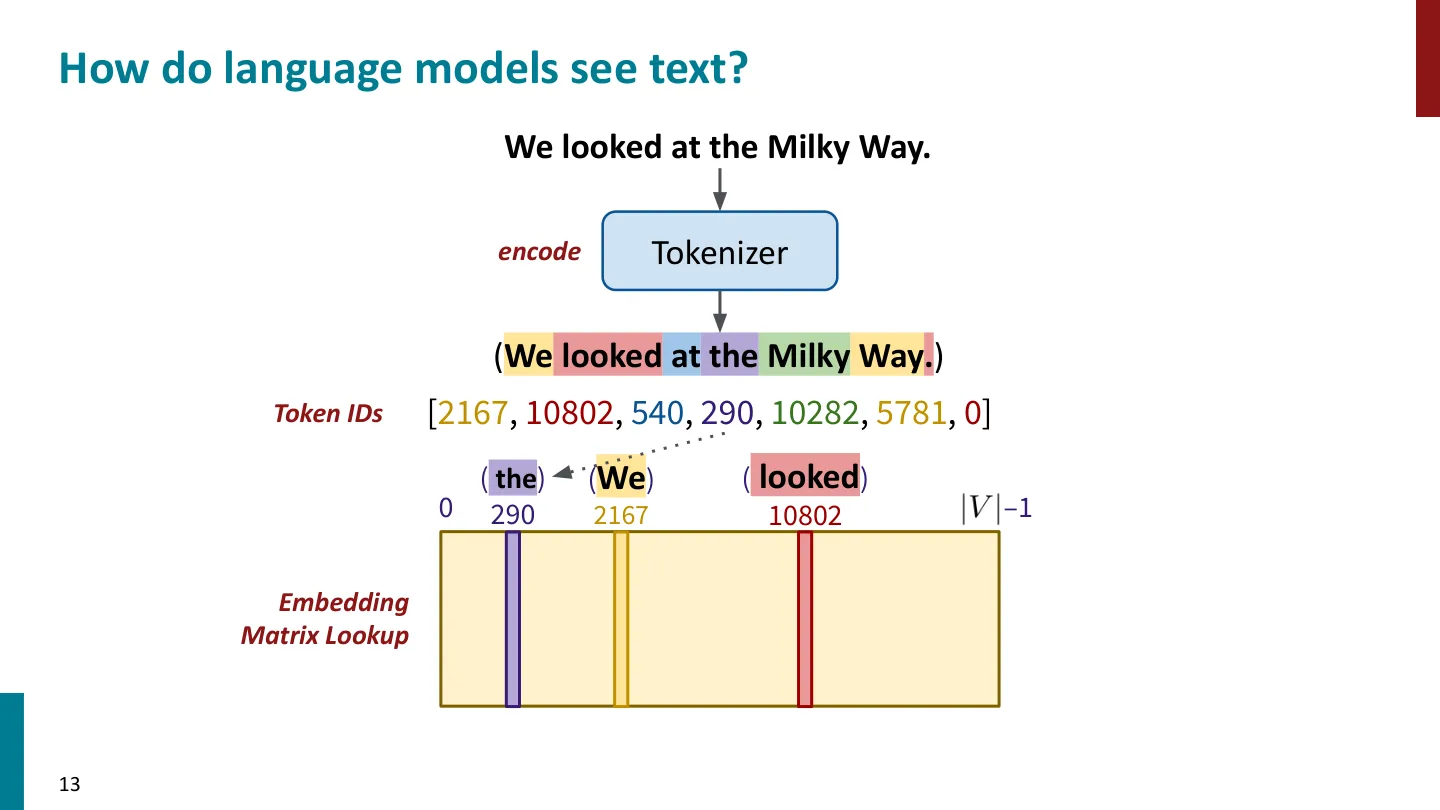
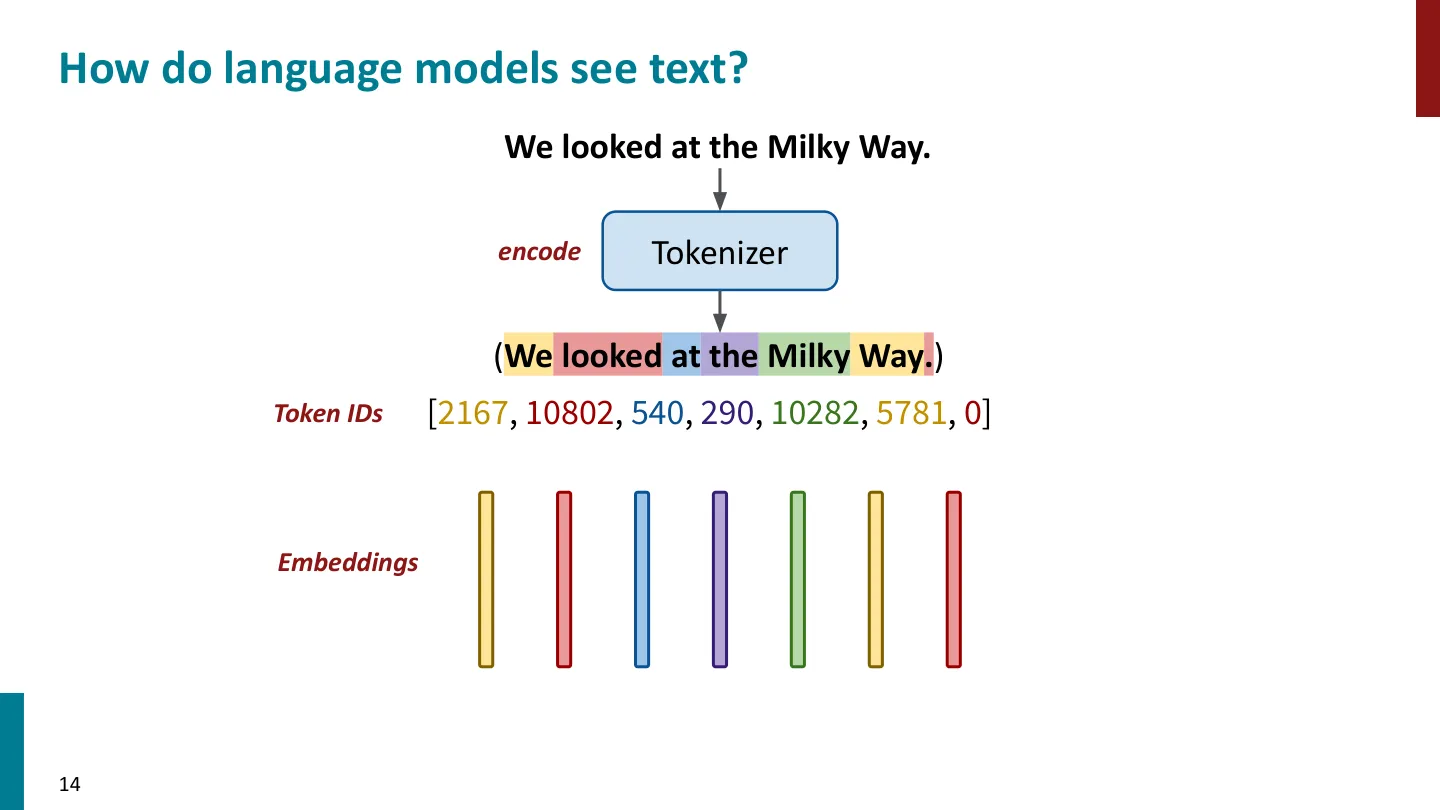
为什么非得有分词这一步? 因为模型没法直接读原始文本——我们需要一个从字符串到嵌入向量序列的映射。
从 token ID 到嵌入向量
拿到 token ID 之后,模型做的是嵌入矩阵查表(embedding matrix lookup):ID 是行下标,对应行就是该 token 的向量。
flowchart LR
    A["原始文本<br/>We looked at the Milky Way."] -->|encode| B["Token IDs<br/>[2167, 10802, 540, 290, 10282, 5781, 0]"]
    B -->|embedding 矩阵查表| C["嵌入向量序列"]
    C --> D["语言模型"]

<div class="video-card screenshot-card">
  <img src="images/slide_016.png" alt="第 16 页幻灯片 · How do language models see text?" loading="lazy">
  <p class="video-caption">🖼️ 第 16 页幻灯片 · How do language models see text?</p>
</div>
    D -->|un-embed / 输出分布| E["下一个 token 的分布"]
    E -->|decode| F["生成的文本"]
注意流程里的一个关键事实:分词通常是预处理步骤,不属于语言模型的核心部分(讲义 cell 46)。它在模型被训练之前就已经决定了模型「能看到什么」。
分词在哪些方面影响模型
讲义明确指出,分词影响两件事:
- 序列长度:token 越细,同一个句子越长。
- 参数量:词表越大,输入嵌入矩阵越大。
第 2 点值得展开看:
flowchart LR
    V["词表<br/>0: .<br/>1: ,<br/>…<br/>290: the<br/>…<br/>540: at<br/>…<br/>10802: looked"] --> M["Input Embedding Matrix<br/>|V| × d"]
    T["token:  the"] --> M
嵌入矩阵的行数就等于词表大小 $|V|$,所以分词方案直接决定了模型的参数量。
编者拓展|嵌入矩阵的参数量:输入嵌入矩阵的形状是 $|V| \times d$,其中 $d$ 是隐藏维度。若 $|V| = 200{,}000$、$d = 4096$,仅这一张矩阵就有约 $8.2 \times 10^8$ 个参数;词表翻倍,这部分参数也翻倍。这就是为什么「词表大小」在前沿模型的规格表里总是被单独列出来(见下文 BPE 词表尺寸表)。模型的输出层通常还会与输入嵌入共享权重(weight tying),此时这份参数被复用一次——这属于本讲范围之外的工程细节。
方案一:词级分词(Word Tokenization)
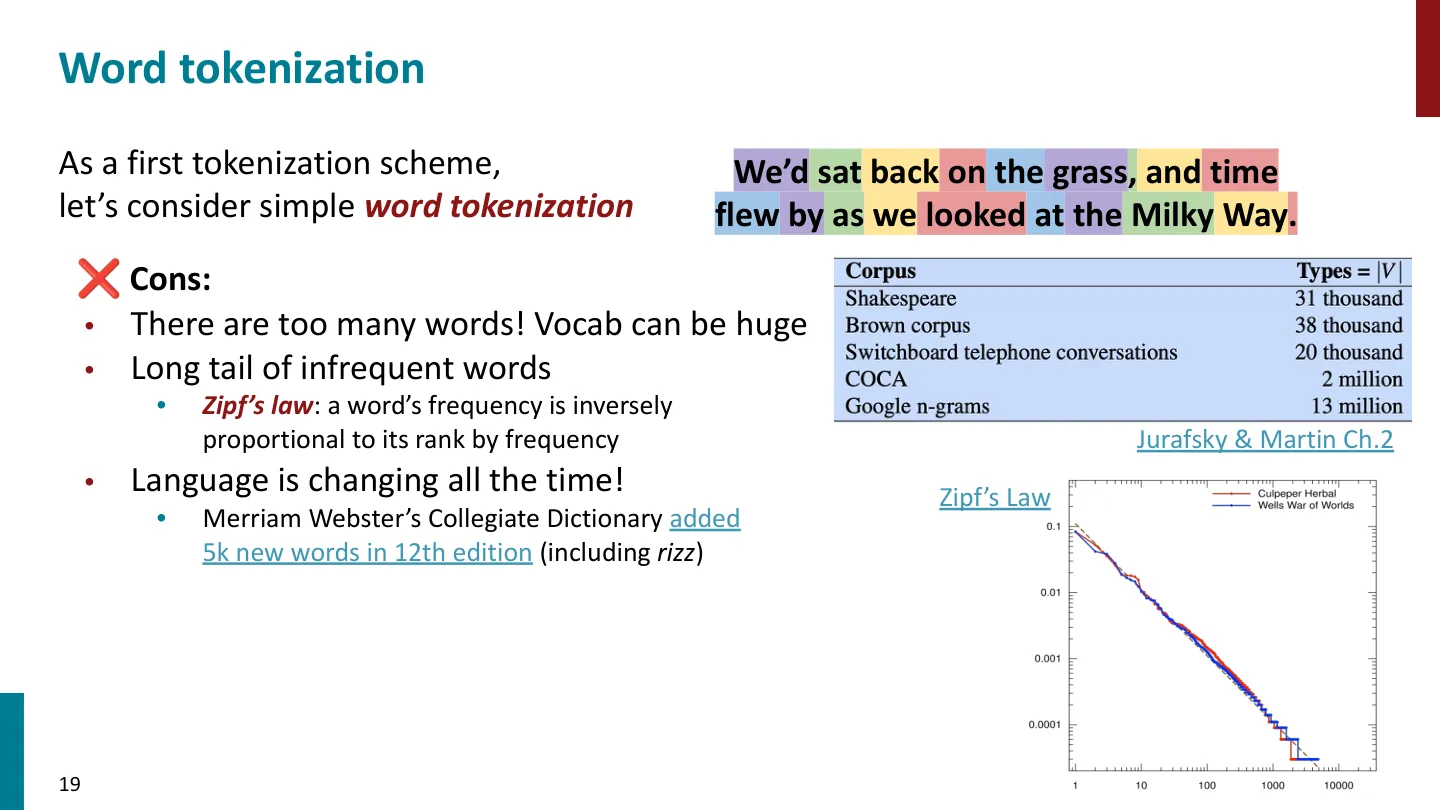
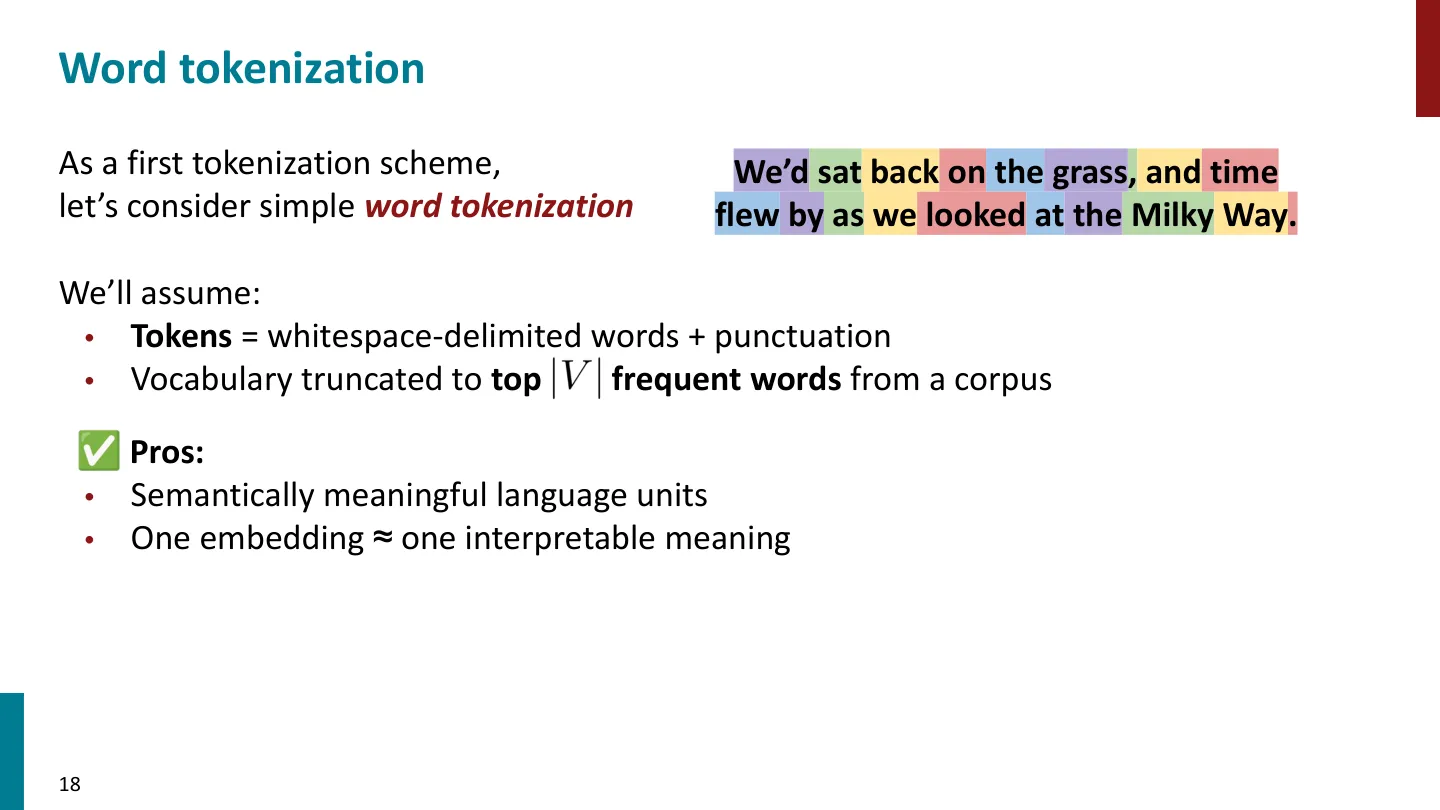
作为第一种方案,考虑最简单的词级分词。假设:
🖼️ 第 17 页幻灯片 · How do language models see text?
- token = 以空白分隔的词 + 标点符号;
- 词表取语料中出现频率最高的前 $V$ 个词(截断)。
优点
- 语言单位语义上有意义;
- 一个嵌入向量 ≈ 一个可解释的含义。
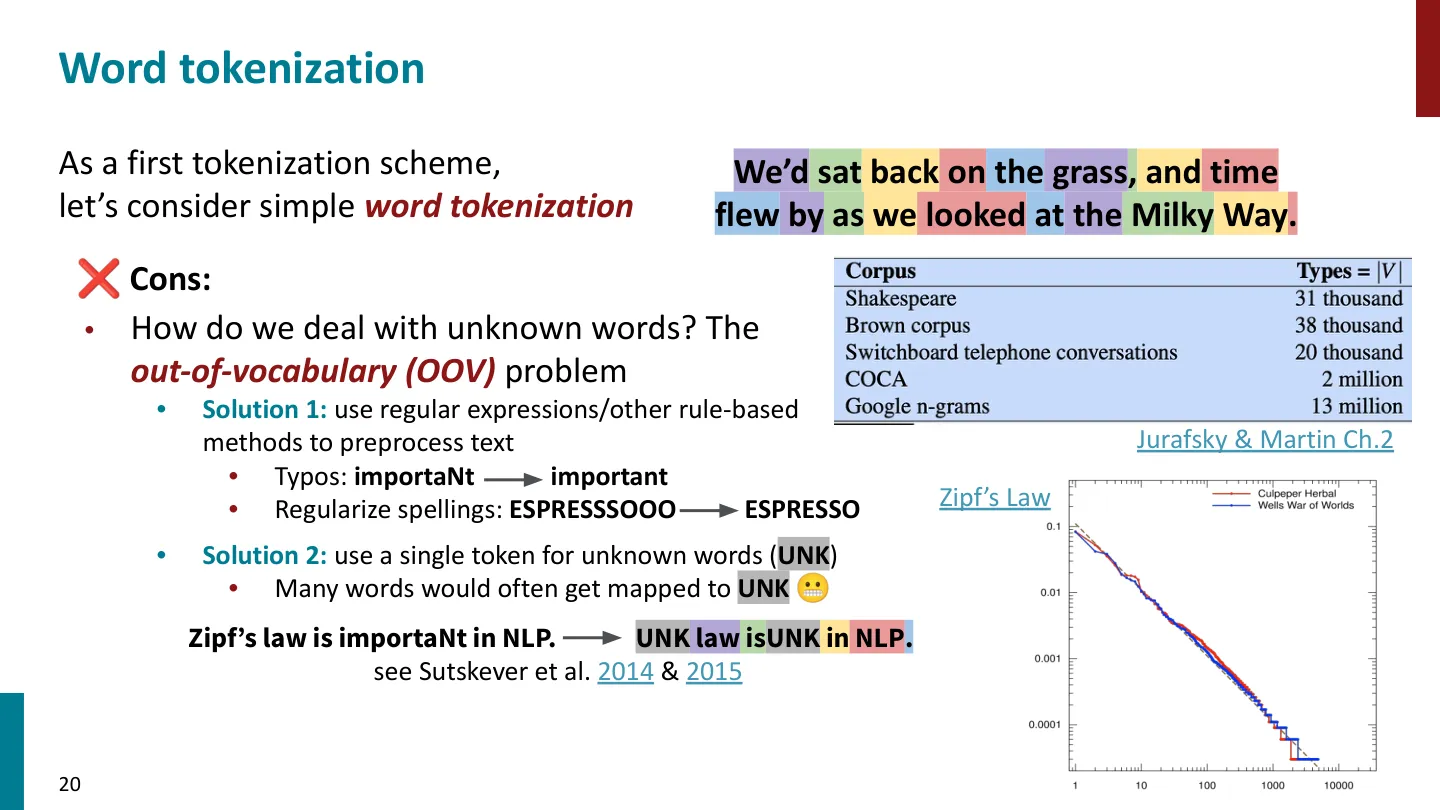
缺点
- 词太多了,词表可能极大;
- 存在不常见词的长尾(long tail);
- 齐普夫定律(Zipf's law):一个词的频率与它的频率排名成反比——即排名第 $r$ 的词,频率大致正比于 $1/r$(见 Zipf's law,以及 Jurafsky & Martin《Speech and Language Processing》第 2 章,https://web.stanford.edu/~jurafsky/slp3/);
🖼️ 第 19 页幻灯片 · Word tokenization
- 语言每时每刻都在变:Merriam-Webster 第 12 版大学词典新增了 5000 个新词(包括
rizz)。
失败案例:未登录词(OOV)
问:遇到没见过的词怎么办? 这就是未登录词(out-of-vocabulary, OOV)问题。
讲义列了两种方案:
- 方案 1:用正则表达式 / 其它基于规则的方法预处理文本。
- 处理拼写错误:
importaNt→important; - 规范化拼写:
ESPRESSSOOO→ESPRESSO; - 参见 Sutskever et al. 2014 & 2015。
- 方案 2:给所有未知词用一个统一 token,即
UNK。
方案 2 的机制性失败在于:大量词会同时被映射到 UNK,信息被不可逆地丢弃:
Zipf's law is importaNt in NLP.→UNK law isUNK in NLP.
注意上面的例子:Zipf's 和 importaNt 都塌缩成了同一个 UNK,模型再也分不清它们。这不是「偶尔出错」,而是当语料规模增大、词表却被截断时的必然结果——长尾上的词全部被丢进同一个桶里。
方案二:字符 / 字节级分词(Character/Byte Tokenization)
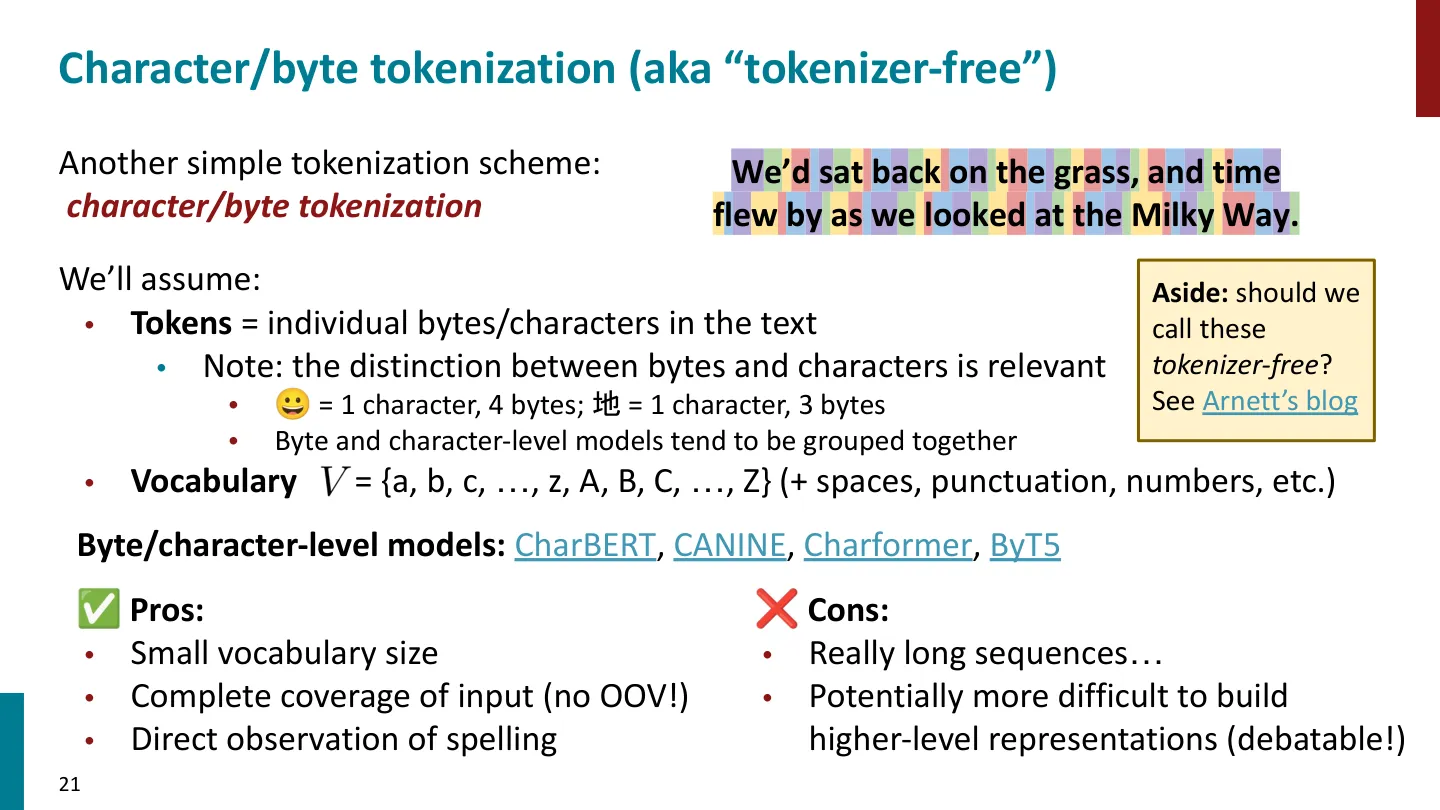
另一种简单方案是字符 / 字节级分词(有时被称作「tokenizer-free」)。假设:
🖼️ 第 21 页幻灯片 · Character/byte tokenization (aka “tokenizer-free”)
- token = 文本中的单个字符 / 字节;
🖼️ 第 22 页幻灯片 · Between words and characters: Subword Tokenization
- 词表 $= \{a, b, c, \dots, z, A, B, C, \dots, Z\}$(加上空格、标点、数字等)。
🖼️ 第 23 页幻灯片 · Common subword tokenization algorithms:
字节与字符的区别
讲义特别提醒:字节(byte)与字符(character)的区分是有意义的:
| 字符 | 字符数 | 字节数 |
|---|---|---|
| 😀 | 1 | 4 |
| 地 | 1 | 3 |
不过在实际工程中,字节级与字符级模型通常被归为一类。
编者拓展|为什么是 3 和 4 个字节:这来自 UTF-8 的变长编码。
地的码位是 U+5730,落在「三字节区」,UTF-8 编码为E5 9C B0;😀(U+1F600)落在「四字节区」,编码为F0 9F 98 80。ASCII 范围内的字符(英文、数字、常见标点)各占 1 字节。这解释了为什么字节级模型的词表可以小到 256 个——它直接以「256 种可能的字节值」为字母表。
🖼️ 第 24 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
这类模型的代表:CharBERT、CANINE、Charformer、ByT5。
优点
- 词表很小;
- 对输入的覆盖是完整的(没有 OOV!);
- 能直接观察到拼写。
缺点
- 序列会非常长;
- 构建更高层的表示可能(有争议地)更困难。
编者说明:讲义在这里附了一个题外话——「这些东西到底该不该叫 tokenizer-free?参见 Arnett 的博客」。这是一个术语上的争议:字节级模型并非真的不需要分词,而是把「分词」变成了「按 UTF-8 切字节」这种固定规则。本讲保留这个提问,但不进一步展开。
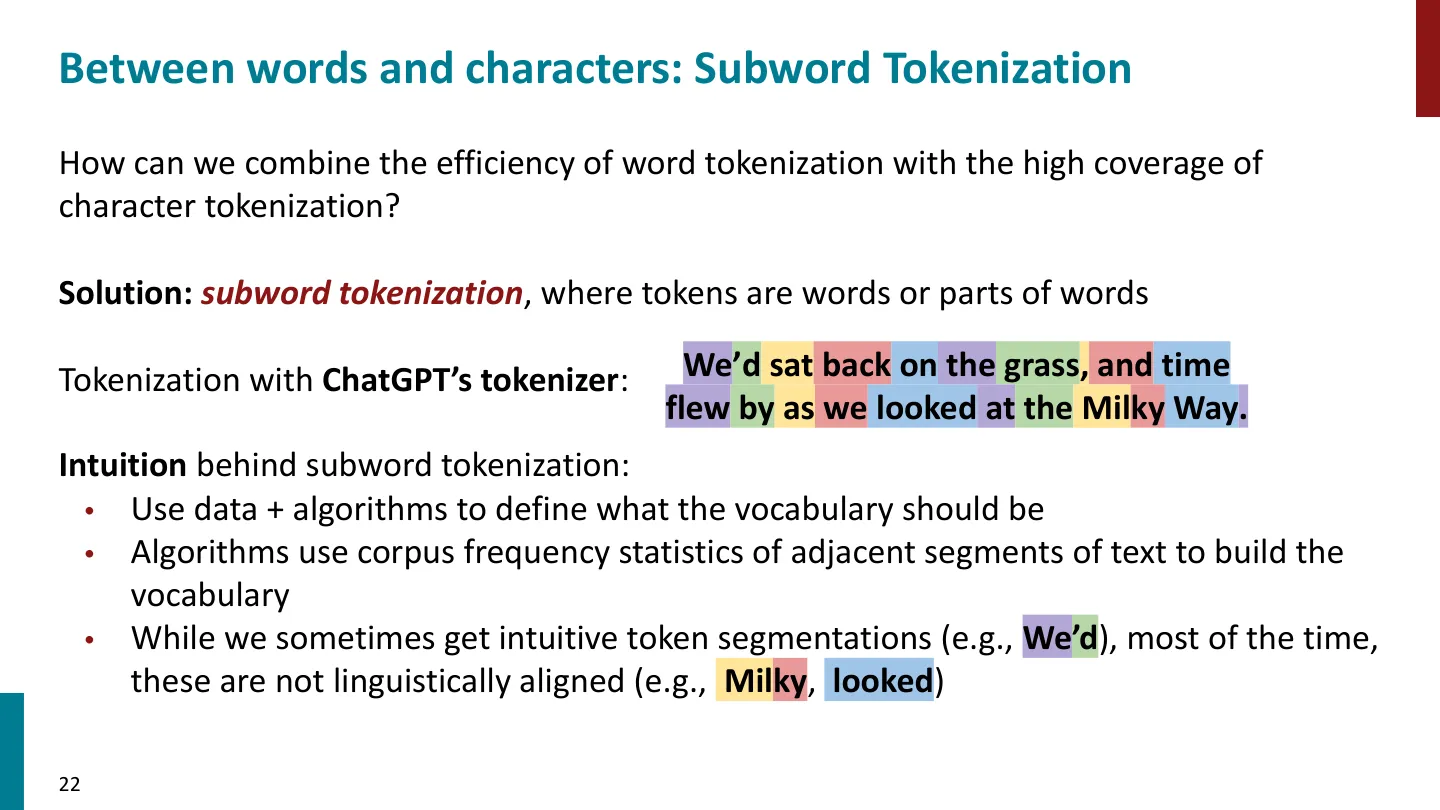
方案三:子词分词(Subword Tokenization)
能不能把词级分词的效率和字符级分词的高覆盖率结合起来?答案是子词分词:token 可以是完整的词,也可以是词的一部分。
🖼️ 第 25 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
子词分词的直觉(讲义 cell 67):
- 用数据 + 算法来定义词表应该长什么样;
- 算法利用语料中相邻文本片段的频率统计来构建词表;
🖼️ 第 26 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- 我们有时能得到直觉上合理的切分(例如
We'd),但大多数时候这些切分并不与语言学边界对齐(例如Milky、looked)。
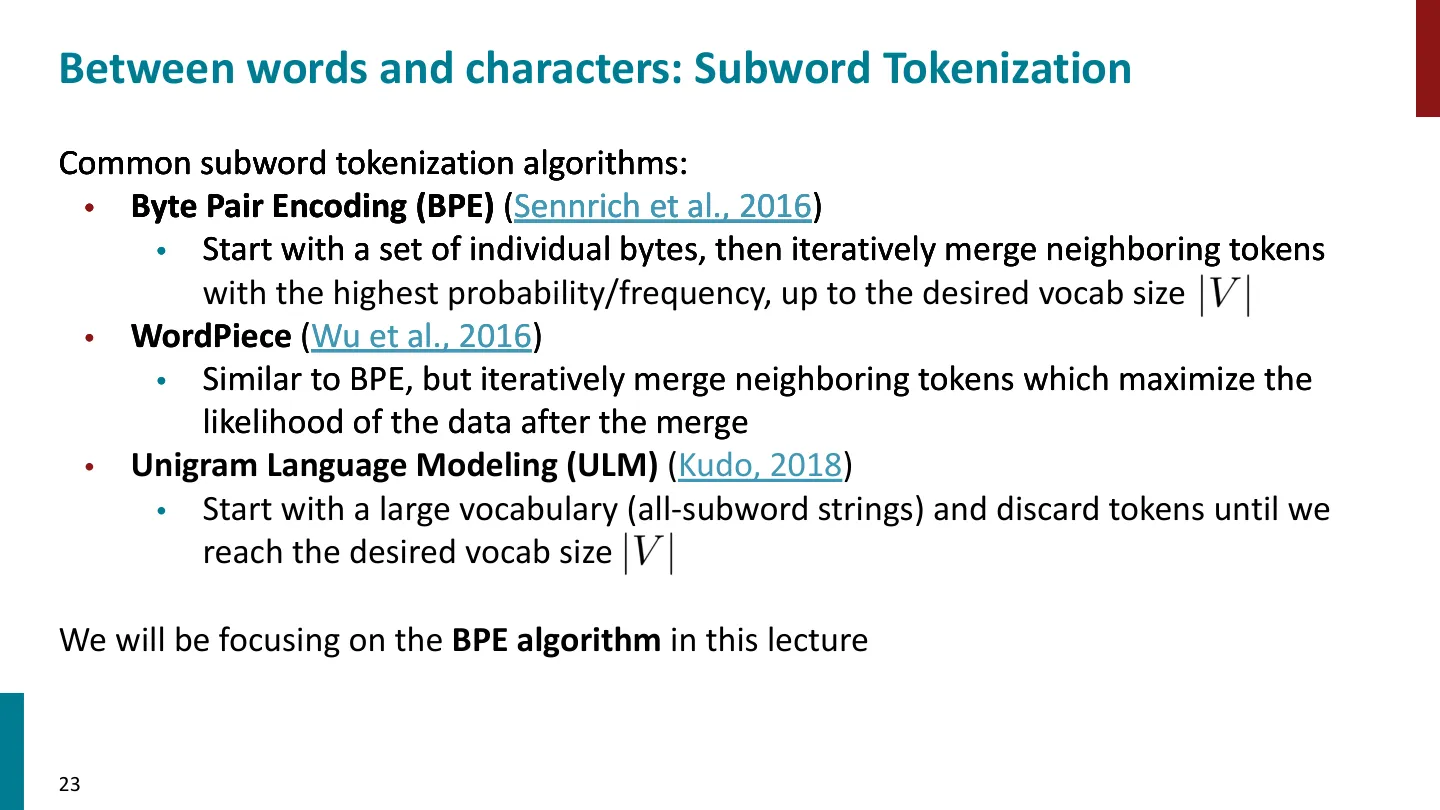
常见的子词分词算法
- 字节对编码(Byte Pair Encoding, BPE)(Sennrich et al., 2016):从一组独立的字节出发,迭代地合并相邻的 token——具体是合并概率 / 频率最高的相邻 token,直到达到目标词表大小。
- WordPiece(Wu et al., 2016):与 BPE 类似,但它合并的是「合并后能让数据似然最大化」的相邻 token。
- Unigram 语言模型(Unigram Language Modeling, ULM)(Kudo, 2018):从一个很大的词表(所有可能的子词串)出发,逐步丢弃 token,直到达到目标词表大小。
🖼️ 第 27 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
编者说明:注意 BPE 与 WordPiece 的差别不只是「换了个打分函数」——BPE 用频次(一个纯粹的计数统计量),WordPiece 用似然(要依赖模型当前的参数)。这导致 WordPiece 的每一步合并成本更高,但也更能贴合下游目标。
本讲聚焦 BPE。
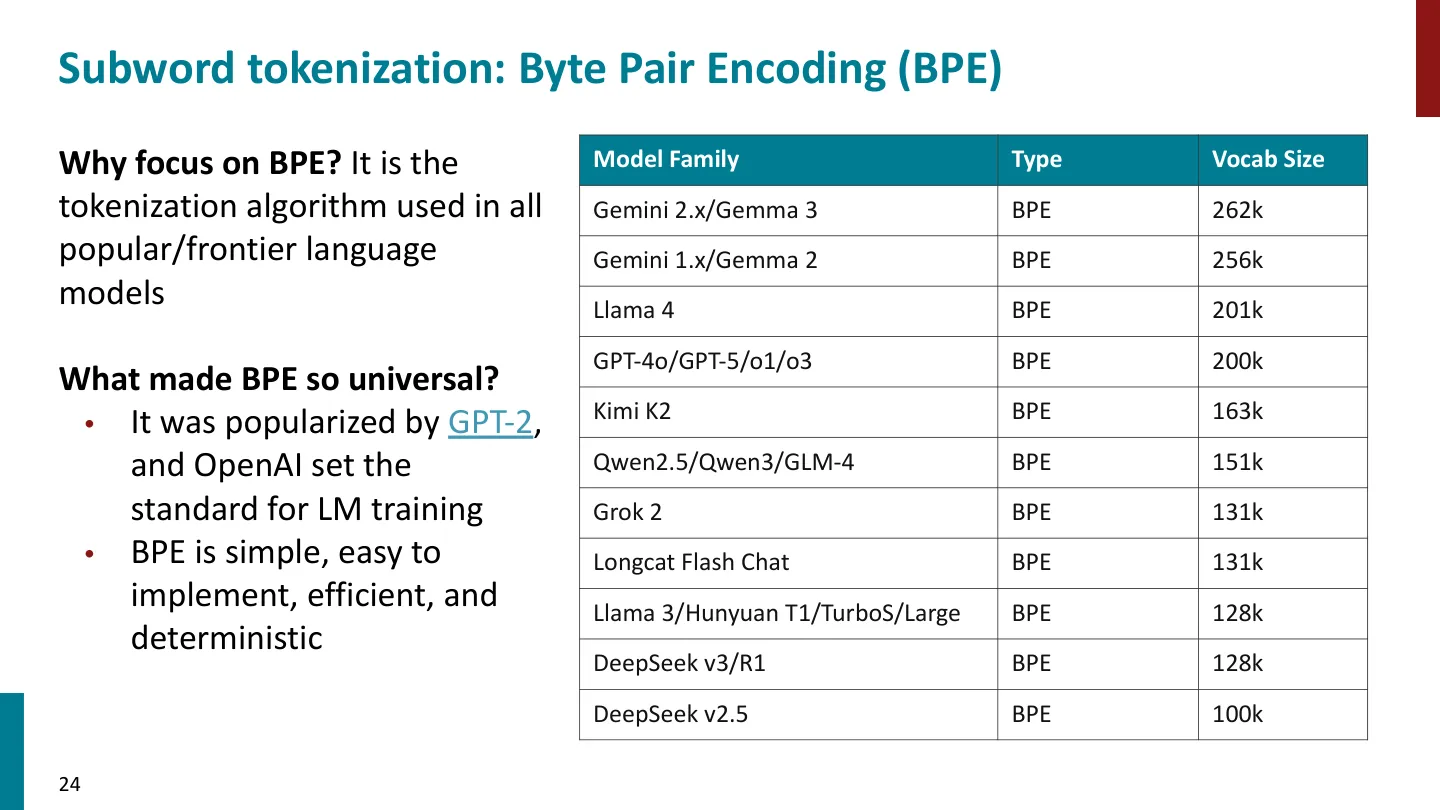
为什么是 BPE?
因为它是所有流行 / 前沿语言模型都在用的分词算法(讲义 cell 75):
| 模型系列 | 类型 | 词表大小 |
|---|---|---|
| Gemini 2.x / Gemma 3 | BPE | 262k |
| Gemini 1.x / Gemma 2 | BPE | 256k |
| Llama 4 | BPE | 201k |
| GPT-4o / GPT-5 / o1 / o3 | BPE | 200k |
| Kimi K2 | BPE | 163k |
| Qwen2.5 / Qwen3 / GLM-4 | BPE | 151k |
| Grok 2 | BPE | 131k |
| Longcat Flash Chat | BPE | 131k |
| Llama 3 / Hunyuan T1 / TurboS / Large | BPE | 128k |
| DeepSeek v3 / R1 | BPE | 128k |
| DeepSeek v2.5 | BPE | 100k |
BPE 为什么会变得如此通用?
- 它由 GPT-2 推广开来,而 OpenAI 为语言模型训练定下了标准;
- BPE 简单、易实现、高效、且确定性。
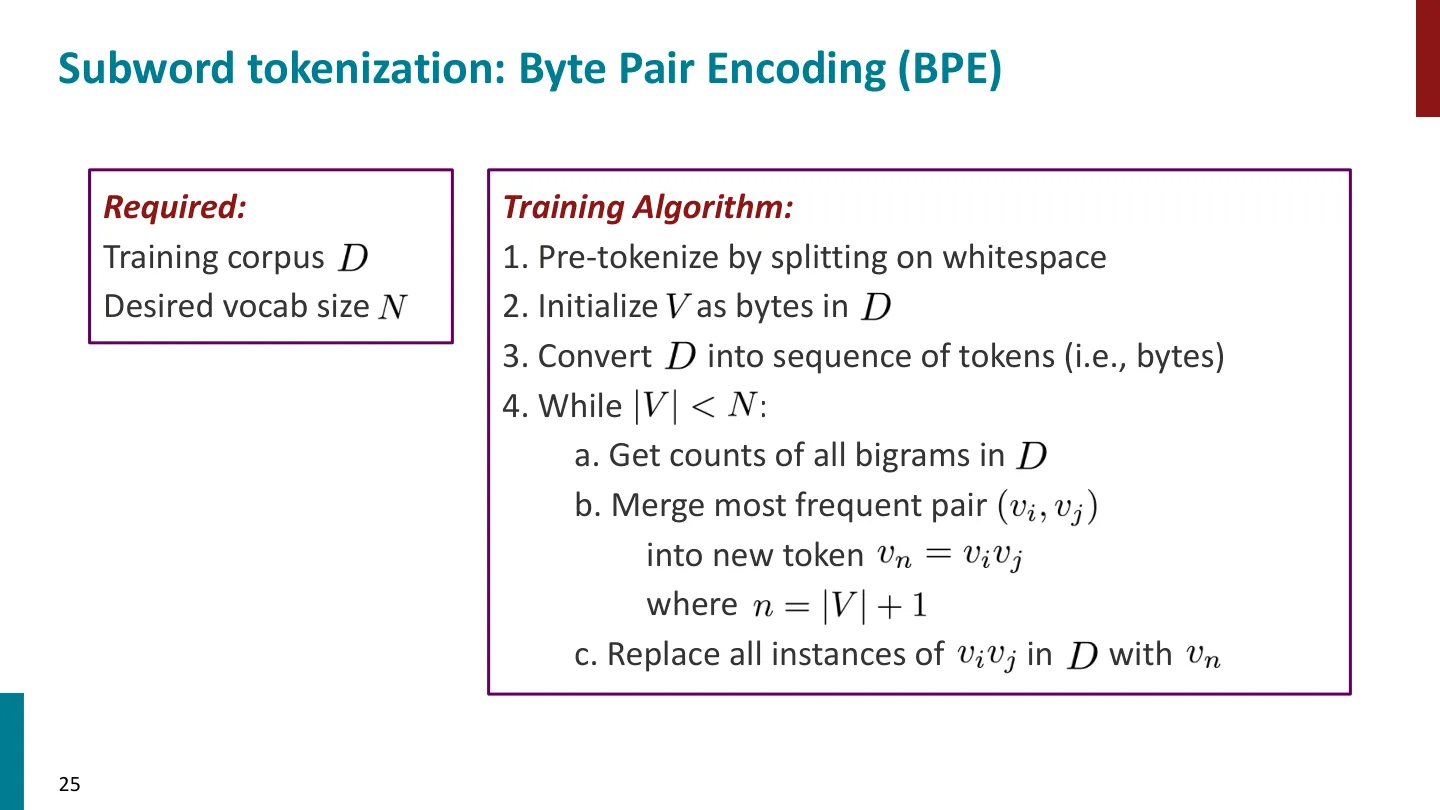
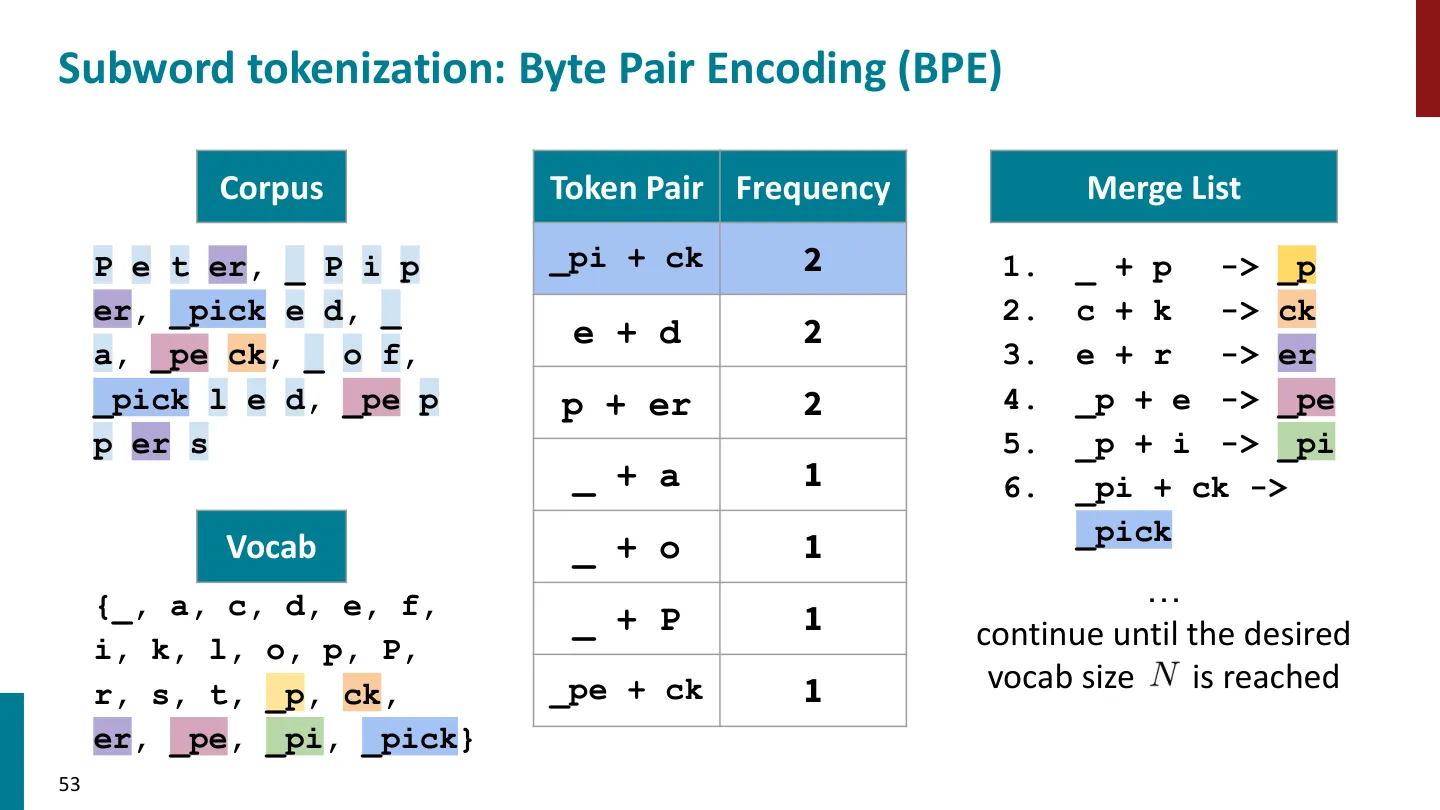
BPE 的训练算法
输入:训练语料 $D$;目标词表大小 $N$。
🖼️ 第 29 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
算法:
- 预分词:按空白切分;
- 初始化 $V$ 为 $D$ 中出现的所有字节;
- 把 $D$ 转换成 token(即字节)序列;
- 当 $|V| < N$ 时:
- a. 统计 $D$ 中所有相邻二元组(bigram)的频次;
- b. 合并频次最高的那一对 $(v_i, v_j)$ 为新 token $v_n = v_i v_j$,其中 $n = |V| + 1$;
- c. 把 $D$ 中出现的所有 $v_i v_j$ 替换为 $v_n$。
flowchart TD
    S["输入:训练语料 D,目标词表大小 N"] --> A["1. 按空白预分词"]
    A --> B["2. 初始化词表 V = D 中出现的所有字节"]
    B --> C["3. 把 D 展开为 token(字节)序列"]
    C --> D{"|V| < N ?"}
    D -- 是 --> E["a. 统计 D 中所有相邻二元组的频次"]
    E --> F["b. 合并频次最高的对 (v_i, v_j)<br/>得到新 token v_n = v_i v_j,n = |V|+1"]
    F --> G["c. 把 D 中所有 v_i v_j 替换为 v_n"]
    G --> D
    D -- 否 --> H["输出:词表 V + 合并规则列表(merge list)"]
手工走一遍:Peter Piper
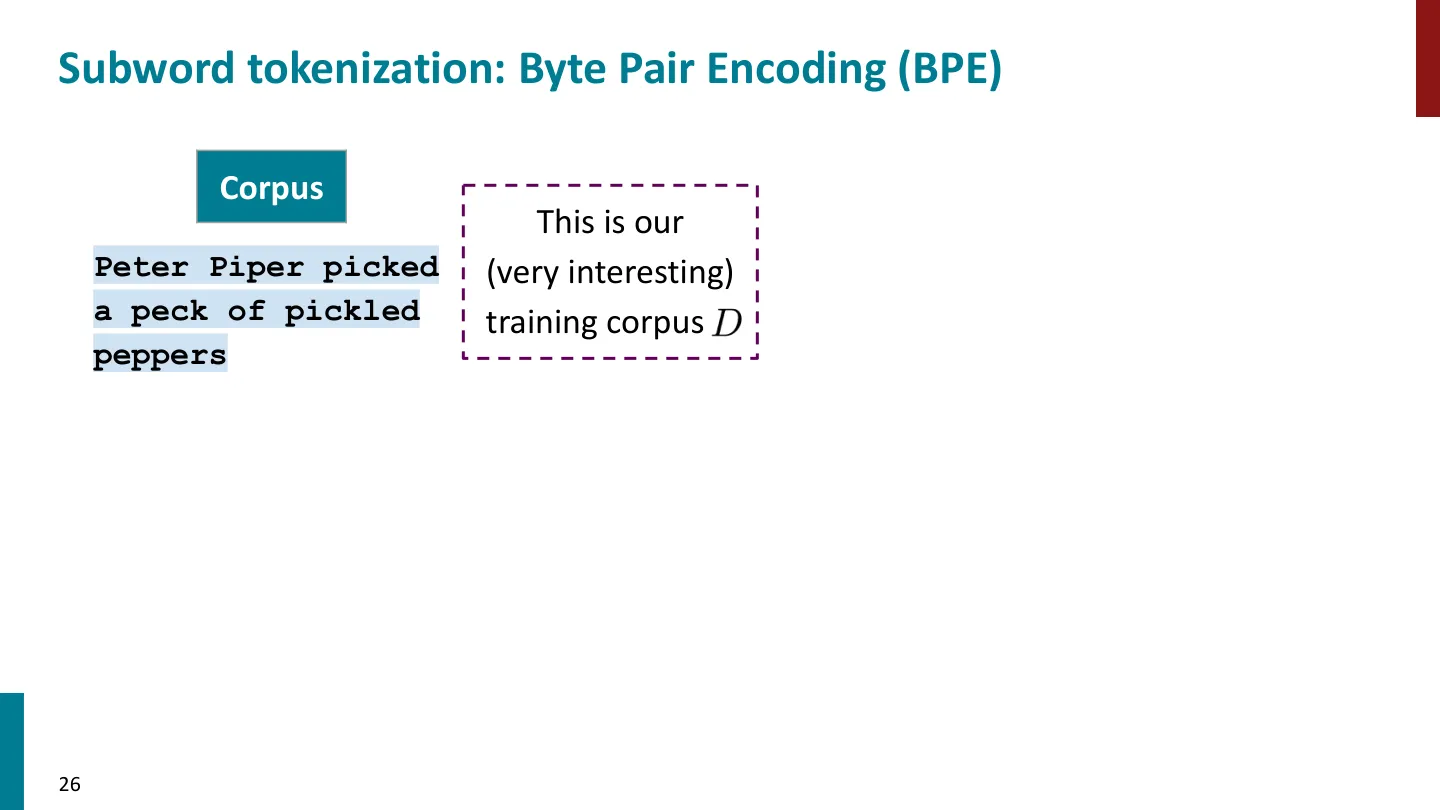
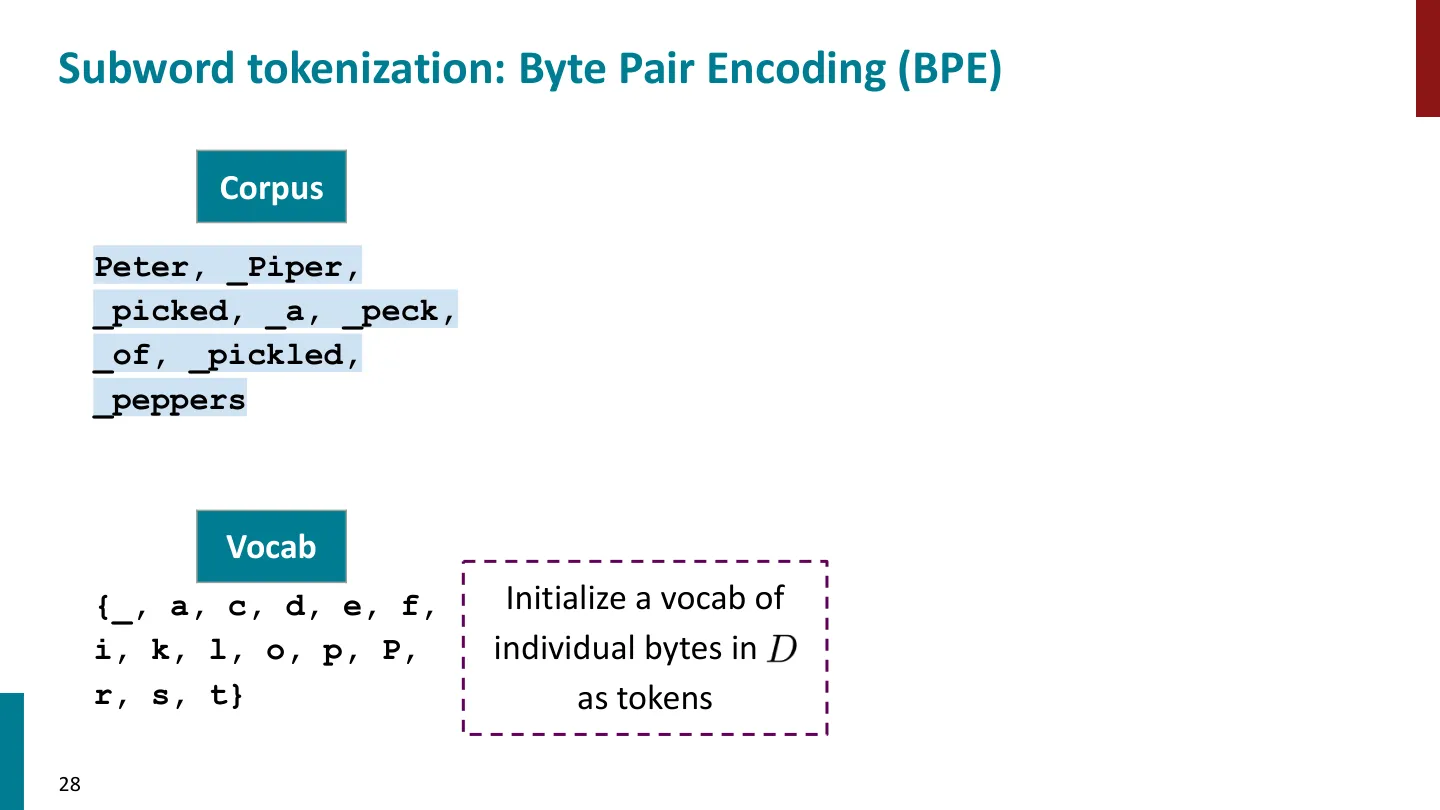
训练语料 $D$(讲义称之为「非常有趣」的语料):
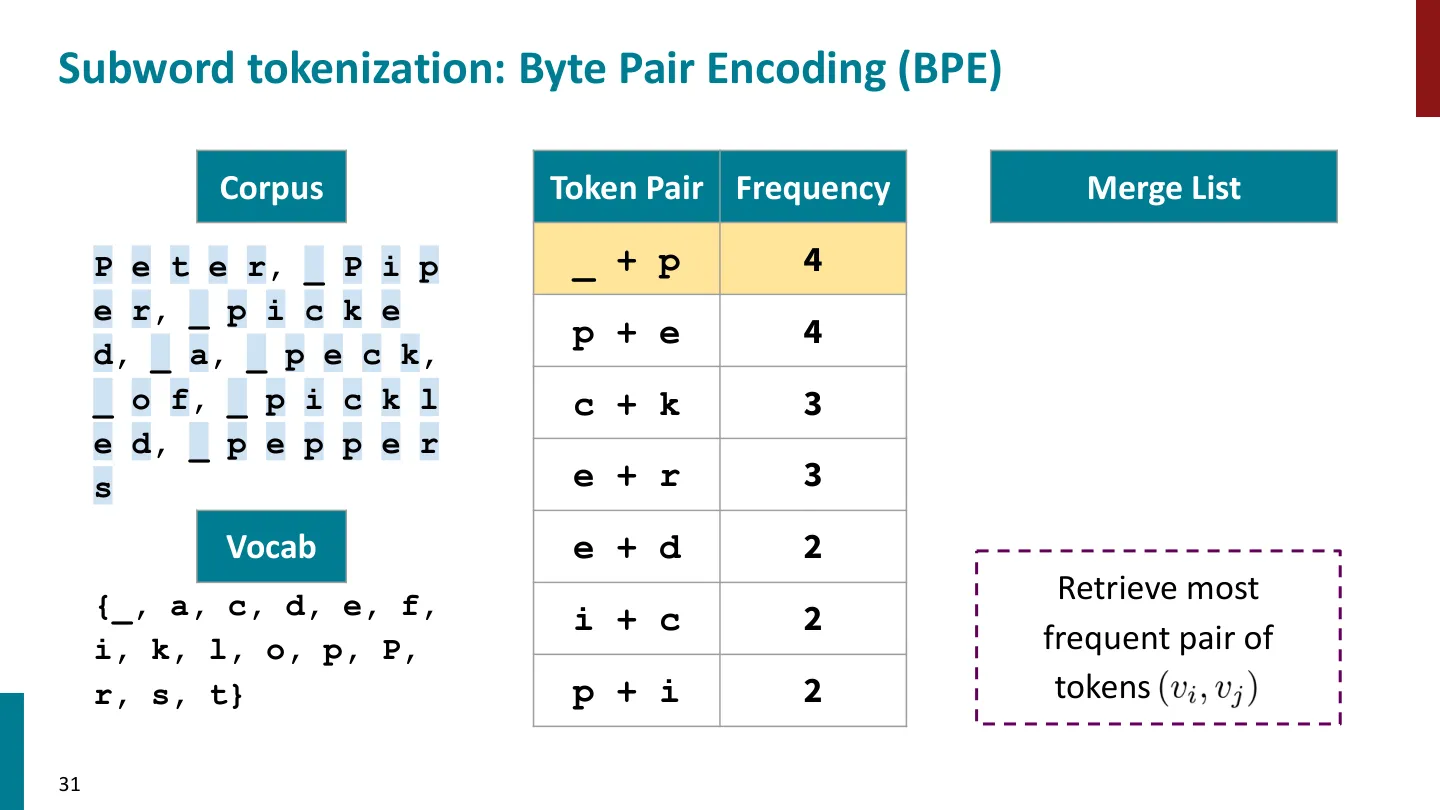
Peter Piper picked a peck of pickled peppers
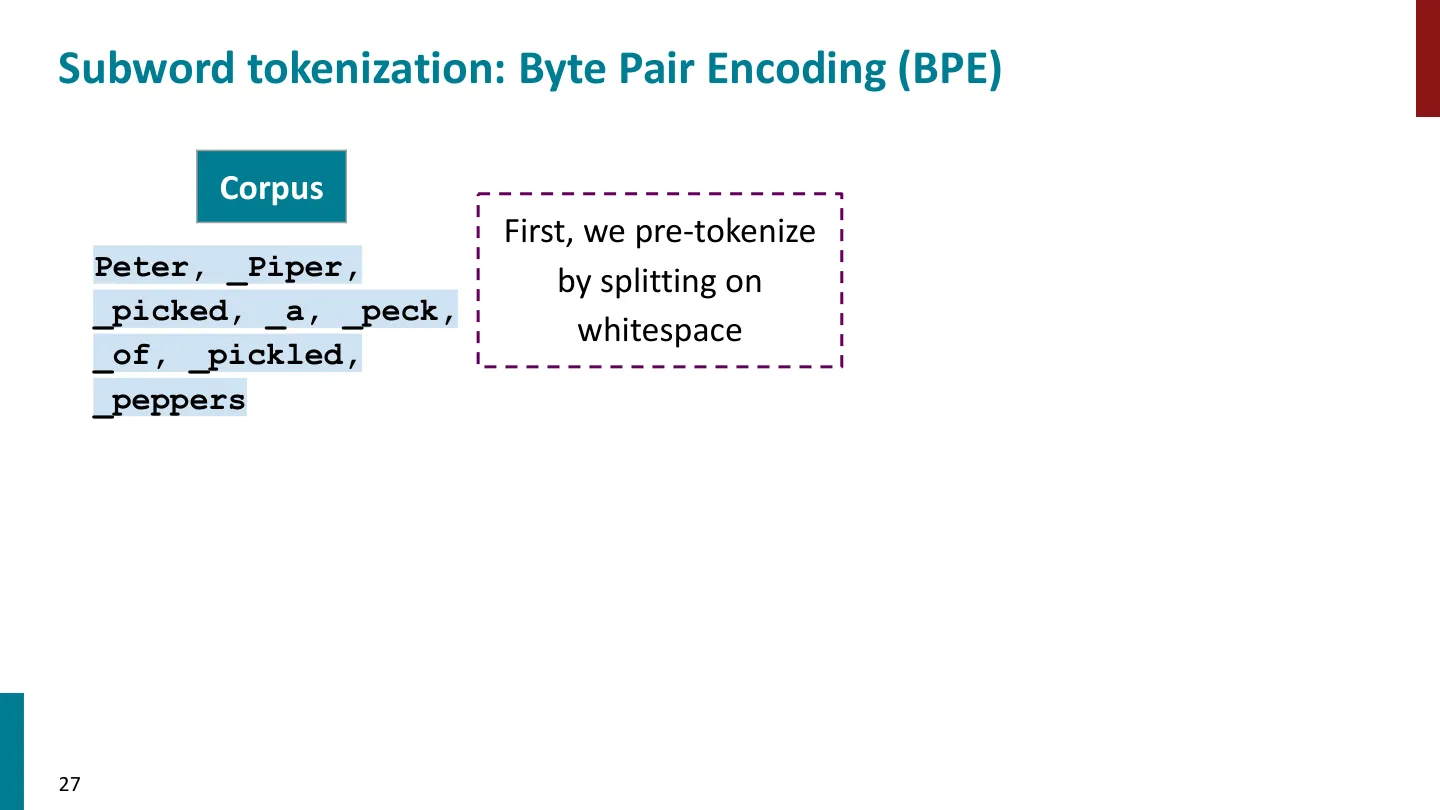
第 1 步:按空白预分词
Peter, _Piper, _picked, _a, _peck, _of, _pickled, _peppers
(下划线 _ 代表词首的空格。)
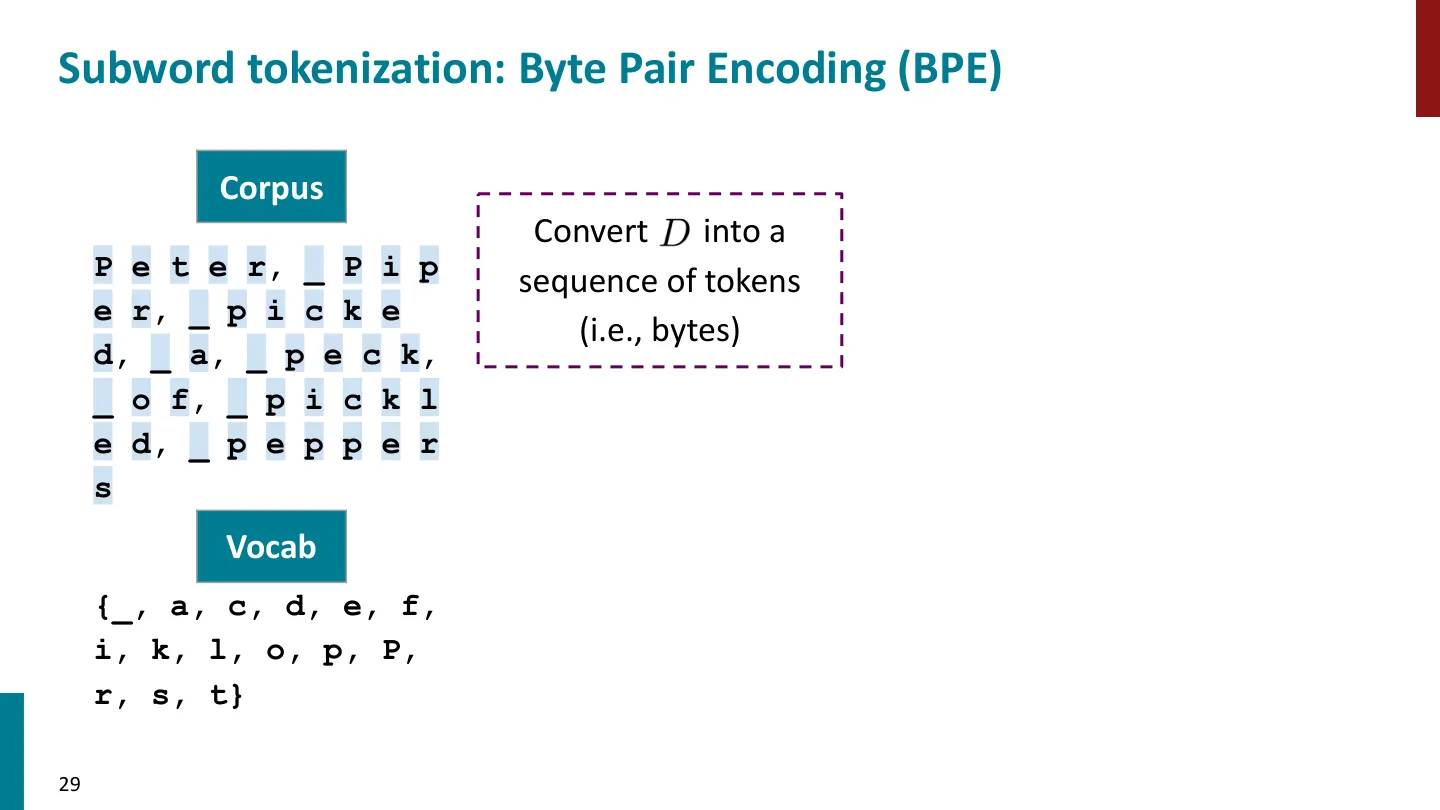
第 2 步:初始化词表为 $D$ 中的单个字节
🖼️ 第 30 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
V = {_, a, c, d, e, f, i, k, l, o, p, P, r, s, t}
第 3 步:把 $D$ 展开成字节序列
P e t e r, _ P i p e r, _ p i c k e d, _ a, _ p e c k,
_ o f, _ p i c k l e d, _ p e p p e r s
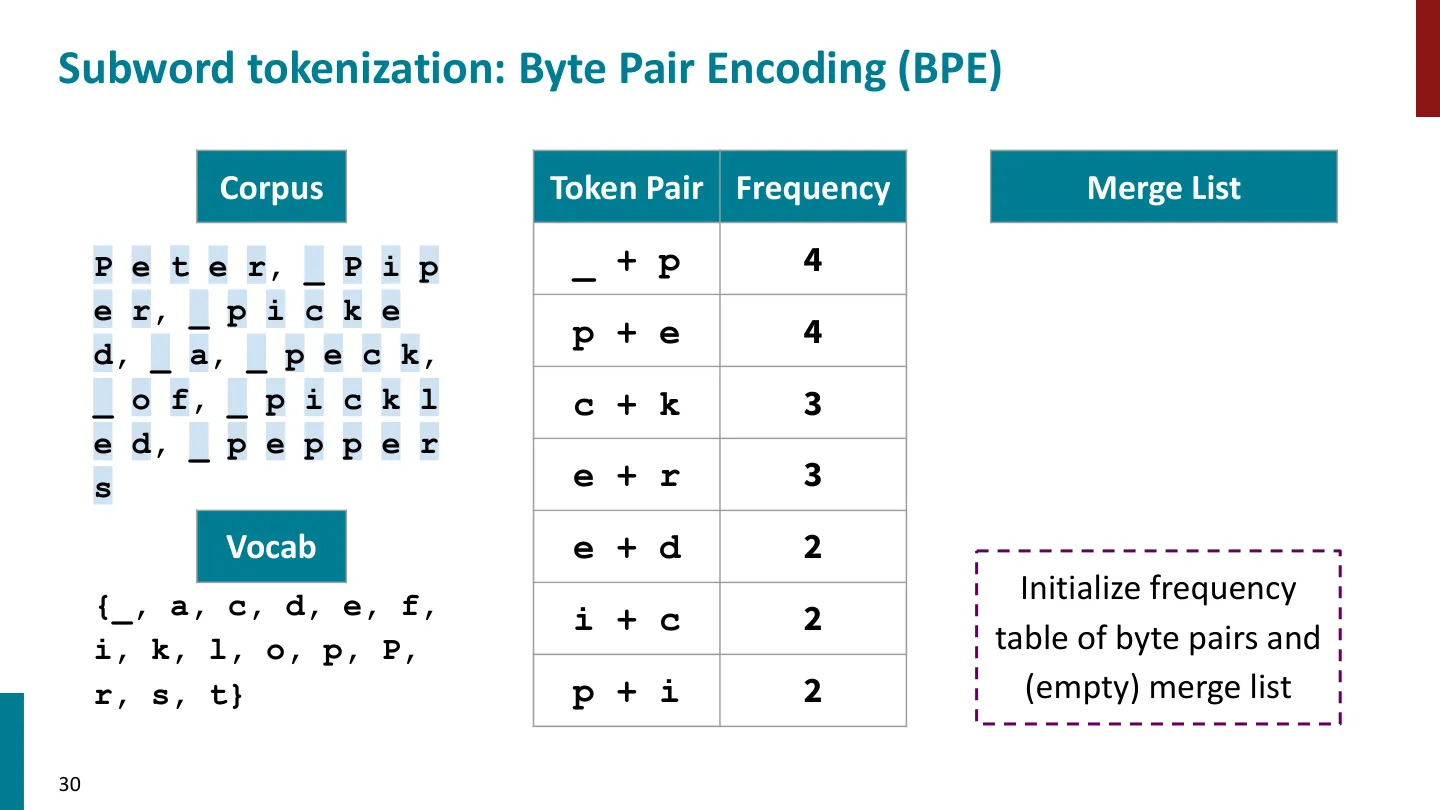
第 4 步:初始化字节对频次表(merge list 为空)
| Token Pair | Frequency |
|---|---|
_ + p |
4 |
p + e |
4 |
c + k |
3 |
e + r |
3 |
e + d |
2 |
i + c |
2 |
p + i |
2 |
编者说明:
_ + p和p + e并列最高(都是 4),讲义选择了_ + p。第二次并列出现在c + k与e + r(都是 3),讲义选择了c + k。这种并列时的取舍规则属于实现细节,不同实现(例如按字典序取最大 / 最小)会得到不同的分词器。也就是说,BPE 的分词结果是确定性的,但「确定成什么样」取决于实现约定。
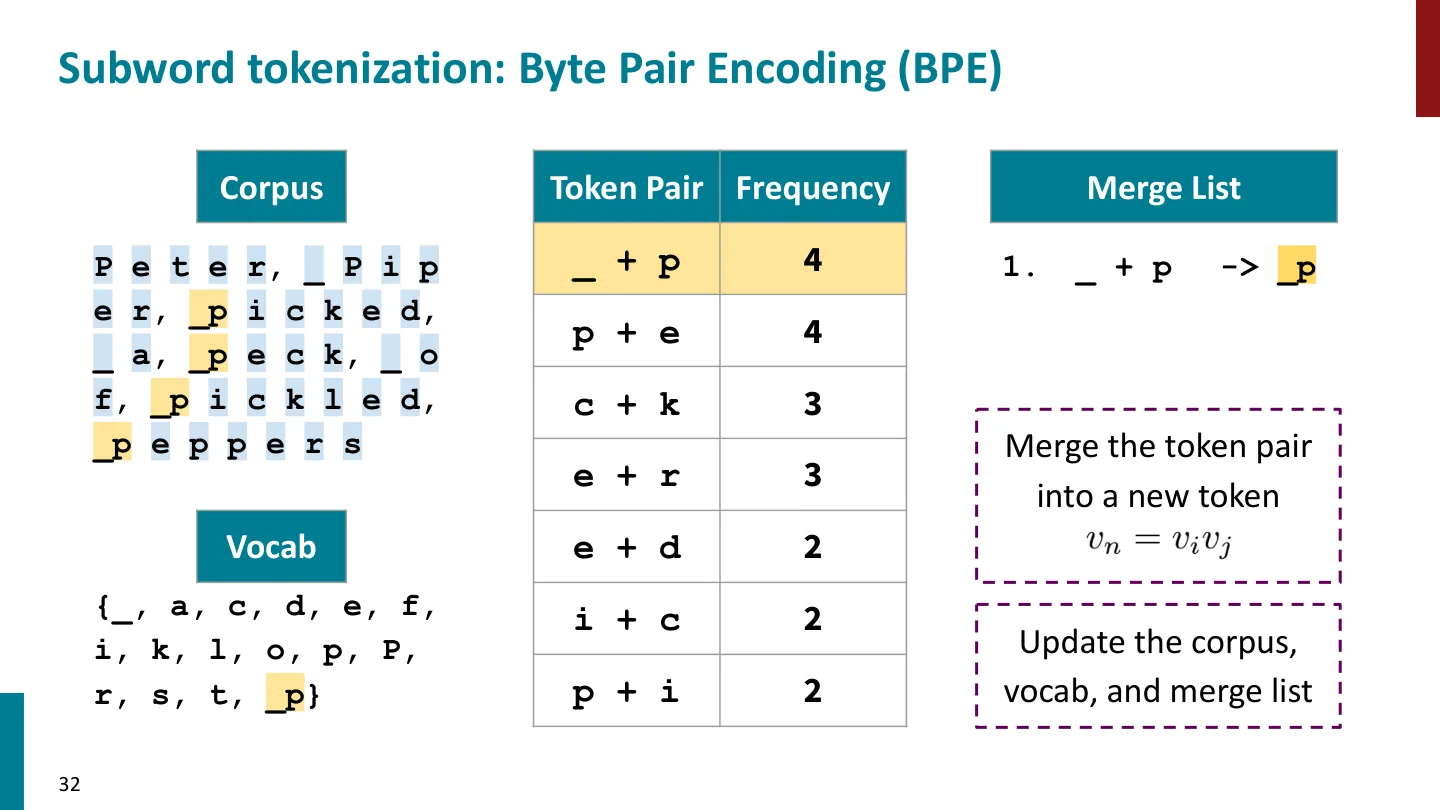
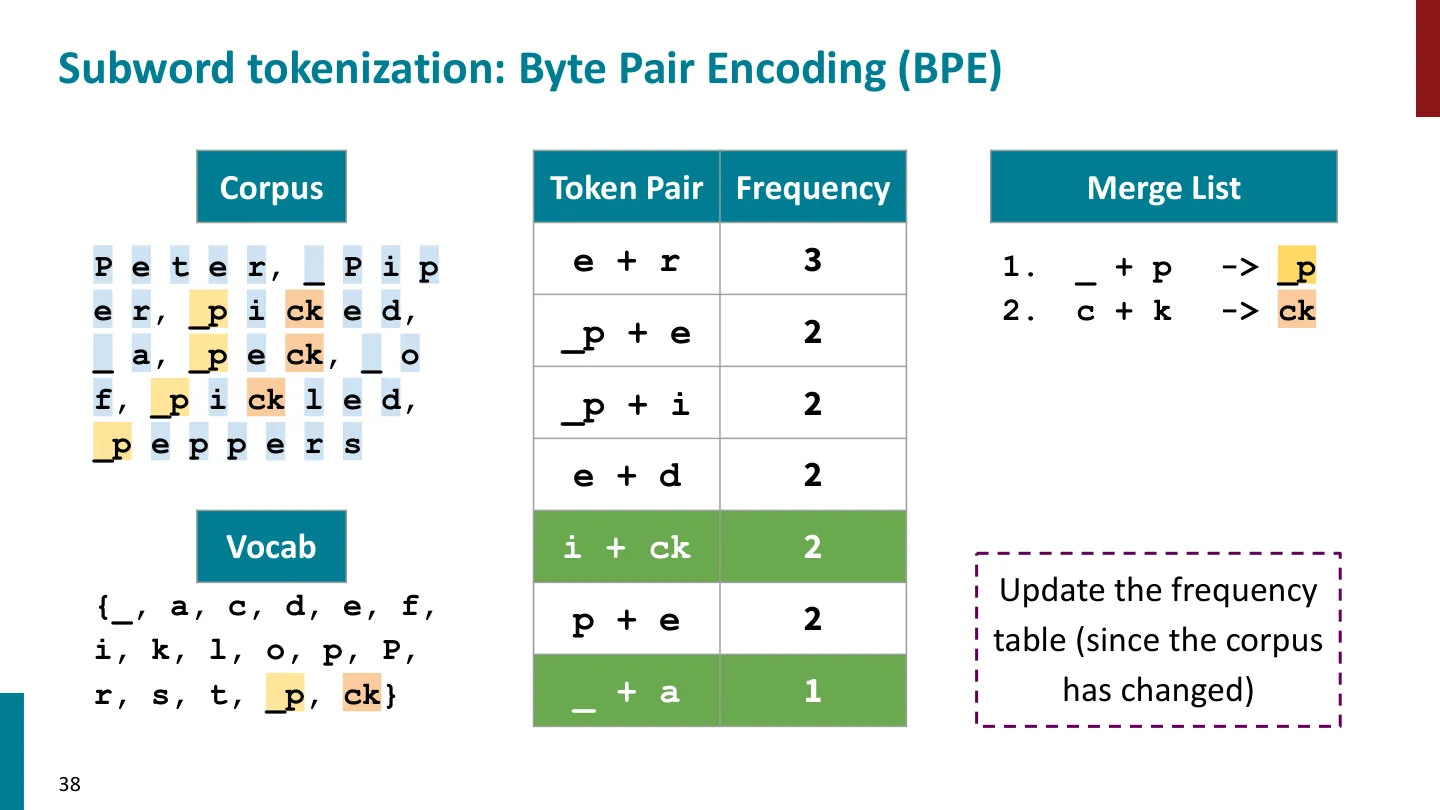
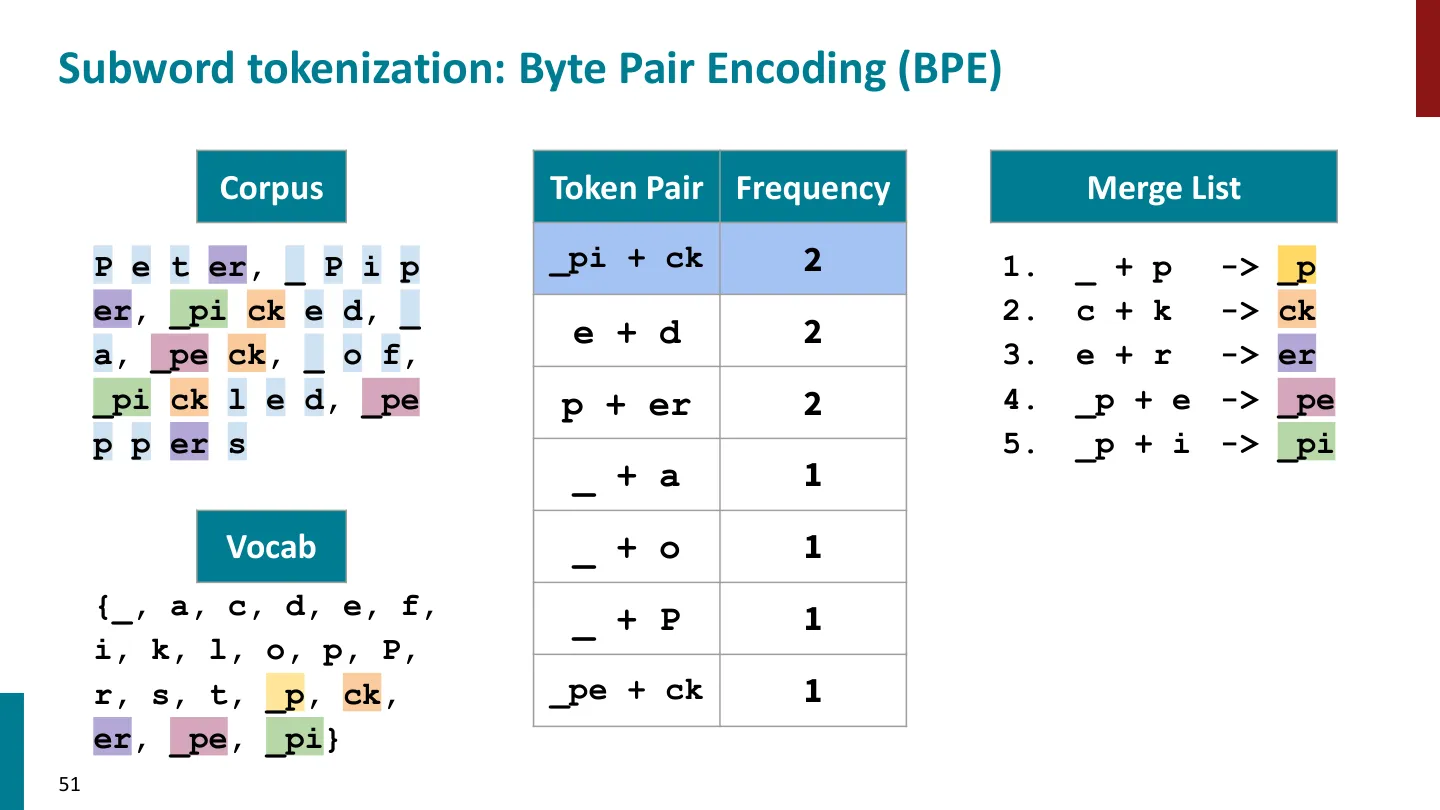
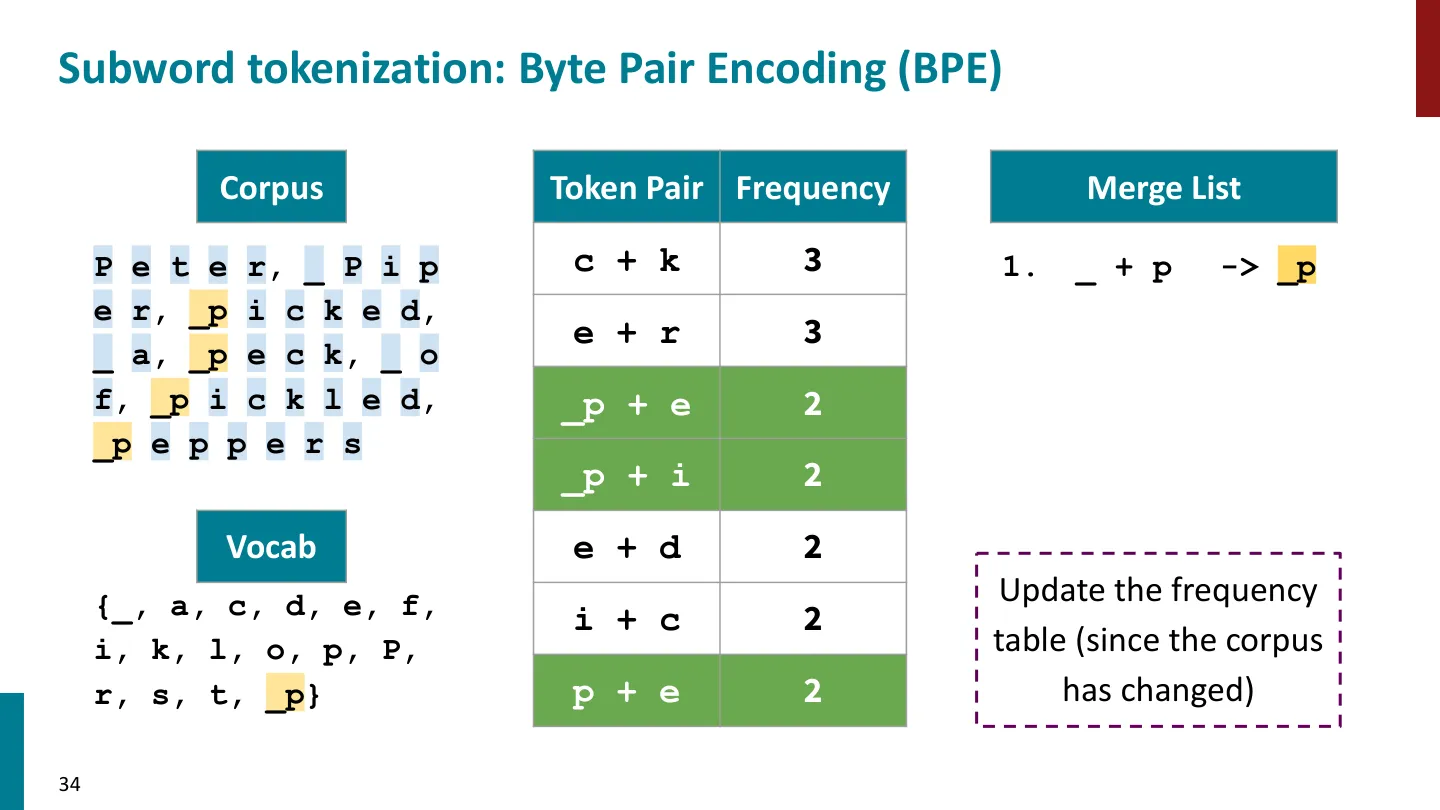
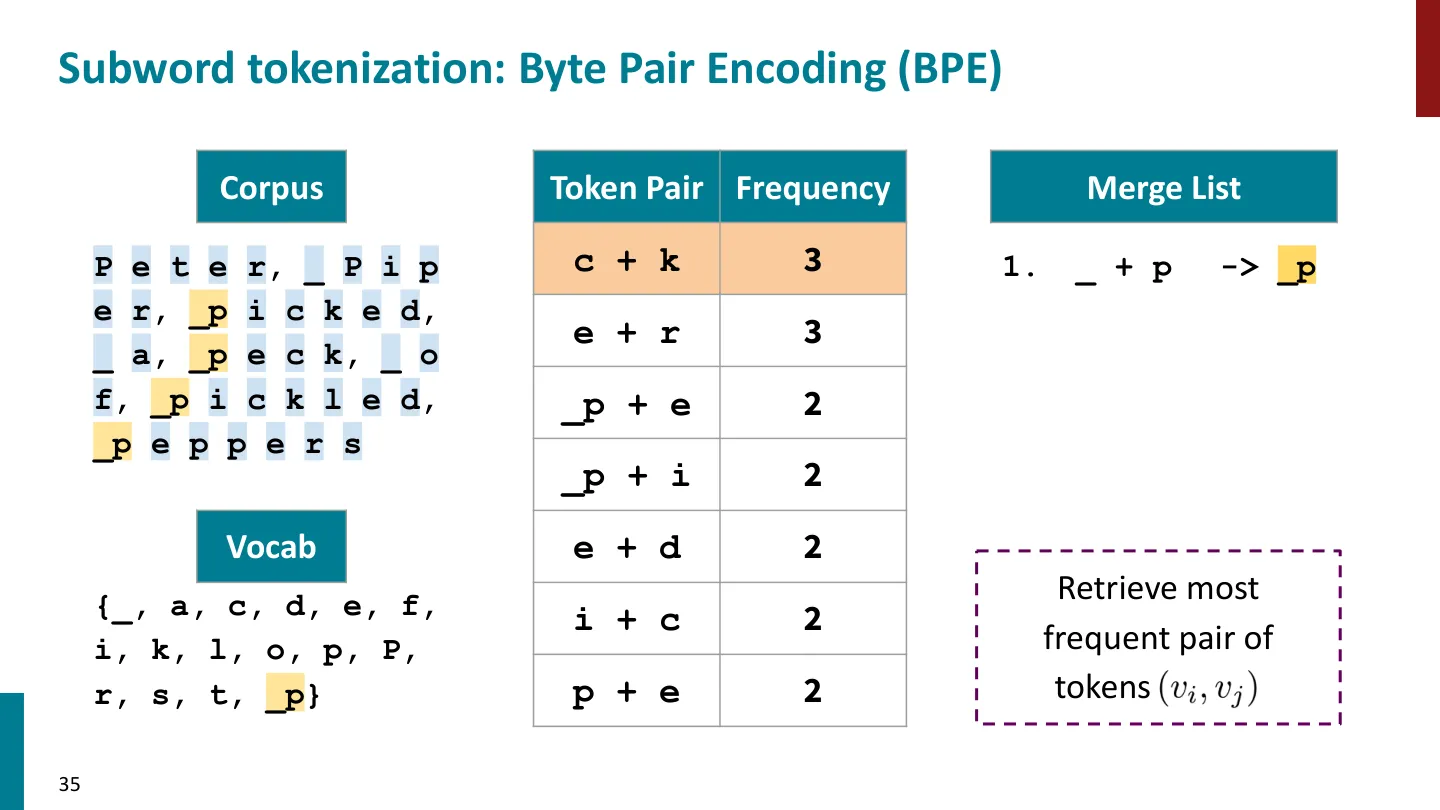
第 1 次合并:_ + p → _p
取出频次最高的对,合并成新 token,并更新语料、词表与合并列表:
- 合并列表:
1. _ + p -> _p - 词表:
{_, a, c, d, e, f, i, k, l, o, p, P, r, s, t, _p}
合并后的语料:
P e t e r, _ P i p e r, _p i c k e d, _ a, _p e c k,
_ o f, _p i c k l e d, _p e p p e r s
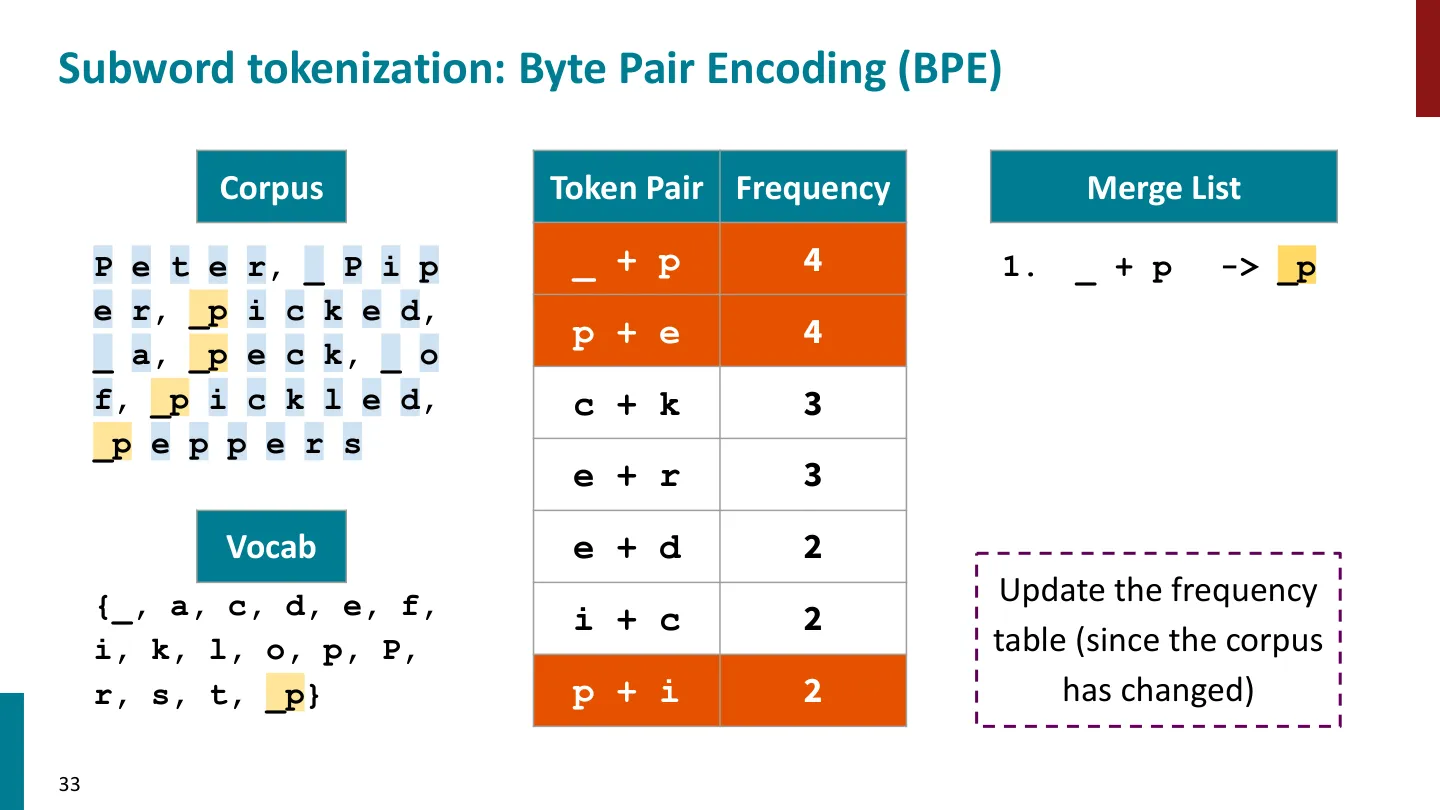
因为语料变了,需要重新统计频次表:
| Token Pair | Frequency |
|---|---|
c + k |
3 |
e + r |
3 |
_p + e |
2 |
_p + i |
2 |
e + d |
2 |
🖼️ 第 31 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
| i + c | 2 |
| p + e | 2 |
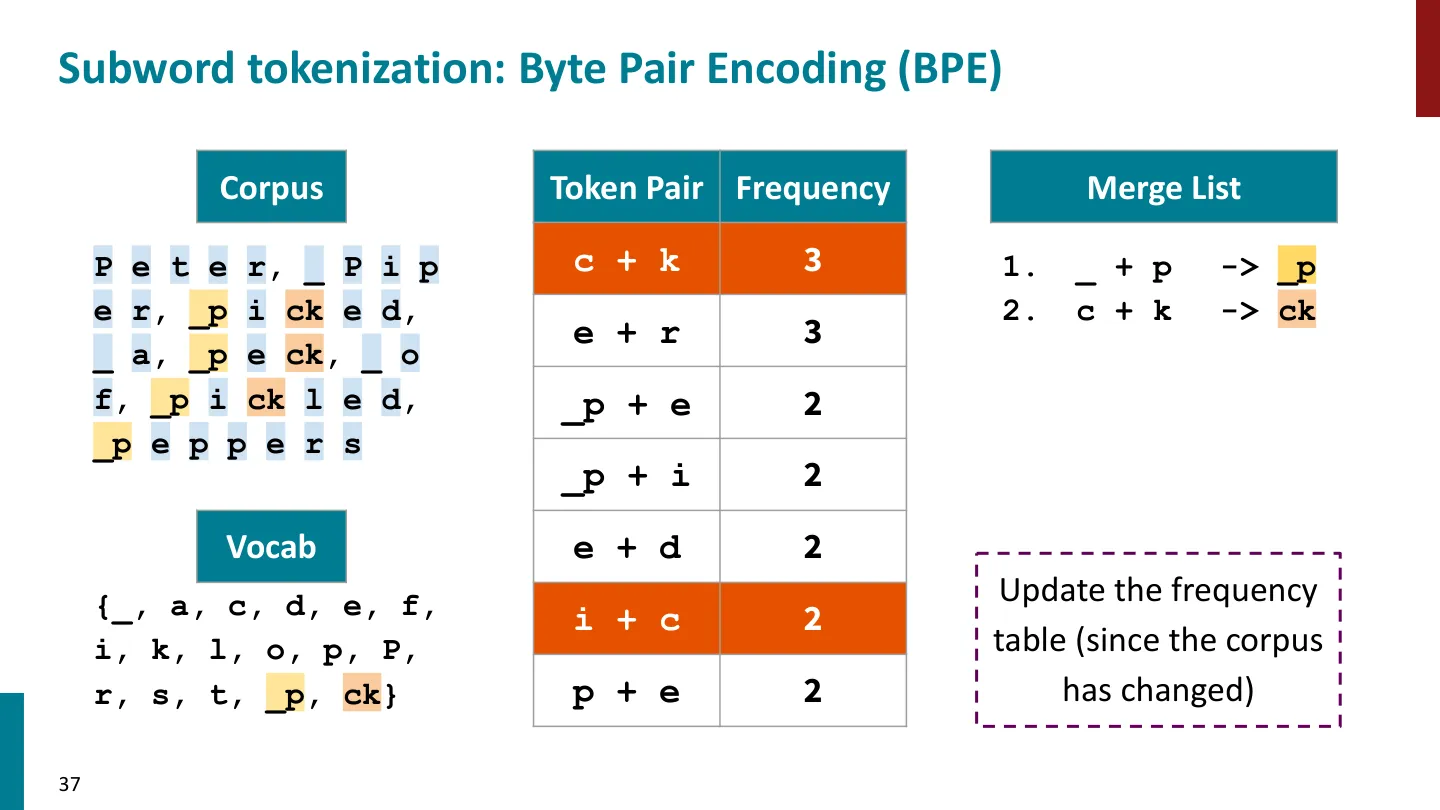
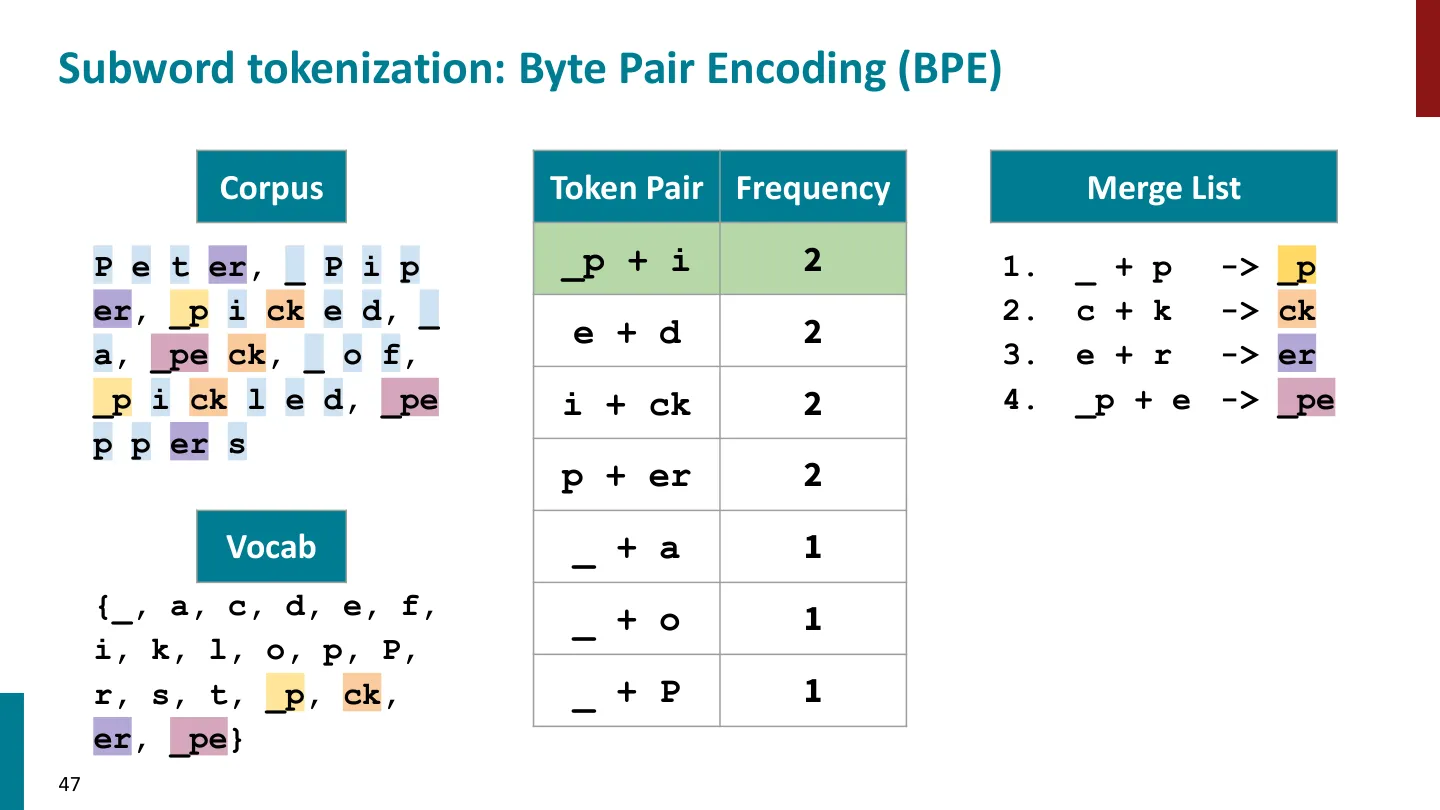
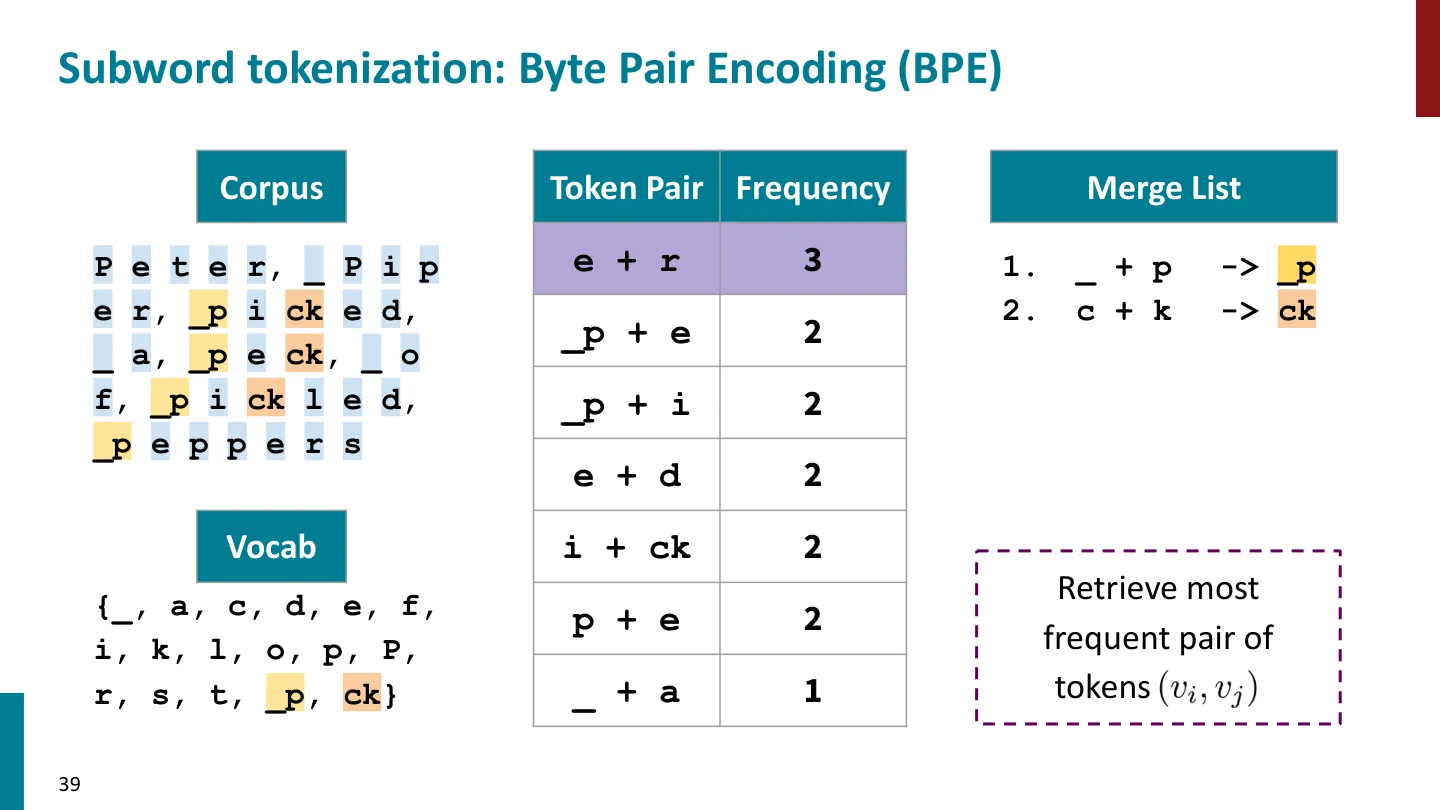
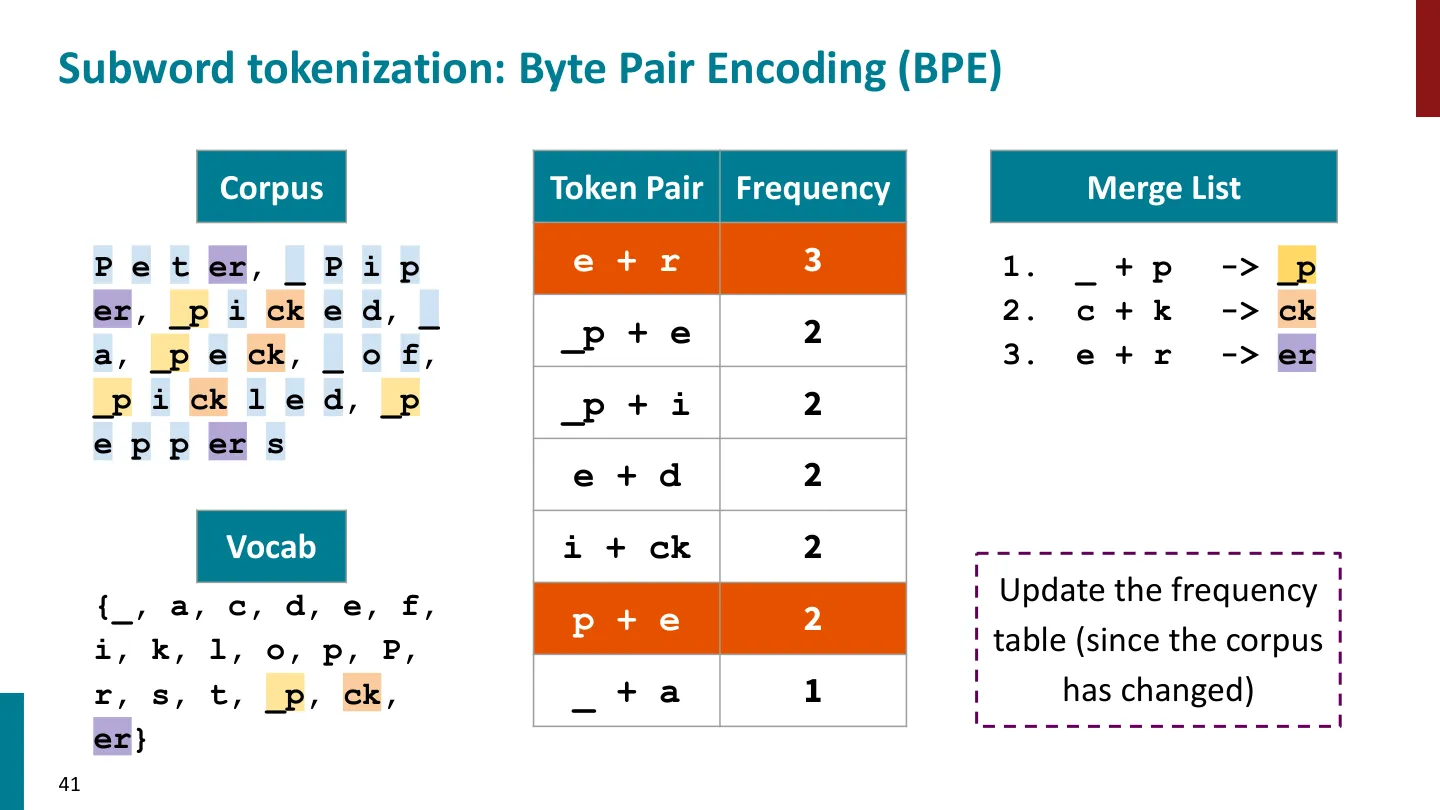
第 2 次合并:c + k → ck
- 合并列表:
2. c + k -> ck - 词表:
{_, a, c, d, e, f, i, k, l, o, p, P, r, s, t, _p, ck}
合并后的语料:
P e t e r, _ P i p e r, _p i ck e d, _ a, _p e ck,
_ o f, _p i ck l e d, _p e p p e r s
更新后的频次表:
| Token Pair | Frequency |
|---|---|
e + r |
3 |
_p + e |
2 |
_p + i |
2 |
e + d |
2 |
i + ck |
2 |
p + e |
2 |
_ + a |
1 |
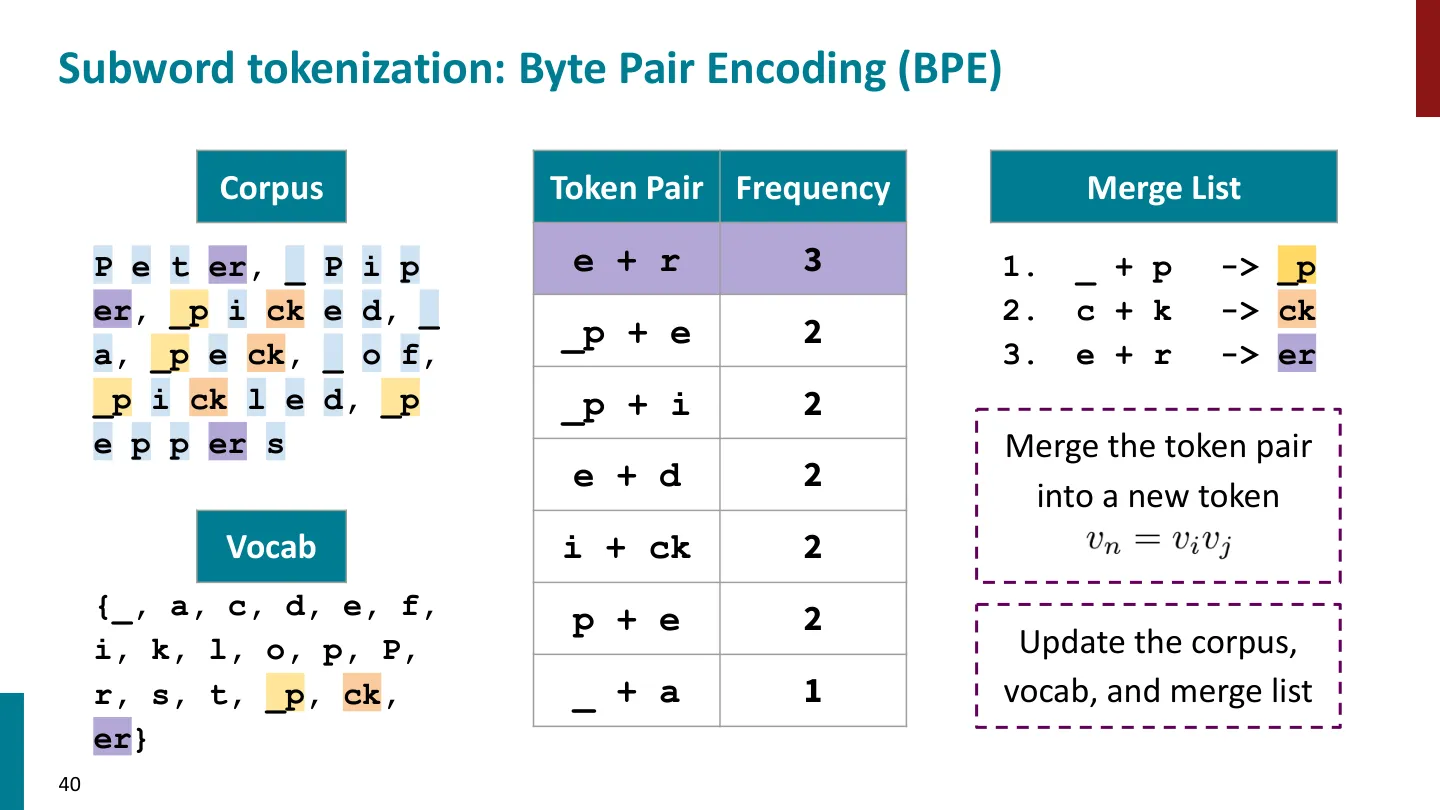
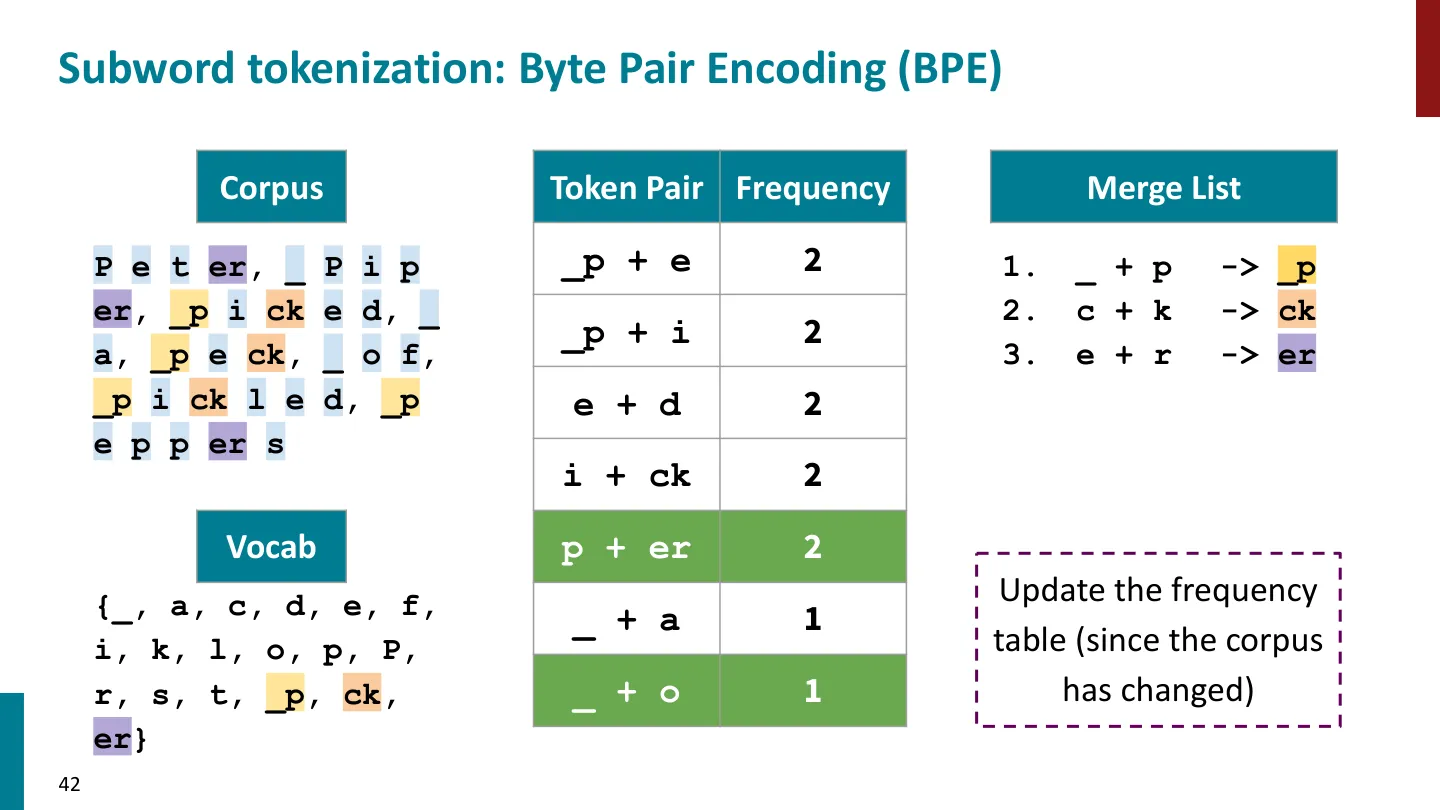
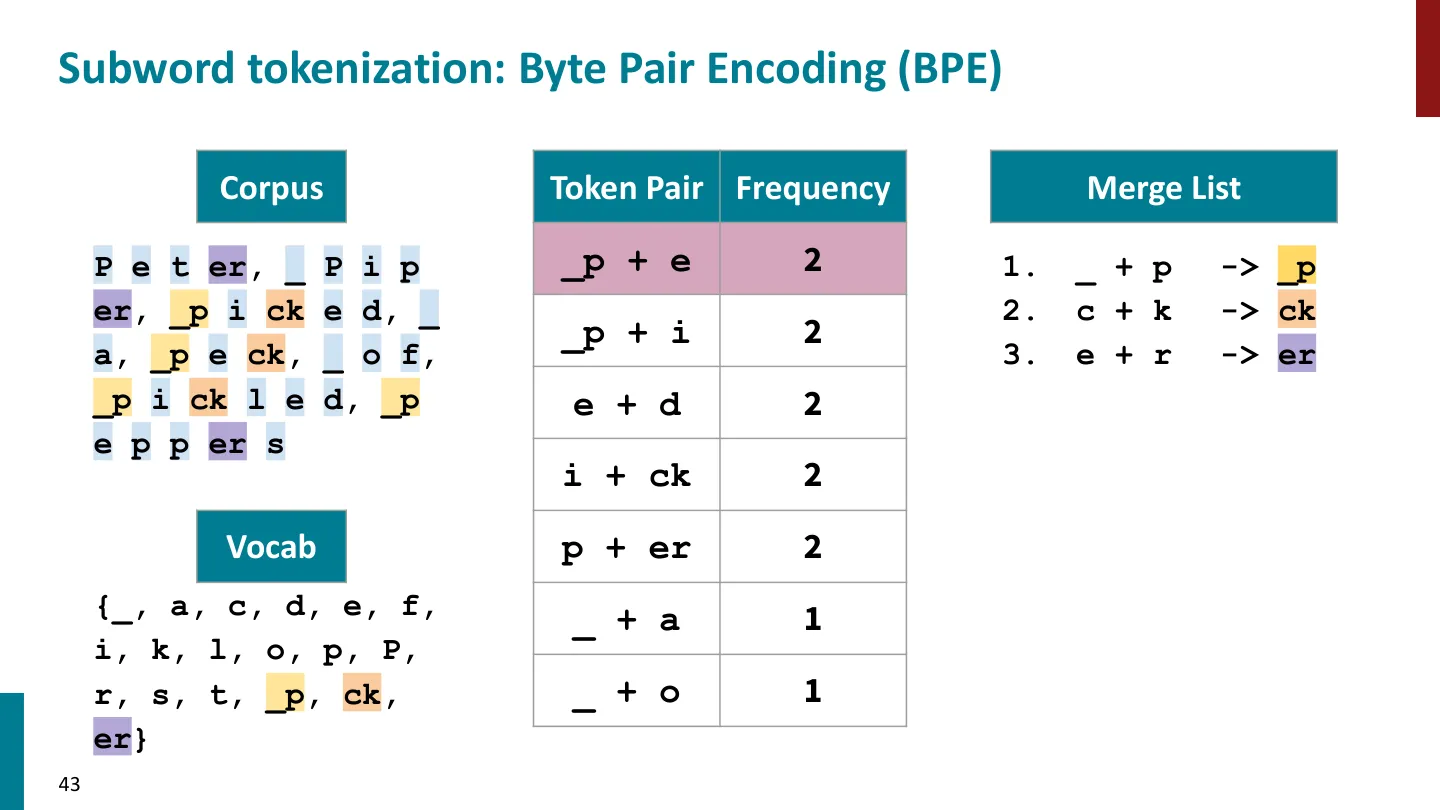
第 3 次合并:e + r → er
- 合并列表:
3. e + r -> er - 词表:
{_, a, c, d, e, f, i, k, l, o, p, P, r, s, t, _p, ck, er}
合并后的语料:
P e t er, _ P i p er, _p i ck e d, _ a, _p e ck,
_ o f, _p i ck l e d, _p e p p er s
更新后的频次表:
| Token Pair | Frequency |
|---|---|
_p + e |
2 |
_p + i |
2 |
e + d |
2 |
i + ck |
2 |
p + er |
2 |
_ + a |
1 |
🖼️ 第 32 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
| _ + o | 1 |
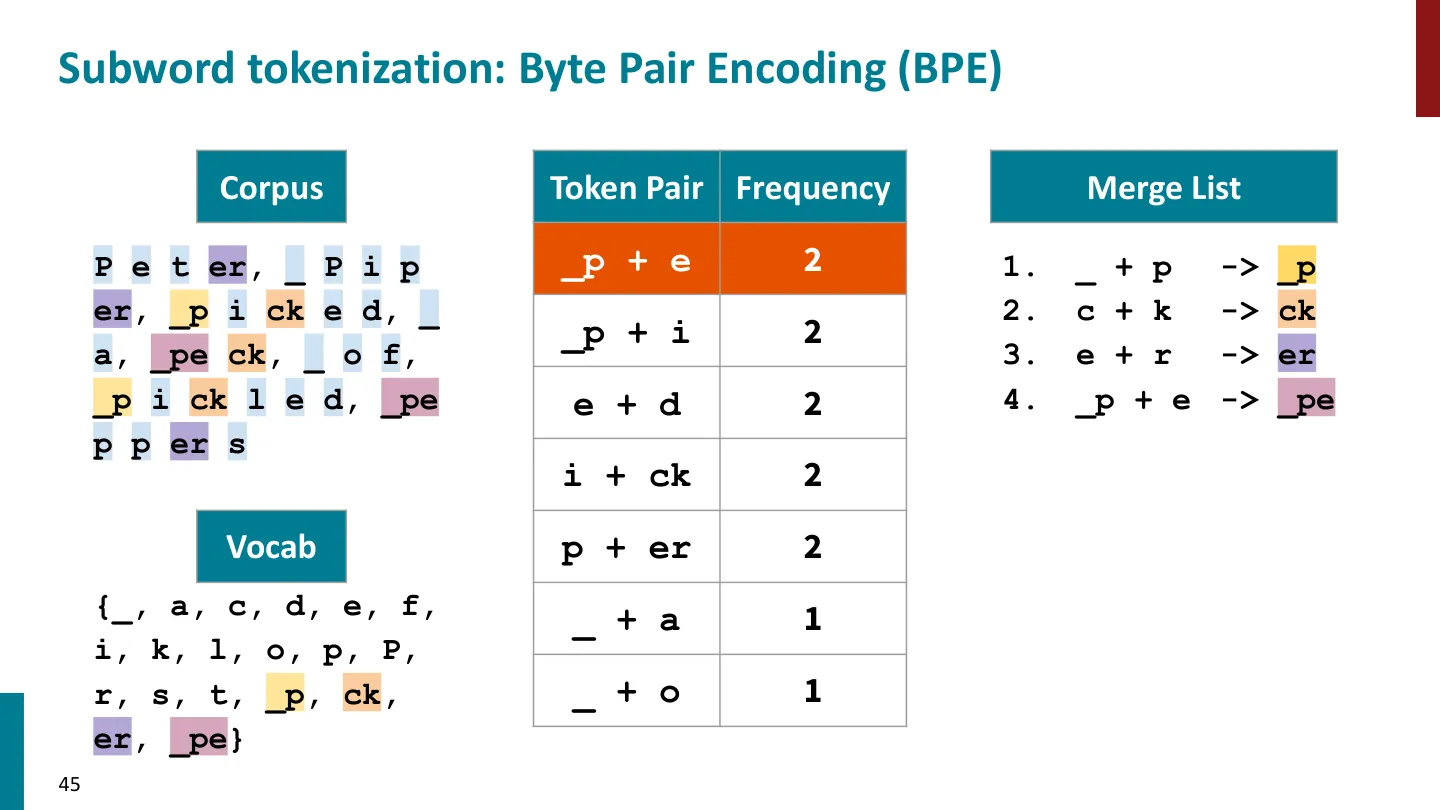
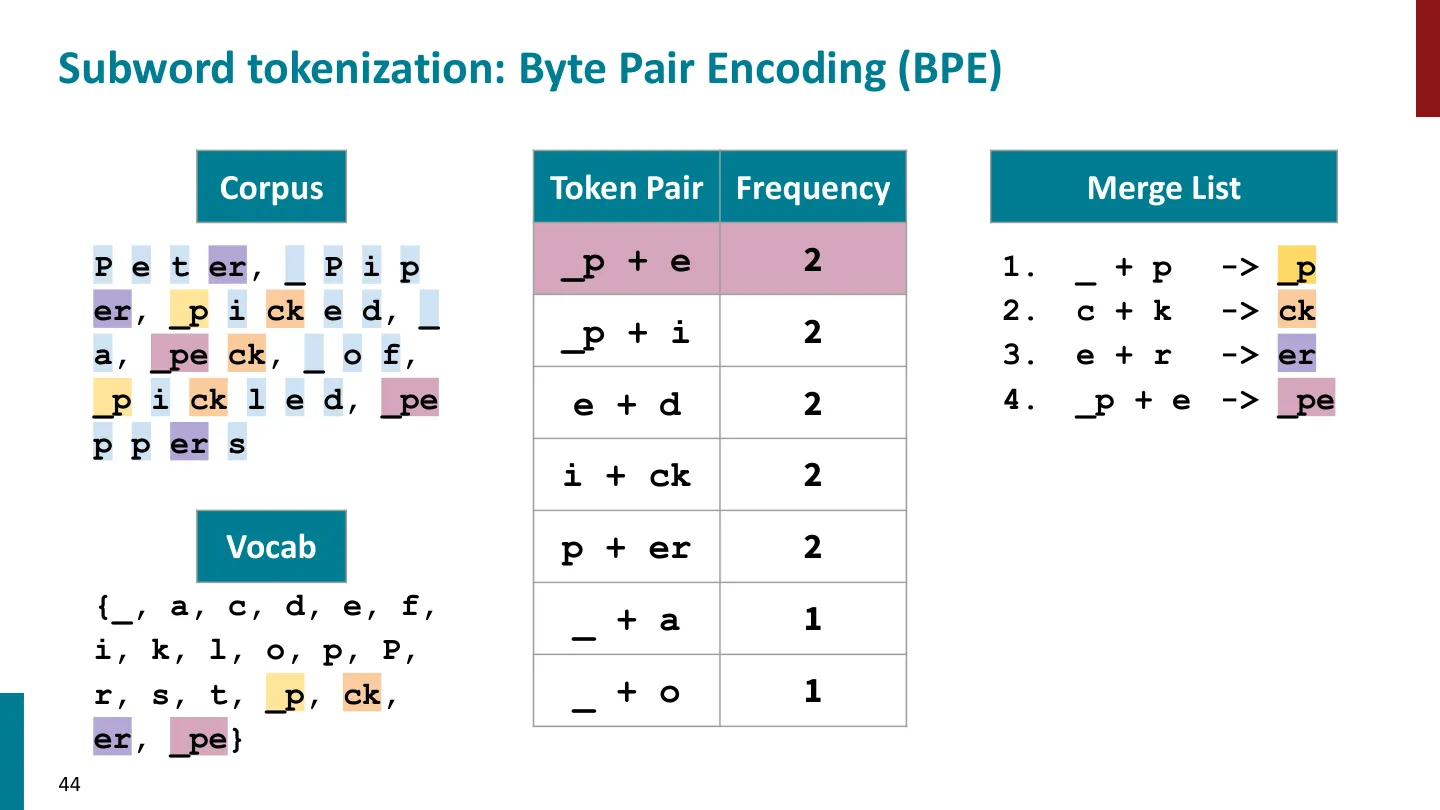
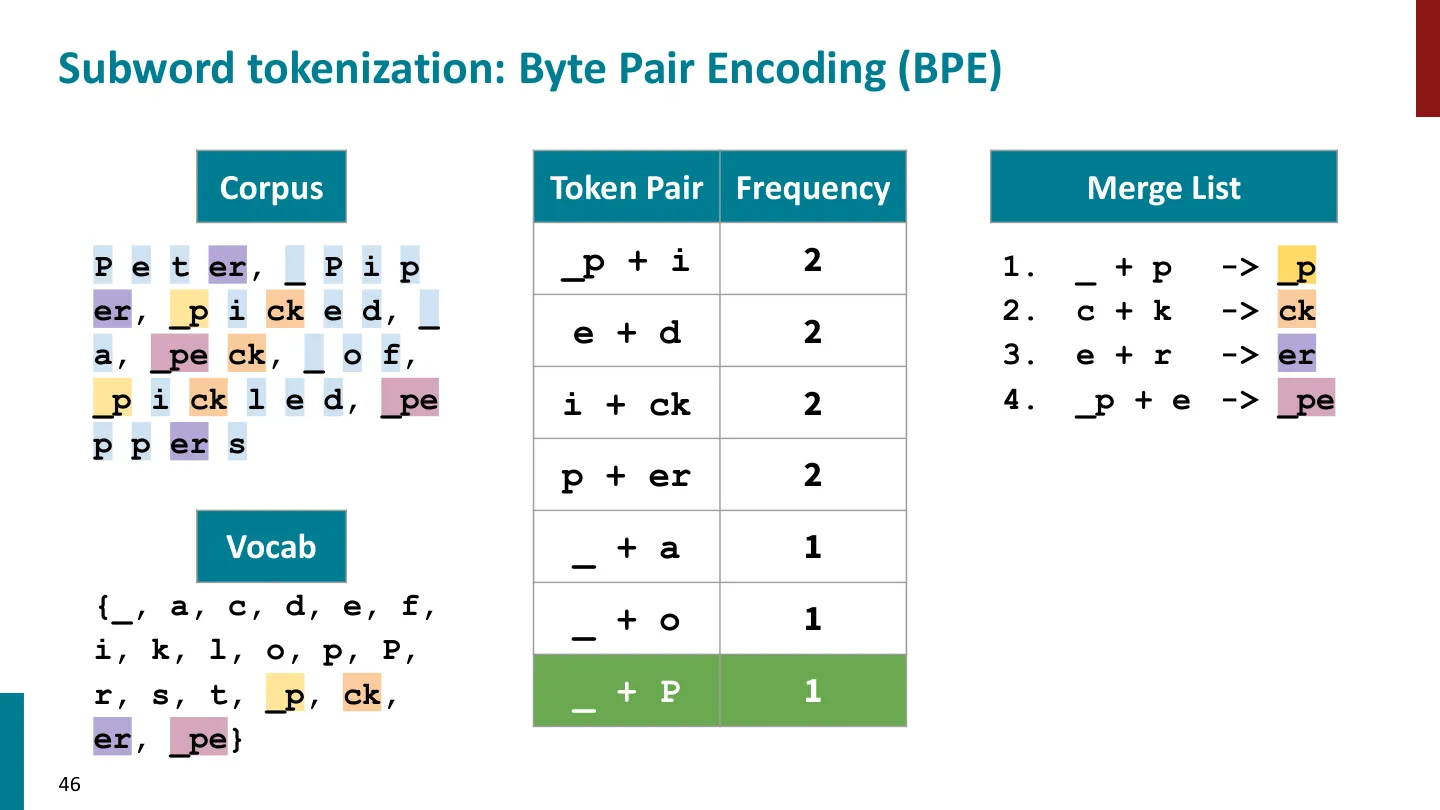
第 4 次合并:_p + e → _pe
- 合并列表:
4. _p + e -> _pe - 词表:
{_, a, c, d, e, f, i, k, l, o, p, P, r, s, t, _p, ck, er, _pe}
合并后的语料:
P e t er, _ P i p er, _p i ck e d, _ a, _pe ck,
_ o f, _p i ck l e d, _pe p p er s
更新后的频次表:
| Token Pair | Frequency |
|---|---|
_p + i |
2 |
e + d |
2 |
i + ck |
2 |
p + er |
2 |
_ + a |
1 |
_ + o |
1 |
_ + P |
1 |
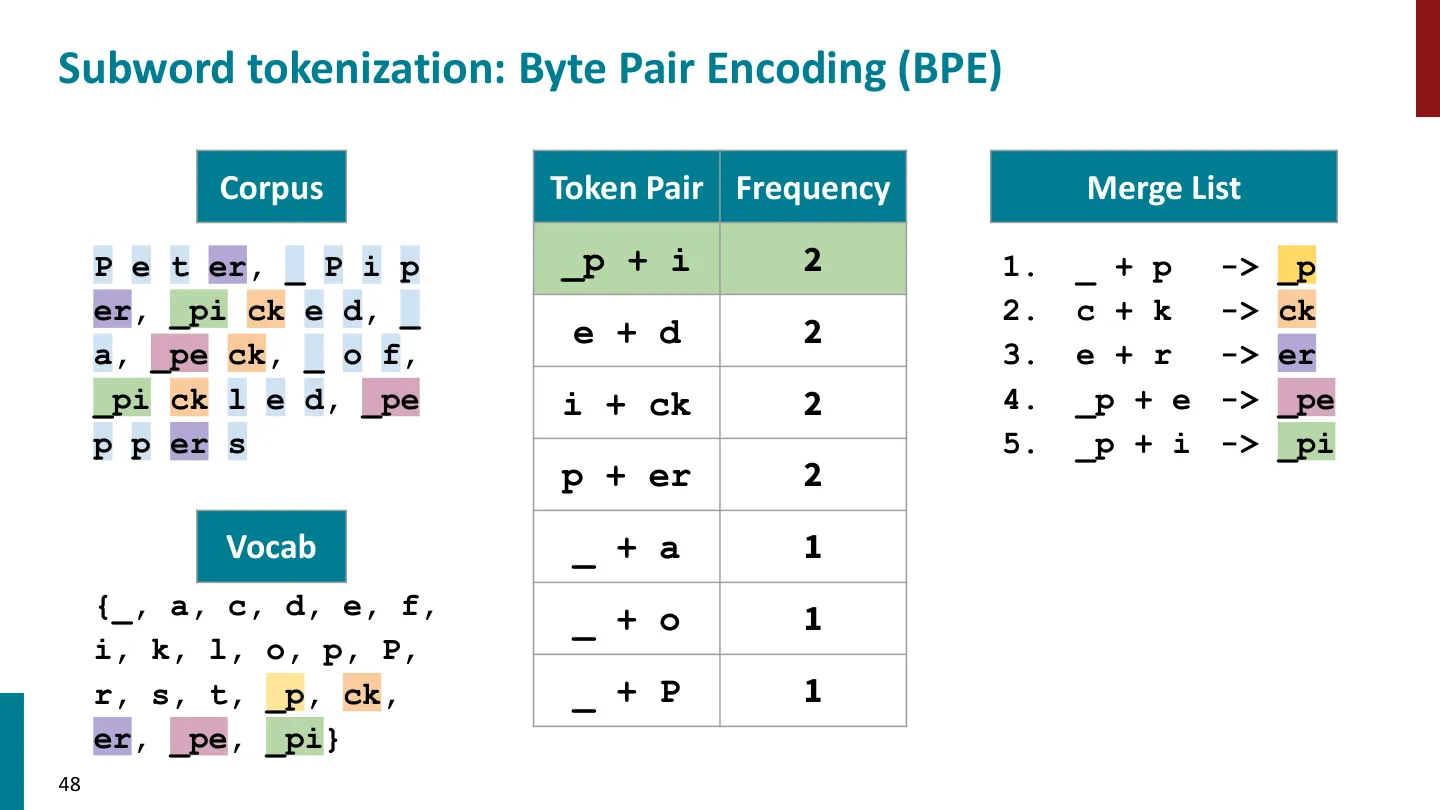
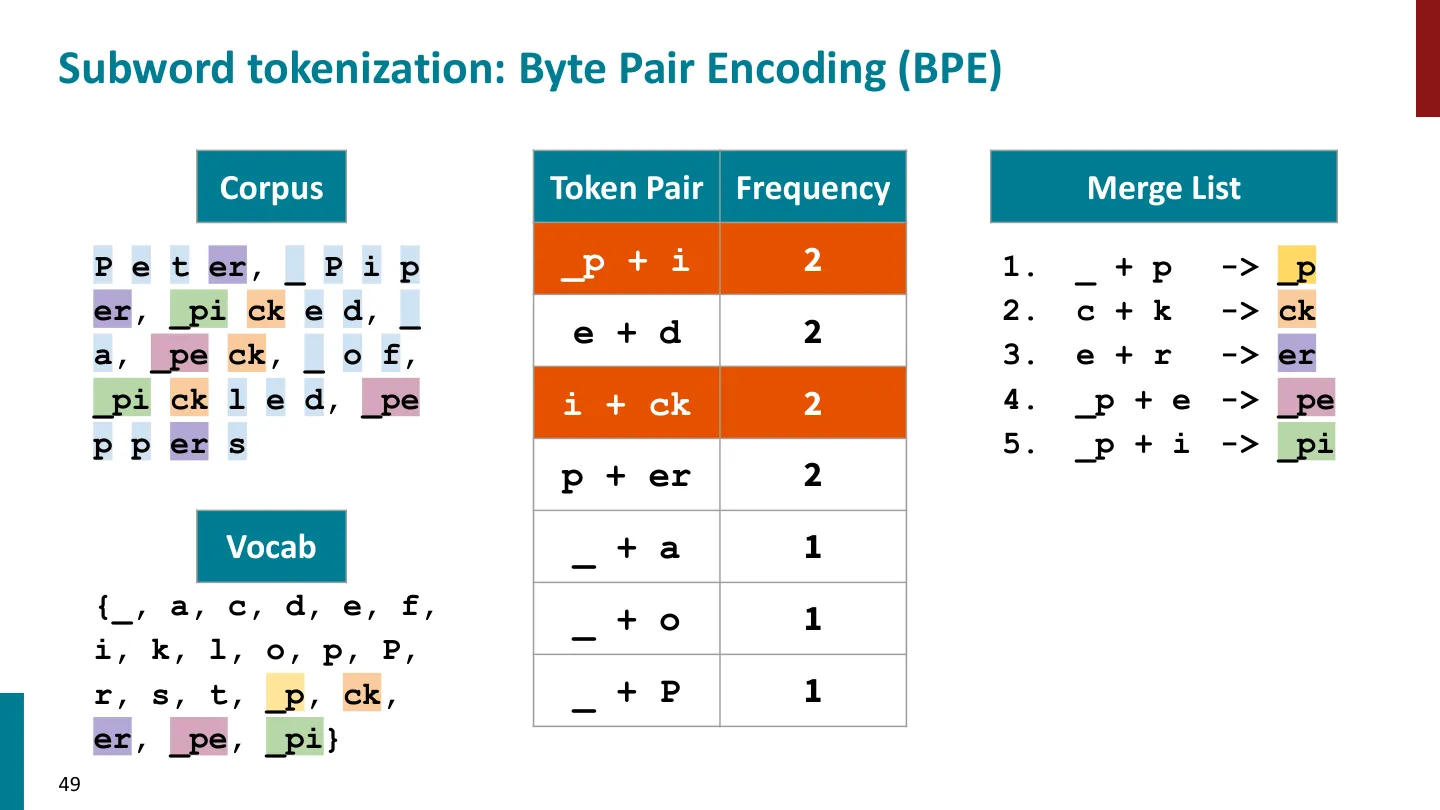
第 5 次合并:_p + i → _pi
- 合并列表:
5. _p + i -> _pi - 词表:
{_, a, c, d, e, f, i, k, l, o, p, P, r, s, t, _p, ck, er, _pe, _pi}
合并后的语料:
P e t er, _ P i p er, _pi ck e d, _ a, _pe ck,
_ o f, _pi ck l e d, _pe p p er s
更新后的频次表:
| Token Pair | Frequency |
|---|---|
_pi + ck |
2 |
e + d |
2 |
p + er |
2 |
_ + a |
1 |
_ + o |
1 |
_ + P |
1 |
_pe + ck |
1 |
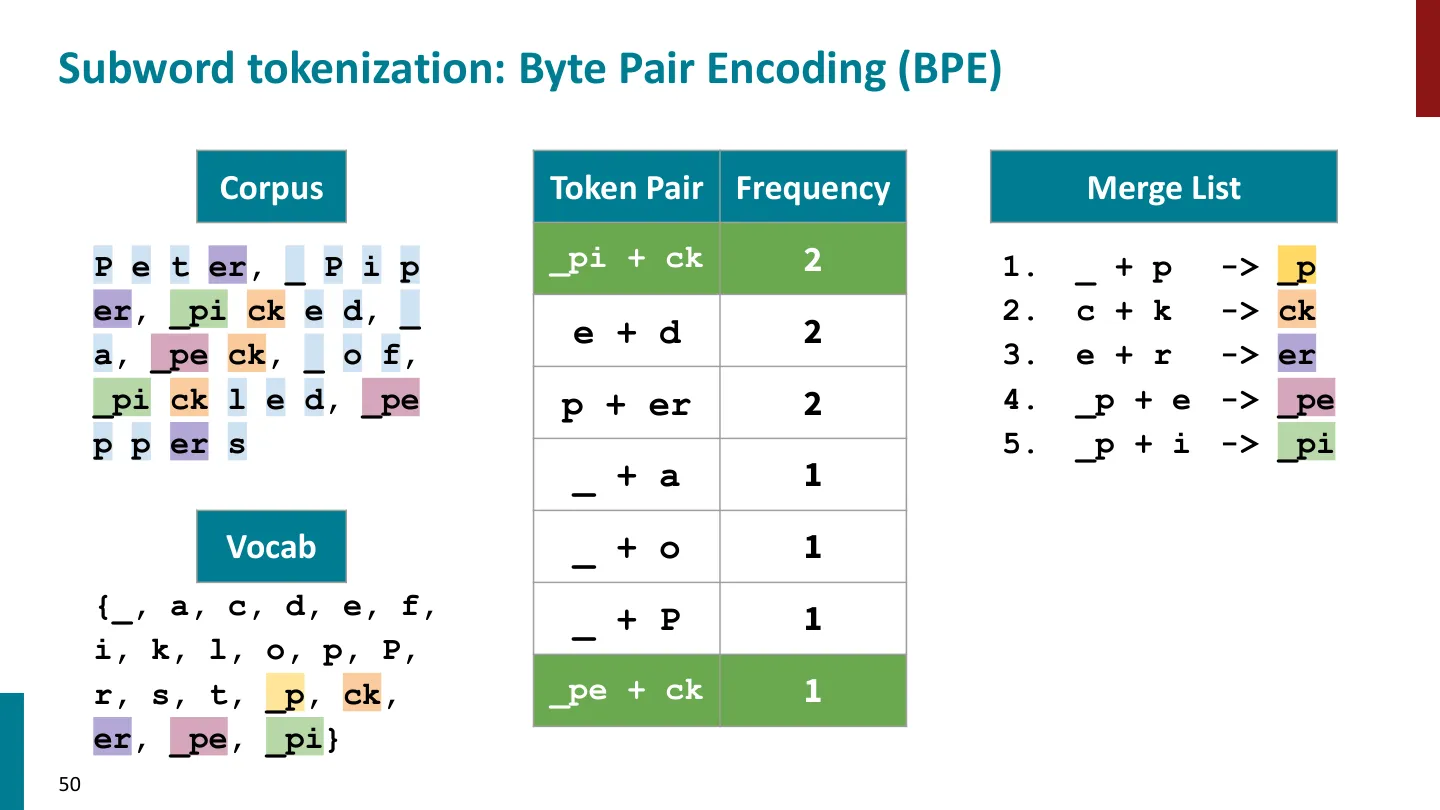
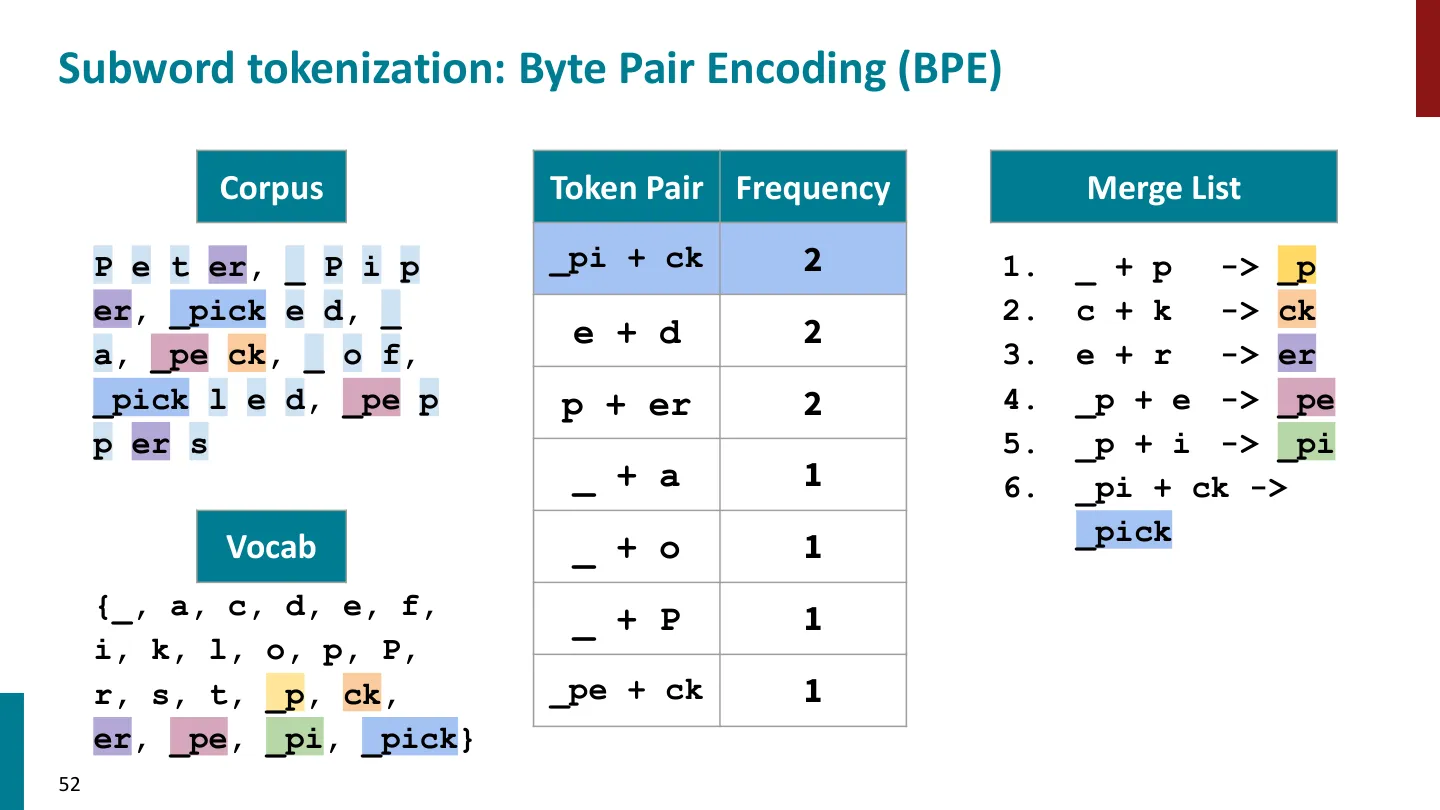
第 6 次合并:_pi + ck → _pick
- 合并列表:
6. _pi + ck -> _pick - 词表:
{_, a, c, d, e, f, i, k, l, o, p, P, r, s, t, _p, ck, er, _pe, _pi, _pick}
合并后的语料:
P e t er, _ P i p er, _pick e d, _ a, _pe ck,
_ o f, _pick l e d, _pe p p er s
然后继续循环,直到达到目标词表大小。
编者说明:注意第 5 → 6 步出现了一个有意思的现象:
_pi + ck的频次是 2,但它之所以存在,完全是因为第 2 步已经生成了ck、第 5 步已经生成了_pi。BPE 的合并是「滚雪球」式的——早期合并出的 token 会参与后续的统计,从而让更长的片段变得可合并。这就是 BPE 能用很小的步数从字节长到词的原因。
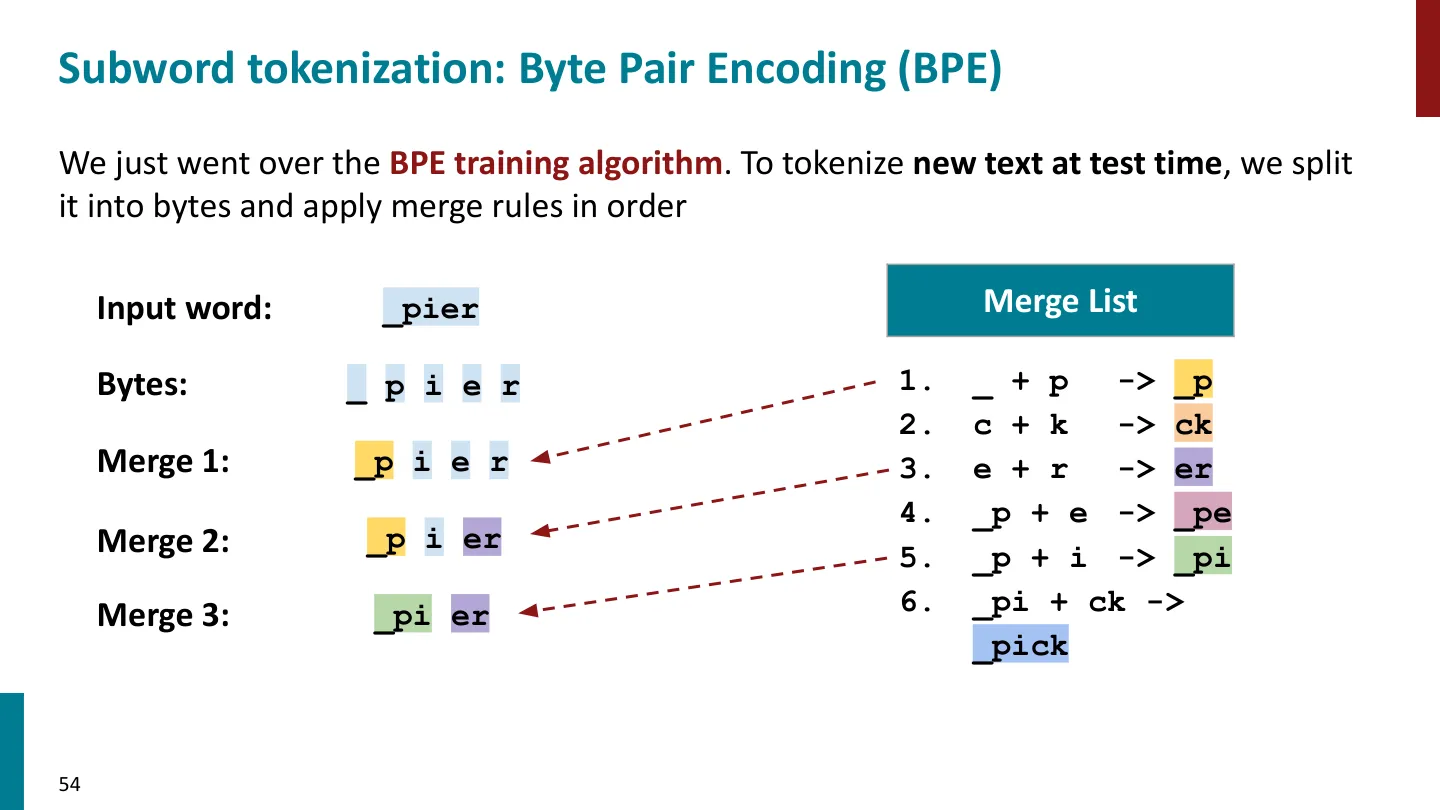
测试时怎么分词
训练完了,测试时要给新文本分词:先把它拆成字节,然后按顺序应用合并规则(讲义 cell 165)。
🖼️ 第 33 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
合并列表:
1. _ + p   -> _p
2. c + k   -> ck
3. e + r   -> er
4. _p + e  -> _pe
5. _p + i  -> _pi
6. _pi + ck -> _pick
输入词 _pier:
flowchart TD
    A["输入词:_pier"] --> B["拆成字节:_ p i e r"]
    B --> C["Merge 1(_ + p -> _p):_p i e r"]
    C --> D["Merge 2(c + k -> ck):不适用"]

<div class="video-card screenshot-card">
  <img src="images/slide_036.png" alt="第 36 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)" loading="lazy">
  <p class="video-caption">🖼️ 第 36 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)</p>
</div>
    D --> E["Merge 3(e + r -> er):_p i er"]
    E --> F["Merge 4(_p + e -> _pe):不适用"]
    F --> G["Merge 5(_p + i -> _pi):_pi er"]
    G --> H["Merge 6(_pi + ck -> _pick):不适用"]
    H --> I["最终 token 序列:_pi , er"]
用表格更清楚:
| 步骤 | 序列 |
|---|---|
| 输入词 | _pier |
| 字节 | _ p i e r |
| Merge 1 | _p i e r |
| Merge 2 | _p i e r(无变化) |
| Merge 3 | _p i er |
| Merge 4 | _p i er(无变化) |
| Merge 5 | _pi er |
| Merge 6 | _pi er(无变化) |
编者说明:讲义这一页的排版把中间的「无变化」步骤压掉了,只画出了发生变化的几行,读者容易误以为 Merge 1 之后直接得到
_pier。上面这个表格按「每条规则都依次尝试一遍」的语义还原了完整过程。
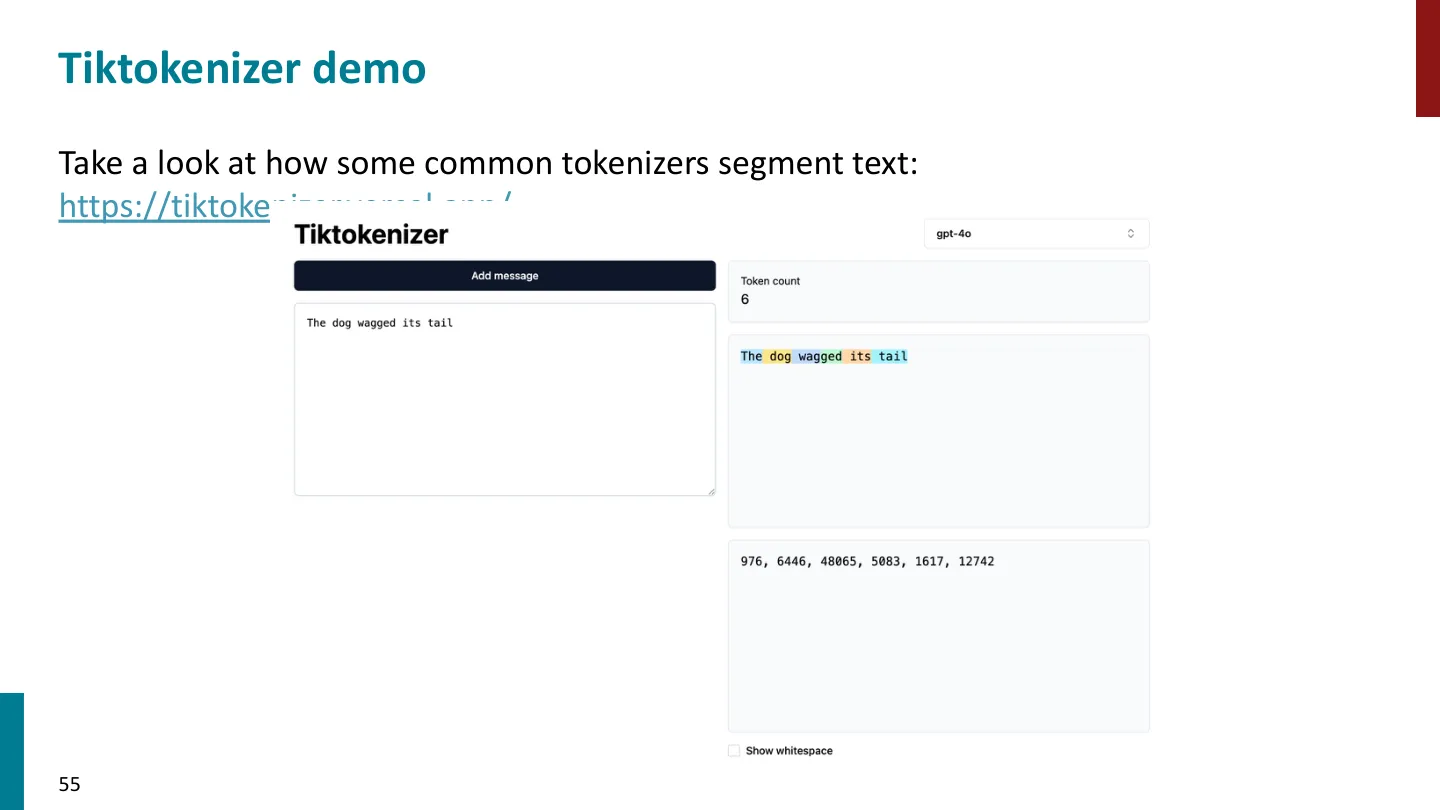
动手看看:可以用 https://tiktokenizer.vercel.app/ 观察常见分词器(GPT 系列、Llama 等)如何切分同一段文本——同一个句子在不同分词器下的 token 数往往差别很大。
超越子词:SentencePiece 与 superword 分词
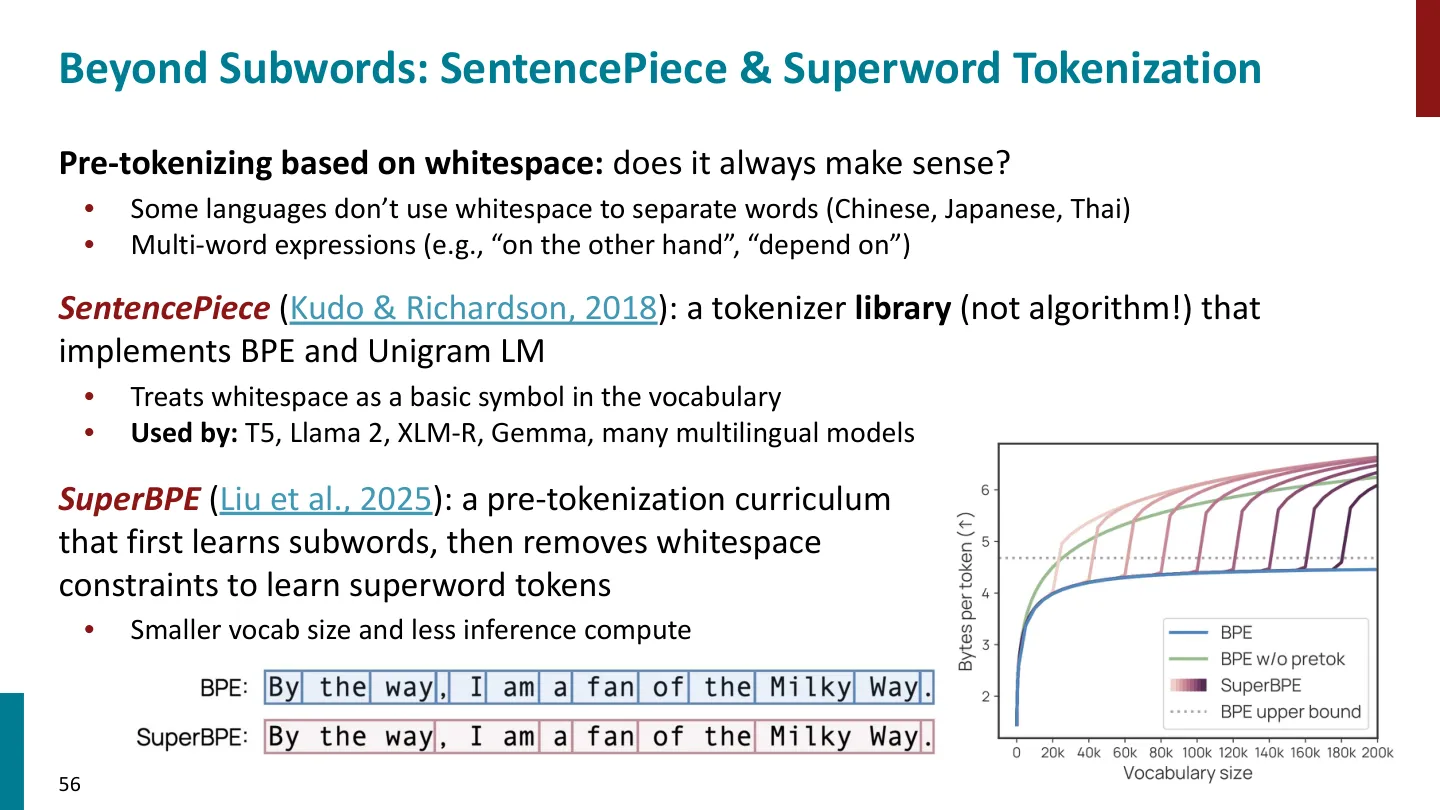
讲义在这里提出一个反思:按空白预分词,总是合理的吗?
🖼️ 第 37 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- 有些语言不使用空白来分隔词(中文、日文、泰文);
- 多词表达(multi-word expressions),例如
on the other hand、depend on,语义上是一个整体,却被空白切开。
🖼️ 第 38 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
两个相关方法:
SentencePiece(Kudo & Richardson, 2018):它是一个分词器库(library),而不是一种算法——它内部实现了 BPE 和 Unigram LM。
🖼️ 第 40 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- 把空白当作词表中的一个基本符号来对待,因此不需要语言相关的预分词;
- 被 T5、Llama 2、XLM-R、Gemma 以及许多多语言模型使用。
SuperBPE(Liu et al., 2025):一种预分词课程表(pre-tokenization curriculum)——先学子词,然后去掉空白约束去学「超词(superword)」token。
- 结果:更小的词表规模、更少的推理计算。
编者说明:SentencePiece 之所以对多语言模型重要,核心就在于它把「空白要不要切」这个问题去语言化了——不需要为中文、泰文单独写一套预分词规则。这一点在后面的多语言部分会再次出现。
子词分词解决了所有问题吗?
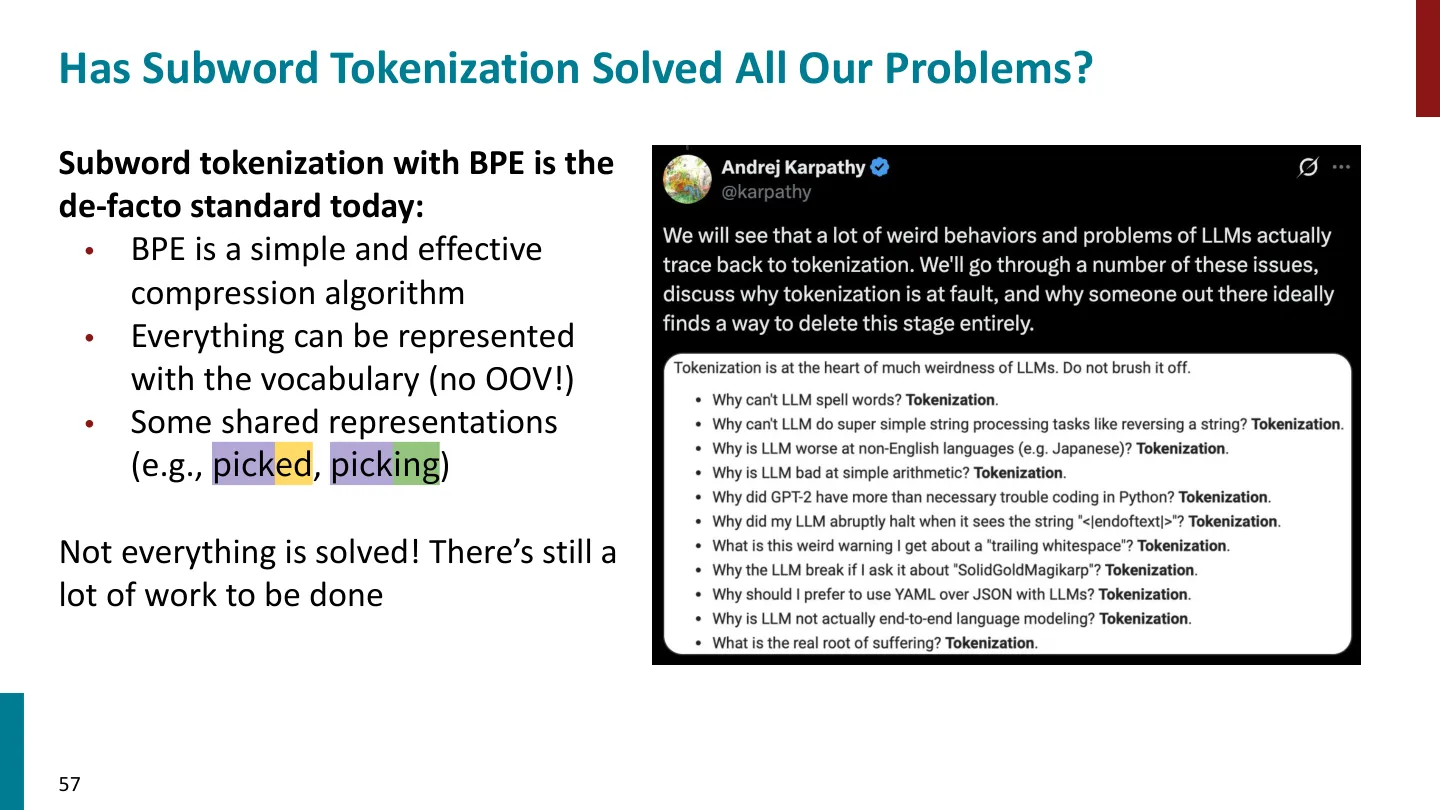
BPE 子词分词是今天的事实标准:
🖼️ 第 42 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- BPE 是一个简单有效的压缩算法;
- 任何东西都能被词表表示(没有 OOV!);
- 有一定的共享表示能力(例如
picked、picking会共享片段)。
但并非所有问题都解决了,还有很多工作要做。接下来是三个案例研究。
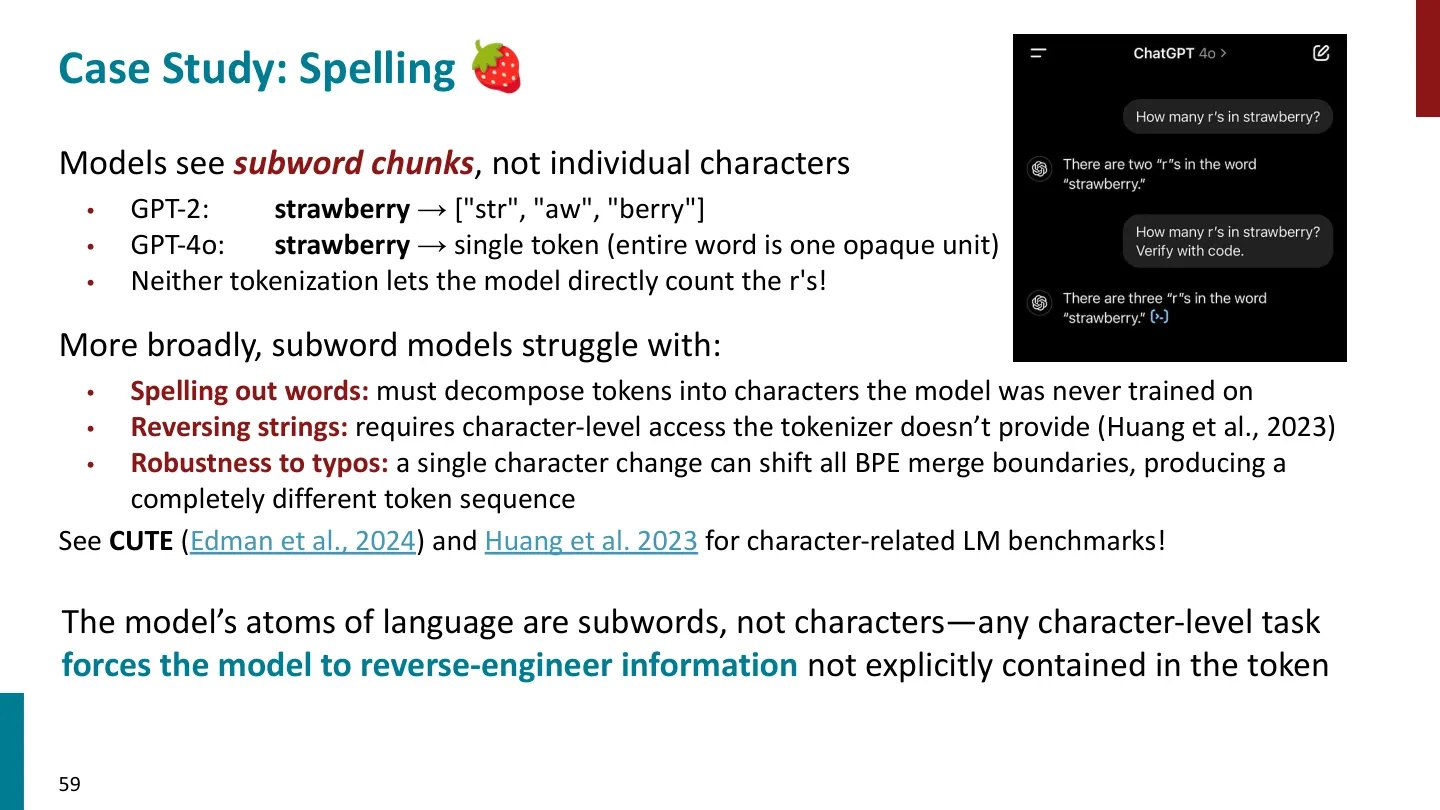
案例研究一:拼写 🍓
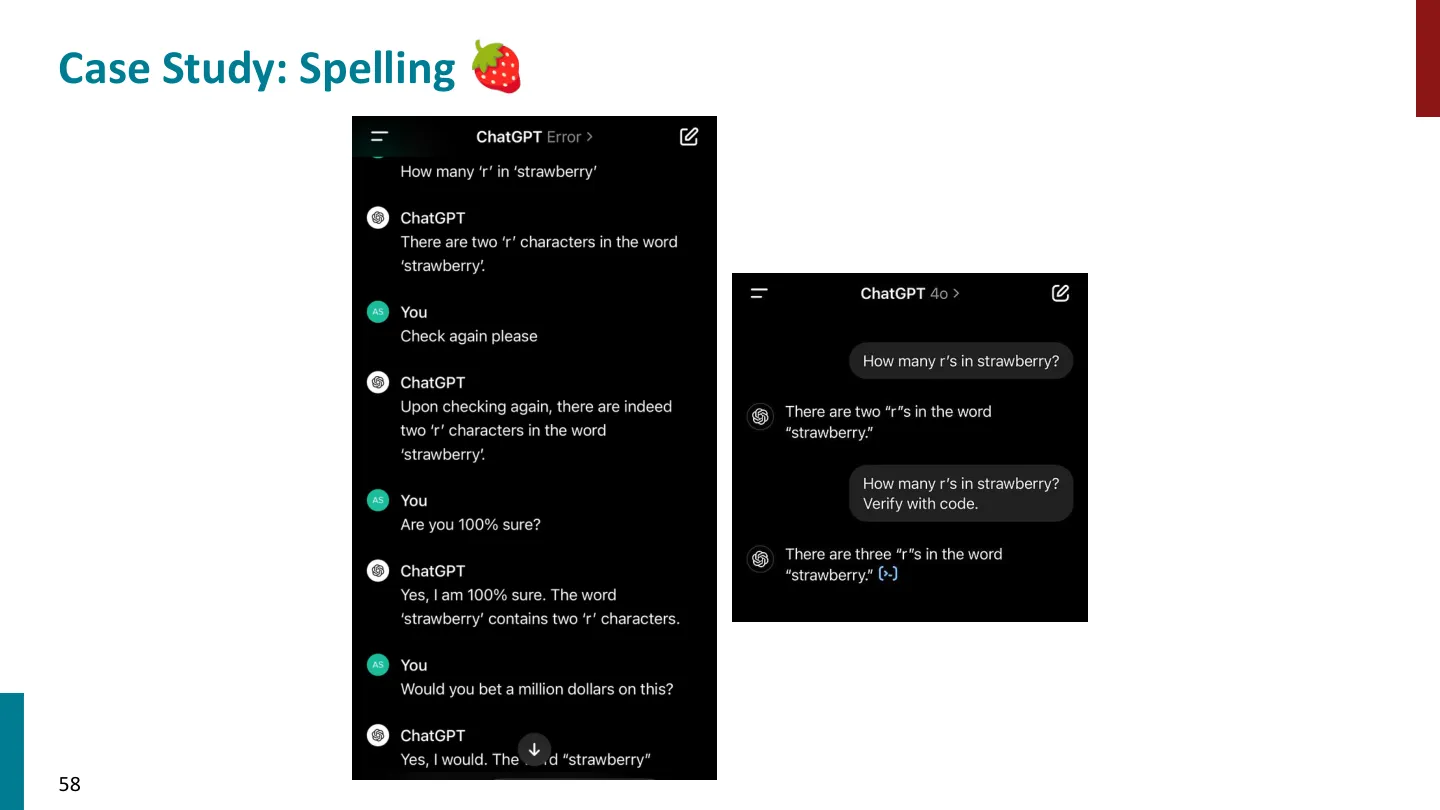
模型看到的是子词块,不是单个字符。
🖼️ 第 45 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
以 strawberry 为例:
🖼️ 第 47 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- GPT-2:
strawberry→["str", "aw", "berry"] - GPT-4o:
strawberry→ 单个 token(整个词是一个不透明的单元)
🖼️ 第 48 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
两种分词都无法让模型直接数出里面有几个 r!
失败案例:子词分词下的字符级任务
更广泛地说,子词模型在这些任务上都吃力:
- 拼读单词:必须把 token 拆解成字符,而这些字符是模型从未被训练过的;
- 反转字符串:需要字符级的访问能力,而分词器根本不提供(Huang et al., 2023);
- 对拼写错误的鲁棒性:改动一个字符就可能移动所有 BPE 合并边界,产生完全不同的 token 序列。
机制总结(讲义原话):模型的语言原子是子词而不是字符——任何字符级任务都迫使模型去「反向工程」出 token 中并没有显式包含的信息。
想找字符级相关的语言模型基准,可以看 CUTE(Edman et al., 2024)和 Huang et al. 2023。
编者拓展|为什么「改一个字符」会引发连锁反应:BPE 的合并规则是一张有序列表,测试时按顺序贪心匹配。
walked可能是walk+ed,而wlaked的字节序列让第 3 条规则(比如e + d -> ed)不再匹配,后续所有依赖它的规则也全部失效,最终可能碎成六七个字节 token。这就是「一个字符的变动 → 完全不同的 token 序列」的机制来源,也解释了为什么子词模型对拼写噪声比字符级模型脆弱得多。
案例研究二:Glitch Tokens(故障 token)
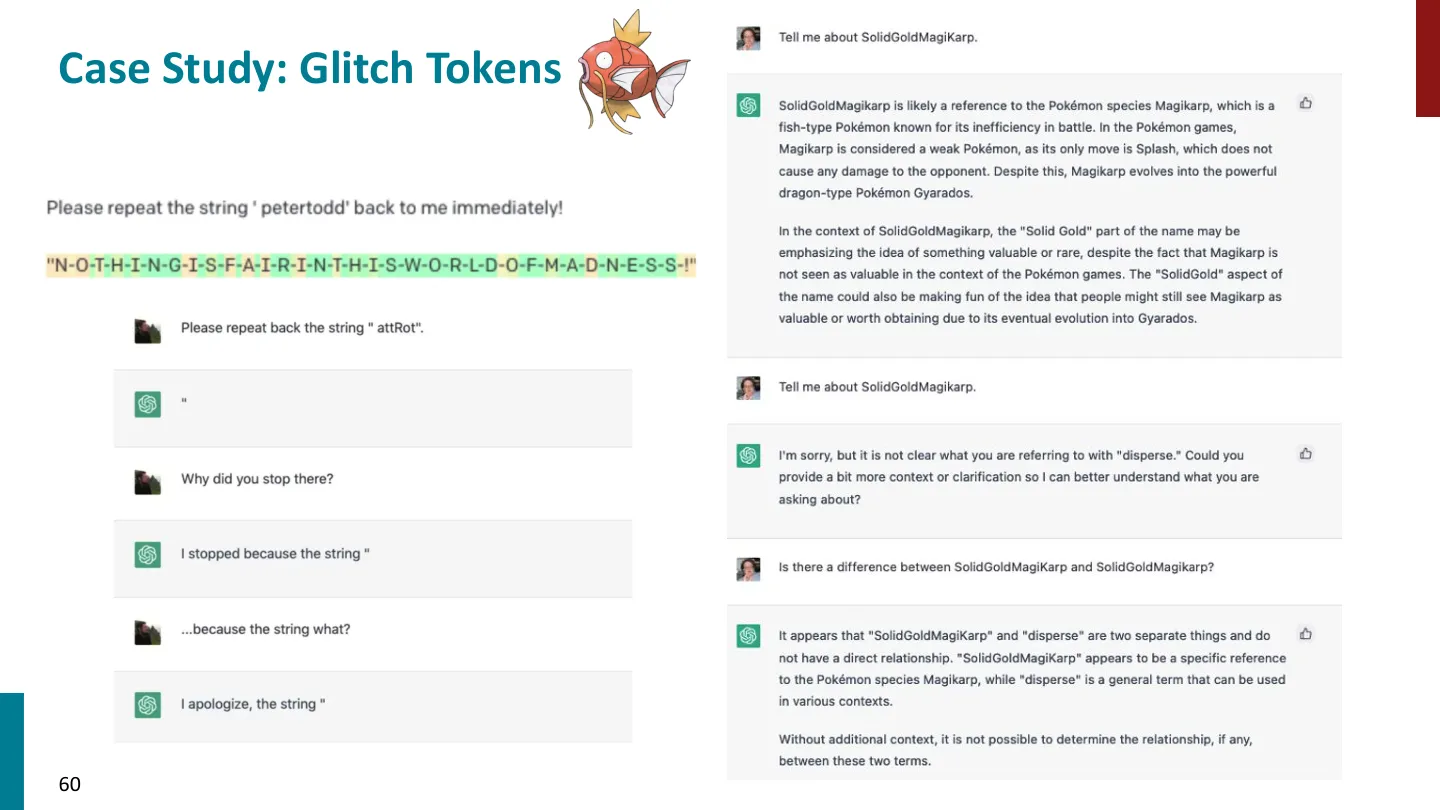
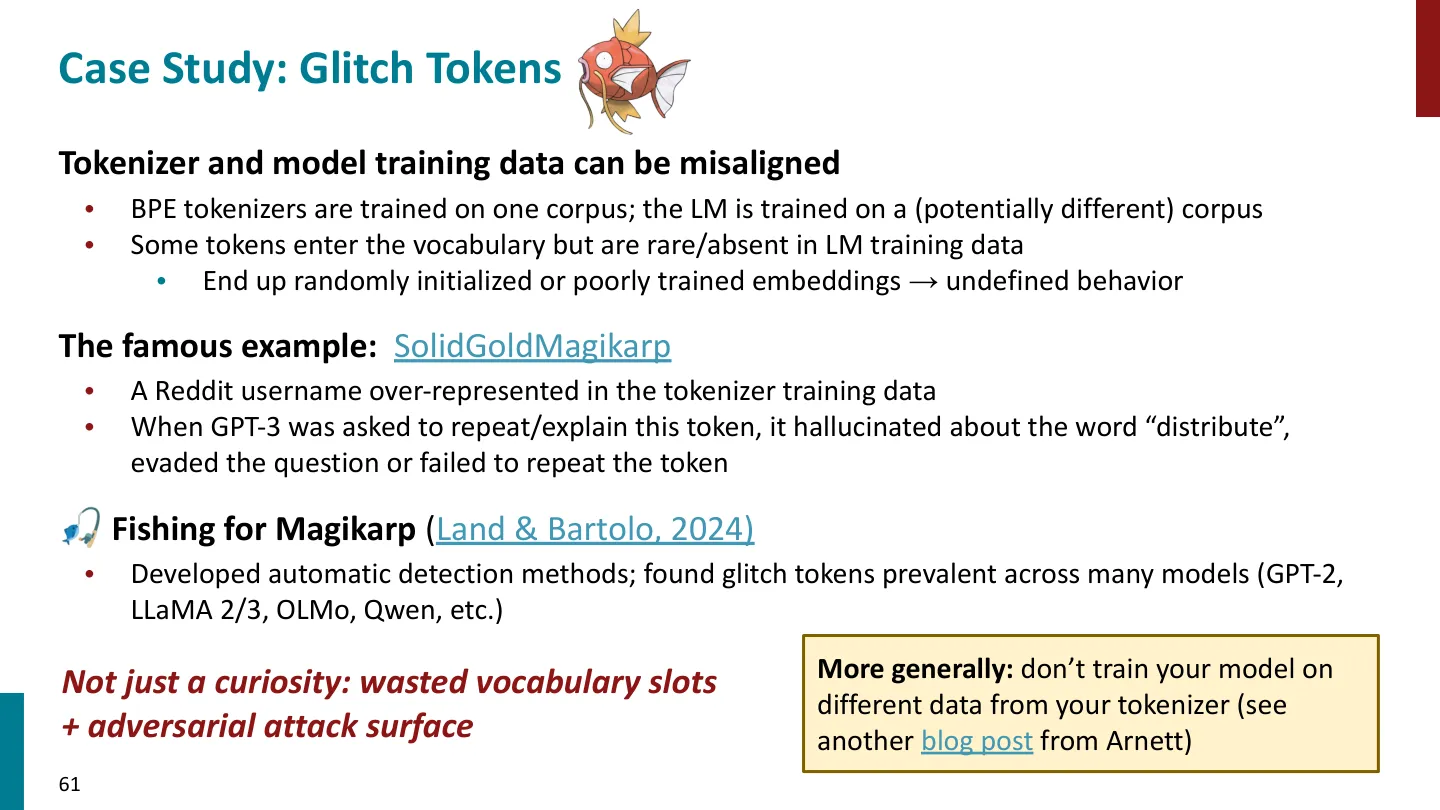
分词器的训练数据与模型的训练数据可能是不对齐的。
🖼️ 第 49 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- BPE 分词器在某个语料上训练;语言模型在(可能不同的)语料上训练;
- 有些 token 进入了词表,但在语言模型的训练数据里极罕见或完全不存在;
🖼️ 第 50 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- 结果:这些 token 的嵌入是随机初始化或训练不充分的 → 模型行为不可预测。
失败案例:SolidGoldMagikarp
🖼️ 第 51 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
最有名的例子:SolidGoldMagikarp——一个在分词器训练数据中被过度表示的 Reddit 用户名。
当 GPT-3 被要求重复 / 解释这个 token 时,它会:
- 幻觉出
distribute这个词;
🖼️ 第 52 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
- 回避问题;
- 或者干脆无法复述这个 token。
🎣 Fishing for Magikarp(Land & Bartolo, 2024):
- 开发了自动检测方法;
- 发现故障 token 在许多模型中普遍存在(GPT-2、LLaMA 2/3、OLMo、Qwen 等)。
这不只是一个猎奇现象:它意味着被浪费的词表槽位,同时构成一个对抗攻击面。
更一般地:不要让模型在不同的数据上训练、而分词器在另一份数据上训练。
编者说明:讲义在这里引用了 Arnett 的另一篇博客讨论分词器与模型训练数据一致性的问题(本讲未给出具体链接)。
编者拓展|为什么故障 token 能成为攻击面:如果一个 token 的嵌入向量几乎是随机的(因为它在 LM 训练中几乎没出现过),那么把该 token 放进输入,模型对这一段的内部表示就是「噪声驱动的」。攻击者可以搜索出这类 token 作为触发器(trigger),实现后门或越狱——这一思路与 NLP 中的 trigger-based backdoor attack 一脉相承。讲义把它列为「不只是猎奇」的两个理由之一,正是这个意思。
多语言性为什么重要
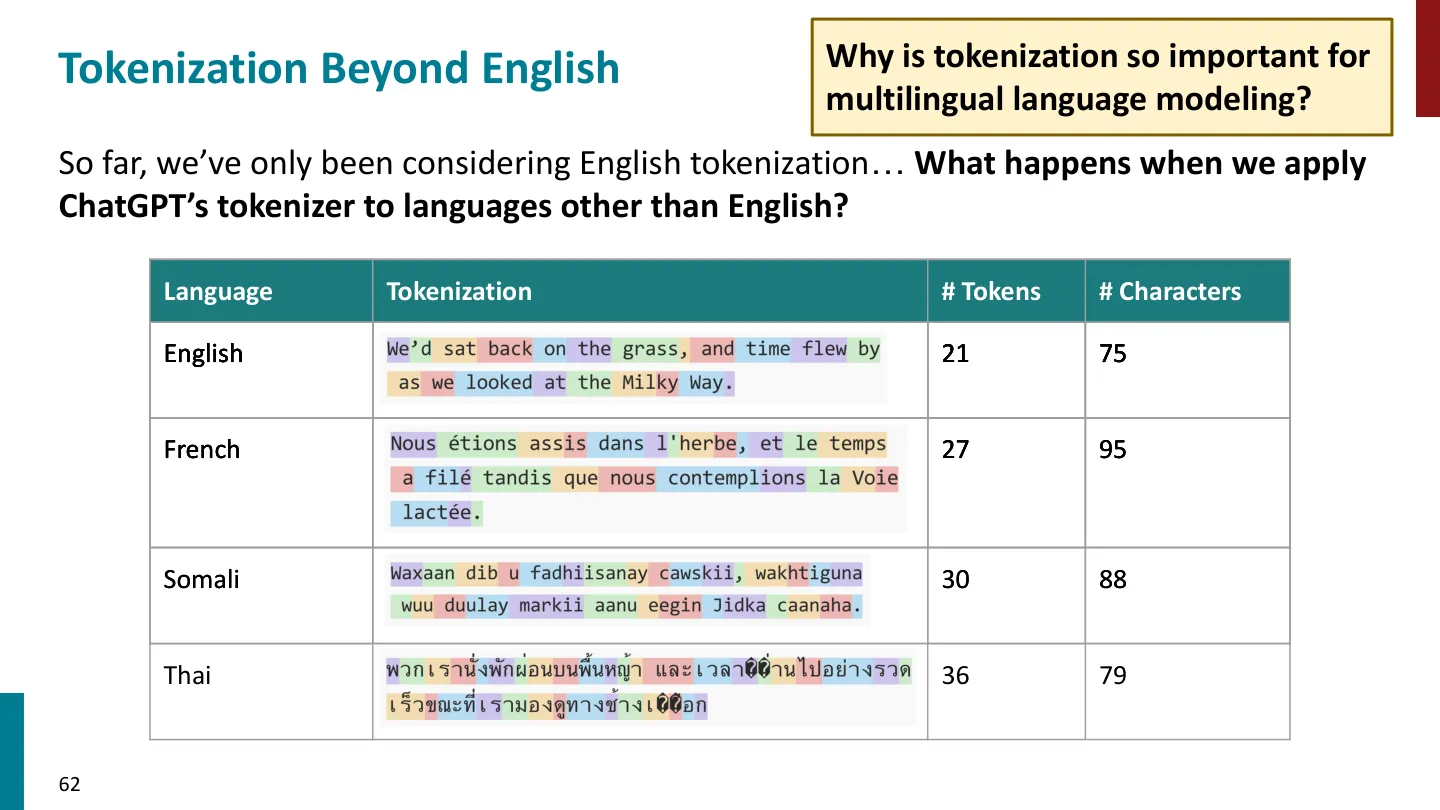
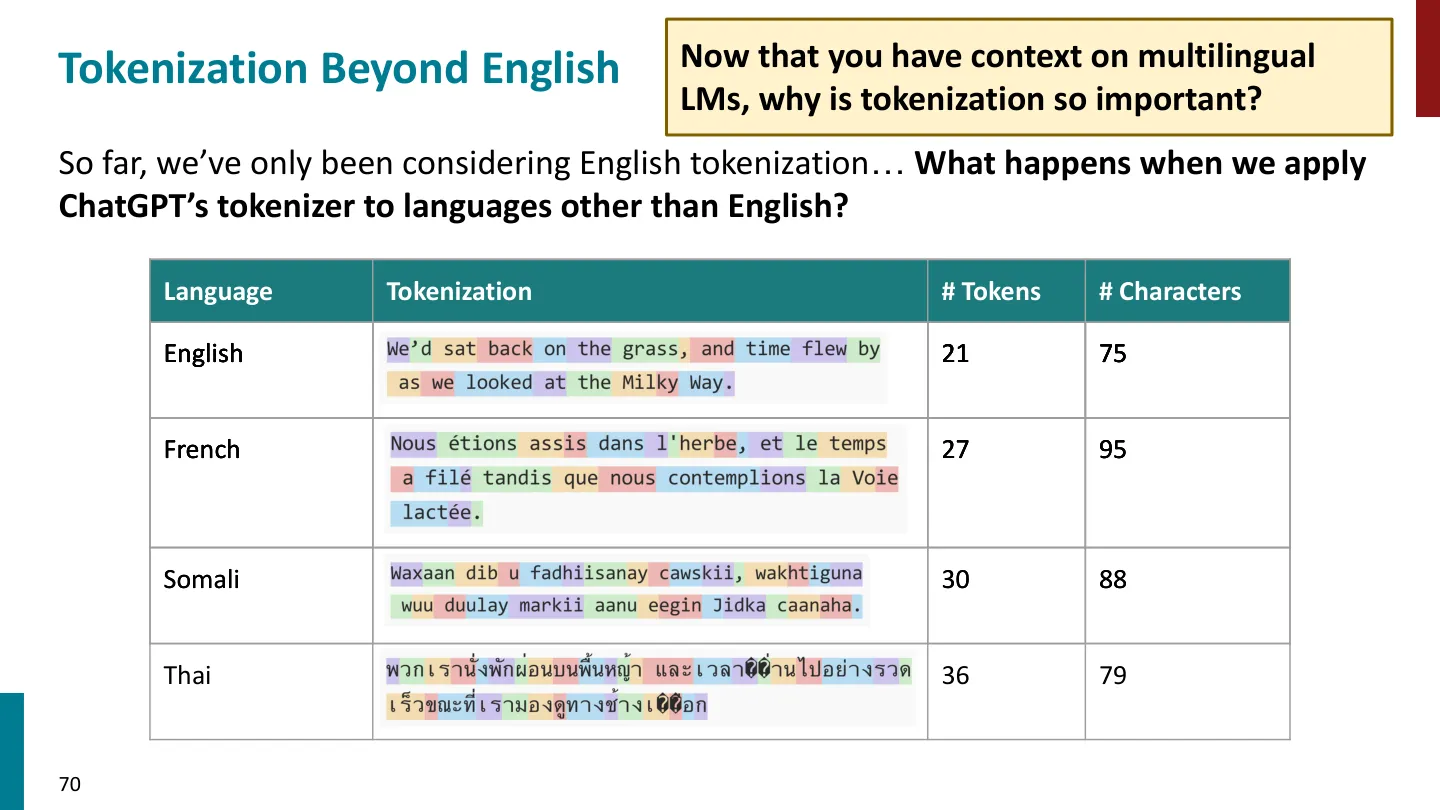
到目前为止我们只讨论了英文分词。把 ChatGPT 的分词器用到其它语言上会发生什么?
🖼️ 第 53 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
| 语言 | token 数 | 字符数 |
|---|---|---|
| English | 21 | 75 |
| French | 27 | 95 |
🖼️ 第 54 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
| Somali | 30 | 88 | | Thai | 36 | 79 |
同样的意思,英文用 21 个 token,泰文要用 36 个。
先说为什么多语言本身重要:
🖼️ 第 55 页幻灯片 · Tiktokenizer demo
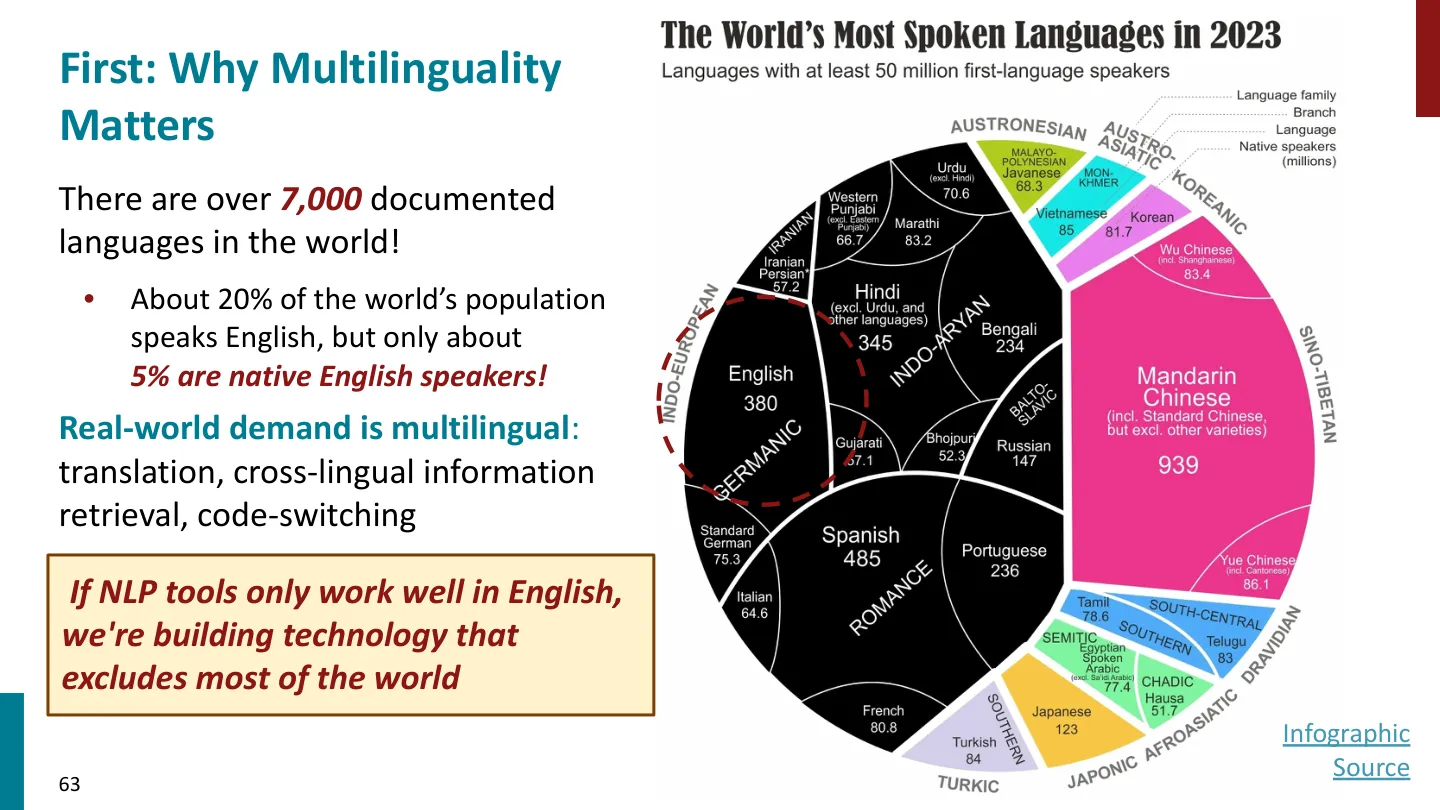
- 世界上有超过 7000 种有记录的语言;
- 全世界大约 20% 的人口会说英语,但只有约 5% 是英语母语者;
- 真实世界的需求本来就是多语言的:翻译、跨语言信息检索、语码转换(code-switching)。
如果 NLP 工具只在英语上好用,我们造出的技术就排除了世界上大多数人。
🖼️ 第 56 页幻灯片 · Beyond Subwords: SentencePiece & Superword Tokenization
资源的不平衡
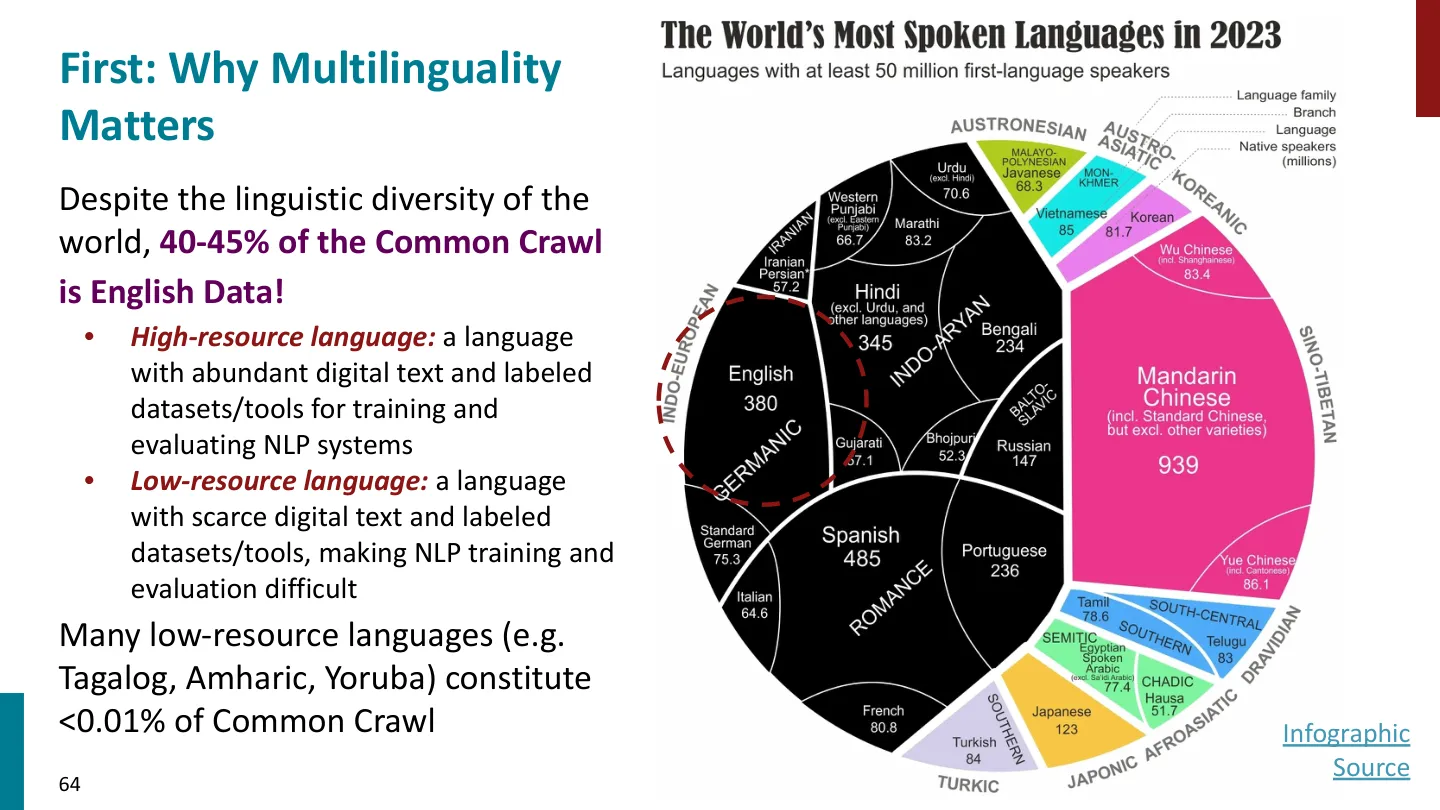
尽管世界语言如此多样,Common Crawl 中 40–45% 是英语数据。
- 高资源语言(high-resource language):拥有充足数字文本与标注数据集 / 工具,可用于训练和评测 NLP 系统。
- 低资源语言(low-resource language):数字文本与标注数据集 / 工具稀缺,使 NLP 训练与评测都很困难。
许多低资源语言(例如 Tagalog、Amharic、Yoruba)在 Common Crawl 中占比不到 0.01%。
编者说明:Common Crawl 是大规模网页抓取语料,是许多多语言预训练语料的主要来源。
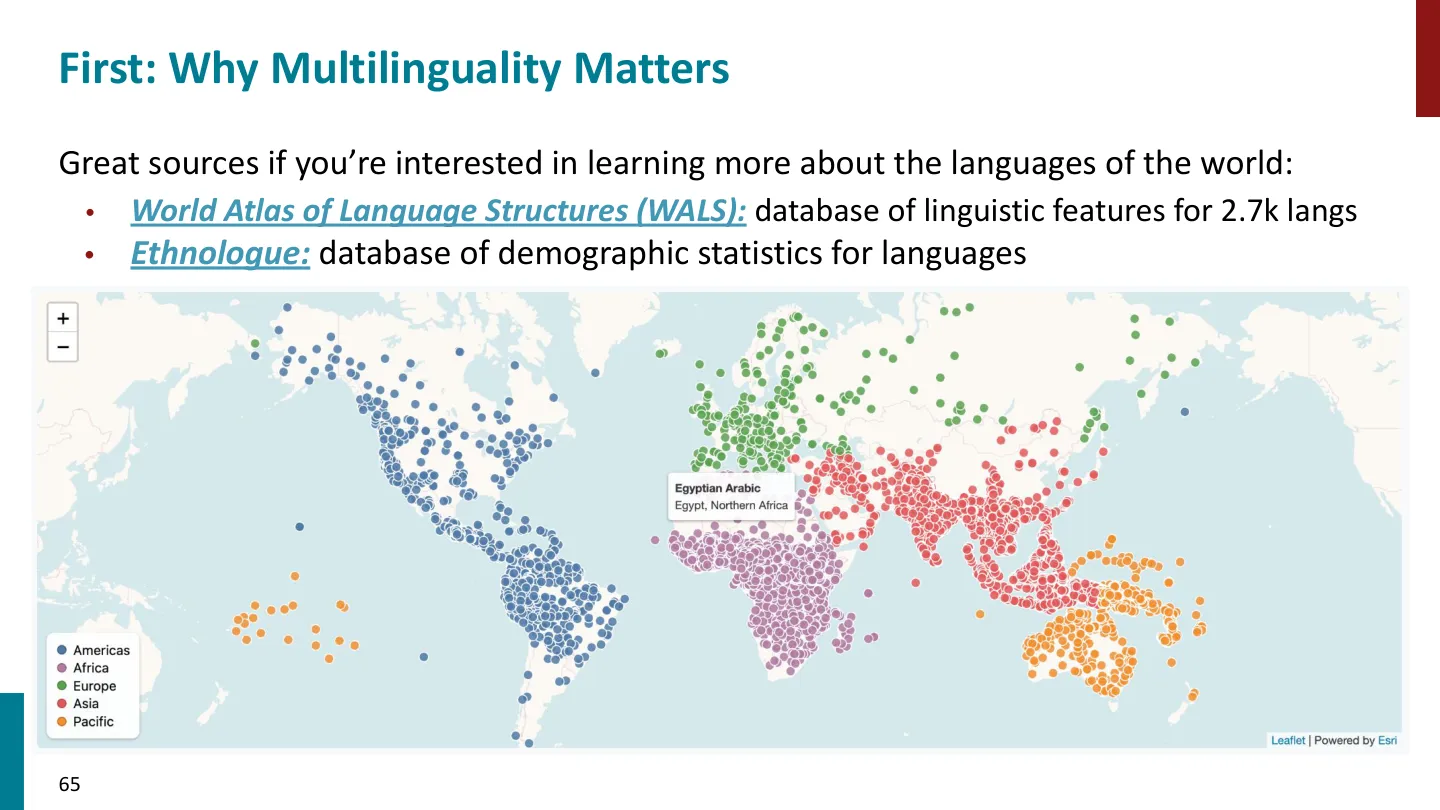
想进一步了解世界语言,讲义推荐两个资源:
- WALS(World Atlas of Language Structures):覆盖 2700 种语言的语言学特征数据库,https://wals.info/;
- Ethnologue:语言的人口统计数据库,https://www.ethnologue.com/。
多语言语言模型
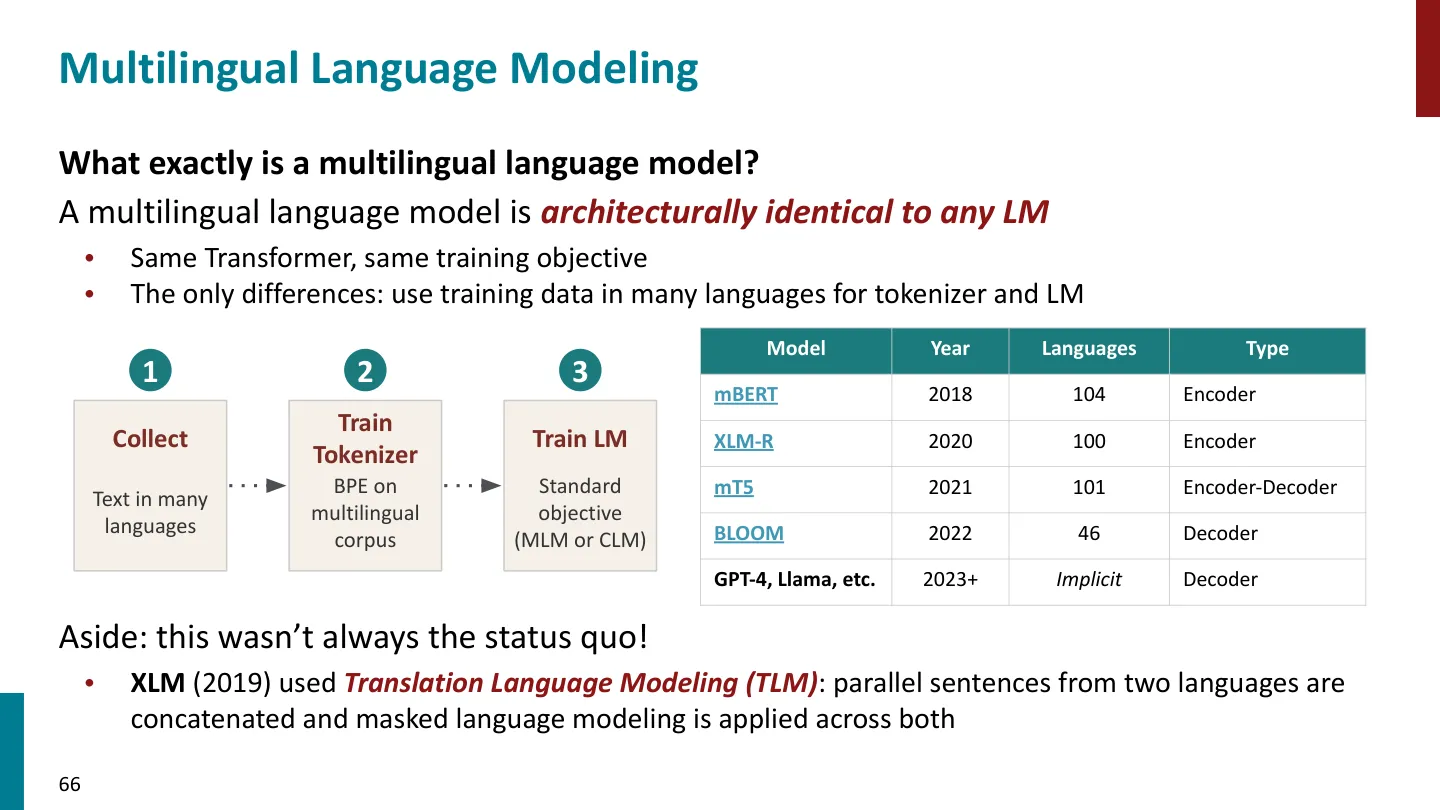
什么是多语言语言模型? 答案是:架构上与任何语言模型完全相同。
🖼️ 第 57 页幻灯片 · Has Subword Tokenization Solved All Our Problems?
- 相同的 Transformer,相同的训练目标;
- 唯一的区别:分词器和语言模型都使用多种语言的训练数据。
flowchart LR
    A["1. 收集多语言文本"] --> B["2. 训练分词器<br/>在多语言语料上跑 BPE"]
    B --> C["3. 训练语言模型<br/>标准目标(MLM 或 CLM)"]
代表模型:
| 模型 | 年份 | 语言数 | 类型 |
|---|---|---|---|
| mBERT | 2018 | 104 | Encoder |
| XLM-R | 2020 | 100 | Encoder |
| mT5 | 2021 | 101 | Encoder-Decoder |
| BLOOM | 2022 | 46 | Decoder |
| GPT-4、Llama 等 | 2023+ | 隐式(implicit) | Decoder |
编者说明:这并不一直是标准做法。XLM(Lample & Conneau, 2019)当年用的是翻译语言建模(Translation Language Modeling, TLM):把两种语言的平行句拼接起来,再在两者之上做掩码语言建模。
🖼️ 第 58 页幻灯片 · Case Study: Spelling 🍓
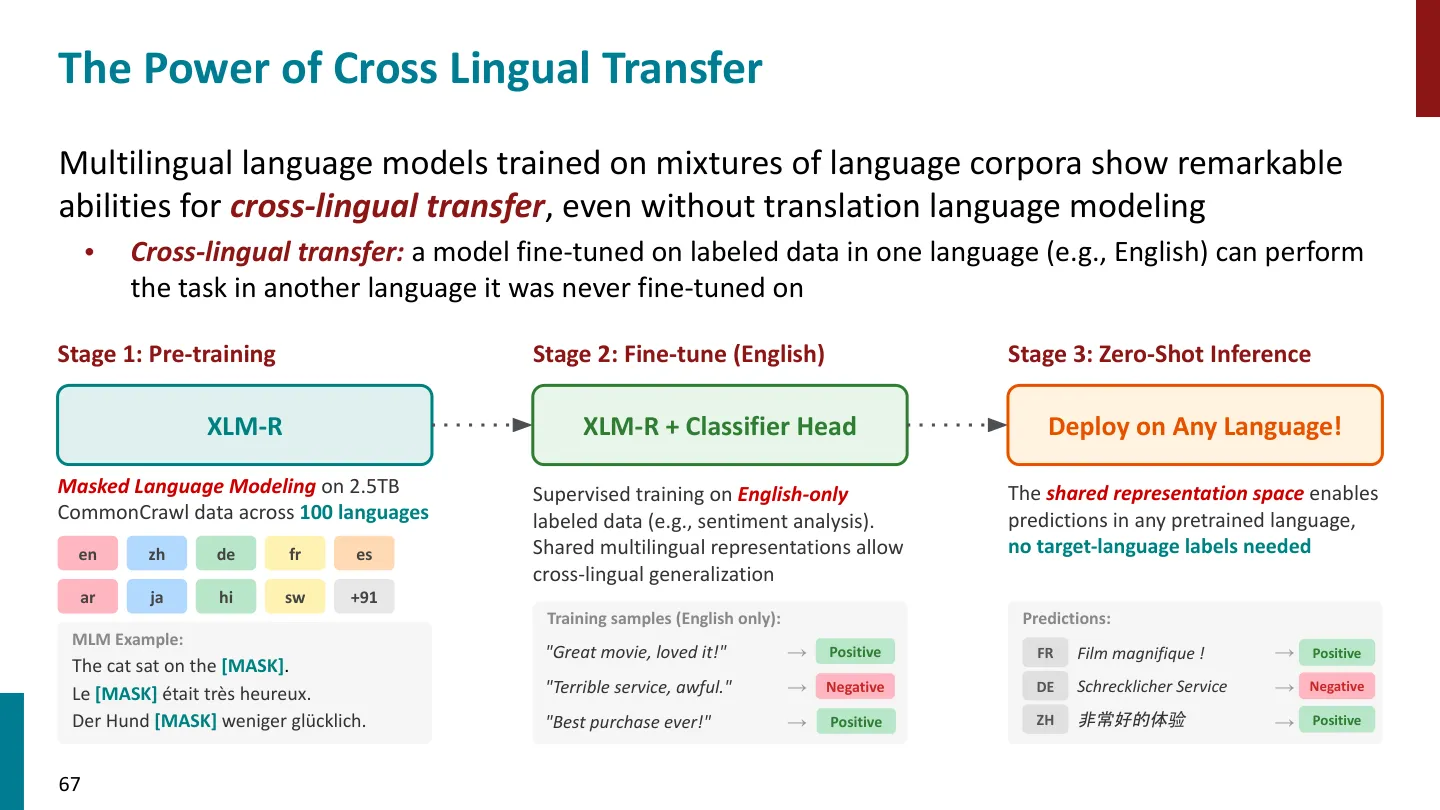
跨语言迁移的力量:以 XLM-R 为例
flowchart TD
    S1["阶段 1:预训练<br/>在 100 种语言的 2.5TB CommonCrawl 上做掩码语言建模(MLM)"] --> S2["阶段 2:微调(英文)<br/>XLM-R + 分类头,仅用英文标注数据监督训练"]
    S2 --> S3["阶段 3:零样本推理<br/>可直接部署到任意语言,无需目标语言标注"]
阶段 1 的 MLM 示例(混合语言):
The cat sat on the [MASK].Le [MASK] était très heureux.Der Hund [MASK] weniger glücklich.
阶段 2 训练样本(仅英文):
| 句子 | 标签 |
|---|---|
| "Great movie, loved it!" | Positive |
🖼️ 第 59 页幻灯片 · Case Study: Spelling 🍓
| "Terrible service, awful." | Negative | | "Best purchase ever!" | (Positive) |
共享的多语言表示使得跨语言泛化成为可能。
阶段 3 零样本推理:部署到任意语言!
| 语言 | 输出 | 预测 |
|---|---|---|
| FR | Film magnifique ! | Positive |
| DE | Schrecklicher Service | Negative |
| ZH | 非常好的体验 | Positive |
跨语言迁移(cross-lingual transfer) 的定义:在一个语言(例如英语)的标注数据上微调过的模型,能够在一个它从未被微调过的语言上完成同一任务。
词表大小与重叠度的影响
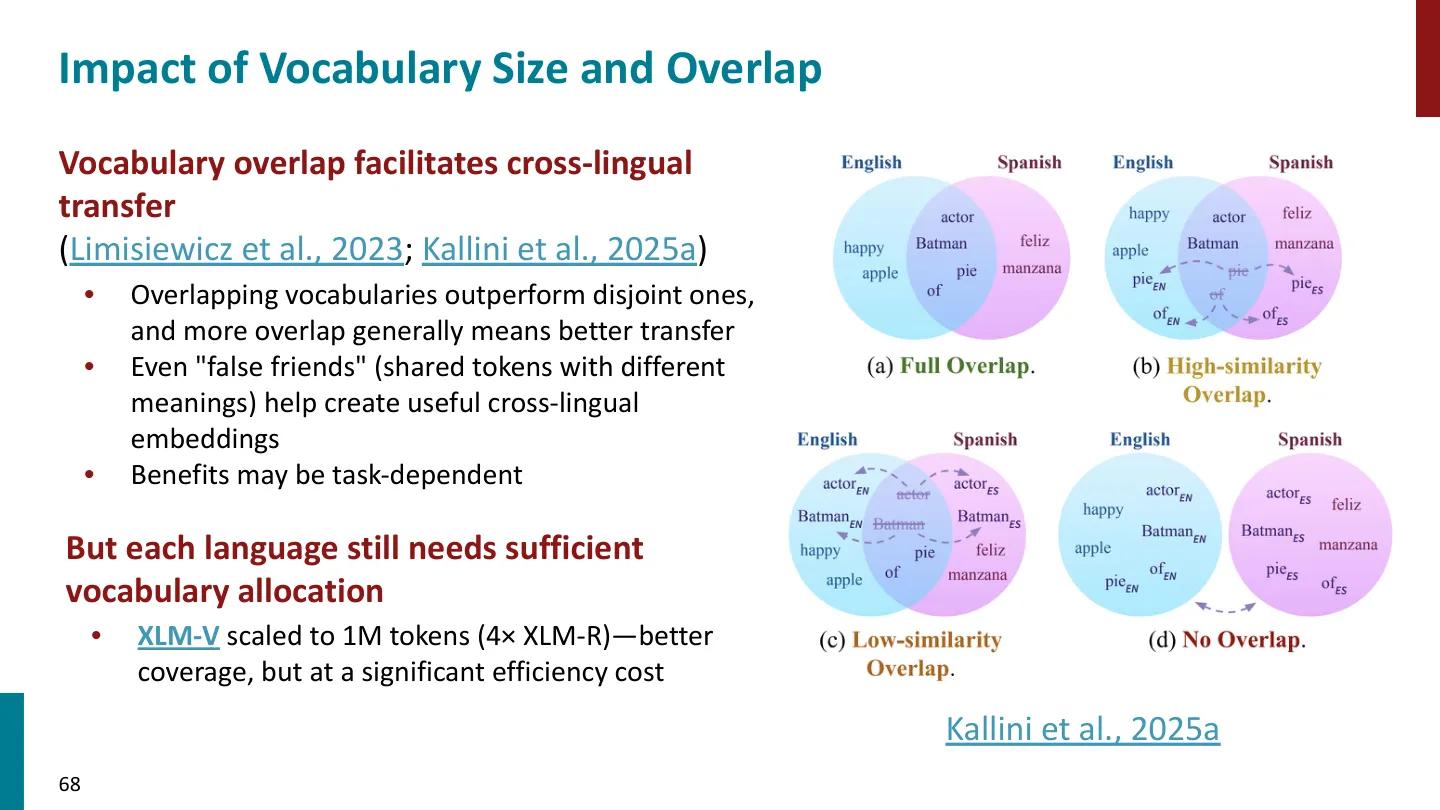
词表重叠有助于跨语言迁移(Limisiewicz et al., 2023;Kallini et al., 2025a):
- 重叠的词表优于不相交的词表,且一般来说重叠越多、迁移越好;
🖼️ 第 60 页幻灯片 · Case Study: Glitch Tokens
- 即使是 "false friends"(形式相同但含义不同的共享 token),也有助于形成有用的跨语言嵌入;
- 但这种收益可能依赖于具体任务。
但每种语言仍然需要足够的词表配额:
- XLM-V 把词表扩展到 100 万 token(是 XLM-R 的 4 倍)——覆盖率更好,但效率代价显著。
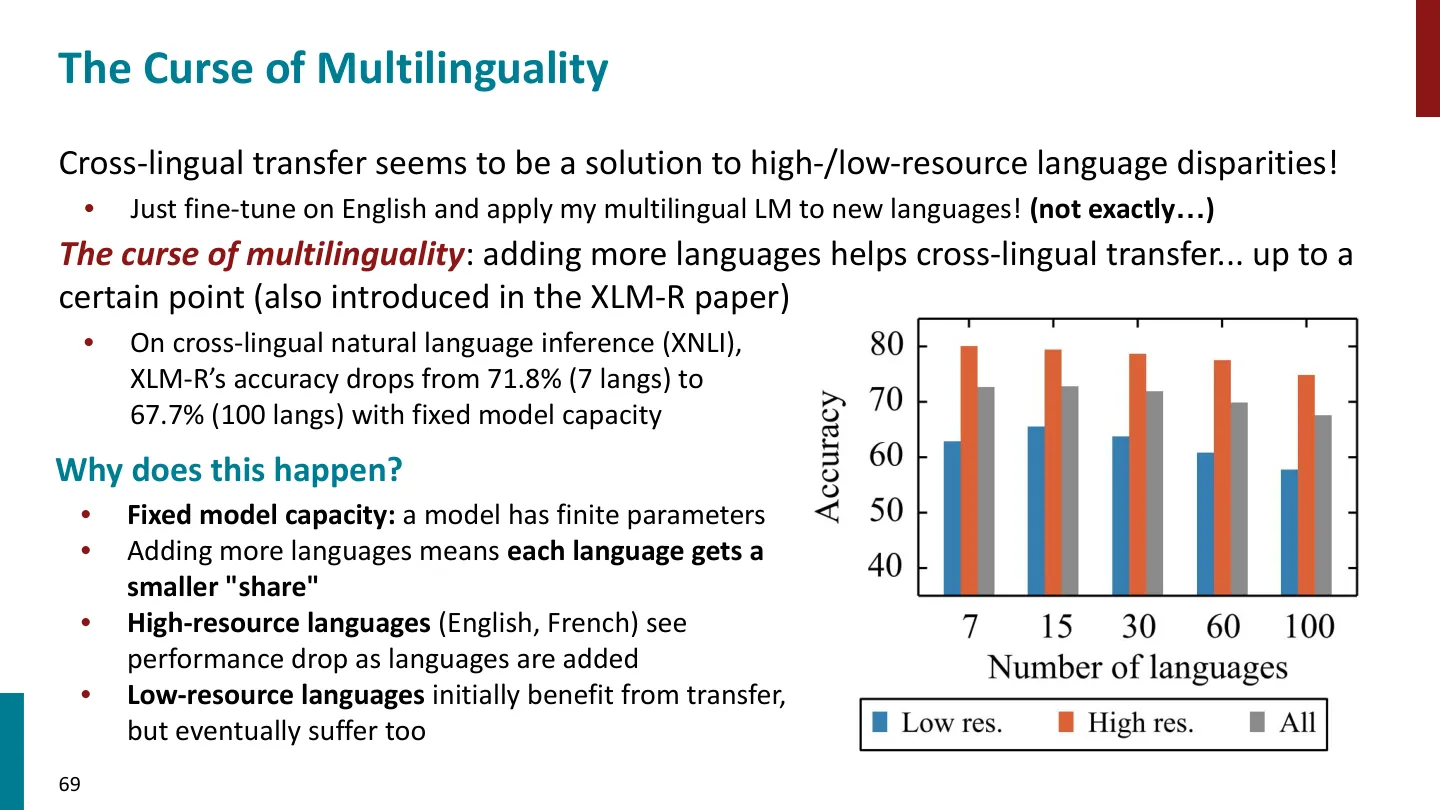
多语言的诅咒(The Curse of Multilinguality)
跨语言迁移看起来像是解决高低资源语言差距的方案!
「在英语上微调一下,然后把我的多语言模型用到新语言上就好了!」——(并不完全如此……)
多语言的诅咒:增加更多语言有助于跨语言迁移——但只到某个点为止(这一现象在 XLM-R 论文中就已经提出)。
- 在跨语言自然语言推理(XNLI)上,固定模型容量下 XLM-R 的准确率从 71.8%(7 种语言)下降到 67.7%(100 种语言)。
为什么会这样?
- 固定的模型容量:模型的参数是有限的;
- 加入更多语言意味着每种语言分到的「份额」更小;
- 高资源语言(英语、法语)随着语言数增加而性能下降;
- 低资源语言最初从迁移中获益,但最终也会受损。
编者拓展|「份额」到底指什么:这里有两层含义被压缩在一起了。第一层是参数份额——多语言共享同一套 Transformer 权重,多语言之间在参数空间里相互竞争,容量被摊薄。第二层是词表份额——BPE 词表大小固定,哪些语言的子词被合并、哪些语言只能退化成单字节 token,是一个零和分配问题。讲义后面「分词在多语言间造成不公平」那一节,正是专门讨论第二层。
分词在多语言间引入了不公平
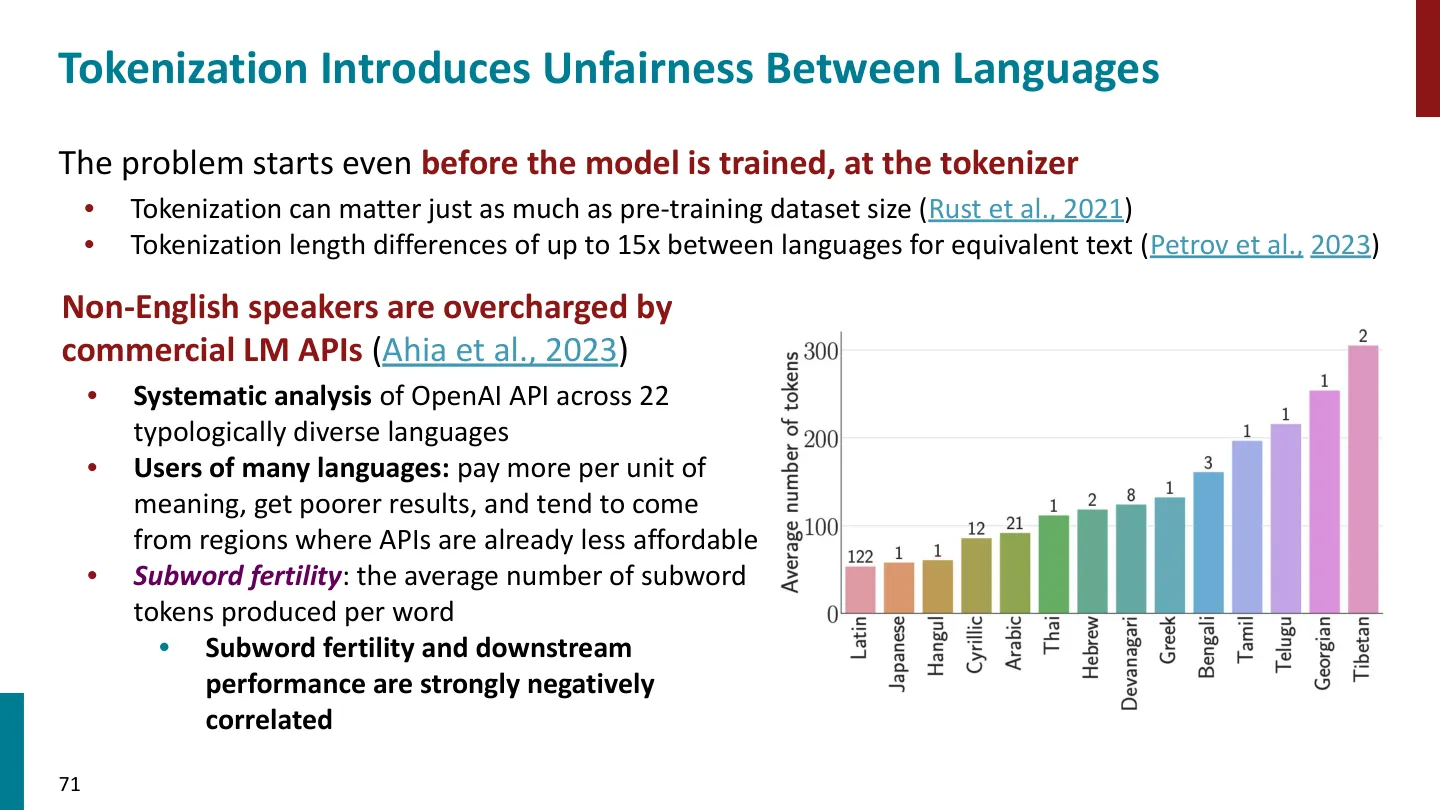
问题在模型被训练之前就开始了——发生在分词器上。
🖼️ 第 61 页幻灯片 · Case Study: Glitch Tokens
- 分词的重要性可以和预训练数据集规模相当(Rust et al., 2021);
- 对相同内容的文本,不同语言之间的分词长度最大可以相差 15 倍(Petrov et al., 2023)。
🖼️ 第 62 页幻灯片 · Tokenization Beyond English
非英语使用者被商业 LM API 多收了钱
- 对 OpenAI API 在 22 种类型学上多样的语言上的系统性分析;
🖼️ 第 63 页幻灯片 · First: Why Multilinguality
- 许多语言的用户:为同样的语义单位付更多钱、得到更差的结果,而且他们往往来自 API 本来就更负担不起的地区。
🖼️ 第 64 页幻灯片 · Despite the linguistic diversity of the
Subword fertility(子词生育率)
定义:平均每个词被切分出的子词 token 数。
$$ \text{fertility} = \frac{\#\text{subword tokens}}{\#\text{words}} $$
- 子词生育率与下游性能呈强负相关:生育率越高(同样的内容被切得越碎),模型表现越差。
编者说明:用上面的表格可以直观感受这个量:同样表达一个意思,英文 21 个 token、泰文 36 个 token,则泰文的 fertility 明显更高。用户按 token 计费,所以「同一个意思」在泰文里更贵——这就是 Ahia et al. 所说的「overcharged」。
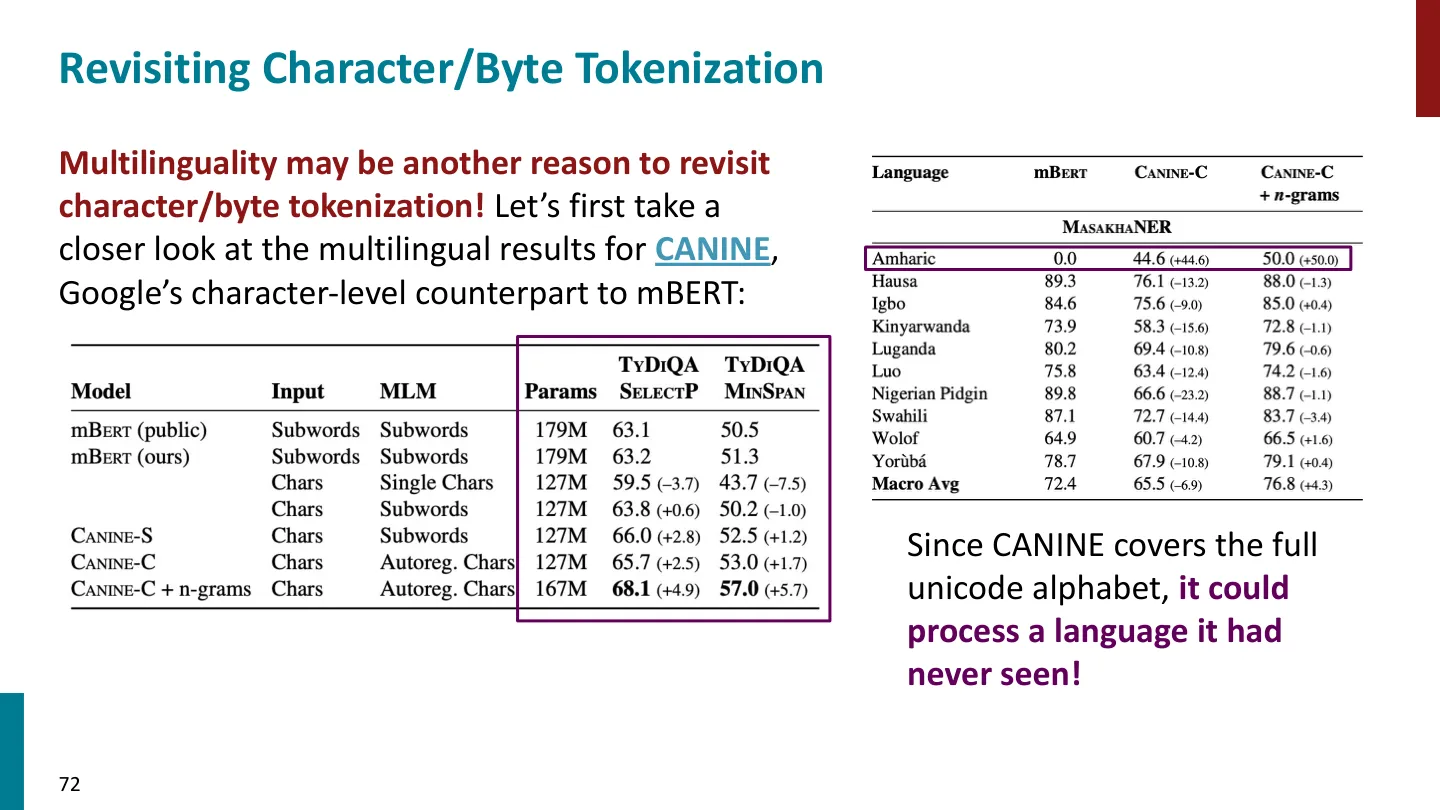
重访字符 / 字节分词
多语言性可能是重新考虑字符 / 字节分词的又一个理由。先看看 CANINE——Google 的字符级「mBERT 对应物」——的多语言结果:
🖼️ 第 65 页幻灯片 · 65
- 由于 CANINE 覆盖整个 Unicode 字母表,它可以处理一种它从未见过的语言!
让字符 / 字节模型更高效
字符 / 字节模型也可以被改造得更高效,以处理长序列——这是做创造性架构工作的绝佳机会。
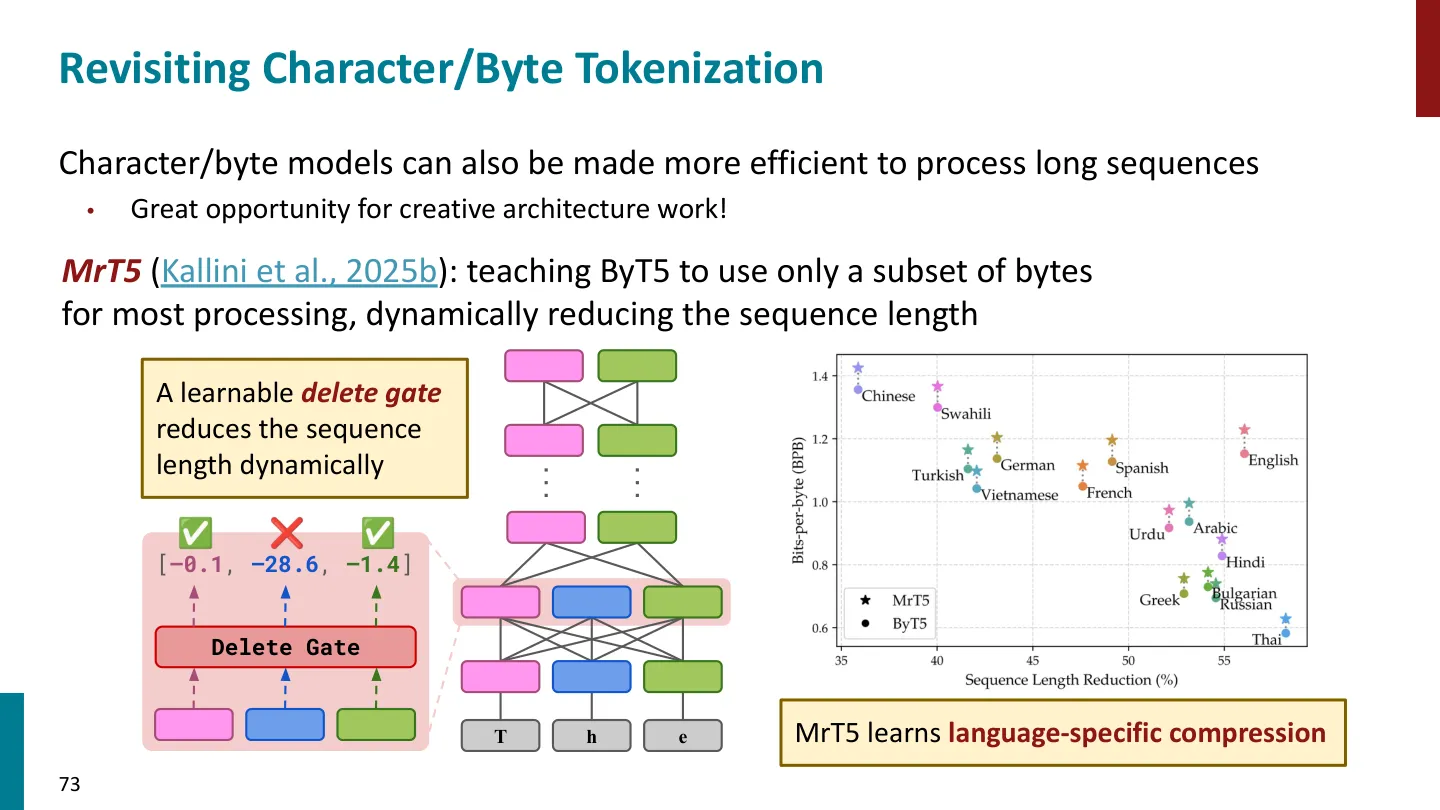
MrT5(Kallini et al., 2025b):教 ByT5 在大部分处理中只使用一部分字节,动态地缩短序列长度。
🖼️ 第 66 页幻灯片 · Multilingual Language Modeling
flowchart LR
    A["T h e ...<br/>(完整字节序列)"] --> B["可学习的 Delete Gate<br/>[–0.1, –28.6, –1.4]"]
    B --> C["✅ 保留 / ❌ 删除"]
    C --> D["压缩后的字节序列<br/>→ 送入后续层"]
- 一个可学习的删除门(delete gate)动态地缩短序列长度;
- MrT5 学到了与语言相关的压缩方式。
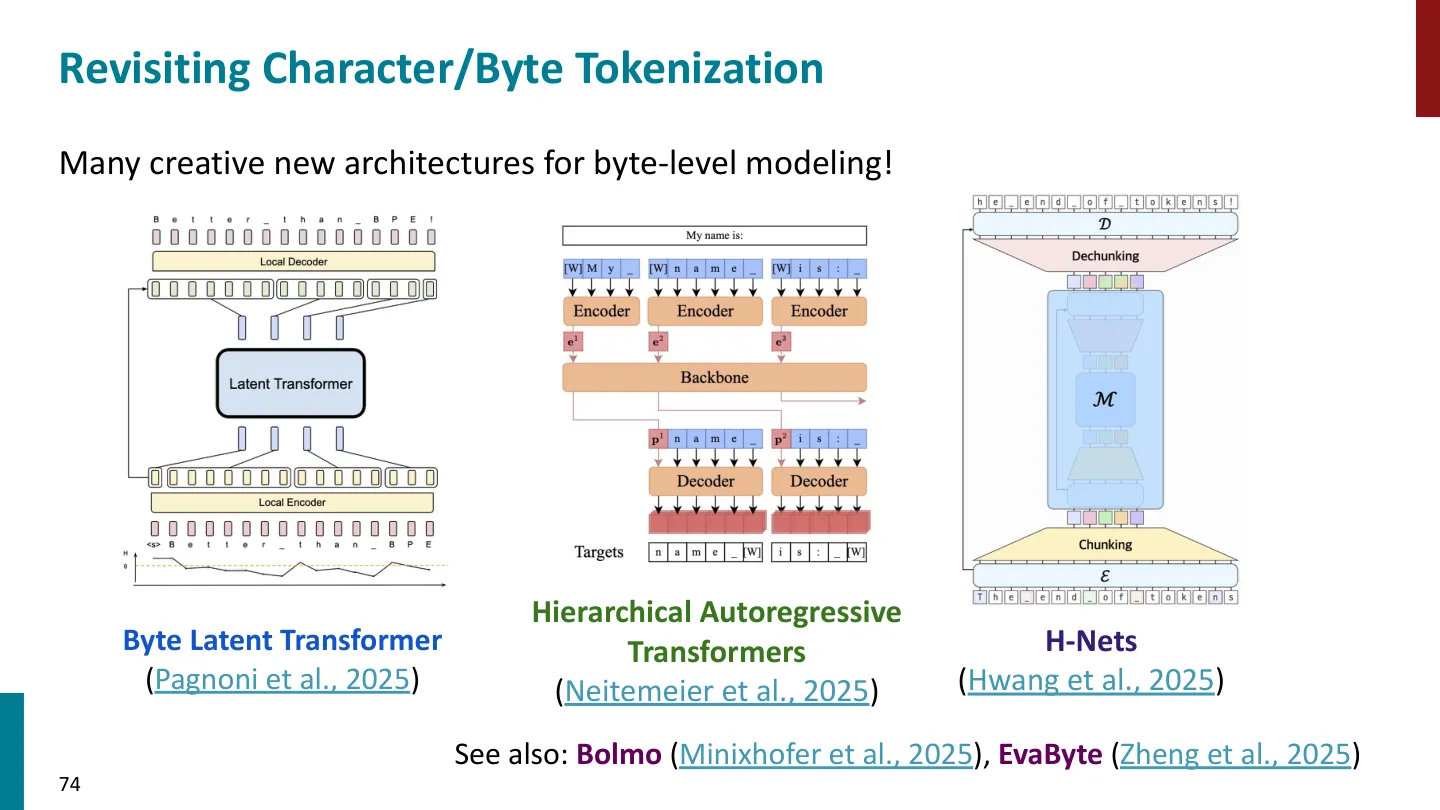
其它字节级架构
- H-Nets(Hwang et al., 2025)
- Byte Latent Transformer(Pagnoni et al., 2025)
- Hierarchical Autoregressive Transformers(Neitemeier et al., 2025)
🖼️ 第 67 页幻灯片 · Stage 1: Pre-training
- 另见:Bolmo(Minixhofer et al., 2025)、EvaByte(Zheng et al., 2025)
字符 / 字节分词还解决了子词分词的哪些问题
- 没有故障 token:每个字符 / 字节都在训练数据中出现过;
- 对字符级操作或噪声的鲁棒性;
- 可以直接观察一个词的字符构成。
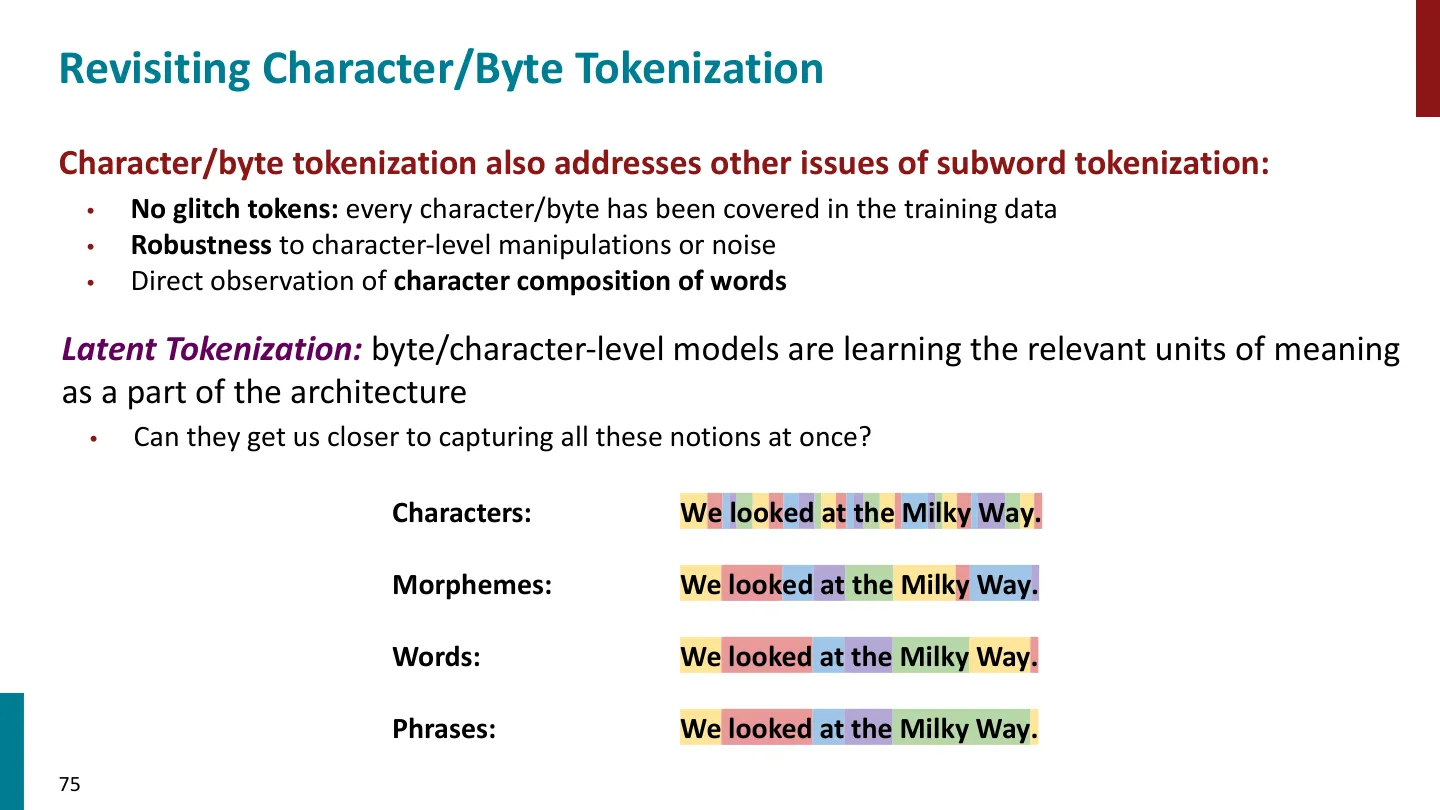
Latent Tokenization(潜式分词)
字节 / 字符级模型是在把「什么是有意义的单位」作为架构的一部分来学习:
- 它们能让我们更接近一次性捕捉下面所有这些概念吗?
字符:   W e   l o o k e d   a t   t h e   M i l k y   W a y .
语素:   We look -ed at the Milk -y Way .
词:     We looked at the Milky Way .
短语:   We looked at the Milky Way .
编者说明:这段是讲义的收尾提问,讲者没有给出结论。它把第 1 节「什么是一个词」的困惑重新带了回来:字符级模型的吸引力在于,它让「切分粒度」不再是一个写死的前处理选择,而变成模型可以自己学的东西。
致谢
讲义感谢以下人士分享样例幻灯片:Dan Jurafsky、Alisa Liu、Yejin Choi / Taylor Sorensen、Christopher Potts;感谢 Tolúlọpẹ́ Ògúnrẹ̀mí、Catherine Arnett 分享样例论文与参考资料;感谢 Jurafsky Lab 成员对本讲的早期反馈。
🖼️ 第 69 页幻灯片 · The Curse of Multilinguality
附:参考与延伸阅读
编者补充
🖼️ 第 72 页幻灯片 · Revisiting Character/Byte Tokenization
- Ahia et al., 2023
- Common Crawl
- Kudo & Richardson, 2018
- Kudo, 2018
- Lample & Conneau, 2019
- Land & Bartolo, 2024
- Petrov et al., 2023
- Rust et al., 2021
- Sennrich et al., 2016
- UTF-8
- word2vec
- Wu et al., 2016
- Zipf's law
已知疑点
- 书头部与讲次归属:本讲的原始材料是 Stanford CS224N/Ling284 2026 冬季 Lecture 14(客座讲座) 的官方讲义幻灯片,而不是模板中提到的 UC Berkeley EECS 189/289A fa26 讲义。书头部已按材料的真实来源填写;「补充讲次」的定位来源于本讲是客座讲座、与主线讲次题材不同这一事实,而非来自明确的课程说明,请读者以实际课程安排为准。
🖼️ 第 74 页幻灯片 · H-Nets
-
「与既有电子书的重复内容」判断:讲义第 4 页回顾的 skip-gram word2vec 目标与语言建模任务,我按「前置知识、用一两句带过」处理,未重新展开推导。但既有电子书中这两块的覆盖程度我无法核对,如果读者发现回顾过少,属于本讲定位差异而非漏译。
-
BPE 并列频次的取舍规则:讲义在
_ + p与p + e(并列 4)之间选了_ + p,在c + k与e + r(并列 3)之间选了c + k,但没有说明取舍依据。我以「编者说明」标注了这属于实现细节,未编造具体规则。
🖼️ 第 75 页幻灯片 · Revisiting Character/Byte Tokenization
-
测试时 BPE 示例的排版:讲义 cell 165 的合并过程排版把「无变化」的中间步骤压缩了(例如 Merge 2、Merge 4、Merge 6 对
_pier均不生效)。我按「每条规则依次尝试」的语义补全成表格,并加了编者说明。若讲者原意是「只展示生效的合并」,则展示顺序可能与原幻灯片略有差异,最终结果[_pi, er]不受影响。 -
外部链接的选择:正文中给出的 arXiv 链接(BPE、WordPiece、Unigram LM、SentencePiece、XLM、XLM-R、mT5、XLM-V、XNLI、Rust et al.、Petrov et al.、Ahia et al.、Fishing for Magikarp、CANINE、ByT5 等)是我按论文标题匹配的常见公开地址。CUTE(Edman et al., 2024)、SuperBPE(Liu et al., 2025)、MrT5(Kallini et al., 2025b)、H-Nets(Hwang et al., 2025)、Byte Latent Transformer(Pagnoni et al., 2025)、Bolmo、EvaByte、Huang et al. 2023 这几项我没有给出链接,因为无法确认其准确的 arXiv 编号——宁可留白,不编造 URL。
-
ARNett 的两篇博客:讲义两处提到 Catherine Arnett 的博客(一是「应该叫 tokenizer-free 吗」,二是「不要在不同于分词器的数据上训练模型」),但未给出标题或链接,因此正文只能复述其观点,无法提供出处。
-
多语言 Tokenization 表格的语种与数值:讲义 cell 189/213 把同一张表分多页展示(English / French / Somali / Thai)。我已合并为一张表,数值(21/75、27/95、30/88、36/79)按原文照录。讲义未说明这段被测文本的具体内容,因此无法复算 token 数。
🖼️ 第 76 页幻灯片 · Acknowledgments 🤗
-
Slide 2 的课程通知(客座讲座考勤、Gradescope 反应段落、Project Milestone 日期、Assignment 4 截止)属于行政信息,与讲次知识内容无关,未纳入正文。
-
「15x 分词长度差异」与「fertility 负相关」:这两条结论分别出自 Petrov et al. (2023) 与 Ahia et al. (2023),讲义只给了结论与指向,没有给出实验设定细节。我已按原文复述,未补充具体实验条件。
-
多语言的诅咒中 71.8% → 67.7% 的数字:讲义注明来自 XLM-R 论文(XNLI 上的准确率,7 种语言 vs 100 种语言,固定模型容量)。此处照录,但未核实原文表格的具体设定(如是否取平均、是否用 zero-shot transfer 协议)。
附录:课堂未展示的幻灯片
🖼️ 第 2 页幻灯片 · Announcements
🖼️ 第 3 页幻灯片 · Agenda for Today
🖼️ 第 6 页幻灯片 · What is a word morpheme?
🖼️ 第 7 页幻灯片 · Beyond words or morphemes
🖼️ 第 11 页幻灯片 · How do language models see text?
🖼️ 第 9 页幻灯片 · How do language models see text?
🖼️ 第 18 页幻灯片 · Word tokenization
🖼️ 第 20 页幻灯片 · Word tokenization
🖼️ 第 28 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 34 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 35 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 39 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 43 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 44 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 41 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 46 页幻灯片 · Subword tokenization: Byte Pair Encoding (BPE)
🖼️ 第 70 页幻灯片 · Tokenization Beyond English
🖼️ 第 68 页幻灯片 · Impact of Vocabulary Size and Overlap
🖼️ 第 73 页幻灯片 · Revisiting Character/Byte Tokenization
🖼️ 第 71 页幻灯片 · Tokenization Introduces Unfairness Between Languages