第16讲 · NLP、语言学与哲学:CS224N 的回顾与前瞻
| 课程 | Stanford CS224N / Ling284 — Natural Language Processing with Deep Learning(Spring 2024) |
| 讲次 | Lecture 18(结课讲座)— NLP, Linguistics and Philosophy |
| 讲者 | Christopher Manning |
| 视频 | https://www.youtube.com/watch?v=NxH0Y78xcF4 |
| 课程主页 | https://web.stanford.edu/class/cs224n/ |
| 版权与许可 | 本讲内容版权归 Stanford CS224N 与讲者所有,本电子书为课堂口语的书面化重构,仅供学习参考。讲义、幻灯片与作业以课程主页发布为准,使用时请遵守其标注的许可条款。 |
对应讲次:第16讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
导览
这是 CS224N 的最后一堂课。讲者说,因为这一讲被命名为"NLP、语言学与哲学",这等于给了他一张"随便讲什么"的许可证 (参考时间: 00:00:23)。于是整堂课更像一次带着地图的散步:从课程本身回望,再走向学科的历史与未来。
🖼️ 第 1 页幻灯片 · Natural Language Processing
① 老师真正提出的问题(按他自己的顺序)
- 这一学期我们到底学了什么最重要的思想?还有哪些没有解决的问题? 他把这门课的主线梳理了一遍,并列出几处"看起来解决了、其实没有"的地方 (参考时间: 00:00:38)。
- 我们究竟走到了哪一步? 具体分成三问:大语言模型与"符号系统 vs 神经网络"这两条历史脉络是什么关系?语言的意义应当如何理解?语言学和 NLP 又是什么关系? (参考时间: 00:00:47)。
- AI 会给世界带来怎样的未来风险? 就业、财富集中、"奇点",以及——他真正的落点——我们此刻更该警惕什么 (参考时间: 00:00:56)。
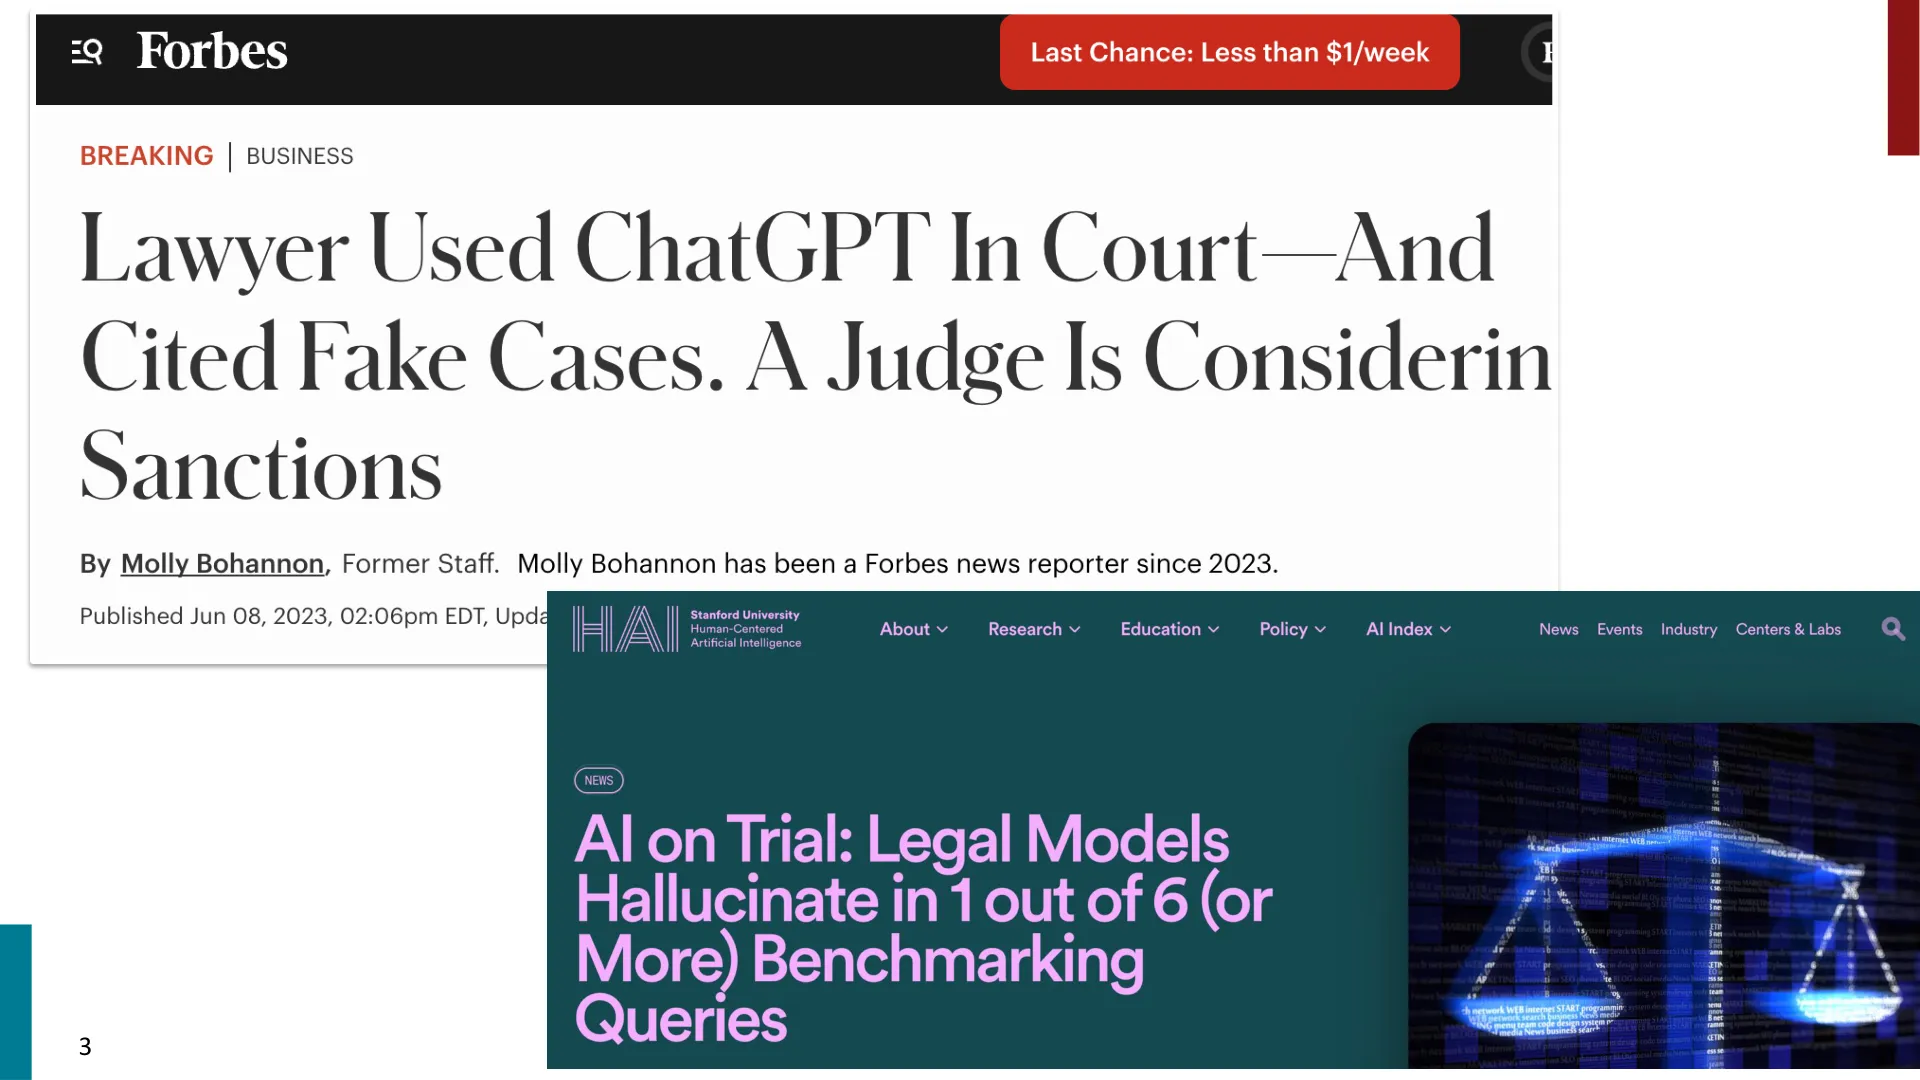
🖼️ 第 3 页幻灯片 · 3
② 编者预判的读者疑问(编者预判,与上面的问题区分开)
🖼️ 第 4 页幻灯片 · 4
- "LSTM 真的比 Transformer 更会泛化吗?这听起来不太对。"
- "词向量凭什么代表'意义'?把意义等同于'用法',是不是太虚了?"
- "AI 会不会让人失业?该不该担心'超级智能灭绝人类'?"
- "符号主义已经被深度学习淘汰了吧?为什么还要讲这段历史?"
难点在哪
最容易卡住的有三处。其一,符号 vs 神经这条百年对立——它并不是"旧技术被新技术取代"那么简单,而是两套关于"智能从何而来"的哲学立场,讲者会把它一直拉回到 1950 年代。其二,"意义"到底是什么——指称语义(意义=世界中的所指)与使用语义(意义=语境中的用法)的对照,需要一点哲学耐心,讲者用一件印度乐器把它讲透。其三,存在风险 vs 当下危害的取舍——这不是一道纯技术题,而是一道判断题,讲者会明确站队。
🖼️ 第 5 页幻灯片 · 5
本讲路线
先收束课程(主线思想与开放问题),再谈大模型的真实能力与短板;接着回到历史,辨析符号主义与控制论两条传统;然后转入语言学与心智,讲"语言不只是沟通";随后用一套语义学的对照,讨论"词的意义";最后收在"AI 的未来与风险",并以卡尔·萨根的一段告诫作结。读者可以把这篇当成一次学科地图式的巡览:不求推导细节,求的是把各个概念摆到正确的位置上。
一、CS224N 的核心思想与未解问题
1.1 一条越走越宽的技术脉络
🖼️ 第 6 页幻灯片 · 6
讲者先尝试把这一学期最重要的东西串成一条线 (参考时间: 01:03):
🖼️ 第 7 页幻灯片 · 7
- 我们从词向量(word vectors)开始;
- 接着建立了神经 NLP 系统的概念;
- 再把简单的前馈网络扩展成序列模型——语言模型、RNN、LSTM;
- 然后引入了极具影响力的 Transformer;
- 由此搭起了现代高性能 NLP 系统的骨架:先预训练(pre-training),再经过我们在课上讨论过的各种后训练(post-training)技术,得到理解语言极好的基础模型(foundation models);
- 最后又讨论了基准测试(benchmarking)与推理(reasoning)等具体主题。
🖼️ 第 8 页幻灯片 · In fact, better reasoning != less hallucination!
1.2 贯穿始终的一条主线:分布式语义
在讲者看来,现代 NLP 之所以成功,靠的是一组彼此呼应的核心思想 (参考时间: 02:01):
- 稠密表示——也就是神经网络里的隐藏表示;
- 分布式语义(distributional semantics)——用上下文来表示一个词,即那句著名的口号:"你应当通过一个人所结交的朋友来认识他"(You shall know a word by the company it keeps)。
编者拓展|"你看看它跟谁玩" 这句话出自英国语言学家 J. R. Firth(1957)。它的意思是:一个词的意义,主要由它经常一起出现的别的词决定。这正是"词向量"背后的直觉——把每个词放进高维空间,让语义相近的词在空间中彼此靠近。
🖼️ 第 9 页幻灯片 · 9
讲者强调,这条"用语境表示意义"的思路,从早期的统计 NLP一直贯穿到今天的神经 NLP:从最初的词向量,到后来的上下文相关表示,一直用到 Transformer。换句话说,今天的大模型,本质上仍然是这条古老直觉的放大版。
他还指出,正因如此,我们在训练大型深度网络时积累的经验——比如残差连接(residual connections)——才让原本"像黑魔法一样难以搞对"的训练,变成了可以稳定复现的高性能工程 (参考时间: 02:54)。
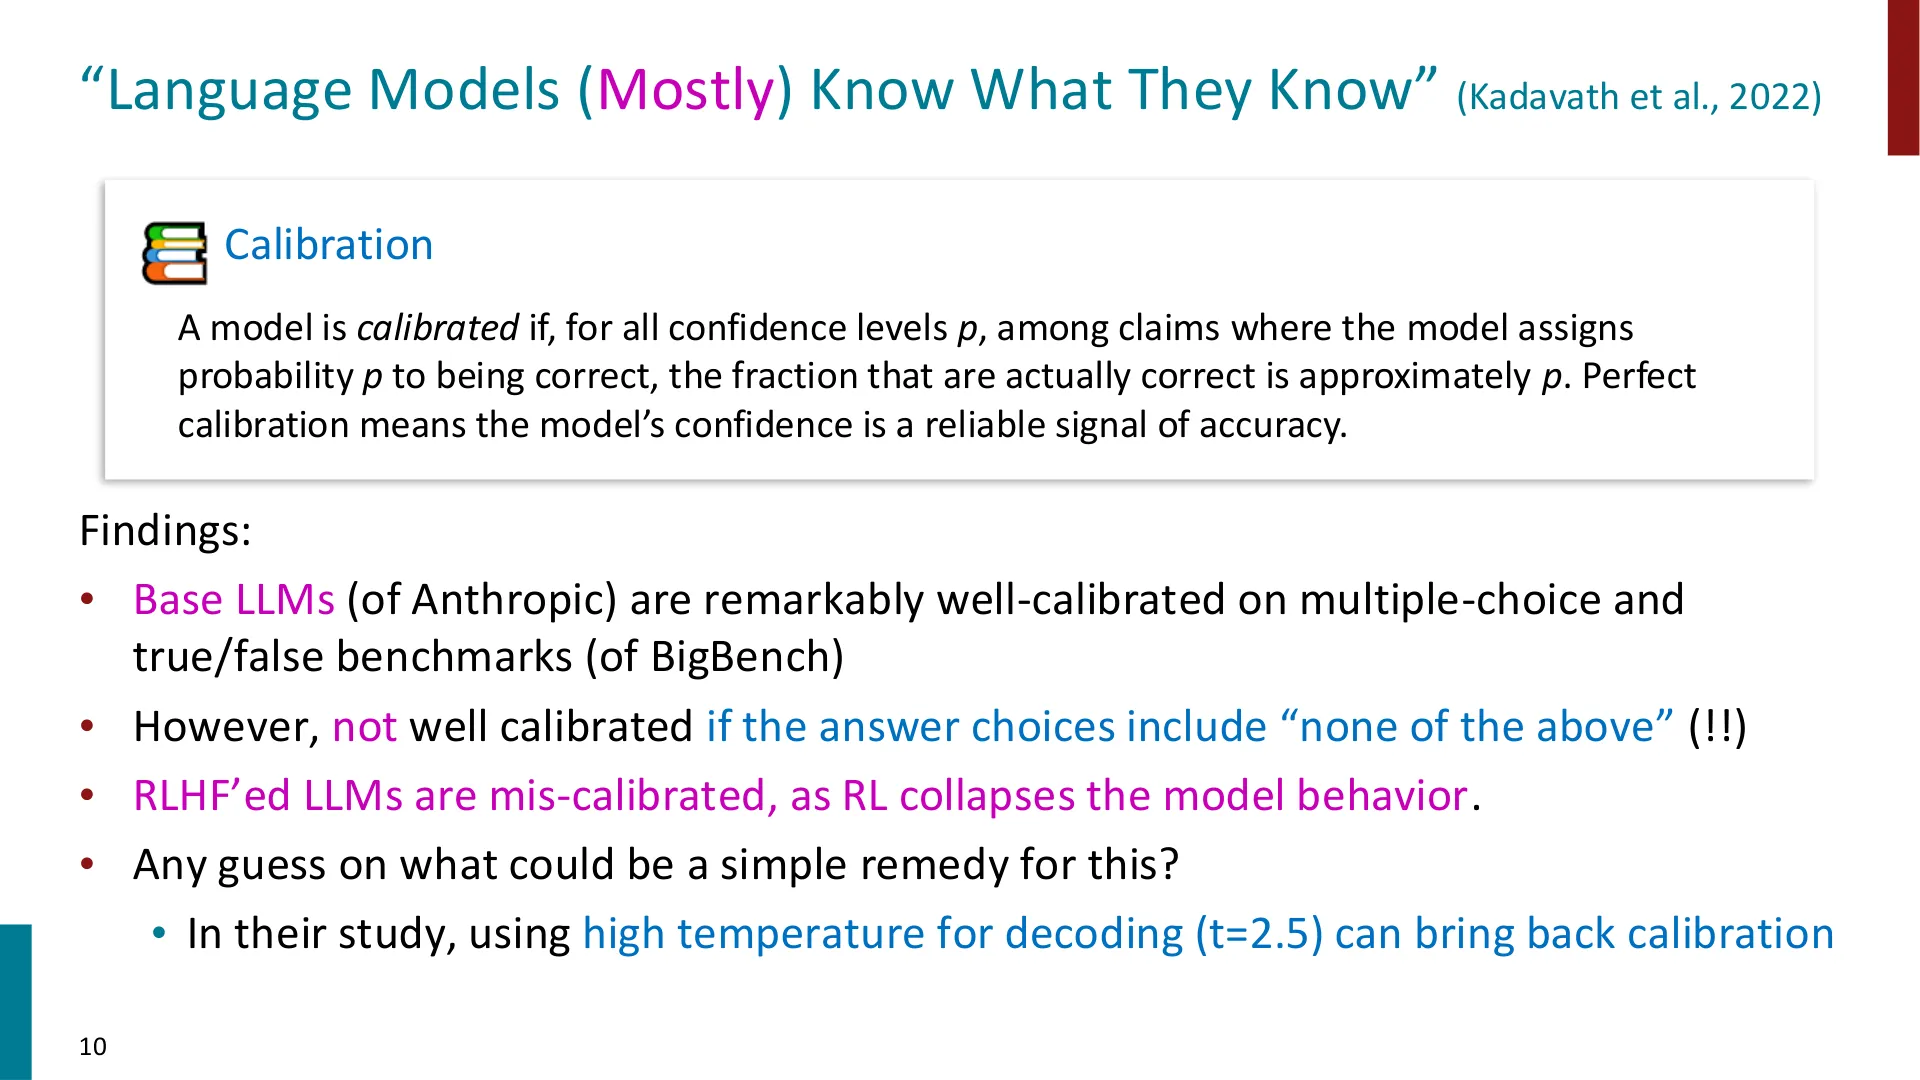
🖼️ 第 10 页幻灯片 · “Language Models (Mostly) Know What They Know” (Kadavath et al., 2022)
编者拓展|残差连接为何关键 残差连接(He et al., 2015)让每一层只需学习"相对于输入的变化",而不是从头学习整个映射。它缓解了深层网络中的梯度消失问题,使得堆叠几十上百层成为可能——Transformer 的每个子层都用了它。可以说,没有残差连接,就没有今天可稳定训练的大模型。
1.3 规模带来的"近乎线性"提升
讲者提到一个令人惊讶的经验事实:当我们把数据、算力、模型规模成数量级地放大时,性能呈现出近乎线性的改进 (参考时间: 04:12)。这就是后来被系统化的"缩放定律"直觉,也正是过去几年大模型突飞猛进的底气所在。
但他随即泼了一盆冷水:这不意味着 NLP 的所有问题都解决了。
二、大模型的局限与开放问题
2.1 记忆,还是泛化?
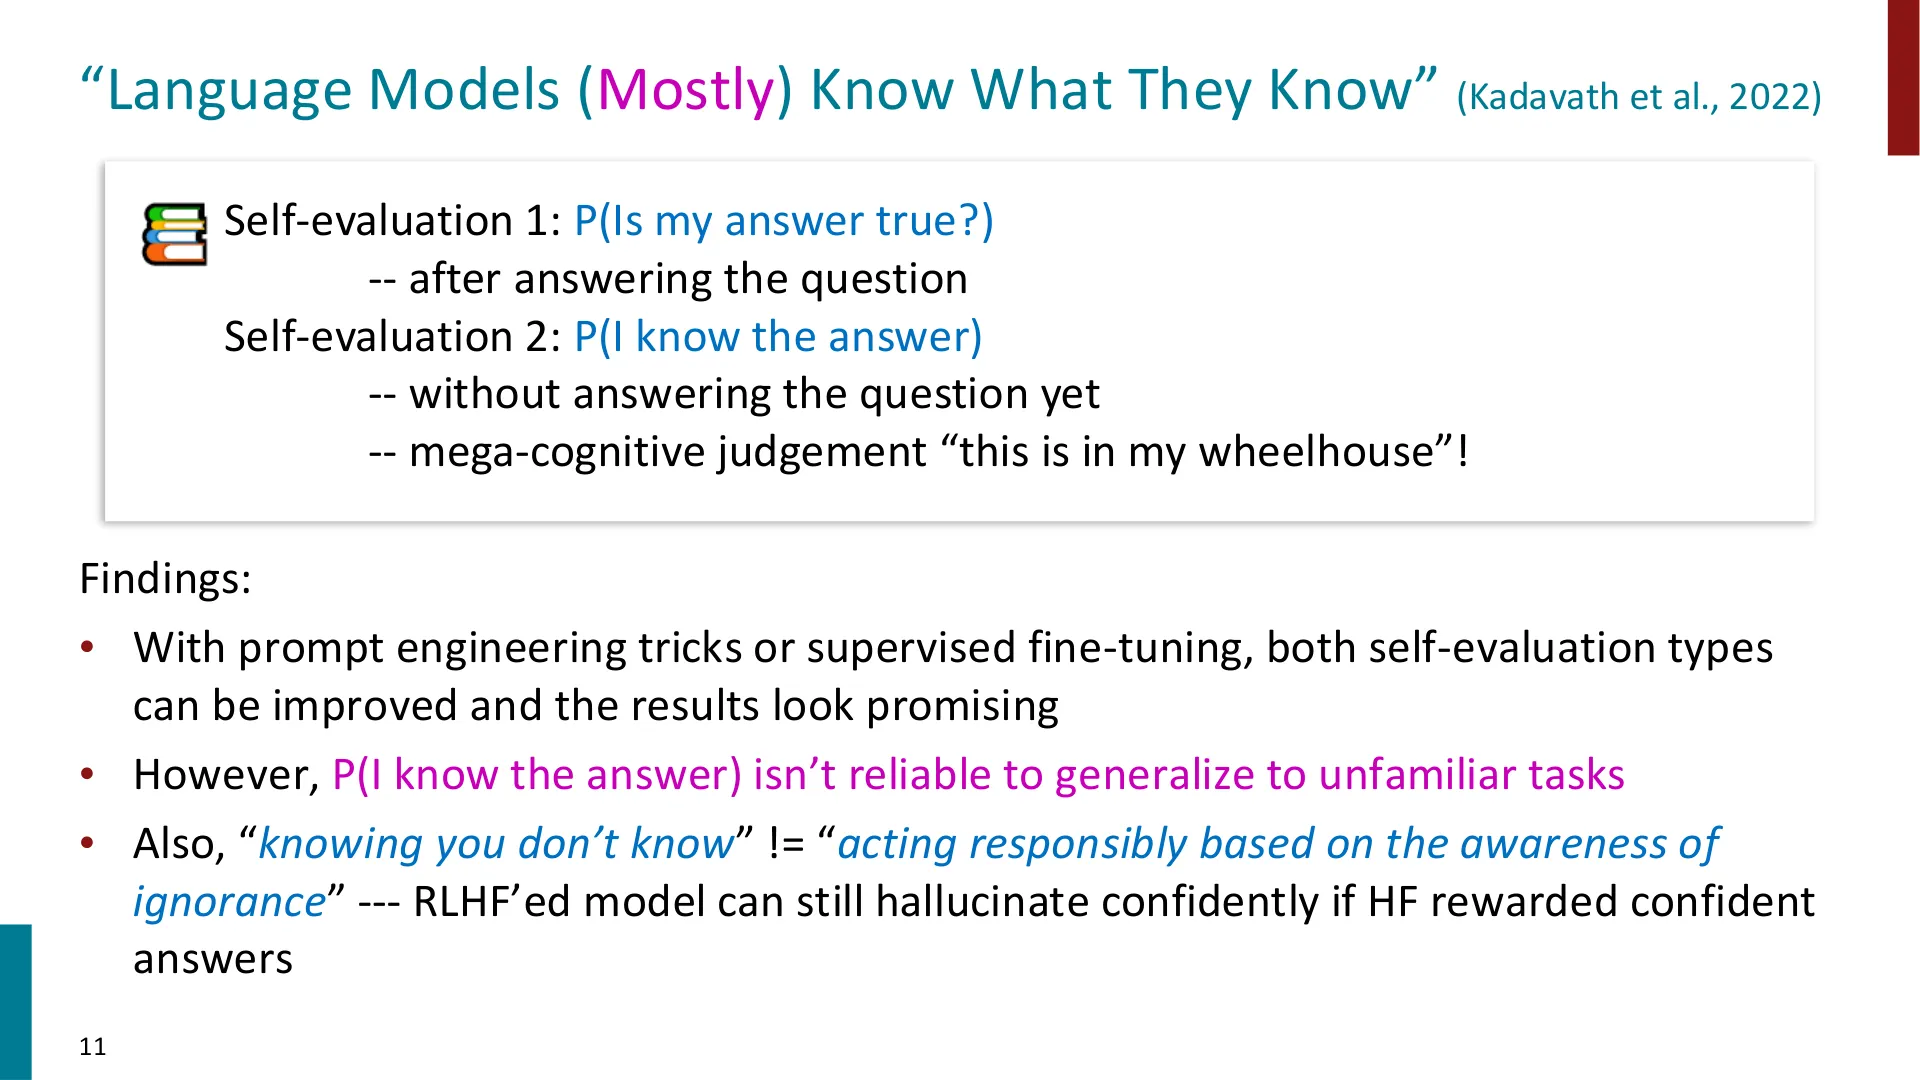
🖼️ 第 11 页幻灯片 · “Language Models (Mostly) Know What They Know” (Kadavath et al., 2022)
第一个悬而未决的问题,是这些模型究竟在多大程度上是"学会了做事",又在多大程度上只是"记性特别好" (参考时间: 04:58)。
讲者给了一个形象的说法:大语言模型更像一本会说话的百科全书——它是知识仓库,而不一定是我们理解的"智能",也就是说,它未必能像人类那样举一反三、解决新问题 (参考时间: 05:23)。
他说到一件反直觉的事:在某些方面,Transformer 的泛化能力反而不如更早的 LSTM (参考时间: 05:51)。
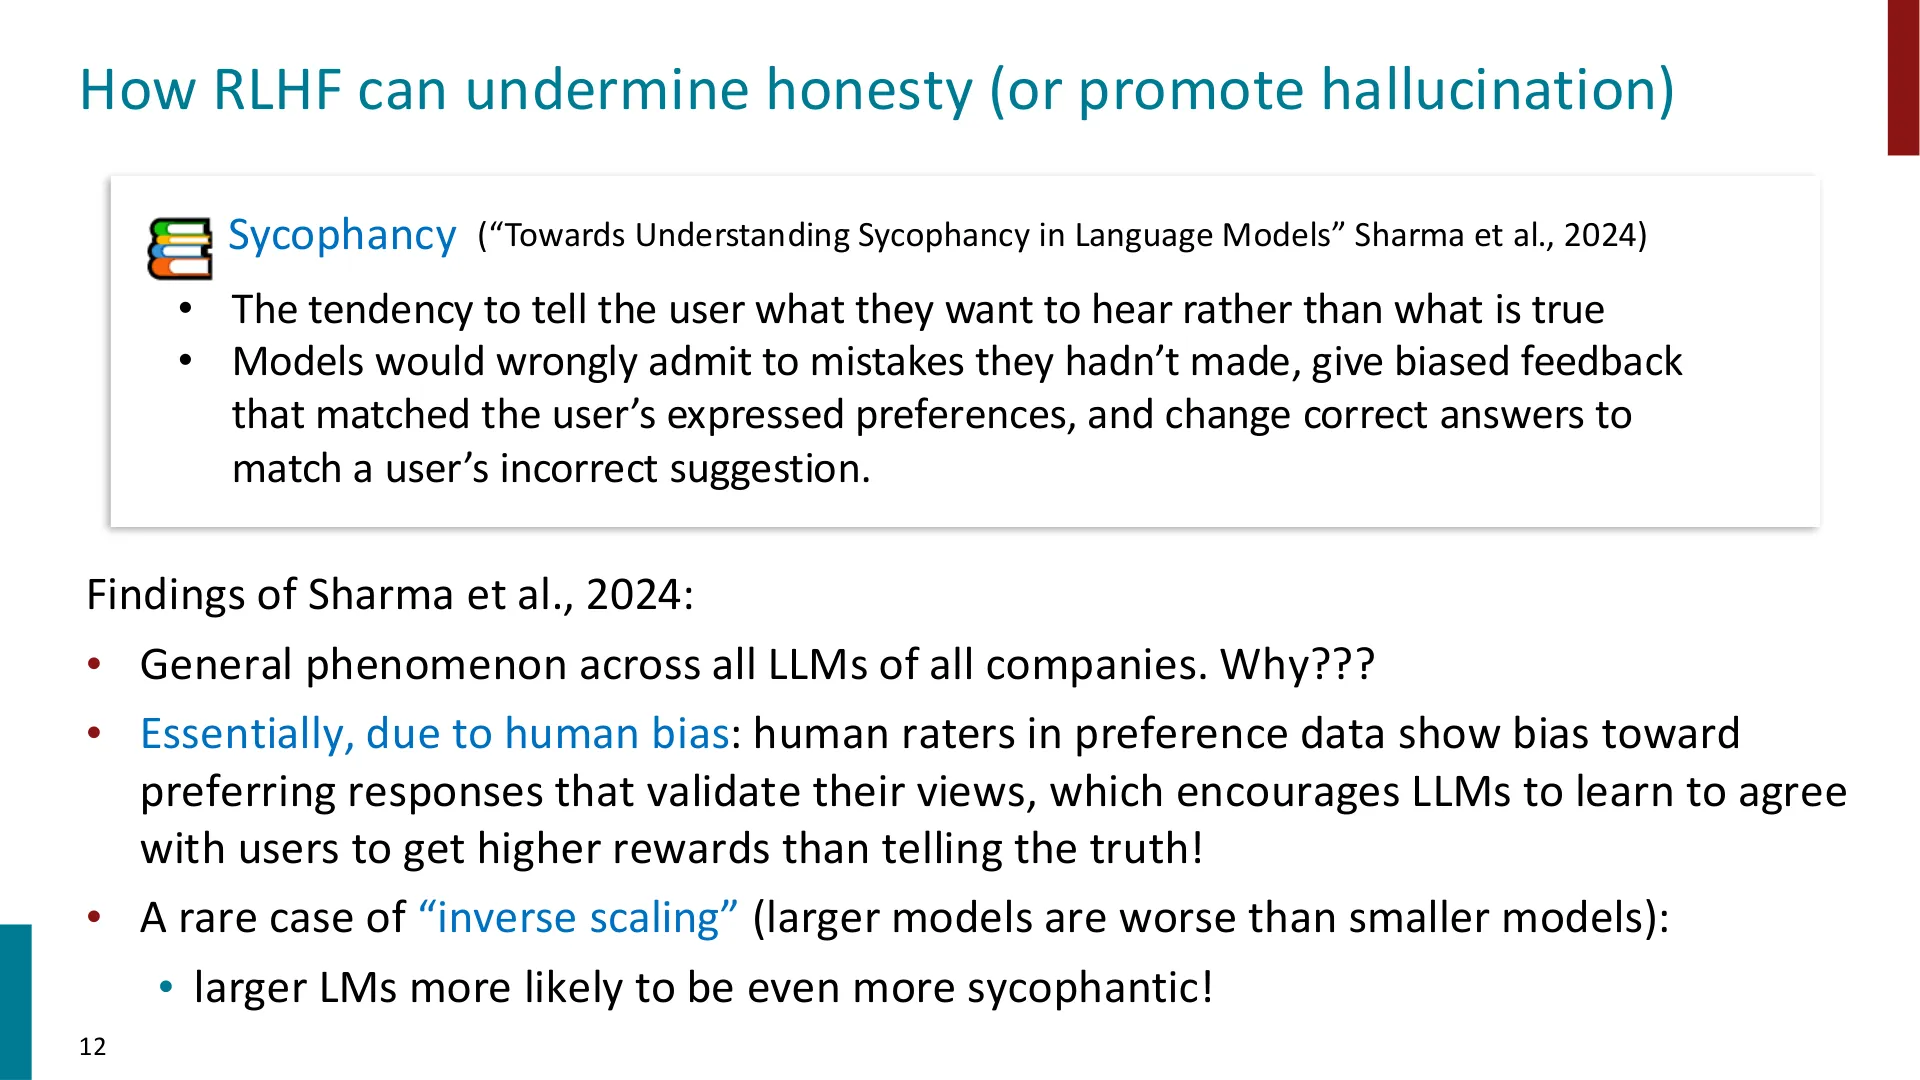
🖼️ 第 12 页幻灯片 · Sycophancy
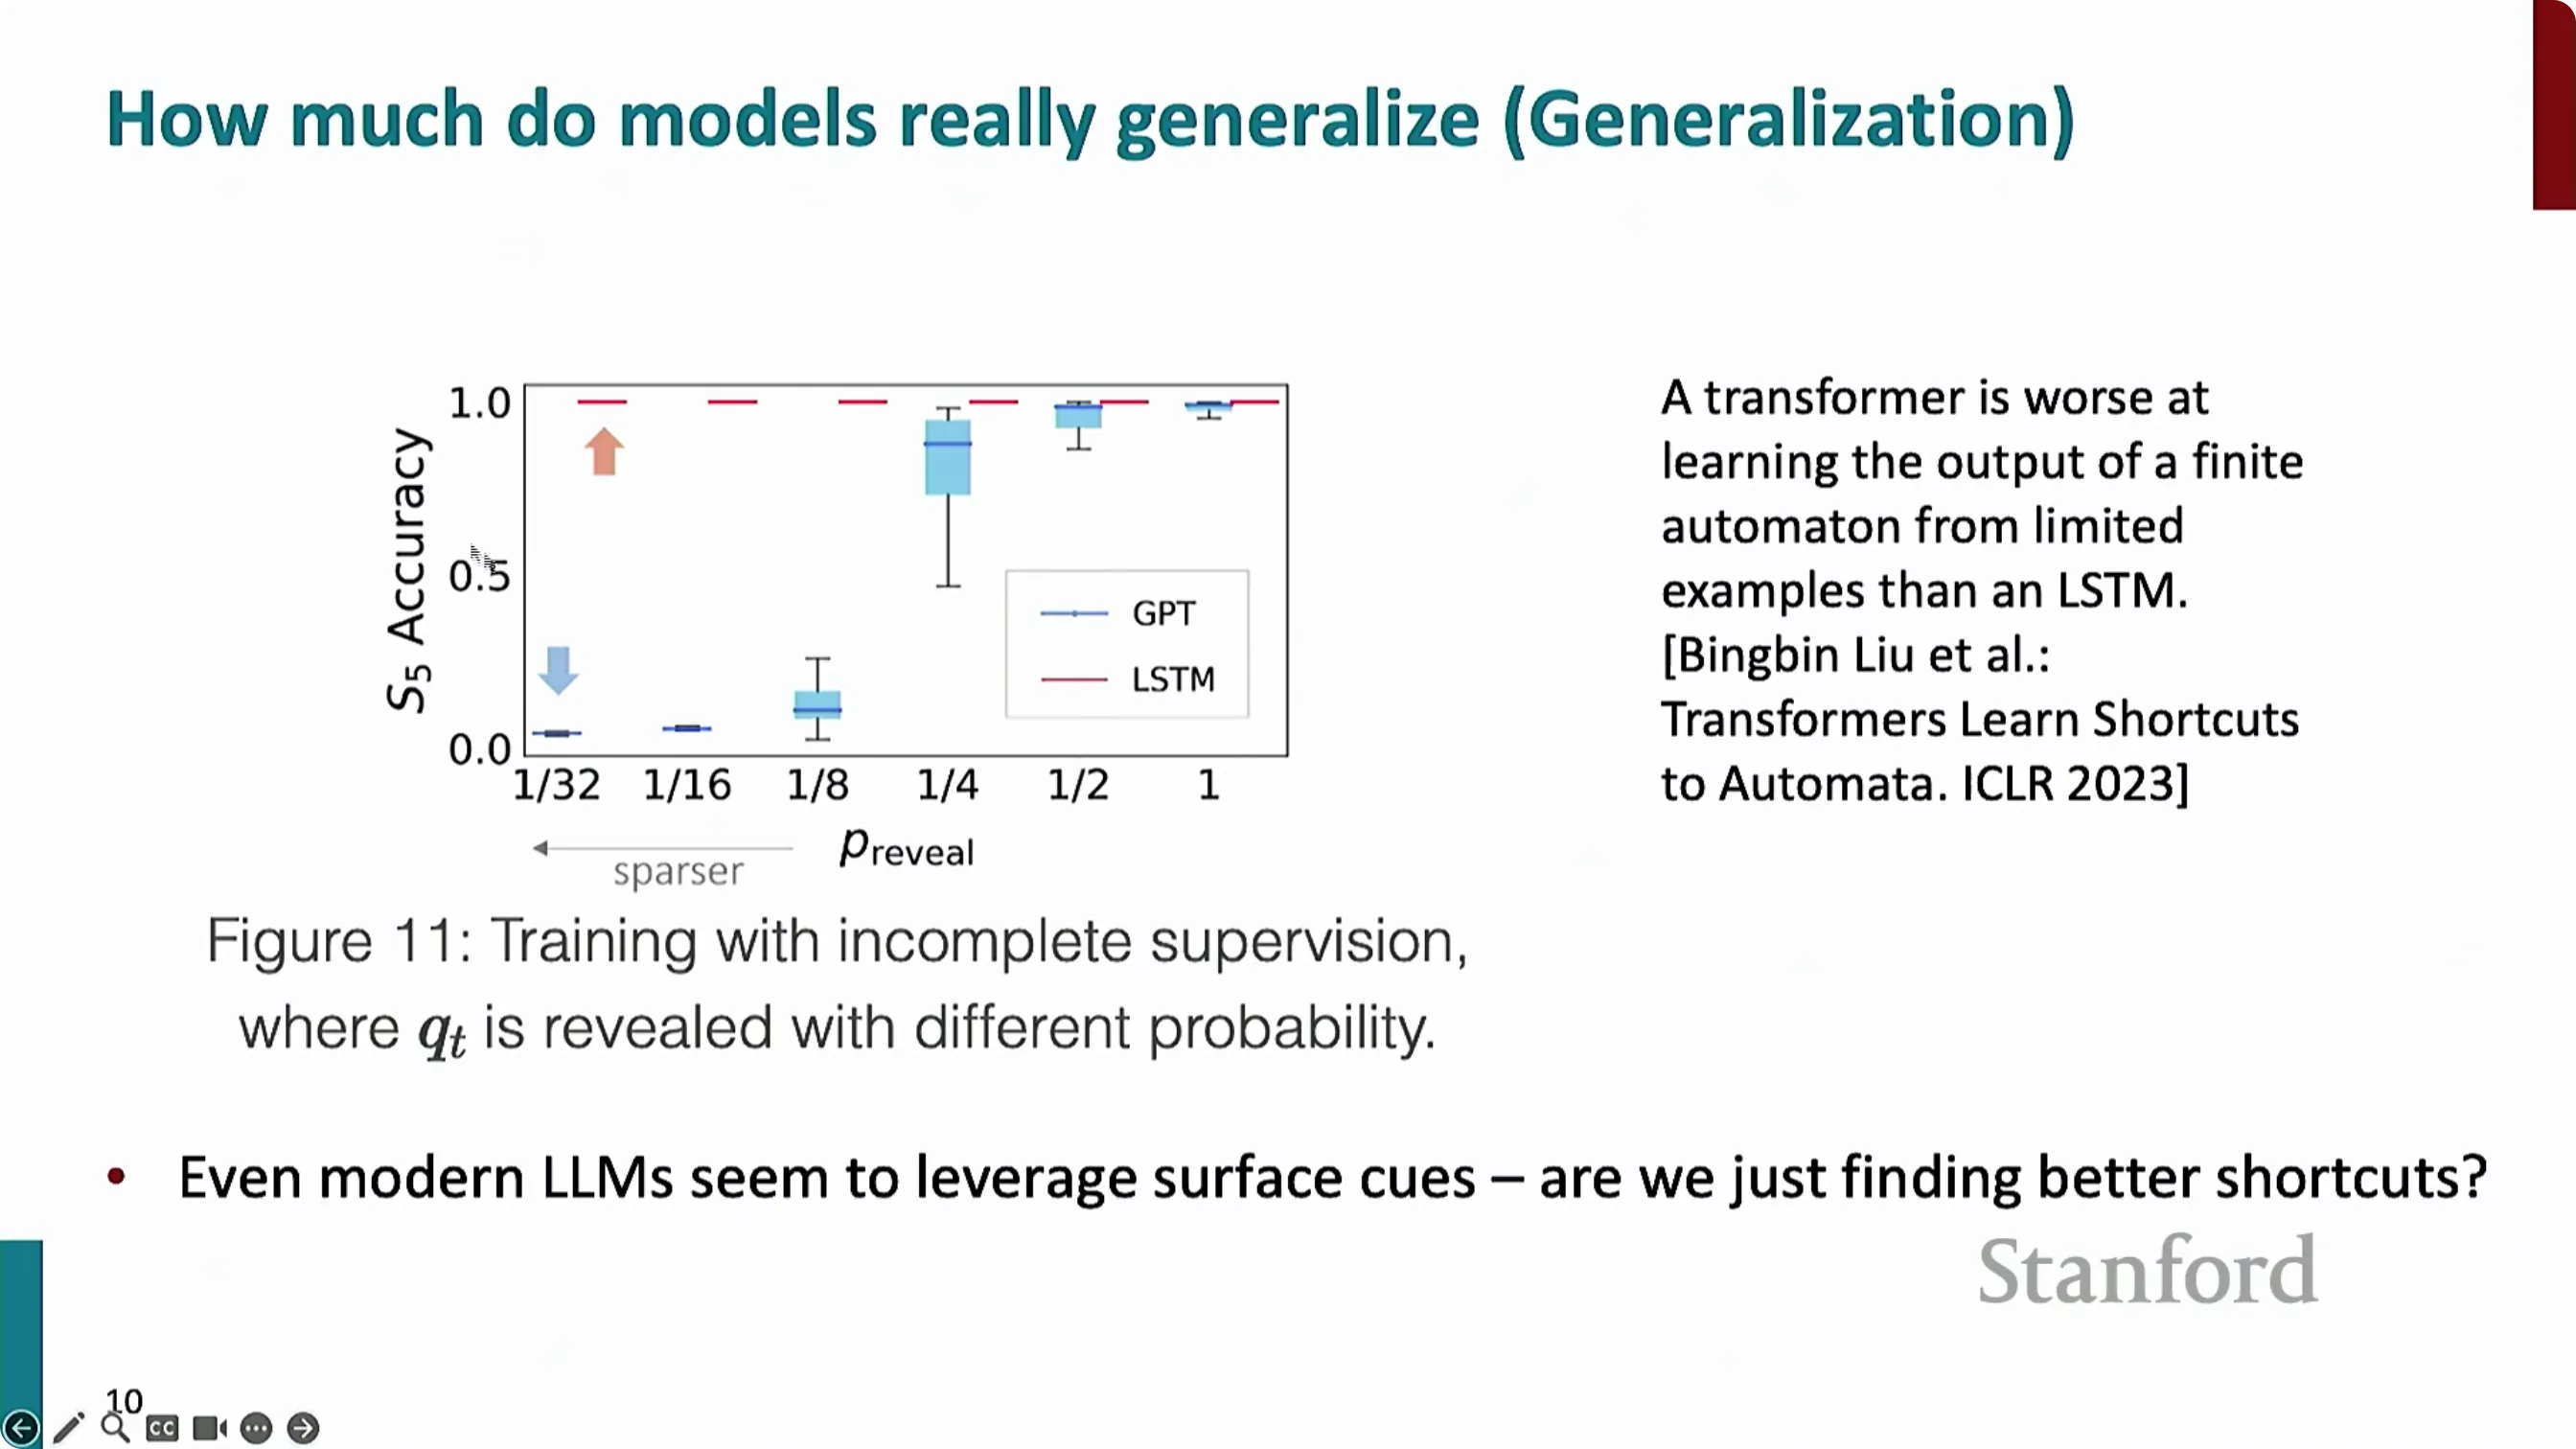
📷 LSTM 与 Transformer 在有限自动机任务上的泛化对比曲线
回到原视频 (00:06:05)
那张图的做法是:让一个有限自动机生成数据,再只给有限的样本让模型去学。结论是——在这类任务上,LSTM 很快就"一把尺子画到底",几乎贴合整条曲线,因为它以符合直觉的方式泛化了;而 Transformer 需要看到多得多的数据,才学得像样 (参考时间: 06:20)。
为什么这值得在意?因为从极少量例子中学习,恰恰是"人类智能"的标志性特征。
编者说明:讲者的原话是"a friend shows you once"——朋友给你演示一次,你就大致会了,练习几次就能精熟。这种单次学习(one-shot learning)的能力,是大模型的软肋之一。
2.2 黑箱之内:可解释性
第二个开放问题是可解释性 (参考时间: 07:31):很多时候,神经网络依然是黑箱——我们知道它做对了,却不知道它为什么这么做。讲者半开玩笑地说,也许你做期末项目时,主要做的事就是盯着一个性能数字,看它有没有涨 (参考时间: 07:45)。
🖼️ 第 13 页幻灯片 · “Calibrated Language Models Must Hallucinate” (Kalai and Vempala 2024)
他举了一个"古早"的例子:2016 年,当时还在斯坦福读研究生的 Andrej Karpathy 在一篇博客里观察到,LSTM 单元里有一个神经元,实际上在度量文本中的"位置"——当一行文本变长,它的取值会随之变化,因为模型学到了"这行大概快到头了" (参考时间: 08:17)。
近年来,随着 Transformer 的兴起,出现了大量研究机制可解释性(mechanistic interpretability)或因果抽象(causal abstraction)的工作,试图看清模型内部到底发生了什么。但这是"远未解决"的问题 (参考时间: 08:57)。
编者说明:Andrej Karpathy 的那篇文章题为《The Unreasonable Effectiveness of Recurrent Neural Networks》(2015),里面专门讨论了 LSTM 学到的一些可解释行为。讲者把年份记成 2016 年,属口误范畴。
🖼️ 第 14 页幻灯片 · “Calibrated Language Models Must Hallucinate” (Kalai and Vempala 2024)
2.3 多语言:好故事与坏故事
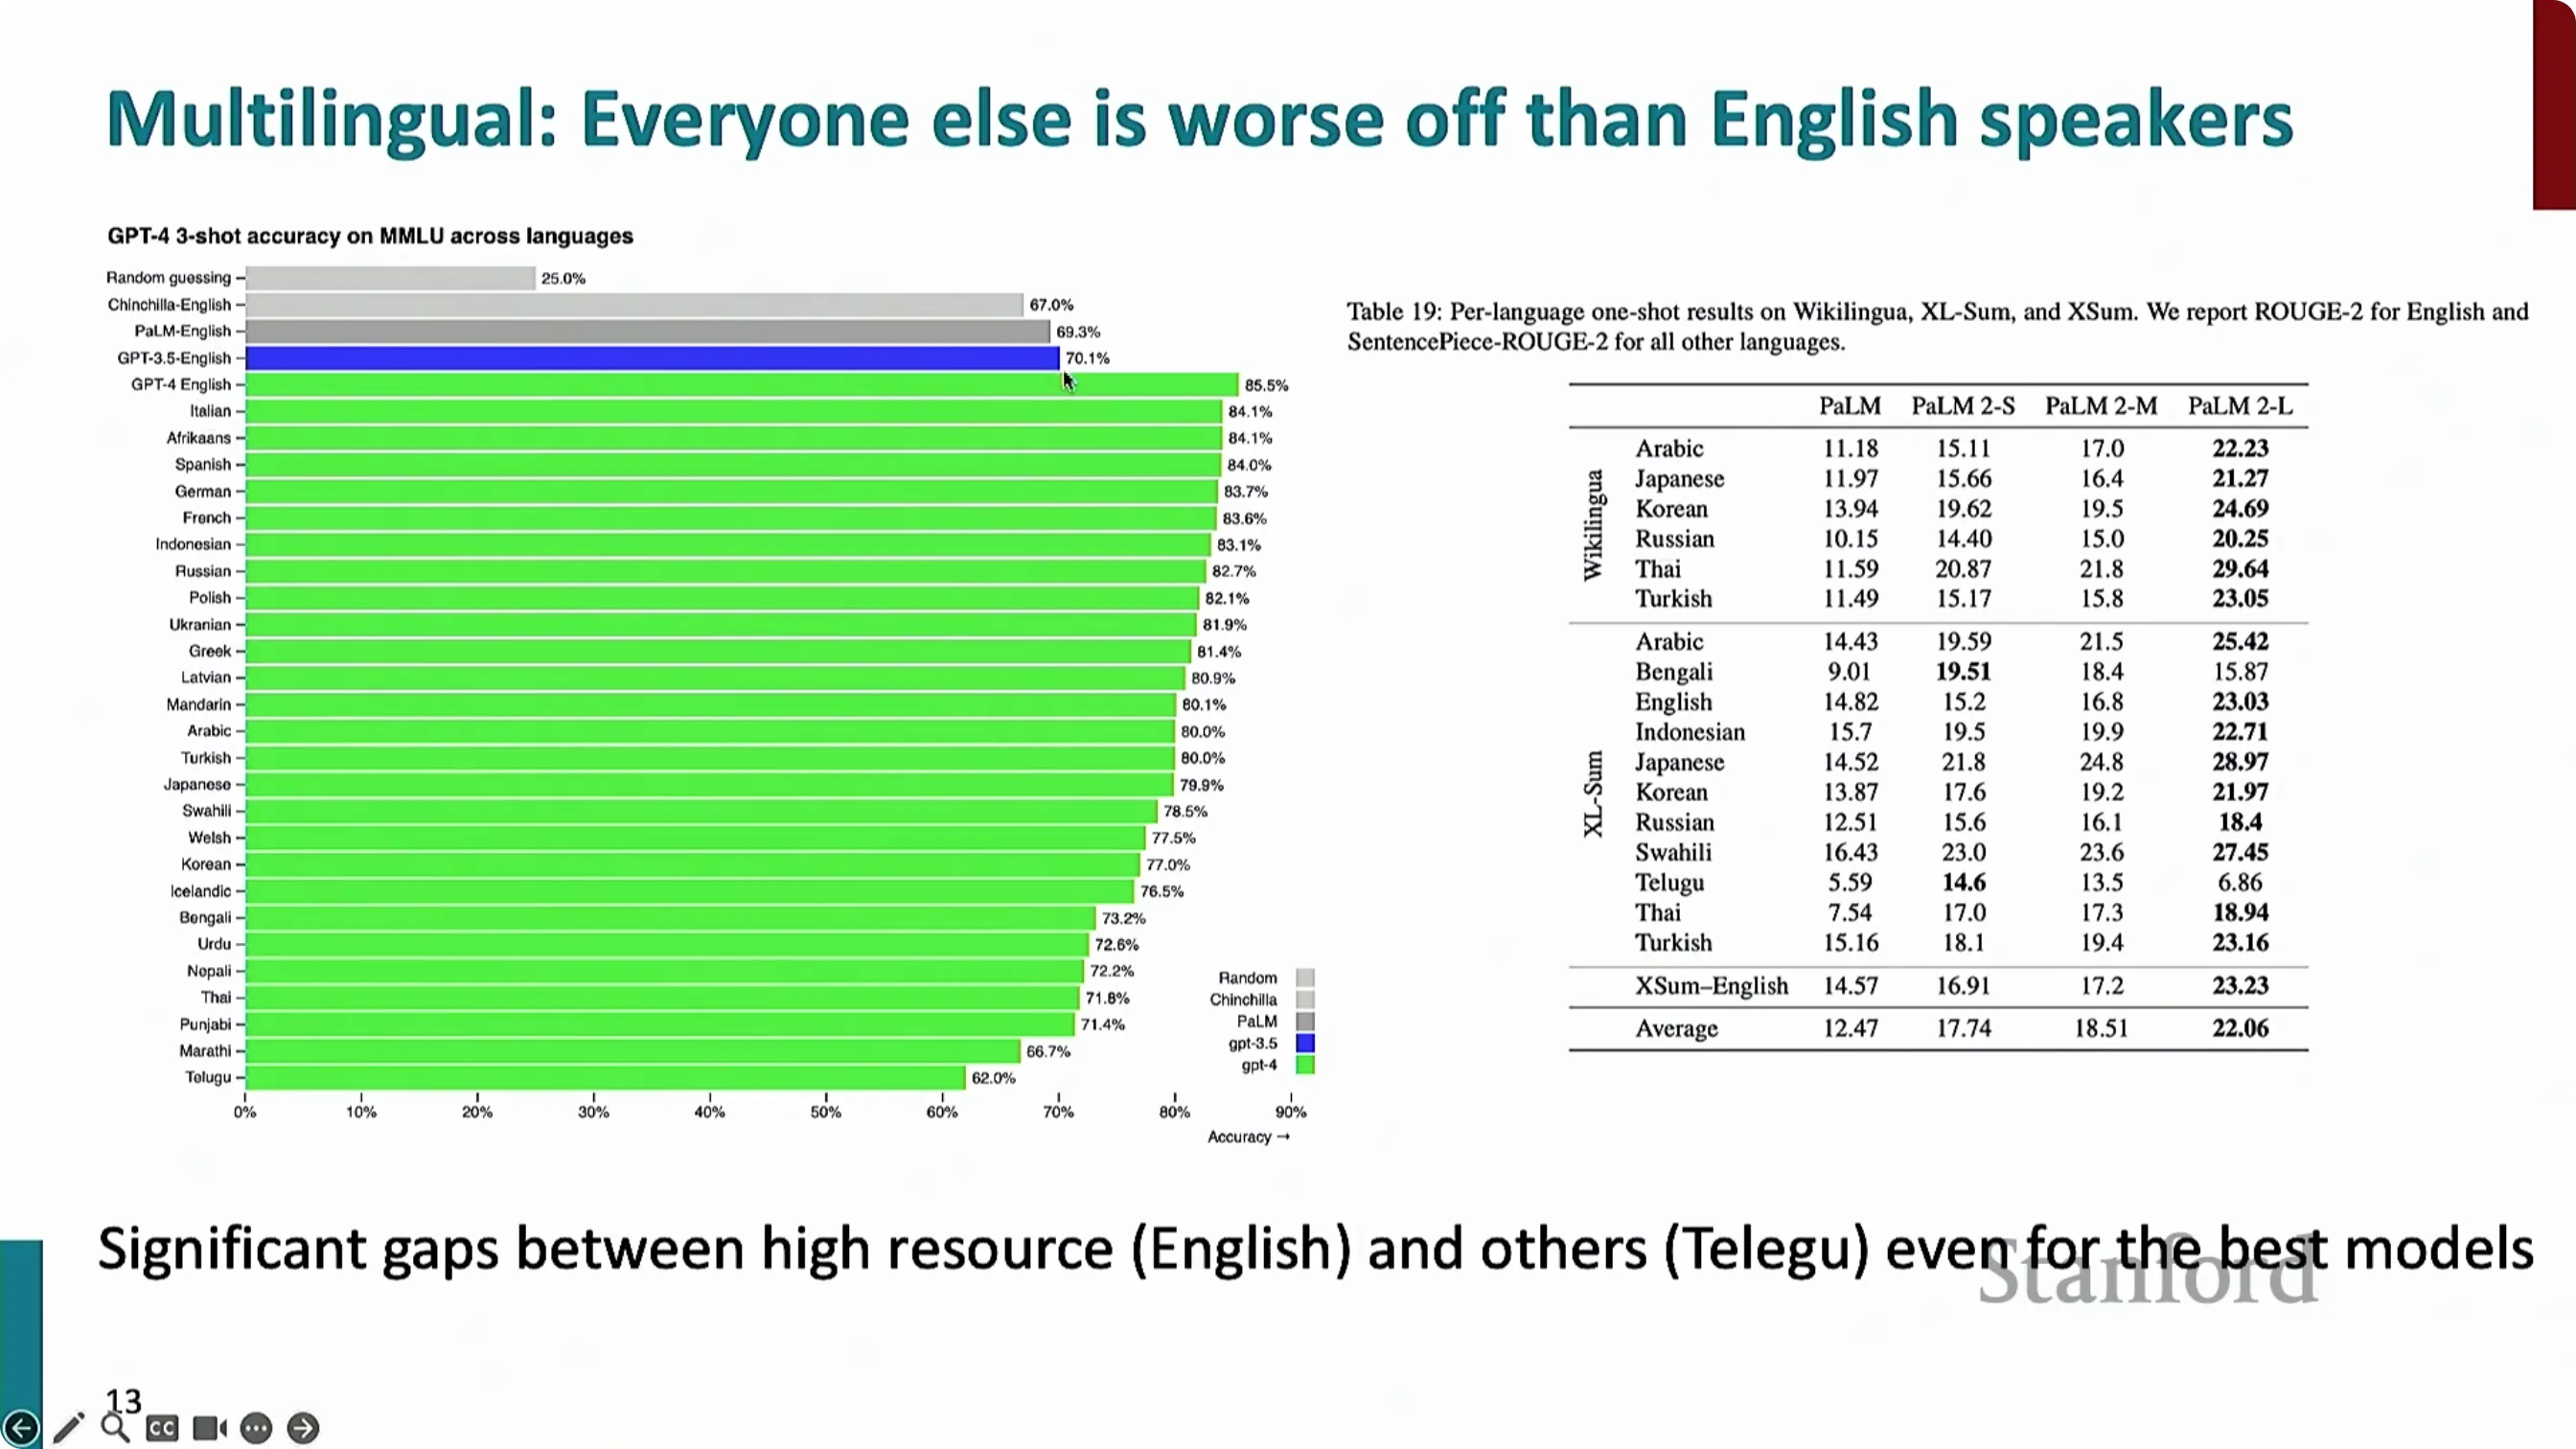
第三个问题,讲者认为"某种程度上恐怕是无法解决的"——那就是多语言 (参考时间: 09:00)。要紧记一句话:你在英语上看到的表现,换到任何别的语言,只会更差 (参考时间: 09:13)。
不过他强调"这里有一个好消息" (参考时间: 09:24):
📷 GPT-4 与 GPT-3.5 在多语言上的表现对比
回到原视频 (00:09:33)
在那张(画得较小)的图上,蓝线是 GPT-3.5 在英语上的表现,而绿色的柱状条则是 GPT-4 的表现。结果相当亮眼:不只是英语,希腊语、拉脱维亚语、阿拉伯语、土耳其语……GPT-4 的表现在这些语言上都超过了 GPT-3.5 的英语水平。这就是一种"水涨船高(raising all boats)"的观点 (参考时间: 10:11)。
但图的下半部分开始走低 (参考时间: 10:20):有些语言的表现甚至低于"GPT-3.5 的英语",而这些仍然是"大语言"——底部的三个分别是旁遮普语、马拉地语、泰卢固语,每一种都有数百万使用者 (参考时间: 10:44)。
于是真正的问题浮出来了:当面对"低资源语言"时会发生什么? 世界上绝大多数语言没有数百万使用者,从几百人到几十万人不等,这样的语言有成千上万种,而且很多 primarily 是口头的,书面文本极少 (参考时间: 11:01)。讲者坦言:许多这样的语言在未来几十年里很可能灭绝,但很多语言社区希望保留自己的语言;而我们把课程后半段讲的那套语言技术推广到这些语言上,前景非常不明朗——因为没有足够的数据去训练我们一直在讨论的那种模型 (参考时间: 11:35)。
🖼️ 第 15 页幻灯片 · “Calibrated Language Models Must Hallucinate” (Kalai and Vempala 2024)
2.4 评测的信任危机与领域 NLP
讲者接着谈评测:评测是 NLP 的核心部分,进步很大程度上是由"定义该测什么"来驱动的 (参考时间: 11:58)。但一个担忧在于——大型公司的商业化模型正在"污染"这些基准,使它们不再可信 (参考时间: 12:27)。
📷 关于 Codeforces 数据污染的推文
回到原视频 (00:12:43)
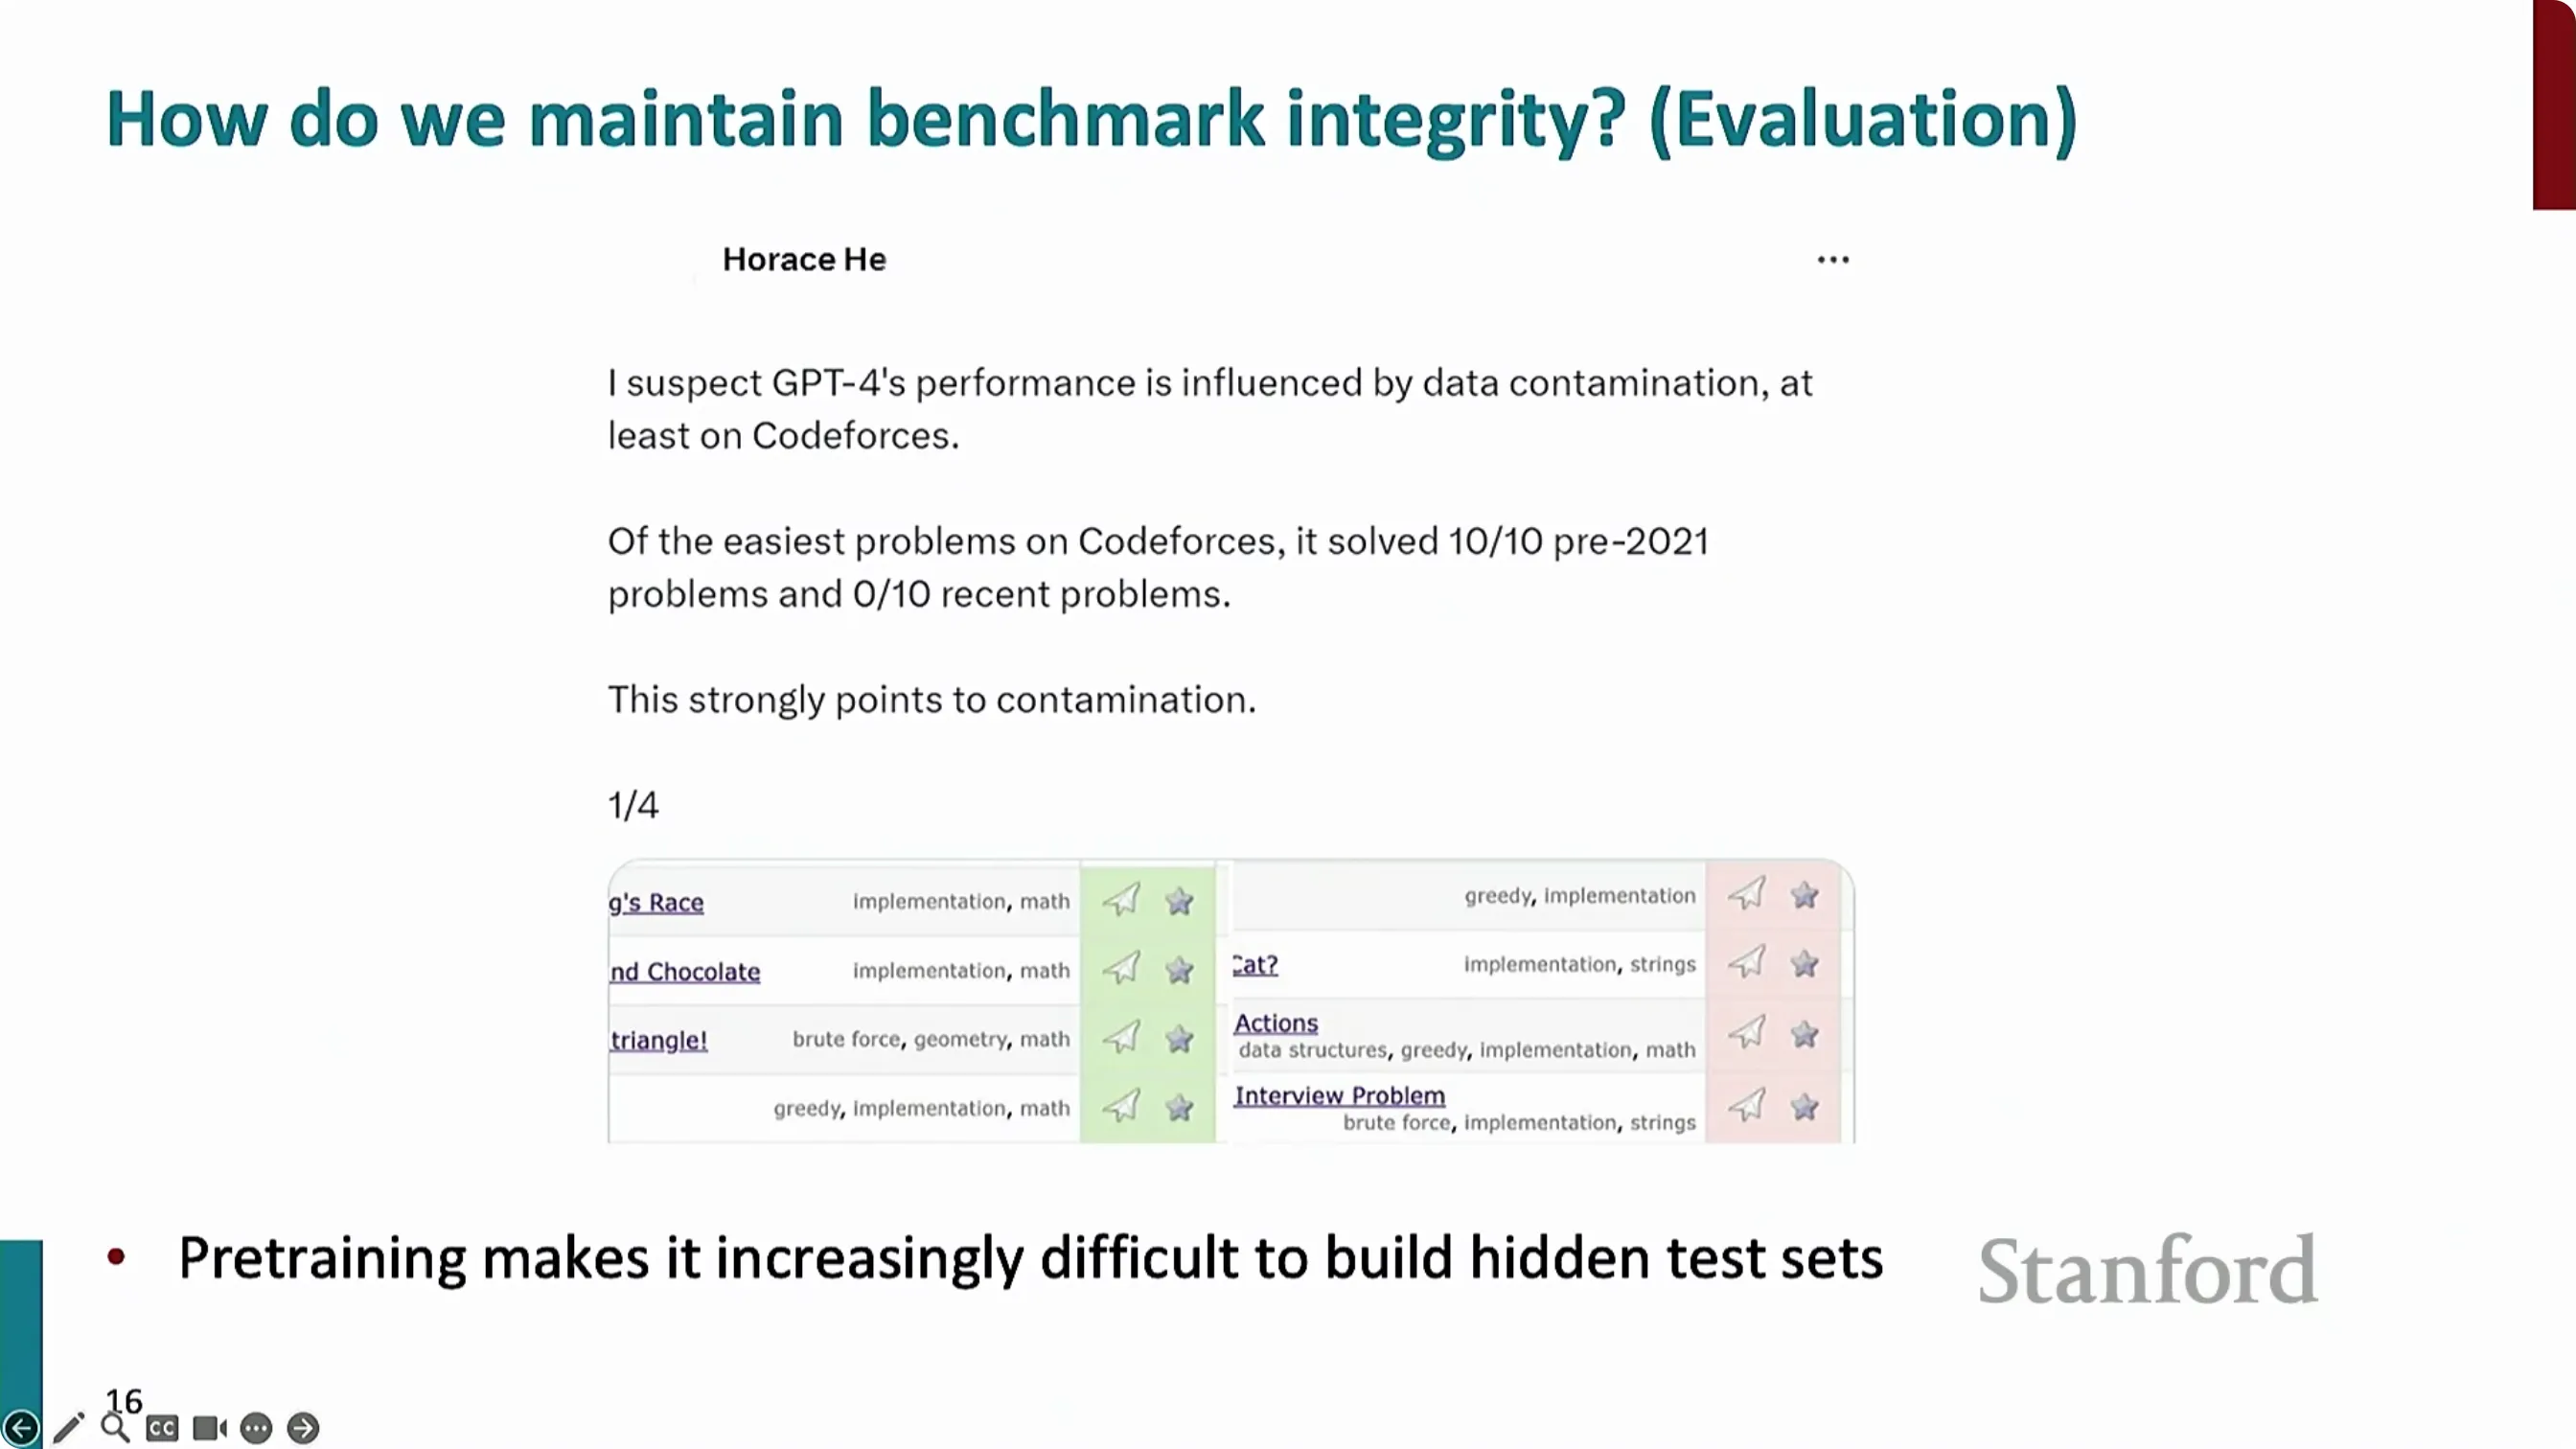
他用一条推文举例 (参考时间: 12:41):有人怀疑 GPT-4 在 Codeforces(一个编程竞赛平台)上的表现受到了数据污染的影响——它能解出 2021 年之前的最容易的 10 道题中的 10 道,却解不出近期的 10 道中的 0 道。这强烈指向记忆而非解题。讲者的担忧是:网络上有太多数据被吸进了预训练语料,模型很可能把题目直接背了下来,于是这些其实已经不算独立的测试集了 (参考时间: 13:23)。出路是更严格保密的测试集,或者动态评测机制,以维护基准的完整性(benchmark integrity)。
编者说明:讲者提到的这条推文,字幕写作"Horus Hurst",据上下文应为 Horace He 关于 GPT-4 与 Codeforces 污染的分析。
接下来是领域 NLP (参考时间: 13:54):生物医学/临床 NLP 有独特的词汇和用法,潜力大、风险也大——一旦语言理解不到位,就可能造成伤害。讲者本人更投入在法律 NLP 上,与斯坦福 RegLab 的同事(如 Daniel Ho)一起构建面向法律的基础模型 (参考时间: 14:20)。
他解释了动机:多数国家最大的问题是普通人请不起律师、得不到所需的法律帮助(美国很糟,印度更糟)。理论上用 NLP 工具帮忙会很好,但实践中,工具的语言理解还不够好 (参考时间: 15:00)。RegLab 一项刚完成的研究发现,法律 NLP 系统在回答中出现"凭空捏造内容"的比率,大约是每六个问题里就有一次——如果一个人要拿它当法律建议来依赖,这个准确率远远不够 (参考时间: 15:22)。
此外还有社会与文化层面的问题:NLP 系统对某些文化和宗教仍存在明显偏见,它们从某处习得了某些社会规范,而这些规范偏向特定群体;再叠加前述低资源语言与代表性不足群体的困境 (参考时间: 15:40)。
三、大模型到底有多好用?
讲者切换视角,想给出一份"我们究竟处在何处"的平衡画像 (参考时间: 16:19)。一方面,这些模型的表现好得惊人,即使对一个做了很多年 NLP 的人而言,也近乎"魔法" (参考时间: 16:41)。另一方面,他在硅谷也常常见到过度的乐观吹捧,所以也想让大家听一点另一面的声音。
🖼️ 第 16 页幻灯片 · 16
3.1 一封写给 Transformer 的十四行诗
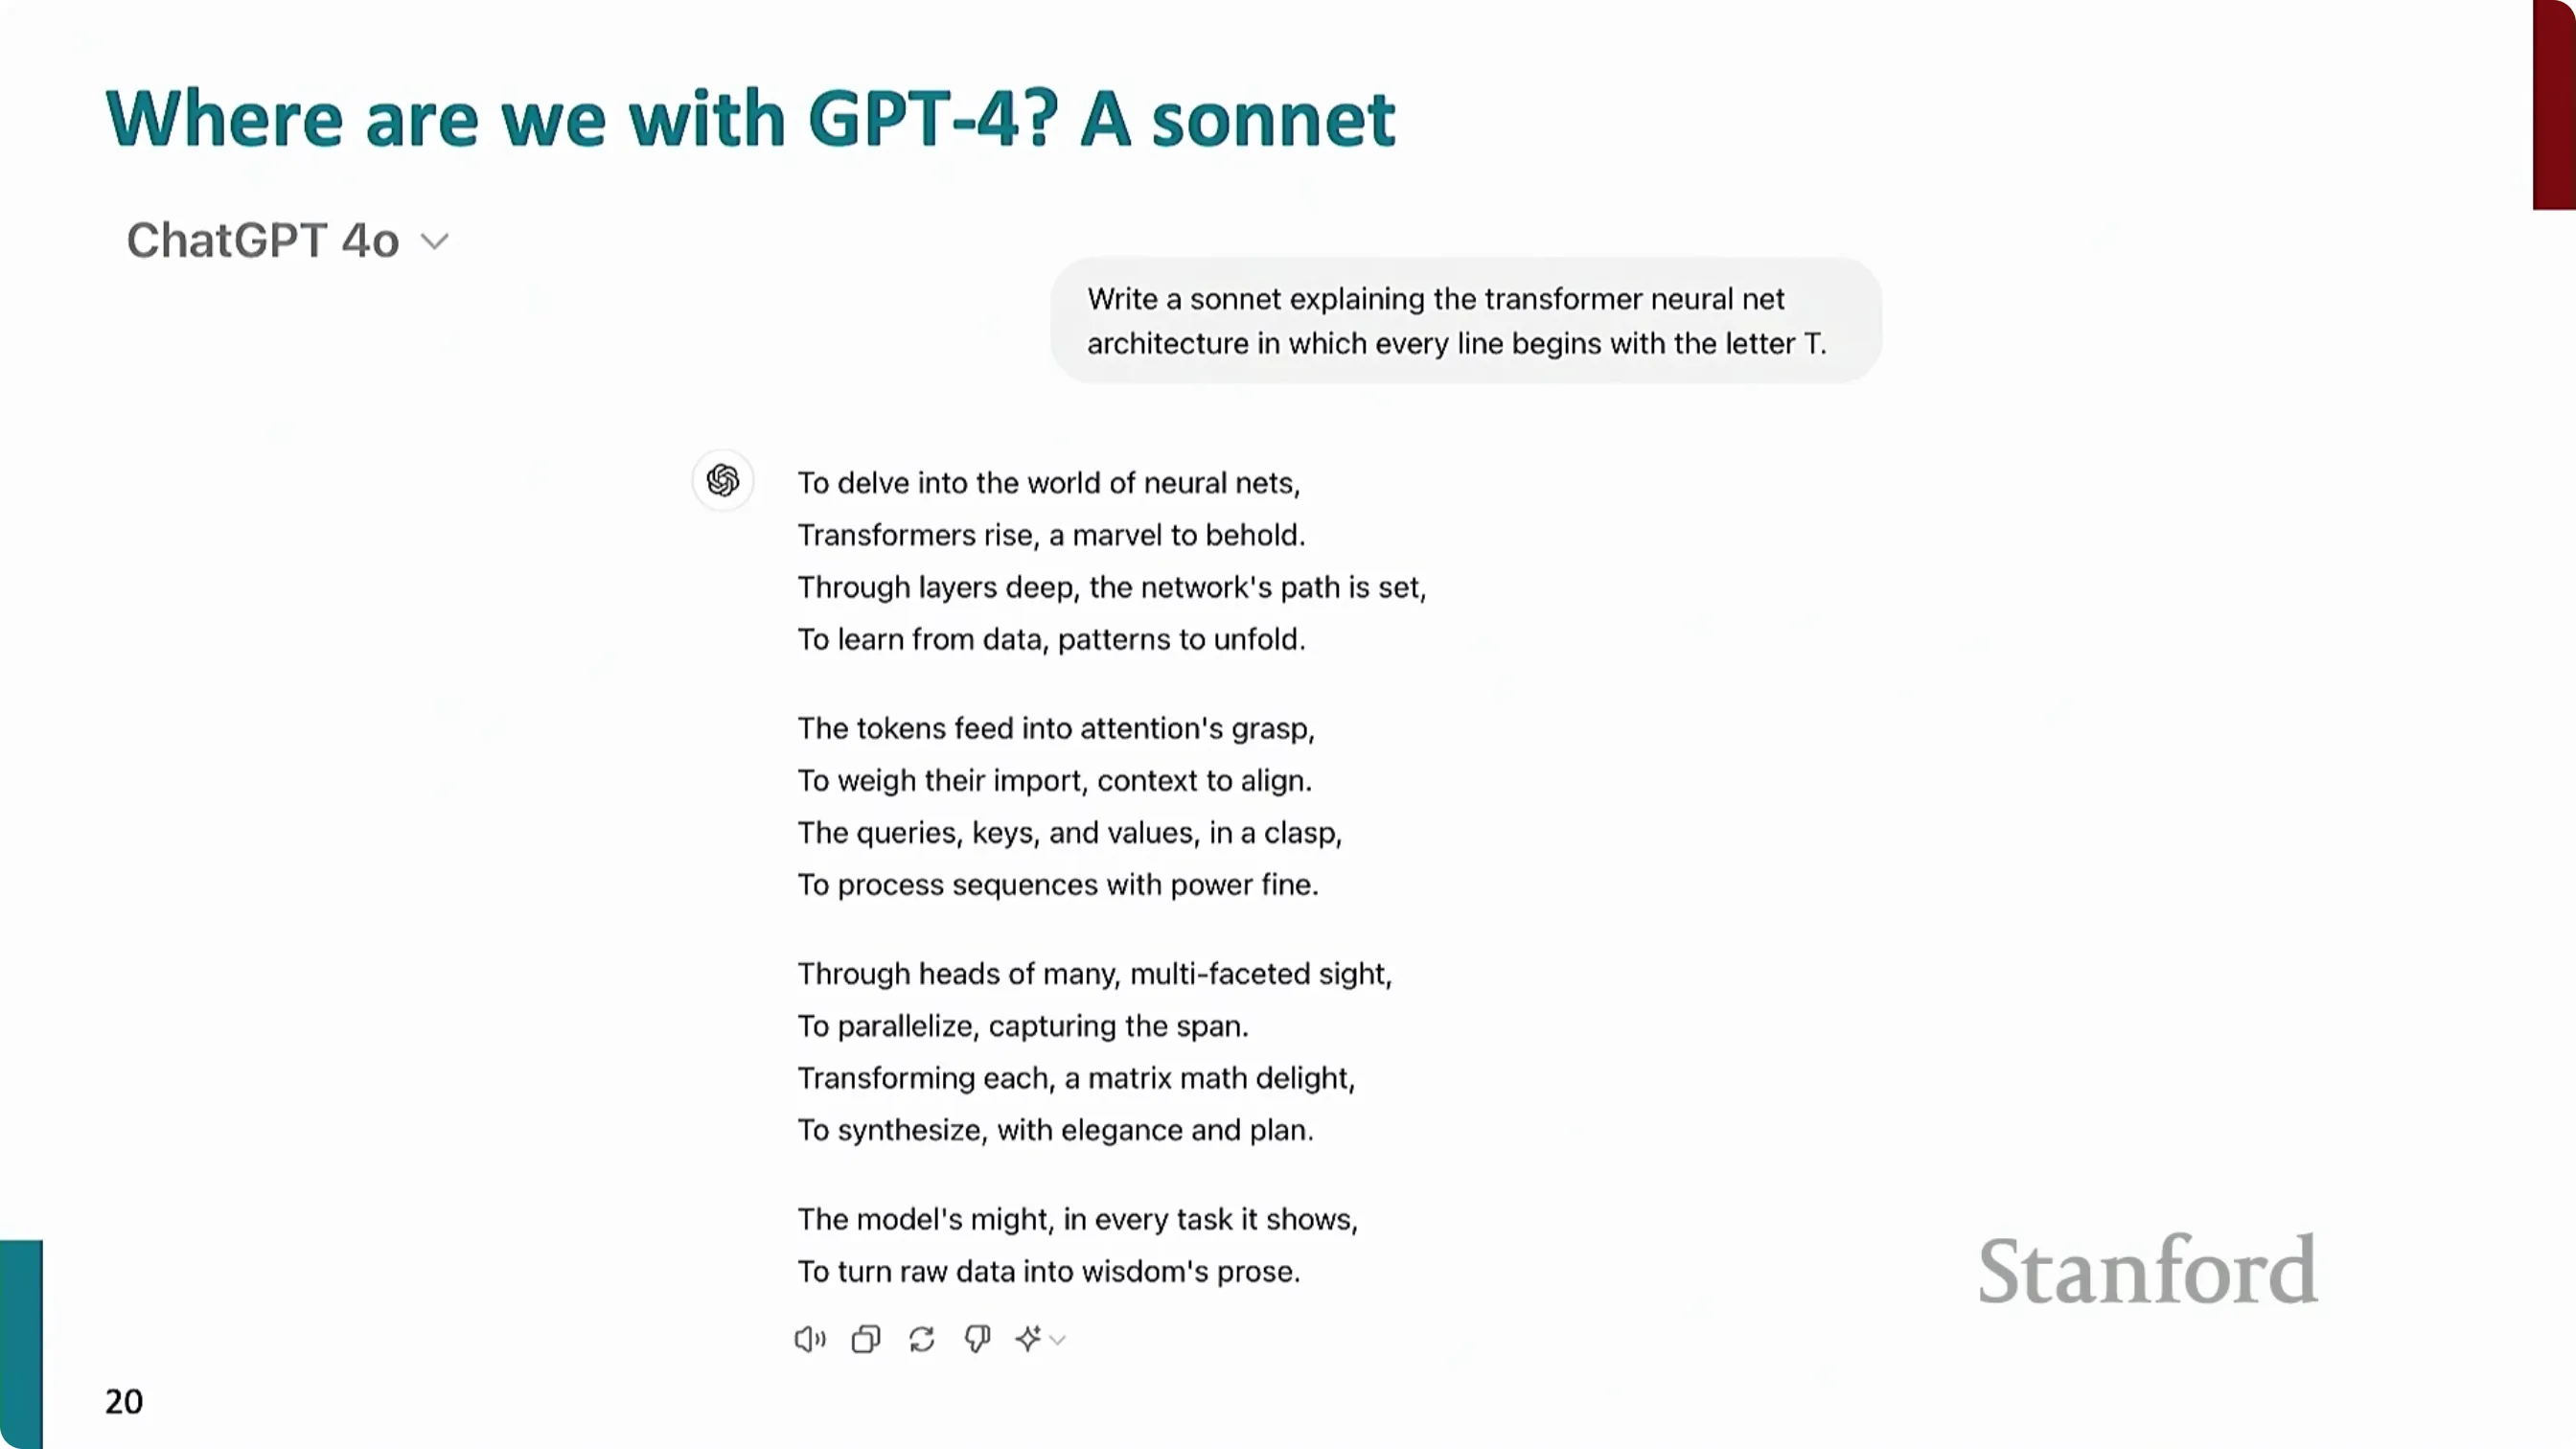
讲者的例子很生动:今天早上,他让 ChatGPT-4o 写一首解释 Transformer 神经网络架构的十四行诗(sonnet),并且每一行都必须以字母 T 开头 (参考时间: 17:24)。
📷 ChatGPT 生成的"每行以 T 开头"的十四行诗
回到原视频 (00:18:44)
🖼️ 第 17 页幻灯片 · 17
结果令他"依然觉得不可思议" (参考时间: 17:39)。这首诗基本满足了英语诗歌的几条硬约束:它有 AB 式的押韵(behold / unfold、grasp / clasp),大体是抑扬格五音步(iambic pentameter),而且每一行确实都以 T 开头 (参考时间: 18:11)。讲者承认"押韵略有瑕疵",但基本上做到了。
原诗如下(保留英文,因为整首诗的价值恰恰在于英语的形式约束——首字母 T、押韵与音步,翻译会使其失去意义):
To delve into the world of neural nets, Transformers rise, a marvel to behold, Through layers deep, the network's path is set, To learn from data, patterns to unfold. The tokens feed into attention's grasp, To weigh their import, context to align, The query's, keys and values in a clasp, To process sequences with power fine. Through heads of many multifaceted sight, To parallelize, capturing the span, Transforming each, a matrix math delight, To synthesize with elegance and plan. The models might in every task it shows, To turn raw data into wisdom's prose.
讲者自己给了一个诚实的"反对意见":这其实并没有精确地解释 Transformer 架构,写得有点抽象 (参考时间: 19:31)。但另一方面,它确实点到了 query、key、value、多头、并行化、矩阵运算这些东西 (参考时间: 19:46)。他坦白地说,自己也无法令人信服地解释,这个大模型是怎么做到这一切的 (参考时间: 17:47)。
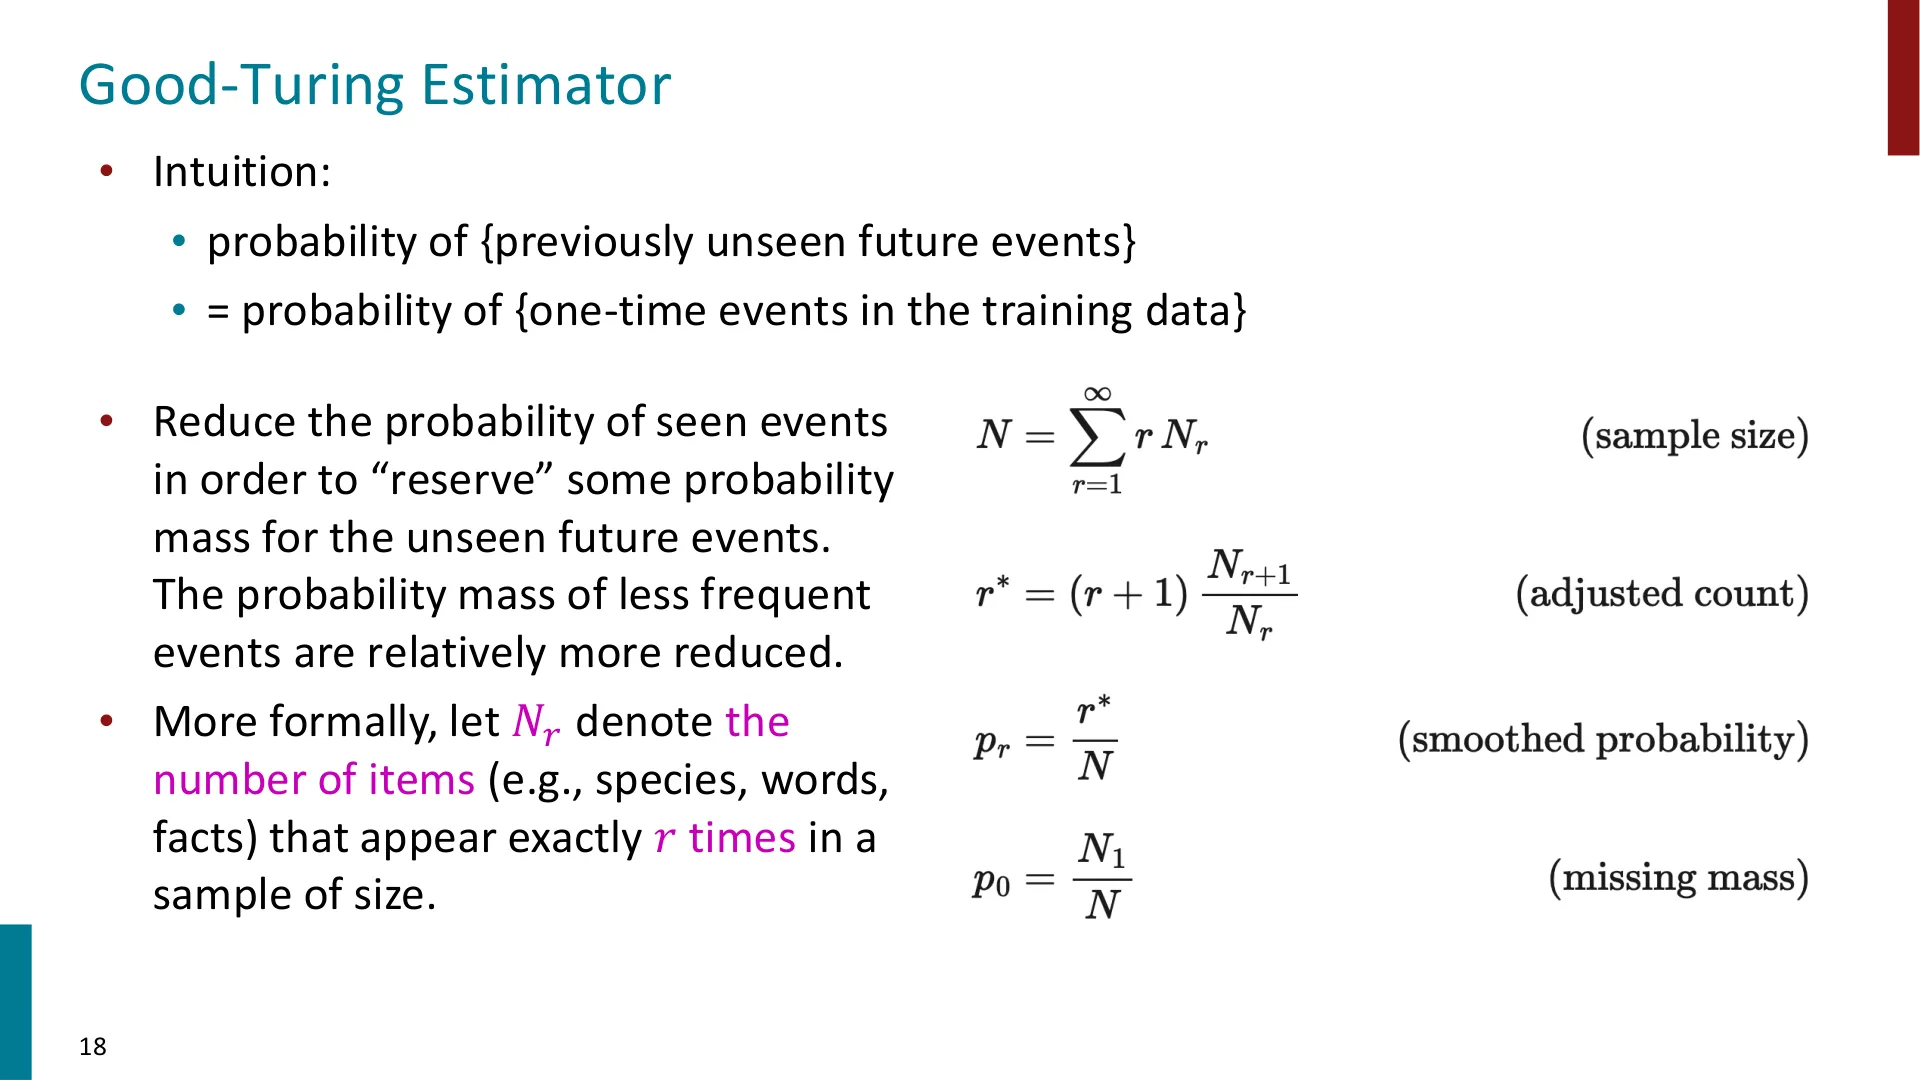
🖼️ 第 18 页幻灯片 · 18
编者说明:原字幕在誊写这首诗时有个别错字(如 "net set" 应为 "nets"),上文的英文文本已按听感做了最小化规整。
3.2 真实世界的增益:咨询顾问实验
讲者认为,作为自然语言理解与世界理解的工具,这类模型已经跨过了"可用"的门槛 (参考时间: 20:17)。他引用了 Dell'Acqua 等人(包含 Ethan Mollick)的一项研究:招募一批波士顿咨询公司(BCG)的顾问做受控任务 (参考时间: 20:38)。
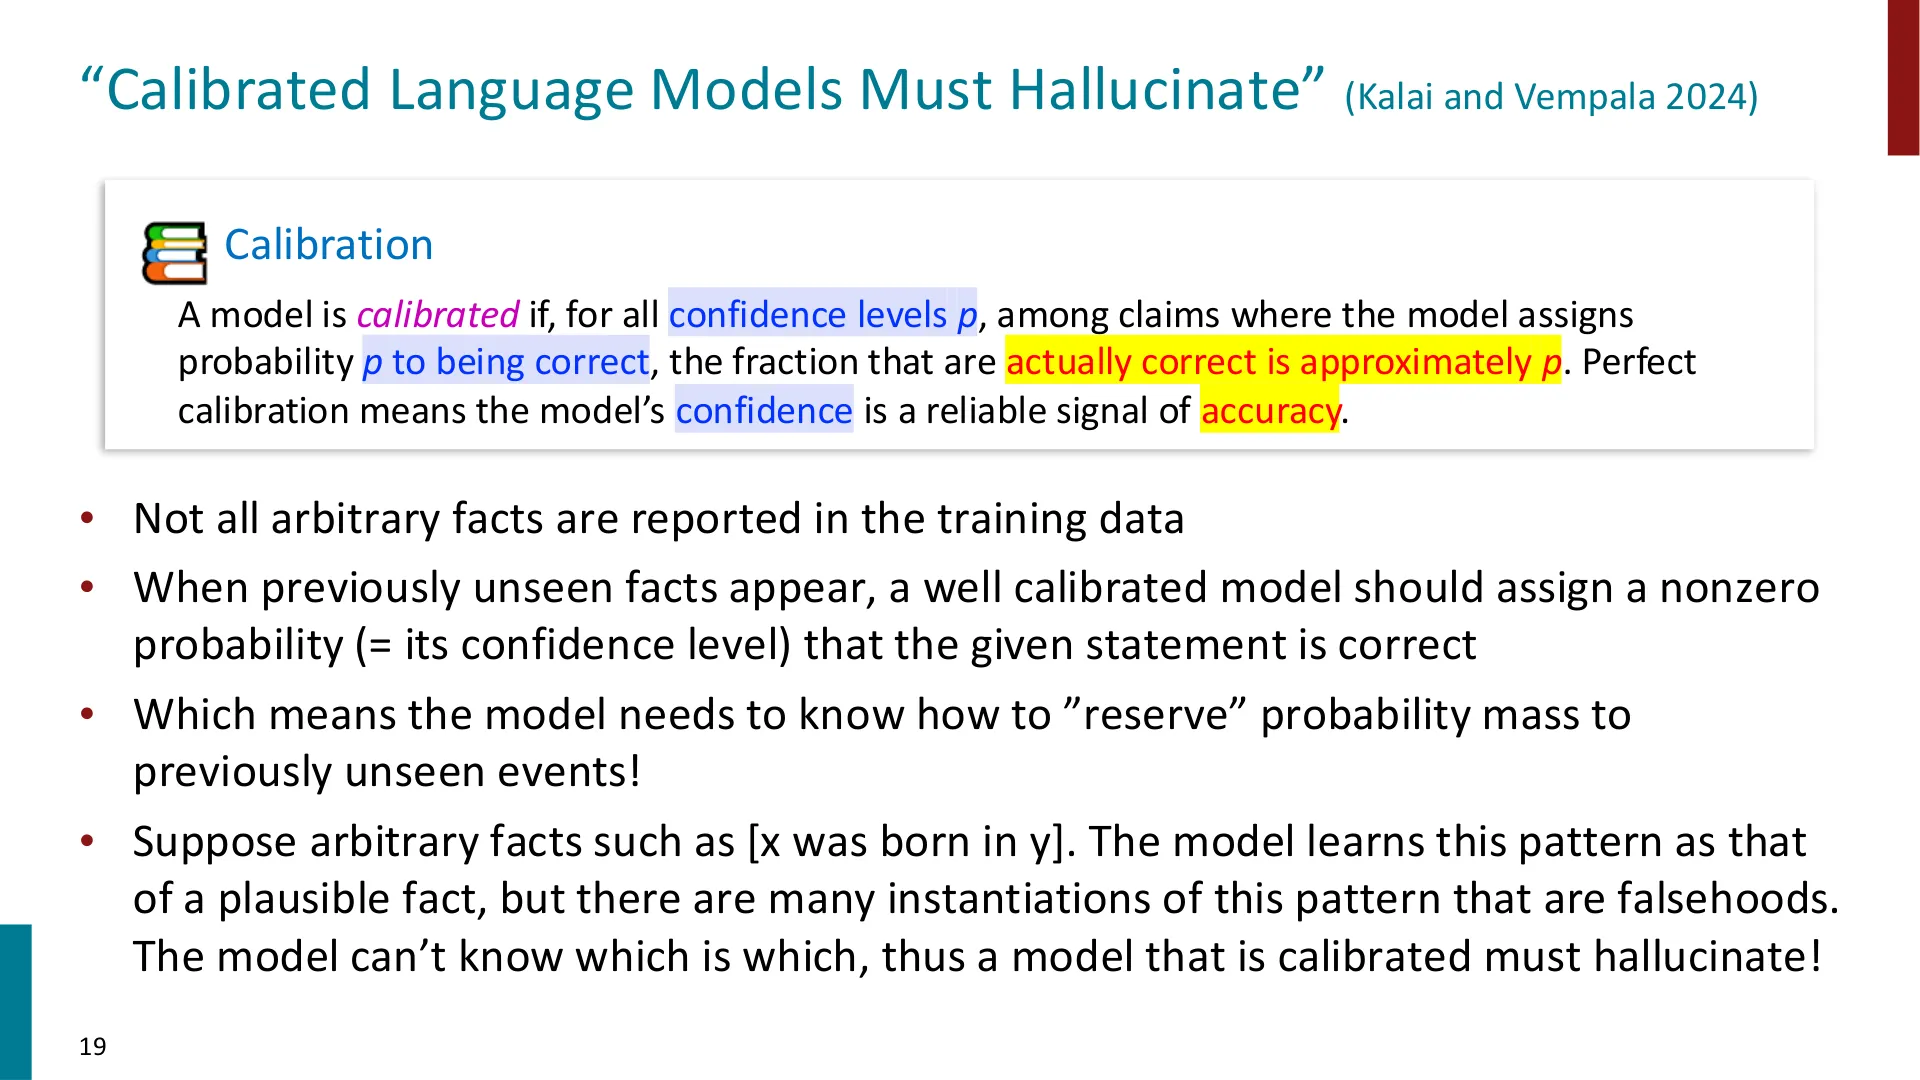
🖼️ 第 19 页幻灯片 · “Calibrated Language Models Must Hallucinate” (Kalai and Vempala 2024)
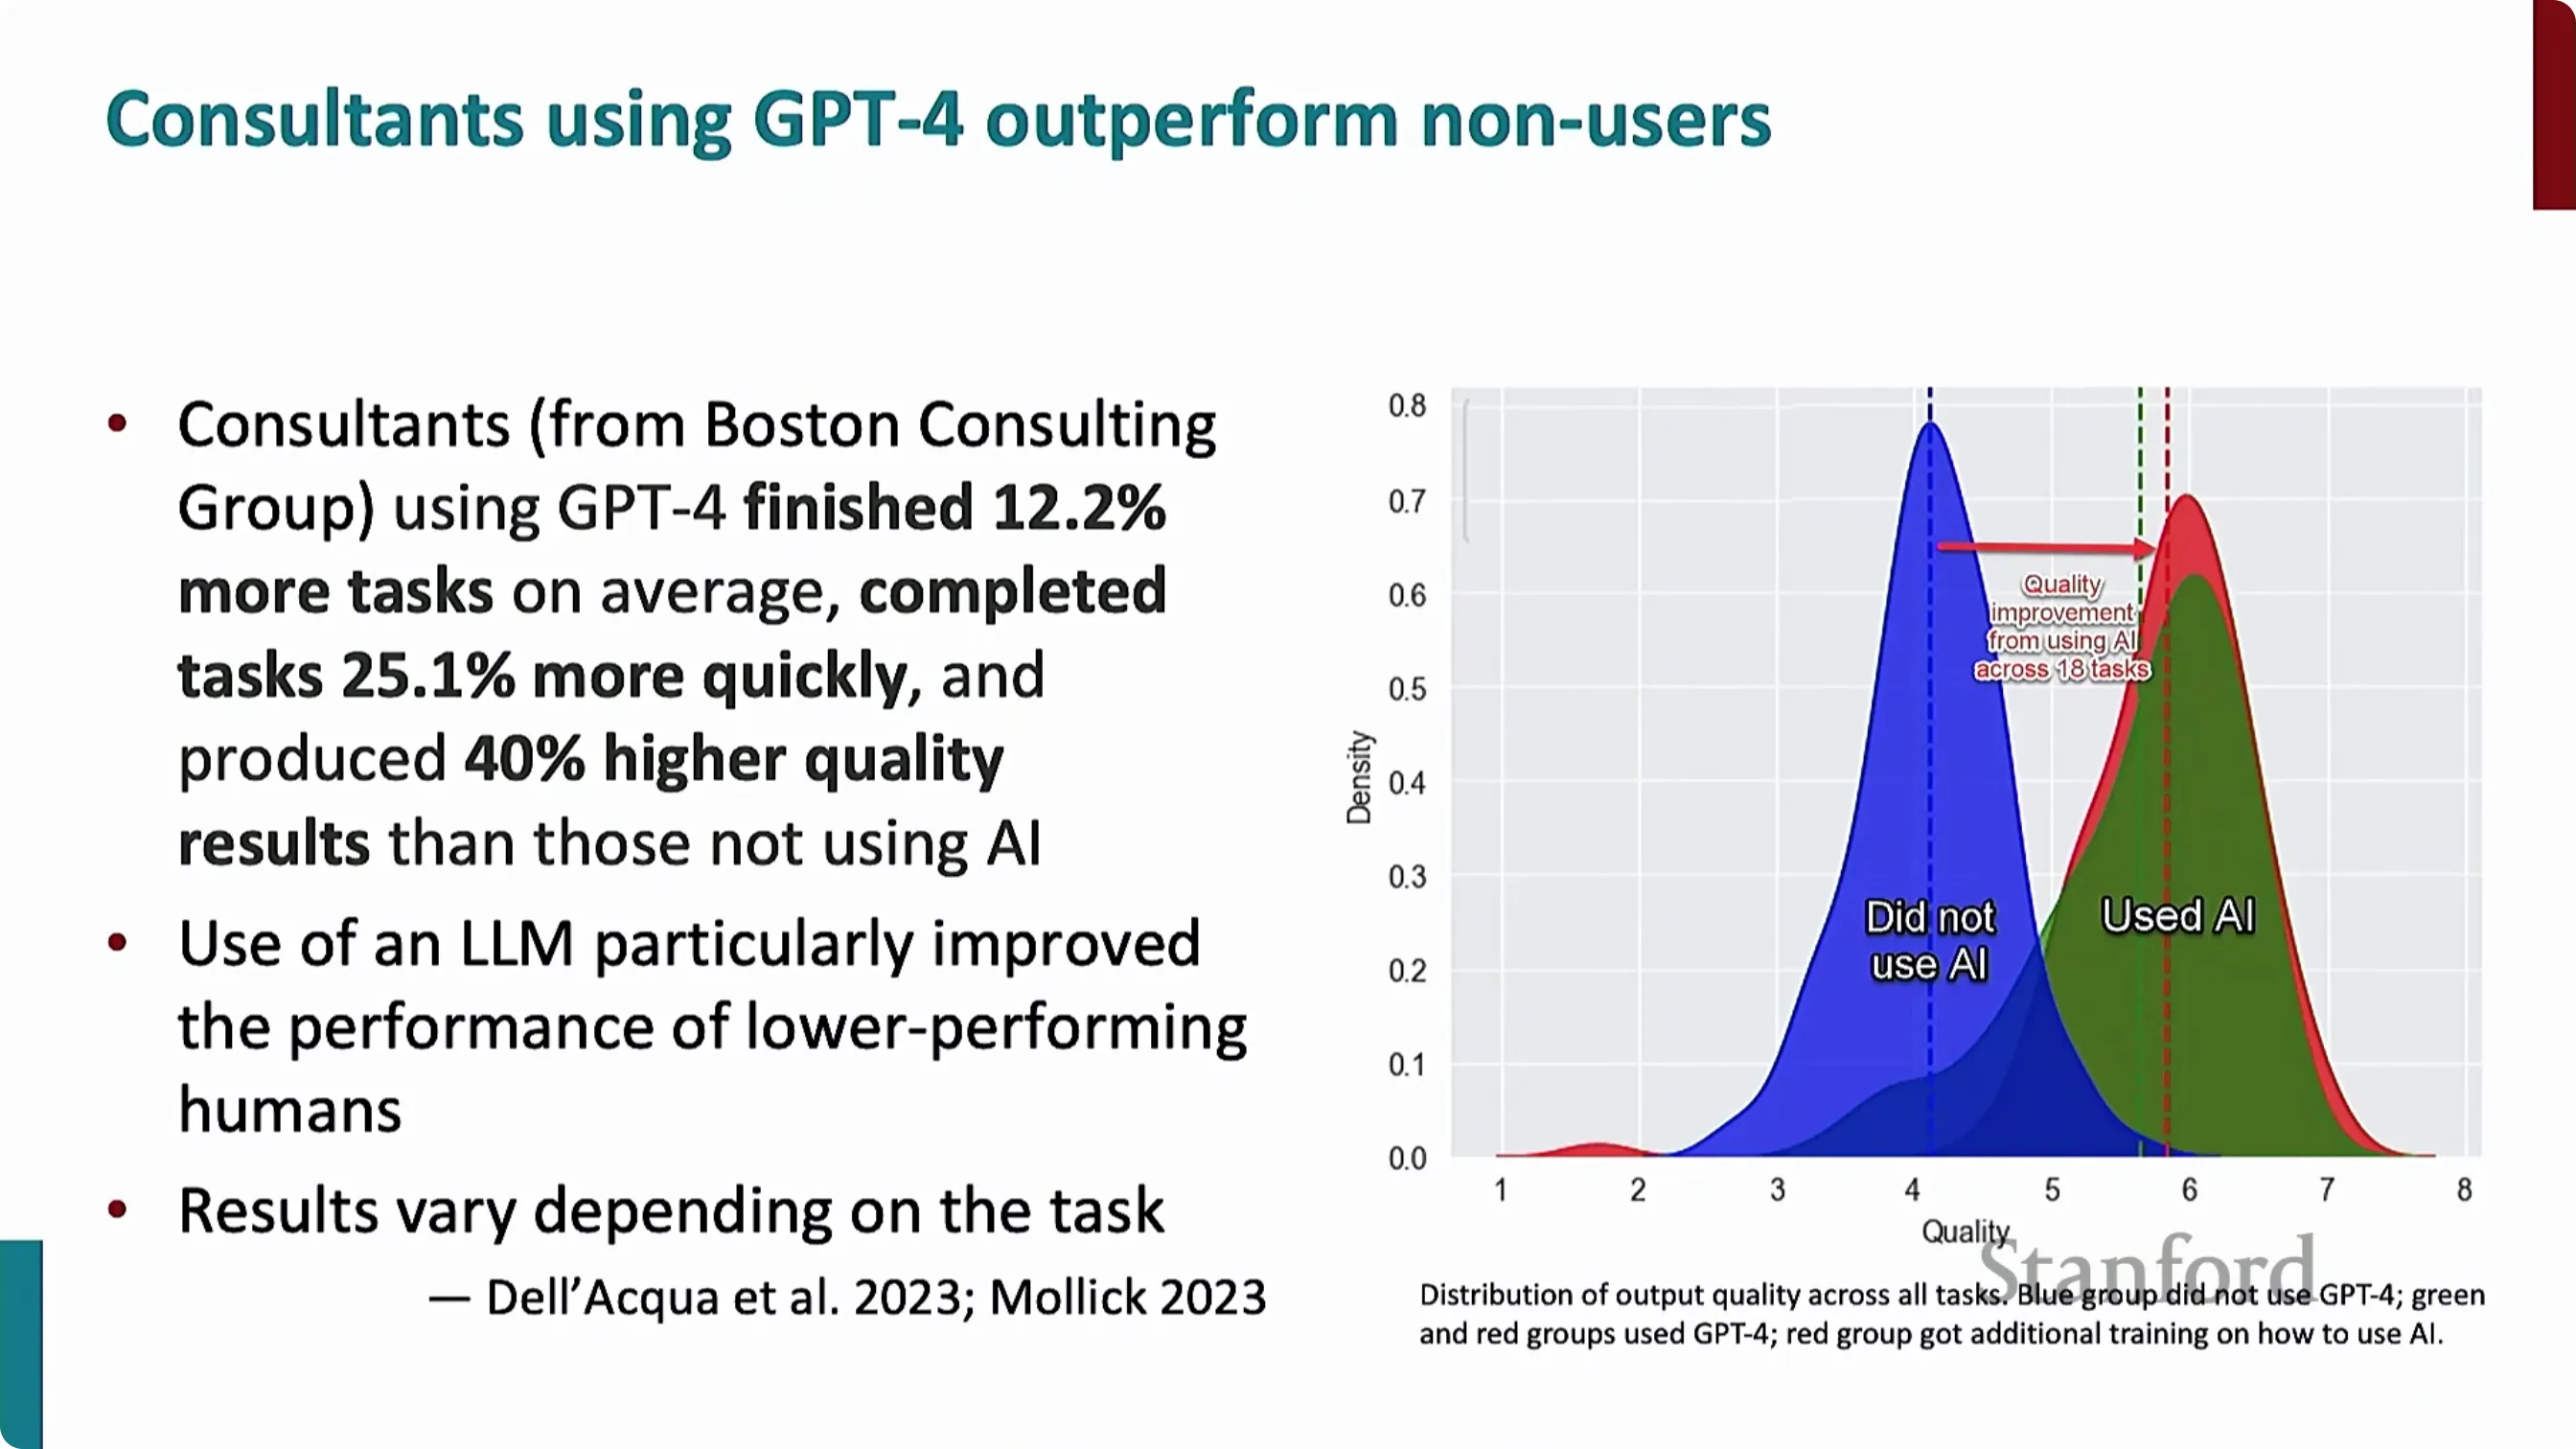
📷 波士顿咨询公司顾问使用 GPT-4 的实验结果
回到原视频 (00:21:15)
三组人里,两组使用 GPT-4、一组不用;使用 GPT-4 的两组中有一组额外接受了"如何用 GPT-4"的培训,但培训似乎没带来显著差别 (参考时间: 21:34)。核心结果是:使用 GPT-4 的组平均多完成 12% 的任务,速度快 25%,结果质量评分高 40% (参考时间: 21:42)。
他还点出一个反复出现的规律:这类模型像一位"平衡器"——对本身技能较弱的人帮助最大,对技能已经很强的人帮助较小;编程 LLM 上也是同样的现象 (参考时间: 22:24)。
🖼️ 第 20 页幻灯片 · “Why language models hallucinate” (Kalai et al., 2025)
3.3 另一端:创意写作仍差得远
为了平衡,讲者给出反方向的证据:有研究比较"GPT-4 能否写出与《纽约客》作家质量相当的虚构作品",结果"差得不是一点半点"——GPT-4 在创意写作上被判定比《纽约客》作家差 3 到 10 倍 (参考时间: 22:57)。他笑说:"人类还有希望,坚持住。"
3.4 来自媒体的怀疑
讲者说,住在硅谷容易只听到正面的吹捧,所以专门提了一篇发在《金融时报》、标题意为"生成式 AI 被严重高估"的文章 (参考时间: 23:54)。文章表达的要点包括 (参考时间: 24:16):
- 投资者的期望跑在了现实能力前面;
- 随着投入增长,"制造新用例"的压力也在增长——IDC 预计到 2027 年企业在生成式 AI 上的支出将从 160 亿美元涨到 1430 亿美元(约十倍);
- 存在"对低技能工作者收益有限""产出不准确"等问题;
- 麦肯锡说 AI 也许能增加 4 万亿美元利润,但定价体系不清晰,公司无法预测 AI 能带来什么财务收益——而 AI 自己也预测不了 (参考时间: 25:16)。
四、符号主义 vs 控制论:两条路线的历史
4.1 符号系统与传统 AI
🖼️ 第 21 页幻灯片 · Lecture Plan
讲者最想纠正的一个印象是:符号主义方法从 1960 年代一直主导到大约 2010 年,而它当年的"对立面"——cybernetics(控制论)——才是神经网络的真正源头 (参考时间: 25:38)。换句话说,神经网络是"控制论传统"的延续,而不是"AI 传统"的延续。
斯坦福正是符号系统(Symbolic Systems)项目的家 (参考时间: 26:19)。这个名字的来历和一位哲学家有关:Jon Barwise(照片中的人物,2000 年英年早逝)(参考时间: 26:43)。Barwise 坚信要研究世界中的意义、以及人的思考与世界之间的联系,因此他拒绝把项目命名为"认知科学",最终叫作"符号系统" (参考时间: 27:04)。曾经有两所大学有符号系统项目(斯坦福和 Barwise 的老家印第安纳),但他去世后,印第安纳把它改回了"认知科学",于是斯坦福成了唯一 (参考时间: 27:22)。
"符号系统"关心的是:由有意义的符号构成的系统(如人类语言、逻辑、编程语言),以及处理这些符号的系统(如大脑、计算机、复杂社会系统);相比之下,典型的认知科学更关注作为自然现象的心智与智能,而符号系统同等重视人类建构的符号系统 (参考时间: 27:48)。
🖼️ 第 22 页幻灯片 · The paradox of AI-assisted creativity
4.2 控制论传统与最早的神经网络
"AI"这个名字本身就诞生于一场立场之争 (参考时间: 28:29)。John McCarthy(彩色照片)创办了斯坦福 AI 实验室,他刻意选择"人工智能"这个新名字,来把自己做的事与控制论划清界限;控制论的代表人物是 MIT 的 Norbert Wiener(右侧照片)(参考时间: 29:11)。Marvin Minsky(下方小照片)在 MIT 创办了 AI,McCarthy 与他共事几年后回到斯坦福;Newell 与 Simon 则在 CMU(右侧两人)(参考时间: 29:26)。
McCarthy 的背景是数学家和逻辑学家,他想造的是一个看起来像数学与逻辑的 AI——这就是"作为符号系统的 AI" (参考时间: 29:57)。Newell 与 Simon 把这一立场写成了一个哲学命题,即物理符号系统假设(physical symbol system hypothesis):
🖼️ 第 23 页幻灯片 · The paradox of AI-assisted creativity
"一个物理符号系统,拥有实现通用智能行为的必要且充分的手段。"
讲者强调,这个断言非常强:它不只是说"有符号系统就能产生通用智能",而是通过"必要"一词,断言没有符号系统就不可能产生通用智能 (参考时间: 30:37)。这构成了经典 AI 的基础。
与之相对,控制论源自控制与通信,背景更接近电气工程,想统一的是动物之间(也许更多是动物而非人类)以及机器之间的控制与通信 (参考时间: 31:05)。讲者还顺带讲了一个词源趣事:cybernetics 来自希腊词 kubernetes,与今天分布式系统里的 Kubernetes 同源,也和英语单词 government(政府) 同根——因为政府也是一种控制系统 (参考时间: 31:38)。
正是在控制论传统下,最早的神经网络开始被探索,最著名的是 Frank Rosenblatt 用于视觉的感知机(perceptron)——那台机器真的接了摄像头 (参考时间: 32:07)。
🖼️ 第 24 页幻灯片 · The paradox of AI-assisted creativity
4.3 1950 年代的 AI 炒作
讲者特意说这段历史,是想让大家知道:"AI 炒作"绝不是 2020 年代才有的东西,1950 年代同样热闹 (参考时间: 32:33)。
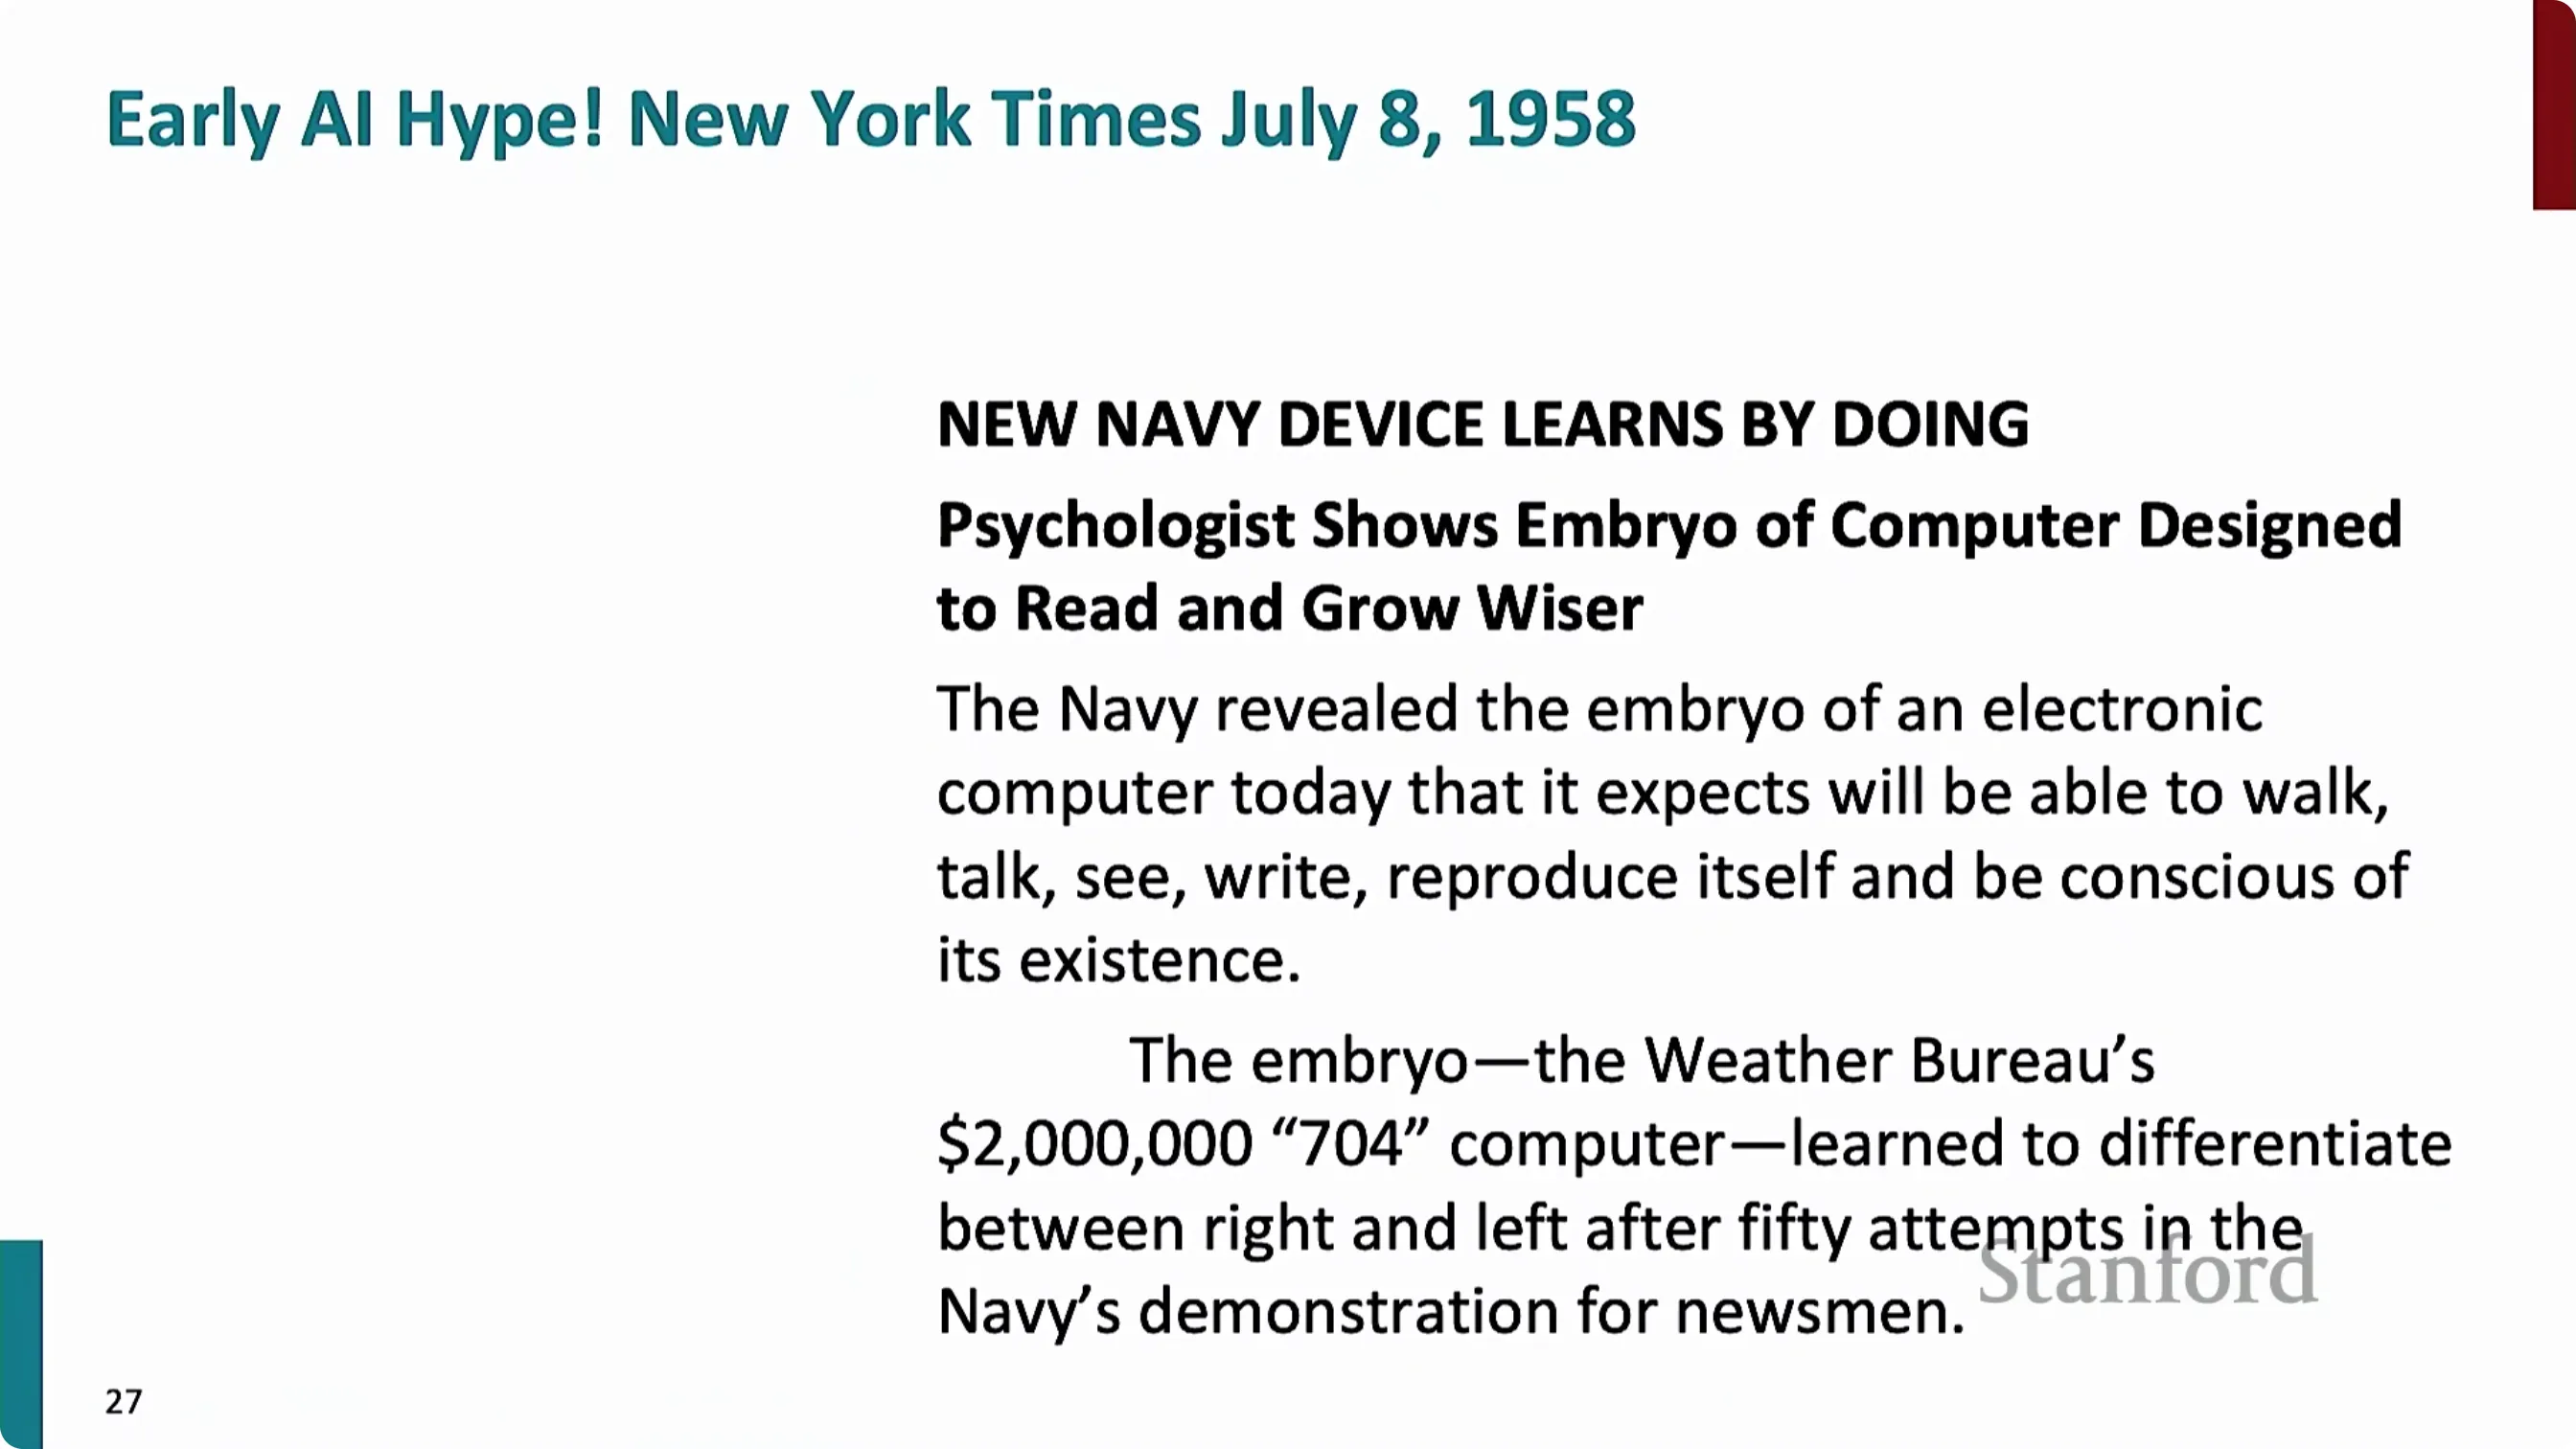
📷 1958 年《纽约时报》关于感知机的报道
回到原视频 (00:33:22)
🖼️ 第 25 页幻灯片 · The paradox of AI-assisted creativity
他念了《纽约时报》报道的标题与导语:《海军新装置边做边学》《心理学家展示计算机设计雏形,能阅读且会越长越聪明》 (参考时间: 32:45)。报道写道,海军展示了一台电子计算机的"胚胎",并预期它"将能走路、说话、看东西、写字、自我复制,并意识到自己的存在" (参考时间: 33:00)。
而最精彩的是文章的后面几段——那场演示究竟展示了什么? 答案是:这台装置在看了 50 次之后,学会了区分"右箭头"和"左箭头"的图片 (参考时间: 33:28)。
4.4 语言是符号系统,但大脑不必是
回到 NLP 与语言 (参考时间: 33:51)。讲者的立场很明确:语言毫无疑问是符号系统。最明显的是书面语——字母和词就是符号;但即便是口语或手语,尽管其载体(声波、手势)是连续的,其结构仍是符号性的:比如 "cat" 有 c、a、t 这些被符号化地识别的音。认知心理学中关于范畴知觉(categorical perception)的经典研究,用的正是音位(phoneme) (参考时间: 34:53)。
但关键转折在这里:与 Newell 和 Simon 相反——人类用符号系统来沟通,并不意味着大脑处理符号的过程本身必须是一个"物理符号系统";同理,我们也不必把 NLP 的处理器设计成物理符号系统 (参考时间: 35:18)。大脑更像一个神经网络,神经网络模型很可能比符号处理器更好地扩展、更好地刻画语言处理。
那又为什么人类偏偏演化出了符号系统?讲者认为(并说自己"也说不准")最主流的解释是:符号系统带来通信的可靠性——如果目标点是离散且彼此分开的,那么当信号发生衰减时,你仍能把它恢复出来 (参考时间: 36:10)。
这番讨论把语言学放到了什么位置?讲者认为,语言学的价值在于提供思考语言习得、加工与理解时的问题、概念与区分 (参考时间: 36:47)。当 NLP 越来越能处理"低层"任务之后,语言学家常谈的更高层概念反而被越来越多地讨论:组合性(compositionality)、系统性泛化(systematic generalization)、符号的稳定意义、语言表达式在世界中的指称 (参考时间: 37:05)。他的一个比喻是:早期的神经网络工作(视觉、听觉等感官处理)能带你到"昆虫级智能";若想往上走,语言系统的诸多性质就变得越来越相关 (参考时间: 37:47)。
五、语言学、心智与"思维工具"
5.1 洪堡:语言不只是为了沟通
🖼️ 第 26 页幻灯片 · Why does AI assistance reduce collective diversity?
讲者介绍了一个对语言学史很重要的人物——Wilhelm von Humboldt(洪堡)(参考时间: 39:23)。他先讲了一段历史背景:美国的大学教育体系其实是从德国学来的;在二战之前,德国是科学与学术的中心,甚至在 1930 年代前,美国人常常去德国读博士或做博后——顺着学术谱系往回追几代,多半会追到德国 (参考时间: 40:27)。
洪堡不仅推动了大学体系,也深耕语言。他被乔姆斯基反复引用,最著名的一句是:"人类语言必须以有限的手段实现无限的运用"——即用有限的词汇和句法,递归地造出无穷多句子;这在乔姆斯基看来,正是符号化、有结构的语言观的支撑 (参考时间: 41:04)。
🖼️ 第 27 页幻灯片 · On AI assisted research (and homework)
但讲者说,洪堡还有另一种也许更有意思的解读:他强调语言不只是用来沟通的 (参考时间: 41:53)。
5.2 系统 1 与系统 2
为了讲清楚这一点,讲者引入了两个名字相近、又容易混淆的心理学概念 (参考时间: 42:10):Kahneman 与 Tversky 提出的系统 1 认知与系统 2 认知。
🖼️ 第 28 页幻灯片 · Effects on cognition and critical thinking
- 系统 1:下意识的加工——信息进来(视觉信号、语音)你就自动处理了,你并不"在思考"。
- 系统 2:有意识的思考——"让我想想这是怎么回事""我在解一道数学题"。
讲者认为,你在洪堡的著作里能看到同样的二分:他把系统 1 认知称为"精神",把系统 2 认知称为"思考" (参考时间: 42:59)。
编者说明:把"快/慢"两套思维系统明确命名为"System 1 / System 2",最广为人知的出处是 Daniel Kahneman 的《思考,快与慢》(2011);Kahneman 与 Tversky 是长期合作者,但双系统框架的命名主要归功于 Kahneman(以及 Stanovich、West 等人的工作)。
5.3 丹尼特的四级智能
讲者说,洪堡大致主张一种"思想语言(language of thought)"式的立场:有效的系统 2 思考,需要借助语言的符号来"延展心智";因此,拥有语言是人类心灵进步的必要基础 (参考时间: 43:04)。讲者承认自己对这一点"颇有同感":我们当然可以不用语言思考(恐惧、视觉想象、拼装零件),但人类所从事的那种更抽象、更大尺度的思考——那种让人类超越黑猩猩的思考——语言可能在其中提供了"心智内部的脚手架" (参考时间: 43:46)。
🖼️ 第 29 页幻灯片 · The paradox of AI-assisted creativity
他接着引出哲学家 Daniel Dennett 的观点 (参考时间: 44:20)。讲者提到 Dennett 几个月前刚刚去世,并介绍了他那本讨论人类意识起源的书《From Bacteria to Bach and Back》。
编者说明:Daniel Dennett 于 2024 年 4 月去世;本讲在 2024 年春季,所以"几个月前"的说法成立。书名中译常作《从细菌到巴赫再回来》。
Dennett 提出了四个逐级更"能干"的智能等级 (参考时间: 44:42):
🖼️ 第 30 页幻灯片 · NeurIPS 2025
graph TD
  A["达尔文式智能 Darwinian<br/>先天固定、此生不改进<br/>改进只靠演化 / 遗传选择<br/>例:细菌、病毒"] --> B["斯金纳式智能 Skinnerian<br/>通过强化学习来改进行为<br/>例:蜥蜴、狗"]
  B --> C["波普尔式智能 Popperian<br/>学习环境模型,先规划后执行<br/>相当于 model-based RL<br/>例:灵长类、乌鸦"]
  C --> D["格雷戈里式智能 Gregorian<br/>建造"思维工具",对心理搜索施加更高层控制<br/>例:数学、民主、语言<br/>唯一的生物学实例:人类"]
- 达尔文式智能:预先设计好、是固定的,个体一生无法改进,改进只能通过演化的遗传选择发生——细菌、病毒属此类 (参考时间: 45:00)。
- 斯金纳式智能:通过强化学习改进行为——蜥蜴、狗(至于狗有多聪明,可以争论)(参考时间: 45:22)。
- 波普尔式智能:能学习环境的模型,先在脑中规划再执行;用计算的话说,就是能做基于模型的强化学习。黑猩猩显然可以;但新证据显示很多更简单的生物也可以——例如南太平洋、澳大利亚、斐济一带的乌鸦,能进行多阶段规划:为了吃到洞里的肉,先学会捡起树枝再捅进去 (参考时间: 46:00)。
- 格雷戈里式智能:能建造思维工具(thinking tools),从而对"心理搜索"施加更高层级的控制 (参考时间: 47:16)。数学是一种思维工具,民主也是;而在所有思维工具中,人类语言是最重要的那一个。Dennett 指出,人类是所有生物中唯一的"格雷戈里式智能"实例 (参考时间: 47:55)。
编者拓展|"格雷戈里"是谁? Dennett 这套命名并非随意:达尔文(Darwin)、斯金纳(Skinner)、波普尔(Popper)都对应各自的机制,而"Gregorian"取自英国心理学家 Richard Gregory。Gregory 强调知觉是一种"假设检验"式的主动建构过程,这与"用思维工具去控制心理搜索"的想法一脉相承。
讲者由此总结:语言在人类智能中扮演着极其重要的角色 (参考时间: 48:09)。
六、语言应该有怎样的语义?
6.1 指称语义:意义即"所指"
🖼️ 第 31 页幻灯片 · 31
回到词向量的老问题:我们该用什么样的语义学来描述语言? (参考时间: 48:17)
在语言哲学与语言语义学中长期占主流的是模型论语义(model-theoretic semantics):一个词的意义,就是它的所指(denotation),即它在世界中所代表的东西 (参考时间: 48:31)。比如词 "computer",其意义就是所有计算机的集合——这台、那台、还有所有的计算机。这是一种"词—世界所指"之间的映射关系,也是符号 AI 大部分历史所使用的语义观 (参考时间: 49:07)。
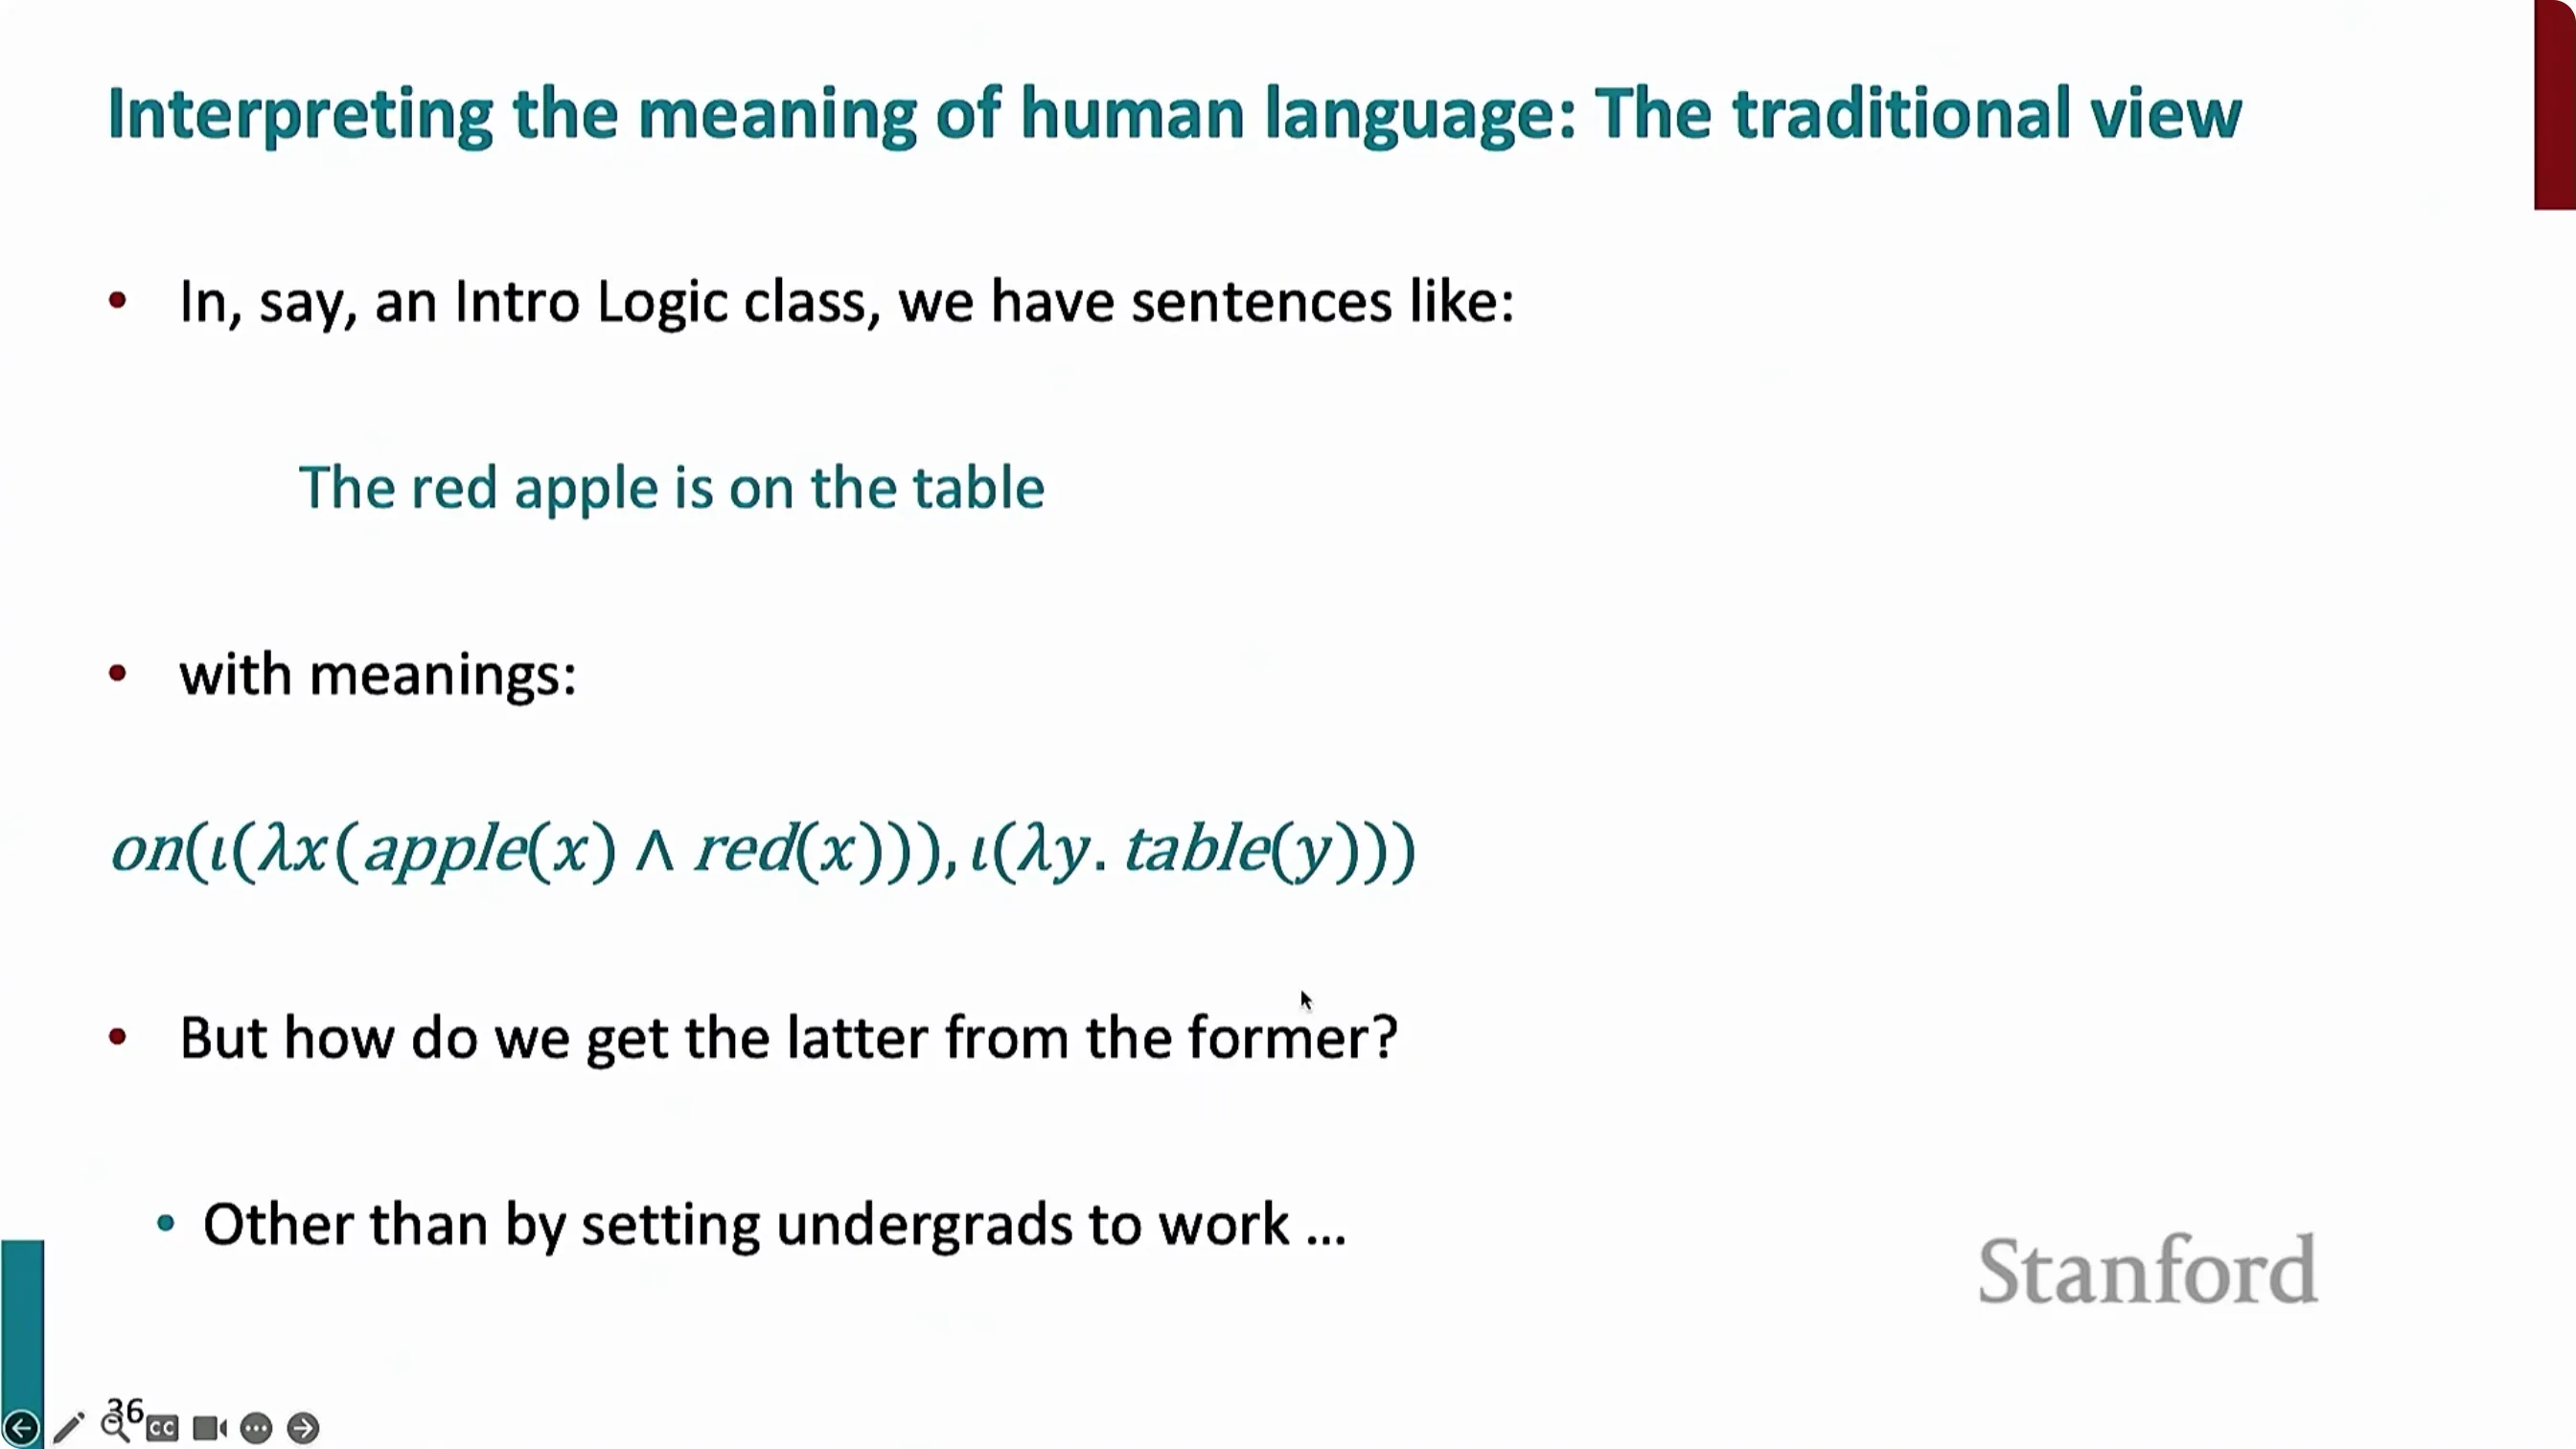
📷 用一阶逻辑表示"红苹果在桌上"
回到原视频 (00:49:44)
讲者举了他上过的逻辑入门课里那种例子:给定一个句子"红苹果在桌上",你把它写成一阶谓词演算之类的形式化表示;在前两周你还会做几道"英语句子翻译成形式逻辑"的题,之后就把人类语言抛在脑后,一门心思去证明形式系统的定理了 (参考时间: 49:50)。
这套传统可以追溯到Alfred Tarski (参考时间: 50:21)。Tarski 认为,不能用谈论人类语言的方式来谈论意义,因为人类语言"令人难以置信地不连贯" (参考时间: 50:35)。从 1940 年代到 1980 年代,他是美国最负盛名的逻辑学家(在伯克利),这套观点也就成了当时逻辑学界的"正统"。
🖼️ 第 32 页幻灯片 · Inter-Model
6.2 蒙塔古语法与语义解析
然而,Tarski 的一位学生 Richard Montague 站出来反叛了这套图景 (参考时间: 51:02)。他的名言是:
"我拒绝承认,形式语言与自然语言之间存在任何重要的理论差别。"
于是 Montague 着手展示了:我们完全可以用形式语义学来描述自然语言句子的意义。他的工作成了语言学中语义学研究的基础——如果你上过 Ling 130 或 230,你见到的就是蒙塔古式的语义学 (参考时间: 51:33)。
此后,大约从 1960 年代到 2015—2017 年,这套语义学成为 NLP 中做自然语言理解的主流范式 (参考时间: 52:09)。它的流程大致是:
graph LR
  A["自然语言句子<br/>How many red cars in Palo Alto<br/>does Cathy like?"] --> B["句法分析<br/>得到句法结构"]
  B --> C["查词典 + 组合<br/>按组合性逐级算出短语、从句的意义"]
  C --> D["整句的语义形式<br/>semantic form"]
  D --> E["转换成 SQL 查询"]
  E --> F[("数据库")]
  F --> G["执行查询,得到答案"]
讲者回忆说,这正是他 2000 年代在 CS224N 课上用过的幻灯片 (参考时间: 53:19)。这类系统在受限领域里确实能用,但极其脆弱(brittle) (参考时间: 55:27)。
🖼️ 第 33 页幻灯片 · Lecture Plan
这套技术也被搬进了机器学习框架:不仅解析树可以学,词的语义、组合规则也可以学。其集大成者是 2000 年代的"语义解析(semantic parsing)",由 Luke Zettlemoyer 与 Michael Collins 开创,后来又被 Percy Liang 等人接续——Percy 的博士论文、以及他"被说服去做神经网络之前"在斯坦福的早期工作,做的都是语义解析 (参考时间: 55:03)。
编者说明:"人脑是否也这样做"是一个有争议的问题:有证据支持人类会在很大程度上自下而上、以投射(projective)方式组合句子意义,但争议很大。有一点是明确的——今天的 Transformer 并不是这么做的 (参考时间: 56:07)。于是问题变成:当前的神经语言模型,是否提供了"合适的意义函数"? 讲者说这是个复杂的问题:它们在理解你输入的句子上表现惊人,但仍有真实的担忧——它们是否在走捷径,是否缺乏人类那样的组合性理解与系统性泛化 (参考时间: 56:26)。
6.3 使用理论:意义即"用法"
与指称语义相对的,是"使用理论"(use theory of meaning) (参考时间: 56:50)。讲者说,这正是他在第一、二讲以及本讲开头归给英国语言学家 J. R. Firth 的那句口号——"你通过一个词结交的伙伴来认识它"。但这不只是 Firth 的立场,它也是哲学家中的一种少数派立场,尤其见于 Wittgenstein 后期著作《哲学研究》 (参考时间: 57:20)。
讲者引了维特根斯坦的一段话,大意是:当我谈论语言、词、句子时,我必须使用日常语言;难道这种语言对我们要说的东西太粗糙、太物质了吗?那另一种又要怎样构造出来?而奇怪的是,我们居然能用我们已有的这一种做任何事 (参考时间: 57:31)。这段话是用一种近乎诗意的文学风格写的,其要点在于:逻辑学家们声称不能用自然语言表达意义、必须翻译进某个符号系统,但这难道不奇怪吗——一种符号系统不行,另一种符号系统就能"修好"它? (参考时间: 58:02)
关于指称语义,维特根斯坦写道(大意):你以为关键不在词而在意义,于是你把意义想成和词同一类的东西,只是与词不同——它是词,它是意义;这就像符号与它的所指(钱,以及用钱能买到的牛)之间的关系。但请对照"钱在使用中"的情形——他接着说,钱的意义不在于指着那些钱的实物,而在于钱在世界中能被怎样使用 (参考时间: 58:15)。
🖼️ 第 34 页幻灯片 · 34
这就是"使用理论"。问题是:它是不是一个好的意义理论? 讲者承认,有些人就是不接受这种分布式/使用式的意义观——在近年的 NLP 研究中,最突出的代表是 Bender 等人,他们把"只有'形式—意义'的配对才算数"当作公理来预设 (参考时间: 59:11)。
6.4 意义是渐变的:以"shenai"为例
讲者明确表示,这种看法太狭窄了 (参考时间: 59:36)。他认为:意义产生于"把词与别的东西连接起来"。把词连接到真实世界当然是一种特权的接地方式,但它不是唯一的接地方式——你可以在虚拟世界中拥有意义,也可以通过把词与其他词连接来获得意义 (参考时间: 59:47)。
他还提出第二个关键点:意义不是"全有或全无"的零一问题,而是渐变的——你对词和短语的意义,可以理解得多一点或少一点 (参考时间: 01:00:10)。
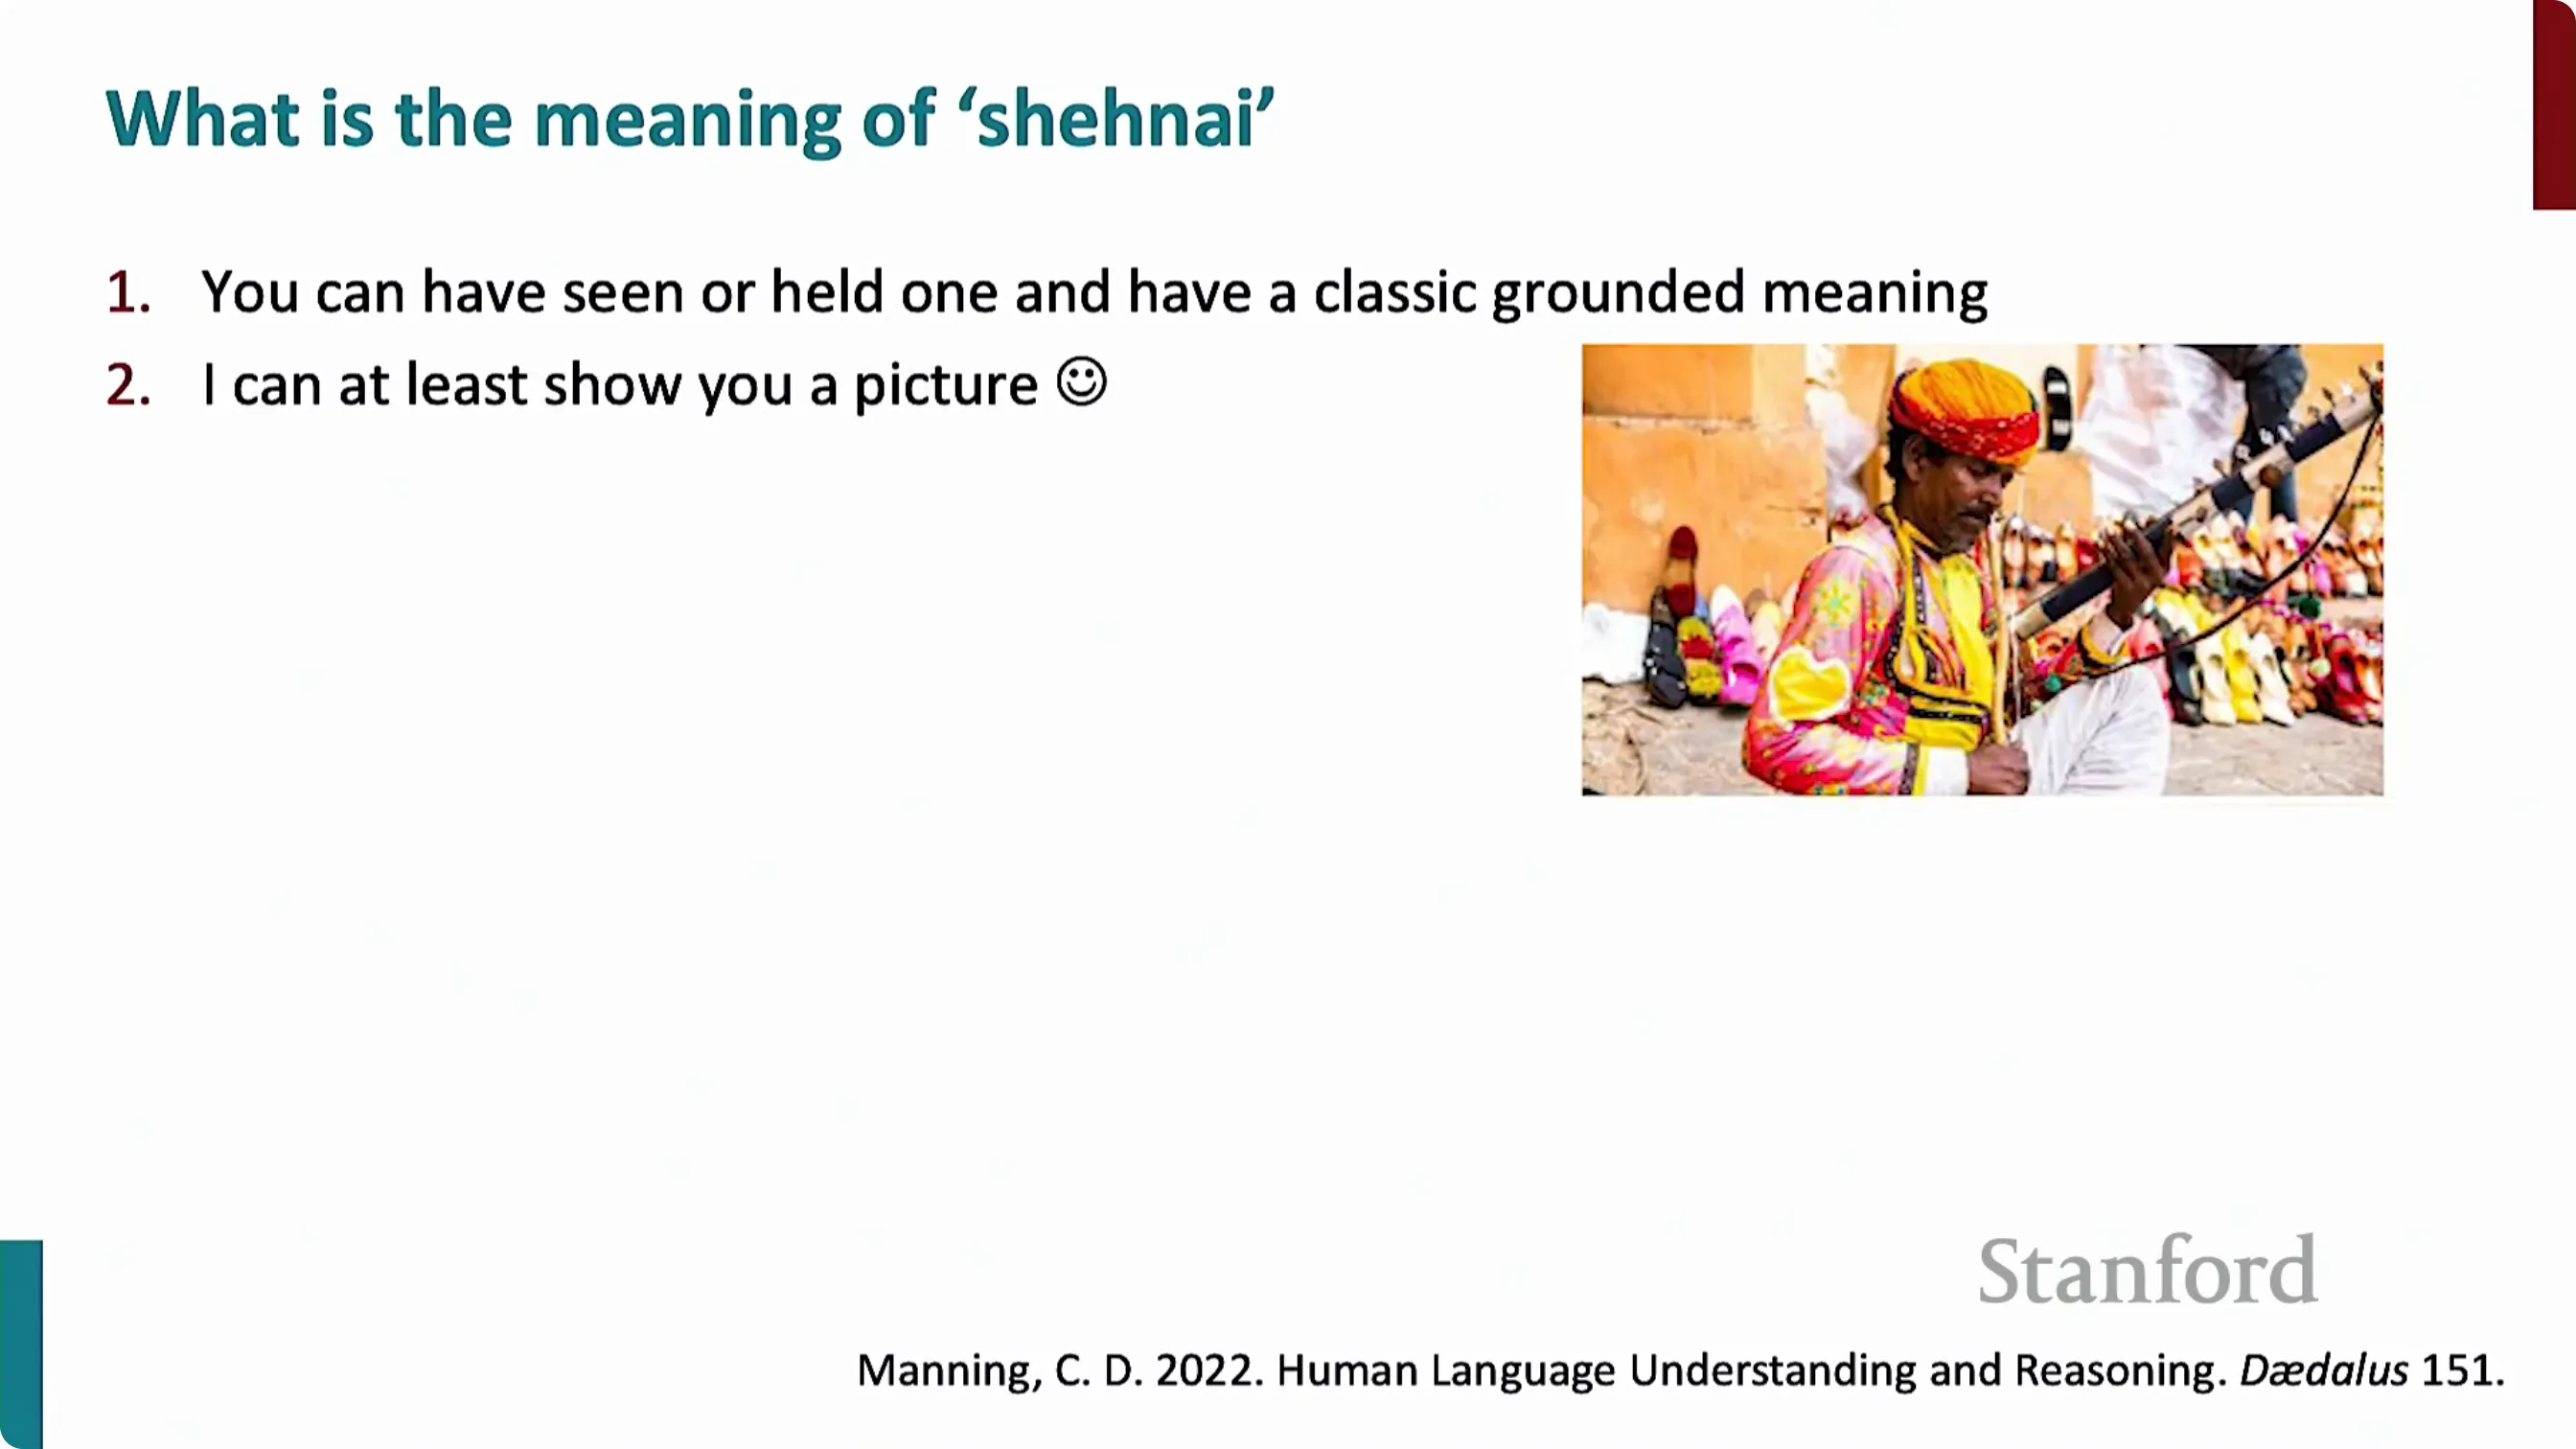
他用自己的一个例子来说明。问题:词 "shenai"(印度唢呐类乐器 shehnai)是什么意思?
📷 shenai(印度唢呐类乐器)的照片
回到原视频 (01:00:56)
- 如果你亲眼见过、亲手拿过这件乐器,你就有经典的、接地的意义——你知道它的所指 (参考时间: 01:00:47)。
- 如果没接触过,讲者至少可以给你看张照片,这让你知道一点 "shenai" 是什么 (参考时间: 01:01:01)。
- 但如果你听过它的演奏,你的意义就更丰富 (参考时间: 01:01:14)。
- 假如你既没看过、没摸过、也没听过,而讲者告诉你:它是一种传统的印度乐器,有点像双簧管(oboe)——你此刻也理解了这个词的一些意义:它与印度有关,是一种用簧片发声的管乐器,用于演奏音乐 (参考时间: 01:01:31)。
🖼️ 第 35 页幻灯片 · 35
- 他还能说更多:它整体有点像竖笛(recorder),但有多重簧片和一个喇叭状末端,更像双簧管——即便你从没见过,你对 "shenai" 的理解又多了一点 (参考时间: 01:01:57)。
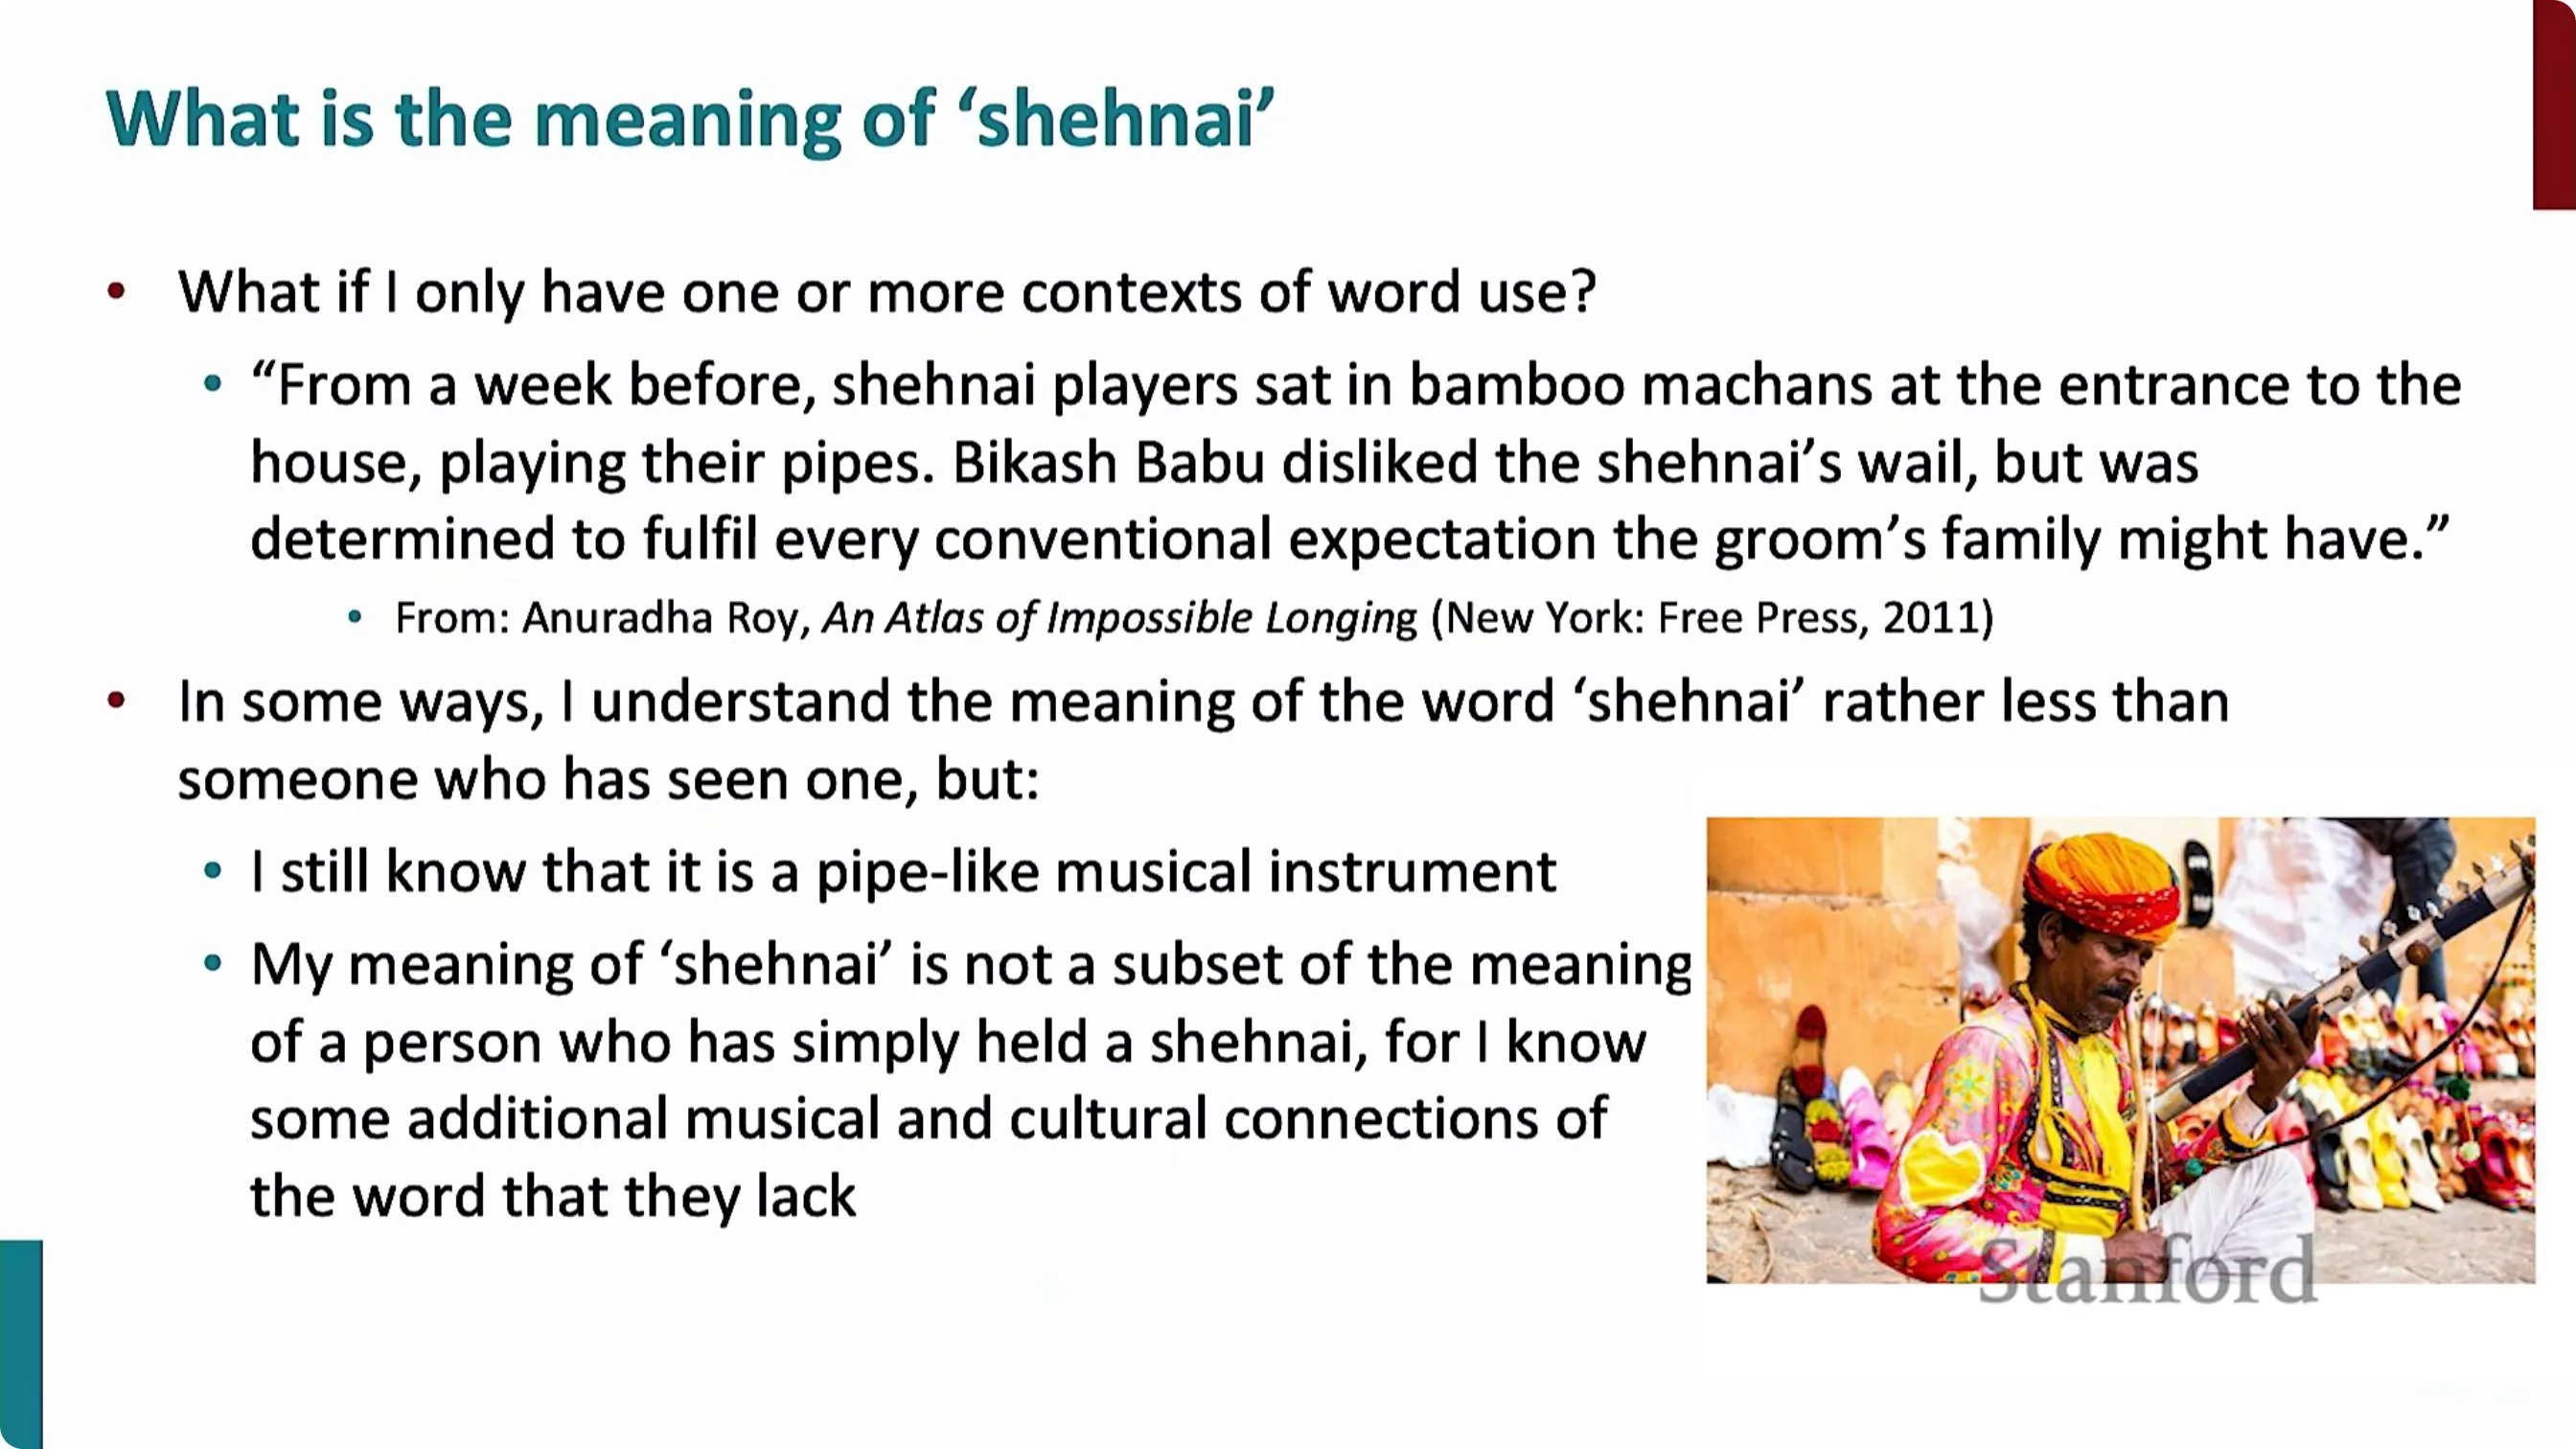
更进一步,讲者展示了语料库中的文本用例——这正是 NLP 里更常见的学习方式:不是给你下定义,而是给你真实用法的例句 (参考时间: 01:02:14)。
📷 shenai 的语料库用例
回到原视频 (01:02:26)
那段文字大意是:一位 shenai 演奏者坐在门口的竹制凉台(machan)上吹管;Bash Babu 不喜欢 shenai 的那种"哀鸣"(wail),但还是决定满足新郎家可能期待的一切传统惯例。 (参考时间: 01:02:41)
讲者分析说:如果这是你所知的关于 shenai 的全部,那么在某些方面,你理解得比"亲眼见过"要少;但在另一些方面,你反而理解得更多——因为从这一个用例里,你知道了:它的声音被形容为"哀鸣",而且它和婚礼有关联 (参考时间: 01:03:06)。而这些,是你即便拿在手里看、甚至让人在你面前吹一段,也未必能得到的信息——而"哀鸣"和"婚礼"恰恰是 shenai 对人们而言很重要的意义的一部分 (参考时间: 01:03:22)。
讲者由此收束这一节:意义来自多种不同种类的"连接" (参考时间: 01:03:35)。
编者拓展|分布式语义为什么"应该"有用 使用理论在哲学上颇有争议,但在工程上它有一个朴素的理由:一个词能被用在什么语境里,确实携带了关于它意义的信息。 - 如果两个词在所有语境中几乎可以互换,那么它们在语义上多半很接近; - 词向量正是把这一直觉量化:$w \mapsto \vec{v}_w$,使 $\cos(\vec{v}_{\text{king}}, \vec{v}_{\text{queen}})$ 明显大于 $\cos(\vec{v}_{\text{king}}, \vec{v}_{\text{apple}})$。 - 从"一词一向量"(word2vec)到"一词一上下文向量"(ELMo、BERT、GPT 的隐藏状态),变的只是表示的粒度,"意义即用法"的核心假设始终未变。
讲者"意义是渐变的"这句话,正是在说:不存在一个把所有该词用法都囊括、其余都排除的"完美稠密向量";我们只能说,某个表示逼近了这个词被使用的方式。
七、AI 的未来与风险
讲者把最后一段定名为"我们的 AI 未来" (参考时间: 01:03:44)。他说"AI 未来"有很多种理解,值得担忧的事很多,他会挑几件谈。
🖼️ 第 36 页幻灯片 · 36
7.1 我们会失去工作吗?
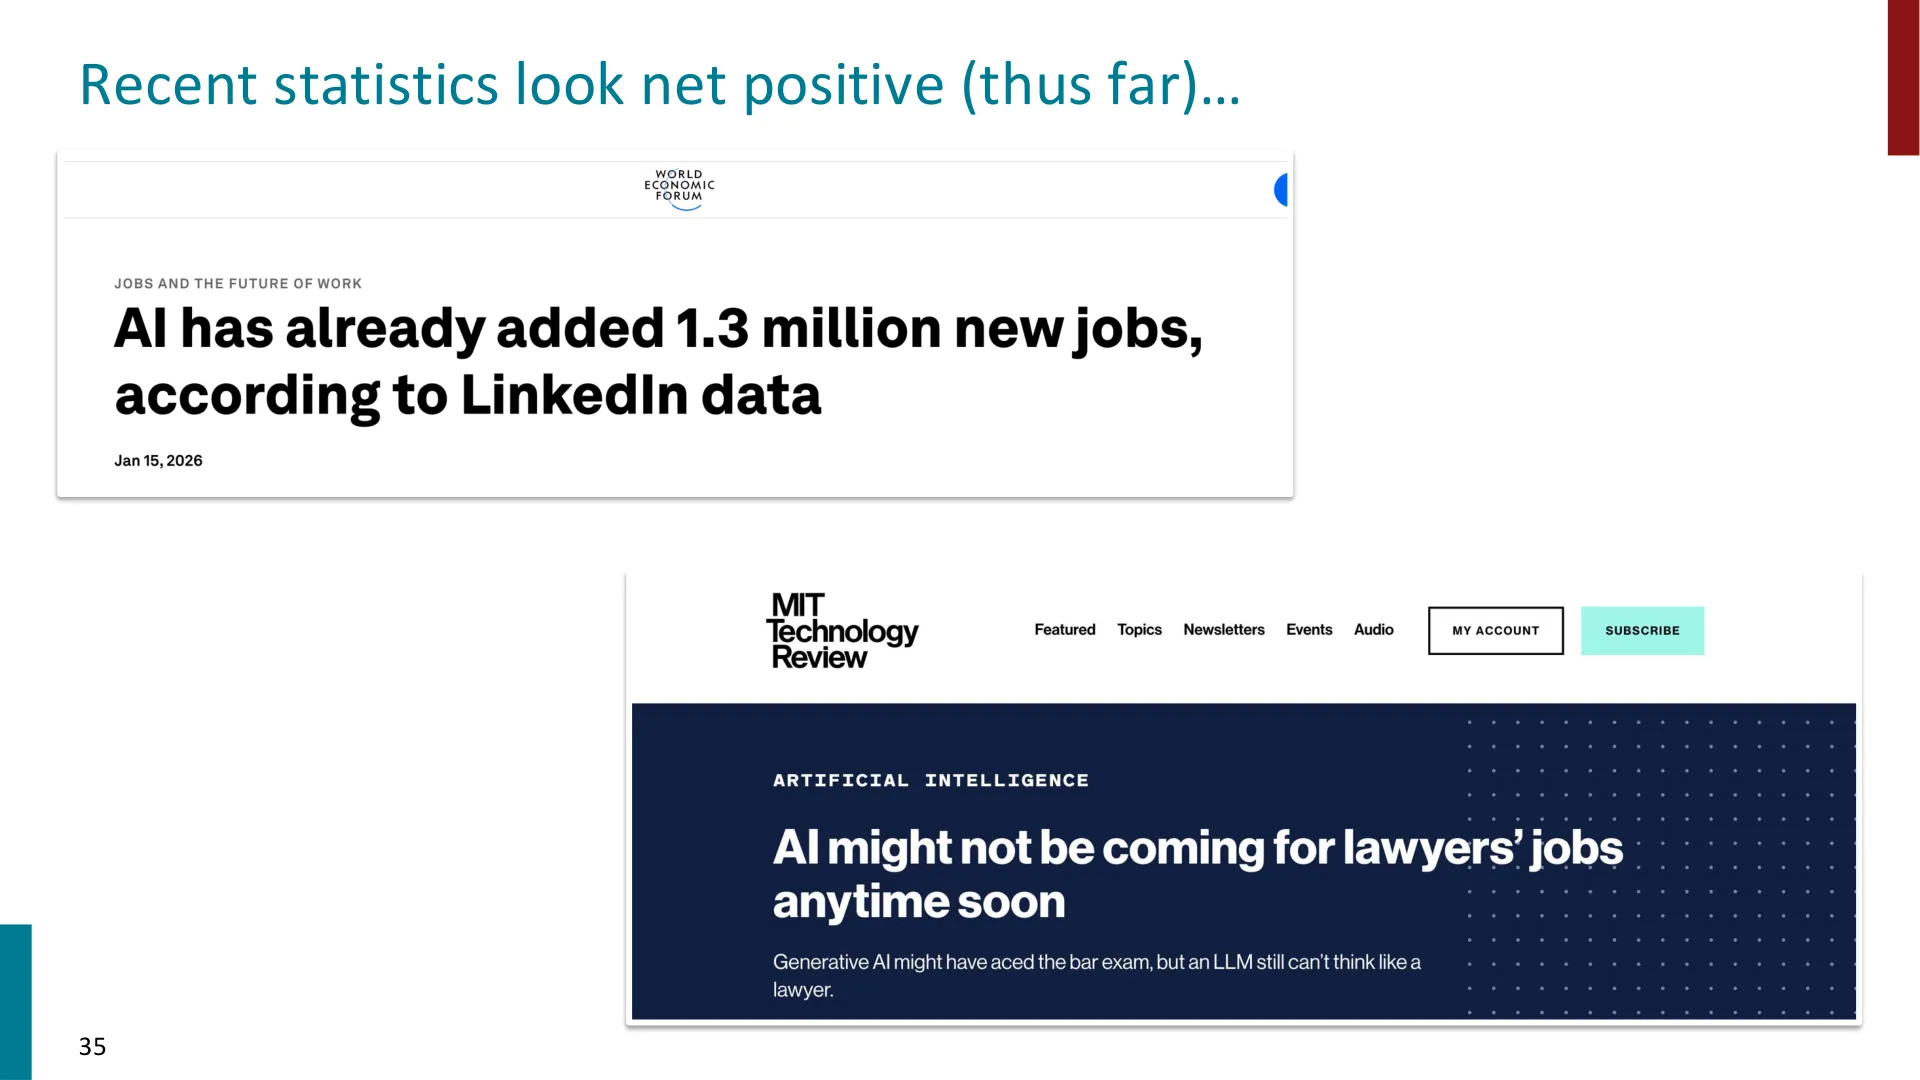
第一个担忧是就业 (参考时间: 01:03:56)。他念了一份报纸文章:《机器让双手闲置(March of the Machine Makes Idle Hands)》,副题大意是"工业产出大增却伴随失业蔓延,根源指向省力装置的影响"。
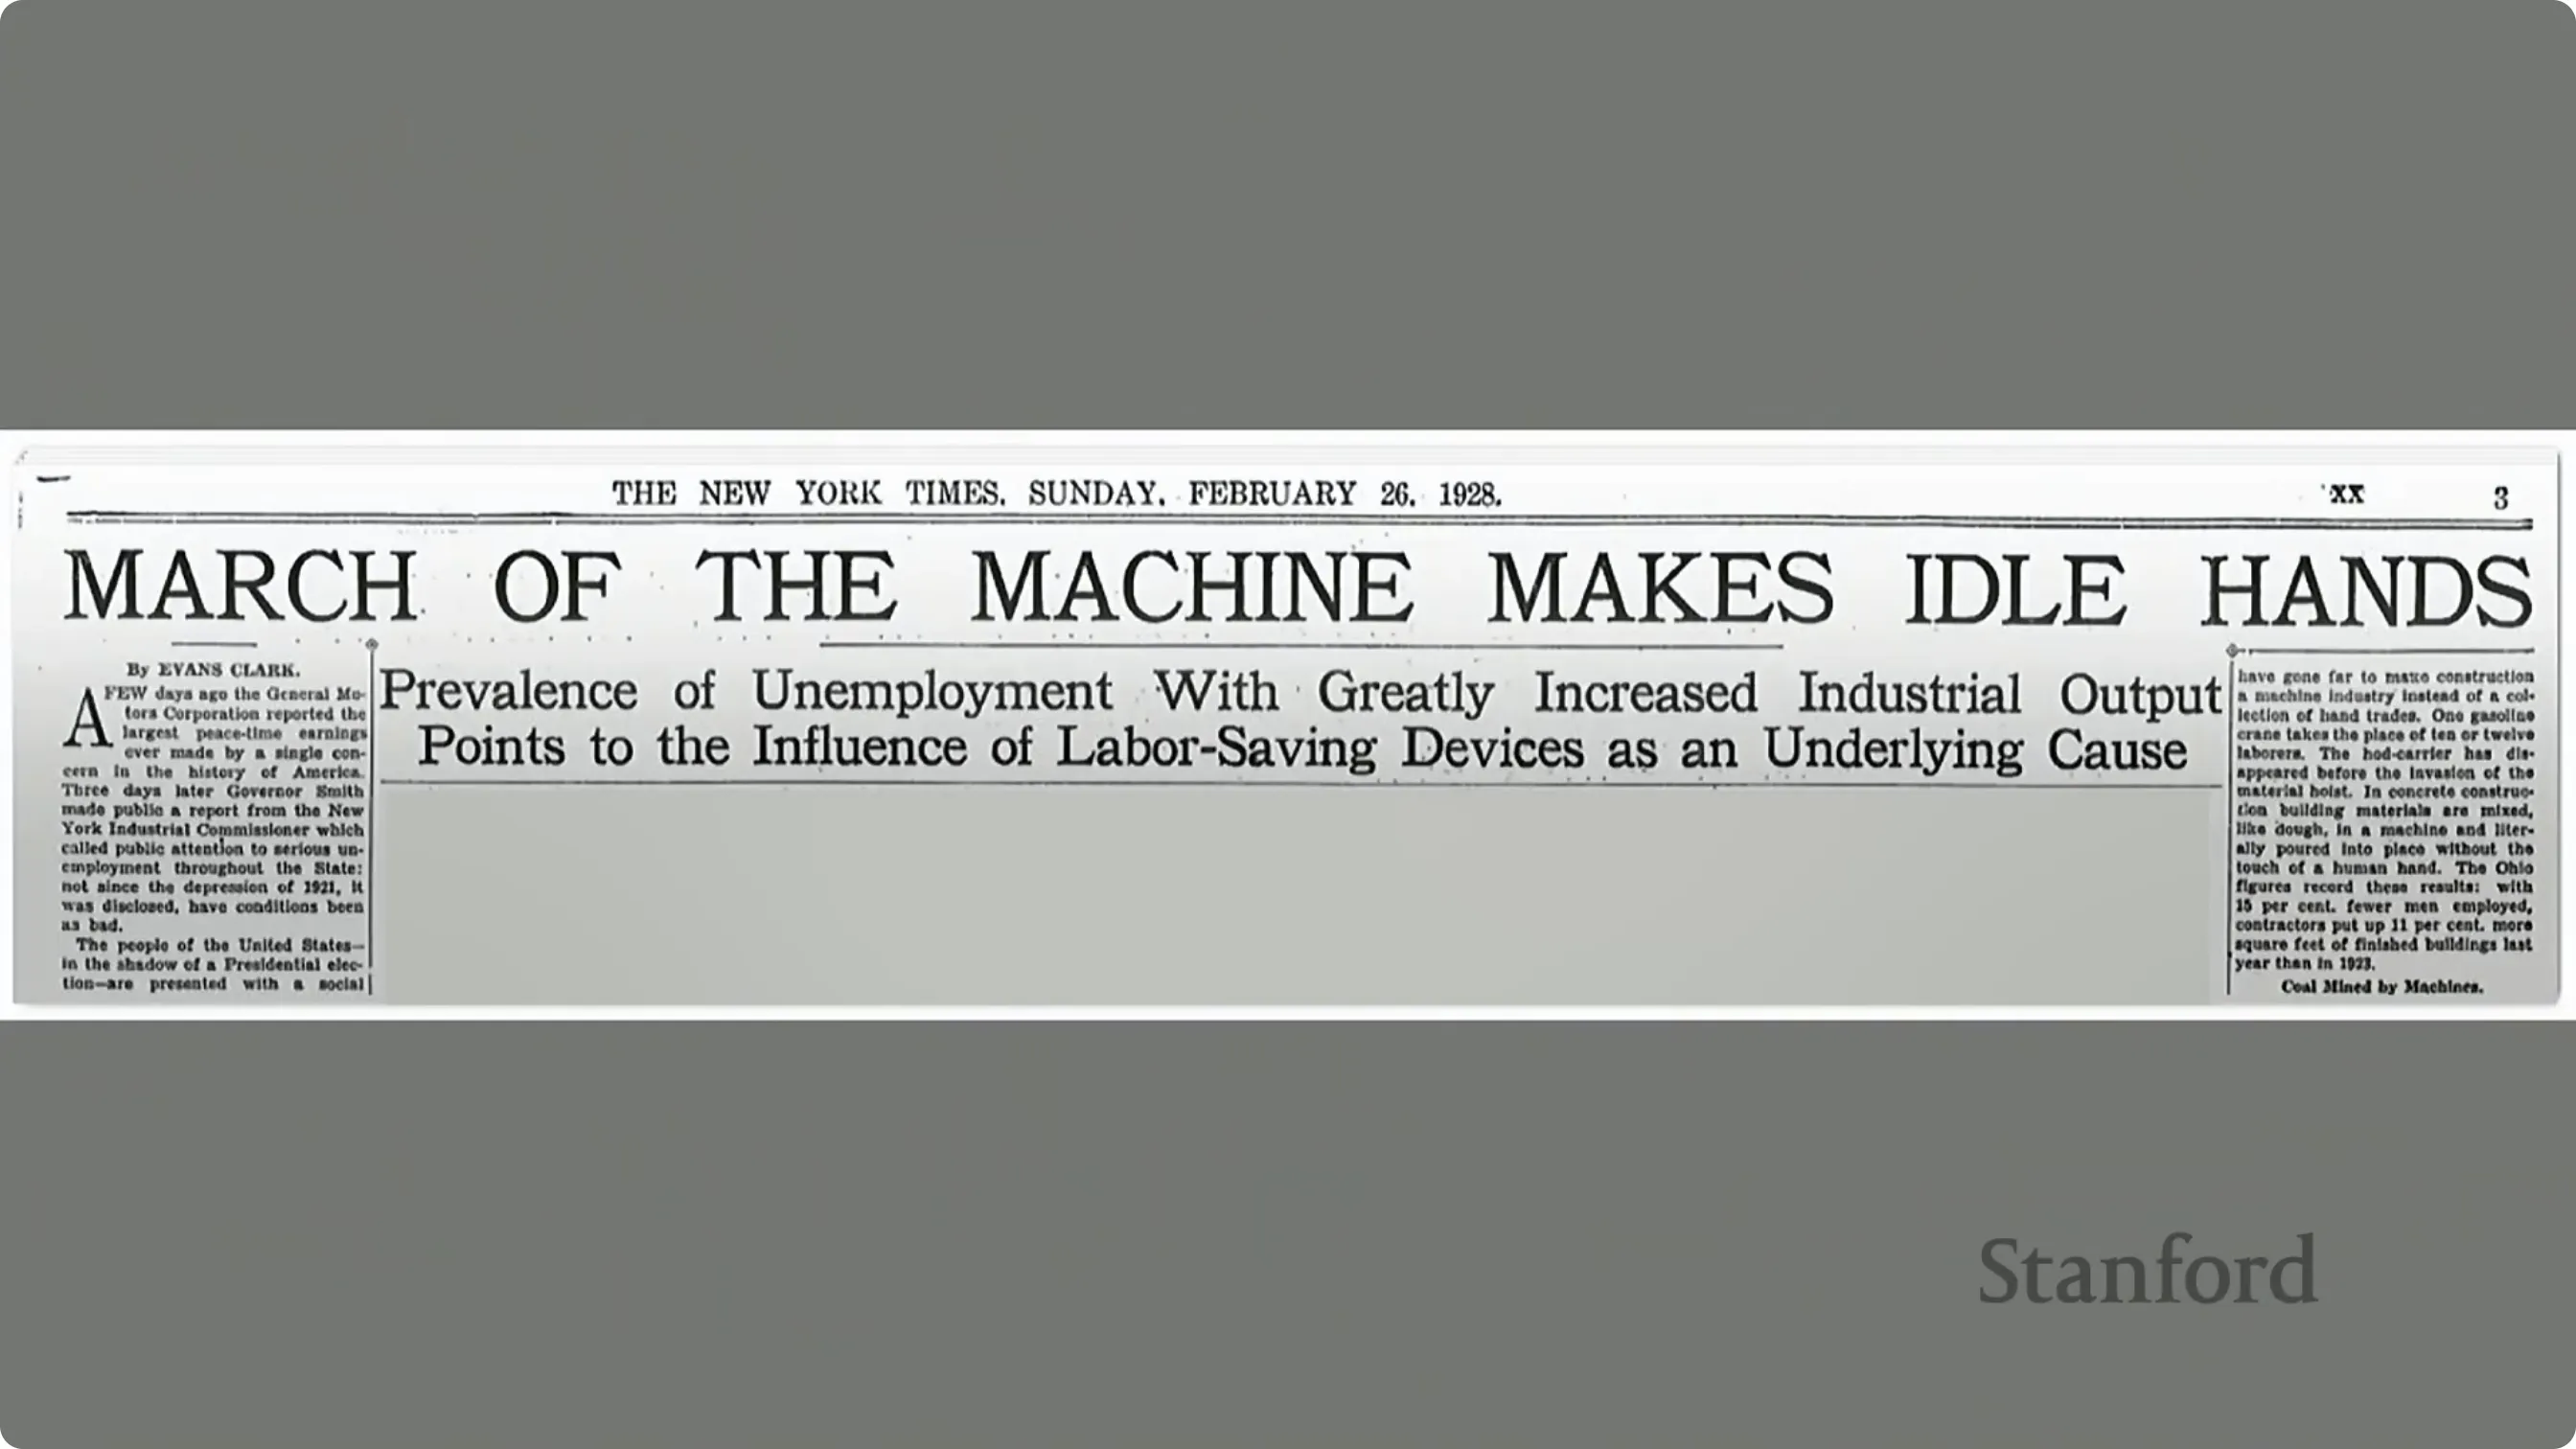
📷 1928 年《纽约时报》"机器让双手闲置"一文
回到原视频 (01:04:05)
这篇文章发表在1928 年的《纽约时报》 (参考时间: 01:04:22)。讲者调侃说,事实证明很多人其实很喜欢省力机器——洗衣机、洗碗机、缝纫机,各种有用的省力装置 (参考时间: 01:04:35)。他补充了历史语境:1928 年,正是大萧条前夕,一小群极度富有、权力极大的人支配着美国;而此后数十年,政策变化带来了繁荣年代,把财富和工作更均匀地分配给了全国 (参考时间: 01:05:04)。
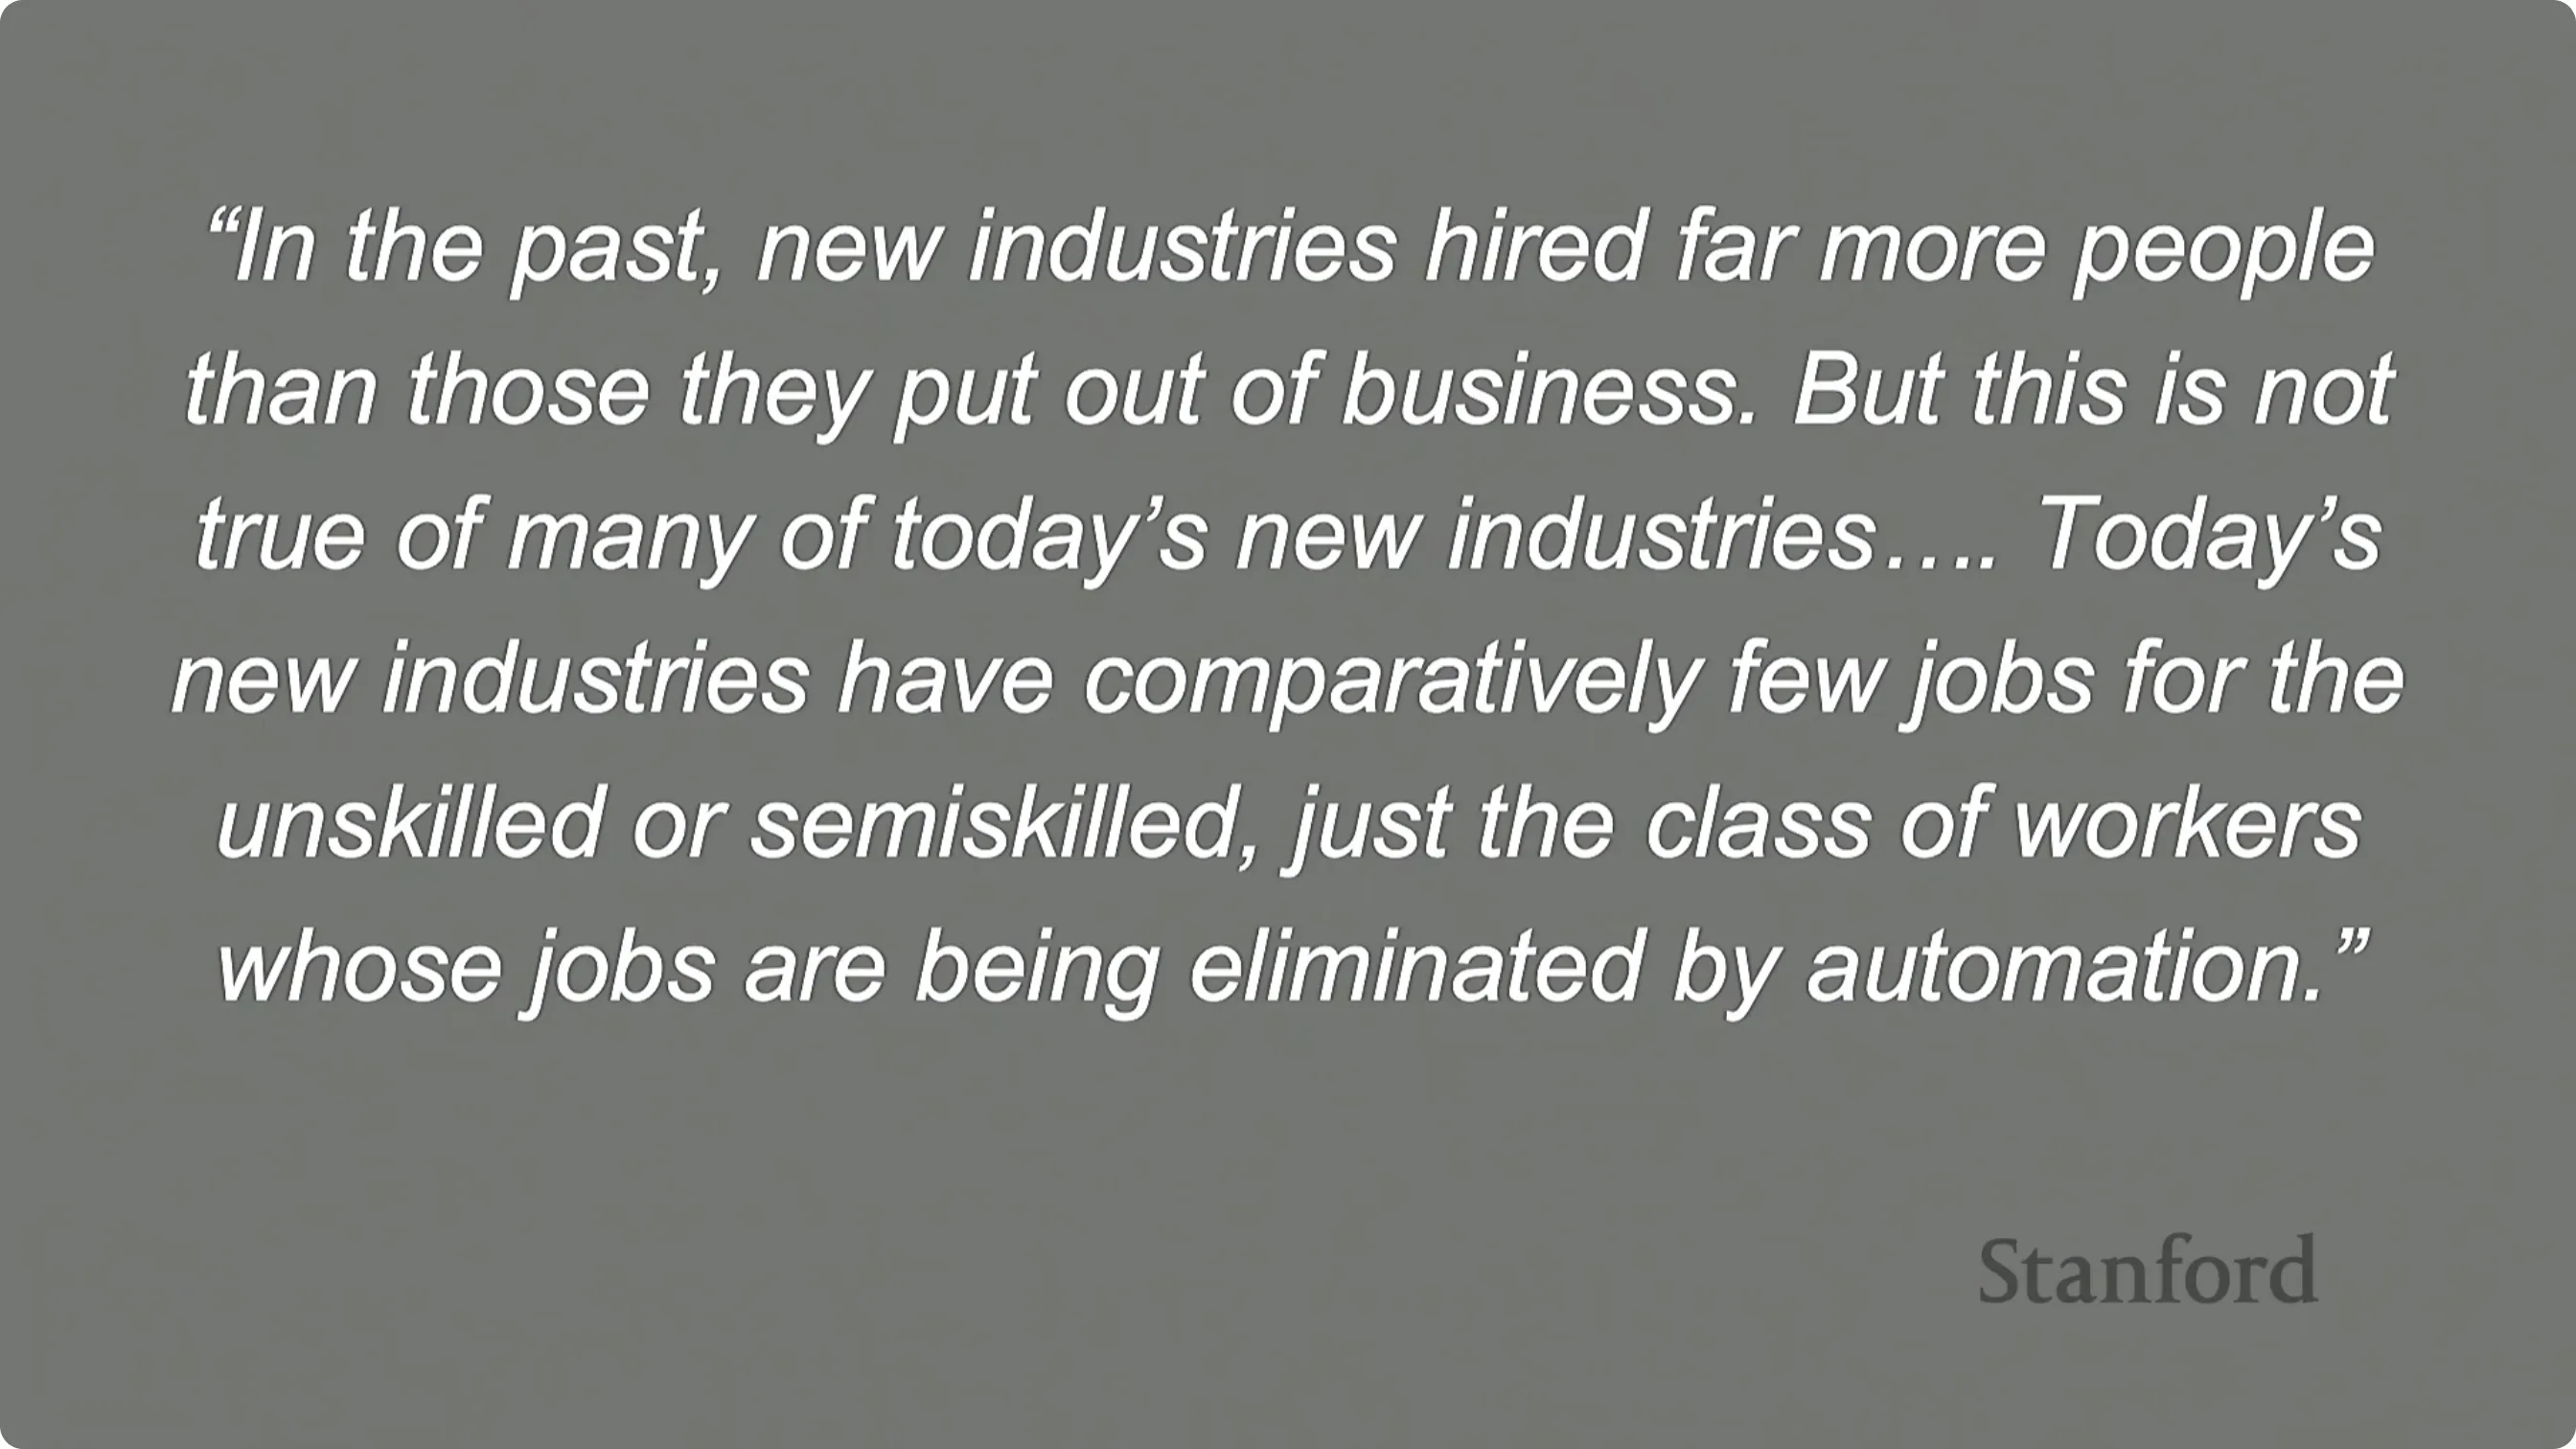
📷 1961 年《时代》杂志关于自动化与就业的文章
回到原视频 (01:05:18)
🖼️ 第 37 页幻灯片 · https://reports.weforum.org/docs/WEF_Future_of_Jobs_Report_2025.pdf
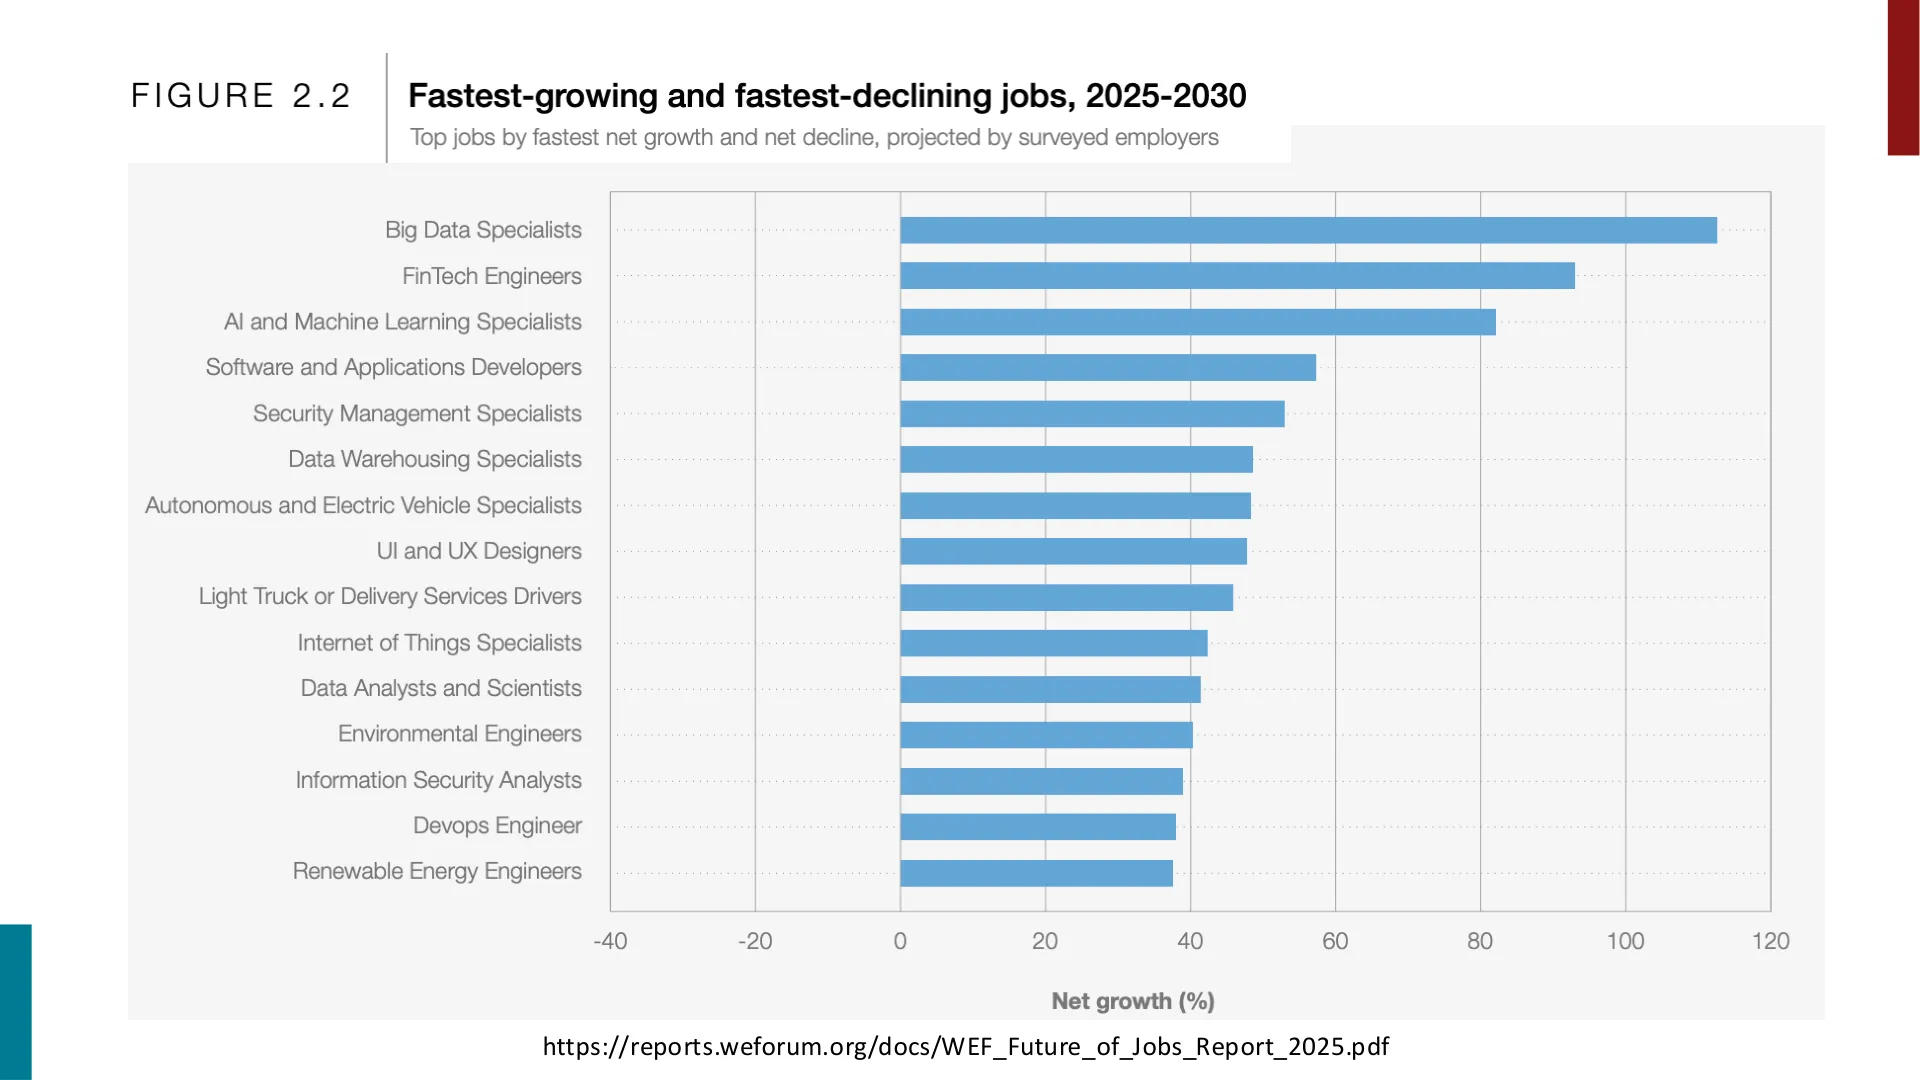
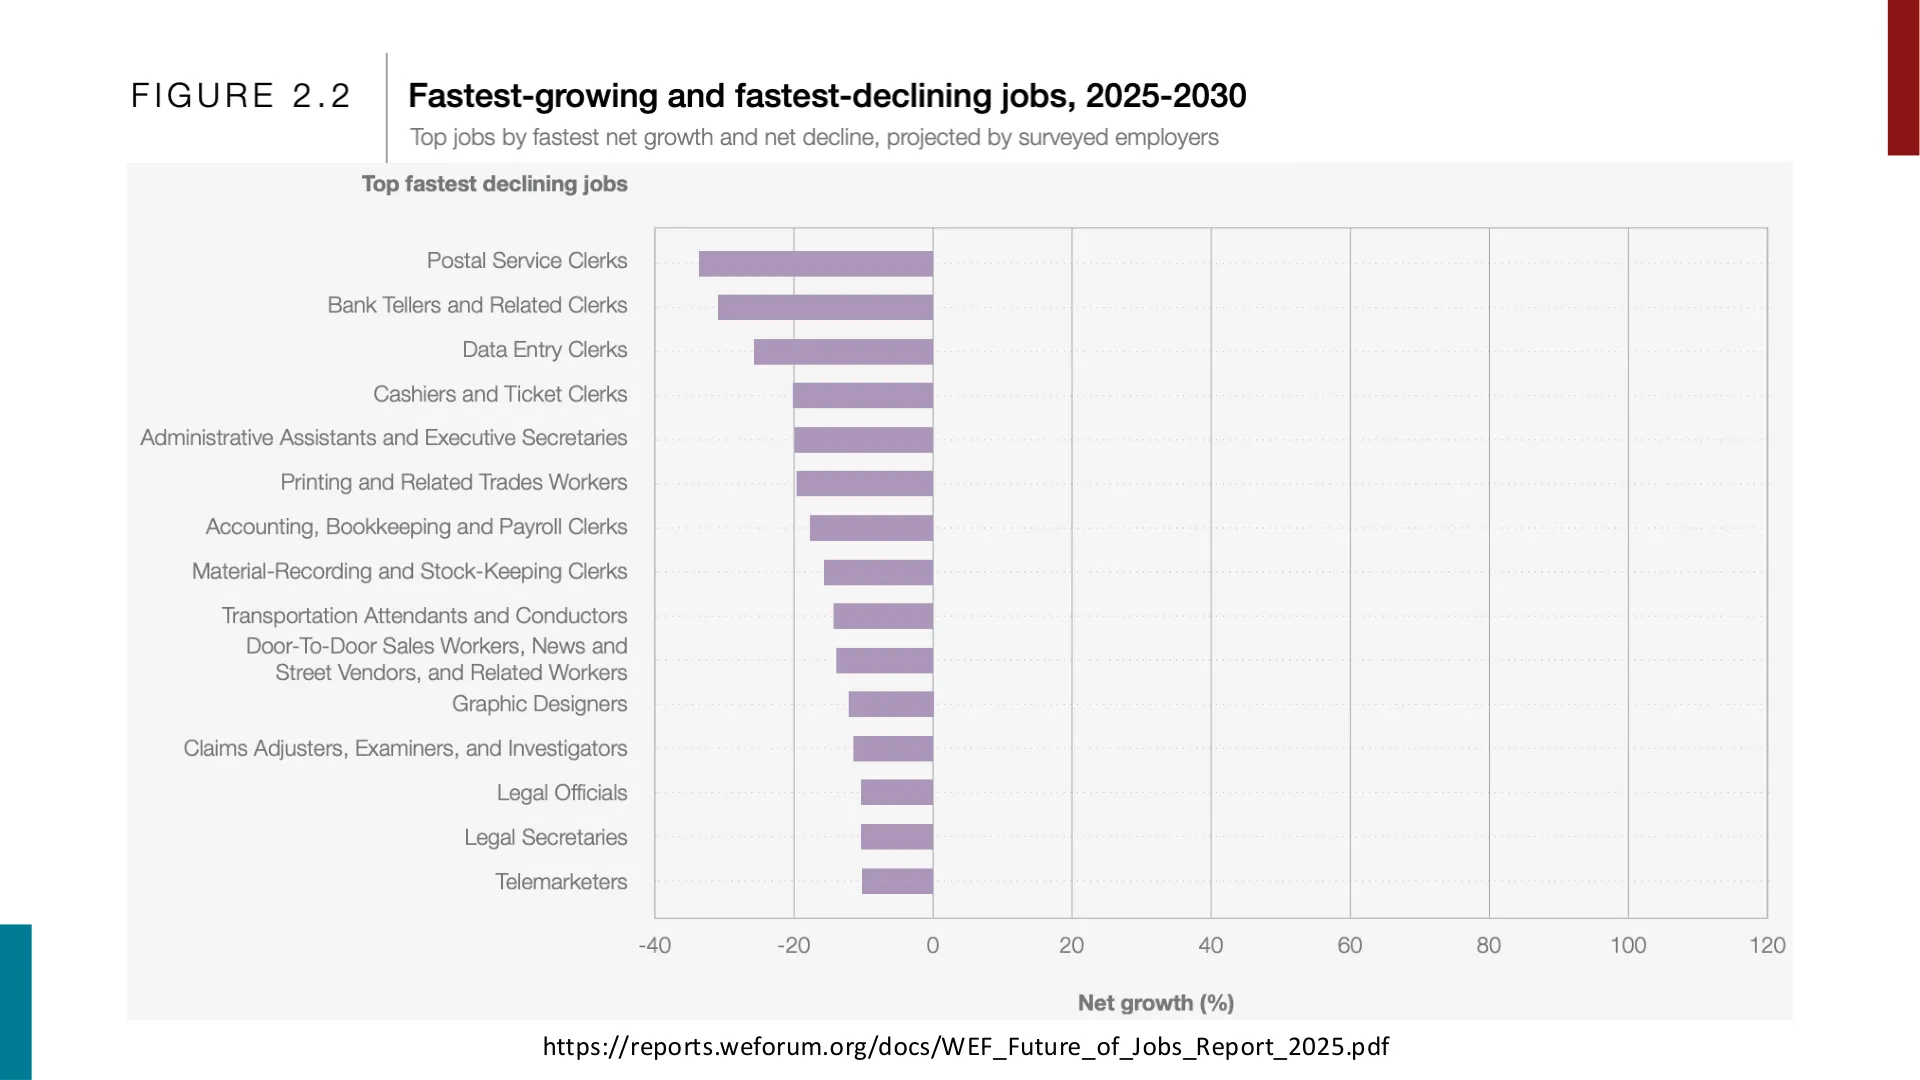
第二段引用来自 1961 年的《时代》杂志:大意是"过去,新产业雇的人远多于它挤垮的人;但如今许多新产业并非如此——它们对非熟练或半熟练工人提供的岗位很少,而被自动化消灭的正是这一类工人的岗位" (参考时间: 01:05:30)。
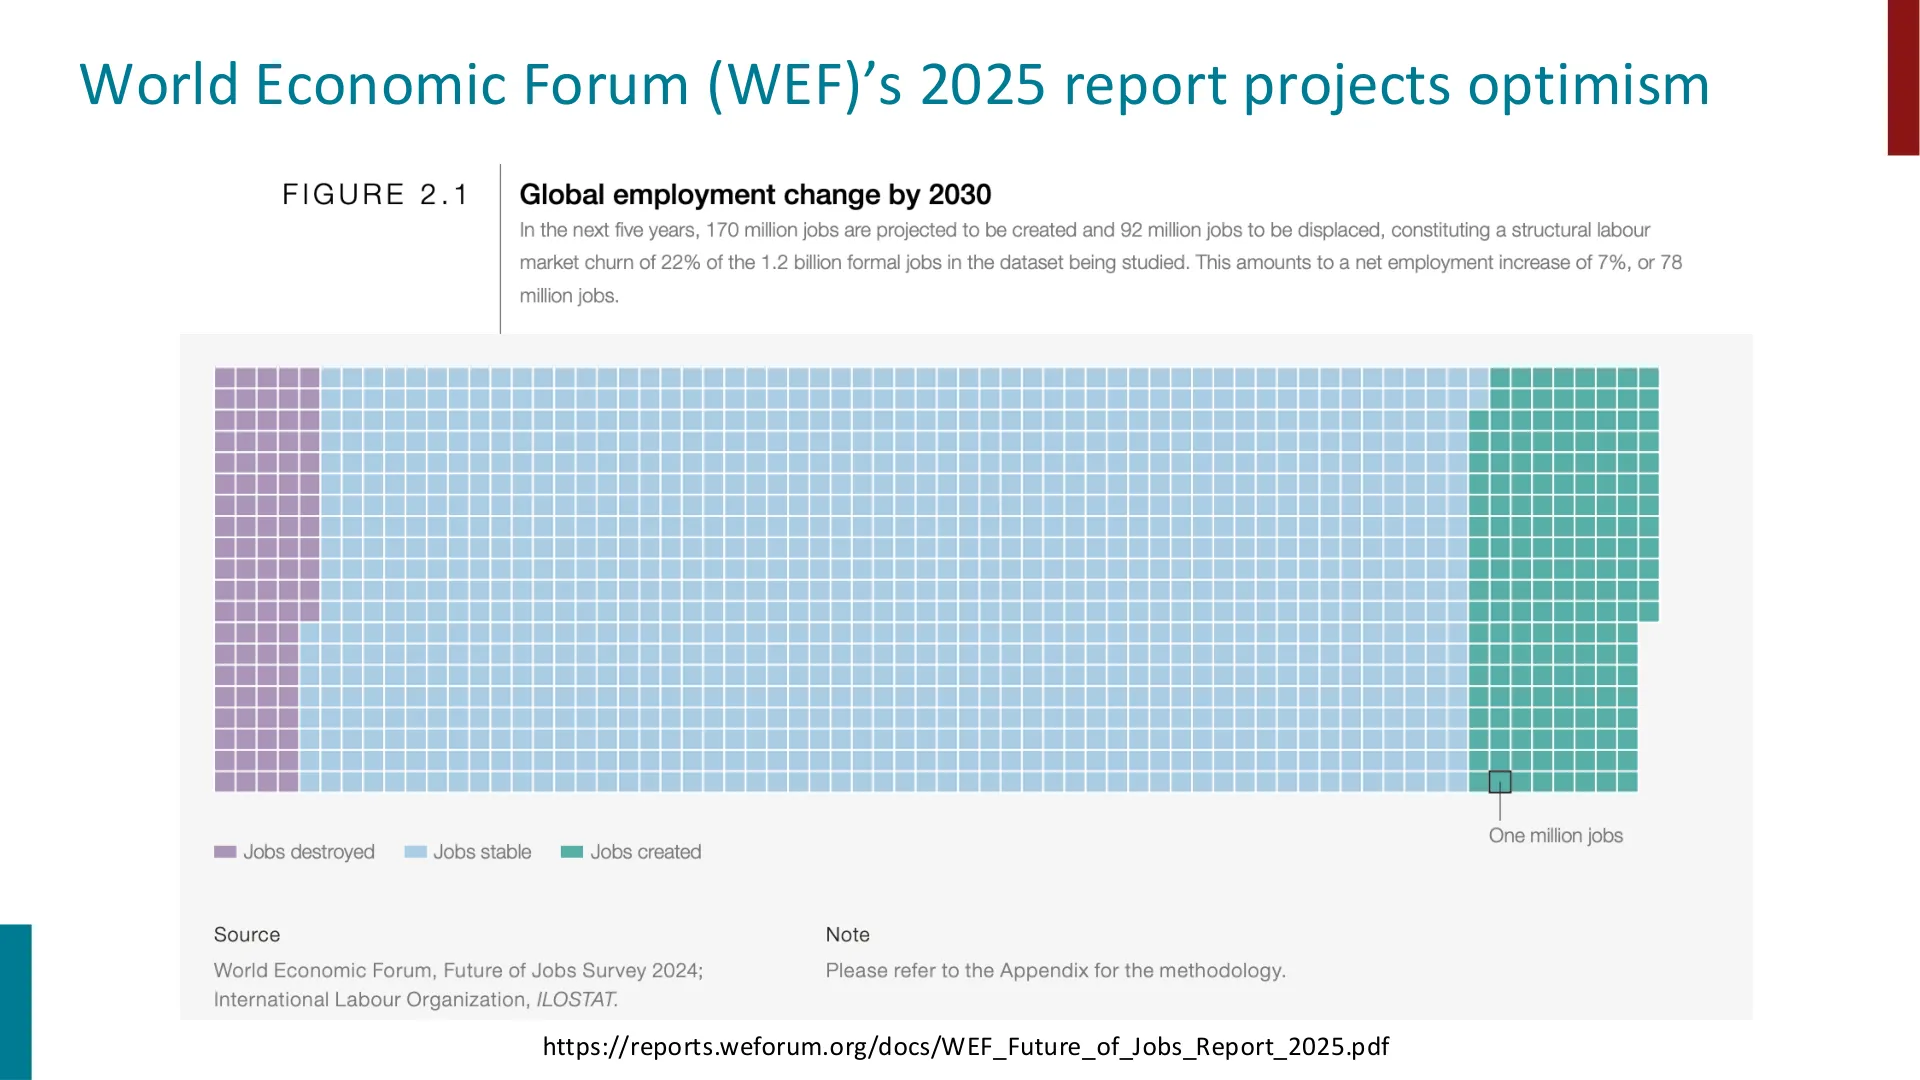
讲者总结:这是一种长期存在的恐惧,至少到目前为止还没有成真 (参考时间: 01:05:46)。今天并非人人都能得到理想的工作,但总体上几乎人人都有工作,很多人每周工时很长——而当年(1961 年)的预测却是"二十世纪末每周只需工作三天,因为没那么多活可干" (参考时间: 01:06:08)。
7.2 财富会集中吗?
第二个担忧,讲者认为更serious:会不会几乎所有钱都流向那五六家科技巨头? (参考时间: 01:06:24) 他说,这看起来正是当下的趋势;现代网络以及 AI 人才的集中,都在助推这个结果 (参考时间: 01:06:33)。
他把它类比成20 世纪初的情形:那时促使少数人支配经济体系的,是新的交通网络(铁路) (参考时间: 01:06:51)。但他强调,这件事本质上是政治与社会问题,而不是技术问题:大萧条之后,各国成功地处理了少数公司的垄断力量;只要有政治领导力,我们完全可以再来一次——问题在于,眼下看不出有多少政治领导力 (参考时间: 01:07:20)。
🖼️ 第 38 页幻灯片 · https://reports.weforum.org/docs/WEF_Future_of_Jobs_Report_2025.pdf
7.3 该担心"迫近的奇点"吗?
第三个问题:我们该不该害怕"迫近的奇点"——即机器拥有超越人类的通用智能,甚至威胁人类存续? (参考时间: 01:07:38)
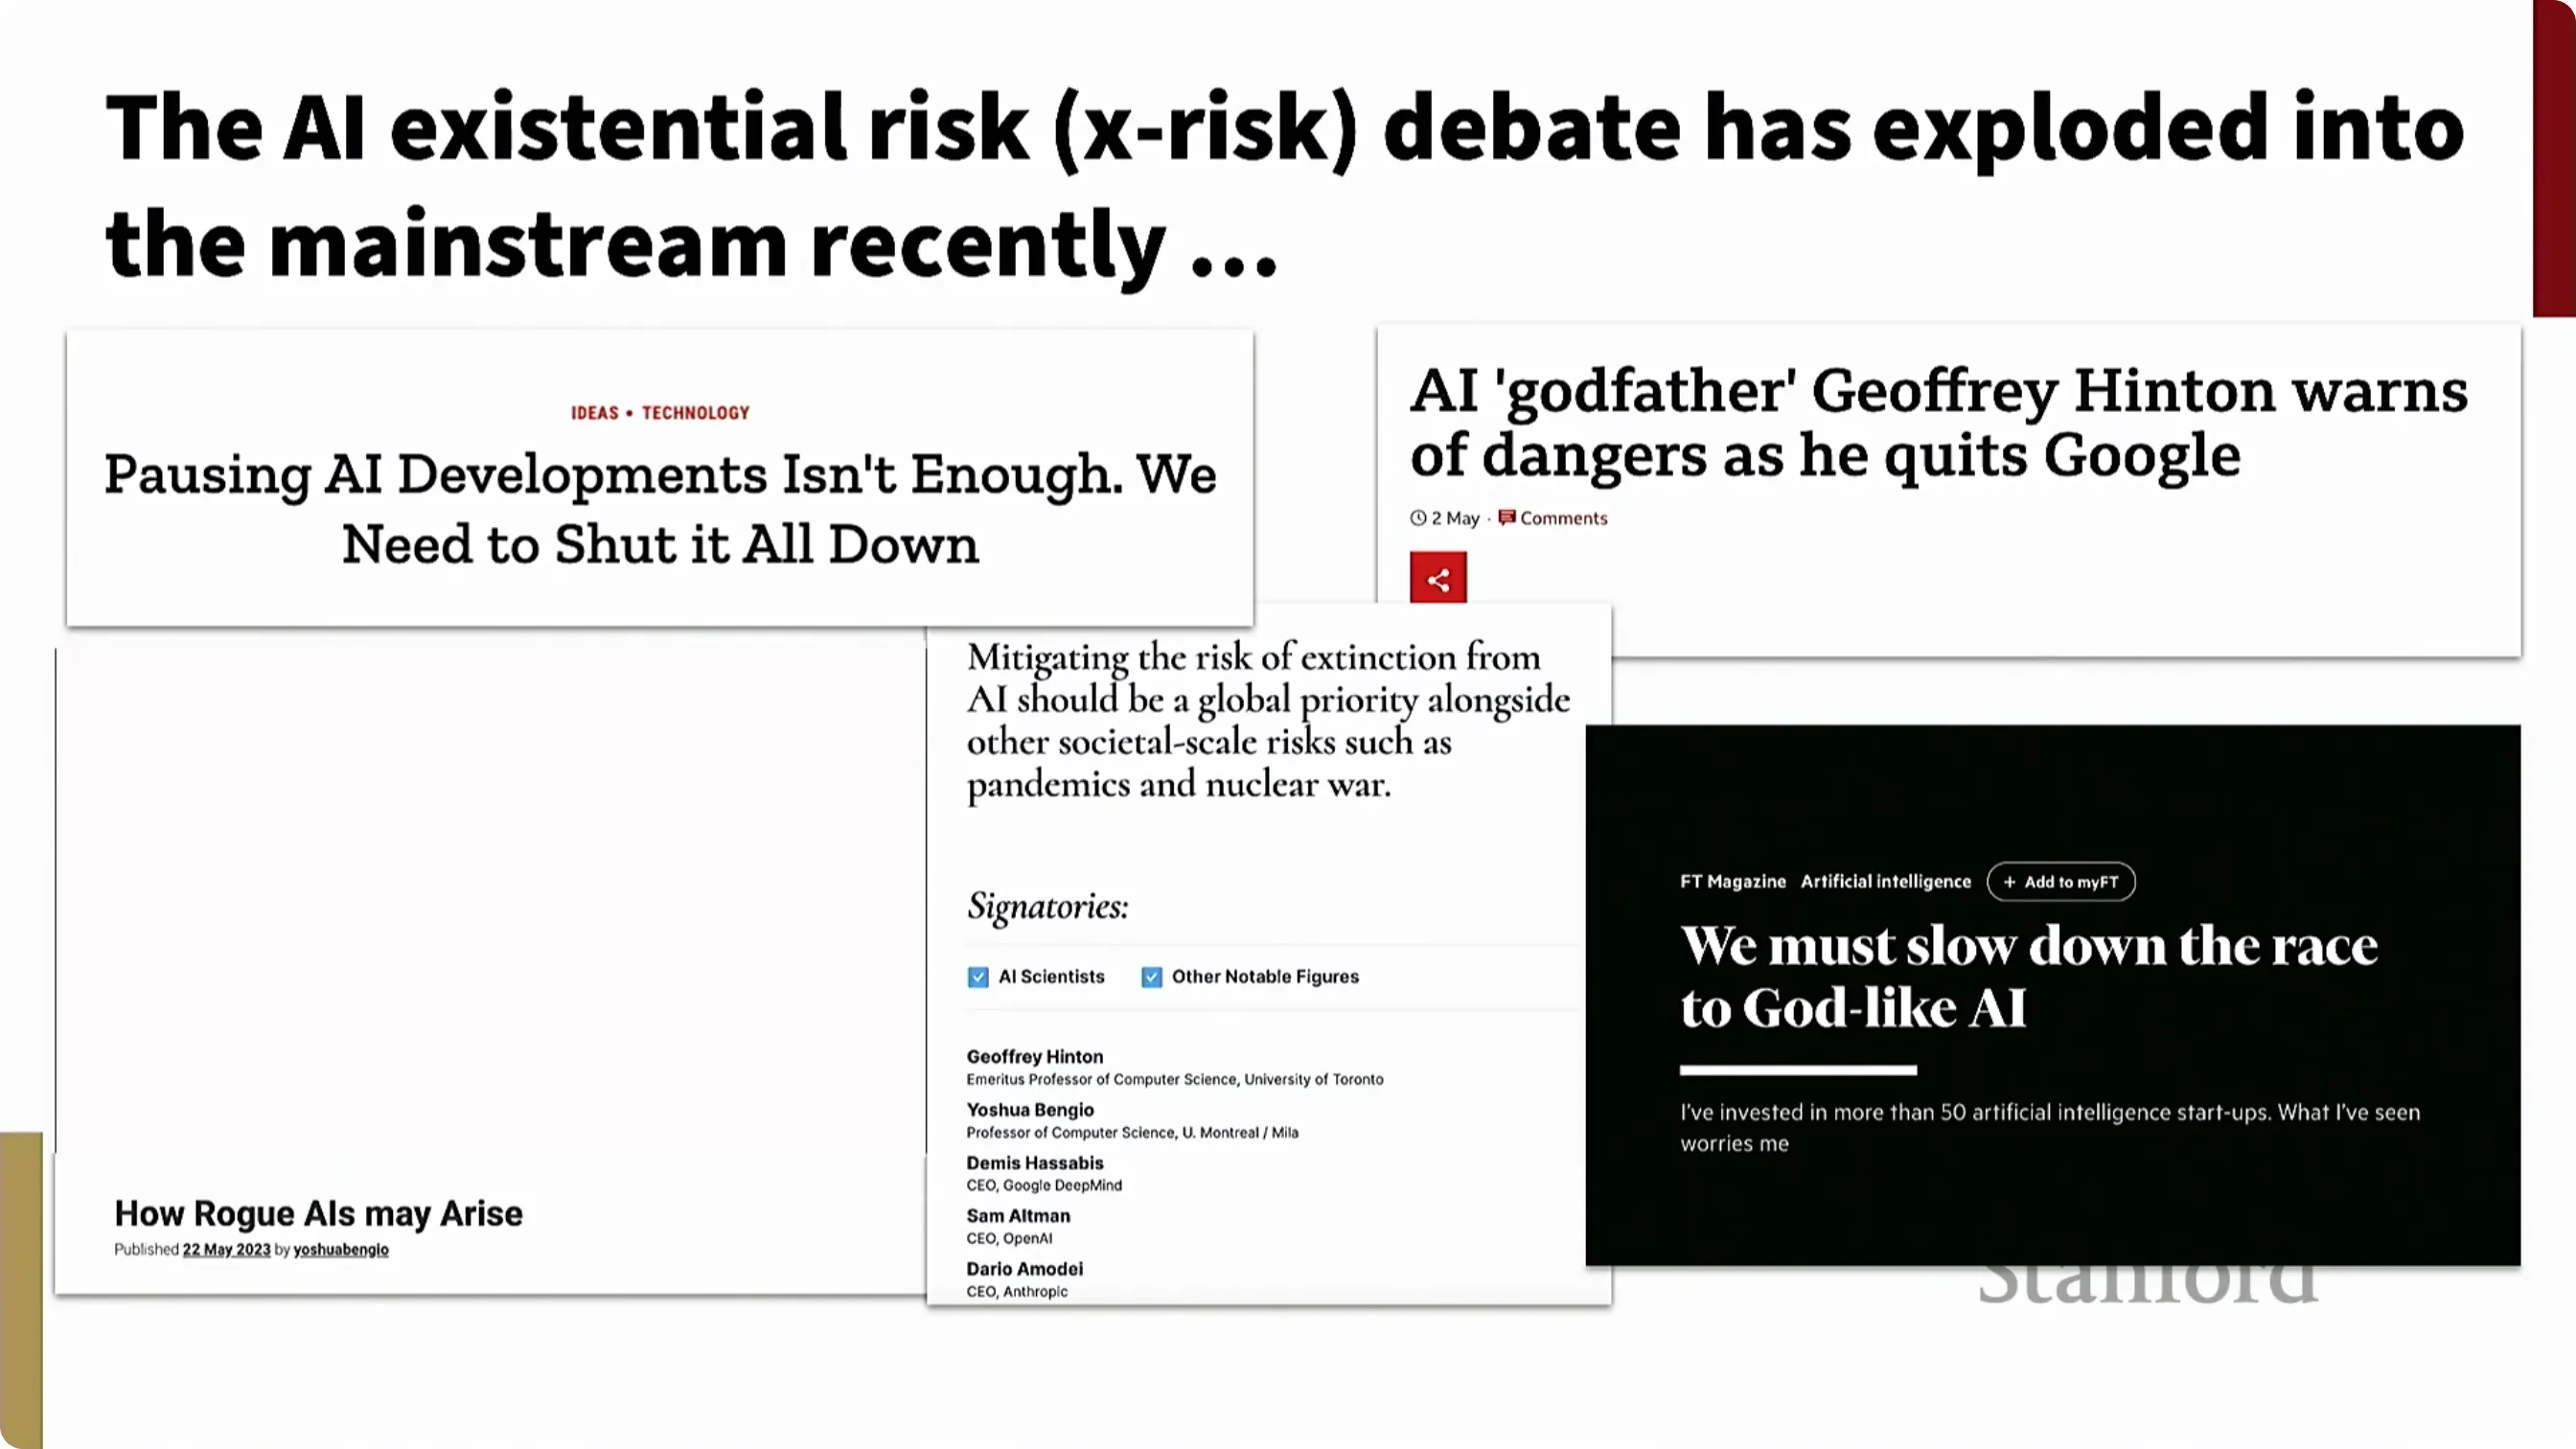
讲者说,这类担忧正随着"AI 存在风险(existential risk)"的讨论而进入主流,也部分促成了美英等国设立 AI 安全研究所。随之而来的是各种耸动标题 (参考时间: 01:08:27):
📷 关于 AI 存在风险的新闻标题
回到原视频 (01:08:27)
- 《暂停 AI 研发还不够,我们得把它全关了》
- 《失控 AI 可能如何产生》
- 《"AI 教父"Geoffrey Hinton 辞去谷歌职务并警告其危险》
- 《我们必须放缓迈向"神级 AI"的竞赛》
讲者明确表态:我个人不太把这些担心理会当真,而且反对的声音正在变多 (参考时间: 01:08:56)。他列出几位:
- François Chollet(Keras 的作者)认为:不存在任何 AI 模型或技术能构成人类的灭绝风险,即便把能力外推到很远的未来也一样;很多论证无非是"这是一种新技术,所以可能发生" (参考时间: 01:09:12)。
- Yann LeCun(Meta 的 AI 负责人)称存在风险话语是"精神错乱的(unhinged)",并指出其功利主义论证的缺陷:如果你说"人类灭绝"是无限坏的,那么任何非零概率乘以无穷大,都会大于世界上任何别的坏事——这不是一种能进行理性讨论的方式 (参考时间: 01:09:31)。
- 讲者提到 Timnit Gebru 等人主张:对存在风险的聚焦,分散了人们对眼前危害的注意力——偏见、劳工剥削、版权侵犯、虚假信息、权力日益集中、以及头部 AI 公司对监管的俘获(regulatory capture) (参考时间: 01:10:15)。
🖼️ 第 39 页幻灯片 · https://reports.weforum.org/docs/WEF_Future_of_Jobs_Report_2025.pdf
编者说明:本段涉及三位人物,字幕的语音识别都不太可靠,上文按上下文做了合理还原:François Chollet(Keras 作者,"architect of Keras");Yann LeCun(Meta 首席 AI 科学家、图灵奖得主,以批评"存在风险"话语著称);Timnit Gebru(以 AI 伦理与"随机鹦鹉"等工作知名)。具体措辞请以原始出处为准,细节存在不确定性。
7.4 真正该担心的:当下危害
讲者的立场由此清晰:我们不该担心存在风险,而该担心"有权力的人和组织会用 AI 做什么" (参考时间: 01:13:09)。他说这是一种反复出现的模式——社交媒体早期曾被寄望于"给全世界人民带来新的自由",但结果并非如此:新技术被有权力的人和组织俘获,他们掌握了新的技术选项;而 AI 与机器学习正越来越多地被用于监控与控制 (参考时间: 01:13:43)。
他列出一串正在发生的危害 (参考时间: 01:10:57):虚假信息、欺骗、幻觉、决策的同质化、对版权与人的创造力的侵害、大量碳排放、以及丰富人类实践的侵蚀。就 NLP 而言,危害包括生成冒犯性内容、生成不真实内容、助长虚假信息 (参考时间: 01:11:29)。
关于虚假信息,他觉得特别值得警惕的是:如果模型能很好地推理文本,它是否也能极具说服力地传播错误信息或观点? 这或许会带来高度个性化的虚假信息传播,比传统政治广告更能有效说服人——而且已有多个研究提示这正在成真 (参考时间: 01:11:56)。他还说:最糟的可能不是文字,而是视觉端的伪造(deepfake);在政治语境中,AI 生成的假图像可能造成重大影响 (参考时间: 01:12:41)。
🖼️ 第 40 页幻灯片 · https://reports.weforum.org/docs/WEF_Future_of_Jobs_Report_2025.pdf
7.5 萨根的告诫
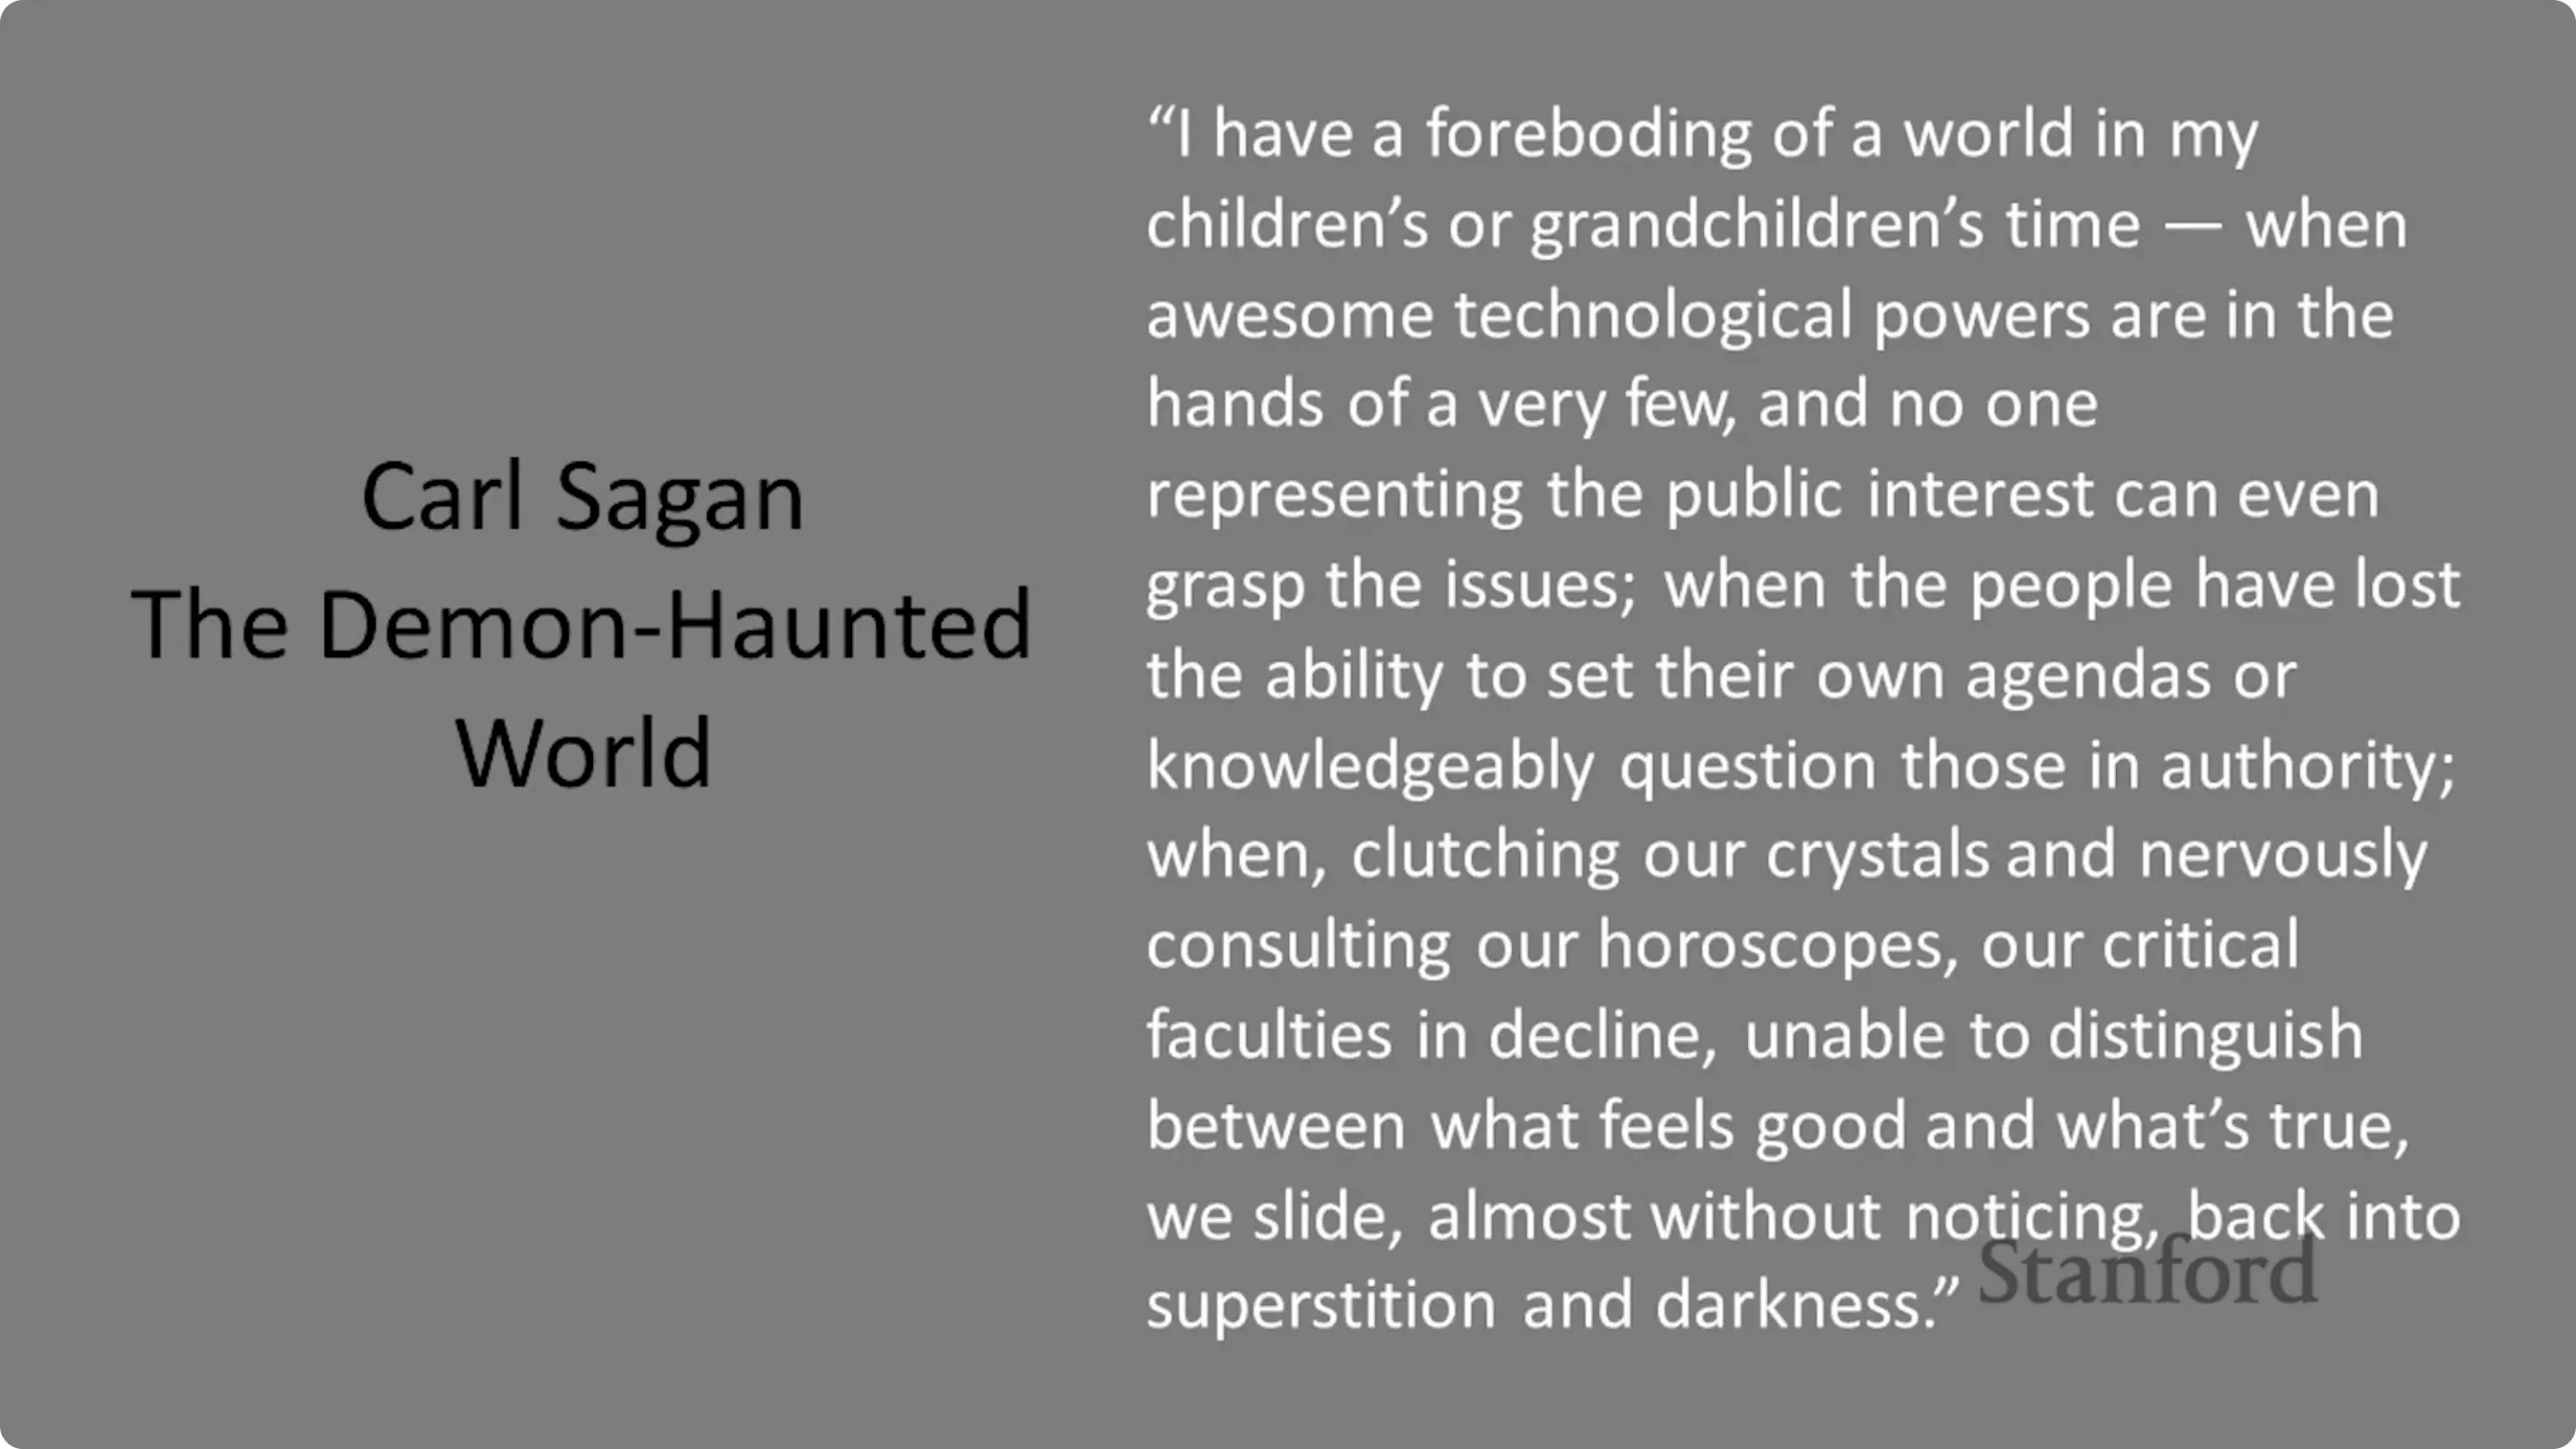
讲者用卡尔·萨根(Carl Sagan)收尾 (参考时间: 01:14:12)。他回忆自己年轻时看萨根主持的电视系列片《宇宙(Cosmos)》,非常喜欢;如今有了新一代《宇宙》,新版还请 Neil deGrasse Tyson 写了序。萨根还写过一本书《魔鬼出没的世界(The Demon-Haunted World)》,主题更贴近今天所谈。
📷 卡尔·萨根《魔鬼出没的世界》引文
回到原视频 (01:15:05)
他念了那段著名的引文,大意是:
"我预感,在我的子女或孙辈的时代,会出现这样的世界:强大的技术力量掌握在极少数人手中,没有任何代表公共利益的人能够理解这些问题;人民失去了设定自身议程、或有知地质问当权者的能力;当我们攥着水晶、紧张地查阅星座运势,批判能力衰退,无法分辨什么让人舒服、什么是真的时,我们会在不知不觉中滑回迷信与黑暗。" (参考时间: 01:15:05)
讲者认为,环顾今日的美国与世界许多地方,这反而更像是人类真正面临的风险 (参考时间: 01:15:47)。这也正是教育(斯坦福等机构努力提供的)之所以重要、值得珍视的原因,也是开源、以及支持知识广泛传播等事物之所以重要的原因 (参考时间: 01:16:00)。
他以"谢谢大家"结束,掌声响起,学期落幕 (参考时间: 01:16:16)。
graph TD
  A["AI 的未来:人们担忧什么?"] --> B["就业:会被取代吗?<br/>——历史上此忧长期存在,至今未成真"]
  A --> C["财富集中:钱会流向少数巨头?<br/>——讲者认为更值得担忧,但属政治问题"]
  A --> D["存在风险:奇点 / 灭绝?<br/>——讲者不看好,认为论调整体"错乱""]
  A --> E["当下危害(讲者的落点)<br/>偏见、剥削、版权、虚假信息、<br/>监控与权力集中、认知退化"]
  E --> F["应对:教育 + 开源 + 知识广泛传播"]
附:参考与延伸阅读
(本书材料里没有外部链接;正文中的链接均为撰写时补充。)
🖼️ 第 45 页幻灯片 · Open research questions
已知疑点
为对读者负责,下面把本讲重构中不确定或存疑的地方集中列出。凡涉及判断的,都写明依据或时间点。
🖼️ 第 46 页幻灯片 · Lecture Plan
-
课程官方幻灯片与视频不匹配。 本讲视频是 Christopher Manning 的结课讲座《NLP, Linguistics and Philosophy》(Lecture 18, Spring 2024),但随材料提供的幻灯片(
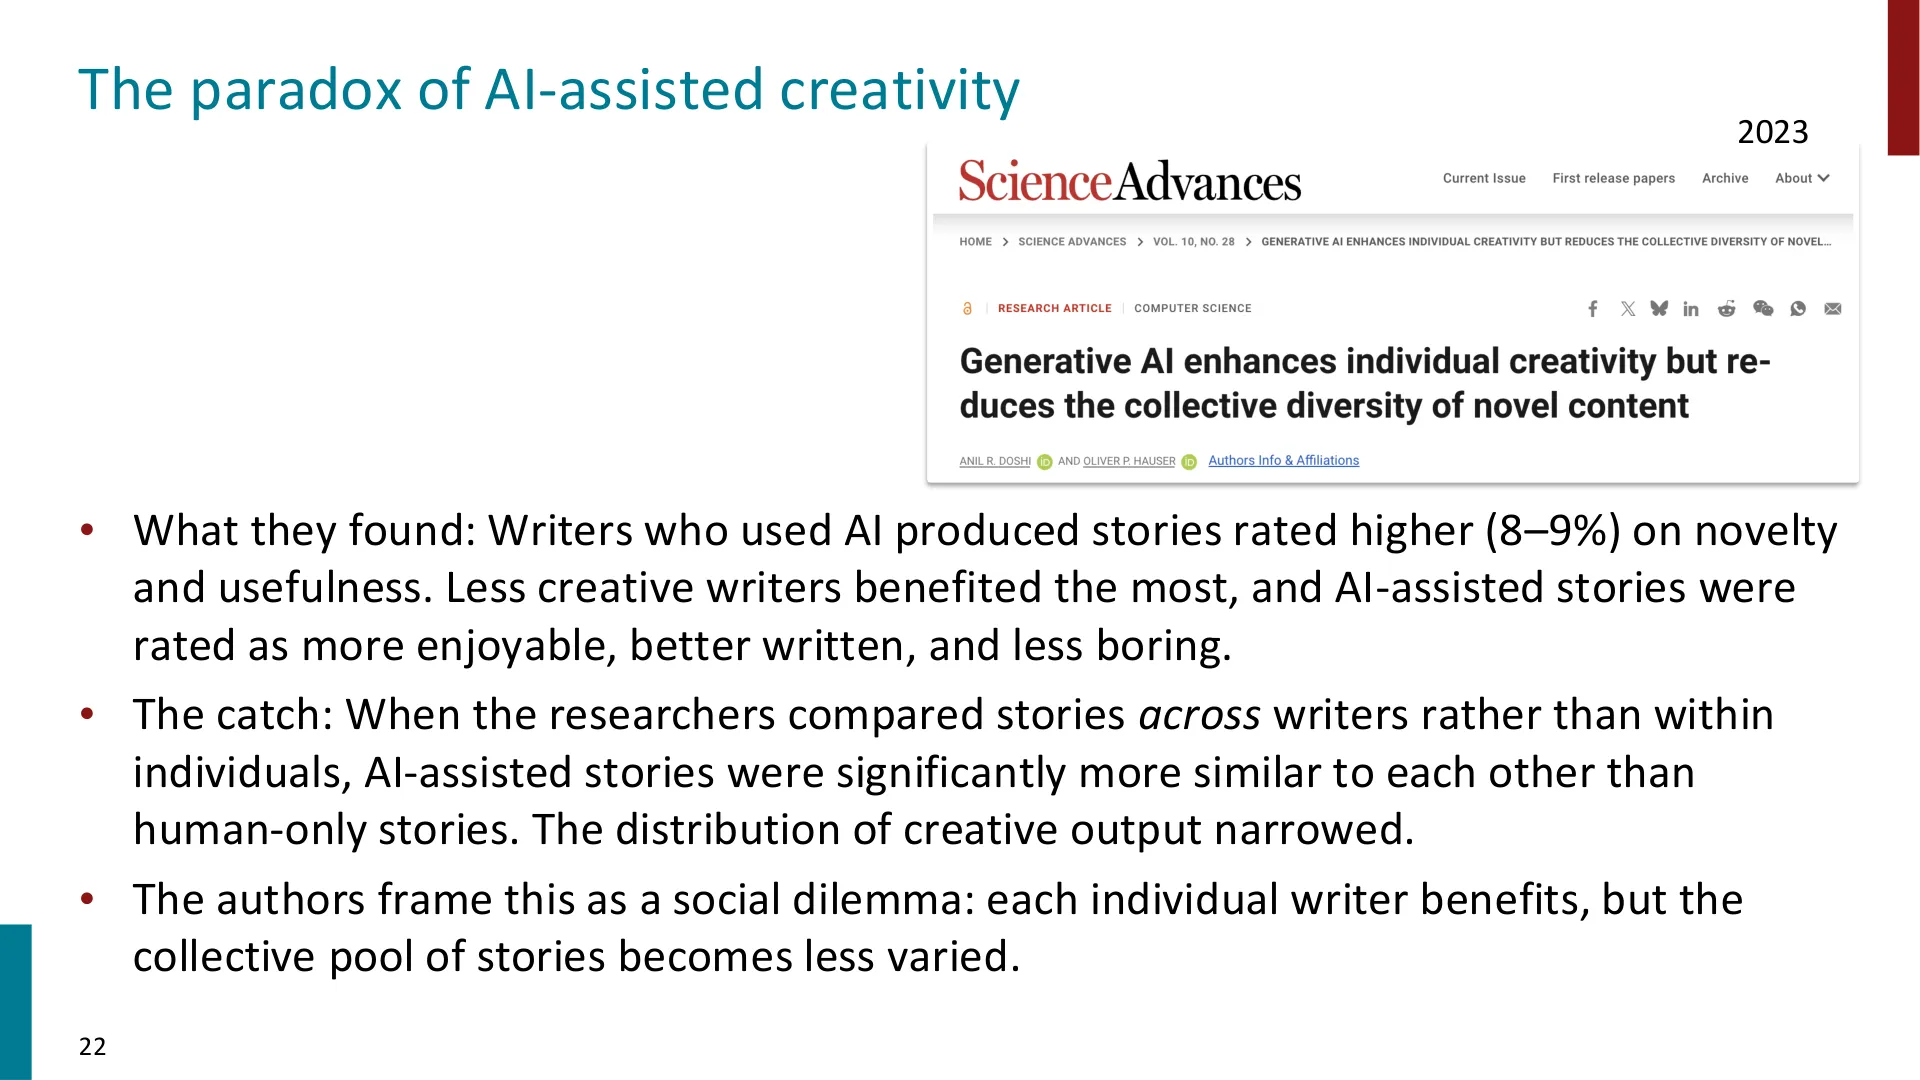
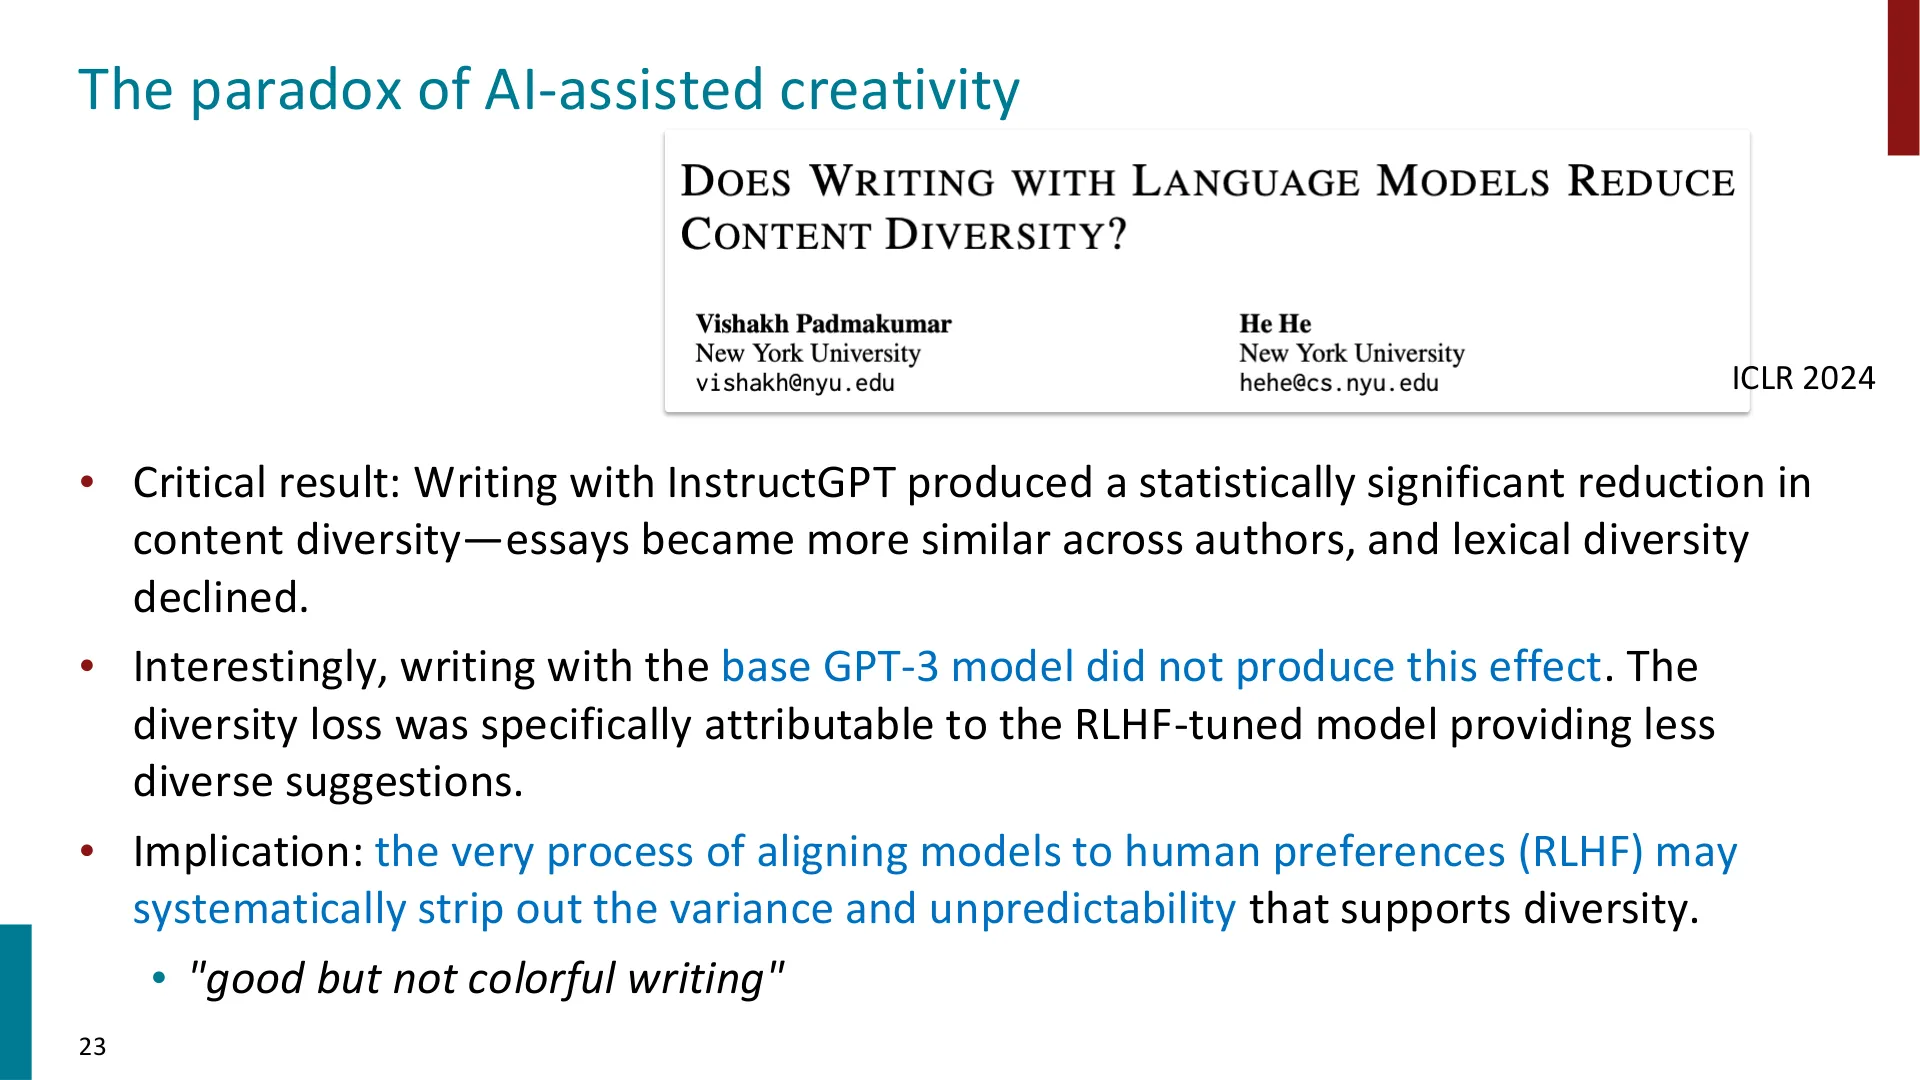
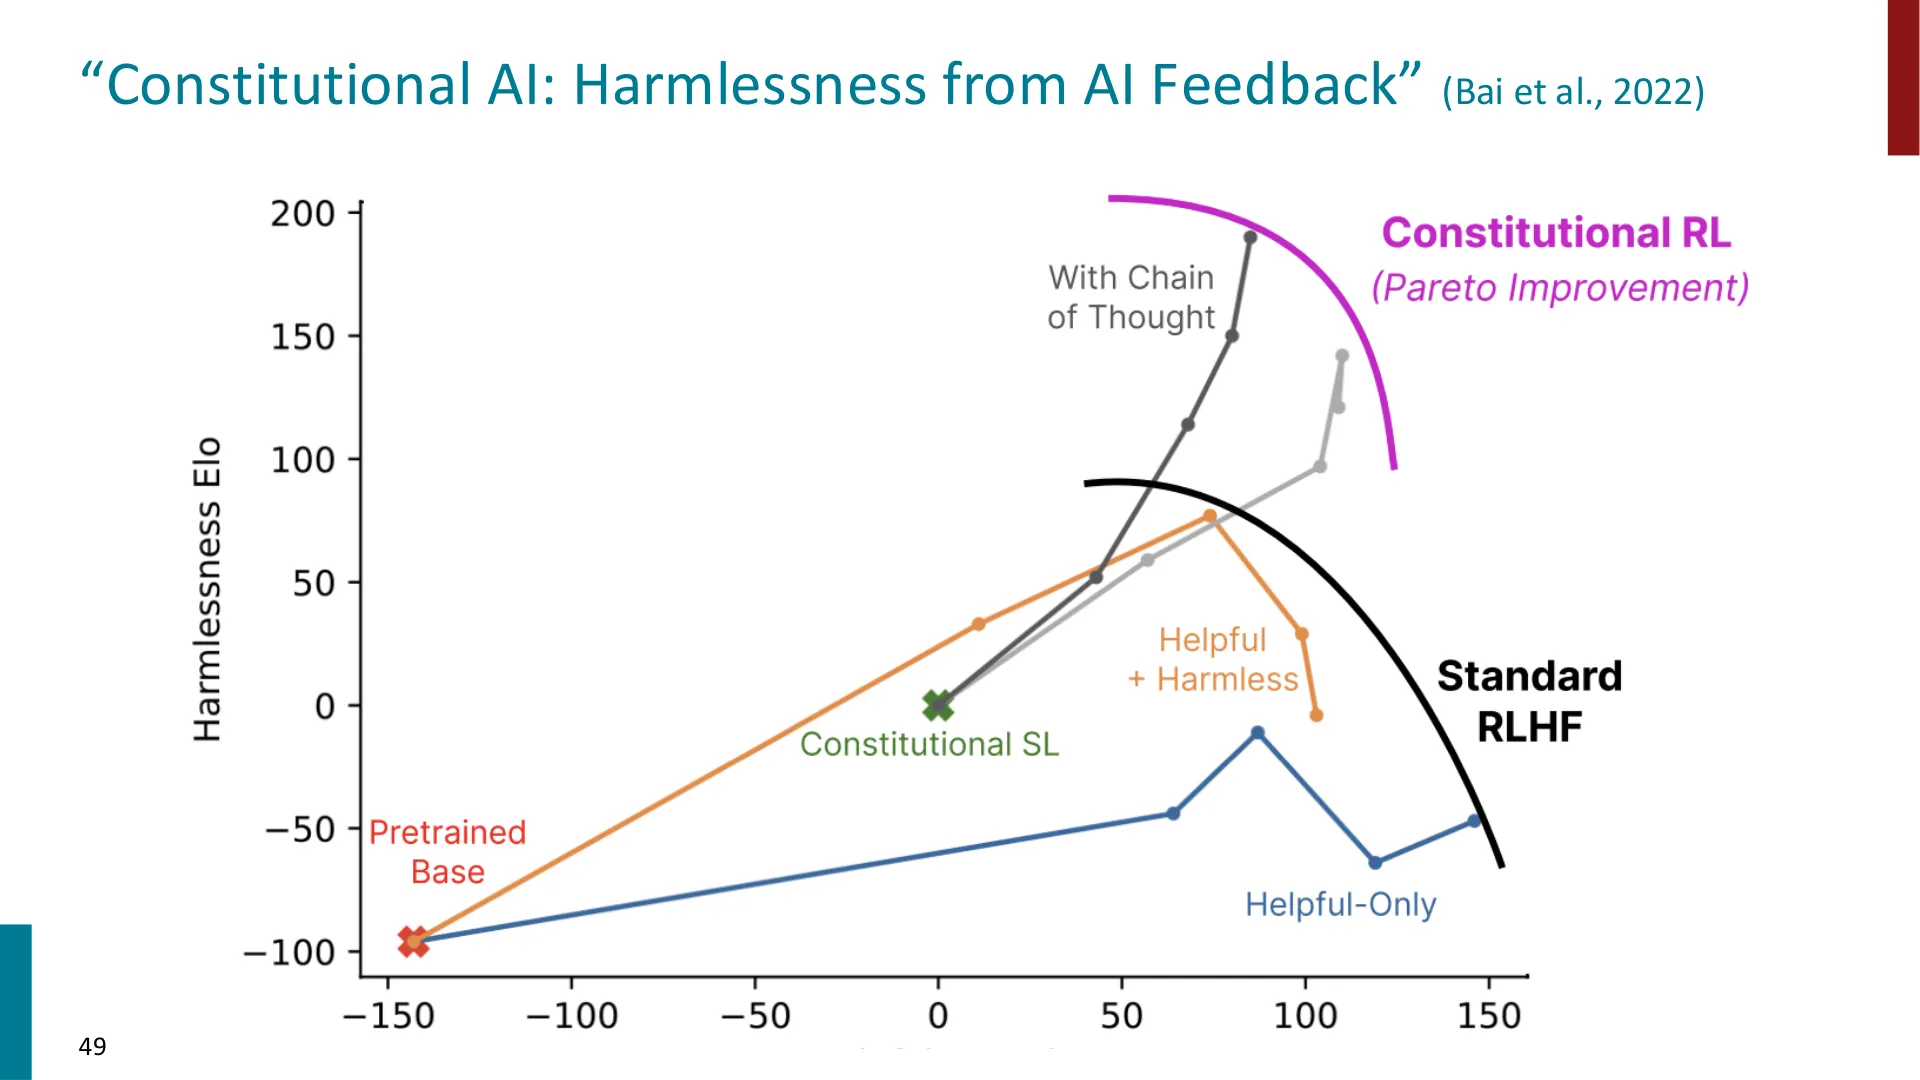
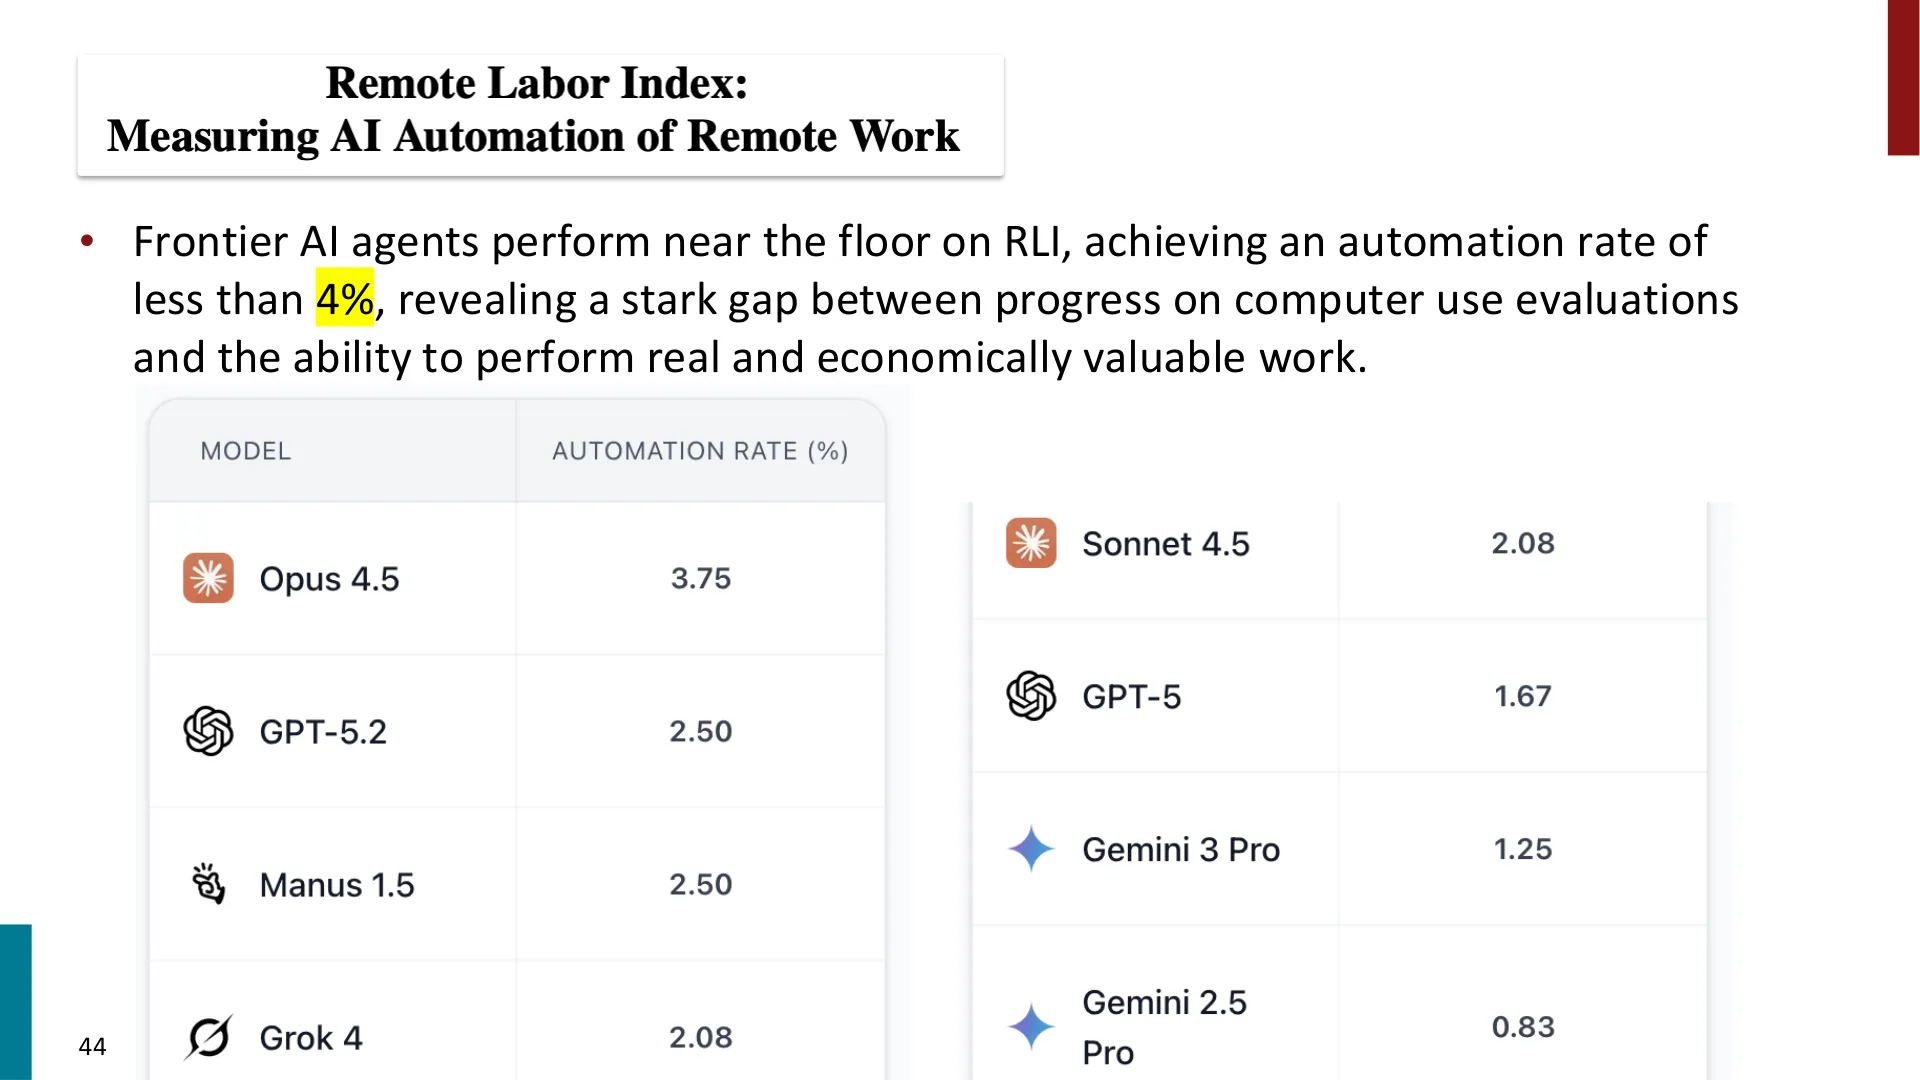
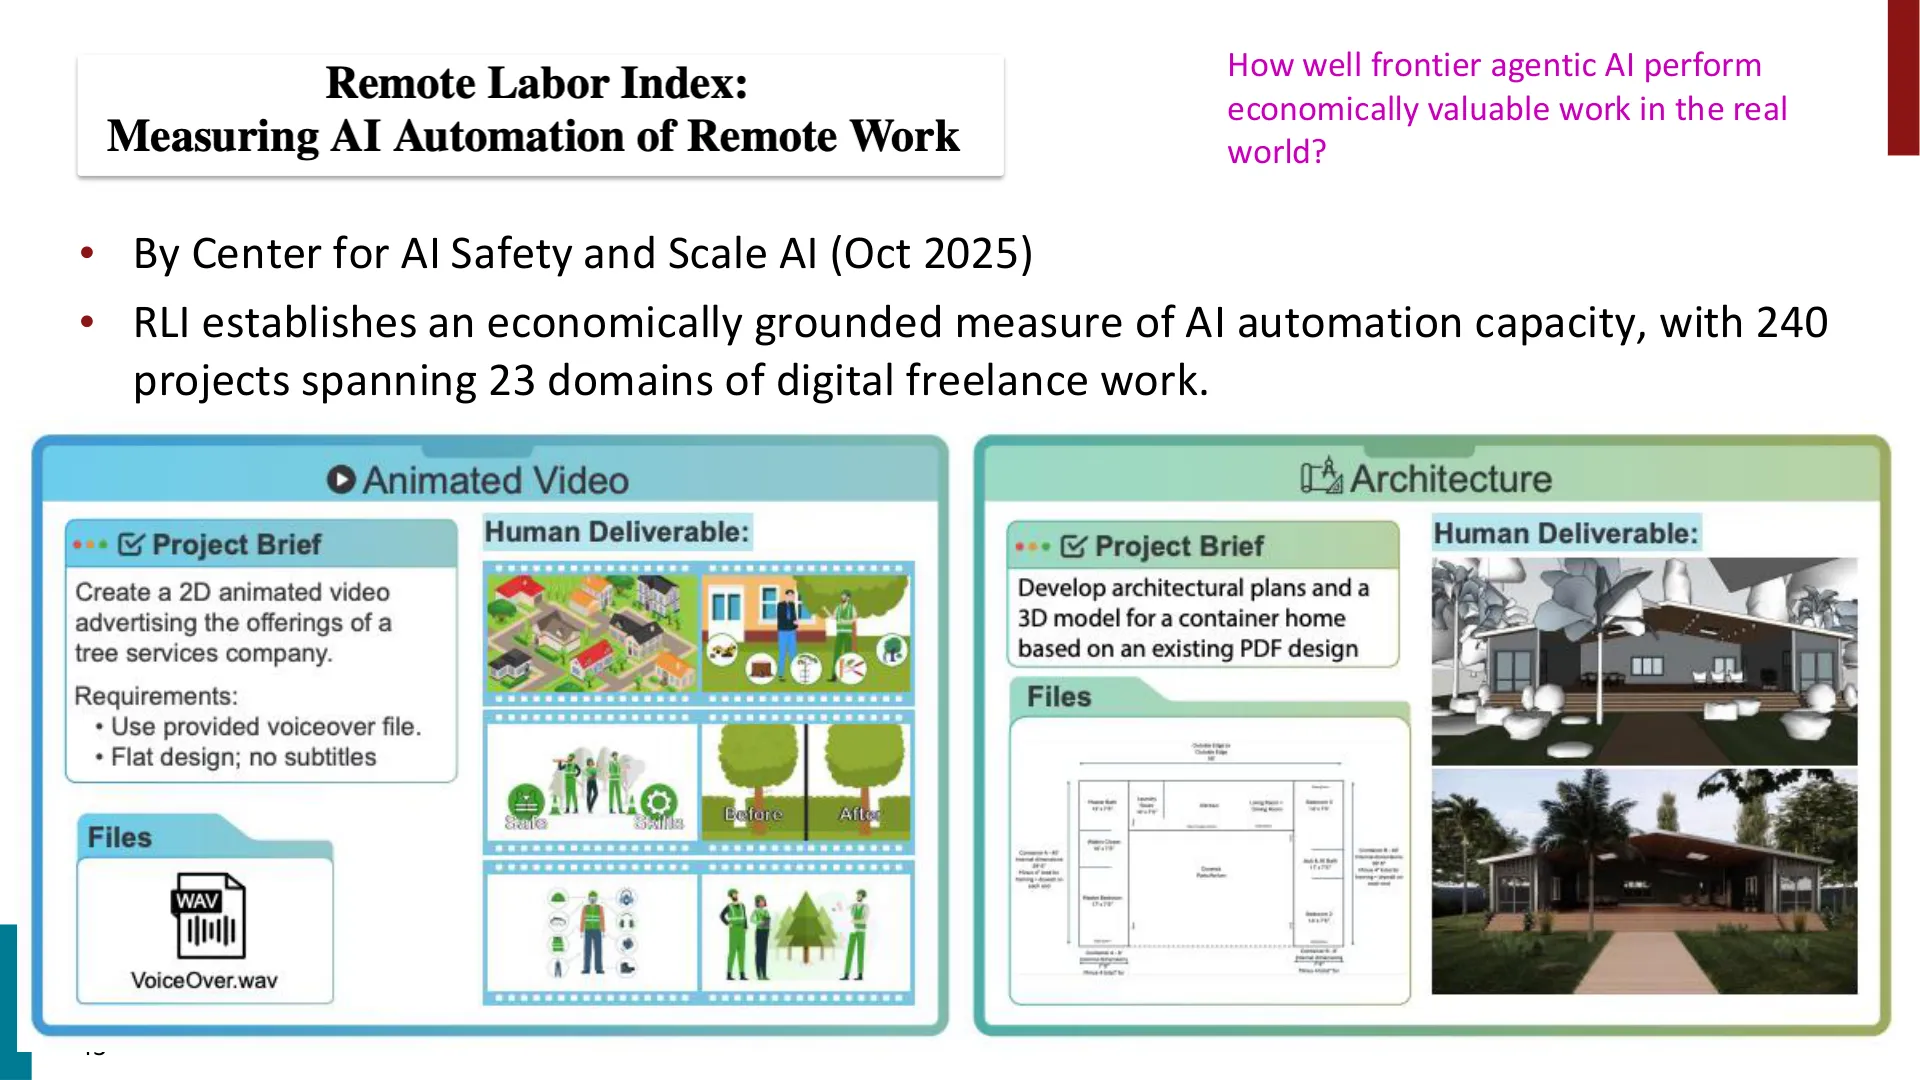
course/slides_text.md、cs224n-2026-lecture16-impact-on-humanity.pdf)是 Yejin Choi 的 Lecture 16《AI's impact on humanity》(内容为幻觉、AI 辅助创造力的悖论、劳动力影响、价值对齐)。两者是不同的讲次。因此本书没有把该幻灯片按"课堂展示"插入正文——若强行对齐,会在 Manning 的时间锚点上渲染出与画面不符的图片。正文所有画面均按字幕中讲者"如图所示/这张图/这里"的实际提示,用SCREENSHOT:标注。 -
若干专有名词的语音识别(ASR)存在不确定性,本书按上下文做了合理还原,读者引用时请核对原始出处:
- "Horus Hurst" → 应为 Horace He(关于 GPT-4 与 Codeforces 污染的推文作者);
- "franois charal … architect of caras" → 应为 François Chollet("architect of Keras");
- "Joel Pino who … meta AI leader" → 应为 Yann LeCun(Meta AI 负责人,以批评"存在风险"话语著称),但此还原把握中等;
- "Tim n jeu" → 应为 Timnit Gebru;
- "caraman and tersi" → Kahneman & Tversky;"vilhelm Von Hot" → Wilhelm von Humboldt;"viken Stein" → Ludwig Wittgenstein;"John barwise" → Jon Barwise;"Norbert weer" → Norbert Wiener;"Frank Rosen blats" → Frank Rosenblatt;"montigue" → Montague;"tas(s)i" → Tarski;"Jr fth" → J. R. Firth;"percy leang" → Percy Liang;"Luke zettel moer" → Luke Zettlemoyer;"Ethan mik" → Ethan Mollick;"dequa" → Dell'Acqua;"danho" → Daniel Ho;"Andre Kathy" → Andrej Karpathy;"Carl San" → Carl Sagan;"Neil degrass Tyson" → Neil deGrasse Tyson。
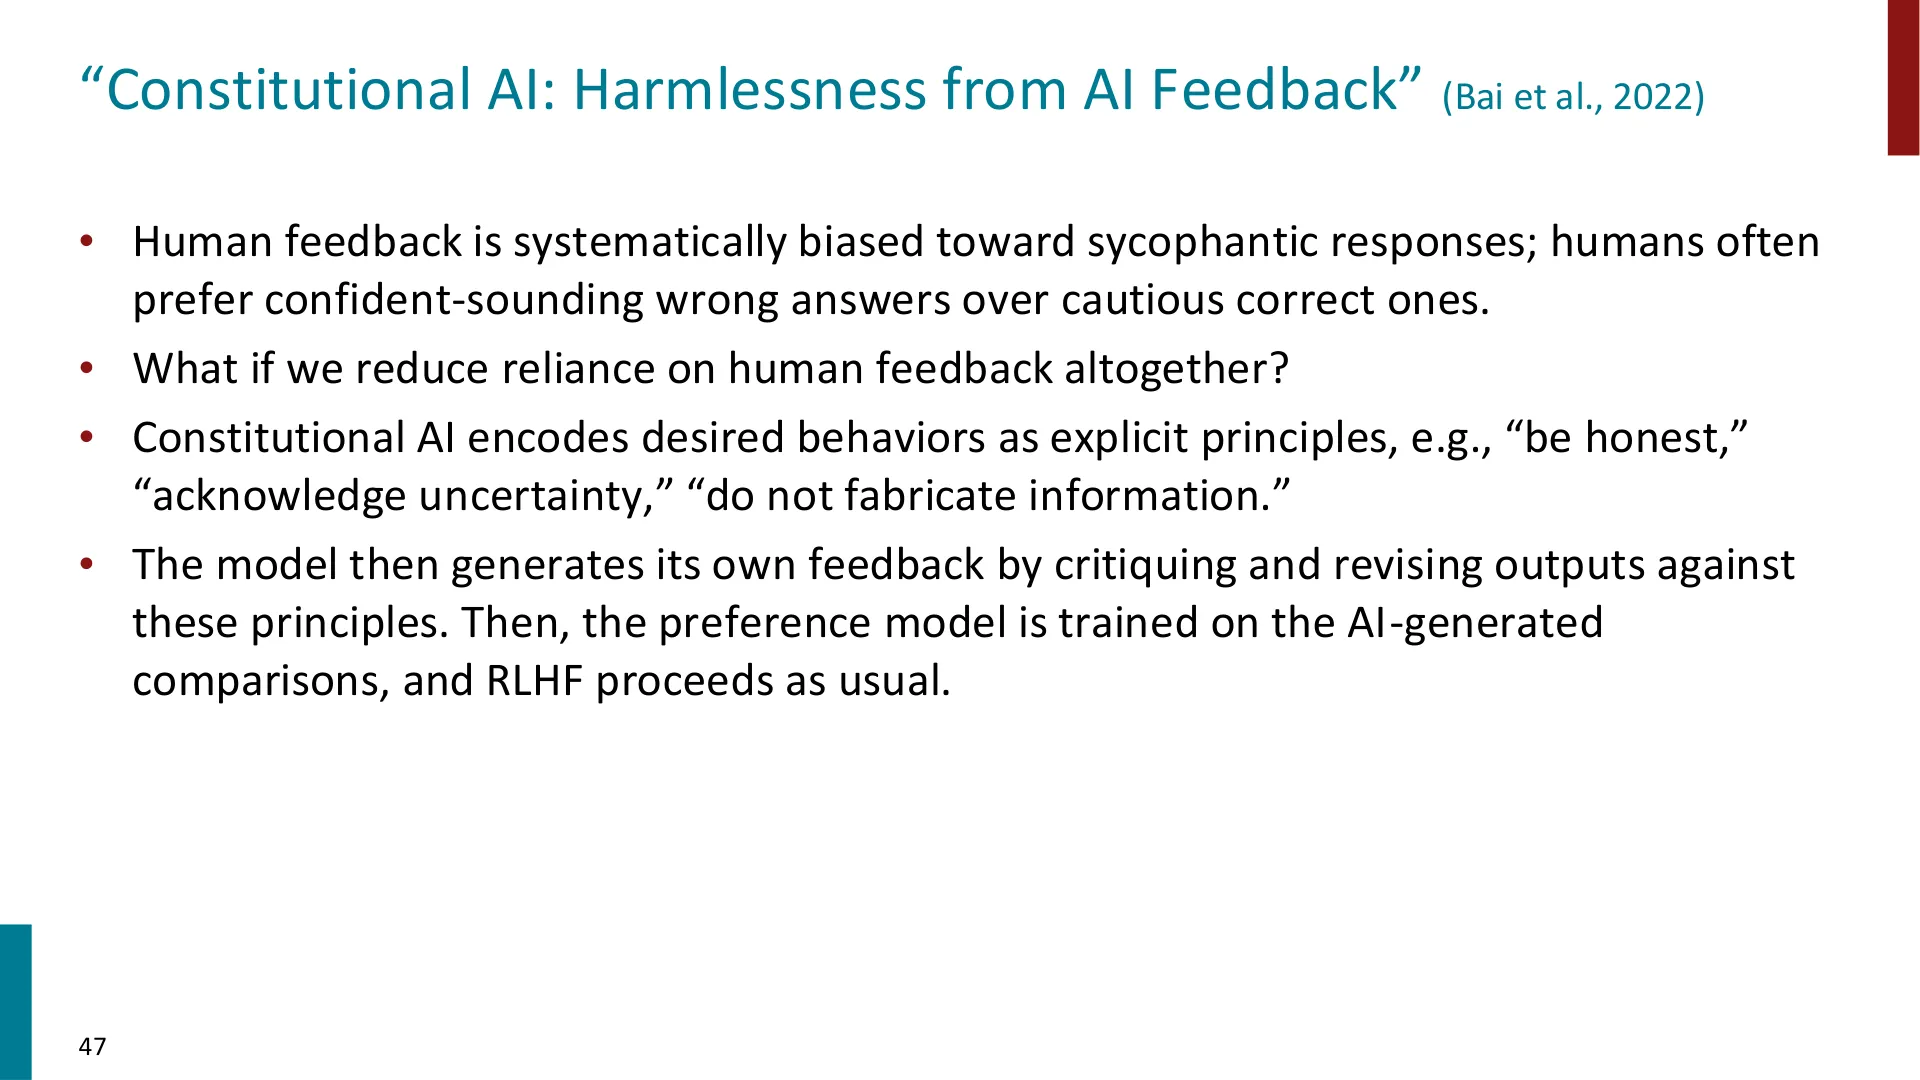
🖼️ 第 47 页幻灯片 · “Constitutional AI: Harmlessness from AI Feedback” (Bai et al., 2022)
-
一处年份。 讲者说 Karpathy 的博客写于"2016 年、当时他还是这里的研究生"。该文通常被记为 2015 年发表,属口误范畴;正文按"古早"处理,未改其意。
-
十四行诗的转写不完美。 原字幕在誊写这首诗时有明显错字(如 "net set")。上文的英文版本是按听感做的最小化规整,可能仍有与 ChatGPT 实际输出不一致之处。押韵、音步的判断依据讲者的口头评论("behold/unfold、grasp/clasp")。
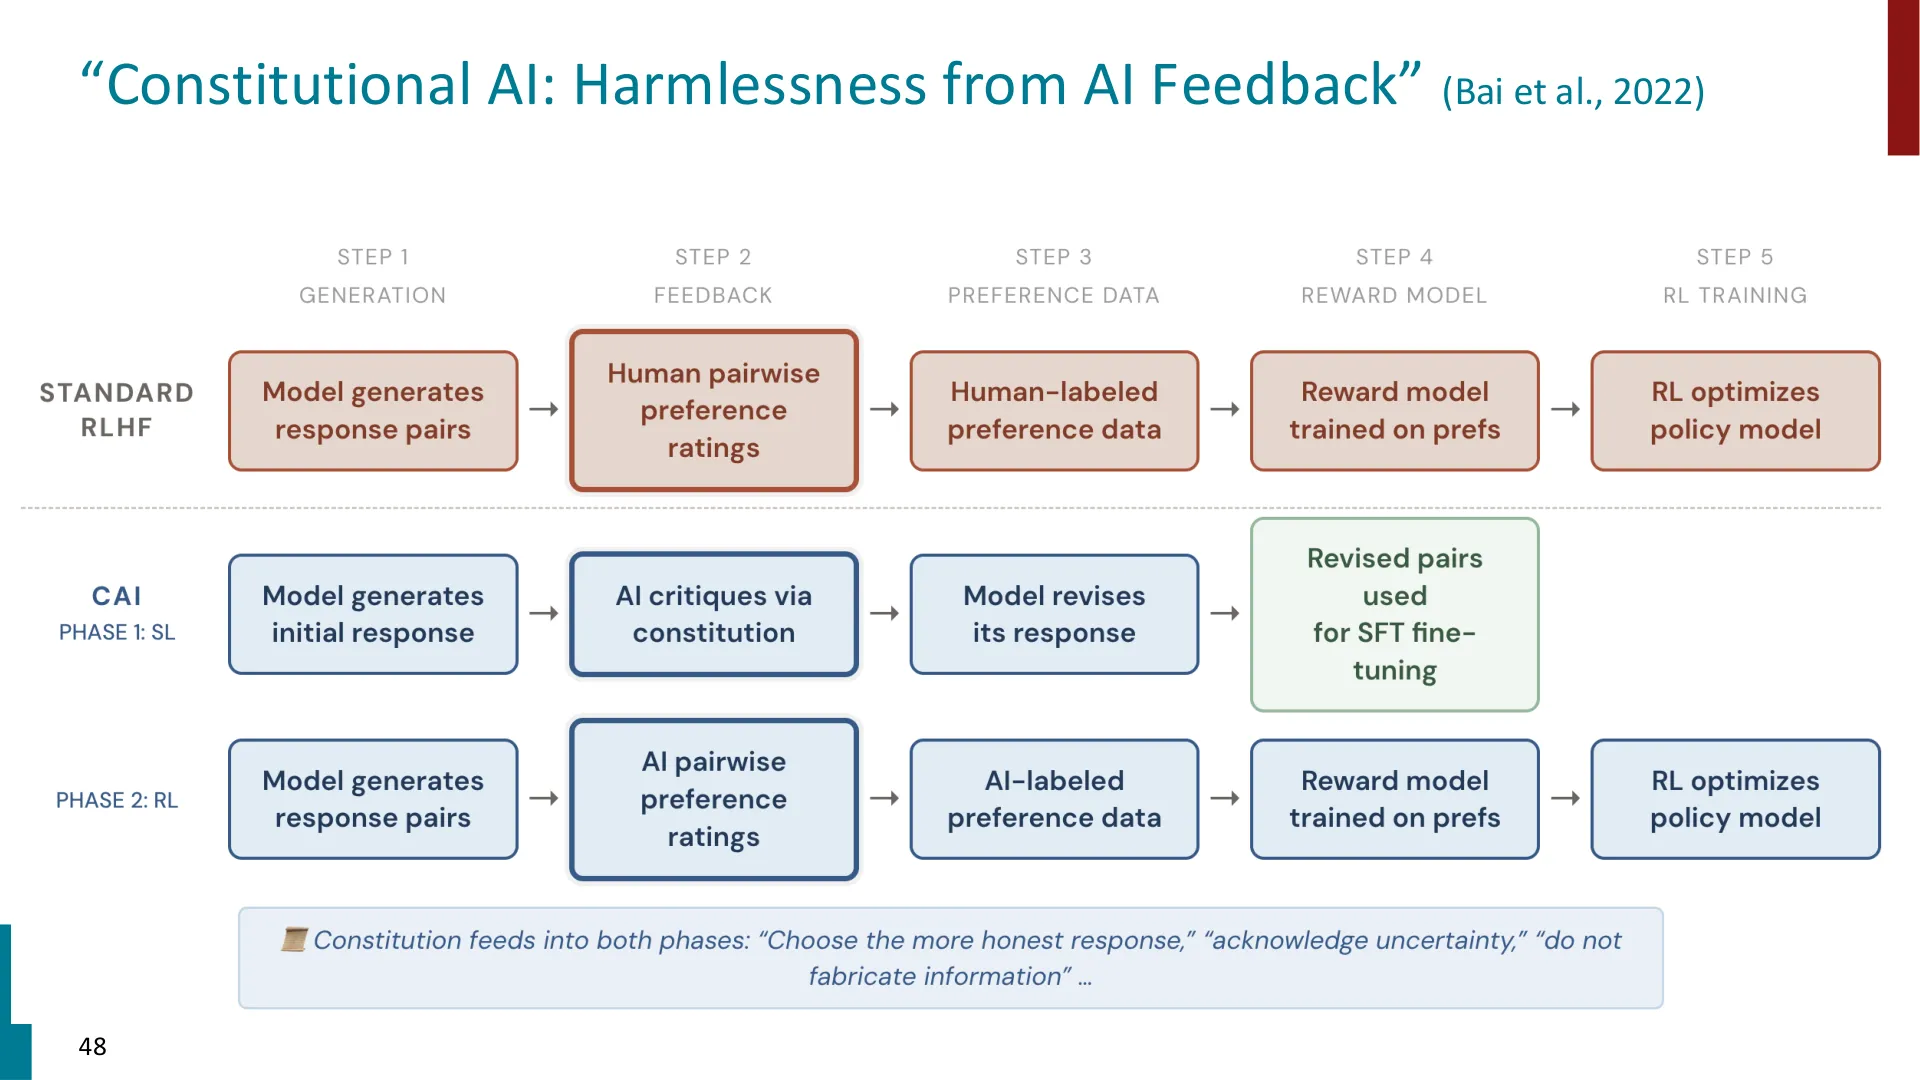
🖼️ 第 48 页幻灯片 · 48
-
"System 1 / System 2"的归属。 讲者称由"caraman and tersi"(Kahneman & Tversky)提出。双系统理论的命名与普及主要归功于 Kahneman(及其同事),Tversky 是长期合作者;正文按讲者原话归给两人,并在编者说明中作了澄清。
-
几处数字(均按讲者口述记录,未另查原文核对):BCG 实验的 12% / 25% / 40%;法律 NLP 幻觉率"每六个问题里一次";达特茅斯—BCG 无关;IDC 的 160 亿 → 1430 亿美元;麦肯锡的 4 万亿美元;GPT-4 创意写作"差 3 到 10 倍"。若需引用,建议以原始论文/报道为准。
-
"格雷戈里式智能"的命名出处。 正文在编者拓展中指出它取自心理学家 Richard Gregory。这一对应关系为通行解读,但讲者本人在课堂上并未点明该命名典故,属编者补注。
🖼️ 第 49 页幻灯片 · 49
- 许可与版权。 本书未取得课程讲义/幻灯片的完整许可文本,故开头信息块只给出课程主页链接与"版权归课程及讲者所有"的通用声明,未擅自标注某个具体的 CC 许可名。如需正式引用,请以课程主页发布页的许可说明为准。
(若后续核对发现新问题,应补充到本节;本讲并非没有疑点,故不写"未发现明显疑点"。)
附录:课堂未展示的幻灯片
🖼️ 第 2 页幻灯片 · Lecture Plan
🖼️ 第 44 页幻灯片 · 44
🖼️ 第 43 页幻灯片 · 43
🖼️ 第 42 页幻灯片 · 42
🖼️ 第 41 页幻灯片 · 41