第17讲 · 多模态深度学习
Stanford CS224N: Natural Language Processing with Deep Learning|2023 春季|第 16 讲
对应讲次:第17讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
编者说明:本讲是一场“特邀报告”,讲者 Douwe Kiela 是 NLP 与多模态方向的研究者。字幕中主持人的引荐把名字听成了 “Dao Aquila / Dara”,以视频标题给出的 Douwe Kiela 为准。讲者在开场自嘲:“我知道大家来上课是因为有出勤分,不是真的冲着我来的”——这属于课堂幽默,保留一句以存其神。
导览
这一讲,老师想回答的核心问题是什么?
Douwe Kiela 自己给这一讲划了范围:这是一门 NLP 课,所以“多模态”里他会以文本为中心,另一模态主要聚焦图像,否则“要讲好几个小时都讲不完”。他真正想串起来的问题链是:
- 什么叫“多模态”?它到底指什么?
- 我们为什么要在乎多模态?——本讲给了三条理由(人类理解世界的方式 / 互联网本身是多模态的 / 文本数据快用完了)。
- 多模态模型怎么搭?——绕不开两个核心积木:特征(features) 和 融合(fusion)。
- 从早期模型到当代大模型,这条线是怎么一步步演化的?
- 怎么评估一个多模态系统是真的会多模态推理,而不是在“作弊”?
- 除图像之外,还有哪些模态(语音、视频、仿真环境、3D、甚至气味)?
难点在哪、为什么容易卡住?
- 最容易卡住的一步是第 3 问里的融合:两个向量 $u$ 和 $v$ 怎么合并,“听起来很容易,其实组合方式非常多”,而多模态文献的绝大部分讨论其实就是围绕“怎么融合最好”。“早融合 / 中融合 / 晚融合”这条谱系是理解后面所有模型的地图。
- 第二个坑是评估陷阱:VQA 数据集早期版本里,图像根本不起作用——只要对“多少 / 几个”类问题统统回答“2”,就能拿到约 70% 的准确率。这提醒我们:模型变强 ≠ 基准变好,很多时候是基准太烂。
读者可能带着什么疑问进来?(① 老师真正提出的问题 / ② 编者预判的读者疑问,两组分开)
① 老师真正提出的问题: - 多模态到底指什么?为什么现在这么热? - 特征怎么抽、模态怎么融合? - CLIP、FLAVA、Flamingo、BLIP-2 这条演化线是怎么走的? - 怎么判断一个多模态模型是不是真的“看懂了”? - 语言能不能还原成视觉?视觉能不能还原成语言?
② 编者预判的读者疑问(编者预判): - “对齐两个模态的向量”具体在数学上是在做什么? - 为什么讲者反复强调 “frozen(冻结)”?冻结到底冻的是什么? - 对比式(contrastive)和生成式(generative)路线,怎么选? - “把音频转成频谱图再当图像处理”,这不是多此一举吗?
本讲路线。
老师先给一个 多模态 概念与动机的开场,接着快速扫一遍早期模型(词级别 → 句子级别 → GAN),然后深潜到特征与融合这两块核心积木,再用一条几乎按年代排列的时间线,从 CLIP 一路讲到 FLAVA → 生成式模型 → Flamingo → BLIP-2 与多模态思维链;之后单独用一节讲评估,最后把视线扩展到语音、视频、仿真、3D、气味等其他模态,并以对未来的预测收尾。
图:本讲整体脉络(编者据讲者大纲整理)
mermaid
graph TD
    A[多模态:定义与动机] --> B[早期模型: 词→句→GAN]
    B --> C[核心积木: 特征 + 融合]
    C --> D[对比式/晚融合: CLIP → ALIGN → LAION]
    D --> E[中/早融合: BERT 家族 ViLBERT/LXMERT/MMBT/UNITER]
    E --> F[FLAVA: 一模型通吃]
    F --> G[生成式: SimVLM → CoCa → Flamingo → BLIP-2]
    G --> H[评估: COCO/VQA/GQA/CLEVR/Winoground]
    H --> I[其他模态: 语音/视频/仿真/3D/气味]
    I --> J[未来预测]
1. 开场与背景
(参考时间: 00:00:05)
本节由 Christopher Manning 引荐。他用几句话勾勒了讲者的背景:Douwe Kiela 来自荷兰,早年学过逻辑,在 Meta(前 Facebook)的 FAIR 研究组工作多年,参与过检索增强生成(RAG)等想法;之后在 Hugging Face 待过一段时间,开始对多模态模型产生兴趣——这正是今天要讲的主题。
编者拓展|RAG 是什么:检索增强生成(Retrieval-Augmented Generation,RAG)把“检索”与“生成”拼在一起:先从外部知识库检索出相关文档,再让语言模型基于检索到的内容生成回答。它的动机是给模型“外挂”一份可更新的知识,减少凭空杜撰。讲者在文末“未来预测”里也会再把它拎出来,并指出 RAG 本身也可以是多模态的。
讲者上台先开玩笑缓和气氛,然后正式开始。
2. 多模态:定义与动机
2.1 “多模态”其实定义模糊
(参考时间: 00:01:40)
讲者开门见山:“多模态”这个概念本身是定义不清的(ill-defined)。查字典,它表示“拥有或涉及若干个 mode / modality / maxima(众数)”。而 “mode” 这个词:
- 可以是非常通用的“类型 / 方式”;
- 也可以是非常精确的统计学含义——概率分布的众数(mode)。
所以,视你读的是哪篇论文,人们有时真的在用这个统计学含义,有时则在用一个很宽泛的“信息类型”含义。宽泛含义下,一种模态可以是图像、语音信号 / 音频,甚至嗅觉等。
本讲的范围被讲者收窄为:以文本为主视角,另一模态主要看图像。
2.2 为什么要在乎多模态
(参考时间: 00:02:50)
讲者给了三条理由:
- 忠实性 / 贴合人类认知(faithfulness):人类理解世界的方式本身就是多模态的——我们用视觉、听觉等多种感官综合(synthesize)信息,而不是只用其中一种。
- 现实需求:互联网就是多模态的。你几乎找不到只有纯文本或纯图片的内容,通常是多种模态的组合。
- 数据算力的现实:语言模型的文本数据快用完了。想让数据侧的 scaling law 继续下去,一个办法是把其他模态都用上——“如果你让你的语言模型也看遍世界上所有的猫视频,它对‘猫’这个概念的理解会好得多。”
讲者因此判断:多模态正是当前基础模型(foundation model)浪潮的主战场之一。
编者说明:这里“文本数据快用完了”指高质量、可获取的文本语料在互联网上的边际增长趋缓,而图像 / 视频 / 音频等模态的数据总量远大于文本,成为继续扩大预训练规模的新来源。
2.3 一个佐证:麦格克效应
(参考时间: 00:04:15)
讲者用 麦格克效应(McGurk effect) 来直观说明多模态知觉:同一段音频,如果配上不同的口型视频,人听到的音节会发生变化。
📷 麦格克效应演示:同一音频配不同口型
回到原视频 (00:04:21)
他说:视频里的人说 “ba”,如果你只听音频,你听到的是 “ba”;但如果把视频换成口型在说别的,用完全相同的音频,你会听到另一个版本。这从根本上说明:人类知觉不是“单通道”的,视觉信息会改写听觉判断。
编者拓展|麦格克效应:1976 年由 McGurk 与 MacDonald 报告。经典演示是:给被试播放辅音 “ba” 的声音,同时展示发 “ga” 的口型,被试普遍报告听到的是第三个音 “da”。它揭示了大脑在做多感官整合,且视觉(唇形)会“压过”听觉线索。教学演示常因播放设备 / 观看条件不同而效果不一,这也是讲者现场说“你得信我”的原因。
2.4 多模态能做什么
(参考时间: 00:05:05)
有了多种模态,可以做很多事。讲者列举了几类典型任务:
- 检索(retrieval):给定文本找图像,或给定图像找文本;
- 图像描述(image captioning):看图生成文字;
- 文生图(text-to-image generation):即图像合成,Stable Diffusion 是大众熟悉的例子;
- 视觉问答(VQA):给图像 + 文字问题,生成新的文字答案;
- 多模态分类:图像 + 文本,输出一个标签(例如判断是否为仇恨言论);
- 更丰富的理解 / 生成:把图像与文本结合起来,支撑需要更深理解或更好生成能力的下游应用。
讲者补了一句行业观察:这个领域现在“超级热”。他半开玩笑地提到一篇论文标题,说“光凭这个标题它引用量就会很高,很多人其实不会去读它”。他还点出一个历史事实:“多模态是下一件大事”这句话,几十年来一直在被说——但现在是真的了。
3. 早期模型:从词向量到对齐
(参考时间: 00:07:15)
讲者从“深度学习革命”那个时间点开始梳理。一个很好的起点是 Richard Socher(诺奖得主、NLP 领域知名学者,字幕听成了 “Richard zoker / Richard Soaker”)等人在多模态上的早期工作。
编者说明:字幕中出现 “Wasabi”“device” 等词,结合上下文应是指学者或论文名,因 ASR 失真无法确证,此处从略,不影响主线。
3.1 核心套路:对齐同一空间
早期模型的基本思路可以概括为:
graph LR
    V[视觉模型] --> VE[图像嵌入向量]
    L[语言模型/词嵌入] --> LE[文本嵌入向量]
    VE --> S[相似度/打分函数]
    LE --> S
    S --> ALIGN[在同一多模态空间中<br/>拉近相似、推远不相似]
- 一边是视觉模型,一边是语言模型(在课程第一讲里学过的词嵌入);
- 需要把它们对齐到同一个多模态空间;
- 做法是引入一个相似度度量 / 打分函数(从支持向量机文献的角度看就是一个核函数(kernel function));
- 再在一个最大间隔(max-margin)损失下,把相似的拉近、不相似的推远。
这样,在多模态嵌入空间中,你就能拿 “auto” 或 “horse” 的词向量,去找离它最近的图像——检索问题迎刃而解。讲者强调:这个套路会在后面的幻灯片里反复出现,只是被包装成更花哨的模型而已,“本质上还是同一套东西”。
3.2 交叉模态迁移与“多模态词向量”
(参考时间: 00:08:55)
除了“图找文 / 文找图”的交叉模态迁移(cross-modal transfer),你还可以把两种信息结合起来,得到多模态词向量,它更贴近人类对词义的理解:
- 想理解 “cat”,可以去维基百科读“猫是小型食肉哺乳动物,人们喜欢把它当宠物”;
- 也可以直接去看猫的图片。
讲者说:对很多人来说,“猫的图片”比文字定义更接近“猫”这个概念的意义。
3.3 视觉词袋(Bag of Visual Words)
(参考时间: 00:09:40)
早期一篇优雅的工作用视觉词袋做多模态分布式语义。讲者先问现场“谁听说过视觉词袋”,结果“没几个人”。他称它“出人意料地简单,又很优雅”。流程是:
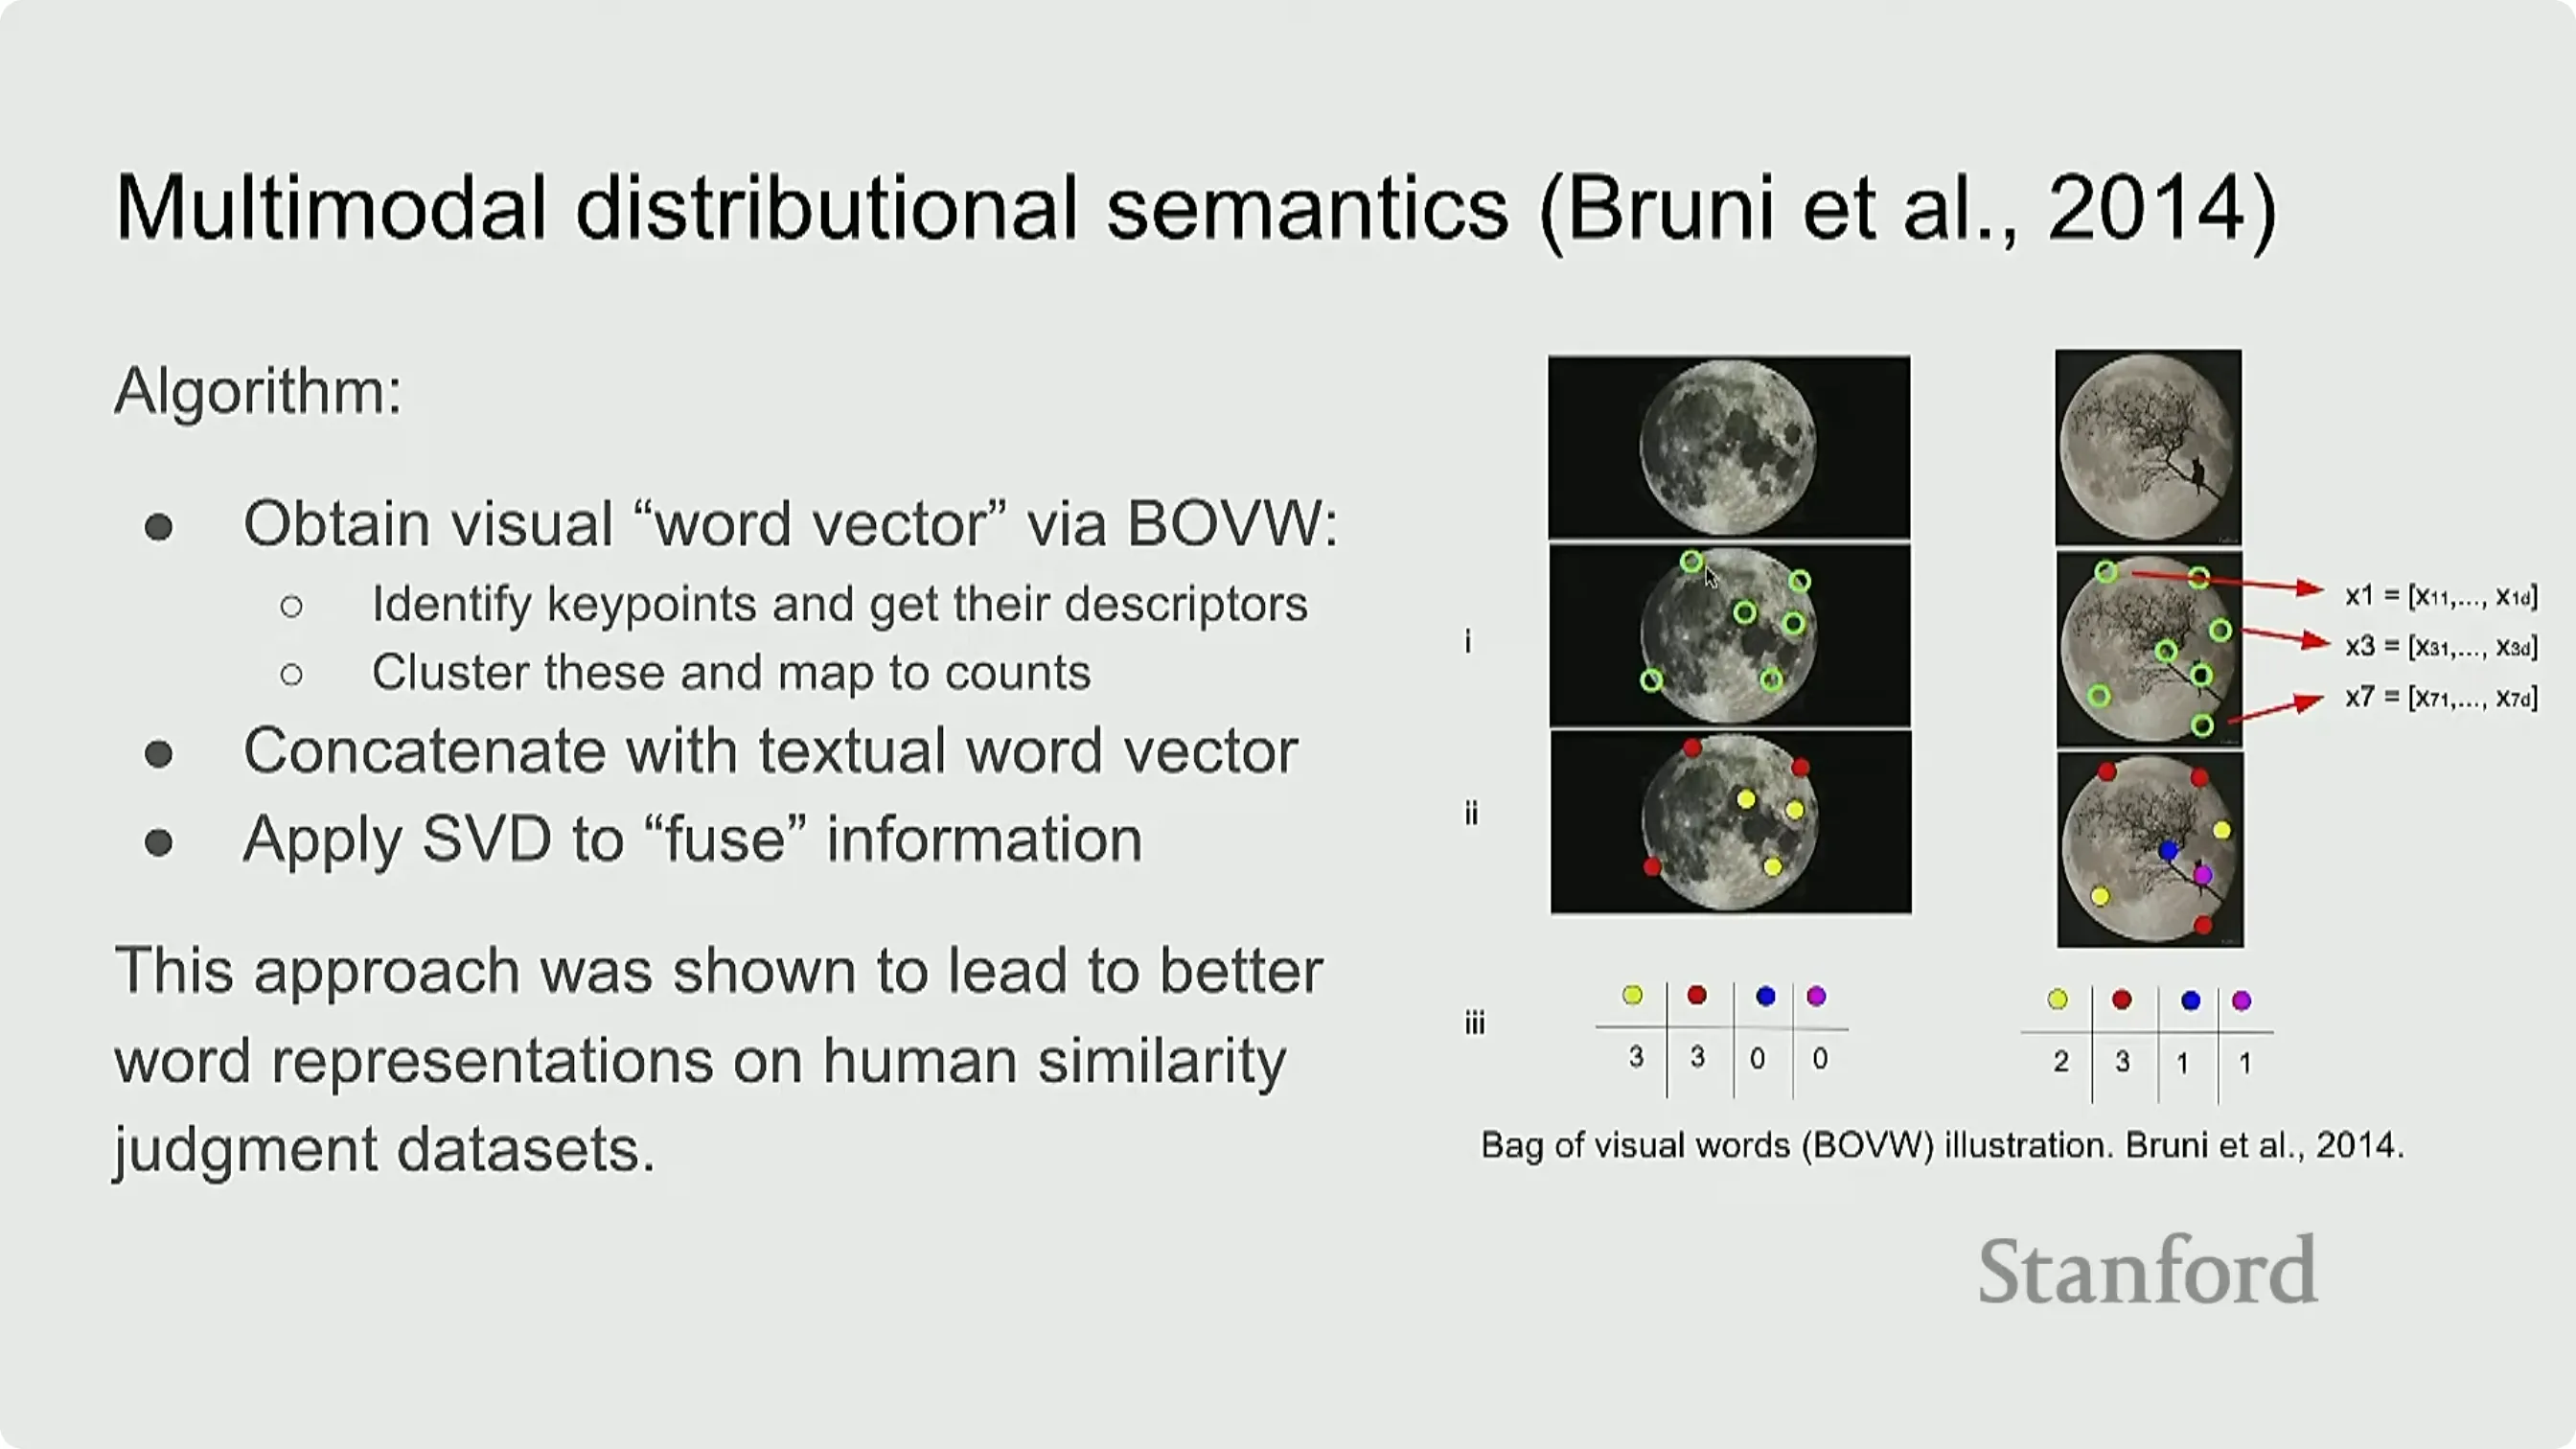
📷 视觉词袋:在月球图上找关键点并聚类
回到原视频 (00:09:57)
- 取一张图(比如月球);
- 用 SIFT 之类的算法找关键点——像素与相邻像素差异大的地方,就是值得关注的点;
- 对每个关键点抽特征描述子(相对较短的向量,比如 32 维,取决于具体实现);
- 用 k-means 对这些描述子聚类,然后统计每个簇出现的次数;
- 把它当成“视觉词袋”,与原版词袋模型一一对应。
在月球图里,红点那种簇恰好出现了 3 次,于是“红点”这个视觉词的计数就是 3。把视觉词袋与文本词袋拼接或用 SVD 融合,就得到更贴近人类意义的词嵌入。
编者拓展|词袋模型与 SIFT - 词袋模型(Bag of Words):把一段文本视为“单词计数向量”,忽略词序。课程第一讲通常会讲它。 - SIFT(Scale-Invariant Feature Transform):Lowe 提出的图像局部特征算法,能在尺度、旋转变化下稳定地找到“角点 / 边缘”等显著位置,并给出方向稳定的描述子。它曾是图像检索的经典工具,后来被深度网络在很大程度上取代。
3.4 把深度学习引进来:卷积特征 + 词嵌入
(参考时间: 00:11:15)
接着,包括讲者在内的一批人开始把深度学习应用到这条路线上:
- 用卷积神经网络(CNN)抽图像特征;
- 把 CNN 特征与词嵌入拼接,得到多模态词向量;
- 或者做更花哨的跳元(skip-gram)预测到图像特征:看到 “cat” 时,不仅预测上下文词,也预测“猫的图片”。
思路“超级简单”,但效果是得到更丰富的词表示。
3.5 从词到句子:组合性理解
(参考时间: 00:12:00)
词毕竟有限,真正重要的是句子。于是研究方向转向句子表示与组合性理解:
- 损失函数与“词—图”对齐类似,只是把词编码器换成句子编码器;
- 论文里常用 LSTM、其他循环神经网络,或递归神经网络;
- 代表工作来自 Andrej Karpathy 与 Richard Socher 等。
讲者提到自己有一篇相对不那么重要的工作,但它说明了一件有趣的事:一份接地的句子表示(grounded sentence representation)——只是用“能预测图片”这个目标训练出的句子编码器——就直接是一个很好的句子表示;把它迁移到情感分类等 NLP 任务上也表现不错。换句话说:只要让模型学会“想象事物的样子”,就能得到很好的语义表示。
编者拓展|为什么“预测图像”会有用:这是“语言接地(grounding)”的一种体现。语言理解模型如果只从词共现里学,容易缺一条感官通道;让句向量去预测对应图像,相当于给语义空间补上了一个视觉锚点,使“像不像”的判断更贴近人类相似度。
3.6 图像描述:把编码器换成 CNN
(参考时间: 00:13:20)
当序列到序列(seq2seq)架构出现后,人们把机器翻译源语言侧的文本编码器,换成一个 CNN,于是就能生成图像描述(caption)。这就是图像描述模型的早期形态。
讲到这儿,课堂出现一段轻松插曲:讲者调侃现在的学生可能已经不怎么学 LSTM 了,“说不定哪天 LSTM 会回归”——他还预言“总有一天 Transformer 会被淘汰,我们走着瞧”。(这是讲者的玩笑与个人判断,编者照录,不做评论。)
3.7 注意力与词—图对齐
(参考时间: 00:13:45)
机器翻译里很早就有的词对齐(alignment),同样可以搬到图像上:把生成序列里的某个词,与图像中的某一区域对齐——用的正是注意力(attention)。讲者说,这样模型在生成 “stop(停)” 来描述“停车标志”时,注意力真的落在停车标志本身上,形成很漂亮的对齐。
3.8 GAN:条件生成图像
(参考时间: 00:15:00)
早期模型的最后一类:GAN(生成对抗网络)。现场“知道 GAN 的人比知道视觉词袋的多得多”。基本套路是生成器 + 判别器:生成器造图,判别器分辨真假;如果把这个过程以一段文本为条件(condition),就能用文本提示生成图像。讲者指出,这正是后来 Stable Diffusion 一代模型的自然前身。
4. 深潜:特征与融合
(参考时间: 00:15:55)
讲者把节奏放慢,进入这一讲的“核心积木”:特征(features)与融合(fusion)。但在此之前,他先回答了一个很自然的问题。
4.1 既然多模态又好又简单,为什么不是人人都做?
(参考时间: 00:16:15)
讲者列出几个现实困难:
- 模态会互相压制:文本在很多场景下比视觉 / 音频强势得多,模型可能只学文本信号、完全忽略图像——这在 VQA 里尴尬地真实发生过(不看图也能答题)。
- 额外模态会带噪声:让机器学习问题变难。
- 覆盖不完整:Facebook 帖子有时有文字、有时有图、有时都有,没有保证——你没法假设两种模态总是同时存在。
- 复杂度:很多时候大家“还没准备好”,实现太复杂,或者不知道怎么设计模型才能把信息真正结合起来。
4.2 特征化:文本、区域特征与稠密特征
(参考时间: 00:17:20)
讲者对比了两种模态的“喂进网络”方式:
- 文本:已经是标准做法——一个 批次 × 序列长度 × 嵌入维度 的 3 维张量。
- 图像:更麻烦。你可以看图像块(patches),用卷积在上面滑动、聚合,但很多时候你不想这么均匀地处理,而想让模型“真的盯住图里的东西”。
于是有了区域特征(region features):先跑一个目标检测器做预处理,再用一个 CNN 主干对每一个子图(比如“滑板”“人”)单独编码成向量。讲者提醒,十几年前用现成的卷积特征替掉整条手工 CV 流水线,曾非常令人惊讶——“人们花了几十年打磨那套流水线,然后被一个 CNN 免费替掉了”;好处是可跨任务轻松迁移(在巴黎找建筑、找花等等)。
接着是稠密特征与 Vision Transformer(ViT):把图像切成扁平化的图块(patches),当成 token 喂进标准 Transformer 做分类——除了输入从词变成图块,其余全是标准 Transformer。
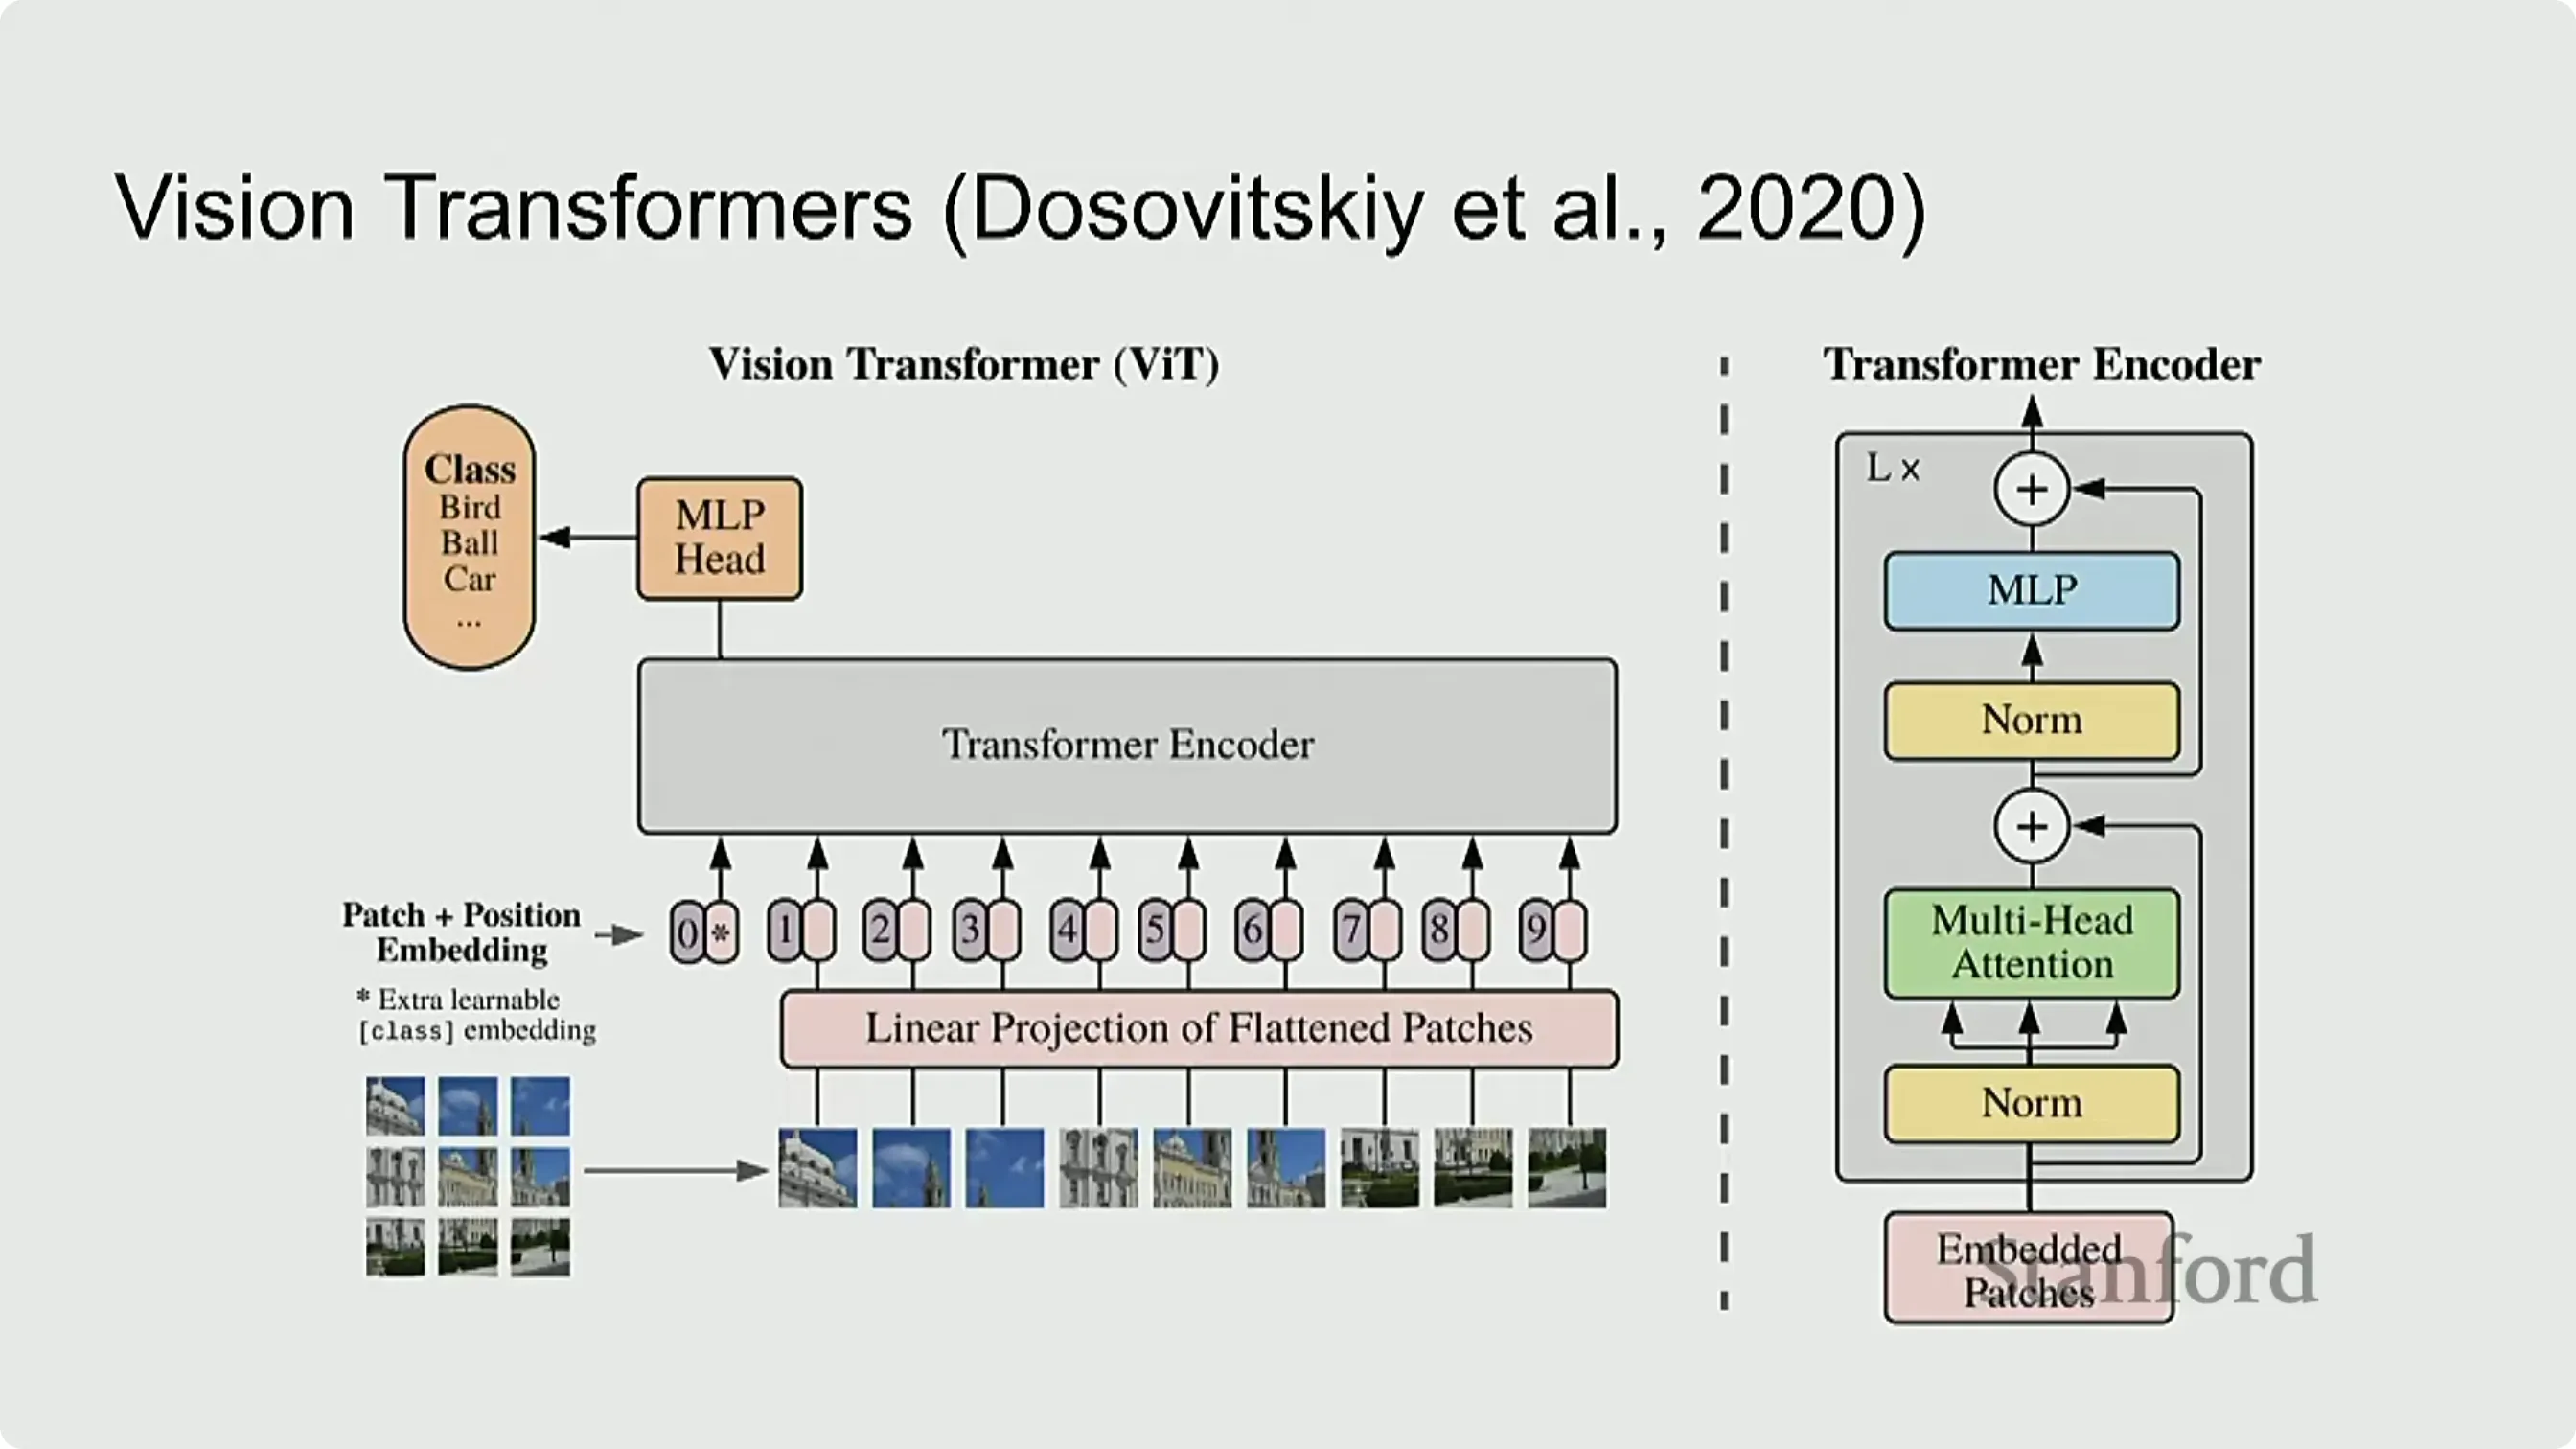
📷 ViT:把图像切成 patch 当作 token 输入 Transformer
回到原视频 (00:20:01)
讲者顺带提到 YOLO(当时已到 YOLO v7)这样的目标检测模型,能给出带标签的边界框 + 分割,作为图像预处理的强工具。
编者拓展|区域特征 vs 稠密特征 - 区域特征:把图像先“结构化”——检测出物体、给每个物体编码。它更贴近语言里“名词”式的理解,但依赖检测器的质量。 - 稠密特征(ViT):不做物体级切分,直接把 patch 当 token,让注意力自己发现结构。它更“端到端”,也更符合后来“能扔的结构就扔掉”的潮流。
4.3 融合:两个向量怎么合
(参考时间: 00:20:40)
讲者说,给定两个向量 $u$ 和 $v$,组合方式非常多:
- 内积 / 相似度(交叉模态、同空间嵌入时最常用);
- 线性投影组合;
- 逐元素相乘或门控(gating);
- 注意力;
- 双线性(bilinear),甚至是紧凑双线性(compact bilinear)。
他总结了一句关键判断:“多模态文献的绝大部分,本质上就是在回答‘怎么融合最好’这一个问题。”
于是就有“融合的层次”这条谱系(讲者说“中融合”这个词是他自己发明的叫法,通俗易懂):
graph TD
    subgraph Early[早融合 Early Fusion]
        A1[一开始就把所有特征拼在一起<br/>用注意力等直接对全部特征建模]
    end
    subgraph Mid[中融合 Middle Fusion]
        A2[先各自处理,在中间层做交互/跨模态注意力]
    end
    subgraph Late[晚融合 Late Fusion]
        A3[完全独立处理,只在最后的分数/logits 处结合]
    end
    Early --> Mid --> Late
- 早融合:一开始就合并所有特征,所有模态从一开始就互相注意;
- 中融合:先分开处理,中间层再交互;
- 晚融合:各自独立处理,只在最后的分数 / logits 处组合,模态之间没有真正交互。
编者拓展|一句话记法:晚融合“便宜但交互少”,早融合“贵但交互多”,讲者在问答里也明确说:“如果能负担得起,越早融合越好。”(the earlier is always the better if you can afford it)
一个有趣的中融合例子:FiLM
(参考时间: 00:22:30)
讲者特别喜欢的论文 FiLM 做了一个很漂亮的调制(modulation)机制:
- 特