第19讲 · 小模型的人工推理艺术:ProRL、Prismatic Synthesis 与 RLP
Stanford CS224N《Natural Language Processing with Deep Learning》2026 官方讲义 · 中文重构 本书是一次补充讲次:既有课堂实录版电子书未覆盖这一讲,内容依据 2026 官方讲义(slides)补全。
| 原始标题 | The Art of Artificial Reasoning for (Small) Language Models(Lecture 19: Open Questions,讲者 Yejin Choi) |
| 讲义来源 | cs224n-2026-lecture19-open-questions.pdf(随材料提供的讲义 PDF) |
| 课程主页 | https://web.stanford.edu/class/cs224n/ |
| 讲者 | Yejin Choi(Stanford & NVIDIA) |
| 材料版权 | 课程材料版权归 Stanford University 及讲者所有,本书仅供学习 |
对应讲次:第19讲(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose,据 run.log)
编者说明:本书所用的书籍头部模板原本为另一门课程(EECS 189/289A fa26)的补充讲次设计,但实际提供的材料是 CS224N 2026 的第 19 讲幻灯片,因此头部按真实来源填写。详见文末「已知疑点」。
编者说明:本讲的原始材料是幻灯片(逐页文字),不是 Jupyter notebook,也没有可运行的代码 cell。因此本文不含代码块,图与结构改用 Mermaid 重绘;讲义中若干页是纯图片(不可提取文字),这些页的内容在正文中标注为「本页为图」。
一、开题:给(小)语言模型的推理艺术
讲者 Yejin Choi 来自斯坦福大学与 NVIDIA。本讲的主题是(小)语言模型的人工推理艺术——在一味堆算力的时代之后,如何让参数量小得多的模型也具备真正的推理能力。
🖼️ 第 1 页幻灯片 · The Art of Artificial Reasoning
讲义(Slide 2)给整场报告起了一个标题式的设问:
🖼️ 第 3 页幻灯片 · A case in point…
Mission Impossible:如何在不违背 scaling law 的前提下,让生成式 AI 走向民主化? 因为(当前的)scaling law 要求极端规模的计算,而只有极少数玩家负担得起。
🖼️ 第 4 页幻灯片 · https://aiworld.eu/story/nvidia-leads-open-source-ai-momentum-as-chinese-labs-close-in
这难道不是不可能完成的任务吗?
一个 2023 年的具体场景
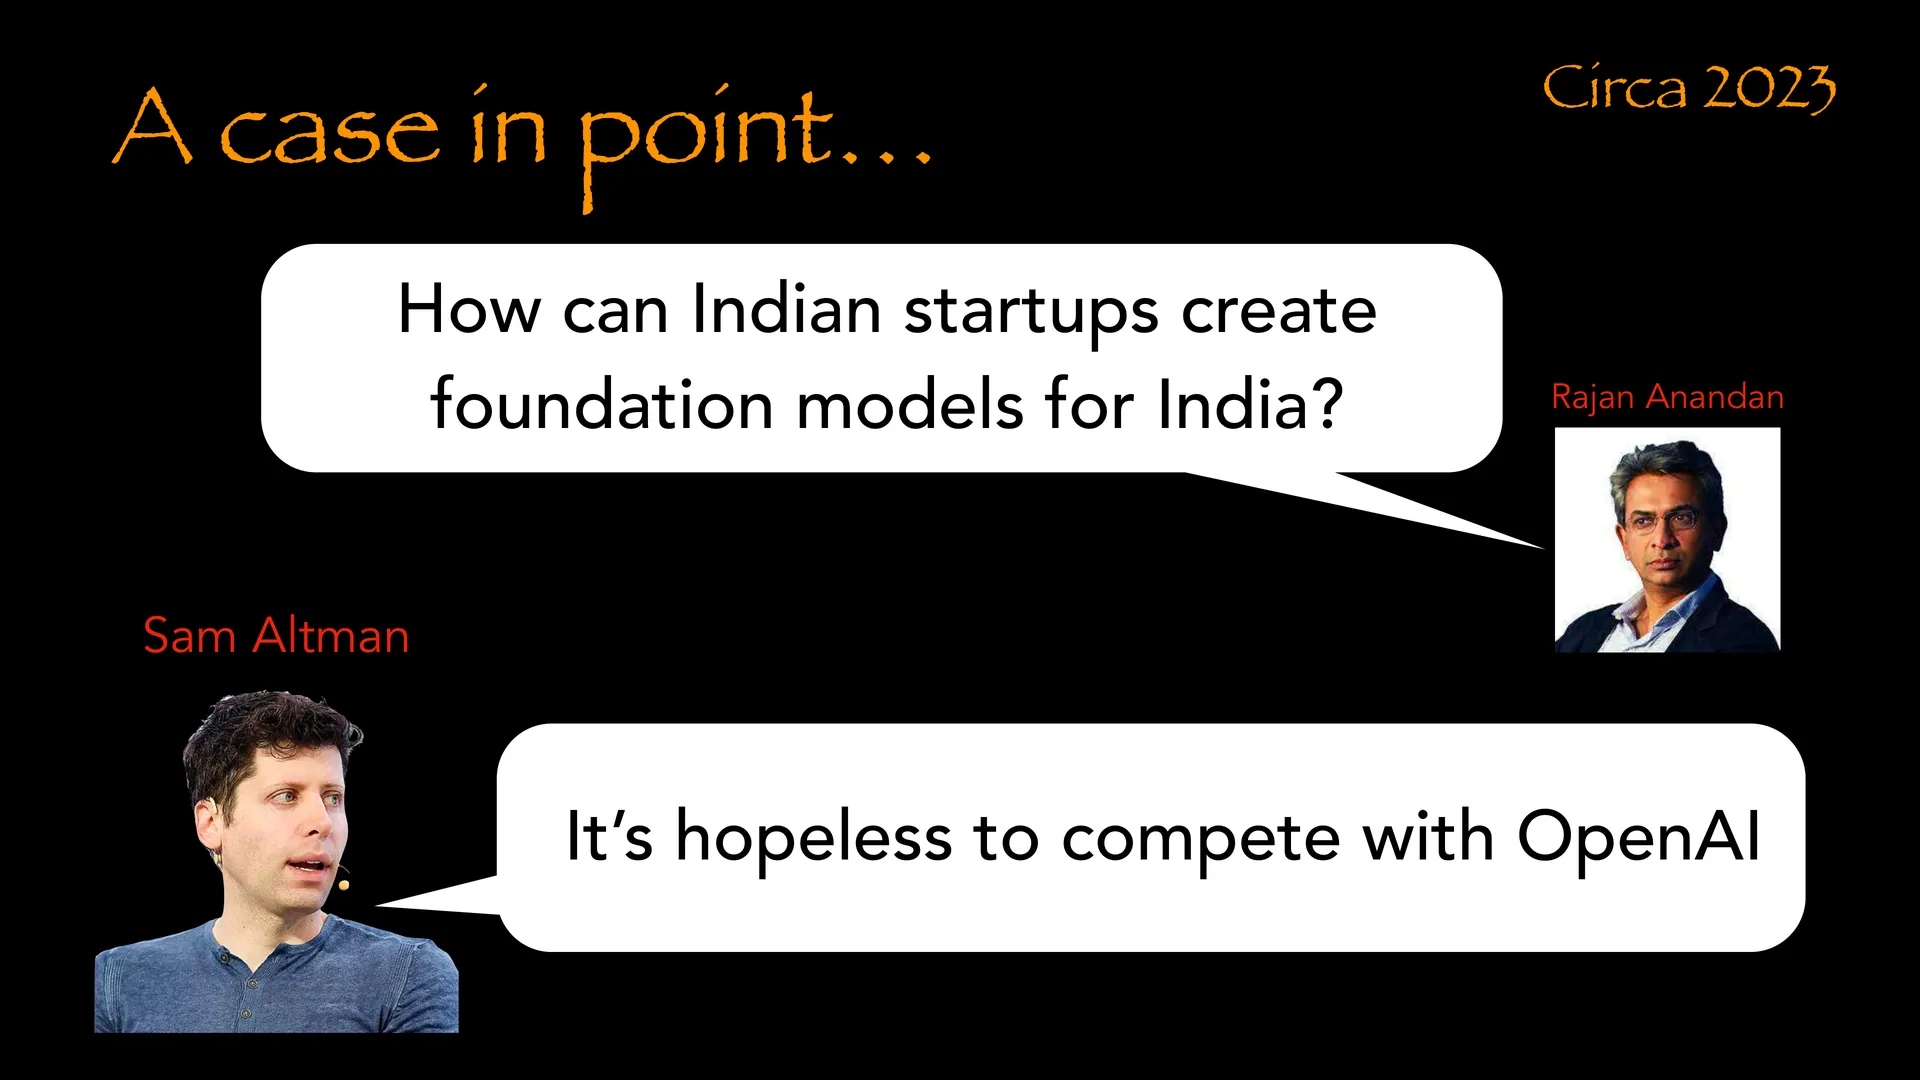
Slide 3 记录了大约 2023 年的一段对话。Rajan Anandan 问:「印度创业公司要怎样为印度打造基础模型?」Sam Altman 的回答是:
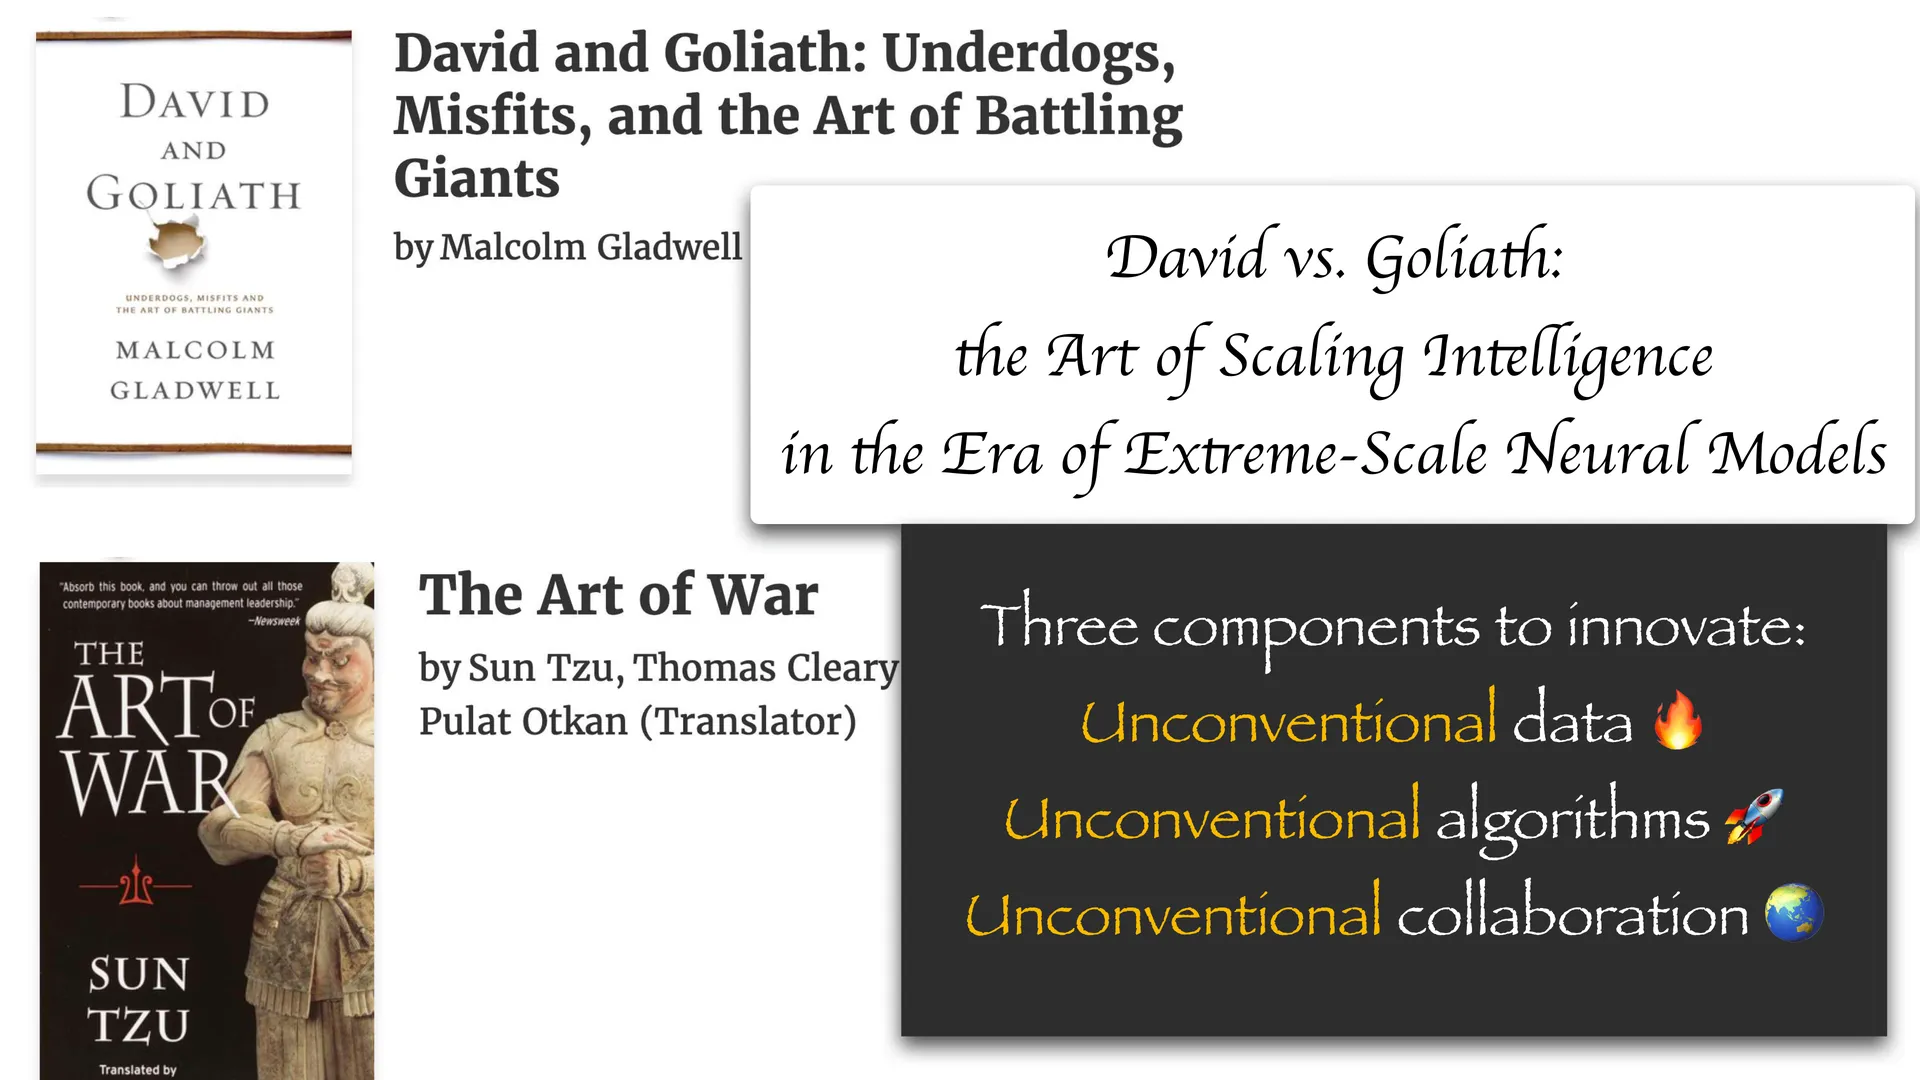
🖼️ 第 6 页幻灯片 · David vs. Goliath:
It's hopeless to compete with OpenAI.(和 OpenAI 竞争是没希望的。)
讲义并没有在这里给出结论,只是把这句话放在了两张「现实打脸」的幻灯片前面。
现实的反转(Slide 4–5,约 2025 年)
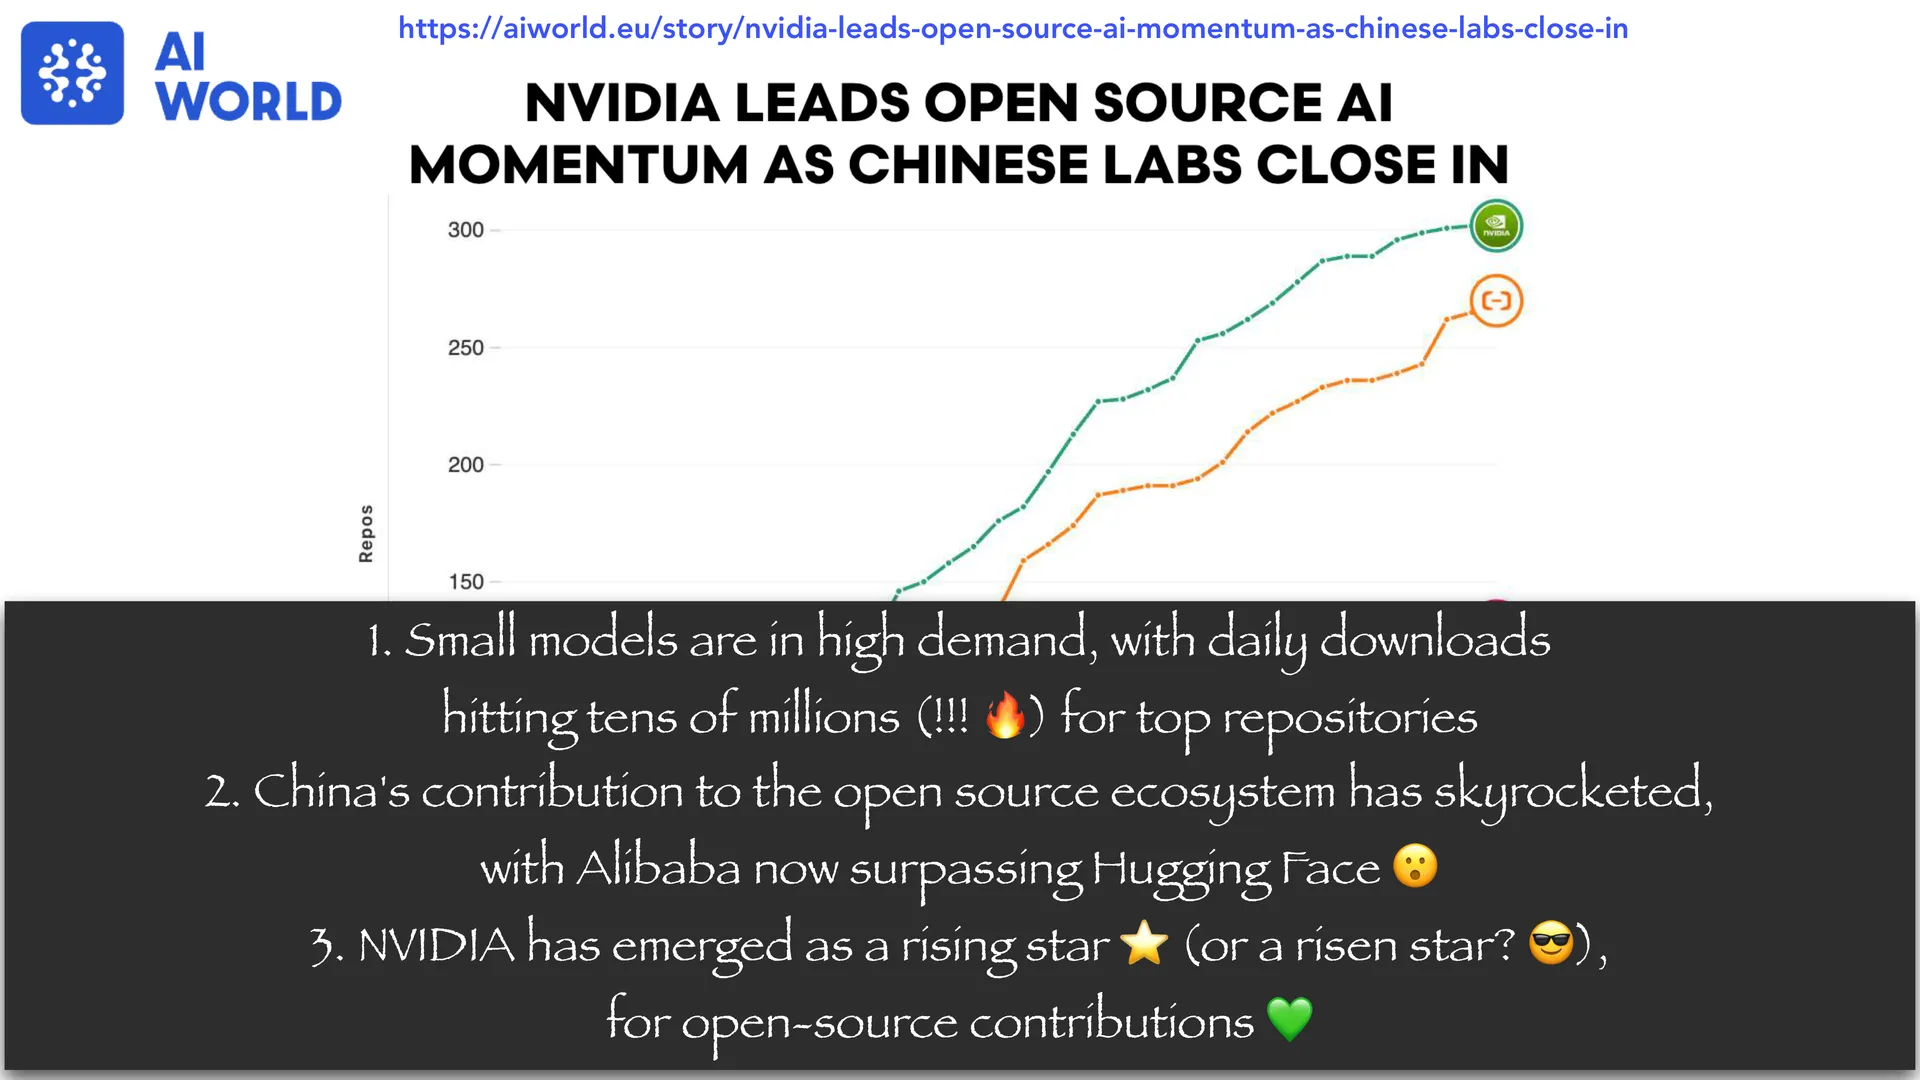
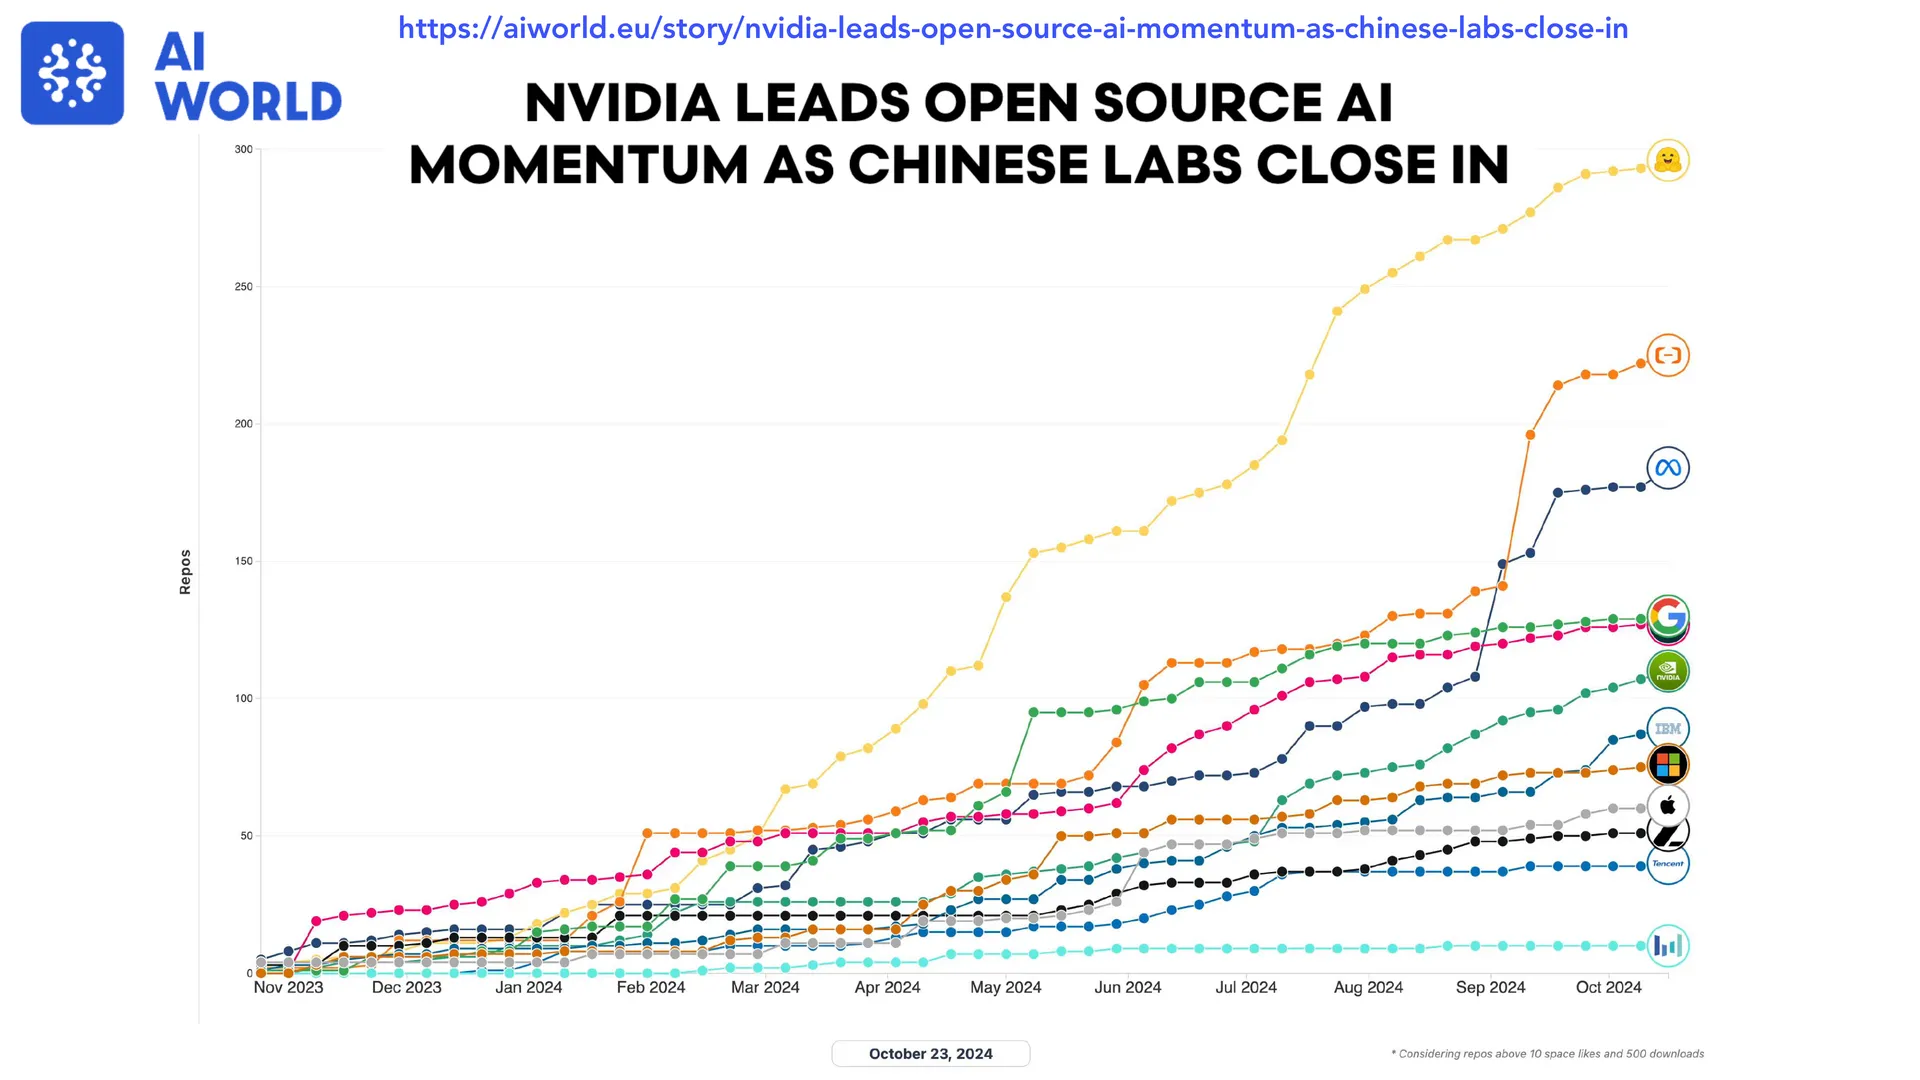
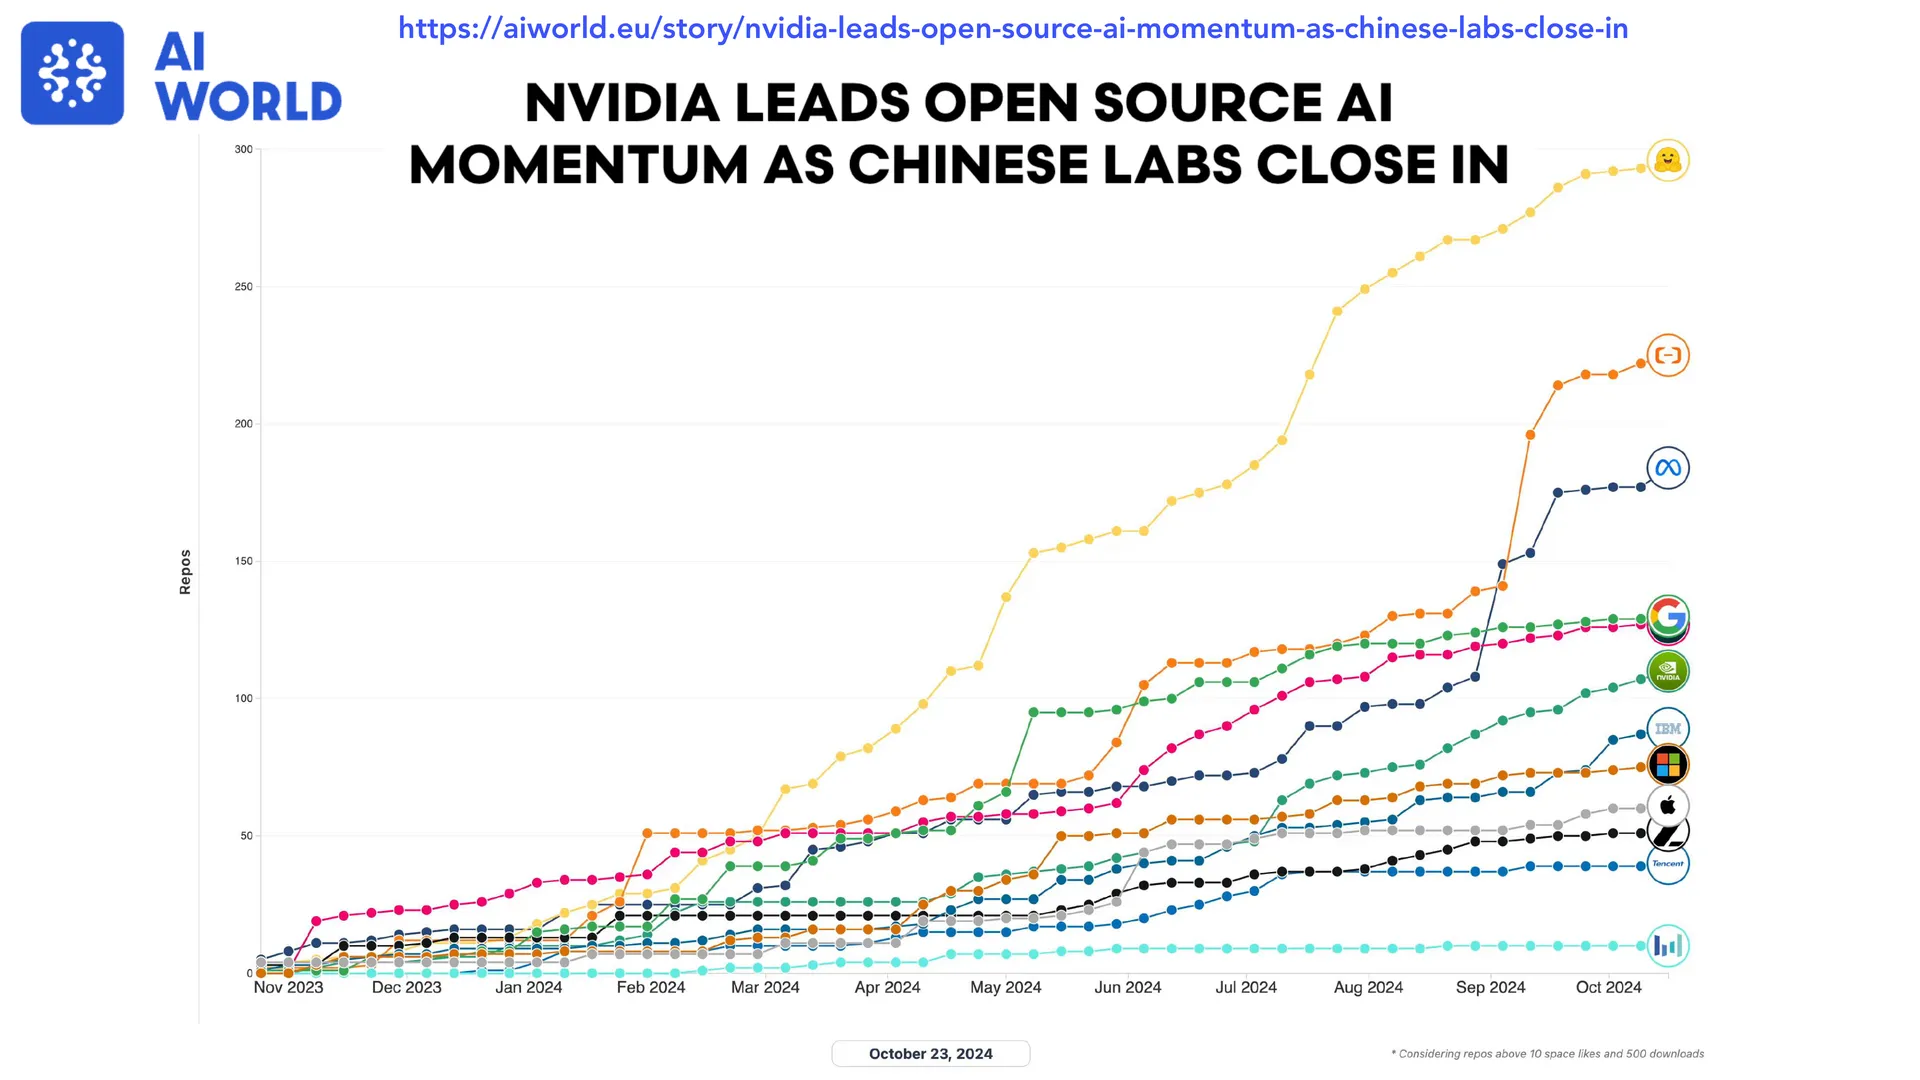
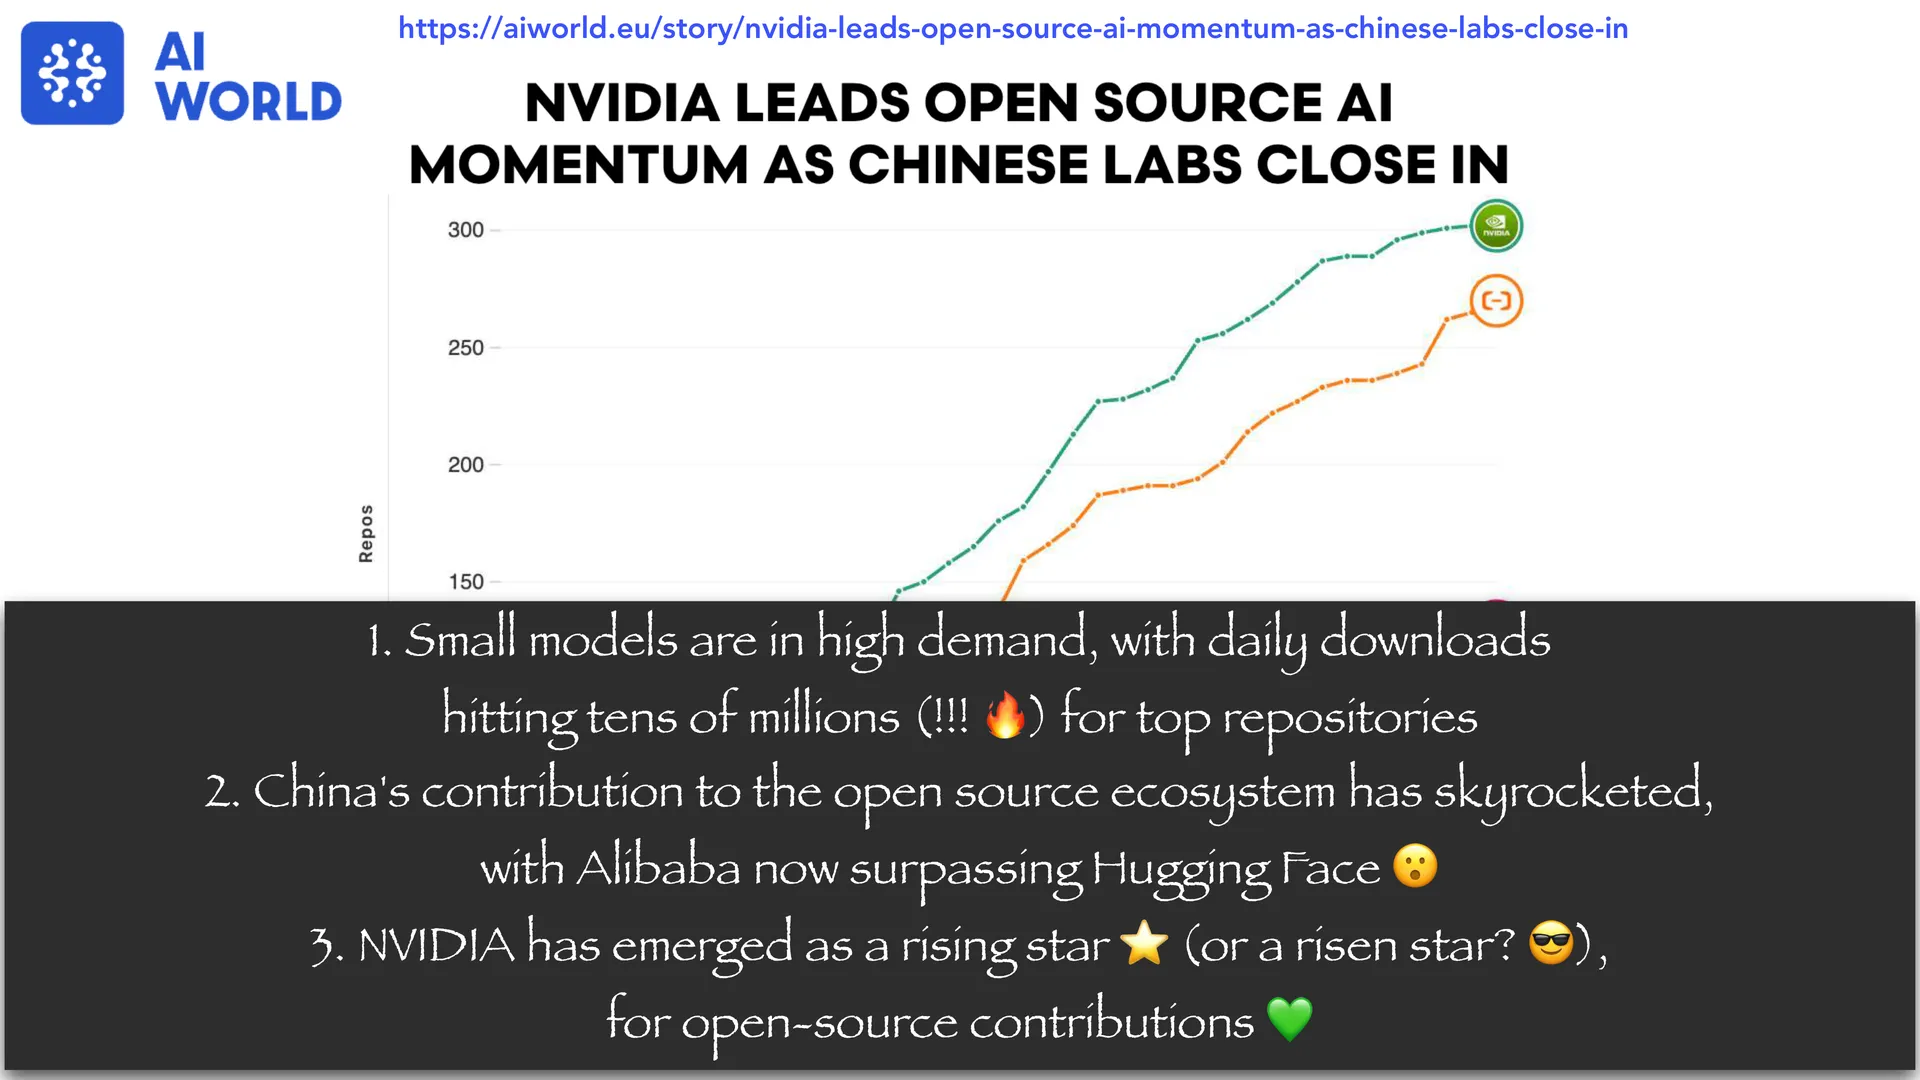
讲义引用了一篇报道 https://aiworld.eu/story/nvidia-leads-open-source-ai-momentum-as-chinese-labs-close-in,列出三条观察:
- 小模型需求极高:头部仓库的日下载量达到数千万次。
- 中国对开源生态的贡献飙升:阿里巴巴在开源模型上的贡献已经超过 Hugging Face。
- NVIDIA 成为开源贡献的「新星」(或者说「已成之星」)。
编者拓展|为什么「小模型」是一个真问题:如果推理能力主要由参数量决定,那么学术机构、中小公司和中等收入国家的开发者将永久出局。整场报告后面三个工作(ProRL、Prismatic Synthesis、RLP)都在回答同一个问题:在算力/数据受限的前提下,能不能用「算法」把推理能力买回来?
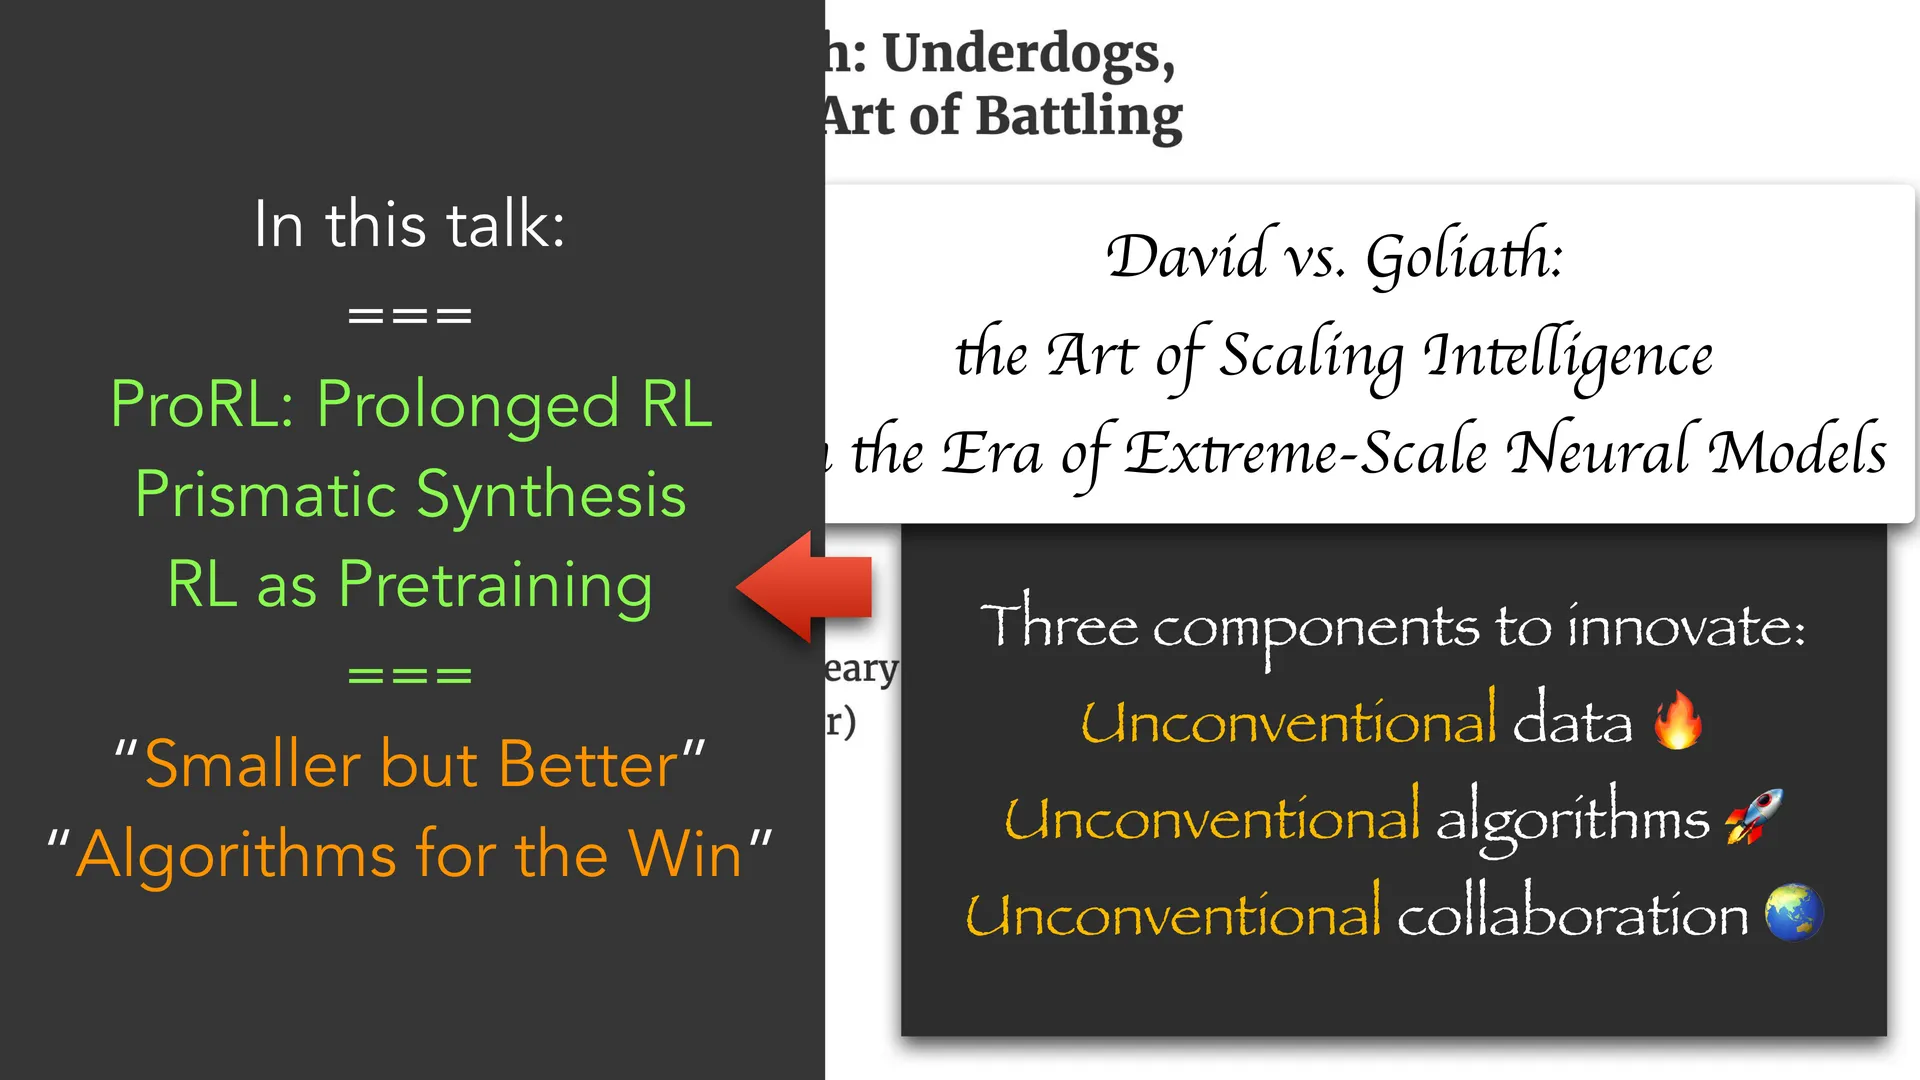
二、David vs. Goliath:三个可创新的维度
讲义反复出现一页标题(Slides 6、10、37、50、69、85、86):
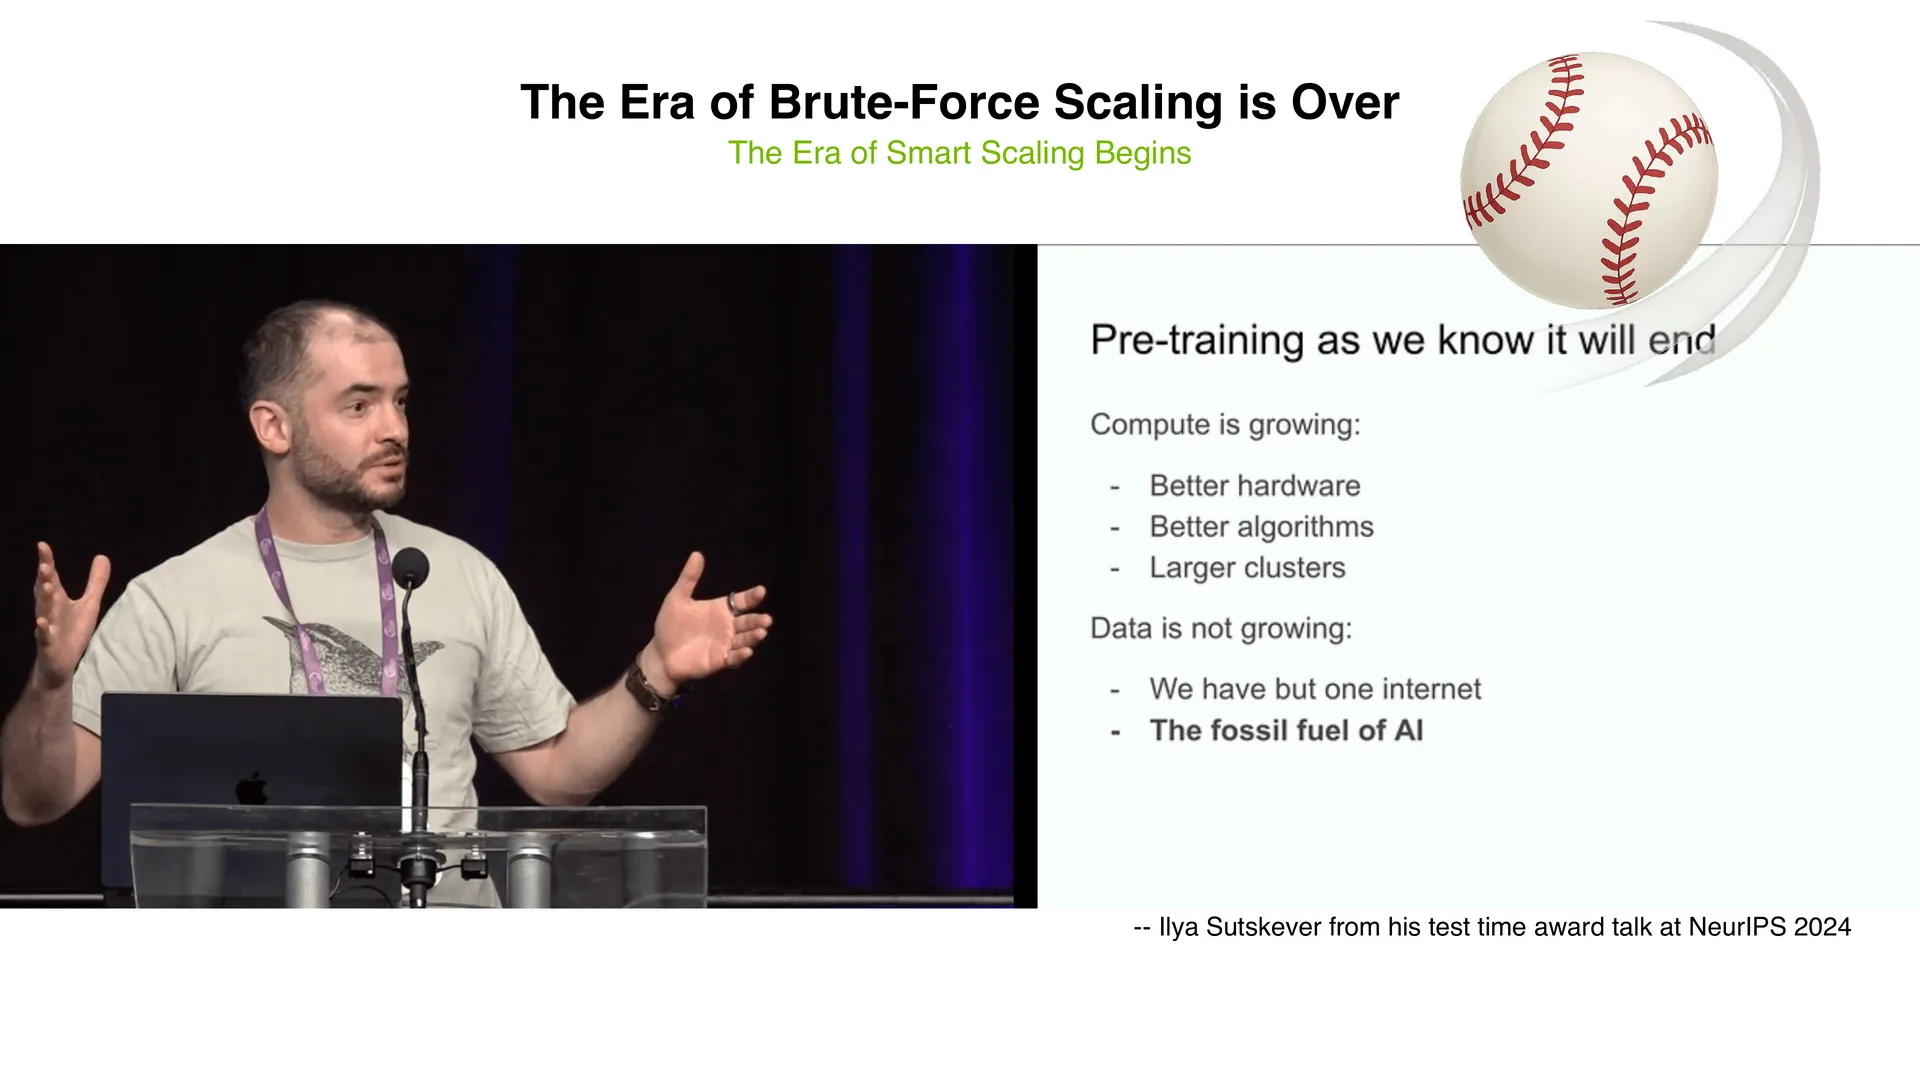
🖼️ 第 7 页幻灯片 · The Era of Brute-Force Scaling is Over
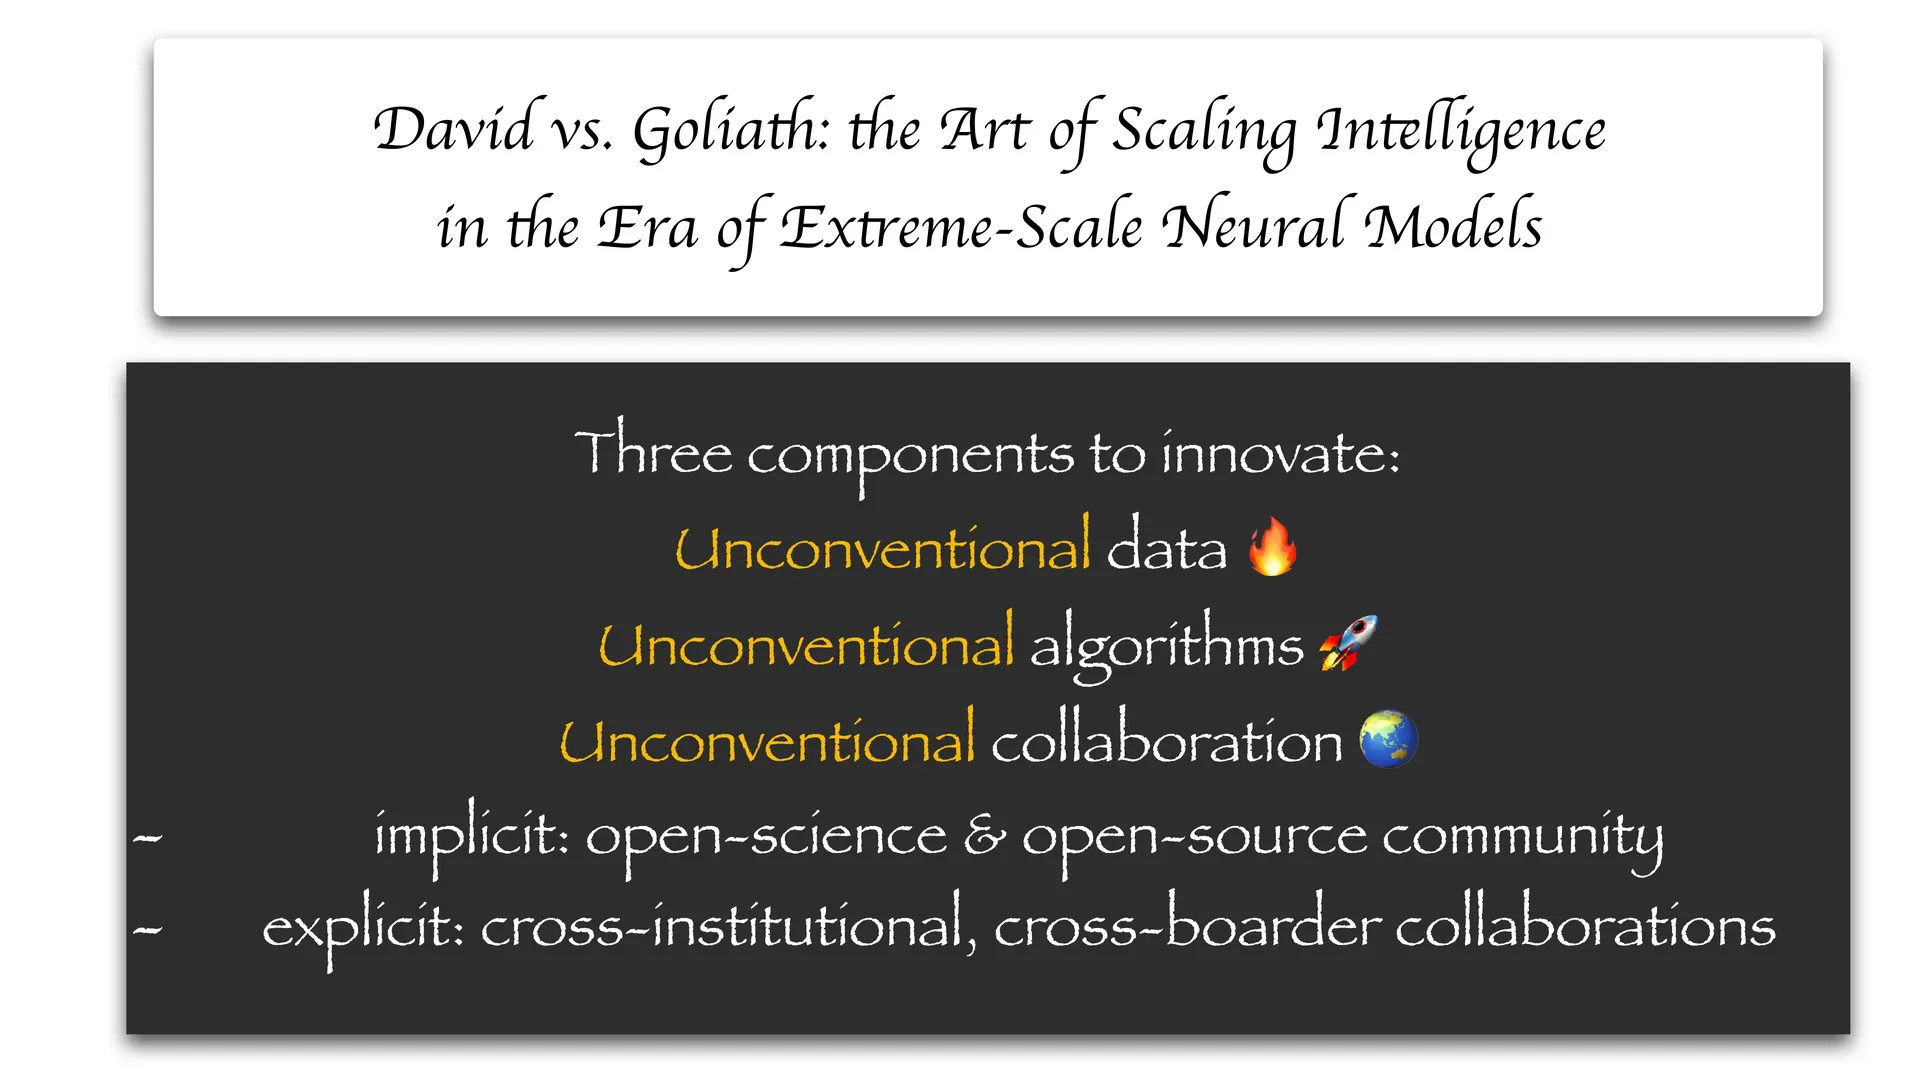
David vs. Goliath:极端规模神经模型时代的智能 scaling 艺术 三个可以创新的组件: - Unconventional data 🔥(非常规数据) - Unconventional algorithms 🚀(非常规算法)
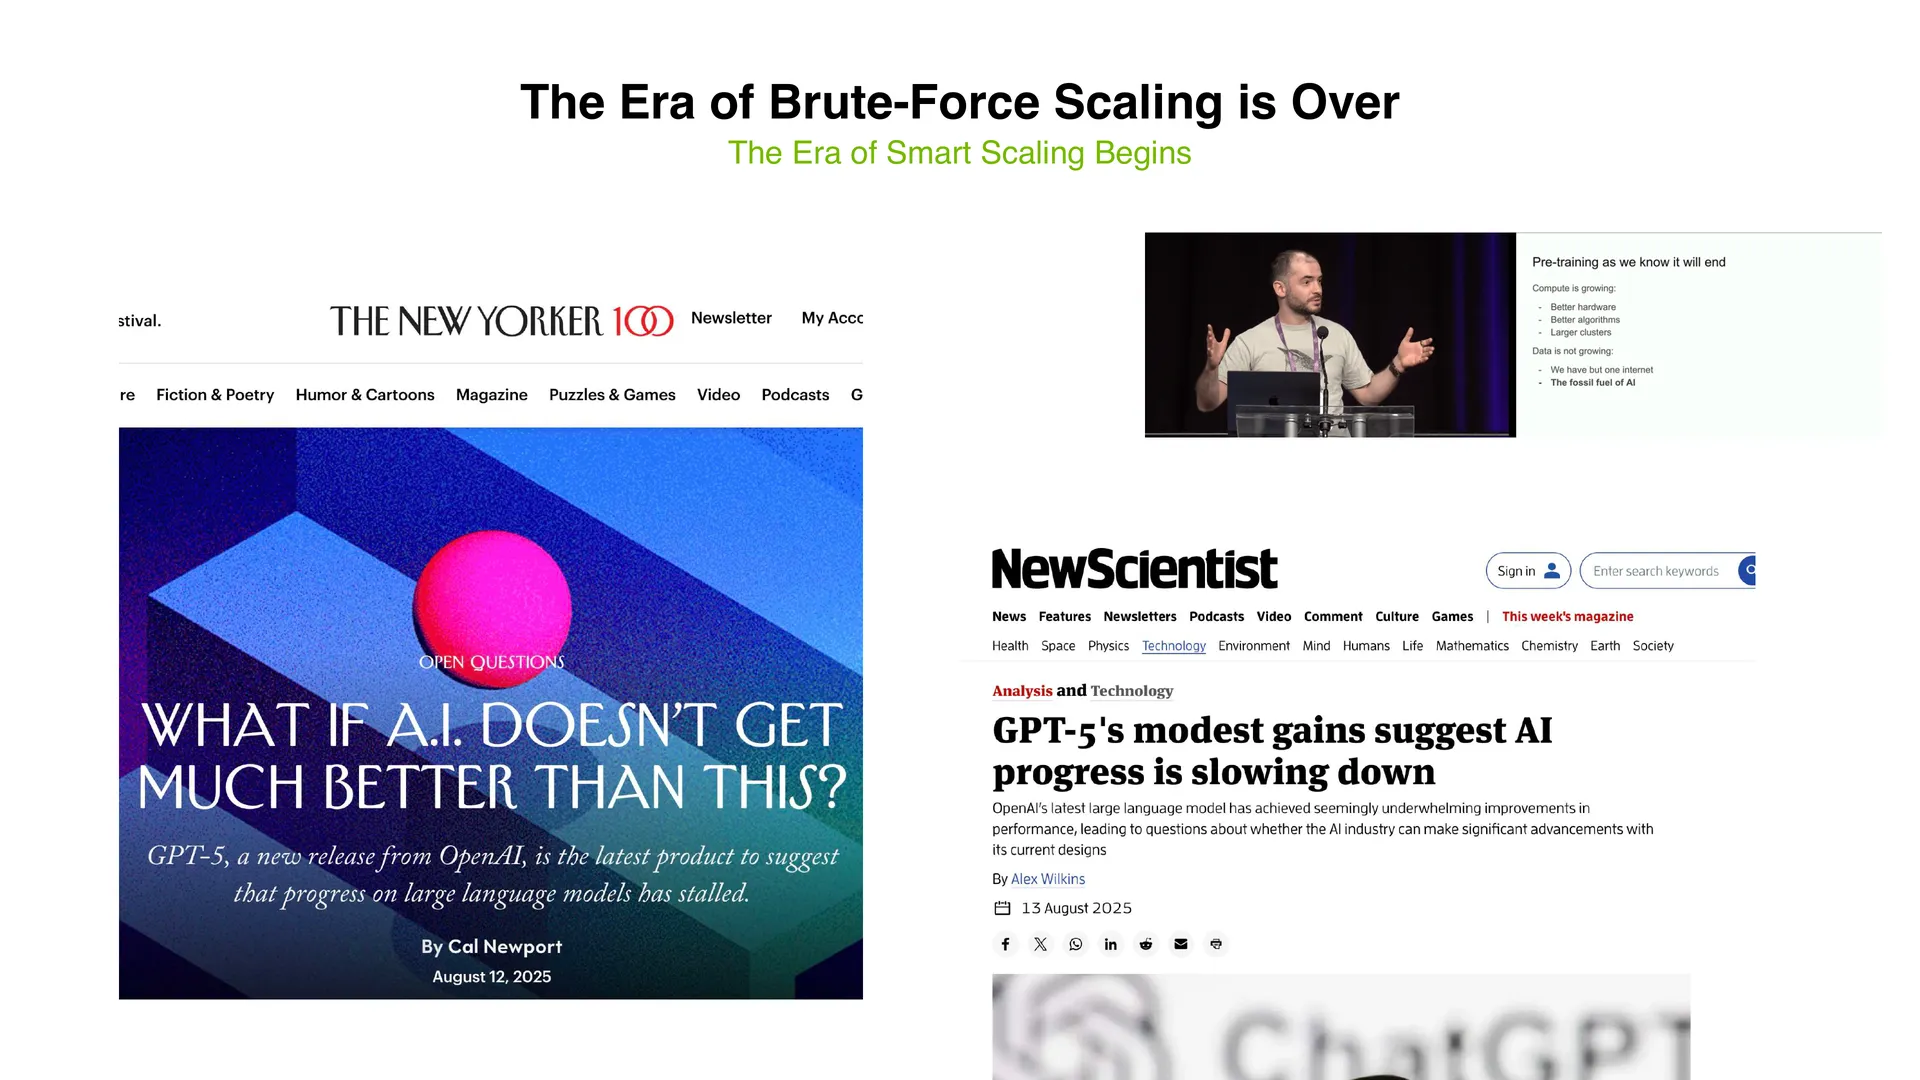
🖼️ 第 8 页幻灯片 · The Era of Brute-Force Scaling is Over
- Unconventional collaboration 🌏(非常规协作)
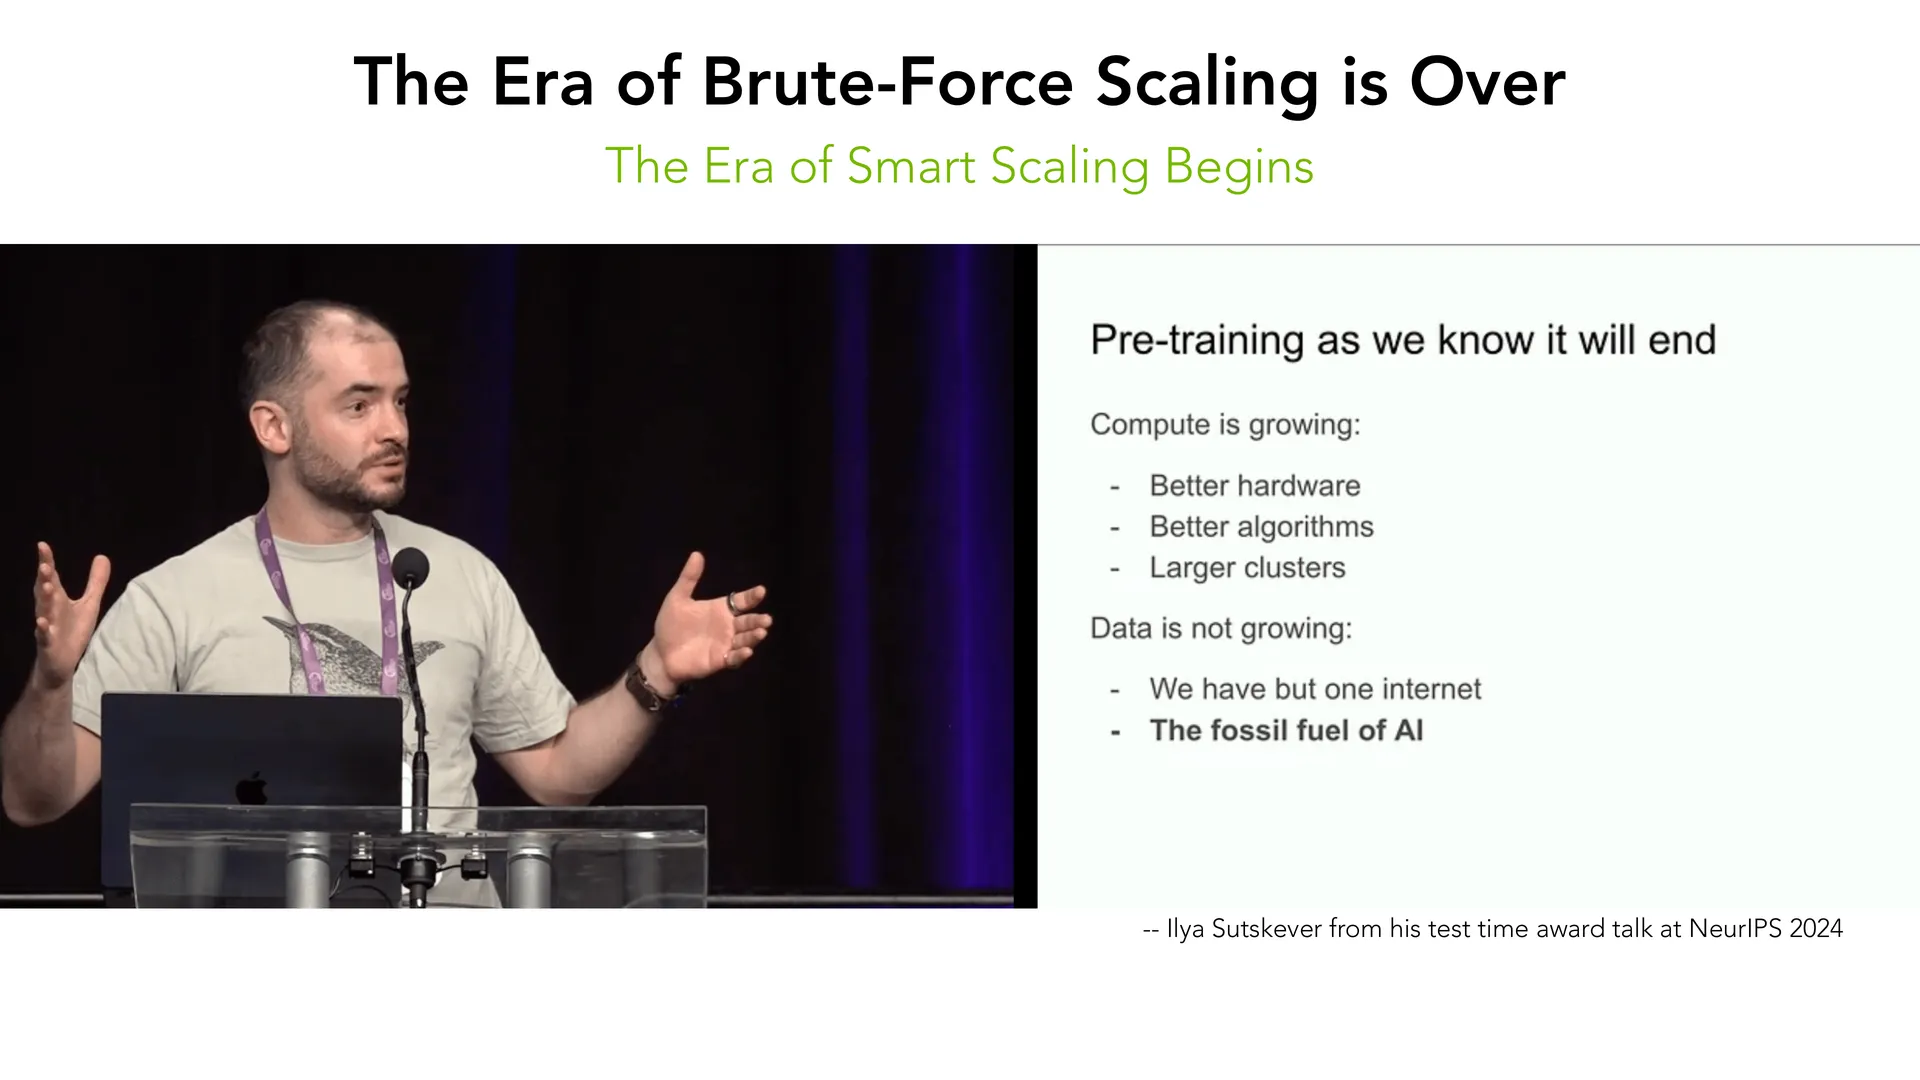
蛮力 scaling 的时代结束了
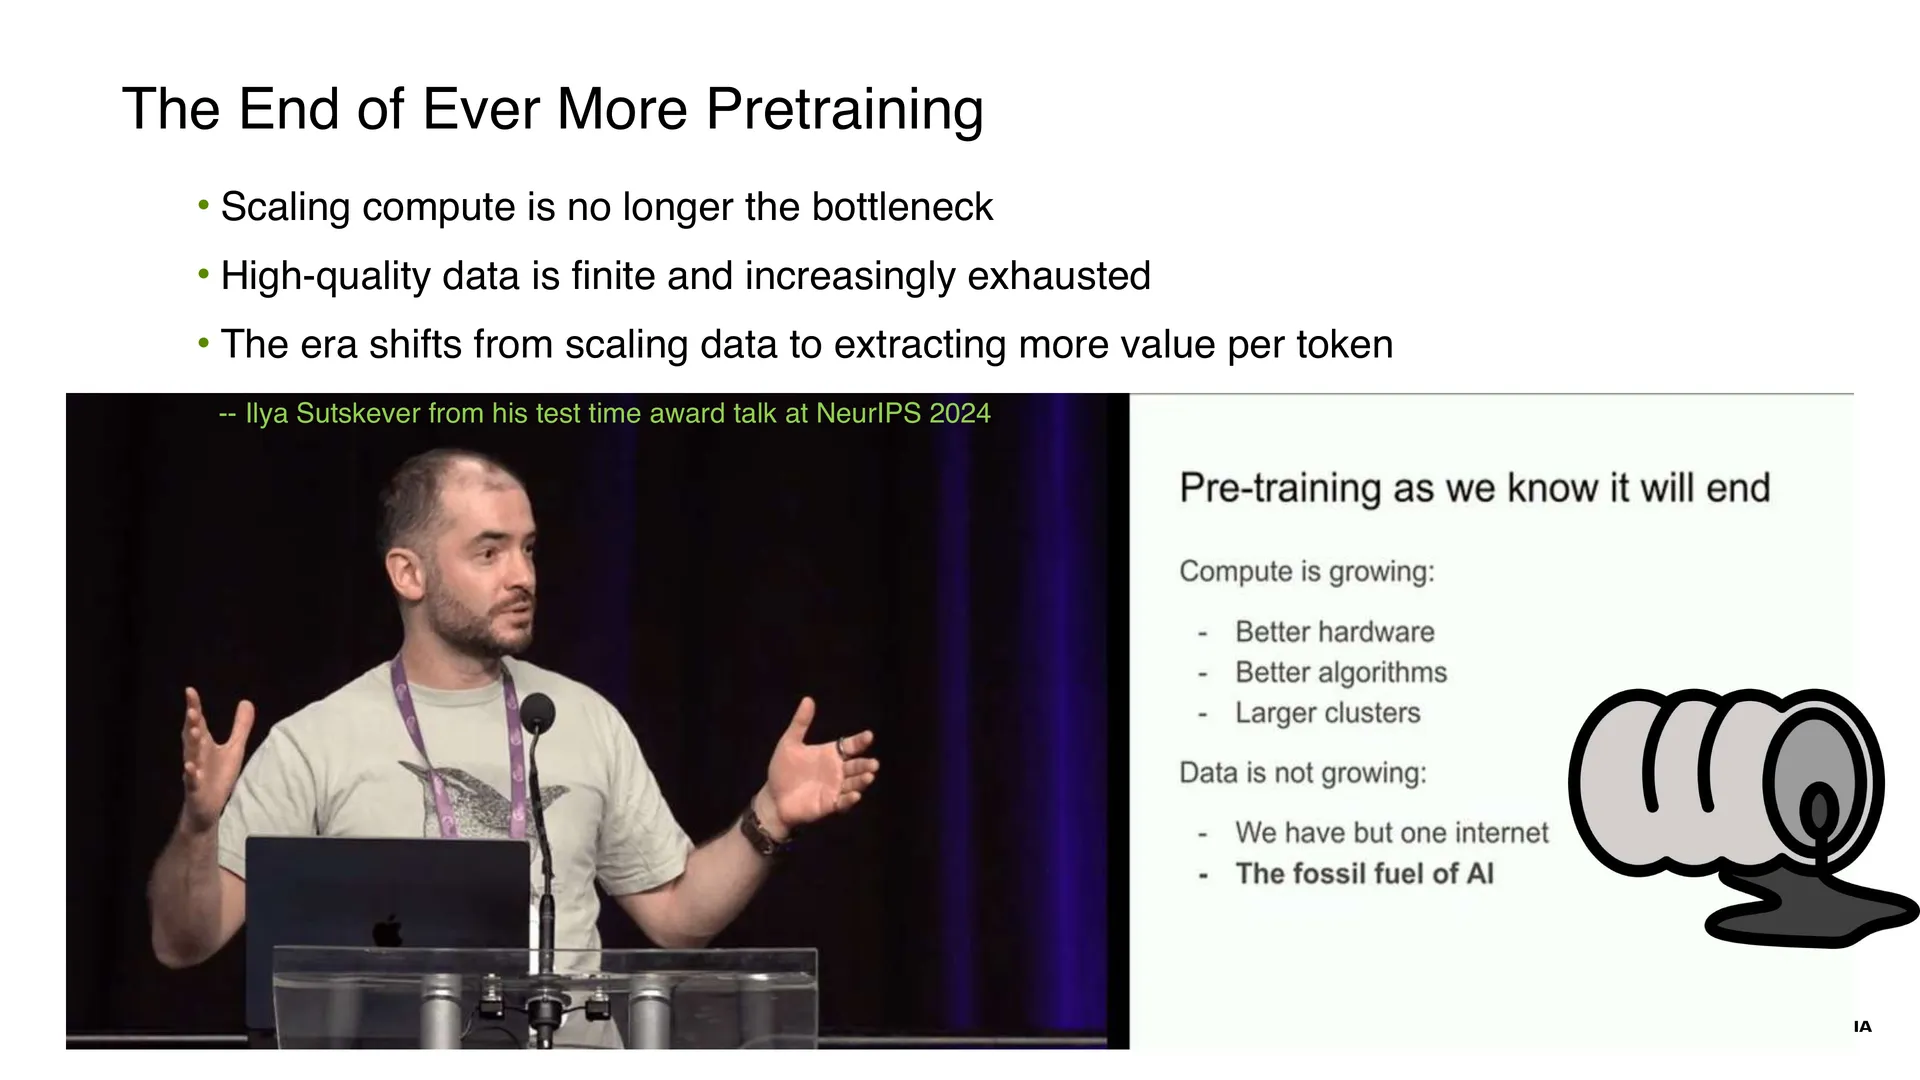
Slide 7 引用了 Ilya Sutskever 在 NeurIPS 2024 的 test-time award talk:
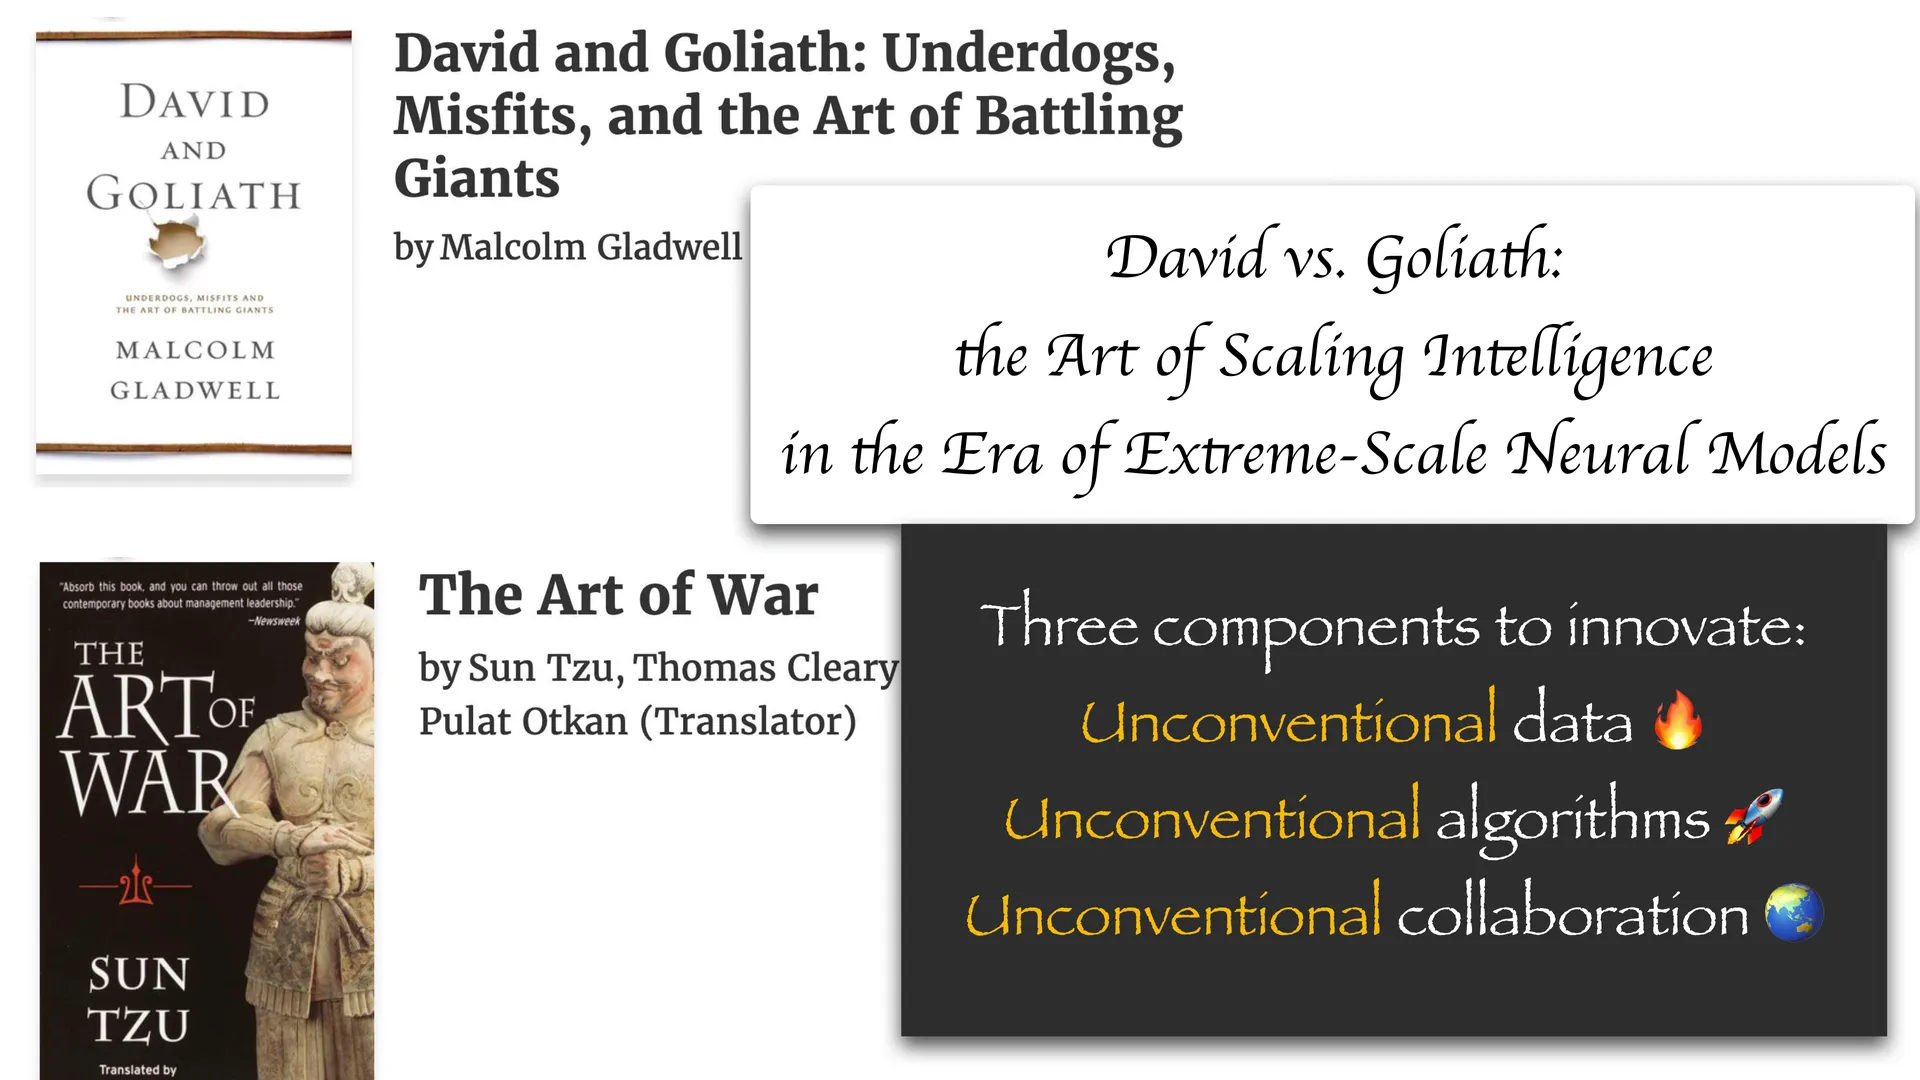
🖼️ 第 10 页幻灯片 · David vs. Goliath:
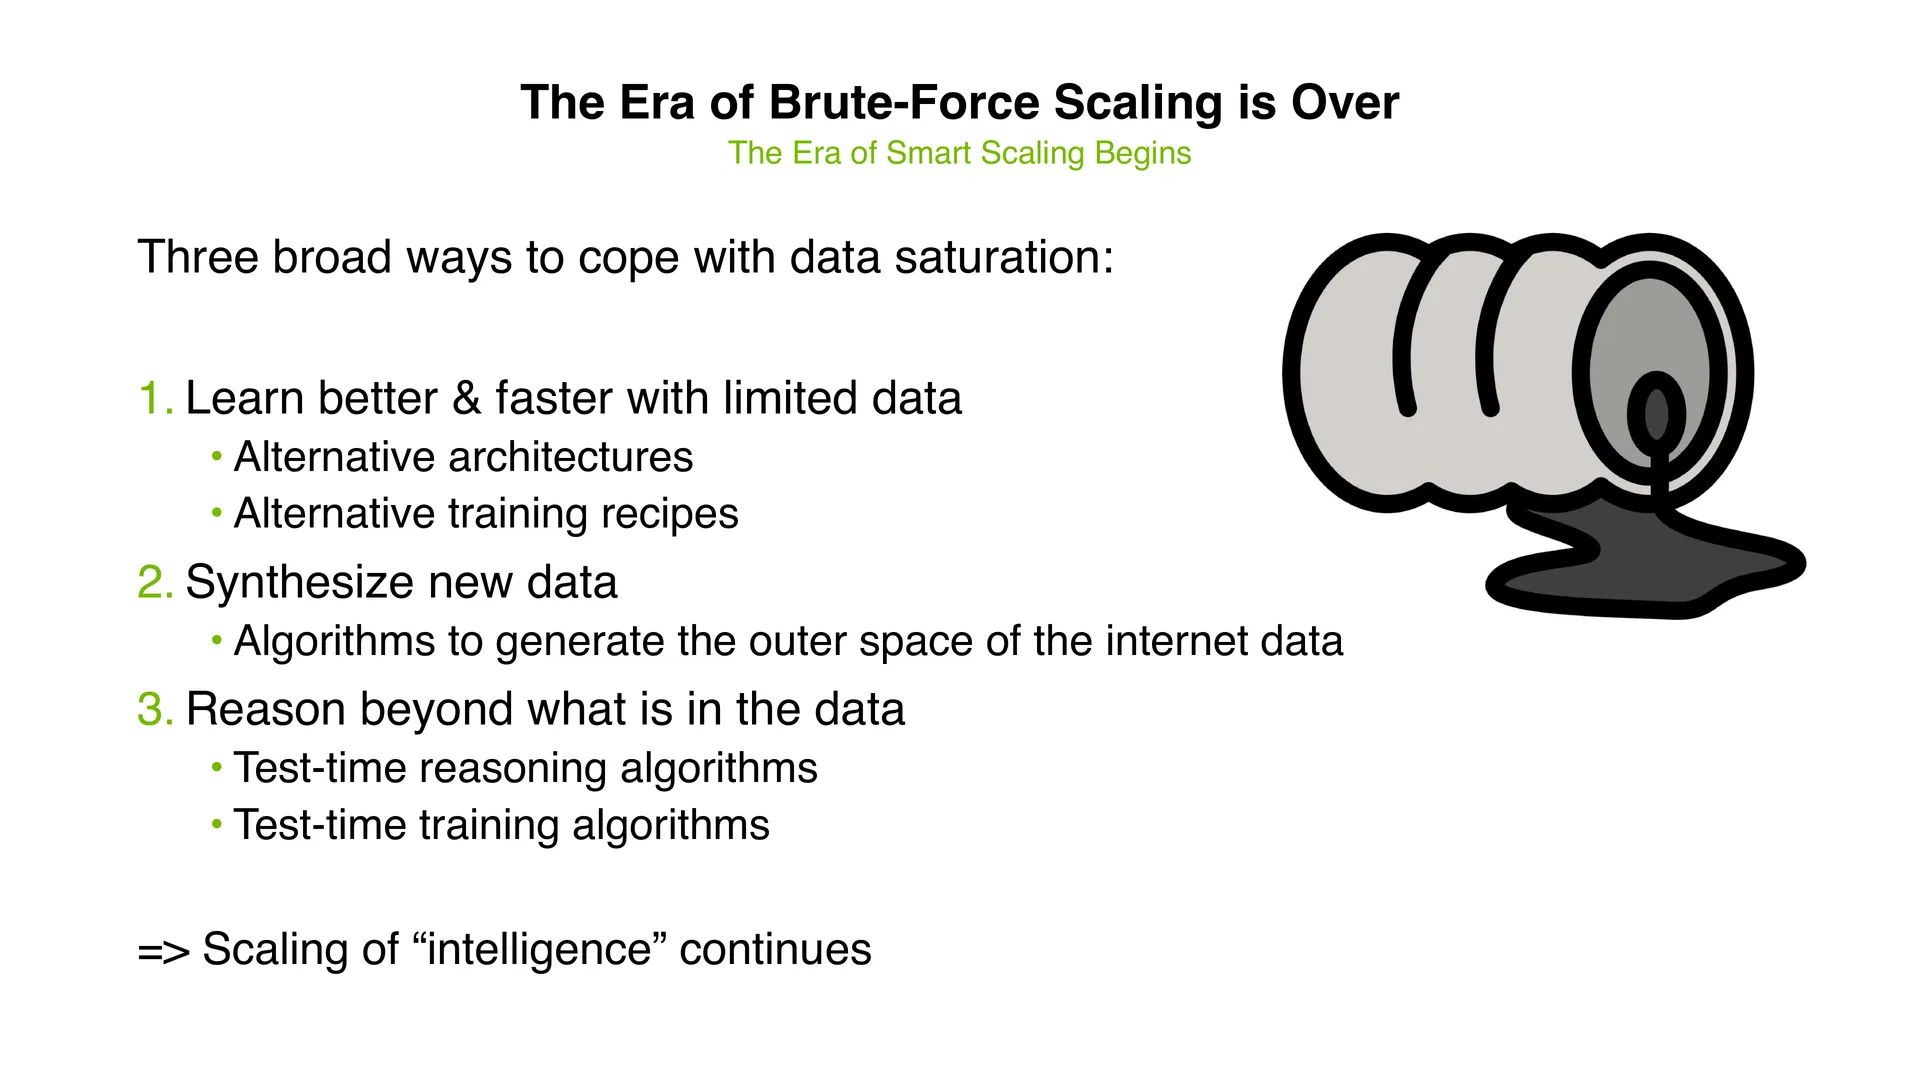
The Era of Brute-Force Scaling is Over. The Era of Smart Scaling Begins. (蛮力 scaling 的时代结束了,聪明 scaling 的时代开始了。)
讲义进一步给出了数据饱和(data saturation)的三种应对方式(Slide 9):
🖼️ 第 11 页幻灯片 · Three components to innovate:
- 用更少的数据学得更好、更快
- 替代性架构(alternative architectures)
- 替代性训练配方(alternative training recipes)
- 合成新数据
- 生成「互联网数据之外的空间」的算法
- 推理出数据之外的东西
- 测试时推理算法(test-time reasoning)
- 测试时训练算法(test-time training)
结论是:「智能」的 scaling 仍在继续,只是推进方式变了。
本讲的三个工作
Slide 11 给出了全场的路线图:
flowchart TD
    A["David vs. Goliath<br/>小模型挑战大模型"] --> B["ProRL<br/>Prolonged RL(延长版强化学习)"]
    A --> C["Prismatic Synthesis<br/>基于梯度的数据多样化"]
    A --> D["RLP<br/>Reinforcement as Pretraining<br/>把 RL 作为预训练目标"]
    B --> E["Smaller but Better"]
    C --> E
    D --> F["Algorithms for the Win"]
第一部分:ProRL —— 延长版强化学习
三、2025:LRM 的崛起与「反 RL」的惊人发现
LRM,而不是 LLM
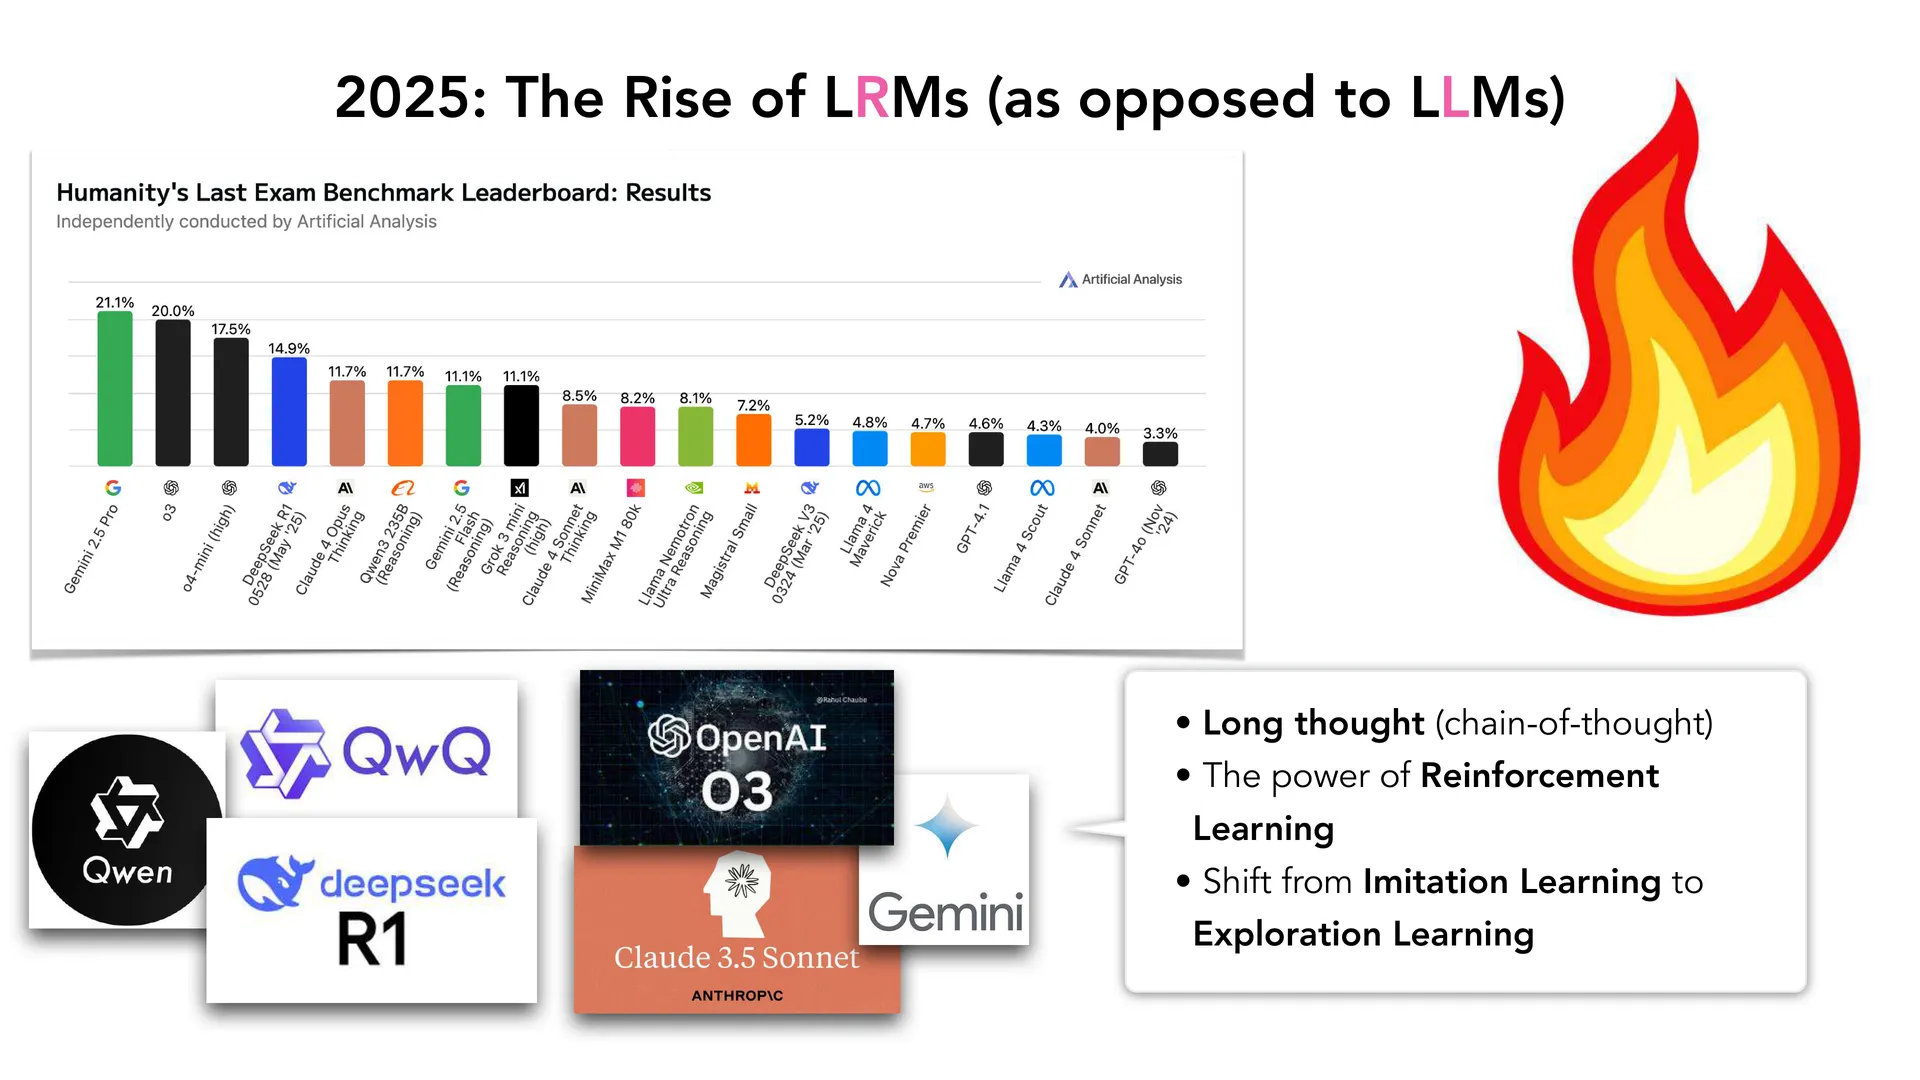
🖼️ 第 13 页幻灯片 · 2025: The Rise of LRMs (as opposed to LLMs)
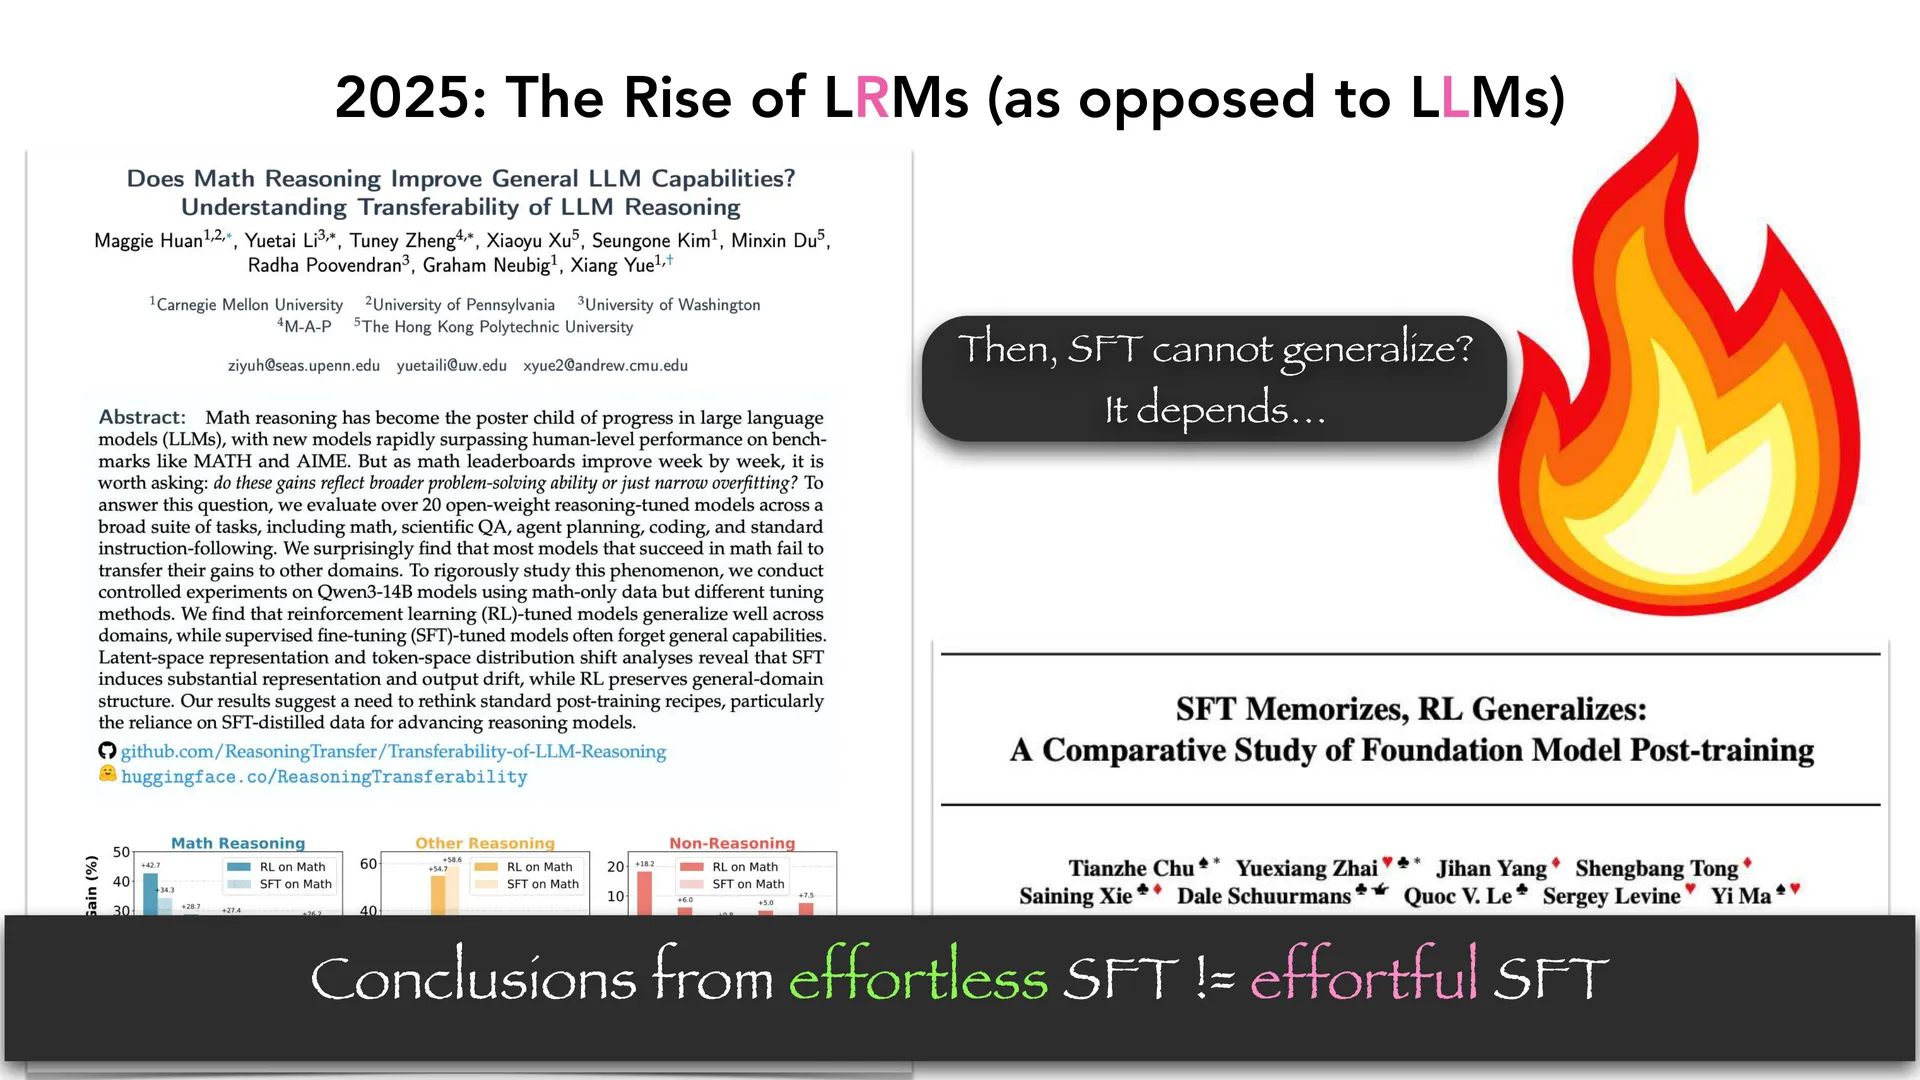
Slide 13 给 2025 年的关键词做了一个重新命名:LRM(Large Reasoning Models) 正在取代 LLM 成为讨论中心。其三个特征:
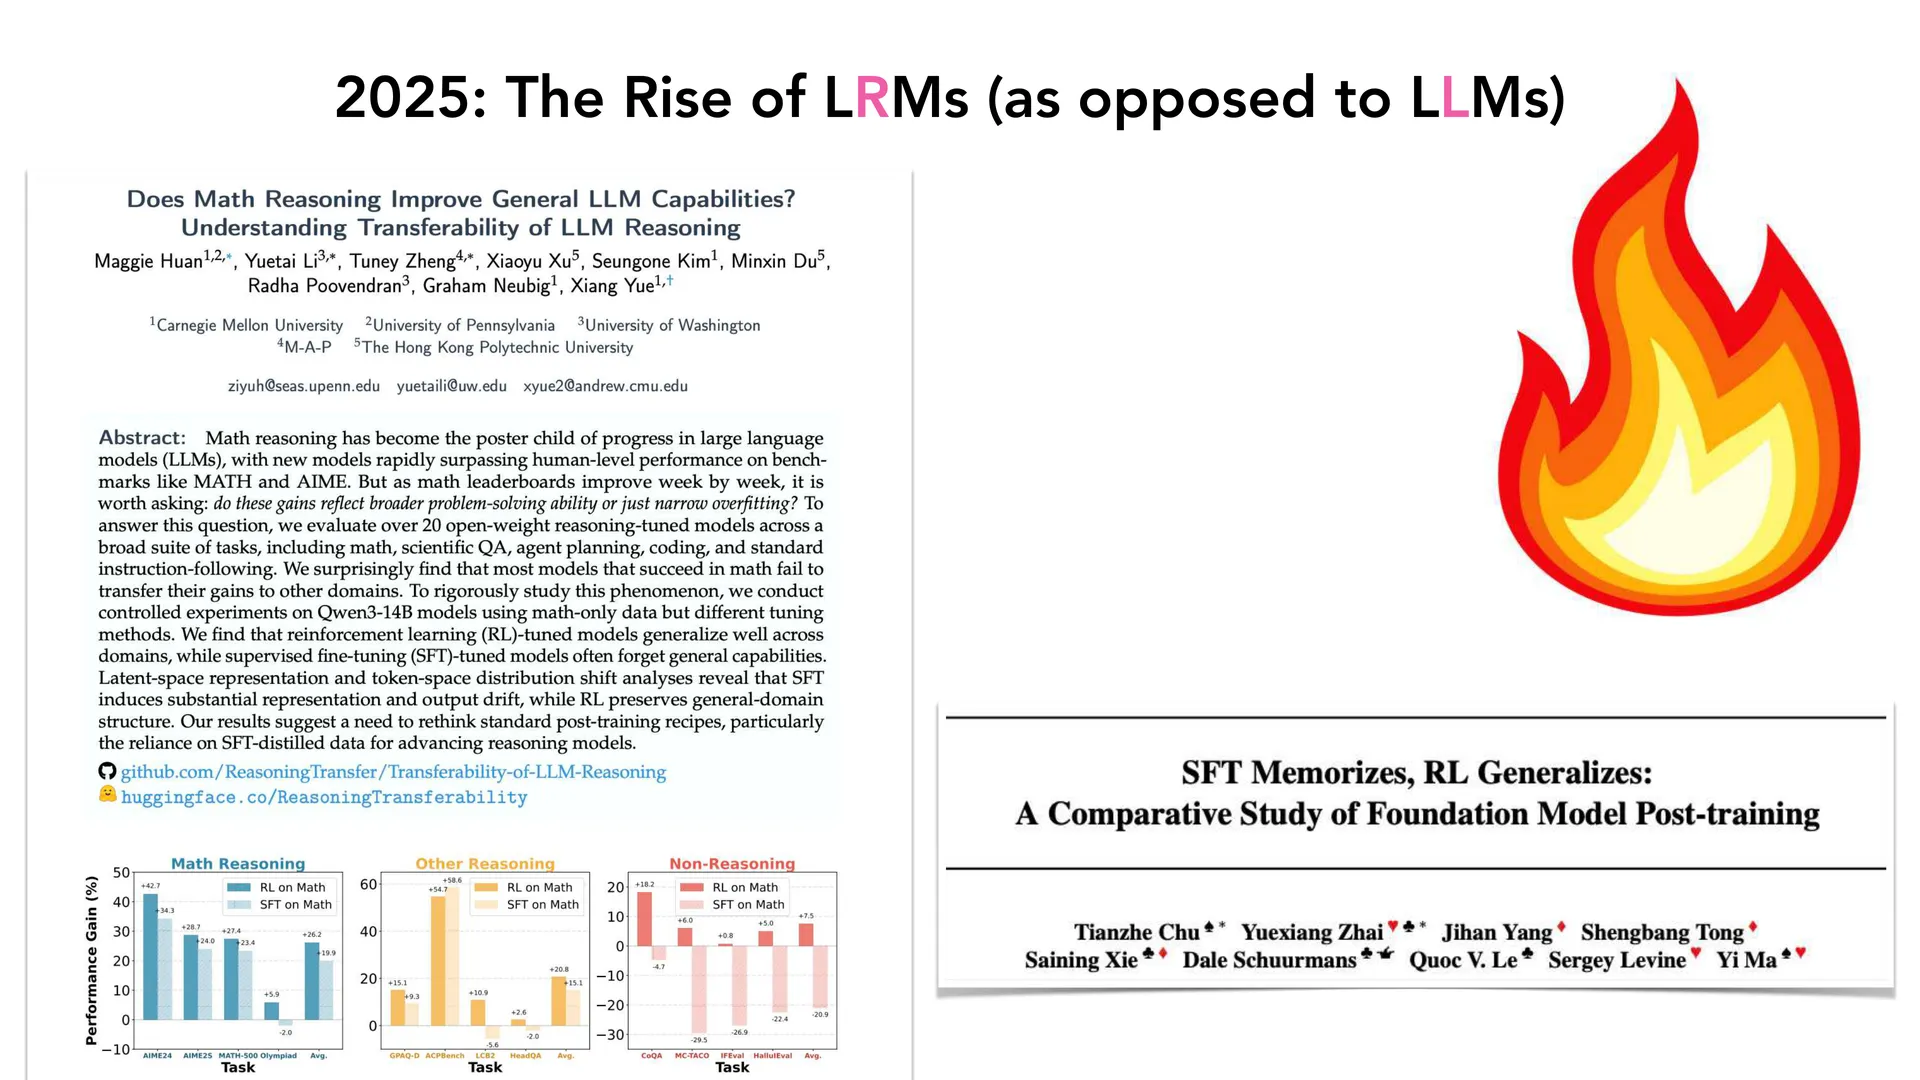
🖼️ 第 14 页幻灯片 · 2025: The Rise of LRMs (as opposed to LLMs)
- Long thought(长链式思考,chain-of-thought)
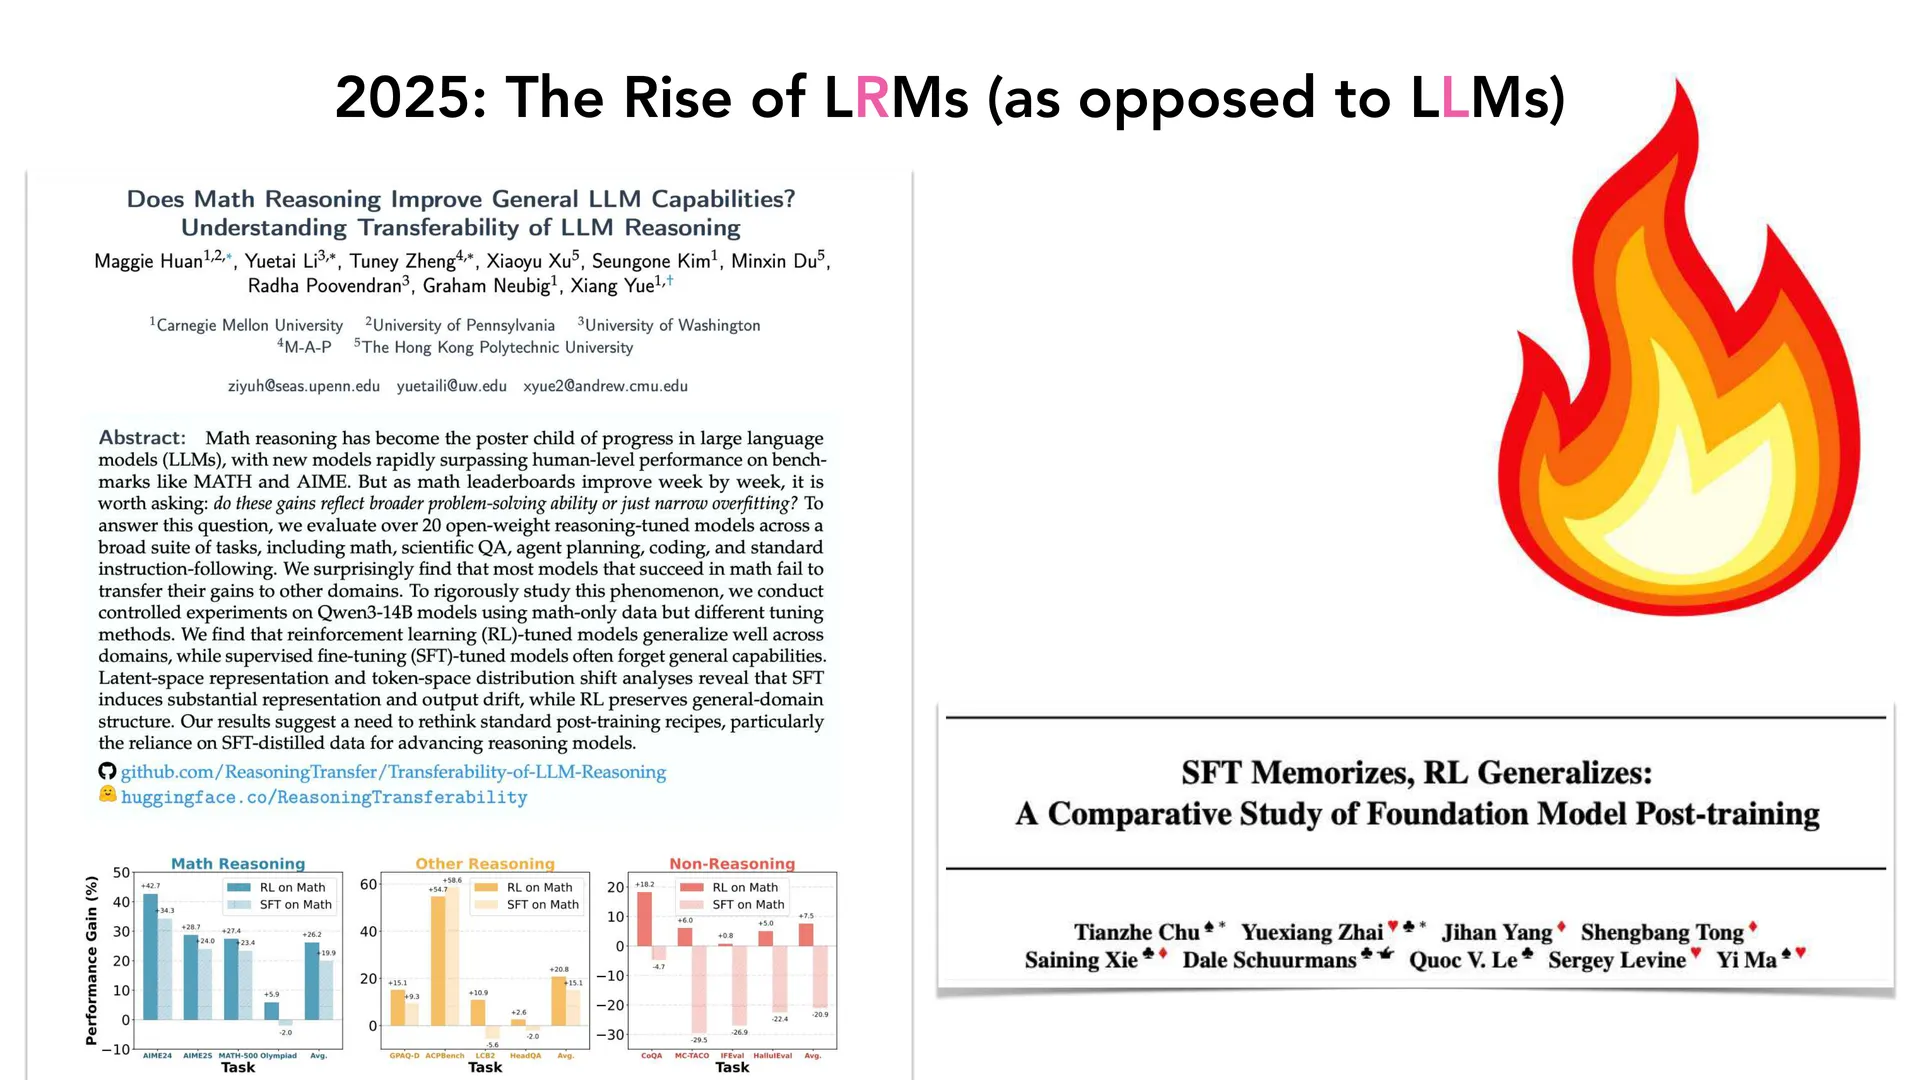
🖼️ 第 15 页幻灯片 · 2025: The Rise of LRMs (as opposed to LLMs)
- 强化学习的力量
- 从模仿学习(Imitation Learning)转向探索学习(Exploration Learning)
编者说明:这里的「模仿学习 → 探索学习」是本讲后半所有工作的共同主线。SFT 是模仿人类/教师给出的答案,RL 则是让模型自己去试、用结果好坏来调整。
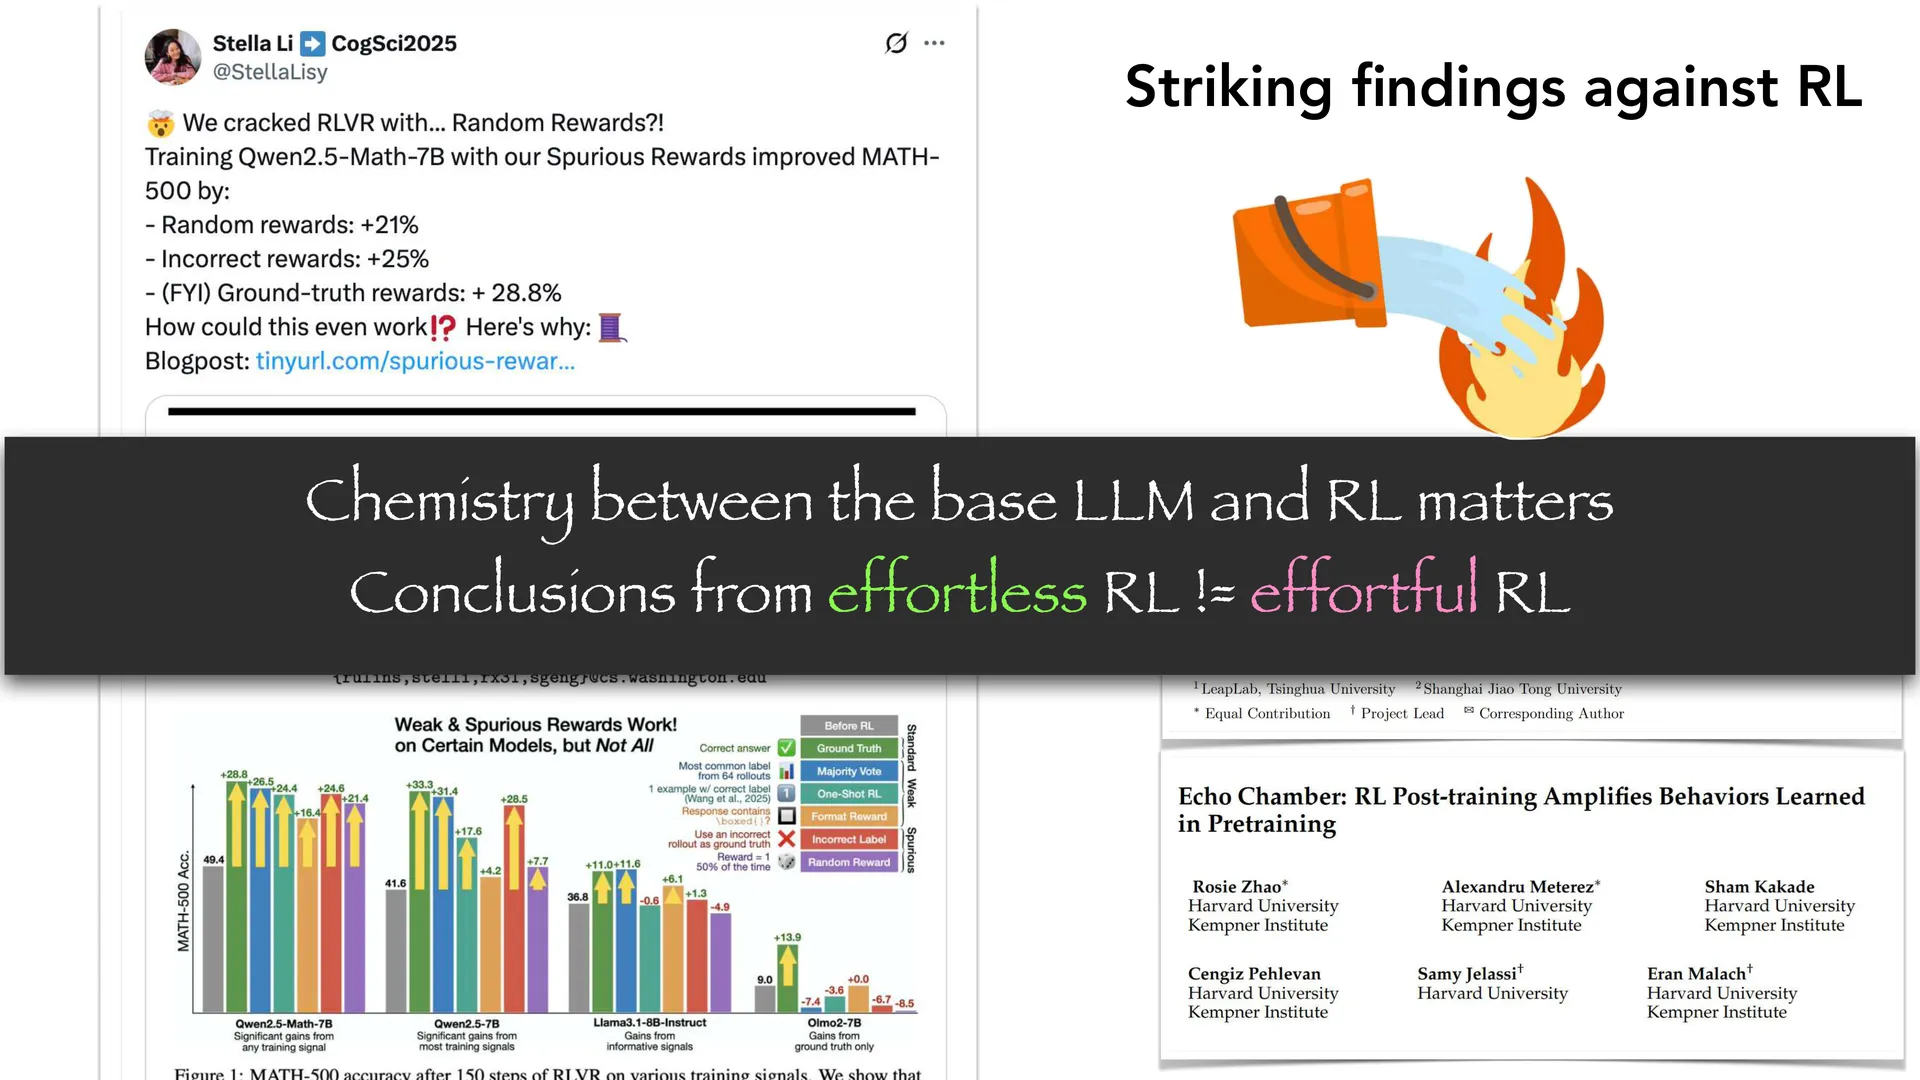
🖼️ 第 16 页幻灯片 · Striking findings against RL
一个反直觉的发现
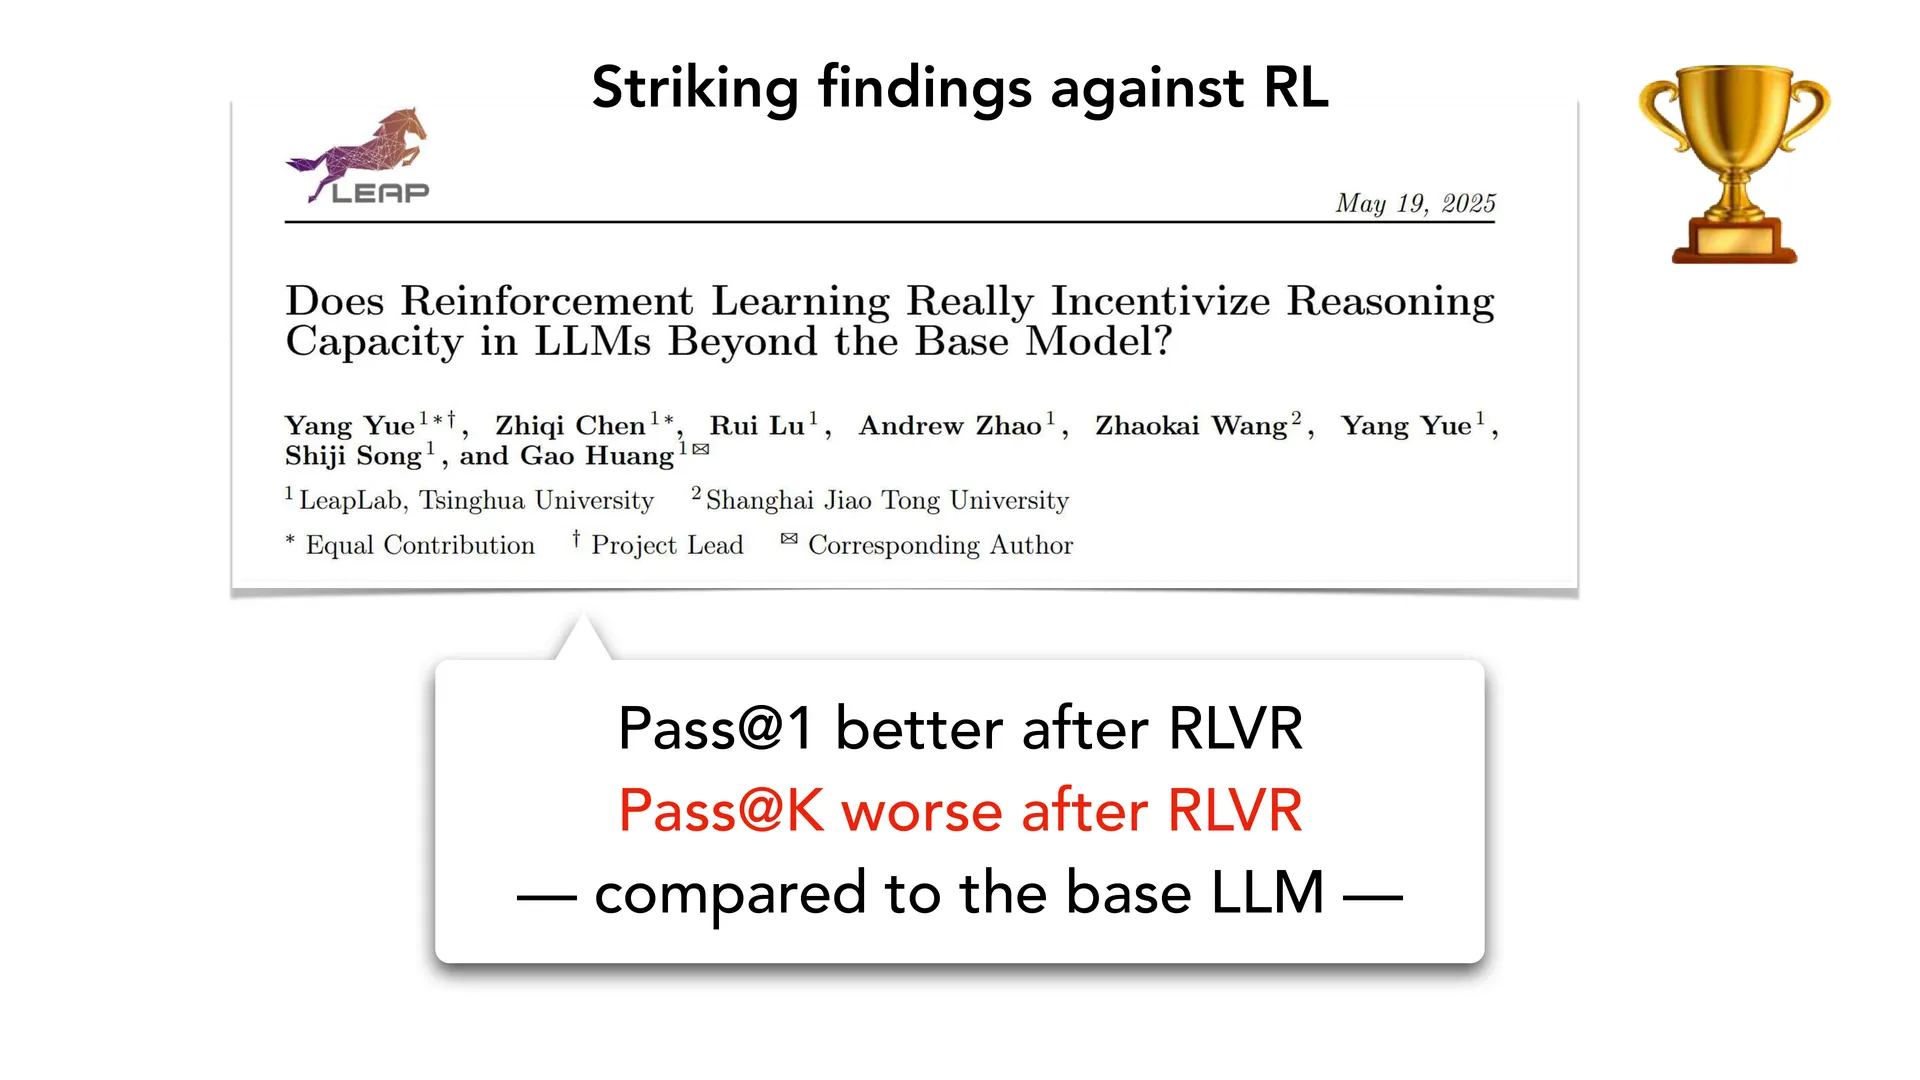
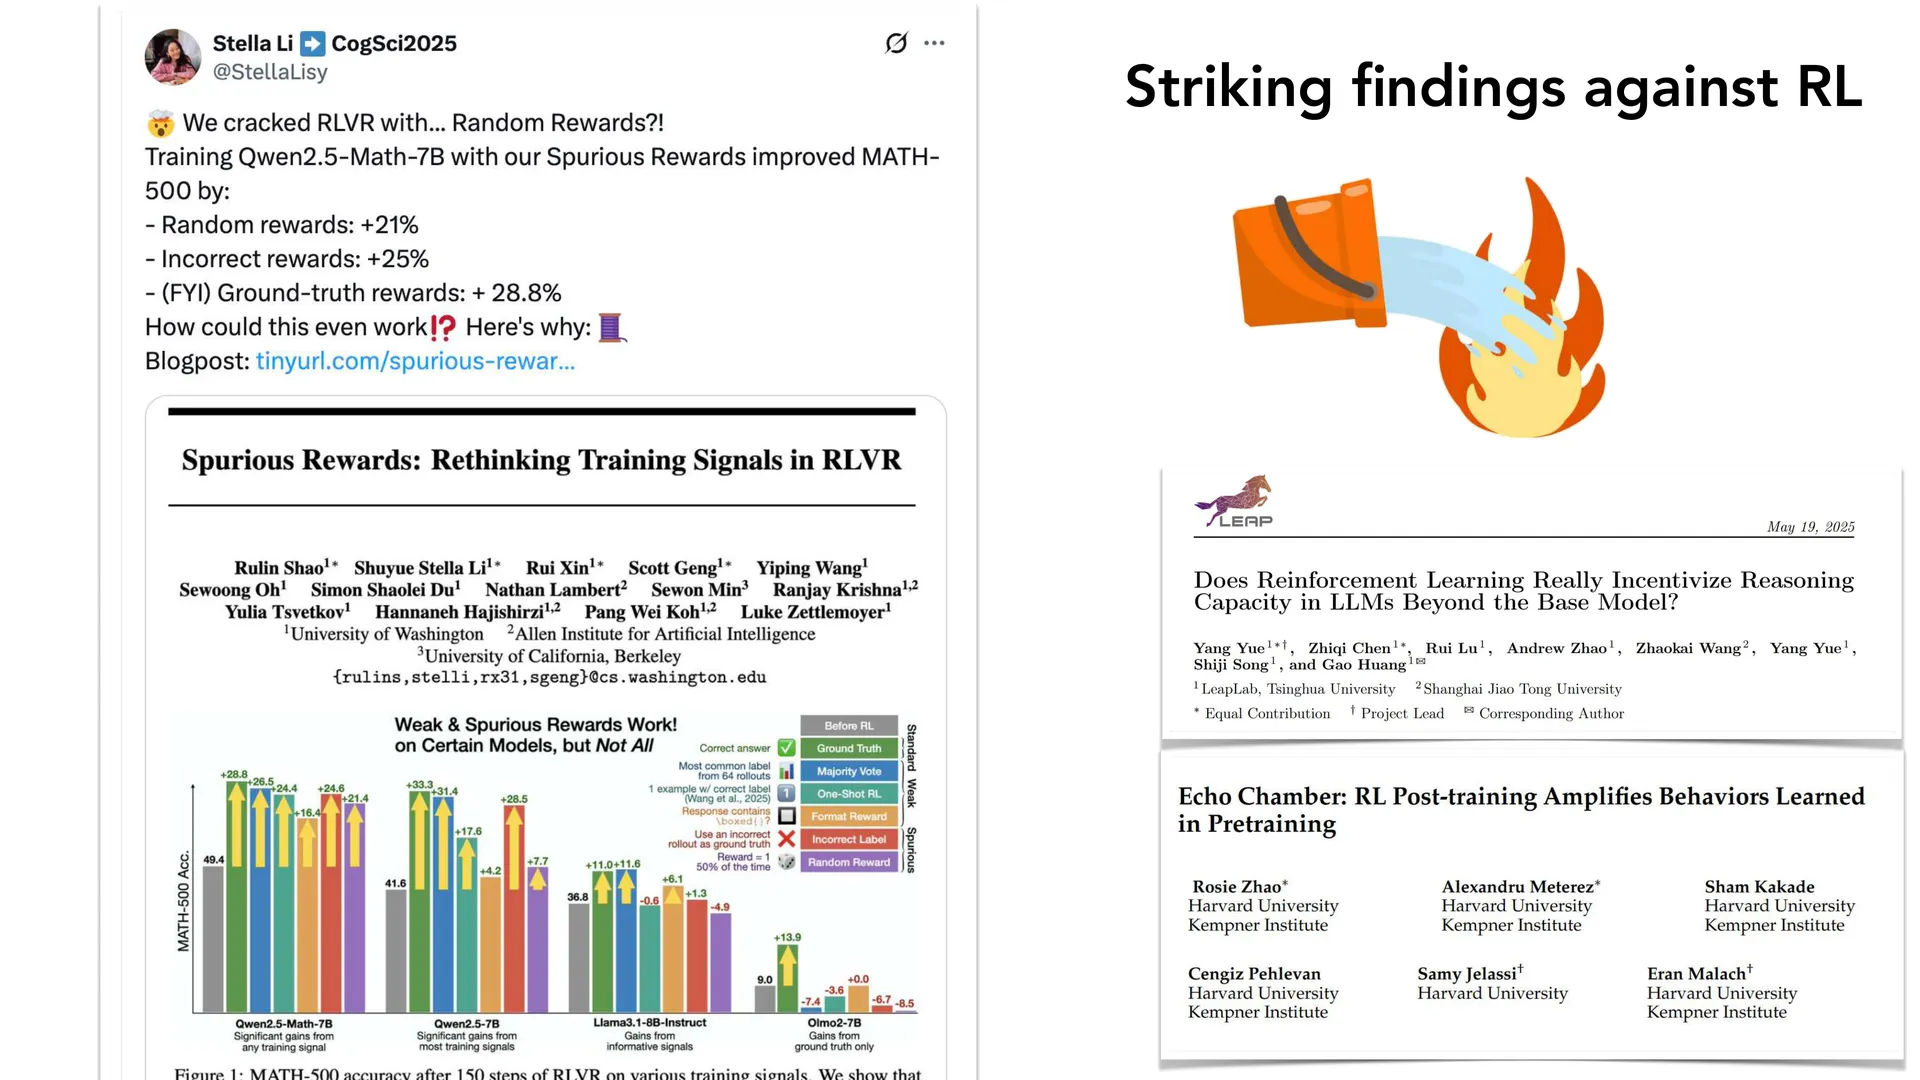
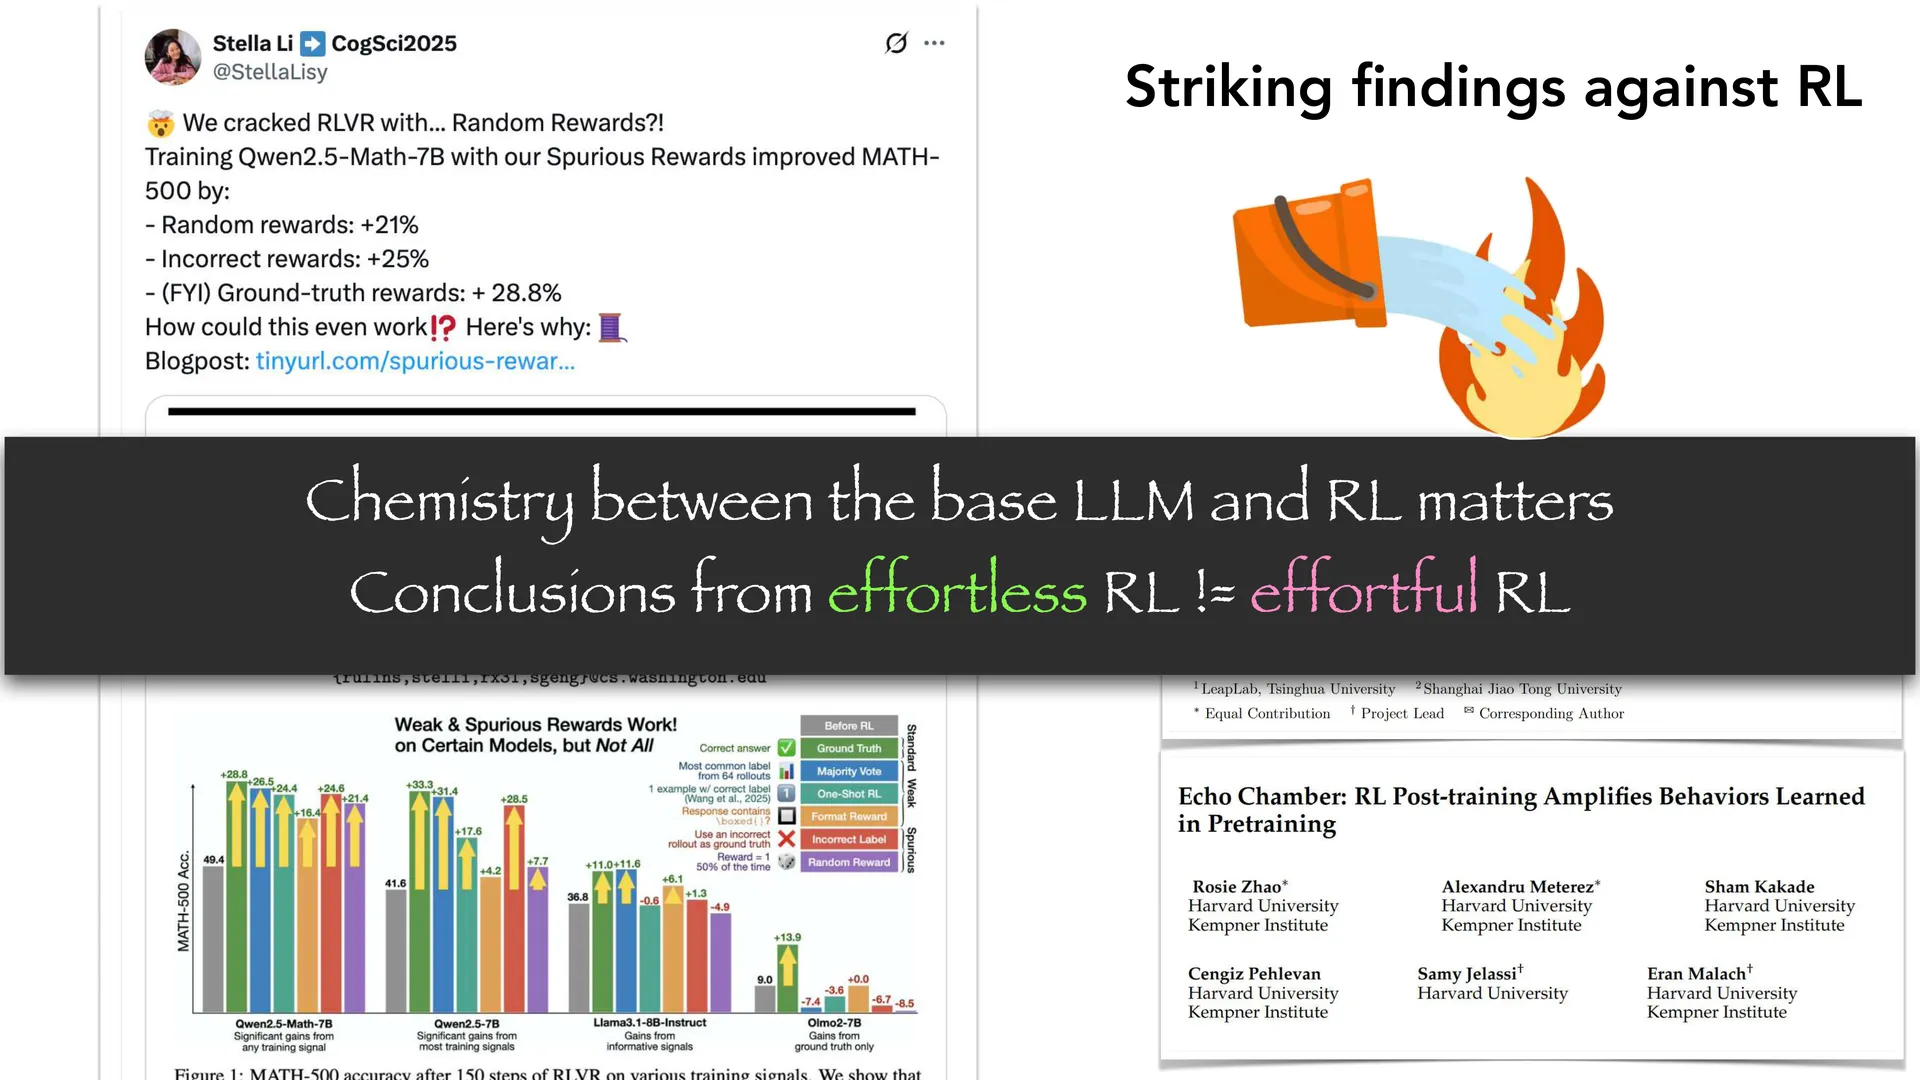
Slide 16–21 反复播放同一页,标题是 Striking findings against RL(针对 RL 的惊人发现):
🏆 Pass@1 better after RLVR,Pass@K worse after RLVR (与 base LLM 相比:做过 RLVR 之后 Pass@1 更好,但 Pass@K 更差。)
🖼️ 第 17 页幻灯片 · Striking findings against RL
编者说明|Pass@1 与 Pass@K 分别衡量什么:Pass@1 是单次采样答对的概率,衡量「典型表现」;Pass@K 是独立采样 K 次至少有一次答对的概率,衡量「模型能力覆盖了多大范围」。 Pass@1 上升、Pass@K 下降,意味着:模型变得更擅长给出那一个它已经会的答案,但可解问题的覆盖面变窄了——它不再探索别的解法。既有的推理书里也常把这个现象与「RL 后的输出多样性下降」联系起来。
🖼️ 第 18 页幻灯片 · Pass@1 better after RLVR
讲义紧接着给出了三条结论(Slide 21、31、34、35):
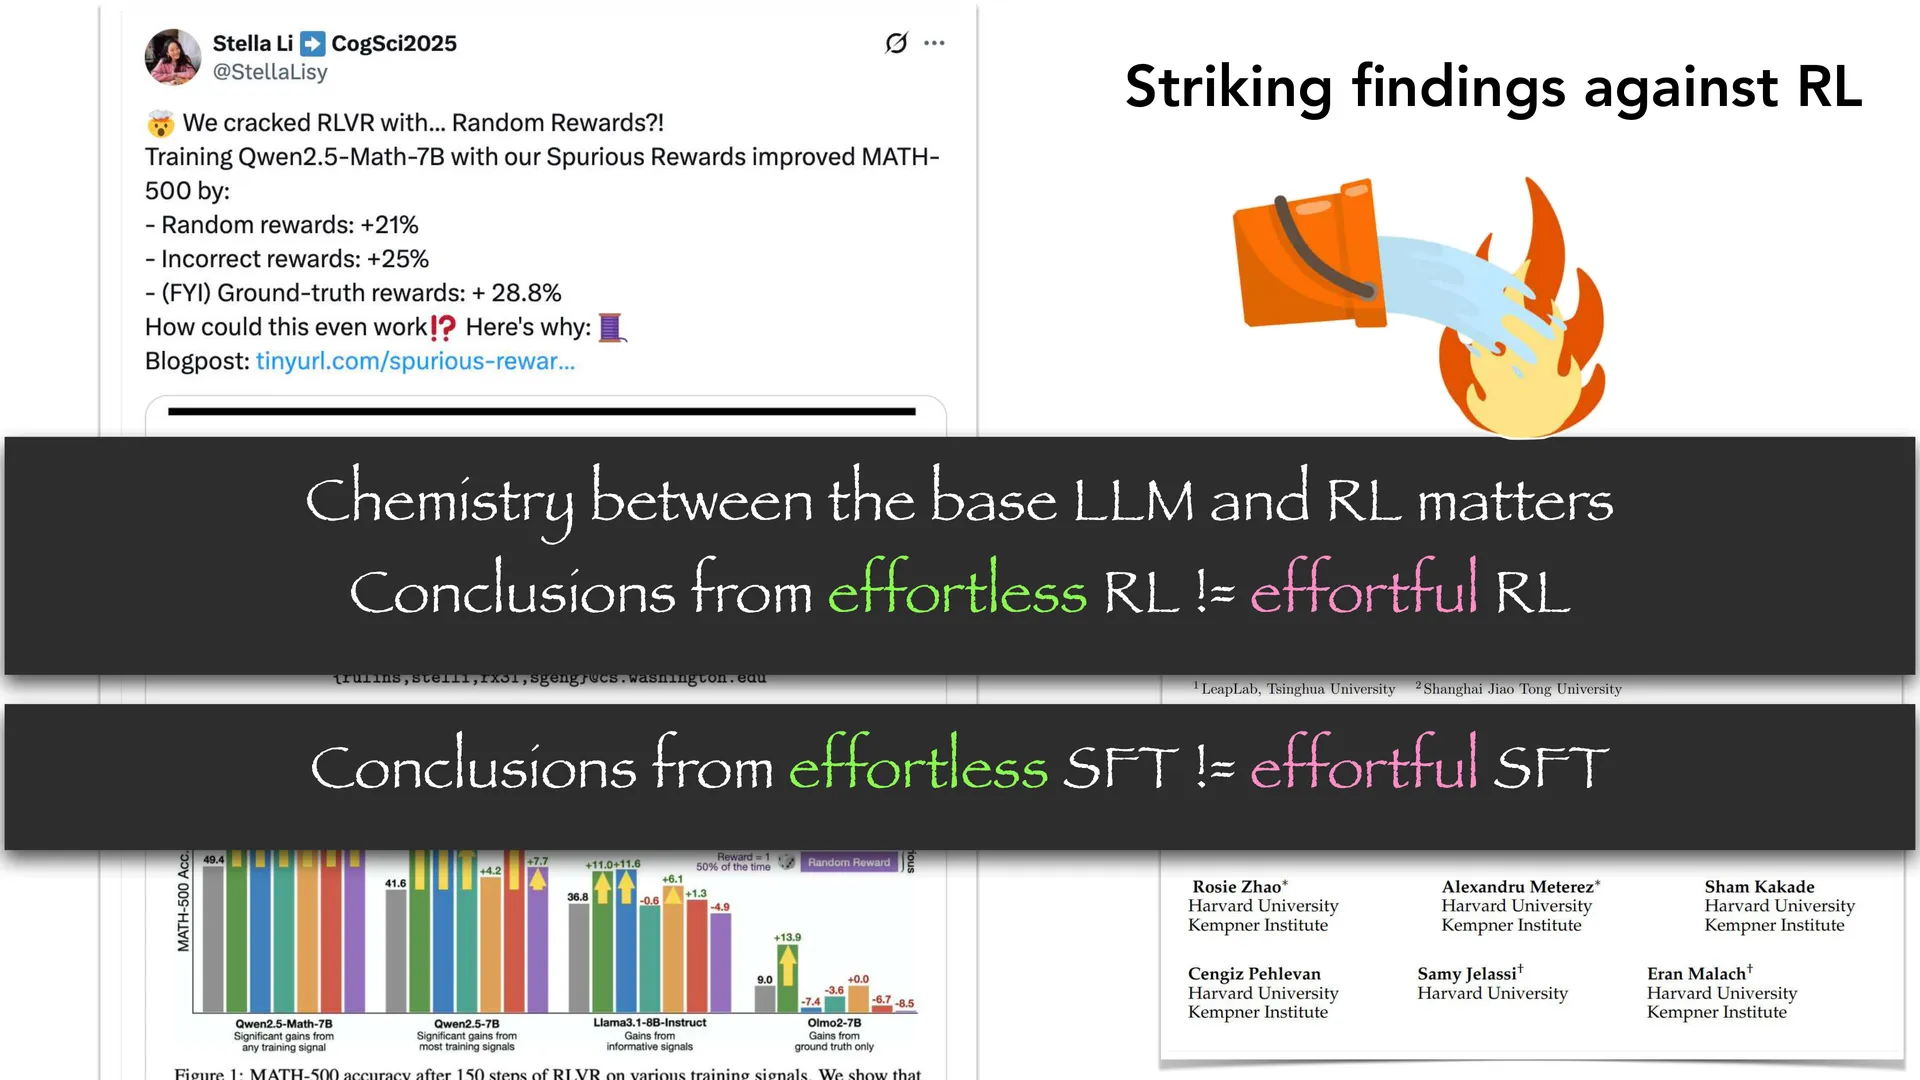
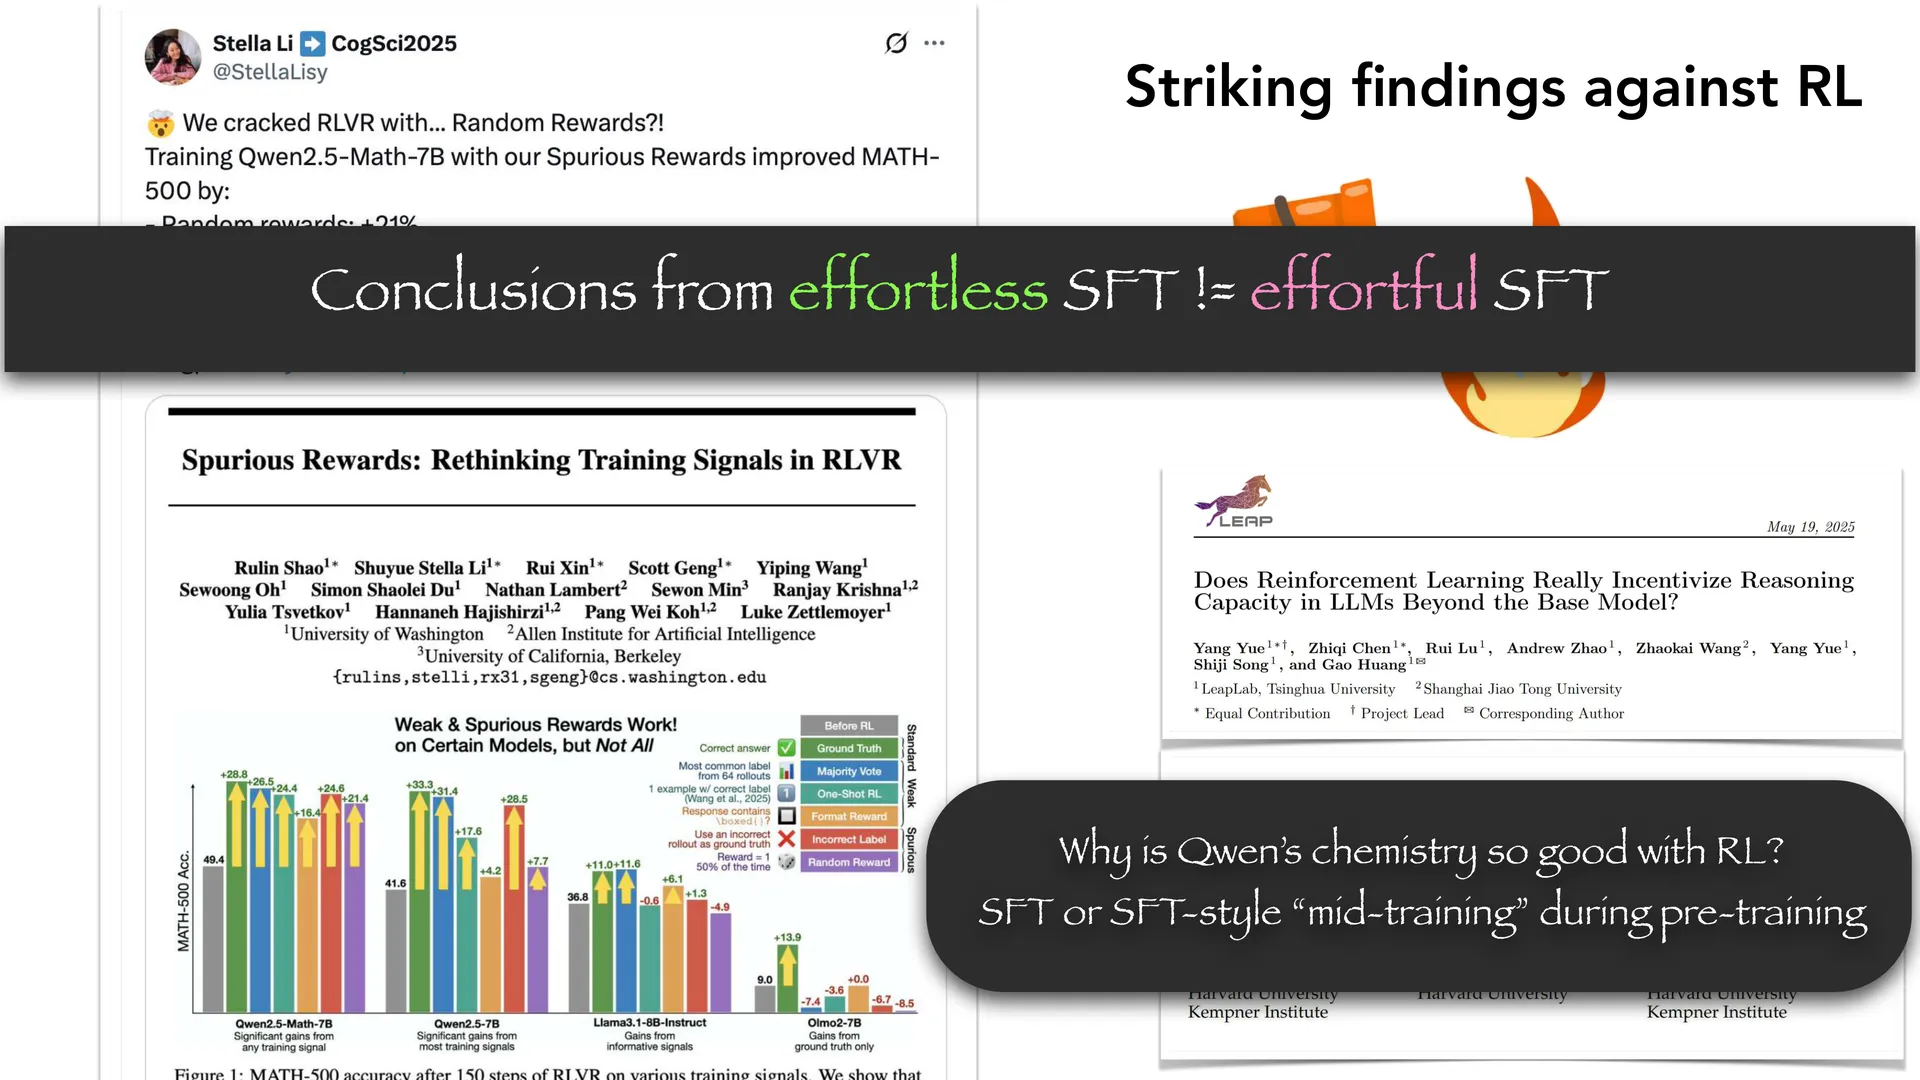
- Chemistry between the base LLM and RL matters(基座模型与 RL 之间的「化学反应」很重要)
- Conclusions from effortless RL ≠ effortful RL(「不用力」的 RL 与「用力」的 RL 得到的结论不一样)
- Conclusions from effortless SFT ≠ effortful SFT(SFT 同理)
ProRL 的动机
Slide 22:
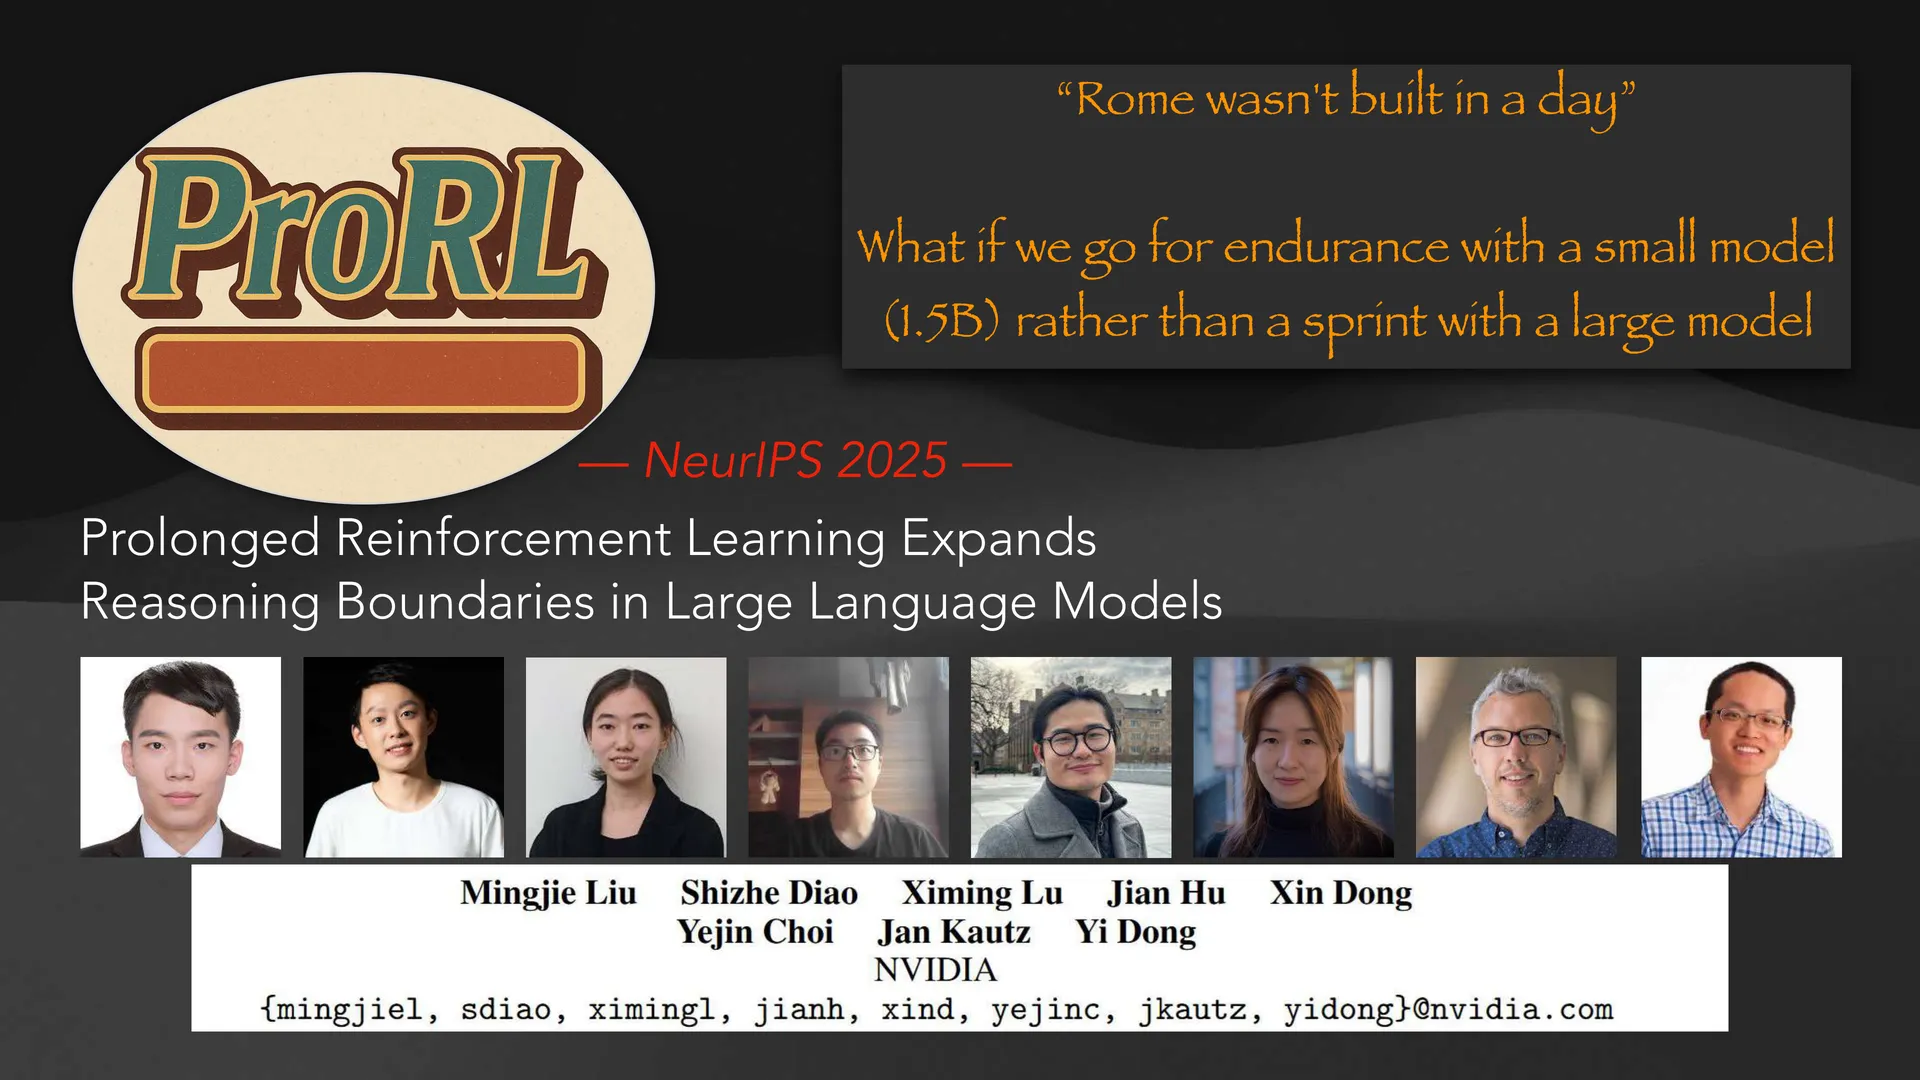
Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models(NeurIPS 2025) 「Rome wasn't built in a day.」(罗马不是一天建成的。) 如果我们用一个小模型(1.5B)跑马拉松,而不是用大模型跑百米冲刺,会怎样?
四、ProRL 的技术底座:DAPO / GRPO
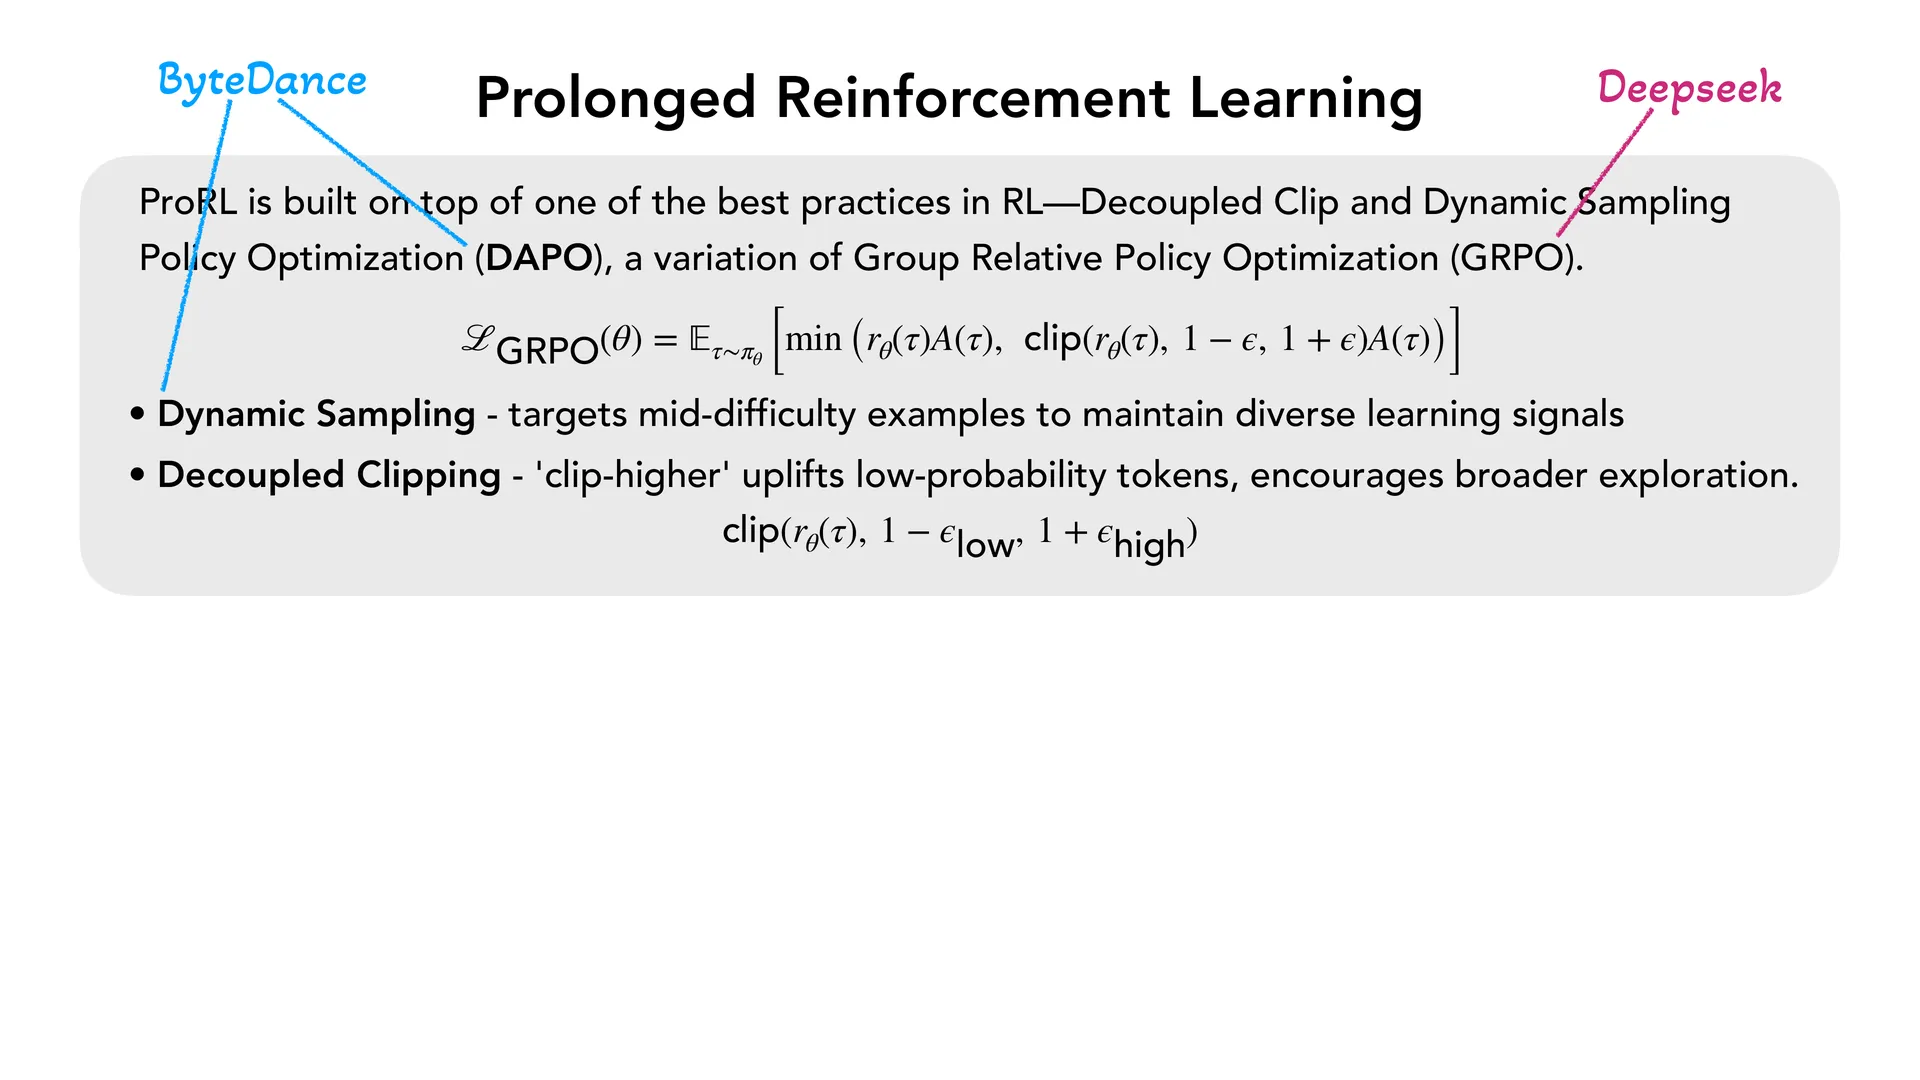
Slide 23–24 说明 ProRL 建立在 DAPO(Decoupled Clip and Dynamic Sampling Policy Optimization) 之上——它是 GRPO(Group Relative Policy Optimization) 的一个变体,分别由 DeepSeek 与 ByteDance 提出。
🖼️ 第 19 页幻灯片 · Striking findings against RL
GRPO 的目标函数(Slide 24 原式):
$$\mathcal{L}_{\text{GRPO}}(\theta) = \mathbb{E}_{\tau \sim \pi_\theta}\Big[ \min\big( r_\theta(\tau) A(\tau),\; \mathrm{clip}\big(r_\theta(\tau),\, 1-\epsilon,\, 1+\epsilon\big) A(\tau) \big) \Big]$$
🖼️ 第 23 页幻灯片 · Prolonged Reinforcement Learning
DAPO 在此基础上改动了两处:
- Dynamic Sampling(动态采样):只挑中等难度的样本来训练,从而维持多样化的学习信号。
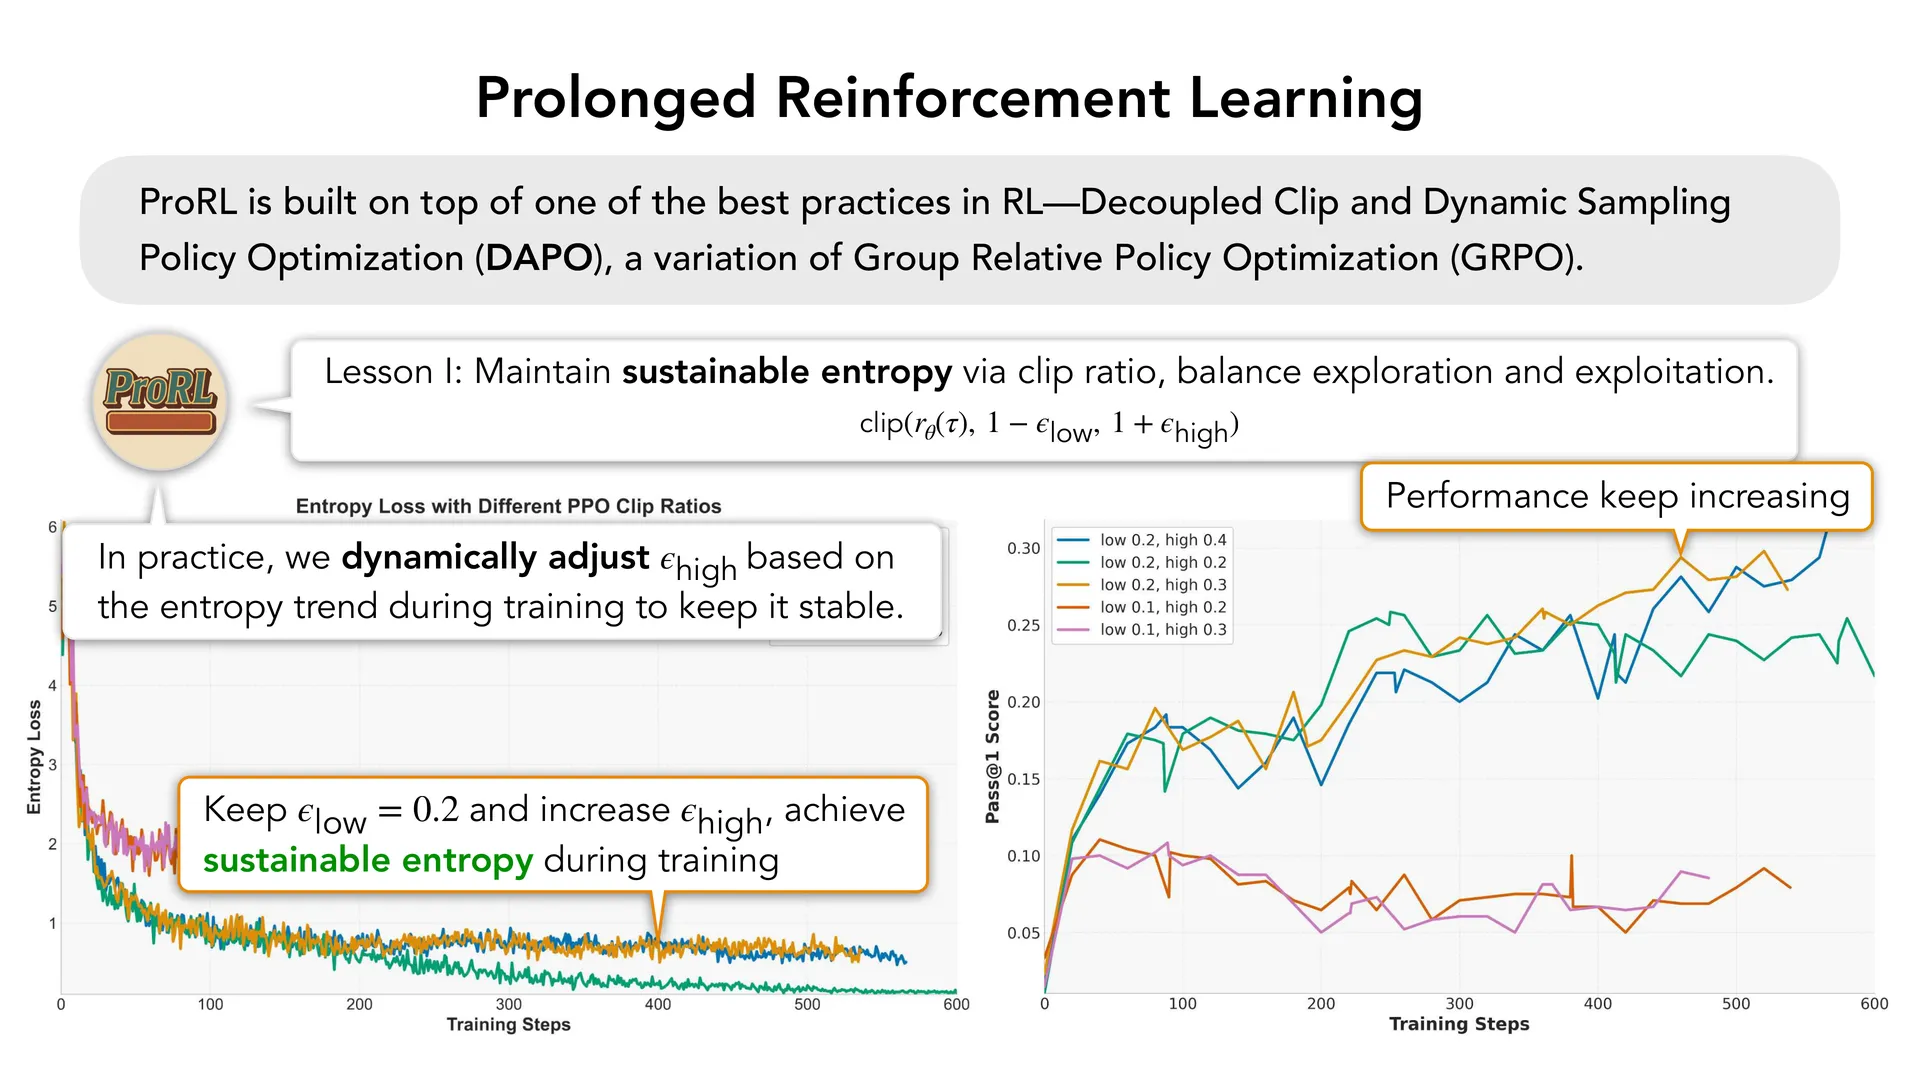
- Decoupled Clipping(解耦裁剪):把上界与下界分开,即
$$\mathrm{clip}\big(r_\theta(\tau),\, 1-\epsilon_{\text{low}},\, 1+\epsilon_{\text{high}}\big)$$
其中「clip-higher」会抬高低概率 token 的概率,从而鼓励更广的探索。
编者拓展|clip-higher 为什么能鼓励探索:在标准的对称裁剪里,重要性比 $r_\theta(\tau)$ 被限制在 $[1-\epsilon, 1+\epsilon]$。对于当前概率极低的 token,这等于给它设了一个很低的「提升上限」——它再有用也涨不上去。把上界单独放成 $1+\epsilon_{\text{high}}$($\epsilon_{\text{high}} > \epsilon_{\text{low}}$),就是给这些低概率 token 松开天花板。这一点与下一节「熵」的故事直接相连:低概率 token 被压制,就是熵坍缩。
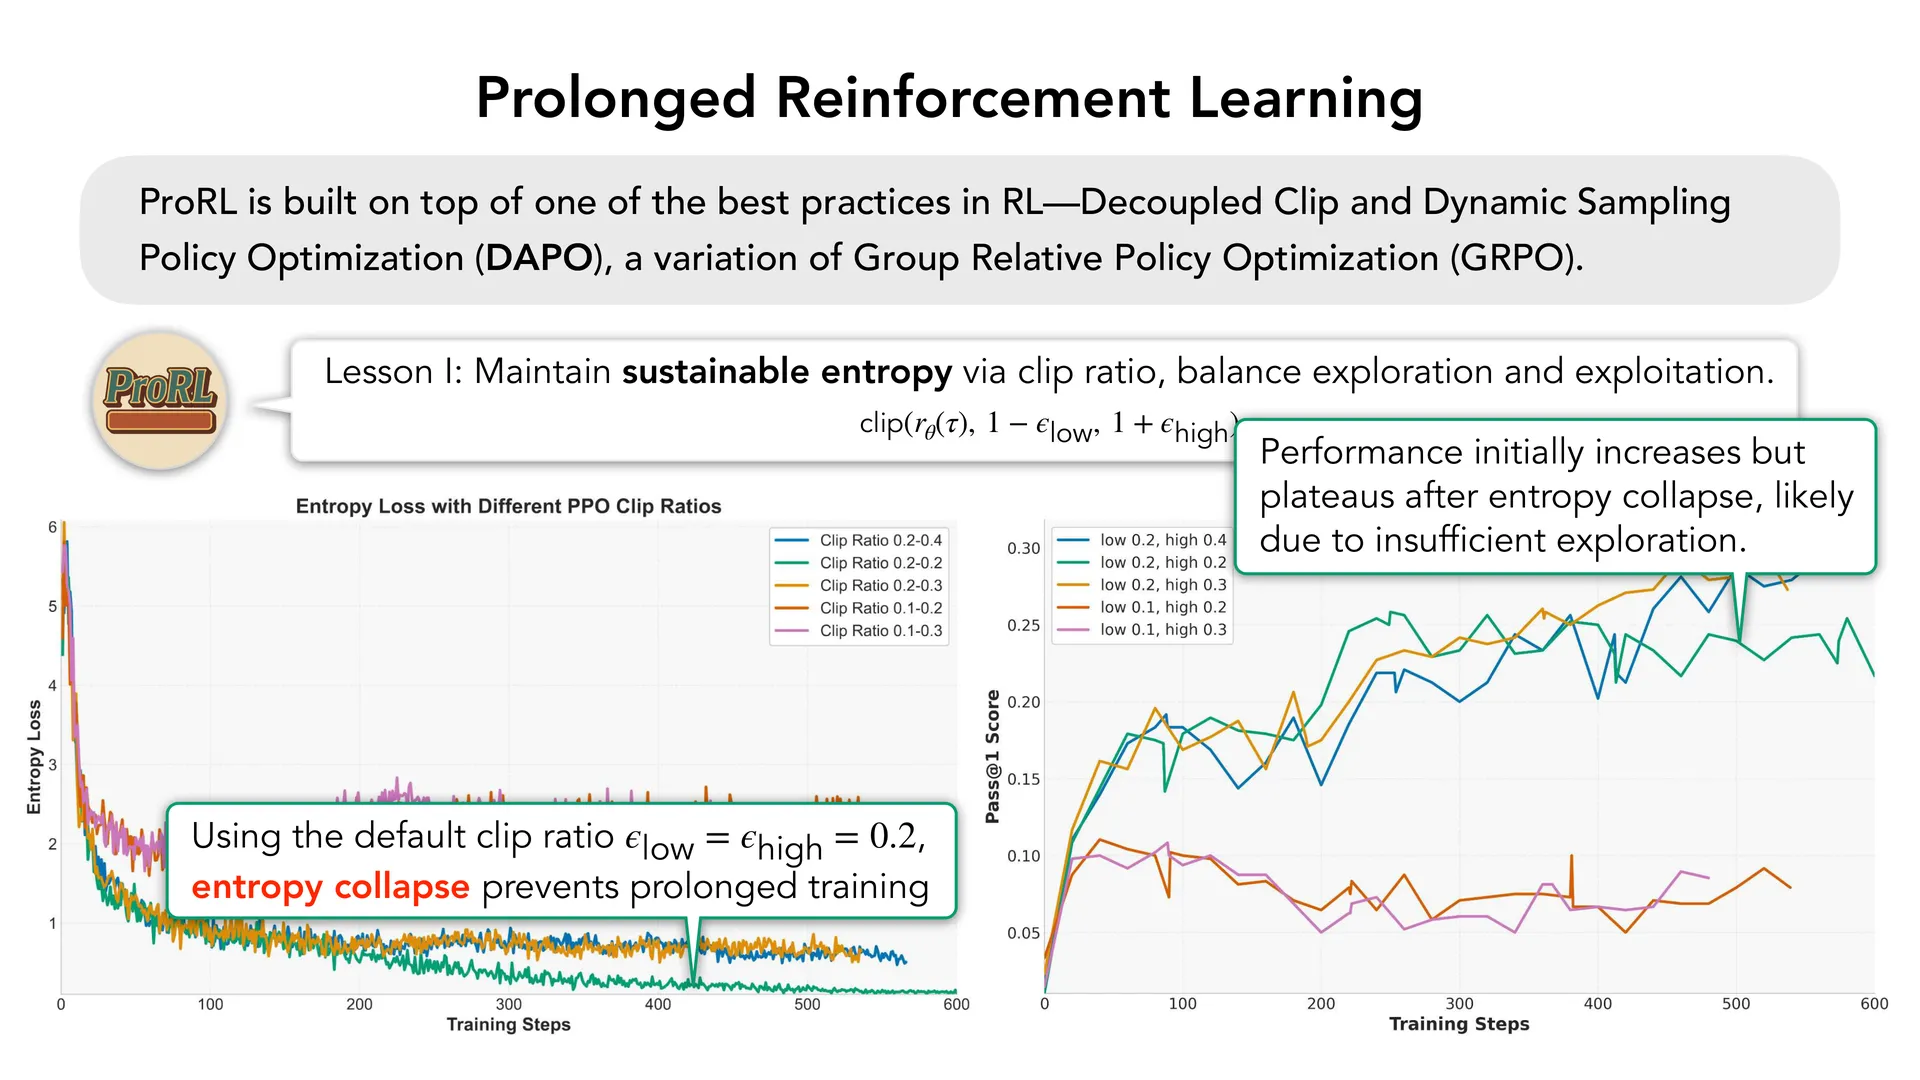
五、ProRL 的教训一:用 clip 比例维持「可持续的熵」
编者说明|熵(entropy)在这里指什么:在 LLM 的 RL 训练里,策略熵通常指模型在每一步输出分布上的平均不确定性。熵高 = 输出多样、愿意探索;熵低 = 输出趋同、近似确定性策略。熵坍缩(entropy collapse) 指训练中熵迅速掉到很低,模型不再探索。
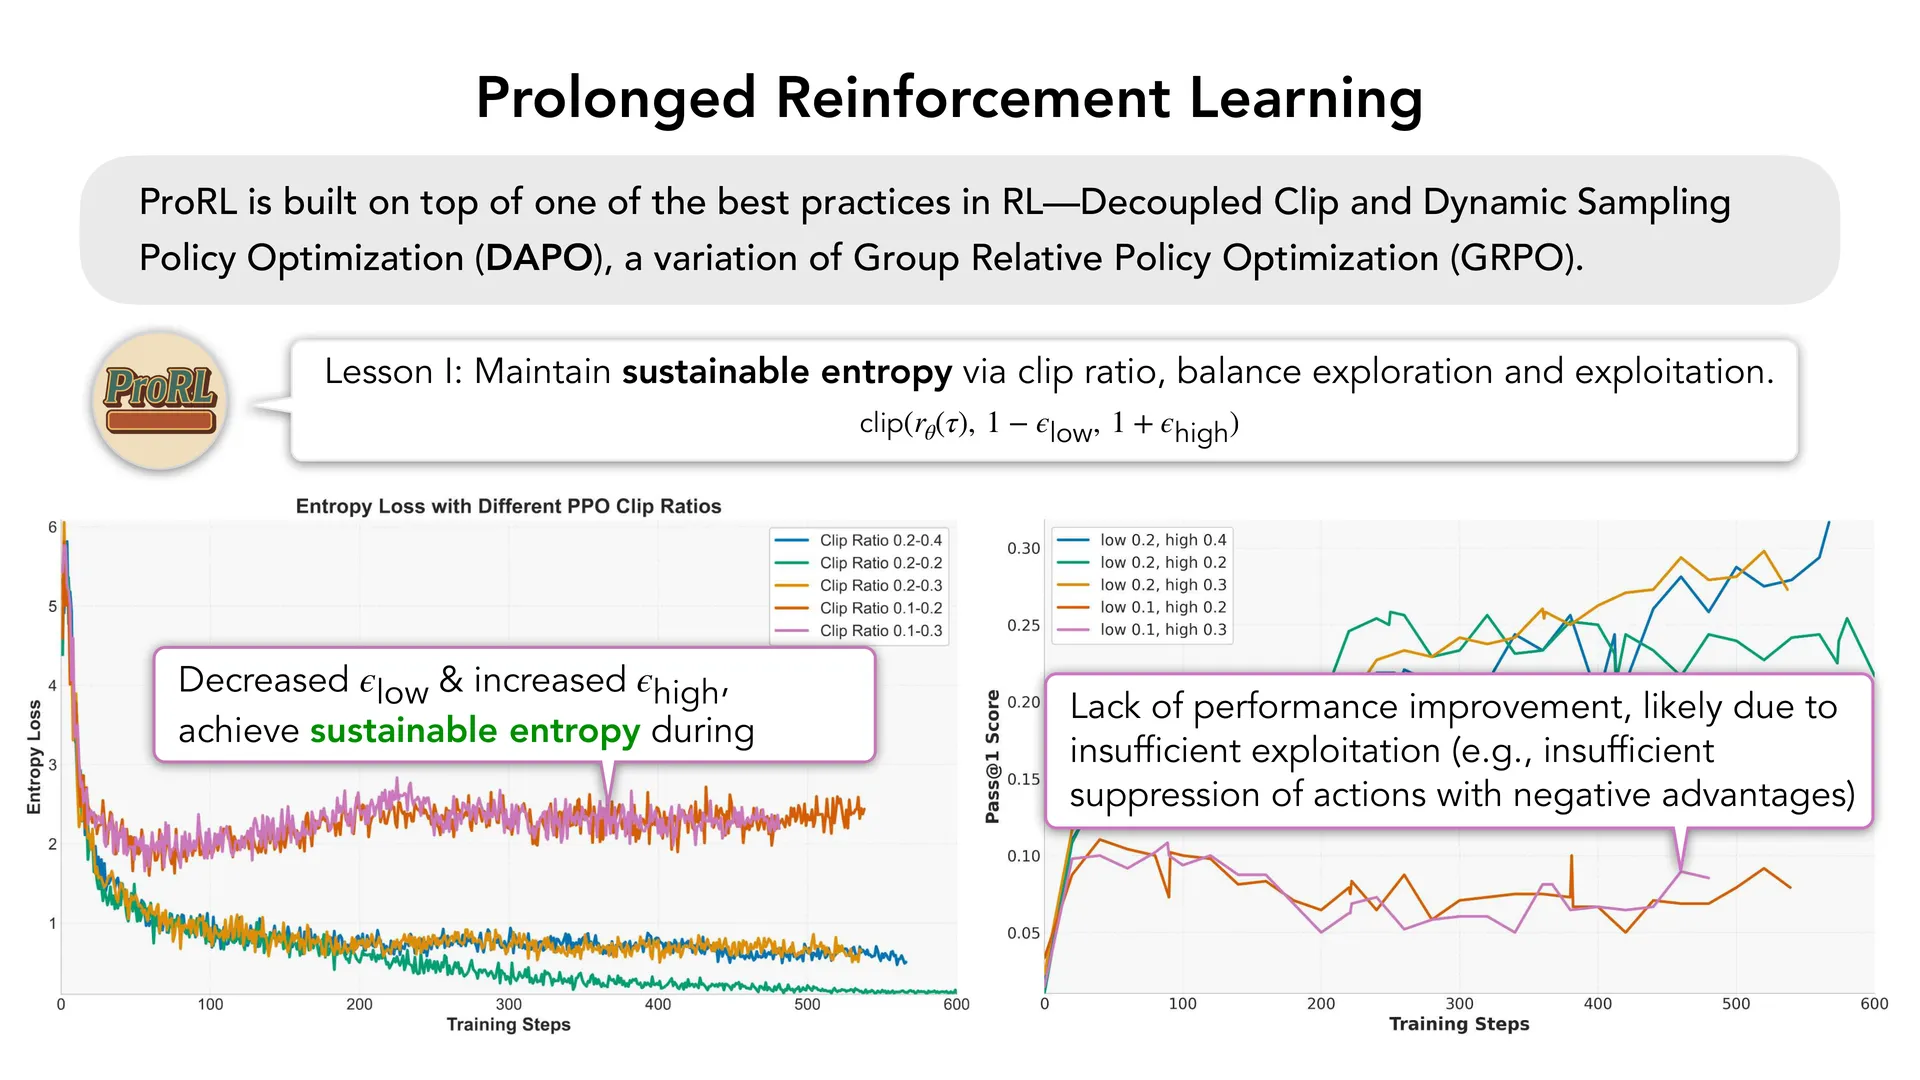
🖼️ 第 26 页幻灯片 · Prolonged Reinforcement Learning
这一节是整讲最完整的「失败 → 分析 → 再失败 → 成功」链条,讲义用了三页讲完(Slides 25–27)。
失败案例一:默认裁剪比导致熵坍缩
失败案例:使用默认裁剪比 $\epsilon_{\text{low}} = \epsilon_{\text{high}} = 0.2$ 时,熵坍缩使长程训练无法继续。
🖼️ 第 29 页幻灯片 · The SOTA 1.5B Reasoning Model
现象是:性能一开始上升,但在熵坍缩之后进入平台期——原因很可能是探索不足。
失败案例二:把 $\epsilon_{\text{low}}$ 调低、$\epsilon_{\text{high}}$ 调高
🖼️ 第 31 页幻灯片 · Chemistry between the base LLM and RL matters
失败案例:降低 $\epsilon_{\text{low}}$ 并提高 $\epsilon_{\text{high}}$,确实实现了可持续的熵,但性能不涨。 原因很可能是利用不足(insufficient exploitation)——例如对负优势动作的压制不够。
也就是说:探索回来了,但模型不再果断地砍掉差的解法。
成功方案:只抬高 $\epsilon_{\text{high}}$
保持 $\epsilon_{\text{low}} = 0.2$,只提高 $\epsilon_{\text{high}}$,即可在训练中维持可持续的熵,性能持续上升。 实践中,讲义根据训练过程中的熵趋势动态调整 $\epsilon_{\text{high}}$,把它维持在稳定水平。
整个决策过程可以画成:
flowchart TD
    A["开始长程 RL 训练"] --> B["尝试默认裁剪比<br/>ε_low = ε_high = 0.2"]
    B --> C["熵坍缩"]
    C --> D["性能先升后平<br/>(探索不足)"]
    D --> E["降低 ε_low 且抬高 ε_high"]
    E --> F["熵可持续<br/>但利用不足<br/>(负优势动作压制不够)"]
    F --> G["ε_low 保持 0.2<br/>只抬高 ε_high"]
    G --> H["熵可持续 → 性能持续上升"]
    H --> I["按训练中的熵趋势<br/>动态调节 ε_high"]
编者拓展|这条链条的一般意义:ProRL 的结论不是「把超参调大就好」,而是探索与利用必须分别由两个自由度控制。$\epsilon_{\text{low}}$ 管「多狠地压制坏动作」(利用),$\epsilon_{\text{high}}$ 管「多宽容地放行低概率好动作」(探索)。把它们绑成一个数,就必然要在这两者之间二选一。这是 DAPO「解耦裁剪」这个设计名字的由来。
六、ProRL 的工程配方与结果
Lesson III:动态调参,把「一条命」跑到底
🖼️ 第 32 页幻灯片 · Conclusion (🌹 vs ☠)
Slide 28 给出长程 RL 训练的工程细节:
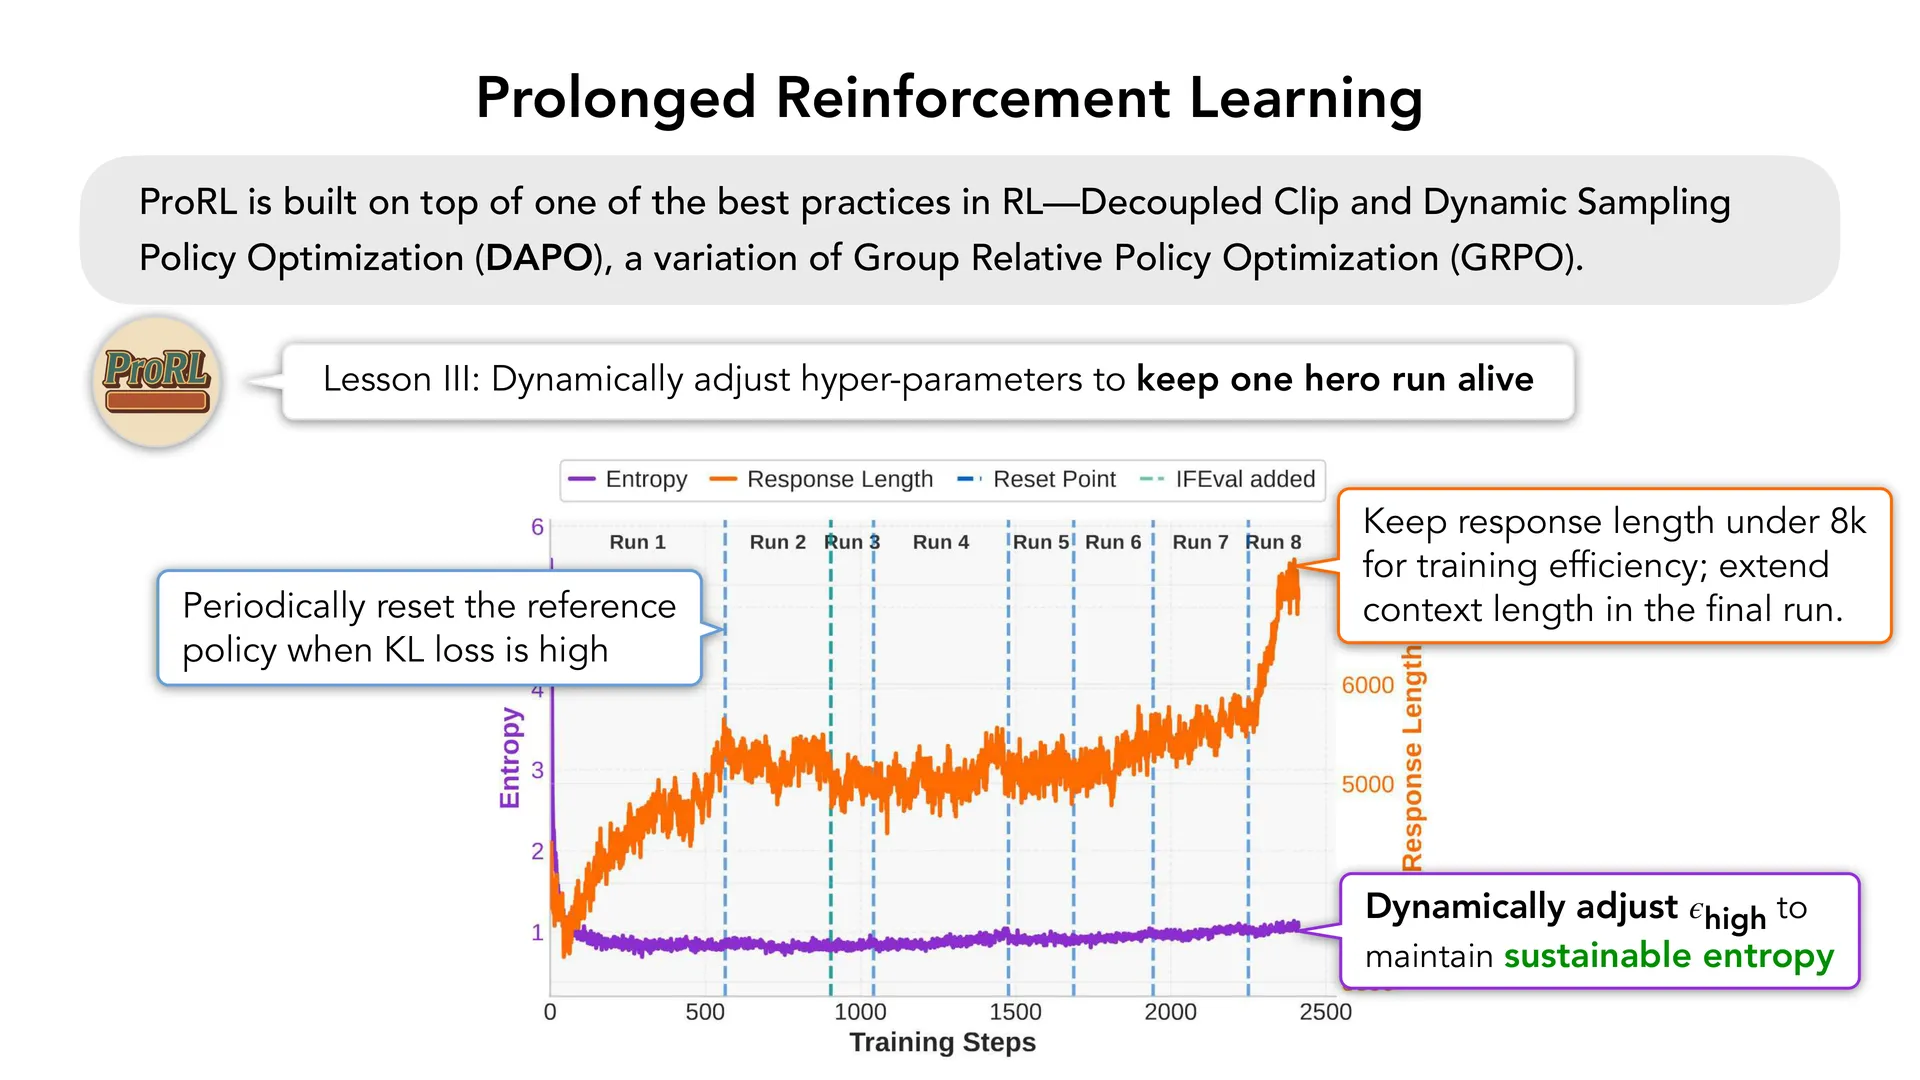
- 当 KL 损失偏高时,周期性地重置 reference policy;
- 动态调整 $\epsilon_{\text{high}}$,以维持可持续的熵;
- 训练时把回复长度控制在 8k 以内以保证训练效率,在最后一次训练中再放开上下文长度。
编者说明:讲义只列出「Lesson I」和「Lesson III」,中间的 Lesson II 没有出现在可提取的文字中(Slides 26–28)。详见文末「已知疑点」。
🖼️ 第 34 页幻灯片 · Chemistry between the base LLM and RL matters
结果:SOTA 的 1.5B 推理模型
Slide 29–30:
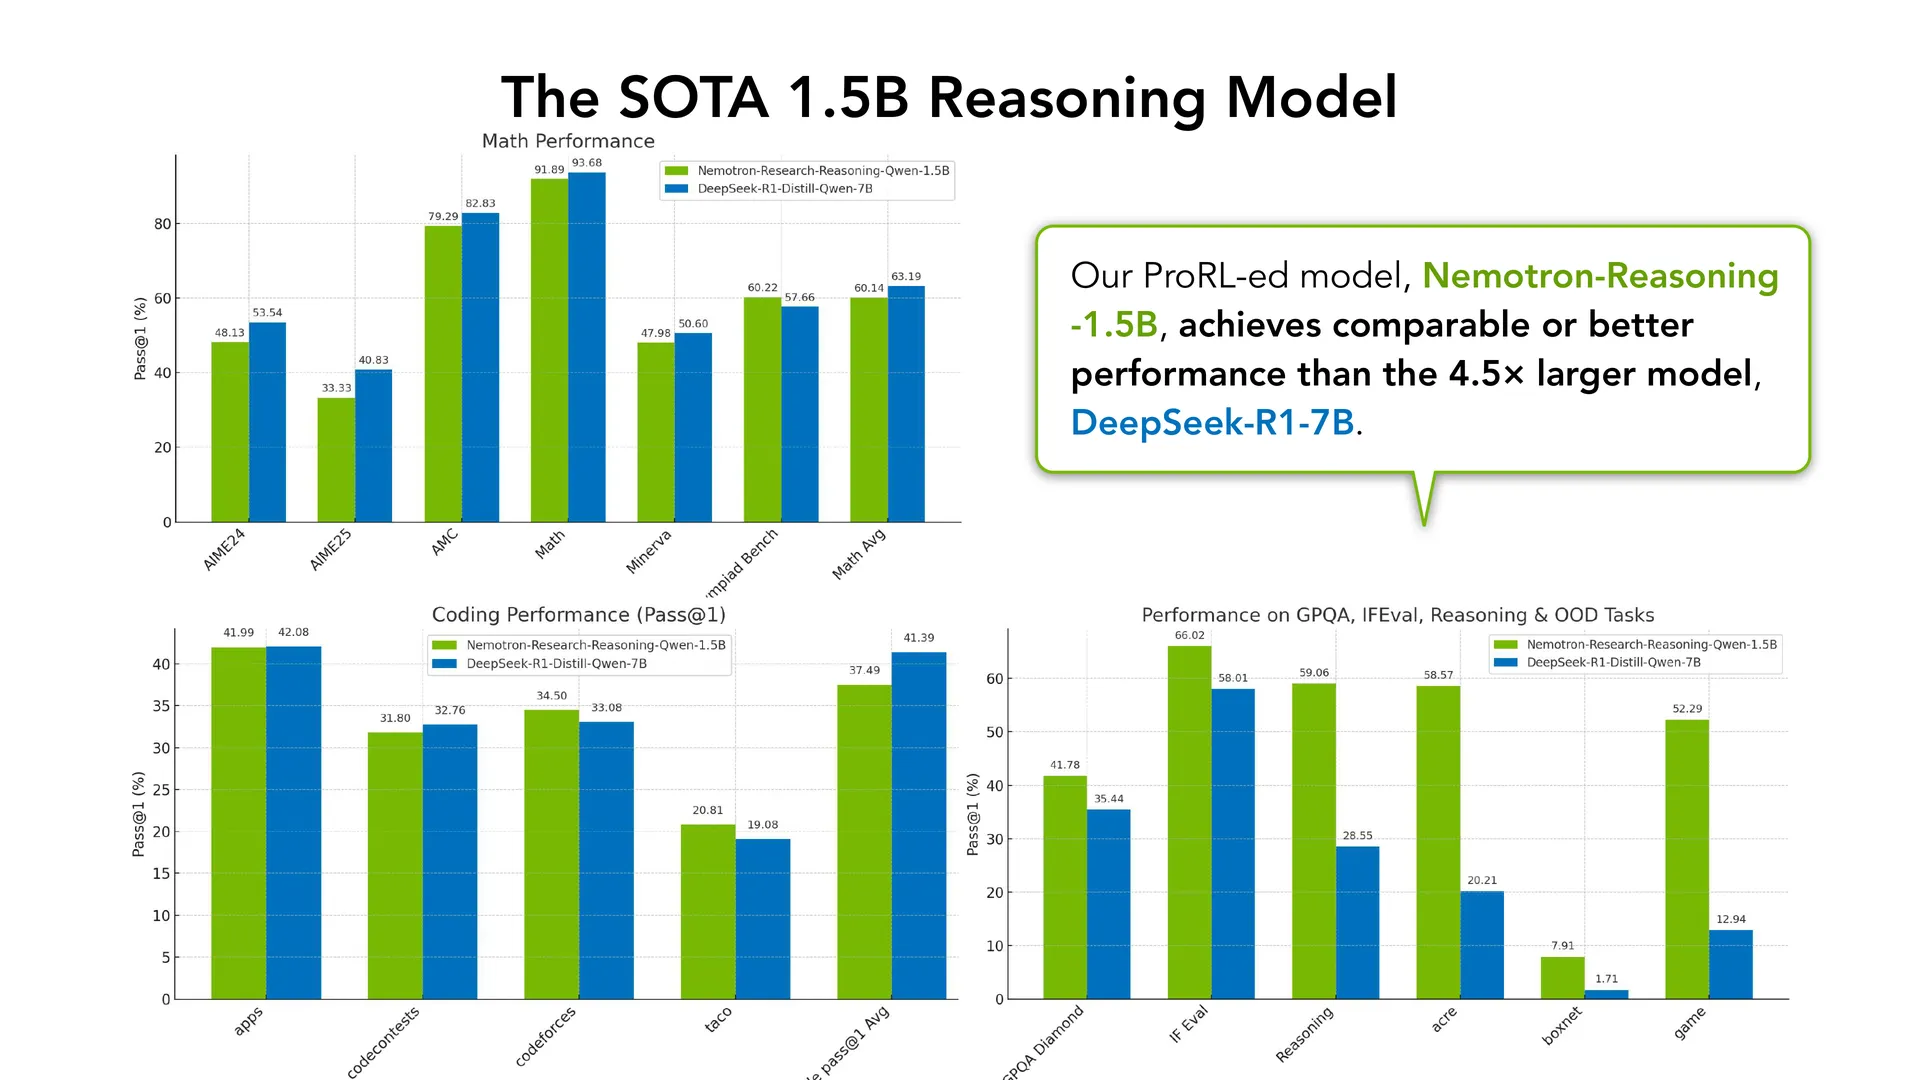
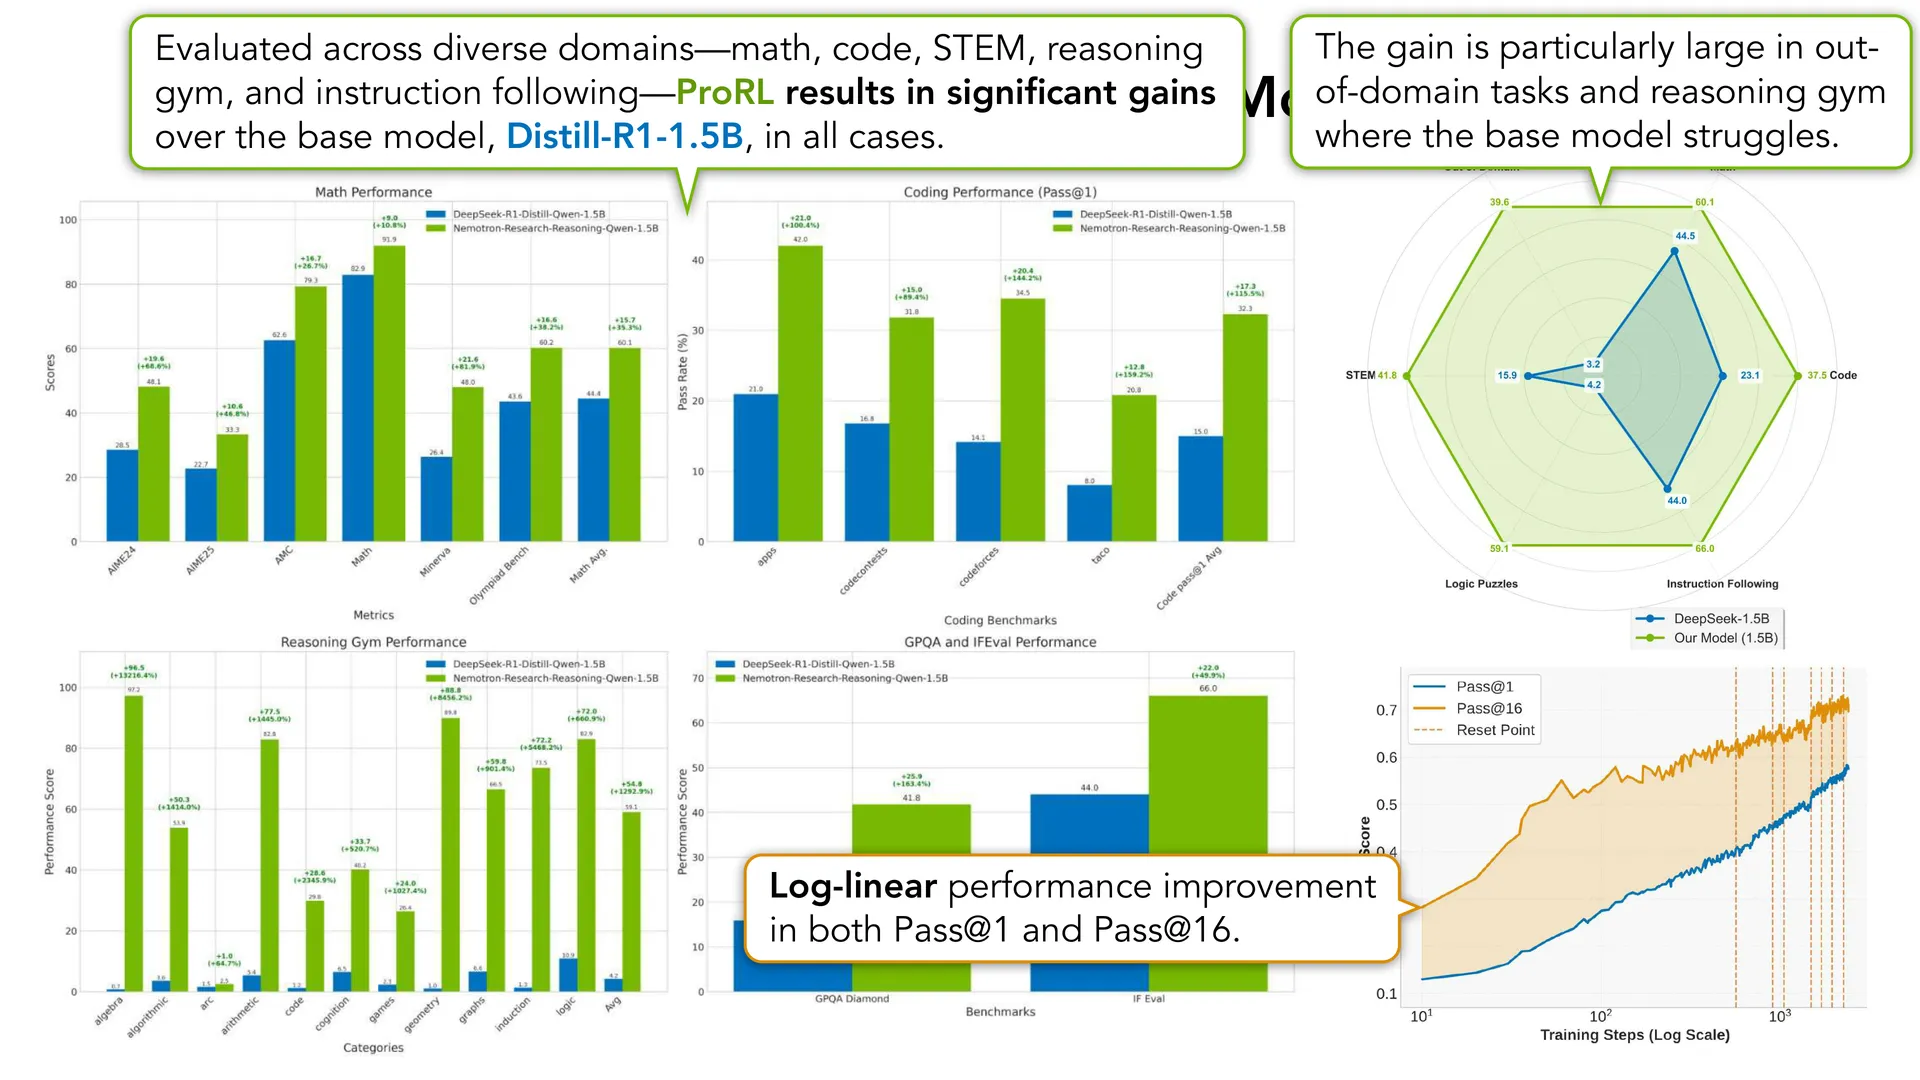
- 在 数学、代码、STEM、reasoning gym、指令跟随等多个领域评估,ProRL 相对基座模型 Distill-R1-1.5B 在所有情况下都取得显著提升。
- 在域外任务(out-of-domain)和 reasoning gym 上增益尤其大——正是基座模型最吃力的地方。
🖼️ 第 35 页幻灯片 · Striking findings against RL
- Pass@1 与 Pass@16 都呈现 log-linear 的性能提升。
🖼️ 第 36 页幻灯片 · 2025: The Rise of LRMs (as opposed to LLMs)
- ProRL 训出的 Nemotron-Reasoning-1.5B,性能与 4.5 倍大的 DeepSeek-R1-7B 相当或更好。
编者说明:请注意最后一条的分量——它直接回应了开头的 Sam Altman 那句话。1.5B 的模型打平/打赢 7B,意味着「小模型 + 用力的算法」在推理任务上可以是划算的。
🌹 与 ☠
Slide 32 用玫瑰与骷髅做了总结:
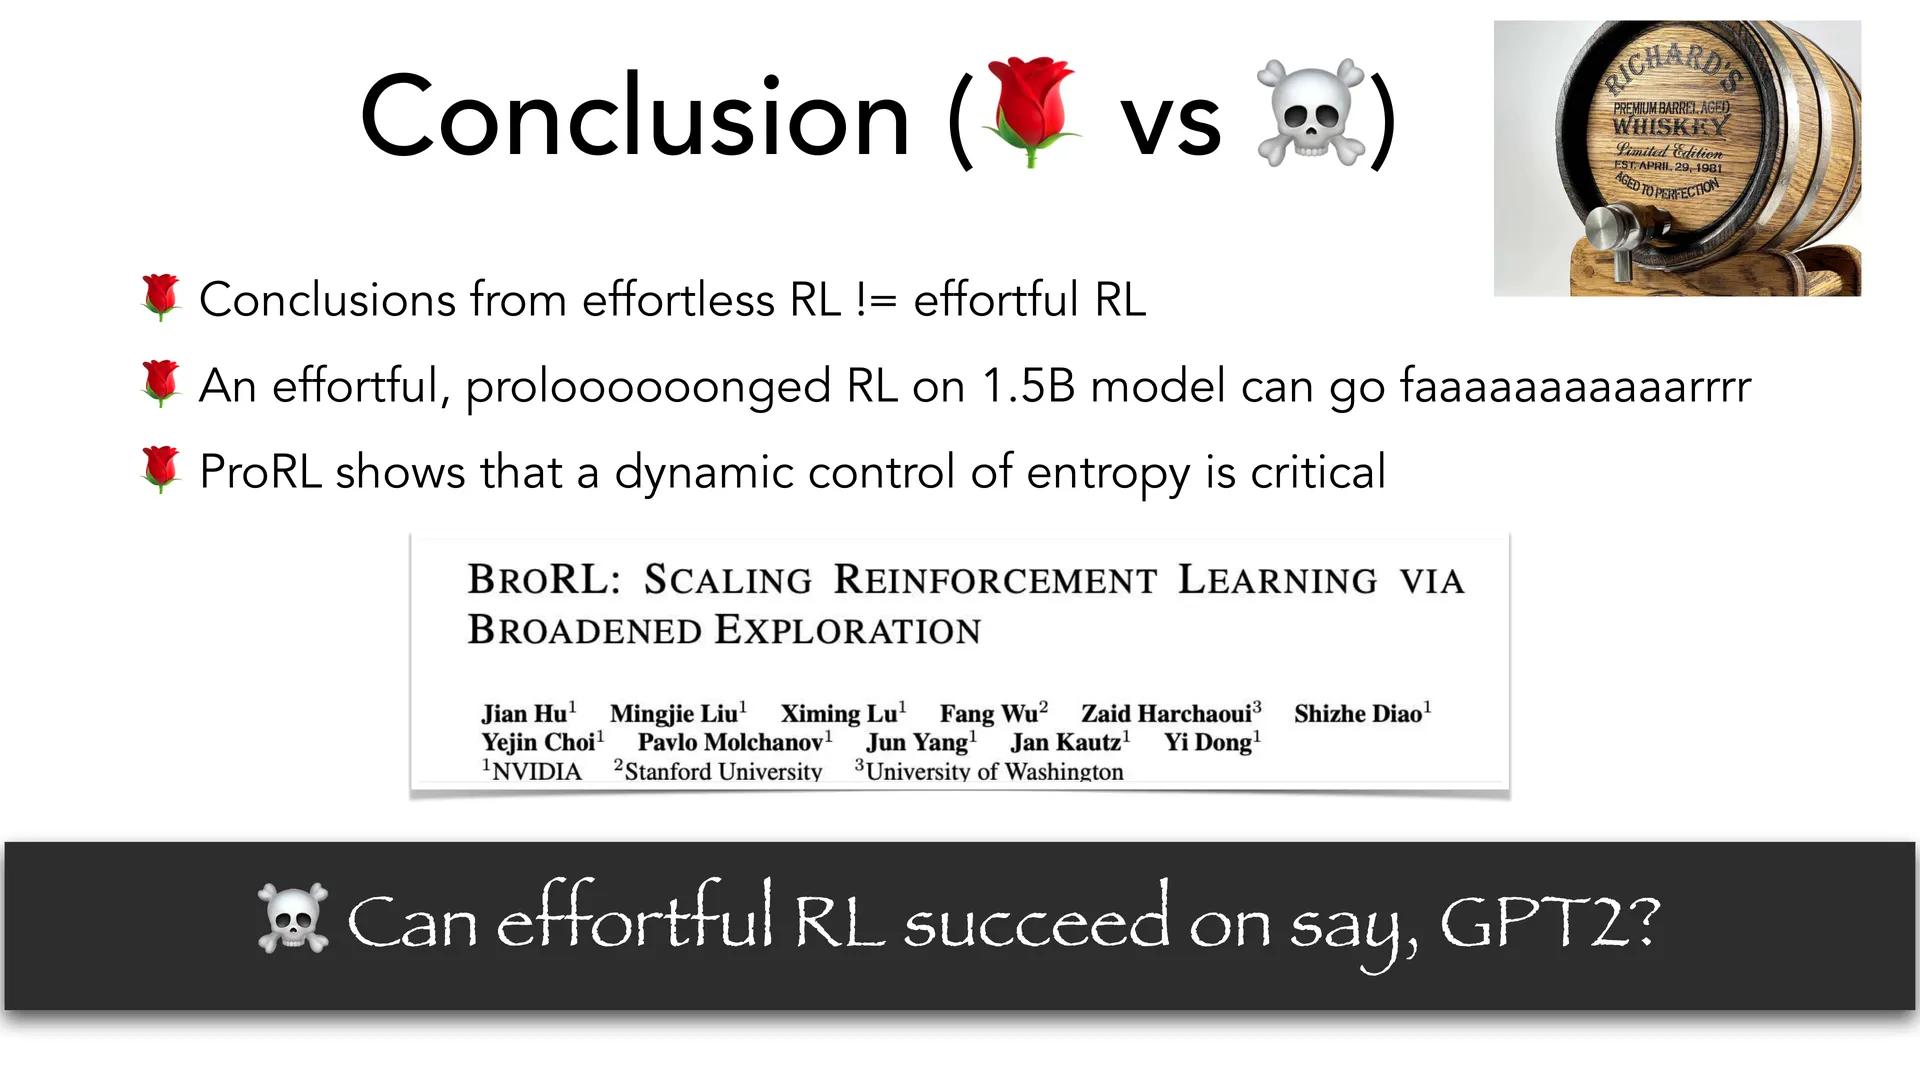
- 🌹 「不用力」的 RL 与「用力」的 RL,结论不同。
- 🌹 在 1.5B 模型上做一次用力的、proloooooonged 的 RL,可以走得很远。
- 🌹 ProRL 表明对熵的动态控制至关重要。
- ☠ 那么,用力的 RL 在比如 GPT-2 上能成功吗?(讲义把它作为一个悬而未决的反问)
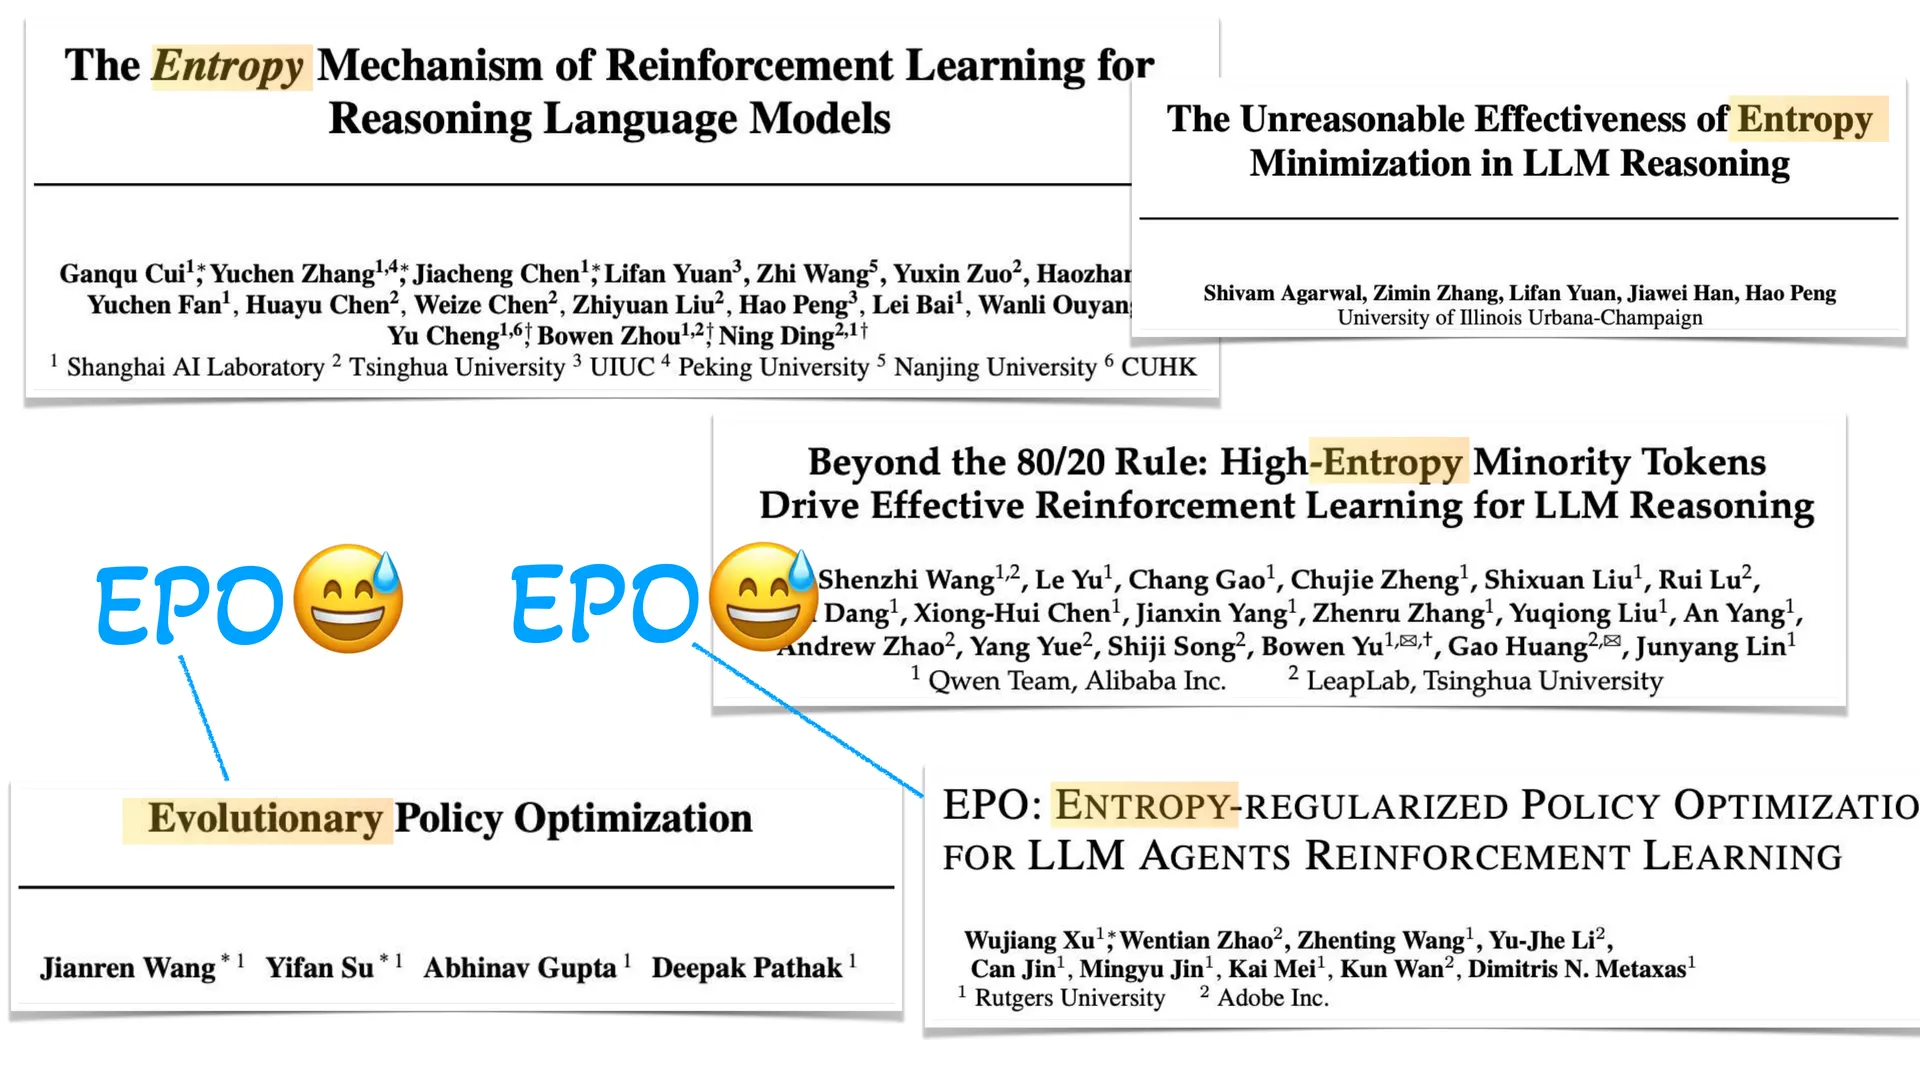
Slide 33 只有两个词:「EPO😅」。讲义没有给出任何解释(见文末「已知疑点」)。
七、SFT 也有同样的结论
Slide 34–36 把话题从 RL 转到 SFT:
🖼️ 第 37 页幻灯片 · Three components to innovate:
Conclusions from effortless SFT ≠ effortful SFT(不用力的 SFT 与用力的 SFT 得到的结论不一样) Why is Qwen's chemistry so good with RL?(为什么 Qwen 与 RL 的「化学反应」这么好?)
🖼️ 第 39 页幻灯片 · The Era of Brute-Force Scaling is Over
——可能是因为在预训练期间就做了 SFT,或 SFT 式的「mid-training」。 Then, SFT cannot generalize? It depends…(那么 SFT 就不能泛化吗?视情况而定……)
🖼️ 第 40 页幻灯片 · Synthetic Data to the Rescue!
编者拓展|「chemistry(化学反应)」这个词在讲什么:讲的其实是基座模型本身的先验。同一个 RL 算法,在不同的基座模型上效果差异可以非常大——有的基座模型「一推就动」,有的怎么推都不动。讲者的解释方向是:如果推理格式的痕迹早在预训练/中期训练阶段就已经进入模型,后面的 RL 就更容易把它激发出来。这个直觉在后面的 RLP 与 FLR 两节中被做成了正式实验。
第二部分:Prismatic Synthesis —— 用梯度衡量数据多样性
八、合成数据能救场吗?
Slide 38–41 引入了第二个工作:
🖼️ 第 42 页幻灯片 · (无标题)
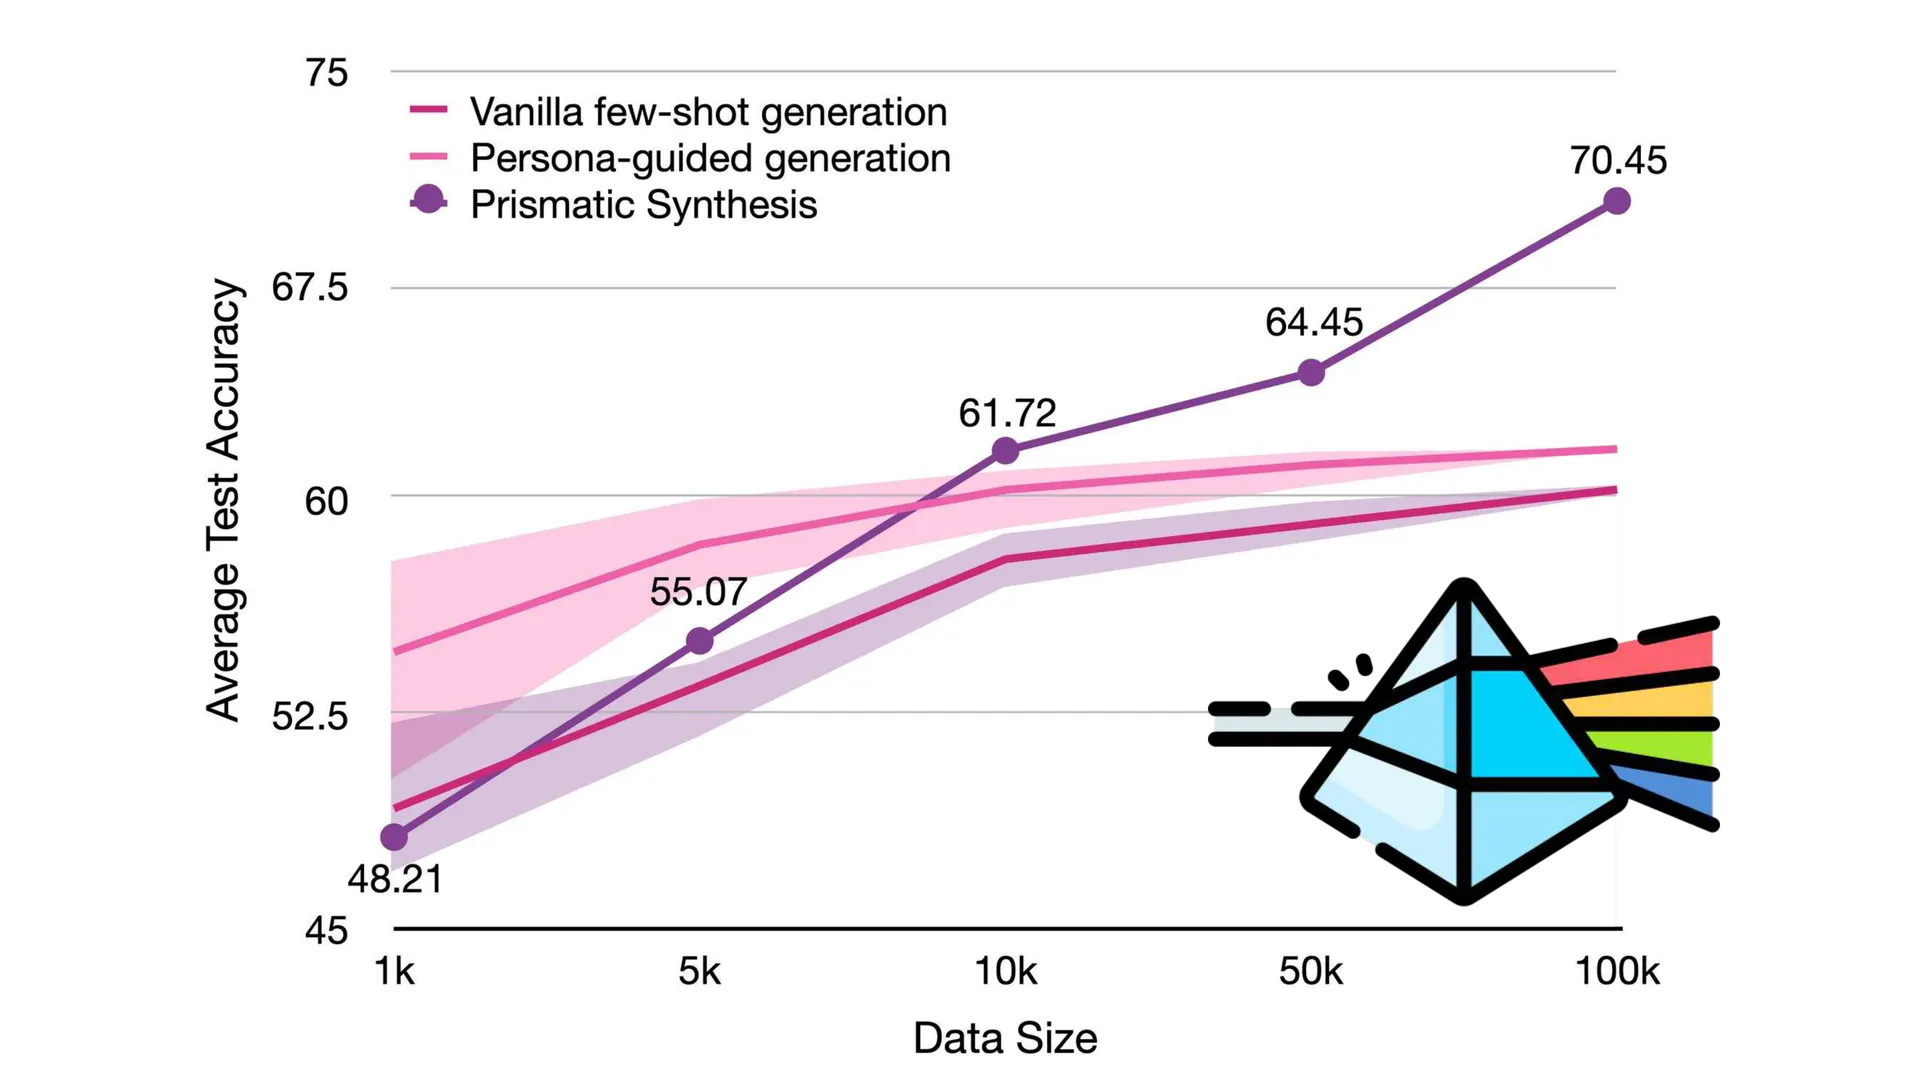
Prismatic Synthesis: Gradient-based Data Diversification Boosts Generalization in LLM Reasoning(NeurIPS 2025)
🖼️ 第 44 页幻灯片 · G-Vendi Score
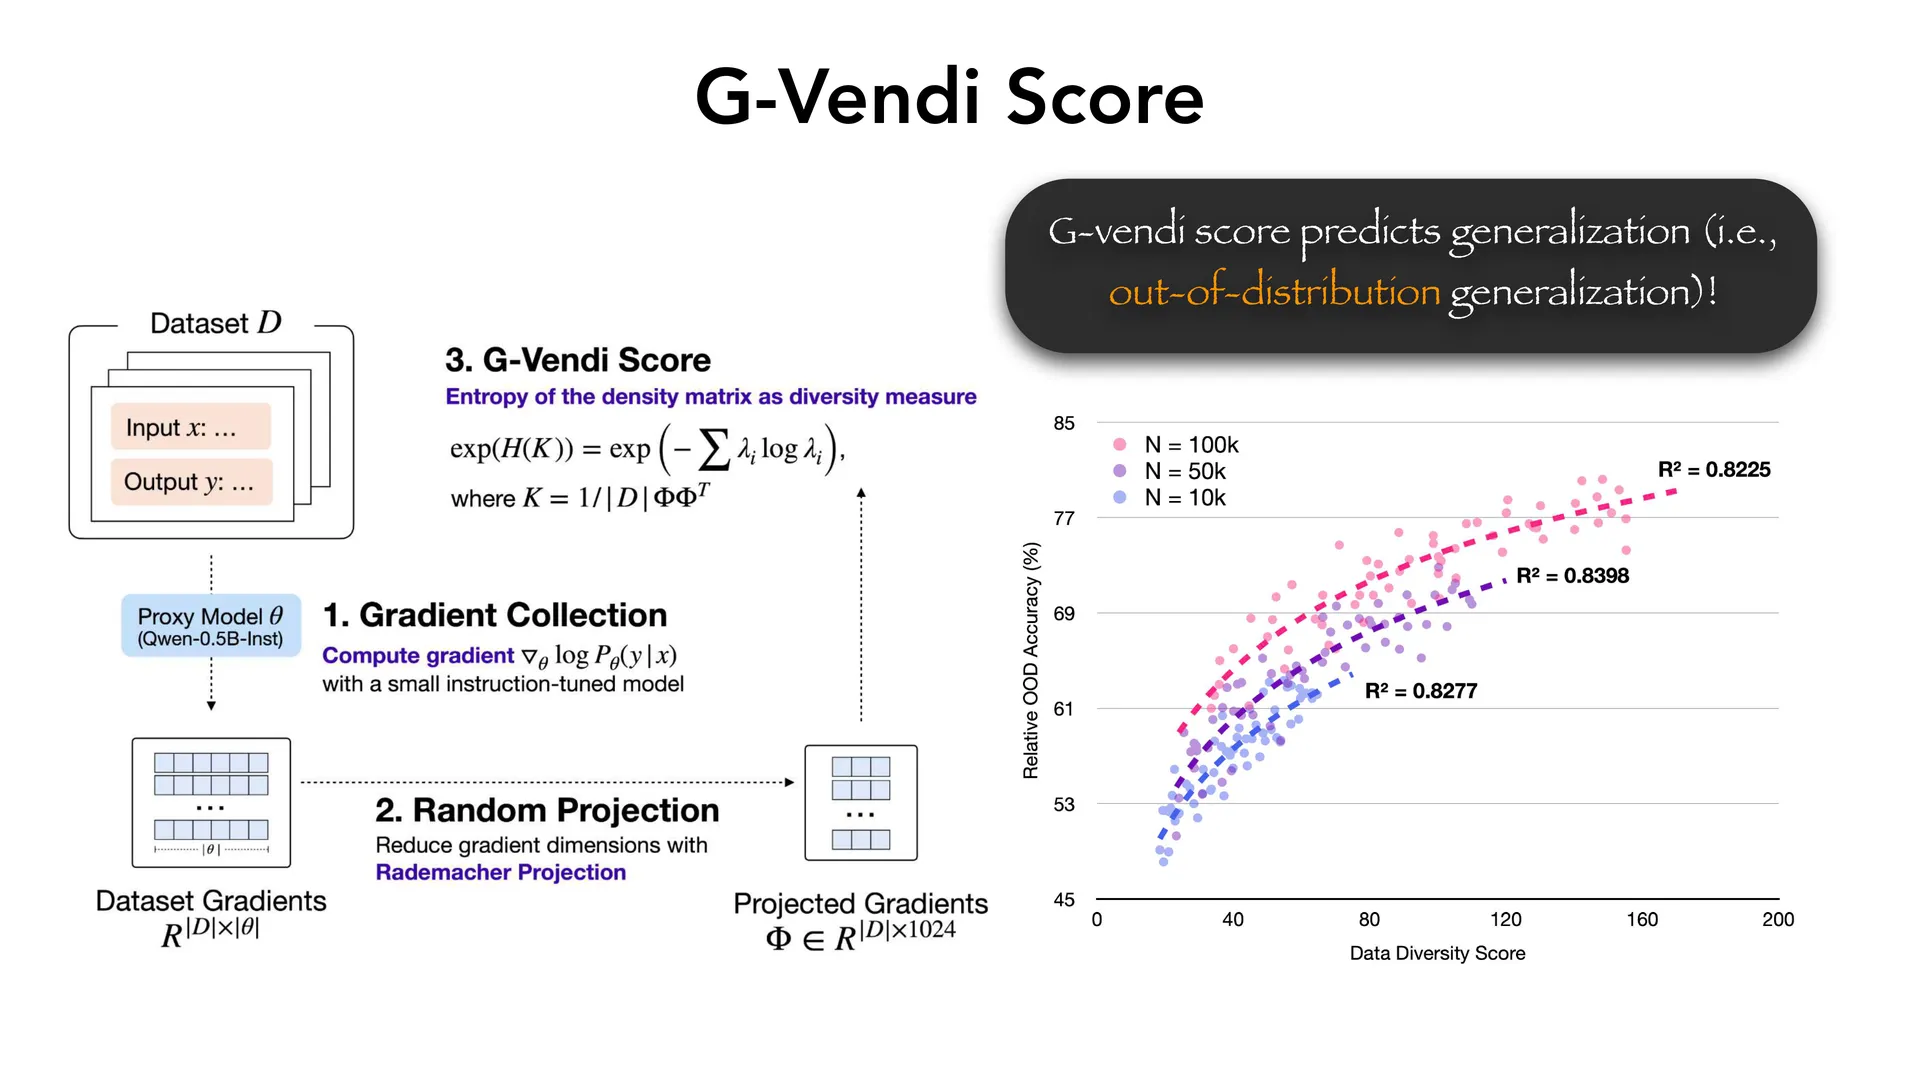
基于梯度的数据多样化,提升 LLM 推理的泛化能力。
背景(Slide 40):
- 合成数据(synthetic data)已经在 mid-training 和后训练中广泛使用,有时甚至用于 LLM 训练的全部阶段。
- 常见的做法与假设是:依赖最大/最强的教师模型。
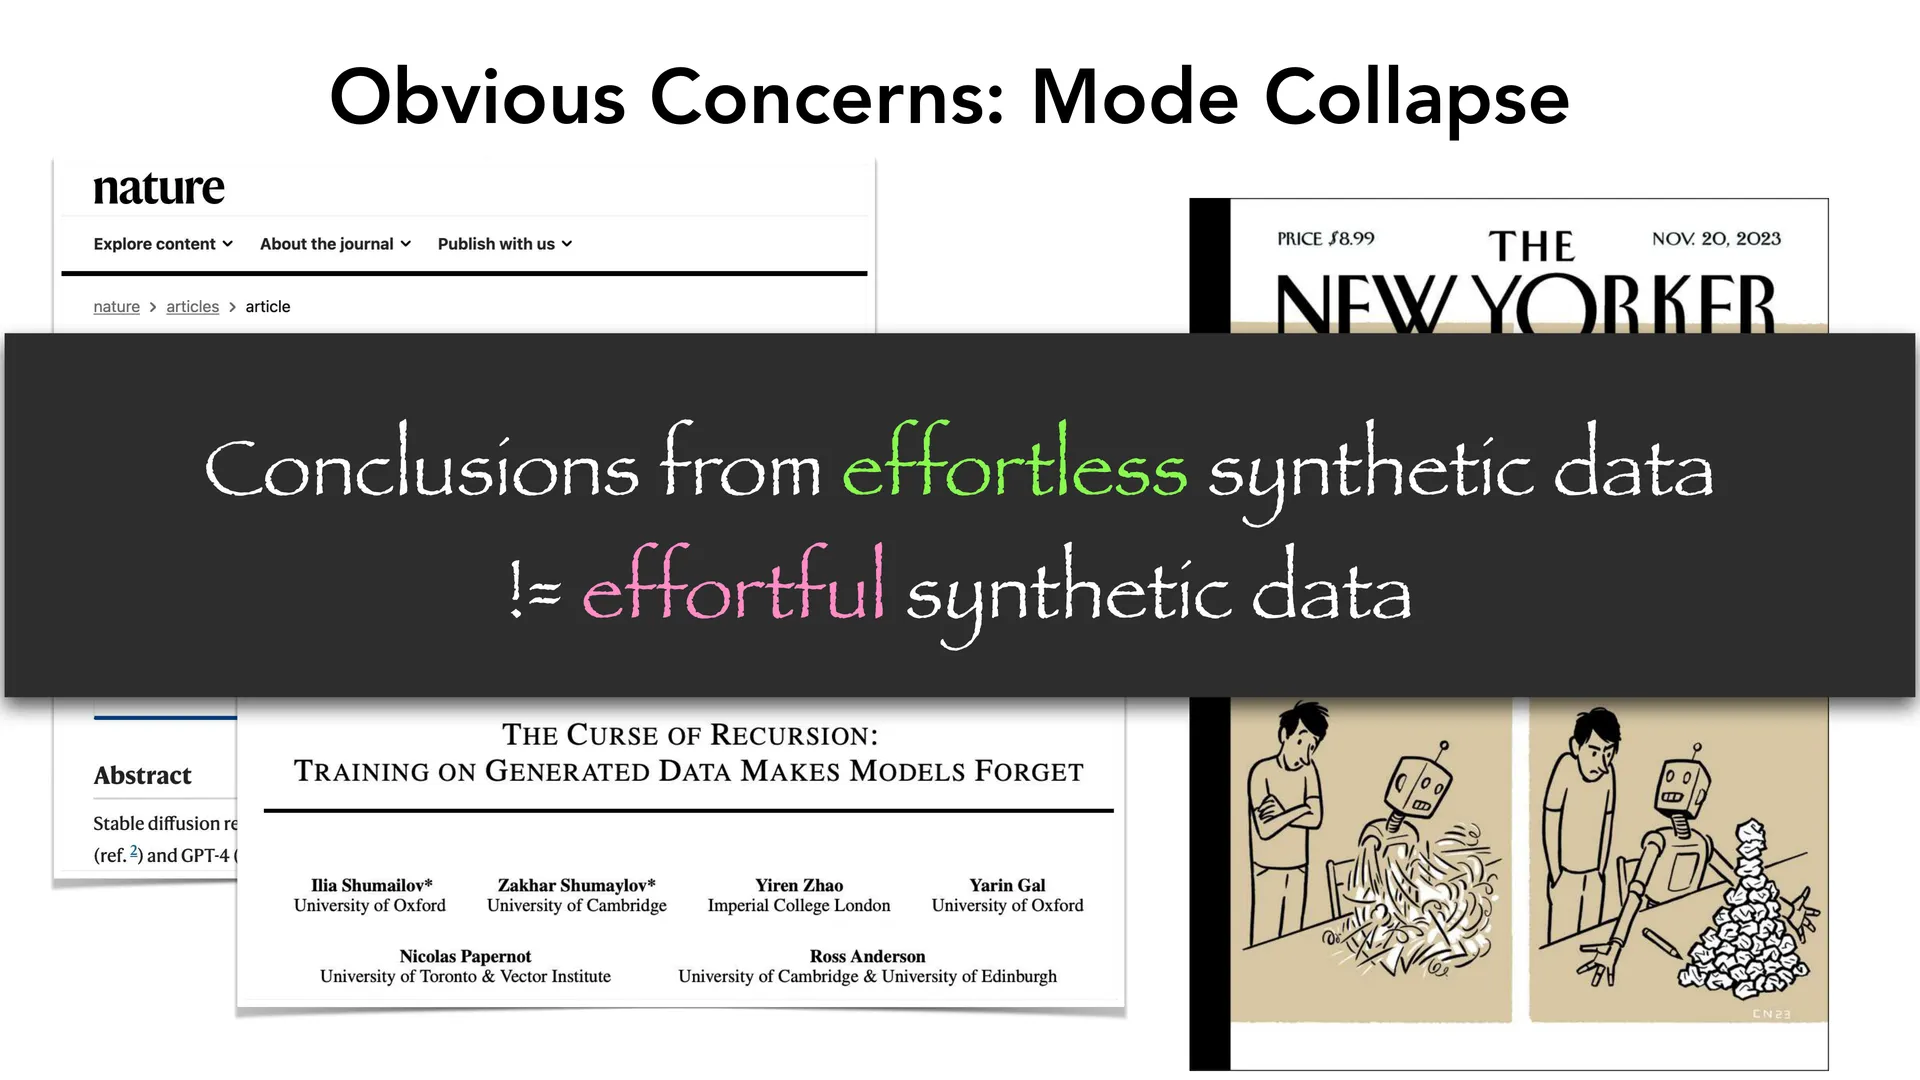
显而易见的担忧:模式坍缩
失败案例:合成数据最明显的风险是模式坍缩(mode collapse)。 结论:effortless synthetic data ≠ effortful synthetic data(不用力地合成数据与用力地合成数据,结果完全不同)。
编者说明|模式坍缩在这里指什么:如果教师模型生成的样本在内容/解法上是同质的(比如同一类题目总是同一种解法),学生模型从中学到的分布就会非常窄。用于训练的样本量可能很大,但它们覆盖的「推理模式」只有少数几种——这正是「多样性」而非「数量」的问题。
九、把梯度当作数据的表示
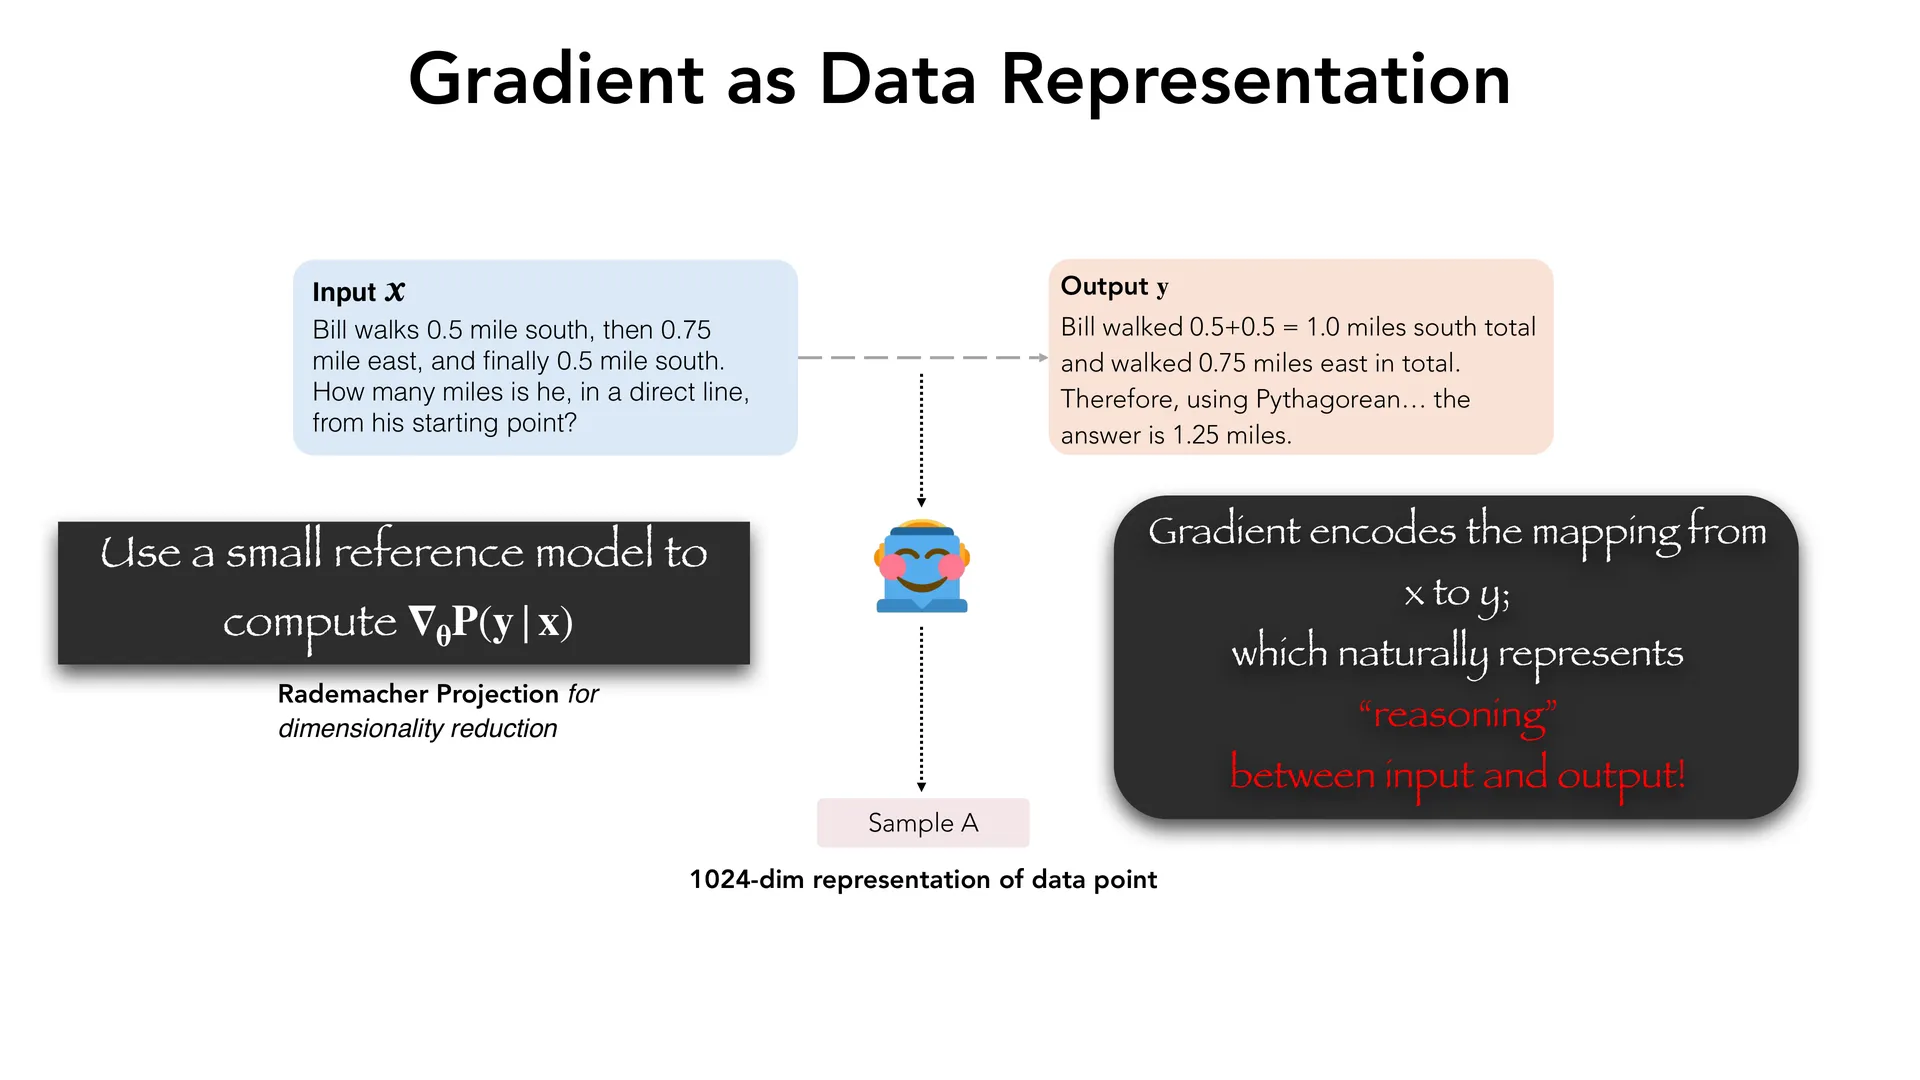
这是 Prismatic Synthesis 的核心想法(Slide 43)。讲义用一道小学数学题做例子:
🖼️ 第 47 页幻灯片 · R1-32B
输入 $\mathbf{x}$:
Bill walks 0.5 mile south, then 0.75 mile east, and finally 0.5 mile south. How many miles is he, in a direct line, from his starting point? (Bill 先向南走 0.5 英里,再向东走 0.75 英里,最后又向南走 0.5 英里。他离出发点直线距离多少英里?)
输出 $\mathbf{y}$:
Bill walked 0.5+0.5 = 1.0 miles south total and walked 0.75 miles east in total. Therefore, using Pythagorean… the answer is 1.25 miles. (Bill 总共向南走了 0.5+0.5 = 1.0 英里,向东走了 0.75 英里。因此用勾股定理……答案是 1.25 英里。)
🖼️ 第 48 页幻灯片 · Prismatic Synthesis improves long-CoT reasoning
做法:
- 用一个小的参考模型(reference model)计算 $\nabla_\theta P(\mathbf{y} \mid \mathbf{x})$;
- 得到一个 1024 维的数据点表示;
🖼️ 第 49 页幻灯片 · Concluding Thoughts
- 用 Rademacher 投影做降维。
讲义对这一做法的解释是:
梯度编码了从 $\mathbf{x}$ 到 $\mathbf{y}$ 的映射,而这个映射本身就自然地表征了输入与输出之间的「推理」。
flowchart LR
    A["输入 x<br/>(题目)"] --> C["参考模型<br/>计算 ∇_θ P(y|x)"]
    B["输出 y<br/>(解答)"] --> C
    C --> D["1024 维表示"]
    D --> E["Rademacher 投影降维"]
编者拓展|Rademacher 投影是什么:用随机 $\pm 1$ 组成的矩阵去乘高维向量,把维度压到 1024 维,同时(以高概率)大致保持任意两点之间的距离。这是随机投影 / Johnson–Lindenstrauss 引理的标准做法,好处是完全不需要训练。讲义只说了它是用来降维的,没有展开。
🖼️ 第 50 页幻灯片 · Three components to innovate:
G-Vendi Score:用多样性预测泛化
Slide 44 给出了一个关键论断:
G-vendi score predicts generalization, i.e., out-of-distribution generalization! (G-vendi 分数可以预测泛化能力,也就是分布外泛化能力。)
编者拓展|Vendi Score 是什么:Vendi Score 是一种多样性度量,可以理解为「一个集合中有效不同元素的个数」。它由 Friedman 与 Dieng 提出(The Vendi Score: A Diversity Evaluation Metric for Machine Learning)。G-Vendi 是把同样的度量施加在样本的梯度表示上,从而度量「这批数据的推理模式有多多样」。注意:「G-Vendi 能预测 OOD 泛化」是讲义原文的主张,其具体实验证据在幻灯片中并未展开(详见「已知疑点」)。
🖼️ 第 51 页幻灯片 · RLP
完整的流水线
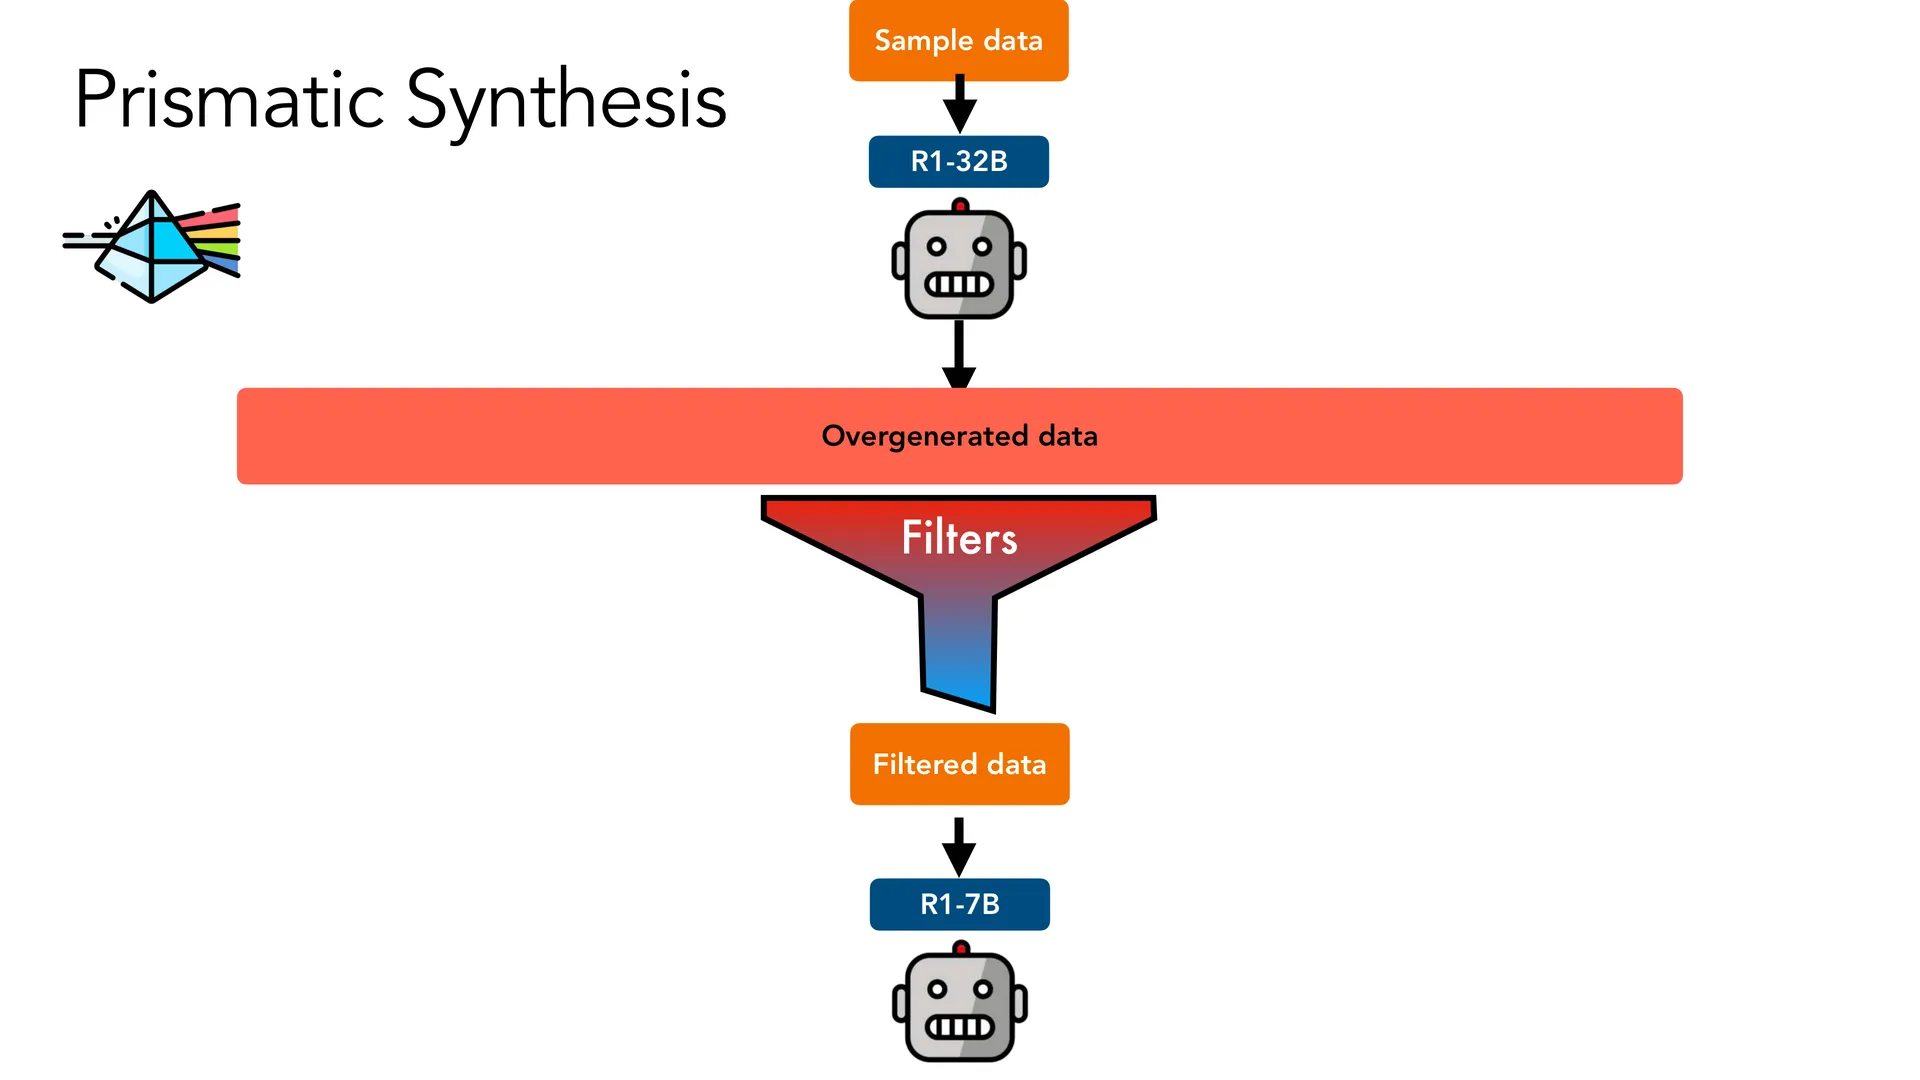
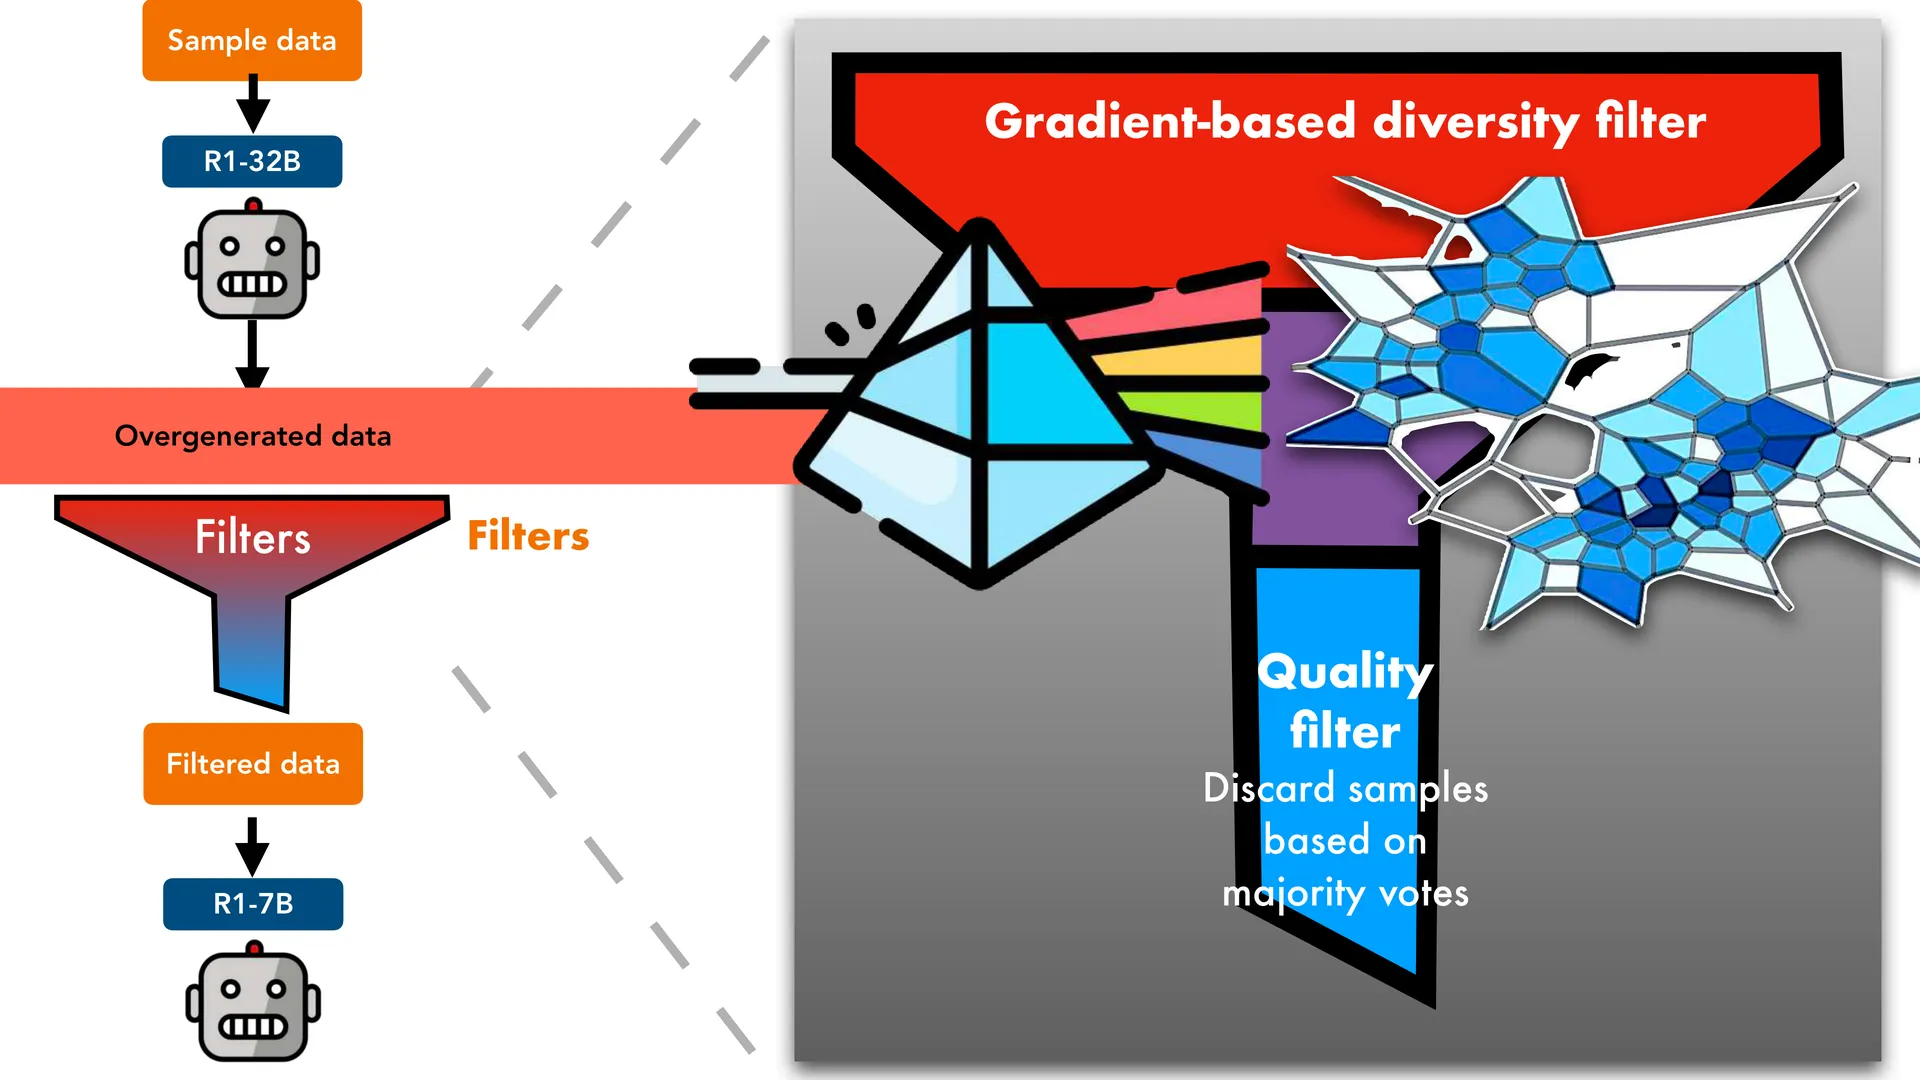
Slides 45–47 给出了数据流水线:
flowchart LR
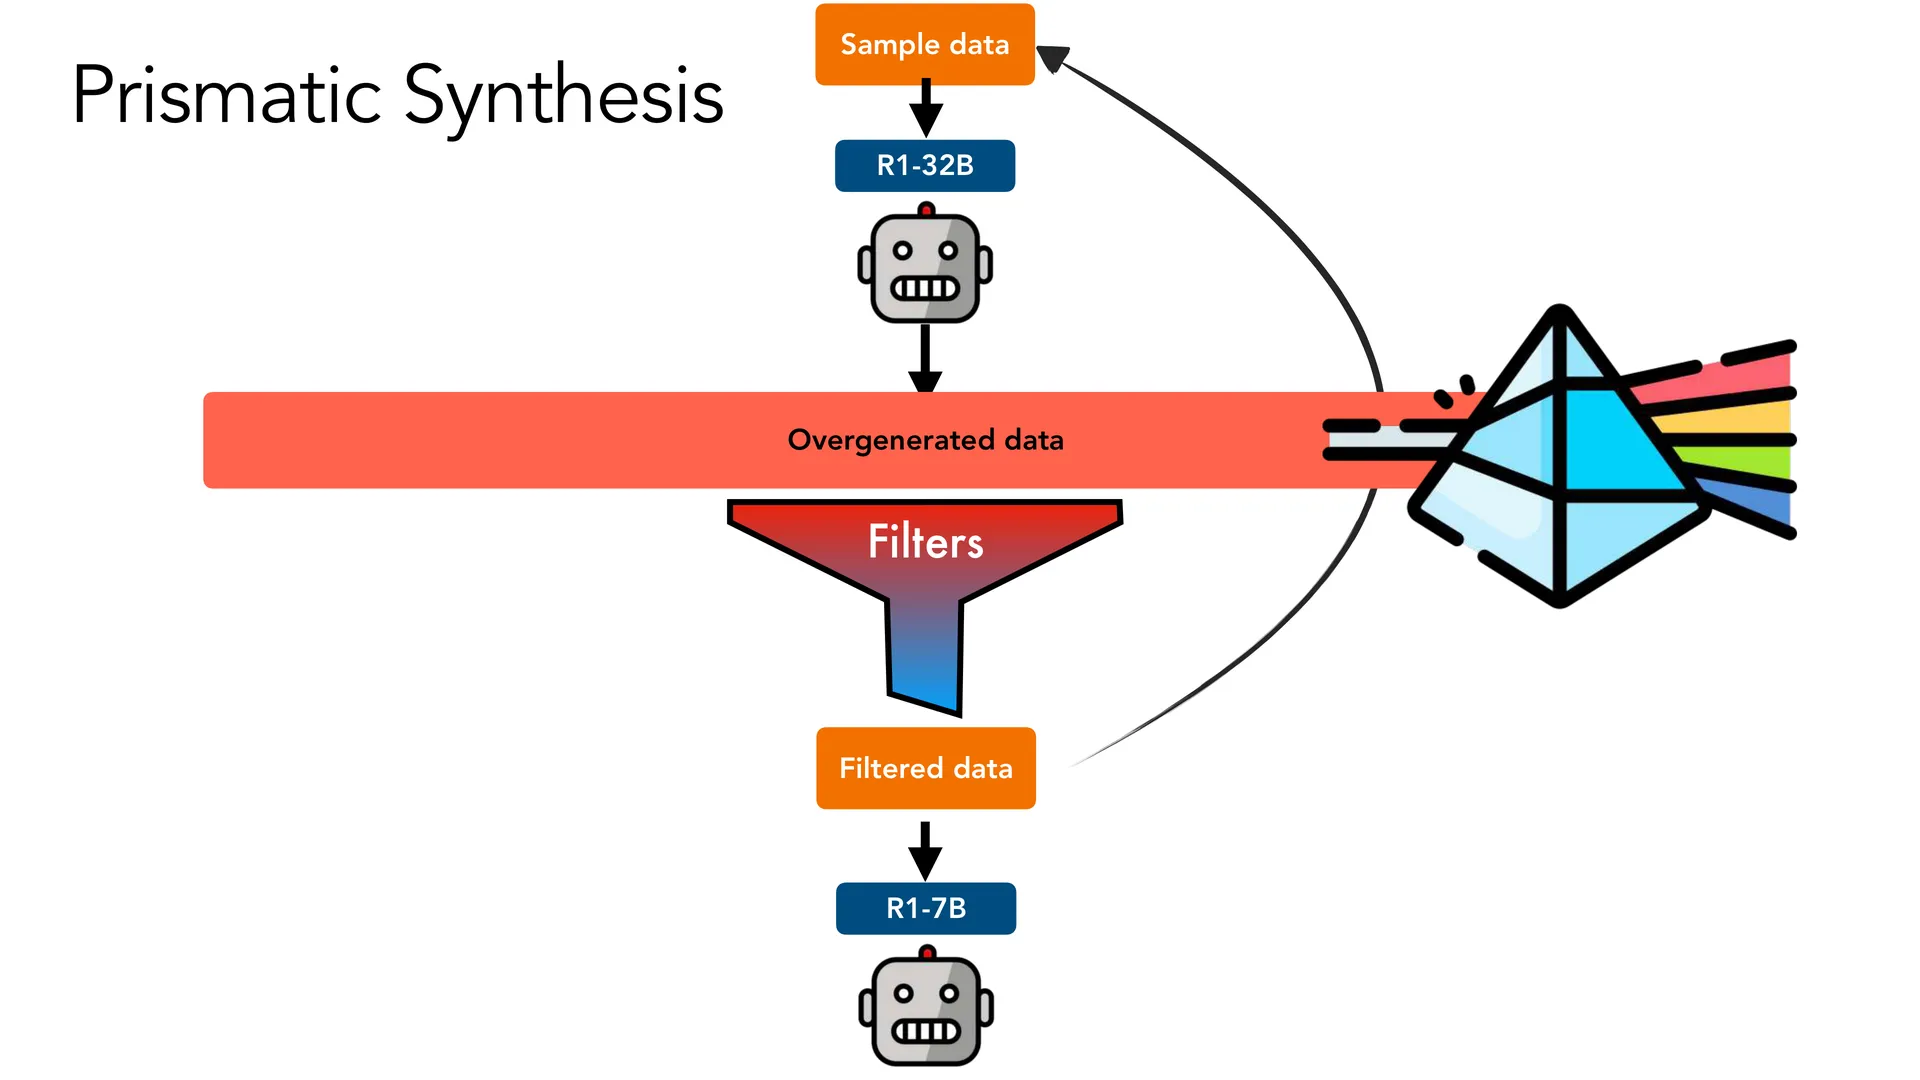
    A["R1-32B<br/>(教师)"] --> B["过量生成<br/>Overgenerated data"]
    B --> C["梯度多样性过滤器<br/>Gradient-based<br/>diversity filter"]
    B --> D["质量过滤器<br/>Quality filter<br/>按多数投票丢弃"]
    C --> E["Filtered data<br/>过滤后的数据"]
    D --> E
    E --> F["训练 R1-7B<br/>(学生)"]
    F --> G["PrismMath-7B"]
其中:
- 梯度多样性过滤器:用上面的梯度表示 + G-Vendi 来挑选推理模式多样的样本;
- 质量过滤器:根据多数投票丢弃样本(即答案不一致/多数投票不通过的样本被丢弃)。
编者说明:讲义的三页 Slide 只画了方框和箭头,没有写清每一步的数据量与具体算法。上面这张图是依据文字标签重绘的;「R1-7B 是被训练的学生」这一读法也与标题(data diversification boosts generalization)以及下面的实验结果一致。
十、Prismatic Synthesis 的效果
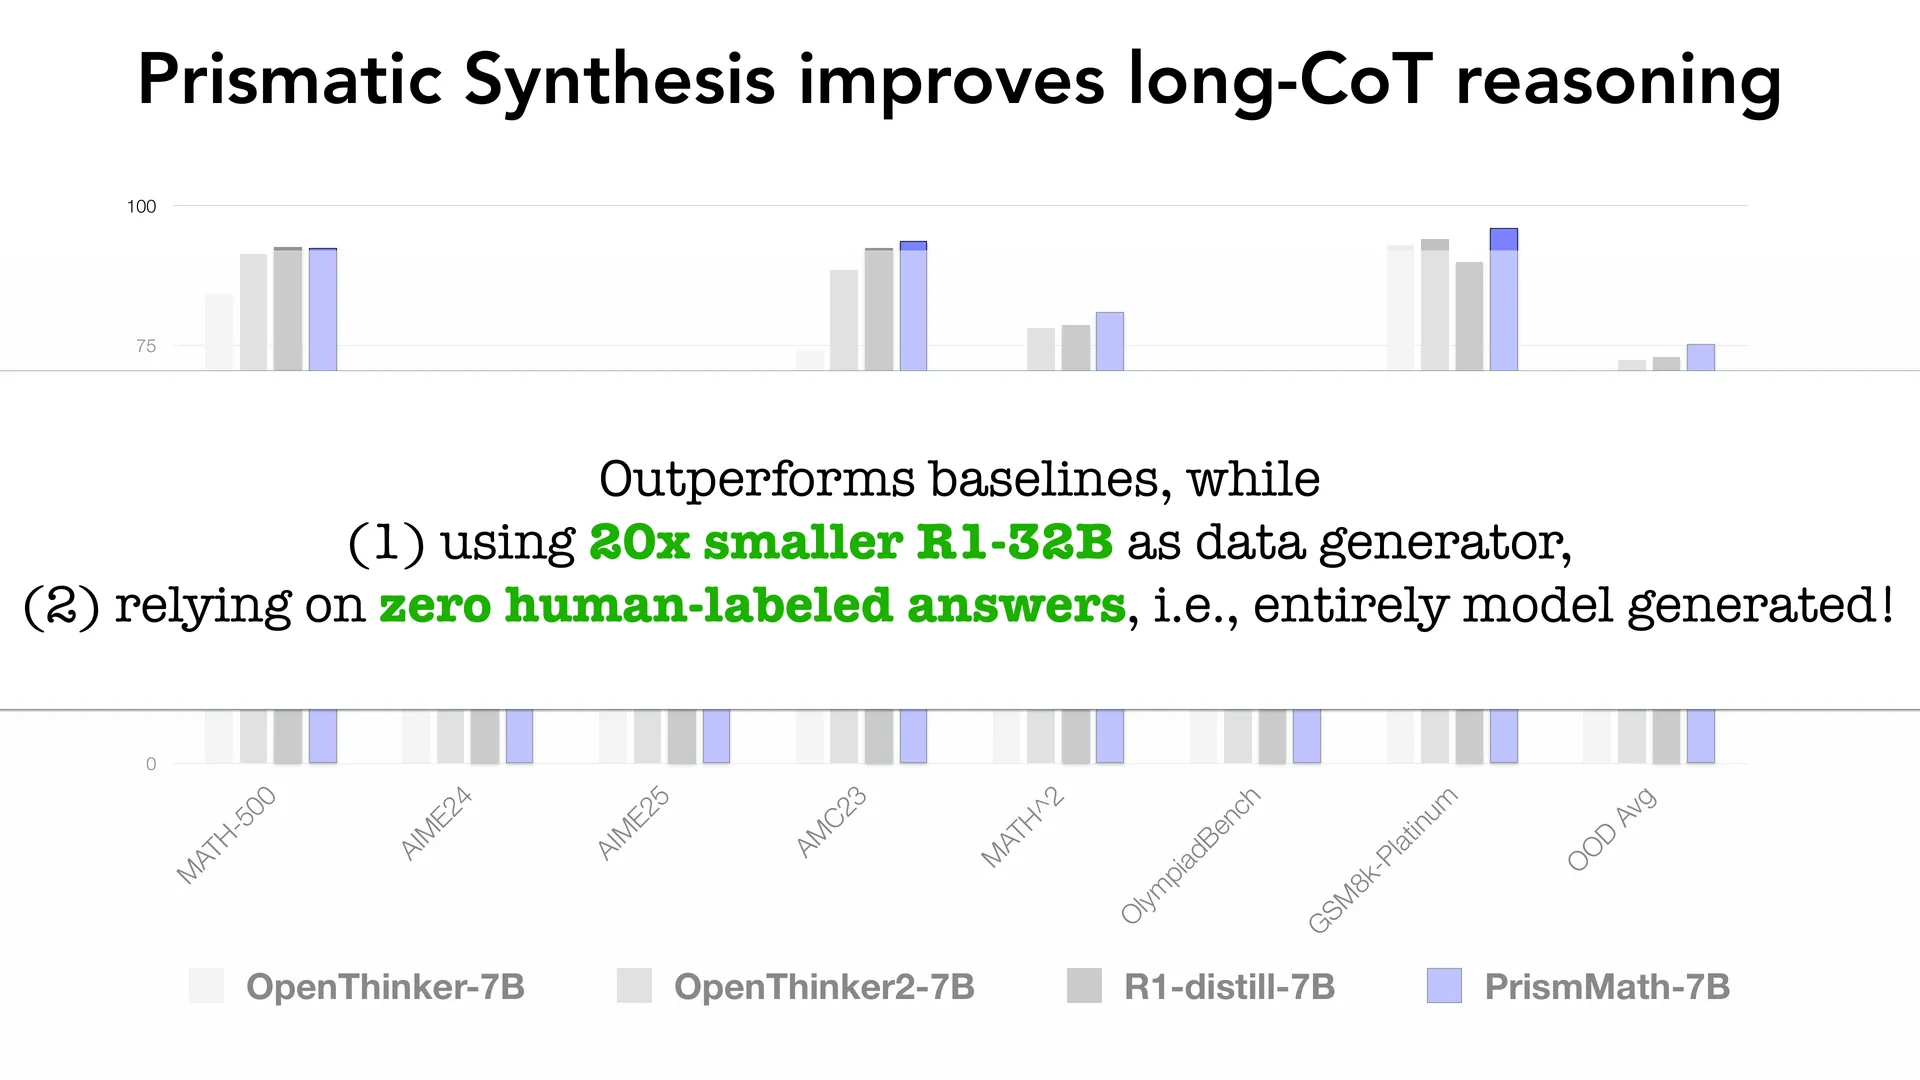
Slide 48 的评估结果(本页为图,讲义文字给出的信息如下):
🖼️ 第 52 页幻灯片 · The End of Ever More Pretraining
- 评估基准:MATH-500、AIME24、AIME25、AMC23、MATH^2、OlympiadBench、GSM8k-Platinum,以及 OOD Avg(域外平均)。
- 对比对象:OpenThinker-7B、OpenThinker2-7B、R1-distill-7B,以及本文提出的 PrismMath-7B。
🖼️ 第 54 页幻灯片 · Vanilla Pretraining vs RLP Pretraining
- 结论:Prismatic Synthesis 改善了长 CoT 推理,PrismMath-7B 优于所有基线,而且
🖼️ 第 56 页幻灯片 · RLP Framework
- 使用的数据生成器是小 20 倍的 R1-32B;
- 完全不依赖人工标注的答案——数据全部由模型生成。
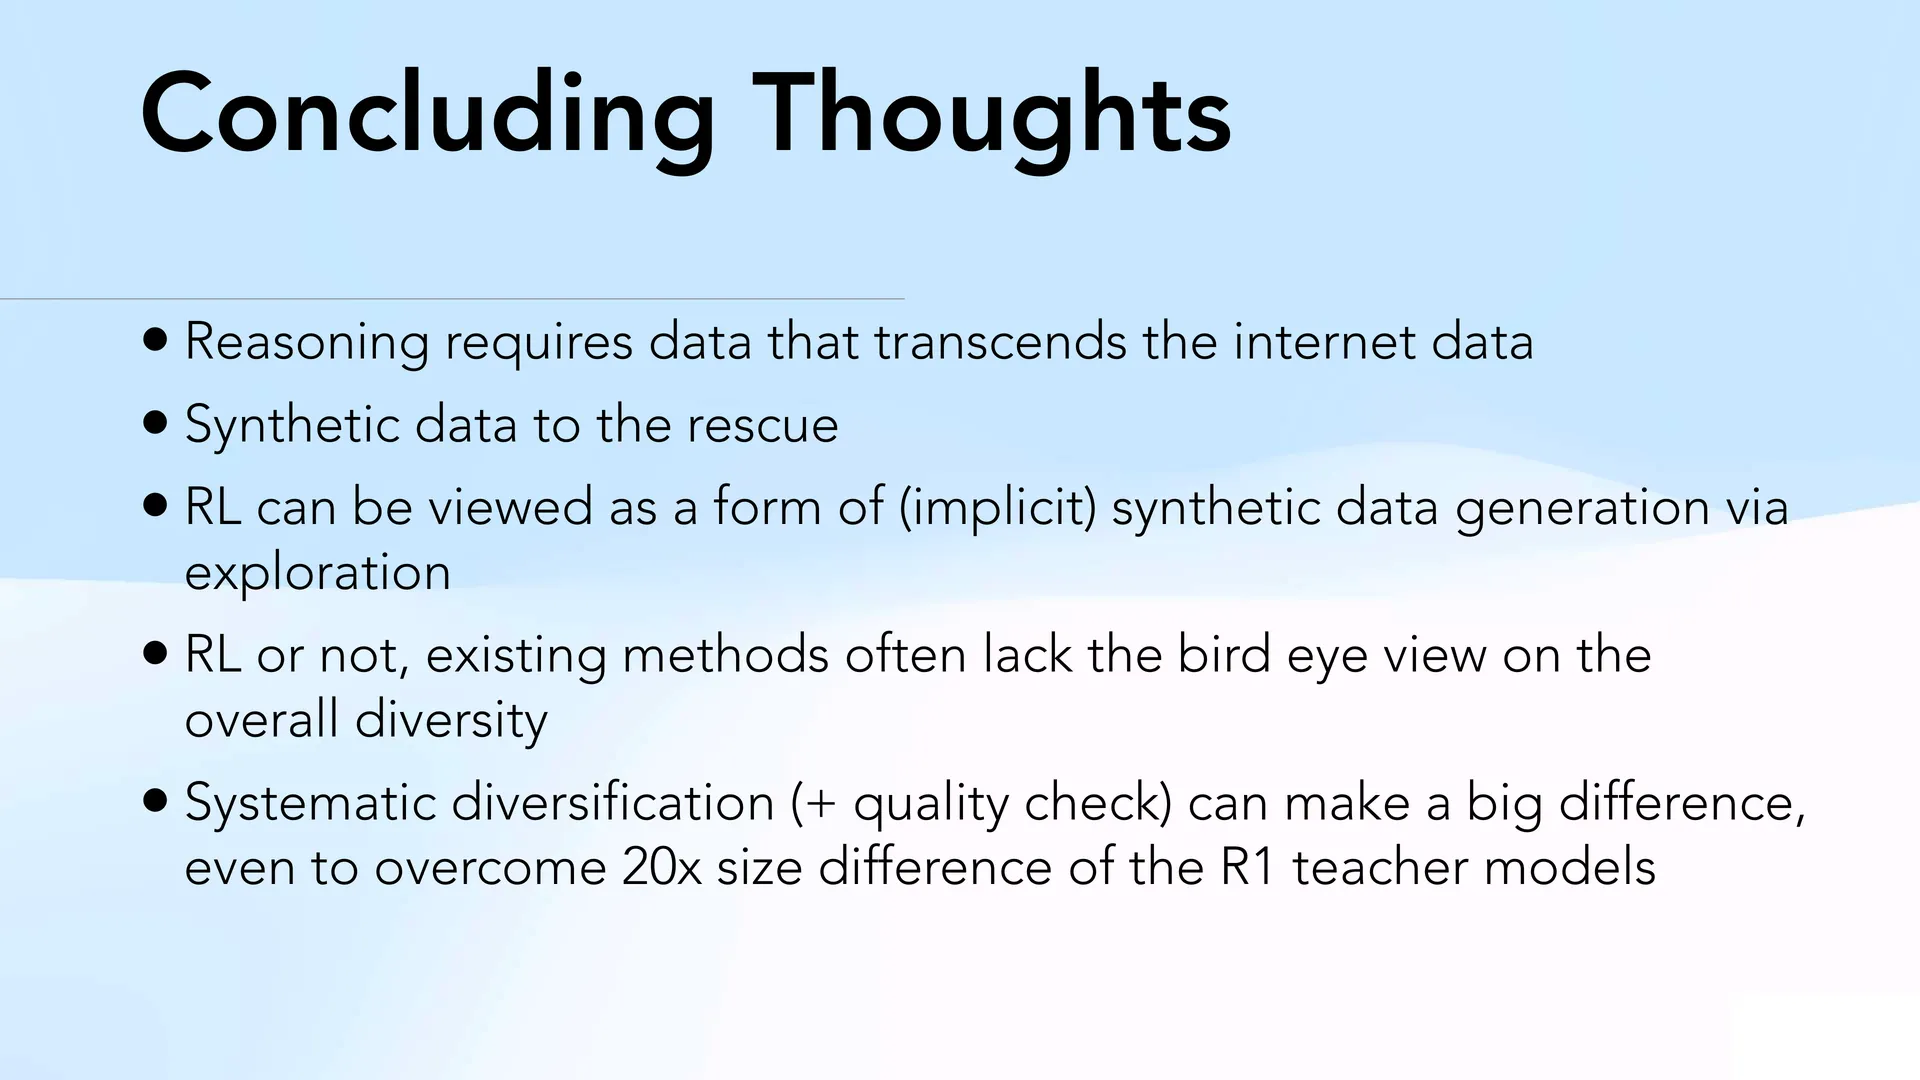
阶段结论
Slide 49:
- 推理所需的数据超越了互联网数据本身;
- 合成数据可以救场;
- RL 可以被看作一种(隐式的)合成数据生成方式——通过探索来生成;
- 无论用不用 RL,现有方法往往缺乏对整体多样性的鸟瞰视角;
- 系统性的多样化(+ 质量检查)能带来巨大差异,甚至能克服 R1 教师模型 20 倍的大小差距。
第三部分:RLP —— 把强化学习变成预训练目标
十一、预训练到底还有什么问题
Slide 52 再次引用 Ilya Sutskever:
🖼️ 第 57 页幻灯片 · Training Recipe
The End of Ever More Pretraining(无休止预训练的终结)
🖼️ 第 59 页幻灯片 · RLP shows a significant improvement on Qwen3-1.7B-Base
- Scaling compute 不再(是)瓶颈;
- 高质量数据是有限的,并且正在被耗尽;
- 时代从「scaling 数据」转向「从每一个 token 里榨取更多价值」。
🖼️ 第 61 页幻灯片 · RLP scales with LLM size (12B) and frameworks
标准 LLM 训练的问题:推理是事后补上的
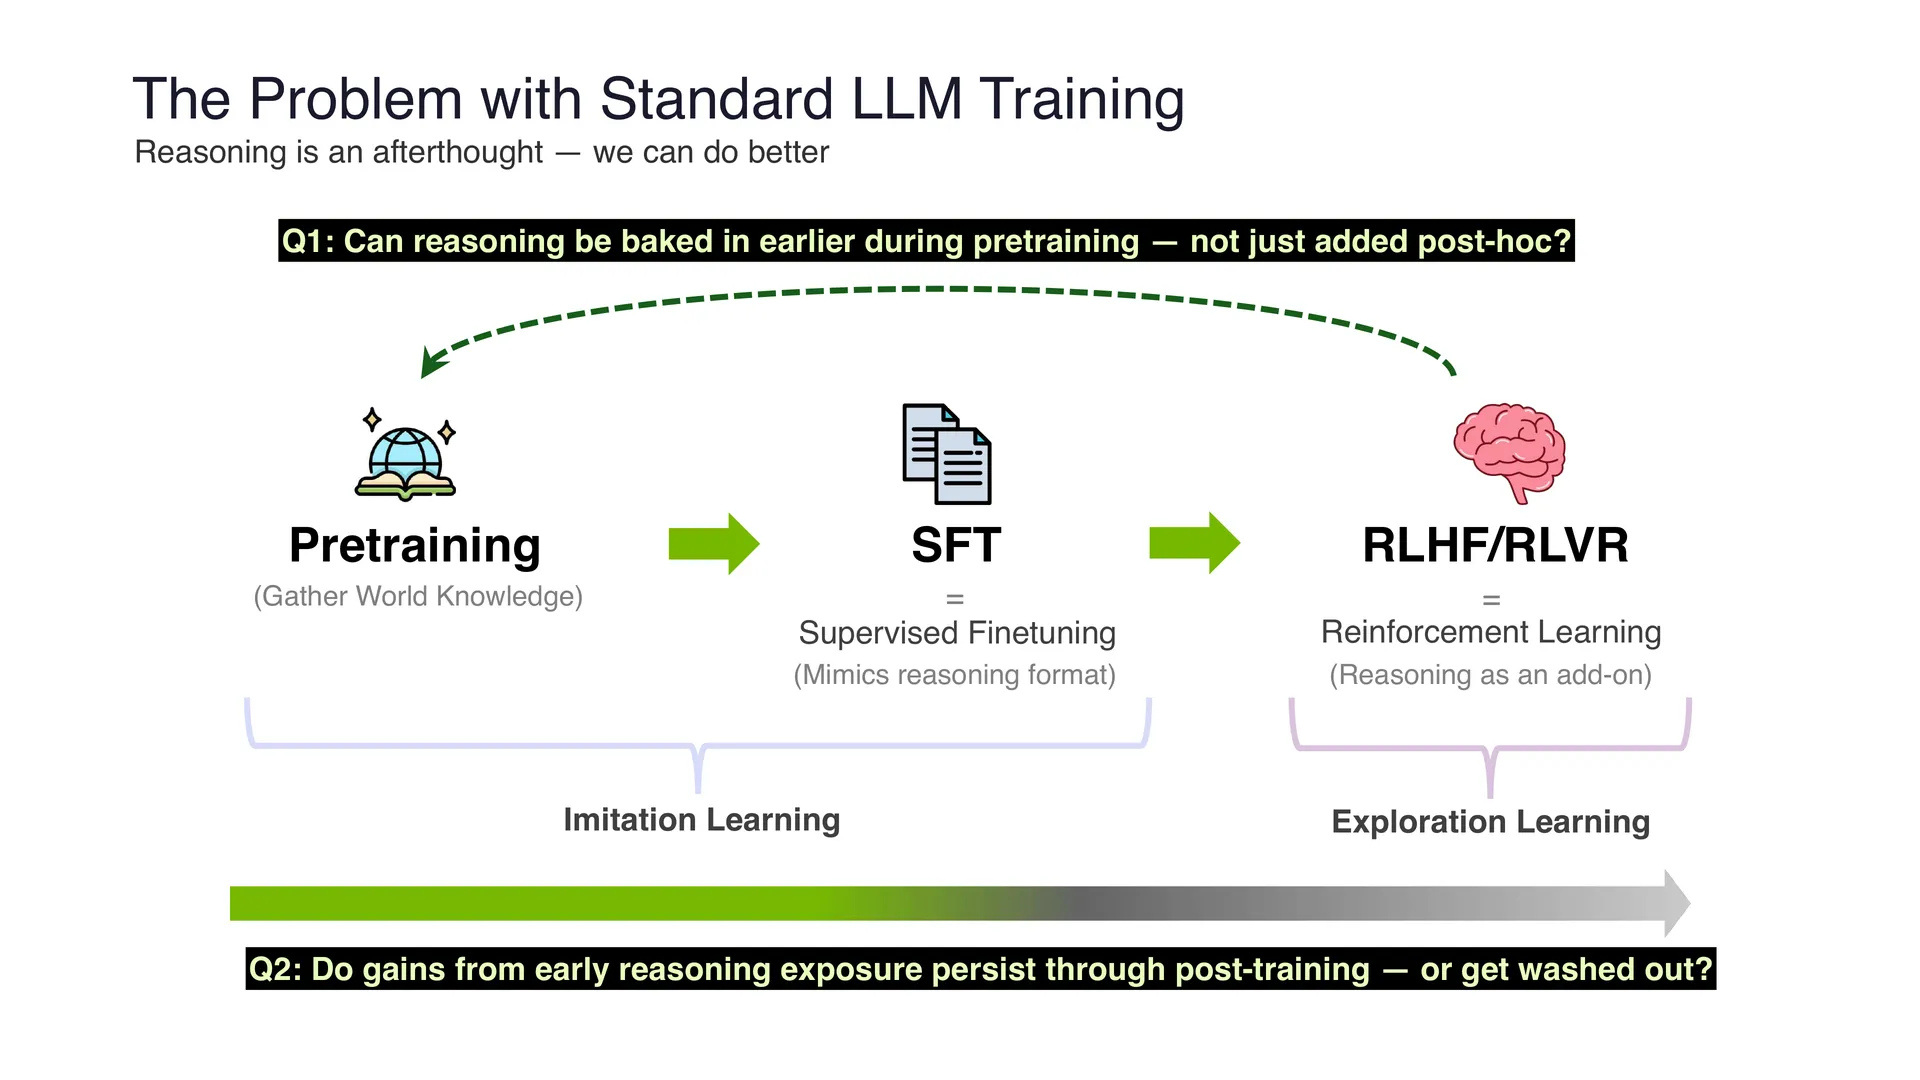
Slide 53 给出了经典三段式:
| 阶段 | 做什么 | 学习范式 |
|---|---|---|
| Pretraining | 收集世界知识(Gather World Knowledge) | —— |
| SFT | 模仿推理的格式(Mimics reasoning format) | Imitation Learning |
| RLHF / RLVR | 把推理当作附加项(Reasoning as an add-on) | Exploration Learning |
讲义因此提出两个问题:
- Q1:能不能在预训练阶段就把推理「烤进去」,而不是事后补丁?
- Q2:早期暴露于推理所带来的增益,能不能熬过后训练,还是会被冲掉?
十二、Vanilla 预训练 vs RLP 预训练
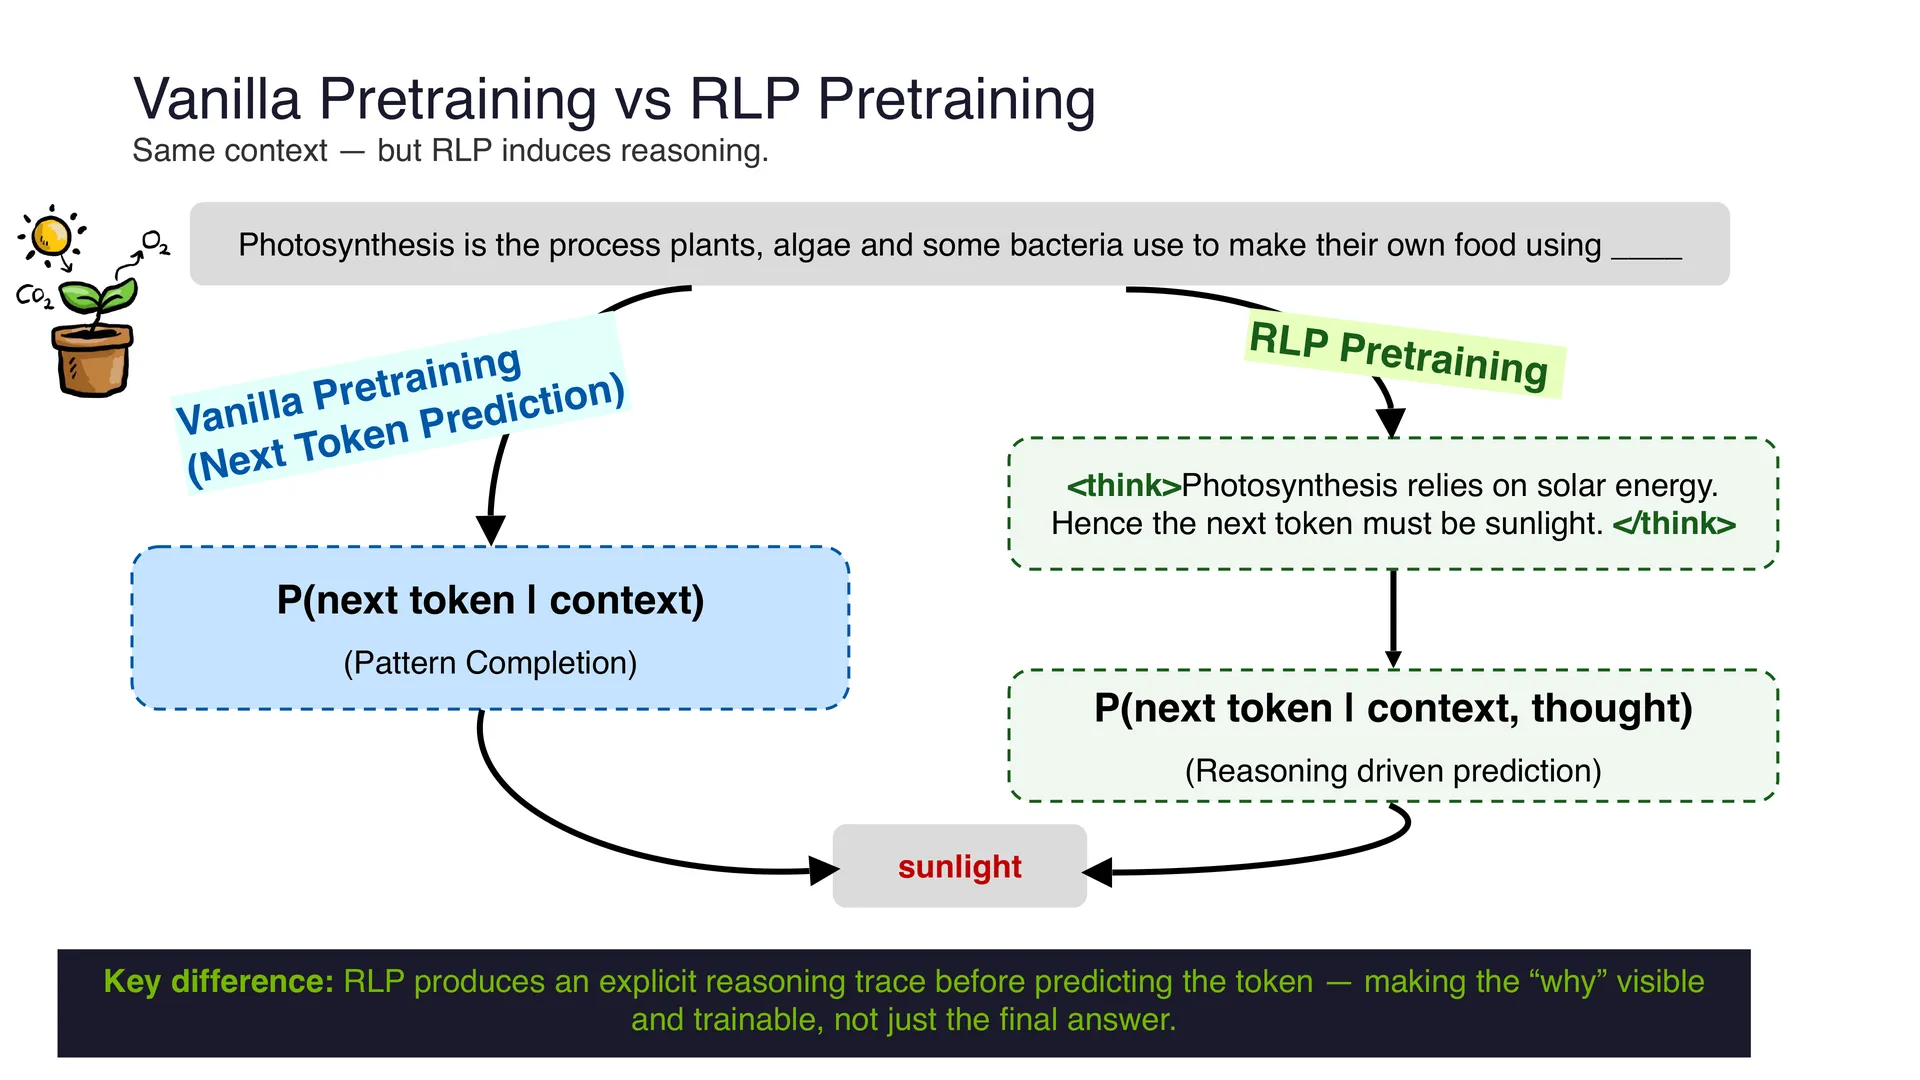
Slide 54 用一个填空题说明了区别。上下文相同:
🖼️ 第 62 页幻灯片 · (无标题)
Photosynthesis is the process plants, algae and some bacteria use to make their own food using ____
Vanilla 预训练(Next Token Prediction,模式补全):
$$P(\text{next token} \mid \text{context}) \;\Rightarrow\; \texttt{sunlight}$$
🖼️ 第 63 页幻灯片 · Reward(thought) = log P(next token | context + thought) − log P(next
RLP 预训练(Reasoning driven prediction):
$$\texttt{
$$P(\text{next token} \mid \text{context}, \text{thought}) \;\Rightarrow\; \texttt{sunlight}$$
🖼️ 第 64 页幻灯片 · Front-Loading Reasoning
关键差异:RLP 在预测 token 之前先产生一条显式的推理轨迹——让「为什么」变得可见、可训练,而不只是最终答案。
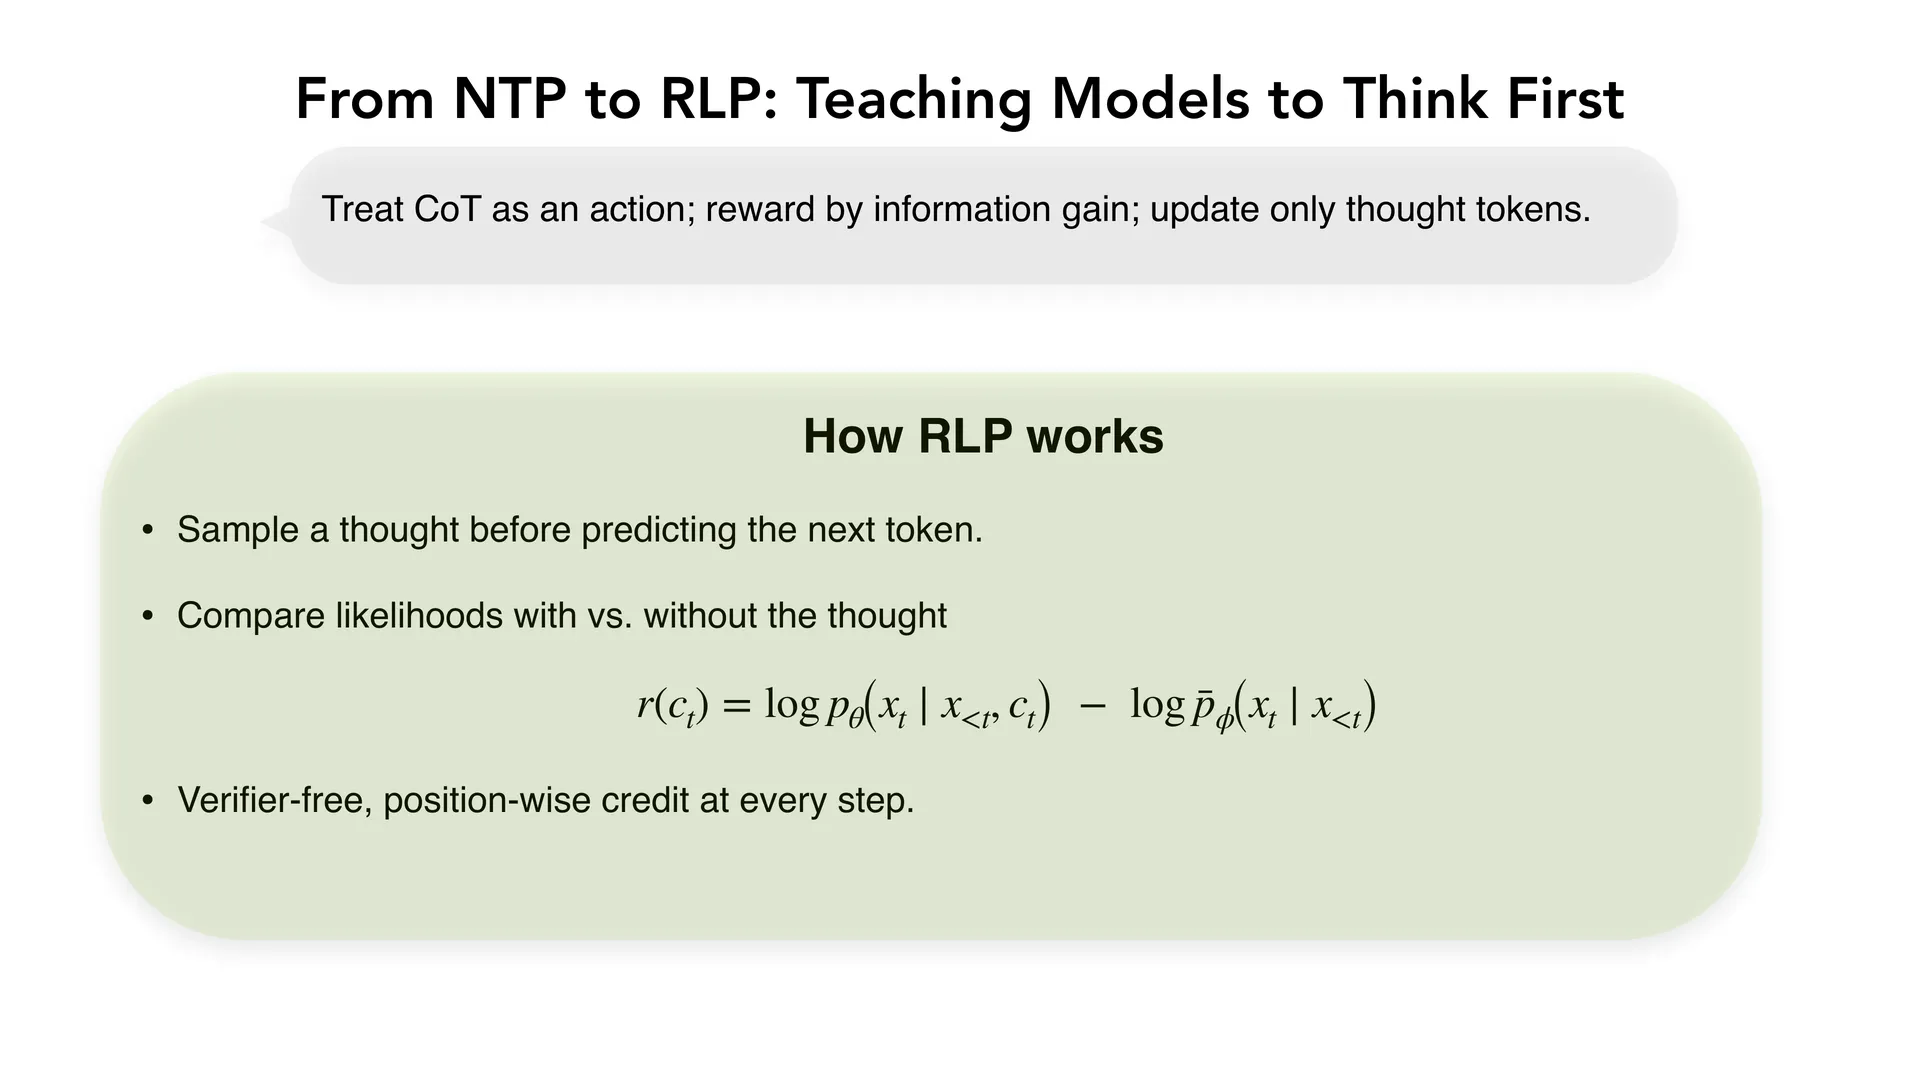
RLP 是怎么工作的
Slide 55–56:
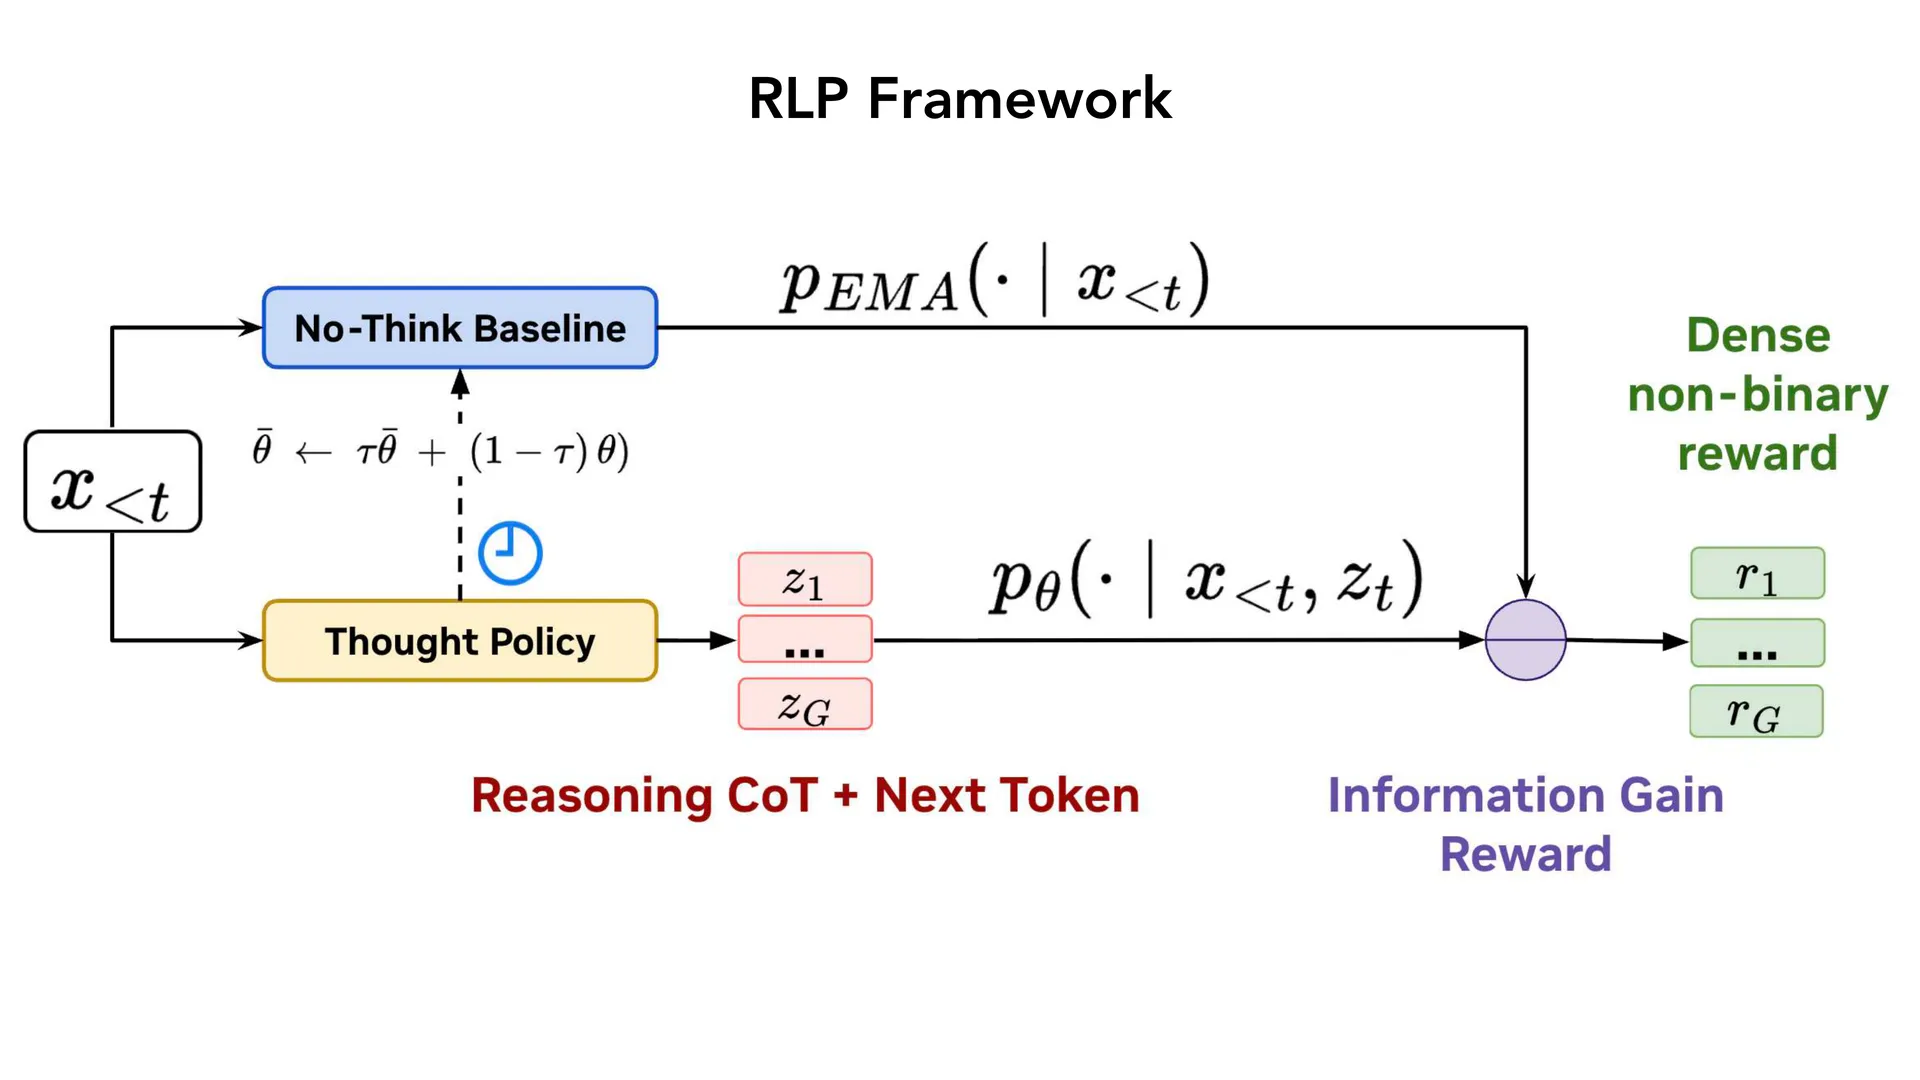
- 在预测下一个 token 之前采样一段「思考」(thought);
- 比较「有思考」与「无思考」两种情况的似然;
- Verifier-free(无需验证器)、position-wise(逐位置)的信用分配,每一步都给。
奖励的定义为:
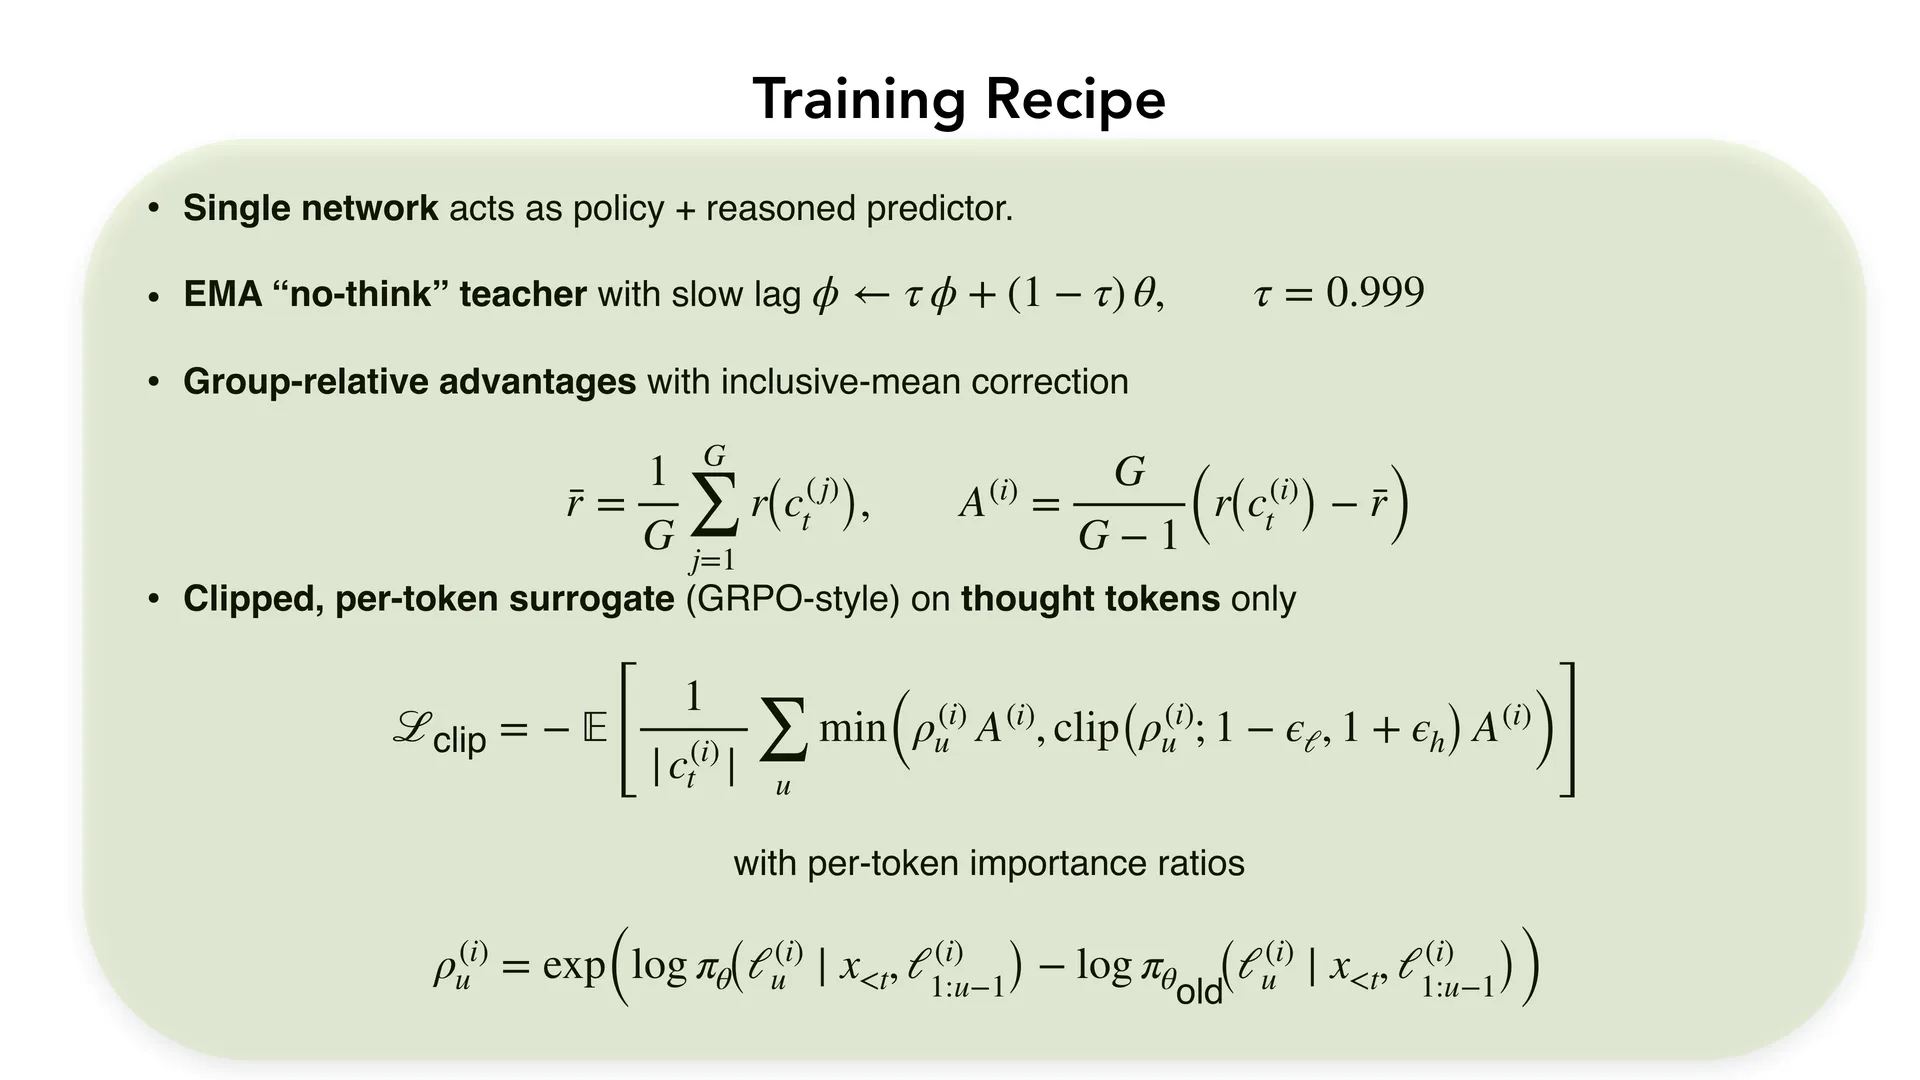
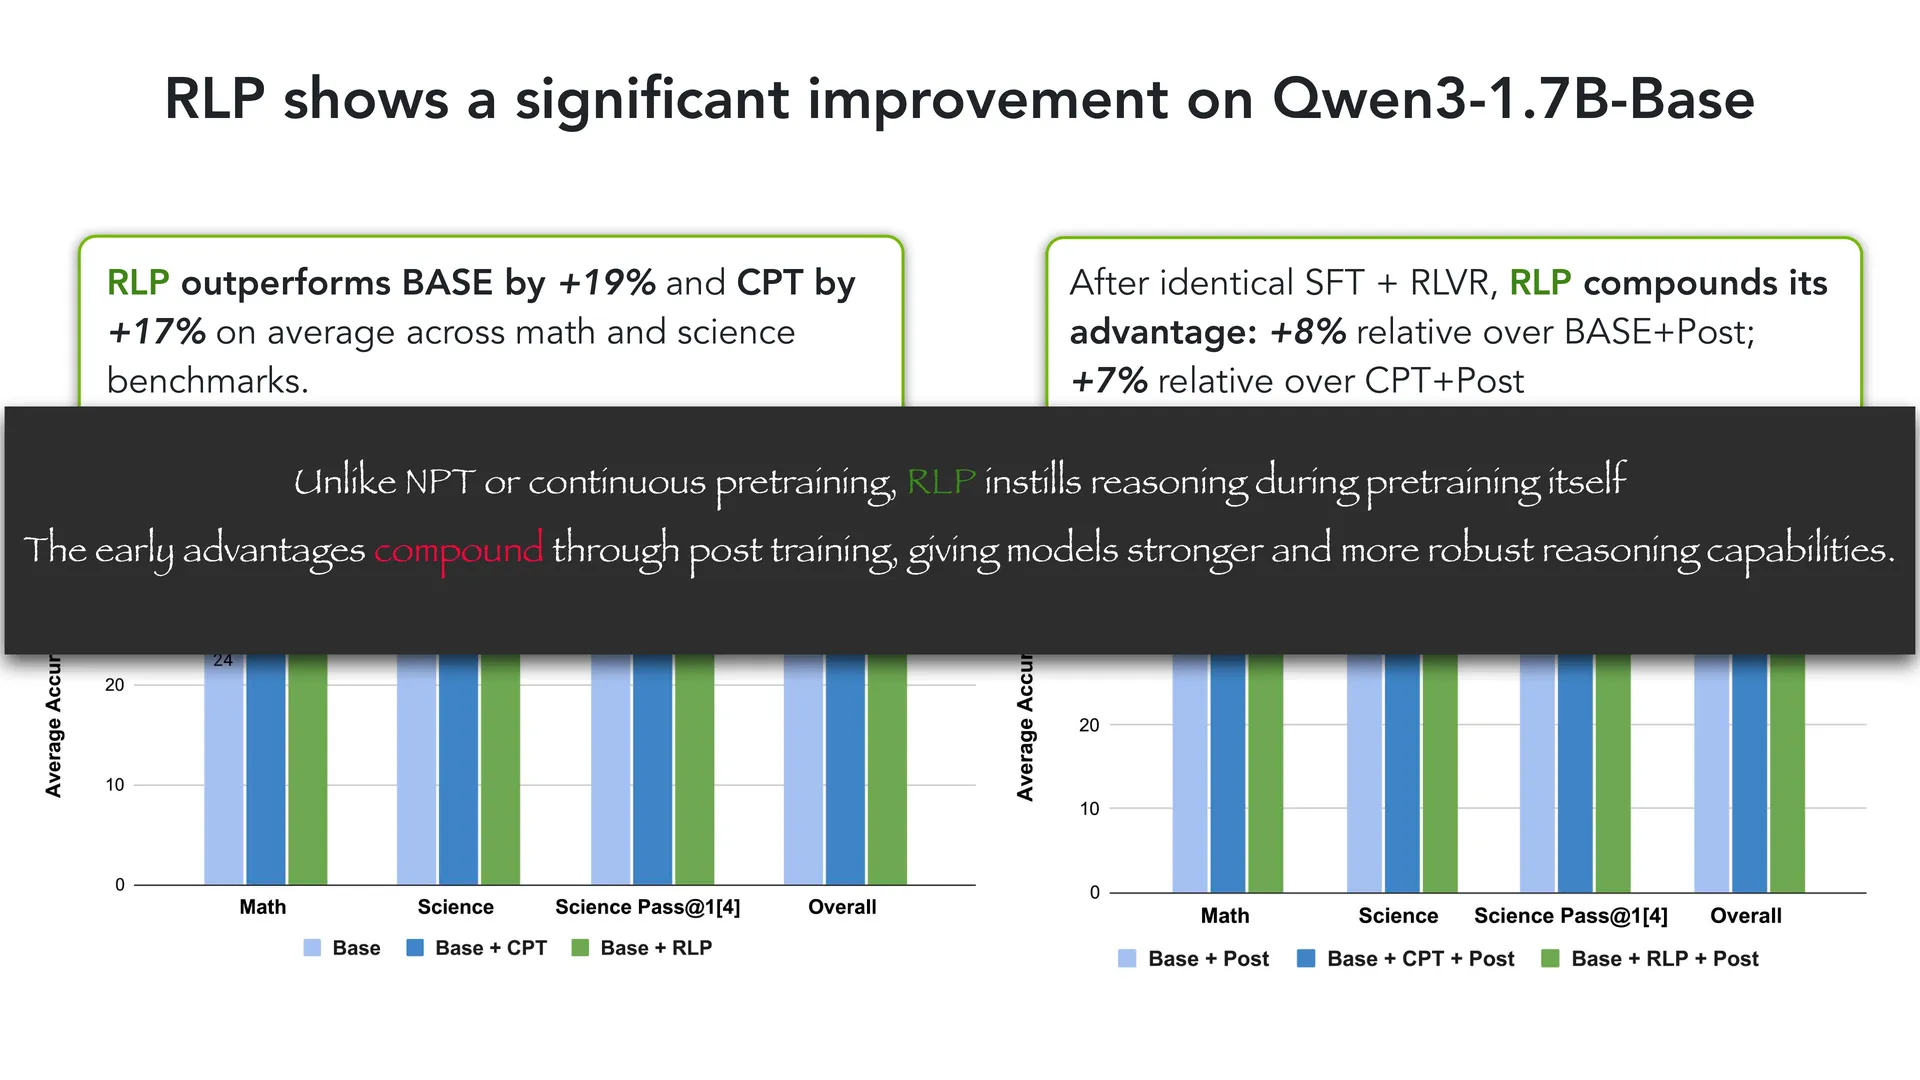
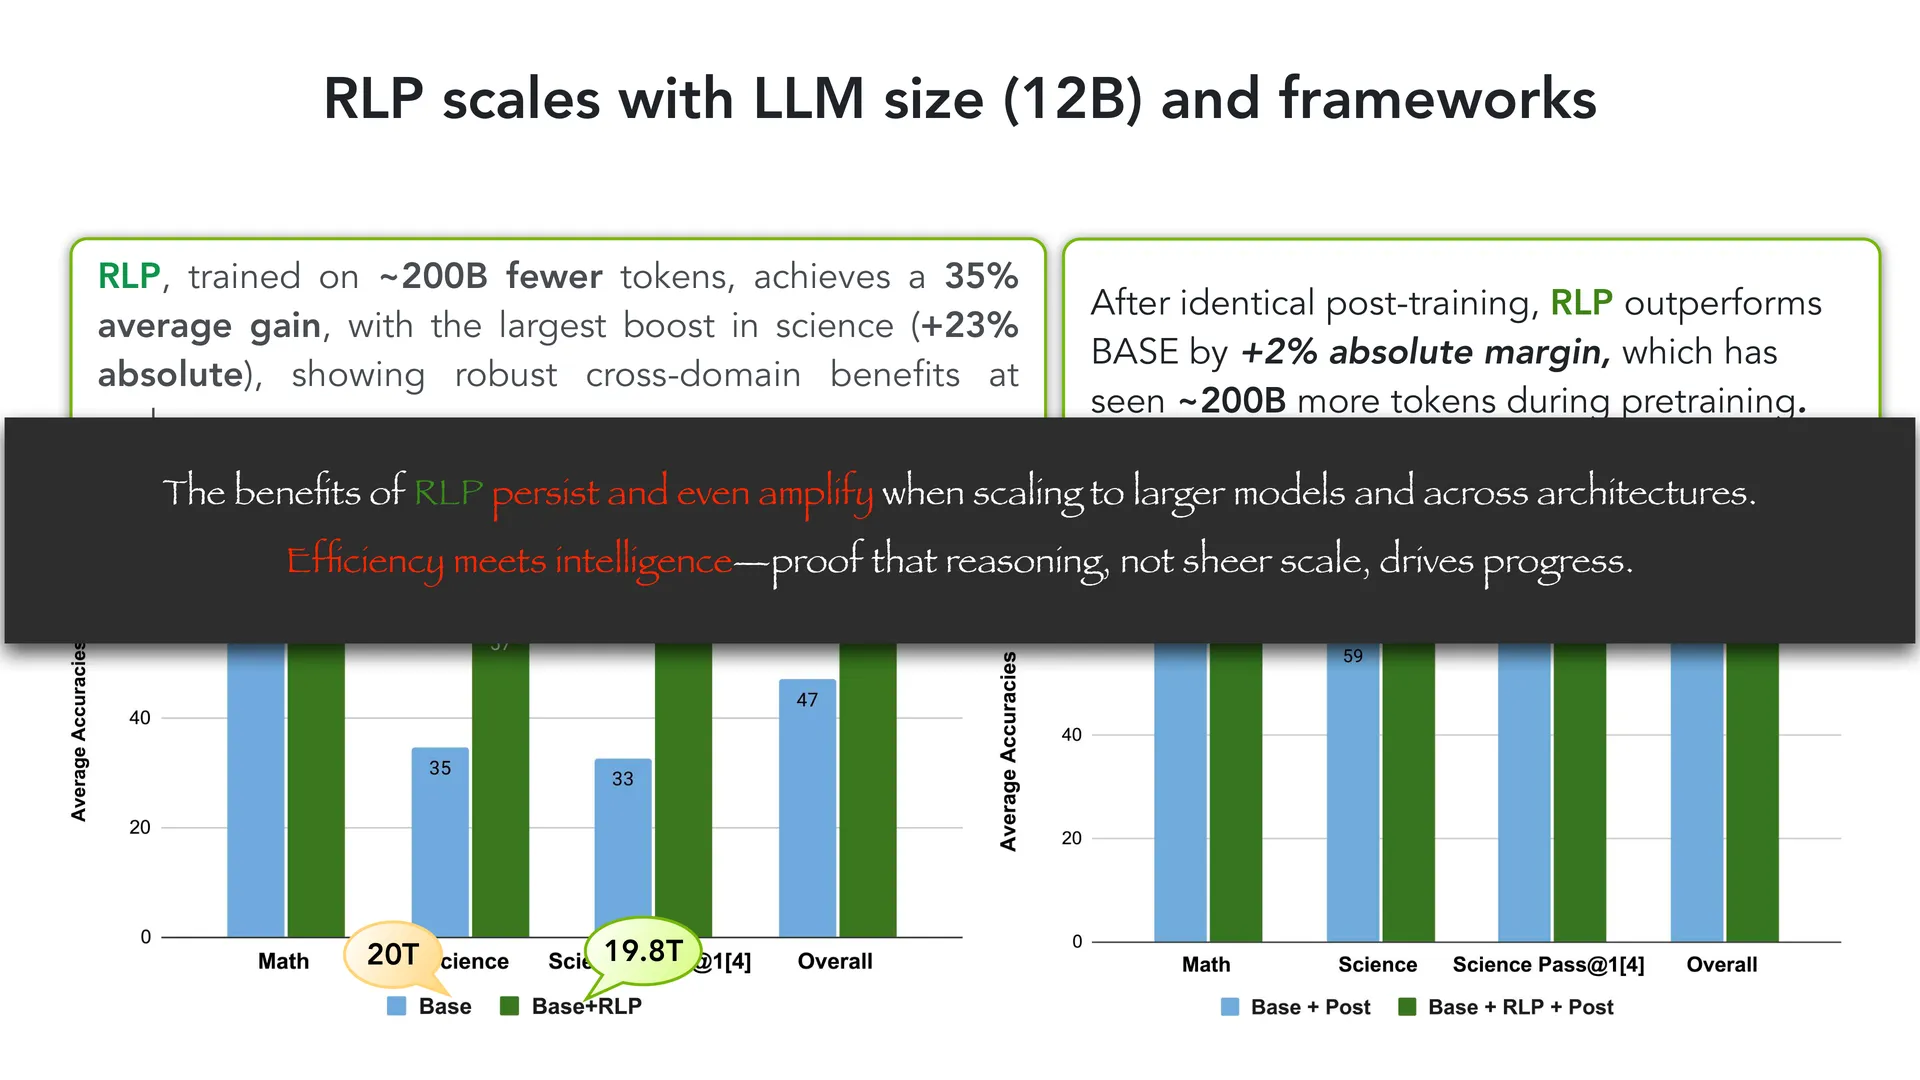
$$r(c_t) = \log p_\theta(x_t \mid x_{ 讲义的总结是: 把 CoT 当作一个动作(action);用信息增益(information gain)作为奖励;只更新 thought token。 🖼️ 第 65 页幻灯片 · Front Loading Reasoning 编者说明|这个奖励在度量什么:它是「有了这段思考之后,下一个真实 token 的对数似然,比没有思考时高了多少」。如果一段思考对预测真有帮助,它就拿到正奖励;如果它没用甚至有害,奖励就是负的。因为 $x_t$ 是预训练语料里本来就有的下一个词,所以不需要任何外部判分器——这就是「verifier-free」的含义。 🖼️ 第 66 页幻灯片 · Front Loading Reasoning Slide 57 给出了完整的训练方法: $$\phi \leftarrow \tau \phi + (1-\tau)\theta, \qquad \tau = 0.999$$ $$\bar{r} = \frac{1}{G}\sum_{j=1}^{G} r(c_t^{(j)}), \qquad A^{(i)} = \frac{G}{G-1}\big(r(c_t^{(i)}) - \bar{r}\big)$$ $$\rho_u^{(i)} = \exp\Big(\log \pi_\theta(\ell_u^{(i)} \mid x_{ $$\mathcal{L}_{\text{clip}} = -\mathbb{E}\left[\frac{1}{|c_t^{(i)}|}\sum_u \min\big(\rho_u^{(i)} A^{(i)},\; \mathrm{clip}(\rho_u^{(i)};\, 1-\epsilon_\ell,\, 1+\epsilon_h)\, A^{(i)}\big)\right]$$ 编者拓展|三处细节的作用
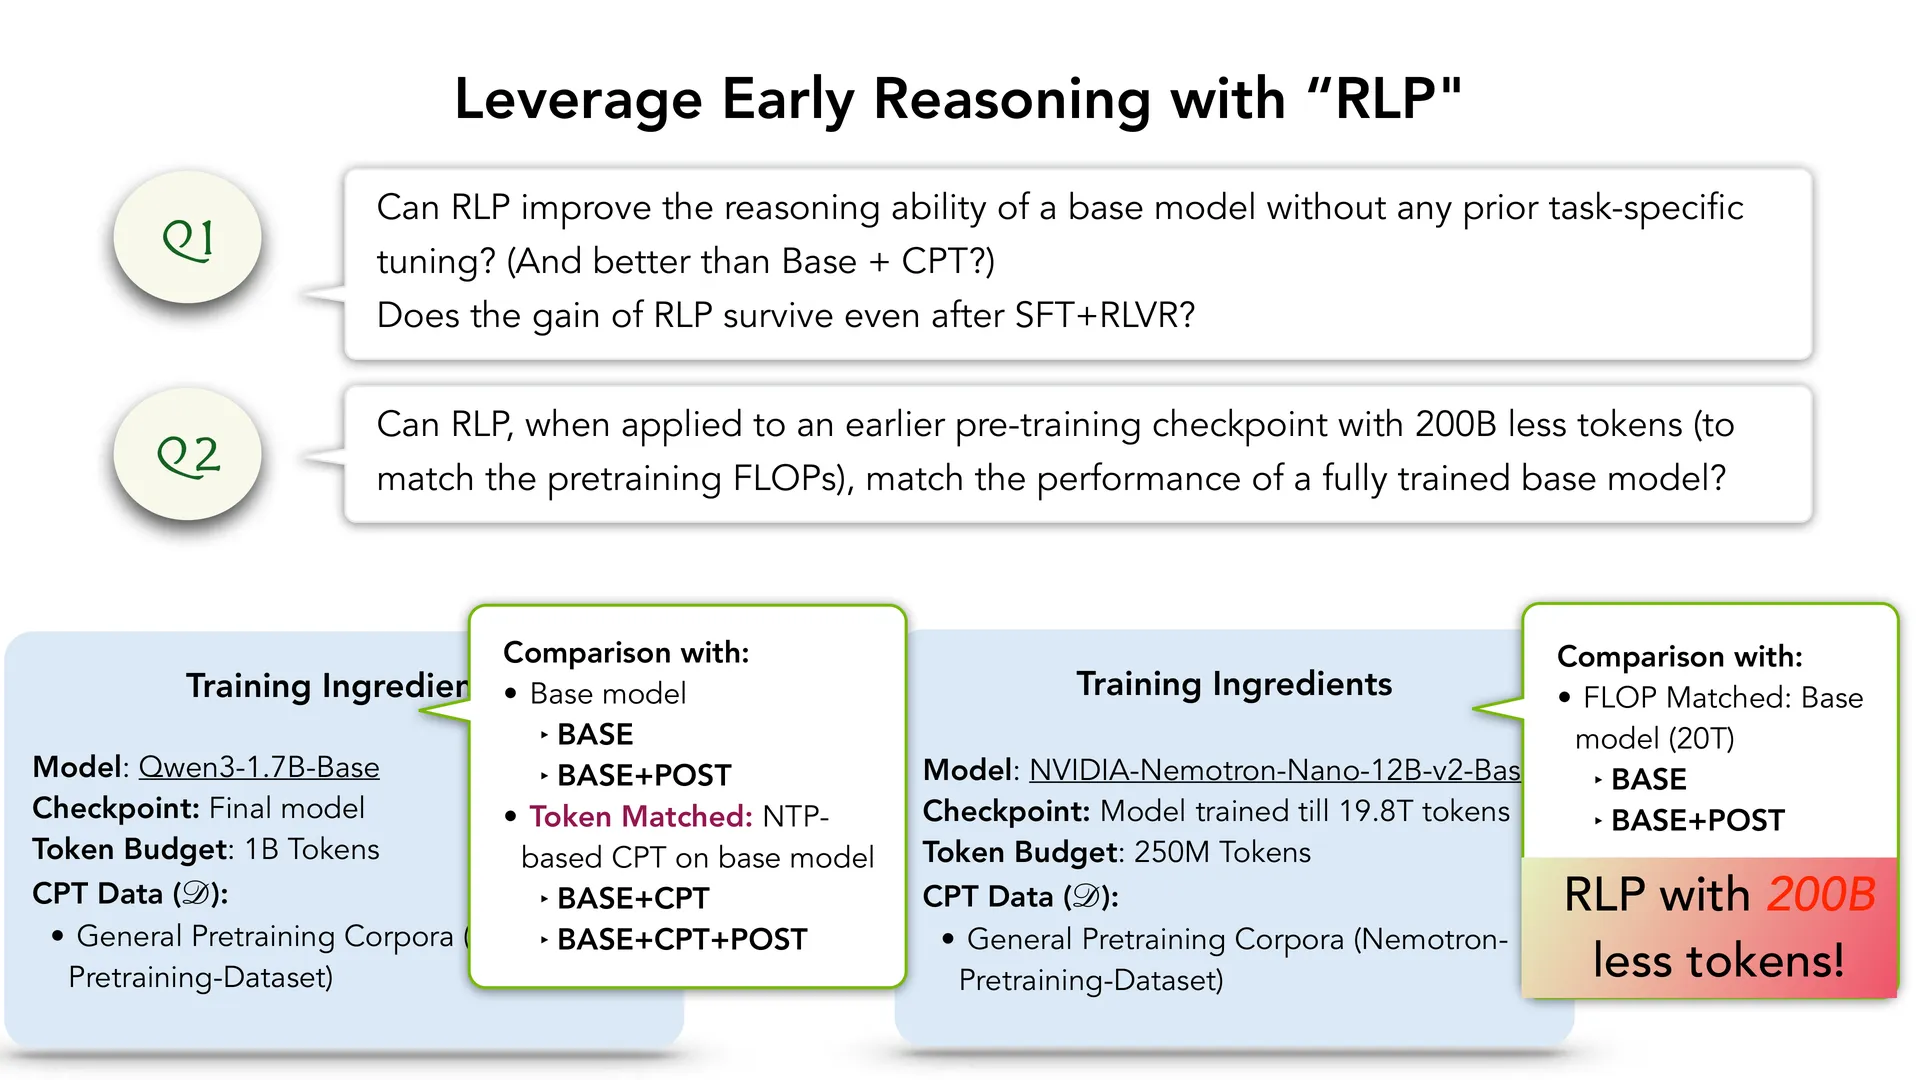
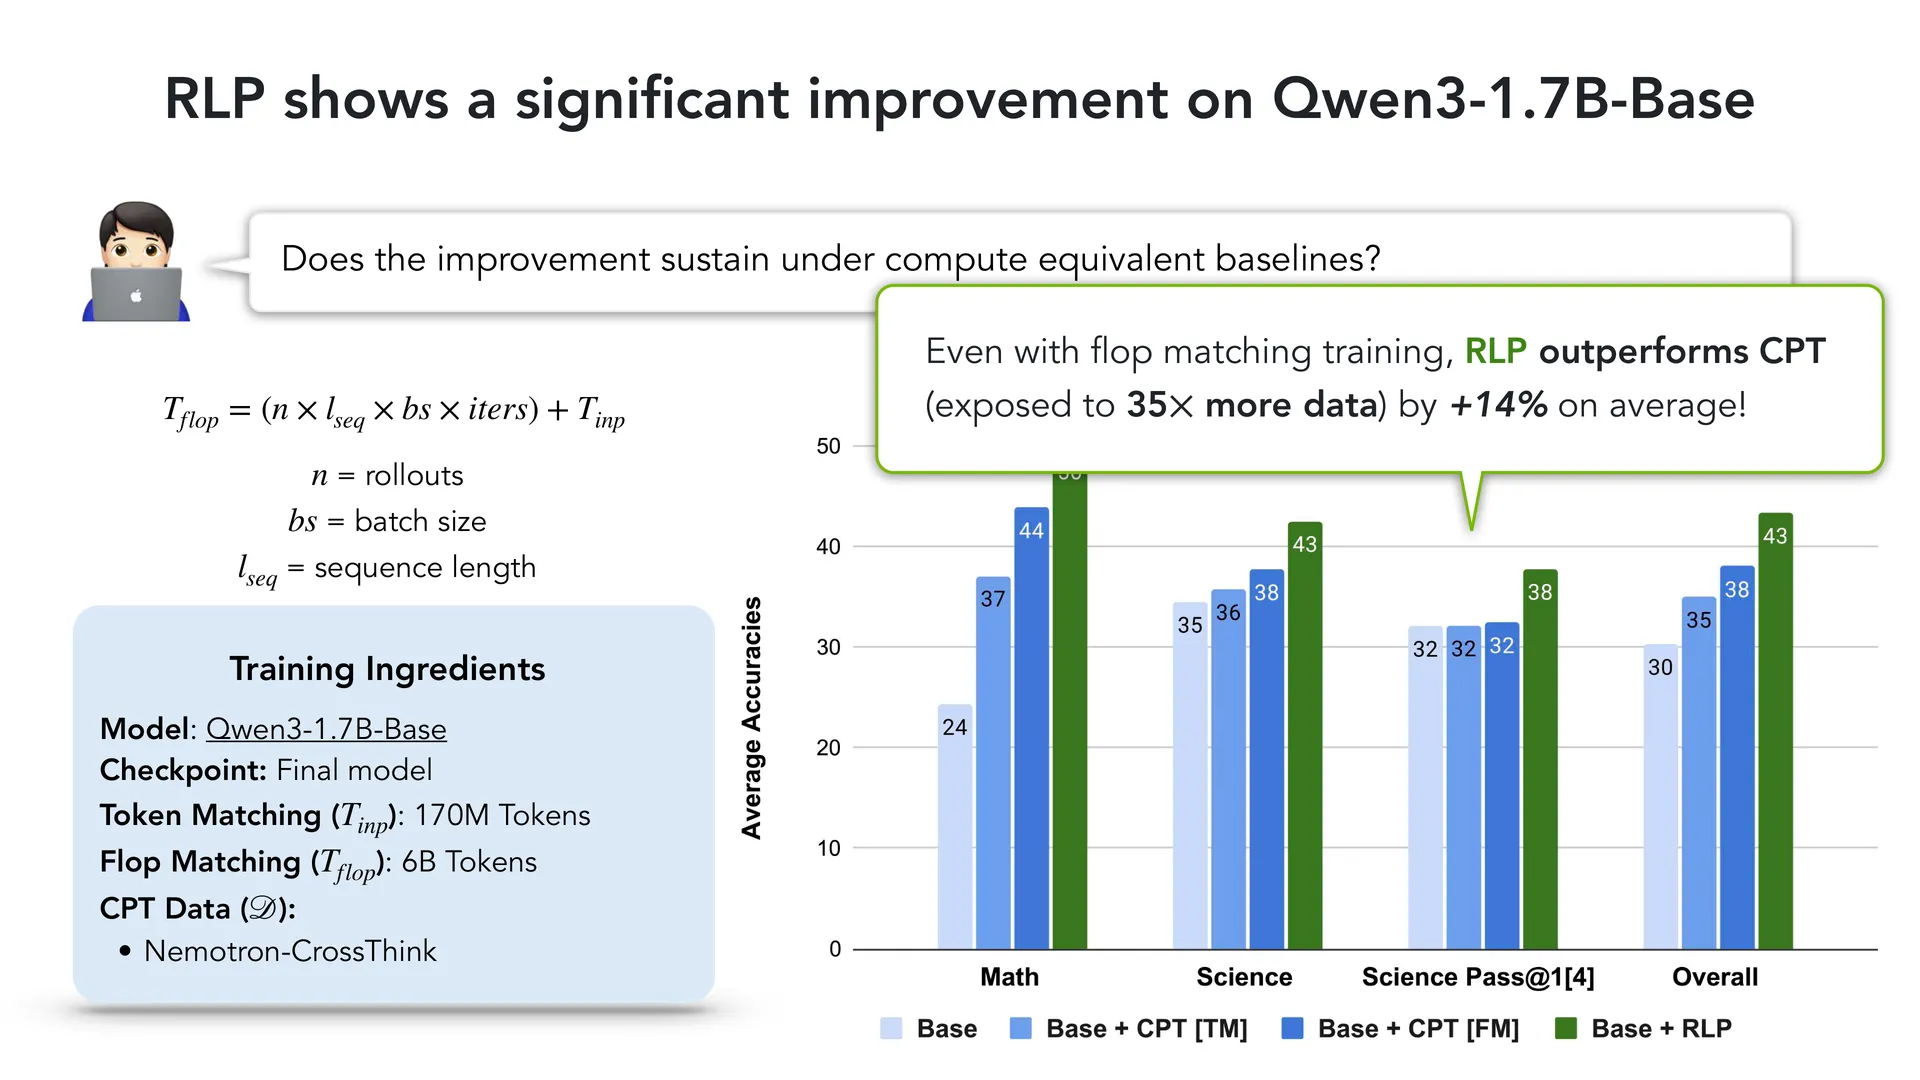
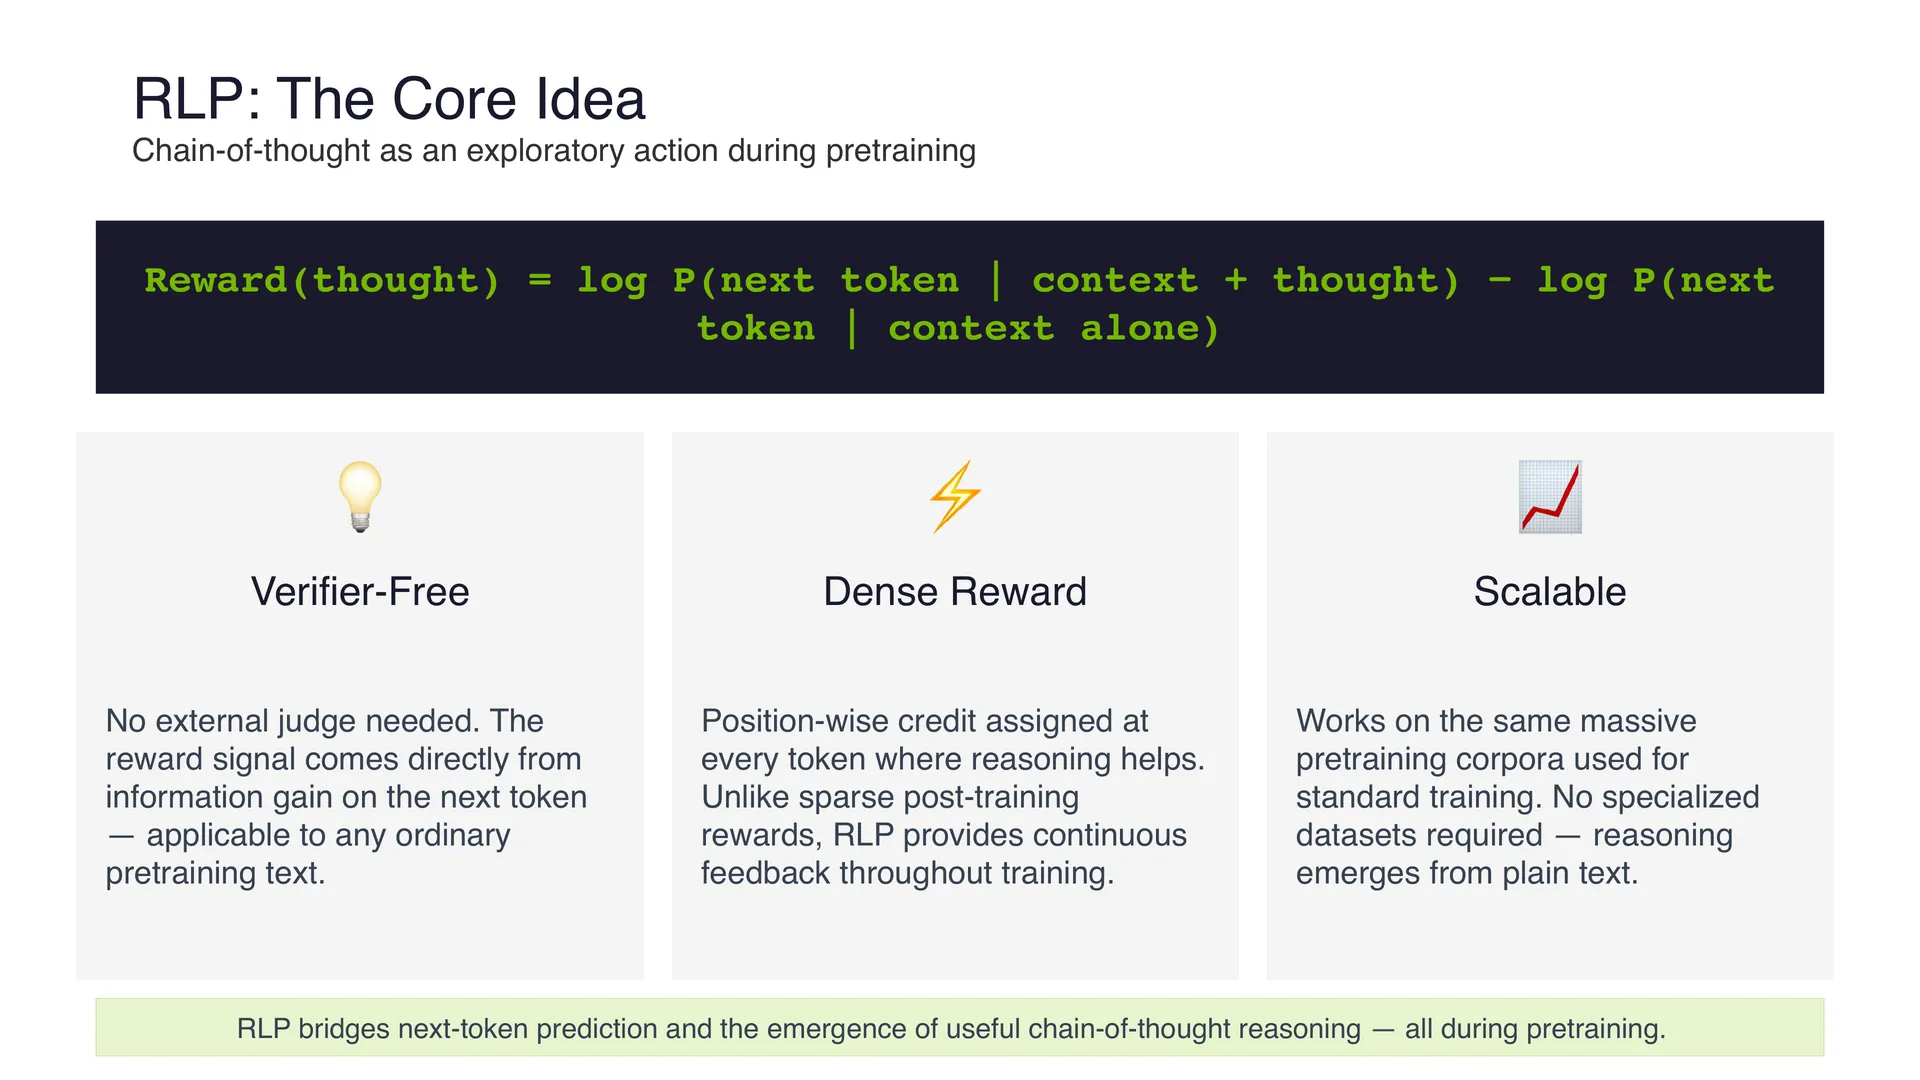
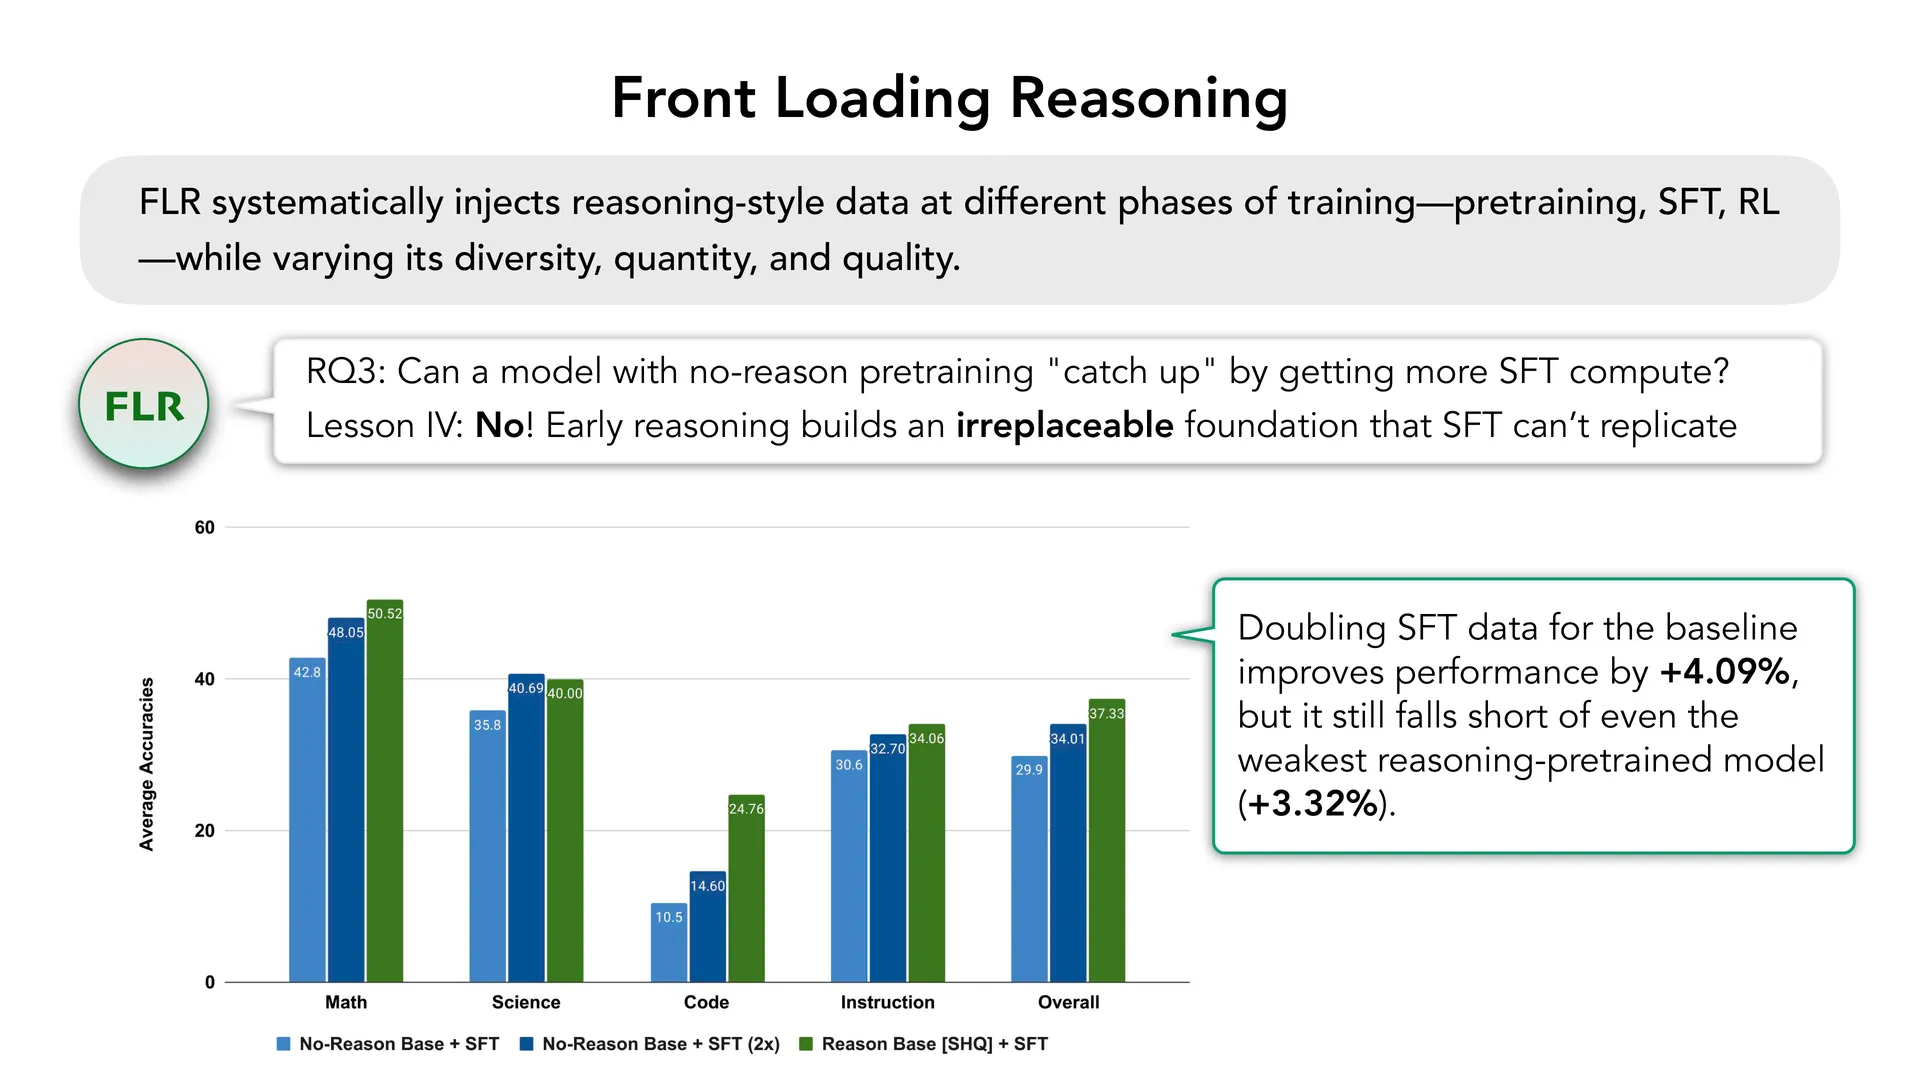
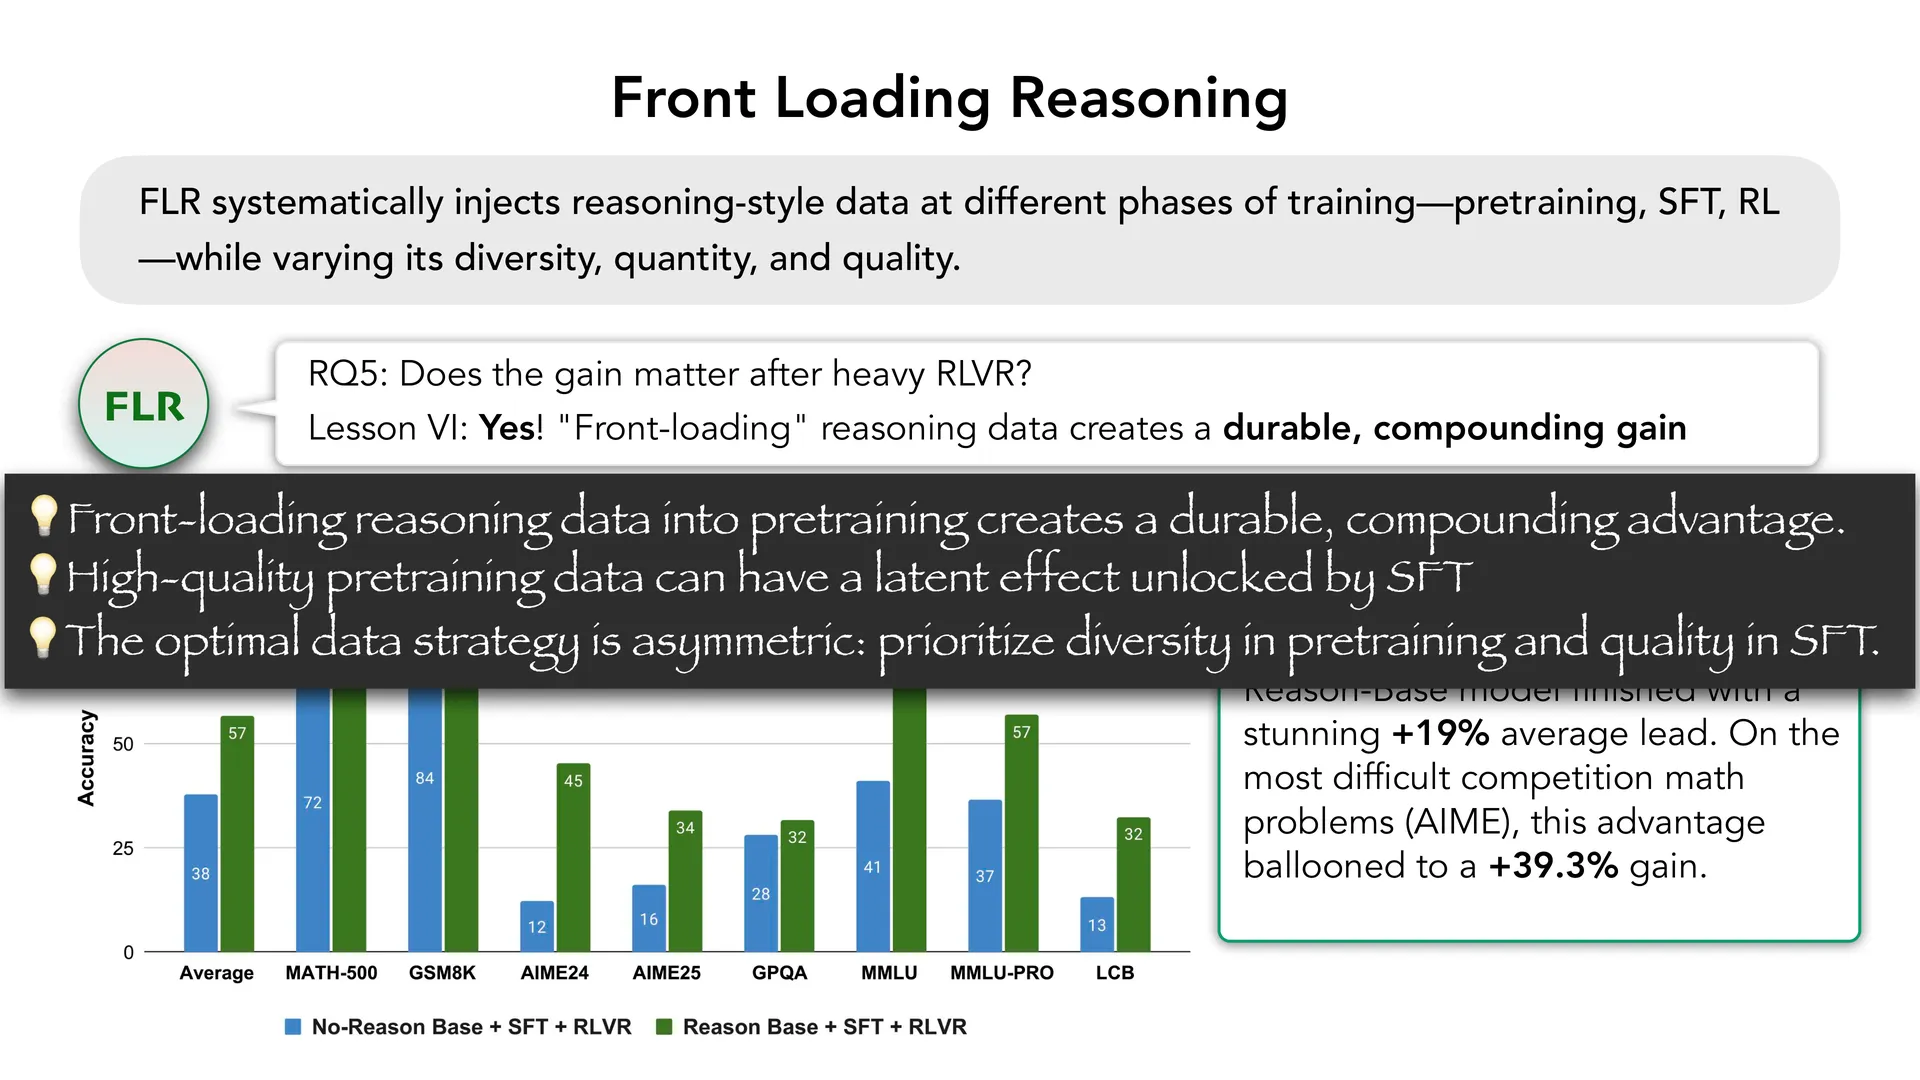
- EMA 教师($\tau = 0.999$):$\phi$ 是 $\theta$ 的极慢滑动平均,相当于一个「不会思考的、稳定的旧版本自己」。它提供的是基线似然 $\log \bar p_\phi(x_t \mid x_{ 🖼️ 第 67 页幻灯片 · Front Loading Reasoning Slide 58 给出了两组实验: 第一组(Qwen3-1.7B-Base): 对照组:BASE、BASE+POST、Token 匹配的 NTP 式 CPT:BASE+CPT、BASE+CPT+POST。 🖼️ 第 68 页幻灯片 · Concluding 第二组(NVIDIA-Nemotron-Nano-12B-v2-Base): 对照组是 FLOP 匹配的基座模型(20T):BASE、BASE+POST。也就是: RLP 少用了 200B tokens! 三个研究问题(Q1–Q3)分别是: 🖼️ 第 69 页幻灯片 · Three components to innovate: Slide 59: Slide 60 回答了「会不会只是算力用得多」这个质疑: 🖼️ 第 70 页幻灯片 · The $$T_{\text{flop}} = (n \times l_{\text{seq}} \times bs \times \text{iters}) + T_{\text{inp}}$$ 其中 $n$ 为 rollouts 数,$bs$ 为 batch size,$l_{\text{seq}}$ 为序列长度。 结论: 即使在 FLOP 匹配的设置下,RLP 仍平均超过 CPT +14%——而 CPT 见到的数据量比 RLP 多出 35 倍(讲义原文写作 "exposed to 35 more data",未写明单位,见「已知疑点」)。 Slide 61: 🖼️ 第 71 页幻灯片 · OpenThoughts3-1M Slide 63 把 RLP 的价值归纳为三条: 核心公式: $$\text{Reward}(\text{thought}) = \log P(\text{next token} \mid \text{context} + \text{thought}) - \log P(\text{next token} \mid \text{context alone})$$ RLP 把 next-token prediction 与有用的链式思考的涌现连接了起来——而且全部发生在预训练阶段。 Slide 64–67 介绍了第三个工作: 🖼️ 第 72 页幻灯片 · 72 Front-Loading Reasoning: The Synergy between Pretraining and Post-Training Data(ICLR 2026)
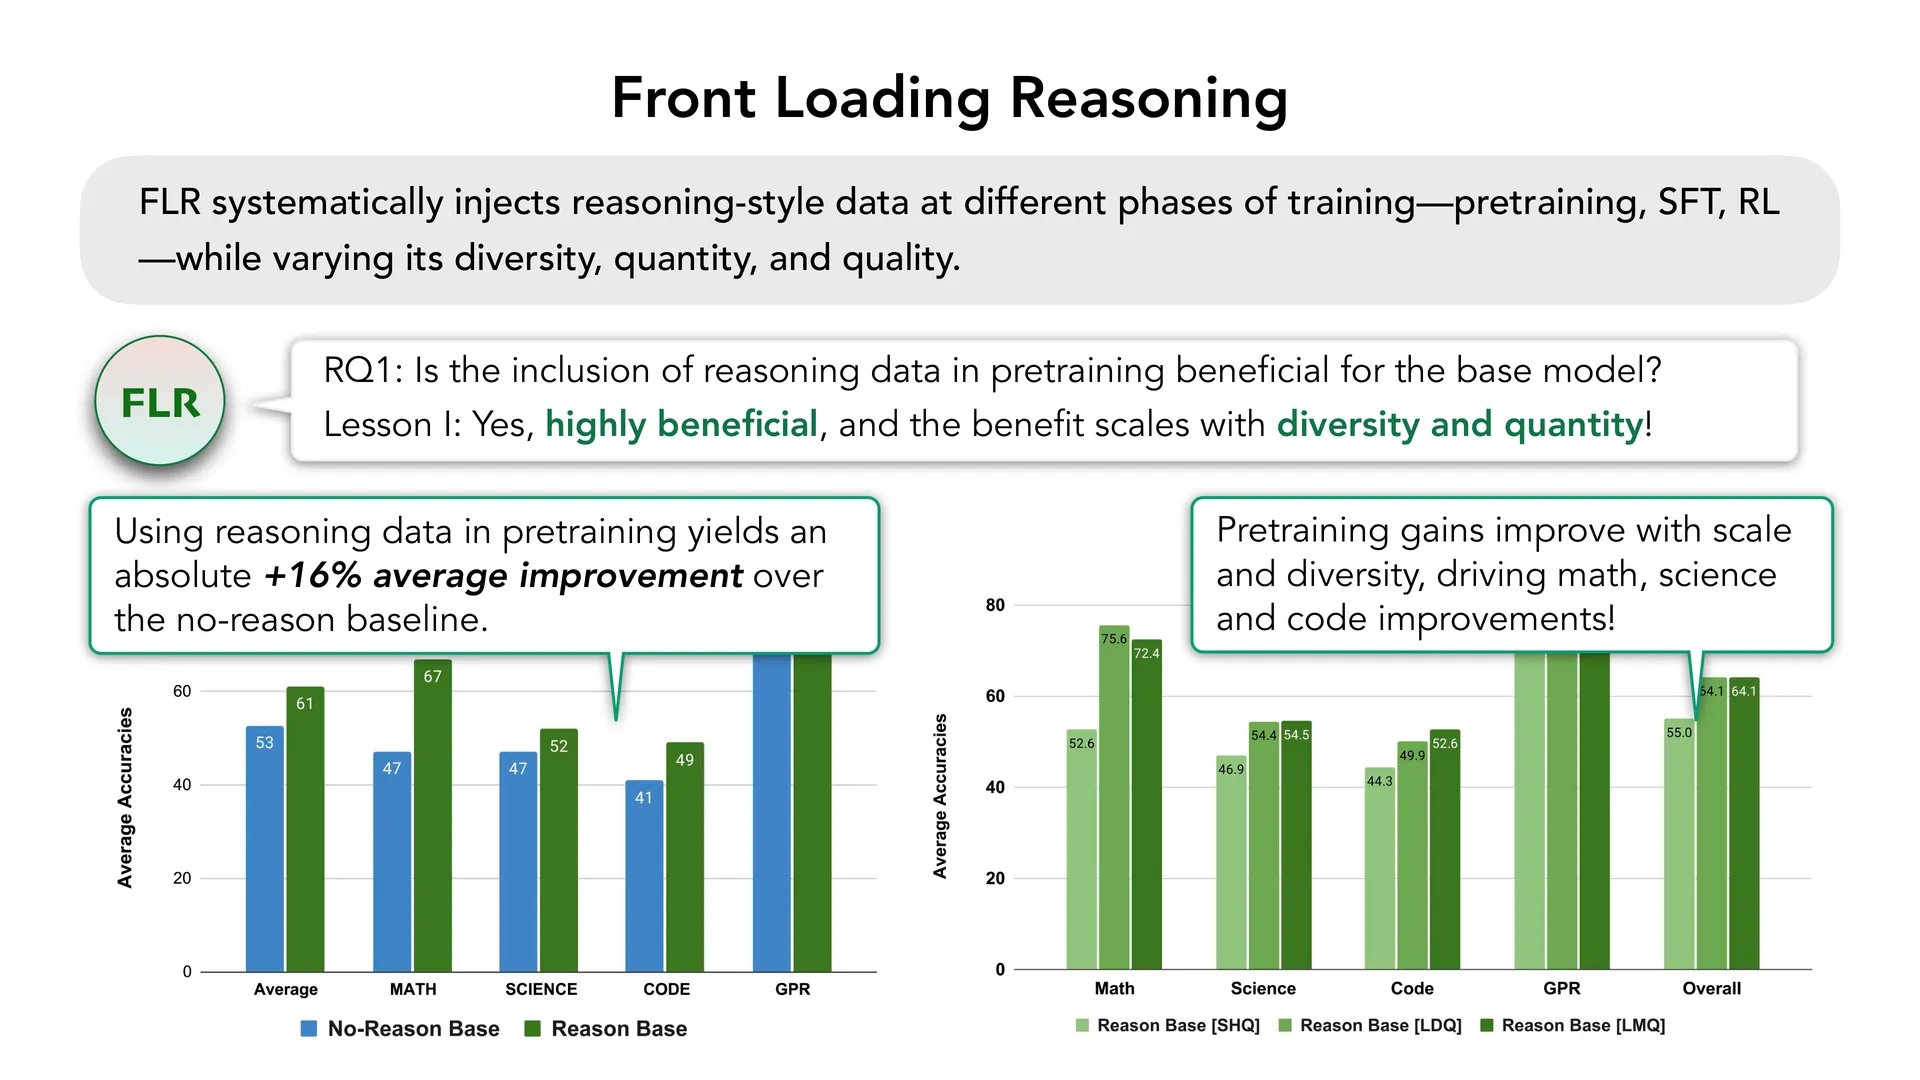
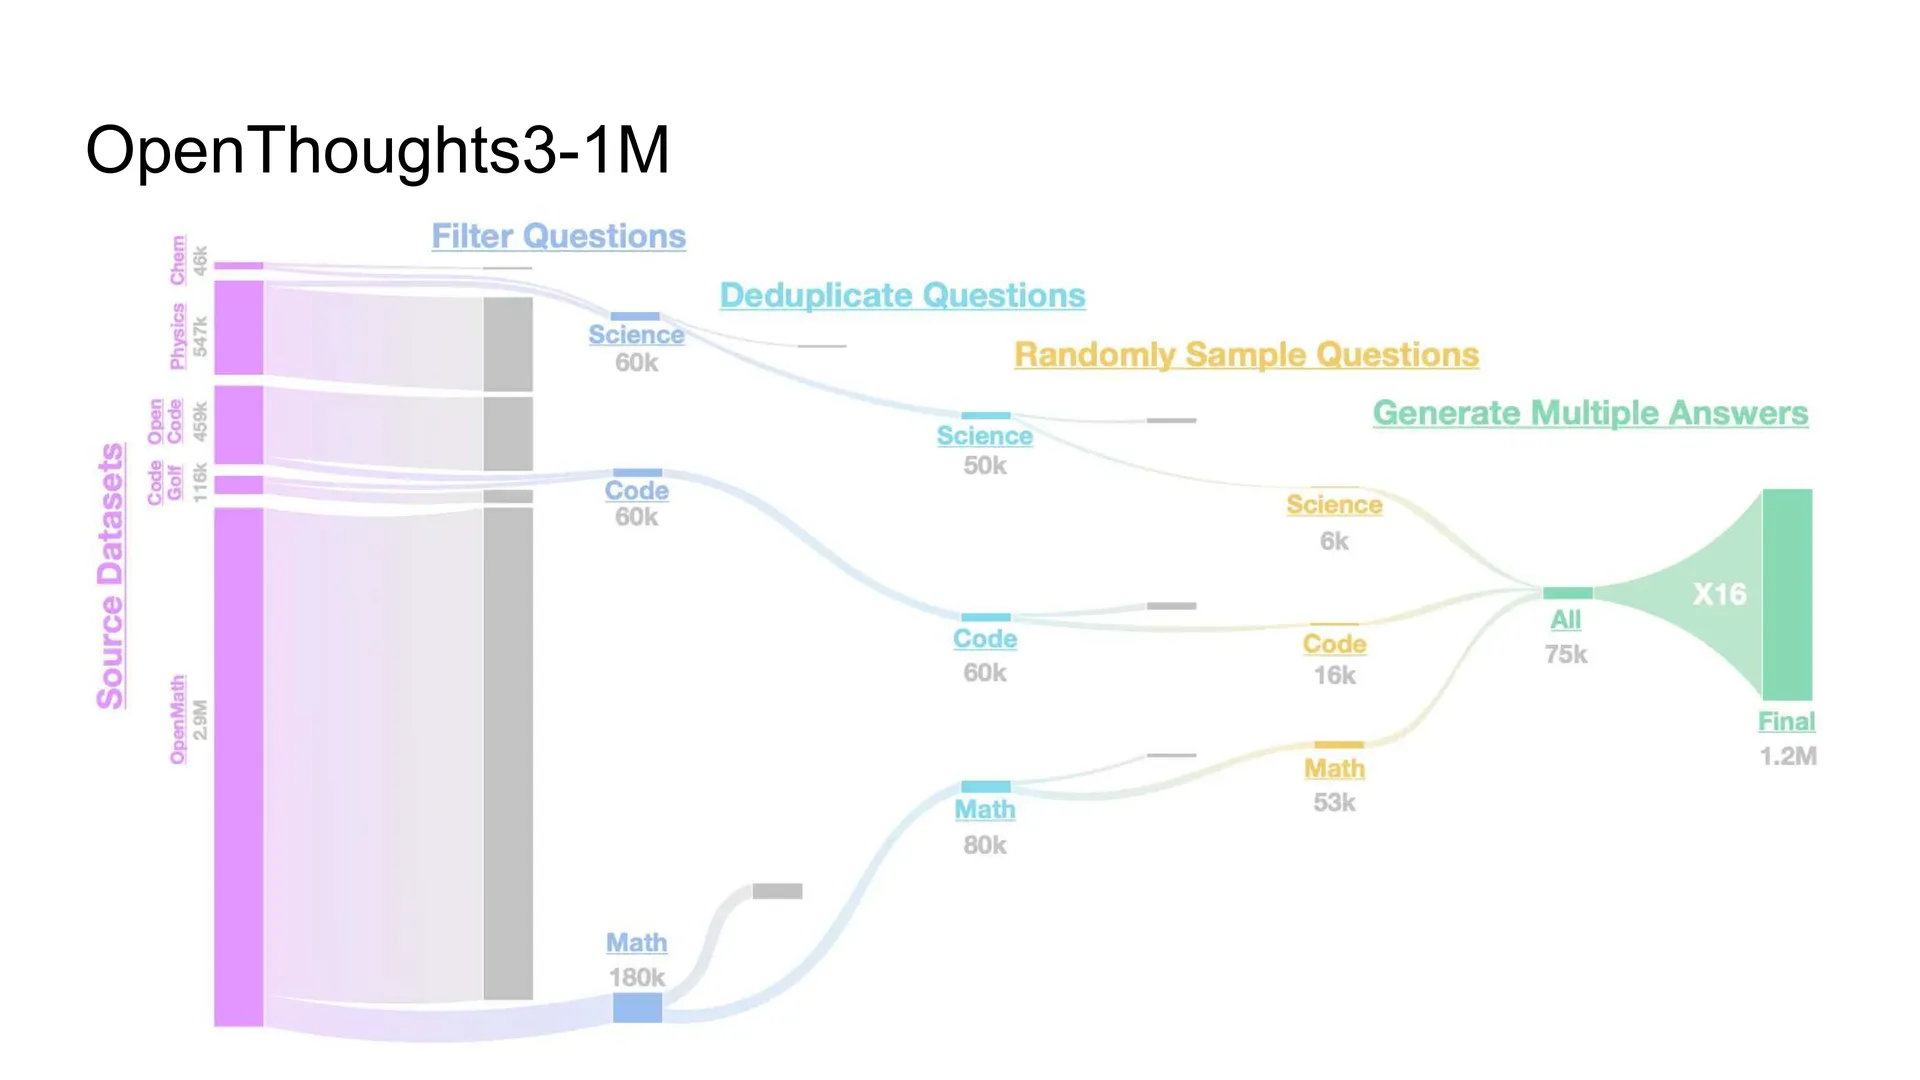
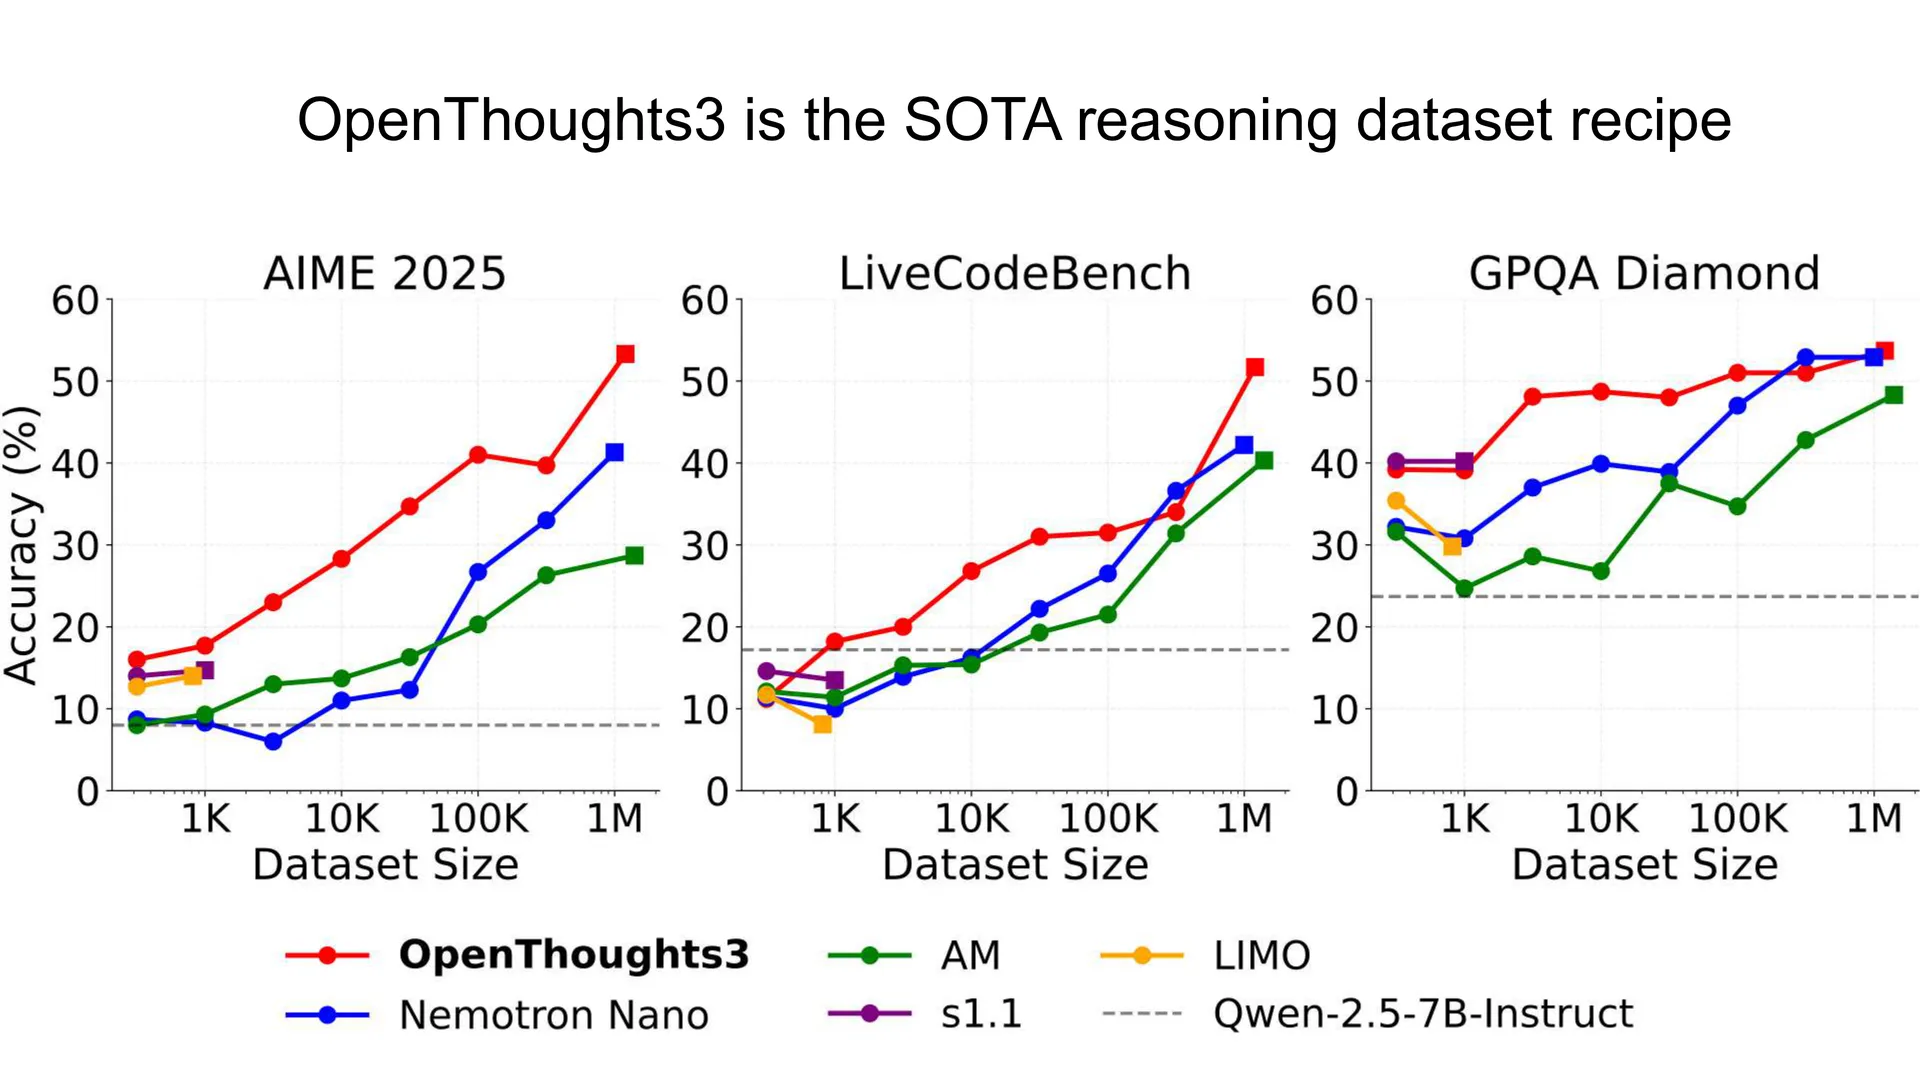
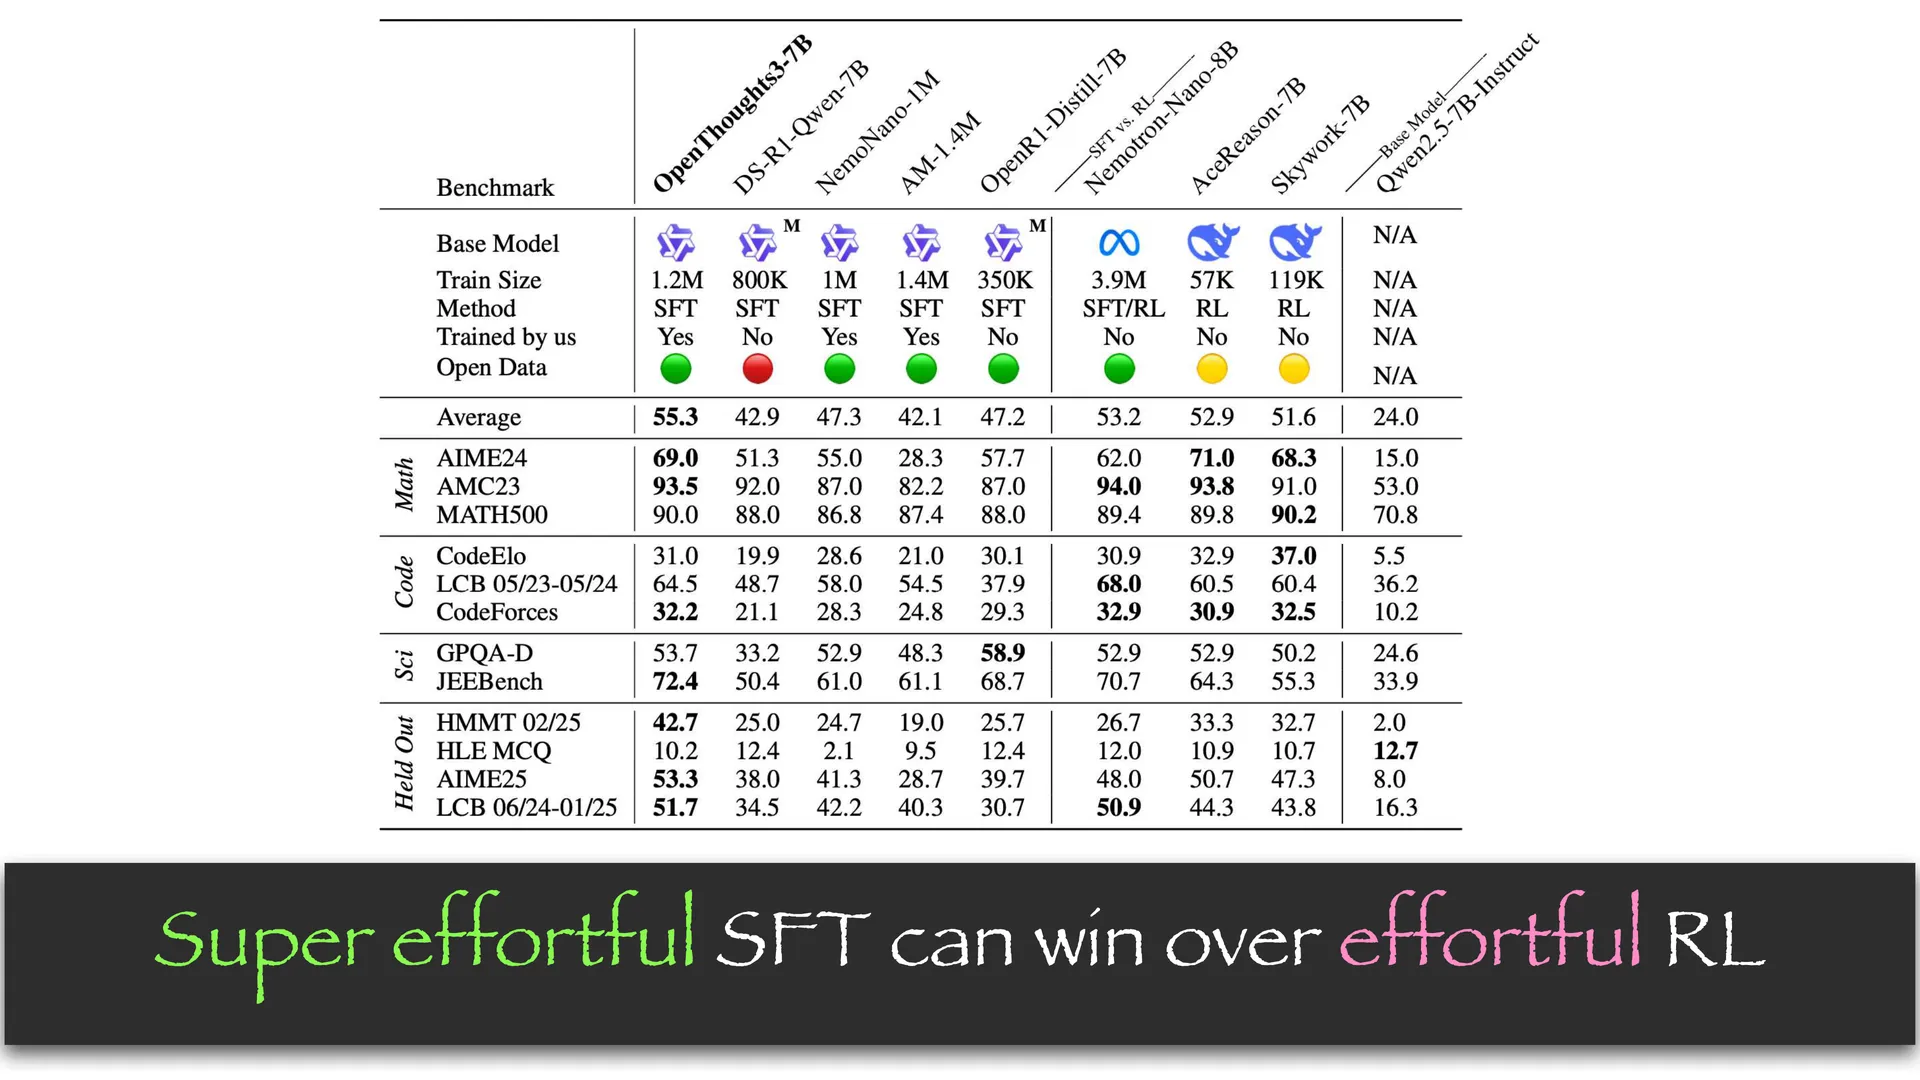
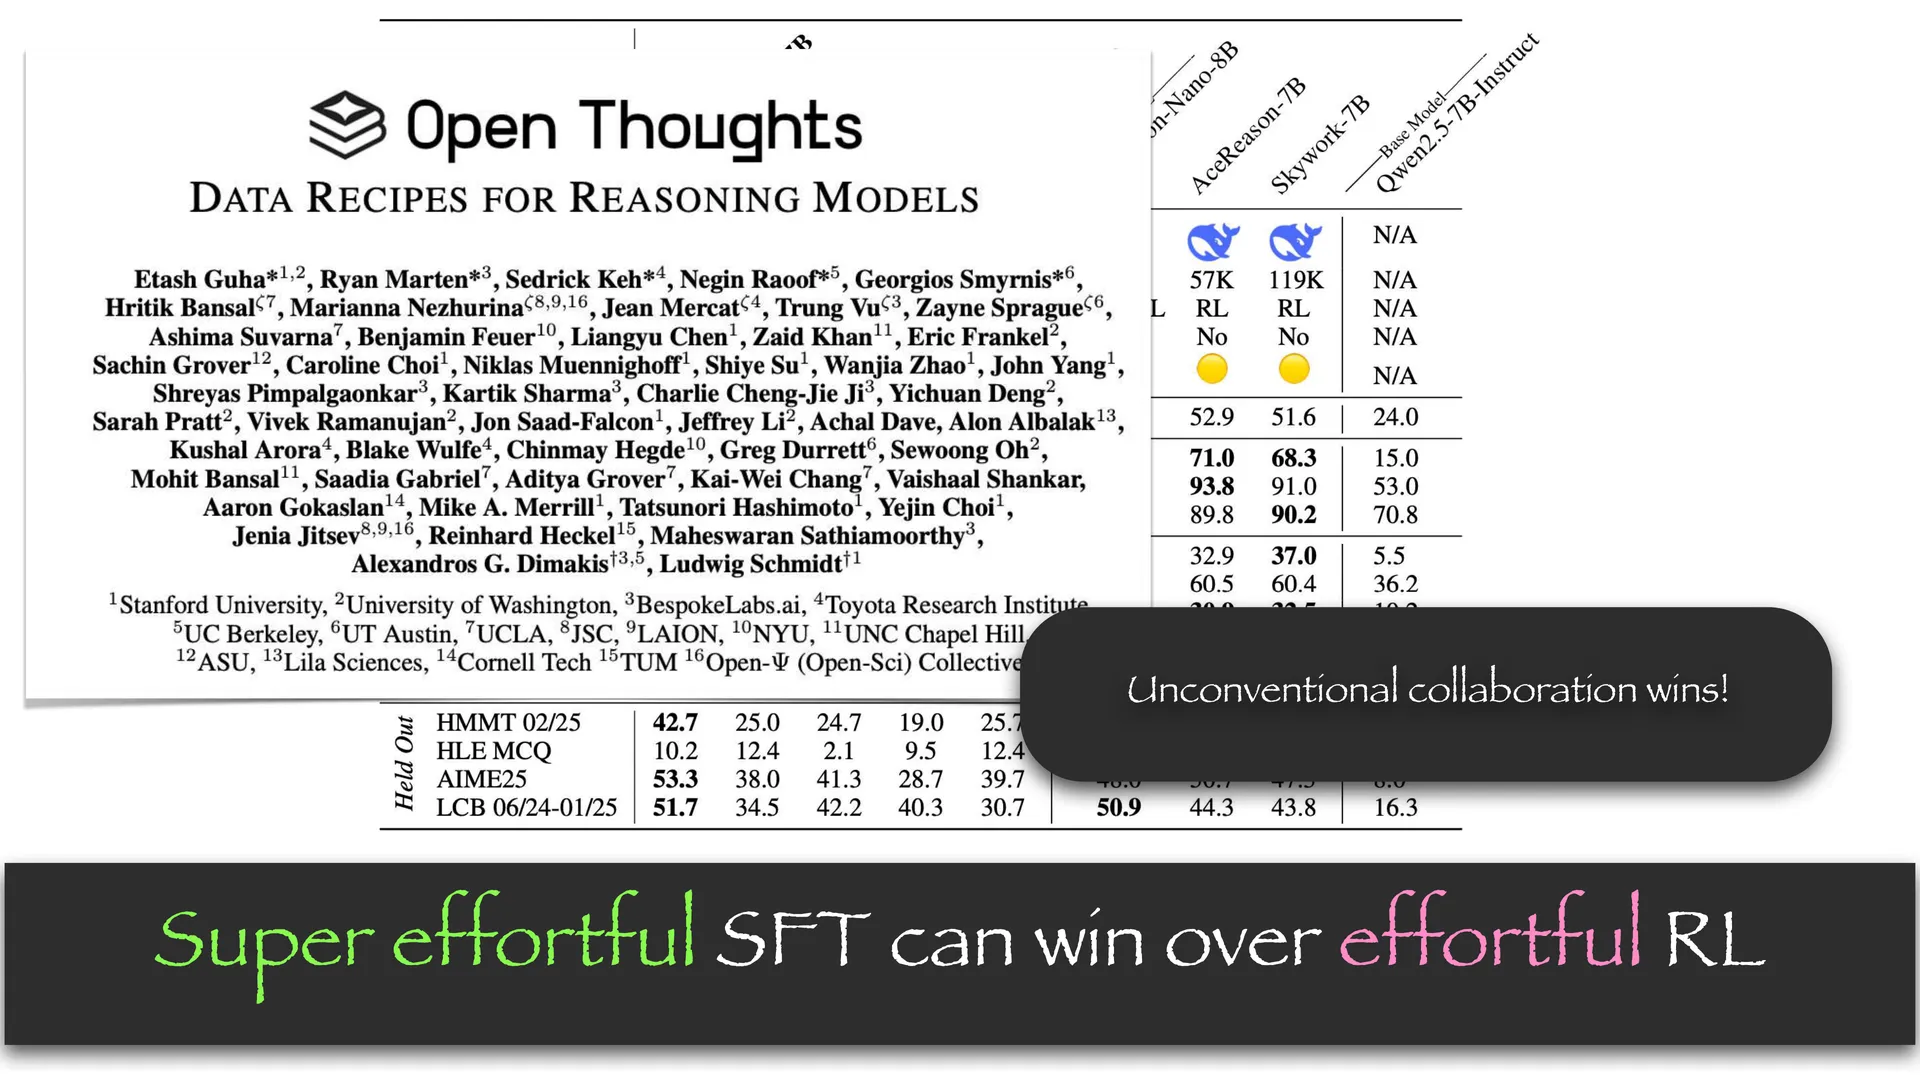
FLR 系统性地在训练的不同阶段——预训练、SFT、RL——注入推理风格的数据,并同时变化其多样性、数量与质量。 🖼️ 第 73 页幻灯片 · Super effortful SFT can win over effortful RL Lesson I:是的,而且非常有益;收益随多样性和数量一起增长。 🖼️ 第 74 页幻灯片 · Super effortful SFT can win over effortful RL 🖼️ 第 75 页幻灯片 · Concluding Thoughts Lesson IV:不能!早期的推理建立了一个 SFT 无法复制的地基。 🖼️ 第 76 页幻灯片 · https://aiworld.eu/story/nvidia-leads-open-source-ai-momentum-as-chinese-labs-close-in 编者说明:这一句的两个数字的比较基准在讲义原文中并不清楚(见「已知疑点」)。可以确定的结论是:加 SFT 算力无法追上早期推理预训练带来的优势。 Lesson VI:有!把推理数据「前置」会形成持久、可复利的增益。 🖼️ 第 77 页幻灯片 · 1. Small models are in high demand, with daily downloads Slide 69 在「Unconventional data / algorithms / collaboration」之外补充了 collaboration 的两层含义: Slide 70–74 用 OpenThoughts 团队(一份很长的作者名单)作为例证,并给出: OpenThoughts3-1M —— OpenThoughts3 是当前 SOTA 的推理数据集配方。 🖼️ 第 78 页幻灯片 · LLM 101: How sausages are made 超级用力的 SFT 可以战胜用力的 RL。
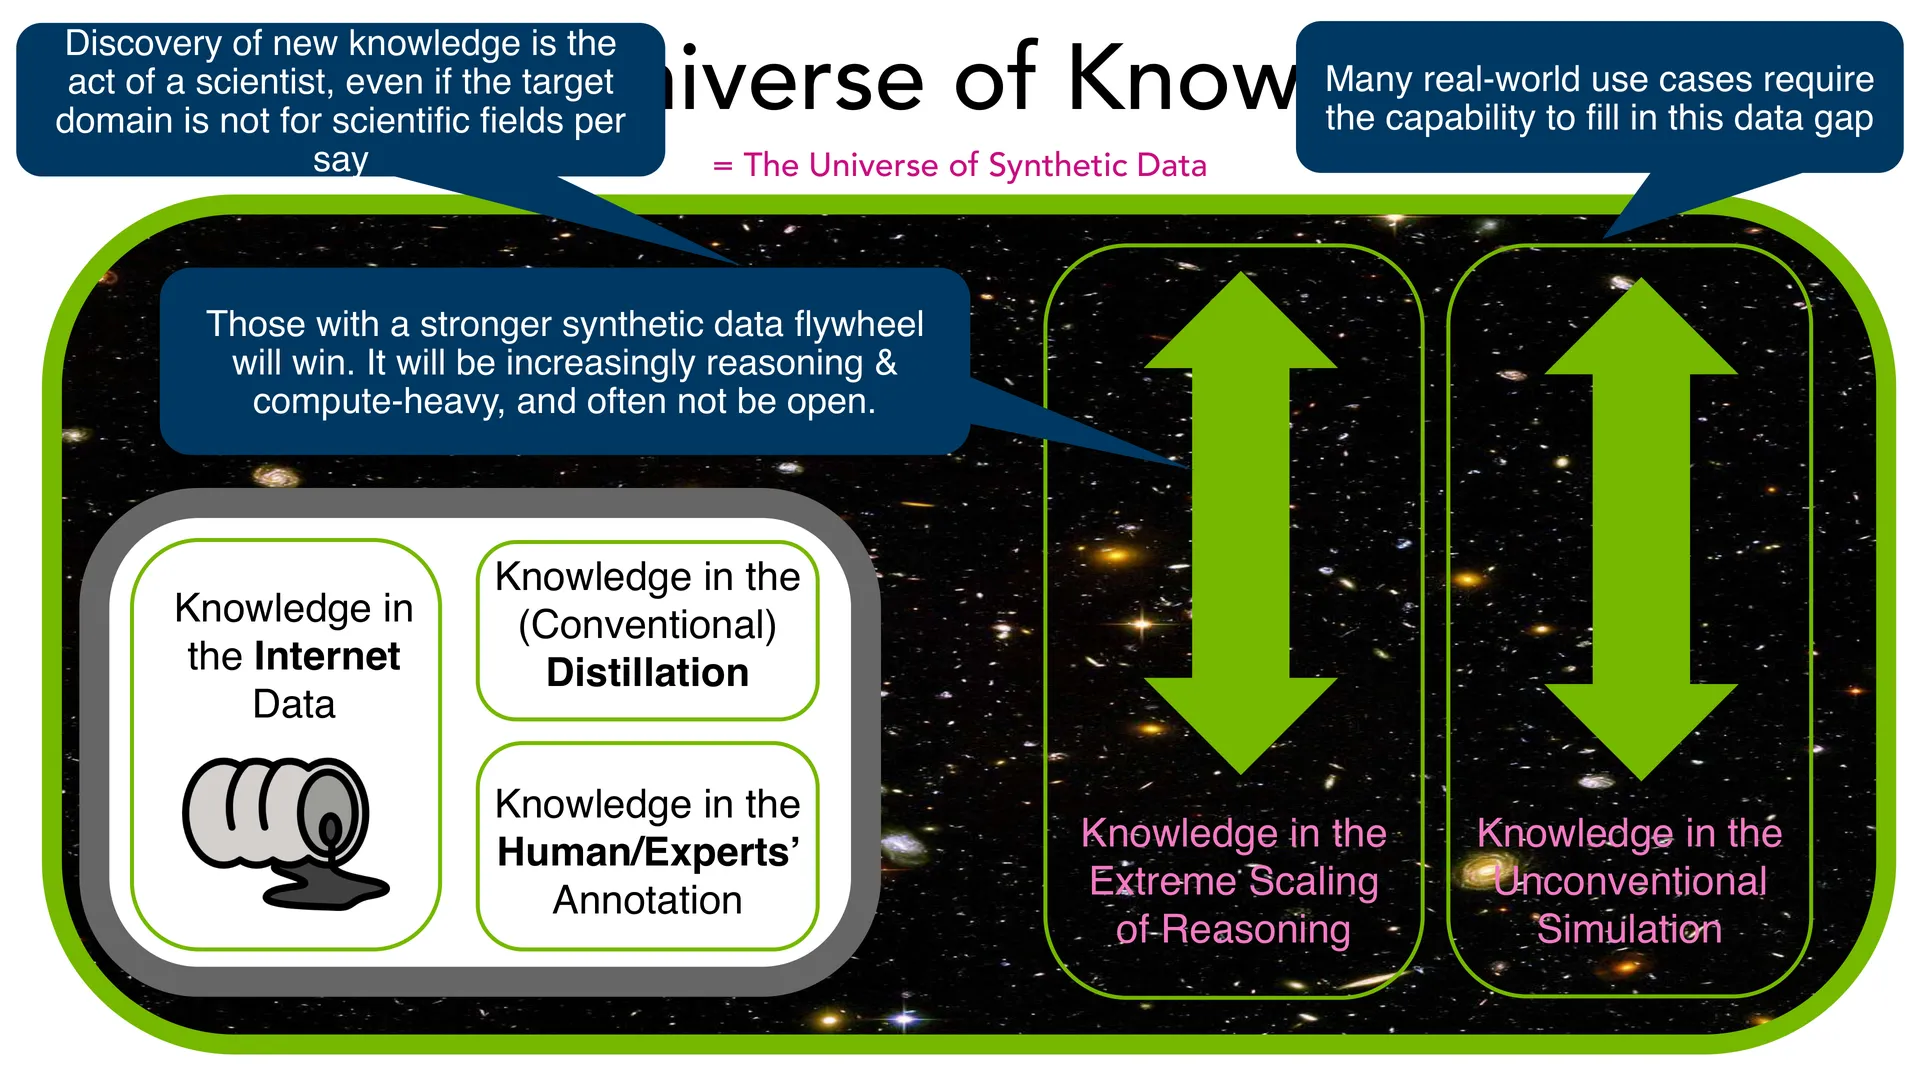
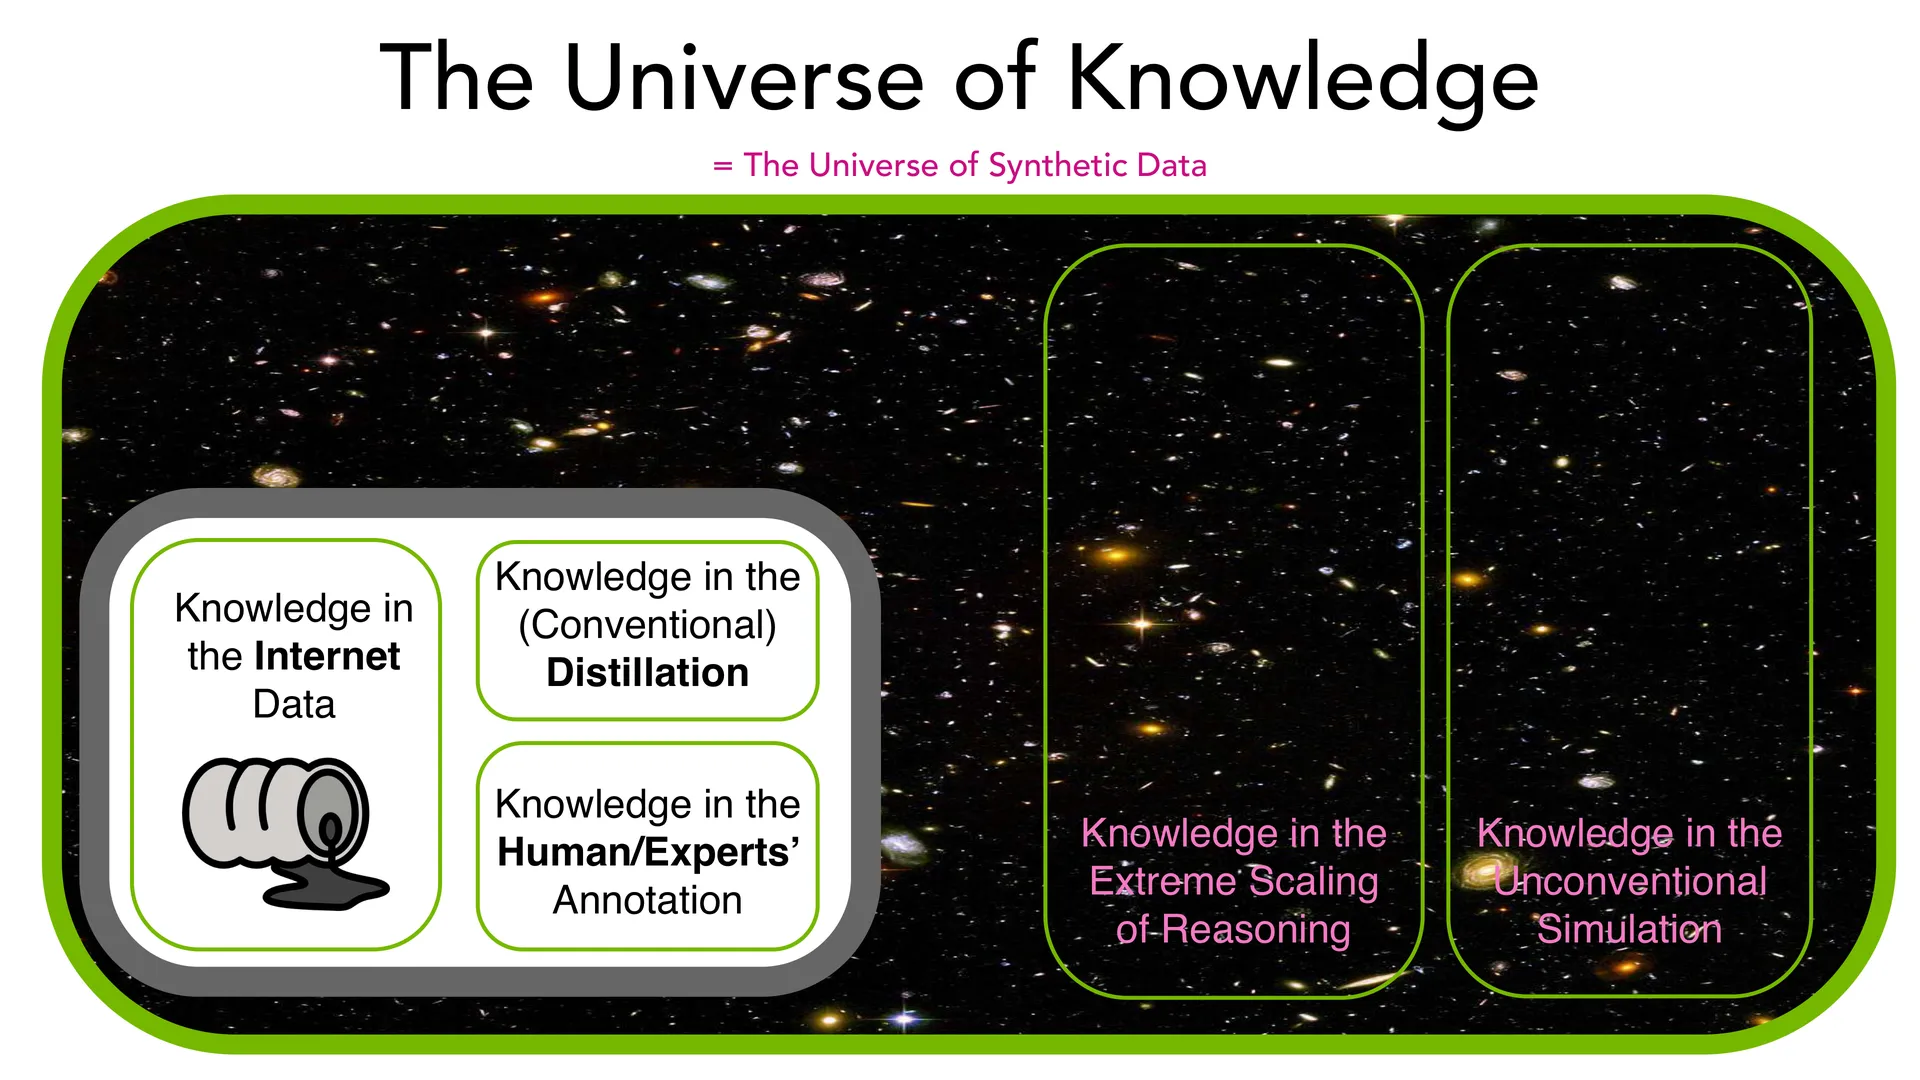
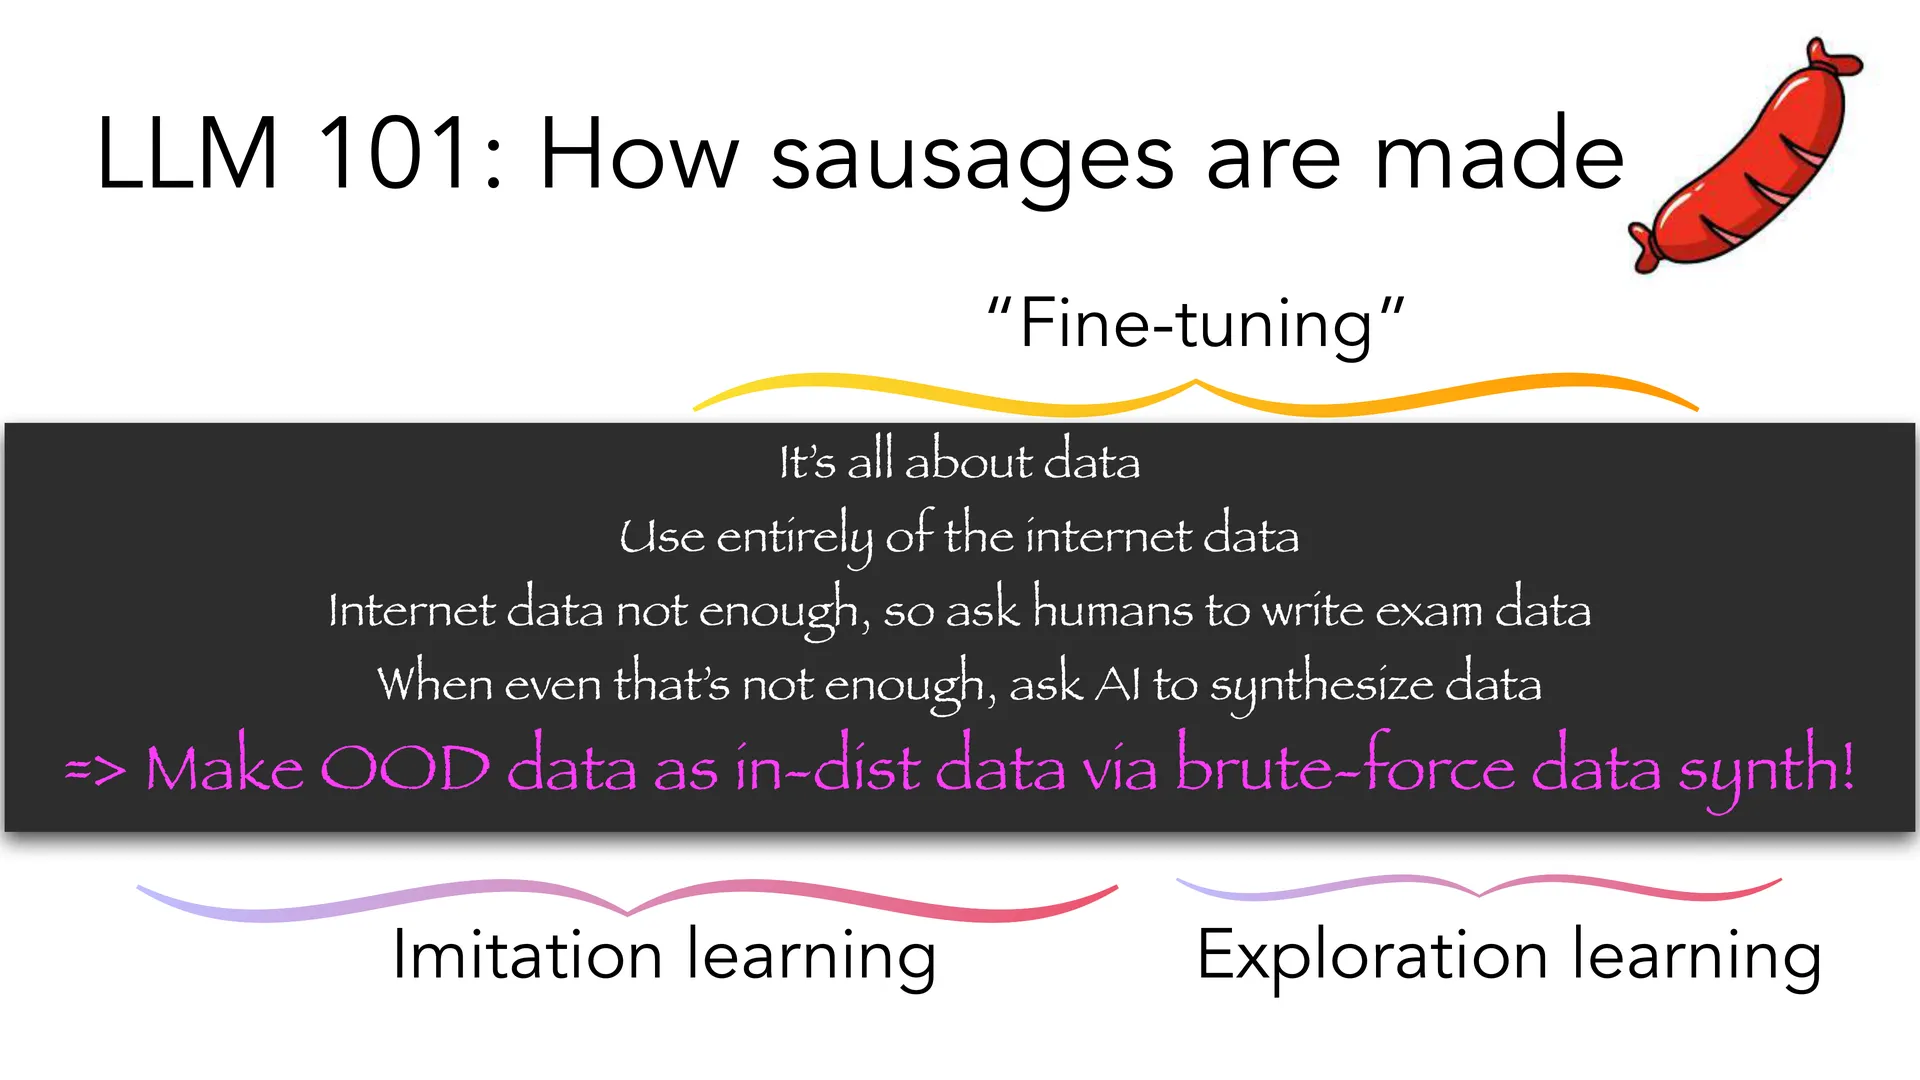
非常规的协作赢了。 Slide 78–79 用一张流程图概括整条流水线: 它的三段式解释极其直白: It's all about data. 🖼️ 第 79 页幻灯片 · LLM 101: How sausages are made Slide 83–84 给出了本讲最有野心的一张图: 知识宇宙 = 合成数据宇宙,其中的五个来源: 🖼️ 第 80 页幻灯片 · (无标题) 讲义补充的几条判断: 🖼️ 第 81 页幻灯片 · (无标题) Slide 87: 而「香肠是怎么做出来的」背后,其实全是人类的成分(Slide 88): 人类的互联网数据——人类智能的产物; 人类砸钱的胆量( $$$$ $$$); Slide 89 留下三个问题: (本书材料里没有外部链接;正文中的链接均为撰写时补充。) 🖼️ 第 86 页幻灯片 · David vs. Goliath: 🖼️ 第 87 页幻灯片 · 👩🚀 🖼️ 第 88 页幻灯片 · How sausages are made: FLR 的 Lesson IV 数字口径不清。 原文为「Doubling SFT data for the baseline improves performance by +4.09%, but it still falls short of even the weakest reasoning-pretrained model (+3.32%)」。+4.09% 与 +3.32% 哪个是增量、哪个是差距、相对什么基准,讲义没有交代,且数值上 4.09 > 3.32 与「仍不及」的表述表面矛盾。本文照录并标注,未做推测性解释。 「exposed to 35 more data」口徑不清。 Slide 60 原文如此,未写单位。本文按「数据量约为 RLP 的 35 倍」理解,但那只是最自然的读法,不排除是排印遗漏了「×」。 🖼️ 第 89 页幻灯片 · Open Research Questions 🖼️ 第 90 页幻灯片 · Thanks! 「EPO😅」无解释。 Slide 33 只出现这个词与一个哭笑不得的表情,讲义未给出任何定义或上下文。本文未做任何推测。 「参考模型」的规模未说明。 Prismatic Synthesis 中用来算梯度的「small reference model」具体多大、与教师/学生模型的关系如何,讲义未交代。 🖼️ Slide 24 流水线的读法。 Slides 45–47 的方框与箭头文字存在重复( 编者引入的外部知识。 以下内容为编写者补充、讲义未展开,证据强度不一: GRPO 出自 DeepSeekMath、DAPO 出自 ByteDance——讲义 Slide 23/72 只写了「Deepseek」「ByteDance」两个署名,本文未给论文编号。
上述内容如有需要,请以原始论文为准。 术语翻译。 本讲把 下面这些页来自官方幻灯片,但课堂录制里没有对应的展示画面。由 🖼️ 第 2 页幻灯片 · Mission Impossible: Democratizing Generative AI 🖼️ 第 5 页幻灯片 · 1. Small models are in high demand, with daily downloads 🖼️ 第 9 页幻灯片 · The Era of Brute-Force Scaling is Over 🖼️ 第 12 页幻灯片 · Prolonged Reinforcement Learning Expands 🖼️ 第 21 页幻灯片 · Chemistry between the base LLM and RL matters 🖼️ 第 20 页幻灯片 · Striking findings against RL 🖼️ 第 25 页幻灯片 · Prolonged Reinforcement Learning 🖼️ 第 22 页幻灯片 · Prolonged Reinforcement Learning Expands 🖼️ 第 27 页幻灯片 · Lesson I: Maintain sustainable entropy via clip ratio, balance exploration and exploitation. 🖼️ 第 28 页幻灯片 · Prolonged Reinforcement Learning 🖼️ 第 30 页幻灯片 · The SOTA 1.5B Reasoning Model 🖼️ 第 33 页幻灯片 · EPO😅 🖼️ 第 38 页幻灯片 · Prismatic Synthesis: 🖼️ 第 41 页幻灯片 · Obvious Concerns: Mode Collapse 🖼️ 第 43 页幻灯片 · Gradient as Data Representation 🖼️ 第 45 页幻灯片 · R1-32B 🖼️ 第 46 页幻灯片 · Gradient-based diversity filter 🖼️ 第 53 页幻灯片 · The Problem with Standard LLM Training 🖼️ 第 55 页幻灯片 · From NTP to RLP: Teaching Models to Think First 🖼️ 第 58 页幻灯片 · Leverage Early Reasoning with “RLP" 🖼️ 第 60 页幻灯片 · RLP shows a significant improvement on Qwen3-1.7B-Base 🖼️ 第 85 页幻灯片 · David vs. Goliath: 🖼️ 第 84 页幻灯片 · The Universe of Knowledge 🖼️ 第 83 页幻灯片 · The Universe of Knowledge 🖼️ 第 82 页幻灯片 · (无标题)
训练配方
十三、RLP 的实验结果
设置
项目
内容
模型
Qwen3-1.7B-Base
检查点
最终模型(Final model)
Token 预算
1B tokens
继续预训练数据 $\mathcal{D}$
通用预训练语料(Nemotron-Pretraining-Dataset)
项目
内容
模型
NVIDIA-Nemotron-Nano-12B-v2-Base
检查点
训练到 19.8T tokens 的模型
Token 预算
250M tokens
继续预训练数据 $\mathcal{D}$
通用预训练语料(Nemotron-Pretraining-Dataset)
Qwen3-1.7B-Base 上的结果
计算量对齐的对照
对齐方式
数值
Token 匹配($T_{\text{inp}}$)
170M tokens
FLOP 匹配($T_{\text{flop}}$)
6B tokens
CPT 数据
Nemotron-CrossThink
扩展到 12B
核心想法一页总结
💡 Verifier-Free
不需要外部判分器。奖励信号直接来自下一个 token 上的信息增益,因此适用于任何普通的预训练文本。
⚡ Dense Reward
逐位置的信用分配,只要推理有帮助,每个 token 都反馈。与后训练的稀疏奖励不同,RLP 在训练全程提供连续反馈。
📈 Scalable
用的就是标准训练所用的大规模预训练语料,不需要专门数据集——推理从普通文本中涌现。
第四部分:Front-Loading Reasoning —— 预训练与后训练数据的协同
十四、把推理「前置」会发生什么
RQ1:预训练里加推理数据有用吗?
RQ3:无推理预训练的模型,能靠多加 SFT 算力追回来吗?
RQ5:在重度 RLVR 之后,这个增益还有意义吗?
三条要点
flowchart LR
    A["预训练<br/>注入推理数据<br/>(优先:多样性)"] --> B["SFT<br/>(优先:质量)"] --> C["RL / RLVR<br/>(探索式学习)"]
    A -. "早期推理地基<br/>SFT 无法复制" .-> C
十五、收尾:合作、数据与开放问题
三个创新维度,缺一不可
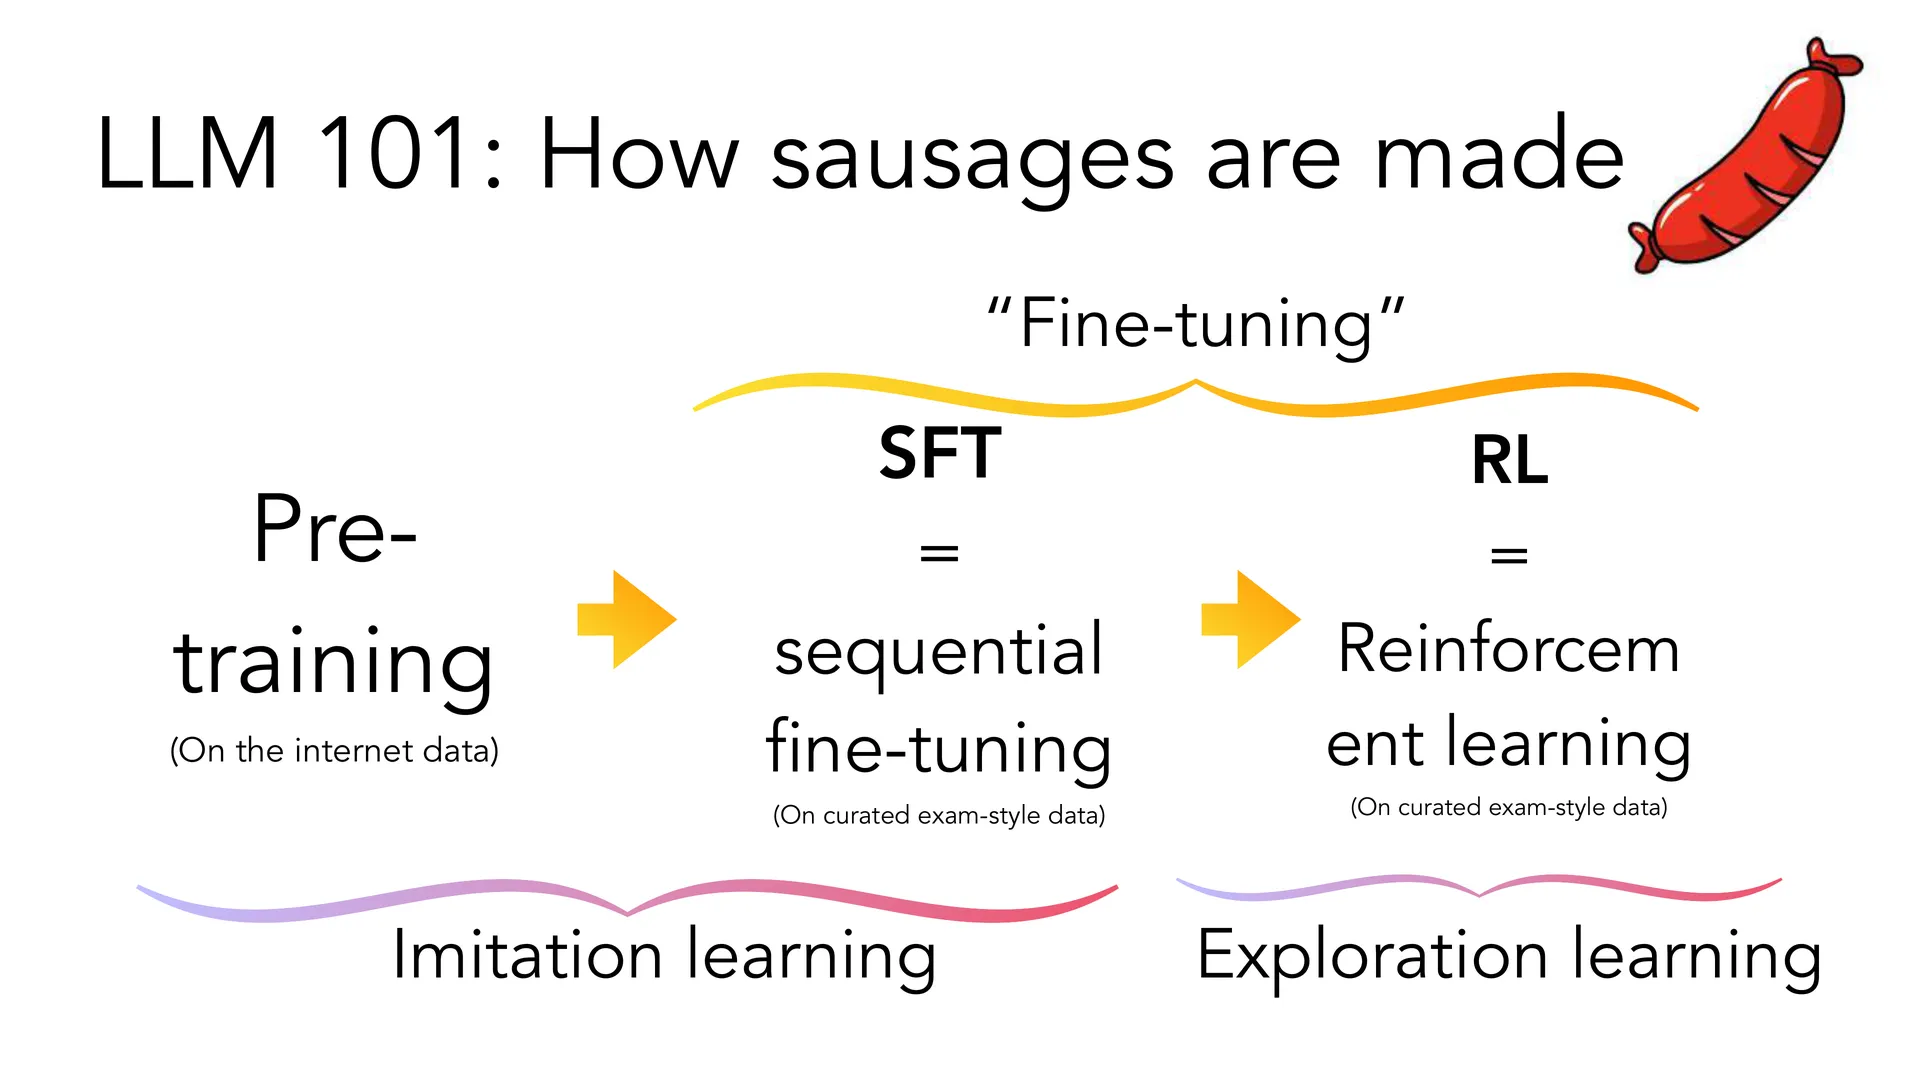
LLM 101:香肠是怎么做出来的
flowchart LR
    A["Pre-training<br/>(在互联网数据上)"] --> B["SFT<br/>(在精挑细选的<br/>考试式数据上)<br/>= 模仿学习"]
    B --> C["RL<br/>(在精挑细选的<br/>考试式数据上)<br/>= 强化学习/探索学习"]
    B -. "统称 Fine-tuning" .- C
知识 = 合成数据的宇宙
AI 与人类智能:像与不像
AI 与人类相似
AI 与人类不同
推理常常是背下来的知识
更多的数据、算力与记忆
存在利用 vs 探索的权衡
更少的抽象与概念化
多样的例子/经验能增强学习
训练与测试之间界限分明
开放研究问题
附:参考与延伸阅读
已知疑点
cs224n-2026-lecture19-open-questions.pdf,讲者 Yejin Choi)。为避免编造来源,头部按真实材料填写;「sp26 老书是否已覆盖本讲内容」这一判断依据不足,故本书未做「跳过前置知识」的删减处理。
R1-32B / Overgenerated data / Filters / Filtered data / R1-7B / Sample data / Prismatic Synthesis),本文按「R1-32B 生成 → 过滤 → 训练 R1-7B」重绘,属于基于标签的合理重构,非讲义明述。LRM(Large Reasoning Model)译作「大推理模型」、exploration learning 译作「探索学习」、mid-training 保留英文、chemistry 保留英文并加引号译作「化学反应」。这几个译法在中文社区尚无统一标准。
附录:课堂未展示的幻灯片
附录:官方幻灯片里课堂未展示的页
vb slides 自动补入,供对照查阅。