T1 · T1 · T1 · Stanford CS224N Python 与 NumPy 复习课
视频:Stanford CS224N: Natural Language Processing with Deep Learning (2023) | Python Tutorial | 讲者:Manasi Sharma 视频地址:https://www.youtube.com/watch?v=8j4wpU98Q74 时长:约 47 分钟(2833 秒)| 本书据课堂字幕重构
对应讲次:T1(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose)
导览
这是一节为 作业 2(Assignment 2) 做准备的 Python + NumPy 上手课。老师开场就交代了它的定位:把你在接下来的作业里会反复用到的那部分 Python 和 NumPy 基础,从零拉一遍((参考时间: 00:05))。
① 老师真正提出的问题
- 我们这门课为什么偏偏选 Python?它和 Java、Matlab 比强在哪?((参考时间: 01:21))
- Python 这门语言本身最需要先知道的东西是什么——变量、类型、布尔值、缩进、几种常见数据结构?
- NumPy 到底在“快”的哪一层上快?它为什么和普通 list 不一样?
- 向量、矩阵、张量在表示上到底差在哪,
(3,)和(1,3)这种形状区别为什么重要? - 广播(broadcasting)是怎么决定“能不能算、往哪边复制”的?
② 读者可能带着的疑问(编者预判)
- 我写过一点 Python,但 NumPy 从没系统学过,能不能跟上?
axis=0和axis=1到底哪个是“行方向”、哪个是“列方向”?*和@有什么区别?为什么有了*还要专门讲矩阵乘法?- “广播”听起来玄,到底什么时候合法、什么时候报错?
难点在哪:最容易卡住的两个地方,一是 axis 的语义(老师反复强调它是“你要 reduce 掉的那个维度”,而不是“结果保留的那个维度”,(参考时间: 27:37)),二是 广播的合法性判定(两条规则、且只有两条,(参考时间: 40:34))。
本讲路线:先讲“为什么是 Python”,再快速过语言基础与三种数据结构(list / tuple / dict),然后转入 NumPy——术语、形状、reshape、axis、两种乘法、dot、索引,最后落到广播与“尽量别写 for 循环”这一实践结论。
一、为什么这门课用 Python
(参考时间: 01:21)
很多同学第一次接触编程是从 Java 开始的,也有人(在其他学科里)习惯了 Matlab。那为什么 NLP / 深度学习领域整体倒向 Python?老师给了三条理由:
- 它是很“高层”的语言,写出来很像英文,初学者上手快;
- 它有一套科学计算生态,功能和 Matlab 类似。讲到 NumPy 时你会看到,它把大量数学、矩阵运算做成了极快的底层例程;
- 深度学习框架直接以 Python 为接口。比如 PyTorch 和 TensorFlow,都是直接和 Python 打交道的。
正因如此,做深度学习的人基本都用 Python。
编者说明:所谓“框架以 Python 为接口”,意思是计算本身(卷积、矩阵乘)跑在 Python 之外,由 C/C++/CUDA 写成的内核执行;Python 只是那层调度与描述的语言。这一点在讲 NumPy 时还会再出现一次,是本讲反复回到的主线。
关于环境搭建(Conda 环境、装包步骤等)——老师说这些内容都写在了课上发的幻灯片里,可以直接照着走;在课上她选择先跳过,把时间留给语言本身((参考时间: 02:12))。
二、Python 语言基础
变量、动态类型与运算
(参考时间: 02:44)
Python 里用 等号 = 把一个值赋给变量。和某些语言不同,你不需要先声明变量的类型:可以先写
x = 10
五行之后再写
x = "hi"
把 x 换成一个字符串,也完全不会报错。这种“类型跟着值走”的风格,是 Python 让人写起来轻松的地方。(在那些必须先声明 int x 的语言里,给 x 赋一个非整数值会直接报错。)
常见的运算都很直白:
a = 3 + 4        # 加法
b = 10 / 4       # 除法,结果是浮点数
c = 2 ** 5       # 乘方:2 的 5 次方,用两个星号 **
关于除法还有一点要留意:如果你希望两个整数相除得到浮点结果,可以用强制类型转换 float(...);反过来想让它明确是整数,就把结果套一个 int(...)。Python 也支持把整数转成字符串——比如你不想真的算 10 + 3,而想拼出字符串 "103",就可以把两个数分别 str(...) 再相加。
x = 10
y = 3
s = str(x) + str(y)   # 结果是字符串 "103",不是 13
这些常见运算在网上都有对照表可查,老师建议大家随时搜一下“在 Python 里怎么写”。
布尔值、None 与缩进
(参考时间: 04:28)
几个容易踩坑的小点:
- 布尔值
True和False必须首字母大写; - Python 没有其他语言的
null,用的是None。它表示“这里没有一个值”,不等于 0。当你需要在if里判断“这个值有没有被赋过”,常用None来占位;函数也可以返回None(表示“什么也没返回”); - 逻辑运算直接写英文:
and、or、not。因为 Python 长得像英文,你可以真的写出“如果 x 等于 3 并且 y 等于 4 就返回 True”这种句子; - 比较用
==(相等)和!=(不等)。一个等号是赋值,两个等号才是判断——这一点要分清; - Python 用缩进(空格或 Tab)而不是花括号来划分代码块。缩进宽度用 2 个还是 4 个空格都行,但整个代码库必须一致,否则会报错。
三、常用数据结构
从这里开始,老师把现场切到了一块在线笔记本——Colab(Google 托管的 Jupyter 笔记本)。它最大的好处是:你不必一次跑完整个文件,可以一格一格(cell)地执行、随时看中间结果;代码下面还能写 Markdown 注释。做项目、调试时,大家都爱用它。
📷 切换到 Colab 笔记本准备现场演示
回到原视频 (00:06:41)
列表(list):可变的数组
(参考时间: 08:06)
list 是“可变的”(mutable)数组——“可变”意味着:声明之后你还能往里加、往里删,而且 list 就是为这种频繁改动而优化的。这一点和后面要讲的 NumPy 数组正好相反:NumPy 数组基本“定死”,想改往往得新建一个。所以如果你要在循环里一次次把元素加进某个更大的东西,用 list 就对了。
names = ["Zach", "Jay"]
print(names[0])      # 输出 "Zach"(Python 从 0 开始数)
names.append("Abby")
print(len(names))    # 输出 3,len 只写三个字母
几个关键点:
- 索引从 0 开始(零索引):
names[0]是第一个元素; - 往末尾加元素用
append(不是add); - 求长度用
len()(不是length,就三个字母); +被重载成了“拼接”:names + ["Abby", "Kevin"]会把两个 list 接在一起;写成names += ["Abby", "Kevin"]就等价于“拿原来的加上这一段再赋回去”。注意["Abby", "Kevin"]是另一条独立的 list,即便你不把它存进变量也合法;- list 里可以放任意类型:整数、浮点数、
None,甚至另一个 list(“list 的 list”)。
切片与负索引
(参考时间: 09:48)
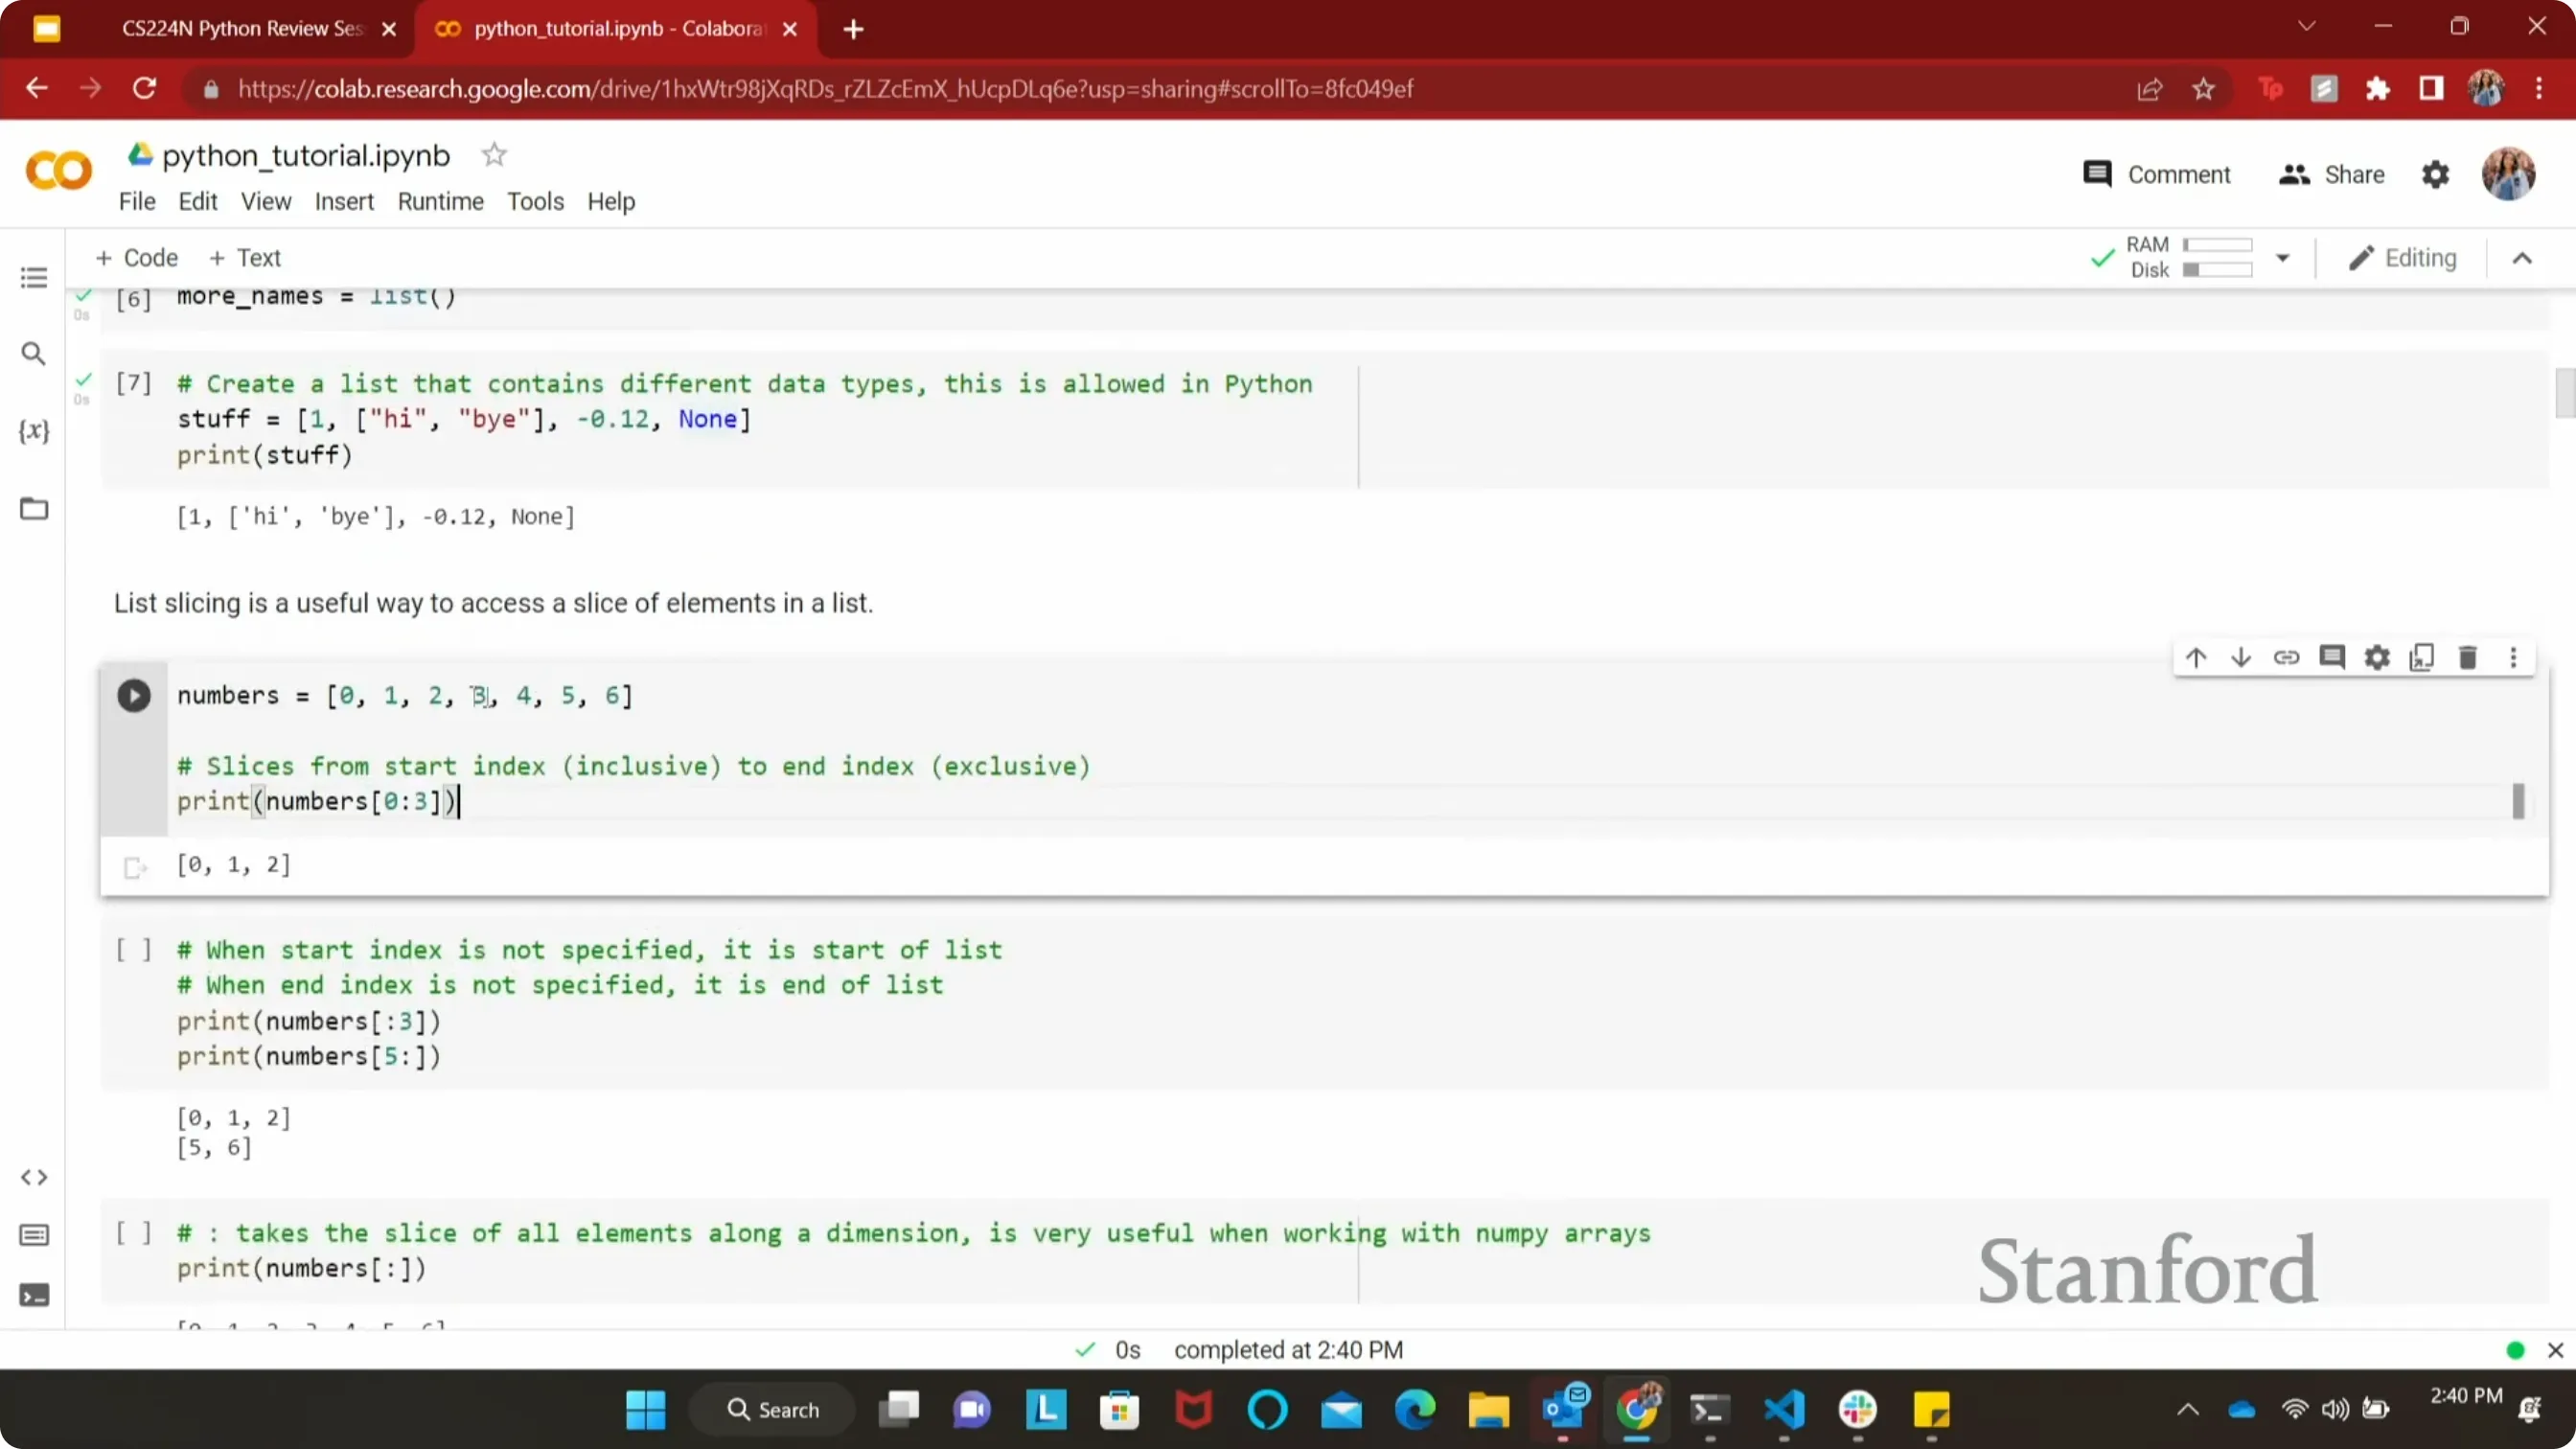
如果只想要 list 的一部分,就用切片。规则是:包含左端,不包含右端。
📷 现场演示列表的切片与负索引
回到原视频 (00:09:55)
nums = [0, 1, 2, 3, 4, 5, 6]
print(nums[0:3])   # [0, 1, 2],注意 3 不包含在内
省略任一端都可以:
nums[:3]→ 从头取到第 3 个(不含):[0, 1, 2];nums[3:]→ 从第 3 个取到末尾:[3, 4, 5, 6]。
一个有趣的事实:单独一个冒号 nums[:] 会把整个 list 取出来,但它在内存里新建了一份副本。这一点很重要——如果只是把 list 直接传给函数(甚至传给 Python 本身的其他地方),传过去的是引用,你改了它原数组也会跟着变;而 nums[:] 得到的是一份独立副本,改它不会影响原数组。
Python 还有一件比较独特的能力:负索引,从后往前数。-1 是最后一个元素,-3 是从后数第三个。所以 nums[-1] 得到 6;nums[-3:] 得到从倒数第三个到末尾的全部元素。
至于 nums[3:-2] 这种看起来有点绕的写法:从 3 开始,到“倒数第二个之前”为止——得到 [3, 4]。
编者说明:把
nums[3:-2]想成先把下标写成"正数"版本会更直观:nums[3:5](因为长度是 7,-2对应下标 5),按“含头不含尾”取[3, 4]。负索引本质上就是“len(nums) + i”。
元组(tuple):不可变的数组
(参考时间: 12:04)
tuple 是不可变的数组——一旦声明,里面的值就不能再改。
name = ("Zach", "Jay")
print(name[0])         # 依然可以读,输出 "Zach"
name[0] = "Bob"        # ✗ TypeError,tuple 不支持赋值
读取、索引的方式和 list 一模一样,只是不能改。
创建空 tuple 可以用 ();只有一个元素的 tuple 要写成 (value,)——那个逗号不能少。
字典(dict):键值映射
(参考时间: 13:04)
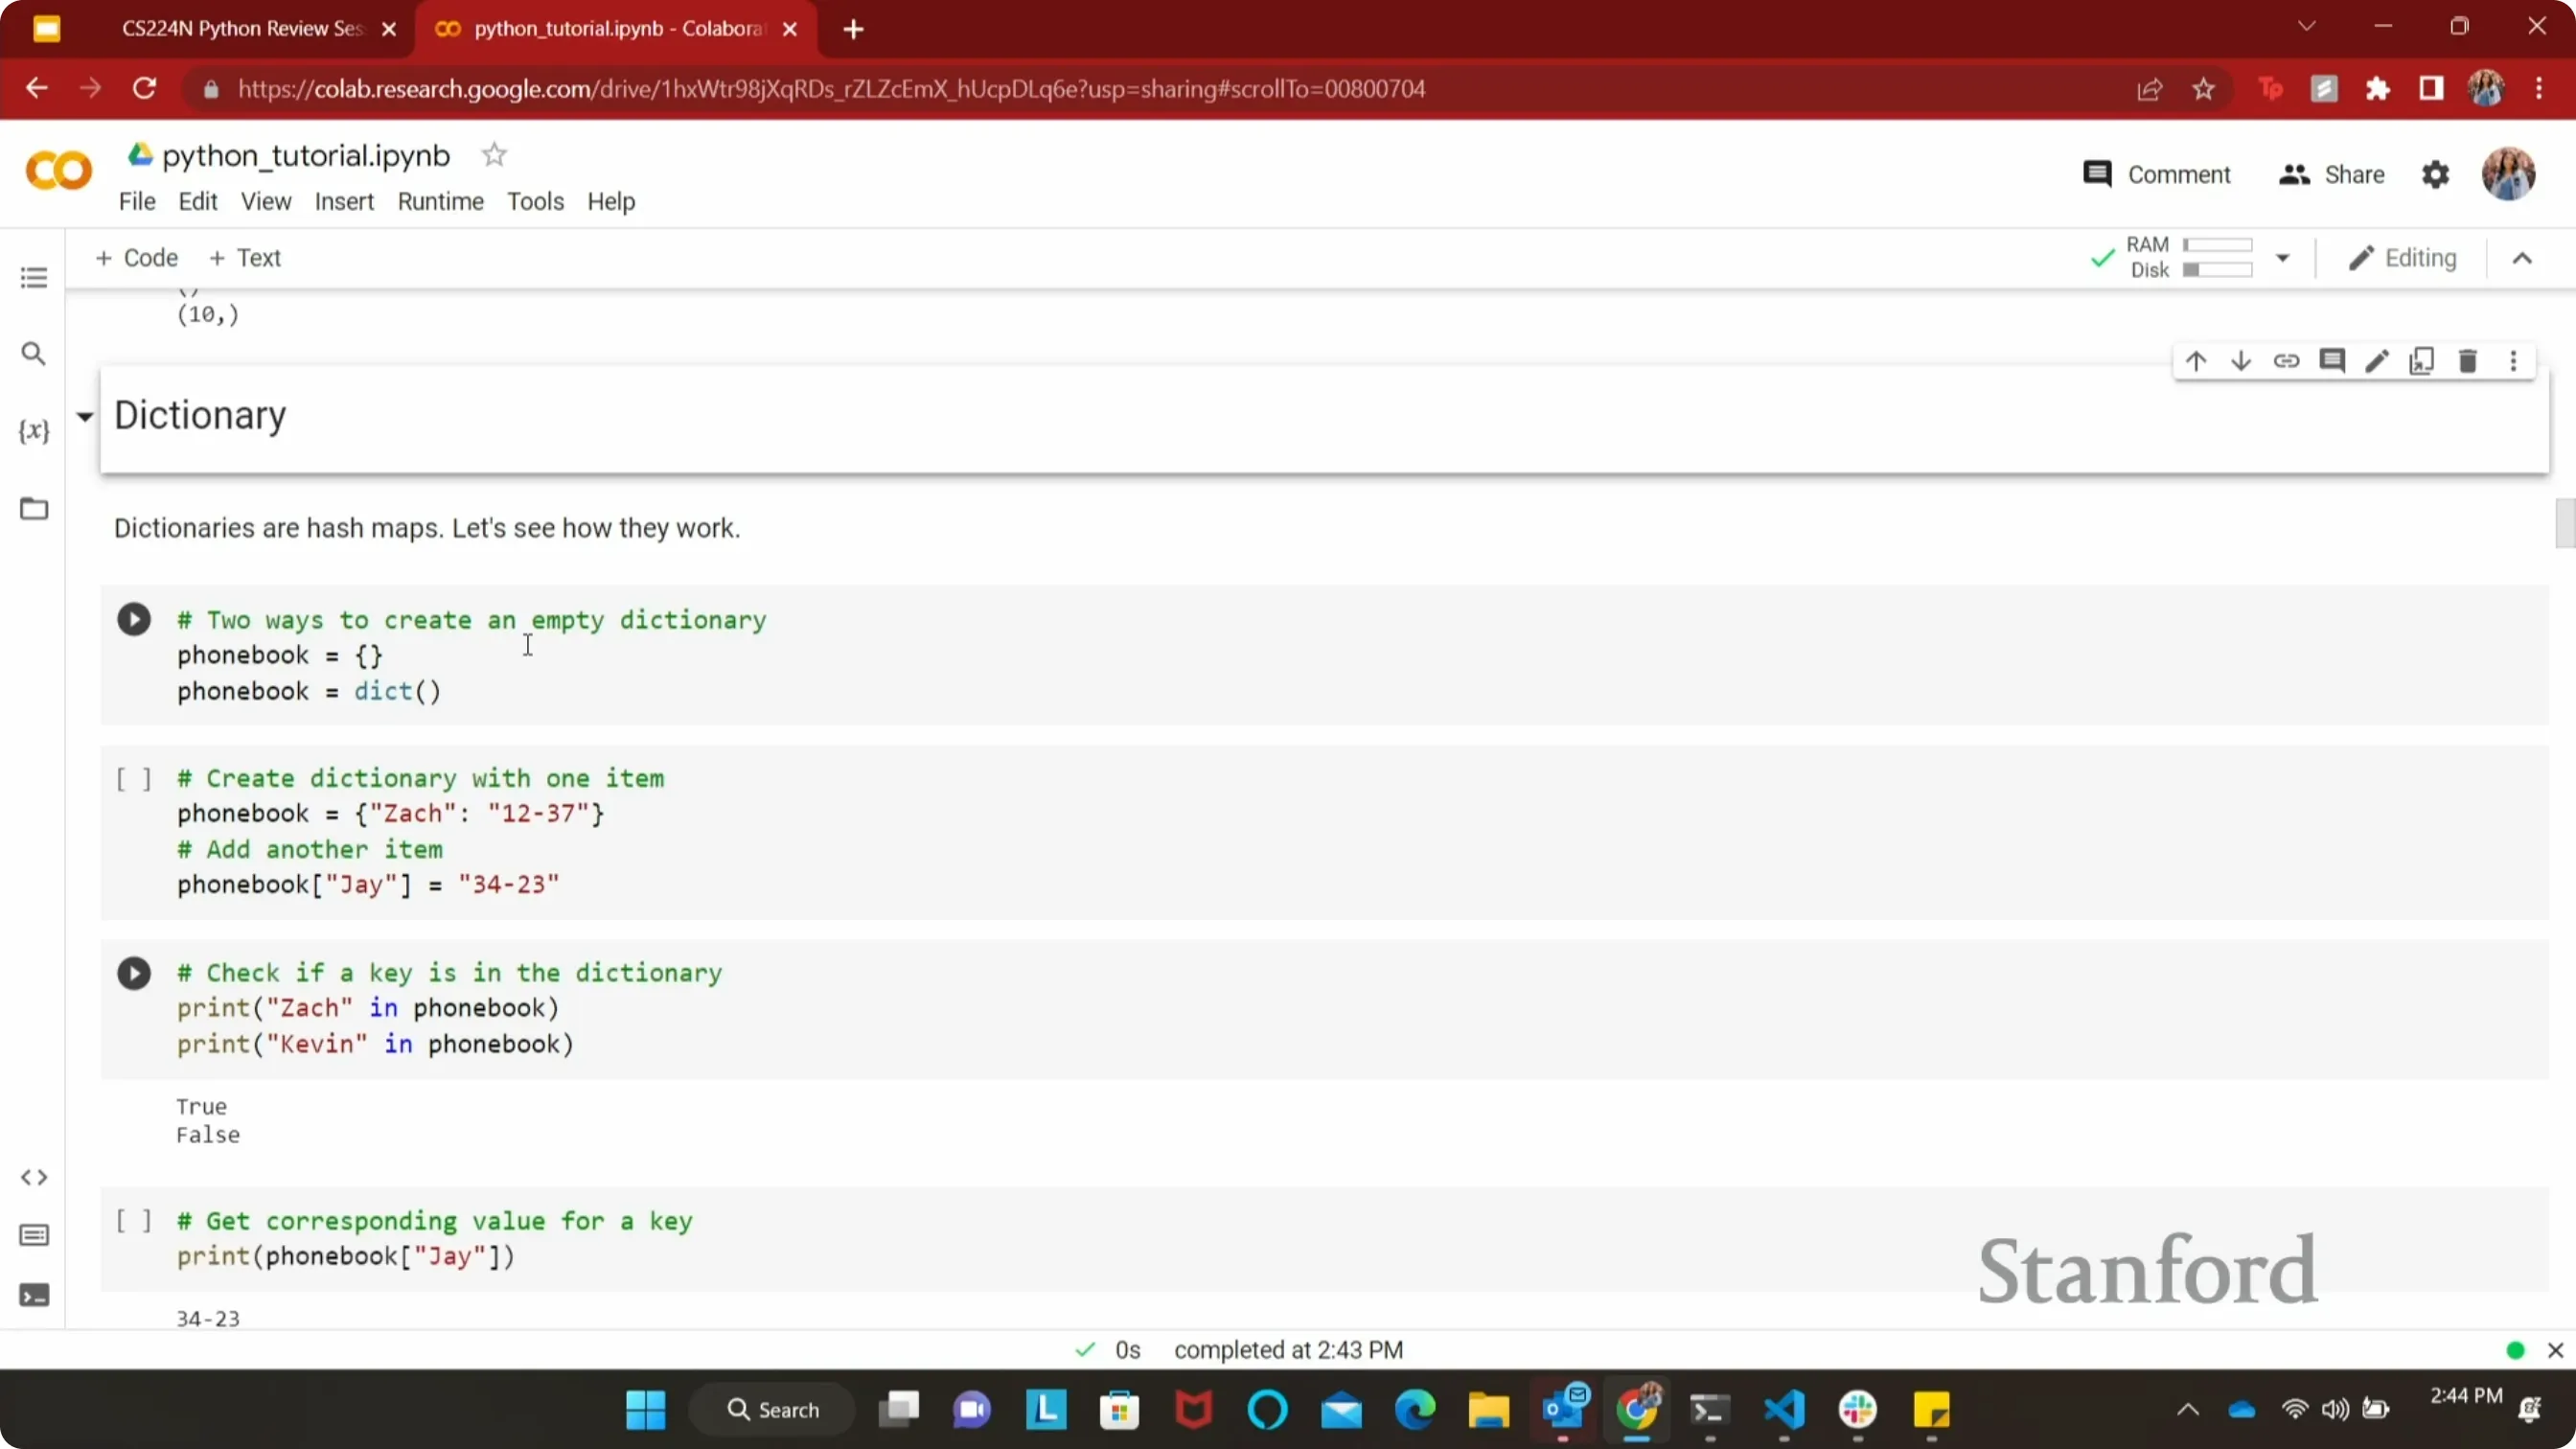
对写过其他语言的同学,dict 就是哈希表 / hash map。它擅长的是把“一个值”和“另一个值”快速对应起来——比如把字符串映射到索引(这在 NLP 作业里会反复用到,因为 NLP 里大量在处理“词表 ↔ 索引”的转换)。
📷 现场演示字典及“键是否存在”的检查
回到原视频 (00:13:15)
phone_book = {"Zach": 12345, "Kevin": 67890}
print(phone_book["Zach"])       # 输出 12345
print("Monty" in phone_book)    # False,这个键不在里面
print("Kevin" in phone_book)    # True
del phone_book["Zach"]          # 用 del 删除一项
几个要点:
- 用
in先检查键是否存在,避免直接去取一个不存在的键而报错; - 想删掉一项,用
del(不是delete)。
循环与 enumerate
(参考时间: 14:47)
循环适合做“重复同类操作”,也适合按顺序遍历 list / 数组。
for i in range(5):
    print(i)          # 依次输出 0 1 2 3 4
range(n) 会返回从 0 到 n-1 的整数(还是“含头不含尾”)。
如果你只想要元素,不需要下标,Python 允许你直接遍历元素,不必先 range(len(...)) 再去索引:
names = ["Zach", "Jay", "Richard"]
for name in names:
    print(name)       # 直接拿到每个元素
但如果你同时要元素和它的位置,就用 enumerate:
for idx, name in enumerate(names):
    print(idx, name)
enumerate 会把“下标”和“值”配对一起给你——这比先 range(len(names)) 再一个个去 names[i] 要省事得多。
遍历字典时:
- 直接
for k in phone_book:拿到的是键(keys); phone_book.values()拿到值;phone_book.items()拿到键和值成对。
四、NumPy 入门
为什么需要 NumPy
(参考时间: 17:40)
NumPy 本质上是一个为数学运算优化的库。人们喜欢 Matlab,是因为它在科研里的数学操作很方便——Python 的对应答案,就是另起一个专门的库。
关键在于它“快”在哪里:NumPy 底层调用的是一批写好的子程序(subroutine),这些子程序用 C / C++ 写成,效率极高。为什么 C/C++ 比 Python 快?因为它们更接近机器语言——机器真正在读的东西。Python 长得像英文句子,这让我们人读起来很舒服,但也意味着电脑要花更多工夫翻译、才能明白你想干嘛。做数据处理时,这个翻译成本就变得相当可观。
NumPy 的做法是:只要你的内存和数据排布成特定格式,它就会去调用这些 C/C++ 子程序,把运算跑得飞快。所以几乎做 NLP 的人都很熟这个库——你会在大矩阵(比如 co-occurrence 矩阵)上跑大量运算,能省时间非常关键。
编者说明:这类“本地例程”在工程里常被称为 BLAS / LAPACK 层——NumPy 的矩阵乘最终会把活交给它们。你不需要直接接触它们,但理解“Python 只是发号施令的那层,真正干活的是底层 C”,能让后面“尽量不要写 for 循环”这条建议变得顺理成章。
NumPy 数组和 list 不一样;两者之间可以轻松互转(用 numpy.array(...))。但要注意:NumPy 运算只能作用于 NumPy 数组,不能直接对 list 做——得先转过去。
向量、矩阵与张量
(参考时间: 20:10)
动手之前先统一术语。矩阵就是“一堆数字排成长方形”,它们之间有特定的运算规则——把数据排成这个格式后,你就能用“矩阵那套规则”去批量处理,而不是一个一个去乘。
- 向量:一维的矩阵(约定俗成,不绝对)。可以是一行,也可以是一列,本质上是“只有一维的一串值”。
- 矩阵:通常指二维的对象。
- 张量(tensor):通常指高维的对象——不止二维,三维、四维乃至更多。(在课上下一次 PyTorch 教程里会正式展开。)
x = np.array([1, 2, 3])                # shape (3,)     —— 一维,向量
z = np.array([[6, 7], [8, 9]])         # shape (2, 2)   —— 二维,矩阵
x 只有一个维度,只有 3 个值;z 有行有列(6,7 是第一行,8,9 是第二行)。这就是“向量”和“矩阵”在代码里的区别。
编者说明:为什么“张量”这个词会特别和 GPU 绑定?因为在 PyTorch 里,
torch.Tensor不只是一个多维数字块——它还带自动求导信息、可以搬到 GPU 上,后台由高度优化的内核执行,正是深度学习需要的那套东西。课堂上讲的 NumPy 张量只是“高维数组”,但两者在多维、逐元素运算的直觉上是一致的。
数组的形状与表示
(参考时间: 22:15)
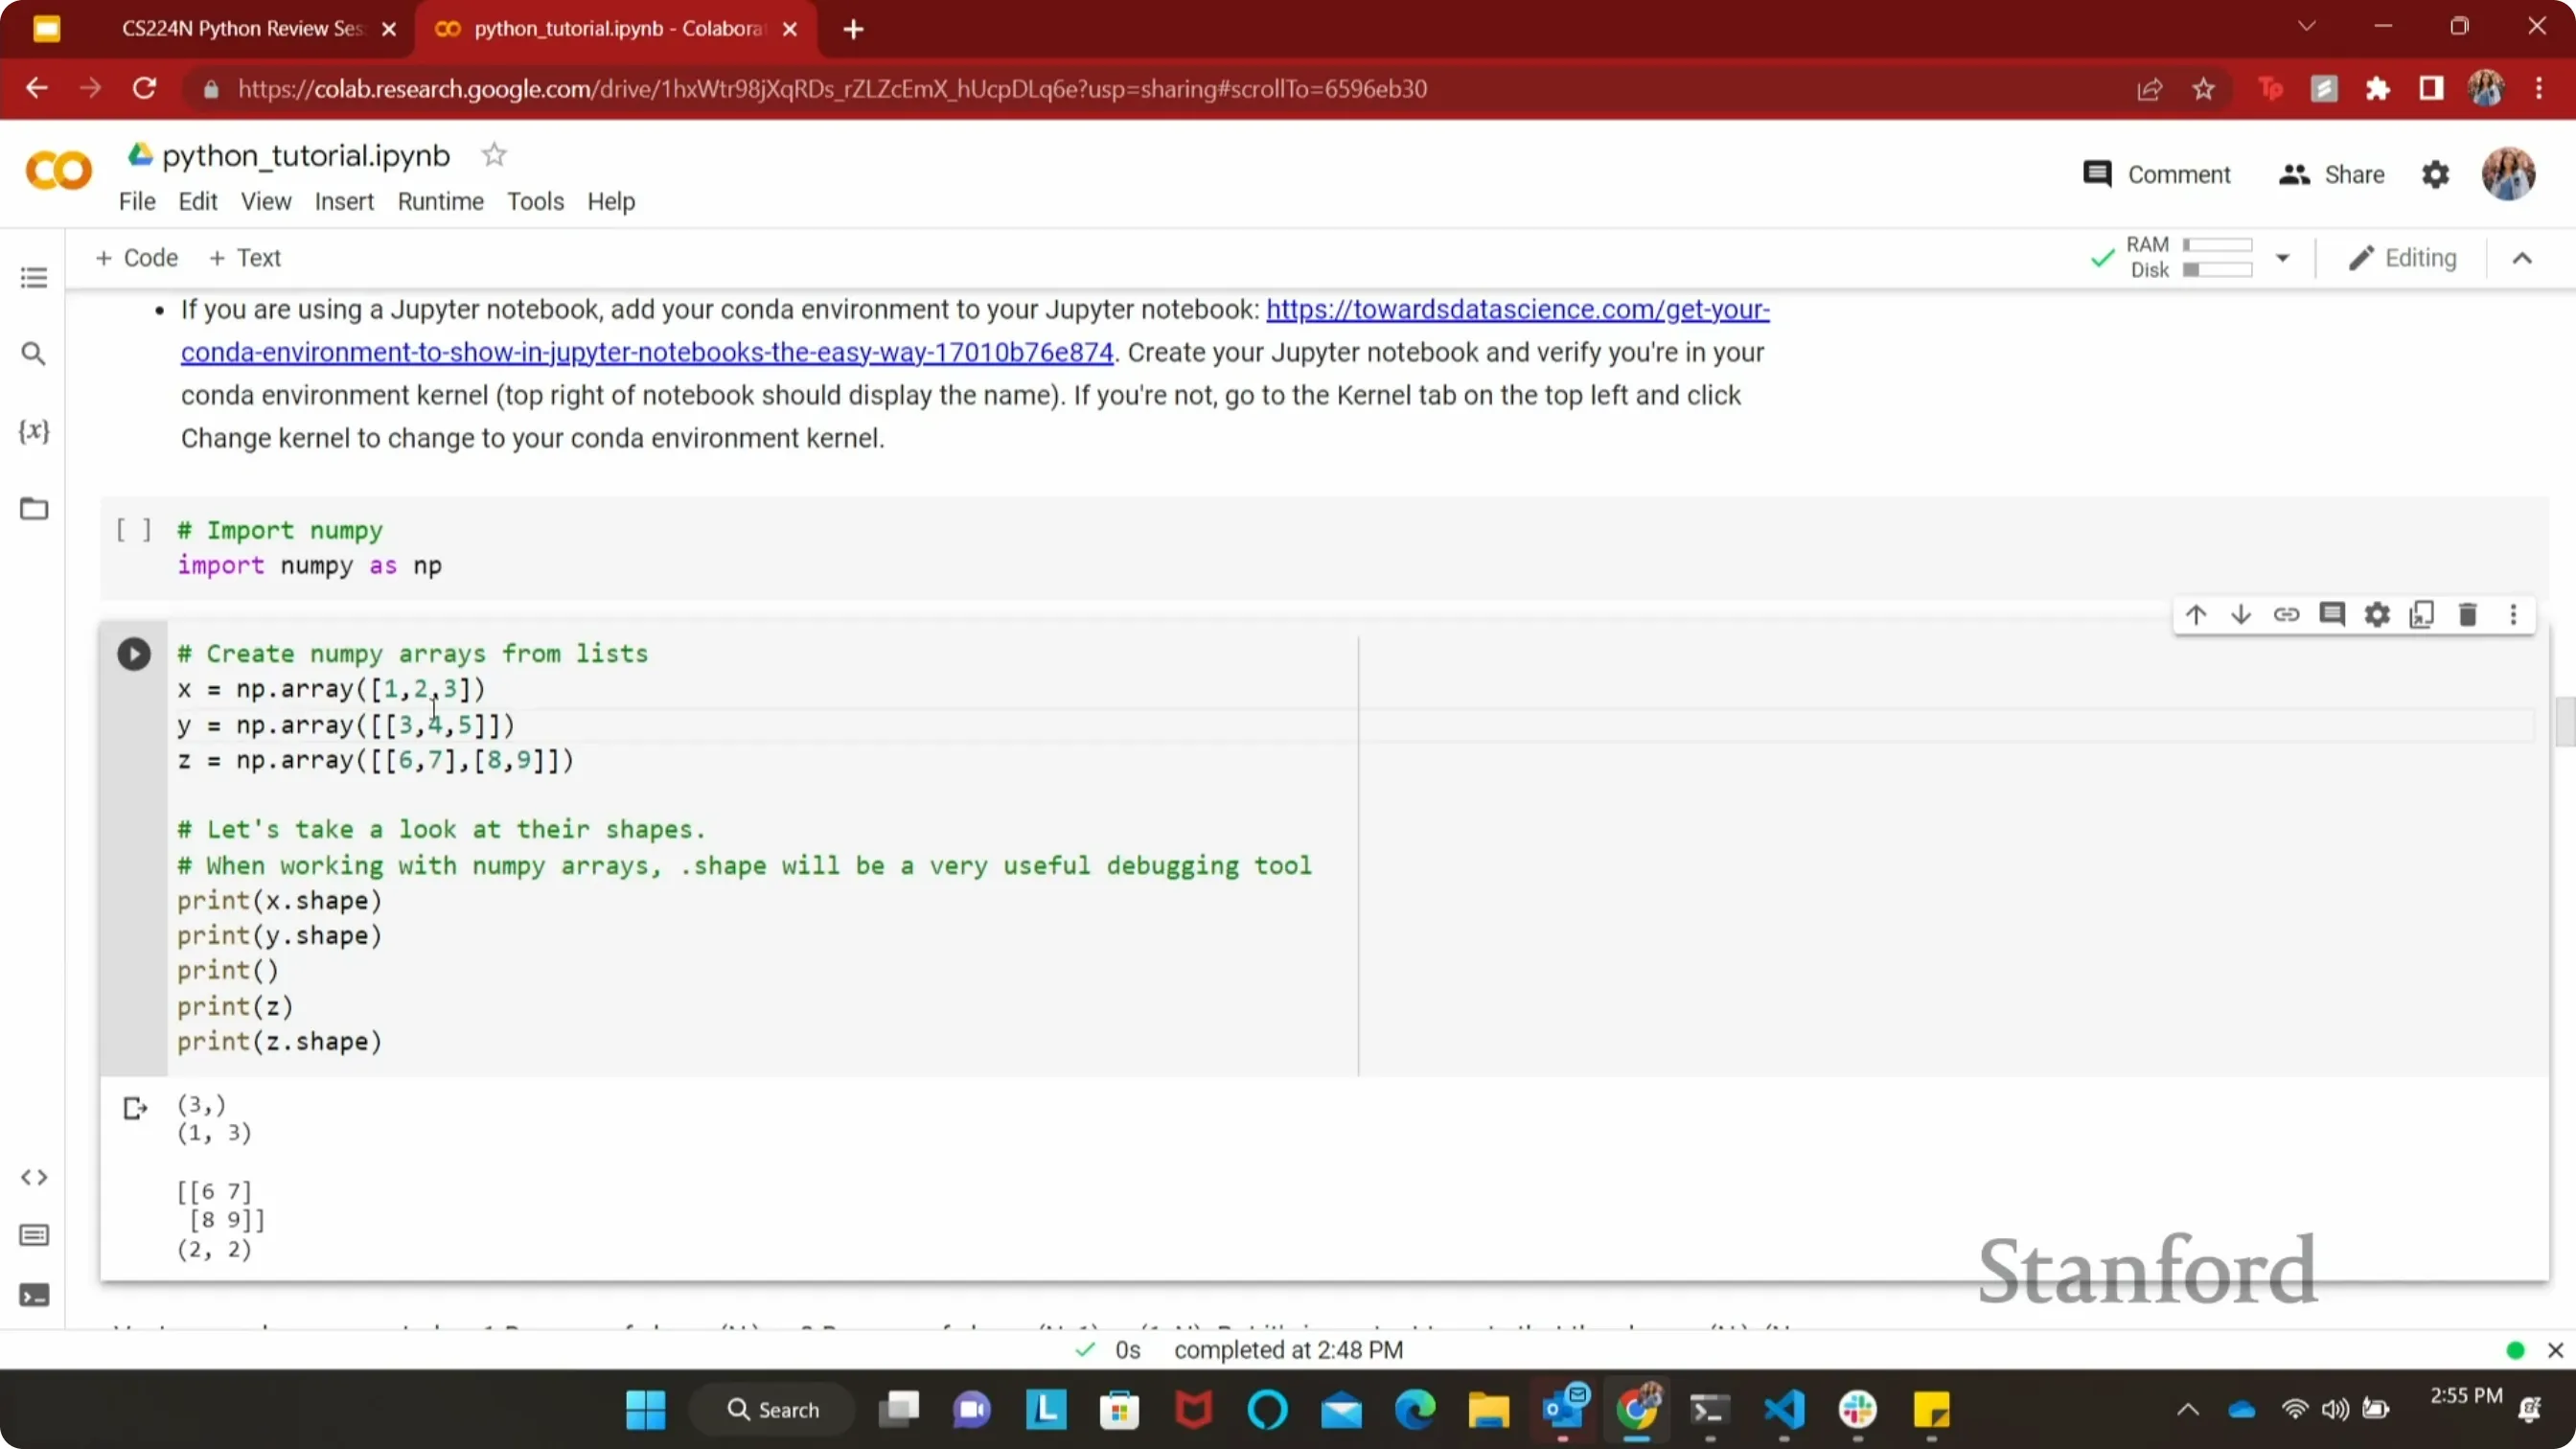
同一个“1, 2, 3”,在 NumPy 里可以有三副面孔:
📷 现场演示同一组数据的不同形状表示
回到原视频 (00:22:30)
import numpy as np

x = np.array([1, 2, 3])          # shape (3,)      一维,三个值
y = np.array([[1, 2, 3]])        # shape (1, 3)    一行三列
w = np.array([[1], [2], [3]])    # shape (3, 1)    三行一列
(3,):只有一个 list,即三个数摆成一串;(1, 3):一个 list 套在另一个 list 里(“list 的 list”);外层决定“有几行”,内层就是那一行;(3, 1):同样两层,只不过每一行只有一个元素,所以你会在每一行上看到“独立的小方块”。
从方括号的层数也能看出来:x 只有一层方括号,y 和 w 有两层。层数 = 维度数——凡是二维的,内层就是“list 的 list”。
为什么这种形状区别要专门讲? 因为它会直接决定广播怎么发生(后面会讲)。如果你想让 1,2,3 沿每一行重复,和 沿每一列重复,形状必须选对。用 reshape 可以在这些形状之间来回切换。
例:一张图片怎么从 2 维长到 4 维
第 1 层:灰度图,ndim=2。 定义:灰度图是一个二维数组 gray,gray[i, j] 是第 i 行、第 j 列像素的灰度值。逐维点名:axis=0 是行(H=256),axis=1 是列(W=256)。
import numpy as np

gray = np.zeros((256, 256), dtype=np.uint8)
gray[0, 0] = 10
gray[0, 1] = 20
gray[1, 0] = 30

print("gray.shape =", gray.shape)
print("gray.ndim =", gray.ndim)
print("gray[0, 0], gray[0, 1], gray[1, 0] =", gray[0, 0], gray[0, 1], gray[1, 0])
gray.shape = (256, 256)
gray.ndim = 2
gray[0, 0], gray[0, 1], gray[1, 0] = 10 20 30
第 2 层:加颜色(R/G/B),ndim=3。 定义:RGB 图是一个三维数组 color,color[i, j, c] 是第 i 行、第 j 列像素在通道 c 上的值,c=0/1/2 分别对应 R/G/B。逐维点名:axis=0 是行(H=256),axis=1 是列(W=256),axis=2 是颜色通道(C=3)。下面用 np.stack 构造具体实例:R 通道取 gray,G 通道取 gray+1,B 通道取 gray+2;实际数据三个通道可独立取值。
import numpy as np

gray = np.zeros((256, 256), dtype=np.uint8)
gray[0, 0] = 10
gray[0, 1] = 20
gray[1, 0] = 30

color = np.stack([gray, gray + 1, gray + 2], axis=-1).astype(np.uint8)

print("color.shape =", color.shape)
print("color.ndim =", color.ndim)
print("color[0, 0] =", color[0, 0])
color.shape = (256, 256, 3)
color.ndim = 3
color[0, 0] = [10 11 12]
第 3 层:加 batch(32 张),ndim=4。 定义:images 是一个四维数组,images[n, i, j, c] 是第 n 张图、第 i 行、第 j 列、通道 c 的值。逐维点名:axis=0 是 batch(N=32),axis=1 是行(H=256),axis=2 是列(W=256),axis=3 是颜色通道(C=3)。下面用 np.stack 沿新的第 0 维堆 32 张图;这里 32 张图暂时相同,batch 维只表示张数。
import numpy as np

gray = np.zeros((256, 256), dtype=np.uint8)
gray[0, 0] = 10
gray[0, 1] = 20
gray[1, 0] = 30

color = np.stack([gray, gray + 1, gray + 2], axis=-1).astype(np.uint8)
images = np.stack([color for _ in range(32)], axis=0)

print("images.shape =", images.shape)
print("images.ndim =", images.ndim)
print("images[0, 0, 0] =", images[0, 0, 0])
images.shape = (32, 256, 256, 3)
images.ndim = 4
images[0, 0, 0] = [10 11 12]
第 4 层:PyTorch 的约定 (N, C, H, W)。 定义:同一组数据在 PyTorch 中按 (N, C, H, W) 排列,images_nchw[n, c, i, j] 与上面的 images[n, i, j, c] 是同一个元素。逐维点名:axis=0 是 batch(N=32),axis=1 是颜色通道(C=3),axis=2 是行(H=256),axis=3 是列(W=256)。np.transpose(images, (0, 3, 1, 2)) 的轴顺序是:结果第 0 维取旧第 0 维(N),结果第 1 维取旧第 3 维(C),结果第 2 维取旧第 1 维(H),结果第 3 维取旧第 2 维(W)。
import numpy as np

gray = np.zeros((256, 256), dtype=np.uint8)
gray[0, 0] = 10
gray[0, 1] = 20
gray[1, 0] = 30

color = np.stack([gray, gray + 1, gray + 2], axis=-1).astype(np.uint8)
images = np.stack([color for _ in range(32)], axis=0)

images_nchw = np.transpose(images, (0, 3, 1, 2))

print("images_nchw.shape =", images_nchw.shape)
print("images_nchw.ndim =", images_nchw.ndim)
print("images[0, 0, 0, :] =", images[0, 0, 0, :])
print("images_nchw[0, :, 0, 0] =", images_nchw[0, :, 0, 0])
print("same data =", np.array_equal(images[0, :, :, 0], images_nchw[0, 0, :, :]))
images_nchw.shape = (32, 3, 256, 256)
images_nchw.ndim = 4
images[0, 0, 0, :] = [10 11 12]
images_nchw[0, :, 0, 0] = [10 11 12]
same data = True
五、NumPy 数组操作
reshape:换形状但数据不变
(参考时间: 25:51)
reshape 是“把数据按新形状重排”。合法的前提只有一条:新旧形状的元素总数必须相等。
a = np.arange(10)              # 10 个连续整数
print(a.reshape(5, 2))         # ✓ 合法:5 × 2 = 10
print(a.reshape(2, 5))         # ✓ 合法
print(a.reshape(10, 1))        # ✓ 合法(列向量)
a.reshape(3, 5)                # ✗ 报错:3 × 5 = 15 ≠ 10
两处容易犯的错:
reshape里为什么有两个括号? 因为reshape接收的是一对维度参数,而 Python 的惯例是把它们装进一个 tuple 传进去——外层括号是函数调用,内层括号就是那个 tuple;- 形状不对时就直接报错——不会有任何隐式补齐。
# 一种等价写法
a.reshape(-1, 1)               # -1 表示“该维自动算”,效果同 (10, 1)
聚合操作与 axis
(参考时间: 26:54)
很多时候你要的“不是一个数,而是一列数”。以 max 为例:
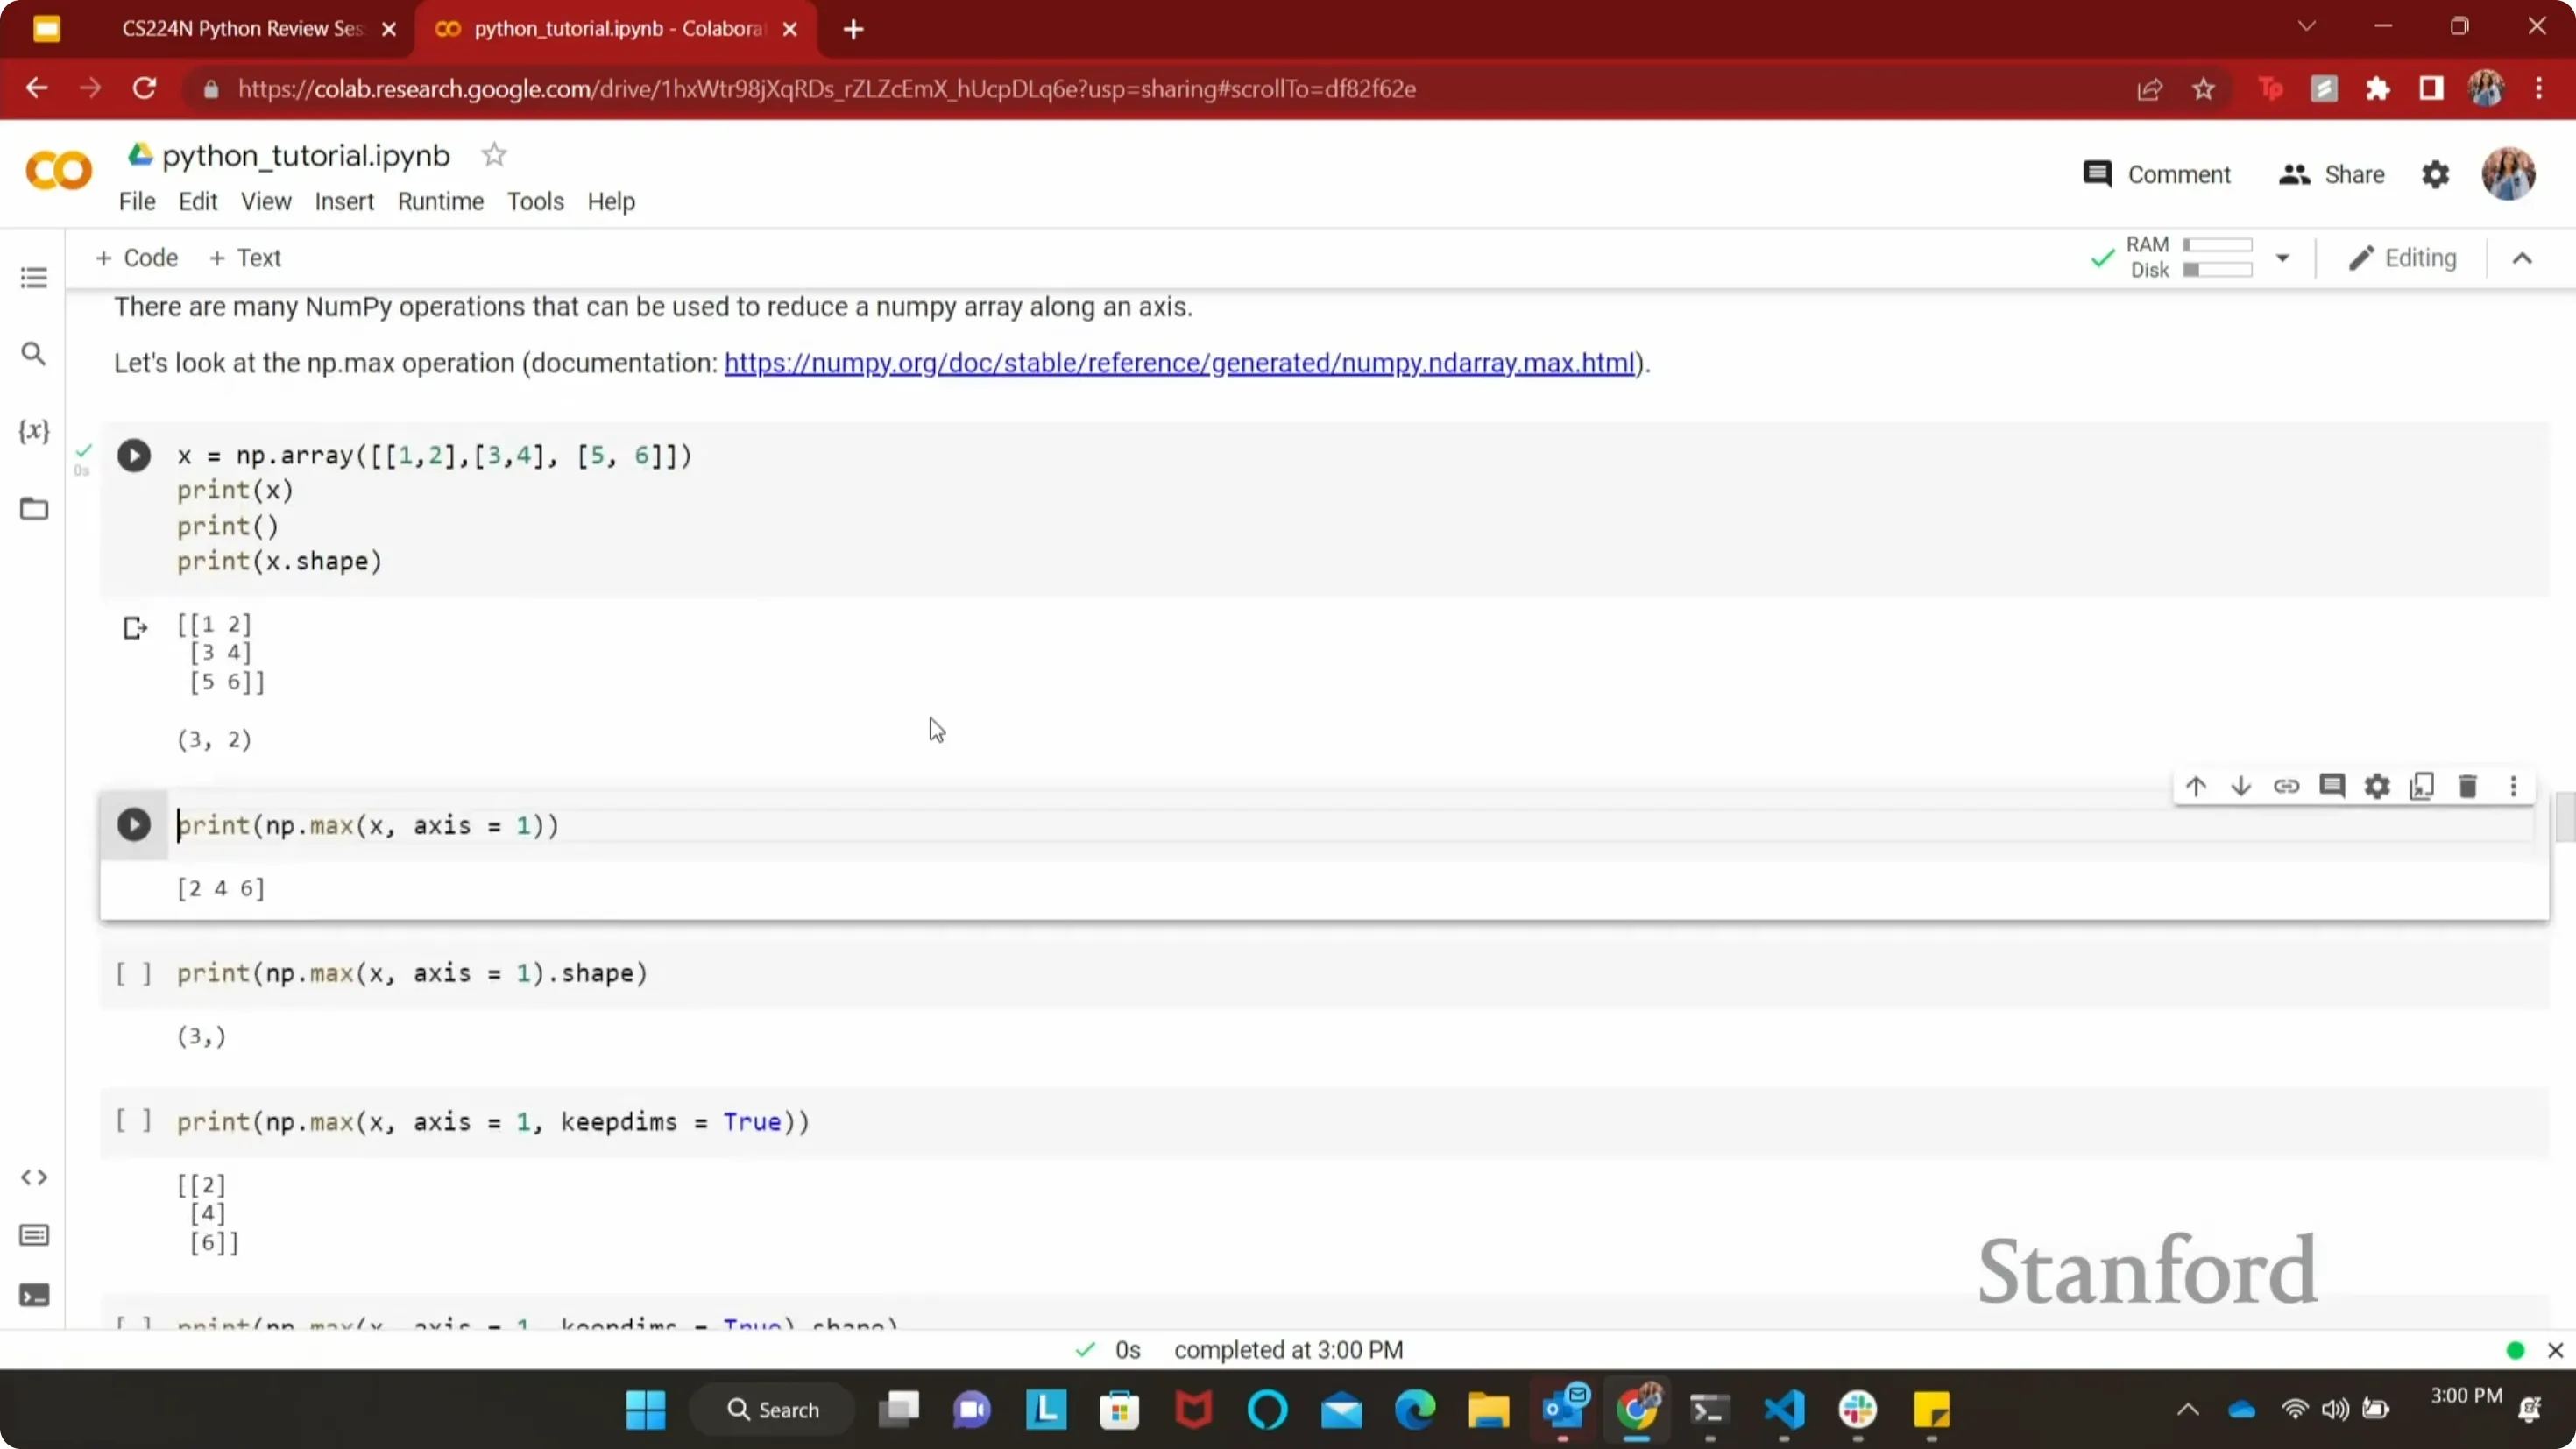
📷 现场演示对数组按轴求最大值
回到原视频 (00:27:00)
x = np.array([[1, 2],
              [3, 4],
              [5, 6]])

np.max(x)               # 整个数组的最大值 → 6
np.max(x, axis=0)       # 每列的最大值    → [5, 6]
np.max(x, axis=1)       # 每行的最大值    → [2, 4, 6]
axis 到底是什么? 老师课上反复强调的那句话是:
axis指的是“你要对哪一维做 reduce(把它压掉)”,不是“你希望结果保留哪一维”。
打个具体的比方——对 (3, 2) 这个矩阵(3 行 2 列):
axis=0表示“沿着行方向(下标 0 的那一维)去压”,于是每列会被“从若干行压成一个值”——结果显示 3 个值(对应 3 行);axis=1表示“沿着列方向(下标 1 的那一维)去压”,于是每行会被从若干列压成一个值——结果显示 2 个值(对应 2 行… 等等,这里是 3 行,axis=1压列,得到 3 个值)。
换句话说:axis 的取值,决定了“少掉的是哪一维”。axis 的直观理解确实不太容易一上来就通,老师建议多跑几组 min / max 之类的例子,很快就体会出来了。
keepdims:保留维度
(参考时间: 29:31)
默认 np.max(x, axis=1) 会把那一维直接删掉,得到一维的 [2, 4, 6]。如果你希望保留结构,让结果仍然是二维(形状 (3, 1)),就加 keepdims=True:
np.max(x, axis=1, keepdims=True) # shape (3, 1),值仍是 [2, 4, 6]
一个常见场景:你想把“每行最大值”再和原矩阵做广播运算——此时结果如果还是一维 (3,),形状对不齐;而 (3, 1) 就能和 (3, 2) 对齐。所以 keepdims 是连接“reduce”和“下一步广播”的一个关键开关。
逐元素乘法 vs 矩阵乘法
(参考时间: 30:09)
这是最容易混淆、也最常出错的一对操作:
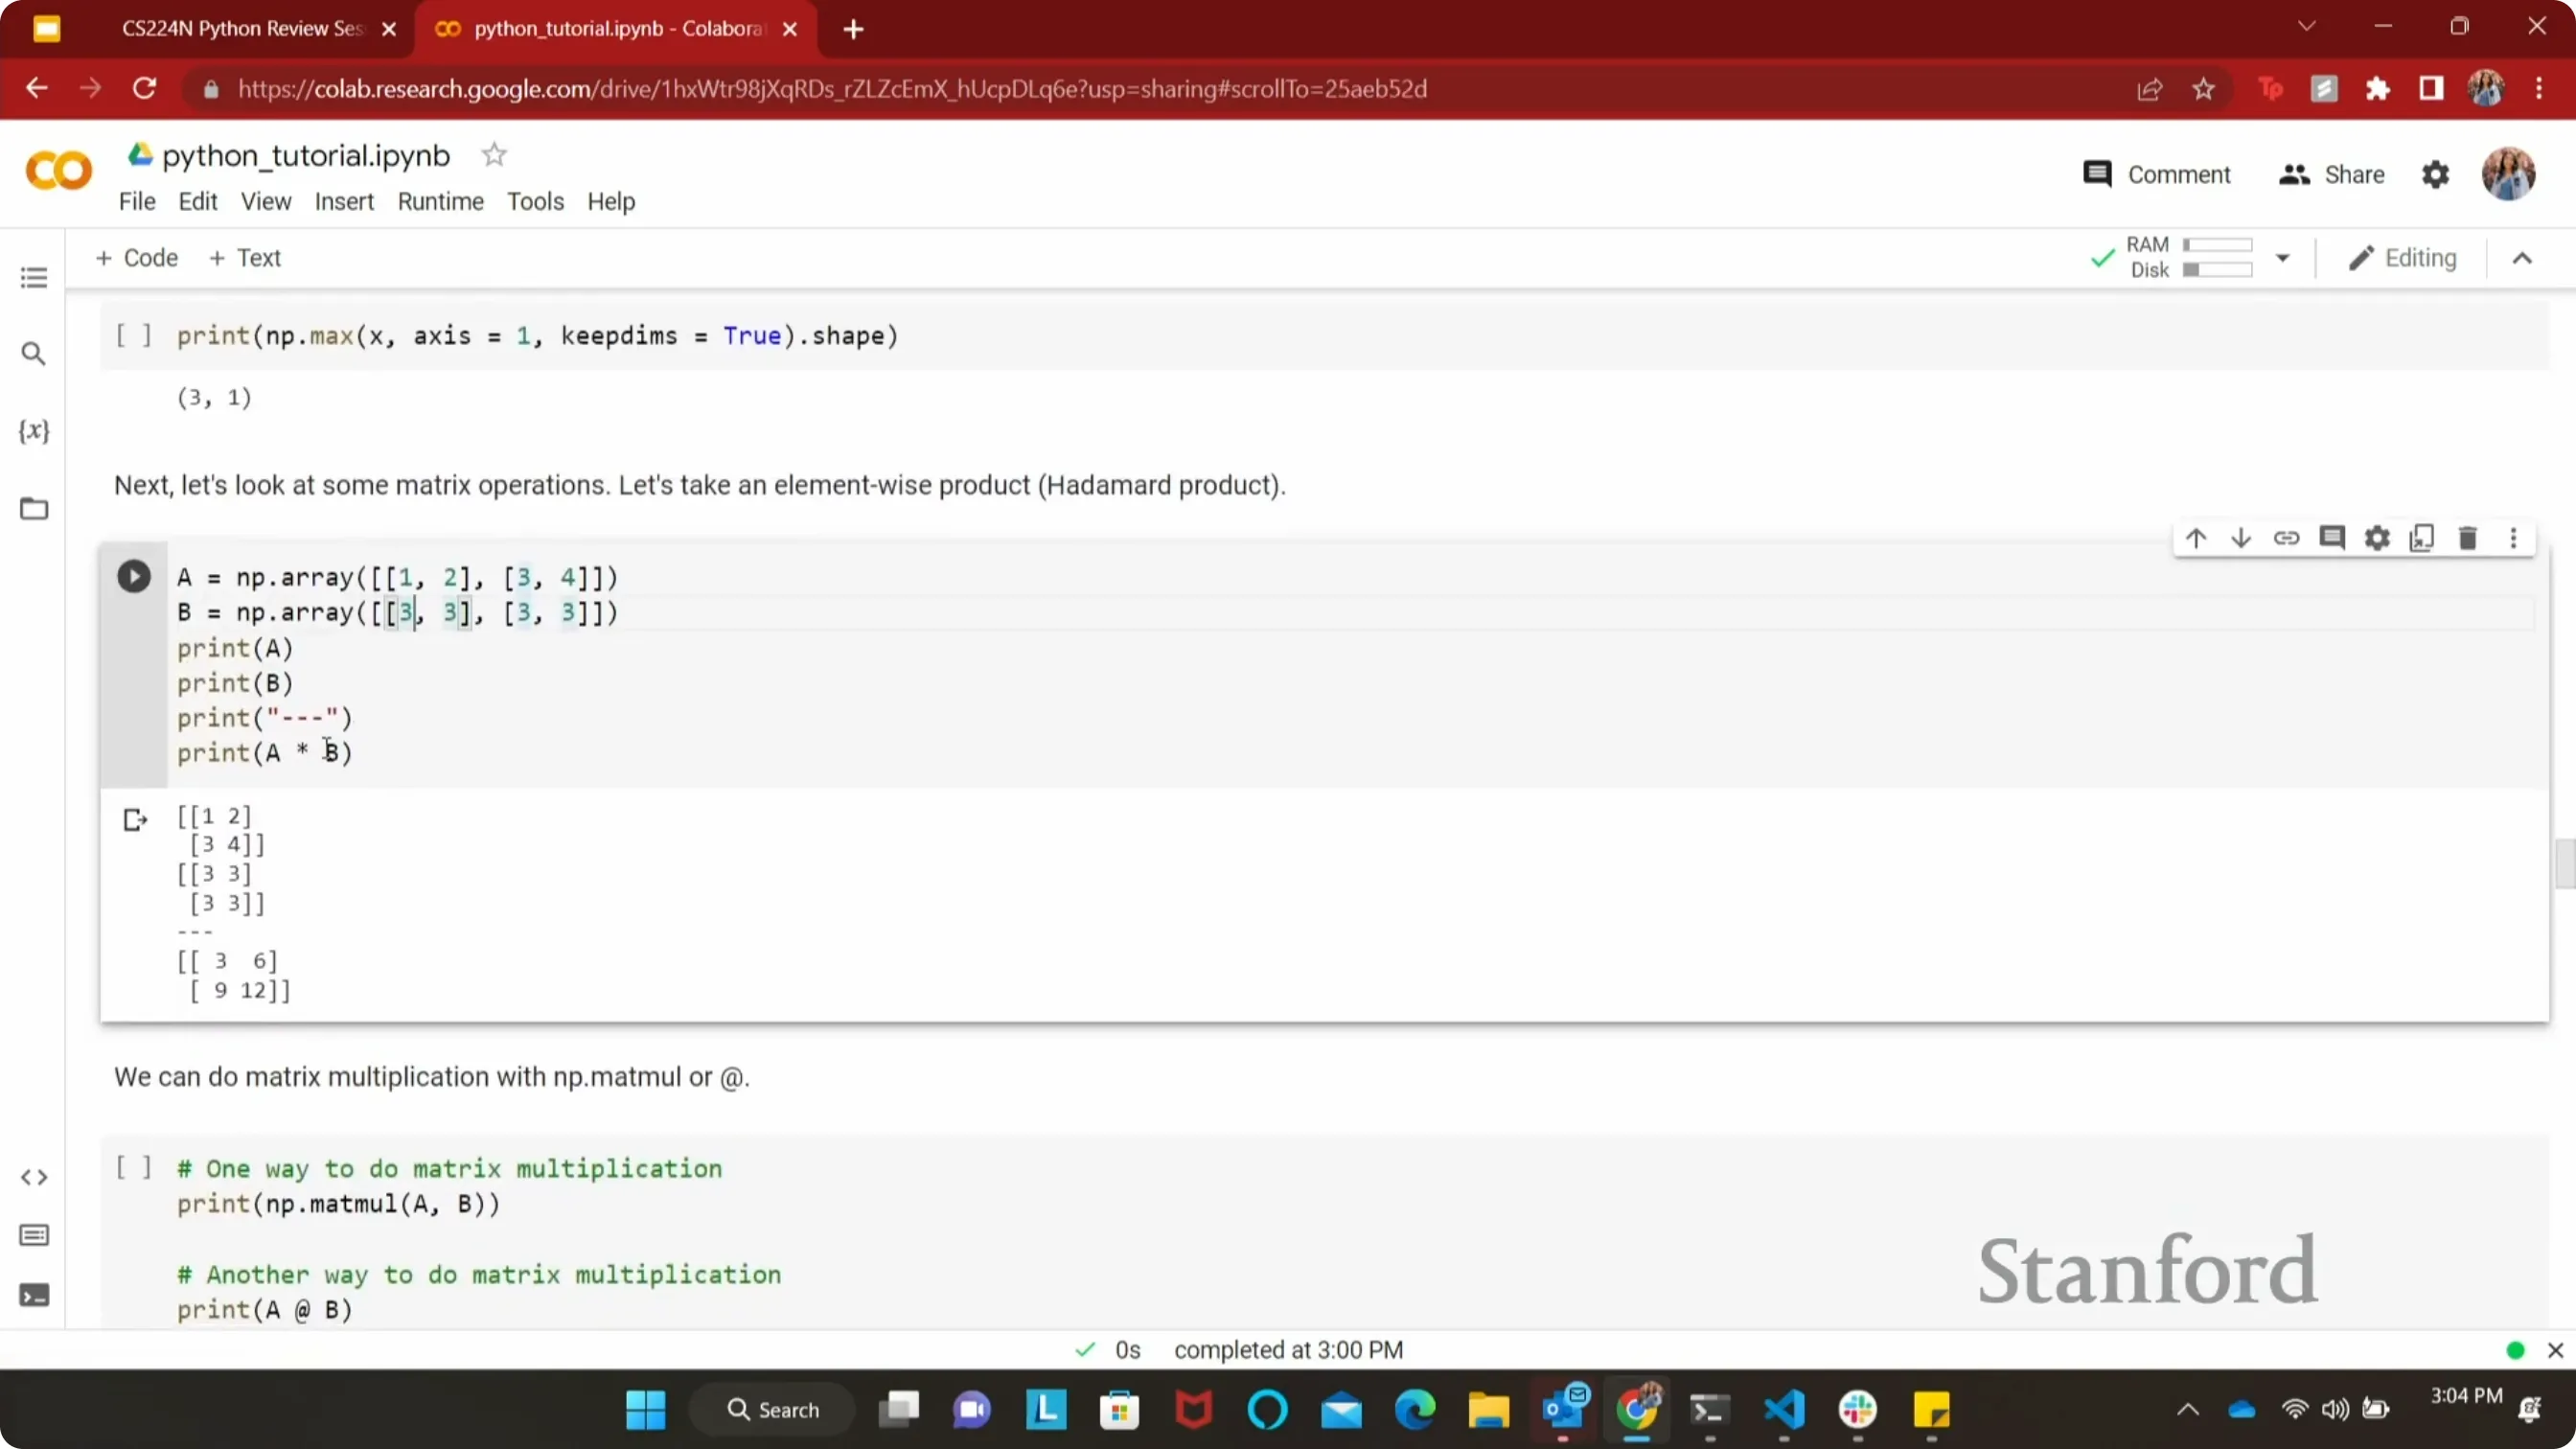
📷 现场演示逐元素乘法与矩阵乘法的区别
回到原视频 (00:30:09)
| 运算 | 写法 | 要求 | 效果 |
|---|---|---|---|
| 逐元素乘法 | a * b |
两数组形状完全一致 | 对应位置的元素相乘 |
| 矩阵乘法 | a @ b 或 np.matmul(a, b) |
a 的第二维 = b 的第一维 |
行 × 列 的内积求和 |
A = np.array([[1, 2],
              [3, 4]])
B = np.array([[5, 6],
              [7, 8]])

A * B          # 逐元素乘:
# [[ 5  12]
#  [21  32]]

A @ B          # 矩阵乘:
# [[1*5 + 2*7, 1*6 + 2*8],
#  [3*5 + 4*7, 3*6 + 4*8]]
矩阵乘法的形状要求:设左矩阵形状 (a, b)、右矩阵形状 (c, d),则必须 b == c,结果形状为 (a, d)。课上给的例子就是 (2, 3) @ (3, 4) 是合法的,但 (2, 3) @ (2, 3) 就会报错——这种“b 对 c”的匹配,是矩阵乘法最常踩的坑。
编者说明:
a * b这类运算在 NumPy 里其实是广播的一个特例——如果形状不完全相同,只要满足广播规则,*会先隐式复制再逐元素乘;形参不对才会报错。初学者常误以为*就是“矩阵乘法”,那是另一个库(如 Matlab 的*)的习惯。
点积(dot product)
(参考时间: 32:15)
点积针对“两个一维向量”:逐元素相乘,再把结果全部相加成一个标量。
u = np.array([1, 2, 3])
v = np.array([1, 10, 100])
print(np.dot(u, v))        # 1*1 + 2*10 + 3*100 = 321
点积的一个重要细节:np.dot 对一维向量就是你期待的“相乘再求和”;对二维及以上的矩阵,它等价于矩阵乘法——不再是“求和成一个数”,而是返回矩阵乘法的结果。
np.dot(A, B) # 二维:等价于 A @ B
所以,如果你想要“对高维数组也得点积”,就得自己把形状对齐——例如把形状调整成 (3, 1) 或 (1, 3),让维度能对上。唯一保证不歧义的,是一维对一维。这是本讲反复出现的主旋律:NumPy 里大部分“报错”都是形状问题。
六、NumPy 索引
基础切片与多维索引
(参考时间: 34:47)
NumPy 的切片与 list 一脉相承,收尾也都是“含头不含尾”。x[:] 会得到一份深拷贝——和你改不动原数组。
多个维度可以各自独立索引——这是 NumPy 比 list 强的地方:
X = np.arange(12).reshape(3, 4)
# [[ 0  1  2  3]
#  [ 4  5  6  7]
#  [ 8  9 10 11]]

X[[0, 2], :]        # 第 0 行和第 2 行,所有列
X[:, 1]             # 所有行的第 1 列
X[1:3, 1:3]         # 行 1..2 与列 1..2 的交叉
要记住三条:
:表示“这一维全要”;axis=0是第一维(行),axis=1是第二维(列),依次类推;- 列清单可以很长。
X[[0, 2], :]中的[0, 2]就是“我要第 0 行和第 2 行”——这就是“两维分别独立索引”。
这种“按维度分别取”的写法,可以一直延伸到高维张量:你有几个维度,就能写几组下标。
布尔索引(Boolean Indexing)
(参考时间: 36:32)
如果你想选“满足某个条件的全部元素”,不必先找到下标再取——直接把它当“遮罩”就好:
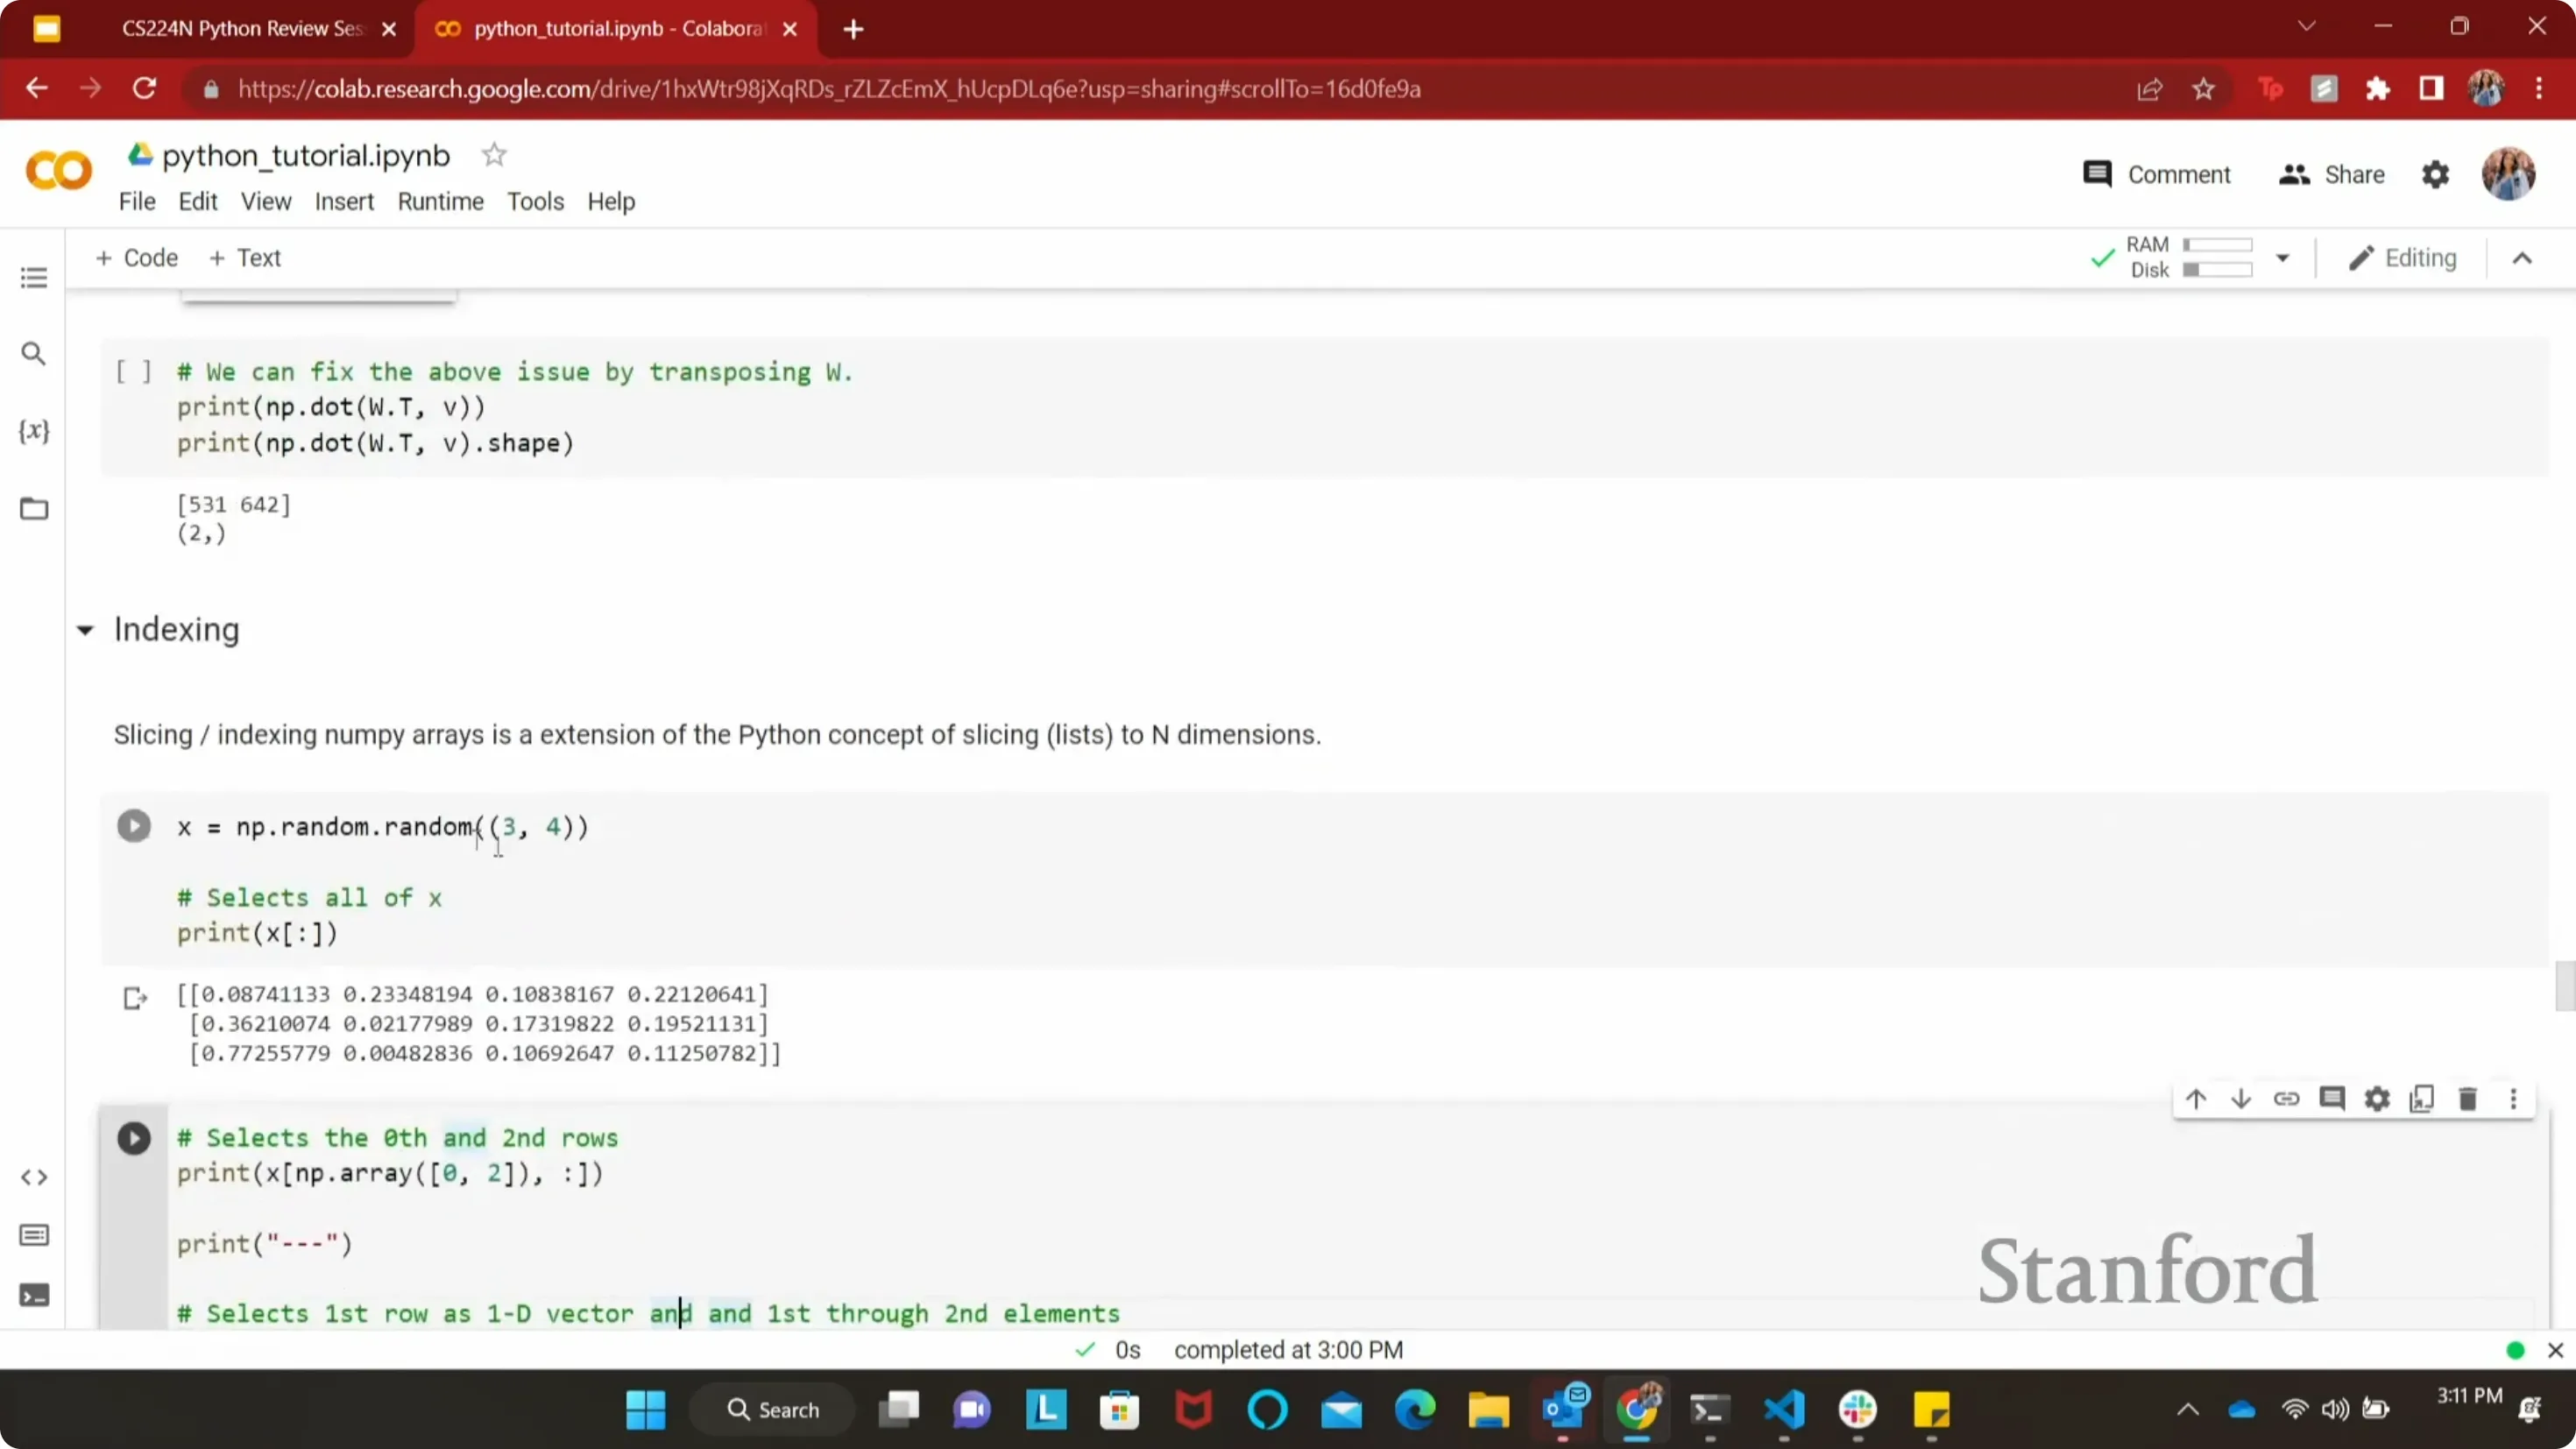
📷 现场演示布尔索引,挑选数组中大于 0.5 的元素
回到原视频 (00:36:35)
x = np.random.rand(10)
big = x[x > 0.5]           # 取所有大于 0.5 的元素
这一行做了两件事:先构造一个“哪些元素大于 0.5”的布尔数组,再用它去索引 x——结果只剩下那些为 True 的元素。
编者说明:布尔索引背后的规则和广播是一致的——布尔遮罩的形状必须能对齐被索引的数组。所以它能用在 N 维数组上:对一个
(m, n)矩阵,X[X > 0]会把条件为真的位置逐个挑出来,得到一维扁平化的结果。
np.newaxis:手动加一维
(参考时间: 37:00)
有时你需要把一个 (3,) 加一个“外围维”,变成 (1, 3) 或 (3, 1)。np.newaxis 就是干这个的:
v = np.array([1, 2, 3])            # (3,)
v_row = v[np.newaxis, :]           # (1, 3)
v_col = v[:, np.newaxis]           # (3, 1)
其中 : 表示“这一维全部保留”,np.newaxis 表示“在这里插入一个新的一维”。它和 reshape 效果等价,只是写法更局部——你只在需要“加一根轴”的地方写它,不用把整个数组的形状都重写一遍。
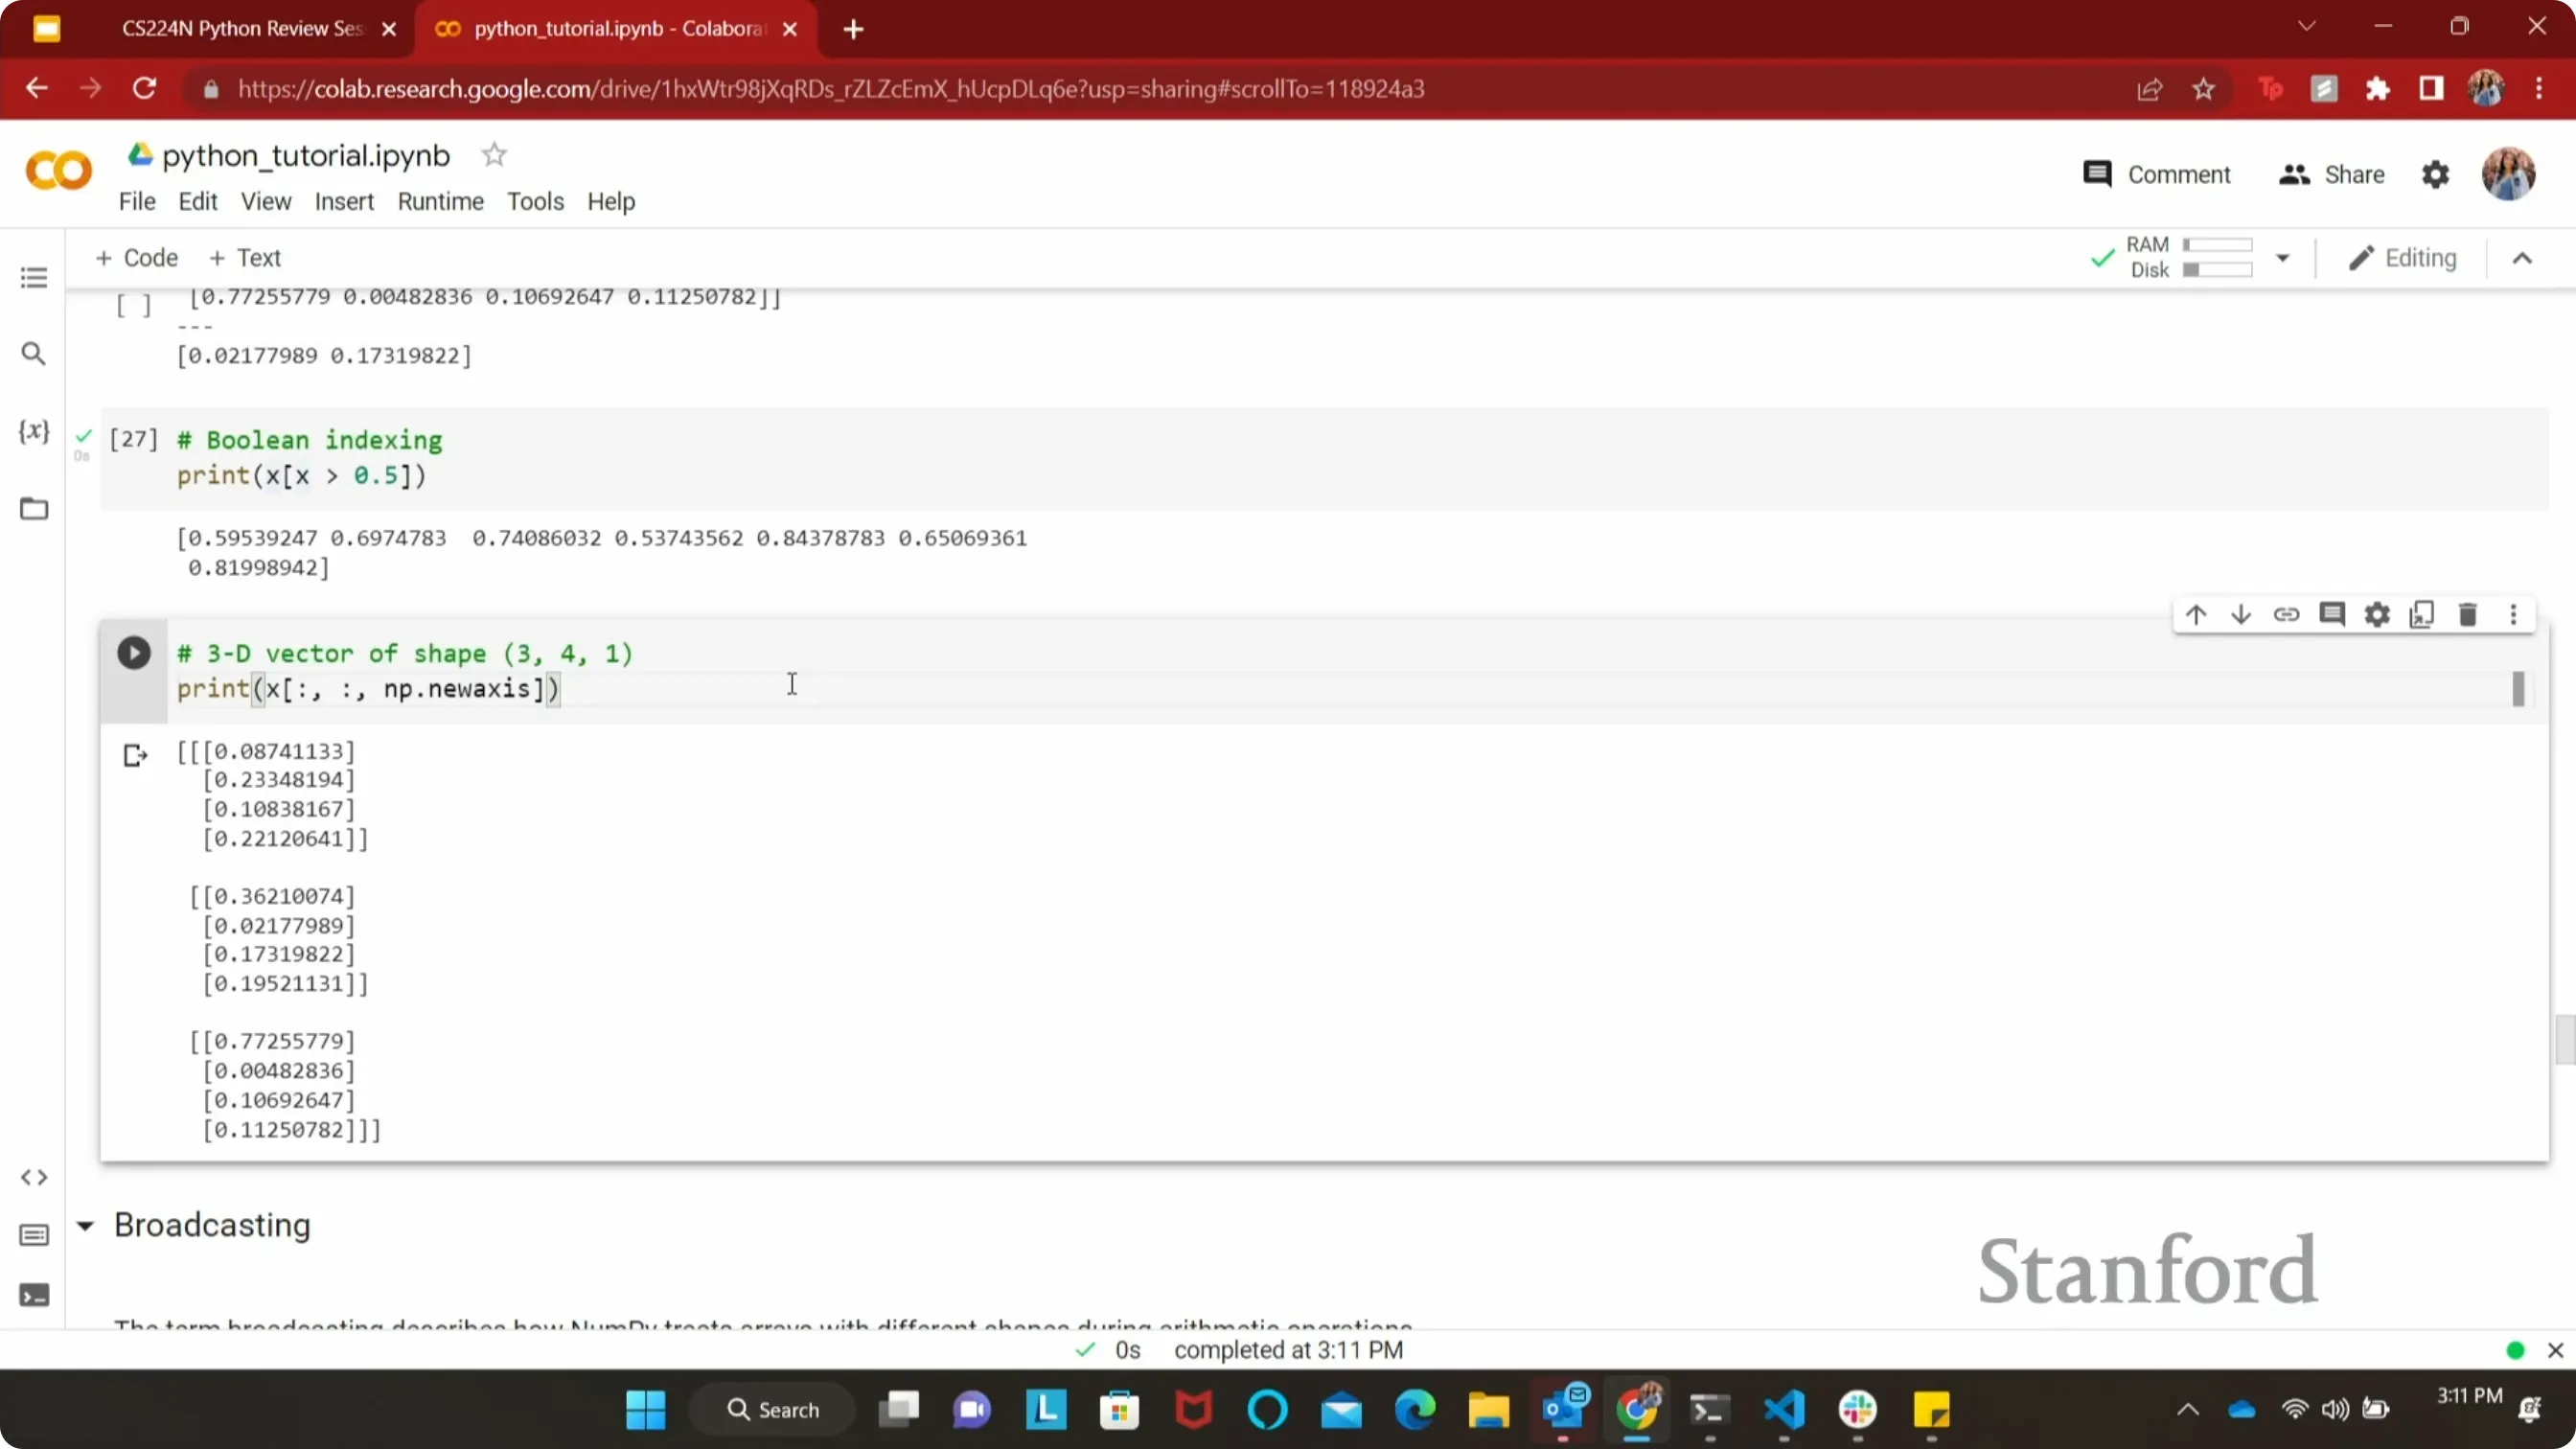
📷 现场演示用 np.newaxis 给数组增加一维
回到原视频 (00:37:10)
编者说明:
v[:, np.newaxis]是 NumPy 里最常见的“转成列向量”的方法,在把“一维数组参与高维广播”时几乎一定会用到。例如(m,)与(n,)想乘积成(m, n)矩阵,就可以写成a[:, None] * b[None, :],这里None就是np.newaxis的别名。
七、广播(Broadcasting)
(参考时间: 38:17)
广播是 NumPy 最核心、也最值得掌握的特性。一句话概括:它允许两个“形状不同”的数组参与同一个运算,NumPy 会在后台把小的那个沿需要的方向复制出去。
📷 课堂上讲解广播的视觉示意
回到原视频 (00:39:50)
比如你要把 [1, 2, 3] 加到每一行(得到一个 m × 3 的矩阵),并不需要真的写“m 行的那个矩阵”,只需:
x = np.zeros((4, 3))
y = np.array([[1, 2, 3]])         # (1, 3)
x + y                              # 自动变成 (4, 3) 的加和
或者把 [1, 2, 3, 4] 加到每一列:
z = np.array([[1], [2], [3], [4]])    # (4, 1)
x + z                                 # 自动变成 (4, 3)
广播的两条规则
(参考时间: 40:34)
NumPy 判断“能不能广播”的依据只有两条:
flowchart TD
    A["两个数组的形状<br/>逐维从尾部对齐"] --> B{"每一维是否满足<br/>相同 或 有一个为 1 ?"}
    B -- 是 --> C["合法:把为 1 的那一维<br/>沿另一方向复制出去"]
    B -- 否 --> D["报错:<br/>operands could not be broadcast"]
    C --> E["运算按对齐后的形状进行"]

    style B fill:#fff3cd
    style D fill:#f8d7da
    style C fill:#d4edda
- 每一维要么相等,要么其中一个为 1——否则不能广播;
- 为 1 的那一维就是“会被复制出去”的那一维——复制由 NumPy 在后台完成,不需要你手动建一个新数组。
逐维对齐时是从尾部比起的(这一点对高维数组尤其重要)。
几个例子:
(3, 4)对(3, 1):第一维 3=3 ✓,第二维 4 与 1 ✓(1 会被复制成 4)。合法,结果(3, 4)。(3, 4)对(1, 4):第一维 3 与 1 ✓,第二维 4=4 ✓。合法,结果(3, 4)。(3, 4)对(2, 4):第一维 3 与 2 ✗(既不等也不含 1)。报错。(3, 1)对(1, 3):第一维 3 与 1 ✓、第二维 1 与 3 ✓,双方都在被复制的维度上,结果(3, 3)。
b = np.array([[1], [2], [3]])     # (3, 1)
print((b + b.T).shape)            # (3, 3)
编者说明:最后一条容易被误解成“
(3,1)和(1,3)相当于把两列向量相乘”,其实不是——广播只是把数据复制出去再逐元素加,不是矩阵乘。想得到矩阵乘,要用@或np.matmul,那是另一套形状要求(见上)。
广播在深度学习里为什么重要
(参考时间: 42:24)
课堂上给了一个非常典型的动机:做深度学习时,你会一次处理一个 batch 的图像,每张图的尺寸相同,但要应用同一个权重矩阵。如果不用广播,你得把权重矩阵复制 batch_size 次再逐个加;用了广播,同一份权重矩阵就够了,NumPy 在后台完成复制。
作业 2 里的“前馈网络”本质上就是这个:对一批输入图像,乘同一个权重矩阵 W(再加偏置 b),只不过 W 和 b 的具体表达式留到课上再讲。唯一能省下大量内存和时间的,就是广播。
八、用 NumPy 替代循环
(参考时间: 45:52)
最后一节给了一条非常实用的经验:处理大矩阵时,尽量不要写 for 循环。原因很简单:Python 的 for 循环几乎比等价的 NumPy 运算慢约 100 倍。
课上的例子是:对一个 1000 × 1000 的矩阵 X,把第 100 行及之后的所有元素加 5。写法有两种:
# 写法一:用 Python for 循环
for i in range(100, X.shape[0]):
    X[i] = X[i] + 5

# 写法二:用 NumPy 切片与算术
X[100:, :] = X[100:, :] + 5
第二种写法用到了切片 X[100:, :]——从第 100 行到末尾,所有列。一行完成,而且因为整个操作都由 NumPy 的底层例程执行,速度可以快一个数量级。
这是本讲最终想让你带走的一句话:能用切片 + 广播 + 数组运算表达的,就不要交给 for 循环。
附:参考与延伸阅读
编者补充
- Colab
- Jupyter
- PyTorch —— PyTorch 官网:查安装、教程与 API 文档
- TensorFlow —— TensorFlow 官网:查安装、教程与 API 文档
已知疑点
以下内容在字幕里无法完全核实,如实列出:
- ASR 误识别的专有名词:字幕把
Colab识别成 “collab”、NumPy识别成 “lumpy / Numpy”、PyTorch识别成 “Pi torch”、np.newaxis识别成 “numpy.new access”、del识别成 “Dell”。本书正文已按正确写法处理。 - 冒号与分号的混淆:字幕多次出现 “semicolon 3” 之类表述,而上下文明明是在讲切片——这里的 “semicolon” 极可能是 冒号
:被识别成了分号。因此正文中的切片都以冒号形式书写。 np.max示例中的轴与结果:字幕里有一段把 “axis 0 → 3 个值”“axis 1 → 2 个值”说得比较乱((参考时间: 27:37 起))。本书按“轴被 reduce 掉”与“结果维度数”两件事重新整理,避免原话可能造成的歧义。请以你的 NumPy 实测为准。Phone book中出现的具体人数 / 键值:字幕没有明确数字,只听到 “Zach / Kevin / Monty” 这三个示例名。正文里用的都是示例值,不代表课上真实输入。(2, 3) @ (3, 4)那个例子所对应的具体矩阵:字幕只给了形状,没有给具体数值。正文里用了自己构造的A / B,仅用于说明运算规则,不是课上原始数据。- 高效 NumPy 例子里
X的具体尺寸:字幕说 “thousand by thousand”,但后面的区间写成了 “between hundred and thousands”。本书按1000 × 1000复述,X[100:, :]的区间也按此理解。 - 老师是否现场演示了
reshape的两个括号解释:字幕有 “outer / inner parentheses” 一段,但语速很快,无法确定书中复述是否完全对应幻灯片原文。若你手边有官方讲义,建议对照。 - 时间的取整:
SCREENSHOT:HH:MM:SS中的秒数由整段字幕的起止时间取整,可能与视频里的实际画面有 1–2 秒的偏差。