T2 · T2 · Stanford CS224N · PyTorch 入门教程
| 课程 | Stanford CS224N — NLP with Deep Learning(2023 冬季) |
| 讲次 | PyTorch Tutorial |
| 讲述人 | Drew Kaul(课程助教) |
| 视频 | YouTube · Uv0AIRr3ptg |
| 配套 Notebook | 课程主页上的 Colab notebook(可复制一份跟着跑) |
| 本书记录方式 | 依据课堂字幕进行书面化重构,术语与代码以课程现场演示为准;补注以「编者说明 / 编者拓展」标出。讲义原文与幻灯片版权归 Stanford CS224N 课程组所有(通常为 CC BY-NC-SA 一类许可),引用请以课程主页为准。 |
对应讲次:T2(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose)
导览
这一讲想回答的核心问题
开场讲者就把目标说得很直接((参考时间: 00:00:05)):今天只做一件事——把 PyTorch 的基础积木搭起来,让你能从此定义更复杂的模型。他按下面的顺序追问:
- 张量(tensor)到底是个什么东西?它和我们熟悉的 NumPy 数组有什么异同?怎么创建、怎么操作?
- 计算梯度这么麻烦的事,能不能不手写?——这就是 autograd。
- 有了张量和梯度,怎么用 PyTorch 现成的「积木」拼出神经网络?
- 最后:怎么把它们塞进一个训练循环,真正把网络「练」起来?
难点在哪
- 形状(shape) 是全程最容易翻车的地方。只要开始把多个操作串起来,几乎没人能靠脑补判断中间张量的形状;常见的调试方法是把每个张量的 shape 打印出来。
- 广播(broadcasting) 的规则本身不难,但一旦维度一多、batch 一叠,就很难一眼看出哪里对不上——而 PyTorch 报错时给出的形状未必是你代码里写的那个。
- 梯度累积 是个反直觉的默认行为:同一段
backward()跑两次,x.grad会变成两倍,不熟悉的人会以为出了 bug。
读者可能带着的疑问
① 课上实际提出的问题(现场提出并等待回答的):
- 「一个 3×2 的张量和一个 2×4 的张量乘起来,结果是什么形状?」((参考时间: 00:08:26))
- 「
x[0]打印出来会是什么,形状是几?」((参考时间: 00:21:07)) - 「同样一段代码我跑了两遍,
x.grad为什么从 12 变成 24?」((参考时间: 00:30:24)) - 「PyTorch 的 linear 层,输入尺寸和输出尺寸怎么写,能不能干脆拒绝算、直接让它报错、然后倒推?」((参考时间: 00:37:01))
② 编者预判的读者疑问(编者预判,未必在课上被问到):
- 张量跟 NumPy 数组到底差在哪?为什么不能直接用 NumPy 写深度学习?
- 反向传播到底替我做了什么?为什么
requires_grad=True不是每个张量都开? - 为什么每次训练迭代都要
zero_grad()?不清零会怎样? nn.Linear到底在做矩阵乘法,还是做了别的什么事?view和reshape有什么区别?
本讲路线
内容顺序是:先「数据」再「梯度」再「模型」最后「训练」——先用一小节把张量当成「多了几个属性的 NumPy 数组」讲透;接着用一句话揭示 autograd 帮你省掉了什么;然后把 nn.Linear、激活函数、nn.Sequential 这些积木一块块搭起来,拼成一个 MLP;最后一口气把整个训练循环的五行代码跑通、看 loss 往下掉。中途还会涉及索引、归约、梯度累积这几个「看着简单、一上手就踩」的点,这些在后面的作业里都会反复出现。
编者说明:本讲不会推导任何公式,也不要求你手写反向传播。它的目标是让你认得这些 API、知道它们各自对应深度学习里的哪一步——真正的数学推导在课程讲义和后续作业中展开。
1. PyTorch 是什么,我们为什么要从张量讲起
(参考时间: 00:01:08) 讲者给出的 PyTorch 定位只有两条:
- 让张量的编写、操作、以及在 GPU 上的加速变得非常容易;
- 让「写神经网络」这件事变得简单——你可以直接调用现成的线性层、损失函数,再把它们按你想要的方式拼起来。
顺着这两条定位,它和 TensorFlow 一起被列为课上的两大主流框架;本书(以及这门课)只讲 PyTorch。
初学者第一个动作通常是:
import torch
import torch.nn as nn
这两个 import 会贯穿整节课:torch 提供张量和基础运算,torch.nn 提供神经网络需要用到的所有「积木」。
编者拓展|为什么是「张量」而不是「数组」 从语法上看,张量几乎就是 NumPy 的
ndarray:多维、支持切片、支持逐元素运算。真正的差异有三点: 1. 设备:张量可以放到 GPU 上(x.to("cuda")),而 NumPy 数组只能待在 CPU 内存里; 2. 自动求导:张量可以挂上requires_grad,让 PyTorch 在后台记录计算图; 3. 生态:几乎所有深度学习算子(卷积、注意力、LayerNorm …)都直接以张量为接口。深度学习之所以吃这几口饭,是因为矩阵乘法是它的主菜,而 GPU 做矩阵乘法比 CPU 快一个数量级。你在课后作业里会反复见到的
@、matmul、einsum,本质上都是在讨好 GPU。
2. 张量基础:从「列表的列表」到 torch.Tensor
(参考时间: 00:02:00) 讲者先从大家都熟的东西入手:一个二维的 Python list of lists。
data = [[1, 2, 3],
        [4, 5, 6]]

x_data = torch.tensor(data)
print(x_data)
tensor([[1, 2, 3],
        [4, 5, 6]])
torch.tensor(...) 接收你写出来的列表的列表,原样转成一个张量对象。形状和数据都不变——只是这个对象现在带上了很多 NumPy 数组没有的属性。
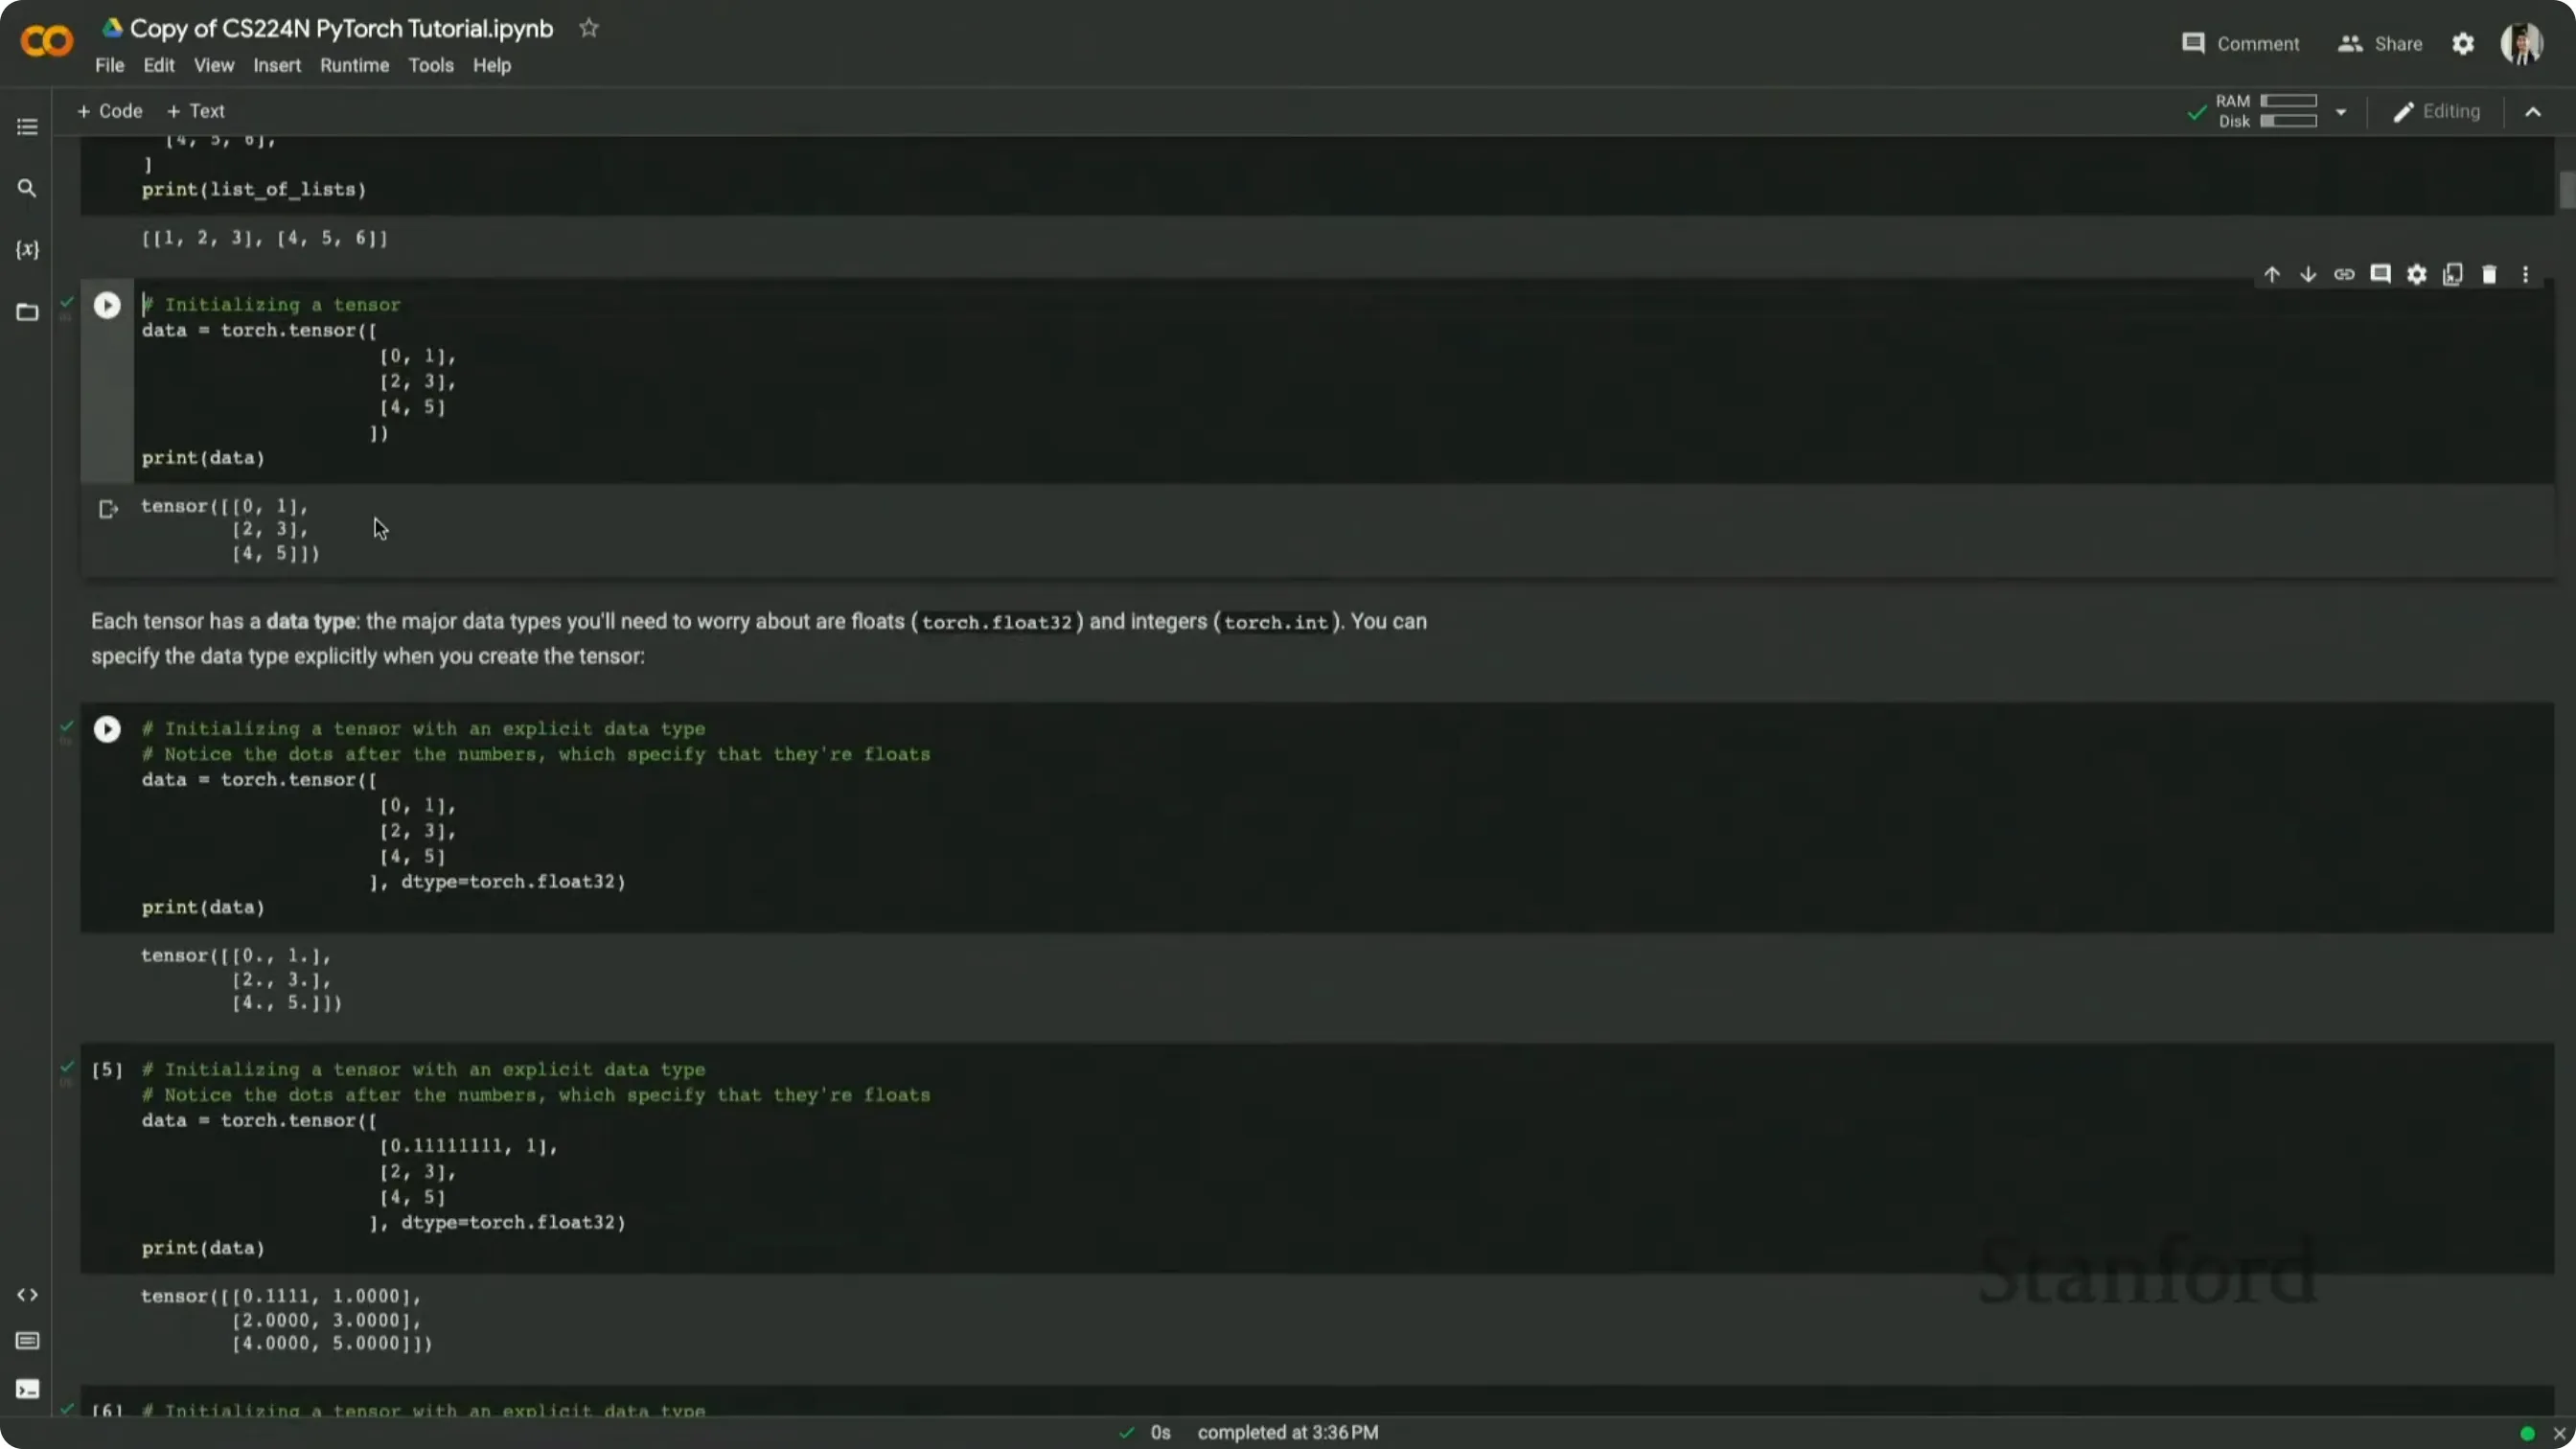
📷 用列表的列表构造张量
回到原视频 (00:03:43)
2.1 张量有「数据类型」
(参考时间: 00:04:04) 每个张量都带一个 dtype。你可以用 dtype= 参数显式指定,也可以交给 PyTorch 默认推断。
# 1) 显式指定为 float32
a = torch.tensor([[1, 2, 3], [4, 5, 6]], dtype=torch.float32)
print(a.dtype)   # torch.float32

# 2) 用浮点数初始化 -> 自动推断为浮点
b = torch.tensor([[1.0, 2.0, 3.0]])
print(b.dtype)   # torch.float32
即便写进去的是一堆整数,只要 dtype=torch.float32,打印出来就会带小数点——这表示它们已经是浮点数了。这是一个很容易被忽略、但在做损失/梯度时立刻会出问题的细节:混合精度、整数张量、CrossEntropyLoss 对 label 的 dtype 要求,都和这个属性直接相关。
2.2 常用的「一次性构造」
(参考时间: 00:05:27) 每次手写一长串数字太烦,PyTorch 提供了一批快速构造的工具:
| 代码 | 作用 |
|---|---|
torch.zeros(3, 4) |
3×4 的全零张量 |
torch.ones(3, 4) |
3×4 的全一张量 |
torch.arange(1, 11) |
1 到 10 的等差张量 |
zeros = torch.zeros(3, 4)
ones  = torch.ones(3, 4)
rng   = torch.arange(1, 11)          # [1, 2, ..., 10]
rng   = rng.reshape(2, 5)             # 也可拉成 2×5
讲者原话大意((参考时间: 00:05:48)):作业里经常需要「先造一个零矩阵占位,再往里填东西」,这种工具能省掉很多显式写元素的麻烦。
2.3 形状:你最好的调试工具
(参考时间: 00:11:19) 讲者在这里下了一个贯穿全讲的判断:
打印张量的 shape,几乎是你调试时最可靠的手段——它比 PyTorch 抛出的报错还可靠,因为 PyTorch 在底层会为了效率偷偷 reshape 张量,报错信息里出现的形状可能不是你代码里写的那个。
x = torch.tensor([1.0, 2.0, 3.0])
print(x.size())        # torch.Size([3])

x3 = torch.zeros(3, 2, 4)
print(x3.shape)        # torch.Size([3, 2, 4])
这里的 (3, 2, 4) 分别对应「第 0 维、第 1 维、第 2 维」的大小。只要你能在脑中把这一串数字跟你期望的语义对上,你就能判断下一步操作合不合法。
编者拓展|从「一张图」到「一个四维张量」 上节课已用图像做过例子,这里再说明这套视觉直觉: - 一张 256×256 灰度图 → 张量形状
(256, 256)- 加上 RGB 三通道 →(256, 256, 3)(不一定是 PyTorch 的通道顺序) - 把 32 张这样的图组成一个 batch →(32, 256, 256, 3)- PyTorch 的约定把通道维提到前面 →(32, 3, 256, 256)同一批数据,只是换了一下通道维的位置。这个约定非常重要:一旦搞反了,
nn.Conv2d会报形状错误,而报错里给出的形状又会被内部 reshape 遮掩,让查错变得困难。
3. 张量操作:从逐元素运算到切片
3.1 逐元素运算与广播
(参考时间: 00:06:48) 最简单的操作是逐元素(element-wise):+ - * / 默认就是每个元素各自算各自的。
x = torch.tensor([[1.0, 2.0], [3.0, 4.0]])
print(x + 2)      # 每个元素 +2
print(x * 2)      # 每个元素 *2
接下来是广播(broadcasting)。其语义可概括为:PyTorch 的广播语义和 NumPy 完全一致。规则是:
把两个张量的维度从末尾开始对齐,缺失的高位用 1 补(left pad with ones),然后逐维比较: - 相等 ✔ - 其中一个是 1 ✔(这个 1 会被「复制」成另一个张量的形状) - 其它情况 ✘ 报错
举例:(3, 1) 和 (1, 4) 广播,结果形状是 (3, 4):
a = torch.tensor([[1], [2], [3]])        # (3, 1)
b = torch.tensor([[10, 20, 30, 40]])     # (1, 4)
print((a + b).shape)   # torch.Size([3, 4])
编者说明:讲者在 (参考时间: 00:07:35) 顺带提到「我不知道 PyTorch 怎么造一个不等长的张量」,并给出了正确做法——不同长度的句子先做 padding,补齐到同一长度再训。原因是:所有张量运算都建立在「固定形状」的假设之上,PyTorch 官方至今也没有提供一个像样的「规则张量 / ragged tensor」标准容器。你在处理变长序列时,通常的解法是 padding +
attention_mask。
3.2 矩阵乘法与批处理
(参考时间: 00:08:59) 张量之间真正有用的乘法是 matmul(矩阵乘法)。讲者先抛出一个问题:3×2 乘 2×4 得什么?答案是 3×4——中间那个 2 咬掉,剩下两边。
A = torch.randn(3, 2)
B = torch.randn(2, 4)

C = torch.matmul(A, B)   # 也可以写成 A @ B
print(C.shape)           # torch.Size([3, 4])
批处理(batching) 是 matmul 的杀手级特性:如果两个张量前面还有 batch 维,那些维度会「像广播一样」自动对齐,而 matmul 只作用在最后两维上:
A = torch.randn(8, 3, 2)   # batch=8, 3x2
B = torch.randn(8, 2, 4)   # batch=8, 2x4
C = A @ B
print(C.shape)             # torch.Size([8, 3, 4])
讲者举了一个更极端的例子((参考时间: 00:10:04)):如果 A 是 (batch, M, 1)、B 是 (batch, 1, N),那么它们的「批内矩阵乘」结果就是 (batch, M, N)——这正是做批量的外积。
编者说明:讲者自己承认在 (参考时间: 00:11:01) 「我一般是直接乘、报错了再打 shape 倒推」——这不是坏习惯,是工程上省时间的做法。真正需要精确推理的,是把一批张量串联成复杂模型的时候;而那种情况正好落在他前面说的「多打 shape」那条建议里。
3.3 归约(reduction):collapse 维度
(参考时间: 00:15:27) 讲者用「张量沿某一维塌缩」来理解归约类操作——这是后面一整节的关键直觉。
先造一个 5×7 的张量,然后对它求和:
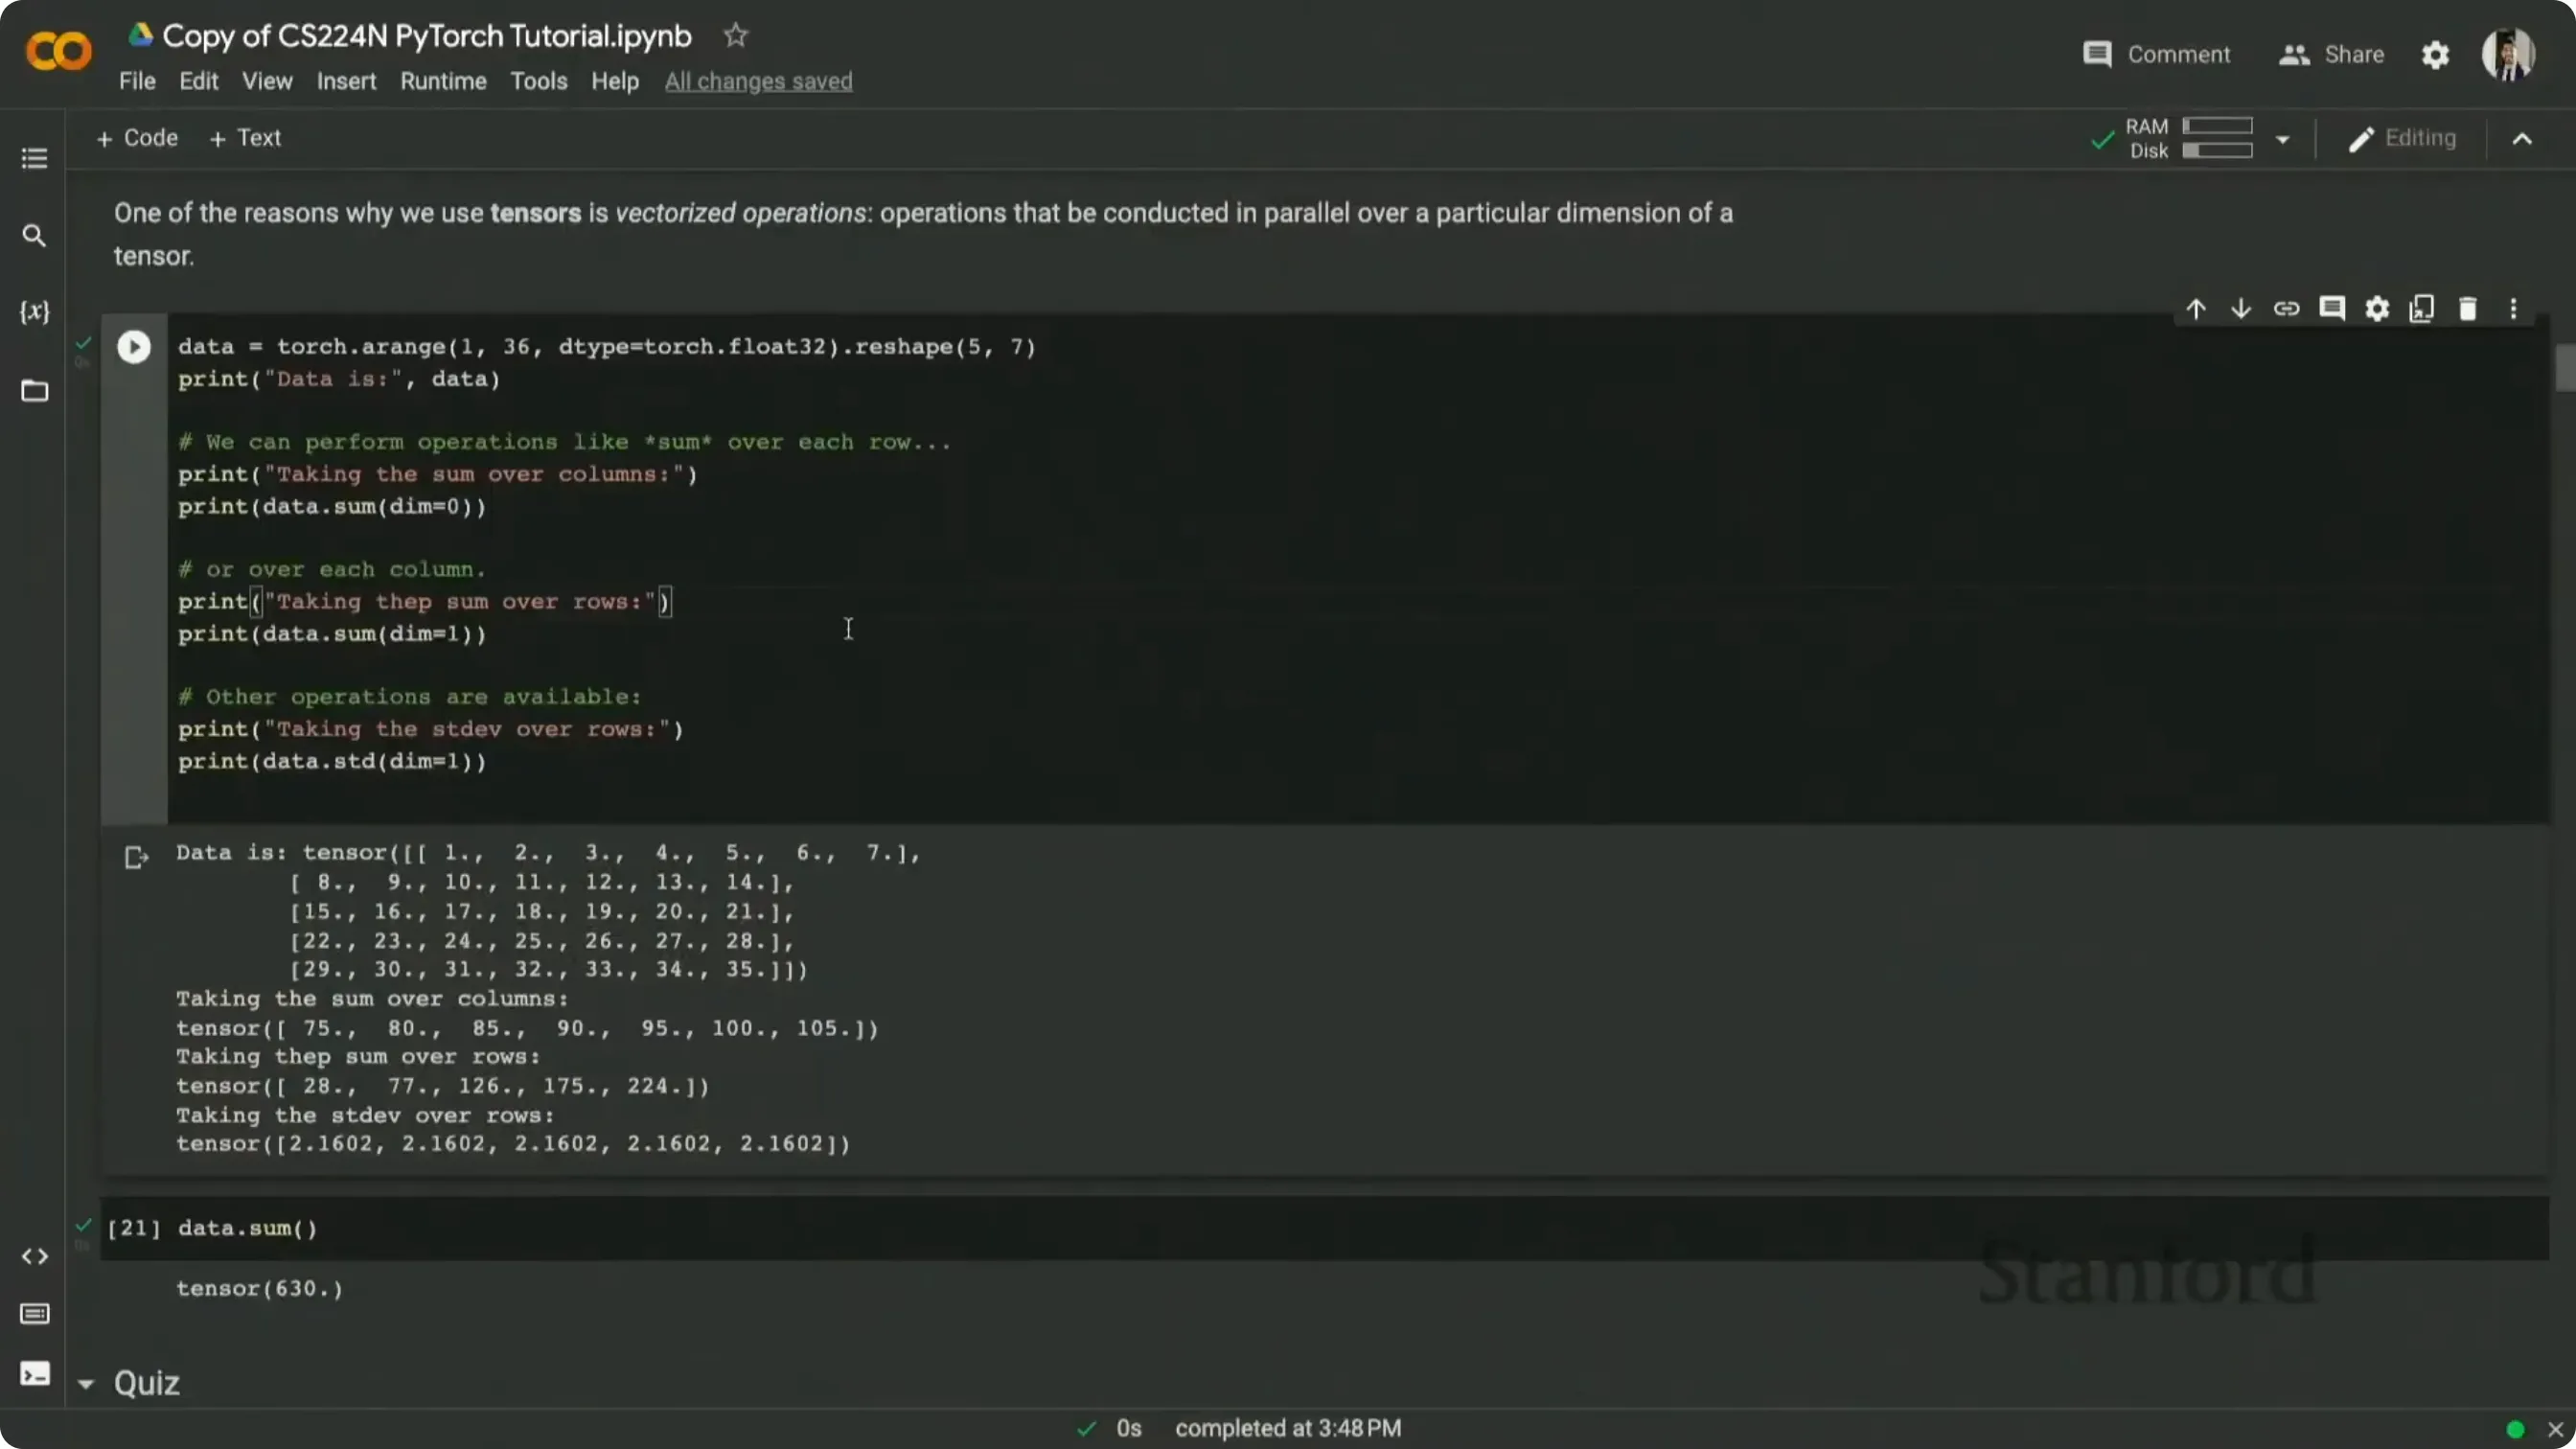
📷 5×7 张量上的归约操作
回到原视频 (00:15:27)
data = torch.arange(1, 36, dtype=torch.float).reshape(5, 7)

total = data.sum()                 # 全部元素相加,得到标量
print(total)                       # tensor(630.)

col_sum = data.sum(dim=0)          # 沿第 0 维塌缩
print(col_sum.shape)               # torch.Size([7])
print(col_sum)                     # tensor([ 75.,  80.,  85.,  90.,  95., 100., 105.])
dim=0 的意思是「第 0 维不被保留」,所以形状从 (5, 7) 变成 (7,)——恰好对应「求每一列的和」。反过来 dim=1 就得到 5 个值,是每一行的和。
讲者在 (参考时间: 00:16:49) 给了一个非常好用的记忆法:
「你在
dim里写的那个维度,就是这个操作会被塌掉的维度。」
这比记「行还是列」清晰多了——尤其当张量变成 3 维、4 维时,「行」和「列」这种说法会彻底崩掉。
sum 只是代表;std、mean、max、normalize 之类的操作都有相同的 dim= 语义。不传 dim= 时,默认对整个张量操作,返回一个标量。
3.4 一个「选择题」:到底在哪一维上求平均?
(参考时间: 00:18:47) 讲到这,讲者抛出一个「quiz」(他说其实是带着答案的题):
- 想求每一行的平均值(保留 5 个值)→ 要塌掉第 1 维 →
data.mean(dim=1) - 想求每一列的平均值(保留 7 个值)→ 要塌掉第 0 维 →
data.mean(dim=0)
print(data.mean(dim=1).shape)   # torch.Size([5])  —— 5 个行均值
print(data.mean(dim=0).shape)   # torch.Size([7])  —— 7 个列均值
检验方法还是那一条:先写出原始 shape,再减去 dim 指定的那一维,看结果对不对得上。用这种机械方法,即使你不确定代码在算「行」还是「列」,也能立刻自查。
3.5 索引与切片
(参考时间: 00:20:37) 讲者说「这一部分容易搞混」,但语义和 NumPy 几乎一样。直接上例子最清楚:
x = torch.arange(1, 13).reshape(3, 2, 2)
print(x.shape)          # torch.Size([3, 2, 2])
这个张量可以理解成「三个 2×2 的小块堆起来」:
块 0: [[1, 2], [3, 4]]
块 1: [[5, 6], [7, 8]]
块 2: [[9,10], [11,12]]
几个常见的切法:
print(x[0])             # tensor([[1,2],[3,4]])  -> shape (2,2)
print(x[:, 0])          # [[1,2],[5,6],[9,10]]   -> shape (3,2)
print(x[:, :, 0])       # [[1,3],[5,7],[9,11]]   -> shape (3,2)
print(x[:, 0, 0])       # tensor([1, 5, 9])
x[0] 里只给了一个下标,等价于 x[0, :, :]:没写的位置默认是冒号,即「这维全要」。所以 x[0] 是「第 0 维取第一个,其余两维全要」,得到 2×2。
x[:, 0, 0] 是「第 0 维全要、第 1 维取第 0 个、第 2 维取第 0 个」,也就是每个块左上角那个数:1, 5, 9。
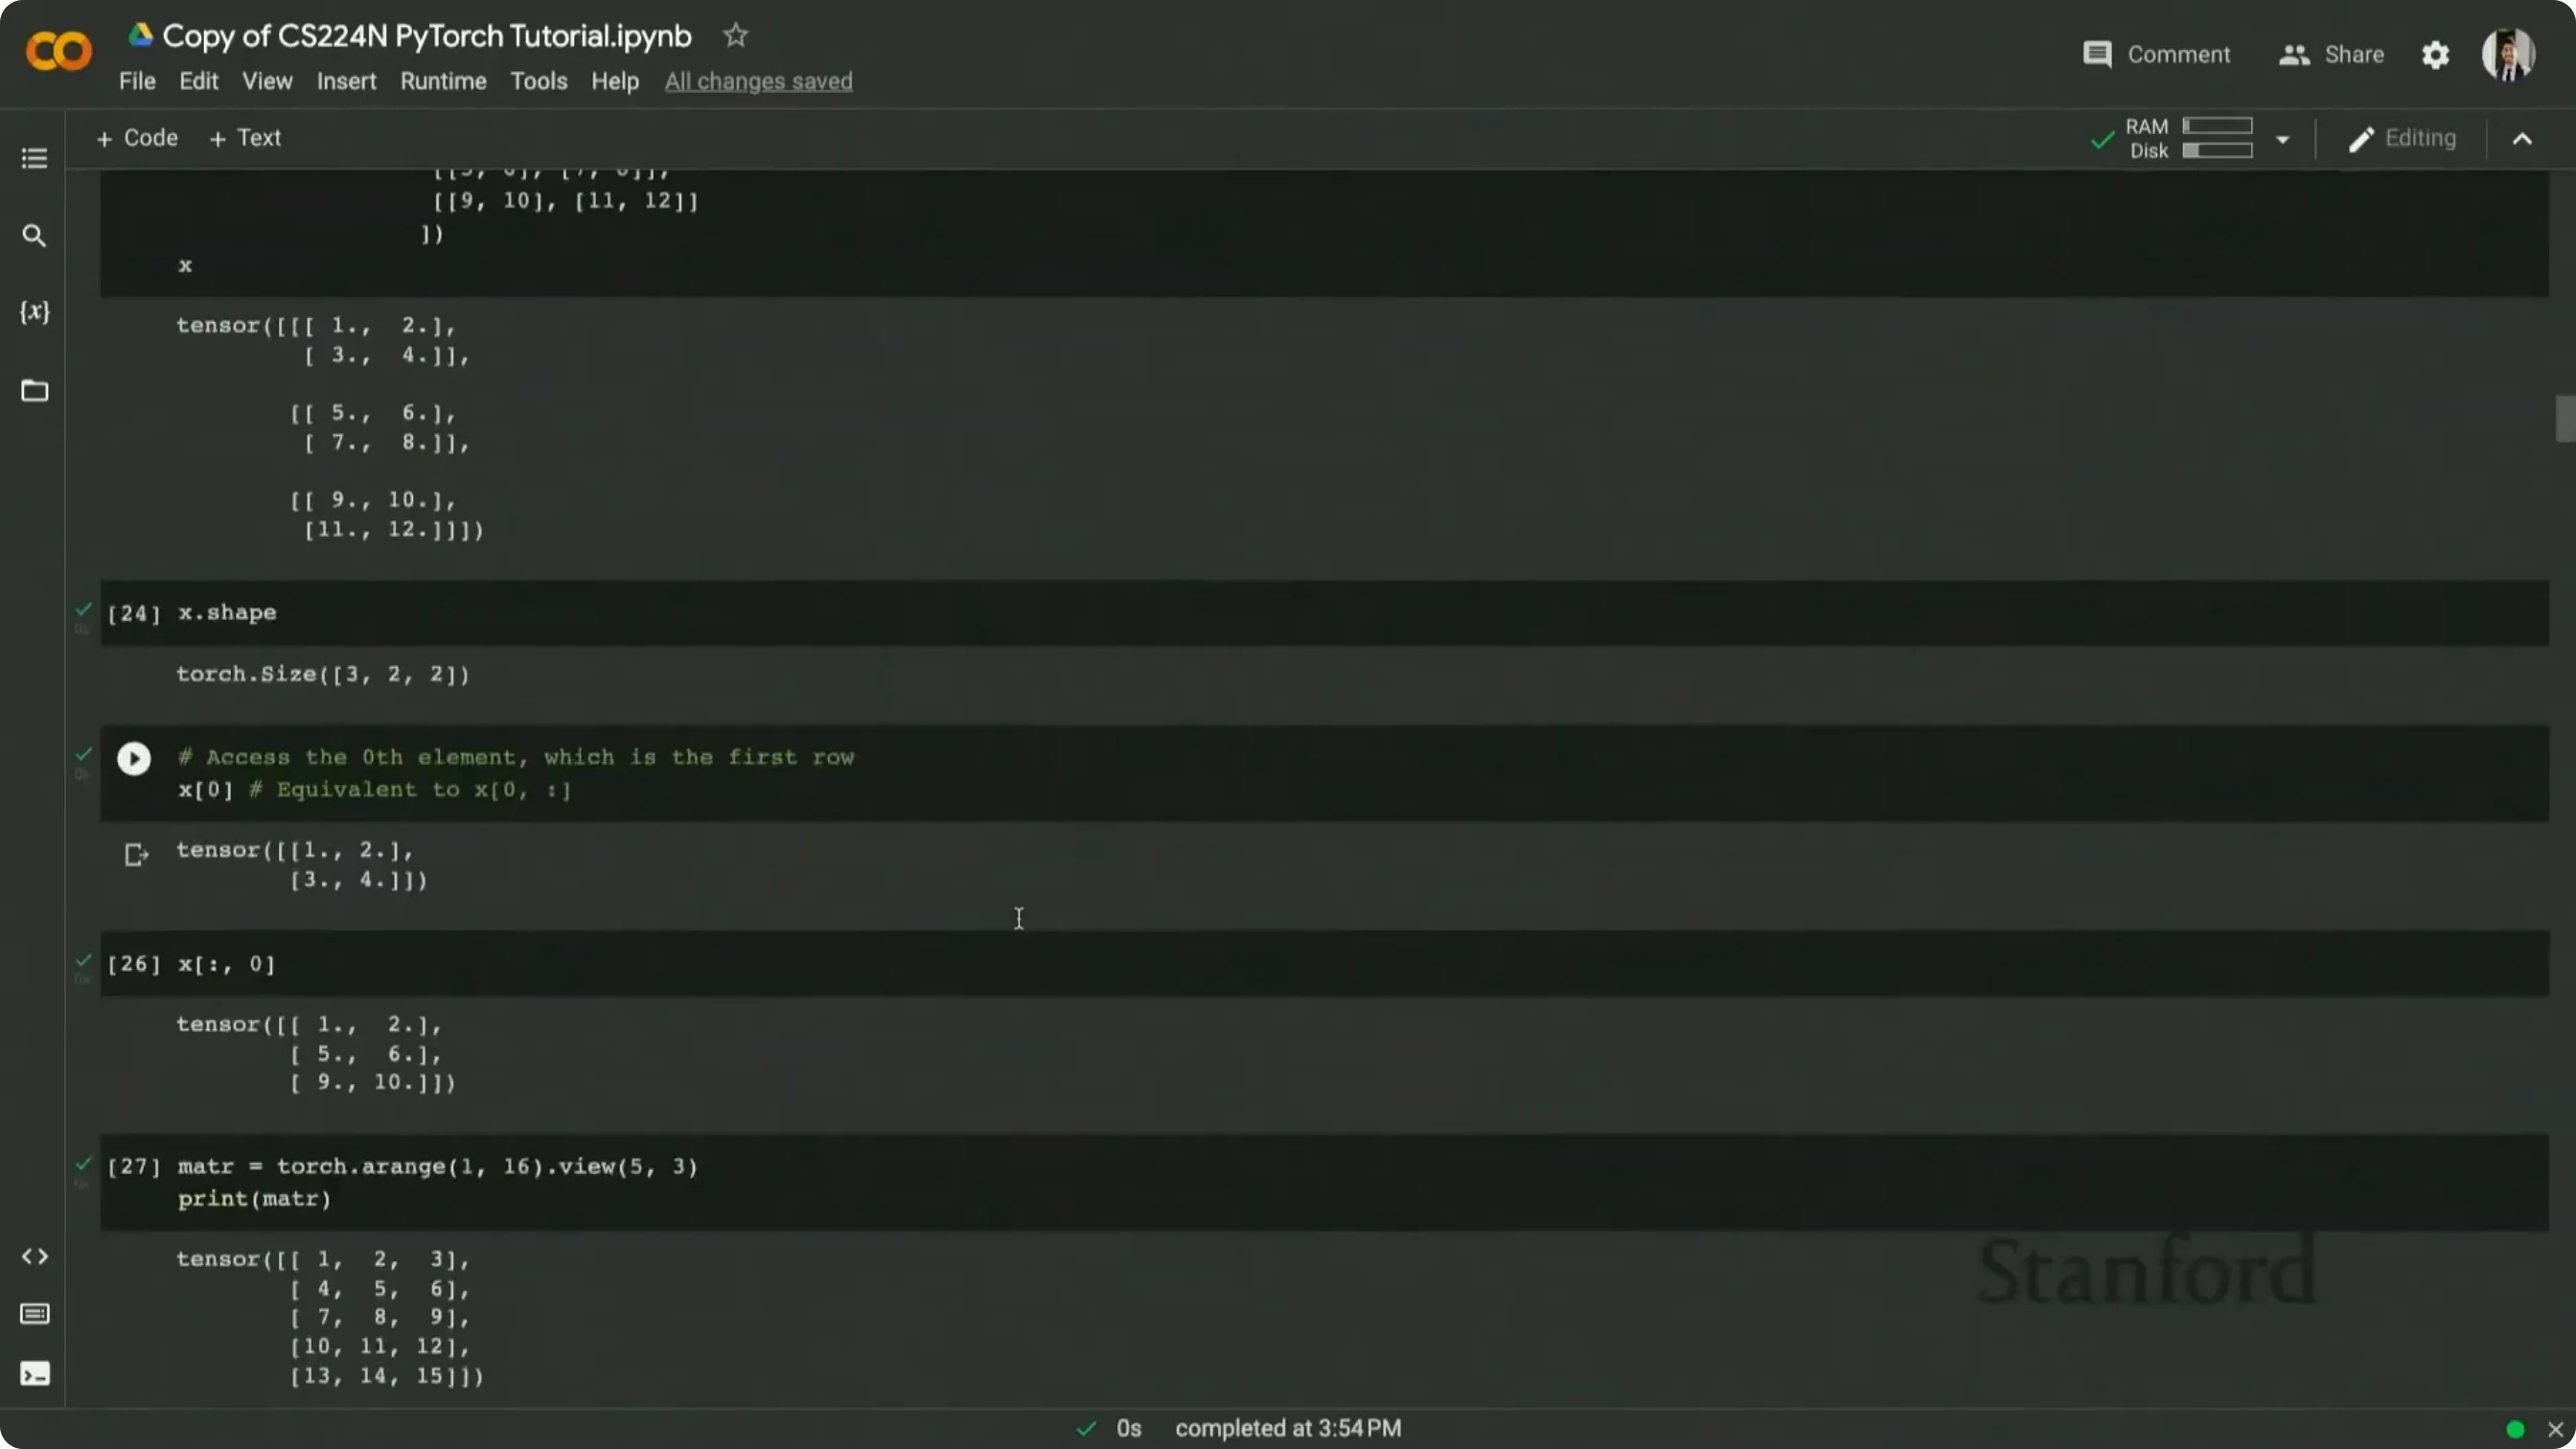
📷 3×2×2 张量上的多维索引
回到原视频 (00:20:37)
列表索引同样可用:想一次性拿第 0、2、4 行,直接传一个下标列表:
y = torch.arange(1, 16).reshape(5, 3)
print(y[[0, 2, 4]])     # 取出第 0、2、4 行
在动笔之前先打印 shape 的原因在于:3 维、4 维张量在没有具体形状的情况下,人脑是靠不住的。
3.6 视图、重塑、转置
(参考时间: 00:12:53) 为什么需要 reshape?因为训练一张图/一个句子的 batch,往往要把数据「折叠」成 batch 的形式:
z = torch.arange(1, 16)        # 15 个元素
z = z.reshape(5, 3)            # 变成 5×3
为什么不是 (15,) 的平铺形状?因为深度学习是「按 batch」训练的:你会把数据组织成「batch_size × 序列长度 × embedding 维度」这种结构。reshape 就是在这个「组织数据」的环节里最常用的工具。
view 和 reshape 的区别,讲者原话大意((参考时间: 00:14:42)):
view只是在原张量的底层存储上换了个视角,不会修改底层张量;reshape会修改张量的形状。编者说明:这里的「修改」措辞比较口语。更准确的说法是:两者返回的都是新张量;
view要求原张量在内存中连续,否则直接报错;reshape在可能的情况下也返回视图(共享底层存储),在不得不复制时则返回拷贝。确认后续不会修改原张量时,view更省内存;不确定时,reshape可以避开连续性限制。
还有 transpose——交换两个维度。比如把 (batch, seq, dim) 变成 (batch, dim, seq);再比如把 (C, H, W) 和 (H, W, C) 互换,这是在用别人的数据(如 PIL 读图)与 PyTorch 之间的必备环节:
img = torch.randn(3, 256, 256)          # (C, H, W)  PyTorch 约定
img = img.permute(1, 2, 0)              # (H, W, C)  给人看
3.7 与 NumPy 互转,以及「向量化」的收益
(参考时间: 00:14:46) 既然两者像成这样,PyTorch 当然给了直接转换的接口:
import numpy as np

arr = np.random.rand(3, 4)
t   = torch.from_numpy(arr)     # NumPy -> 张量
arr2 = t.numpy()                # 张量 -> NumPy(共享底层内存,需小心)
紧接着是一个看起来很基础的问题:既然有 NumPy,为什么还要张量?
答案有三层((参考时间: 00:15:12) 起):
- 向量化操作:PyTorch 把「一批数据上的同一操作」编译成高度优化的 kernel,可以批量执行、可以上 GPU。你写
x.sum(dim=0),它内部就是一次 vectorized 归约,而不是 Python 的for循环; - GPU:这是最关键的。神经网络里全是
matmul,CPU 和 GPU 的差距在这里是数量级的; - 生态:
nn.Linear、nn.Conv2d、nn.CrossEntropyLoss、optim.Adam……全都现成。用 NumPy 你得自己写这些,还得自己写反向传播和优化器。
编者说明:课讲到这里时顺带提到「你们现在这个作业里,有一部分就是要把 for 循环向量化」——这就是为什么前面铺垫了那么多
dim、reshape、索引。向量化不是可选技能,是作业里的硬要求。
4. 自动求导:autograd 替你做了什么
(参考时间: 00:27:03) 讲者把 autograd 称为 PyTorch 最酷的特性之一。它做的事情,用一句话概括:
你定义网络 = 你定义了一堆计算节点;前向时数据流过这些节点;PyTorch 在后台把这些节点的梯度信息记下来,等到你调用一次
.backward(),它按链式法则一次性算出所有梯度并缓存起来。
也就是说,你不需要手写: - 每个算子的反向公式; - 链式法则的展开; - 梯度的缓存与累加。
你只需要:
loss.backward()
一个调用,把这一整套都交出去。
graph LR
    x["x = 2.0<br/>requires_grad=True"] --> sq["x * x = 4"]
    sq --> y["y = 3 * x² = 12"]
    y -.->|".backward()"| g["x.grad = dy/dx = 6x = 12"]
    g --> step["optimizer.step()<br/>按梯度更新参数"]
4.1 requires_grad:为什么需要这个开关
(参考时间: 00:28:29) 新建张量时 requires_grad 的默认值是 False;把它设成 True,PyTorch 就会开始给这个张量记录梯度。
为什么要这个开关?讲者的原话解释((参考时间: 00:28:59)):
- 训练时:你需要梯度来更新参数,所以要开;
- 推理(inference)时:网络不再更新,梯度一点意义都没有,反而白白占显存、白白算一遍——所以要关。
编者拓展|在推理时关掉梯度 关法有两种: - 整个
with块:with torch.no_grad(): preds = model(x)- 临时切换:torch.set_grad_enabled(False)这是生产部署里最基础的一条性能优化——
no_grad()能省下大量显存和计算。它也是后面作业里要求你必须用在 eval 阶段的东西。
4.2 一个最小的求导例子
(参考时间: 00:29:09) 讲者用一个最简单的函数把 autograd 跑了一遍:
$$y = 3x^2,\qquad \frac{dy}{dx} = 6x$$
当 $x=2$ 时,梯度应该是 $6 \times 2 = 12$。
x = torch.tensor([2.0], requires_grad=True)
y = 3 * x ** 2
y.backward()
print(x.grad)       # tensor([12.])
结果正好是 12。这里 x.grad 就是 autograd 帮你算出来、缓存下来的梯度。
4.3 梯度累积:反直觉,但是默认行为
(参考时间: 00:30:24) 讲者又写了一行 z = 3 * x ** 2,再调一次 z.backward(),然后打印 x.grad——结果是 24,而不是 12。
原因:PyTorch 的 .grad 是累积(accumulate)的,不是覆盖(overwrite)的。两次 backward() 各贡献 12,加起来就是 24。
x = torch.tensor([2.0], requires_grad=True)
(3 * x ** 2).backward()
print(x.grad)       # tensor([12.])
(3 * x ** 2).backward()
print(x.grad)       # tensor([24.])  ← 累积了
这不是 bug,这是为了训练设计的:一个 batch 里有很多样本,每一个样本都会贡献一点梯度,你希望它们加起来形成一次更新,而不是每来一个样本就覆盖掉上一个的贡献。
推论:每次训练迭代开始前,必须把梯度清零,否则上一个 batch 的贡献会「泄漏」到这一个 batch 里。这就是后面训练循环里 optimizer.zero_grad() 的由来。
编者说明:讲者在 (参考时间: 00:34:04) 描述得更具体——
.grad是另一个和x同形状的张量,每一次「某个量对 x 的梯度非零」的backward()都会往里加一份。所以你在调试时如果看到梯度是 12 的倍数,先怀疑自己忘了清零,别怀疑梯度公式。
5. 神经网络:用现成的积木拼一个 MLP
(参考时间: 00:34:38) 有了张量、有了 autograd,最后一块拼图就是 torch.nn——所有的网络层、损失函数都在这。
5.1 nn.Linear:本质上是一次仿射变换
(参考时间: 00:35:24) 一个 linear 层只需要两个参数:
linear = nn.Linear(in_features=4, out_features=2)
语义是:把输入的最后一维从 4 映射到 2,前面所有维原样保留。例如:
x = torch.randn(2, 3, 4)          # (2, 3, 4)
linear = nn.Linear(4, 2)
y = linear(x)
print(y.shape)                    # torch.Size([2, 3, 2])
「批维」的直觉需要再次说明:第一维 2 是批量大小(batch size),中间可能还有序列长度、时间步等等任意多的维,只有最后那一维会被 nn.Linear 变换。
底层它做的是一次仿射变换(即 "essentially just performing a simple ax plus b"):
$$\mathbf{y} = \mathbf{x}\mathbf{W}^\top + \mathbf{b}$$
其中 $\mathbf{W}$ 形状是 $(\text{out}, \text{in})$,$\mathbf{b}$ 形状是 $(\text{out},)$。传 bias=False 就退化成纯线性 $\mathbf{x}\mathbf{W}^\top$。
5.2 一个「报错 → 倒推」的小插曲
(参考时间: 00:37:01) 讲者演示了一个常见的失误:故意把 in_features 写错。
x = torch.randn(2, 3, 4)
linear = nn.Linear(2, 2)          # 故意把 in 写成 2(应该是 4)
y = linear(x)                     # 报错!
报错信息给出的形状是 6 x 4 和 2 x 2——注意看,6 x 4 并不是你写的 2 x 3 x 4。PyTorch 内部把它折叠成了 (2*3) x 4 = 6 x 4,所以你看报错时容易发懵。
与其盯着报错信息猜,直接 print(x.shape) 能一眼看出最后一维是 4,据此把 in_features 改成 4 即可。
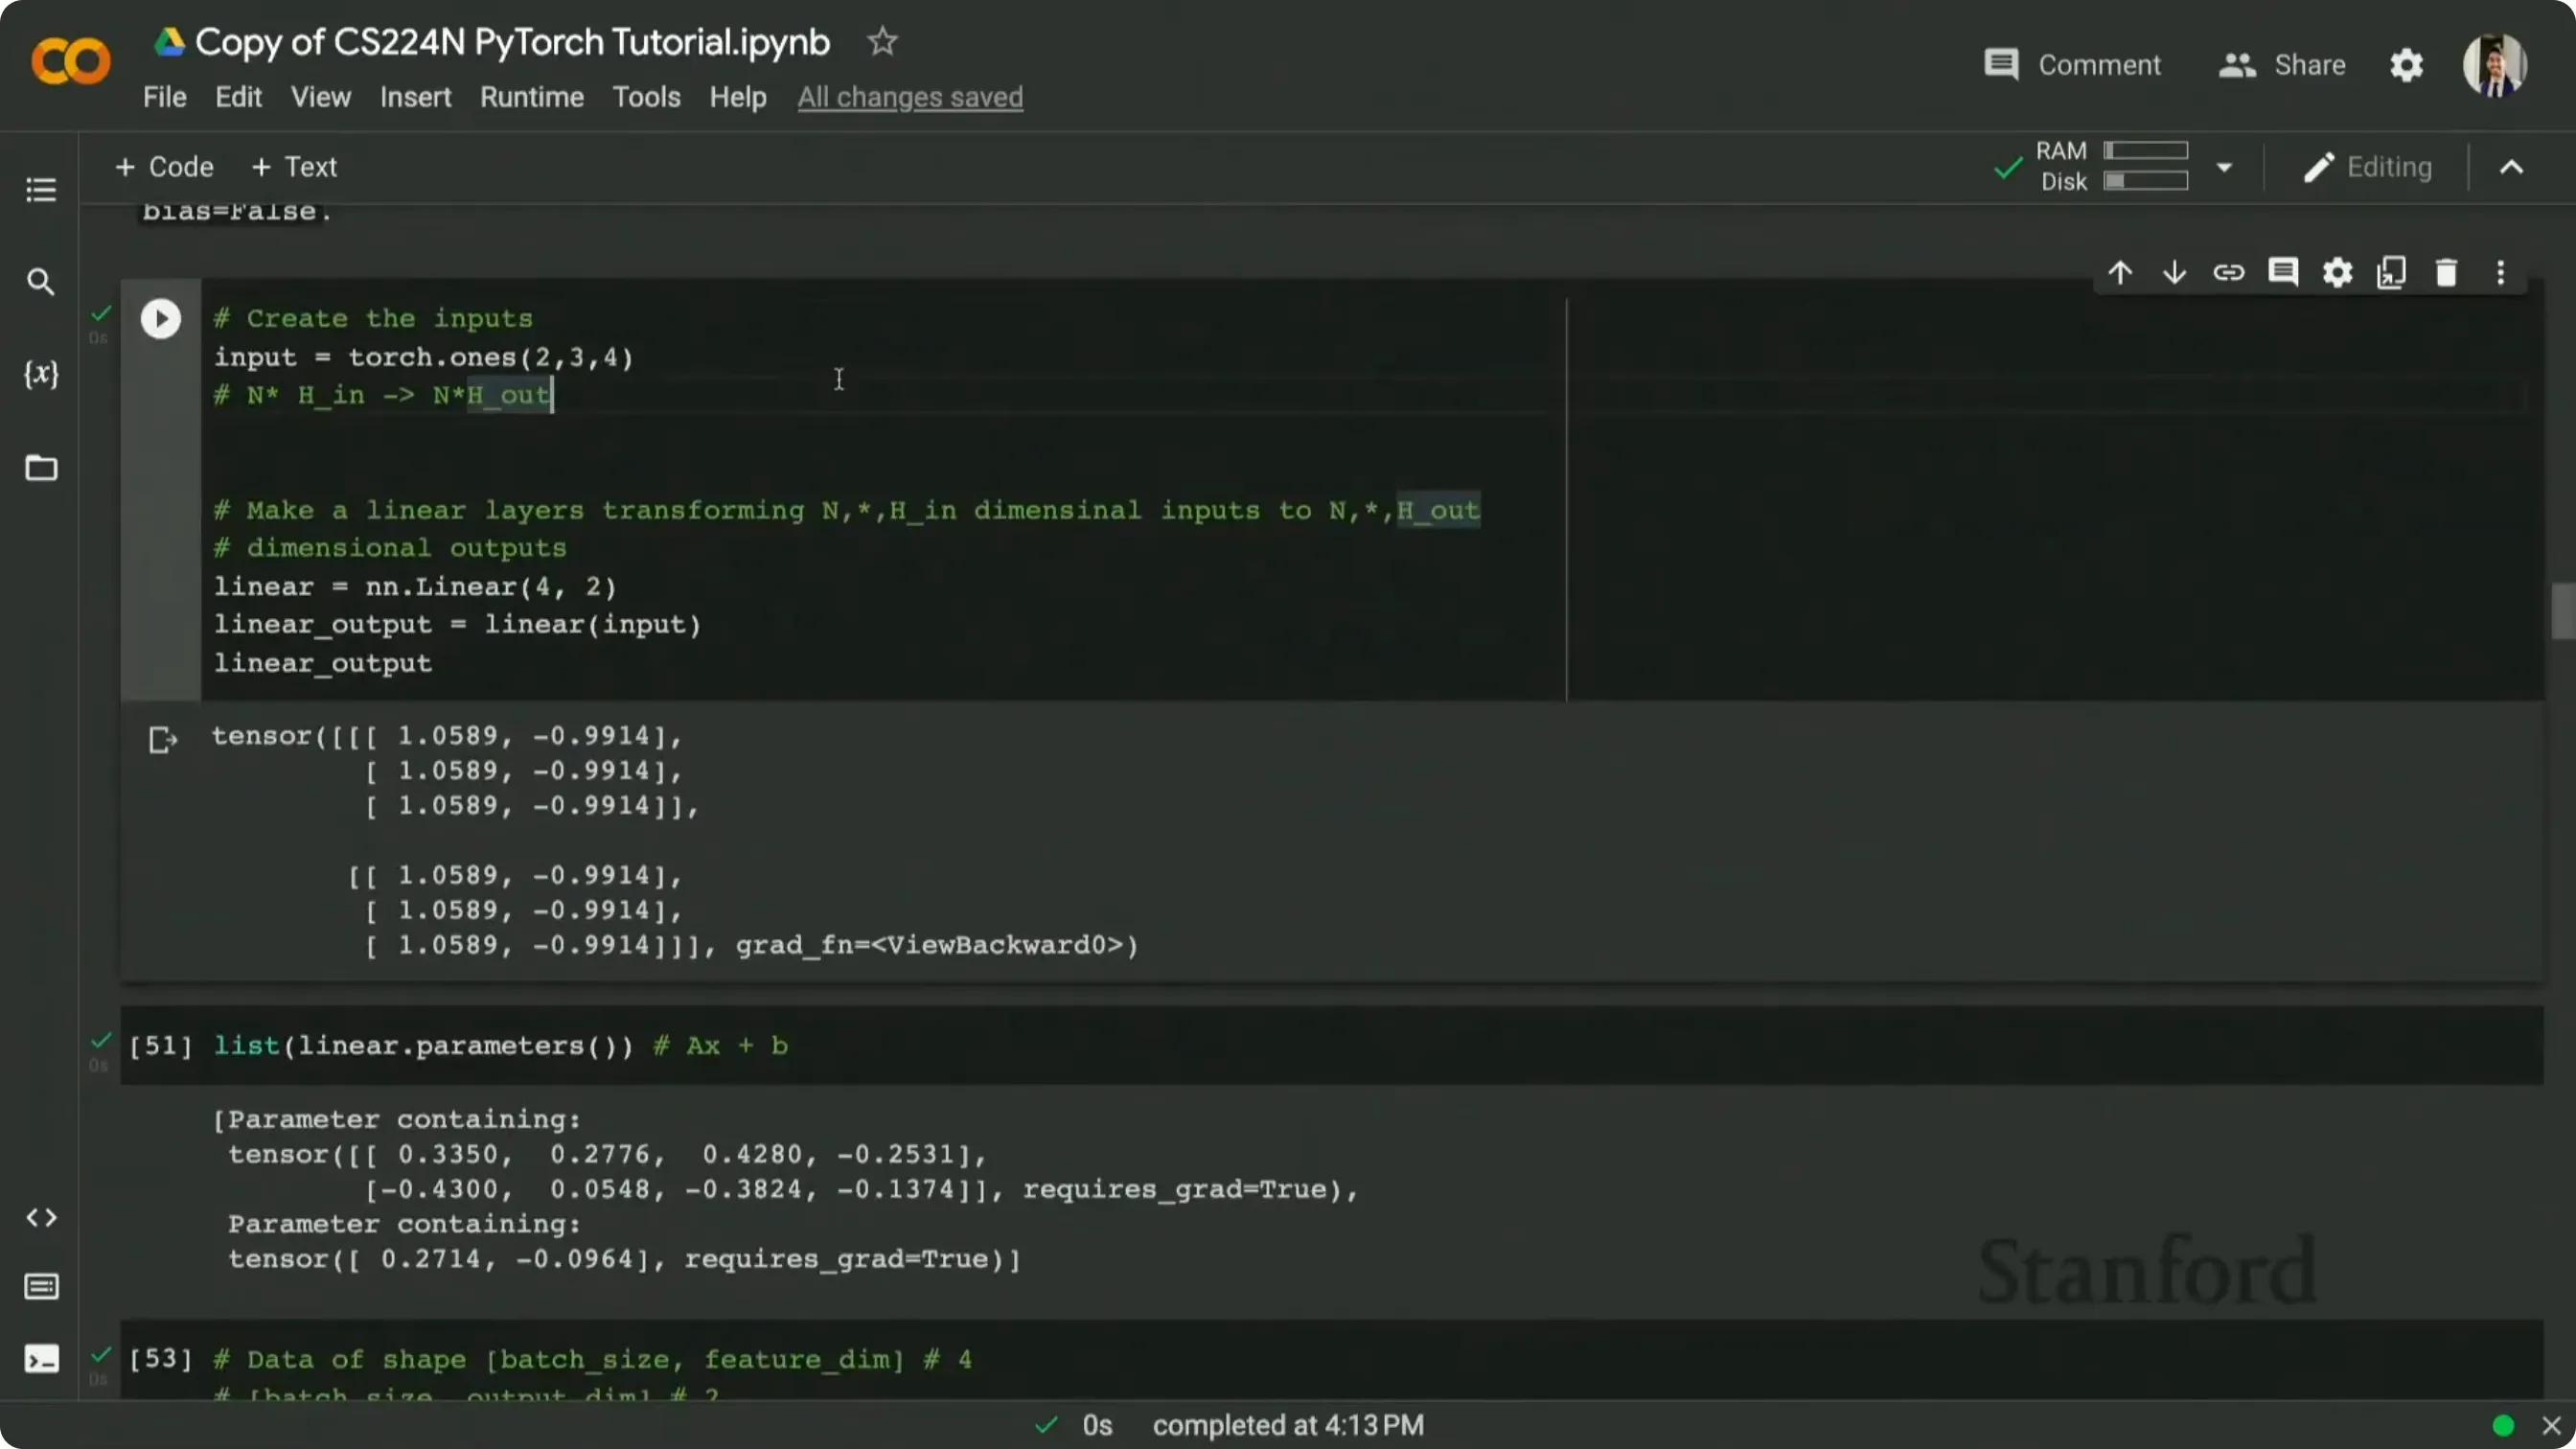
📷 linear 层的输入输出与报错倒推
回到原视频 (00:36:17)
5.3 看看模型里到底存了什么
(参考时间: 00:39:44) 一个 Linear 层里其实存了两组参数:
linear = nn.Linear(4, 2)
for name, p in linear.named_parameters():
    print(name, p.shape)
weight torch.Size([2, 4])
bias   torch.Size([2])
两份都带 .grad 属性(初始为 None,第一次 backward() 之后才会填上)。训练的过程,本质上就是不断让 .grad 里累积的数值去推动 weight 和 bias 一点点向最优值移动。
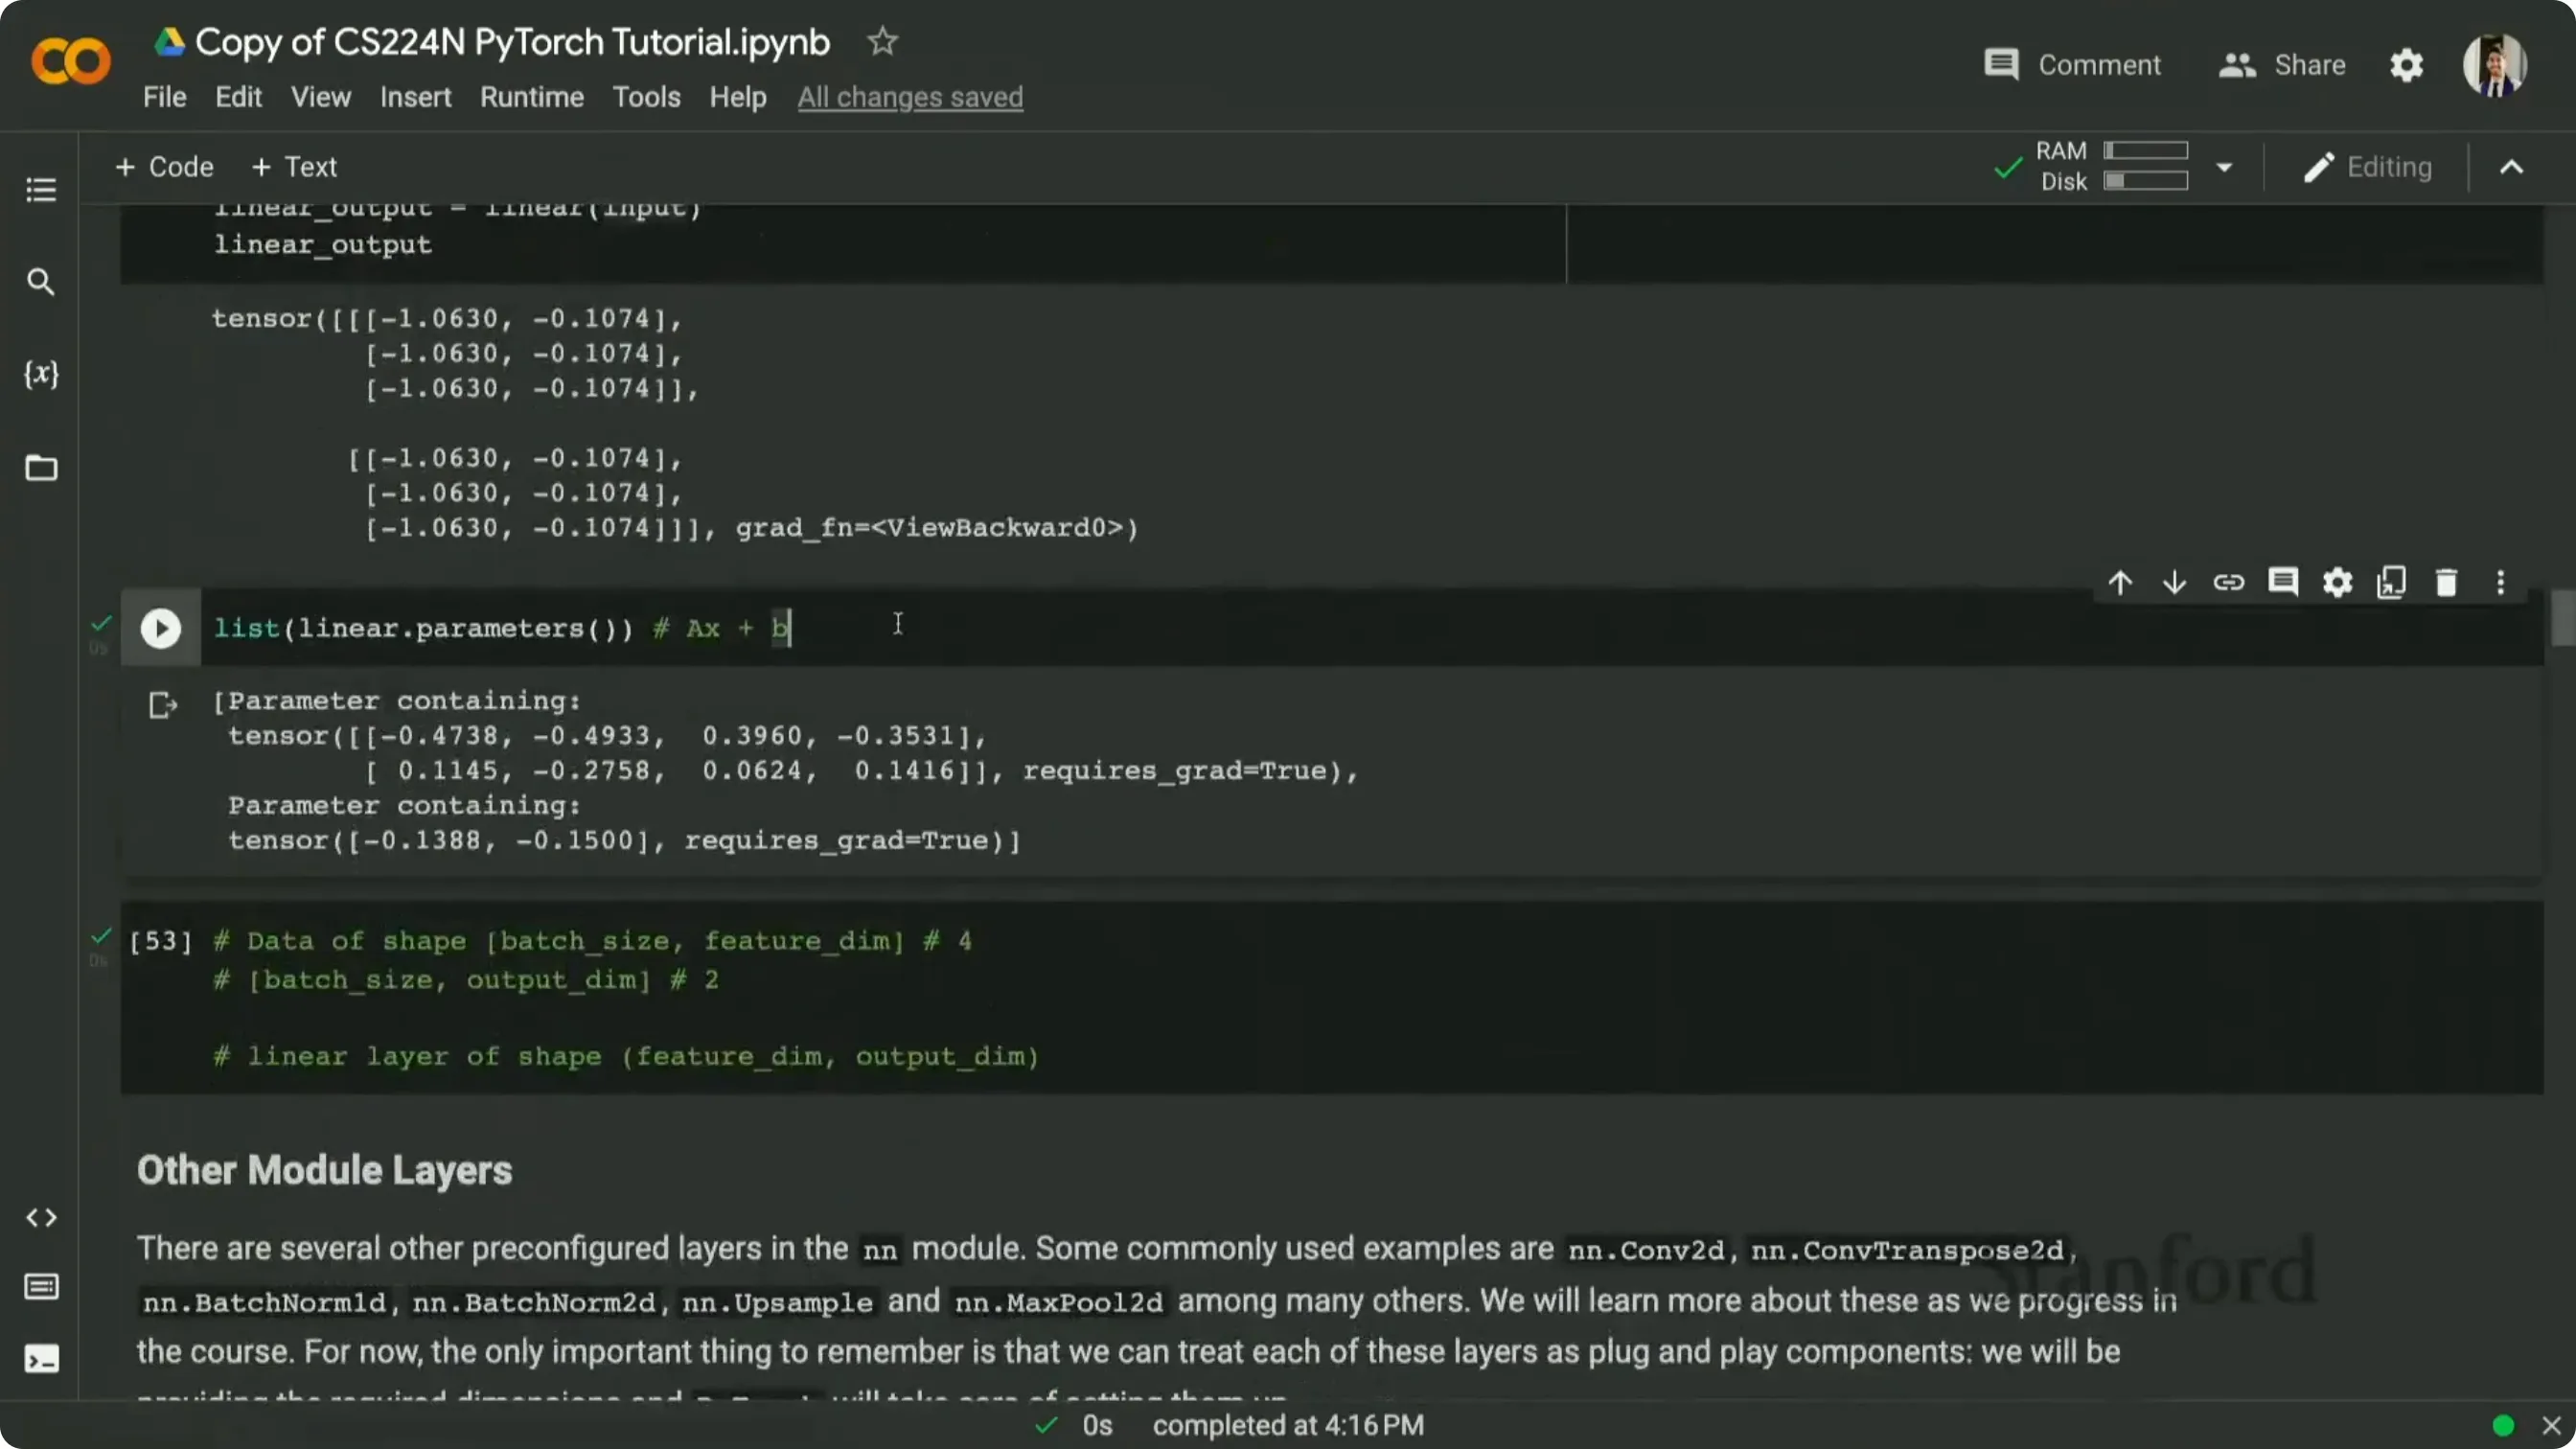
📷 打印模型参数,查看 weight 和 bias
回到原视频 (00:39:44)
5.4 其他常用层
(参考时间: 00:40:24) 讲者用一句话带过了一堆同门师兄弟(用法和 nn.Linear 一样,都是「实例化 → 调用」):
nn.Conv2d:二维卷积nn.ConvTranspose2d:转置卷积nn.BatchNorm2d:批归一化nn.Upsample:上采样nn.MaxPool2d:最大池化- …… 以及官方文档里的一长串
关键点是一致的:它们都是「内置的积木」,你只要 nn.Xxx(...) 实例化、像函数一样调它,就完成了一次前向。
5.5 激活函数与 nn.Sequential:把积木叠起来
(参考时间: 00:41:11) 神经网络之所以叫「非线性」,靠的就是激活函数。讲者现场用的是 sigmoid(nn.Sigmoid()),但作者说明:ReLU、GELU、Tanh 都是同类。
想按顺序叠两个层,最直观的写法是这样:
layer1 = nn.Linear(4, 8)
act    = nn.Sigmoid()
但它每次都要手动写两行调用。PyTorch 提供了 nn.Sequential 把一串层组合成一个模块:
block = nn.Sequential(
    nn.Linear(4, 8),
    nn.Sigmoid(),
)
out = block(x)     # 一次调用,内部按顺序全部执行
这就是「把接下来的操作全部塞进去、只调一次」的写法。
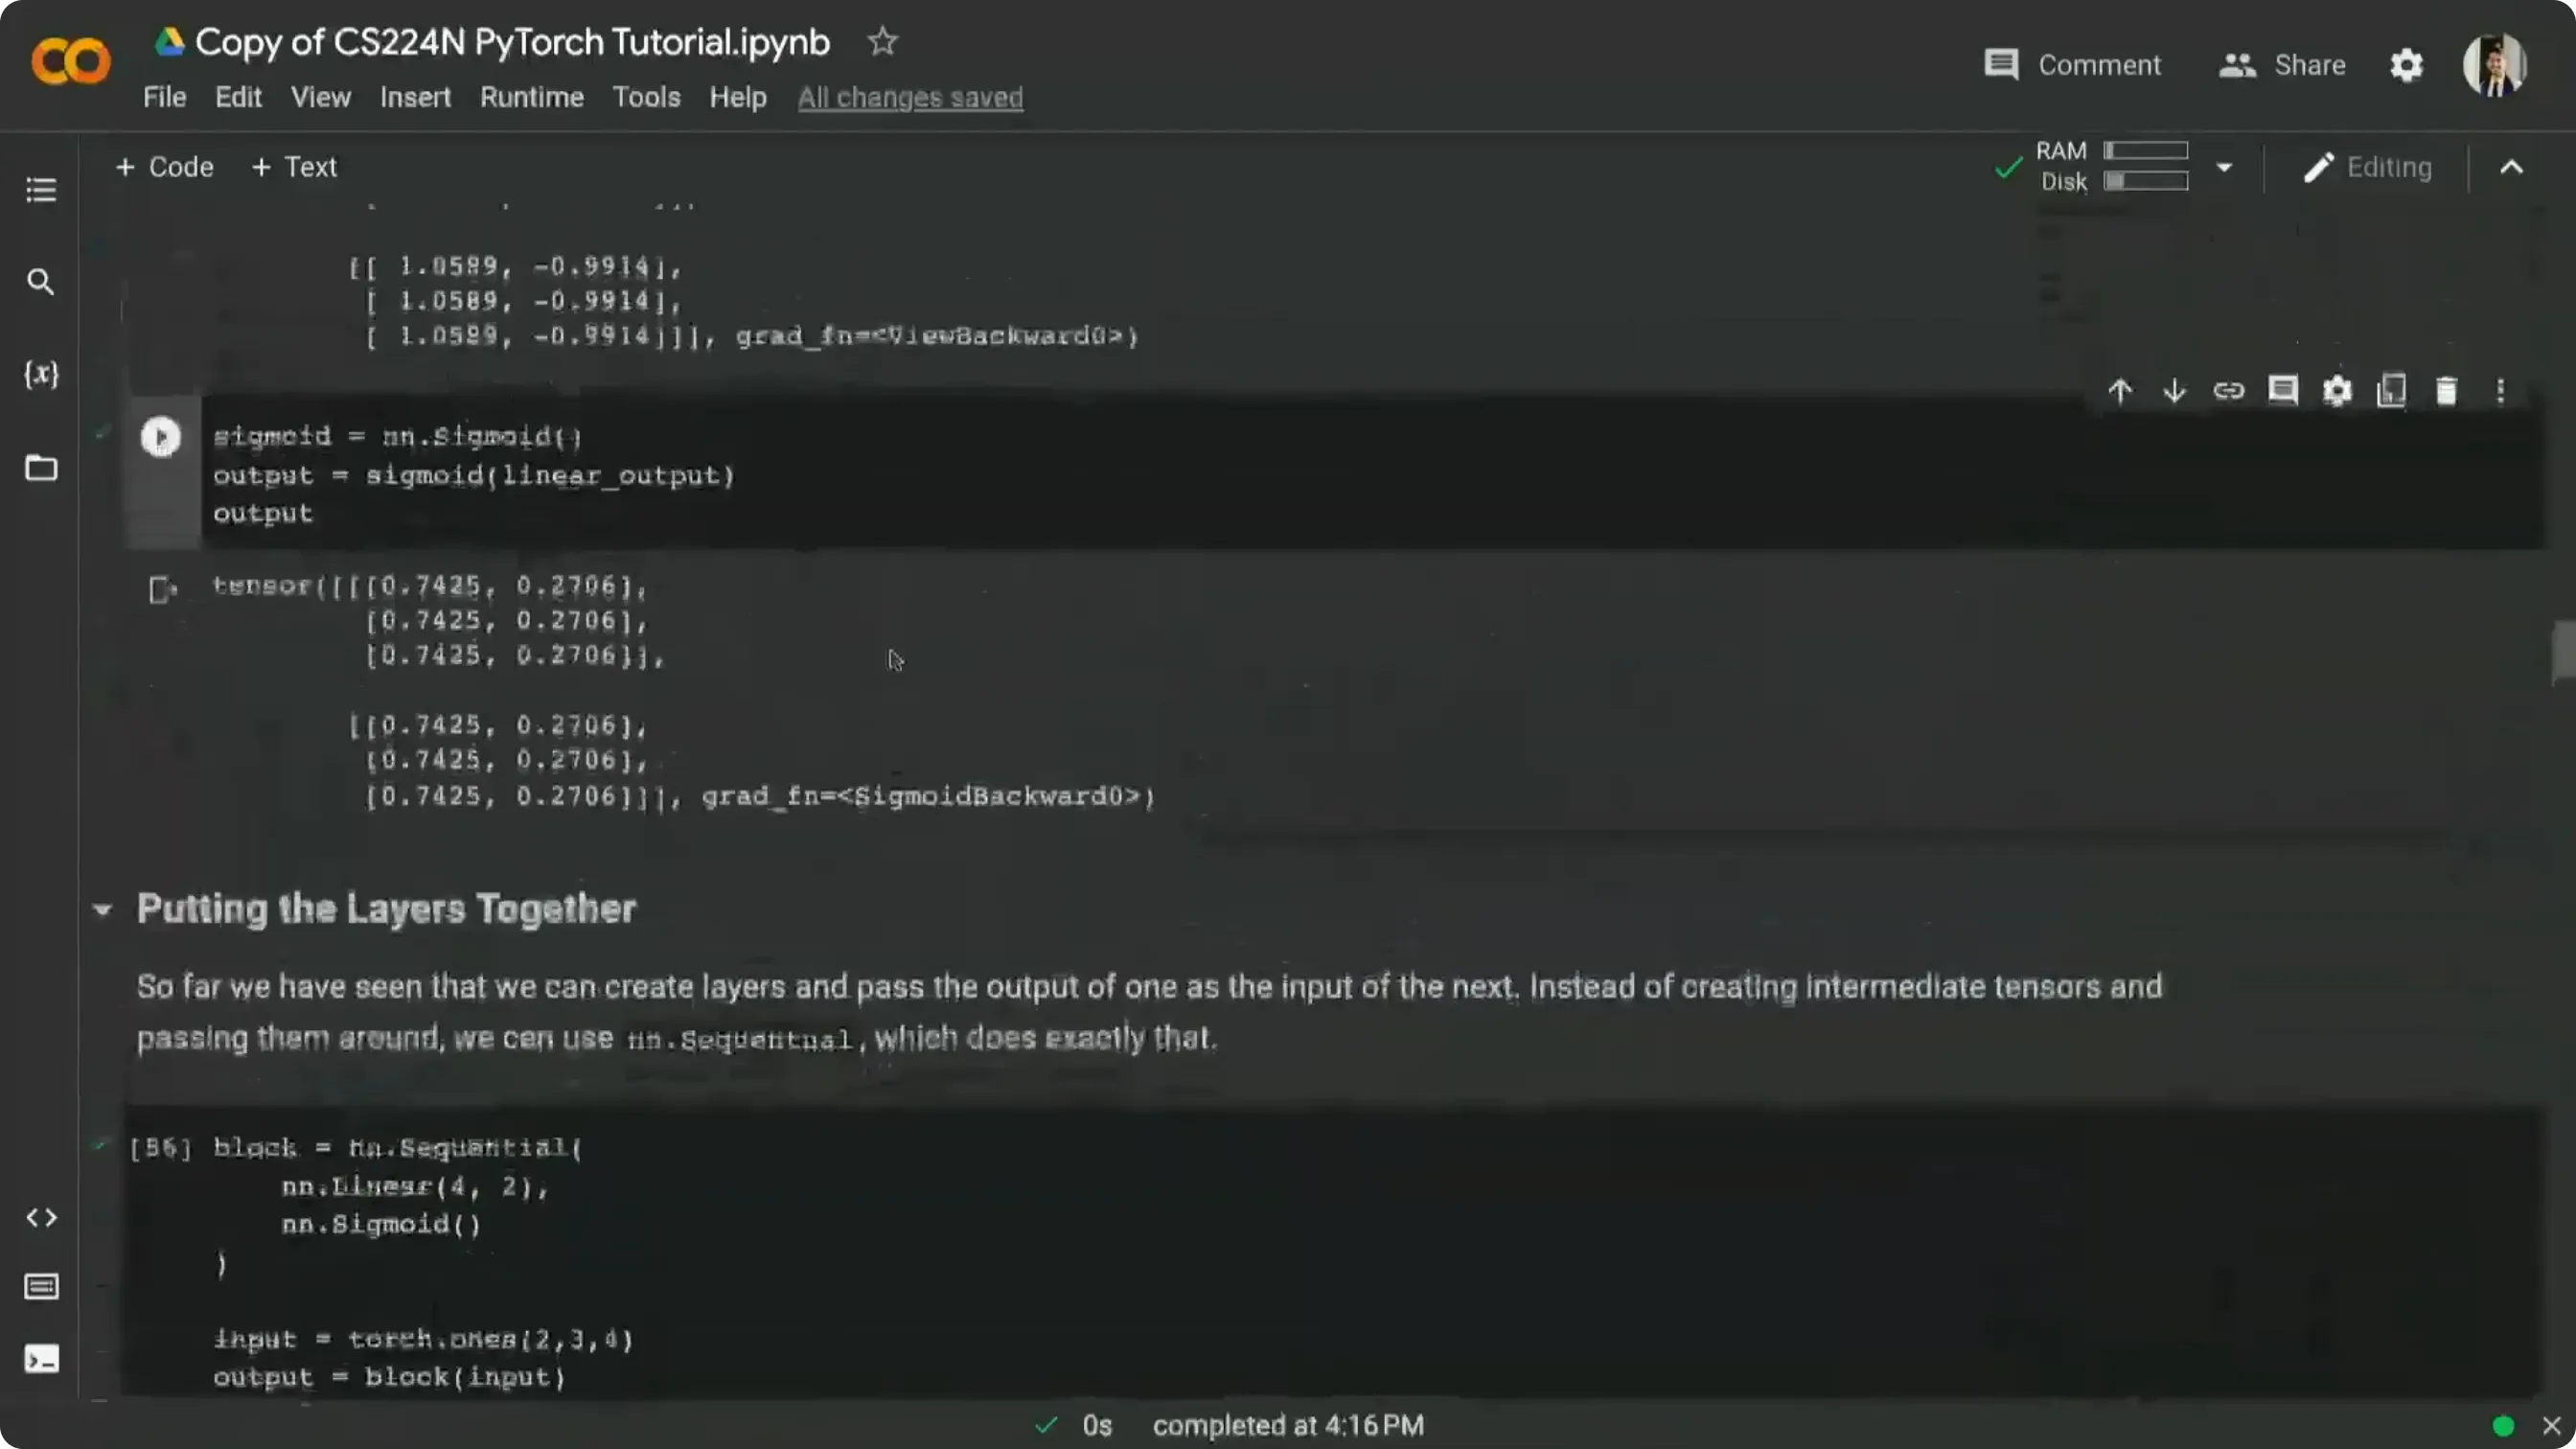
📷 用 nn.Sequential 把多层叠加成一个块
回到原视频 (00:41:05)
5.6 定义自己的网络:继承 nn.Module
(参考时间: 00:42:08) 真正要写模型时,标准套路是继承 nn.Module,然后至少实现两个东西:
__init__:在这里实例化你要用到的所有层;forward:在这里规定数据怎么流过这些层。
一个最小可运行的 MLP:
class MLP(nn.Module):
    def __init__(self, input_size, hidden_size, output_size):
        super().__init__()
        self.model = nn.Sequential(
            nn.Linear(input_size, hidden_size),
            nn.Sigmoid(),
            nn.Linear(hidden_size, output_size),
        )

    def forward(self, x):
        return self.model(x)

model = MLP(input_size=4, hidden_size=8, output_size=2)
out = model(torch.randn(2, 3, 4))
print(out.shape)   # torch.Size([2, 3, 2])
讲者原话提醒((参考时间: 00:43:18)):你也可以不写 nn.Sequential,把每一层单独存成属性、在 forward 里一行一行调用——两种写法都对。nn.Sequential 省事,逐个调用灵活;写论文/复杂模型时通常用后者。
编者说明:这里没有展开的是为什么模型必须继承
nn.Module:只有这样,PyTorch 才能通过model.parameters()自动发现注册过的所有参数,交给优化器;也只有这样,model.to("cuda")之类的批量操作才能顺着模块树递归下去。它是一个「约定大于配置」的设计。
6. 优化器与训练循环
(参考时间: 00:43:48) 前面所有准备都是为了这一步:真正让网络变好。讲者说得很轻松:你已经有 backward() 计算好的梯度了,现在只差一个东西——拿这些梯度去更新参数。
import torch.optim as optim
optim 里放着所有常用优化器。这里使用的是 Adam:
optimizer = optim.Adam(model.parameters(), lr=1e-3)
这里的 model.parameters() 会把整棵模块树里所有的 weight / bias 收集起来一起交给优化器。损失函数也直接调用现成的交叉熵损失(nn.CrossEntropyLoss())。
6.1 一个完整的训练迭代
(参考时间: 00:44:24) 讲者说,把这几个动作叠起来,就是完整的训练循环。整个骨架只有五行:
graph TD
    A["开始一个 epoch"] --> B["optimizer.zero_grad()<br/>清零上一个 batch 的梯度"]
    B --> C["preds = model(x)<br/>前向传播"]
    C --> D["loss = criterion(preds, y)<br/>计算损失"]
    D --> E["loss.backward()<br/>反向传播、累积梯度"]
    E --> F["optimizer.step()<br/>按梯度更新参数"]
    F --> G{"还有 epoch?"}
    G -->|是| A
    G -->|否| H["训练结束"]
用代码写出来:
import torch
import torch.nn as nn
import torch.optim as optim

model = MLP(input_size=4, hidden_size=8, output_size=2)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)

for epoch in range(10):
    optimizer.zero_grad()                  # ① 清零梯度
    preds = model(x)                       # ② 前向
    loss = criterion(preds, y)             # ③ 计算损失
    loss.backward()                        # ④ 反向:算梯度、累加
    optimizer.step()                       # ⑤ 更新参数
    print(f"epoch {epoch}, loss = {loss.item():.4f}")
五步的顺序非常关键,尤其是在「清零」这一步上——它必须放在 backward() 之前,否则上一个 batch 的梯度会污染这一次的更新(这正是 4.3 节的累积行为的延伸)。
6.2 跑一遍会看到什么
(参考时间: 00:45:49) 讲者说,把上述代码跑起来:
- 起始的 training loss 是很高的;
- 只要 10 个 epoch,网络基本就把数据完全拟合了;
- 再把
model的参数打出来对比训练前后,能看到weight、bias确实变了——这就证明optimizer.step()在工作。
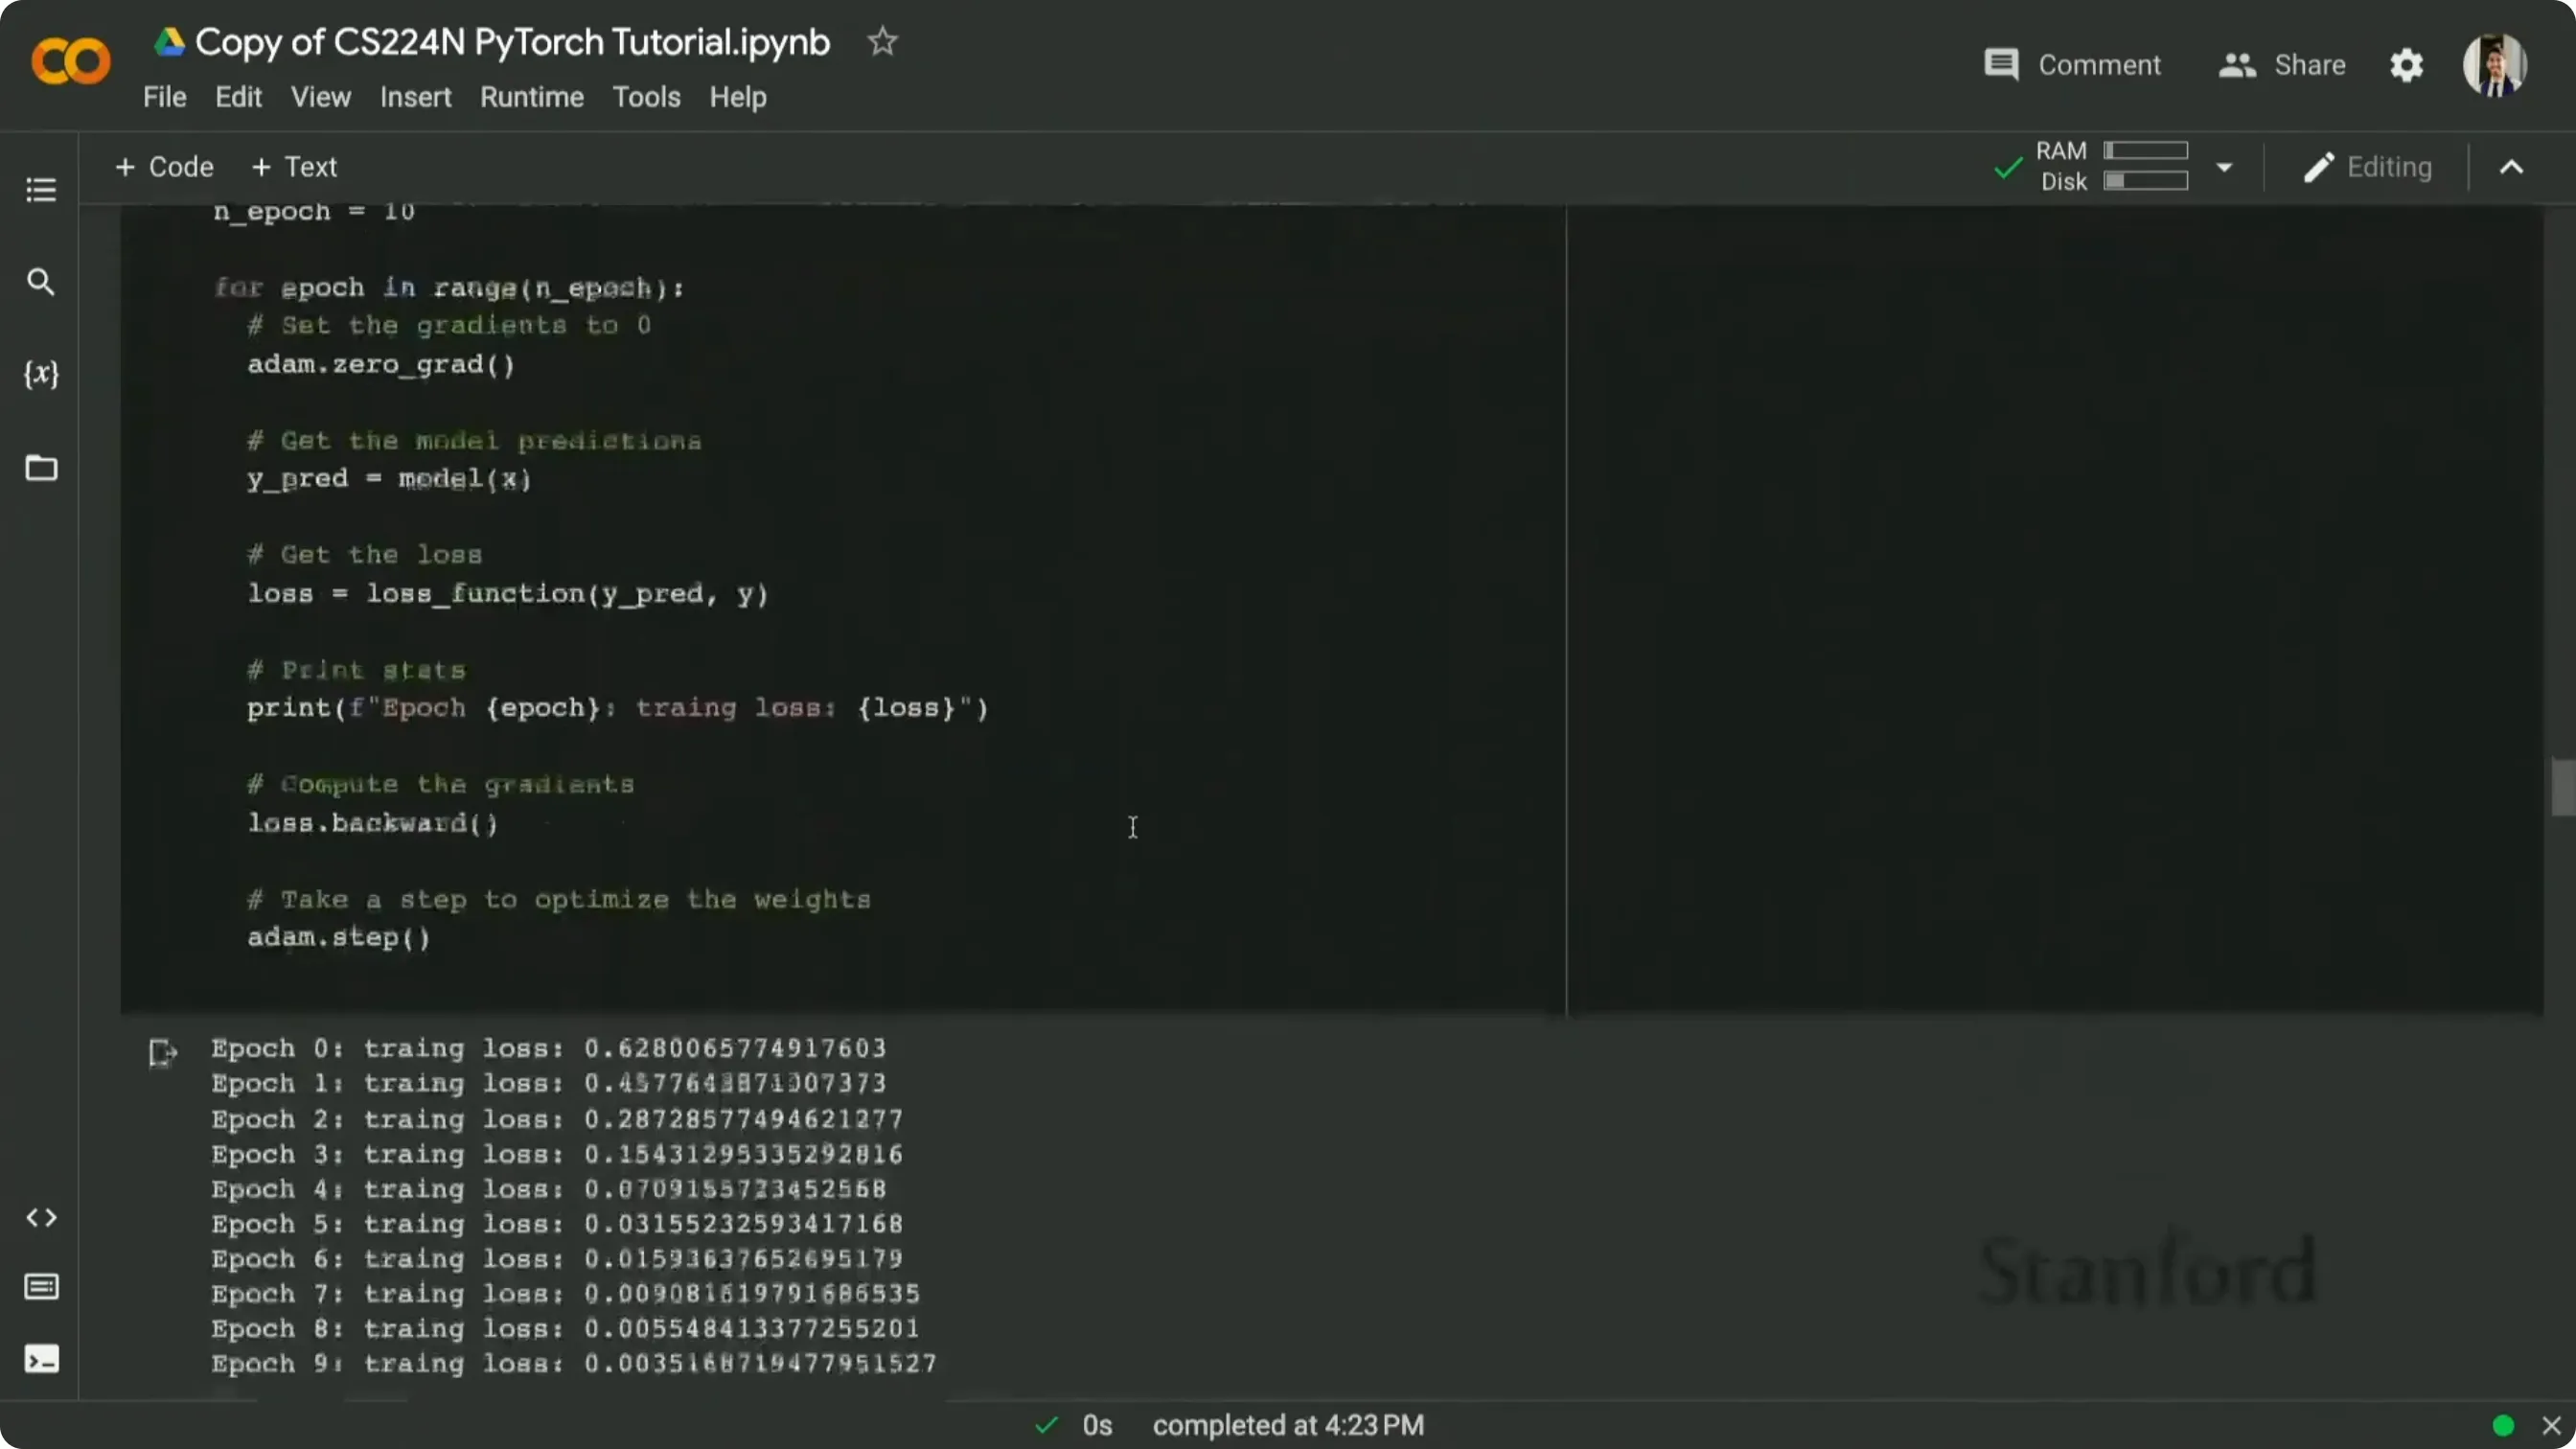
📷 运行训练循环,观察 loss 下降
回到原视频 (00:45:02)
编者说明:本节用的是一个很小的合成数据集(讲者在 (参考时间: 00:44:18) 用「随机数据 + 让模型去拟合」的方式搭例子),所以「10 个 epoch 就完全拟合」是合理结果,不代表真实任务上的收敛速度。做真实任务时,你要看的是验证集 loss / 准确率,而不是训练集 loss 一路降到 0。
编者拓展|
CrossEntropyLoss到底在算什么 交叉熵损失先把模型输出(logits $\mathbf{z}$)过一遍 softmax,得到概率 $\hat{\mathbf{y}} = \mathrm{softmax}(\mathbf{z})$,再和 one-hot 标签 $\mathbf{y}$ 算$$\mathcal{L} = -\sum_{k} y_k \log \hat{y}_k$$
它内置了 softmax,所以你不要在模型最后再加一层
nn.Softmax——那会导致 softmax 被算两次,训练几乎不收敛。这是新手最常见的错误之一。
附:参考与延伸阅读
编者补充
已知疑点
本节列出重构过程中拿不准、或字幕本身不清晰的地方,供读者核对原视频。
add operator应为@:讲者在 (参考时间: 00:10:01) 说「你可以直接用 add 运算符,就像 NumPy 那样」。根据上下文,他指的应该是@运算符(矩阵乘),而不是加法+。此处字幕的 ASR 可能识别错误,这里按「@是matmul的简写」来理解。view与reshape的措辞:讲者在 (参考时间: 00:14:42) 说「view 只创建视图、原张量形状不变;reshape 修改张量」。更精确的说法见 3.6 节的编者说明——两者都返回新张量,差别在于是否要求内存连续、是否可以拷贝。讲者的口语化描述方向没错,但容易让初学者误以为reshape是原地操作(in-place)。- 「Aether / atom 优化器」:多处字幕为
atom或类似词,结合上下文和 PyTorch API,应为 Adam 优化器。此处按 Adam 理解。 - 「law stop backward」→
loss.backward():(参考时间: 00:45:33) 附近,字幕把loss.backward识别成了类似「law stop backward」的词,这里按loss.backward()还原。 - 「shocked all of that away」:(参考时间: 00:28:13) 附近。语义是「把整块复杂度都甩给 PyTorch」,字幕可能是
shove或chuck的口语误拼,不影响理解,但原文此处无法精确核对。 torch.a range→torch.arange:(参考时间: 00:06:13) 附近,字幕把arange断开成「a range」,这里按torch.arange修正。- 结尾承诺的 demo 未在本视频中出现:开场((参考时间: 00:00:42))说「如果最后有时间,我们走一个小 demo,把整个流程串起来解决一个真实 NLP 任务」。但视频约 47 分钟,讲者在 (参考时间: 00:41:03) 明说「我时间有点不够了」,随后直接收束到训练循环——完整 demo 在本段录像中并未展开。若课程另有 demo 视频,应以那一段为准,本书记录到的只是「前面四部分」。
nn.Linear的公式写成ax + b:讲者在 (参考时间: 00:36:07) 用「ax plus b」概括。这在输入是向量时成立;在输入是高维张量(例如(B, T, D))时,它实际是沿最后一维的仿射变换——见 5.1 节的编者补充。措辞本身没算错,只是从一维推广到多维时要补一句。nn.Sequential的命名:讲者在 (参考时间: 00:41:42) 使用了nn.Sequential,字幕识别为nn.sequential(小写)。PyTorch 官方写法是nn.Sequential(大写 S),已在正文中修正。