T3 · T3 · Stanford CS224N · Hugging Face Transformers 实战教程
| 课程 | Stanford CS224N — Natural Language Processing with Deep Learning(2023 冬季) |
| 主讲人 | Eric Frankel(助教) |
| 视频 | YouTube · b80by3Xk_A8 |
| 时长 | 约 48 分钟 |
对应讲次:T3(Stanford CS224N 自然语言处理)
制作模型:deepseek-flash(vb compose)
整理说明:本文由课堂字幕重构,保留讲解顺序、现场演示与代码片段。凡标注「编者说明」「编者拓展」的内容均为整理者所加,不属于主讲人的课堂陈述;正文中的时间锚点用于溯源。
导览
这一讲想回答的核心问题
本节的目标非常具体:怎样用 Hugging Face 的 transformers 库,把一个预训练 Transformer 模型从「找到它」一路走到「跑起来、微调完」? 内容没有按教科书的顺序讲 Transformer 结构,而是按一个使用者真正会遇到的顺序,把这条路径拆成三段:
- 模型从哪里来?——Hugging Face Hub
- 文本怎么送进去?——Tokenizer
- 输出怎么读、怎么训练?——Model 与 Trainer
难点在哪
最容易卡住的地方是「tokenizer 到底做了什么」。它看起来只是 tokenizer("一句话") 一个函数调用,但里面同时做了切词、查表转 ID、补特殊符号、生成 attention mask 四件事。多数初学者第一次看到 input_ids 和 attention_mask 时,不知道第二位的那串 0/1 是干什么的,于是就卡在这里。
第二个坎是「模型输出里的 shape」。当屏幕上打印出 [1, 7, 768] 这样的张量时,如果不清楚每一位分别代表什么,后面所有关于 hidden states 和 attention 的讨论都会变成看天书。
读者可能带着的疑问
① 课上真正被问到的问题(现场提问):
- tokenizer 是不是把输入变成一张「模型输入字典」?
- 它是否保证把每个词映射到模型训练时用的那个索引?
model.eval()究竟做了什么?- 打印出来的 shape 每一位是什么意思?
- attention 热力图的颜色该从哪头读?
- 早停的 patience 该设多少?
② 编者预判读者会有的疑问:
AutoTokenizer和某个具体类(比如BertTokenizer)有什么区别,该用哪个?model(**model_inputs)这种写法是什么 Python 语法?- 二分类任务为什么还要输出两个 logits,而不是一个?
- 为什么在把数据喂进
Trainer之前,要把label改名为labels(复数)? - 有了
Trainer之后,还需要自己手写 PyTorch 训练循环吗?
本讲路线
装包 → 在 Hub 上挑一个模型 → 深入 tokenizer(篇幅最大)→ 加载模型、认识不同任务头 → 把 tokenizer 的输出喂进模型 → 打开开关看模型内部(hidden states 与 attention)→ 用 IMDb 准备一份可微调的小数据集 → 对比两种训练写法(手写 PyTorch 循环 / Trainer)→ 保存 checkpoint 与回调。
整条链路上反复出现的一个心态是:Hugging Face 的模型就是 PyTorch 的 nn.Module,该 backward 就 backward,该写循环就写循环,不需要把它当成另一套东西。
一、为什么值得学,以及环境准备
(参考时间: 00:00:04)
这个教程的主题就是使用 Hugging Face 的 transformers 库。它的价值在于:你可以直接拿现成的、基于 Transformer 的 NLP 模型来用,而不必从头训练。这些模型的用途包括课程的大作业(custom final project),也包括以后任何需要快速搭一个 NLP 基线的场合。它和 PyTorch 的接口尤其顺,模型本身就是 PyTorch 模块,前面课上学过的训练流程可以原样搬过来。
如果某一处不够细,最好的补充材料是 Hugging Face 自己的文档——里面的 tutorial、walkthrough 和可以直接运行的 notebook 都相当完整。开场即指出了这条「备用路线」。
安装两个包
(参考时间: 00:01:08)
在 Google Colab 里,第一步是安装两个包:
!pip install transformers datasets
transformers:所有预训练模型从这里来;datasets:提供现成的数据集(本例中用于情感分析),省去自己找数据、写下载脚本的功夫。
此外还有一个辅助函数,用来把分词过程中间每一步的结果打印出来,方便观察 encoding 到底做了哪些事。这个函数不是库的一部分,纯粹为了教学展示。
编者说明:
datasets库其实不是「只用于下载数据」的,它还提供map、filter、set_format等一整套内存友好的数据处理接口,后面第七节会大量用到。如果不装它,你就得用pandas或纯 Python 自己写预处理,代码量会明显增加。
二、从 Hub 上挑一个模型
(参考时间: 00:02:07)
使用 Hugging Face 的标准流程,第一步是在 Hub 上找到一个模型。Hub 上模型的数量非常多:BERT、GPT-2、Google 的 T5-small 等等,这些预训练模型的权重全部公开、可以自由下载。如果你心里有某个想用的模型,大概率能找到它的某个版本。
Hub 还提供按任务筛选的入口。比如想做 zero-shot classification,侧边栏里就有一批专门擅长这类任务的模型。所以第二步是确定你要做哪类任务——本例选的是情感分析(sentiment analysis)。
第三步,需要两样东西才能把模型真正跑起来:
- Tokenizer:把输入文本切成模型能接受的最小单元(token),并把每个 token 映射成一个离散的 ID。模型只认这些 ID。
- 模型本体:吃进 ID,吐出预测。
graph TD
    A[在 Hub 上选定 checkpoint] --> B["AutoTokenizer.from_pretrained"]
    A --> C["AutoModel*.from_pretrained"]
    D[原始文本] --> B
    B --> E["input_ids + attention_mask"]
    E --> C
    C --> F["logits / loss / hidden_states / attentions"]
    F --> G["argmax 得到预测<br/>或 backward 更新参数"]
本例用的 checkpoint
(参考时间: 00:03:41)
导入的两个类:
from transformers import AutoTokenizer, AutoModelForSequenceClassification
对应的 checkpoint 是一个已经在情感数据上训练过的 RoBERTa-large 英文模型。这两个 from_pretrained 调用会自动下载初始化所需的关键文件(包括权重二进制文件)。
checkpoint = "siebert/sentiment-roberta-large-english"

tokenizer = AutoTokenizer.from_pretrained(checkpoint)
model = AutoModelForSequenceClassification.from_pretrained(checkpoint)
使用方式非常简单:在 Hub 页面把这个字符串复制下来即可。
编者说明:字幕里这一串模型名被语音识别弄成了「cbert」「sent」之类的碎片,从上下文("sentiment … Roberta … large English")推断应为
siebert/sentiment-roberta-large-english。详见文末「已知疑点」。编者拓展|
Auto前缀是什么意思
AutoTokenizer不是一个具体的分词器,而是一个工厂。你给它一个 checkpoint 名字,它会去读该 checkpoint 目录下的config.json,从中得知「这个模型原本用的是什么分词器」,然后再实例化正确的那一个(可能是BertTokenizer、RobertaTokenizer、GPT2Tokenizer……)。好处是:你换模型时不需要改 import。想从 RoBERTa 换到 BERT,只改
checkpoint字符串即可。代价是:你放弃了对具体类的显式声明。如果你明确知道要用哪一种,直接写
BertTokenizer.from_pretrained(...)也完全可以,两者行为一致。
三、Tokenizer:把文本变成模型能吃的 ID
(参考时间: 00:05:47)
Tokenizer 的职责是预处理:拿到原始字符串,输出模型能理解的数字。
它有两种用法:
- 模型专用分词器:每个 checkpoint 都有配套的那一个;
AutoTokenizer:帮你根据模型类型自动挑出正确的那个。
课上有一个很关键的问题:
「它是不是保证所有东西都映射到模型训练时用的那个索引上?」 「是的,这正是
AutoTokenizer有用的原因。」
如果索引对不上,模型看到的就是一堆乱码 ID,输出自然毫无意义。所以分词器必须和模型配对,不能混用。
fast 与 slow 两种实现
(参考时间: 00:06:44)
分词器有两种实现:
| 类型 | 实现语言 | 说明 |
|---|---|---|
| 普通分词器 | Python | 逐字符处理,逻辑清晰 |
tokenizer_fast |
Rust | 速度更快 |
两者的输出语义完全一致,差别只在推理耗时。用 AutoTokenizer 时默认拿到的就是 fast 版。
编者说明:fast 版还额外提供一些 slow 版没有的能力,最典型的两个是
word_ids()(每个 token 属于原句的第几个词)和char_to_word(每个字符属于第几个词)。讲者在 00:10:07 附近演示的正是这类功能——当你需要做 token 级别的标注任务(如 NER)时,必须靠它把 token 的对齐关系还原回原词。
内部到底做了哪几步
(参考时间: 00:08:43)
先看一个最简单的调用:
input_str = "Hugging Face Transformers is great"
model_inputs = tokenizer(input_str)
它看起来像一个普通函数,返回的东西却是一个包含多个键的对象。下面把内部拆开:
graph LR
    A["原始字符串<br/>Hugging Face Transformers is great"] --> B["切分为 token"]
    B --> C["查词表转成 ID"]
    C --> D["补上模型需要的特殊 token<br/>如 [CLS] / [SEP]"]
    D --> E["input_ids + attention_mask"]
对应到具体 API:
tokens = tokenizer.tokenize(input_str)
# ['Hugging', 'Face', 'Transform', 'ers', 'is', 'great']

ids = tokenizer.convert_tokens_to_ids(tokens)
# [2011, 2227, ...]

full_ids = tokenizer.build_inputs_with_special_tokens(ids)
# [101, 2011, 2227, ..., 102]   ← 多了句首/句尾标记
注意第二行:Transformers 被切成了 Transform + ers 两段。这是 subword 分词的结果,不是 bug。
编者拓展|为什么会有 subword
如果按整词建表,词表会爆炸(几十万甚至上百万),而且遇到没见过的词只能给
[UNK]。如果按字符切,序列又太长,模型难以学到词级语义。Subword 分词(BPE、WordPiece、SentencePiece)折中:高频词整词保留,低频词拆成常见片段。这样词表能控制在 3 万~ 5 万量级,同时任何字符串都能被表示出来(最坏情况拆到字符)。
Transformers→Transform+ers,就是因为它作为一个整体不够常见,但两个片段都很常见。
两种访问方式
(参考时间: 00:08:21)
model_inputs 的返回值同时支持两种写法:
model_inputs["input_ids"]   # 像字典一样按下标取
model_inputs.input_ids      # 像属性一样点出来
两者等价,选顺手的即可。这种「既是字典又是对象」的设计在 Hugging Face 的输出类型里非常常见(BatchEncoding、ModelOutput 都是这个套路)。
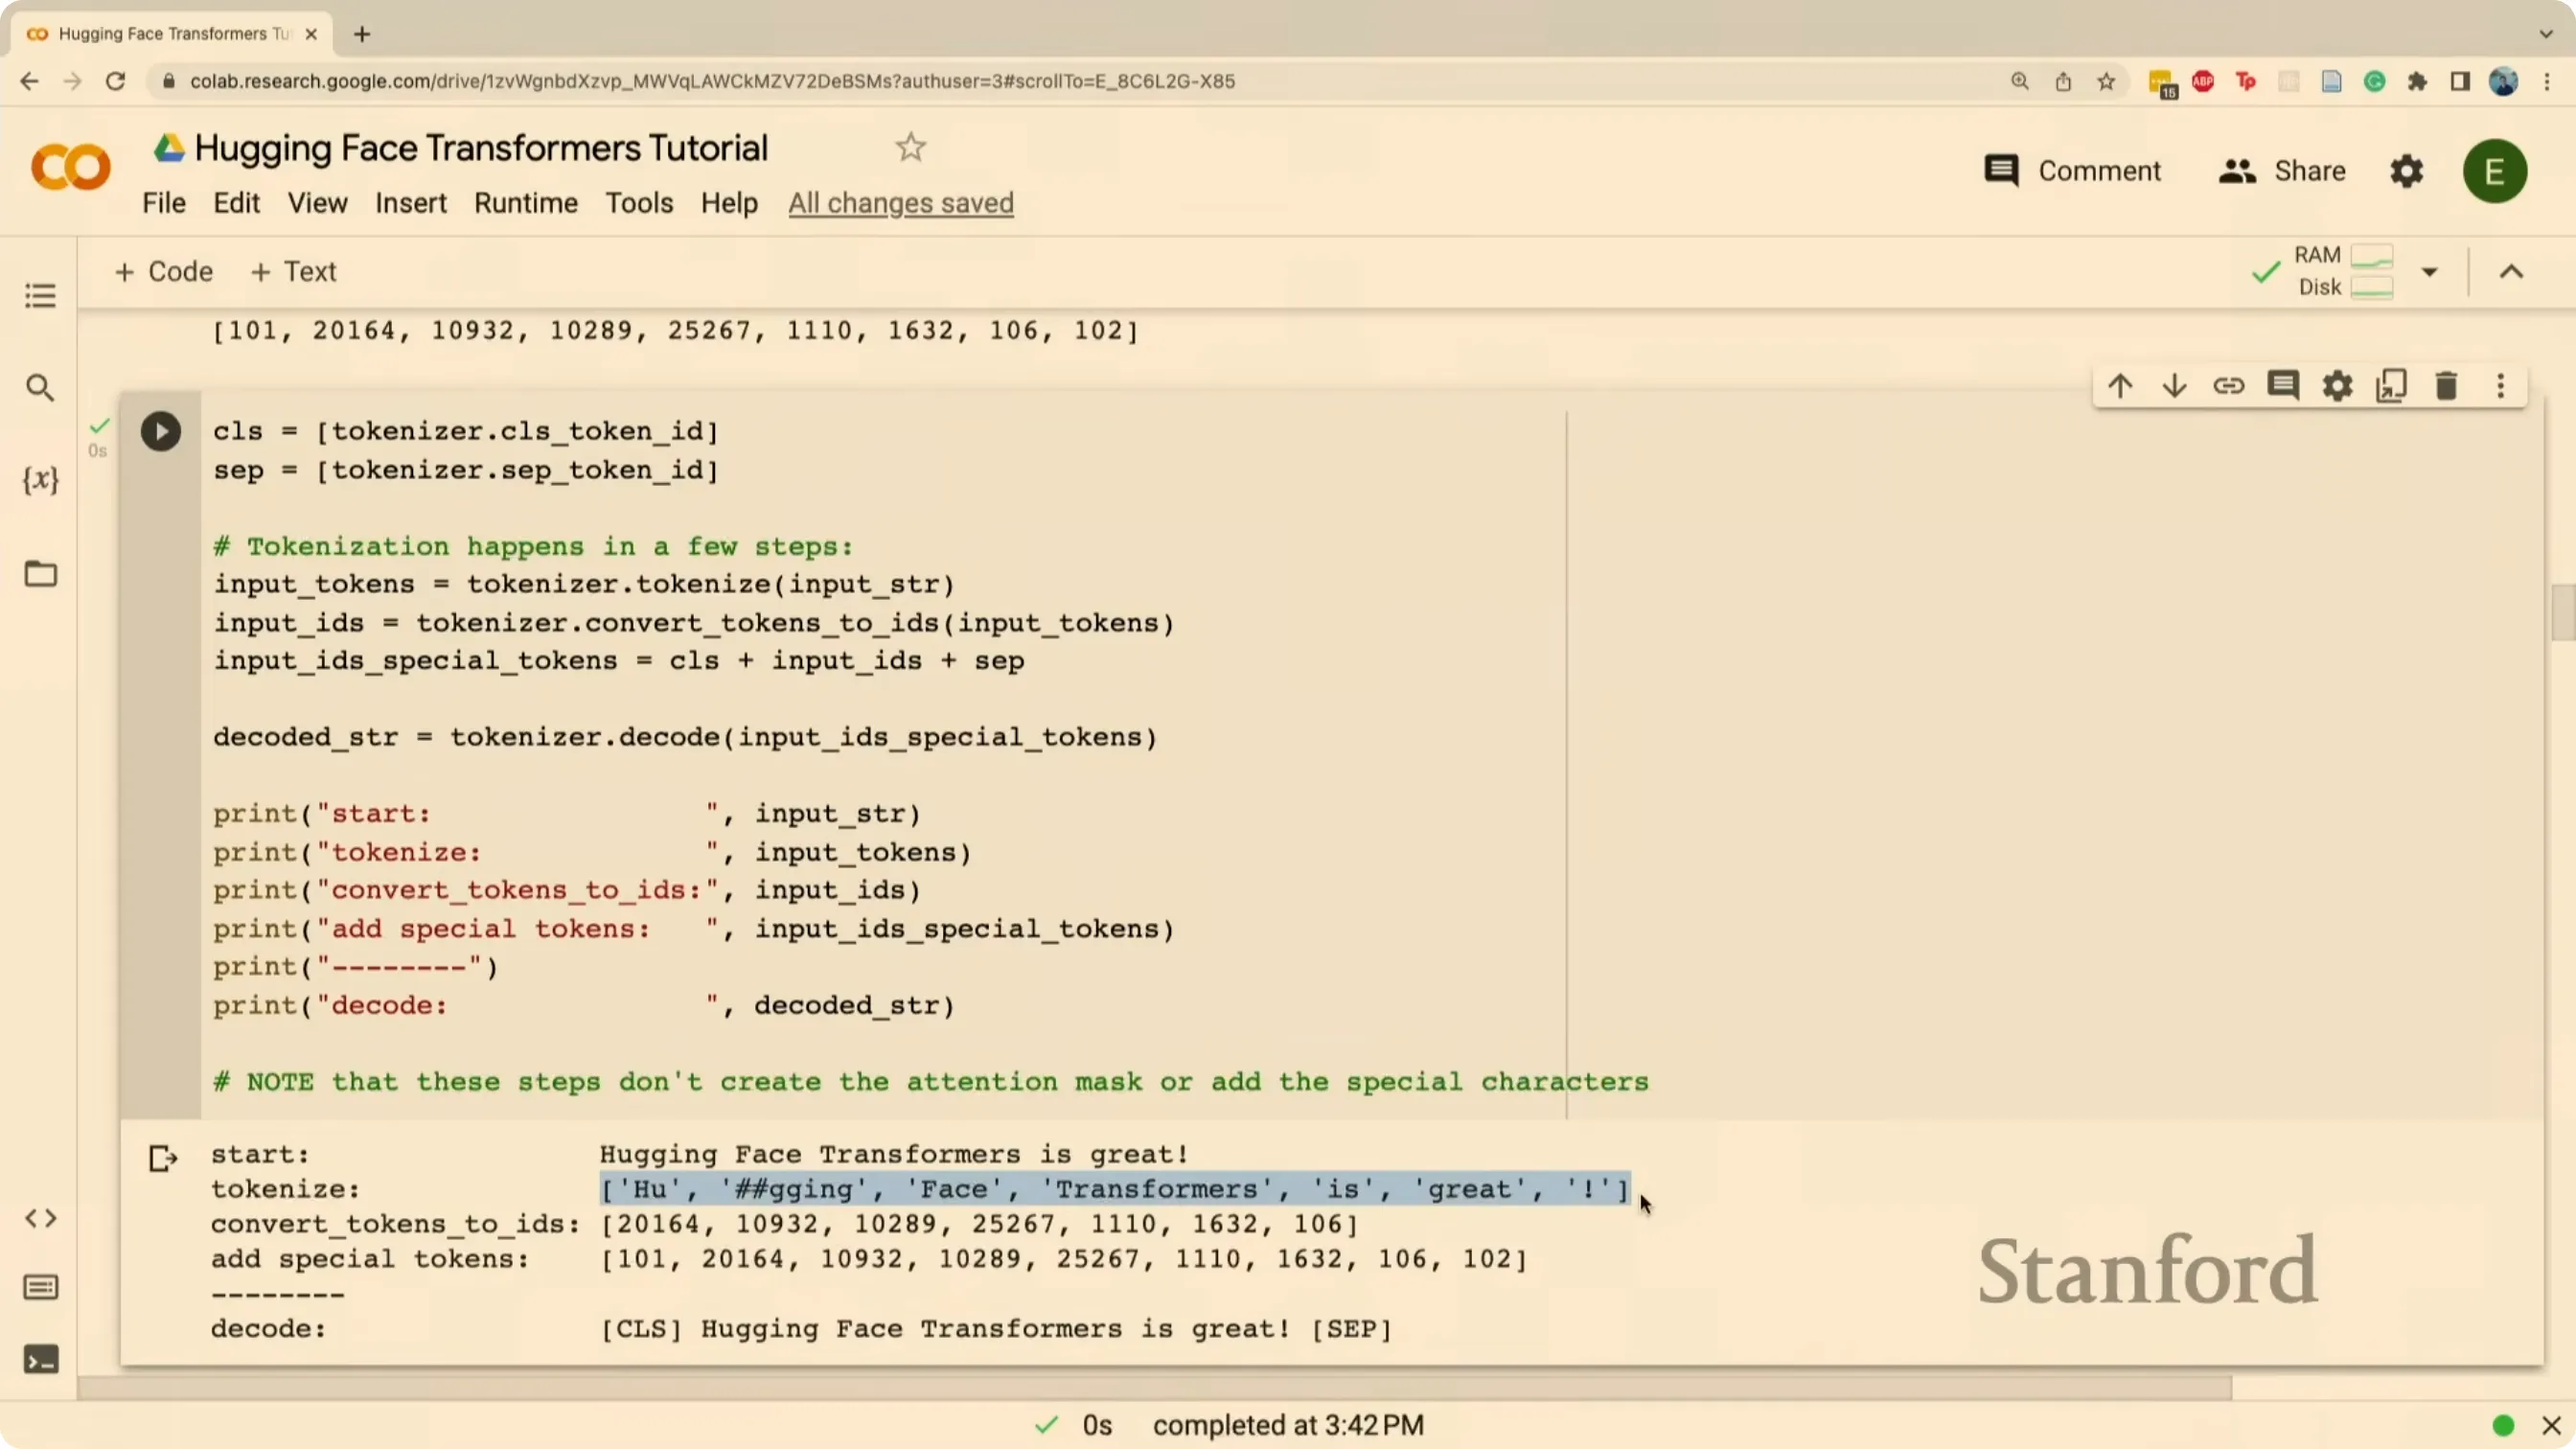
📷 分词四步流程每一步的中间结果
回到原视频 (00:09:15)
一个小插曲:空格算不算 token 的一部分
(参考时间: 00:11:52)
课上有人问:看 token 字符串里的 ## 或前导空格标记,是不是意味着「这个词前面应该有一个空格」?
在 Hugging Face 这个例子里,Hugging 本身就是一个完整的词,所以不应该有前导空格。这类细节确实可能和直觉不一致,但总体上分词器的输出是稳定一致的,绝大多数情况下默认输出通常已足够使用。
编者说明:不同分词器的空格约定不同。 - WordPiece(BERT 系)用
##前缀表示「这个片段紧接前一个片段」,因此##ers表示它不是词首。 - BPE(GPT-2、RoBERTa 系)用Ġ(一个特殊 Unicode 字符)表示「这个 token 前面有空格」。所以在 RoBERTa 的分词器里,
Ġgreat才代表「空格 + great」。这些标记只是编码约定,不影响模型计算。
返回张量、自动 padding 与截断
(参考时间: 00:10:25)
默认情况下,tokenizer 返回的是 Python 列表。如果后续要送进 PyTorch,可以让它直接返回张量:
model_inputs = tokenizer(input_str, return_tensors="pt")
批量处理时,句长不一致,需要对齐。做法是设置 padding:
batch = tokenizer(
    ["Hugging Face Transformers is great",
     "I like NLP"],
    padding=True,
    truncation=True,
    return_tensors="pt",
)
padding=True:把所有序列补齐到同一批次内最长的那个;truncation=True:超过模型最大长度时截断;return_tensors="pt":返回torch.Tensor而不是 list。
默认的 padding token 是 [PAD],其 ID 为 0。同时,tokenizer 会把 attention mask 对应位置的 0 填好——这正是 attention mask 的用途:告诉模型「这些位置是补出来的,别当真」。
(参考时间: 00:37:03) 课上有人追问:「我们已经手动截断了,那 padding 是怎么均摊到所有样本上的?」
回答分两种情况:
- 手动设一个较大的截断上限(本例就这么做);
- 设
padding=True,让 tokenizer 按当前批次里的最长序列来补。
关键是第二种:不需要把整个数据集读进内存再统一 pad。按 batch 补就足够了,这也是 DataLoader 走的标准做法。
一次性解码整个 batch
(参考时间: 00:13:04)
反过来,把 ID 还原成文本可以用 batch_decode:
tokenizer.batch_decode(model_inputs["input_ids"], skip_special_tokens=True)
加 skip_special_tokens=True 会把 [CLS]、[SEP]、<pad> 这些装饰性符号去掉,只留下真正的文本内容。当你想确认「我喂进去的东西模型到底看见了什么」时,这个是最好用的调试手段。
例:一张图片怎么从 2 维长到 4 维
下面四段代码,每段都独立可运行,跑完看 shape 和 ndim 怎么一步步变。
第 1 步:灰度图,2 维
一幅灰度图 = 一个二维数组:第 0 维是行,第 1 维是列。每个位置存一个数值(亮度),没有“颜色”这一维。
import torch

gray = torch.zeros(256, 256, dtype=torch.uint8)

print(gray.shape)
print(gray.ndim)
h, w = gray.shape
print(f"第 0 维 = 行 = {h},第 1 维 = 列 = {w}")
print(gray[0].shape)      # 取第 0 行 → 一个长度 256 的向量
print(gray[:, 0].shape)   # 取第 0 列 → 一个长度 256 的向量
torch.Size([256, 256])
2
第 0 维 = 行 = 256,第 1 维 = 列 = 256
torch.Size([256])
torch.Size([256])
第 2 步:加上颜色通道,变 3 维
彩色图 = 灰度图再加一维,这一维长度为 3,装 R、G、B 三个值。做法是沿最后新增一维把三张同尺寸的图堆起来。
import torch

gray = torch.zeros(256, 256, dtype=torch.uint8)

r = gray.clone()
g = gray.clone()
b = gray.clone()
rgb = torch.stack([r, g, b], dim=-1)   # dim=-1 表示新维加在最后

print(rgb.shape)
print(rgb.ndim)
print(rgb.shape[0], rgb.shape[1], rgb.shape[2])
print(rgb[0, 0])        # 第 0 行第 0 列这一个像素的 3 个通道值
print(rgb[0, 0].shape)  # 该像素的形状 = (3,)
torch.Size([256, 256, 3])
3
256 256 3
tensor([0, 0, 0], dtype=torch.uint8)
torch.Size([3])
此时三维依次是:行(256)、列(256)、颜色通道(3)。
第 3 步:一次喂 32 张,变 4 维
模型一次吃一批图。把 32 个 (256, 256, 3) 沿最前面新增一维堆起来,就得到 (32, 256, 256, 3)。
import torch

rgb = torch.zeros(256, 256, 3, dtype=torch.uint8)

batch = torch.stack([rgb.clone() for _ in range(32)], dim=0)  # dim=0 表示新维加在最前

print(batch.shape)
print(batch.ndim)
n, h, w, c = batch.shape
print(f"batch={n}, 行={h}, 列={w}, 通道={c}")
print(batch[0].shape)     # 取第 0 张图 → 回到 3 维
print(batch[:, 0].shape)  # 取全部 32 张图的第 0 行 → 行维被“抽走”,剩 (32, 256, 3)
torch.Size([32, 256, 256, 3])
4
batch=32, 行=256, 列=256, 通道=3
torch.Size([256, 256, 3])
torch.Size([32, 256, 3])
四维依次是:batch(32)、行(256)、列(256)、颜色通道(3)。
第 4 步:换成 PyTorch 的 (N, C, H, W) 约定
PyTorch 的卷积层默认要求通道维排在第 1 位,而不是最后一位。数据一个元素都不用动,只把维度的顺序改掉:permute(0, 3, 1, 2) 的意思是“新张量的第 0 维取旧的第 0 维,第 1 维取旧的第 3 维,第 2 维取旧的第 1 维,第 3 维取旧的第 2 维”。
import torch

batch = torch.zeros(32, 256, 256, 3, dtype=torch.uint8)   # (N, H, W, C)

nchw = batch.permute(0, 3, 1, 2)                          # → (N, C, H, W)

print(nchw.shape)
print(nchw.ndim)
n, c, h, w = nchw.shape
print(f"N={n}, C={c}, H={h}, W={w}")
print(nchw.data_ptr() == batch.data_ptr())   # 同一块内存,没有复制数据
print(nchw.is_contiguous())                  # 只是改了 stride,内存排布没变
print(torch.equal(nchw.permute(0, 2, 3, 1), batch))  # 换回去,逐元素相等
torch.Size([32, 3, 256, 256])
4
N=32, C=3, H=256, W=256
True
False
True
四维依次是:N=32(batch)、C=3(颜色通道)、H=256(行/高)、W=256(列/宽)。
data_ptr() 相同、is_contiguous() 为 False,说明这不是新数据,只是同一块内存被换了个读法。(32, 256, 256, 3) 和 (32, 3, 256, 256) 存的像素值完全相同,区别只在维度顺序。
四步汇总:
| 步骤 | shape | ndim | 逐维点名 |
|---|---|---|---|
| 1 | (256, 256) |
2 | 行、列 |
| 2 | (256, 256, 3) |
3 | 行、列、通道 |
| 3 | (32, 256, 256, 3) |
4 | batch、行、列、通道 |
| 4 | (32, 3, 256, 256) |
4 | batch、通道、行、列 |
四、加载模型:Auto 类与任务专用头
(参考时间: 00:14:10)
加载模型的过程和 tokenizer 高度对称:要么选具体模型类,要么用 AutoModel 系列。AutoModel 会读取 checkpoint 的配置,自动帮你完成初始化,开销几乎可以忽略。
同一个骨架,不同的头
(参考时间: 00:14:49)
预训练 Transformer 的底层架构是相同的,区别在于接在顶上的那个「头」(head)。头决定了模型能做哪类任务,也决定了哪些参数在微调时会被更新。
以 DistilBERT 为例:
| 类名 | 用途 | 头部结构 |
|---|---|---|
DistilBertForSequenceClassification |
序列分类 | 池化 + 线性层(输出 num_labels 维) |
DistilBertForMaskedLM |
掩码语言建模 | 词表维度的线性层 |
DistilBertModel |
只取表示 | 无头,直接输出 hidden states |
重点在于:这些任务专用的类,Hugging Face 已经写好,不需要自己拼一个分类层。
from transformers import AutoModelForSequenceClassification

model = AutoModelForSequenceClassification.from_pretrained(checkpoint)
三类架构
(参考时间: 00:16:19)
graph TD
    A[Transformer 骨架] --> B["Encoder-only<br/>BERT / DistilBERT"]
    A --> C["Decoder-only<br/>GPT-2"]
    A --> D["Encoder-Decoder<br/>BART / T5"]
    B --> B1["分类、抽取式问答、句向量"]
    C --> C1["自回归文本生成"]
    D --> D1["翻译、摘要、seq2seq"]
架构决定了能做什么,也决定了不能做什么。讲者举了一个具体的反例(00:17:35):你无法把 BERT 或 DistilBERT 当作 seq2seq 模型来用,因为 DistilBERT 只有 encoder,没有 decoder。这不是 API 的限制,而是模型结构本身的限制。
编者拓展|模型选型的最短路径
拿到一个任务,先问「输入到输出是什么形态」:
- 一句话 → 一个标签(情感分析、垃圾邮件识别):encoder-only + 分类头。
- 一句话 → 一段话(翻译、摘要):encoder-decoder。
- 一段前缀 → 续写(对话、代码补全):decoder-only。
- 一句话 → 一个向量(检索、聚类、相似度):encoder-only 的基础模型(
AutoModel),不带任务头。最后一种经常被忽略:如果你只是想要句向量,加载
AutoModelForSequenceClassification反而是浪费——那个分类头在推理时会被丢掉,但权重仍然占显存。
设定类别数
(参考时间: 00:19:02)
做分类时,必须告诉模型一共有几类:
model = AutoModelForSequenceClassification.from_pretrained(
    checkpoint, num_labels=2
)
如果打印模型结构,会看到一条警告:分类头的部分参数还没有训练过。这是正常的——预训练阶段模型没见过你的分类任务,那个新加的分类层是随机初始化的,需要在你自己的数据上微调。
一个限制:分词器与模型必须配对
模型的选择和架构类型需要匹配。加载什么类型的模型,就要用与之配套的分词器,否则 ID 会错位。
五、把 tokenizer 的输出喂给模型
(参考时间: 00:19:30)
两种传参写法
写法一:显式指名
outputs = model(
    input_ids=model_inputs["input_ids"],
    attention_mask=model_inputs["attention_mask"],
)
写法二:解包(也可称为「有点 Pythonic 的写法」)
outputs = model(**model_inputs)
** 的作用是把字典的键当作参数名、值当作实参展开。因为 model_inputs 的键恰好就叫 input_ids 和 attention_mask,正好对得上模型签名,所以能直接用。
两种写法结果完全相同。第二种更短,但前提是你清楚字典里有哪些键。
编者说明:如果用
**展开,而你后来往model_inputs里塞了模型不认识的多余键(比如text、label),会直接报TypeError: unexpected keyword argument。这也是为什么后面第七节要remove_columns(["text"])并rename_column("label", "labels")——不是形式主义,是为了让**batch能跑通。
输出里有什么
(参考时间: 00:21:05)
outputs = model(**model_inputs)
print(outputs)
输出包含三部分:
logits:形状[batch_size, num_labels]。本例传入 1 条样本、2 个类别,所以是[1, 2];loss:仅当你在输入里带了labels时才存在;- (打开开关时)
hidden_states、attentions。
课上有人问:二分类任务,为什么还要输出两个 logits,而不是一个?
确实有点别扭,理论上一个标量加 sigmoid 就够了。但这是 Hugging Face 的统一设计——所有分类类任务都用 num_labels 个 logits + softmax,二分类只是 num_labels=2 的特例。好处是接口统一,多分类和二分类的代码完全一样。
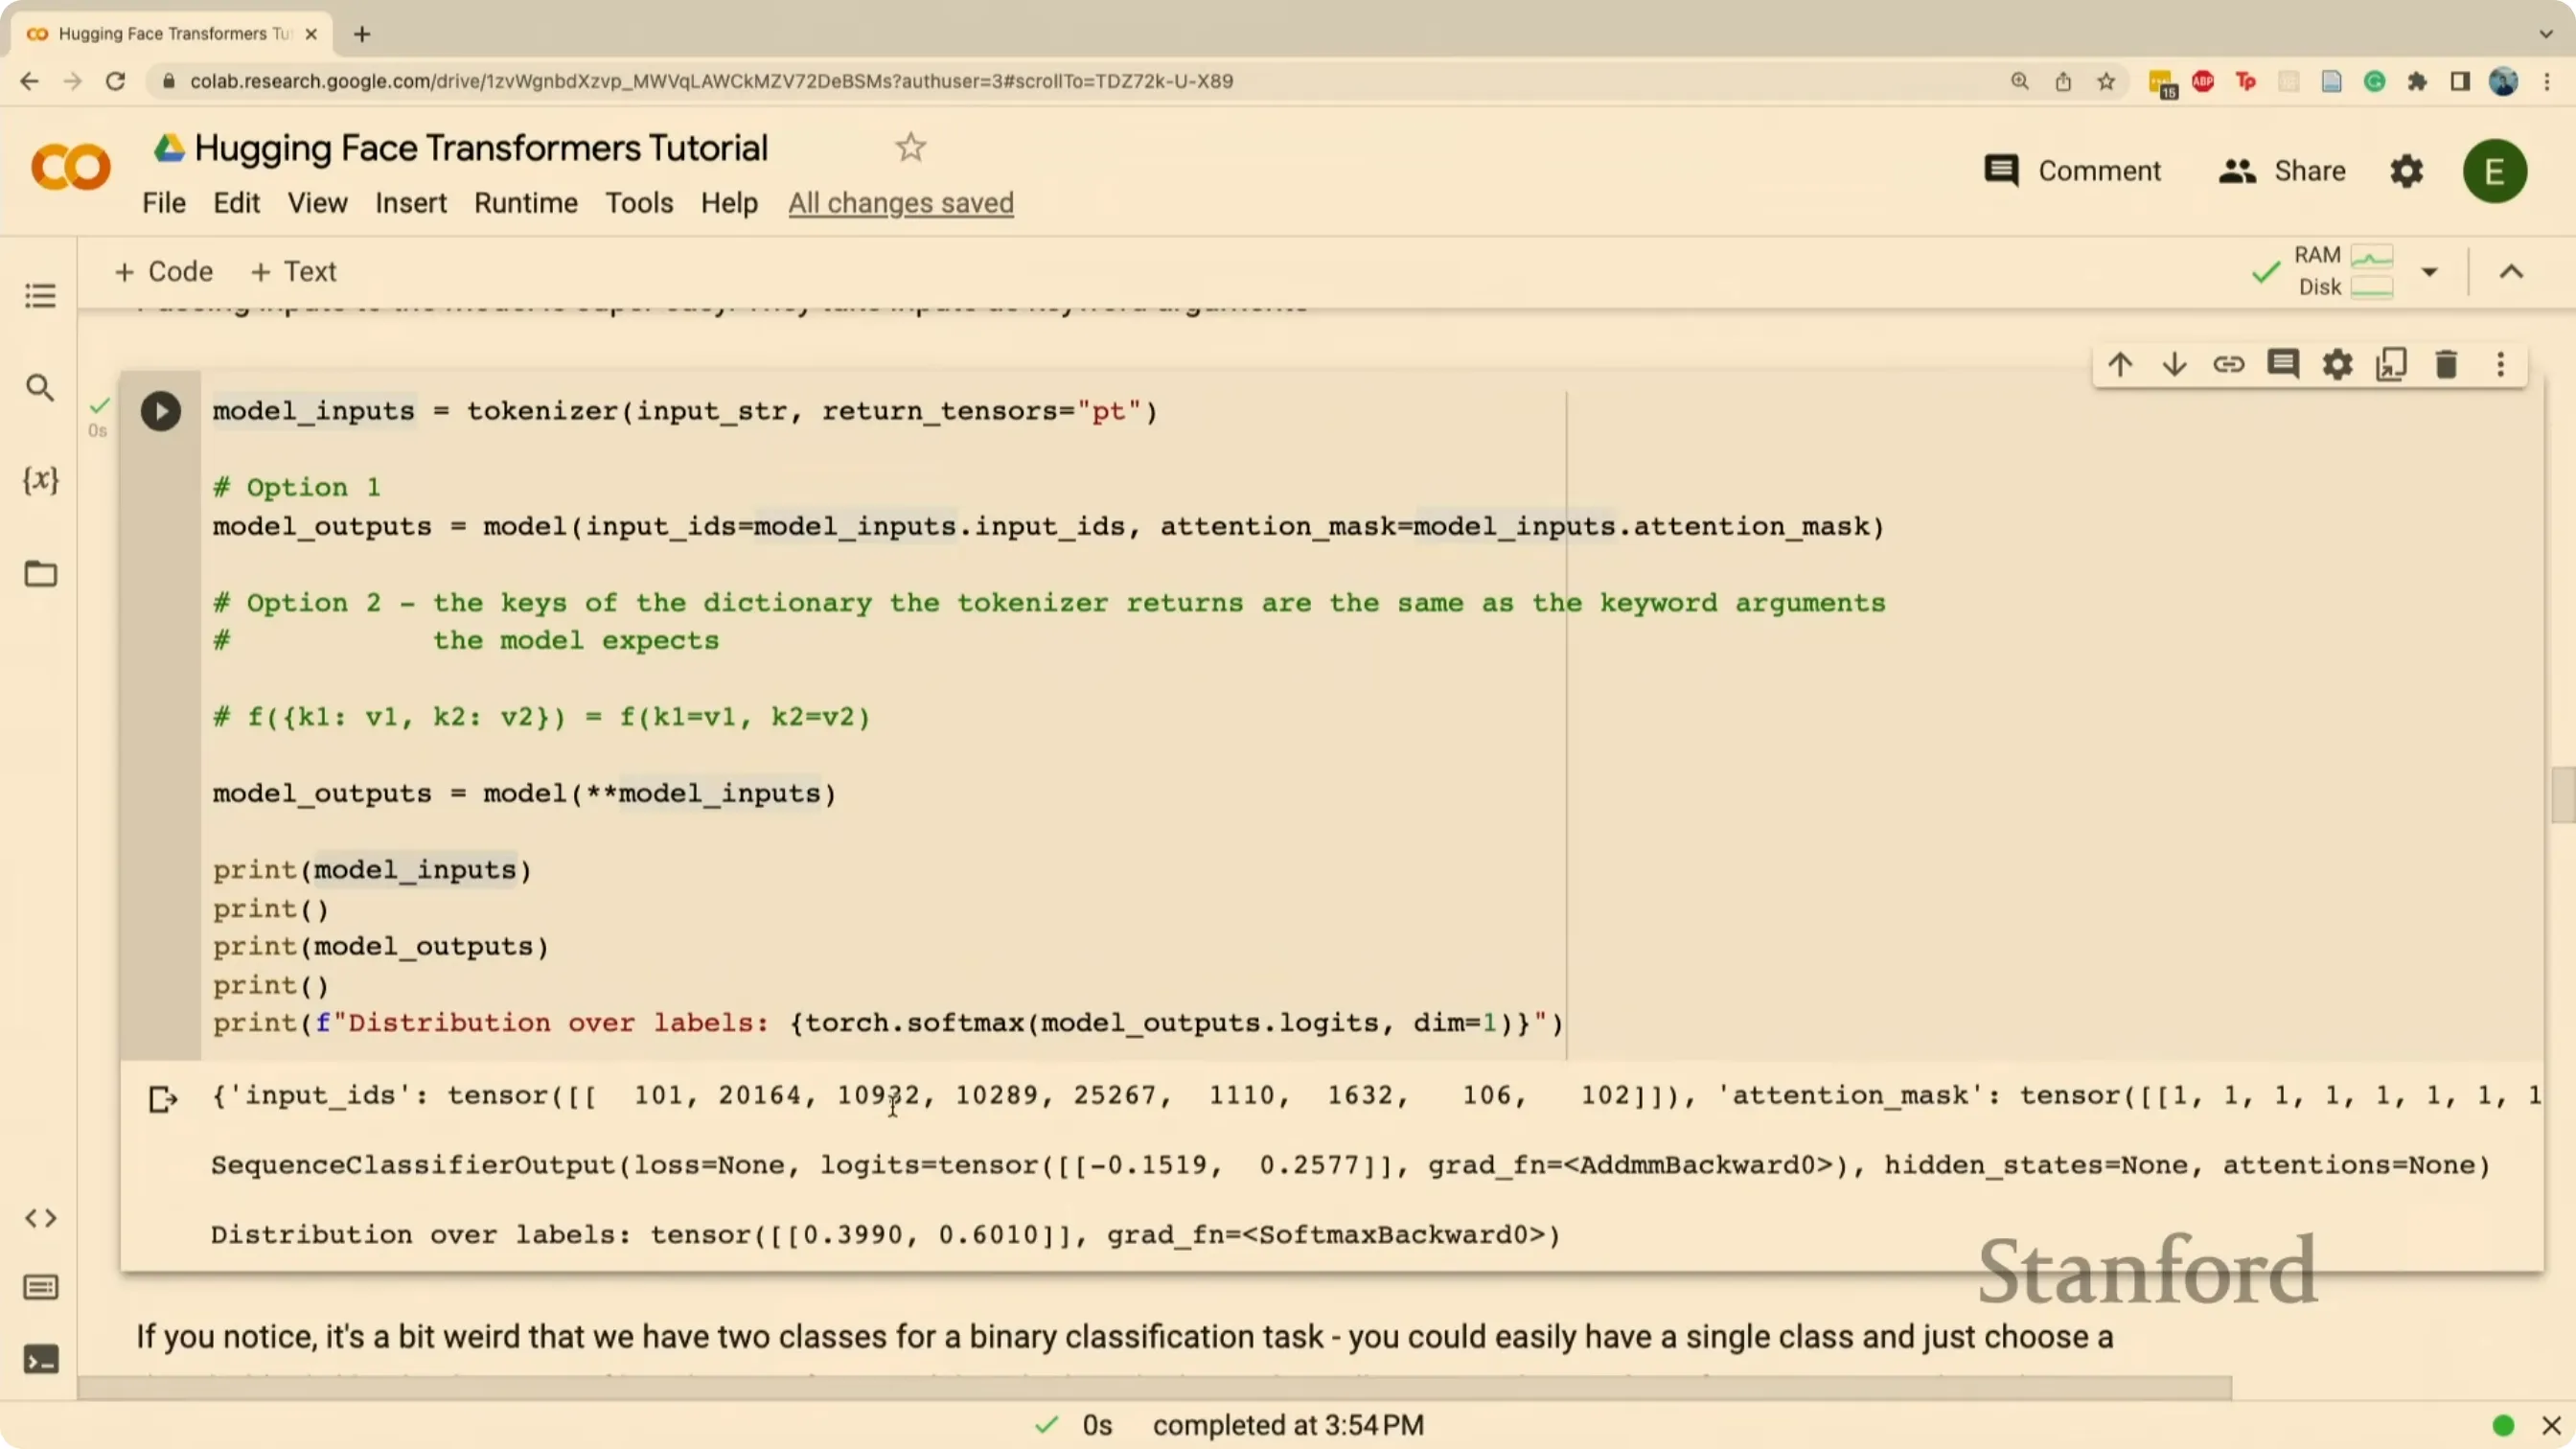
📷 模型输出中的 logits 与标签分布
回到原视频 (00:21:13)
模型就是 PyTorch 模块
(参考时间: 00:22:01)
从 Hub 加载下来的模型,本质上是 torch.nn.Module 的实例。所以前面学过的所有操作照旧可用:
loss = outputs.loss
loss.backward()          # 反向传播
model.parameters()       # 拿到全部可训练参数
model.parameters() 会返回一大串张量,其中就包括词嵌入矩阵——一个很大的、会被梯度更新的权重表。
让 Hugging Face 顺手帮你算 loss
(参考时间: 00:22:57)
如果不想到外面再调一次 torch.nn.functional.cross_entropy,可以直接把标签塞进去:
import torch

model_inputs["labels"] = torch.tensor([1])   # 1 = positive, 0 = negative
outputs = model(**model_inputs)
print(outputs.loss)
只要输入里带了 labels,返回的 ModelOutput 就会多出一个 loss 字段,内部已经算好了交叉熵。这是最省事的写法。
编者拓展|这个 loss 到底是什么
AutoModelForSequenceClassification内部计算的是标准的(多类)交叉熵:$$ \mathcal{L} = -\frac{1}{N}\sum_{i=1}^{N}\log\frac{\exp(z_{i,\,y_i})}{\sum_{c=1}^{C}\exp(z_{i,\,c})} $$
其中 $z_{i,c}$ 是第 $i$ 条样本在第 $c$ 类上的 logit,$y_i$ 是真实类别,$C$ 是类别数。方括号里那一项就是 softmax 后真实类的概率。
注意:它用
CrossEntropyLoss,而不是BCEWithLogitsLoss——即便你的任务是二分类。这就解释了为什么要有两个 logits。
取预测结果
(参考时间: 00:23:44)
只要取 logits 里数值最大的那个下标:
import torch

pred = torch.argmax(outputs.logits, dim=-1)
这个 pred 就是模型给出的预测类别。整个「分类—算 loss—拿预测」的流程,全部可以在 Hugging Face 的返回值里完成,不需要额外引入别的库。
六、看进模型内部:hidden states 与 attention
(参考时间: 00:24:25)
如果你想知道模型「为什么这么判断」,Hugging Face 提供了直接的入口。
打开两个开关
model = AutoModelForSequenceClassification.from_pretrained(
    checkpoint,
    output_attentions=True,
    output_hidden_states=True,
)
model.eval()

model_inputs = tokenizer(input_str, return_tensors="pt")

with torch.no_grad():
    outputs = model(**model_inputs)
两个关键参数:
output_attentions=True:让模型额外返回每一层的注意力权重;output_hidden_states=True:让模型额外返回每一层输出的隐状态。
这两个开关默认是关的,因为打开会显著增加显存占用——尤其是层数多、序列长的时候。
model.eval() 与 torch.no_grad()
(参考时间: 00:26:45)
课上有人问 model.eval() 到底做了什么。这是所有 PyTorch 模块通用的方法,它把模型切换进「评估模式」,关掉那些只在训练时才需要的行为。
具体来说,eval 模式会:
- 关闭 Dropout(不再随机丢弃神经元);
- 让 BatchNorm 使用running statistics 而不是当前 batch 的统计量。
torch.no_grad() 是另一件事:它告诉 PyTorch 不要构建计算图,因为这里不需要反向传播。两者配合使用,既能省显存,也能小幅提速。
(参考时间: 00:27:36) 有人接着问:「既然模型已经是预训练好的,能不能直接评估?」
可以;但这是完全没经过微调的原始模型。它的注意力权重反映的是预训练阶段学到的东西,不一定和具体任务相关。
读 shape
(参考时间: 00:27:47)
print(len(outputs.hidden_states))              # 层数 + 1(含 embedding 层输出)
print(outputs.hidden_states[0].shape)
print(outputs.attentions[0].shape)
典型输出形状是 [batch_size, seq_len, hidden_dim],例如 [1, 7, 768]:
| 维度 | 含义 |
|---|---|
| 第 0 维 | batch size(本例为 1) |
| 第 1 维 | 序列长度(token 数) |
| 第 2 维 | 隐藏维度(DistilBERT 为 768) |
注意力张量的形状是 [batch_size, num_heads, seq_len, seq_len]。最后两维分别对应「查询词」和「被关注的词」——这正是课上那句「对应到 query word 和 key word」的意思。
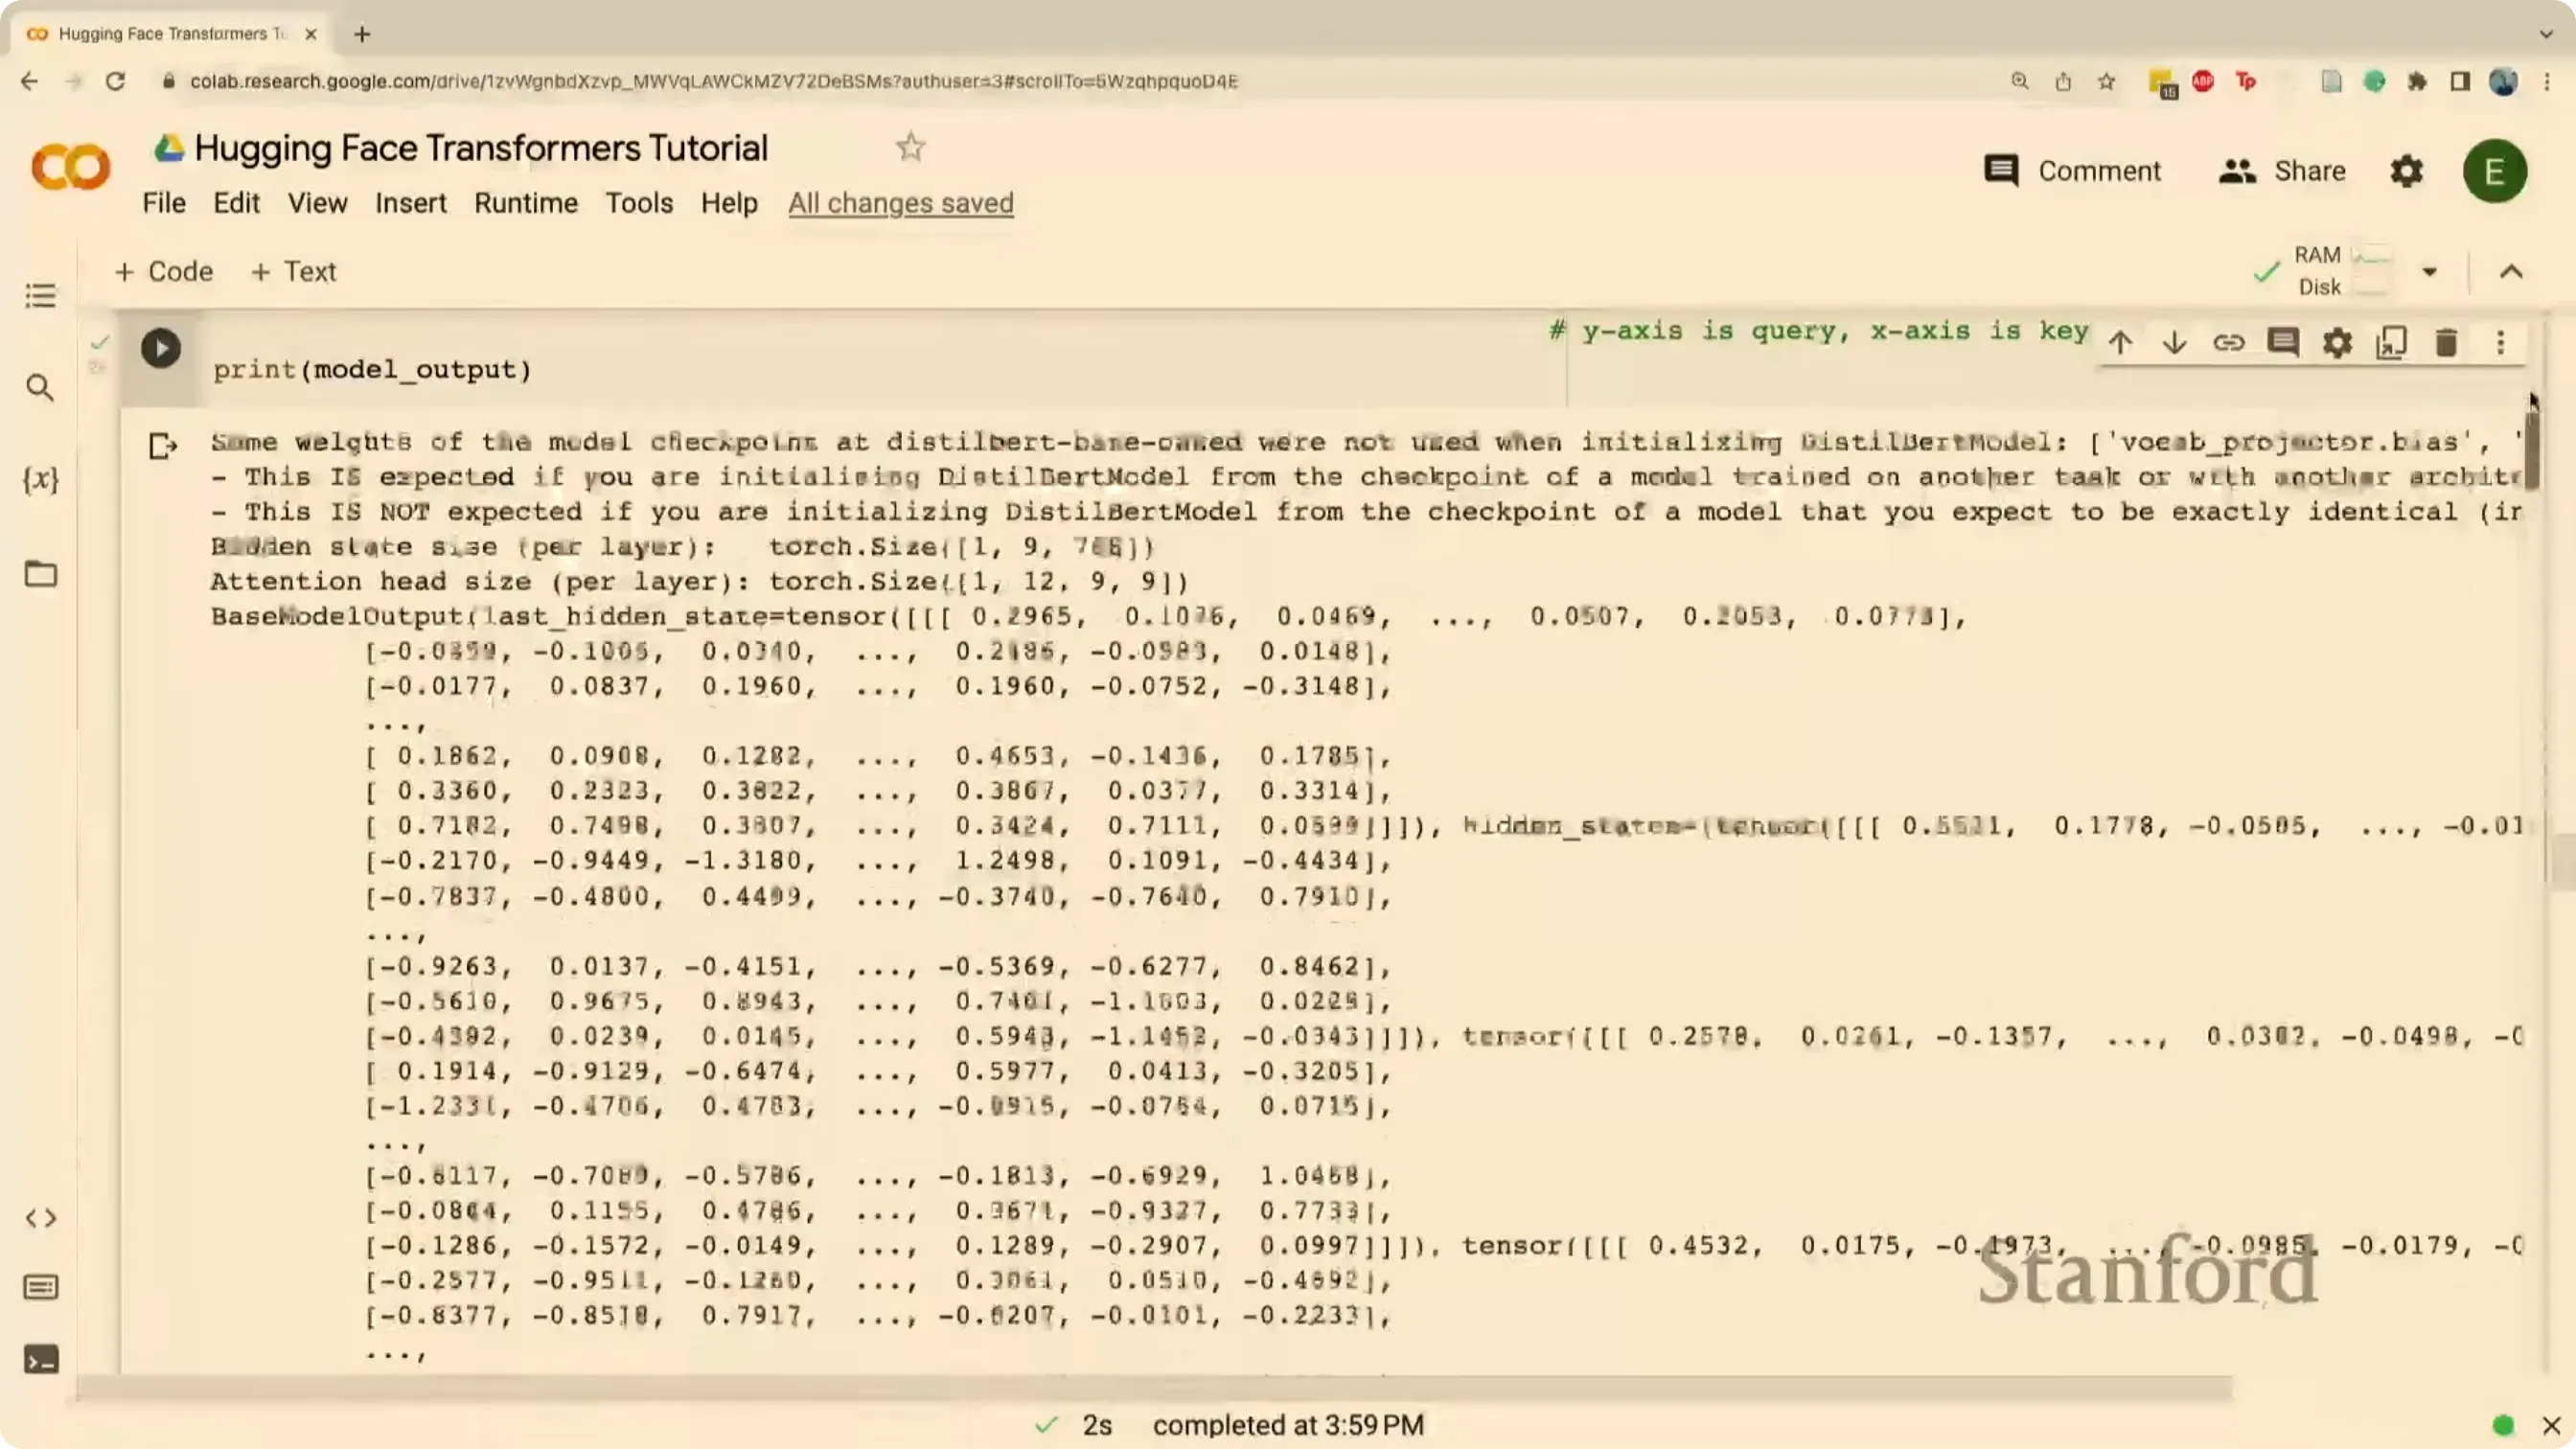
📷 逐层 hidden states 与 attention 的形状打印结果
回到原视频 (00:25:52)
编者拓展|
hidden_states为什么比层数多一个它返回的是一个元组,长度 = 层数 + 1。第 0 项是 embedding 层的输出(还没经过任何 Transformer block),第 1 项是第 1 层的输出,依此类推。所以 DistilBERT(6 层)会返回 7 个张量。
这个设计在做层间探针(probing)时很有用:你可以分别拿每一层的表示去训练一个线性分类器,看语义信息是在哪一层开始变得可分。
画成热力图
(参考时间: 00:29:14)
把每一层、每个头的注意力权重画出来,是最直观的可视化方式:
import matplotlib.pyplot as plt

layer_id, head_id = 0, 0
attn = outputs.attentions[layer_id][0, head_id].detach().cpu().numpy()

tokens = tokenizer.convert_ids_to_tokens(model_inputs["input_ids"][0])

fig, ax = plt.subplots(figsize=(6, 5))
im = ax.imshow(attn, cmap="viridis")
ax.set_xticks(range(len(tokens))); ax.set_xticklabels(tokens, rotation=90)
ax.set_yticks(range(len(tokens))); ax.set_yticklabels(tokens)
fig.colorbar(im)
plt.tight_layout()
plt.show()
坐标轴的解释:
- y 轴:模型的不同层;
- x 轴:同一层里的不同 attention head;
- 每个格子内部:该头在该层对各个 token 的注意力分布。
颜色上,黄色 = 数值大(注意力强),深色 = 接近 0。
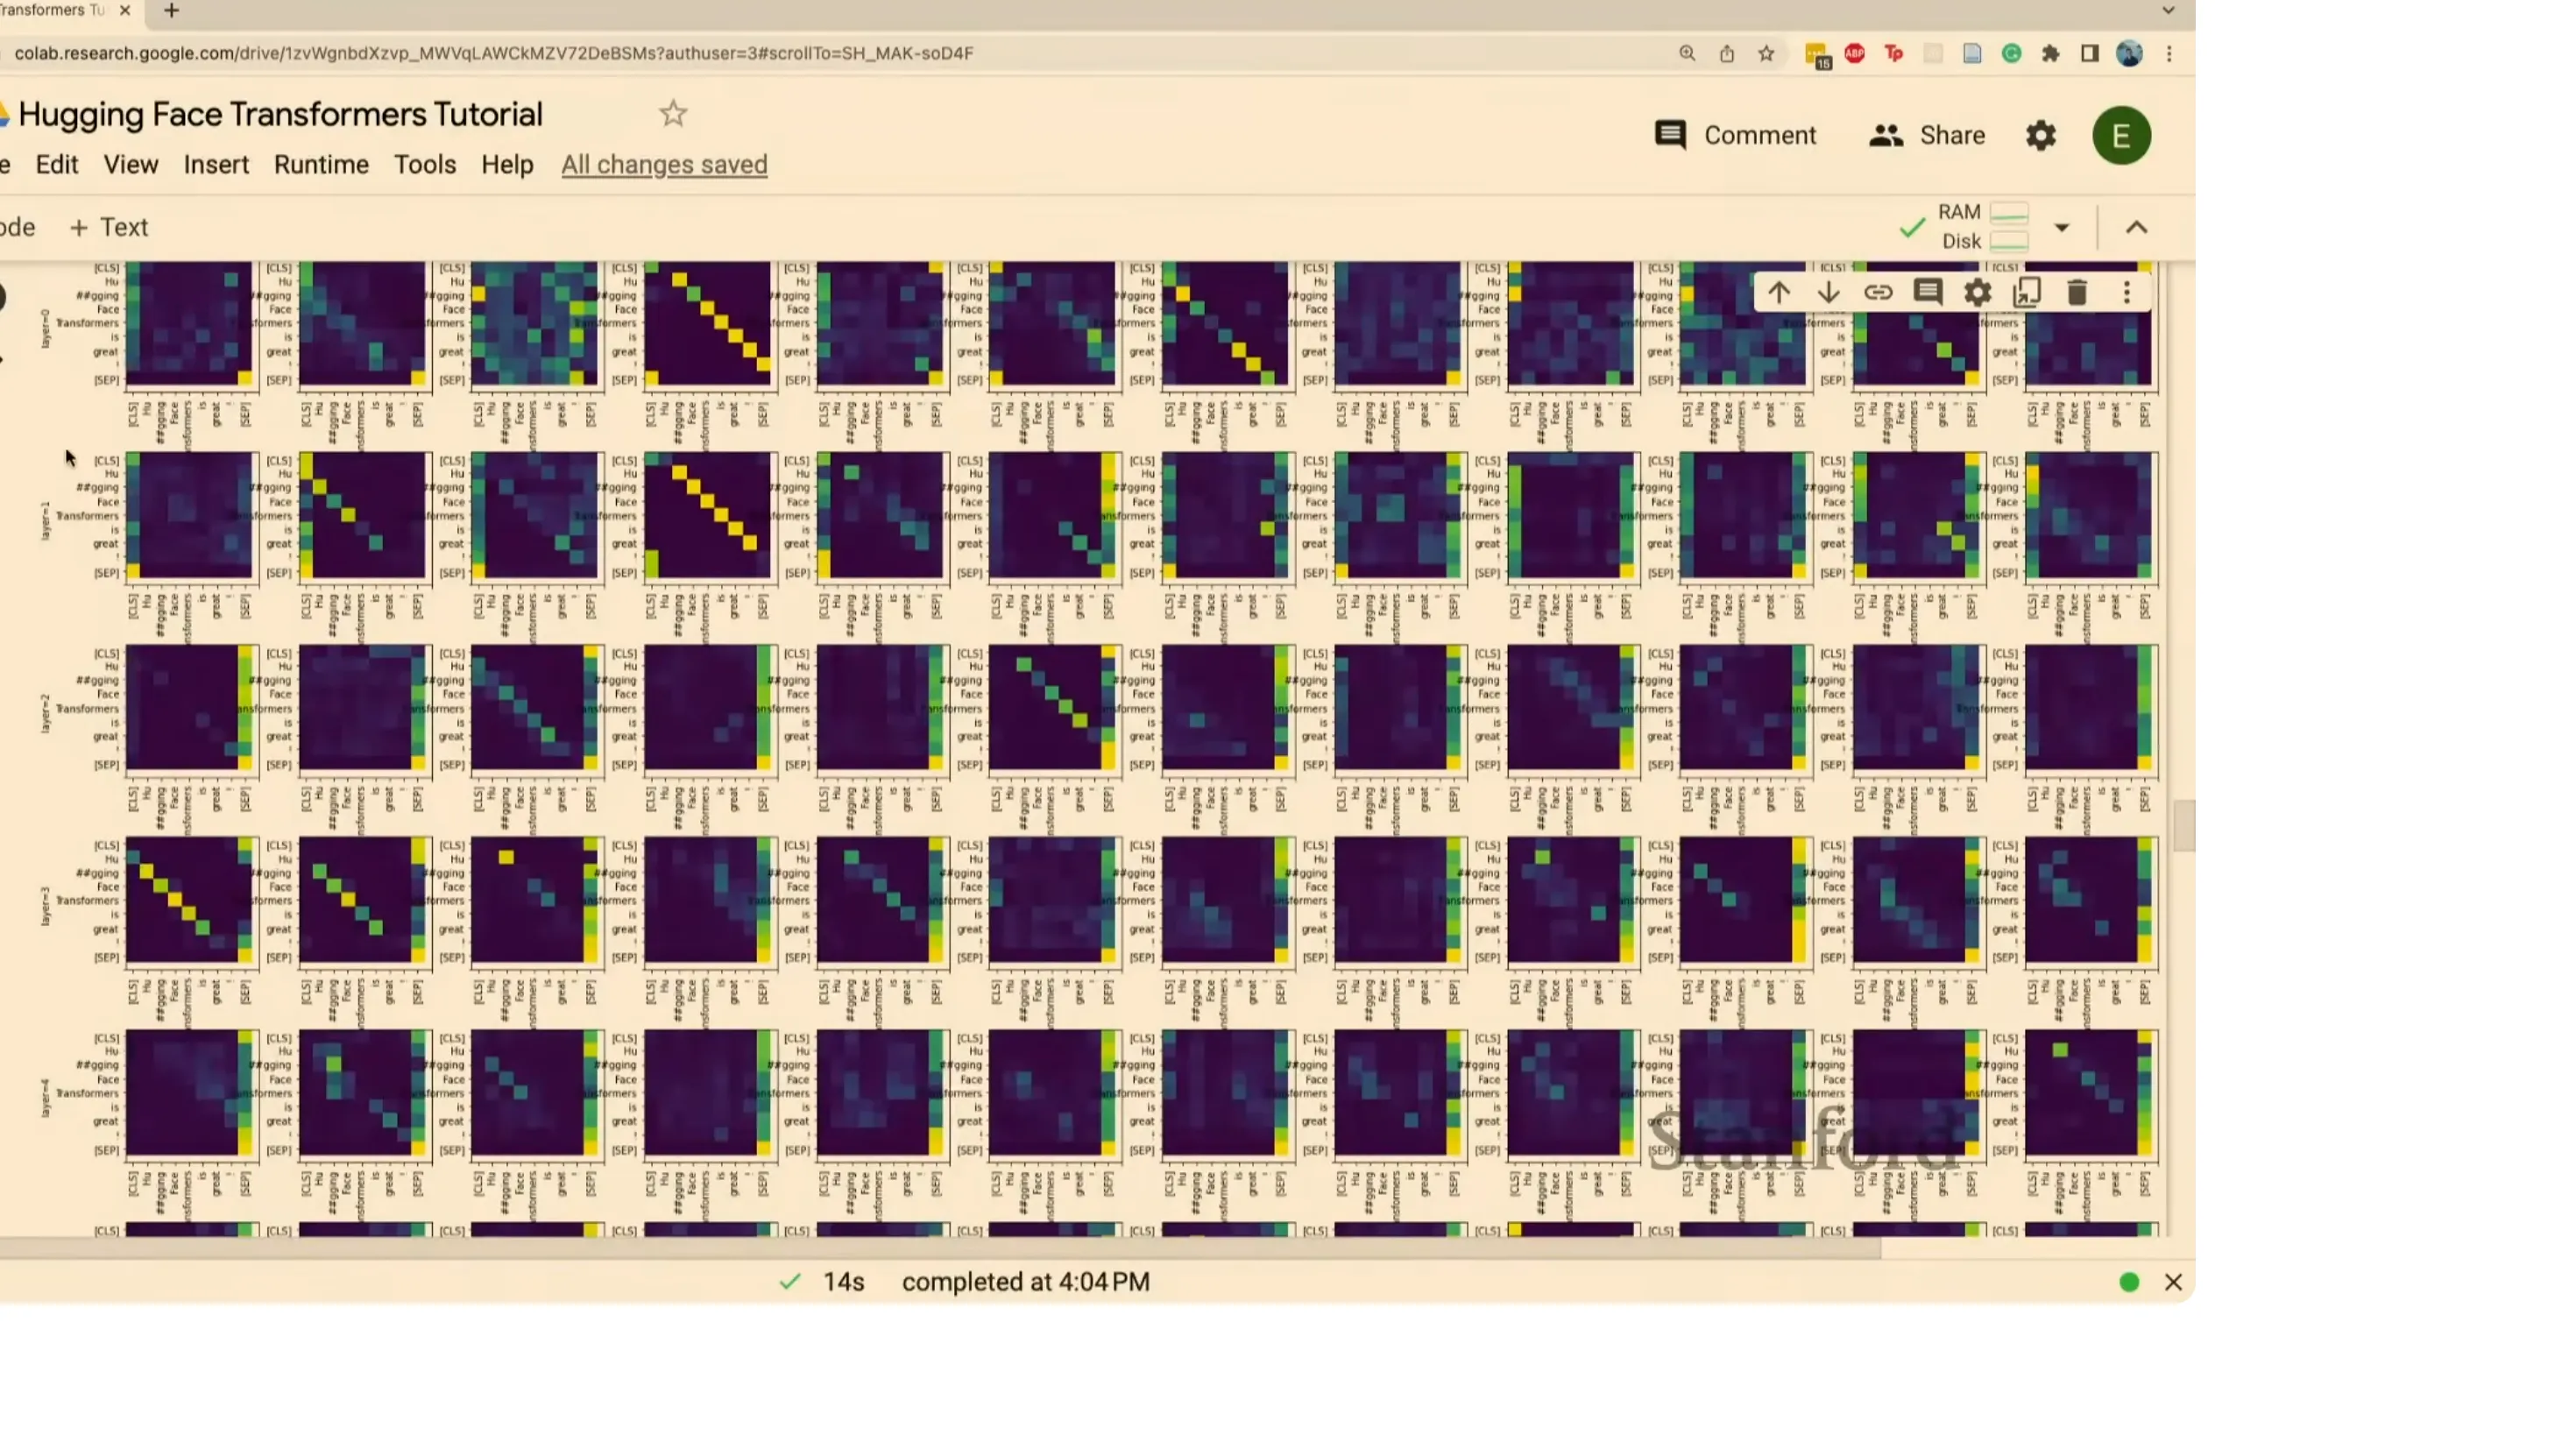
📷 逐层逐头的 attention 热力图
回到原视频 (00:30:04)
编者说明:现场画的那张图,外层其实是「层 × 头」的网格,每格嵌一个小热力图,对应
[seq_len, seq_len]的注意力矩阵。上面这段代码画的是单格版本,形状更小、更容易看清。要复现网格版,对outputs.attentions双层循环即可。编者拓展|注意力权重的含义与局限
一层的注意力是这样算的:
$$ \alpha_{ij} = \frac{\exp!\left(\frac{q_i \cdot k_j}{\sqrt{d_k}}\right)}{\sum_{j'}\exp!\left(\frac{q_i \cdot k_{j'}}{\sqrt{d_k}}\right)} $$
$\alpha_{ij}$ 表示第 $i$ 个 token 在生成自己的表示时,从第 $j$ 个 token 处取了多少信息。行的和恒为 1。
常见误读是「注意力权重高 = 这个词重要」。这在单层单头里勉强成立,但在多头多层的模型里并不必然——不同头可能学的是完全不同的模式(有的关注相邻词,有的关注句法依存,有的关注标点)。近年也有工作指出,attention 权重与实际的梯度归因并不总是一致。把它当作观察工具,而不是解释结论,是更稳妥的使用方式。
七、微调:把数据集准备好
(参考时间: 00:31:33)
这一节被定位为「一个项目里最常做的事」:手上有一个预训练模型,但它在具体任务上并不够好,所以要微调。
加载数据集
(参考时间: 00:32:03)
Hugging Face 不只托管模型,也托管数据集:
from datasets import load_dataset

imdb = load_dataset("imdb")
IMDb 是一个电影评论情感数据集,标签只有正/负两类,正好对应上一节的情感分析任务。
为了能在 CPU 上快速演示,做了两件事:
- 截断:只保留每条评论的前 ~50 个 token;
- 缩小规模:从训练集里抽出 128 条做训练、32 条做验证。
graph LR
    A["load_dataset('imdb')"] --> B["DatasetDict<br/>shuffle + select"]
    B --> C["map: tokenize<br/>padding + truncation"]
    C --> D["remove_columns('text')<br/>rename_column('label','labels')"]
    D --> E["set_format('torch')"]
    E --> F["DataLoader(batch_size=16)"]
    F --> G["送入模型训练"]
用 DatasetDict 组装
(参考时间: 00:32:44)
from datasets import DatasetDict

shuffled = imdb["train"].shuffle(seed=42)

small = DatasetDict({
    "train":      shuffled.select(range(128)),
    "validation": shuffled.select(range(128, 160)),
})
DatasetDict 基本上就是一个字典的包装:键是划分名(train / validation),值是各自的 Dataset。
注意这里的 shuffle 只做了一次,然后从同一份打乱后的数据里切出前 128 条和后 32 条。如果对训练集和验证集分别 shuffle,两者会有重叠。
检查一下内容:
small["train"][:2]
返回的还是一个字典:
text:影评原文(一个列表);label:对应的标签,1 = 正面,0 = 负面。
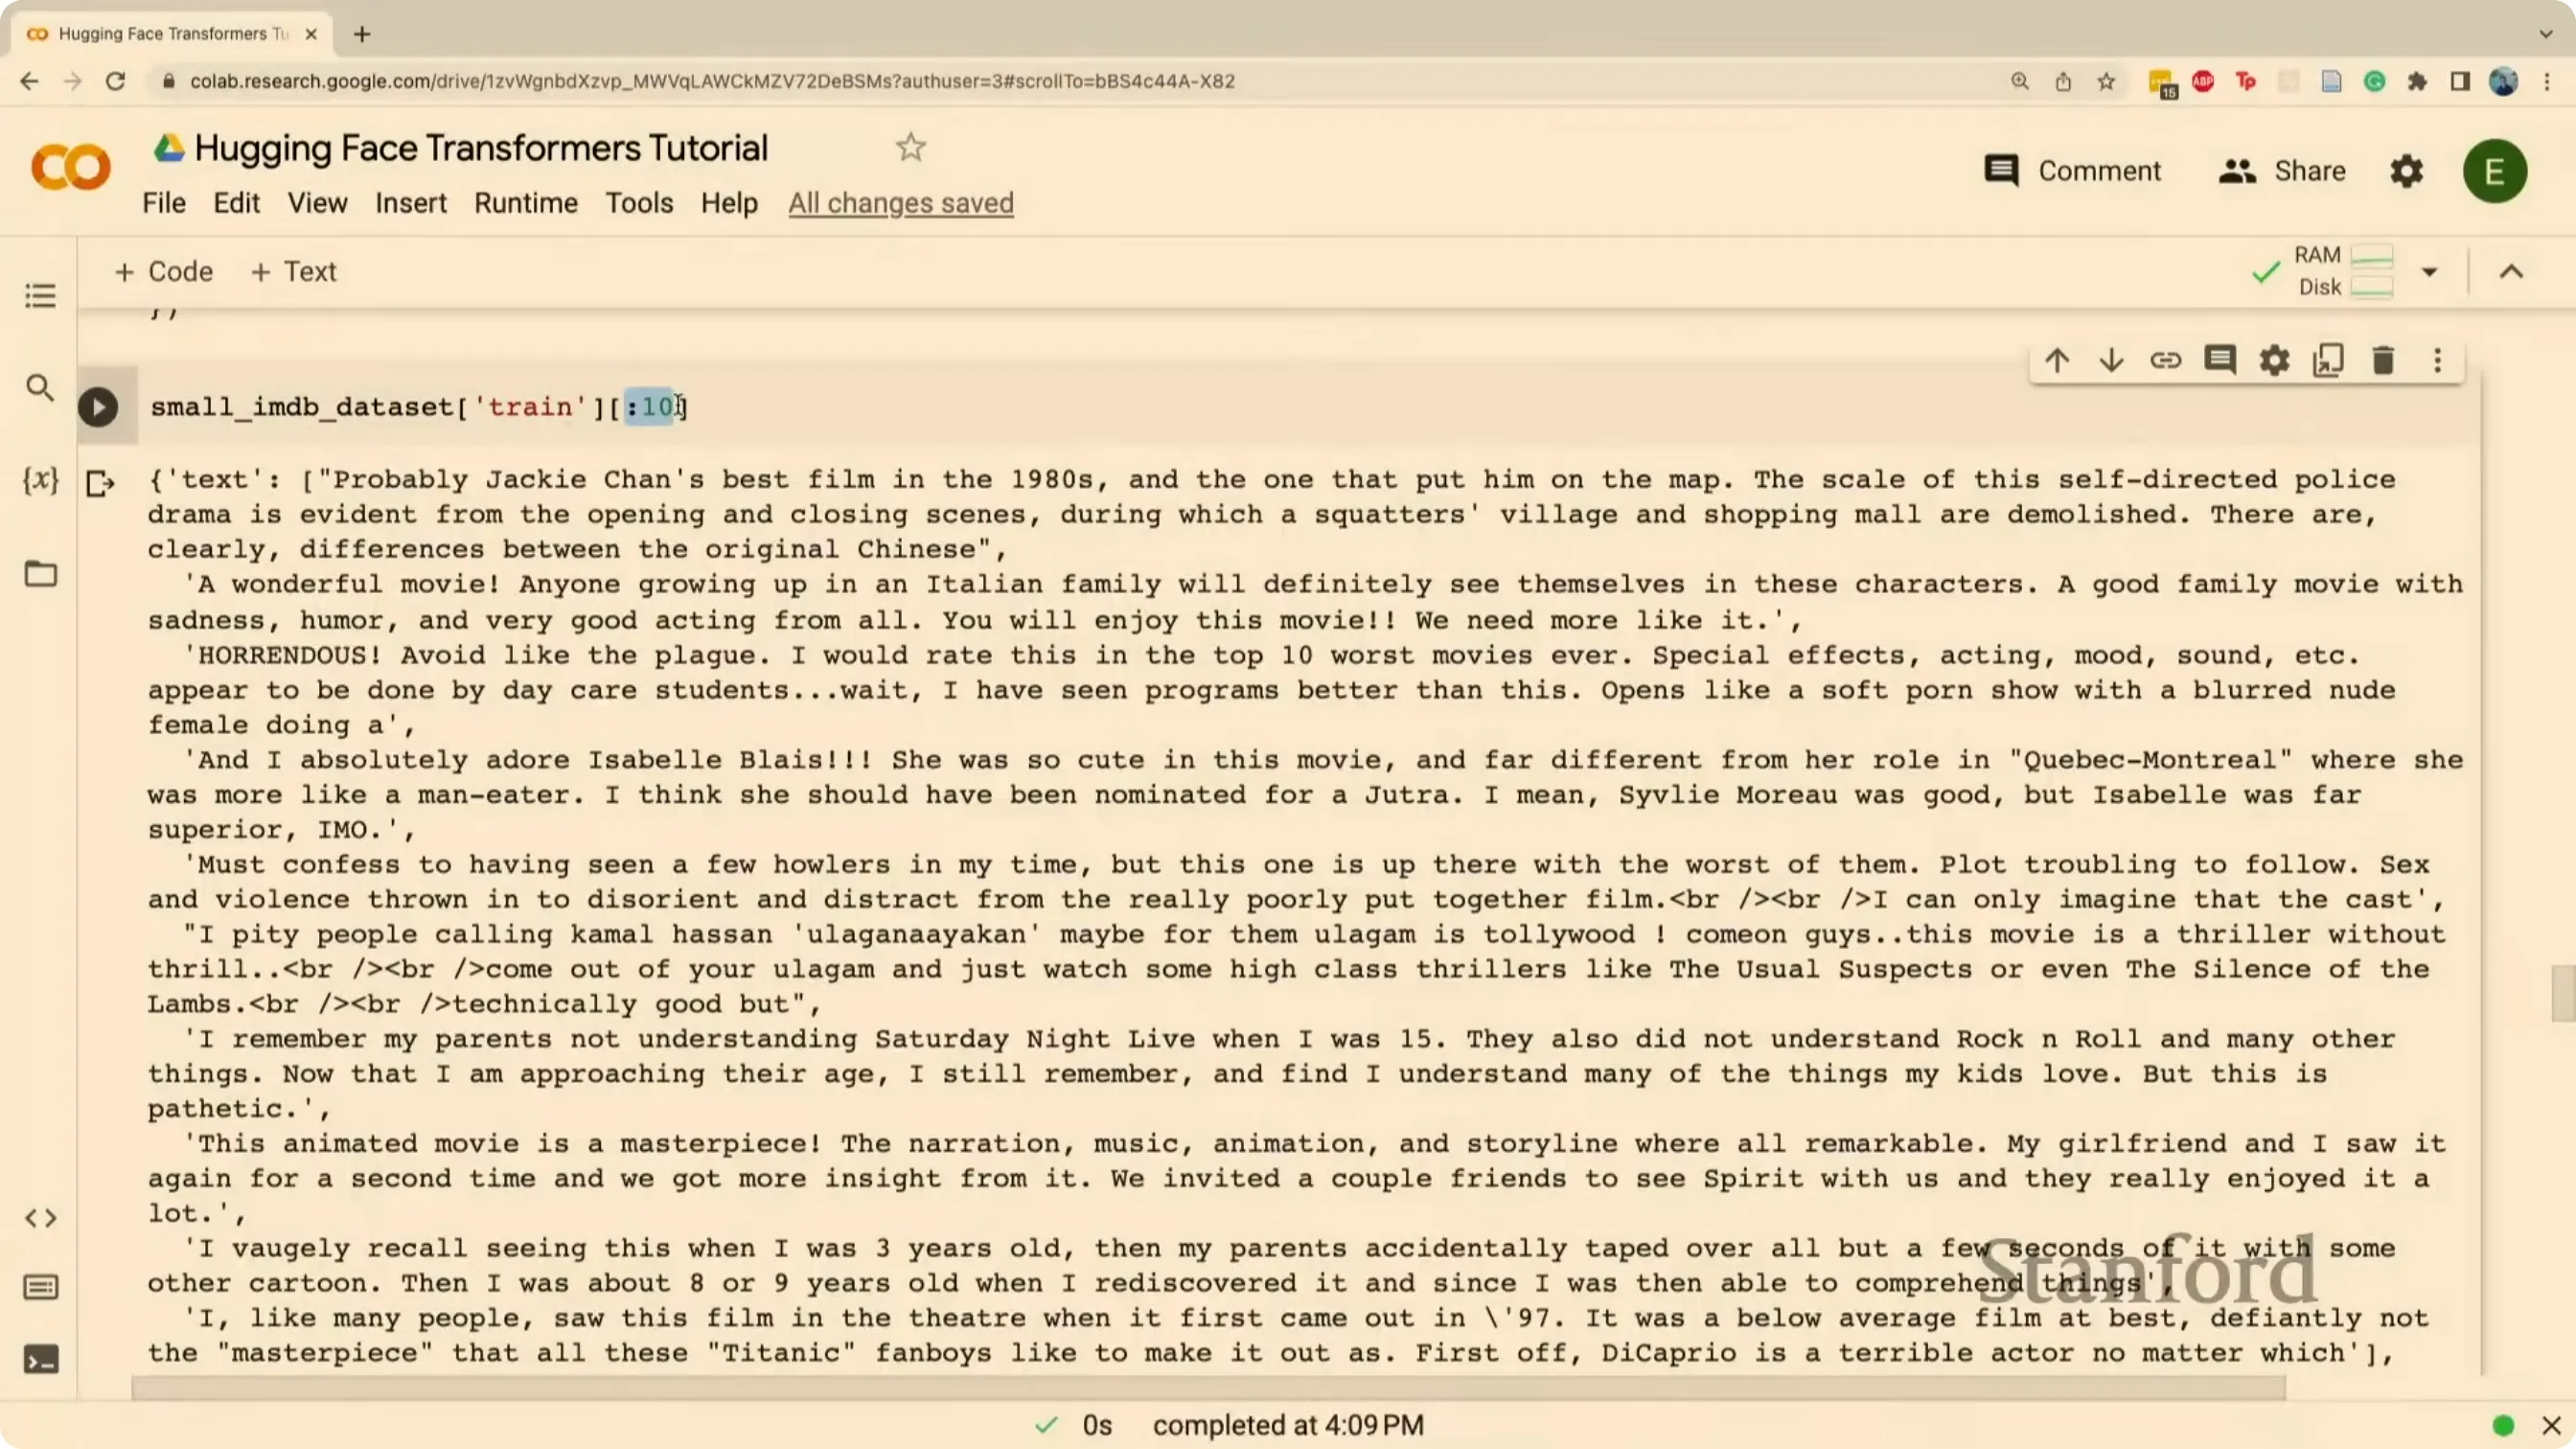
📷 DatasetDict 前几条样本的内容与标签
回到原视频 (00:34:06)
用 map 批量分词
(参考时间: 00:34:36)
def tokenize_fn(examples):
    return tokenizer(
        examples["text"],
        padding="max_length",
        truncation=True,
        max_length=50,
    )

small = small.map(tokenize_fn, batched=True, batch_size=16)
要点:
map会对数据集里的每一条执行这个函数;batched=True表示一次传入一批(而不是一条),tokenizer 本身支持批量输入,效率高得多;padding="max_length"+max_length=50:统一补/截到 50 个 token;- 返回值里有
input_ids和attention_mask,map会自动把它们作为新列合并进数据集。
课上有人问这些 ID 是怎么加进去的,回答很干脆:自动的。不需要手动往数据集里塞字段,tokenizer 返回什么,map 就写什么。
清理列与切换格式
(参考时间: 00:35:38)
small = small.remove_columns(["text"])
small = small.rename_column("label", "labels")
small.set_format("torch")
三件事,各有原因:
- 删掉
text:已经 tokenize 过了,原始文本不再需要,留着只会占内存; label→labels:Hugging Face 的模型签名要求参数名叫labels(复数)。改名之后,model(**batch)才能把标签自动喂进去并返回loss;set_format("torch"):让取出来的样本是torch.Tensor而不是 Python 列表,可以直接进 PyTorch 模型。
做完之后再看一眼:
small["train"][:2]
现在只剩下三列:labels、input_ids、attention_mask。这正是模型需要的全部输入。
装进 DataLoader
(参考时间: 00:38:39)
from torch.utils.data import DataLoader
from transformers import DataCollatorWithPadding

collator = DataCollatorWithPadding(tokenizer=tokenizer)

train_loader = DataLoader(
    small["train"], batch_size=16, shuffle=True, collate_fn=collator
)
eval_loader = DataLoader(
    small["validation"], batch_size=16, collate_fn=collator
)
到这里,数据部分就绪。
编者说明:讲者在课上用的是普通
DataLoader(他说「typical normal data loader」),字幕里没有明确出现DataCollatorWithPadding。这里补上它是因为:如果前面用的是padding="max_length",各条长度已经一致,确实不需要 collator;但如果你改用padding=True(按批动态补),就必须在 collate 阶段做 padding,否则DataLoader拼不出方阵,会直接报错。两种写法讲者都提到过(00:37:03),只是演示里选了前者。
八、训练模型:两种写法
(参考时间: 00:39:02)
有两条路:两条路都对,取决于想控制到什么程度。
graph TD
    A[准备好 dataset + DataLoader] --> B{选哪种写法}
    B -->|方式 A| C["手写 PyTorch 循环<br/>AdamW + linear schedule"]
    B -->|方式 B| D["Trainer<br/>TrainingArguments + Trainer"]
    C --> E["每一步都由你控制"]
    D --> F["训练/评估/保存/日志由框架托管"]
方式 A:原生 PyTorch
(参考时间: 00:39:02)
整体结构和课上讲过的任何 PyTorch 训练循环完全一样,只有 optimizer 和 scheduler 的来源稍有不同——可以从 transformers 包里直接 import:
import torch
from transformers import AdamW, get_linear_schedule_with_warmup

epochs = 3
optimizer = AdamW(model.parameters(), lr=2e-5)

num_training_steps = len(train_loader) * epochs
num_warmup_steps = 0
scheduler = get_linear_schedule_with_warmup(
    optimizer,
    num_warmup_steps=num_warmup_steps,
    num_training_steps=num_training_steps,
)

model.train()
for epoch in range(epochs):
    for batch in train_loader:
        outputs = model(**batch)     # batch 里已经有 labels,loss 自动算好
        loss = outputs.loss

        loss.backward()
        optimizer.step()
        scheduler.step()
        optimizer.zero_grad()
几个要点:
model.train():切回训练模式,重新打开 Dropout(与第六节的eval()相对);**batch:前面做的列名改造,就是为这一行服务的;- 线性衰减(linear schedule):学习率随训练步数逐渐下降,前期大步走、后期小步调。它被列为可选项而不是必须项。
编者拓展|为什么微调常用很小的学习率
从头训练时,学习率通常取 $10^{-3}$ 量级;微调预训练模型时,通常取 $10^{-5}$ 到 $2\times10^{-5}$。
原因是预训练权重已经落在一个不错的解附近,你需要的是沿着损失面轻轻挪动,而不是重新跳一次。学习率太大,几轮之内就会把预训练学到的表示冲掉(灾难性遗忘)。
配合 warmup 更稳:前若干步把学习率从 0 线性升到目标值,避免一上来就把刚刚随机初始化的分类头带偏。
方式 B:Trainer
(参考时间: 00:41:00)
Trainer 把上面整个循环封装进了一个类。
第一步:定义训练参数
from transformers import TrainingArguments

args = TrainingArguments(
    output_dir="./checkpoints",          # checkpoint 存哪
    logging_dir="./logs",                # 日志存哪
    per_device_train_batch_size=16,
    per_device_eval_batch_size=32,
    num_train_epochs=3,
    evaluation_strategy="epoch",         # 每个 epoch 评估一次
    learning_rate=2e-5,
)
TrainingArguments 基本上就是一个参数字典,可配置项非常多——warmup steps、warmup ratio、weight decay、梯度累积、混合精度等等。需要什么就查文档加什么。
第二步:定义评估指标
import numpy as np

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    preds = np.argmax(logits, axis=-1)
    return {"accuracy": float((preds == labels).mean())}
这个函数会被 Trainer 在评估时调用,入参是 (logits, labels) 的元组,出参是一个指标字典。除了 accuracy,你完全可以在这里算 F1、召回率等任意指标。
第三步:实例化并训练
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=args,
    train_dataset=small["train"],
    eval_dataset=small["validation"],
    tokenizer=tokenizer,
    compute_metrics=compute_metrics,
)

trainer.train()
原本几十行的训练循环,现在浓缩成了 trainer.train() 一行。
(参考时间: 00:45:47) 运行时它会实时打印进度、当前 epoch、已用时间、loss 等,比手写循环的日志好看得多。
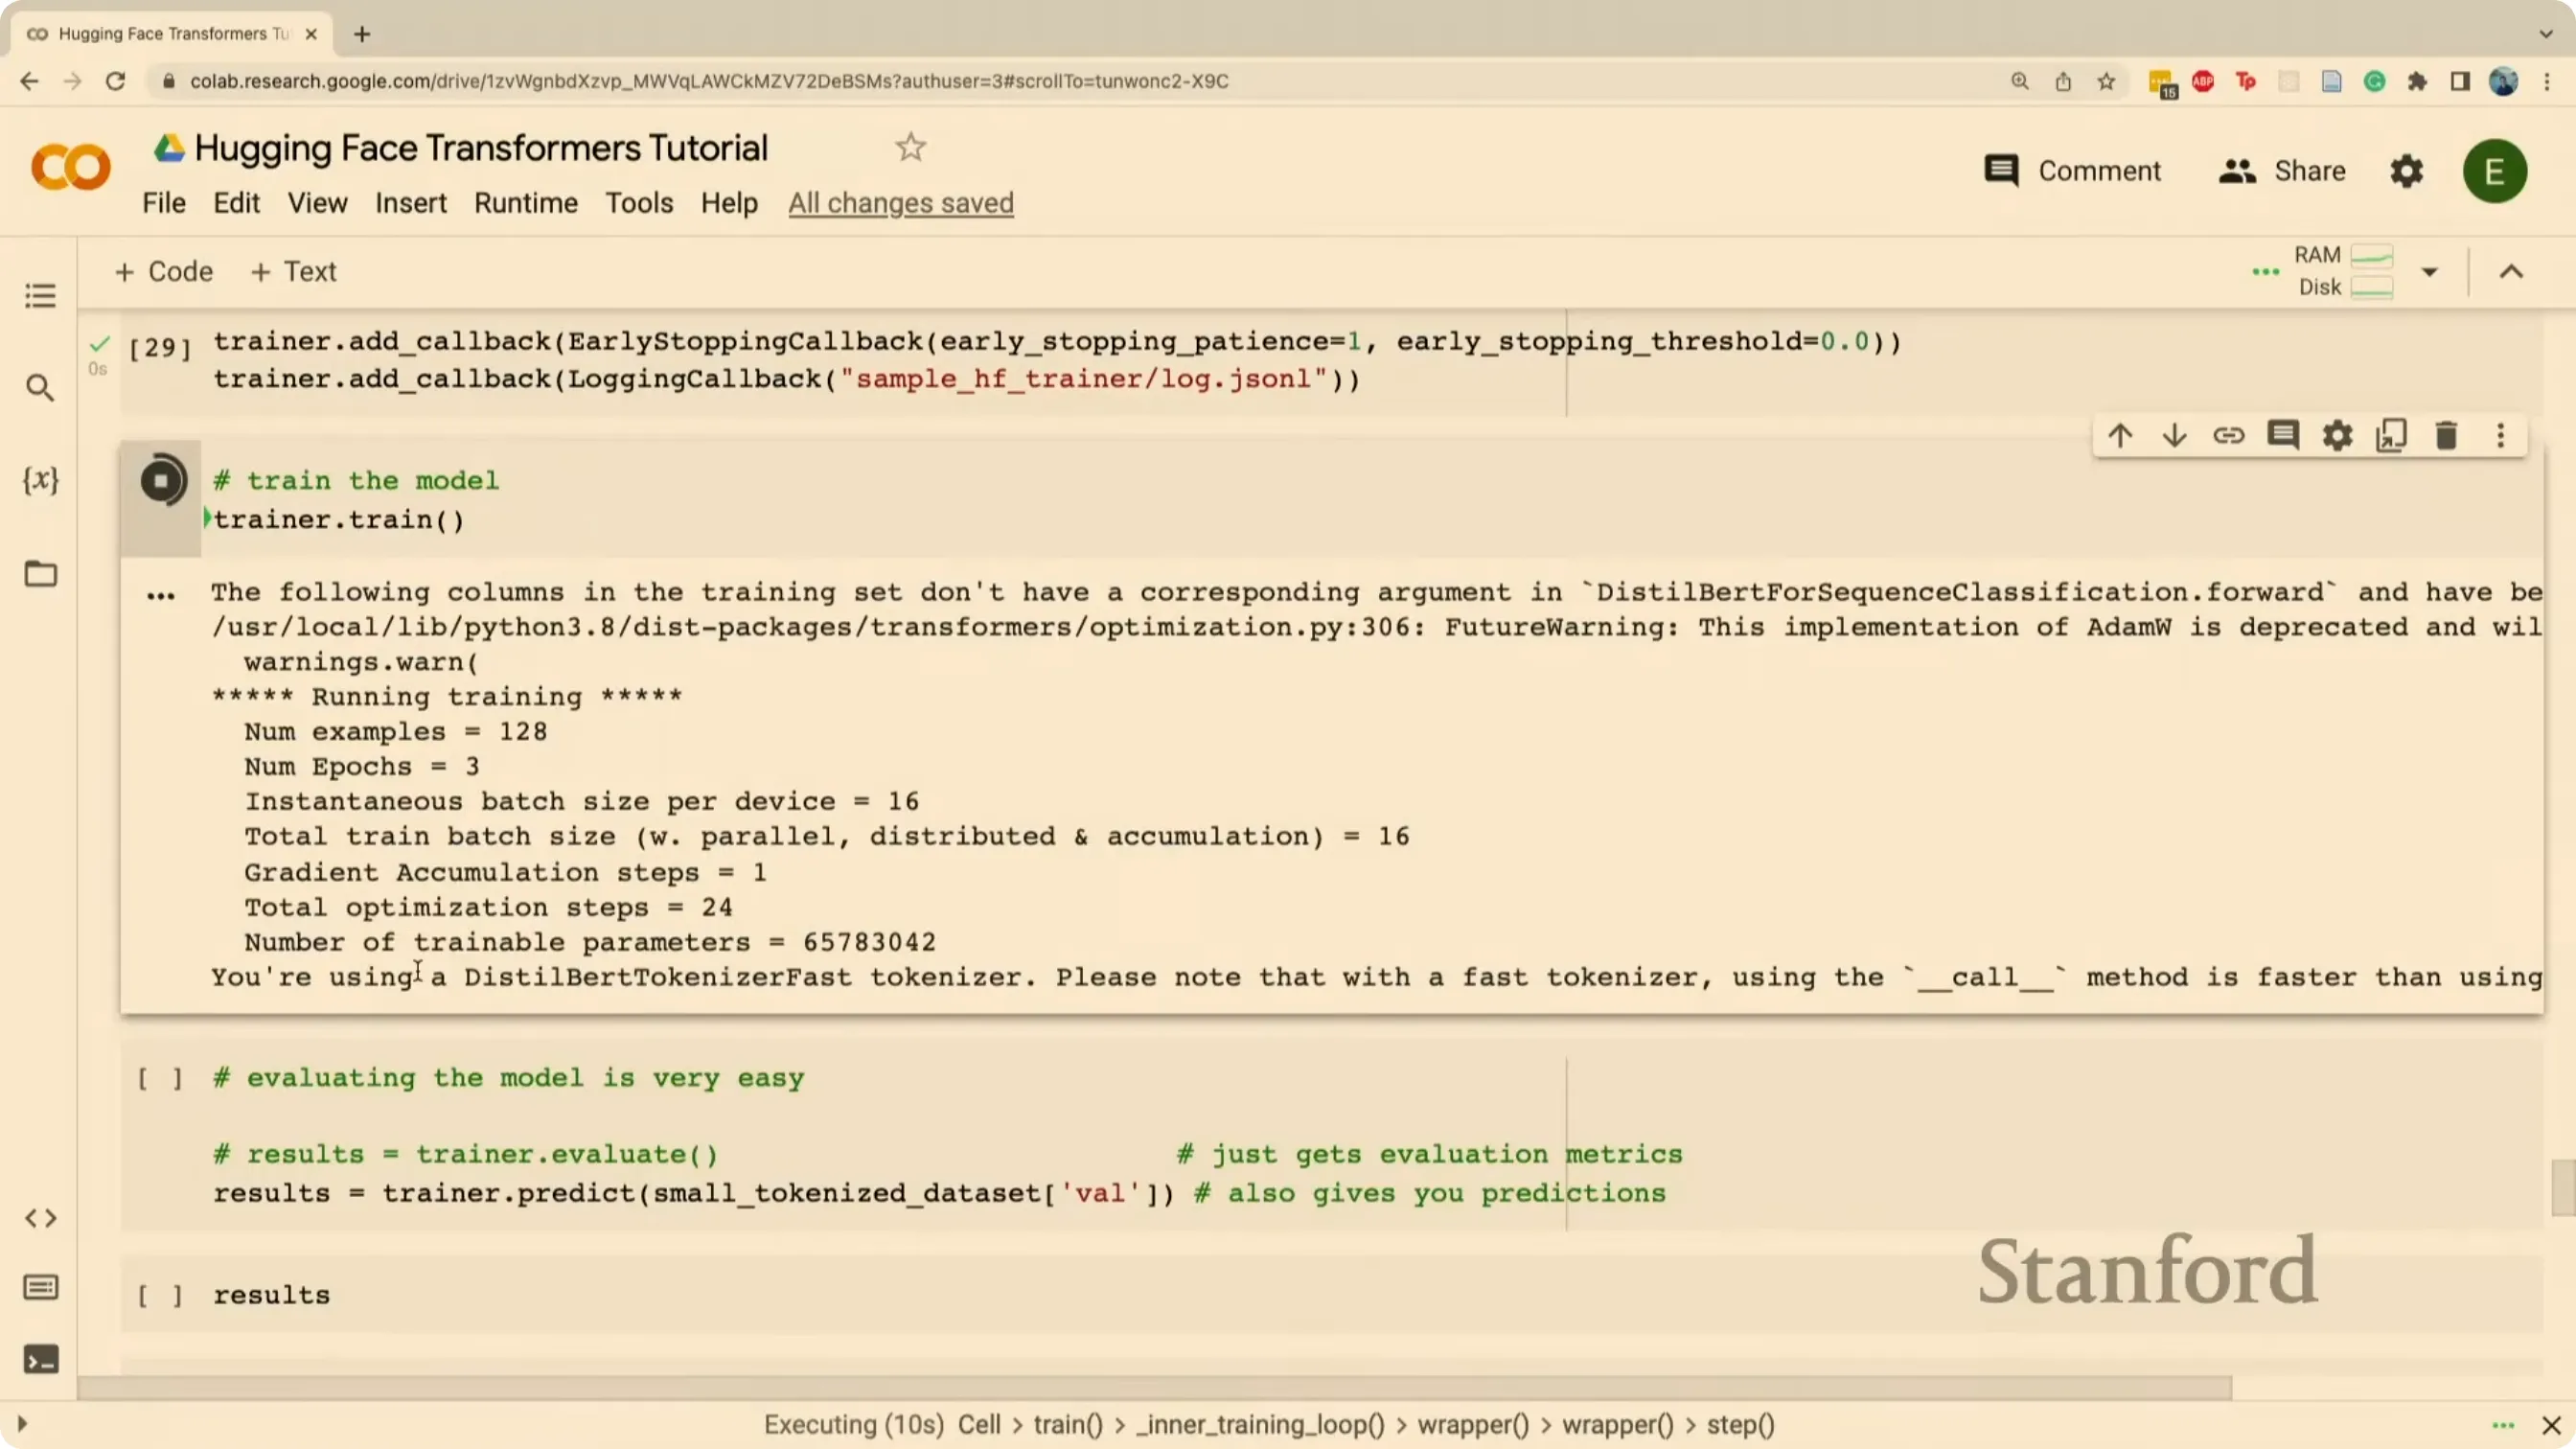
📷 Trainer 训练过程中打印的日志
回到原视频 (00:45:47)
编者说明:现场跑这段时遇到了一次「目录不存在」的小报错(
TrainingArguments的output_dir还没创建)。这类问题在 Colab 里很常见:若output_dir指向尚未创建的路径就会报错,指向已存在的路径或提前os.makedirs可避免。
第四步:预测
predictions = trainer.predict(small["validation"])
trainer.predict 会返回一个包含 predictions(logits)、label_ids、metrics 的对象,语义和 trainer.evaluate 接近,但额外保留了原始预测值。
回调与早停
(参考时间: 00:44:13)
如果需要在训练过程中插入自定义行为(比如每个 epoch 结束后做点什么),可以挂 callback:
from transformers import EarlyStoppingCallback

trainer = Trainer(
    ...,
    callbacks=[EarlyStoppingCallback(early_stopping_patience=2)],
)
- LoggingCallback:把训练过程的信息写下来,属于工具性用途,不重要但方便;
- EarlyStoppingCallback:如果连续若干个 epoch 验证指标都没提升,就提前停止,省算力也省时间。
课上有人问 patience 该设多少,回答是:没有固定答案,取决于模型和数据集,凭经验定。
保存与恢复
(参考时间: 00:46:39)
训练过程中,Trainer 会把 checkpoint 存到 output_dir 下,命名类似 checkpoint-500、checkpoint-1000。
要恢复训练或做推理,直接加载那个目录:
model = AutoModelForSequenceClassification.from_pretrained(
    "./checkpoints/checkpoint-8"
)
加载之后的使用方式和最初完全一样——tokenize、喂进去、取 logits。
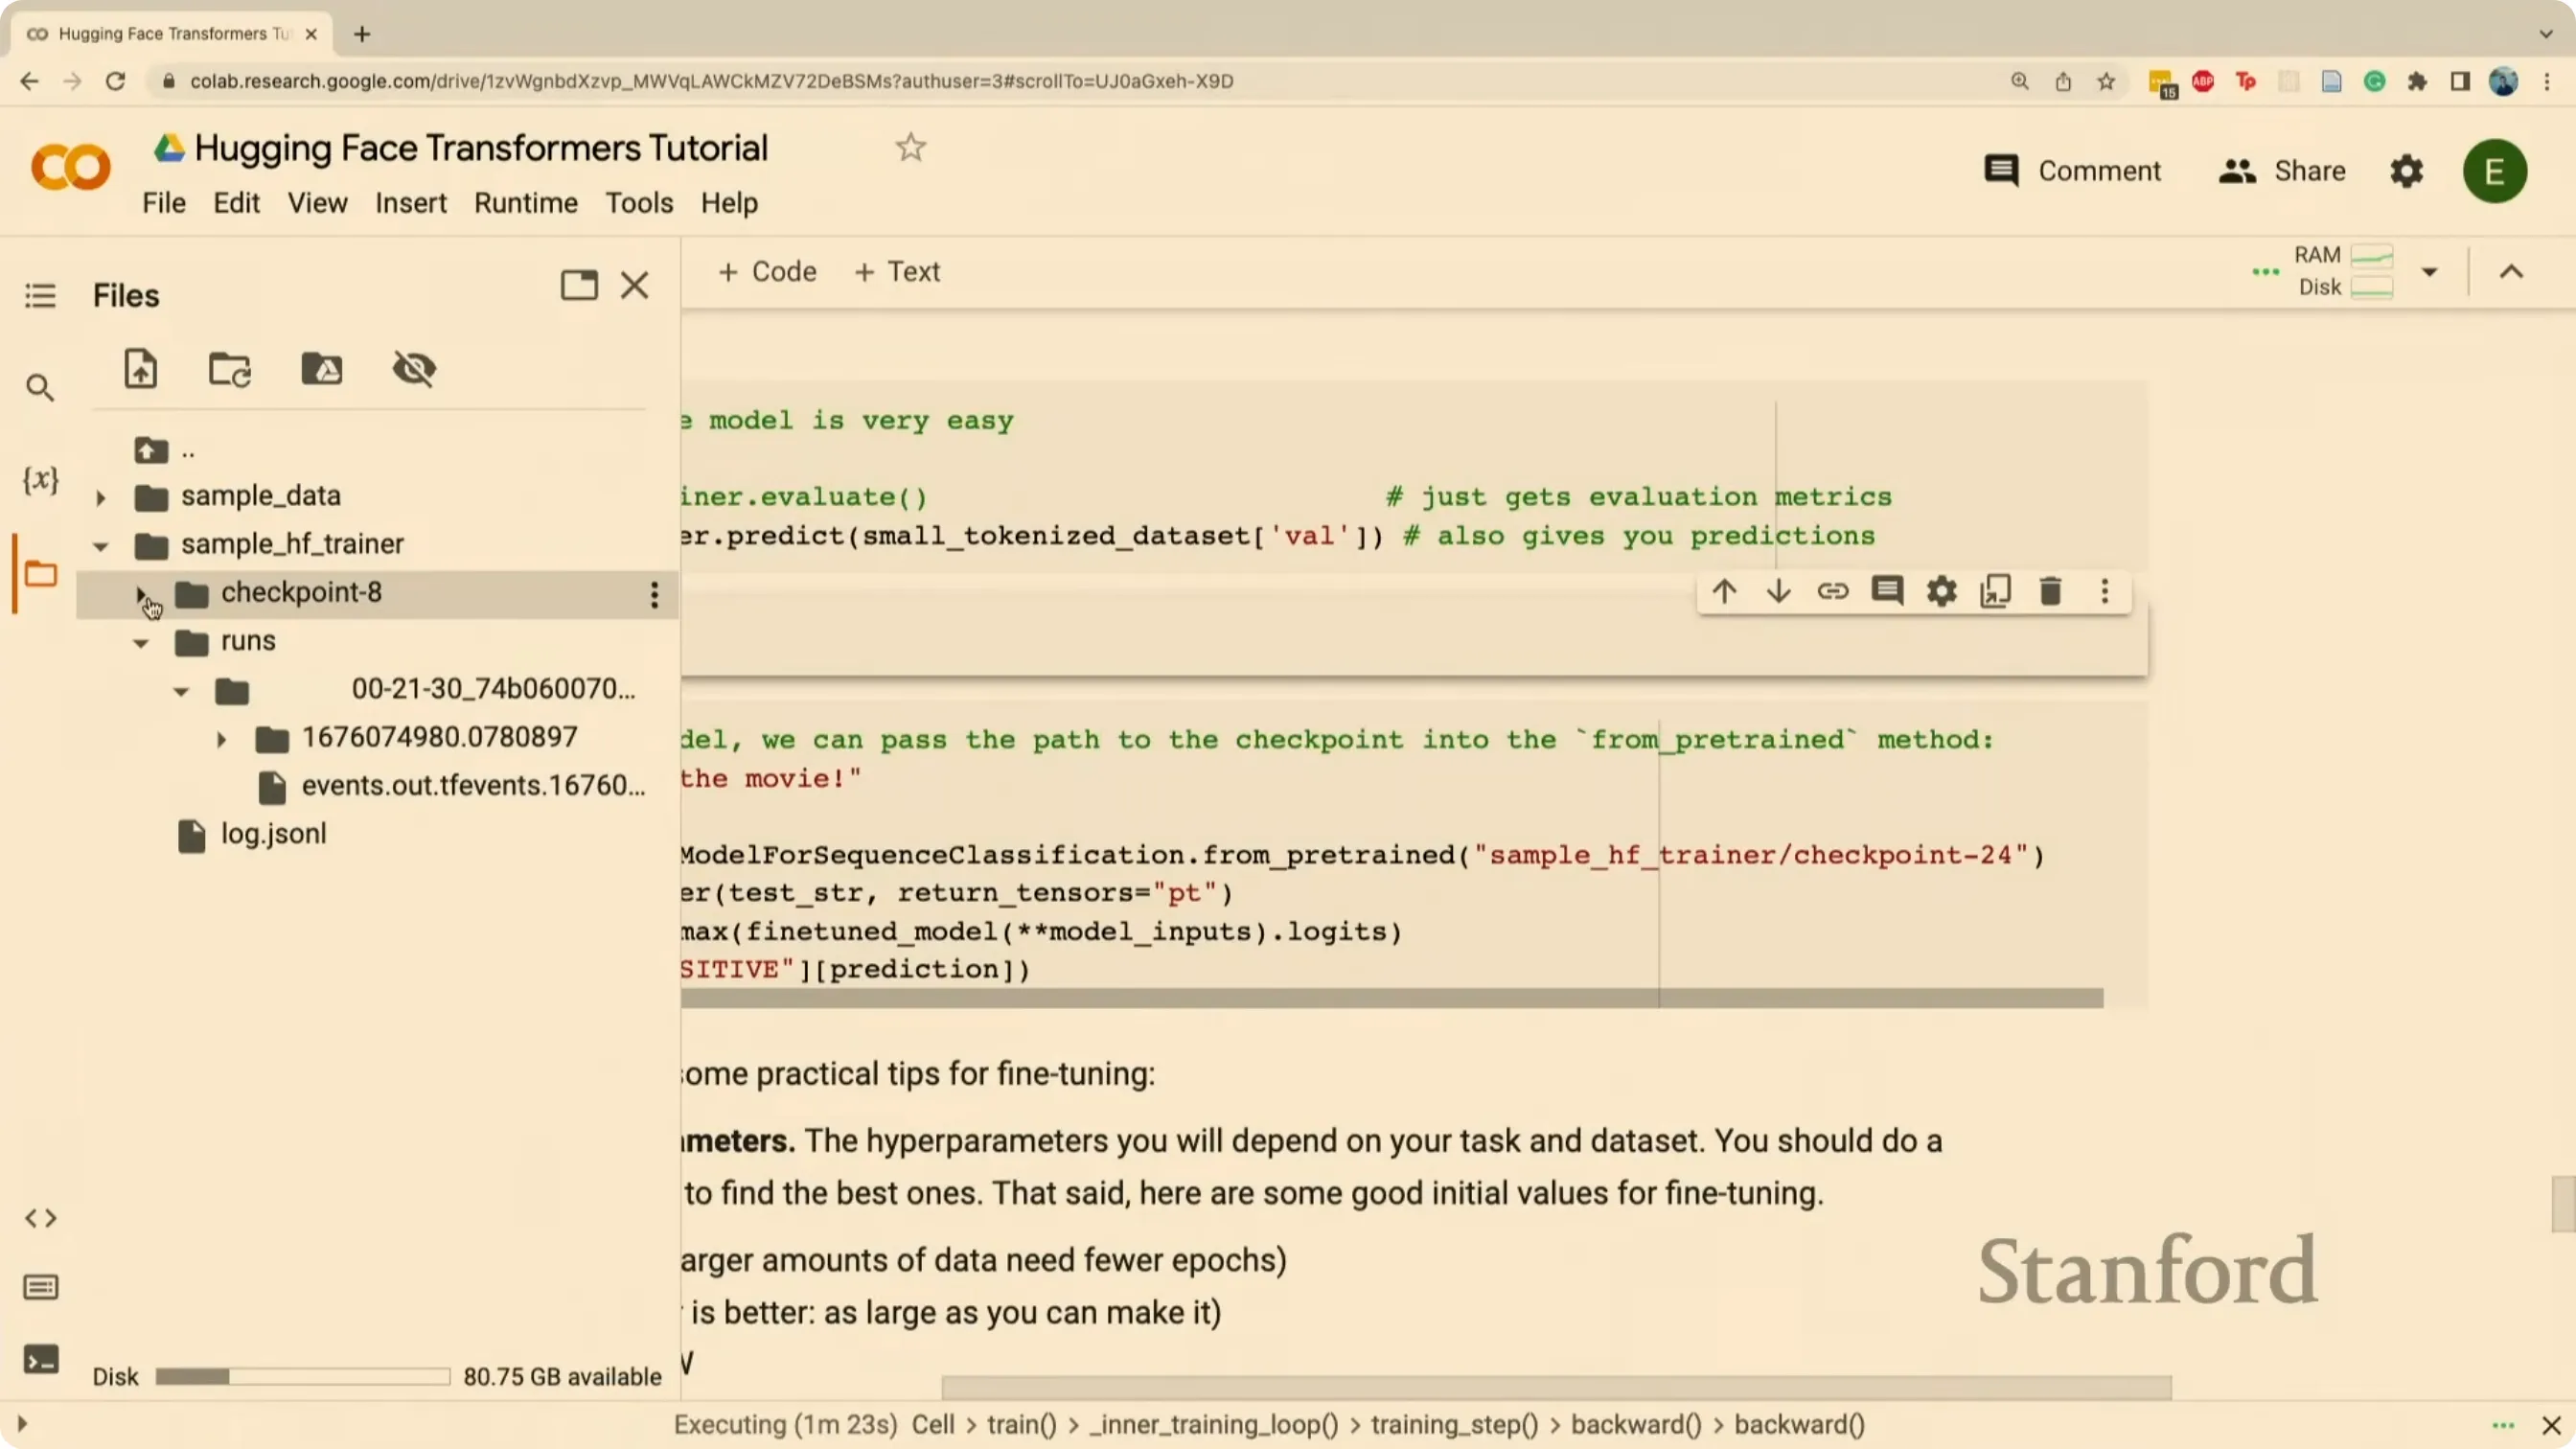
📷 checkpoint 目录下的保存结果
回到原视频 (00:47:00)
编者说明:演示里目录名是
checkpoint-8,对应的应该是保存策略(save_steps)比较小的情况。生产环境一般会设save_strategy="epoch",目录名就是checkpoint-<步数>的形式。
九、还有哪些没讲到的
(参考时间: 00:47:11)
配套 notebook 里还有若干附录,覆盖了本讲没有展开的主题:
- 文本生成(generation):如何用 decoder-only 模型续写文本;
- 自定义数据集:如何写一个自己的
Dataset类,而不只是用load_dataset; - Pipeline 接口:把「分词 → 模型 → 后处理」串成一行调用,适合快速验证和 demo。
关于 pipeline,可描述为「用一个预训练模型、通过 pipeline 接口非常方便地完成某个任务」——本质上就是把前面几节的手工步骤全部包起来。对于只想快速看一眼效果、不需要定制训练的场景,这是最高效的入口。
附:参考与延伸阅读
编者补充
- Google Colab
- Hugging Face
- Hugging Face Hub —— Hugging Face 模型库,可检索并下载预训练模型
- PyTorch
- YouTube · b80by3Xk_A8
已知疑点
-
情感分析 checkpoint 的确切名字 字幕在多处把模型名识别成了「cbert」「sent … Roberta」「large English」这类碎片(00:03:41、00:04:15、00:04:46)。从上下文("sentiment … Roberta … large English")推断,本节使用的是
siebert/sentiment-roberta-large-english,但无法从字幕中完全确证。如果你要照着重跑,请以 notebook 原文为准。 -
训练/验证集的切分方式 讲者说「shuffle 一下,取前 128 条做训练、后 32 条做验证」(00:33:19)。但从字幕无法判断 shuffle 是只做了一次、再切两段,还是分别 shuffle 了两次。本文按前一种写法(一次 shuffle 后切段)呈现,以避免训练/验证重叠——如果 notebook 里其实是两次 shuffle,那就是讲者演示时的疏忽,而非有意设计。
-
是否使用了
DataCollatorWithPadding字幕里只出现了「import 一个普通的 PyTorch data loader」(00:38:39),没有明确提到 collator。本文在第七节按padding="max_length"的前提补上了 collator 作为说明,并标注为编者补充。实际 notebook 中可能只是裸DataLoader。 -
「用于截断输出的辅助函数」指什么 00:32:29 处讲者说「这是一个 helper function,用来截断我们得到的输出」,但没有说明这个函数是自己写的还是库里的。本文按「在
tokenizer里设max_length」来理解,若原 notebook 另有实现(比如对text字段做字符串切片),此处会与原文有出入。 -
attention 热力图的坐标轴 00:30:21 处讲者描述「y 轴是层,x 轴是头」,同时又提到「每个格子内部展示 token 之间的注意力」。字幕没有说清外层网格与内层热力图的确切组织方式。本文按外层「层 × 头」、内层
[seq_len, seq_len]来理解,并标注了这一点的不确定性。 -
附录部分的三类内容 结尾提到的生成、自定义数据集、
Pipeline三个附录(00:47:11 起)只给了标题,没有讲具体内容。本文只做了简述,未展开细节——这部分需要看原 notebook。 -
Trainer演示中的目录报错 00:41:50 附近讲者说「我觉得我们少了一个目录」,随后画面似乎跳过了。字幕没有记录这个报错的具体内容和修复方式,本文按常见情况(output_dir不存在)做了推测性说明,标注为「编者说明」。