第1讲 · 深度学习炼金术:用预测与实验理解训练
斯坦福大学 CS312《深度学习炼金术》(2026 年秋季)官方课堂幻灯片 · 中文重构
| 原始标题 | Deep learning alchemy |
| 材料来源 | lecture_01.pdf(第 1 讲幻灯片,课程主页提供) |
| 课程主页 | https://deep-learning-alchemy.github.io/ |
| 材料版权 | 课程材料版权归原课程方及授课教师所有,本书仅供学习 |
对应讲次:第1讲(Stanford CS312 深度学习炼金术)
制作模型:deepseek-flash(vb compose)
一、旧直觉失效:从凸优化到混沌训练
深度学习在今天几乎无处不在:大语言模型(Large Language Model, LLM)、Waymo 的自动驾驶、AlphaFold 的蛋白质结构预测、AlphaGo 的博弈。领域不同、数据模态不同、成功标准不同,但底层方法都是深度学习——讲义用一句话概括这种局面:深度学习无处不在(Deep Learning Everywhere)。
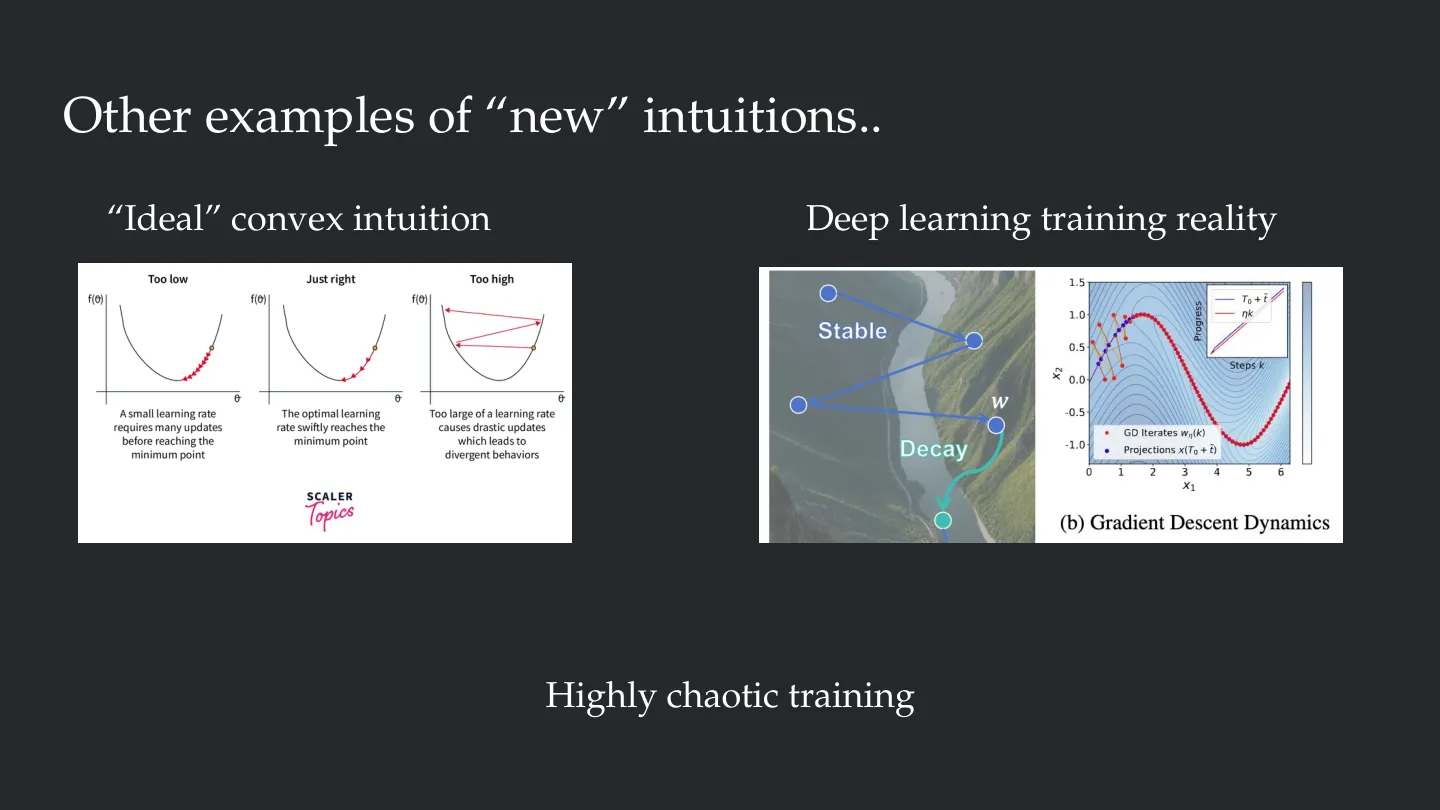
🖼️ 这一页用理想凸优化直觉与真实训练混沌性的对比,给“炼金术”提供了最直观的视觉入口。
这种"不合理的有效性"(on the unreasonable effectiveness of deep learning)带来一个尴尬的知识状况。在深度学习之前,我们对"学习系统为什么会work"有一套相当自信的直觉:损失曲面是凸的、梯度下降会收敛到全局最优、泛化能力可以用均匀收敛(uniform convergence)一类的界来刻画。而在深度学习之后,我们观察到的现象和这套直觉对不上。于是大家开始总结"新的直觉"。
讲义紧接着给出了一个更尖锐、也更诚实的提醒:这些新直觉本身是脆弱的(brittle)。只要把超参数调对,你昨天刚总结出的"某某现象"可能立刻就不成立。我们对深度学习的理论仍然高度依赖经验性的 know-how(手上功夫),而且我们并不清楚自己那套漂亮的心智模型(mental model)究竟在什么时候会把人带偏。
最典型的正面对撞,是"理想的凸优化直觉"与"真实的深度学习训练"之间的差距。前者想象损失曲面是一个光滑的碗:你沿着梯度稳稳下滑,损失曲线单调、平滑、可预测。后者常常是高度混沌(highly chaotic)的训练过程——损失会突然尖峰、会长平台、会因为学习率改一个数量级而面目全非。
编者拓展|凸直觉到底在哪一步断掉:凸优化里,"局部极小即全局极小"这条性质成立,因此梯度下降的终点可以被证明;而深度网络的损失曲面是非凸的,参数的置换对称性使极小点成片出现,再加上小批量(minibatch)采样带来的梯度噪声、学习率与局部曲率的耦合,训练轨迹不再有单调下降的保证。讲义并没有要求你现在就能推出这些,它只是先用一张图告诉你:你在数学课上学到的那套收敛图像,不是深度学习训练的真实图像。至于真实图像长什么样,是后面"优化 1 / 优化 2"两个单元的任务。
正因为没有通用理论、直觉又脆弱,讲义把当下的深度学习实践称为炼金术(alchemy):直觉与试错主导,而非从第一原理推导。
二、炼金术式教学:没有通用理论时怎么教
"炼金术"这个说法不只是吐槽,它直接决定了这门课怎么教。讲义的判断是:深度学习目前没有通用理论,直觉与试错主导实践;而教学(以及研究)常常并不反映这个现实——课堂上倾向于讲可证明、可写成定理的东西,论文里倾向于讲干净的故事,于是学生学到的是一个被整理过的世界,而不是真实做研究时面对的世界。
既然要"拥抱炼金术",就要先排除几种被讲师明确判定为"错误"的教法:
- 用"经典"理论教深度学习——凸优化、均匀泛化(uniform generalization)。这些工具本身没错,但它们描述的并不是深度网络实际发生的事。
- 阅读并背诵现象——把文献里读到的经验规律记下来。问题在于这些现象往往是脆弱的,条件一变就翻车。
- 项目制学习——放养式地"做个项目就懂了"。讲师的调侃很直接:这种模式下唯一在学习的是 claude。
编者说明:讲义原文里的 "claude" 指 AI 编程助手,是一种代称式的玩笑。它指向的是"把思考外包给模型"这种学习方式,而不是某个具体产品。
那么正确的方式是什么?讲义给出的主张只有一句,但它是整门课的地基:
可靠地预测实验结果,才会带来真正的理解。
课程本身被设计成一场教学实验("This class itself is an experiment!"),基于两个想法:
- 理解需要交互与掌握(interaction and mastery)——你不能只读,必须动手、必须被追问;
- 预测会迫使你做实验,并建立你自己的"世界模型"(world model)——因为要预测,你必须先猜、再跑、再看自己错在哪。
这也解释了为什么这门课的考核是预测题而不是推导题:预测是强制你形成世界模型的手段。
三、预测题示例:混合残差
抽象地说"要能预测"很容易,具体到一道题就不那么容易了。讲义直接给了官网上的一道题(标注难度:Hard)(讲义 Slide 10):
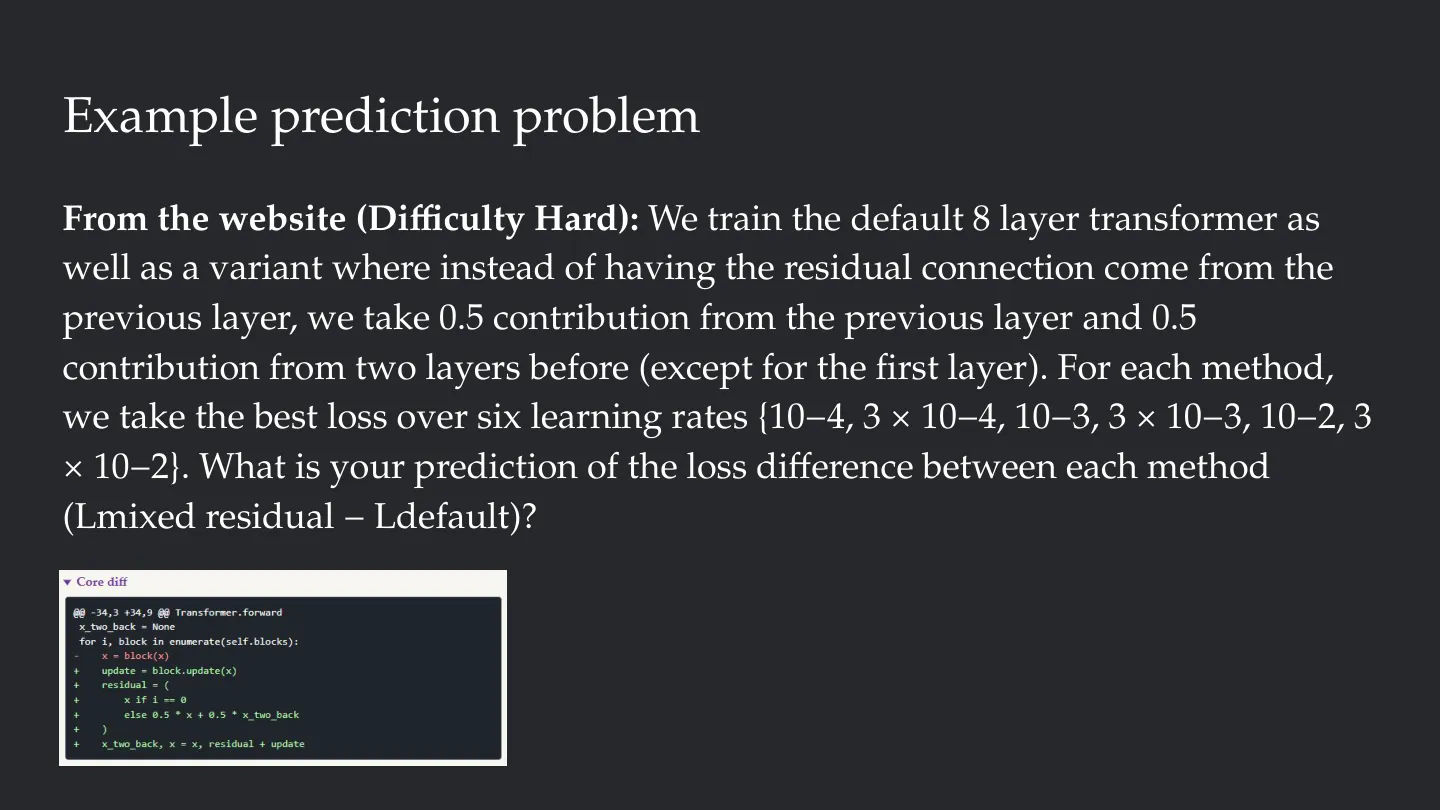
🖼️ 把“预测式学习”落成一道具体的 hard 题,让读者看到课程作业和测验的真实形式。
我们训练默认的 8 层 transformer,以及一个变体:它的残差连接不再只来自上一层,而是从上一层取 $0.5$ 的贡献、从上上层取 $0.5$ 的贡献(第一层除外)。对每种方法,我们在六个学习率 $\{10^{-4},\,3\times10^{-4},\,10^{-3},\,3\times10^{-3},\,10^{-2},\,3\times10^{-2}\}$ 上取最优损失。请预测两种方法的损失差 $L_{\text{mixed residual}} - L_{\text{default}}$。
编者说明:为便于后文引用,把题干里的文字描述写成符号就是 $h_t = 0.5\,h_{t-1} + 0.5\,h_{t-2}$($t\ge 2$,第一层保持默认)。这个式子是本书对题干的形式化,讲义原文只给了文字描述。
这道题的几个特征值得注意,它们几乎定义了整门课的题型风格:
- 改动很小、很局部:只动了残差连接的取值方式,模型层数、宽度、数据、优化器全都不变;
- 给了搜索预算:六个学习率、每种方法取最优,意味着题目问的不是"某个特定配置下谁更好",而是"在各自调好之后谁更好";
- 答案是差分:问的是 $L_{\text{mixed}} - L_{\text{default}}$ 的正负与量级,而不是某条曲线的绝对值。
这道题有客观答案(可以机械判分),但要答对,你必须对"残差连接在训练中到底起什么作用"有可操作的直觉——而这个直觉,正是第六节之后那些实验要去建立的。
四、预测什么:深度学习的"世界模型"
为什么把预测抬到这么高的位置?讲义给了两条类比。
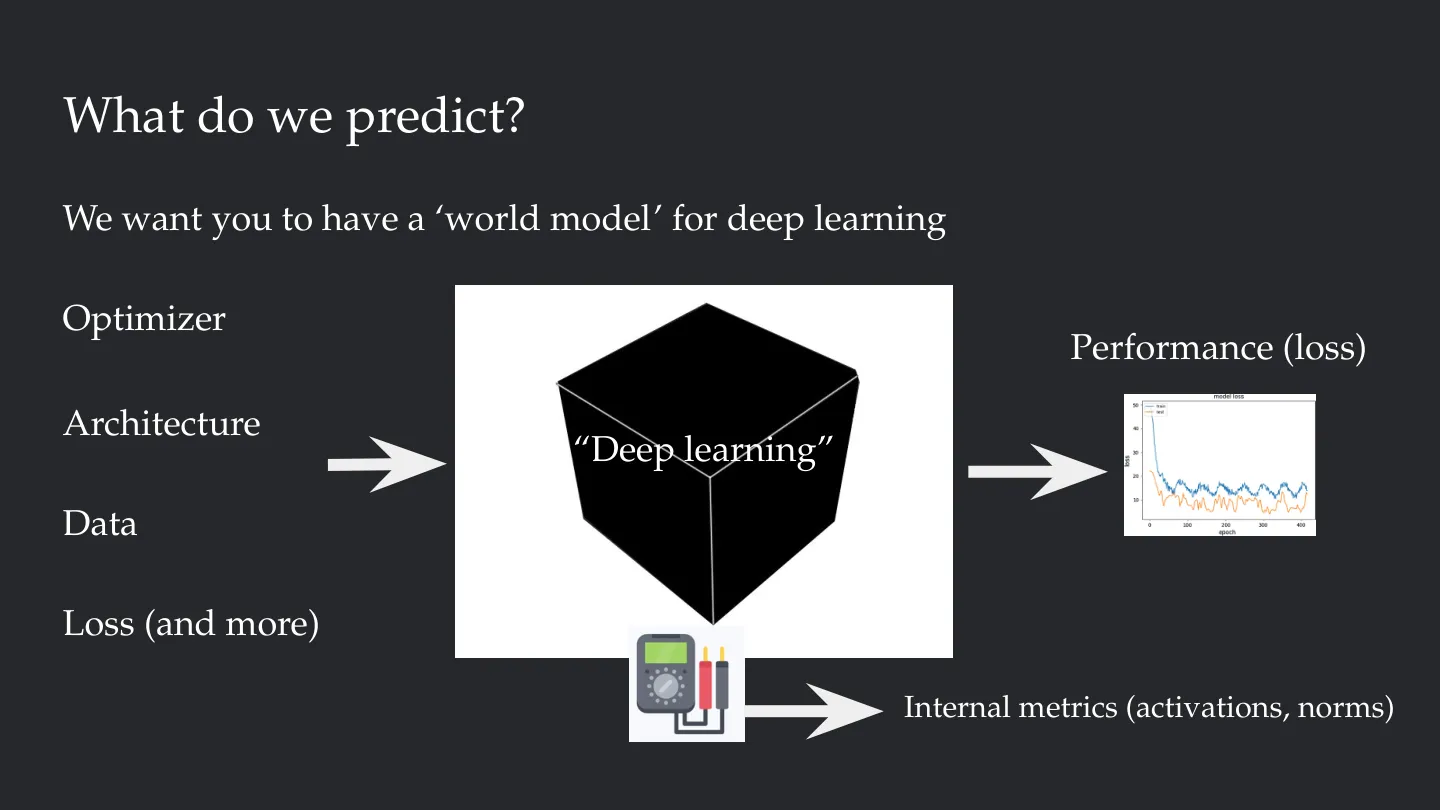
🖼️ 这张总览图把深度学习的输入选择与可预测输出对齐,适合作为全书反复引用的框架图。
第一,预测是科学的核心。早期天文学建立在预测日食等天象之上;Eddington 的日食观测则是对广义相对论的一次预测检验。科学史上,一个理论的力量往往不体现在它能解释什么,而体现在它敢预测什么。
第二,预测也是机器学习的核心。讲义的说法很贴切:这就像语言模型——作业里你可以随便(预)训练,想怎么跑就怎么跑;然后你被考核的,是你预测一个复杂系统行为的能力。
那么具体预测什么?讲义画了一张总览图:左边是你可调的输入侧选择,右边是你希望预测的输出侧量。
- 输入侧:优化器(optimizer)、架构(architecture)、数据(data)、损失(loss),以及更多;
- 输出侧:性能(performance loss),以及内部指标(internal metrics)——激活值(activations)、范数(norms)。
flowchart LR
    A["输入侧(你的选择)<br/>Optimizer · Architecture · Data · Loss"] --> B["深度学习训练"]
    B --> C["输出侧:Performance(loss)"]
    B --> D["输出侧:内部指标<br/>activations · norms"]
课程希望你在这一门课结束时,拥有一个关于深度学习的世界模型:给定一组输入改动,你能预测输出会往哪个方向动、动多少、在什么条件下会翻车。
编者说明:预测不等于猜数字。讲义在后面(第五节)特意提到"不要过度拟合我们的设定"——记住某次实验的 loss 是 $3.1234$ 没有意义,有意义的是"改动输入 → 输出如何变化"这条经验规律。
五、课程路线图:七次作业与考核
课程的核心内容被切成七次作业(assignments),它们同时就是这门课的知识地图:
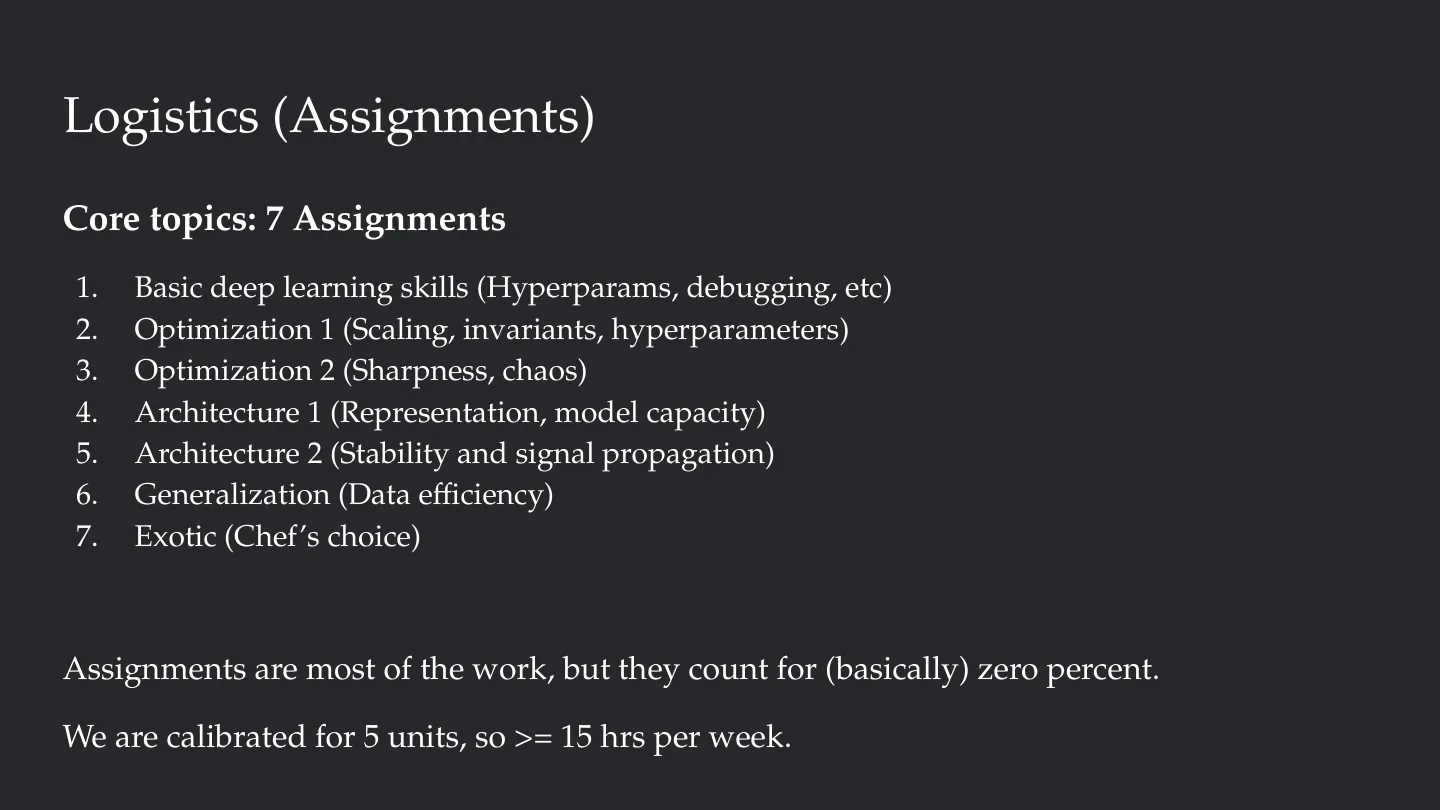
🖼️ 七次作业列表就是整门课的知识地图,能帮助读者把后续章节和作业主题对应起来。
- 基础深度学习技能——超参数、调试等;
- 优化 1——尺度(scaling)、不变量(invariants)、超参数;
- 优化 2——尖锐度(sharpness)、混沌(chaos);
- 架构 1——表示(representation)、模型容量(model capacity);
- 架构 2——稳定性与信号传播(signal propagation);
- 泛化——数据效率(data efficiency);
- Exotic——讲师自选(chef's choice)。
作业占了课程工作量的大头,但几乎不计分("basically zero percent")。课程按 5 units 校准,预期投入每周至少 15 小时。
为什么作业是 0 分,却还必须做
讲义给了两条理由解释"为什么作业不计分":
- 很多人会用 AI 助手把它写掉(claude code it)。往好了说这毫无用处,往坏了说这并不公平;
- 作业不计分,课程才敢采用宽松的 AI 使用政策(你想怎么用就怎么用)。
那为什么还要做?因为作业是测验的准备:
- 测验占成绩的 85%;
- 你不能在测验中拿到部分分,如果你没有可引用的作业实验;
- 讨论课(tutorial)会当面检验你是否真的理解。
唯一的例外是加分题(bonus question):课程预计每次测验会用 0–2 道由学生出的题,被选中以及题目难度都会带来加分。
测验:一连串预测题
- 共 7 次测验,每次对应一次作业,大约每 1.5 周一次(第一次例外,在第 1 周);
- 每次测验是一系列预测题(prediction problems):
- 每道题都附带一个 diff,完整指定一次 run 和要看的指标;
- 每道题都有客观答案,可以机械判分。
- 部分分机制:你可以在答题理由(rationale)里"引用"自己做过的作业实验;引用有效的作业实验最多可拿回 75% 的分数。但你不能把作业带进考场——你必须记得自己跑过什么。
- AI 使用披露:课程会用 LLM 处理判分中的机械环节(例如把测验理由与作业实验做匹配)。
题目难度分三档,这个分档很能说明课程到底想要什么:
| 难度 | 需要什么 |
|---|---|
| Easy | 做了作业、记住了那些 run,就能拿到 |
| Medium | 能跟着引导做开放式的外推(extrapolation) |
| Hard | 能外推 并且 有直觉,可能只能拿部分分 |
至于"预测任意实验是否公平"这个必然会有的质疑,讲义的回应分三层:第一,课程会挑选有意义的结果指标,不会问你无意义的第四位小数;第二,如果全班都考砸了,那是讲师的失败;第三,现实世界本来就不公平——你的实验设计本身就依赖于你的预测:这次 run 稳定吗?橙色会赢蓝色吗?我的 baseline 合理吗?最后还补了一句关键提醒:不要过度拟合我们的设定,课程想教的是过程与心态(a process and mindset)。
7 次 40 分钟的测验听起来很多,讲义的辩解是:正因为次数多,每道题权重就低,成绩会被平均掉;而且作业本身就是测验准备,不期望你额外花时间。
讨论课
- 30 分钟、线下的讨论(tutorials),4 名学生 + 1 名讲师/助教;
- 从第 3 周开始(过了 add/drop 之后),第 2–3 周排时间与分组;
- 内容:讨论上一次作业(和测验);
- 占成绩 15%,评分宽松,只分三档:
- Fail:明显没做作业(或者只是让 AI 跑了一遍);
- Low pass:理解自己跑了什么、为什么跑;
- High pass:能在作业概念上表现出一定程度的泛化。
- 讲义的原话是:如果每个人都做了作业,那这就只是一次有趣的小组 ML 聊天。
编者说明:讲义还包含选课、waitlist、算力申请等教务信息(例如算力由赞助方提供,需要用斯坦福邮箱开通,且明令不得把课程算力用于科研,课程方有监控手段)。这类信息时效性强,与知识内容无关,本书不再展开。
六、课程在真实深度学习流水线中的位置
要理解一门课,得先知道它不讲什么。讲义用一条真实的深度学习流水线来划定边界:
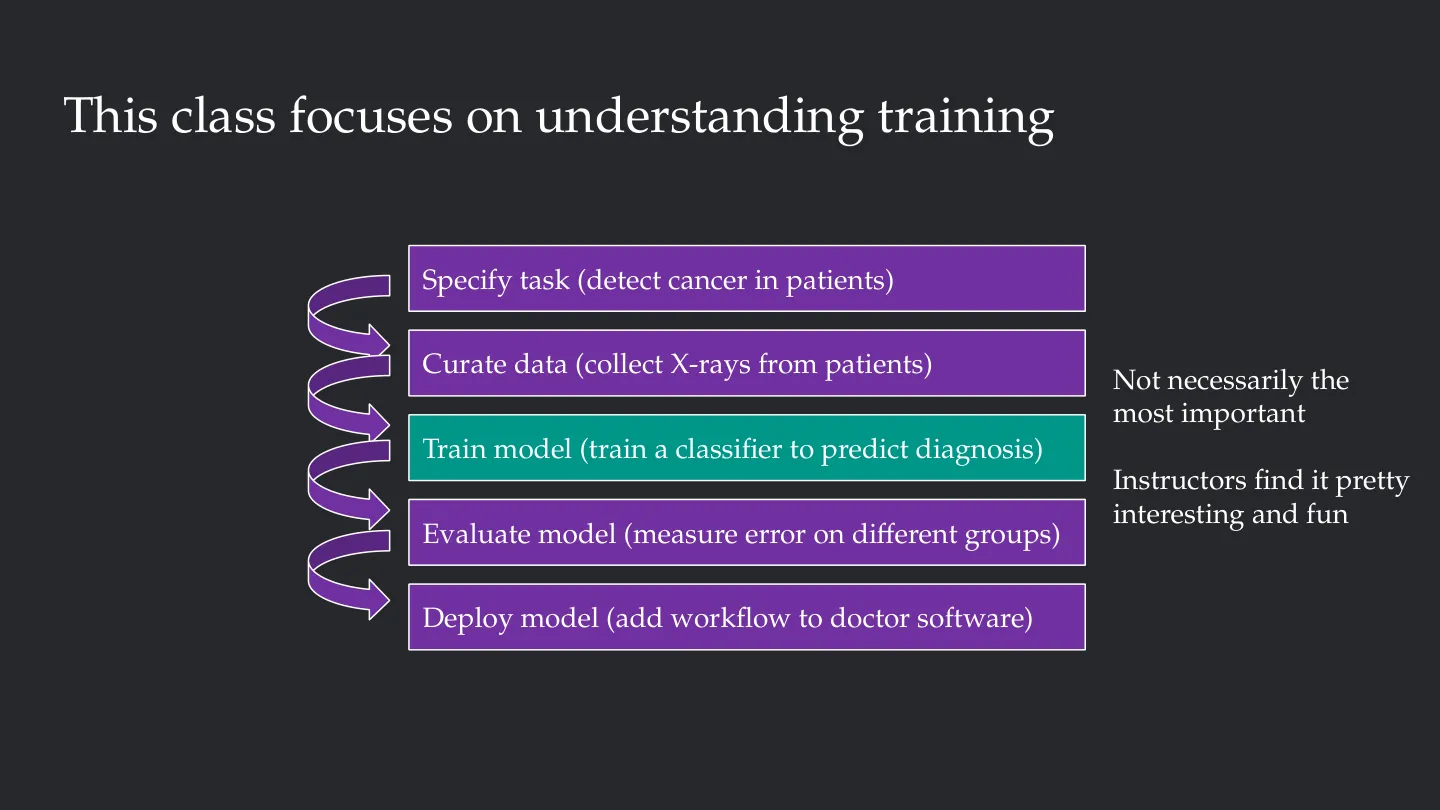
🖼️ 完整流水线图加上“聚焦训练”的标注,清楚界定课程范围,避免读者误以为本课覆盖全部工程环节。
- 定义任务——例如在病人中检测癌症;
- 整理数据——收集病人的 X 光片;
- 训练模型——训练一个分类器来预测诊断;
- 评估模型——在不同人群上测量误差;
- 部署模型——接进医生的软件工作流。
flowchart LR
    A["定义任务<br/>检测癌症"] --> B["整理数据<br/>收集 X 光片"] --> C["训练模型<br/>训练分类器"]
    C --> D["评估模型<br/>分群体测误差"] --> E["部署模型<br/>接入医生软件"]
    style C fill:#ffe9b3,stroke:#c98a00,stroke-width:2px
这门课只研究训练这一段。讲义也很坦诚地标注了两点:训练不一定是整条流水线里最重要的环节;但它是讲师觉得有趣、并且最适合做实验的部分。
编者说明:明确边界对初学者尤其重要。这门课不会教你数据标注流程、不会教你上线与监控、也不会教你如何定义产品指标——它研究的是"给定任务与数据,模型内部到底发生了什么"。带着这个预期读后面的章节,就不会觉得"怎么一直在调 loss"。
七、为什么从预训练开始
训练有很多种形态:预训练(pre-training)、微调(fine-tuning)、强化学习(reinforcement learning)、对齐(alignment)、对比学习(contrastive learning)、RLHF……这门课绝大部分篇幅聚焦在预训练上。
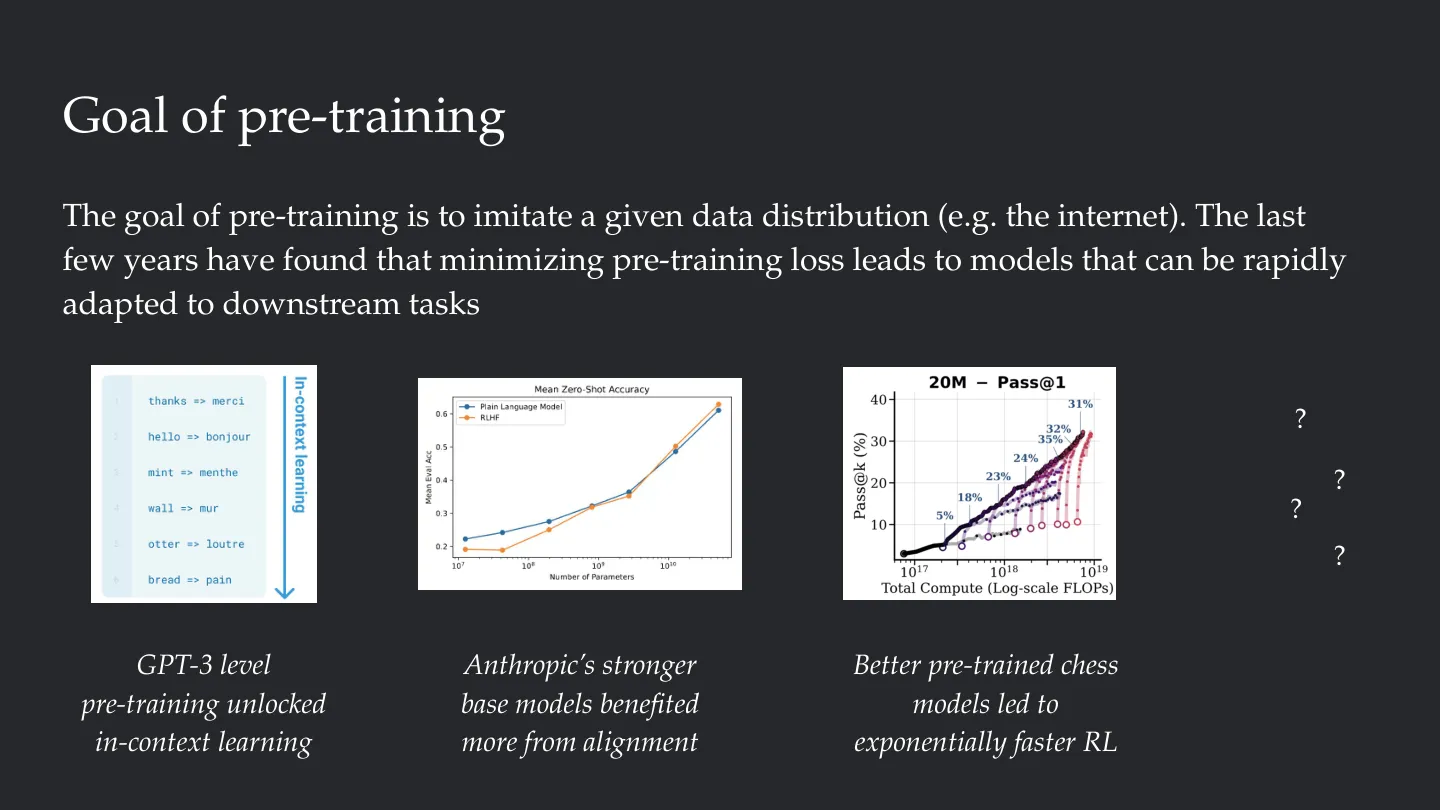
🖼️ 这一页把预训练目标与下游能力之间的经验联系放在一起,适合作为预训练单元的入口。
预训练的目标可以用一句话说清:模仿一个给定的数据分布(例如互联网文本)。
这句话听起来很朴素,但过去几年的经验发现,最小化预训练损失会得到可以快速适配到下游任务的模型。讲义举了三个例子:
- GPT-3 级别的预训练解锁了上下文学习(in-context learning);
- 更好的预训练棋类模型,使后续强化学习快了指数级;
- Anthropic 更强的基座模型,从对齐中获益更多。
(图中还留了若干问号,意思是:这条"预训练更好 → 下游更好"的链条上还有很多环节没有被完全解释清楚。)
课程选预训练作为主战场,有三条方法论上的理由:
- 验证损失对下游效用的预测性较好,噪声相对小——你优化的量和你在意的量之间有可测的联系;
- 预训练可以小规模研究,因为有缩放定律(scaling laws)——小规模 run 的结果可以预测大规模实验的结果;
- 预训练更容易推理,因为所有训练都从零开始(from scratch),没有"继承来的混乱"。
由于预训练在语言模型上最成熟,前四次作业都将采用语言模型设定,并遵循标准做法。讲义也提前安抚:看不懂术语没关系——在 9/23(周三)17:00–19:00 有一场补充讲座,按官网上的 LLMs 101 讲义介绍深度学习与语言建模的基础概念(计划录像),并预告它"会比正式课程更直白、更枯燥"。
八、预训练算法的四个部件
讲义用一个"卡通图"(cartoon)把预训练算法拆成四个部件。这是全讲最值得记住的结构,因为它给出了后面所有实验的分类框架:
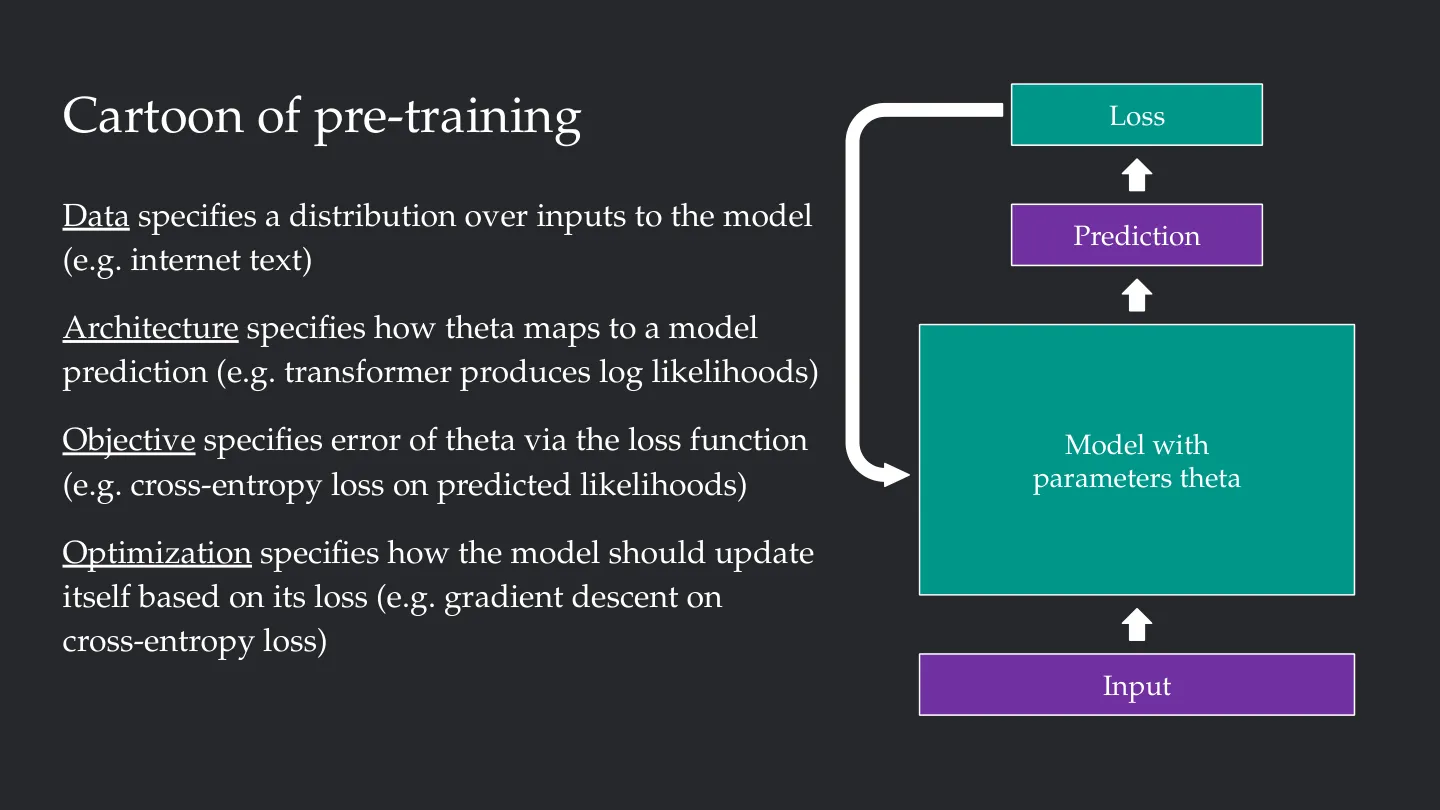
🖼️ 最终的“cartoon”把 data、architecture、objective、optimization 四件套一次讲清,是全讲最值得保留的结构图。
- Data(数据):指定模型输入的分布,例如互联网文本;
- Architecture(架构):指定参数 $\theta$ 如何映射到模型预测,例如 transformer 输出对数似然(log likelihood);
- Objective(目标):用损失函数定义 $\theta$ 的错误程度,例如对预测似然取交叉熵损失(cross-entropy loss);
- Optimization(优化):指定模型如何根据自己的损失更新自己,例如对交叉熵损失做梯度下降。
flowchart LR
    D["Data<br/>输入服从的分布"] --> M["模型 Q_θ"]
    A["Architecture<br/>θ 如何变成预测"] --> M
    O["Optimization<br/>如何用损失更新 θ"] --> M
    M --> L["Objective<br/>损失 L(θ)"]
    L --> O
注意这张图里有一个隐含的顺序:数据 → 模型 → 预测 → 损失 → 更新 → 回到模型。你之后看到的每一个实验,本质上都是在固定其中三个部件、只动一个,然后观察损失曲线的变化。
九、小规模实验平台
课程为本讲之后的所有实验准备了一个小型测试台(testbed),配一套默认训练配方——你会在整个学期里对它熟悉到不能再熟悉。讲义的评价是:它反映了大规模深度学习的许多方面,也在另一些方面与之不同。
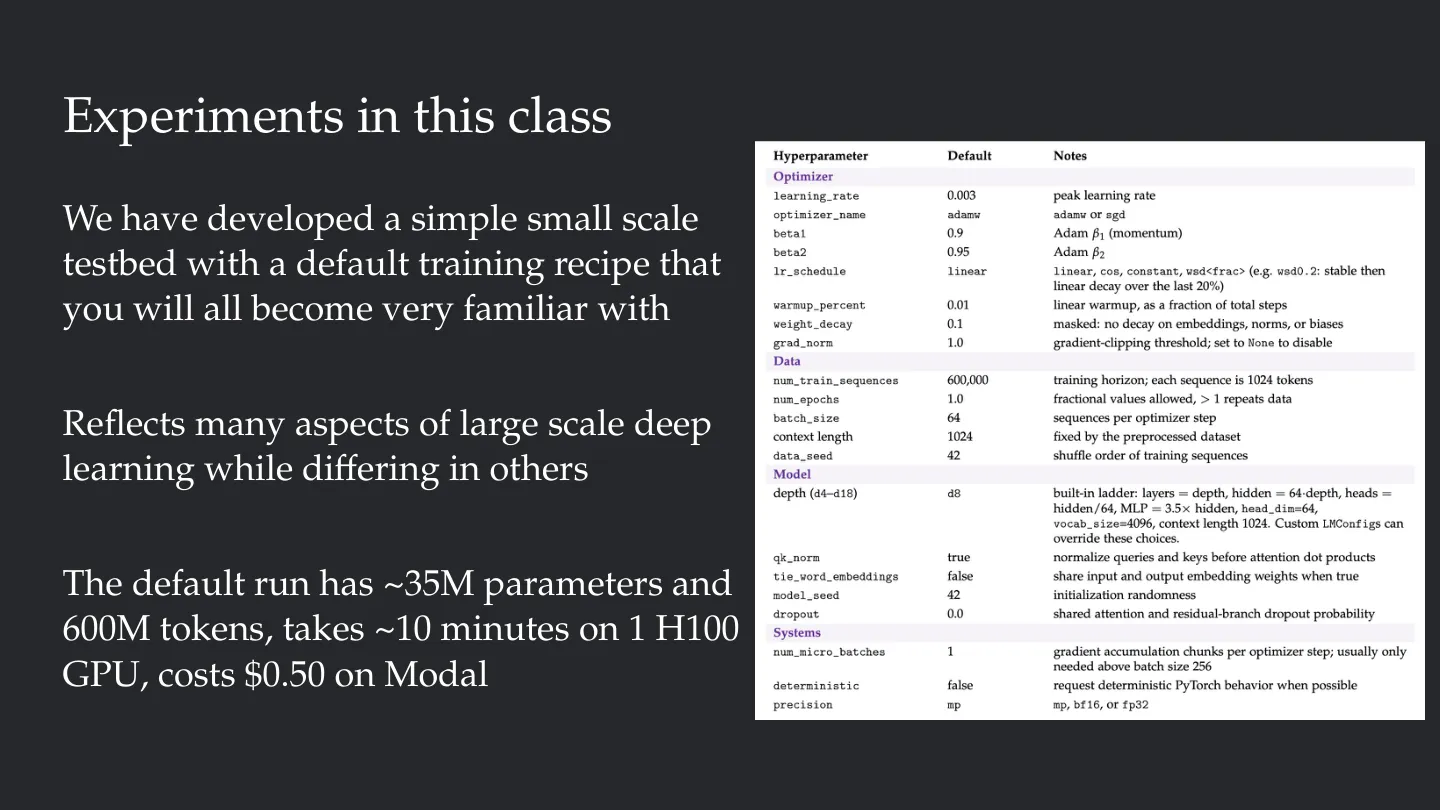
🖼️ 给出默认实验台的规模、成本与定位,读者才能理解后续实验为何可以大量重复。
默认 run 的规模与成本:
刻意设计得这么小、这么快,是为了让"跑实验 → 看结果 → 改假设"这个循环能在一次自习里转上十几圈。对读者来说,这意味着后面所有内容都应当被理解为可复现的小模型炼金术:结论先在这个 35M 的设定里成立,至于能不能外推到真正的规模,是 scaling laws 的问题。
编者说明:讲义提到课程算力由赞助方提供(需要斯坦福邮箱开通),并明确要求不得把课程算力用于科研,课程方有监控手段。这是课程管理规则,不是技术内容。
十、默认目标:自回归交叉熵
默认目标(objective)的形式化如下。模型 $Q_\theta$ 要预测来自真实分布 $P$ 的序列 $x$ 的似然。课程使用自回归(auto-regressive)模型,即把整条序列的概率分解为逐 token 的条件概率乘积:
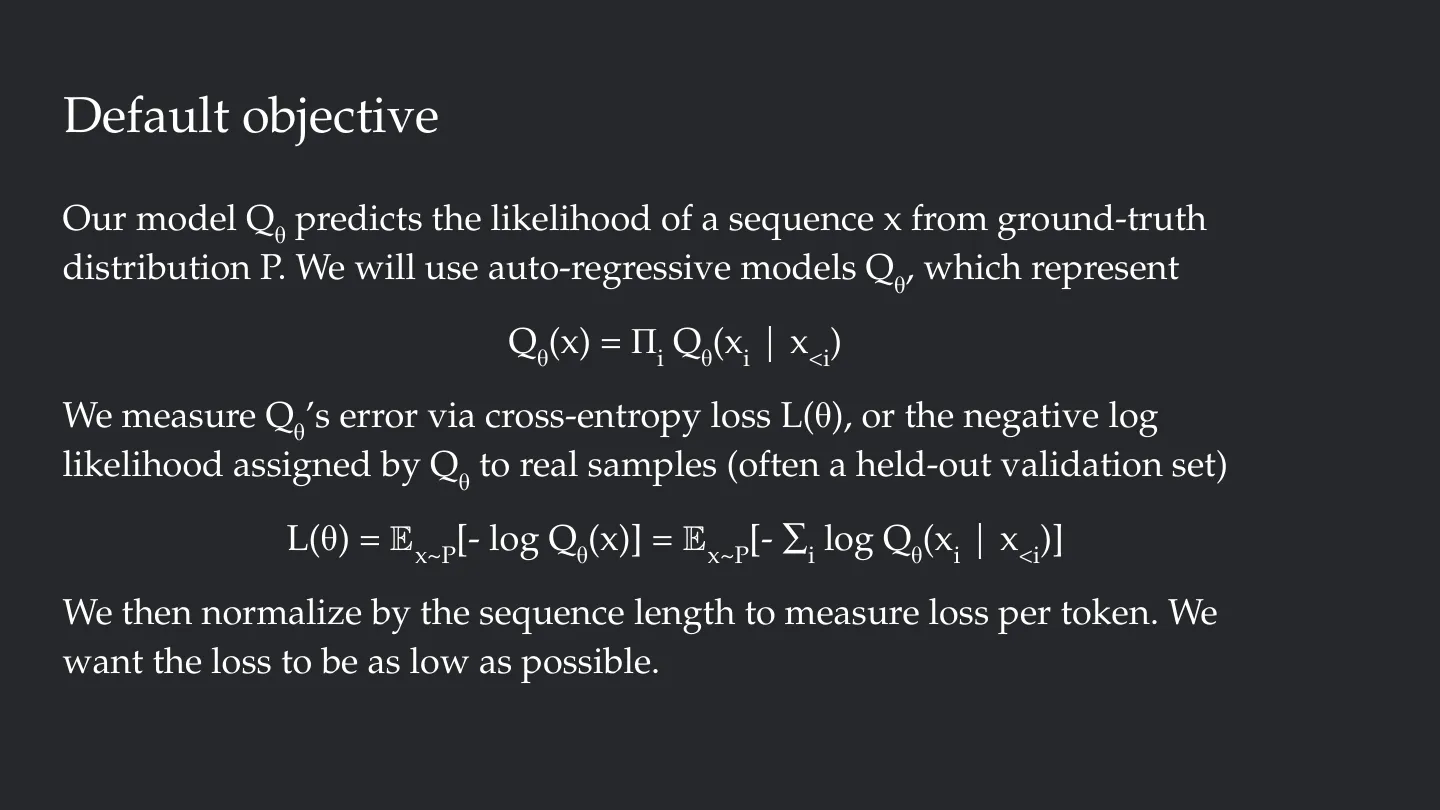
🖼️ 公式页把自回归建模、交叉熵和 per-token 归一化放在一起,是理解后续 loss 曲线的基础。
$$Q_\theta(x) = \prod_i Q_\theta(x_i \mid x_{ 其中 $x_{ $$L(\theta) = \mathbb{E}_{x \sim P}\left[-\log Q_\theta(x)\right] = \mathbb{E}_{x \sim P}\left[-\sum_i \log Q_\theta(x_i \mid x_{ 最后按序列长度归一化,得到每 token 损失(loss per token)。训练目标就是让这个损失尽可能低。 编者拓展|为什么除以序列长度:上面的损失是整条序列的对数似然求和取负,它的量级随序列长度线性增长——长度 1024 的序列和长度 32 的序列没法直接比较。按长度归一化后,损失变成"平均每个 token 的负对数似然",与序列长度无关,才能在不同设定之间横向比较,也才能让不同 batch 的梯度尺度大致稳定。另一个常见的直观刻度是困惑度(perplexity),定义为 $\exp(\text{per-token loss})$,可以理解为"模型在每一步平均在多少个候选 token 之间犹豫";困惑度越低越好。困惑度不在讲义中,属于标准语言模型文献里的常识性换算。 默认架构是一个 Llama 风格的 8 层 transformer: 🖼️ 架构示意图把 residual stream、RMS norm、attention/MLP 的堆叠关系可视化,比纯文字更适合初学者。 讲义补充了两点工程约定:训练更深的模型时通常保持固定的宽高比(aspect ratio);这个架构处理的序列长度为 1024 个 token。 编者说明:讲义明确说"不认识这些术语没关系",并安排了补充讲座。这里只给最小限度的辨认线索,不展开推导:pre-norm 指把归一化放在子层(attention / MLP)之前,残差流本身不做归一化;RMS norm 是一种只用均方根缩放、不减均值的归一化(见 RMSNorm);RoPE 用旋转的方式把位置信息编码进 attention 的 query/key;SwiGLU 是带门控的 MLP 变体。这些细节会在"架构 1 / 架构 2"两个单元里被逐个拆开做消融。 默认优化配方如下: 🖼️ 优化器示意图与学习率调度说明配合,能帮助读者把更新公式和实际训练配方对应起来。 参数更新的基本形式是 $$\theta_{t+1} = \theta_t - \alpha \nabla_\theta L(\theta)$$ 讲义在这张示意图旁边放了一句很重要的免责声明:不要相信示意图(do not trust schematic)——真实的优化轨迹并不像画出来的那样平滑下降。你真正的直觉要在"优化 1 + 优化 2"两个单元里自己建立。 编者说明:讲义在同一页里既说"用随机梯度下降",又说"优化器为 AdamW",字面上略有张力。合理的读法是:这里的 "SGD" 泛指"用小批量随机梯度做迭代更新"这一大类方法,而具体的更新规则由 AdamW 给出(带动量与自适应步长的更新)。本讲不展开 AdamW 的公式,留待优化单元。 编者拓展|warmup 与线性衰减在做什么:warmup 指训练最初若干步把学习率从很小的值升到峰值,之后再线性降到接近 0。常见的工程解释有两条:训练初期参数的梯度尺度不稳定,直接用大学习率容易一步走飞;Adam 类优化器在最初若干步的二阶矩估计还很不准,更新步长会被放大。线性衰减则让训练后段步长变小,使损失能落进较窄的极小区域。这两条都是经验性的工程共识,不是讲义原文,也没有在这门课里被证明。 第一个具体演示非常朴素:用同一个默认模型,训练六个不同的学习率,把六条损失曲线画在一起。 🖼️ 用真实 loss 曲线展示学习率对训练结果的影响,是把超参数直觉可视化的好例子。 这是整门课方法论的缩影——不是先讲理论再验证,而是先跑一组只改一个变量的实验,让曲线自己说话:学习率这个小数字,如何系统性地改变训练的动态。至于"为什么曲线长这样",讲义明确留给了后面的优化单元。 编者说明:本材料是幻灯片的文字层,图中的具体曲线与数值没有随文字提供,因此本书不给出"哪个学习率最好""差了多少"之类的结论。请把它当作一个待你在实验台上复现的观察任务:在默认配方下,学习率偏离最优点时,损失曲线是先变慢、还是先变抖、还是直接发散? 课程的一个单元开始时,你会拿到一份建议探索方向的作业。有些部分比较结构化,有些则更开放。讲义用一个完整的例子演示"作业题 → 自己设计 run → 写报告"的流程。 🖼️ 这一页把“如何设计受控实验来回答一个架构问题”具体化,适合作为实验方法示例。 第 (a) 问建议:把每个组件依次去掉,再训练模型。于是作者启动了 6 次默认 run,每次修改一个组件,测量损失。在报告中,他会把这些图和自己跑了什么的说明放在一起——这就是一份可被引用的实验证据。 第 (b) 问的目标是理解残差连接在训练中的作用。为了建立理解,作者设计了 8 次 run: 编者拓展|这是一个 2×4 的因子设计:四种"扰动条件"(scale 0.5、scale 2.0、noise 0.1、noise 1.0)乘以两个学习率,正好 $4\times 2 = 8$ 次 run。这种"每个维度取两三个值、做笛卡尔积"的设计,是深度学习中性价比最高的实验方式:它能同时告诉你主效应(哪种扰动影响大)和交互效应(某种扰动是否只在高学习率下才致命)。注意这里刻意包含了"几乎无害"的扰动(如 scale 0.5)和"应该很致命"的扰动(如 noise 1.0),目的是探出系统的边界在哪里——这正是下一节那道 hard 题所需要的能力。 讲完实验方法,讲义让听众现场做了一次"随堂测验"(pop quiz)。它展示了测验题的真实形态: 🖼️ 展示一道 hard 预测题的实际形式,让读者看到课程如何考核“世界模型”。 编者说明:讲义在第 59 页给出了随堂测验的提交表单地址(bit.ly/312quiz0)。这是课堂内的即时活动,与本书读者无关;这里提到它只是为了说明"测验"在课程中是高频、当堂发生的,而不是期末一次性的大考。 做完题,讲义公布答案,然后做了两段点评(commentary)——这两段才是这一讲真正的教学点。 🖼️ 这一页的 commentary 指出实验结果与预训练直觉的偏差,是“预测—实验—修正”循环的收尾。 失败案例:作业里的消融实验看起来很有信息量,但它漏掉了"pre-norm 在默认或更高学习率下根本训不起来"这件事。 这个失败不是"跑错了实验",而是"实验设计的覆盖范围不够"。你在作业里做逐组件消融时,大概只在默认学习率附近跑了几次 run,看到的是"去掉某个组件,损失变差了一点"。但这个结论只在那个学习率成立。一旦把学习率提到默认值或更高,pre-norm 这个条件本身就会让训练失败——于是你基于低学习率建立的直觉,在高学习率区间直接失效。 机制层面,讲义只给了现象("prenorm doesn't train at default/higher learning rates"),没有给出推导。这一点很重要:它说明失败的原因往往不在模型里,而在你的实验网格里——你的直觉是从一个太窄的参数切片上归纳出来的。 与上一题形成对照的是:和课程里的若干示例实验一致,残差连接对相当剧烈的修改是相对稳健的——把 skip connection 缩放 0.5、甚至加不小的噪声,训练依然能进行。也就是说,"残差很重要"这句话是对的,但"残差一旦被扰动就会崩"是错的。 这两条点评合起来,正好演示了这门课希望你形成的循环: 预测错了不是终点,而是下一轮实验设计的输入:你应当问"我在哪个维度上没有采样",而不是"记住这个答案"。 编者拓展|为什么这个结论有点反直觉:在常见的工程经验里,pre-norm(把归一化放在子层之前、残差流不归一化)通常被认为比 post-norm 更容易训练,因为它的残差路径上没有归一化,梯度可以更直接地回传。而讲义这里报告的是"pre-norm 在默认或更高学习率下不训练"。两者不一定矛盾——差别可能来自模型规模(35M)、层数(8 层)、学习率调度、QK norm 等其他设计的选择。但本材料没有给出机制解释,所以这里只把它记录为本课程设定下的经验事实,不要直接当作普遍规律外推。这也恰好是第一节那句话的实例:现象是脆弱的。
十一、默认架构:8 层 Llama 风格 Transformer
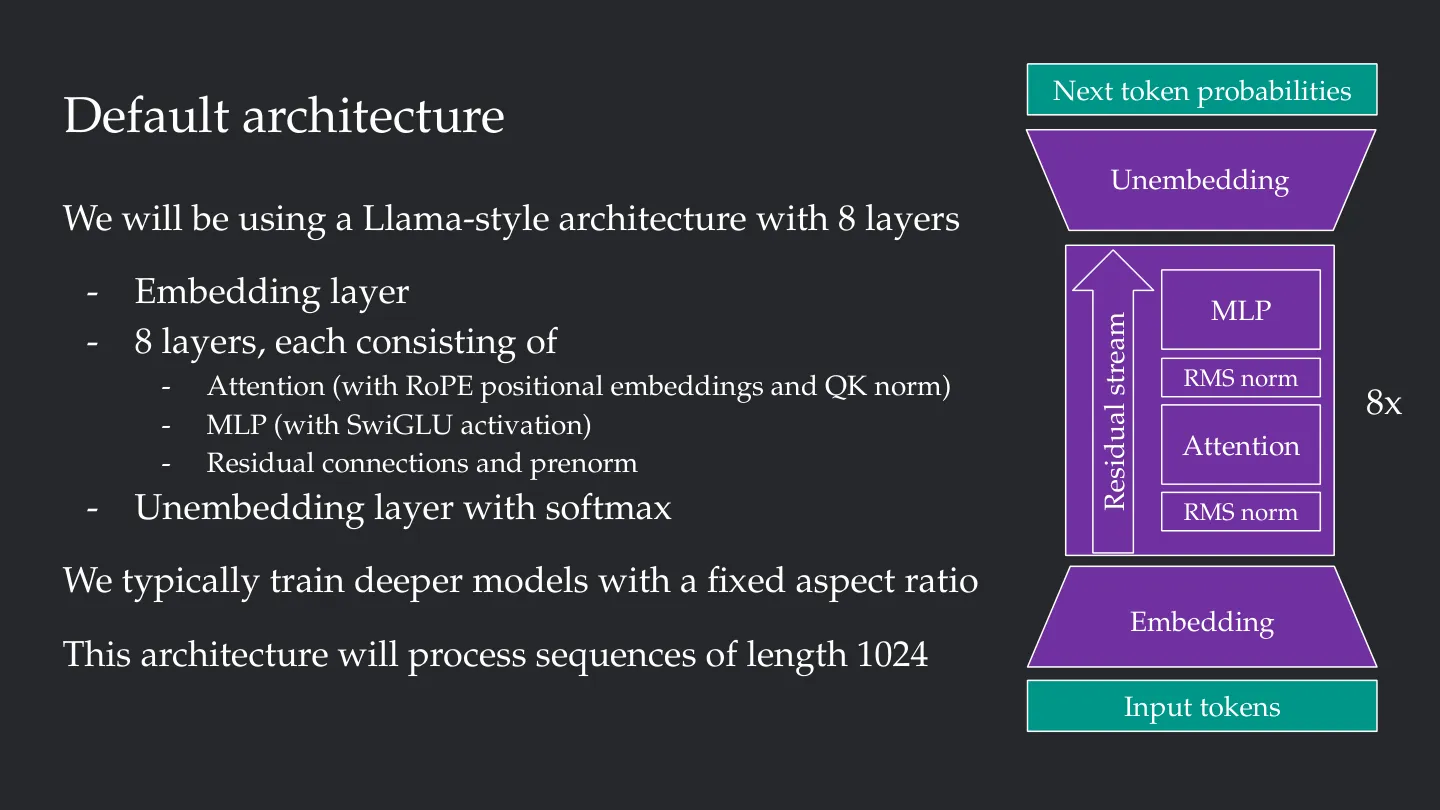
flowchart TD
    X["输入 token"] --> E["Embedding"]
    E --> B["8 × Transformer block"]
    B --> U["Unembedding + softmax"]
    U --> P["下一个 token 的概率"]

    subgraph one ["单个 block 内部(pre-norm)"]
        direction TB
        I["残差流输入"] --> N1["RMS norm"] --> AT["Attention<br/>RoPE + QK norm"] --> S1["加回残差流"]
        S1 --> N2["RMS norm"] --> ML["MLP<br/>SwiGLU"] --> S2["加回残差流"]
    end
十二、默认优化配方
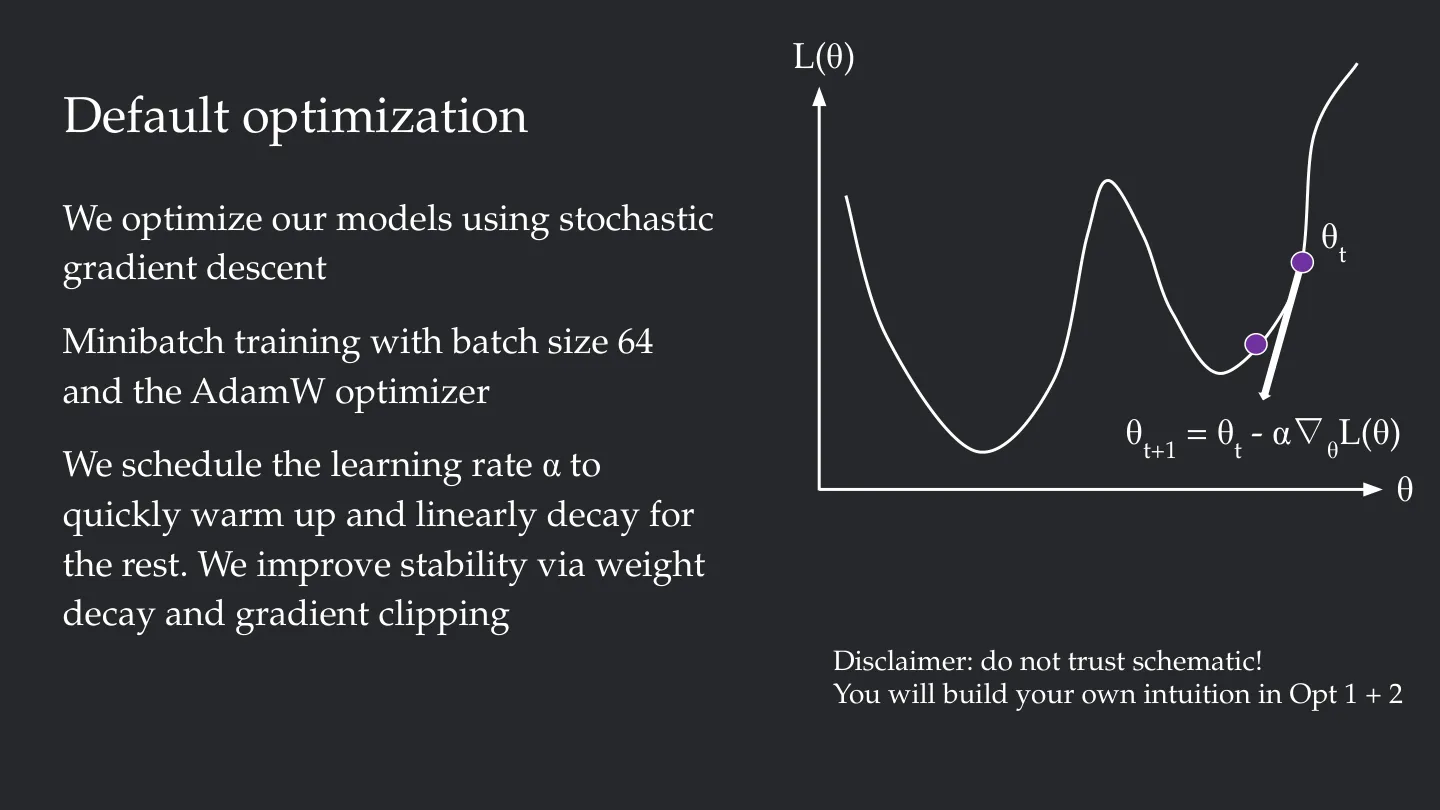
十三、示例运行:六个学习率
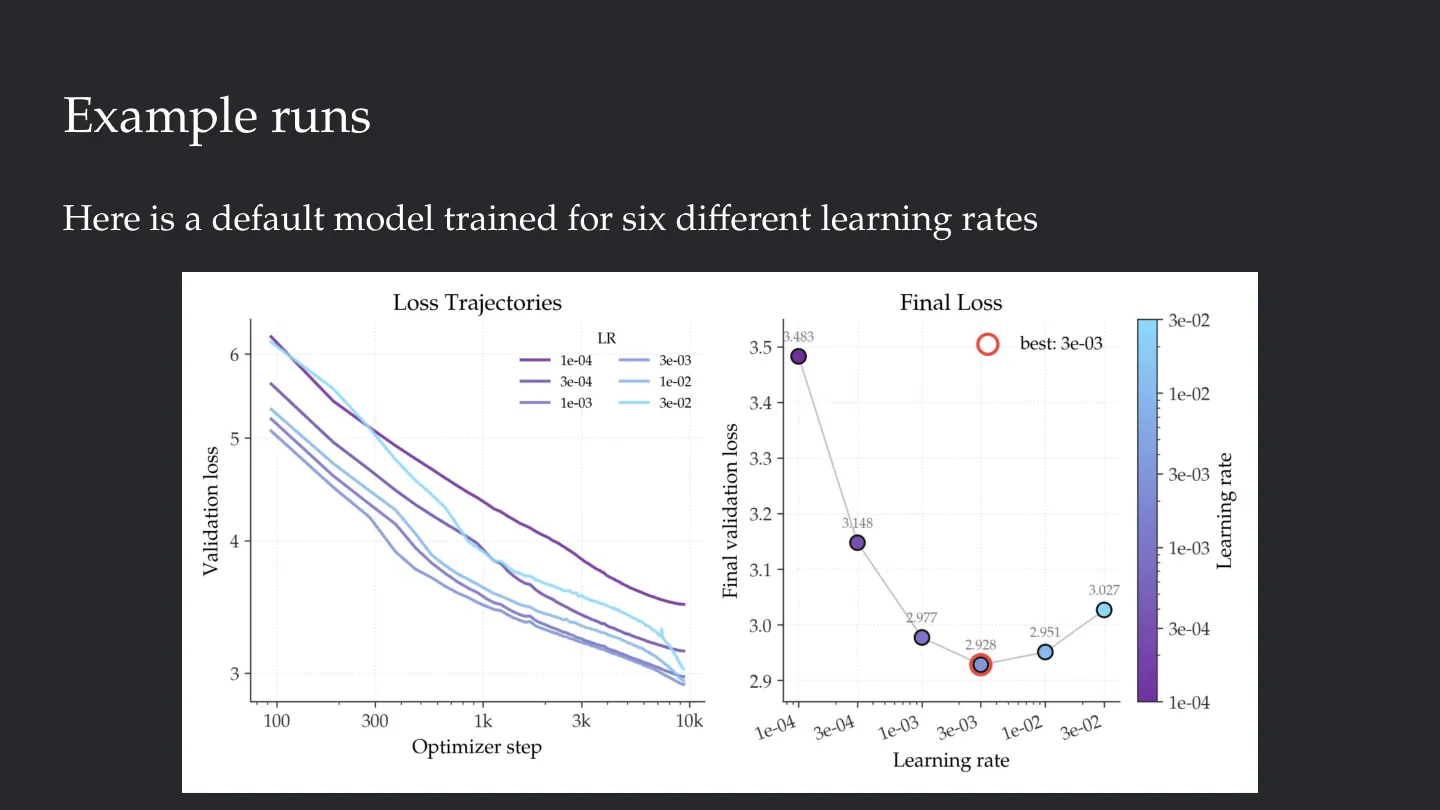
十四、实验走查:从探索设计到残差实验
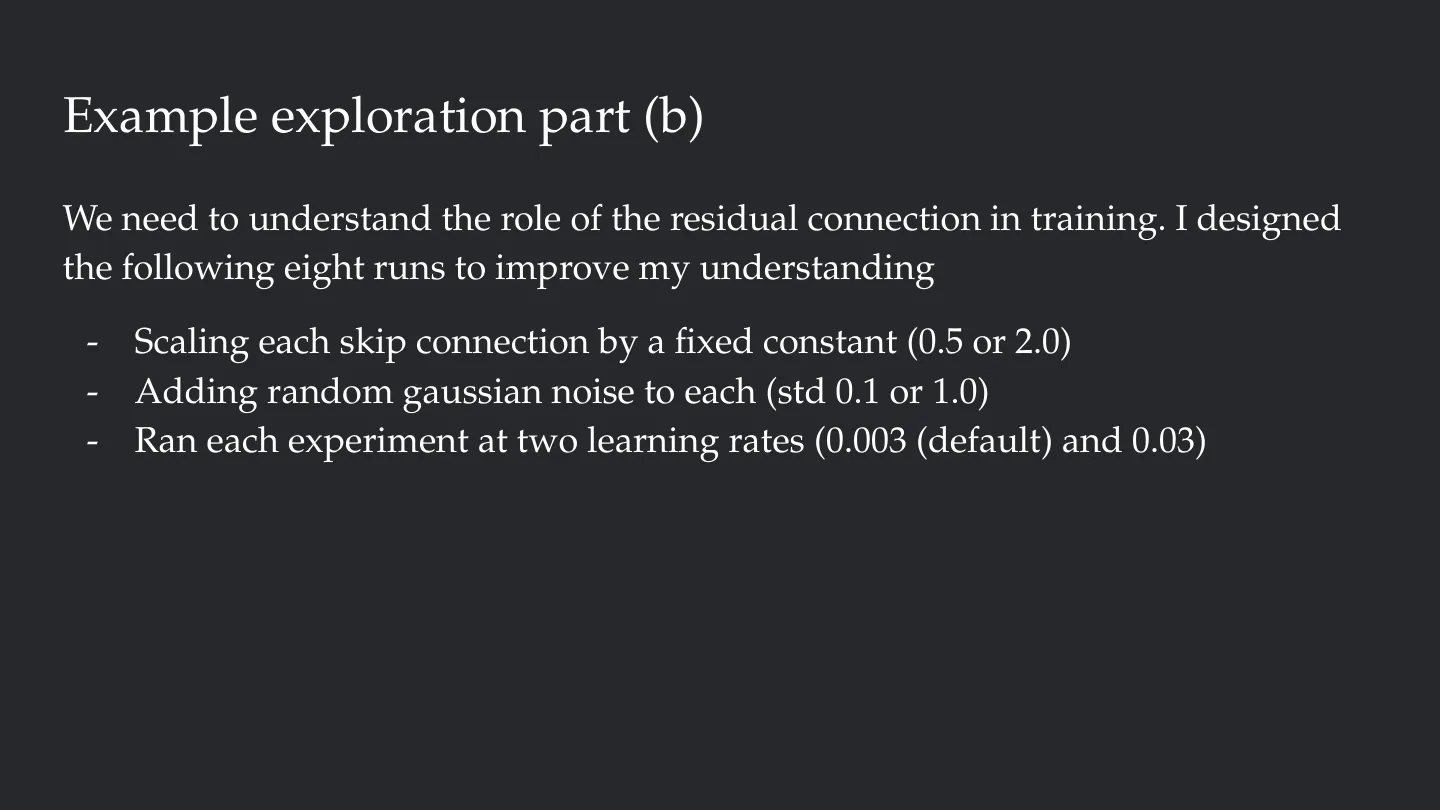
探索部分 (a):逐组件消融
探索部分 (b):残差连接到底在做什么
十五、小测示例:困难预测题
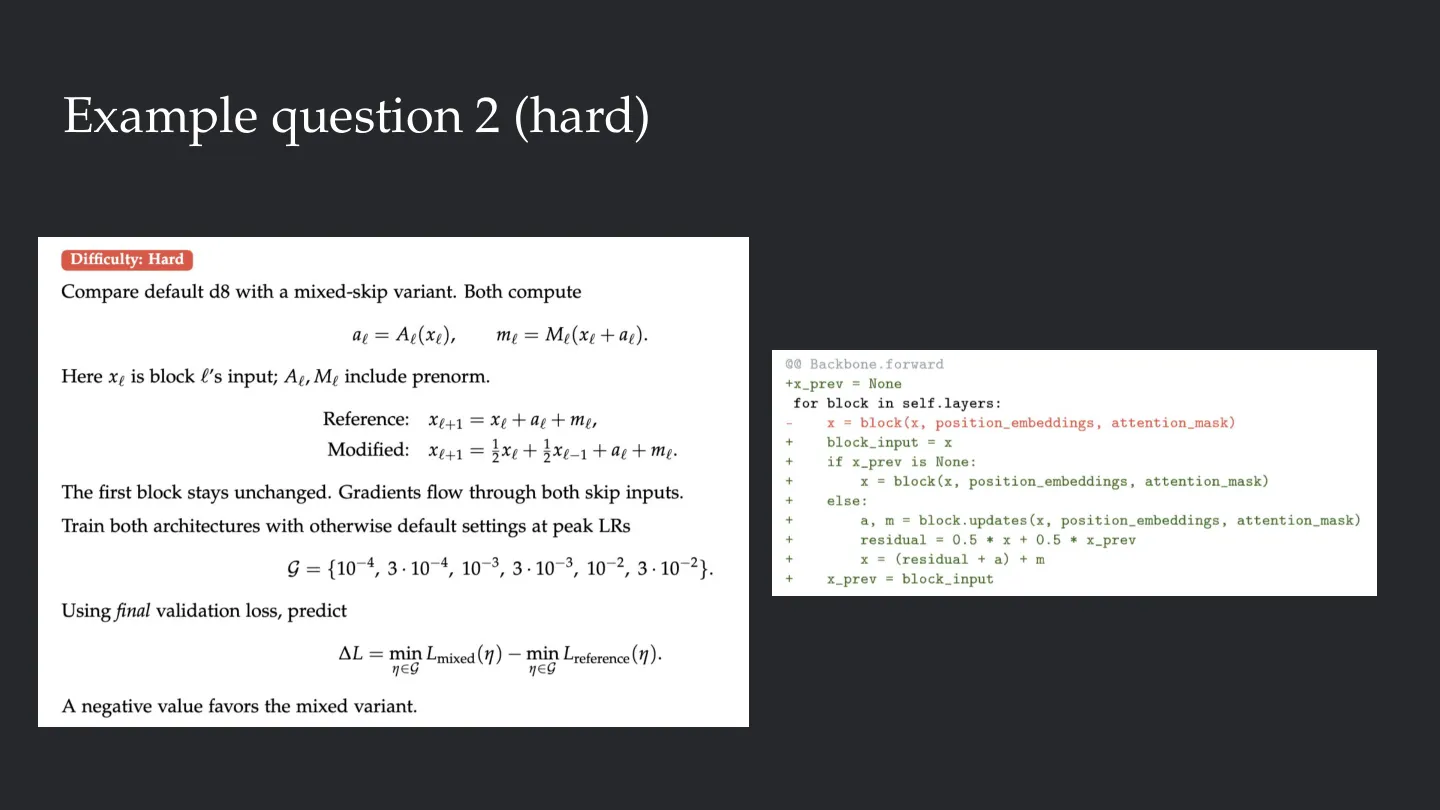
十六、从答案回看直觉:prenorm 的盲点
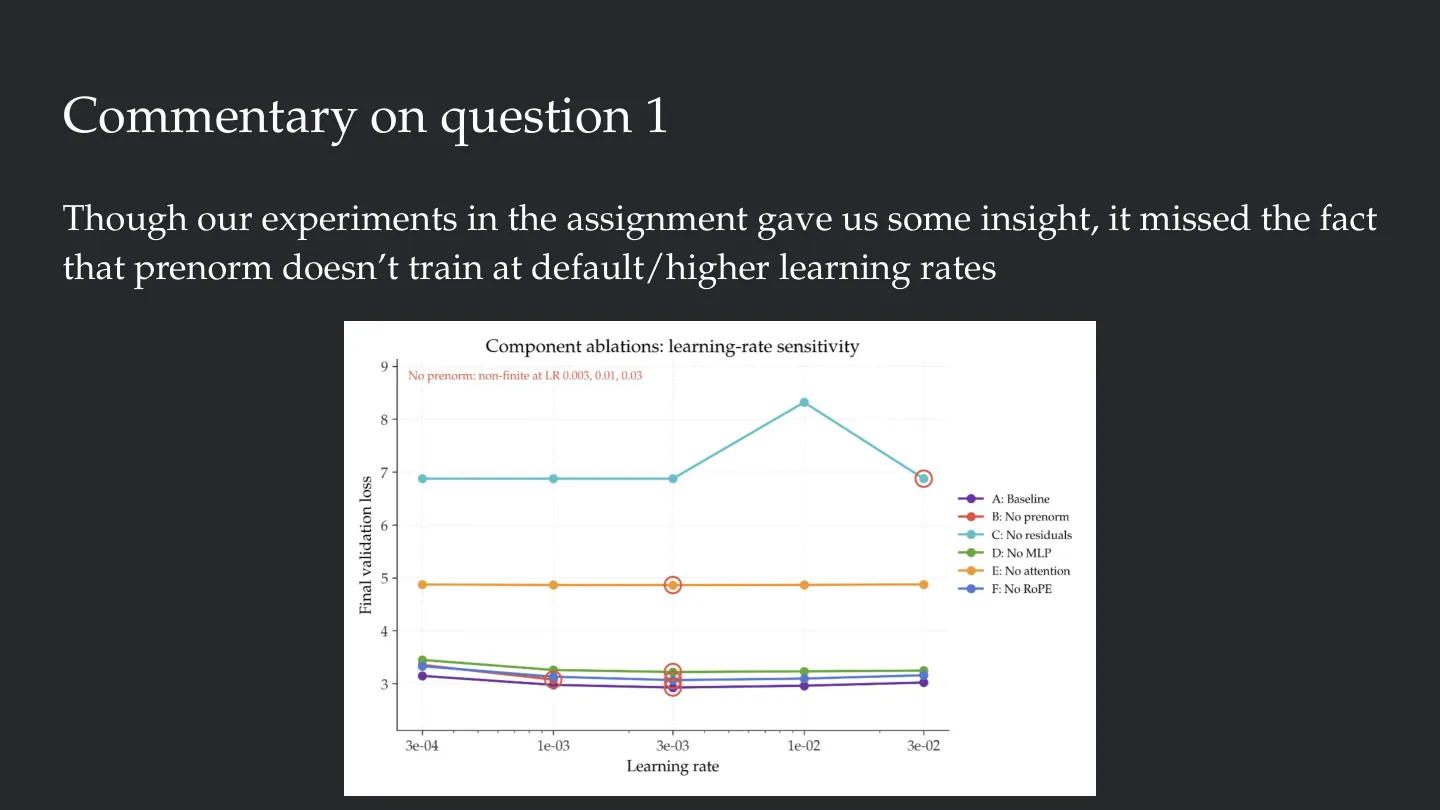
点评一:作业实验给出的洞察可能漏掉关键条件
点评二:残差对大幅修改其实相当稳健
flowchart LR
    A["预测<br/>基于当前世界模型"] --> B["实验<br/>只改一个变量"]
    B --> C["对比预测与结果"]
    C --> D["修正世界模型<br/>补上漏掉的条件"]
    D --> A
附:参考与延伸阅读
编者补充
已知疑点