第2讲 · 深度学习实验的基本功:超参数、规模化、随机性与调试
斯坦福大学 CS312《深度学习炼金术》(2026)官方课堂幻灯片 · 中文重构
| 原始标题 | Lecture 2: Basics |
| 材料来源 | lecture_02.pdf(课程主页逐讲幻灯片) |
| 课程主页 | https://deep-learning-alchemy.github.io/ |
| 材料版权 | 课程材料版权归原课程方及授课教师所有,本书仅供学习 |
对应讲次:第2讲(Stanford CS312 深度学习炼金术)
制作模型:deepseek-flash(vb compose)
一、引言:深度学习是一门实验科学
这一讲开宗明义地给出一个判断:深度学习今天已经是一门实验科学,而不是纯理论学科。判断是不是「实验科学」,看的不是它用不用数学,而是看它的知识是怎么生产出来的——靠设计实验、跑实验、从实验结果里归纳规律。
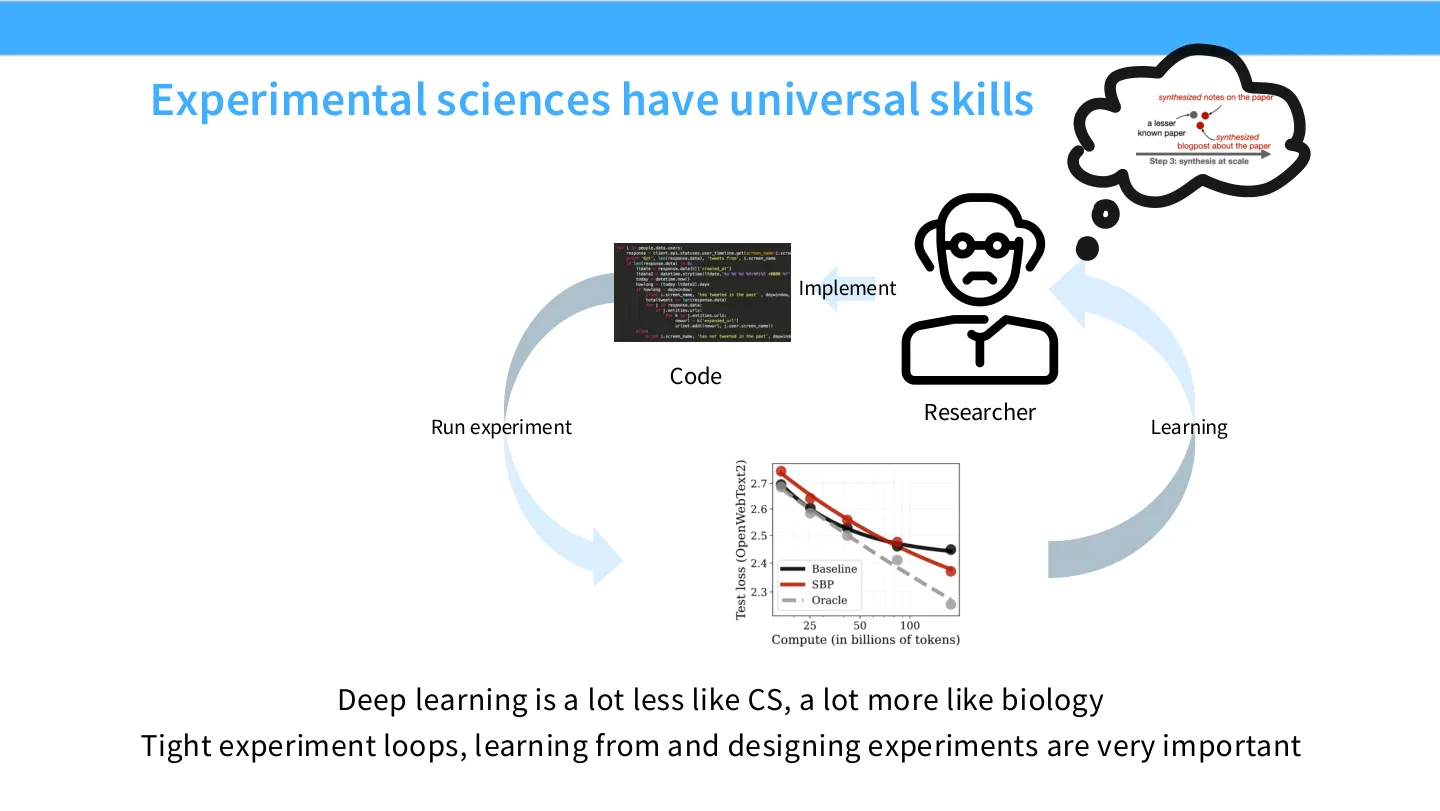
🖼️ 这张图画出了「Code / Researcher / Run experiment / Learning / Implement」的闭环,是整讲的总纲,正文里描述不如直接看图清楚
讲义进一步给了更尖锐的类比:深度学习不太像计算机科学,更像生物学。生物学的研究者很少能从一个公理系统往下推,他们的日常是设计一个能区分两种假设的实验,然后观察。深度学习现在的状态几乎一样。
在这种学科形态下,研究者最核心的技能不是推导,而是那个紧密的实验循环(tight experiment loop):
flowchart LR
    A["实现<br/>Implement"] --> B["跑实验<br/>Run experiment"]
    B --> C["从结果中学习<br/>Learning"]
    C --> A
    C -.->|"提出新假设 / 新设计"| A
这个循环之所以叫「紧密」,是因为它的周期越短,你单位时间内能获得的信息越多。会做深度学习研究的人,往往不是想法最多的人,而是循环转得最快、且每一圈都能学到东西的人。
本讲按四块内容组织,正好对应「让这个循环跑得又快又可信」的四个基本功:
- 第一部分:超参数(hyperparameters)——你手拧的那些旋钮,决定了实验结论的真假;
- 第二部分:规模化(scaling)——怎么用便宜的实验推断昂贵的实验;
- 第三部分:随机性(stochasticity)——同一个实验跑两遍结果不同,差异多少才算「真有区别」;
- 第四部分:调试(debugging)——训练不听话时,看什么、怎么定位。
编者说明:讲义的标题页只写了「B A S I C S」(基本功),这里译为「基本功」而非「基础」,是因为四块内容都不是入门知识,而是做研究时反复用得上的操作技能。
二、超参数:那些由人手工拧的旋钮
讲义给的定义很直白:超参数就是任何由我们手工选择的量,其中很多属于所谓的「干扰参数」(nuisance parameter)——它们不是我们真正想研究的对象,但你不设置它们,实验就跑不起来。
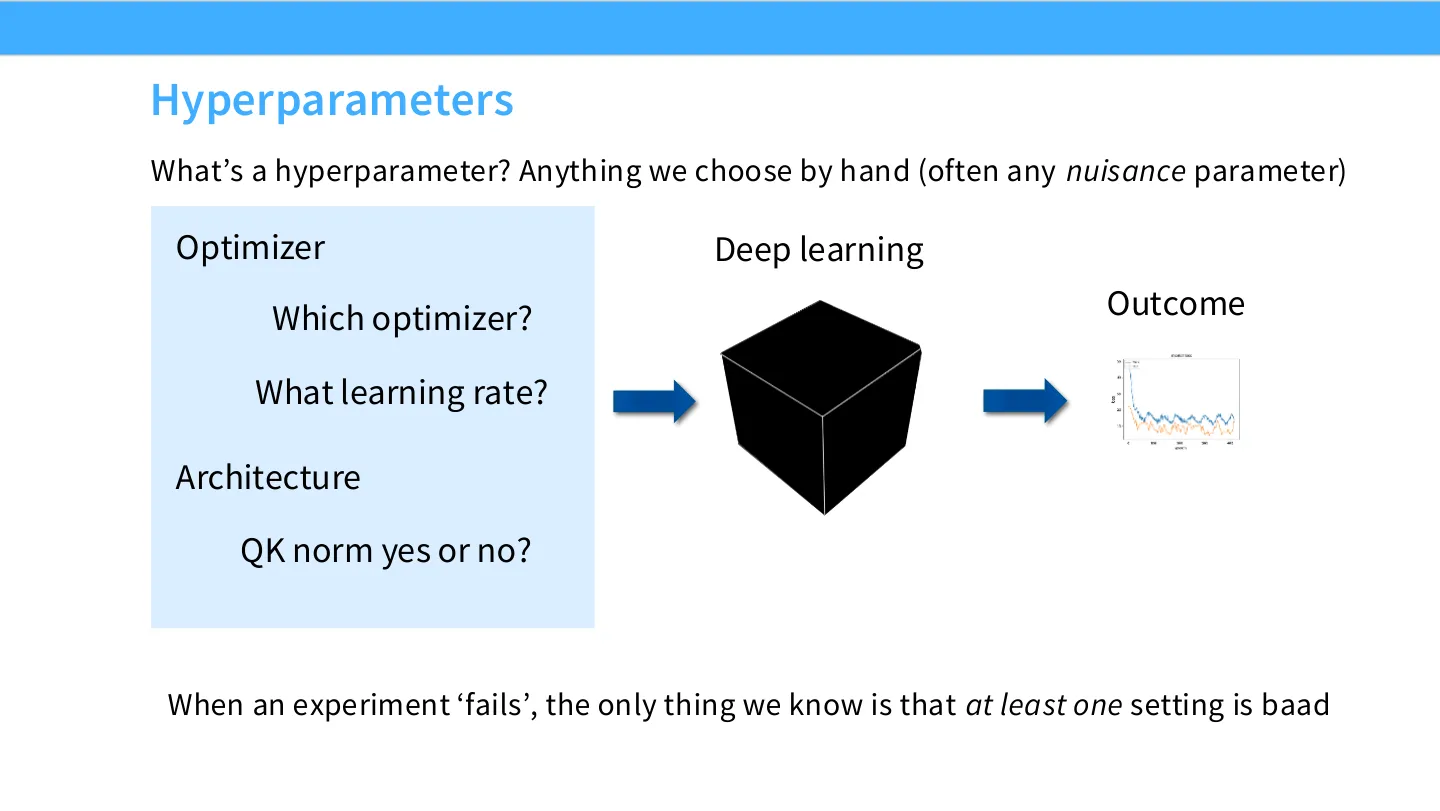
🖼️ 这张图把「结果 ← 优化器 / 学习率 / 结构选择」的因果拆开,正好支撑「失败时不知道是哪颗旋钮坏了」这一要点
常见的、也是最重要的(讲义 slide 7 反复强调学习率,甚至把它写了两遍)包括:
- 学习率(learning rate)——几乎所有实验里最敏感的一个;
- 模型尺寸与形状(model size / shape)——层数、宽度、注意力头数等;
- 训练步数(number of steps);
- 以及结构性的选择:用哪个优化器?要不要 QK norm(对注意力里 query 与 key 的点积做归一化)?
这里有一个非常关键的认识论问题:当一次实验「失败」时,我们唯一能确定的只是「至少有一个设置是坏的」。而坏的是哪一个?完全不知道。
这张图值得多看两眼:它把「结果 ← 优化器 / 学习率 / 架构」的因果拆开摆在台面上。因为旋钮多且互相耦合,错误归因在深度学习里是常态而不是例外——你会以为是模型结构不行,其实只是学习率差了一个数量级。后面三个案例,全部在讲这件事。
编者拓展|为什么叫「干扰参数」:统计学里的 nuisance parameter 指的是「为了估计你真正关心的参数,不得不一起估计、但你并不关心的量」。深度学习里的超参数正是这个角色:你想知道的是「这个方法好不好」,但你必须先选一个学习率;而你选的这个学习率会把「方法好不好」的结论污染掉。要减少污染,办法只有两个——一是把超参数调到接近最优,二是把超参数也当作实验变量去研究(这正是后面几节做的事)。
三、案例一:差分隐私语言模型的调参之痛
第一个案例来自一个开放问题:如何构建一个满足差分隐私(differential privacy)的语言模型。设定是这样的:
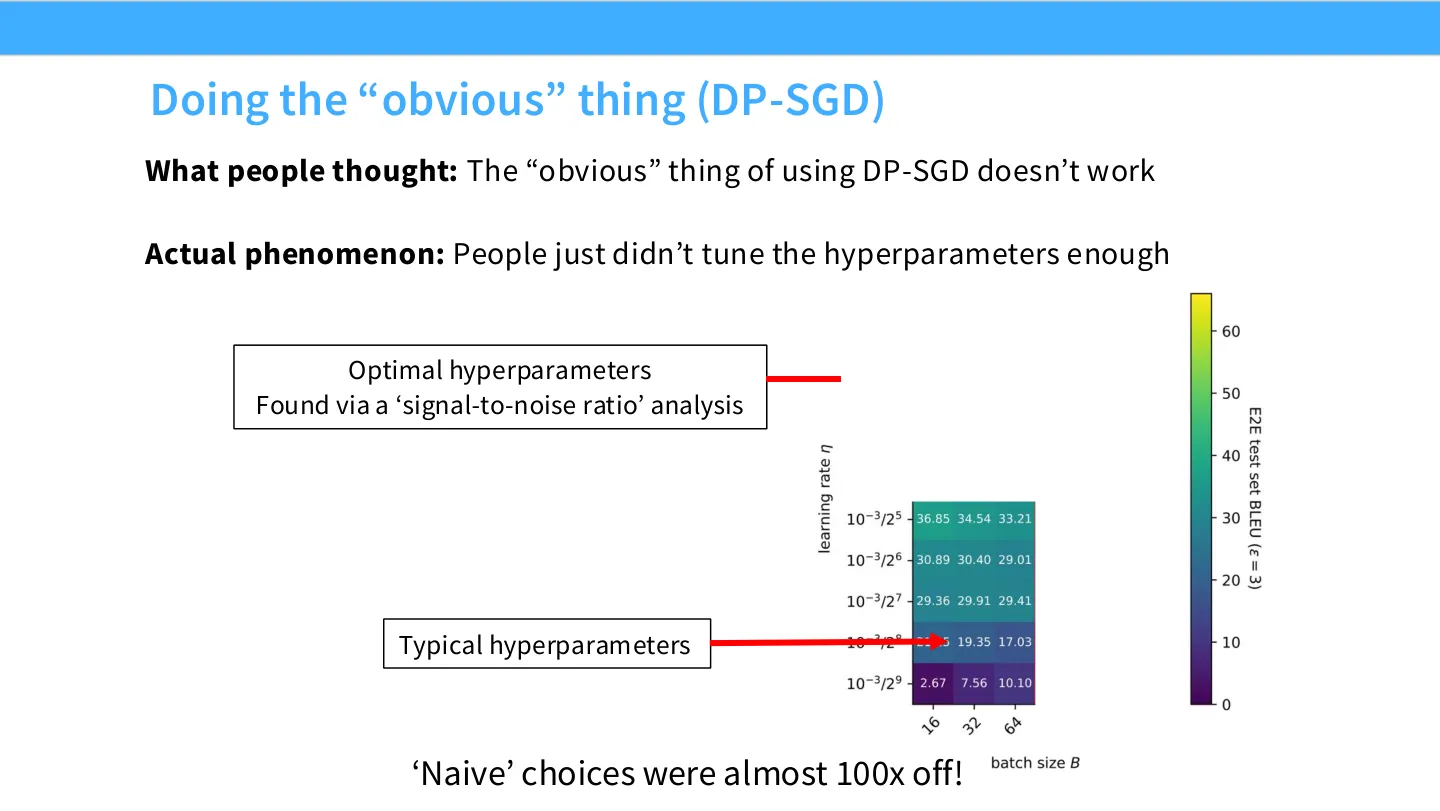
🖼️ 这页把「典型超参数 vs 最优超参数」并排放出来,直观显示 naive 选择差了接近 100 倍,是案例的核心证据
- 手上有公开数据训练出来的大语言模型(large LM);
- 手上有私有数据,不能泄露;
- 目标是用公开模型 + 私有数据,训练出一个「私有下游模型」,并且保证它对私有数据的依赖满足差分隐私。
这条路是走得通的。技术上「显然的做法」是 DP-SGD(差分隐私随机梯度下降):对每个样本的梯度做裁剪、再加高斯噪声,然后照常更新。
社区一度得出的结论是:DP-SGD 这个「显然的做法」不 work。于是有人判定这条路走不通。
真相是另一回事。讲义把两组超参数并排放在一起:一组是大家典型会用的(typical hyperparameters),一组是通过信噪比(signal-to-noise ratio)分析推出来的最优超参数。结果:
「想当然」的选择与最优选择相差接近 100 倍。
于是结论被彻底翻转:实际现象是人们根本没有把超参数调够,而不是方法本身无效。
失败案例:把「方法不 work」当成结论。 它的失败机制在于:DP-SGD 里存在一组强耦合的量——裁剪范数 $C$、噪声乘子 $\sigma$、batch size $B$、学习率 $\eta$。噪声是按 $C$ 与 $\sigma$ 的比例注入的,而学习率又决定了你能在多大噪声下有效前进;这几个量配不齐,梯度信号就被噪声淹没,训练自然「不 work」。换句话说,你以为你在测试方法,其实你在测试自己随手填的那组数字。
编者拓展|信噪比分析在算什么:DP-SGD 的每次更新大致是「裁剪后的平均梯度 + 高斯噪声」,于是噪声相对于梯度的相对强度,取决于 $C$、$\sigma$ 与 $B$ 的比值。所谓信噪比分析,就是先算出「在这个隐私预算下,噪声有多强」,再反过来确定学习率与裁剪范数该放大到什么量级,使得每步的有效位移仍是信号主导的。这一步的要点不在于公式细节,而在于它说明:最优超参数是可以被推导、被预言的,而不是靠暴力搜索碰出来的。
四、案例二与三:重复数据与优化器替换
案例二:重复使用数据能不能提升性能?
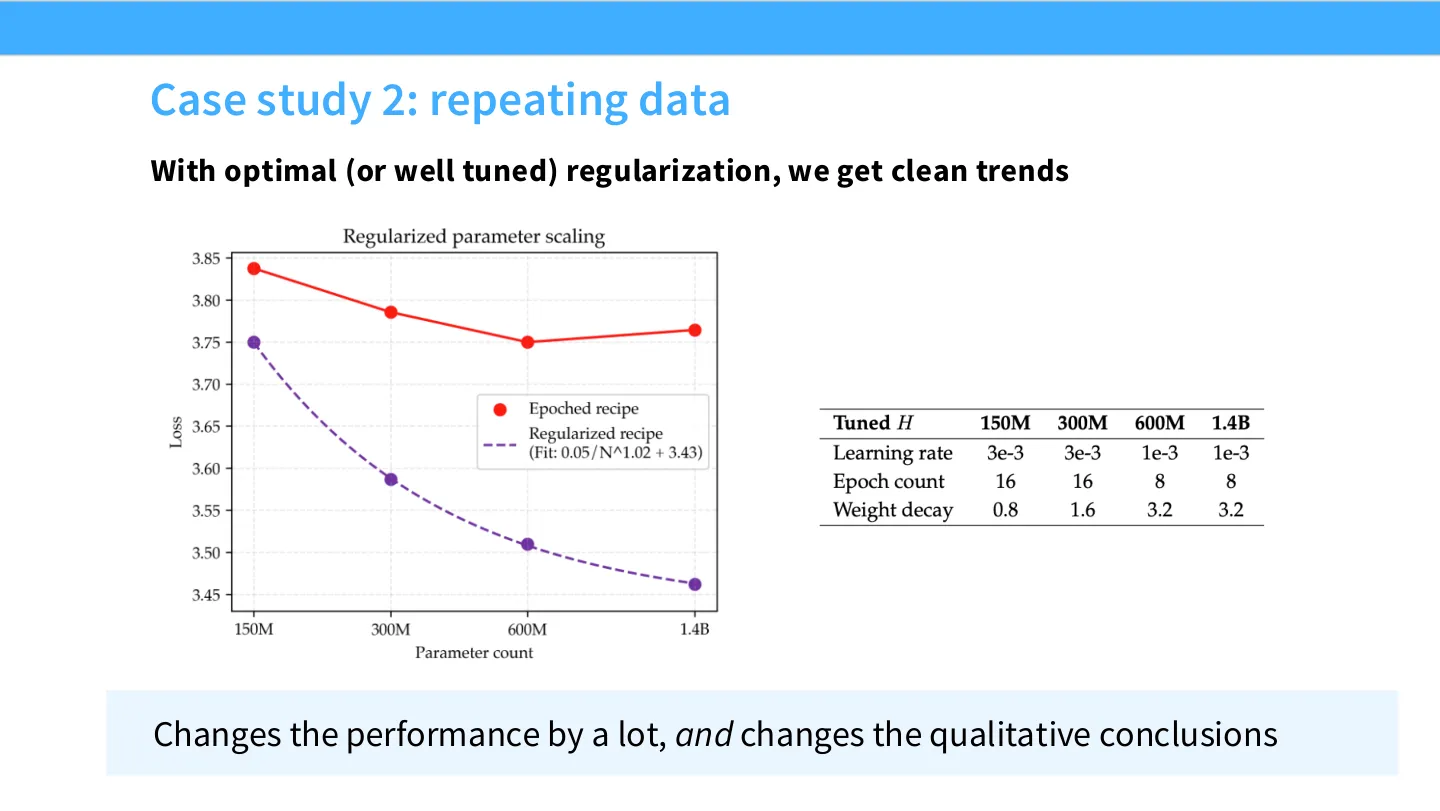
🖼️ 这页展示「用最优/充分调校的正则化后趋势变干净」,是案例二的反转点,比第 10 页的「无收益」结论更能说明问题
直觉上,数据不够就多训几遍。讲义给出的观察是:超过某个临界点之后,重复数据即使配上无限算力也不再带来收益;幻灯片上标出的具体配置是「600M 参数模型 + 200M 数据集」。也就是说,在数据受限的区间里,加算力救不了你。
但故事在这里出现反转。当正则化被调到最优(或被充分调好)之后,曲线变得干净了,而且性能变化幅度很大,甚至定性结论都变了——原本「重复数据没收益」的结论,其实是「正则化没调好」的产物。
这就是为什么这一页比「无收益」那一页更重要:「没有收益」本身就是一次调参事故的读数。
案例三:AdamW 的替代品。
第三点是更普遍的一条规律:不同的优化器需要不同的超参数(而不是「换掉优化器、其他照抄」),而且它们最优超参数的规模化规律很可能也不一样。这意味着你不能把 AdamW 上调好的那一套设定,直接搬到另一个优化器上做公平比较。
三个案例指向同一件事:超参数决定了你会得出什么科学结论。这也直接解释了讲义后面那句警告——超参数空间是一个 21 维甚至更高维的搜索问题,如果「超参数 → 损失」是这 21 维里的任意函数,那它看起来是没希望的;但它不是任意函数,它有很多规律可循,这就是后面几节的内容。
编者说明:案例二、案例三在幻灯片上没有标注论文出处。笔者没有在正文里补具体文献名,以免张冠李戴;读者若想追溯,可在课程主页的 reading 列表里找对应周次。
五、从一维切片到二维曲面:LR 与 batch size 怎么配
接下来讲义带着大家完整走一遍「超参数调查」的流程。核心问题是:学习率(LR)与 batch size(BS)到底该怎么设? 用的材料是 StepFun 的一项大规模缩放律研究。
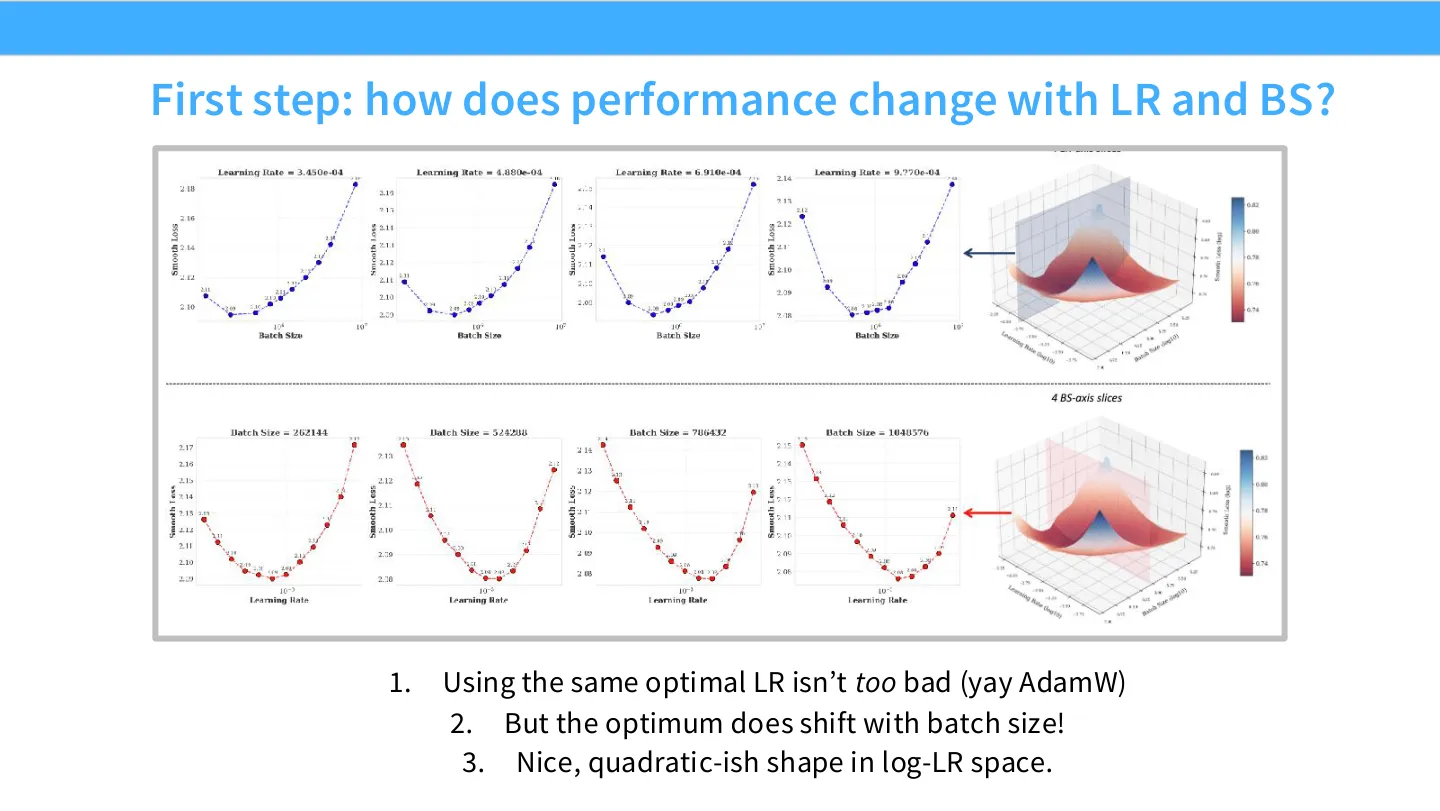
🖼️ 这页是 LR 扫描的一维切片,把「最优点随 batch size 移动」和「log-LR 空间的二次型」两件事同时画出来
第一步,先固定 batch size,扫学习率,看性能怎么变。三个观察:
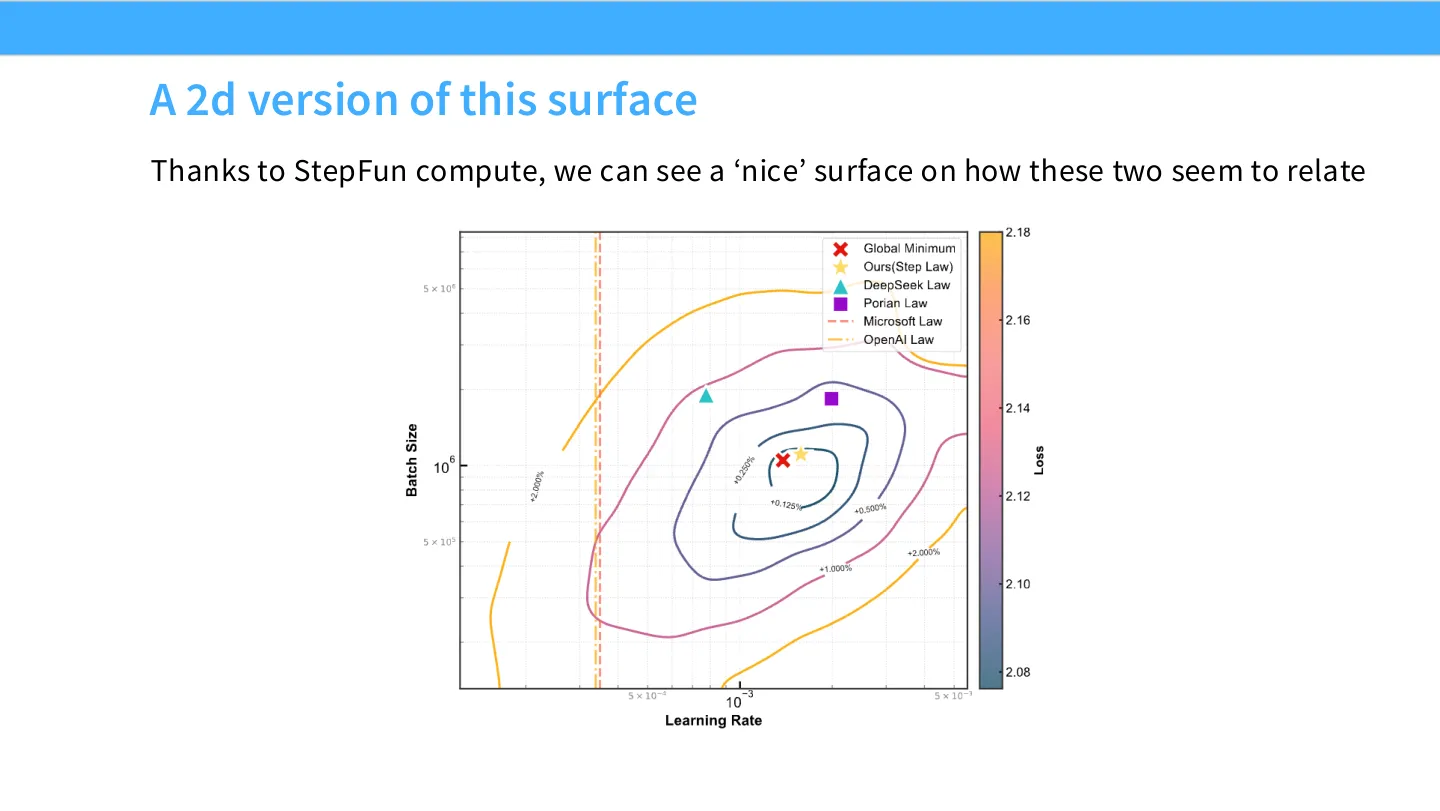
🖼️ 二维曲面图是StepFun 算力换来的关键图,单靠文字很难让人建立 LR–BS 联合形状的直觉
- 沿用同一个「最优学习率」跨不同 batch size,也不算太差——这是 AdamW 这类自适应优化器的好处;
- 但最优点确实会随 batch size 移动,不是不动的;
- 在 log-LR 空间里,损失曲线呈现出漂亮的、近似二次型(quadratic-ish) 的形状。
第 3 点非常实用:如果 $\text{loss}$ 在 $\log\eta$ 上近似是抛物线,那么你只要在几个点上采样,就能拟合出顶点位置,不必做密集网格搜索。
第二步,做二维扫描(LR × BS)。讲义感谢 StepFun 的算力,让我们能看到一张「漂亮」的曲面——LR 与 BS 这两个量之间呈现出相当平滑的联合结构。
编者拓展|为什么 log-LR 上常是抛物线:在最优学习率附近对损失做二阶泰勒展开,$\text{loss}(\log\eta)\approx \text{loss}^\* + \frac{1}{2}k(\log\eta-\log\eta^\*)^2$,这本身就是抛物线。它的实用价值是:你只需要知道顶点在哪、曲率多大,前者告诉你怎么设,后者告诉你「设偏了会掉多少」——曲率小的方向可以偷懒,曲率大的方向必须调准。
另外,工程上常用的两条经验规则是「线性缩放」(batch size 翻倍,学习率也翻倍)与「平方根缩放」(学习率 $\propto \sqrt{\text{batch size}}$)。讲义下一节会告诉我们:这类规则只是局部近似,真正的位移要按模型规模与数据规模重新测。
六、最优点会随规模移动
这是超参数部分最重要的一条结论。讲义问:这张 LR–BS 的曲面,随模型规模与数据规模变化时会怎么移动?
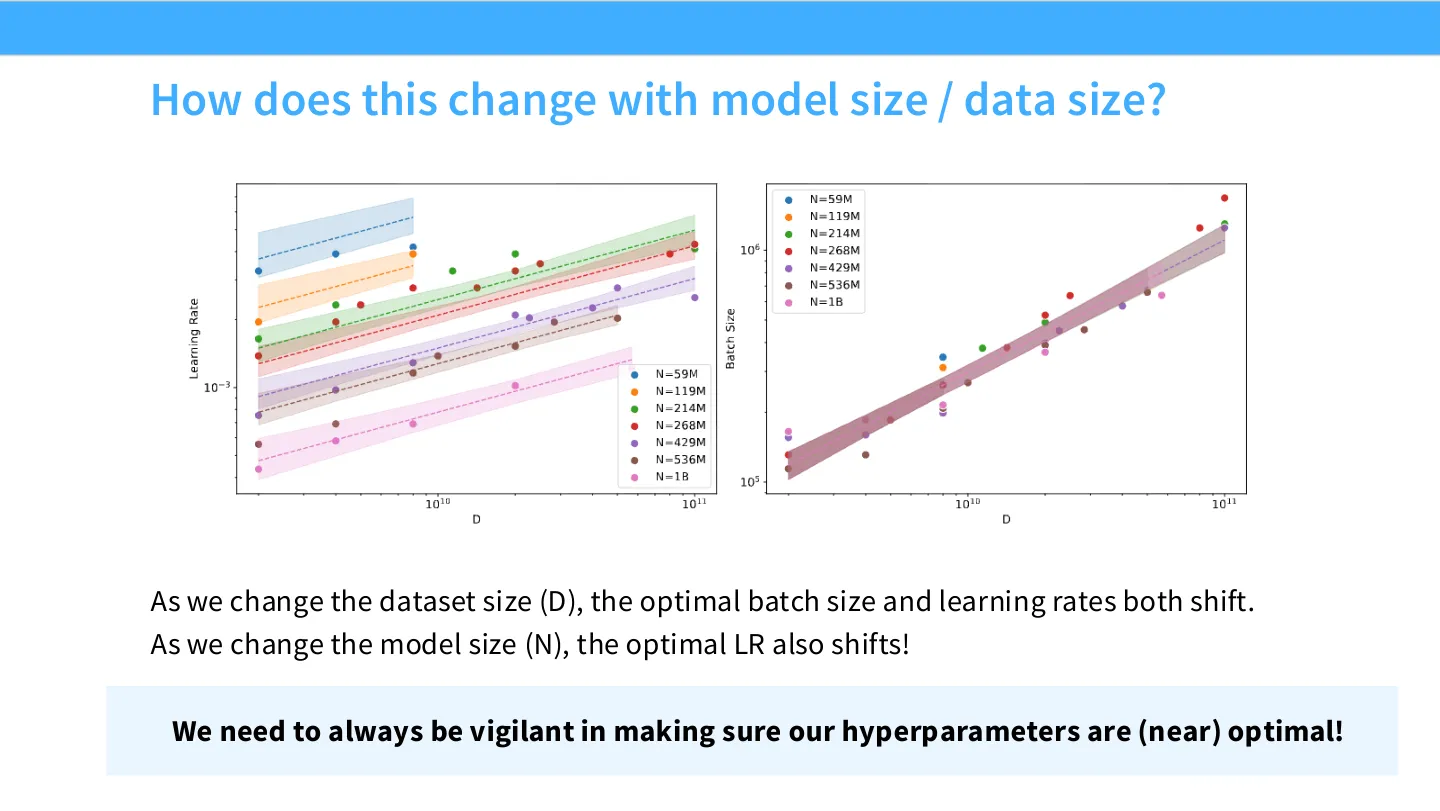
🖼️ 这页把「随 D 移动 / 随 N 移动」的位移画在一起,是本节论点的直接证据
- 数据量 $D$ 变化时,最优 batch size 与最优学习率都会移动;
- 模型规模 $N$ 变化时,最优学习率同样会移动。
由此得到的纪律是:每次换规模、换设定,都要重新确认超参数是否还在(近)最优点,绝不能把上一组实验的超参数直接沿用到下一组。
讲义随后给出了一个「粗粒度的心智模型」,三条:
- 超参数需要被持续重新调,尤其是在用新方法、进新设定的时候;
- 要对「该调什么、怎么调」有感觉(这靠经验积累,不靠背清单);
- 算力要花得有效率——超参数这件事归根到底是试错,试错的成本就是算力。
最后讲义用一句总结给这整块定性:超参数是实证机器学习研究里最不光鲜、但极其重要的部分。理论上不难(「搜就完了」),实践上很复杂,复杂在三点:
- 搜对的变量、在对的尺度上搜(这需要经验);
- 有足够的严谨性去证伪自己的设定(你是不是在用一个没调好的基线做比较?);
- 选对实验的尺度,在「实验数量」与「保真度」之间权衡。
编者拓展|「证伪自己的设定」具体指什么:一个很常见的自欺是「新方法 A 比基线 B 好」。但如果 B 用的是默认超参数、A 用的是你精心调过的超参数,这个比较毫无意义。严谨的做法是给 B 同等的调参预算(哪怕只是随机搜索几十组),并把「B 的最好成绩」拿来做对照。这一步会花掉你相当一部分算力,但它是让结论成立的前提。
七、实验效率:昂贵实验与廉价代理
讲义把视角拉高:深度学习某种程度上是一个「跑实验的数量游戏」——你能跑的实验越多,学到的东西越多。回到那个三环节循环:
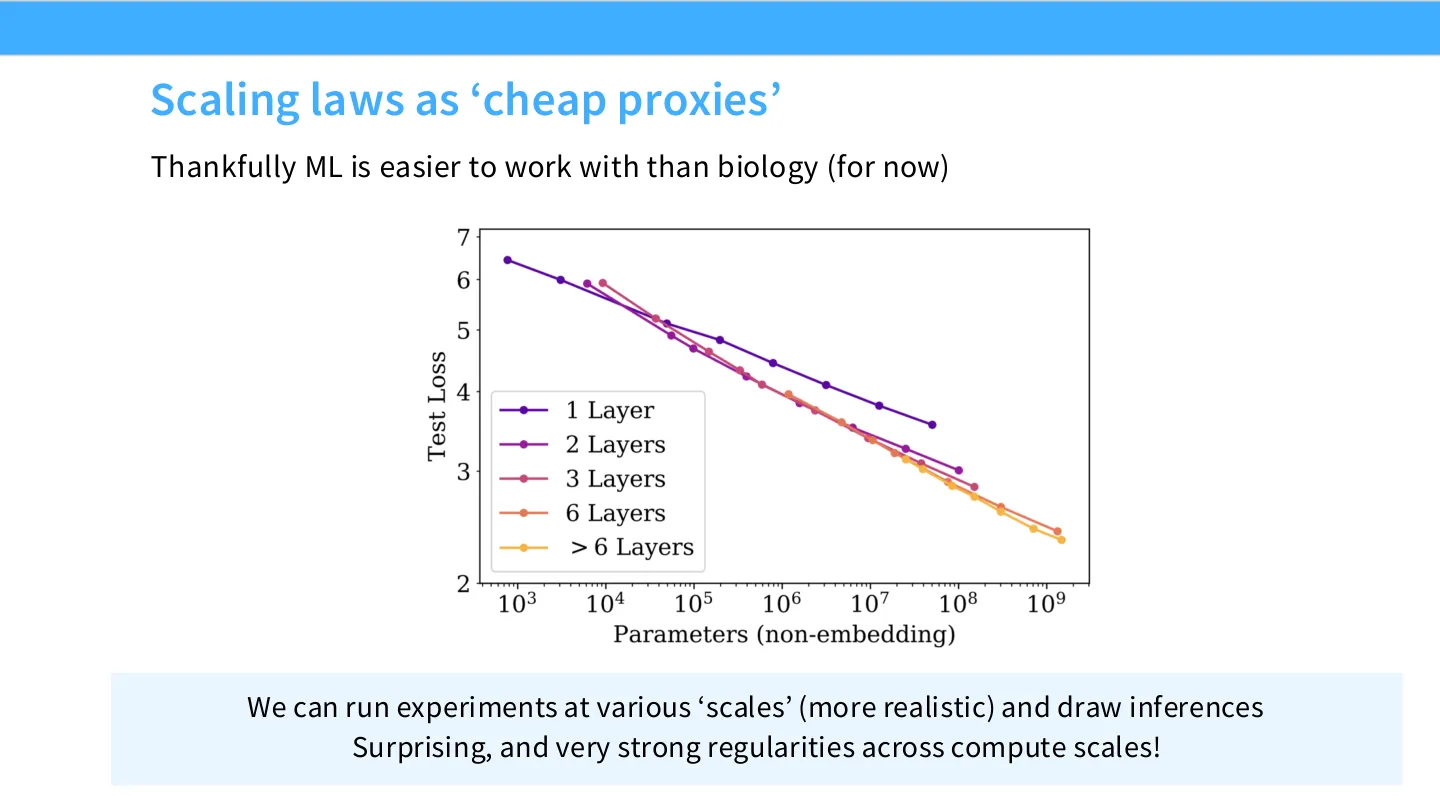
🖼️ 这页把「廉价代理 / scaling laws」的角色点明,并配了跨算力尺度的规律性证据,是这一部分的枢纽
flowchart LR
    A["实现<br/>Implement"] --> B["跑实验<br/>Run experiment"]
    B --> C["学习<br/>Learning"]
    C --> A
    A -.->|"瓶颈:过去很慢<br/>现在有 agent 帮忙"| A
    B -.->|"瓶颈:FLOPs 受限"| B
    C -.->|"瓶颈:人的思考速度"| C
三个环节各有一个瓶颈:
- 学习:实验跑完了,你得有时间思考和吸收(不过你个人也许很快);
- 实现:随着编码 agent 的普及,这一环正变得越来越容易;
- 跑实验:这一环被 FLOPs 卡死。而且在越大的实验室,你的实验规模越大,这个瓶颈越硬。
于是问题变成:怎么把实验跑得更有效率? 讲义给出了核心答案:缩放定律(scaling laws)。
LLM 时代的实验越来越贵,这件事并不孤独——生物学面对的是同样的困境:你不能在人身上做一万组实验,所以你需要一个便宜、可控、并且你清楚其适用边界的模型系统(model system),比如细胞系、小鼠。
ML 比生物学幸运的地方在于:你可以在不同的「尺度」上真的把实验跑出来(小模型、中模型、大模型),然后从中做推断。而令人惊讶的是,跨算力尺度存在非常强的规律性——这正是「代理」能成立的原因。
一个提效率的小技巧:vmap。 要在很大的超参数网格上搜索,你希望模型越小越好;但小模型常常因为 kernel launch 开销而效率极低(每次运算还没来得及占满 GPU,就结束了)。讲义给的答案是:用 vmap——它是「广义的批处理(generalized batching)」,能把「一整个超参数网格上的模型」当成一个批次向量化地跑,从而把 kernel launch 开销摊薄。
编者拓展|vmap 的用法直觉:以 JAX 的
jax.vmap为例,你写一个「单个模型前向」的函数f(params, batch),vmap(f, in_axes=(0, None))就会返回一个「对一批 params 同时前向」的函数。它并不复制代码,而是在编译期把循环变成张量维度,因此同一份 kernel 能一次算完 N 组超参数。这正是「用小模型搜大网格」在经济上可行的前提。注意它与数据并行的 batch 是两个不同的维度,实践中常常是「vmap套在超参数维、pmap/分片套在数据维」。
八、缩放定律简史与联合缩放公式
缩放定律并不是 2020 年才有的想法,它的历史比大多数人以为的早得多。
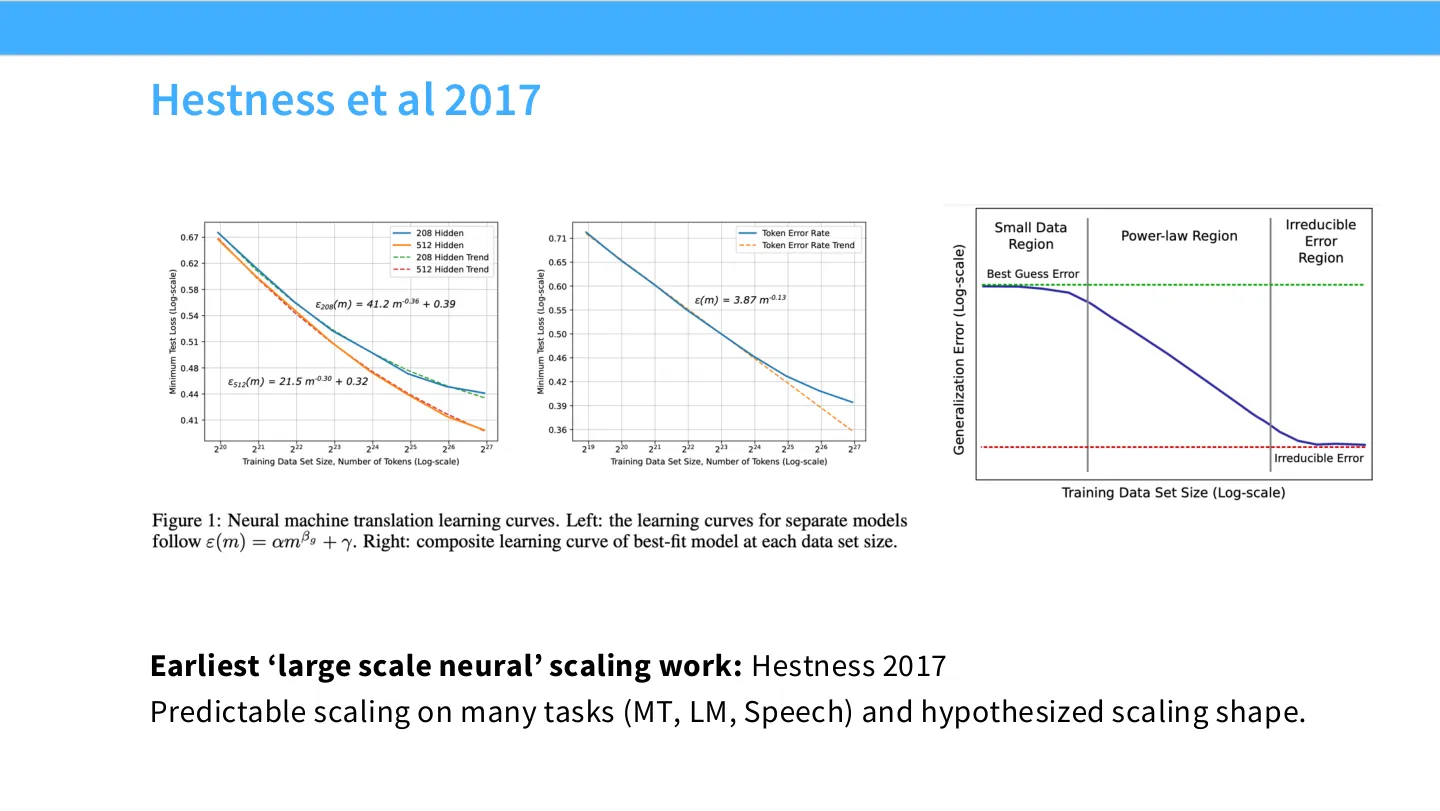
🖼️ Hestness 2017 的多任务可预测缩放图是这一段的经典图,能让读者一眼看到「不同任务都落在同一种形状上」
- 最早的数据缩放定律论文可以追溯到 1993 年;
- Kolachina 等人 2012 的工作给出了「数据量 ↔ 下游性能」之间的幂律(power law)关系,是对函数形式的早期检验;
- Hestness 2017 是最早的「大规模神经网络」缩放工作:在机器翻译、语言模型、语音等多个任务上都观察到了可预测的缩放行为,并提出了缩放曲线形状的假设。
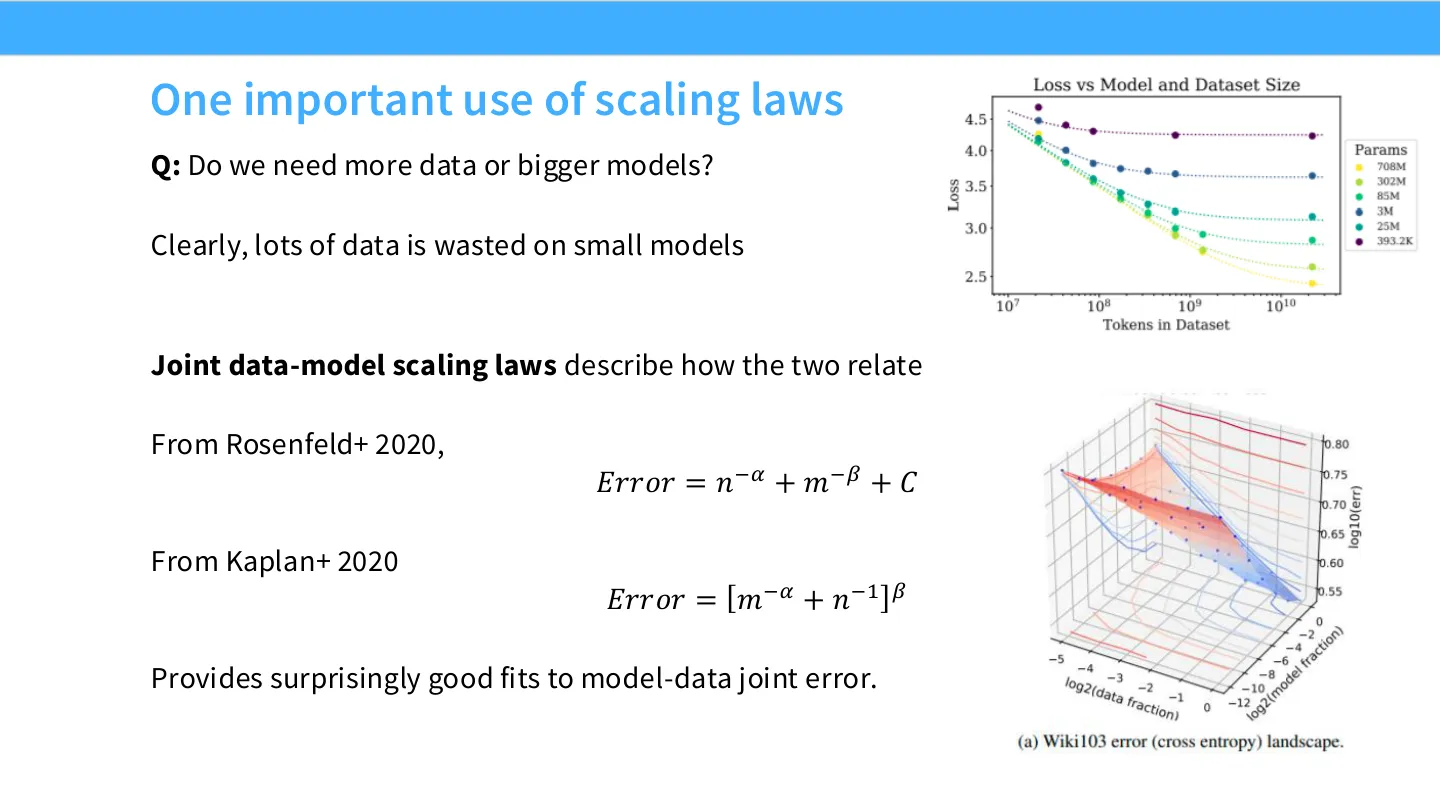
🖼️ 这页给出了 Rosenfeld 与 Kaplan 两个联合缩放公式,属于关键公式页,正文照抄公式不如配原图
(讲义注明这一部分的材料取自 CS336,那门课的第 9/10 讲有整整一讲讲缩放定律。)
缩放定律最重要的一个用途,是回答一个非常具体的工程问题:我该加数据,还是该加模型? 讲义先给了一个直观观察:大量数据被浪费在小模型上了——数据量远超模型容量时,多出来的数据几乎白给。于是需要联合的数据—模型缩放律来刻画两者的关系:
Rosenfeld 等人(2020):
$$ \text{Error} = n^{-\alpha} + m^{-\beta} + C $$
Kaplan 等人(2020):
$$ \text{Error} = m^{-\alpha} + n^{-1\beta} $$
讲义的评价是:这些形式对模型—数据联合误差的拟合意外地好。
但——缩放定律不是免费的。讲义专门列了一页「坑(pitfalls)」,提醒这里头有大量细节容易翻车:
- 参数 / FLOPs 该怎么记账:什么算参数?embedding 查表算不算一次 FLOP? 记账口径不同,拟合出来的指数就不同;
- 最优超参数会随尺度变化(上一节刚讲过),所以「同一个配置放大 10 倍」往往不是同一个实验;
- 总体而言,缩放曲线可能一直看起来很漂亮,直到它突然不漂亮。
讲义还给了一个「预告」:真正让缩放变得可操作的关键技巧,是为最优超参数本身找到缩放规则,或者找到不变量(invariance),例如学习率满足 $\eta = O(\sqrt{\text{batch size}})$。有了这类规则,超参数搜索与规模外推的复杂度都会被大幅压缩。
编者说明:幻灯片上 Kaplan 2020 的公式在 PDF 文字提取中出现了明显的排版损坏(原文呈现为 $m^{-\alpha} + n^{-1\beta}$),无法确认其确切写法。查阅原文(Kaplan et al., Scaling Laws for Neural Language Models, 2020)后可知其形式是把数据项与模型项合成为一个幂次表达式;这里按幻灯片原样转录并标注存疑,详见文末「已知疑点」。
编者拓展|幂律里的 $C$ 是什么:Rosenfeld 那一条里的常数 $C$ 通常被解释为「不可约误差」——即使数据和模型都无限大,任务本身的熵也还在那里。它的存在很实用:它告诉你这条曲线最终会压平,所以「无限堆算力」在数学上就注定有天花板。这也是第 6 节那条实践纪律的理论版本:边际收益递减是可预测的,别等实验撞墙才发现。
九、随机性:现代深度学习是一个随机过程
现在进入第三部分。讲义先问一个最基础的问题:我们说「方法 A 比方法 B 好」时,这个「好」在统计上站得住吗?
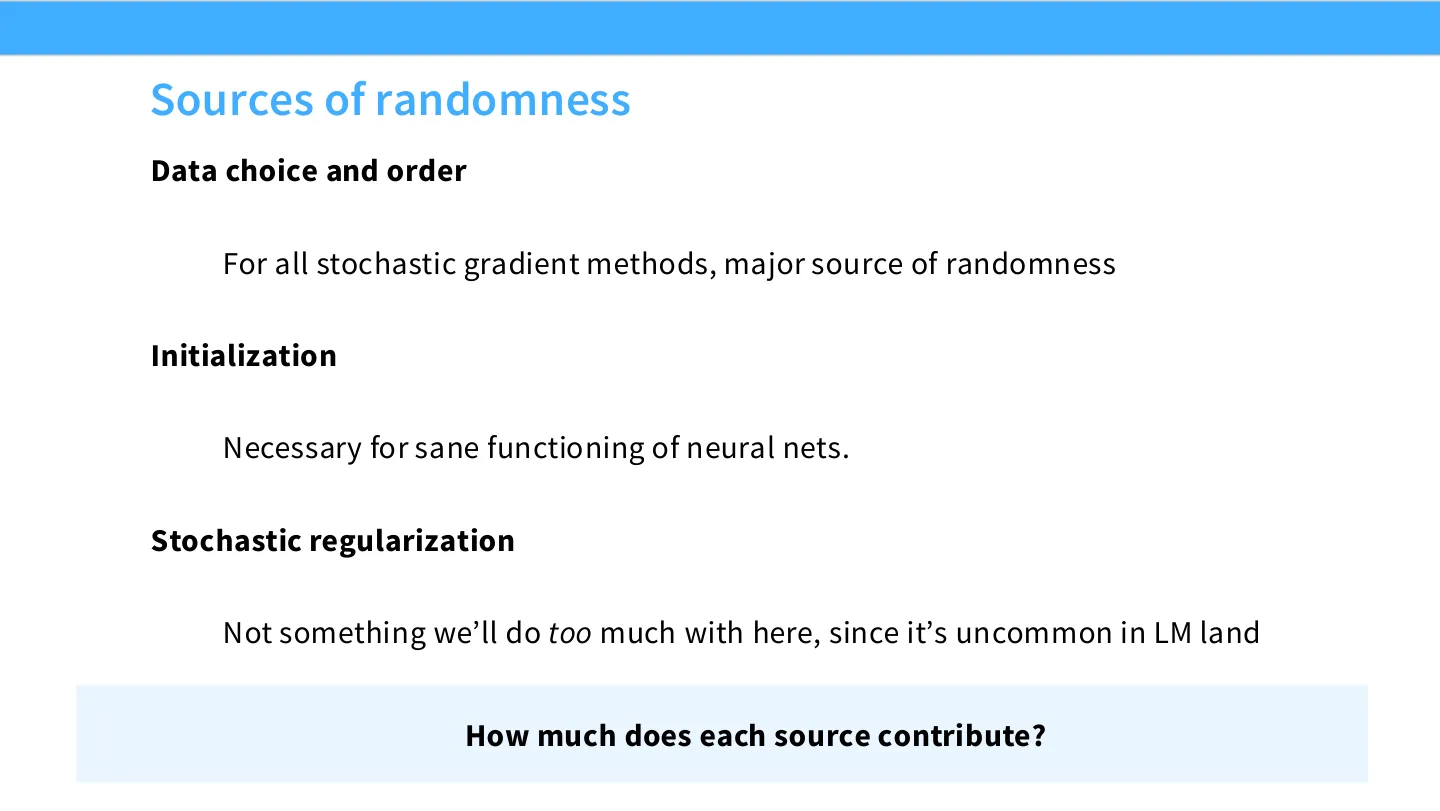
🖼️ 这页把三类随机源并列成清单,是本节的结构图,正文按它组织最自然
要回答它,先得承认一件事:现代深度学习是一个随机过程。
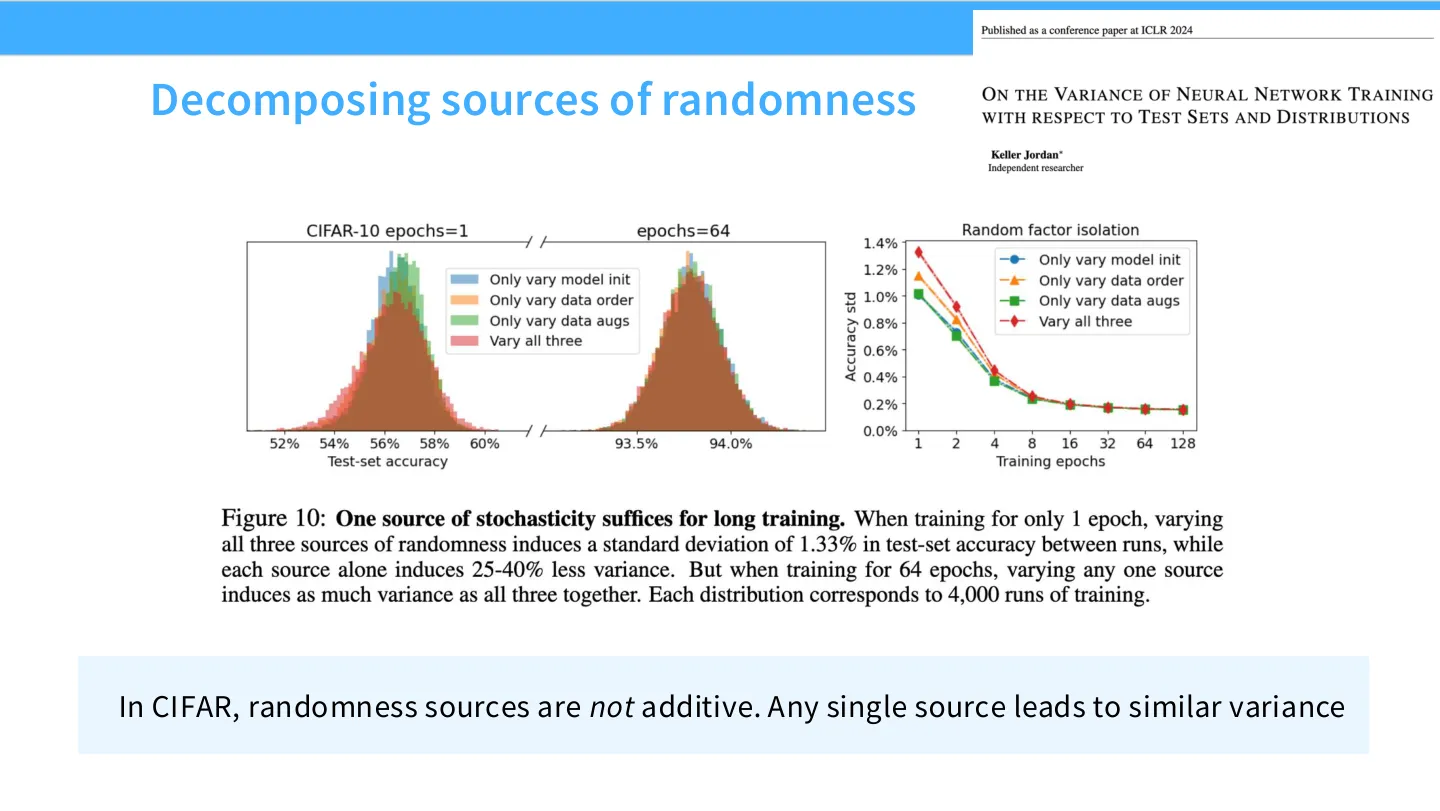
🖼️ CIFAR 上方差分解的实验结果很难用文字讲清楚「不可加、任一来源都造成相近方差」,需要看图
我们大多用 SGD 及其变体(如 Adam)训练模型,其中一部分原因是算力效率。minibatch SGD 是在随机采样出的一小批样本的损失上做梯度下降——随机性直接来自采样本身。
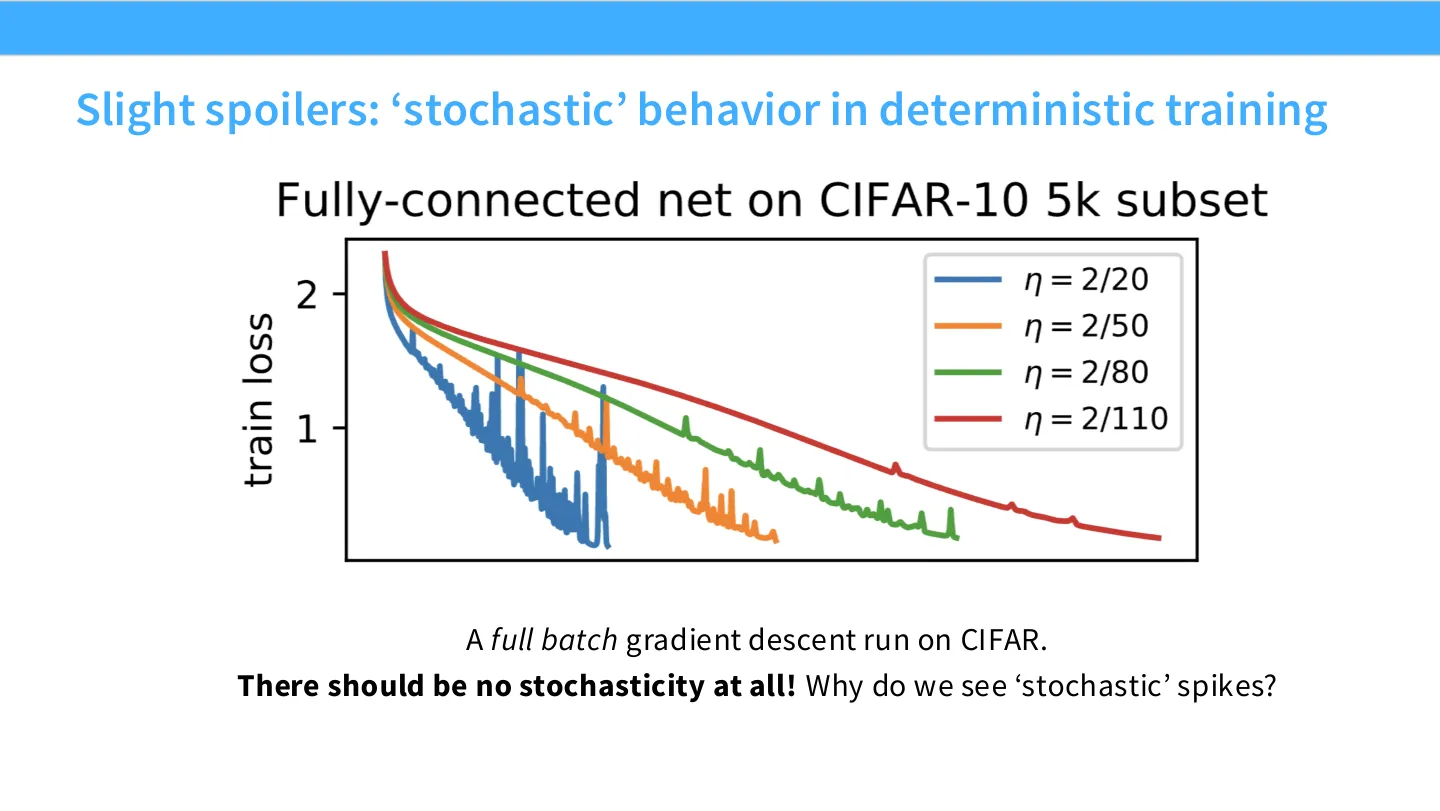
🖼️ 全批量梯度下降本应无随机性却出现尖峰,这张图是本节最有力的「反常识」证据
此外,神经网络的初始化也是随机的。讲义给了两个经典方案($D_{in}$ 为输入维度、$D_{out}$ 为输出维度):
Glorot / Xavier 初始化
$$ W \sim \mathrm{Unif}\left[-\sqrt{\frac{6}{D_{in}+D_{out}}},\ \sqrt{\frac{6}{D_{in}+D_{out}}}\right] $$
He 初始化
$$ W \sim \mathcal{N}\left(0,\ \frac{2}{D_{in}+D_{out}}\right) $$
(还有更多方案。重点不在具体分布,而在做对称性破坏(symmetry breaking)——如果所有权重相同,同一层的所有神经元梯度也相同,网络就退化成一个线性模型。)
随机性有三个来源,讲义把它们的地位分得很清楚:
| 随机源 | 说明 | 在本课程中的分量 |
|---|---|---|
| 数据的选择与顺序 | 对所有随机梯度方法都是主要随机源 | 重点 |
| 初始化 | 神经网络正常工作的必要条件 | 重点 |
| 随机正则化(如 dropout) | 在 LM 领域并不常见 | 本讲不展开 |
问题来了:这三个来源各自贡献多少方差?
讲义在 CIFAR(CIFAR-10/100)上做了分解实验,结论很有意思:这些随机源不满足可加性。任何一个单一来源单独存在时,都会带来相近量级的方差——也就是说,你没法说「初始化占 40%、数据顺序占 60%」。
为了理解这件事,讲义给了三种关于「深度学习随机性」的心智模型:
| 心智模型 | 直觉 | 对应的口号 |
|---|---|---|
| SGD 像布朗运动(Brownian motion) | 随机游走,扰动累积但总体有界 | 「小扰动保持靠近」 |
| SGD 像 GD + 噪声 | 在真实梯度上下注噪声,噪声被平均掉 | 「小扰动保持靠近」 |
| SGD 像混沌系统(chaotic system) | 无穷小的扰动会被指数放大 | 「小扰动跑到很远」 |
前两个模型意味着初值附近的小扰动不会把你带到别处;第三个模型意味着恰恰相反。而在混沌系统里,无穷小的扰动可以导致宏观尺度的分歧——天气、人类行为都是例子。那么训练深度网络呢?
讲义在这里放了一个「轻微剧透」:在一个全批量(full batch)梯度下降的 CIFAR 训练里,本应完全没有随机性——没有采样、没有 dropout、初始化固定。但训练曲线上仍然出现了「随机」的尖峰。
那为什么会这样?
编者拓展|确定性的训练为什么会「抖」:讲义只把现象摆出来,没有给结论。工程上常见的解释有两条,都属于外部知识、非讲义原文: 1. 浮点运算的非结合性:多线程/多卡归约时求和顺序不固定,$(a+b)+c \neq a+(b+c)$ 在浮点里成立,于是每次前向的末位比特不同; 2. 混沌放大:上面第 2 条解释的微小差异,被深度网络这个高维非线性系统在几千步里指数放大,最终表现为肉眼可见的曲线分叉。
这两条合起来正好对应上一段那两种心智模型:短期内「小扰动保持靠近」,长期内「小扰动跑到很远」。这也解释了为什么「固定随机种子」并不能保证两次训练完全一致——种子只固定了采样与初始化,固定不了归约顺序。
讲义的总结是:了解你的随机性。历史上很多优秀的架构工作,都来自对随机性的细致处理。
十、显著性检验:知道你的随机性
回到那个基础问题:方法 A 真的比方法 B 好吗?
这个问题有很多层次(比如两者的超参数是不是都调好了),但讲义说,先从一个更基础的层次开始:这个差异在统计上显著吗?
统计学复习:通常我们计算标准误(standard error):
$$ \mathrm{SE} = \frac{\text{标准差}}{\sqrt{n}} $$
然后取 $1.96 \times \mathrm{SE}$ 作为95% 置信区间。
现在设定:你有两个方法,各自画了误差棒,两条误差棒有重叠。差异显著吗?
讲义的回答是:在机器学习里,常常是显著的。
原因是关键观察:损失的变化里有很大一部分是「题目难度」的方差,而不是训练本身的波动。 换句话说,不同样本(或不同随机种子下的同一批样本)之间的难易差异,会同时抬高 A 和 B 的误差棒;但如果 A 在同一批样本上都比 B 好一点点,这个「都」就是信息——误差棒的形状掩盖了配对结构。
因此正确的工具是配对检验(paired test):比较每一对观测的差值 $d_i = \text{loss}_A^{(i)} - \text{loss}_B^{(i)}$,而不是比较两组各自的均值。配对 t 统计量是
$$ t = \frac{\bar{d}}{s_d / \sqrt{n}} $$
其中 $\bar d$ 是差值的均值、$s_d$ 是差值的标准差。当两个方法在同一批「难题」上都难、在「简单题」上都简单时,$s_d$ 会远小于各自的 $s$,于是 $t$ 变大——原本不显著的差异变得显著。
讲义的收尾是平衡的:对随机性保持警惕,知道你的随机性;但在 ML 里事情通常没那么糟。
编者说明:幻灯片引用了一篇 Minitab 的博客来区分「配对 t 检验」与「双样本 t 检验」(https://blog.minitab.com/en/blog/statistics-and-quality-data-analysis/t-for-2-should-i-use-a-paired-t-or-a-2-sample-t),核心就是上面这点:同一实验单元上的两次测量应当配对比较。在 ML 里,「实验单元」可以是同一个随机种子、同一个数据子集,或同一道评测题。
十一、调试:我们到底该看什么
最后一部分:当事情不 work 的时候怎么办? 讲义列了三类故障:
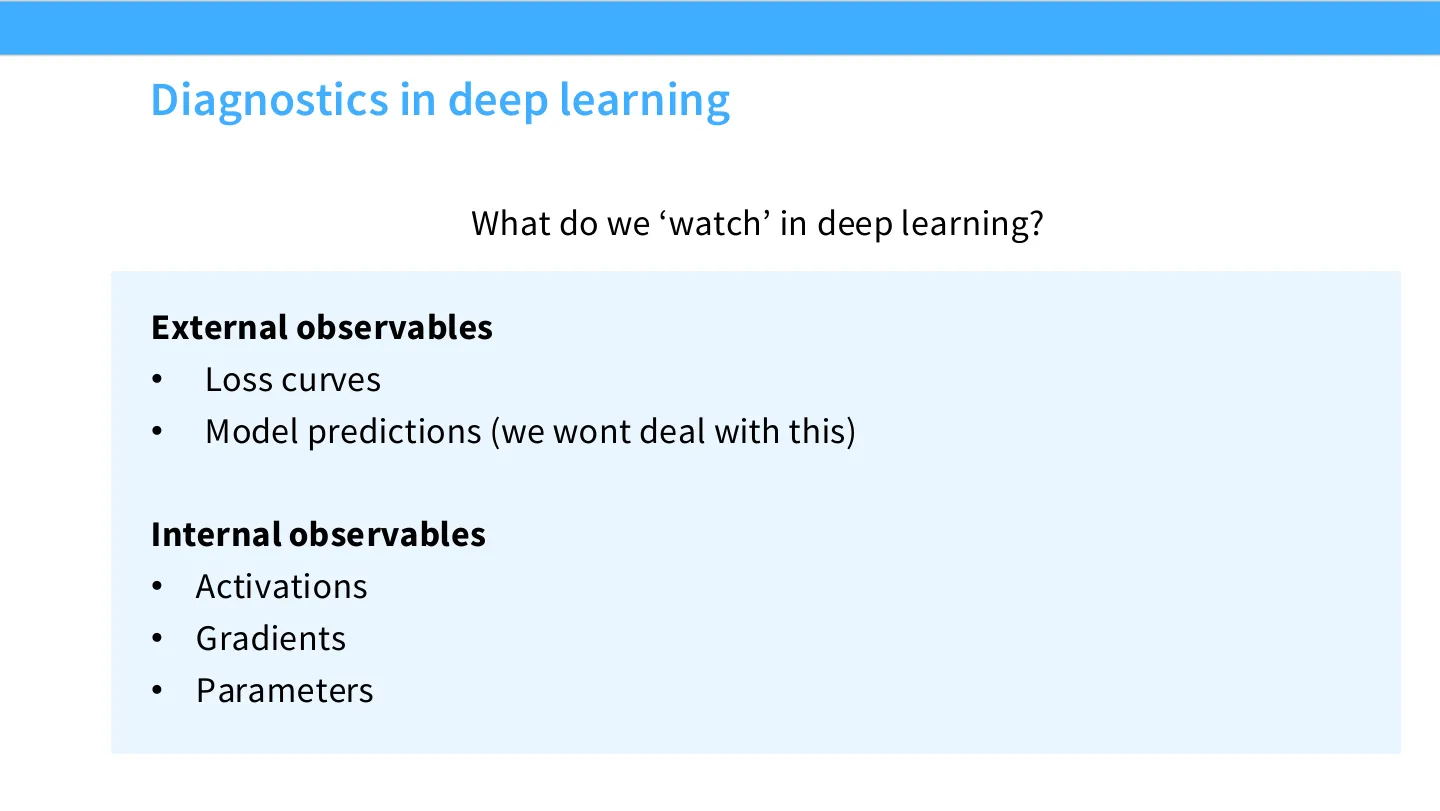
🖼️ 这页把「外部 / 内部可观测量」列成一张清单,是后面所有调试内容的索引图
- 训练炸了(training blows up)——损失变 NaN / 飞向无穷;
- 训练停了(training stops)——损失不再下降,卡在平台;
- 没那么好(less good than I thought)——能跑,但结果不如预期。
这三类的共同点是:光看最终数字你无法定位原因,所以我们需要调试工具去看模型内部发生了什么。
讲义把可观测量分成两类:
| 类别 | 具体内容 |
|---|---|
| 外部可观测量(external observables) | 损失曲线;模型预测(本讲不涉及) |
| 内部可观测量(internal observables) | 激活值(activations)、梯度(gradients)、参数(parameters) |
那什么时候该动用「内部」诊断?讲义给了非常明确的对应关系:
- 隔离出错的组件 → 看激活值与梯度 / 余切(cotangents);
- 追踪动力学与时间效应 → 看参数(及优化器状态);
- 判断整体健康度 → 看损失曲线的形状。
编者说明:「余切(cotangent)」是反向传播里的术语——对某一层输出的梯度,相对于该层输入的梯度而言被称为余切。它不是新概念,只是把「反向传回来的那个量」叫得更精确,因为它未必是标量损失的梯度(例如在自定义反向传播或二阶方法里)。用「余切」而不是笼统的「梯度」,能避免在多层结构里指代不清。
十二、损失曲线作为诊断工具
损失曲线是最便宜、最常用的诊断信号——它不需要你插入任何 hook,训练脚本里本来就有。
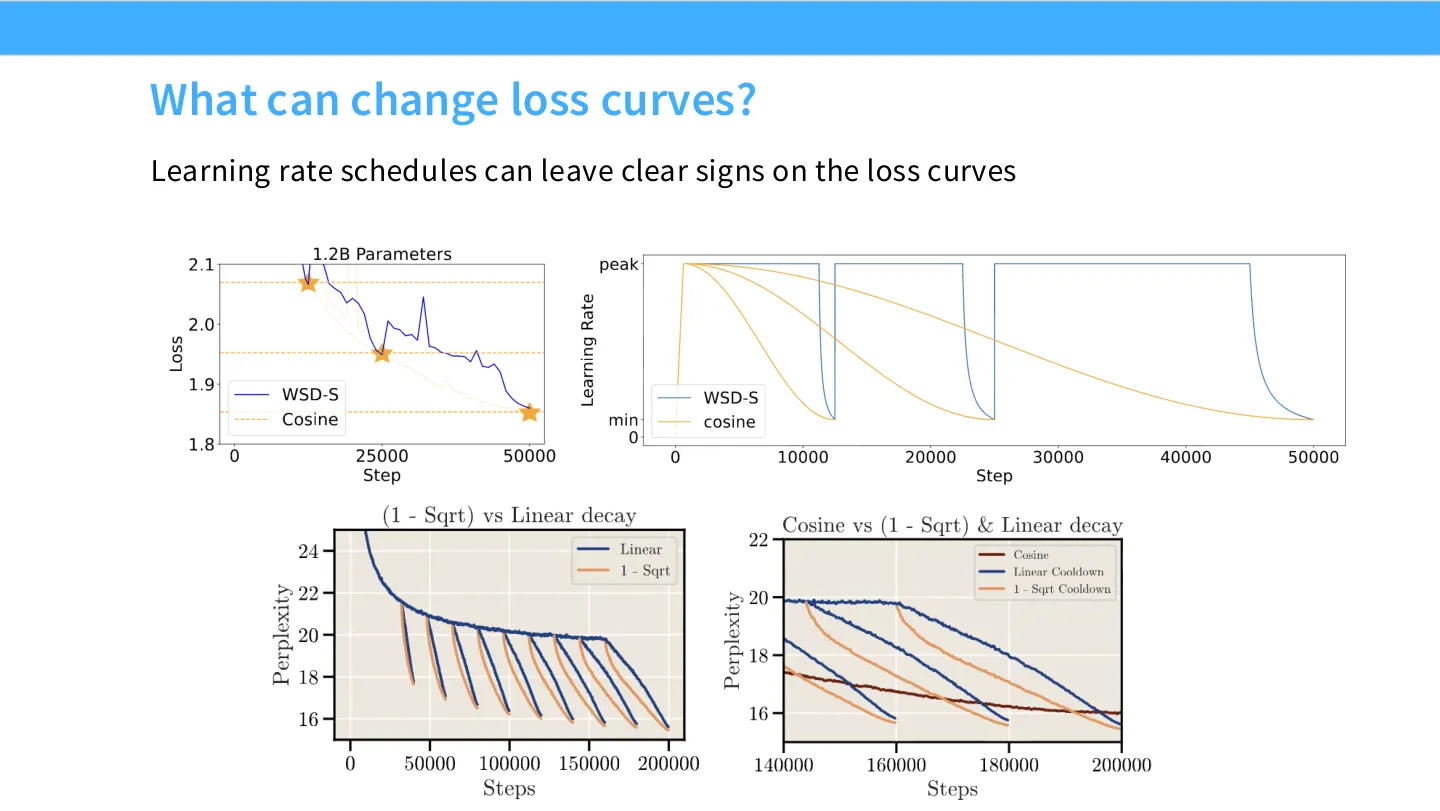
🖼️ 这页把不同学习率调度在损失曲线上的「签名」画出来,属于只有看图才能记住的模式
而它会告诉你很多事:学习率调度(learning rate schedule)会在损失曲线上留下非常清晰的「签名」。
具体来说,几种典型调度各有各的形状:
- 预热(warmup):最开始的若干步学习率从很小线性升上来,曲线表现为先平、后陡降;如果预热太长,你会看到一段「白白的」平台;
- 衰减(decay):cosine 或 step decay 在切换点之后让曲线突然变光滑、变慢,甚至在衰减瞬间出现一个小的台阶;
- 重启(restart):周期性把学习率抬回去,曲线呈锯齿状——每次抬起时损失上跳,衰减后重新下降。
所以实践中的第一条纪律是:看到异常形状,先回去检查调度与学习率设定,而不是先去怀疑模型结构。
编者拓展|把「签名」当成故障字典:常见的对应关系是——曲线在某个学习率切换点突然发散,多半是学习率抬得太猛或梯度裁剪没开;曲线长时间平坦后突然下降,多半是预热过长或初始化尺度不合适;曲线的波动幅度随训练单调变大,往往意味着参数范数在无约束地增长(这正是第十四节 Marin 案例的形状)。这些对应关系不是定理,但作为排查顺序非常有效:先从最便宜、最可能的解释查起。
十三、内部诊断:激活、梯度与 QK norm
追踪激活与余切,能告诉我们信号在网络中是否健康地传播。直觉是:如果某一层的激活值在训练中指数级地缩小(或放大),那这一层的梯度也会同样地缩小(或放大),于是它要么学不动,要么把训练炸掉。
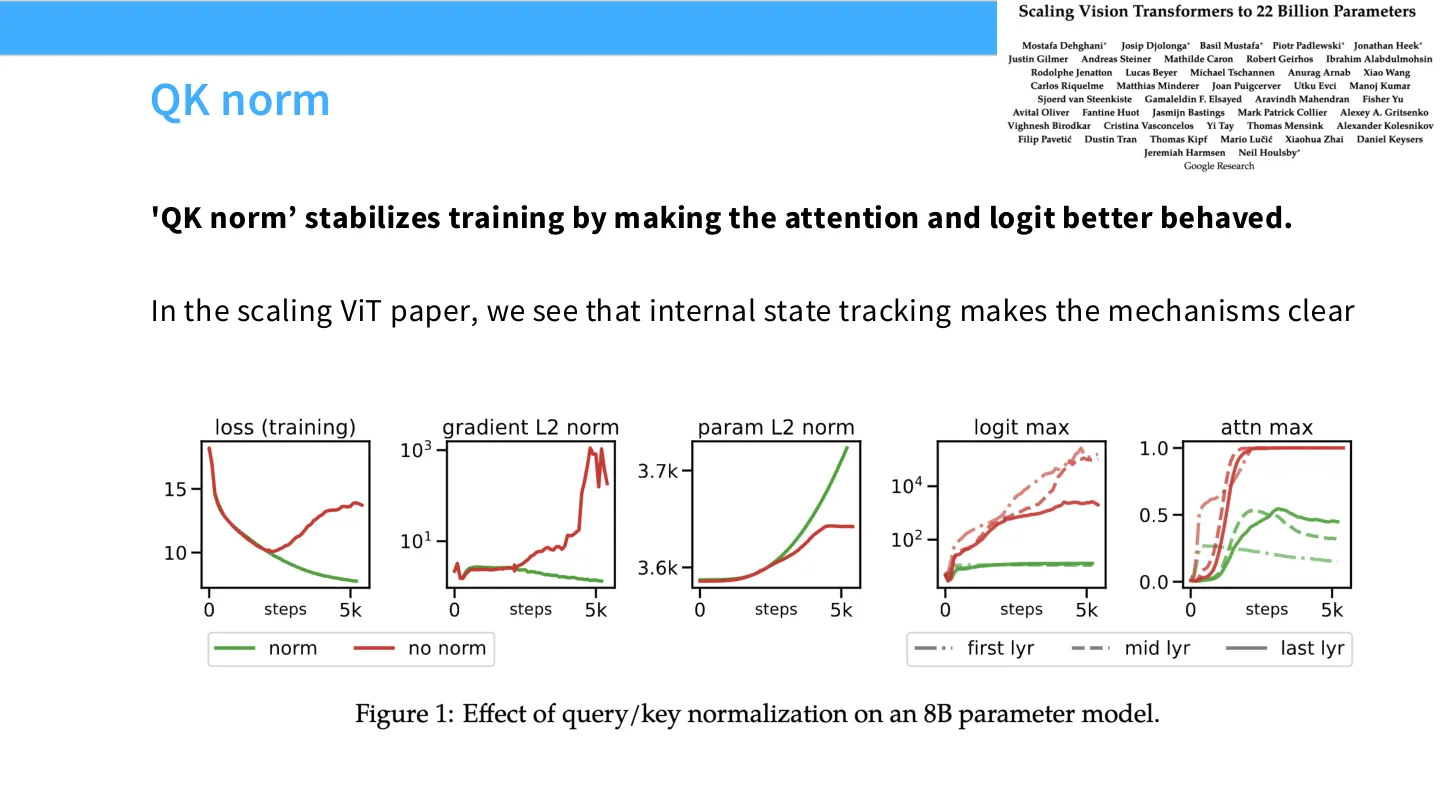
🖼️ 这页是 QK norm 的具体机制与内部状态追踪示例,是「内部诊断真的能解释机制」的最好例证
梯度范数同样信息量很大,它能说明模型是否在有效地训练。讲义举的例子是 pre-norm 结构下的 layer norm:把 LayerNorm 放在残差分支的输入端(pre-norm),梯度范数在整个训练过程中能保持相当稳定;这与 post-norm 的行为形成对照。
QK norm 则是一个具体的「用内部诊断解释机制」的例子:它通过让 attention 与 logits 更规矩(better behaved) 来稳定训练。而在 scaling ViT 那篇论文里,正是内部状态追踪让这个机制变得清楚——你能看到究竟是哪个量被压住了、压到什么程度,从而明白「稳定」是怎么来的,而不是把它当成一个魔法开关。
讲义进一步列出三条「建立正常行为直觉」的调试基本功:
- 知道什么是「正常」的。
- 损失非单调、带尖峰正常吗?正常的话,幅度多大算正常?
- 内部统计量应该增长还是收缩?增长/收缩多少算正常?
- 知道你的不变量(invariances)。
- 有些量可以「炸掉」而完全不影响模型行为——最好的例子就是 LayerNorm 之后的量:LayerNorm 会把尺度归一化掉,所以你看到的那个范数涨了 10 倍,对最终输出可能毫无影响。如果你不知道这个不变量,就会去修一个根本不需要修的东西。
- 和「已知好的对照(known good controls)」比较。
- 手上要有一批你确信能跑通的小规模 baseline,出问题时能拿来对照。
十四、实战:Marin 训练过程中的异常与修复
这是整讲最有「现场感」的一节:一次真实的训练事故。
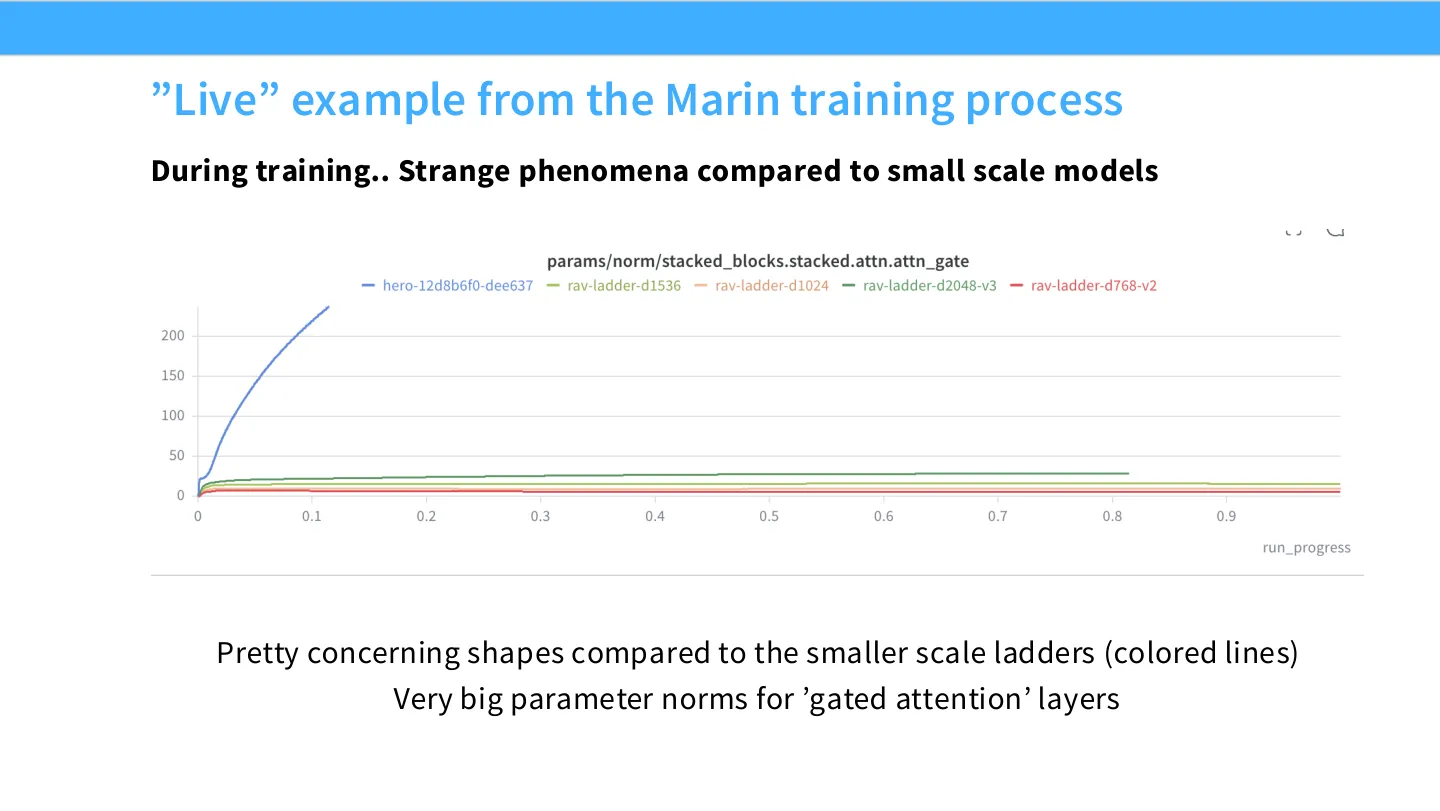
🖼️ 这是老师讲的真实训练事故现场图:异常的参数范数曲线与小规模阶梯的对比,是整节课最「现场感」的一页
现象:在一次 Marin 的训练过程中,出现了与小规模模型完全不同的奇怪现象:
- 曲线形状与小规模「阶梯」(图上那些彩色线,代表一系列从小到大、已知正常的训练)相比,相当令人担忧;
- 「门控注意力」(gated attention)层的参数范数非常大。
排查步骤:
- 顺着参数范数的异常往上追,发现早期层的 attention gate 把激活值压得很小;
- 于是这些早期层对残差流(residual stream)的贡献几乎可以忽略——它们等于「什么都没干」;
- 而模型为了补偿,让这些层的参数范数长得极大。
解法出乎意料地轻:加一点权重衰减(weight decay),把范数拉回到「正常(sane)」的范围内,问题就消失了。
这一节的方法论要点比结论更重要:
- 一次只改一个变量(change one thing at a time);
- 从已知好(或已知坏)的配置向内插值(interpolate)——不要一步跳到远方,要在已知正常的小规模与出问题的大规模之间找一个中间点,看现象从哪一步开始出现;
- 始终保留小规模对照组——那些彩色阶梯线就是对照组,没有它们,你根本不知道「这个形状算不算异常」。
十五、总结:像实验科学家一样做深度学习
讲义用四条收束整讲:
- 实验科学需要实验技能——像生物学家或神经科学家那样思考,重视实验设计与实验循环;
- 对系统保持偏执(be paranoid)——超参数与随机性都要盯紧,任何一次「失败」都可能是你自己设错的读数;
- 要讲效率,要有好的「模型系统」——也就是缩放定律:用便宜的实验去代理昂贵的现实,并且清楚代理的适用边界;
- 要有对照(controls)——始终与已知的好状态和坏状态比较,这是调试唯一可靠的坐标系。
编者说明:这一讲的四块内容(超参数、规模化、随机性、调试)表面上互不相干,实际上服务于同一个目标:让你的实验结论可信、且单位算力获得的信息量最大。超参数决定结论的真假,规模化决定你能做多贵的实验,随机性决定差异是否显著,调试决定出问题时你能不能定位。缺任何一块,那个「紧密的实验循环」都会在某处断掉。
附:参考与延伸阅读
编者补充
已知疑点
- 标题翻译:原始幻灯片标题页写成「B A S I C S」(字母间加空格,属排版效果),译为「基本功」。依据:
lecture_02.pdf第 1 页;本讲四块内容均属研究操作技能而非入门知识。 - Kaplan 2020 公式疑似排版损坏:幻灯片第 29 页在 PDF 文字提取中呈现为 $m^{-\alpha}+n^{-1\beta}$,无法确定原式。正文按幻灯片原样转录并加了说明。查阅原文后可知其形式与幻灯片呈现不同,故正文未擅自改写为「标准形式」,以免与讲义冲突。
- Rosenfeld 2020 公式中的符号:幻灯片写作 $n^{-\alpha}+m^{-\beta}+C$,但未说明 $n$ 与 $m$ 分别对应「数据量」还是「模型规模」。正文按上下文(先数据后模型)解读,此对应关系属推断。
- 案例二、案例三的文献出处缺失:重复数据(600M 参数 / 200M 数据集)与 AdamW 替代优化器两项,幻灯片均未标注论文,正文未补具体文献名。若要追溯,建议查课程主页对应周的 reading。
- StepFun 缩放律研究未给出处:幻灯片第 14–17 页引用了 StepFun 的大规模研究,但未给论文标题或链接。正文只按幻灯片描述现象,未补任何具体数值(如最优 LR 随 BS 的指数)。
- He 初始化公式的写法存疑:幻灯片写作 $W\sim\mathcal N\!\left(0,\frac{2}{D_{in}+D_{out}}\right)$,而常见的 He 初始化是 $W\sim\mathcal N(0, 2/D_{in})$。两者不一致,正文按幻灯片原样转录,未作更正。
- 全批量 GD 仍出现「随机尖峰」的成因:讲义明确只说「Slight spoilers」,未给解释。第九节「编者拓展」里给出的浮点非结合性 + 混沌放大两条解释属外部工程经验,讲义无对应文字,证据强度为「常见解释」而非「本讲结论」。
- Marin 与
openathena.ai博客的关系:幻灯片第 30 页给了 https://openathena.ai/blog/delphi/ 作为缩放定律陷阱的出处,第 54–55 页讲 Marin 训练过程;材料未明说二者是同一项目,正文未把它们强行关联。 - 「1.96 × SE = 95% CI」的适用范围:这是大样本正态近似;讲义按「统计学复习」的口径给出,正文未展开小样本 $t$ 分布的修正。
- 本讲未涉及代码 cell:材料为幻灯片逐页文字,没有可直接运行的演示代码,因此正文没有代码块。第七节提到的
vmap用法是「编者拓展」中的示意图,非讲义原文代码。