第4讲 · 优化器(一):参数化与预条件
Stanford CS312 深度学习炼金术(2026) 官方课堂幻灯片 · 中文重构
| 原始标题 | Optimizers 1: Parameterization and Preconditioning |
| 材料来源 | lecture_04.pdf(课程主页第 4 讲幻灯片) |
| 课程主页 | https://deep-learning-alchemy.github.io/ |
| 材料版权 | 课程材料版权归原课程方及授课教师所有,本书仅供学习 |
对应讲次:第4讲(Stanford CS312 深度学习炼金术)
制作模型:deepseek-flash(vb compose)
一、从规模到极限:为什么要重新审视参数化
模型越大,试错成本越高。很多在窄模型上“随手一设”的超参数,到了宽模型上会变成决定训练能否收敛的关键:初始化方差取多大、每一层的输出乘子取多大、学习率要不要随宽度缩小、不同层要不要用不同的学习率。这些选择单独看都很小,但在无限宽极限下会被放大成量级问题。
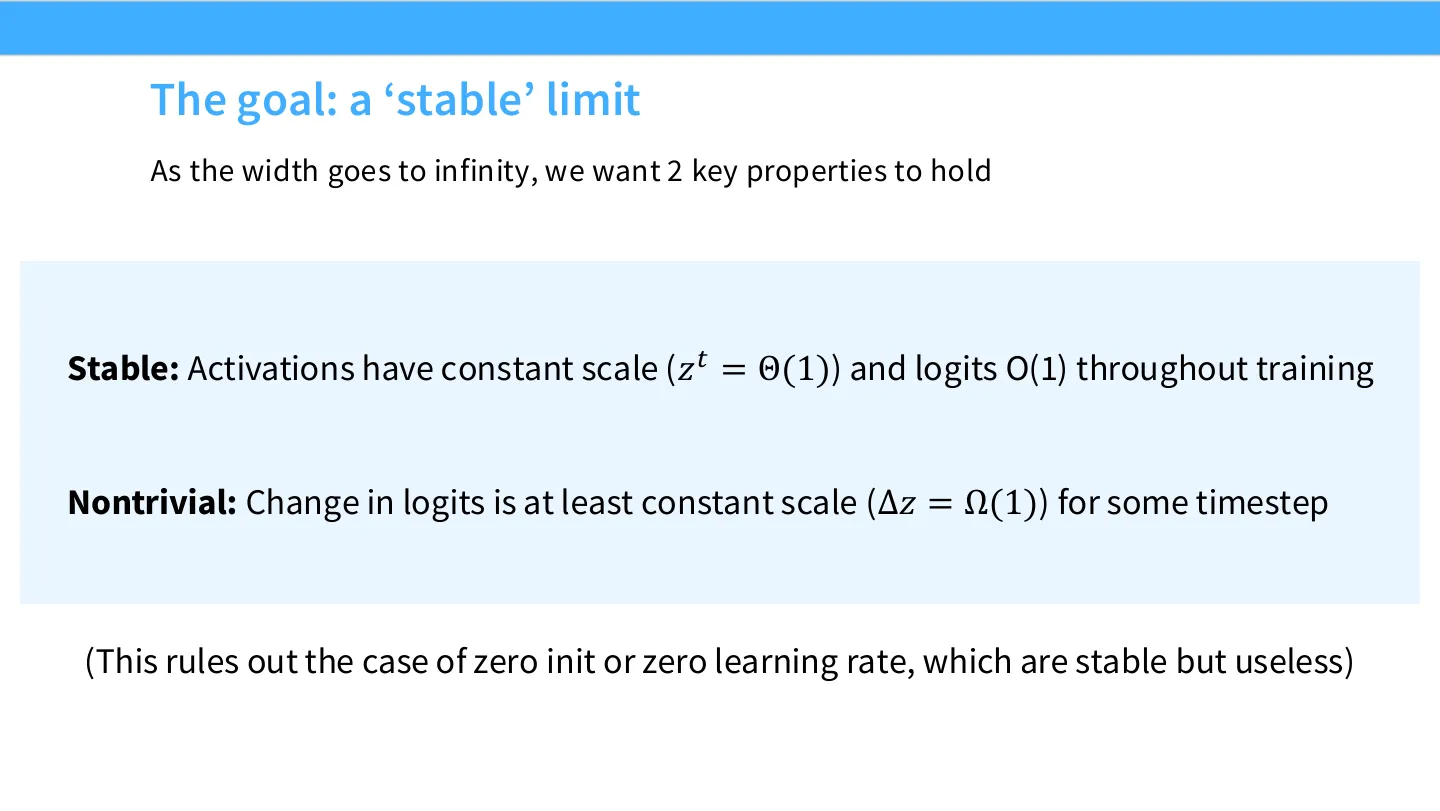
🖼️ “稳定(stable)+ 非平凡(nontrivial)”这两条判据是全讲所有推导的出发点,后面每一组约束都是在为这两条服务
本讲的核心问题可以写成两句话:
- 为什么学习率必须随模型宽度变化?
- 有没有一种参数化,使得在小模型上调好的超参数可以迁移到大模型?
方法上,讲义采用“轻理论”(theory lite):先写一个足够简单、可以手算量级的玩具模型,再研究这个模型在宽度趋于无穷时的极限,最后把结论特化到 Transformer。讲义给出的路线是:
- 从一个简单模型出发;
- 写下我们允许的“干预”,也就是初始化尺度、输出尺度、学习率尺度;
- 研究这个玩具模型的尺度极限;
- 再特化到 Transformer。
玩具模型的设定是:宽度 $n\to\infty$,深度固定,训练步数固定,输入范数固定,损失对输出的梯度也固定在常数阶。为什么选这个模型?因为它简单到可以追踪量级,又足够丰富,能保留“特征学习”这类关键现象。
在这个极限下,我们希望同时得到两条性质:
- 稳定(stable):整个训练过程中,激活值保持常数尺度,即 $z_t=\Theta(1)$,logits 为 $O(1)$;
- 非平凡(nontrivial):至少在某些时刻,logits 的变化达到常数尺度,即 $\Delta z=\Omega(1)$。
第二条排除了零初始化或零学习率这种“稳定但没用”的情形:网络确实不炸,但也什么都不学。
编者说明|$\Theta$、$O$、$\Omega$ 的读法:$f(n)=\Theta(1)$ 表示 $f$ 被两个正常数从上下夹住;$f(n)=O(1)$ 表示它最多是常数阶,可以更小;$f(n)=\Omega(1)$ 表示它至少是常数阶,不能趋于零。后面所有“稳定性约束”本质上都在要求某些量不要随 $n$ 发散。
一个著名的“稳定但不够好”的极限是神经正切核(Neural Tangent Kernel, NTK)。在 NTK 参数化下,宽度 $m$ 很大时,隐藏层输出写成
$$ \frac{1}{m}\sum_i a_i \phi(w_i^\top x), $$
保持 $a=O(1)$、$w=O(1)$、学习率为 $O(1)$。这时每个权重在训练中只改变 $O(m^{-1/2})$,模型始终停留在初始化附近,等价于在 $\nabla_\theta f(x)$ 空间里做核回归。
失败案例|NTK 极限:稳定但学不到特征。 这个极限的激活和 logits 都很稳定,但第一层几乎不变,模型只是初始化点附近的一个局部线性模型。它丢掉了“特征学习”这个深度网络最重要的现象,实际表现通常也比标准神经网络设置差。可见稳定性不是 scaling 的全部;我们还要让模型在极限下真正学得动。
这就引出了 μP 式参数化的出发点:既然输出尺度、初始化尺度、学习率尺度都是我们可以选择的,那么能不能找到一组选择,使得极限同时稳定且非平凡?
二、abc 参数化:把架构选择写成指数
设宽度为 $n$。讲义用三个指数 $(a_l,b_l,c_l)$ 来统一描述第 $l$ 层的缩放方式:
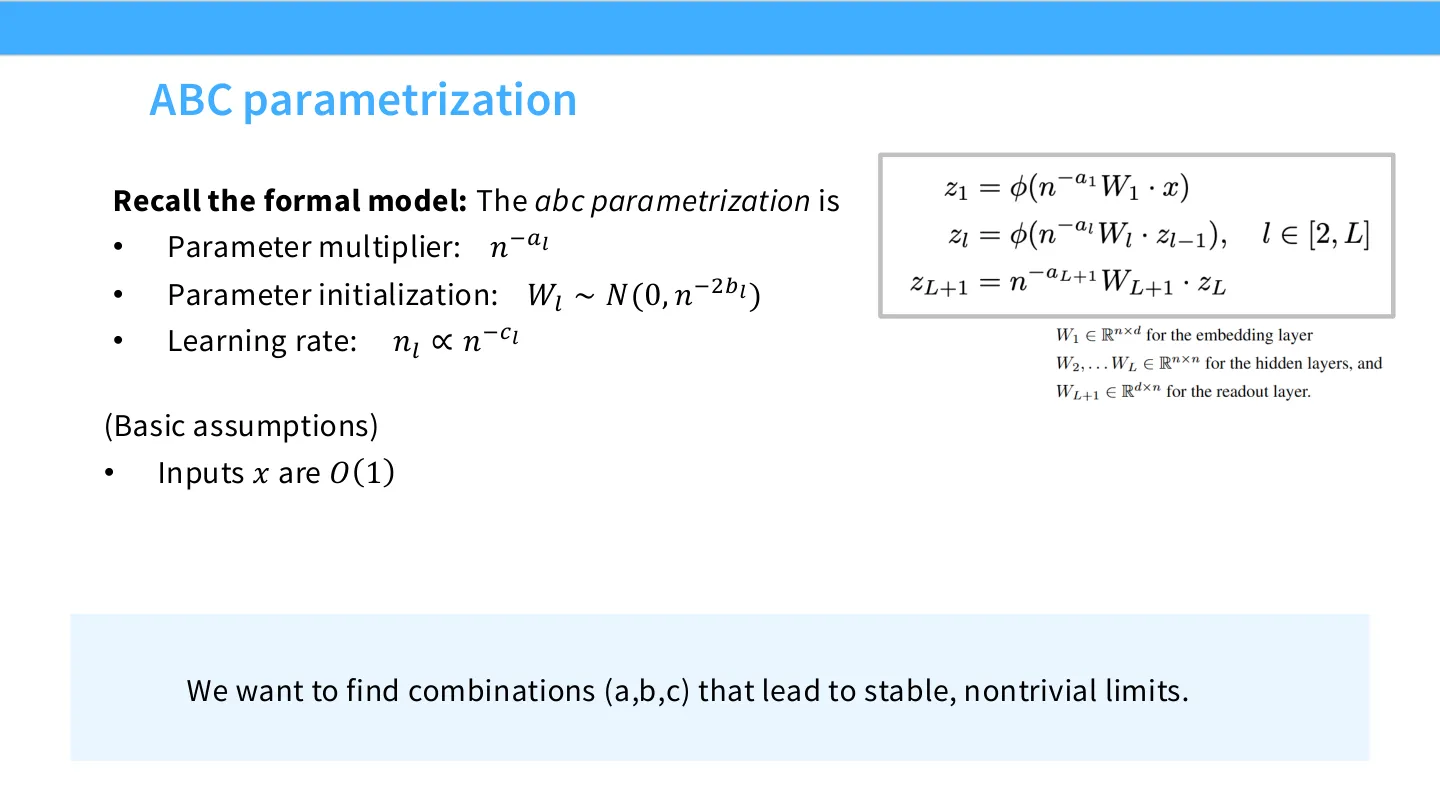
🖼️ 这页把 a/b/c 三个指数的定义一次列全,是后面所有约束方程的符号基础,读者需要反复回看
$$ \text{参数乘子: } n^{-a_l},\qquad W_l\sim \mathcal N(0,n^{-2b_l}),\qquad \eta_l\propto n^{-c_l}. $$
也就是说,前向传播里实际使用的是 $n^{-a_l}W_l$;初始化时每个元素的尺度是 $n^{-b_l}$;这一层的学习率按 $n^{-c_l}$ 缩放。讲义还假设输入 $x$ 是 $O(1)$。
我们的目标不是逐层调超参数,而是找出能同时满足“稳定”和“非平凡”的 $(a,b,c)$ 组合。这样一来,“无限宽极限”就从一个模糊的直觉,变成了一个可以代数求解的约束满足问题:给定 $(a,b,c)$,算出激活、梯度、更新的量级;要求这些量级既不爆炸也不消失;最后看哪些组合可行。
编者说明|$(a,b,c)$ 不是网络的物理参数:它们描述的是“当宽度 $n$ 变化时,某一层怎样缩放”的坐标。同一份有限宽网络,可以用不同的 $(a,b,c)$ 去参数化;不同的选择在 $n\to\infty$ 时会得到不同的极限行为。NTK 是其中一种,μP 是另一种。
三、热身:初始化时的激活稳定性
先只看前向传播。第一层的输入维度记为 $d$,假设 $d$ 不随宽度 $n$ 增长,输入元素是 $O(1)$。第一层权重 $W_1\in\mathbb R^{n\times d}$ 的元素标准差是 $n^{-b_1}$。对每个输出坐标,
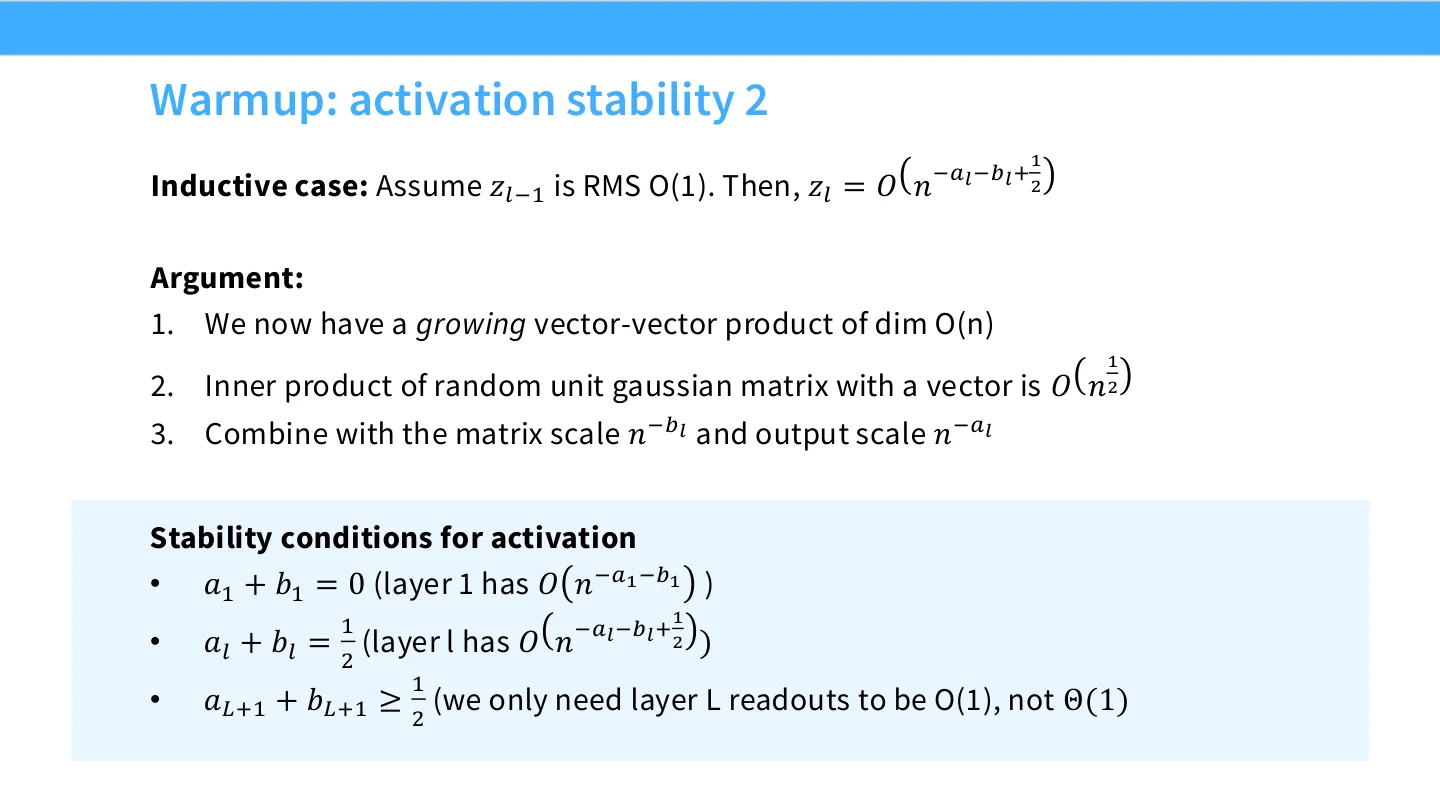
🖼️ 归纳步的推导和三条稳定性条件是本节的主结果,公式排版在页面上比口述更清楚
$$ z_{1,i}=n^{-a_1}\sum_{j=1}^{d}W_{1,ij}x_j. $$
求和只有固定的 $d$ 项,每一项是 $O(n^{-b_1})$,所以 $z_1$ 的典型大小是 $O(n^{-a_1-b_1})$。要让第一层激活是 $\Theta(1)$,需要
$$ a_1+b_1=0. $$
再看隐藏层。假设上一层 $z_{l-1}$ 的均方根(Root Mean Square, RMS)是 $O(1)$。第 $l$ 层权重 $W_l\in\mathbb R^{n\times n}$ 的元素标准差是 $n^{-b_l}$。计算
$$ (W_l z_{l-1})_i=\sum_{j=1}^{n}W_{l,ij}z_{l-1,j}. $$
这是 $n$ 个随机项相加,正负号大致抵消,典型大小是 $\sqrt n\cdot n^{-b_l}\cdot O(1)=n^{1/2-b_l}$。再乘上输出尺度 $n^{-a_l}$,得到
$$ z_l=O\left(n^{-a_l-b_l+\frac12}\right). $$
要让隐藏层激活保持 $\Theta(1)$,需要
$$ a_l+b_l=\frac12. $$
最后一层是读出层。我们只需要 logits 是 $O(1)$,不要求它是 $\Theta(1)$,所以条件放宽为
$$ a_{L+1}+b_{L+1}\ge \frac12. $$
把三条写在一起:
$$ a_1+b_1=0,\qquad a_l+b_l=\frac12\ (l=2,\dots,L),\qquad a_{L+1}+b_{L+1}\ge \frac12. $$
He 初始化正是这个框架的一个特例。 讲义写出
$$ W\sim \mathcal N\left(0,\frac{2}{D_{\text{in}}}\right). $$
对隐藏层,$D_{\text{in}}=n$,标准差约为 $\sqrt{2/n}=O(n^{-1/2})$,所以 $b_l=1/2$;同时没有额外的输出乘子,$a_l=0$。于是 $a_l+b_l=1/2$,正好满足隐藏层稳定条件。Glorot/Xavier 初始化也是类似的“让激活在初始化时跨层保持稳定”的思路。
编者拓展|第一层的 $b$ 为什么常常写成 0:如果第一层输入维度 $d$ 不随宽度 $n$ 增长,那么 $W_1$ 的初始化尺度按 $1/\sqrt d$ 写,而不按 $1/\sqrt n$ 写;相对于 $n$ 的指数就是 $b_1=0$。讲义在 Kaiming 一页写 $b_l=1/2$,主要是在说隐藏层和最后层;第一层要单独看,否则会和 $a_1+b_1=0$ 表面冲突。
失败案例|只保证初始化稳定是不够的。 Kaiming/He 初始化只能保证“初始化那一瞬间”激活不爆炸;训练开始后,权重更新会改变每一层的输入分布,激活仍然可能逐层漂移。讲义在这里明确说:我们还缺两块东西——对更新量级的推理(“非平凡”判据),以及保证这种性质在整个训练过程中都成立的动力学分析。
四、梯度与优化器:更新到底有多大
现在看反向传播。思路和前向完全一样,只是方向反过来:每一层做一次矩阵向量乘积,都会贡献一个 $\sqrt n$ 的因子;每一层有权重尺度 $n^{-b_i}$ 和输出尺度 $n^{-a_i}$。讲义假设损失对最后一层权重的梯度是稳定的,即 $\partial L/\partial W_{L+1}=\Theta(1)$。按讲义的记法,第 $l$ 层梯度的量级写成
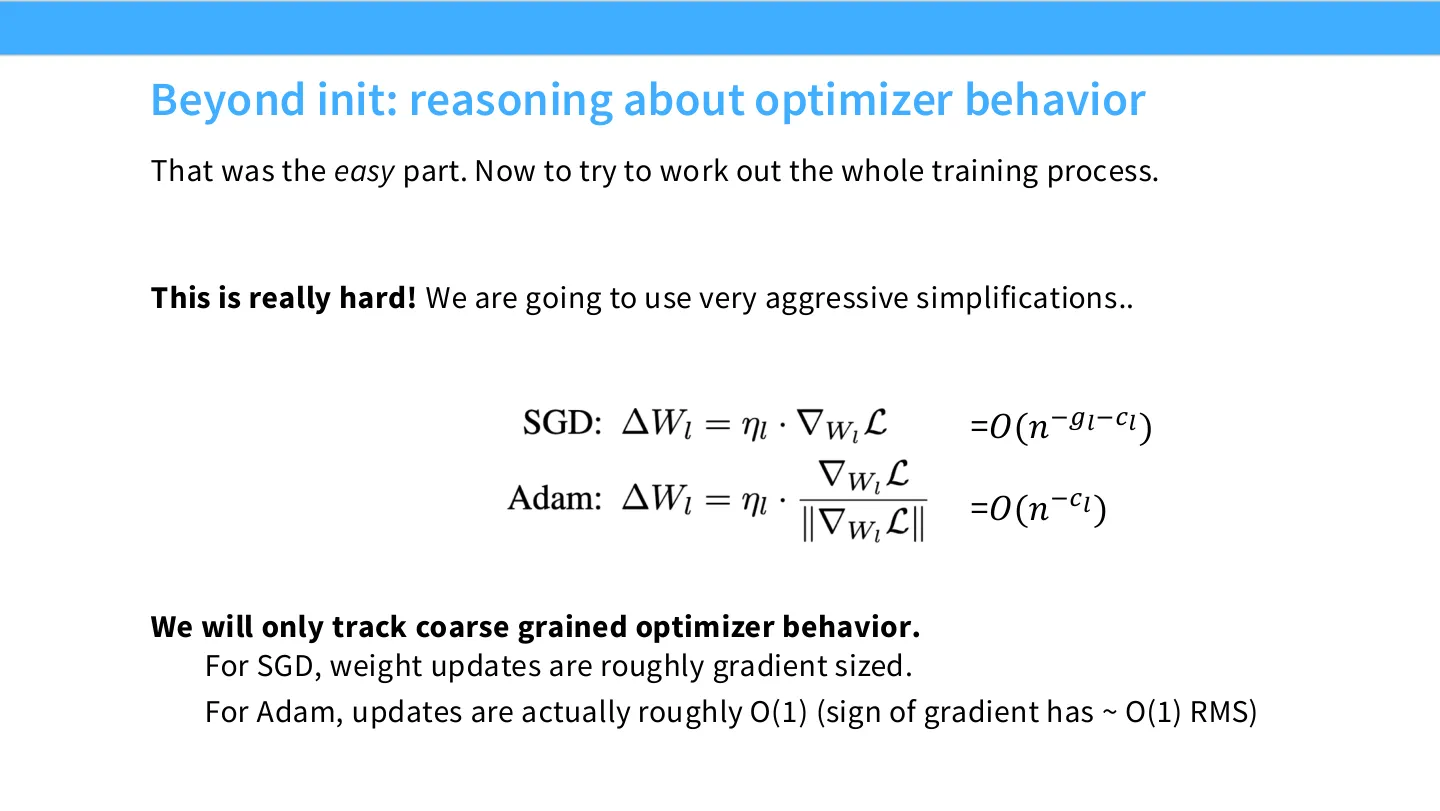
🖼️ 页面把 SGD 的 O(n^{-g_l-c_l}) 与 Adam 的 O(n^{-c_l}) 并排写出,是理解“为什么 Adam 下约束不一样”的最短路径
$$ \frac{\partial L}{\partial W_l}=O(n^{-g_l}), $$
其中
$$ g_l=a_l+a_{L+1}+b_{L+1} +\sum_{i=l+1}^{L}\left(a_i+b_i-\frac12\right). $$
这个公式的直觉是:从第 $l+1$ 层到最后一层,每一层反向传播都贡献一个 $n^{1/2-b_i-a_i}$ 的因子;当前层再乘上输出尺度 $n^{-a_l}$。对当前权重 $W_l$ 求导时,当前层的 $b_l$ 不以同样的方式进入求和项,所以公式里没有单独的 $b_l$。
如果中间层已经满足激活稳定条件 $a_i+b_i=1/2$,求和项消失,公式化简为
$$ g_l=a_l+a_{L+1}+b_{L+1}. $$
对最后一层,有
$$ g_{L+1}=a_{L+1}. $$
接下来要把“优化器”翻译成更新量级。讲义做了一个非常激进的简化:不追踪优化器的全部细节,只看粗粒度行为。
- 对随机梯度下降(Stochastic Gradient Descent, SGD),权重更新大致和梯度同阶:
$$ \Delta W_l=\eta_l\cdot \frac{\partial L}{\partial W_l} =O(n^{-c_l-g_l}). $$
- 对 Adam,更新量级近似是 $O(1)$ 的:因为 Adam 会除以梯度尺度的 RMS,每个坐标的更新幅度大致只由学习率决定,
$$ \Delta W_l=O(n^{-c_l}). $$
编者说明|Adam 的更新为什么近似 $O(1)$:Adam 的更新可以粗略写成 $\eta\cdot m/\sqrt v$,其中 $m$ 是一阶动量,$v$ 是二阶动量。分母 $\sqrt v$ 正好抵消了梯度的整体尺度,所以每个坐标的更新幅度主要由学习率 $\eta$ 控制。讲义用“梯度的符号有 $O(1)$ 的 RMS”来表达这一点。
这一步是 μP 区别于“只分析初始化”的关键:优化器选择直接改变了约束的形式。SGD 下,梯度的指数 $g_l$ 会进入更新量级;Adam 下,更新量级只由 $c_l$ 控制,梯度尺度被约掉了。
五、训练过程中的稳定性:对齐指数与逐层约束
初始化稳定只解决了 $t=0$。现在要追踪激活随训练时间的变化。把 $t$ 时刻第 $l$ 层激活写成
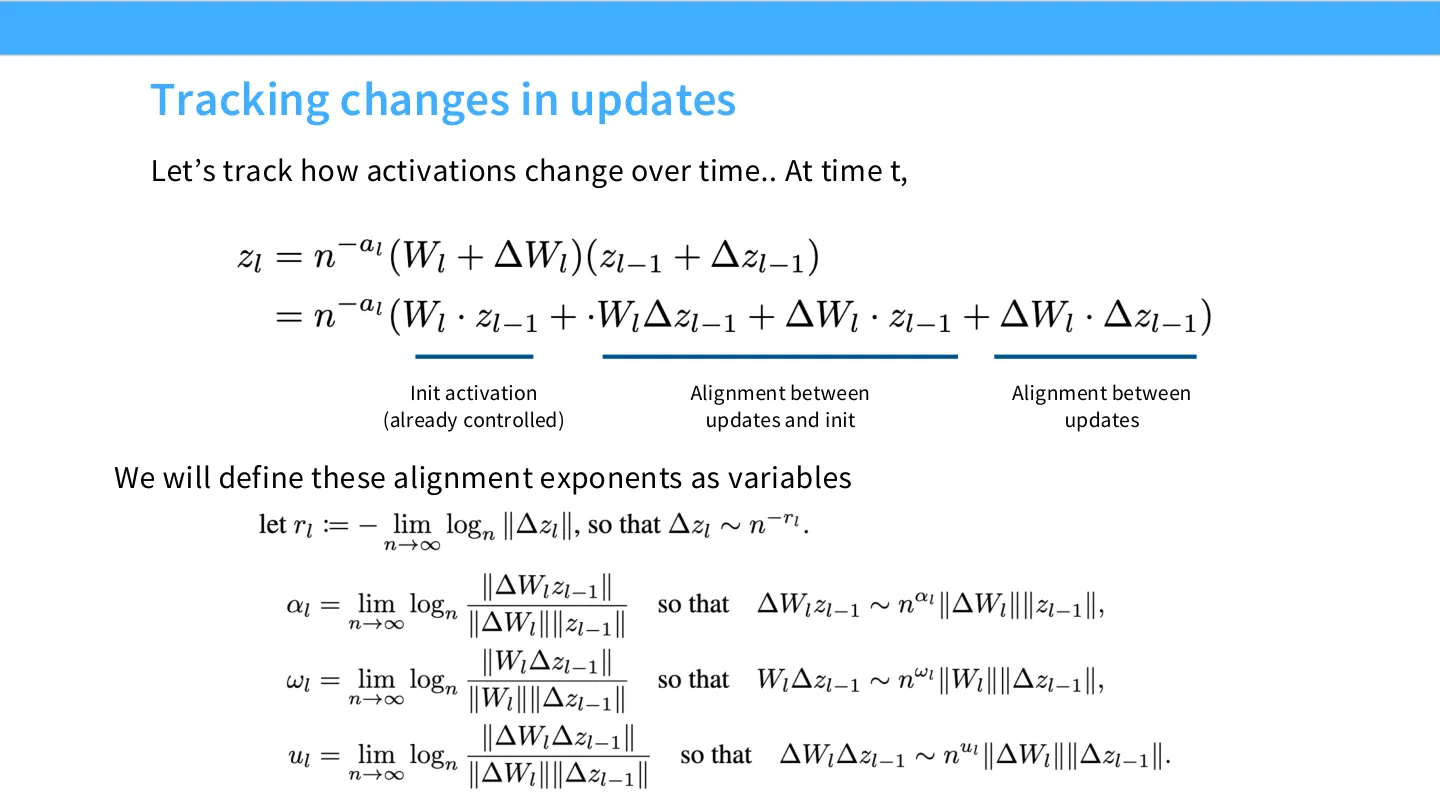
🖼️ 三项分解的示意图是本节全部代数的来源,没有图很难说清 r、α、ω、u 各自乘在哪一项上
$$
🖼️ 中间层是最典型的情形,三个量级项与对应的三条约束在页面上对齐展示,便于读者照搬到其他层
其中 $z_l^0$ 是初始化激活,已经由上一节控制住;$\Delta z_l^t$ 是训练带来的变化。定义变化指数 $r_l$:
$$ \Delta z_l^t=\Theta(n^{-r_l}). $$
$r_l$ 越小,变化越大;$r_l=0$ 表示变化达到 $\Theta(1)$,也就是真正的“特征学习”。
在每一层,变化不是只来自本层的权重更新,还会通过上一层的变化传播过来。讲义把第 $l$ 层的变化拆成三项:
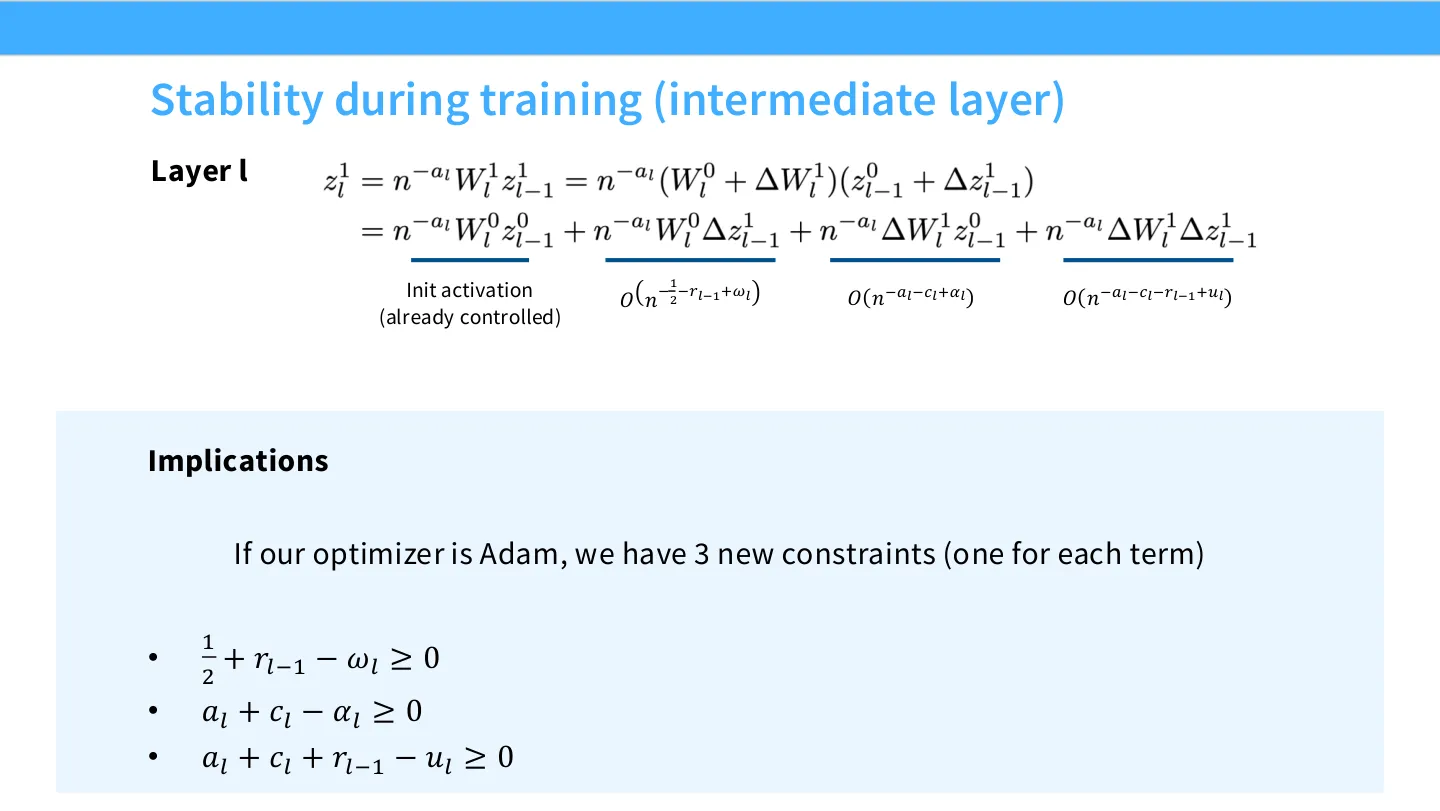
$$ \begin{aligned} &O\left(n^{-\frac12-r_{l-1}+\omega_l}\right),\\ &O\left(n^{-a_l-c_l+\alpha_l}\right),\\ &O\left(n^{-a_l-c_l-r_{l-1}+u_l}\right). \end{aligned} $$
这三项分别对应:
- 初始权重 $W_l^0$ 乘上上一层激活的变化 $\Delta z_{l-1}$;
- 权重更新 $\Delta W_l$ 乘上初始激活 $z_{l-1}^0$;
- 权重更新 $\Delta W_l$ 乘上激活变化 $\Delta z_{l-1}$。
其中 $r_l$ 描述变化本身的大小;$\alpha_l,\omega_l,u_l$ 是对齐指数,描述矩阵/向量之间是“随机独立”还是“方向一致”。随机独立时,求和会出现 $\sqrt n$ 的抵消,基线指数是 $1/2$;如果更新和某个方向高度对齐,指数可以接近 $1$。
先看第一层。我们希望 $z_1^t=\Theta(1)$,而 $z_1^0=\Theta(1)$ 已经成立,所以变化项
$$ n^{-a_1}\Delta W_1^t x $$
必须是低阶的,即 $O(1)$。如果优化器是 Adam,$\Delta W_1=O(n^{-c_1})$,于是变化是 $O(n^{-a_1-c_1})$,得到约束
$$ a_1+c_1\ge 0. $$
再看中间层。三项都必须不超过 $O(1)$,否则激活会随宽度爆炸。把每一项的指数写成“非负”的形式,就得到三条约束:
$$ \frac12+r_{l-1}-\omega_l\ge 0,\qquad a_l+c_l-\alpha_l\ge 0,\qquad a_l+c_l+r_{l-1}-u_l\ge 0. $$
最后看 logits。最后一层的变化同样有三项:
$$ \begin{aligned} &O\left(n^{-a_{L+1}-b_{L+1}-r_L+\omega_{L+1}}\right),\\ &O\left(n^{-a_{L+1}-c_{L+1}+\alpha_{L+1}}\right),\\ &O\left(n^{-a_{L+1}-c_{L+1}-r_L+u_{L+1}}\right). \end{aligned} $$
对应三条约束:
$$ a_{L+1}+b_{L+1}+r_L-\omega_{L+1}\ge 0, $$
$$ a_{L+1}+c_{L+1}-\alpha_{L+1}\ge 0, $$
$$ a_{L+1}+c_{L+1}+r_L-u_{L+1}\ge 0. $$
除了“不爆炸”,还要“有变化”。非平凡性要求这三项中至少有一项达到 $\Theta(1)$,也就是它的指数恰好为 $0$。否则 logits 几乎不动,训练再稳也没有意义。
编者说明|“physics math” 的风险:讲义自己提醒,这套推导有一个不太严谨的地方。我们假设各项“正交 enough”,不会发生领头阶抵消。但完全可能出现
$$
n+\log n-n=O(\log n)
$$ > 这种灾难性抵消:两个 $\Theta(n)$ 的项相减,领头阶消失了。物理里也常用这种“领头阶量级”计算,但在数学上需要额外假设。讲义的结论应当理解为“在一般位置下成立”,而不是逐项严格证明。 实际训练中,对齐指数大约落在 $0.5$ 到 $1.0$ 之间,而不是理论里最理想的极端值。理论推导常常取保守值;这也是为什么后面的实验验证很重要。 ## 六、把所有约束合起来:哪些 $(a,b,c)$ 可行 现在把激活、梯度、训练动态的约束汇总。它们形成一大组关于 $(a,b,c)$ 与对齐参数 $(r,\alpha,\omega,u)$ 的不等式。可以把它们整理成下面这张表:
| 来源 | 约束 | |---|---| | 第一层激活 | $a_1+b_1=0$ | | 隐藏层激活 | $a_l+b_l=\frac12$ | | 输出层激活 | $a_{L+1}+b_{L+1}\ge \frac12$ | | 梯度量级 | $g_l=a_l+a_{L+1}+b_{L+1}+\sum_{i=l+1}^{L}(a_i+b_i-\frac12)$,且 $g_{L+1}=a_{L+1}$ | | Adam 第一层 | $a_1+c_1\ge 0$ | | Adam 中间层 | $\frac12+r_{l-1}-\omega_l\ge 0$;$a_l+c_l-\alpha_l\ge 0$;$a_l+c_l+r_{l-1}-u_l\ge 0$ | | Adam 输出层 | $a_{L+1}+b_{L+1}+r_L-\omega_{L+1}\ge 0$;$a_{L+1}+c_{L+1}-\alpha_{L+1}\ge 0$;$a_{L+1}+c_{L+1}+r_L-u_{L+1}\ge 0$ | | 非平凡性 | 输出层三项中至少一项为 $\Theta(1)$ | > **编者说明|约束怎么读**:以 $a_l+c_l-\alpha_l\ge 0$ 为例,它来自第二项 $O(n^{-a_l-c_l+\alpha_l})$。这一项要不超过 $O(1)$,就需要指数 $-a_l-c_l+\alpha_l\le 0$,移项就是 $a_l+c_l-\alpha_l\ge 0$。其他不等式同理。 在这些约束下,我们还要选择对齐参数。讲义说可以取不同的值,例如 $\alpha_l=u_l=1$ 或 $\alpha_l=u_l=1/2$。在这份讲义采用的规范选择里,取 $$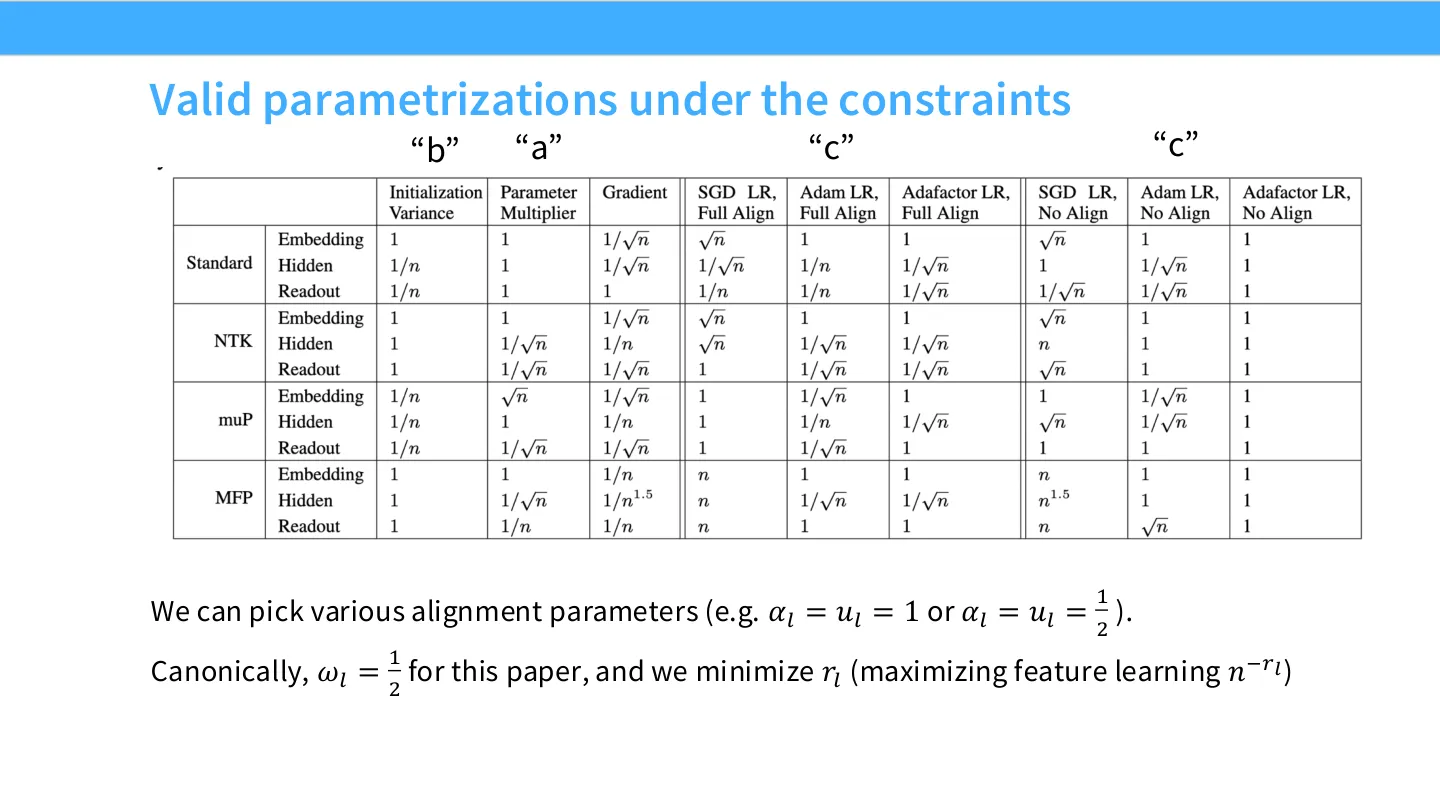
🖼️ 可行域在 (a,b,c) 空间里的图示,能直观说明“为什么 μP 只是众多可行解中的一条”
\omega_l=\frac12,
$$ 并尽量**最小化 $r_l$**。最小化 $r_l$ 就是最大化特征学习项 $n^{-r_l}$:$r_l$ 越接近 $0$,激活变化越接近 $\Theta(1)$。 这张图想要传达的是:满足约束的 $(a,b,c)$ 不止一组,而是形成一个可行区域;μP 只是其中被论文选中的一条解。不同的对齐假设、不同的 $\omega_l$ 选择,会把你带到可行域里的不同位置。 ## 七、μP 真的有用吗:实验结果 理论推导再漂亮,也要看实验。讲义给出几条实证结果。
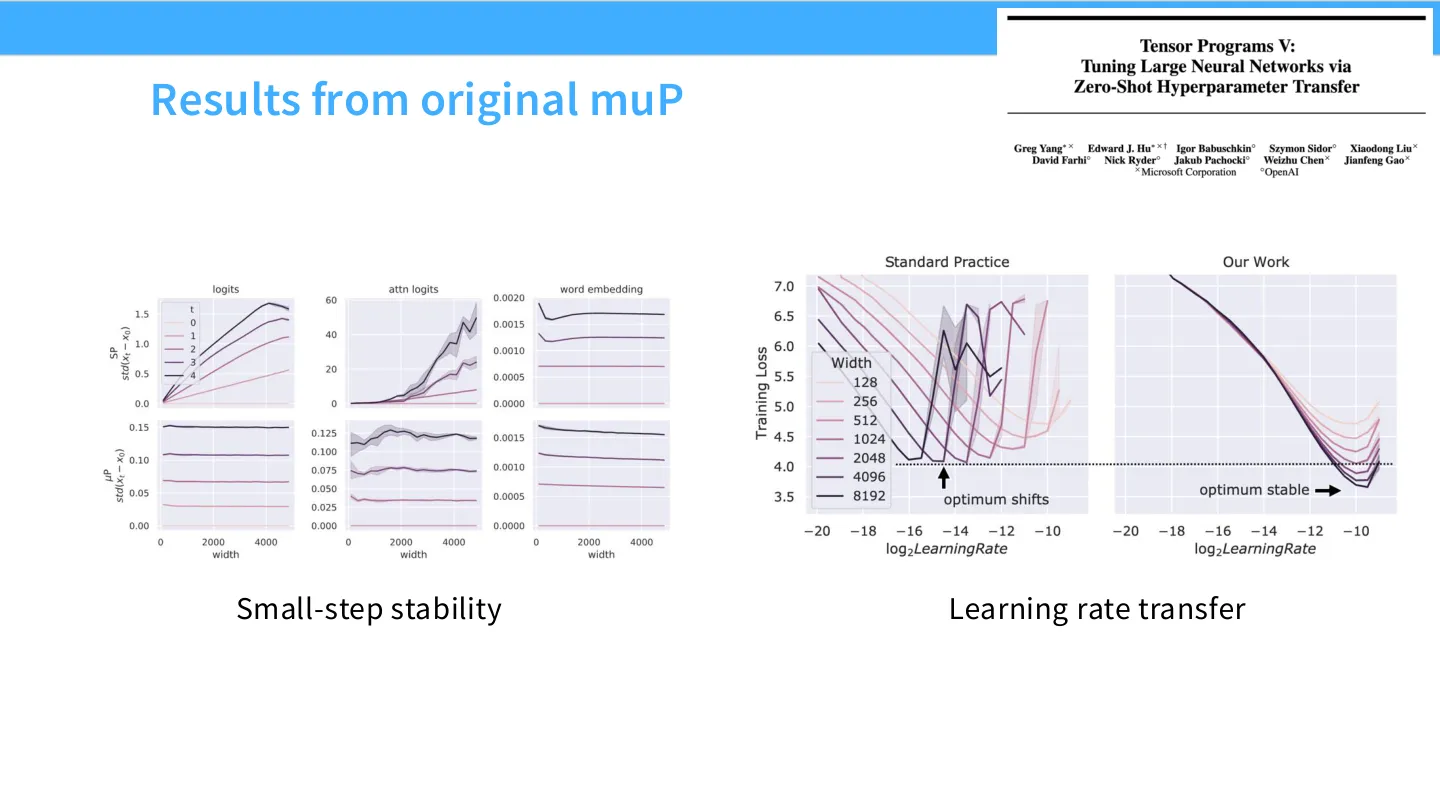
🖼️ “小步长稳定 + 学习率迁移”两张图是 μP 最核心的两条实证卖点,文字描述不如直接看图
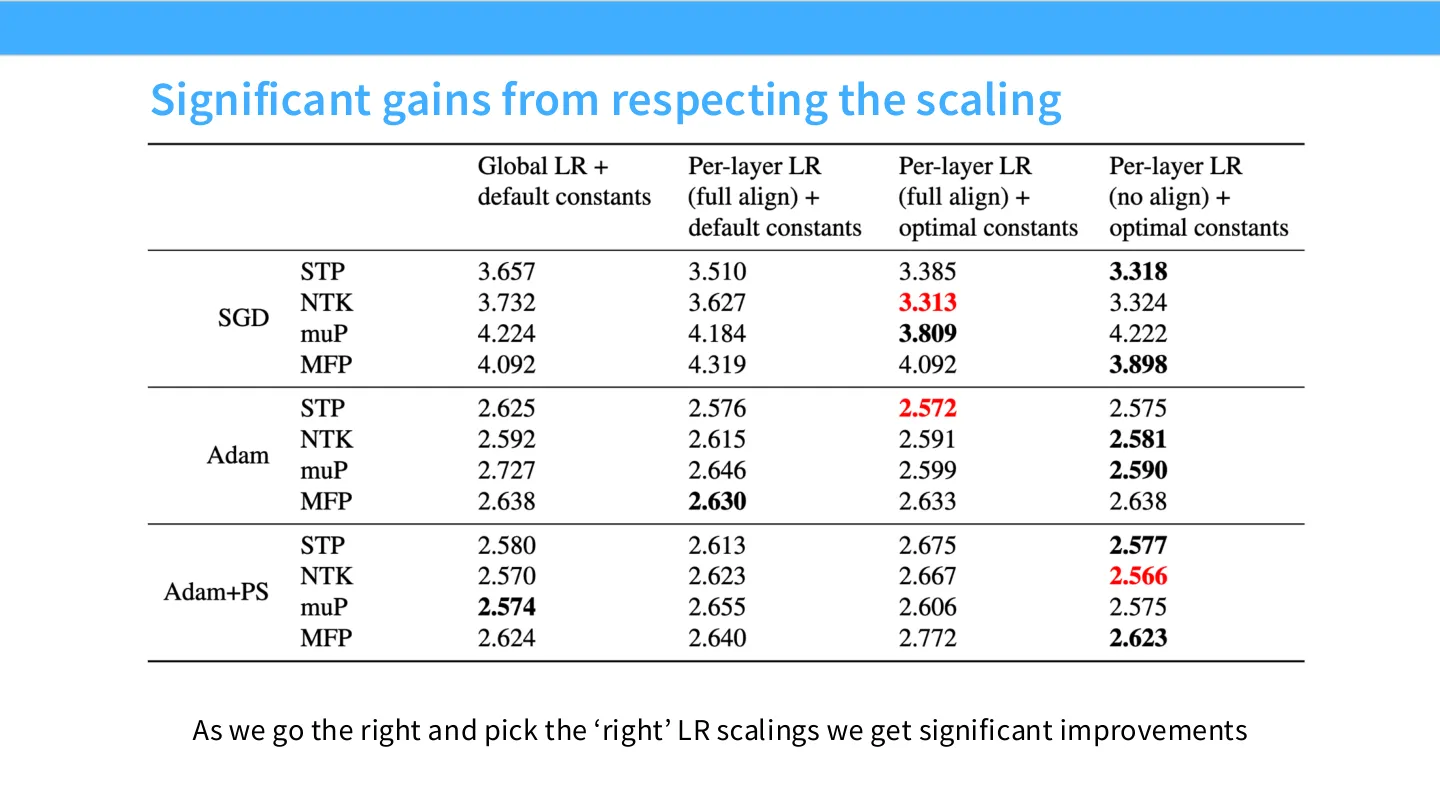
🖼️ 选对学习率缩放带来的性能差距是本节结论性的一张图,说明这套指数并非纸上谈兵
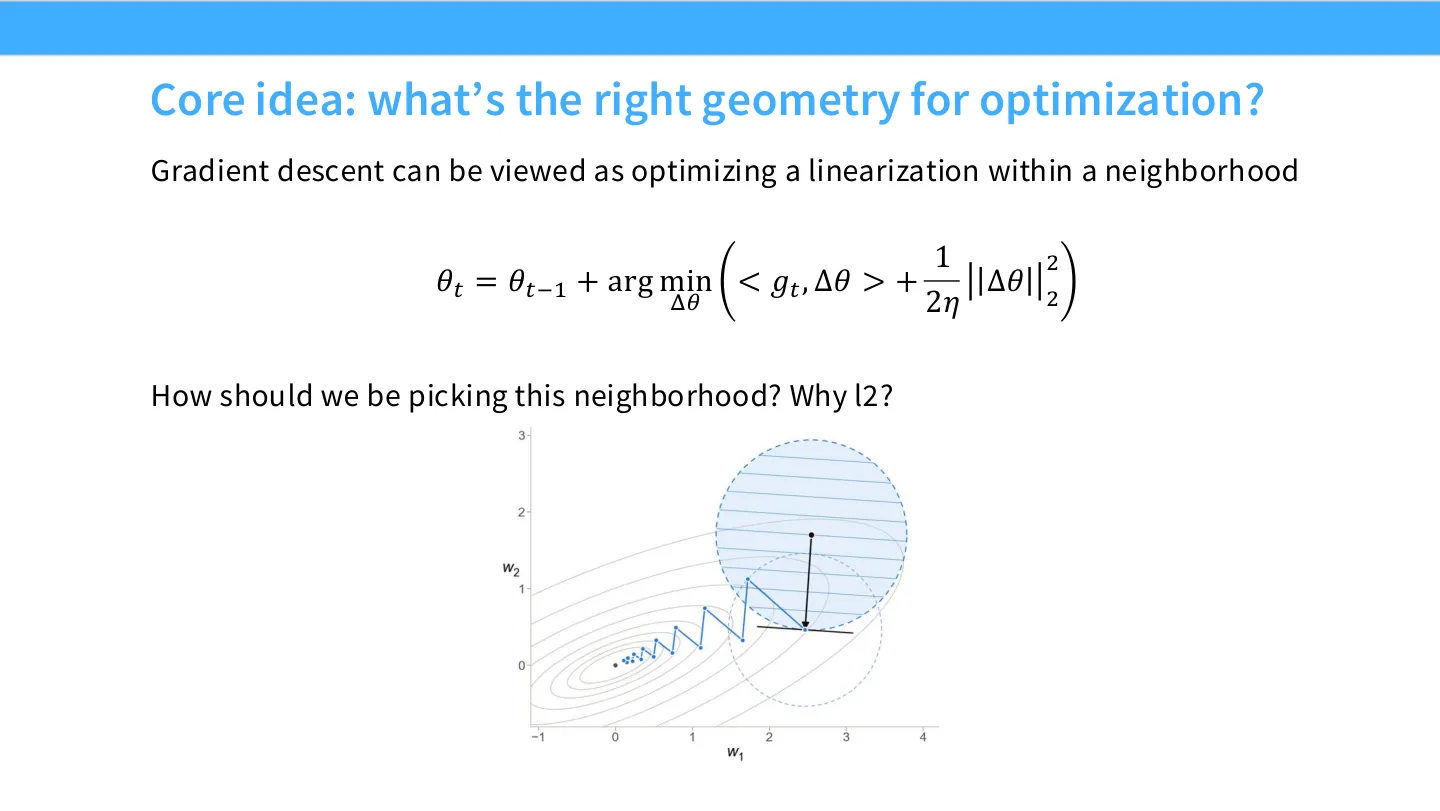
🖼️ 把 GD 写成“线性化 + 邻域约束”的公式,是整节论证的起点,也是提问“为什么是 L2”的依据
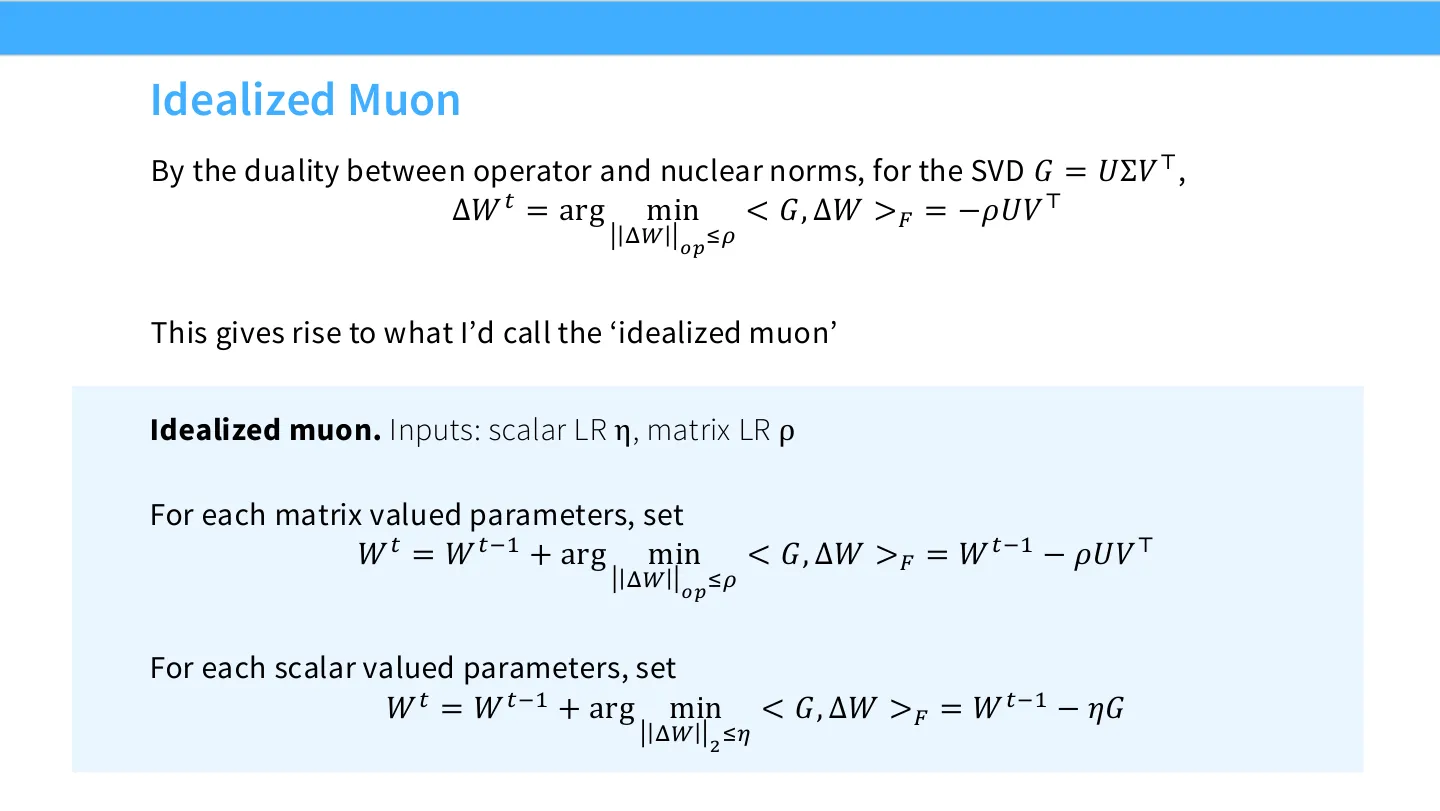
🖼️ 对偶性推出 -ρUV^T 这一步以及理想化 Muon 的算法框,是本节要交付的核心结果
\theta_t=\theta_{t-1}+\arg\min_{\Delta\theta} \left\langle g_t,\Delta\theta\right\rangle +\frac{1}{2\eta}|\Delta\theta|_2^2.
$$ 对 $\Delta\theta$ 求导,最优解是 $$
\Delta\theta^\star=-\eta g_t,
$$ 也就是普通的梯度下降。这里的关键问题是:为什么邻域用 $L_2$ 球?$L_2$ 只是一个隐含假设。换一个范数,就会得到另一种更新规则,也就是另一种“预条件”。 从 μP 的视角看,优化器可以直接控制的量是 $$
n^{-a_l}\Delta W_l z_l.
$$ 如果 $\Delta W_l$ 是一个**等距映射(isometry)**,即 $\|\Delta W_l z\|=\|z\|$(对方阵而言),那么这一项的尺度就只由 $n^{-a_l}$ 和 $z_l$ 决定,不会因为权重更新的随机性而随宽度乱掉。于是问题变成:能不能让参数更新本身接近一个等距映射? 一个自然的做法是,在算子范数球内最小化与梯度的内积: $$
\Delta W_t= \arg\min_{|\Delta W|_{\text{op}}\le \rho} \left\langle G,\Delta W\right\rangle_F.
$$ 这里 $\|\cdot\|_{\text{op}}$ 是**算子范数**,$\rho$ 是矩阵学习率。 > **编者拓展|算子范数与核范数的对偶**:对矩阵 $G=U\Sigma V^\top$,核范数是奇异值之和 $\|G\|_*=\sum_i\sigma_i$,算子范数是最大奇异值 $\|G\|_{\text{op}}=\sigma_{\max}$。两者互为对偶: > > $$ > > \|G\|_*=\max_{\|\Delta W\|_{\text{op}}\le 1}\langle G,\Delta W\rangle_F. > $$
因此
$$
\min_{|\Delta W|{\text{op}}\le \rho}\langle G,\Delta W\rangle_F =-\rho|G|* =-\rho\sum_i\sigma_i.
$$ > 取到最小值的 $\Delta W$ 正是 $-\rho UV^\top$:它把 $G$ 的所有奇异值都替换成同一个值 $1$,只保留左右奇异向量的方向。 这就得到**理想化 Muon**: - 对矩阵参数: $$
W_t=W_{t-1}-\rho UV^\top;
$$ - 对标量参数: $$
W_t=W_{t-1}-\eta G.
$$ 矩阵参数用矩阵学习率 $\rho$,标量参数用普通学习率 $\eta$。从效果上看,$UV^\top$ 相当于把梯度矩阵“白化”:不管原来的奇异值谱长什么样,更新都把所有奇异值推成 $1$。这就是后面“单位奇异值”故事的来源。 ## 九、实用 Muon:用 Newton–Schulz 代替 SVD 理想化 Muon 每步都要对梯度矩阵做**奇异值分解(Singular Value Decomposition, SVD)**,取出 $U$ 和 $V$,再算 $UV^\top$。对大规模矩阵来说,SVD 太慢,这是一个纯系统工程问题:算法正确,但跑不动。
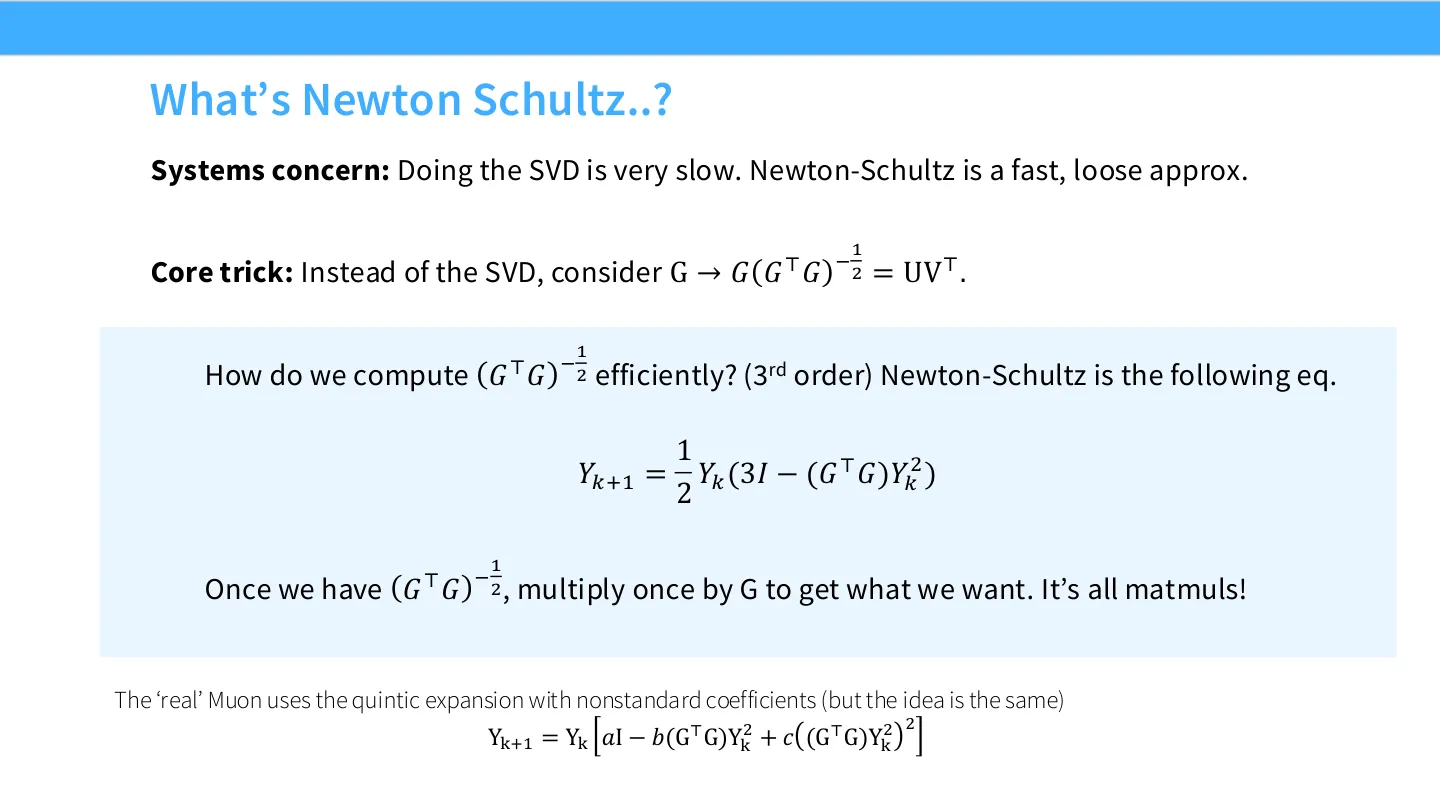
🖼️ Newton–Schulz 迭代式是本节唯一需要精确呈现的公式,且它把“理论上的极分解”变成“可跑的 matmul”
G(G^\top G)^{-1/2}=UV^\top.
$$ 验证一下:若 $G=U\Sigma V^\top$,则 $$
G^\top G=V\Sigma^2 V^\top,\qquad (G^\top G)^{-1/2}=V\Sigma^{-1}V^\top,
$$ 所以 $$
G(G^\top G)^{-1/2} =U\Sigma V^\top V\Sigma^{-1}V^\top =UV^\top.
$$ 于是问题变成:怎样快速计算 $(G^\top G)^{-1/2}$?讲义给出三阶 **Newton–Schulz** 迭代: $$
Y_{k+1}=\frac12 Y_k\left(3I-(G^\top G)Y_k^2\right).
$$ 迭代若干步后,$Y_k\approx (G^\top G)^{-1/2}$,再乘一次 $G$,就得到近似 $UV^\top$。整个过程只有矩阵乘法,没有 SVD。 > **编者拓展|Newton–Schulz 与标量牛顿法**:对正数 $a>0$,迭代 > > $$ > > y_{k+1}=\frac12 y_k(3-a y_k^2) > $$
会收敛到 $1/\sqrt a$。这其实是牛顿法求方程 $f(y)=1/y^2-a=0$ 的根。矩阵版本把 $a$ 换成 $G^\top G$、把 $y$ 换成矩阵 $Y$,就得到上面的迭代。三阶版本每步收敛更快;实际实现为了速度,并不追求收敛到固定点,而是只跑固定步数。
真实 Muon 使用的是五次展开:
$$ Y_{k+1}=Y_k\left(aI-b(G^\top G)Y_k^2 +c\left((G^\top G)Y_k^2\right)^2\right), $$
其中 $a,b,c$ 是非标准系数。讲义特别指出:这些系数并不收敛到正确的固定点,但这没关系——它本来就不是用来求精确逆平方根的,而是用 5 步做一个足够好的快速近似。
从理想 Muon 到实用 Muon,讲义列出三处改动:
- 用动量 $B_t$,而不是原始梯度 $G_t$;
- 用 Newton–Schulz 5 步,而不是 SVD 加符号;
- 对其他参数使用 AdamW 等成熟优化器,而不是 SGD。
十、Muon 的规模化与工程补丁
Muon 最早在 Jordan Keller 的博客里以 nanoGPT 实验出现:在小规模上就有明显收益,随后又被放大到更大的训练规模。讲义用一条从 nanoGPT 到大规模的外推曲线说明:Muon 不是只在玩具模型上有效的技巧。
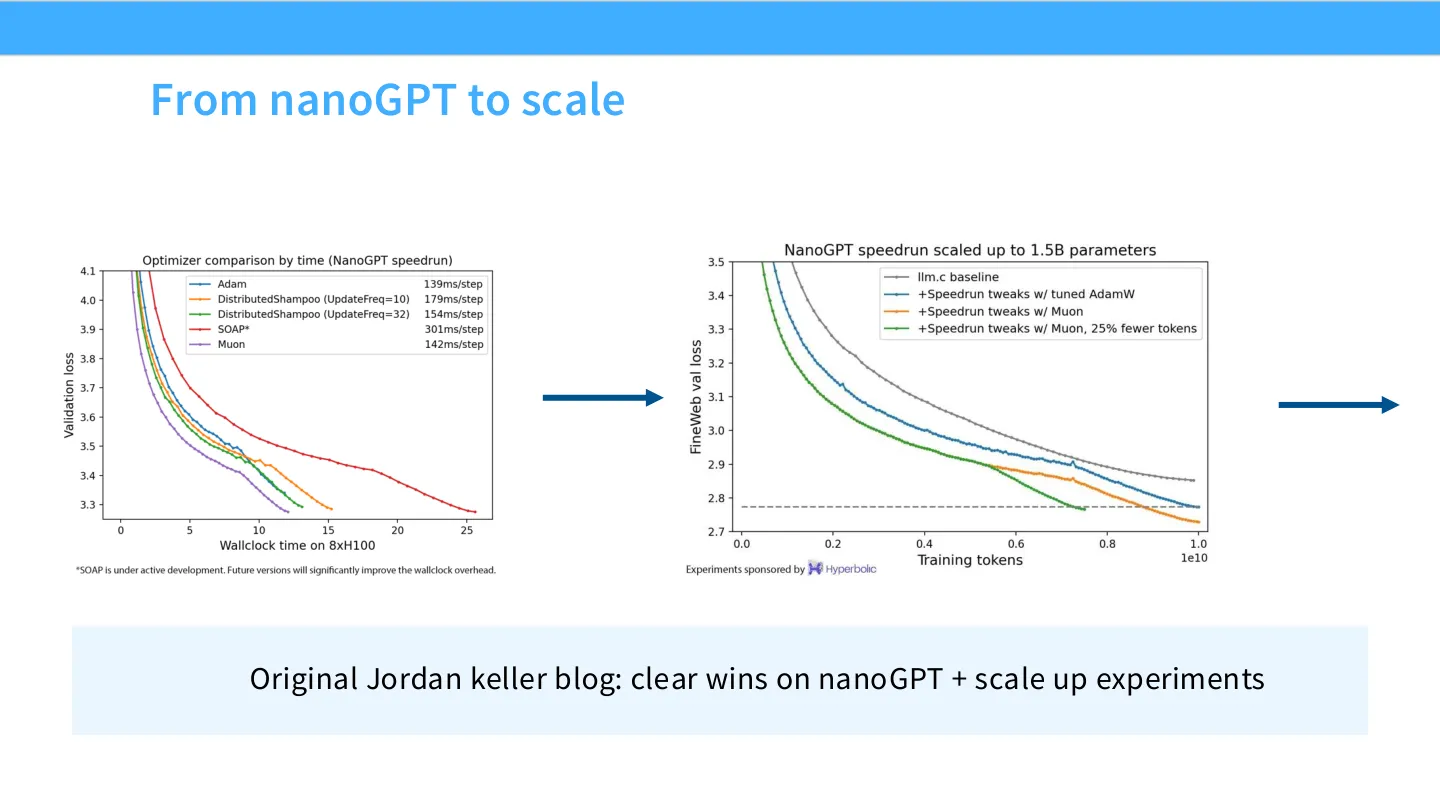
🖼️ 从 nanoGPT 到大规模的外推曲线是 Muon 出圈的直接证据,读者需要看到这条曲线
在真实的大规模训练中,Muon 也表现出了可用的 scaling 行为。但工程实现不能只照搬理想公式,Kimi 的 Muon 实现给出了几条实用补丁:
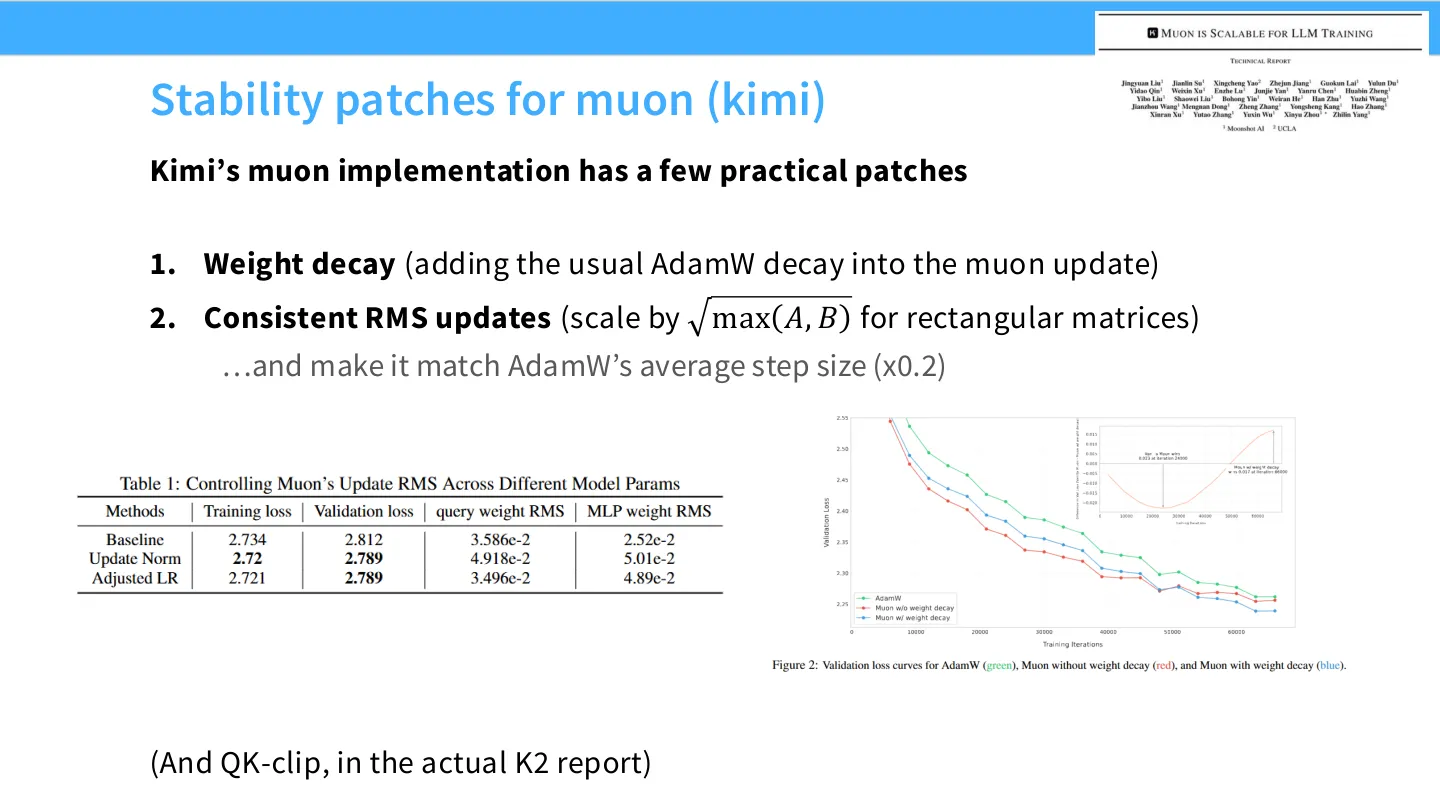
🖼️ 工业实现的三条补丁以清单形式排列,适合作为读者自己复现时的检查表
- 权重衰减:把 AdamW 里常见的 weight decay 加进 Muon 更新。Muon 的正交化更新本身不包含权重衰减,需要显式补上。
- 一致的 RMS 更新:对矩形矩阵,按 $\max(A,B)$ 做 RMS 对齐,避免更新幅度因为矩阵形状不同而漂移。
- 对齐 AdamW 的平均步长:整体乘一个系数(讲义写作 $\times 0.2$),让 Muon 的平均更新幅度和 AdamW 可比。
- QK-clip:在实际的 K2 报告里,还对注意力里的 QK logits 做裁剪,作为额外的稳定性手段。
编者说明|为什么需要这些补丁:理论上的“等距更新”假设矩阵是方阵、更新是纯正交化的;真实训练里有矩形矩阵、有 AdamW 混用、有注意力 logits 爆炸。补丁的作用不是改变 Muon 的核心思想,而是给理论假设和工程现实之间加一层稳定兜底。
十一、追问 Muon:单位奇异值真的是全部吗
Muon 为什么有效?一个解释来自 μP 的“更新约束”:我们希望更新在算子范数下是等距的,而 $UV^\top$ 正好把所有奇异值推成 1。这个论证在讲义里被称为 Bernstein 和 Newhouse 的论证。除此之外,还可以用更新秩(update rank)做实证检验:看梯度更新矩阵的有效秩如何变化,以及 Muon 是否真的在把更新推向“满秩、单位奇异值”的形态。
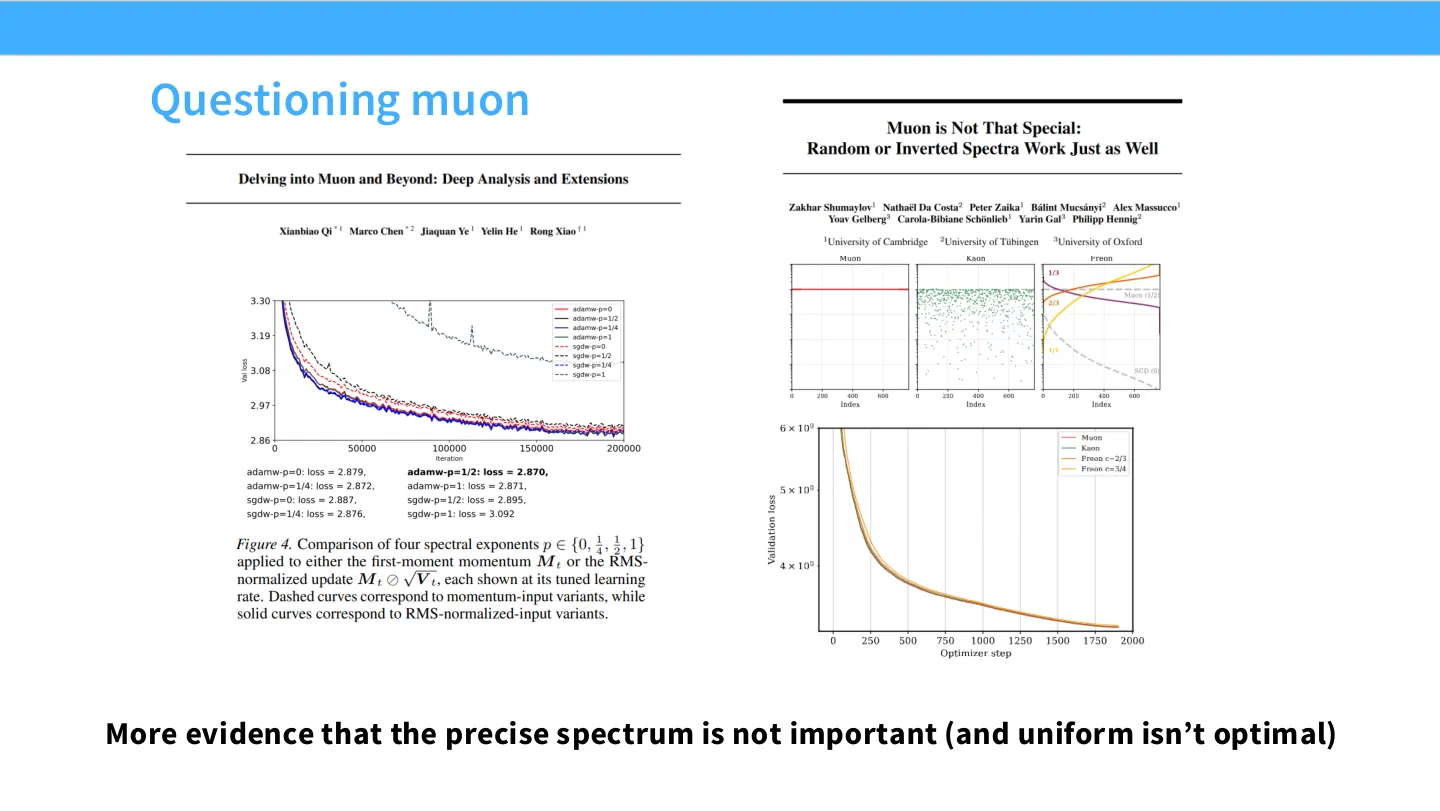
🖼️ 关于谱形状的实验图是本节唯一的实证证据,也是给读者留下“理论尚未闭合”印象的关键一页
但实验给出的信号并不是“单位奇异值就是全部”。讲义展示的证据表明:梯度更新谱的精细形状并没有那么重要;把所有奇异值都压成同一个值也未必是最优的。换句话说,“把奇异值全推成 1”这个故事只对了一半:它解释了 Muon 为什么能稳定更新,但不能解释所有性能差异。
编者说明|NQM 在讲义中没有定义:最后一页总结里出现了“NQM”这个缩写,但幻灯片没有展开它的全称和定义。本书不替它补一个可能错误的解释;读者只需知道它是讲义用来讨论“正确的模型应该是什么”的一个例子,和 norm-invariant loss、scaling limits 并列。
把这一讲收束一下,方法论可以总结成三步:
- 先找核心现象:范数、特征学习、奇异值——哪些量在 scaling 时真正决定行为?
- 再选模型:NQM、norm-invariant loss、scaling limits——用一个足够简单、又能保留这些现象的理论模型。
- 最后清楚理论的边界:NQM 与 Muon 的对比说明,理论能解释一部分,但不能解释全部;实验和工程补丁仍然是必要的。
这也是“Optimizers 1”的总体教训:优化不是一个可以靠单一公式解决的问题,而是轻量理论、量级计算和实证观察之间反复校准的过程。
附:参考与延伸阅读
(本书材料里没有外部链接;正文中的链接均为撰写时补充。)
已知疑点
- 梯度指数 $g_l$ 的求和边界:幻灯片第 21 页的文字里,求和上下限以及是否含 $-1/2$ 显示不完整。本书按可见形式写成 $g_l=a_l+a_{L+1}+b_{L+1}+\sum_{i=l+1}^{L}(a_i+b_i-\frac12)$,并在中间层满足 $a_i+b_i=1/2$ 时化简为 $g_l=a_l+a_{L+1}+b_{L+1}$。依据:第 21 页幻灯片及其“Additional constraints”一句。
- 第一层 $a_1+b_1=0$ 与 Kaiming 的 $b_l=1/2$ 表面冲突:本书按“第一层输入维度不随宽度增长,故 $b_1=0$”来解释;这是根据第 17–19 页的推导做出的合理补充,幻灯片没有逐字说明。
- 对齐指数 $r,\alpha,\omega,u$ 的严格定义:幻灯片只给出三项分解和“alignment between updates and init / between updates”的定性说明,没有形式化定义。本书按“随机独立基线为 $1/2$、完全对齐接近 $1$”来解释;依据是第 23–26 页的量级项。
- 实验结果的具体数值:第 31–34 页只有图,没有给出学习率迁移的数值范围或性能提升的具体数字。本书只说“曲线几乎重合”“显著提升”,不补任何未出现在材料里的数值。
- NQM 的含义:第 49 页只出现缩写,未定义。可能是与 norm-invariant loss 相关的模型,但证据不足,本书不展开。
- Bernstein 和 Newhouse 的论证:第 45 页只提名,没有给出推导细节;本书只按幻灯片提及,不补外部证明。
- QK-clip 与 $\max(A,B)$ RMS 对齐的实现细节:第 44 页只给清单式补丁,没有给公式。本书照录“scale by $\max(A,B)$”“$\times 0.2$”“QK-clip”这些说法,不补具体实现。
- 图片引用说明:正文中的
SLIDE:xx指幻灯片页码;文本材料没有图内坐标和曲线数值,图注只按页面主题撰写。